この記事のポイント
 Amazon Redshift・BigQuery・Snowflake・Databricks等を横断できるマルチDWH対応が最大の差別化点
- テーブル・行・列レベル権限の伝播とadmin配布で、既存ガバナンスを崩さず導入できる設計
- Business・Enterprise・Eduで2026年9月10日に提供告知、利用量はChatGPT Workのプラン利用枠またはクレジットとして計上
- dbt・Genie Ontology・Snowflake Horizonの意味レイヤーを継承し、指標定義を再構築せずに使える
- NTT DATAでは非エンジニアが自分でダッシュボードを作成。データエンジニアの役割は個別クエリ作成からアクセス制御・監査証跡の維持へシフト
Microsoft MVP・AIパートナー。LinkX Japan株式会社 代表取締役。東京工業大学大学院にて自然言語処理・金融工学を研究。NHK放送技術研究所でAI・ブロックチェーンの研究開発に従事し、国際学会・ジャーナルでの発表多数。経営情報学会 優秀賞受賞。シンガポールでWeb3企業を創業後、現在は企業向けAI導入・DX推進を支援。
ChatGPT Work Data agentは、OpenAIが2026年9月10日に発表したエンタープライズデータ分析用のプラグイン型AIエージェントです。
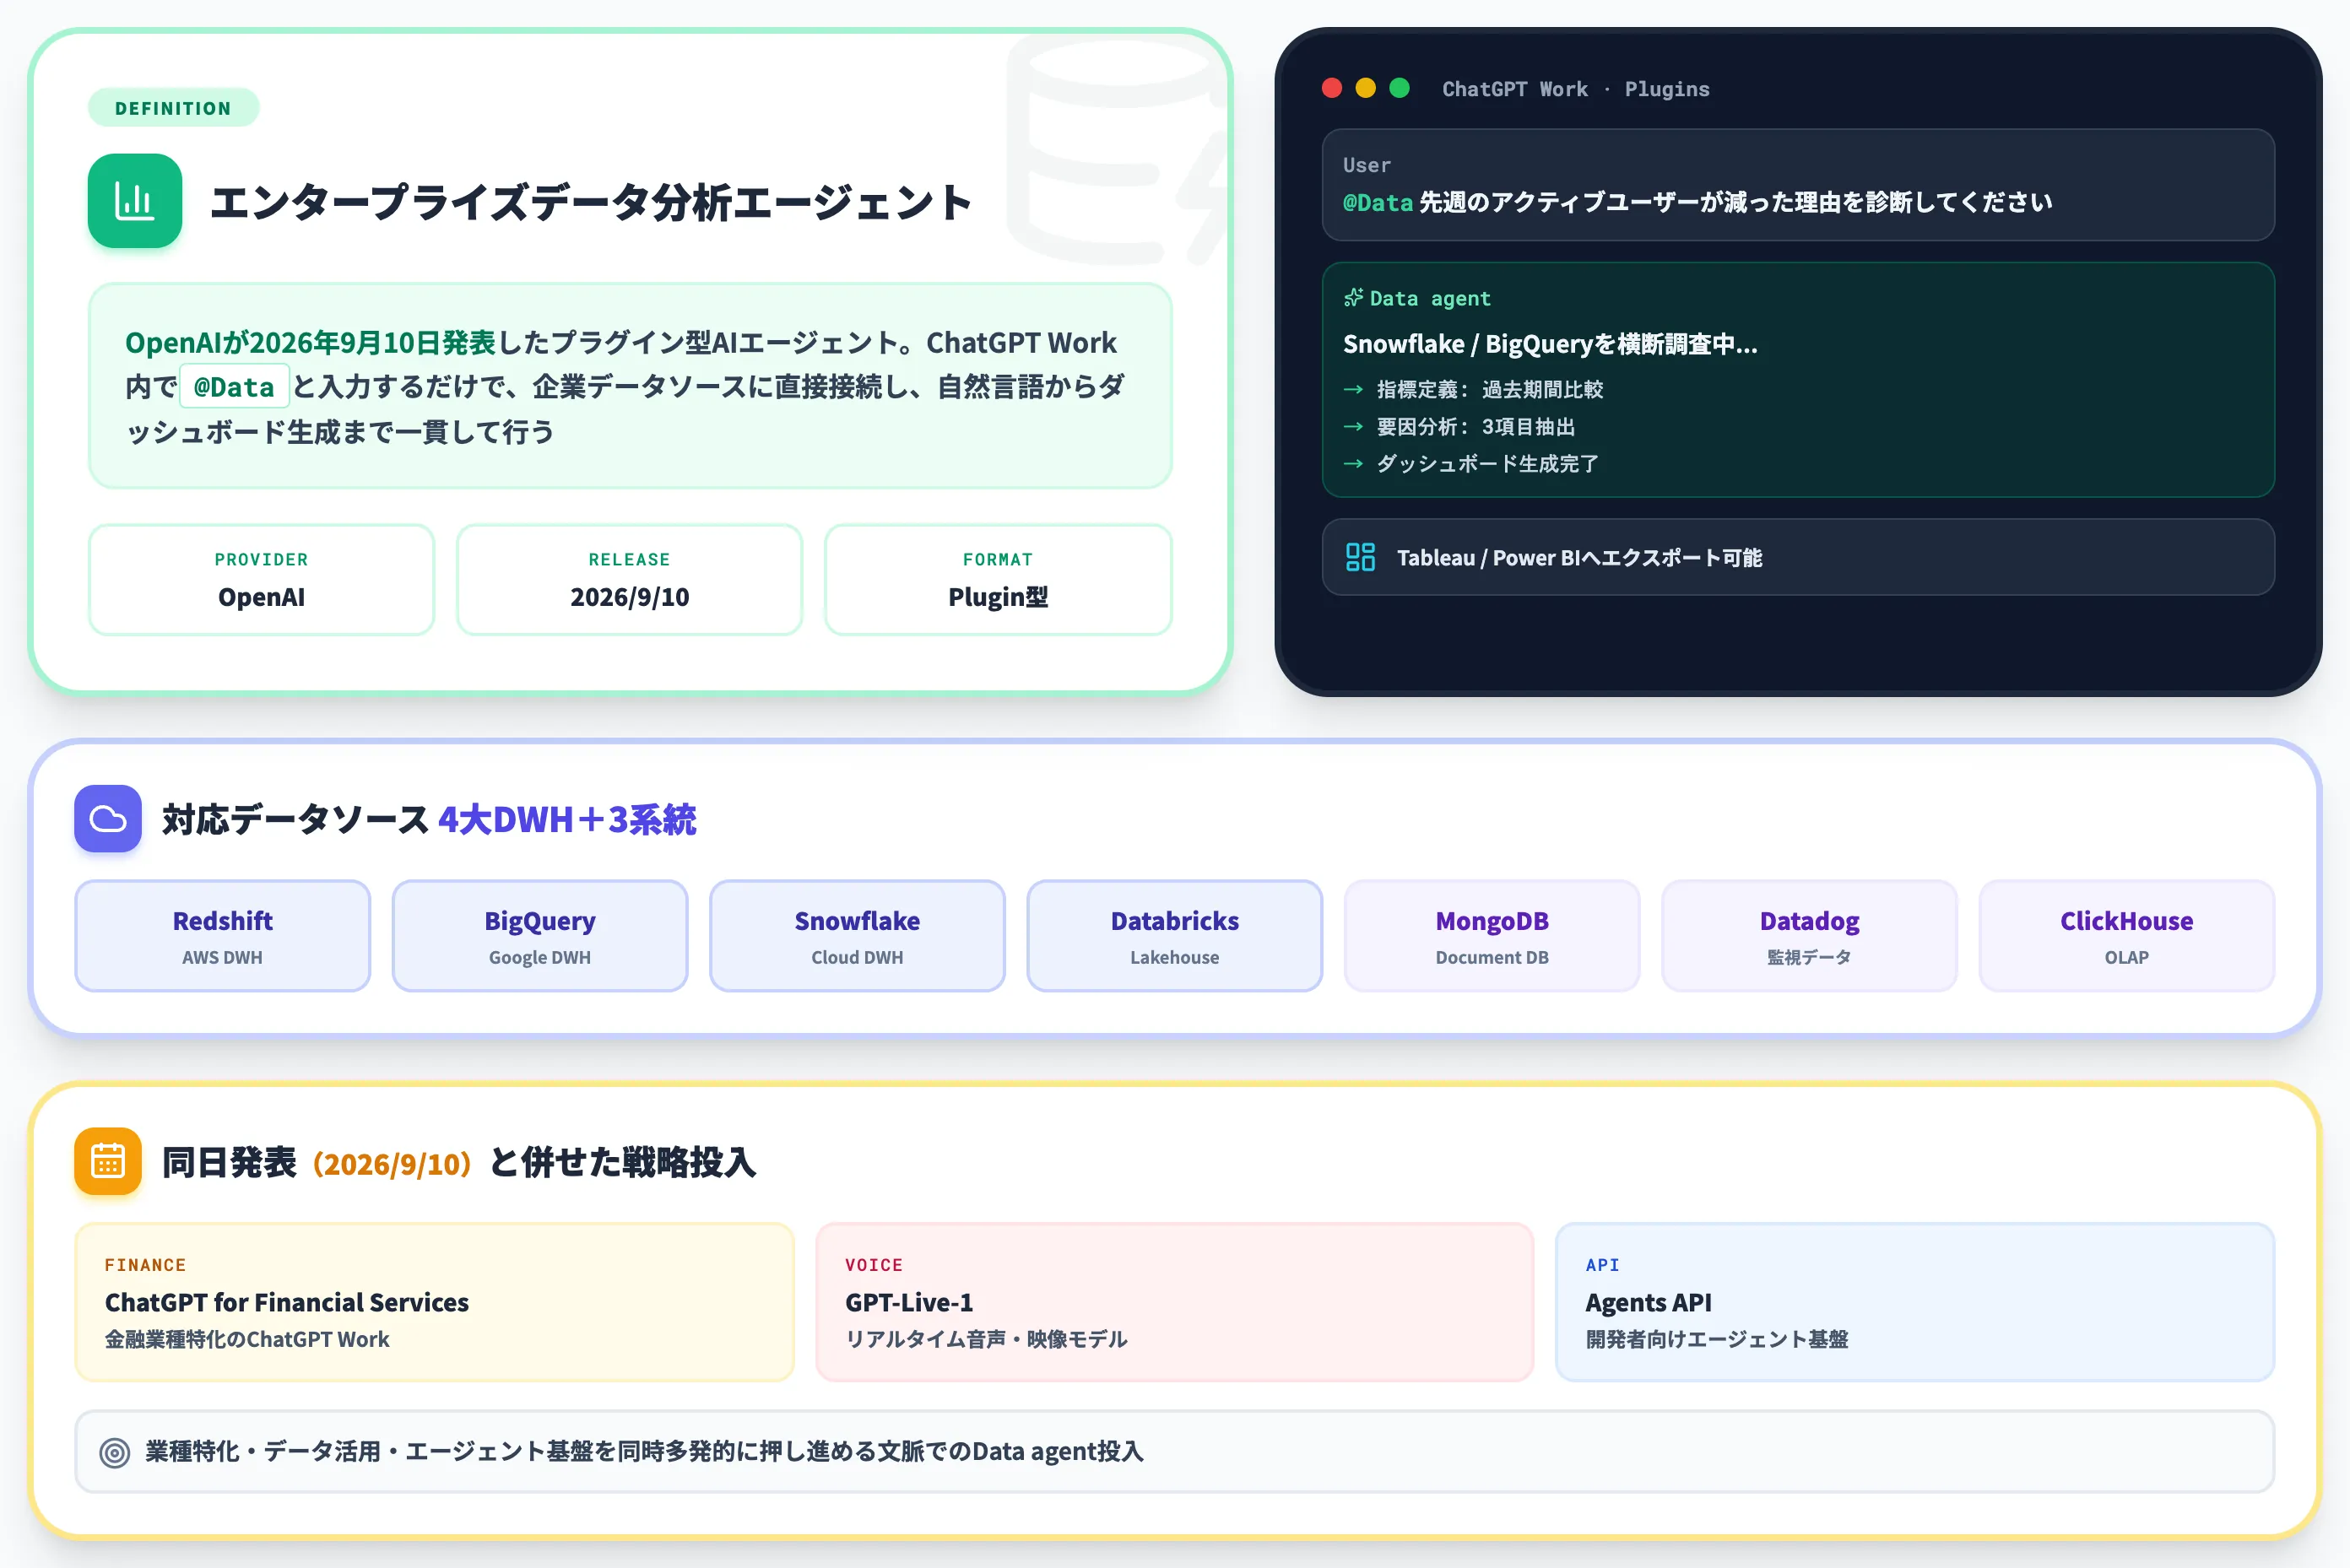
Amazon Redshift・Google BigQuery・Snowflake・Databricks・MongoDB・Datadog・ClickHouse等のデータソースに接続し、SQLを書かずに自然言語の質問からダッシュボード・サマリ・グラフを生成します。
本記事では、対応データソースや料金プラン、使い方、セキュリティ・ガバナンス、既存BI基盤との使い分け、NTT DATAなどの導入事例までを、2026年9月時点の公式情報で体系的に解説します。
目次
ChatGPT Work Data agentとは?OpenAIが9月10日発表したエンタープライズデータ分析エージェント
ChatGPT Work Data agentの対応データソースとセマンティックレイヤー
ChatGPT Work Data agentの料金プランと利用条件
PluginsディレクトリからData agentを導入する
ChatGPT Work Data agentのセキュリティ・ガバナンス
ChatGPT Work Data agentと既存BI基盤の使い分け
vs Microsoft Fabric Data Agent
vs Snowflake Cortex Analyst / Databricks Genie One
ChatGPT Work Data agentの導入事例と実務での価値
ChatGPT Work Data agentとは?OpenAIが9月10日発表したエンタープライズデータ分析エージェント
ChatGPT Work Data agent(データx
cエージェント)は、OpenAIが2026年9月10日に発表した、エンタープライズデータ分析用のプラグイン型AIエージェントです。
ChatGPT Workの中で @Data コマンドから呼び出し、既存のデータソース接続とガバナンス範囲でエンドユーザーが利用できる設計です。
同日にChatGPT for Financial Services・GPT-Live-1・Agents APIも発表されており、OpenAIが業種特化・データ活用・エージェント基盤を同時多発的に押し進める文脈で投入された新機能です。
ChatGPT Work Data agentの主要機能
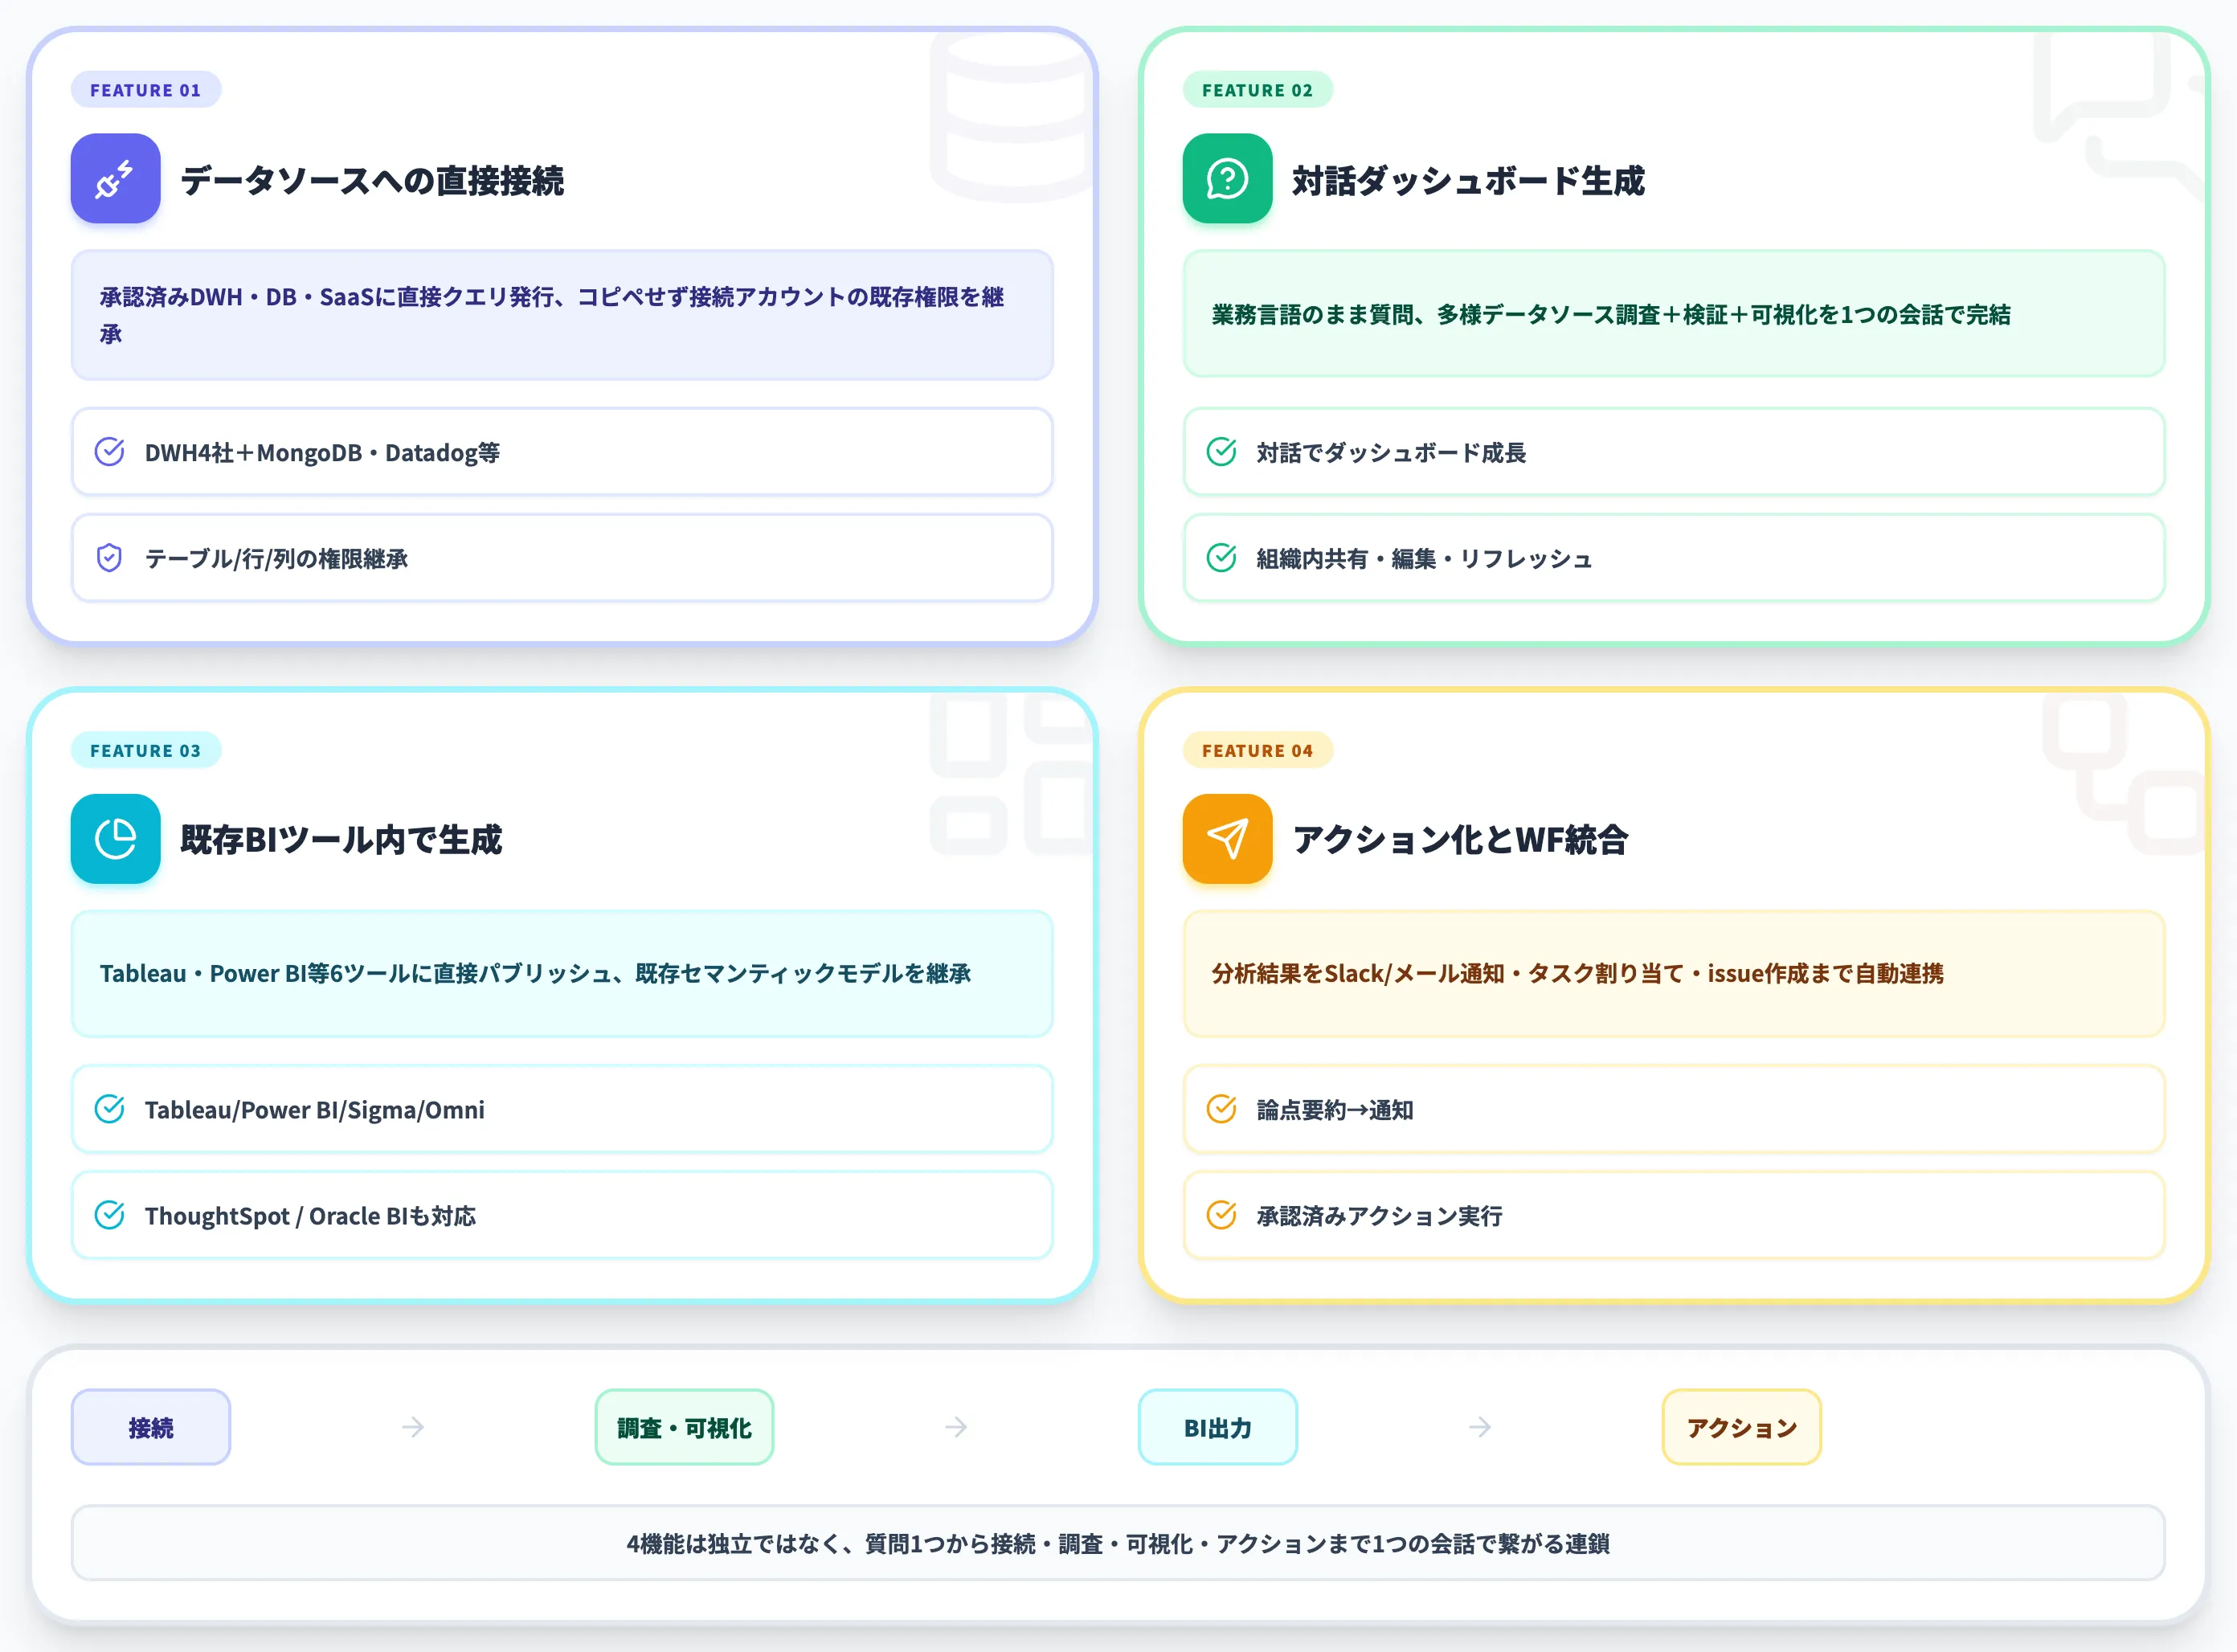
Data agentは「データソースに直接繋がる」「対話でダッシュボードを作る」「既存BIツール内に成果物を出す」「アクションに繋げる」の4つの機能で構成されます。
本セクションでは、それぞれが実務で何を意味するかを整理します。
データソースへの直接接続と権限伝播
Data agentは、承認済みのデータソースに対して直接クエリを発行し、結果をコピー&ペーストせずに分析します。
対応先はAmazon Redshift・Google BigQuery・Snowflake・Databricksなどの主要データウェアハウスに加え、MongoDB・Datadog・ClickHouse・Google Drive・SharePointにまで及びます。
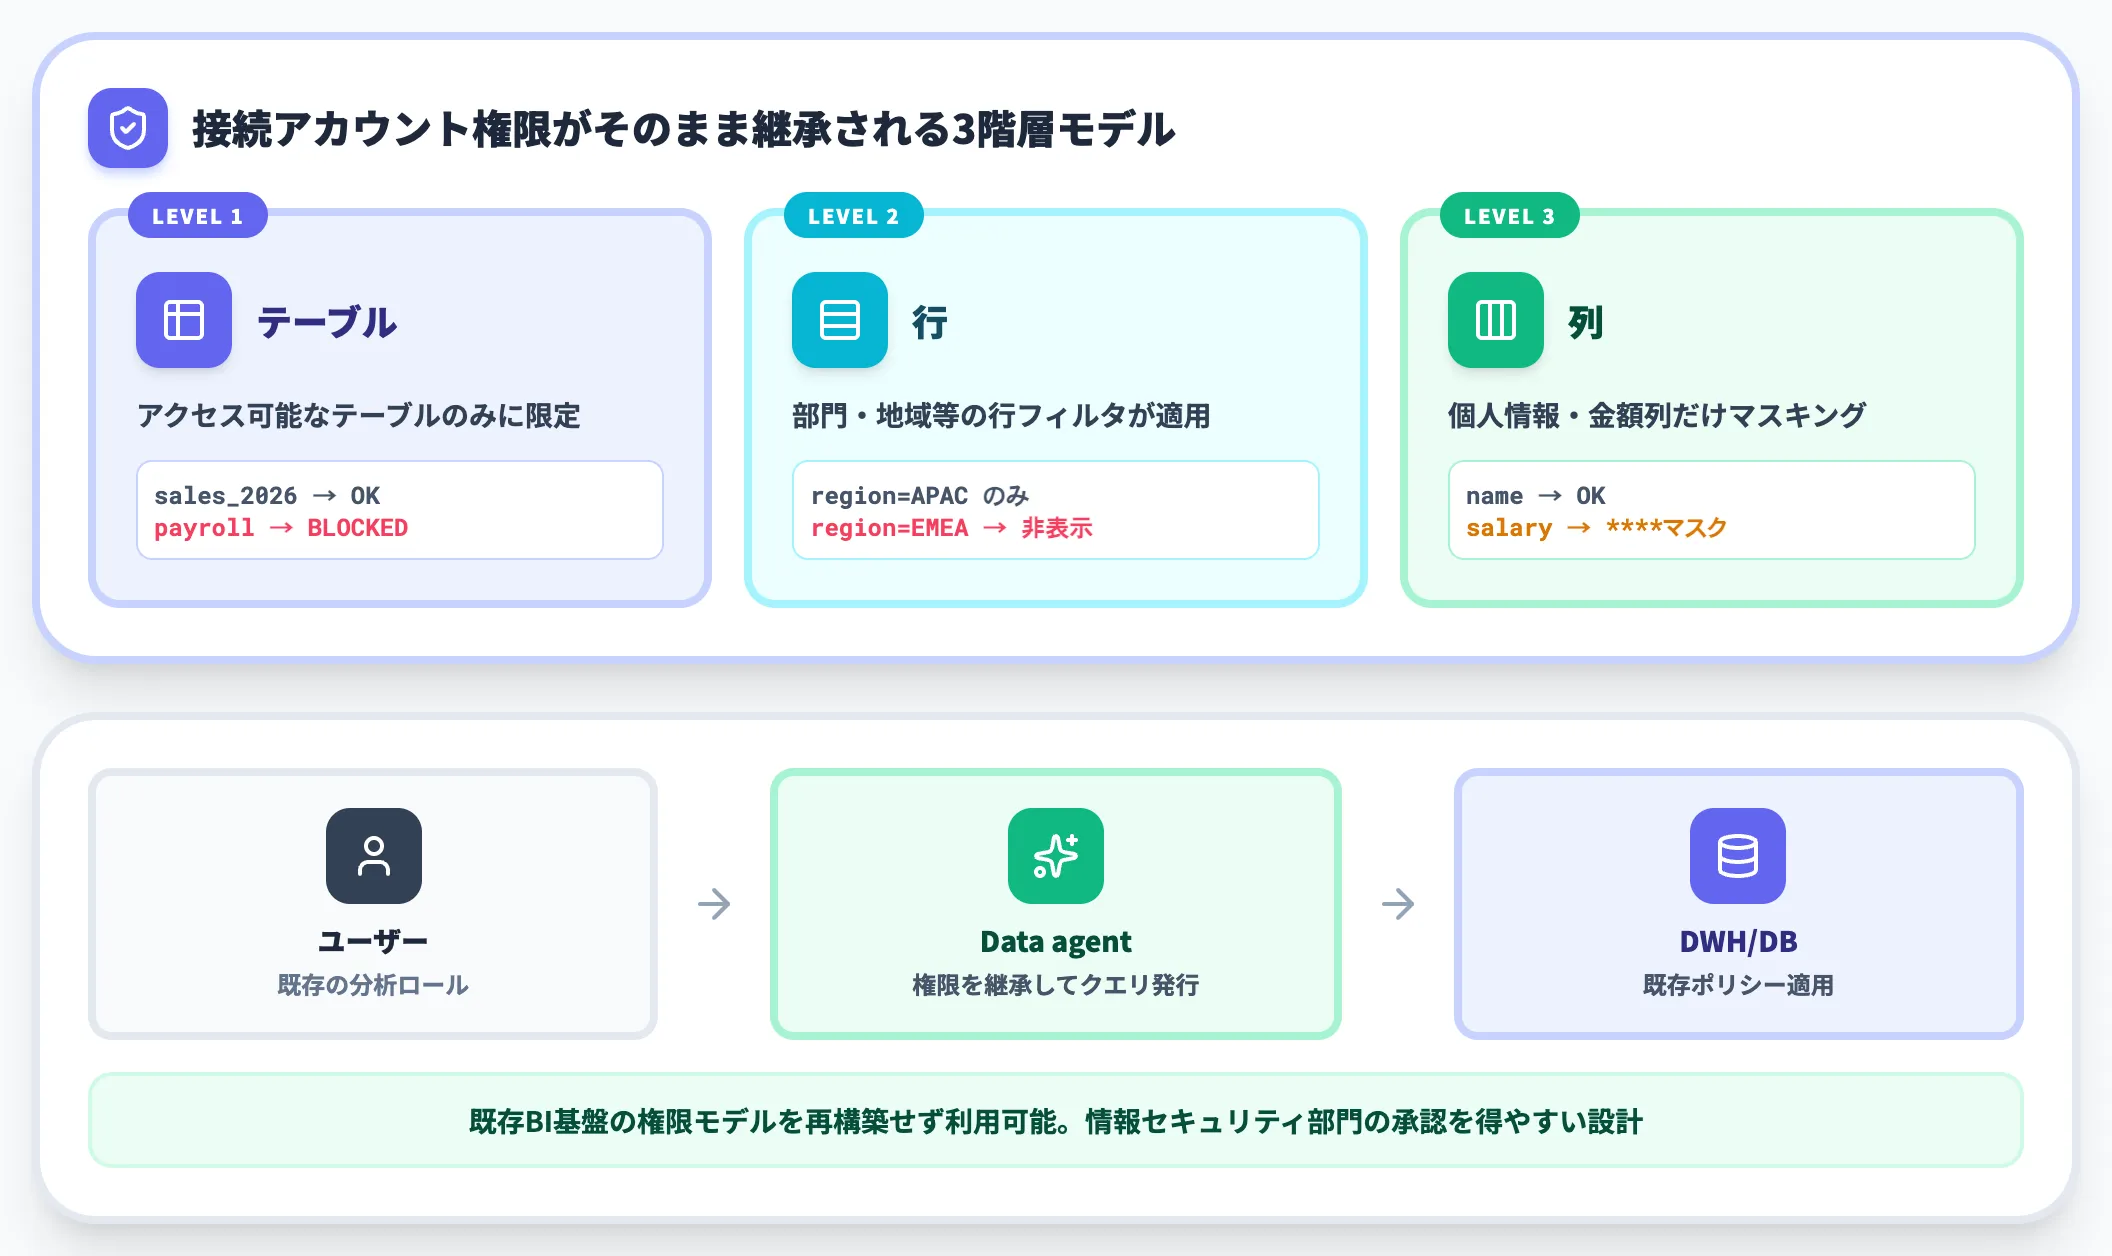
接続にあたっては、接続アカウントの既存権限(テーブル・行・列レベル)がそのまま継承される設計です。
ユーザーが本来アクセスできない列は、Data agent経由でも見えません。これは既存BI基盤との共存を前提とした設計で、権限モデルを再構築する必要がないため、社内の情報セキュリティ部門が承認しやすい構造になっています。
質問→調査→ダッシュボード生成の対話ワークフロー
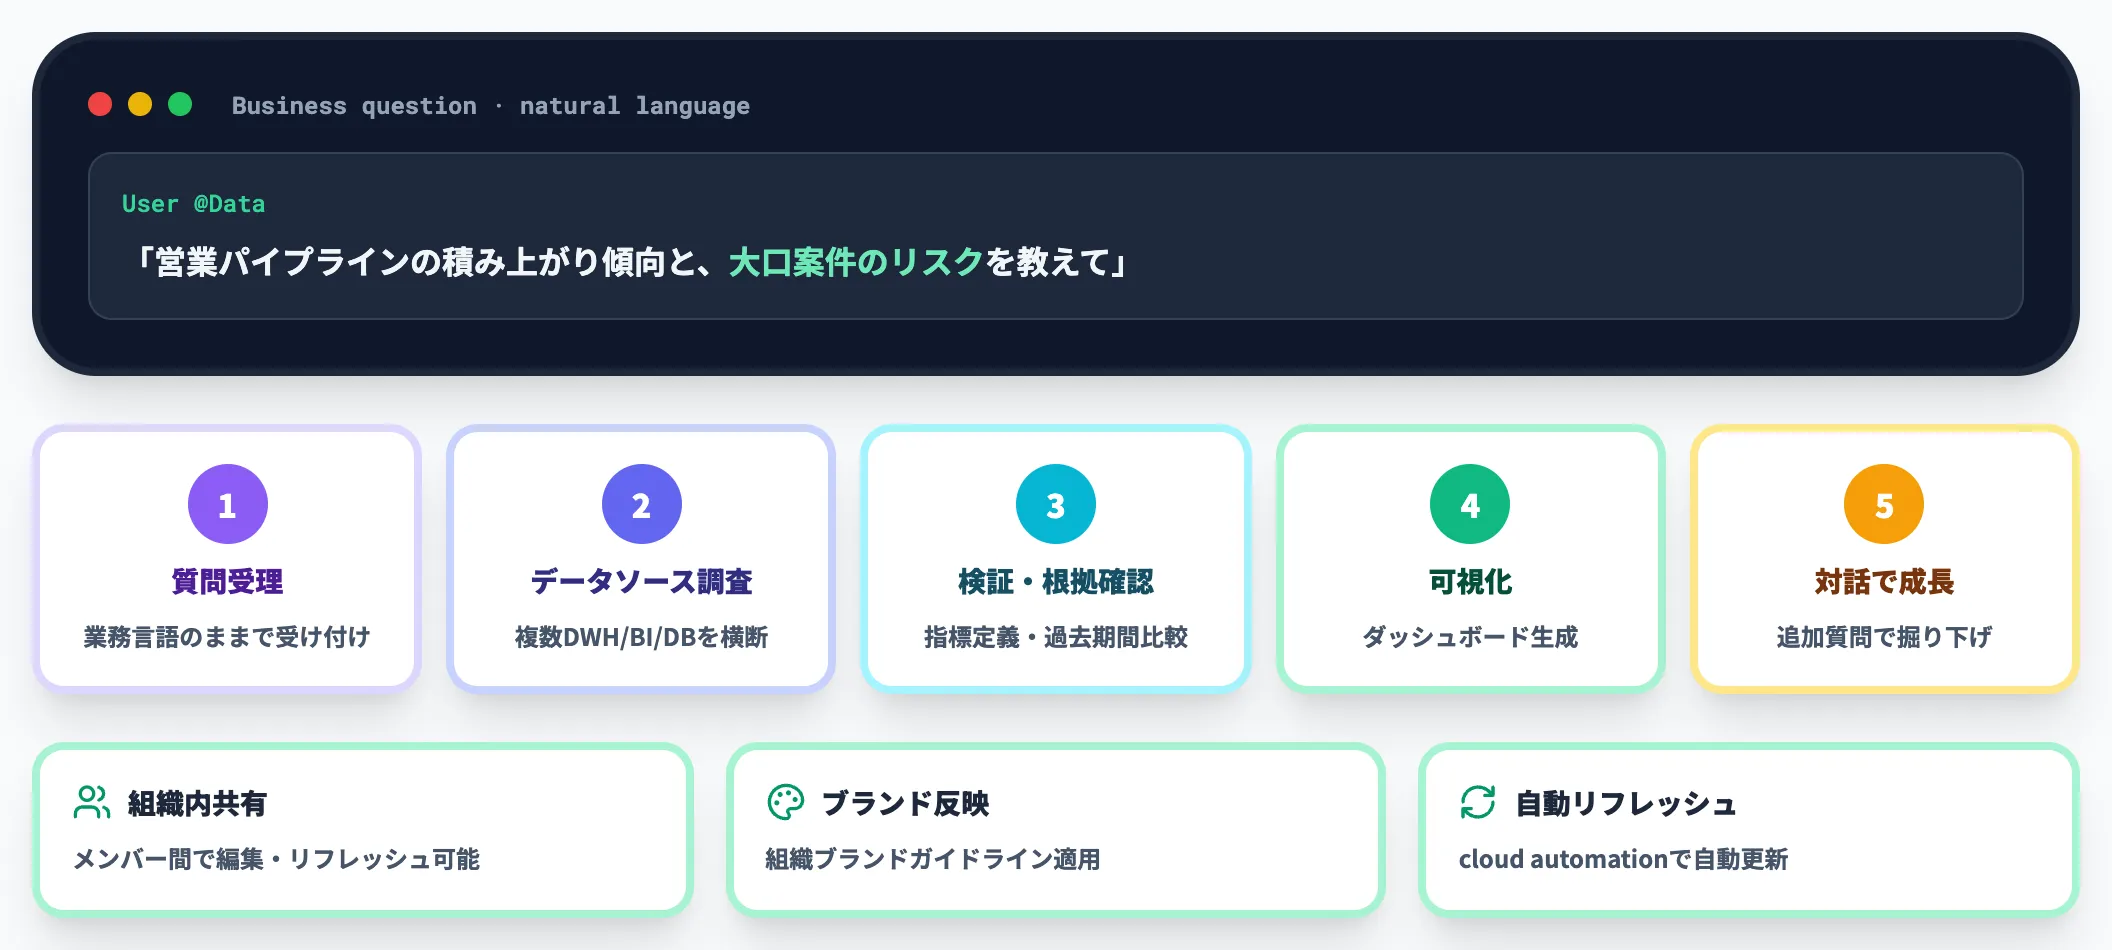
Data agentは、ユーザーの質問を受け取ってから多様なデータソースを調査し、結果を検証し、可視化まで一貫して行います。
質問の投げ方は「先週のアクティブユーザーがなぜ減ったのか」「営業パイプラインの積み上がり傾向と大口案件のリスク」のような業務言語のままで構いません。エージェントが指標定義や過去期間との比較を自動で組み立て、各知見の根拠を確認できる形で返します。
追加質問で分析を掘り下げると、対話の中でインタラクティブなダッシュボードに成長するのがData agent最大の特徴です。ダッシュボードは組織内のメンバーで共有・編集・リフレッシュでき、ブランドガイドラインを反映した見た目のカスタマイズにも対応します。
既存BIツール内でのダッシュボード生成
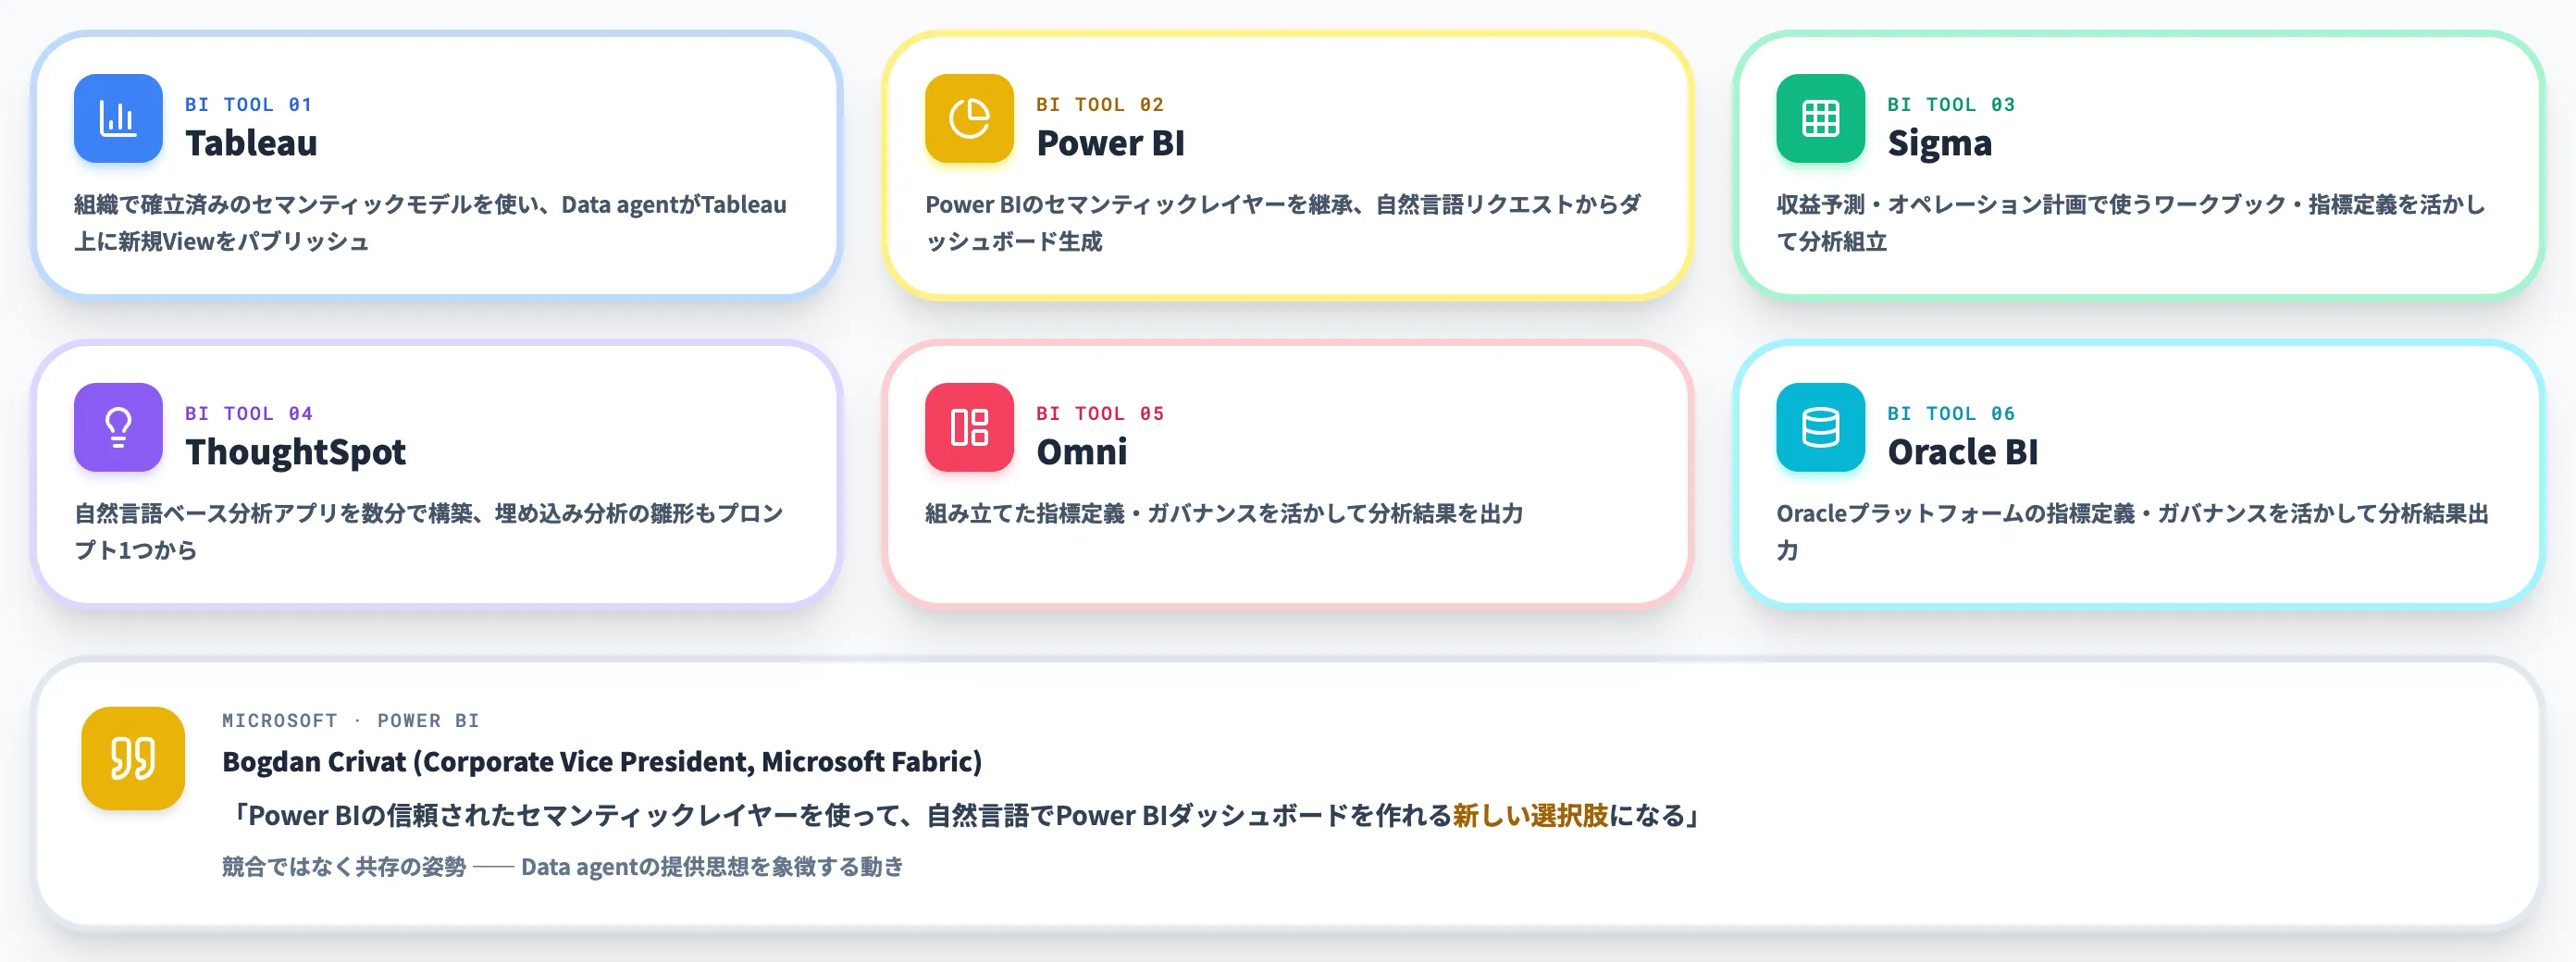
Data agentが生成したダッシュボードは、ChatGPT Work内で完結させることも、既存のBIツール側にプッシュすることもできます。
対応BIツールはTableau・Power BI・Sigma・ThoughtSpot・Omni・Oracle BIの6ツールで、いずれもエンタープライズBI市場の主要プレイヤーです。既にBIツールで運用中のセマンティックモデル・ダッシュボード権限をそのまま活かしながら、自然言語による作成レイヤーだけをChatGPT Workに寄せる構成が可能になります。
Microsoft Fabric担当のBogdan Crivat(Corporate Vice President, Microsoft Fabric)は、公式コメントで「Power BIの信頼されたセマンティックレイヤーを使って、自然言語でPower BIダッシュボードを作れる新しい選択肢になる」と述べています。競合ではなく共存を打ち出している点は、Data agentの提供思想を象徴する動きです。
アクション化とワークフロー統合
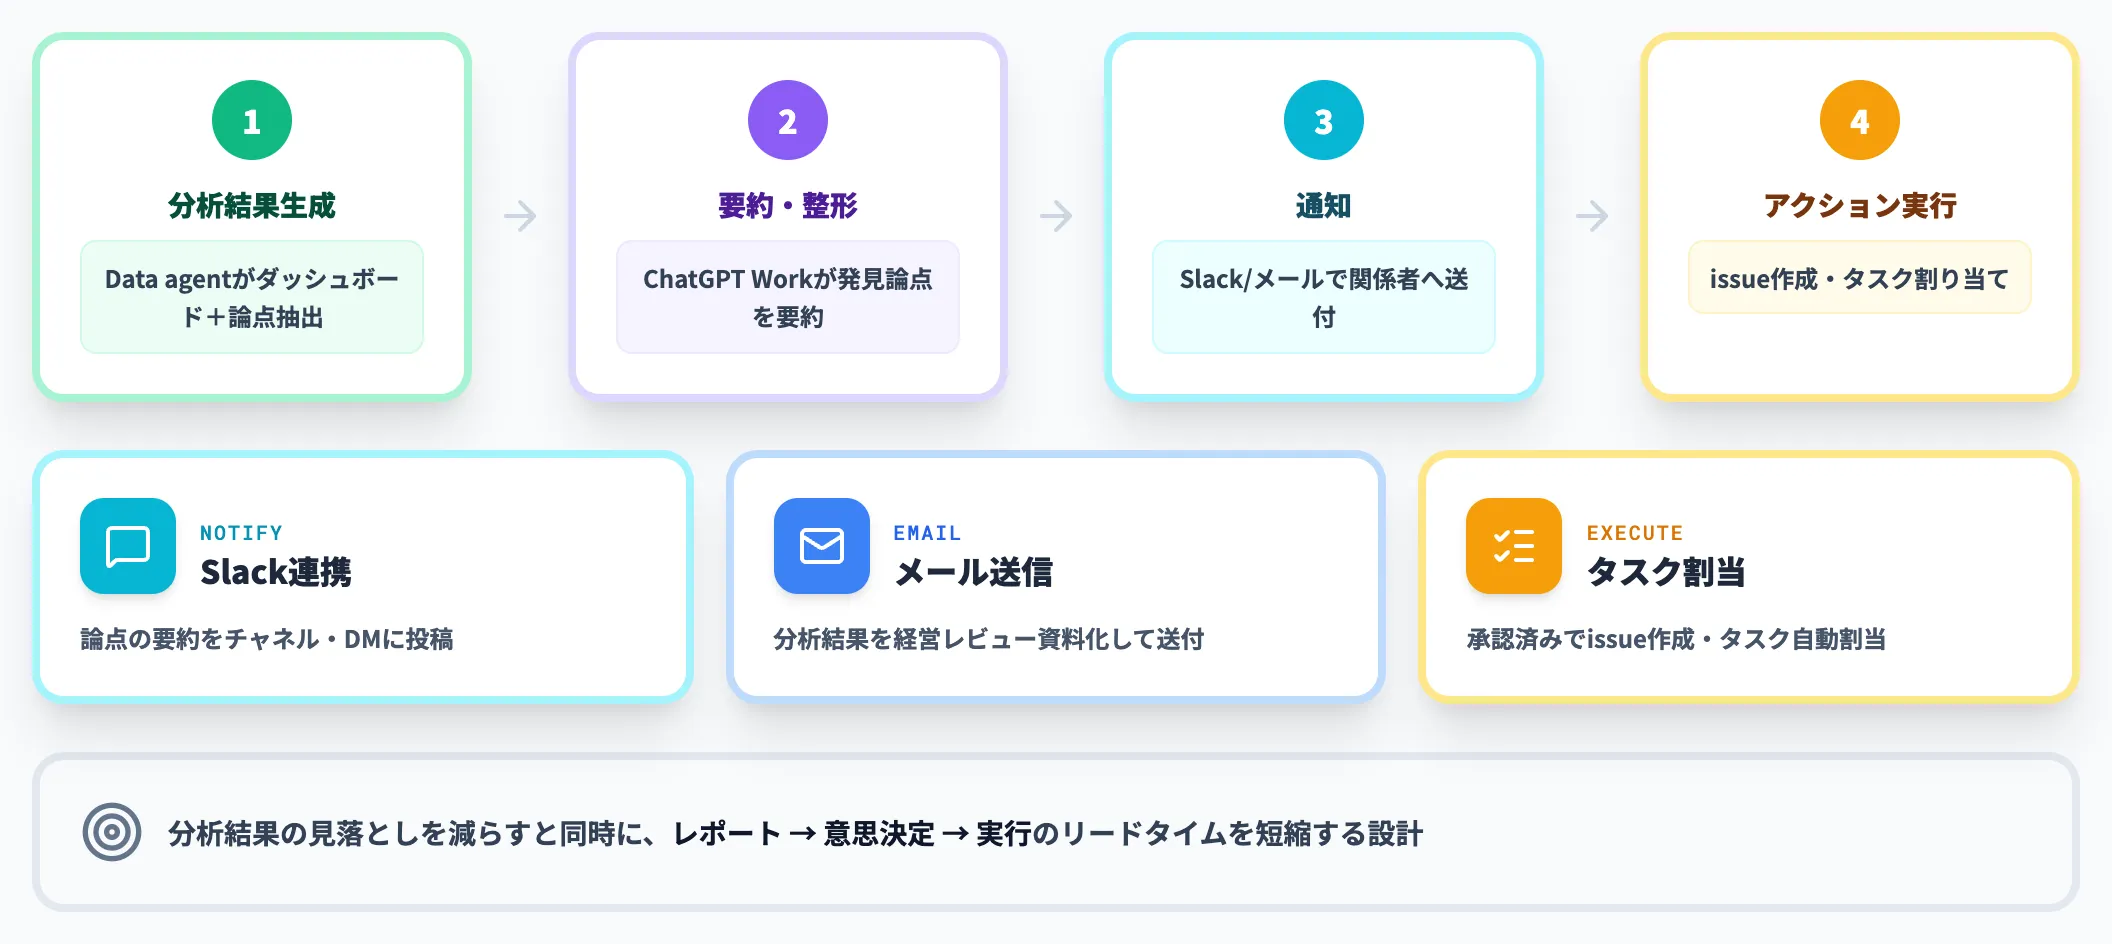
Data agentは分析結果を「見せて終わり」ではなく、次のアクションまで繋げるよう設計されています。
具体的には、発見された論点をChatGPT Workが要約し、Slackやメール経由でチームメンバーに通知したり、承認済みのアクション(issue作成・タスク割り当て等)を接続済みツールで実行できます。分析結果の見落としを減らすと同時に、レポート→意思決定→実行のリードタイムを短縮する設計です。
4機能は独立ではなく、質問1つから接続・調査・可視化・アクションまでを1つの会話で繋げる連鎖として動きます。
これが「BIレポートを待つ」ワークフローとの決定的な差になります。
ChatGPT Work Data agentの対応データソースとセマンティックレイヤー
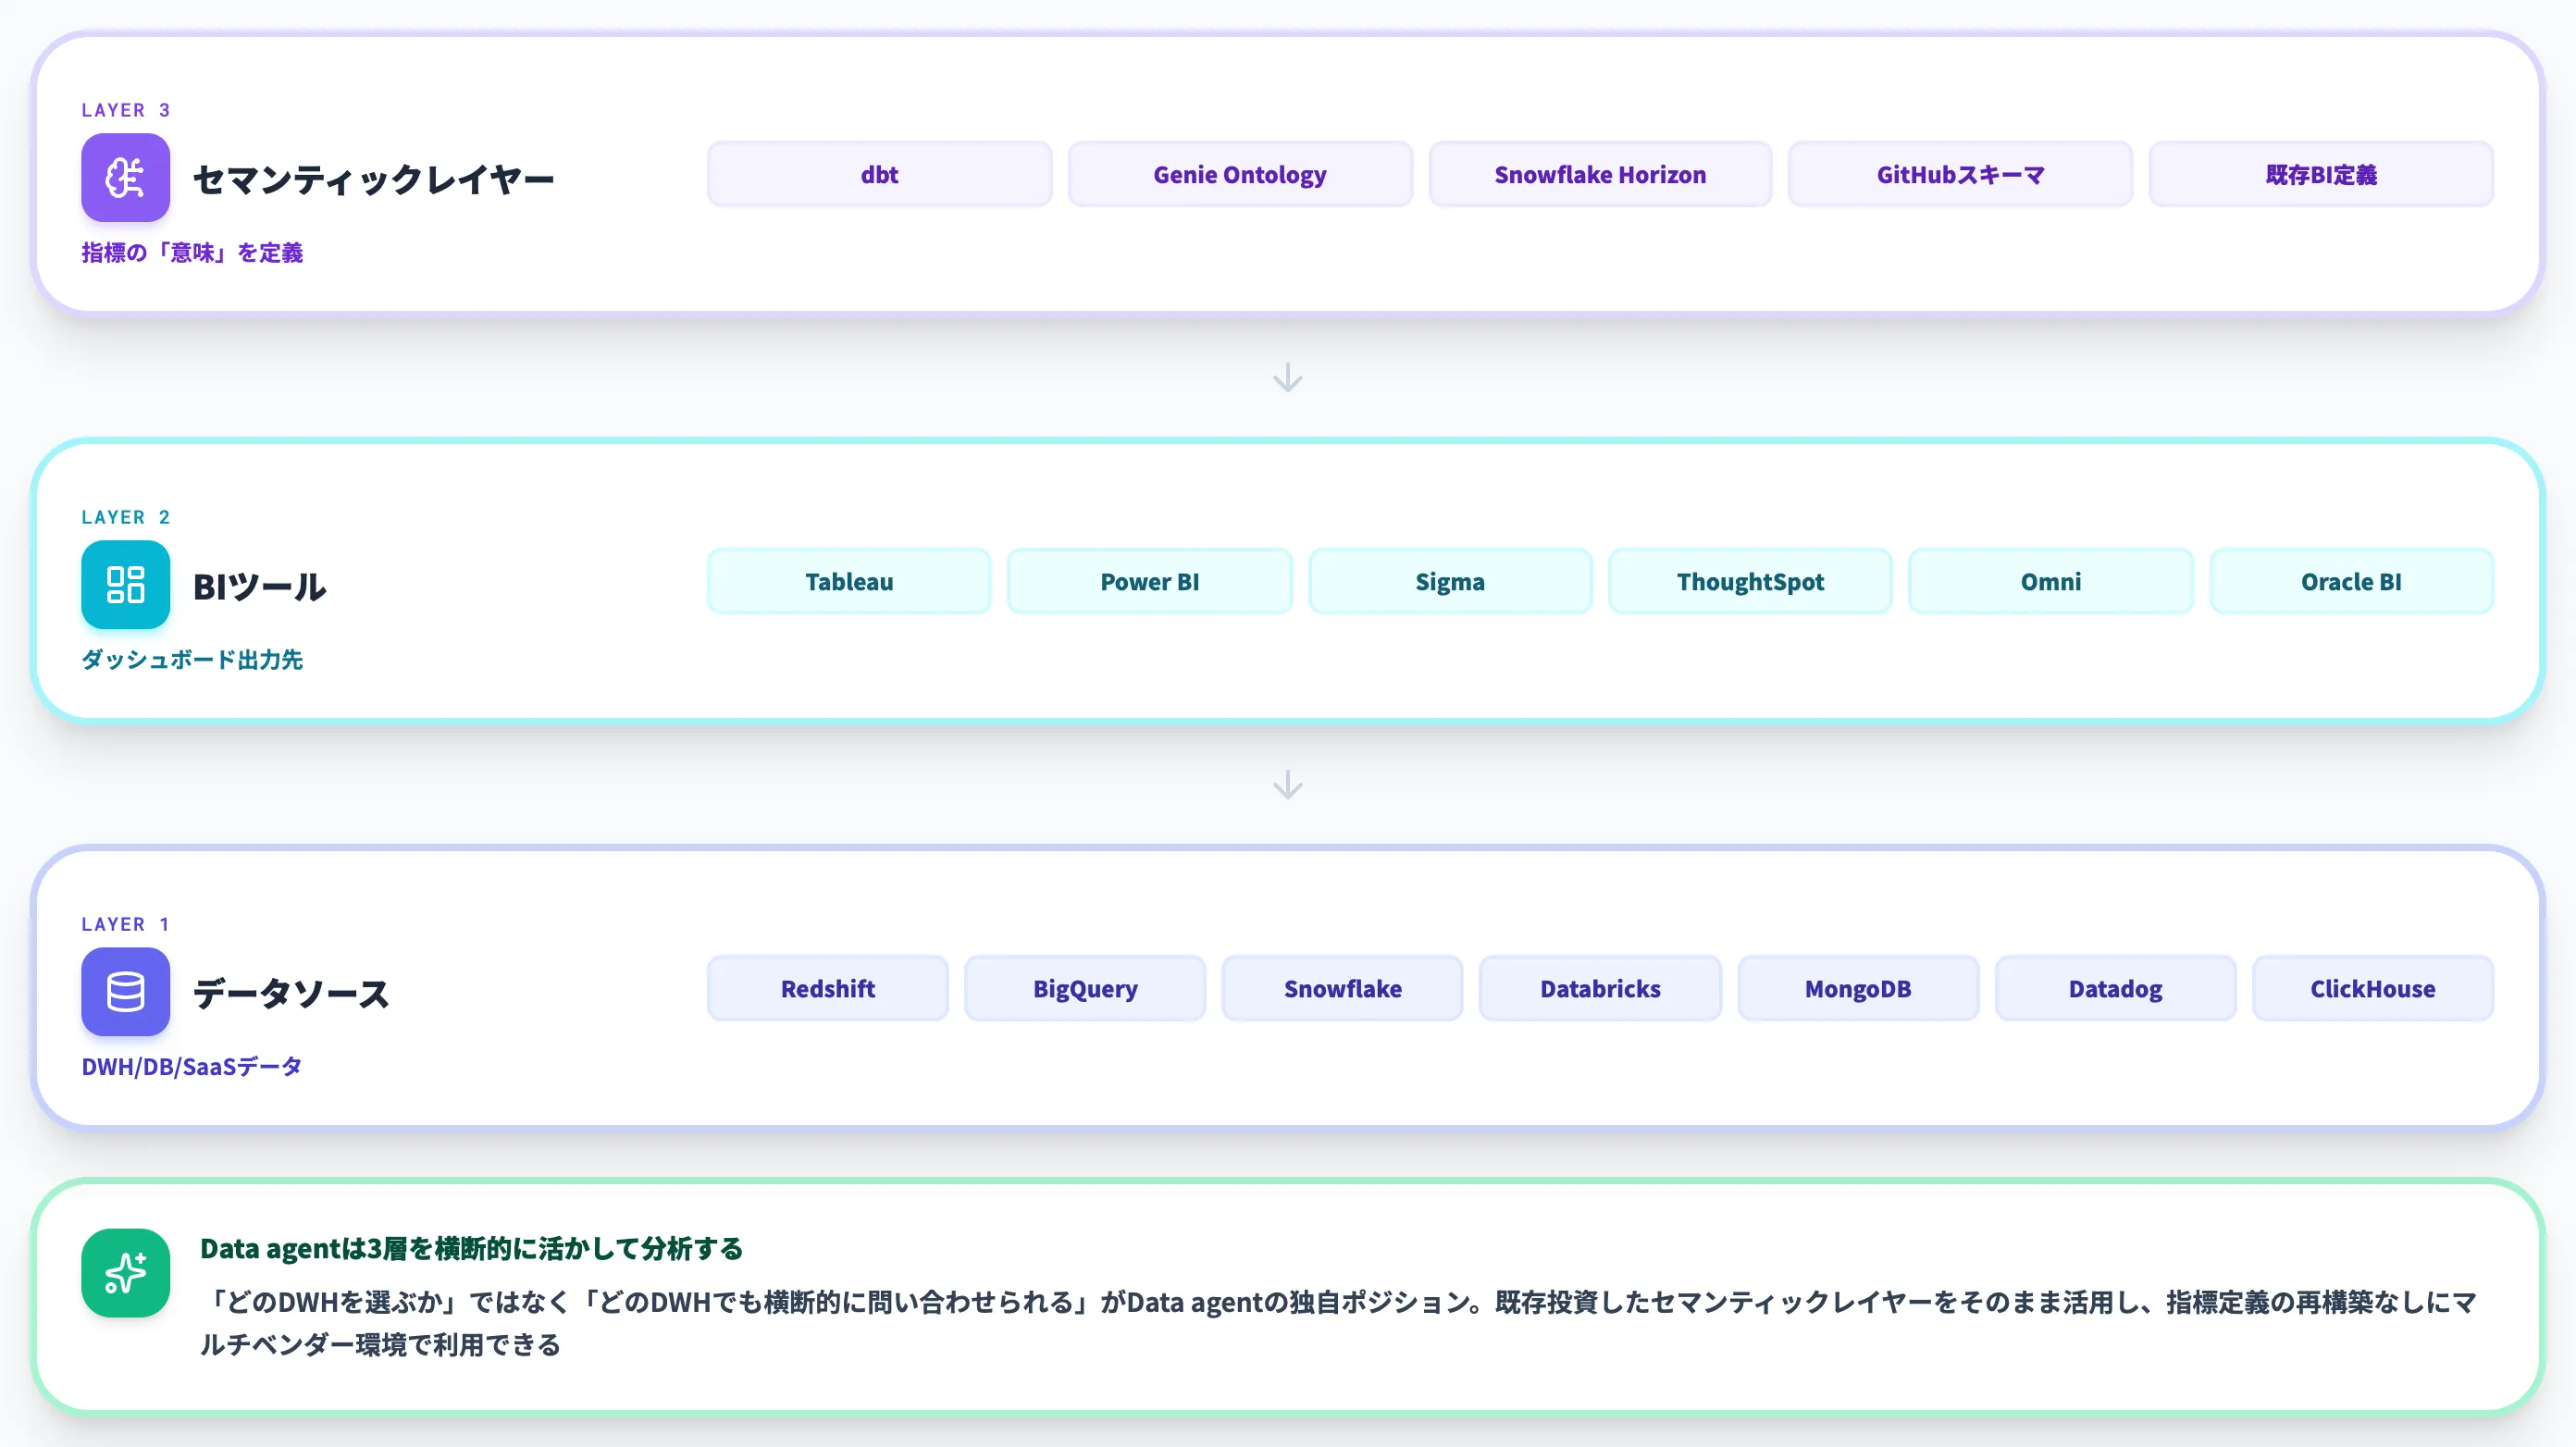
Data agentは、データウェアハウス・BIツール・セマンティックレイヤーの3層に横断的に対応します。
本セクションでは、対応リストとそれぞれが意味するものを整理します。
対応データウェアハウス・DBカタログ
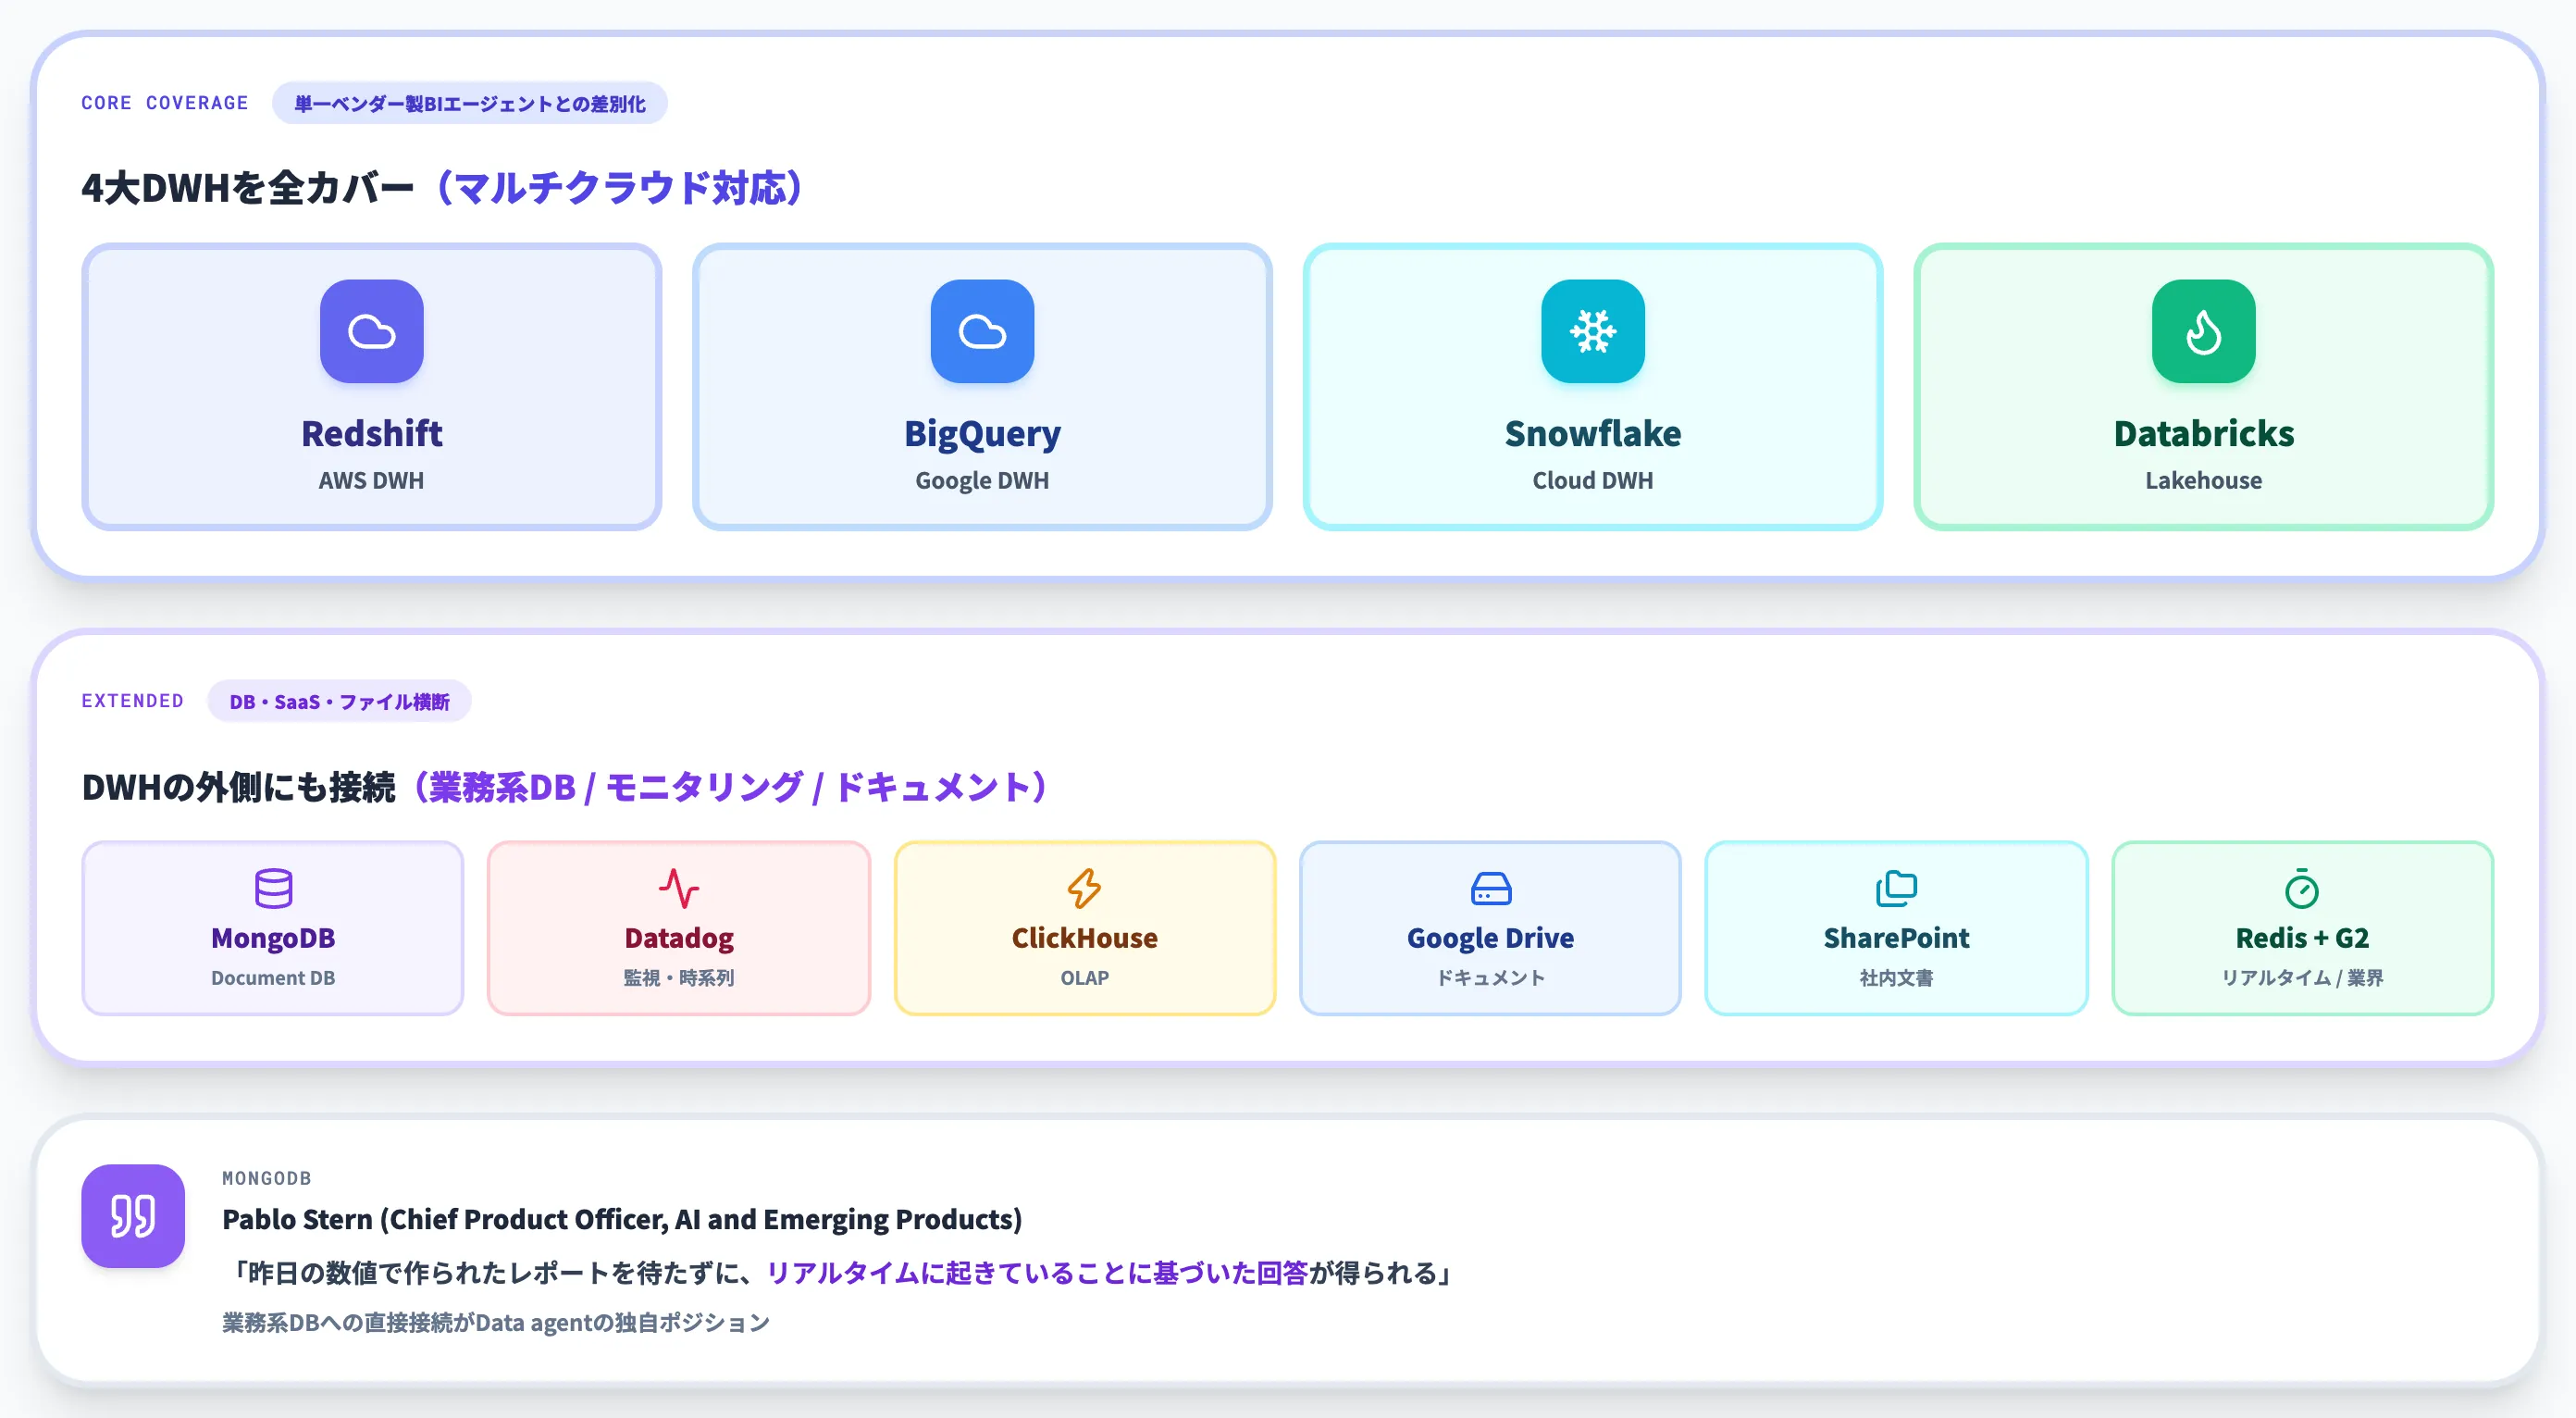
Data agentが接続できる主要データソースを、以下の表で整理しました。
| カテゴリ | 対応データソース | 主な用途 |
|---|---|---|
| データウェアハウス | Amazon Redshift、Google BigQuery、Snowflake、Databricks | 構造化データの集計・分析基盤 |
| NoSQL・ドキュメントDB | MongoDB | リアルタイムアプリのイベント・注文データ |
| モニタリング・時系列DB | Datadog | 稼働メトリクス・ログの傾向分析 |
| 分析用OLAP | ClickHouse | リアルタイム分析ワークロード |
| ファイル・ドキュメント | Google Drive、SharePoint | 社内ドキュメント・レポートの参照 |
| リアルタイムデータ層 | Redis | セッション・イベントストリームの照会 |
| 業界データ | G2 | 買い手インテント・競合動向の参照 |
DWH4社(Redshift・BigQuery・Snowflake・Databricks)を全てカバーしている点が、Fabric Data AgentやSnowflake Cortex Analyst等の単一ベンダー製BIエージェントに対する明確な差別化です。
マルチクラウド戦略で複数DWHを併用している企業でも、分析入口を1つに寄せられます。
MongoDBのPablo Stern(Chief Product Officer, AI and Emerging Products)は、公式コメントで「昨日の数値で作られたレポートを待たずに、リアルタイムに起きていることに基づいた回答が得られる」と述べており、業務系DBへの直接接続がData agentの独自ポジションであることを示しています。
対応BIツールとダッシュボード連携
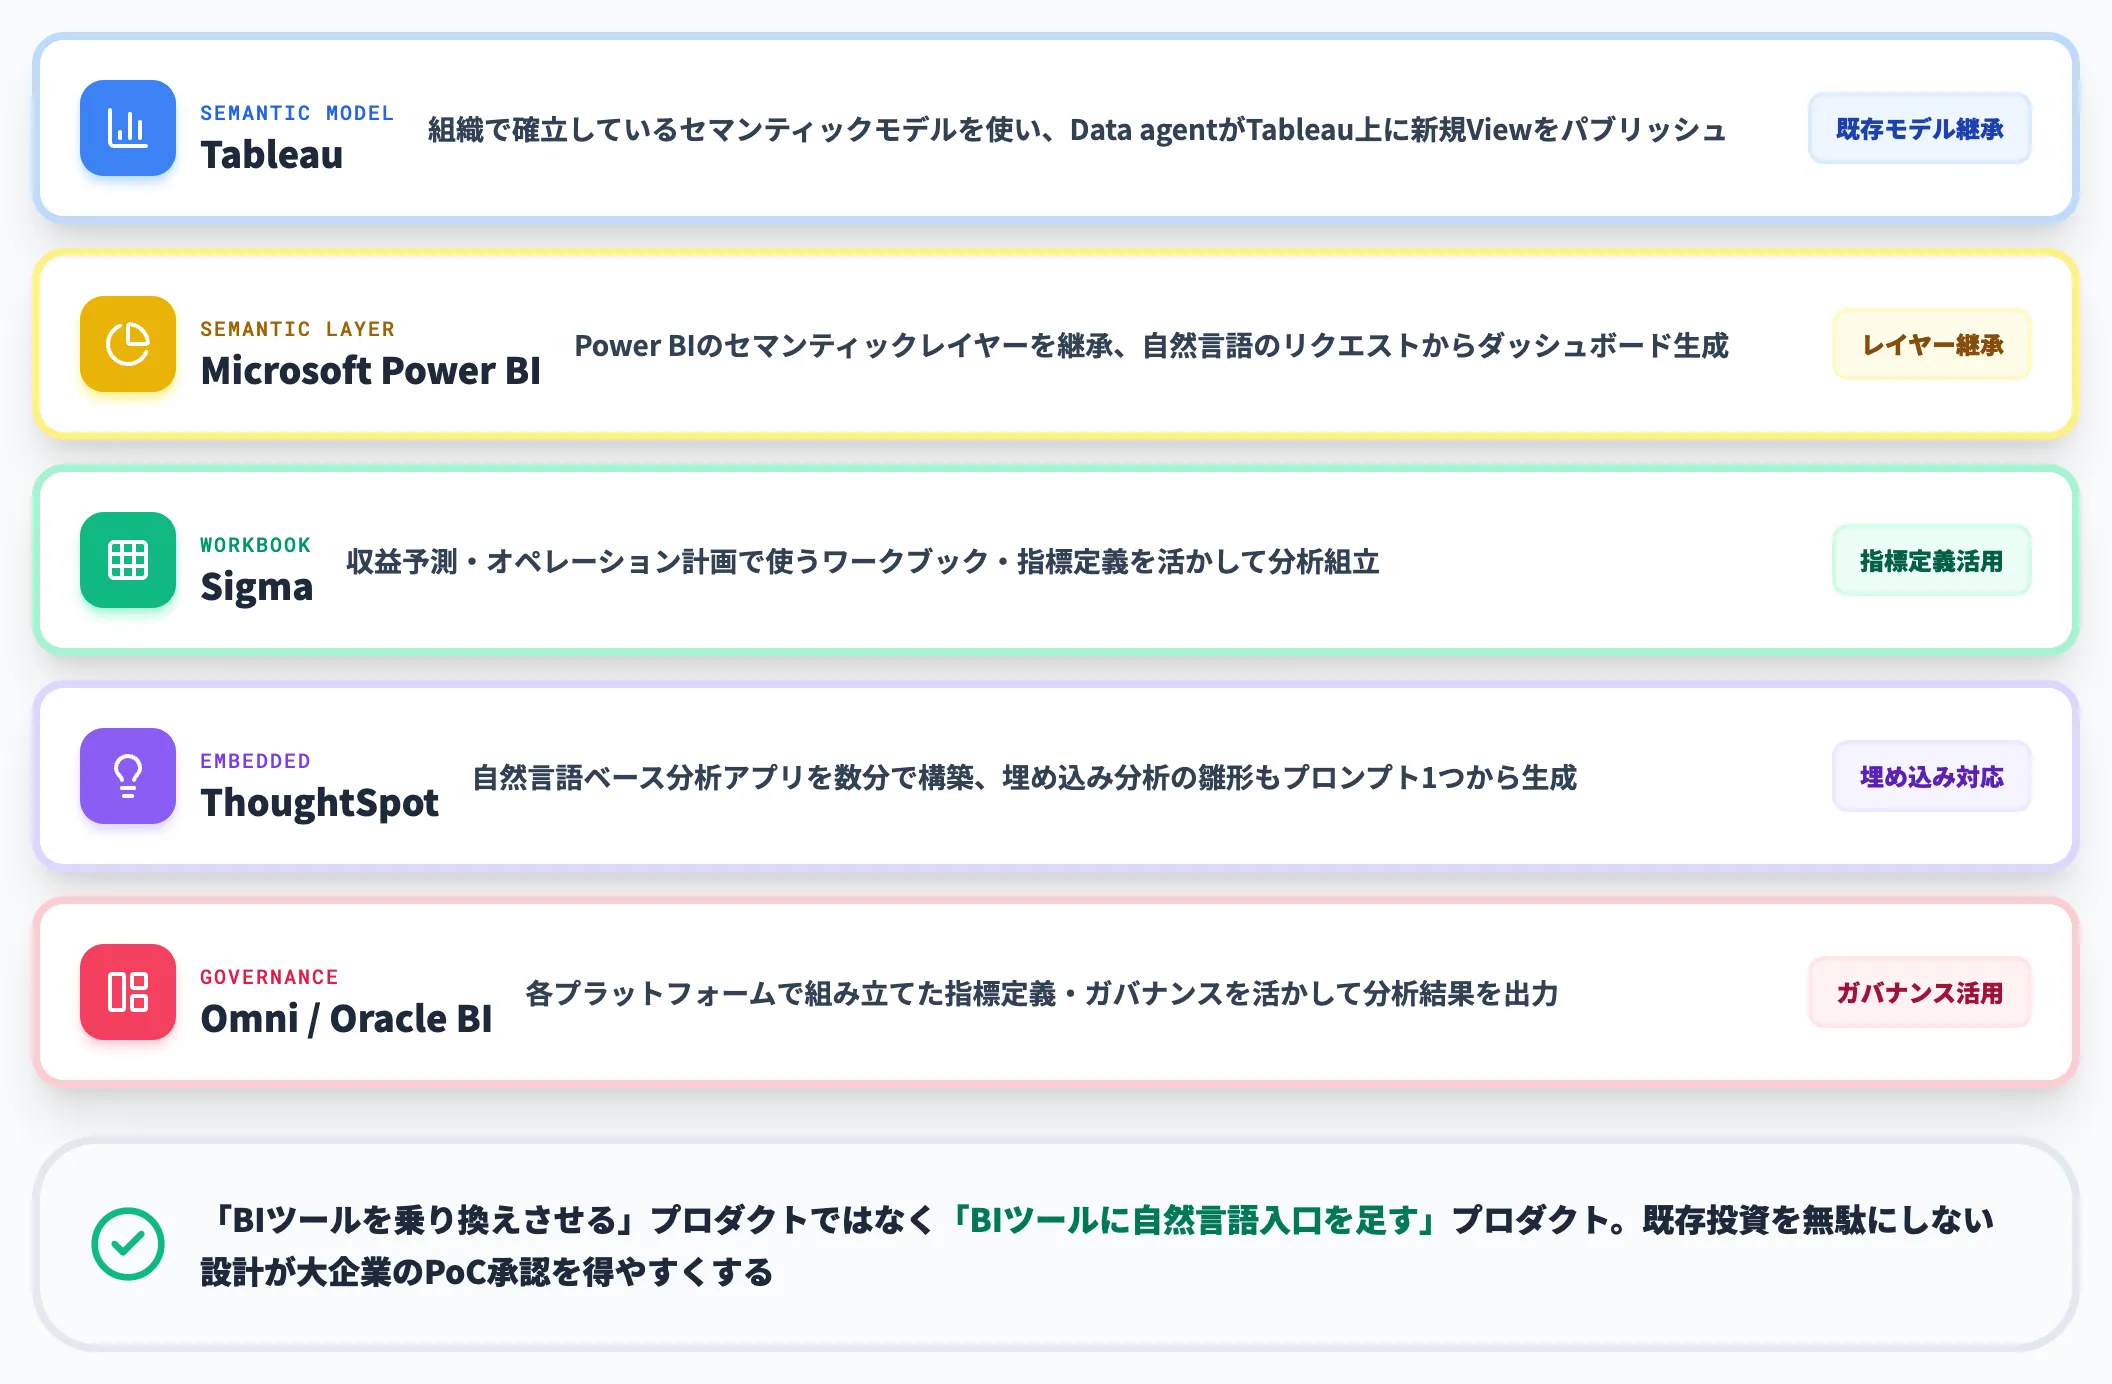
Data agentは、既存のBI環境の中にダッシュボードを直接作れる連携を持ちます。
-
Tableau
組織で確立しているセマンティックモデルを使い、Data agentがTableau上に新規Viewをパブリッシュする
-
Microsoft Power BI
Power BIのセマンティックレイヤーを継承し、自然言語のリクエストからPower BIダッシュボードを生成する
-
Sigma
収益予測・オペレーション計画で使われているワークブック・指標定義を活かして分析を組み立てる
-
ThoughtSpot
自然言語ベースの分析アプリを数分で構築、埋め込み分析アプリの雛形もプロンプト1つから生成する
-
Omni・Oracle BI
それぞれのプラットフォームで組み立てた指標定義・ガバナンスを活かして分析結果を出力する
「BIツールを乗り換えさせる」プロダクトではなく「BIツールに自然言語入口を足す」プロダクトである点が、Data agentの立ち位置を最もよく表しています。既存の投資を無駄にしない設計は、大企業でのPoC承認を得やすくします。
セマンティックレイヤーの継承
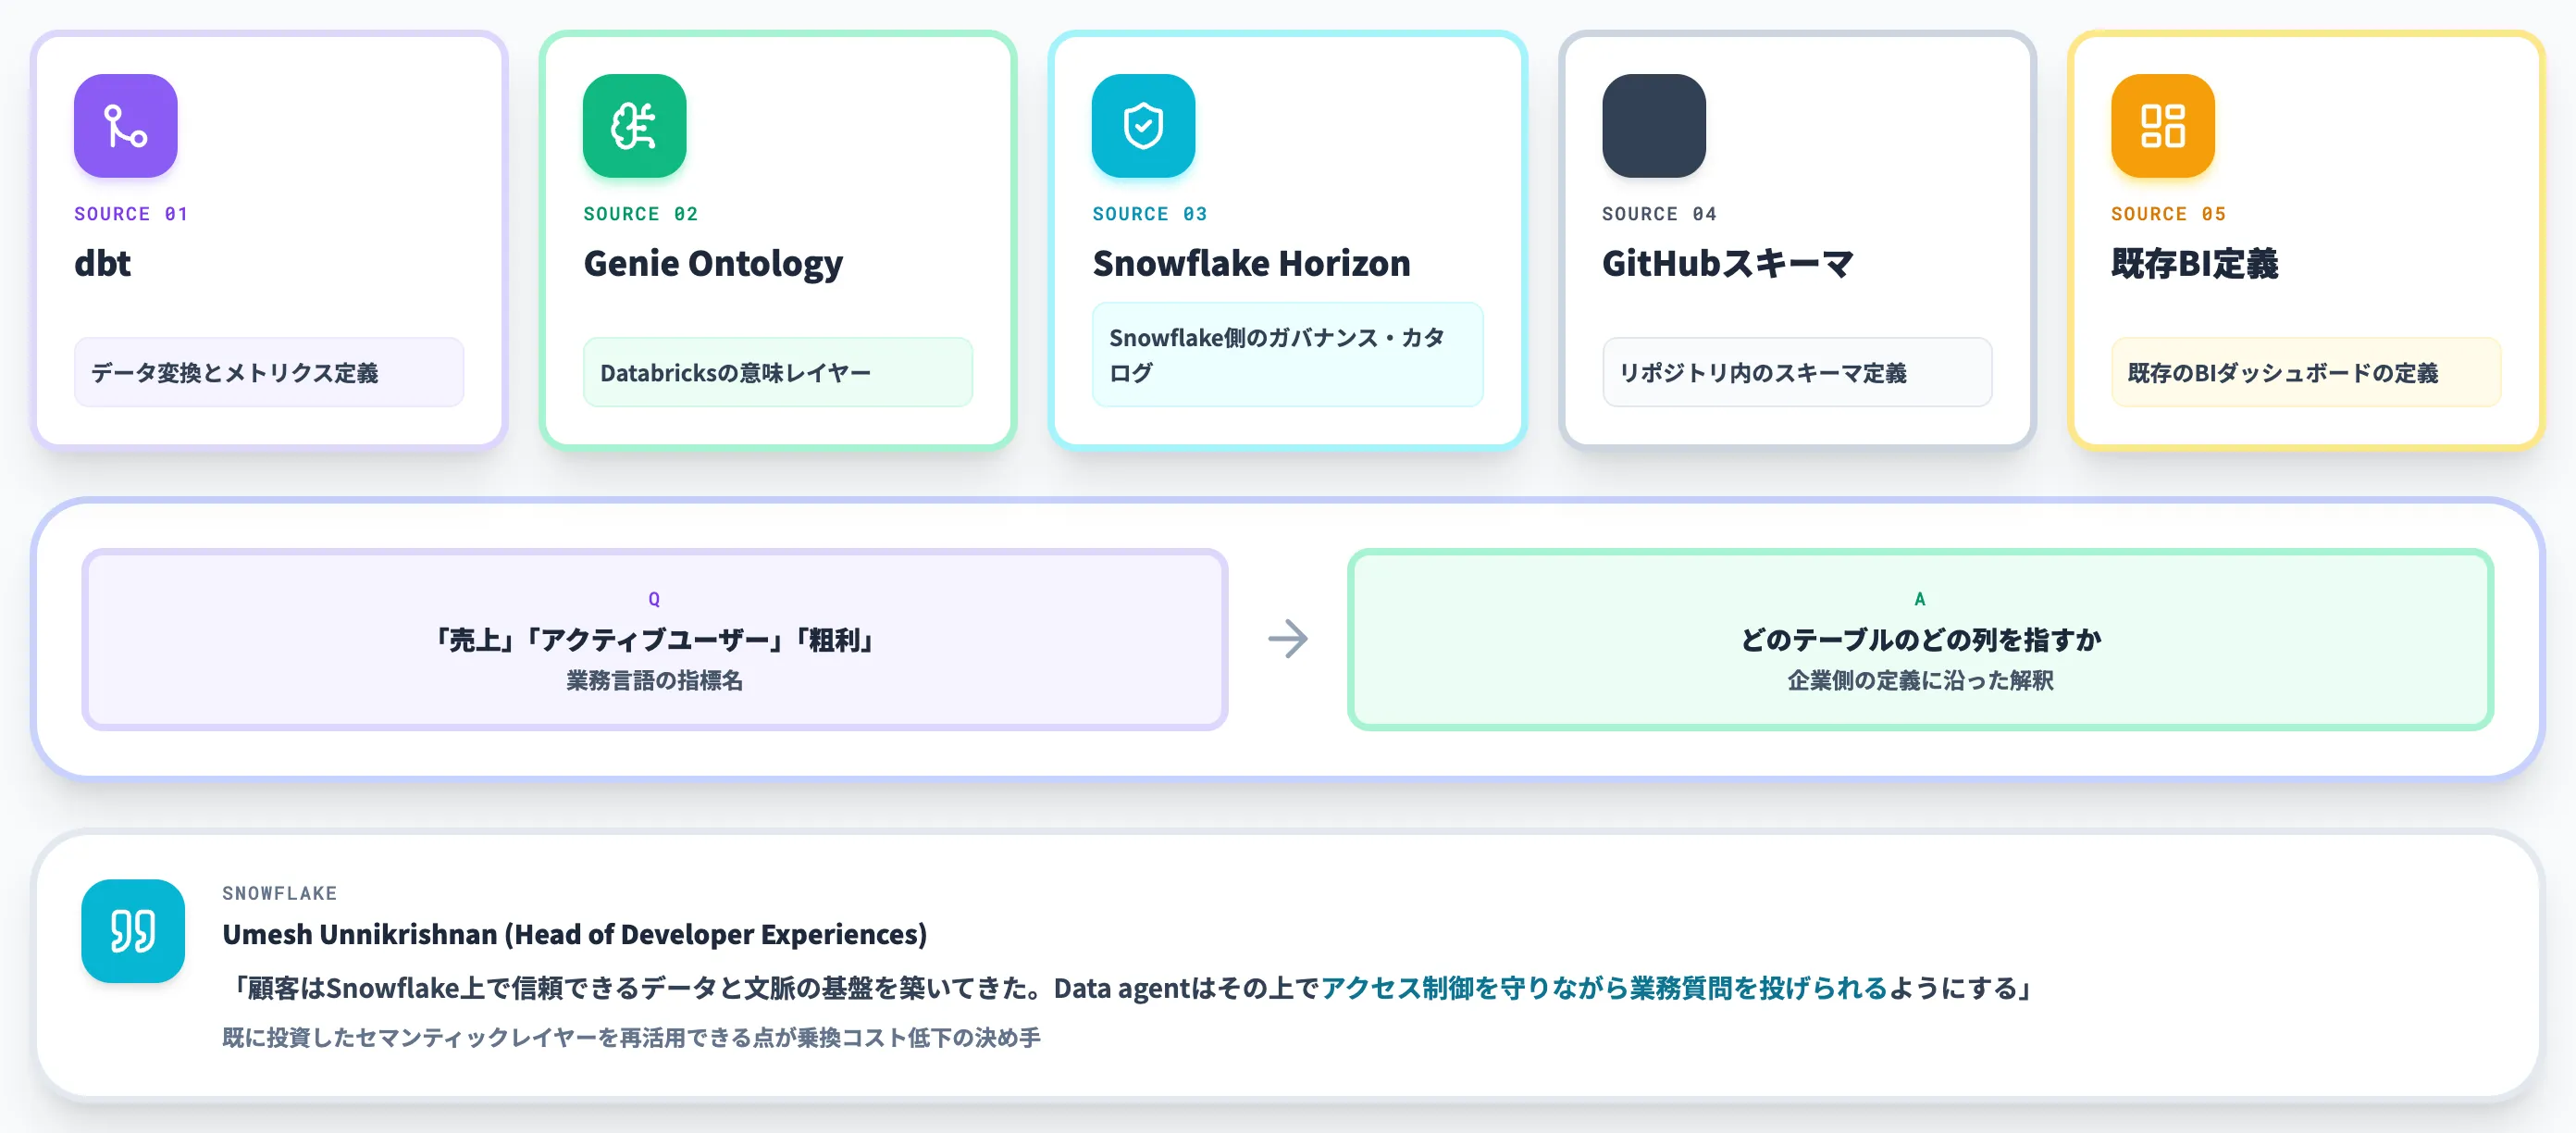
Data agentは、企業内で定義済みの「指標の意味」を積極的に取り込む設計になっています。
具体的な参照元はdbt(データ変換とメトリクス定義)・Databricks Genie Ontology(Databricksの意味レイヤー)・Snowflake Horizon Catalog(Snowflake側のガバナンス・カタログ基盤)・GitHub上のスキーマ定義・既存のBIダッシュボードの5系統です。「売上」「アクティブユーザー」「粗利」といった指標名がどのテーブルのどの列を指すかを、企業側の定義に沿って解釈します。
これは、オントロジーやAI-ready dataに投資してきた企業ほど、Data agentの回答精度を高く引き出せる構造を意味します。
「まず意味レイヤーを整えてから、その上に自然言語エージェントを載せる」というBI基盤の流れと合致した設計です。
Snowflakeを担当するUmesh Unnikrishnan(Head of Developer Experiences)は公式コメントで、「顧客はSnowflake上で信頼できるデータと文脈の基盤を築いてきた。Data agentはその上でアクセス制御を守りながら業務質問を投げられるようにする」と述べています。
既に投資したセマンティックレイヤーを再活用できる点が、企業側の乗換コストを下げる決め手になっています。
ChatGPT Work Data agentの料金プランと利用条件
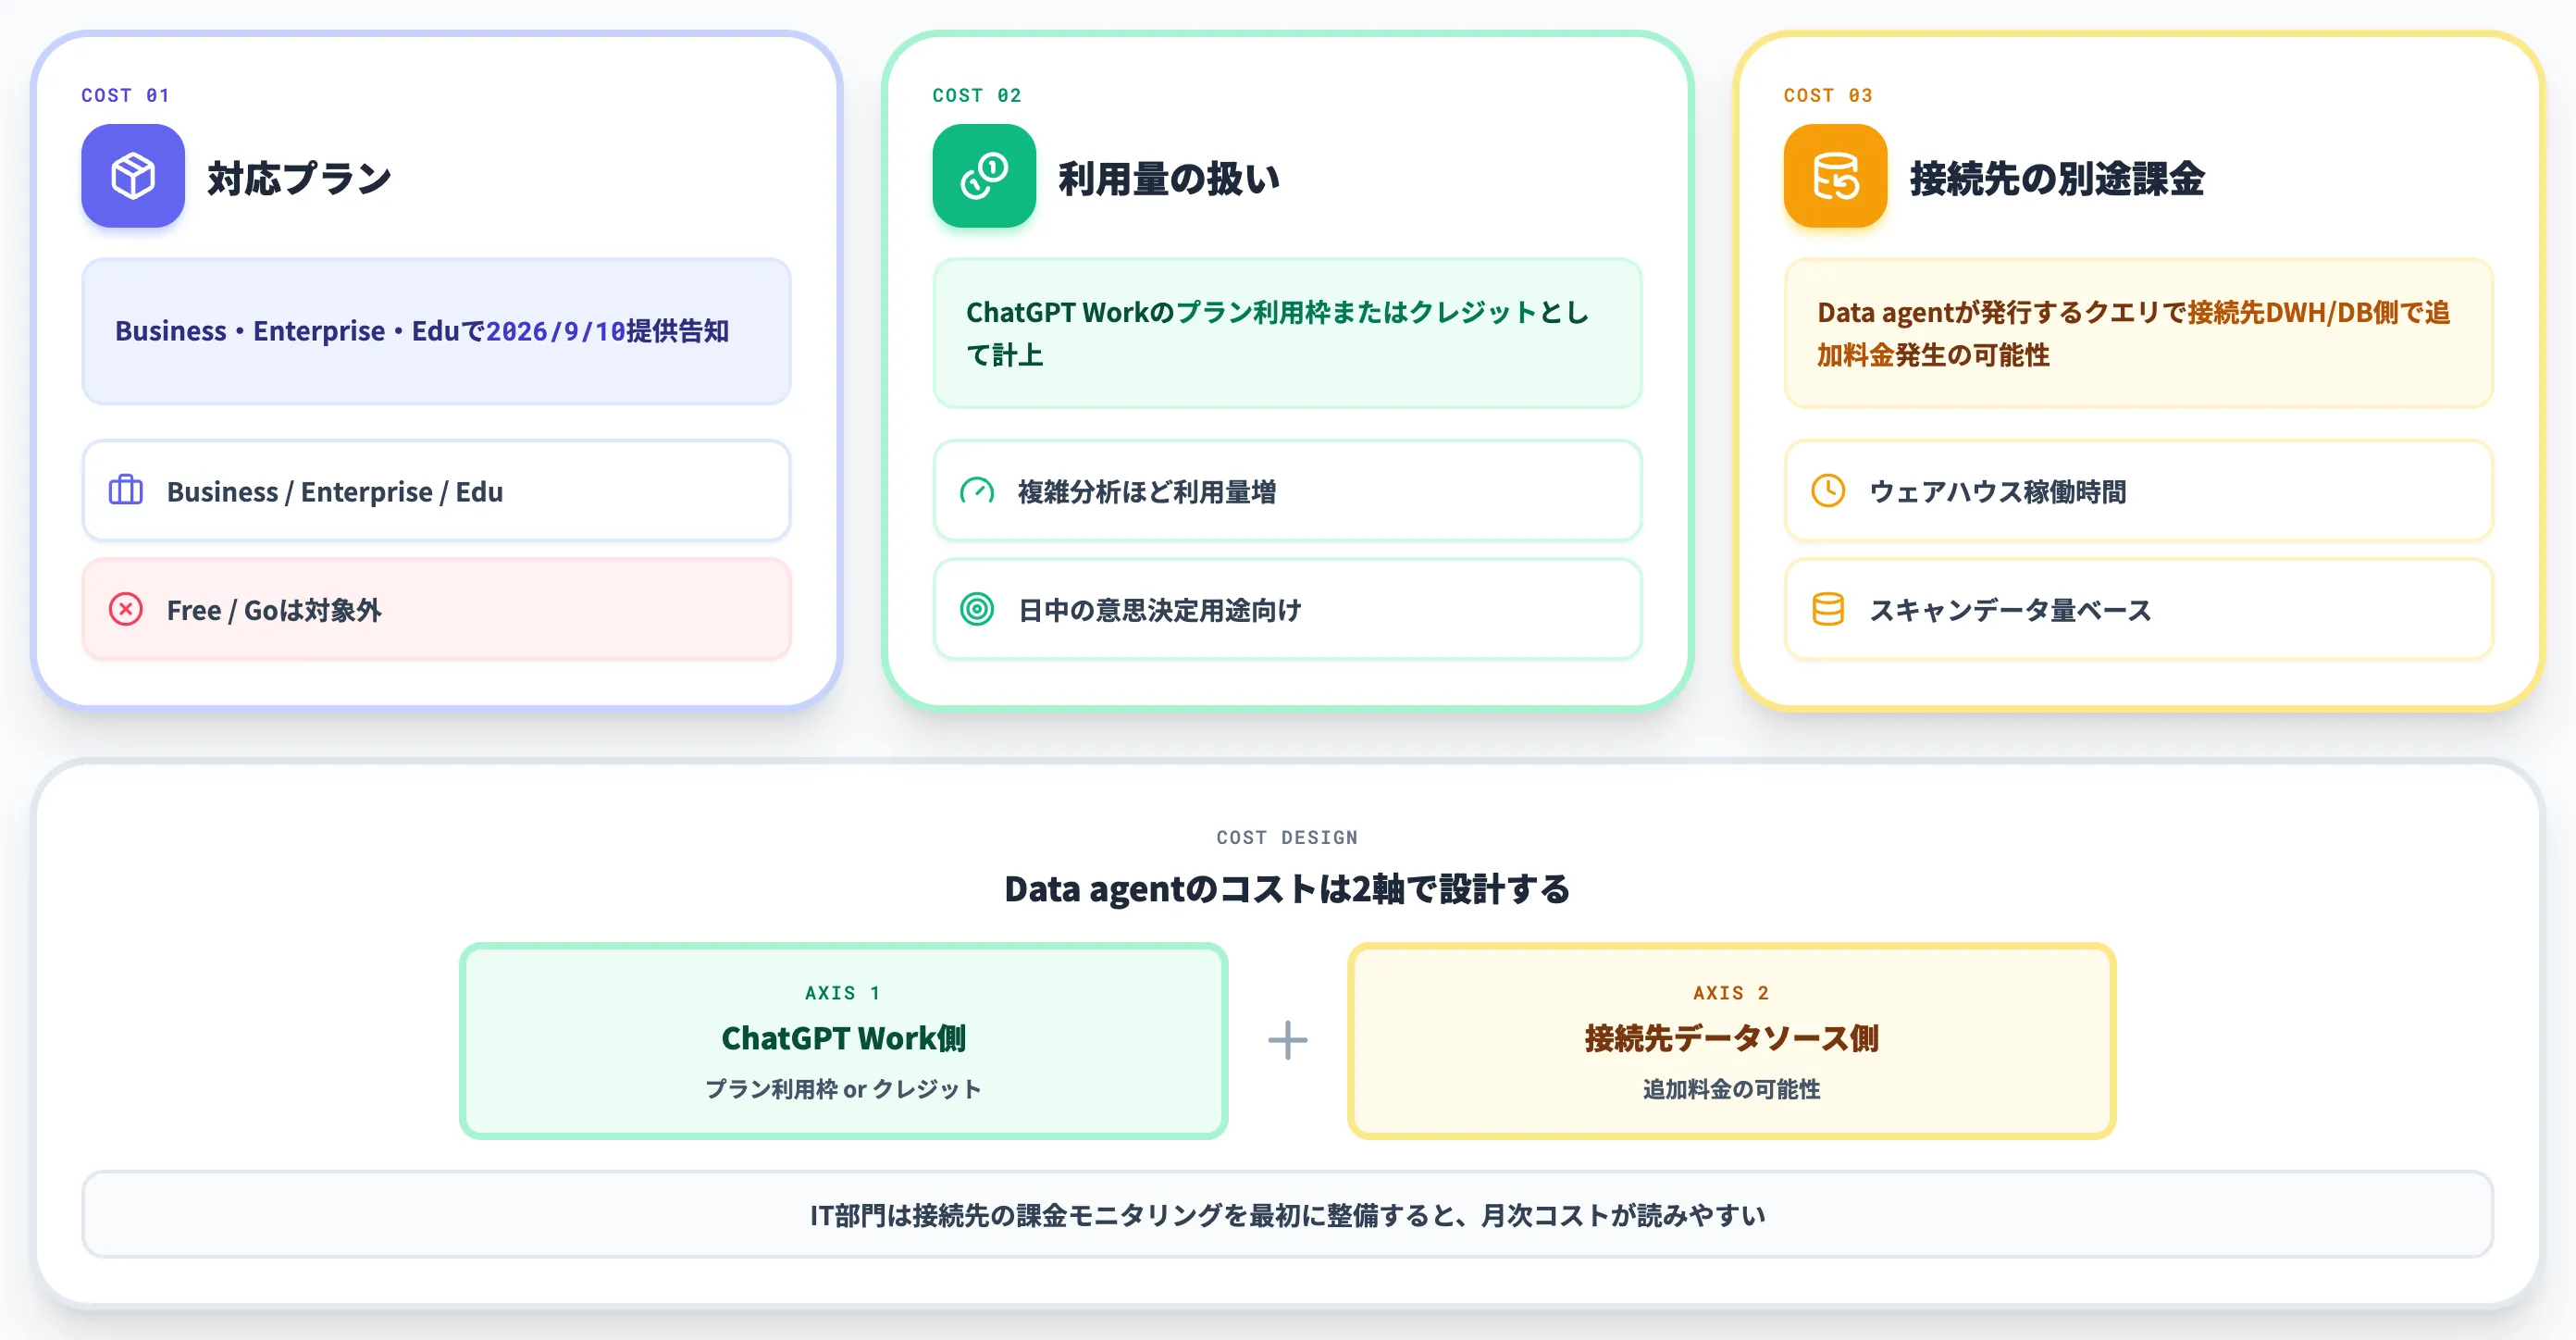
Data agentの料金は、ChatGPT Workの利用プランに含まれる形で提供されます。
本セクションでは、対応プラン・課金モデル・接続先データソースの料金を整理します。
対応プランと配布方法
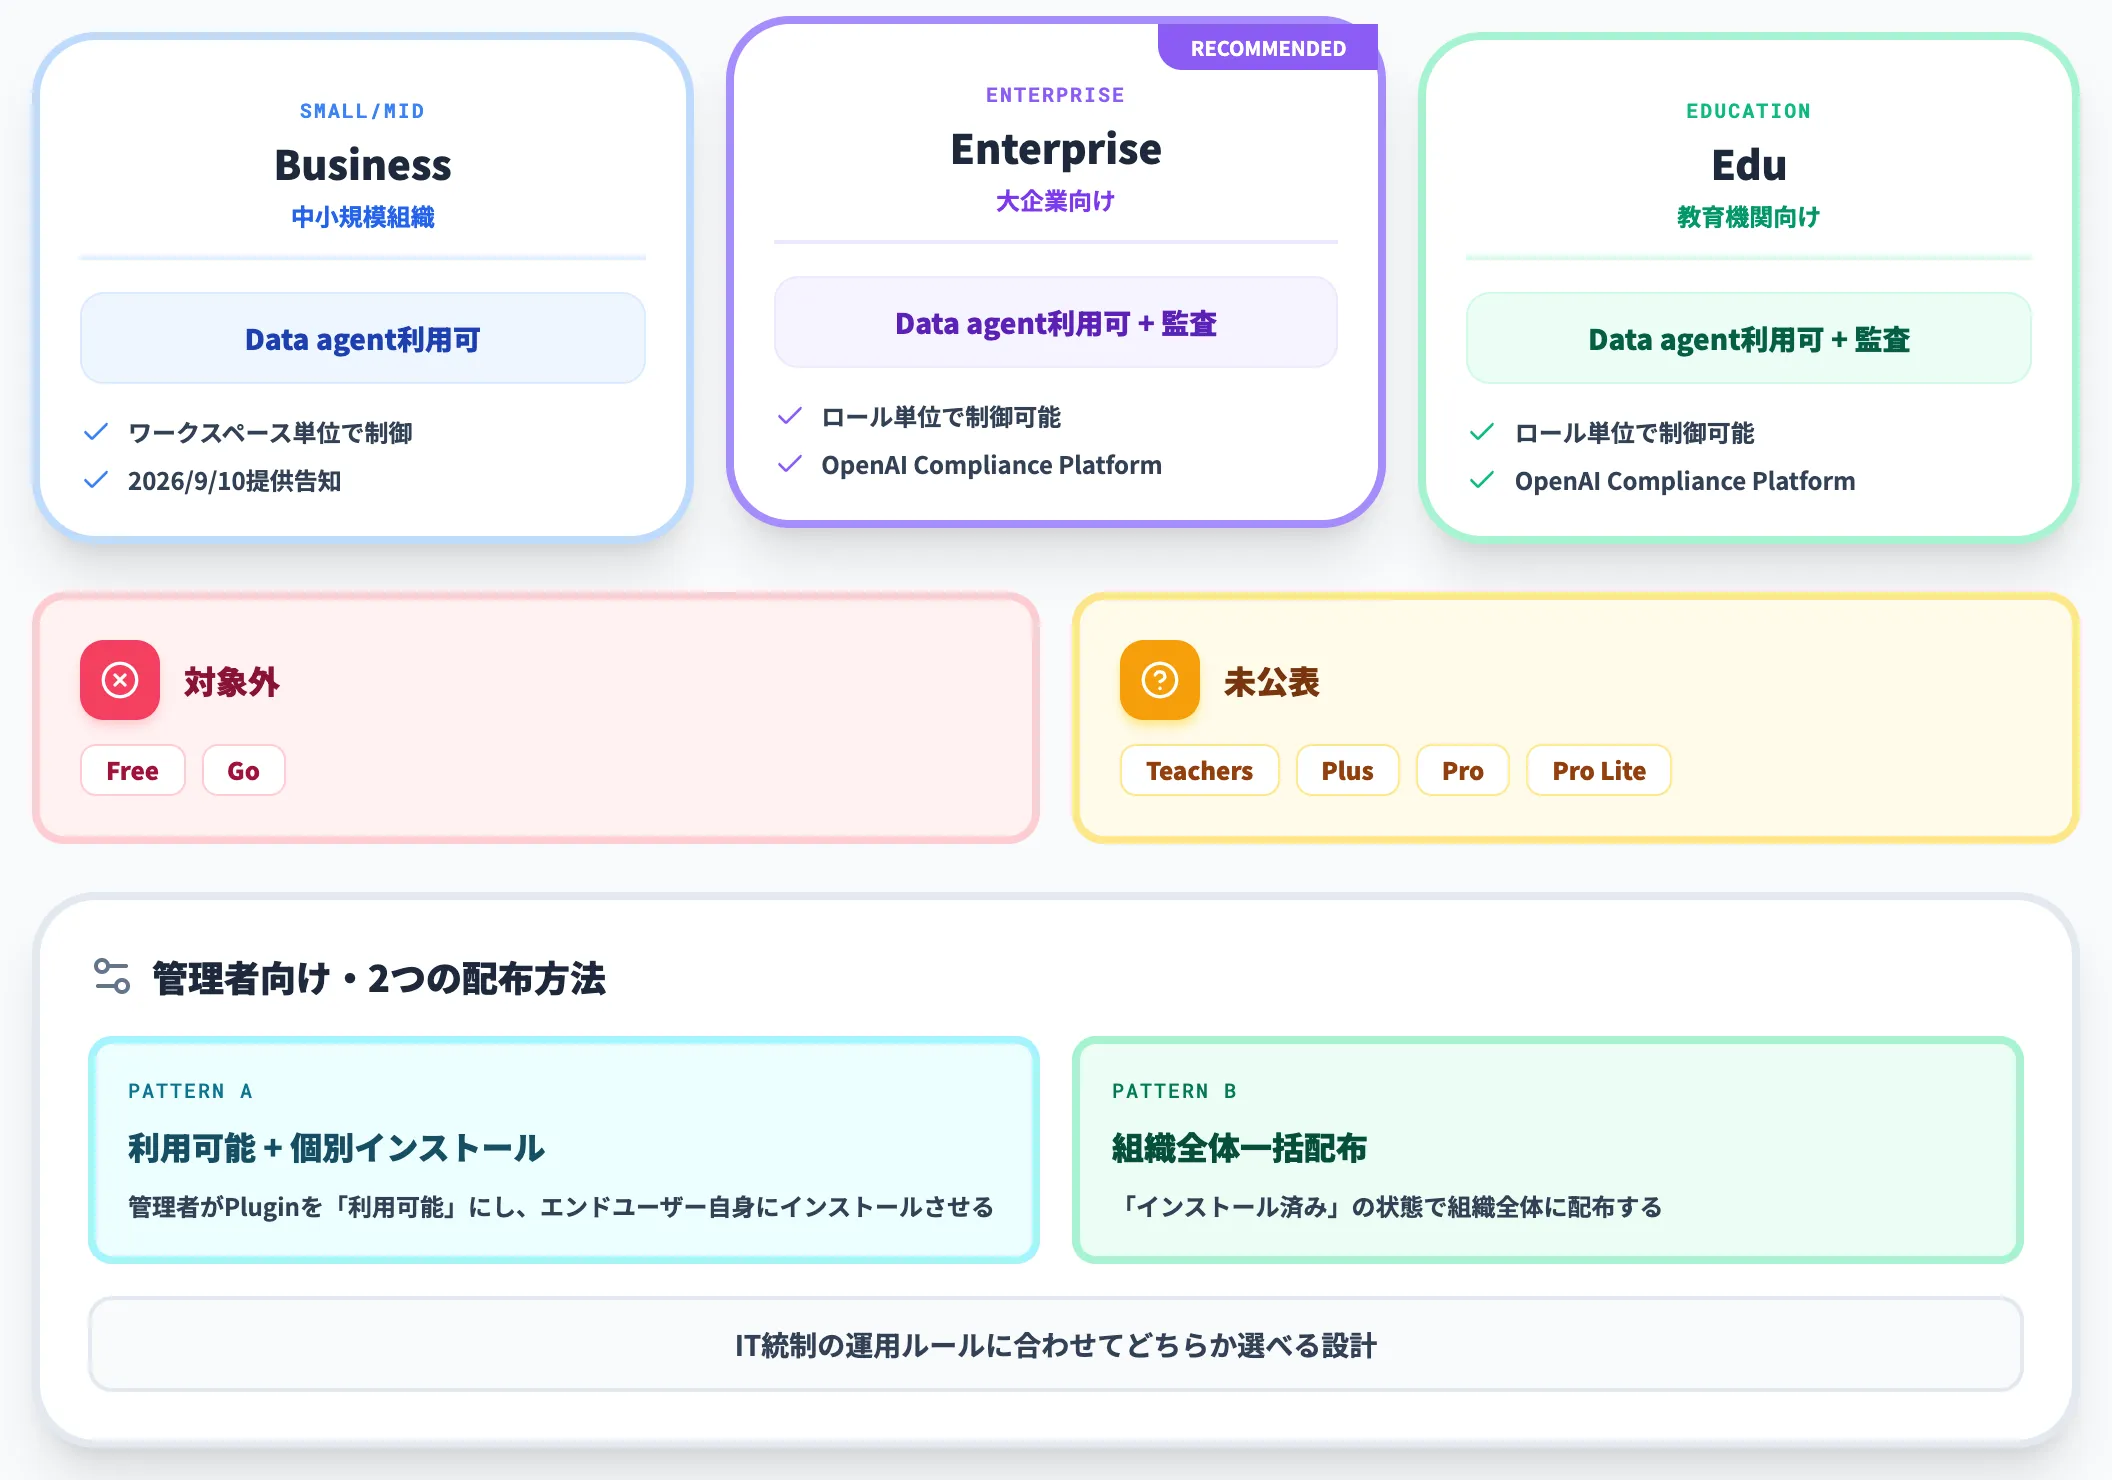
Data agentは、ChatGPT Workの一機能として、Business・Enterprise・Eduの各プランで2026年9月10日に提供が告知されました。Teachers・Plus・Pro・Pro Liteでの提供可否や展開時期は現時点で公式には明示されていません。
実際の利用可否はプラン、Workspace設定、ロール、展開の進み具合によって変わります。Free・Goプランは対象外です。
配布方法は2通りあります。管理者がPluginを「利用可能」にしてエンドユーザー自身にインストールさせるパターンと、「インストール済み」の状態で組織全体に配布するパターンです。
IT統制の運用ルールに合わせてどちらかを選べる設計になっています。
Data agentの利用量の扱い
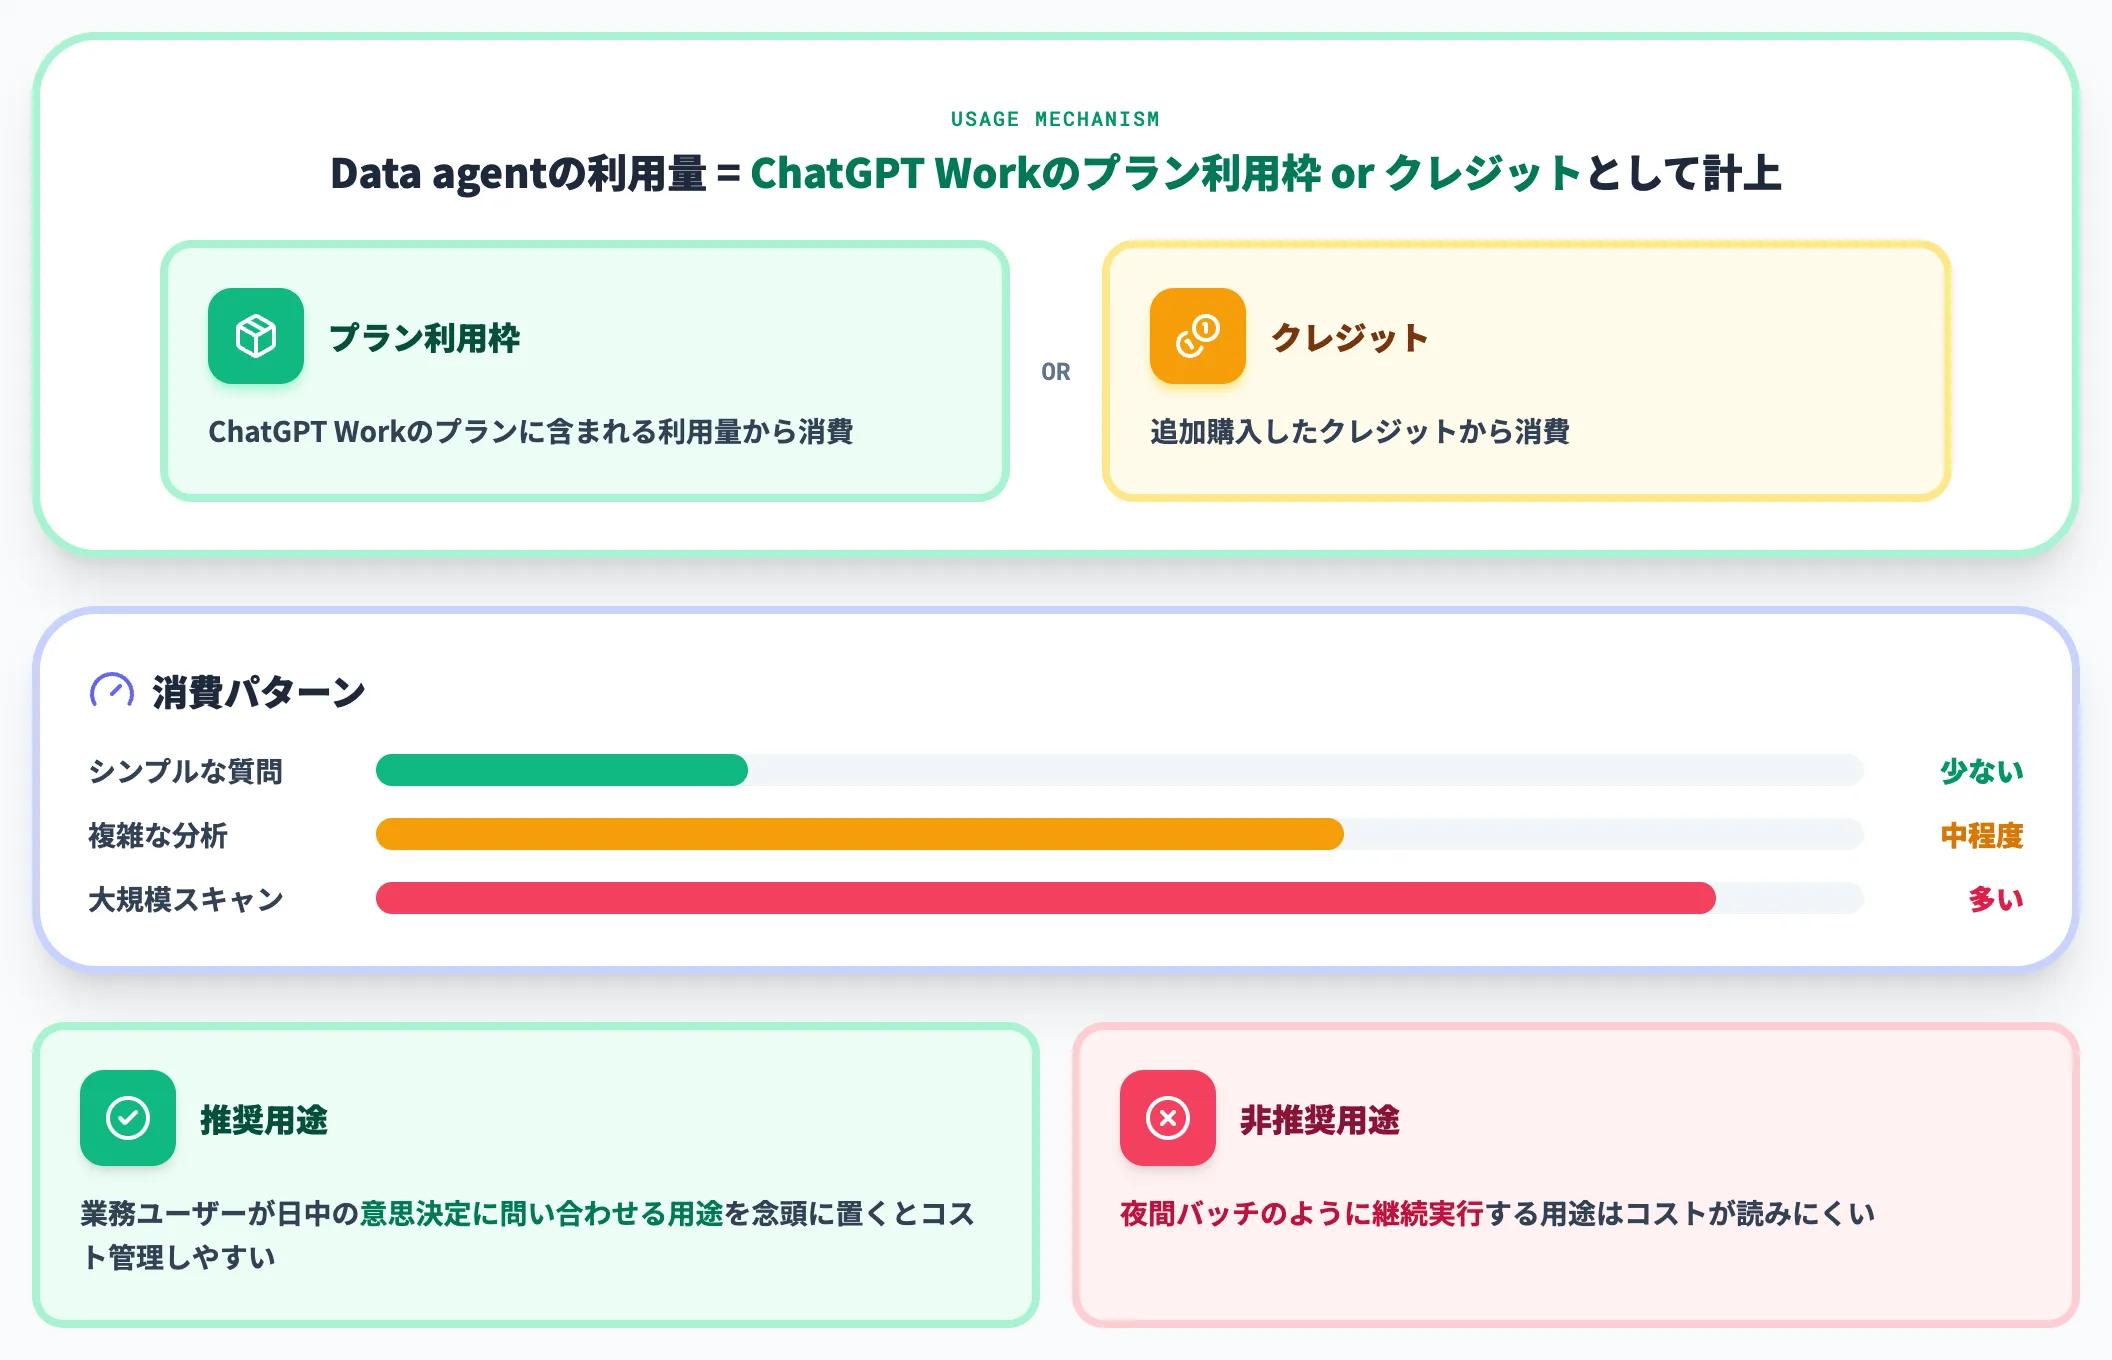
Data agentの利用量は、ChatGPT Workのプラン利用枠またはクレジットとして計上されます。具体的な料金体系はプランごとに異なります。
複雑な分析タスクや大規模なデータスキャンほど、ChatGPT Workの利用量を多く消費します。夜間バッチのように継続実行する用途ではなく、業務ユーザーが日中の意思決定に問い合わせる用途を念頭に置くと、コスト管理がしやすくなります。
接続先データソースの料金(別途課金)
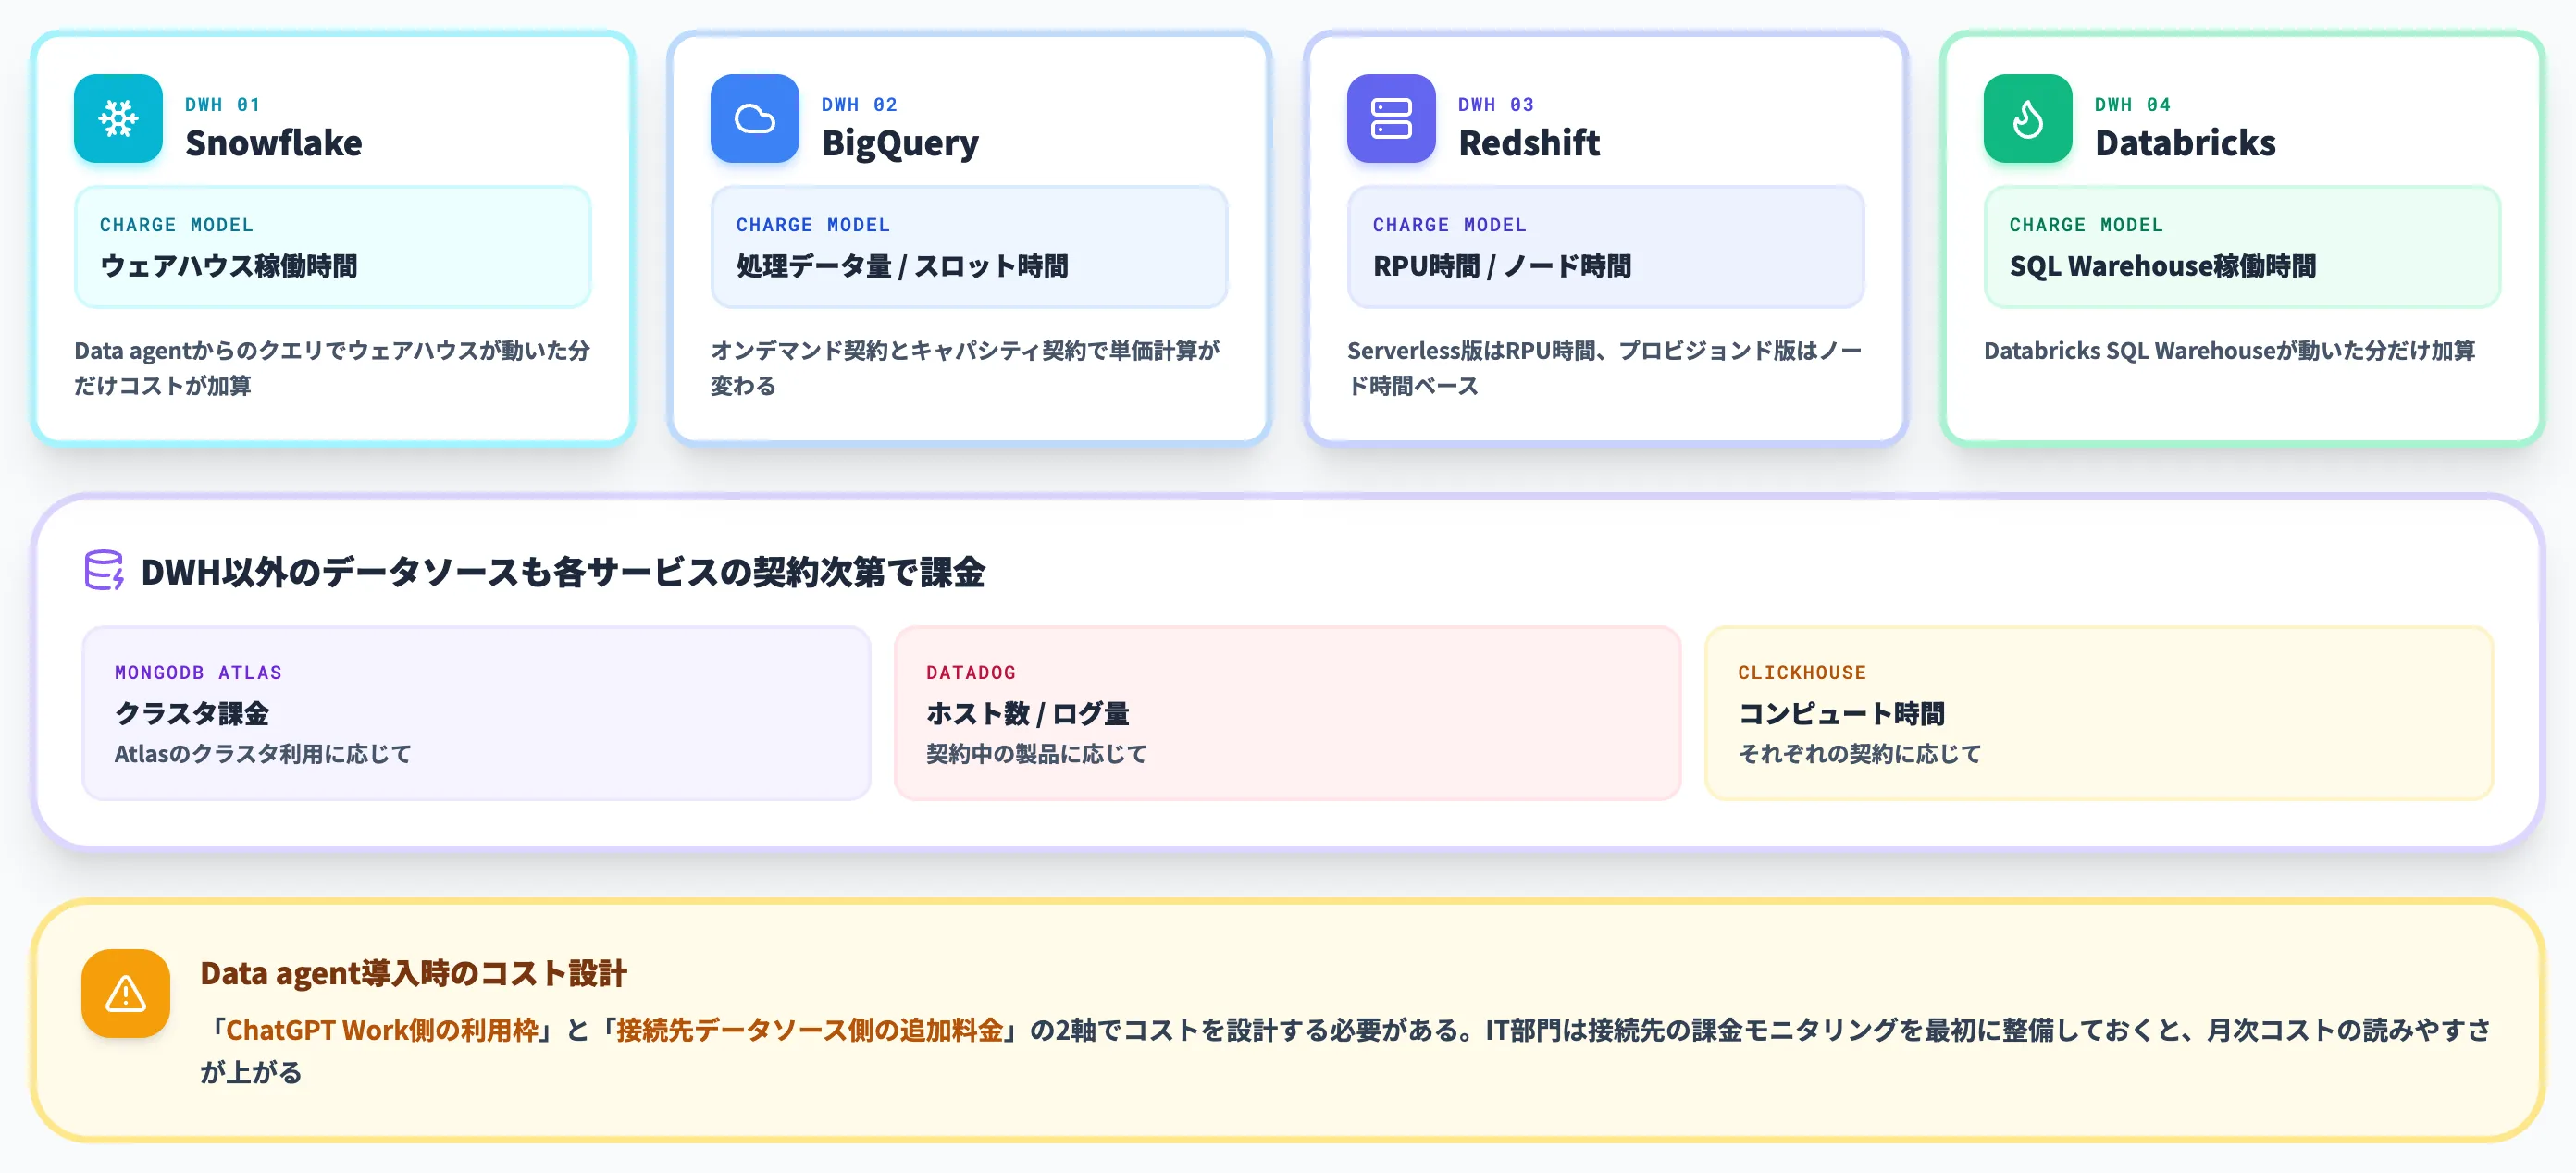
Data agentから発行されるクエリは、接続先のデータソース側で追加料金が発生する可能性があります。課金モデルは契約方式によって異なります。
-
Snowflake
ウェアハウスの稼働時間に応じて課金される。Data agentからのクエリでウェアハウスが動いた分だけコストが加算される
-
BigQuery
処理データ量またはスロット時間ベース。オンデマンド契約とキャパシティ契約で単価計算が変わる
-
Redshift
Redshift Serverlessの場合はRPU時間、プロビジョンド版の場合はノード時間ベース
-
Databricks・MongoDB Atlas・Datadog・ClickHouse
Databricks SQL Warehouseの稼働時間・MongoDB Atlasのクラスタ課金・Datadogは契約中の製品に応じたホスト数やログ量・ClickHouseのコンピュート時間など、それぞれの契約に応じた課金モデル
Data agent導入時は「ChatGPT Work側の利用枠」と「接続先データソース側で発生し得る追加料金」の2軸でコストを設計する必要があります。IT部門は接続先の課金モニタリングを最初に整備しておくと、月次コストの読みやすさが上がります。
ChatGPT Work Data agentの使い方
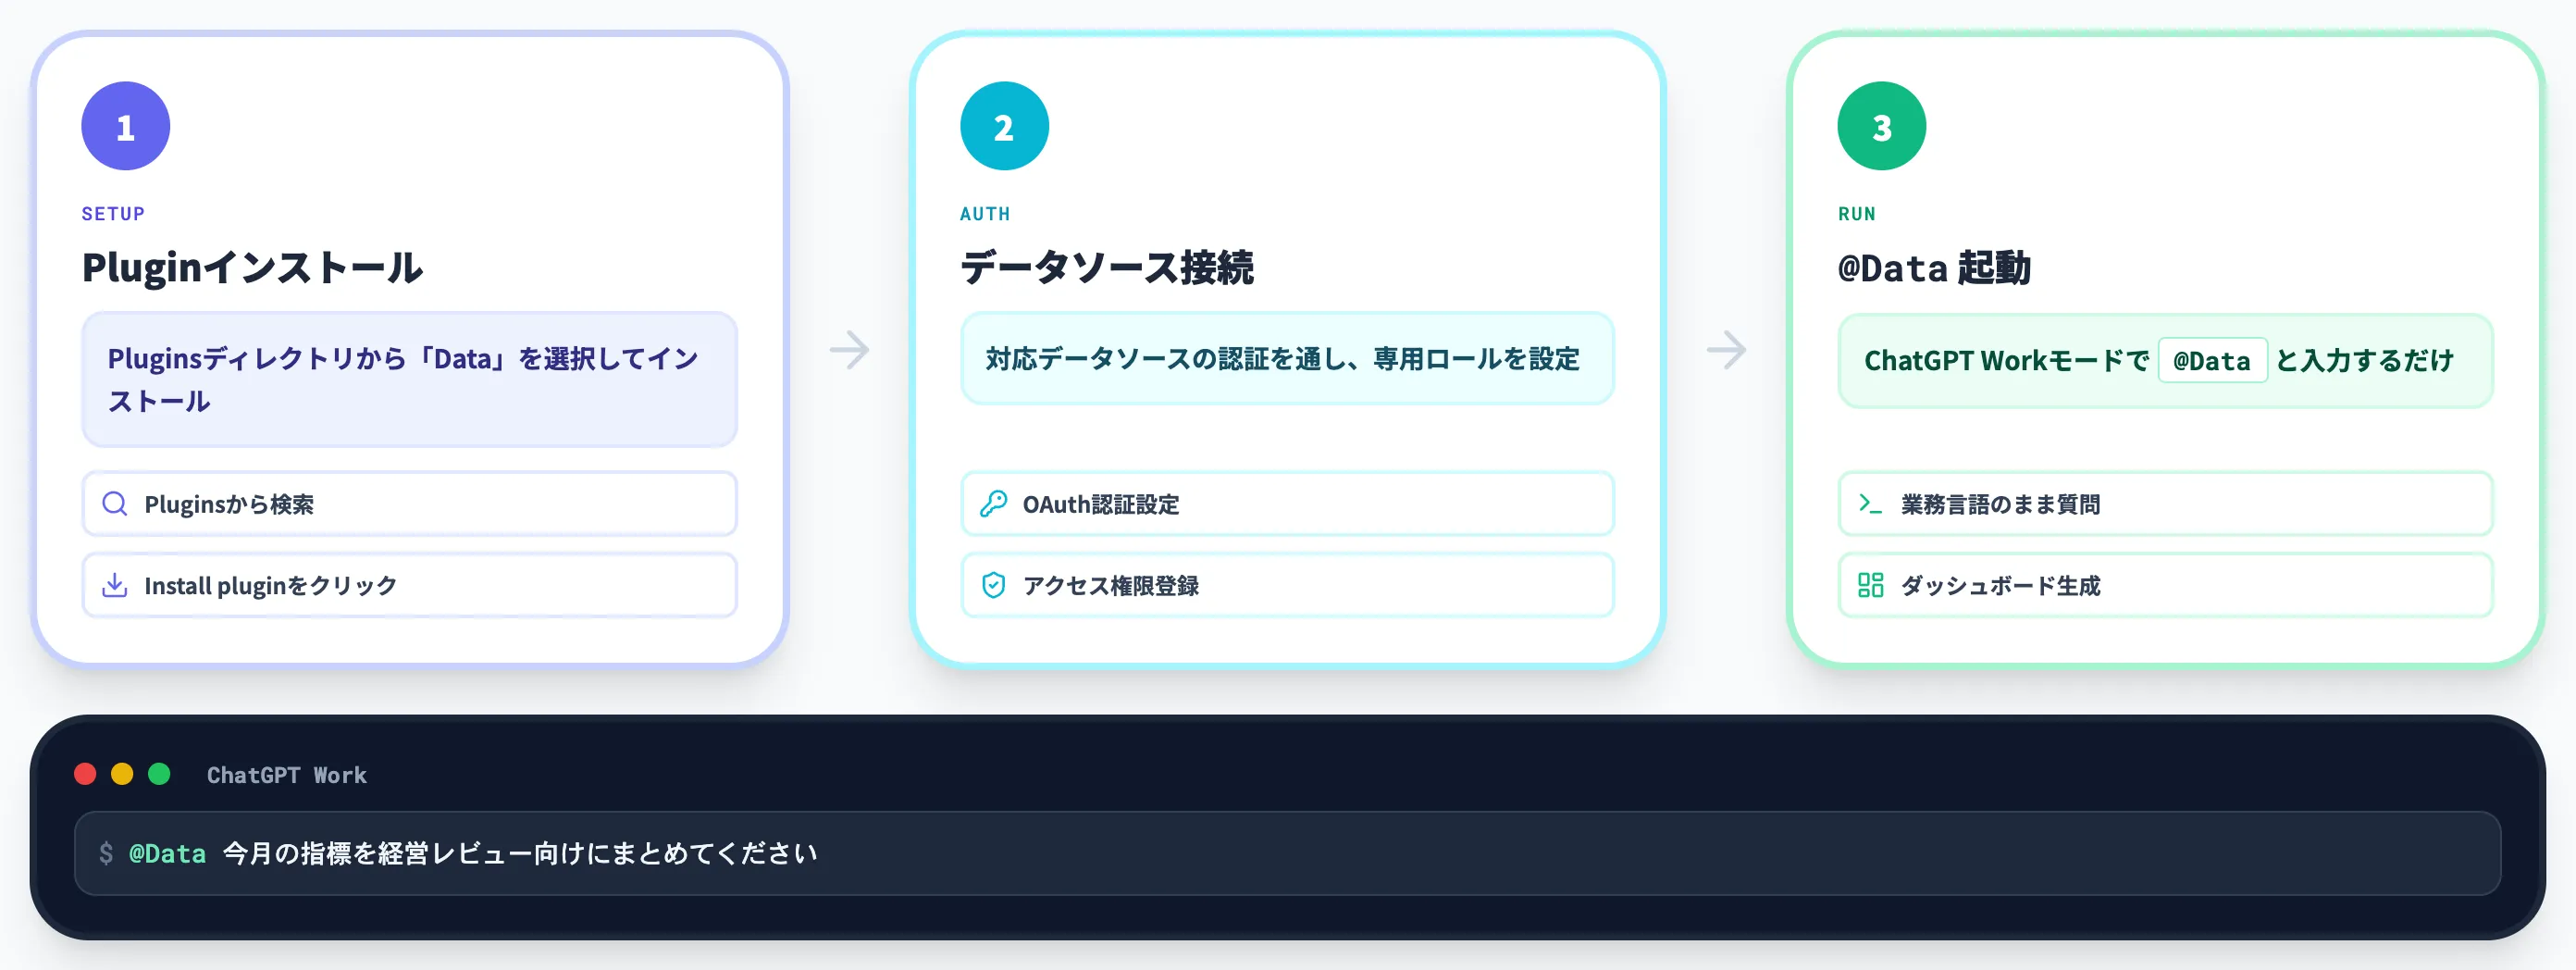
Data agentは「Pluginのインストール→データソース接続→「@Data」起動」の3ステップで利用開始できます。
本セクションでは、それぞれの手順と代表プロンプトを整理します。
PluginsディレクトリからData agentを導入する
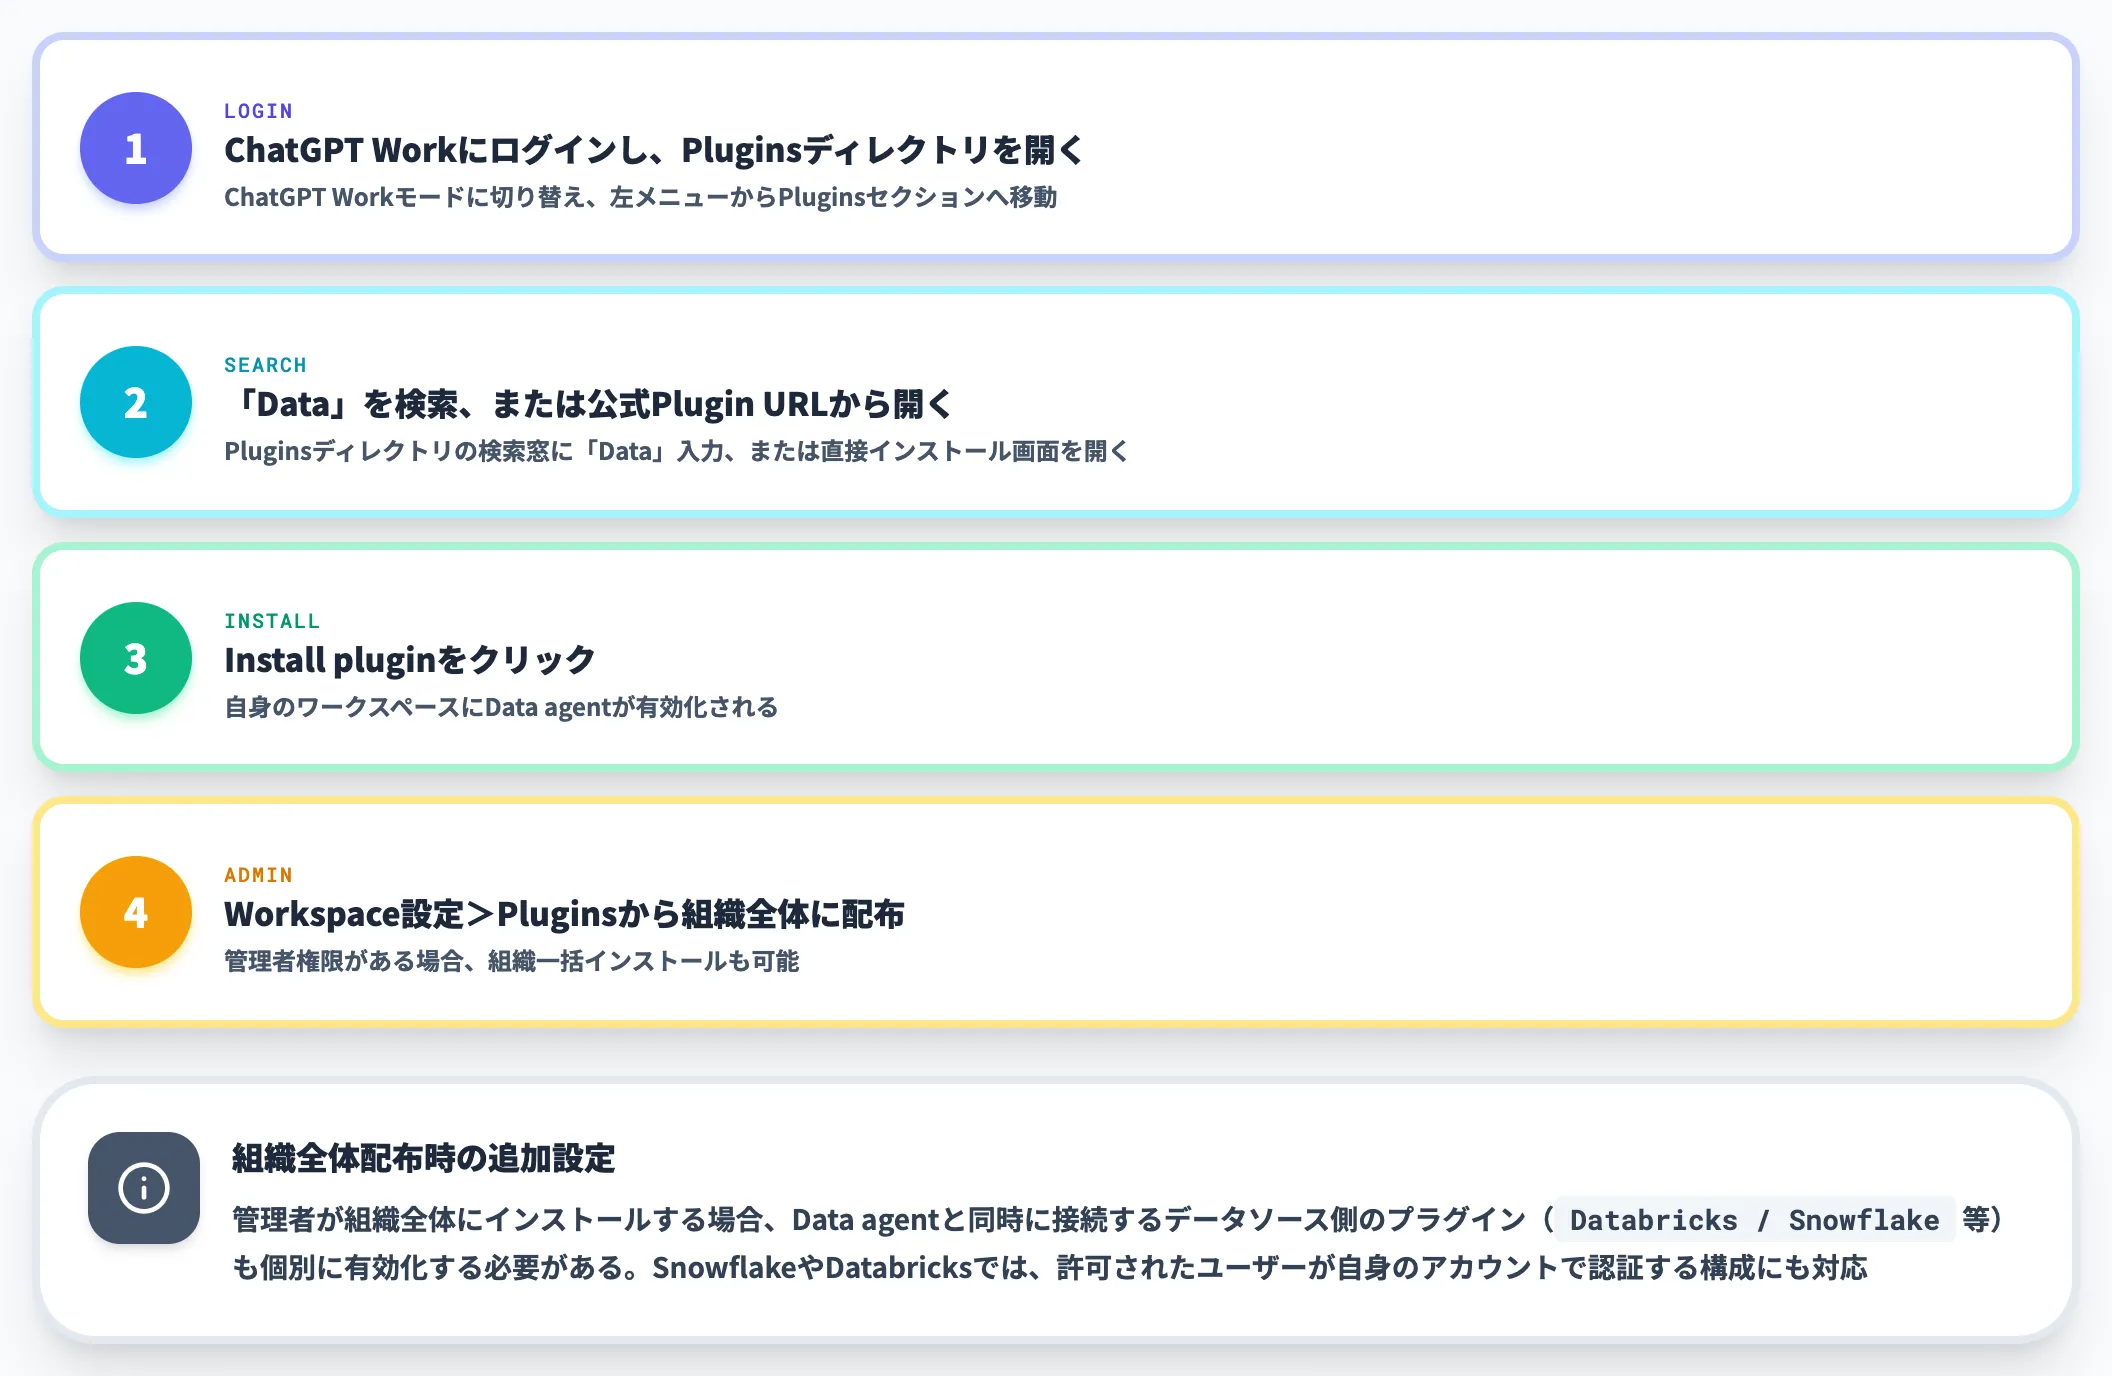
Data agentは、ChatGPT WorkのPluginsディレクトリに「Data」として登録されています。
導入手順は次のとおりです。
- ChatGPT Workにログインし、Pluginsディレクトリを開く
- 「Data」を検索、または公式のData plugin URLから直接インストール画面を開く
- Install pluginをクリック
- 管理者権限がある場合は、Workspace設定 > Plugins から組織全体に配布する
管理者が組織全体にインストールする場合、Data agentと同時に接続するデータソース側のプラグイン(Databricks・Snowflake等)も個別に有効化する必要があります。
接続方式・アプリの利用範囲・必要な権限は管理者側で設定し、SnowflakeやDatabricksでは許可されたユーザーが自身のアカウントで認証する構成にも対応できます。
データソース接続の初期設定
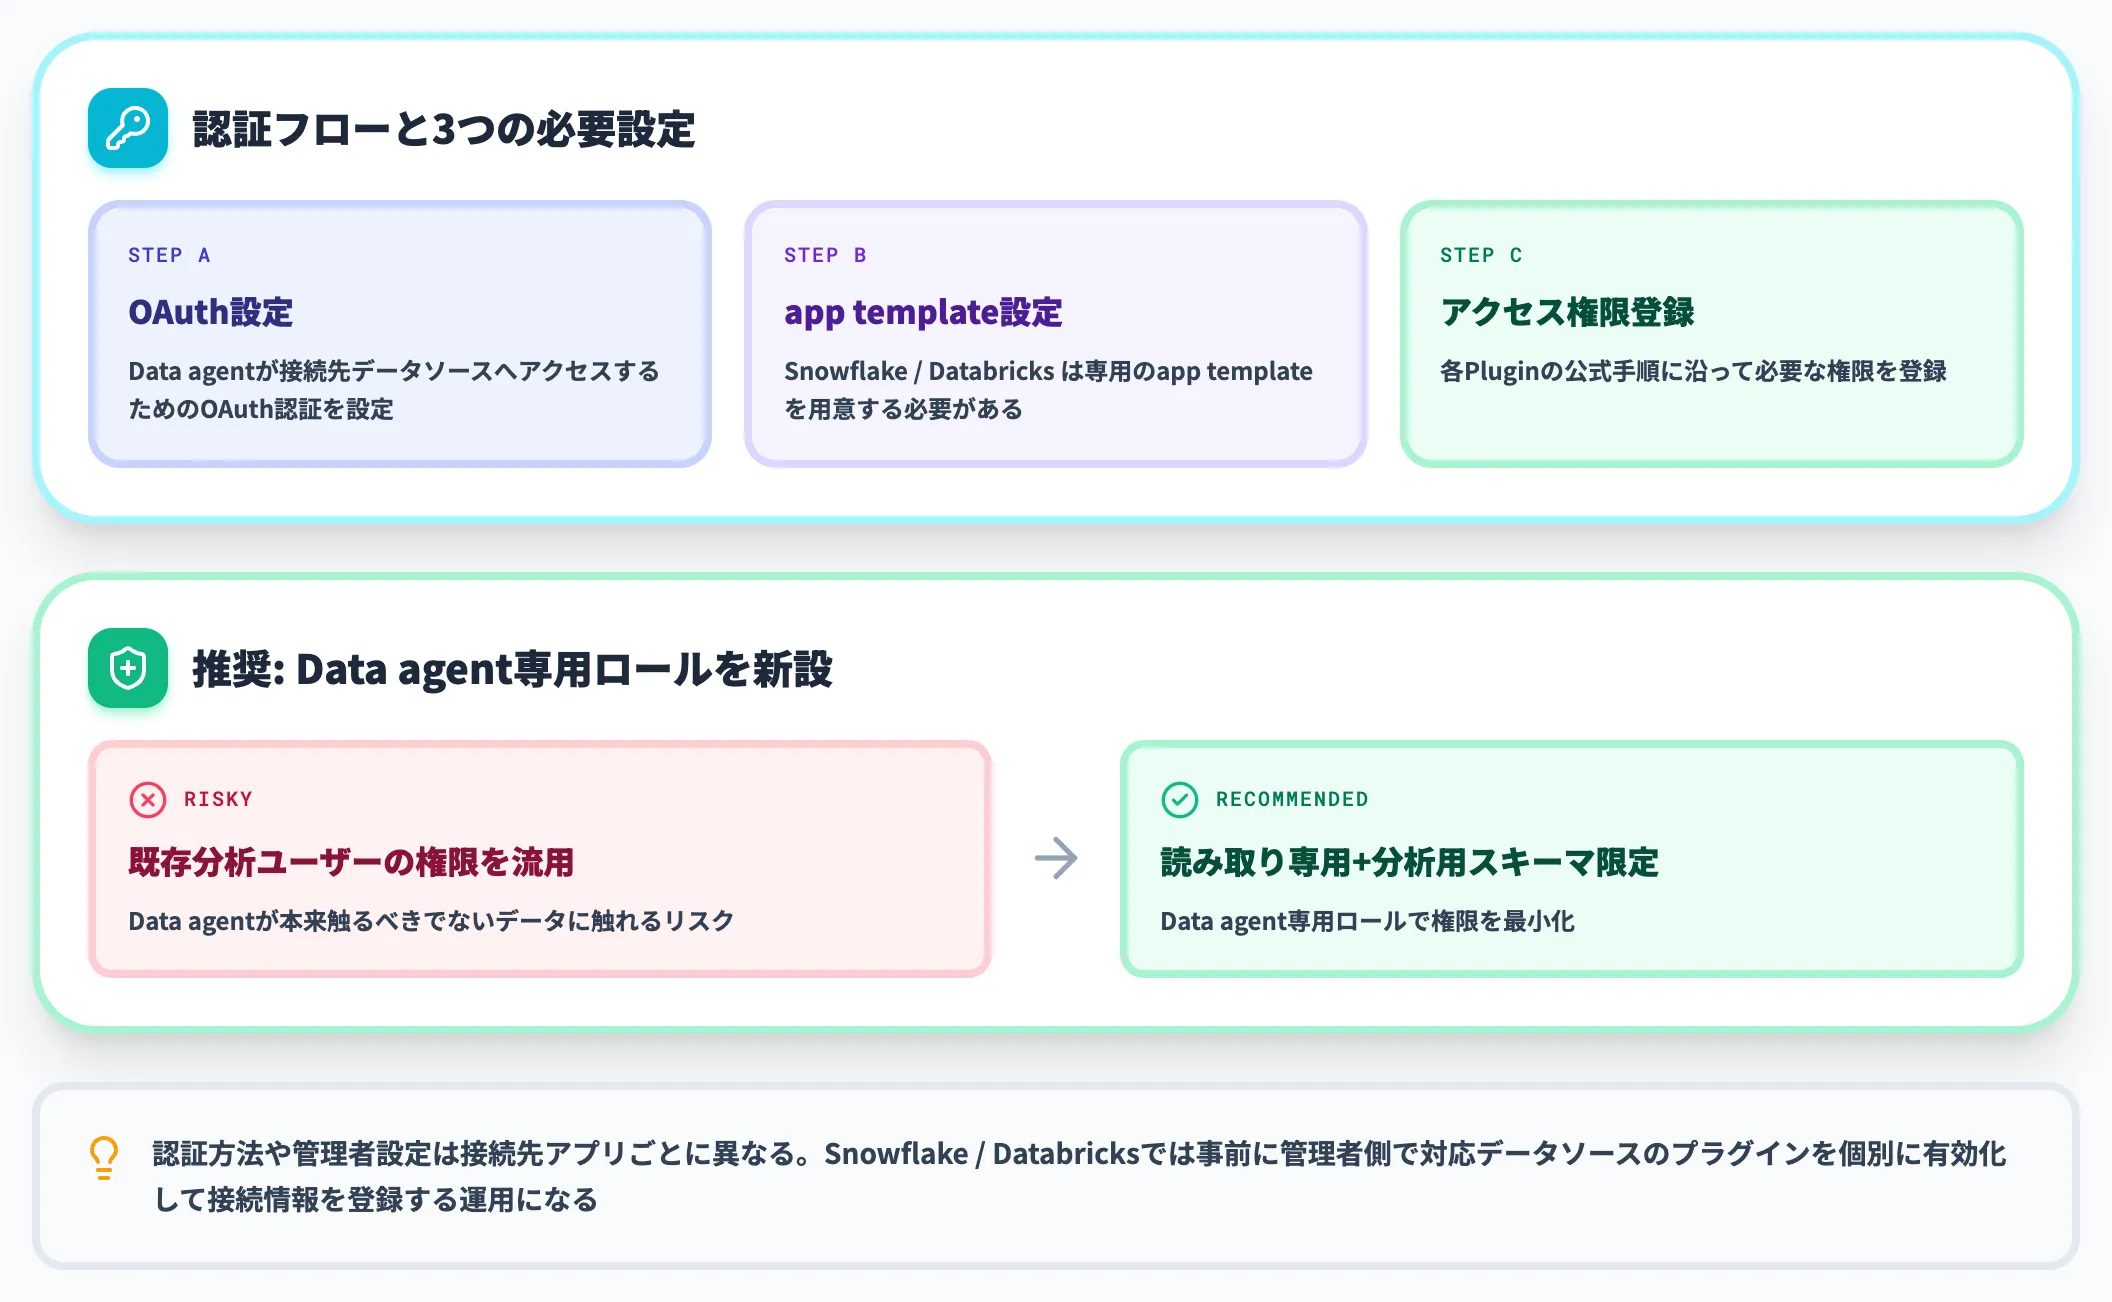
Data agentが実際にクエリを投げるためには、それぞれの対応データソース側で接続認証を通す必要があります。認証方法や管理者設定は接続先アプリごとに異なるため、必要なOAuth設定・app template・アクセス権限を各Pluginの公式手順に沿って設定します。
SnowflakeやDatabricksでは、専用のapp template設定を用意する必要があるケースがあり、事前に管理者側で対応データソースのプラグインを個別に有効化して接続情報を登録する運用になります。
接続時のロール設計は、Data agent専用のロール(読み取り専用+分析用スキーマのみ)を新設するのが実務的な推奨です。既存分析ユーザーと同じ権限で使うと、Data agentが本来触るべきでないデータに触れるリスクが残ります。
@Dataによる起動と代表プロンプト3種
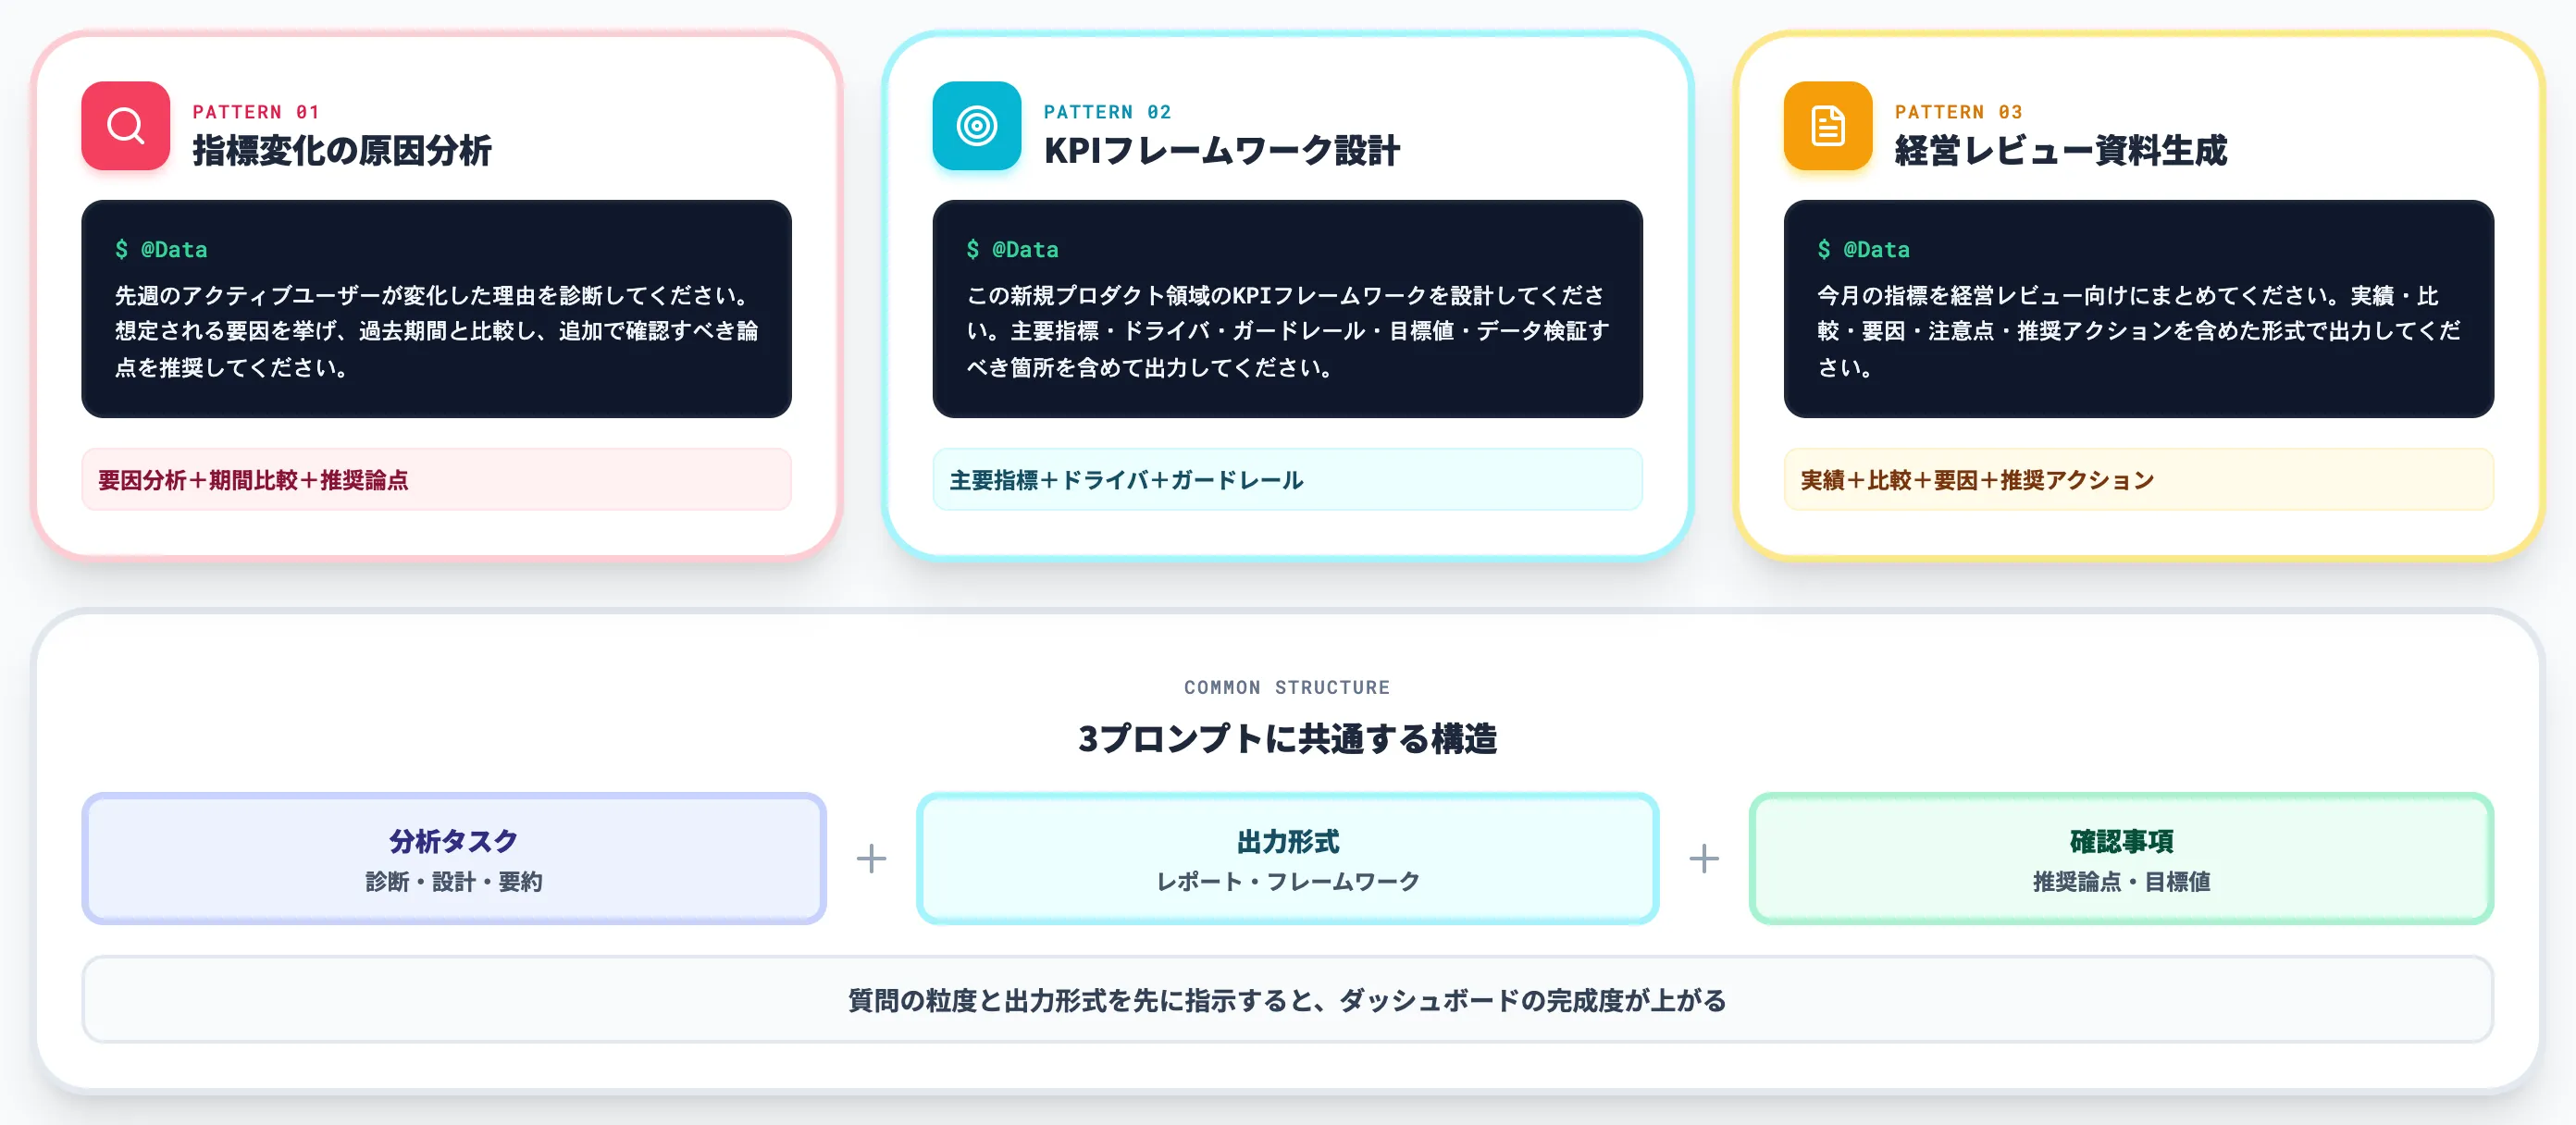
Data agentは、ChatGPT Workモードで「@Data」と入力するだけで起動します。
OpenAIが公式で用意しているスタータープロンプトは、実務で頻出する3つのパターンに分かれています。
-
指標変化の原因分析
@Data 先週のアクティブユーザーが変化した理由を診断してください。想定される要因を挙げ、過去期間と比較し、追加で確認すべき論点を推奨してください。
-
KPIフレームワークの設計
@Data この新規プロダクト領域のKPIフレームワークを設計してください。主要指標・ドライバ・ガードレール・目標値・データ検証すべき箇所を含めて出力してください。
-
経営層向けレビュー資料の生成
@Data 今月の指標を経営レビュー向けにまとめてください。実績・比較・要因・注意点・推奨アクションを含めた形式で出力してください。
3つのプロンプトはいずれも「分析タスク+出力形式+確認事項」を明示している点が共通しています。Data agentに聞くときは、質問の粒度と出力形式を先に指示すると、ダッシュボードの完成度が上がります。
ダッシュボードの共有と編集
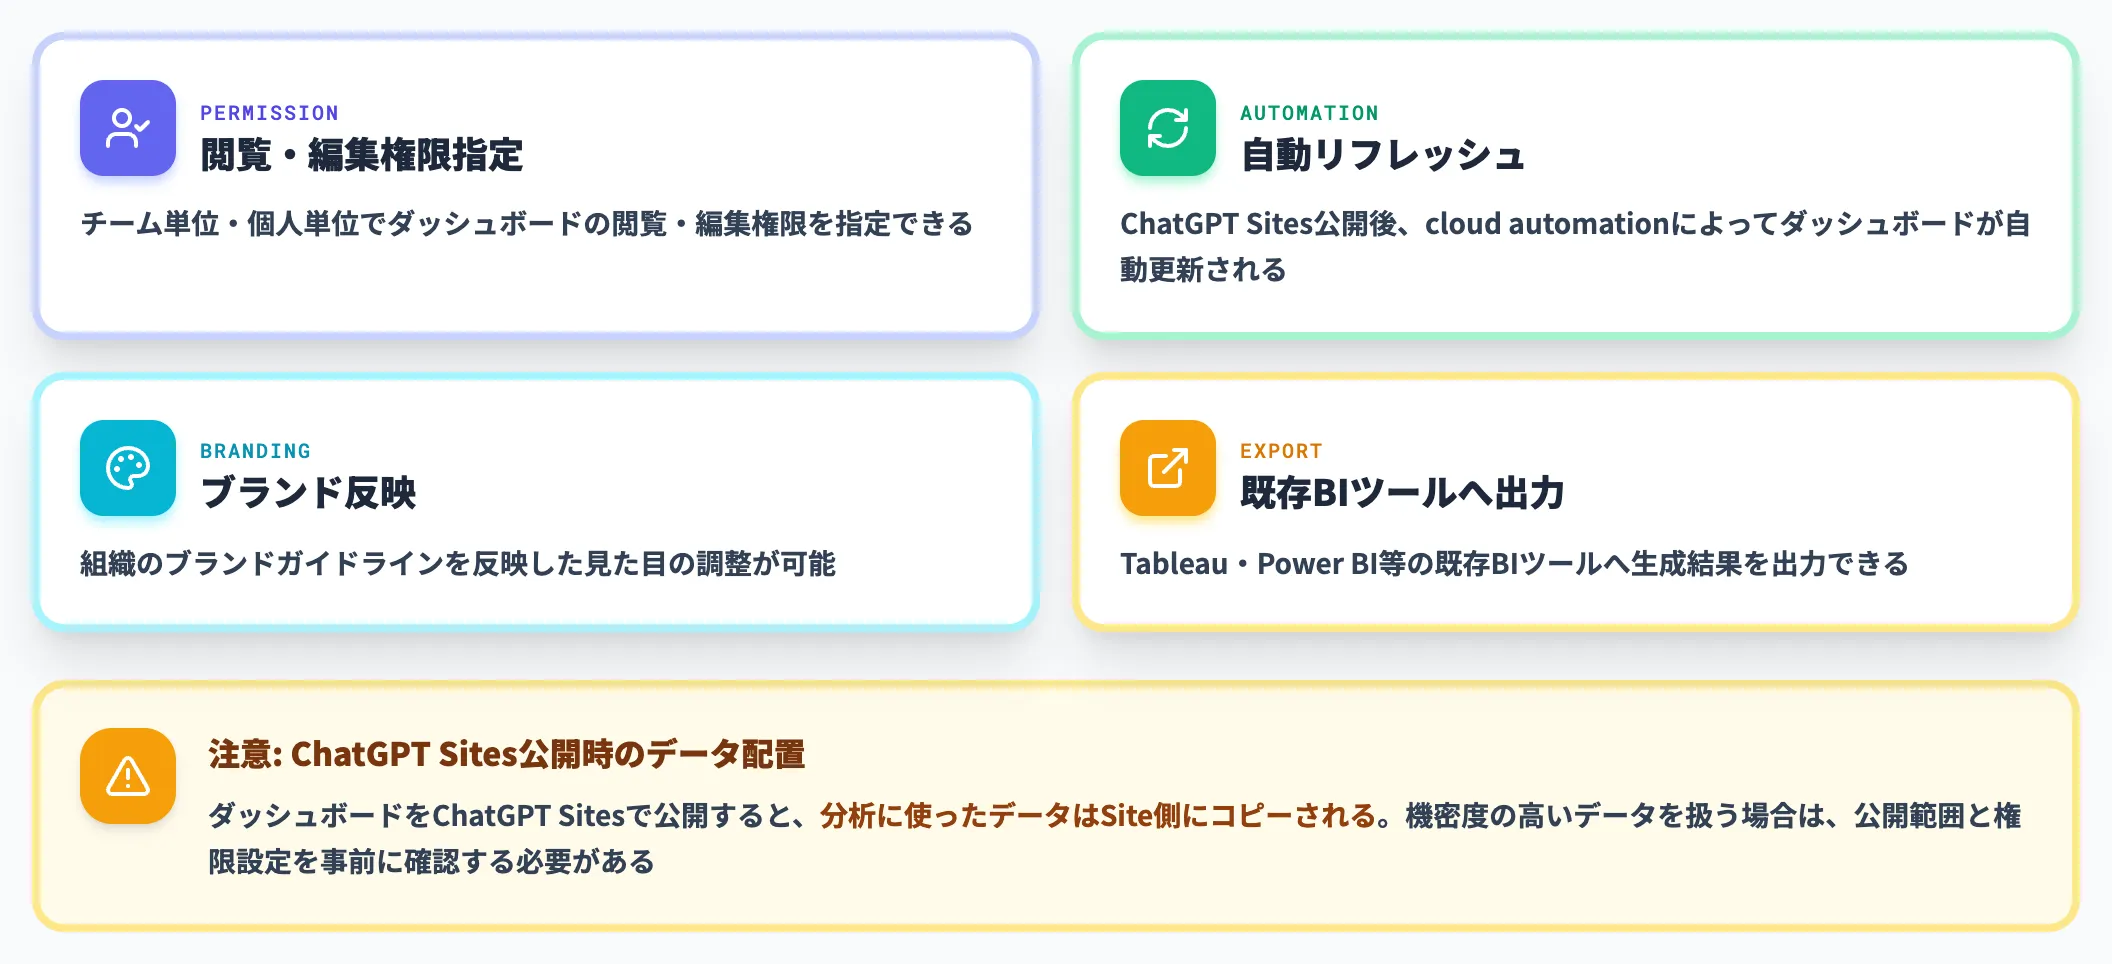
Data agentが生成したダッシュボードは、ChatGPT Sitesを介して共有・編集・自動リフレッシュが可能です。
具体的にできる操作は次のとおりです。
- チーム単位・個人単位の閲覧・編集権限の指定
- ChatGPT Sites公開後のcloud automationによる自動リフレッシュ
- 組織のブランドガイドラインを反映した見た目の調整
- Tableau・Power BI等の既存BIツールへの出力
注意点として、ダッシュボードをChatGPT Sitesで公開すると、分析に使ったデータはSite側にコピーされます。機密度の高いデータを扱う場合は、公開範囲と権限設定を事前に確認しておく必要があります。
ChatGPT Work Data agentのセキュリティ・ガバナンス
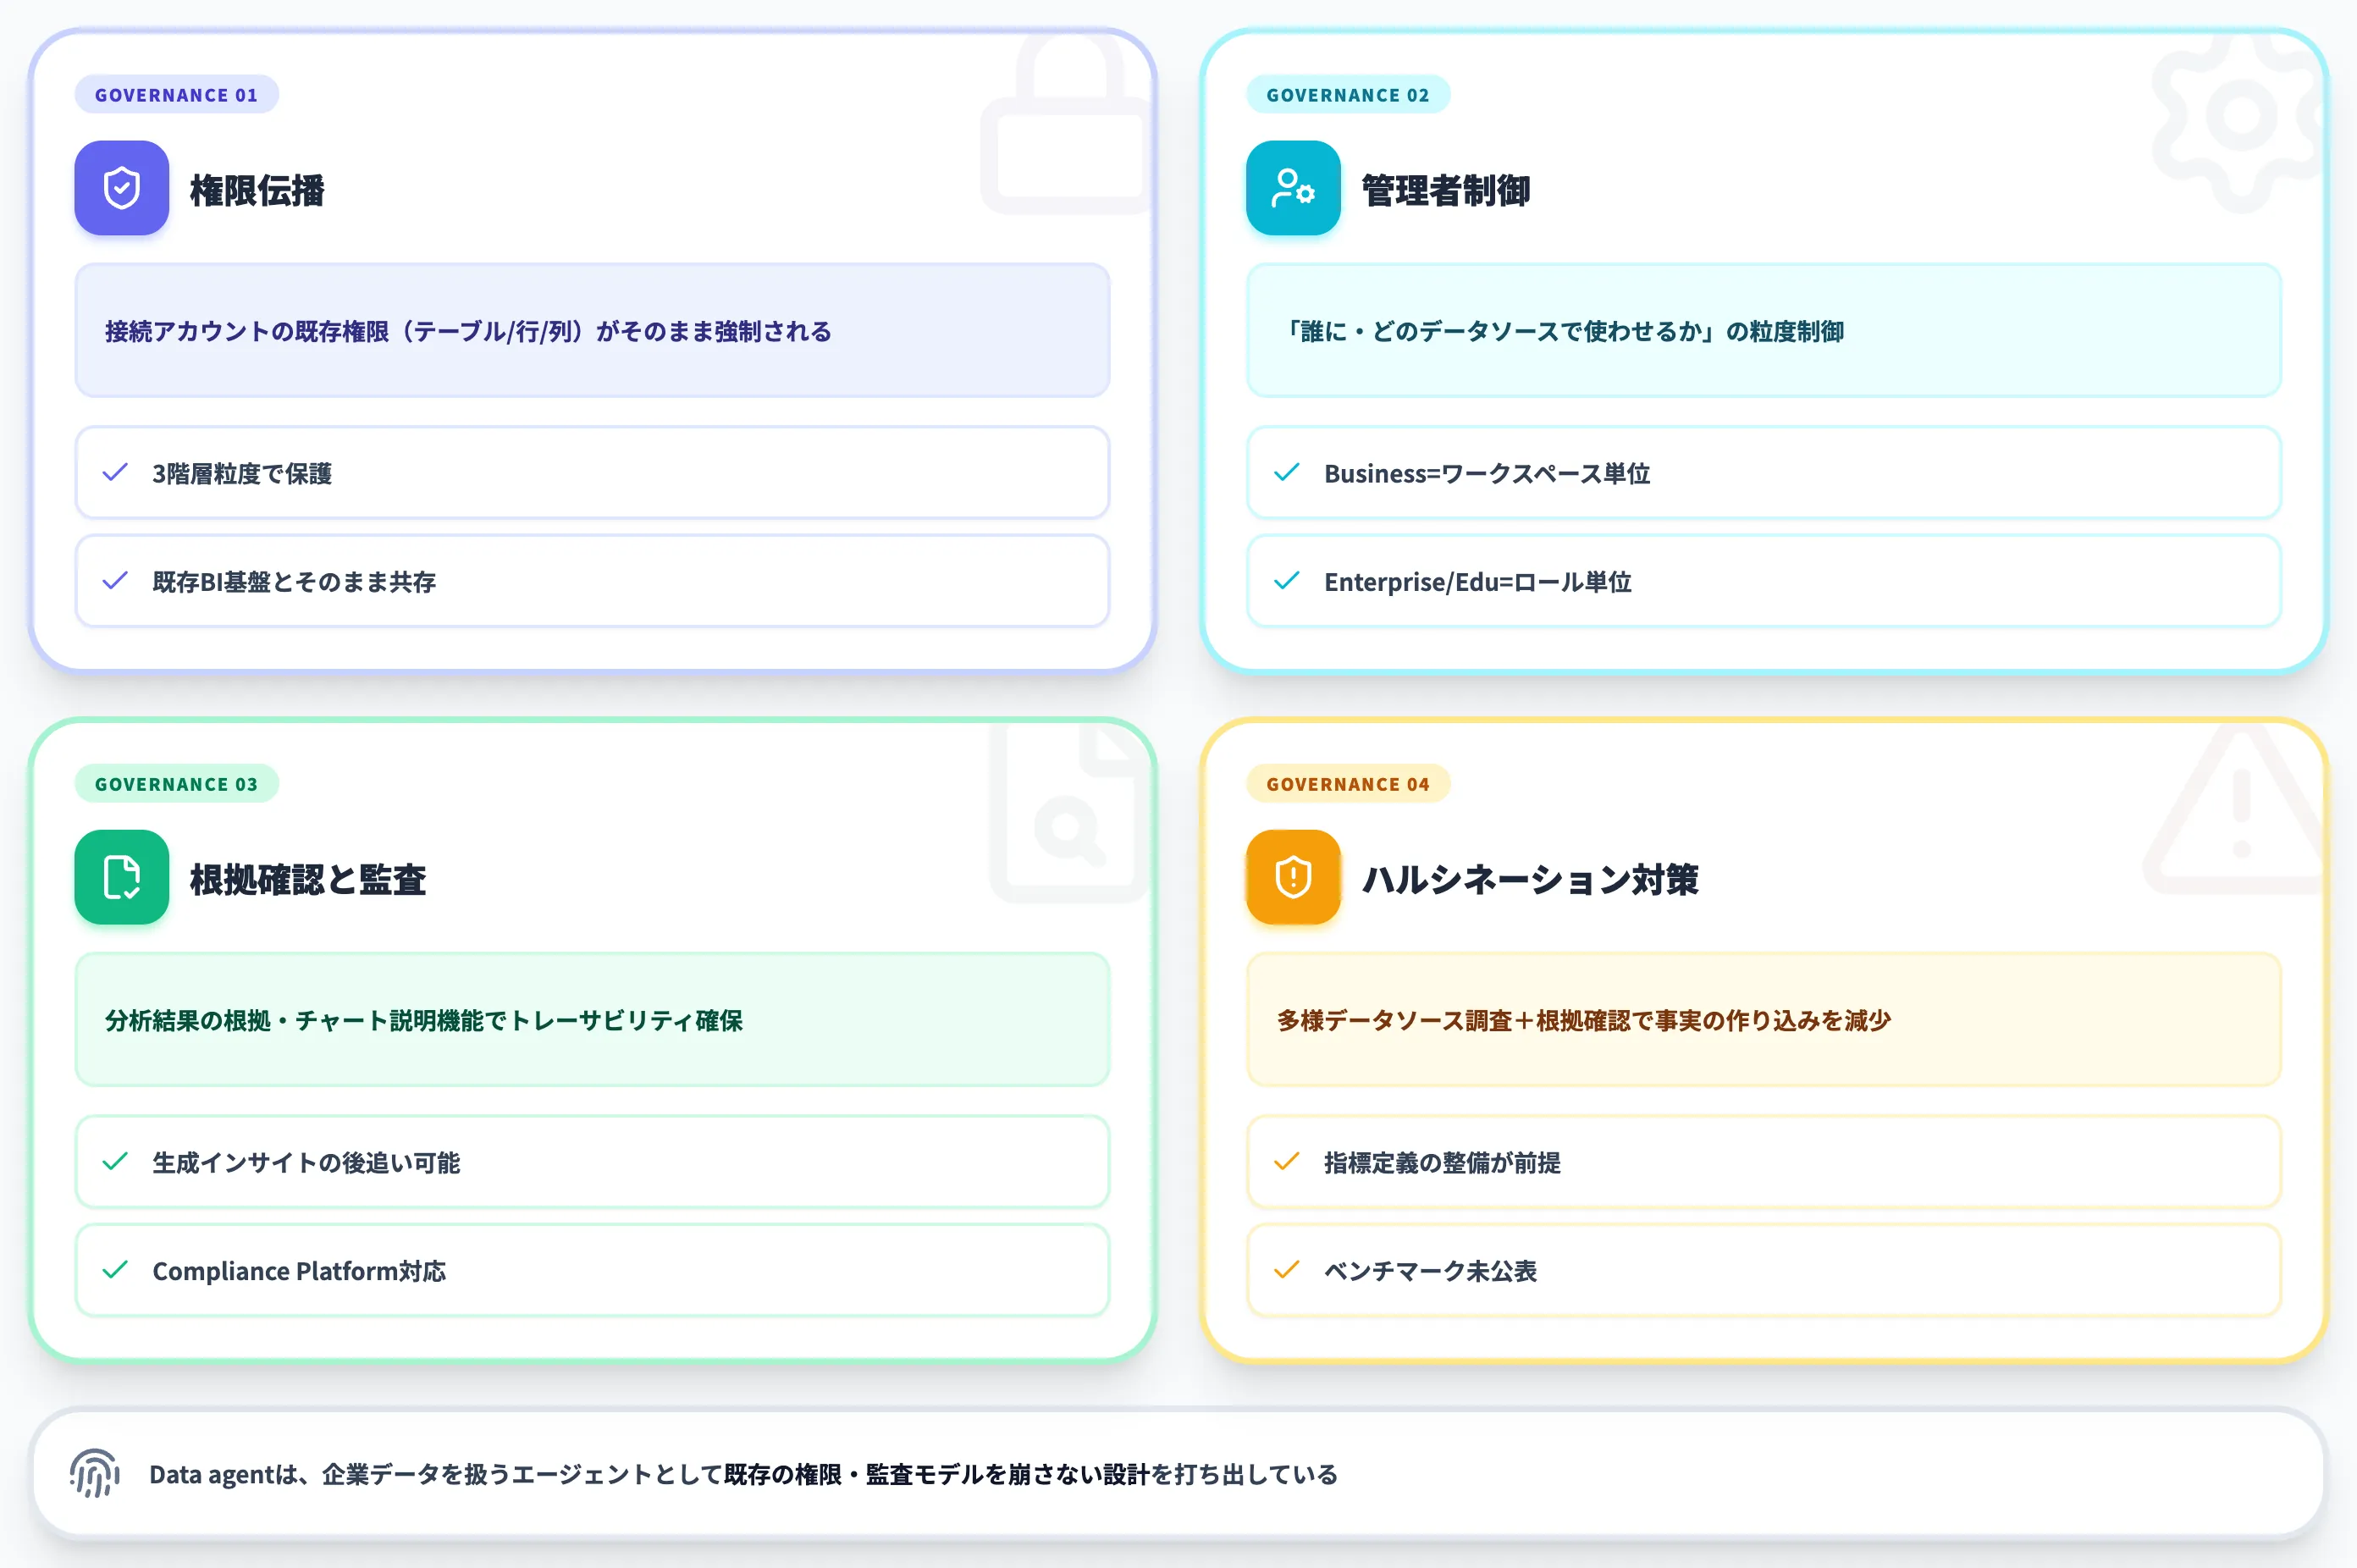
Data agentは、企業データを扱うエージェントとして、既存の権限・監査モデルを崩さない設計を打ち出しています。
本セクションでは、権限伝播・管理者制御・監査・ハルシネーション対策の4点を整理します。
テーブル・行・列レベル権限の伝播
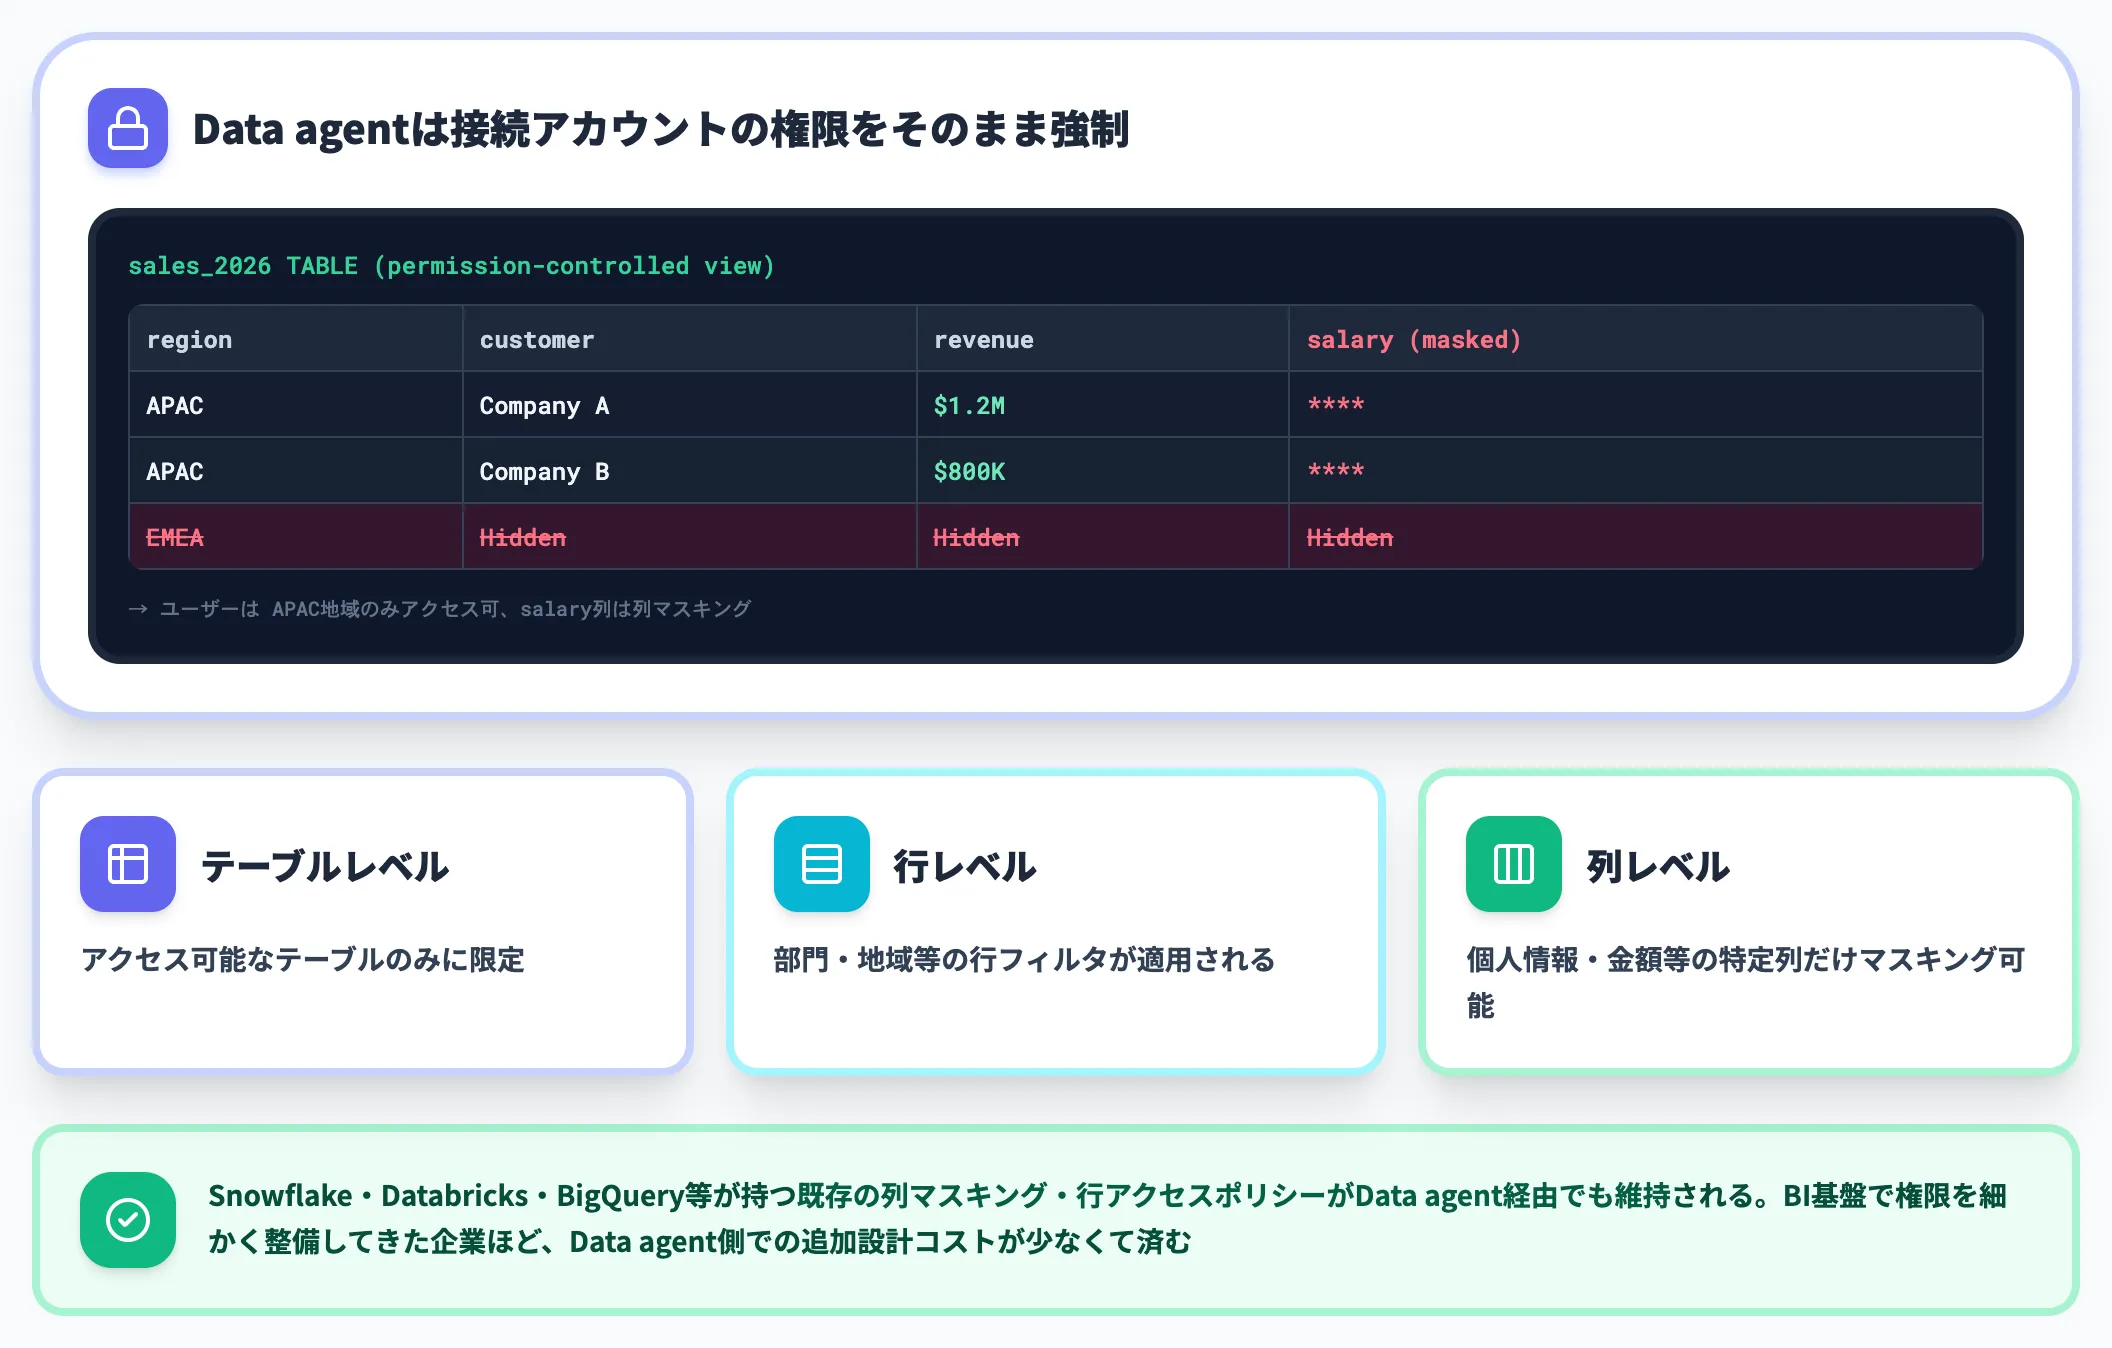
Data agentが発行するクエリは、接続アカウントの既存権限をそのまま強制します。
対応する権限粒度は3階層です。
- テーブルレベル: アクセス可能なテーブルのみに限定
- 行レベル: 部門・地域等の行フィルタが適用される
- 列レベル: 個人情報・金額等の特定列だけマスキング可能
これは、Snowflake・Databricks・BigQuery等が持つ既存の列マスキング・行アクセスポリシーがData agent経由でも維持されることを意味します。
BI基盤で権限を細かく整備してきた企業ほど、Data agent側での追加設計コストが少なくて済みます。
管理者による接続範囲と利用ロール制御
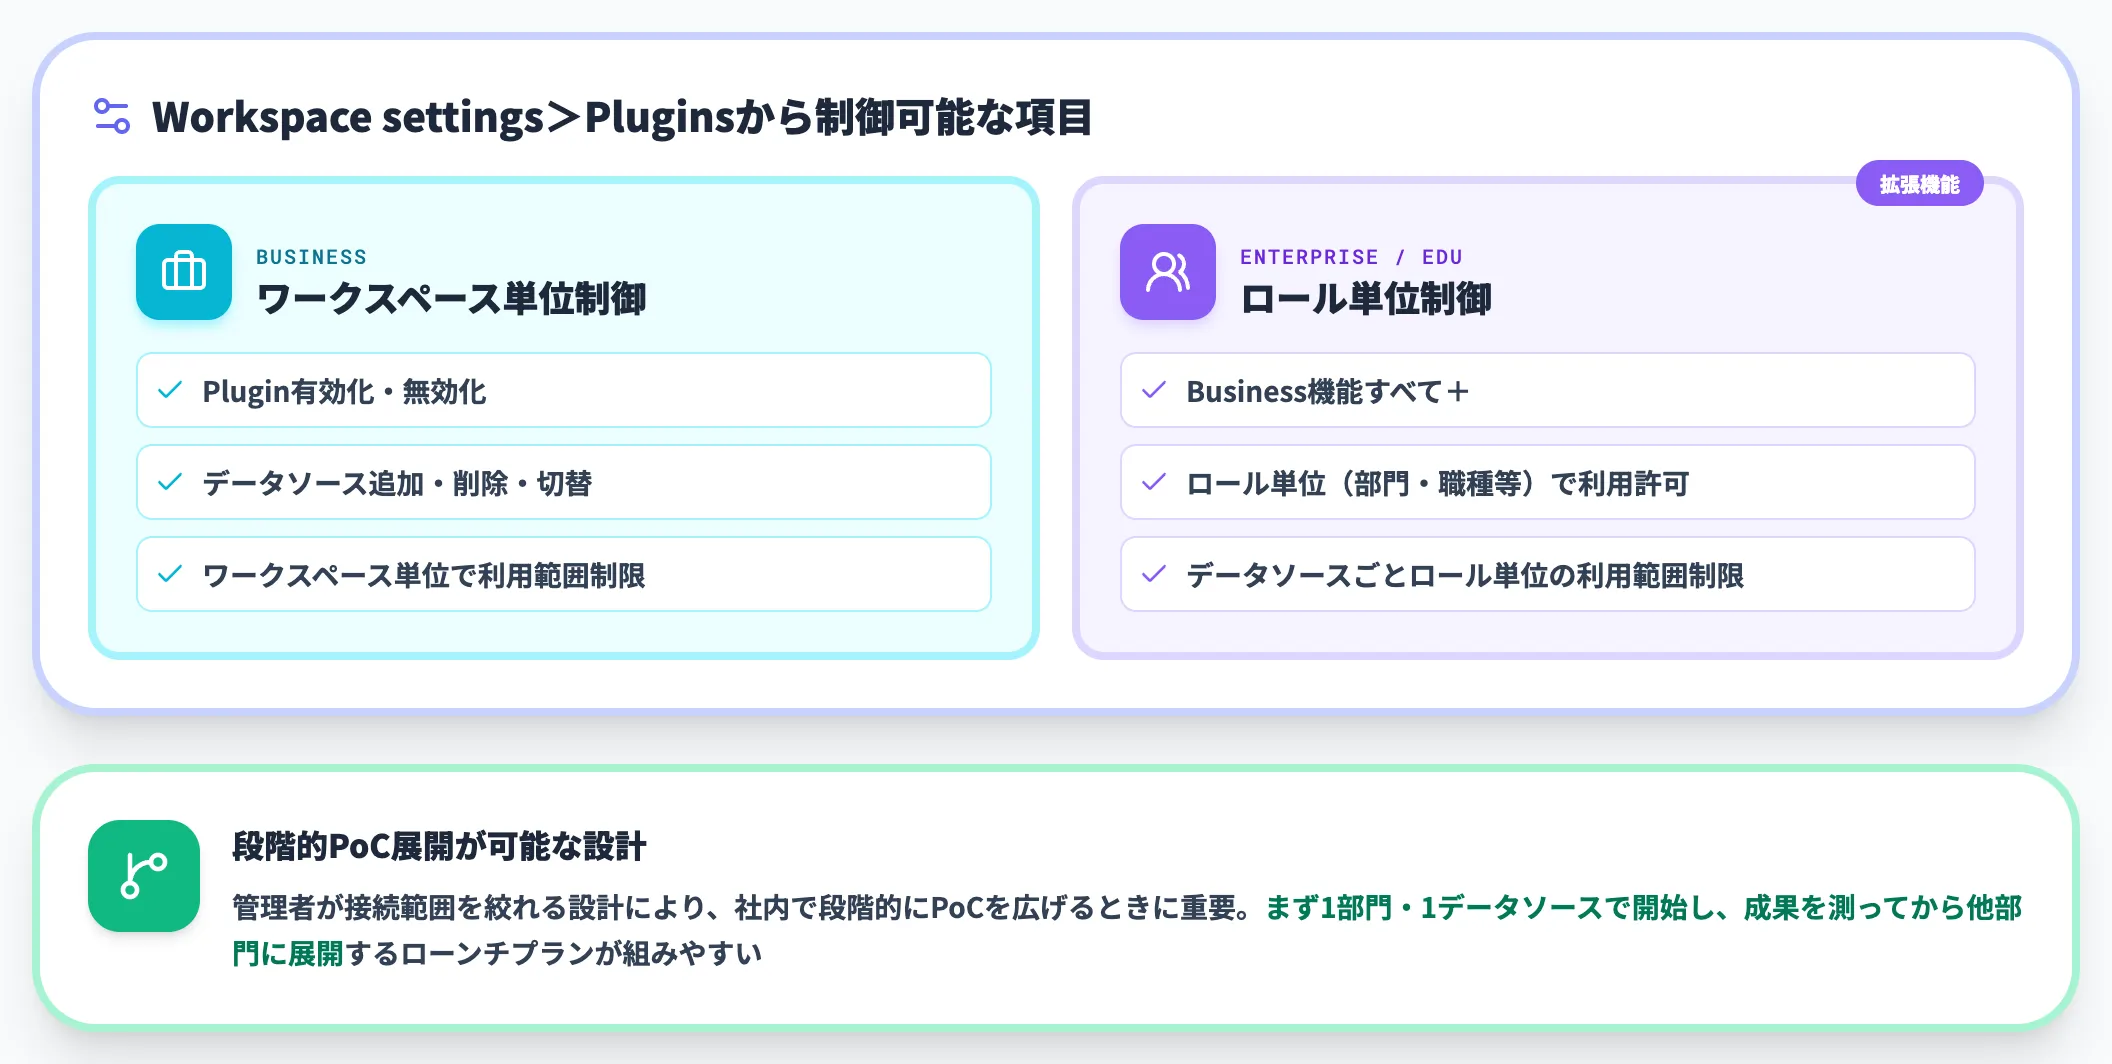
Business・Enterprise・Edu各プランの管理者は、Data agentを「誰に・どのデータソースで使わせるか」を制御できます。
制御の粒度はプランで異なり、Businessはワークスペース単位、Enterprise・Eduはロール単位まで踏み込めます。
管理画面(Workspace settings > Plugins)から、以下の設定が行えます。
- ワークスペース全体へのPlugin有効化・無効化(Business含む全プラン)
- ロール単位(部門・職種等)でのPlugin利用許可(Enterprise・Edu)
- 接続するデータソースの追加・削除・切替
- データソースごとの利用範囲制限(Enterprise・Eduではロール単位、Businessはワークスペース単位)
管理者が接続範囲を絞れる設計は、社内で段階的にPoCを広げるときに重要です。まず1部門・1データソースで開始し、成果を測ってから他部門に展開するローンチプランが組みやすくなります。
分析結果の根拠確認と監査ログ
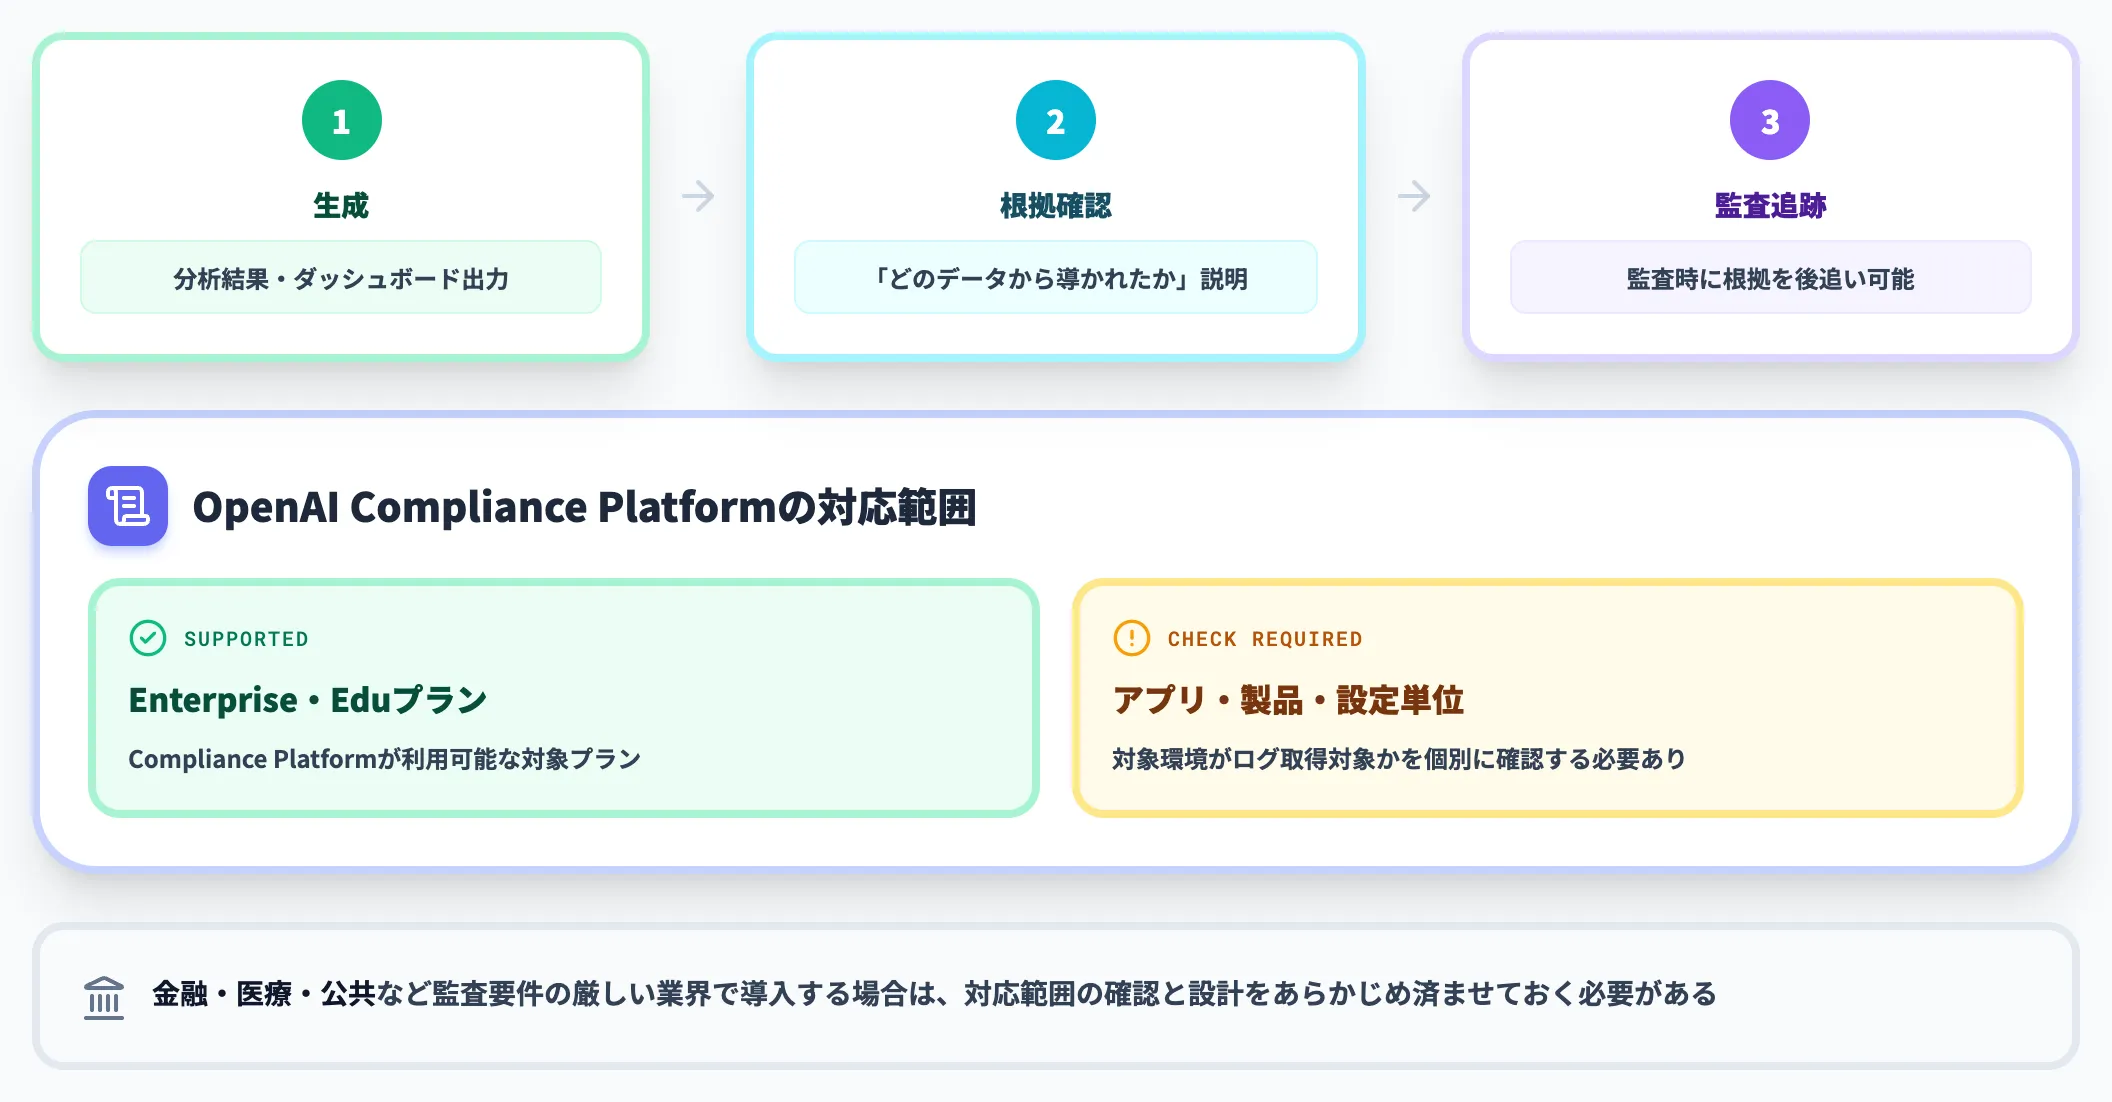
Data agentは、分析結果の根拠を確認したり、チャートを支える情報の説明を求めたりする機能を備えています。
これにより、生成されたインサイトが「どのデータからどのように導かれたか」を後追いで説明可能です。監査時に「そのダッシュボードの数値の根拠は?」と問われても、Data agentに根拠の説明を求める形で追跡できます。
組織側の監査ログとしては、OpenAI Compliance Platformが利用できるEnterprise・Eduプランが対象になります。
ただしCompliance Platformによる監査を前提とする場合は、対象環境に加えてアプリ・製品・設定がログ取得対象かを個別に確認する必要があります。金融・医療・公共など監査要件の厳しい業界で導入する場合は、対応範囲の確認と設計をあらかじめ済ませておく必要があります。
ハルシネーション対策と限界
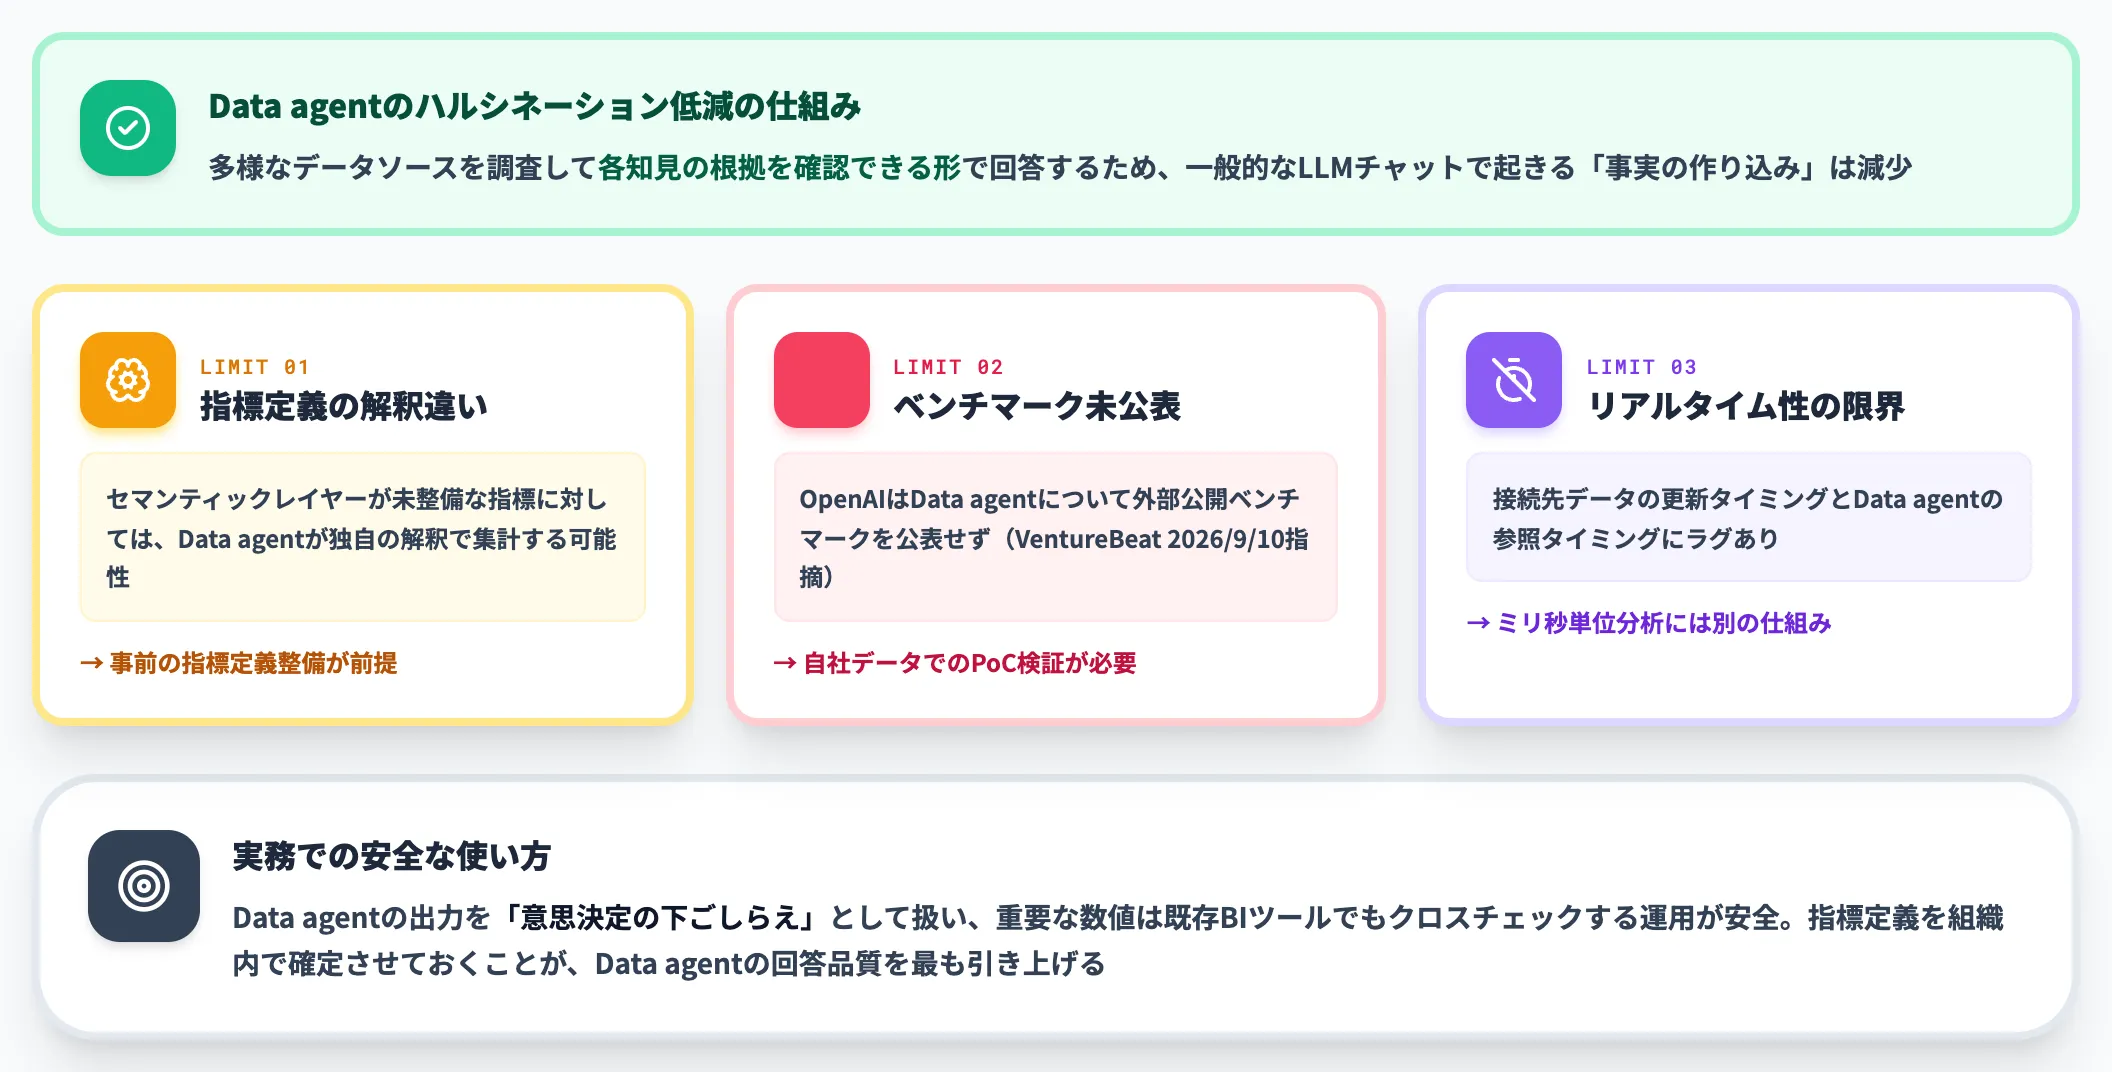
Data agentは、多様なデータソースを調査して各知見の根拠を確認できる形で回答するため、一般的なLLMチャットで起きる「事実の作り込み」は減ります。
ただし、以下のような限界も残ります。
-
指標定義の解釈違い
セマンティックレイヤーが未整備な指標に対しては、Data agentが独自の解釈で集計する可能性がある
-
ベンチマーク未公表
VentureBeatは2026年9月10日、OpenAIがData agentについて外部公開ベンチマークを公表していない点を指摘している。競合ベンダーが公表する各種スコアは対象タスクが異なるため直接比較には使えず、Data agent自体の第三者検証スコアがない状態が続いている
-
リアルタイム性の限界
接続先のデータが更新されるタイミングとData agentの参照タイミングにラグがある。厳密なリアルタイム分析(ミリ秒単位の在庫確認等)には別の仕組みが必要
実務での使い方としては、Data agentの出力を「意思決定の下ごしらえ」として扱い、重要な数値は既存BIツールでもクロスチェックする運用が安全です。指標定義を組織内で確定させておくことが、Data agentの回答品質を最も引き上げます。
ChatGPT Work Data agentと既存BI基盤の使い分け
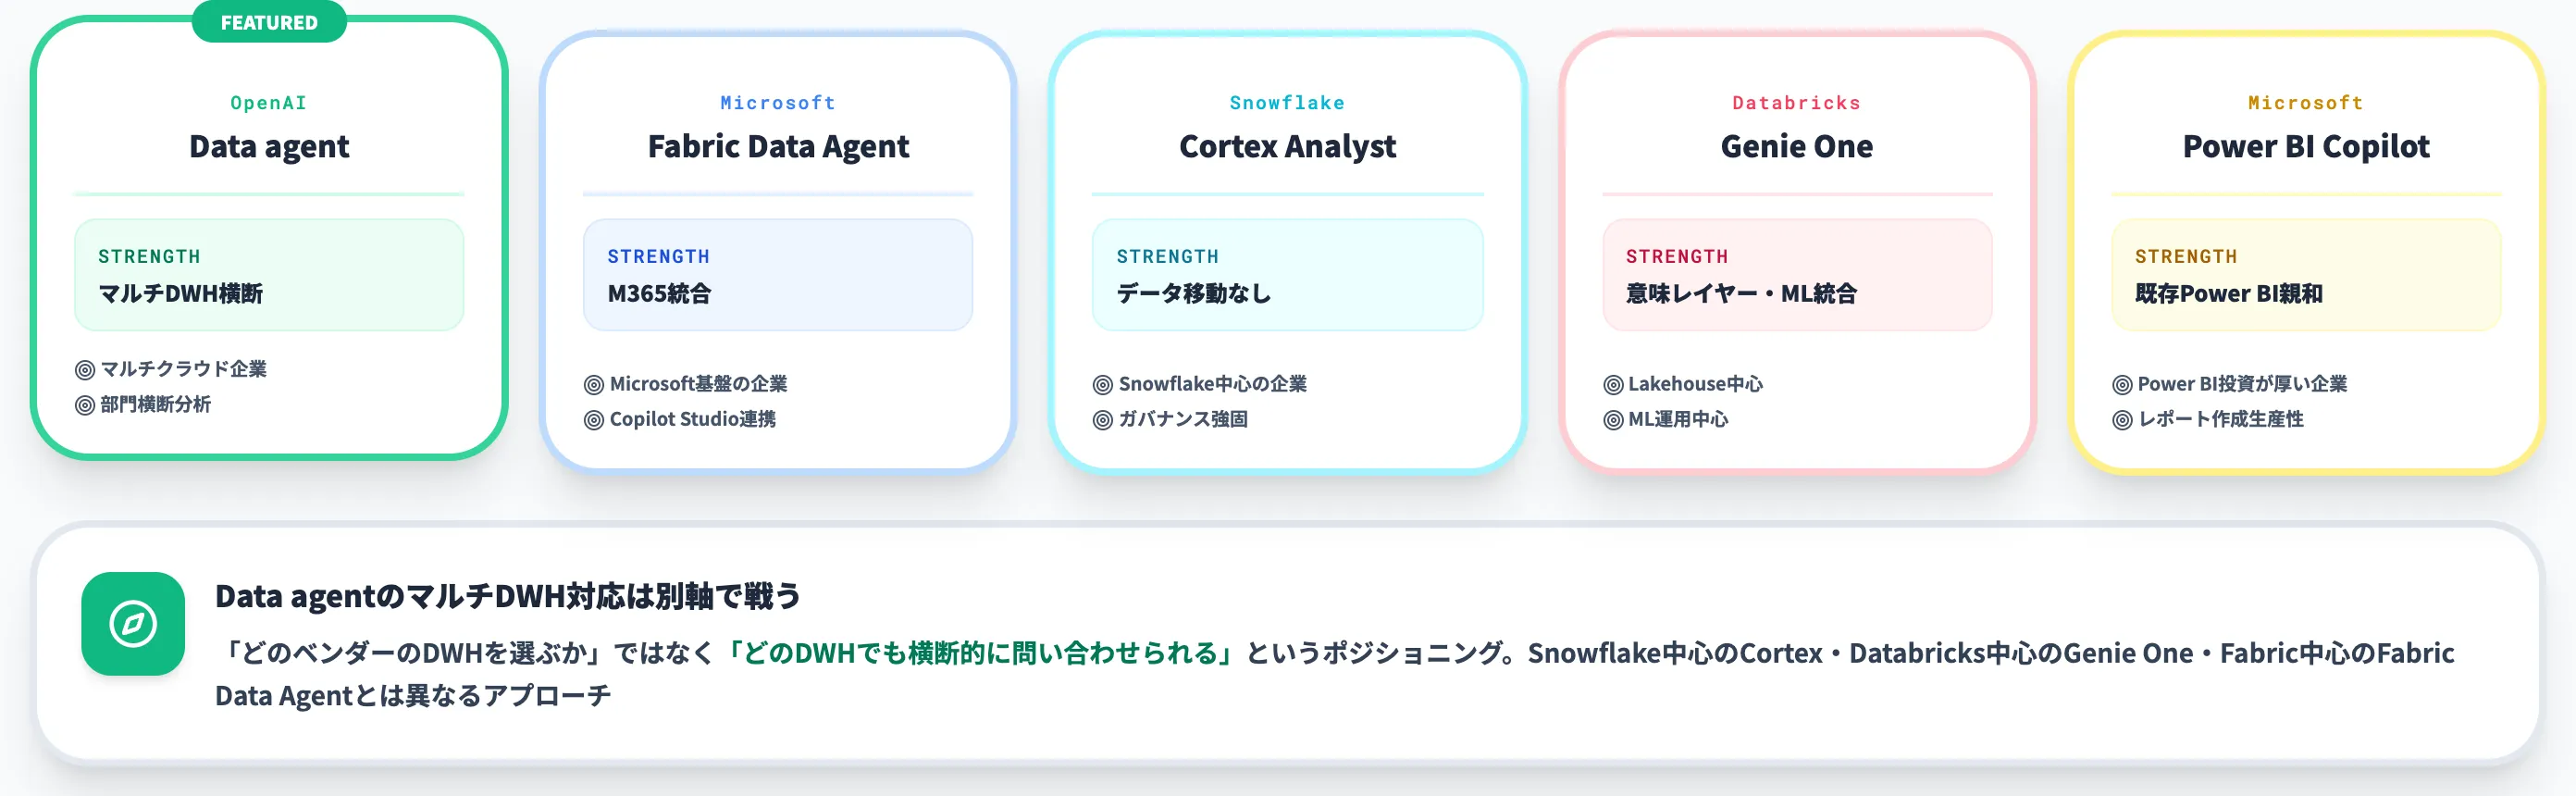
Data agentは、既存のBIエージェント・BIコパイロットと役割が重なる部分があります。
本セクションでは、主要な競合4サービスとの比較と、ケース別の使い分けを整理します。
主要BIエージェントとの機能比較
まず、Data agentと主要な競合BIエージェントの立ち位置を、以下の表で整理しました。
| 製品 | 提供元 | 対応データソース | 強み | 想定される主戦場 |
|---|---|---|---|---|
| ChatGPT Work Data agent | OpenAI | マルチDWH+BIツール横断 | データソース非依存・ワークフロー統合 | マルチクラウド企業・部門横断分析 |
| Microsoft Fabric Data Agent | Microsoft | Fabric(OneLake中心) | M365・Copilot Studio統合 | Microsoft基盤でDXを進める企業 |
| Snowflake Cortex Analyst | Snowflake | Snowflake内完結 | データ移動なし・ガバナンス強固 | Snowflake中心の企業 |
| Databricks Genie One | Databricks | Databricks中心+外部ツール接続 | Genie Ontologyでの意味レイヤー・ML統合 | Lakehouse・ML運用中心の企業 |
| Power BI Copilot | Microsoft | Power BI上のセマンティックモデル | 既存Power BIレポートとの親和性 | Power BI既存投資が厚い企業 |
Data agentのマルチDWH対応は、Snowflake中心のCortexやDatabricks中心のGenie One、Fabric中心のFabric Data Agentとは違う軸で戦うことを意味します。
「どのベンダーのDWHを選ぶか」ではなく「どのDWHでも横断的に問い合わせられる」というポジショニングです。
vs Microsoft Fabric Data Agent
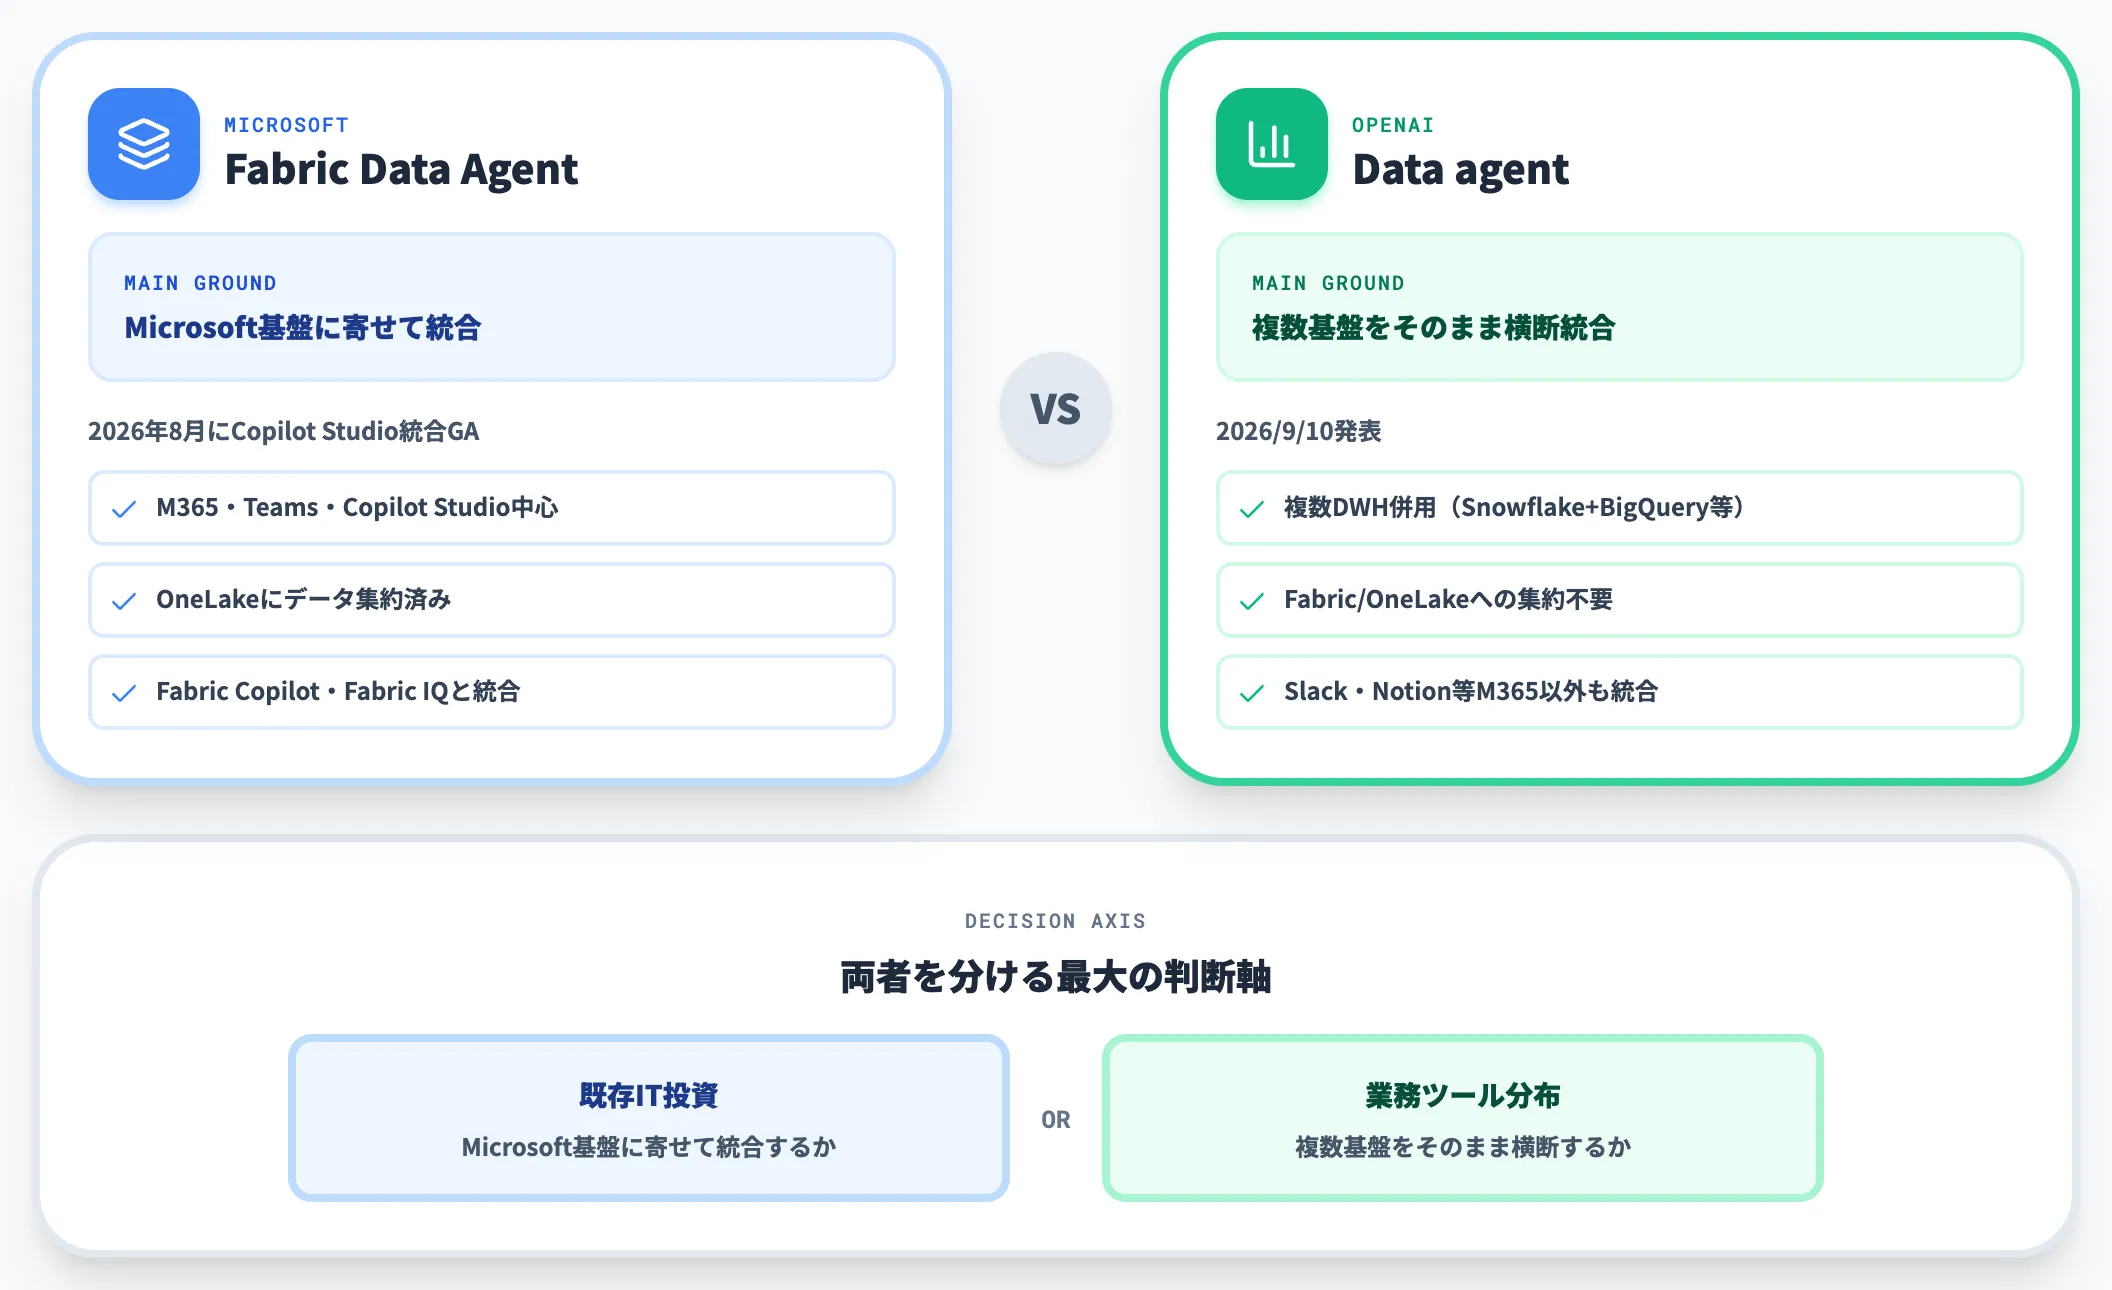
Microsoft Fabric Data Agentは、2026年8月にCopilot Studio統合がGAされたBIエージェントで、OneLake・Lakehouse・セマンティックモデルへの自然言語問い合わせに対応します。
両者の使い分けは、既存のIT投資と業務ツールの分布で決まります。
-
Fabric Data Agentが有利なケース
Microsoft 365・Teams・Copilot Studioが業務の中心で、OneLakeにデータを集約している。既存のFabric CopilotやFabric IQと統合したい
-
Data agentが有利なケース
複数DWH(Snowflake+BigQuery+Redshift等)を併用しており、各DWHをFabric・OneLakeへ集約・ミラーリングせずに横断したい。M365以外のワークフローツール(Slack・Notion等)も含めて統合したい
「Microsoft基盤に寄せて統合する」思想と「複数基盤をそのまま横断して統合する」思想の違いが、両者を分ける最大の判断軸です。
vs Snowflake Cortex Analyst / Databricks Genie One
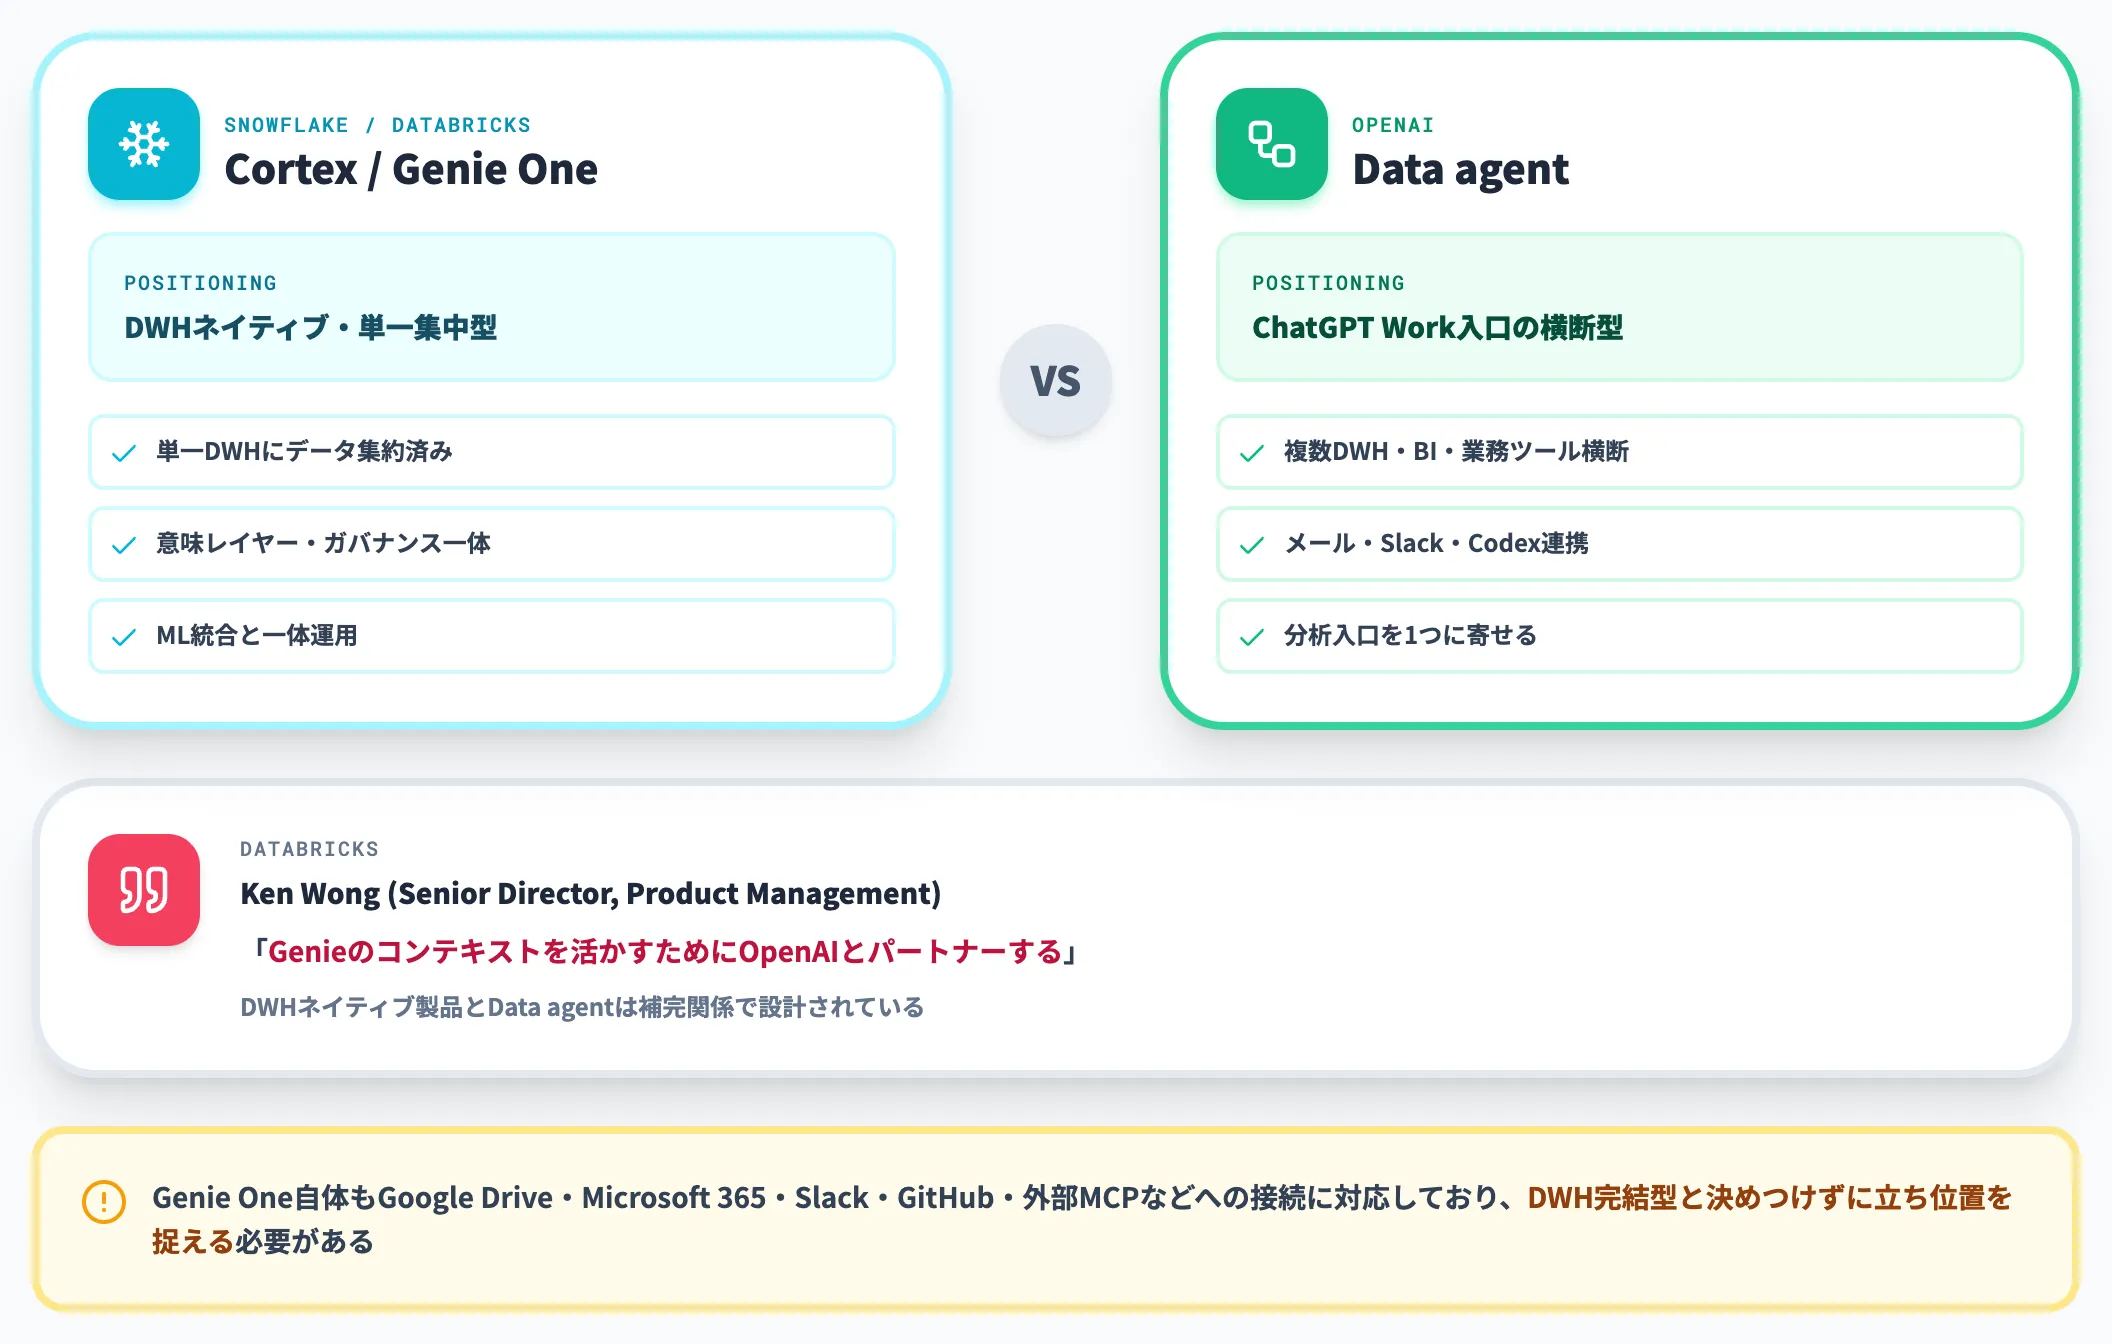
Snowflake Cortex AnalystとDatabricks Genie Oneは、それぞれのDWHを中心に利用する自然言語BIエージェントです。
Genie One自体もGoogle Drive・Microsoft 365・Slack・GitHub・外部MCPなどへの接続に対応しており、DWH完結型と決めつけずに立ち位置を捉える必要があります。
-
Cortex Analyst / Genie Oneが有利なケース
データが単一DWHに集約されており、DWHベンダーが提供する意味レイヤー・ガバナンス・ML統合と一体で運用したい
-
Data agentが有利なケース
複数DWH・BIツール・業務ツールを横断してどう統合するかを主軸にしたい。DWHのデータをChatGPT Workの他機能(メール作成・Slack連携・Codex経由の開発タスク等)と組み合わせて、分析入口を1つに寄せたい
Data agentは、DWHネイティブのCortex・Genie Oneに対して「ChatGPT Workを入口に複数のDWH・BI・業務ツールを横断する構成」を前面に出しています。
Databricksを担当するKen Wong(Senior Director, Product Management)自身が公式コメントで「Genieのコンテキストを活かすためにOpenAIとパートナーする」と述べており、DWHネイティブ製品とData agentは補完関係で設計されています。
vs Power BI Copilot
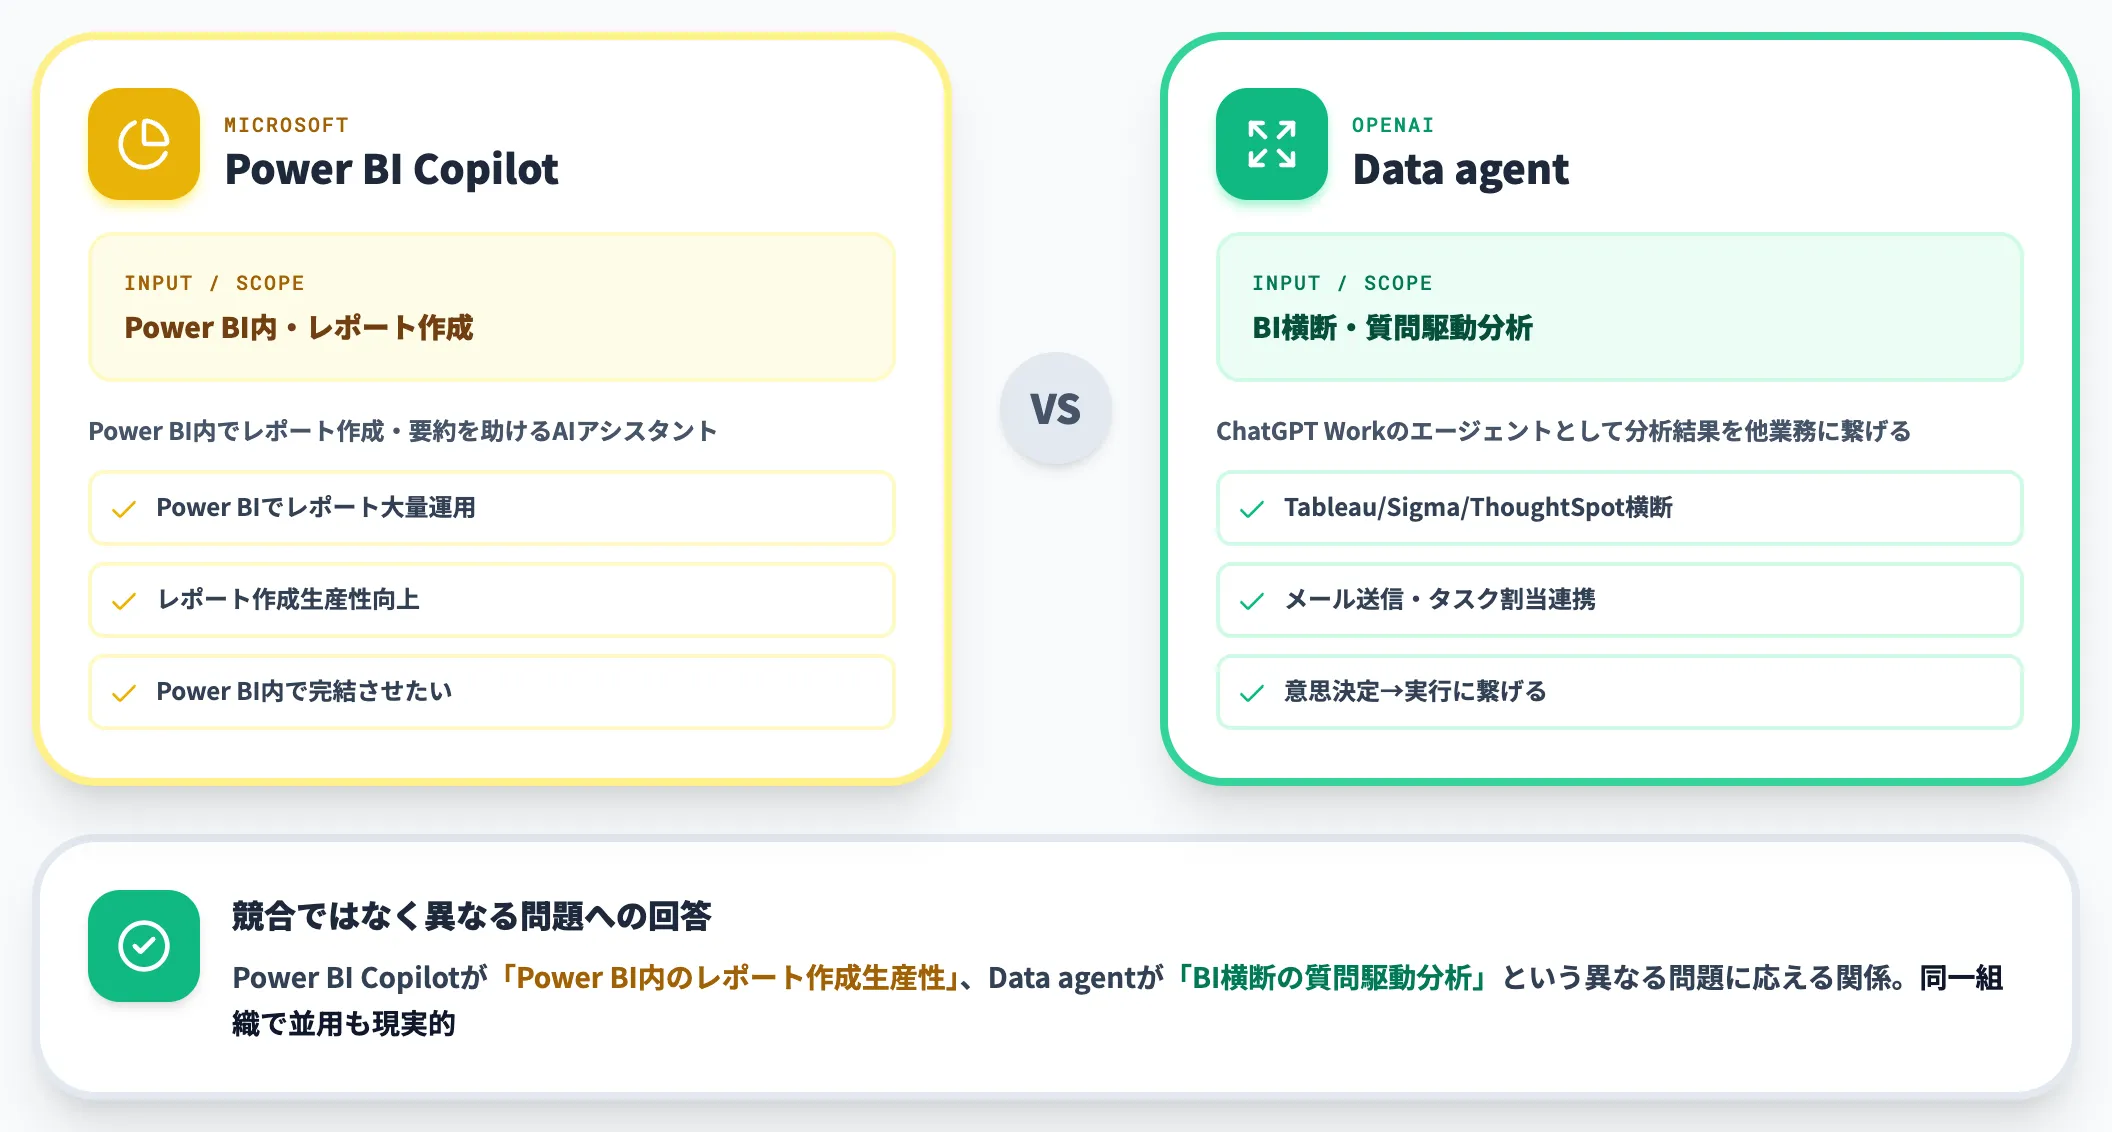
Power BI Copilotは、Power BI内でレポート作成・要約を助けるAIアシスタントです。
両者の使い分けはシンプルで、「入口」と「対象」で分かれます。
-
Power BI Copilotが有利なケース
既にPower BIで大量のレポートを運用しており、レポート作成の生産性を上げたい。Power BIの中で完結させたい
-
Data agentが有利なケース
Power BI以外のツール(Tableau・Sigma・ThoughtSpot等)とも横断したい。ChatGPT Workのエージェントとして、分析結果を他業務(メール送信・タスク割り当て等)に繋げたい
両者は競合というより、Power BI Copilotが「Power BI内のレポート作成生産性」、Data agentが「BI横断の質問駆動分析」という異なる問題に応える関係です。同一組織で並用も現実的です。
ケース別推奨とベンチマーク未公表の含意
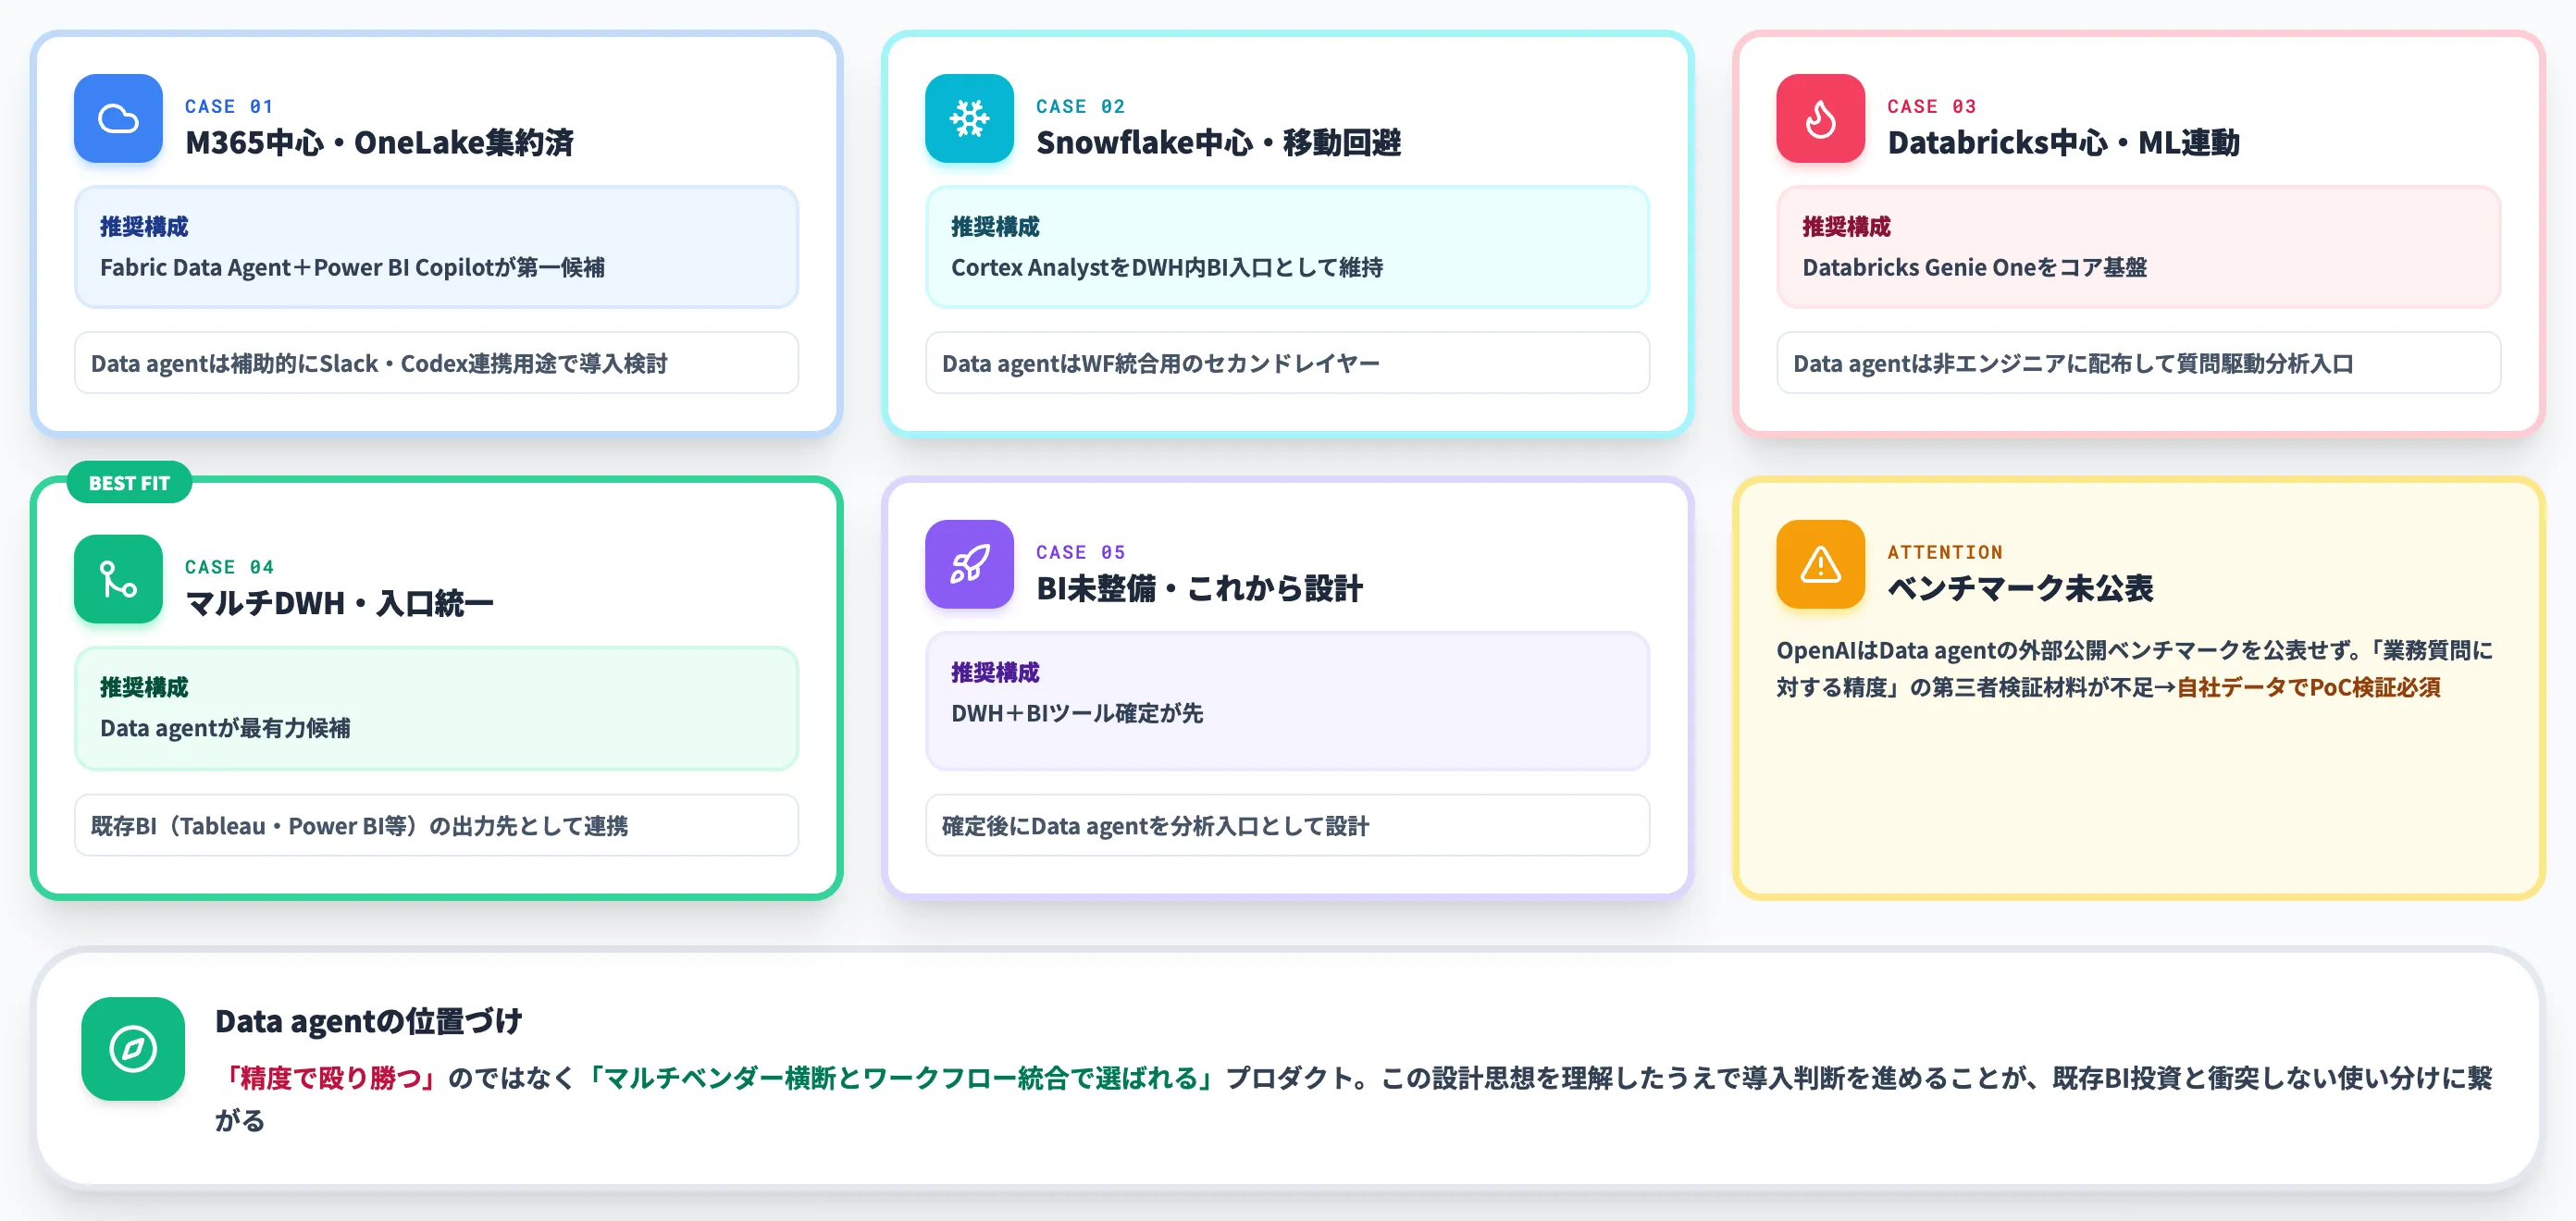
上記を踏まえて、企業側のケース別の推奨を整理します。
-
Microsoft 365中心・OneLake集約済み
Fabric Data Agent+Power BI Copilotが第一候補。Data agentは補助的にSlack・Codex連携用途で導入検討
-
Snowflake中心・データ移動を避けたい
Snowflake Cortex AnalystをDWH内BI入口として維持しつつ、Data agentは業務ワークフロー統合用のセカンドレイヤーとして導入
-
Databricks中心・ML運用と連動
Databricks Genie Oneをコア基盤にしつつ、Data agentは非エンジニアの営業・経営企画に配布して質問駆動分析の入口を用意
-
マルチDWH併用・分析入口を統一したい
Data agentが最有力候補。既存BI(Tableau・Power BI等)の出力先としてData agentを繋げる
-
BI基盤未整備・これから設計する
まずDWH(Snowflake or Databricks or BigQuery)とBIツール(Power BI or Tableau)を確定させ、そのうえでData agentを分析入口として設計
ベンチマーク未公表の点は、意思決定の際に留意すべきポイントです。OpenAIはData agentについて外部公開ベンチマークを公表していません。
競合ベンダーが公表するスコアは対象タスクが異なるため直接比較には使えず、「業務質問に対する精度」を第三者検証で確かめる材料が不足しています。企業側は自社のデータでPoCを回して精度を測る必要があります。
Data agentの位置づけは、「精度で殴り勝つ」のではなく「マルチベンダー横断とワークフロー統合で選ばれる」プロダクトです。この設計思想を理解したうえで導入判断を進めることが、既存BI投資と衝突しない使い分けに繋がります。
ChatGPT Work Data agentの導入事例と実務での価値
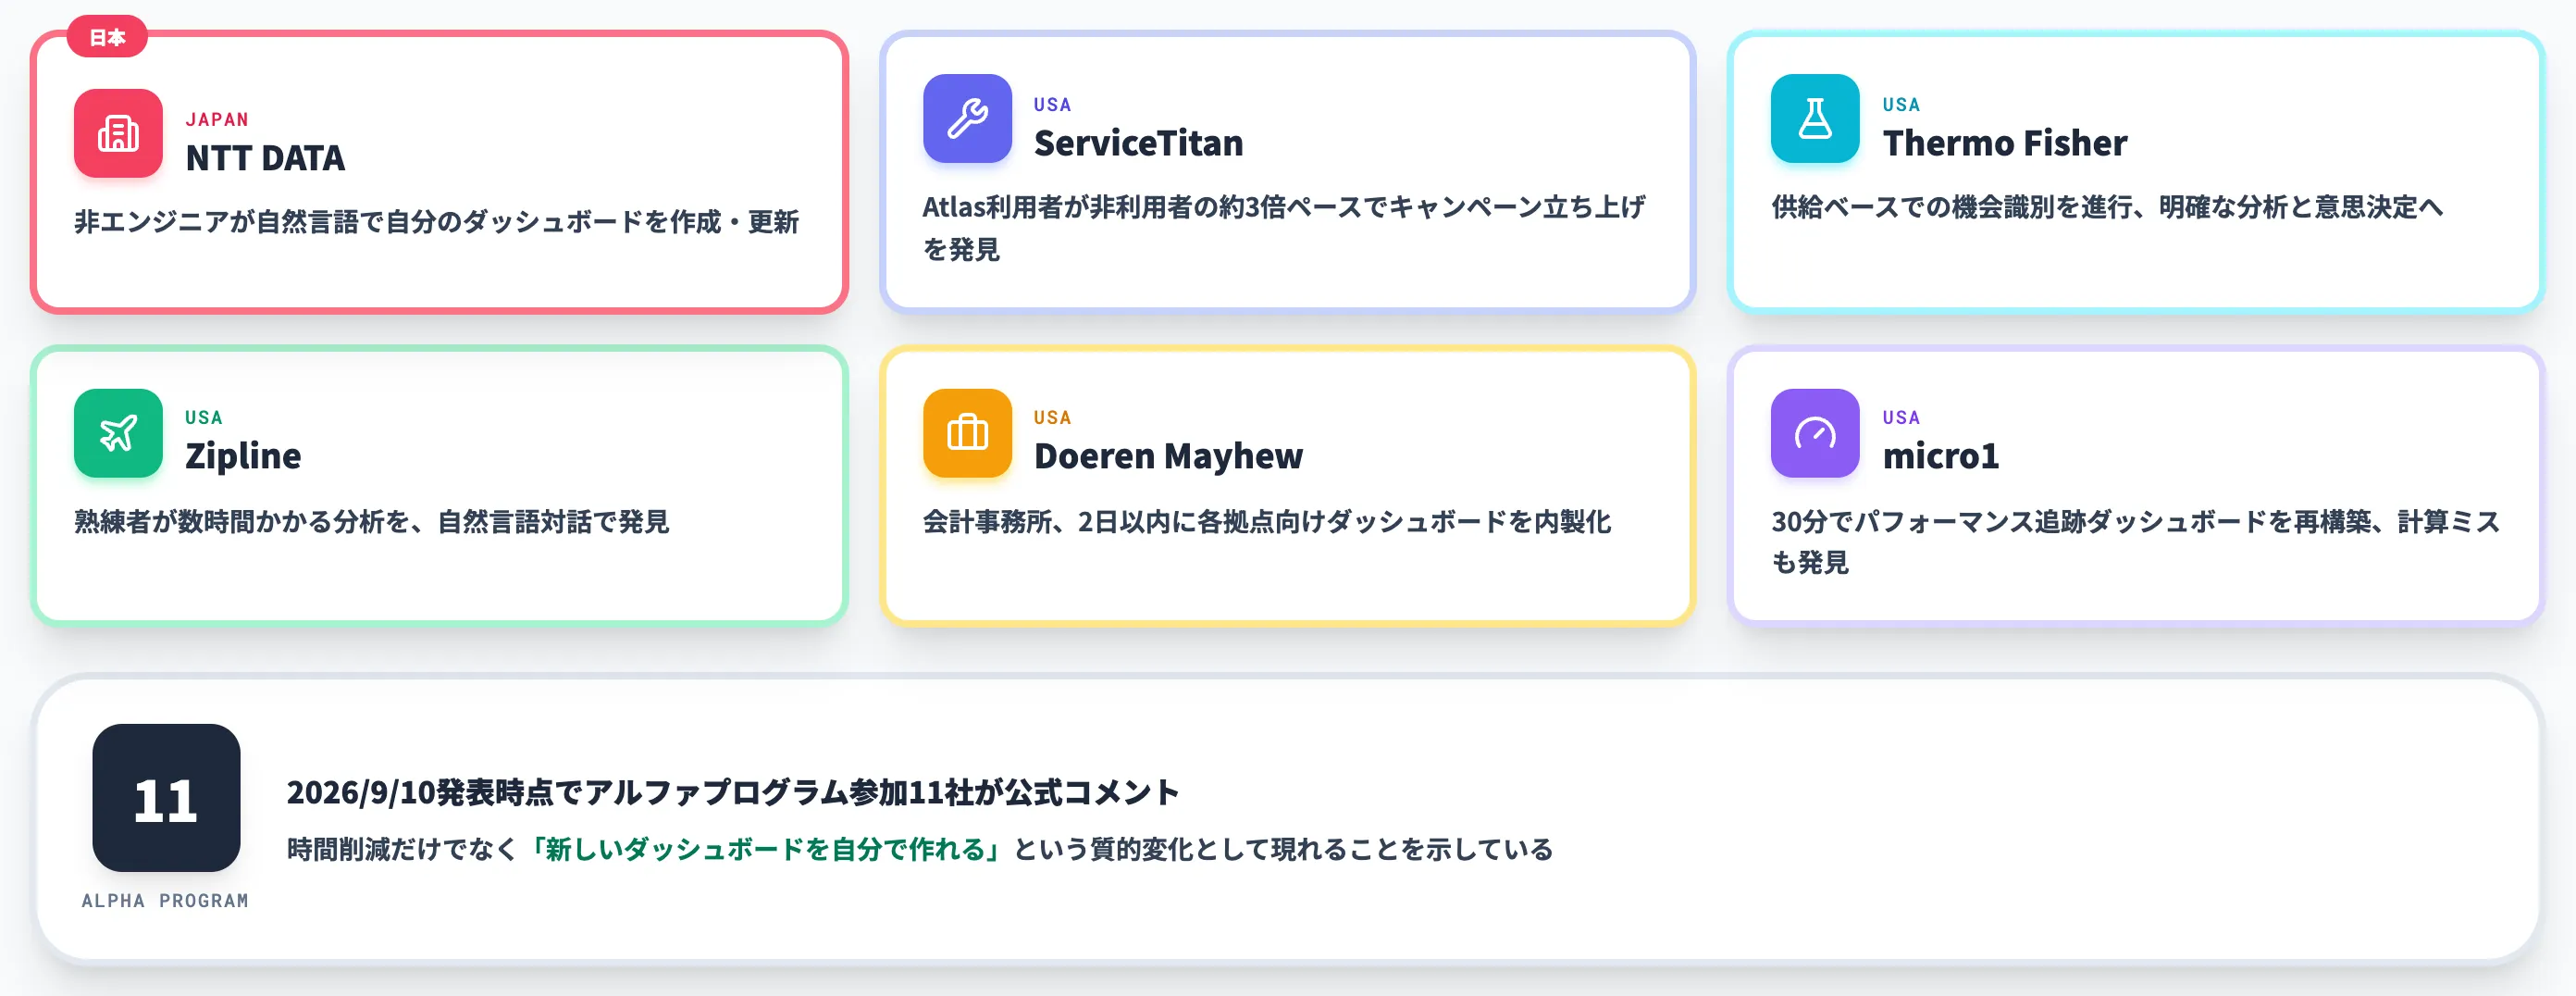
Data agentは、2026年9月10日の発表時点でOpenAIのアルファプログラム参加企業11社が公式コメントを寄せています。
本セクションでは、公表事例からData agentが実務で生み出した価値と、データエンジニアの役割変化を整理します。
NTT DATAでのダッシュボード内製化
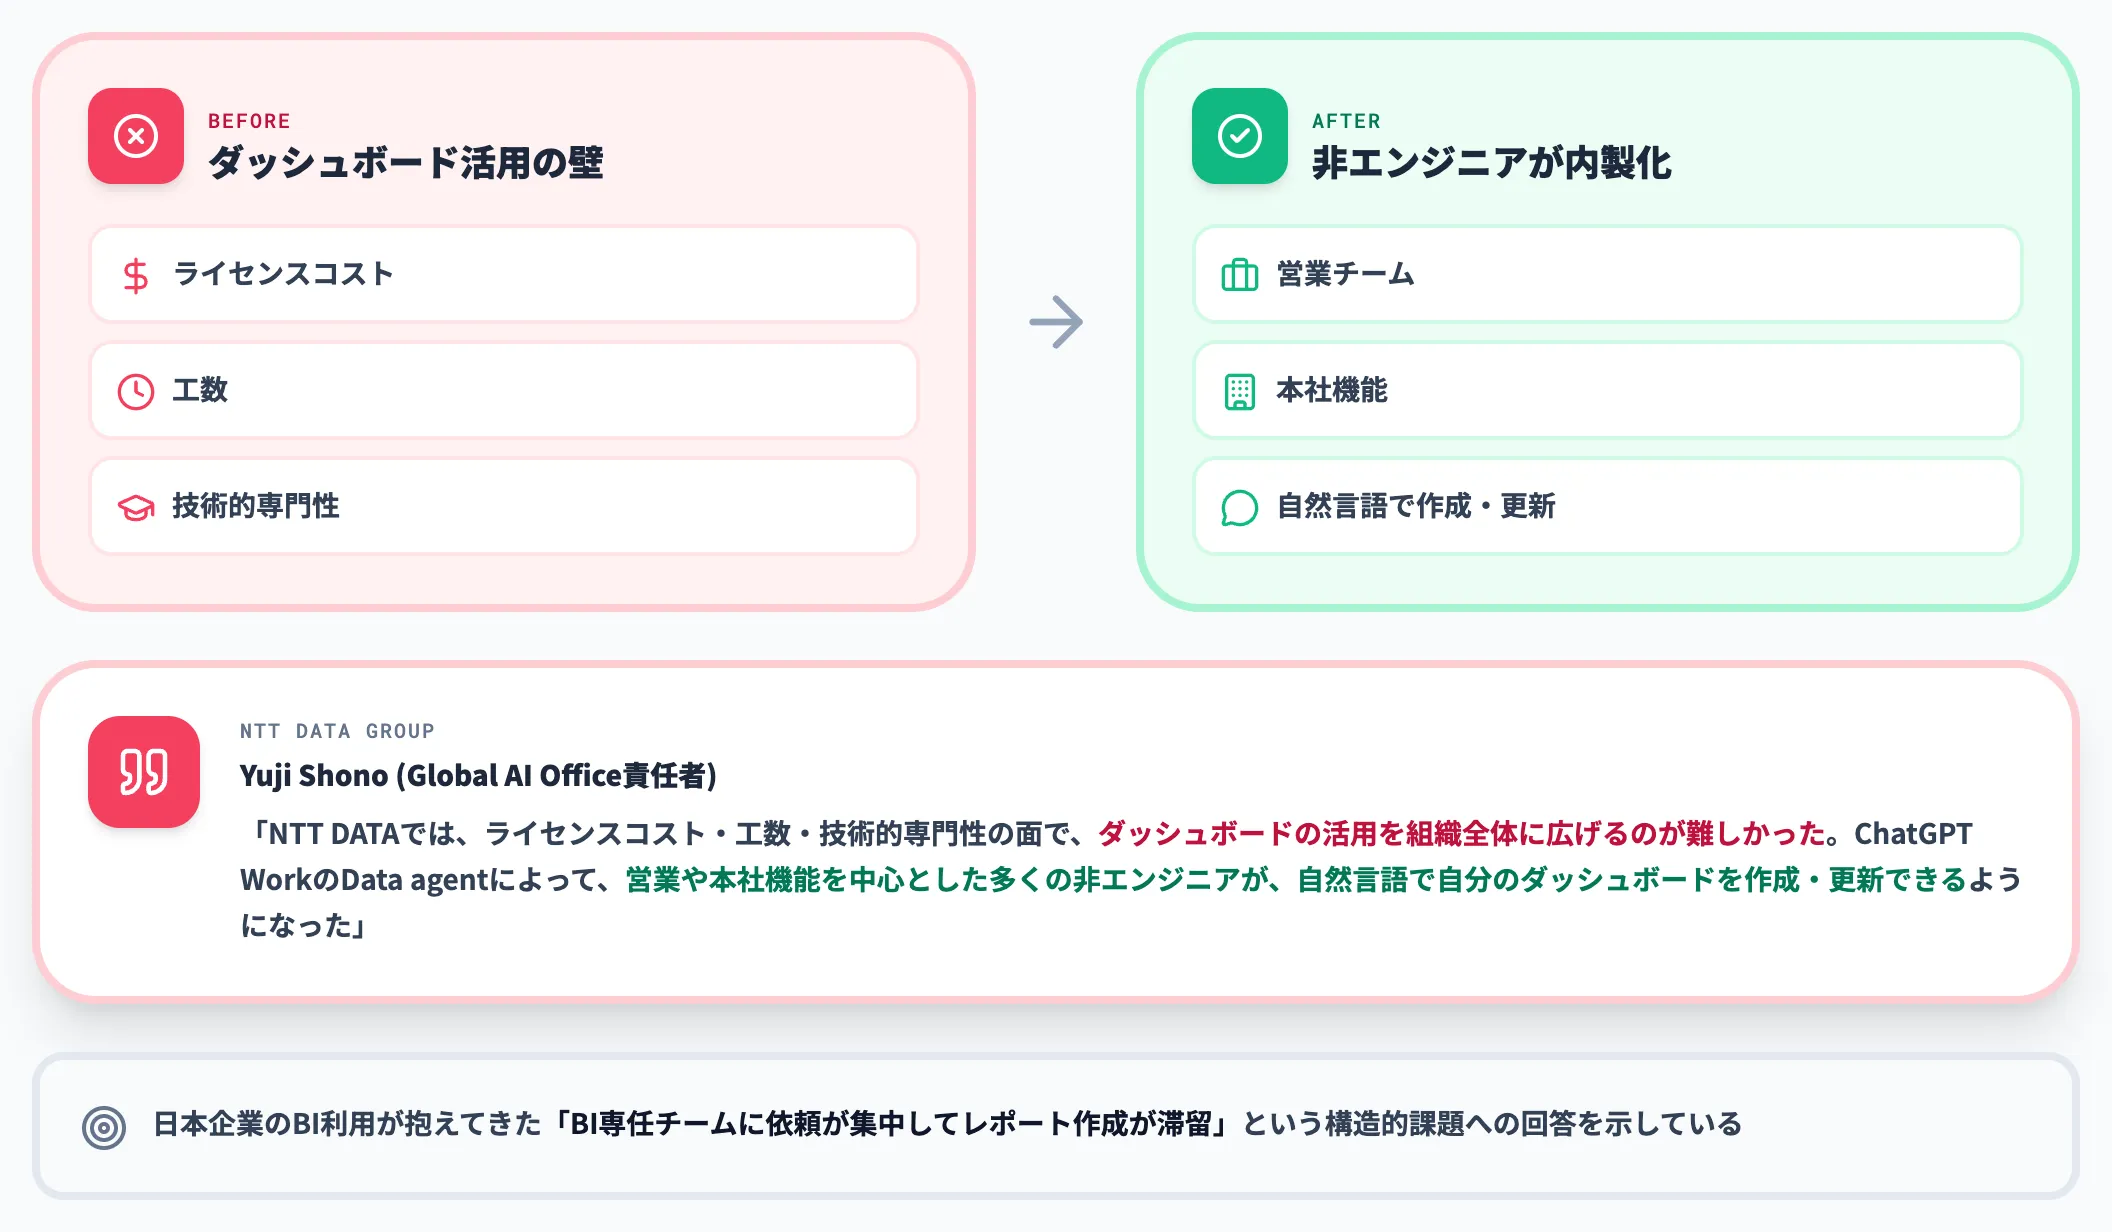
日本市場の視点で最も注目すべき事例は、NTT DATAがData agentのアルファプログラムに参加している点です。
NTT DATA Group のGlobal AI Office責任者Yuji Shono氏は、公式ページに次のコメントを寄せています。
「NTT DATAでは、ライセンスコスト・工数・技術的専門性の面で、ダッシュボードの活用を組織全体に広げるのが難しかった。ChatGPT WorkのData agentによって、営業や本社機能を中心とした多くの非エンジニアが、自然言語で自分のダッシュボードを作成・更新できるようになった。」
「非エンジニアがダッシュボードを内製する」というワークフロー変化は、日本企業のBI利用が抱えてきた構造的な課題への回答です。
BI専任チームに依頼が集中してレポート作成が滞留する状態が、Data agentで解消される可能性を示しています。
米国での導入事例
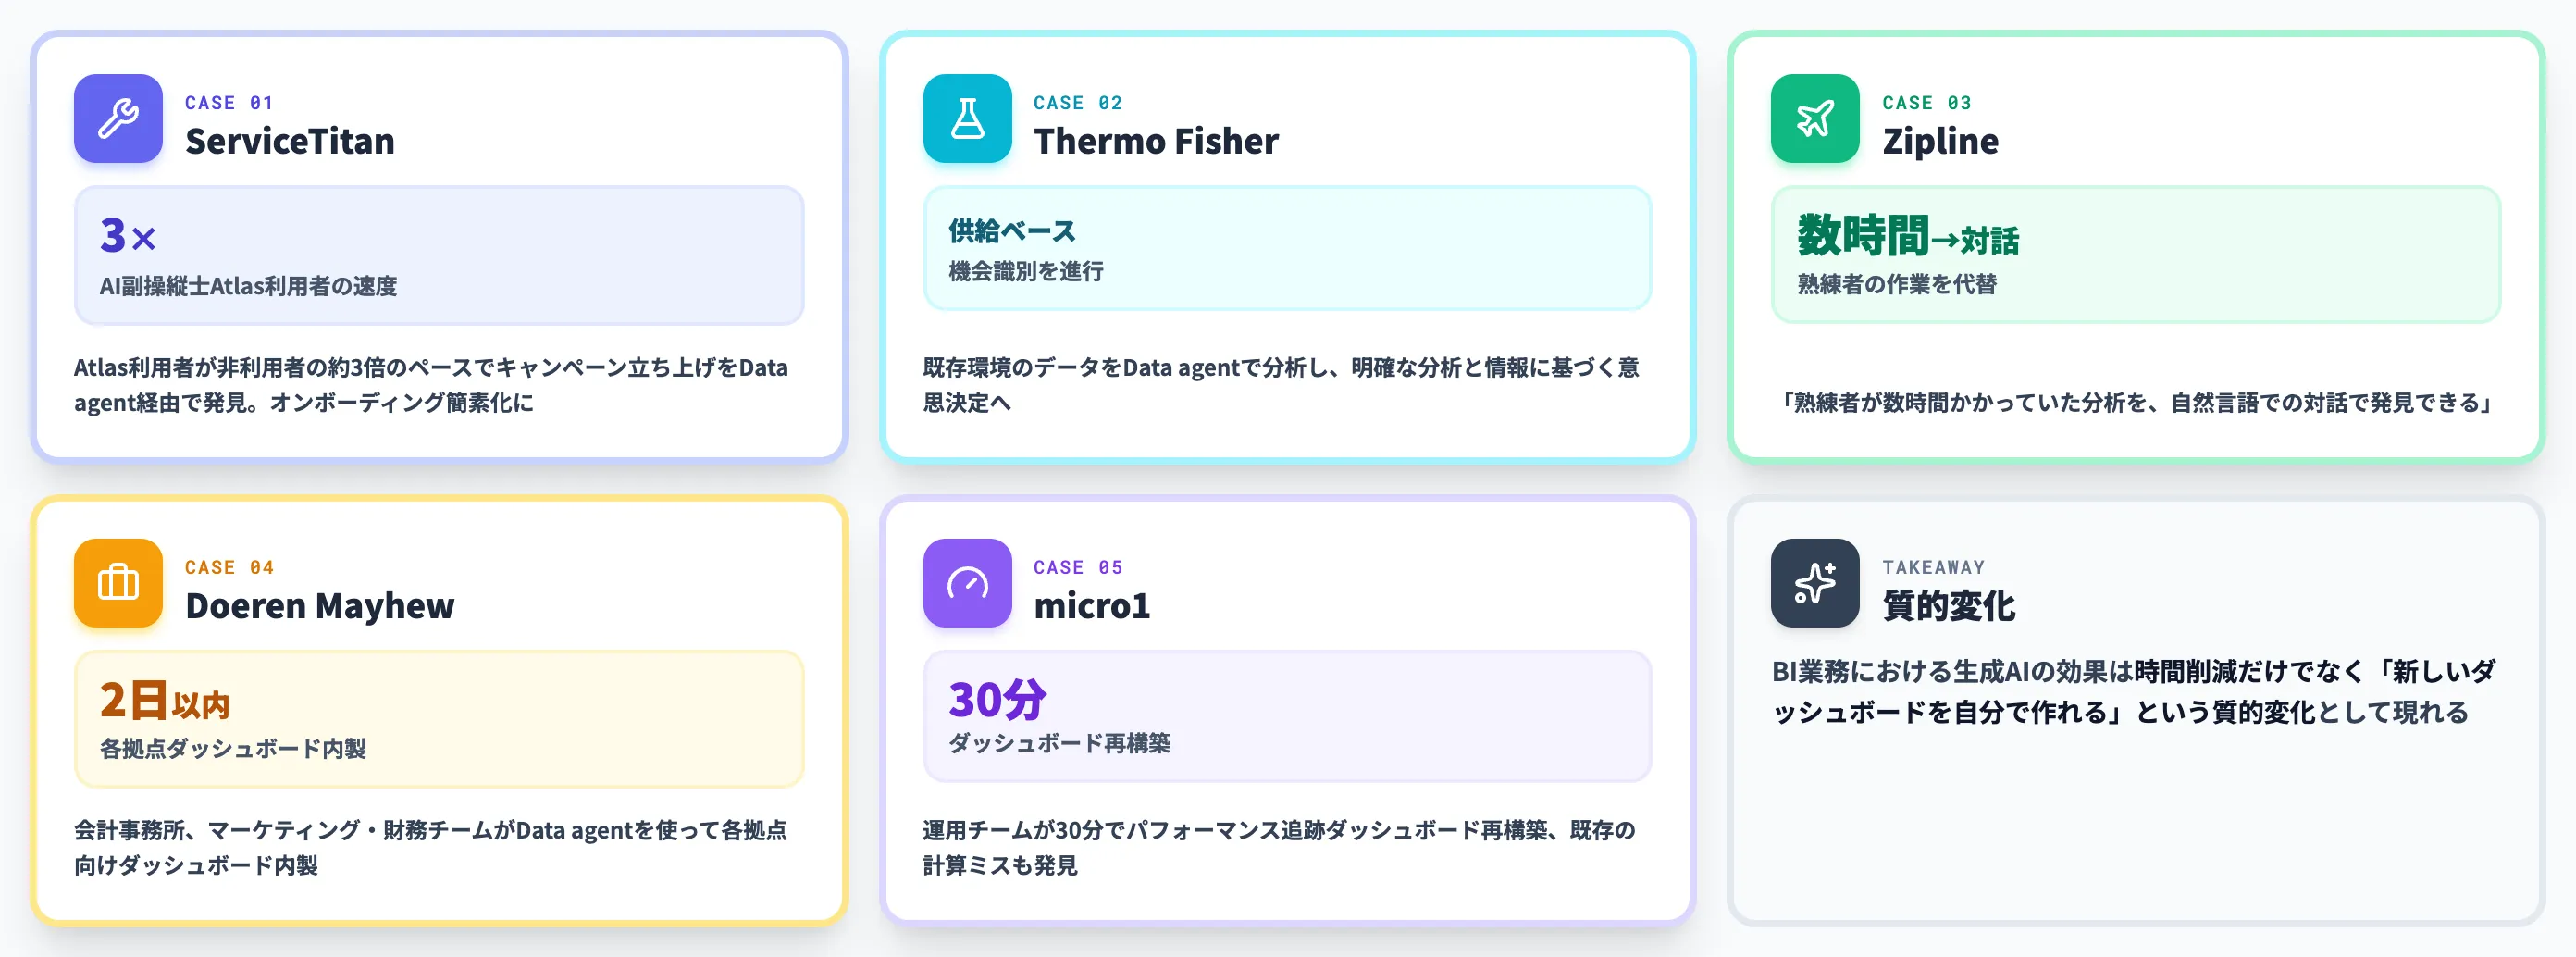
米国側の公式事例からは、Data agentがどのような効率化として報告されているかが読み取れます。
-
ServiceTitan
AI副操縦士「Atlas」の利用者が非利用者の約3倍のペースでキャンペーンを立ち上げていることをData agent経由で発見。オンボーディングの簡素化に繋げた
-
Thermo Fisher Scientific
既存環境のデータをData agentで分析し、より明確な分析と情報に基づく意思決定につながる可能性を見込んで、供給ベースでの機会識別を進めている
-
Zipline
「熟練者が数時間かかっていた分析を、自然言語での対話で発見できるようになった」と評価
-
Doeren Mayhew(会計事務所)
2日以内にマーケティング・財務チームがData agentを使って各拠点向けダッシュボードを内製した
-
micro1
運用チームが30分でパフォーマンス追跡ダッシュボードを再構築し、既存ダッシュボードの計算ミスも発見した
Ziplineが語る「熟練者なら数時間かかる分析を短縮」と、micro1が語る「30分でダッシュボードを再構築」という別々の実績は、生成AIの効果がBI業務では「時間削減」だけでなく新しいダッシュボードを自分で作れるという質的変化として現れることを示しています。
OpenAI社内の運用モデル
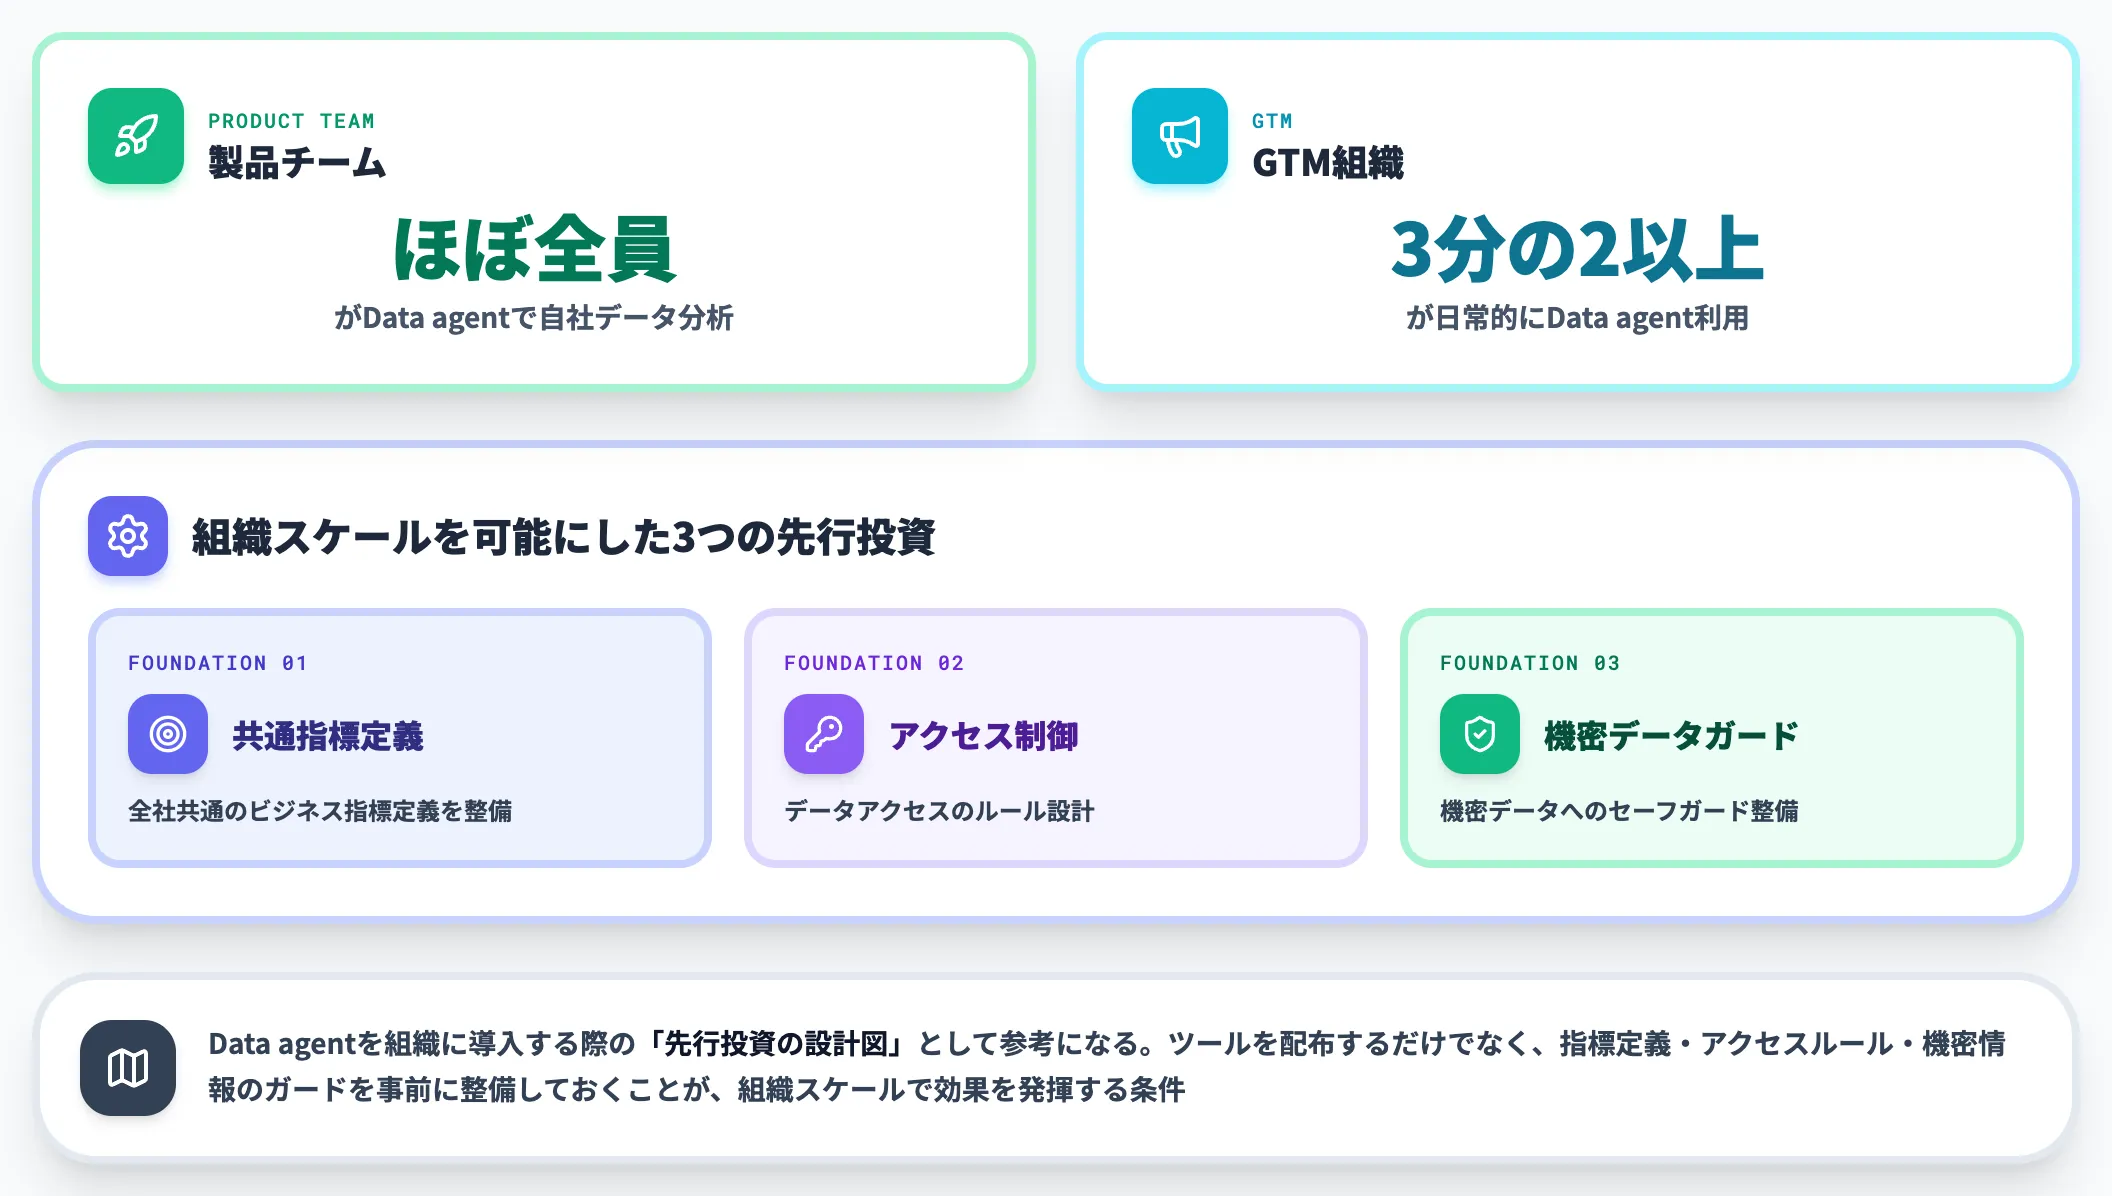
Data agentは、OpenAI社内で既に広範に運用されています。
OpenAIの発表によれば、製品チームのほぼ全員、GTM組織の3分の2以上がData agentを使って自社データを分析している状態です。これを可能にしているのは、OpenAI社内のデータチームが以下3点を整備したためだと公表されています。
- 全社共通のビジネス指標定義
- データアクセスのルール設計
- 機密データへのセーフガード
この構造は、Data agentを組織に導入する際の先行投資の設計図として参考になります。ツールを配布するだけでなく、指標定義・アクセスルール・機密情報のガードを事前に整備しておくことが、Data agentの効果を組織スケールで発揮する条件です。
データエンジニアの役割シフト
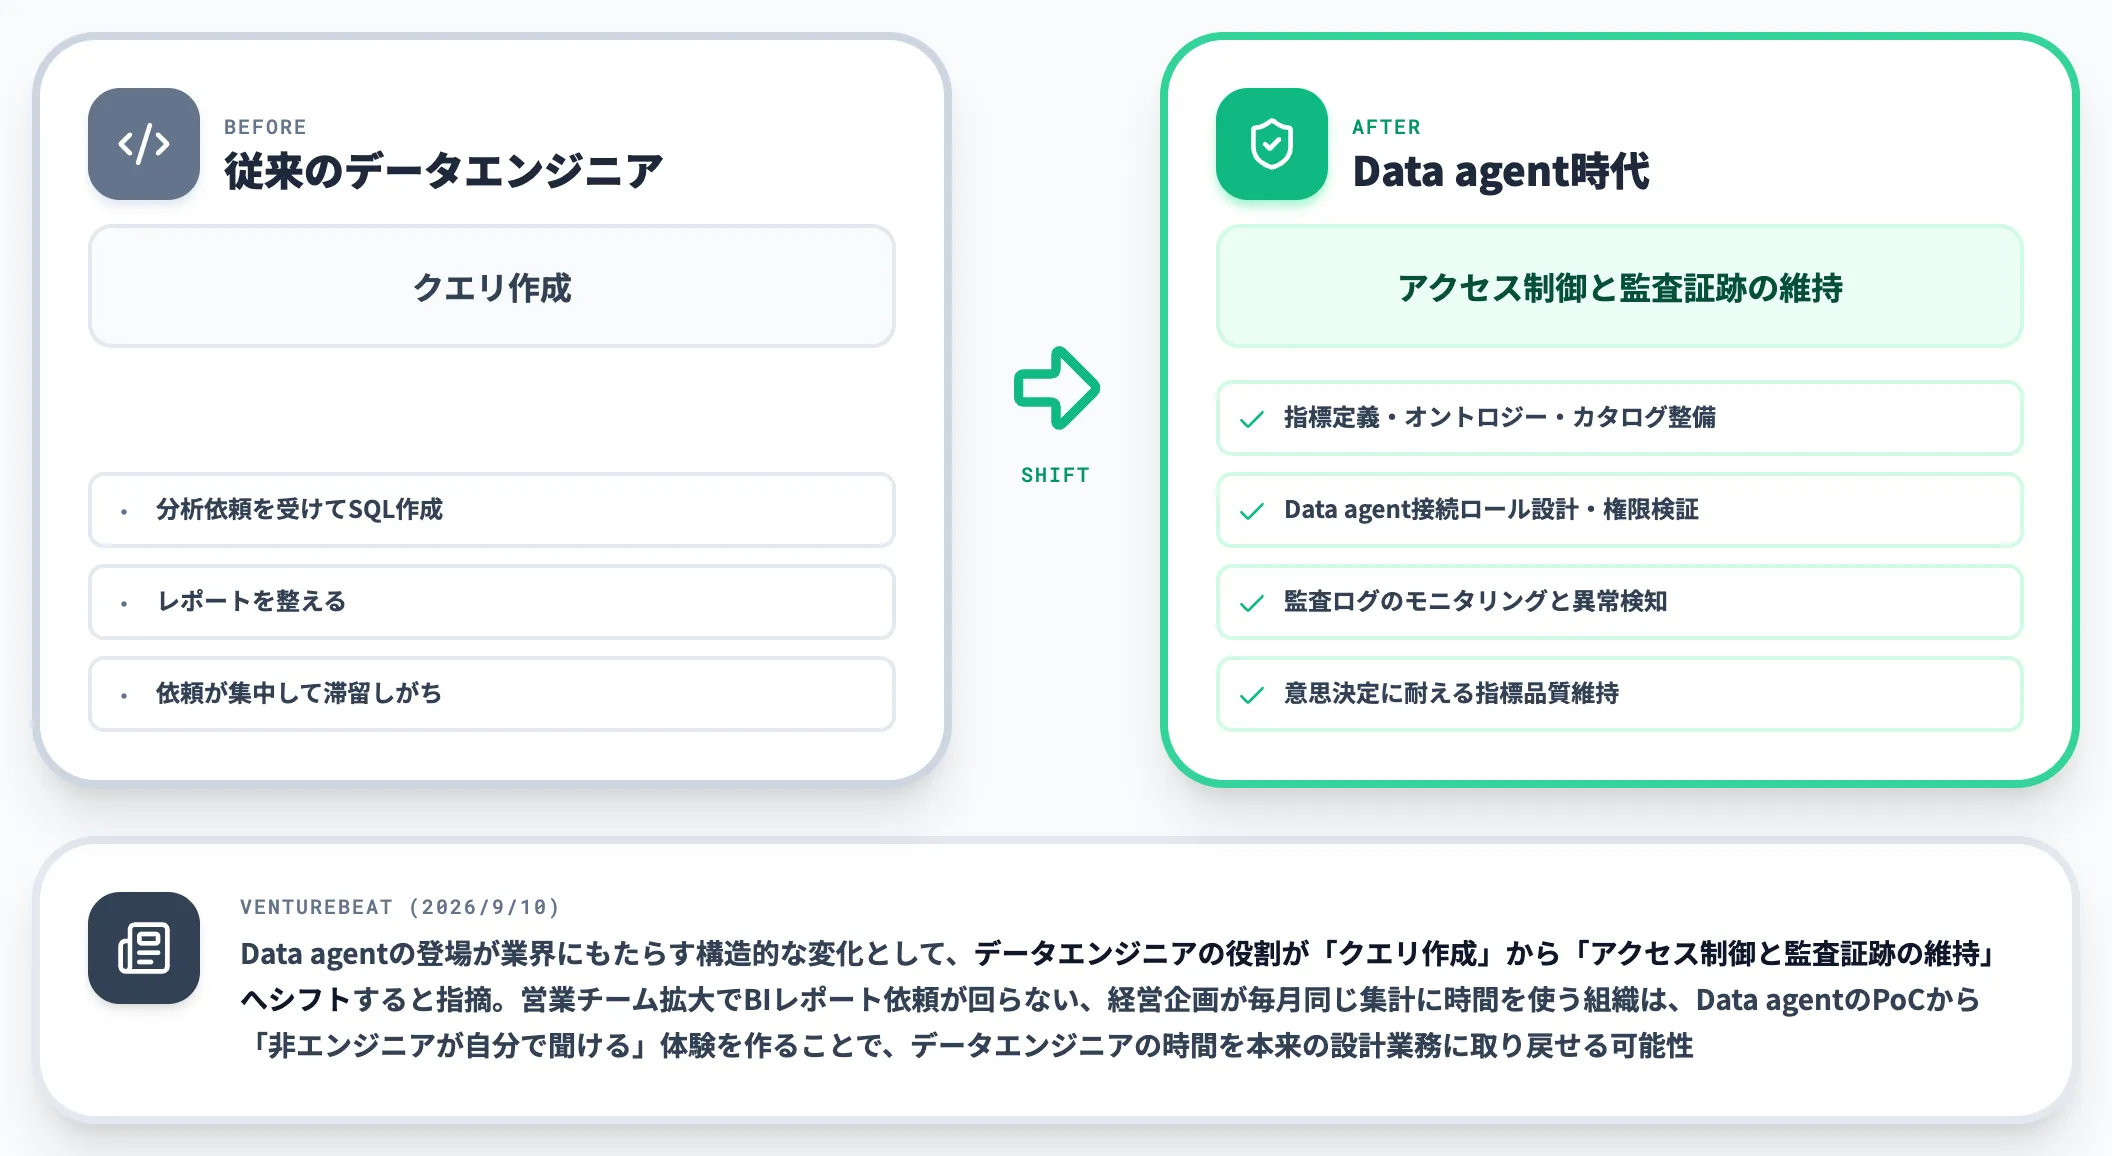
VentureBeatは、Data agentの登場が業界にもたらす構造的な変化として、データエンジニアの役割が「クエリ作成」から「アクセス制御と監査証跡の維持」へシフトすると指摘しています。
これは、AI総研の導入支援現場でも見え始めている変化と一致します。従来のデータエンジニアは、業務ユーザーからの分析依頼を受けてSQLを書き、レポートを整える役割を担ってきました。
Data agentが業務ユーザー側に「クエリを書かずに自分でデータに問い合わせられる」体験を提供することで、データエンジニアは以下のような役割に軸足を移すことになります。
- 指標定義・オントロジー・データカタログの整備
- Data agent接続用のロール設計と権限伝播の検証
- 監査ログのモニタリングと異常検知
- 意思決定に耐える指標品質の維持
営業チームの拡大に伴いBIレポート依頼が回らなくなる、経営企画が毎月同じ集計を依頼するために多くの時間を使う——そんな状態にある組織は、Data agentのPoCから「非エンジニアが自分で聞ける」体験を作ることで、データエンジニアの時間を本来の設計業務に取り戻せる可能性があります。
Data agentで見つけた数字を、申請から基幹システムへの入力まで進める
Data agentで非エンジニアが自分で数字を確認できるようになると、次に残るのは、その数字をもとにした申請や発注、基幹システムへの入力です。Data agentは発見した論点の通知やタスクの割り当てまでを会話の中で進めますが、経費や請求のように業務システムへ反映する処理は、社内の承認ルートと記録の残し方に合わせて組む必要があります。
分析の先にある業務の処理を受け持つのが、Microsoft Fabricをデータ基盤に置くAIエージェント基盤です。AI総合研究所のAI Agent Hubでは、社員がTeamsからAgentを呼び出し、OneLakeのデータを参照しながら、申請の作成から基幹システムへの入力までを進めます。
- 業務システムのデータをコピーせずにOneLakeで参照する
SAPやSalesforceのデータをFabric OneLakeに仮想統合するため、物理的なコピーを作らずに、Agentが複数のシステムのデータを横断して参照します。
- 申請の可否は担当者がTeamsで決める
Agentが作った申請は、フロー判定Agentが回付先を判定してTeamsに通知し、担当者はスマホのTeamsから承認や差戻しを行えます。
- Agentの実行記録を次の分析に回す
Agentの実行ログと処理の履歴はFabricに集約されるため、どの処理がどこで止まったかを、業務データと同じ場所で分析に回せます。
AI総合研究所の専任チームが、Data agentで見えてきた課題のうち、Agentに処理まで任せる業務を1つ選ぶところから伴走します。
分析の結果を申請と入力まで進める

回付と承認はTeamsで人が行う
Data agentで非エンジニアが自分で数字を確認できるようになったあと、その数字をもとにした申請や基幹システムへの入力は、社内の承認ルートに沿って進める仕組みが必要です。AI Agent Hubでは、OneLakeのデータを参照するAgentが申請を作り、Teamsで担当者が判断したうえで基幹システムに反映します。
まとめ
本記事では、ChatGPT Work Data agentについて、主要機能・対応データソース・料金・使い方・セキュリティ・既存BI基盤との使い分け・導入事例までを、2026年9月時点の公式情報で解説しました。
2026年9月時点で押さえておくべきポイントは次の3つです。
- Redshift・BigQuery・Snowflake・Databricks等のマルチDWH横断とBIツール内ダッシュボード生成を両立するプラグイン型エージェント
- 接続アカウントの既存権限が伝播し管理者制御と分析根拠説明で既存ガバナンスを崩さない設計、Business・Enterprise・Eduで2026年9月10日提供告知
- Fabric Data Agent・Snowflake Cortex Analyst・Databricks Genie One・Power BI Copilotとは提供思想が異なりマルチベンダー横断とワークフロー統合で選ばれる位置づけ、ベンチマーク未公表のため自社データのPoC検証が推奨
日本企業の視点では、NTT DATAのアルファ事例が示すとおり、非エンジニアがダッシュボードを内製できる価値が最も大きいポイントです。BIレポート依頼が滞留している組織なら、まず1部門・1データソースでPoCを回し、指標定義とアクセス制御を整えたうえで展開を広げるのが現実的な第一歩になります。