この記事のポイント
 Kria AI SOMは米国時間2026年7月23日発表のRyzen AI Embedded X100を核にした新型SOM、従来のFPGA中心KriaからCPU+GPU+NPU中心へ設計転換
- COM-HPCフォームファクター準拠(SAPPHIRE製EDGE+ APEX X100はClient Size B)、SOMはx86 SoC+最大128GB統合メモリに絞りFPGAはキャリア基板側に分離配置
- AMD委託テスト(Ryzen AI Max+ 395をX199相当に設定したプロキシ機・モデル評価)でNVIDIA Jetson AGX Thor T5000比リアルタイム信頼性3.4倍・同時エージェント2.3倍と対抗する構成
- Ryzen AI Embedded X100プロセッサのサンプルは2026年6月出荷開始、Kria AI SOMと開発プラットフォームの量産と一般提供はQ4 2026予定、産業温度版X199iのLast Time Buyは2037年で長期BOM設計に対応
- 開発プラットフォームの公式価格は未発表(第三者ブログの予想として$5,000超が言及される程度)、Kria AI SOM本体の量産提供はODM経由が中心(Developer PlatformはAMD・世界各地の販売代理店経由で提供予定・具体的な注文先・国内取扱は未発表)
Microsoft MVP・AIパートナー。LinkX Japan株式会社 代表取締役。東京工業大学大学院にて自然言語処理・金融工学を研究。NHK放送技術研究所でAI・ブロックチェーンの研究開発に従事し、国際学会・ジャーナルでの発表多数。経営情報学会 優秀賞受賞。シンガポールでWeb3企業を創業後、現在は企業向けAI導入・DX推進を支援。
Kria AI SOM(クリア エーアイ ソム)は、AMDが米国時間2026年7月23日(日本時間7月24日)のAdvancing AI 2026で発表した、Physical AI向けの新型System-on-Module(SOM)です。
Ryzen AI Embedded X100を業界標準のCOM-HPCフォームファクター基板に載せ、Zen 5 CPU最大16コア・RDNA 3.5 iGPU・XDNA 2 NPU 50 TOPS・128GB LPDDR5x統合メモリを1枚に集約しています。
従来のKria K24/K26がZynq UltraScale+ MPSoC(FPGA+Arm)を核にしていたのに対し、Kria AI SOMはx86 SoC+NPUを核とし、SOM本体からFPGAを外してキャリア側に置く設計転換をしています。
本記事では、Kria AI SOMの正体(Ryzen X100とCOM-HPCの組み合わせ)・搭載SoCの中身・既存Kriaシリーズとの関係・想定用途(Humanoid・自律機・産業自動化)・AMD Kria AI Robotics Developer Platformの構成・ソフトウェアスタック・NVIDIA Jetson AGX Thorとの比較・価格と入手性・SIer視点の採用判断論点までを、2026年9月時点で体系的に解説します。
目次
Kria AI SOMとは?Ryzen X100をCOM-HPC 1枚に載せたAMDの新型Physical AIモジュール
Kria AI SOMに搭載されたRyzen AI Embedded X100の中身
Zen 5 CPU最大16コア——リアルタイム制御と汎用処理を同居
RDNA 3.5 iGPU最大40 CU——ディスクリートGPU級のグラフィックスと推論を統合
XDNA 2 NPU 50 TOPS——低電力・低遅延のAI推論専用ブロック
LPDDR5x 128GB統合メモリ——大規模モデル向けの容量
Kria AI SOMのハードウェア構成——COM-HPC規格とFPGA分離設計
SOM本体の搭載構成——SoCと統合メモリ、そしてFPGAは非搭載
キャリアボード側のSpartan UltraScale+ FPGA——センサー融合・カスタムI/O
カメラ入力とセンサーI/O——2基のFAKRA x4・IMU・多重ネットワーク
Kria AI SOMが担うPhysical AIとロボット・産業機器の想定用途
VLA(Vision-Language-Action)推論——Physical AIの中核ユースケース
AMD Kria AI Robotics Developer Platform——ターンキー評価キットの構成
Kria AI SOMのソフトウェアスタックと開発エコシステム
対応フレームワーク——PyTorch・ONNX・ROS 2・MoveIt
AMD ROCm・Ryzen AI Software・Robotics Software Suite
CUDA→HIP移行——NVIDIA Jetsonからの乗り換えパス
AMD Open Robotics Partner Network——30社超のエコシステム
Kria AI SOMとNVIDIA Jetson AGX Thorの比較
AMD公表値——リアルタイム信頼性・空きCPU・同時エージェント
供給スケジュール——X100サンプル2026年6月、Kria AI SOM量産Q4 2026
産業温度版のLast Time Buy 2037——長期BOM設計に対応
入手ルート——SOMはODM経由、Developer PlatformはAMD・販売代理店経由
既存Kria K26/Jetson AGX Thor/Kria AI SOMの使い分け
開発人材の確保——ROCm・Ryzen AI Software・Robotics Software Suiteを扱えるチーム
コンシューマ版Ryzen AI Max+ 395で先行PoCする裏技
Kria AI SOMとは?Ryzen X100をCOM-HPC 1枚に載せたAMDの新型Physical AIモジュール
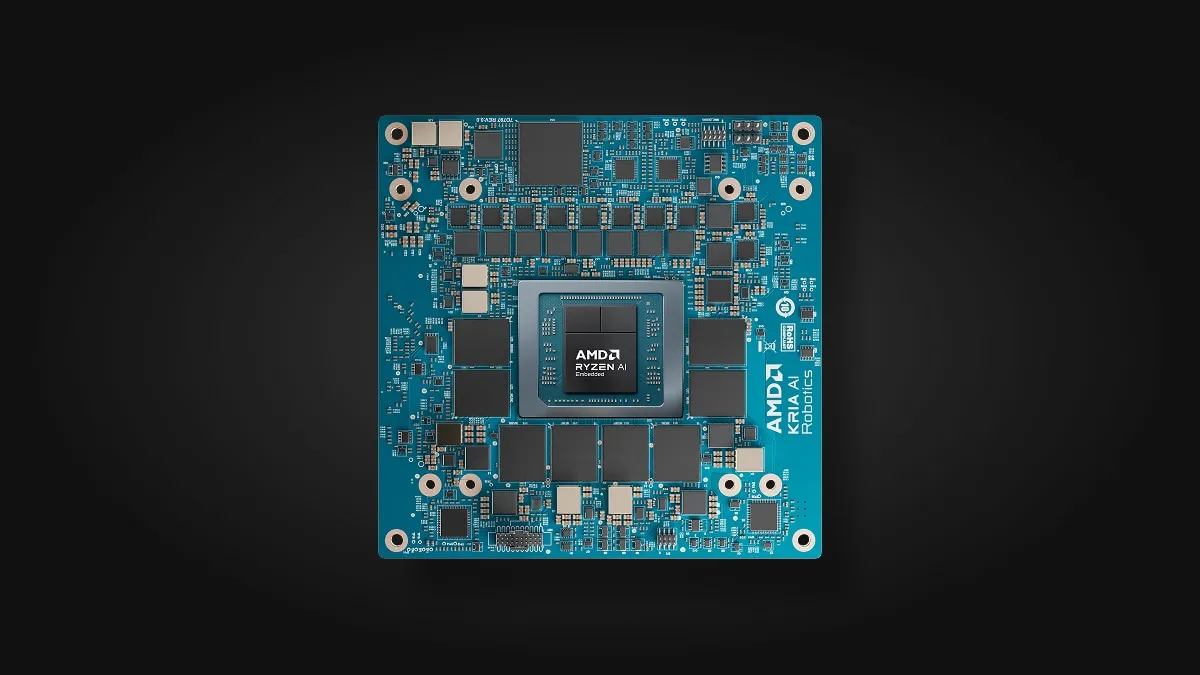
Kria AI SOM(Ryzen AI Embedded X100搭載モジュール)のローンチキービジュアル(出典:AMD Kria AI Solutions)
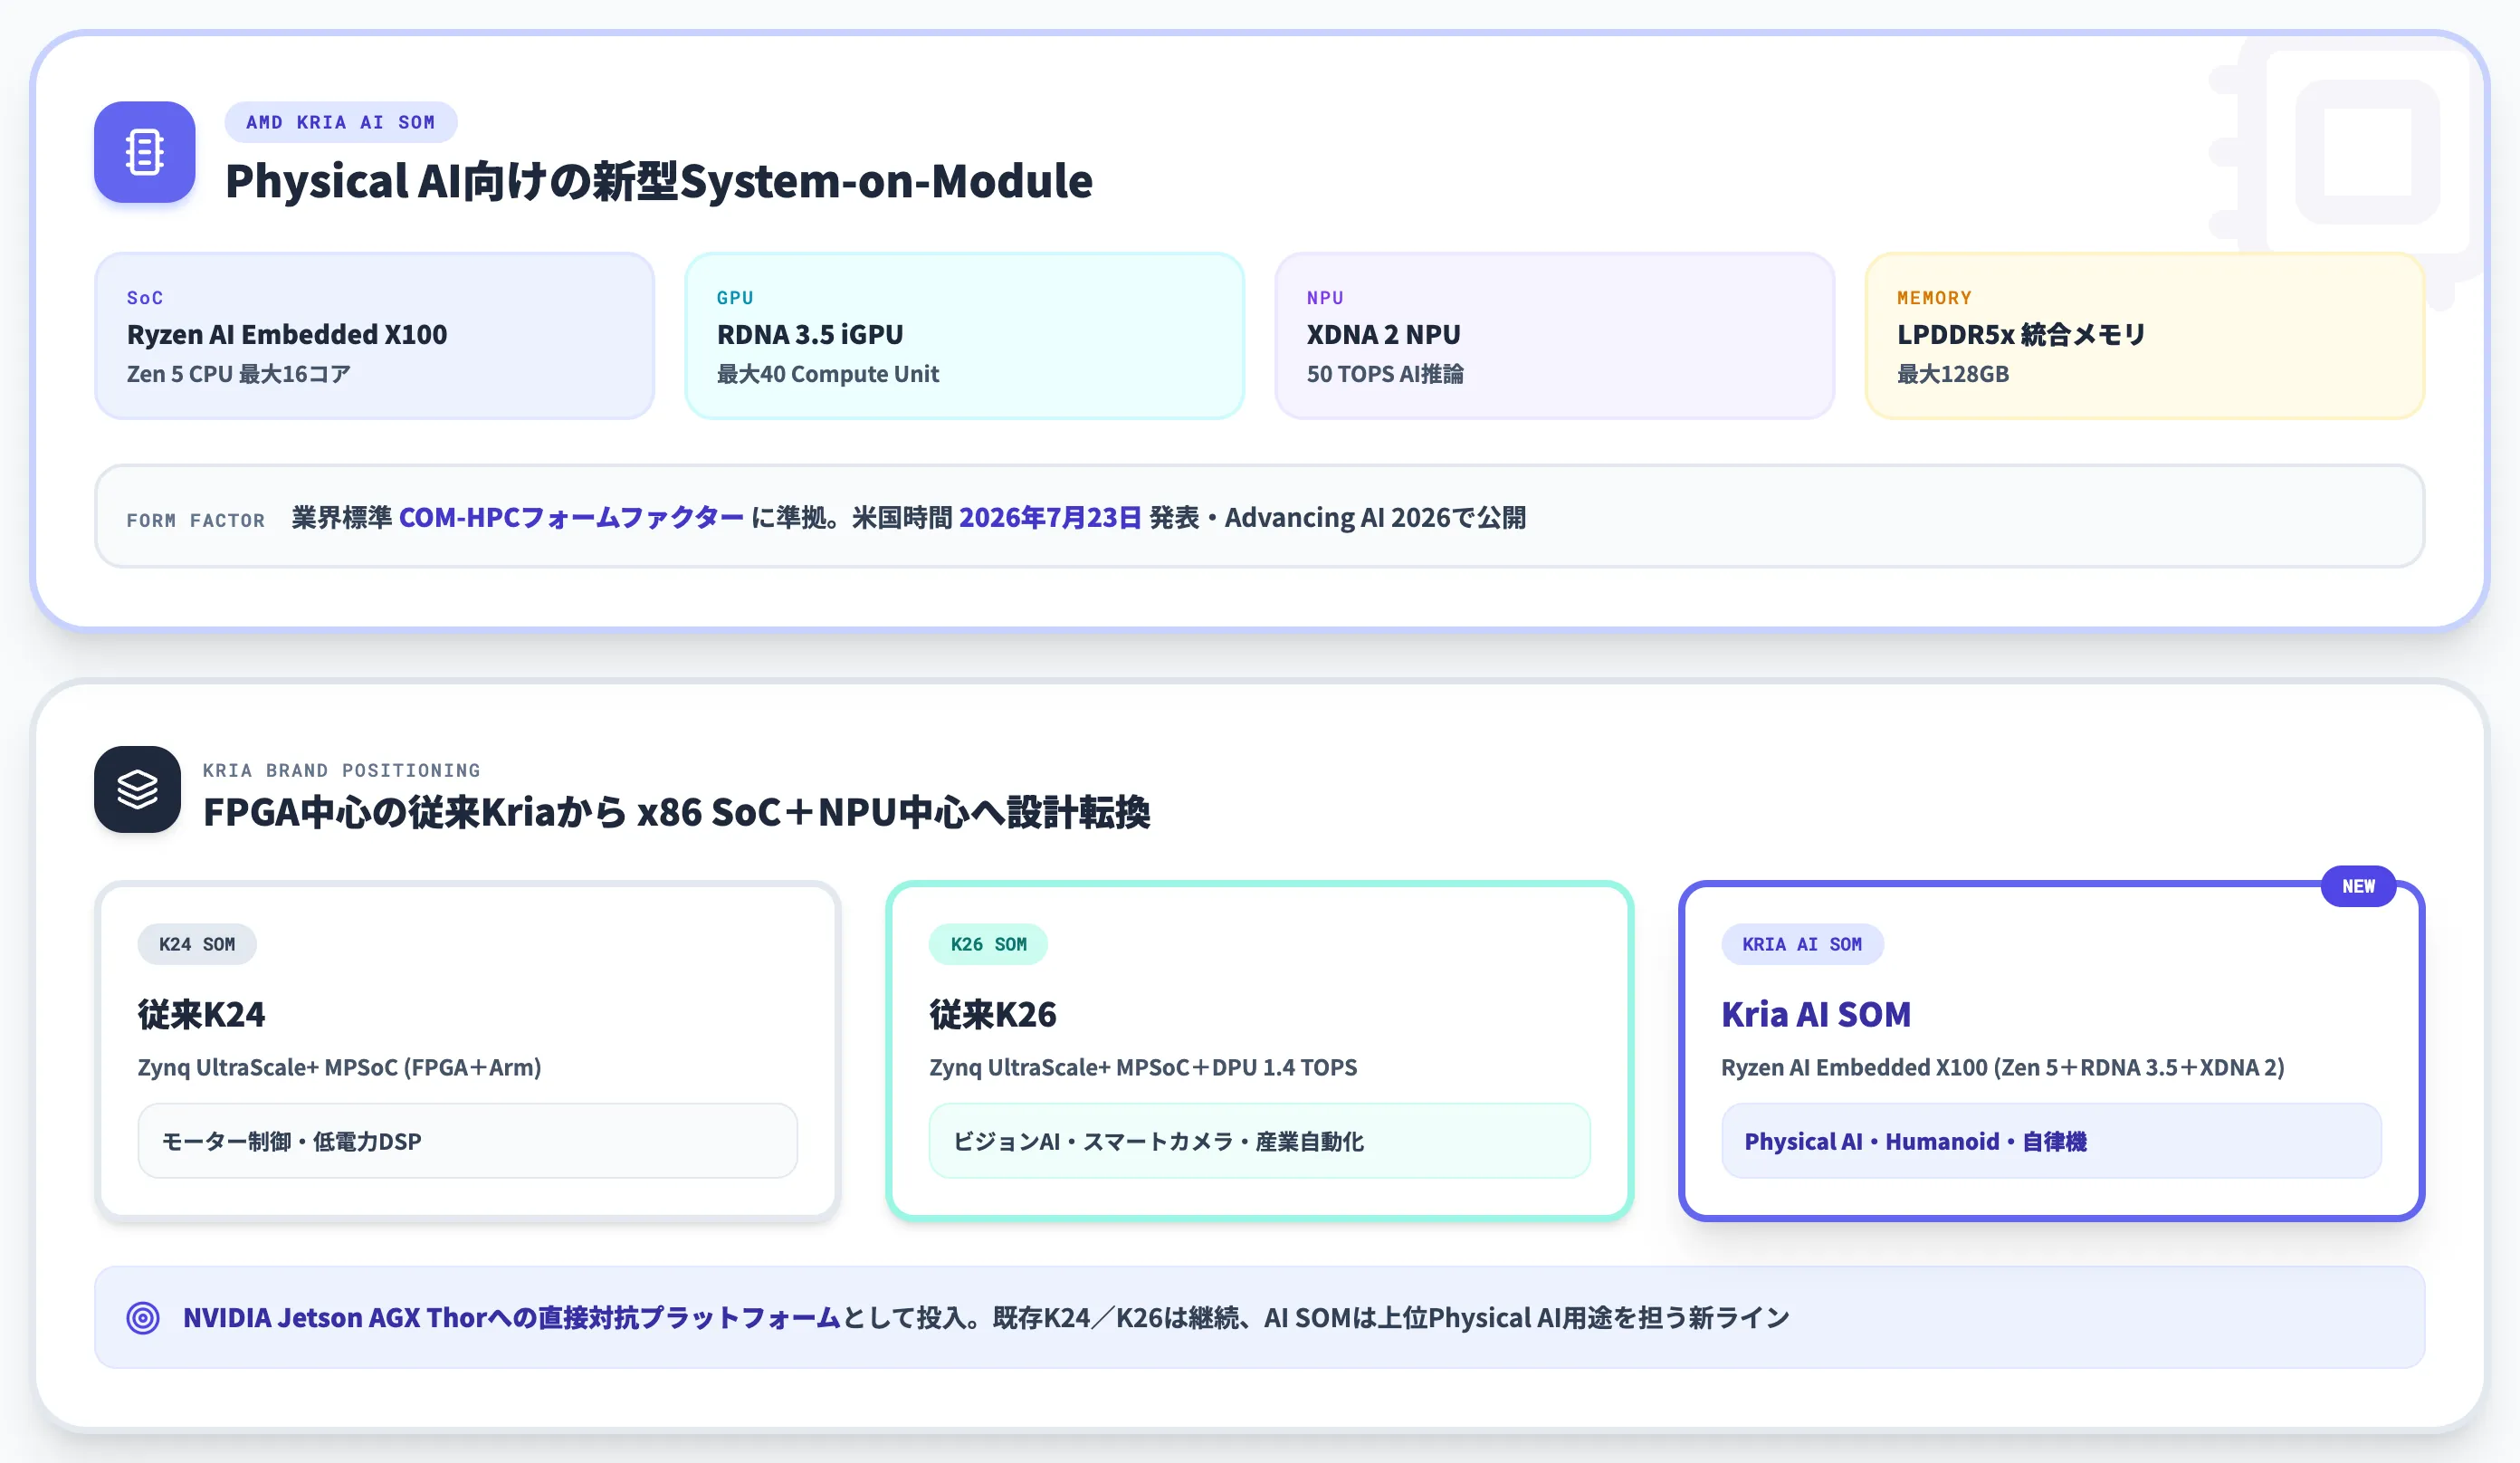
Kria AI SOMは、AMDがAdvancing AI 2026で発表した、Physical AI向けの新型System-on-Module(SOM)です。
業界標準のCOM-HPCフォームファクターに準拠し、Ryzen AI Embedded X100シリーズを核に、Zen 5 x86 CPU最大16コア・RDNA 3.5 iGPU最大40 Compute Unit・XDNA 2 NPU 50 TOPS・最大128GB LPDDR5x統合メモリを1枚のモジュール基板にまとめています(AMD公式仕様は「COM-HPC form factor」までを一般説明としており、Client Type Size Bという具体サイズはSAPPHIRE製EDGE+ APEX X100など個別ODM製品での仕様)。
従来のKria SOM(K24/K26)はZynq UltraScale+ MPSoC(FPGA+Arm CPU)を核にビジョンAI・モーター制御を担っていました。
対してKria AI SOMは、x86 SoC+NPUを核に据え、SOMからFPGAを外してキャリアボード側に置くという設計転換をしています。同じ「Kria」ブランドでも、狙う用途と技術スタックが根本から変わった別ラインです。
「Physical AI」と呼ぶ領域——ロボット・自律機・産業自動化・医療機器などリアルタイム性が求められる自律システム——を単一SoCで担う狙いで設計されており、NVIDIA Jetson AGX Thorへの直接対抗プラットフォームとして投入されました。
Kriaシリーズの中での位置づけ
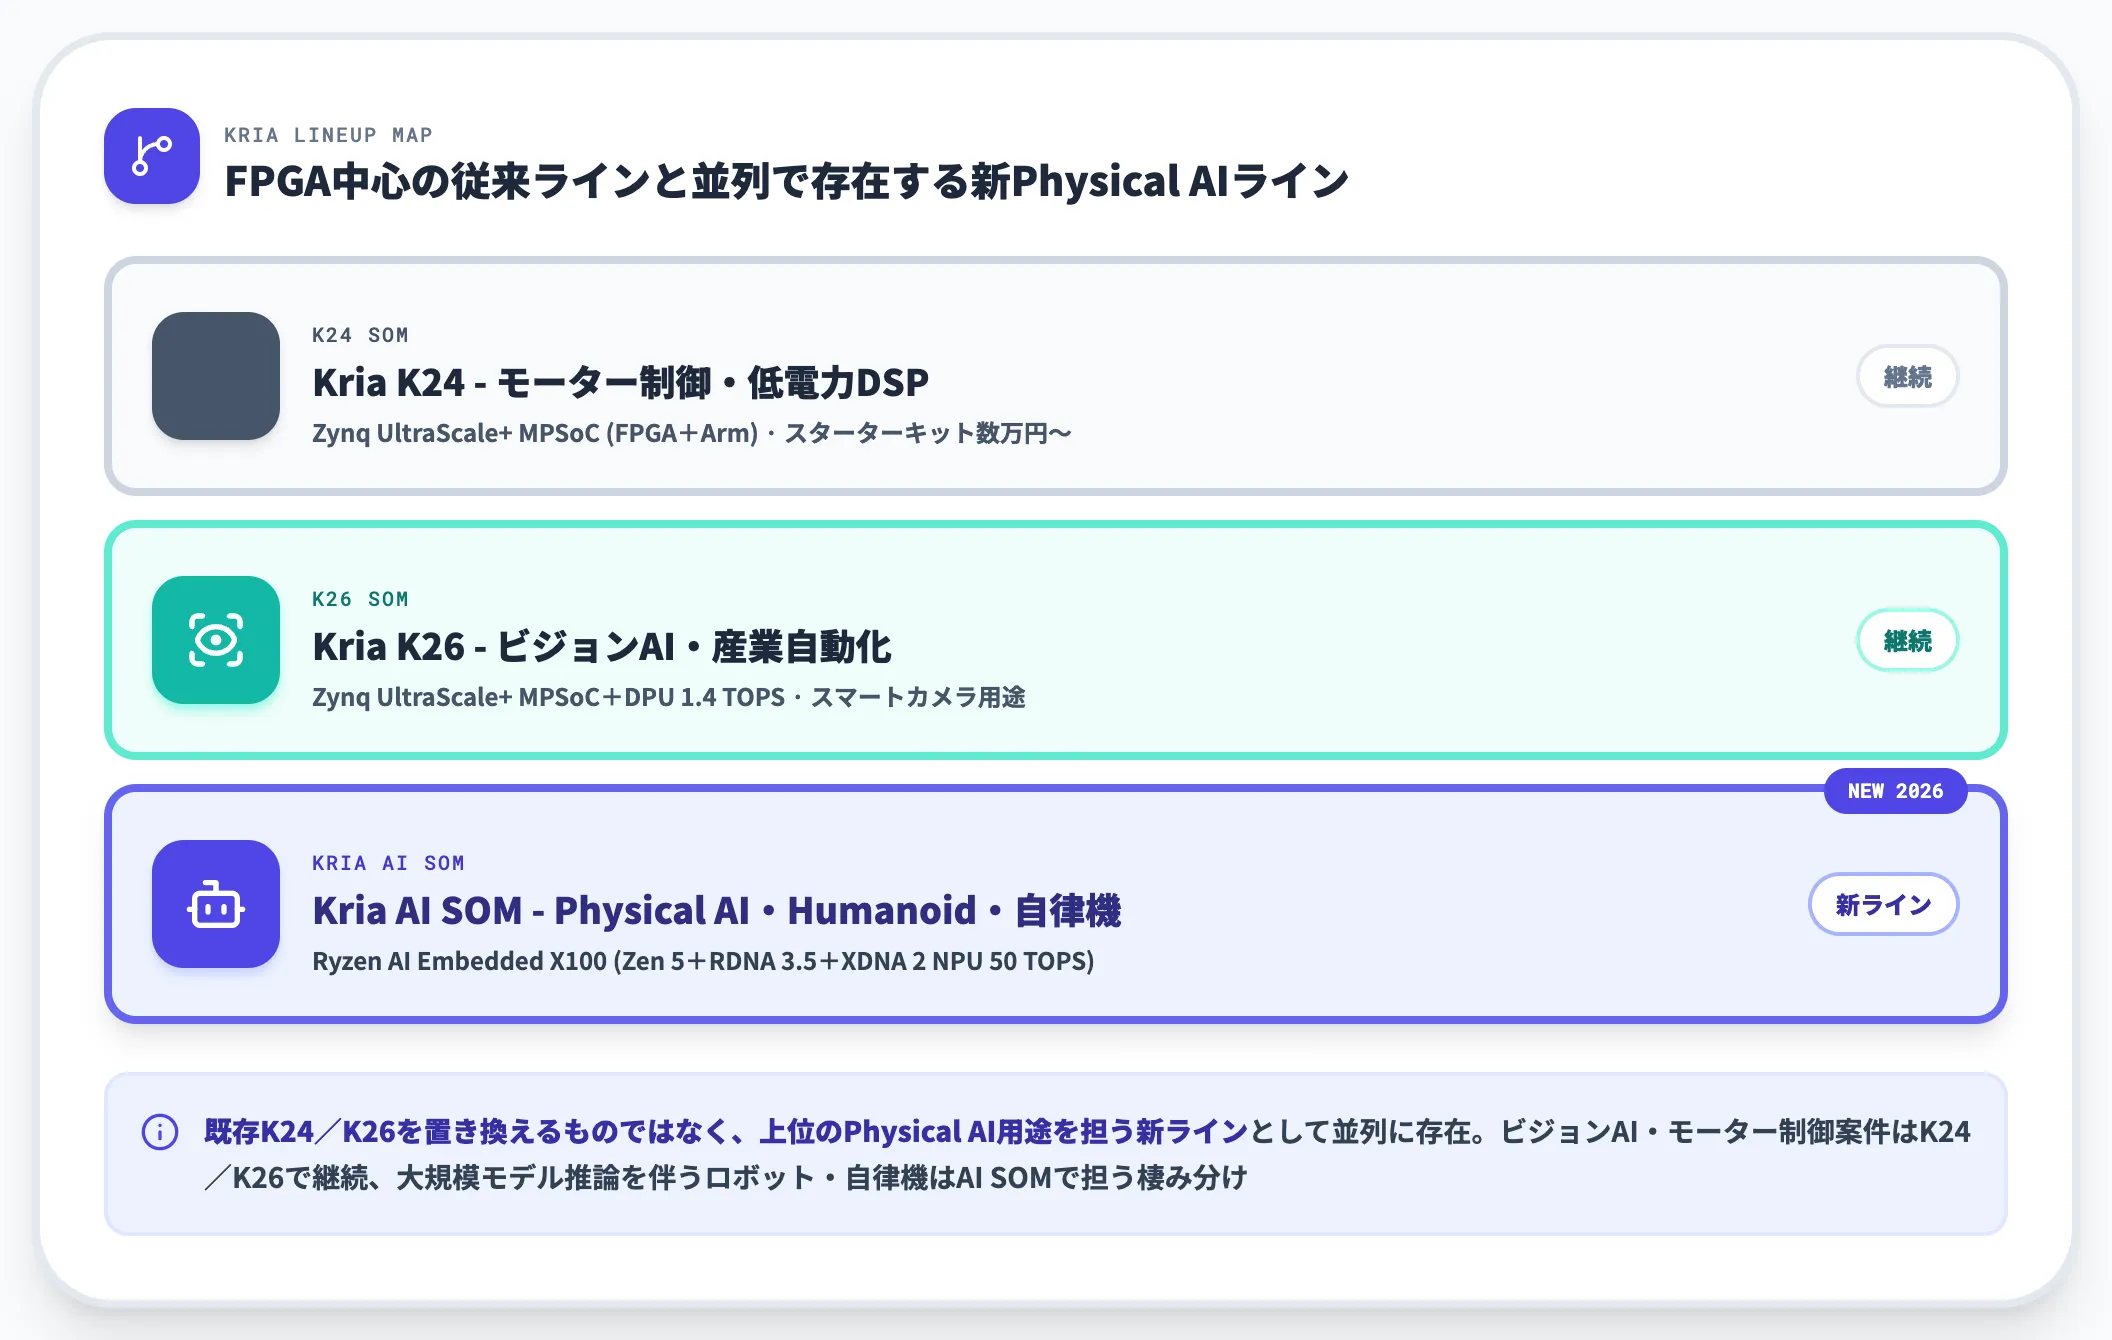
Kriaブランドは、これまで「Zynq UltraScale+ MPSoCを載せた小型FPGA SOM」というアイデンティティで統一されていました。Kria AI SOMの登場で、このブランドはFPGA専用から組み込みプロセッサ全般へ拡張されています。
以下の表で、Kriaシリーズの3ラインナップを整理しました。同じKriaブランドでも、搭載SoC・想定用途・価格帯が明確に分かれます。
| ライン | 搭載SoC | 主な用途 | 想定価格帯 |
|---|---|---|---|
| Kria K24 SOM | Zynq UltraScale+ MPSoC(FPGA+Arm) | モーター制御・低電力DSP | スターターキット数万円〜 |
| Kria K26 SOM | Zynq UltraScale+ MPSoC(FPGA+Arm・DPU 1.4 TOPS) | ビジョンAI・スマートカメラ・産業自動化 | スターターキット数万円〜 |
| Kria AI SOM | Ryzen AI Embedded X100(Zen 5+RDNA 3.5+XDNA 2 NPU 50 TOPS) | Physical AI・Humanoid・自律機 | 開発PF公式価格未発表 |
Kria AI SOMは既存のK24/K26を置き換えるものではなく、より上位のPhysical AI用途を担う新ラインとして並列に存在します。
既存のビジョンAI・モーター制御案件はK24/K26で継続、Humanoid Robotや自律走行のようなリアルタイム性と大規模モデル推論を同時に求める案件はKria AI SOMで担う、という棲み分けです。
Kria AI SOMに搭載されたRyzen AI Embedded X100の中身
AMD Ryzen AI Embedded X100シリーズプロセッサの実物ショット(出典:AMD Ryzen AI Embedded X100 Series)
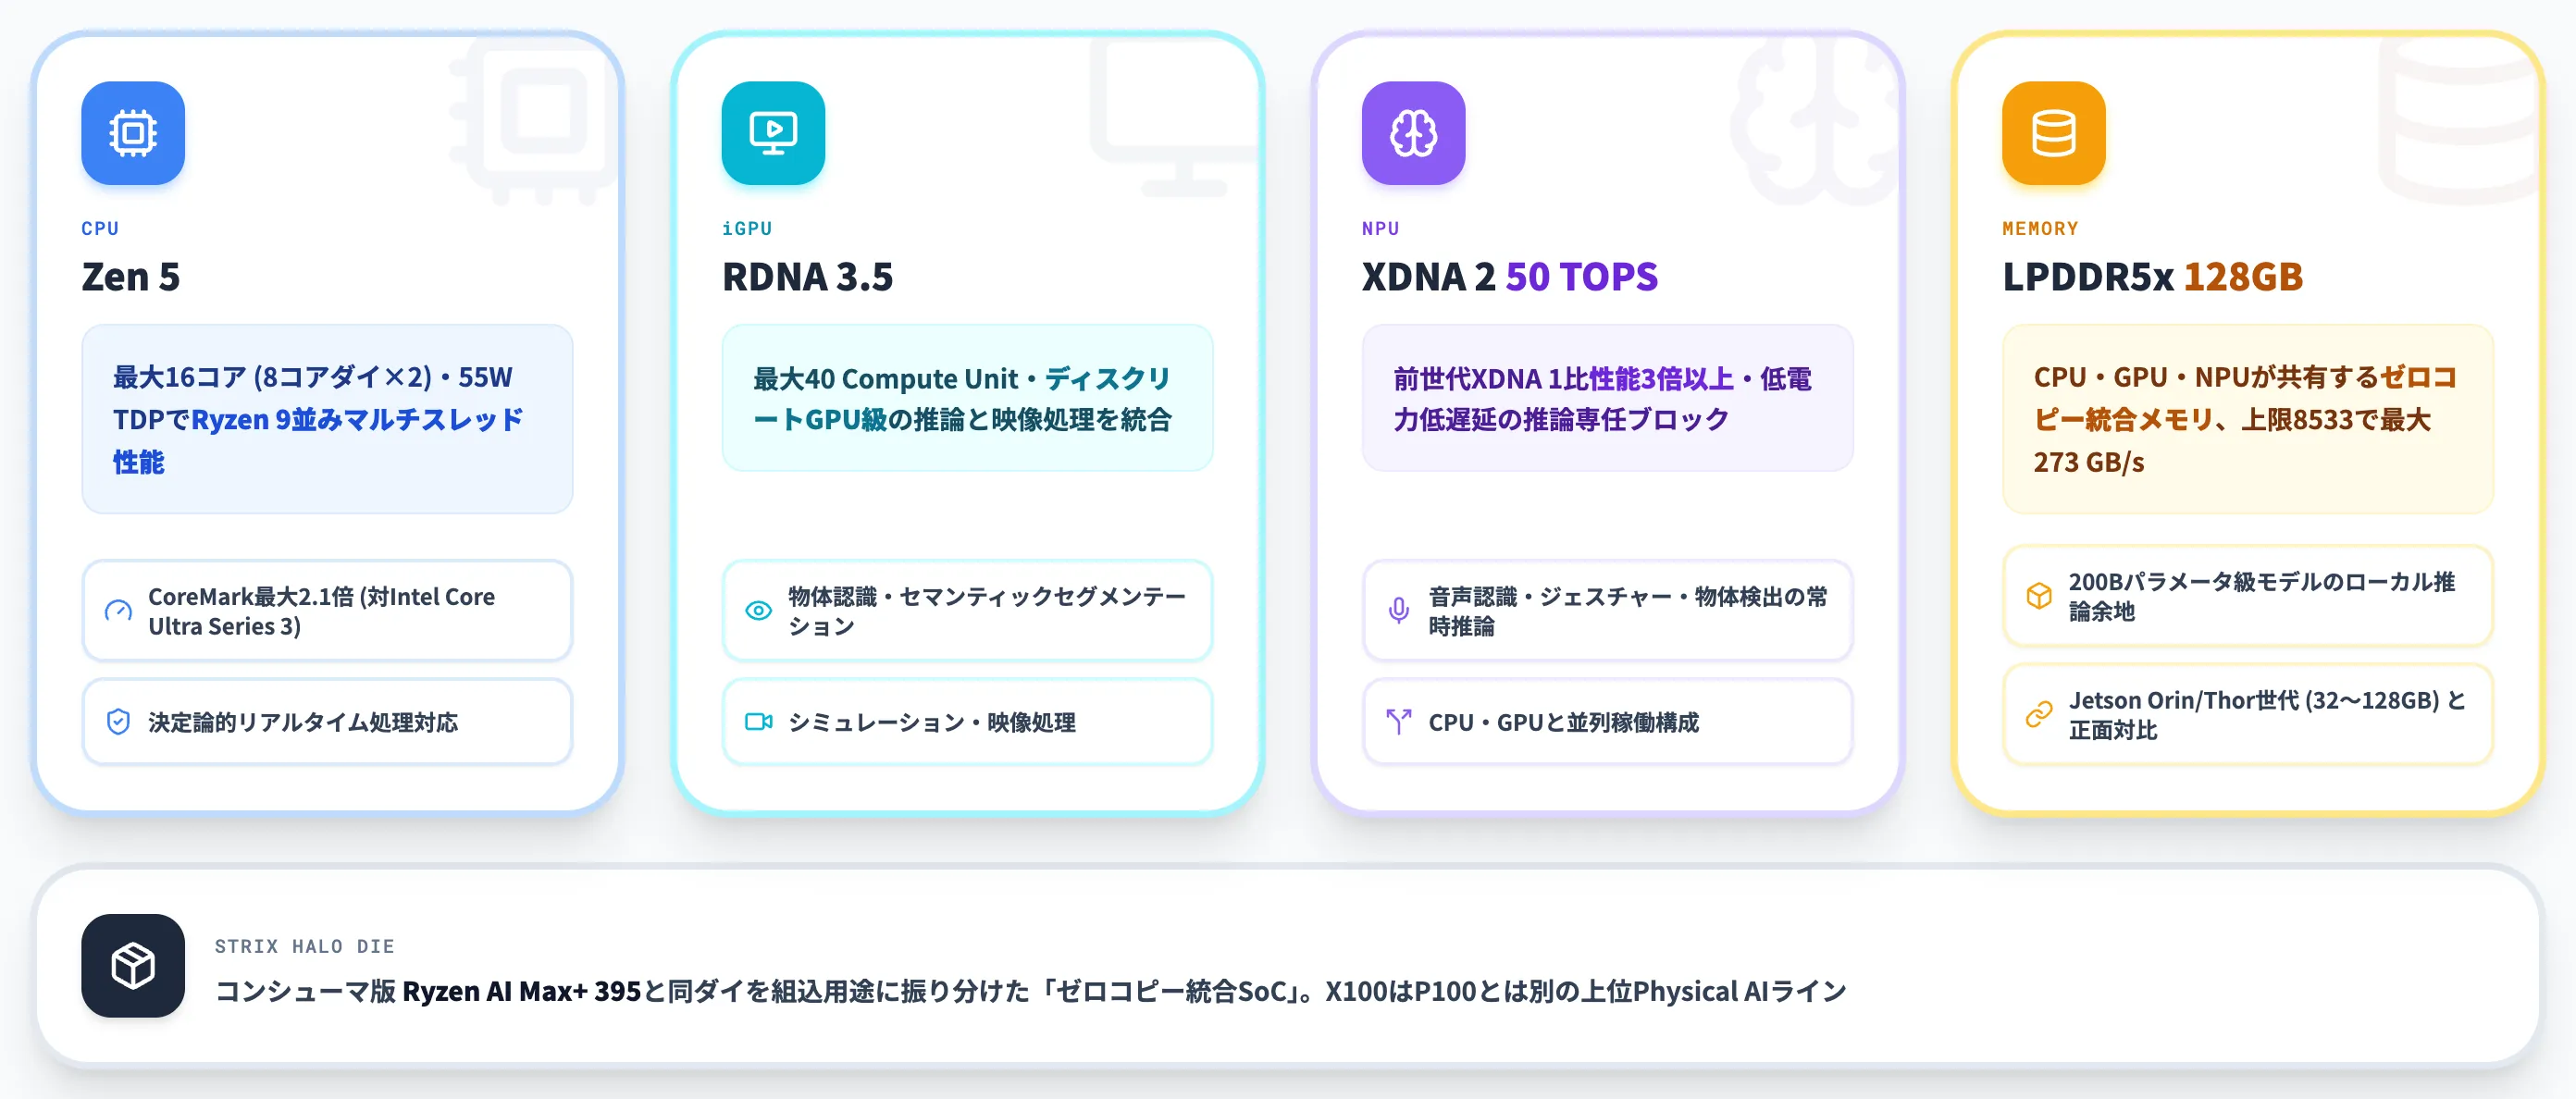
Kria AI SOMの性能を理解するうえで最初に押さえるべきは、モジュール上に載っているのが「Ryzen AI Embedded X100」というx86 SoCシリーズであるという点です。
コンシューマ向けのRyzen AI Max+ 395(コードネーム「Strix Halo」)と同じダイを組み込み用途に振り分けた製品で、CPU・GPU・NPUを1チップに束ねた「ゼロコピー統合SoC」として設計されています。
本セクションでは、Kria AI SOMの心臓部にあたるX100の主要スペックを、Kria AI SOMを検討する視点で整理します。プロセッサ単体の詳細な深掘り(全6モデルの型番差・CUDA→HIP移行・ベンチマーク条件の読み解き)は、Ryzen AI Embedded X100とは?で扱っています。
Zen 5 CPU最大16コア——リアルタイム制御と汎用処理を同居
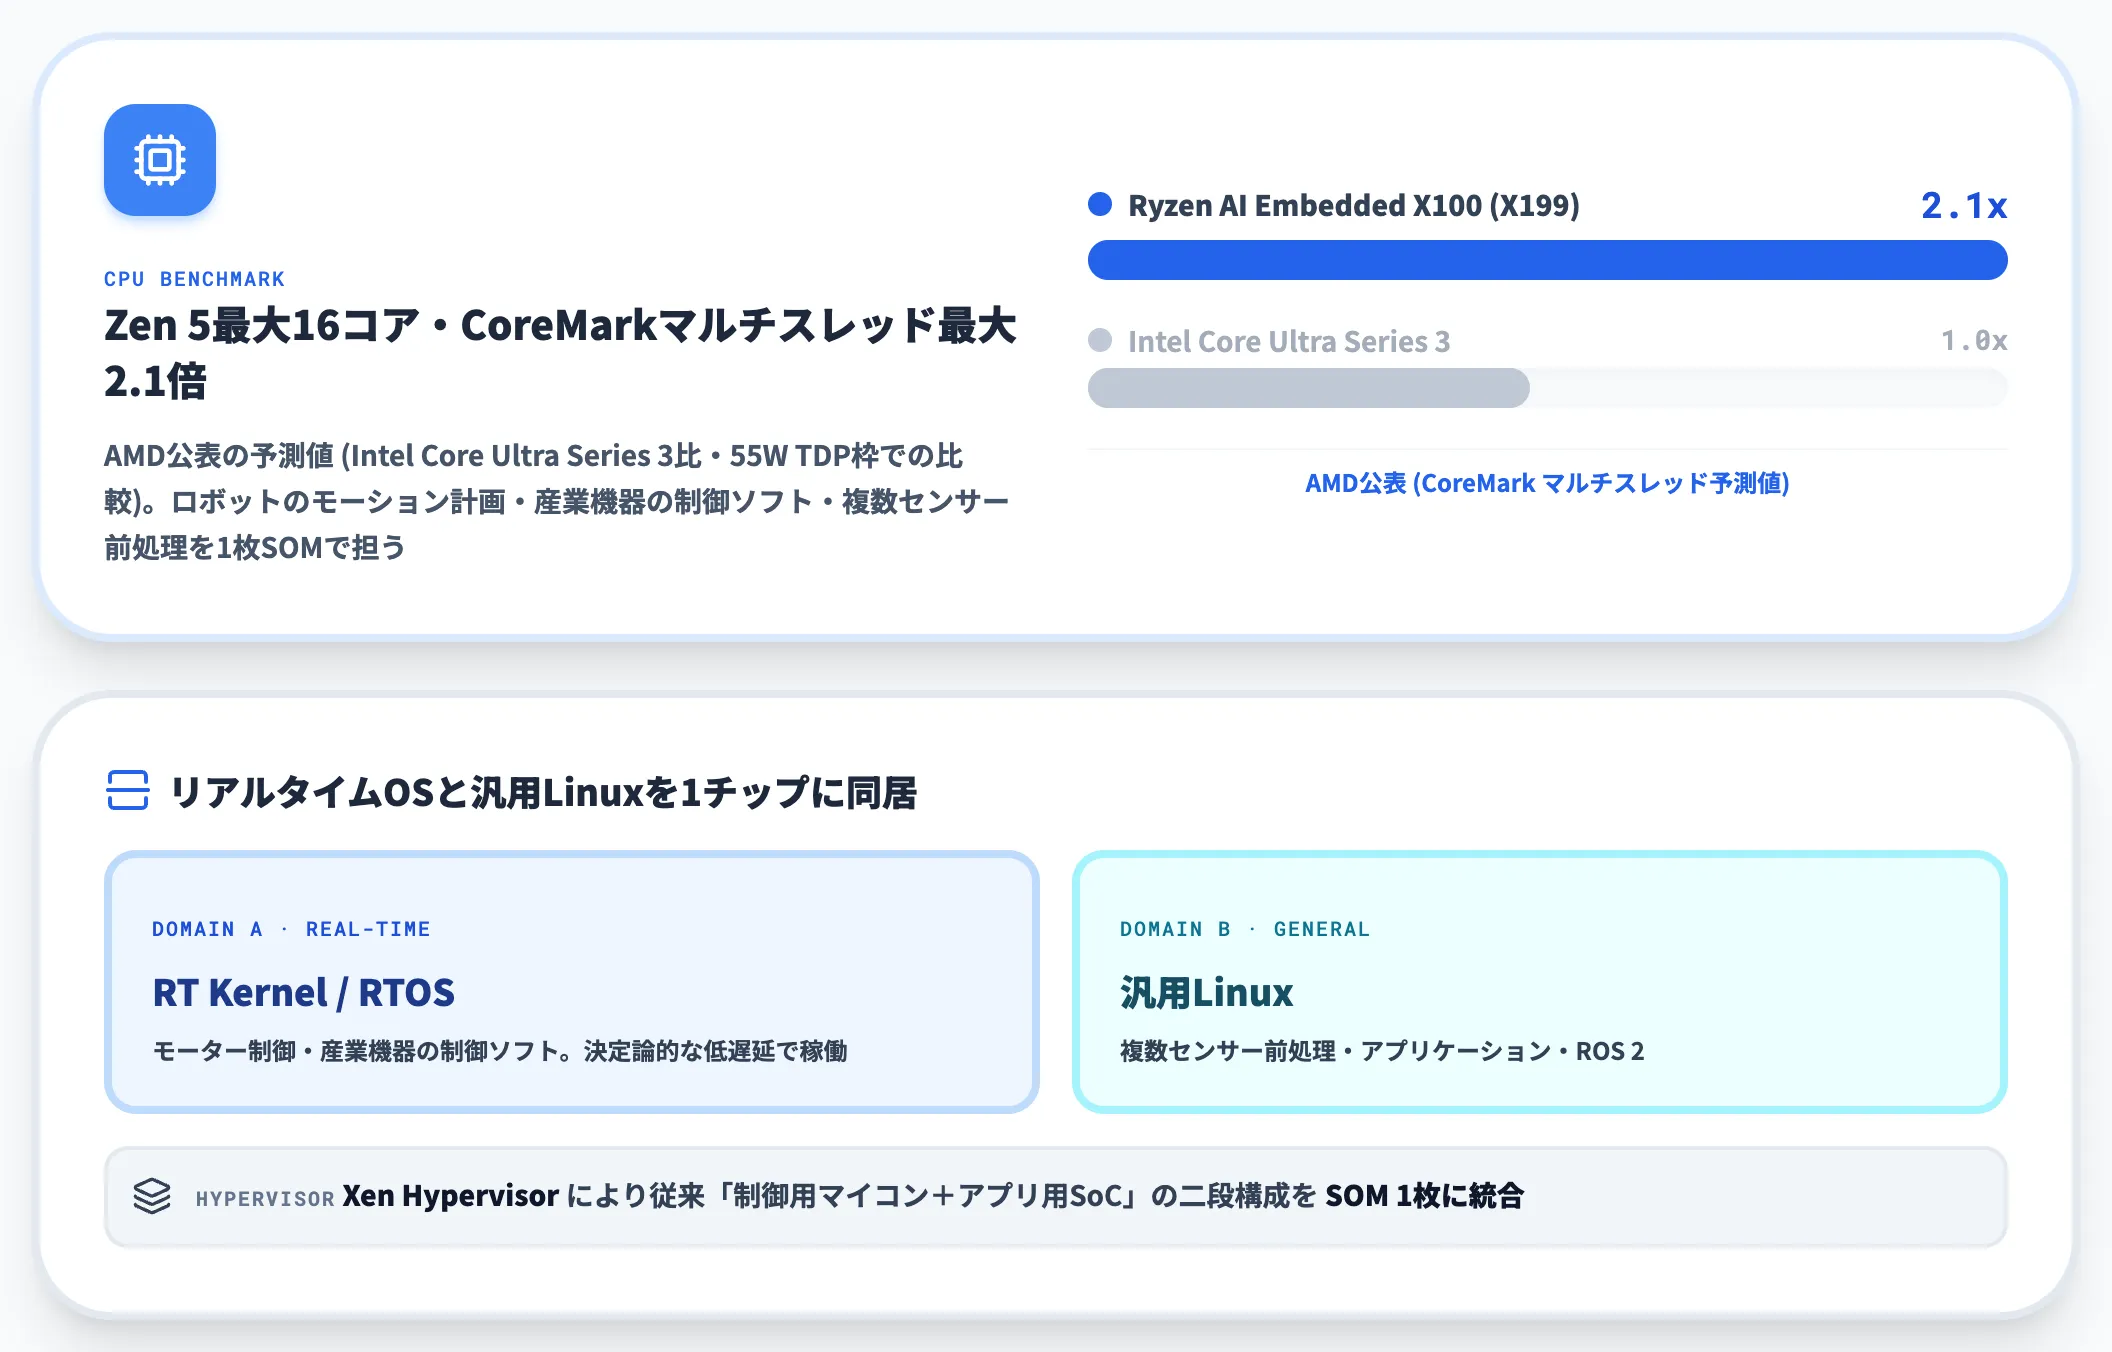
X100シリーズのCPU側は、最大16コアのZen 5(8コアダイ×2)を搭載します。上位モデルのX199では、5.0〜5.1GHz級のクロックが出るデスクトップRyzen 9並みのマルチスレッド性能を、55W TDPの組み込み枠で成立させている点が特徴です。
AMD公式は、Intel Core Ultra Series 3比でCoreMarkによるマルチスレッドCPU整数スループットが最大2.1倍になる見込み(AMD公表の予測値)と公表しています。ロボットのモーション計画、産業機器の制御ソフト、複数センサーの前処理といった「汎用CPUで回したい重い処理」を、SOM 1枚で担いやすいスペックです。
さらに決定論的なリアルタイム処理に対応し、リアルタイムOSと汎用Linuxを1チップ上で同居させるXen Hypervisor+RT Kernel構成にも対応します。
従来「制御用マイコン+アプリ用SoC」の二段構成で組んでいたロボット・産業機器を、Kria AI SOM 1枚に統合できる可能性があります。
RDNA 3.5 iGPU最大40 CU——ディスクリートGPU級のグラフィックスと推論を統合
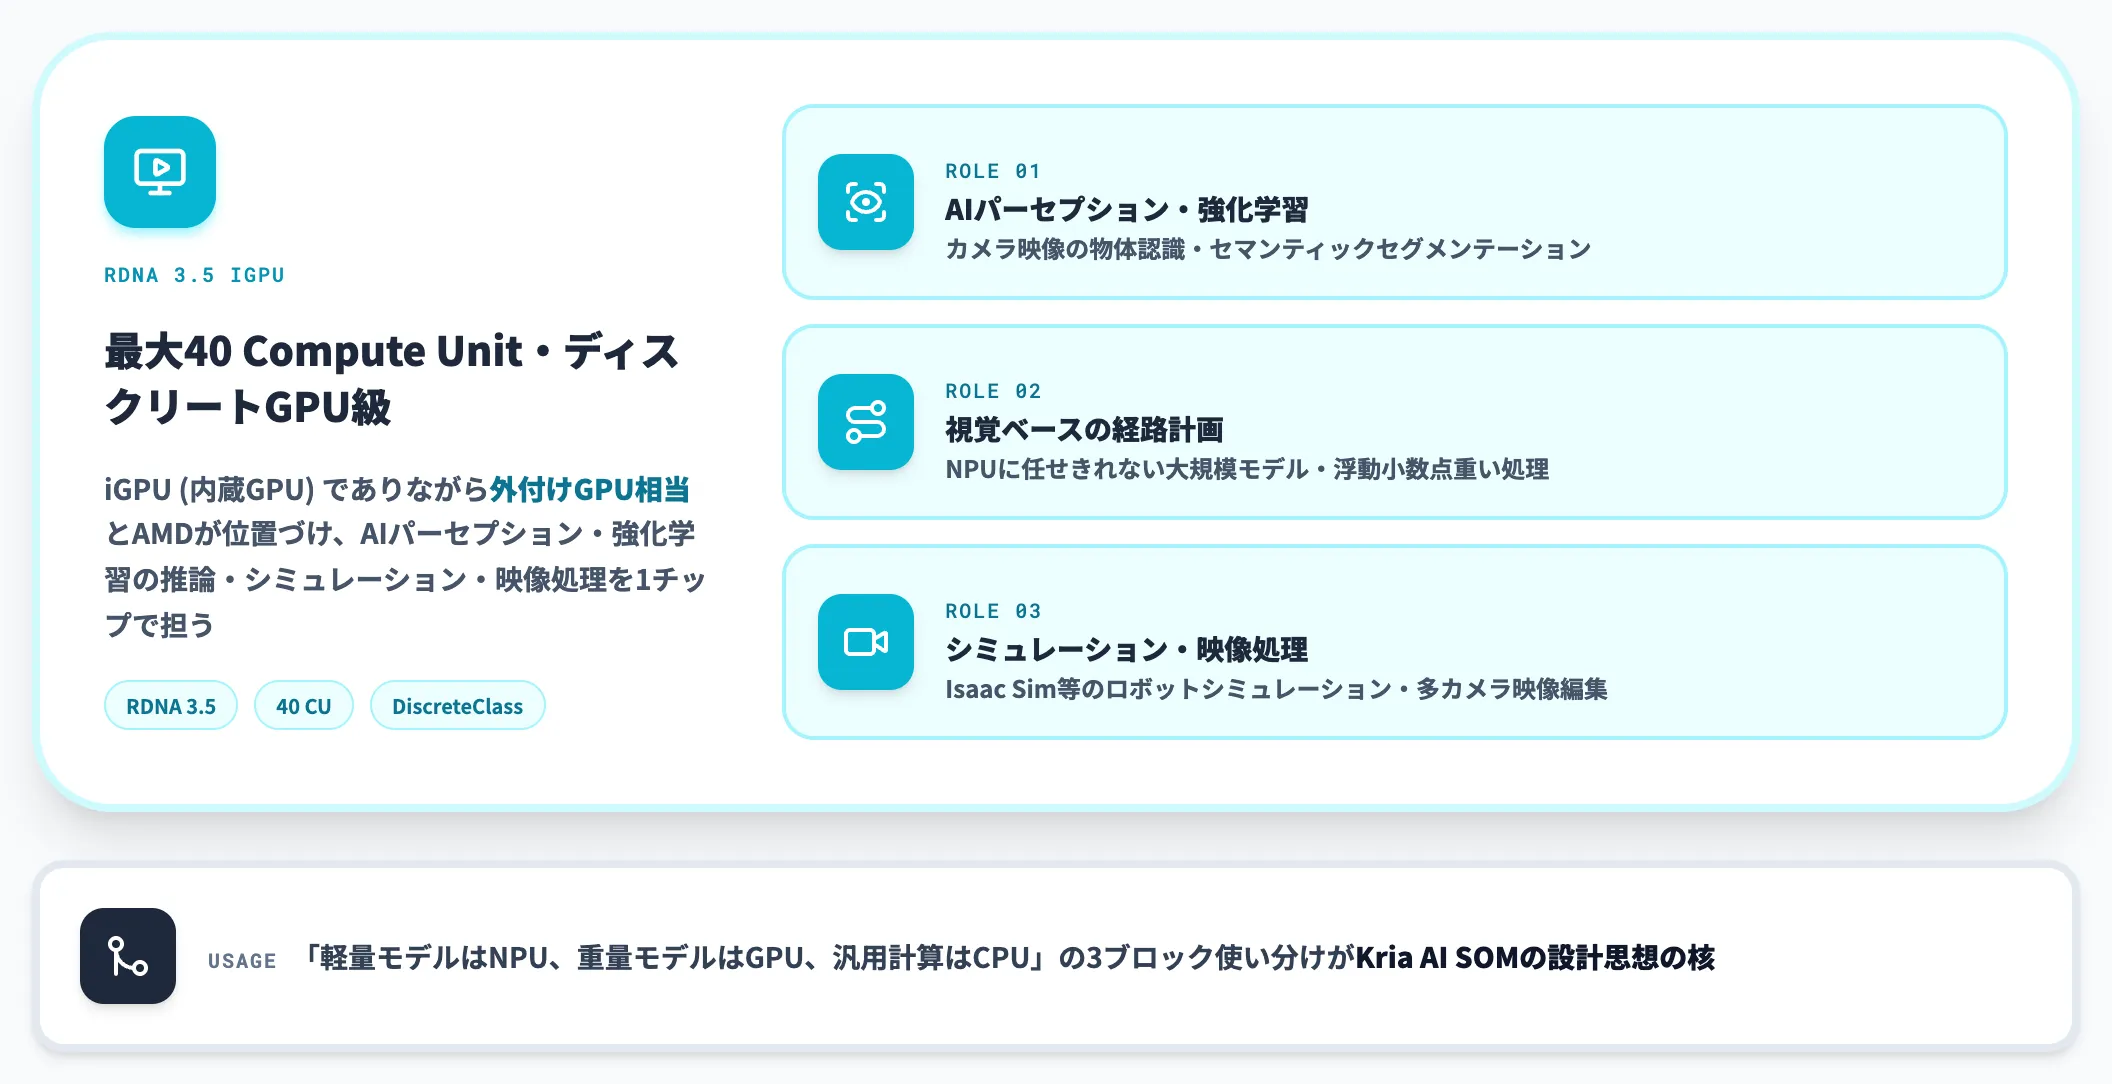
GPU側はRDNA 3.5世代のiGPU、最大40 Compute Unitを統合します。iGPU(内蔵GPU)でありながら「ディスクリートクラス」(外付けGPU相当)とAMDが位置づけるほどのスペックで、AIパーセプションや強化学習の推論、シミュレーション、映像処理を1チップで担います。
ロボティクスや自律機の文脈では、カメラ映像の物体認識・セマンティックセグメンテーション・視覚ベースの経路計画をNPUに任せきれない場面でGPUに寄せる、といった使い分けが可能になります。
XDNA 2 NPU 50 TOPS——低電力・低遅延のAI推論専用ブロック
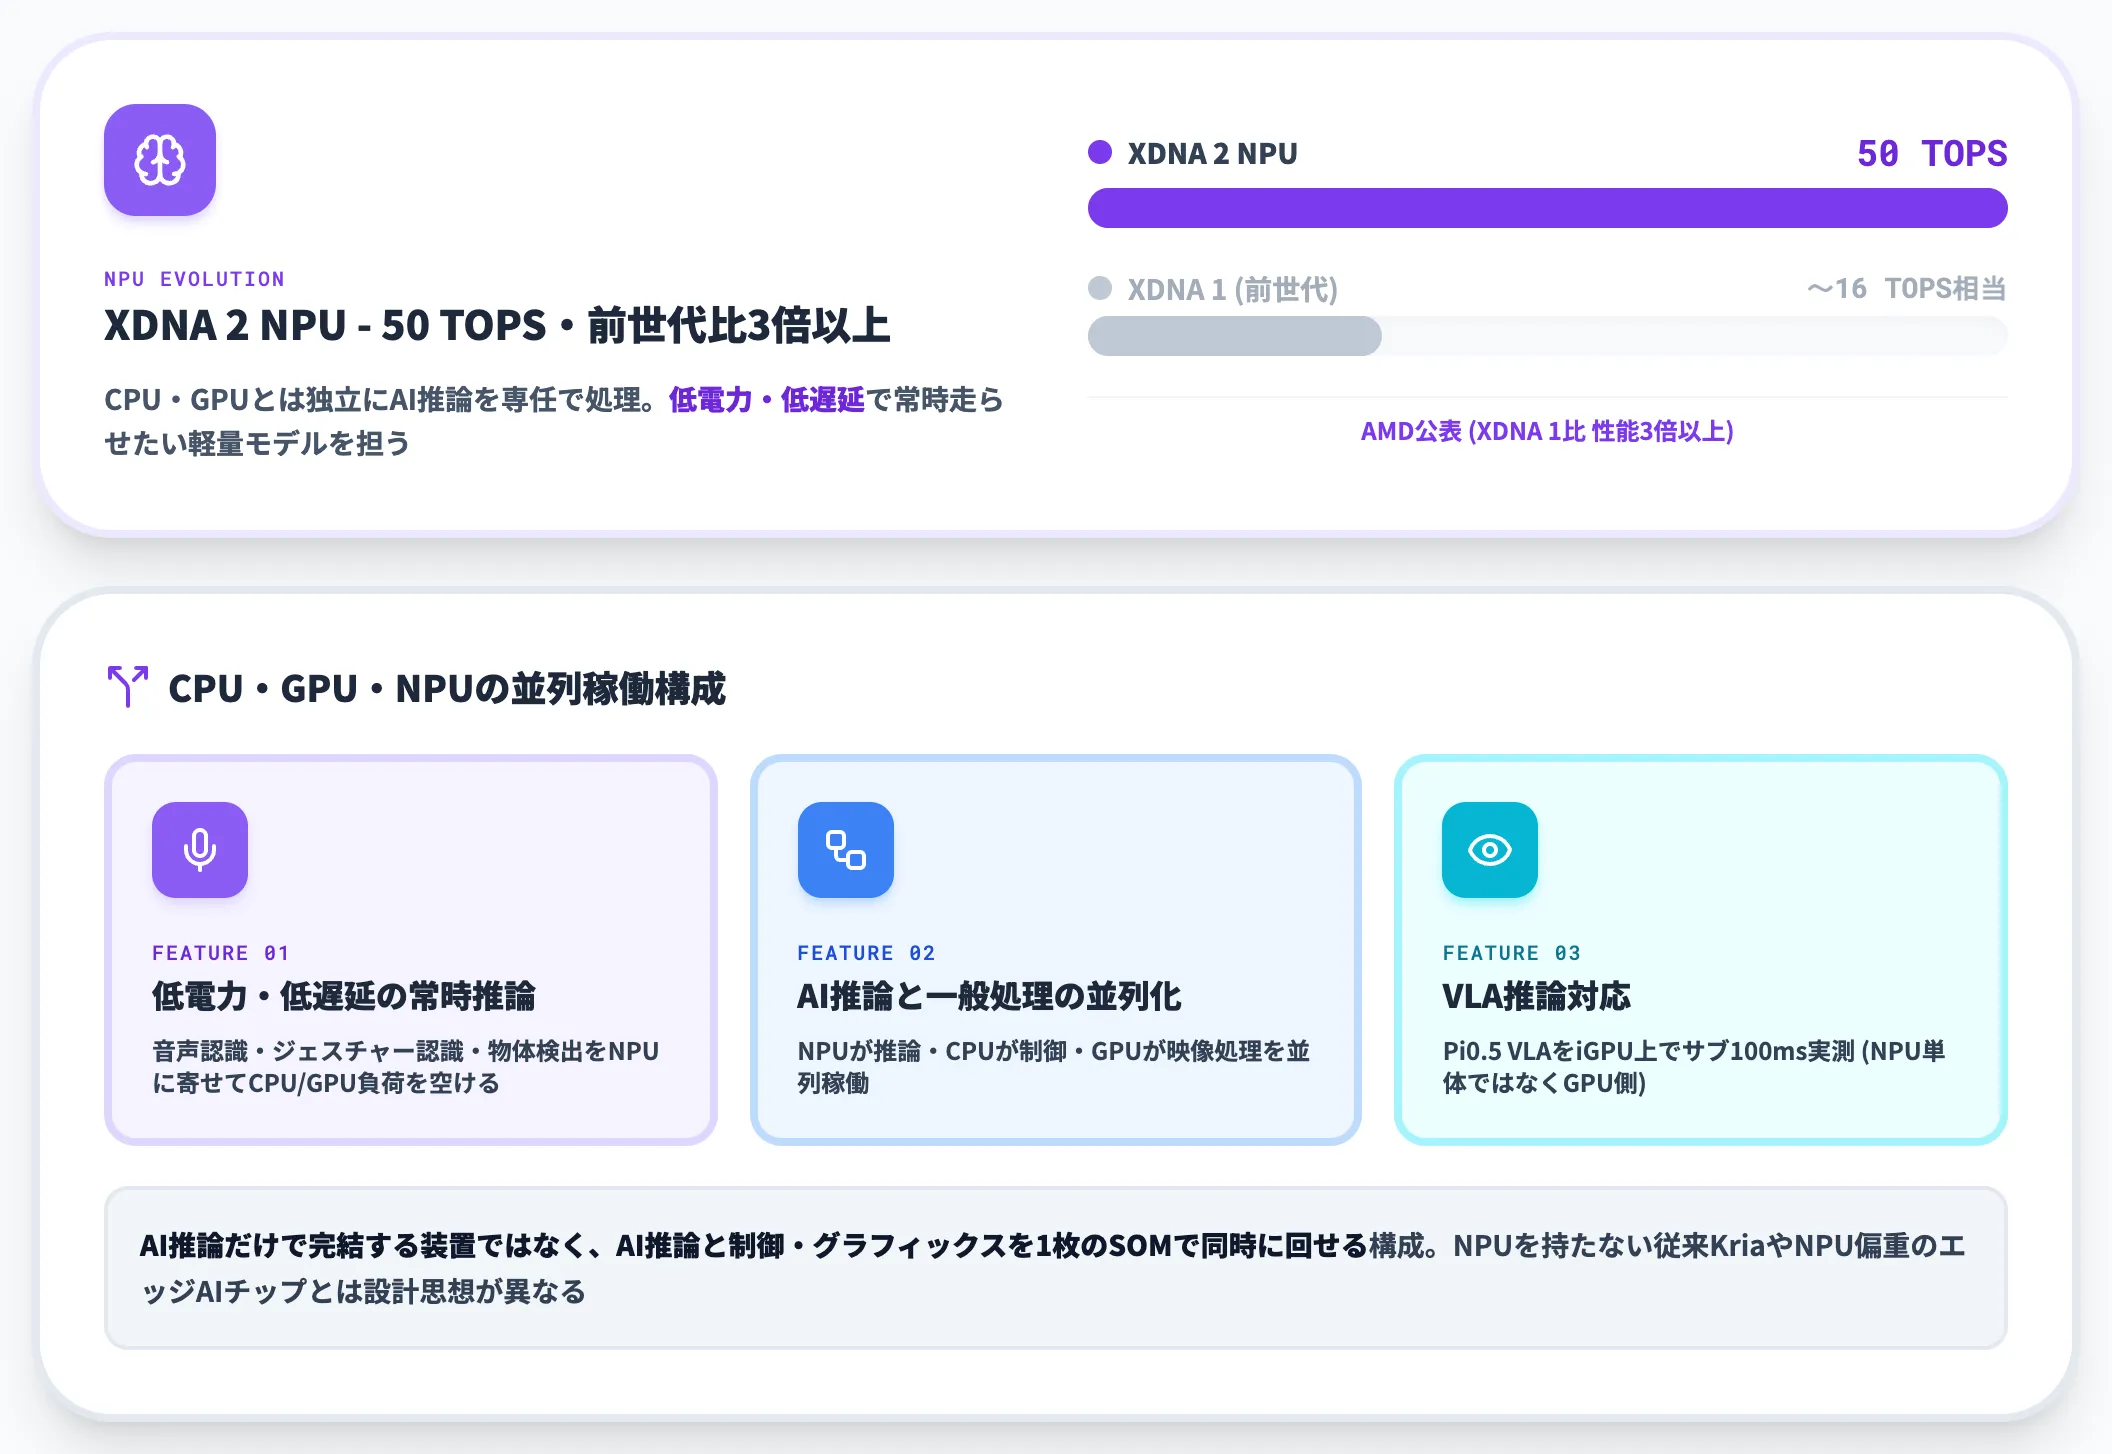
X100の代表的な特徴が、XDNA 2 NPUによる50 TOPSのAI推論性能です。XDNA 2は前世代のXDNA 1比で性能3倍以上とされ、NPUとしてCPU・GPUとは独立にAI推論を専任で処理します。
-
低電力・低遅延の常時推論
音声認識・ジェスチャー認識・物体検出のような「常時走らせたい軽量モデル」をNPUに寄せ、CPU/GPUの負荷を空けたまま実行できる
-
AI推論と一般処理の並列化
NPUが推論を回している間、CPUは制御ループ・GPUは映像処理と、3種のブロックが並列に稼働する構成
-
VLA(Vision-Language-Action)推論への対応
AMDはembedL経由のPi0.5 VLAモデルをRDNA 3.5 iGPU上で走らせたベンチマークで「サブ100ms」の推論時間を公表しており、ロボットが「見る→言語で理解する→動く」をエッジ側で完結できる水準(NPU単体ではなくGPU側の実測)
ここでのポイントは、AI推論だけで完結する装置ではなく、AI推論と制御・グラフィックスを1枚のSOMで同時に回せる構成という点です。NPUを持たない従来Kriaや、逆にNPUに寄せすぎたエッジAIチップとは、狙う設計思想が違います。
LPDDR5x 128GB統合メモリ——大規模モデル向けの容量
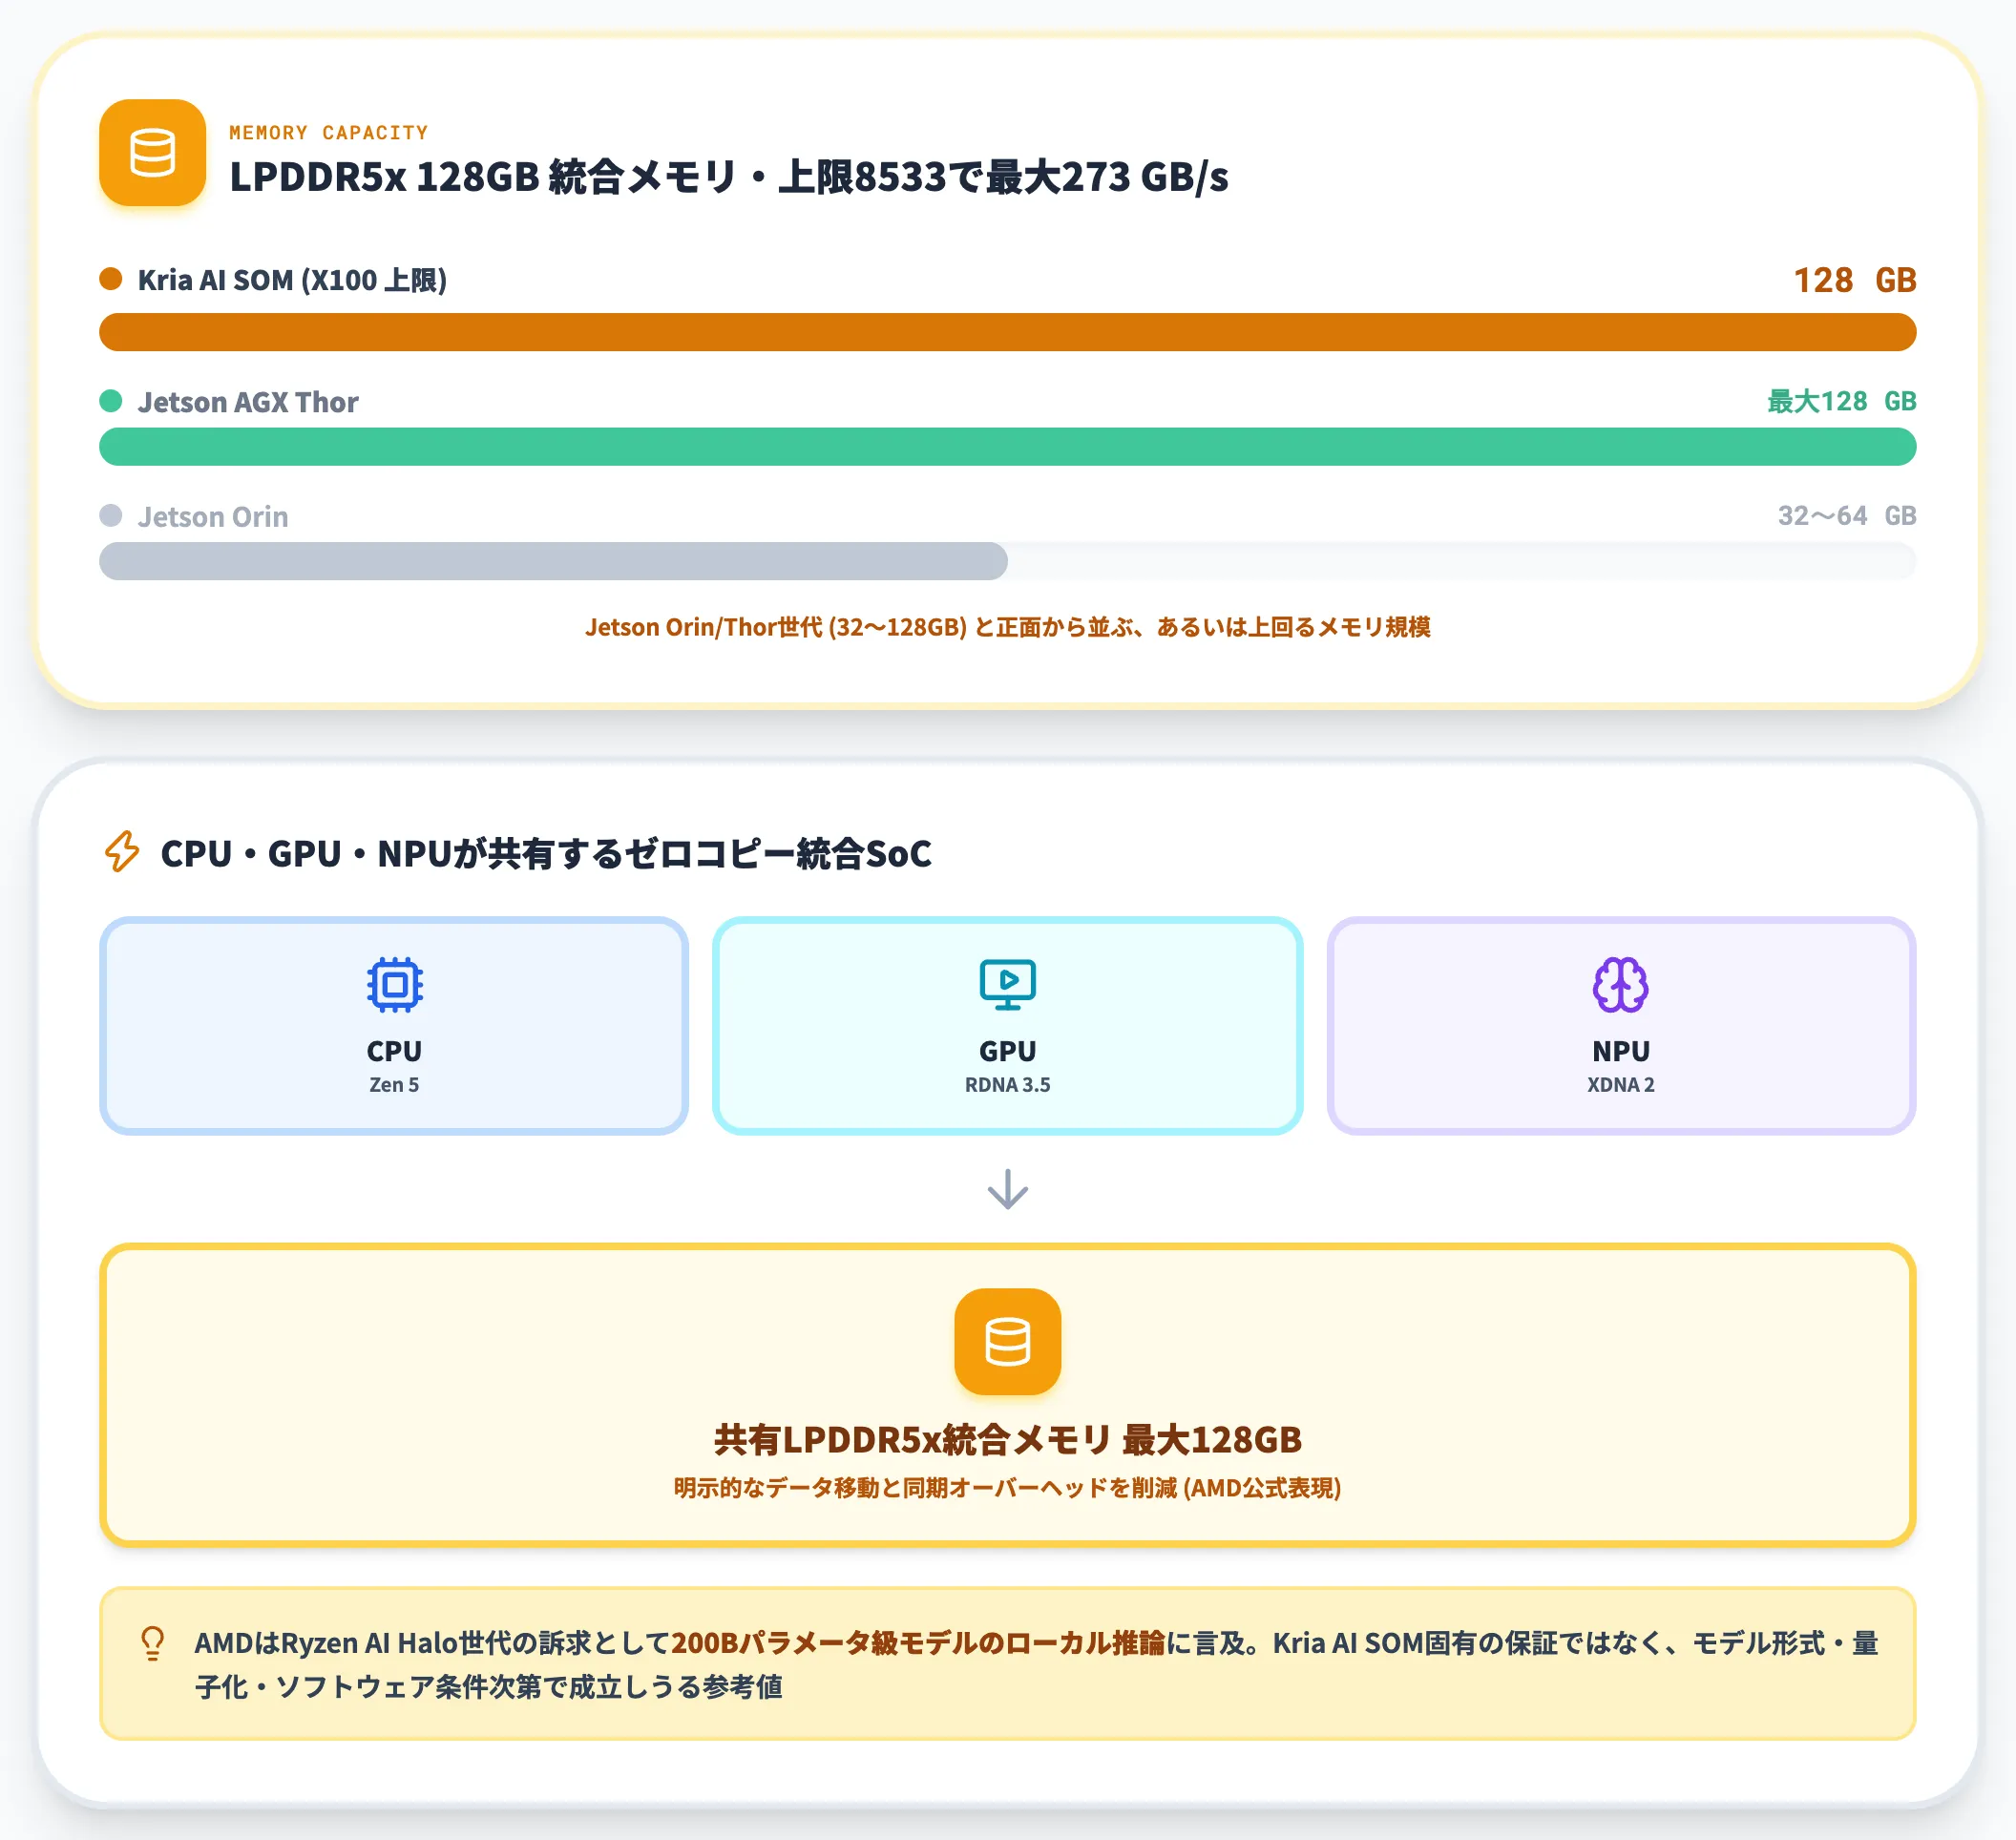
Ryzen AI Embedded X100シリーズの対応上限はLPDDR5x-8533で最大273 GB/sです。ODM各社が実装するKria AI SOM製品のメモリ仕様は個別に異なり、SAPPHIRE製EDGE+ APEX X100(Size B)は最大8000MT/s・240GB/s、congatec製COM-HPC Size C対応SOMはLPDDR5x-8533など、ODMごとに実装値が変わります。
CPU・GPU・NPUが同じメモリを共有する設計により、AMD公式表現では明示的なデータ移動と同期オーバーヘッドを削減できるとされます(すべてのメモリコピー・遅延が消えるわけではありません)。
128GBという容量は、エッジデバイスの水準を大きく超えます。AMDはRyzen AI Halo世代の訴求として200Bパラメータ級モデルのローカル推論に触れており、これはKria AI SOM固有の保証ではなく、モデル形式・量子化・ソフトウェア条件次第で成立しうる参考値です。
NVIDIA Jetson Orin/Thor世代(32〜128GB)と正面から並ぶ、あるいは上回るメモリ規模を持つ点は事実です。
P100シリーズとX100の使い分け
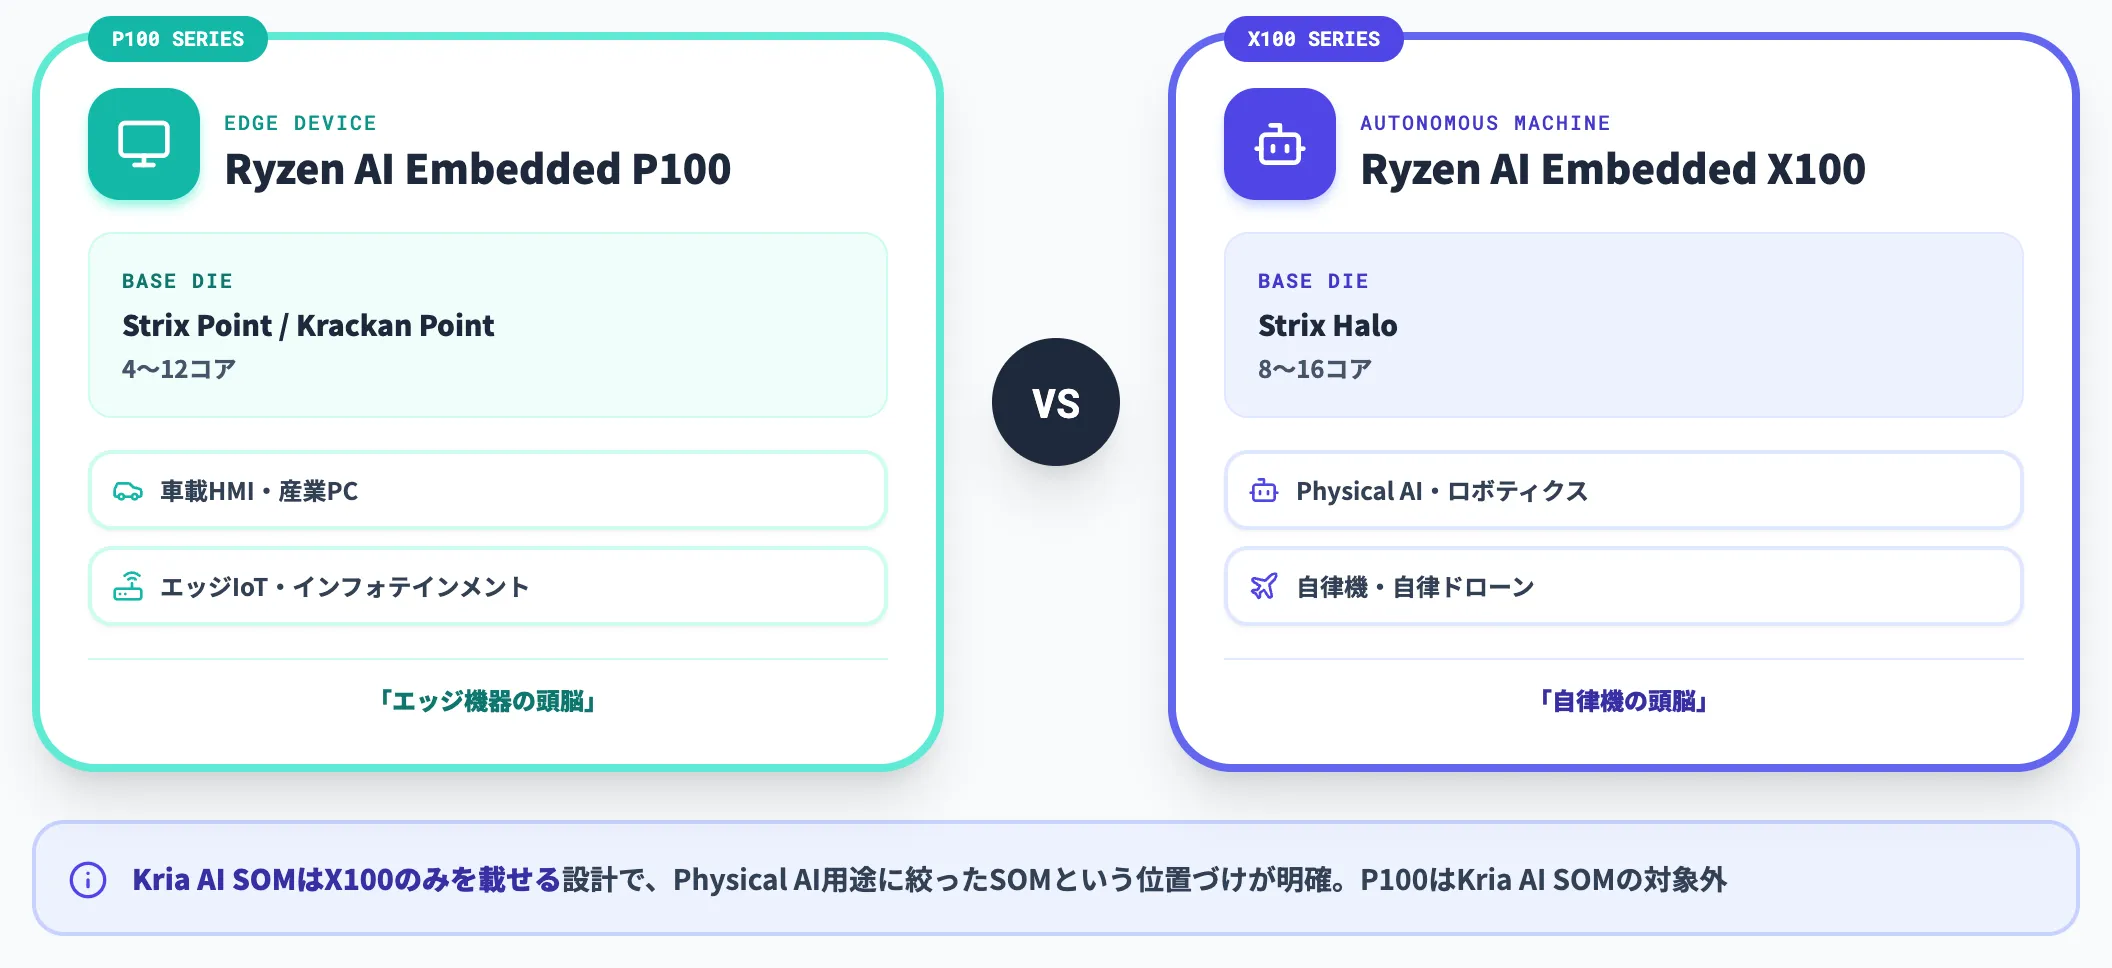
Ryzen AI EmbeddedブランドはP100とX100の2系列で構成されます。Kria AI SOMに載るのはX100ですが、P100シリーズとの使い分けは検討時に混同されやすい論点です。
| シリーズ | ベースSoC | コア数 | 主な用途 |
|---|---|---|---|
| Ryzen AI Embedded P100 | Strix Point/Krackan Point | 4〜12コア | 車載HMI・産業PC・エッジIoT・インフォテインメント |
| Ryzen AI Embedded X100 | Strix Halo | 8〜16コア | Physical AI・ロボティクス・自律機・自律ドローン |
P100は「エッジ機器の頭脳」として広めのユースケースをカバーし、X100は「自律動作するロボット・機械の頭脳」に特化して性能を振ったラインです。
Kria AI SOMはこの上位ラインX100のみを載せており、Physical AIに用途を絞ったSOMという位置づけが明確になっています。
Kria AI SOMのハードウェア構成——COM-HPC規格とFPGA分離設計
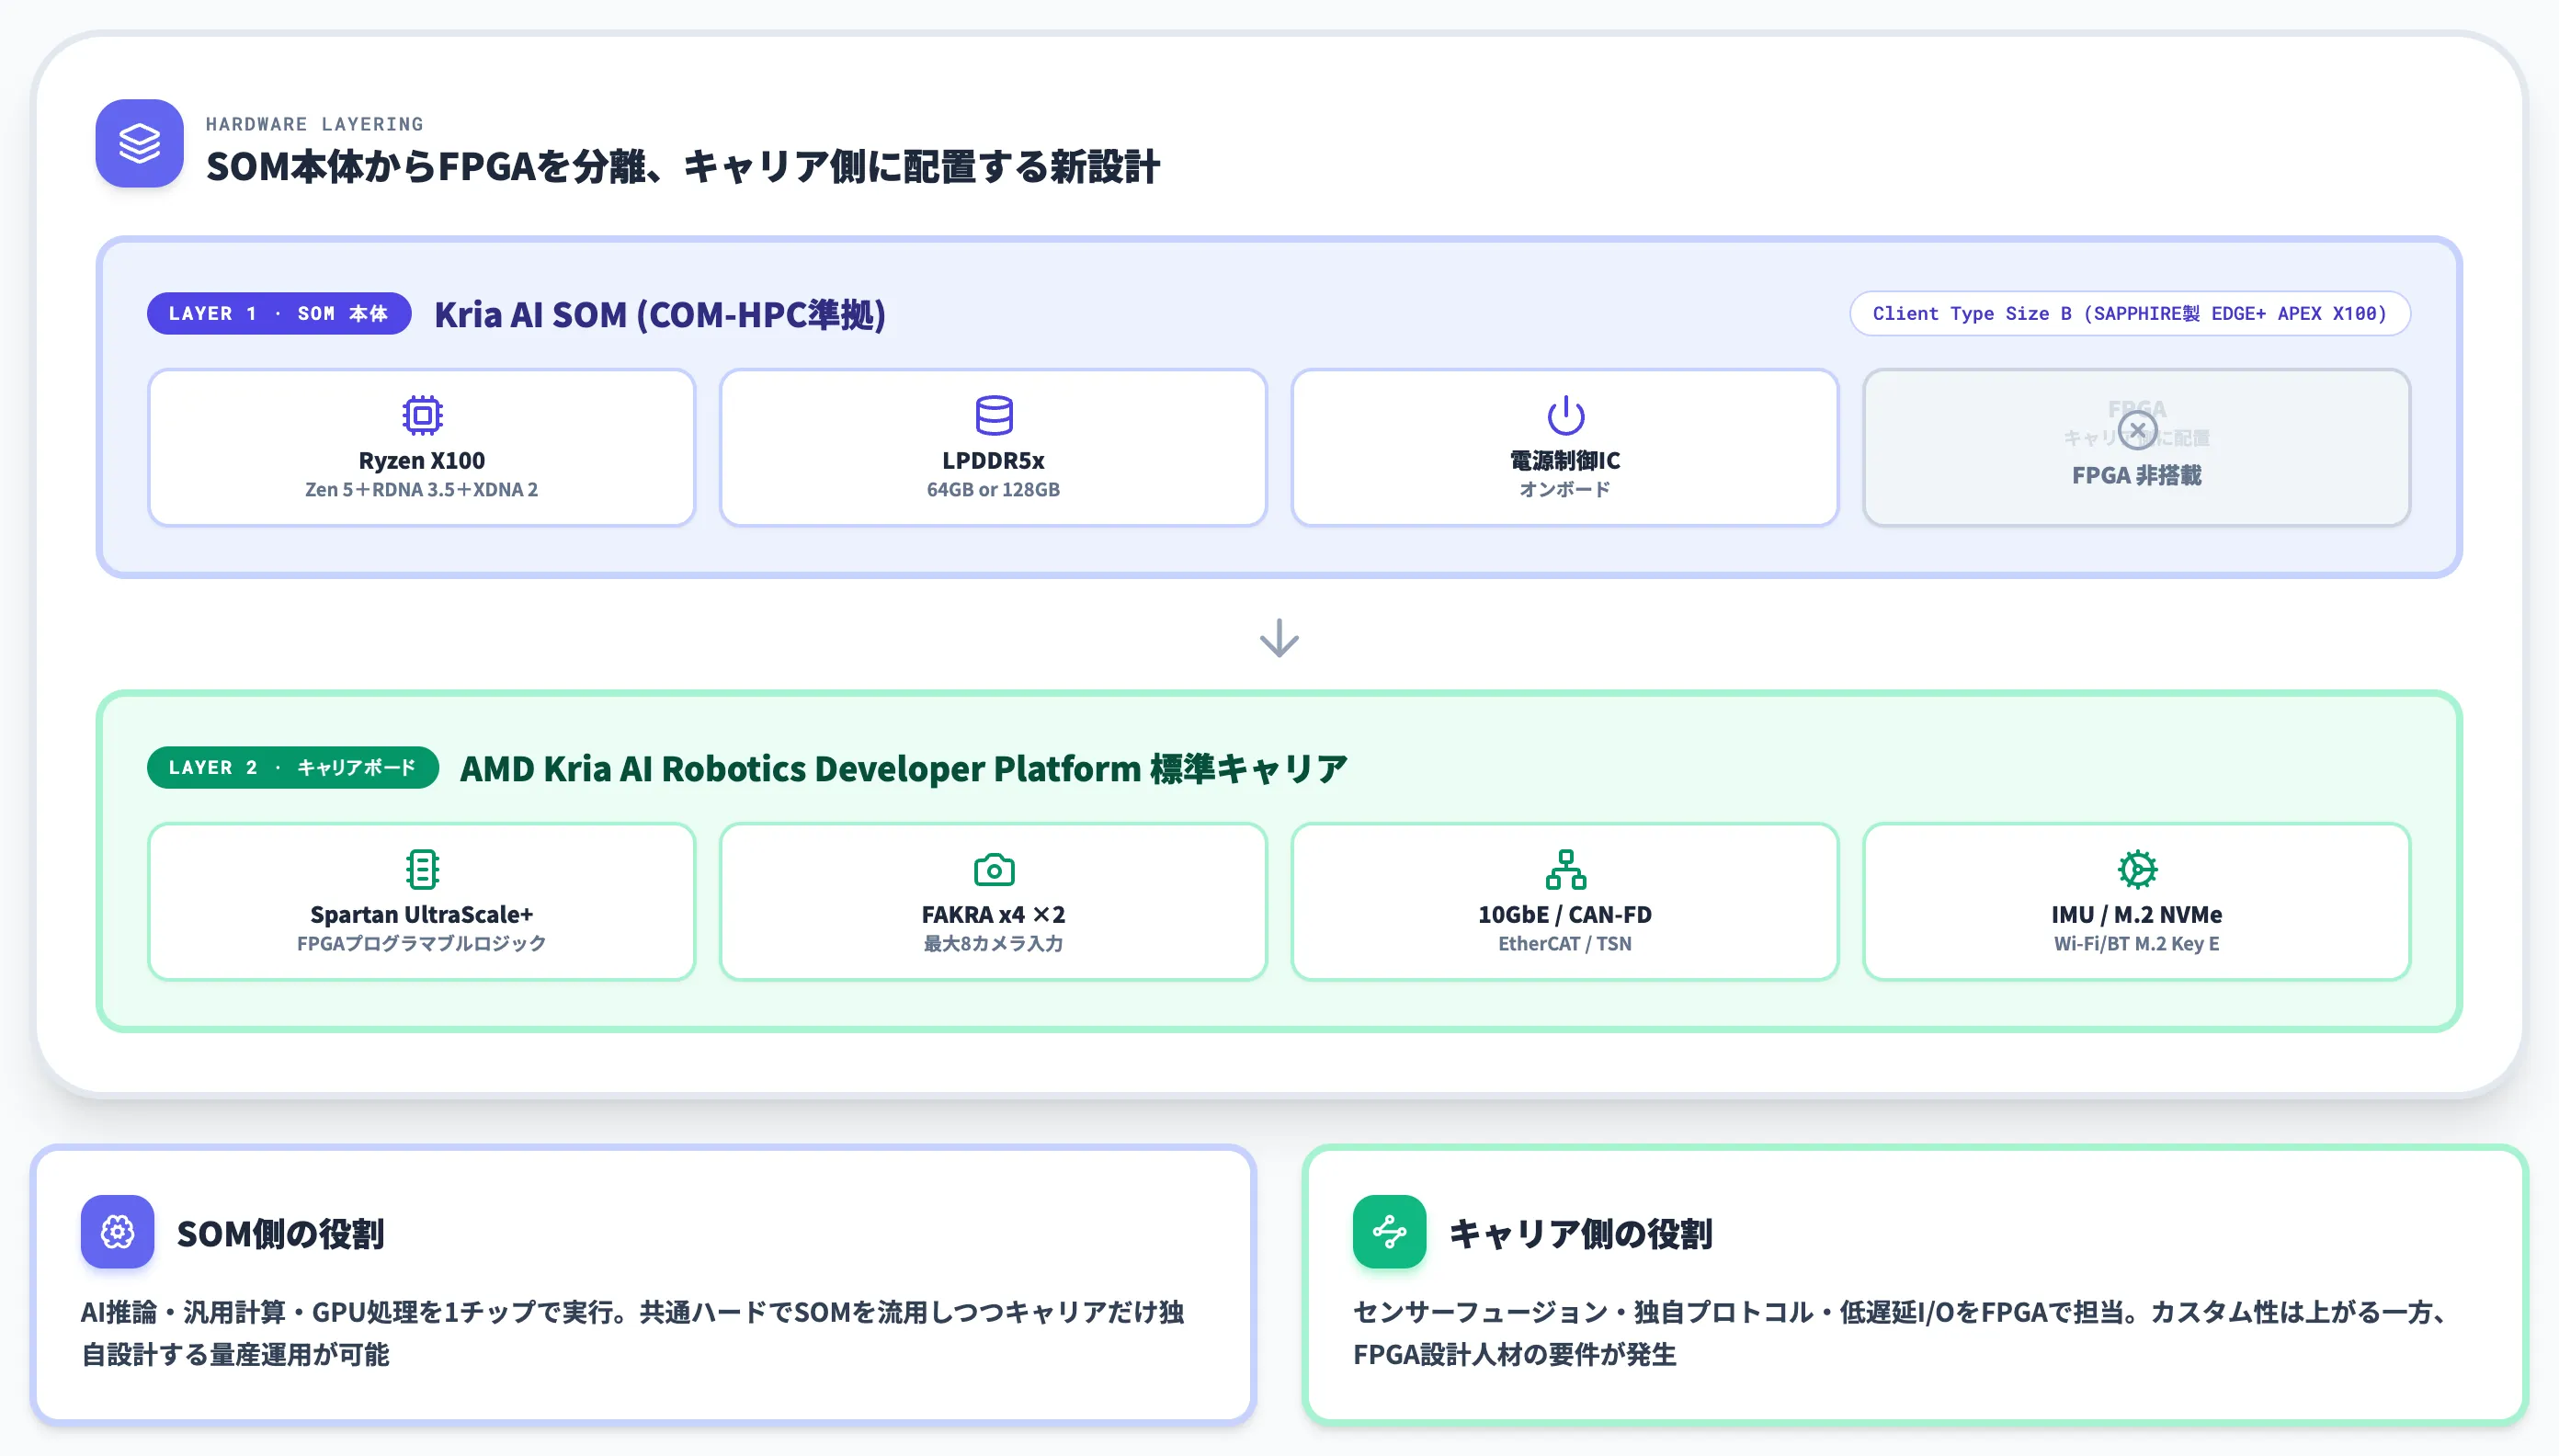
Kria AI SOMは、従来のKria SOM(K24/K26)と物理的に異なる規格・設計思想で作られています。ここでは、モジュール規格・搭載構成・キャリアボード側の役割の3点で整理します。
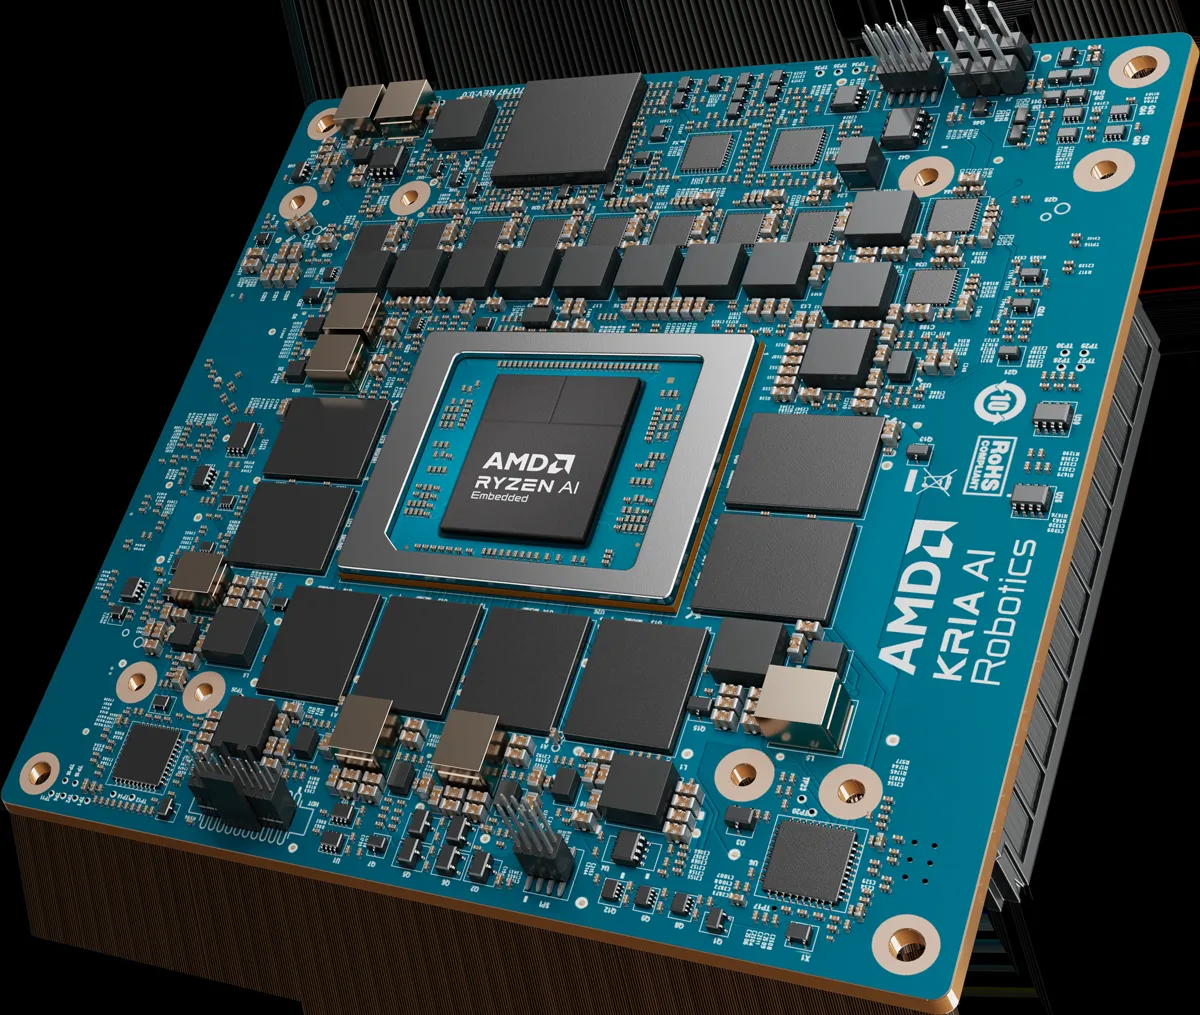
Kria AI SOMのCOM-HPCフォームファクターボード(斜めアングル・具体的なサイズ区分はODMごとに異なる)(出典:AMD Kria AI Solutions)
COM-HPCフォームファクターへの準拠
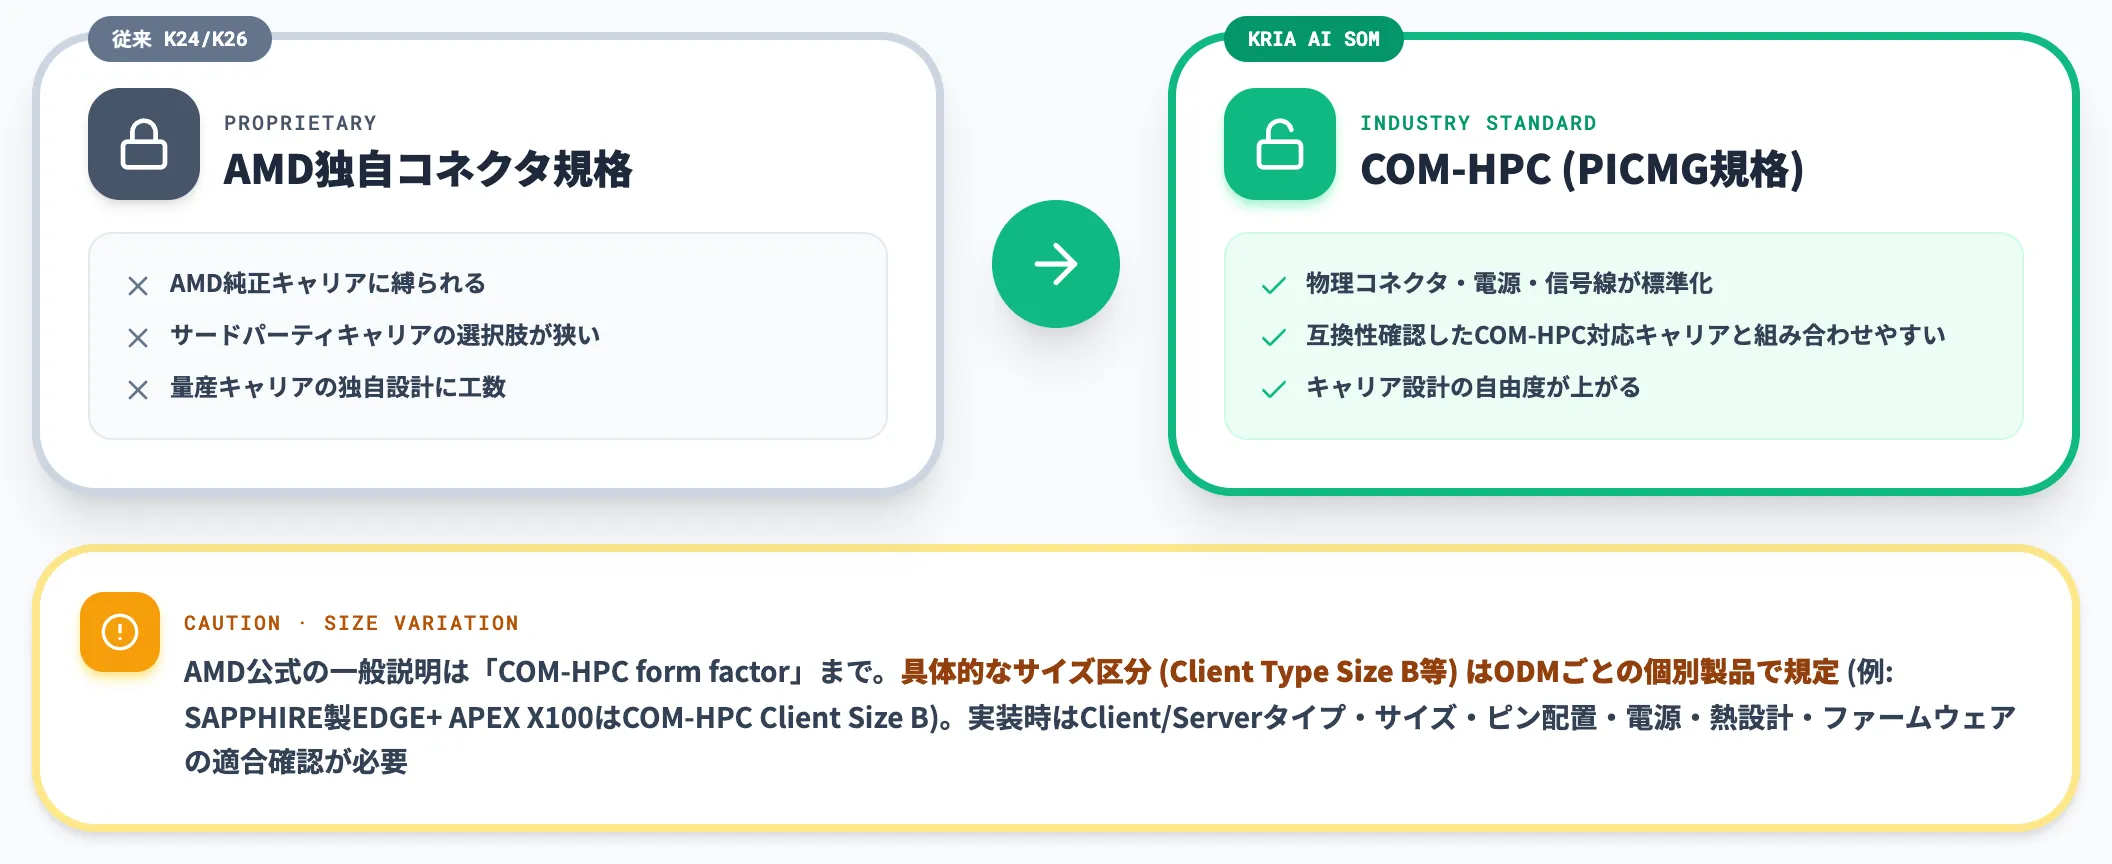
Kria AI SOMはCOM-HPCフォームファクターという業界標準規格に準拠しています。COM-HPCはPICMG(PCI Industrial Computer Manufacturers Group)が策定した組み込み向けモジュール規格で、SOMをキャリアボードに接続する物理コネクタ・電源・信号線を標準化しています。
AMD公式の一般説明は「COM-HPC form factor」までで、具体的なサイズ区分(Client Type Size B等)はODMパートナー各社の個別製品で規定されます(例:SAPPHIRE製EDGE+ APEX X100はCOM-HPC Client Size B)。
従来のKria K24/K26はAMD独自のコネクタ規格でしたが、Kria AI SOMではCOM-HPCに切り替えたことで、キャリアボード設計の自由度が上がり、互換性を確認したCOM-HPC対応キャリアと組み合わせやすい構造になっています(Client/Serverタイプ・サイズ・ピン配置・電源・熱設計・ファームウェアの適合確認は実装時に必要)。
SOM本体の搭載構成——SoCと統合メモリ、そしてFPGAは非搭載
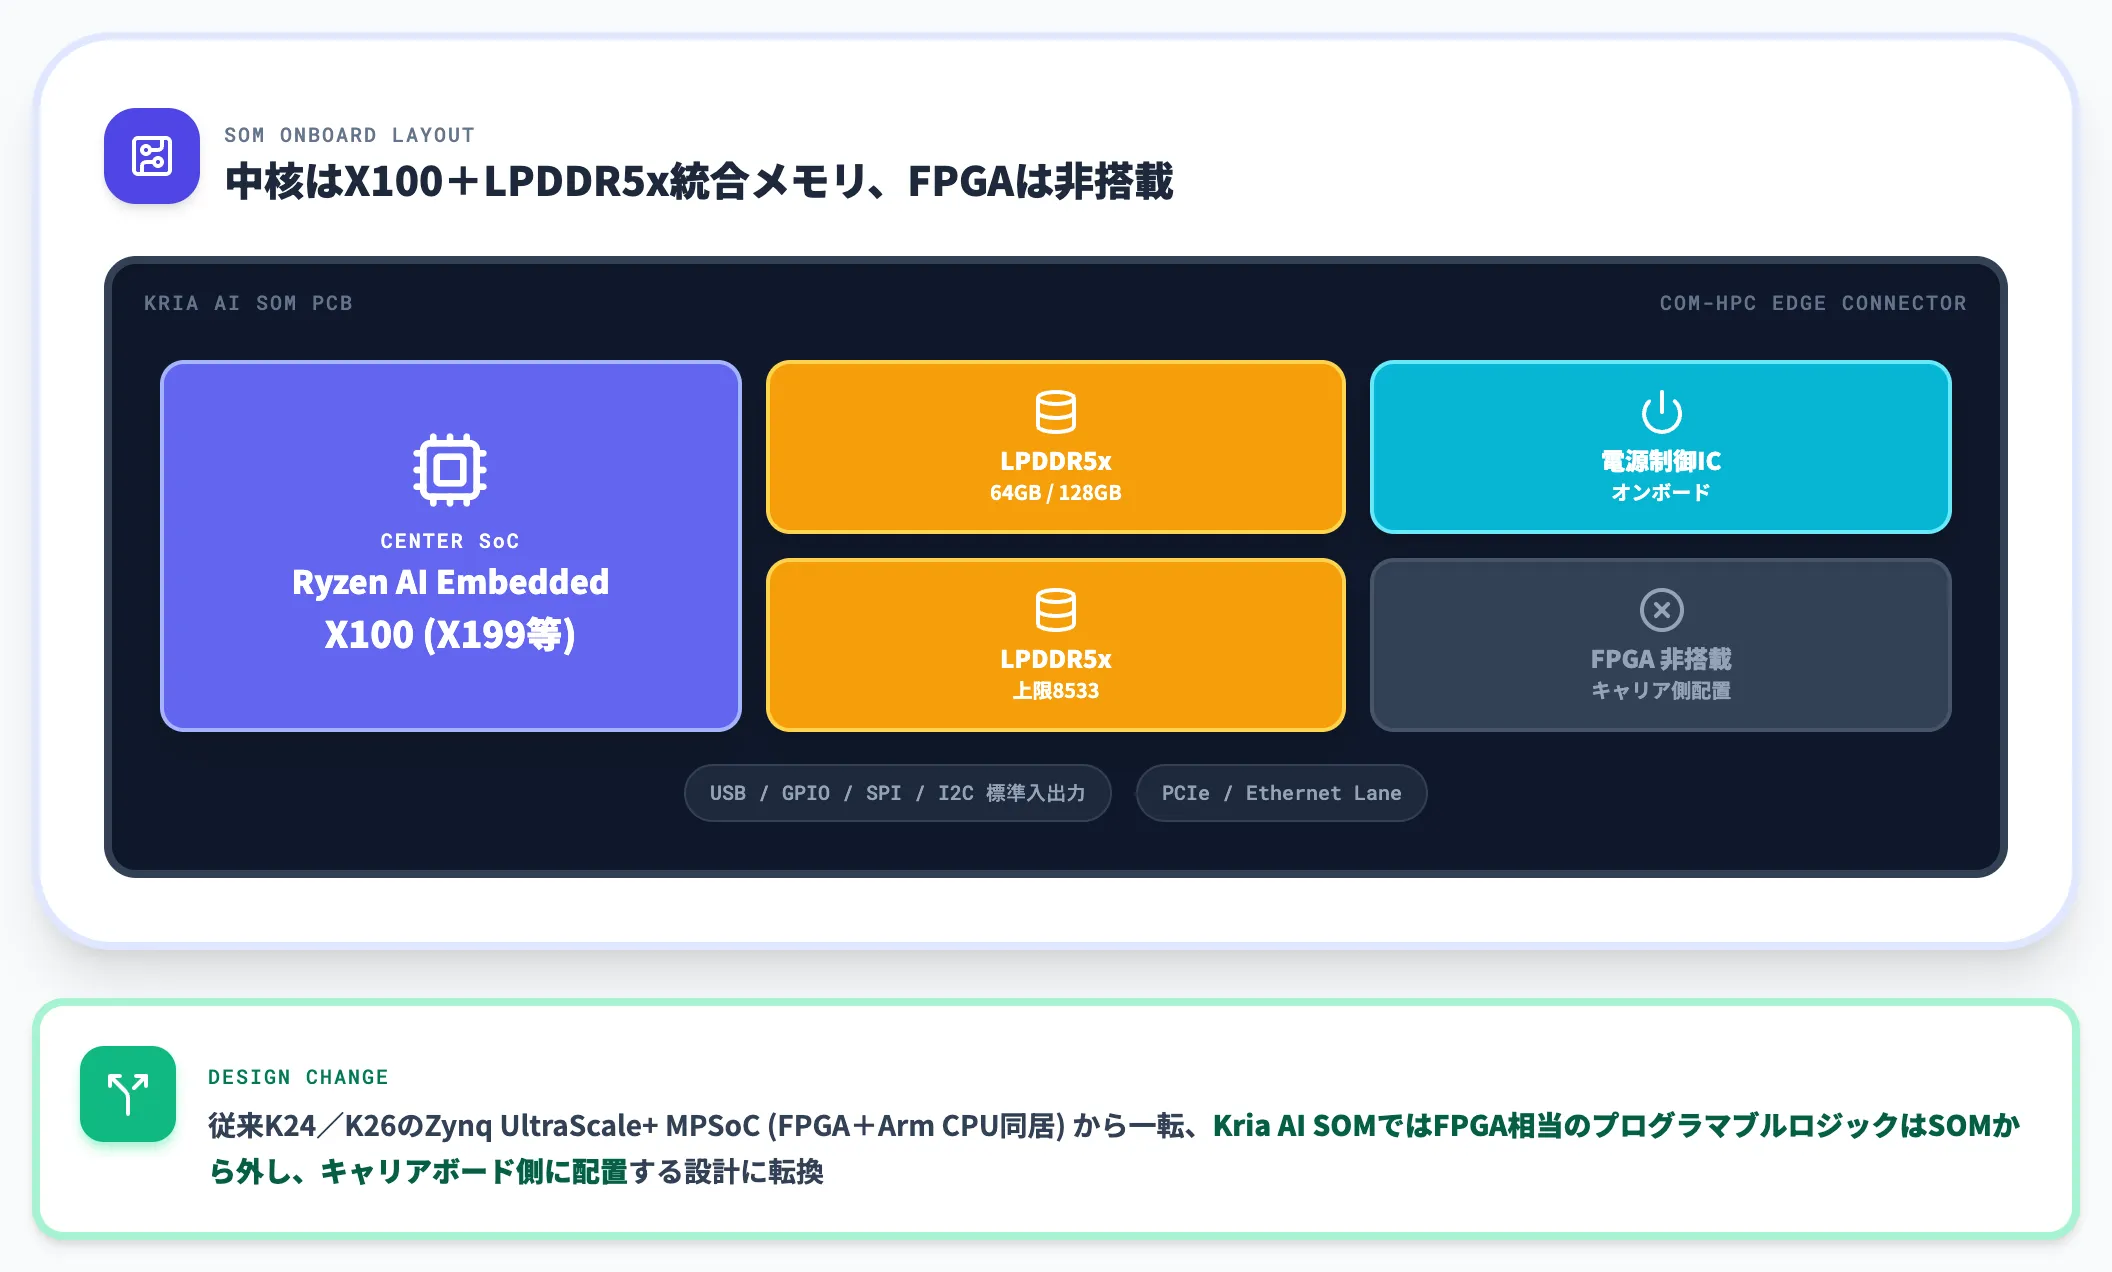
Kria AI SOM本体に載っているのは、Ryzen AI Embedded X100(X199等)とLPDDR5x統合メモリが中核です。AMD Kria AI Robotics Developer Platformの公表構成では64GBまたは128GBが採用されており、ODM製SOMの実装容量はSAPPHIRE等のパートナー各社によって異なります。加えて、電源制御ICと標準的な入出力インターフェースが基板上にまとまっています。
ここで重要なのが、Kria AI SOM本体にはFPGAが載っていないという点です。
従来のKria K24/K26はZynq UltraScale+ MPSoC上にFPGAプログラマブルロジックとArm CPUが同居していましたが、Kria AI SOMではFPGA相当のプログラマブルロジックはSOMから外され、キャリアボード側に配置される設計になっています。
キャリアボード側のSpartan UltraScale+ FPGA——センサー融合・カスタムI/O
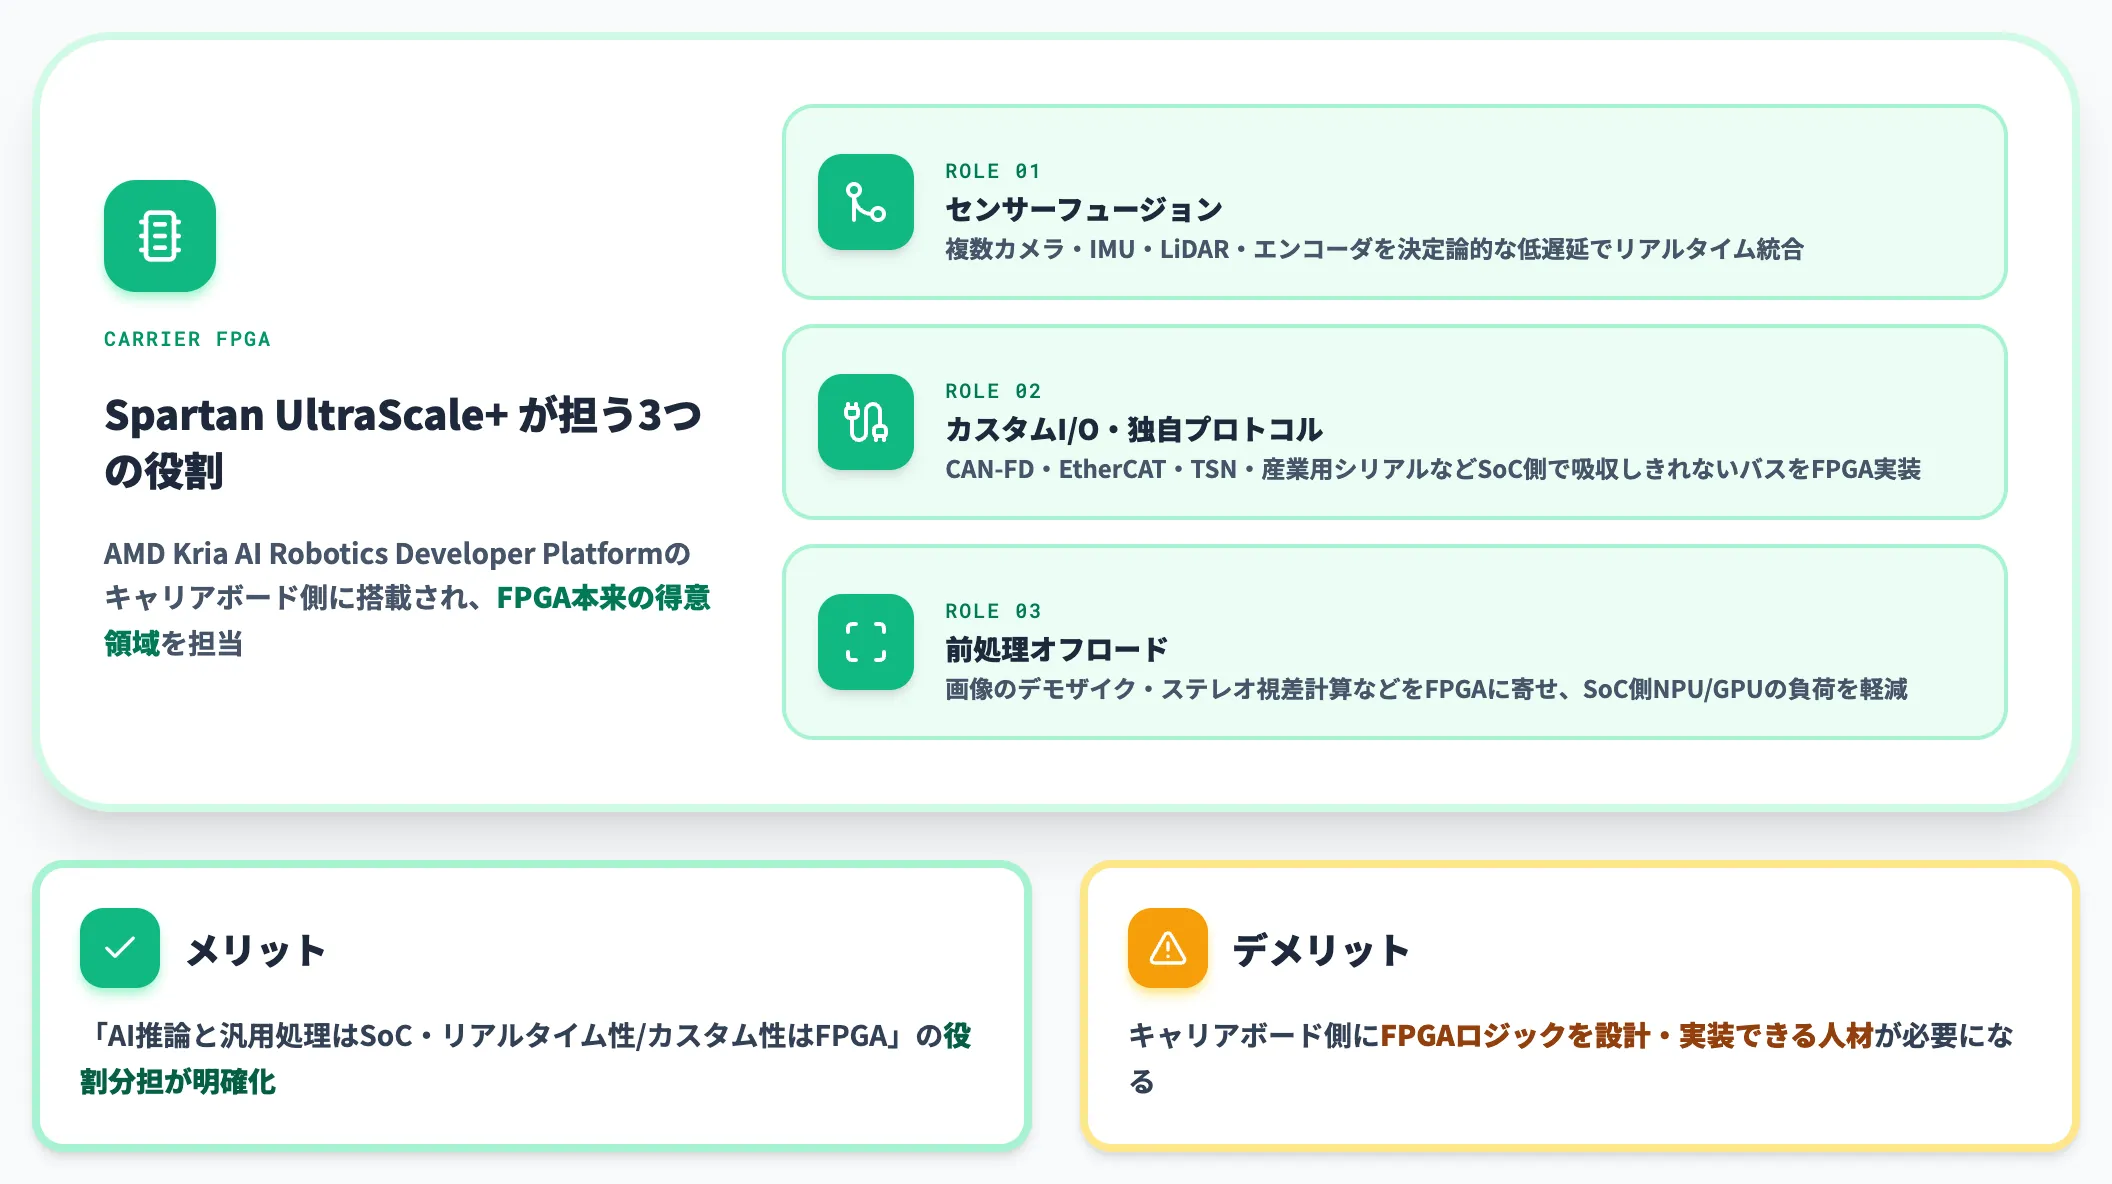
AMDのKria AI Robotics Developer Platformでは、キャリアボード側にSpartan UltraScale+ FPGAが別途搭載されます。
ここでFPGA本来の役割——センサーフュージョン・低遅延カスタムI/O・独自プロトコル処理——を担う設計です。
-
センサーフュージョン
複数カメラ・IMU・LiDAR・エンコーダの信号を、決定論的な低遅延でリアルタイム統合
-
カスタムI/O・独自プロトコル
CAN-FD・EtherCAT・TSN・産業用シリアルなど、SoC側では吸収しきれない業界特殊プロトコルをFPGAで実装
-
前処理オフロード
カメラ画像のデモザイク・ステレオ視差計算などの前処理をFPGAに寄せ、SoC側のNPU/GPU負荷を軽減
この分離設計のメリットは、「AI推論と汎用処理はSoC、リアルタイム性・カスタム性はFPGA」という役割分担が明確になる点です。
逆にデメリットもあり、キャリアボード側にFPGAロジックを設計・実装する人材が必要になります。従来Kria K26のようにSOM本体にFPGAプログラマブルロジックが内包されるシンプルなハード構成(開発用途にはKV260/KR260等のStarter Kitが別途提供)とは、開発・量産時の役割分担が変わります。
カメラ入力とセンサーI/O——2基のFAKRA x4・IMU・多重ネットワーク
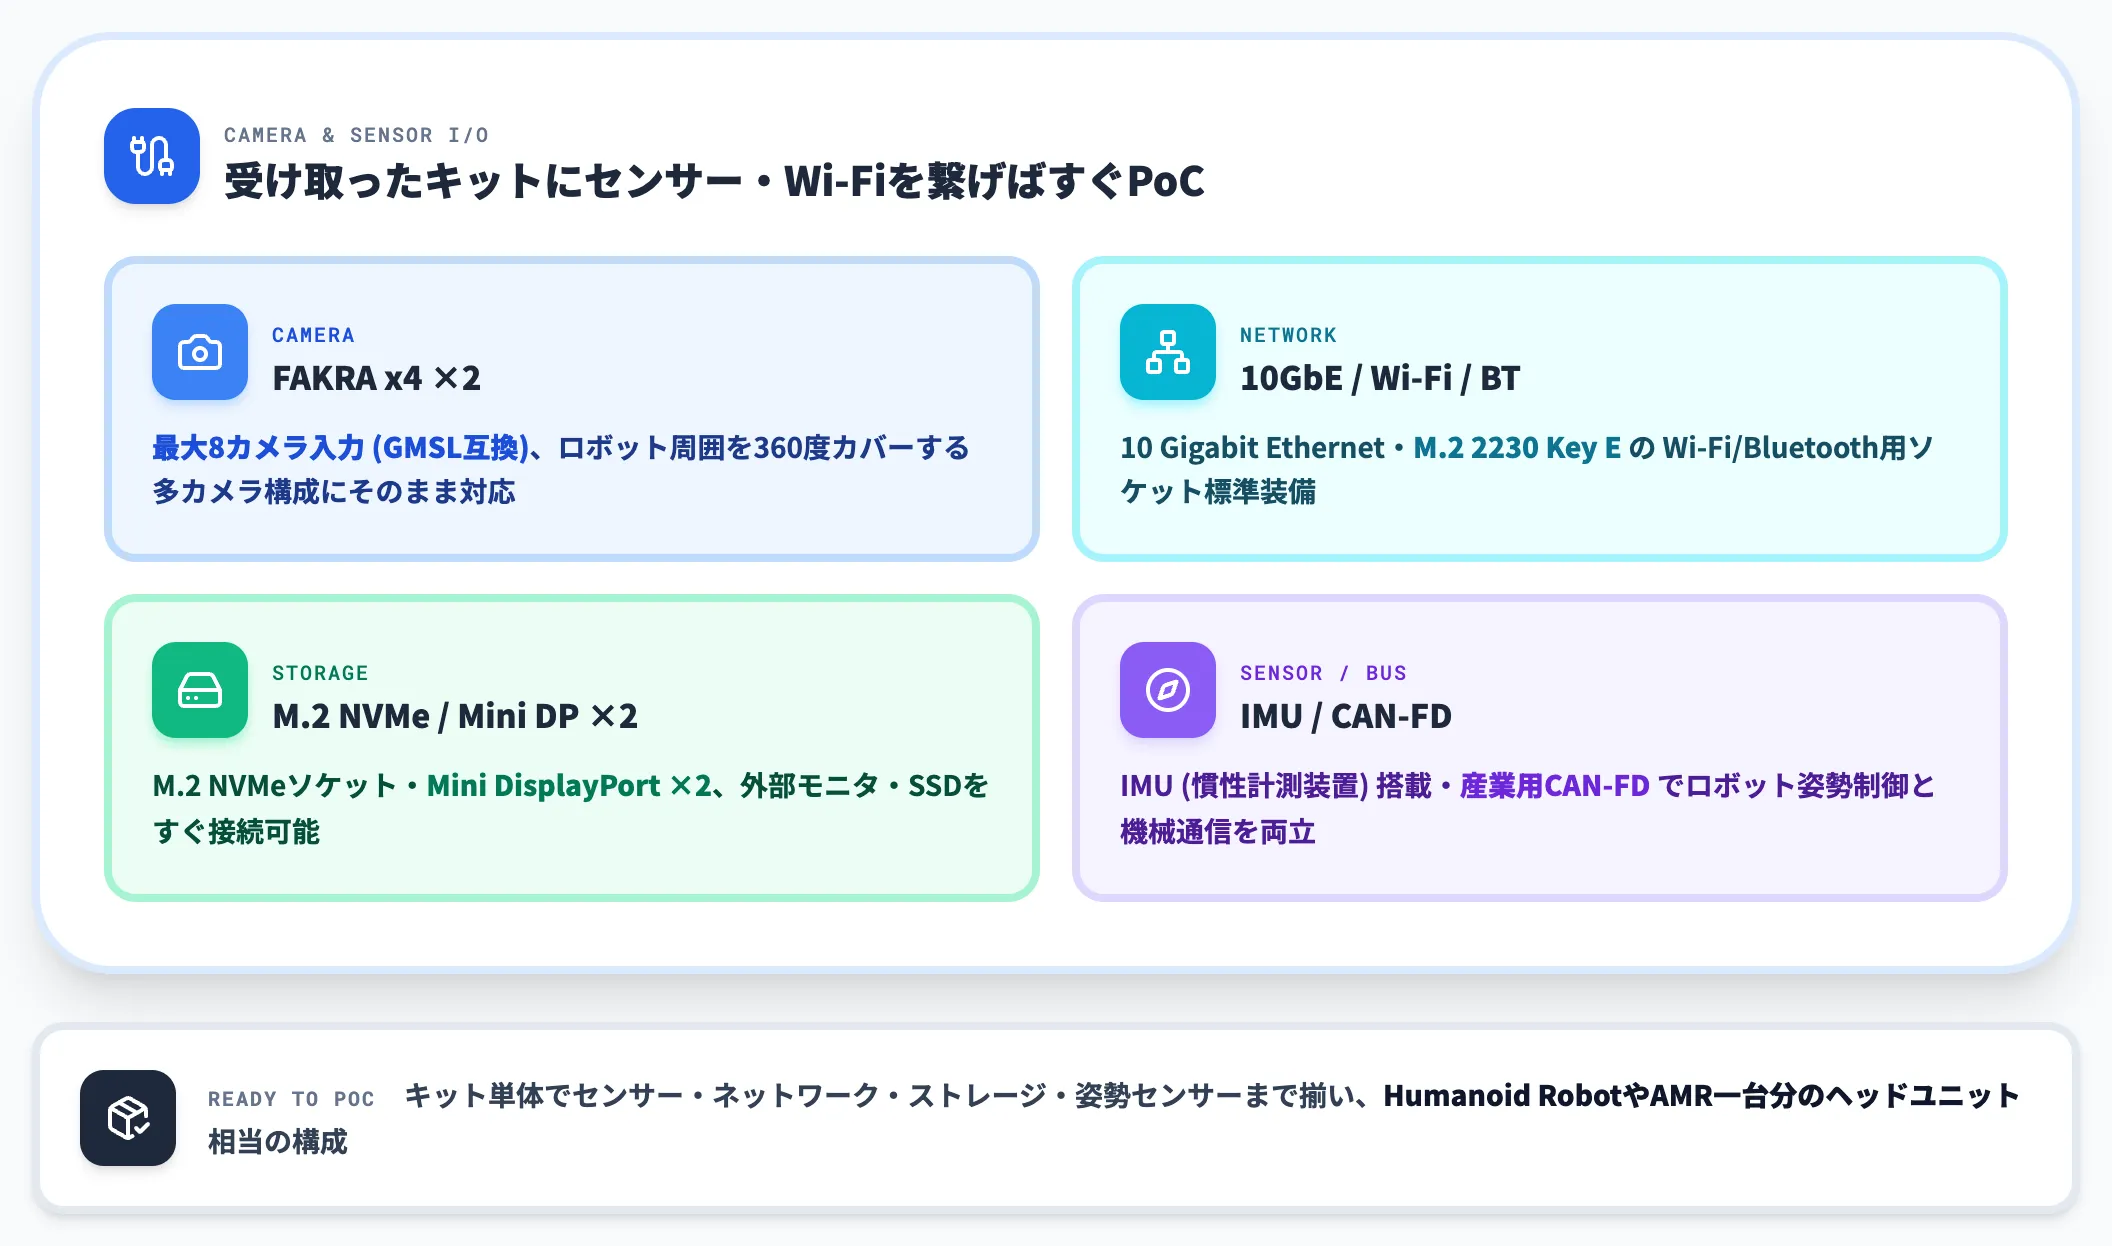
AMD Kria AI Robotics Developer Platformの構成では、2基のFAKRA x4コネクタ経由で最大8カメラ入力(GMSL互換)を受けられ、ロボット周囲を360度カバーするような多カメラ構成にそのまま対応します。
そのほかM.2 NVMeソケット・Wi-Fi/Bluetooth用M.2 2230 Key Eスロット・Mini DisplayPort×2・IMU・10 Gigabit Ethernet・産業用CAN-FDなどが標準装備で、受け取ったキットにセンサー・Wi-Fiモジュールを繋げばすぐPoCが始められる構成になっています。
Kria AI SOMが担うPhysical AIとロボット・産業機器の想定用途
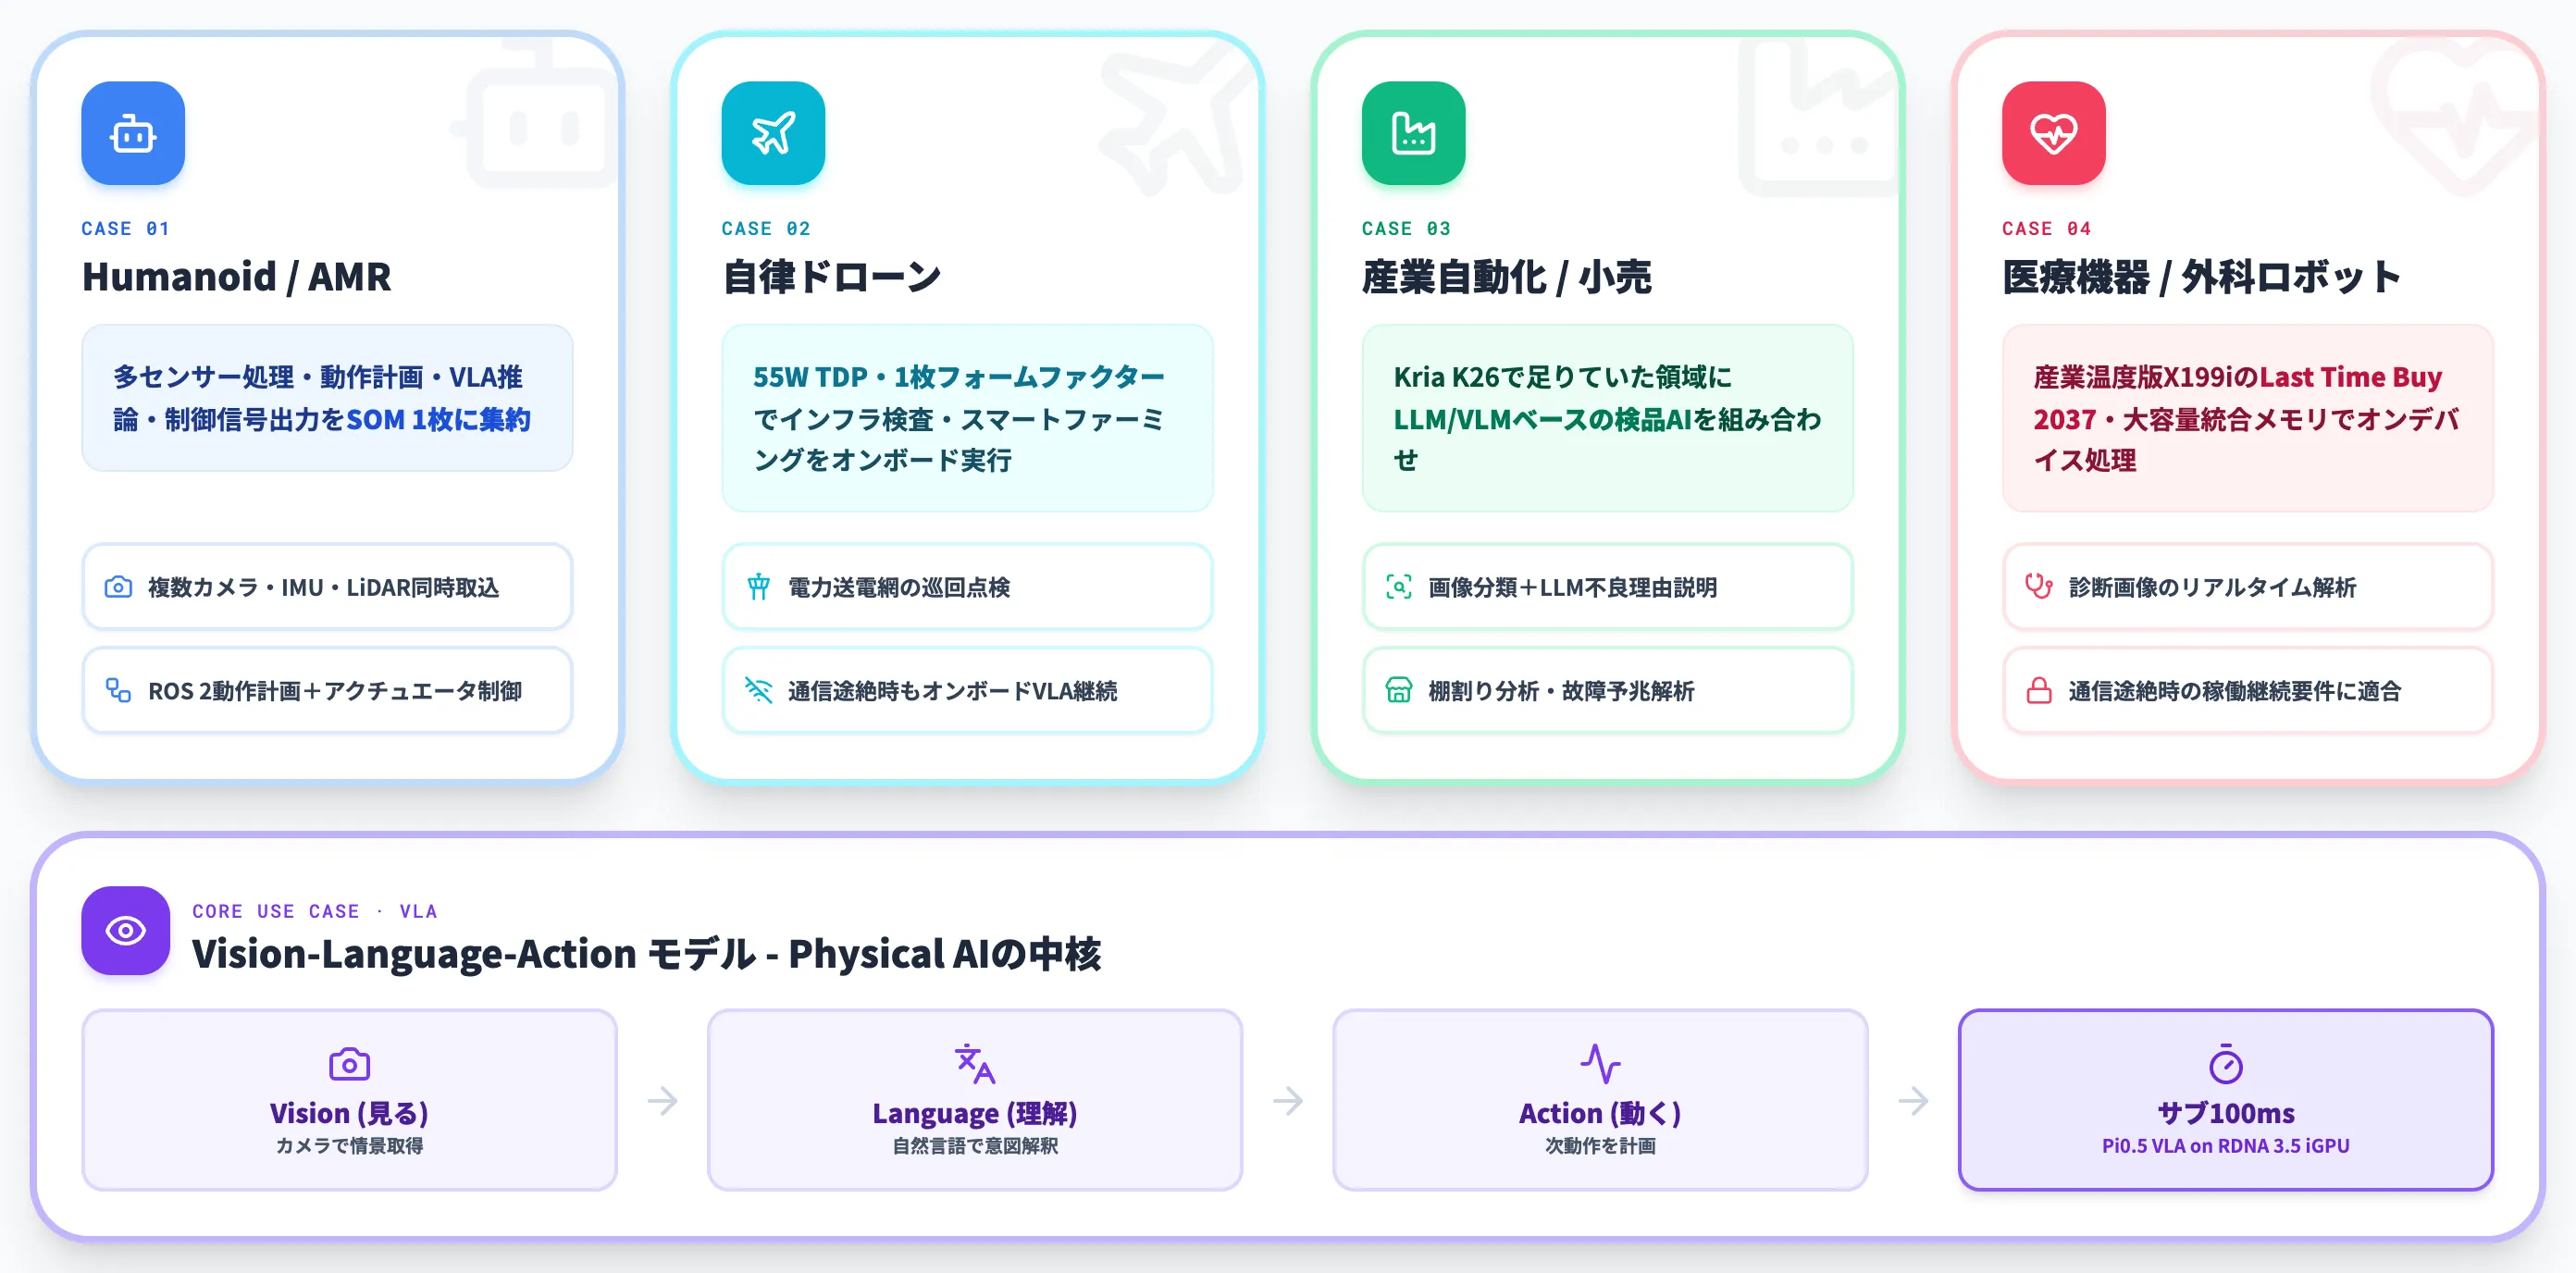
Kria AI SOMは汎用SOMではなく、Physical AI(物理世界で自律動作するAI)を特定用途としたSOMとして設計されています。ここでは、AMDが公式に想定用途として挙げているアプリケーション領域を整理します。
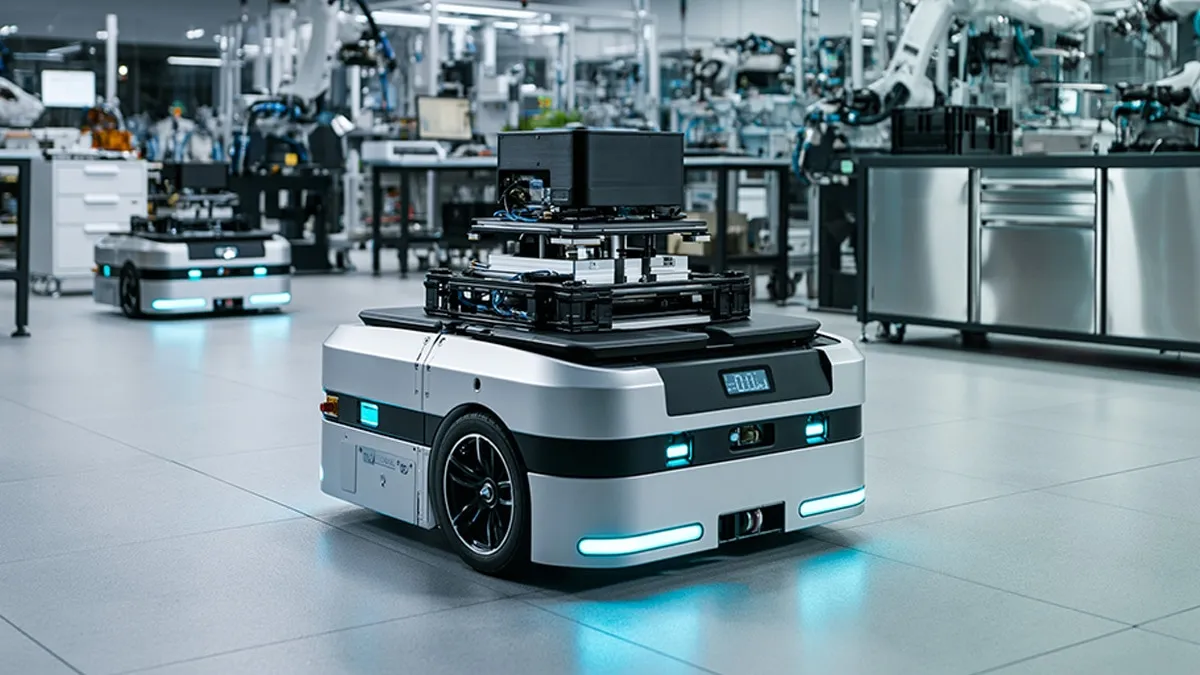
スマートファクトリーで稼働するAMR(自律搬送車)——Kria AI SOMが想定するPhysical AI用途の一例(出典:AMD Ryzen AI Embedded X100 Series)
ヒューマノイド・AMR・協働ロボット
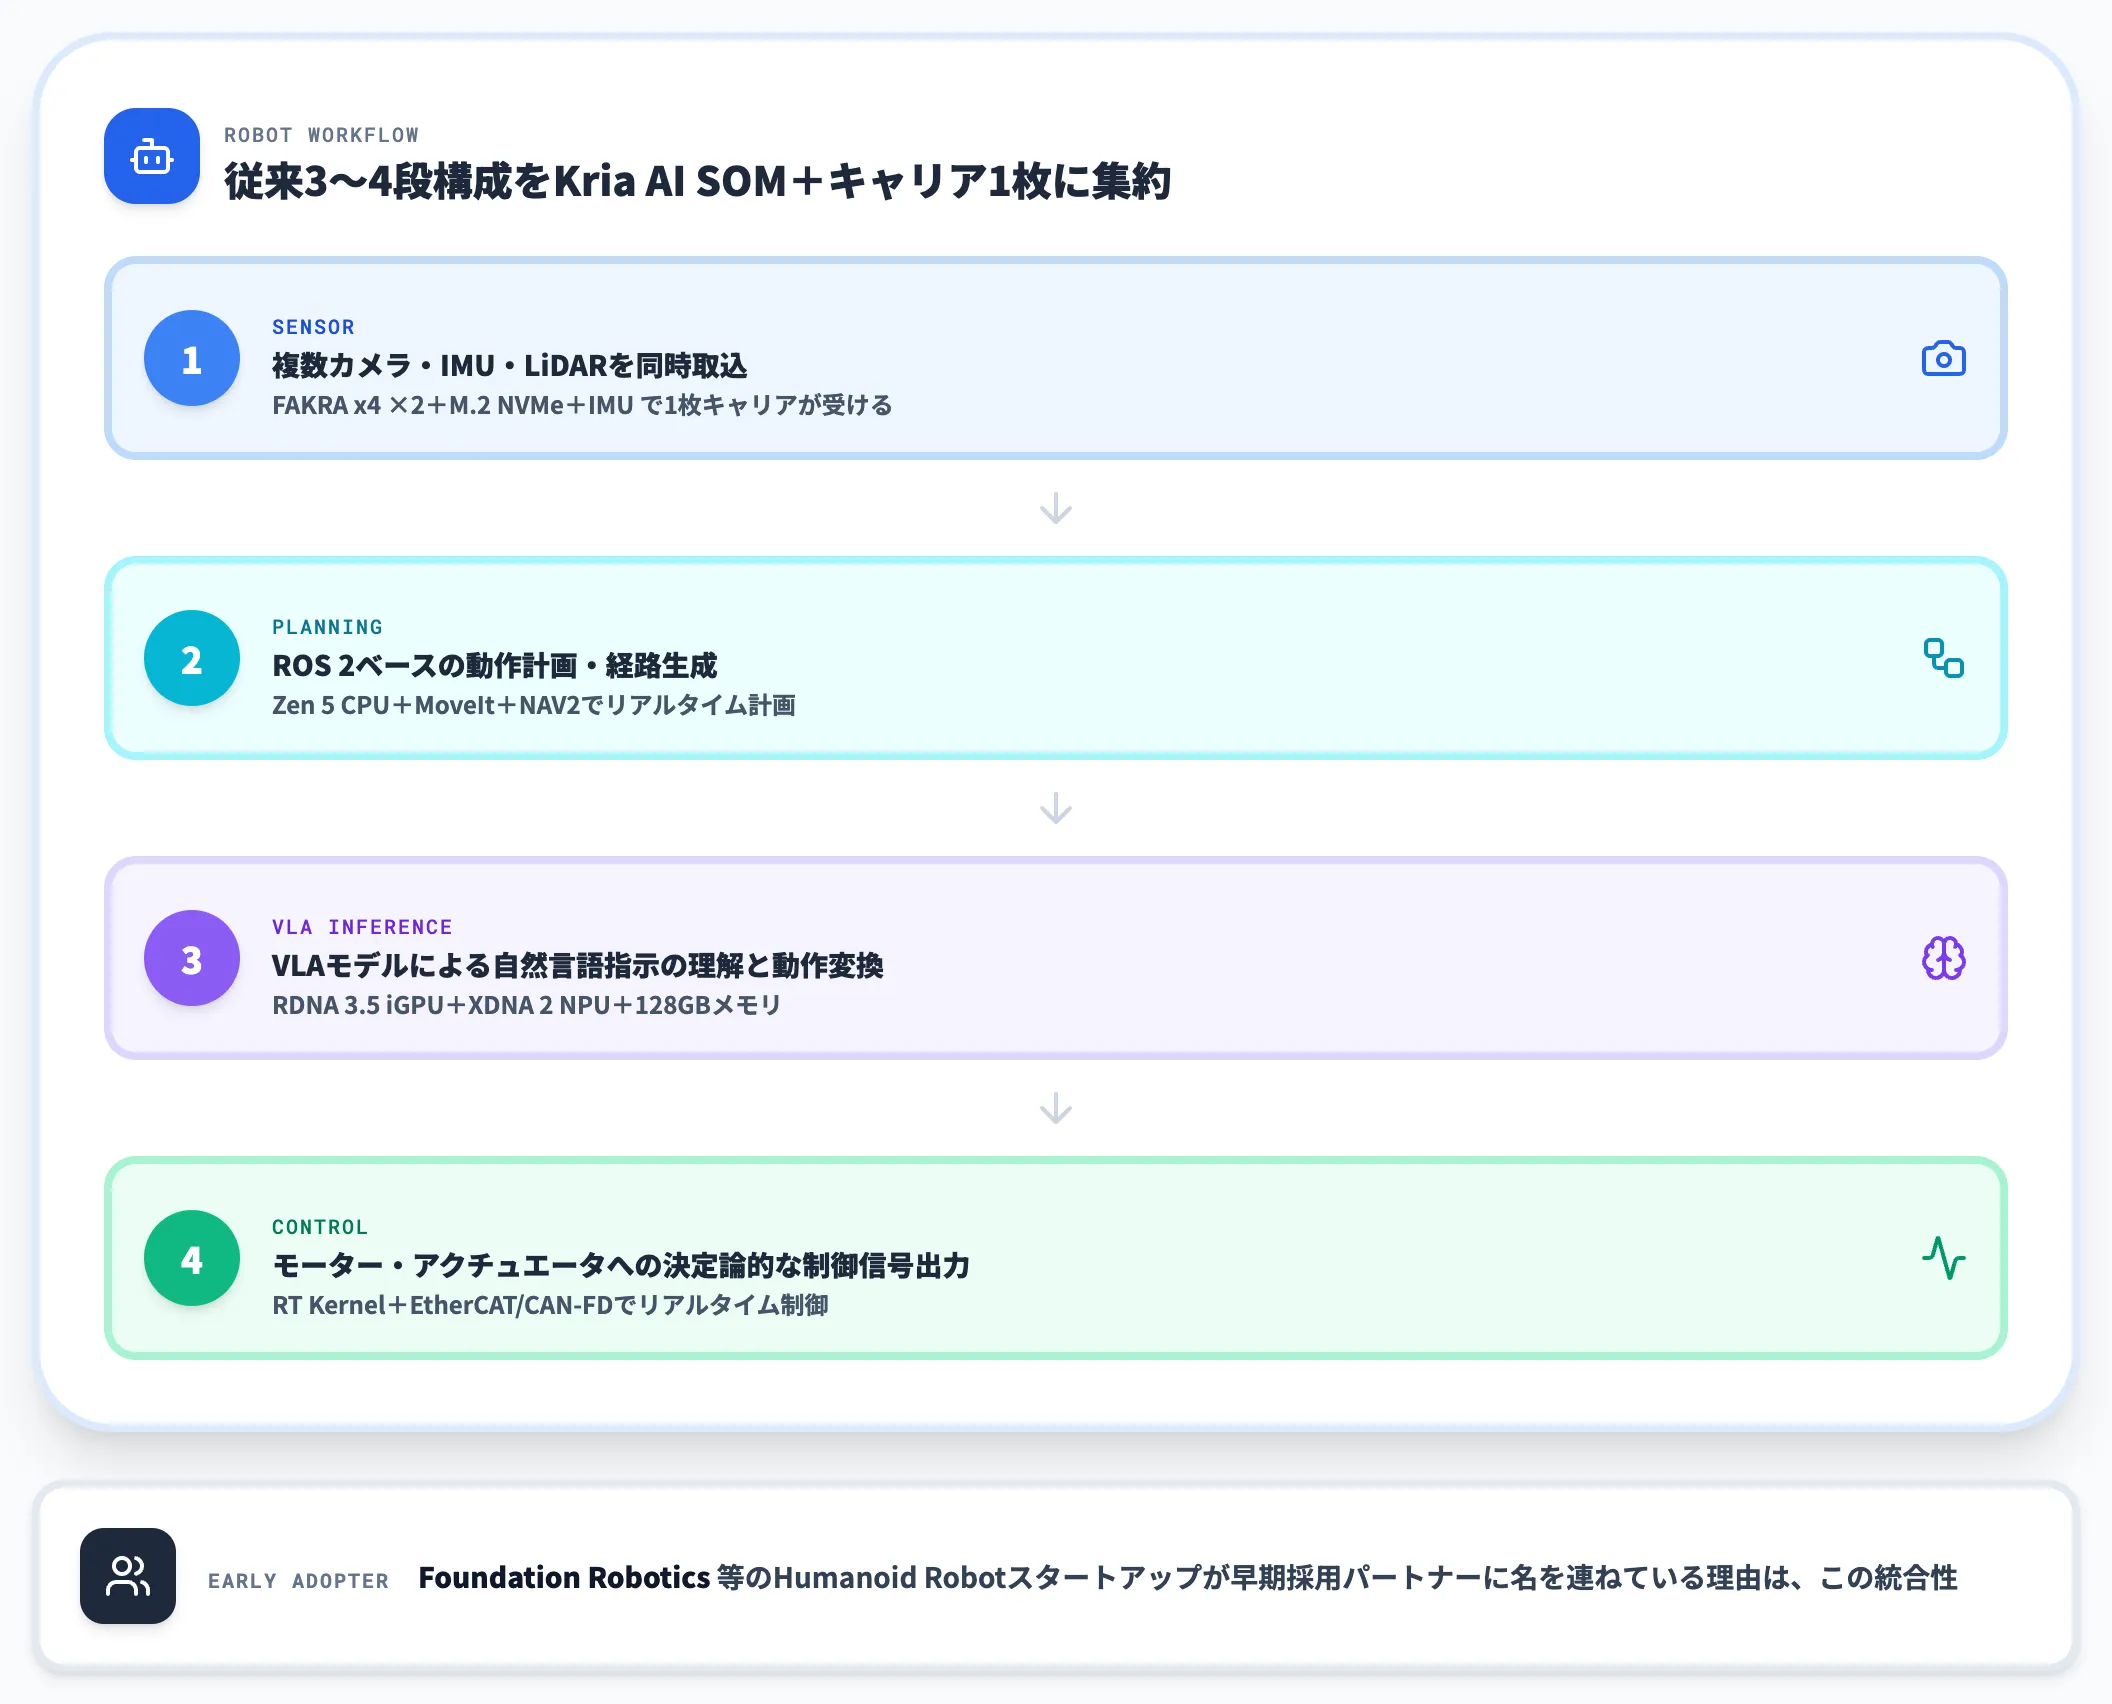
第一の想定用途がヒューマノイドロボット・AMR・協働ロボット(Autonomous Mobile Robot / Cobot)です。これらは共通して「多センサー入力・リアルタイム制御・大規模AIモデル推論」を1台の中で完結させる必要があります(AIロボットの全体像、小型ヒューマノイドのReachy Miniなど、Kria AI SOM級のプラットフォームが担う典型ワークロード)。
Kria AI SOMは、以下のような要件を1枚のモジュールで満たします。
- 複数カメラ・IMU・LiDARを同時に取り込むセンサー処理
- ROS 2ベースの動作計画・経路生成
- VLA(Vision-Language-Action)モデルによる自然言語指示の理解と動作変換
- モーター・アクチュエータへの決定論的な制御信号出力
従来はこれらを「制御用マイコン+GPU計算機+通信モジュール」の3〜4段構成で組んでいたところを、Kria AI SOM+キャリア1枚に集約できるのが最大の変化です。
Foundation RoboticsなどのHumanoid Robotスタートアップが早期採用パートナーに名を連ねているのは、この統合性が理由です。
自律ドローン・インフラ検査・スマートファーミング
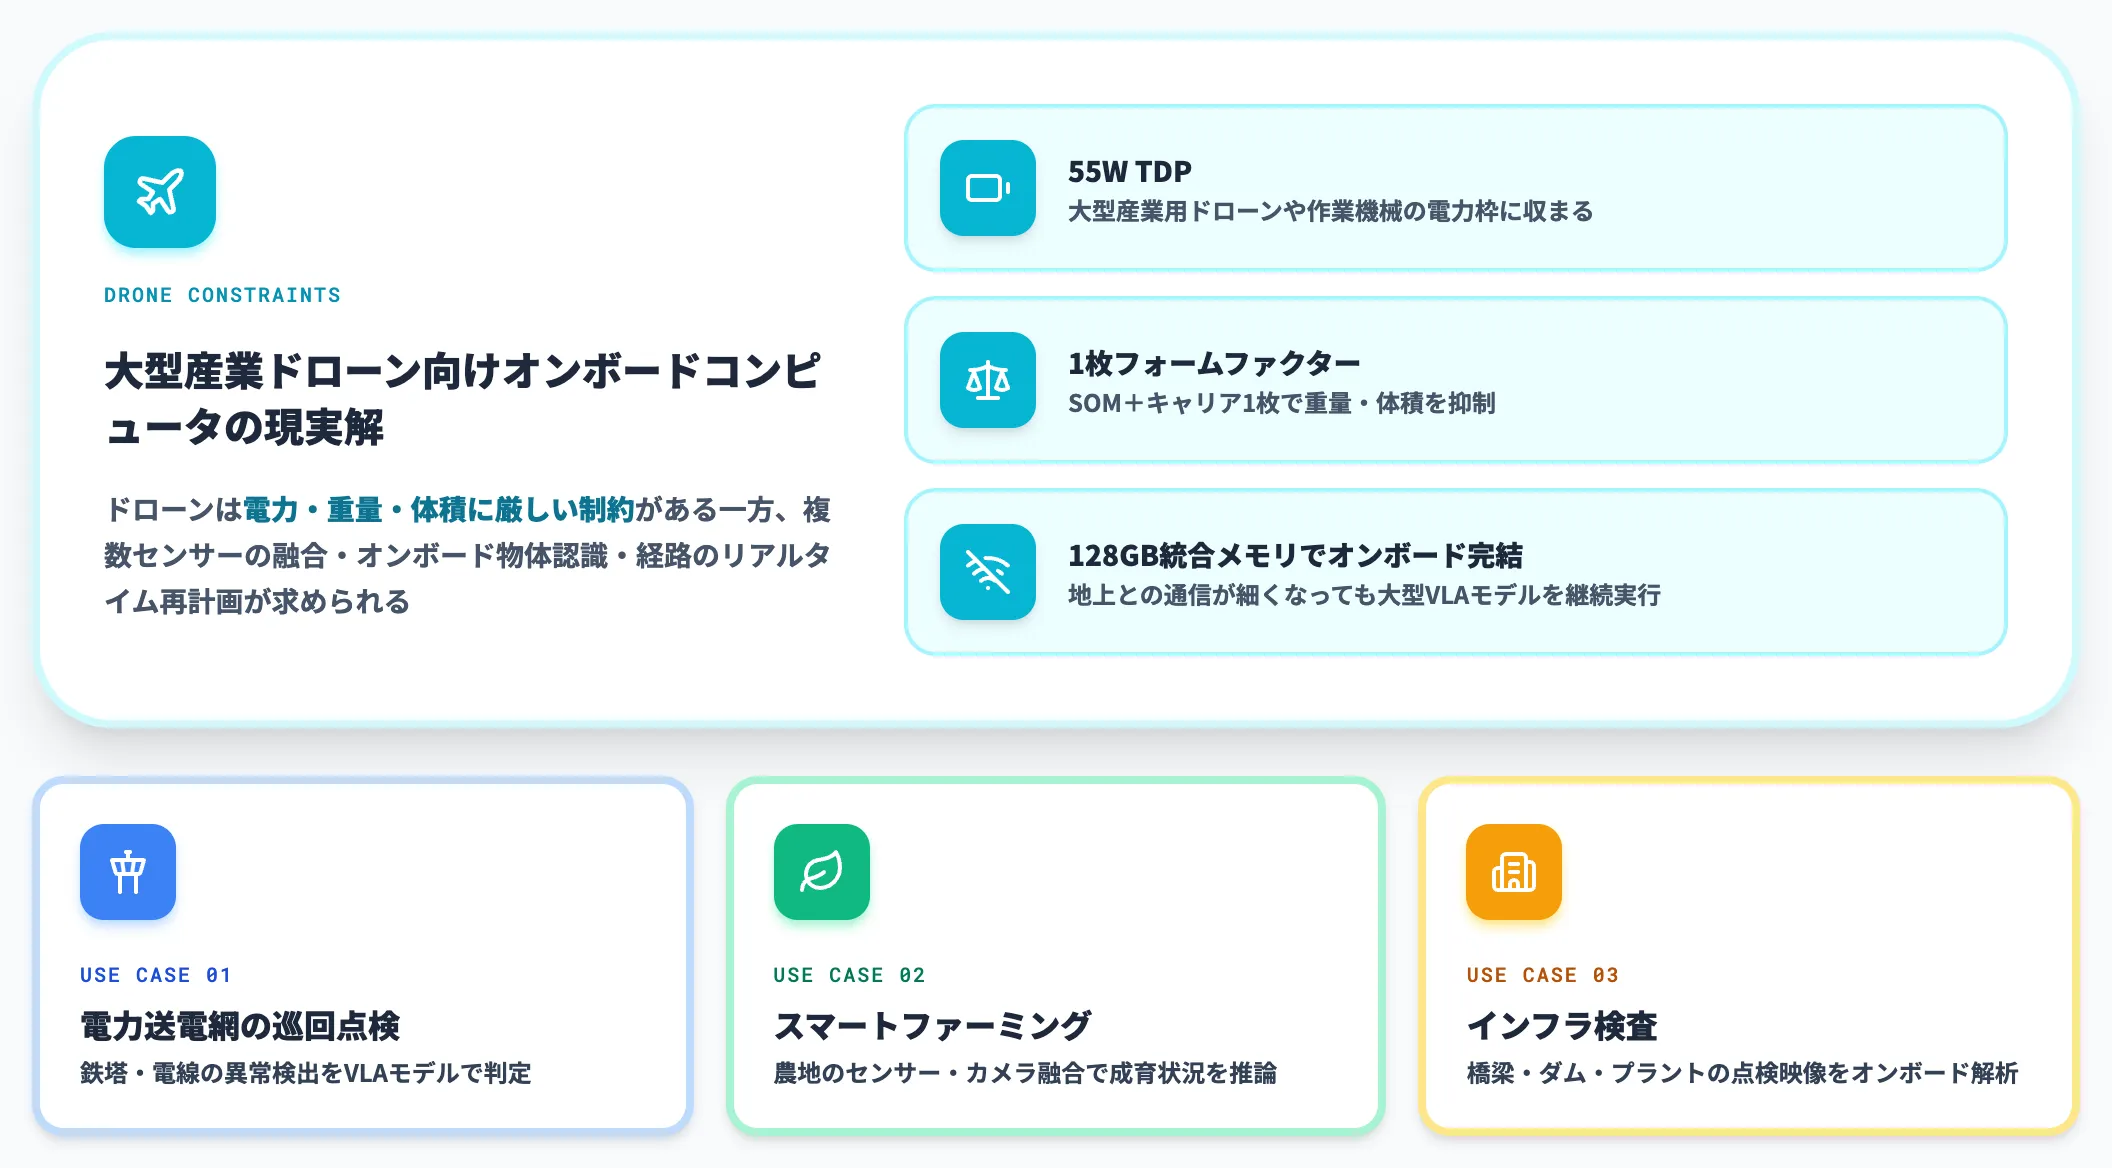
第二の想定用途が、自律ドローンによるインフラ検査・スマートファーミング・電力送電網の巡回点検などの分野です。ドローンは電力・重量・体積に厳しい制約がある一方、複数センサーの融合・オンボードでの物体認識・経路のリアルタイム再計画が求められます。
Kria AI SOMの55W TDPと1枚のフォームファクターは、大型産業用ドローンや作業機械のオンボードコンピュータとして現実的なサイズ感です。X100の128GB統合メモリを活かせば、地上との通信が細くなった状態でも大型VLAモデルをオンボードで走らせ、判断を続けられます。
産業自動化・マシンビジョン・スマート小売
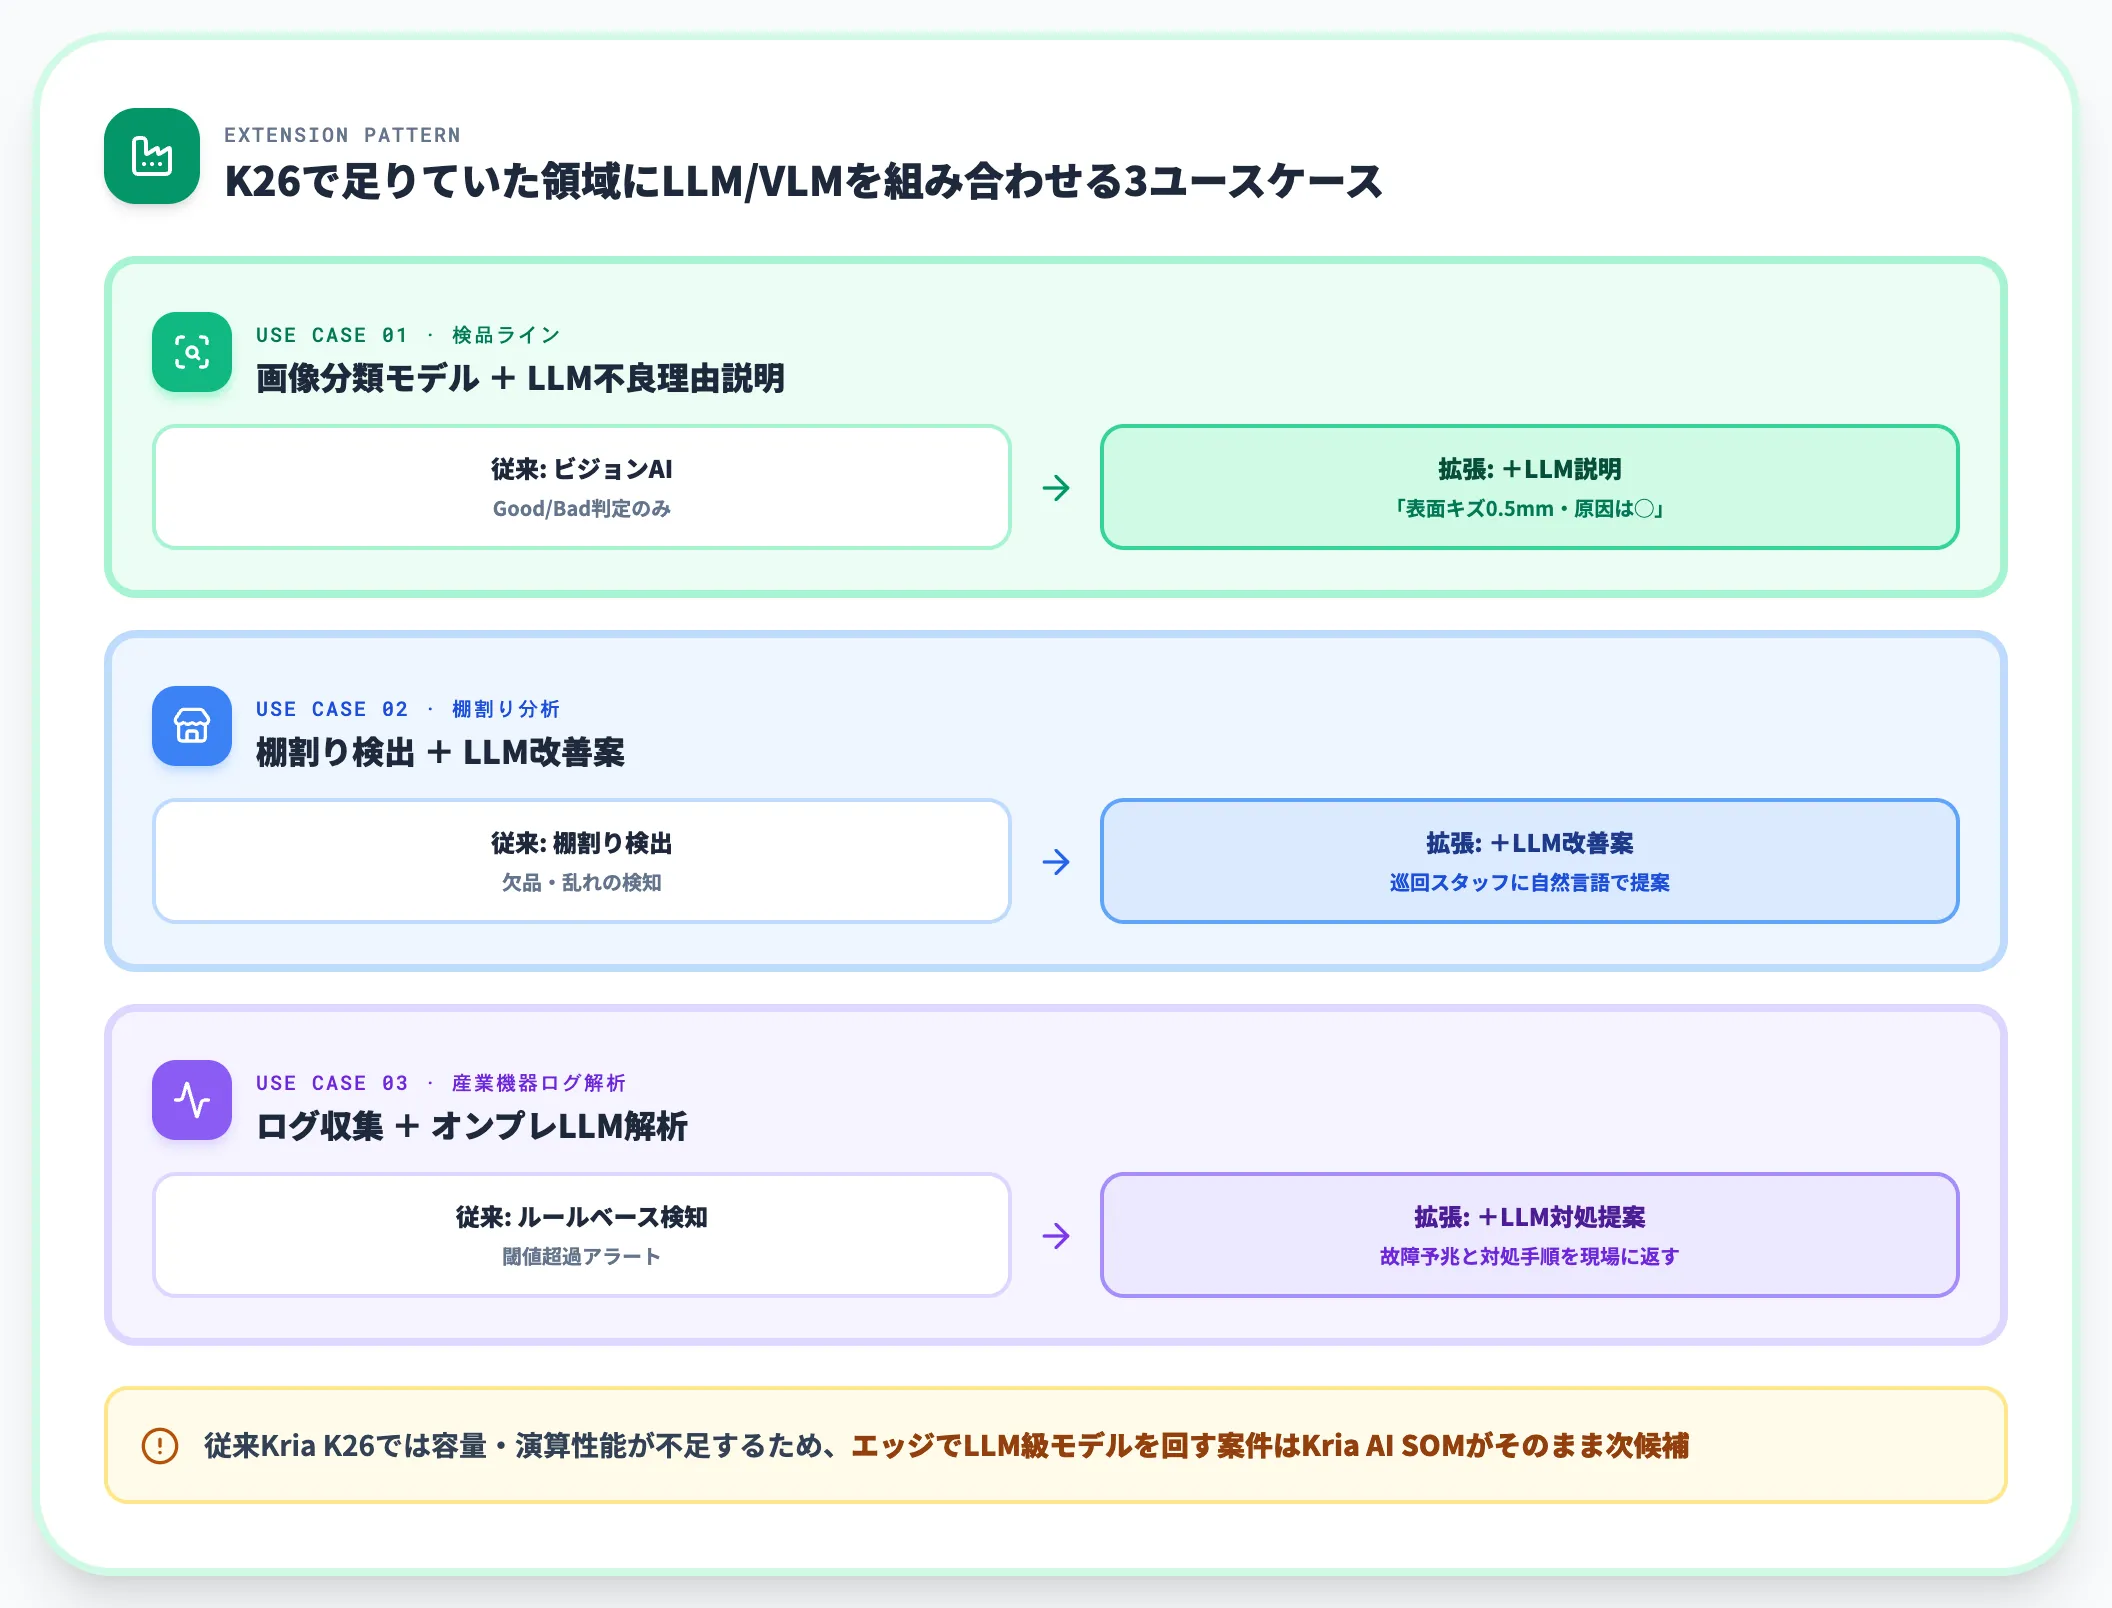
工場自動化・マシンビジョン・スマート小売の領域では、従来のKria K26 SOM(DPU 1.4 TOPS)で足りていた用途に加え、より大規模なLLM/VLMベースの検品AI・棚割り最適化AIを組み合わせる案件が増えています。
- 検品ラインでの不良判定を「画像分類モデル+LLMによる不良理由説明」に拡張する
- 棚割り分析にLLMを組み合わせ、店舗巡回スタッフに自然言語で改善案を返す
- 産業機器のログをオンプレLLMで解析し、故障予兆と対処手順を現場に返す
これらは「軽量なビジョンAI」だけでは実装できず、エッジでLLM級モデルを回す必要がある案件です。従来のKria K26では容量・演算性能が不足するため、Kria AI SOMがそのまま次候補になります。
医療機器・外科ロボット・診断画像処理
医療領域では、外科支援ロボット・診断画像のリアルタイム解析・遠隔手術のオンボード処理などが対象です。
米国HIPAAでは適切なBAA締結と安全管理措置を満たせばクラウド処理も許容されますが、適用法・契約・データ分類・通信要件(低遅延要件や通信途絶時の稼働継続)によっては、装置内でのオンデバイス処理が現実的な選択になります。
Ryzen AI Embedded X100シリーズの産業温度版X199iのLast Time Buy 2037年(プロセッサ側の長期供給スケジュール)と、大容量統合メモリによるオンボード推論は、医療機器の長期供給要件とオンデバイス処理ニーズに噛み合う設計です(X199i搭載Kria AI SOMの製品化・供給条件は各ODMに要確認)。
VLA(Vision-Language-Action)推論——Physical AIの中核ユースケース
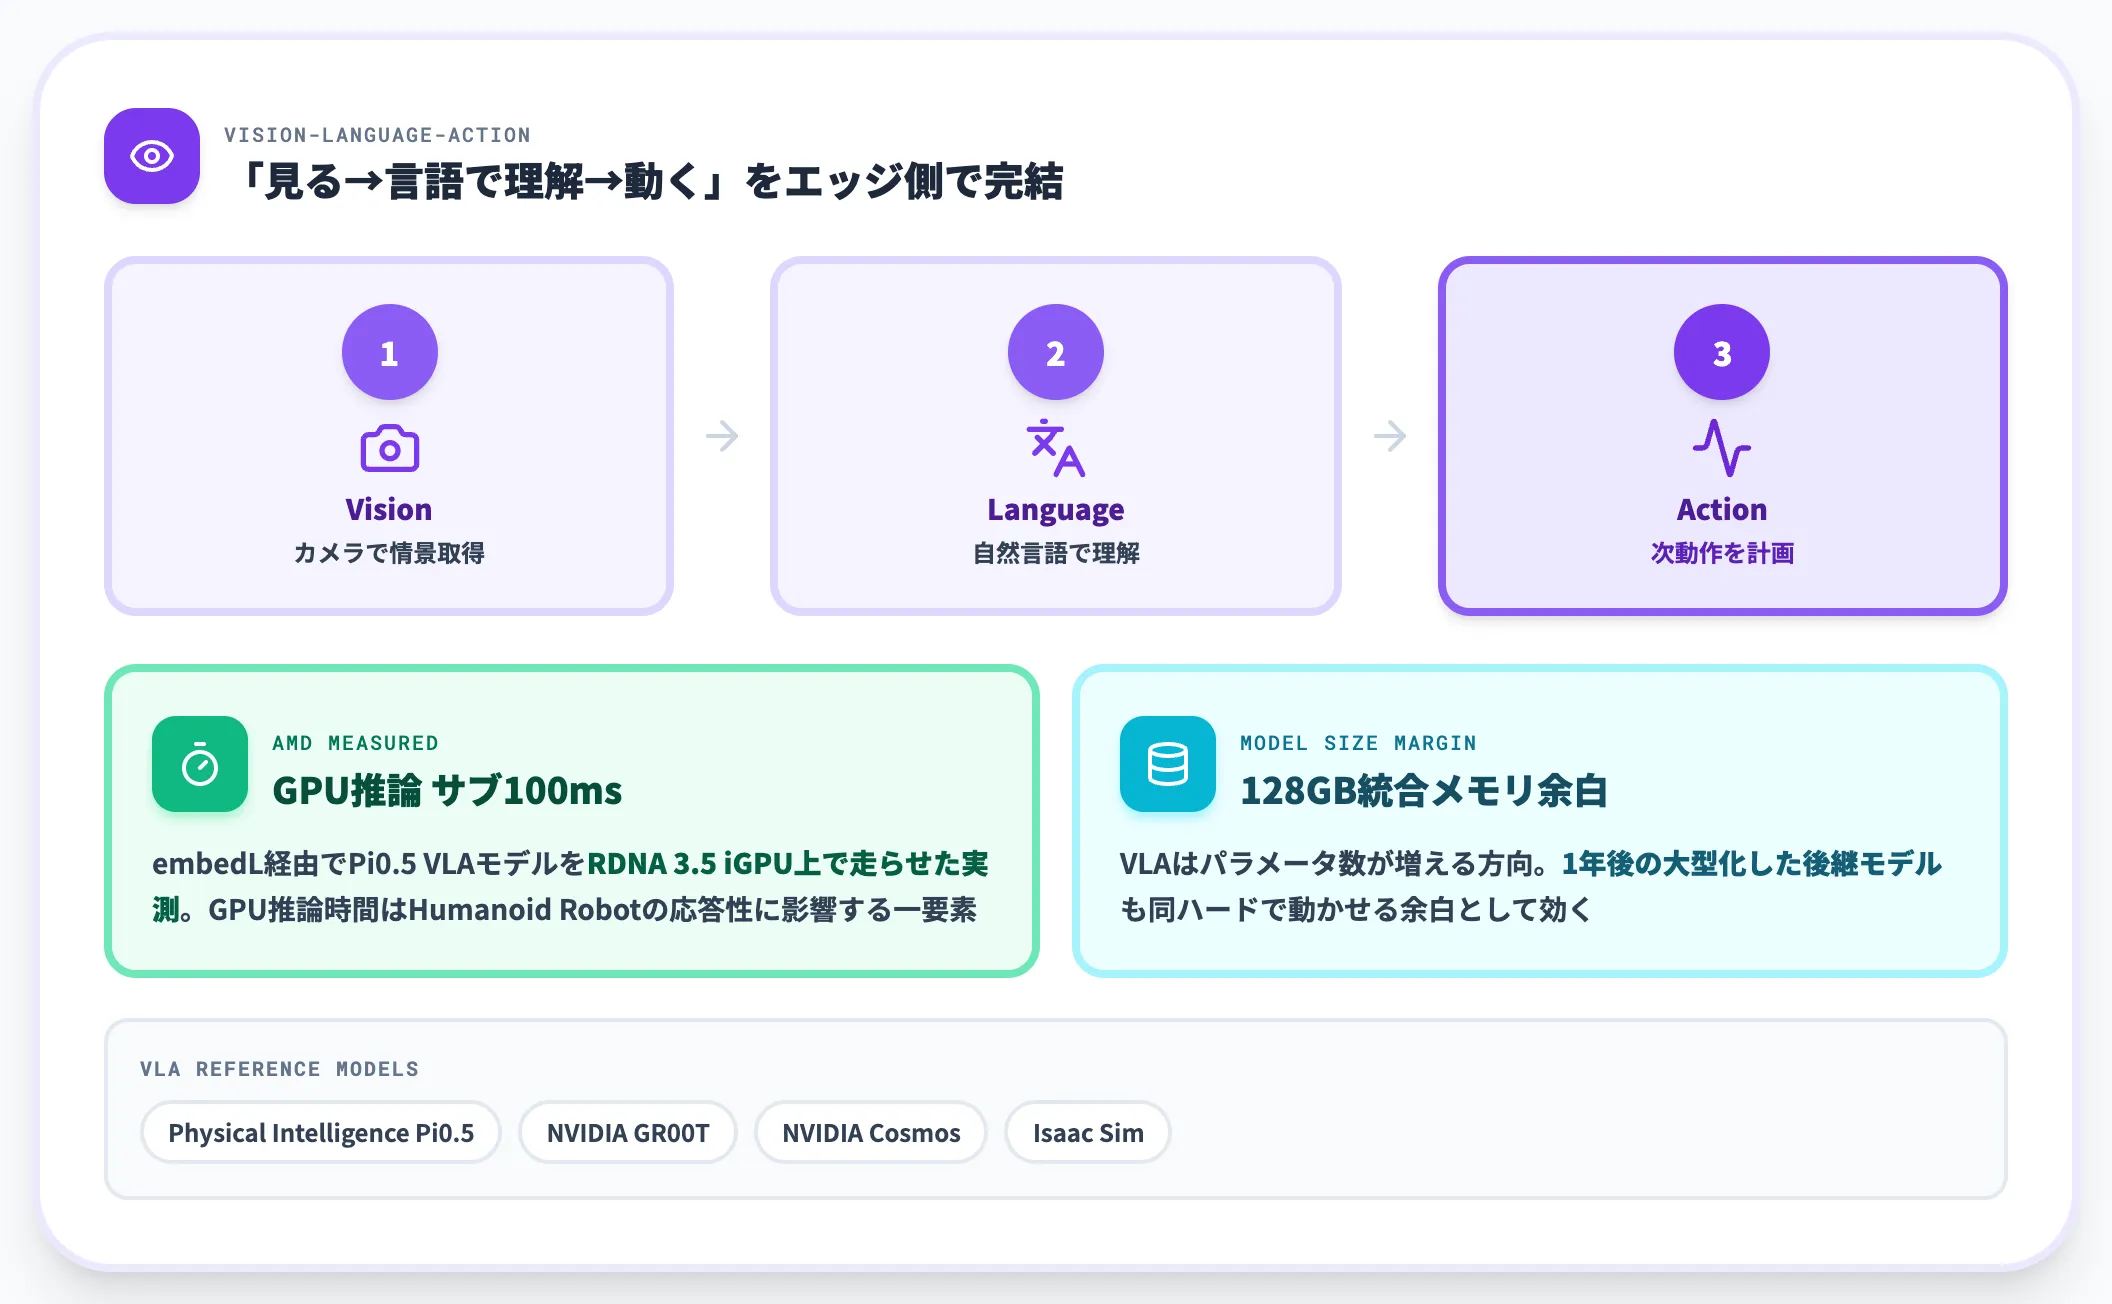
Physical AIの中核となるのがVLA(Vision-Language-Action)モデルです。VLAは「カメラで見た情景を言語で理解し、次の動作を計画する」ロボット向けの大規模モデルで、Physical IntelligenceやNVIDIA GR00T、シミュレーション基盤のNVIDIA Cosmos・Isaac Simなどが代表例です。
AMDは、embedL経由でPi0.5 VLAモデルをRDNA 3.5 iGPU上で走らせた実測としてGPU推論単体でサブ100msの推論時間を公表しています(脚注1:AMD Advancing AI 2026発表)。
サブ100msはAMDがVLA推論の低遅延性を示す指標であり、GPU推論時間はHumanoid Robotの応答性に影響する一要素です(センサー入力からアクチュエータ動作までのエンドツーエンド応答時間はGPU推論以外のパイプラインも含むため、別途評価が必要です)。
VLAモデルは今後もパラメータ数が増える方向にあり、128GB統合メモリという広いキャパシティは、モデル世代交代に対する余白として効いてきます。「今日出たVLAモデル」だけでなく「1年後の大型化した後継モデル」も同じハードで動かせる可能性を残す設計です。
AMD Kria AI Robotics Developer Platform——ターンキー評価キットの構成
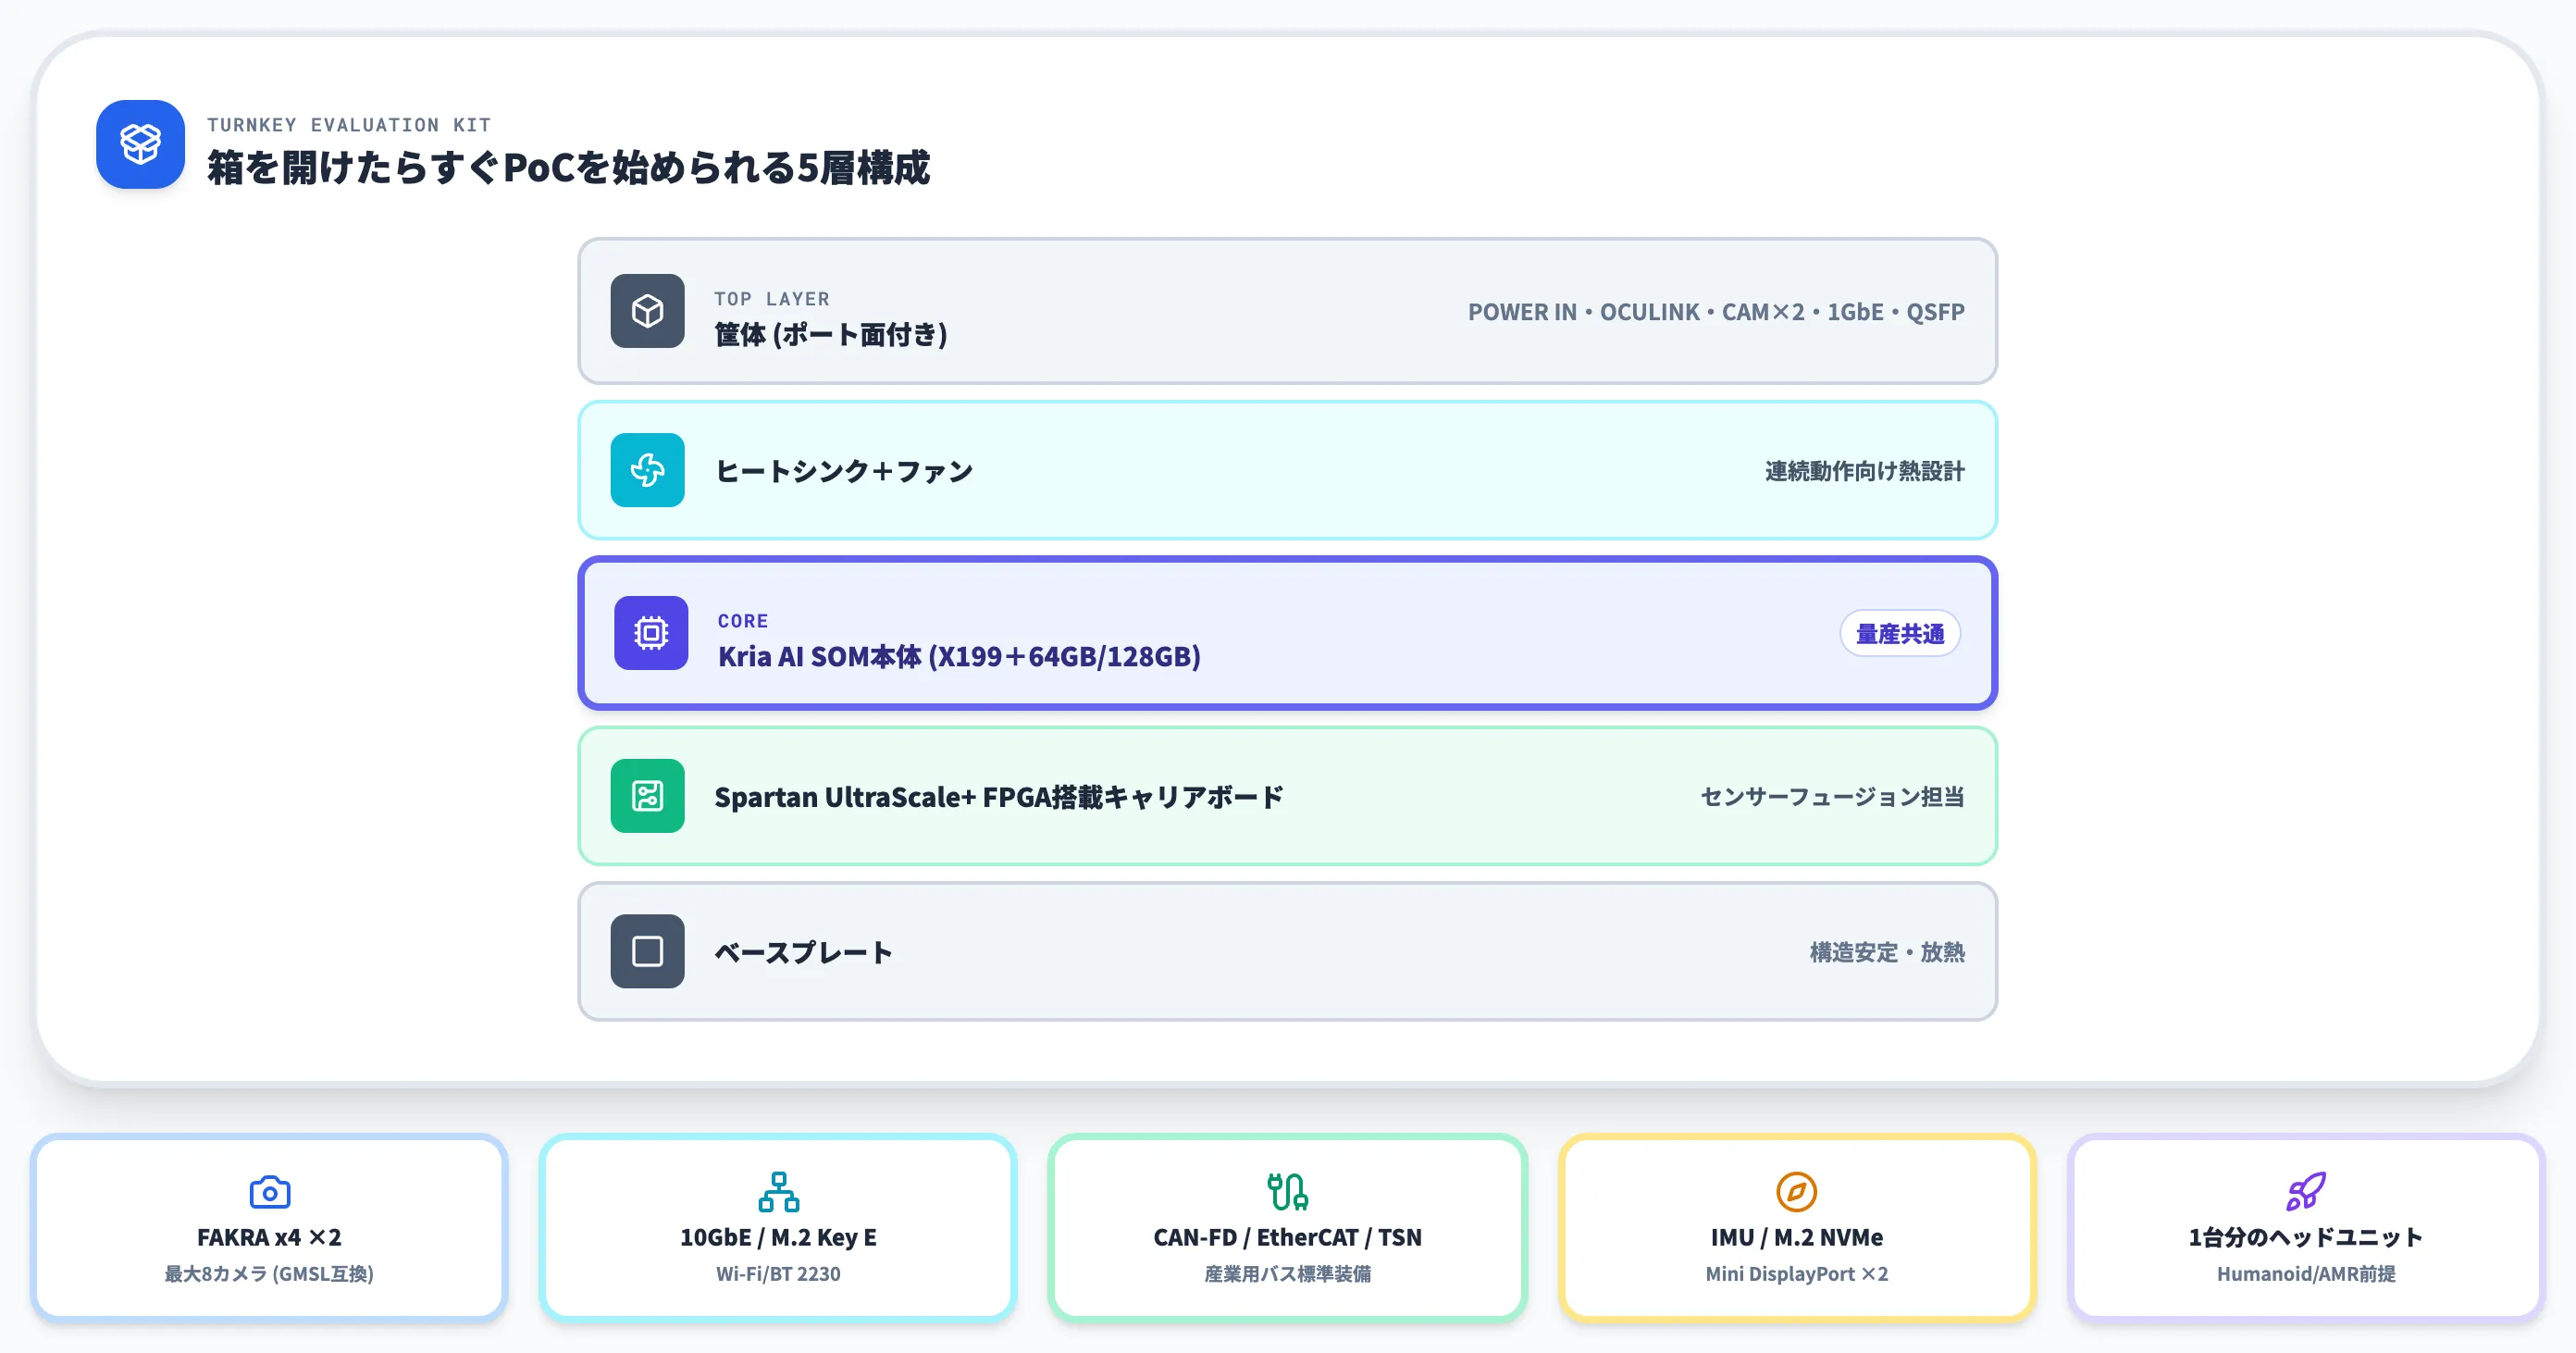
Kria AI SOMを個別に扱うのではなく、AMDが同時発表したのがAMD Kria AI Robotics Developer Platformです。SOM単体では評価が難しい実装をPoCまで一気通貫でカバーする、ターンキー評価キットとして提供されます。
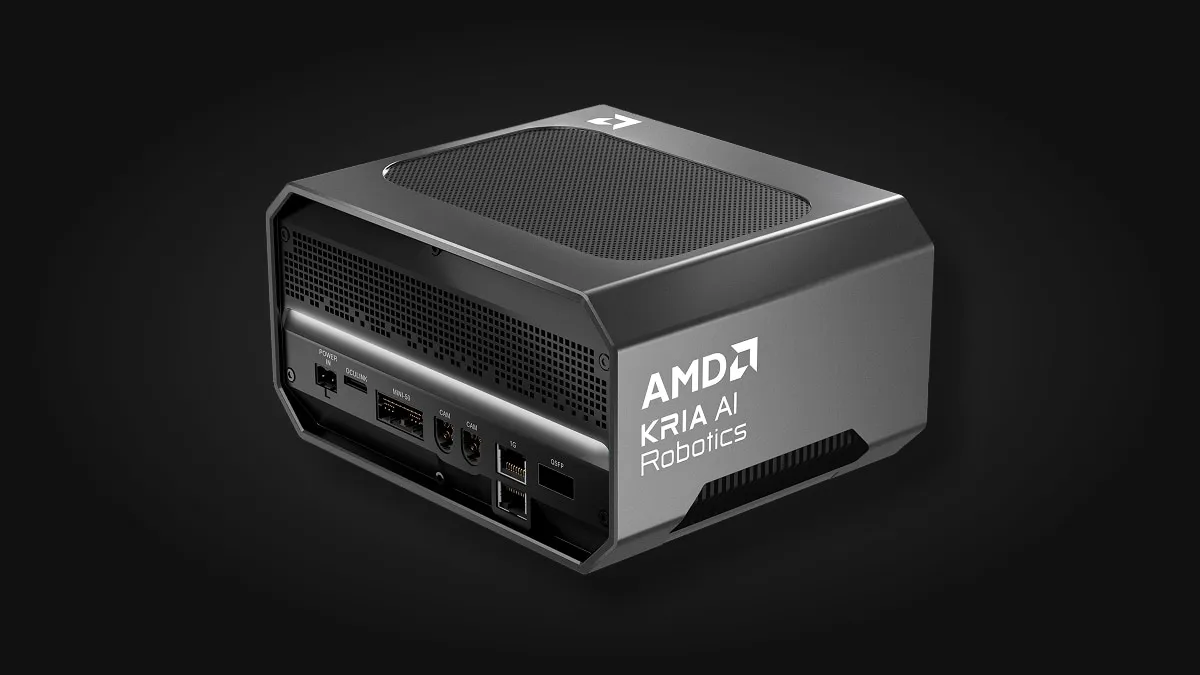
AMD Kria AI Robotics Developer Platformの完成品筐体(前面にPOWER IN・OCULINK・MINI-SO・CAM×2・1GbE・QSFPポートを配置)(出典:AMD Kria AI Solutions)
プラットフォーム構成——SOM+キャリア+周辺一式
Developer Platformの物理レイヤー構成は、上段の筐体(ポート面付き)→ヒートシンク+ファン→Kria AI SOM本体(Ryzen X100搭載)→Spartan UltraScale+ FPGAを載せたキャリアボード→ベースプレートという5層です。SOMを取り外して別キャリアに組み替える将来的な拡張・カスタマイズも視野に入った設計になっており、量産時にSOM本体を共通化しつつキャリアだけ独自設計する運用が現実的にできます。
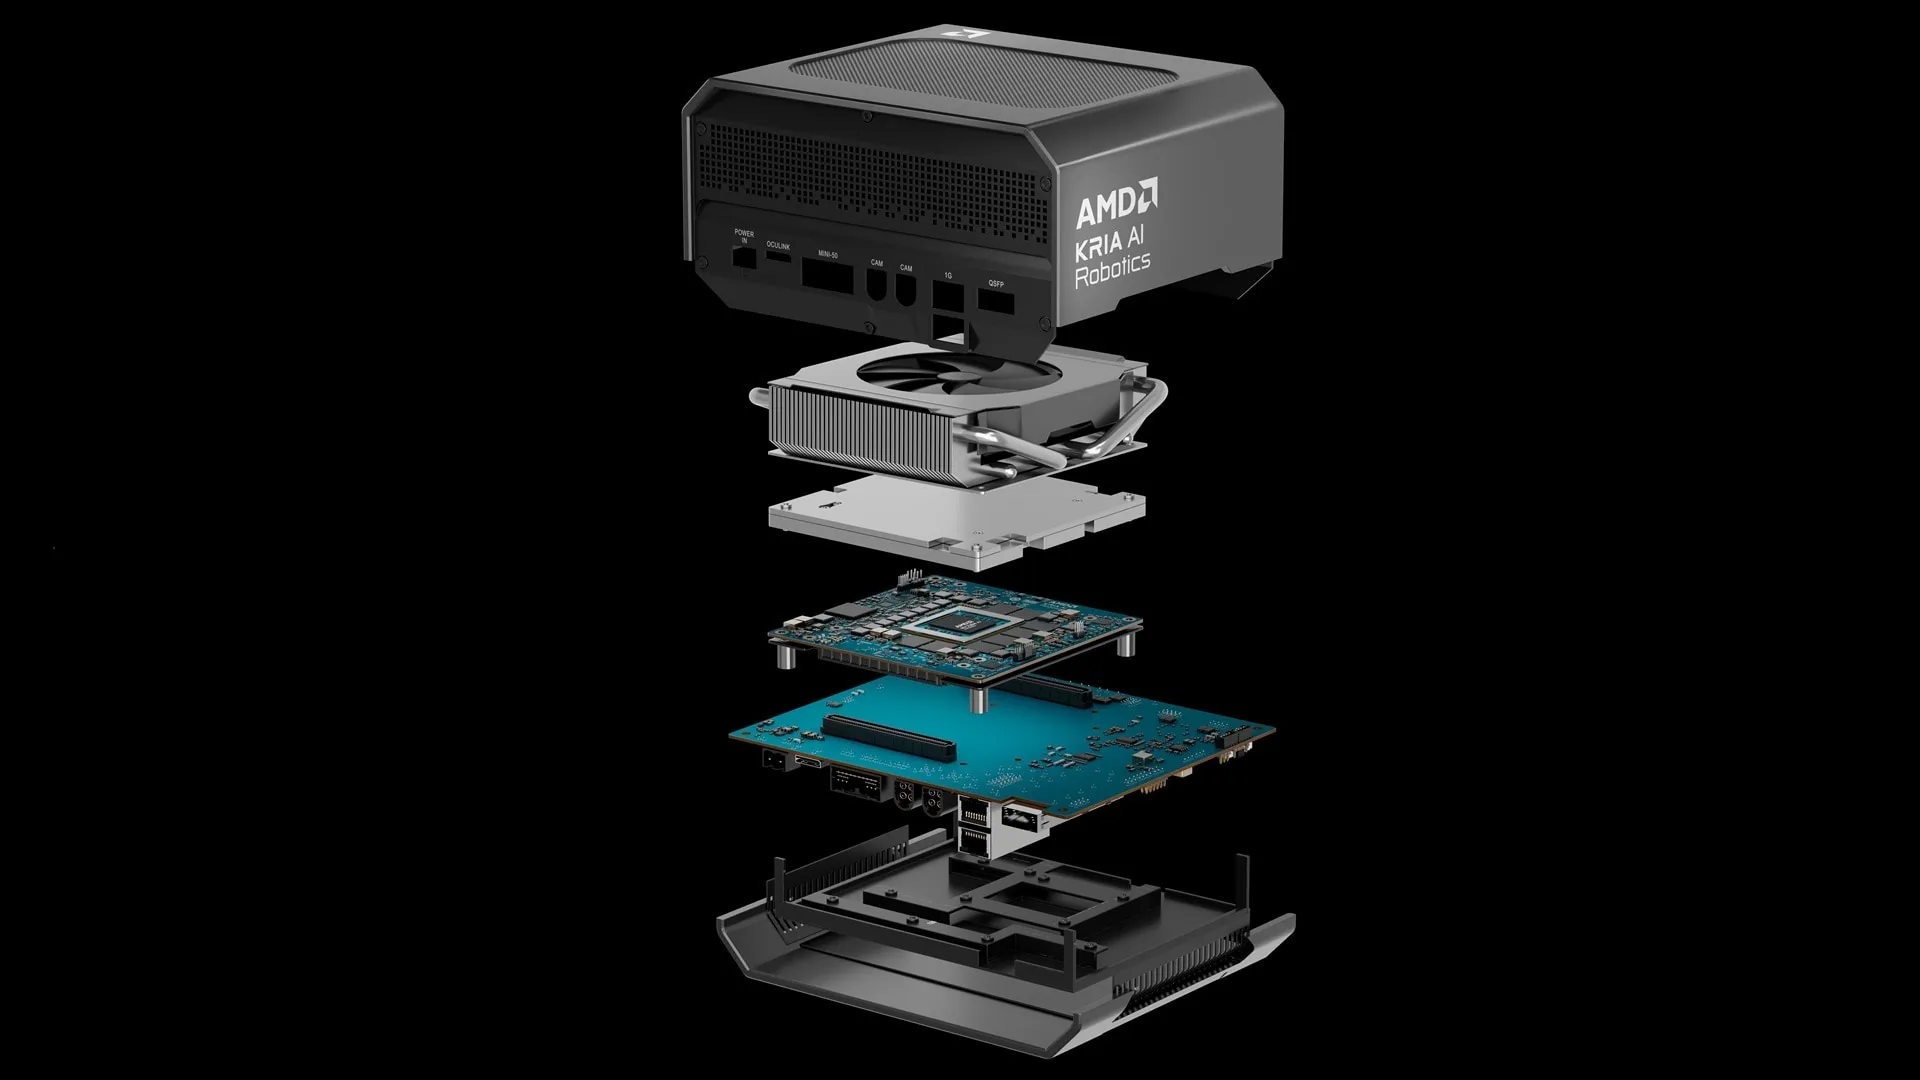
Kria AI Robotics Developer Platformの分解構造(上から筐体・ヒートシンク/ファン・Kria AI SOM本体・キャリアボード・ベースプレートの5層構成)(出典:AMD Newsroom AAI 2026)
Kria AI Robotics Developer Platformの構成は以下のとおりです。
単体のSOMを買って自分でキャリアを設計する必要がなく、箱を開けたらセンサーを繋いですぐPoCが始められる構成になっています。
-
Kria AI SOM本体
X199(16C+40CU)、64GBまたは128GB LPDDR5xメモリ搭載
-
Spartan UltraScale+ FPGA搭載キャリアボード
センサーフュージョン・カスタムI/O・独自プロトコル処理を担当
-
カメラインターフェース
2基のFAKRA x4自動車グレードコネクタ(GMSL互換)経由で最大8カメラ入力に対応
-
ネットワーク・通信
10 Gigabit Ethernet・M.2 2230 Key EのWi-Fi/Bluetooth用ソケット・産業用CAN-FD・EtherCAT/TSN対応
-
センサー・入出力
IMU(慣性計測装置)搭載、M.2 NVMeソケット、デュアルMini DisplayPort
この構成は、単に「開発ボード」というより、Humanoid RobotやAMR一台分のヘッドユニットを丸ごと想定した設計です。
実際にロボット筐体に組み込むときの配線・センサー配置を、開発段階からそのままシミュレーションできる想定です。
想定される開発ワークフロー
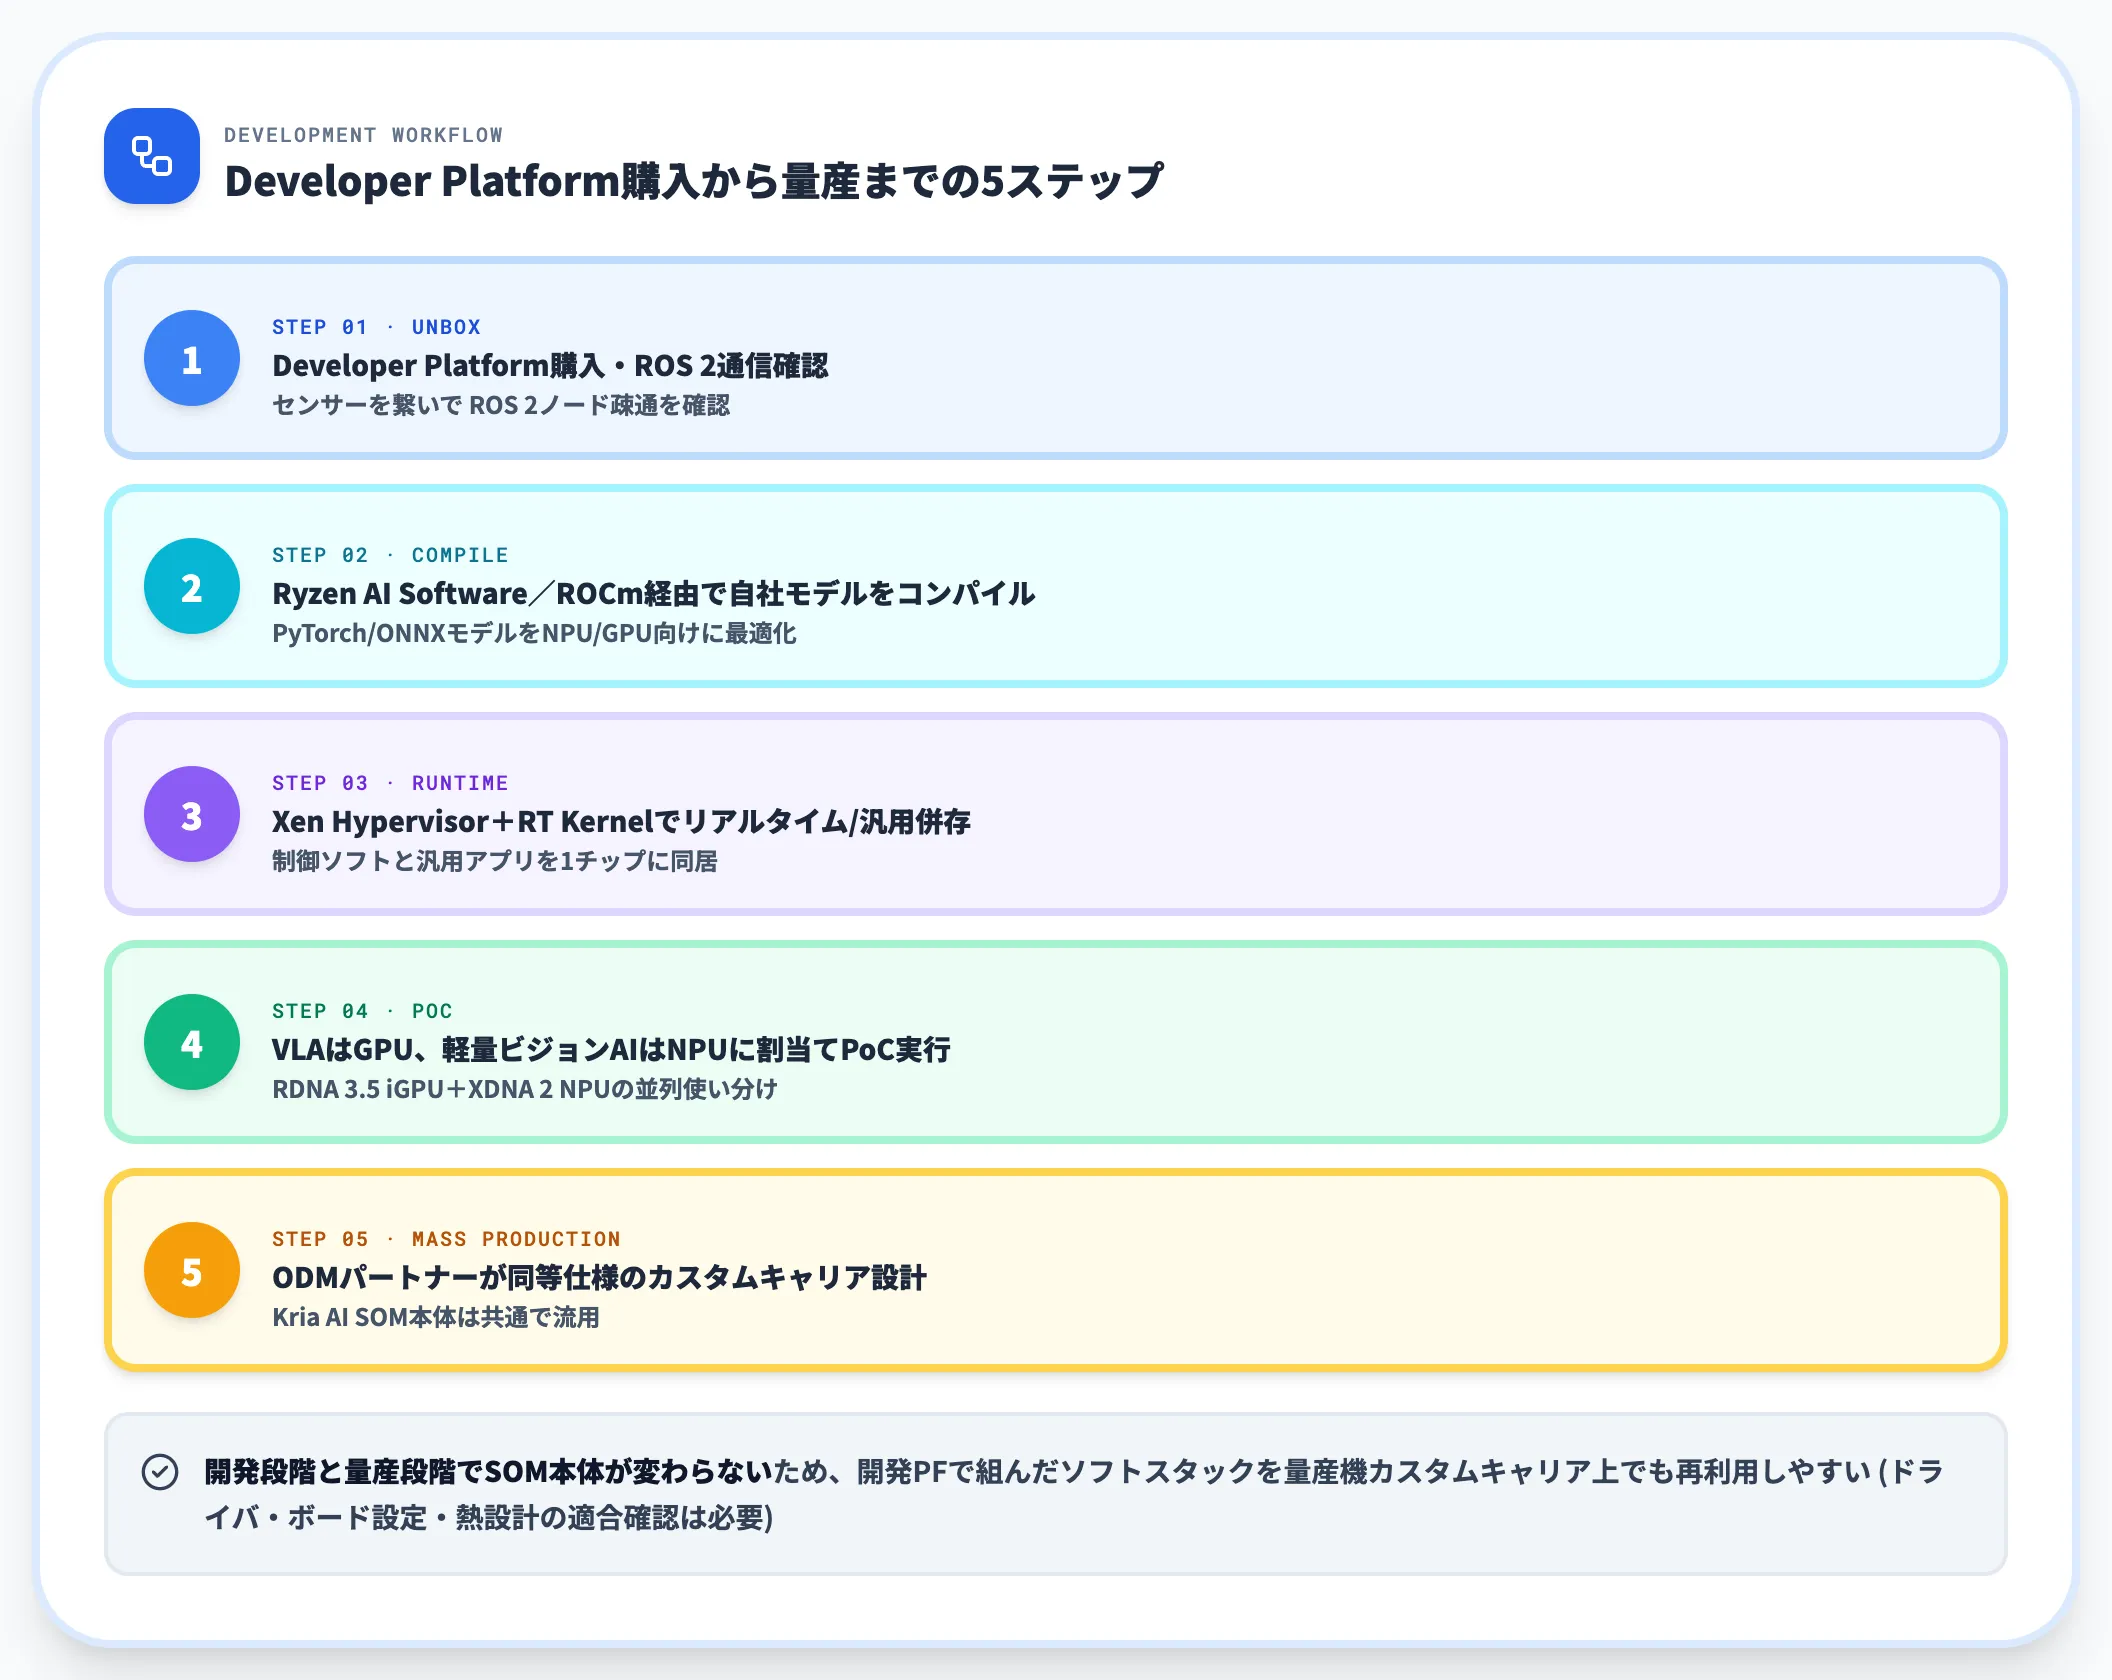
Kria AI Robotics Developer Platformが想定する開発ワークフローは、大まかに以下の流れです。
- Developer Platformを購入し、センサーを繋いでROS 2で通信を確認する
- Ryzen AI Software/ROCm経由で自社モデル(PyTorch/ONNX)をコンパイル・NPU/GPU向けに最適化する
- Xen Hypervisor+RT Kernel上で、リアルタイム制御ソフトと汎用アプリを併存で動かす
- VLAモデルはGPU(RDNA 3.5 iGPU)で、対応する軽量ビジョンAIモデルはNPUに割り当ててPoC実行
- 量産段階でODMパートナーが同等仕様のカスタムキャリアを設計、Kria AI SOM本体は共通で流用
ここでのポイントは、開発段階と量産段階でSOM本体が変わらないことです。開発PFで組んだソフトウェアスタックを、量産機のカスタムキャリア上でも再利用しやすい(ドライバ・ボード設定・熱設計の適合確認は必要)ため、開発から量産までのソフト移植コストを抑えやすい設計です。
Kria AI SOMのソフトウェアスタックと開発エコシステム
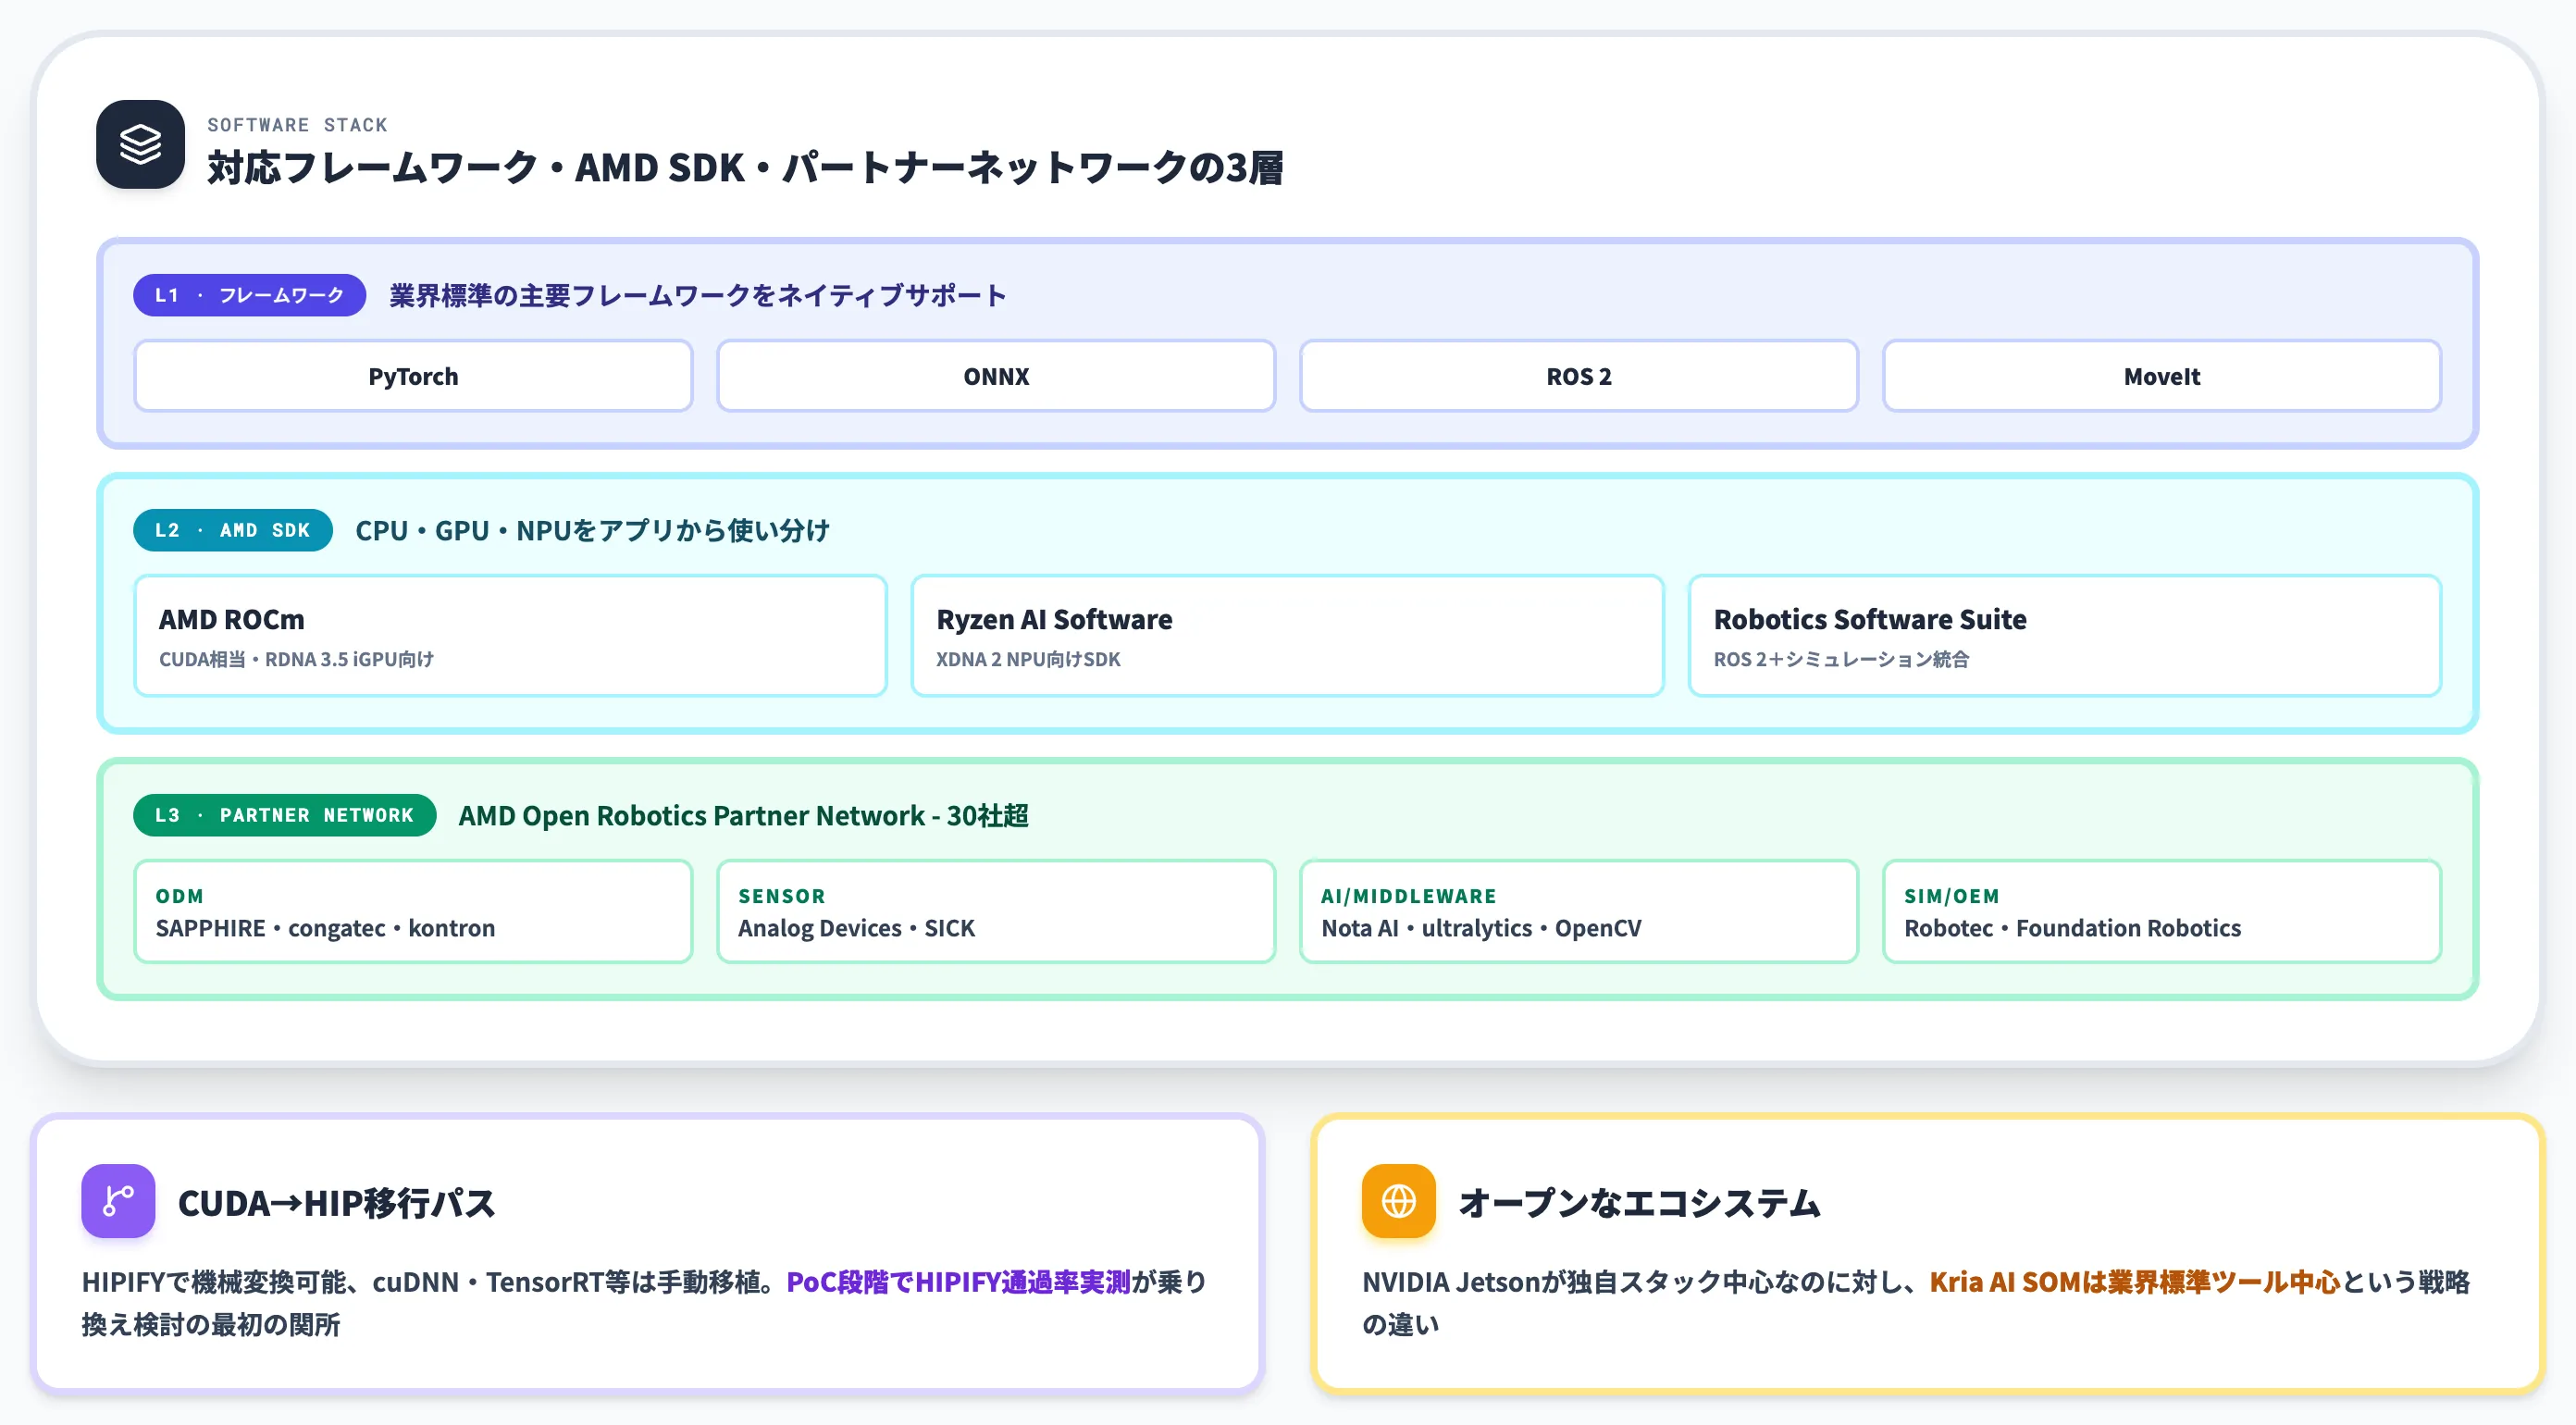
Kria AI SOMは、単体のハードウェアではなく、AMDが用意するソフトウェアスタック一式とセットで提供されます。ここでは、対応フレームワーク、AMD側の主要SDK、パートナーネットワークの3レイヤーで整理します。
対応フレームワーク——PyTorch・ONNX・ROS 2・MoveIt
Kria AI SOMは、業界標準の主要フレームワークをネイティブでサポートします。
| フレームワーク | 役割 |
|---|---|
| PyTorch | AIモデルの学習・推論の標準フレームワーク。ONNX変換前提の元モデル |
| ONNX | フレームワーク横断のモデル交換フォーマット。デプロイの共通言語 |
| ROS 2 | ロボット向けのミドルウェア。センサー通信・動作計画の標準 |
| MoveIt | ROS上で動作するマニピュレーション・動作計画ライブラリ |
この4本立ては、Physical AIエンジニアが「今使っている道具」の主要フレームワークを利用できる構成です。従来Kria(Vitis AI中心)から乗り換える場合も、業界標準のPyTorch→ONNXの経路を活かしやすくなります。
AMD ROCm・Ryzen AI Software・Robotics Software Suite
AMDのソフトウェアスタックは2大系統に分かれます。Robotics Core SDK側はロボットの動作生成・シミュレーション(ROS 2・NAV2・MoveIt2・GAZEBO)を、Physical AI SDK側はAIモデルの実行と最適化(ROCm・Ryzen AI Software・PyTorch・TensorFlow)を担い、両者が下段のCPU/GPU/NPU(=Kria AI Roboticsハードウェア)を共有する構成です。
ロボット制御とAI推論を別々のSDKで書きながら、実行時は同じハードで並列に走らせられるのが、Kria AI SOMのソフトウェア面での特徴になります。
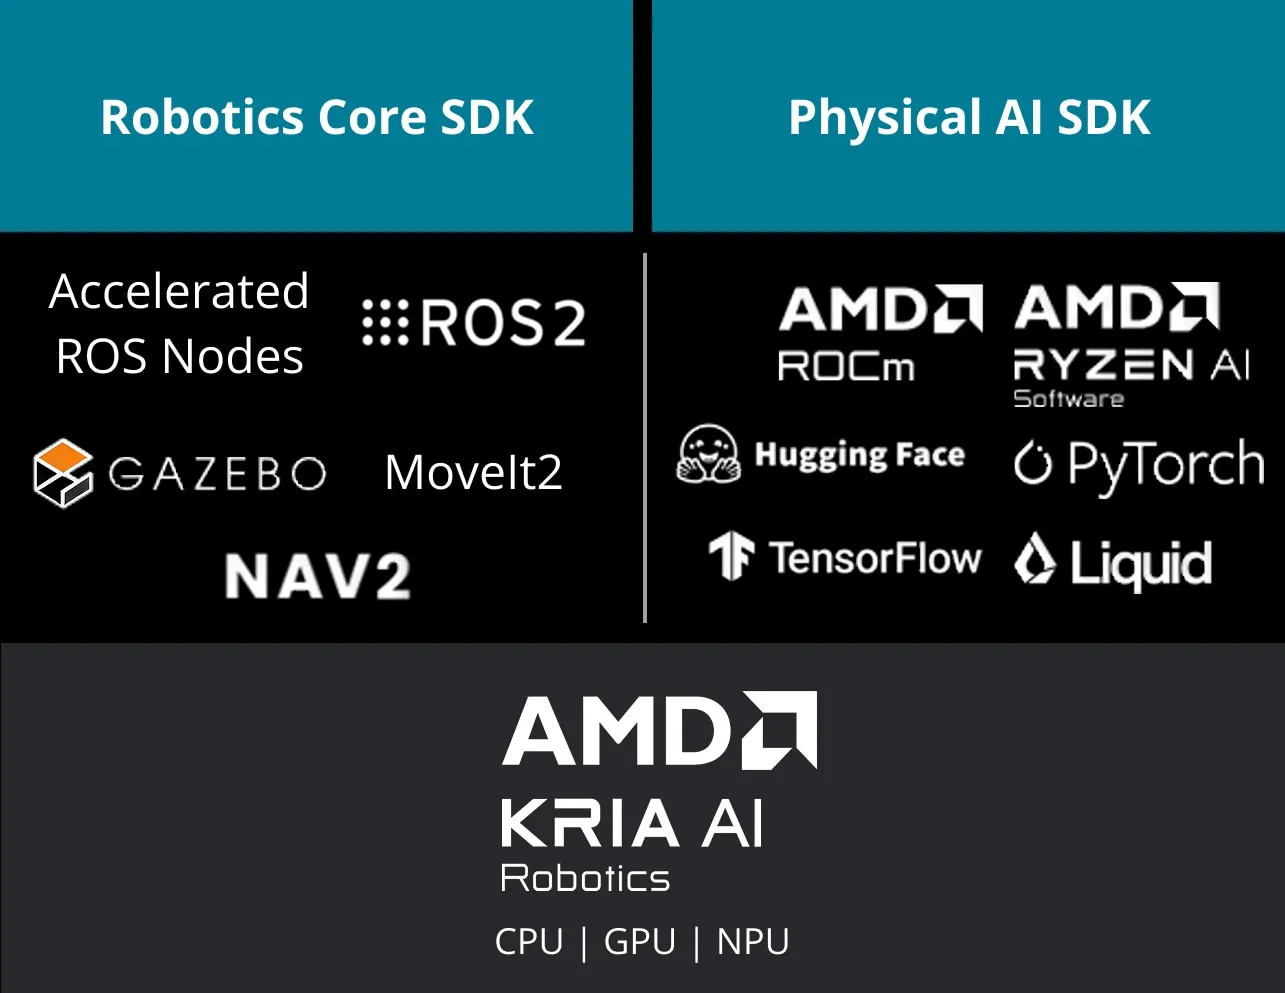
AMDが用意するPhysical AI向けソフトウェアスタックの2大系統(左:Accelerated ROS Nodes・ROS2・GAZEBO・MoveIt2・NAV2などのRobotics Core SDK/右:AMD ROCm・Ryzen AI Software・Hugging Face・PyTorch・TensorFlow・LiquidなどのPhysical AI SDK)(出典:AMD Kria AI Solutions)
AMD側が用意するSDK群は以下の3本が公式スタックの中心です。それぞれ担う層が異なります。
-
AMD ROCm
NVIDIA CUDAに相当するGPU計算ライブラリ。RDNA 3.5 iGPU向けの推論・並列計算をカバー
-
AMD Ryzen AI Software
Ryzen AI Embedded X100固有のNPU(XDNA 2)向けSDK。NPU向けモデルコンパイル・最適化を担当
-
AMD Robotics Software Suite
ROS 2・MoveIt・センサードライバ・シミュレーション連携を束ねたロボット開発向け統合パッケージ
キャリア側Spartan UltraScale+ FPGAの開発ツール(Vitis AIをどう位置づけるか等)は、2026年9月時点でAMDから追加資料が示されていません。Vitis AI 6.2はVersal AI Edge系のGAが中心で、Spartan UltraScale+向けの利用可否・推奨SDKは今後のAMDアナウンス待ちです。
この3本を使い分けることで、NPU・iGPU・CPUの計算リソースを1つのアプリケーションから活用できます。
逆に言えば、開発チームは複数のSDKを理解する必要があるため、後述の「導入判断で見落としがちな観点」で扱う人材要件の論点にもつながります。
CUDA→HIP移行——NVIDIA Jetsonからの乗り換えパス
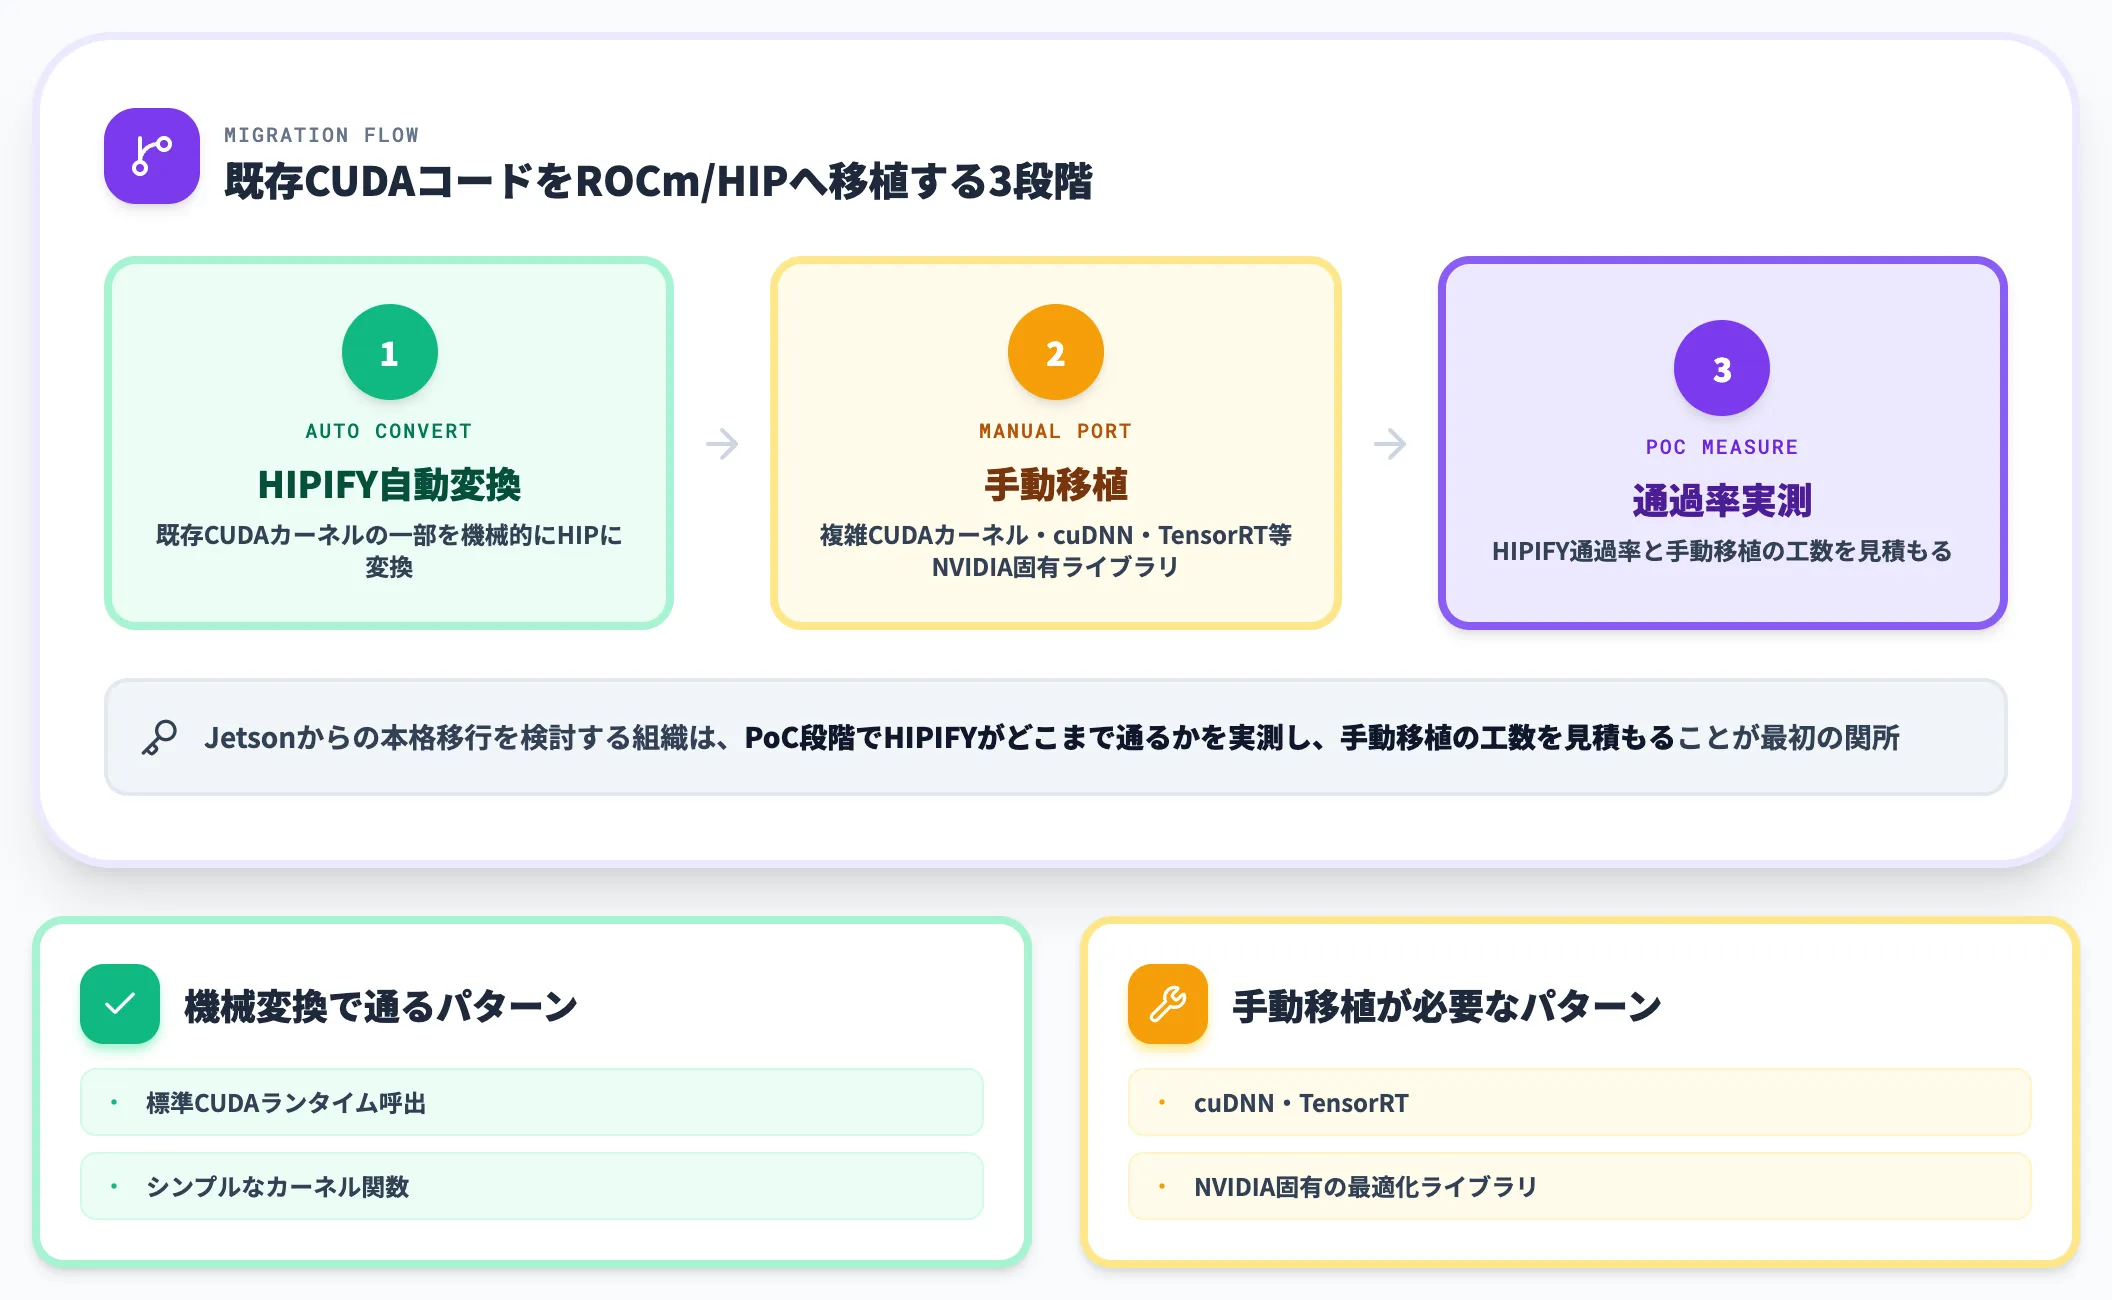
NVIDIA JetsonからKria AI SOMへの移行を検討する場合、最大の論点が既存のCUDAコードをROCm/HIPへ移植する作業量です。
AMDはCUDAコードをHIP(Heterogeneous-Compute Interface for Portability)に自動変換する「HIPIFY」ツールを提供しており、既存のCUDAカーネルの一部は機械的に変換できます。ただし複雑なCUDAカーネル・NVIDIA固有ライブラリ(cuDNN・TensorRT等)を使っている箇所は手動変換が必要になります。
Jetsonからの本格移行を検討する組織は、PoC段階でHIPIFYがどこまで通るかを実測し、手動移植の工数を見積もることが最初の関所になります。
AMD Open Robotics Partner Network——30社超のエコシステム
パートナーネットワークは3レイヤー×7カテゴリで構成されます。
Platform & Reference SystemsにはARBOR・congatec・iBASE・iEi・kontron・SAPPHIRE・SEAVOなどのODMが並び、Open Robotics AI StackにはArchetype・Liquid・Nota AI・ultralytics・OpenCV・open robotics・QNXなどのAIモデルとミドルウェアが揃い、Validation & Physical AI Labにはmachineering・ROBOTECのシミュレーションとdigital twin consortium・mass roboticsの業界団体が入ります。
ODMからシミュレーション・団体までを1つのエコシステムに束ねることで、開発から量産までの時間短縮(Time-to-Market)を狙う設計です。
Kria AI SOMと同時に発表されたのが、AMD Open Robotics Partner Networkです。ODM・ISV・センサーベンダー・シミュレーションプロバイダー・システムインテグレーターを含む30社超のパートナー企業で構成される、階層型エコシステムです。
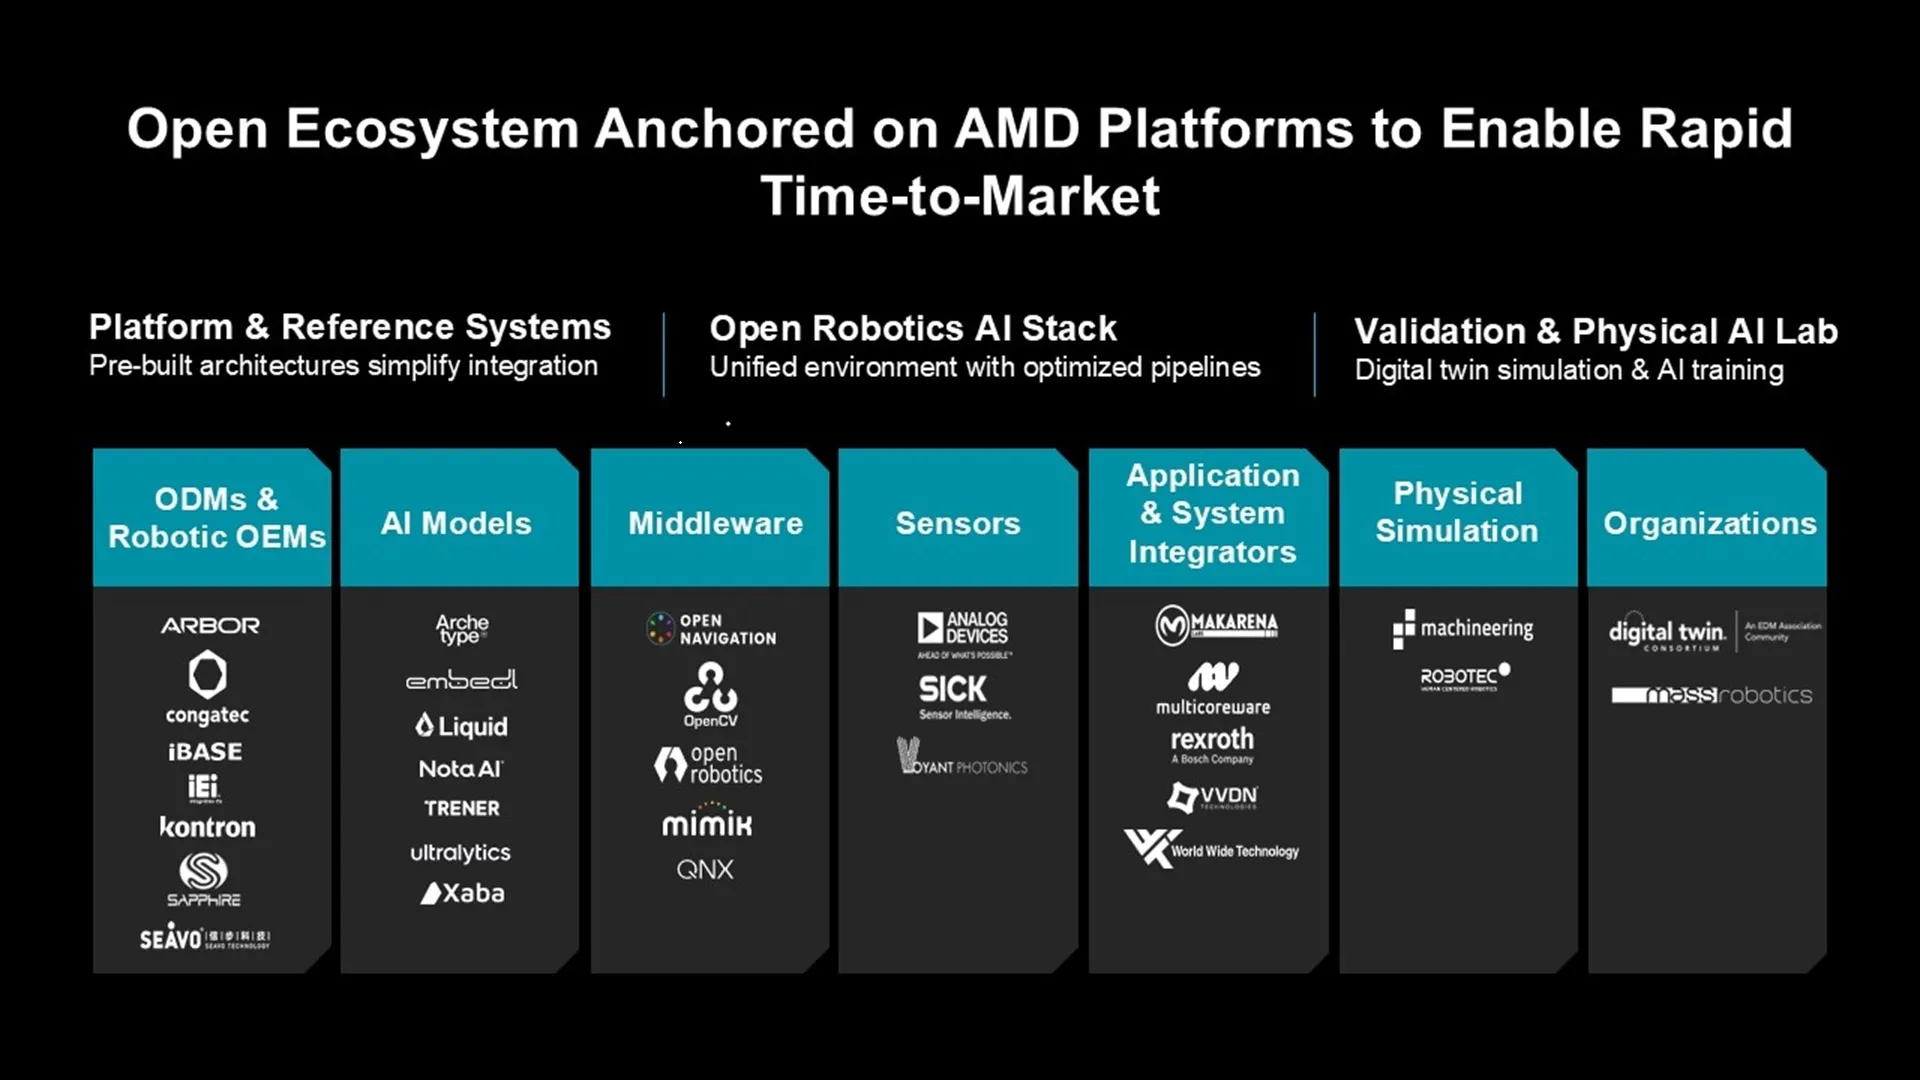
AMD Open Robotics Partner Networkの参加パートナー(発表時30社超・ODMs&Robotic OEMs/AI Models/Middleware/Sensors/Application&System Integrators/Physical Simulation/Organizationsの7カテゴリで構成)(出典:AMD Newsroom AAI 2026 Robotics Partner Network)
主要パートナーの例を挙げると、センサー層ではAnalog Devices・SICK・Voyant Photonics、ソフトウェア層ではOpen Robotics・OpenCV、デジタルツイン層ではRobotec、初期採用企業ではCastec International(半導体ファブ用AMR)・Foundation Robotics(Humanoid Robot)が参加しています。
このパートナーネットワークが意味するのは、「AMD 1社の中に閉じたSDKだけでロボットを作る」構成ではなく、「業界標準のツールとセンサーを組み合わせて開発する」オープンな枠組みであるということです。
NVIDIA Jetsonエコシステムが独自スタック中心なのに対し、Kria AI SOMは業界標準ツール中心という戦略の違いが表れています。
Kria AI SOMとNVIDIA Jetson AGX Thorの比較
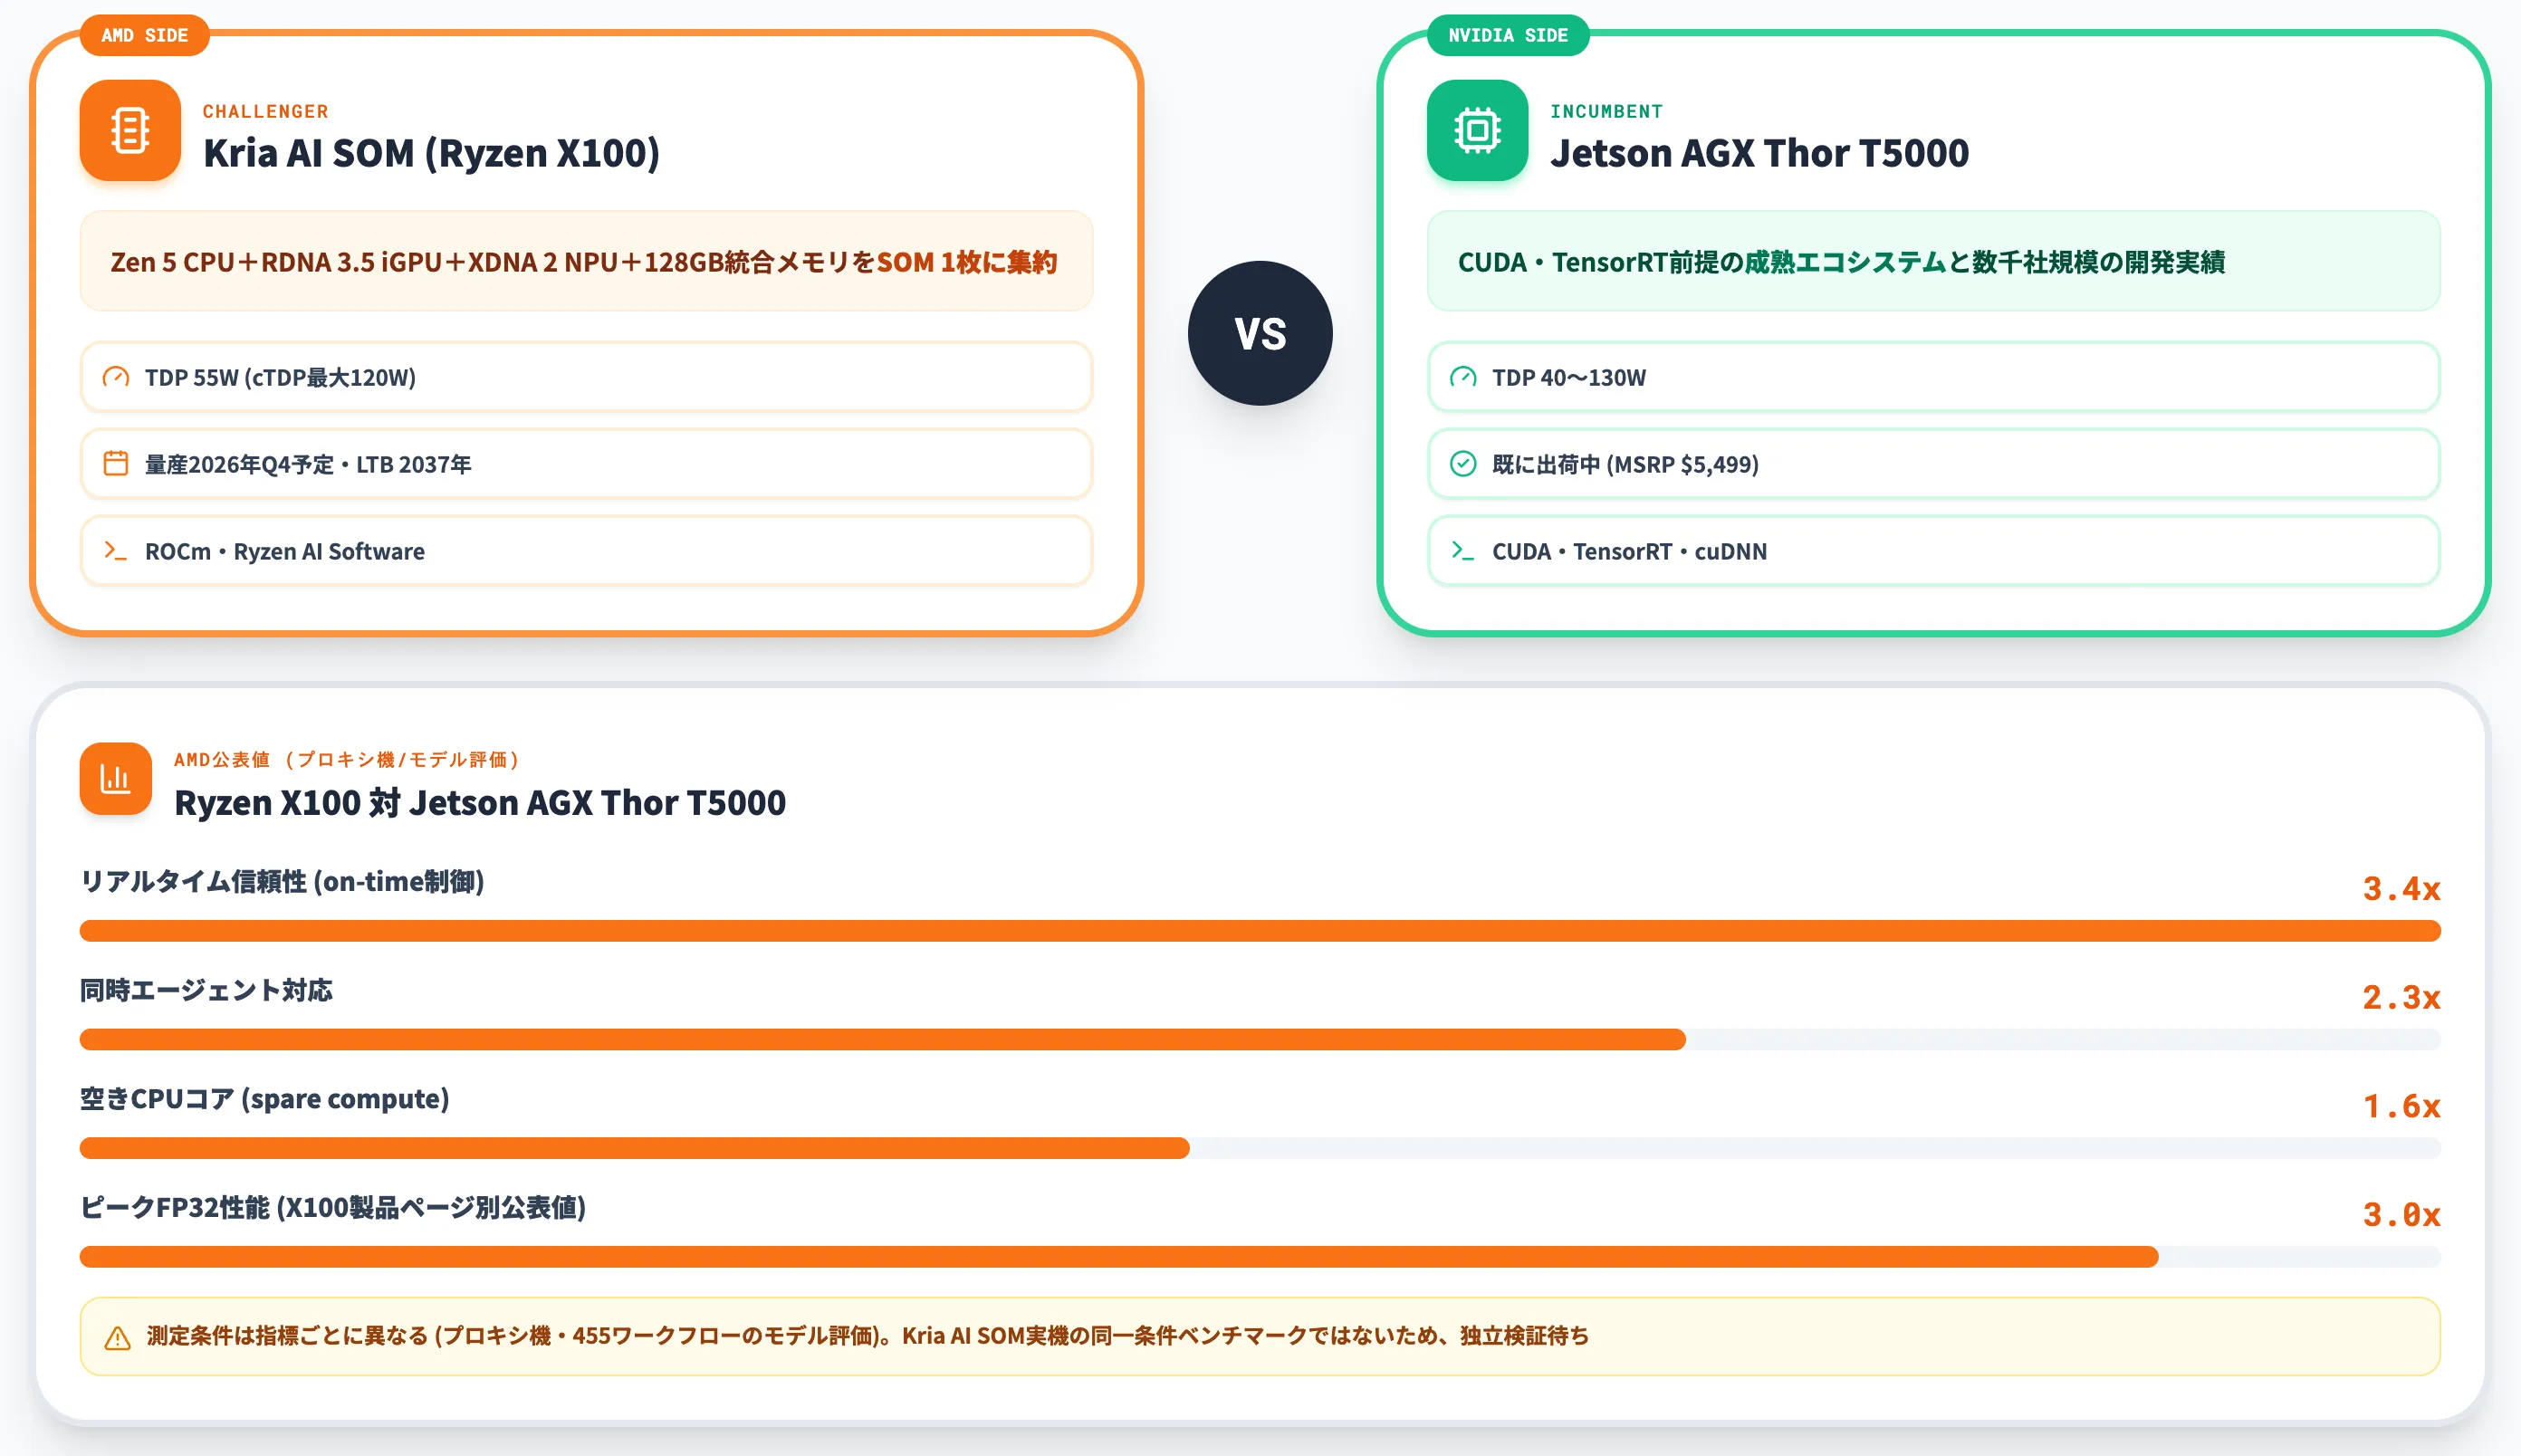
Kria AI SOMを検討する多くの読者にとって、直接の比較対象はNVIDIA Jetson AGX Thorです。
AMDは公式に「Jetson Thor T5000への対抗」を明言しているため、両者は同じ市場を狙う正面衝突の関係にあります。
AMD公表値——リアルタイム信頼性・空きCPU・同時エージェント
AMDが公式発表で公表している、Ryzen AI Embedded X100とNVIDIA Jetson Thor T5000の性能比較値は以下のとおりです。測定・算出根拠は指標ごとに異なり、Kria AI SOM実機の同一条件ベンチマークではない点に注意してください。
| 指標 | Ryzen AI Embedded X100 対 Jetson Thor T5000 | 測定条件 |
|---|---|---|
| リアルタイム信頼性(on-time制御) | 最大3.4倍 | AMD委託プロキシ機測定 |
| 空きCPUコア(spare compute) | 最大1.6倍 | AMD委託プロキシ機測定 |
| 同時エージェント対応 | 最大2.3倍(234エージェント対応) | 455ワークフローのモデル評価 |
| ピークFP32性能 | 最大3倍 | AMD X100製品ページ別公表値 |
これらの数値は全てAMD側の公表値ですが、根拠は3種類に分かれます。3.4倍・1.6倍はRyzen AI Max+ 395搭載Mini PCをX199相当に設定したAMD委託プロキシテスト、2.3倍は455ワークフローのモデル評価、ピークFP32最大3倍はAMD X100製品ページ上の別公表値です。
いずれもKria AI SOM実機ではない測定条件を含むため、同一条件での独立ベンチマークが出そろうまでは慎重に読む必要があります。「制御信頼性・CPU余剰・並列エージェント」に振った比較軸は、Physical AI向けSOMとして重視すべき指標を的確に押さえています。
消費電力とTDP——55W vs 40〜130W
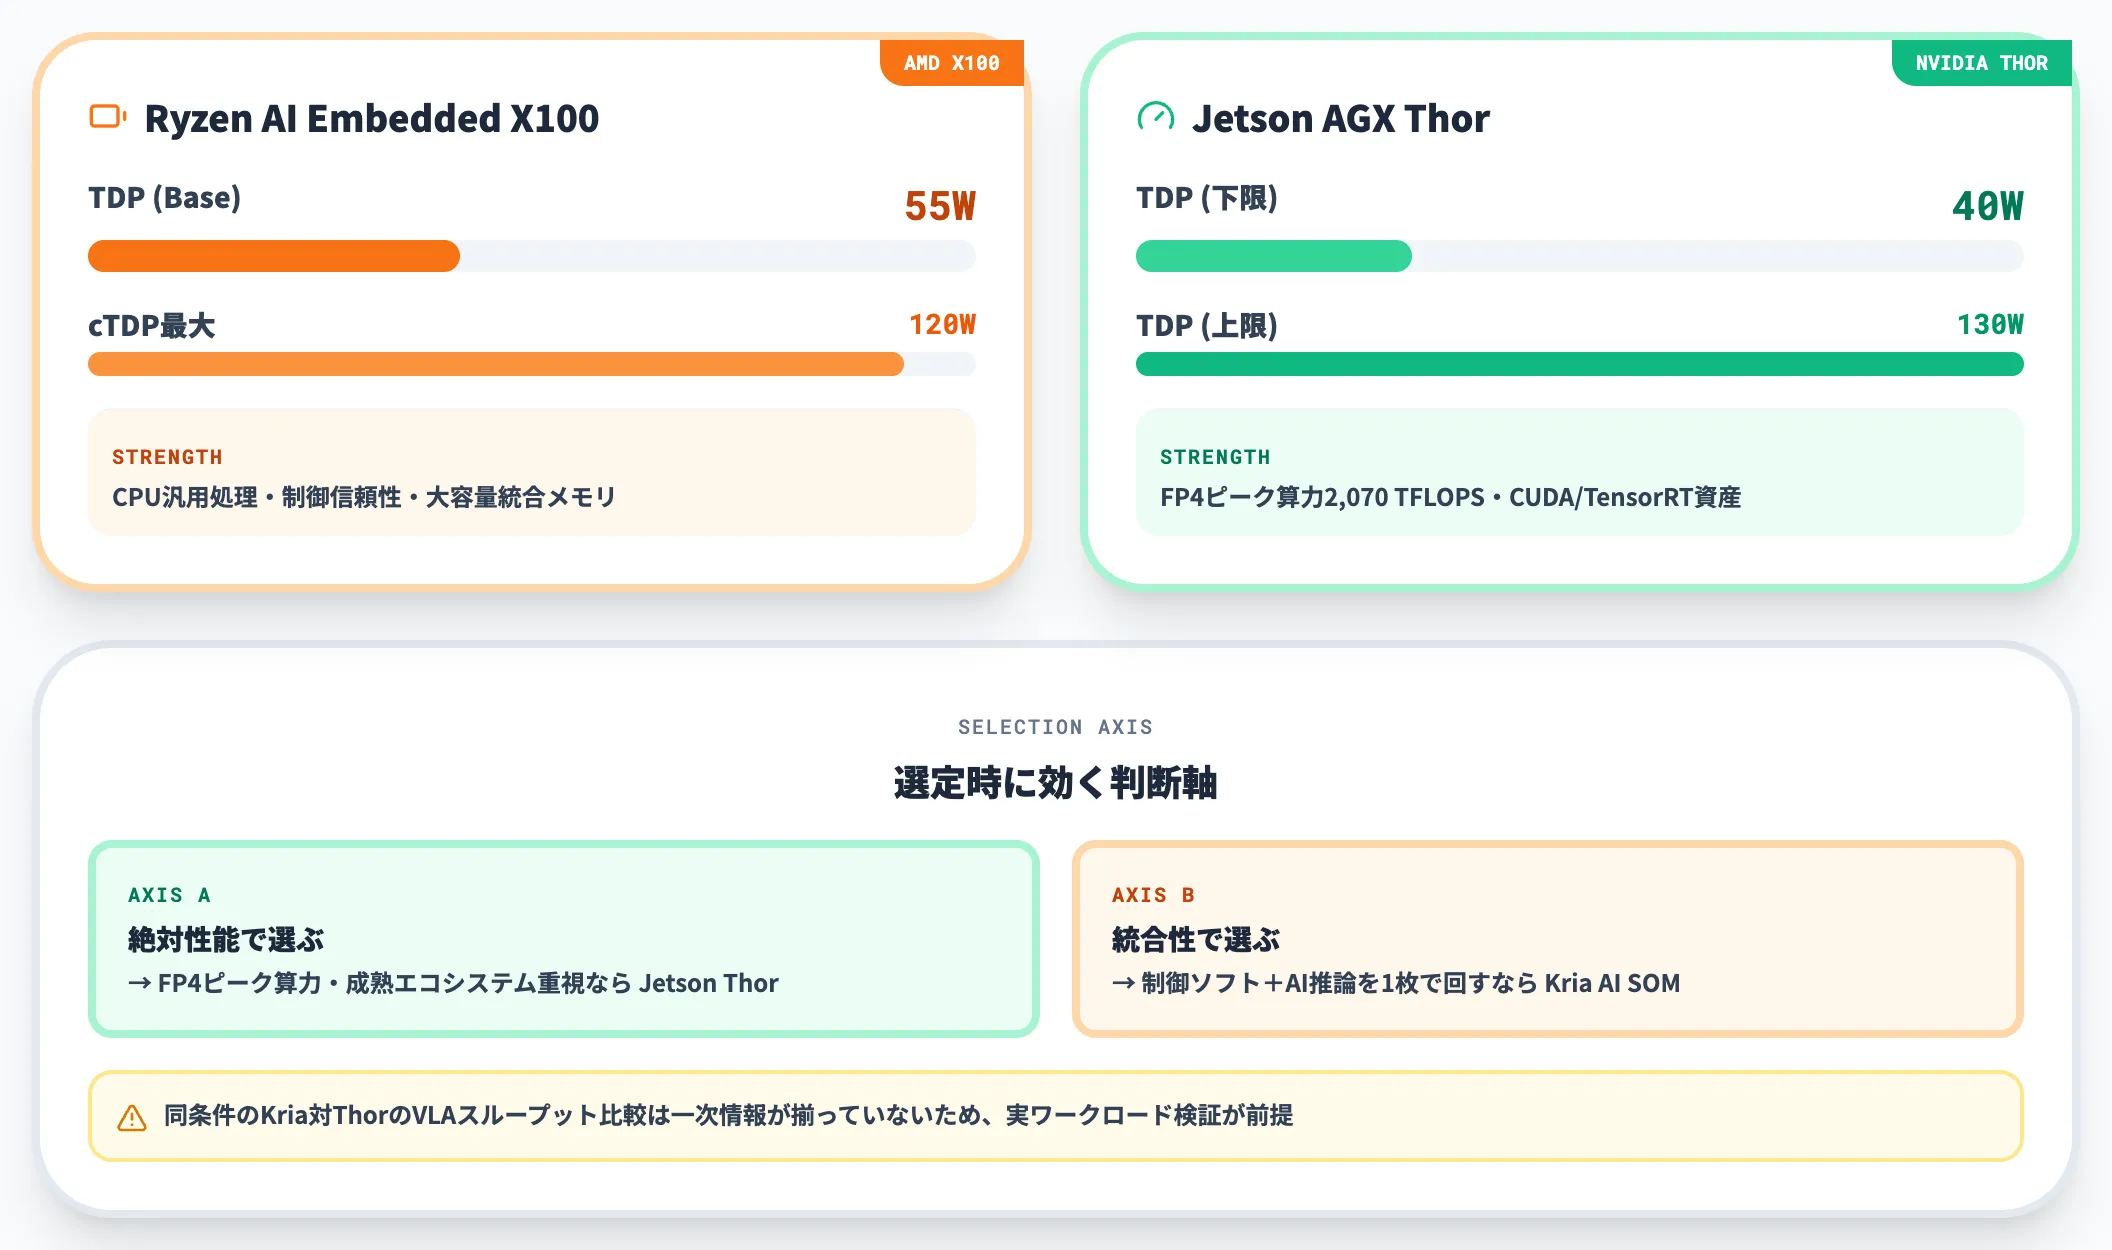
消費電力の観点では、Ryzen AI Embedded X100がTDP 55W(cTDP最大120W)、Jetson AGX Thorが40〜130Wの範囲で動作します。
ワットあたりのAI性能はJetson Thorが「AGX Orinの3.5倍」と公表しており、Jetson Thorの2,070 TFLOPS(Sparse FP4)はX100のFP32公表値とは演算精度・スパース条件が異なるため直接比較はできませんが、FP4ピーク算力の絶対値としては大きな値です。
選定時に効いてくる論点は、「絶対性能で選ぶか、CPU汎用処理・制御信頼性・大容量統合メモリで選ぶか」という軸です。
FP4ピーク算力やCUDA/TensorRT資産・成熟エコシステムを重視する場合はJetson Thorが候補、ロボット全体の制御ソフト+AI推論をSOM 1枚で回したい場合はKria AI SOMが候補となります。同条件のKria対ThorのVLAスループット比較は一次情報が揃っていないため、いずれを選ぶにしても実ワークロードでの検証が前提です。
エコシステム・エンジニア人材
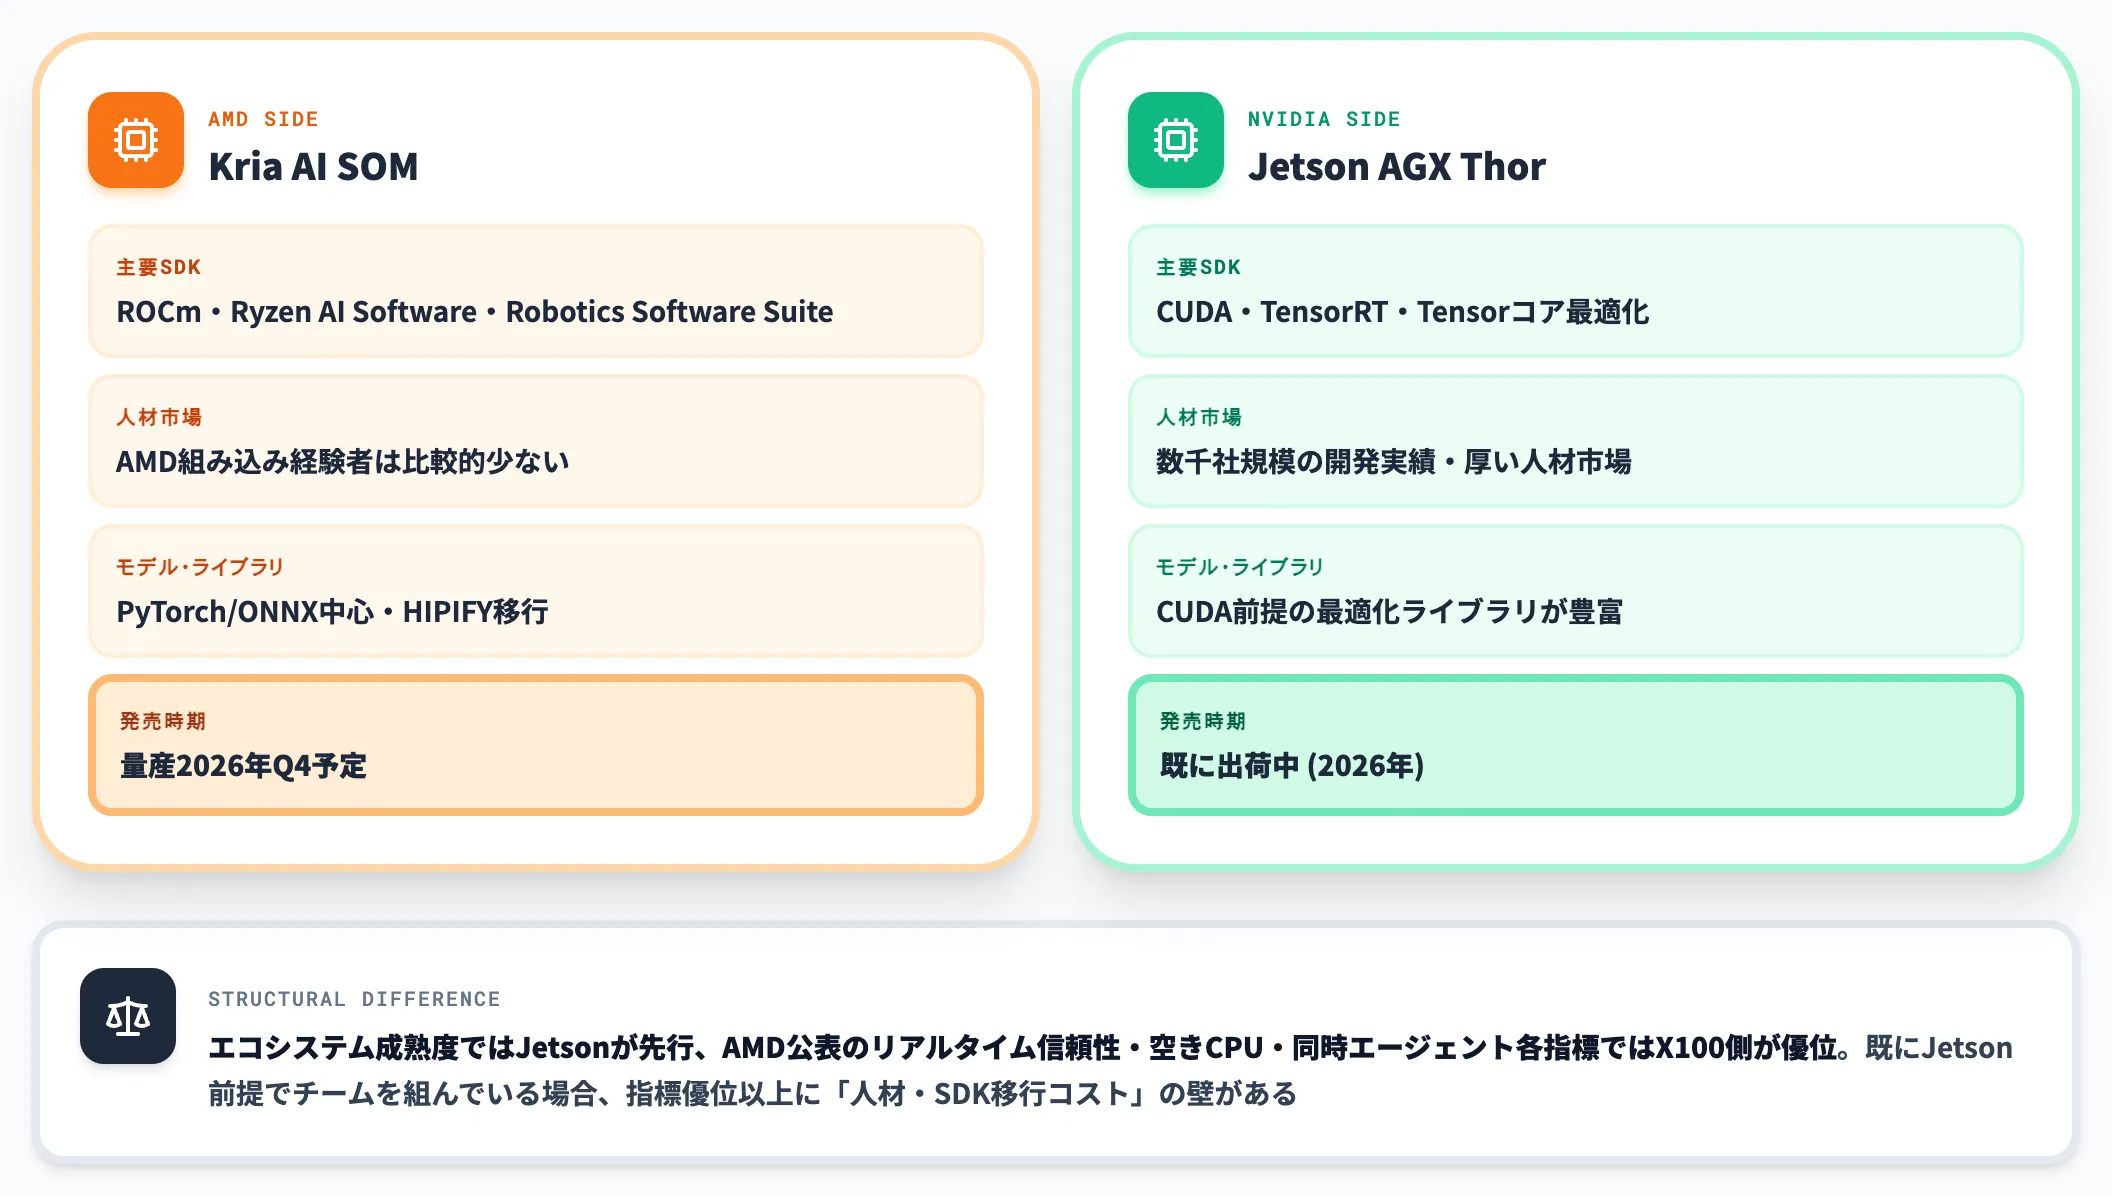
もう一つの差が、エコシステムの成熟度とエンジニア人材の入手性です。
| 項目 | Kria AI SOM | Jetson AGX Thor |
|---|---|---|
| 主要SDK | ROCm・Ryzen AI Software・Robotics Software Suite | CUDA・TensorRT・Tensorコア向け最適化 |
| エンジニア人材 | AMD組み込み経験者は比較的少ない | 数千社規模の開発実績、人材市場が厚い |
| モデル・ライブラリ | PyTorch/ONNX中心、HIPIFYでCUDA移行 | CUDA前提のNVIDIA最適化ライブラリが豊富 |
| 発売時期 | 量産2026年Q4予定 | 既に出荷中(2026年) |
この比較から読み取れるのは、エコシステム成熟度ではJetsonが先行、AMD公表のリアルタイム信頼性・空きCPU・同時エージェントの各指標ではX100側が優位という構図です。
既にJetson前提でチームを組んでいる場合、Kria AI SOMへの乗り換えは指標別の優位以上に「人材・SDK移行コスト」の壁があります。
Kria AI SOMの価格・入手性・供給保証
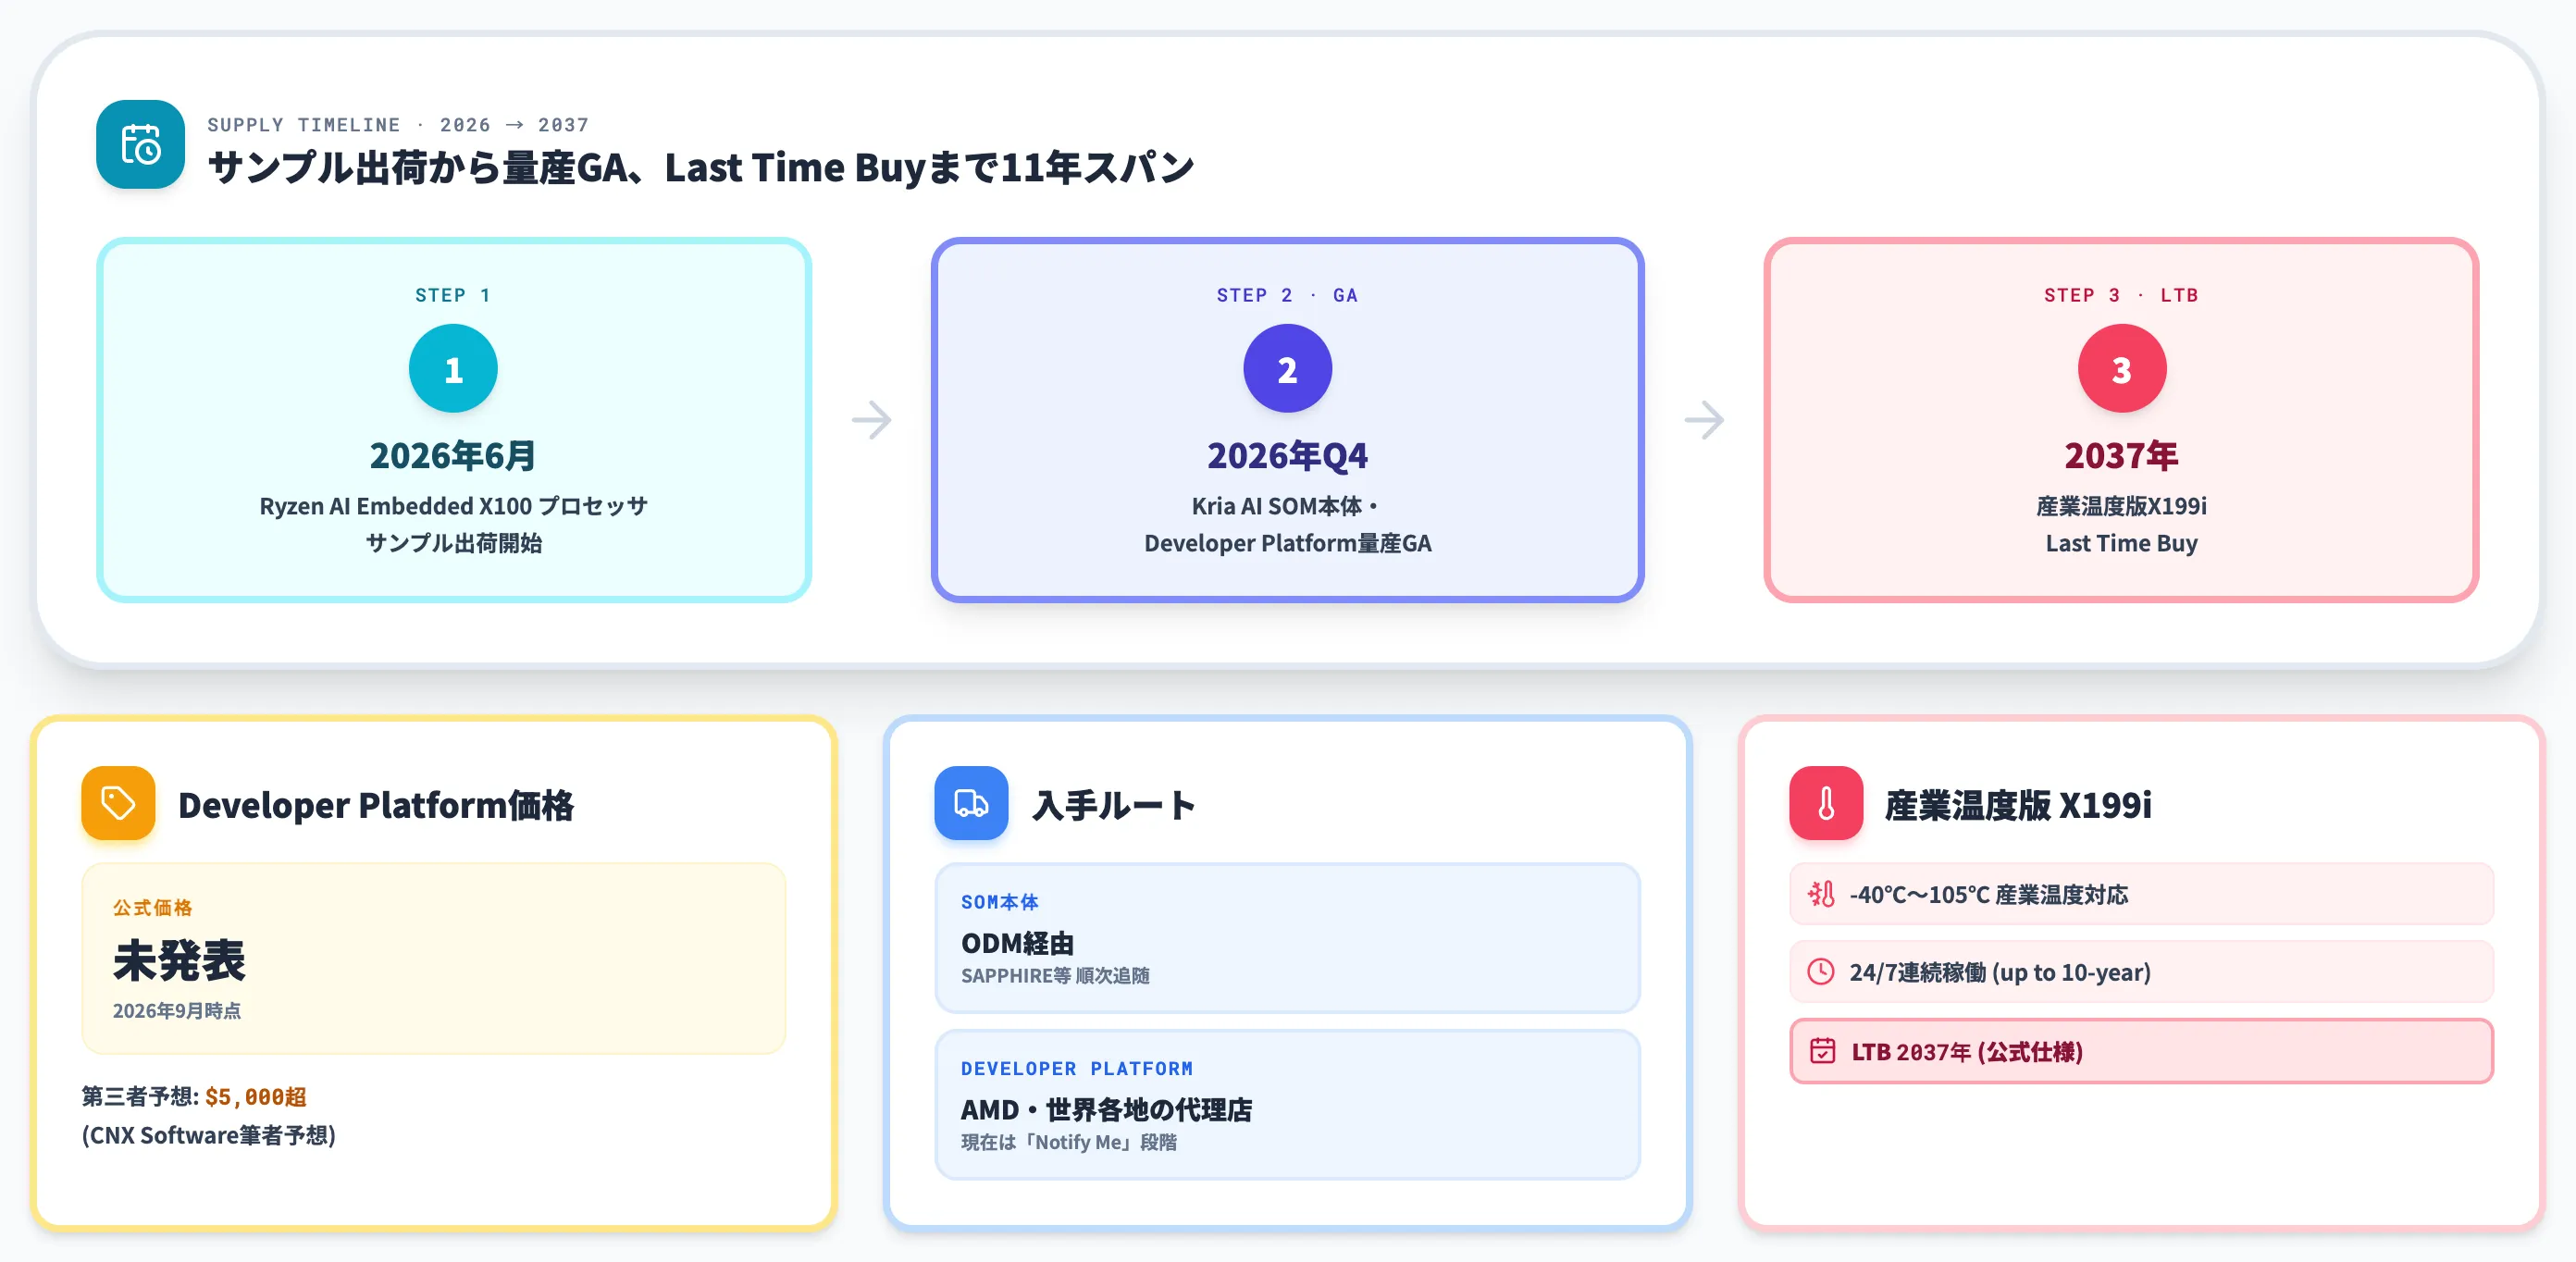
Kria AI SOMは2026年9月時点で正式な一般販売前の段階にあり、価格・入手ルートは検討時に整理しておくべき論点です。
供給スケジュール——X100サンプル2026年6月、Kria AI SOM量産Q4 2026
AMDが公表しているスケジュールは以下のとおりです。
- 2026年6月:Ryzen AI Embedded X100プロセッサのサンプル出荷開始(Kria AI SOM/Developer Platformのサンプル開始時期は別途)
- 2026年Q4(10〜12月):Kria AI SOM本体・AMD Kria AI Robotics Developer Platformの量産・一般提供(GA)開始
- 2037年:産業温度版X199iのLast Time Buy(長期供給の具体的な条件は型番・契約先ごとにAMDまたはODMに要確認)
2026年9月時点では、Developer Platformの量産GA前でサンプル評価段階です。
PoCを始めるならサンプル入手申請・ODMパートナー経由の相談から、量産設計に組み込むなら2026年Q4以降が現実的なタイムラインになります。
価格帯——公式価格未発表、第三者予想は$5,000超
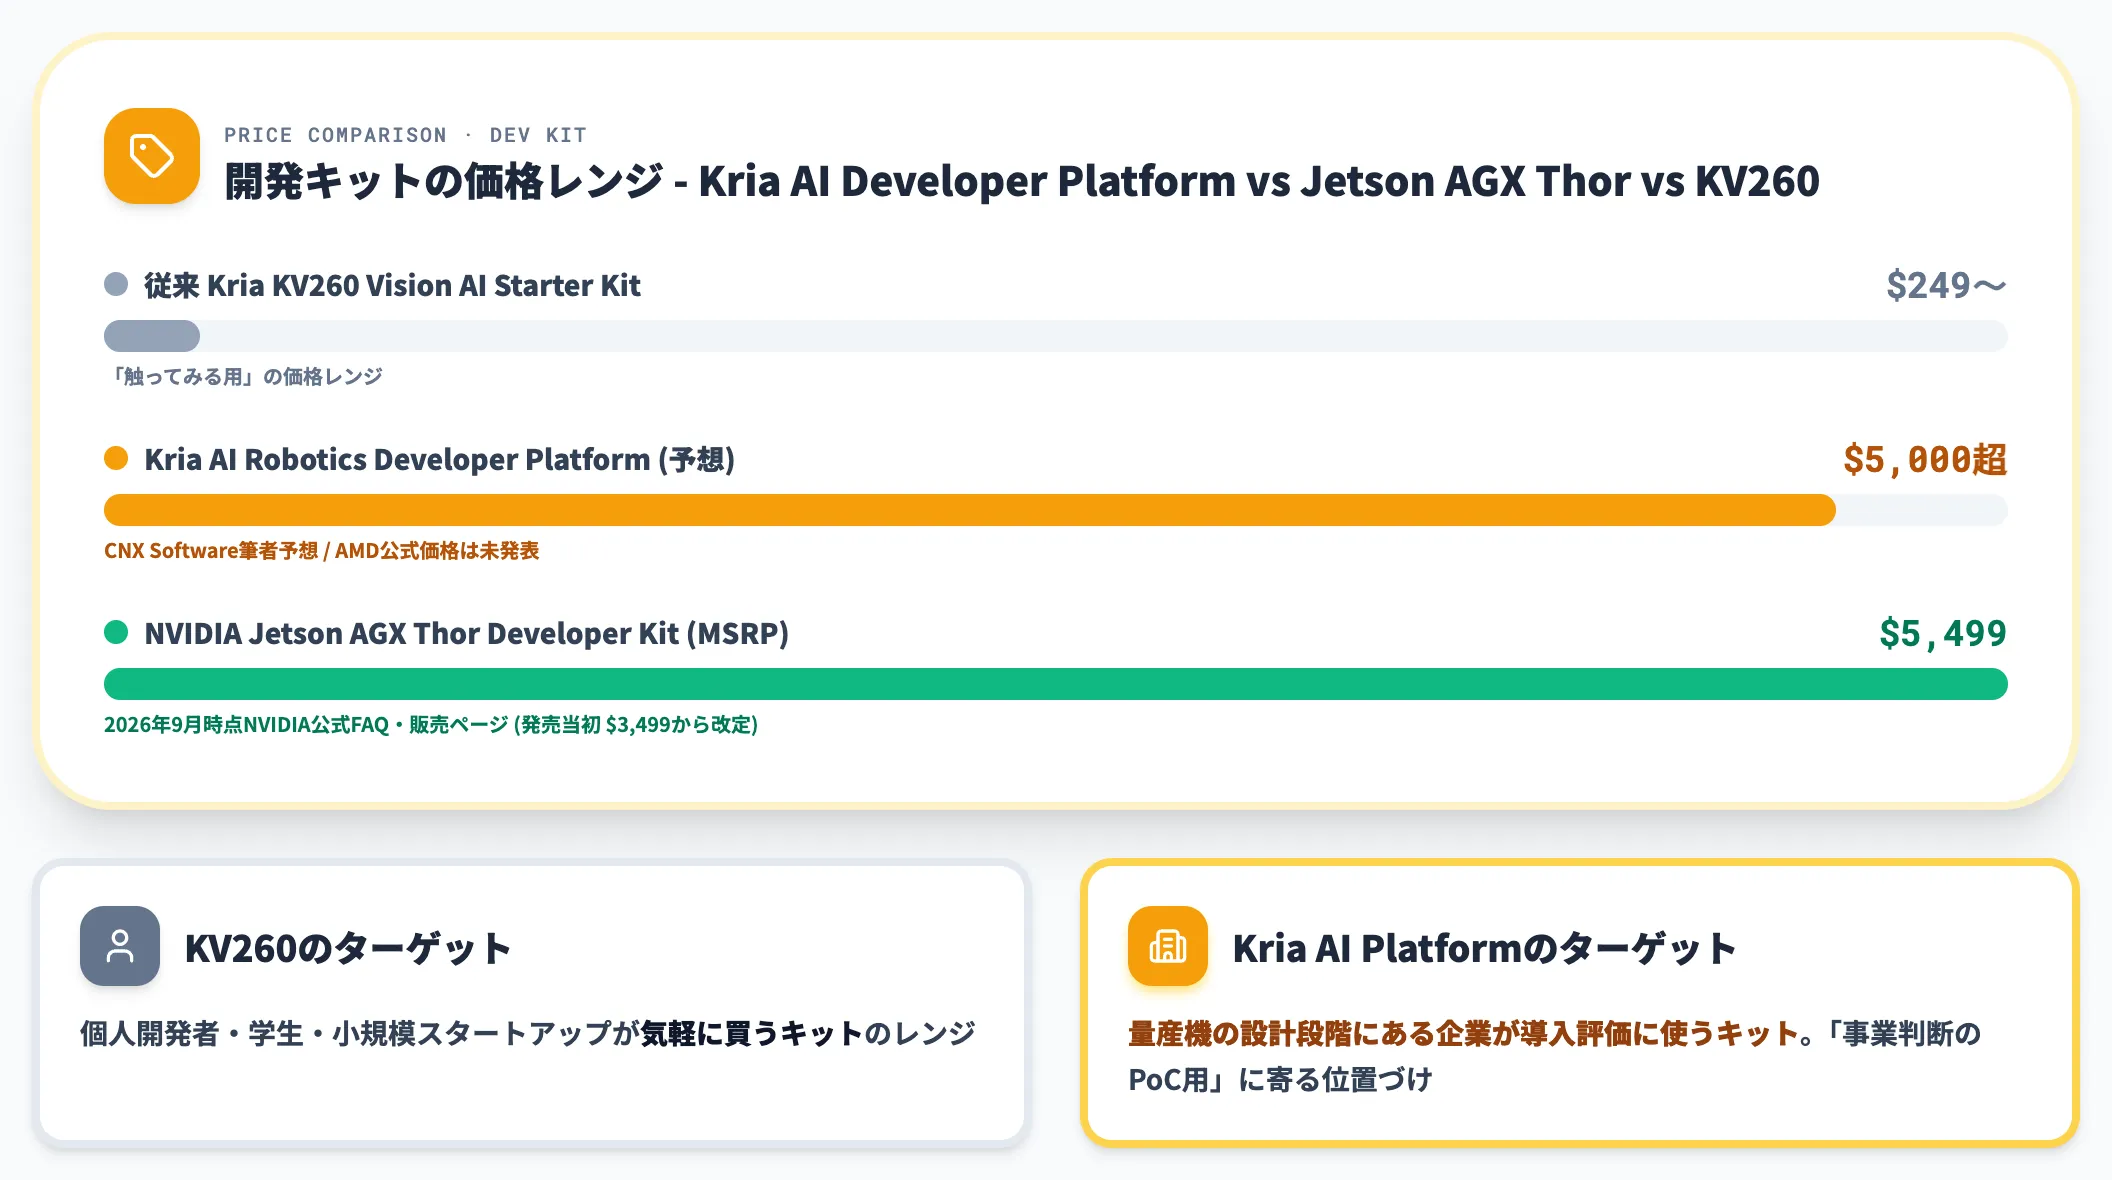
Kria AI Robotics Developer Platformの公式価格は、2026年9月時点で未発表です。AMDは「NVIDIA Jetson AGX Thor Developer Kitに対抗する」と公表しており、CNX Softwareの筆者予想として**$5,000超**が言及されています(他媒体で同水準の公式言及は確認できていません)。
比較対象のNVIDIA Jetson AGX Thor Developer Kitは、発売当初$3,499でしたが、2026年9月時点のNVIDIA公式FAQ・販売ページではMSRP $5,499に改定されています。
旧来のKria KV260 Vision AI Starter Kit($249〜)と比べれば、明らかに別の価格レンジに位置する開発キットです。
仮にCNX Software予想どおり$5,000超となる場合、価格レンジの意味合いは「個人開発者・小規模スタートアップが気軽に買うキットではなく、量産機の設計段階にある企業が導入評価に使うキット」に近づきます。
既存Kria KV260が「触ってみる用」なら、Kria AI SOMは「事業判断のPoC用」に寄る位置づけです(公式価格発表後に再確認が必要)。
産業温度版のLast Time Buy 2037——長期BOM設計に対応
産業向け機器の設計で最も効いてくるのが、産業温度版(X199i/X188i/X168i等)の長期供給スケジュールです。
- 動作温度範囲:-40℃〜105℃(産業温度対応)
- 24/7連続稼働を想定した信頼性設計(AMD公式は「up to 10-year」の連続運用に触れる表現あり)
- X199iのLast Time Buyは2037年(AMD X199i公式仕様の記載)
製造業向け機器・医療機器・鉄道・エネルギーインフラのような「10〜15年の長期にわたって同じBOMで作り続けたい」領域では、Last Time Buyまでの調達期間が採用判断の決め手になります。
コンシューマ向けチップが2〜3年で世代交代する市場で、2037年までの調達スケジュールが公式に示されている事実は稀有です。
ただし総合的な長期供給条件は型番・契約先・ODMごとに条件が異なる(「最低10年間の供給保証」といった一括の表現ではなく個別合意ベース)ため、量産設計に組み込む前にAMDおよび調達先ODMに確認してください。
入手ルート——SOMはODM経由、Developer PlatformはAMD・販売代理店経由
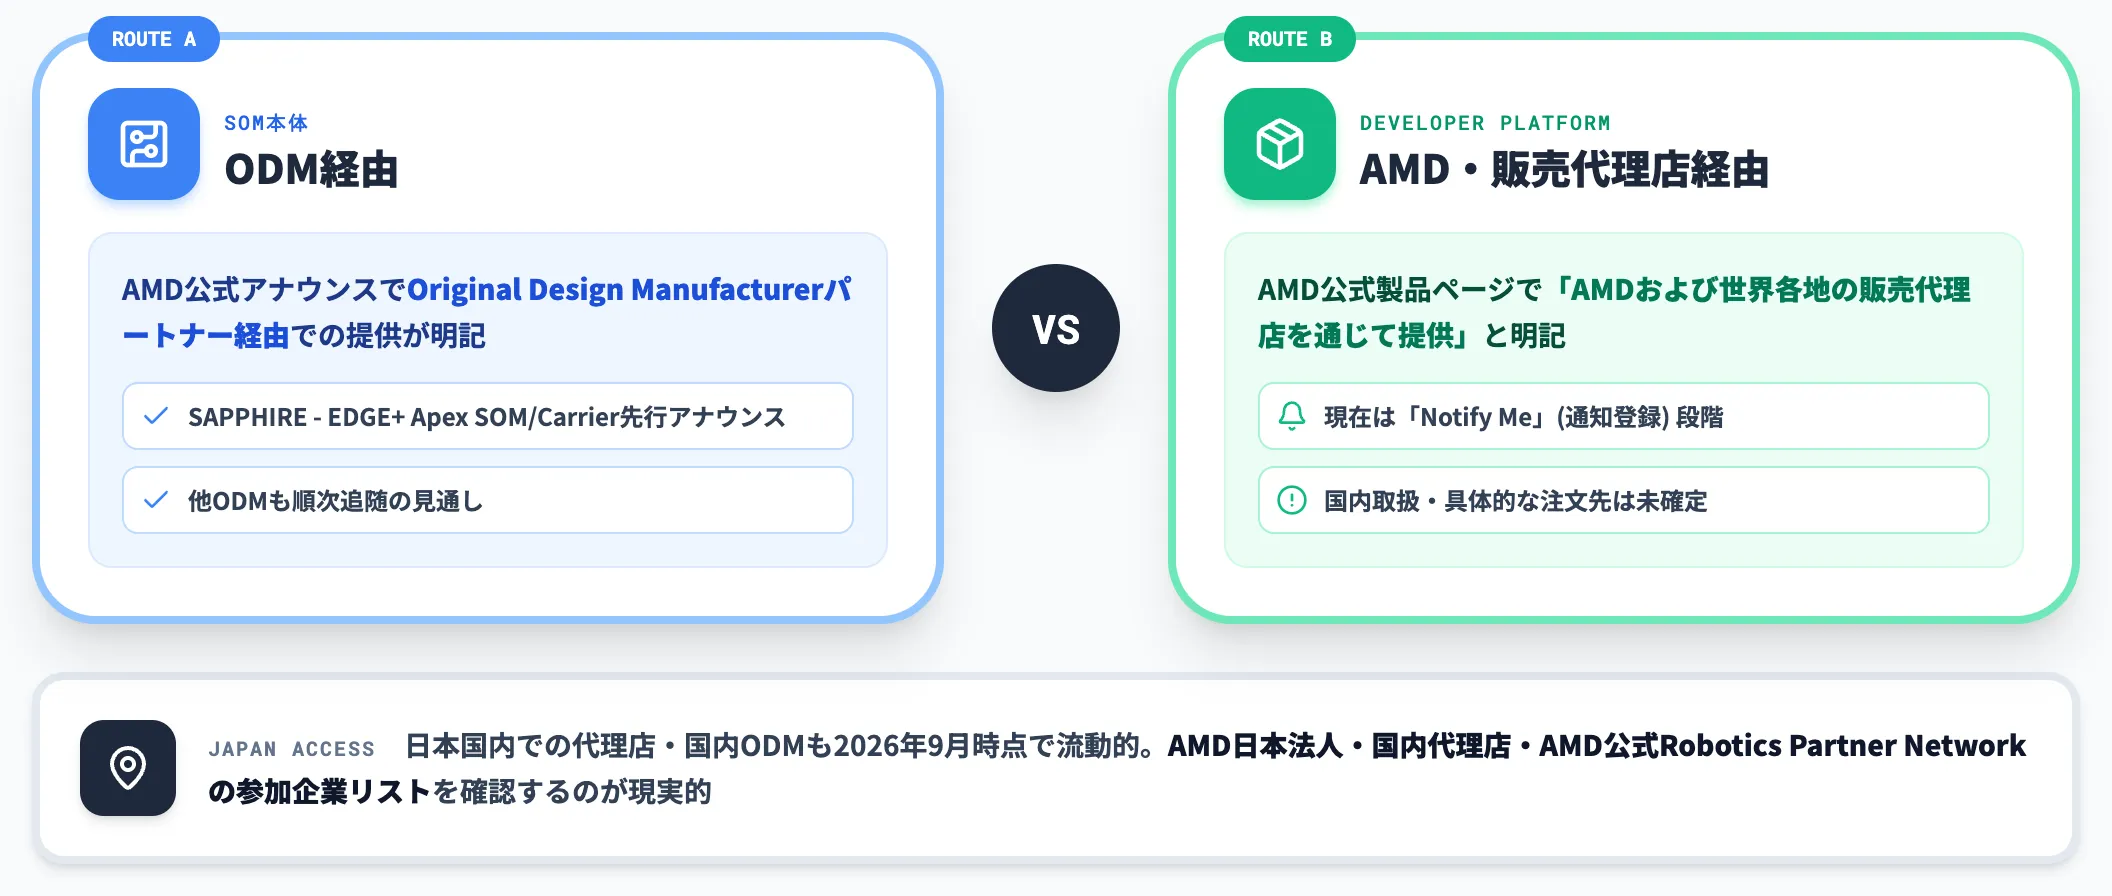
- Kria AI SOM本体
AMDの公式アナウンスでODM(Original Design Manufacturer)パートナー経由での提供が明記されています。
既にSapphireが「EDGE+ Apex SOM/Carrier Robotics Platform」として先行アナウンスしており、他ODMも順次追随する見通しです。
- AMD Kria AI Robotics Developer Platform
AMD公式製品ページで「AMDおよび世界各地の販売代理店を通じて提供」と明記されています。
ただし2026年9月時点では具体的な注文先・国内取扱・価格は未確定で、公式ページ上は「Notify Me」(通知登録)の段階です。
日本国内での取り扱い代理店・国内ODMの状況も、2026年9月時点で流動的です。導入検討時は、AMD日本法人・国内代理店・AMD公式Robotics Partner Networkの参加企業リストを確認するのが現実的な入手ルートの探し方になります。
Kria AI SOMの採用判断で見落としがちな観点
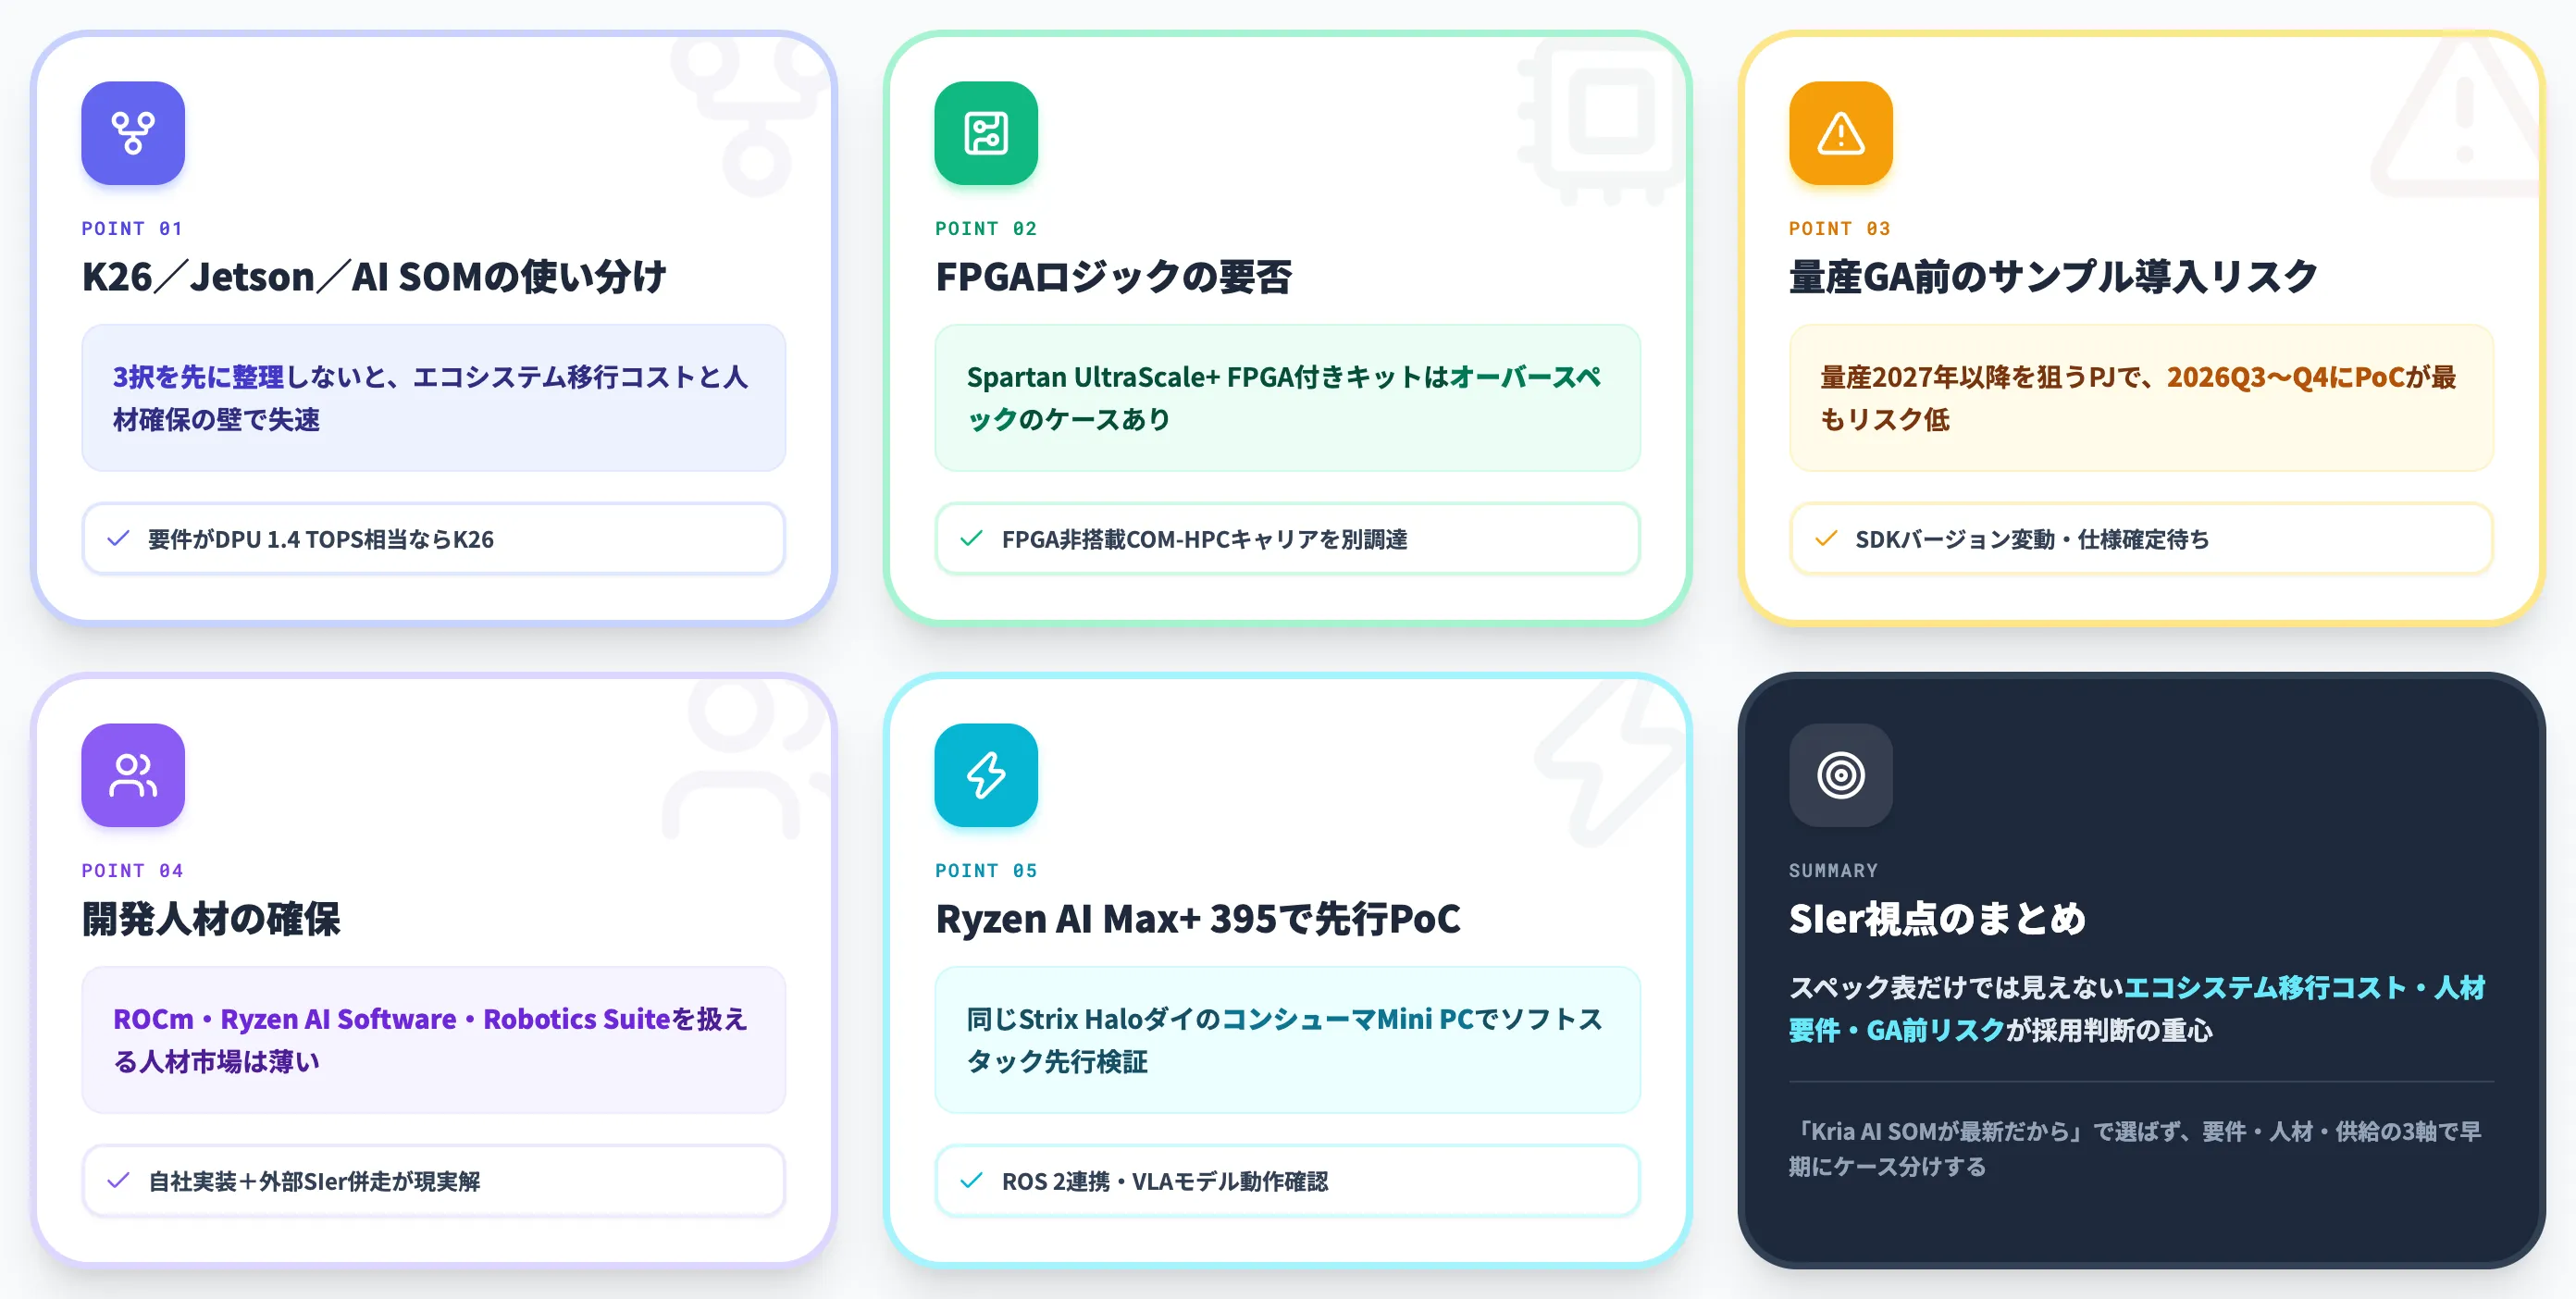
Kria AI SOMは新製品であり、公式スペック表だけでは見えない採用判断の論点があります。ここでは、SIerとして企業の導入支援に入る立場から、見落とされやすい実務論点を整理します。
既存Kria K26/Jetson AGX Thor/Kria AI SOMの使い分け
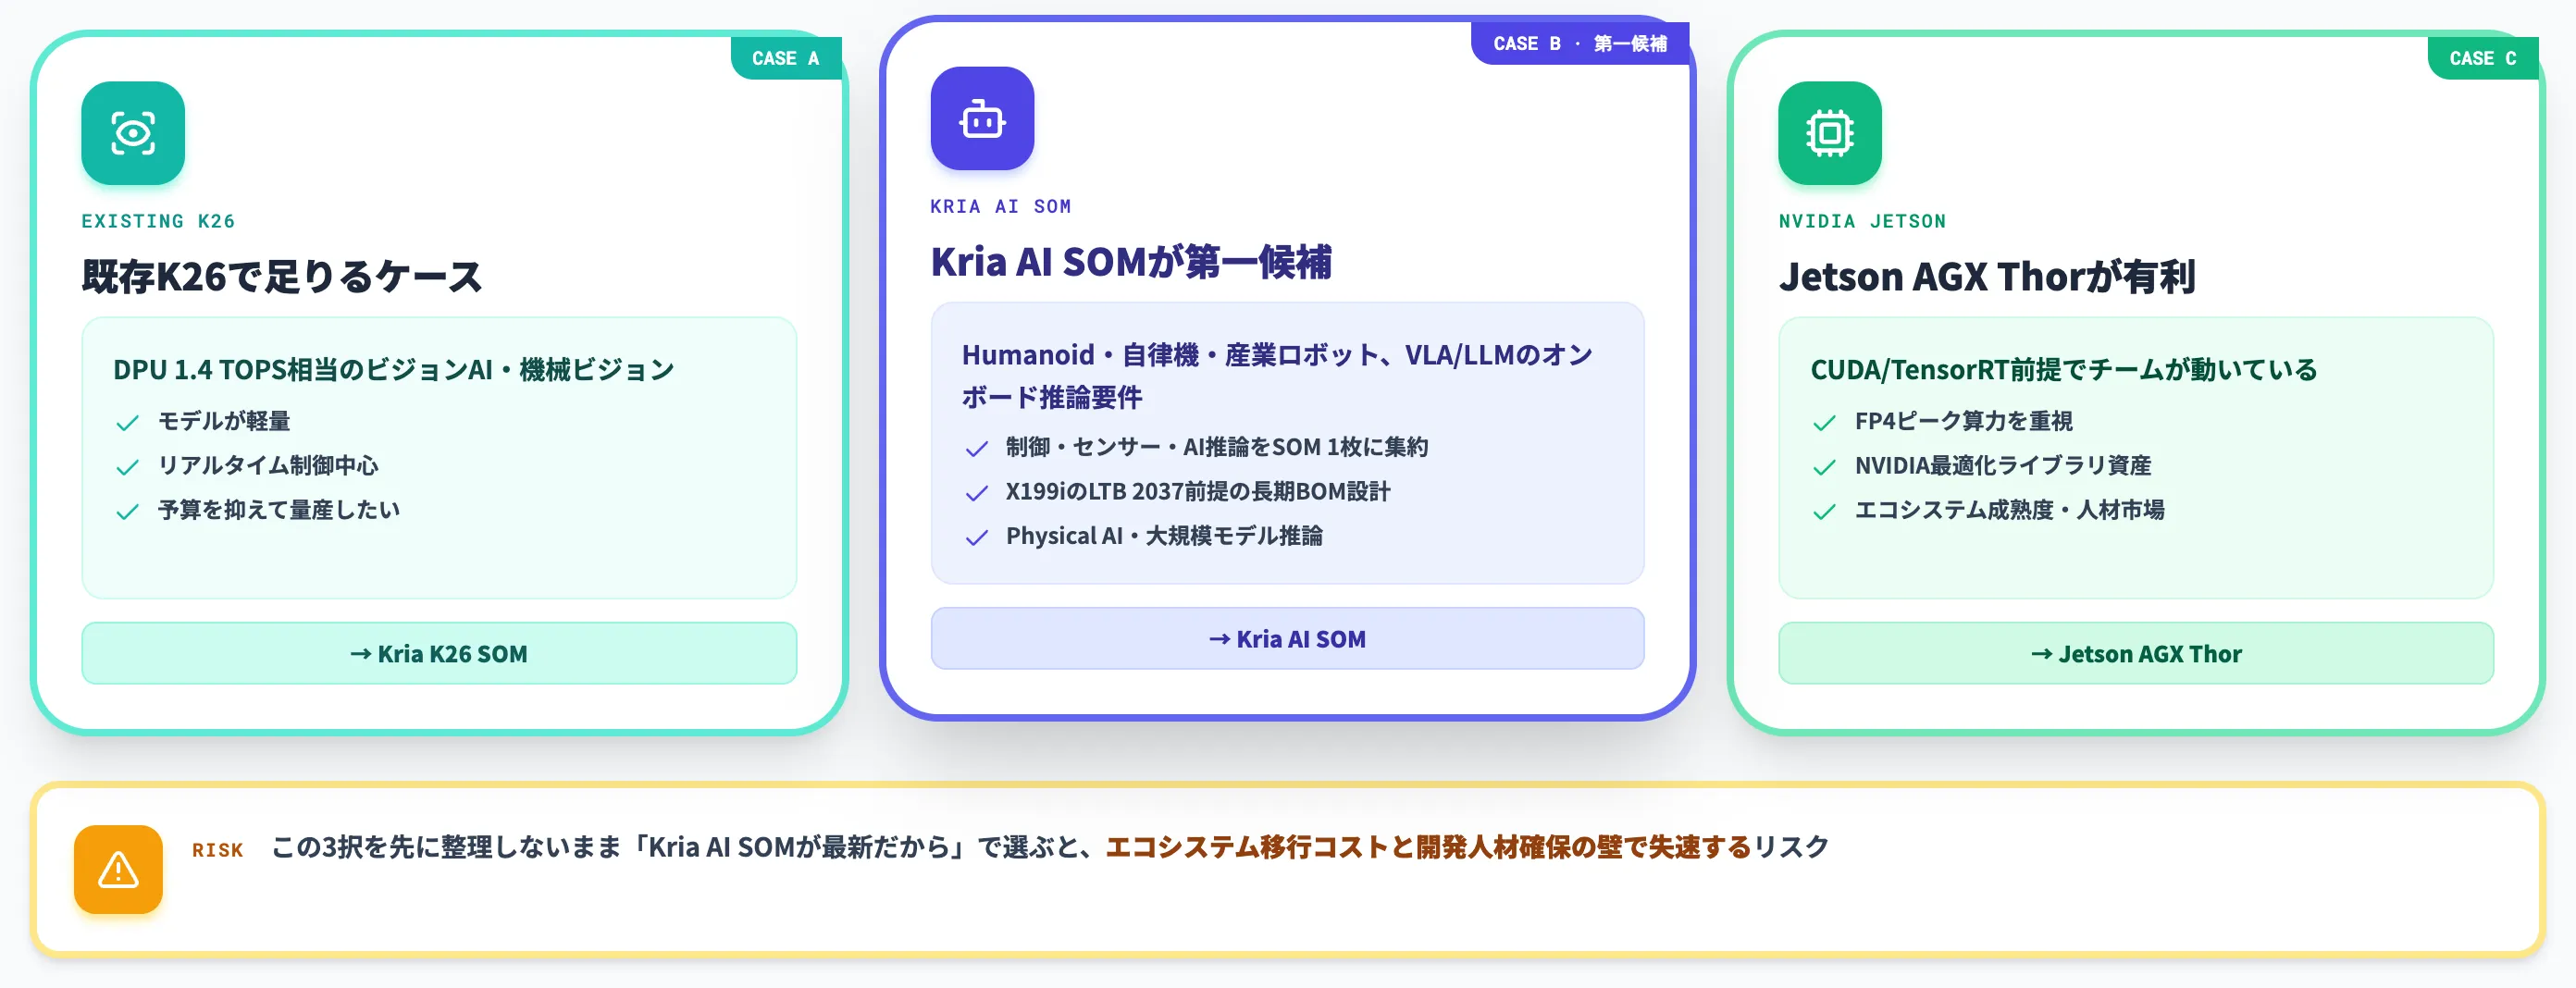
「Physical AI/エッジ推論向けにKria AI SOMを検討したい」と相談を受けた場合、AI総研の実務観察では以下の3つの使い分けから入るのが妥当です。
-
既存Kria K26で足りるケース
DPU 1.4 TOPS相当のビジョンAI・スマートカメラ・機械ビジョン。モデルが軽量で、リアルタイム制御中心。予算を抑えて量産したい
-
Kria AI SOMが第一候補になるケース
Humanoid・自律機・産業ロボットで、VLA/LLMモデルのオンボード推論が要件。制御ソフト・センサー処理・AI推論をSOM 1枚に集約したい。プロセッサ側でRyzen AI Embedded X100シリーズの産業温度版X199iのLast Time Buy 2037年を前提とした長期BOM設計が必要(X199i搭載Kria AI SOMの製品化はODMごとに要確認)
-
NVIDIA Jetson AGX Thorが有利なケース
既にCUDA/TensorRT前提でチームが動いている。FP4ピーク算力やNVIDIA最適化ライブラリ資産を重視する。エコシステム成熟度と人材市場の厚みを重視する(VLA推論の実スループットは同条件比較の一次情報が揃っていないため、乗り換え検討時は実ワークロードで検証)
この3択を先に整理しないまま「Kria AI SOMが最新だから」で選ぶと、エコシステム移行コストと開発人材確保の壁で失速するリスクがあります。
FPGAロジックが本当に必要か——キャリア設計の判断
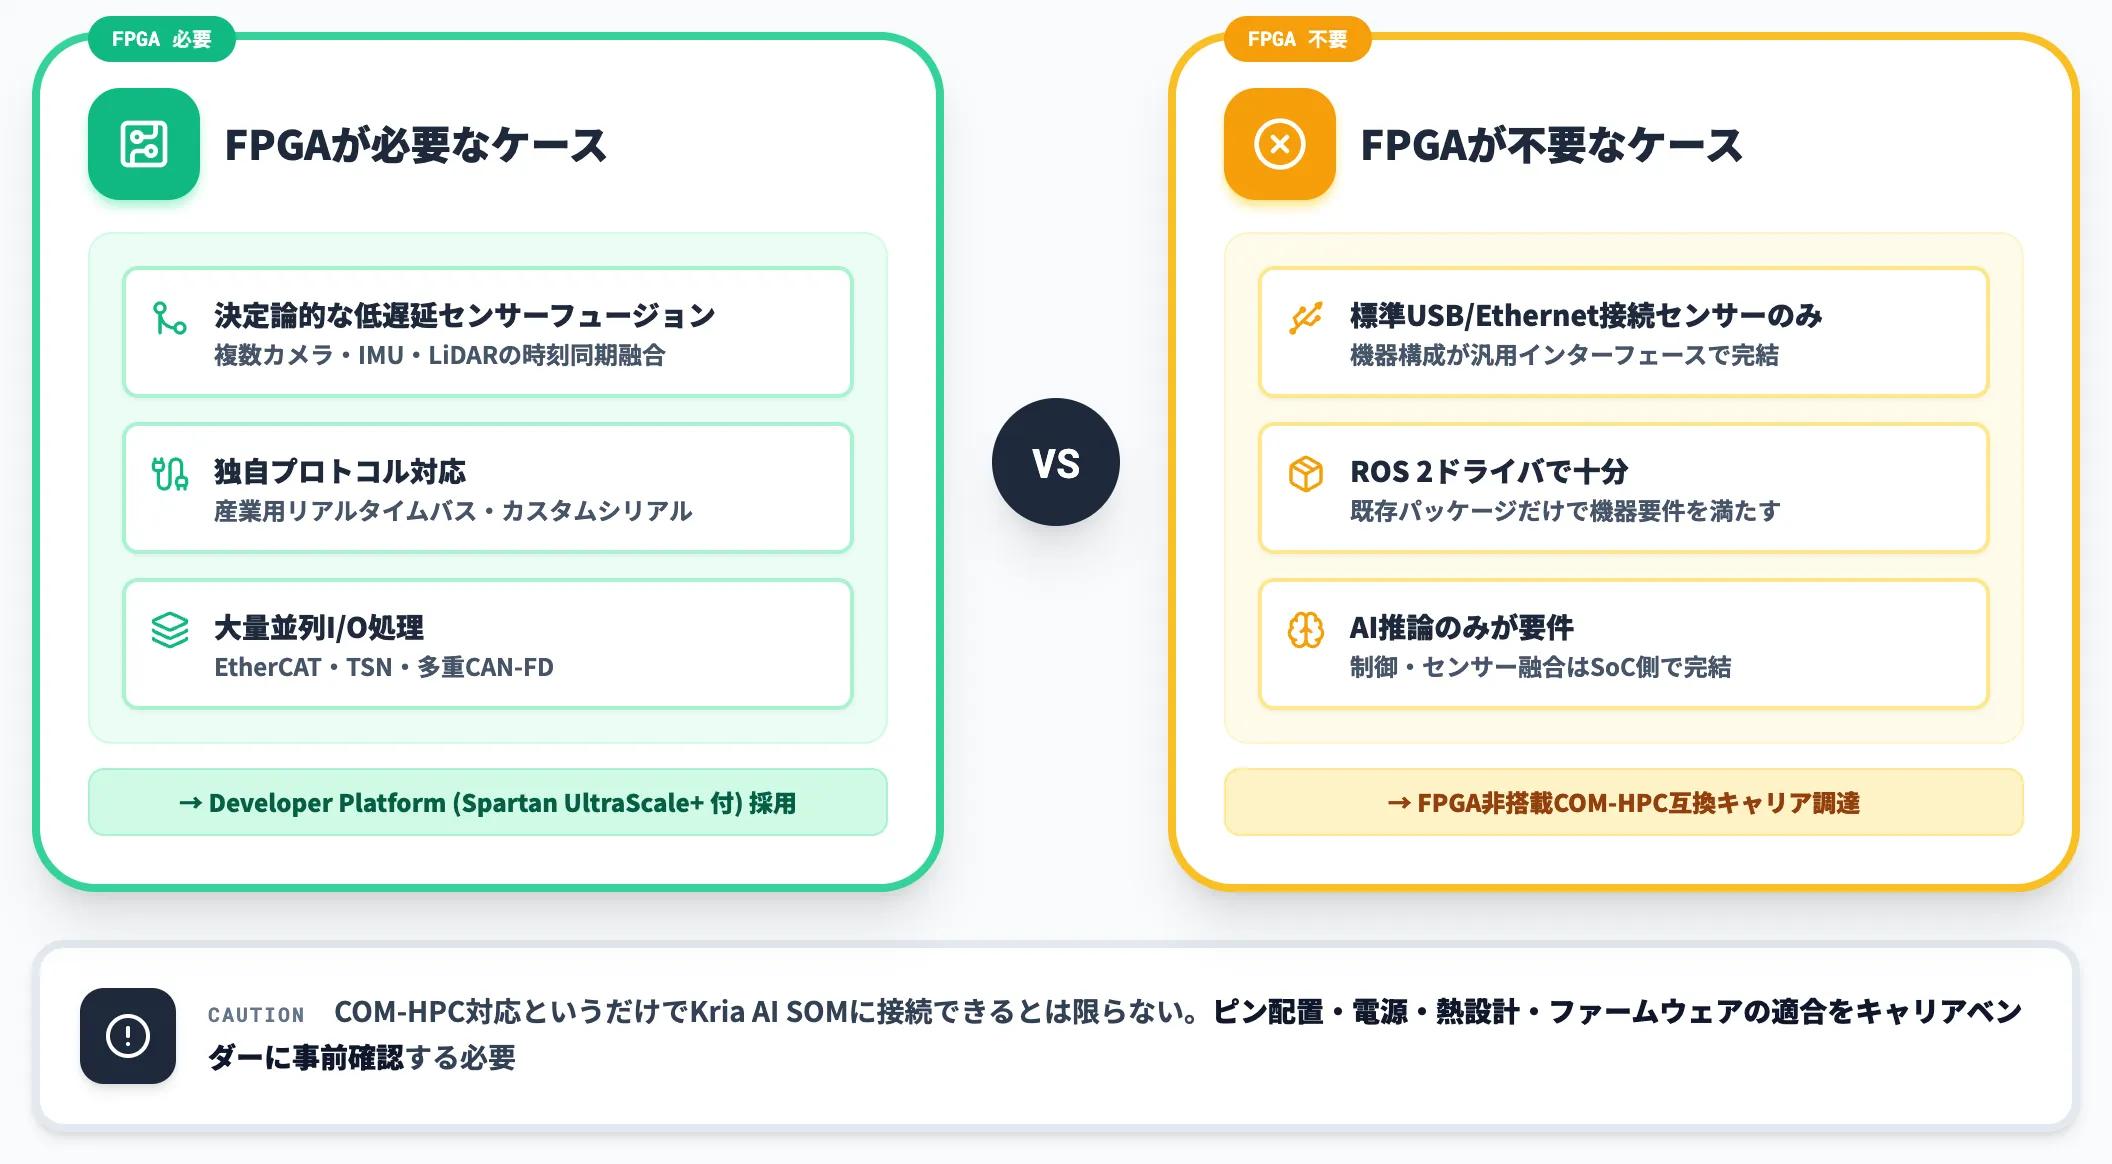
Kria AI SOMは本体からFPGAを外し、キャリア側に置いた設計です。ここで検討すべきなのが、「そもそも自社案件でFPGAロジックが本当に必要か」という論点です。
-
FPGAが必要なケース
決定論的な低遅延センサーフュージョン、独自プロトコル対応、大量並列I/O処理、産業用リアルタイムバス
-
FPGAが不要なケース
標準的なUSB/Ethernet接続センサーのみ、ROS 2ドライバで十分な機器構成、AI推論のみが要件
FPGAが不要な案件で、AMD Kria AI Robotics Developer Platform(Spartan UltraScale+ FPGA付き)を採用するとオーバースペックになります。
この場合、Kria AI SOMとの互換性を確認したFPGA非搭載のCOM-HPC対応キャリアを他社から調達するか、AMDに直接構成を相談する道が現実的です(COM-HPC対応というだけでKria AI SOMに接続できるとは限らないため、ピン配置・電源・熱設計・ファームウェアの適合をキャリアベンダーに事前確認する必要があります)。
量産前のサンプル導入リスク——2026年Q4 GA前の判断
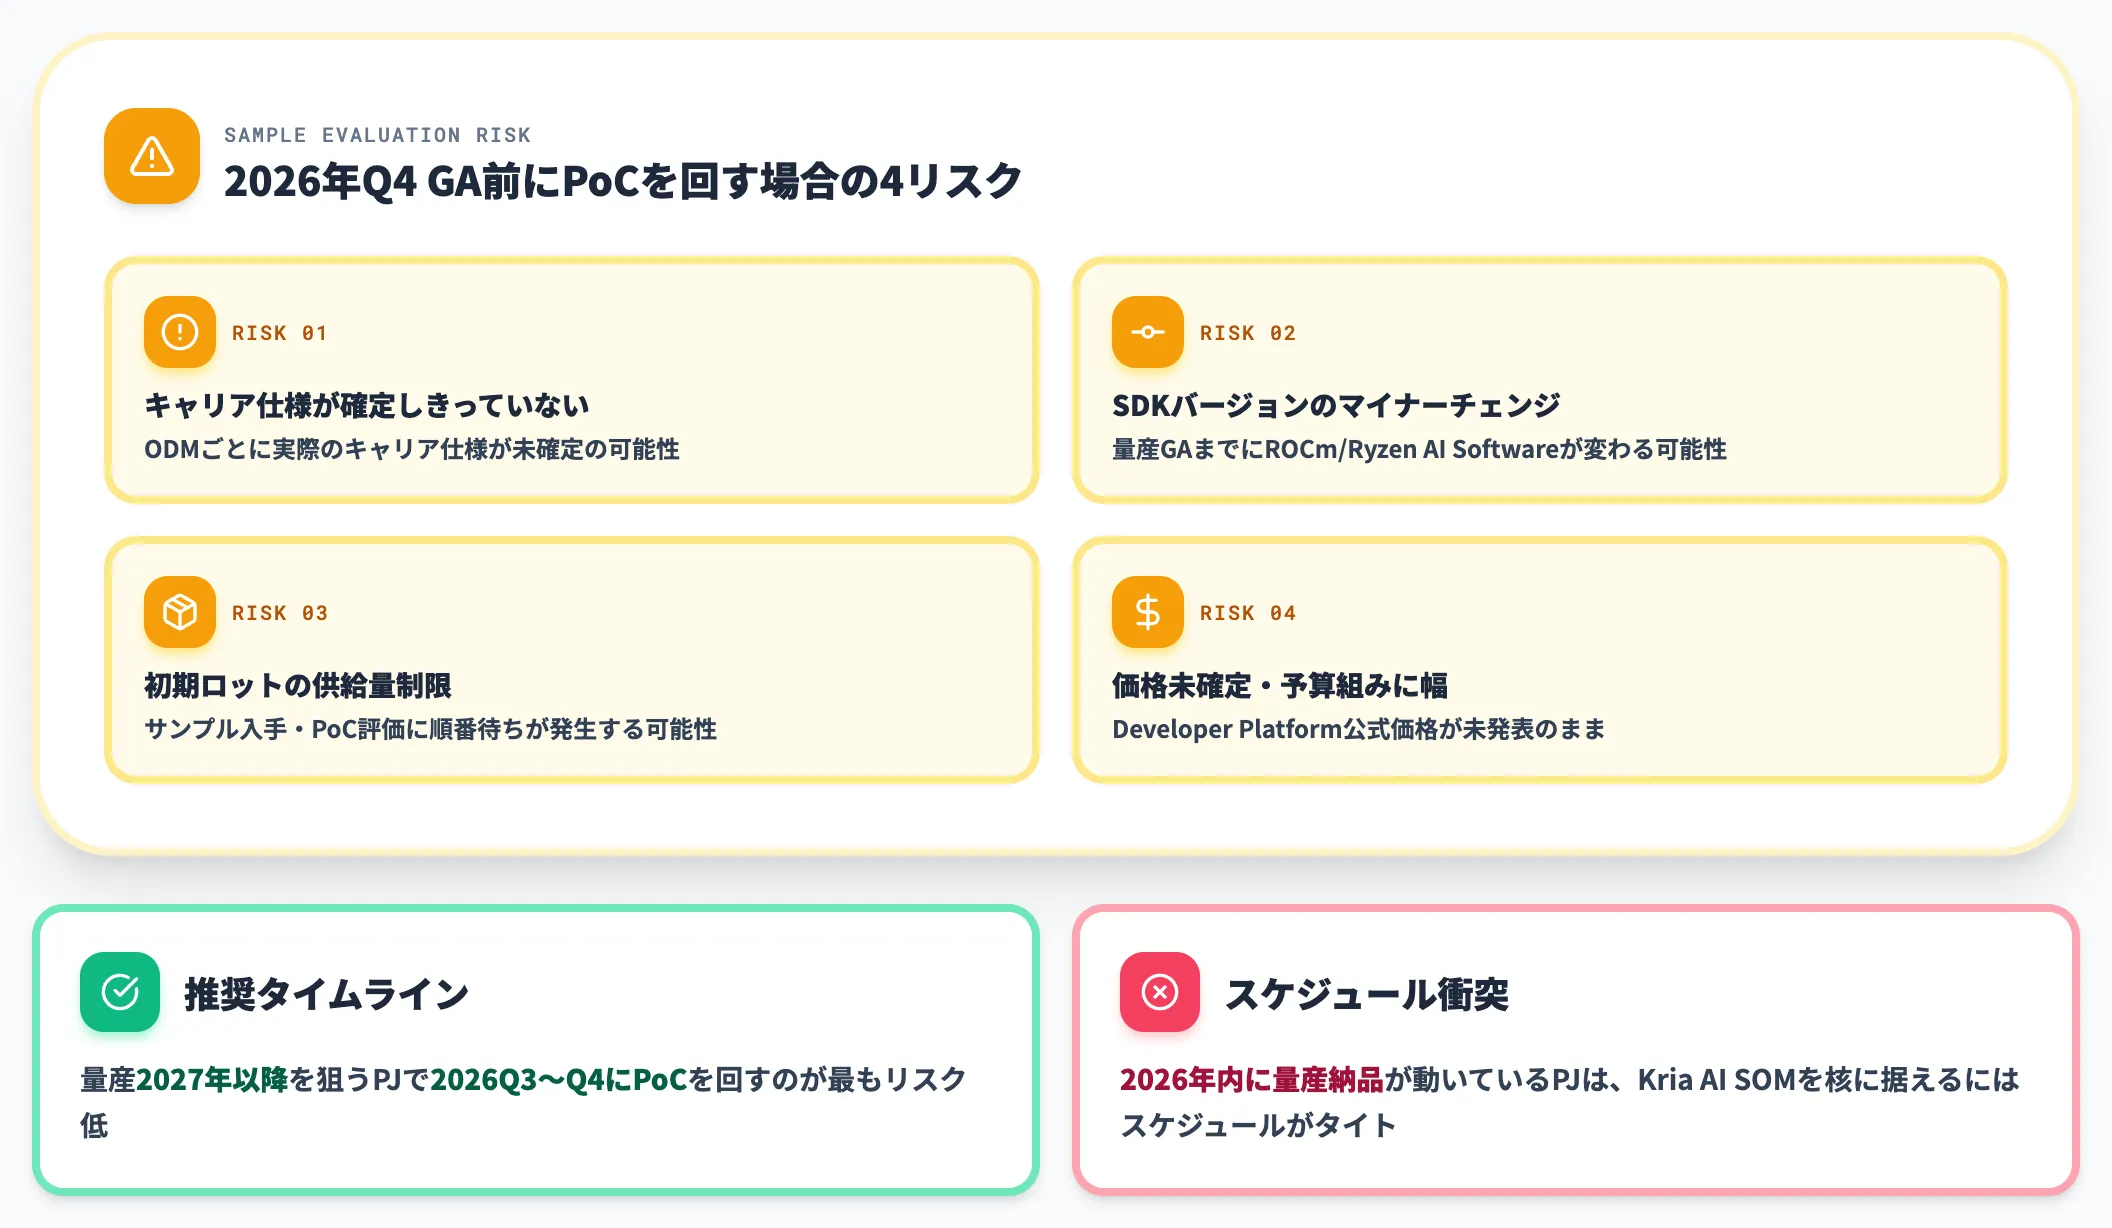
2026年9月時点はサンプル評価段階で、量産GA前です。この時期にPoCを進める場合、以下のリスクを織り込んでおくべきです。
- ODMごとに実際のキャリア仕様が確定しきっていない可能性
- SDKバージョンが量産GAまでにマイナーチェンジする可能性
- 初期ロットの供給量が限定される可能性
- 価格が確定しないため事業計画の予算組みに幅が出る
これらのリスクを踏まえると、「量産2027年以降を狙うプロジェクトで、2026年Q3〜Q4にPoCを回す」タイムラインが最もリスクを抑えられます。
逆に「2026年内に量産納品」が動いている案件は、Kria AI SOMを核に据えるにはスケジュールがタイトです。
開発人材の確保——ROCm・Ryzen AI Software・Robotics Software Suiteを扱えるチーム
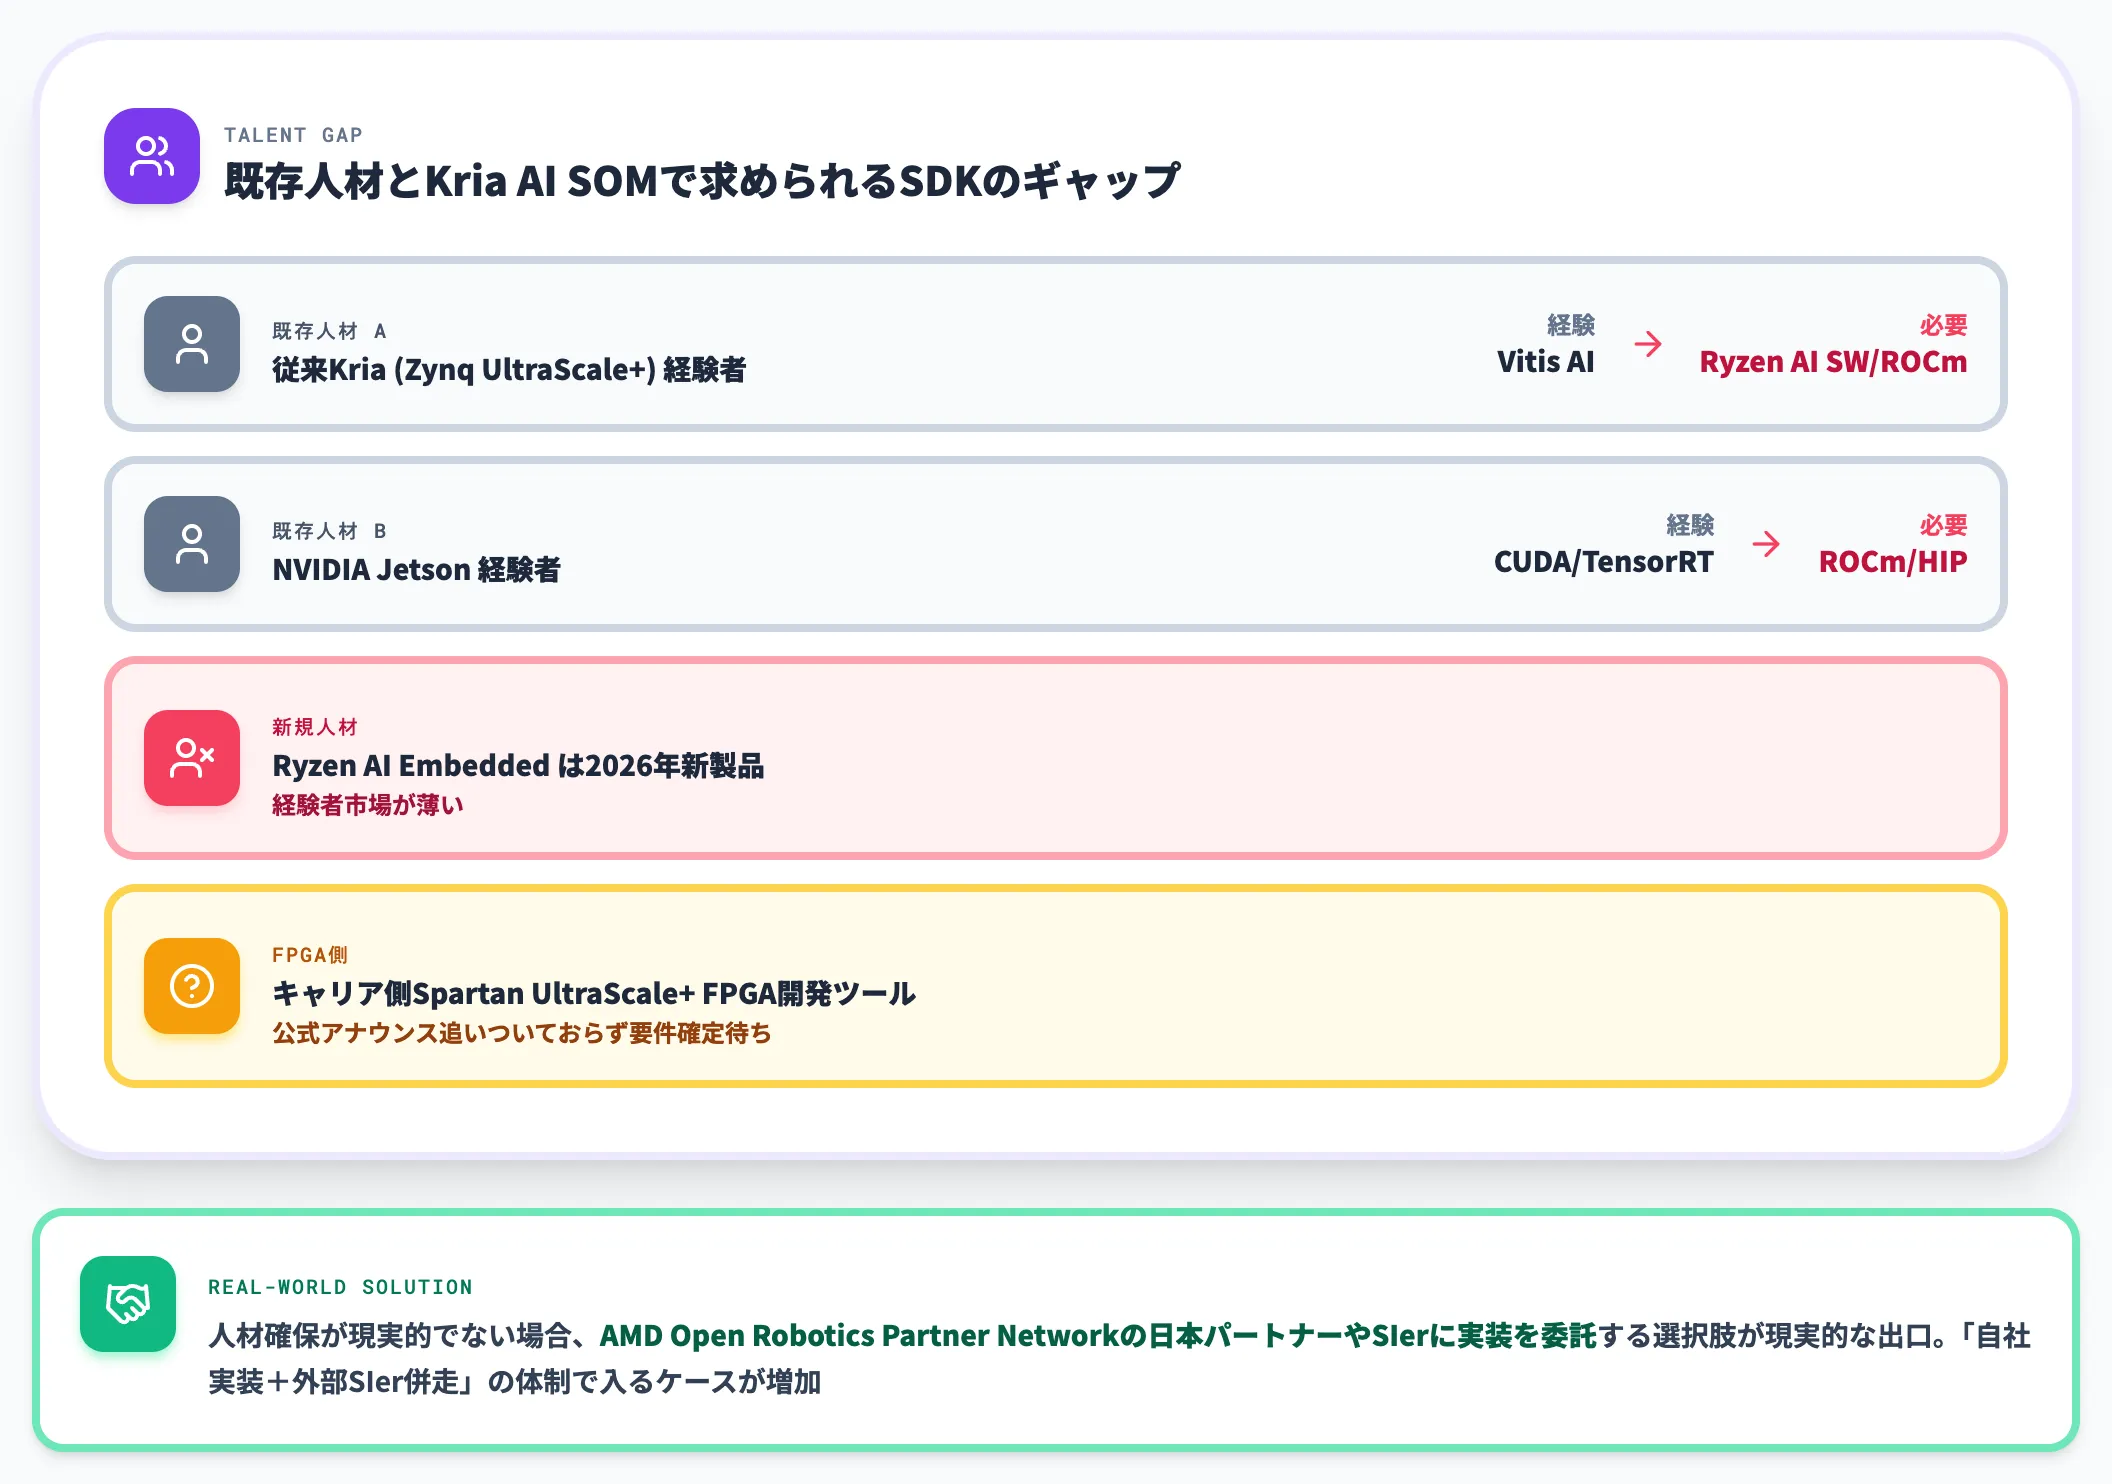
エコシステム論点の裏返しで、AMD側のSDK群(ROCm・Ryzen AI Software・Robotics Software Suite)を扱える人材の確保が採用判断で最も重い論点になります。
- 既存の従来Kria(Zynq UltraScale+)経験者はVitis AI経験があるが、Ryzen AI SoftwareやROCmは別領域
- NVIDIA Jetson経験者はCUDA/TensorRT経験があるが、ROCm/HIPは別領域
- Ryzen AI Embedded自体が2026年発表の新製品のため、経験者市場が薄い
- キャリア側Spartan UltraScale+ FPGAの開発ツールは公式アナウンスが追いついておらず、FPGA開発人材の要件確定は追加資料待ち
この人材確保が現実的でない場合、AMD Open Robotics Partner Networkの日本パートナーやSIerに実装を委託する選択肢が現実的な出口になります。
AI総研の実務観察でも、Kria AI SOM級の新規プラットフォームは「自社実装+外部SIer併走」の体制で入るケースが増えています。
コンシューマ版Ryzen AI Max+ 395で先行PoCする裏技
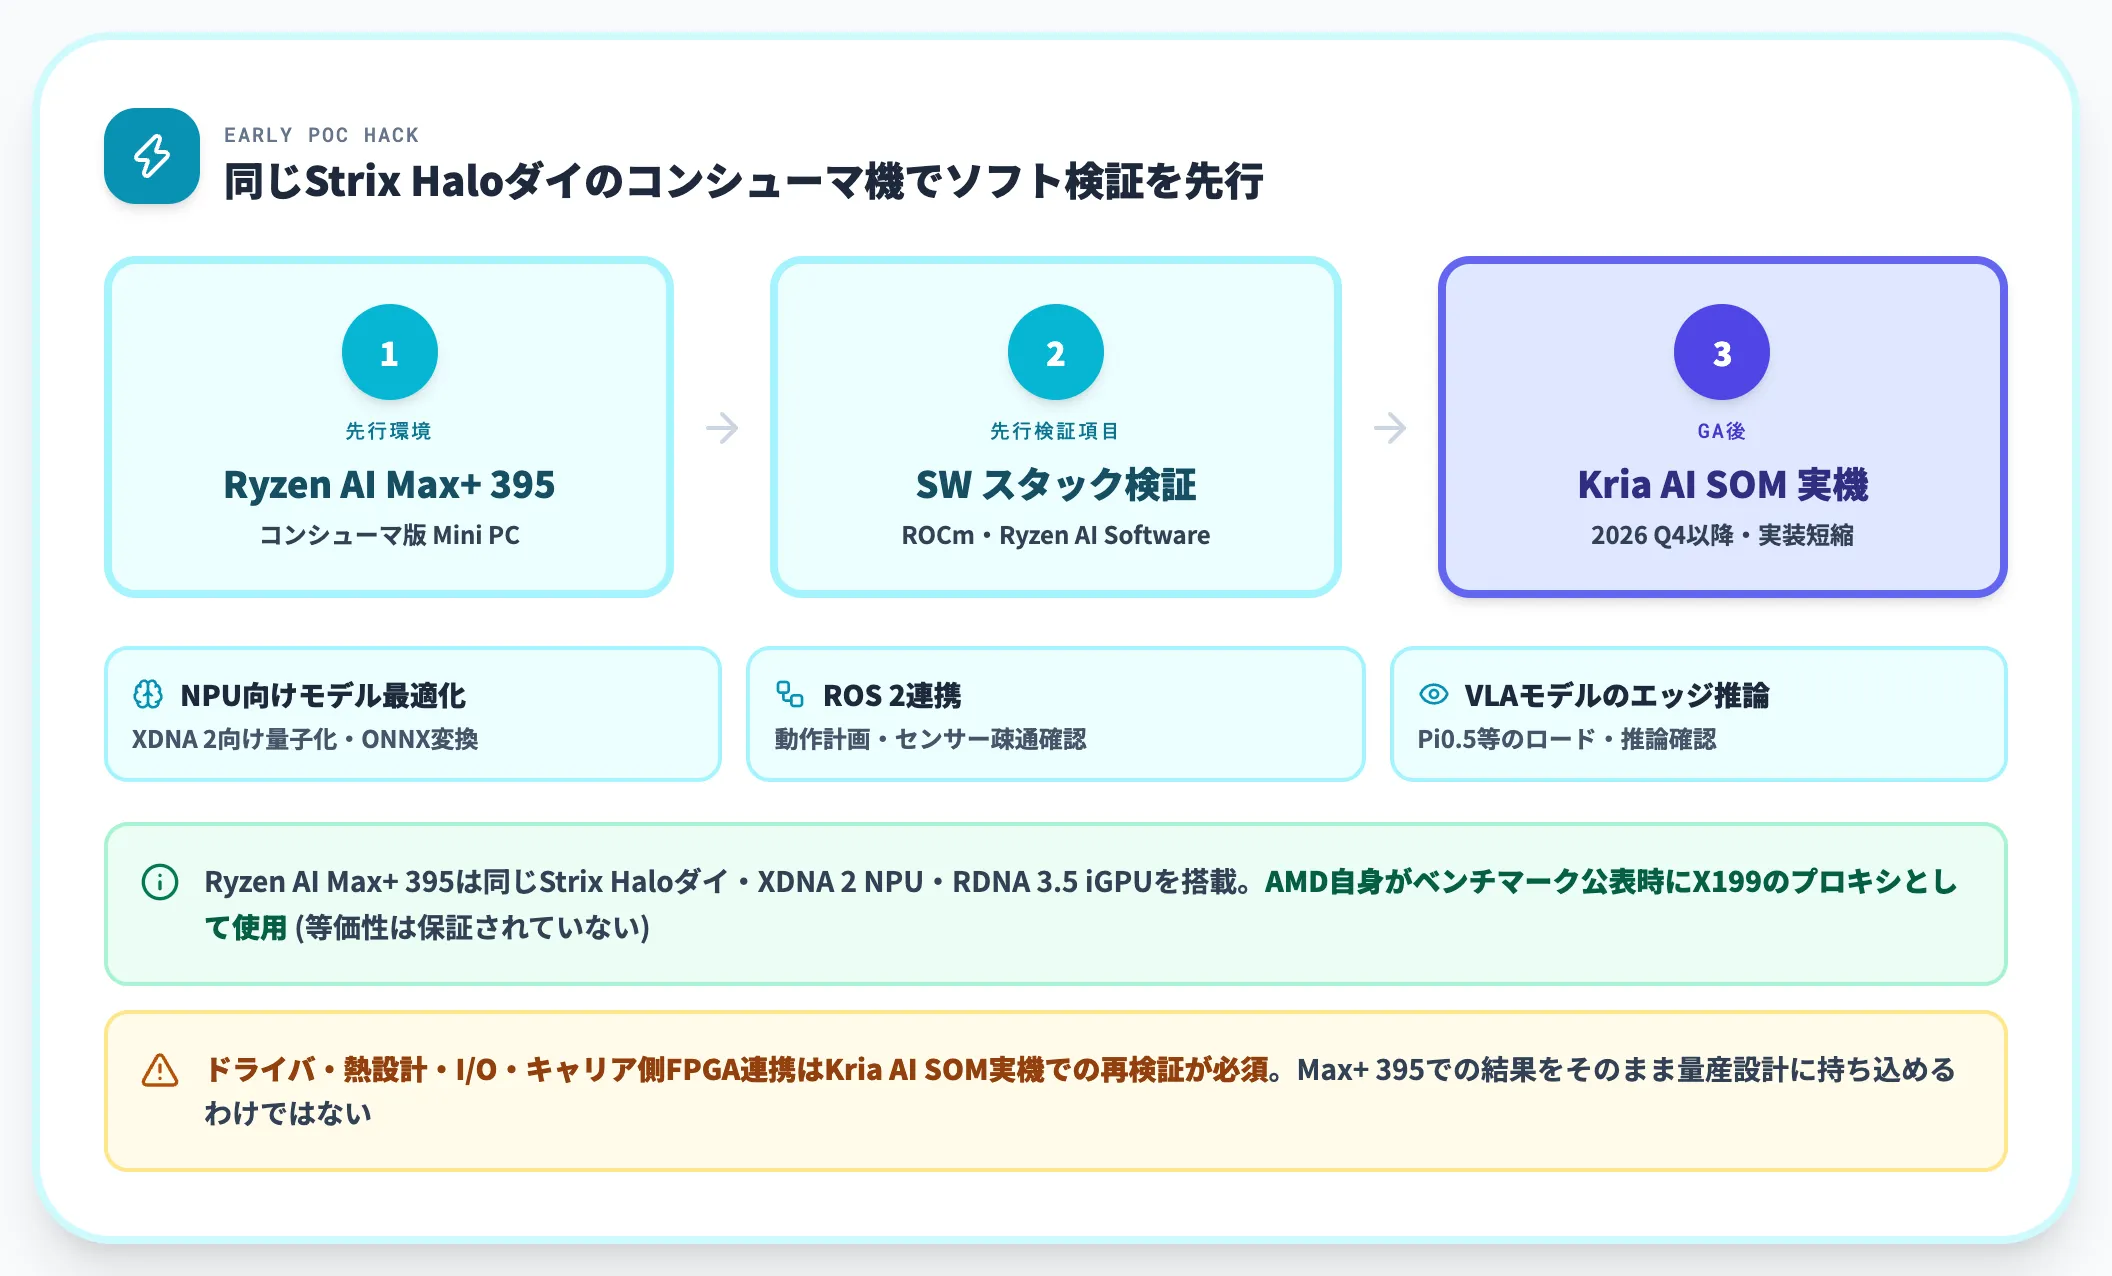
Kria AI SOMの量産GAを待たずにPoCを進める現実的な方法として、コンシューマ版のRyzen AI Max+ 395搭載Mini PCでソフトウェアスタックを先行検証する手があります。
Ryzen AI Max+ 395は同じStrix Haloダイ・XDNA 2 NPU・RDNA 3.5 iGPUを搭載しており、AMD自身がベンチマーク公表時にX199のプロキシとして使用しています("configured to reflect" 表現。等価性そのものは保証されていない)。
ソフトウェアの先行検証用プロキシとしてROCm・Ryzen AI Softwareの動作確認を進めておく手が現実的で、「NPU向けモデル最適化」「ROS 2連携」「VLAモデルのエッジ推論」をPoCで回しておけば、Kria AI SOMの量産GA後の実装の一部を短縮できます。ただしドライバ・熱設計・I/O・キャリア側FPGA連携はKria AI SOM実機での再検証が必須で、Max+ 395での結果をそのまま量産設計に持ち込めるわけではありません。
これは、既存Jetson前提のチームがROCm/HIPへの移行検証を「今から始める」場合にも同じ手が使えます。
Kria AI SOM世代のPhysical AI基盤を設計・PoC・量産まで一気通貫で支援するなら
Kria AI SOMは、Ryzen AI Embedded X100・COM-HPCフォームファクター・Spartan UltraScale+ FPGAキャリア・ROCm/Ryzen AI Software/Robotics Software Suite・ROS 2・Xen Hypervisorなど、組み合わせるスタックが非常に厚い新プラットフォームです。ハード単体を評価するだけでは不十分で、上位のロボット制御ソフト・AIモデルパイプライン・量産キャリア設計まで含めた統合設計が要求されます。
AI総合研究所は、Physical AI基盤の設計・PoC・量産設計を、SIerとして一貫して支援します。加えて、上位のAIエージェント基盤としてAI Agent Hubを提供し、ロボットが「ミッションを受け取り、複数のAIエージェントに分解し、実行結果をレポートする」オーケストレーション層まで含めた総合設計をご支援できます。
-
PoC段階の伴走
サンプル入手・Ryzen AI Max+ 395による先行検証・PyTorch/ONNXモデルのNPU向け最適化・ROS 2連携までを段階的に支援
-
キャリアボード設計の判断支援
Developer Platform標準構成でよいか、FPGA非搭載の互換性を確認したCOM-HPCキャリアで良いか、量産向けの独自キャリアを起こすべきかを、案件要件から逆算して整理
-
Jetsonからの移行検証
既存CUDAコード資産のHIPIFY通過率実測・NVIDIA固有ライブラリの代替検討・移行コスト見積もりを、PoC段階で数値化
-
上位AIエージェント基盤の設計
ロボットからのミッション受付・複数エージェントへのタスク分解・実行監査・セキュリティ統制を、AI Agent Hubで統合管理
Kria AI SOM世代のPhysical AI基盤を、事業として動くレベルまで実装したいという相談があれば、AI Agent Hubのサービスページから詳細をご確認ください。
Physical AI基盤の実装をLinkXが伴走

Kria AI SOM世代のロボット・産業機器設計をSIerとして支援
量産Q4 2026を待たずにコンシューマ版Ryzen AI Max+ 395で先行PoCを進めたい、NVIDIA Jetson前提の既存設計をKria AI SOMに置き換えるかを比較したい、COM-HPCキャリアボードの実装まで一気通貫で任せたい、といったご相談はLinkX Japanまでお問い合わせください。ROCm・ROS 2・Ryzen AI Softwareを含むPhysical AI基盤の設計・PoC・量産設計を、SIerとして一貫してご支援します。
まとめ
本記事では、Kria AI SOMについて、Ryzen AI Embedded X100搭載の新型SOMとしての位置づけ・ハードウェア構成・想定用途・開発プラットフォーム・ソフトウェアスタック・NVIDIA Jetson AGX Thor比較・価格と入手性・採用判断論点までを、2026年9月時点で解説しました。
2026年時点で押さえておくべきポイントは次の3つです。
- Kria AI SOMは従来のFPGA中心Kriaから設計転換した新ラインで、Ryzen AI Embedded X100(Zen 5+RDNA 3.5+XDNA 2 NPU 50 TOPS)とCOM-HPC規格を核にPhysical AI用途を単一SOMで担う
- AMD委託プロキシテスト(Ryzen AI Max+ 395をX199相当に設定)でNVIDIA Jetson AGX Thor T5000比リアルタイム信頼性3.4倍、455ワークフローのモデル評価で同時エージェント2.3倍と対抗する構成で、量産と一般提供は2026年Q4予定、産業温度版X199iのLast Time Buyは2037年
- 開発プラットフォームの公式価格は未発表(第三者ブログの予想として$5,000超・競合Jetson AGX Thor Developer KitはMSRP $5,499)で、仮に$5,000超で登場する場合は量産機の設計フェーズでPoCを回す企業向けに寄る。エコシステム移行コストと開発人材の確保が採用判断の主要論点
Physical AIをエッジで走らせる設計をこれから始める企業にとって、Kria AI SOMはNVIDIA Jetson AGX Thorと並ぶ有力な選択肢です。事業判断としては、「絶対性能で選ぶか、制御ソフト+AI推論の統合性で選ぶか」の軸で早期にケース分けし、コンシューマ版Ryzen AI Max+ 395で先行PoCを始めるところから着手するのが、最も実用的な第一歩になります。