この記事のポイント
 リサーチプレビュー段階でCopilot CLI限定、まず第1ターンの単発タスクで試すのが公式推奨
- Autoは1リクエスト1モデル、HydraFusionは必要に応じて複数モデルを1ターンで走らせる設計
- 3ベンチ全てでコスト減、ただし品質でOpus 5を上回ったのはTerminalBench 2.1の1本のみ
- 追加料金なしで走ったモデルのトークン合算、Autoにある10%割引のHydraFusion適用は公式記載なし
- 使うモデルの指定・除外は不可で中間出力も非表示、統制重視ならAutoが無難
Microsoft MVP・AIパートナー。LinkX Japan株式会社 代表取締役。東京工業大学大学院にて自然言語処理・金融工学を研究。NHK放送技術研究所でAI・ブロックチェーンの研究開発に従事し、国際学会・ジャーナルでの発表多数。経営情報学会 優秀賞受賞。シンガポールでWeb3企業を創業後、現在は企業向けAI導入・DX推進を支援。
HydraFusion(ハイドラフュージョン)は、GitHubが2026年9月4日に公開したCopilot CLI向けのリサーチプレビューです。
モデルを1つ選ぶのではなく、タスクごとに実行計画を組み立て、必要に応じて複数モデルを1ターンで走らせます。
従来のAutoモデル選択が割り当てるのは1リクエストに1モデルでしたが、HydraFusionは下書きから修正までを組み立てます。
本記事では、実行パターン、ベンチマーク結果、Autoとの使い分け、料金、制約を2026年9月時点で整理します。
HydraFusionとは?モデルではなくワークフローを選ぶ仕組み
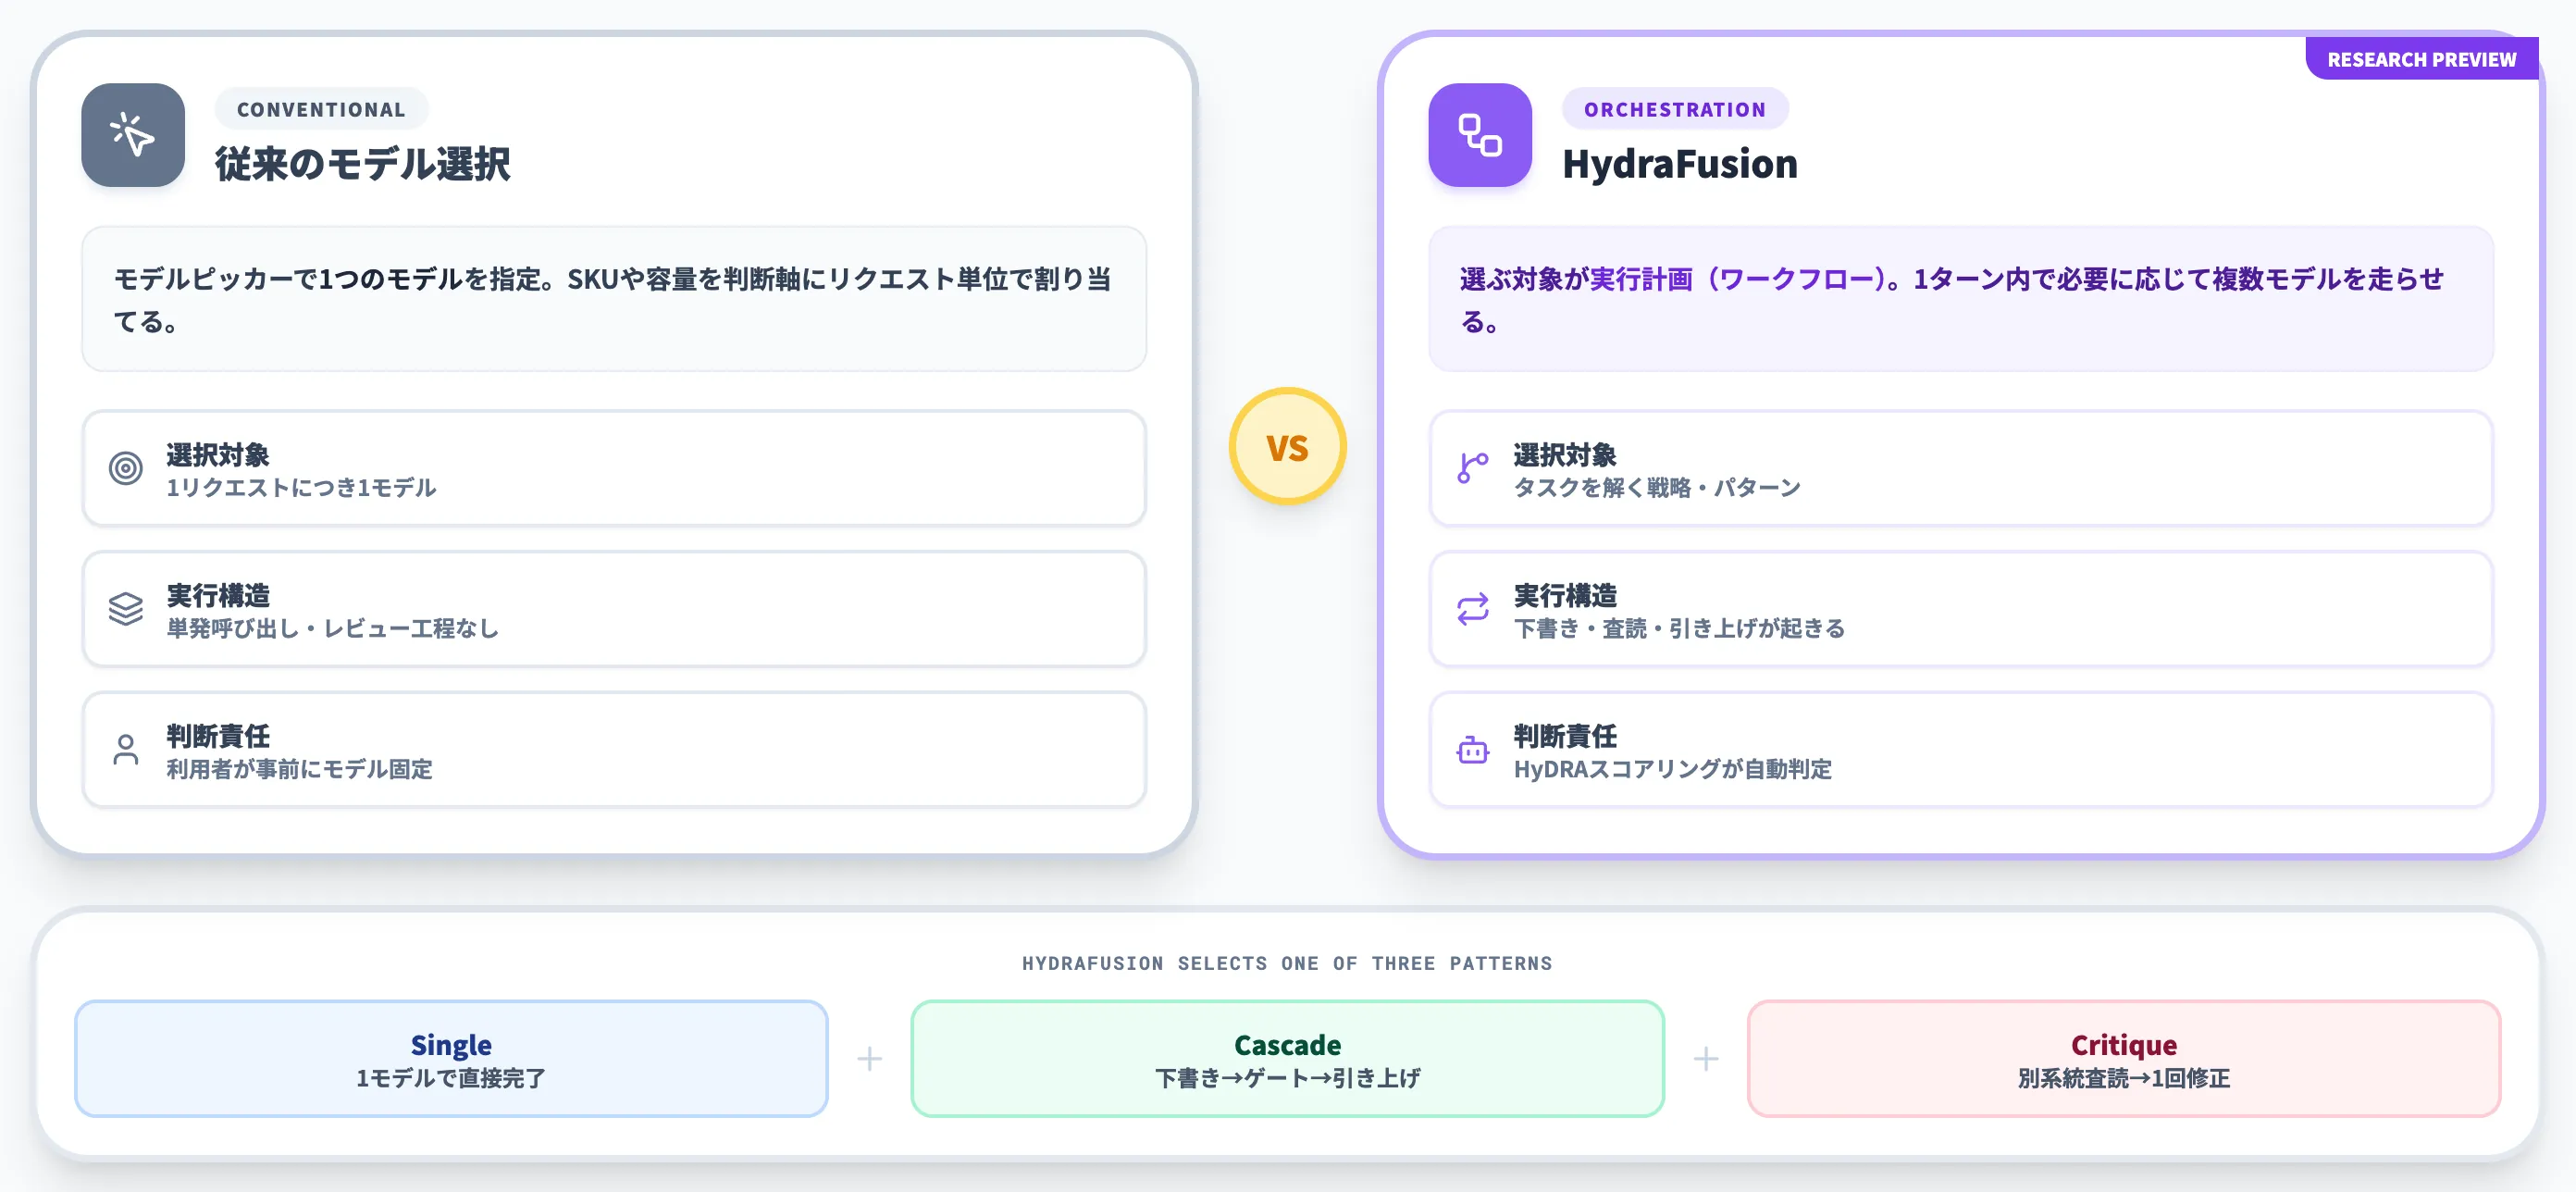
HydraFusion(ハイドラフュージョン)は、GitHubが2026年9月4日に公開した、GitHub Copilot CLIで複数のAIモデルを実行時に組み合わせるリサーチプレビュー機能です。
従来のモデルピッカーと根本的に違うのは、選ぶ対象がモデルではなく、そのタスクをどう解くかという実行計画になっている点です。
GitHubのCPOであるMario Rodriguez氏はVentureBeatの取材に対し、答えているのは「このタスクにどのモデルか」ではなく「このタスクを解く最適な戦略は何か」だと説明しています。
Auto V1・HyDRAから続く3世代目
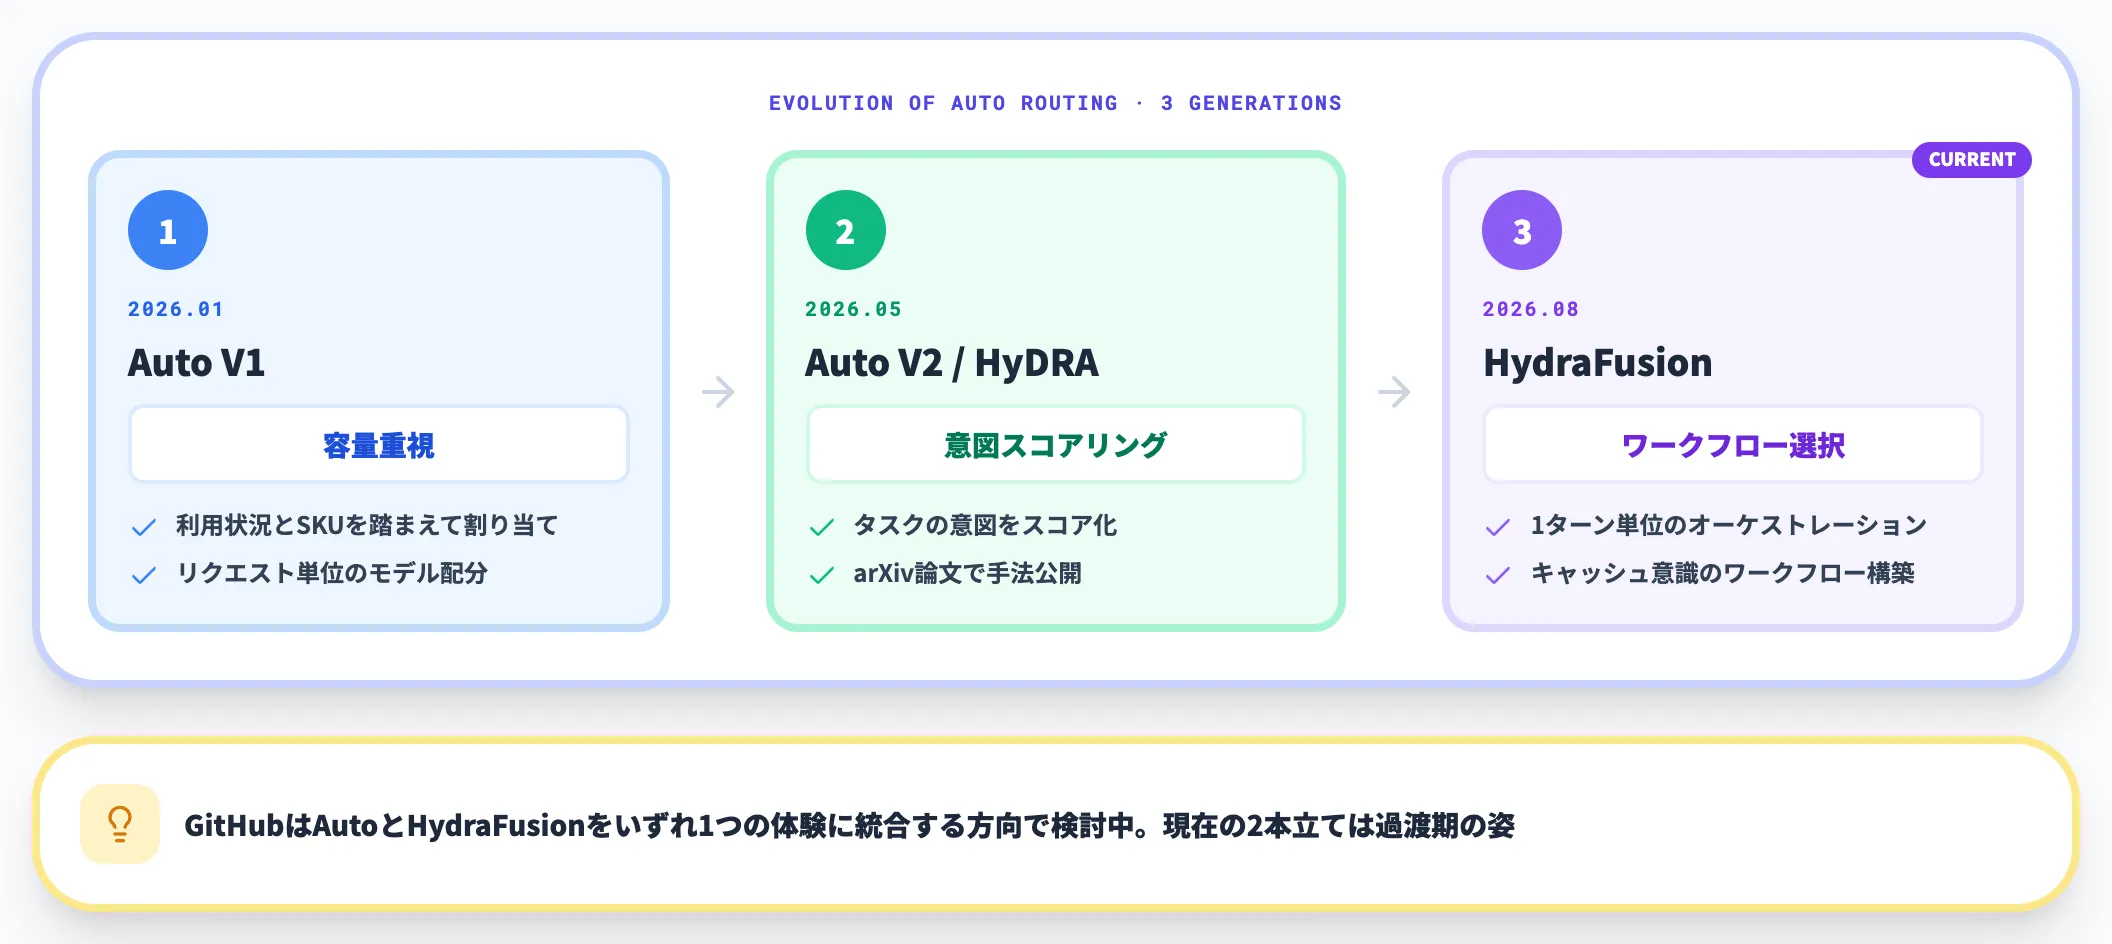
HydraFusionは突然出てきた新機能ではなく、GitHubが2026年に入ってから積み上げてきた自動ルーティングの3世代目にあたります。
公式のCommunity Discussionでは、次の系譜が示されています。
-
Auto V1(2026年1月)
利用状況とSKUを踏まえてリクエストごとにモデルを割り当てる、容量重視の初期版。
-
Auto V2(HyDRA/2026年5月)
タスクの意図をスコア化して割り当て先を決める方式。arXivの論文として手法が公開されている。
-
HydraFusion(2026年8月)
1ターン単位でのオーケストレーションと、キャッシュを意識したワークフロー構築に踏み込んだ世代。
名前が示すとおり、HydraFusionはHyDRAの延長線上にあります。GitHubはAutoとHydraFusionをいずれ1つの体験に統合する方向で検討していると明言しており、現在の2本立ては過渡期の姿と捉えるのが妥当です。
HydraFusionが選ぶ3つの実行パターン
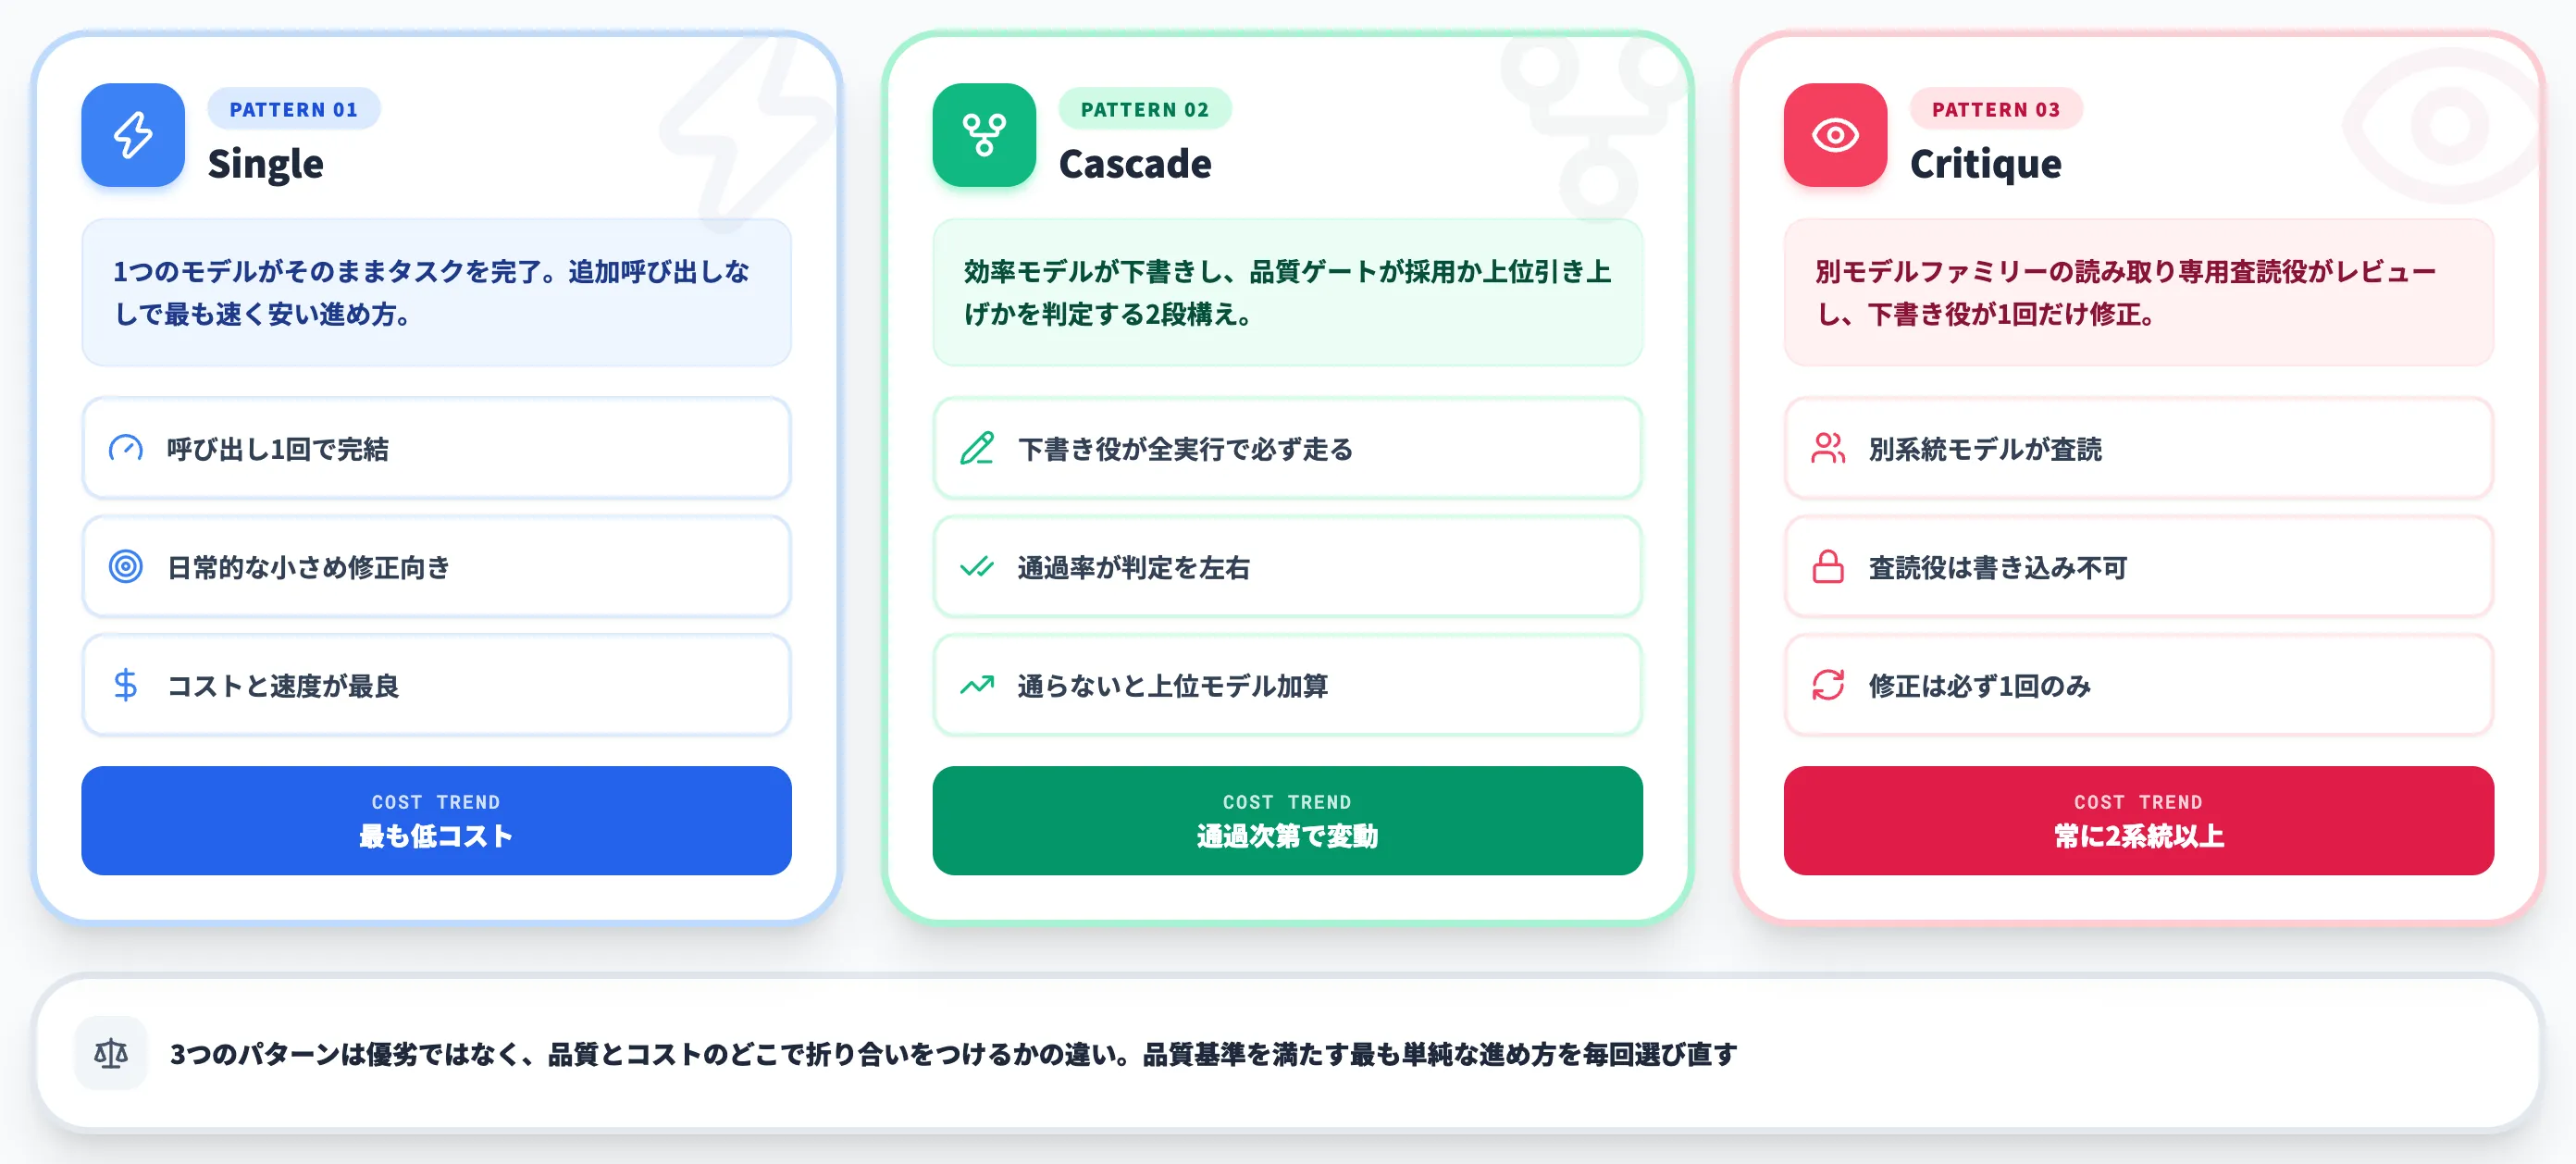
HydraFusionは、ワークフローの選択を最適化問題として扱います。品質の基準を満たすなかで最も単純な進め方を選び、追加のモデル呼び出しは結果が良くなる見込みがあるときだけ使う設計です。
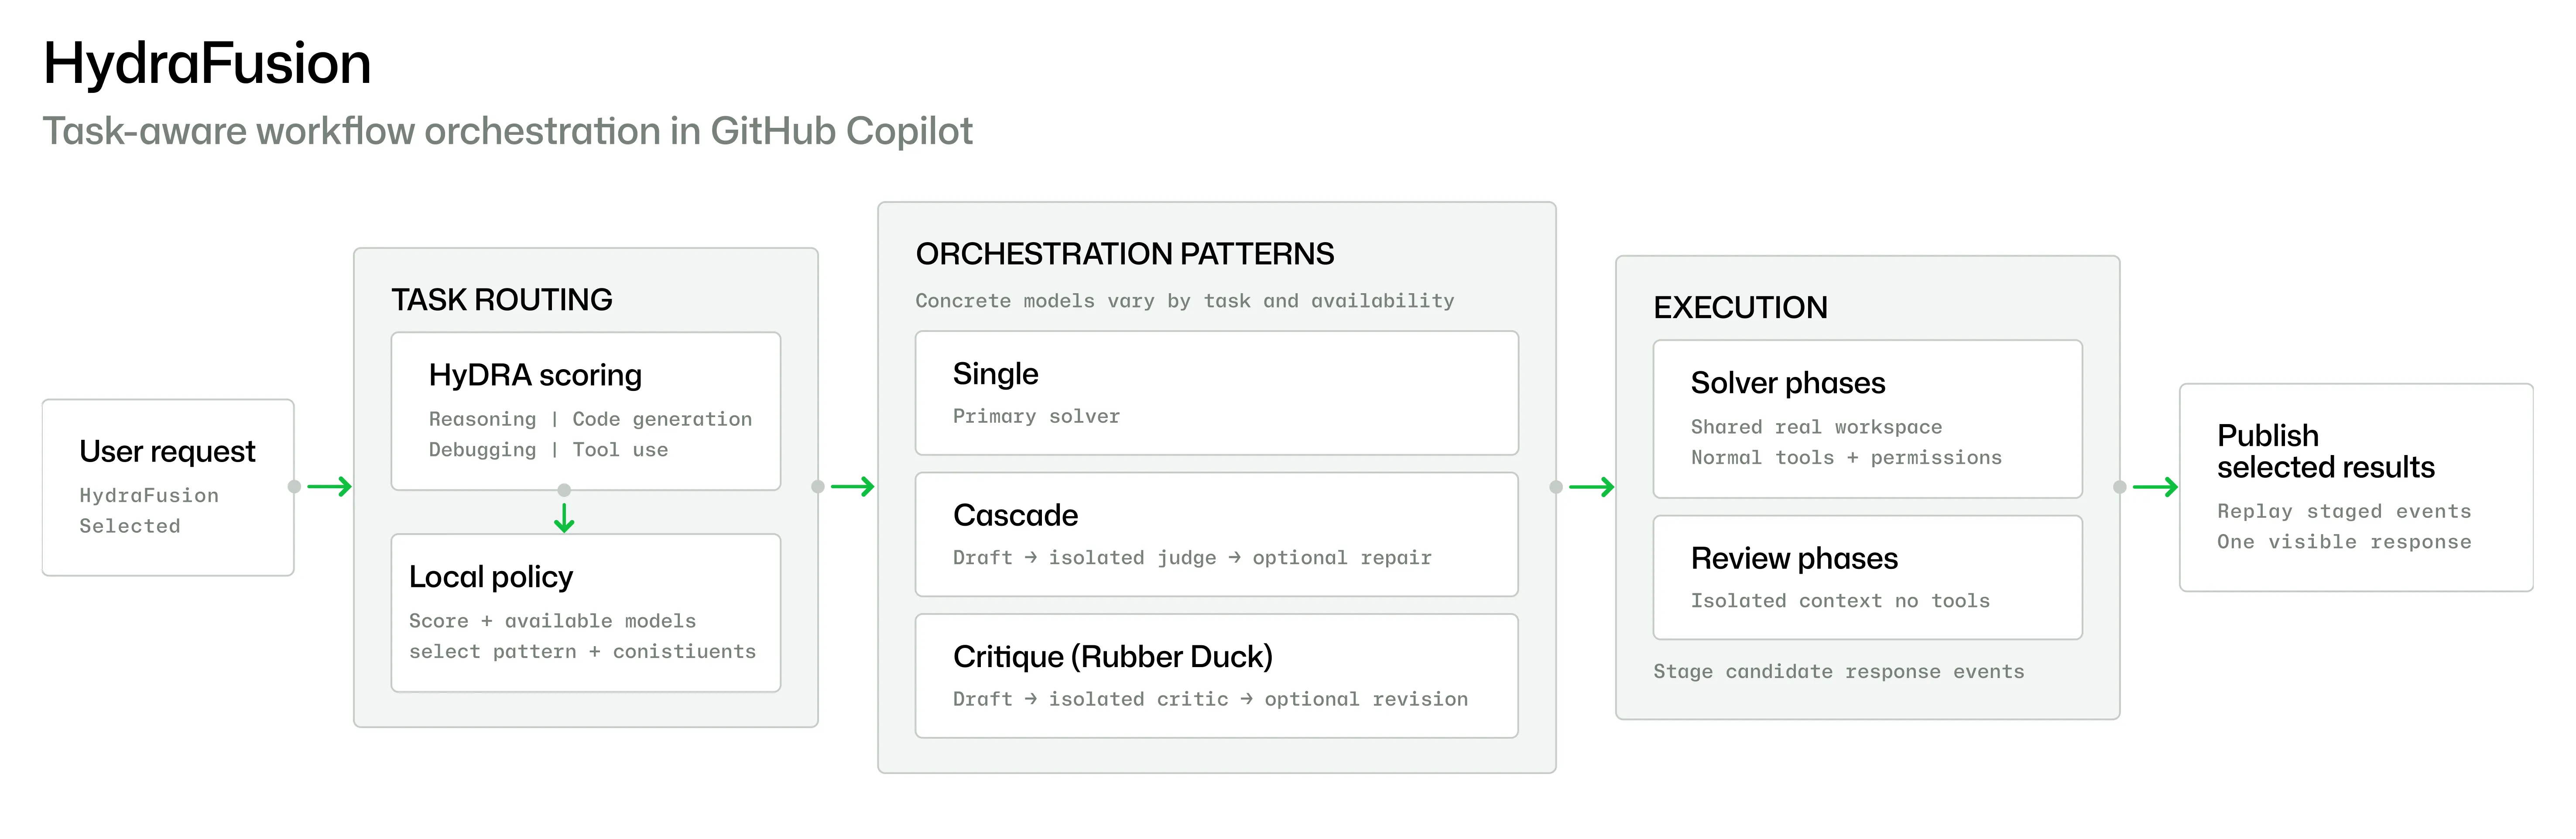
リクエストの受付から結果の公開までの流れ(出典:GitHub Blog)
公式の構成図は、左からリクエストの受付、ルーティング、パターンの選択、実行、結果の公開という並びです。ルーティングの箱にはHyDRAスコアリングと書かれており、後述する4つの能力シグナルがここで評価されます。
実行の箱では、解決役が共有ワークスペースと通常の権限で動くのに対し、査読役はツールを持たない隔離環境に置かれる構造が示されています。
本セクションでは、現在提供されている3つの実行パターンと、その選択を左右する判断材料を整理します。
以下の表は、3パターンの動き方とコストの傾向をまとめたものです。
| パターン | 動き方 | コストと速度の傾向 |
|---|---|---|
| Single | 1つのモデルがタスクを直接解く | 追加の呼び出しがなく最も速くて安い |
| Cascade | 効率的なモデルが下書きし、品質ゲートが採用か引き上げかを判定 | 判定を通れば安く済み、通らなければ上位モデル分が加算される |
| Critique | 下書きの後に別系統が読み取り専用で査読し、下書き役が1回だけ修正 | 常に2系統以上が動くため、単発より高く遅い |
この3つは優劣ではなく、品質とコストのどこで折り合いをつけるかの違いです。1回で解けるものにレビュー工程を足しても効果は限られ、逆に難しい問題に単発で挑むと精度が出にくくなります。
Singleは1つで直接解く
Singleは、選ばれた1つのモデルがそのままタスクを完了させるパターンです。追加の呼び出しが発生しないため、速度とコスト効率がそのまま残ります。
日常的な小さめの修正や、仕様がはっきりしている実装では、査読や引き上げの工程を挟む利点は小さくなります。HydraFusionが「最も単純な進め方を選ぶ」と説明されているのは、この判断を毎回やり直すという意味です。
Cascadeは品質ゲートで昇格を判定
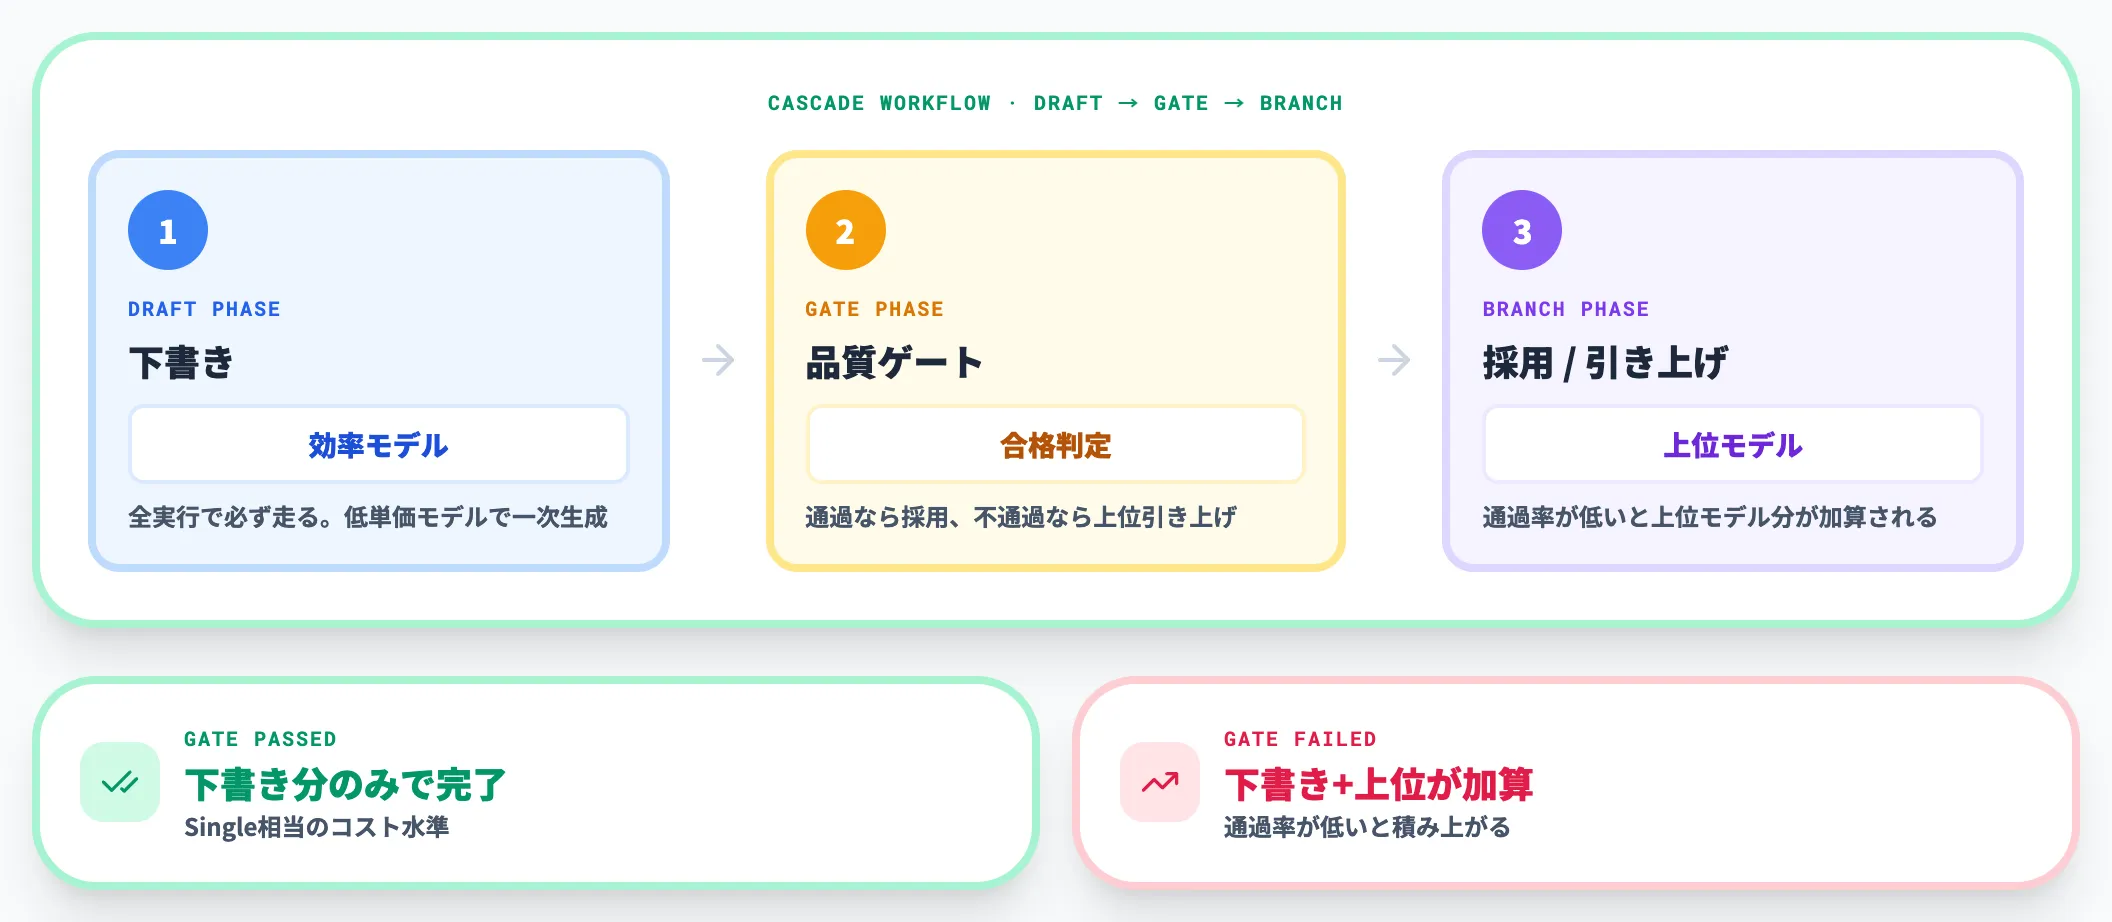
Cascadeは、コスト効率の高いモデルにまず下書きを作らせ、その結果を品質ゲートが評価して、そのまま採用するか上位に引き上げるかを決める2段構えです。
ここで注意したいのが、コストの積み上がり方です。下書き役は全てのCascade実行で必ず走り、上位モデルは判定を通らなかった分だけ追加で走ります。
つまり判定の通過率が低いタスクほど、下書き分がまるごと上乗せされます。VentureBeatの記事でも、開発者のAwan Farz氏がこの構造を指摘しています。安いモデルを挟めば常に安くなるわけではない、という点は見積もりの前提として押さえておく必要があります。
Critiqueは別系統が査読して1回だけ直す
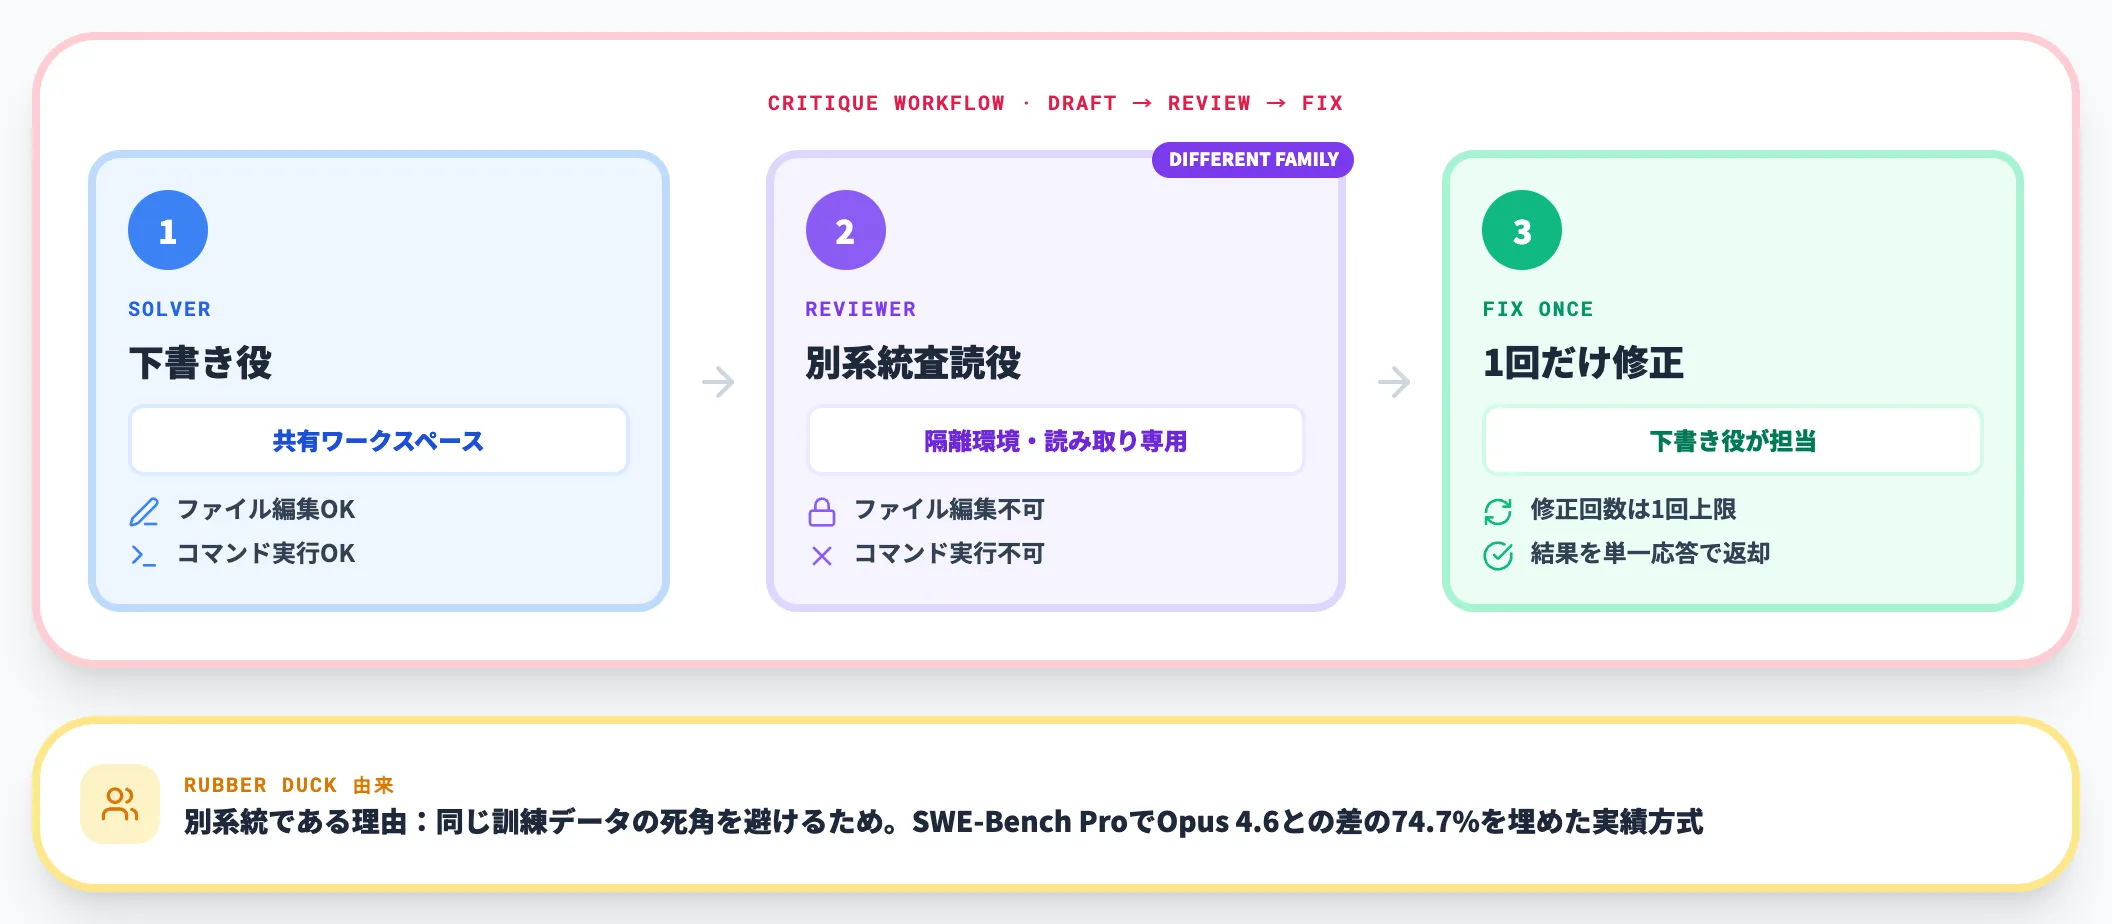
Critiqueは、1つのモデルが結果を作り、別のモデルファミリーから来た読み取り専用の査読役がそれをレビューし、下書き役が1回だけ修正するパターンです。
査読役が別系統である点には理由があります。GitHubは4月に公開したRubber Duckで同じレビュー方式を先に導入しており、その発表ブログでは、自分の作業を自分でレビューするモデルは同じ訓練データと同じ死角に縛られたままだと説明しています。
Rubber Duckの検証では、SWE-Bench ProにおいてClaude Sonnet 4.6とRubber Duckの組み合わせがClaude Opus 4.6単独に迫り、性能差の74.7%を埋めたと報告されています。
HydraFusionのCritiqueは、この実績のある方式を自動選択の対象に組み込んだものです。査読役はファイルを編集できず、コマンドも実行できないため、査読の過程でリポジトリが書き換わることはありません。
パターンを決める4つの能力シグナル
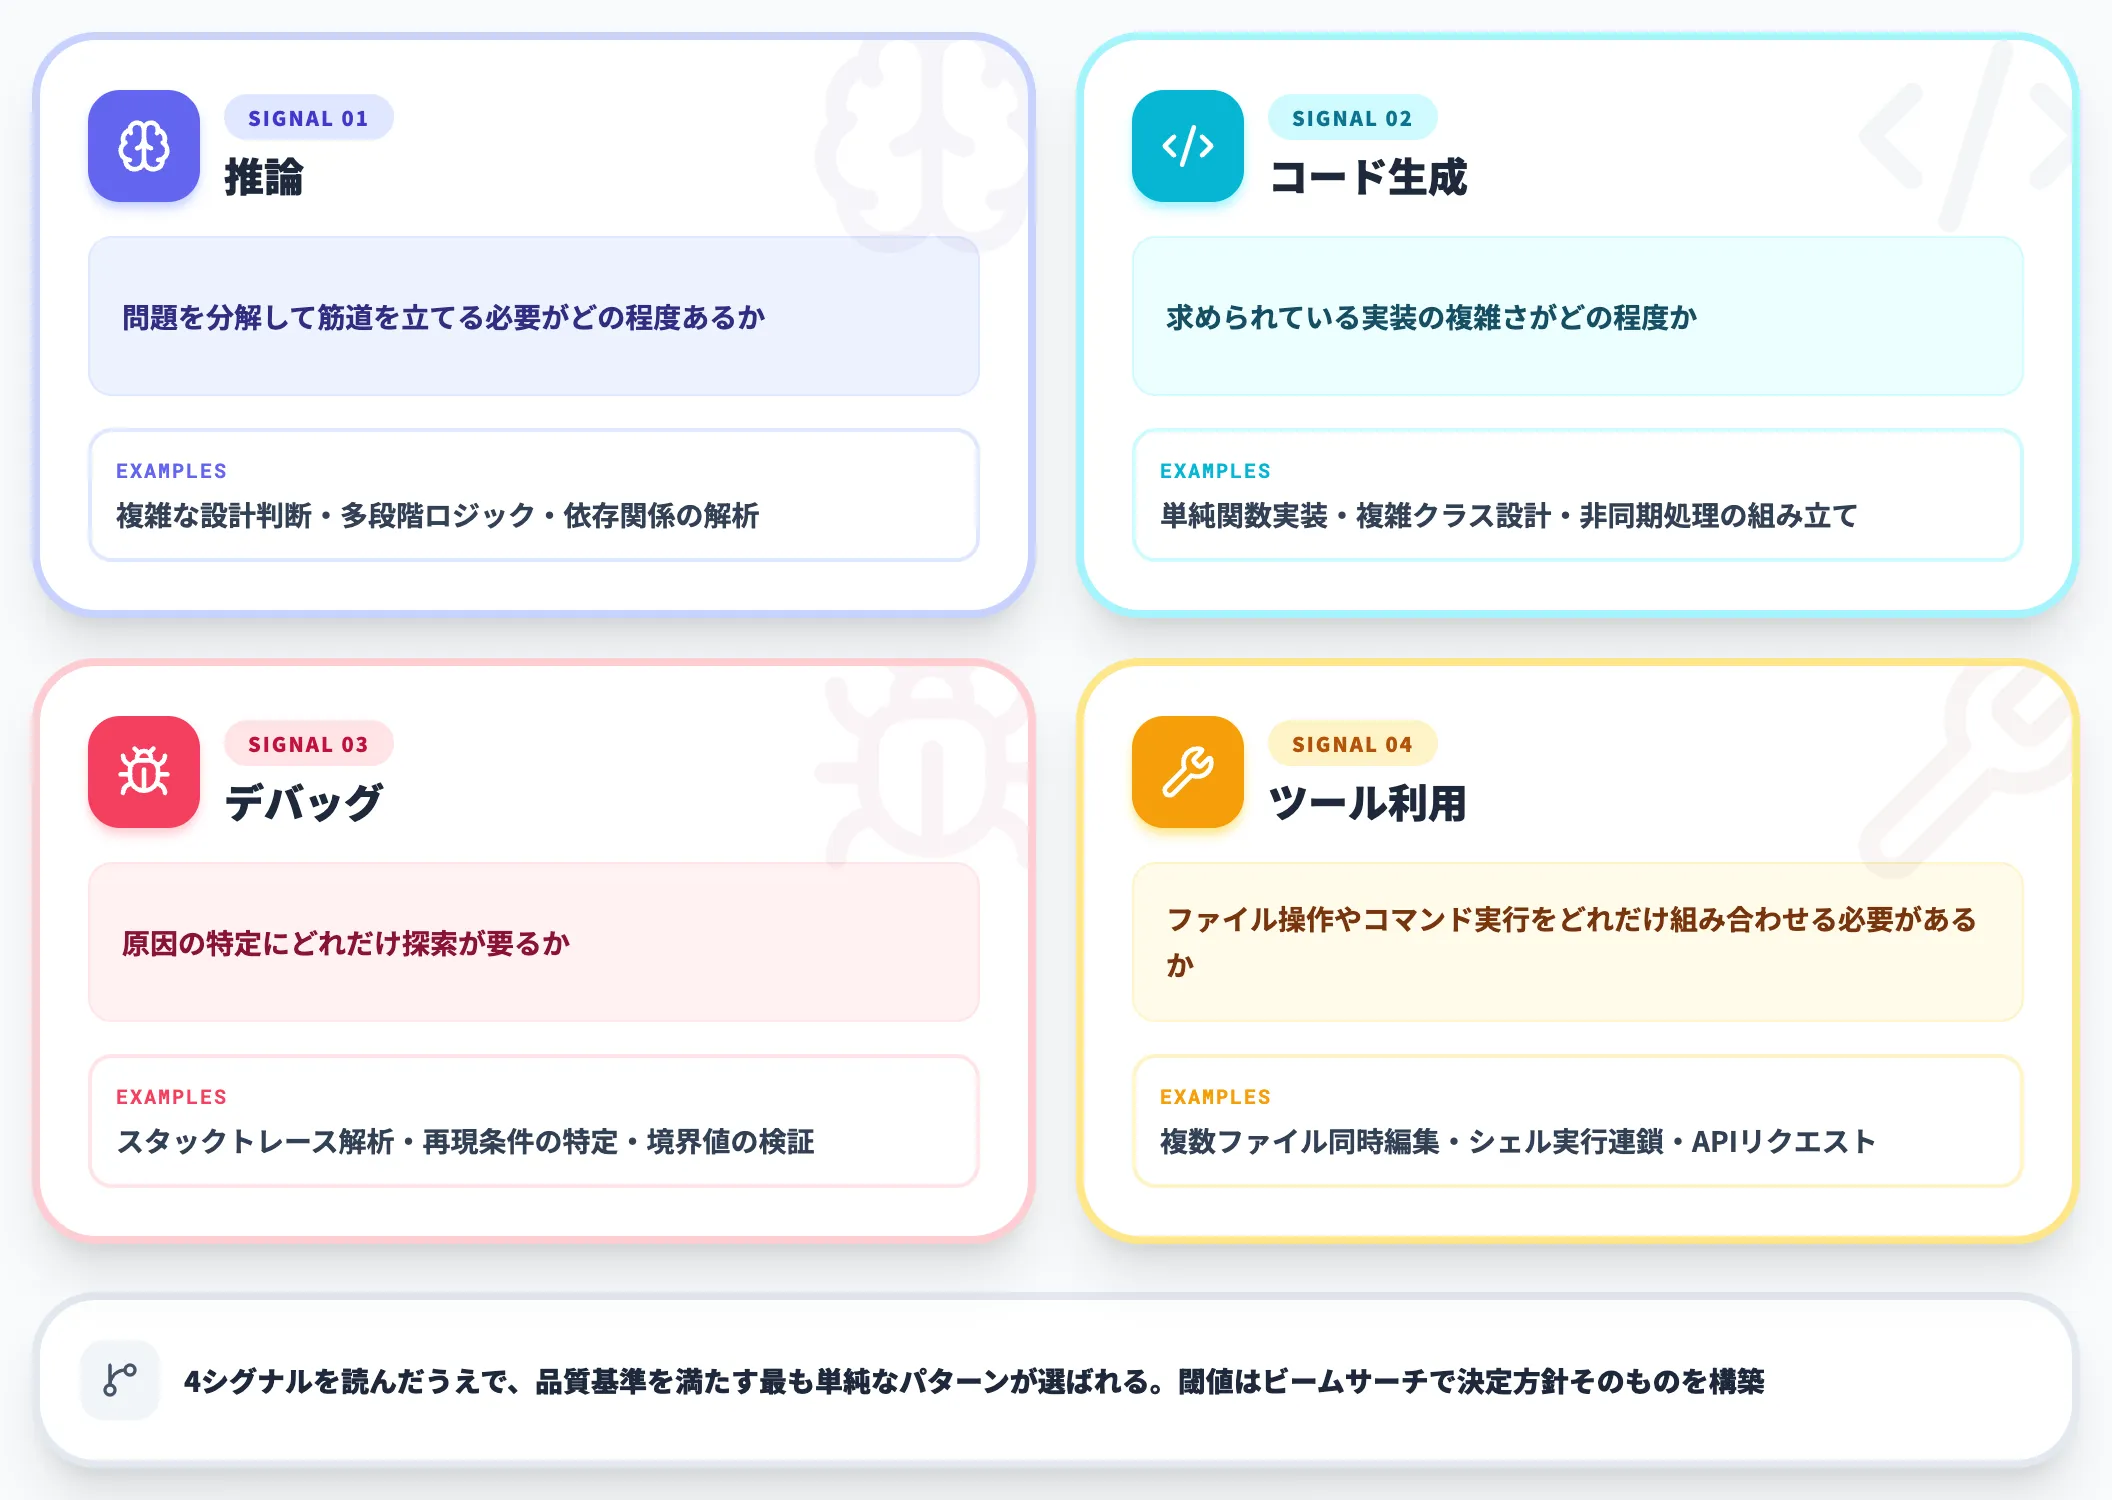
どのパターンを使うかは、GitHubが能力シグナルと呼ぶ4つの観点から判断されます。
-
推論
問題を分解して筋道を立てる必要がどの程度あるか
-
コード生成
求められている実装の複雑さがどの程度か
-
デバッグ
原因の特定にどれだけ探索が要るか
-
ツール利用
ファイル操作やコマンド実行をどれだけ組み合わせる必要があるか
この4つを読んだうえで、品質の基準を満たす最も単純なパターンが選ばれます。
閾値は人手で調整されたものではなく、ビームサーチ(有望な候補だけを残しながら探索する手法)で決定方針そのものを構築したと公式ブログに記載があります。
HydraFusionのベンチマーク結果とコスト削減率
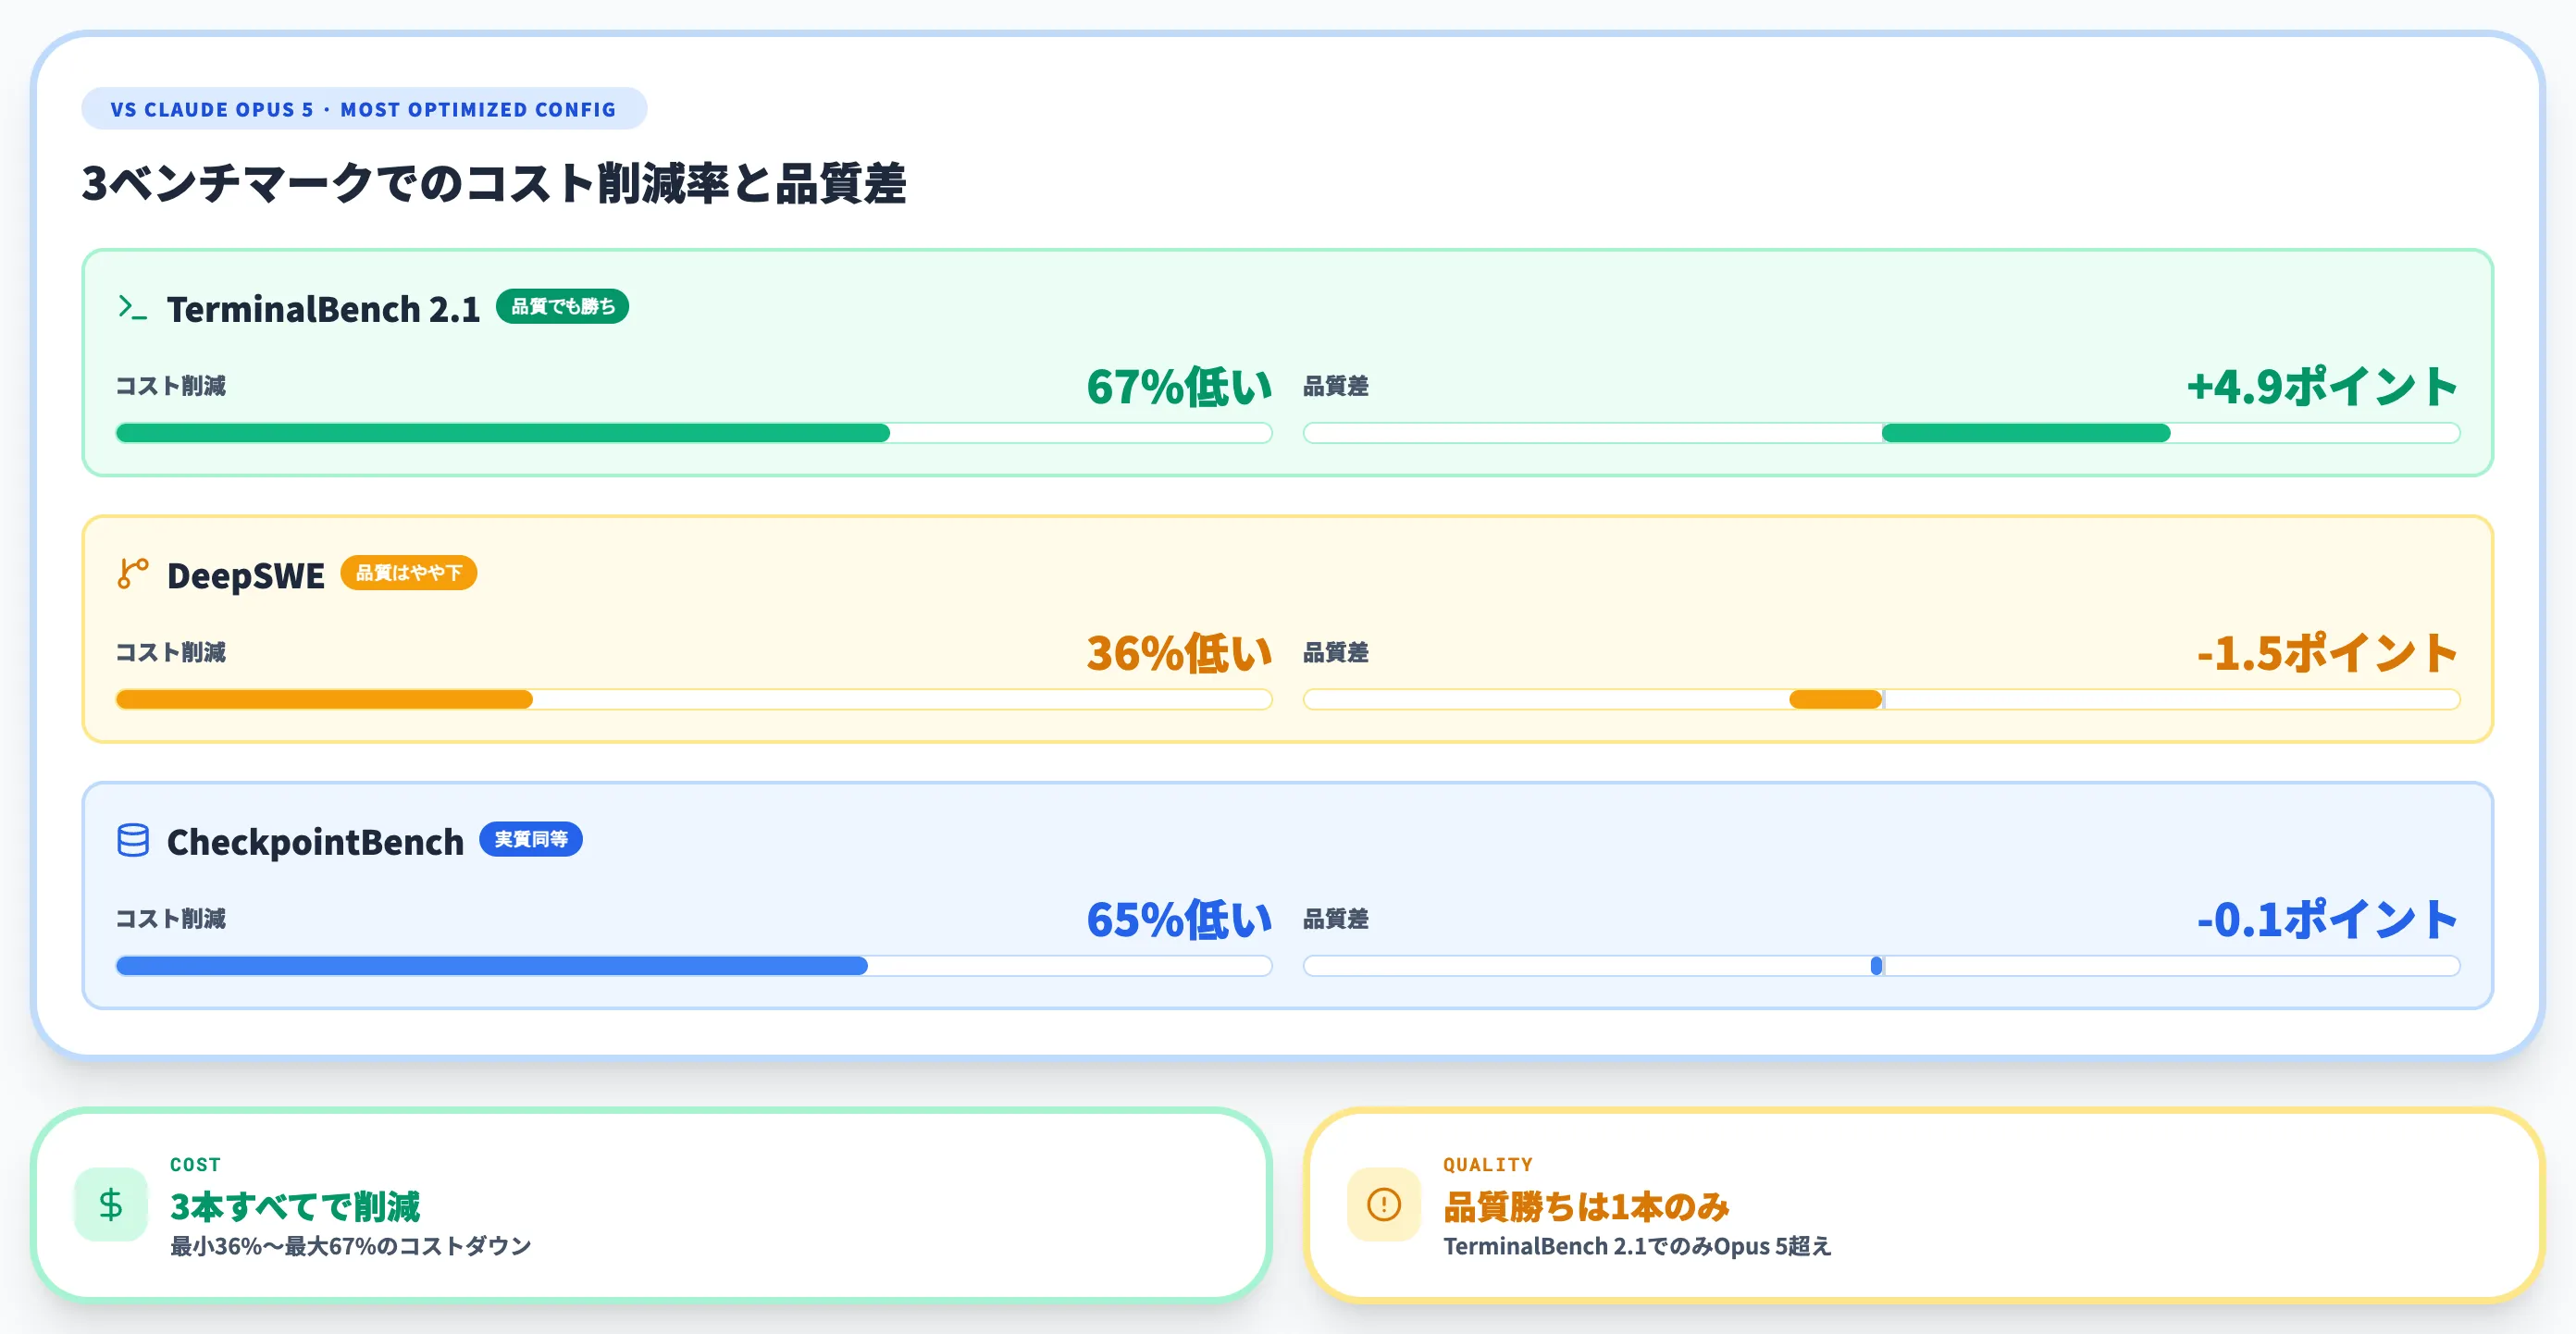
GitHubは3つのエージェント型コーディングベンチマークで、HydraFusionをClaude Opus 5およびGPT-5.6 Solと比較しています。
公表された数値と、その数値をどう読むべきかを順に見ていきます。
3つのベンチマークで出た数値
以下の表は、Claude Opus 5を基準としたHydraFusionの結果です。いずれも公式ブログで公表された、最も調整が進んだ構成での値です。
| ベンチマーク | Opus 5比のコスト | Opus 5比の品質 |
|---|---|---|
| TerminalBench 2.1 | 67%低い | +4.9ポイント |
| DeepSWE | 36%低い | -1.5ポイント |
| CheckpointBench | 65%低い | -0.1ポイント |
3本すべてでコストが下がっている一方、品質でOpus 5を上回ったのはTerminalBench 2.1の1本だけです。残る2本はわずかに下回っています。
公式が公開している散布図では、この関係が位置で読み取れます。
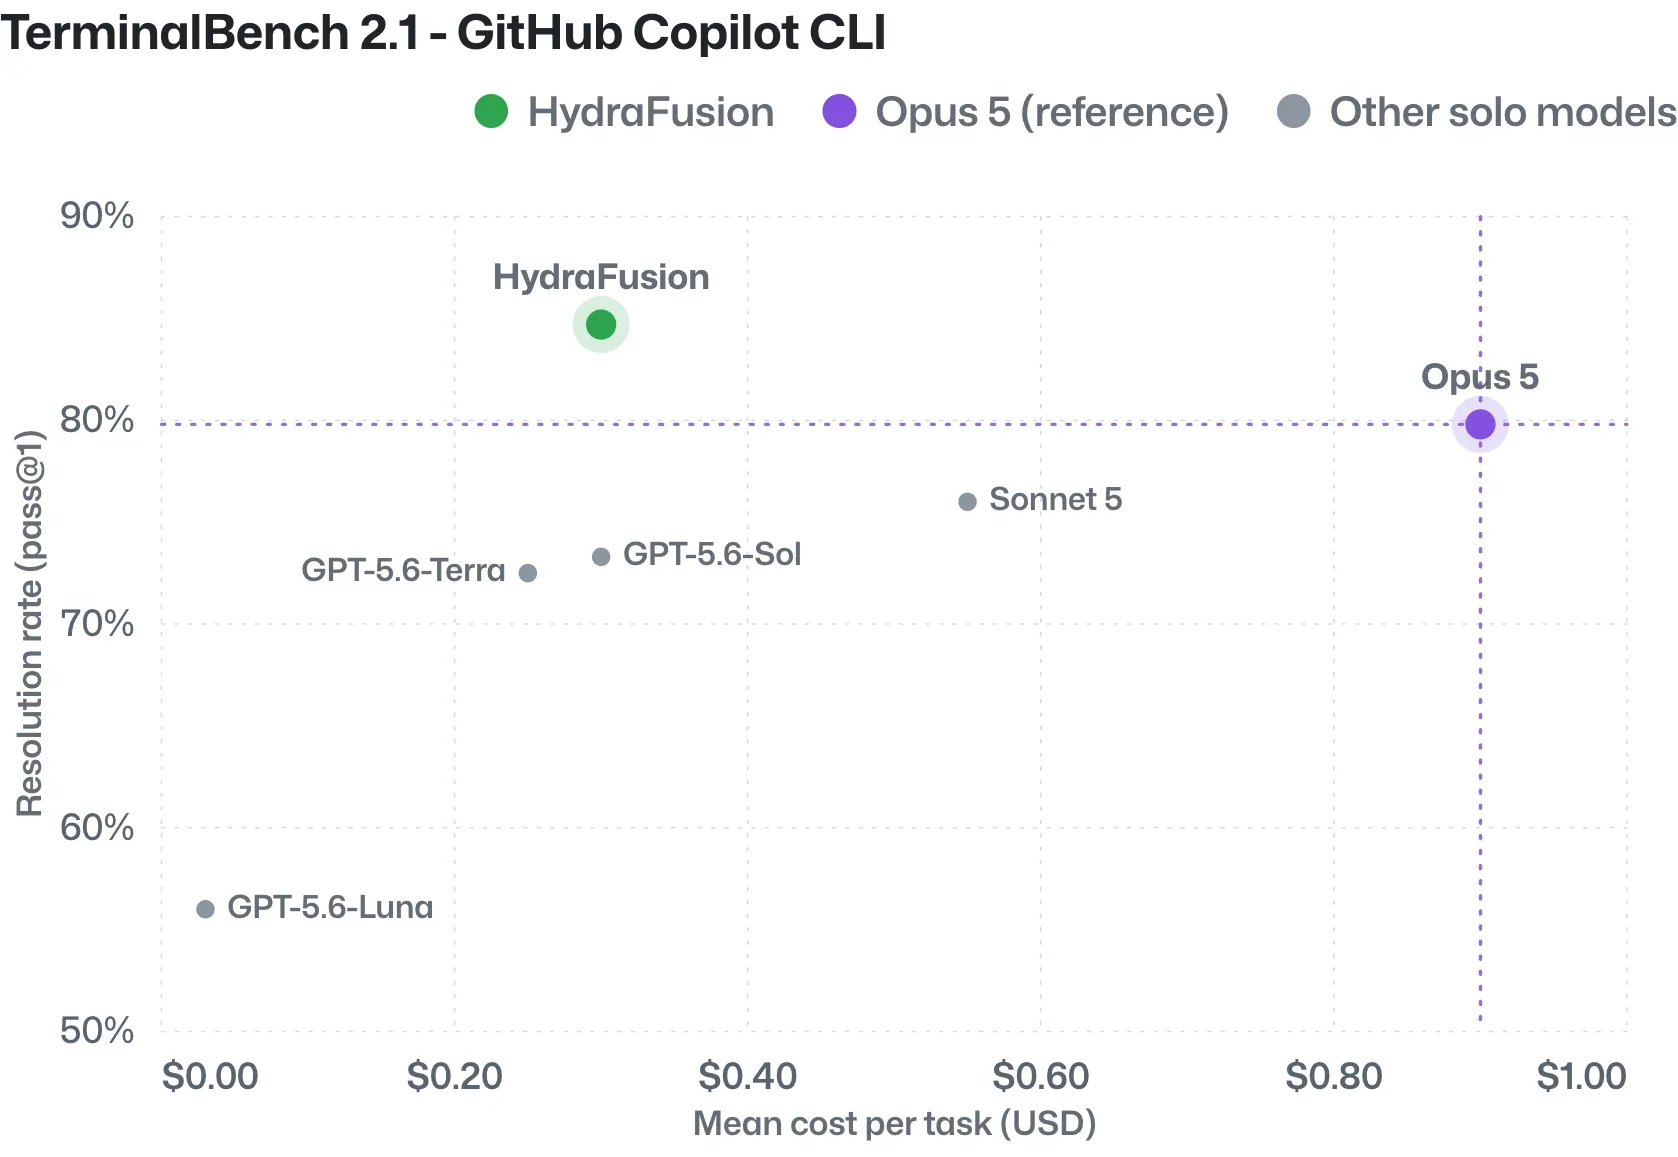
TerminalBench 2.1におけるタスク単価と解決率(出典:GitHub Blog)
横軸がタスク1件あたりの平均コスト、縦軸が解決率です。HydraFusionは1件あたり0.30ドル前後で解決率85%近くに位置し、0.90ドル前後で80%のOpus 5より左上に立っています。Sonnet 5やGPT-5.6 Solといった単独モデルは、いずれもその下に並びます。
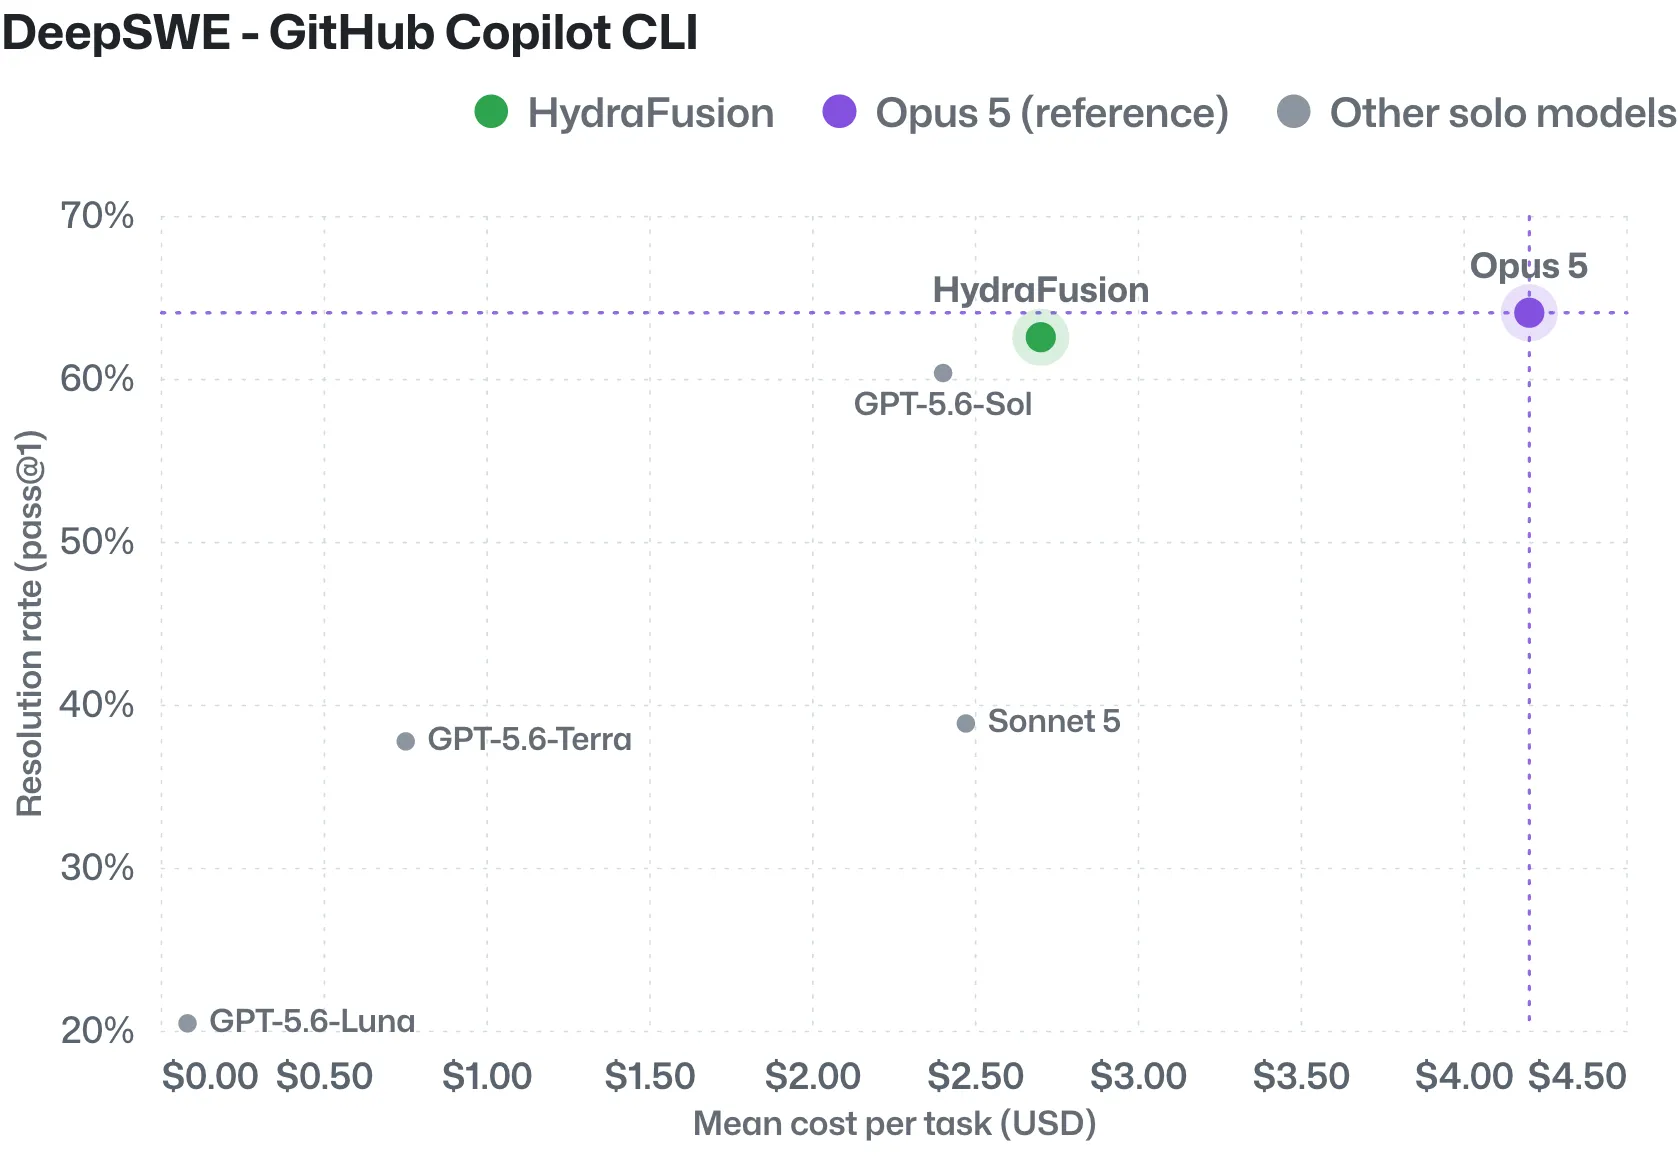
DeepSWEにおけるタスク単価と解決率(出典:GitHub Blog)
DeepSWEでは構図が変わります。Opus 5が1件あたり4.30ドル前後で解決率64%付近に立ち、HydraFusionは2.70ドル前後で62%台と、真下ではなく左下に位置します。コストは下がったが解決率は届いていない、という表の数値がそのまま形に出ています。
この差は用途によって意味が変わります。CheckpointBenchの0.1ポイント差は実質的に同等と読んでよく、コストが65%下がるなら選ぶ理由になります。一方でDeepSWEの1.5ポイント差は、大規模なリポジトリ改修のように失敗の手戻りが大きい領域では無視しにくい幅です。
VentureBeatは、公式が掲げるフロンティア品質という表現と、実際の表の内容にはずれがあると指摘しています。導入判断では、コスト削減の数字だけでなく、自社の作業がどのベンチマークに近いかを見るほうが実務的です。
CheckpointBenchは実セッション由来
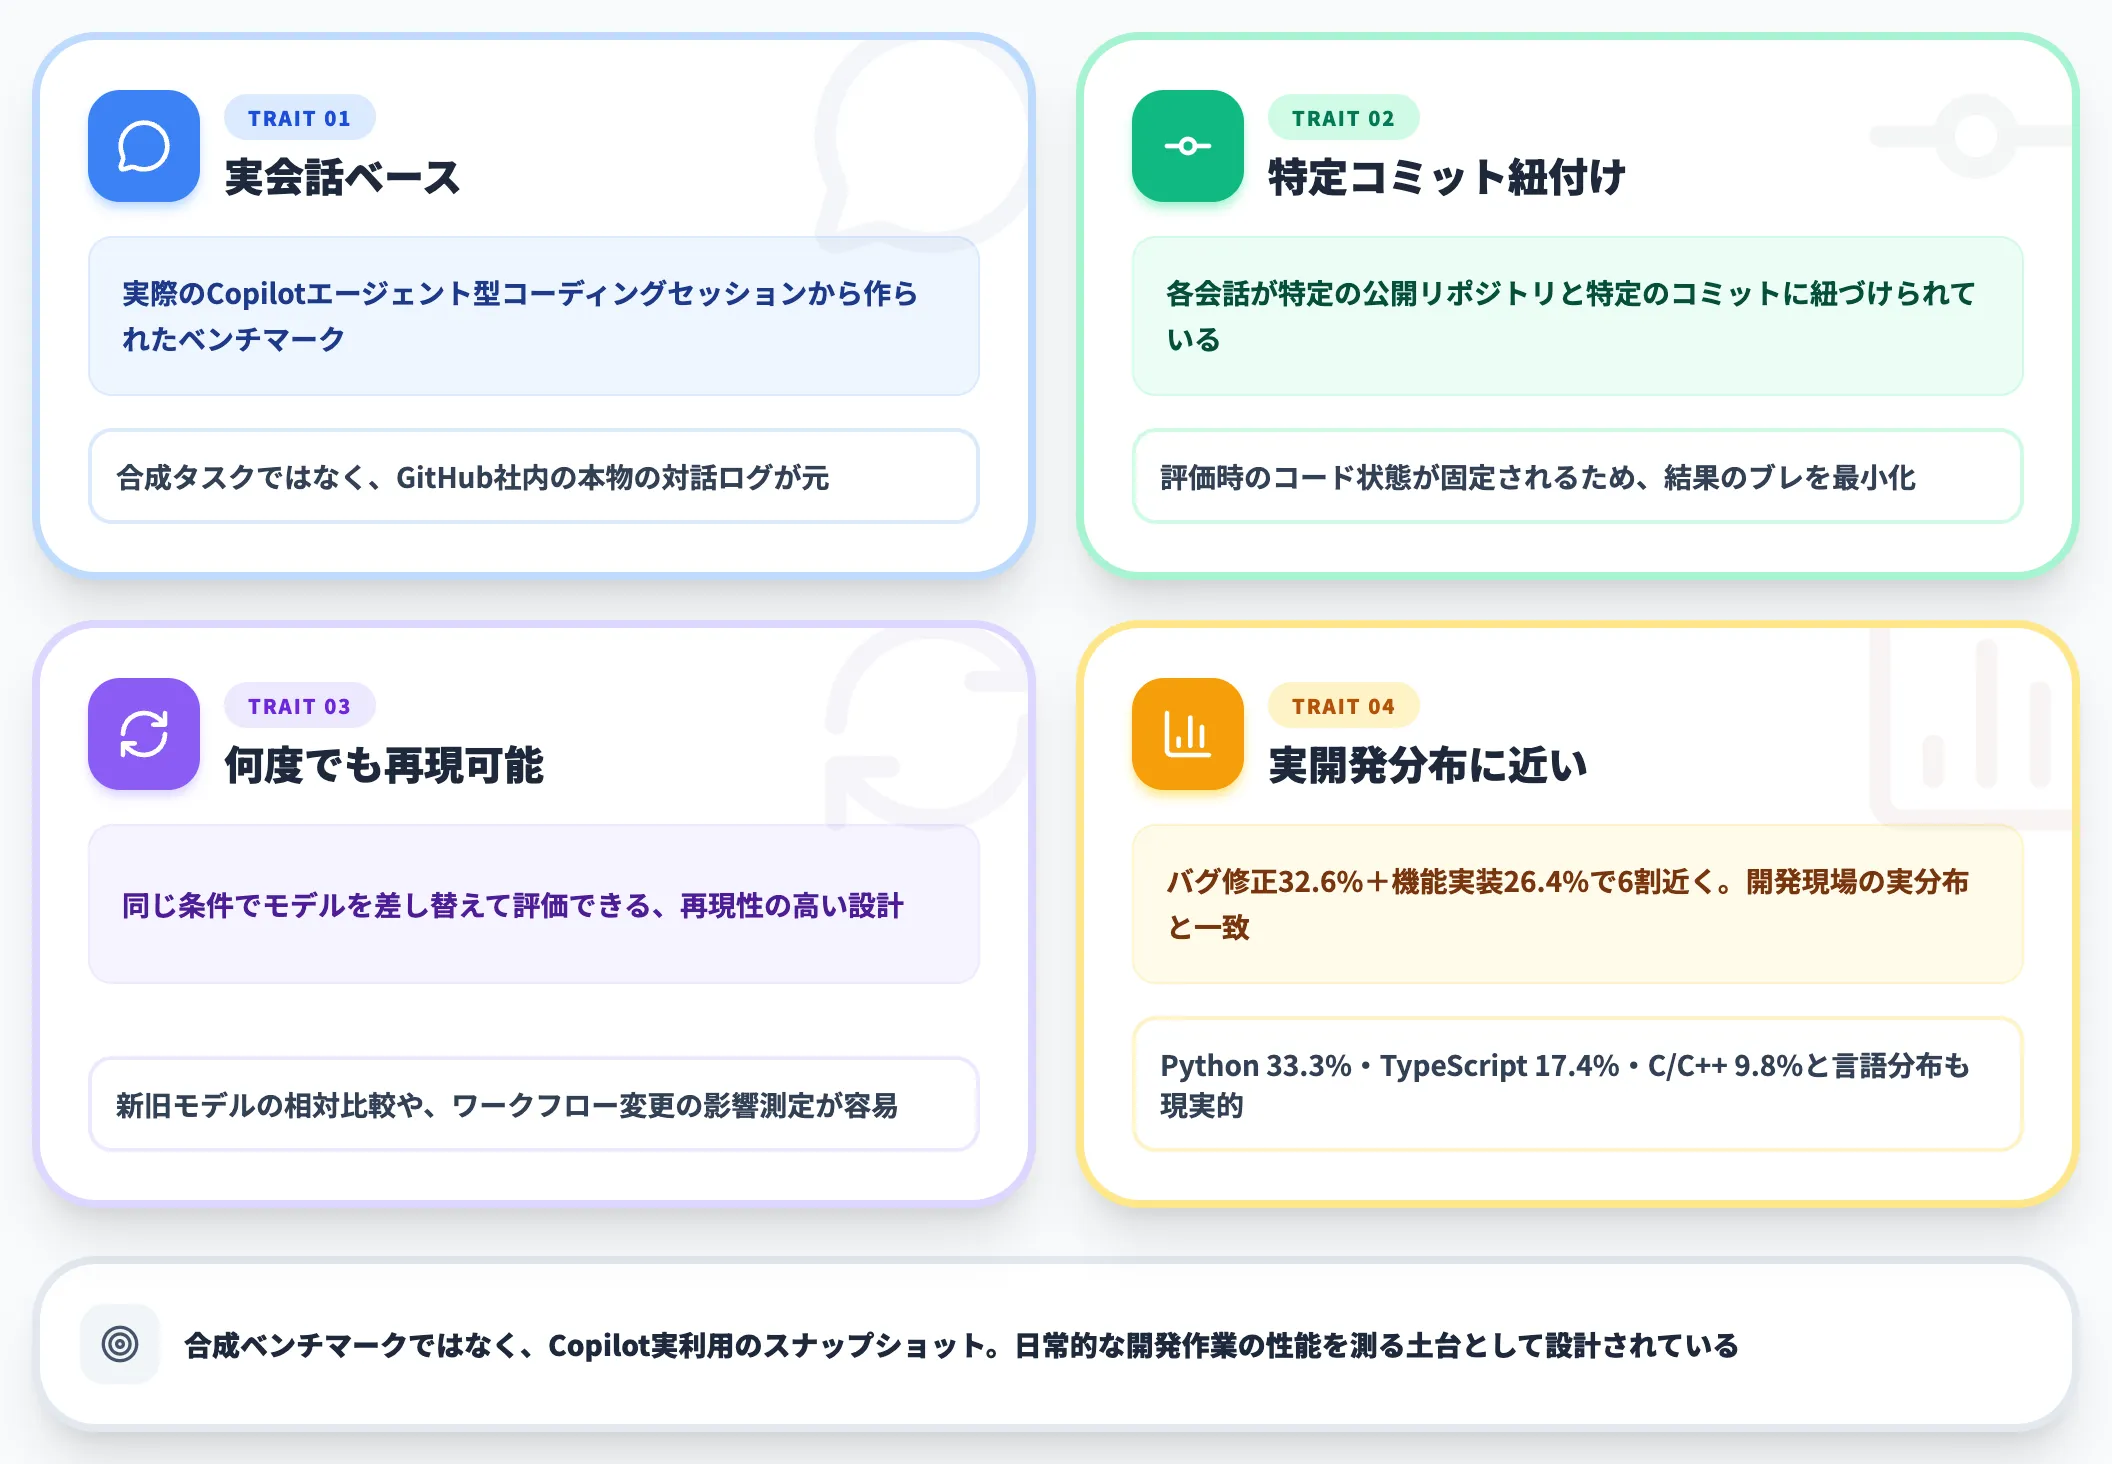
3本のうちCheckpointBenchは、GitHubの社内ベンチマークです。実際のCopilotのエージェント型コーディングセッションから作られている点が、他の2本と性質を分けています。
各会話は特定の公開リポジトリと特定のコミットに紐づけられており、何度でも同じ条件で再現できます。中身の構成は公式が内訳として公開しています。
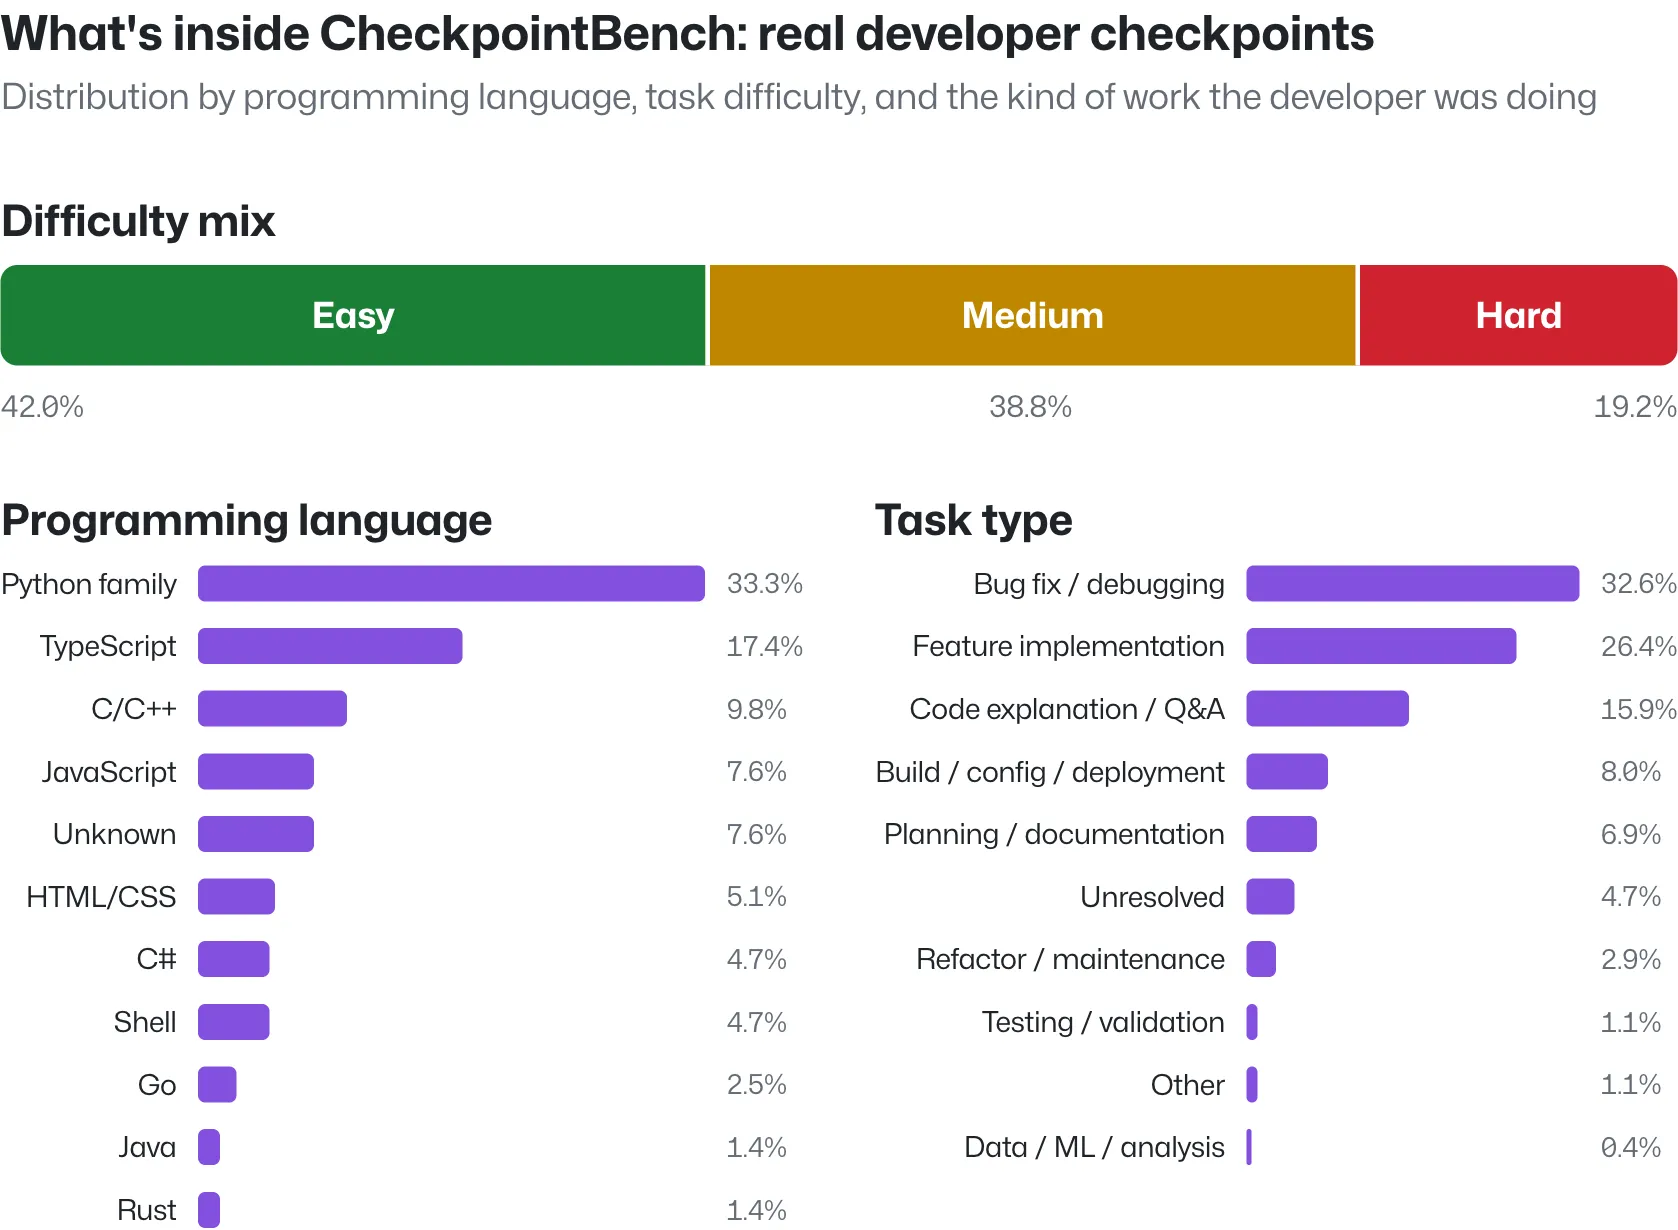
CheckpointBenchの難易度・言語・作業種別の内訳(出典:GitHub Blog)
難易度はEasyが42.0%、Mediumが38.8%、Hardが19.2%という配分です。言語はPython系が33.3%で最も多く、TypeScriptが17.4%、C/C++が9.8%と続きます。作業の種類ではバグ修正とデバッグが32.6%、機能実装が26.4%、コードの説明と質疑が15.9%を占めます。
バグ修正と機能実装で6割近くを占める構成は、実際の開発現場の分布に近いものです。
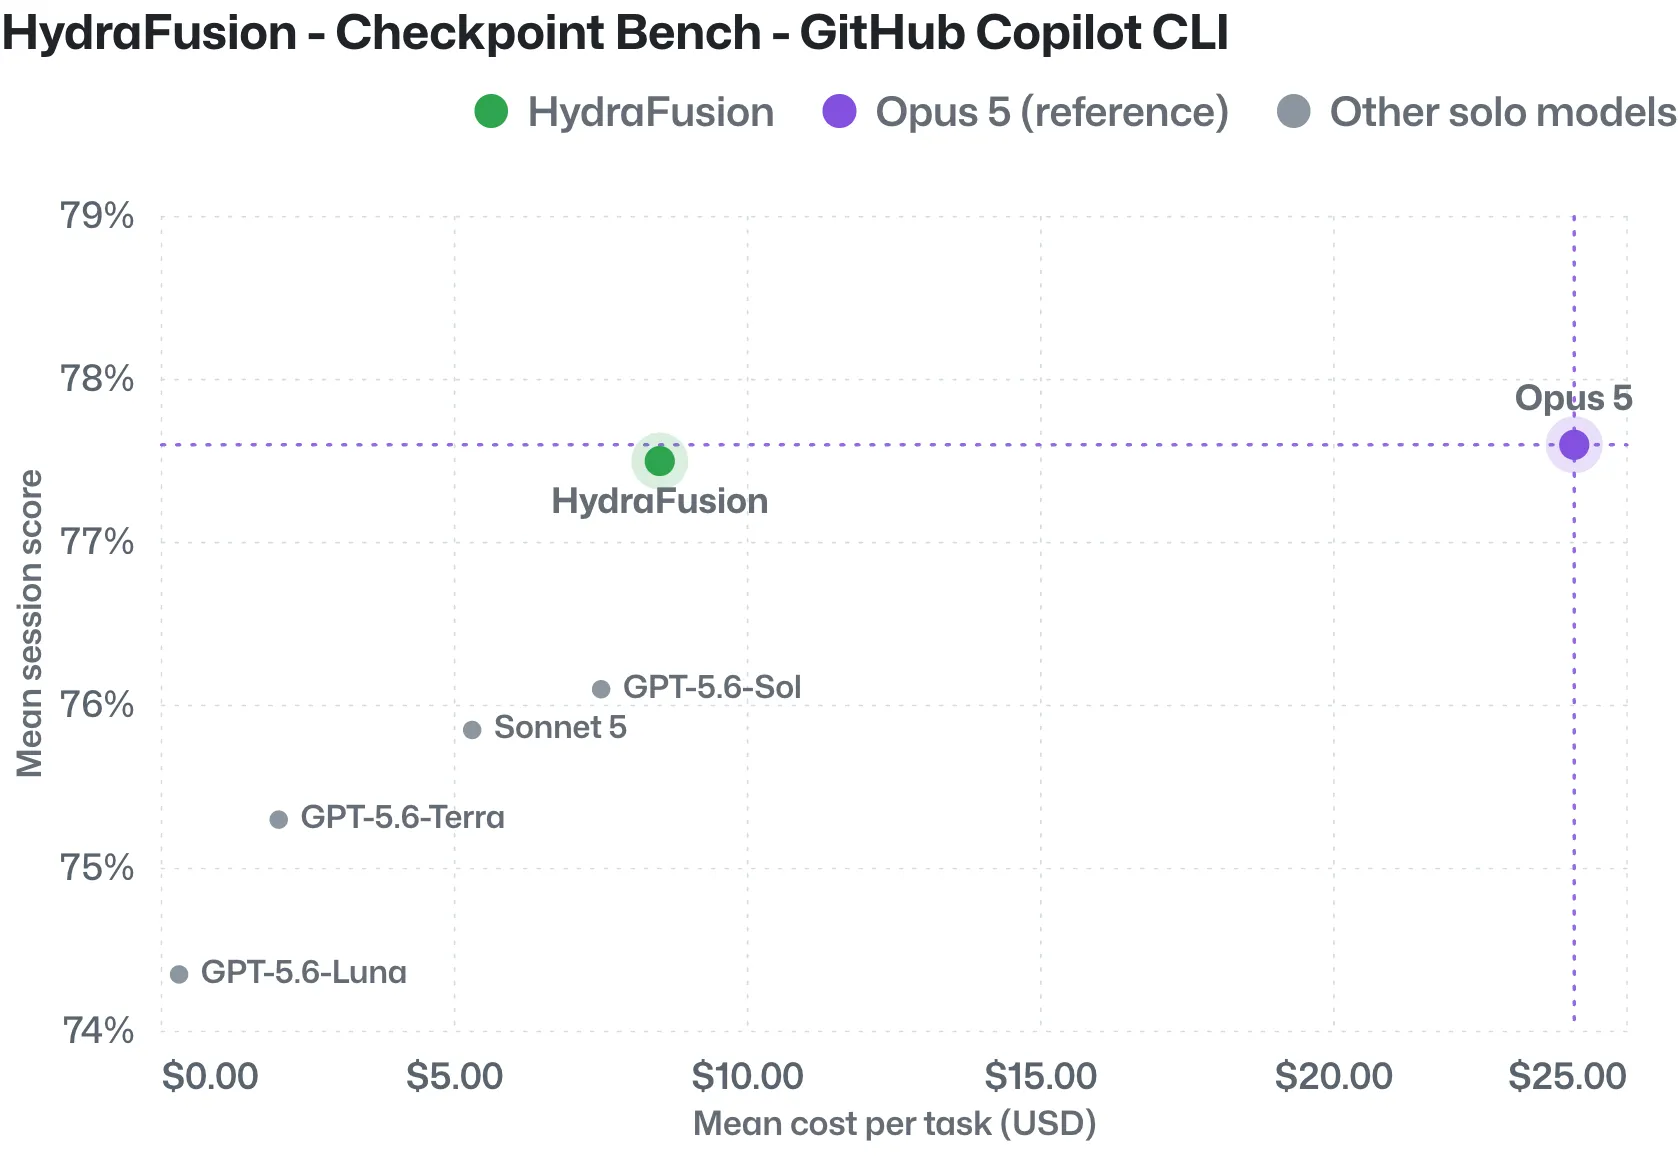
CheckpointBenchにおけるタスク単価とセッションスコア(出典:GitHub Blog)
散布図では、Opus 5が1件あたり25ドル近くでスコア77.6%付近、HydraFusionが8.50ドル前後で77.5%付近に並びます。縦の位置がほぼ重なったまま、横だけが3分の1に寄った形です。日常的な作業なら品質を落とさずにコストだけ下げられる可能性を示しています。
評価条件から読み取れる限界
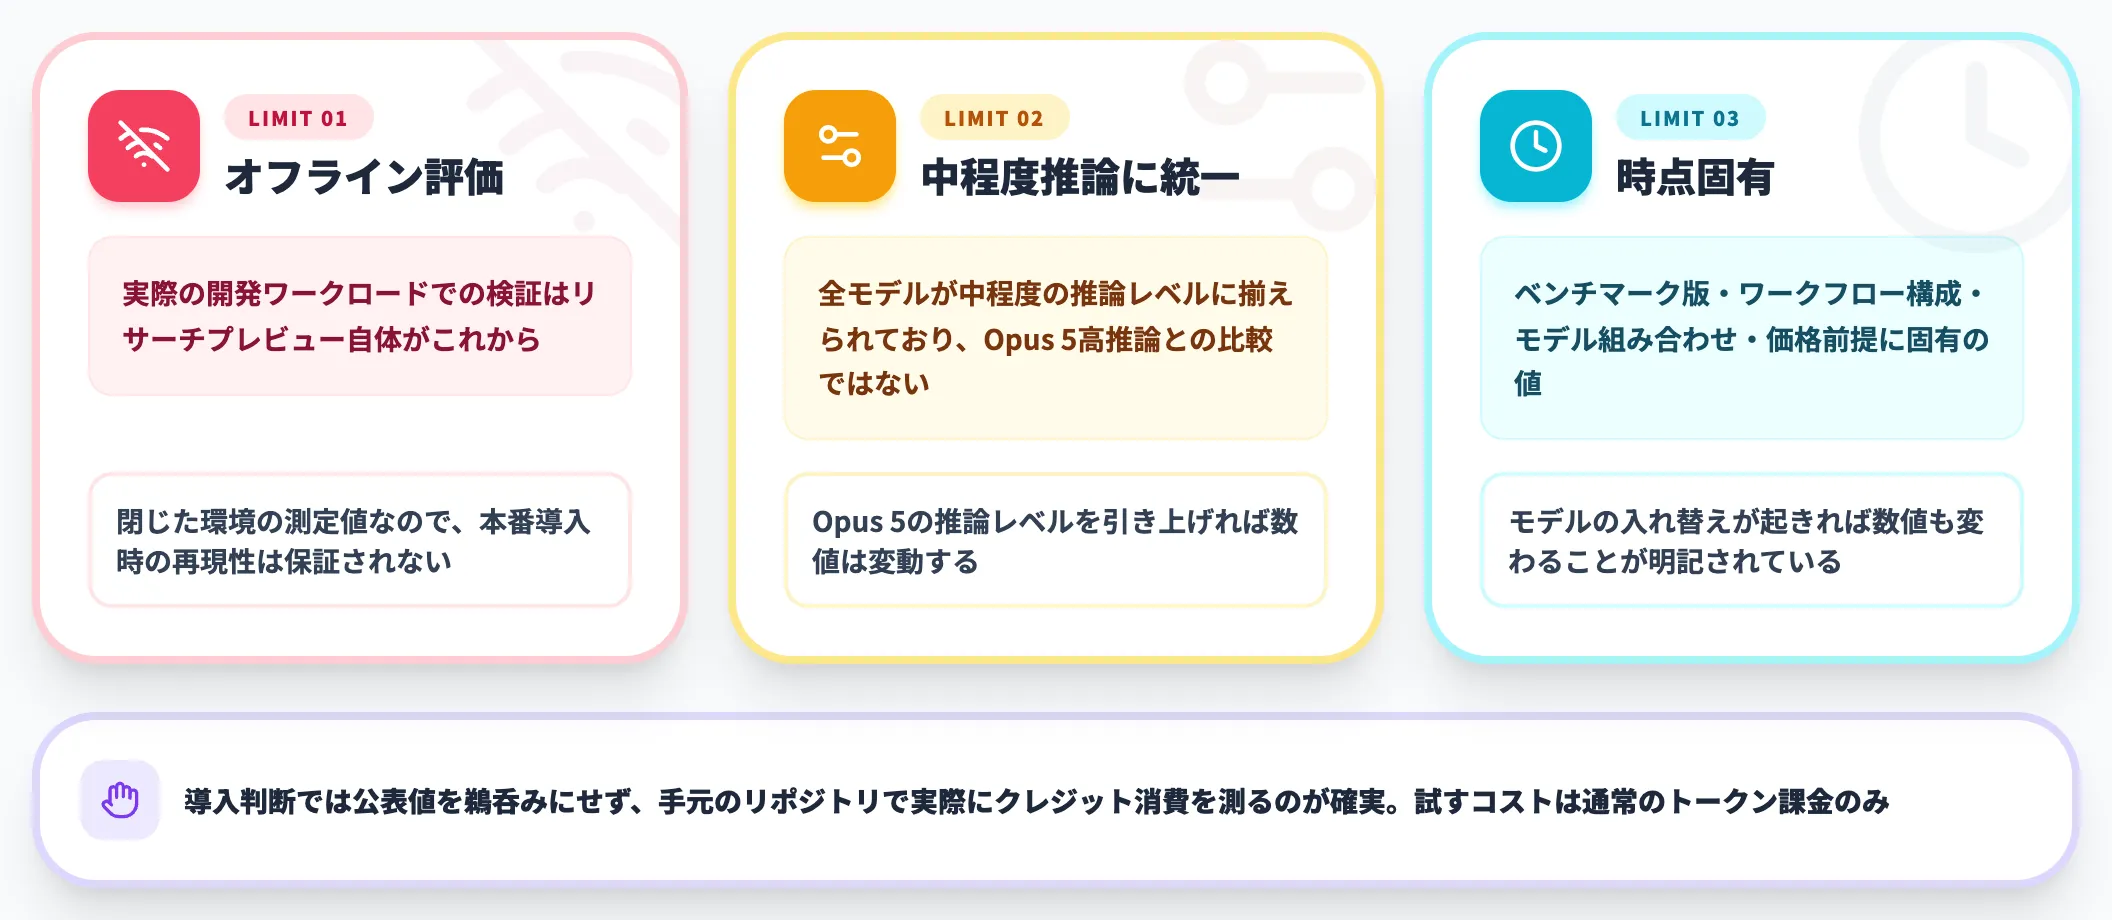
公表された数値には、いくつか前提がついています。導入を検討するなら、この前提のほうが重要です。
まず、すべてオフライン評価であり、実際の開発ワークロードでの検証はこのリサーチプレビュー自体がこれから行う段階です。
次に、全モデルが中程度の推論レベルに揃えられています。推論レベルを上げたOpus 5と比べた結果ではありません。
さらに、結果は評価時点のベンチマーク版・ワークフロー構成・モデルの組み合わせ・価格前提に固有のものだと明記されています。モデルの入れ替えが起きれば数値も変わります。
自社で判断するなら、公表値を鵜呑みにせず、手元のリポジトリで実際にクレジット消費を測るのが確実です。試すこと自体のコストは、後述する料金セクションのとおり通常のトークン課金だけで済みます。
HydraFusionとAutoモデル選択の違い
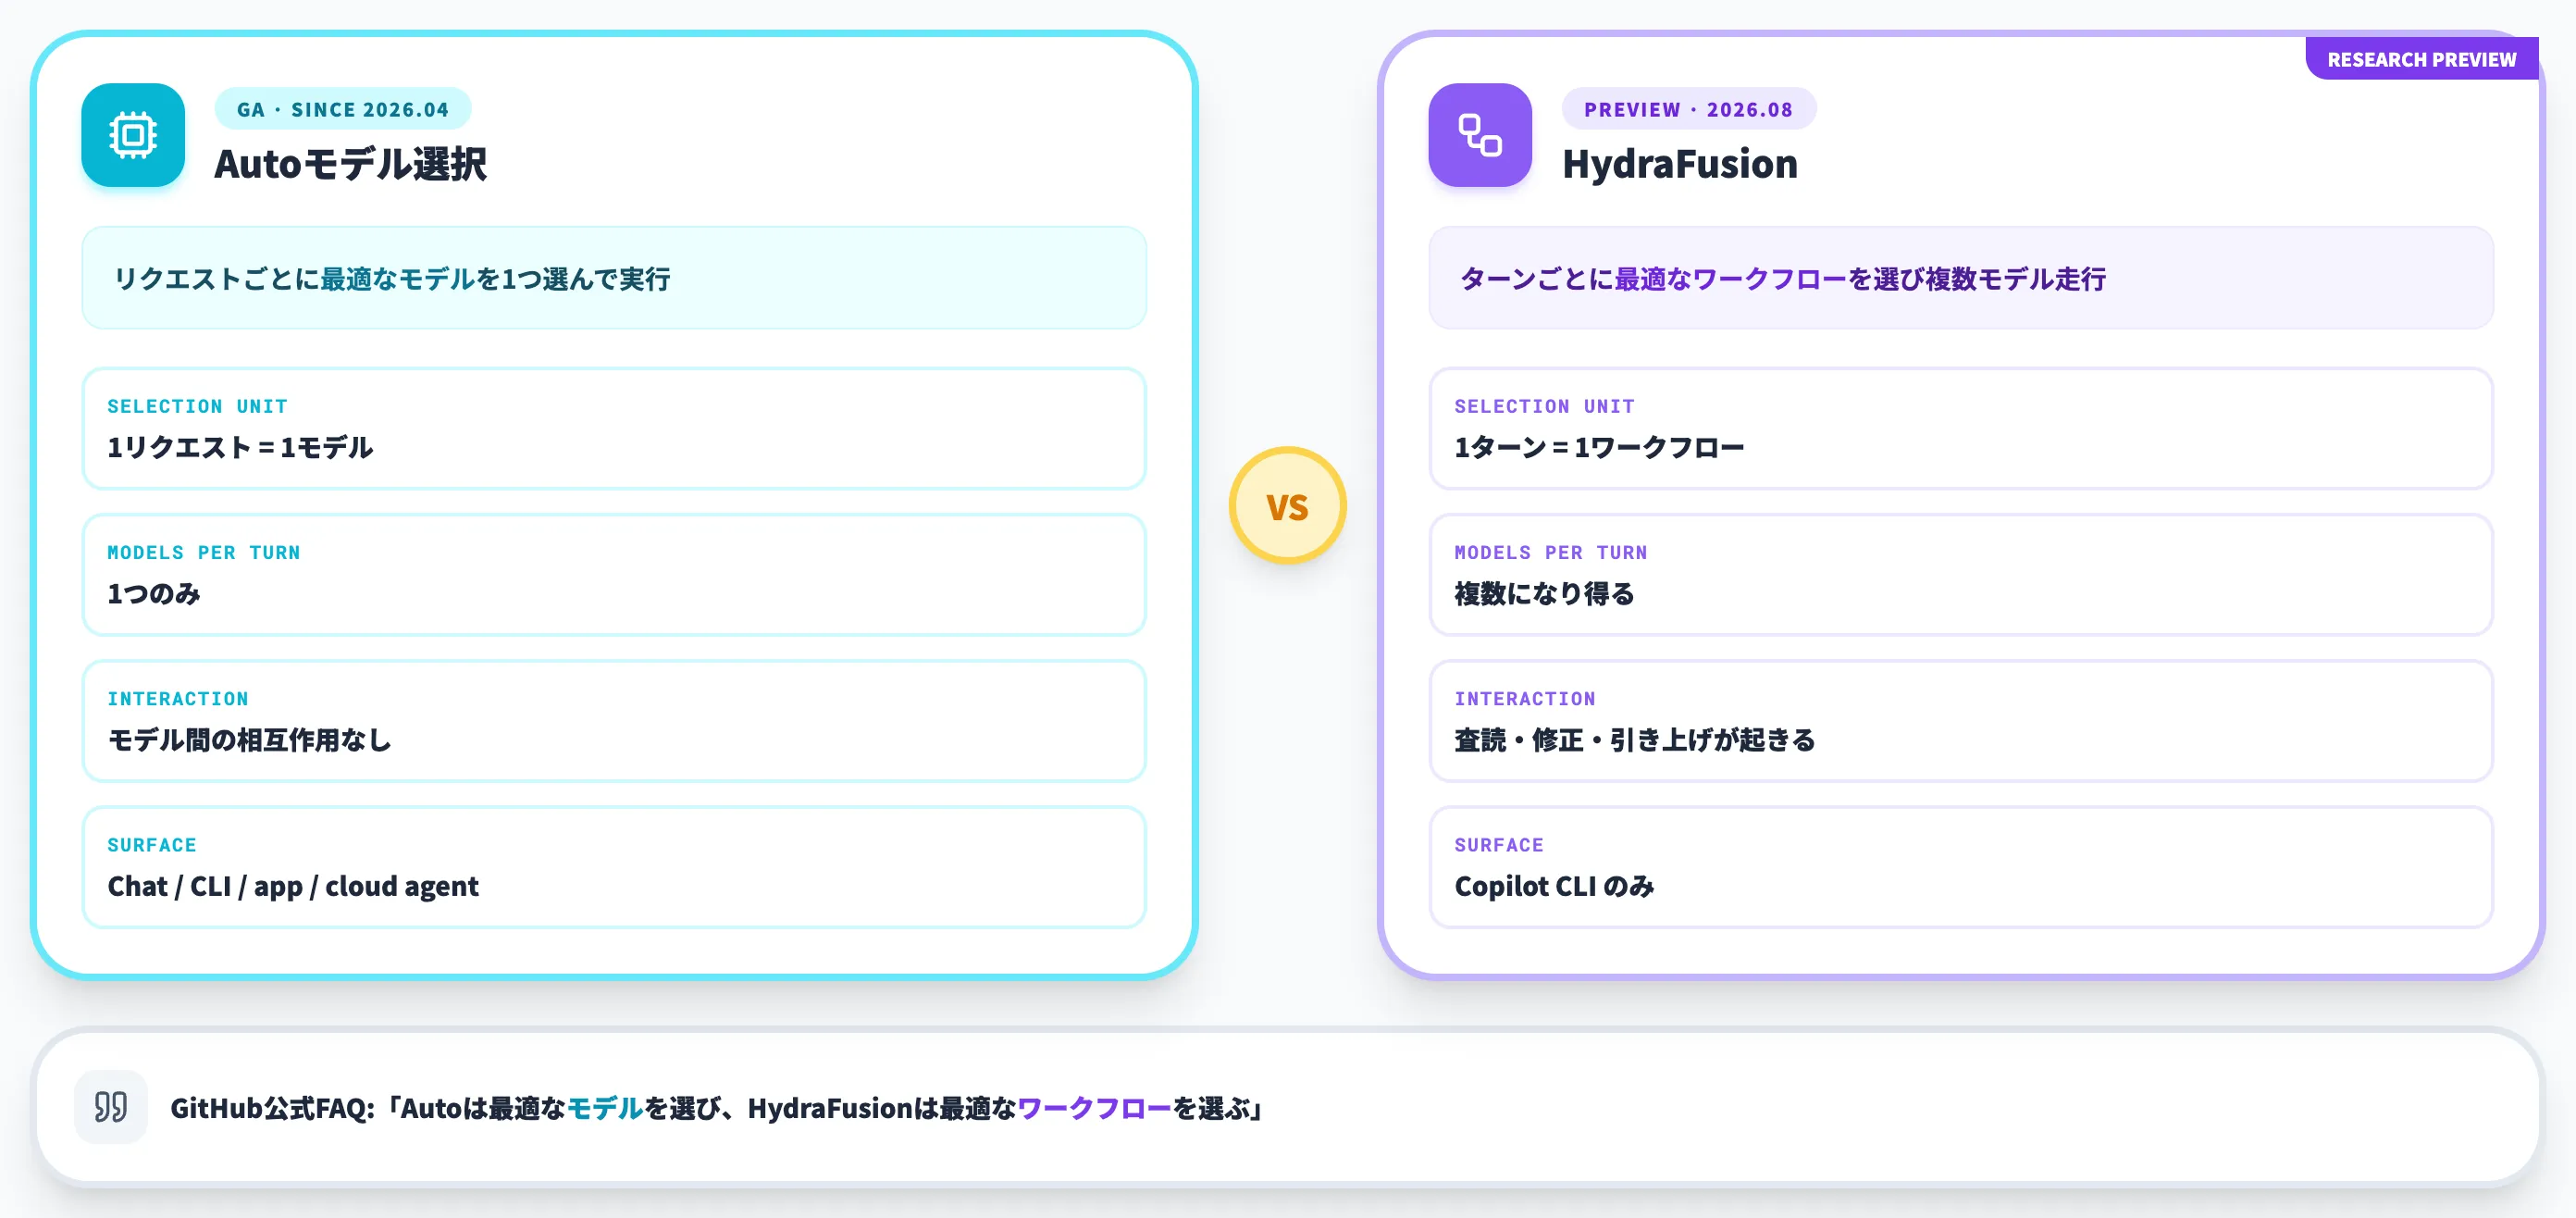
Copilot CLIには2026年4月からAutoモデル選択があり、こちらも「モデルを自分で選ばなくていい」機能です。HydraFusionとどう違うのか、公式FAQでも最初に取り上げられている論点です。
本セクションでは、両者の設計思想の違いと、実務でどちらを選ぶかを整理します。
選ぶ対象がモデルかワークフローか
違いは、選択の単位が1つのリクエストか1つのターンかという点に集約されます。
以下の表で、AutoとHydraFusionの動き方を並べました。
| 項目 | Autoモデル選択 | HydraFusion |
|---|---|---|
| 選ぶ対象 | 1リクエストにつき1つのモデル | そのターンをどう解くかのワークフロー |
| 1ターンで動く数 | 1つ | 複数になり得る |
| モデル同士の相互作用 | なし | 査読・修正・引き上げが起きる |
| 提供面 | Copilot Chat、CLI、GitHub Copilot app、cloud agent | Copilot CLIのみ |
| 提供状況 | 一般提供 | リサーチプレビュー |
GitHubの公式FAQは、この差を「Autoは最適なモデルを選び、HydraFusionは最適なワークフローを選ぶ」と表現しています。必要と判断されたときに複数のモデルを1ターンで走らせ、互いにレビューさせて結果を統合するのがHydraFusion側の役割です。
10%割引の扱いが違う
見落とされやすいのが、コスト面の扱いです。
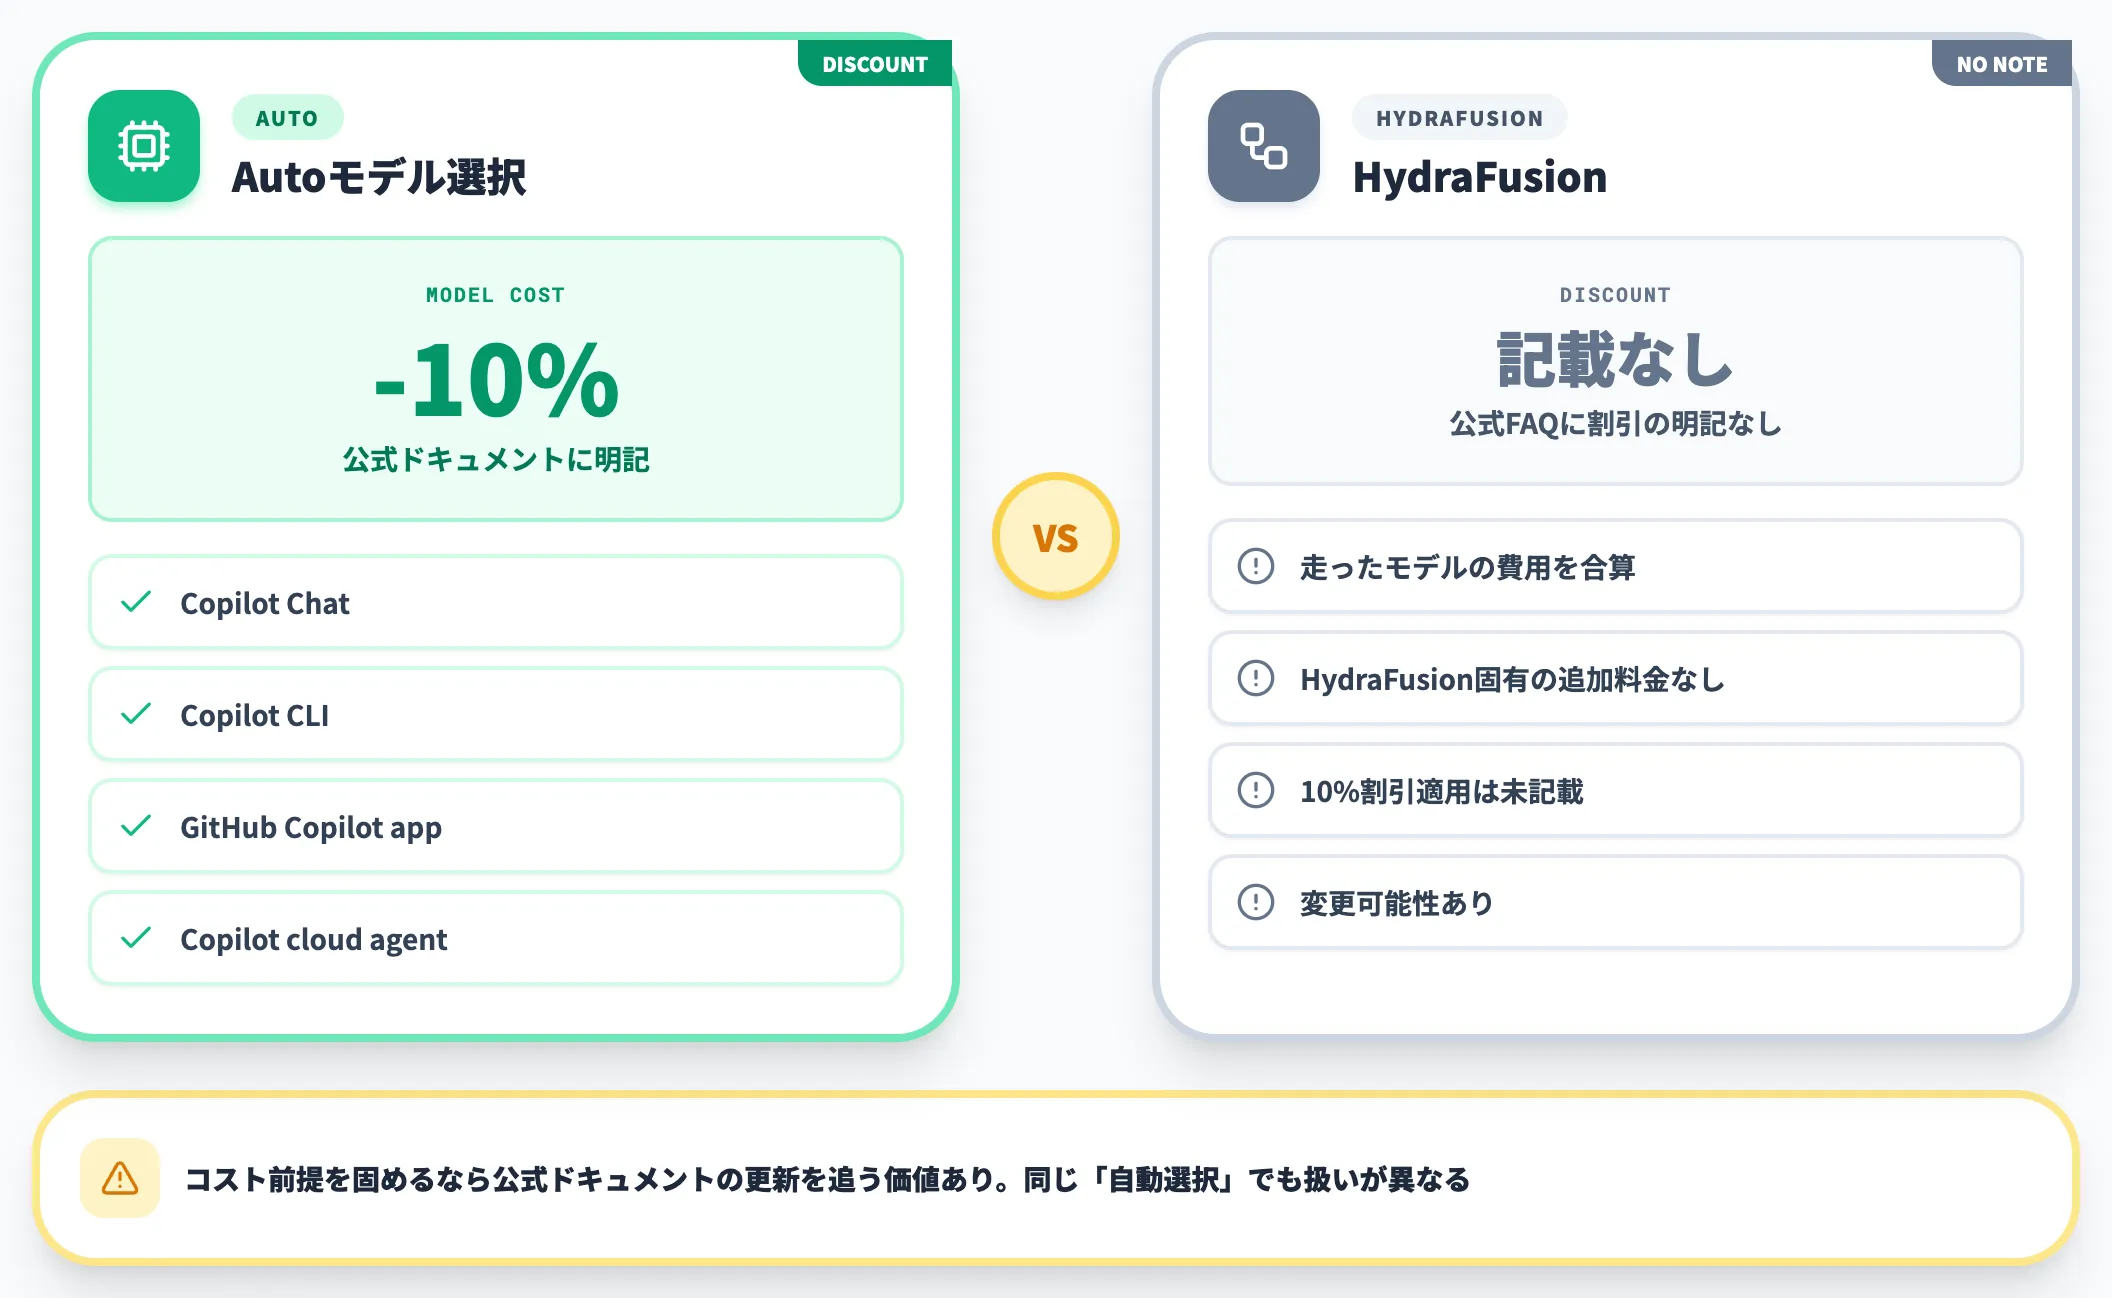
GitHubの個人向け課金ドキュメントには、有料プランでAutoモデル選択を使う場合、Copilot Chat・Copilot CLI・GitHub Copilot app・Copilot cloud agentでモデル費用が10%割引になると明記されています。
一方、HydraFusionについては公式に割引の記載がありません。公式FAQにあるのは「HydraFusion固有の追加料金はなく、走ったモデルの費用を合算する」という説明だけです。
つまり同じ「自動で選んでもらう」でも、Auto側には明示された割引があり、HydraFusion側にはその記載がない状態です。ここは今後の変更もあり得るため、コスト前提を固めるなら公式ドキュメントの更新を追っておく価値があります。
どちらを選ぶかの判断
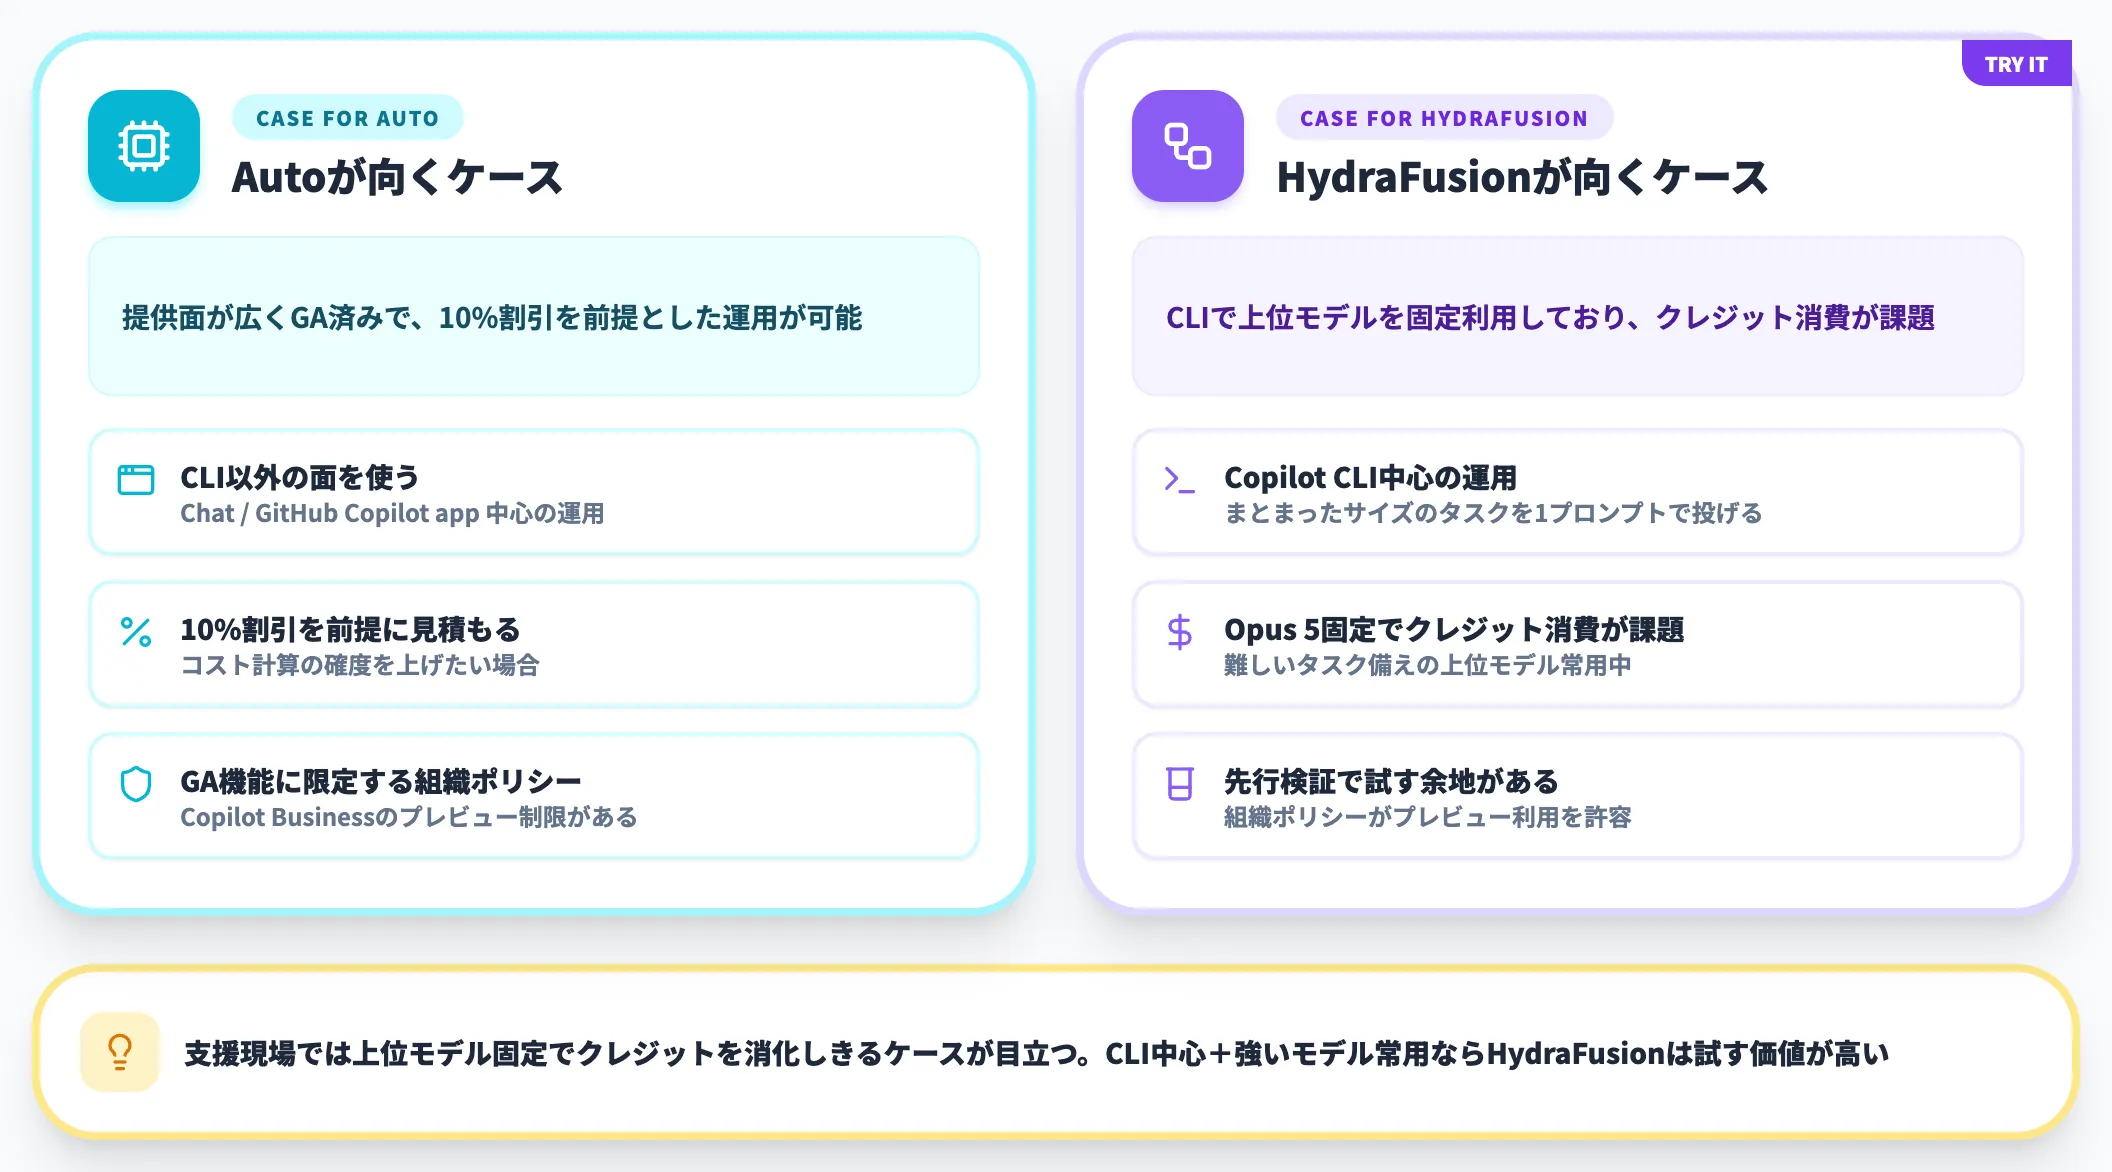
現時点での使い分けは、次のように整理できます。
-
Autoが向くケース
ChatやGitHub Copilot appなど、CLI以外の面を使う場合。10%割引を前提にコストを見積もりたい場合。Copilot Businessのように、組織のポリシーで一般提供済みの機能に限定している場合。
-
HydraFusionが向くケース
Copilot CLIで、まとまったサイズのタスクを1回のプロンプトで投げる場合。Claude Opus 5のような上位モデルを常用していてクレジット消費が課題になっている場合。
支援の現場でも、上位モデルを固定で使い続けてクレジットを消化しきってしまうケースが目立ちます。もし手元のCopilotの利用がCLI中心で、かつ「難しいタスクに備えて常に強いモデルを選んでいる」状態なら、HydraFusionは試す価値が高い選択肢です。
HydraFusionの使い方
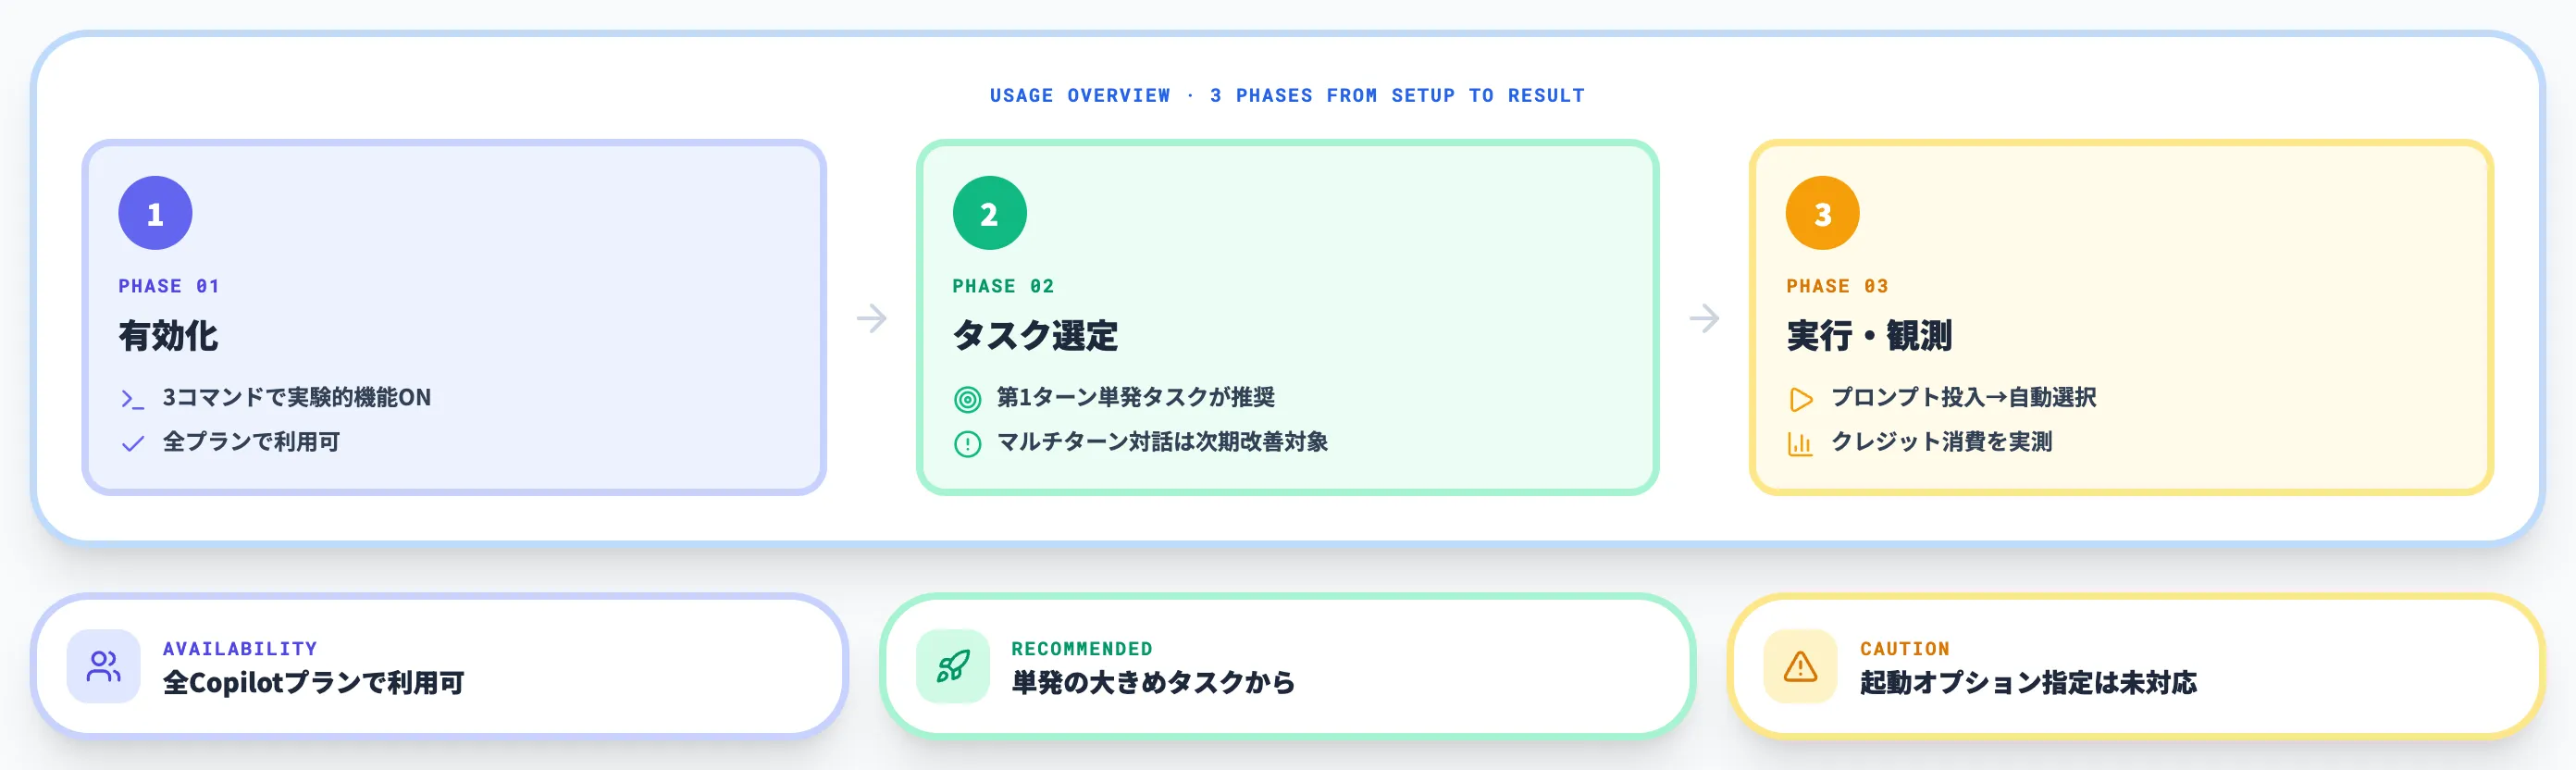
HydraFusionは実験的機能として提供されているため、モデルピッカーに出す前にひと手間必要です。
ここでは、有効化の手順と、どんなタスクから試すべきかを整理します。
有効化までの3ステップ
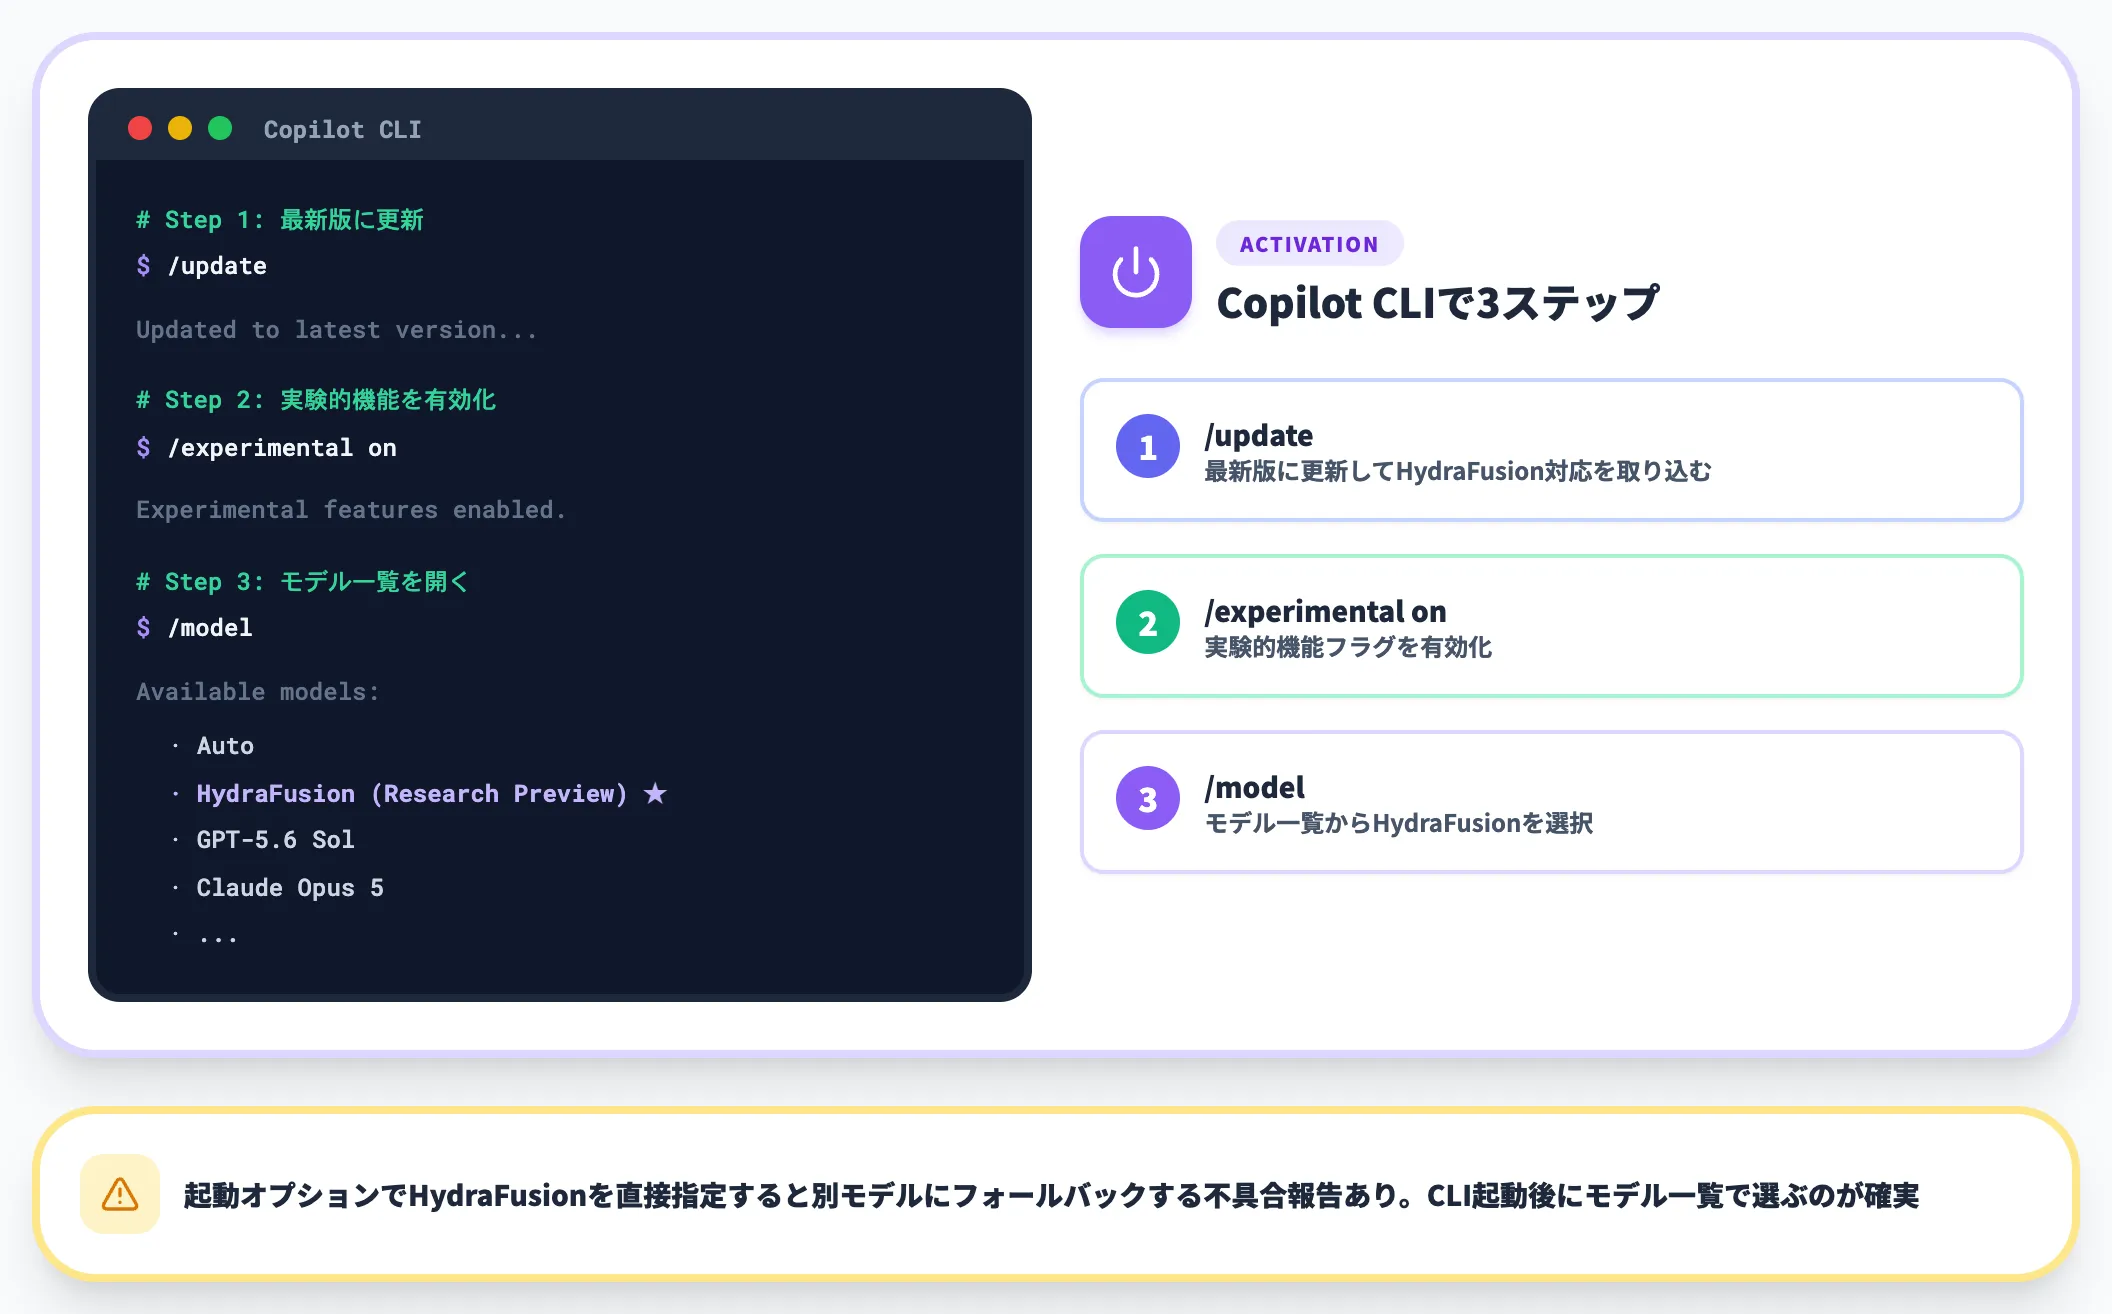
すべてのGitHub Copilotプランで利用できます。Copilot CLIを起動したうえで、次の順に実行します。
/update
/experimental on
/model
最初のコマンドで最新版に更新し、次のコマンドで実験的機能を有効化します。最後にモデル一覧を開き、HydraFusion (Research Preview)を選択すれば準備完了です。
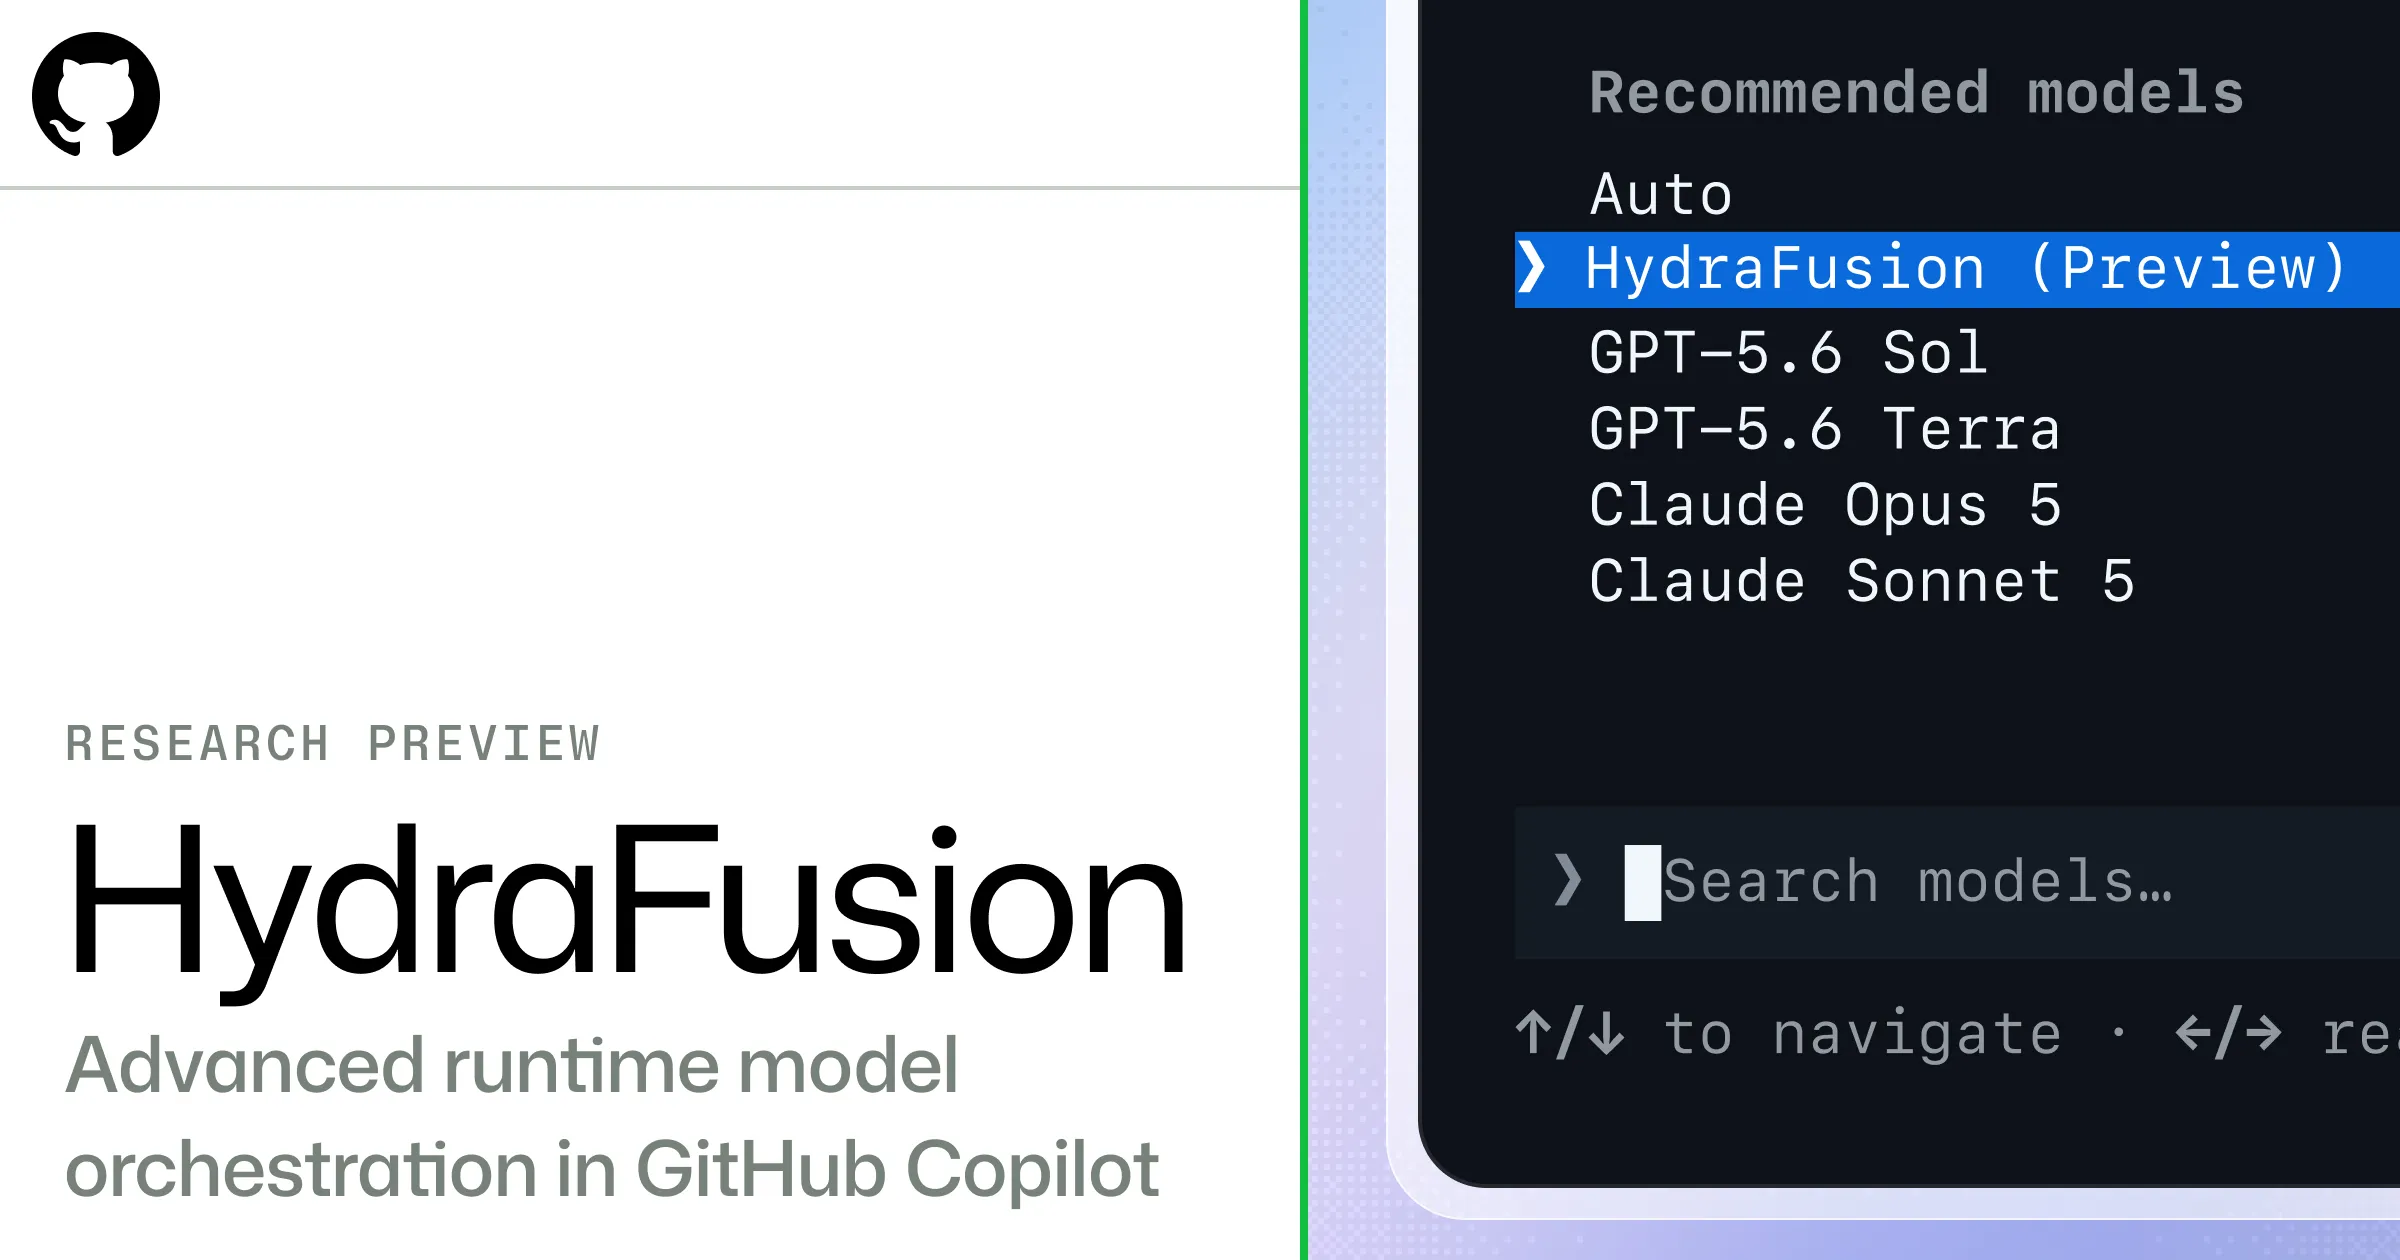
モデル一覧に並ぶHydraFusion(出典:GitHub Blog)
公式が公開している画面では、推奨モデルの一覧にAutoと並んでHydraFusionが表示されています。GPT-5.6 SolとTerra、Claude Opus 5とSonnet 5も同じ一覧に個別で並んでおり、HydraFusionがこれらと同じ階層の選択肢として置かれていることが分かります。
実験的機能を有効にした直後は、モデル一覧に反映されるまで再起動が必要になる場合があります。
向いているのは単発の大きめタスク
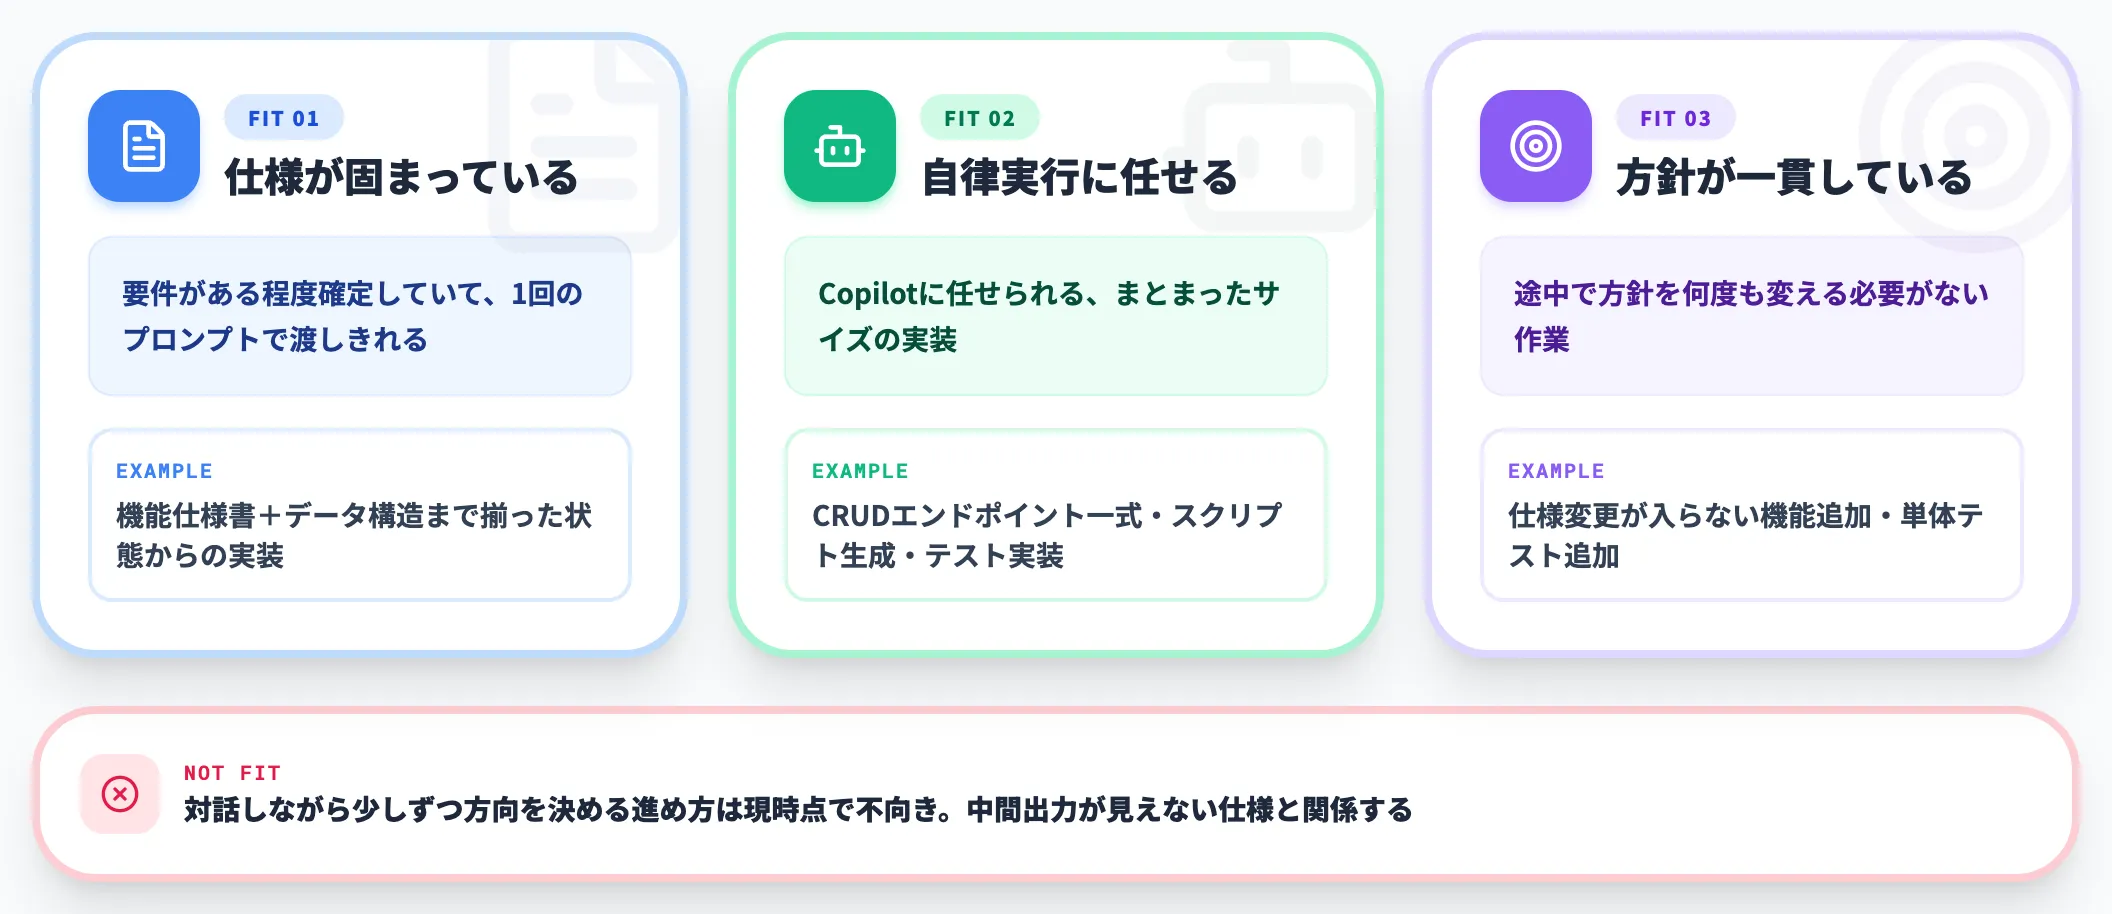
GitHubは、このプレビューで最初に試すべき対象を明確に指定しています。第1ターンの単発プロンプトで完結するコーディングタスクです。
長い対話を重ねるマルチターンの性能は、次の改善対象として挙げられている段階です。現時点では、以下のような使い方が公式の推奨に沿います。
- 仕様がある程度固まっていて、1回のプロンプトで渡しきれるタスク
- Copilotに自律実行させて任せられる、まとまったサイズの実装
- 途中で方針を何度も変える必要がない作業
逆に、対話しながら少しずつ方向を決めていく進め方には、まだ向いていません。この点は、後述する中間出力が見えない仕様とも関係します。
先行ユーザーが報告している消費量
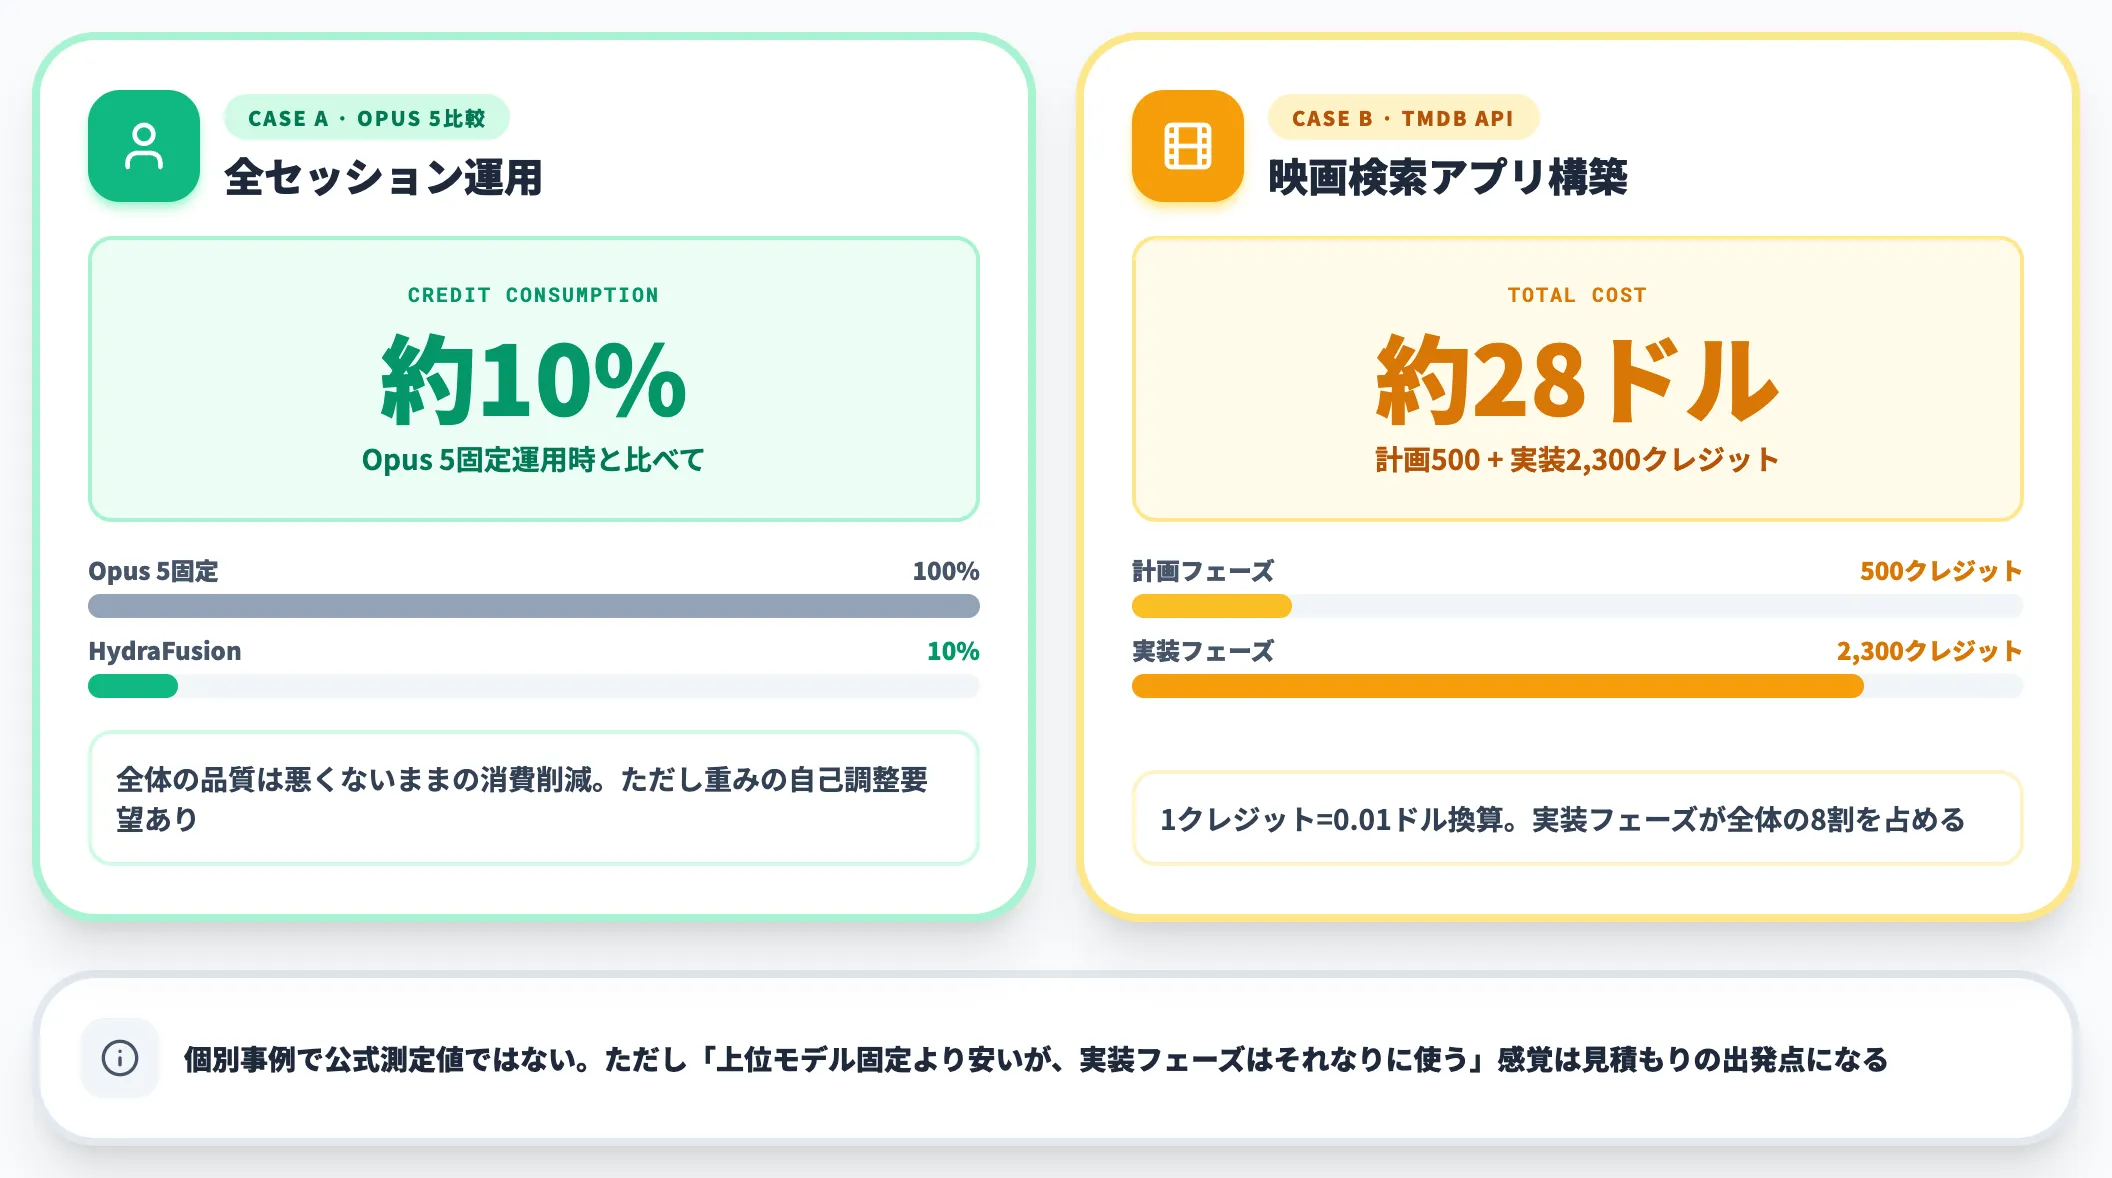
公開から数日で、Community Discussionには実際に使ったユーザーの報告が集まっています。数値は環境やタスクに依存しますが、傾向をつかむ手がかりにはなります。
あるユーザーは、これまでOpus 5で全セッションを回していた場合と比べて、全体の品質は悪くないままクレジット消費が普段の10%程度に収まったと報告しています。同時に、コストと品質の重みを自分で調整できるようにしてほしいという要望も出しています。
別のユーザーは、TMDB APIを使った映画検索アプリの構築で、計画フェーズに約500クレジット、実装フェーズに約2,300クレジットを消費したと投稿しています。1クレジットは0.01ドルなので、合計で約28ドル相当になります。
これらは個別の事例であり、公式の測定値ではありません。ただし「上位モデル固定より安く済むが、実装フェーズはそれなりに使う」という感覚は、見積もりの出発点として参考になります。
HydraFusionの料金とクレジット消費
HydraFusionを使ううえで、料金体系そのものは複雑ではありません。難しいのは、事前にいくらかかるかを読むことです。
以下では、課金の考え方と、呼び出され得るモデルの単価を順に確認します。
課金はフェーズの合算
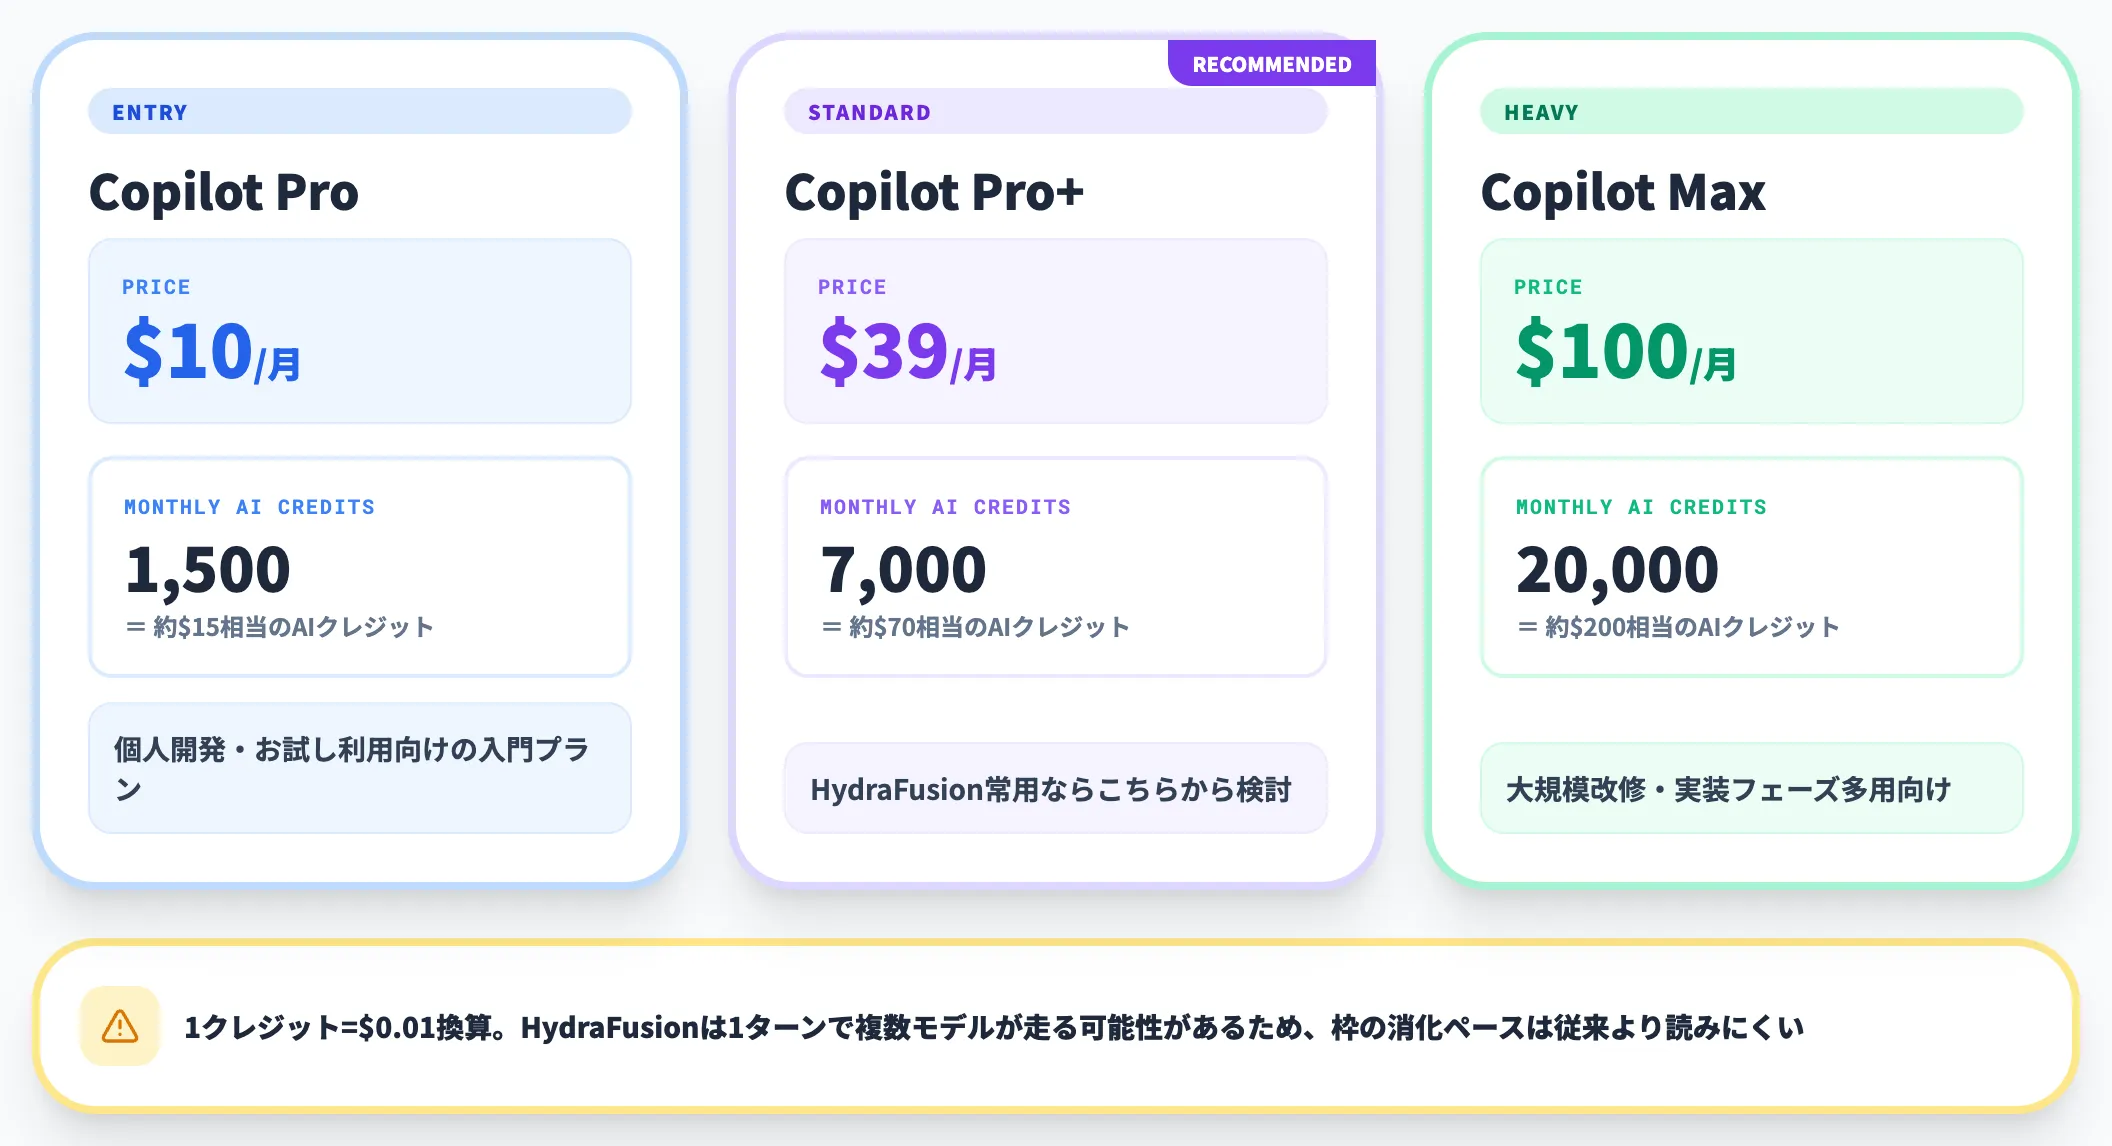
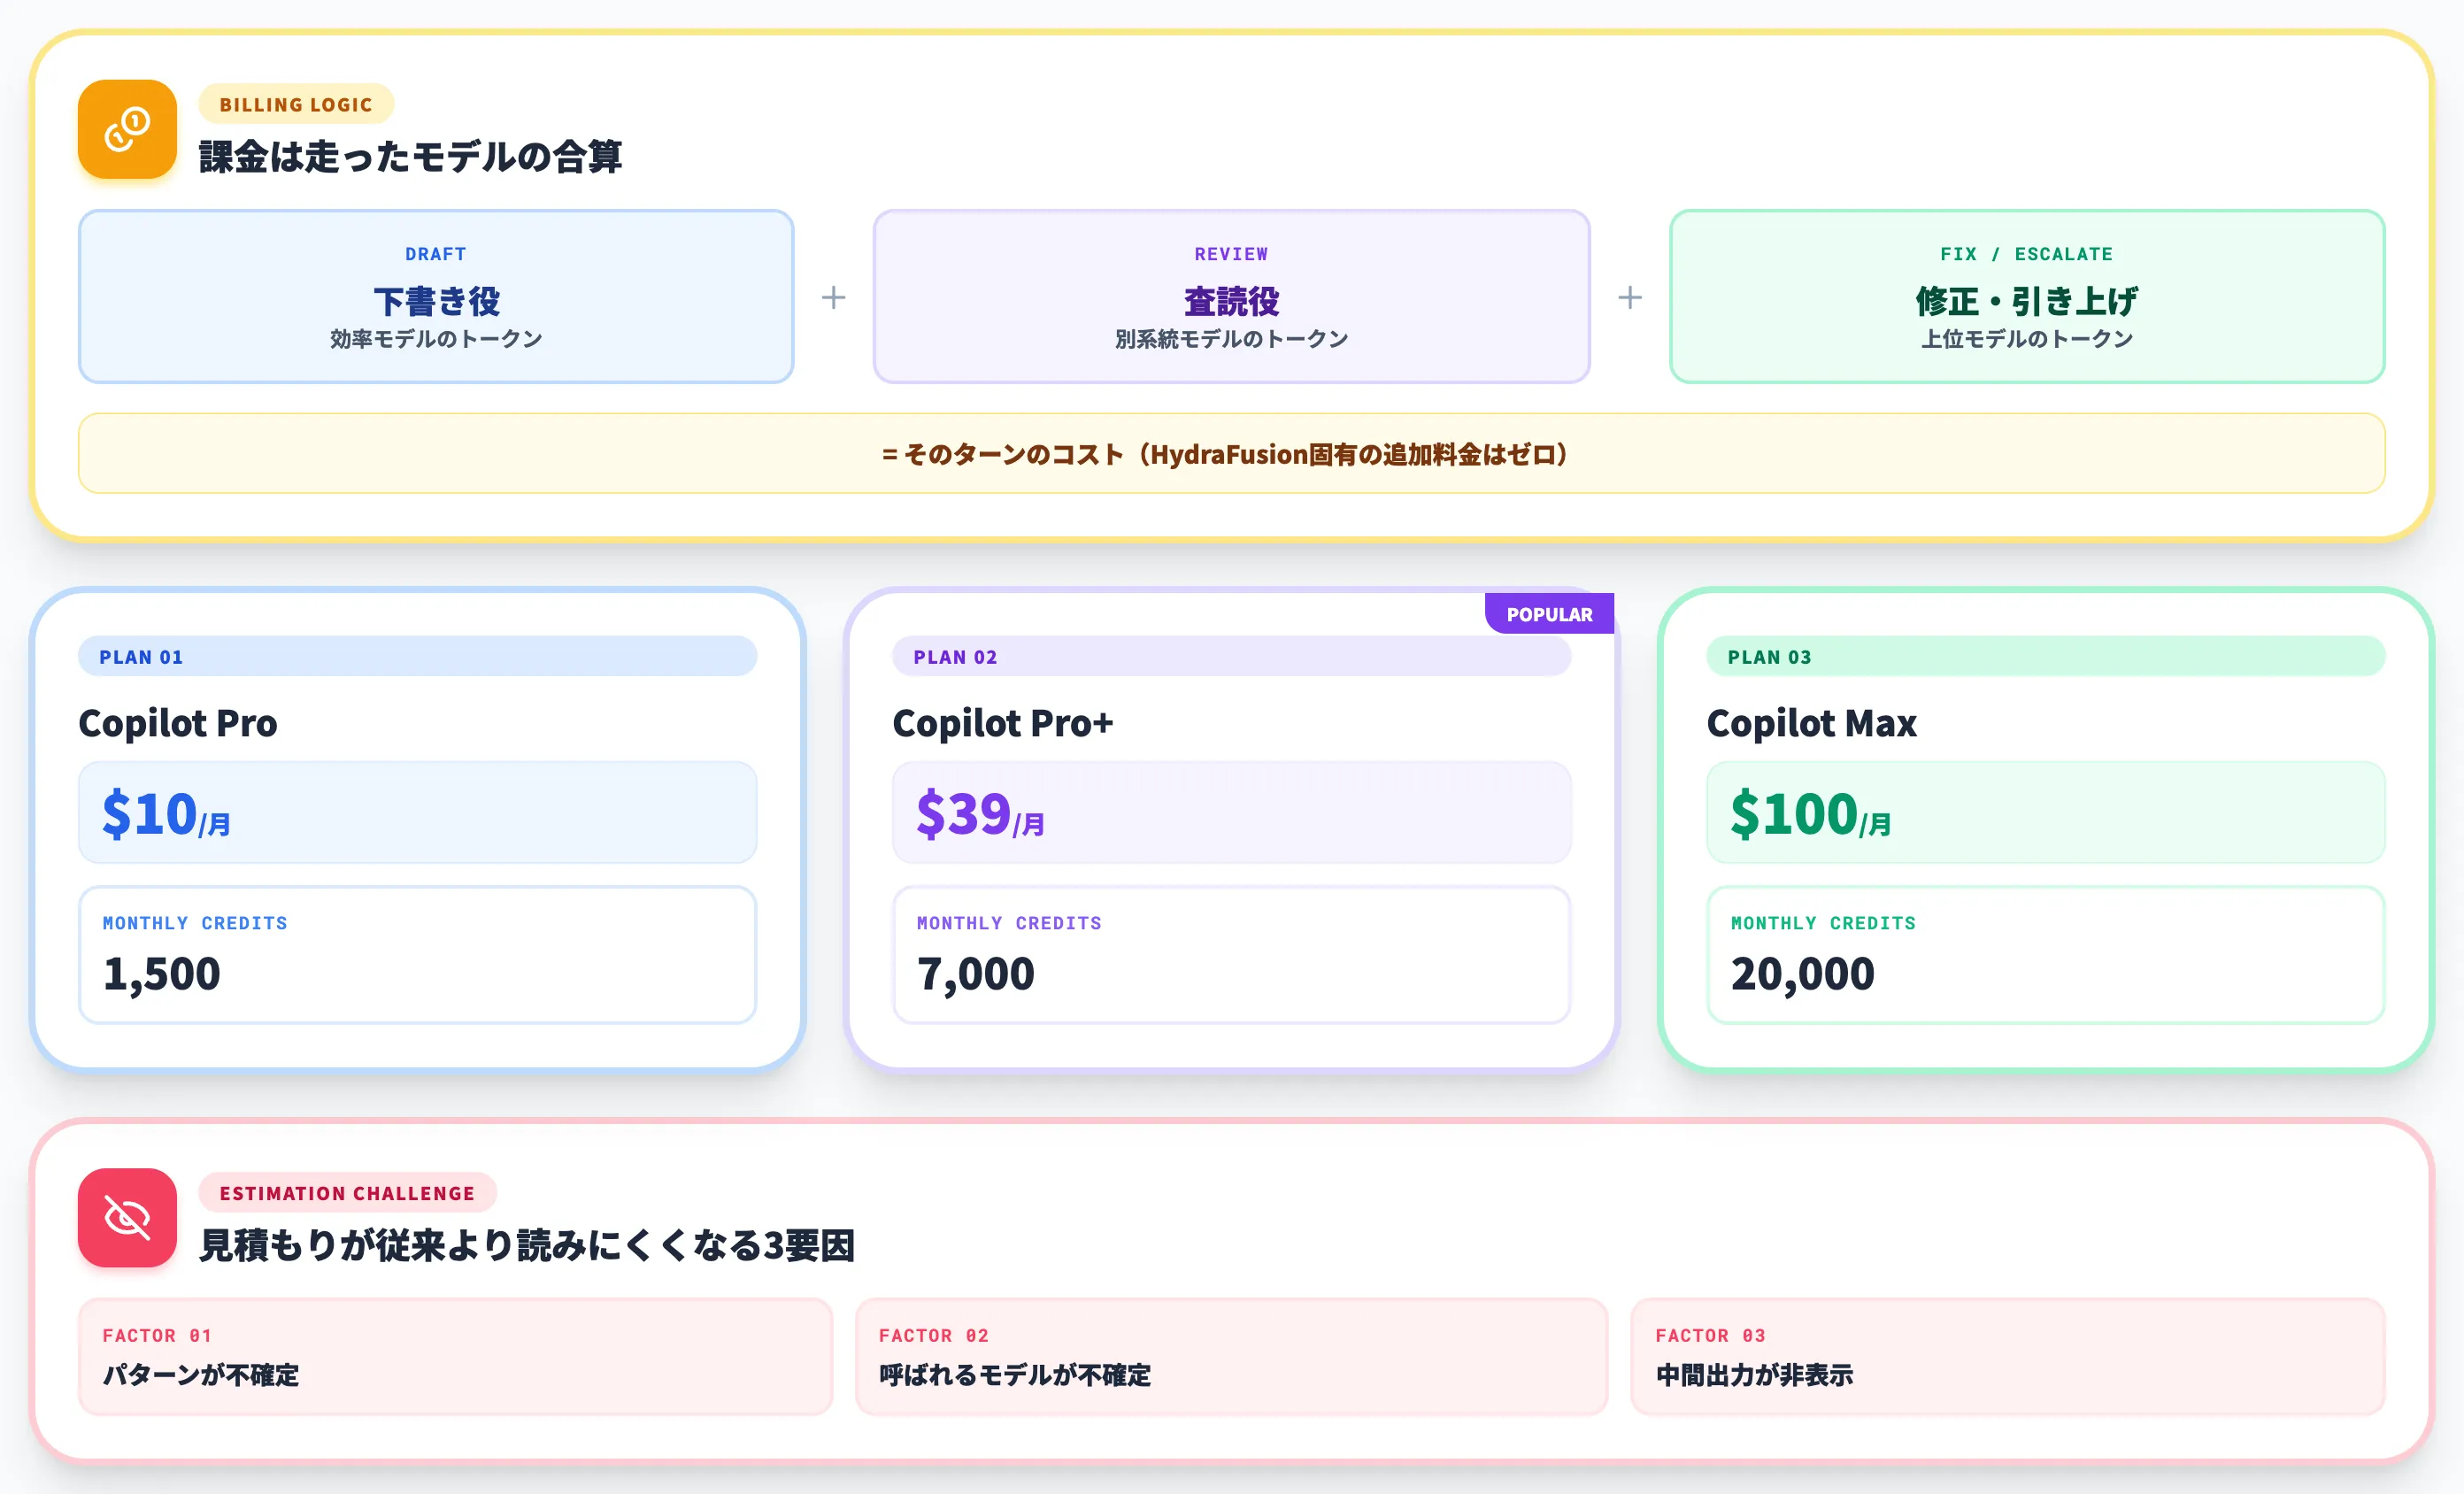
GitHubの公式FAQは、HydraFusion固有の課金は存在しないと明記しています。走ったモデルの費用を合算したものが、そのターンのコストです。
Copilotの課金は2026年6月に従量課金へ移行しており、入力・出力・キャッシュのトークン数をモデルごとの単価で換算してAIクレジットにします。1クレジットあたり0.01ドルの換算です。
ここで効いてくるのが、前述したCascadeの構造です。下書きと上位モデルの両方が走れば、そのターンの費用は2回分の合算になります。Critiqueも同様に、下書き・査読・修正の3工程が積み上がります。
各プランに含まれるクレジットは、公式の課金ドキュメントで次のように定められています。
| プラン | 月額 | 月間AIクレジット |
|---|---|---|
| Copilot Pro | 10ドル | 1,500 |
| Copilot Pro+ | 39ドル | 7,000 |
| Copilot Max | 100ドル | 20,000 |
Copilot ProとPro+の差はクレジット枠が中心です。HydraFusionのように1ターンで複数回の呼び出しが起きる使い方では、枠の消化ペースが従来より読みにくくなる点に注意が必要です。
Copilotの料金プラン全体の構成は別記事で扱っています。
呼び出され得るモデルの単価
GitHubは、HydraFusionが使うモデルの固定的な一覧を公表していません。公式FAQは、軽量なモデルから強い推論モデルまでを含む選定済みの組み合わせから選ぶとし、新しいモデルが出れば入れ替わるため一覧は出さないと説明しています。
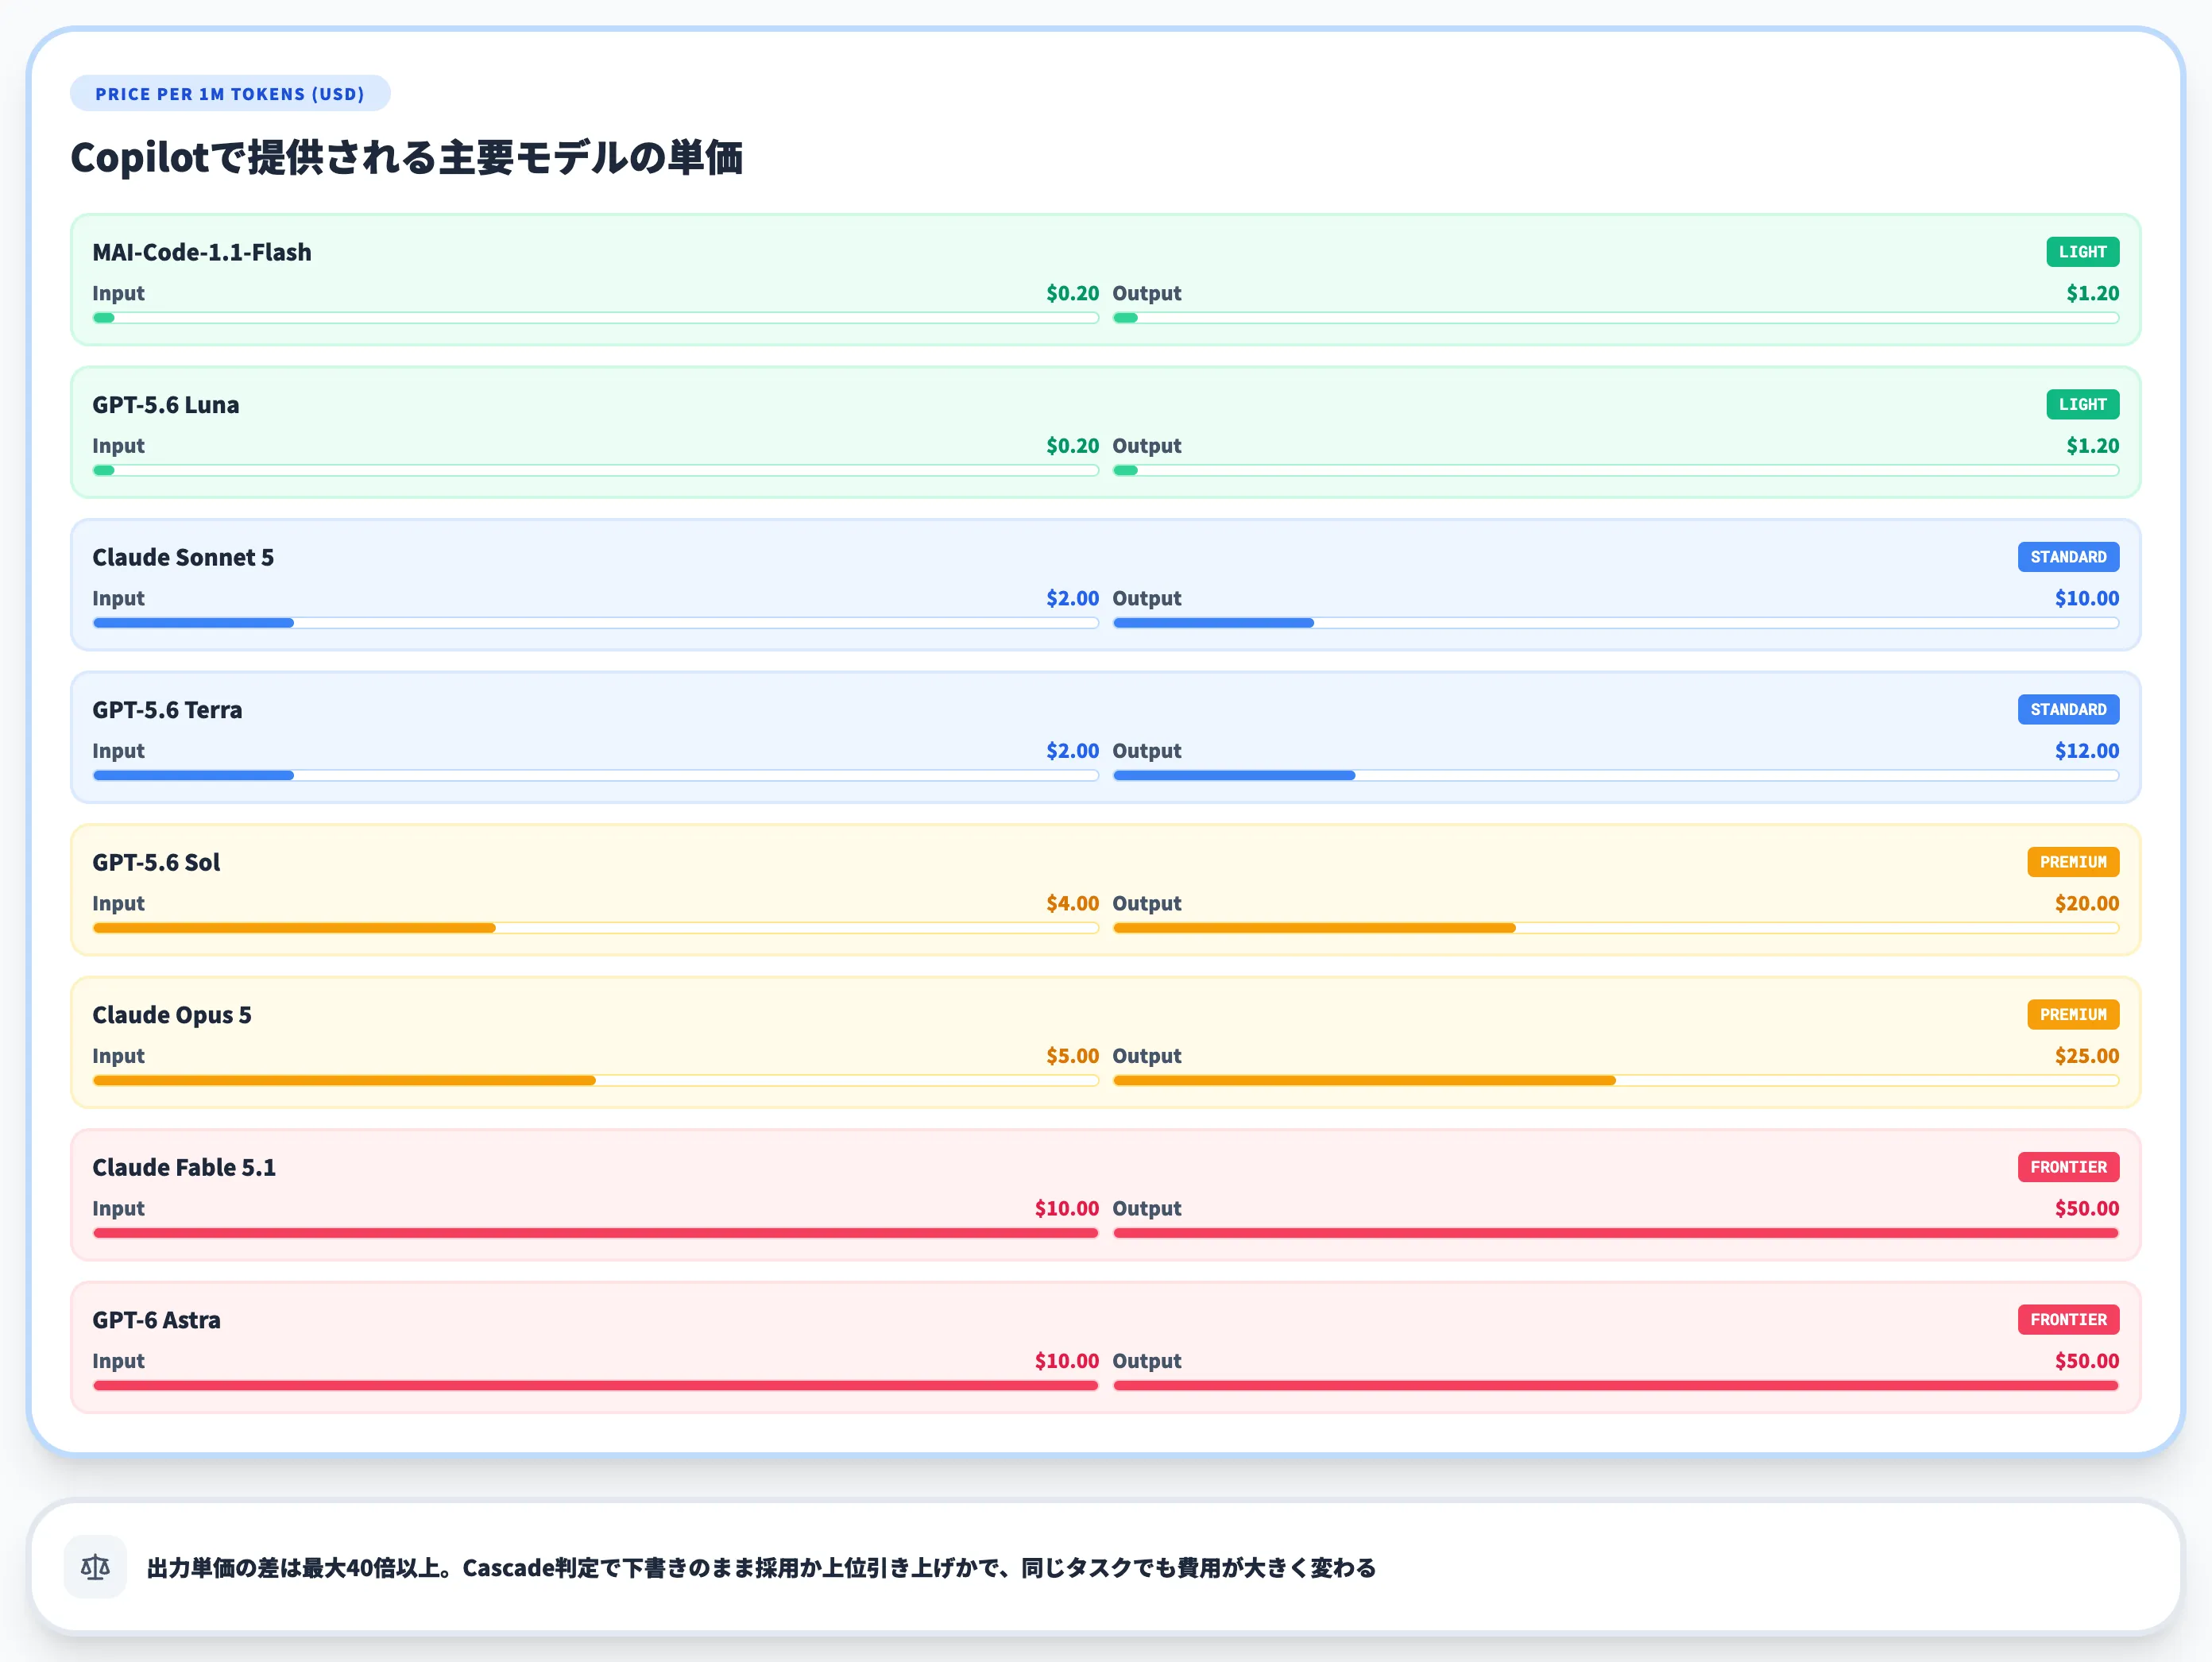
参考として、Copilotで提供されている主なモデルの単価を並べます。以下は公式の料金表から抜粋した、100万トークンあたりのドル建て価格です。
| モデル | 入力 | 出力 |
|---|---|---|
| MAI-Code-1.1-Flash | 0.20 | 1.20 |
| GPT-5.6 Luna | 0.20 | 1.20 |
| Claude Sonnet 5 | 2.00 | 10.00 |
| GPT-5.6 Terra | 2.00 | 12.00 |
| GPT-5.6 Sol | 4.00 | 20.00 |
| Claude Opus 5 | 5.00 | 25.00 |
| Claude Fable 5.1 | 10.00 | 50.00 |
| GPT-6 Astra | 10.00 | 50.00 |
軽量モデルと上位モデルでは、出力単価に40倍以上の開きがあります。Cascadeの品質ゲートが機能して下書きのまま採用されるか、上位に引き上げられるかで、同じタスクでも費用が大きく変わる理由がここにあります。
なお、HydraFusion向けのプラグインを公開しているサードパーティ開発者は、Lernaのリポジトリで、HydraFusionが受け付けるモデルIDは6種類でそれ以外は拒否されると記載しています。GitHub公式の情報ではないため確定的には扱えませんが、選定済みの組み合わせが限定的であることを示す外部の観測です。
見積もりが読みにくい理由
料金の仕組みは単純でも、事前見積もりは従来より難しくなります。理由は3つあります。
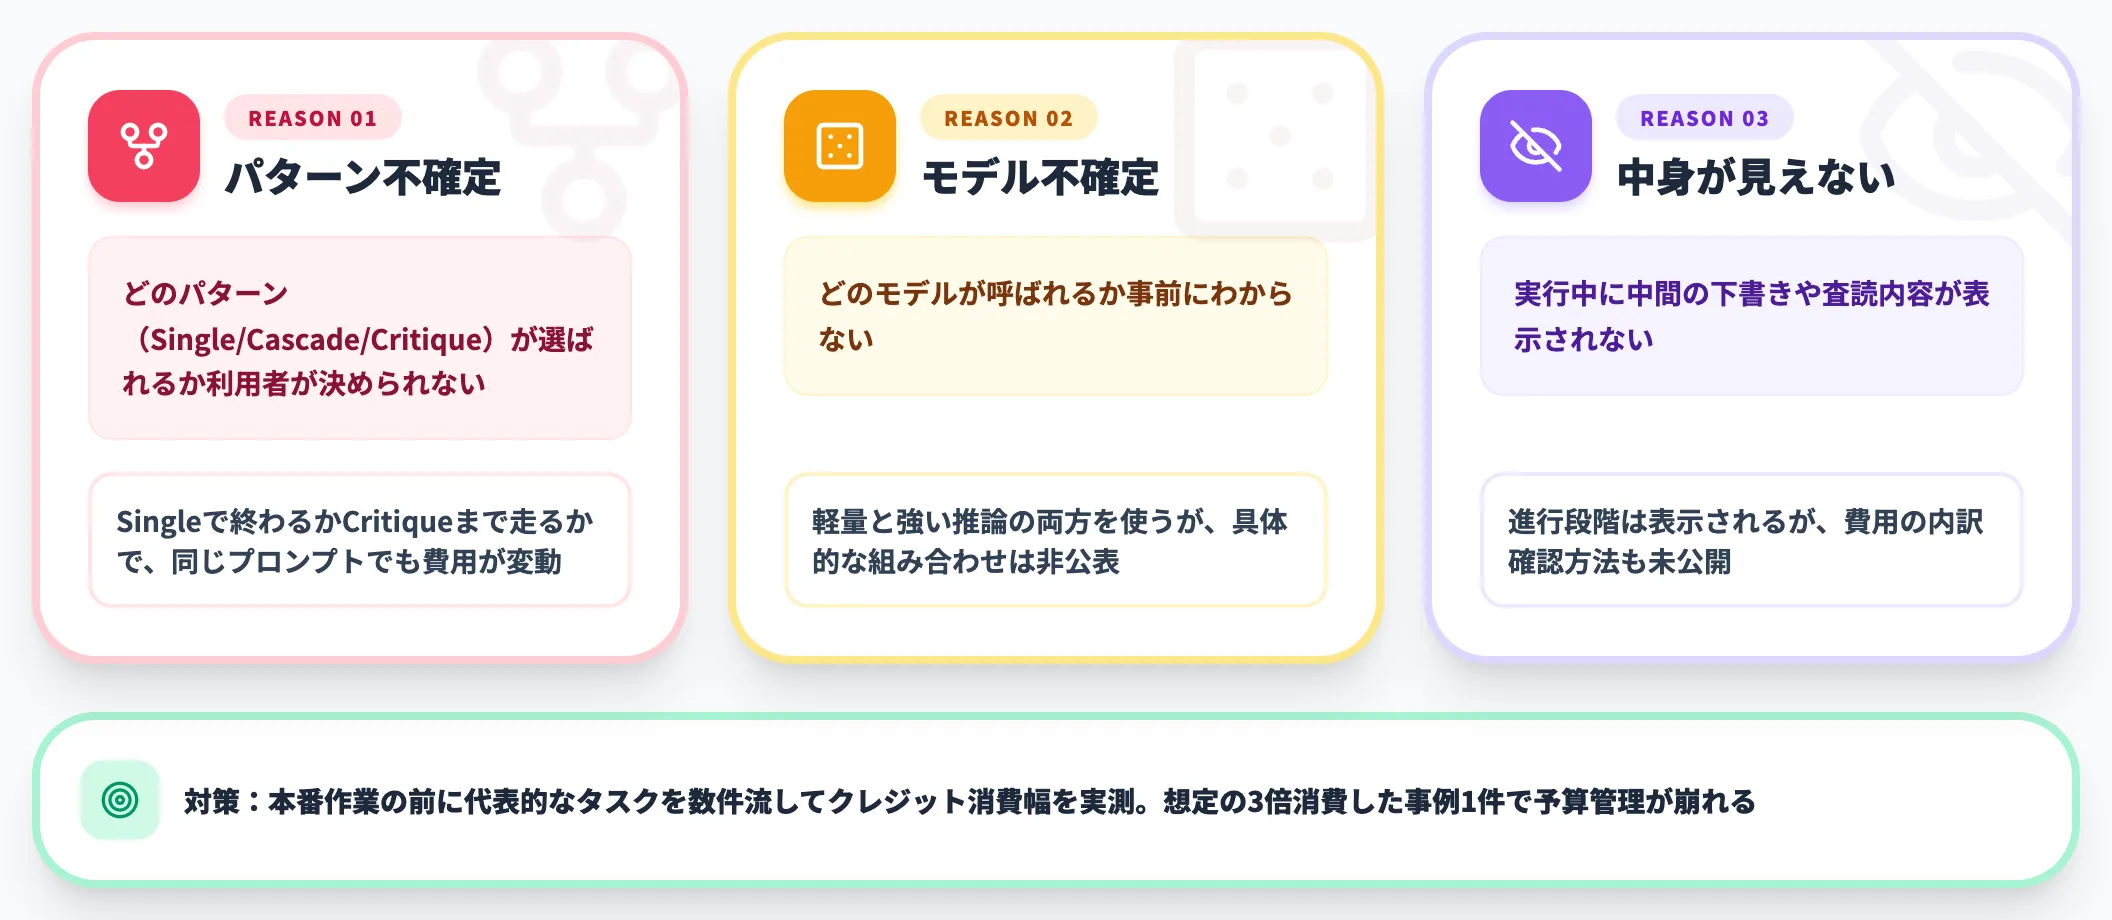
1つ目は、どのパターンが選ばれるかを利用者が決められないことです。Singleで終わるかCritiqueまで走るかで、同じプロンプトでも費用が変わります。
2つ目は、どのモデルが呼ばれるか事前にわからないことです。公式は軽量なモデルと強い推論モデルの両方を使うとしていますが、具体的な組み合わせは公表されていません。
3つ目は、実行中に中身が見えないことです。進行段階は表示されますが、中間の下書きや査読内容は表示されず、費用の内訳を確認する方法も公式には示されていません。
この不確実性を抑えるなら、本番の作業に適用する前に、代表的なタスクを数件流してクレジット消費の幅を実測しておくのが現実的です。特に組織で使う場合、想定の3倍消費した事例が1件出ただけで予算管理が崩れます。
HydraFusionの制約と安全設計
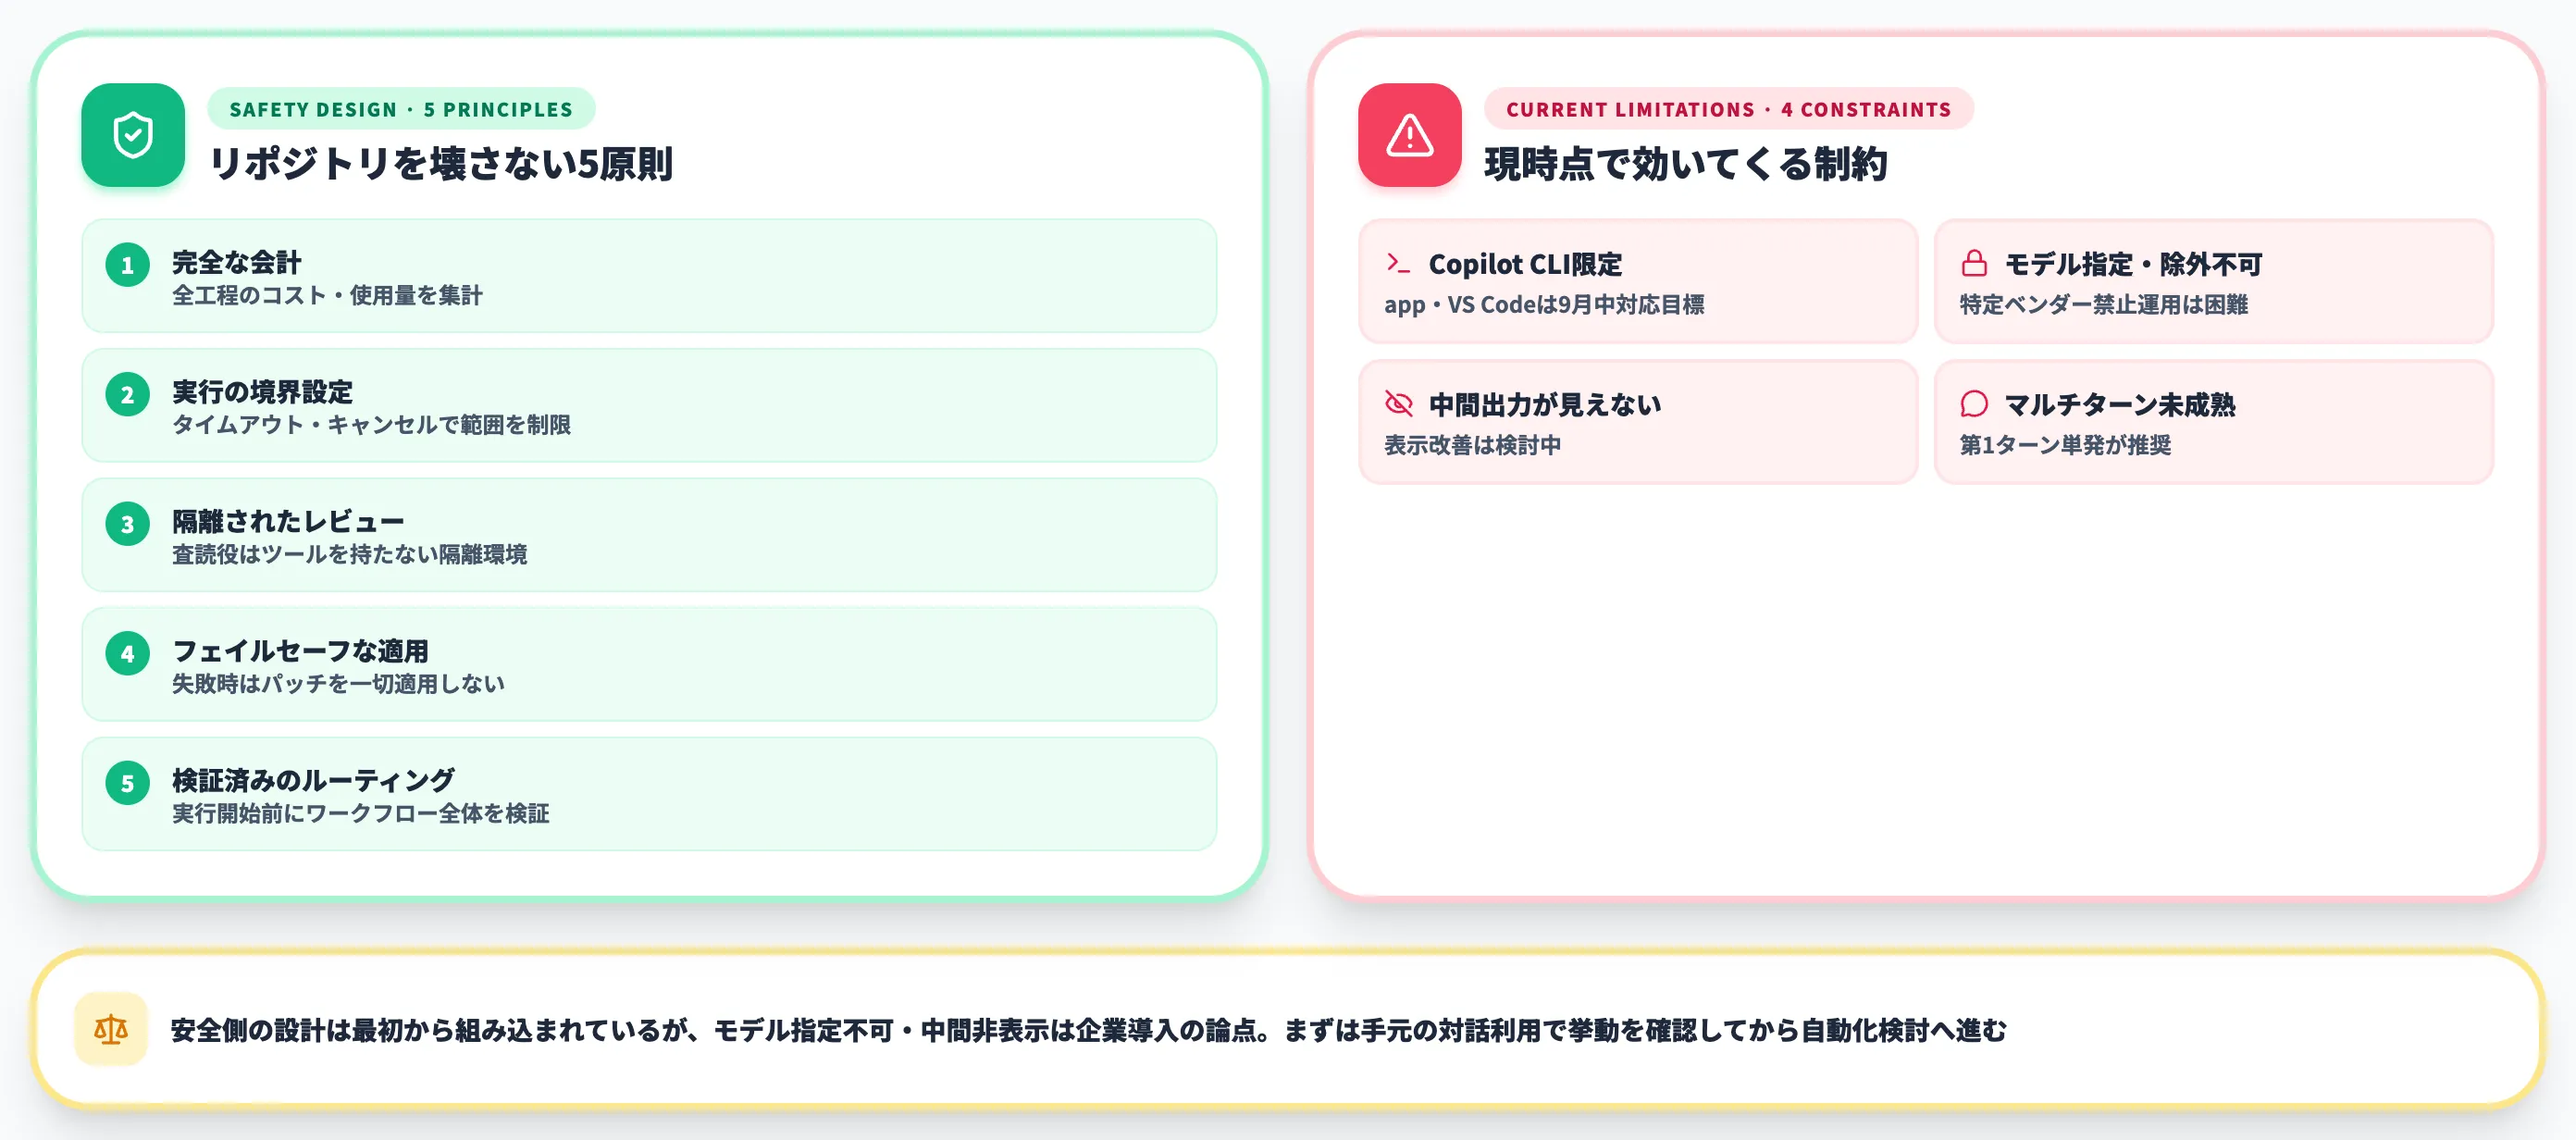
リサーチプレビューである以上、制約は多く残ります。ただしリポジトリを扱う機能として、安全側の設計は最初から組み込まれています。
本セクションでは、公表されている運用原則と、現時点で効いてくる制約を整理します。
リポジトリを壊さないための5原則
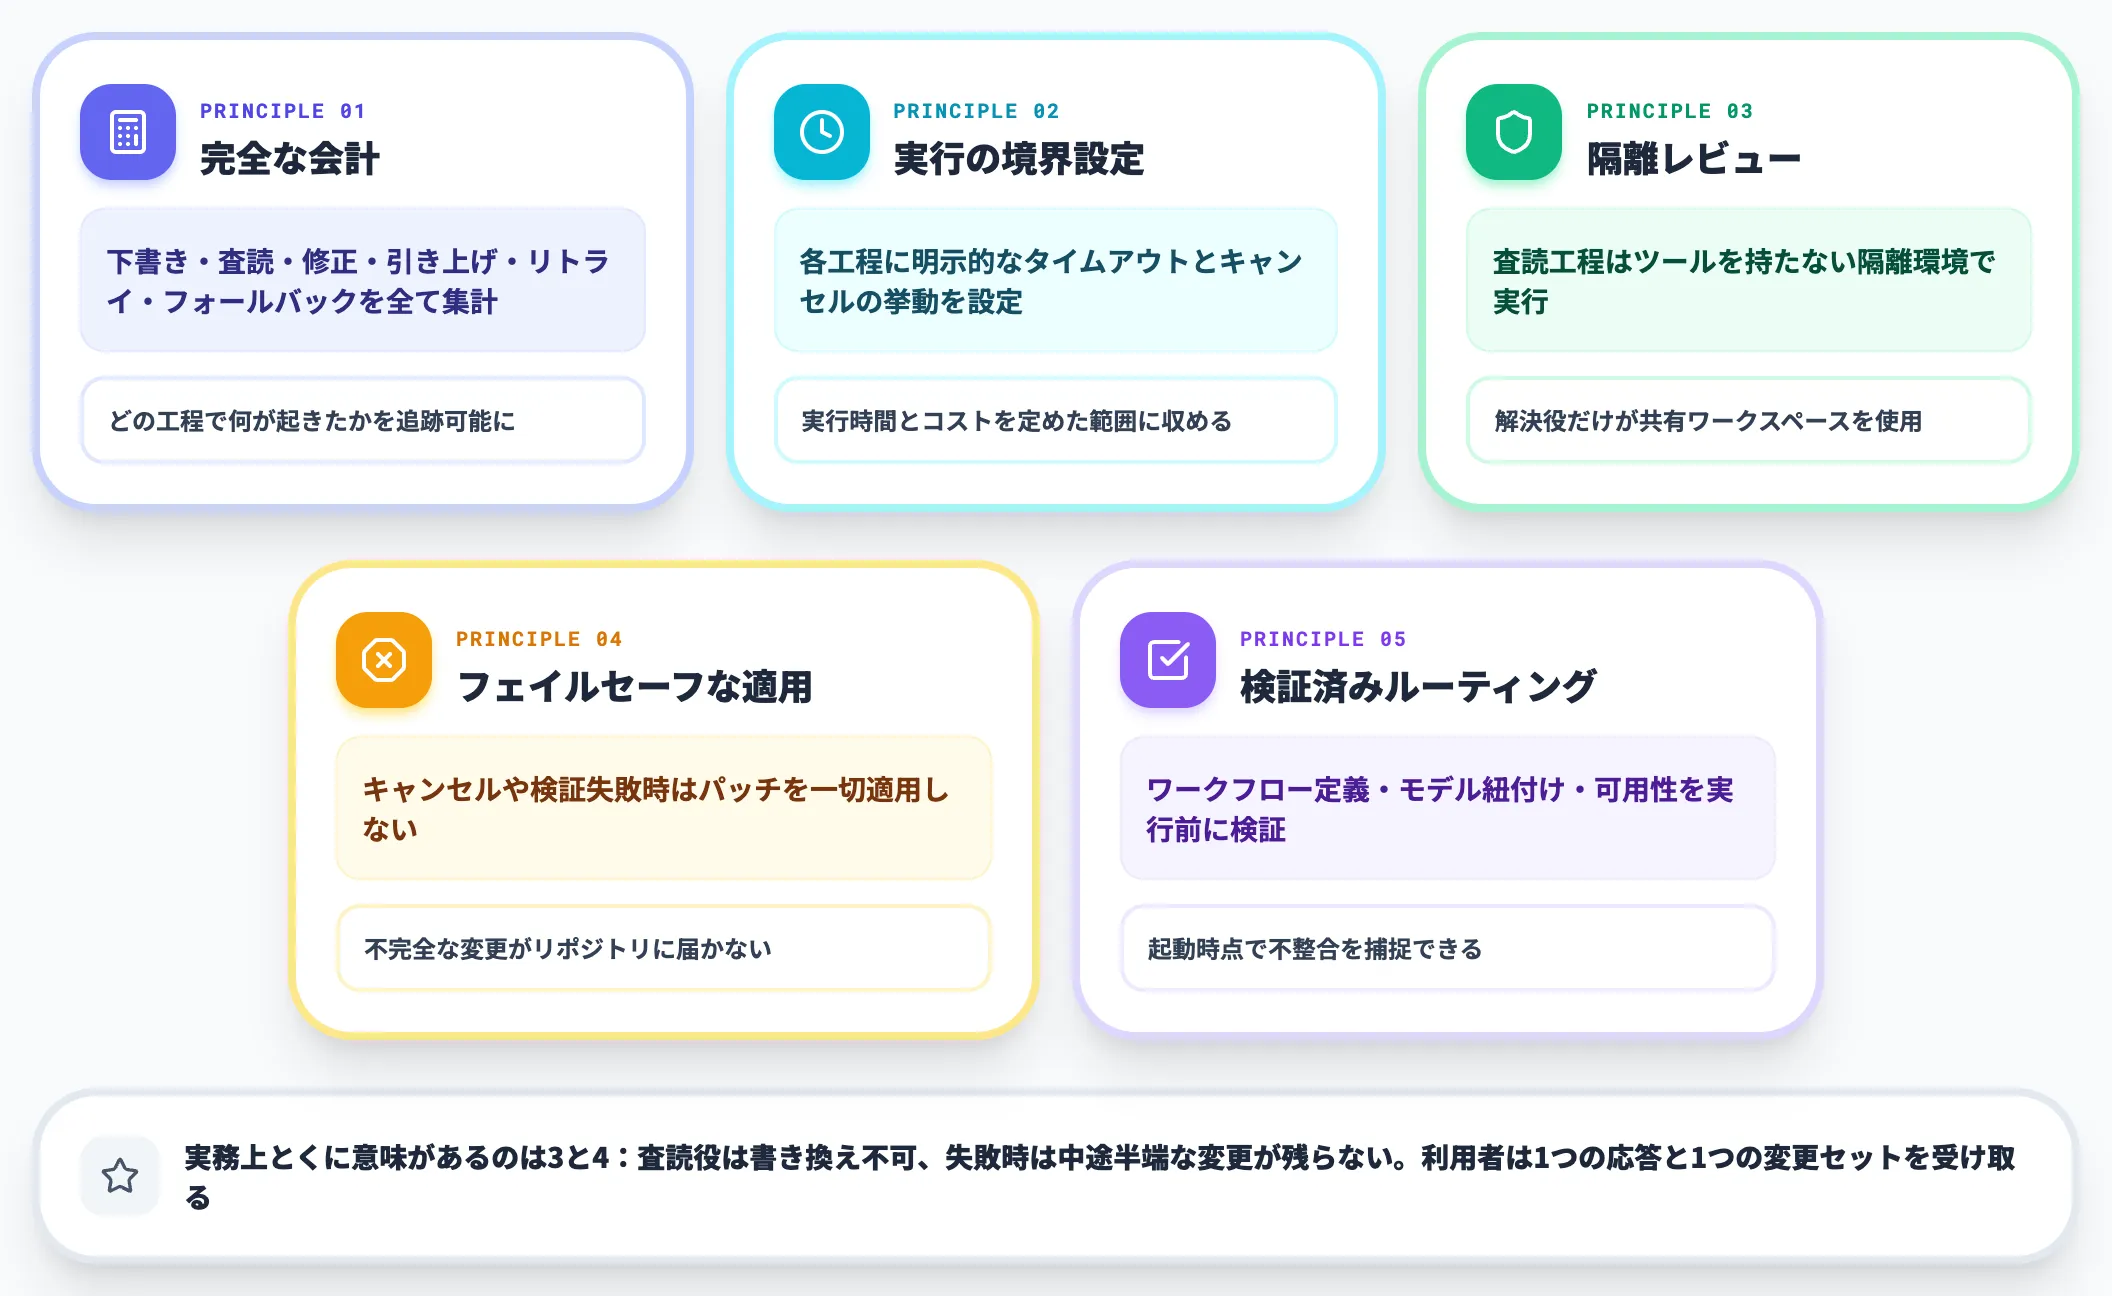
GitHubは、HydraFusionが5つの運用原則の上に構築されていると説明しています。複数のモデルが同じ作業領域に関わる以上、実行と適用の制御が不可欠だという前提です。
-
完全な会計
下書き・査読・修正・引き上げ・リトライ・フォールバックを含む全工程のコストと使用量を集計する
-
実行の境界設定
各工程に明示的なタイムアウトとキャンセルの挙動を持たせ、実行時間とコストを定めた範囲に収める
-
隔離されたレビュー
査読の工程はツールを持たない隔離環境で走らせる。解決役だけが共有ワークスペースと通常の権限管理下のループを使う
-
フェイルセーフな適用
ワークフローがキャンセルされたり検証に失敗した場合はパッチを一切適用せず、不完全な変更がリポジトリに届かないようにする
-
検証済みのルーティング
ワークフロー定義・モデルの紐付け・フォールバックの挙動・モデルの可用性を、実行開始前に検証する
実務上とくに意味があるのは3つ目と4つ目です。査読役がファイルを書き換えられないため、レビュー工程がリポジトリに影響することはありません。途中で失敗した場合も中途半端な変更が残らず、利用者が受け取るのは1つの応答と1つの変更セットになります。
現時点で効いてくる制約
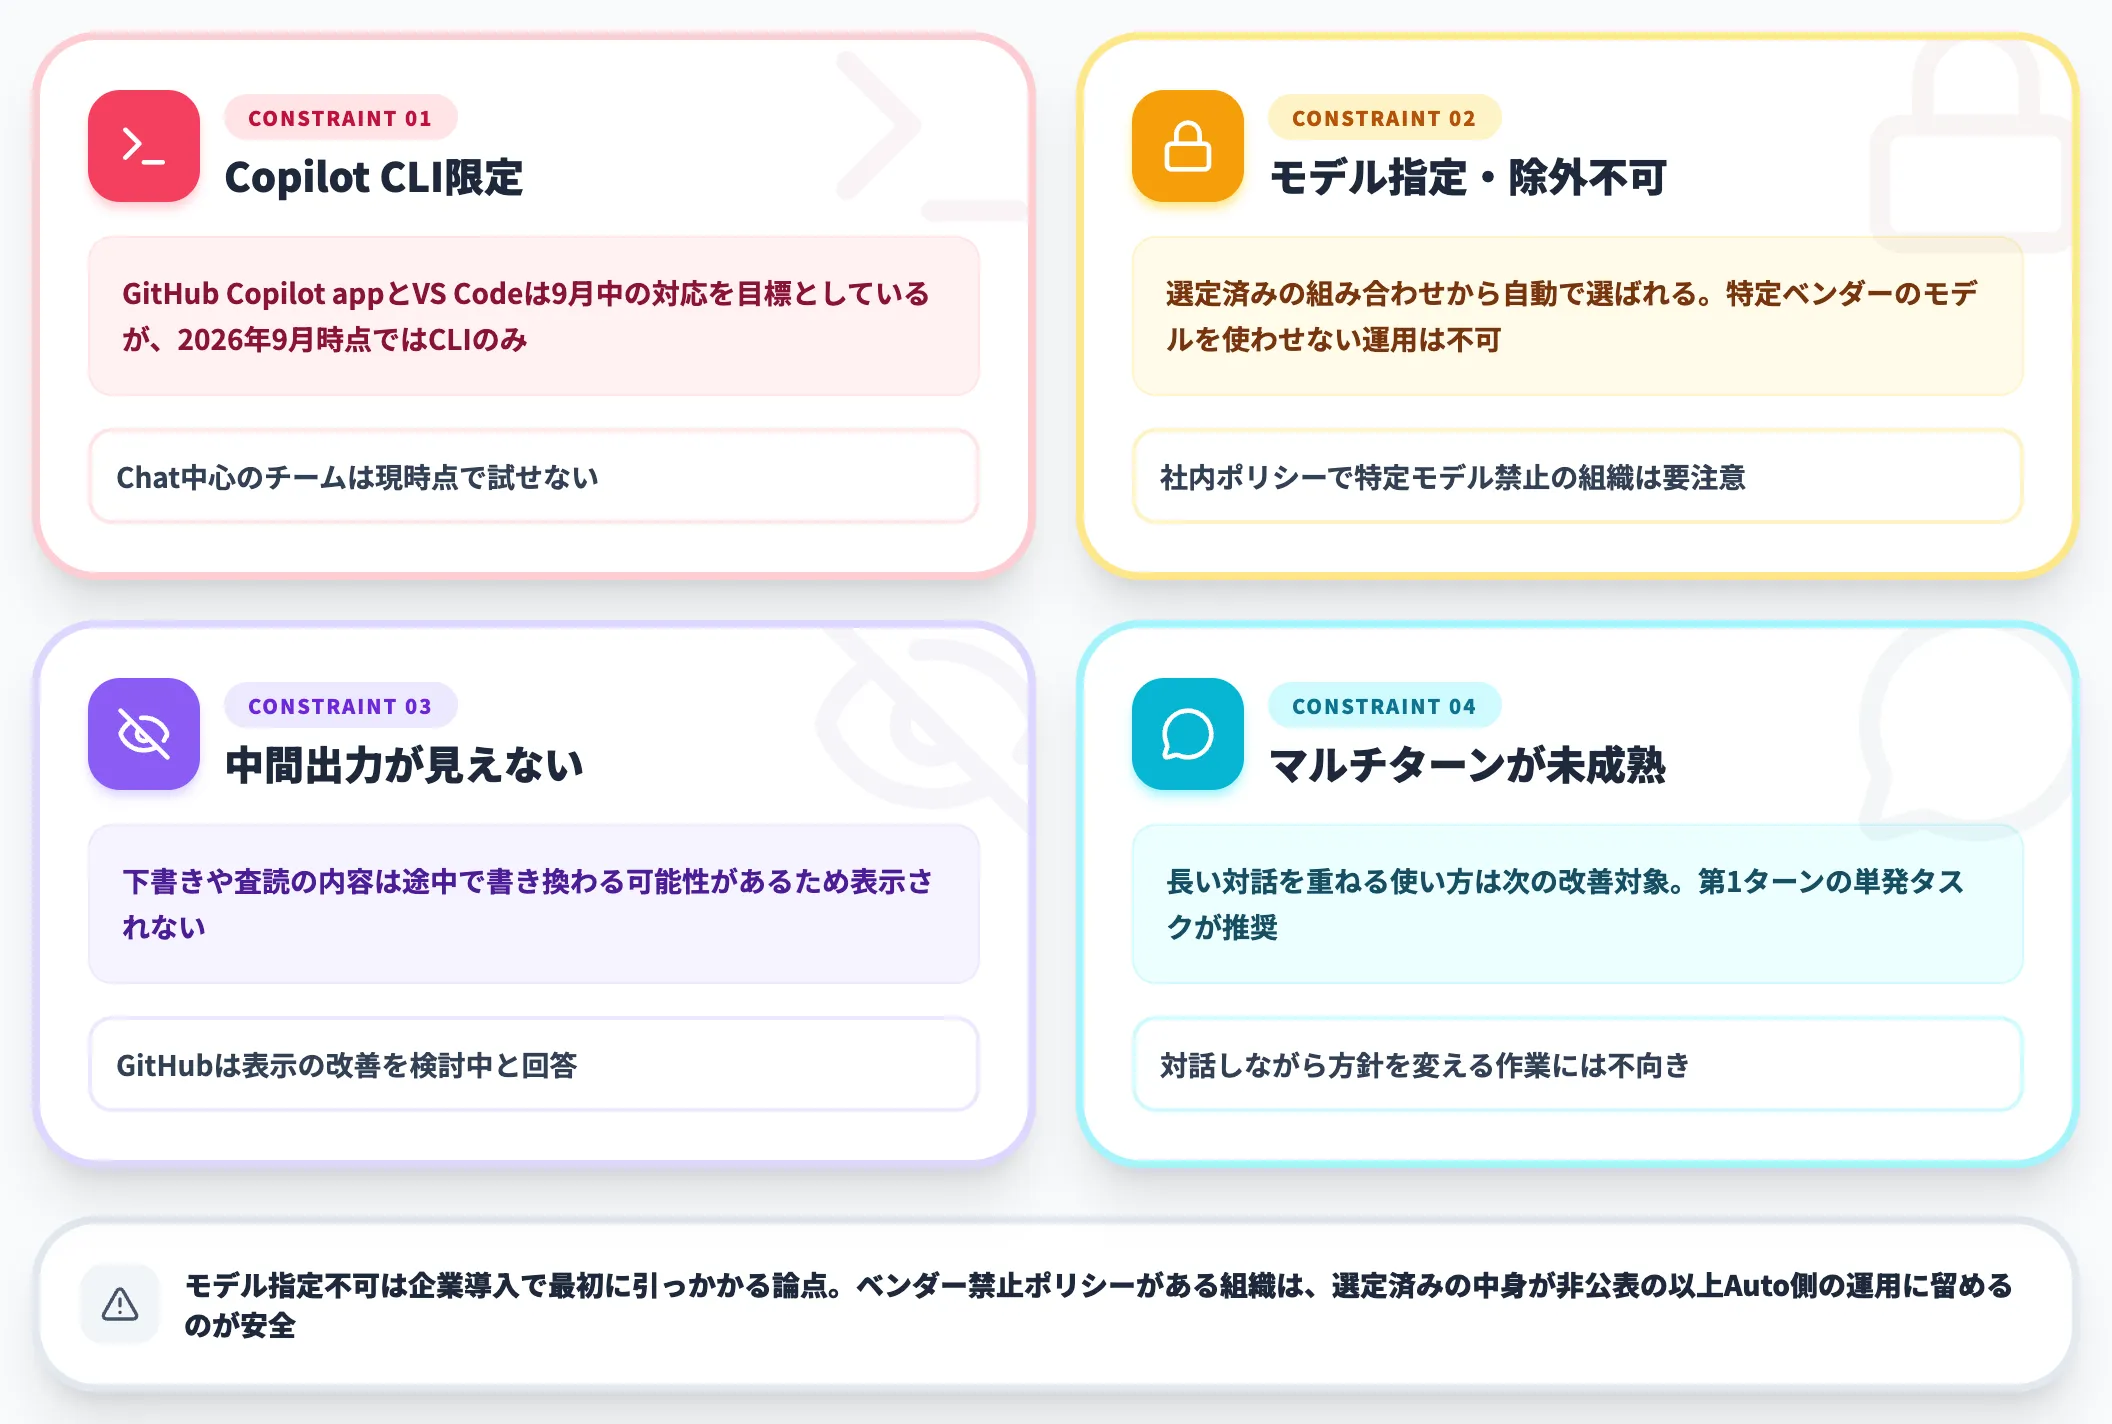
一方で、現時点の制約は業務利用の判断に直結します。
-
Copilot CLI限定
GitHub Copilot appとVS Codeは9月中の対応を目標としているものの、2026年9月8日時点ではCLIのみ
-
モデルの指定・除外ができない
選定済みの組み合わせから自動で選ばれる。特定ベンダーのモデルを使わせない運用は現時点では不可
-
中間出力が見えない
下書きや査読の内容は途中で書き換わる可能性があるため表示されない。GitHubは表示の改善を検討中と回答している
-
マルチターンが未成熟
長い対話を重ねる使い方は次の改善対象。第1ターンの単発タスクが推奨される
モデルの指定ができない点は、企業導入で最初に引っかかる論点です。特定ベンダーのモデルを社内ポリシーで禁止している組織では、選定済みの組み合わせの中身が公表されていない以上、現時点ではAuto側の運用に留めるのが安全な判断になります。
報告されている不具合
Community Discussionでは、公開直後から複数の不具合が報告され、GitHub側も調査中と回答しています。
- プランモードからHydraFusionに切り替えようとすると、以前のモデルに戻ってしまう
- 起動オプションでのモデル指定が認識されず、別のモデルで起動する
- ターンが終わっているのに、進行中の表示が残り続ける
いずれもリサーチプレビュー段階として想定される範囲ですが、GitHub Agentic Workflowsのような無人実行の仕組みにそのまま組み込むのは時期尚早です。
まずは手元での対話利用に留め、挙動が安定してから自動化の検討に進むのが妥当な順序になります。
HydraFusionと他社のモデルルーティングの比較
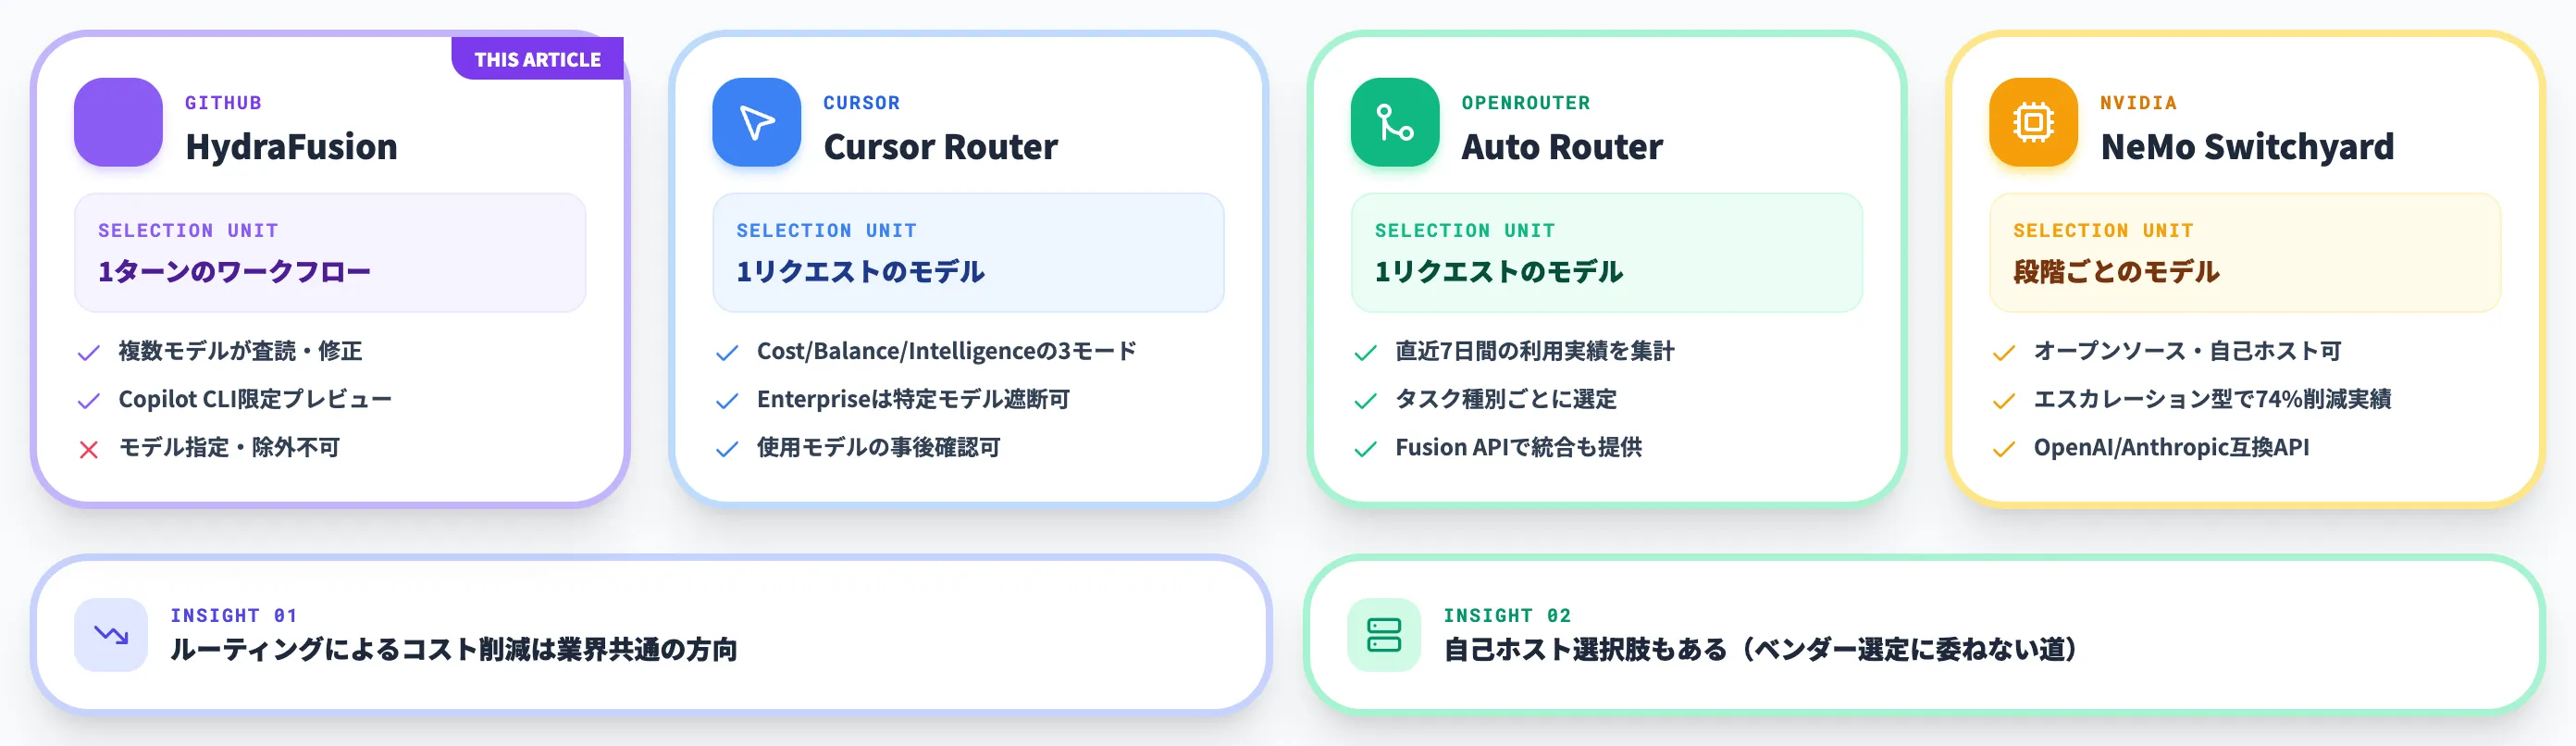
モデルルーティングはGitHub固有の取り組みではありません。2026年に入ってから、主要なコーディング支援ツールとインフラ層の双方で同じ方向の実装が進んでいます。
ここからは、HydraFusionの立ち位置を業界横断で確認します。
以下の表は、主要なルーティング機能の設計を並べたものです。
| 名称 | 提供元 | 選ぶ単位 | 特徴 |
|---|---|---|---|
| HydraFusion | GitHub | 1ターンのワークフロー | 必要に応じて複数モデルが査読・修正。Copilot CLI限定のプレビュー |
| Cursor Router | Cursor | 1リクエストのモデル | Cost・Balance・Intelligenceの3モードを指定。Enterpriseは特定モデルを遮断できる |
| Auto Router | OpenRouter | 1リクエストのモデル | 直近7日間の利用実績を集計してタスク種別ごとに選定 |
| NeMo Switchyard | NVIDIA | 段階ごとのモデル | オープンソースで自己ホスト可能。エスカレーション型など複数のルーター |
この並びで見ると、HydraFusionだけが選択の単位を1ターンのワークフローに置いていることがわかります。
他の3つは、リクエストや工程ごとに回答役のモデルを割り当てる設計です。同じターンの中で別系統のモデルが査読し、下書き役が修正まで行う点が、HydraFusion側の違いになります。
一方で、統制の効かせ方は他社のほうが進んでいます。Cursorは公式ドキュメントで、Enterpriseプランなら特定のモデルを遮断でき、遮断されたモデルは許可済みの代替にフォールバックすると説明しています。
どのモデルが使われたかを後から確認する設定も用意されています。
複数のモデルに1つの回答を作らせるという発想自体も、GitHub独自のものではありません。
OpenRouterは複数モデルの回答を突き合わせて統合するFusion APIを提供しており、NVIDIAはNeMo Switchyardについて、LangChainによる検証でエスカレーション型ルーターが74%のコスト削減を示したと公表しています。
実務的な示唆は2つあります。
1つは、ルーティングによるコスト削減は業界共通の方向であり、特定ツールの一時的な優位ではないという点です。
AIエージェントにコード作業を任せる規模が広がるほど、単価の高いモデルを固定で使い続ける運用は維持しにくくなります。
もう1つは、自己ホストという選択肢が存在する点です。NVIDIAのSwitchyardはApache系のオープンソースとして公開されており、OpenAI互換とAnthropic互換のAPIを受け付けます。
ベンダーが選定したモデル群に委ねたくない組織にとっては、ルーティングの方針を自社で持つ道が用意されています。
モデル選びを仕組みに任せるほど、業務の記録と承認は自社の側に置いておく
HydraFusionでは、どのモデルとパターンが走るかを利用者が選べず、途中の下書きや査読の中身は表示されません。リポジトリには検証に失敗した変更を適用しない歯止めがありますが、経費や申請のような社内の業務をAIエージェントに任せるなら、何を処理したかを自社でたどれる記録と、業務システムに反映する前に人が確かめる段階を、先にそろえておく必要があります。
この記録と人の確認を、Agentごとに作り込まず、社内のAgentに共通の仕組みとして持たせるのが、業務エージェントの実行基盤です。AI総合研究所のAI Agent Hubは、社員がTeamsから呼び出すAgentを、作ったツールを問わず1つの管理画面にまとめます。
- Agentが処理した中身を記録に残す
どの社員がどのAgentを呼び出し、Agentが何を処理したかが実行ログに残るため、結果に疑問が出たときに、管理画面から処理の経緯をさかのぼれます。
- 業務システムに反映する前に人が承認する
Agentの判定を担当者がTeamsで承認してから次の処理に進む流れを組めるため、誤った判定がそのまま基幹システムに書き込まれずに済みます。
- 業務データの行き先を自社のテナントに限る
Agentが扱う申請書や請求書のデータは、基盤ごと自社のAzureテナント内で処理されるため、使ってよいクラウドやベンダーを定めた社内ポリシーに照らして、どこでデータを扱うかを説明しやすくなります。
AI総合研究所の専任チームが、人の承認を挟んだ運用から始め、記録を見ながら自動で進める処理を増やしていくところまで伴走します。
AIに任せた業務の中身を記録に残す

業務システムへの反映の前に人が承認する
HydraFusionのようにモデル選びを仕組みに任せる場面が増えるなか、社内業務で使うAIエージェントは、処理の記録と人の承認を自社の側に置いておくと、自動で進める範囲を広げやすくなります。経費精算や請求書処理の例は、AI Agent Hubのサービスページのユースケース例からご覧いただけます。
まとめ
本記事では、HydraFusionを「Copilot CLIで複数のモデルを実行時に組み合わせる機能」として整理し、3つの実行パターン・ベンチマーク結果・Autoモデル選択との違い・使い方・料金とクレジット消費・制約と安全設計・他社との比較を解説しました。
2026年9月時点で押さえておくべきポイントは次の3つです。
- Autoとの違いは、選ぶ対象が1つのモデルではなく1ターン分の解き方にある点で、査読や上位モデルへの引き上げは必要と判断されたときだけ加わる
- 3つのベンチマークすべてでコストは下がったものの、品質でOpus 5を上回ったのはTerminalBench 2.1の1本にとどまる
- どのモデルとパターンが走るかを利用者が選べず、途中の下書きや査読の内容は表示されないため、統制を重視する組織は現時点ではAutoで運用するほうが安全
Copilot CLIでHydraFusionを試すなら、次の2段階で進めるのがAI総合研究所のおすすめです。
まずは、仕様の固まった単発のタスクを数件選んでHydraFusionで流し、自社のリポジトリでクレジットの消費量を実測します。
続いて、普段使っているモデルでの消費と比べたうえで使う範囲を本番の作業へ広げ、無人実行の仕組みへの組み込みは、挙動が安定してからにします。
モデルルーティングはGitHubに限らず主要なツールが進めている方向で、AIに任せるコード作業が増えるほど、単価の高いモデルを固定で使い続ける運用は成り立ちにくくなります。
HydraFusionは選ぶ単位を1ターンのワークフローまで広げた仕組みですが、統制の面では他社が先を行っており、今は手元で試しながら見極める段階にあります。