この記事のポイント
 2026年11月5日発表のNVIDIA Research最新技術。Physical AI向けVLMの視覚プランニングを並列生成で高速化
- Flash Primitive Decodingで視覚プリミティブを1回の推論で生成。ロボット向け軌跡デコードを最大12倍、MolmoSpacesタスクの推論全体でJetson Thor 5.1倍/DGX Spark 5.2倍の高速化
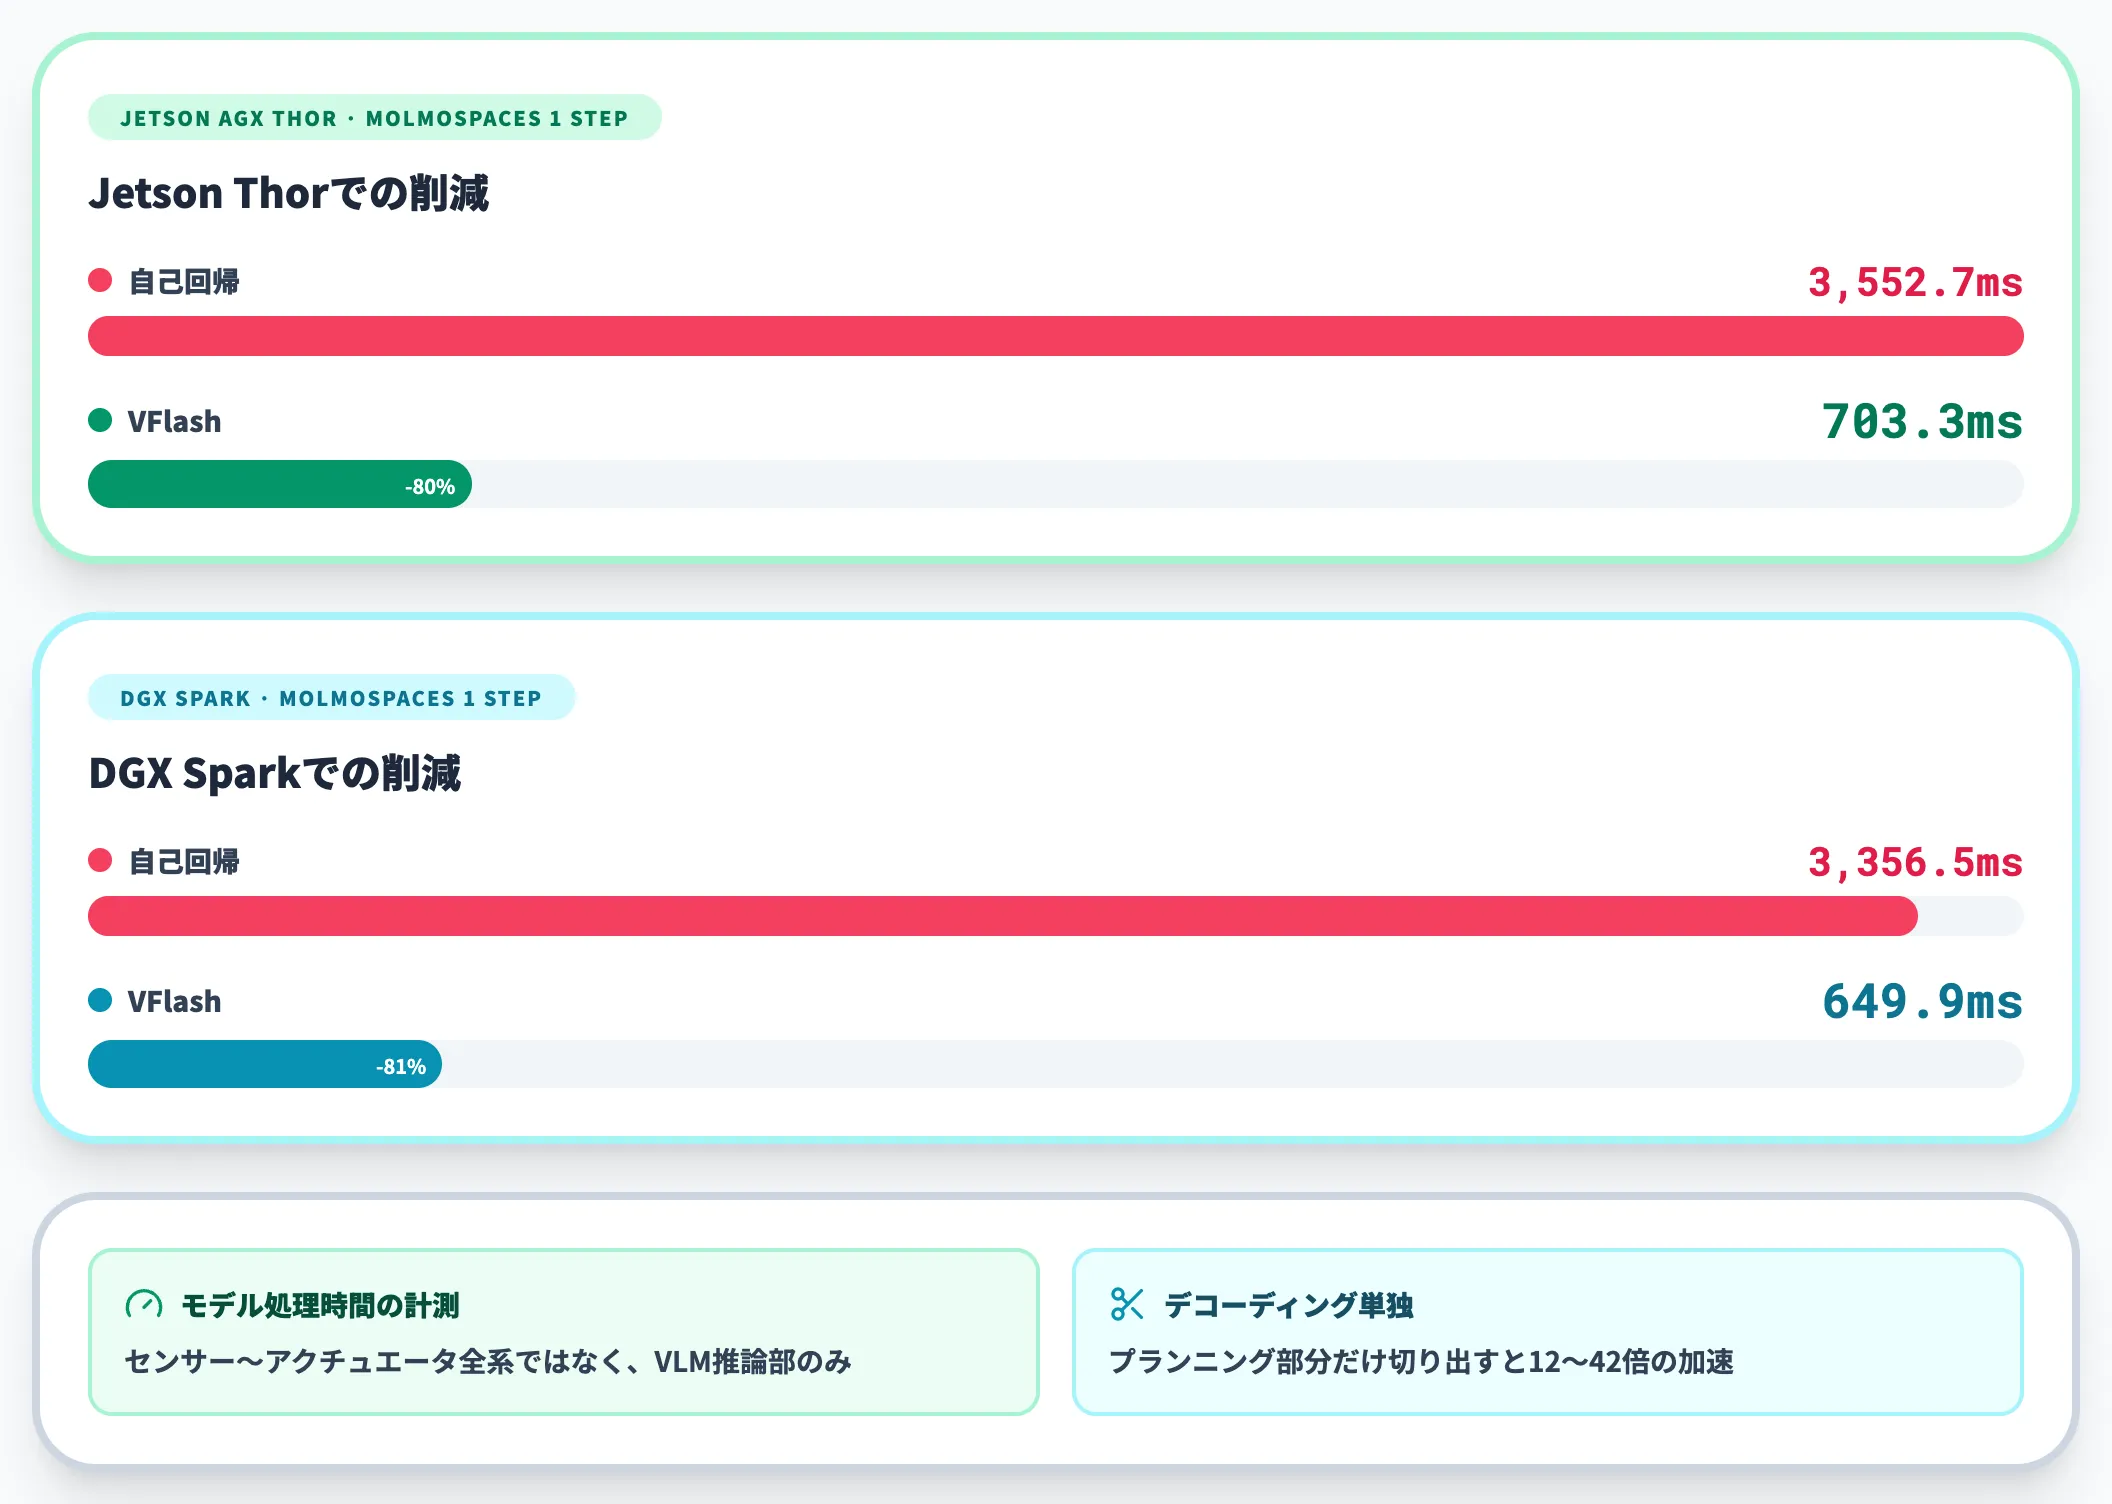
- Jetson Thorで推論レイテンシ3,552.7ms→703.3ms(約80%削減)。DGX Sparkでも3,356.5ms→649.9msを計測(いずれもモデル処理時間)
- MolmoSpaces成功率70.2%(従来62.6%)、3D軌跡誤差を最大61%削減。精度と速度を同時改善と公表
- コードはApache 2.0でNVlabs/Eagleリポジトリに公開済み。モデルチェックポイントは追って公開予定
Microsoft MVP・AIパートナー。LinkX Japan株式会社 代表取締役。東京工業大学大学院にて自然言語処理・金融工学を研究。NHK放送技術研究所でAI・ブロックチェーンの研究開発に従事し、国際学会・ジャーナルでの発表多数。経営情報学会 優秀賞受賞。シンガポールでWeb3企業を創業後、現在は企業向けAI導入・DX推進を支援。
VFlashは、NVIDIA Researchが2026年11月5日に発表した、ロボットや自動運転向けVLM(ビジョン言語モデル)の視覚プランニングを並列化する新しいデコーディング手法です。
Flash Primitive Decodingという独自手法により、座標を1トークンずつ順番に生成する従来の自己回帰方式を、1回の推論で視覚プリミティブ全体を生成する並列方式に置き換えます。
本記事では、VFlashが解決する従来のレイテンシ問題、Flash Primitive Decodingの仕組み、ロボット操作と自動運転ベンチマークでの性能、対応ハードウェアと採用コスト構造、既存VLA加速手法との違い、実務での活用判断軸までを体系的に解説します。
目次
VFlashとは?NVIDIAがVLMの視覚プランニングを並列化する高速デコーディング手法
VFlash以前のVLA/VLM推論が抱えていたボトルネック
VFlashのFlash Primitive Decodingの仕組み
VFlashの性能評価——ロボット操作と自動運転ベンチマーク
既存VLA加速手法(PD-VLA・OpenVLA-OFT・Spec-VLA)とVFlashの違い
VFlashとは?NVIDIAがVLMの視覚プランニングを並列化する高速デコーディング手法
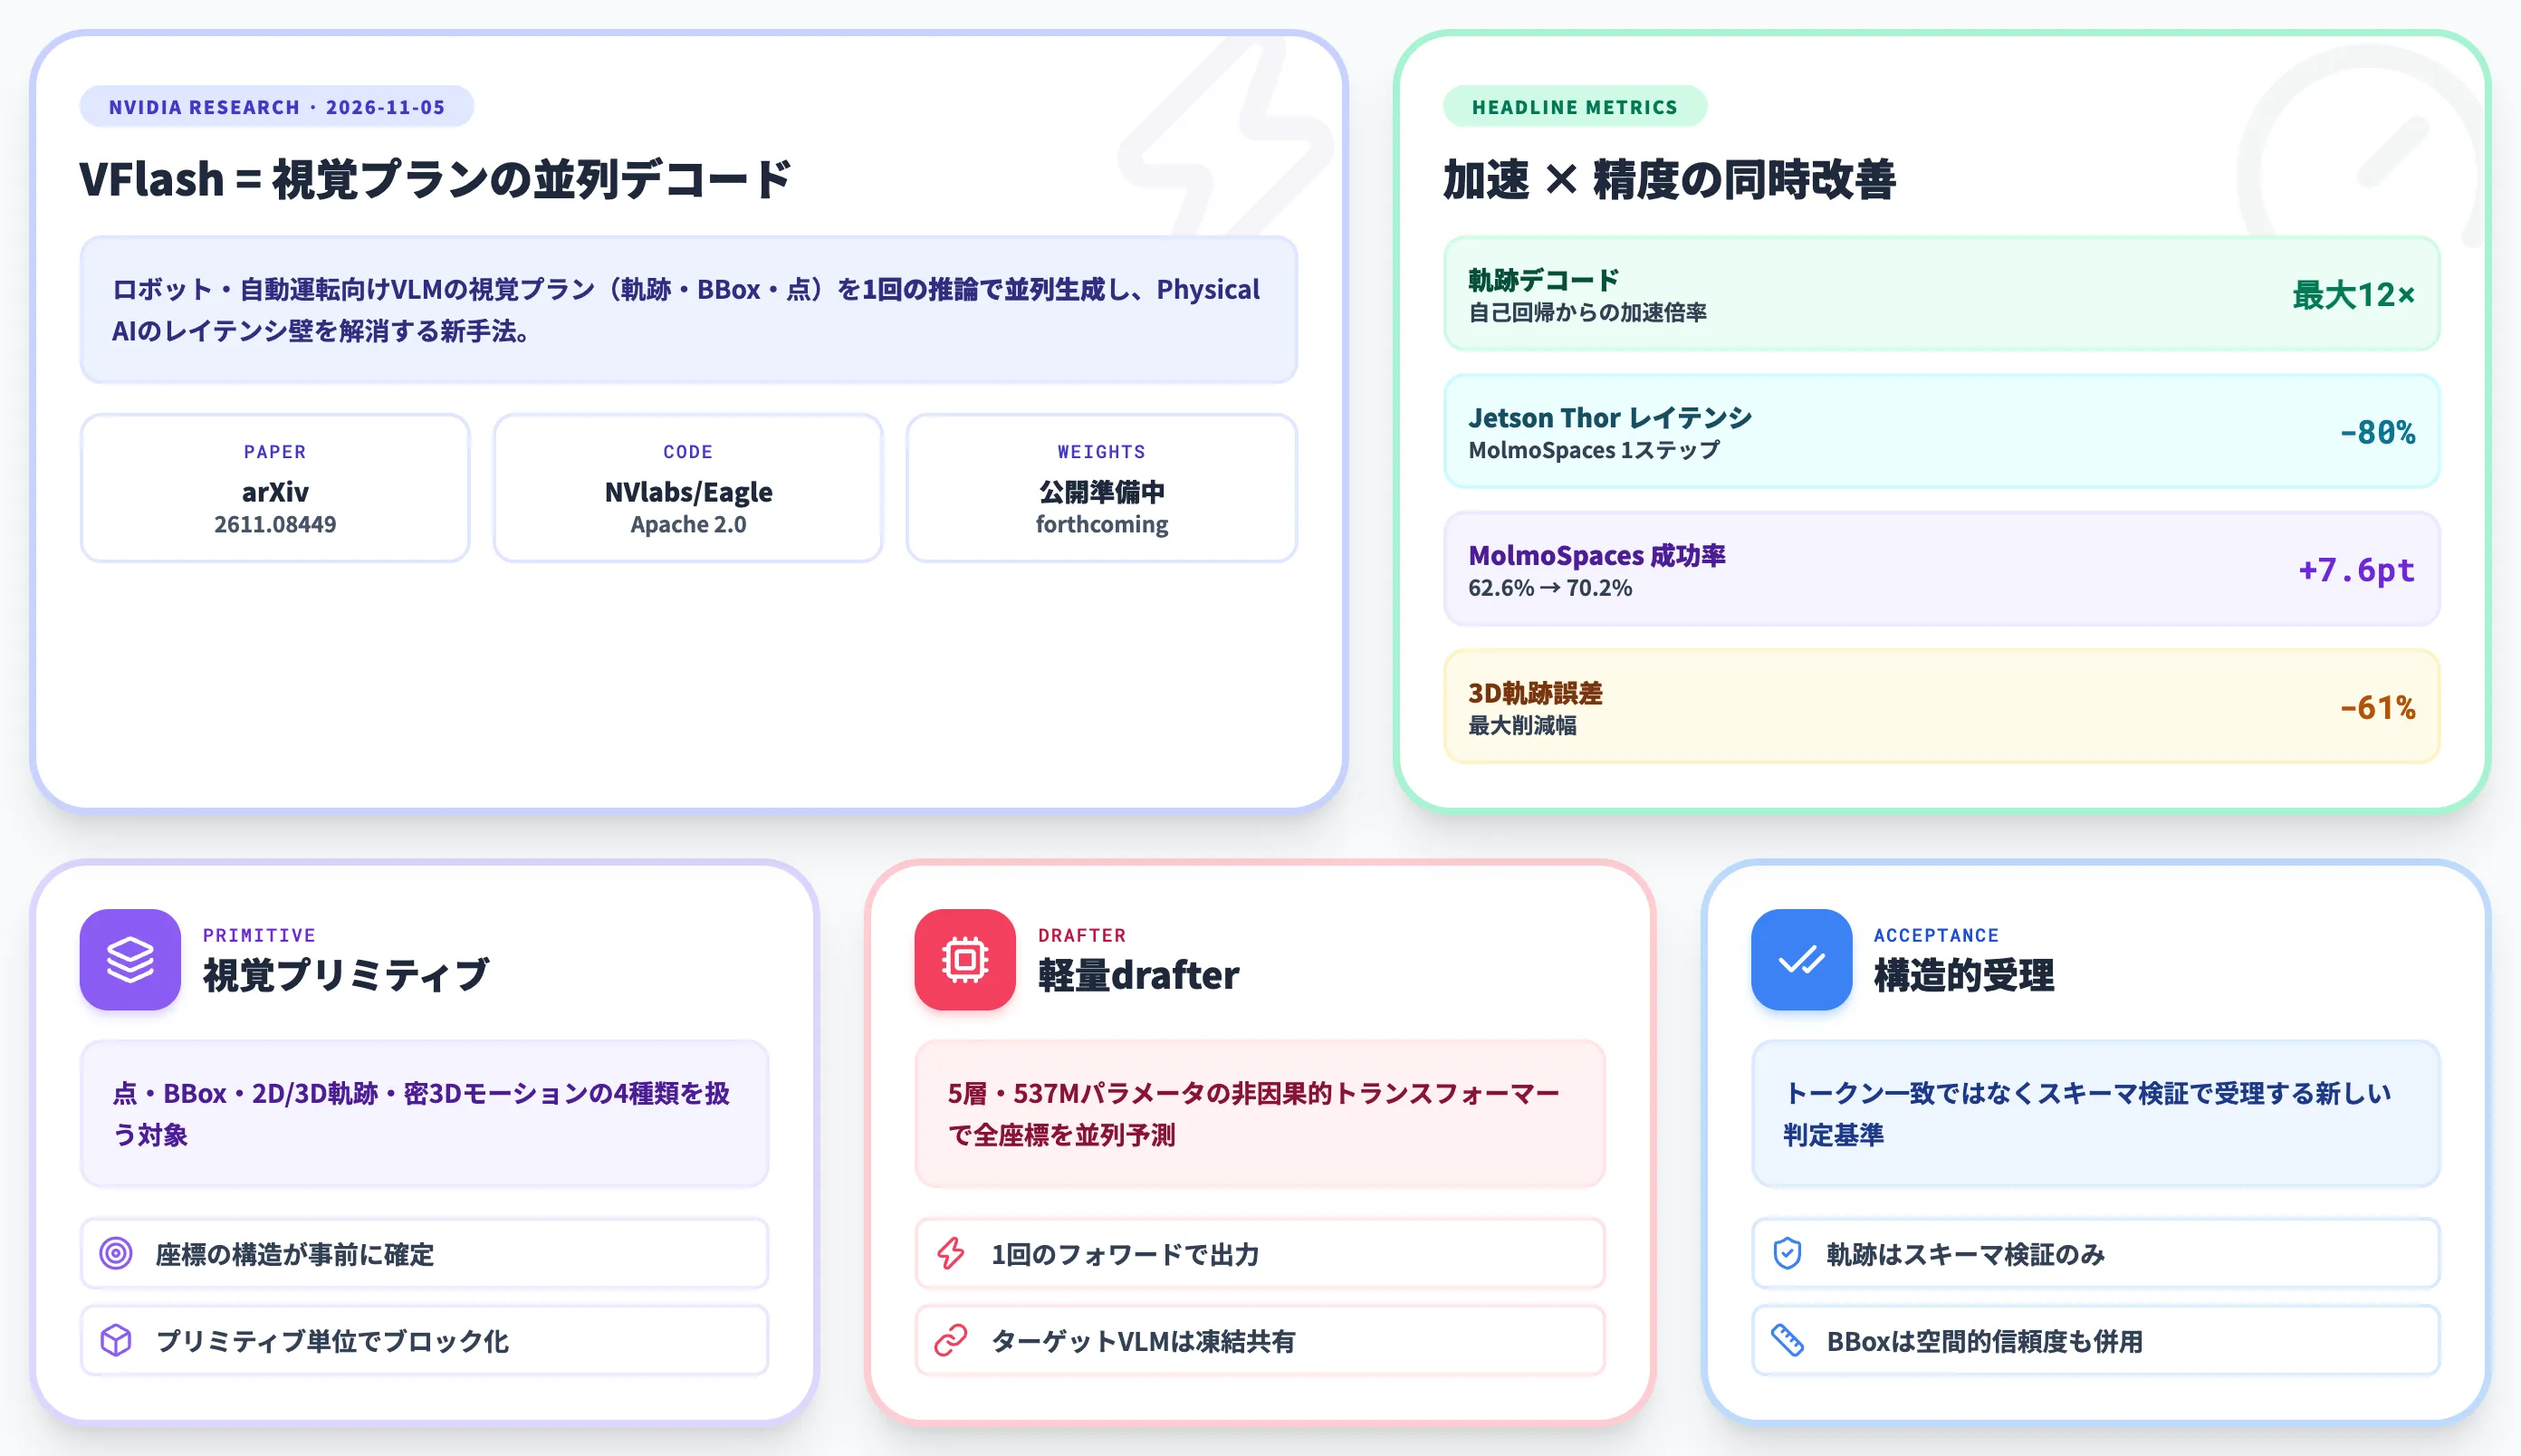
VFlash(ブイフラッシュ)とは、NVIDIA Researchが2026年11月5日に発表した、ロボットや自動運転向けVLM(ビジョン言語モデル)の視覚プランニングを並列デコーディングで高速化する新しい推論手法です。
論文タイトルは「VFlash: Fast, Accurate Visual Planning via Flash Primitive Decoding」で、arXivに2611.08449として掲載されています。
NVIDIA Research公式プロジェクトページは、VFlashが扱う視覚プリミティブの構造から並列デコード機構、Jetson Thor・DGX Sparkでの推論レイテンシ比較、3D精度と推論時間のトレードオフまでを1枚の俯瞰図にまとめています。
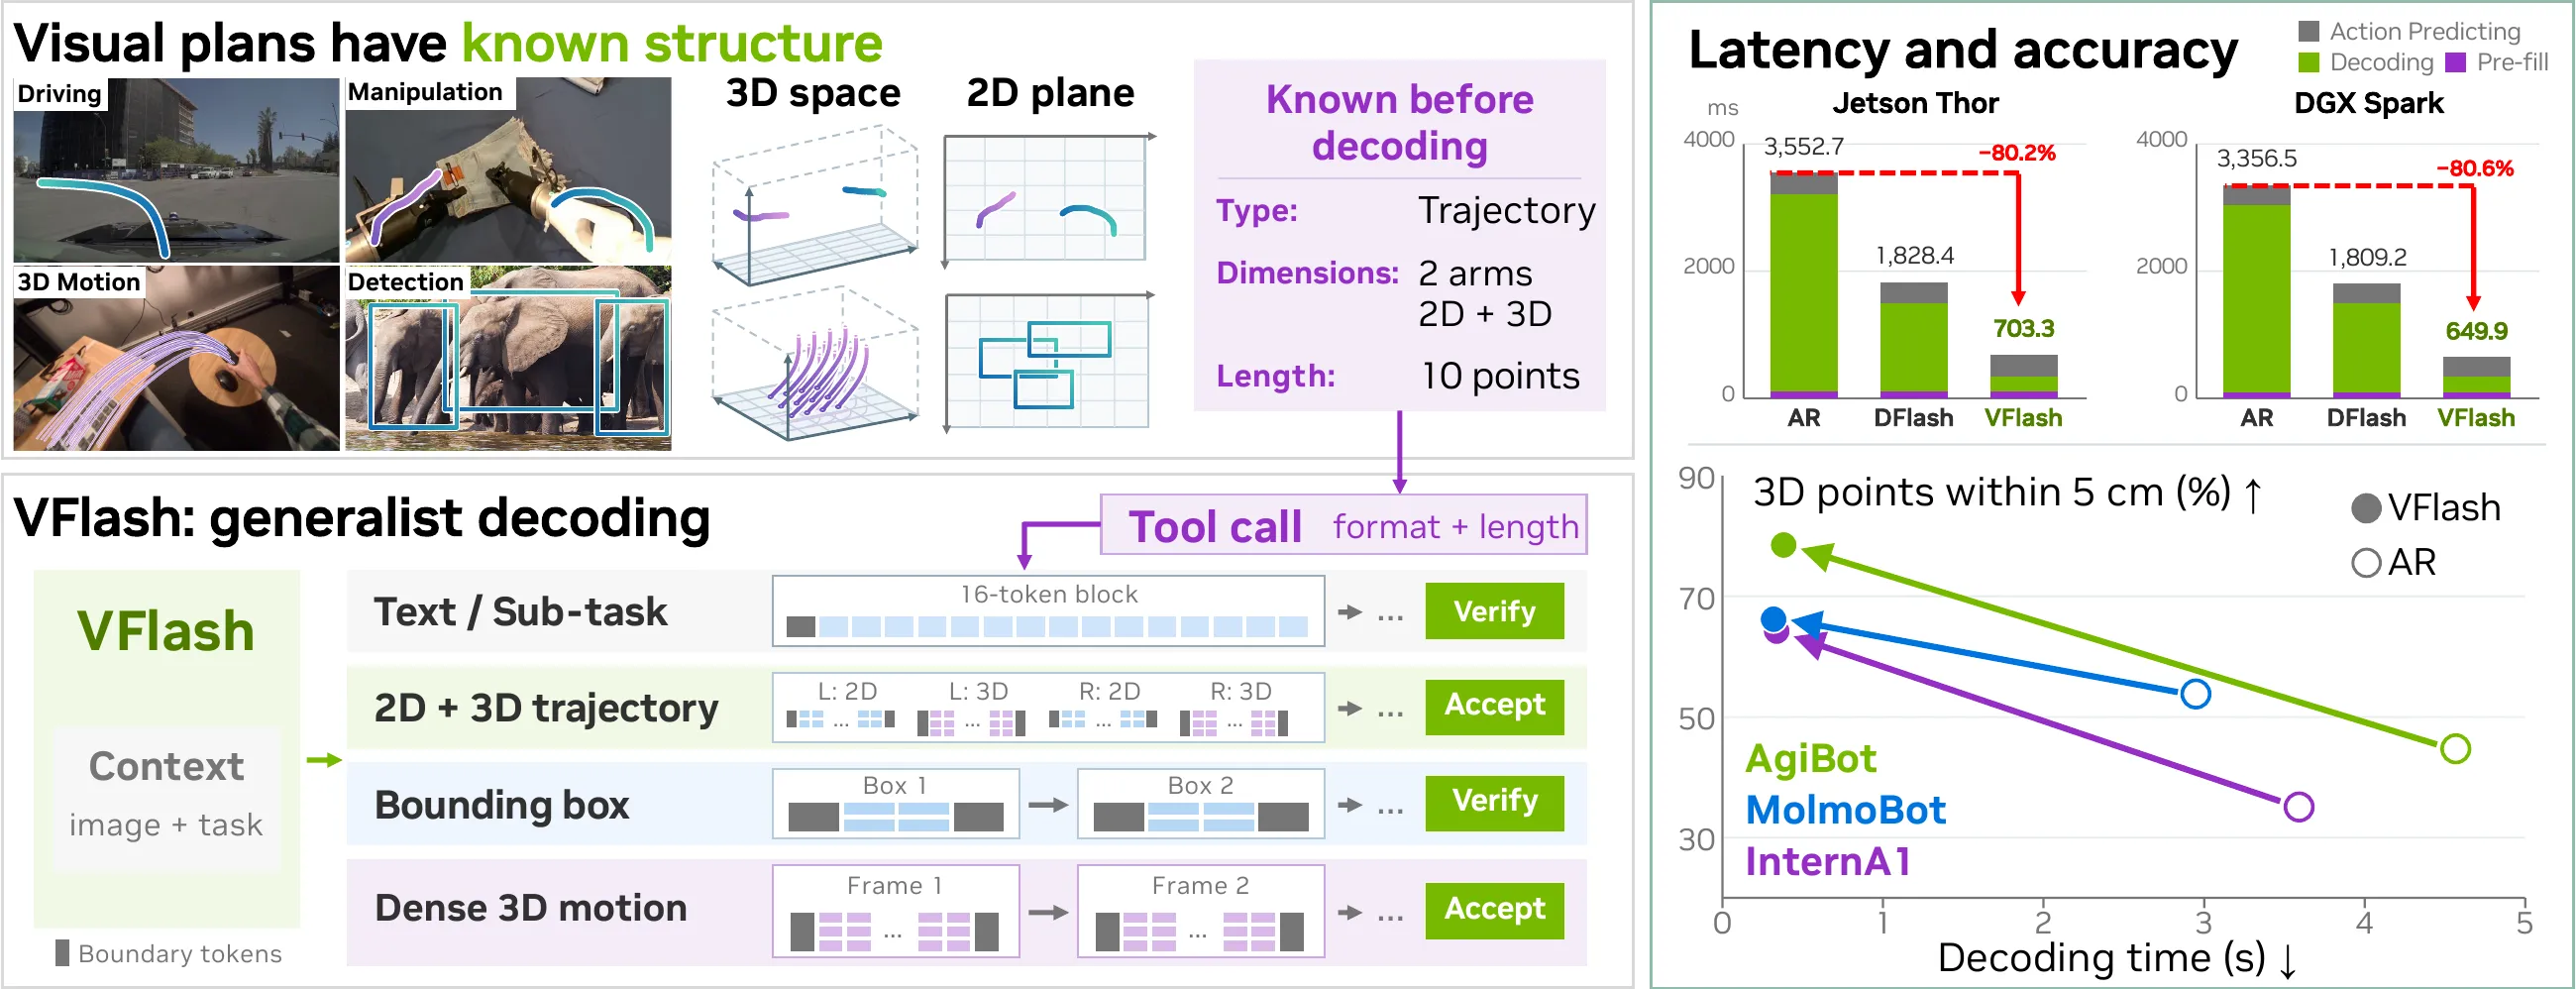
VFlashが扱う4種類の視覚プリミティブ(テキスト/2D+3D軌跡/ボックス/密3Dモーション)とJetson Thor・DGX Sparkでの推論レイテンシ・精度(出典:NVIDIA Research)
Physical AI(フィジカルAI)の実装で問題になるのは、VLMが視覚プランを座標1トークンずつ逐次生成する自己回帰方式だと、ロボットや自動運転の制御周期に推論が間に合わない点です。VFlashはこの制約に対し、視覚プリミティブの構造が事前に分かっていることを利用し、プリミティブ全体を1回の推論で並列生成する軽量drafterを導入します。
NVIDIA Eagleとしての位置づけ
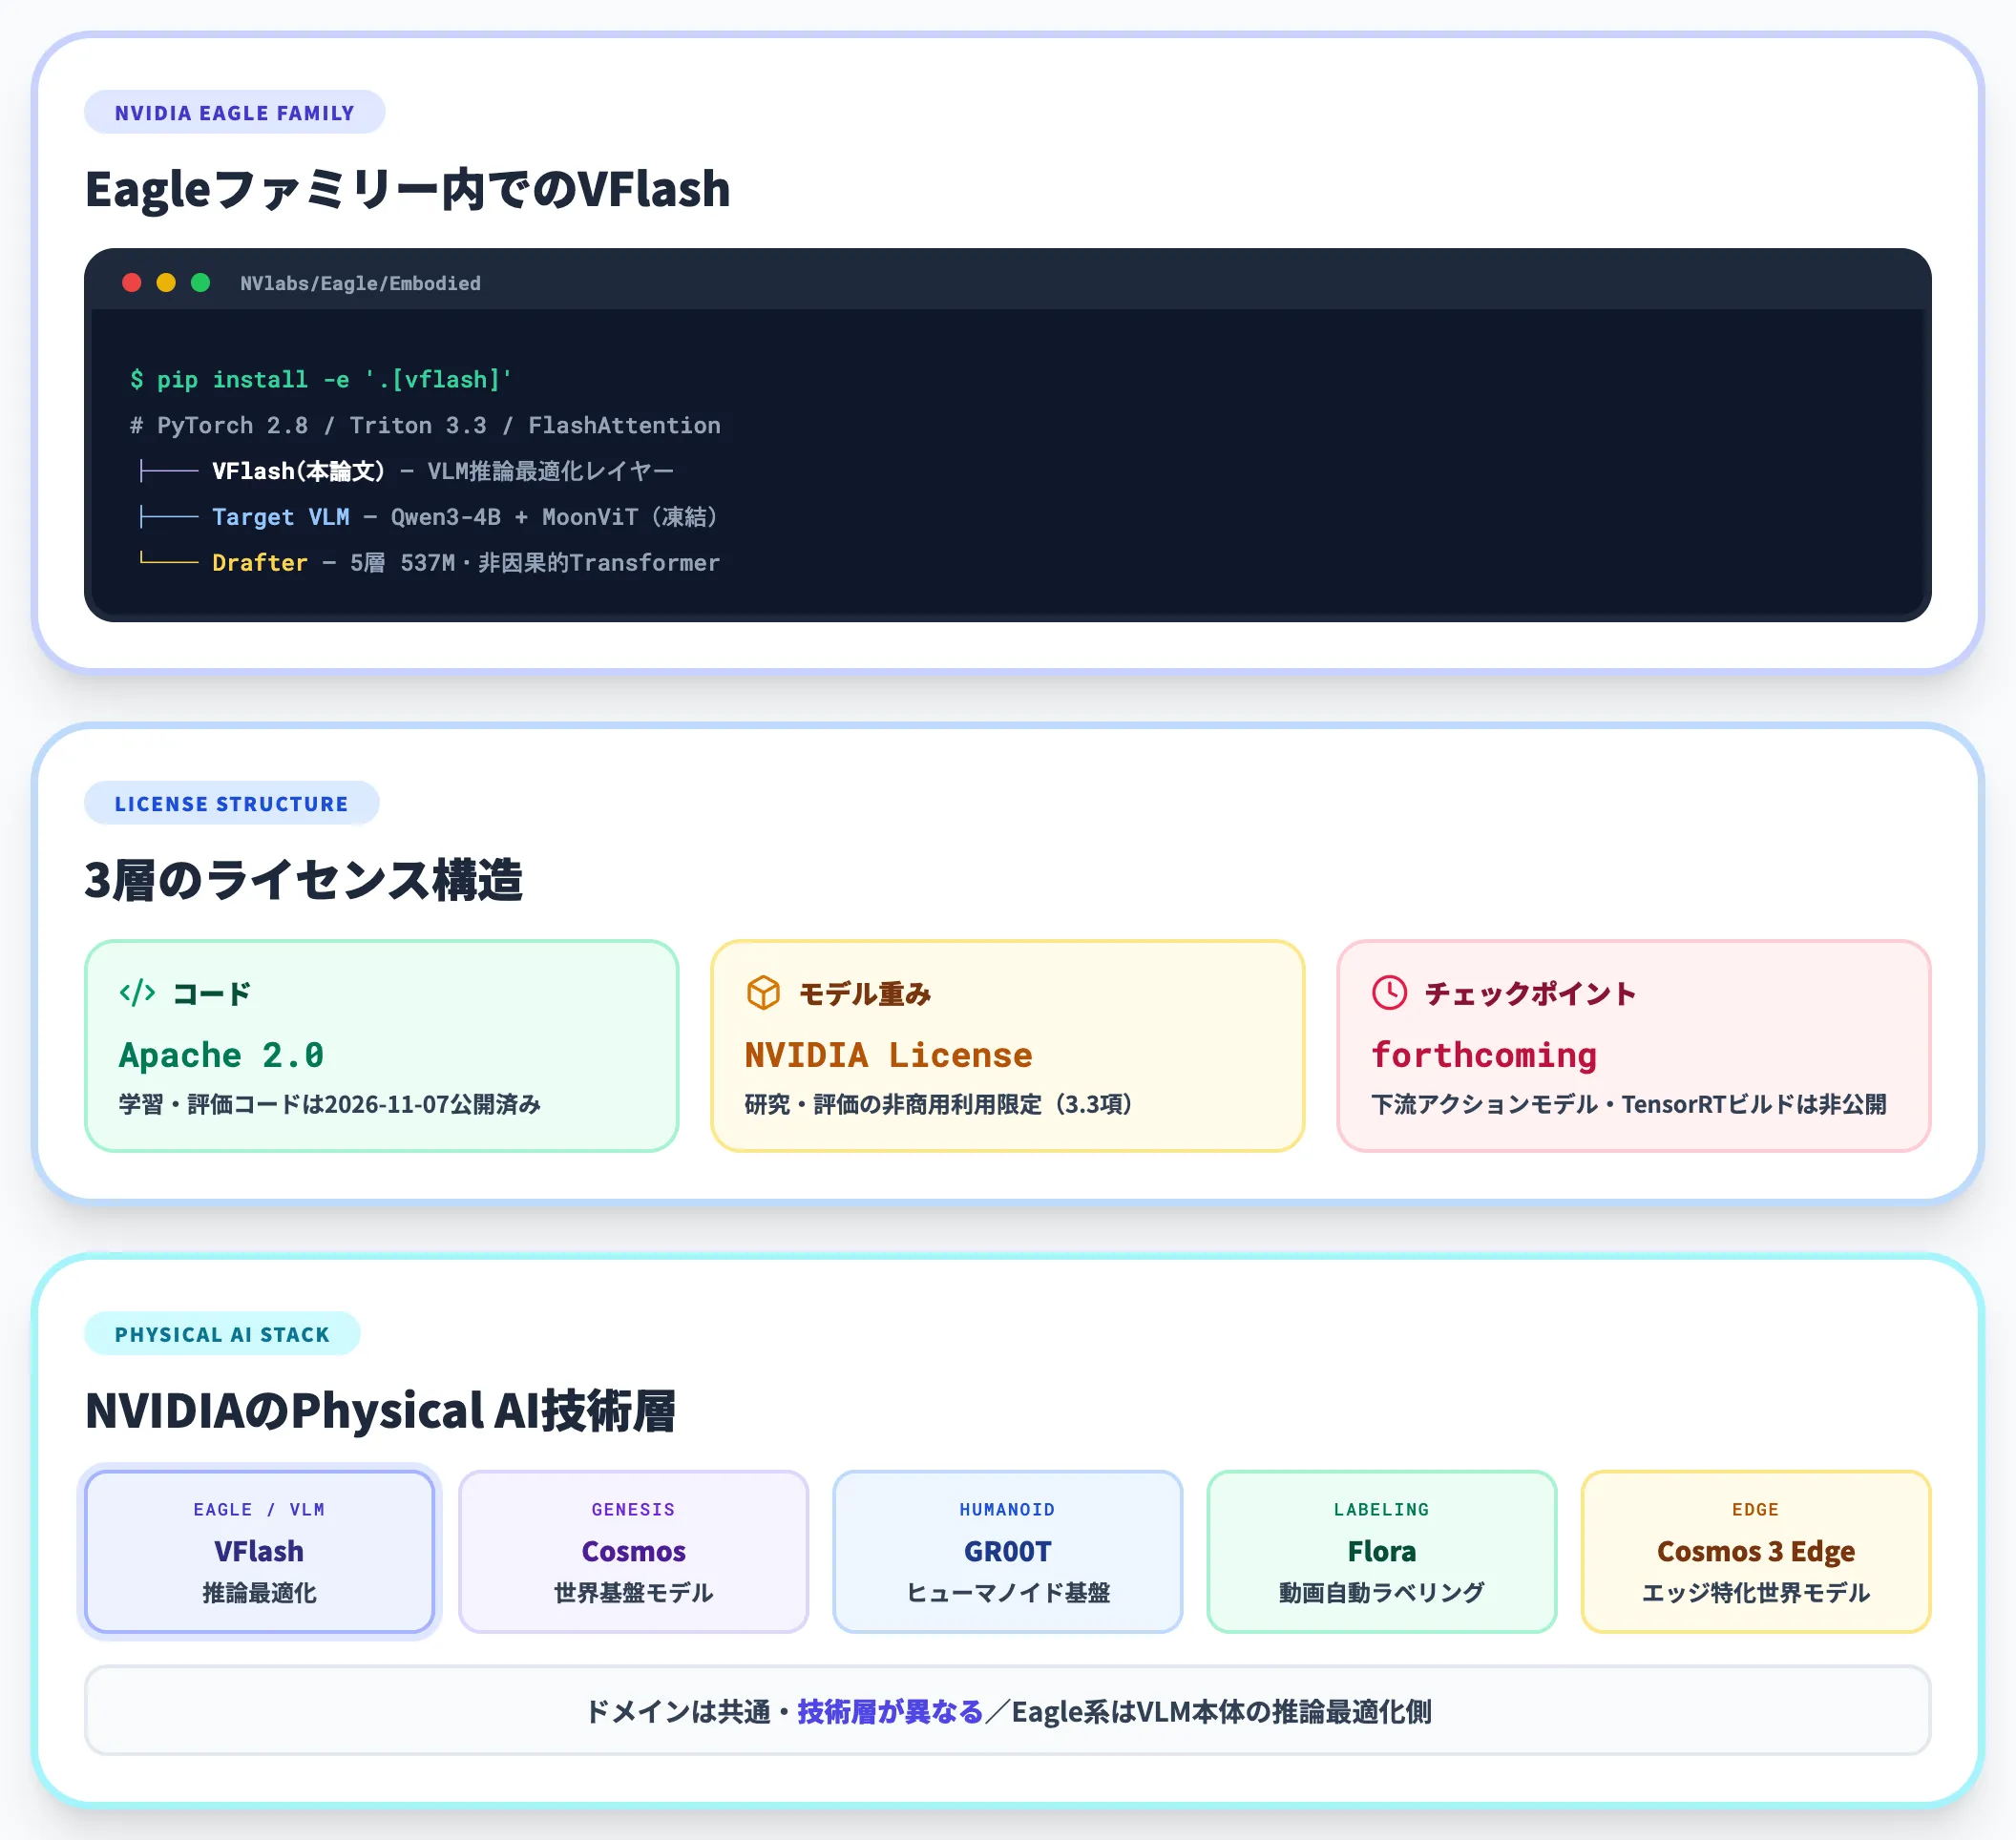
VFlashはNVIDIAの大型ビジョン言語モデル群「NVIDIA Eagle」の一部として、「NVlabs/Eagle」リポジトリの「Embodied」サブディレクトリに実装が公開されています。
-
コードライセンス
Apache 2.0(学習・評価コードは2026年11月7日にGitHub公開)
-
モデルライセンス
NVIDIA License(研究・評価目的の非商用利用に限定。詳細は「LICENSE_MODEL」3.3項を参照)
-
チェックポイント公開状況
論文時点では「forthcoming(準備中)」。ターゲットVLMとdrafterの重みに加え、論文の下流アクションモデル(MolmoSpacesで条件付けされるworld action model)と速度計測ランタイム(TensorRTビルド含む)も公開対象外で、公式性能を完全再現する場合は追加の実装工数が必要
Physical AI向けの他のNVIDIA製モデル群であるNVIDIA Cosmos(世界基盤モデル)、NVIDIA GR00T(ヒューマノイド基盤モデル)、NVIDIA Flora(ロボット動画自動ラベリング)、Cosmos 3 Edge(エッジ推論特化世界モデル)とはドメインは共通だが技術層が異なり、Eagle系はVLM本体の推論最適化側に位置しています。
VFlash以前のVLA/VLM推論が抱えていたボトルネック
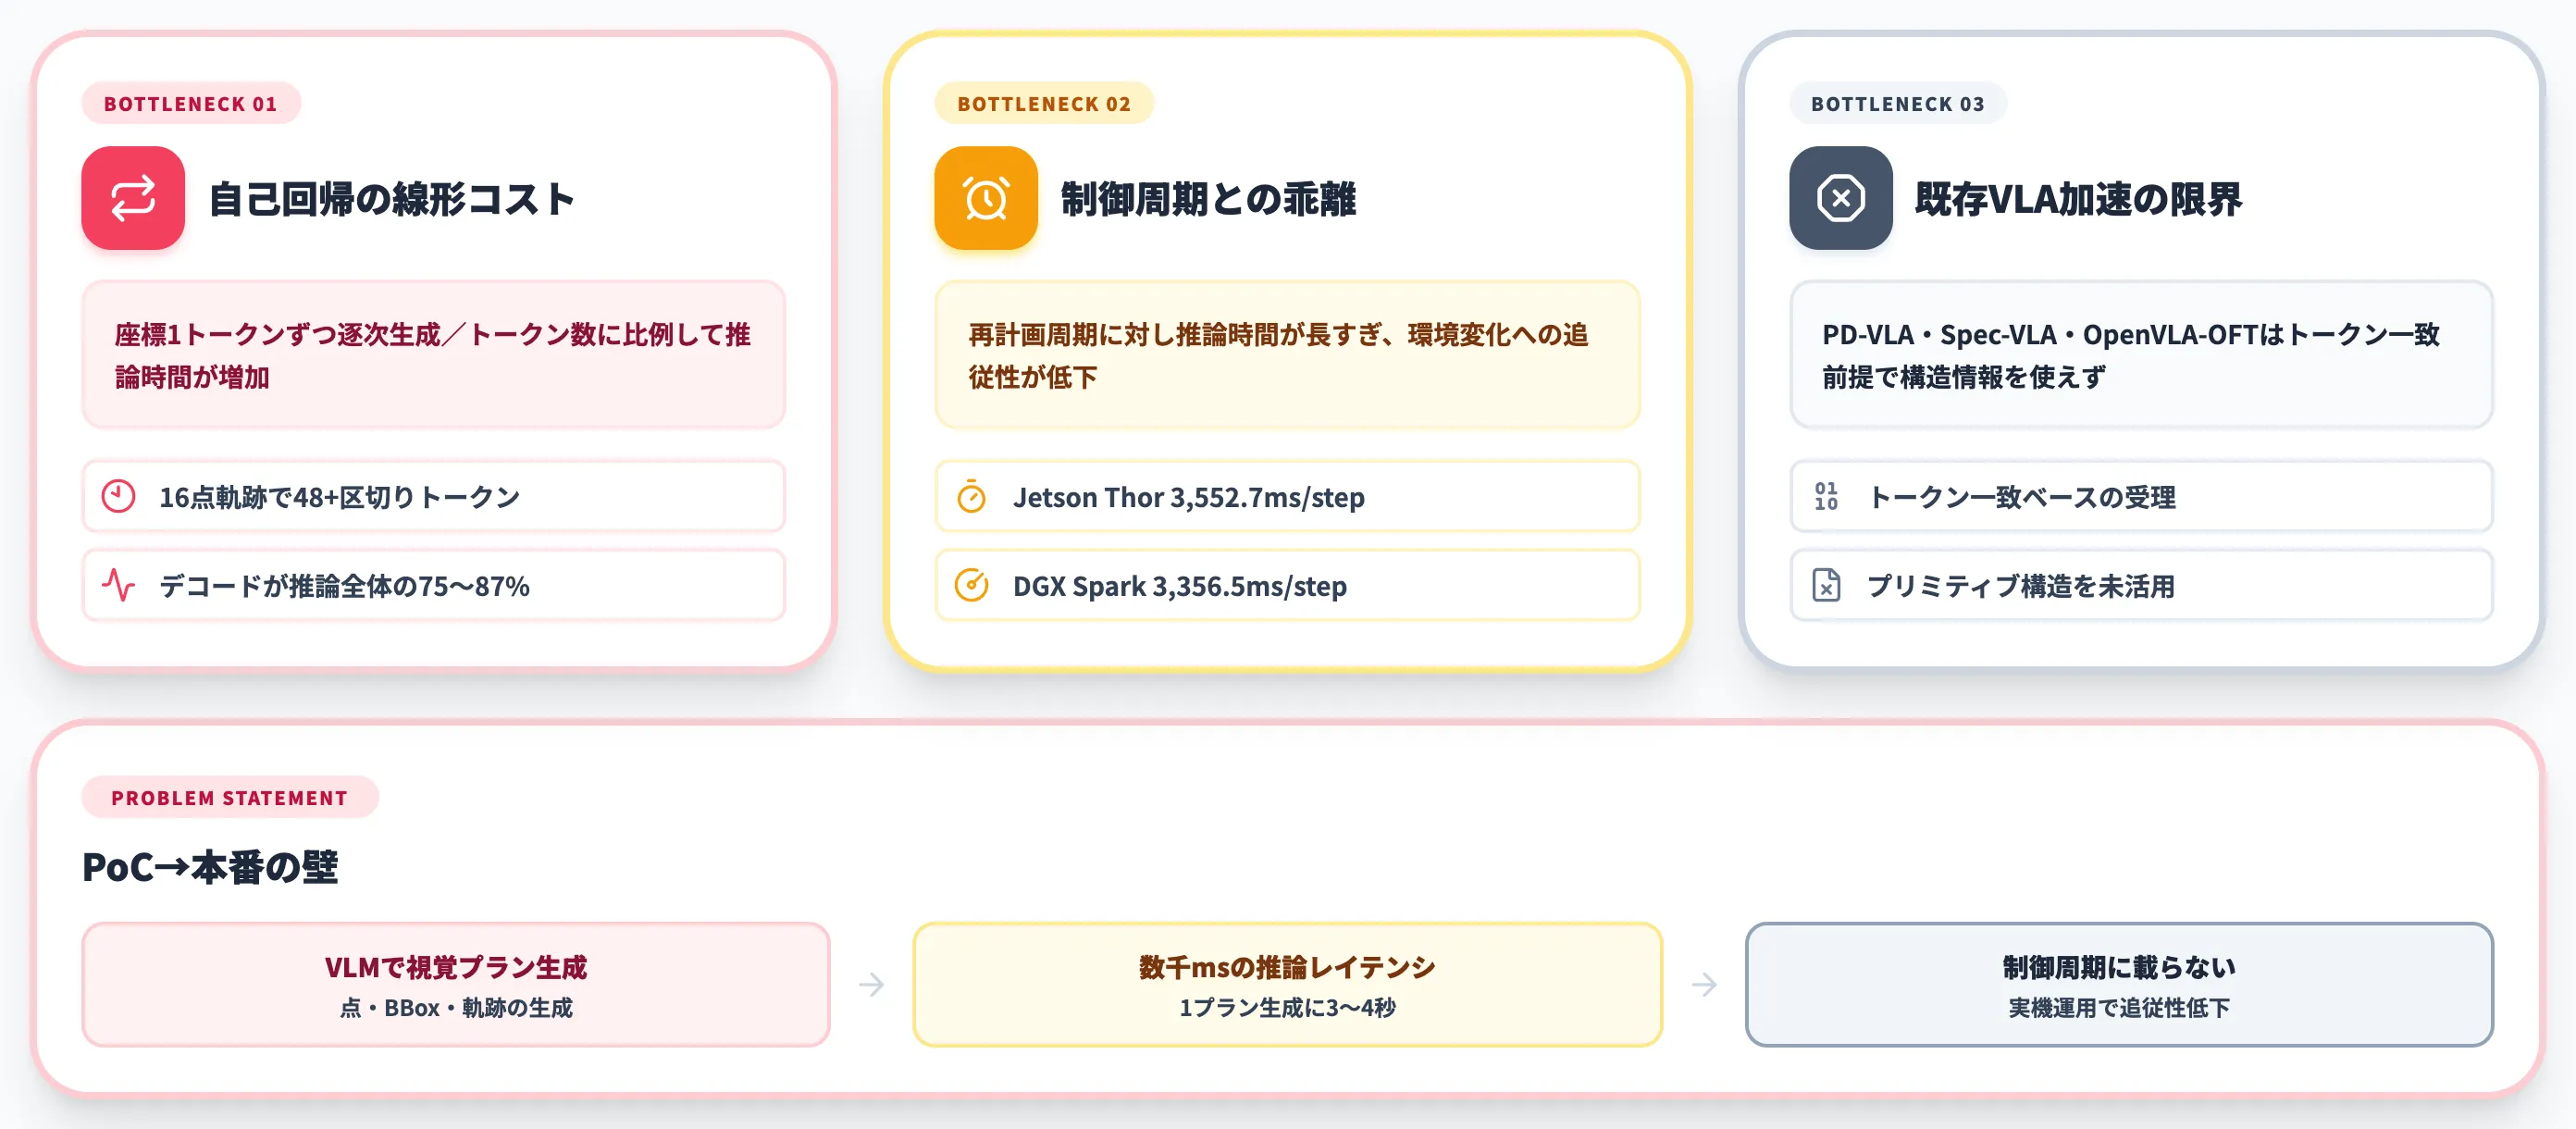
VFlashが解決しようとしている課題は、「VLMの視覚プラン生成が遅すぎてロボット・自動運転のリアルタイム制御に載らない」というPhysical AI実装の実務的な壁です。
本セクションでは、なぜ従来の自己回帰デコーディングではエッジ推論が間に合わなかったのかを、具体的なレイテンシ数値とともに整理します。
自己回帰デコーディングのボトルネック
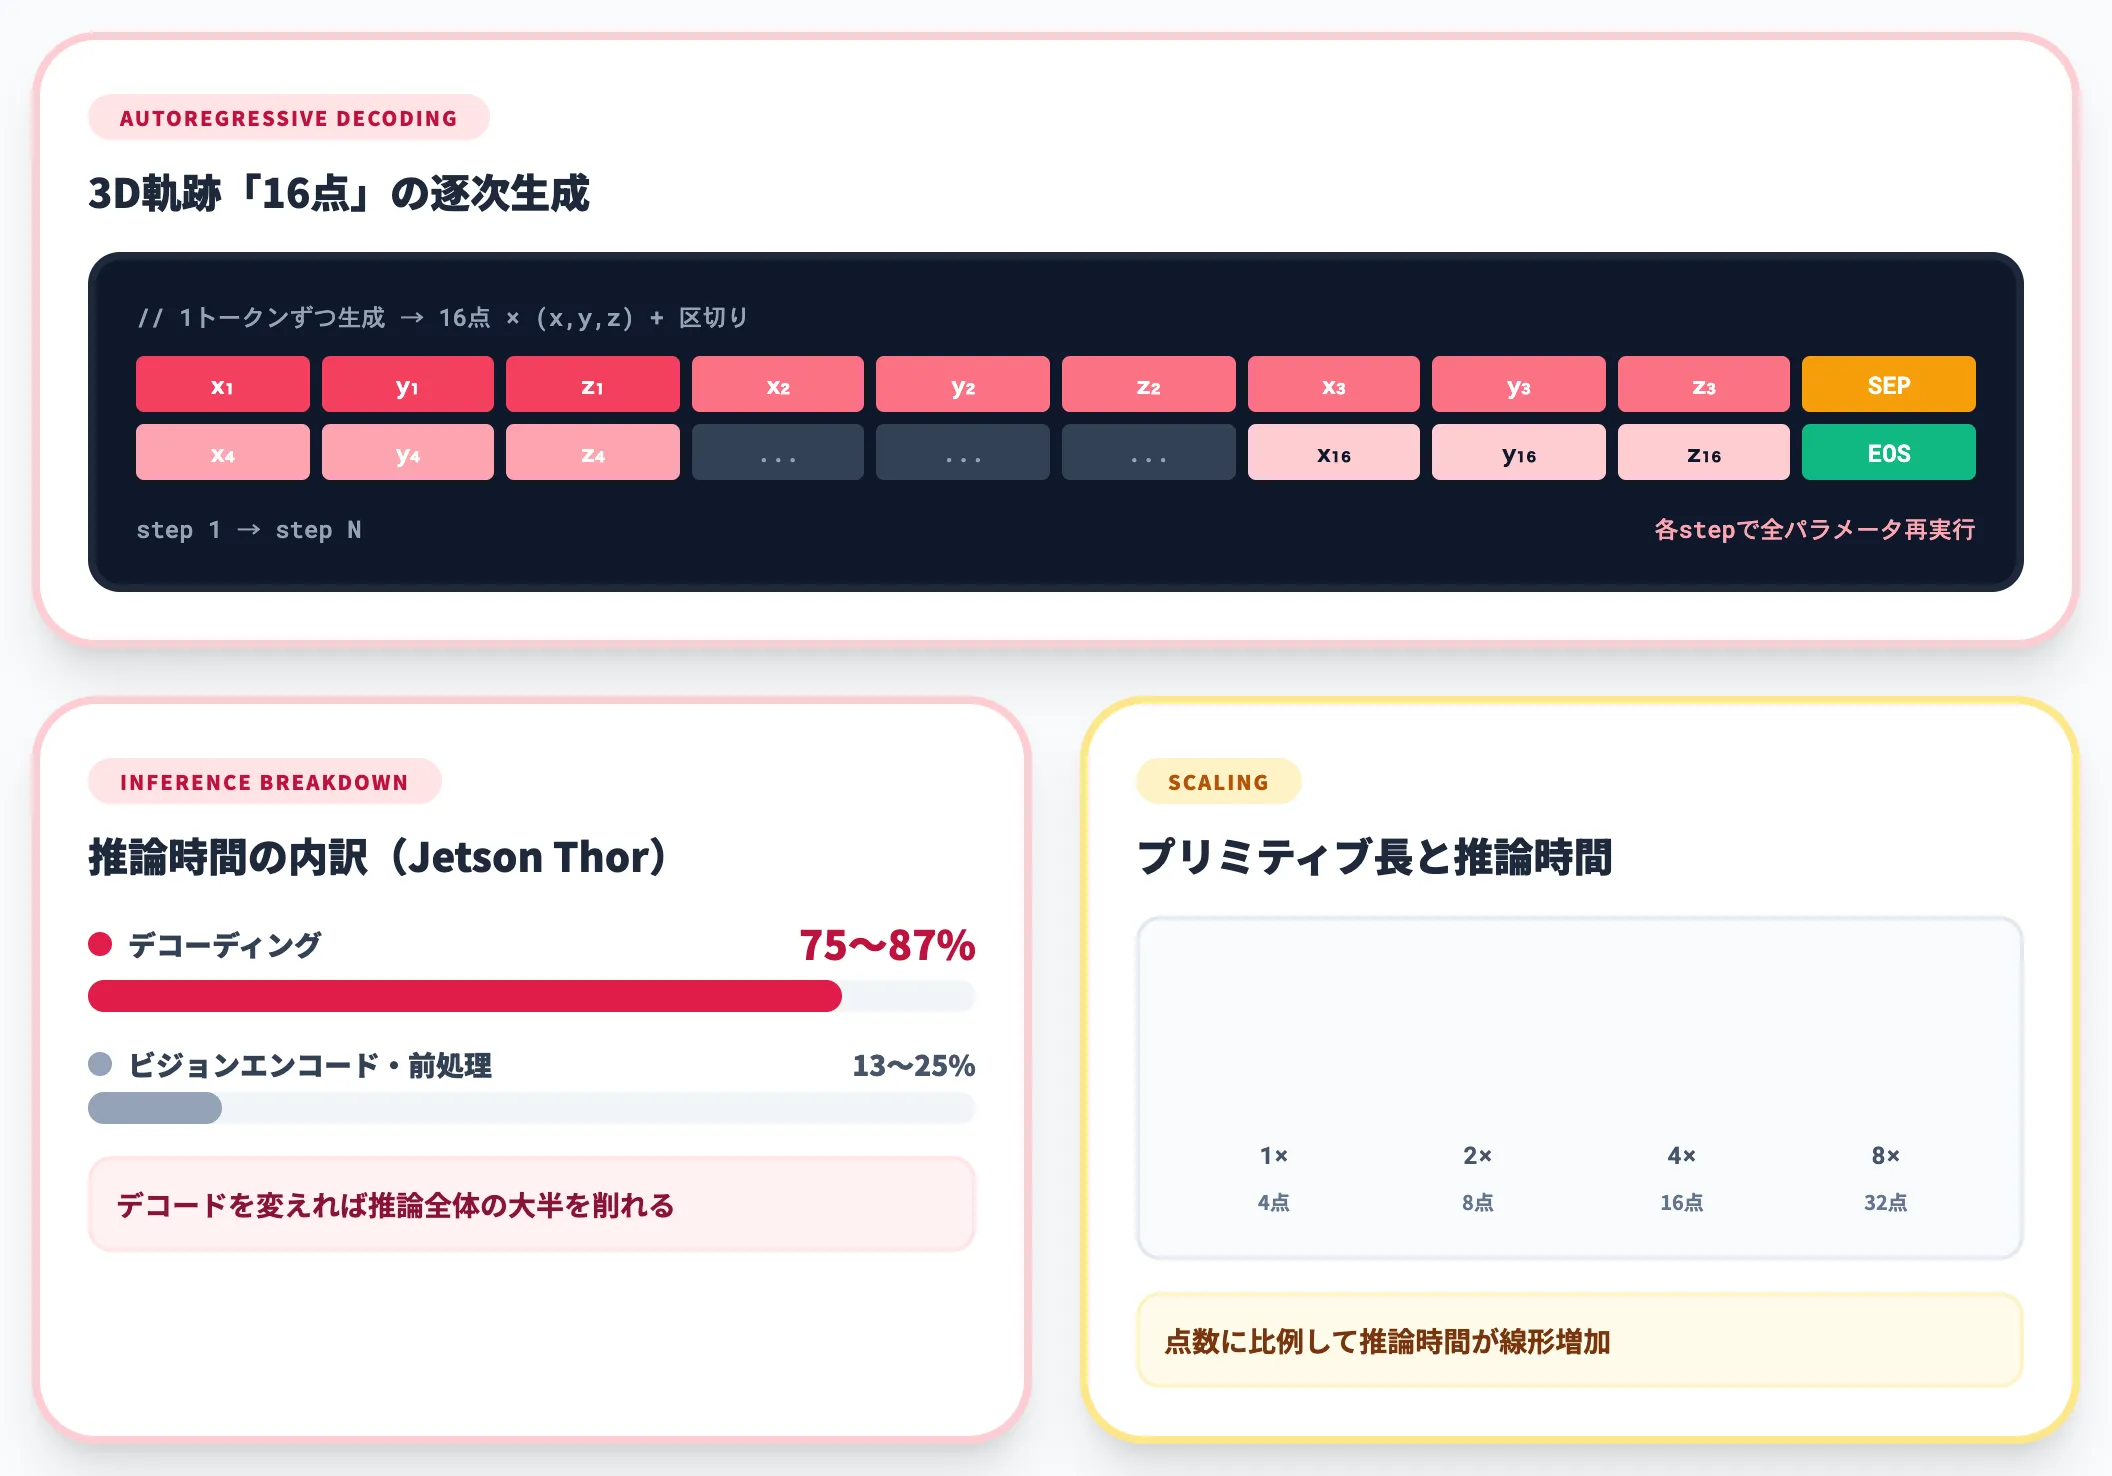
本論文の基本モデルでは、各座標値(x, y, z)を1つの専用トークンで表現し、1トークンずつ逐次生成します。
例えば3D軌跡で16点の経路を出力する場合、点ごとにx・y・zの座標トークンに加え、プリミティブの区切りトークンも含めて数十トークン規模を逐次的に生成する必要がありました。
自己回帰は1トークン生成するたびに全パラメータを再実行するため、トークン数に比例して推論時間が増えます。
NVIDIA公式プロジェクトページによれば、Jetson Thorでの計測でデコーディング工程が推論全体の75〜87%を占めていると報告されており、プリミティブを長くするほど推論時間は概ね線形に増加していきます。
ロボット制御系が求めるレイテンシ要件
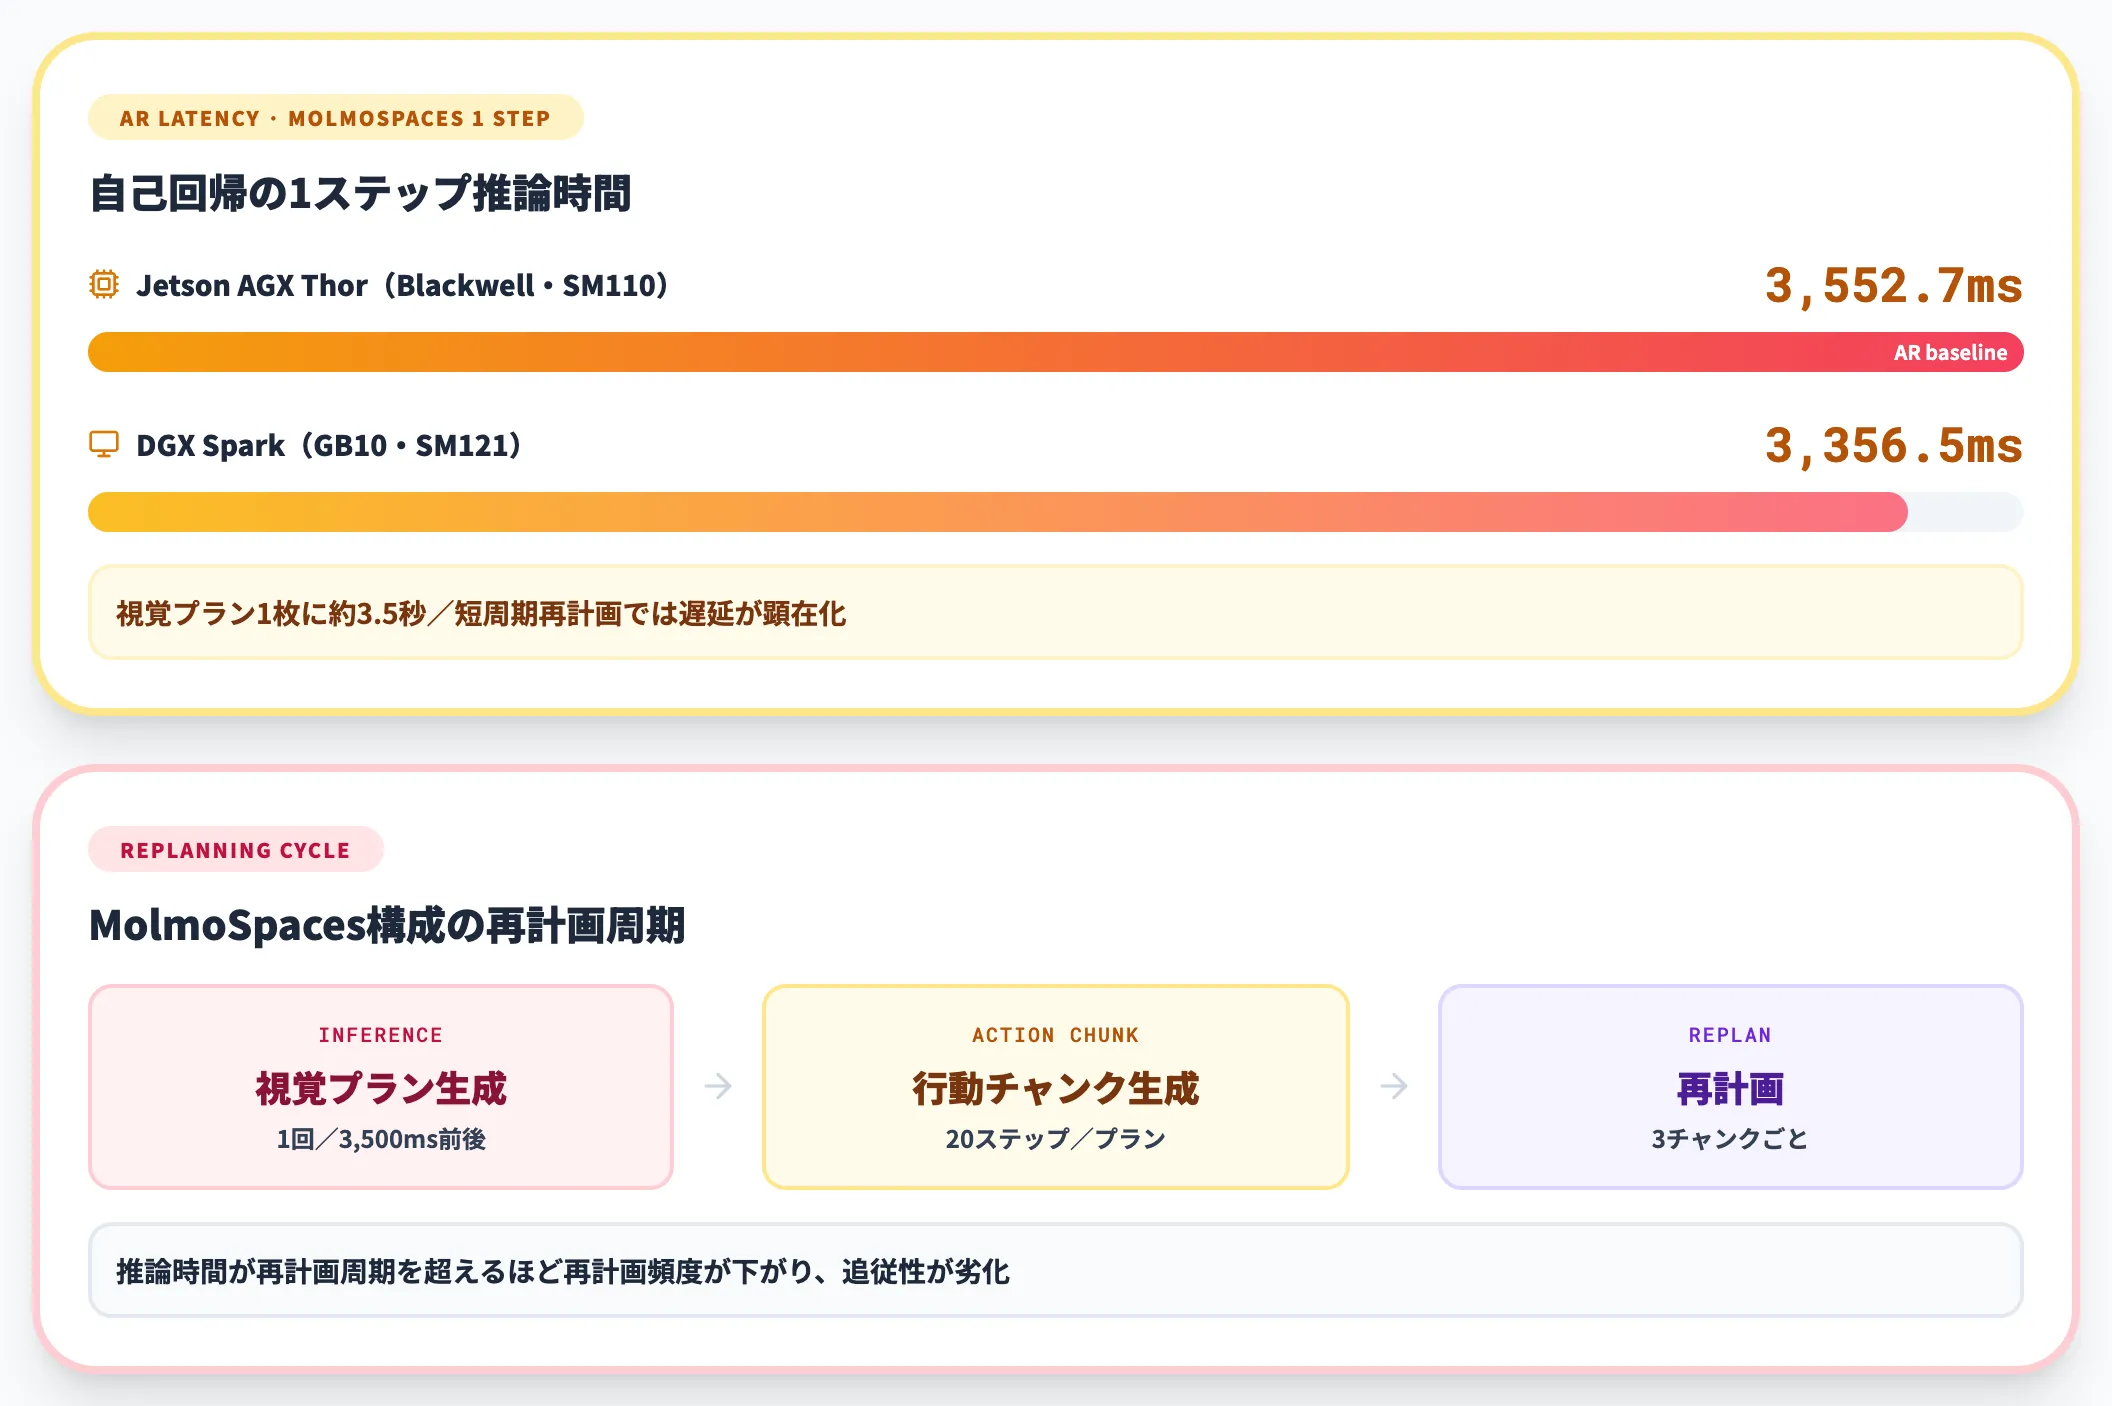
ロボット操作や自動運転の制御系は、低レベルの制御周期とは別に、視覚プランを更新する再計画周期を持つ設計が一般的です。
例えば公式のMolmoSpaces構成では、1回の推論で20ステップ分の行動チャンクを生成し、3チャンクごとに視覚プランを再計画します(なお公式評価では推論中にシミュレーターを停止するため、評価上は再計画遅延の影響が直接は現れない設計)。
実機で非同期に動かす場合、推論時間が再計画周期を超えるほど再計画の頻度が下がり、環境変化への追従性が落ちていきます。
NVIDIAが論文内で公表した計測値では、自己回帰デコーディングによるMolmoSpacesタスクの1ステップあたりの推論レイテンシは、Jetson AGX Thorで3,552.7ミリ秒、DGX Sparkで3,356.5ミリ秒でした。
3.5秒規模の視覚プラン生成では、短周期の再計画を要する実機運用で遅延が顕在化する水準です。
既存VLA加速手法の限界
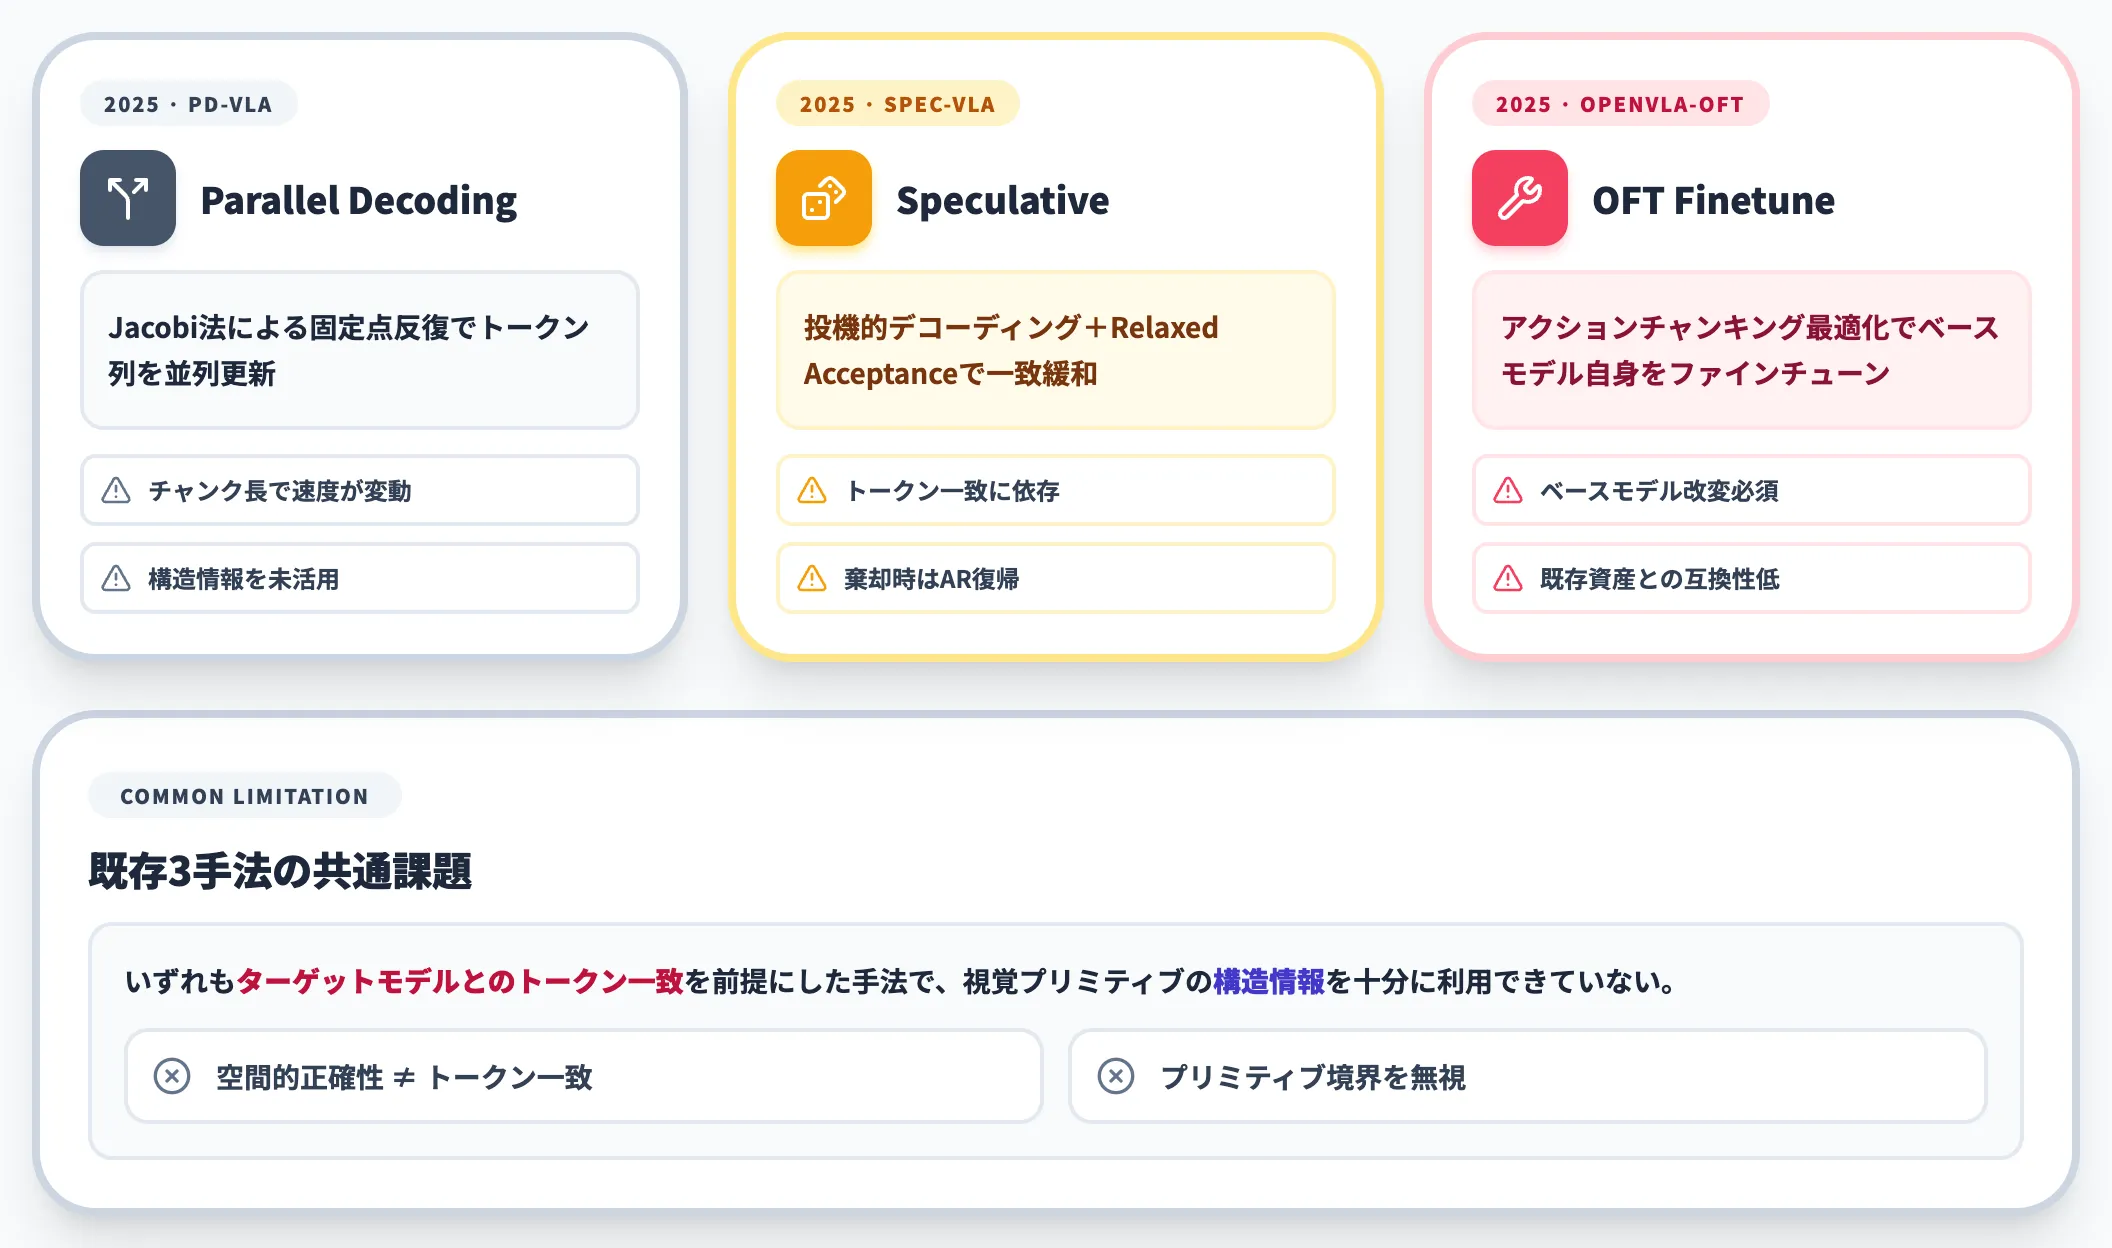
Physical AIコミュニティでも、この問題に対処するためのVLA(Vision-Language-Action)加速手法が複数提案されてきました。
代表的な既存手法は、PD-VLA(Parallel Decoding VLA)の並列デコーディング、Spec-VLAの投機的デコーディング、OpenVLA-OFTのアクションチャンキング最適化などです。
これらは一定の高速化を実現したものの、ターゲットモデルとのトークン一致を前提にした手法が多く、視覚プリミティブの構造情報を十分には使えていないという課題がありました。
VFlashの出発点は、「視覚プランの空間的正確性はトークン単位の一致を再現する必要がない」という観察です。この前提転換が、後述のFlash Primitive Decodingという新しい設計を可能にしています。
VFlashのFlash Primitive Decodingの仕組み
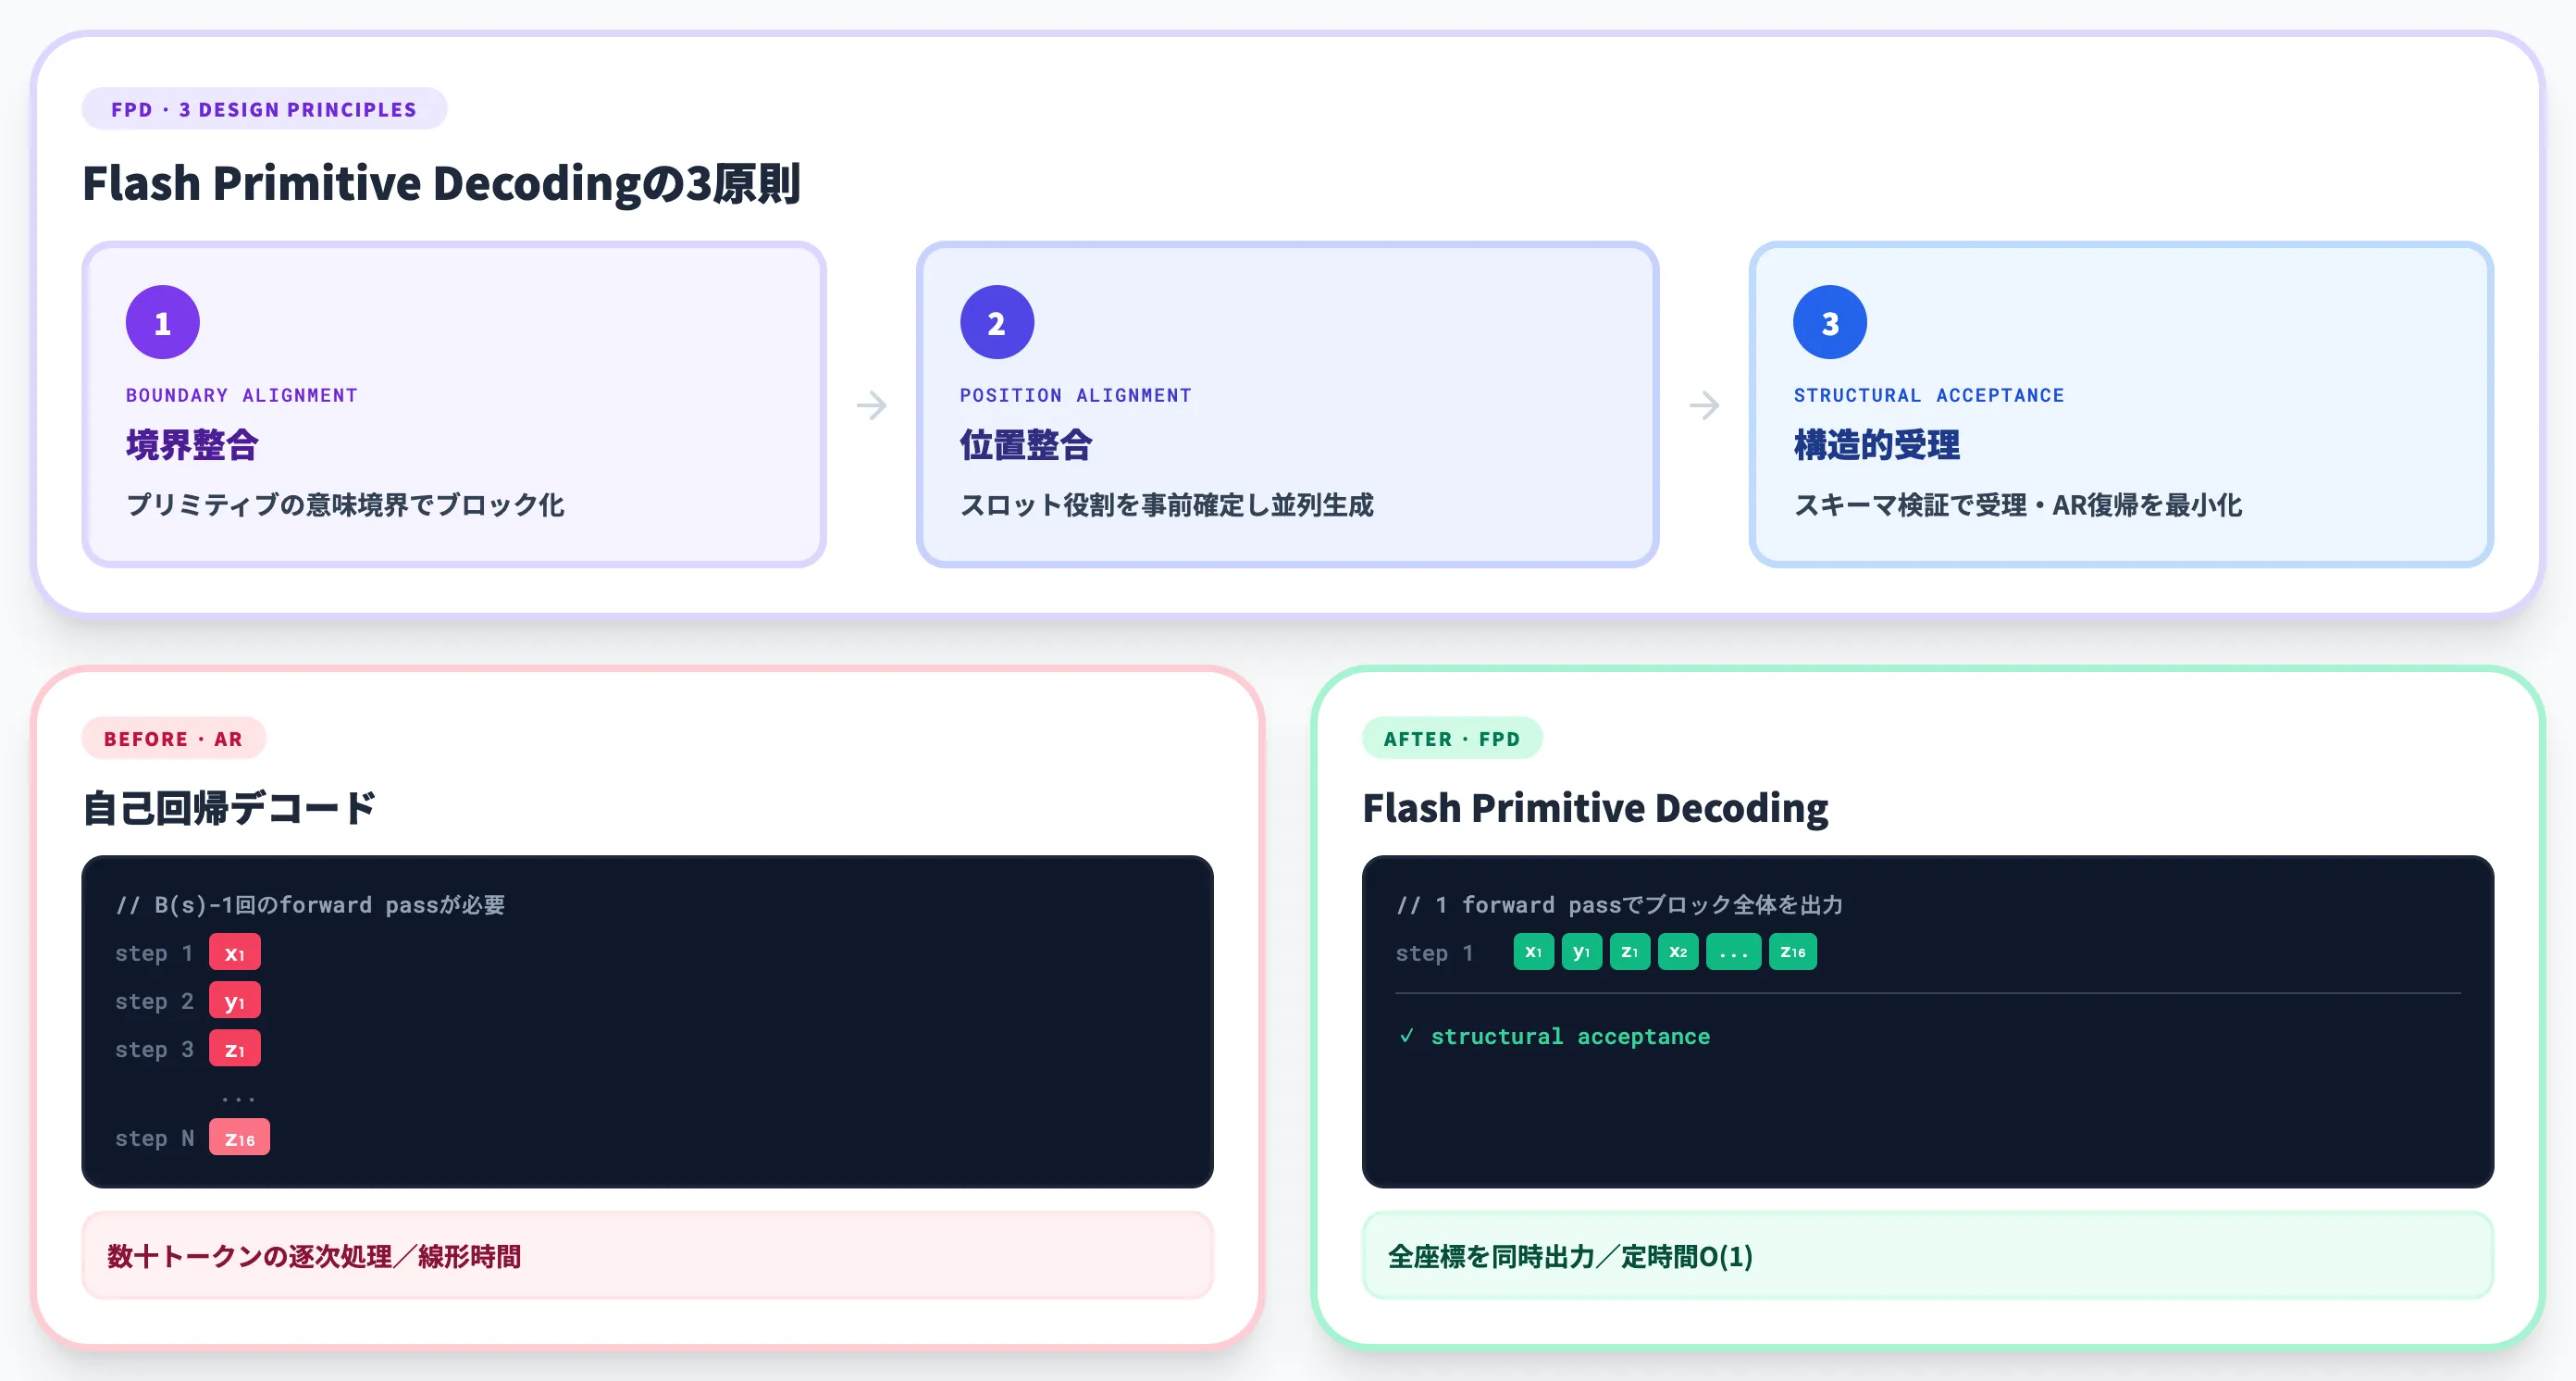
ここからは、VFlashの中核技術であるFlash Primitive Decoding(FPD)の仕組みを分解します。
従来の自己回帰デコーディングと何が違うのか、なぜ構造的に高速化できるのかを、3つの設計原則に沿って整理します。
視覚プリミティブの構造を事前に利用する
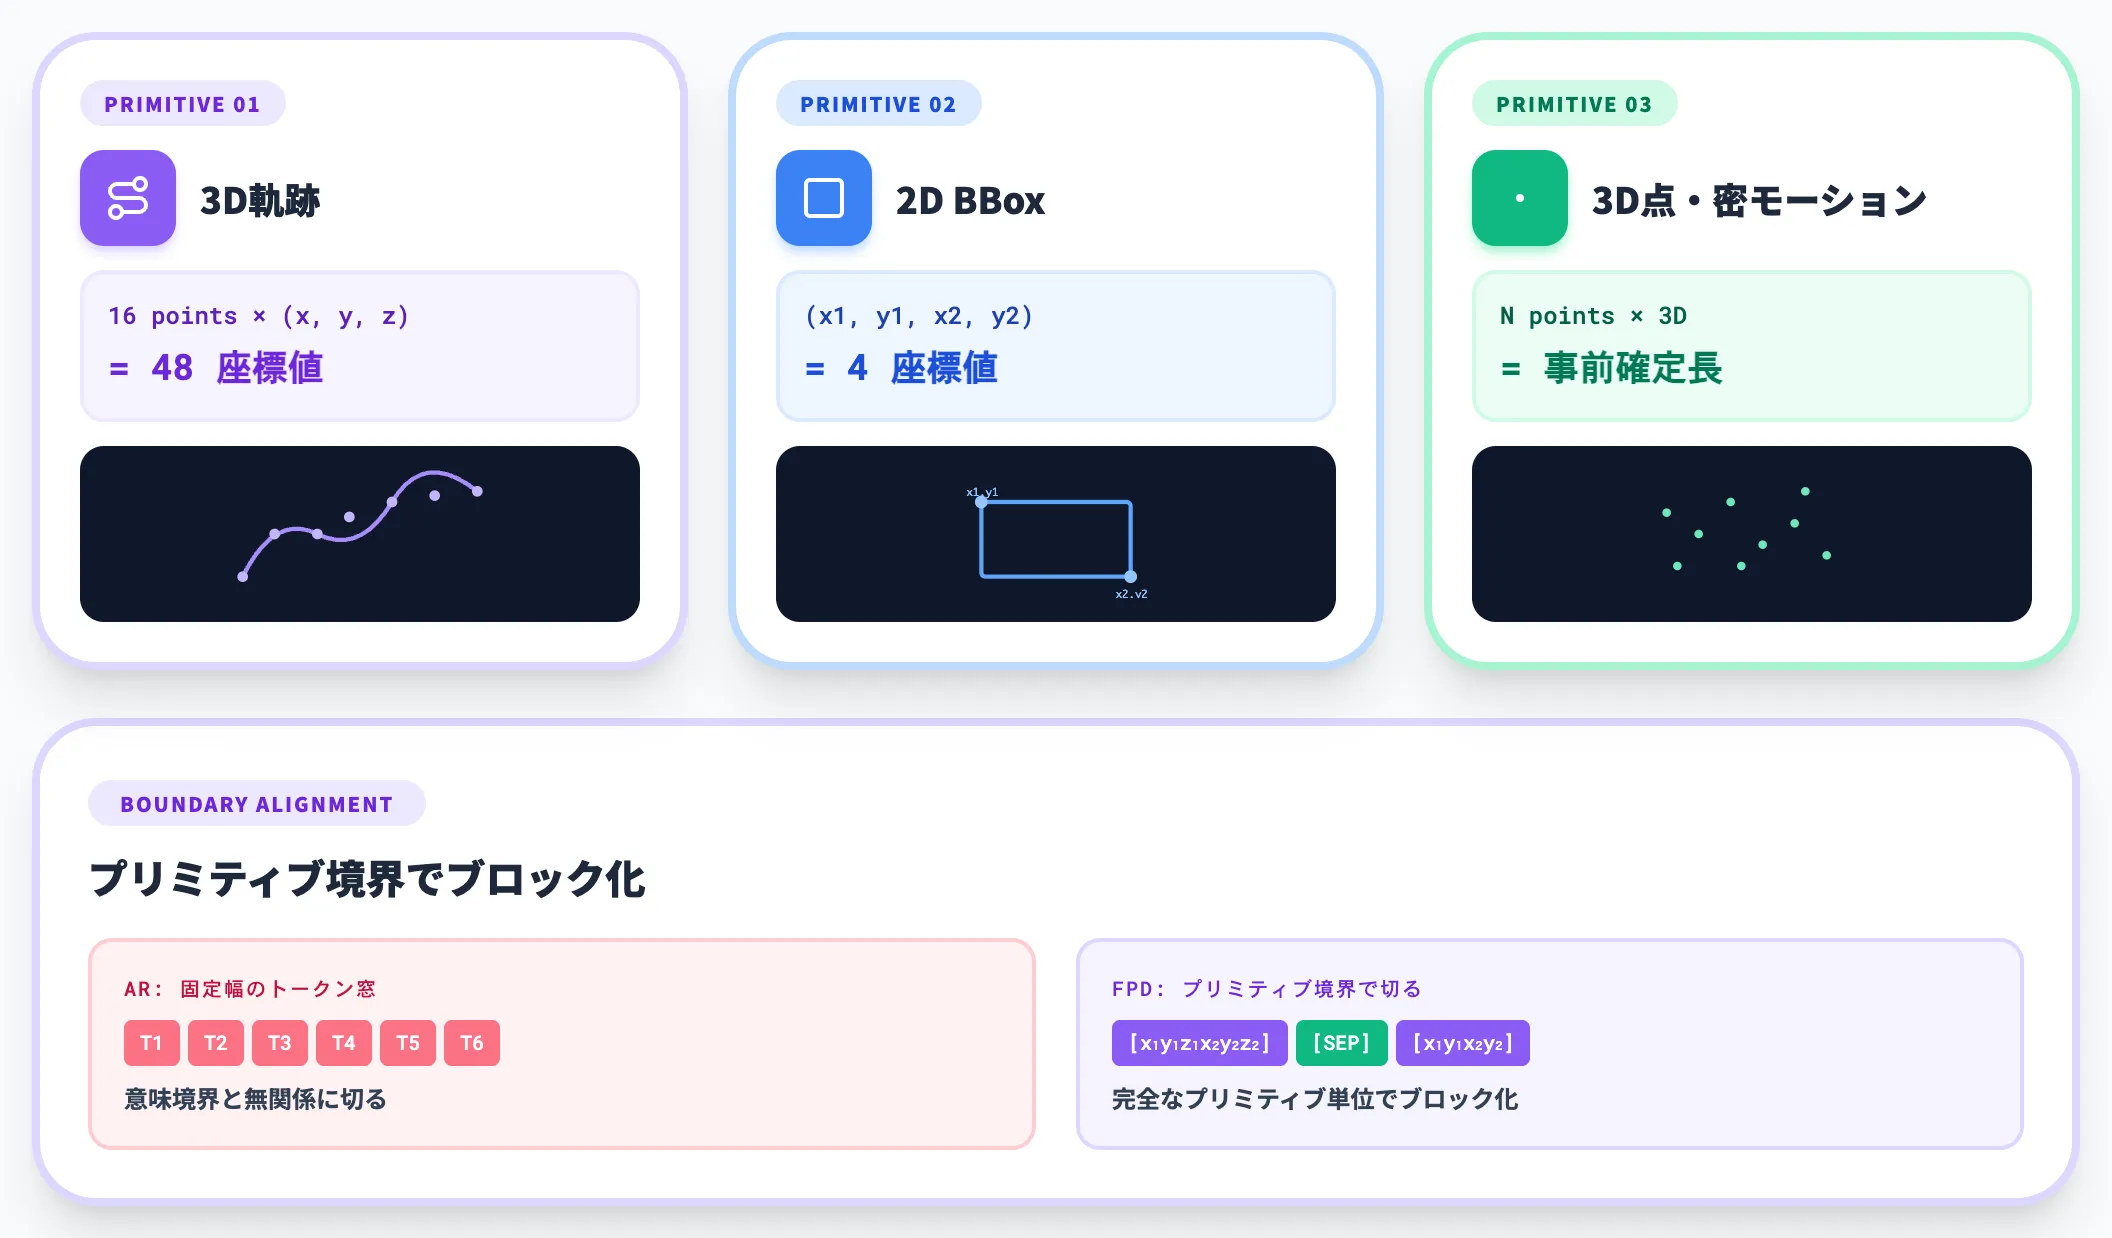
Flash Primitive Decodingの第一原則は境界整合(Boundary Alignment)です。
視覚プラン(点、バウンディングボックス、軌跡)は、開始・終了・次元数・長さがプランの意味論として事前に決まっているという特徴があります。
例えば3D軌跡なら「16点 × (x, y, z) = 48座標値」、2Dバウンディングボックスなら「(x1, y1, x2, y2) の4座標値」といった構造が先に決まります。
VFlashはこの構造情報をプリミティブ単位でブロック化し、各ブロックが1つの完全なプリミティブ全体をカバーするように設計します。
自己回帰のように固定幅のトークン窓で切るのではなく、プリミティブの意味境界に合わせてブロックを切るのがポイントです。
軽量drafterで1回の推論で全座標を並列生成
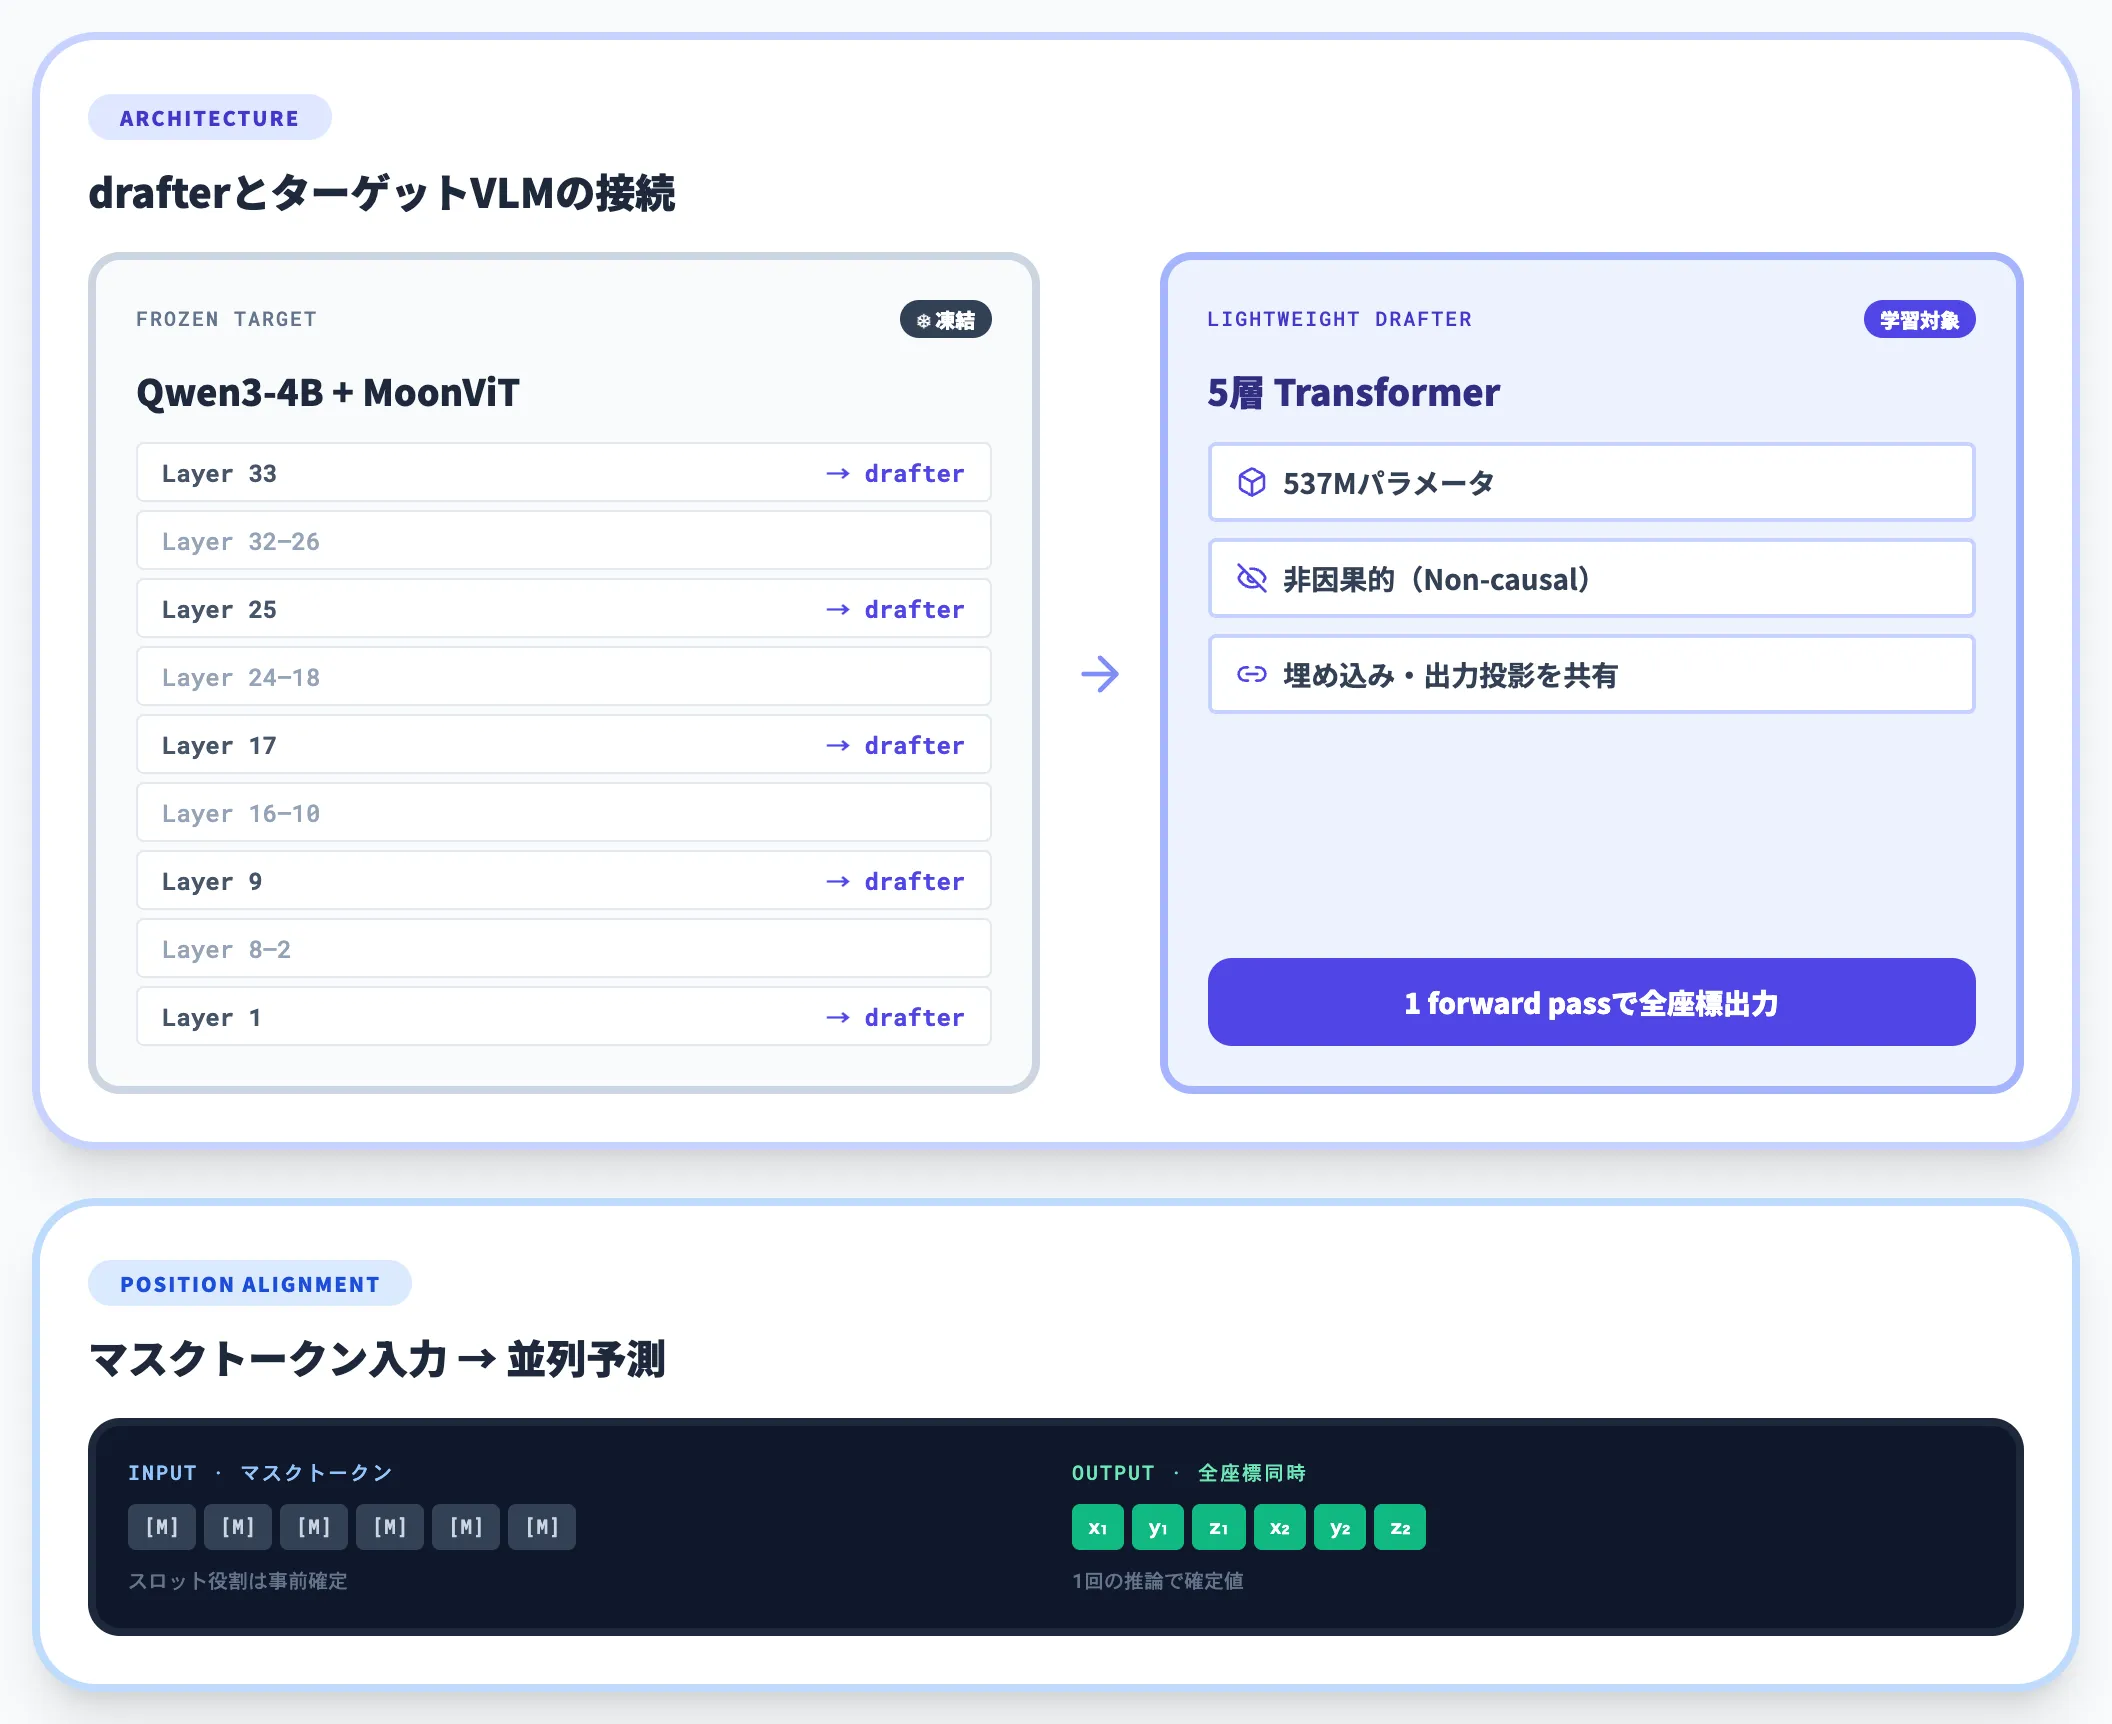
第二原則は位置整合(Position Alignment)です。
ブロック内の各スロット(座標位置)には、「このスロットは何番目の点のx座標」「このスロットは区切りトークン」といった役割が、推論前からすべて確定している状態になります。
この前提のもと、VFlashは5層の非因果的トランスフォーマーからなる軽量drafter(537Mパラメータ)で、ブロック全体の座標値を1回の推論で並列に予測します。
drafterは凍結されたターゲットVLM(本論文ではQwen3-4B + MoonViT)の1・9・17・25・33層の特徴量を条件とし、ターゲットの埋め込み層と出力投影層を共有する軽量な設計です。
自己回帰のようにB(s)-1回の推論を繰り返すのではなく、マスクトークンを並べた入力に対してただ1回のフォワードパスでプリミティブ全体を生成します。
構造的受理基準で投機的デコードを置き換える
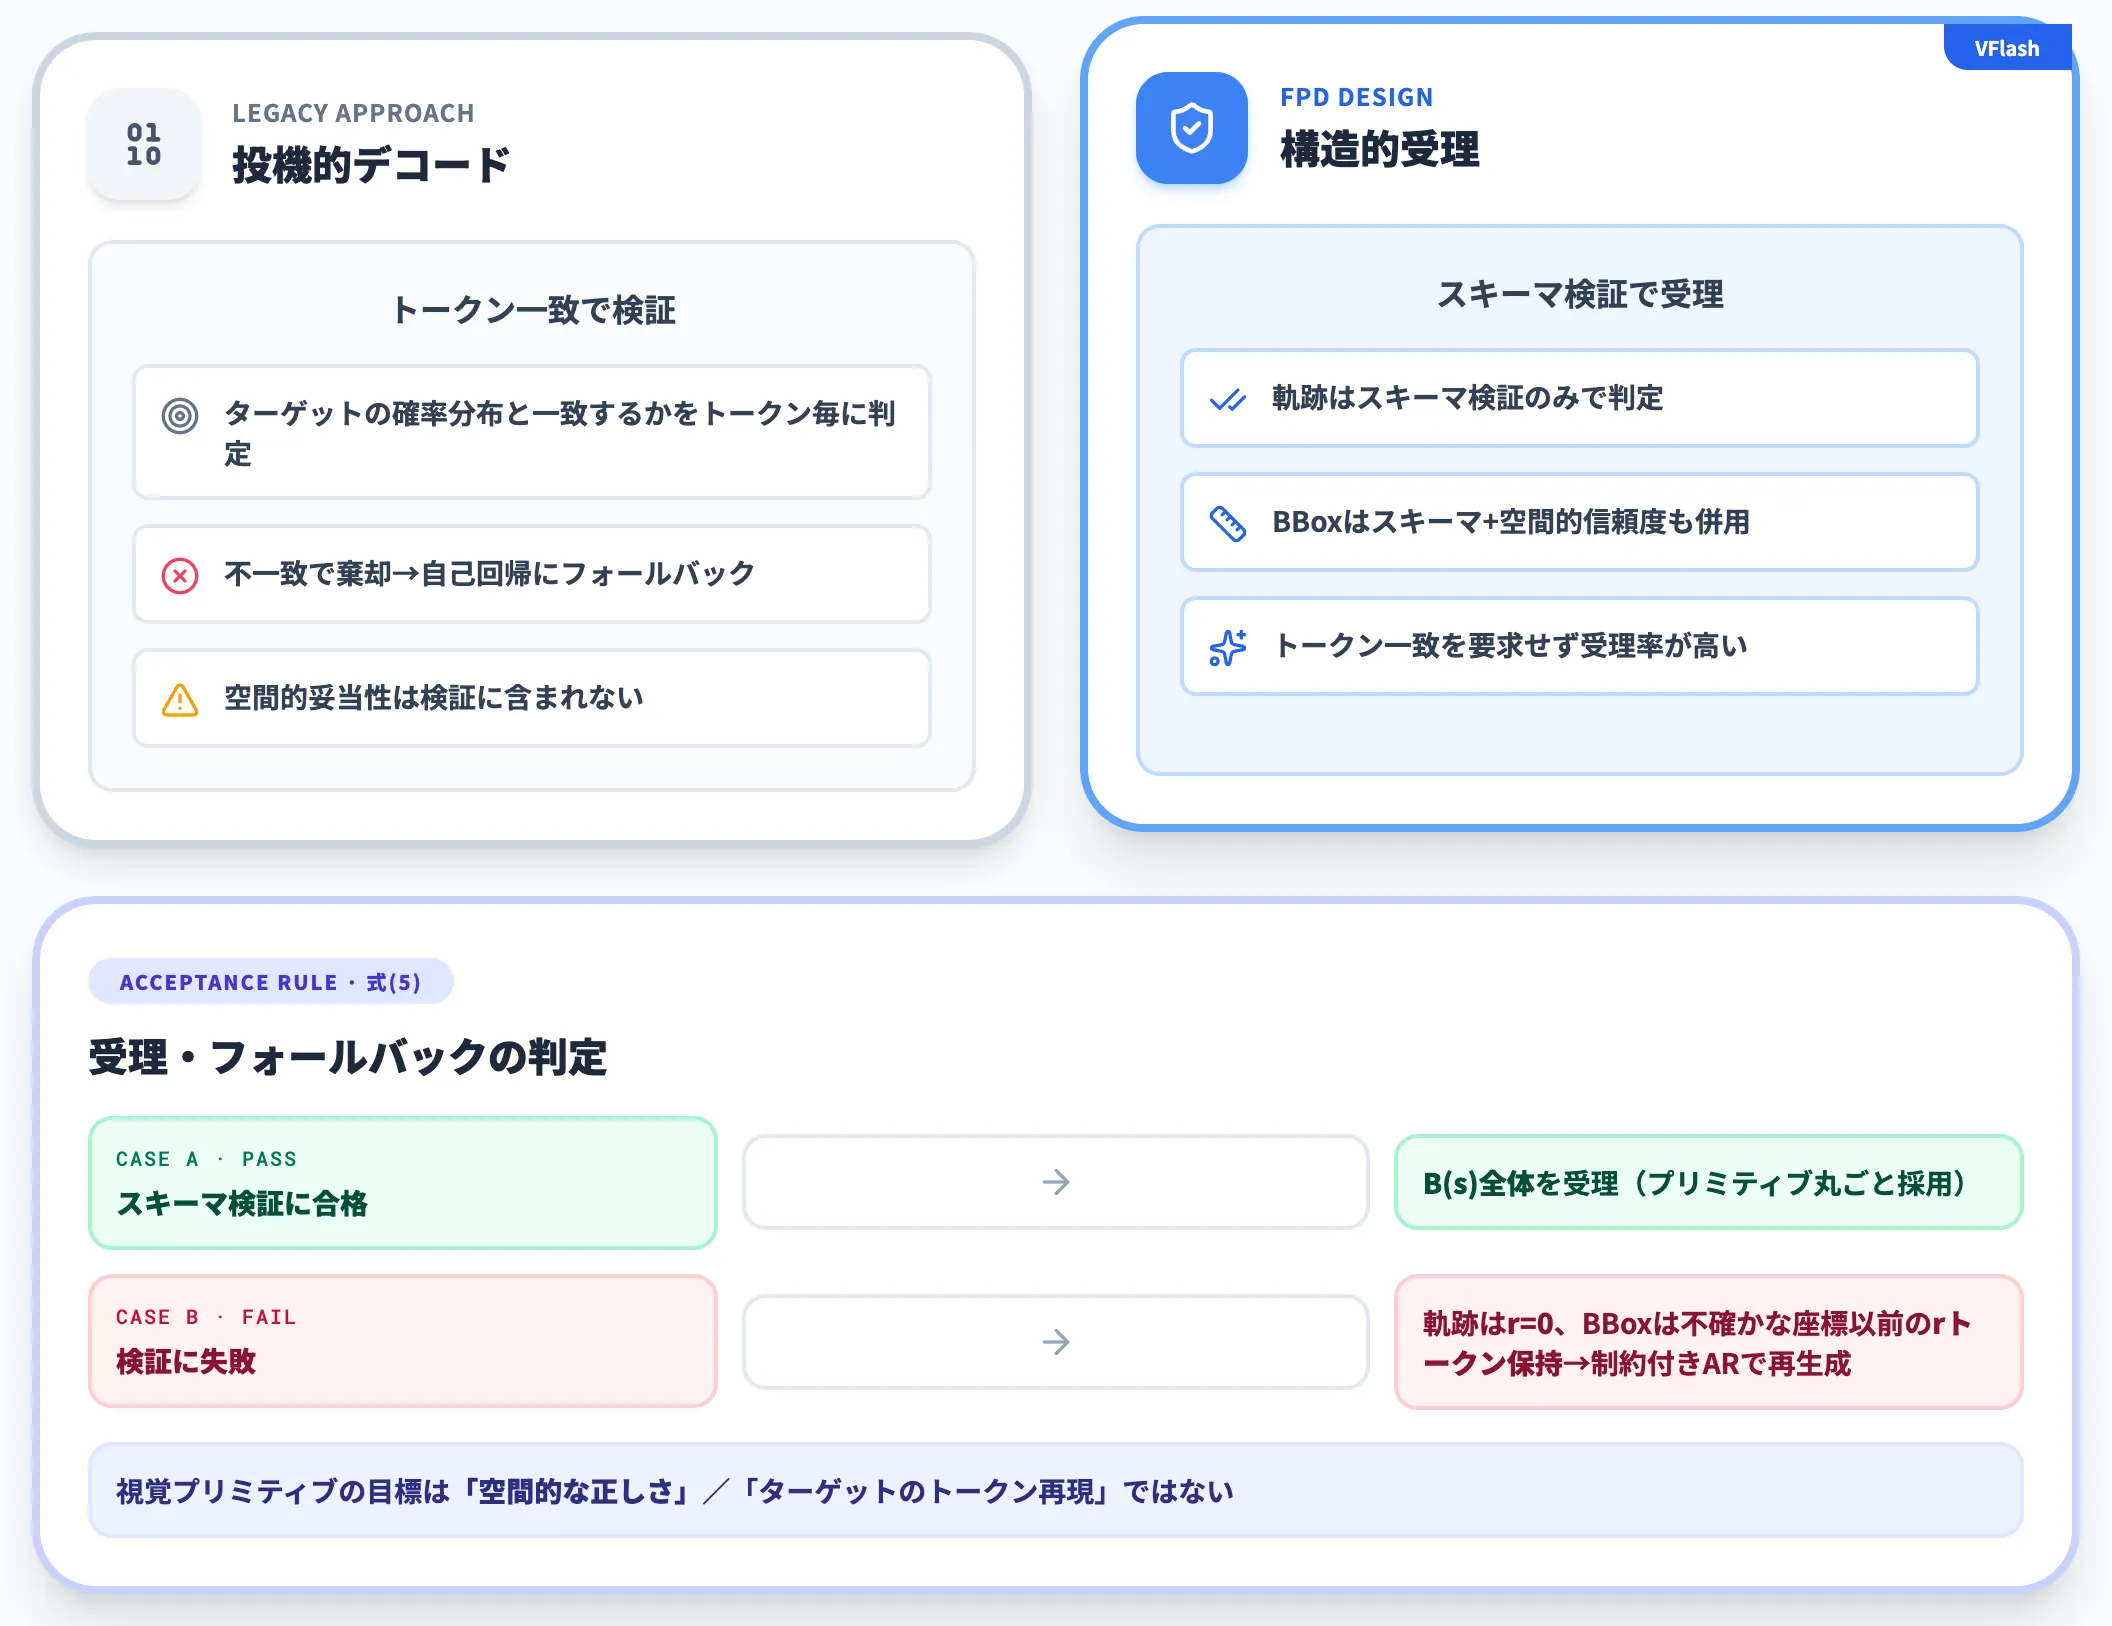
第三原則は構造的受理(Structural Acceptance)です。
一般的な投機的デコーディングは、「drafterの予測がターゲットモデルの確率分布と一致するか」をトークンごとに検証し、不一致が出たら棄却して自己回帰にフォールバックします。
VFlashはこの検証条件を根本的に変更し、軌跡はスキーマ検証、ボックスはスキーマ検証に空間的信頼度の判定を併用した受理設計に置き換えます。
論文の式(5)で定式化されている判定は、以下のように整理できます。
| 判定条件 | 受理するブロック | フォールバック動作 |
|---|---|---|
| スキーマ検証(ボックスは空間的信頼度判定も併用)に合格 | B(s)(プリミティブ全体) | drafterの予測を丸ごと受理 |
| 検証に失敗 | 軌跡はr=0、ボックスは不確かな座標より前のrトークンまで | 保持したプレフィックス以降を制約付き自己回帰で再生成 |
表の判定基準から読み取れるのは、「スキーマが整っていればターゲットとのトークン一致を要求しない」という設計思想です。
視覚プリミティブはそもそも「空間的な正しさ」が目標であって、「ターゲットのトークン列を正確に再現すること」は目標ではない——という前提転換こそが、Flash Primitive Decodingの本質的な加速源になっています。
VFlashの性能評価——ロボット操作と自動運転ベンチマーク
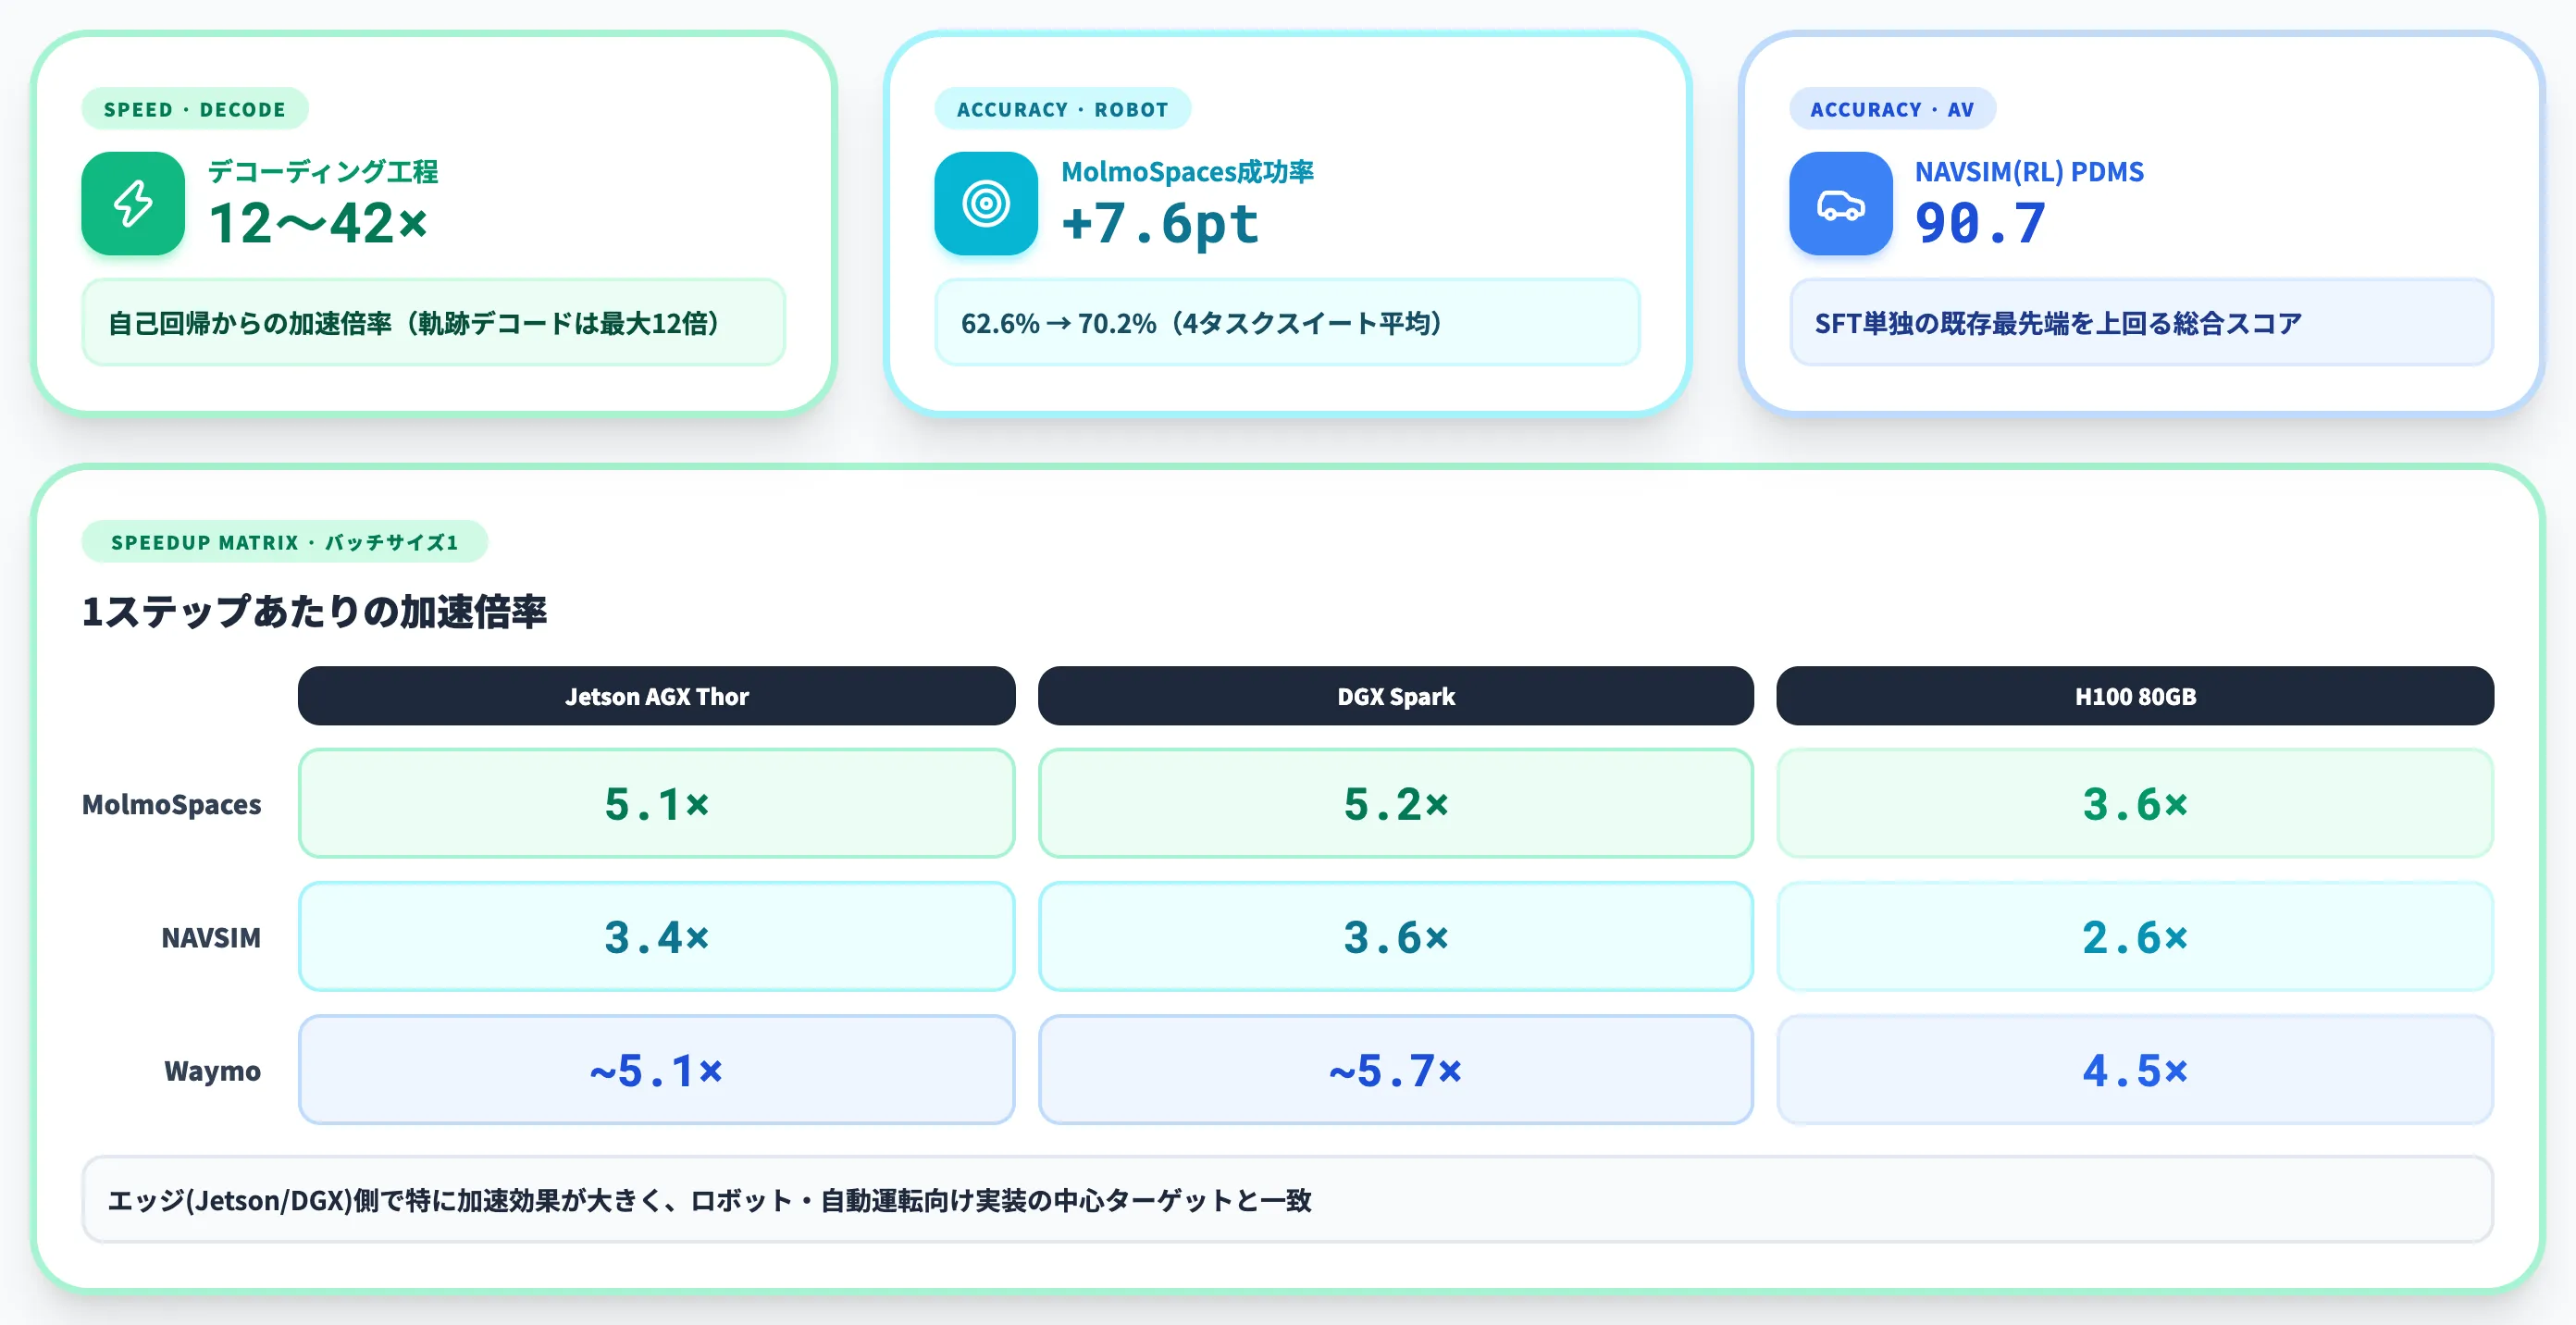
VFlashは2026年11月5日版の論文で、ロボット操作・自動運転・視覚プリミティブ予測の3領域で性能評価を公開しています。
本セクションでは、代表的なベンチマーク結果と、Jetson Thor・DGX Spark・H100の各プラットフォームでのレイテンシ削減数値を整理します。
ロボット操作ベンチマークの成功率
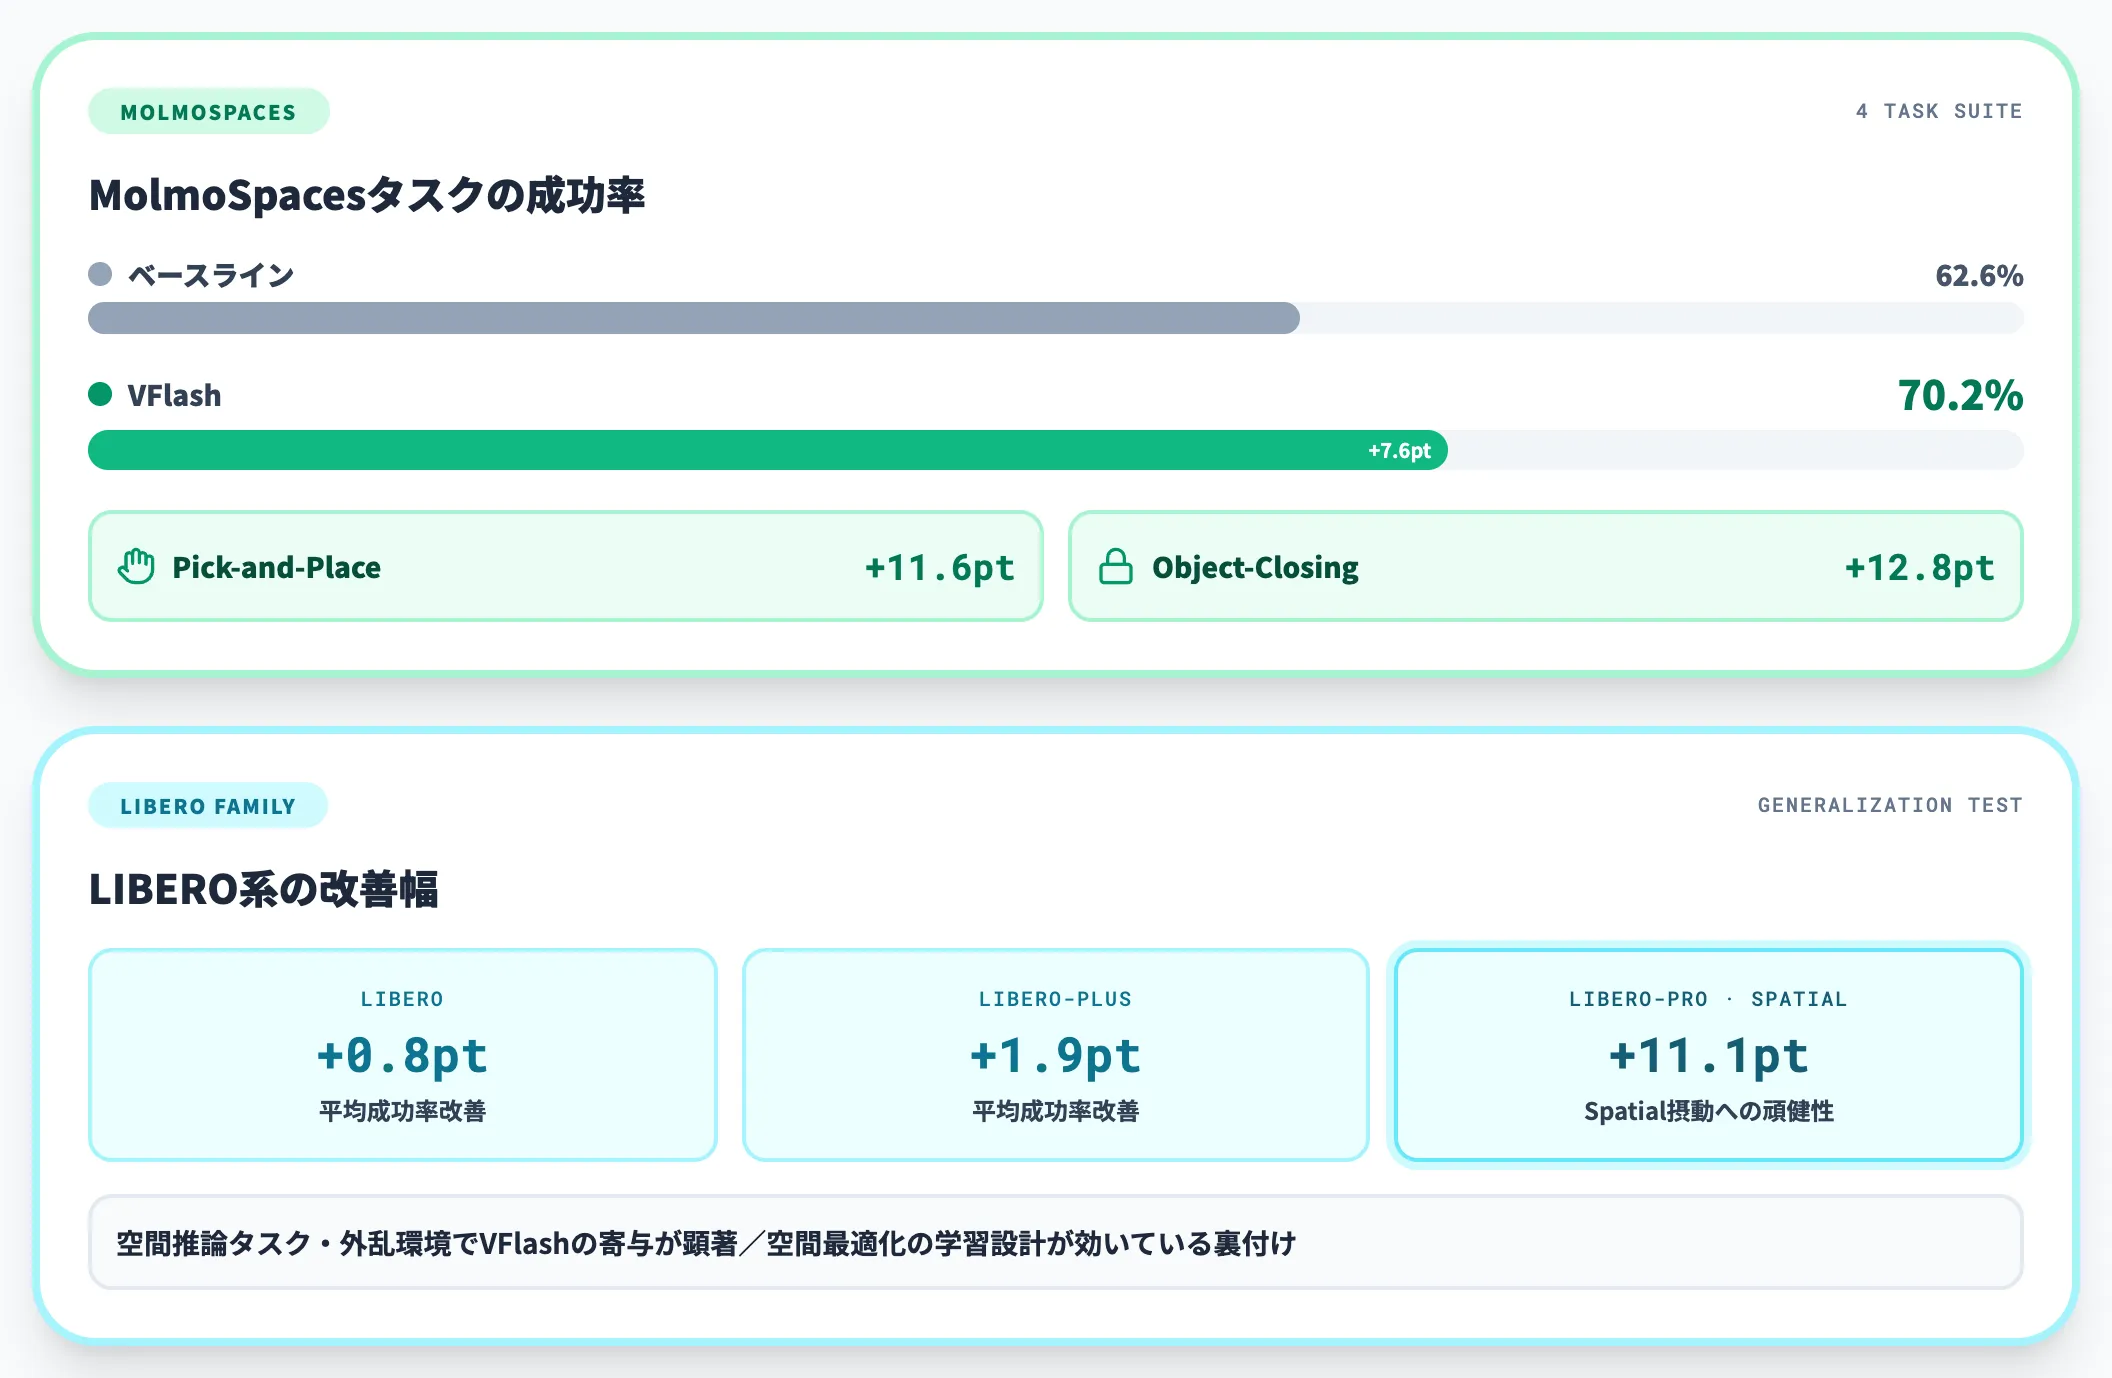
まず、MolmoSpacesとLIBEROという2系統のロボット操作ベンチマークでの結果を見ます。
以下の表は、NVIDIA公式プロジェクトページが公開している主要タスクの成功率です。
| ベンチマーク | 指標 | ベースライン | VFlash | 改善幅 |
|---|---|---|---|---|
| MolmoSpaces(4タスクスイート平均) | 平均成功率 | 62.6% | 70.2% | +7.6pt |
| MolmoSpaces Pick-and-Place | 成功率 | — | — | +11.6pt |
| MolmoSpaces Object-Closing | 成功率 | — | — | +12.8pt |
| LIBERO | 平均成功率改善 | — | — | +0.8pt |
| LIBERO-Plus | 平均成功率改善 | — | — | +1.9pt |
| LIBERO-PRO(Spatial摂動) | 成功率改善 | — | — | +11.1pt |
表から読み取れるのは、Pick-and-PlaceやObject-Closingといった空間推論を強く必要とするタスクほどVFlashの寄与が大きく、LIBERO-PROのSpatial摂動のような外乱に対する頑健性テストでも顕著に改善している点です。
空間的正しさを直接最適化する学習設計が、タスクの難しさに合わせて効いているという裏付けになっています。
NVIDIAは評価に使ったロボット操作環境のシーンも公開しており、キッチンシンク上に置かれた複数の物体をロボットアームが把持するタスクが代表例として示されています。
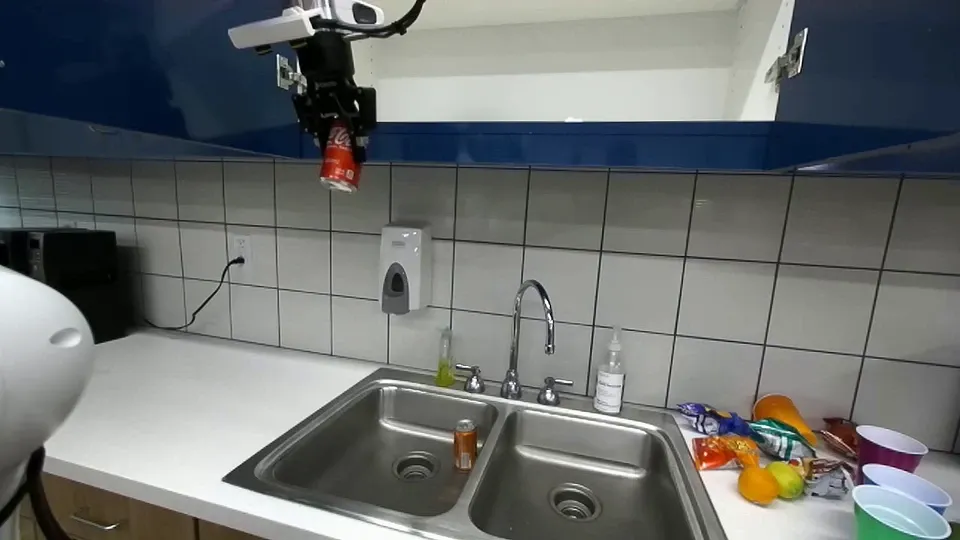
VFlashの視覚プランニング評価で使われたロボット操作シーン(シンク上の物体を把持するタスク)(出典:NVIDIA Research)
自動運転ベンチマーク
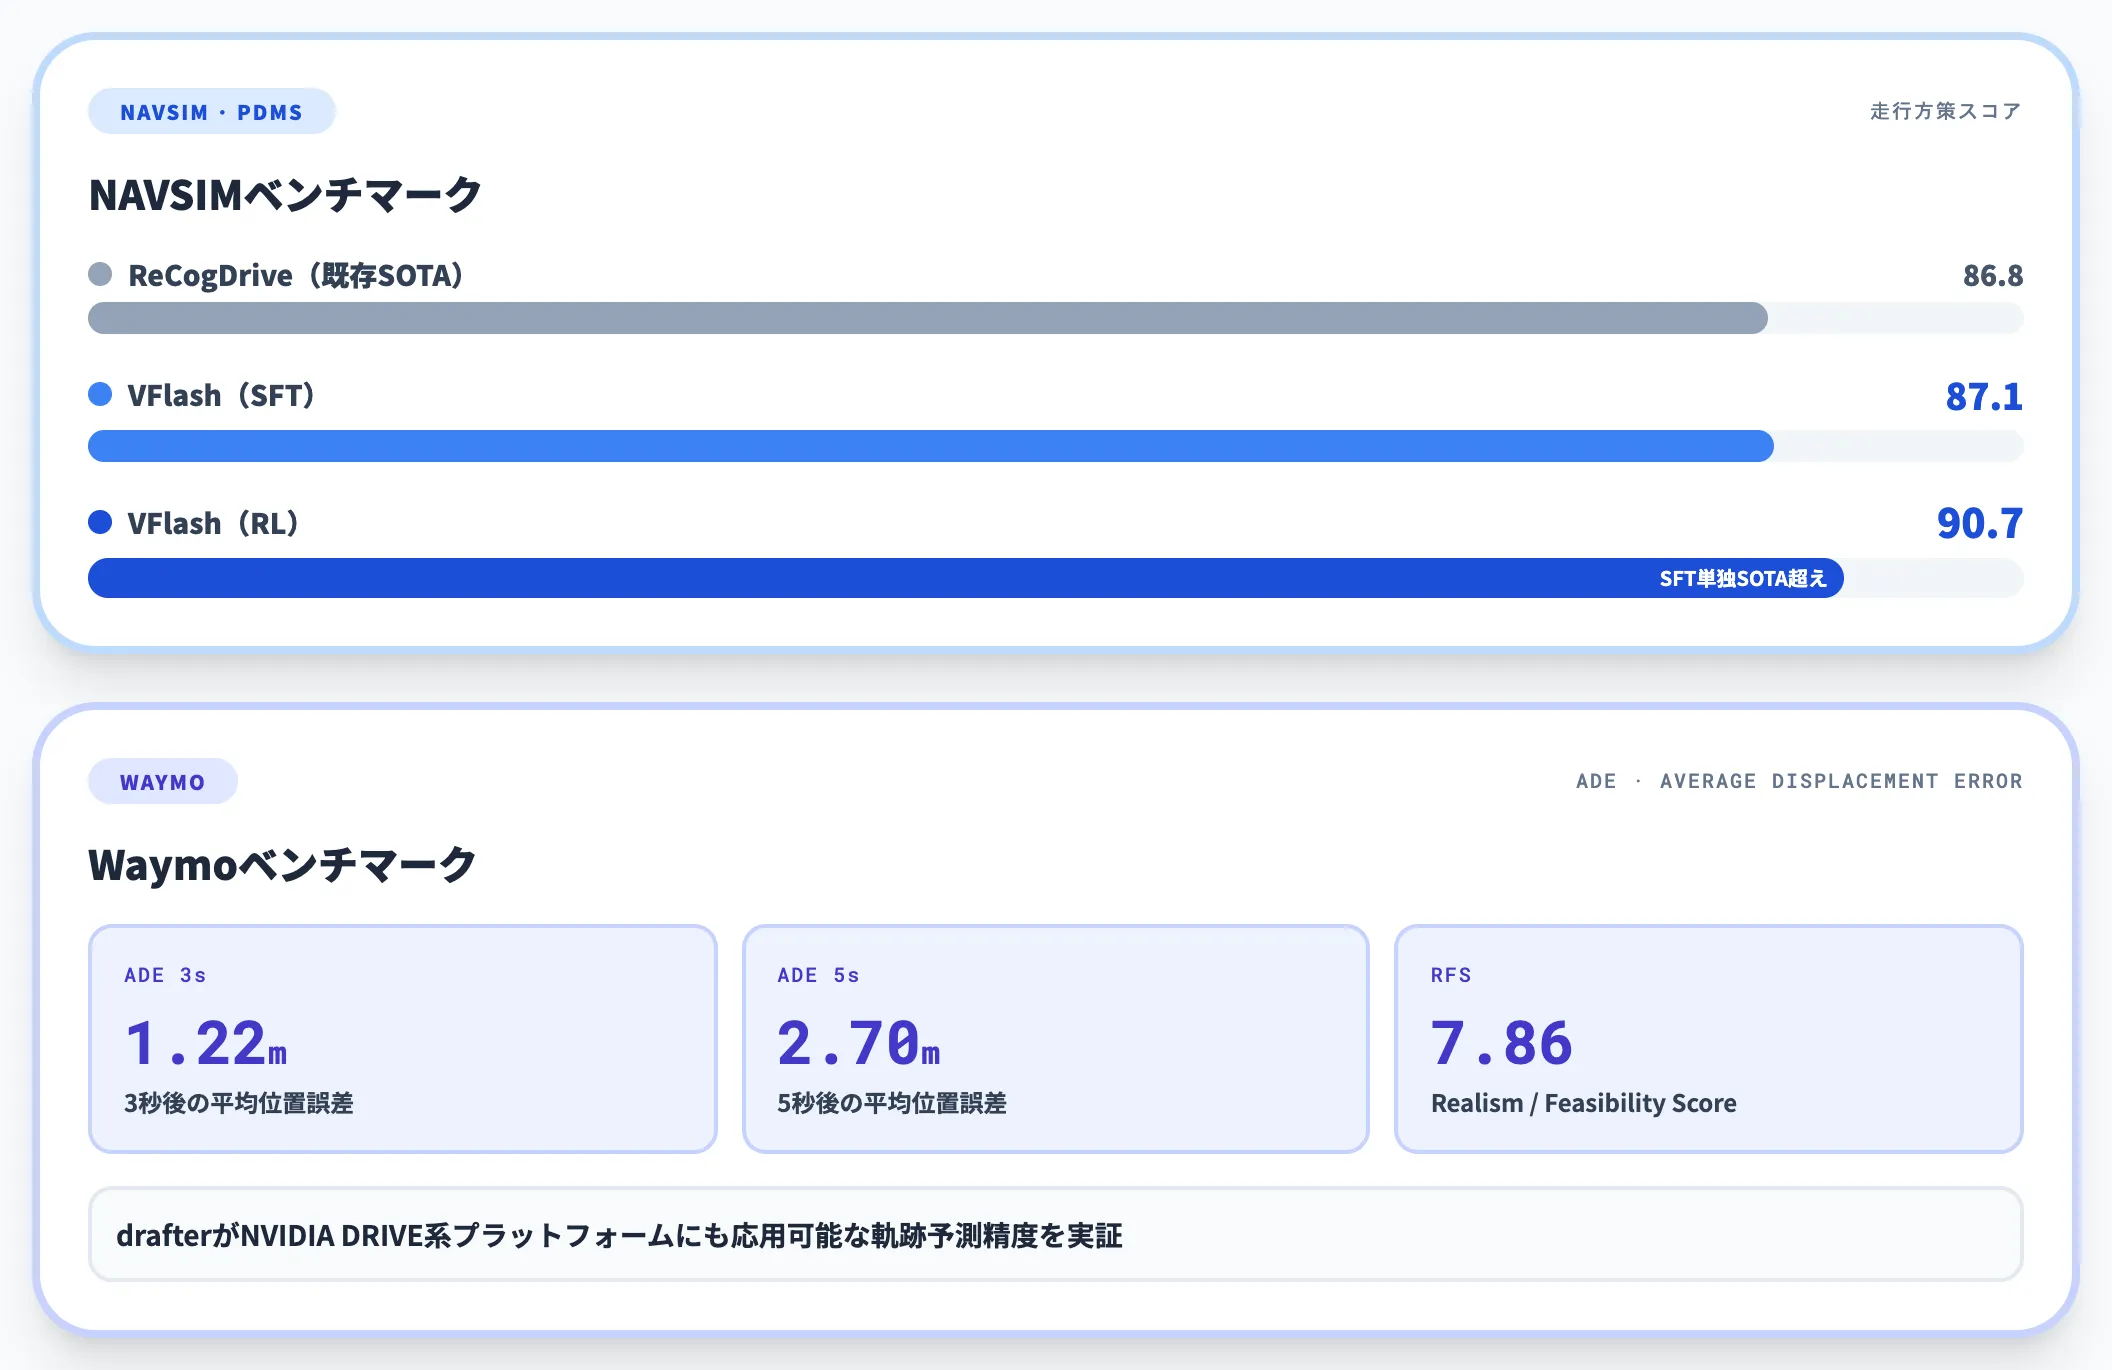
VFlashはロボット向けだけでなく、自動運転ベンチマークでも評価されています。
| ベンチマーク | 指標 | 既存手法比較 | VFlash |
|---|---|---|---|
| NAVSIM(SFT) | PDMS | ReCogDrive 86.8 | 87.1 |
| NAVSIM(RL) | PDMS | — | 90.7 |
| Waymo | ADE3s(m) | — | 1.22 |
| Waymo | ADE5s(m) | — | 2.70 |
| Waymo | RFS | — | 7.86 |
自動運転のPDMS(PDM Score)はNAVSIMが定義した走行方策の総合スコアで、ADE(Average Displacement Error)は予測軌跡と正解軌跡の平均位置誤差を示す指標です。
NAVSIMでRL込み90.7 PDMSはSFT単独の既存最先端を上回る水準で、VFlashの軽量drafterがNVIDIA DRIVE系の自動運転プラットフォームにも応用可能であることを示しています。
公式プロジェクトページでは、評価に使われたNAVSIM・Waymoそれぞれの走行シーン例が掲載されています。
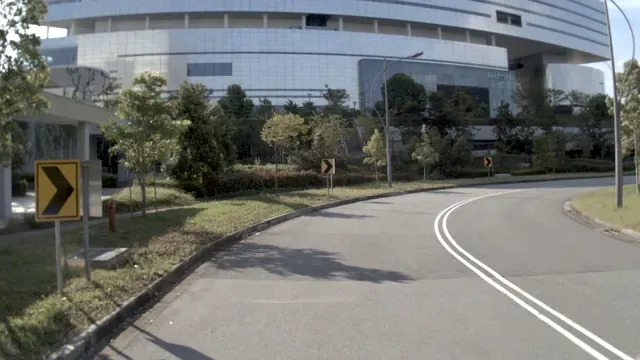
VFlashが評価されたNAVSIM自動運転ベンチマークの走行シーン(出典:NVIDIA Research)
VFlashが評価されたWaymo自動運転ベンチマークの走行シーン(出典:NVIDIA Research)
推論レイテンシの削減数値
空間的な精度向上と並んで、VFlashの中核の訴求はレイテンシ削減です。
以下の表は、公式プロジェクトページと論文が公開している、バッチサイズ1での1ステップあたりのレイテンシ削減倍率です。
| タスク | Jetson AGX Thor | DGX Spark | H100 80GB |
|---|---|---|---|
| MolmoSpaces | 5.1倍 | 5.2倍 | 3.6倍 |
| NAVSIM | 3.4倍 | 3.6倍 | 2.6倍 |
| Waymo | 約5.1倍 | 約5.7倍 | 4.5倍 |
MolmoSpaces固有の数値として、公式プロジェクトページおよび論文の計測では、Jetson AGX Thorでの1ステップのレイテンシが3,552.7ミリ秒から703.3ミリ秒(約80%削減)、DGX Sparkでは3,356.5ミリ秒から649.9ミリ秒に圧縮されたと報告されています(Interesting Engineeringの解説記事にも同数値が掲載)。
さらに、推論全体のうちデコーディング工程だけを切り出すと12〜42倍の高速化が実現しており、残りの前処理・ビジョンエンコーディング工程を変えずにプランニング部分だけを置き換えるという設計の意義がここに表れています。
VFlashが動作するハードウェアと採用コスト構造
VFlashはOSSとして公開されているため、ライセンス料という意味での「料金」は発生しません。
ただし実運用では、学習・推論のハードウェア、エッジ推論用のJetsonモジュール、既存VLAパイプラインへの統合工数など、採用に伴うコスト構造が存在します。本セクションでは2026年11月時点の公開情報をもとに整理します。
対応ハードウェア
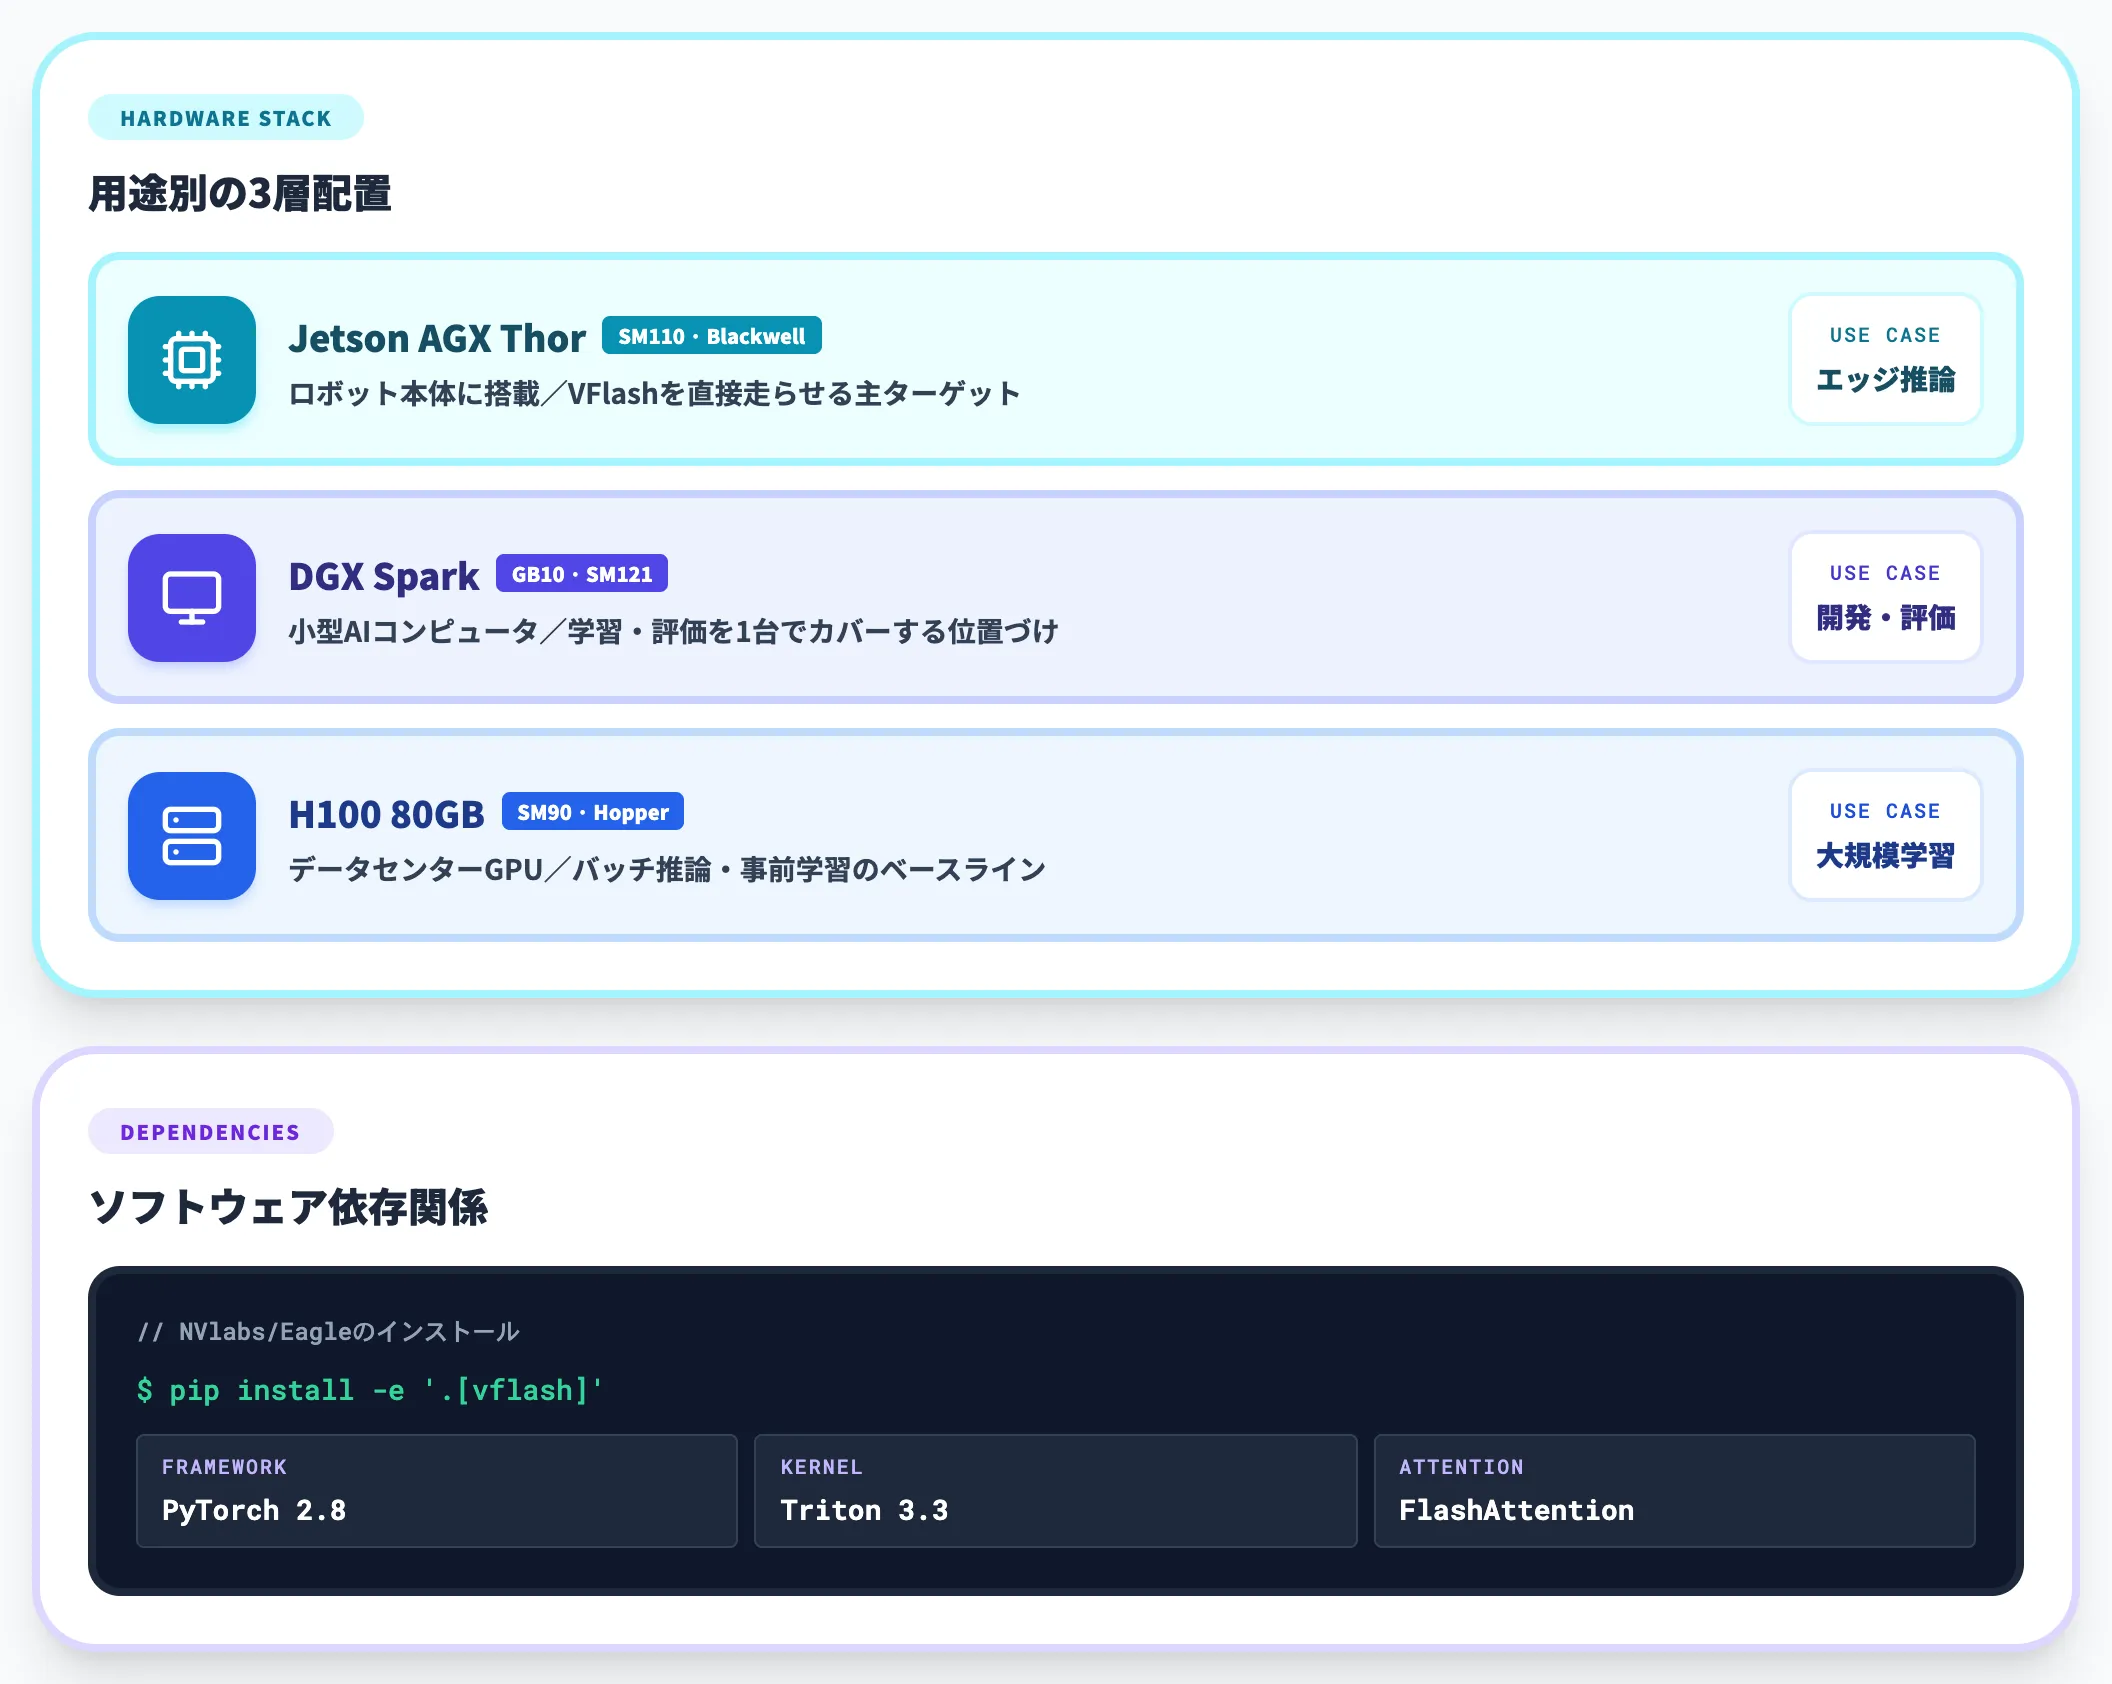
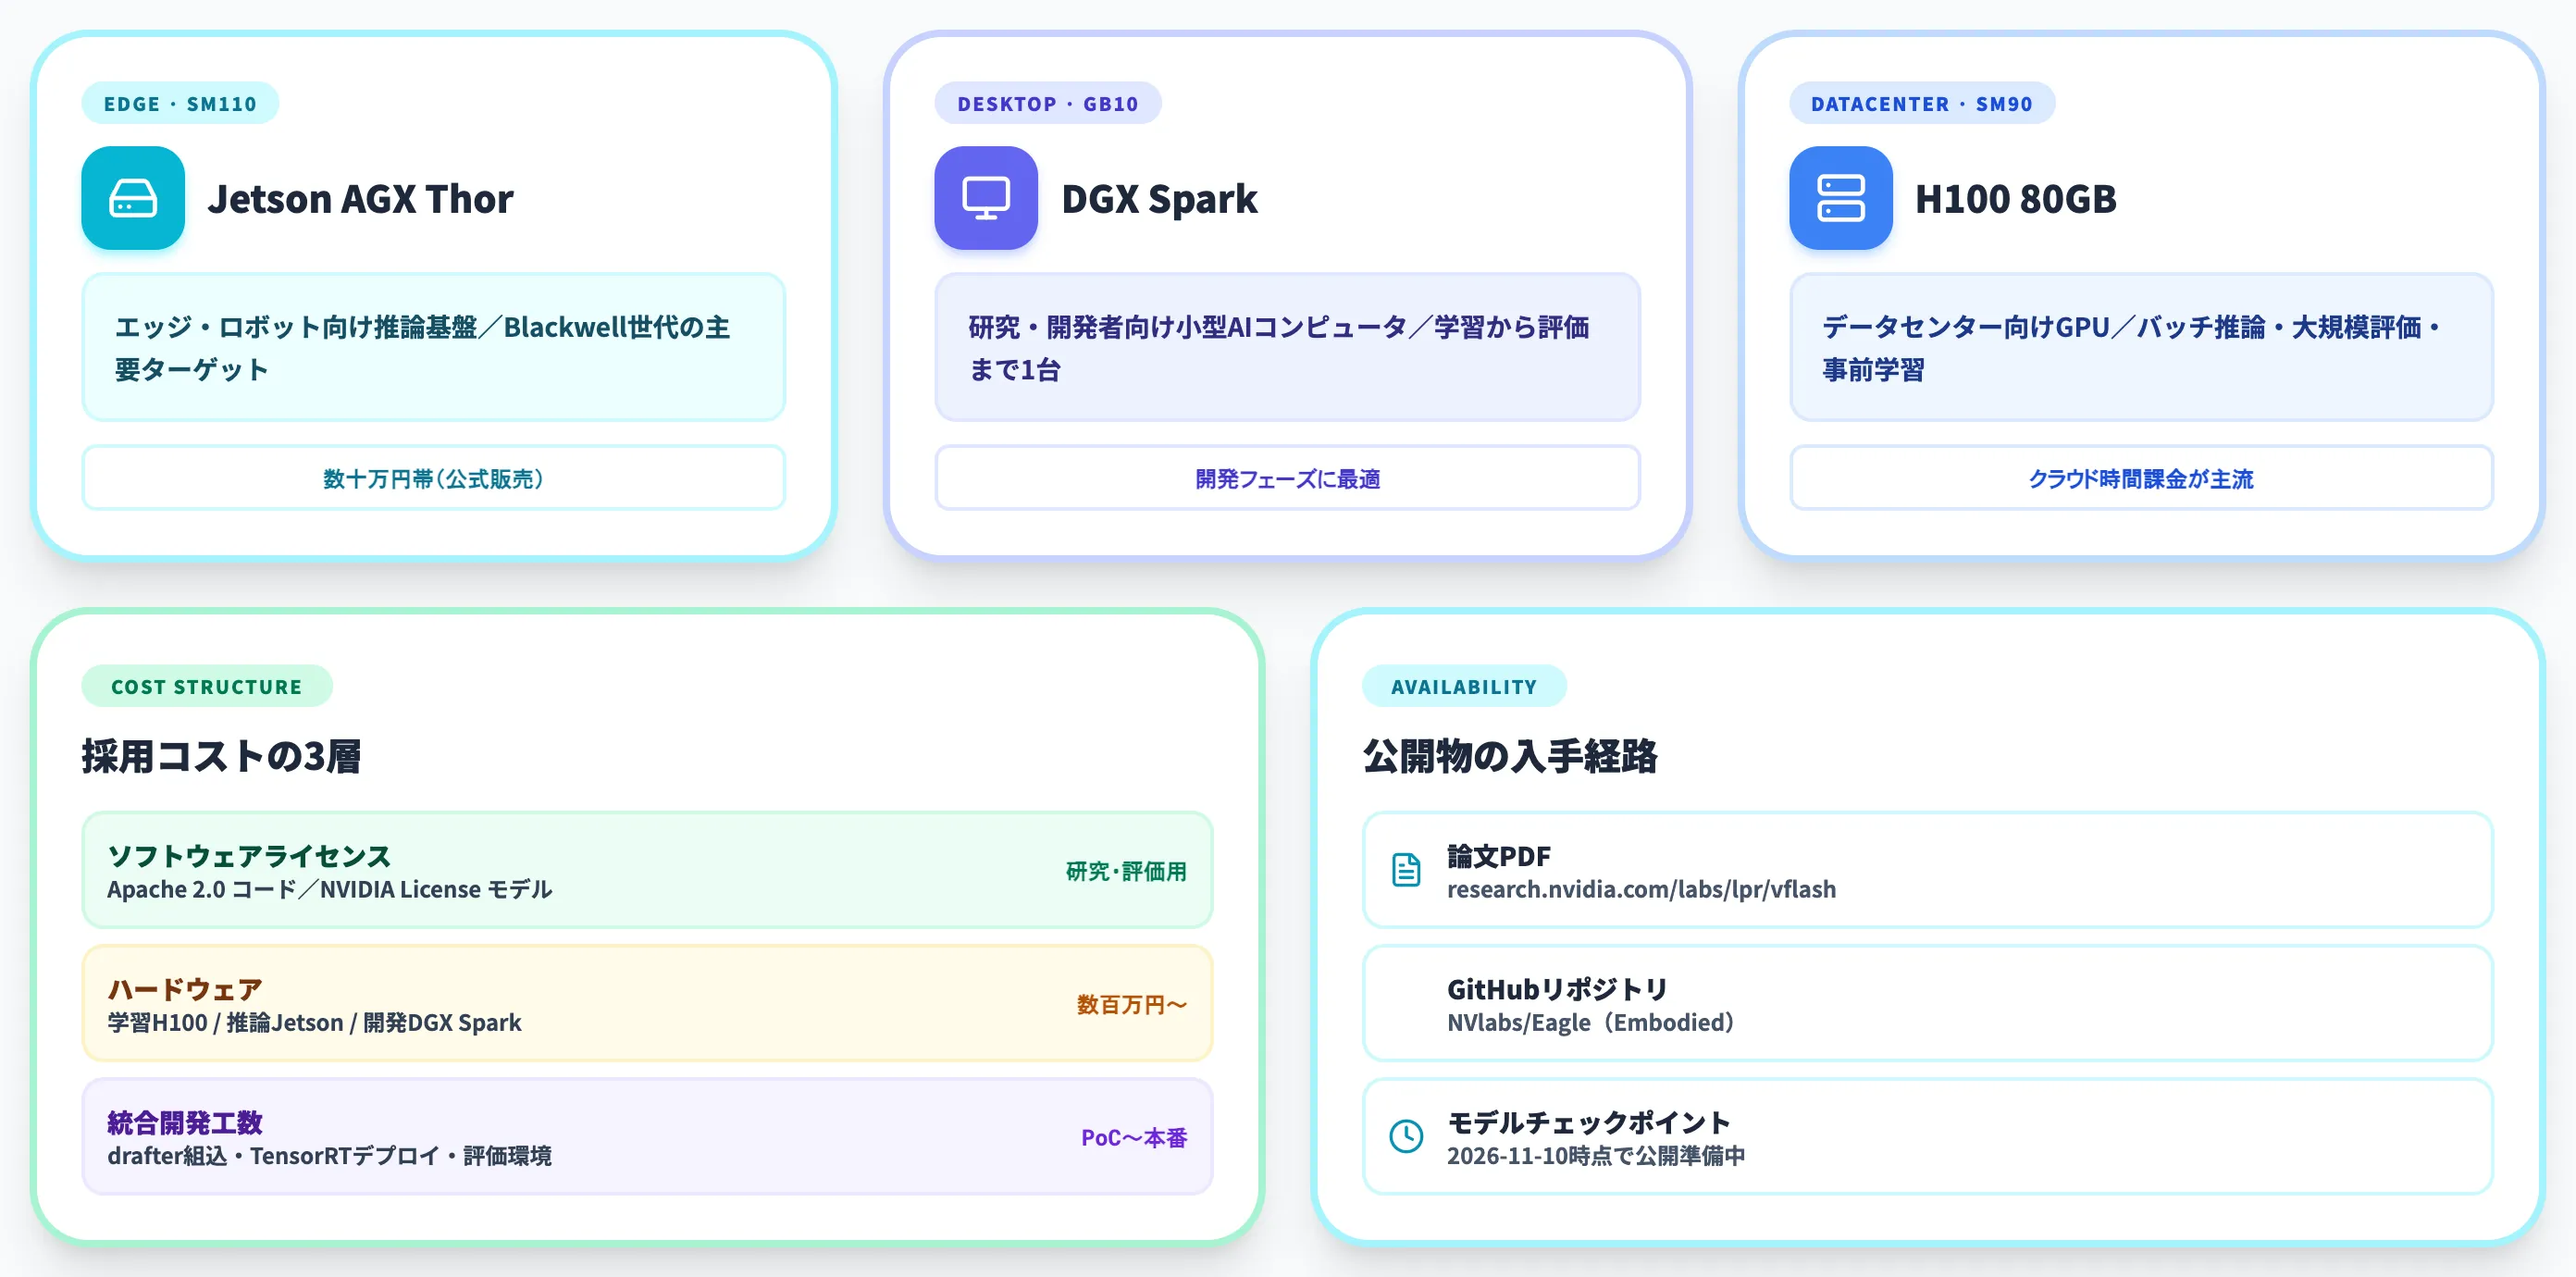
NVIDIAの論文では、VFlashを以下3つのプラットフォームで評価しています。
-
NVIDIA Jetson AGX Thor(SM110、Blackwell世代)
エッジ・ロボット向けの推論基盤。本体販売価格は公式リリース時点で数十万円帯で、エッジ側に搭載して直接VFlashを走らせる主要ターゲット
-
NVIDIA DGX Spark(GB10/SM121)
研究・開発者向けの小型デスクトップAIコンピュータ。学習から評価まで1台でカバーできる位置づけ
-
NVIDIA H100 80GB(SM90)
データセンター向けGPU。バッチ推論・大規模評価・事前学習のベースラインとして使用
評価コードはNVIDIAの「NVlabs/Eagle」リポジトリで「pip install -e '.[vflash]'」の形式でインストールでき、PyTorch 2.8、Triton 3.3、FlashAttentionを依存関係として必要とします。
コスト構造の内訳
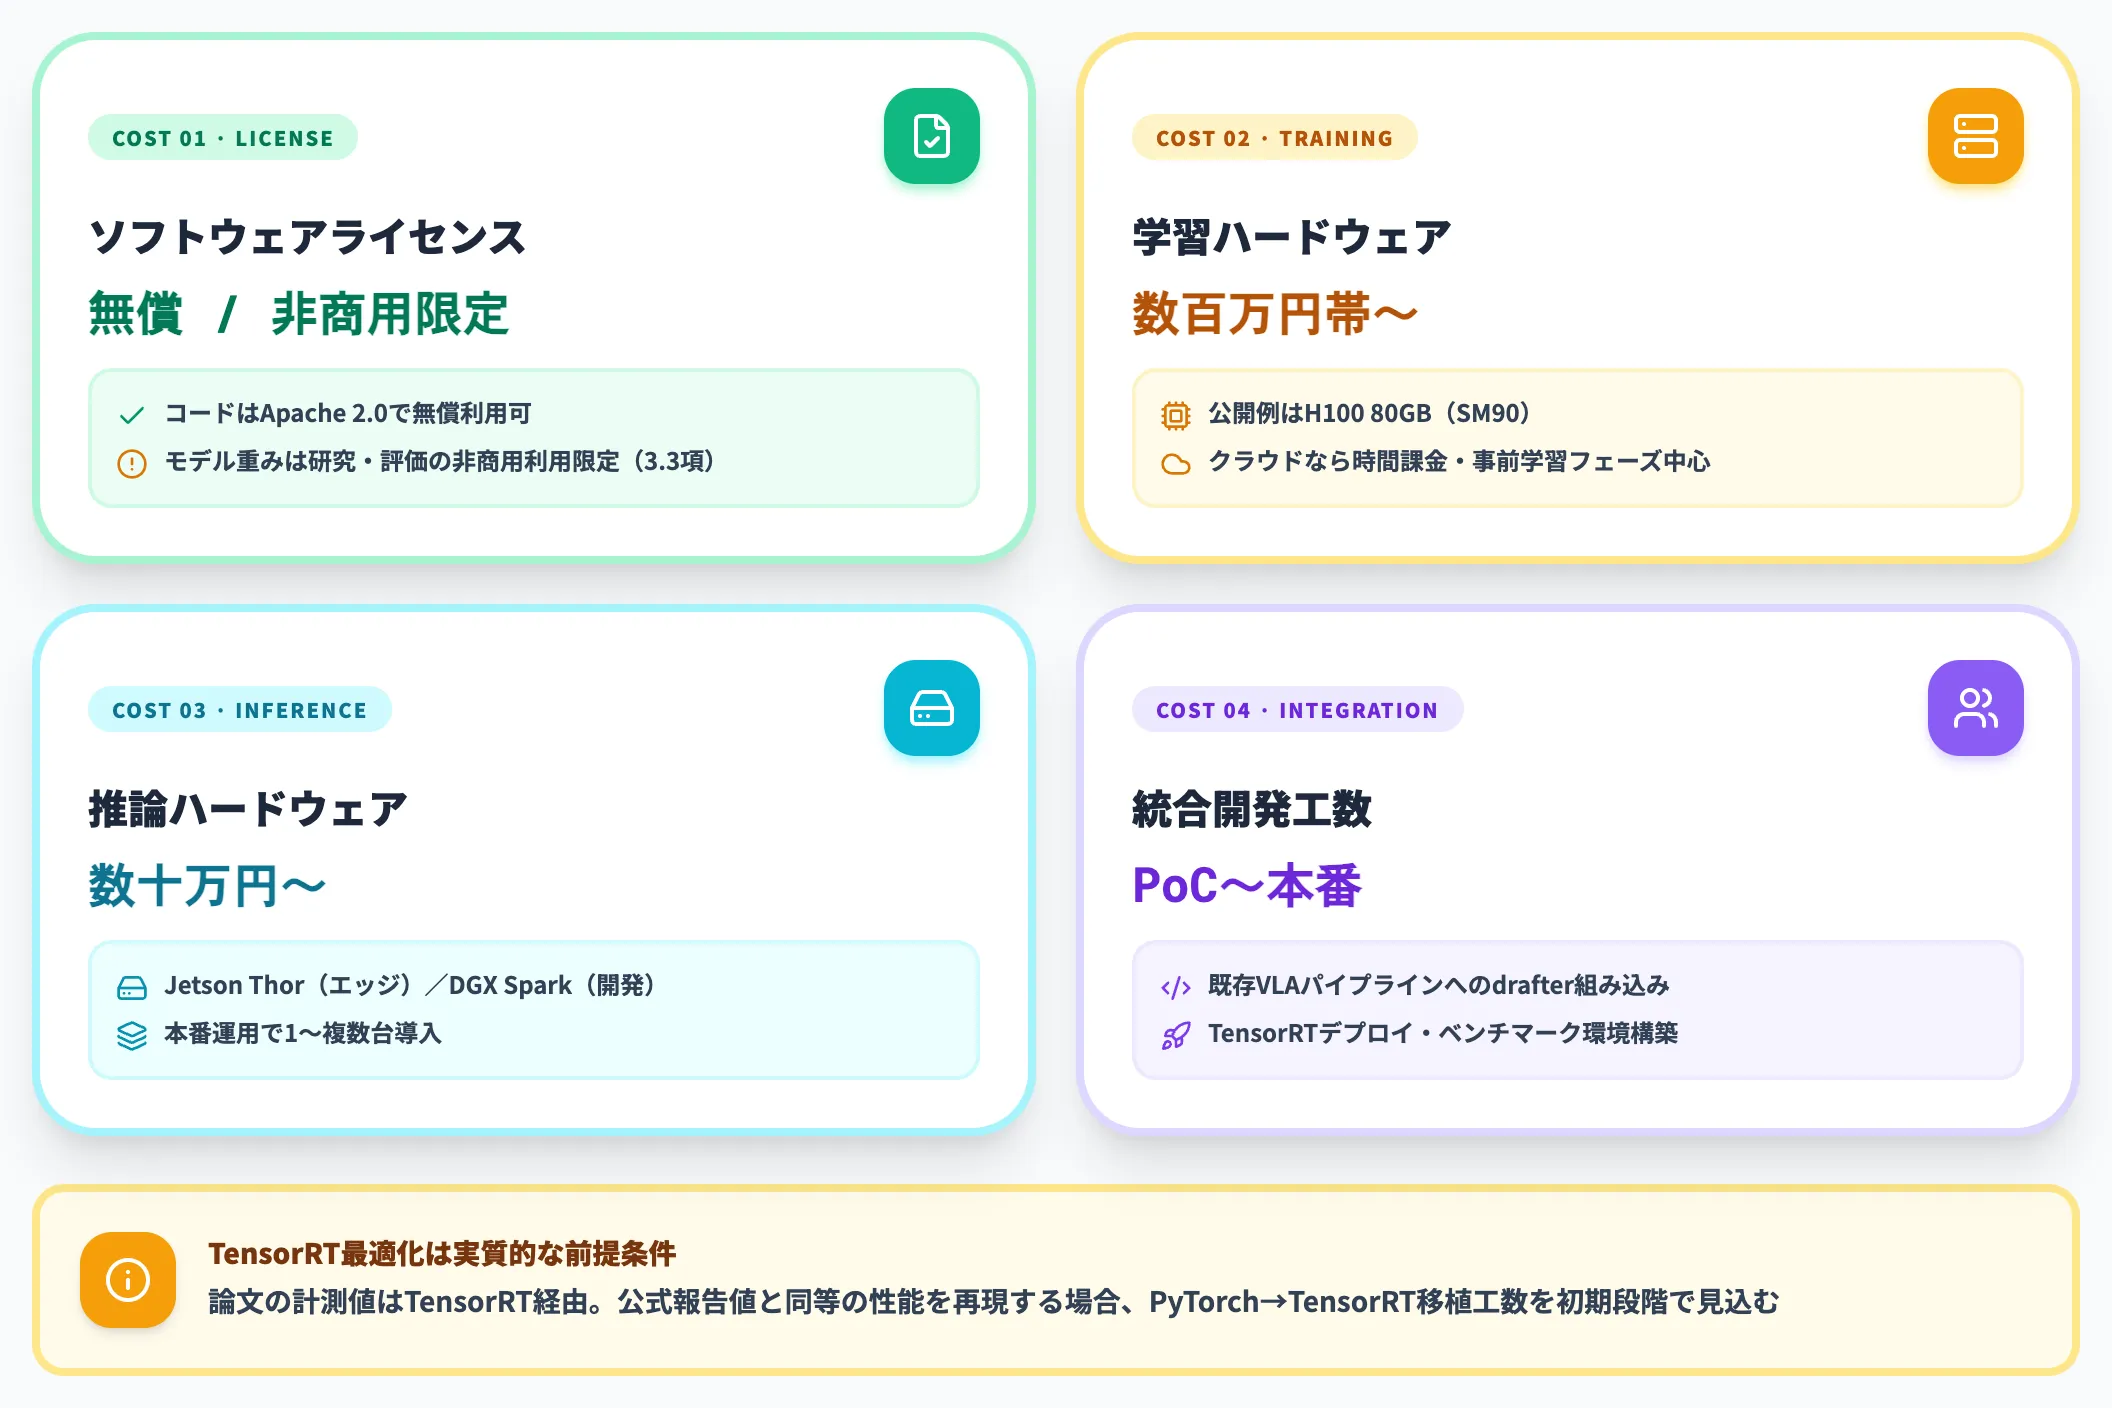
VFlash採用時に発生するコストを、ライセンス・ハードウェア・開発工数の3層に整理します。
| コスト項目 | 発生タイミング | 内容 |
|---|---|---|
| ソフトウェアライセンス | 利用時 | コードはApache 2.0で無償。モデル重みは研究・評価目的の非商用利用限定(NVIDIA License 3.3項)で商用利用は不可 |
| 学習ハードウェア | 事前学習・ファインチューン時 | H100クラスのGPU(公開例はH100 80GB)。クラウドなら時間課金、オンプレなら数百万円帯 |
| 推論ハードウェア | 本番運用時 | Jetson Thor(エッジ)またはDGX Spark(開発)。1〜複数台導入 |
| 統合開発工数 | PoC〜本番 | 既存VLAパイプラインへのdrafter組み込み、TensorRTデプロイ、評価ベンチマーク環境構築 |
論文では、計測値取得にTensorRTを使用した旨がNVIDIA TSEチームへの謝辞(Acknowledgement・p.11)として記載されています。
本番環境でTensorRTを必須とする公式言明はないものの、公式報告値と同等の性能を再現したい場合はTensorRTでの最適化が参考条件になります。
モデルチェックポイントは2026年11月10日時点で未公開のため、現段階は論文・コードを参照した事前検証とPoC設計段階が中心になります。
コードと公開物の入手経路
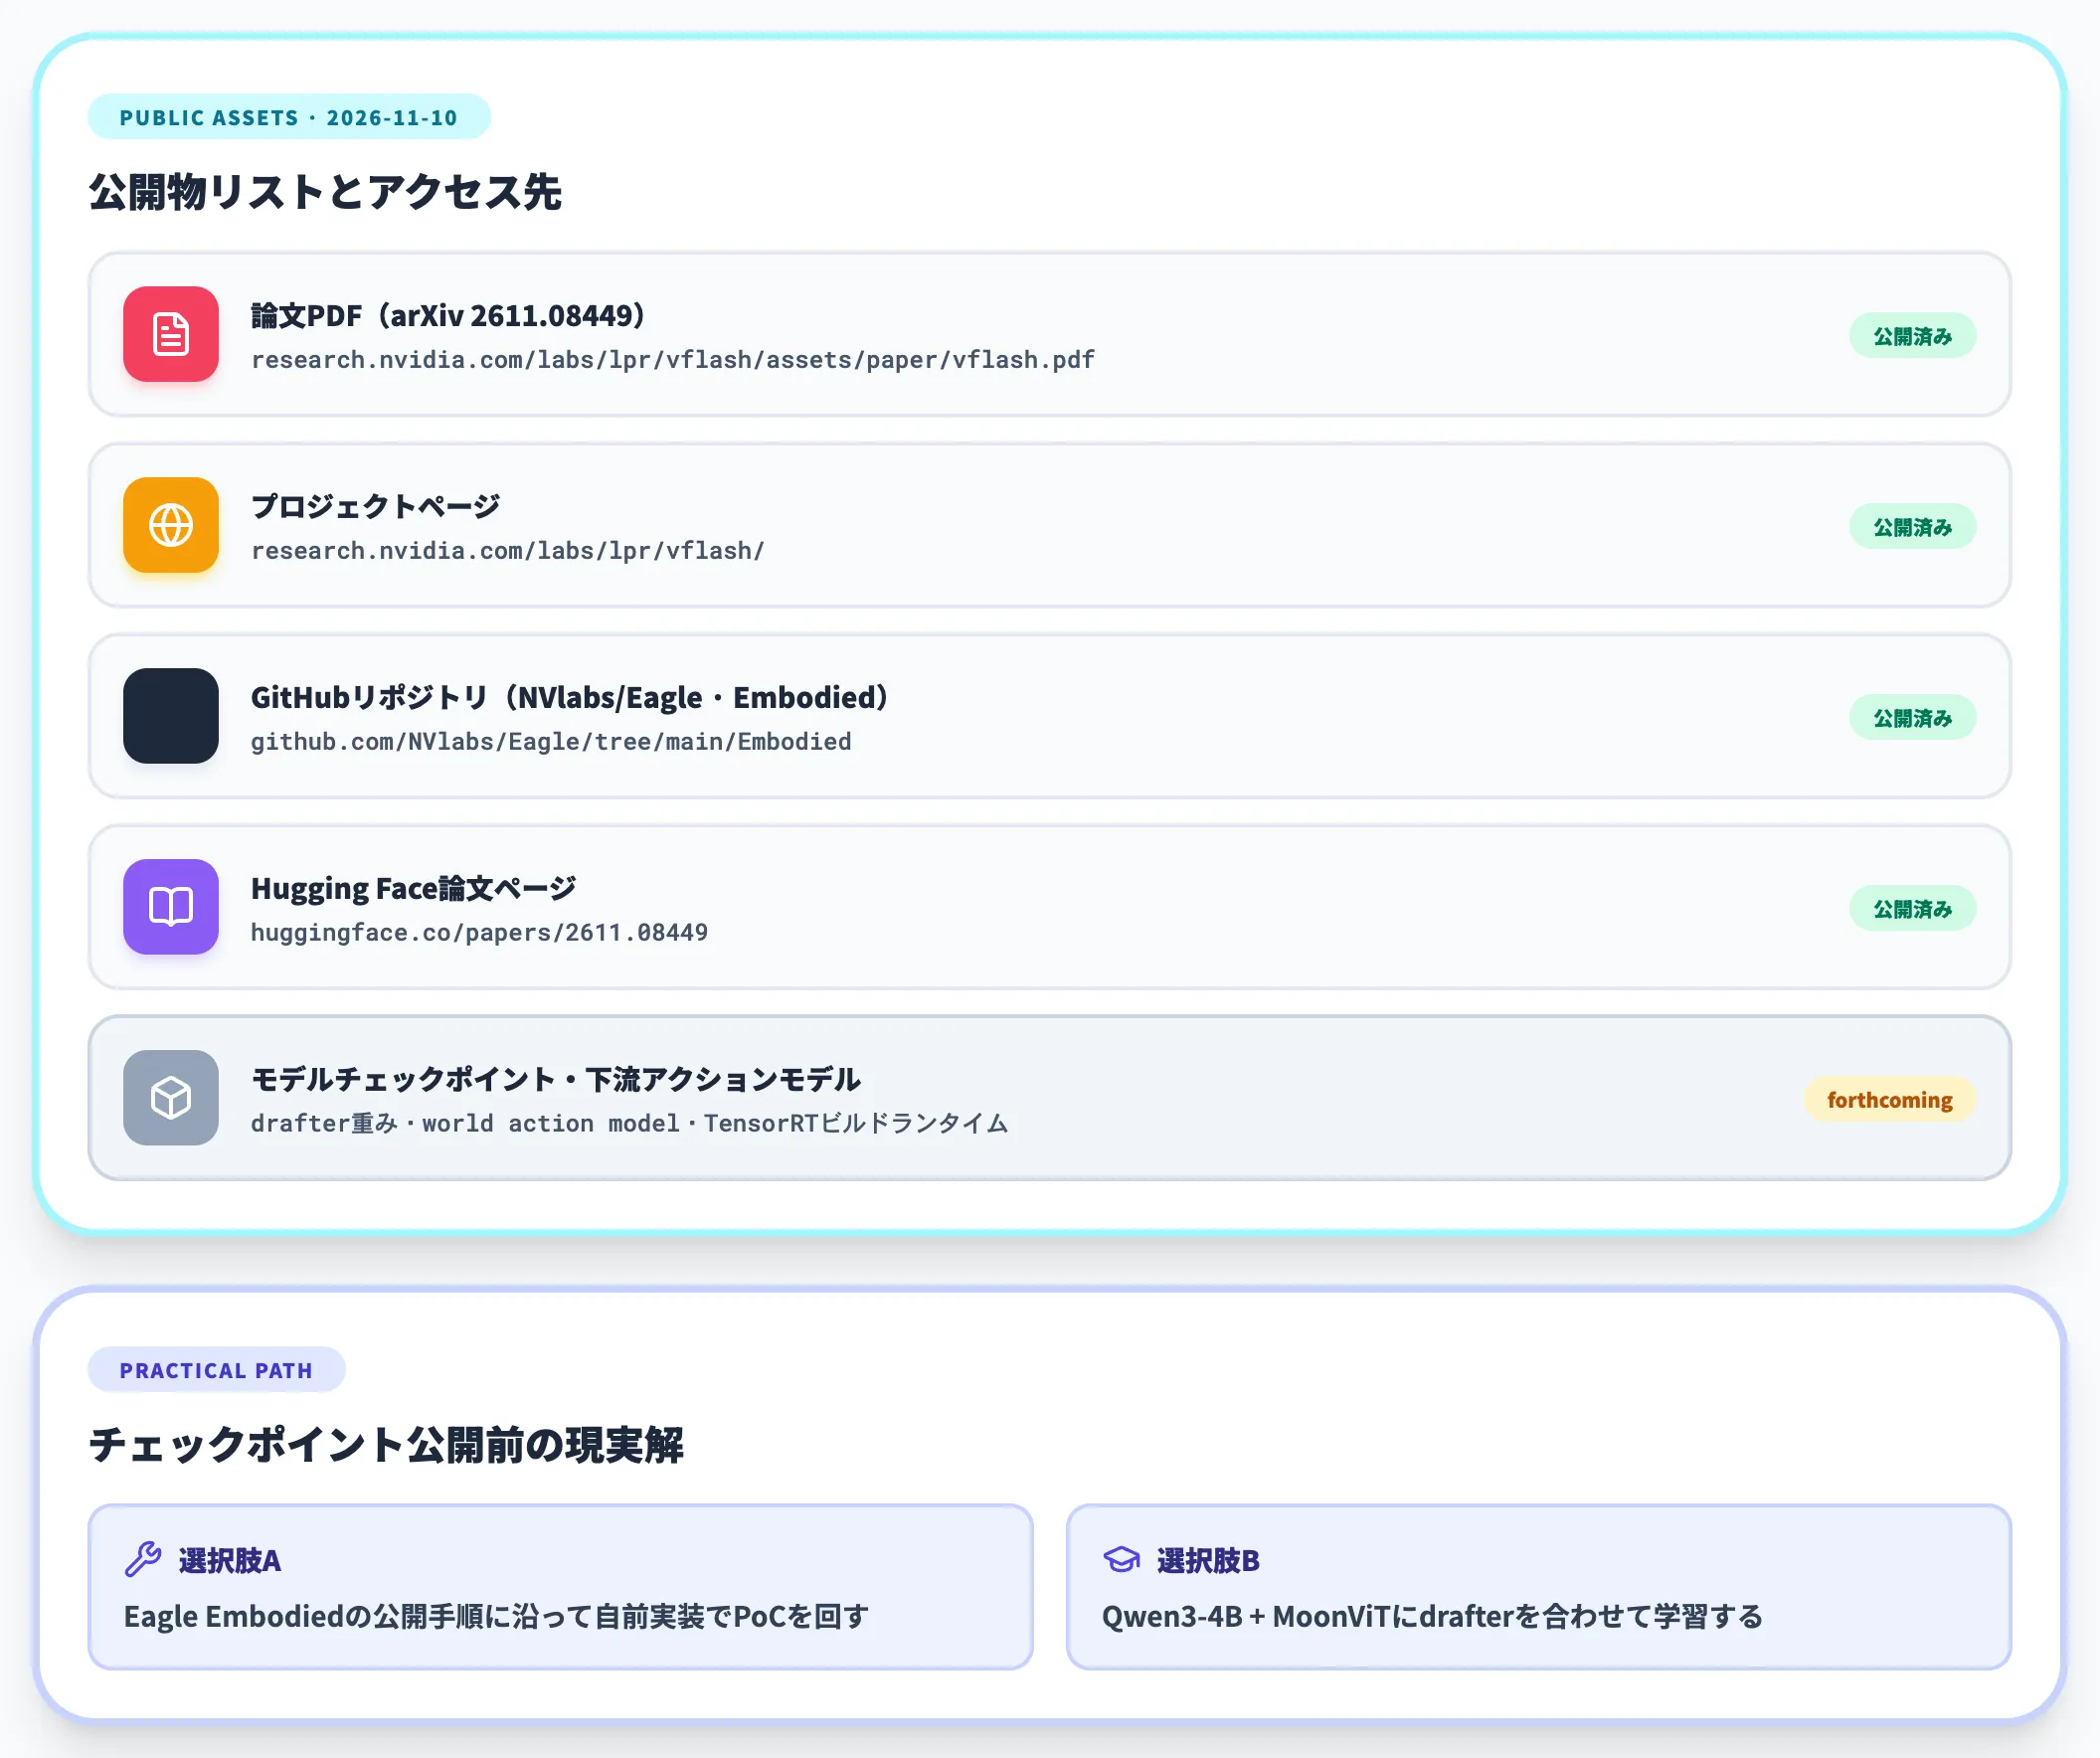
VFlashを自社で評価する場合、現時点で利用可能な公開物は以下のとおりです。
-
論文PDF
VFlash: Fast, Accurate Visual Planning via Flash Primitive Decoding
-
GitHubリポジトリ
NVlabs/Eagle(Embodiedサブディレクトリ)
-
Hugging Face論文ページ
Papers - 2611.08449
モデルチェックポイントが公開されるまでは、Eagle Embodiedの公開手順に沿って自前実装でPoCを回すか、公式のターゲットモデル(論文ではQwen3-4B + MoonViT)にdrafterを合わせて学習する選択肢が現実的です。
既存VLA加速手法(PD-VLA・OpenVLA-OFT・Spec-VLA)とVFlashの違い
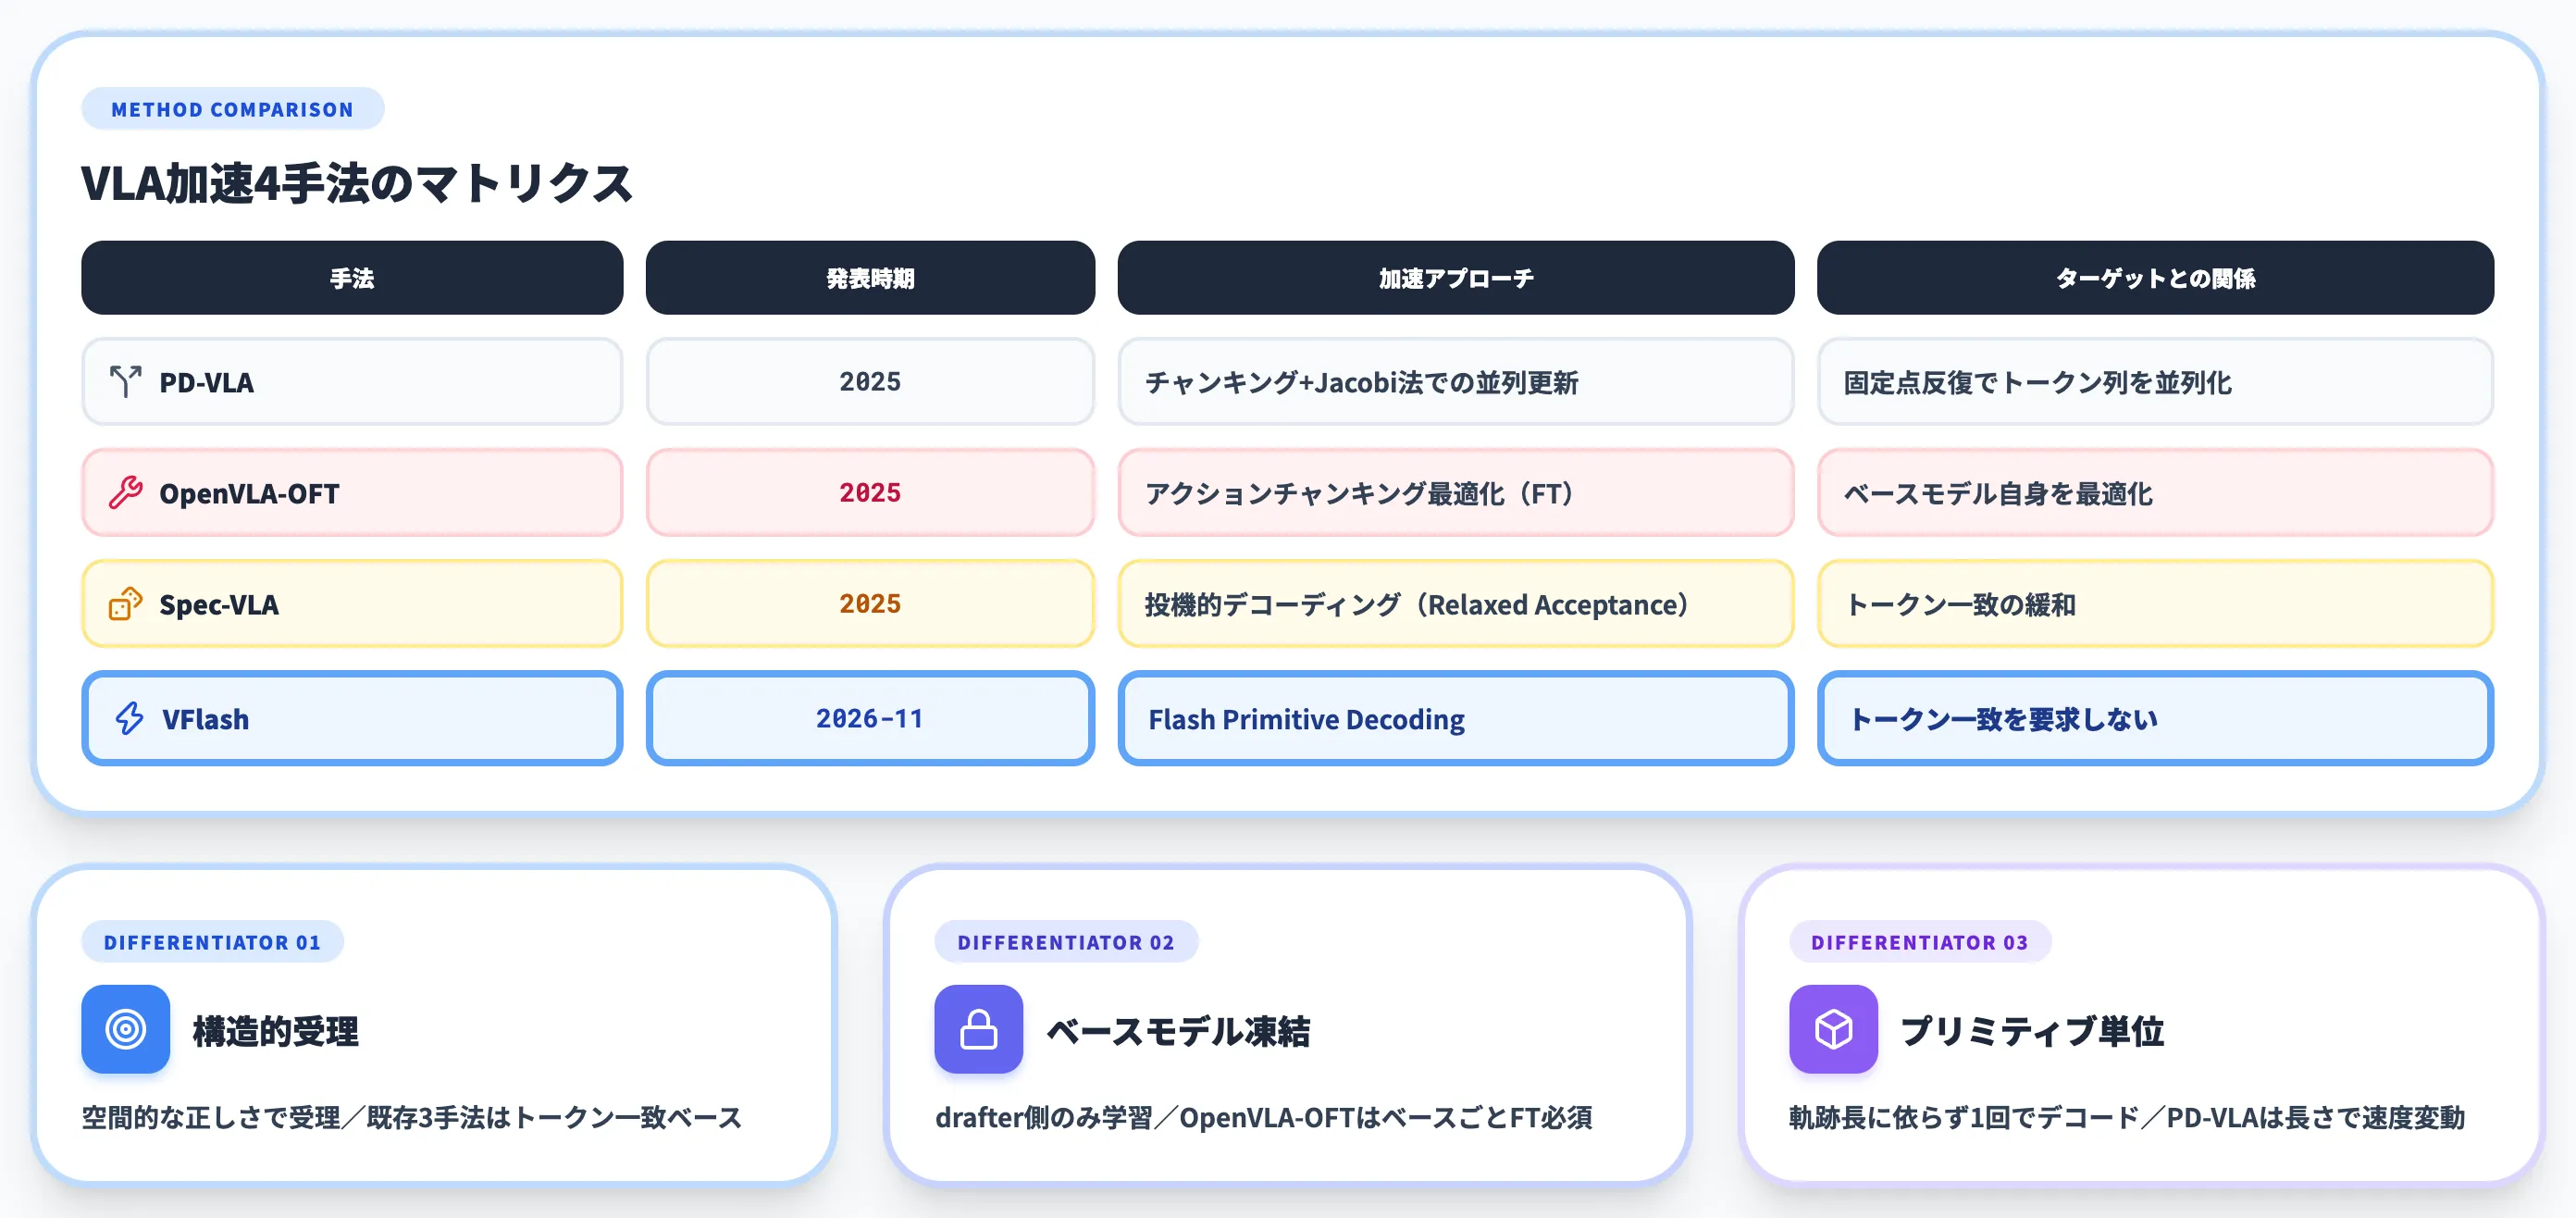
VFlashは「Physical AI向けVLM加速」というドメインで登場したため、既存のVLA(Vision-Language-Action)加速手法との位置関係を明確にしておくことが、採用判断の前提になります。
本セクションでは、代表的な3手法との技術的な違いを整理します。
加速アプローチの比較
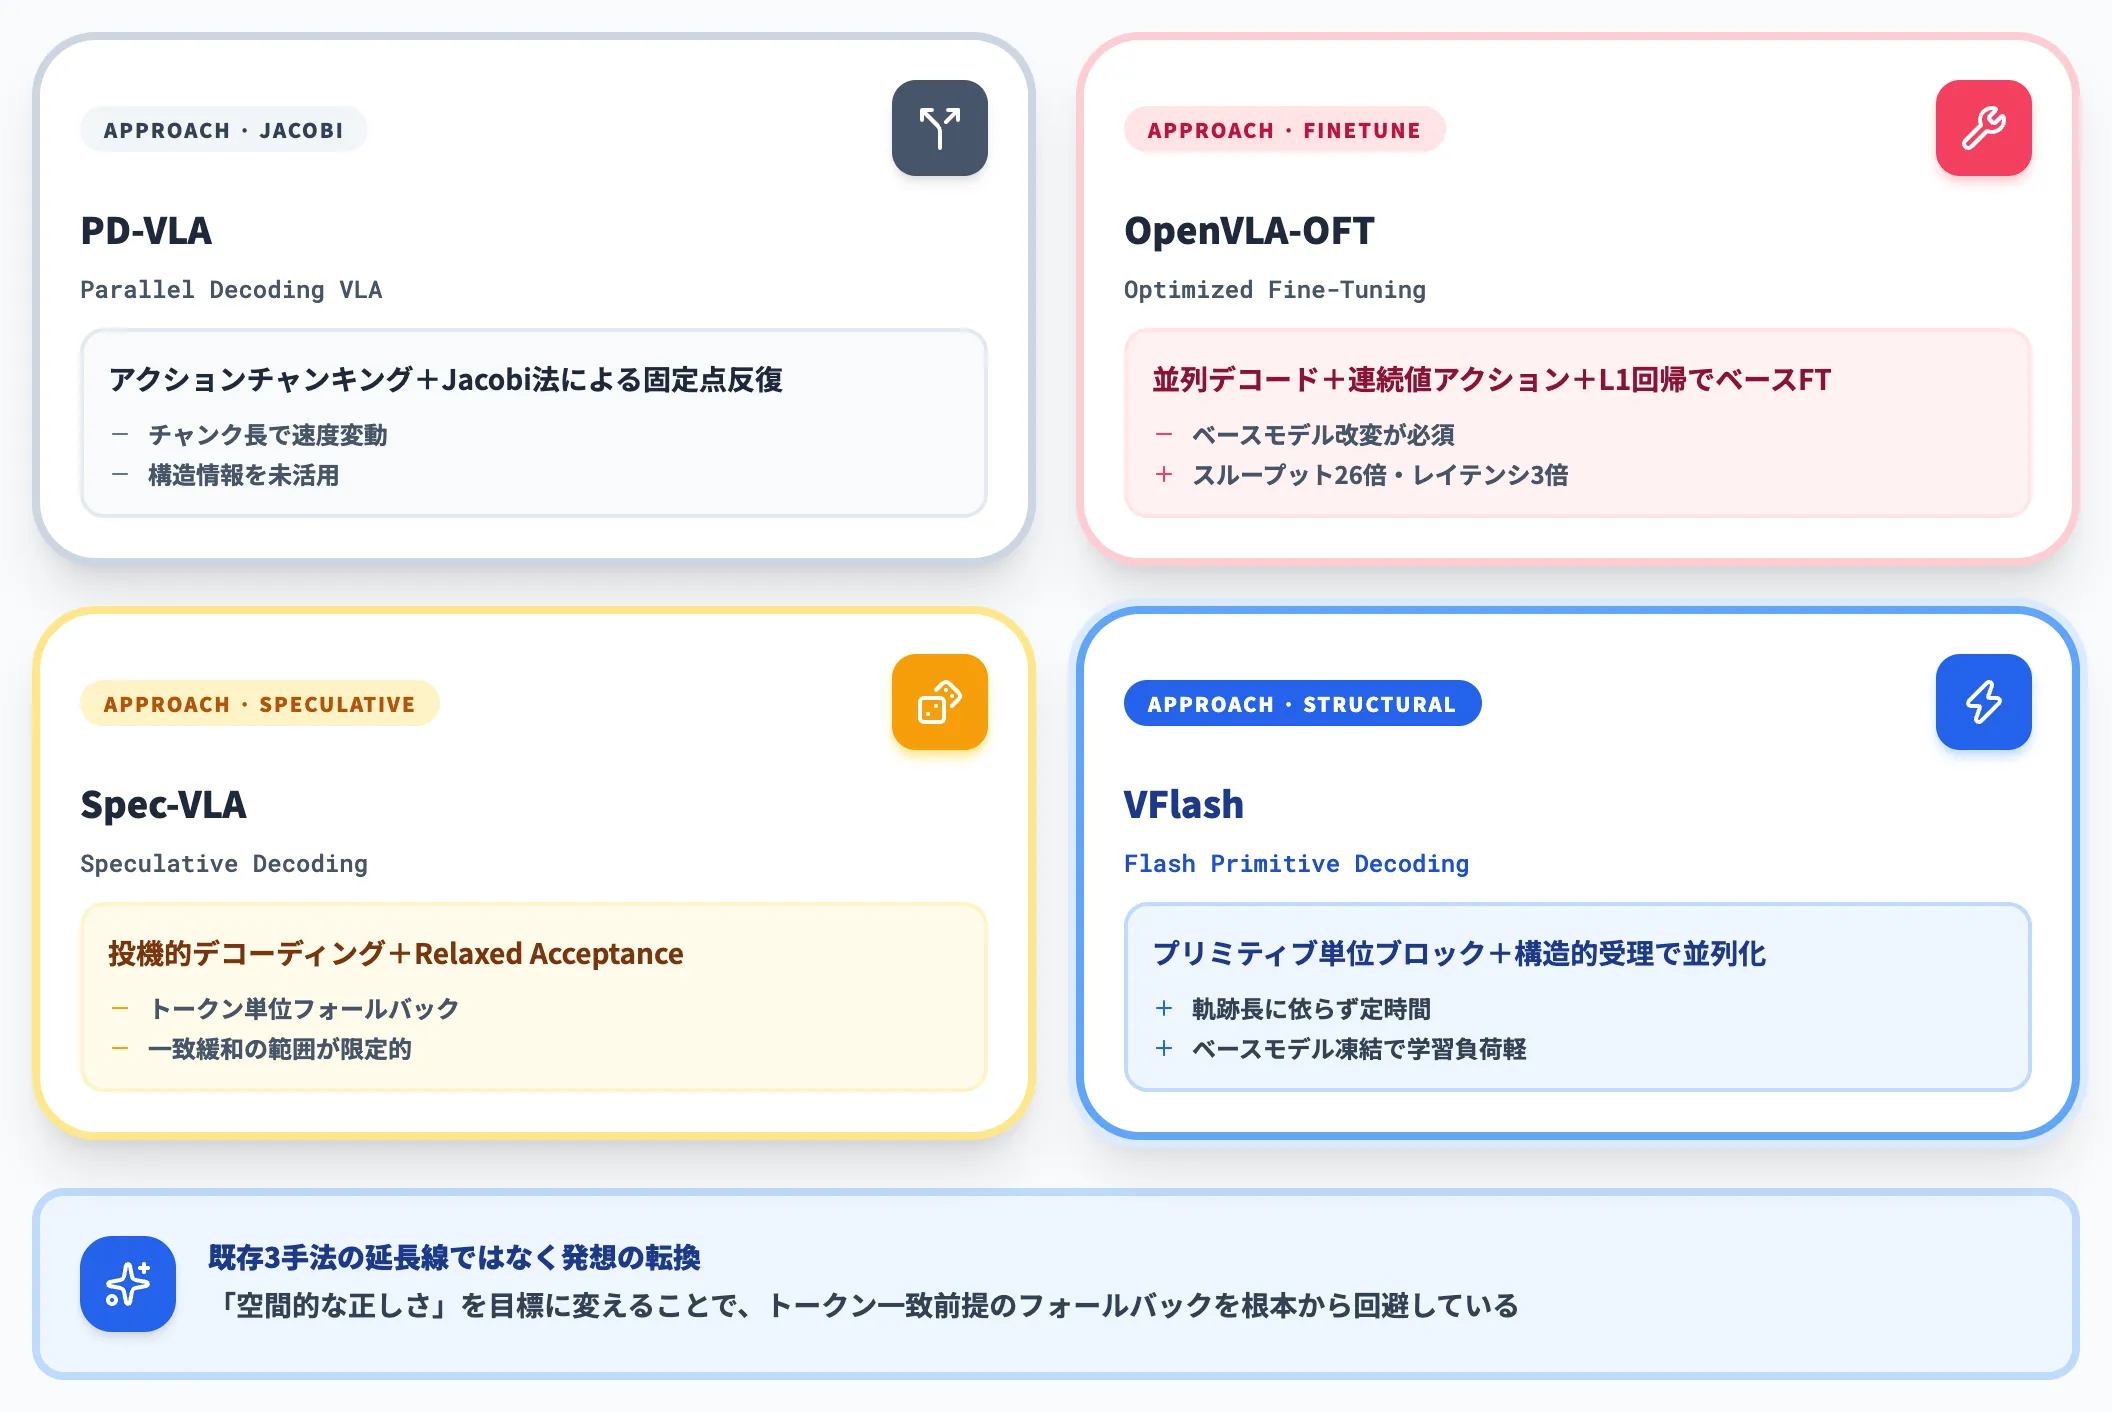
まず、各手法が「何を並列化しているか」を整理します。
| 手法 | 発表時期 | 加速アプローチ | ターゲットとの関係 |
|---|---|---|---|
| PD-VLA | 2025年 | アクションチャンキング+Jacobi法による固定点反復での並列更新 | 固定点反復でトークン列を並列更新 |
| OpenVLA-OFT | 2025年 | アクションチャンキング最適化(ファインチューン) | ベースモデル自身を最適化 |
| Spec-VLA | 2025年 | 投機的デコーディング(Relaxed Acceptance) | トークン一致の緩和 |
| VFlash(NVIDIA) | 2026年11月 | Flash Primitive Decoding(構造的受理による並列化) | トークン一致を要求しない |
表から読み取れる最大の差分は、受理判定の設計です。
OpenVLA-OFTは並列デコードと連続値アクション・L1回帰の組み合わせでベースモデル自身をファインチューンする設計で、PD-VLAはJacobi法による固定点反復でトークン列を並列更新します。
Spec-VLAは投機的デコーディングの受理条件を部分的に緩めています。VFlashはこれをさらに進めて、空間的な妥当性(軌跡はスキーマ検証、ボックスはスキーマ検証+空間的信頼度判定)で受理する設計に踏み込んでいます。
既存手法との速度・精度の違い
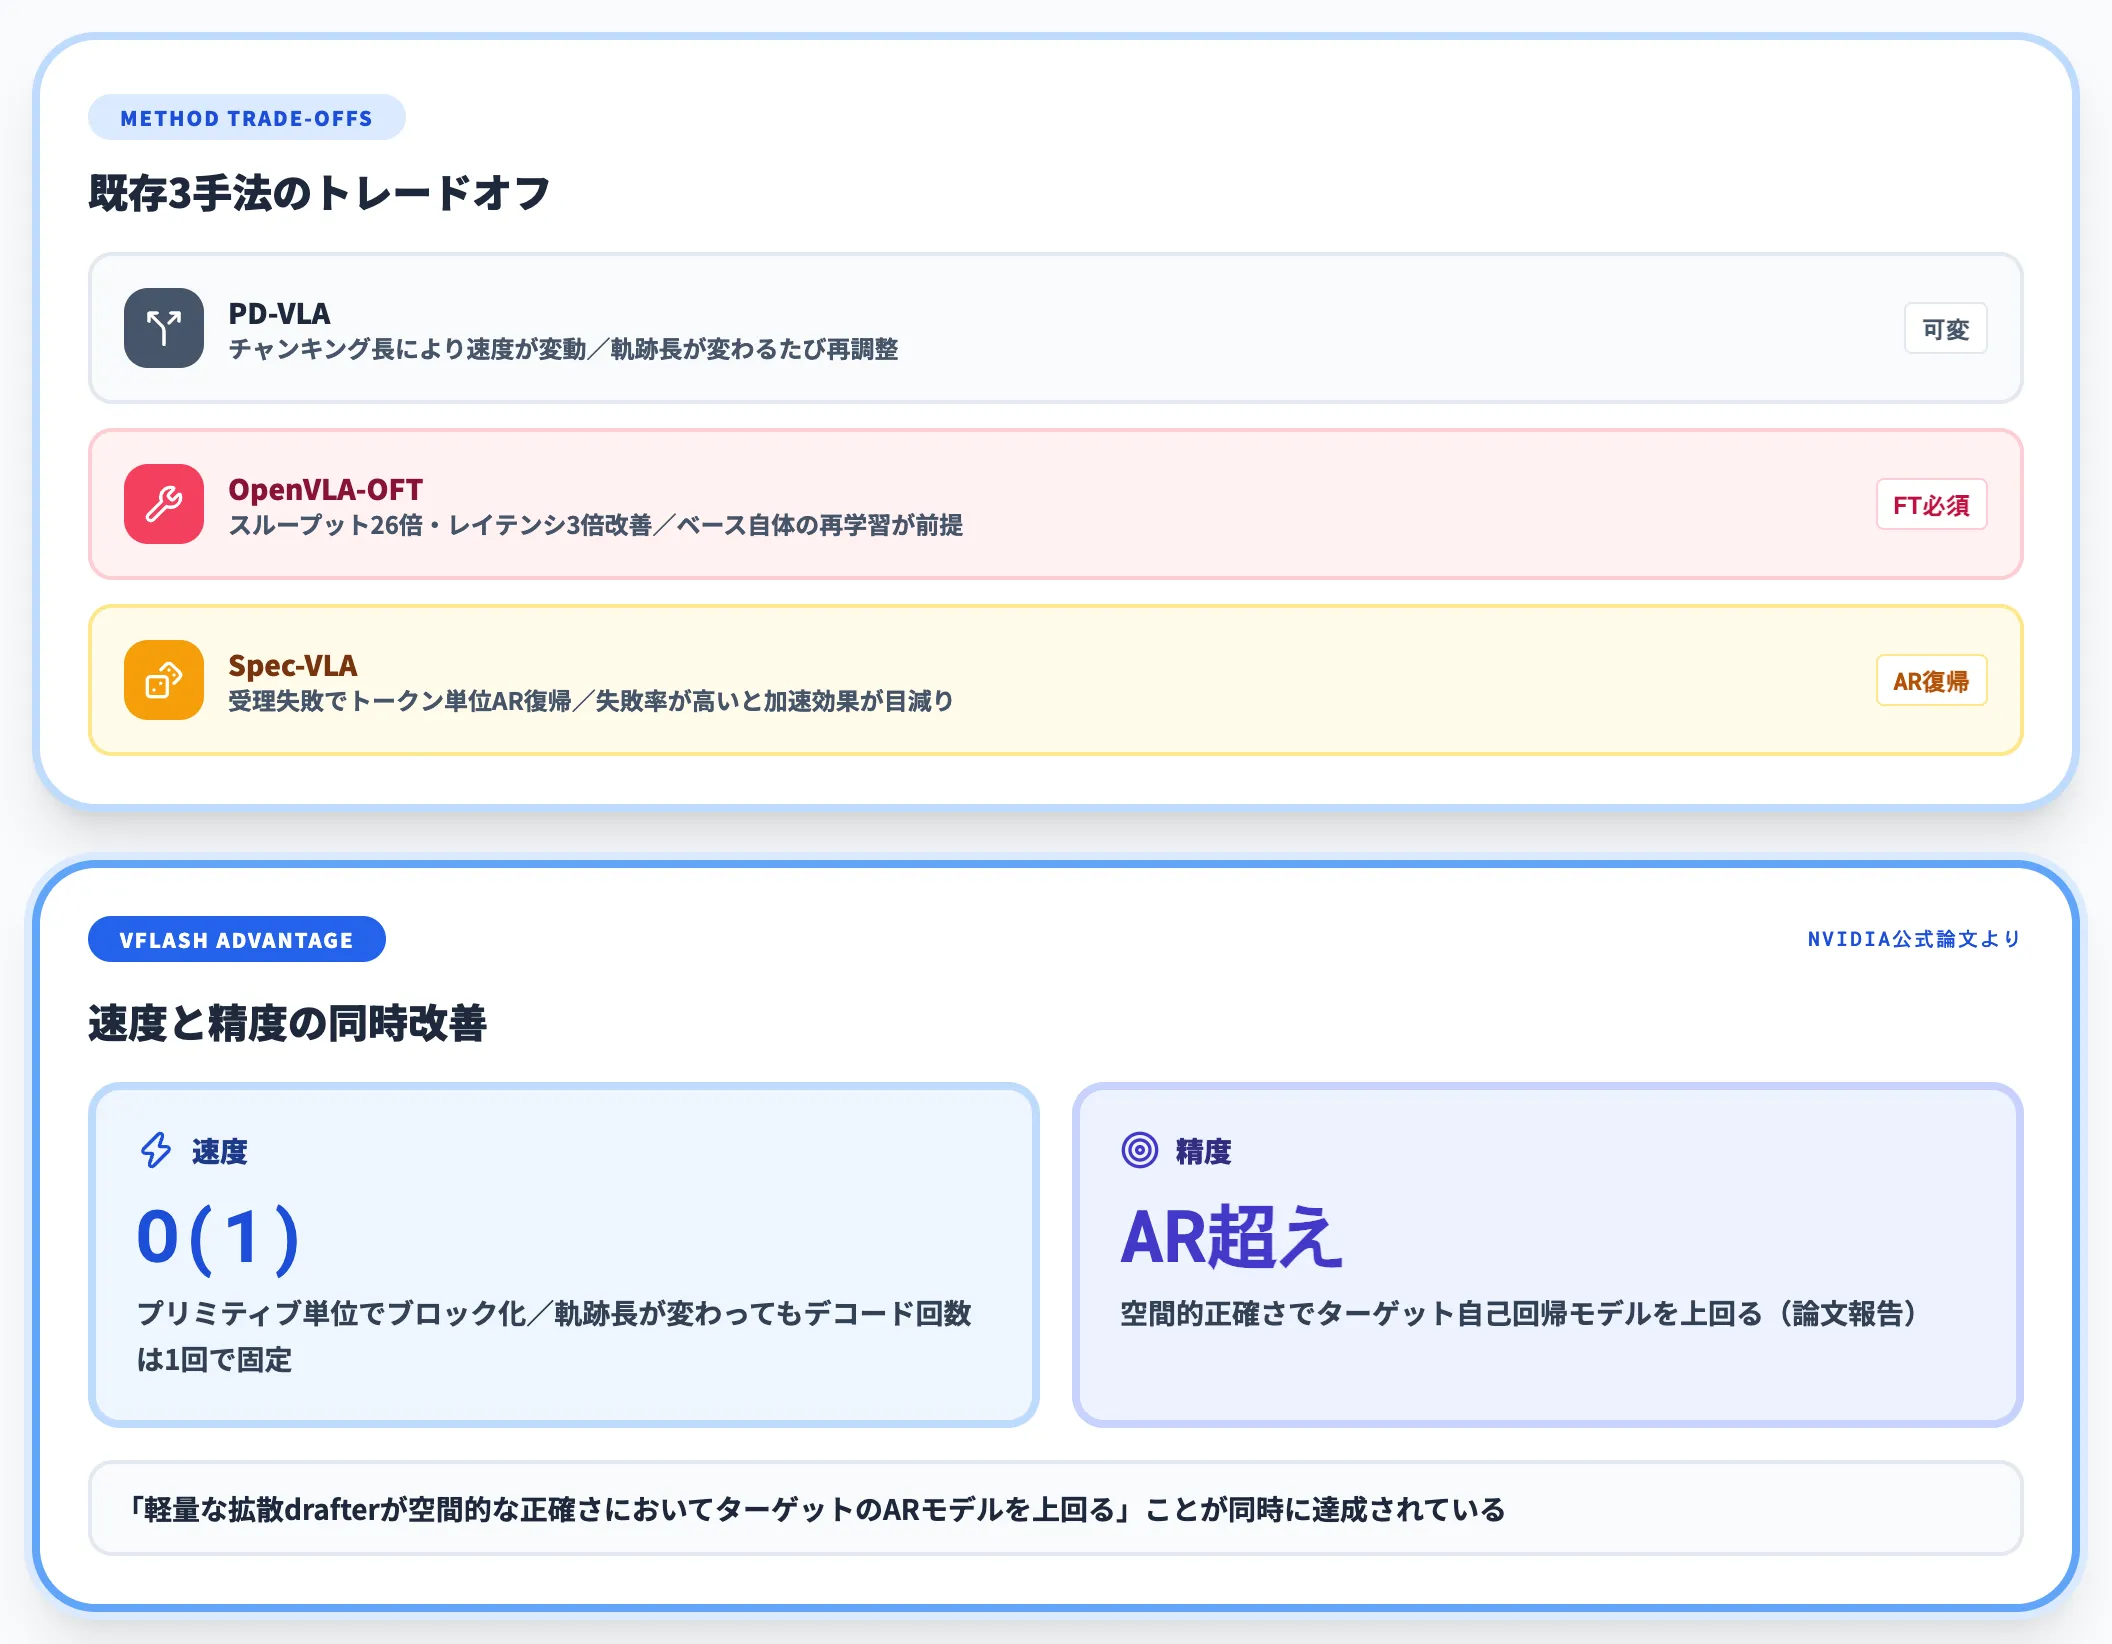
既存手法の報告値と比較すると、VFlashの位置づけがさらに明確になります。
-
PD-VLAはアクションチャンキング長によって速度が変動するのに対し、VFlashはプリミティブ単位で設計されているため、軌跡長が変わってもデコーディング回数は1回で固定される
-
OpenVLA-OFTは行動生成スループットを26倍、レイテンシを3倍に高速化と報告されているが、ベースモデル自身をファインチューンする必要がある。VFlashはターゲットVLMの適応学習後に凍結し、drafter学習の段階ではdrafterのみを学習する2段階構成を取る
-
Spec-VLAは投機的デコーディングを採用するため、受理失敗時にはトークン単位のフォールバックが発生する。VFlashは保持したプレフィックス以降を制約付き自己回帰で再生成する設計で(軌跡はr=0、ボックスは不確かな座標より前のrトークンを保持)、プリミティブ構造を前提に受理・再生成を切り分ける
NVIDIA自身の論文では、「軽量な拡散drafterが空間的な正確さにおいてターゲットの自己回帰モデルを上回ることができる」と報告されており、速度と精度を同時に改善できる点が既存手法との差別化ポイントになっています。
System-1 VLMという概念上の位置づけ
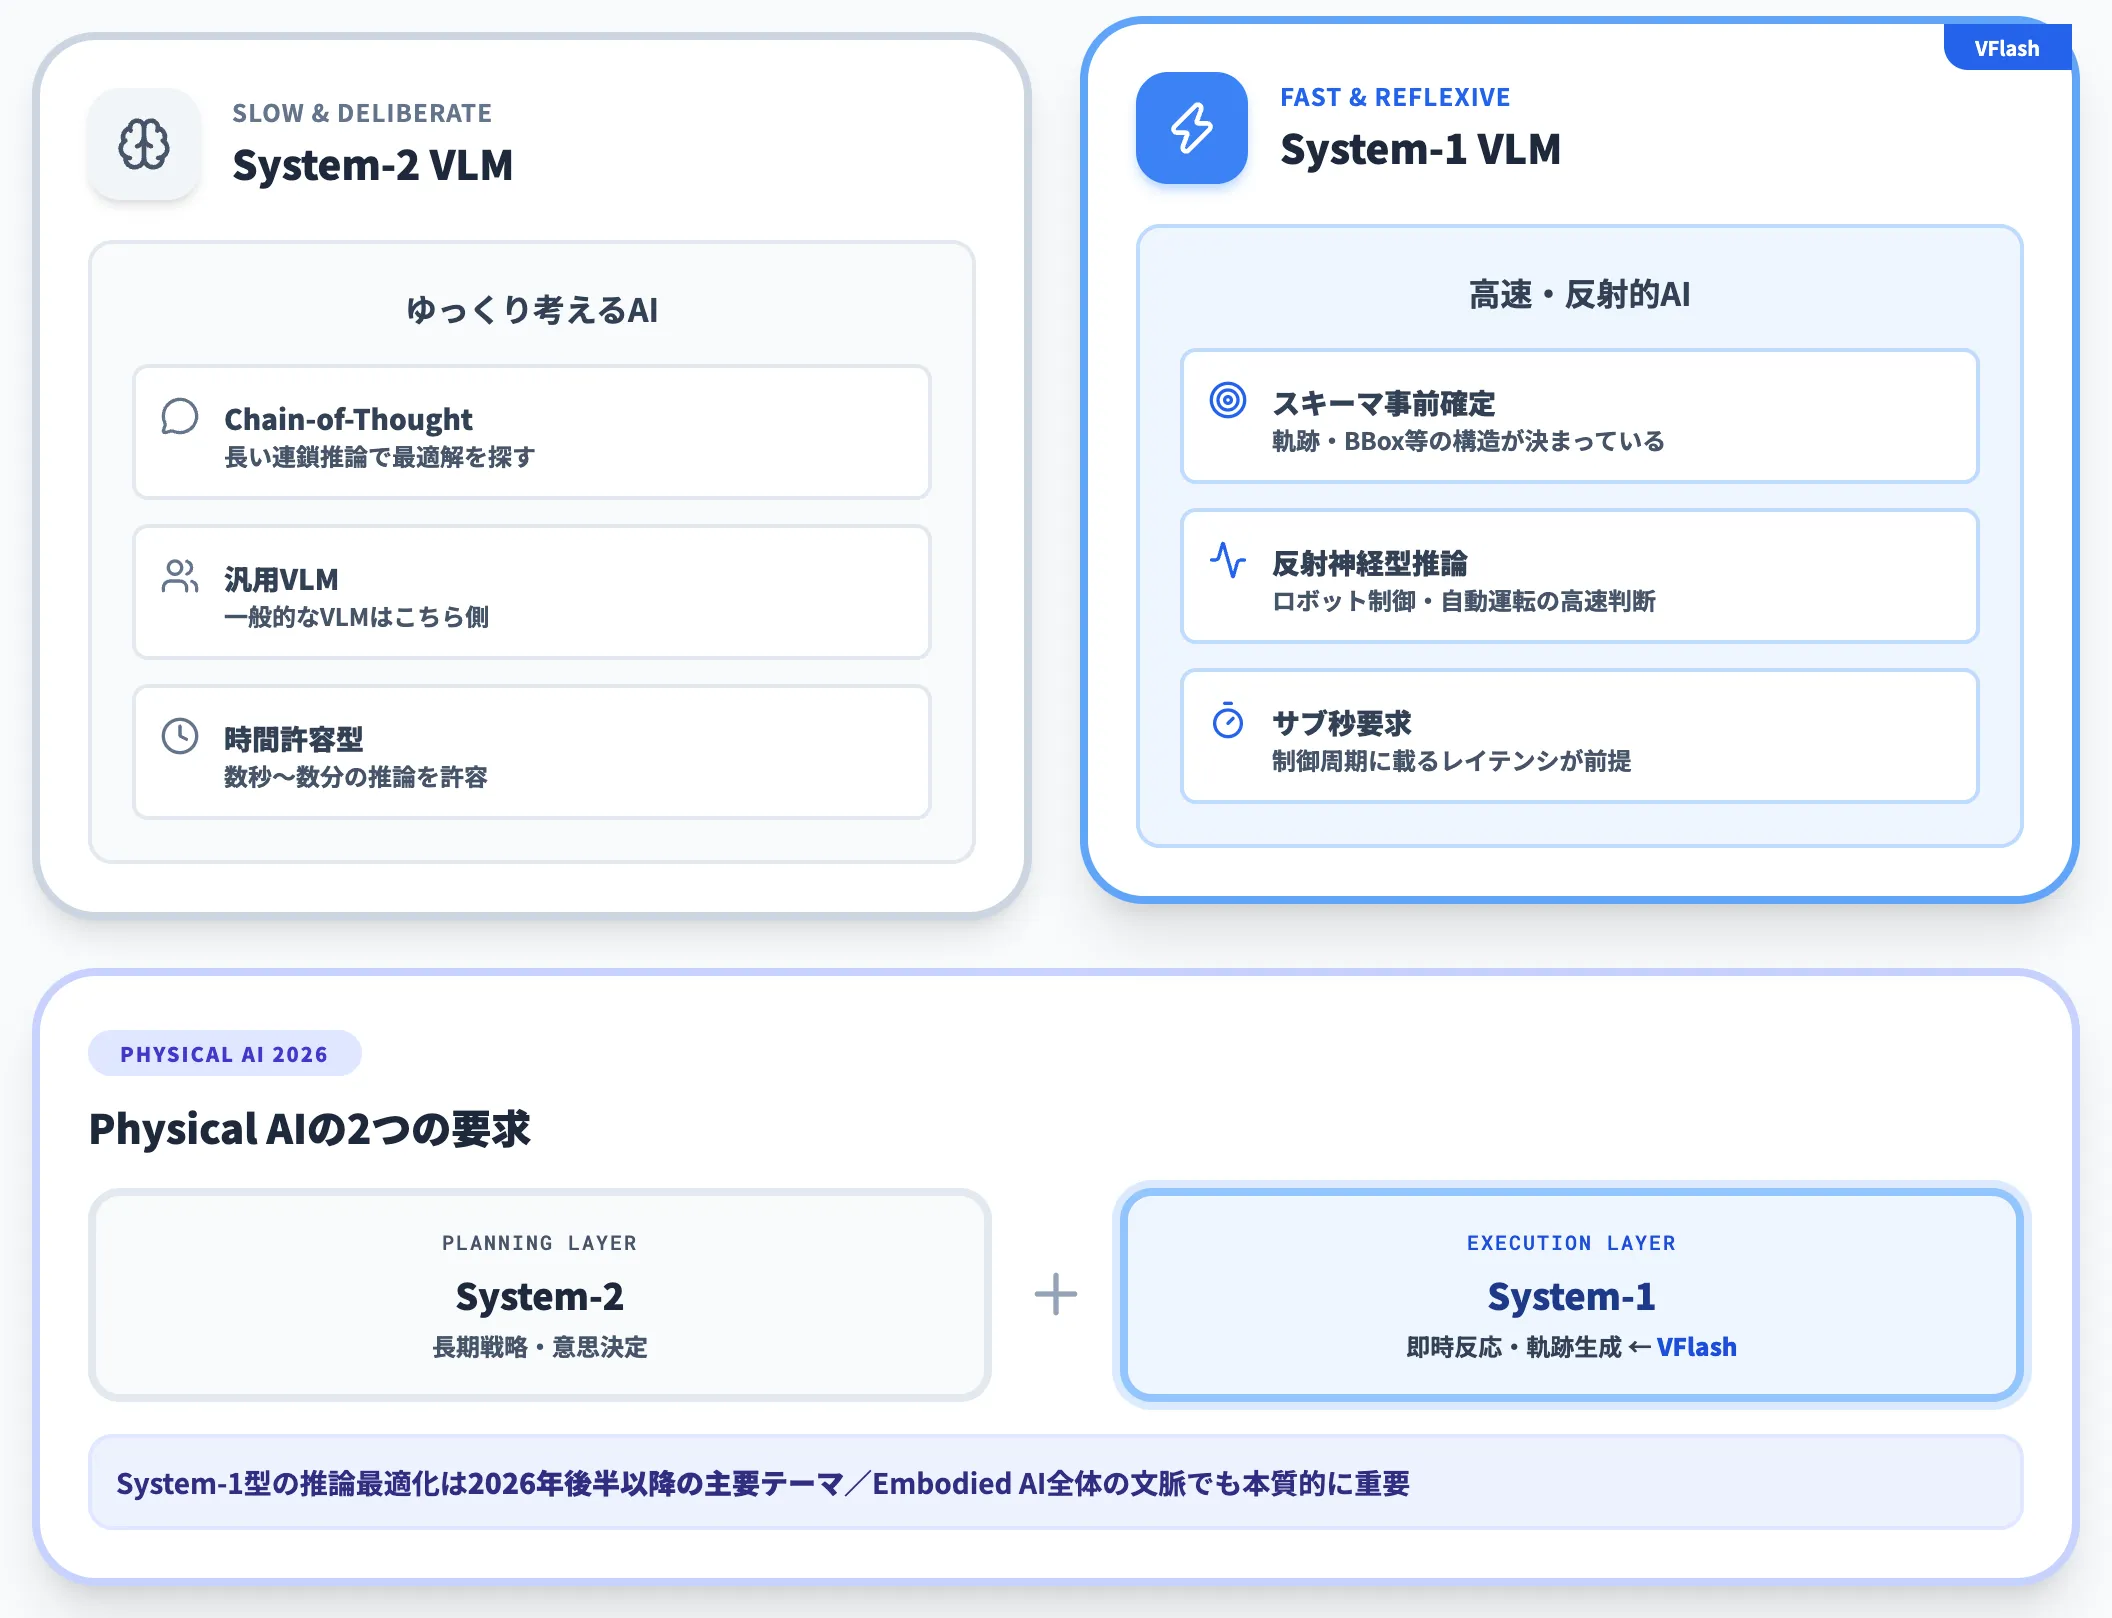
VFlashが特異なのは、技術的な加速手法であると同時に、「System-1 VLM」というコンセプトを体現している点です。
-
System-2型VLM
長い連鎖推論(Chain-of-Thought)を回しながら最適解を探す、ゆっくり考えるAI。一般的な汎用VLMはこちら側に寄っている
-
System-1型VLM
事前にスキーマが決まっている空間判断(軌跡・バウンディングボックス)を、高速・反射的に出力するAI。VFlashはこの領域の基礎技術として位置づけられる
Physical AIはロボット制御や自動運転のような人間の反射神経に相当する高速判断を要求するため、System-1側の最適化が本質的に重要です。Embodied AI全体の文脈でも、System-1型の推論最適化が2026年後半以降の主要テーマになることが見えてきています。
VFlashの応用先と実務での活用判断軸
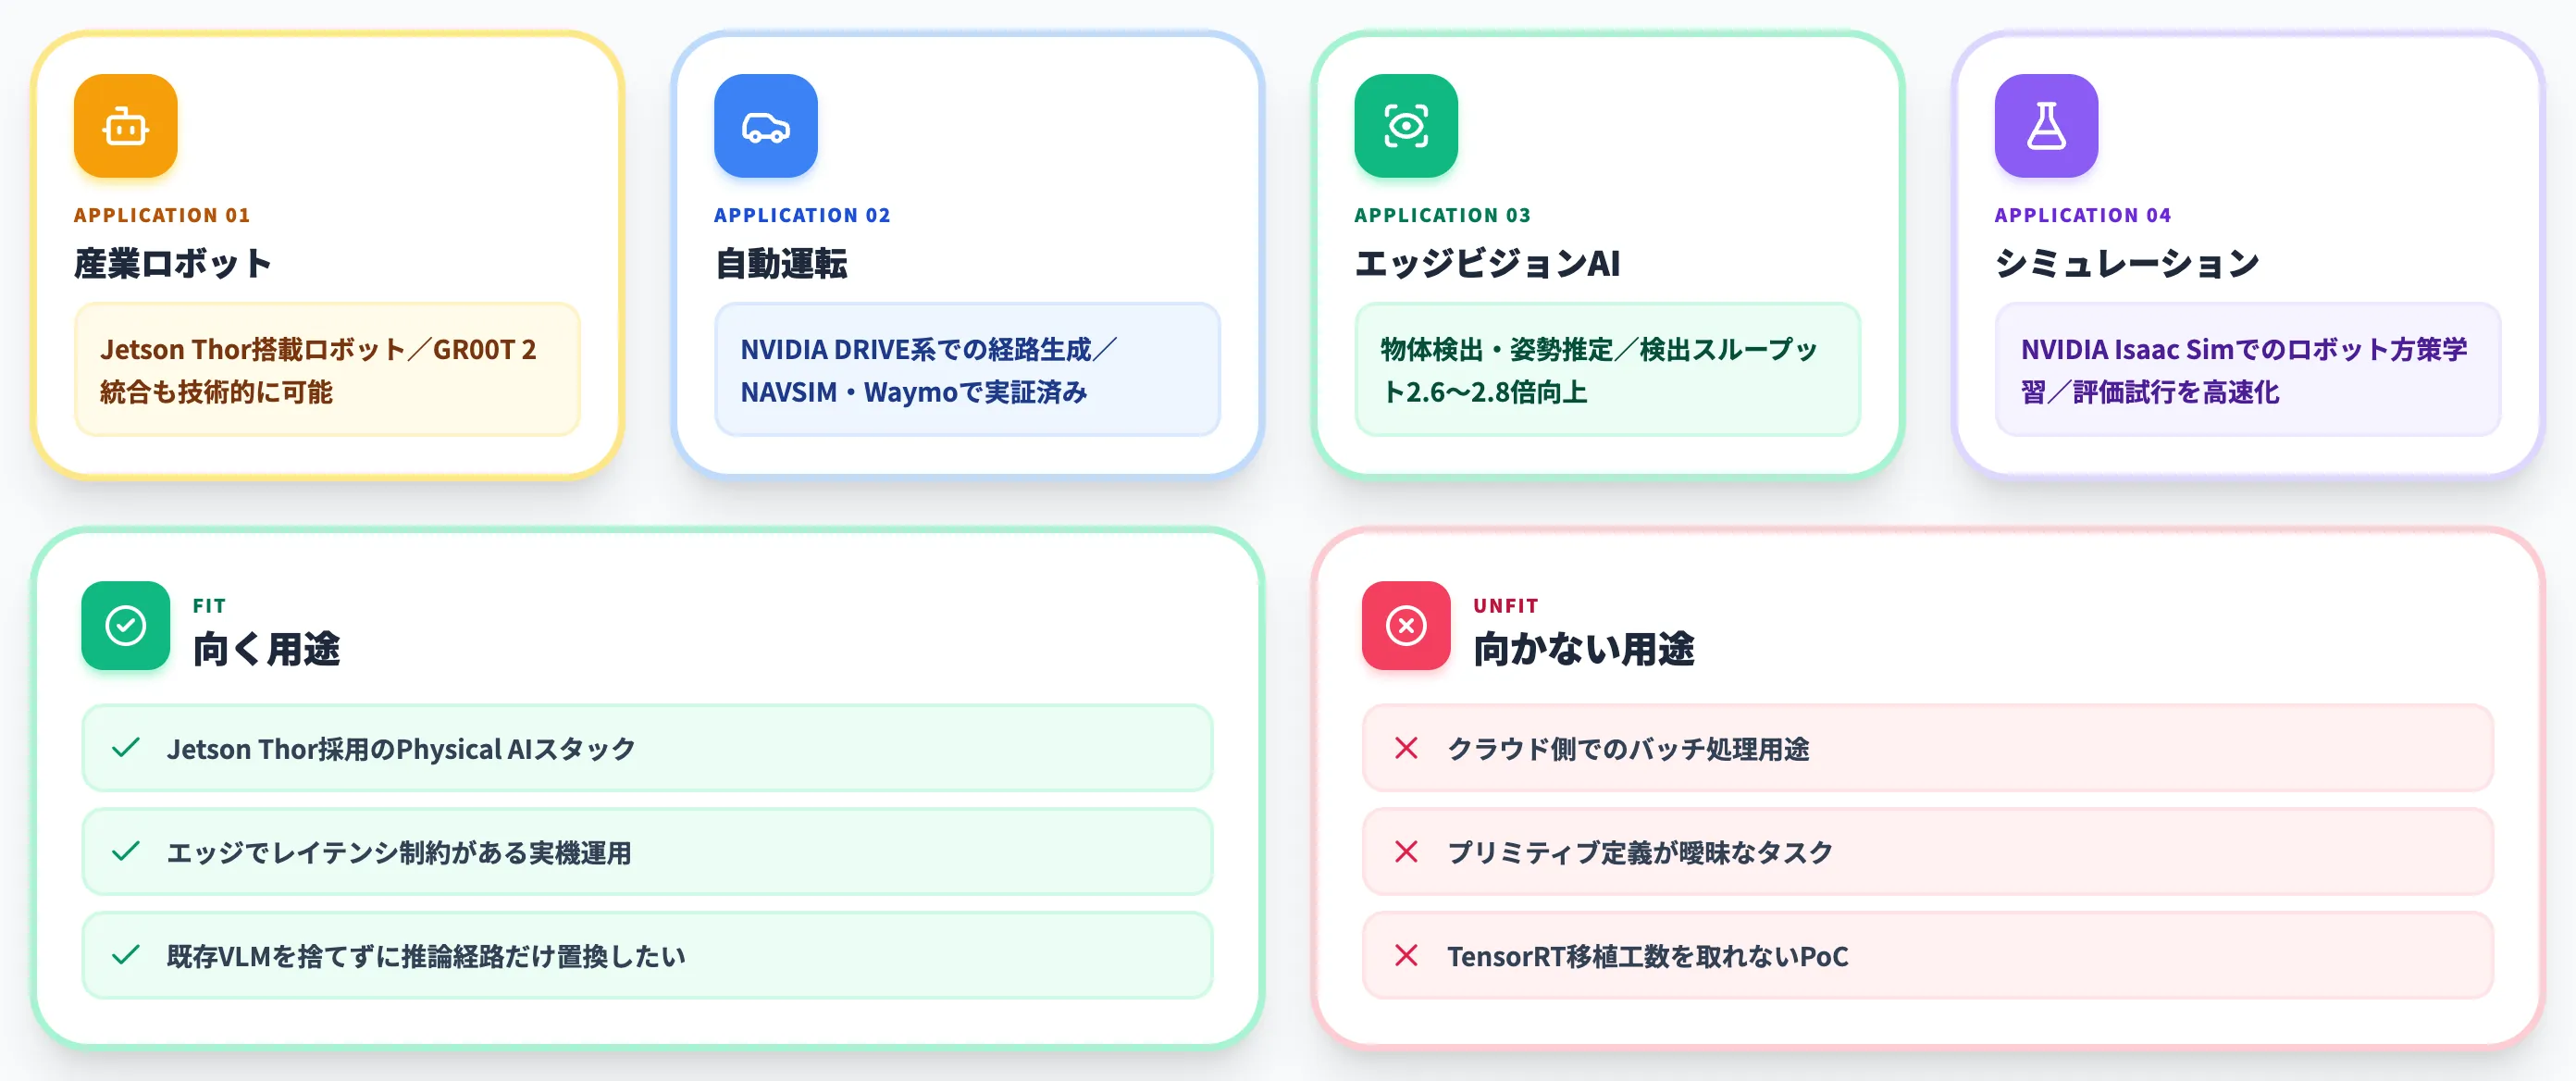
VFlashは研究段階の技術ですが、公開済みの評価結果とハードウェア対応から、応用の見込まれる領域と採用判断の軸は現時点でもかなり具体的に描けます。
本セクションでは、主要な応用分野と、SIer視点で検討すべき導入判断ポイントを整理します。
応用が期待される領域
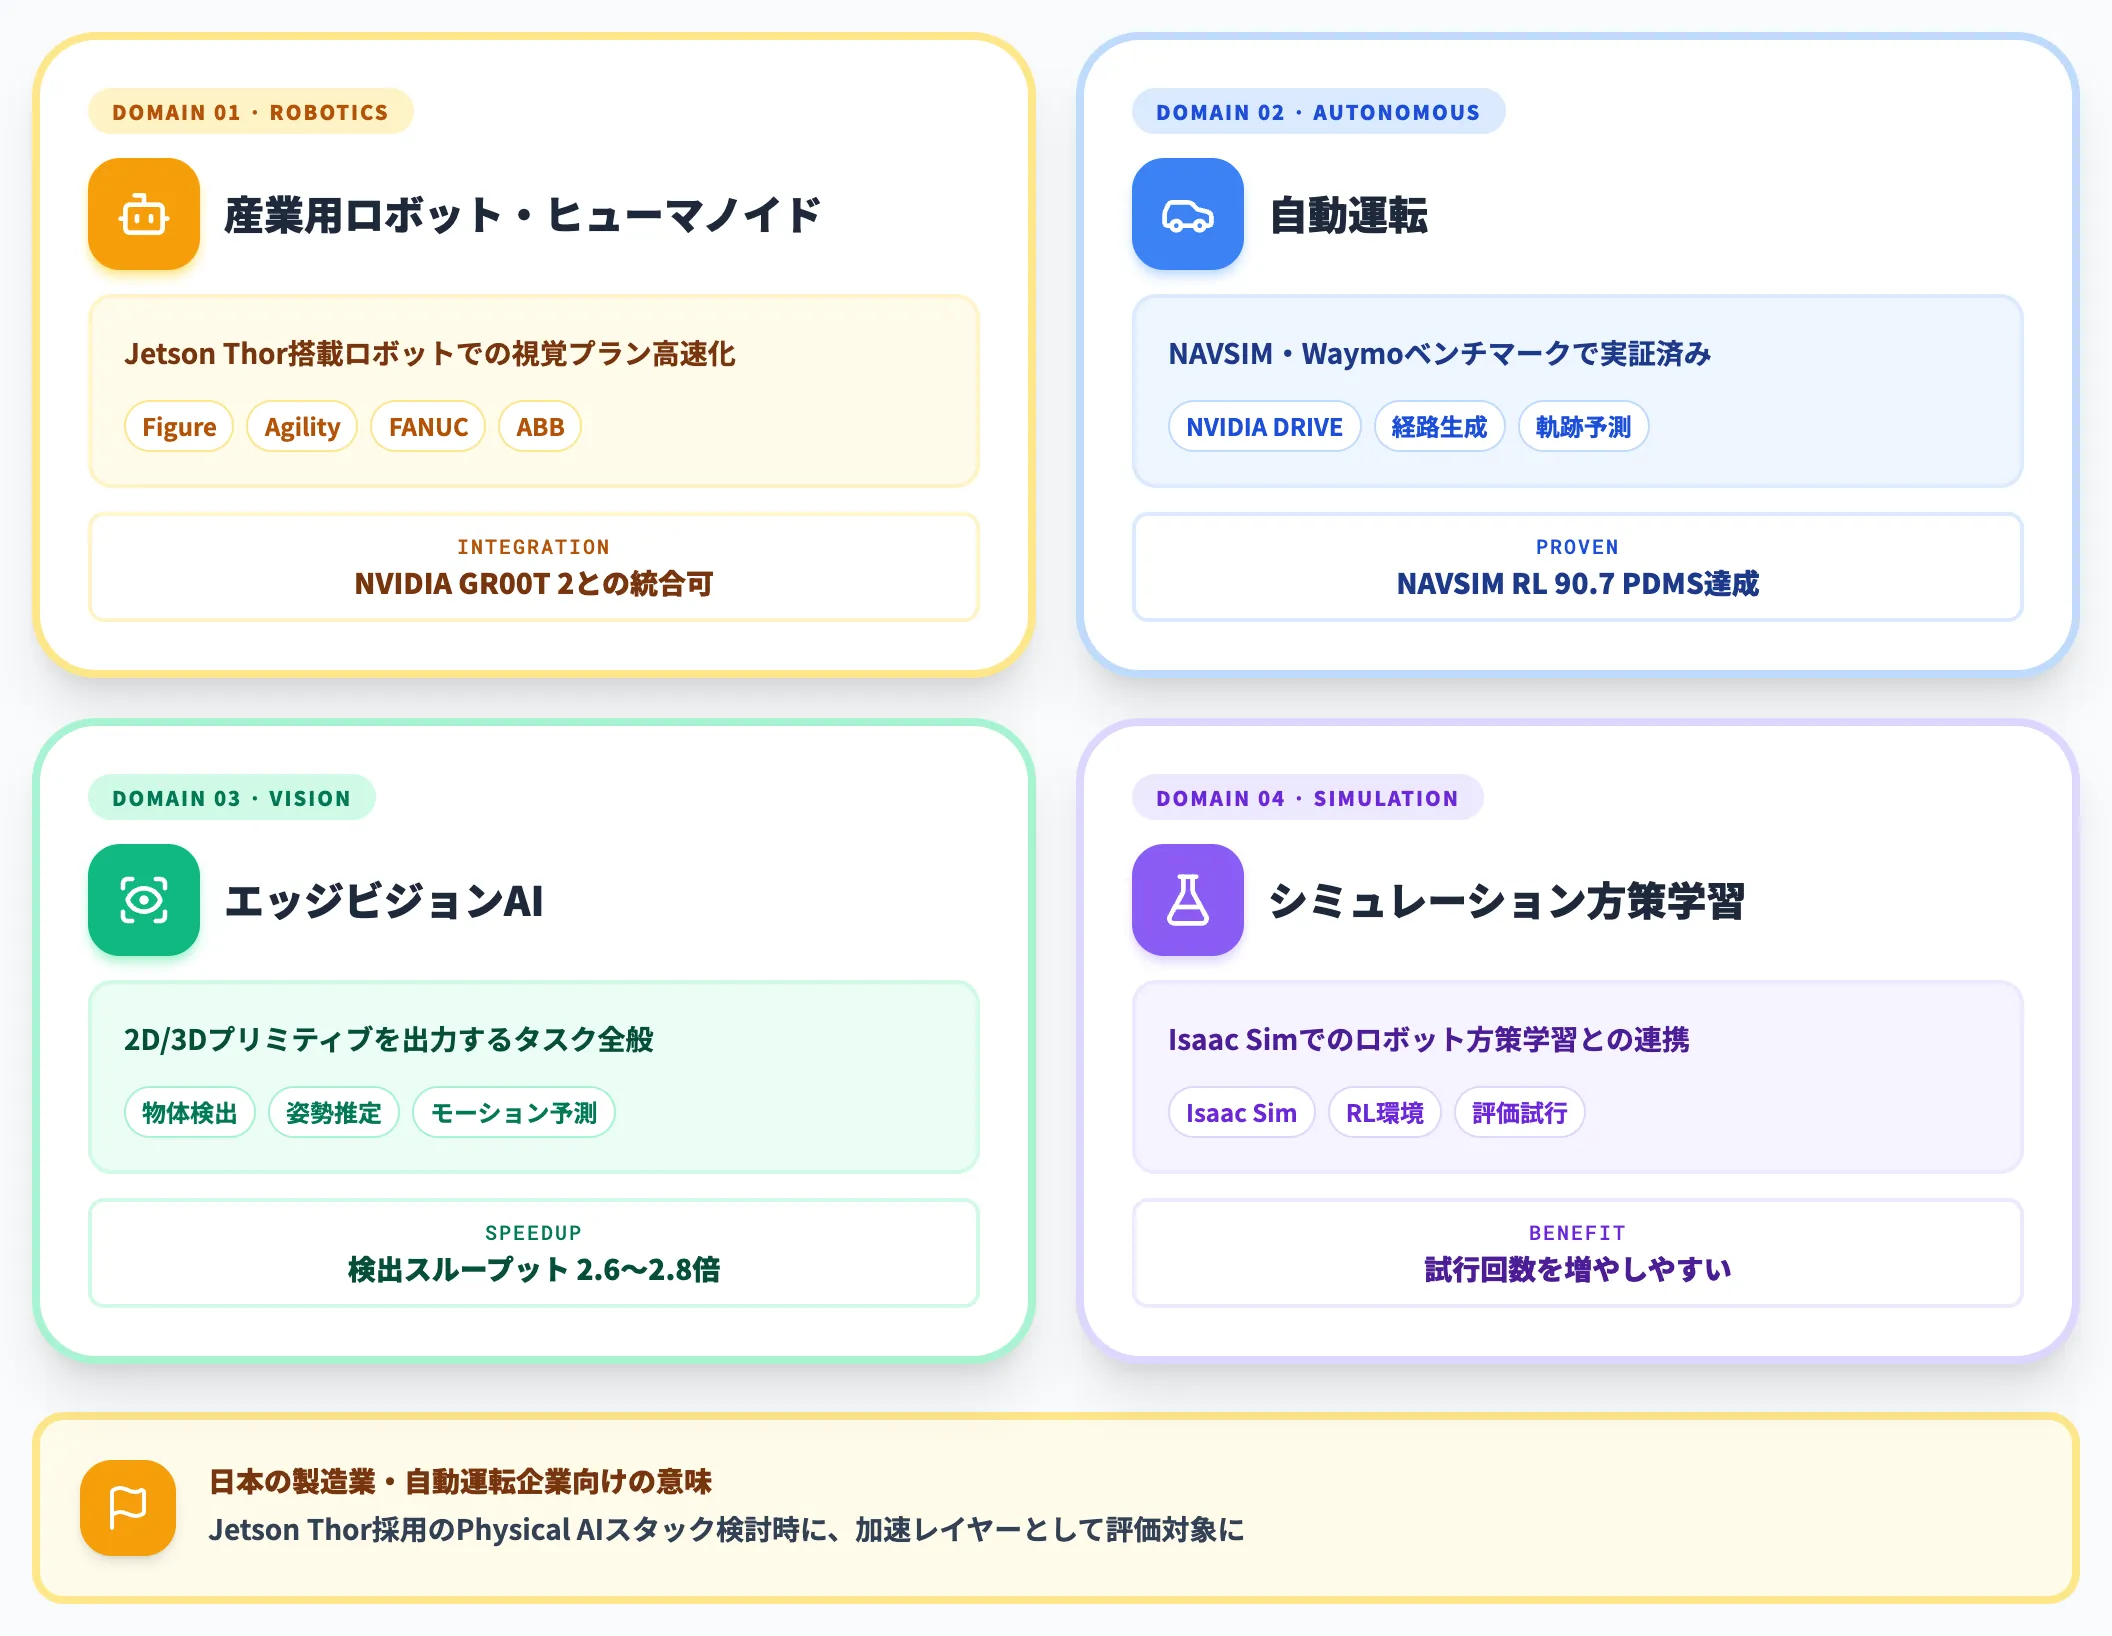
VFlashのアーキテクチャから、応用先は空間的視覚プランを要求するPhysical AIタスク全般に広がります。
-
産業用ロボット・ヒューマノイド
Jetson Thor搭載ロボット(Figure、Agility、FANUC、ABB等のパートナー群)での視覚プラン高速化。NVIDIA GR00T 2のようなヒューマノイド基盤モデルとの統合も技術的に可能
-
自動運転
NAVSIM・Waymoベンチマークで実証済み。NVIDIA DRIVE系プラットフォームでの経路生成の高速化に直接応用できる
-
エッジビジョンAI
物体検出・姿勢推定・モーション予測など、2D/3Dプリミティブを出力するタスク全般。2.6〜2.8倍のオブジェクト検出スループット向上が報告されている
-
シミュレーション環境での方策学習
NVIDIA Isaac Simでのロボット方策学習との連携。高速推論により評価試行回数を増やしやすい
日本の製造業・自動運転企業にとっては、Jetson Thor採用のPhysical AIスタックを検討する際の加速レイヤーとして評価対象になります。
採用判断で詰まる3つの観点
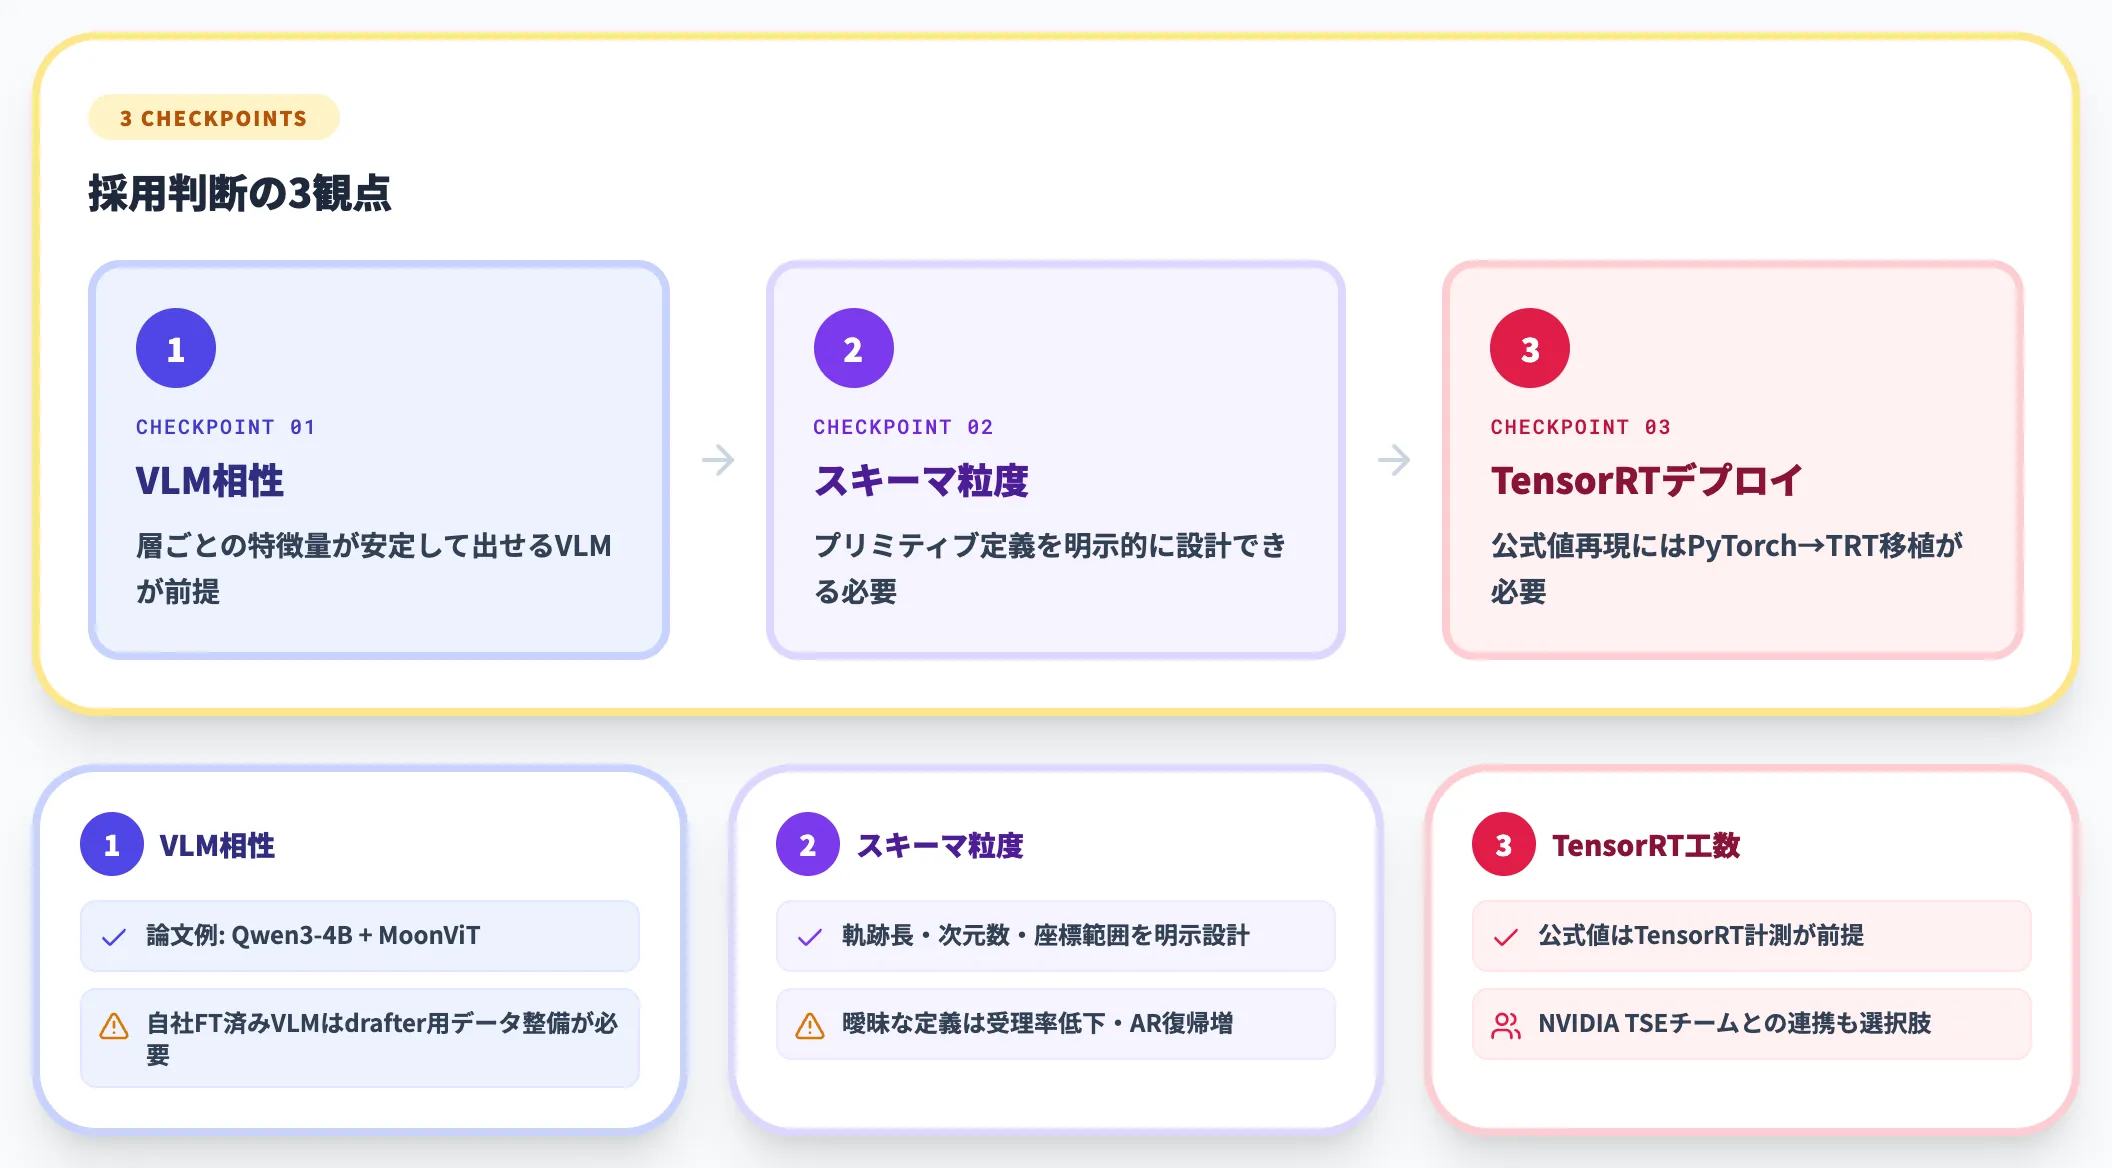
VFlashを自社のPhysical AIスタックに組み込むかを判断する際、実務上で詰まりやすい論点を3つに整理しました。
-
ターゲットVLMとの相性
VFlashはターゲットVLMを凍結してdrafterを後付けする設計のため、既存のVLMが層ごとの特徴量を安定して出せること(論文例ではQwen3-4B + MoonViT)が前提。自社でファインチューン済みの独自VLMを使う場合、drafter学習用のデータ整備が必要になる
-
スキーマ検証の実装粒度
Flash Primitive Decodingの受理基準はスキーマ検証に依存するため、自社タスクのプリミティブ定義(軌跡長・次元数・座標範囲)を明示的に設計できることが導入条件。曖昧なプリミティブ定義のまま入れると、受理率が落ちてフォールバック頻度が増える
-
TensorRTへのデプロイ工数
論文の計測値はTensorRTで取得されているため、公式報告値と同等の性能を再現する場合はPyTorch実装からTensorRTへの移植工数を初期段階で見込む必要がある。公式ではNVIDIA TSEチームの支援が謝辞に記載されており、エンタープライズ導入ではNVIDIAサポートとの連携も選択肢に入る
VFlashで速くする反射的な判断と、記録を読んで時間をかける判断を分ける
VFlashがJetson Thorで3,552.7ミリ秒から703.3ミリ秒に縮めたのは、軌跡やボックスのように答えの形が先に決まっている空間判断で、記事でいうSystem-1の側です。工場でAIに任せたい仕事を並べると、設備をいつ止めて点検するか、部品の仕様変更がどこに響くかのように、図面や過去の記録を読み比べて答えを出す、時間をかけてよい判断が多く残ります。こうした検討は制御周期に間に合わせる必要がなく、エッジのGPUを増やすより、材料になる記録をAIが読める形に整えておくことが鍵になります。
時間をかけて考える側を受け持つのが、図面や設備のデータをOneLakeに集め、品質保証や管理など部門別に用意したテンプレートAgentを、社員がTeamsから使うAI Agent Hubです。
- 点検に入る時期を、異常の予兆から決める
設備の稼働データから異常の予兆を見つけ、ラインを止めて点検するか、次の計画保全まで稼働を続けるかを、テンプレートAgentが見極めます。
- 仕様変更の影響を、関係する図面からたどる
部品の仕様が変わったときは、オントロジーで結んだ図面や部品の関係から、影響の出る範囲とリスクを洗い出します。
- 熟練者の勘どころを、理由ごと若手に渡す
熟練者が日常の業務で積み重ねてきた判断を形式知として蓄積し、若手がTeamsで尋ねると、過去の事例と理由を示します。
AI総合研究所の専任チームが、エッジに置く処理とAgentに回す検討の線引きから、最初のテーマを自社のデータで動かすところまで伴走します。
制御周期の外にある判断をAIで支える

保全や設計変更を図面と記録から考える
VFlashが速くするのは、ロボットや自動運転の制御周期に間に合わせる、反射的な空間判断です。設備の点検時期や仕様変更の影響のように、図面や記録を読み比べて答えを出す検討を受け持つ、部門別のテンプレートAgentの一覧は、AI Agent Hubの製造業向けページにまとめています。
まとめ
本記事では、VFlashを「VLMの視覚プランを並列に生成する、NVIDIA Researchの高速デコーディング手法」として整理し、自己回帰方式の課題・Flash Primitive Decodingの仕組み・ベンチマーク結果・動作環境とコスト・既存手法との違い・採用の判断軸を解説しました。
2026年11月時点で押さえておくべきポイントは次の3つです。
- VFlashはターゲットVLMとのトークン一致を求めず、プリミティブの形式が整っていればdrafterの出力を丸ごと受理する
- 既存のVLA加速手法と違って速度と精度が両立し、空間推論を強く求めるタスクほど成功率の伸びが大きい
- 現時点で公開済みなのは学習と評価のコードまでで、重みは準備中で、そのライセンスは研究・評価目的の非商用利用に限定されている
AI総合研究所が支援してきたPhysical AIの案件に照らすと、VFlashを採用できるかの見通しは、次の2つの作業で立ちます。
まずは、自社のタスクで扱うプリミティブについて、軌跡の長さ・次元数・座標の範囲を書き出し、スキーマ検証で受理を判定できる形に定義します。
続いて、組み合わせるVLMが層ごとの特徴量を安定して出せるかを確かめ、drafterの学習データを用意する手間と、TensorRTへ移植する工数を見込んでおきます。
レイテンシが壁になってPoCから先に進めなかった案件に、手元のVLMを残したまま推論の経路だけを置き換えるという選択肢が加わりました。
VFlashはJetson Thorを積んだロボットや自律搬送機に向く技術で、クラウドでまとめて処理する用途なら、既存のバッチ推論最適化に寄せる方が投資に見合います。