この記事のポイント
 ネオクラウドはAIのGPU計算を中心に設計された業態で、ハイパースケーラーとの単価差は比較ペア次第で1.1〜2.8倍の帯に広がる
- 海外はCoreWeave・Nebius・Lambda・Crusoe・Nscaleが主力で、2026年にMeta・Microsoftとの大型契約が集中
- 日本はソフトバンク・KDDI・さくらが経産省クラウドプログラム認定で先行、ソフトバンクはGB200 NVL72搭載GPUクラウドを10月提供開始
- 学習ワークロードはネオクラウド、本番推論と業務システムはハイパースケーラーに寄せる併用が実務の第一選択
- ベンダーロックイン・SLA・NVIDIAとの循環取引懸念は導入前に経営層レベルで確認すべき論点
Microsoft MVP・AIパートナー。LinkX Japan株式会社 代表取締役。東京工業大学大学院にて自然言語処理・金融工学を研究。NHK放送技術研究所でAI・ブロックチェーンの研究開発に従事し、国際学会・ジャーナルでの発表多数。経営情報学会 優秀賞受賞。シンガポールでWeb3企業を創業後、現在は企業向けAI導入・DX推進を支援。
ネオクラウド(Neocloud)とは、AIワークロード向けにGPU計算を中心に設計された、新興のクラウド事業者カテゴリを指す言葉です。
CoreWeaveの受注残1,040億ドル、NebiusとMetaの最大約270億ドル契約、ソフトバンクのInfrinia AI Cloud OS搭載GPUクラウド(2026年10月提供開始発表)など、2024年末から2026年にかけて業界地図が一気に書き換わりました。
本記事では、ネオクラウドの定義とハイパースケーラーとの違い、技術基盤(ベアメタルGPU・InfiniBand・液冷)、海外・日本の主要事業者、GPU単価比較、選定判断軸、導入前に押さえるべきリスクまで、2026年10月時点の最新情報で体系的に解説します。
目次
ネオクラウドとは?AIワークロードに特化したGPU計算クラウドの総称
ネオクラウドとハイパースケーラーの違い——業態・契約形態・価格の3軸比較
ネオクラウドを支える技術基盤——ベアメタルGPU・InfiniBand・液冷
海外の主要ネオクラウド事業者——CoreWeave・Nebius・Lambda・Crusoe・Nscale
Lambda——Microsoft数十億ドル契約で大型顧客側にも展開
日本のネオクラウド事業者——経産省クラウドプログラム認定7社
ネオクラウドのGPU単価比較——H100・H200・B200・GB200
ネオクラウドを選ぶ場面・選ばない場面——学習と推論の棲み分け
ネオクラウドとは?AIワークロードに特化したGPU計算クラウドの総称
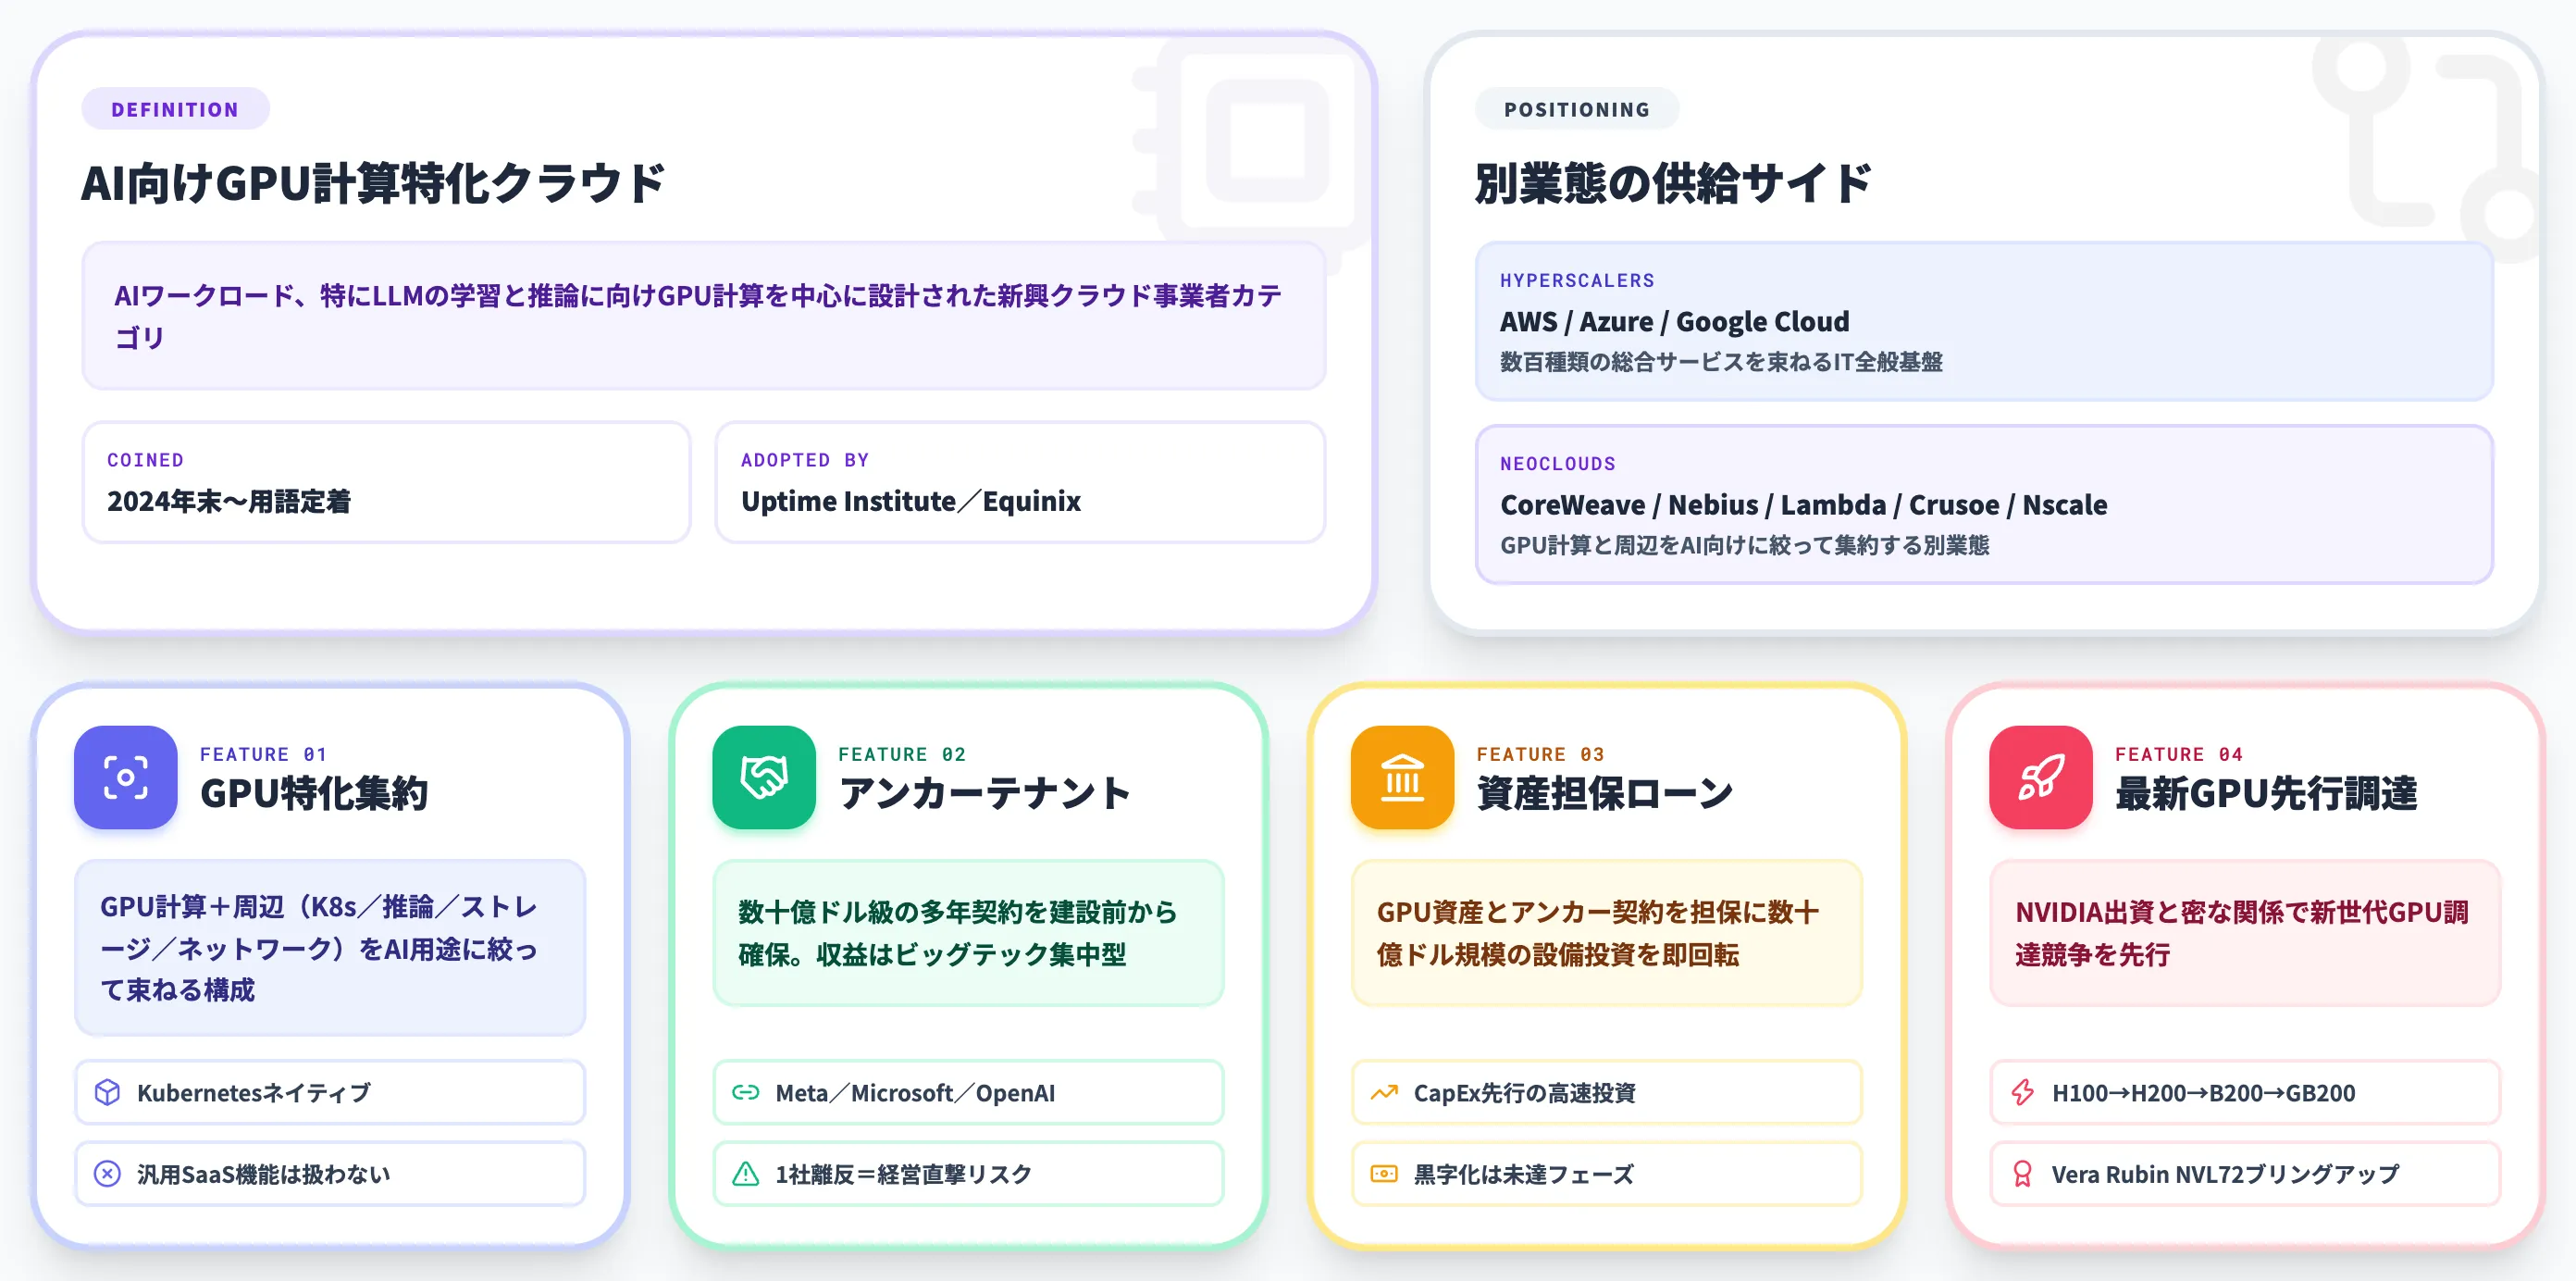
ネオクラウド(Neocloud)とは、AIワークロード、特に大規模言語モデル(LLM)の学習と推論に向けてGPU計算を中心に設計された、新興のクラウド事業者カテゴリを指す言葉です。
用語自体は2024年末ごろから業界で使われ始め、2025年にUptime InstituteやEquinixなどの業界団体・DC事業者が採用したことで一気に定着しました。
CoreWeave・Nebius・Lambda・Crusoe・Nscaleといった海外プレイヤーに加え、日本ではソフトバンク・KDDI・さくらインターネットなどが参入しており、Amazon Web Services・Microsoft Azure・Google Cloudといった既存のハイパースケーラーとは別業態の供給サイドとして扱われます。
AI向けに絞った事業モデル
ネオクラウドが「新しいクラウド」と呼ばれる理由は、サービスの中身ではなく事業モデルの切り口にあります。ハイパースケーラーが数百種類のサービスを総合提供するのに対し、ネオクラウドはGPU計算と周辺(Kubernetes環境・推論サービス・ストレージ・ネットワーク)をAI向けに絞って集約し、アンカーテナントとの長期契約と資産担保ローンで建設・運用するという、まったく異なる経済モデルを持ちます。CoreWeaveのようにサーバレス推論・モデル開発ツール・監視機能まで拡張している事業者も出ています。
ネオクラウドとハイパースケーラーの違い——業態・契約形態・価格の3軸比較
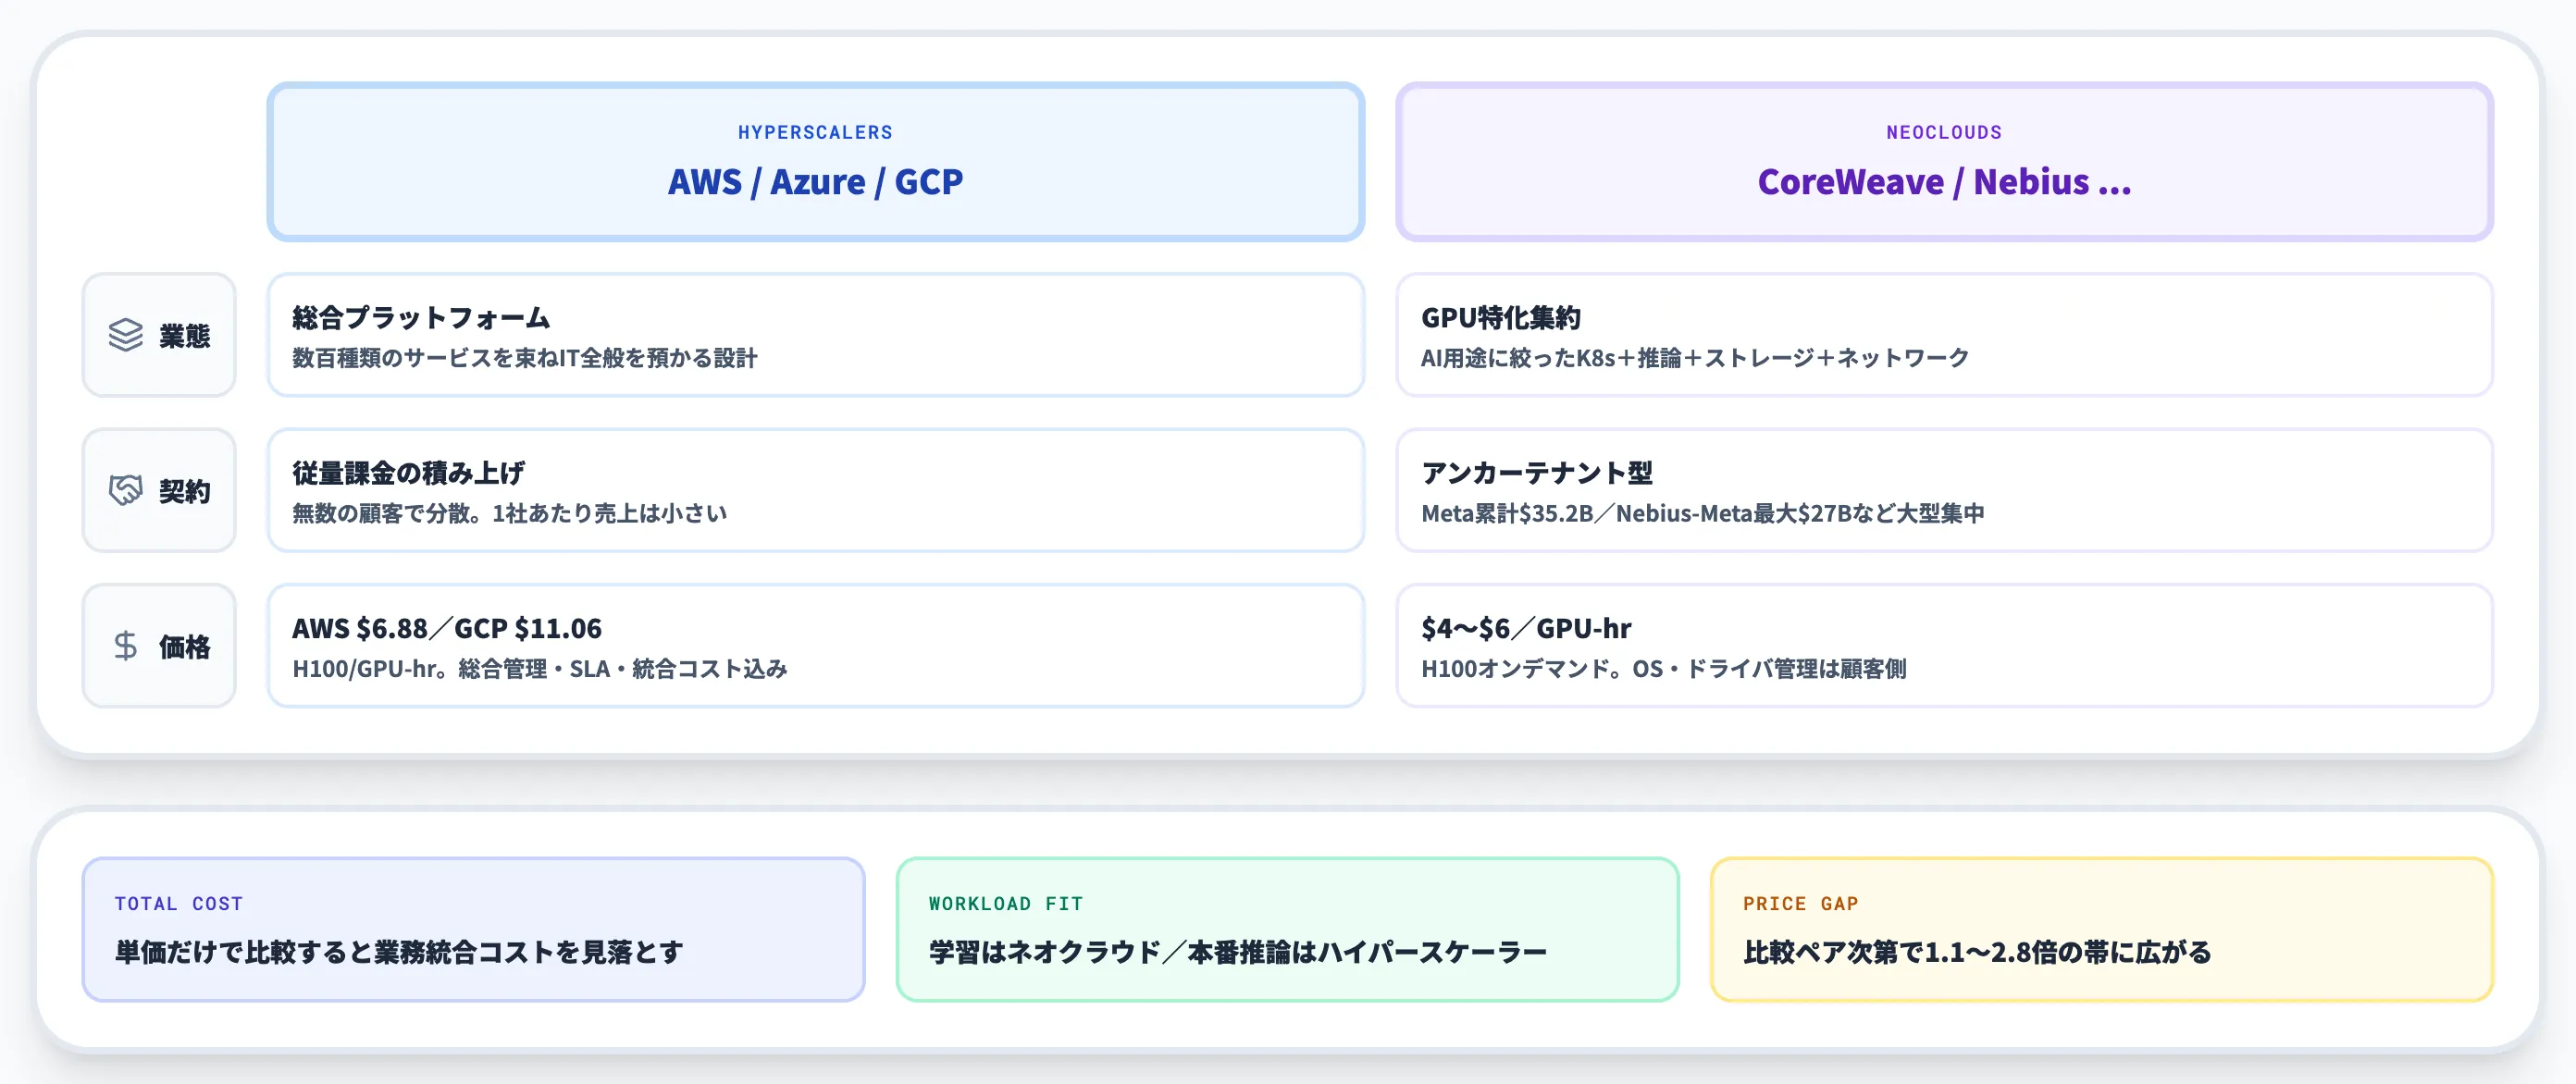
ネオクラウドとハイパースケーラーの違いは、「どちらが優れているか」ではなく「どういうワークロードに向くか」で見るのが実務的です。
本セクションでは、業態・契約形態・価格の3軸で両者を整理し、どのレイヤーが決定的に異なるのかを明らかにします。
業態の違い——総合プラットフォーム vs 単品特化
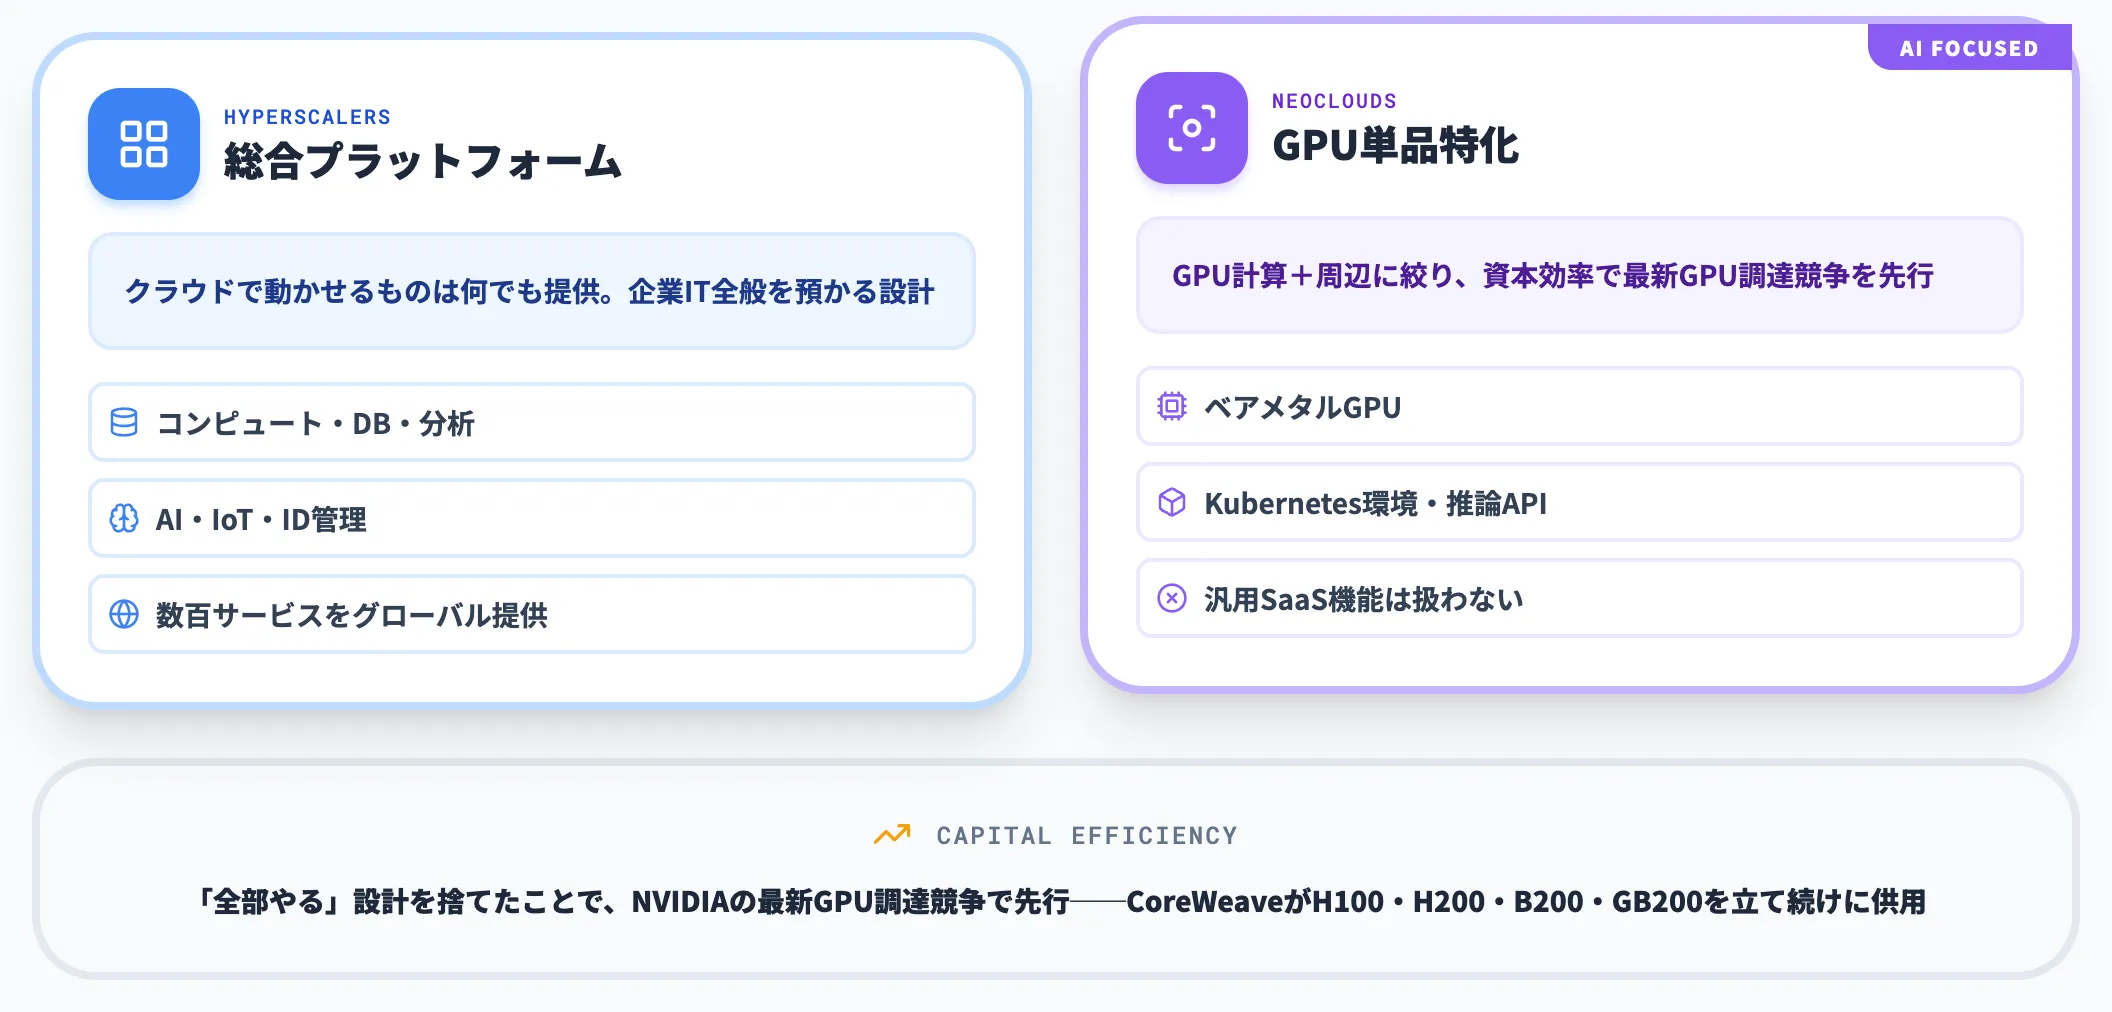
ハイパースケーラーは「クラウドで動かせるものは何でも提供する」総合プラットフォームです。コンピューティング・データベース・分析・AI・IoT・ネットワーク・ID管理など、数百のサービスを束ねて企業のIT全般を預かる設計です。
一方、ネオクラウドが提供するのはGPU計算を中心に、Kubernetes環境・推論サービス・ストレージ・ネットワークをAI用途に絞って束ねた構成です。
社内ID基盤・業務SaaS・サーバレス関数のような汎用クラウド機能は原則として扱いません(CoreWeave等は推論・モデル開発ツール等までカバーを広げていますが、総合プラットフォームと呼ぶ段階ではありません)。
この違いは、スタートアップの資本効率にそのまま反映されます。CoreWeaveはNVIDIAからの出資と資産担保ローン、長期顧客契約を組み合わせて、最新GPU世代の調達と稼働開始を速いサイクルで回しており、「全部やる」設計を捨てたことでNVIDIAの最新GPUの調達競争で先行してきました。
契約形態の違い——オンデマンド vs アンカーテナント型
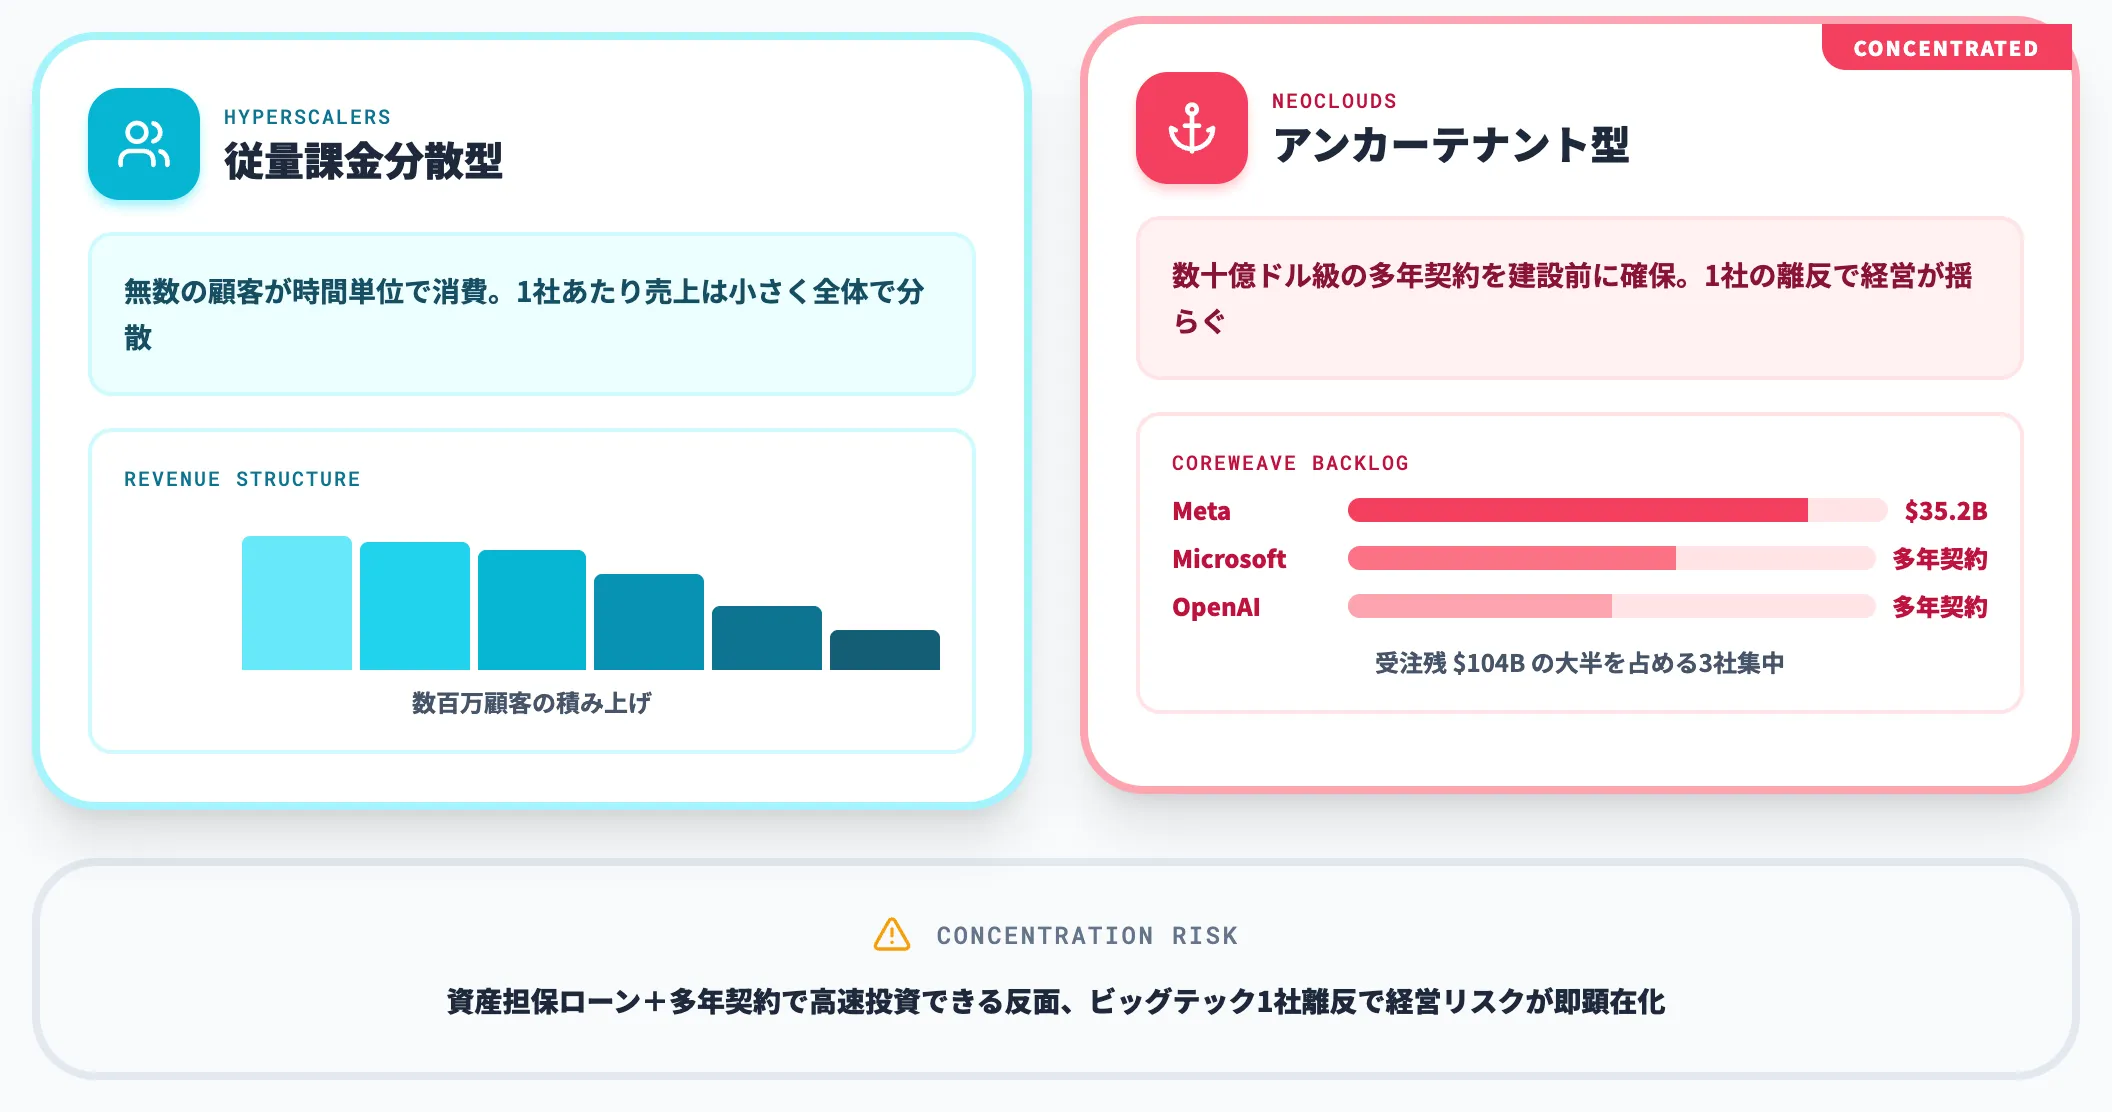
ハイパースケーラーのクラウド収益は、無数の顧客による従量課金の積み上げで成り立ちます。1顧客あたりの売上は小さく、全体で分散しています。
ネオクラウドの収益構造はこれとまったく違います。CoreWeaveの受注残1,040億ドル(2026年6月末時点)のうち、Microsoft・Meta・OpenAIの3社が大きな比率を占めると報告されており、Metaだけでも累計352億ドル(2026年4月9日に発表された210億ドル規模の拡張を含む)が同社と結ばれています。
Nebiusも2026年3月に発表されたMetaとの最大約270億ドル契約(120億ドルの専用容量+追加約150億ドルを5年間)で、売上の中核が大型アンカーテナントに偏る典型的な構造です。
このアンカーテナント型は、建設前から巨大顧客の多年契約が確保されているため、資産担保ローンで数十億ドル規模の設備投資を即座に回せる反面、1社の離反で経営が揺らぐ顧客集中リスクを常に抱えます。
価格の違い——オンデマンドGPU単価の帯
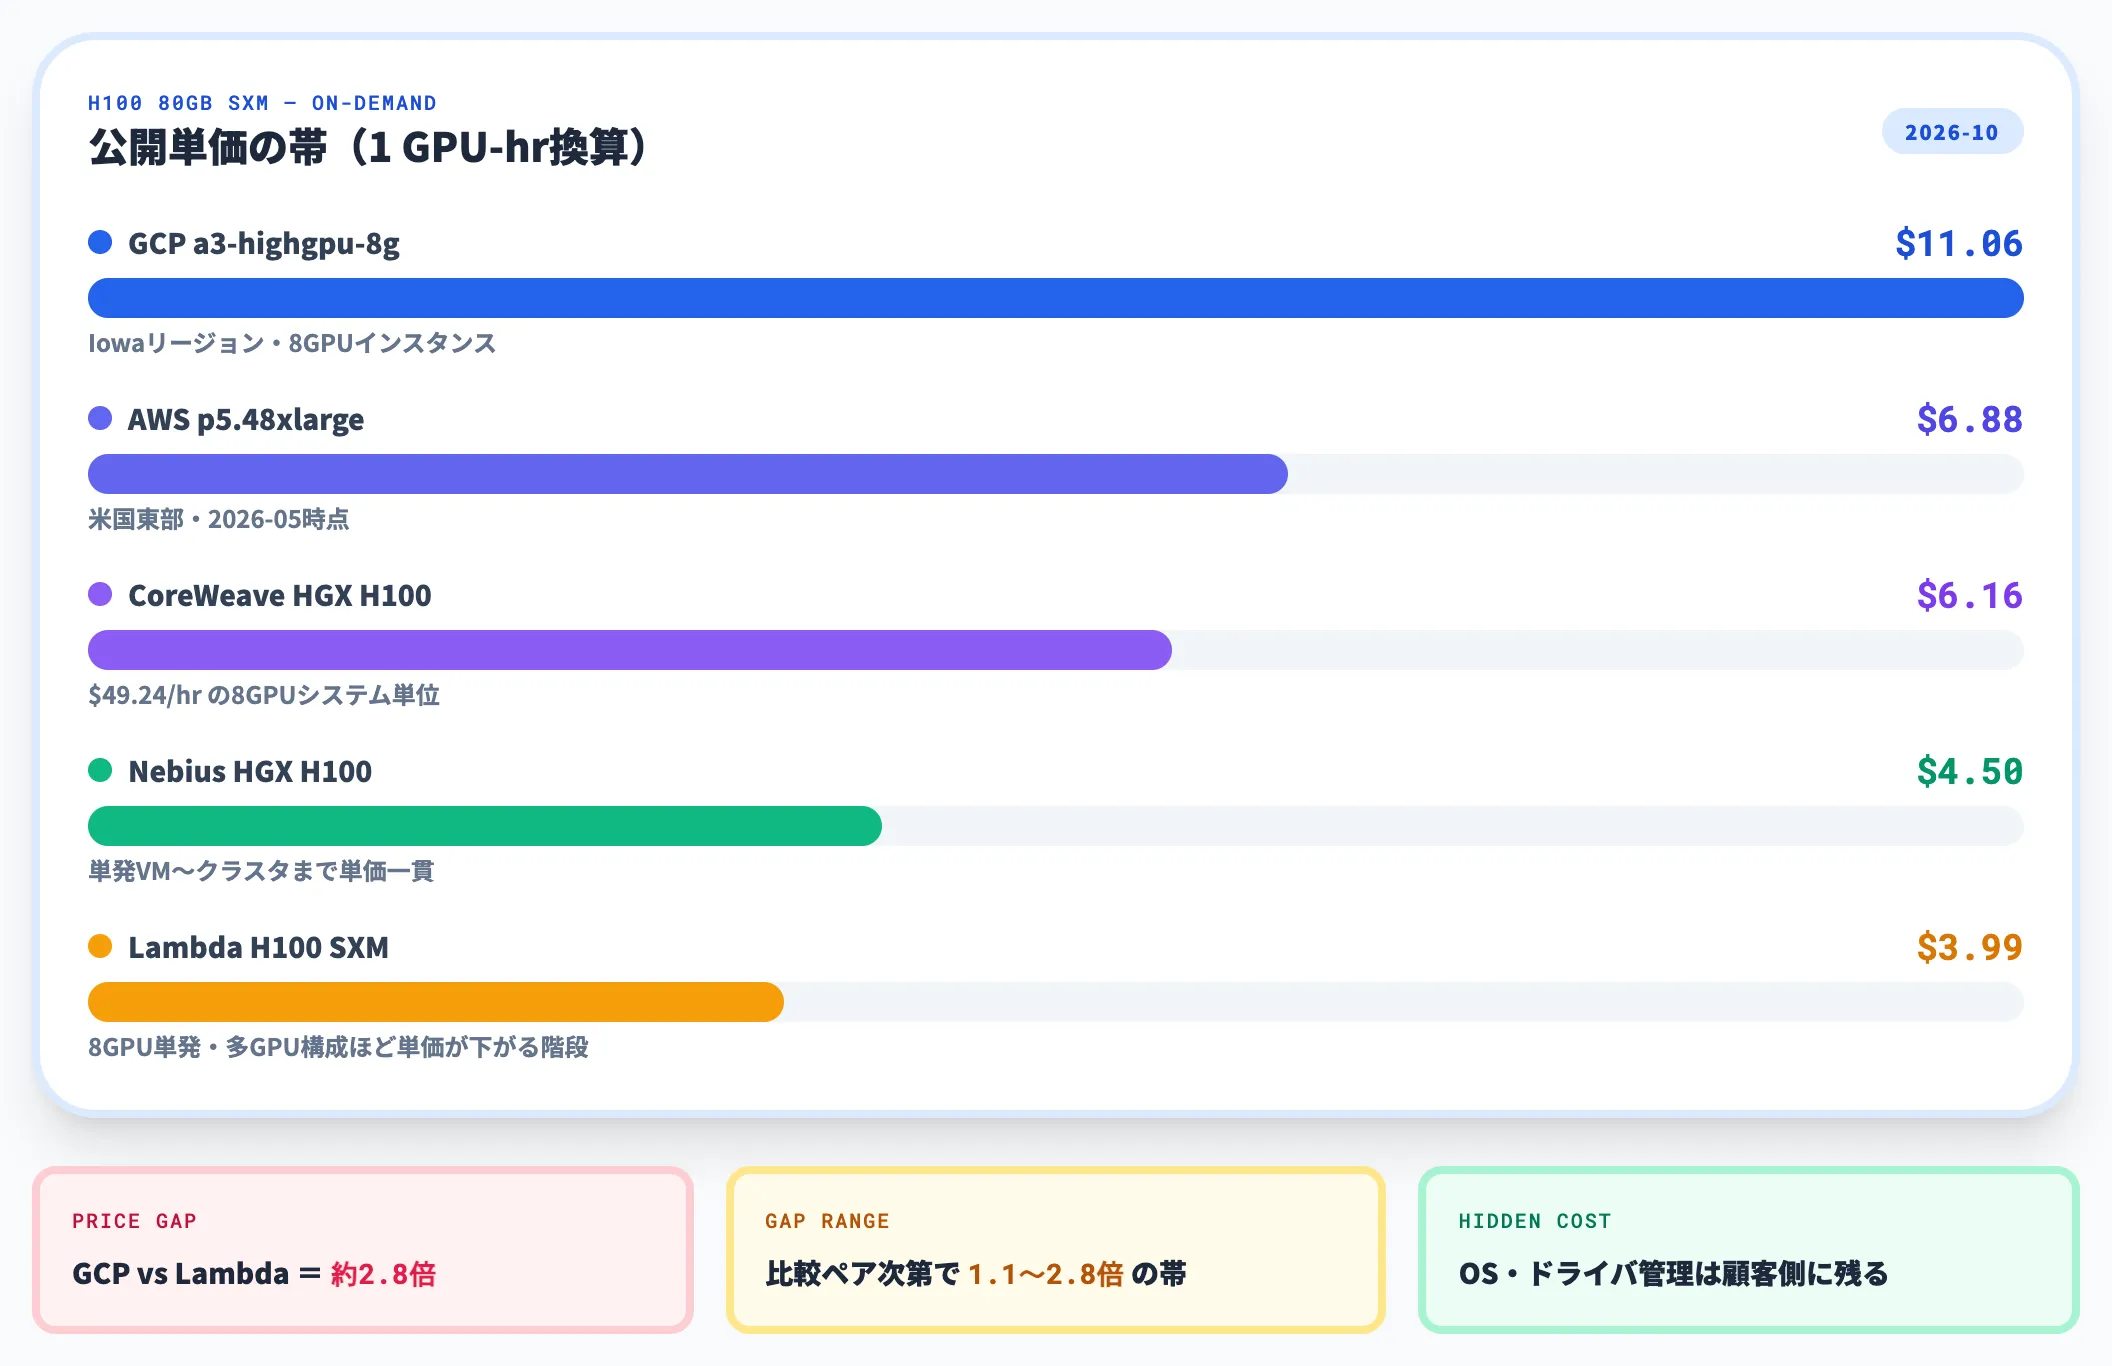
実運用で最も意識されるのが、オンデマンドGPU単価の差です。以下の表で、同一GPU構成におけるハイパースケーラーとネオクラウドの代表的な公開単価(2026年10月時点)を整理しました。
| GPU構成 | ハイパースケーラー代表価格 | ネオクラウド代表価格 |
|---|---|---|
| NVIDIA H100 80GB SXM(オンデマンド) | AWS p5.48xlarge 約$6.88/GCP a3-highgpu-8g 約$11.06/GPU-hr | $4〜$6/GPU-hr |
| NVIDIA H200 141GB(オンデマンド) | $10〜$14/GPU-hr | $5〜$6.5/GPU-hr |
| NVIDIA B200 180GB(オンデマンド) | 公開限定 | $6.7〜$9/GPU-hr |
| NVIDIA GB200 NVL72 | AWS P6e-GB200 Capacity Blocks(予約)約$10.58/Azure ND GB200 v6(従量)約$27.04/GPU-hr | $10.5/GPU-hr〜($42/hrの4GPUインスタンス換算) |
価格差は構成・リージョン・契約条件で大きく振れます。H100 8GPUインスタンスのオンデマンド公開単価を揃えて比較すると、GCP a3-highgpu-8g(Iowa)が約$88.49/hr=約$11.06/GPU-hr、AWS p5.48xlarge(米国東部・2026-05時点)が約$6.88/GPU-hr。
これに対しCoreWeave HGX H100は$49.24/hr=約$6.16/GPU-hr、Nebius HGX H100は$4.50/GPU-hr、Lambda H100 SXMは8GPU単発$3.99/GPU-hr。ハイパースケーラーの最安AWSとネオクラウドのCoreWeaveを並べればほぼ横並び、GCPとLambdaなら約2.8倍と、比較ペア次第で1.1〜2.8倍の帯に広がります。
2025年2月時点のUptime Institute分析(DGX H100 1システム:ハイパースケーラー約$98/hr・ネオクラウド約$34/hr=約3倍差)と比べると、ハイパースケーラー側のSpot/Reserved整備で比較条件によっては差が縮む場面も出てきています。
ネオクラウドを支える技術基盤——ベアメタルGPU・InfiniBand・液冷
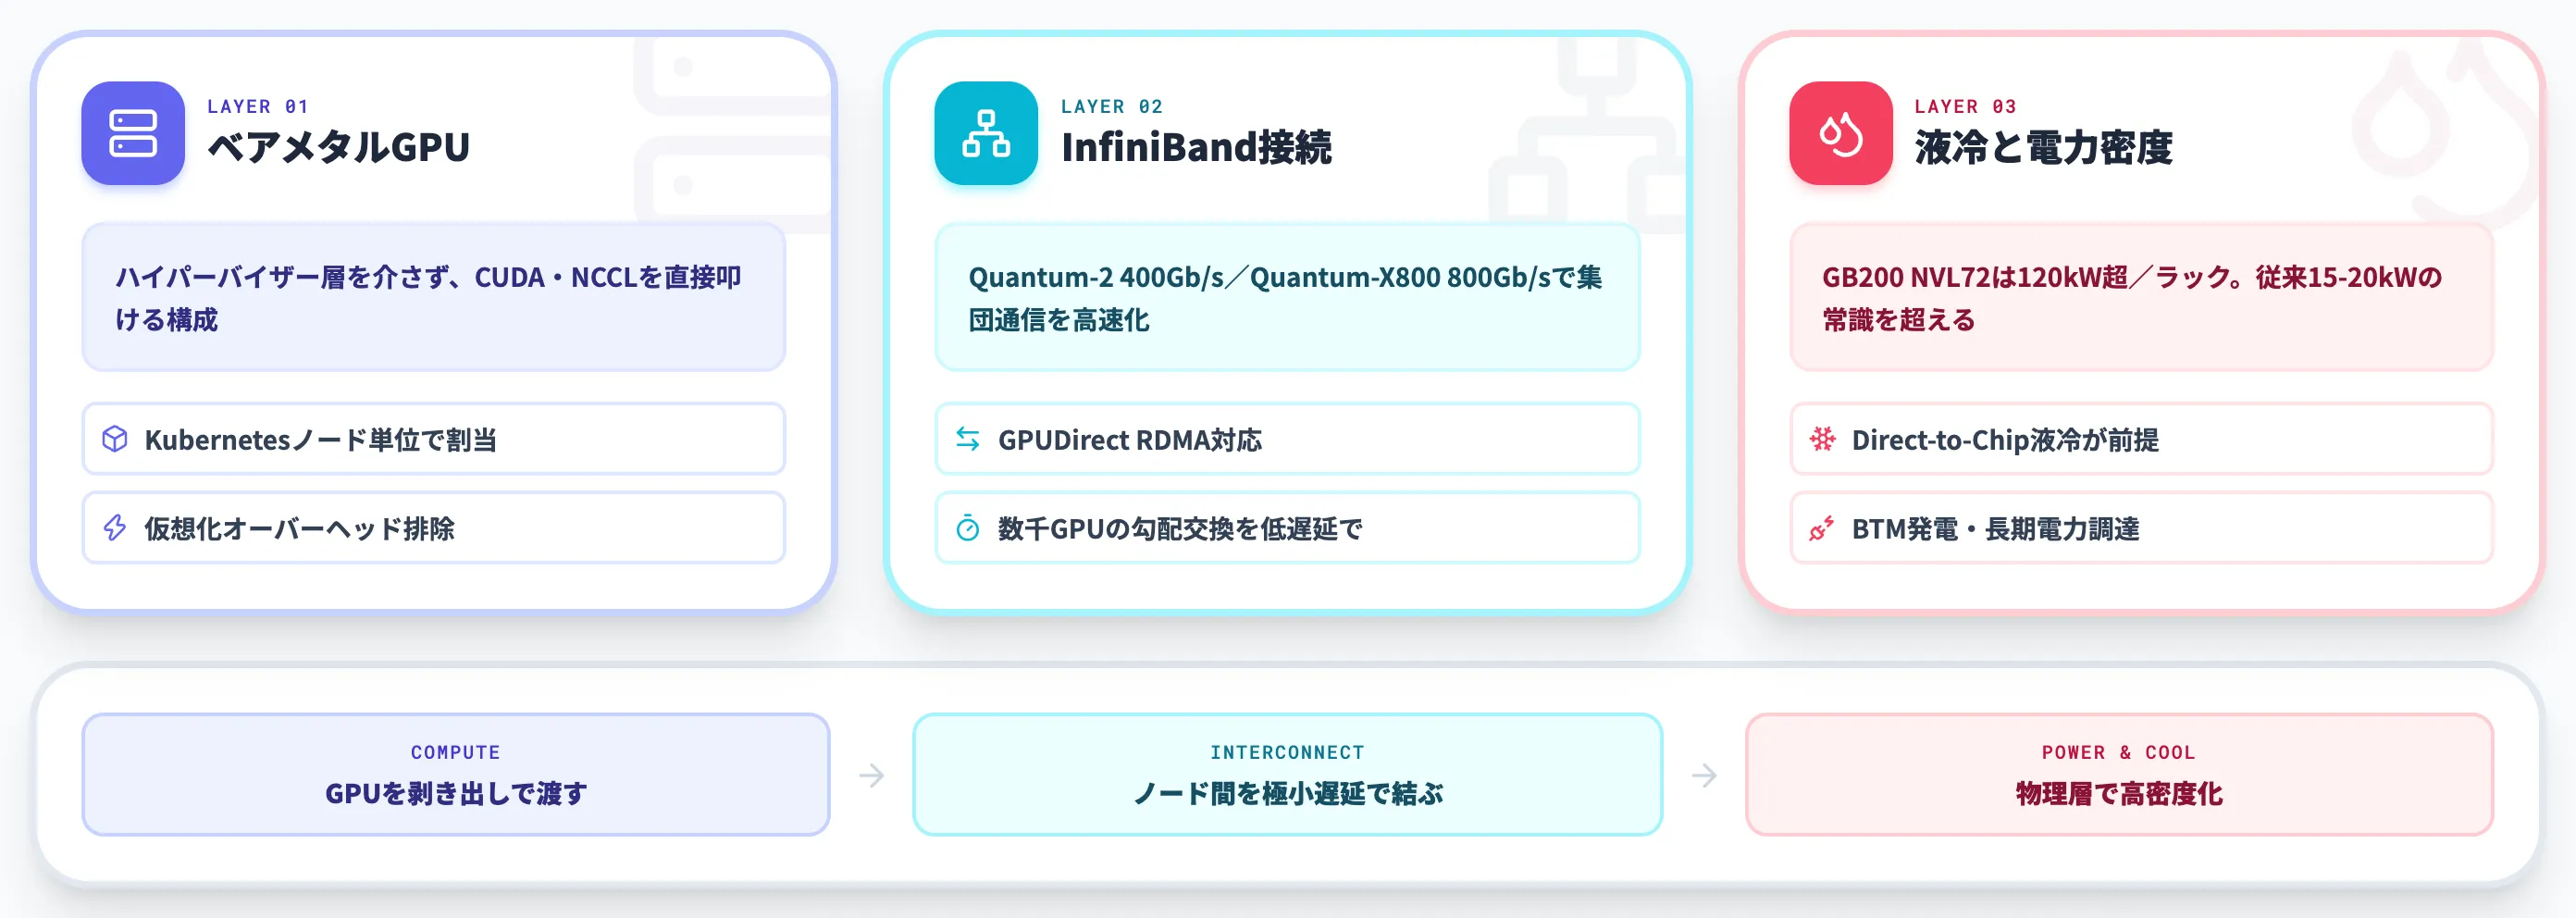
ハイパースケーラーより安い単価を成立させているのは、「GPU計算に絞って集約する」という事業設計だけではありません。
AI学習・推論に最適化された物理層の設計選択が、価格差を支えるもう一つの要因です。
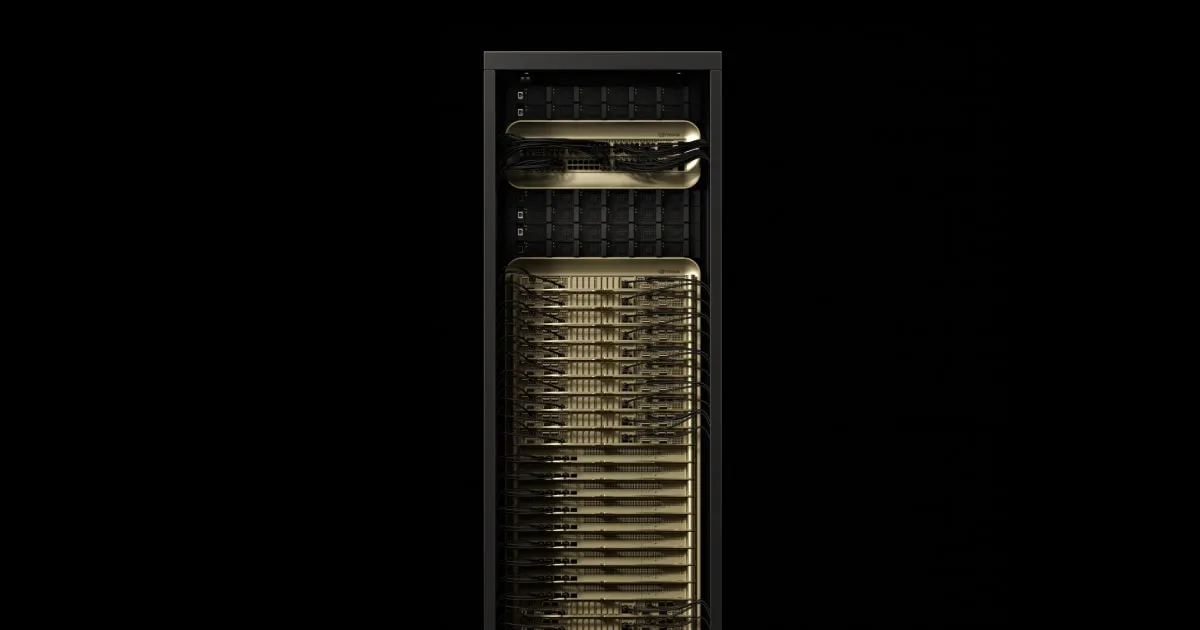
NVIDIA GB200 NVL72ラック——液冷配管前提の最新GPU構成(出典:NVIDIA)
ベアメタルGPUとKubernetesによる割り当て
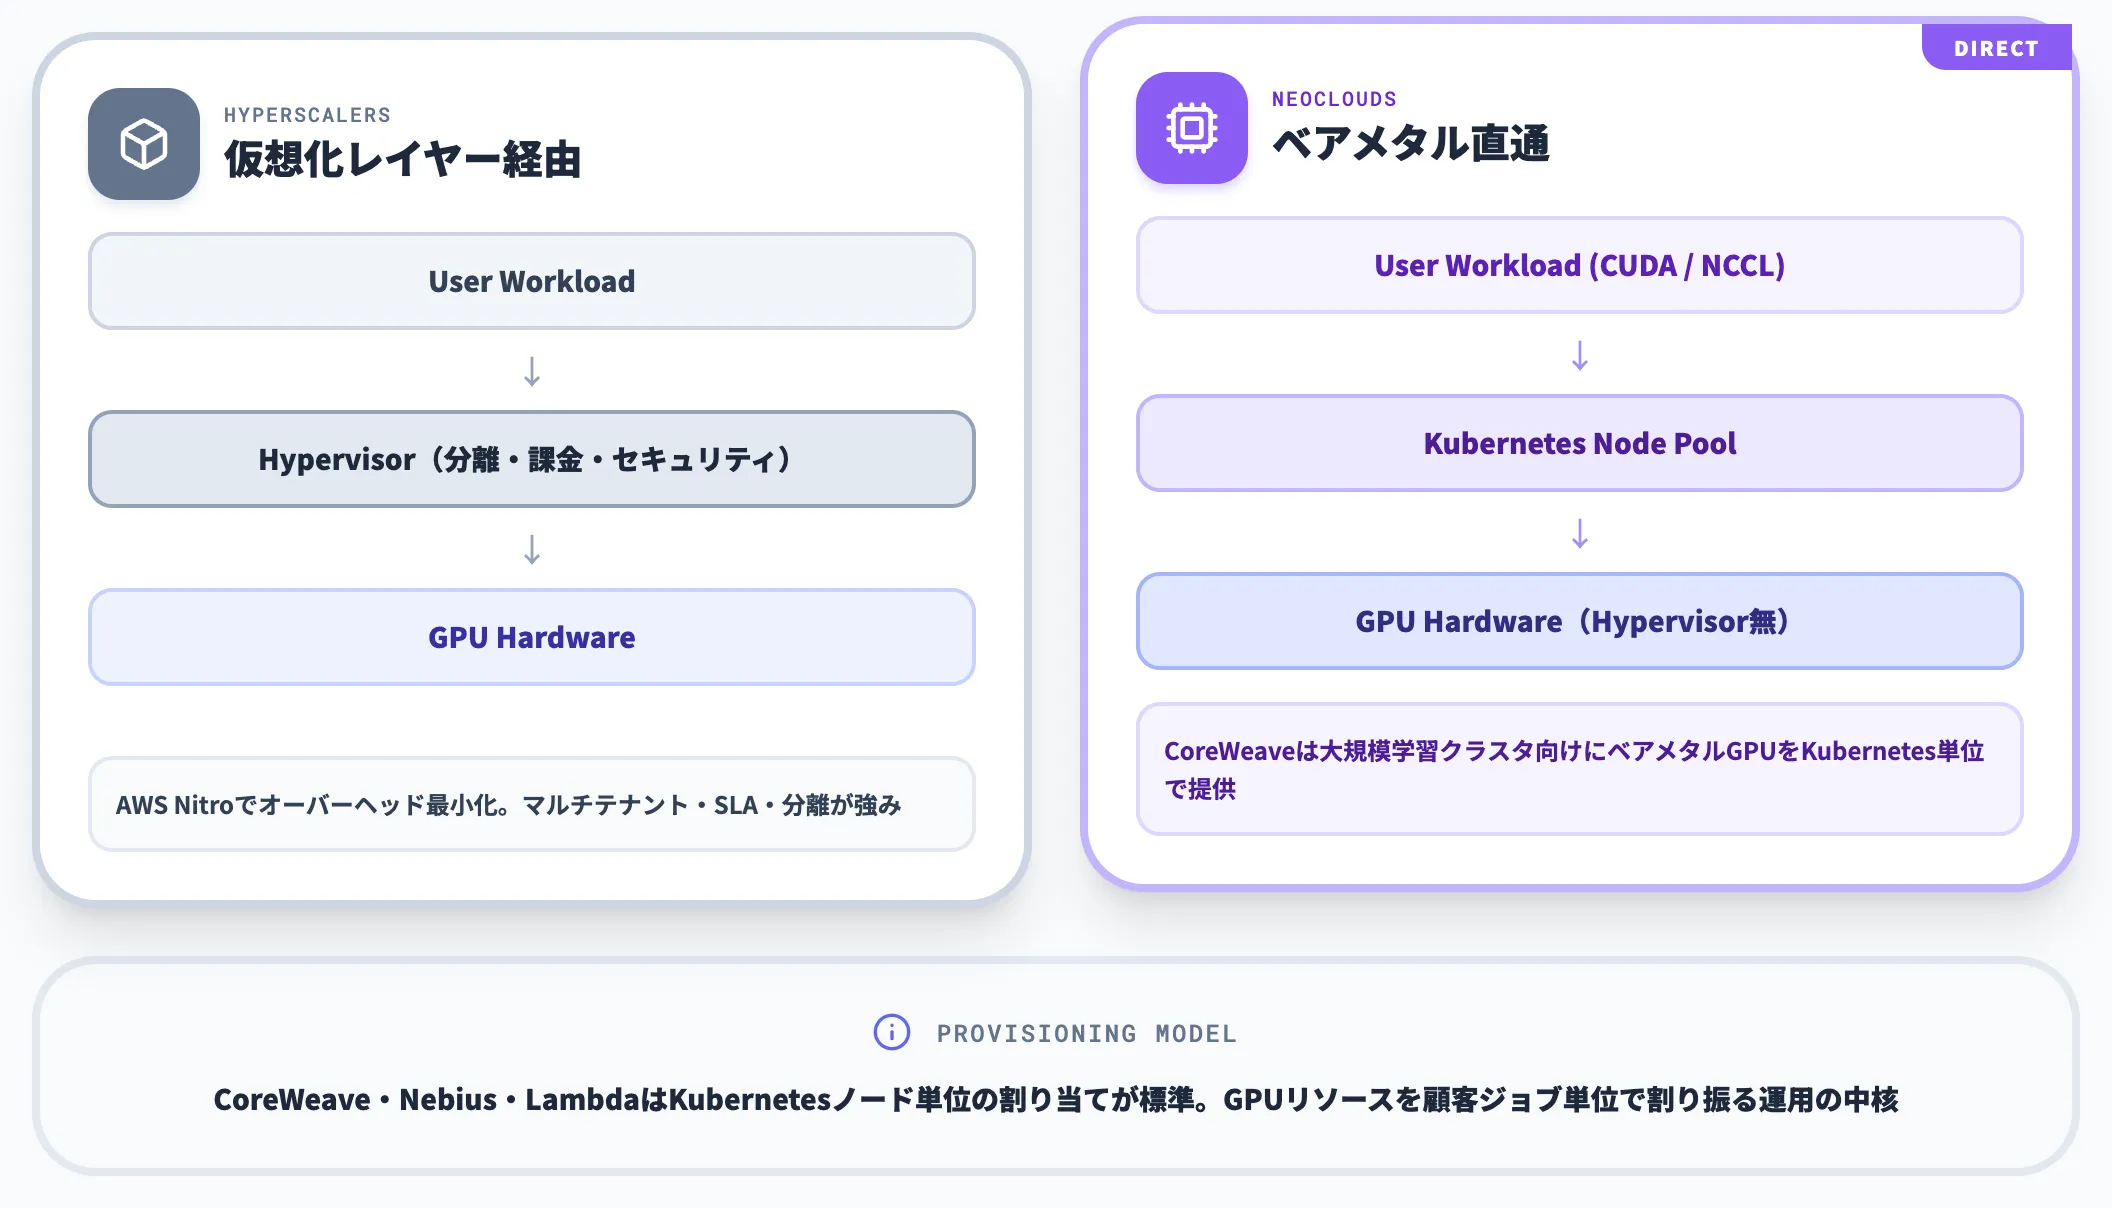
ハイパースケーラーが提供するGPUインスタンスは、仮想化レイヤー(ハイパーバイザー)を介するものが多く、マルチテナント運用・課金管理・セキュリティ分離を担保しています。
AWSはNitro Systemでハイパーバイザー層のオーバーヘッドを最小化しているものの、ベアメタル提供とVM提供では構成要件が異なります。
ネオクラウド側はベンダーごとに提供形態が分かれます。CoreWeaveは大規模学習クラスタ向けにベアメタルGPUをKubernetes単位で提供し、ハイパーバイザー層を介さずにCUDA・NCCLを叩ける構成を取っています。NebiusはVM中心のCompute製品を標準としつつ、大規模ワークロード向けには仮想化オーバーヘッドを抑えた構成を用意しています。Lambdaも1-Click ClustersでGPUノード単位の確保が可能です。
Kubernetesによるノード割り当ては、CoreWeave・Nebius・Lambdaのいずれも採用している標準的な作法で、GPUリソースを顧客ジョブ単位に割り振る運用の中核になっています。
InfiniBandによるノード間接続とRDMA
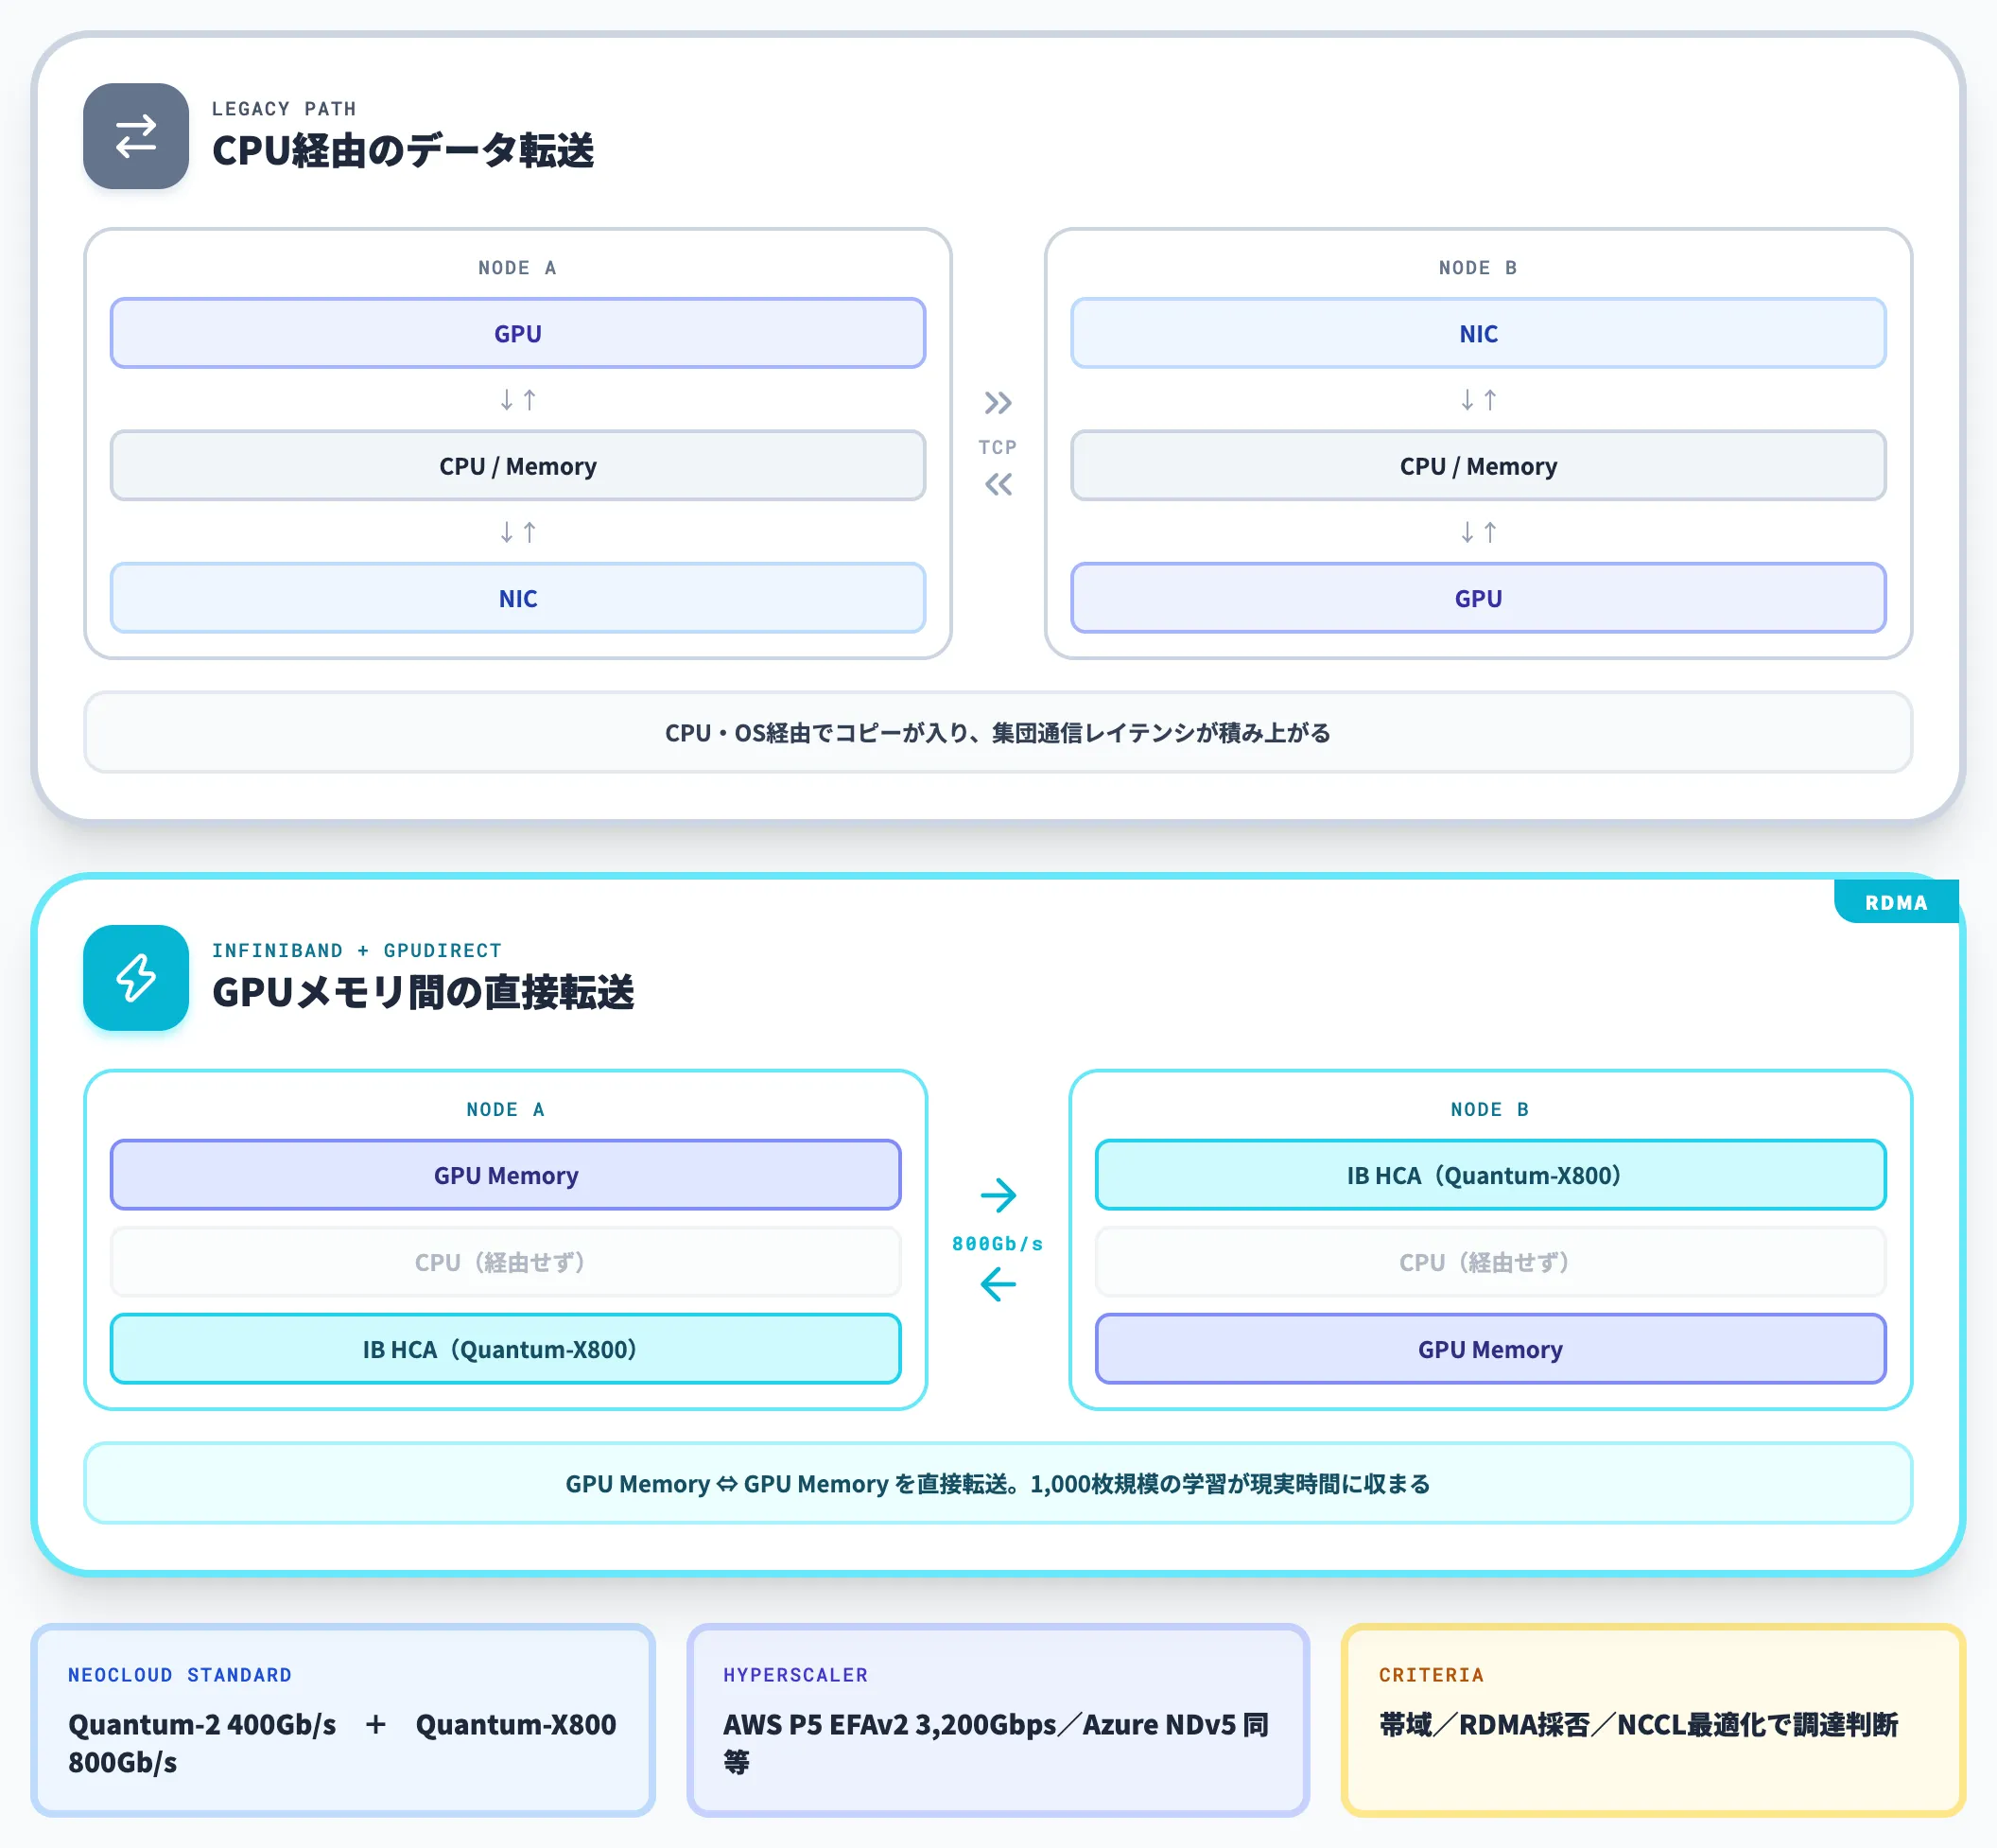
LLMの学習は、数百〜数千枚のGPUを束ねて1つのジョブとして動かします。このときGPU同士が勾配を交換する集団通信のスピードが、学習時間を直接左右します。
ネオクラウドはNVIDIA Quantum-2 InfiniBand 400Gb/sや、次世代のNVIDIA Quantum-X800 800Gb/sを採用したクラスタを前提にすることが多く、低レイテンシの集団通信が実現しやすい設計です。
ハイパースケーラー側もAWS P5インスタンスがEFAv2でノードあたり3,200Gbps、Azure NDv5が同程度の構成を提供しており、「ネオクラウド=高速ネットワーク、ハイパースケーラー=遅い」という一括区分は成り立ちません。
InfiniBandはRDMA(Remote Direct Memory Access)に対応しており、GPUDirect RDMA等の対応ドライバ・ライブラリを前提に、CPUを経由せずにGPUメモリ間で直接データを転送できます。1,000枚規模の学習クラスタでは学習時間がそのまま費用に跳ね返るため、ノード間帯域・RDMAの採否・集団通信ライブラリ(NCCL)の最適化状況が調達判断に効いてきます。
NVIDIAのInfiniBand系ネットワークは世代更新が速く、ネオクラウドは最新世代の採用スピードで優位を取るケースが多く見られます。
液冷と電力密度の壁
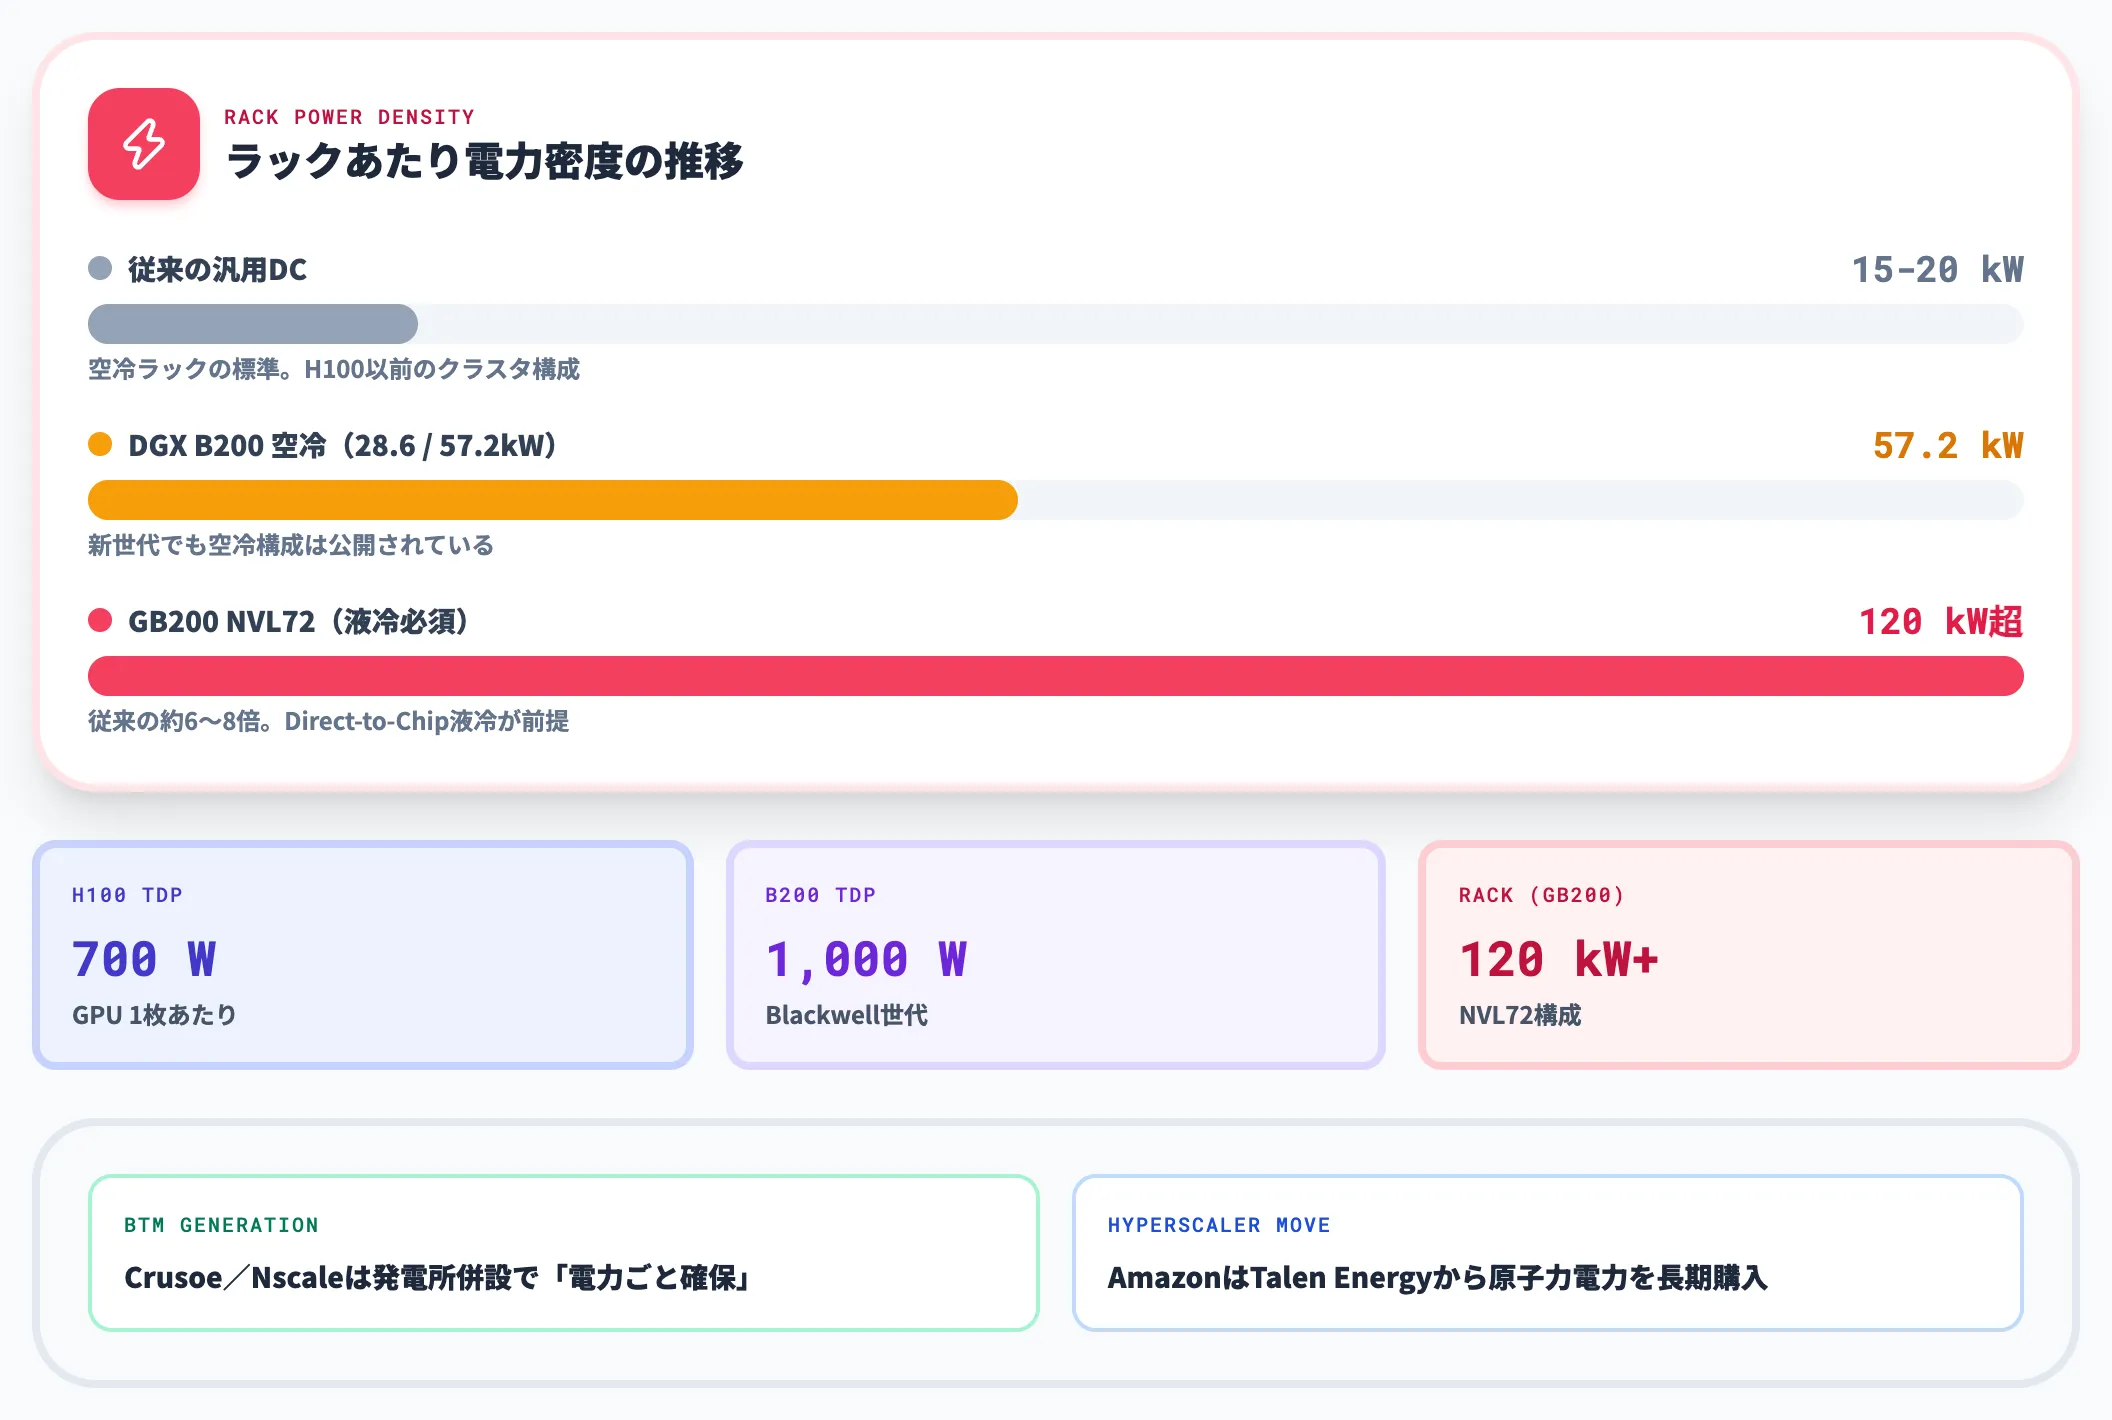
NVIDIA H100の1枚あたり熱設計電力(TDP)は700W、Blackwell世代のB200は1,000W、GB200 NVL72のラック単位では120kW超に達します。
従来の汎用データセンターのラックあたり電力供給は15〜20kW前後が標準で、GB200世代の120kWを収容するには液冷を前提とした設計が必要になります。ただしNVIDIAはDGX B200の空冷ラック構成(28.6kW/57.2kWなど)も公開しており、「新世代GPUが全部液冷必須」ではありません。
ネオクラウドの新規DCは、最初からダイレクト液冷(Direct-to-Chip Liquid Cooling)または浸漬冷却を前提に設計されているケースが多いです。CoreWeaveは2026年Q2にNVIDIA Vera Rubin NVL72の業界初のブリングアップと検証を完了し、9月30日にはCognitionによる本番利用の開始を発表しており、新世代GPUに即応するための物理層更新を事業優位として積み上げています。
電力供給も重要論点で、ネオクラウドはCrusoeやNscaleのようにビハインド・ザ・メーター(Behind-the-Meter)発電所の併設や、独自の長期電力調達契約で「電力ごと確保する」姿勢を打ち出しています。ハイパースケーラー側もAmazonがTalen Energyから原子力電力を長期購入する契約を結ぶなど、電力調達競争はネオクラウド固有の論点ではなく業界全体の構造的課題として進んでいます。
海外の主要ネオクラウド事業者——CoreWeave・Nebius・Lambda・Crusoe・Nscale
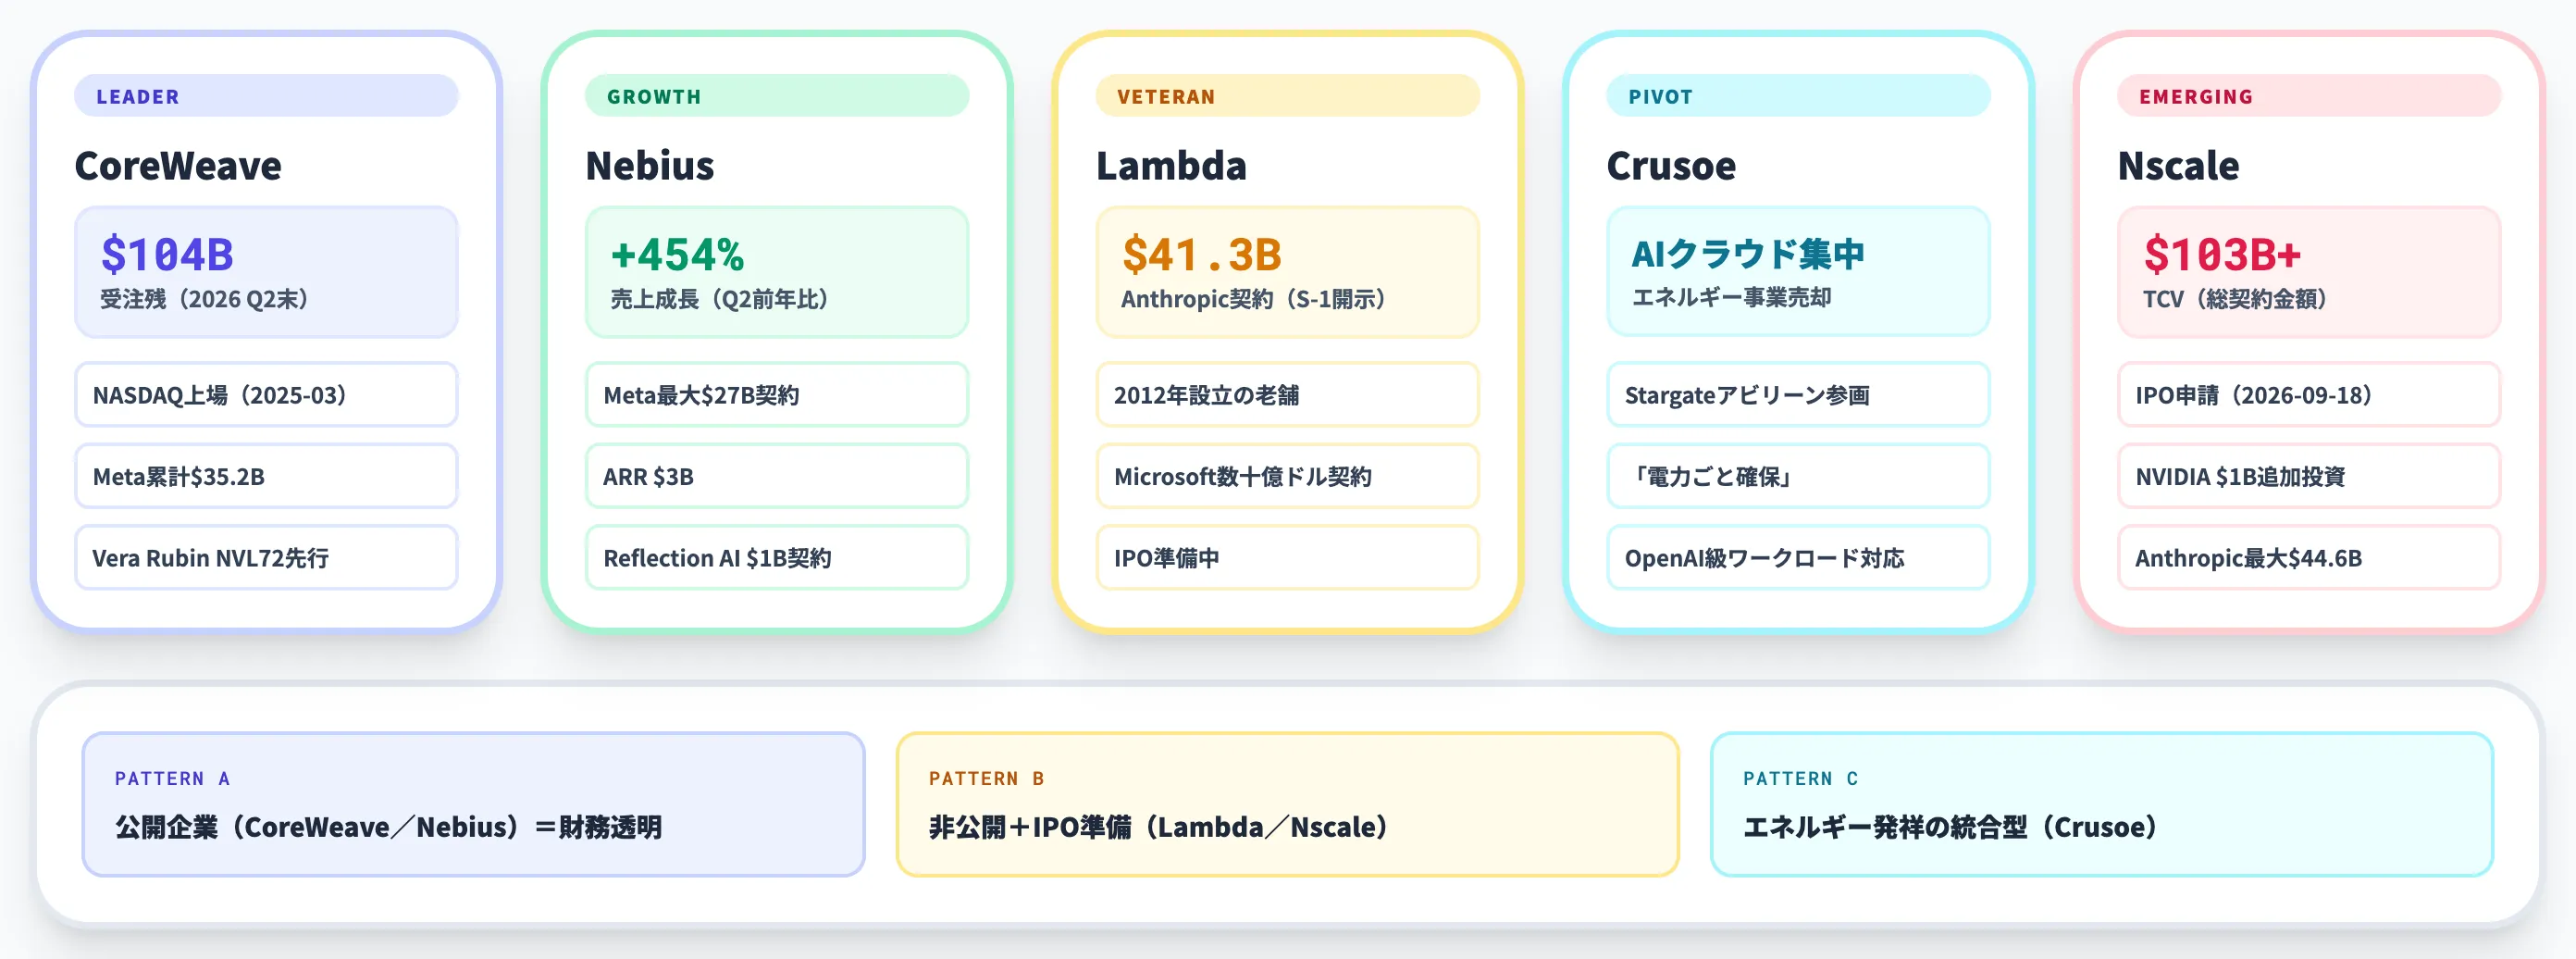
海外のネオクラウド市場は、2026年に入って上位5社の順位が明確になりました。公開企業(CoreWeave・Nebius)と非公開企業(Lambda・Crusoe・Nscale)で情報開示の深さが違うため、各社の立ち位置と最新財務を整理します。
CoreWeave——受注残$104Bのトッププレイヤー
2026年Q2決算(8月11日発表)の主要数値は以下のとおりです。
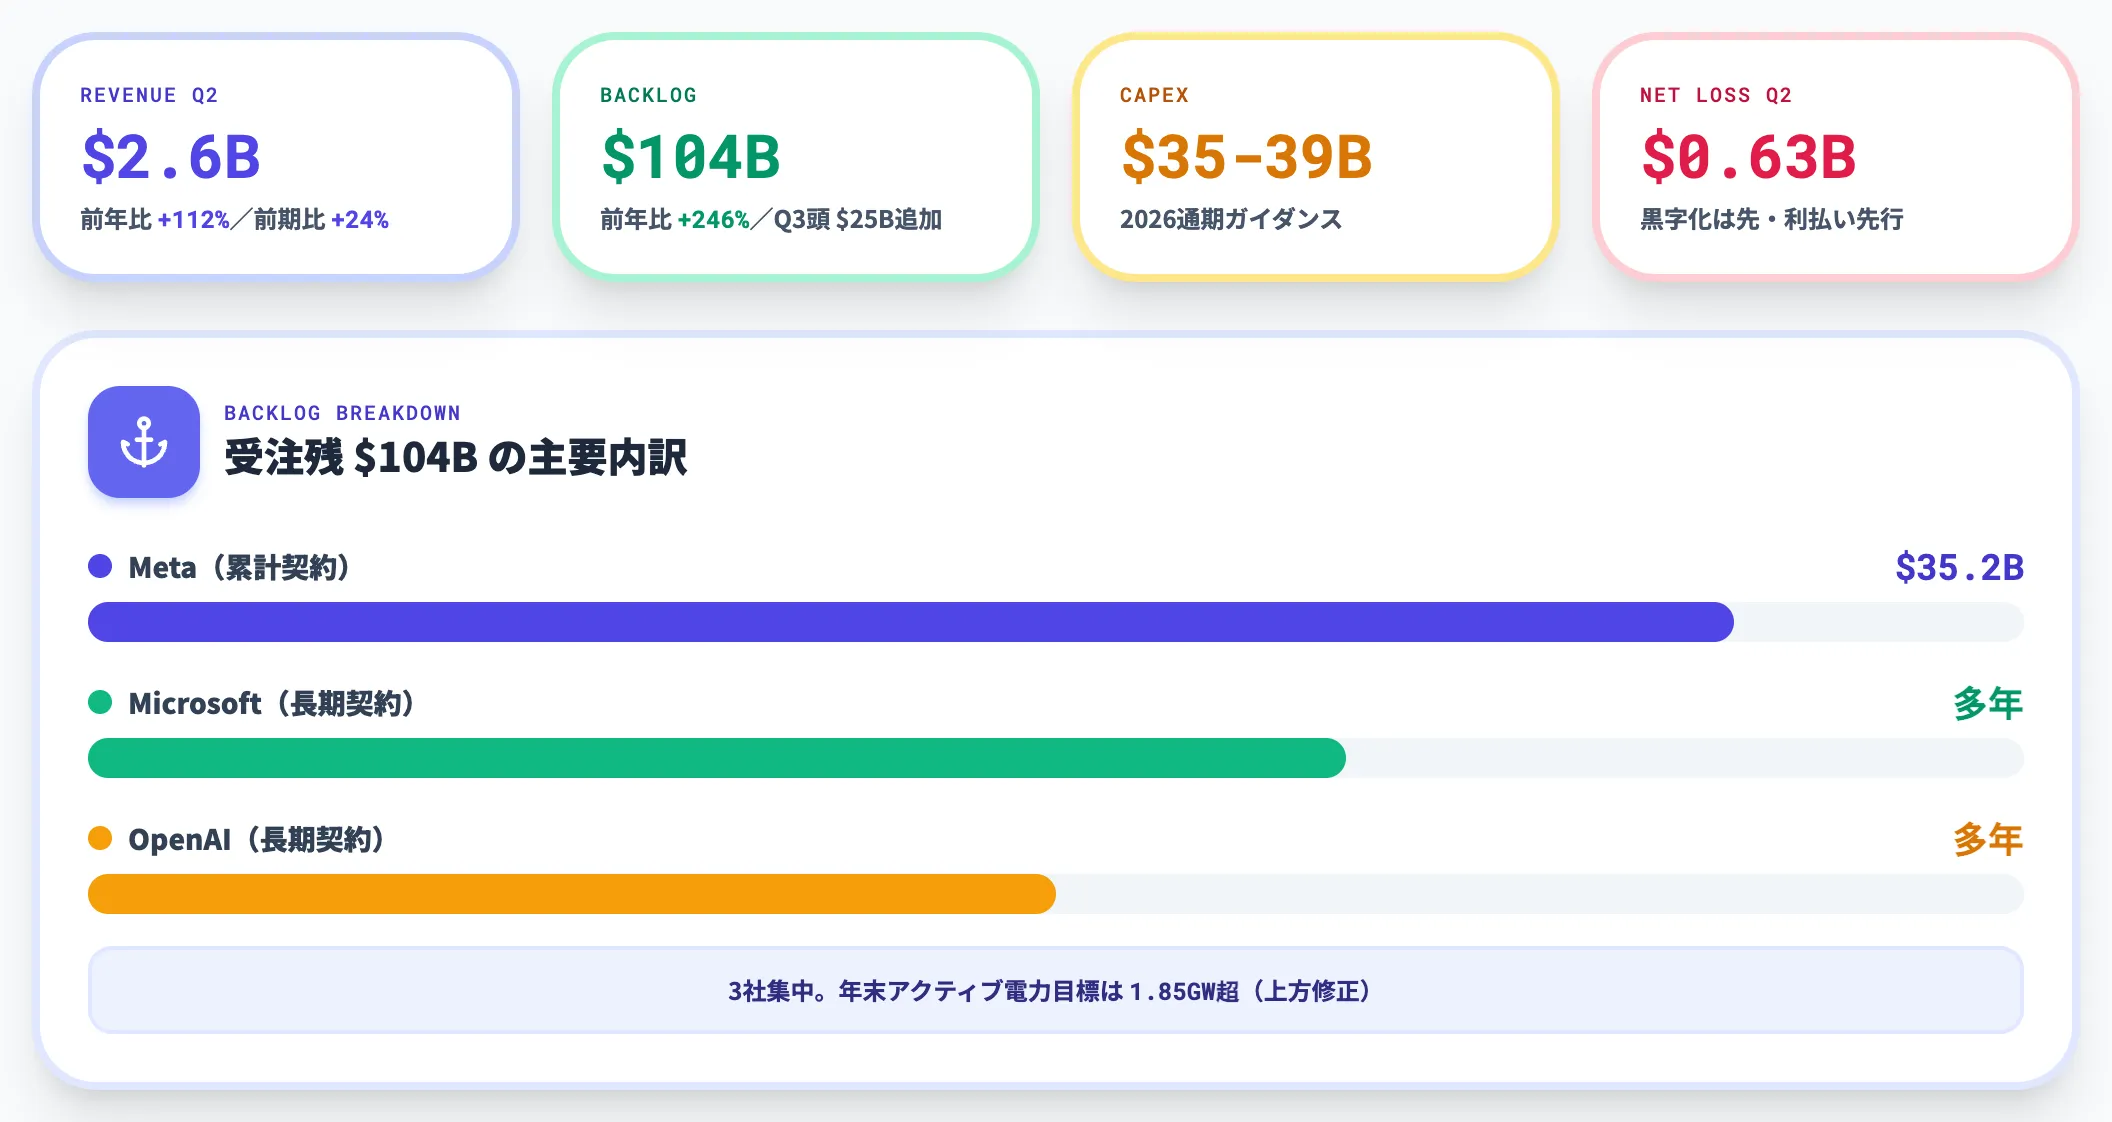
CoreWeaveはネオクラウド業態の最大手で、2025年3月に上場(NASDAQ:CRWV)しました。
| 指標 | 数値 | 備考 |
|---|---|---|
| 四半期売上 | 26億ドル | 前年比+112%、前期比+24% |
| 受注残 | 1,040億ドル | 前年比+246%、Q3冒頭に250億ドル追加 |
| 2026年通期ガイダンス | 124億〜132億ドル | 調整後営業利益9.6億〜11.5億ドル |
| CapEx | 350億〜390億ドル | 大規模設備投資継続 |
| 年末アクティブ電力目標 | 1.85GW超 | 当初目標から上方修正 |
この数字は「ネオクラウドの黒字化はまだ先」という市場懸念を反映しています。売上は急伸しているものの、350億ドル規模のCapExが先行して利払いが膨らみ、2026年Q2の純損失は約6.3億ドルに達しています。
Metaとの累計352億ドル契約、Microsoft・OpenAIとの長期契約が受注残の大半を占めており、顧客集中リスクはNebiusと並んで経営上の最大論点です。
Nebius——Meta $27B契約で急成長
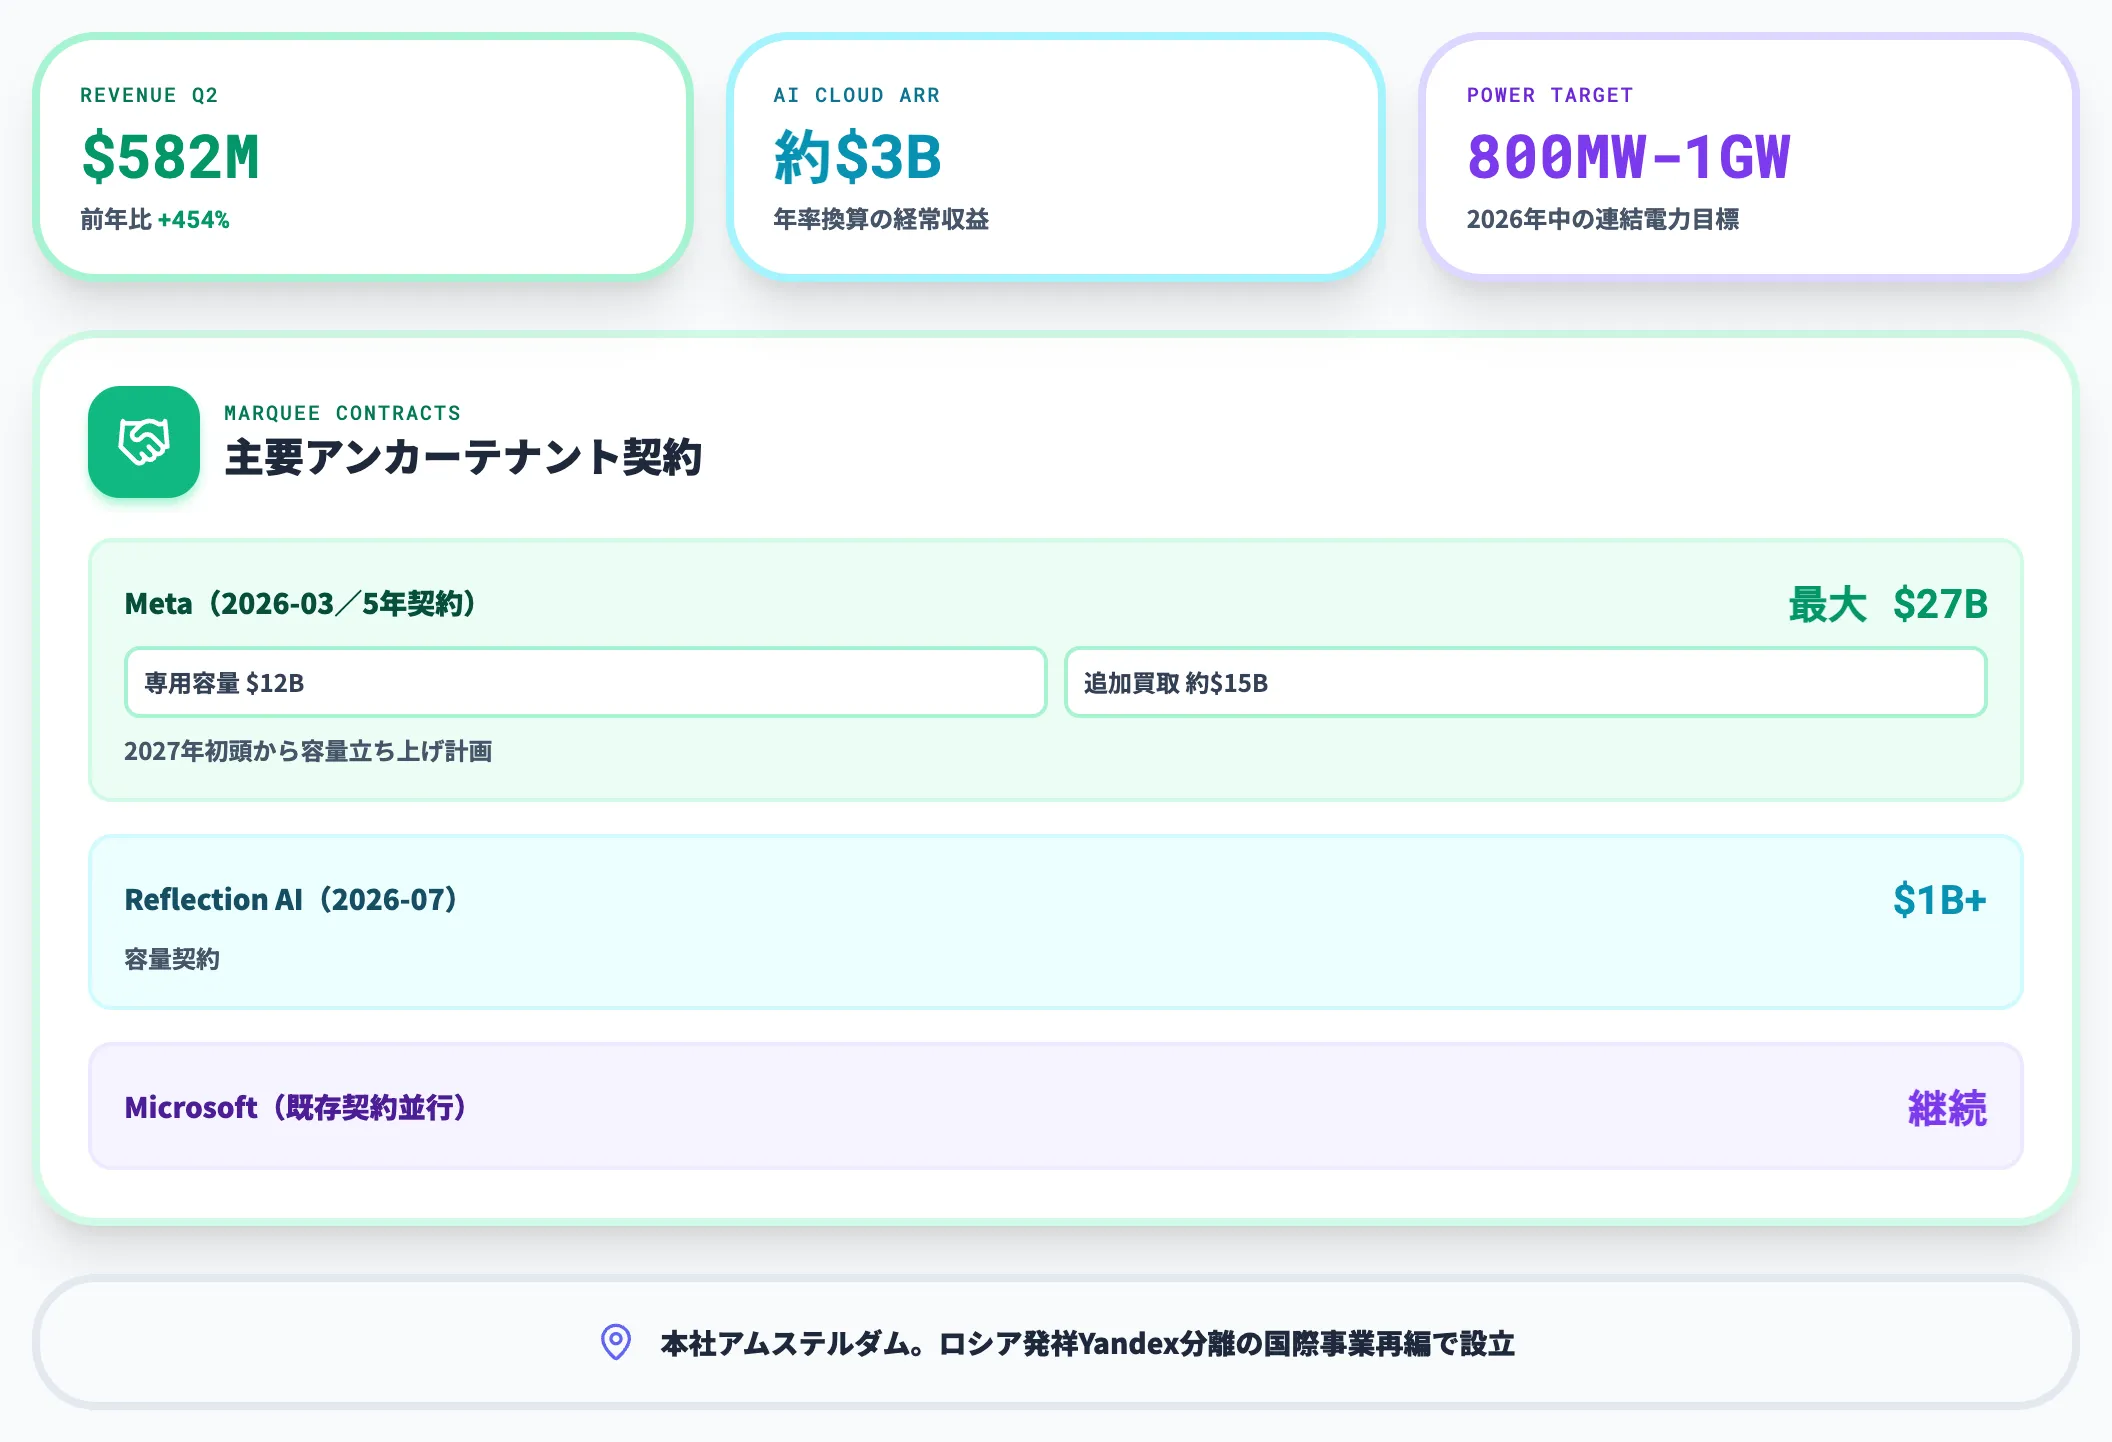
Nebiusはアムステルダム拠点のネオクラウドで、ロシア発祥のYandexから分離したインターナショナル事業を再編して設立されました。2026年Q2の売上は約5.82億ドル(前年比+454%)、AIクラウドのARRは約30億ドルに達しています。
成長を支えているのが、2026年3月に締結されたMetaとの5年最大約270億ドル契約です。内訳は専用容量120億ドル+追加約150億ドルで、追加部分は第三者に販売できなかった余剰容量をMetaが買い取る構造です。2027年初頭から容量が立ち上がる計画です。
加えて、2026年7月にはReflection AIと10億ドル超の容量契約を締結しており、Microsoftとの既存契約も並行して走っています。これら大型アンカーテナントの契約が、Nebiusのキャパシティ拡張を牽引しています。
連結電力目標は2026年中に800MW〜1GWを掲げており、Metaの容量立ち上げに向けた物理層投資が加速しています。
Lambda——Microsoft数十億ドル契約で大型顧客側にも展開
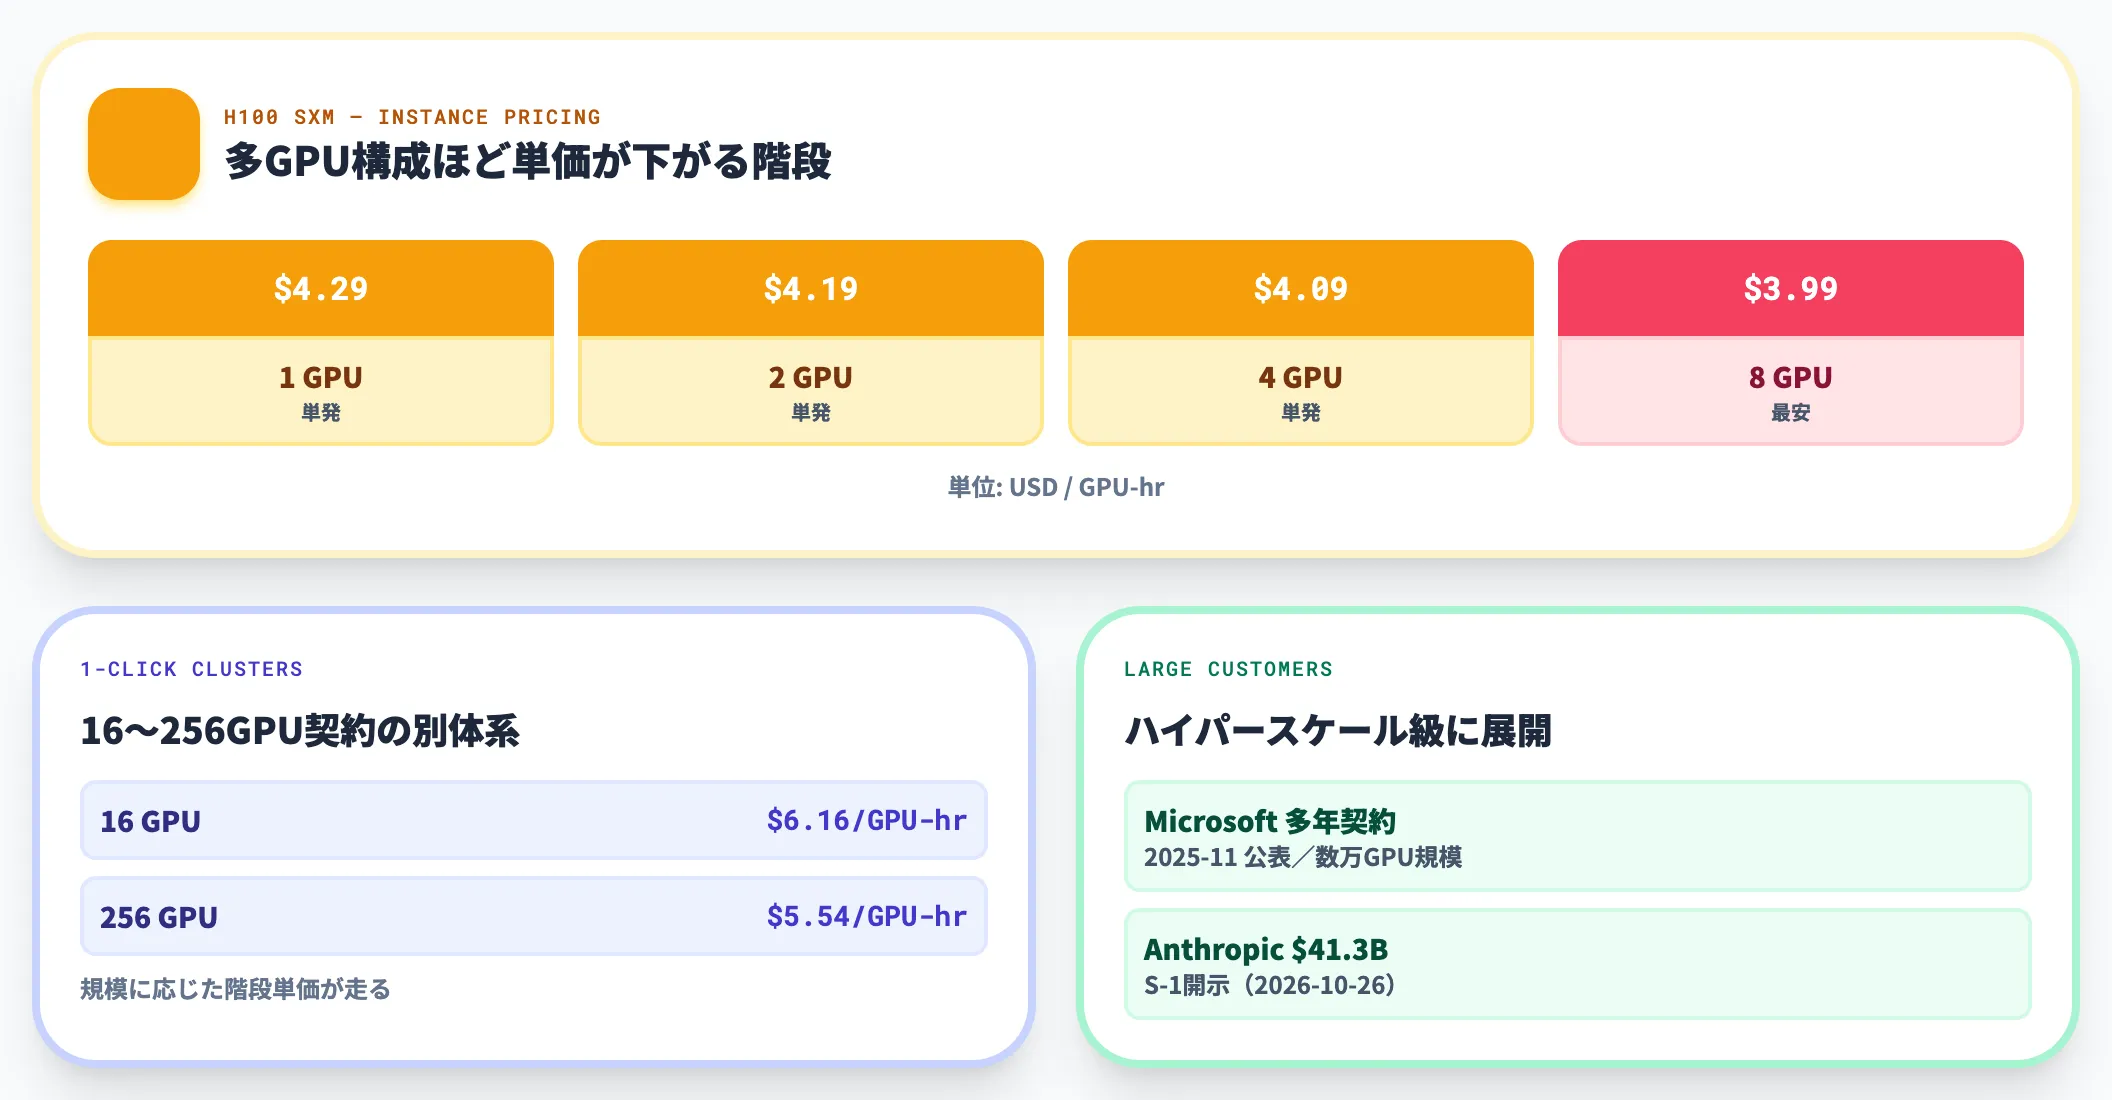
Lambdaは2012年設立のGPUクラウド老舗で、研究者・AIスタートアップ向けのオンデマンドGPUで早くから知名度を確立していました。非公開企業のため財務開示は限定的ですが、IPO準備中であることが報じられています。
従来は中小規模の学習・推論ジョブを広く拾うスタイルでしたが、2025年11月にMicrosoftと数十億ドル規模・数万GPUの多年契約を公表し、大規模契約型のビジネスにも軸足を広げました。加えてAnthropicが2026年10月26日に提出したS-1では、Lambdaとの計算資源契約が合計約413億ドルと開示されており、顧客ポートフォリオがハイパースケール側に広がっています。
インスタンス型は多GPU構成ほど単価が下がる設計で、H100 SXMは8GPU単発$3.99〜1GPU単発$4.29/GPU-hr。1-Click Clusters契約(16〜256GPU)は規模に応じて$6.16〜$5.54/GPU-hrと、別体系の階段単価が走ります。
Crusoe——AIインフラ事業への集中
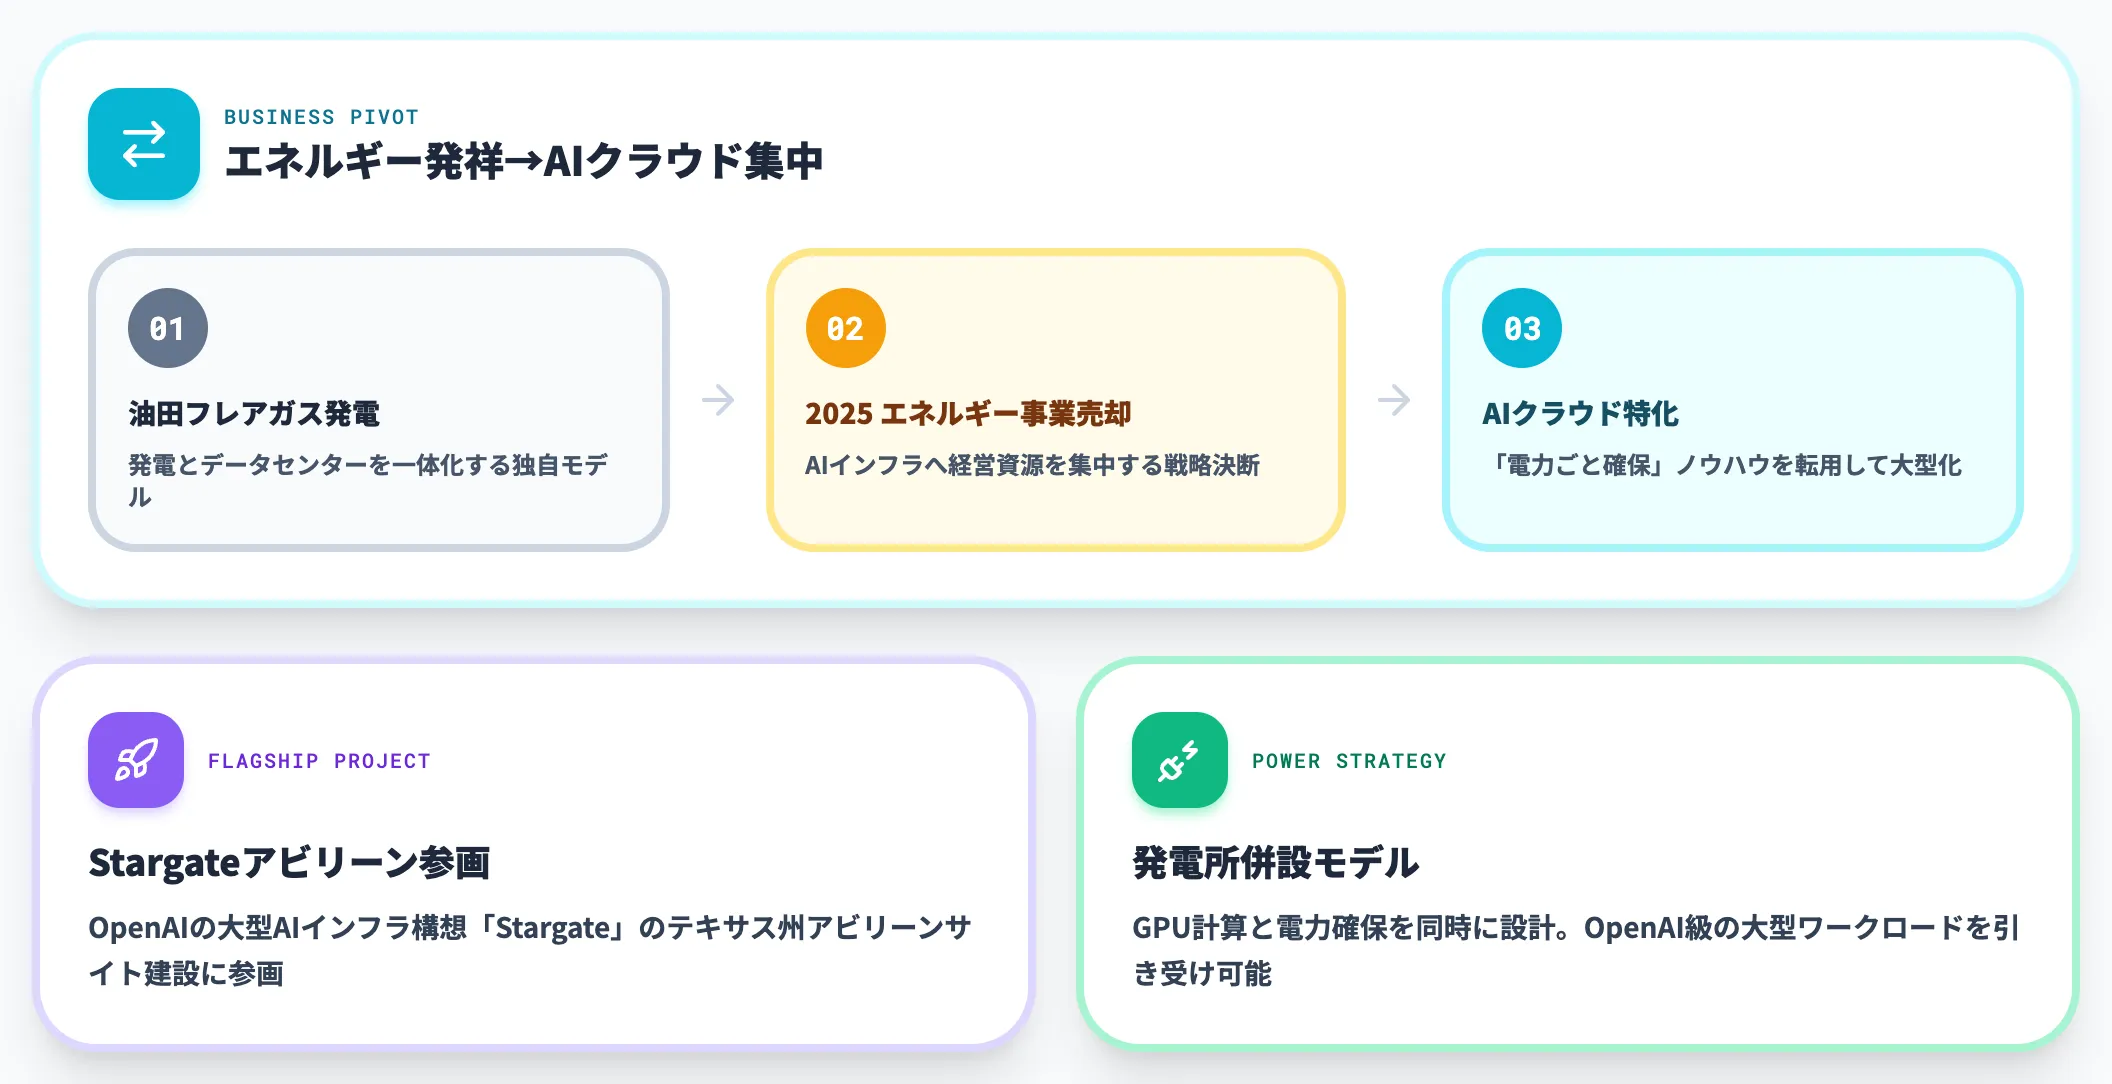
Crusoeは、もともと油田フレアガス発電とデータセンター建設を一体化する独自モデルで知られていましたが、2025年にそのエネルギー事業を売却し、現在はAIクラウドインフラ事業に集中する戦略に切り替えています。
Stargateプロジェクトのテキサス州アビリーンのサイト建設にも参画しており、「電力ごと確保する」ノウハウを転用しながら、OpenAIクラスの大型ワークロードを引き受ける事業体の一つとして名前が上がっています。
Nscale——NVIDIA $1B追加投資とIPO申請
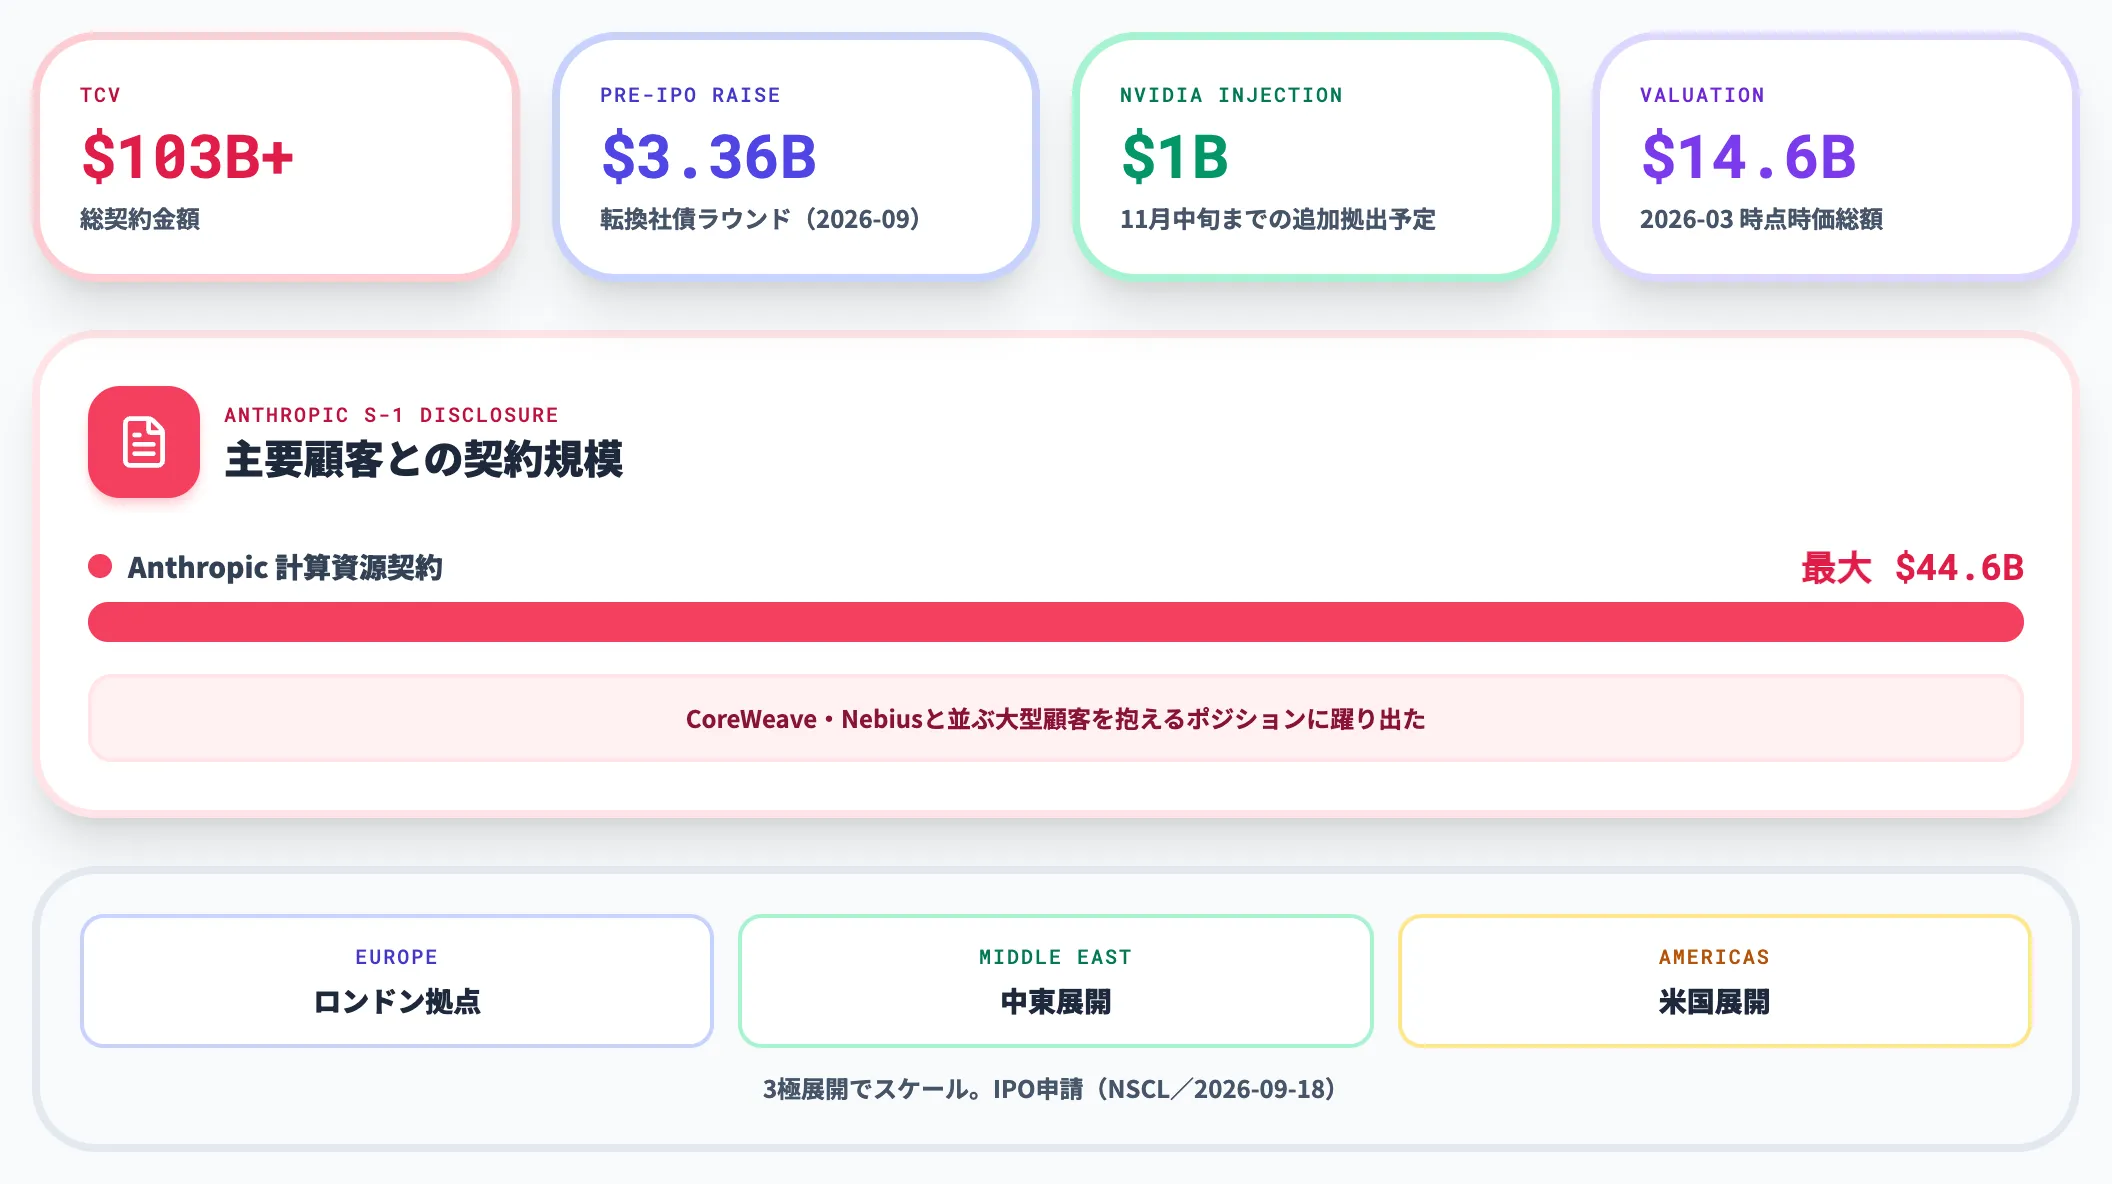
Nscaleはロンドン拠点の新興ネオクラウドで、2026年9月18日にIPO申請(NSCL)、同月25日に33.6億ドルのプレIPO転換社債ラウンドを発表しました。Third Point主導、NVIDIAが10億ドルを11月中旬までに追加拠出予定という構成です。
総契約金額(TCV)は1,030億ドル超、Anthropicが2026年10月26日に提出したS-1ではNscaleとの計算資源契約が最大約446億ドルと開示されており、CoreWeave・Nebiusと並ぶ大型顧客を抱えるポジションに躍り出ました。
2026年3月には時価総額146億ドルで資金調達済みで、ヨーロッパ・中東・米国の3極展開でスケールさせる戦略を取っています。
日本のネオクラウド事業者——経産省クラウドプログラム認定7社
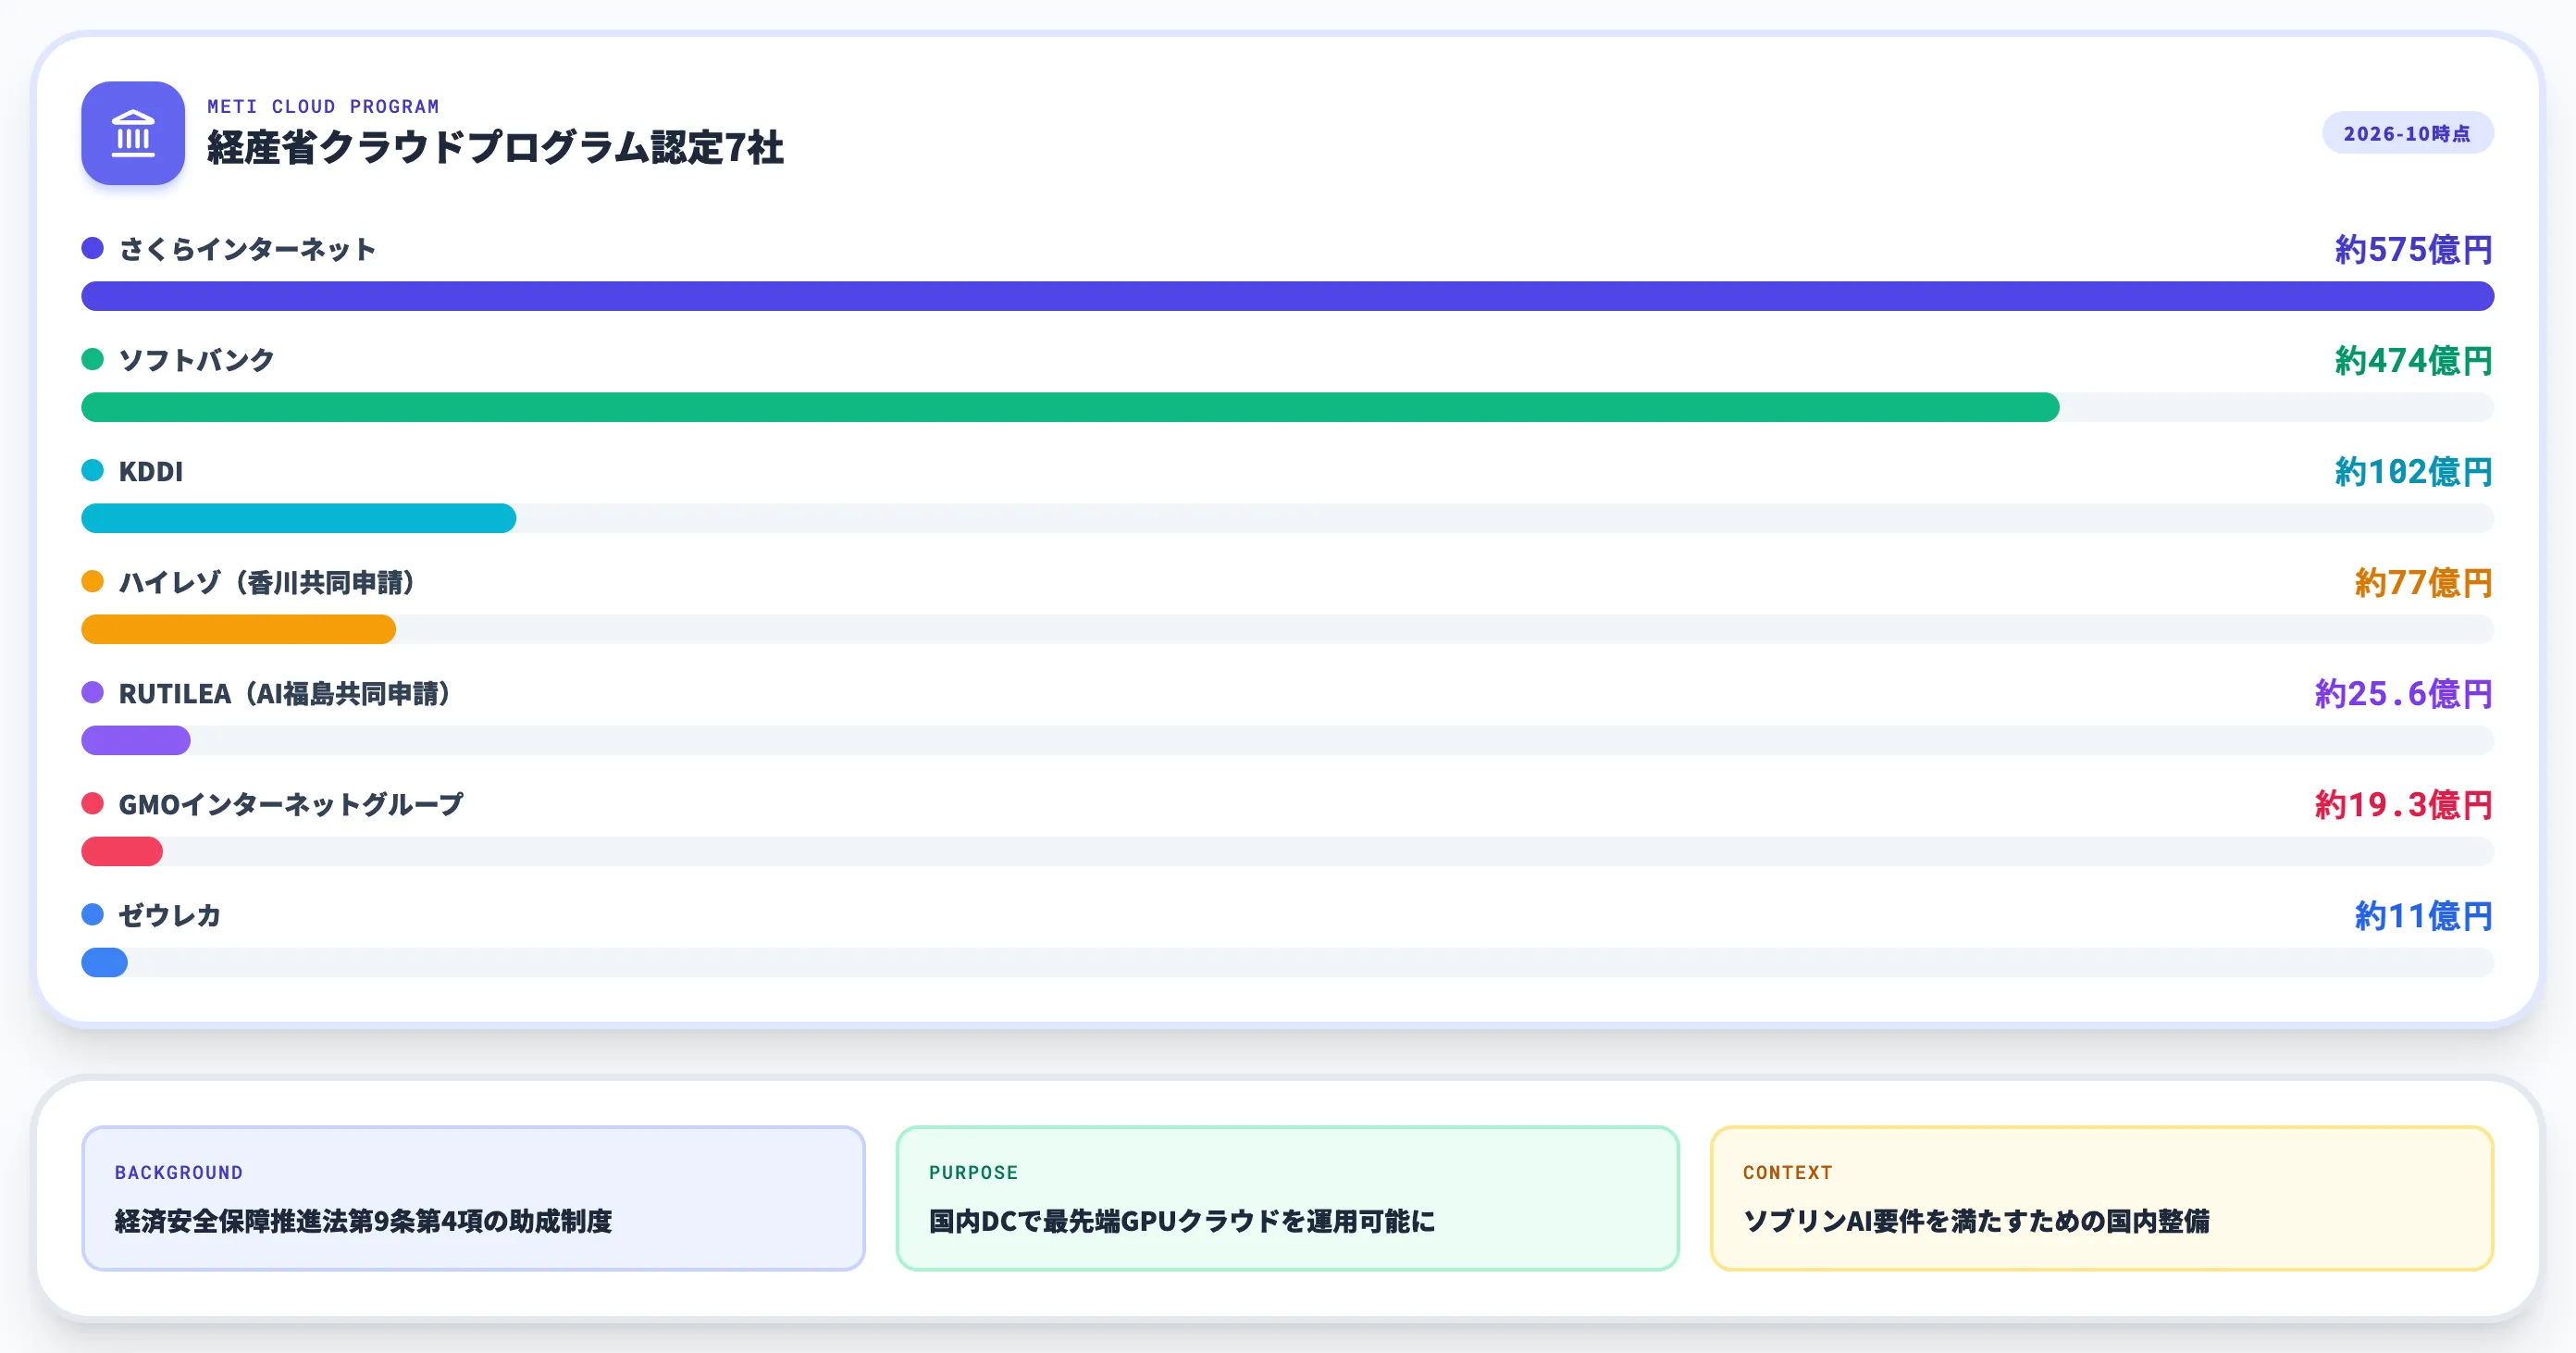
日本国内でも、2024年〜2026年にかけてネオクラウド事業者が急増しました。背景にあるのが、経済安全保障推進法に基づくクラウドプログラム認定で、GPU計算基盤の国内整備に多額の助成が投じられています。
経産省クラウドプログラム認定の全体像
経済産業省のクラウドプログラムは、経済安全保障推進法第9条第4項に基づき、国内でのAI計算基盤整備を支援する助成制度です。累計の認定助成額は以下のとおりです(2026年10月時点)。
| 事業者 | 最大助成額(累計) | 主な認定時期 |
|---|---|---|
| さくらインターネット | 約575億円 | 2023年6月(約68億円)+2024年2月(約6億円)+2024年4月(約501億円)累計 |
| ソフトバンク | 約474億円 | 2023年7月(約53億円)+2024年5月(約421億円) |
| KDDI | 約102億円 | 2024年4月 |
| ハイレゾ(ハイレゾ香川共同申請) | 約77億円 | 2024年4月 |
| RUTILEA(AI福島共同申請) | 約25.6億円 | 2024年4月 |
| GMOインターネットグループ | 約19.3億円 | 2024年4月 |
| ゼウレカ | 約11億円 | 2023年11月 |
2024年4月19日の5社認定発表(さくら・KDDI・ハイレゾ・RUTILEA・GMO)が最大規模で、以降もソフトバンクの追加認定(2024年5月)などが続き、日本政府がGPU計算基盤を経済安全保障上の論点として扱っていることが見て取れます。
これらは「日本国内の企業が国内DCで最先端GPUクラウドを運用できる状態」を作るための施策で、海外ネオクラウドへの依存を減らすソブリンAI(Sovereign AI)の文脈で動いています。
さくらインターネット・KDDIの先行組
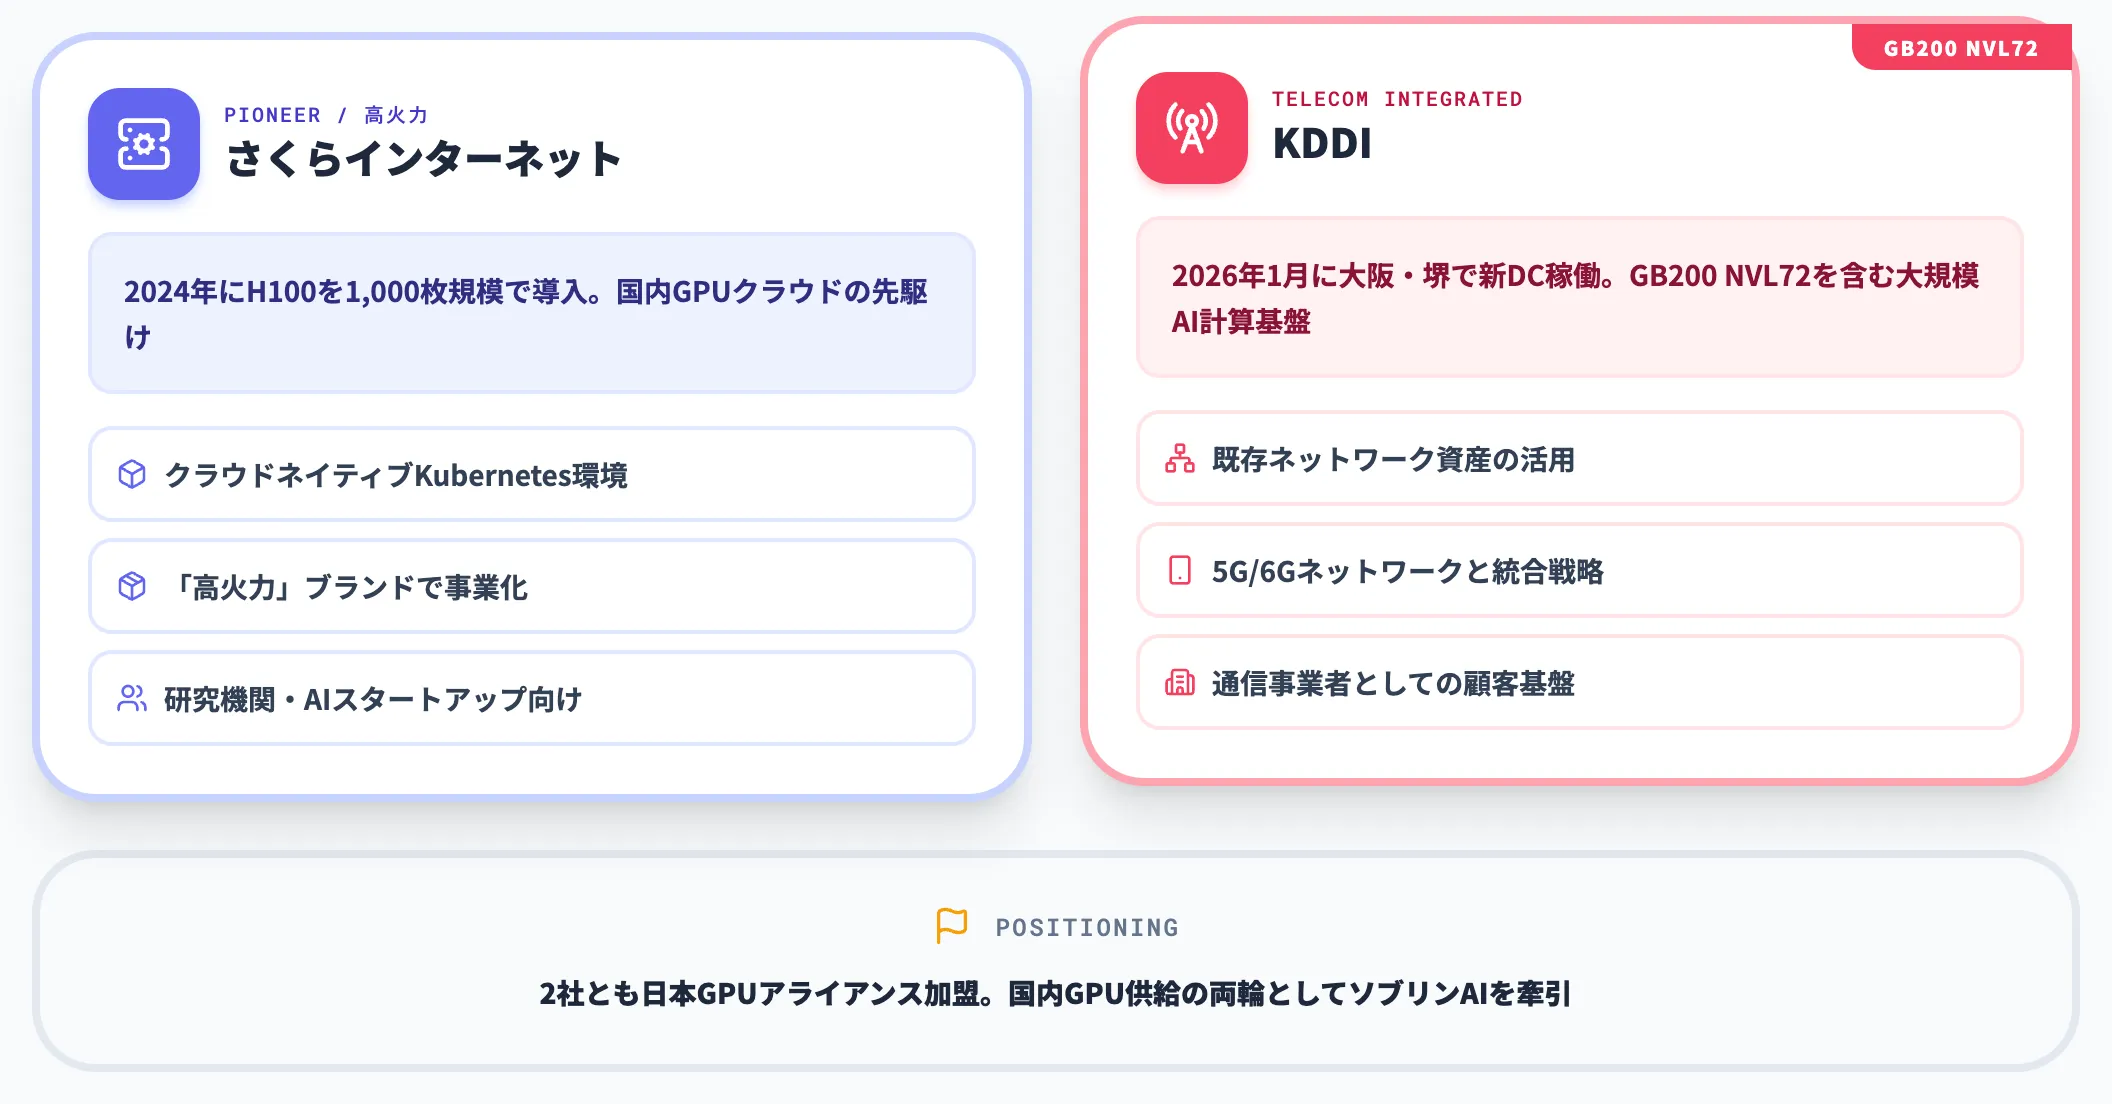
さくらインターネットは2024年にH100を1,000枚規模で導入し、国内GPUクラウドの先駆けとして事業化しました。GPU時間貸しとは別に、クラウドネイティブなKubernetes環境を組み合わせた「高火力」ブランドで、研究機関・AIスタートアップへの提供を進めています。
KDDIは2026年1月に大阪・堺の新データセンターを稼働させ、NVIDIA GB200 NVL72を含む大規模AI計算基盤を立ち上げました。通信事業者としての既存ネットワーク資産を活かし、ネオクラウド事業と5G/6Gネットワークサービスを統合する戦略を取っています。
ソフトバンクのInfrinia AI Cloud OS
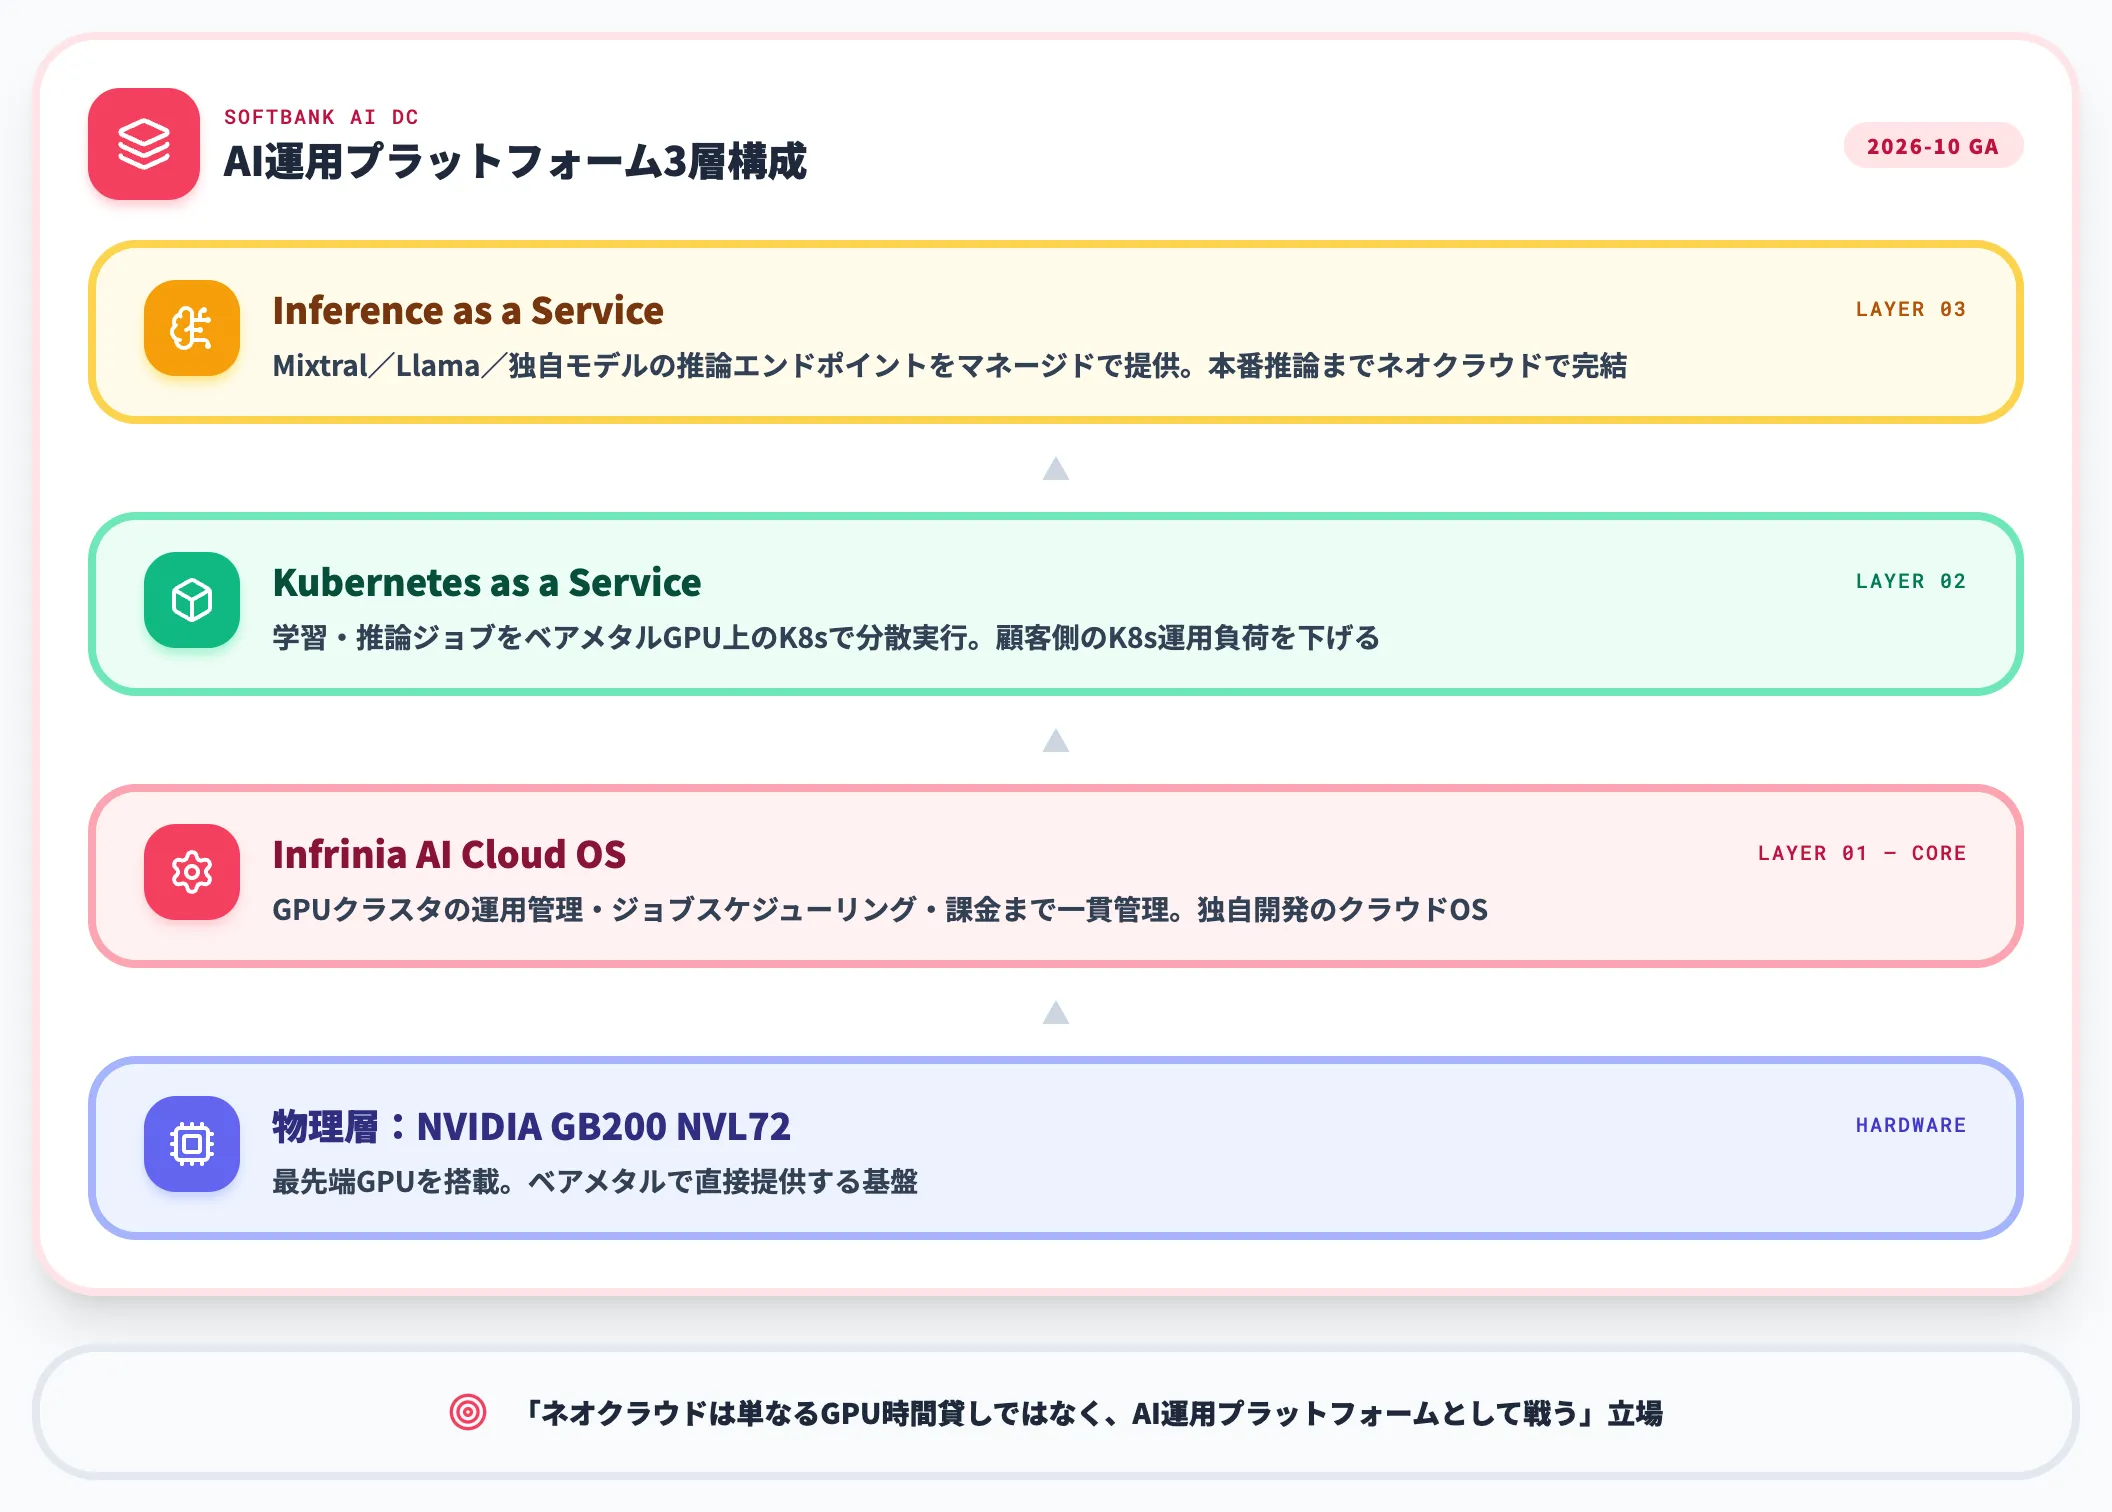
ソフトバンク株式会社は2026年5月25日に、ネオクラウド事業として「AIデータセンター GPUクラウド」を発表しました。
独自開発の「Infrinia AI Cloud OS」を搭載し、NVIDIA GB200 NVL72など最先端GPUをKubernetes as a Service(KaaS)・Inference as a Service(Inf-aaS)として提供する設計です。
提供開始時期は2026年10月で、ベータ版は2026年5月から限定展開されています。差別化要素は以下の3点です。
-
Infrinia AI Cloud OS
GPUクラスタの運用管理・ジョブスケジューリング・課金まで一貫して扱うソフトバンク独自のクラウドOS。ハイパースケーラーのような総合管理を、GPU特化の設計で軽量化。
-
Kubernetes as a Service
学習・推論ジョブをKubernetes上で分散実行する環境を、ベアメタルGPUの上に直接提供。顧客側のKubernetes運用負荷を下げる。
-
Inference as a Service
Mixtral・Llama・独自モデルなど、よく使われるLLMの推論エンドポイントをマネージドで提供。学習だけでなく本番推論までネオクラウドで完結できる設計。
Infrinia AI Cloud OSは、「ネオクラウドは単なるGPU時間貸しではなく、AI運用プラットフォームとして戦う」というソフトバンクの立場を表しています。さくらインターネットも「高火力 DOK」でコンテナ型のGPUサービスを提供するなど、国内各社ともGPU提供だけに留まらないレイヤー競争に入っています。
日本GPUアライアンスとデータ主権
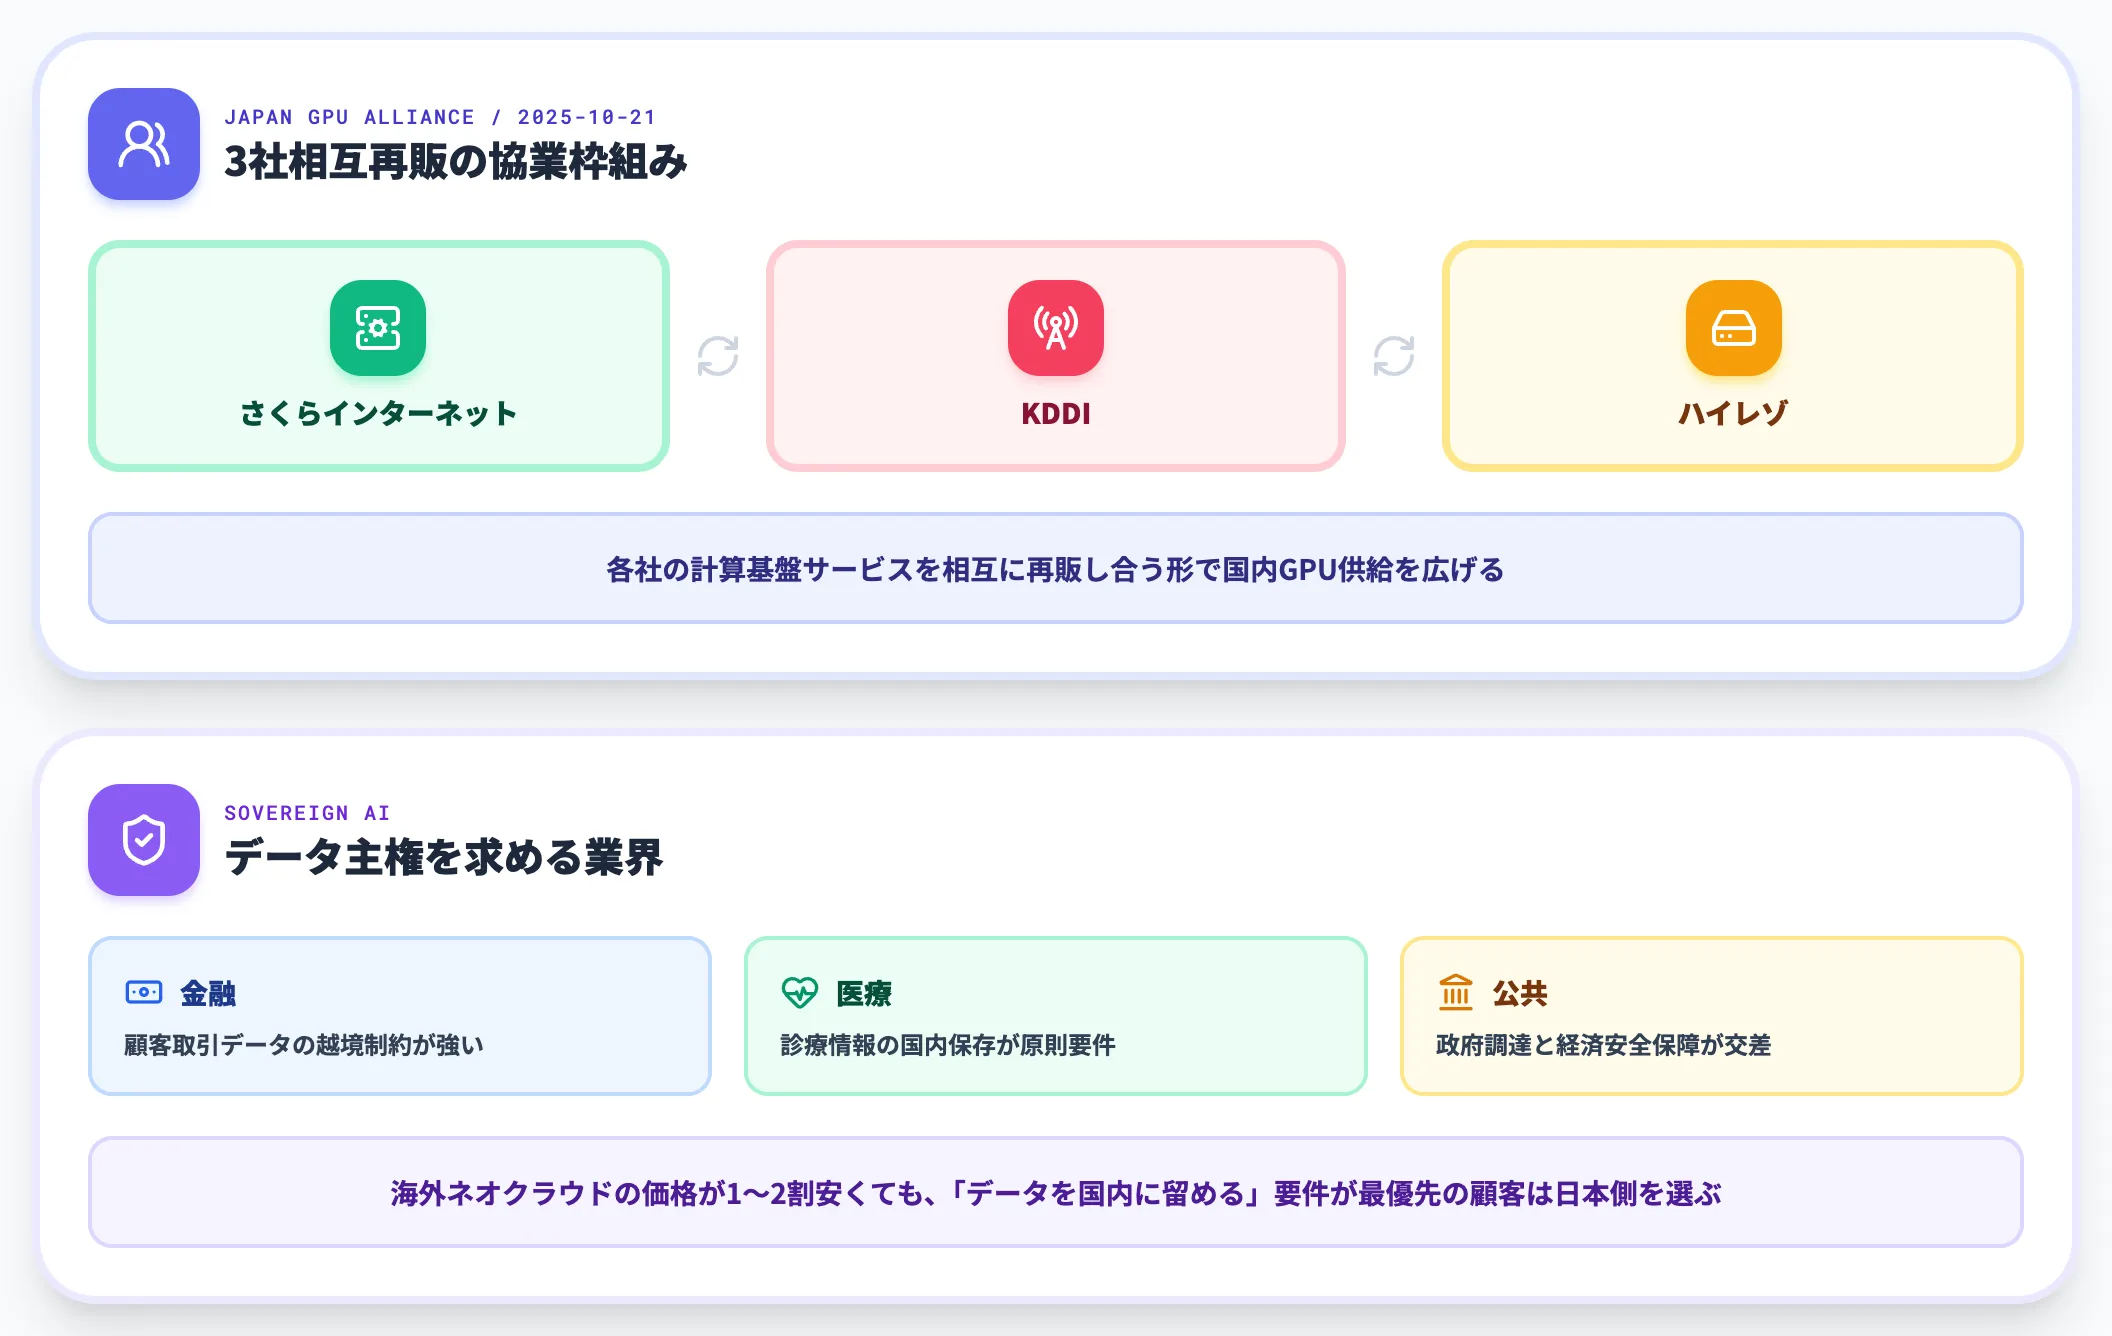
日本GPUアライアンスは、2025年10月21日にKDDI・さくらインターネット・ハイレゾの3社が設立した協業枠組みで、各社の計算基盤サービスを相互に再販し合う形で国内GPU供給を広げています。
日本企業がAI学習データや推論ログを海外DCに置かずに運用したいというソブリンAI要件は、金融・医療・公共の業界で特に強く、国内ネオクラウド事業者を選ぶ最大の理由になっています。海外ネオクラウドの価格が国内より1〜2割安くても、「データを国内に留める」要件が最優先の顧客は日本側を選びます。
ネオクラウドのGPU単価比較——H100・H200・B200・GB200
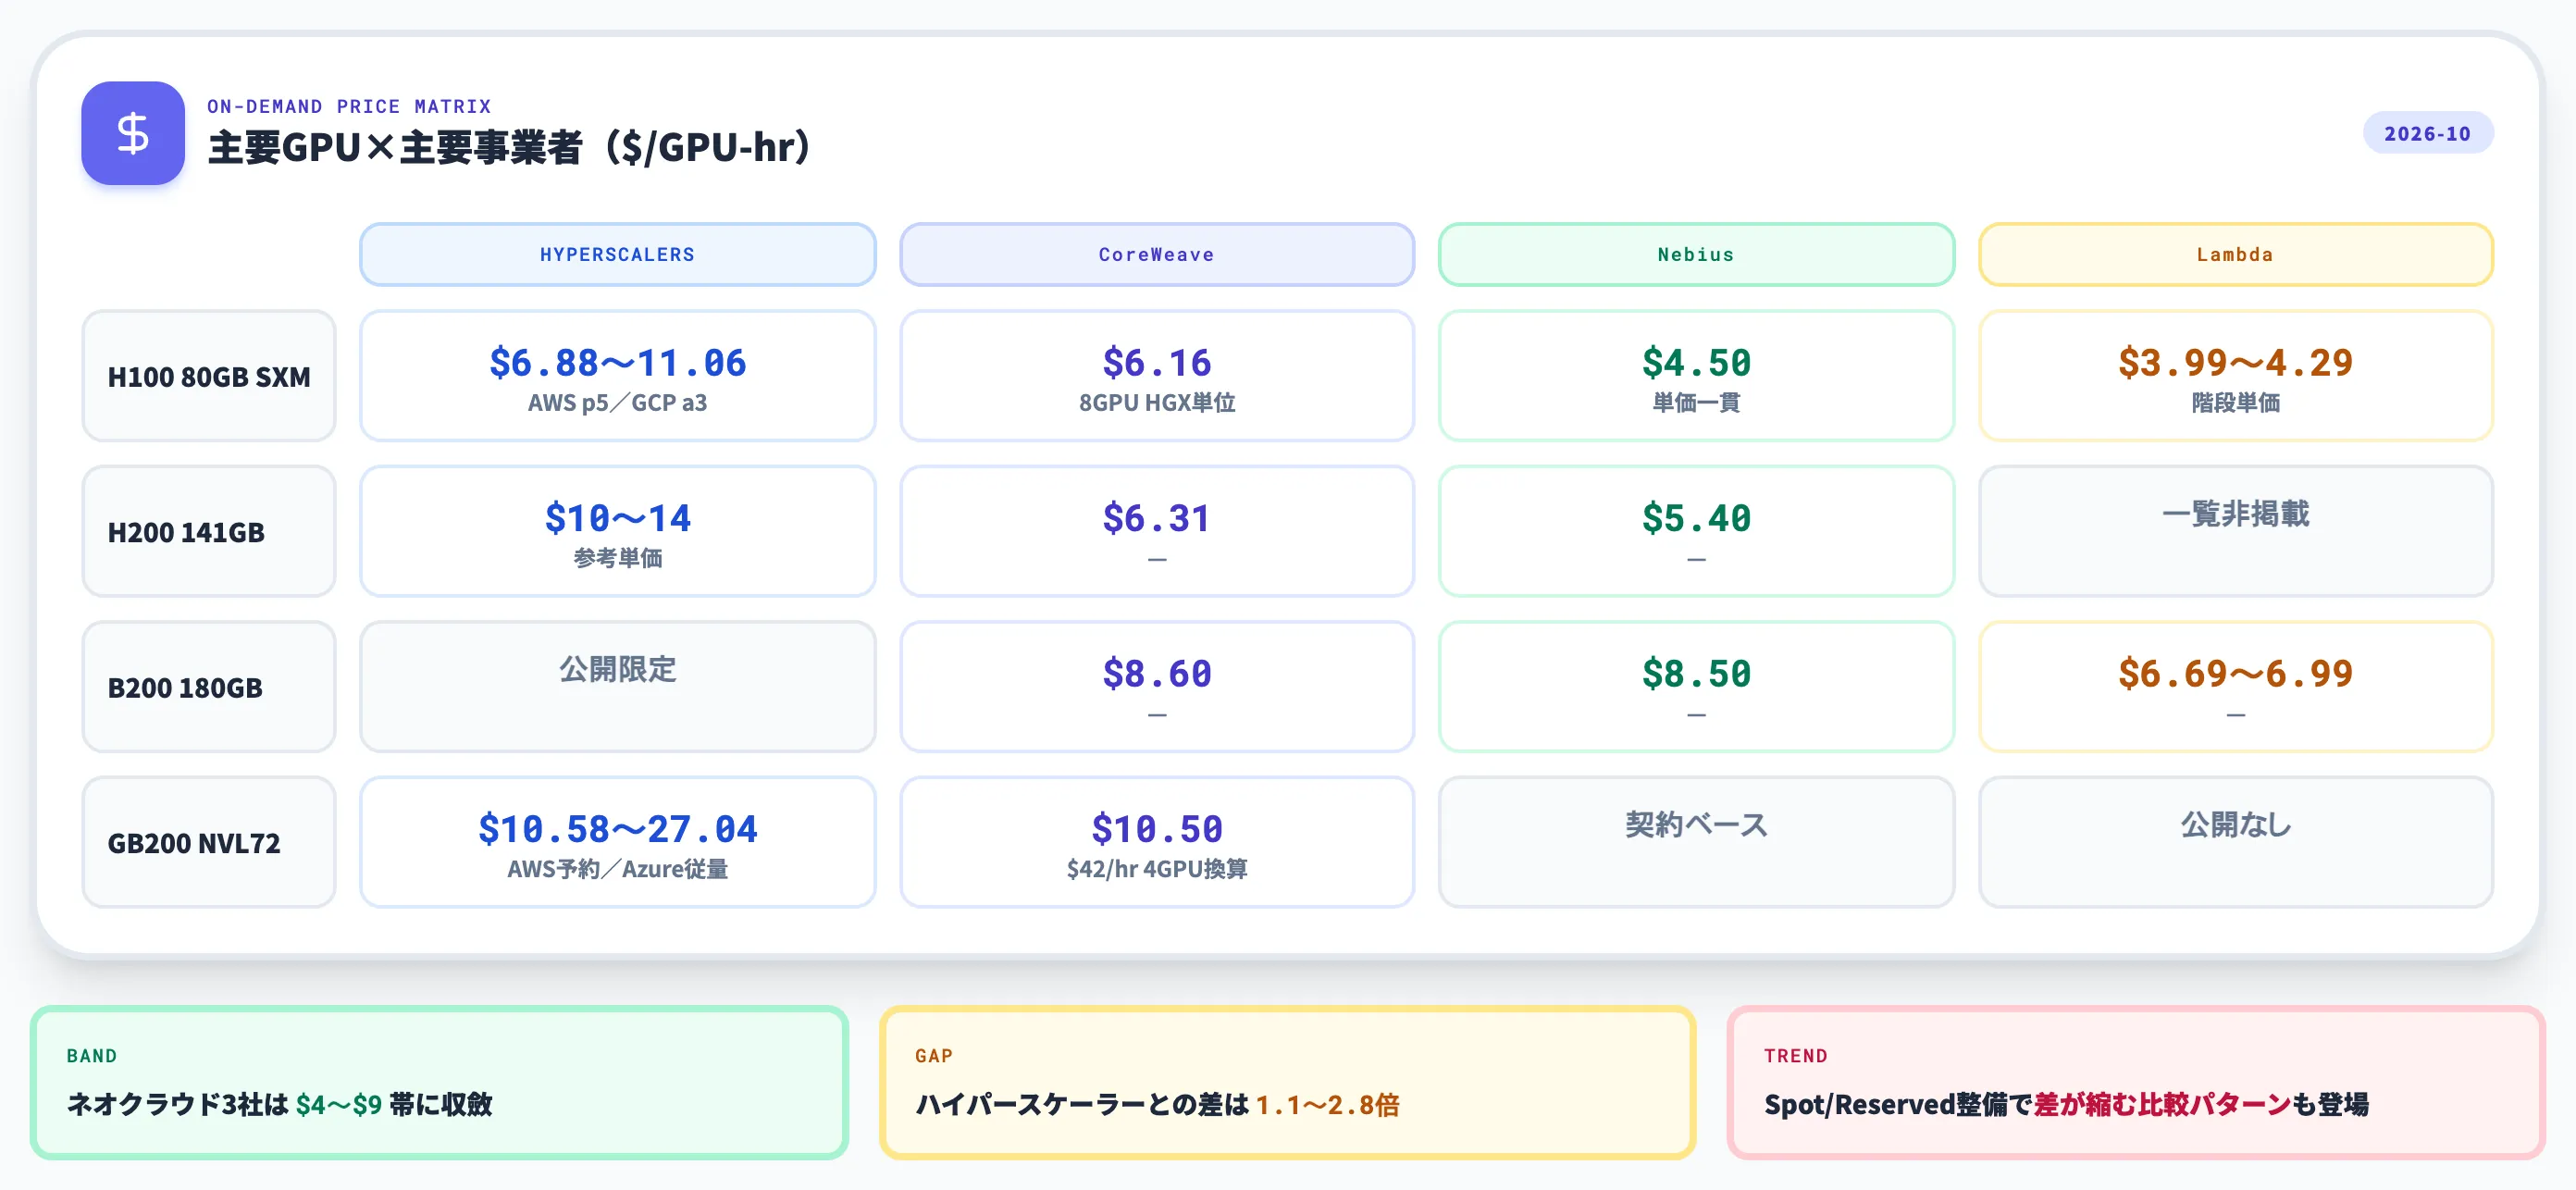
ネオクラウドを検討するときに最も具体的な数字になるのが、GPU単価です。2026年10月時点で公開されている代表的な単価を整理します。
オンデマンド単価の比較表
以下の表で、主要GPUのオンデマンド単価(2026年10月時点)を事業者タイプ別にまとめました。ネオクラウドは各社公式pricingページ掲載の公開価格、ハイパースケーラーはAWS/Azure/GCPの参考単価です。
| GPU | ハイパースケーラー代表価格 | CoreWeave | Nebius | Lambda |
|---|---|---|---|---|
| H100 80GB SXM | AWS p5.48xlarge 約$6.88/GCP a3-highgpu-8g 約$11.06/GPU-hr | $6.16/GPU-hr | $4.50/GPU-hr | $3.99〜$4.29/GPU-hr |
| H200 141GB | $10〜$14/GPU-hr | $6.31/GPU-hr | $5.40/GPU-hr | 一覧非掲載 |
| B200 180GB | 公開限定 | $8.60/GPU-hr | $8.50/GPU-hr | $6.69〜$6.99/GPU-hr |
| GB200 NVL72 | AWS P6e-GB200 Capacity Blocks(予約)約$10.58/Azure ND GB200 v6(従量)約$27.04/GPU-hr | $10.50/GPU-hr($42/hrの4GPUインスタンス換算) | 契約ベース | 公開なし |
この表から分かるのは、ネオクラウド3社の単価が$4〜$9/GPU-hrの帯に収斂している点と、ハイパースケーラーの公開オンデマンド単価と比較して比較ペア次第で1.1〜2.8倍程度の差がある点です。
Lambdaはインスタンス型は多GPU構成ほど単価が下がる設計で、H100 SXMは8GPU単発$3.99・4GPU単発$4.09・2GPU単発$4.19・1GPU単発$4.29/GPU-hrと、ノード内GPU数が多いほど単価が安くなります。1-Click Clusters契約(16〜256GPU)では規模に応じて$6.16〜$5.54/GPU-hrと別体系の階段が走ります。
Nebiusは単発VMからクラスタまで単価が一貫しており、Preemptibleなら$0.79〜まで下がります。CoreWeaveは8GPUのHGXシステム単位での公開(H100 $49.24/hr=$6.16/GPU)で、構成の最低単位がやや大きい設計です。
2025年2月のUptime Institute分析が「DGX H100 1システムでハイパースケーラー約$98/hr・ネオクラウド約$34/hr」という当時の相場で3倍差を示していましたが、2026年時点では構成・事業者次第で差が縮む比較パターンも出てきており、単価差だけでネオクラウドを選ぶ判断は条件を揃えて行う必要があります。
契約形態別の価格構造
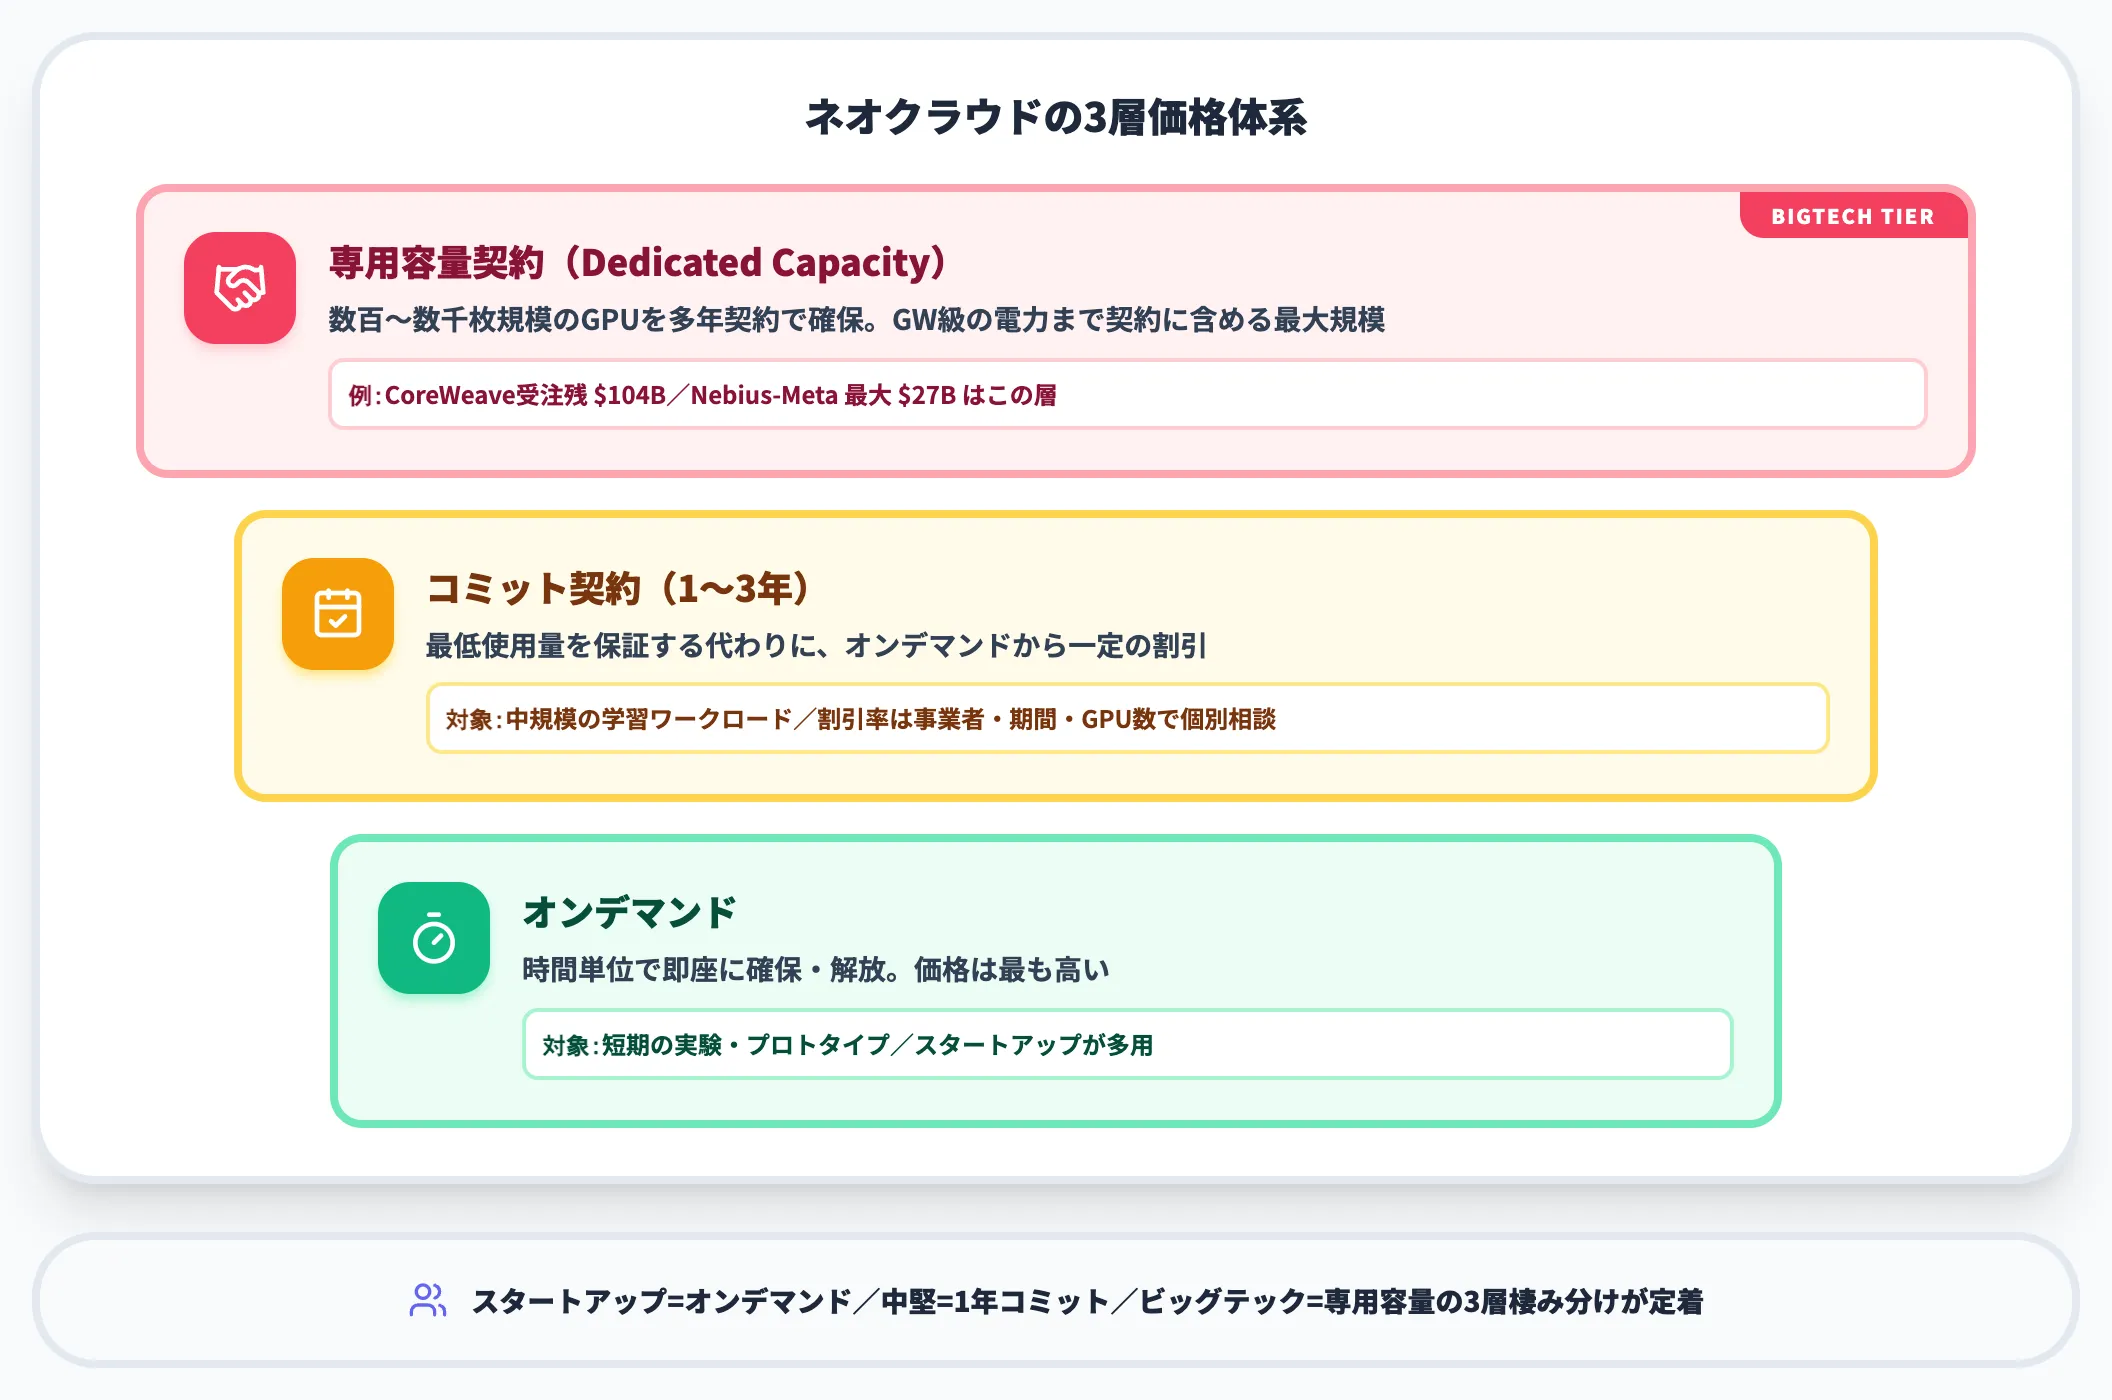
オンデマンド単価だけで判断すると、年契約・多年契約での大幅な割引を見落とします。ネオクラウドの価格体系は以下の3層になっています。
-
オンデマンド
時間単位で即座に確保・解放できる。価格は最も高いが、短期の実験・プロトタイプ向け。
-
コミット(1〜3年契約)
最低使用量を保証する代わりに、オンデマンドから一定の割引を受ける仕組み(割引率は事業者・期間・GPU数で個別相談)。中規模の学習ワークロード向け。
-
専用容量契約(Dedicated Capacity)
数百〜数千枚規模のGPUを多年契約で確保する。価格は非公開だが、Microsoft・MetaのようにGW級の電力まで含めて契約する最大規模。CoreWeaveの受注残1,040億ドル・NebiusのMeta最大約270億ドルはこの層。
実務では、スタートアップはオンデマンド、中堅企業は1年コミット、ビッグテックは専用容量契約という3層の棲み分けが定着しています。
単価だけで判断してはいけない理由
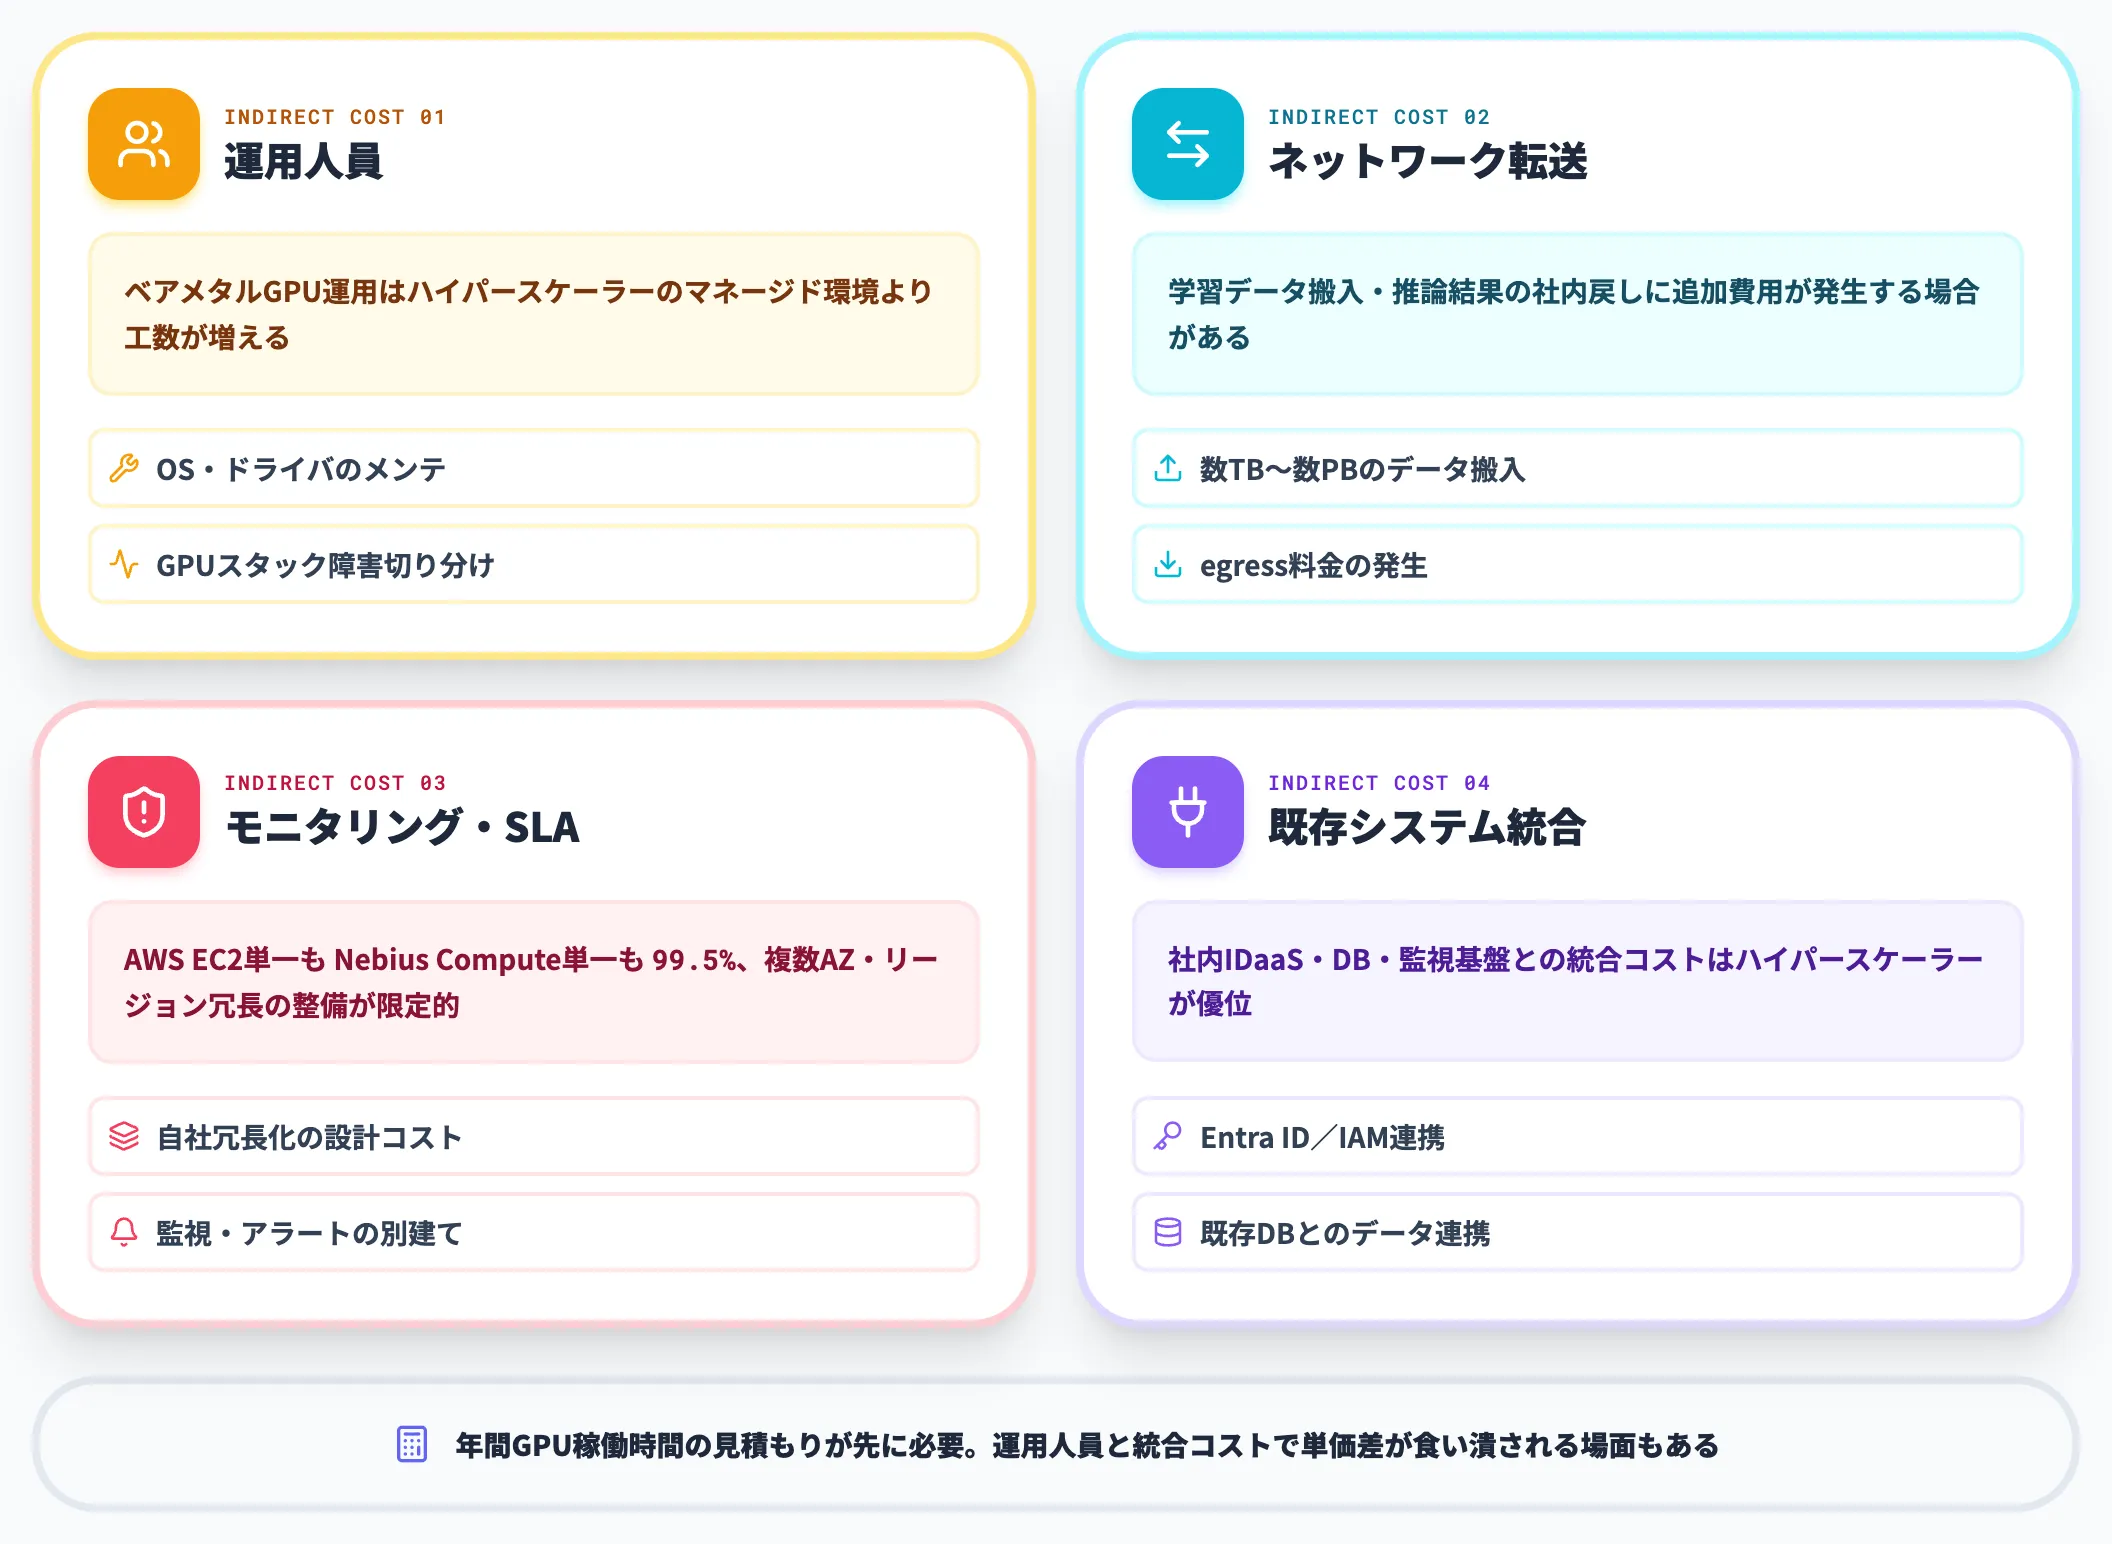
ネオクラウドの価格優位は、計算そのものに関する直接的な話です。しかし実運用では、以下の間接コストを計算に入れる必要があります。
- 運用人員: ベアメタルGPUの運用はハイパースケーラーのマネージド環境より工数が増える
- ネットワーク転送: 学習データのDCへの初回搬入、推論結果の社内への戻しに追加費用が発生する場合がある
- モニタリング・SLA: AWS EC2単一インスタンスとNebius Compute単一VMはどちらも99.5%で水準自体に大差はないが(AzureはPremium管理ディスク構成等で単一VM 99.9%を提示)、ネオクラウド側は複数AZ・リージョン冗長の整備が限定的なことが多く、本番用途では自社冗長化の設計コストを見込む
- 既存システム統合: 社内IDaaS・データベース・監視基盤との統合コストはハイパースケーラー側が優位
単価差が大きくても、運用人員と統合コストで差分が食い潰される場面は少なくありません。「どれくらいの学習・推論量を回すか」で損益分岐が決まるため、年間GPU稼働時間の見積もりが先に必要になります。
ネオクラウドを選ぶ場面・選ばない場面——学習と推論の棲み分け
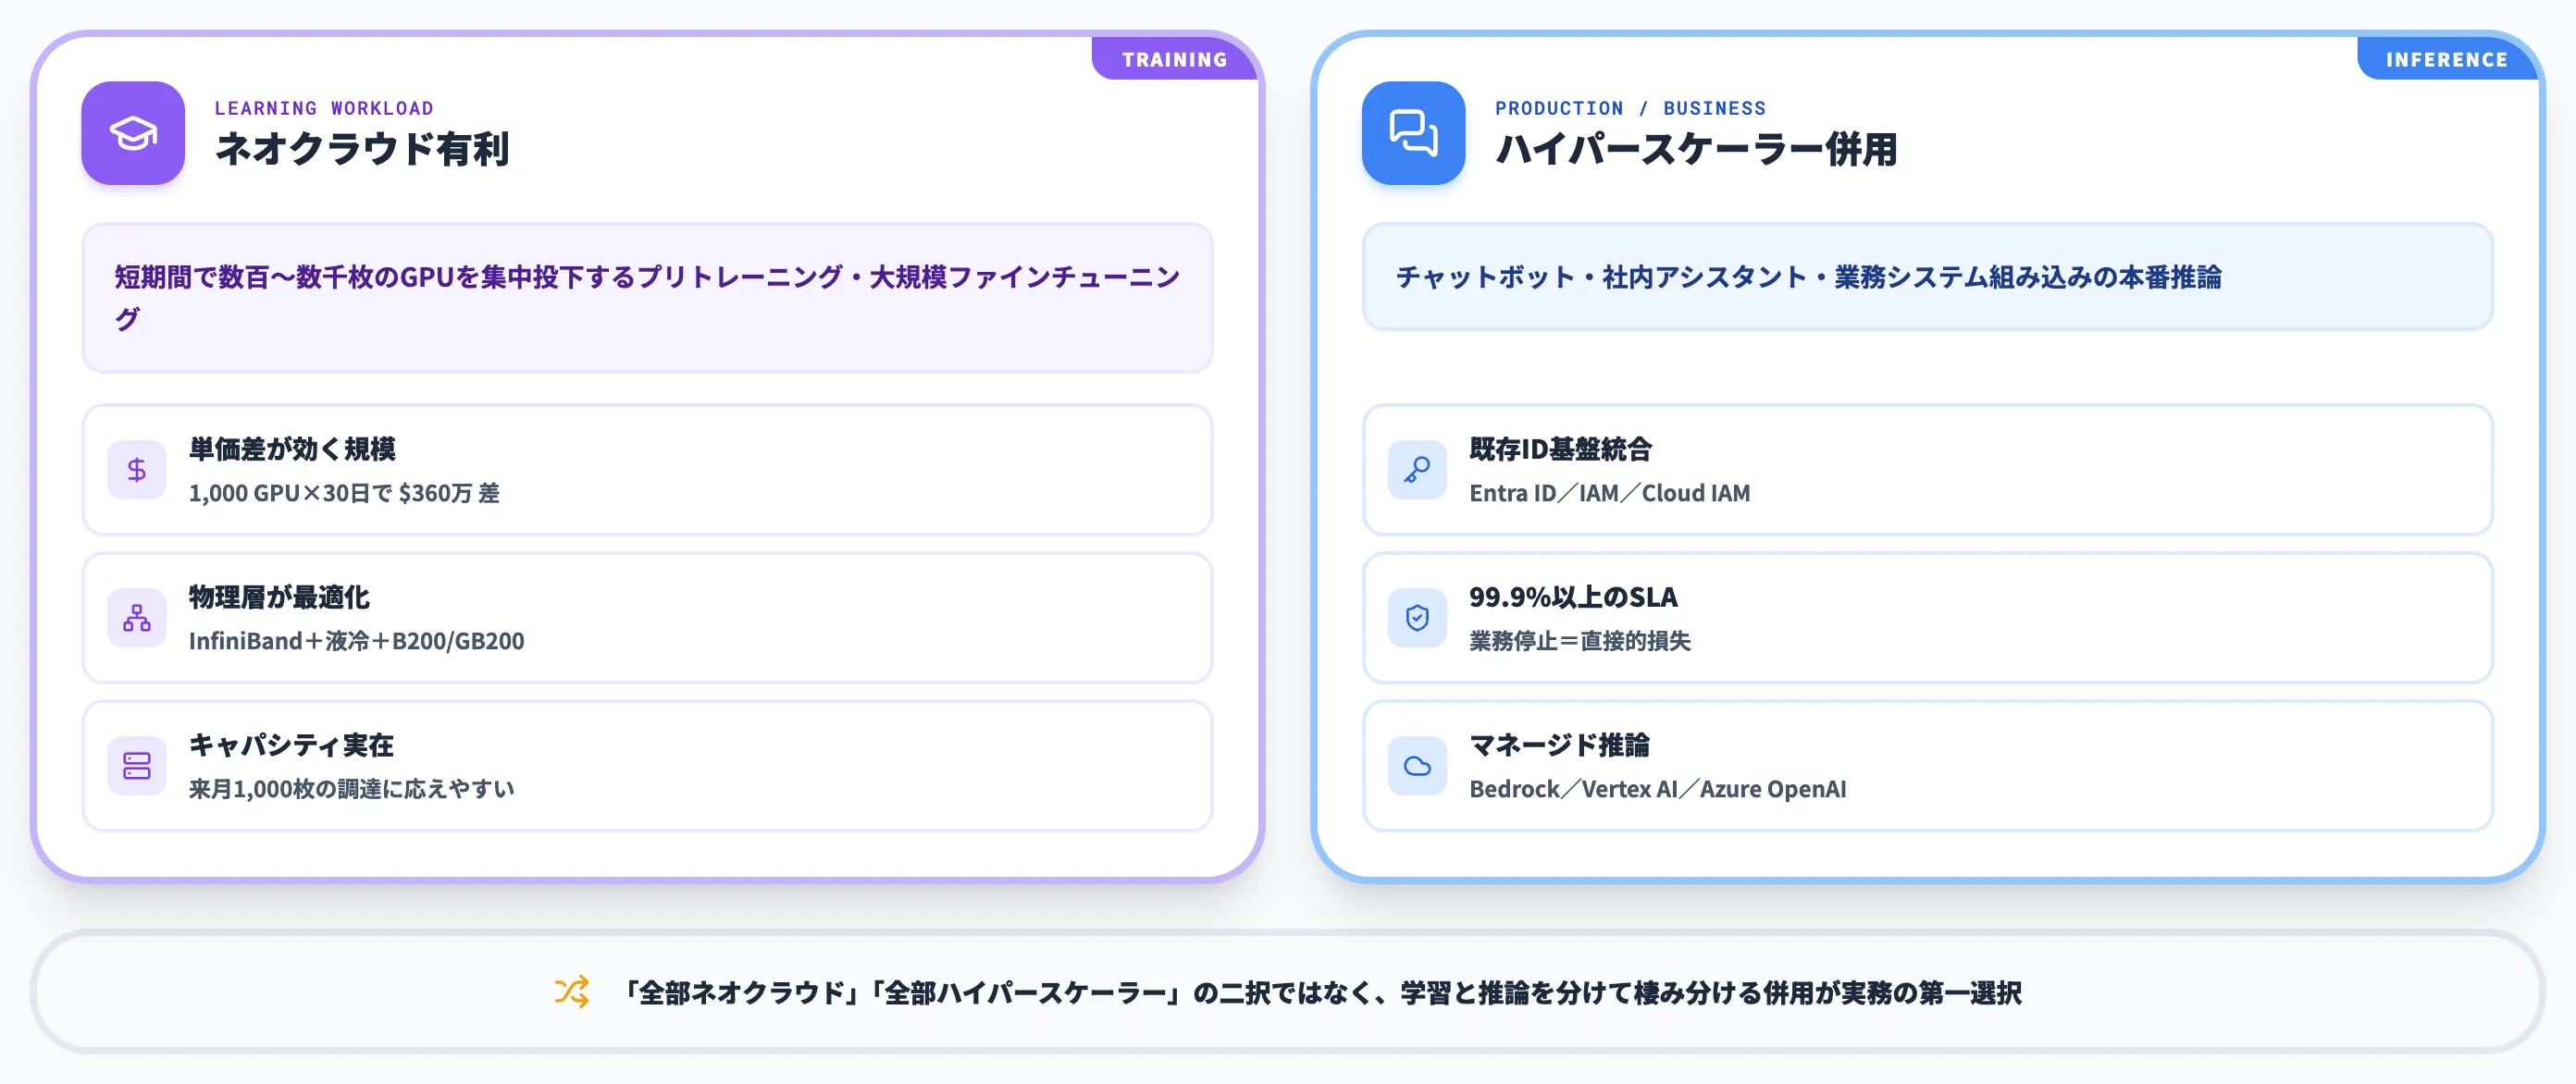
ネオクラウドとハイパースケーラーのどちらを選ぶかは、ワークロードの種類で判断するのが実務的です。
AI総研が導入支援の現場で見てきた棲み分けのパターンを、ワークロード別・企業規模別に整理します。
学習ワークロードはネオクラウド有利
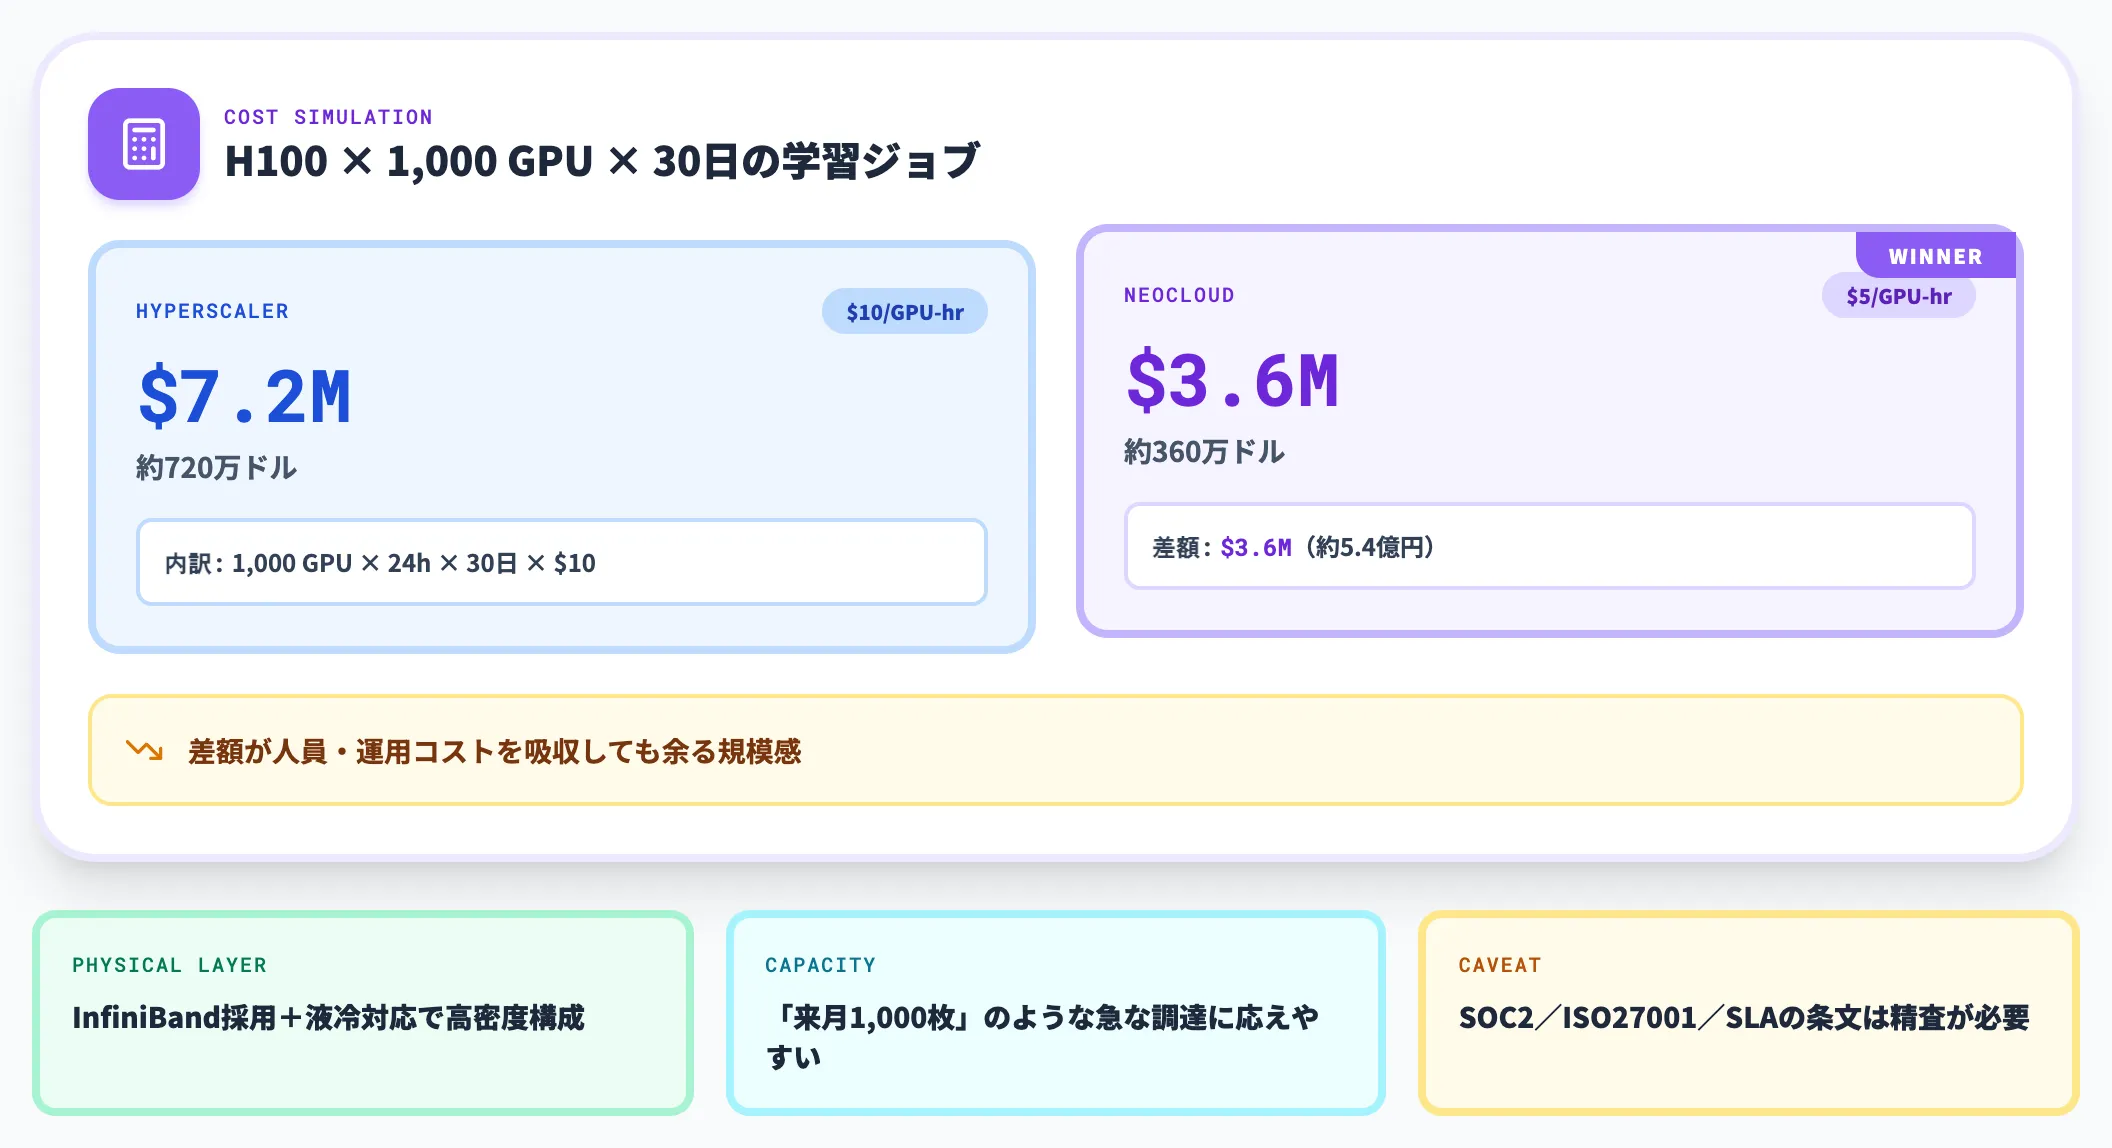
LLMのプリトレーニング・ファインチューニング・大規模な蒸留は、短期間に数百〜数千枚のGPUを集中投下する類のジョブです。この領域ではネオクラウドが圧倒的に有利です。
理由は3つあります。
- 構成次第で単価差が大きい
1,000GPU×30日のH100学習ジョブ(単価$10/GPU-hrと$5/GPU-hrで試算)は、ハイパースケーラー側で約720万ドル、ネオクラウド側で約360万ドル前後。差額が人員・運用コストを吸収しても余る規模感
- InfiniBand採用と、B200/GB200など高密度構成での液冷対応
1,000GPU規模の集団通信を本気で回すなら、ネオクラウドの物理層設計が有利な場面が多い
- キャパシティが実在する
ハイパースケーラーは「来月1,000枚」のような急な調達が難しいが、ネオクラウドは余剰容量を持つことがある
ただし、学習データが特定リージョンに縛られる場合や、個人情報・機密データを扱う場合は、SOC2・ISO27001・SLAの条文を精査する必要があります。
本番推論と業務システムはハイパースケーラー併用
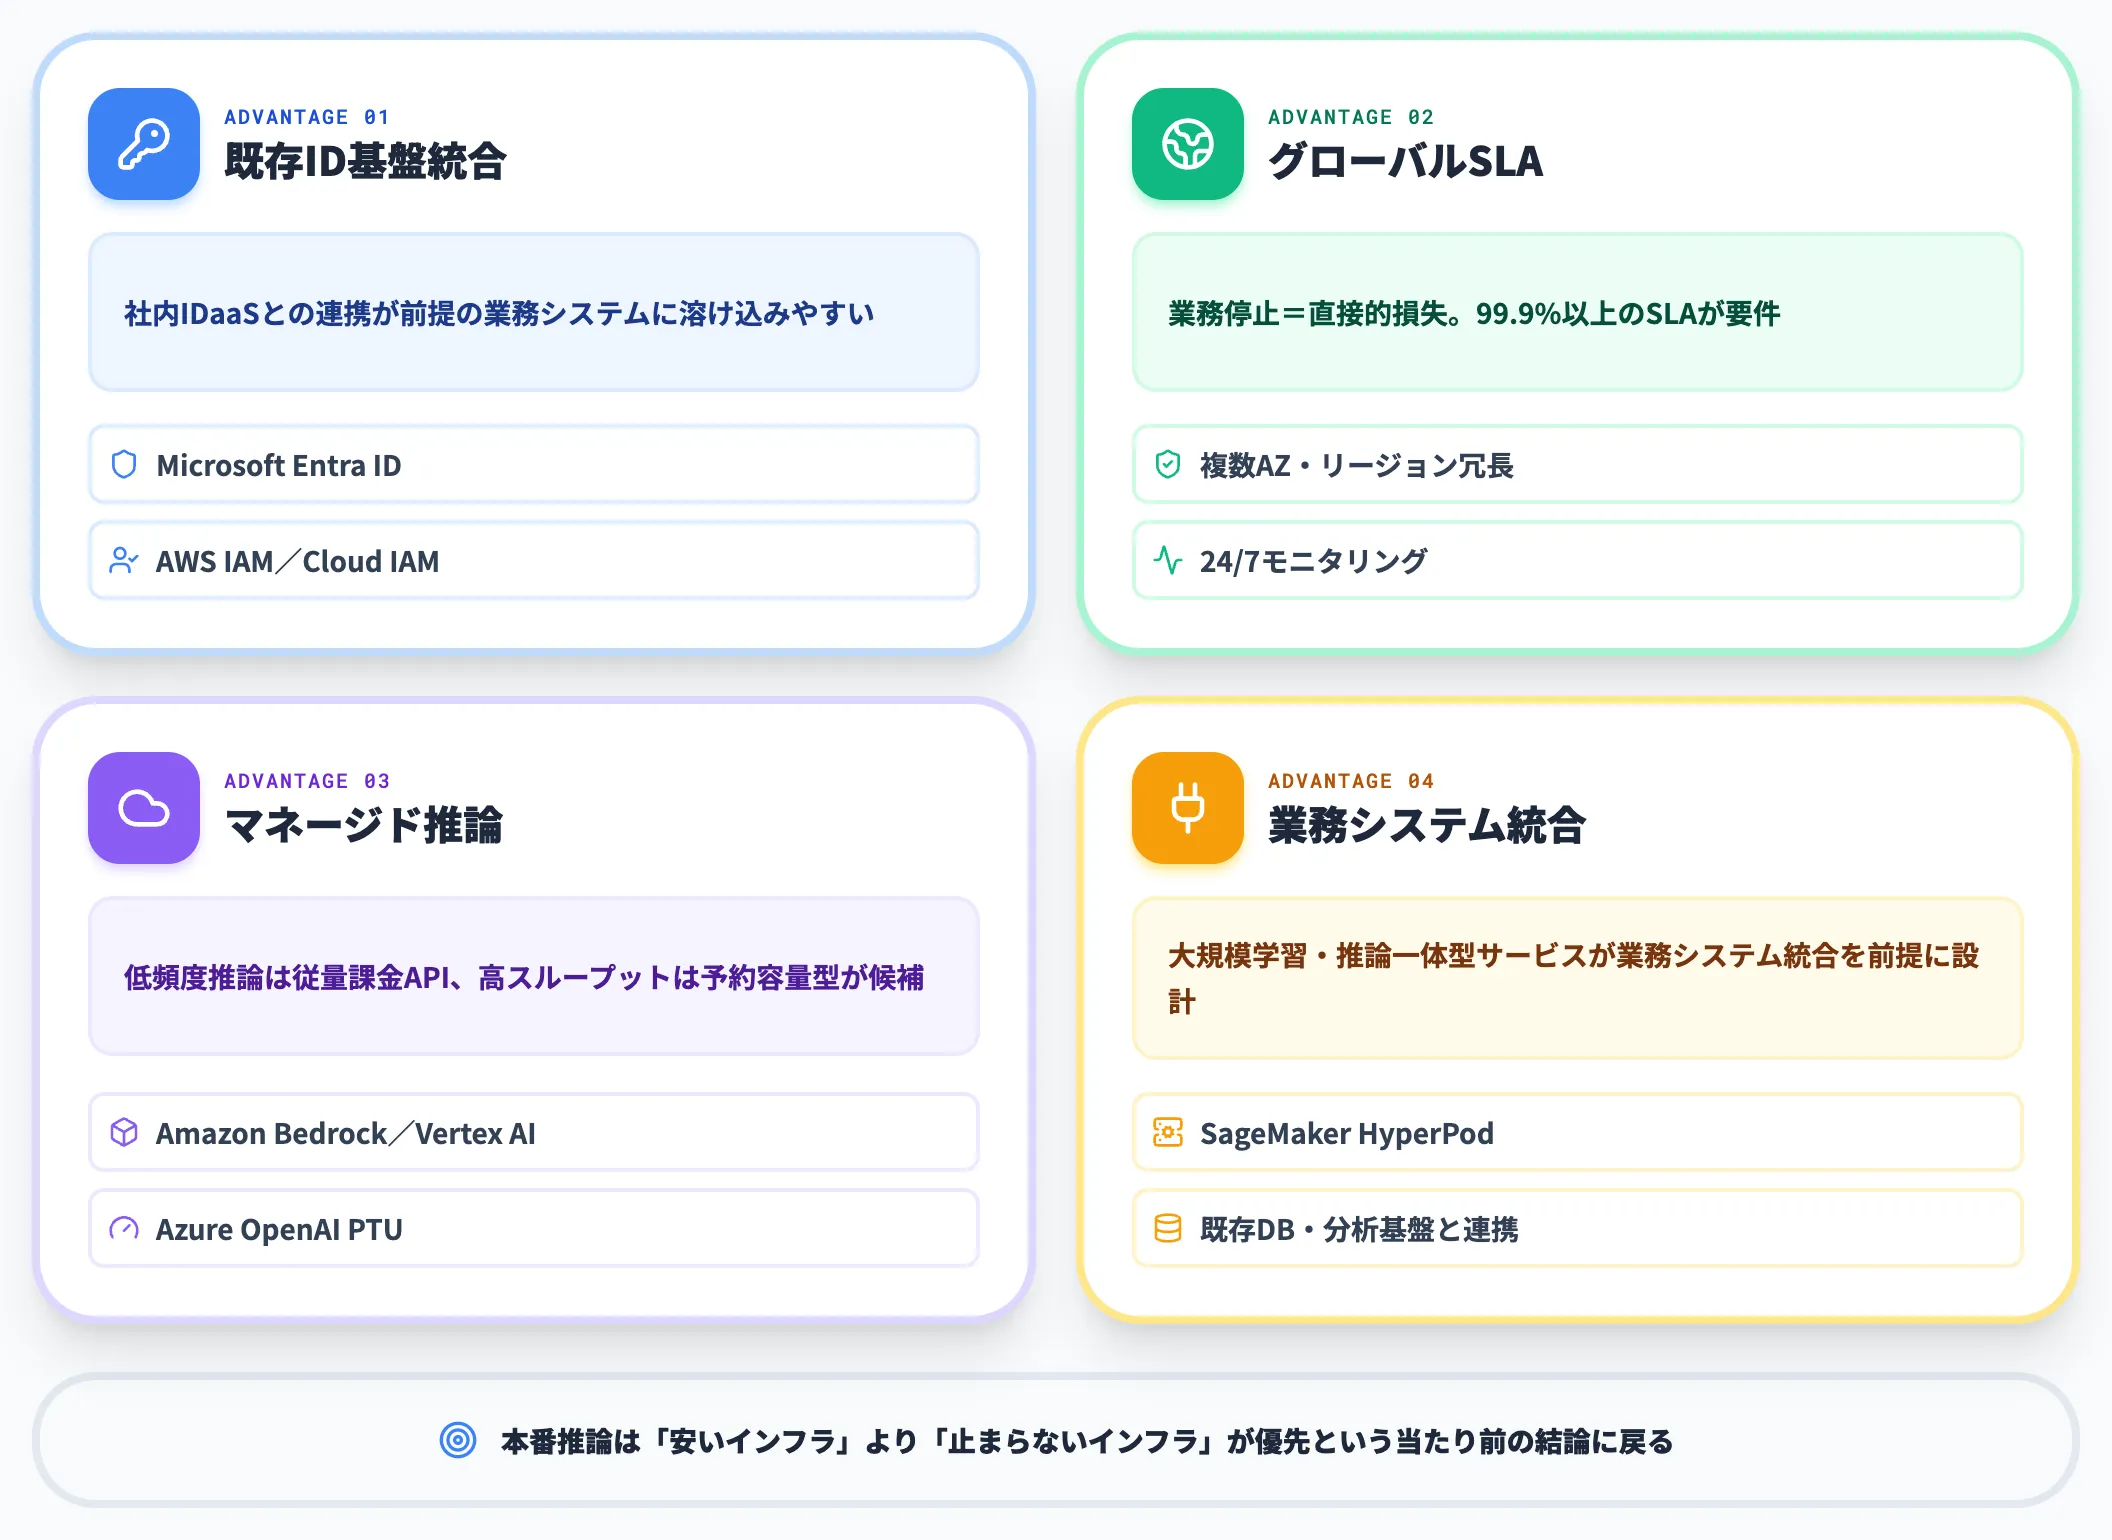
一方、本番運用の推論(Inference)、特にチャットボット・社内アシスタント・業務システムに組み込まれるAIは、ハイパースケーラーに寄せるのが基本線です。
- 既存ID基盤との統合
Microsoft Entra ID・AWS IAM・Google Cloud IAMとの連携が前提のため
- グローバルリージョンのSLA
業務停止=直接的な損失になる本番推論は、99.9%以上のSLAが要件
- サーバレス・マネージド
低頻度の推論を安く回すなら、Azure OpenAIの従量課金API・Amazon Bedrock・Vertex AIなどのマネージド推論が運用コストを下げる(高スループットが必要なワークロードにはAzure OpenAI PTUなどの予約容量型が候補)
- 業務システム統合
SageMaker HyperPodのような大規模学習・推論一体型のサービスは、既存業務システムとの統合が前提
推論の単価だけ見るとネオクラウドのほうが安い場合もありますが、業務統合・SLA・運用一体性の価値が単価差を上回ります。本番推論は「安いインフラ」より「止まらないインフラ」が優先という当たり前の結論に戻ります。
ケース別の推奨——スタートアップ・エンプラ・日本企業
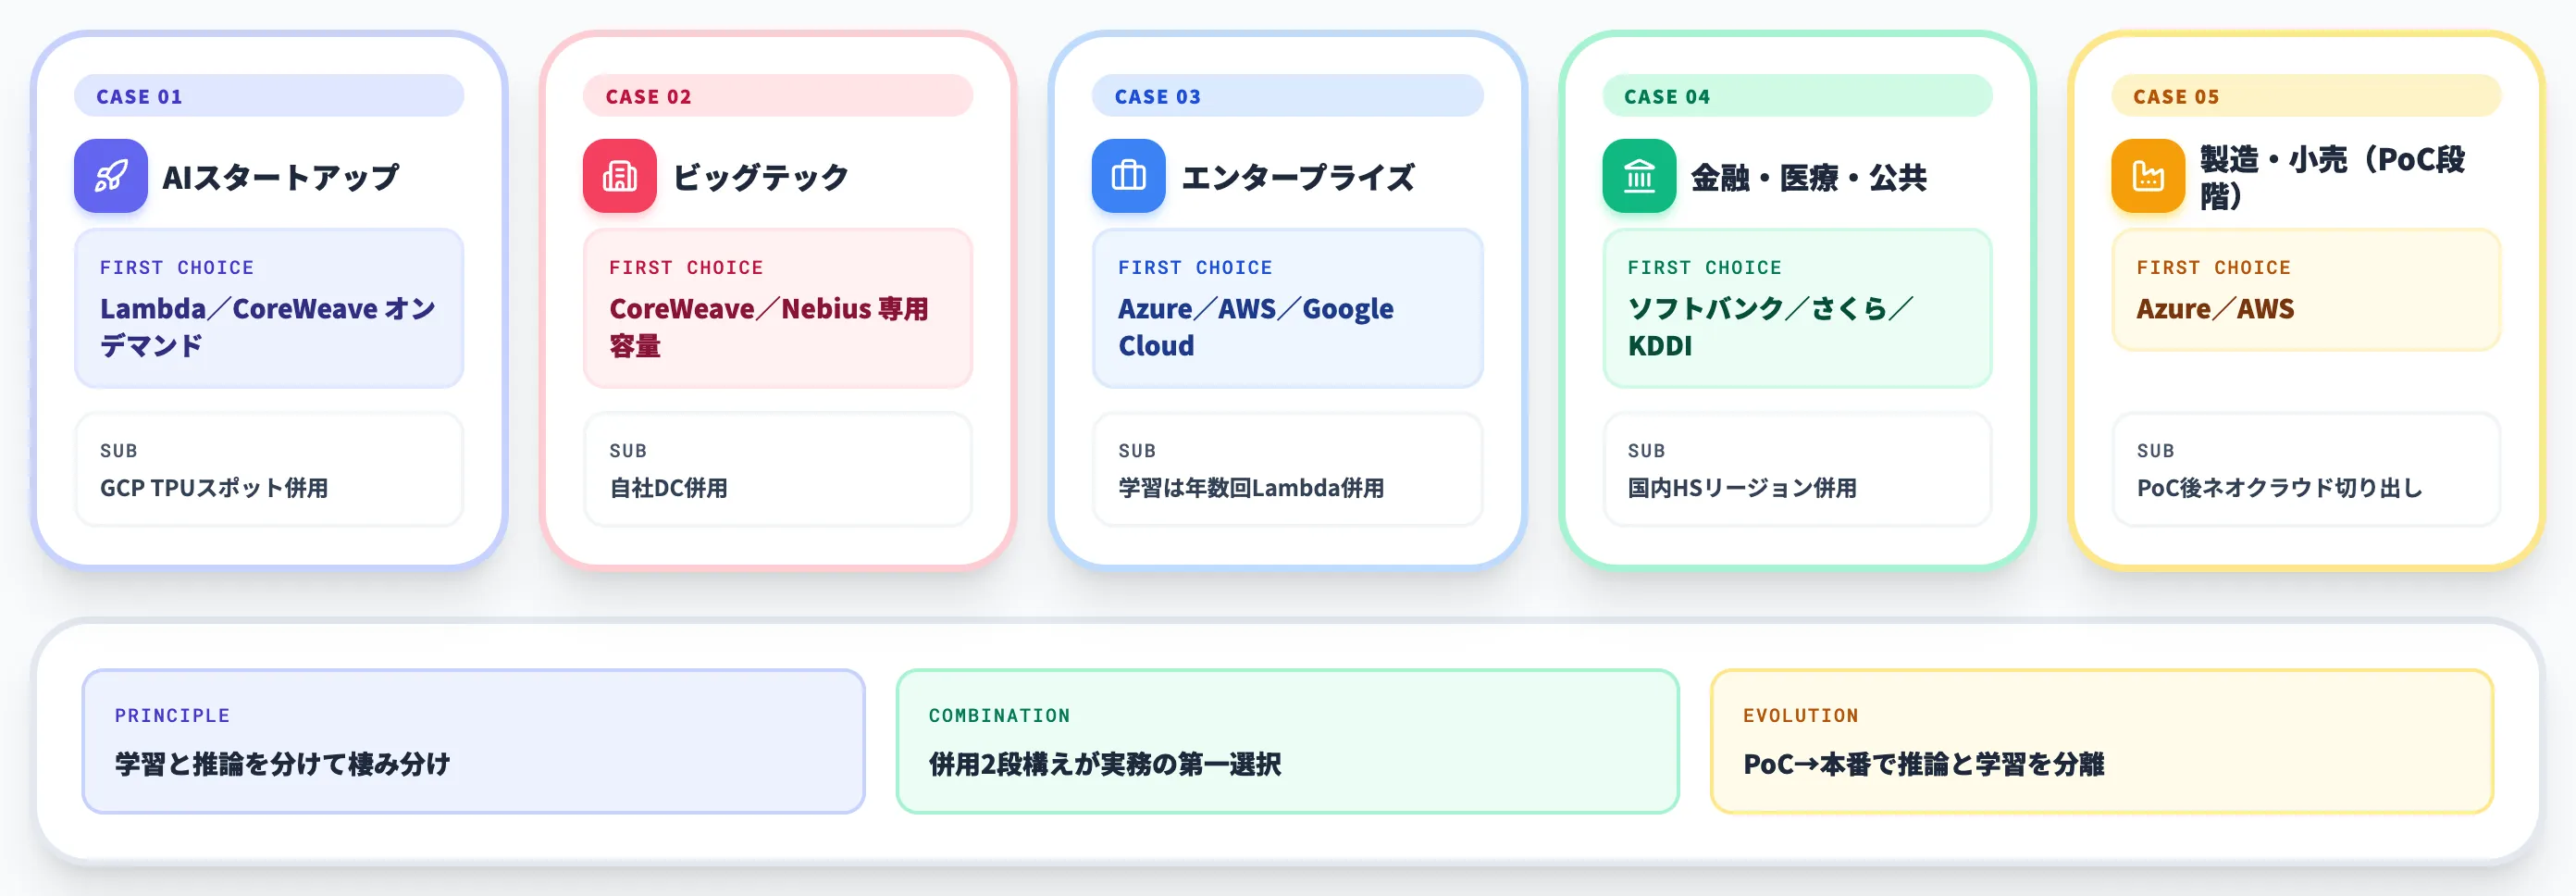
実務上の判断は、企業規模とワークロードの組み合わせで次のように整理できます。
| ケース | 第一候補 | 補助 |
|---|---|---|
| AIスタートアップ(学習が主) | Lambda・CoreWeaveのオンデマンド | Google Cloud TPUをスポットで併用 |
| ビッグテック・大規模AI企業 | CoreWeave・Nebiusの専用容量 | 自社DC併用 |
| エンタープライズ(本番推論主) | Azure・AWS・Google Cloud | 学習は年数回Lambda併用 |
| 日本の金融・医療・公共 | 国内ネオクラウド(ソフトバンク・さくら・KDDI) | 国内ハイパースケーラーリージョン併用 |
| 製造業・小売(PoC段階) | Azure・AWS | PoC後に学習ワークロードをネオクラウドに切り出す |
どの企業規模でも「全部ネオクラウド」「全部ハイパースケーラー」の二択ではなく、学習と推論を分けて棲み分ける併用が実務の第一選択です。
Azure/AWSの比較などで推論側のハイパースケーラーを決め、学習側のネオクラウドを別途調達する2段構えが現実的です。
ネオクラウド導入前に押さえるべきリスク・論点
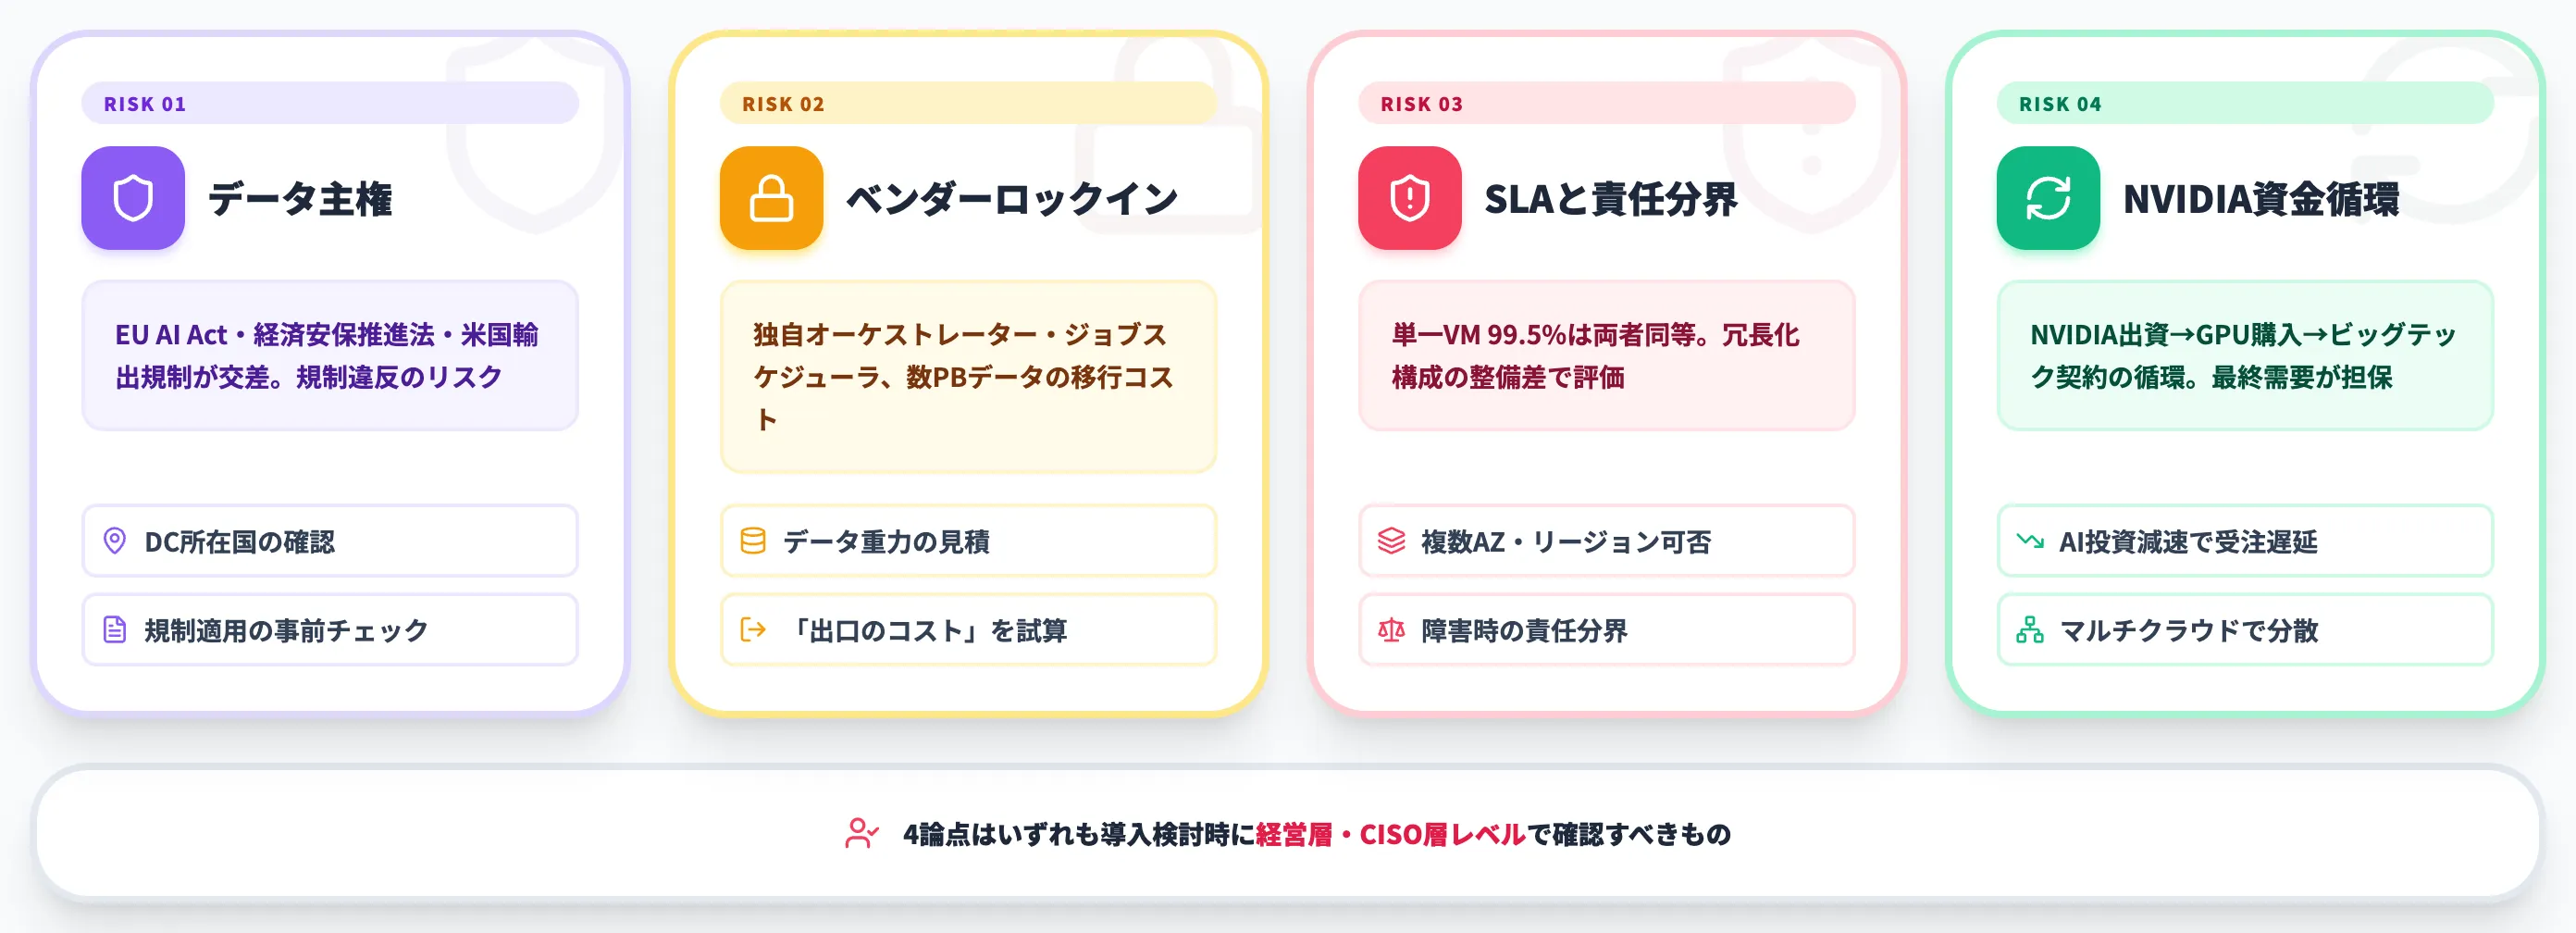
価格優位と調達スピードだけでネオクラウドを採用すると、後工程で経営リスクに跳ね返る論点があります。
導入前に経営層・CISO層レベルで必ず確認しておくべき4つの論点を整理します。
データ主権とソブリンAI
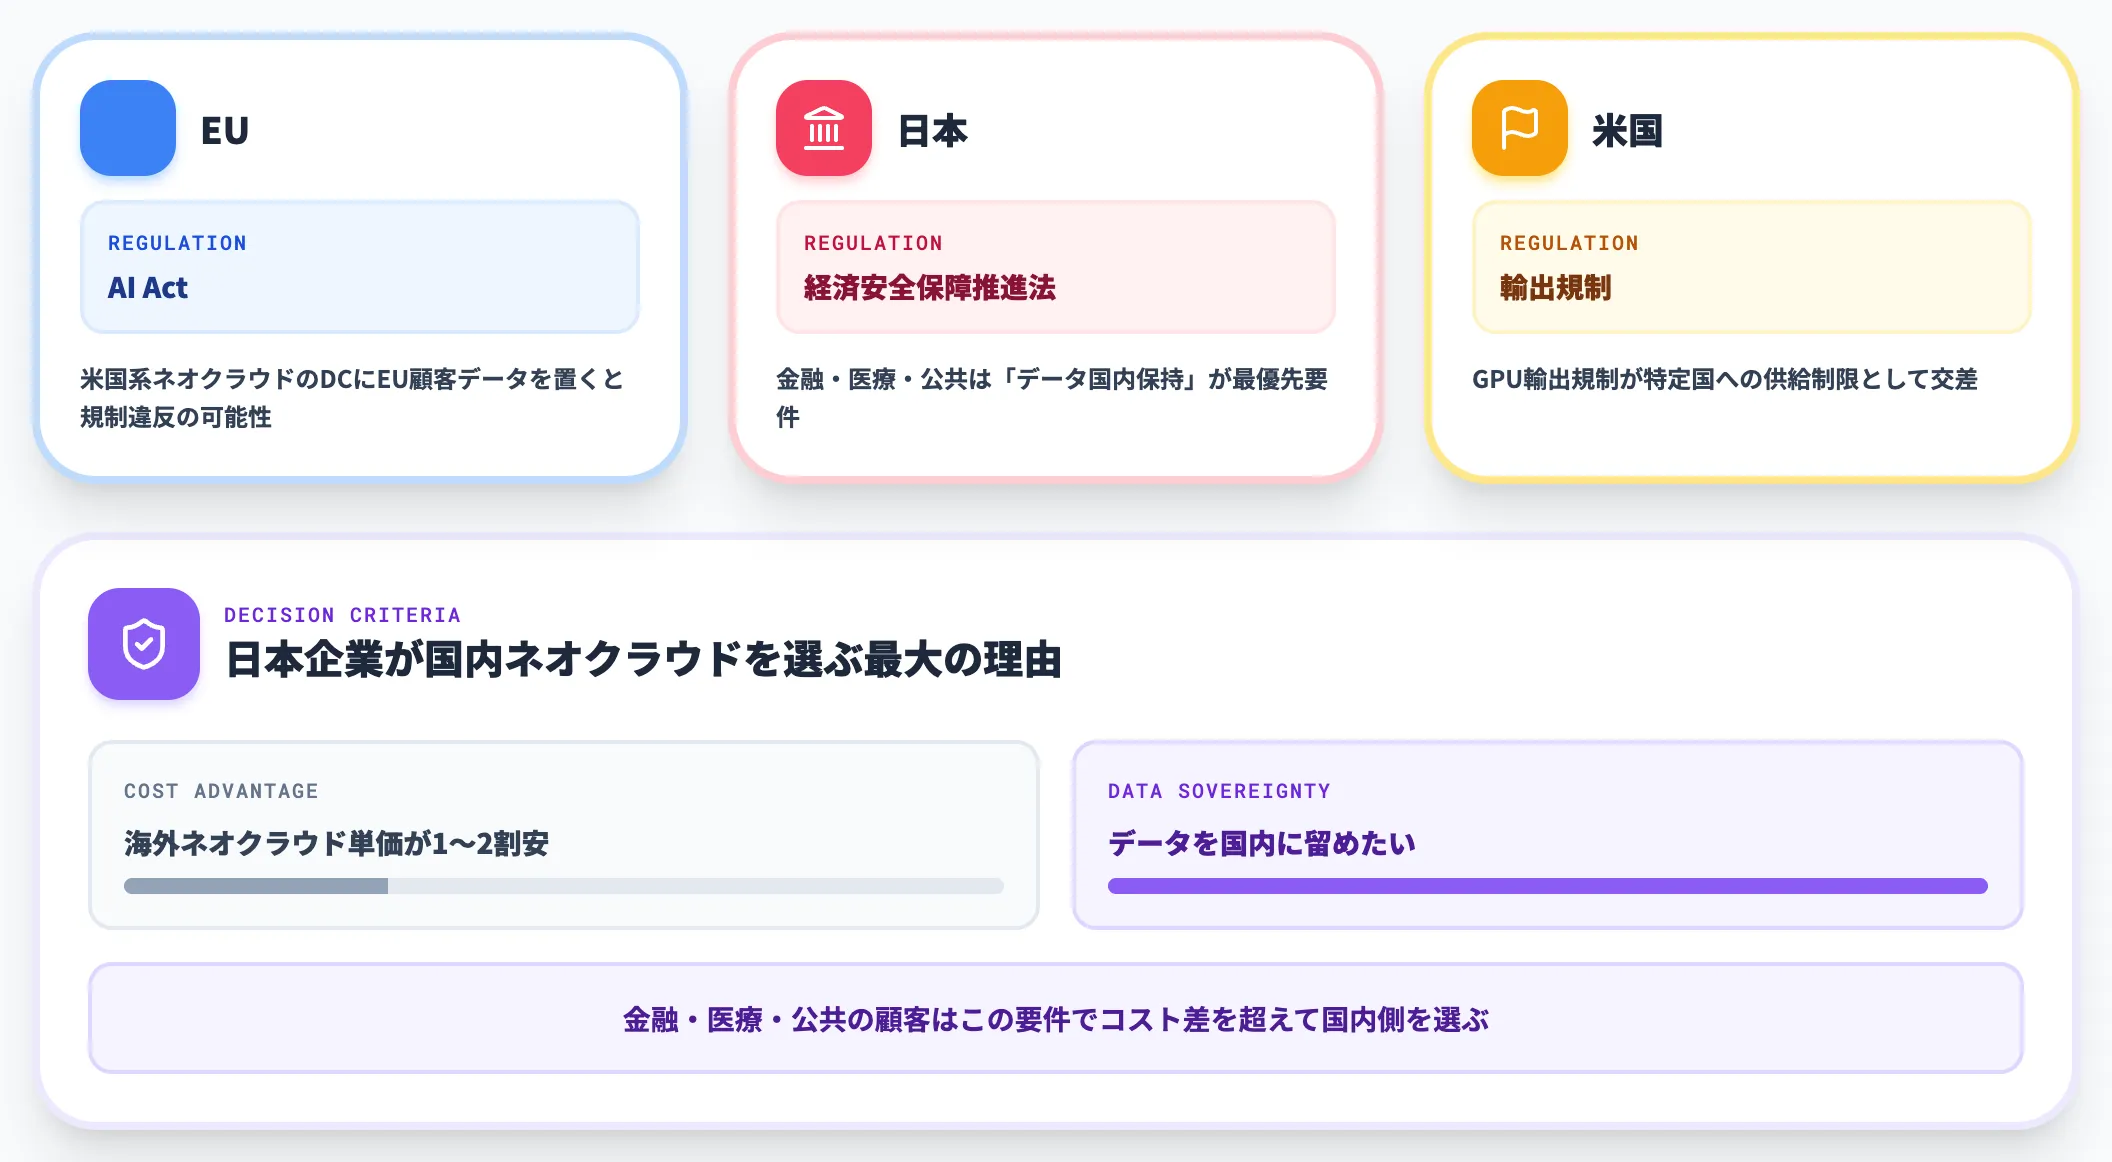
学習データ・推論ログがどの国のDCに置かれるかは、2026年時点で経営上の重要論点になりました。
EUのAI Act・日本の経済安全保障推進法・米国の輸出規制が交差する領域で、米国系ネオクラウドのDCにEU顧客データを置くと規制違反になるケースがあります。
日本企業が国内ネオクラウド(ソフトバンク・さくら・KDDI)を選ぶ最大の理由はコストではなく、「データを国内に留めたい」という要件です。海外ネオクラウドの単価が1〜2割安くても、金融・医療・公共の顧客はこの要件で国内側を選びます。
ベンダーロックインと移行コスト
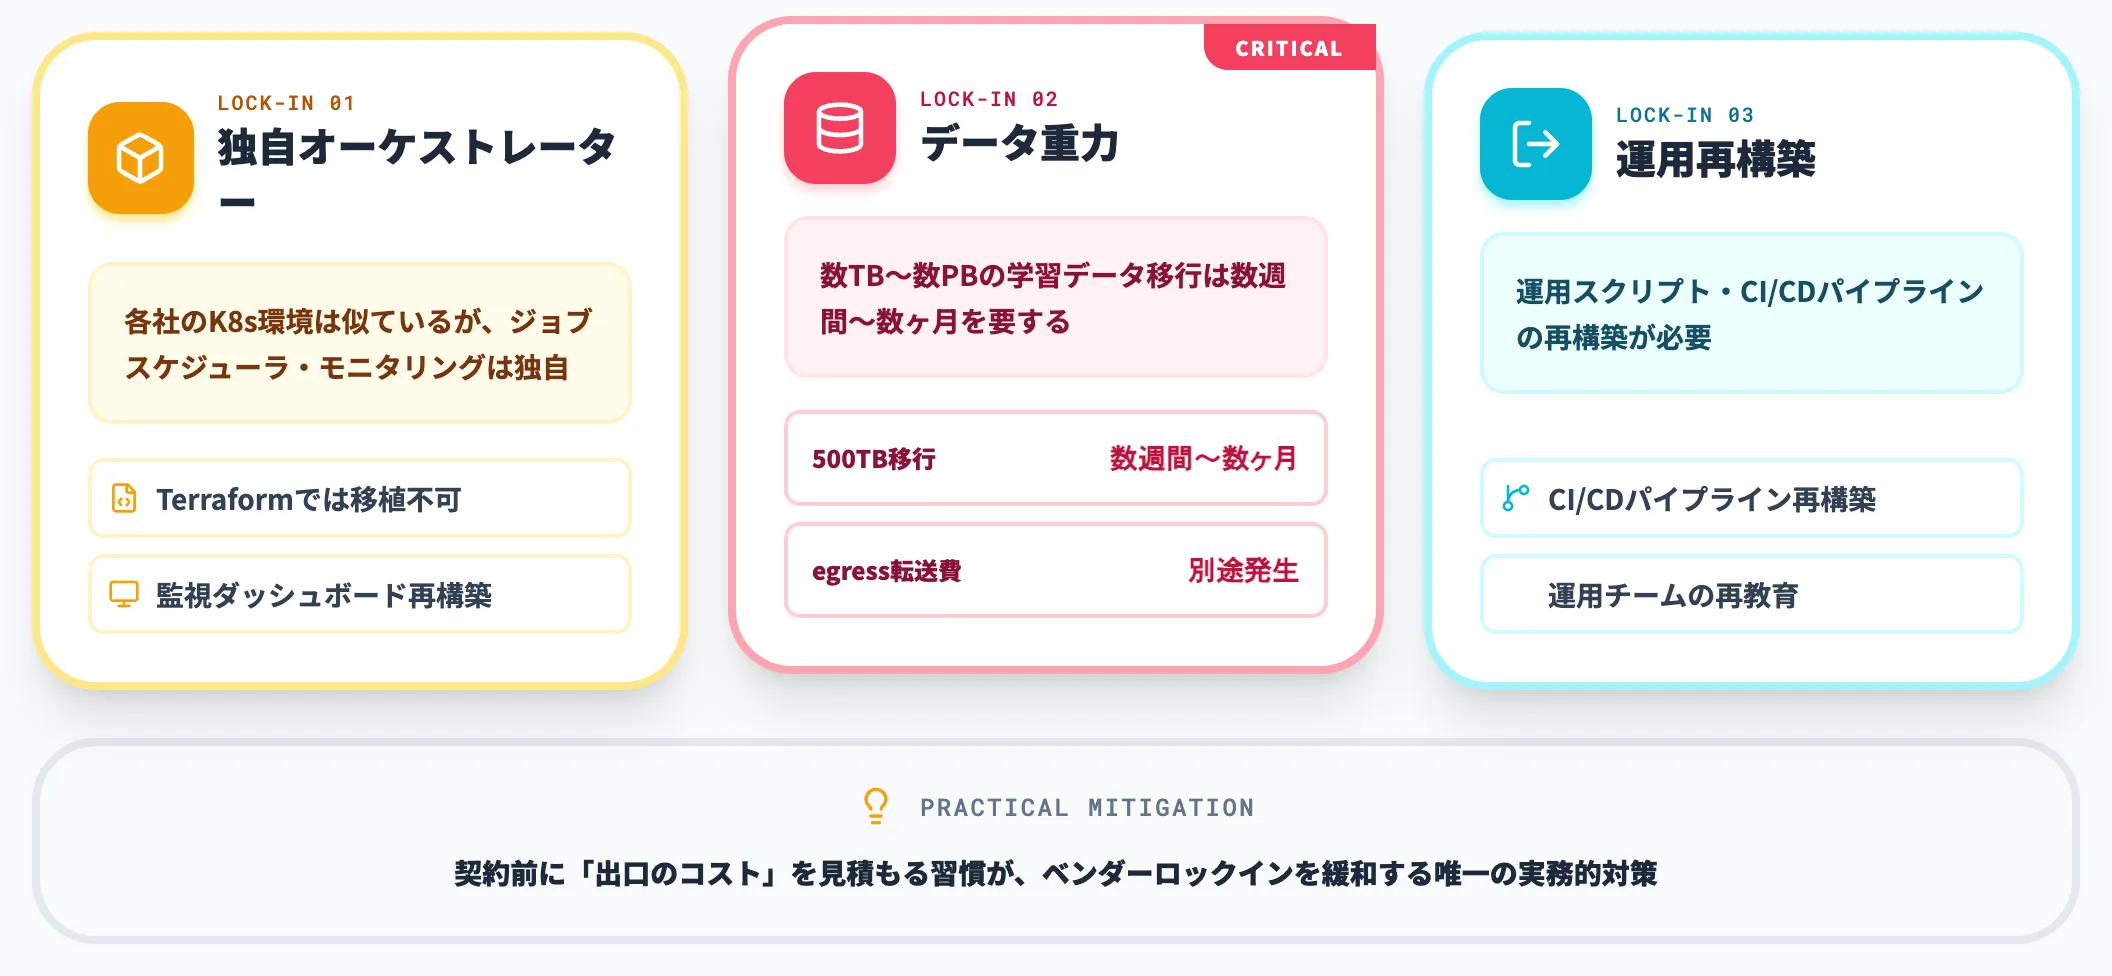
ネオクラウド各社のKubernetes環境は似ていますが、独自のオーケストレーター・モニタリング・ジョブスケジューラが乗っています。
CoreWeaveで動いていた学習ジョブをNebiusに移すとき、Terraformレベルでは移植できても、運用スクリプト・監視ダッシュボード・CI/CDパイプラインの再構築が必要になります。
データ重力(Data Gravity)の問題もあります。数百TB〜数PBの学習データをS3互換ストレージに置いた場合、他社DCへの転送に数週間〜数ヶ月を要し、転送費も発生します。契約前に「出口のコスト」を見積もる習慣が、ベンダーロックインを緩和する唯一の実務的対策です。
SLAと障害時の責任分界
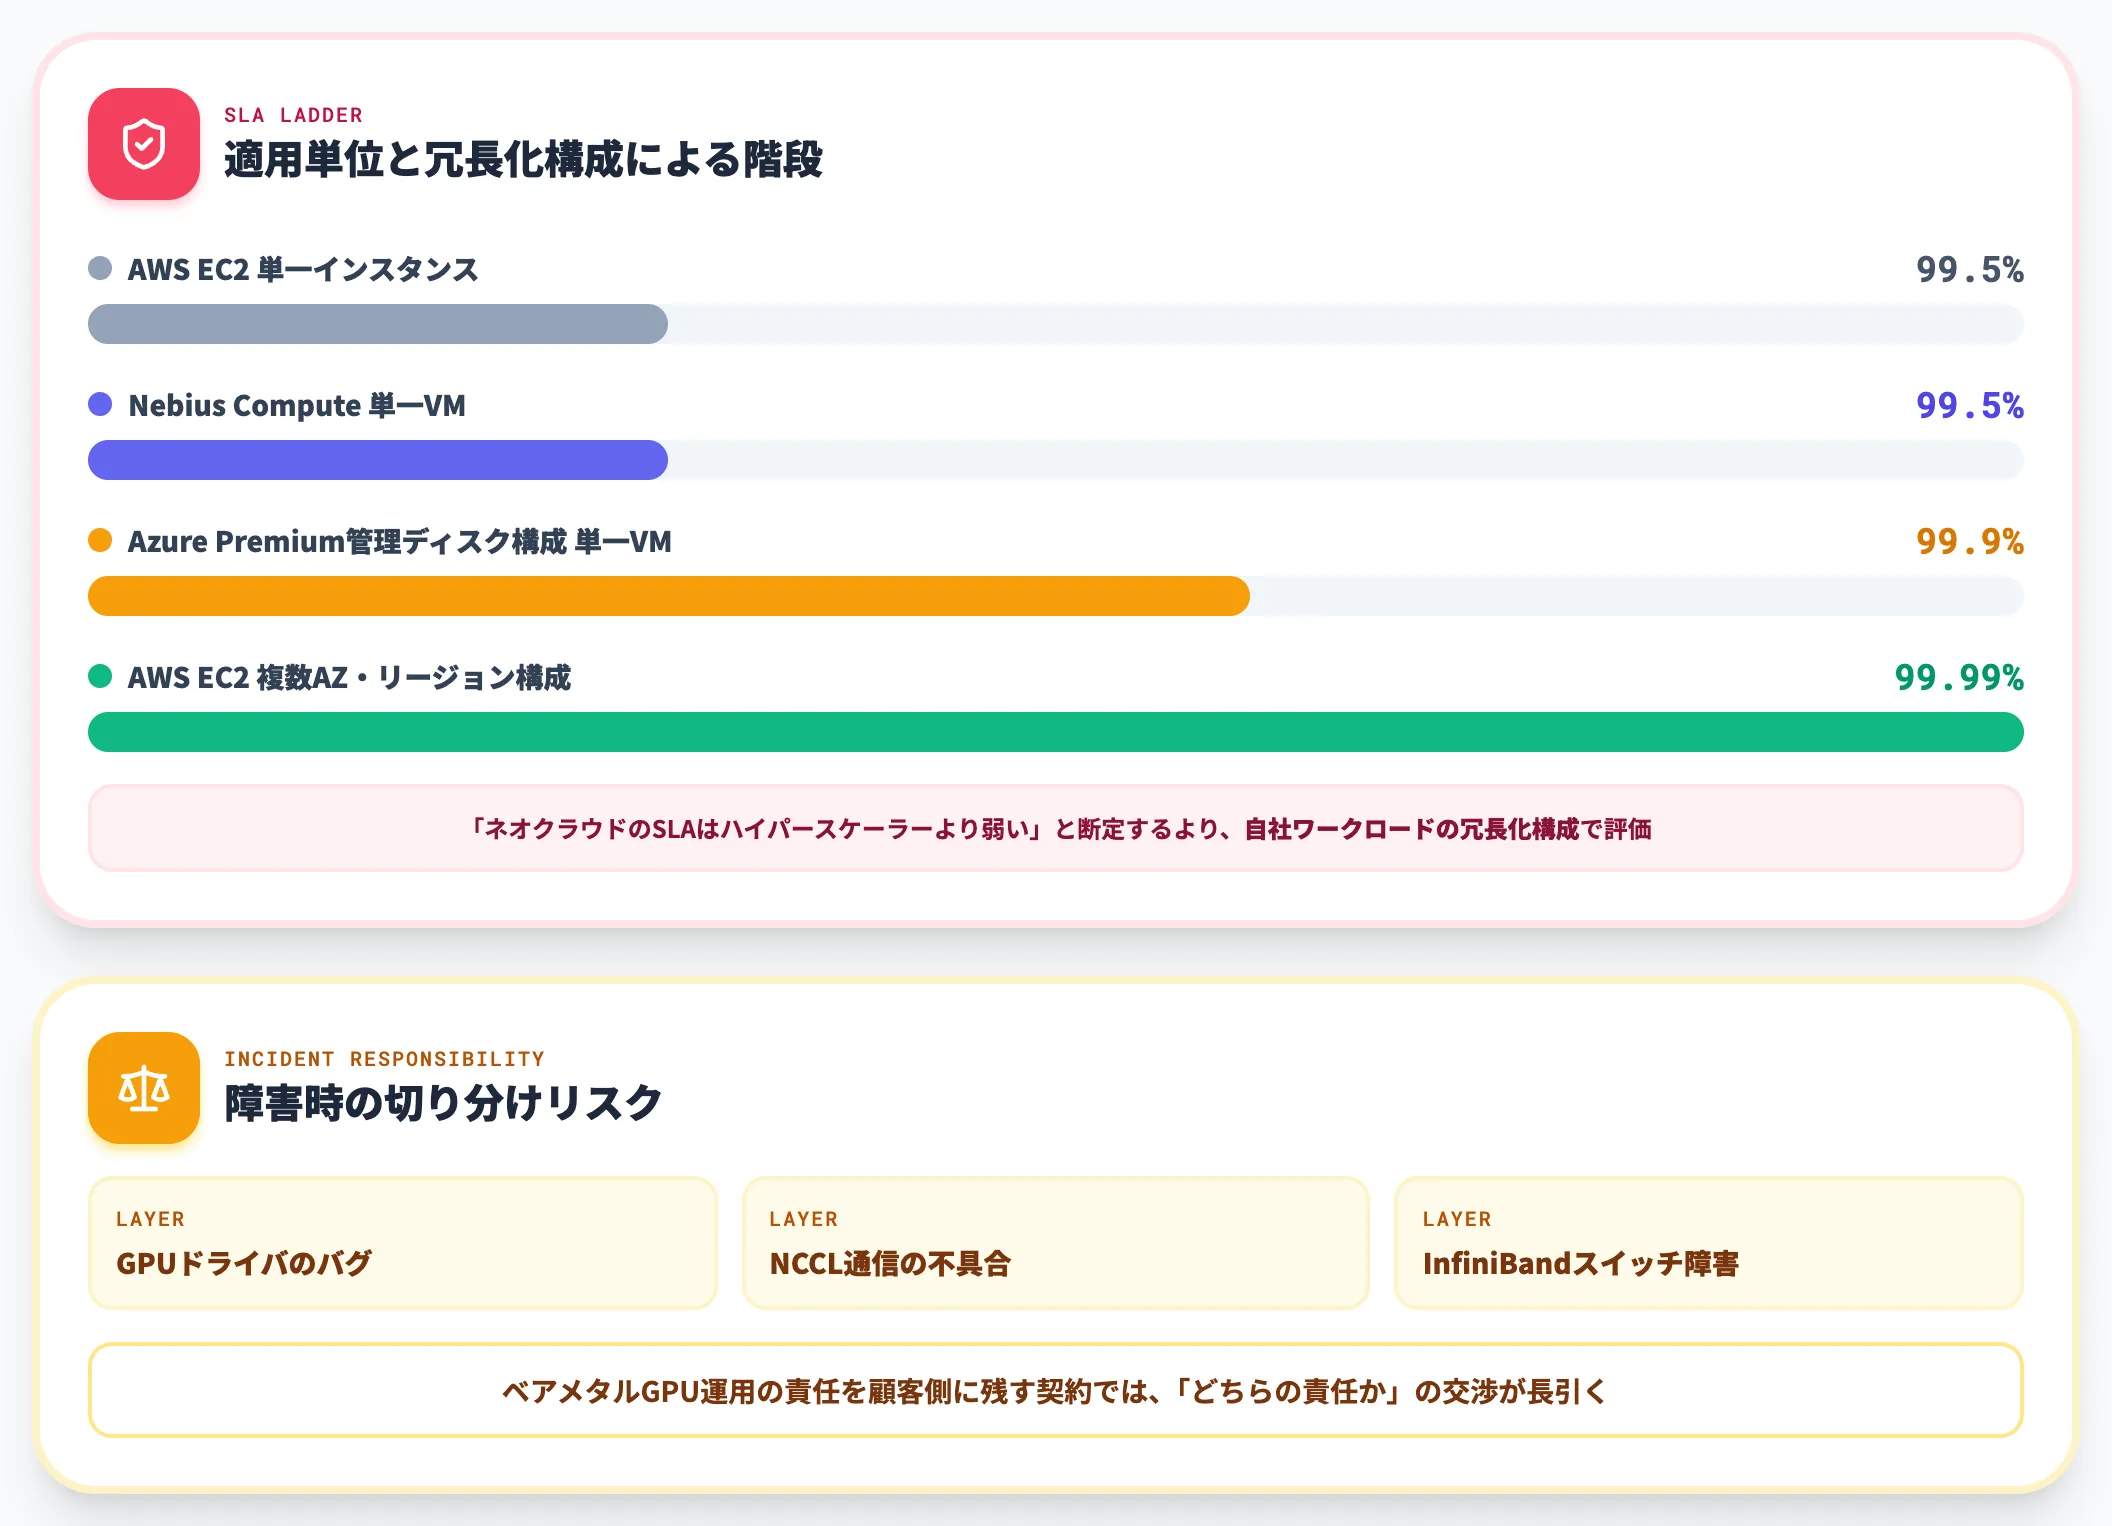
SLAは適用単位と冗長化構成で数値が大きく変わります。AWS EC2は単一インスタンス99.5%で、複数AZまたはリージョン構成を取ったときに99.99%まで上がる契約です。Nebius Computeの単一VMも同じく99.5%で、ハイパースケーラーとネオクラウドで単一VM単位のSLA水準に大差はありません。
「ネオクラウドのSLAはハイパースケーラーより弱い」と断定するより、自社ワークロードがどの冗長化構成を前提にするかで評価したほうが現実に即しています。
加えて、障害時の原因切り分けの責任分界が曖昧になりやすい点にも注意が必要です。ベアメタルGPU運用の責任を顧客側に残す契約では、GPUドライバのバグ・NCCL通信の不具合・InfiniBandスイッチの障害などで「どちらの責任か」の交渉が長引きます。
NVIDIAとの資金循環リスク
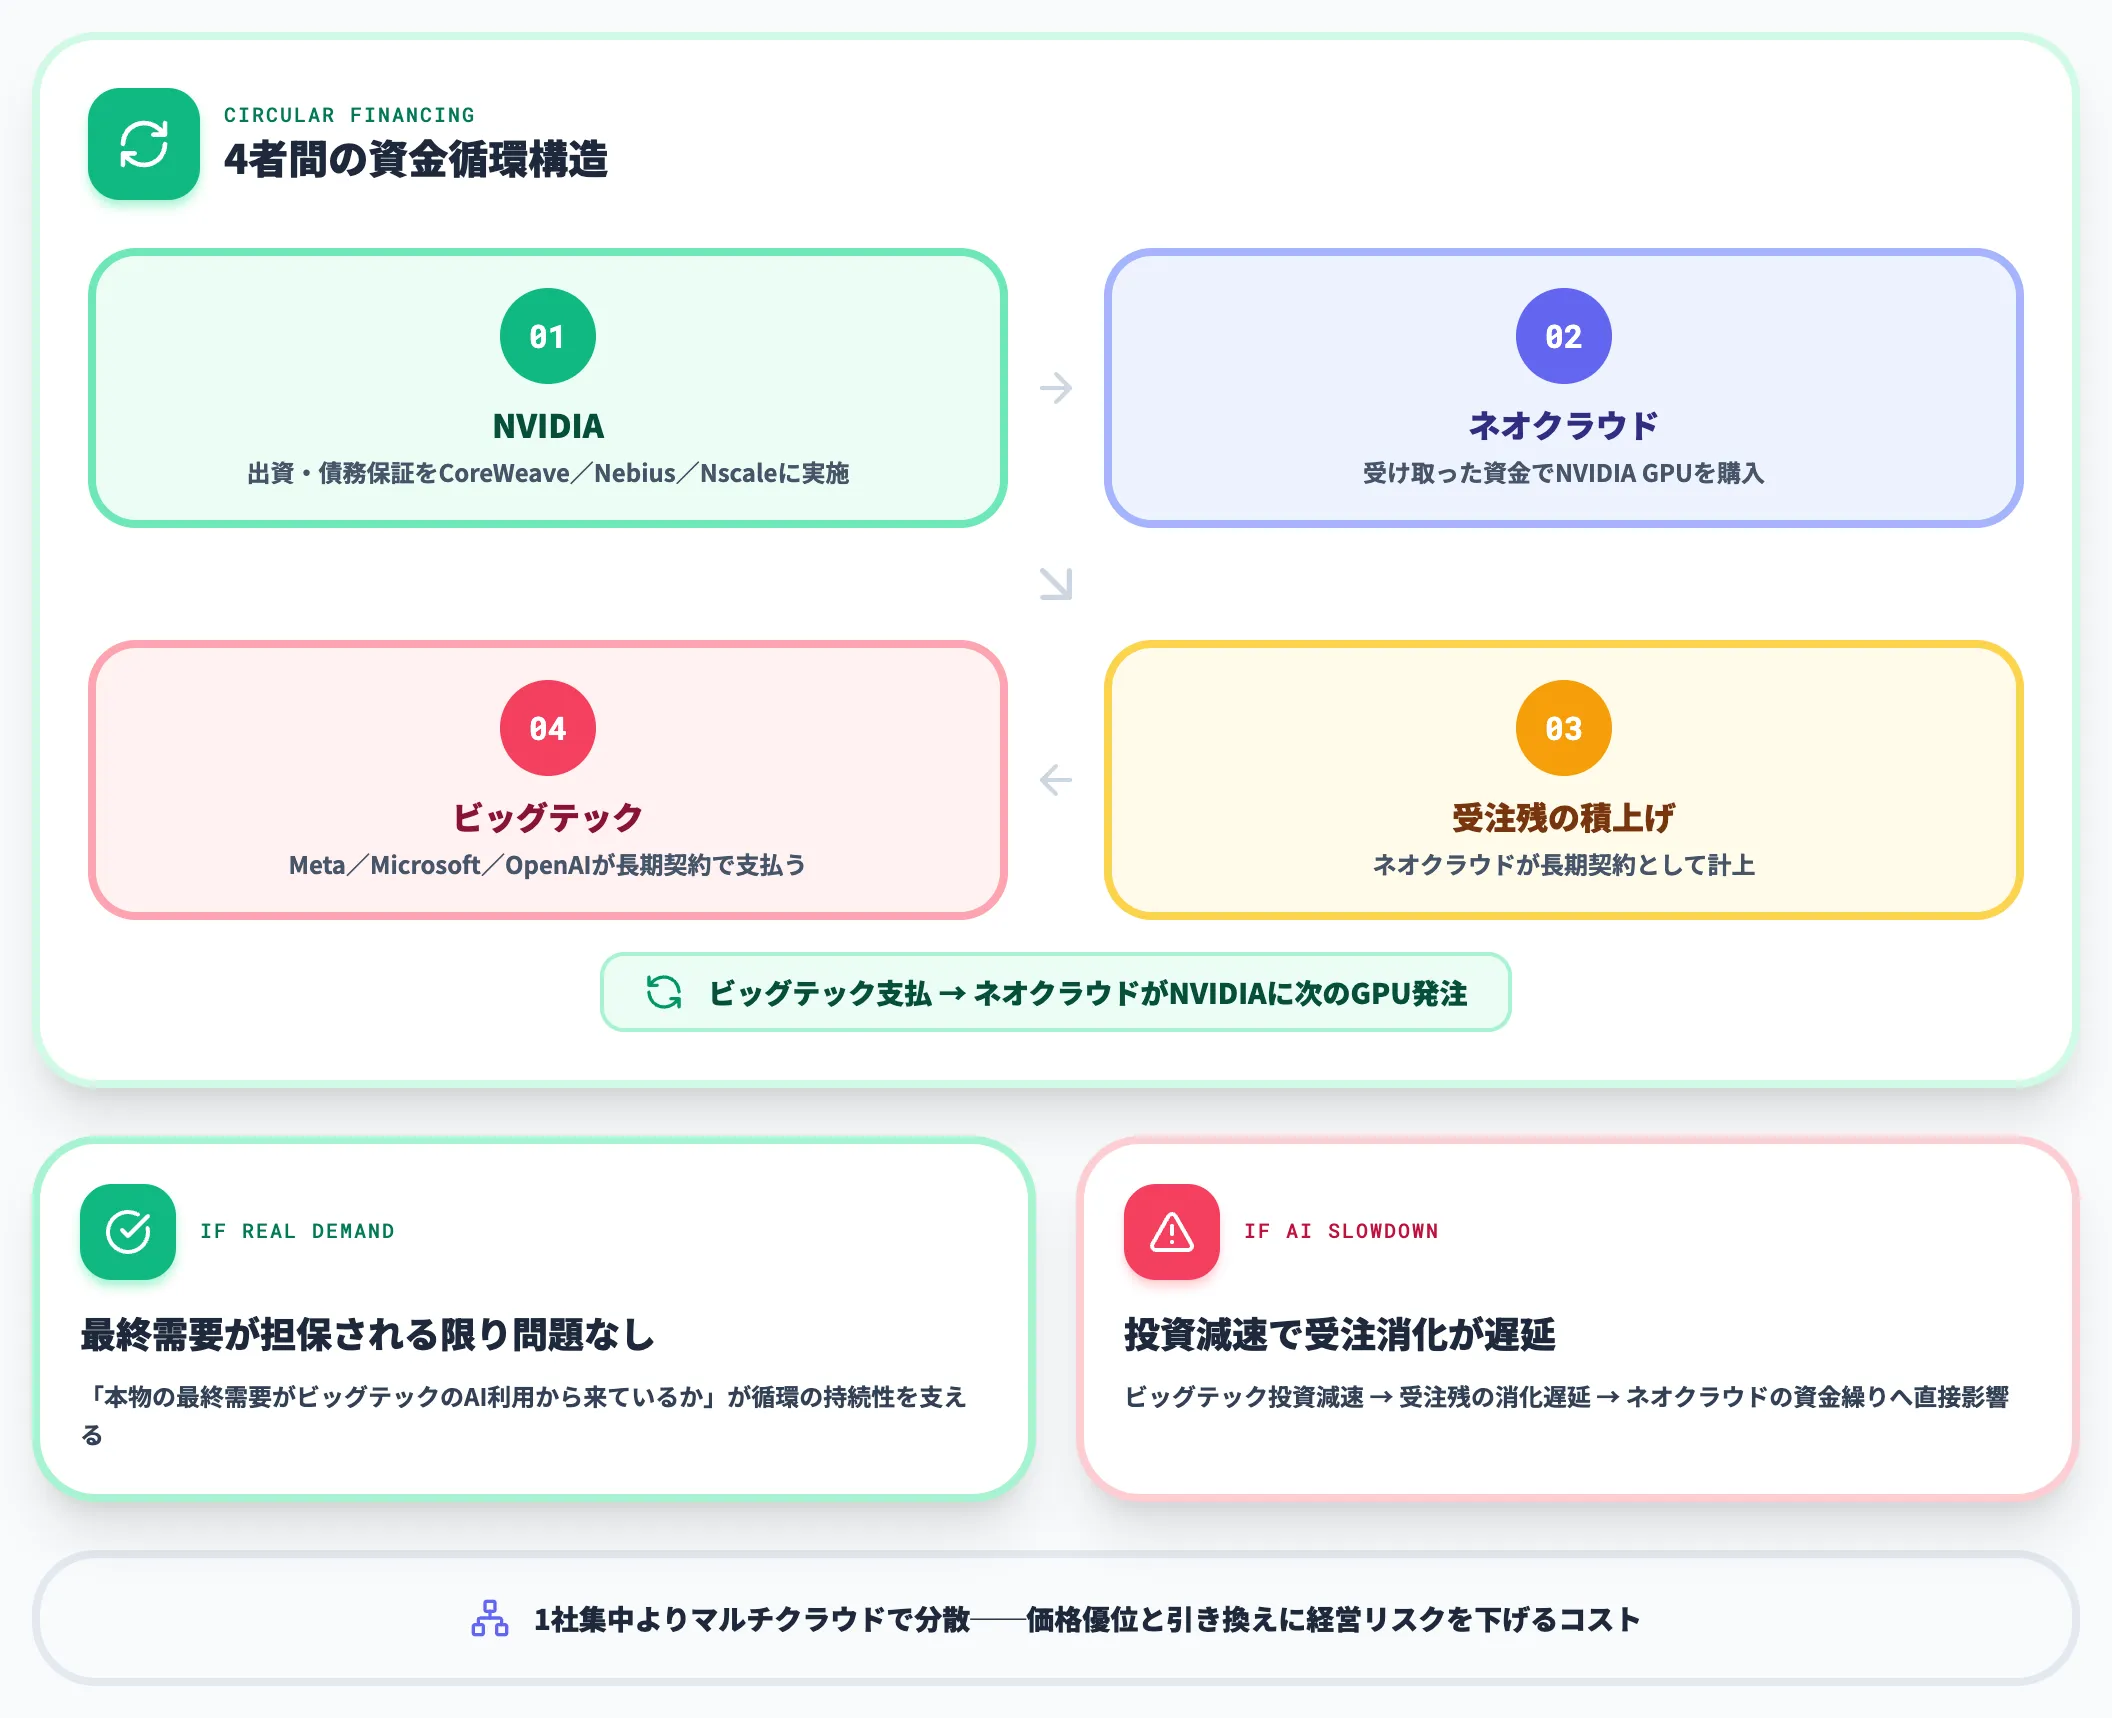
もう一つ注視すべきなのが、NVIDIAと主要ネオクラウドの間に走っている資金循環です。
io-Fundなど複数の投資家が懸念を表明している構造は以下です。
- NVIDIAがCoreWeave・Nebius・Nscaleに出資または債務保証
- その資金でネオクラウドがNVIDIAのGPUを購入
- NVIDIAの売上として計上
- ネオクラウドはビッグテック(Meta・Microsoft・OpenAI)と長期契約を結び、受注残として積み上げる
- ビッグテックが支払う→ネオクラウドがNVIDIAに次のGPU発注
この循環は「本物の最終需要がビッグテックのAI利用から来ているか」が担保されている限り問題ありません。しかし、ビッグテック側のAI投資が減速すれば、受注残の消化が遅れ、ネオクラウドの資金繰りに直接影響します。CoreWeaveの純損失6.3億ドル(2026年Q2)が示すように、現時点のネオクラウドは「黒字化前の高速投資フェーズ」にあります。
導入検討時には、自社の計算需要が特定ネオクラウドの経営継続性にどこまで依存するかを評価しておく必要があります。1社集中よりマルチクラウドで分散させる判断は、価格優位と引き換えに経営リスクを下げるためのコストと考える価値があります。
学習はネオクラウドで回し、業務AIの本番推論はAzureの自社テナントに置く
ネオクラウドの単価差が効くのは、数百枚のGPUを短期間に集める学習の側です。社内アシスタントや業務システムに組み込むAIの本番推論は、Entra IDとの統合やSLAが優先されるため、ハイパースケーラーに寄せるのが基本線になります。推論側をAzureに置くなら、そこで動かす業務AIの認証とデータを同じテナントの中にそろえておくと、運用を1か所にまとめやすくなります。
推論側に置く業務AIの受け皿になるのが、自社のAzureテナントの中に構築するAIエージェント基盤です。AI総合研究所のAI Agent Hubでは、社員がTeamsから業務特化のAgentを呼び出し、経費精算や請求書処理などの業務を任せます。
- 社員の認証と権限は既存のEntra IDでそろえる
社内のアカウント体系をそのまま使うため、業務AIのために別のID基盤を立てる必要がなく、使える社員をAgentごとに区切っておけます。
- 業務データの置き場所を自社のAzure環境に決めておく
Agentが読み書きする業務データは自社のAzure環境に保持されるため、学習を海外のネオクラウドに出すかどうかとは別に、業務側のデータの所在を自社で押さえておけます。
- 推論の結果を業務システムへの入力までつなげる
経費や請求書の内容をAgentが読み取ってSAP ConcurやDynamics 365へ入力するため、AIの出力を人が転記する手間が残りません。
AI総合研究所の専任チームが、学習と推論の置き場所を分けたうえで、Azure側で最初にAgentに任せる業務を選ぶところから伴走します。
業務AIの推論を自社のAzureで動かす

社員の認証は既存のEntra IDで
学習をネオクラウドに切り出しても、社内アシスタントや業務システムに組み込むAIの本番推論は、既存のID基盤や業務システムとつなぎやすいハイパースケーラー側に置くのが基本線です。AI Agent Hubでは、社員がTeamsからAgentを呼び出し、業務データを自社のAzure環境に置いたまま業務システムへの入力まで進めます。
まとめ
本記事では、ネオクラウドを「AIの学習と推論に向けてGPU計算を中心に設計された新興のクラウド事業者」として整理し、ハイパースケーラーとの違い・技術基盤・海外と日本の主要事業者・GPU単価の比較・選ぶ場面と選ばない場面・導入前に確認すべきリスクを解説しました。
2026年10月時点で押さえておくべきポイントは次の3つです。
- ハイパースケーラーとの単価差は比べる相手と構成しだいで大きく変わり、OSやドライバの管理を利用者側が担う分の負担まで含めて判断する必要がある
- 学習データや推論ログを国内に留めたい業界では、単価の安い海外勢より国内のネオクラウドが第一候補になる
- 主要なネオクラウドは大口顧客への依存とNVIDIAとの資金循環を抱えており、計算需要を1社に集中させない分散が、相手の経営が揺らいだときの備えになる
ネオクラウドを候補に入れる場合、AI総合研究所の導入支援では次の手順で採否を詰めていきます。
まずは、学習と推論それぞれの年間GPU稼働時間を見積もり、運用人員やデータ転送の費用まで含めて損益分岐を試算します。
続いて、オンデマンドで短期間の検証を行い、年単位のコミットに切り替える前に、データを他社へ移すときの費用やSLAの適用単位、障害時の責任の分け方を確かめます。
AIの計算資源は、ハイパースケーラーのサービスの1つとして買うものから、GPUに特化した事業者と比べて選ぶものへと変わってきました。
ネオクラウドは安さだけで決めると運用や移行の費用で足をすくわれますが、総額と事業者の経営体力まで見ておけば、ハイパースケーラーと並ぶGPUの調達先として長く付き合える相手になります。