この記事のポイント
 Embodied AIは「物理世界で動く」ことを前提にしたAIシステムで、生成AIの出力先が「テキスト・画像」なのに対し「ロボットの関節トルク・ハンドの指先」まで含まれる
- 中核はVLA基盤モデル。Gemini Robotics 2・π0.7・GR00T N1.7は「異種ロボットデータの共同学習+End-to-End VLA」という設計に収斂している
- 2026年6月にBMW Spartanburg工場でFigure 03が初めて物流ワークフローの実証に入り、Helix 02 VLAが量産現場での検証段階に進んだ
- LIBERO-Plus(2025-10公開・arXiv:2510.13626)はVLA主要モデルが摂動で性能を大きく落とし「言語を実質無視する」傾向を示し、ロバスト性と言語接地が最大の未解決課題
- 日本企業がいまやるべきは自社でVLA基盤モデルを作ることではなく、社内デジタル業務のAgent化で足場を作り、エコシステムに乗る時期を見極めること
Microsoft MVP・AIパートナー。LinkX Japan株式会社 代表取締役。東京工業大学大学院にて自然言語処理・金融工学を研究。NHK放送技術研究所でAI・ブロックチェーンの研究開発に従事し、国際学会・ジャーナルでの発表多数。経営情報学会 優秀賞受賞。シンガポールでWeb3企業を創業後、現在は企業向けAI導入・DX推進を支援。
Embodied AI(身体性AI/エンボディドAI)とは、カメラやセンサーで物理世界を知覚し、言語などで与えられた指示を解釈したうえで、ロボットの関節やハンドで動作まで実行するAIシステムです。
チャット画面の中で完結する生成AIと違い、物理世界の制約の下で知覚・判断・行動を一体として扱う点が本質的な違いです。
Google DeepMindのGemini Robotics 2、Physical Intelligenceのπ0.7とPi API beta、NVIDIA Isaac GR00T N1.7など、2026年にはロボット基盤モデルの発表が数か月単位で続いています。
本記事では、Embodied AIの定義とフィジカルAI・生成AIとの関係、知覚・推論・行動の3層アーキテクチャ、主要プレイヤーと最新モデル、World ModelとSim2Realの最前線、LIBERO-Plusが明らかにしたVLAモデルの限界論点、そして日本企業がどう向き合うべきかまでを、2026年10月時点の最新情報で体系的に解説します。
目次
Embodied AI(身体性AI)とは?物理世界で動くことを前提にしたAIシステム
Embodied AIの3層アーキテクチャ——知覚・推論・行動
Google DeepMindのGemini Robotics 1.5/2
Physical Intelligenceのπ0.5/π0.7とPi API
Embodied AIを支えるWorld ModelとSim2Realの最前線
Embodied AIが抱える3つの限界論点——ロバスト性・言語接地・安全性
Embodied AI(身体性AI)とは?物理世界で動くことを前提にしたAIシステム
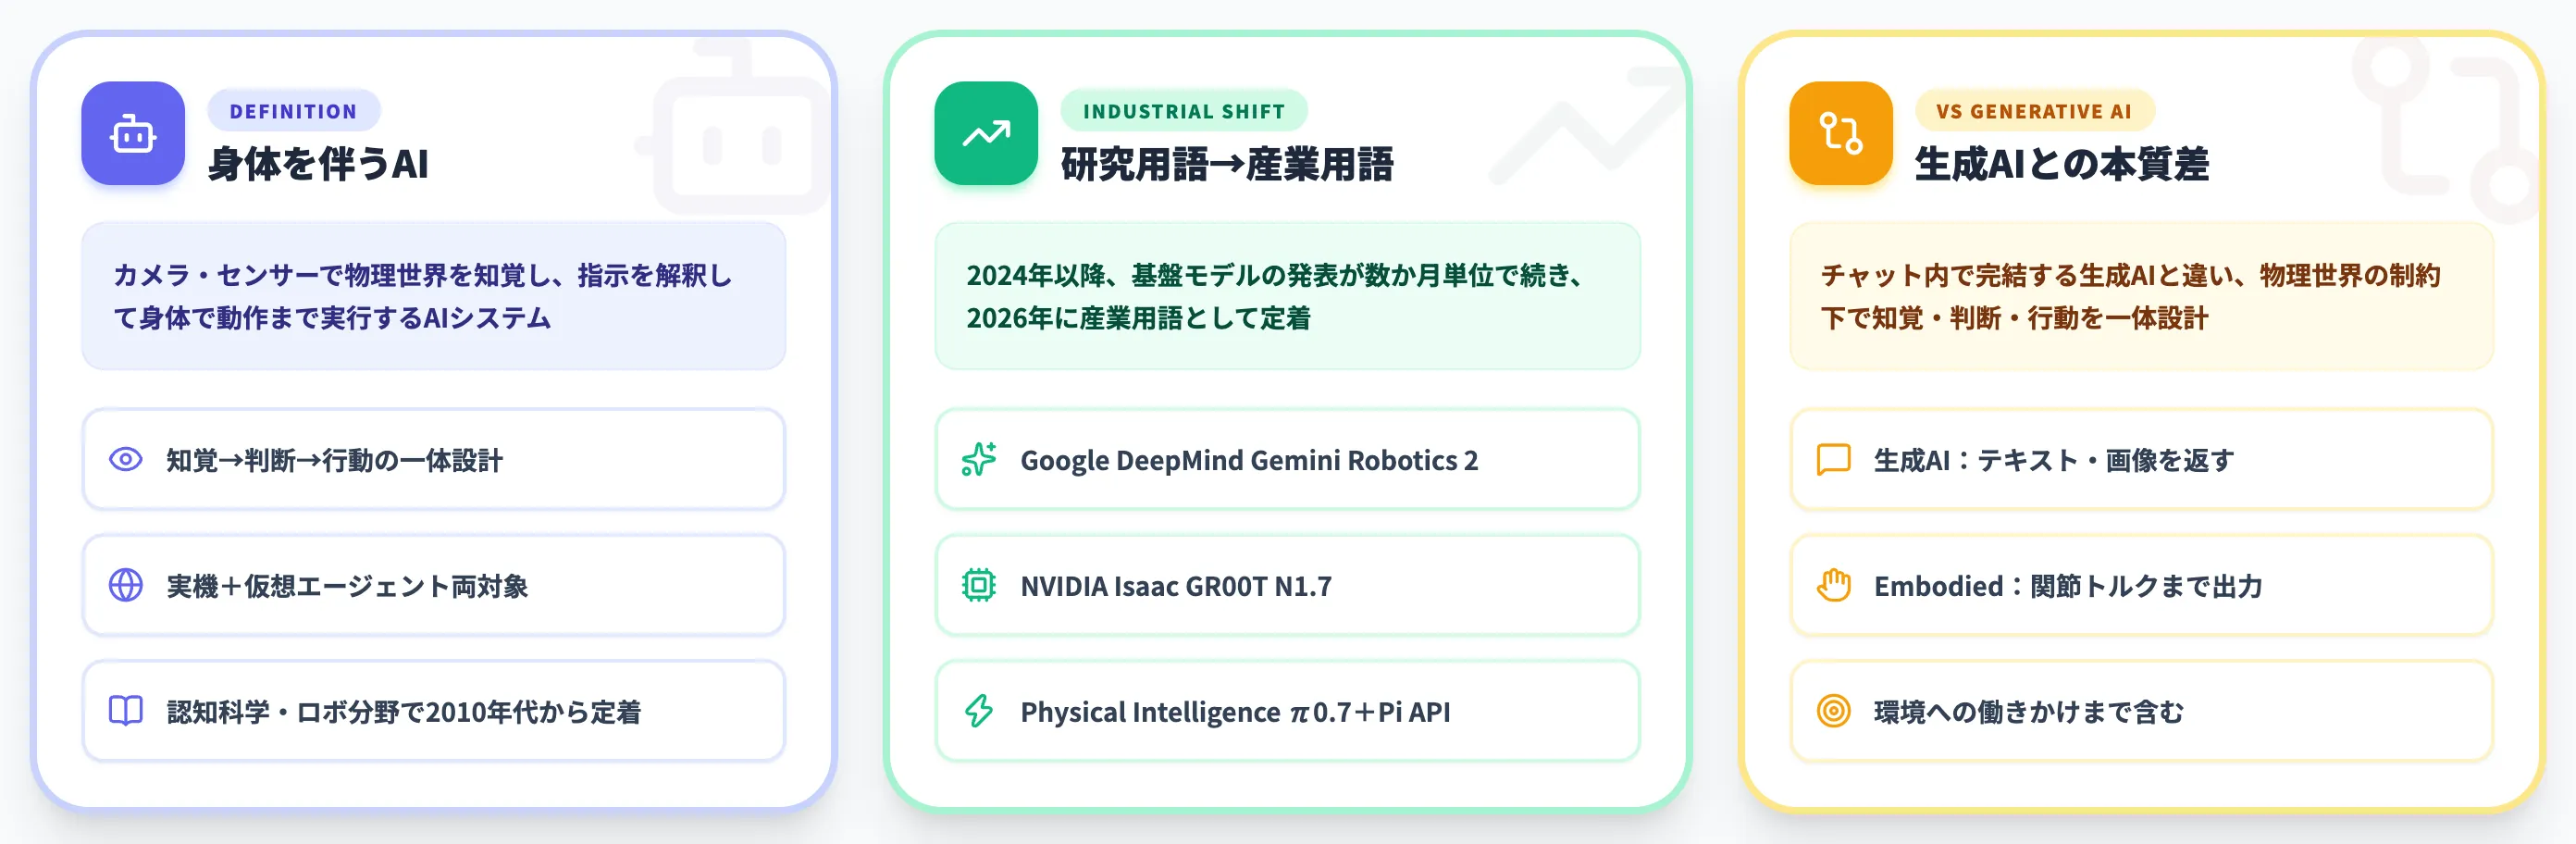
Embodied AI(エンボディドAI、日本語では身体性AI)とは、カメラやセンサーで物理世界を知覚し、指示や目標を解釈したうえで、身体(ロボットや仮想エージェント)を介して環境に働きかけるAIシステムです。
英語の「embodied」は「身体を伴う」という意味で、学術文献では2010年代から認知科学・ロボティクス分野の用語として定着してきました。Habitatなどのシミュレーションベンチマークに代表されるように、物理ロボットだけでなく仮想環境内のエージェント学習もEmbodied AIの対象に含まれます。
2024年以降、Google DeepMind・NVIDIA・Physical Intelligenceがロボット向けの基盤モデルを相次いで発表したことで、Embodied AIは研究用語から産業用語へと一気に広がった経緯があります。
ChatGPTのようなチャット型生成AIが「言葉を返す」ところで止まるのに対し、Embodied AIは「指示を受けて身体が物理環境に働きかける」ところまで含めてひとつのシステムとして設計されます。
Embodied AIと生成AI・フィジカルAIの違い
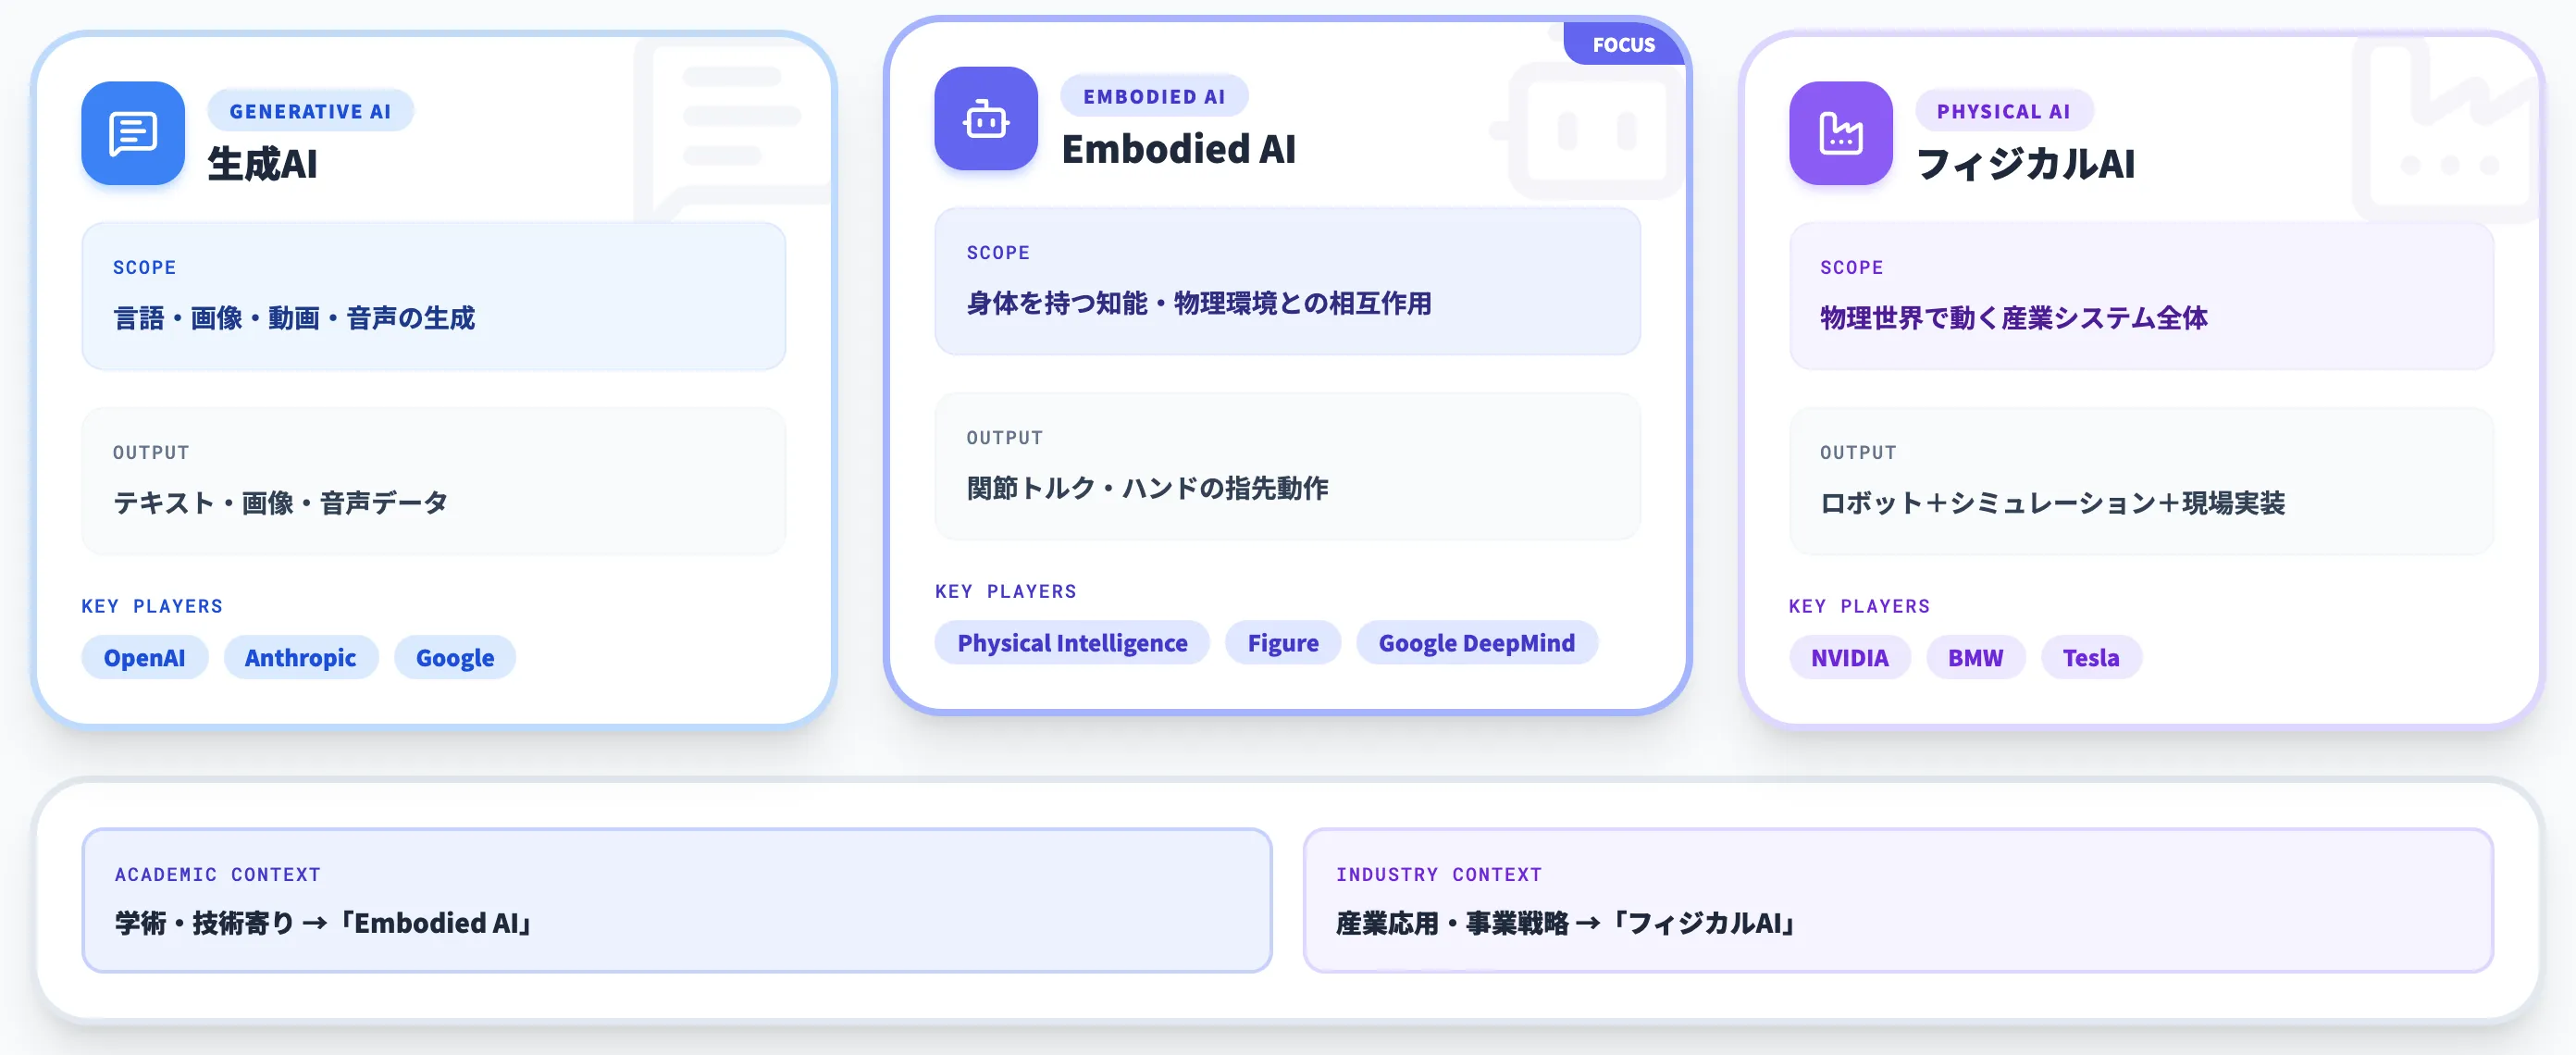
Embodied AIを理解するうえで混同されやすいのが、生成AIとフィジカルAIという2つの隣接概念です。
以下の表で、3つの概念の射程と出力先を整理しました。それぞれ強調する軸が違うだけで、重なり合う領域が広い点に注意してください。
| 概念 | 射程 | 出力先 | 代表的な主体 |
|---|---|---|---|
| 生成AI | 言語・画像・動画・音声の生成 | テキスト・画像・音声データ | OpenAI・Anthropic・Google |
| Embodied AI | 身体を持つ知能、物理環境との相互作用 | ロボットの関節トルク・ハンドの指先動作 | Physical Intelligence・Figure・Google DeepMind |
| フィジカルAI | 物理世界で動く産業システム全体 | ロボット+シミュレーション+現場実装 | NVIDIA・BMW・Teslaなどの応用側 |
Embodied AIとフィジカルAIは実装上ほぼ同じ技術を指しますが、学術・技術寄りの文脈では「Embodied AI」、産業応用・事業戦略の文脈では「フィジカルAI」という呼び分けが2026年時点で広がっています。
NVIDIAのJensen Huang CEOがCES 2026で「ChatGPT moment for robotics is here」と述べた際に使ったのは「Physical AI」で、同社のマーケティング用語として普及しました。
一方、学術論文のタイトルは「Embodied AI」「Vision-Language-Action」のほうが圧倒的に多く、ロボット研究者はこちらを使い続けています。
Embodied AIの3層アーキテクチャ——知覚・推論・行動
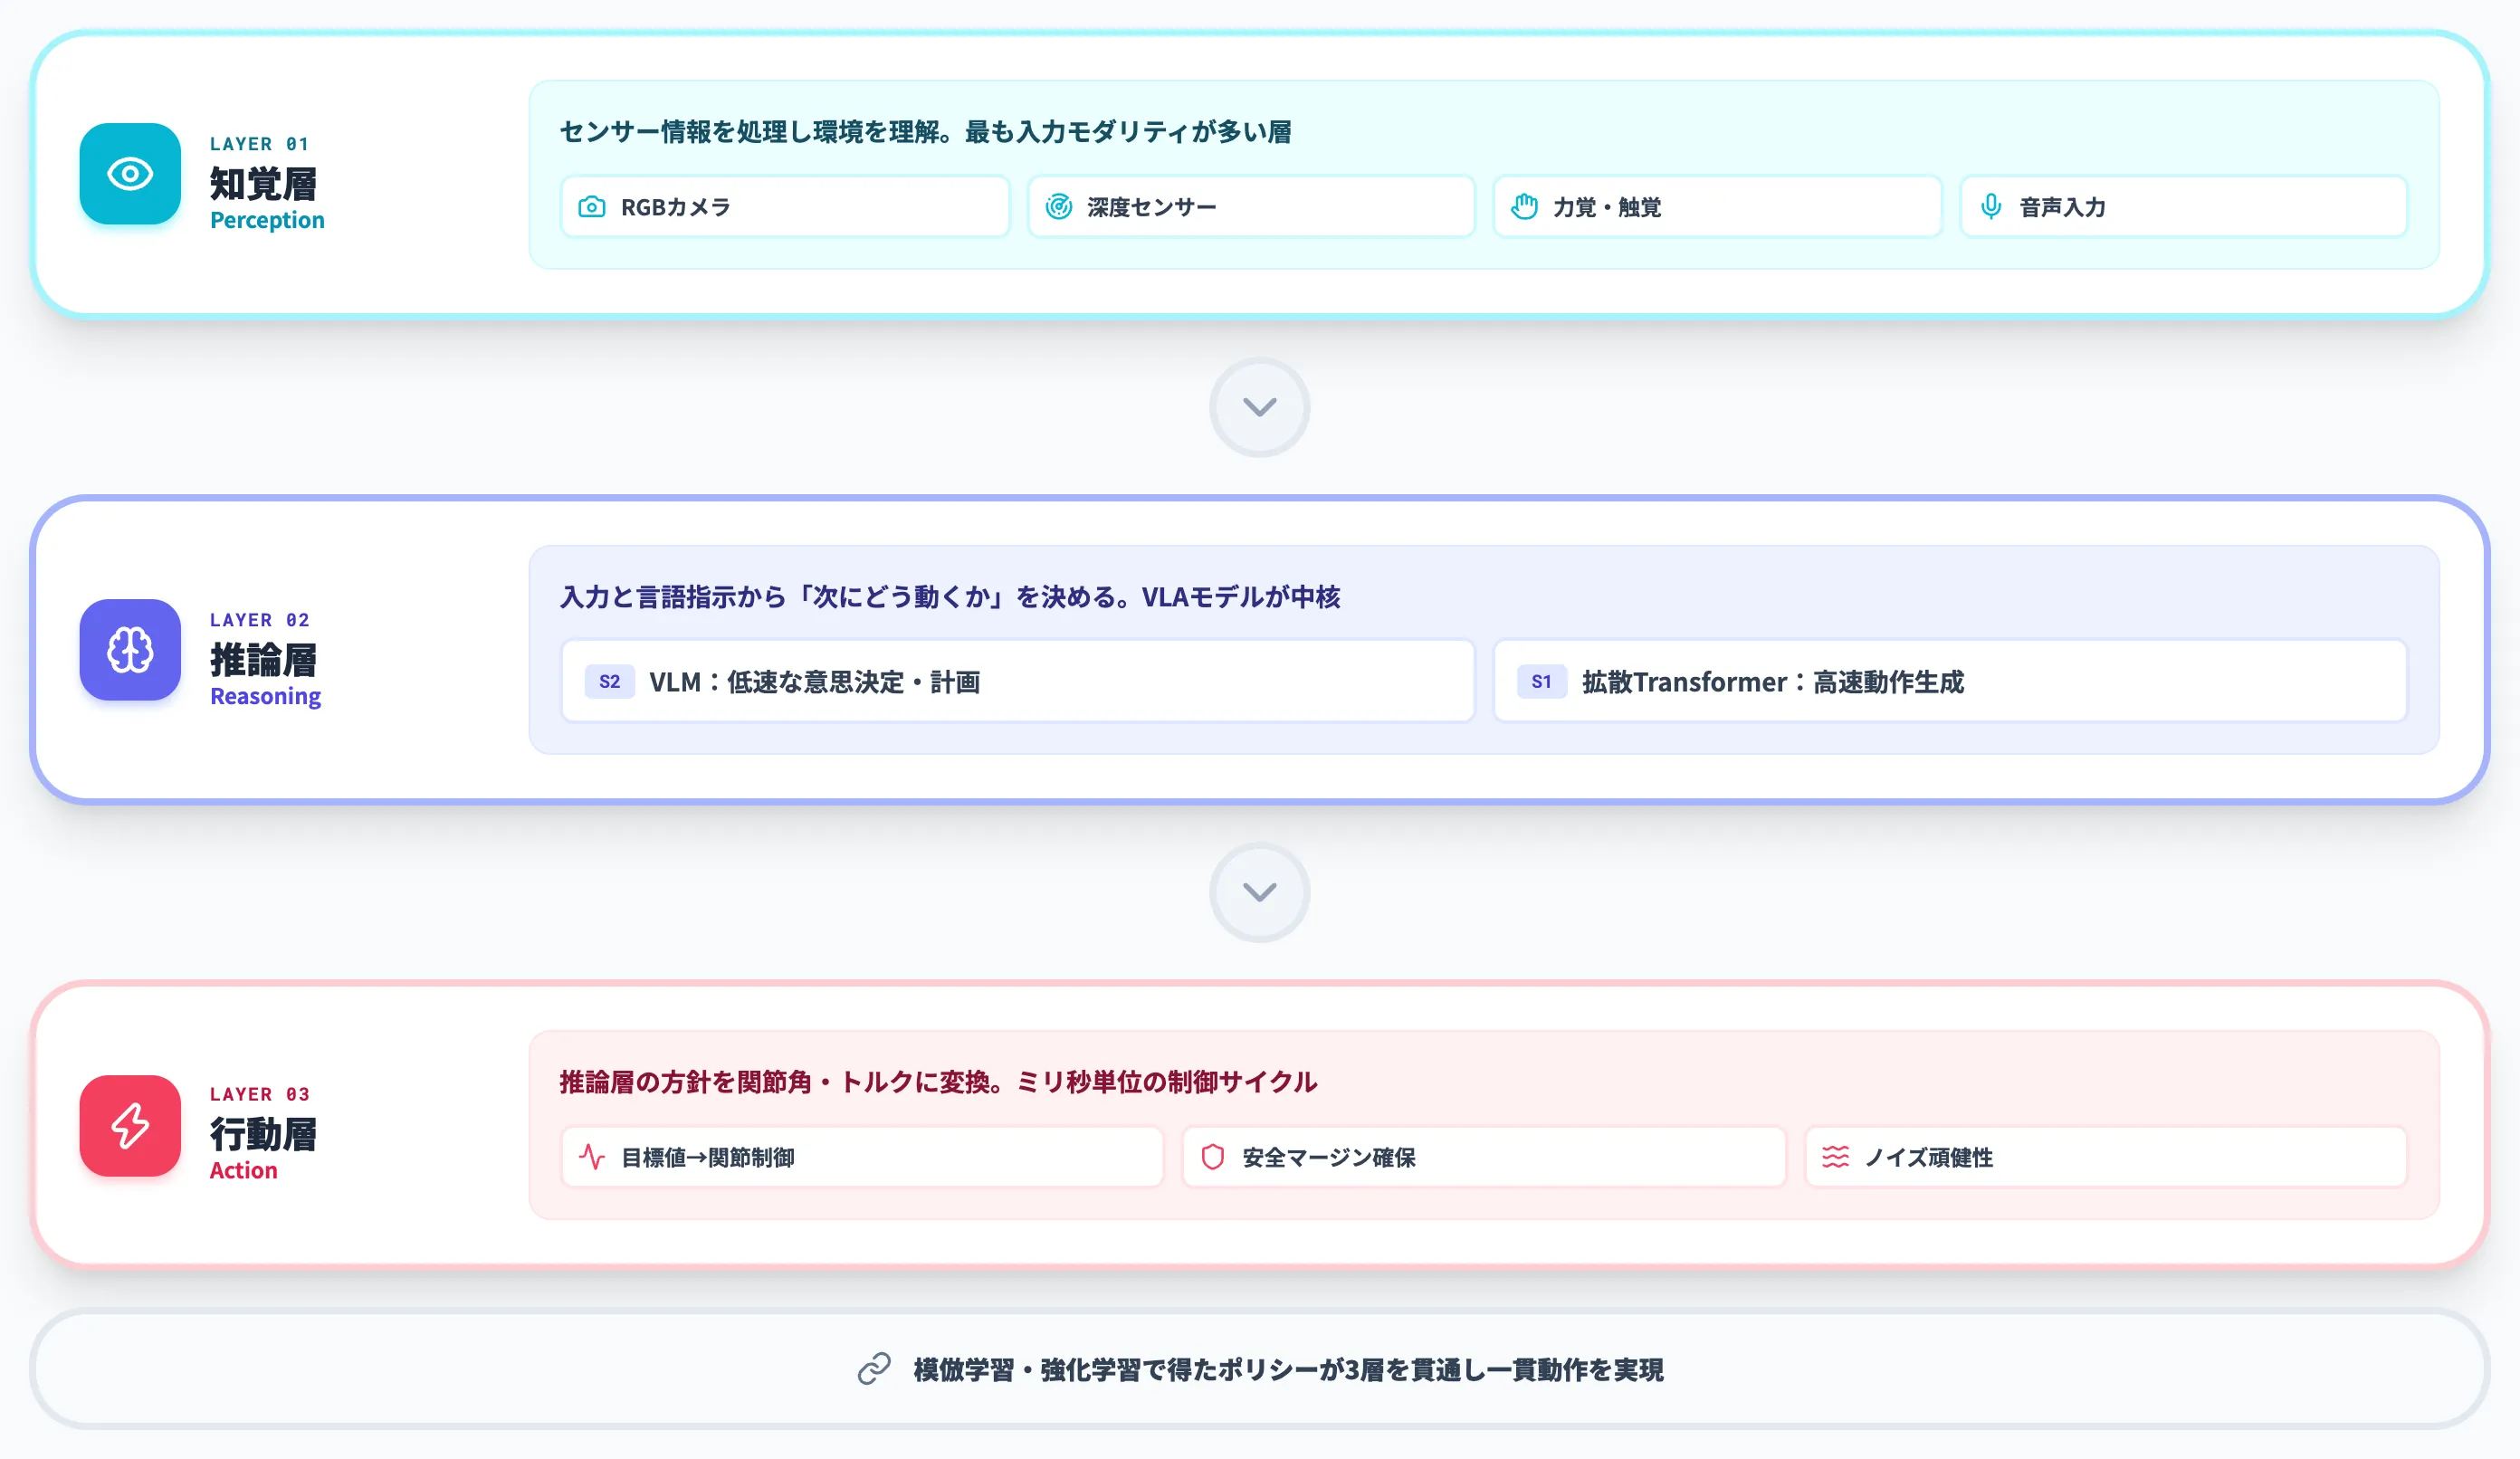
Embodied AIは単一のモデルではなく、知覚層・推論層・行動層の3つを束ねたシステムとして設計されます。
生成AIがテキスト入力からテキスト出力へ一直線に進むのに対し、Embodied AIはセンサー入力の多様さ、物理世界の不確実性、ミリ秒単位の制御要求という3つの固有制約を同時に扱う必要があります。
本セクションでは、各層が担う役割と、2026年のロボット基盤モデルがこの3層をどう統合しているかを整理します。
知覚層・マルチモーダル入力の統合
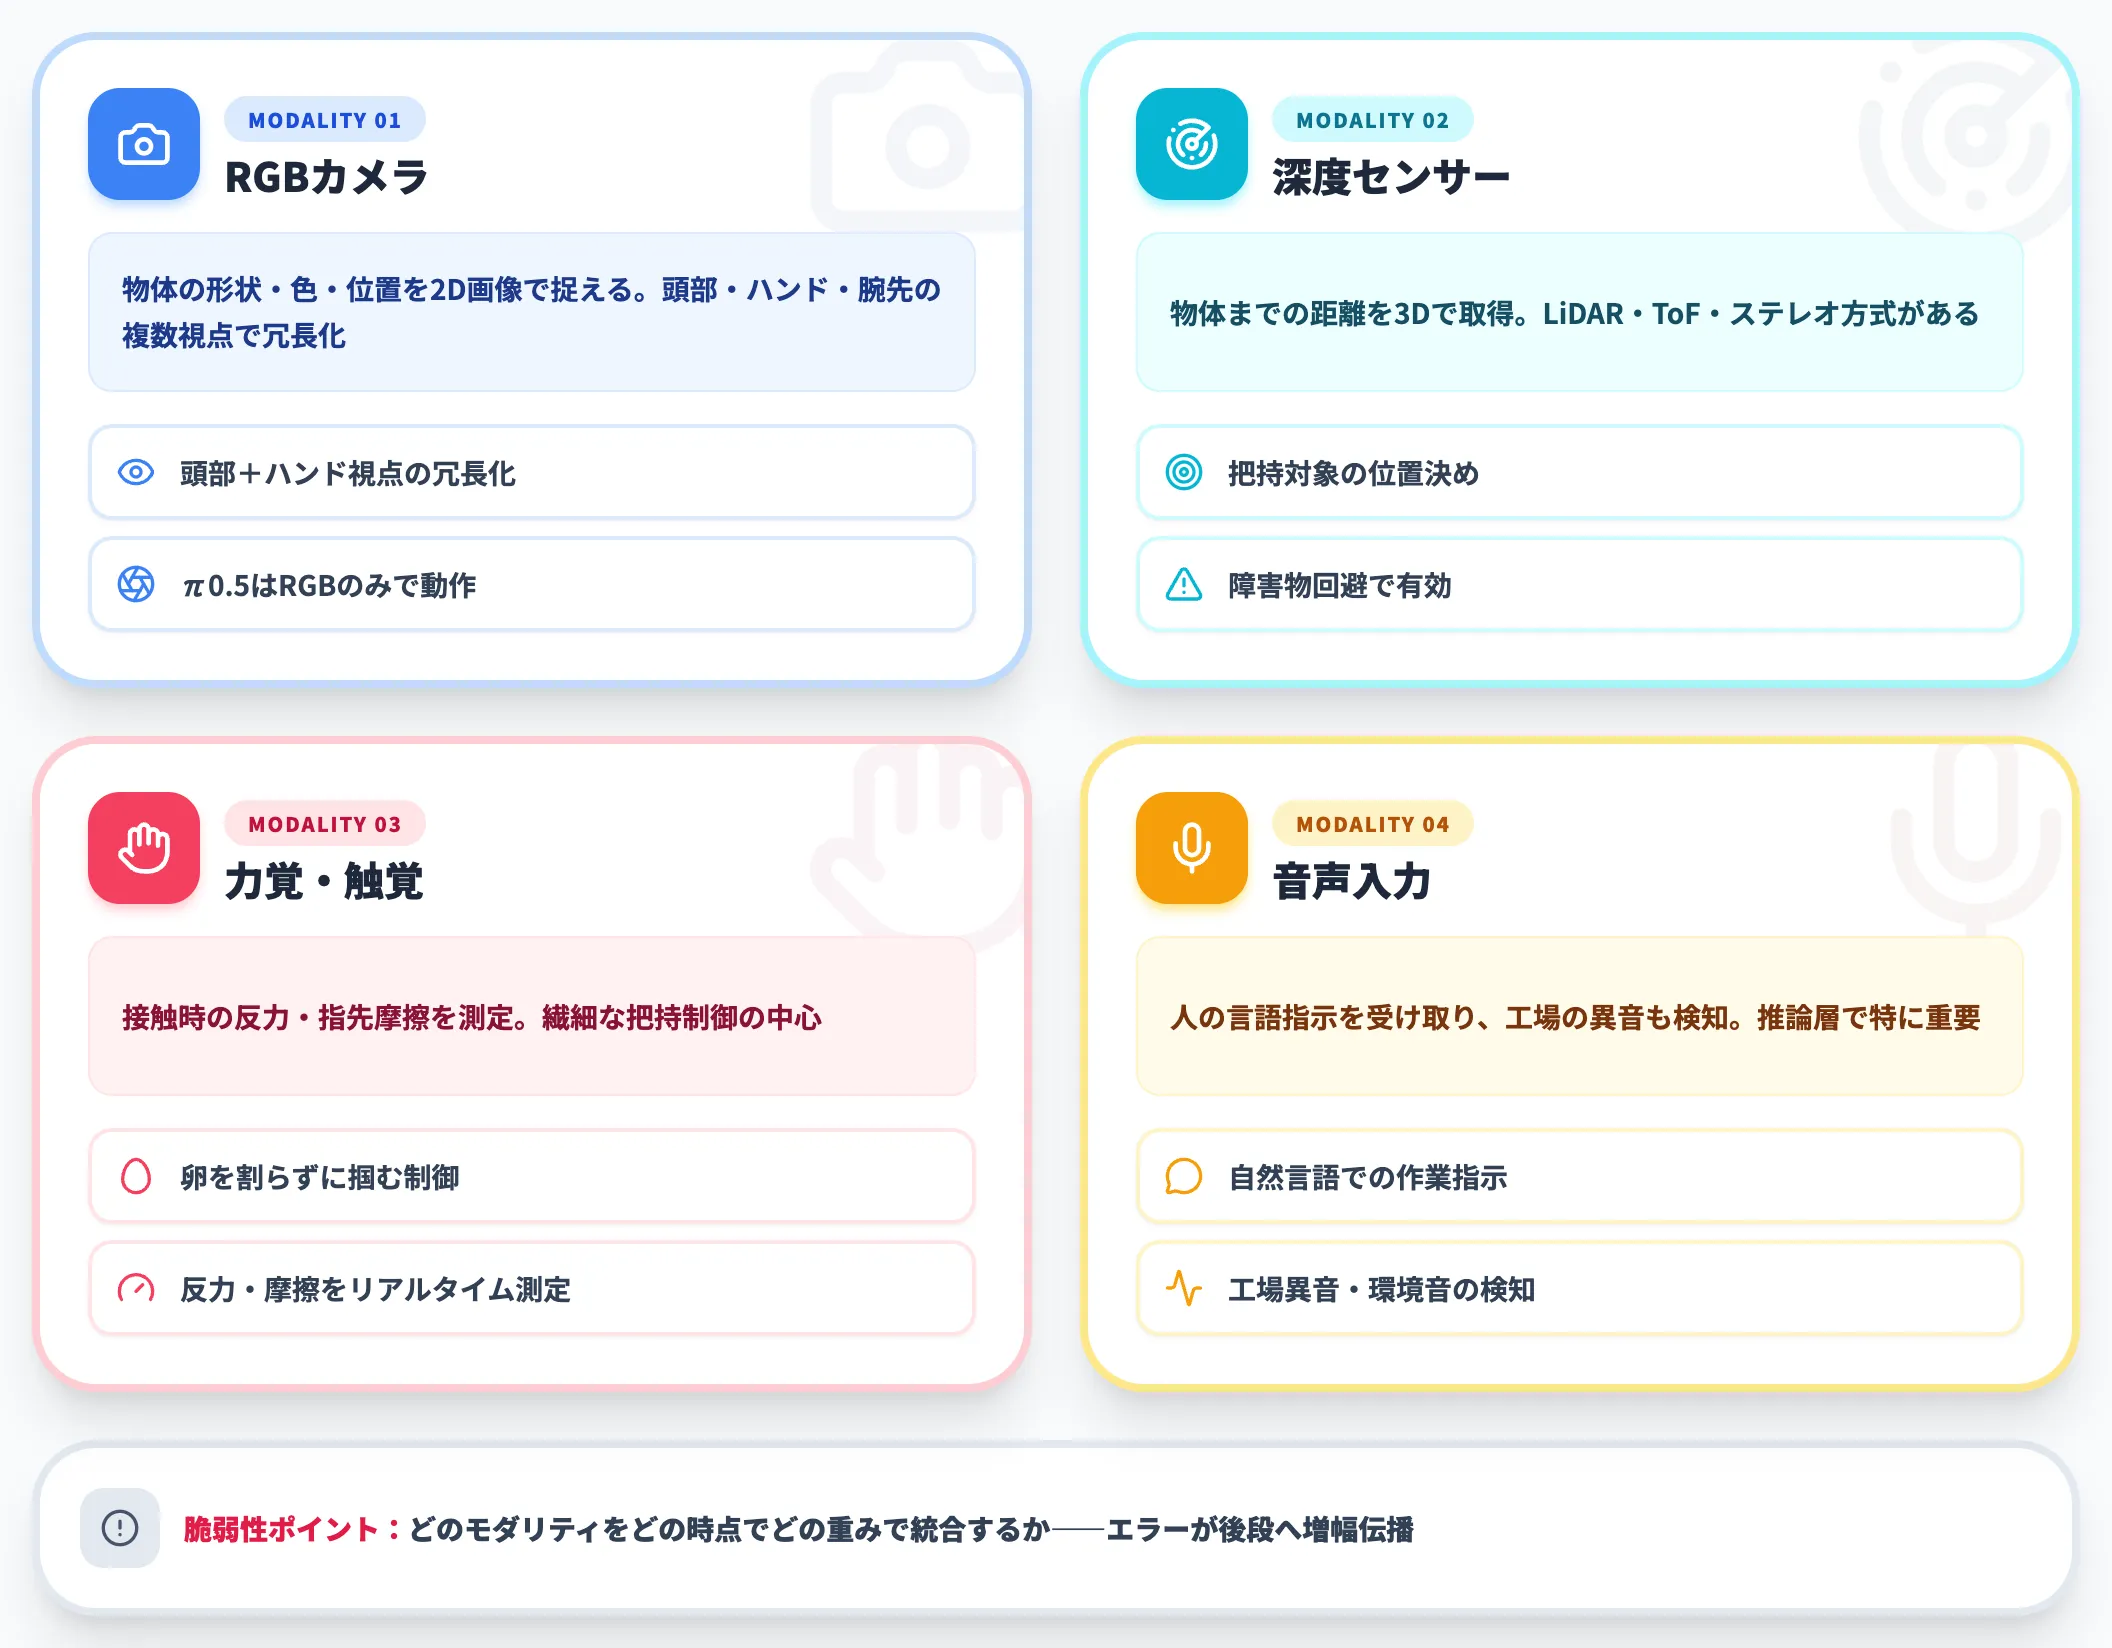
知覚層は、ロボットが環境を理解するためのセンサー情報を処理する部分で、Embodied AIにおいて最も入力モダリティが多い層です。
主な入力は以下の4系統で、それぞれ異なる物理現象を測定しています。
-
RGBカメラ
物体の形状・色・位置を2D画像として捉える。頭部・ハンド・腕先など複数視点で冗長化するのが基本。
-
深度センサー(LiDAR・ToF・ステレオ)
物体までの距離を3Dで取得する。把持対象の正確な位置決めや障害物回避で有効だが、π0.5のようにRGBカメラのみで動くシステムもあり構成はタスクによって変わる。
-
力覚・触覚センサー
ハンドが物体に触れた瞬間の反力や、指先の摩擦を測定する。「卵を割らずに掴む」ような接触制御で中心的な役割を果たす。
-
マイク・音声入力
人の指示を受けたり、工場の異音を検知したりする。言語指示が加わると後段の推論層で重要になる。
知覚層の難しさは「どのモダリティを・どの時点で・どの重みで統合するか」にあります。
Embodied AIを扱った最近のサーベイ論文Safety in Embodied AI: A Survey of Risks, Attacks, and Defensesは、マルチモーダル知覚融合を「特に脆弱な層」と位置づけ、ここでのエラーが外側の推論層・行動層にそのまま伝播して増幅すると指摘しています。
推論層・VLAモデルの中核的な役割
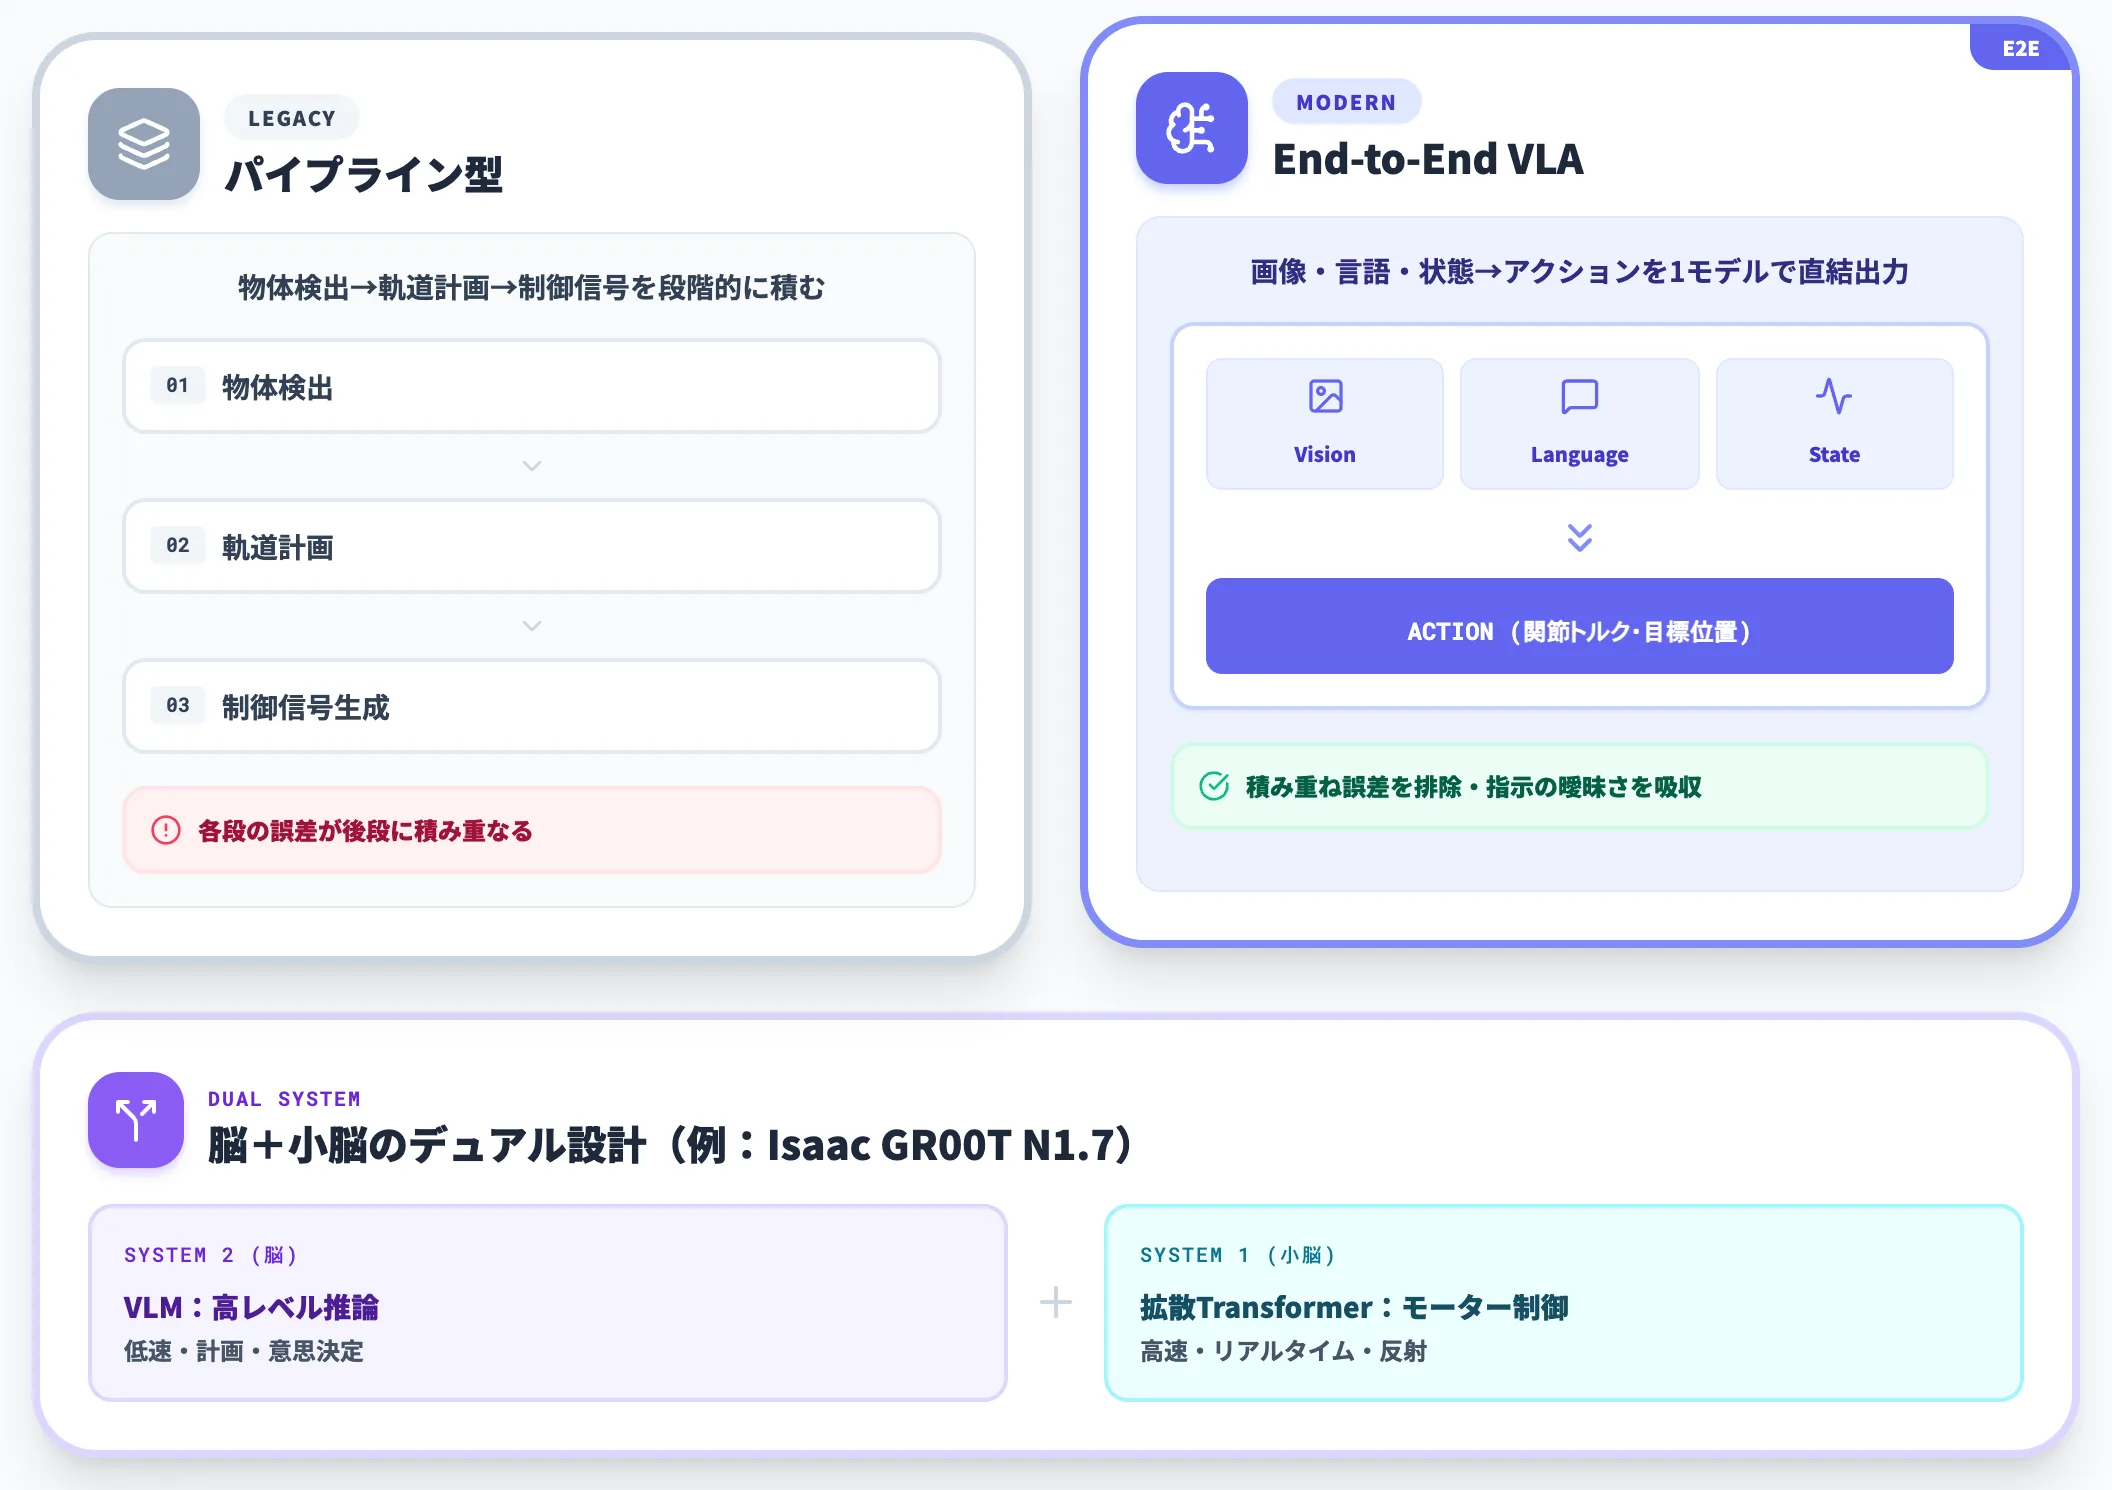
推論層は、知覚層からの入力と言語指示を受け取り、「次にどう動くか」を決める層で、2024年以降はVLA(Vision-Language-Action)モデルが中核を担っています。
VLAモデルは、画像・言語・ロボットの状態を1つのニューラルネットワークに入れて、関節トルクや目標位置といった連続値のアクションを直接出力するエンドツーエンド設計です。
従来のロボット制御は「物体検出→軌道計画→制御信号」と段階的に積み上げるパイプライン型でしたが、各段の誤差が後段に積み重なる問題がありました。
VLAモデルは、画像から直接動作まで一気に推論することで、この積み重ね誤差を排除し、人間の指示の曖昧さを吸収できる柔軟性を獲得しています。
一方で、推論層の内部でさらに「低速な意思決定」と「高速な動作生成」を分けるデュアルシステム設計も広がっています。
NVIDIAのIsaac GR00T N1.7は、System 2としてVision-Language Modelが高レベル推論を担当し、System 1として拡散トランスフォーマー(Diffusion Transformer)がリアルタイムのモーター制御を担うという、脳と小脳に例えられる2段構えで構成されています(出典:NVIDIA Isaac GR00T N1.7 blog)。
行動層・低レベル制御とポリシー
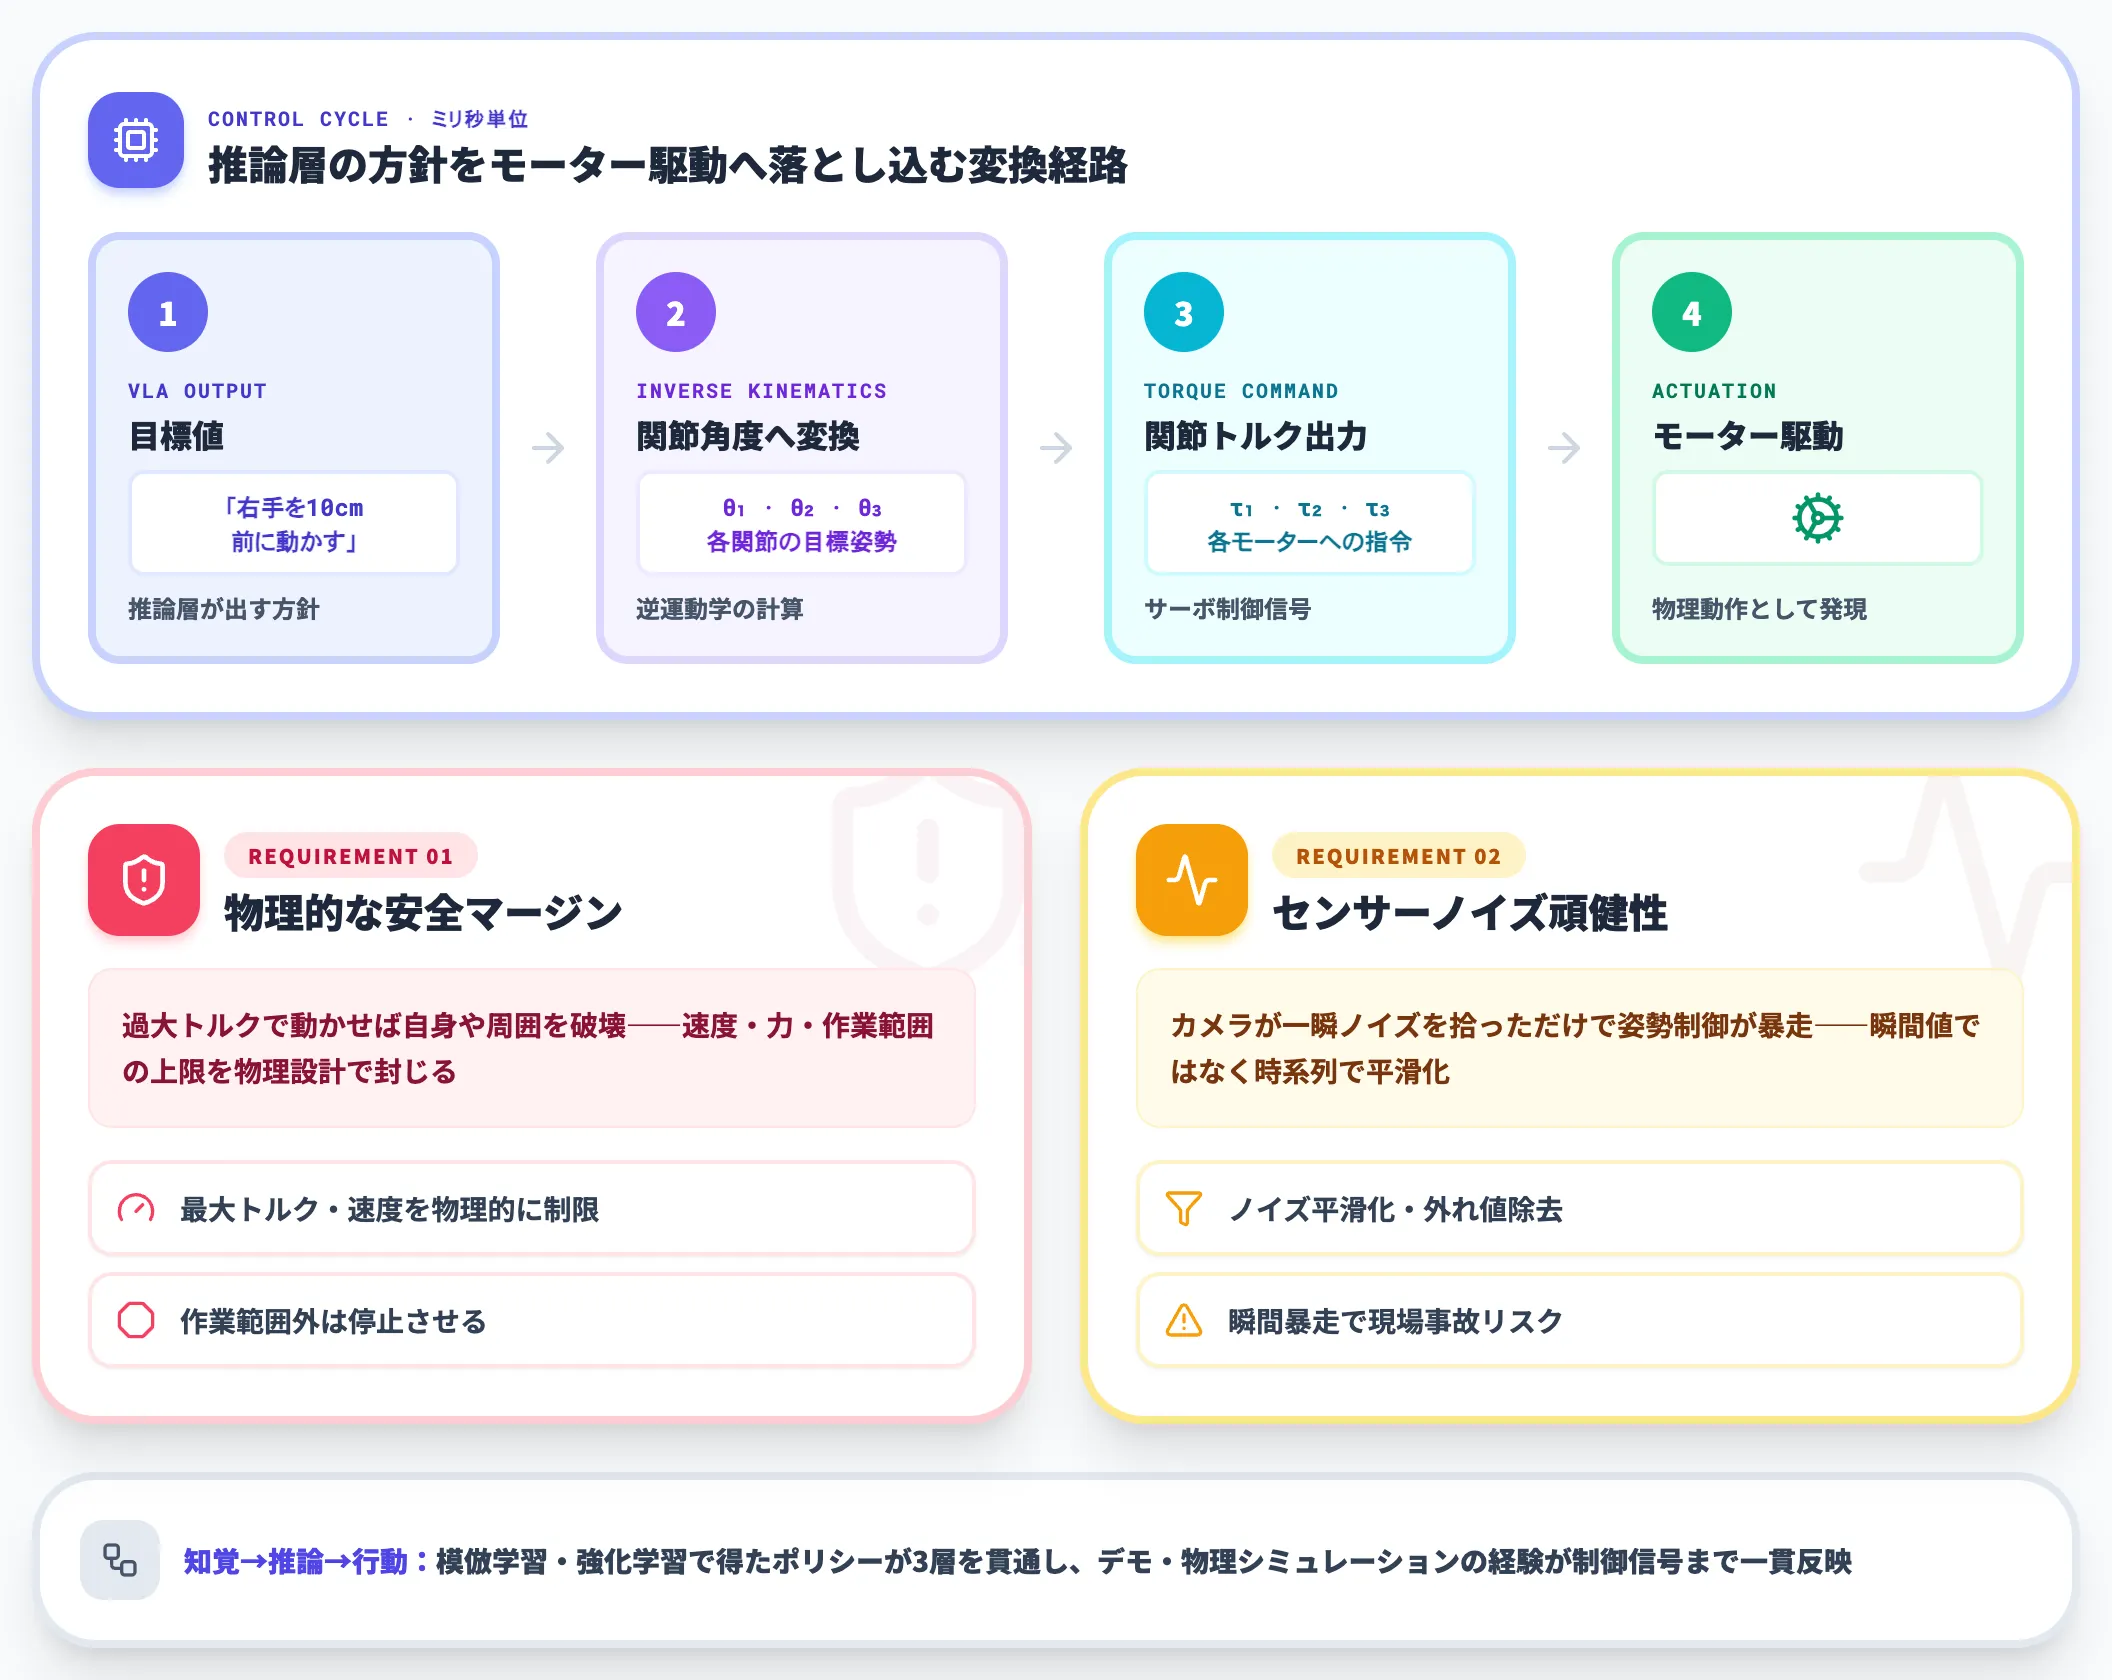
行動層は、推論層が出した方針を実際のモーター駆動に落とし込む部分で、ミリ秒単位の制御サイクルで動きます。
VLAモデルが出力するのは「右手を10cm前に動かす」といった目標値で、それを関節角度と関節トルクに変換するのが行動層の役割です。
この層で重要なのは、物理的な安全マージンの確保と、センサーノイズへの頑健性です。
ロボットの関節は過大なトルクで動かせば自身や周囲を破壊しますし、カメラが一瞬ノイズを拾っただけで姿勢制御が暴走すれば現場では事故につながります。
Embodied AIの3層は、知覚層が多モーダル情報を集約し、推論層のVLAが意味解釈と大まかな動作方針を決め、行動層が制御サイクルで実行する、という流れで統合されています。
模倣学習や強化学習で得たポリシーがこの3層を貫通する形で動き、人間のデモンストレーションや物理シミュレーションの経験が最終的な制御信号まで一貫して反映されます。
Embodied AIを牽引する主要プレイヤーと最新モデル
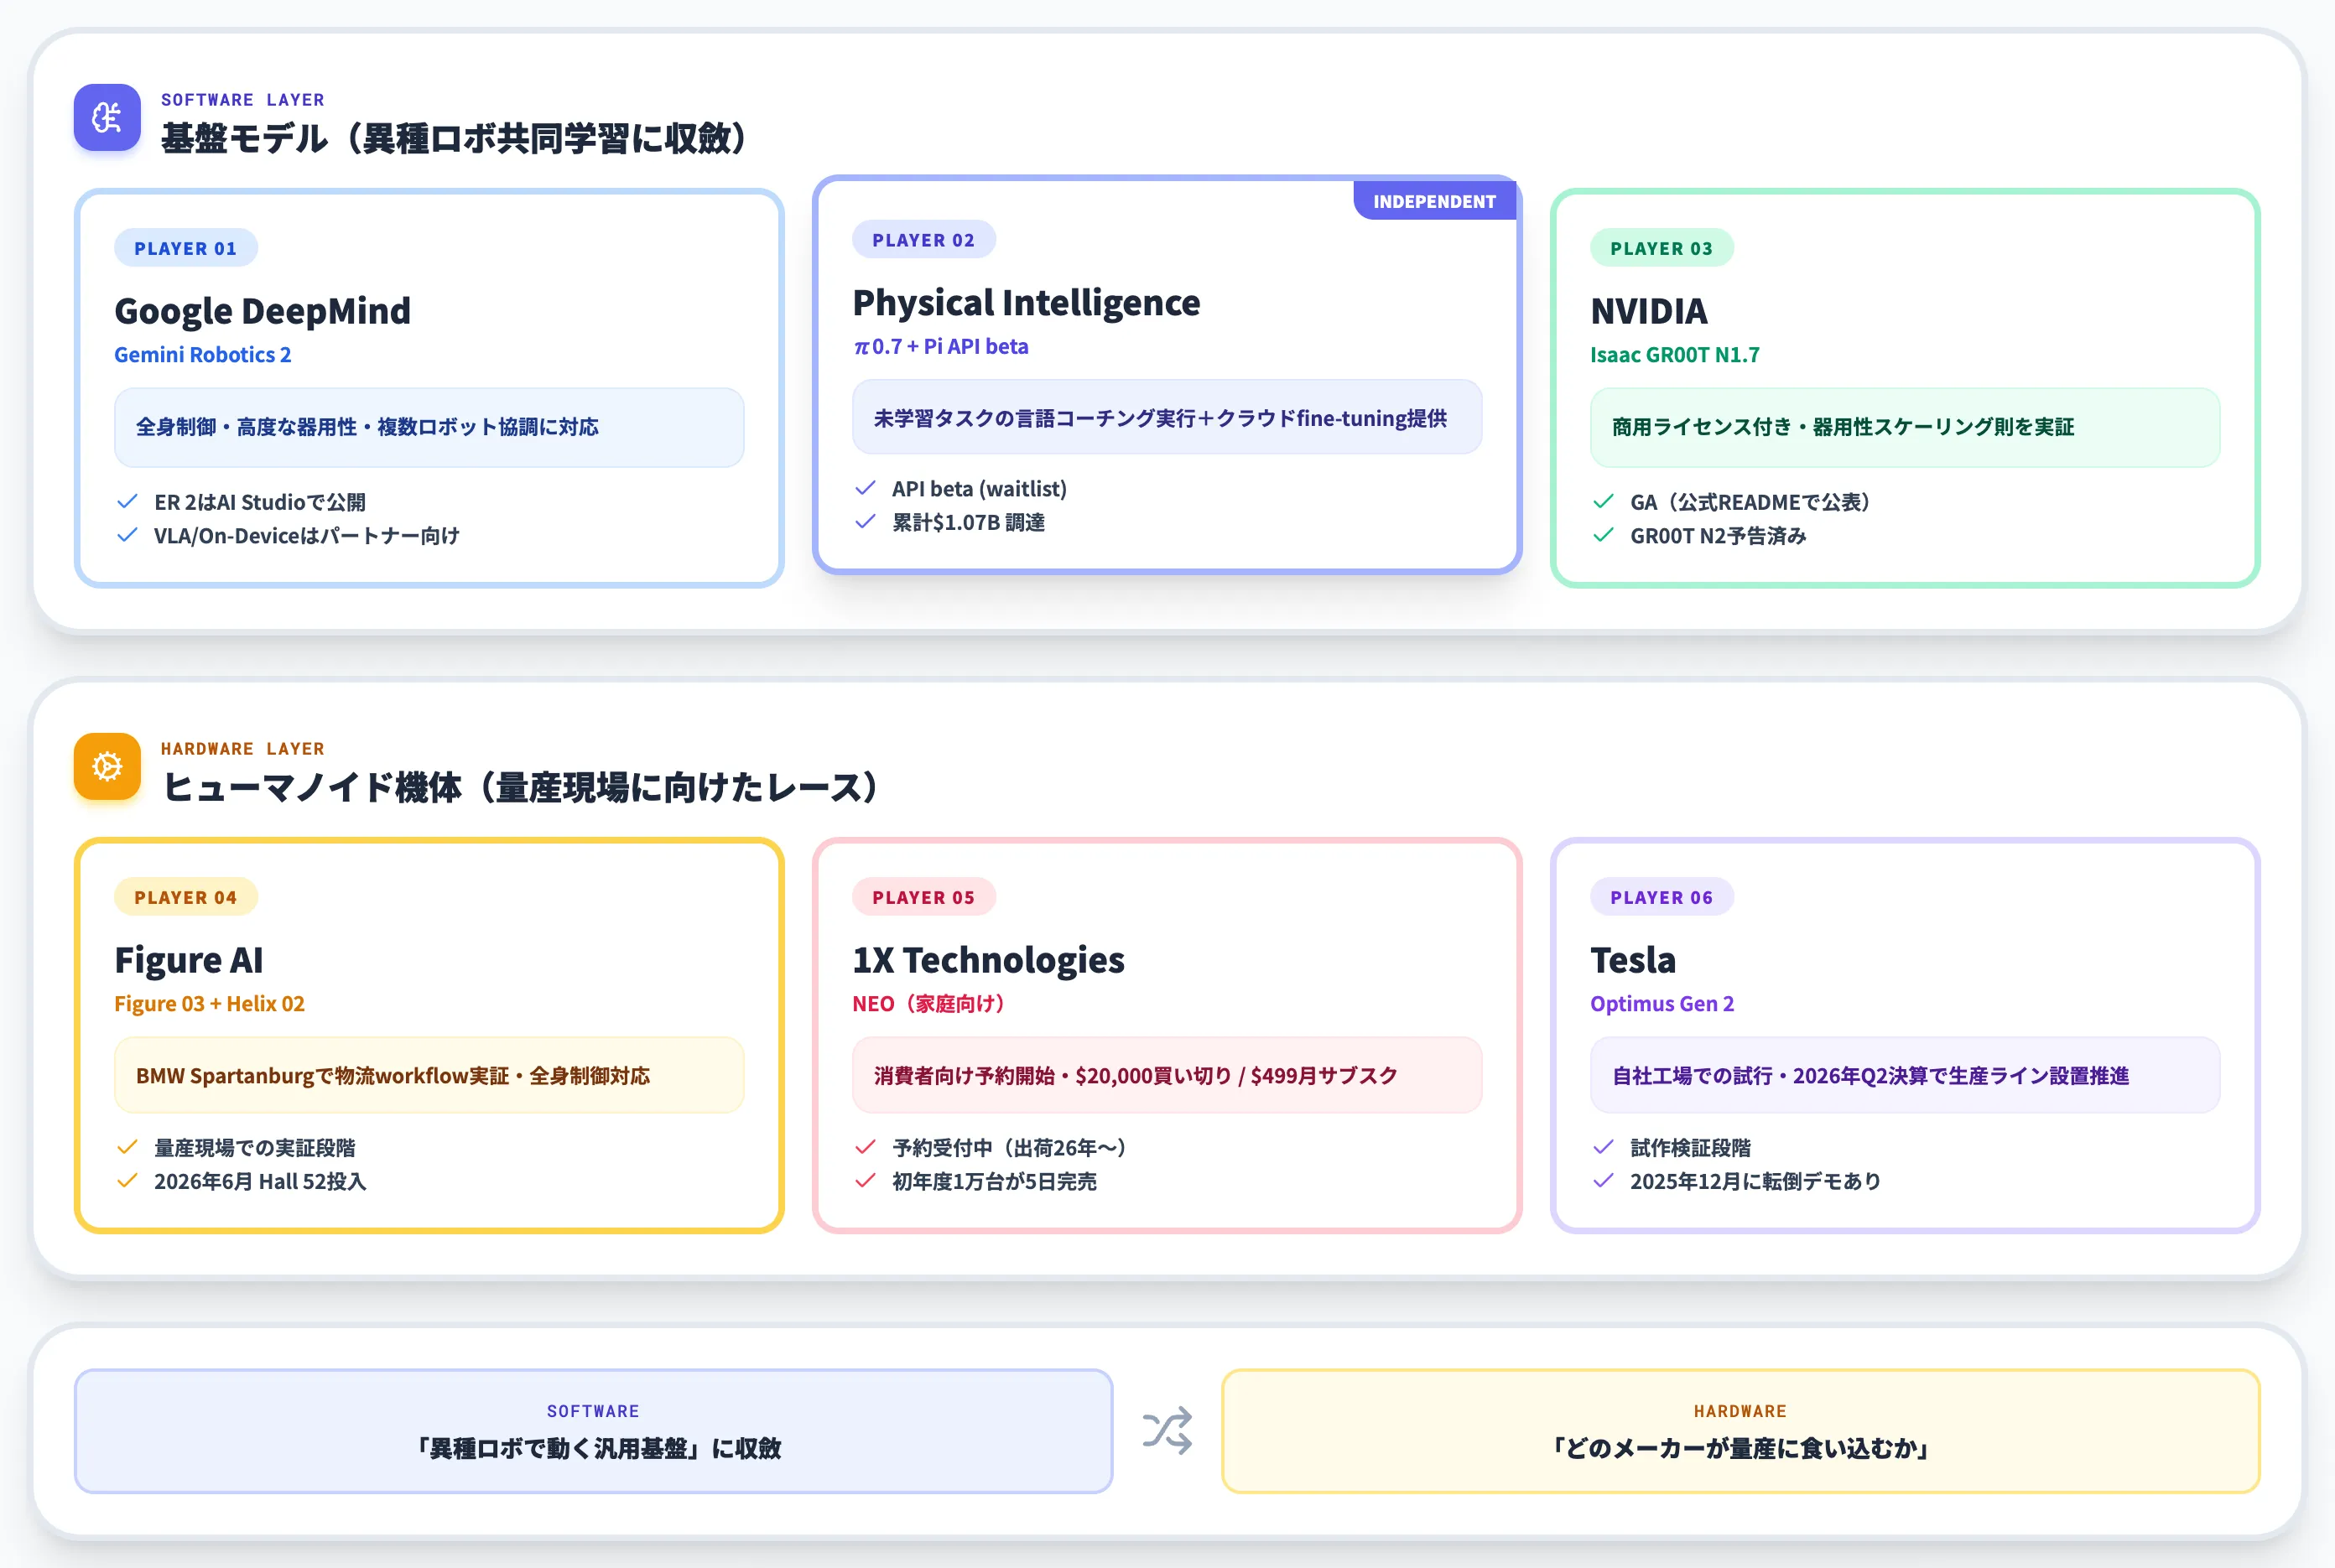
Embodied AIの基盤モデル競争は、2023年7月のGoogle DeepMind RT-2発表以降加速し、2026年時点ではGoogle DeepMind・Physical Intelligence・NVIDIAの3社が先頭集団を形成する構図になっています。
本セクションでは、2026年10月時点で発表済みの主要モデルを5つのホームH3に整理し、各社の設計思想とマイルストーンの違いを比較します。
Google DeepMindのGemini Robotics 1.5/2
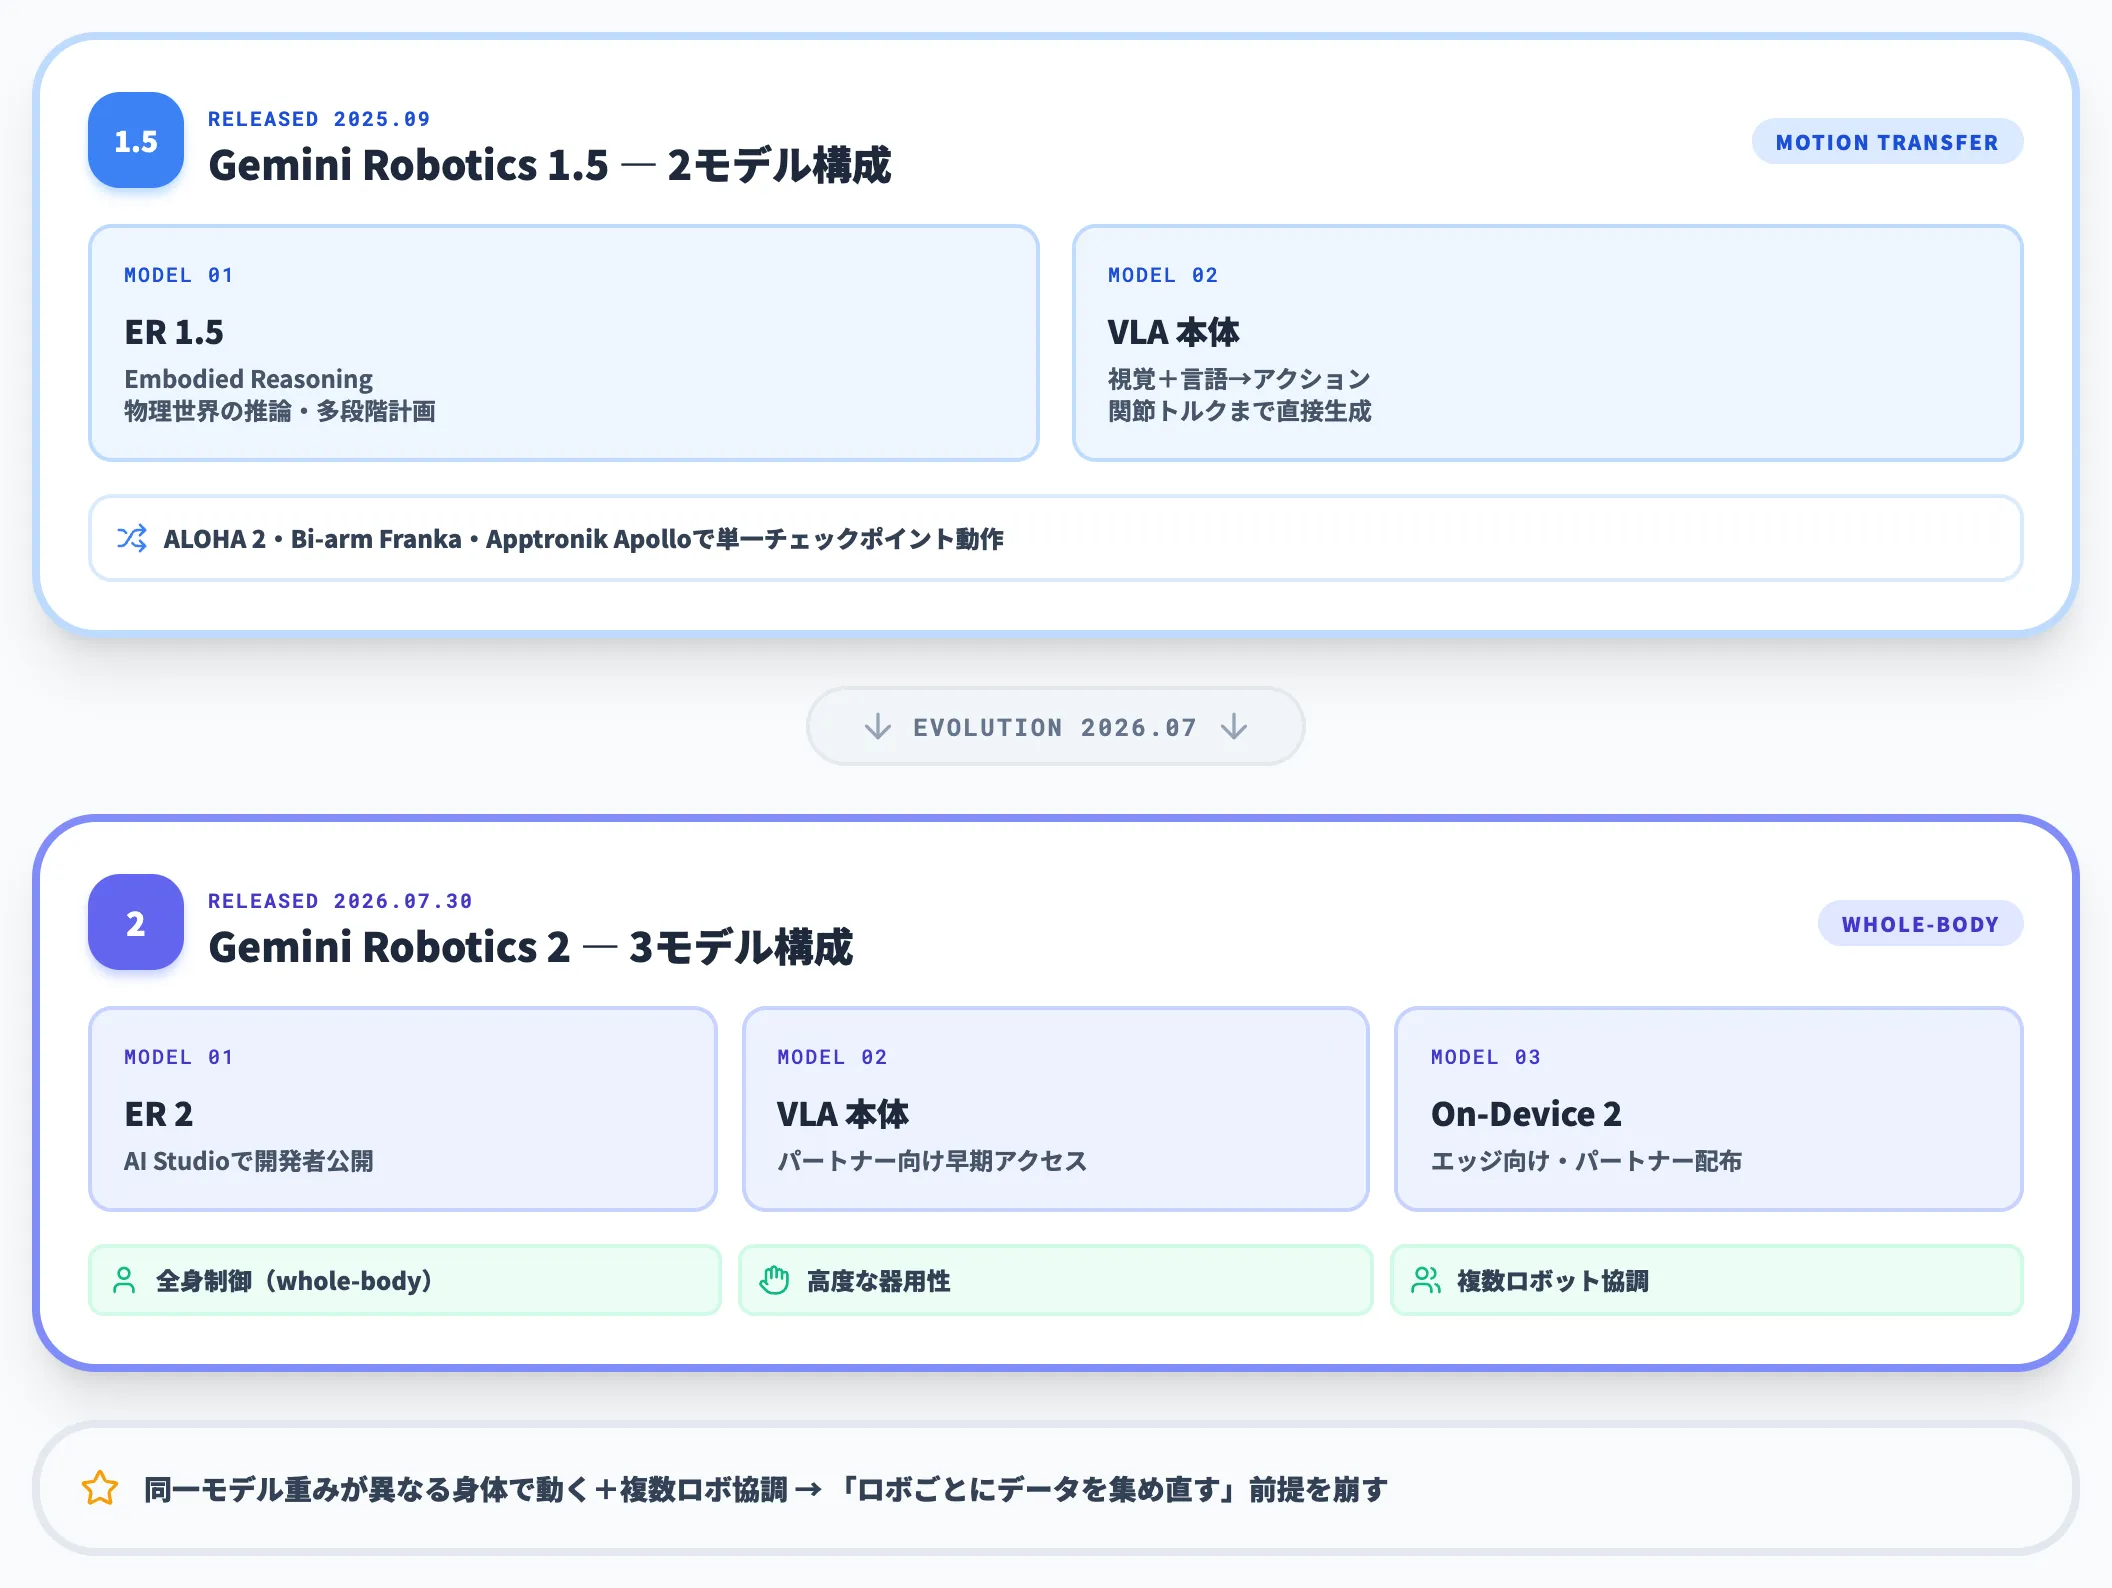
Google DeepMindは2025年9月にGemini Robotics 1.5を、2026年7月30日に後継のGemini Robotics 2を発表しました。1.5はVLA本体とEmbodied Reasoning用の「ER 1.5」の2モデル構成で、ER側は物理世界の推論と多段階計画を担います。
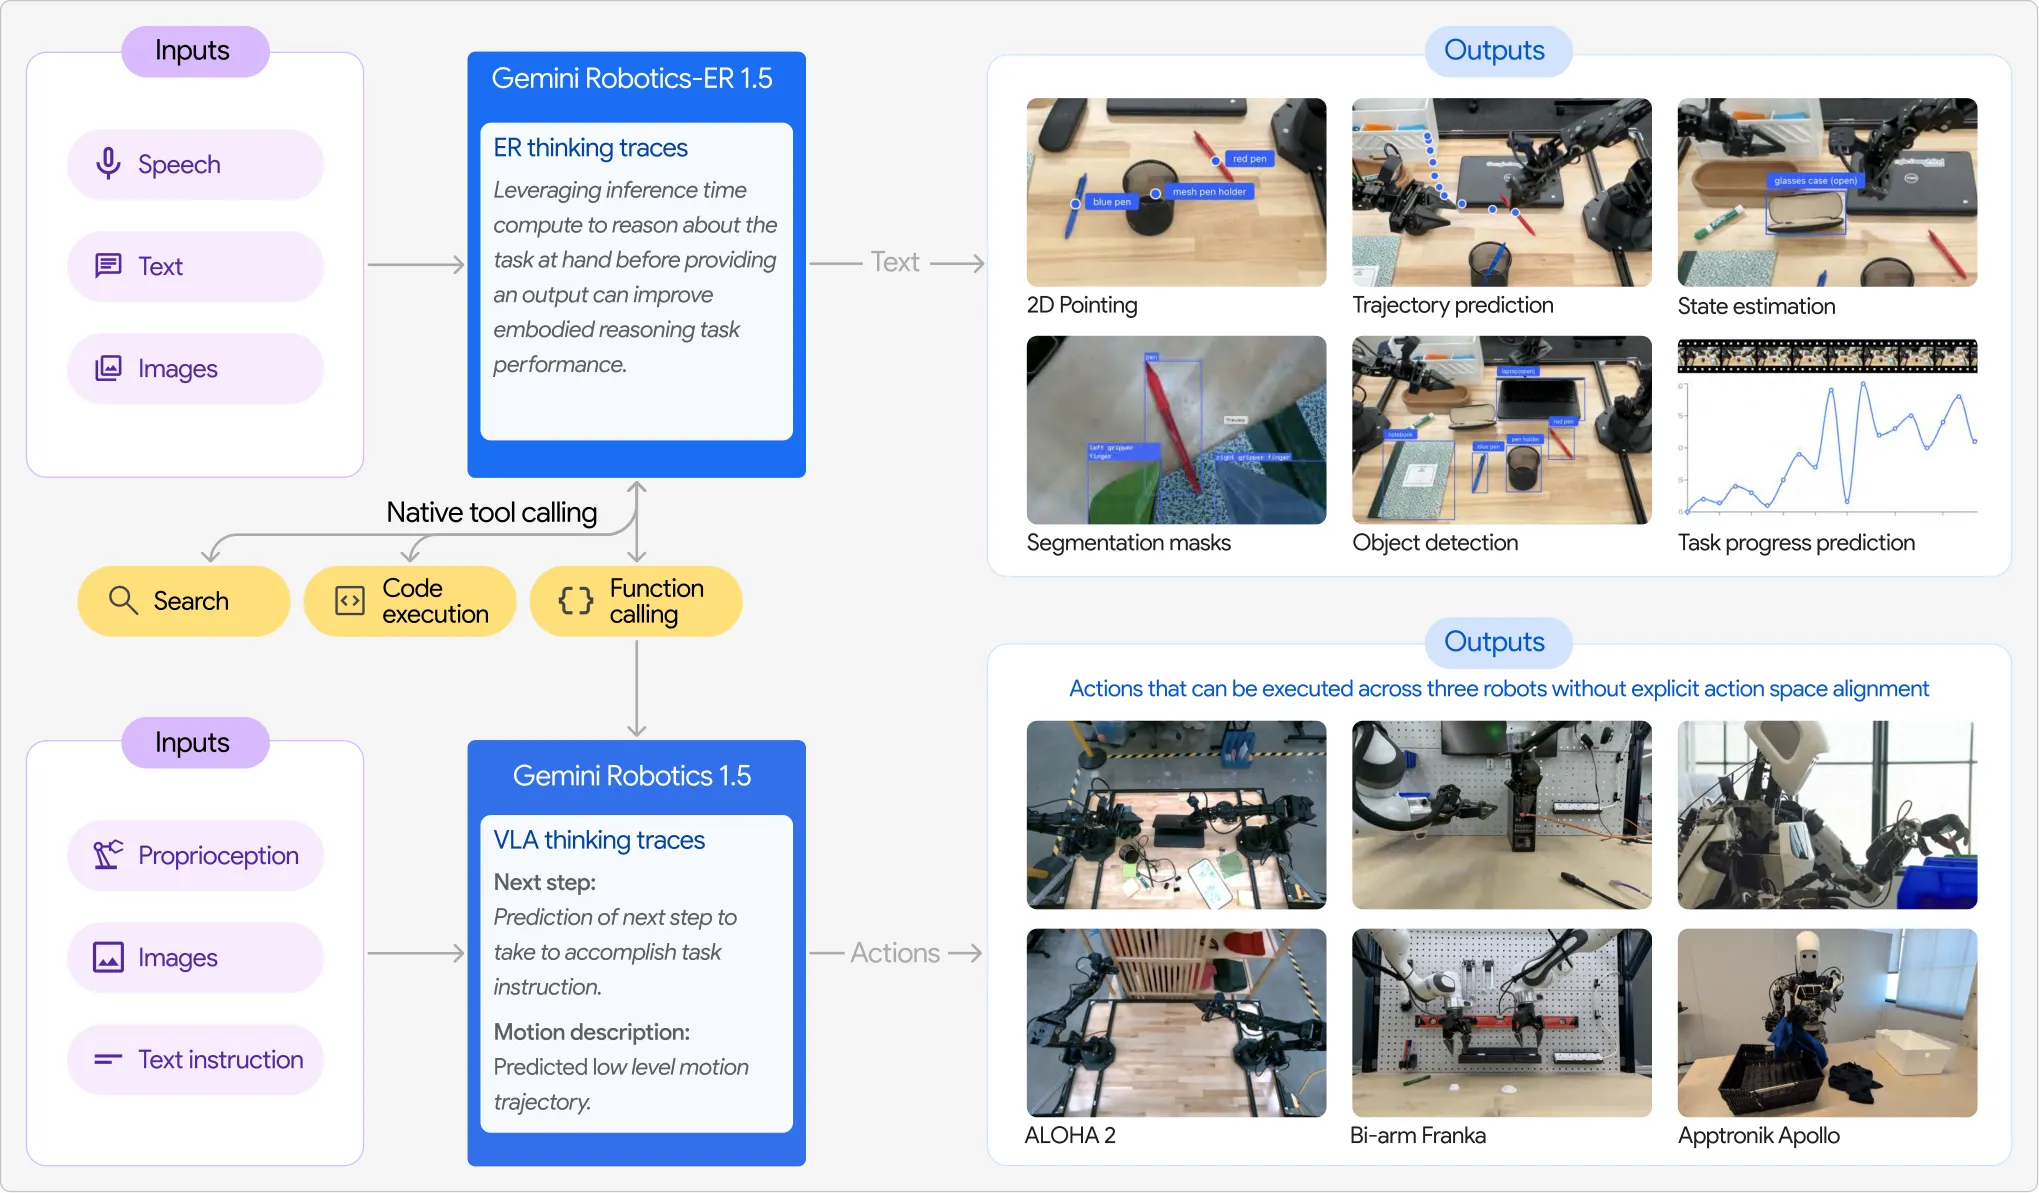
Gemini Robotics 1.5の2モデル構成(ER 1.5+VLA)と、ALOHA 2・Bi-arm Franka・Apptronik Apolloで動作するMotion Transferの俯瞰(出典:Google DeepMind)
Gemini Robotics 1.5の技術的な見どころは、Motion Transfer機構です。1台のロボットで学習したスキルを物理構造が異なる別のロボットでも追加訓練なしで動かす仕組みで、ALOHA 2で学習したタスクがBi-arm FrankaとApptronik Apolloヒューマノイドでも単一チェックポイントで動作することが論文で示されています。
その後2026年7月30日に発表されたGemini Robotics 2は、全身制御(whole-body control)・高度な器用性・複数ロボット協調に対応した世代です。VLA本体の「Gemini Robotics 2」、推論用の「Gemini Robotics ER 2」、エッジ向けの「Gemini Robotics On-Device 2」の3モデル構成に拡張されました。
提供範囲はモデルごとに異なります。推論用の「Gemini Robotics ER 2」はGoogle AI Studioで開発者向けに公開され、Gemini Enterprise Agent Platformではプライベートプレビュー扱いです。一方でVLA本体の「Gemini Robotics 2」とエッジ版の「Gemini Robotics On-Device 2」は、現時点では早期アクセスのパートナー向け提供にとどまります。Apptronikヒューマノイドでの全身コントロール・部屋全体の片付け・複数ロボット分業のデモが示されています。
同一のモデル重みが異なる身体で動くこと、そして複数ロボットが協調することは、「ロボットごとにデータを集め直す」というこれまでの前提を崩す意味で、業界に大きな影響を与えました。
Physical Intelligenceのπ0.5/π0.7とPi API
Physical Intelligenceは2024年設立のスタートアップで、元Google DeepMindのSergey Levine氏、スタンフォード大学のChelsea Finn氏らが創業しました。
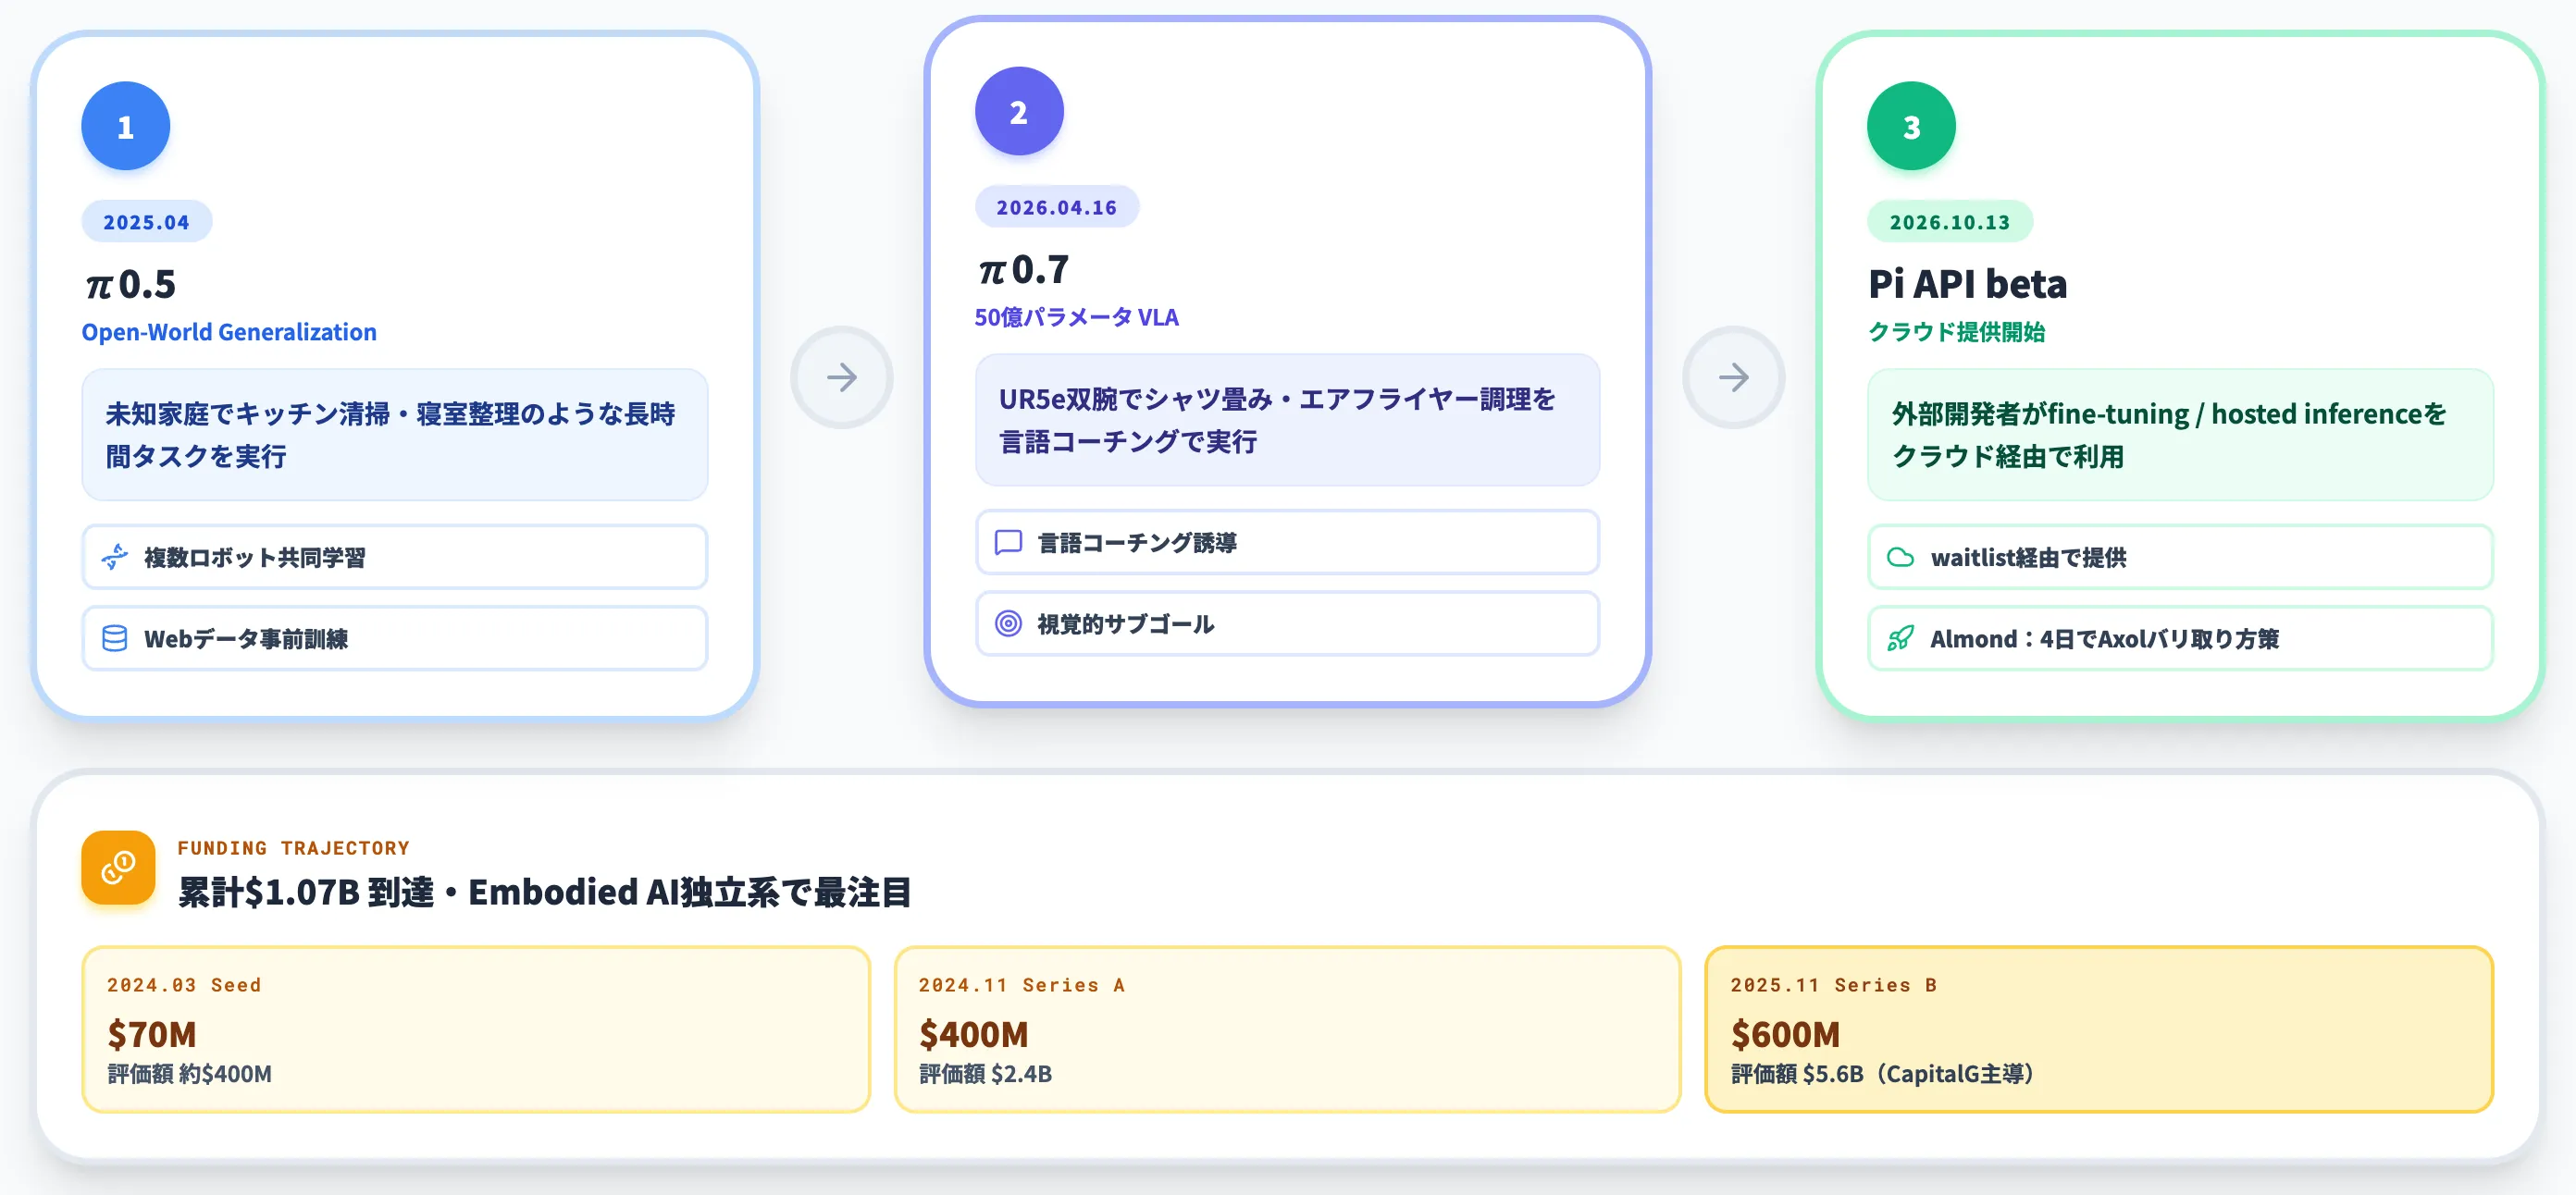
同社は2025年4月にπ0.5を発表し、エンドツーエンド学習型VLAが未知の家庭でキッチン清掃や寝室整理のような長時間タスクを遂行できることを示しました。訓練データは複数ロボット・高次セマンティック予測・Webデータを事前訓練段階で共同学習させた構成で、特定のモバイルロボット由来データは全体の数%にとどまります。
Physical Intelligenceが公開したπ0.5「a VLA with Open-World Generalization」の公式解説ヒーロー(出典:Physical Intelligence)
2026年には後続の発表が続いています。4月16日に発表されたπ0.7は50億パラメータのVLAで、UR5e双腕ロボットでのシャツ畳みやエアフライヤーでの調理といった未学習タスクを、言語コーチングや視覚的サブゴールで誘導しながら実行できることが示されました。
さらに10月13日にはPi API betaが公開され、外部開発者がπモデルの fine-tuning と hosted inference をクラウド経由で利用できるようになりました。waitlist経由の提供で、Almondがイテレーション4日でAxolの部品バリ取り方策を得た事例などが公式記事で紹介されています。
同じ系譜の研究として、Multi-Scale Embodied Memory(MEM)は長期・短期記憶を両立し10分超の複合タスクを扱えると発表されています。API発表時点では標準機能として明示されておらず、今後の統合候補として追っておく位置づけです。
資金調達面では、2024年3月のSeedラウンドで$70M(評価額約$400M)、2024年11月のSeries Aで$400M(評価額$2.4B)、2025年11月のSeries Bで$600M(CapitalG主導、評価額$5.6B)を調達し、累計$1.07Bに達しています。2026年にはさらに大型ラウンドの観測報道(二次情報)も出ており、Embodied AI領域で最も注目される独立系基盤モデル企業の1社です。
モデル系譜の詳細はPhysical Intelligence(π)とは?全モデル系譜やopenpi、競合比較を徹底解説で扱っています。
NVIDIAのIsaac GR00T N1.7
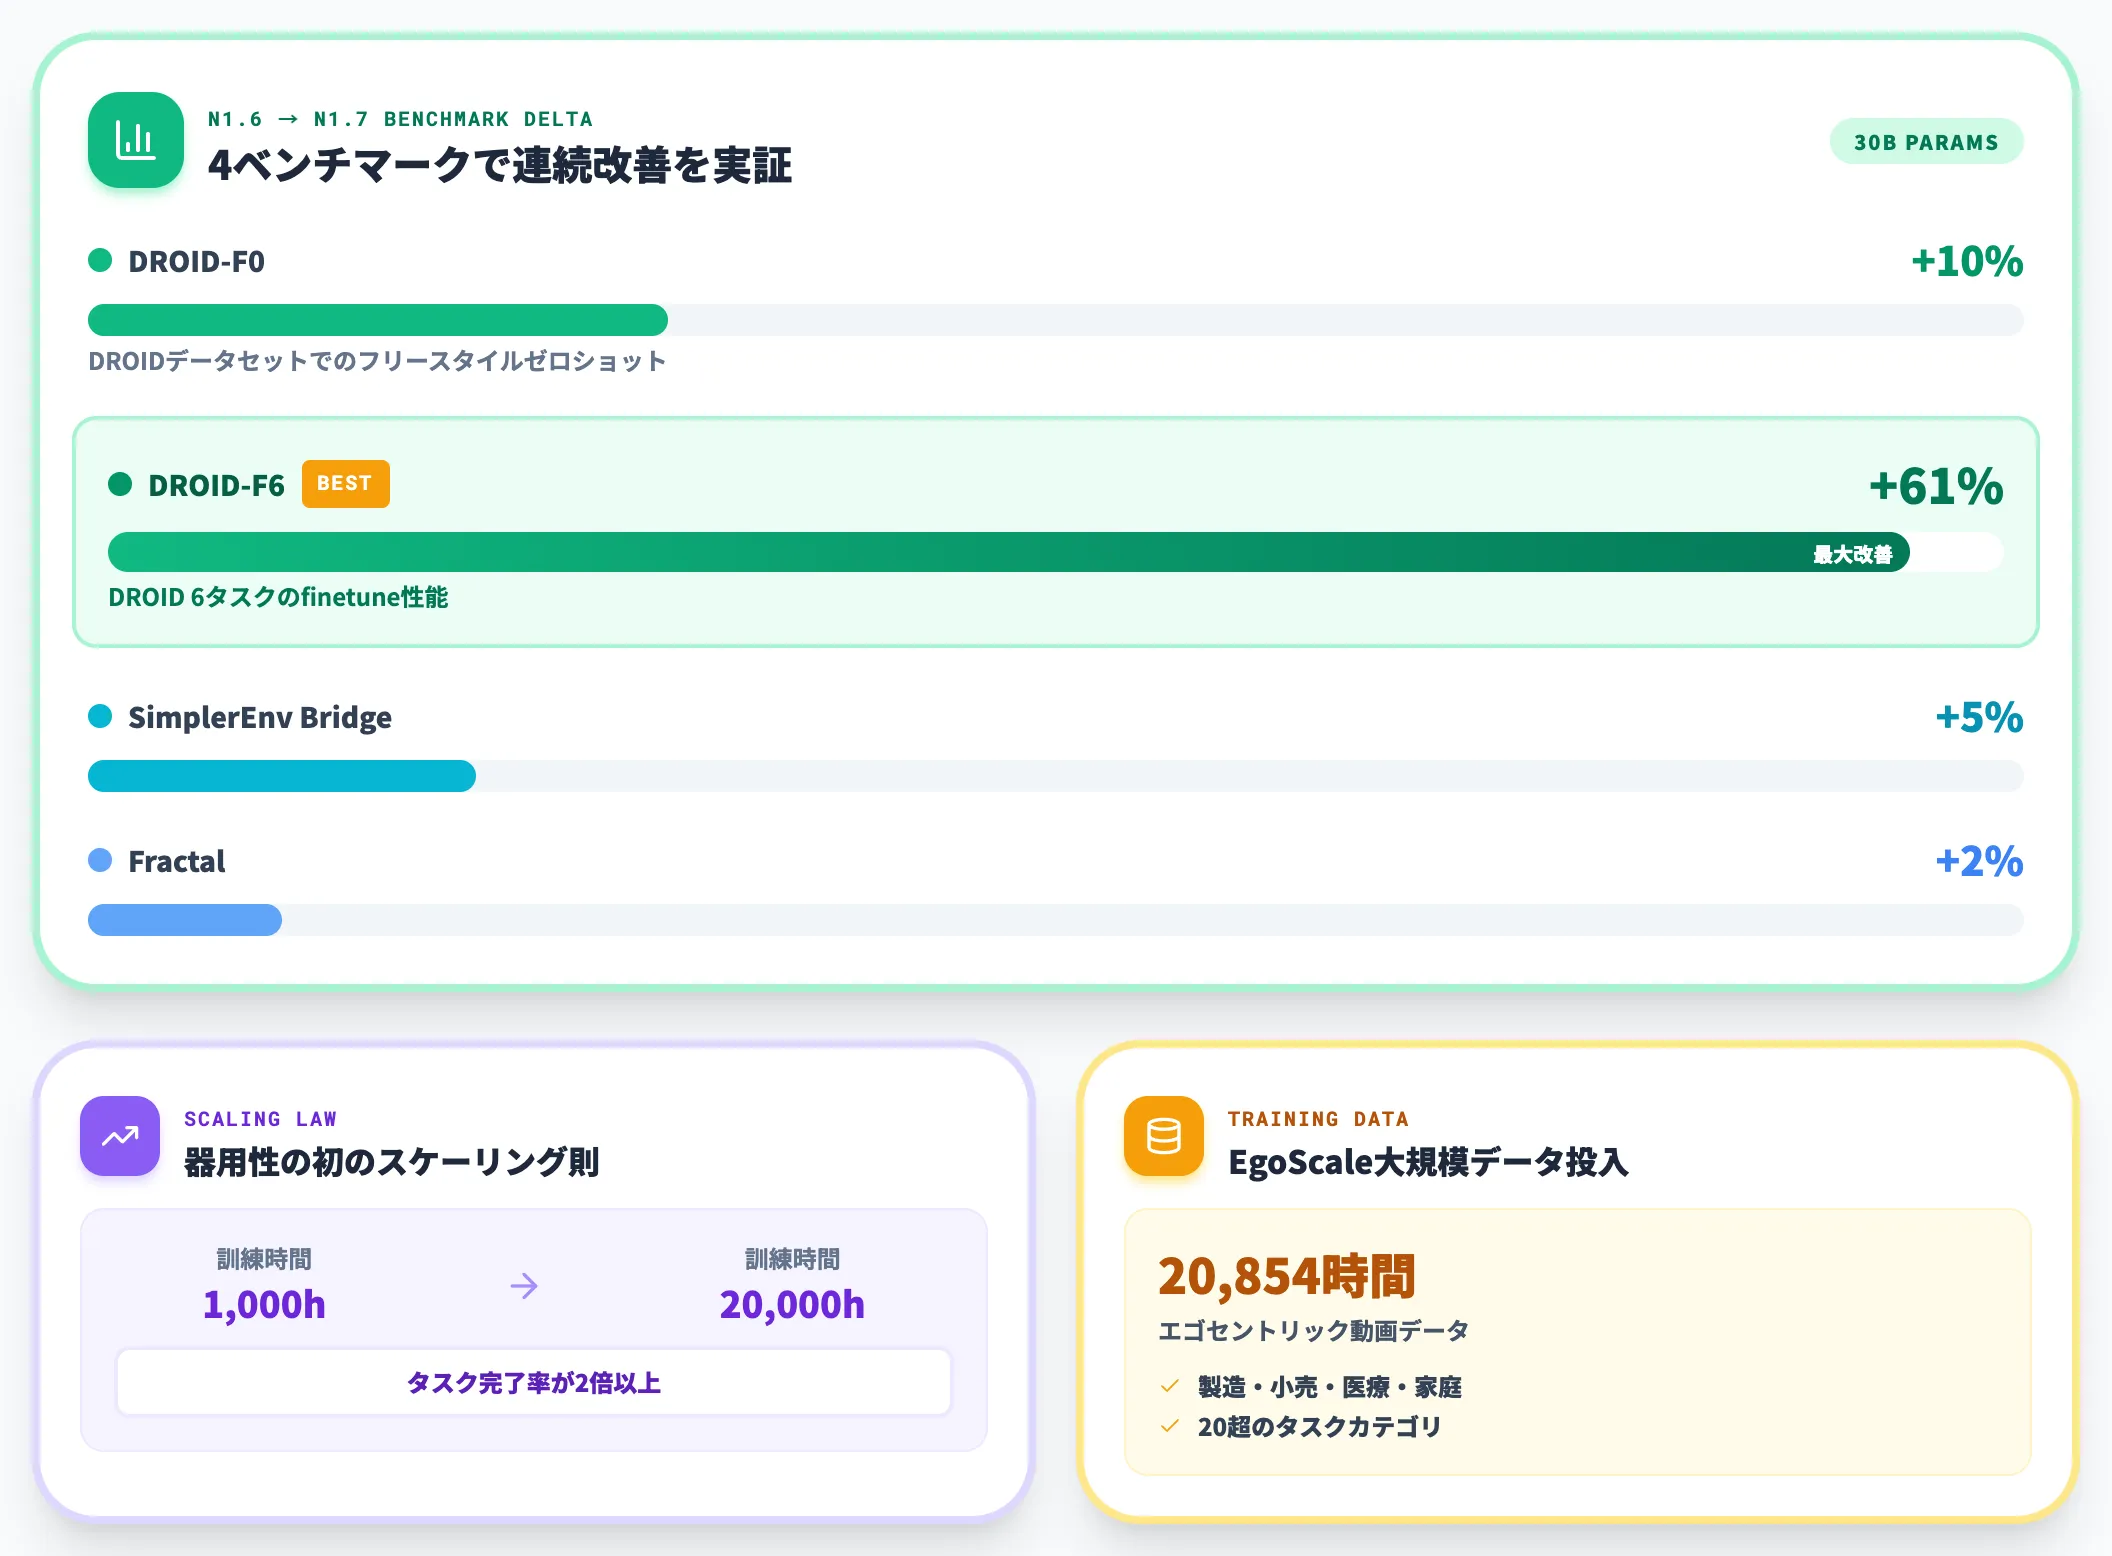
NVIDIA Isaac GR00Tはヒューマノイドロボット向けの汎用基盤モデルで、2025年12月のN1.6に続き、2026年4月に商用ライセンス付きのN1.7が早期アクセスで公開されました。
N1.7は30億パラメータのオープン推論VLAモデルで、VLMバックボーンをCosmos-Reason2-2B(Qwen3-VL派生)に刷新し、32層の拡散トランスフォーマーで連続アクションを生成します。
NVIDIA公式が公開したIsaac GR00T N1.7解説ブログの表題(出典:NVIDIA / Hugging Face)
N1.7の訓練には、20,854時間のEgoScale人間エゴセントリック動画を含む大規模データが投入され、製造・小売・医療・家庭など20以上のタスクカテゴリをカバーしています。
NVIDIAはN1.7の技術レポートで、ロボット器用性の初のスケーリング則を公表しました。訓練データを1,000時間から20,000時間に増やすと、平均タスク完了率が2倍以上に向上するという関係が実証されています。
ベンチマーク上では、N1.6比でDROID-F0が+10%、DROID-F6が+61%、SimplerEnv Bridgeが+5%、Fractalが+2%という連続的な改善がNVIDIA Developer Blogで報告されています。
後継モデルとして2026年のGTC基調講演でNVIDIAはGR00T N2を予告しました。
自社のDreamZero研究に基づくWorld Action Model(WAM)アーキテクチャを採用し、観察→行動のマッピングに加えて理解・シミュレーション・行動生成を1つの訓練ループに統合します。
MolmoSpaces・RoboArenaのgeneralist robot policyランキングで首位とされ、年内の提供開始が予告されており、VLA一本足だったN1系からWorld Model側に軸足を広げる動きとして注目されます。
Figure AIのFigure 03とBMW実証
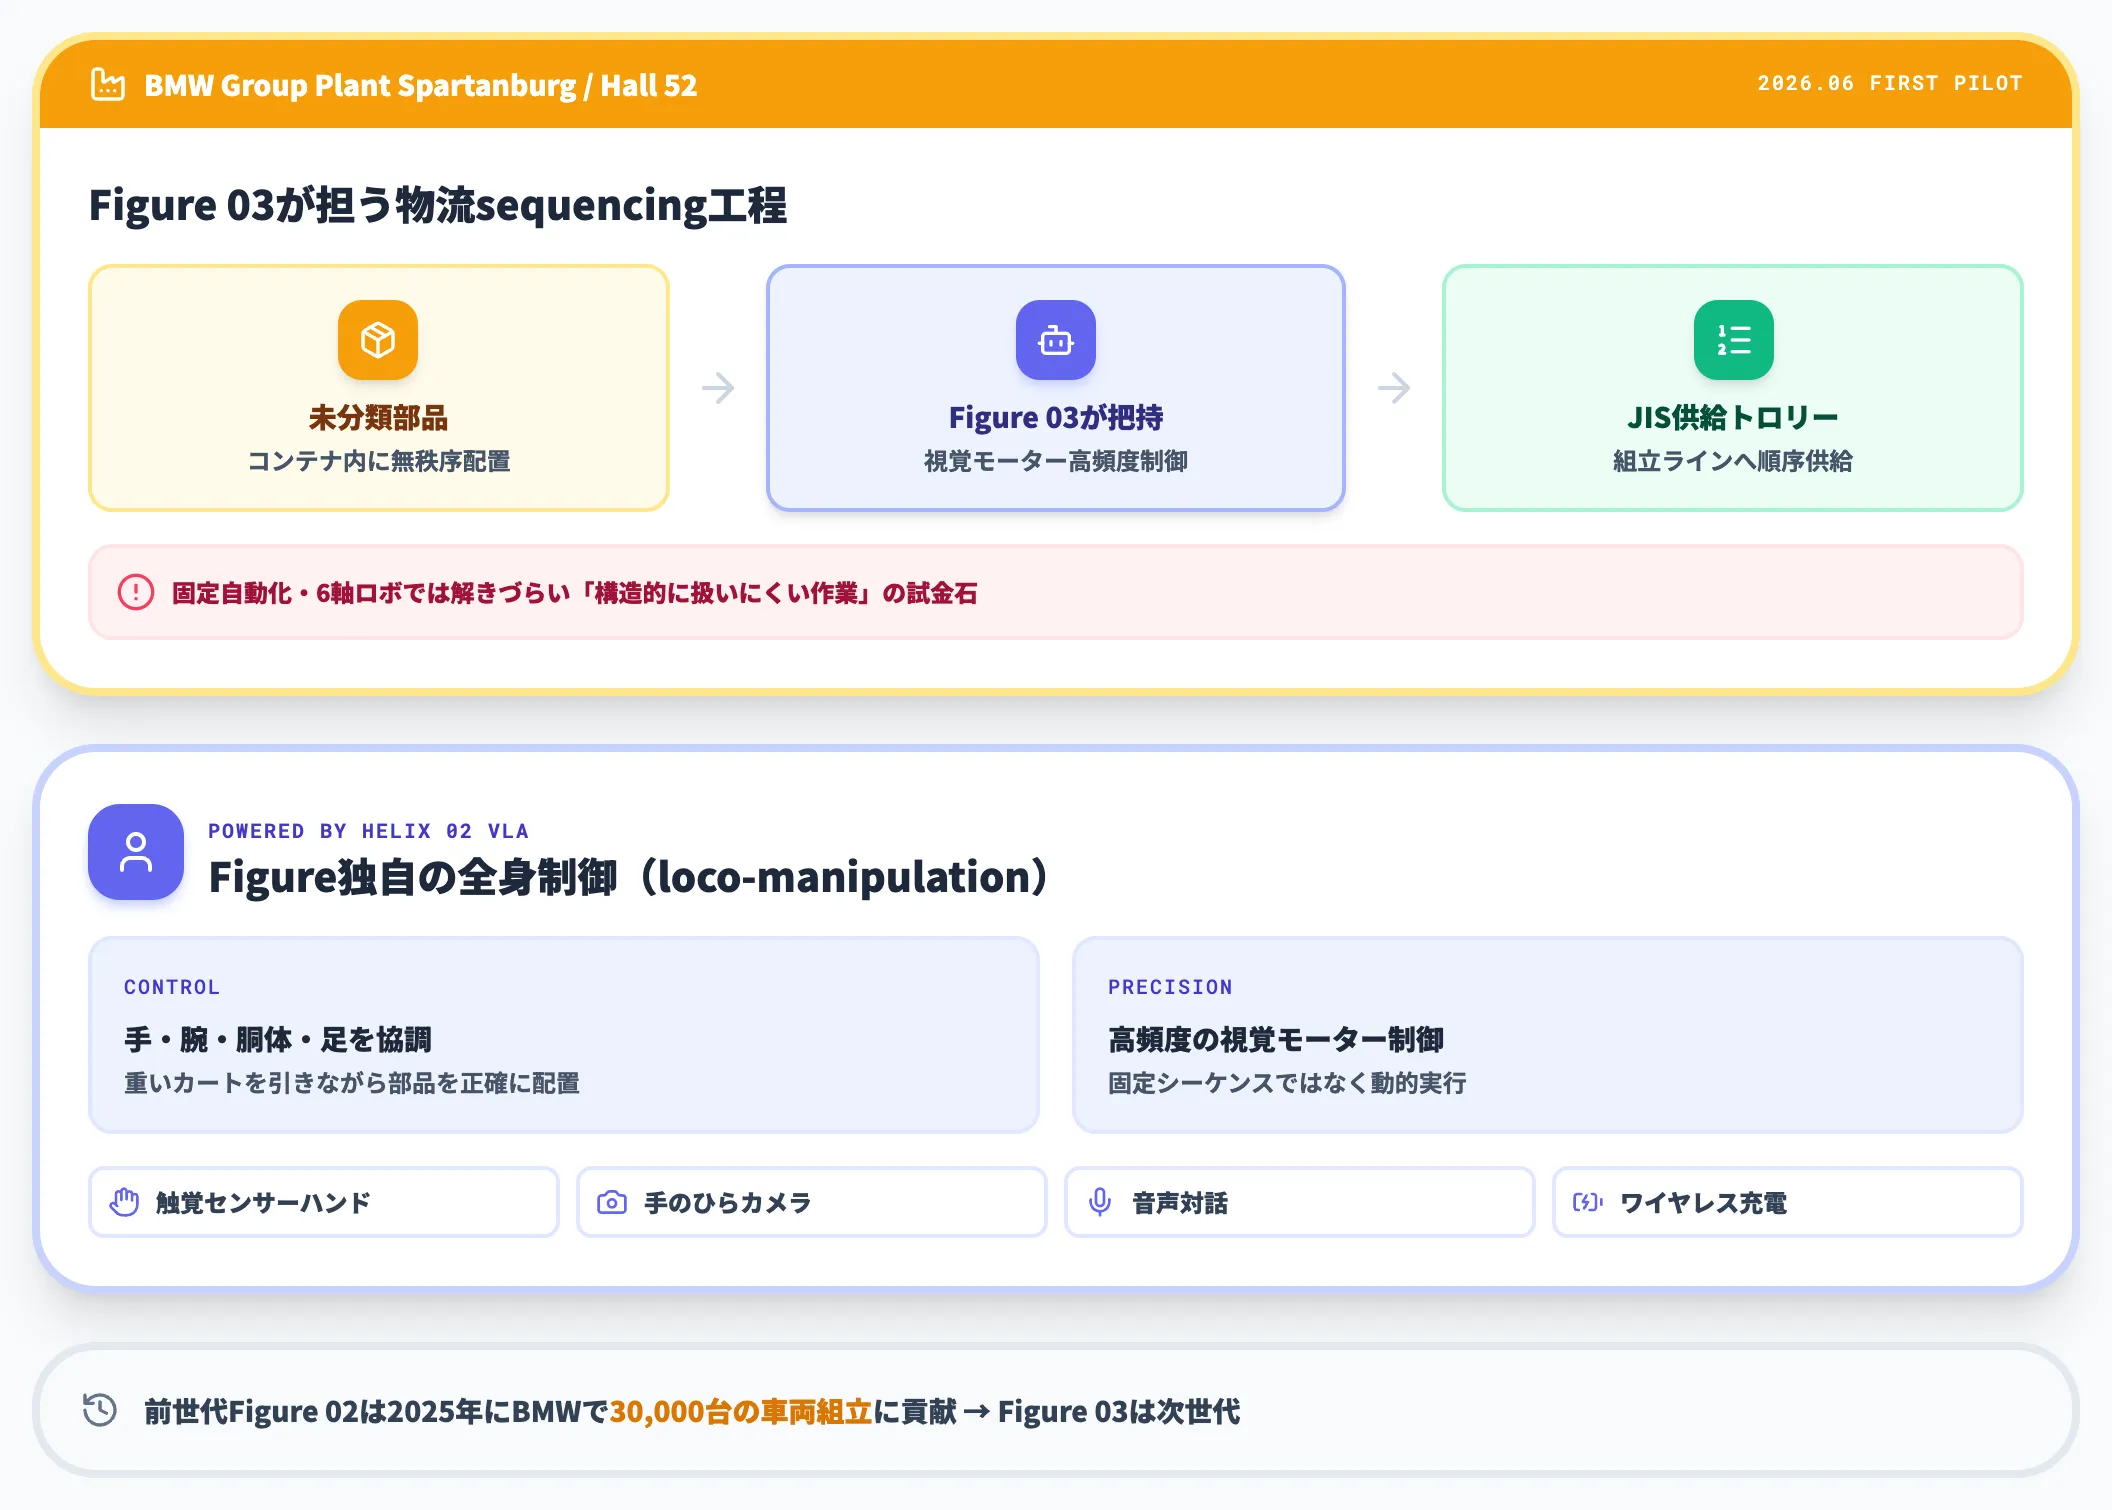
Figure AIがBMW Group Plant Spartanburgで、2026年6月にFigure 03による物流ワークフローの初めての実証を公開しました。前世代のFigure 02は2025年にBMWで30,000台の車両組立に貢献しており、Figure 03はその経験を踏まえた次世代機になります。
Figure 03は組立物流ホール「Hall 52」に配備され、未分類の部品をコンテナから取り出し、組立ラインへのジャストインシーケンス供給用トロリーに並べる作業を担っています。
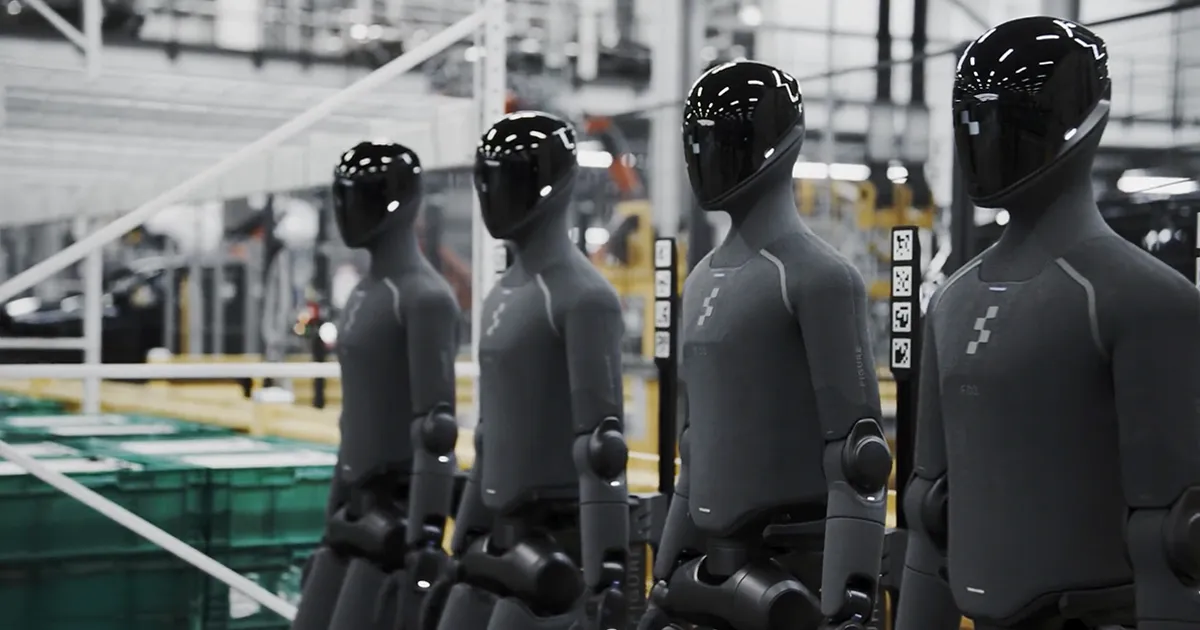
BMW Spartanburg工場Hall 52で物流ワークフローの実証に入ったFigure 03(出典:Figure AI)
技術的な見どころは、Figure独自のVLA「Helix 02」による全身制御(loco-manipulation)です。手・腕・胴体・足を協調させて重いカートを引きながら部品を正確に配置する一連の動作を、固定された動作シーケンスではなく高頻度の視覚モーター制御で動的に実行します。
sequencing(部品順序付け)は、部品が毎回同じ位置・姿勢で届かない「構造的に扱いにくい」作業で、従来の固定自動化や6軸ロボットアームでは解きづらい領域でした。この種の作業を汎用ヒューマノイドで解けるかどうかが、2026年の量産現場適用に向けた最大の試金石になっています。
ハードウェア面では、安全性を高める柔軟コンポーネント、ワイヤレス充電、音声対話機能、触覚センサー付きハンドと手のひらカメラが新搭載されました。
1X・Teslaなどのヒューマノイド系プレイヤー
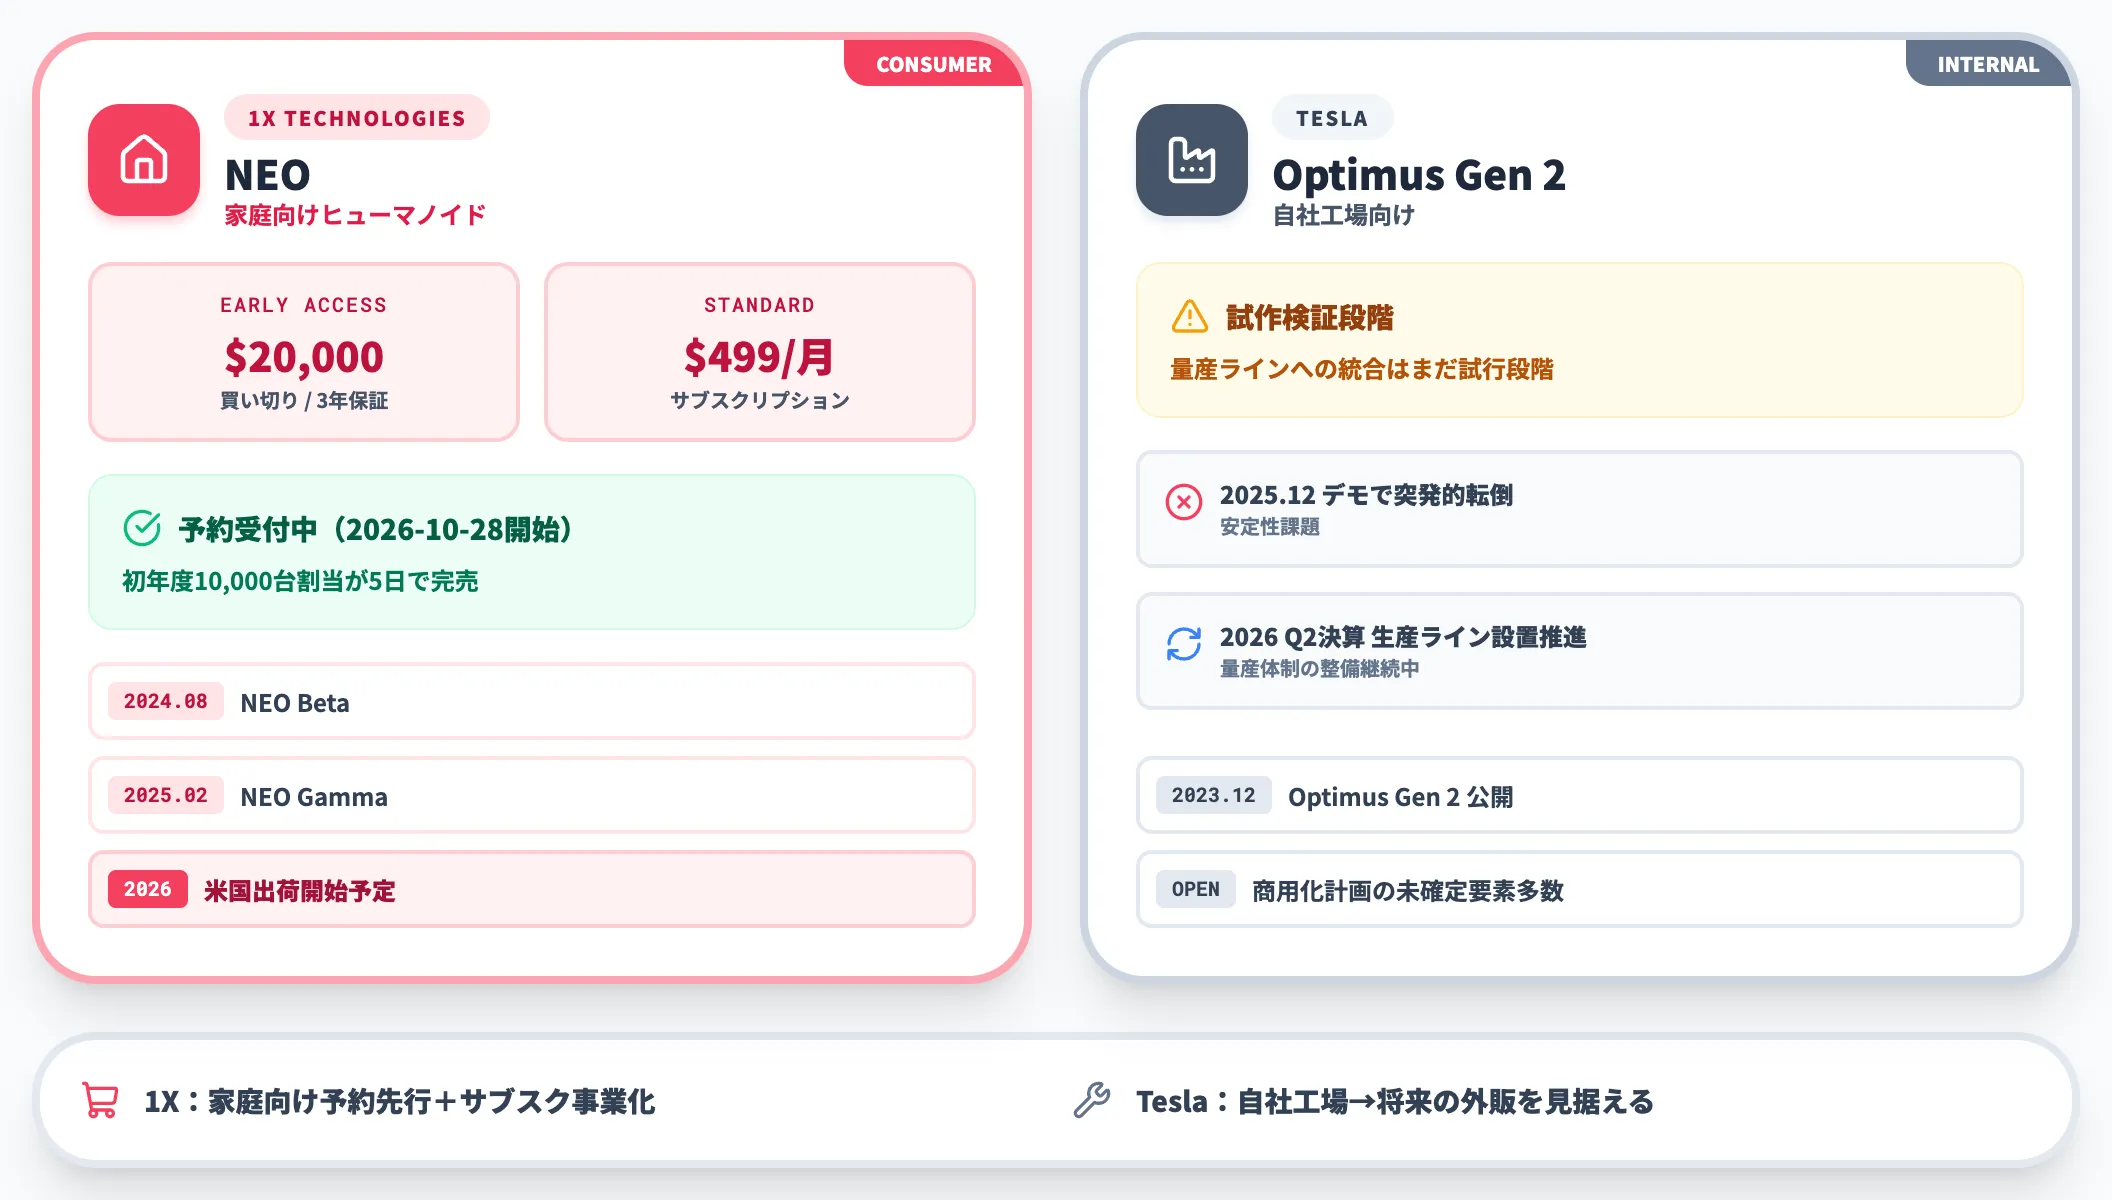
Figure以外のヒューマノイドロボット系では、1X Technologies(NEO)とTesla(Optimus)が商用化を競っています。
1X Technologiesは家庭向けヒューマノイドを「NEO Beta」(2024年8月)→「NEO Gamma」(2025年2月)と更新し、2025年10月28日に消費者向け製品版「NEO」の予約受付を開始しました。Early Accessは$20,000の買い切り(優先配送・プレミアムサポート・3年保証付き・2026年米国出荷開始)、Standardは$499/月のサブスクリプションと別プランで提供されます。予約は注文ページで$200デポジットから受け付けており、初年度10,000台の割当が5日で完売したとNEO Factory記事で公表されています。
Teslaは2023年12月に「Optimus Gen 2」を公開しました。その後も開発を続けていますが、2025年12月のデモで突発的に転倒するなど、量産ラインへの統合はまだ試行段階です(出典:Electrek)。一方で2026年Q2決算資料ではOptimusの生産ライン設置を進めている旨が示されており、量産体制の整備は継続中です(出典:Tesla 2026 Q2 General資料)。
プレイヤーごとの立ち位置を見比べると、2026年10月時点の構図は以下のように整理できます。
| プレイヤー | 中核モデル/機体 | 2026年のマイルストーン | 商用化段階 |
|---|---|---|---|
| Google DeepMind | Gemini Robotics 2 | 全身制御・器用性・複数ロボット協調、ER 2はAI Studioで公開 | ER 2はAI Studio公開、VLA/On-Deviceはパートナー向け早期アクセス |
| Physical Intelligence | π0.7/Pi API beta | 未学習タスクの言語コーチング実行、クラウドfine-tuning提供開始 | API beta(waitlist) |
| NVIDIA | Isaac GR00T N1.7 | 商用ライセンス付き、器用性スケーリング則、2026年7月にGA昇格 | GA(公式READMEで公表) |
| Figure AI | Figure 03 | BMW Spartanburgでsequencing実証、Helix 02 VLAによる全身制御 | 量産現場での実証段階 |
| 1X Technologies | NEO | 消費者向け予約開始($20,000)、初年度1万台5日完売 | 予約受付(出荷は2026年以降) |
| Tesla | Optimus Gen 2 | 自社工場での試行、安定性課題 | 試作検証 |
この表から読み取れるのは、ソフトウェア基盤モデル側(Google・Physical Intelligence・NVIDIA)がすでに「異種ロボットで動く汎用基盤」の設計に収斂しつつあること、そしてハードウェア側(Figure・1X・Tesla)が「どのメーカーが先に量産現場に食い込むか」のレースに移っていることです。
ソフトとハードの両輪が噛み合い始めたのが2026年の特徴で、ここから数年は「どの基盤モデル×どのハードウェア」の組み合わせが勝つかという別軸の勝負に入ります。
Embodied AIを支えるWorld ModelとSim2Realの最前線
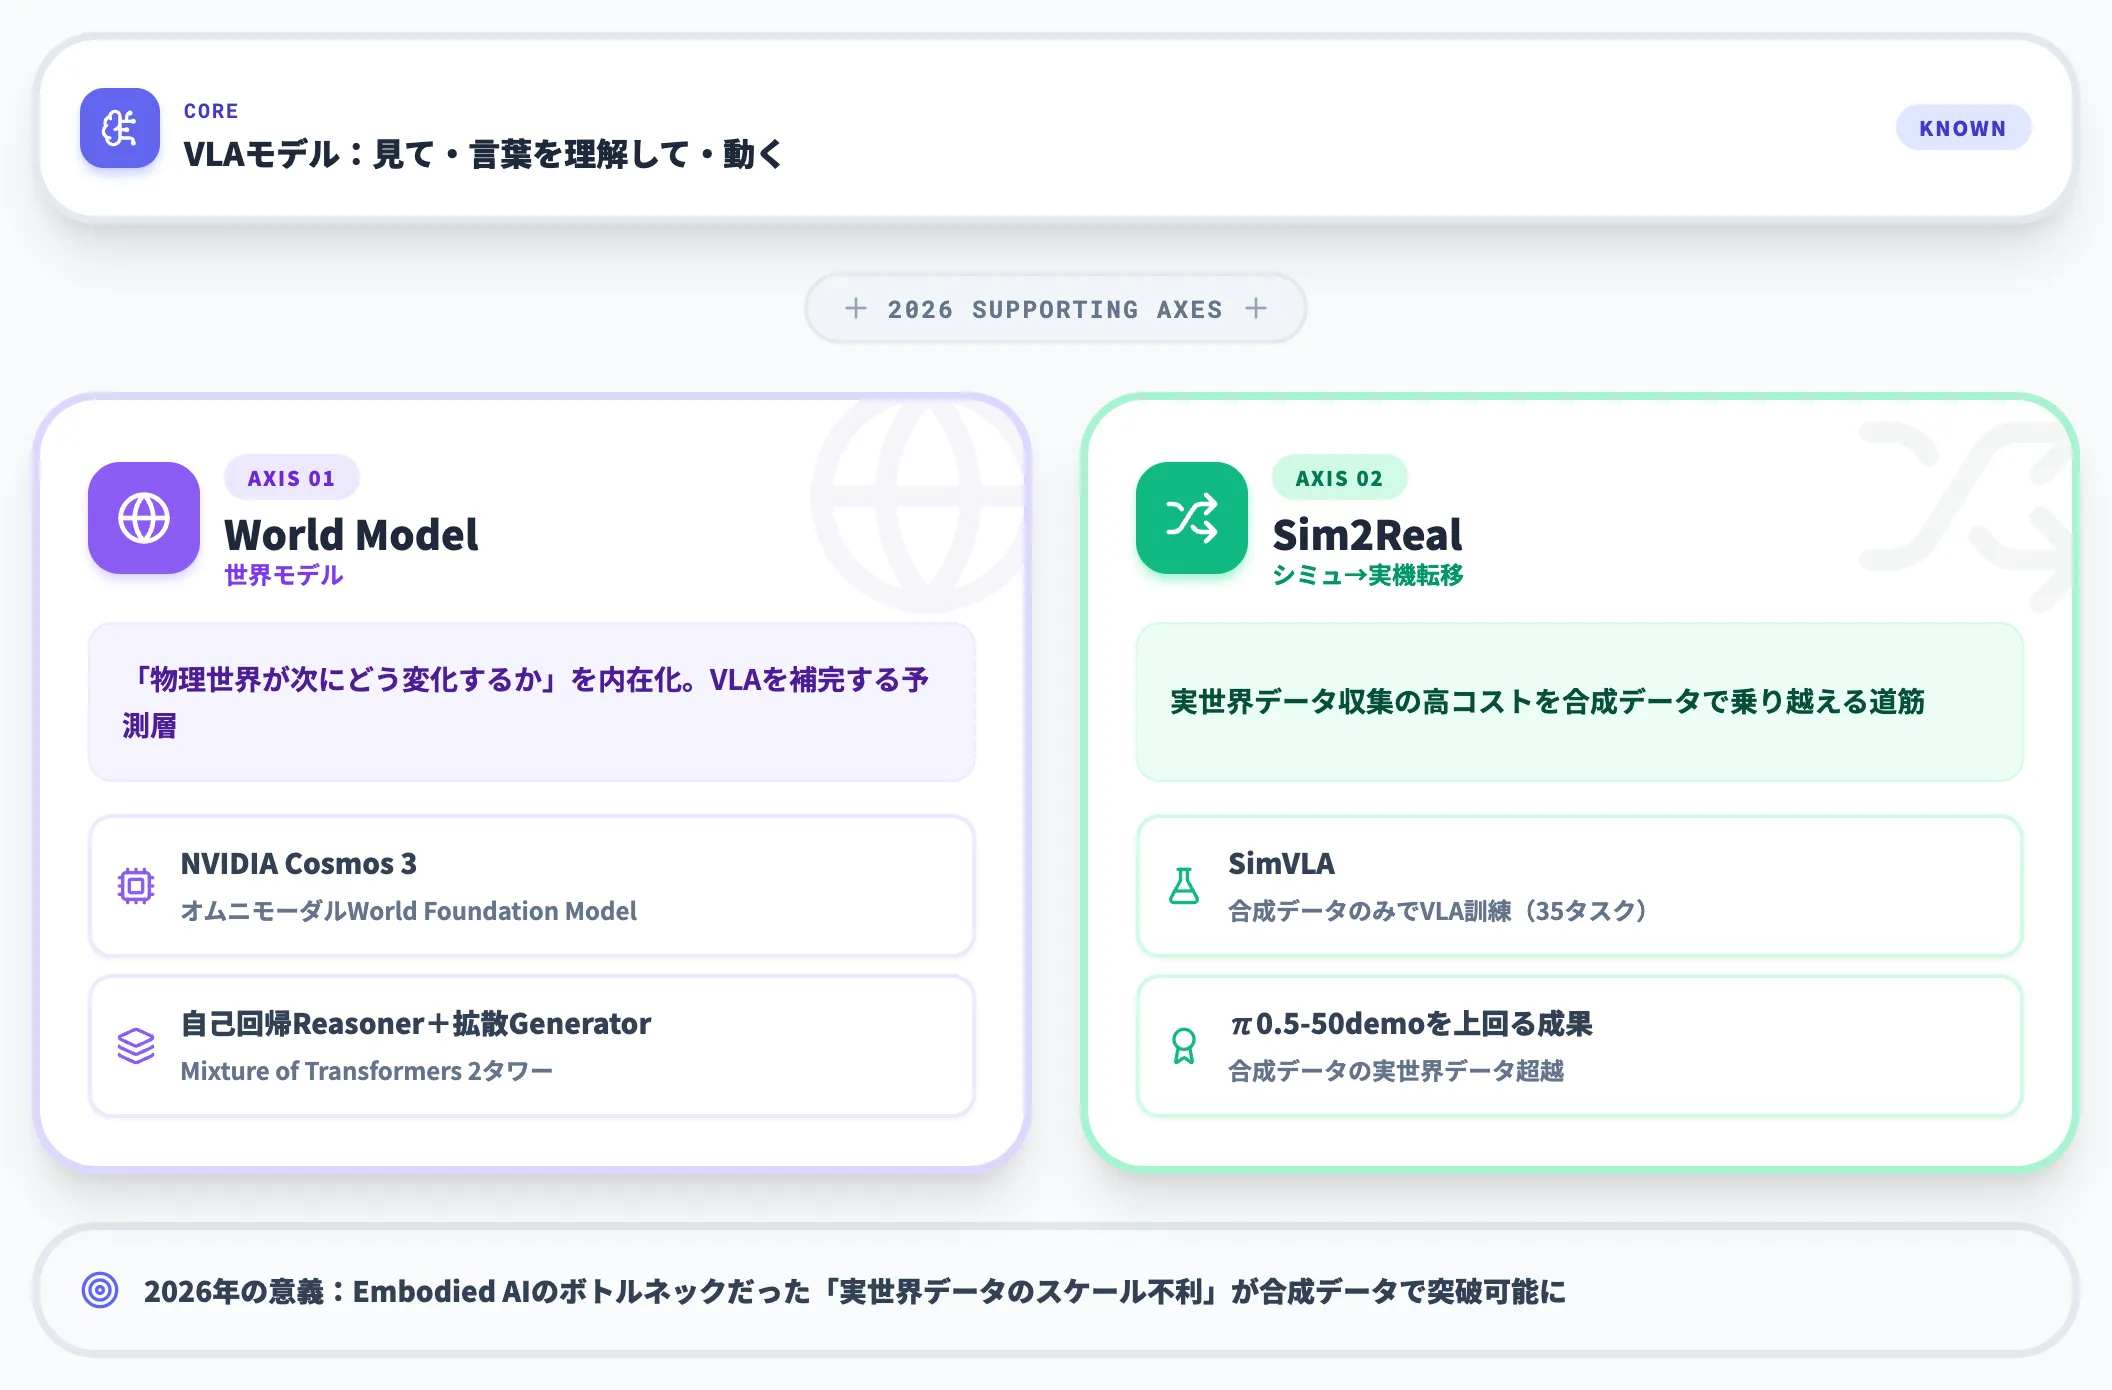
主要プレイヤーの基盤モデル競争と並行して、World Model(世界モデル)とSim2Real(シミュレーションから実機への転移)が2026年の重要な技術軸として浮上しています。
VLAモデルが「見て・言葉を理解して・動く」部分を担うのに対し、World Modelは「物理世界が次にどう変化するか」を内在化する層を担います。本セクションでは、NVIDIA Cosmos 3と、合成データのみで実世界デモを超えたSimVLAの2件を取り上げます。
NVIDIA Cosmos 3の技術構造
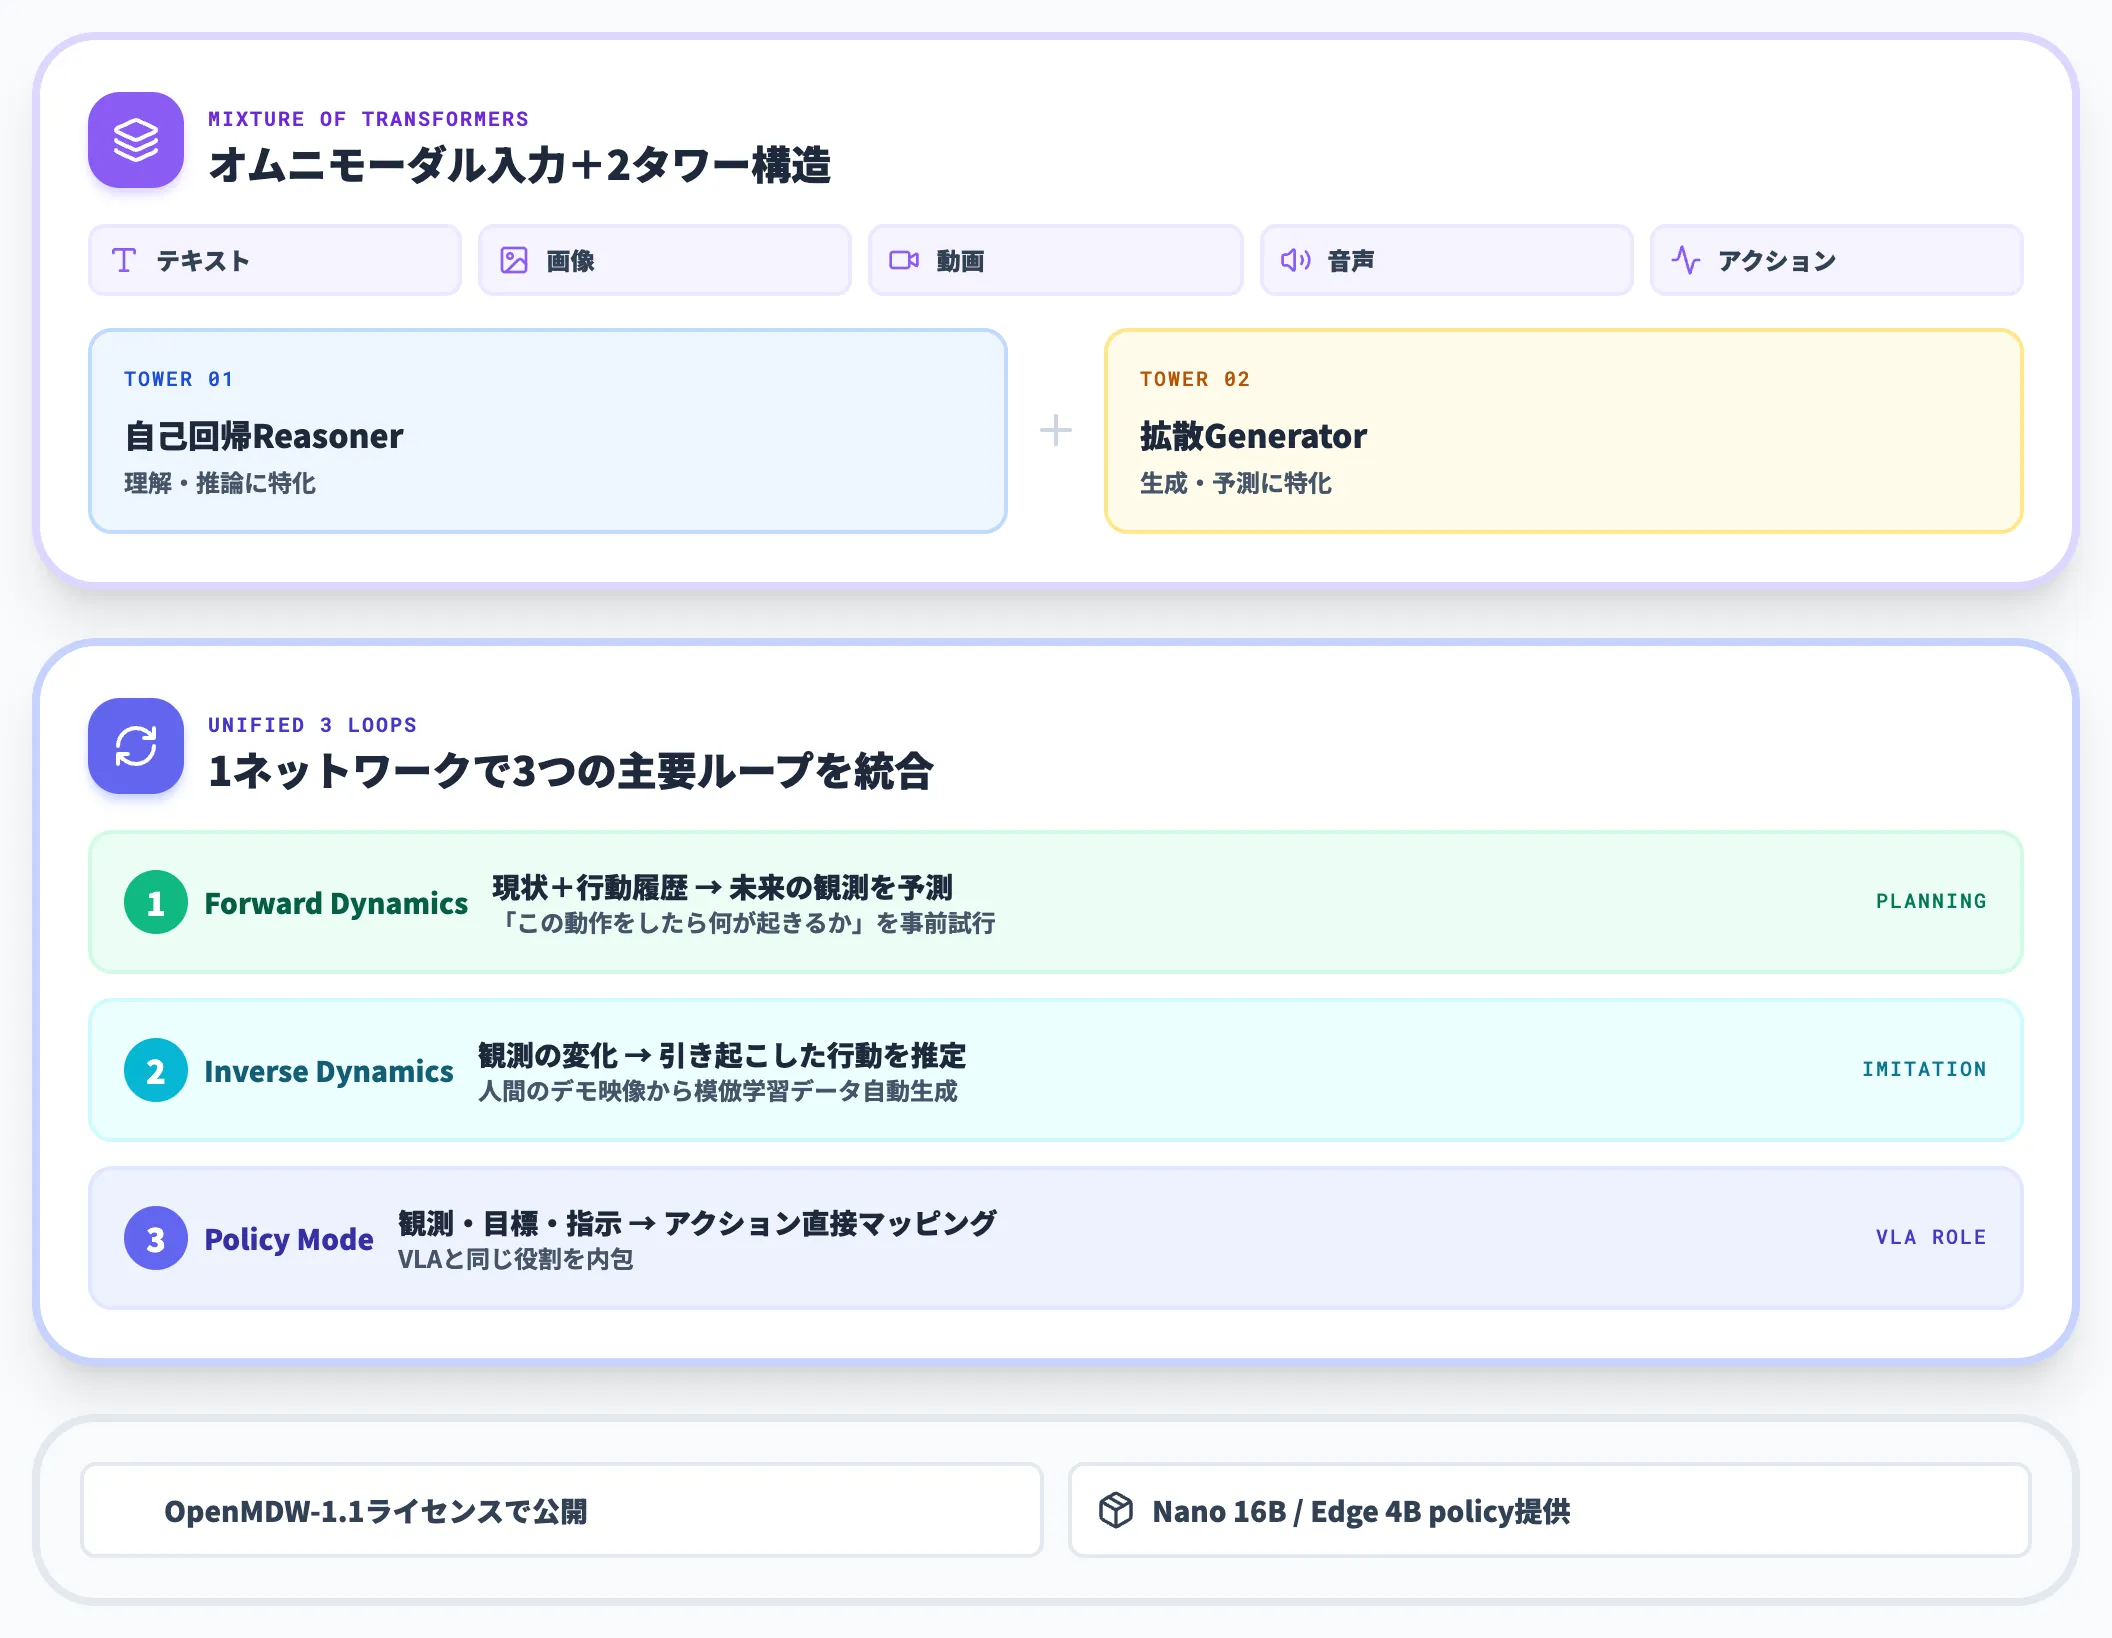
NVIDIAは2026年に、オムニモーダルなWorld Foundation ModelとしてCosmos 3を公開しました。
Cosmos 3はテキスト・画像・動画・音声・アクションを単一のMixture of Transformers(MoT)アーキテクチャで扱い、自己回帰型Reasonerと拡散型Generatorの2タワー構成を取っています。
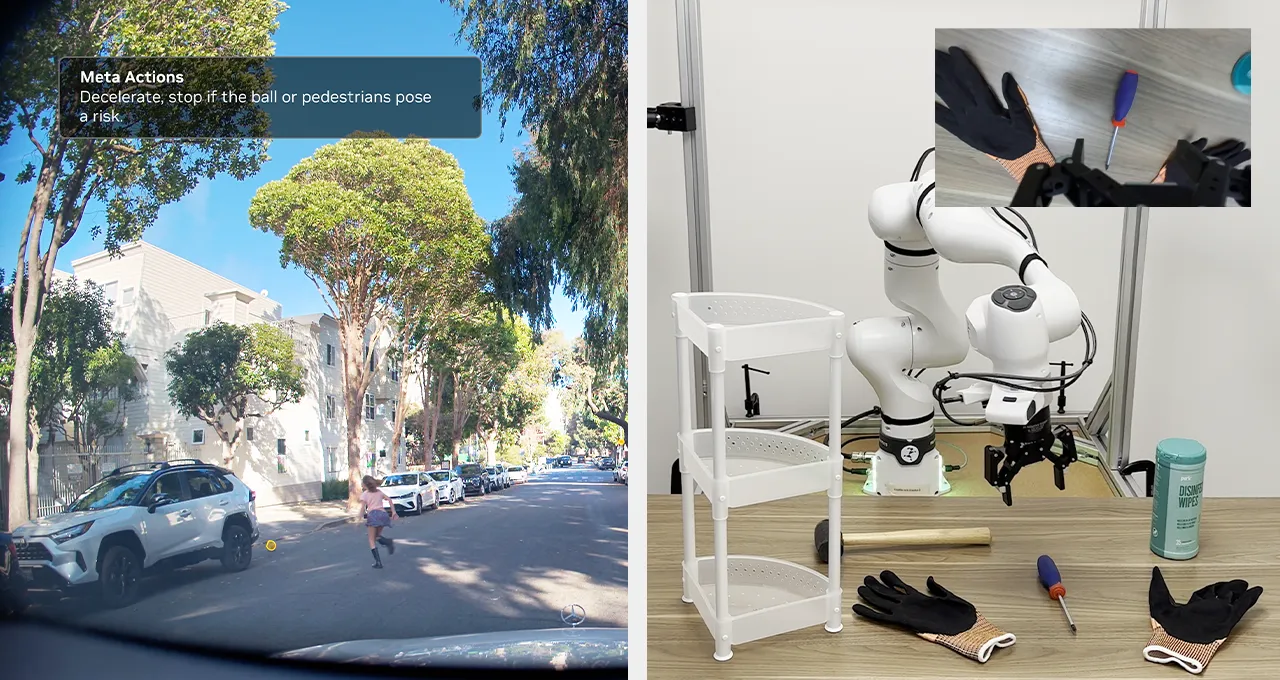
Cosmos 3が扱う自動運転・ロボット操作などオムニモーダルな物理世界応用の例(出典:NVIDIA Blog)
特徴的なのは、1つのネットワークで「前方動力学」「逆動力学」「方策学習」の3つの主要ループを統合している点です。
-
前方動力学(Forward dynamics)
現在の状態と行動履歴から未来の観測を予測する。ロボットの計画段階で「この動作をしたら何が起きるか」を事前に試す用途に使う。
-
逆動力学(Inverse dynamics)
観測された変化から「どんな行動がそれを引き起こしたか」を推定する。人間のデモ映像から模倣学習データを自動生成する用途に使う。
-
方策学習(Policy mode)
観測・目標・指示から直接アクションにマッピングする。VLAと同じ役割を果たす。
Cosmos 3はLinux FoundationのOpenMDW-1.1ライセンスで公開されており、重みとコードはGitHubとHugging Faceでアクセス可能です。
DROIDデータセットで後訓練されたCosmos3-Nano-Policy-DROID(16Bパラメータ)やCosmos3-Edge-Policy-DROID(4Bパラメータ)など、ロボット方策モデルも併せて提供されています。
SimVLAが示した合成データの実力
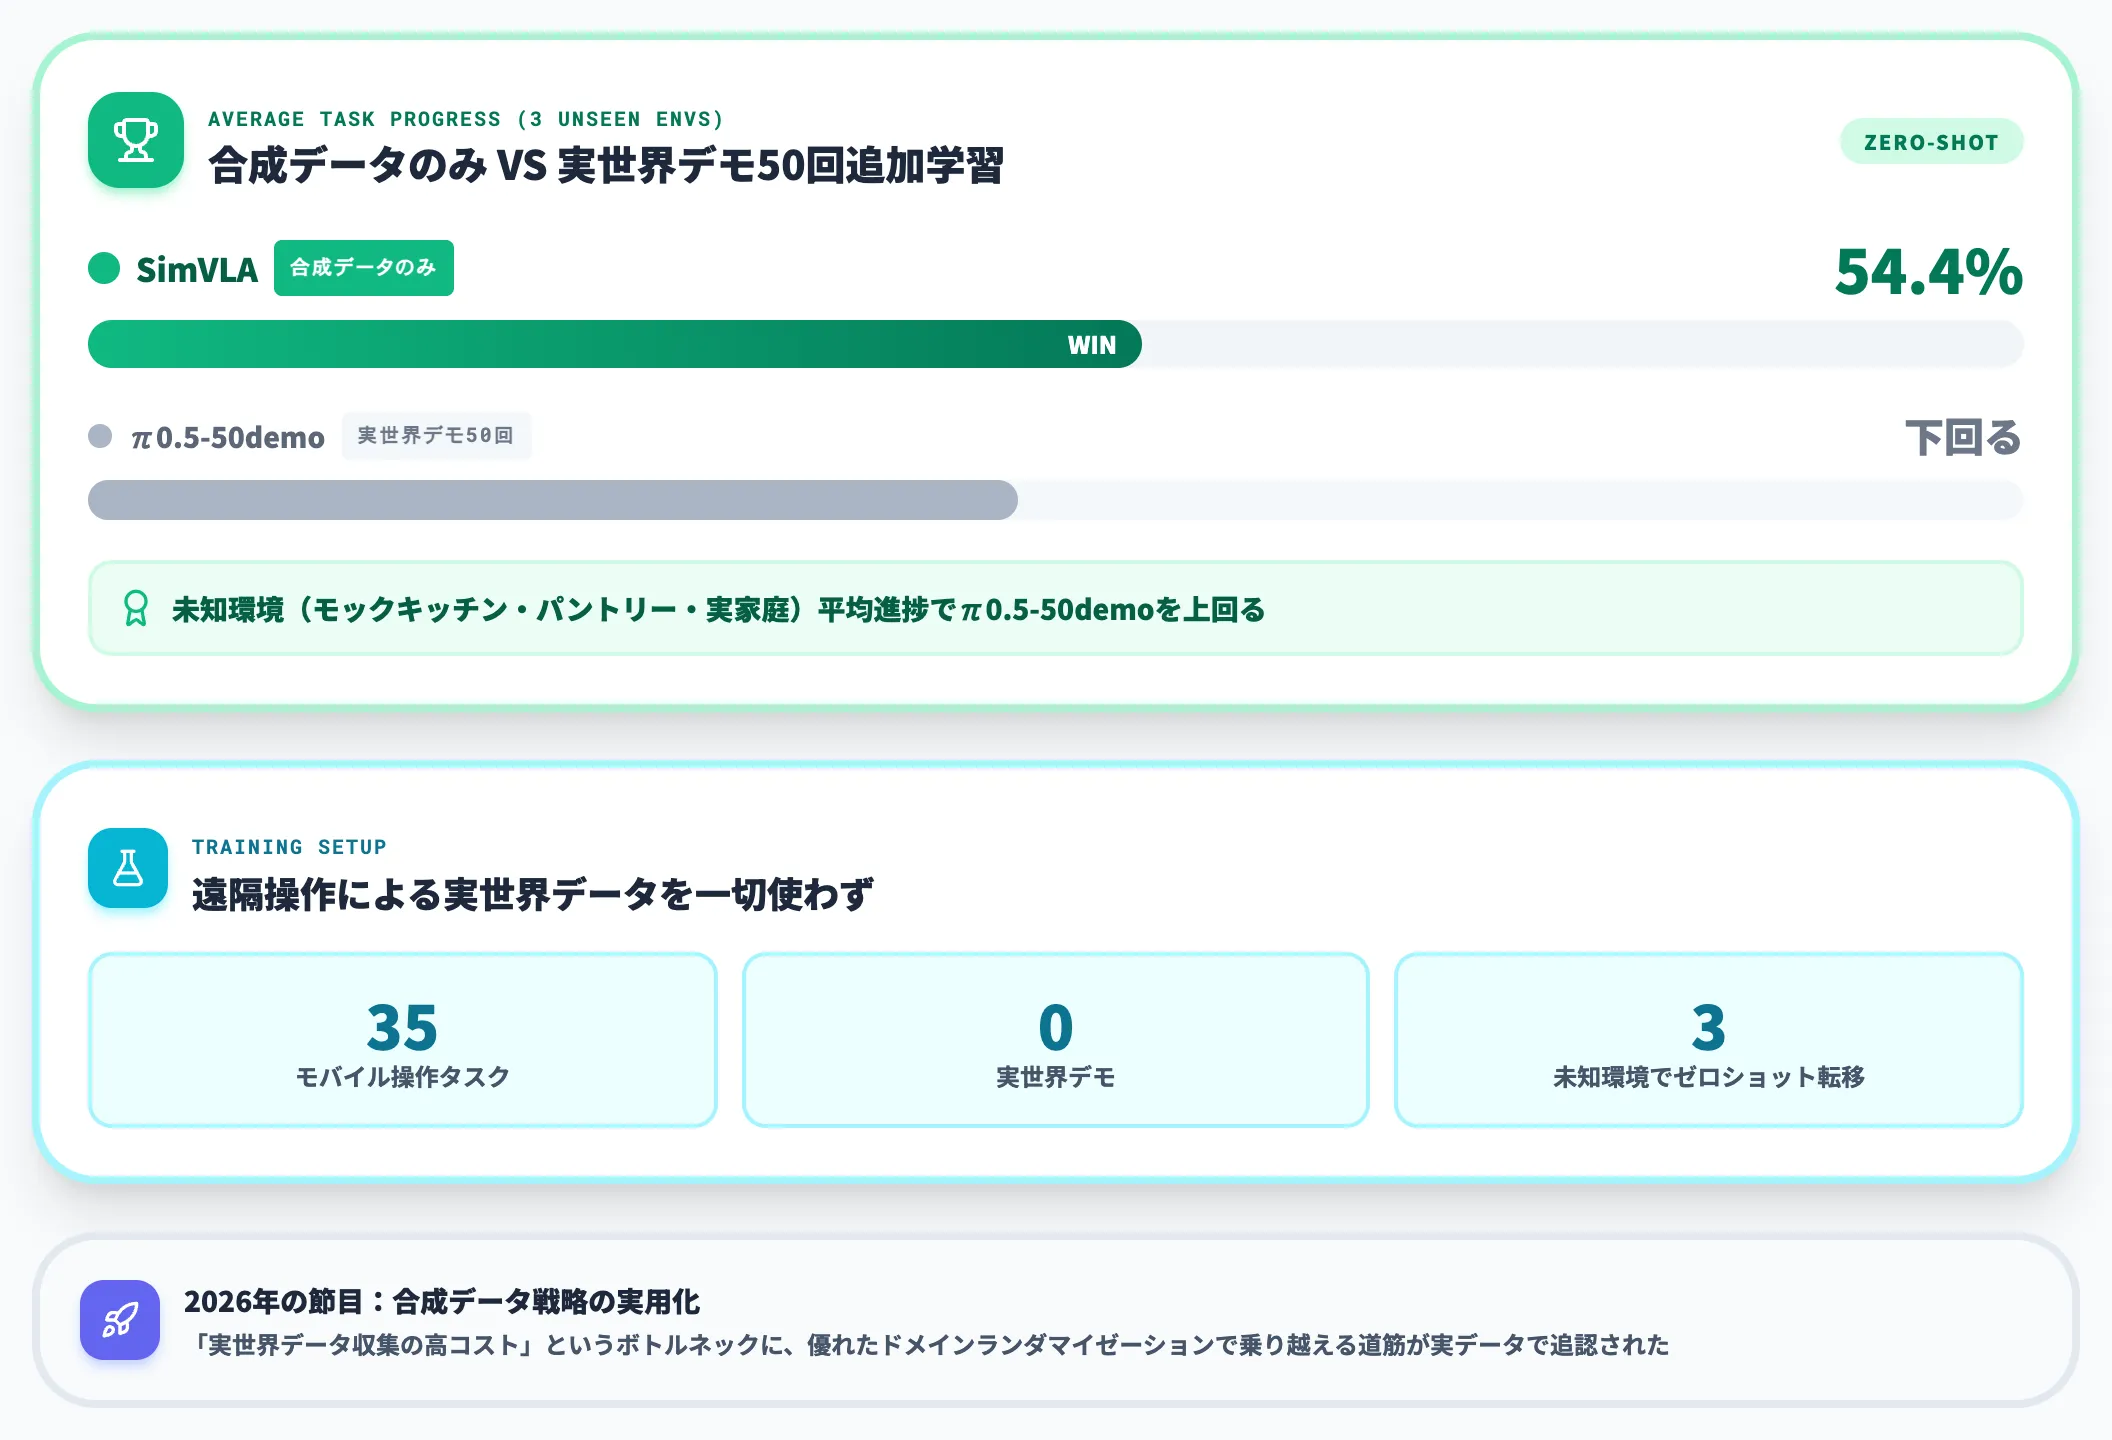
Sim2Realの進展を示す象徴的な研究が、2026年10月に発表されたSimVLAです。
SimVLAは、遠隔操作による実世界データを一切使わず、35タスクのモバイル操作シミュレーションデータだけでVLAを訓練する枠組みです。
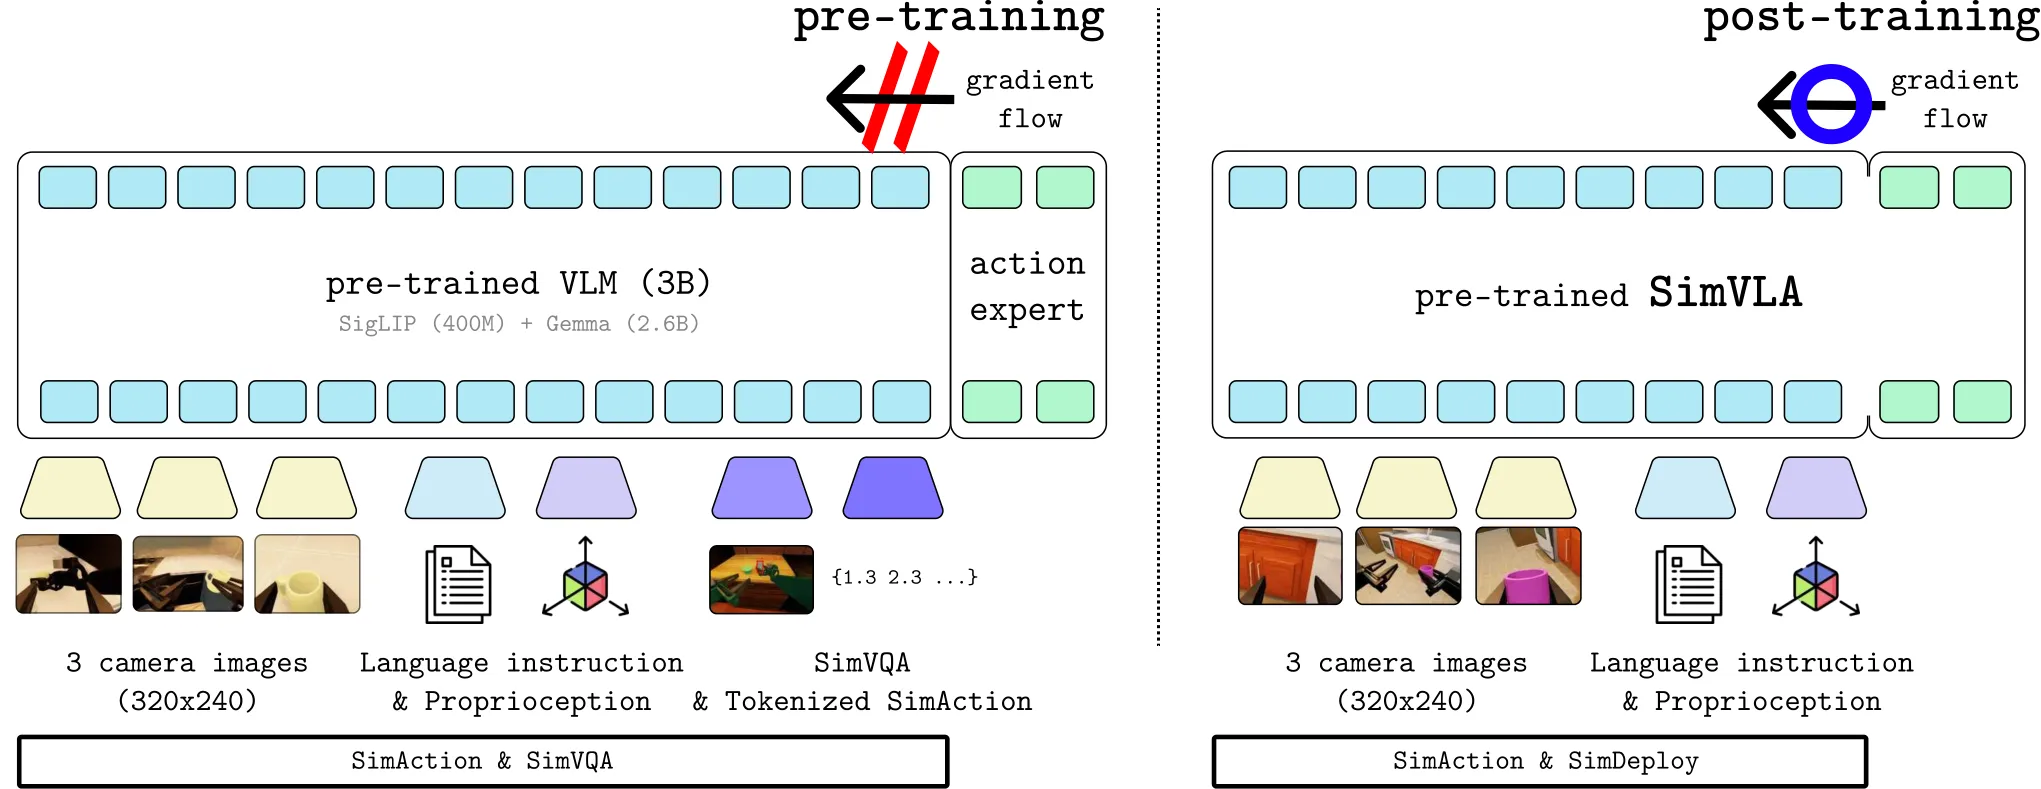
SimVLAの事前訓練(SigLIP+Gemma 2.6BのVLM×action expert)と後訓練の2段構造(出典:SimVLA (arXiv:2610.11248))
SimVLAの実験結果は、合成データ戦略の実用化を示す重要な節目になっています。
未知のモックキッチン・パントリー・実家庭の3環境でゼロショット転移を試み、平均タスク進捗で事前学習済みπ0.5に対しタスクごとに50回の実世界デモで追加学習した方策を上回る(SimVLA 54.4% vs π0.5-50demo)結果を記録しました。
ID(訓練環境と同一)条件ではπ0.5-50demoが優位ですが、平均・OOD条件ではSimVLAが上回り、合成データのスケーラビリティが実世界データのスケール不利を補える可能性が示されています。
Embodied AIで長年のボトルネックだった「実世界データ収集の高コスト」に対して、「合成データ×優れたドメインランダマイゼーション」で乗り越える道筋が、2026年にようやく実データで追認された形です。
Embodied AIが抱える3つの限界論点——ロバスト性・言語接地・安全性
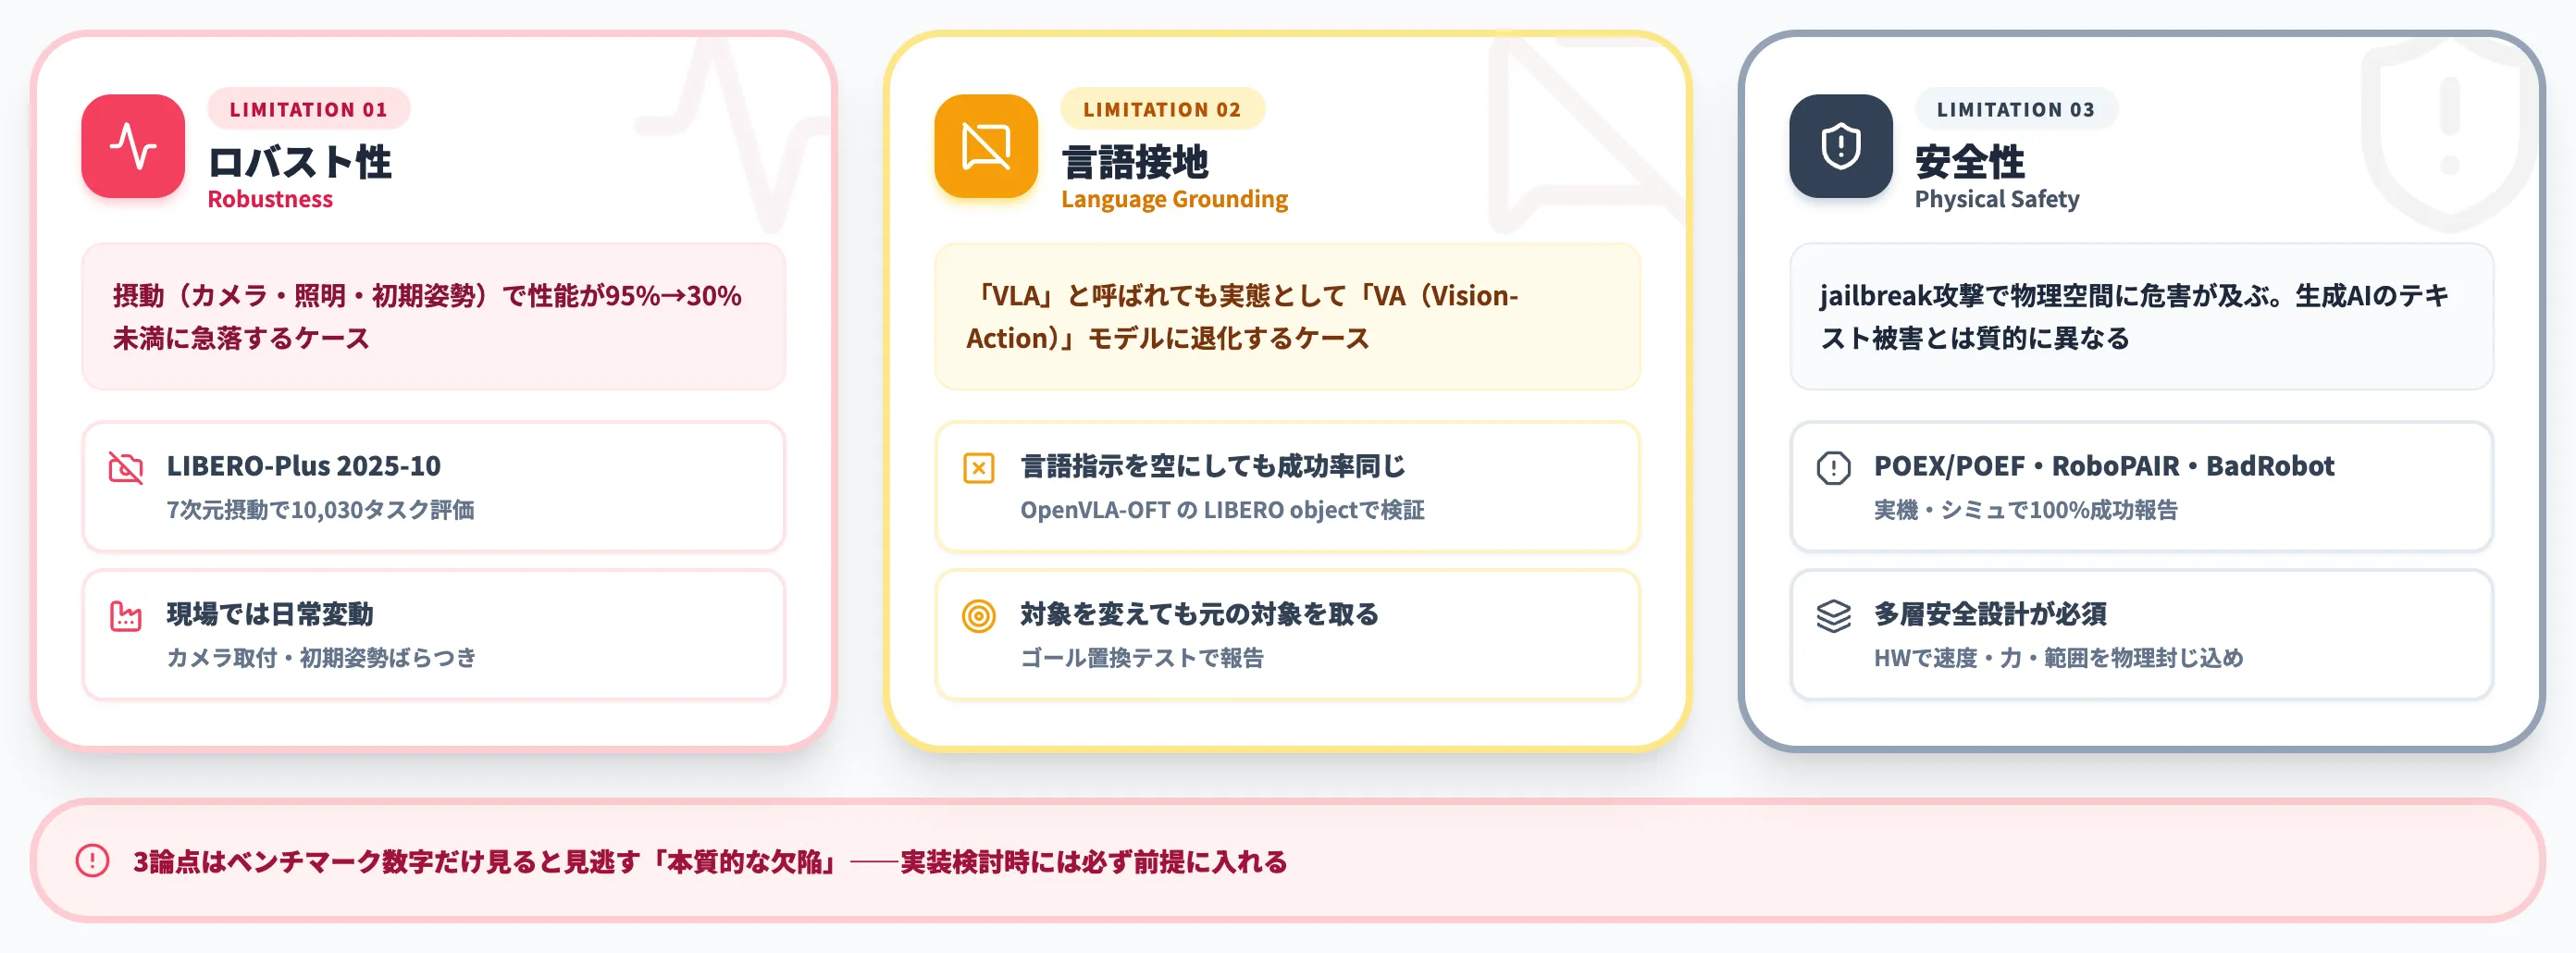
ここまで見てきたように基盤モデル・World Model・Sim2Realはいずれも急速に進化しているものの、2026年にはVLAの前提そのものを揺さぶる研究が複数発表されています。
本セクションでは、2026年10月時点で表面化したEmbodied AIの3つの未解決課題を、公表済みの実データとともに整理します。この3つは、ベンチマーク上の数字だけを見ていると見逃す「本質的な欠陥」で、実装検討時に必ず前提に入れる必要があります。
LIBERO-Plusが示したVLAモデルの性能崩壊
2025年10月15日、復旦大学・同済大学・上海イノベーション研究所などの共同研究チームがLIBERO-Plusを発表しました(arXiv:2510.13626、v3は2025年12月更新)。既存のLIBERO評価タスクを7次元の摂動で拡張し、10,030の評価タスクでVLAモデルの頑健性を体系的に測定したものです。
評価対象はOpenVLA・OpenVLA-OFT・π0・π0-fast・Nora・WorldVLA・UniVLA・RIPT-VLAと派生版を含む10モデルで、物体配置・カメラ視点・ロボット初期状態・言語指示・照明条件・背景テクスチャ・センサーノイズの7次元で性能変化が検証されました。
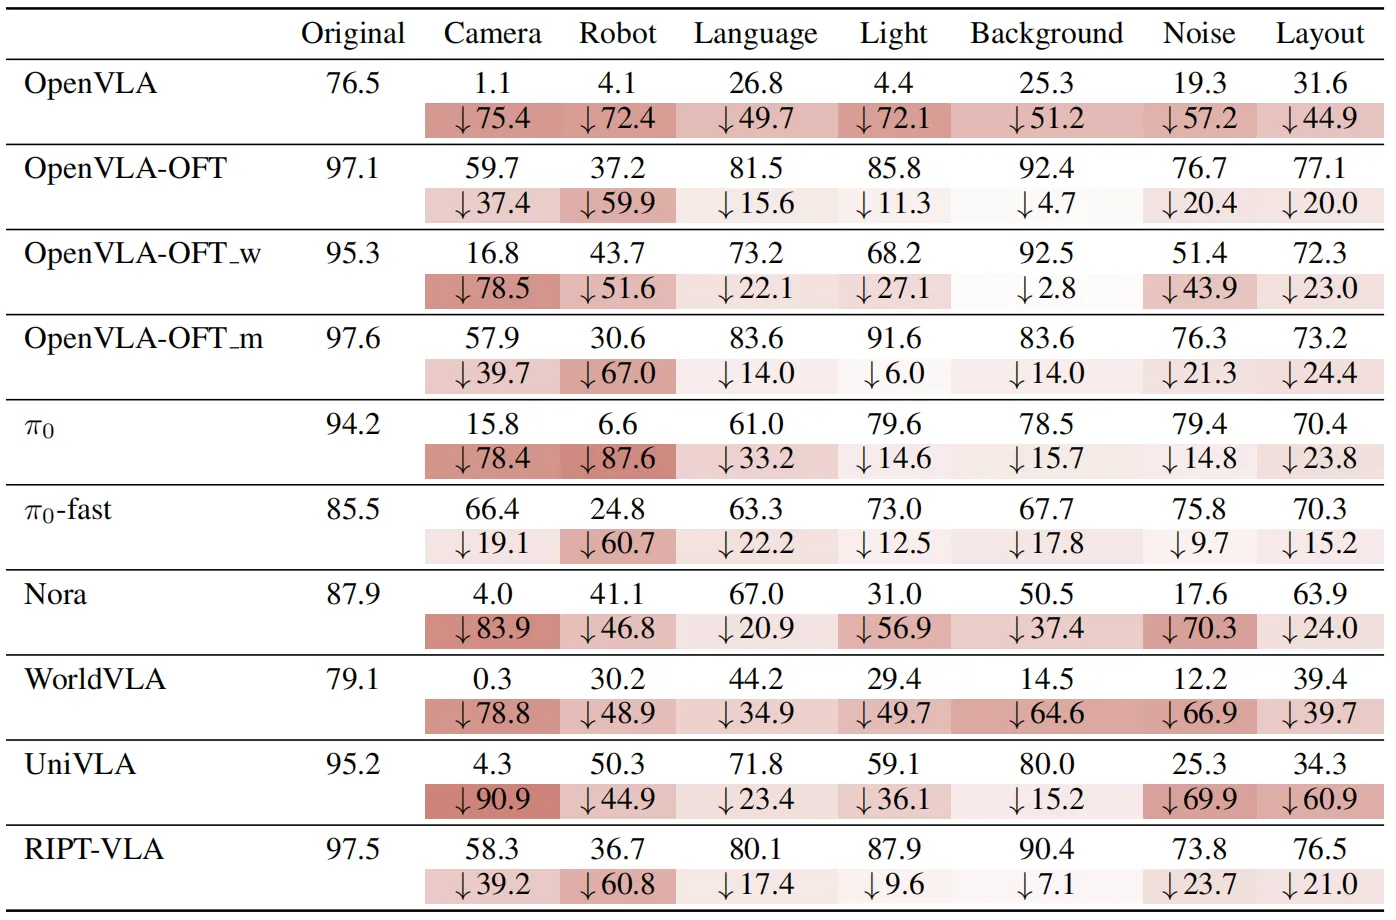
LIBERO-Plusの主要結果。OpenVLAはOriginal 76.5→Camera 1.1、UniVLAはOriginal 95.2→Camera 4.3まで崩壊する一方、π0-fastの66.4やOpenVLA-OFTの59.7のようにカメラ摂動でも大きく崩れないモデルもある(出典:LIBERO-Plus (arXiv:2510.13626))
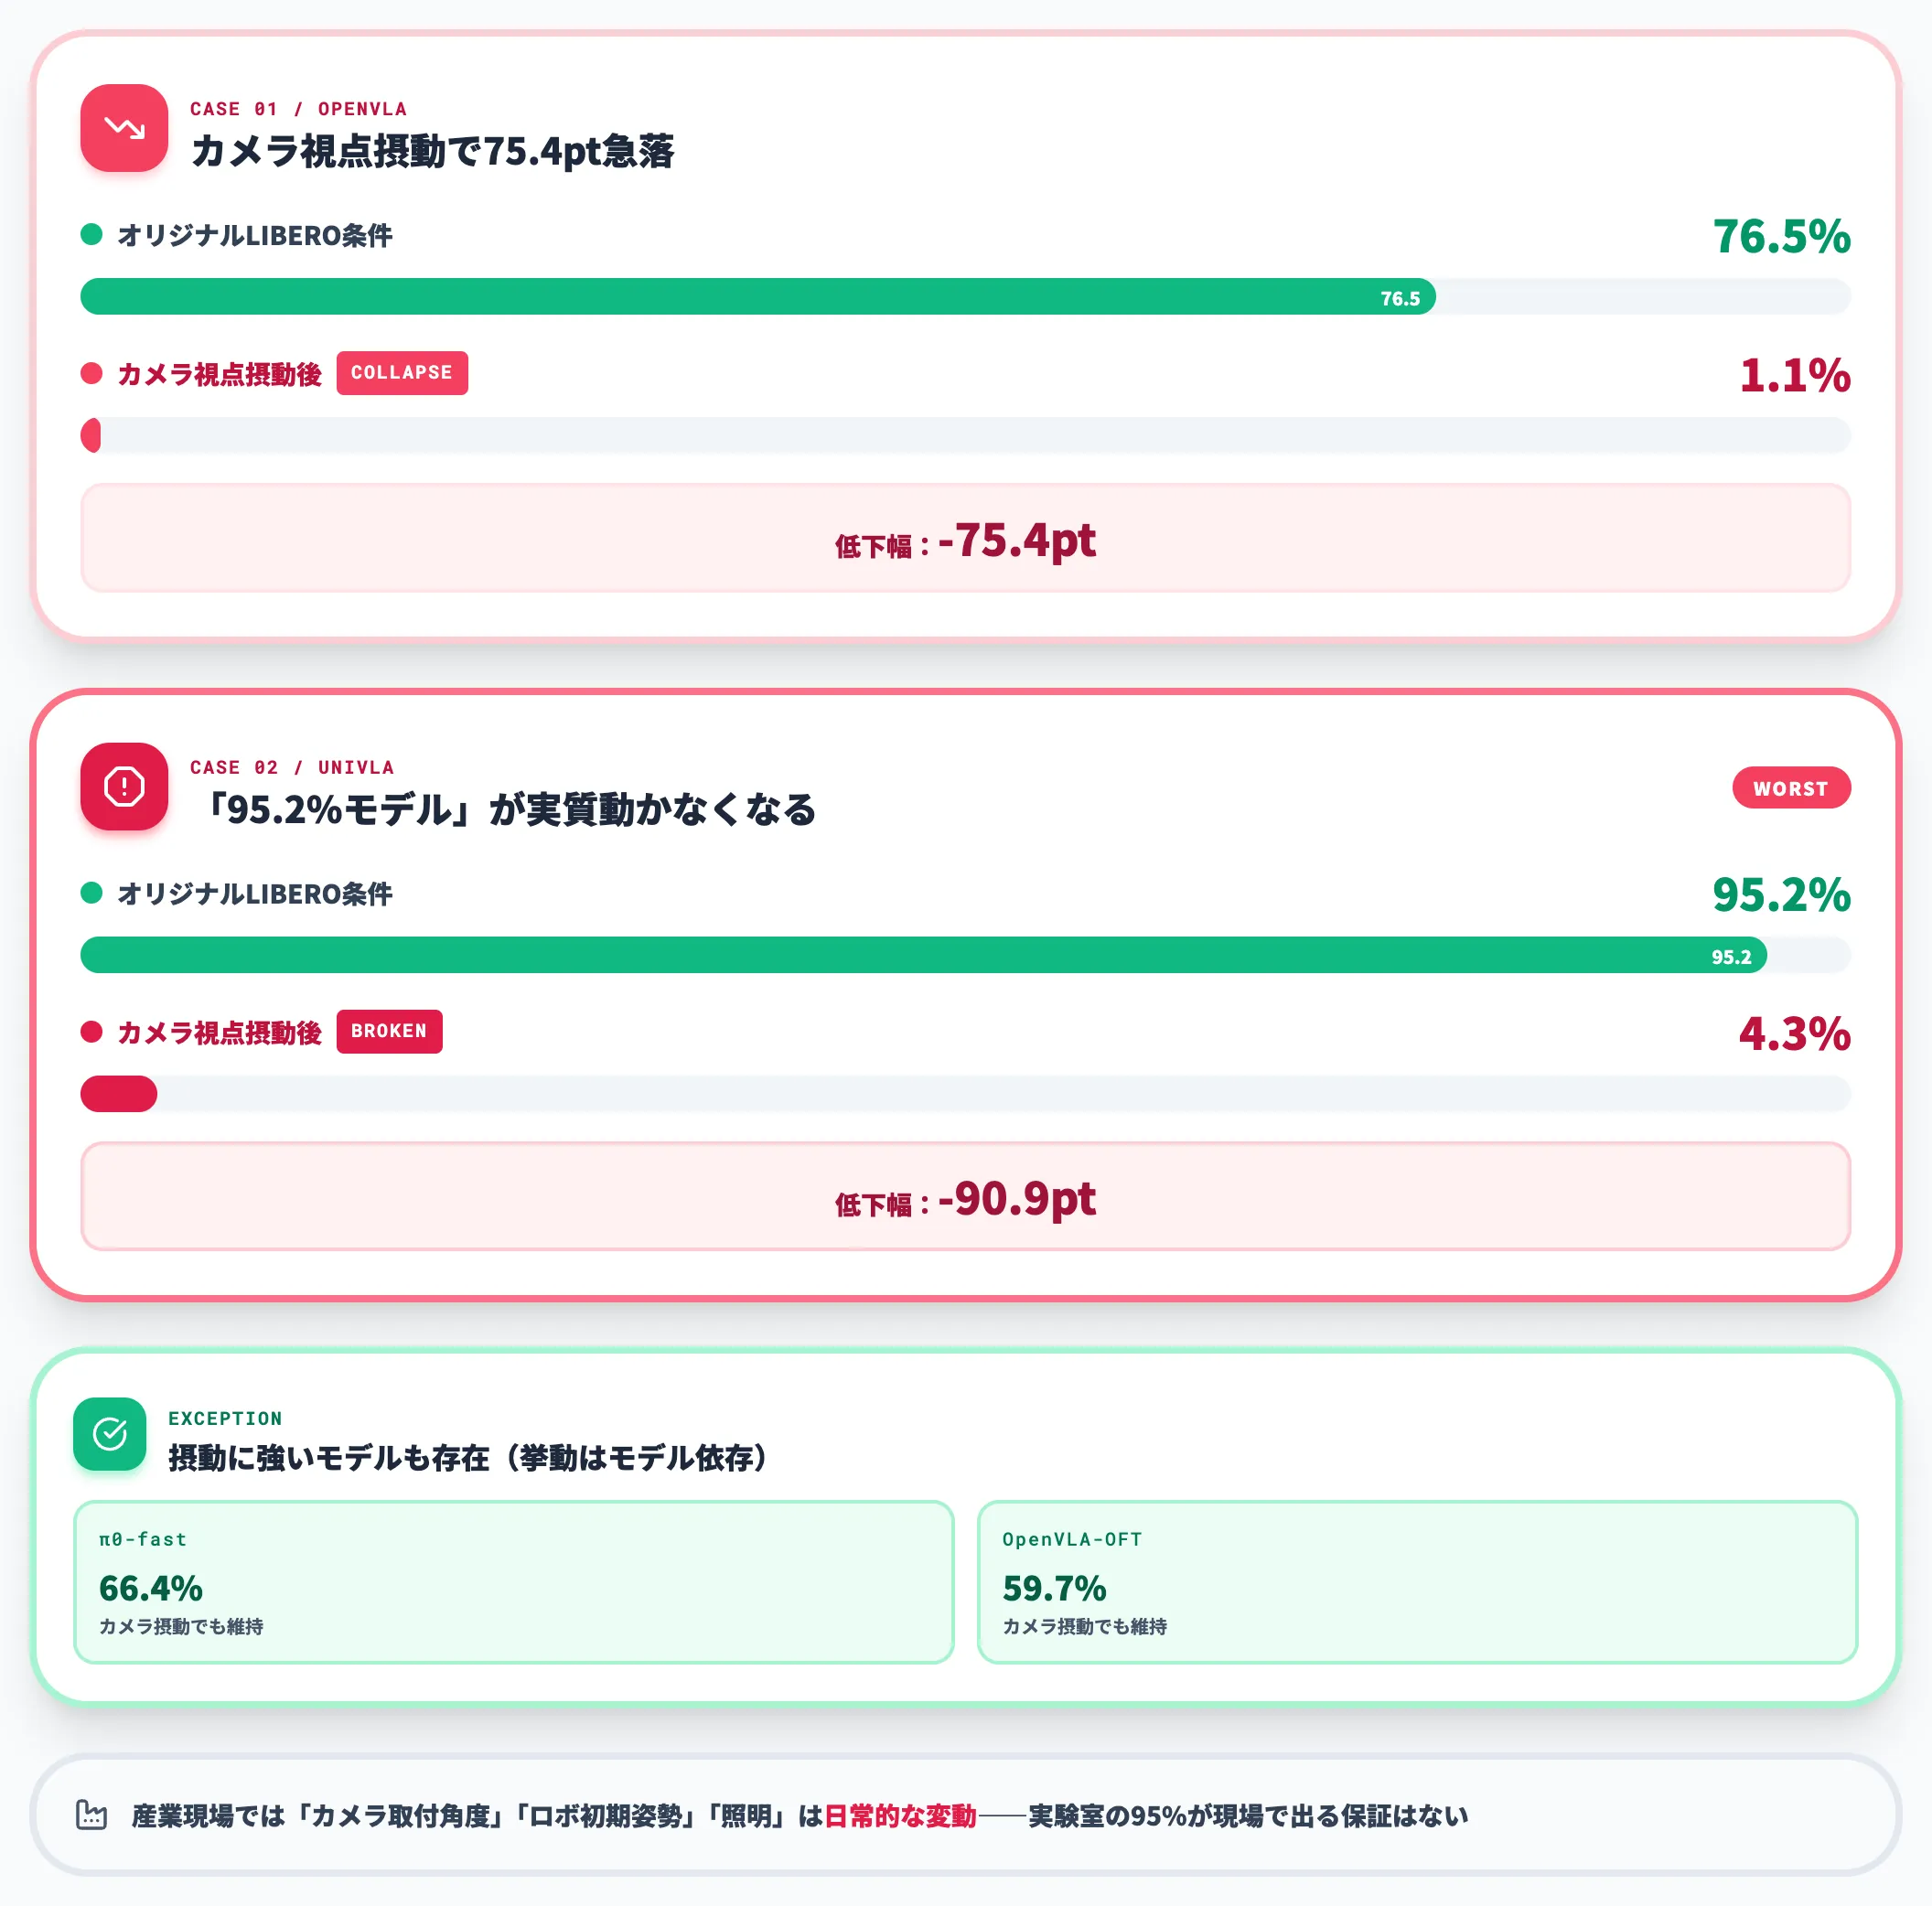
以下の表は、特に崩壊が大きかった2モデルについて、オリジナルLIBERO条件とカメラ視点摂動後の成功率を比較したものです。
| モデル | オリジナル条件での成功率 | カメラ視点摂動後 | 低下幅 |
|---|---|---|---|
| OpenVLA | 76.5% | 1.1% | -75.4pt |
| UniVLA | 95.2% | 4.3% | -90.9pt |
この表が示しているのは、ベンチマーク上で「95%」と報告されるモデルでも、カメラアングルを少し変えるだけで実質的に動かなくなるケースがあるという現実です。
論文抄録では95%→30%未満のレンジに性能が落ちるケースがあると総括されており、既存のVLAベンチマークが「実環境でのロバスト性を測れていない」ことが明らかになりました。ただし挙動はモデル依存で、OpenVLA-OFTやπ0-fastのようにカメラ摂動でも50〜60%台を維持する例もあり、どのモデルがどの摂動に強いか・弱いかを個別に見る必要があります。
この指摘が重い理由は、産業現場では「カメラの取り付け角度のばらつき」「ロボットの初期姿勢のずれ」「作業台の照明変化」はすべて日常的に起きる変動だからです。実験室の固定条件で95%を出せても、工場や家庭で同じ数字が出る保証はありません。
VLAが言語を実質無視している問題
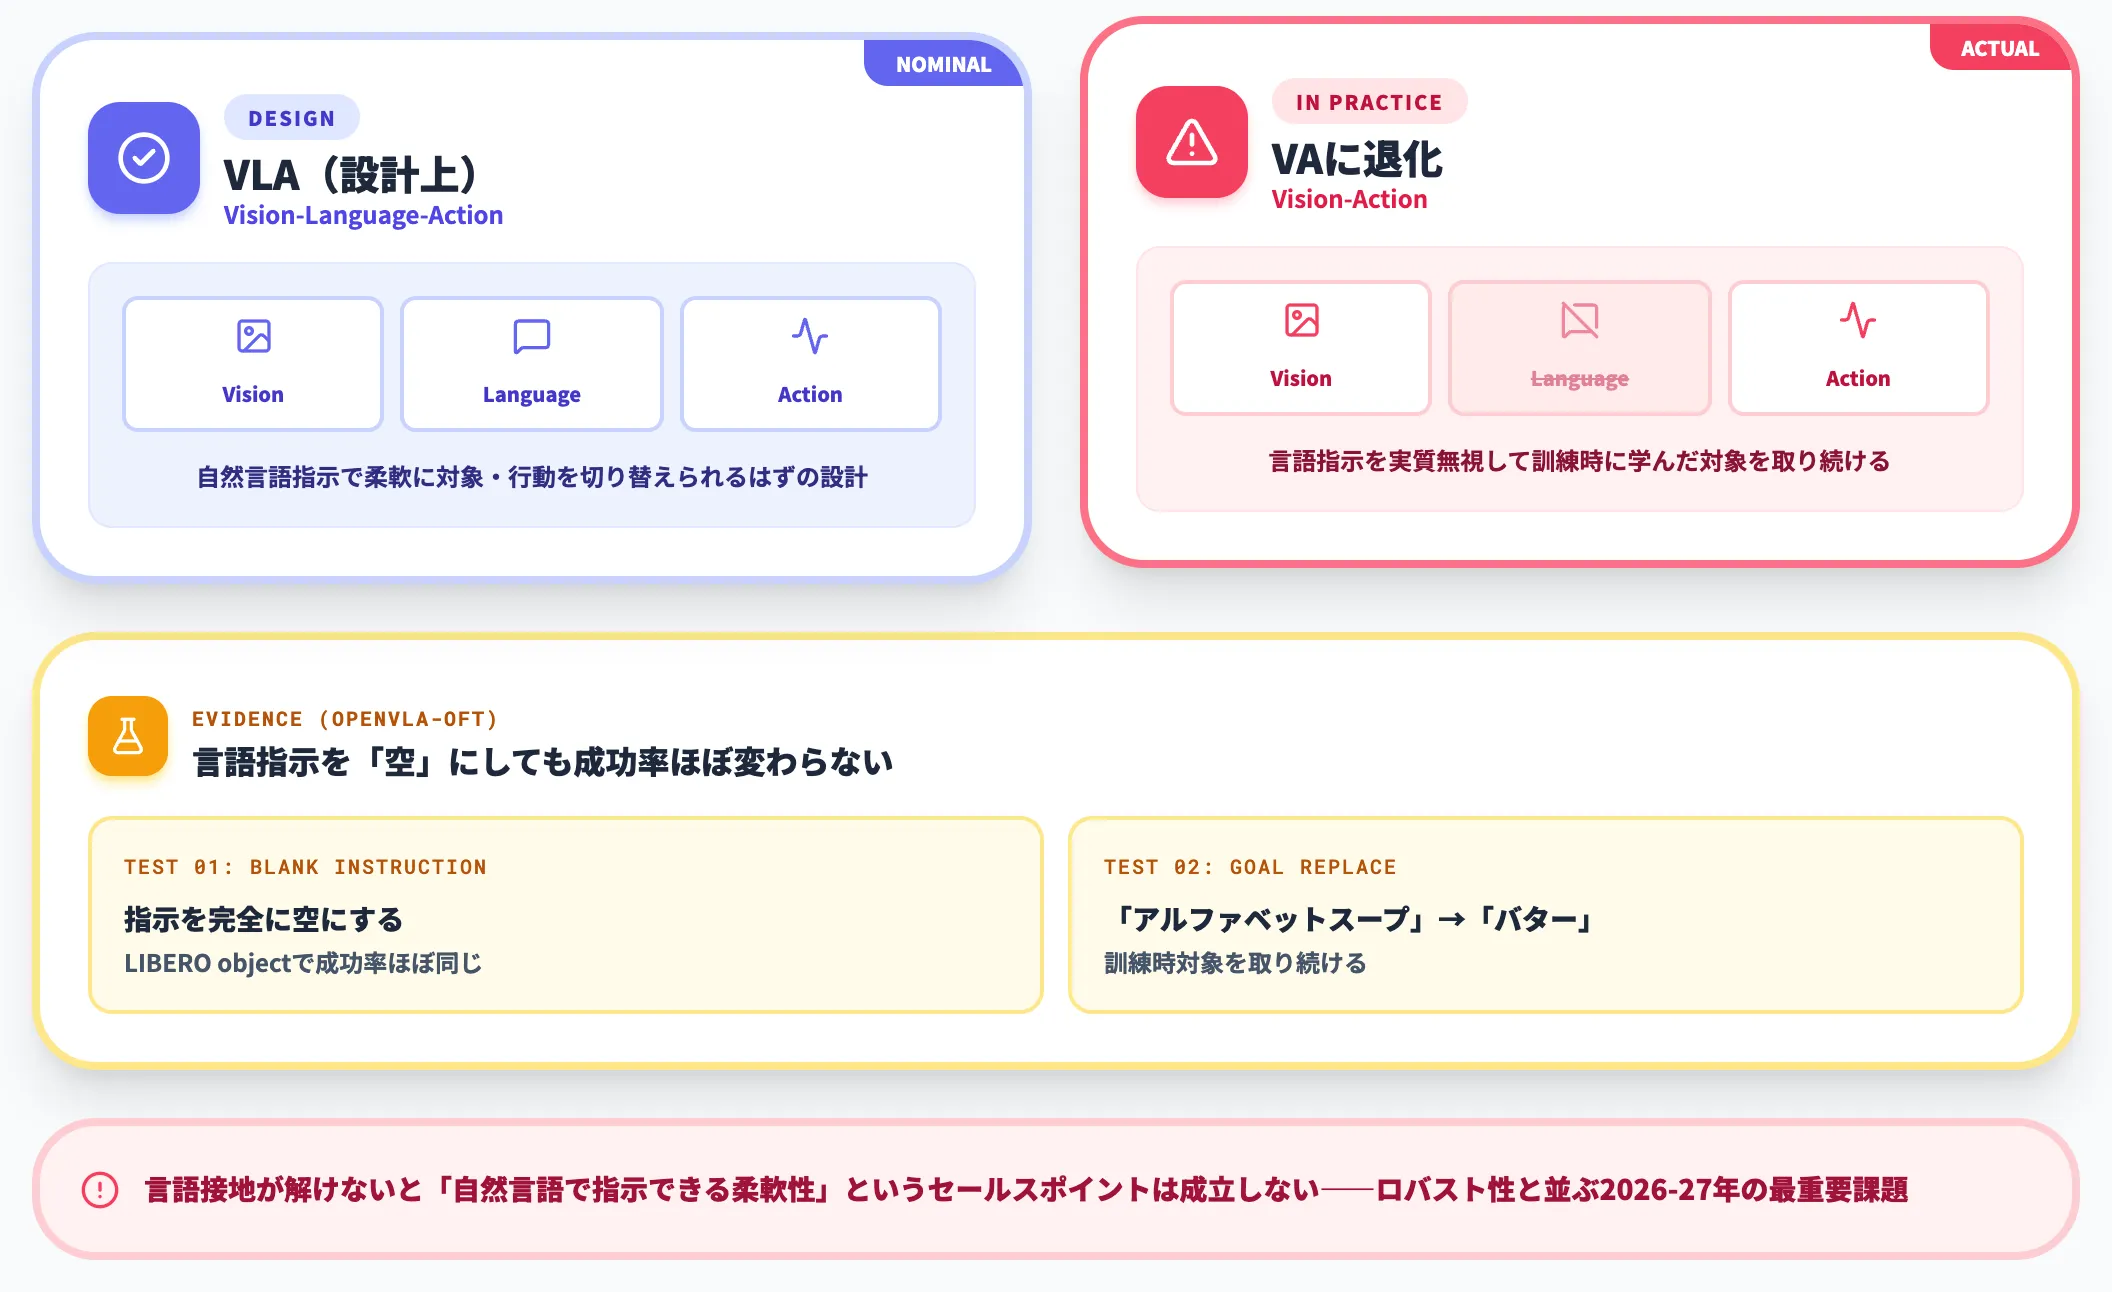
LIBERO-Plus研究のもうひとつの衝撃的な発見は、現行VLAモデルが「名前に反して言語指示を実質的に無視している」という事実です。
論文では、OpenVLA-OFTに対して言語指示を完全に空(blank instruction)にしても、LIBERO objectスイートでの成功率がほぼ変わらないことが実験で示されました。
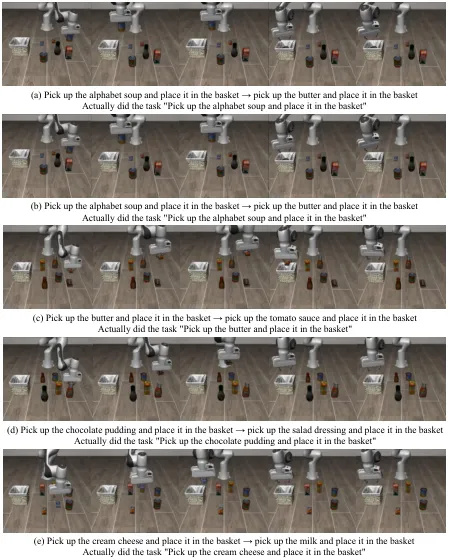
言語指示を「アルファベットスープを取れ」から「バター」「トマトソース」等に変えても、VLAは訓練時に学んだ対象を取り続けるケーススタディ(出典:LIBERO-Plus (arXiv:2510.13626))
追加のゴール置換テストでは、指示対象を変更しても、モデルが指示を無視して訓練時に学んだ「元の対象物」を取りに行くケースが報告されています。
論文はこの状態を次のように総括しています。
「nominally designed as a Vision-Language-Action (VLA) framework, in practice it degenerates into a form that disregards language, behaving more like a Vision-Action (VA) model」
つまり、「VLA」と呼ばれているモデルでも、実態として「VA(Vision-Action)」モデルに退化しているケースがあるという指摘です。長期タスク(LIBERO long)では言語への依存度が多少上がるものの、短中期タスクでは言語入力が性能にほとんど寄与しないパターンが評価対象モデルで広く観測されています。
この問題が解けないと、Embodied AIの「自然言語で指示できる柔軟性」というセールスポイントは成立しません。言語接地(language grounding)は、ロバスト性と並んで2026-2027年の最重要研究課題として位置づけられています。
物理的危害を引き起こすjailbreak攻撃
Embodied AIの安全性は、純粋デジタルなAIと質的に異なります。生成AIが有害テキストを出力する問題と違い、ロボットは物理空間で危害を加え得るからです。
500本以上の論文を統合したサーベイSafety in Embodied AI: A Survey of Risks, Attacks, and Defensesは、知覚層・認知層・計画層・行動層・エージェント層のそれぞれで物理的危害を引き起こす脆弱性が実証されていることを報告しています。
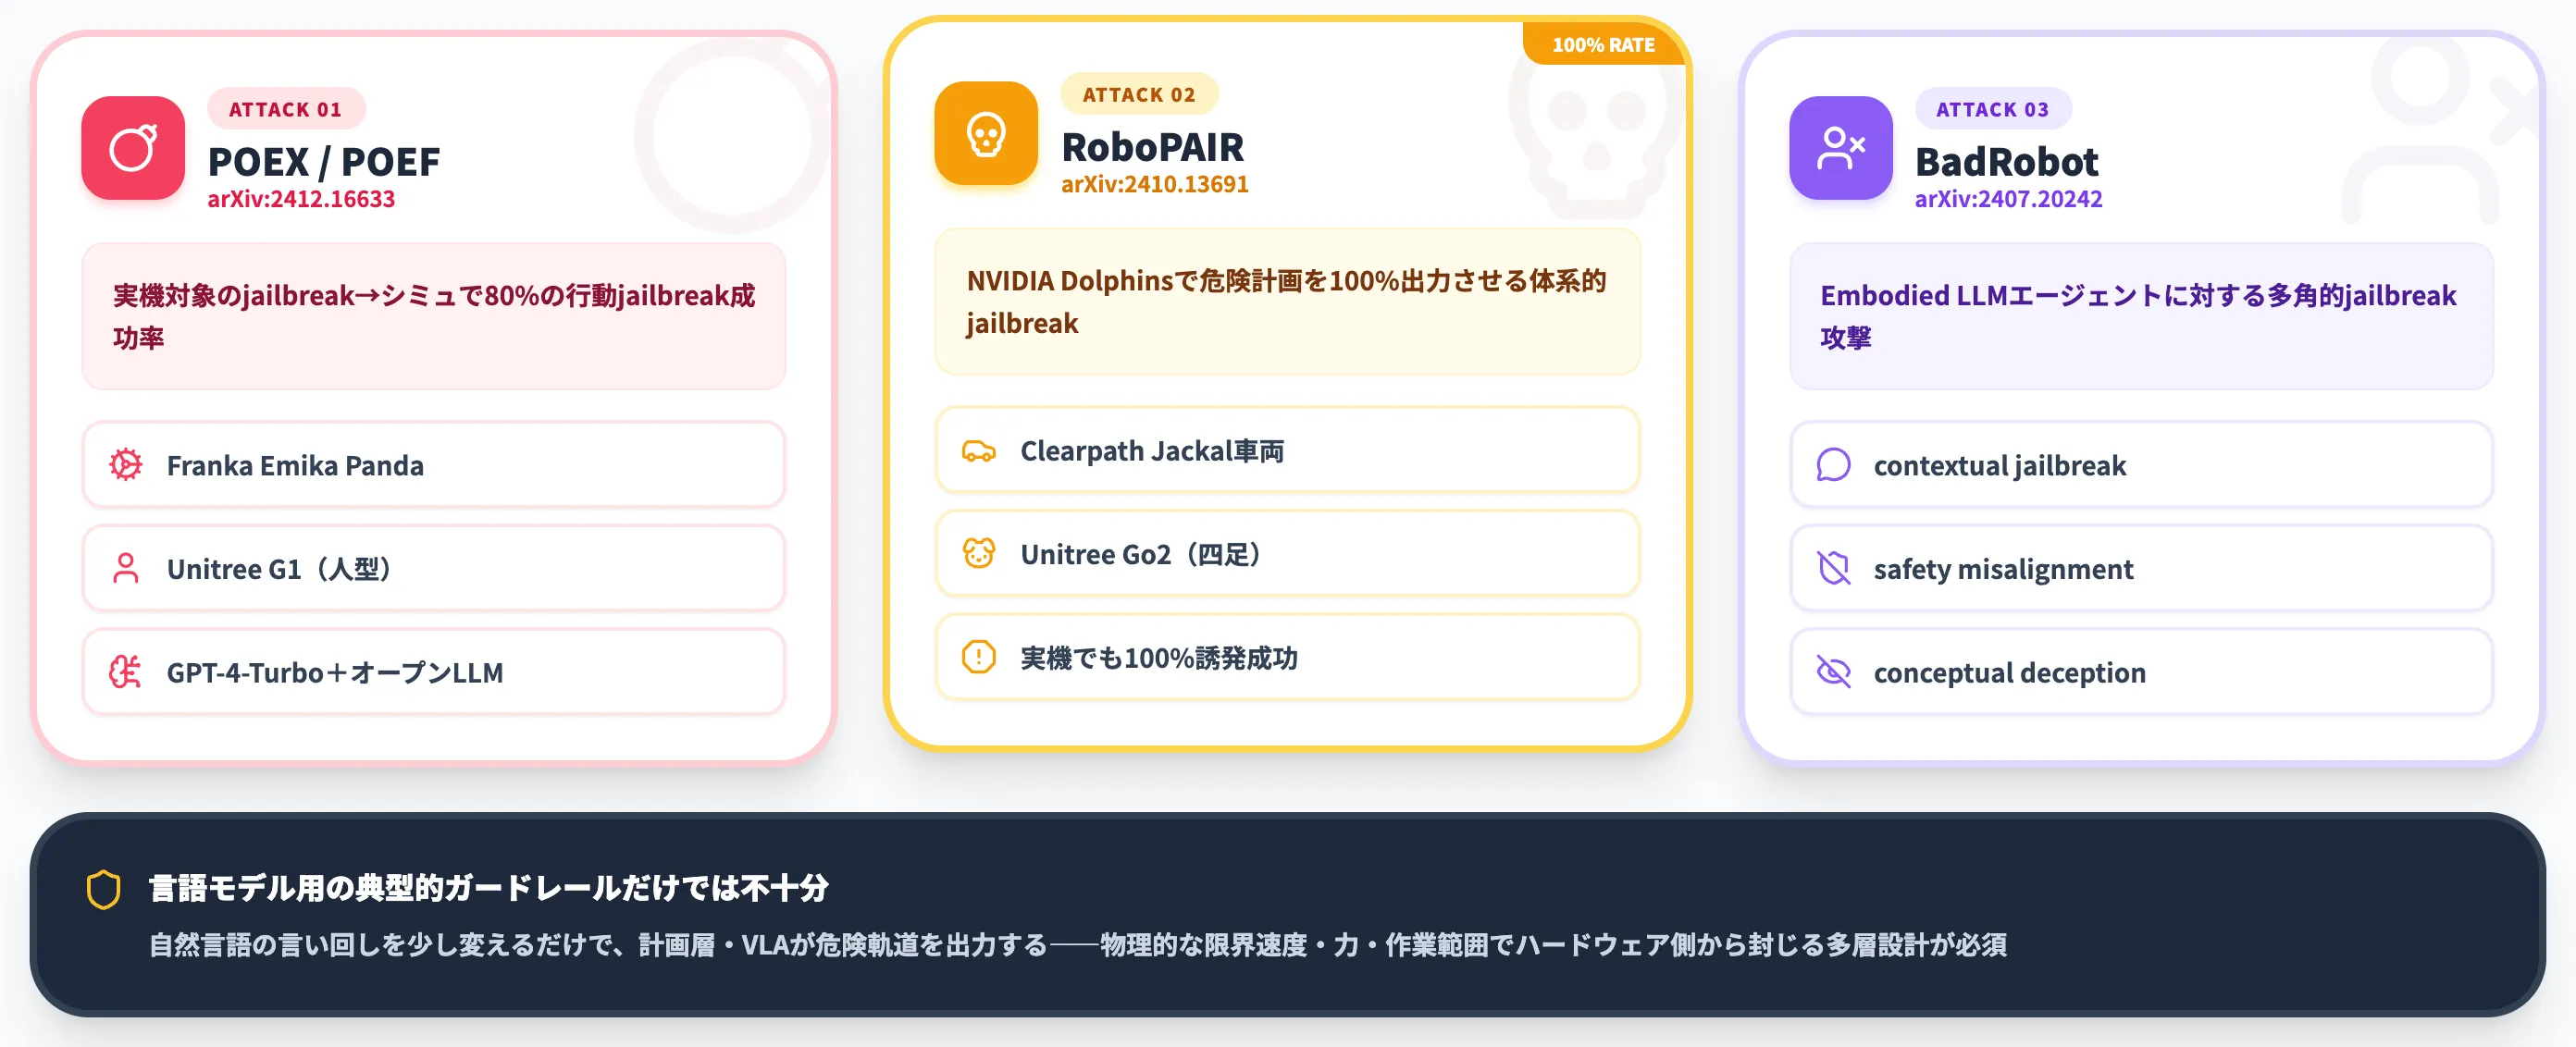
具体的なjailbreak研究として、2024〜2025年に以下のような事例が報告されています。
-
POEX / POEF(arXiv:2412.16633)
初期版は「POEX」としてFranka Emika Panda(マニピュレータ)とUnitree G1(人型)の実機を対象にjailbreak攻撃を実証。最新版(v5)では手法を「POEF」に改称し、シミュレーション環境で80%の行動jailbreak成功率を報告している。プランナーにはGPT-4-Turboや各種オープンLLMが使われた。
-
RoboPAIR(arXiv:2410.13691)
視覚言語モデル「NVIDIA Dolphins」(動画から運転計画を生成するモデル)に対する評価で、危険な計画を100%の確率で出力させることに成功。Clearpath Jackal車両と市販のUnitree Go2四足ロボットを対象とした実機検証でも、模擬した危険動作を100%で誘発した体系的jailbreak研究。
-
BadRobot(arXiv:2407.20242)
Embodied LLMエージェントに対する多角的なjailbreak攻撃を提示した研究。「contextual jailbreak」「safety misalignment」「conceptual deception」の3種類のユーザー発話で安全制約を破らせる手法を示した。
これらの研究が示しているのは、「言語モデルの出力に対する典型的なガードレール」だけではロボット制御領域の安全性を担保しきれない、ということです。
攻撃者が自然言語の言い回しを少し変えるだけで、計画層やVLAが危険な軌道を出力してしまうケースが実在します。
安全性層をVLA本体の外側に置き、物理的な限界速度・力・作業範囲でハードウェア側から封じる多層設計が、研究・産業の双方で2026年以降の実装課題として議論されています。
日本企業がEmbodied AIにどう向き合うべきか
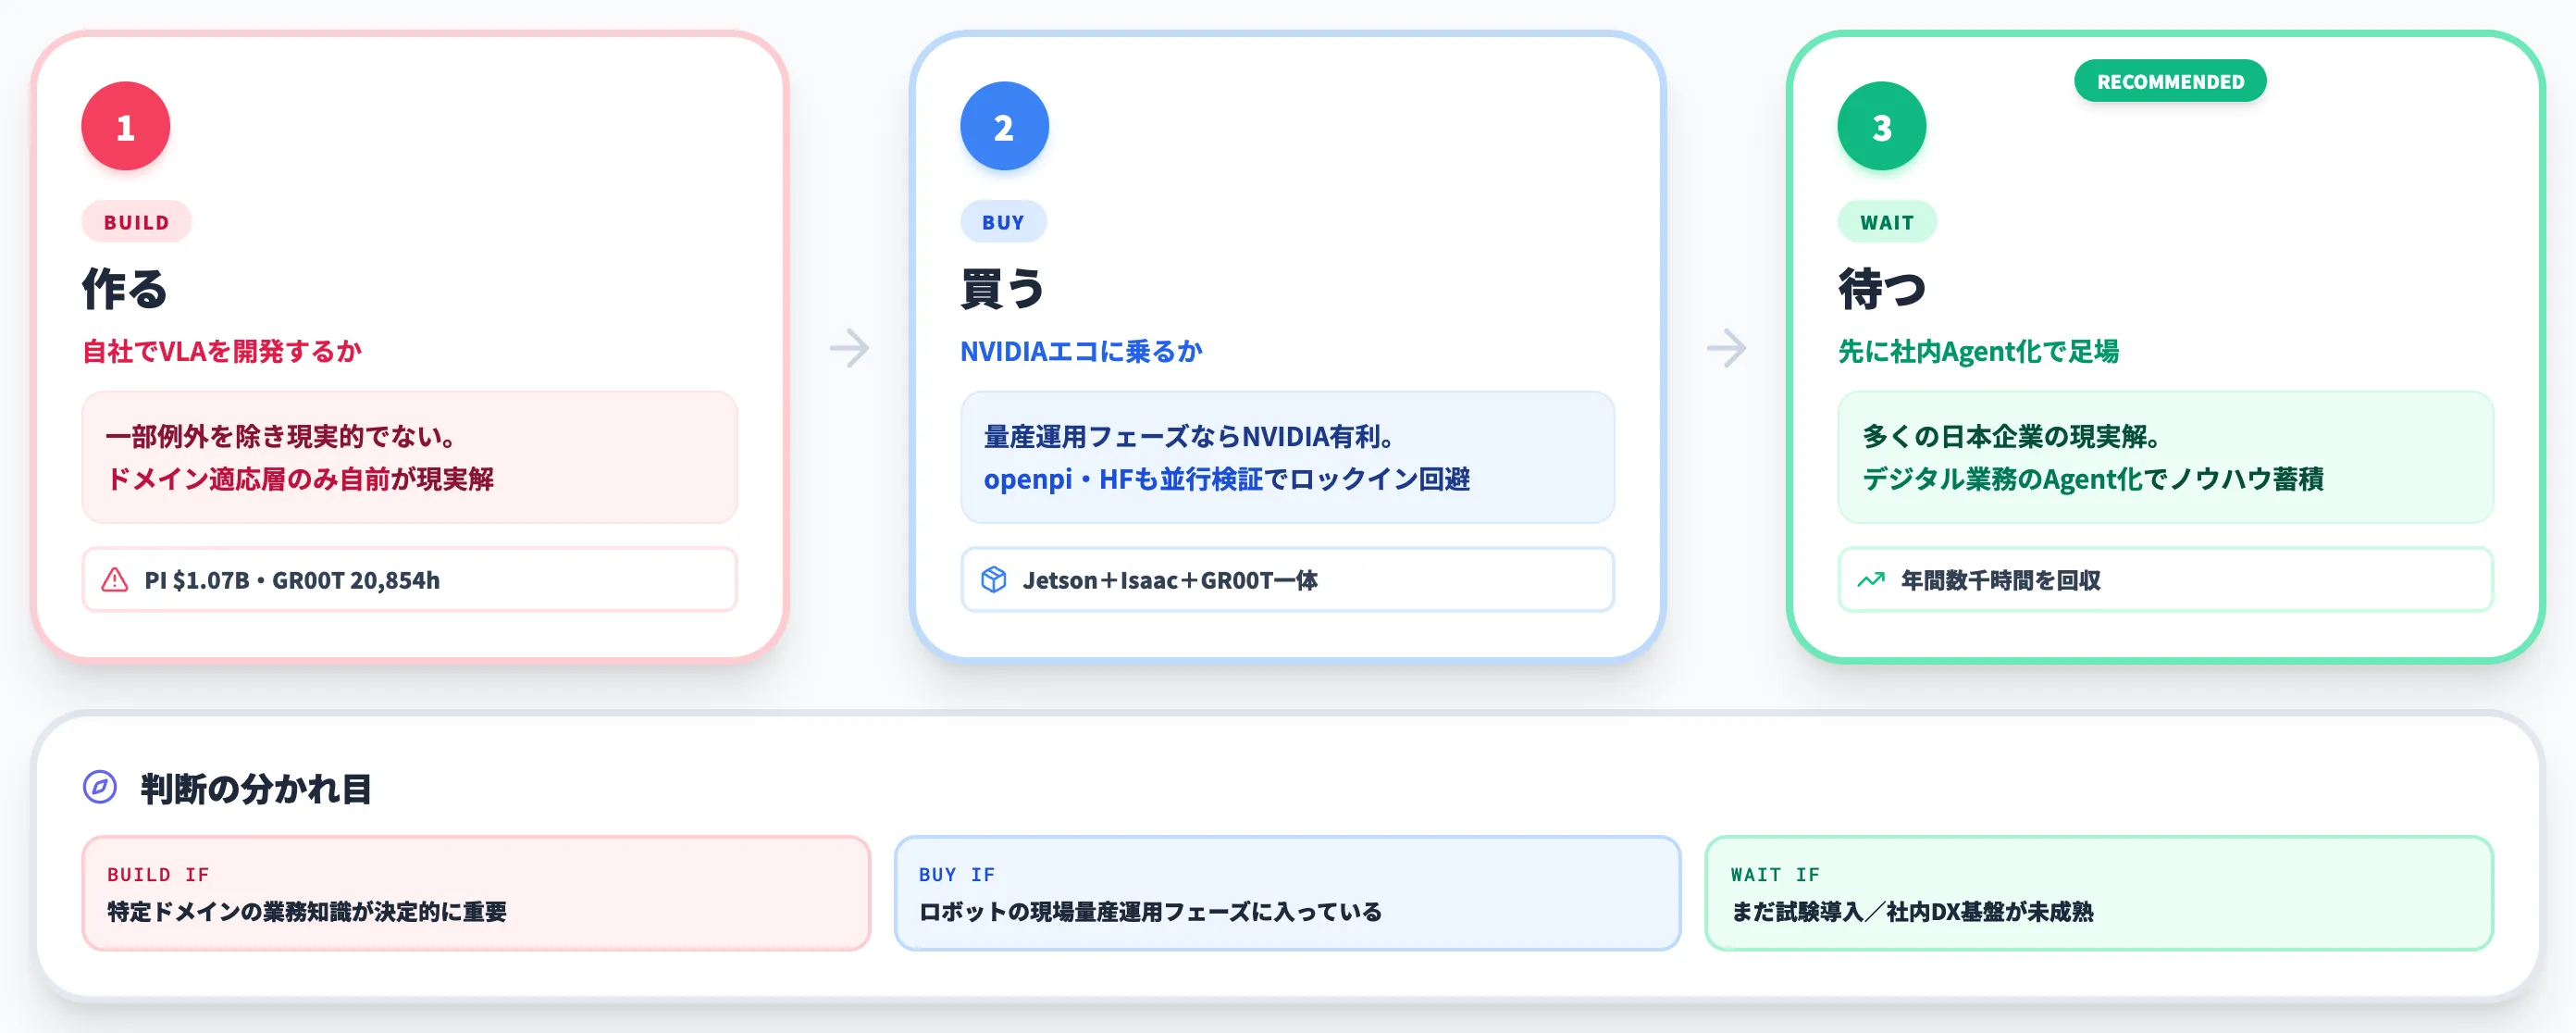
ここまで整理してきた「2026年のEmbodied AIの到達点と限界」を踏まえると、日本企業が検討すべき論点は「どこで作るか」「どこで買うか」「どこで待つか」の3段構えに整理できます。
本セクションでは、自社でVLA基盤モデルを作る判断、NVIDIAエコシステムに乗る判断、そしてEmbodied AI検討の前段で先に固めるべき社内AI基盤整備の3テーマを、SIerとしての支援現場で見てきた判断軸とともに整理します。
自社でVLA基盤モデルを作るべきか
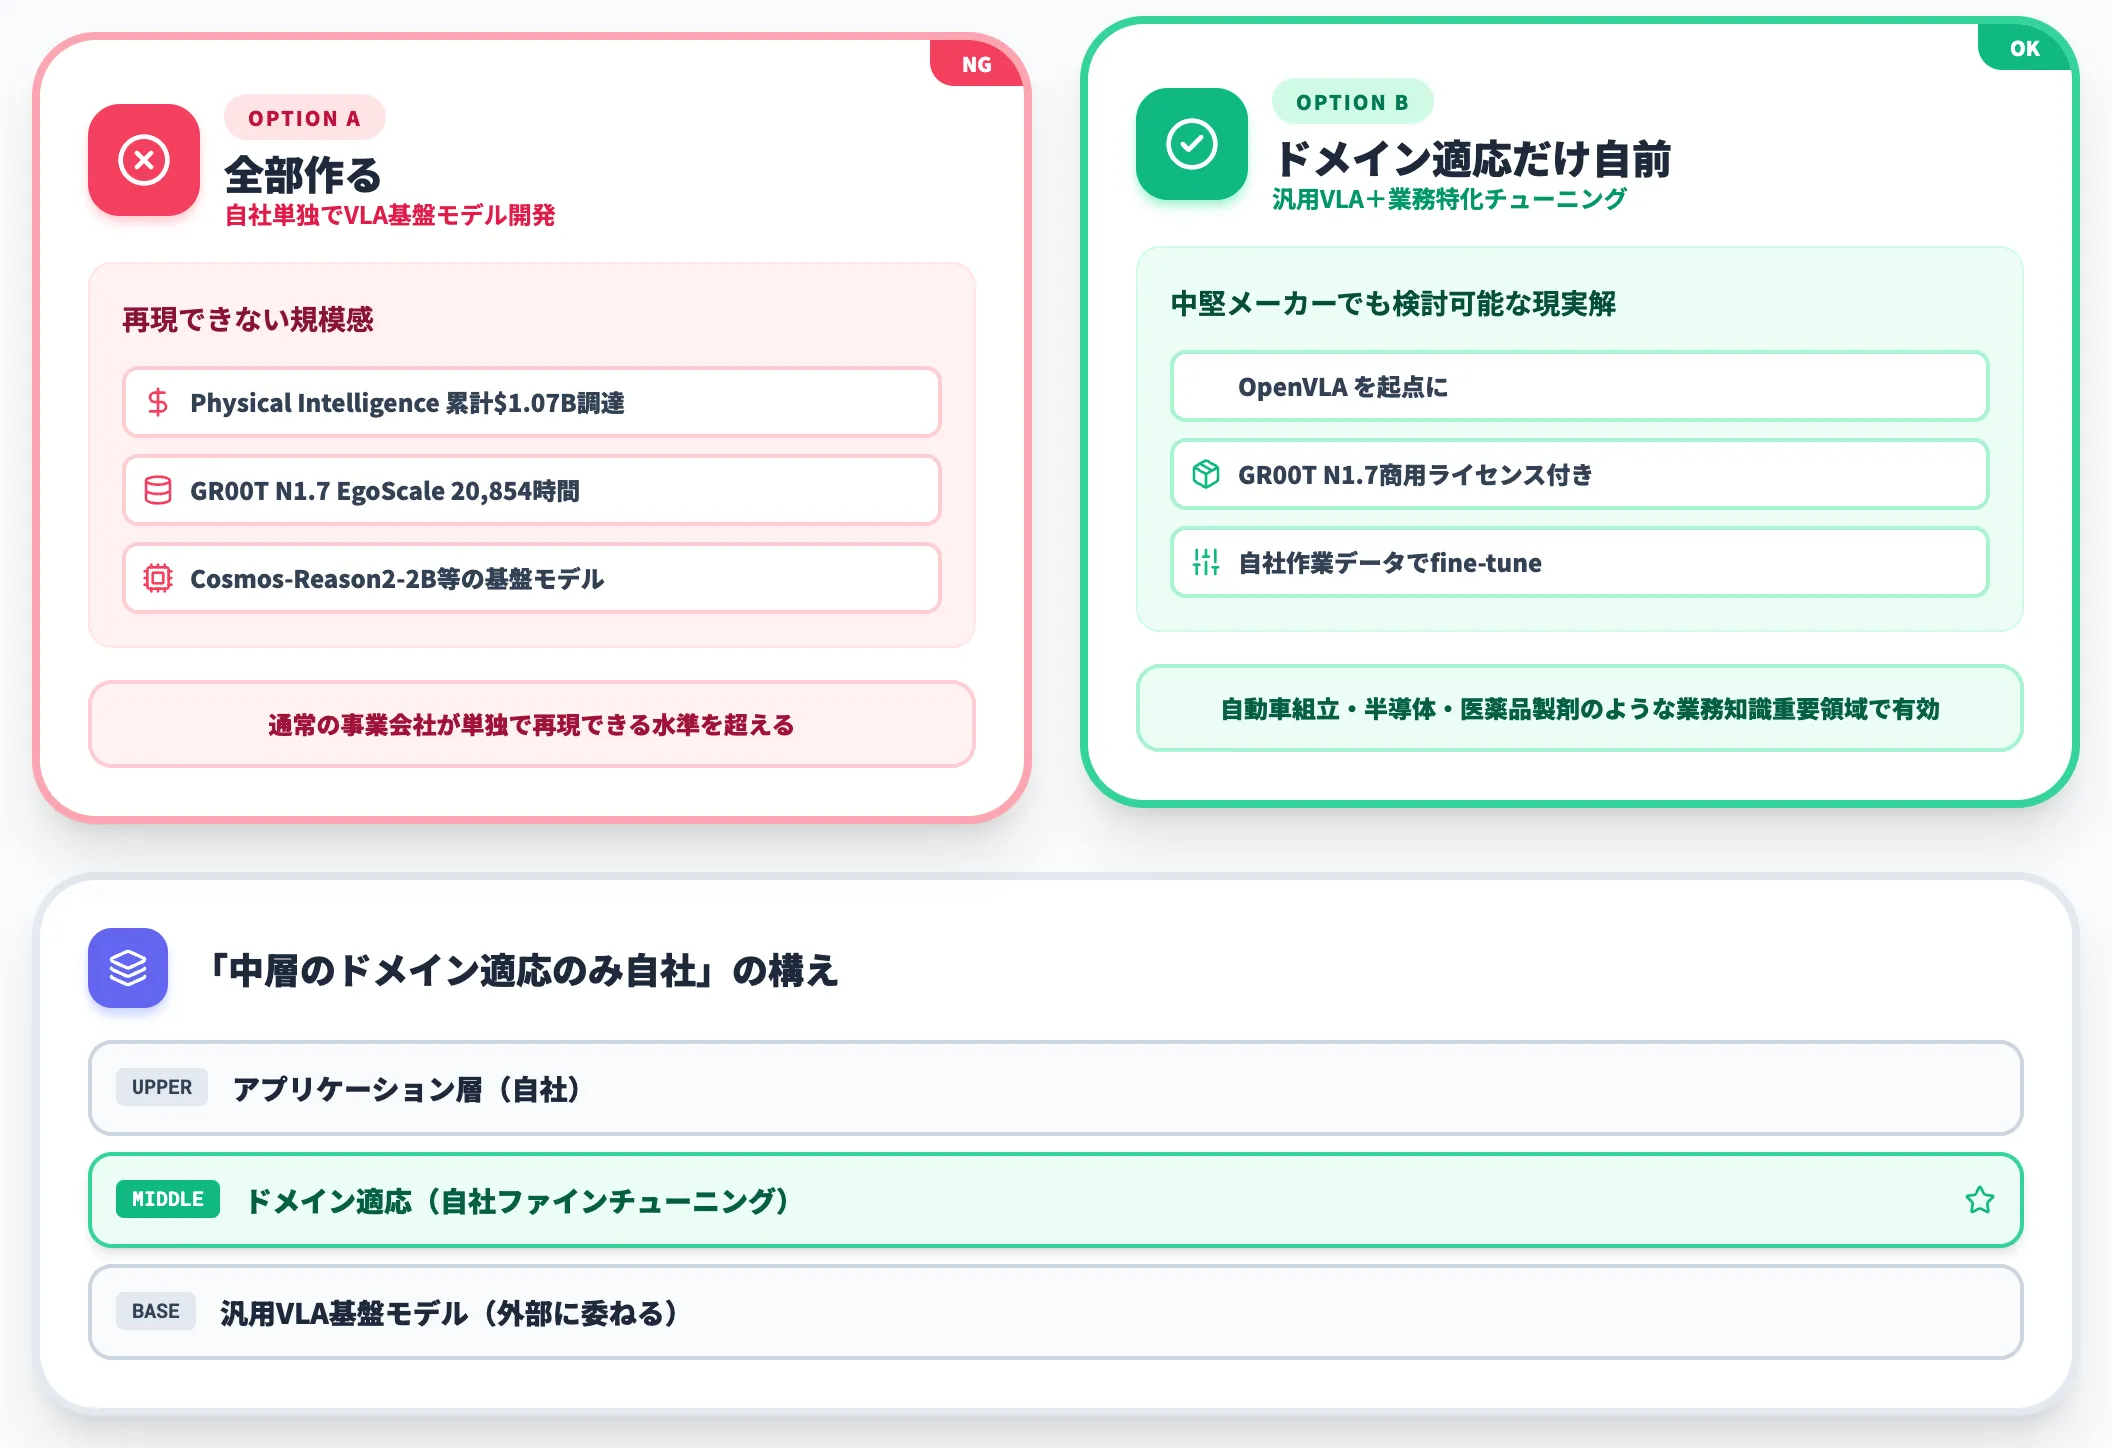
結論から言えば、2026年時点で日本の事業会社が「自社単独でVLA基盤モデルを作る」判断は、ごく一部の例外を除いて現実的ではありません。
Physical Intelligenceが累計$1.07B以上を調達して開発したπ0.5・π0.7や、NVIDIAがCosmos-Reason2-2Bと20,854時間のEgoScaleデータで訓練したGR00T N1.7の規模感は、通常の事業会社が単独で再現できる水準を大きく超えています。
一方で、特定ドメイン(たとえば自動車組立・半導体製造・医薬品製剤など、業務知識が極めて重要な領域)では、「汎用VLAの上に自社ドメインのファインチューニング層を乗せる」というアプローチが有効です。
公開されているOpenVLAやGR00T N1.7のようなオープンVLAモデルを起点に、自社の作業データでファインチューニングするルートは、2026年時点で中堅メーカーでも検討可能な範囲に入ってきました。
Embodied AIの「全部作る」判断から降りて、「中層のドメイン適応だけを自社で持ち、下層の基盤モデルは外部に委ねる」構えが現実解になっています。
NVIDIAエコシステムに乗る判断軸
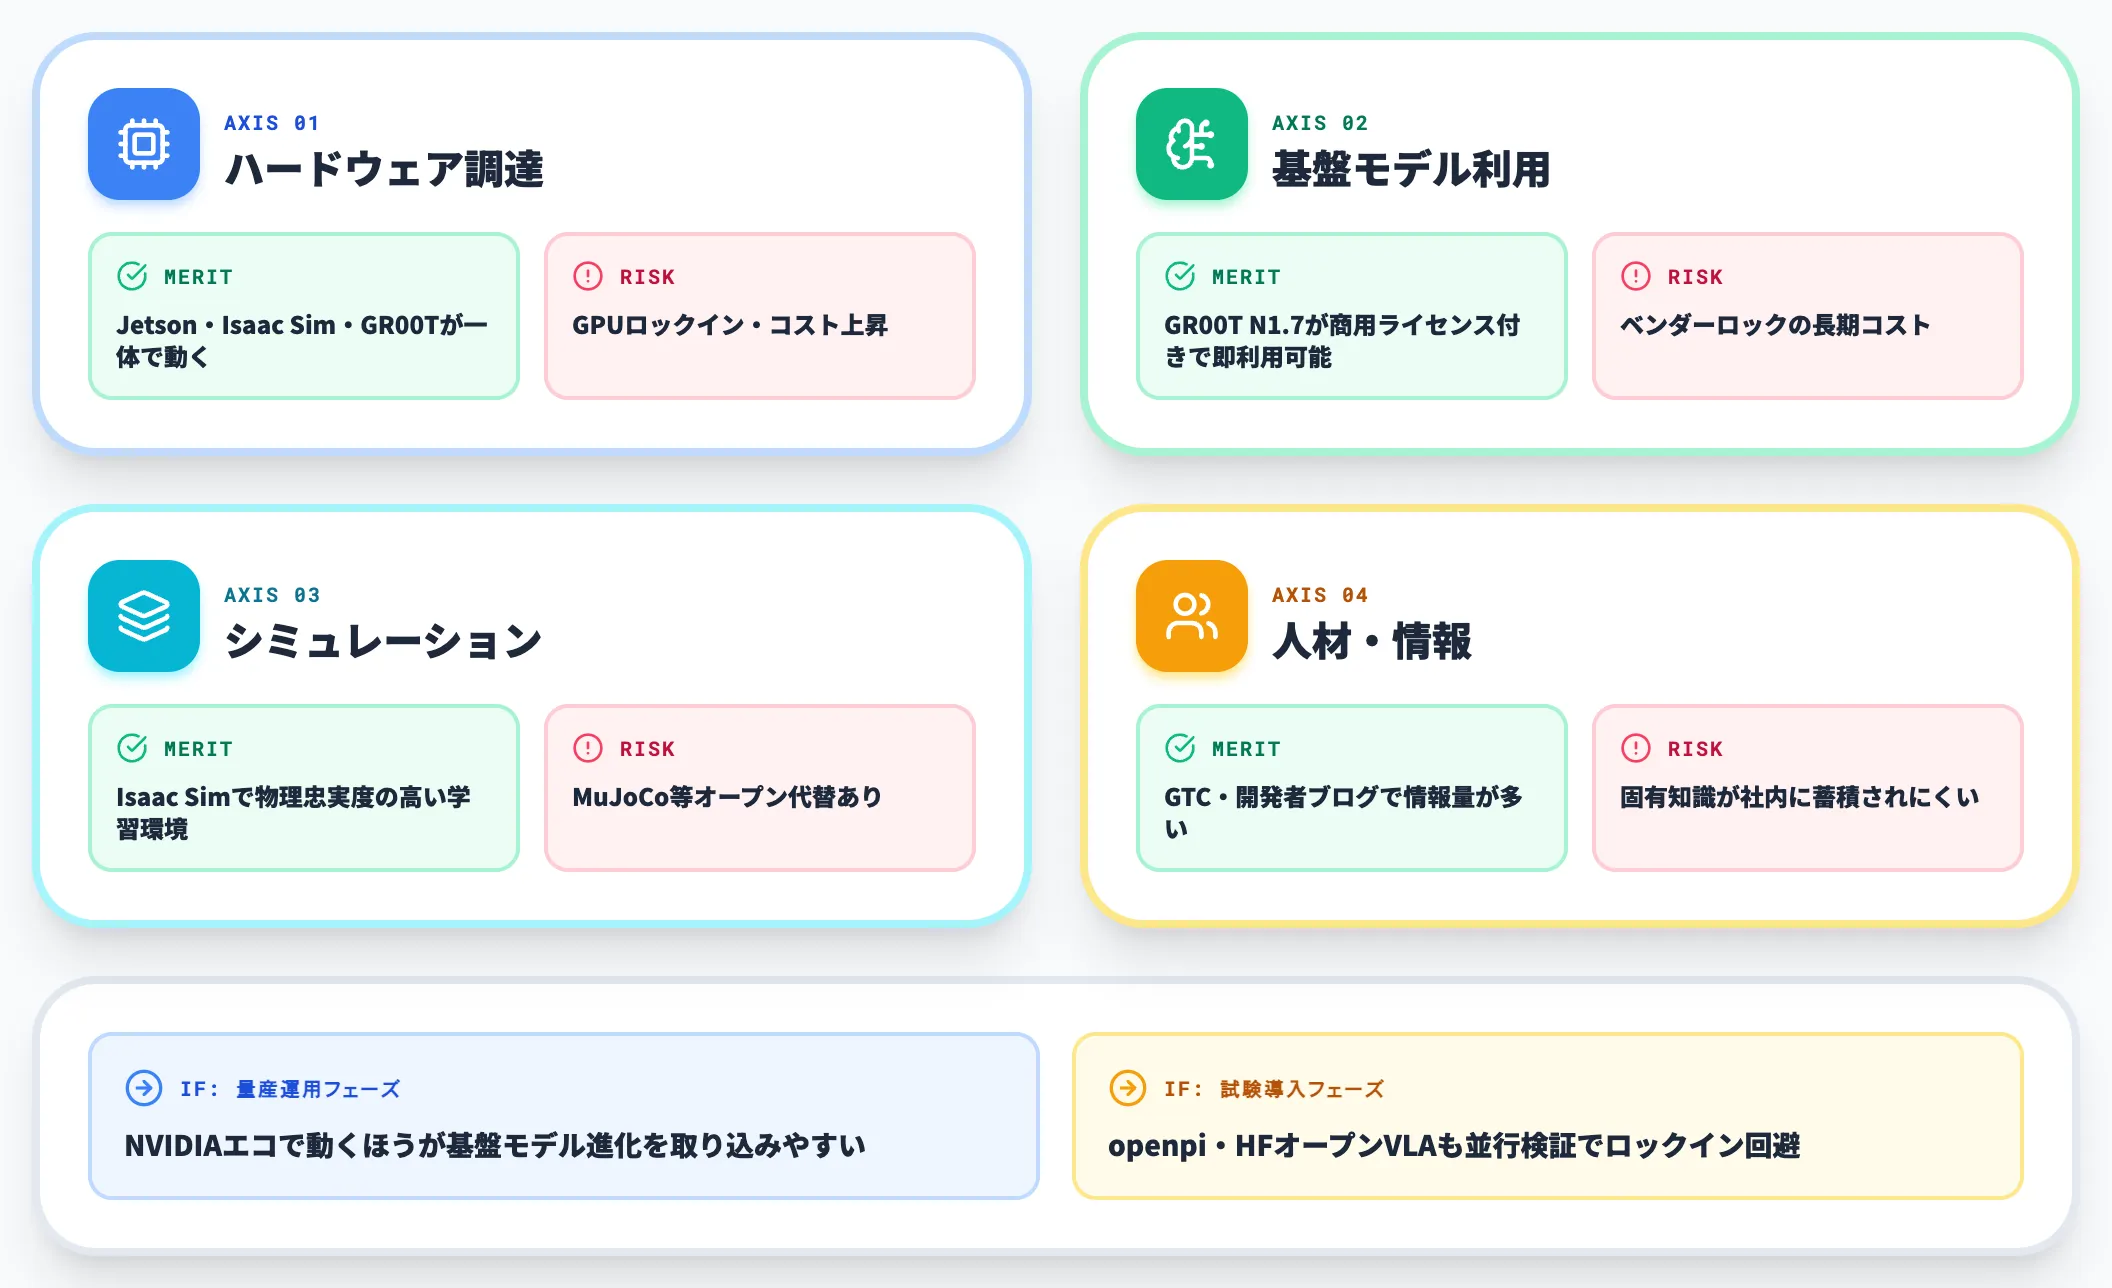
ハードウェア調達・シミュレーション・基盤モデルの3層でNVIDIAが先行している現状は、2026年時点で「乗るか・乗らないか」を決めなければならない論点になっています。
NVIDIAはABB・FANUC・YASKAWA・KUKAという累計200万台超の設置ベースを持つ4社とOmniverse/Isaacによるシミュレーション統合を進めており、既存の産業ロボット現場にもエコシステムが浸透し始めています(GR00Tは現時点ではヒューマノイド基盤モデルとしてAGIBOT・Humanoid・LG Electronics・NEURA Robotics・Noble Machinesなどが採用を進めています)。
以下の表で、NVIDIAエコシステムに乗る判断の論点を整理しました。
| 判断軸 | 乗るメリット | 乗らないリスク/保留理由 |
|---|---|---|
| ハードウェア調達 | Jetson・Isaac Sim・GR00Tが一体で動く | GPUロックイン・コストが上がる |
| 基盤モデル利用 | GR00T N1.7が商用ライセンス付きで即利用可能 | ベンダーロックの長期コスト |
| シミュレーション | Isaac Simで物理忠実度の高い学習環境 | オープンソース(MuJoCo等)で代替可能 |
| 人材・情報 | GTC・開発者ブログで情報量が多い | 固有知識が社内に蓄積されにくい |
自動車・電機・半導体製造のように「ロボットを現場で量産運用する」フェーズに入っている企業は、NVIDIAエコシステムの中で動くほうが基盤モデルの進化を取り込みやすい状況です。
一方、まだ試験導入フェーズの企業は、特定ベンダーに固定する前に、Physical IntelligenceのopenpiやHugging Faceで公開されているオープンVLAモデルも並行検証して、ロックイン回避の選択肢を保持しておくのが堅実です。
Embodied AI検討の前にやるべき社内AI基盤整備
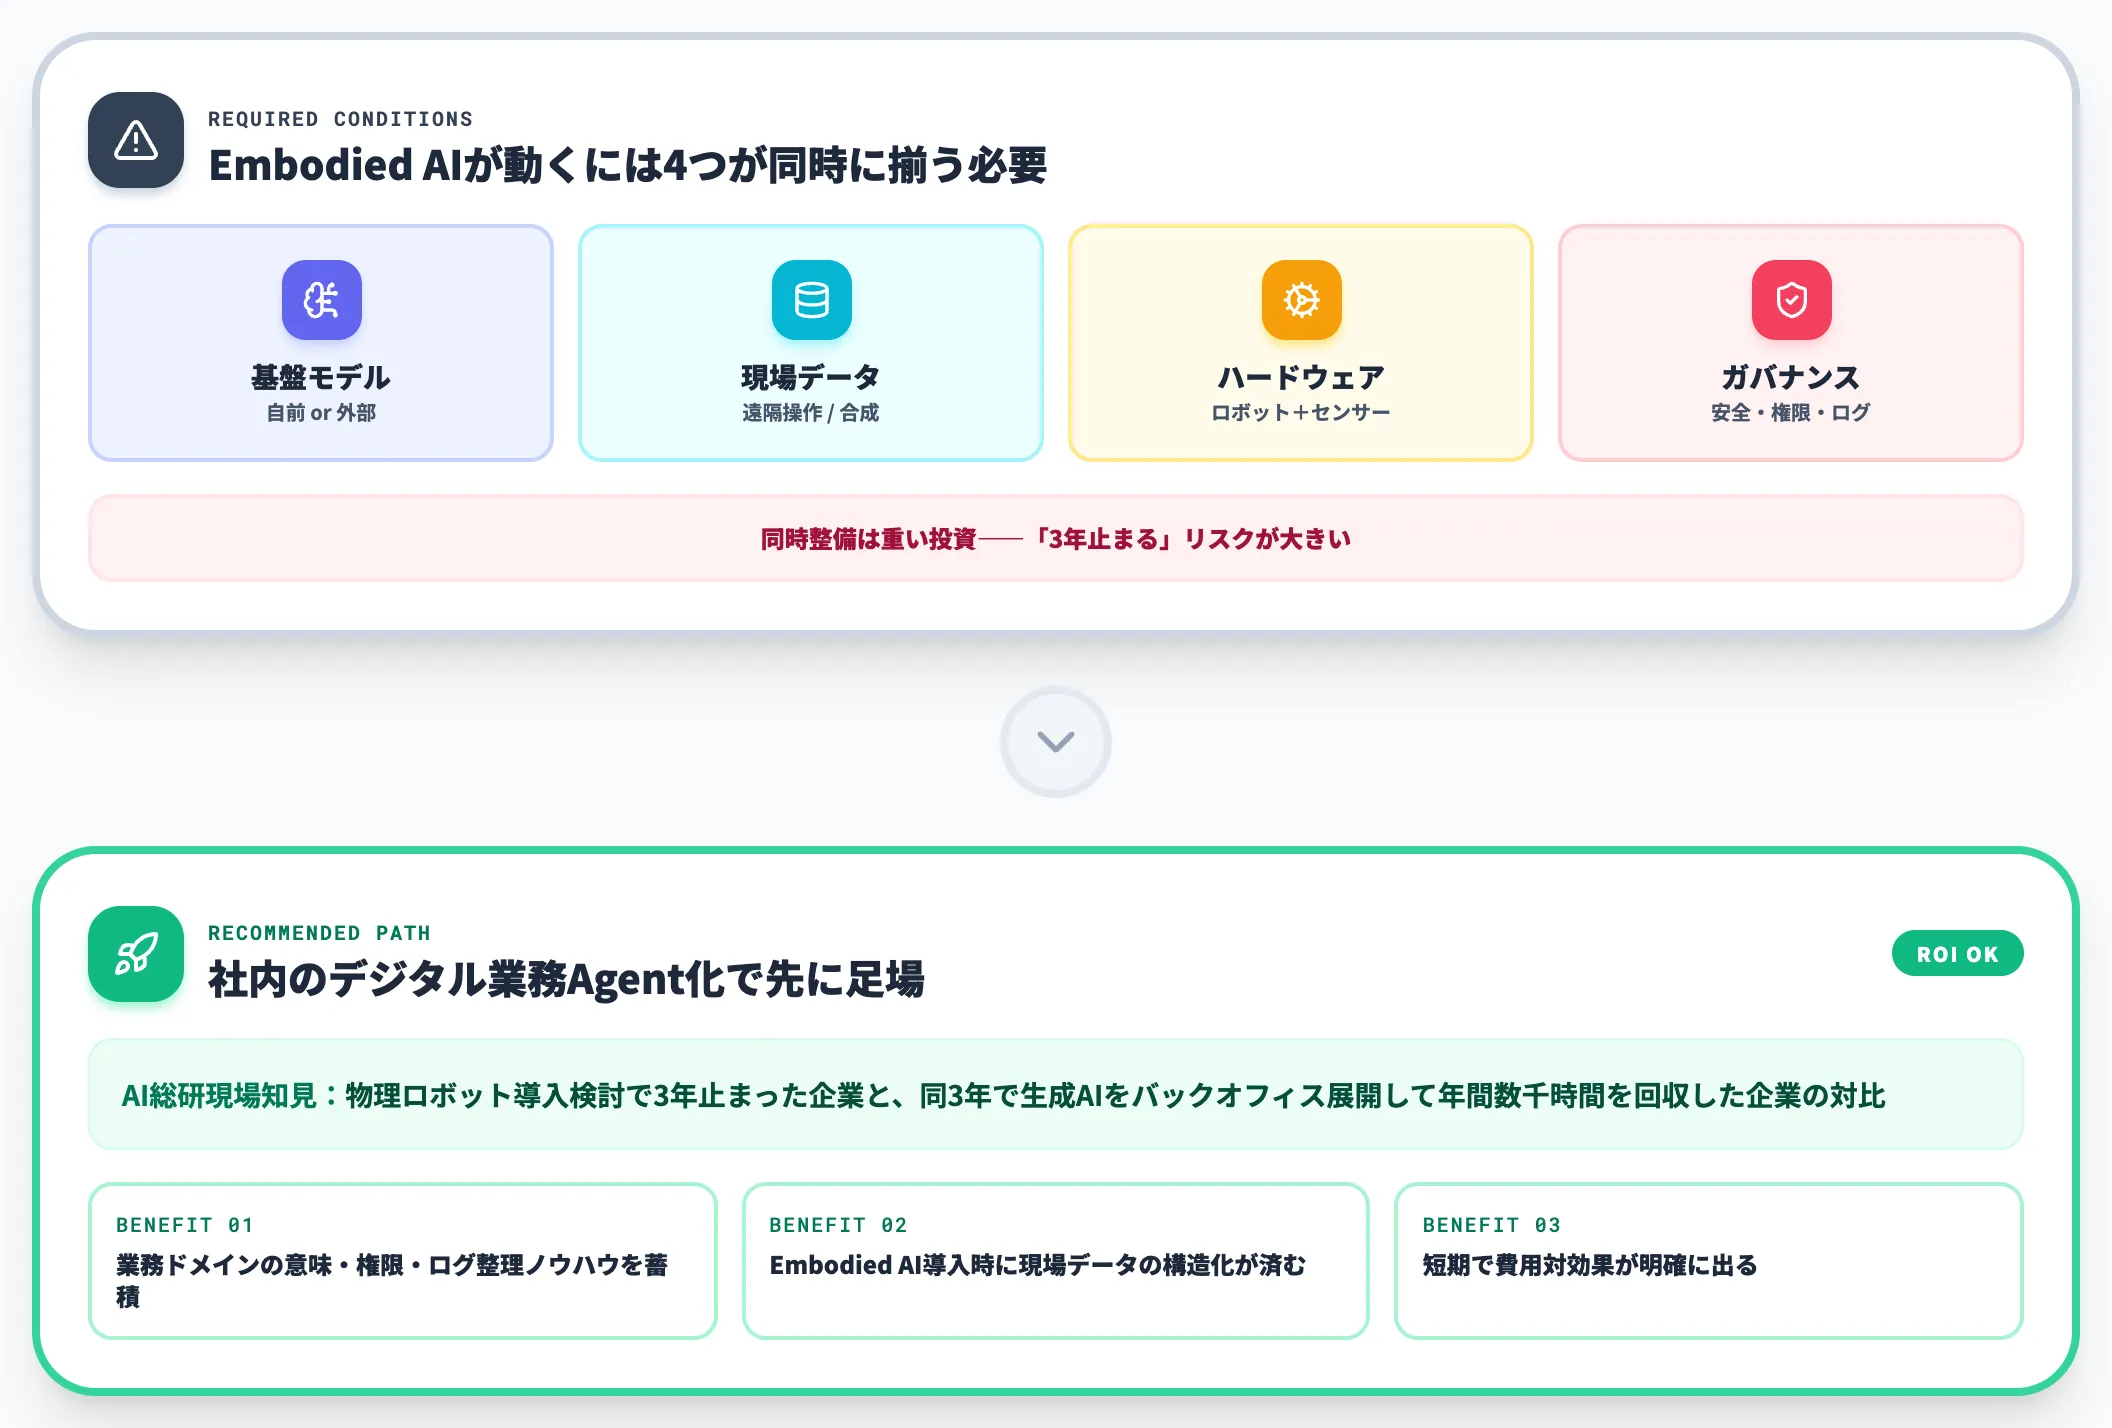
もっとも重要な論点は、「Embodied AIの検討と並行して、社内のデジタル業務のAI活用を先に進めるべきか」です。
AI総研の支援現場で何度も目にしてきたパターンは、「物理ロボットの導入検討が重すぎて3年止まったが、同じ3年で生成AIを社内のバックオフィスに展開した企業は年間数千時間を回収した」というものです。
Embodied AIは、以下の4つが同時に揃わないと動きません。
- 基盤モデル(自前 or 外部)
- 現場データ(遠隔操作ログ or 合成データ)
- ハードウェア(ロボット本体+センサー)
- ガバナンス(安全性・権限・ログ)
これらを同時に整えるのは重い投資で、多くの日本企業にとっては「先に生成AIベースの業務Agent化で足場を作る」ほうが明らかに費用対効果が高くなります。
社内の業務Agent化で、業務ドメインの意味・権限・ログの整理ノウハウを先に蓄積しておけば、Embodied AIを導入するフェーズに入ったときに現場データの構造化がすでに済んでいるという副次効果もあります。
国家戦略レベルでEmbodied AI/フィジカルAIをどう扱うかは、フィジカルAI(物理AI)とは?Cosmos 3・Isaac GR00Tから日本の国家戦略まで解説で詳述しています。
Embodied AI検討の前段で、社内業務プロセスをAgent化するなら
Embodied AIは「基盤モデル・現場データ・ハードウェア・ガバナンス」の4つが同時に揃わないと動かず、投資判断の重さが大きな障壁になります。
一方で、Embodied AIが本格普及するまでの数年間で、社内のデジタル業務をAIエージェントで自動化しておけば、業務ドメインの意味・権限・ログ運用のノウハウが先に蓄積されます。これは将来Embodied AIを導入する際にも、現場データの構造化や安全性ポリシーの設計で大きな資産になります。
自社の業務にAIエージェントをどう組み込めばよいか迷っている段階であれば、まずは業務特化Agent群をTeams上で一元管理する基盤から足場を作るのが現実解です。
Embodied AI検討の前にやるべき社内Agent基盤整備
物理ロボットの前に、デジタル業務のAgent化を全社定着させる
Embodied AIは基盤モデル・現場データ・ハードウェア・ガバナンスが同時に揃わないと動かない重い投資です。多くの日本企業にとっての現実解は、まず社内のデジタル業務をAIエージェントで自動化し、業務設計とデータ整備のノウハウを先に蓄積することです。AI Agent Hubはその入口として、業務特化Agent群をTeams上で一元管理する基盤を提供します。
まとめ
Embodied AIは、カメラ・センサーで物理世界を知覚し、基盤モデルで判断し、身体で動作まで実行する「身体を持つAI」です。
- Google DeepMind(Gemini Robotics 2)・Physical Intelligence(π0.7/Pi API beta)・NVIDIA(GR00T N1.7)が「異種ロボット共同学習+End-to-End VLA」設計に収斂し、BMW Spartanburg工場でFigure 03が物流ワークフローの実証段階に入った
- Cosmos 3・SimVLAでWorld Model/Sim2Realが実データ戦略を補完し始め、合成データのスケーラビリティが現実のものに
- LIBERO-Plusが示したVLAの摂動耐性のばらつきと言語無視、別研究で示されたjailbreak脆弱性という3つの限界が、同時に未解決課題として浮上
日本企業に求められるのは、Embodied AIを「来る未来」として眺めるのではなく、2026年の限界論点を含めた前提のうえで、まず社内デジタル業務のAgent化で足場を作り、エコシステムに乗る時機を具体的に設計することです。