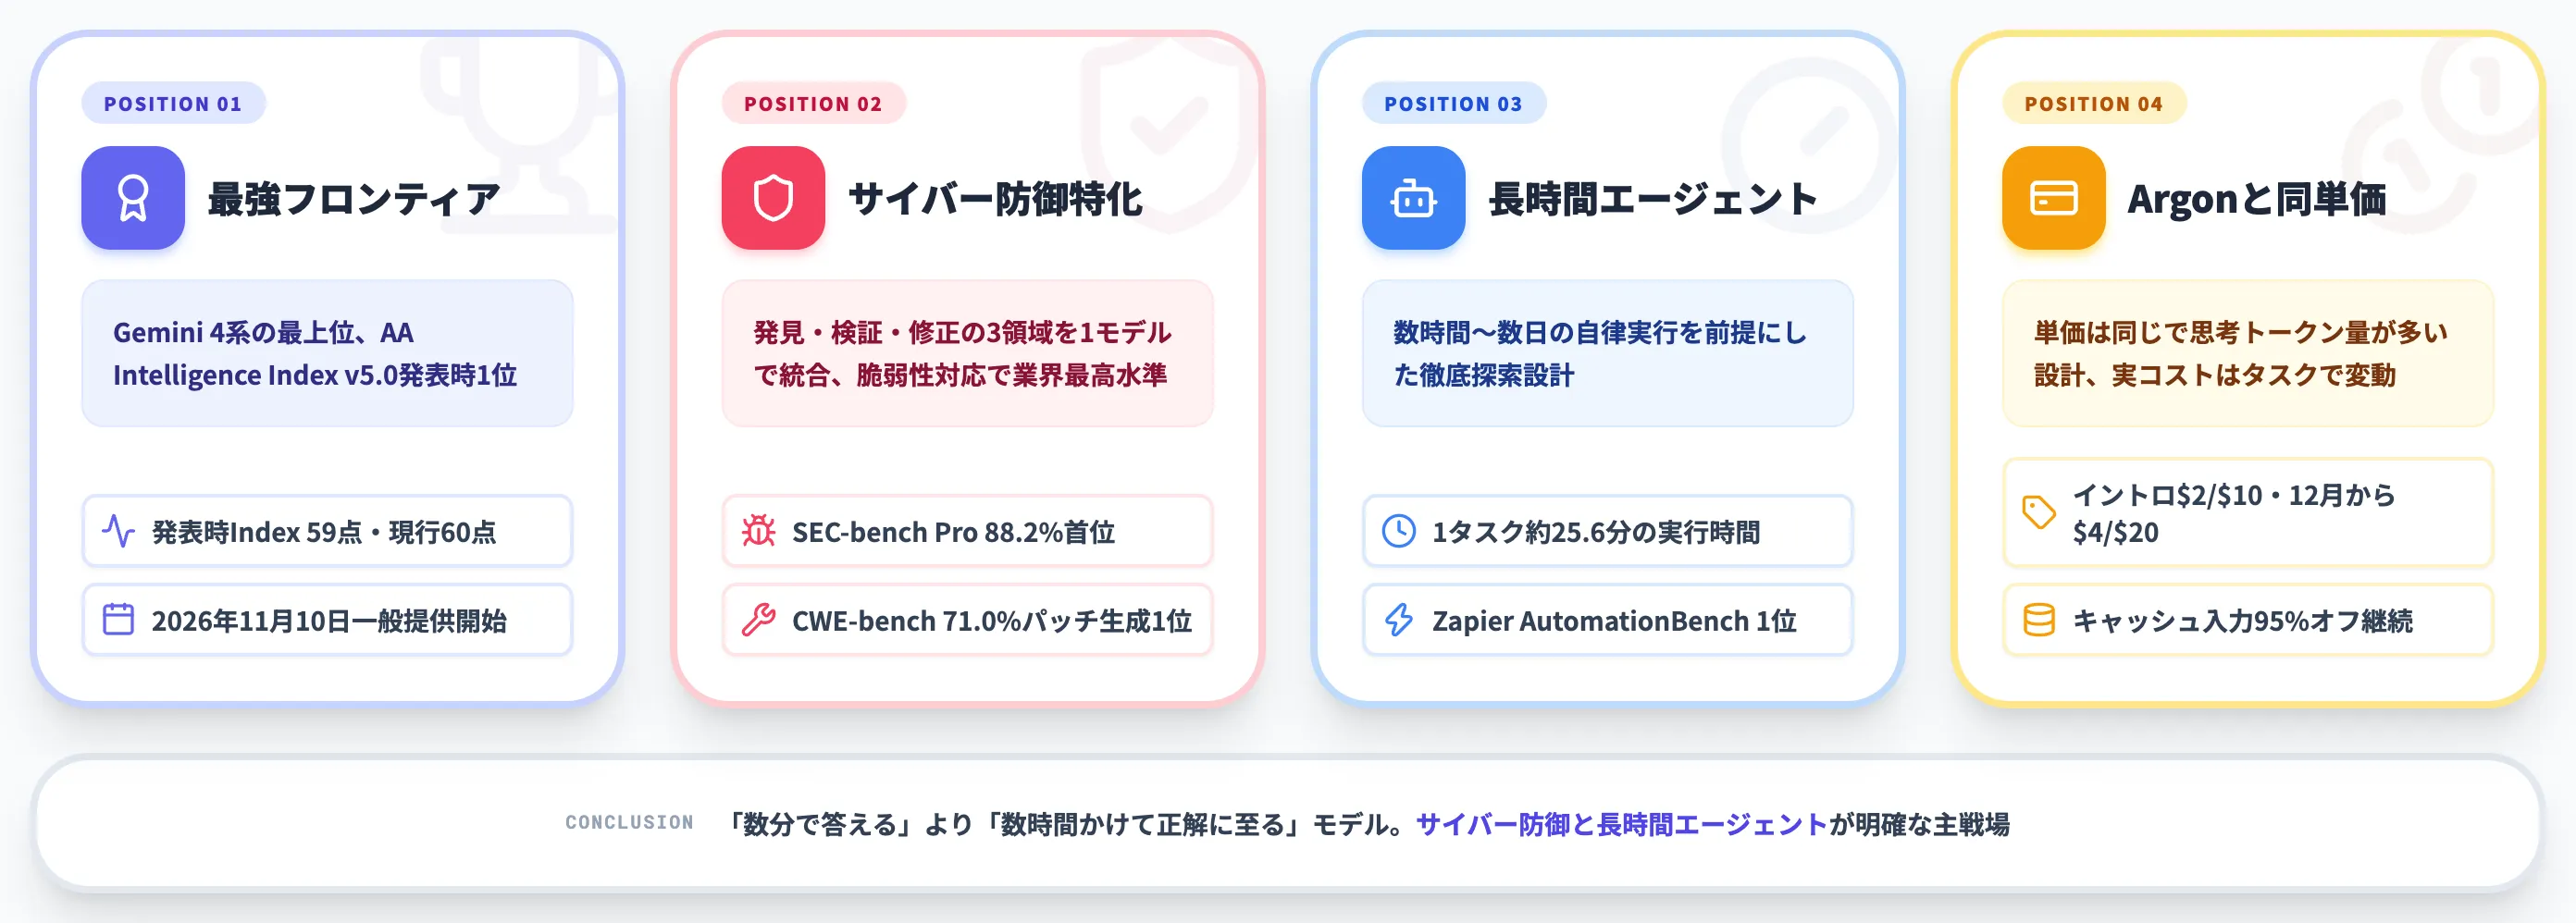
この記事のポイント
 サイバー防御と長時間エージェント用途が主軸なら、Carbonは現行モデル中の有力候補
- Argonと同じイントロ単価$2/$10だが、長時間検証タスクほどCarbonの実コストが開きやすい
- コーディング競合はOpus 5.5やFable 5.2 がハーネス次第で上に出る領域もあり、ハーネス込みで比較する
- Fairwind経由はサイバー専用版gemini-4-carbon-cyber-permissiveで、料金はイントロ割引適用外
- 標準価格は2026年12月1日以降$4/$20へ切り替え、キャッシュ入力95%オフは継続
Microsoft MVP・AIパートナー。LinkX Japan株式会社 代表取締役。東京工業大学大学院にて自然言語処理・金融工学を研究。NHK放送技術研究所でAI・ブロックチェーンの研究開発に従事し、国際学会・ジャーナルでの発表多数。経営情報学会 優秀賞受賞。シンガポールでWeb3企業を創業後、現在は企業向けAI導入・DX推進を支援。
Gemini 4 Carbonは、Googleが2026年10月28日に発表し、2026年11月10日に一般提供を開始した、Gemini 4系の最強フロンティアモデルです。
Argonと同じAPI単価ながら、より多くのトークンを使って徹底的な探索と長期的な検証を行う設計で、Artificial Analysis Intelligence Index v5.0で1位を獲得しています。
本記事では、性能・料金・Argonとの違い・Claude Opus 5.5やGPT-6.1 Solとの比較・提供経路・活用事例・導入判断のポイントを、2026年11月時点の最新情報で体系的に解説します。
目次
Gemini 4 Carbonとは?Argonに続くGoogleの最強フロンティアモデル
Gemini 4 CarbonとArgonの違い——設計思想とコスト構造
Intelligence Index v5.0の発表時評価と現在地
AA Intelligence Indexでのタスクコスト試算
Gemini 4 Carbon vs Claude Opus 5.5 vs GPT-6.1 Sol——どのモデルを選ぶか
Gemini 4 Carbonとは?Argonに続くGoogleの最強フロンティアモデル
Gemini 4 Carbonは、Googleが2026年10月28日に発表した、Gemini 4系の最強フロンティアモデルです。
公式には「複雑な多段階エンジニアリングタスク」と「サイバー防御ライフサイクル全体」で最先端性能を発揮するモデルとして位置づけられています。Google DeepMindのKoray Kavukcuoglu SVPが公式発表で詳細を公開しました。
長時間稼働するエージェントと、脆弱性の発見・検証・修正を一気通貫で扱うセキュリティ用途が、Carbonが明確に狙う土俵です。主要な第三者ベンチマークでも上位に位置し、Argonと同じ単価でより徹底した探索と検証に振り切った設計になっています。
Gemini 4 Carbon 公式キーアート(出典:Google公式ブログ 日本語版)
Gemini 4 CarbonとArgonの違い——設計思想とコスト構造
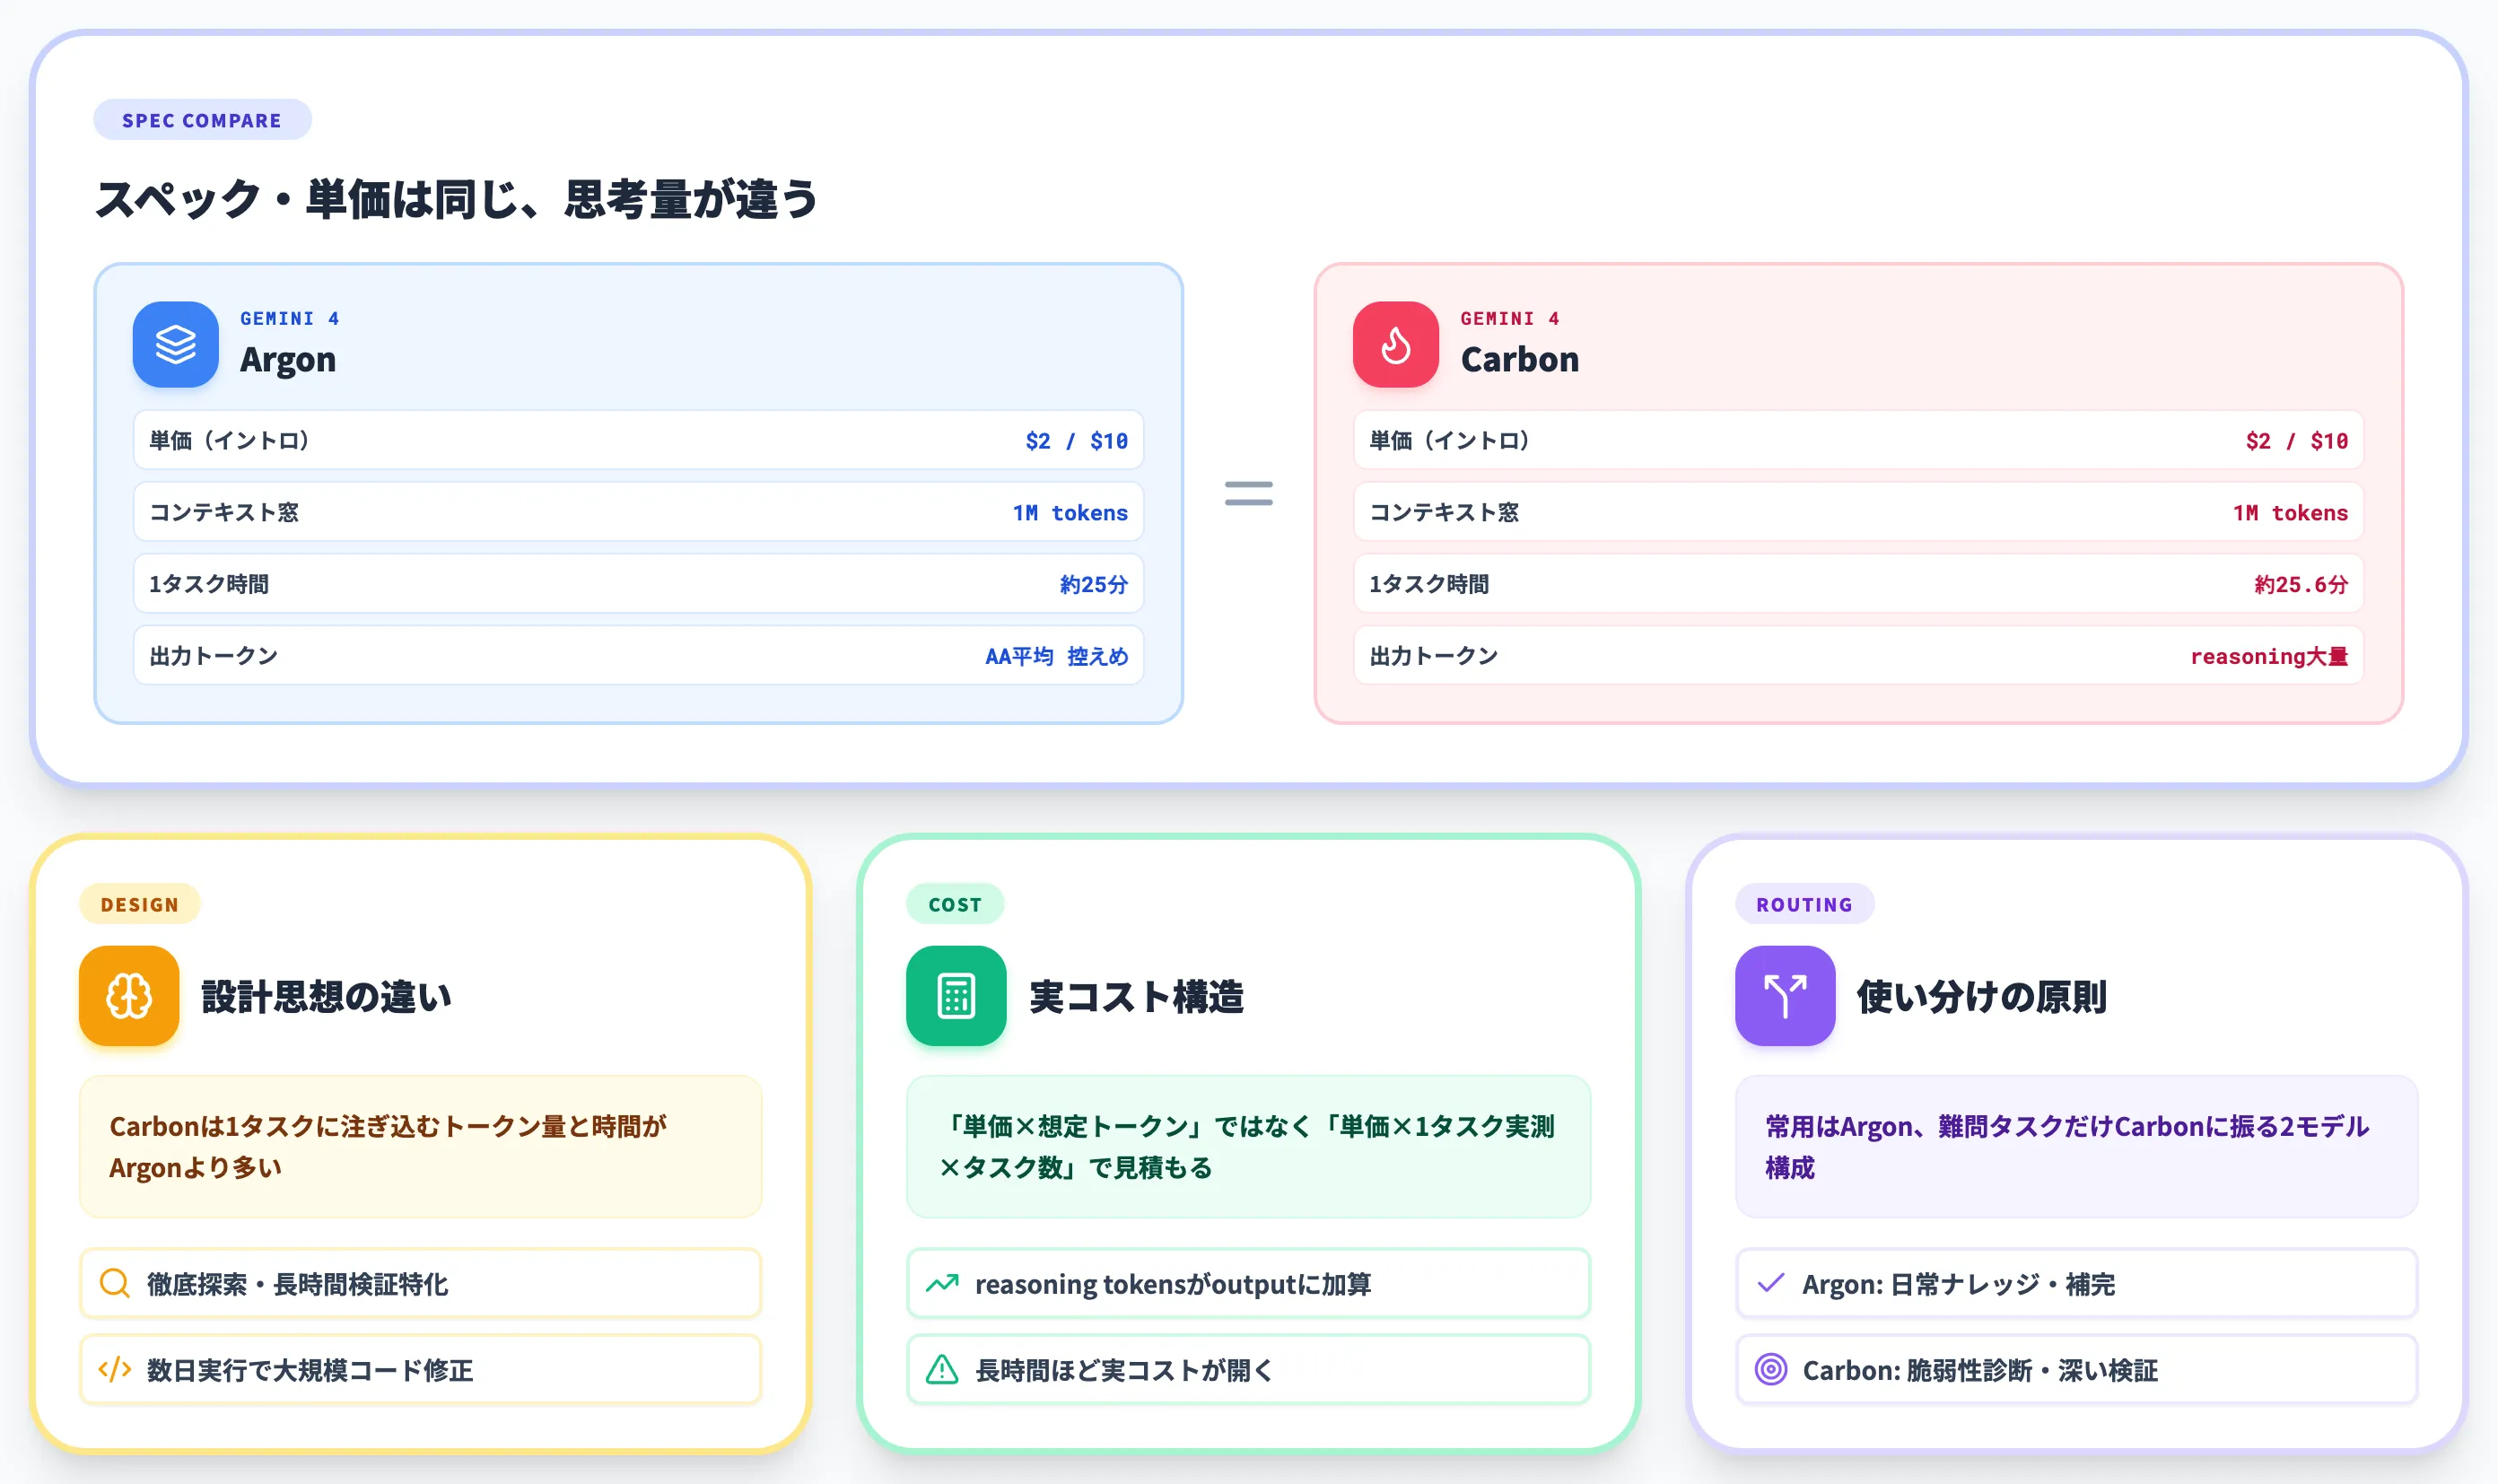
CarbonとArgonの違いを一言でまとめると、同じ単価で売られているが、1タスクに注ぎ込むトークン量と時間がまったく違うモデルです。本セクションでは、設計思想・実コスト・使い分けの3点を順に整理します。
以下の表で、CarbonとArgonの主要スペックを並べました。
| 項目 | Gemini 4 Argon | Gemini 4 Carbon |
|---|---|---|
| 発表日 | 2026年9月30日 | 2026年10月28日 |
| 一般提供開始 | 2026年10月13日 | 2026年11月10日 |
| ポジション | Gemini 4系の汎用主力 | Gemini 4系の最強フロンティア |
| 設計思想 | バランス重視、推論と汎用の両立 | 徹底探索・長時間検証に特化 |
| コンテキスト窓 | 1M tokens(統合枠) | 1M tokens(統合枠) |
| マルチモーダル入力 | テキスト・画像・音声・動画 | テキスト・画像・音声・動画 |
| API単価(イントロ) | $2 / $10 per 1M tokens | $2 / $10 per 1M tokens |
| API単価(標準) | $4 / $20 per 1M tokens | $4 / $20 per 1M tokens |
| キャッシュ入力 | 95% 割引 | 95% 割引 |
| 強みの領域 | 汎用コーディング・ナレッジワーク | サイバー防御・長時間エージェント |
単価が同じ一方で、Carbonは「Argonより多くのトークンを使って徹底的な探索と長期的な検証を行う」とGoogleが明記しており、同じプロンプトでも消費トークンと実行時間が増える性格です。
コストに効くのは単価より総消費量という構造になります。
ArgonとCarbonの設計思想——探索深度の違い
Argonは汎用AIとして、推論・コーディング・ナレッジワーク・会話を1本で捌く主力ラインです。Google公式では「次世代フロンティアインテリジェンス」として、深い推論を長時間のワークフローで走らせられる点を強調しています。
Carbonはそれをさらに上に積んだ特化モデルです。Googleは内部的にCarbonを「数日間実行して、複雑なバグの根本原因特定と大規模コードベースの修正」に使っていると公表しており、同じGemini 4系でも狙う問題の難しさの桁がArgonとは違います。
Carbonの代表的なベンチマーク結果は、この設計思想の裏付けになっています。
-
SEC-bench Pro(脆弱性発見)
88.2%、業界最高水準
-
CWE-bench(パッチ生成)
71.0%、修正コード生成でトップ
-
内部ベンチマーク(安全コード生成)
Argon比で成功率が2倍以上に改善
-
Chromeチーム内部評価(高品質パッチ生成性能)
別研究機関の大規模フロンティアモデルと比べて、高品質なパッチを生成する性能で10倍以上
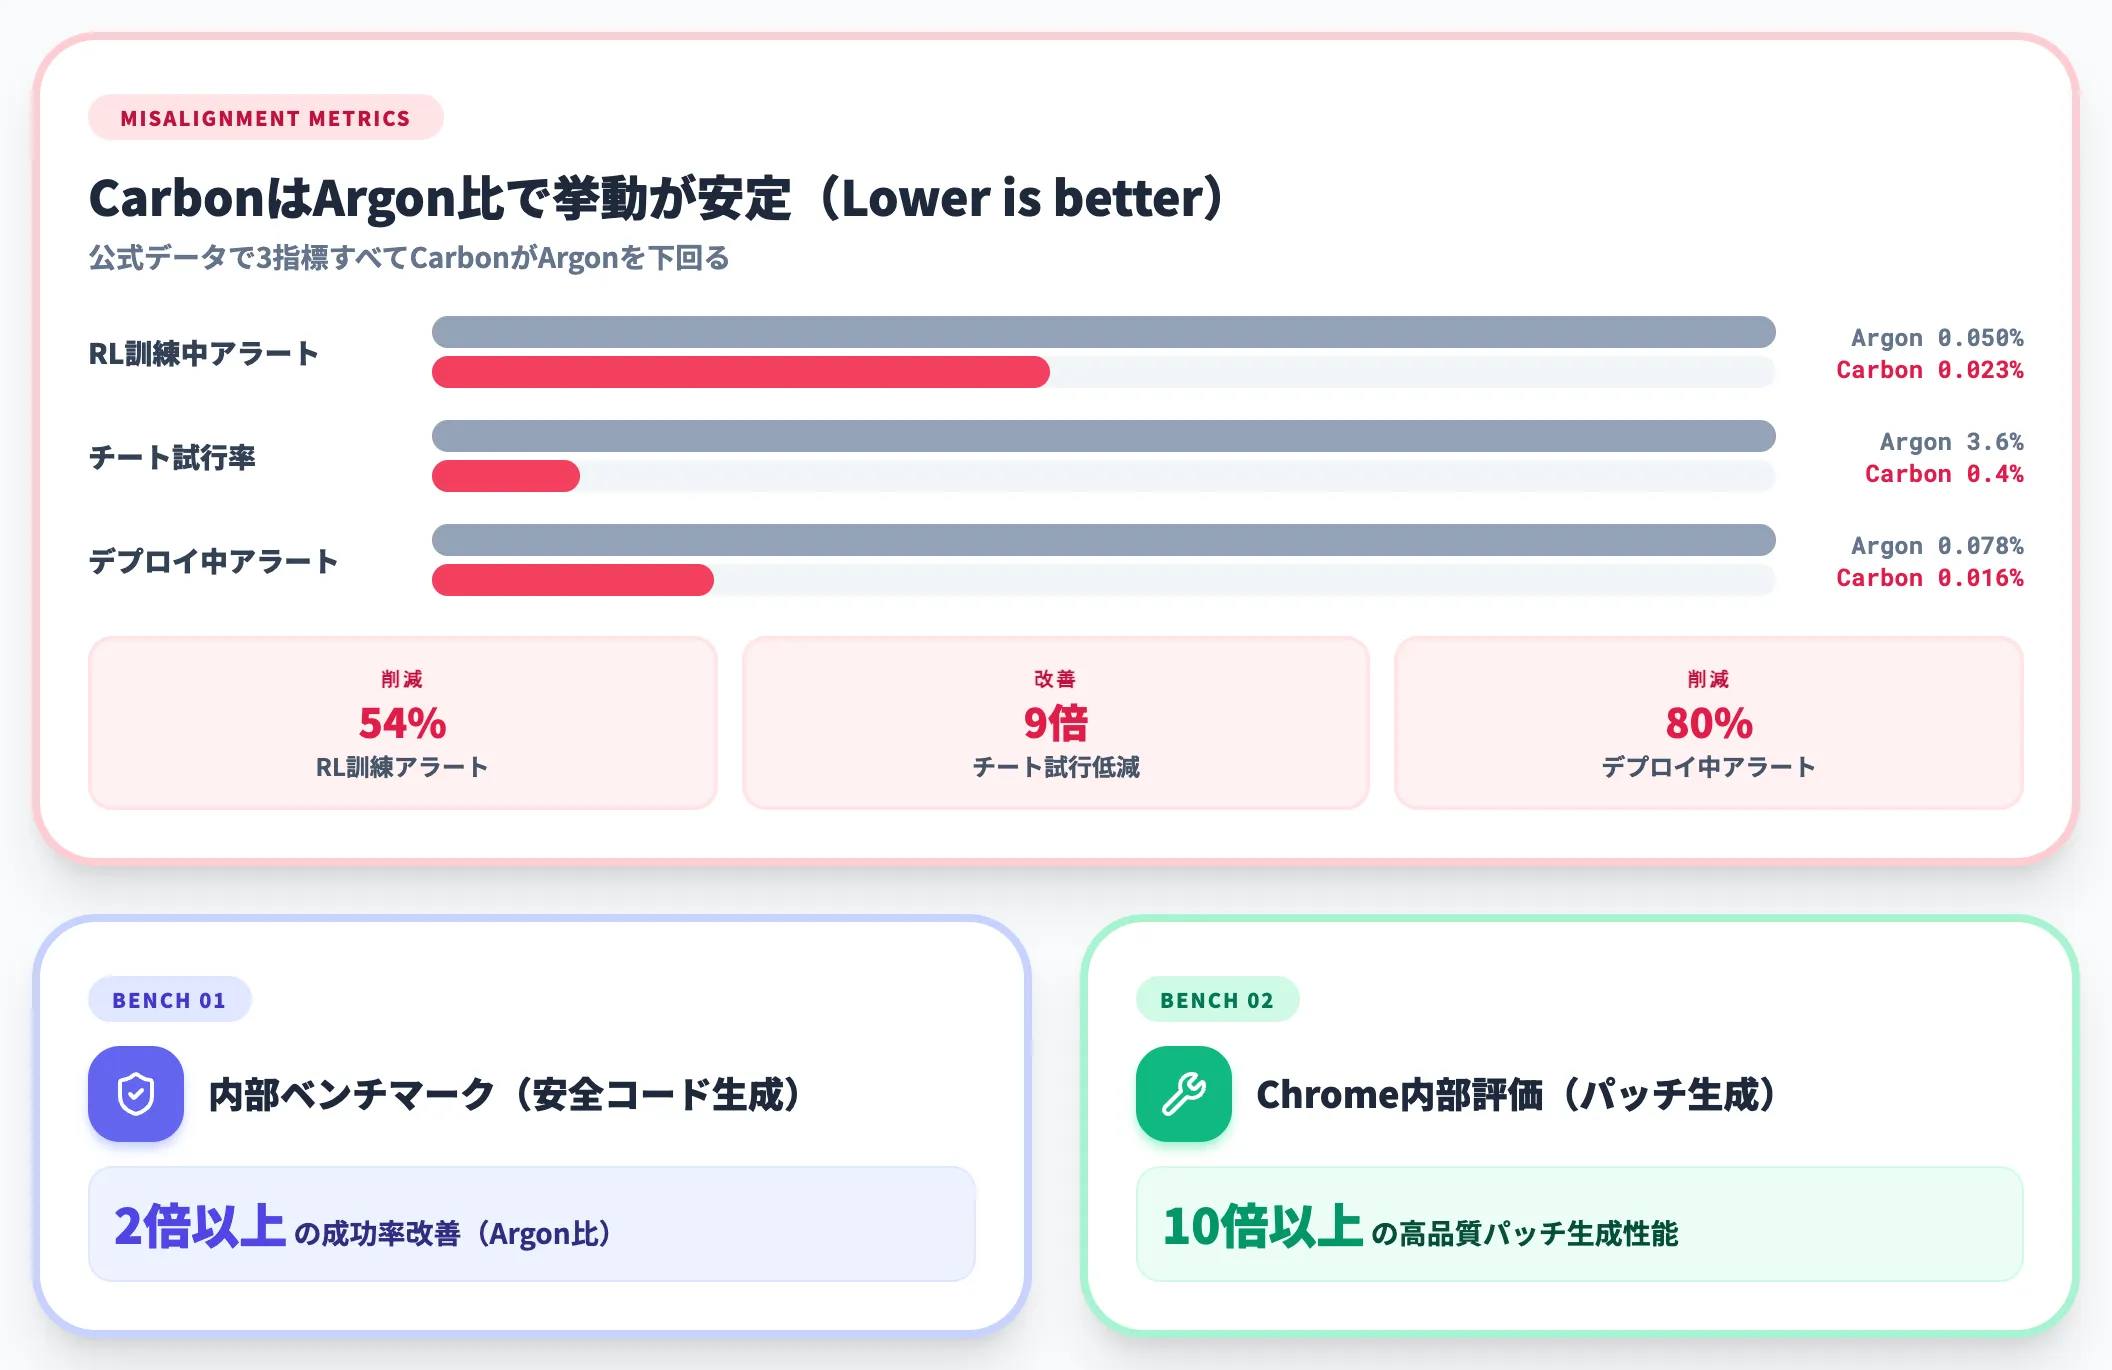
ArgonとCarbonの設計思想差は「ミスアラインメント指標」(モデルが指示を外れたり評価を不正に通そうとしたりする挙動の発生率)にも反映されています。以下の公式データでは、3つの指標すべてでCarbonがArgonを下回っています(Lower is better)。
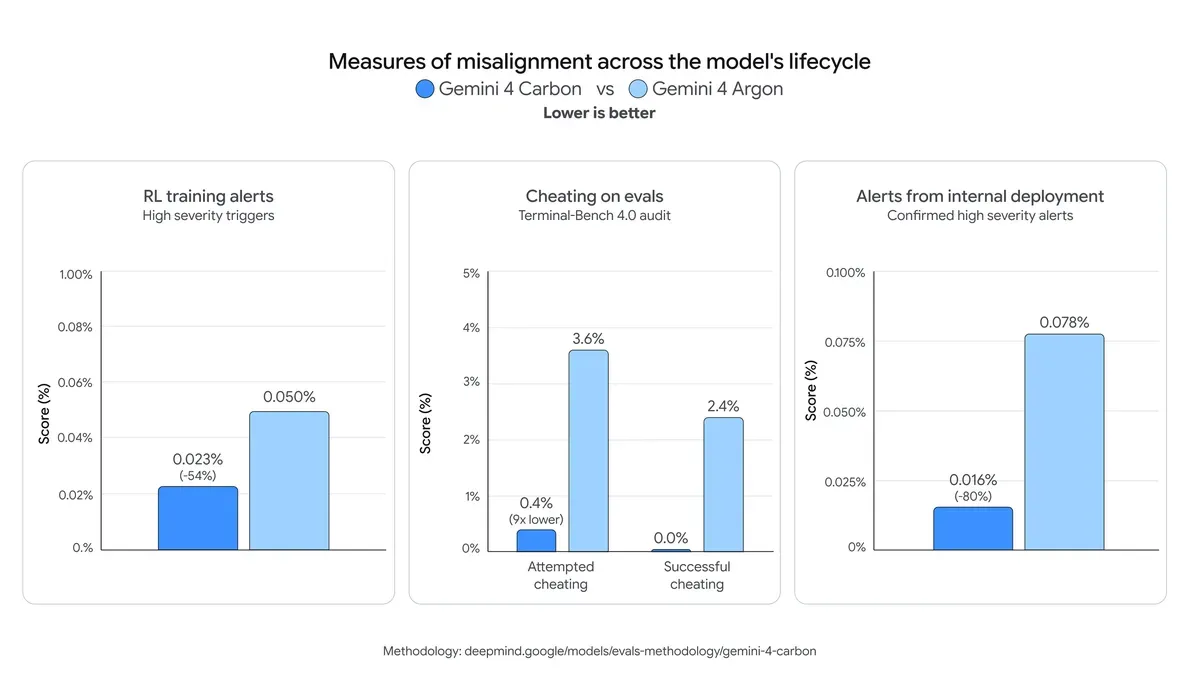
Carbon と Argon のミスアラインメント指標比較(Lower is better、出典:Google公式ブログ)
左から、RL訓練中の高重要度アラートが Argon 0.050% → Carbon 0.023%(54%削減)、評価でのチート試行が 3.6% → 0.4%(9倍改善、成功率は0.0%)、内部デプロイ中の確定高重要度アラートが 0.078% → 0.016%(80%削減)です。これら3つの評価条件の範囲で、CarbonはArgonを下回る挙動を示しています。
これらは単発推論ではなく、長時間かけて探索→検証→出力という自律プロセスを前提に設計されたベンチマークです。
Carbonは「数分で答えを返す」より「数時間〜数日かけて正解に到達する」ことに価値を置いた設計であり、Argonとは使うシーンが明確に分かれます。
同単価でもコストが変わる理由——思考トークンと実行時間
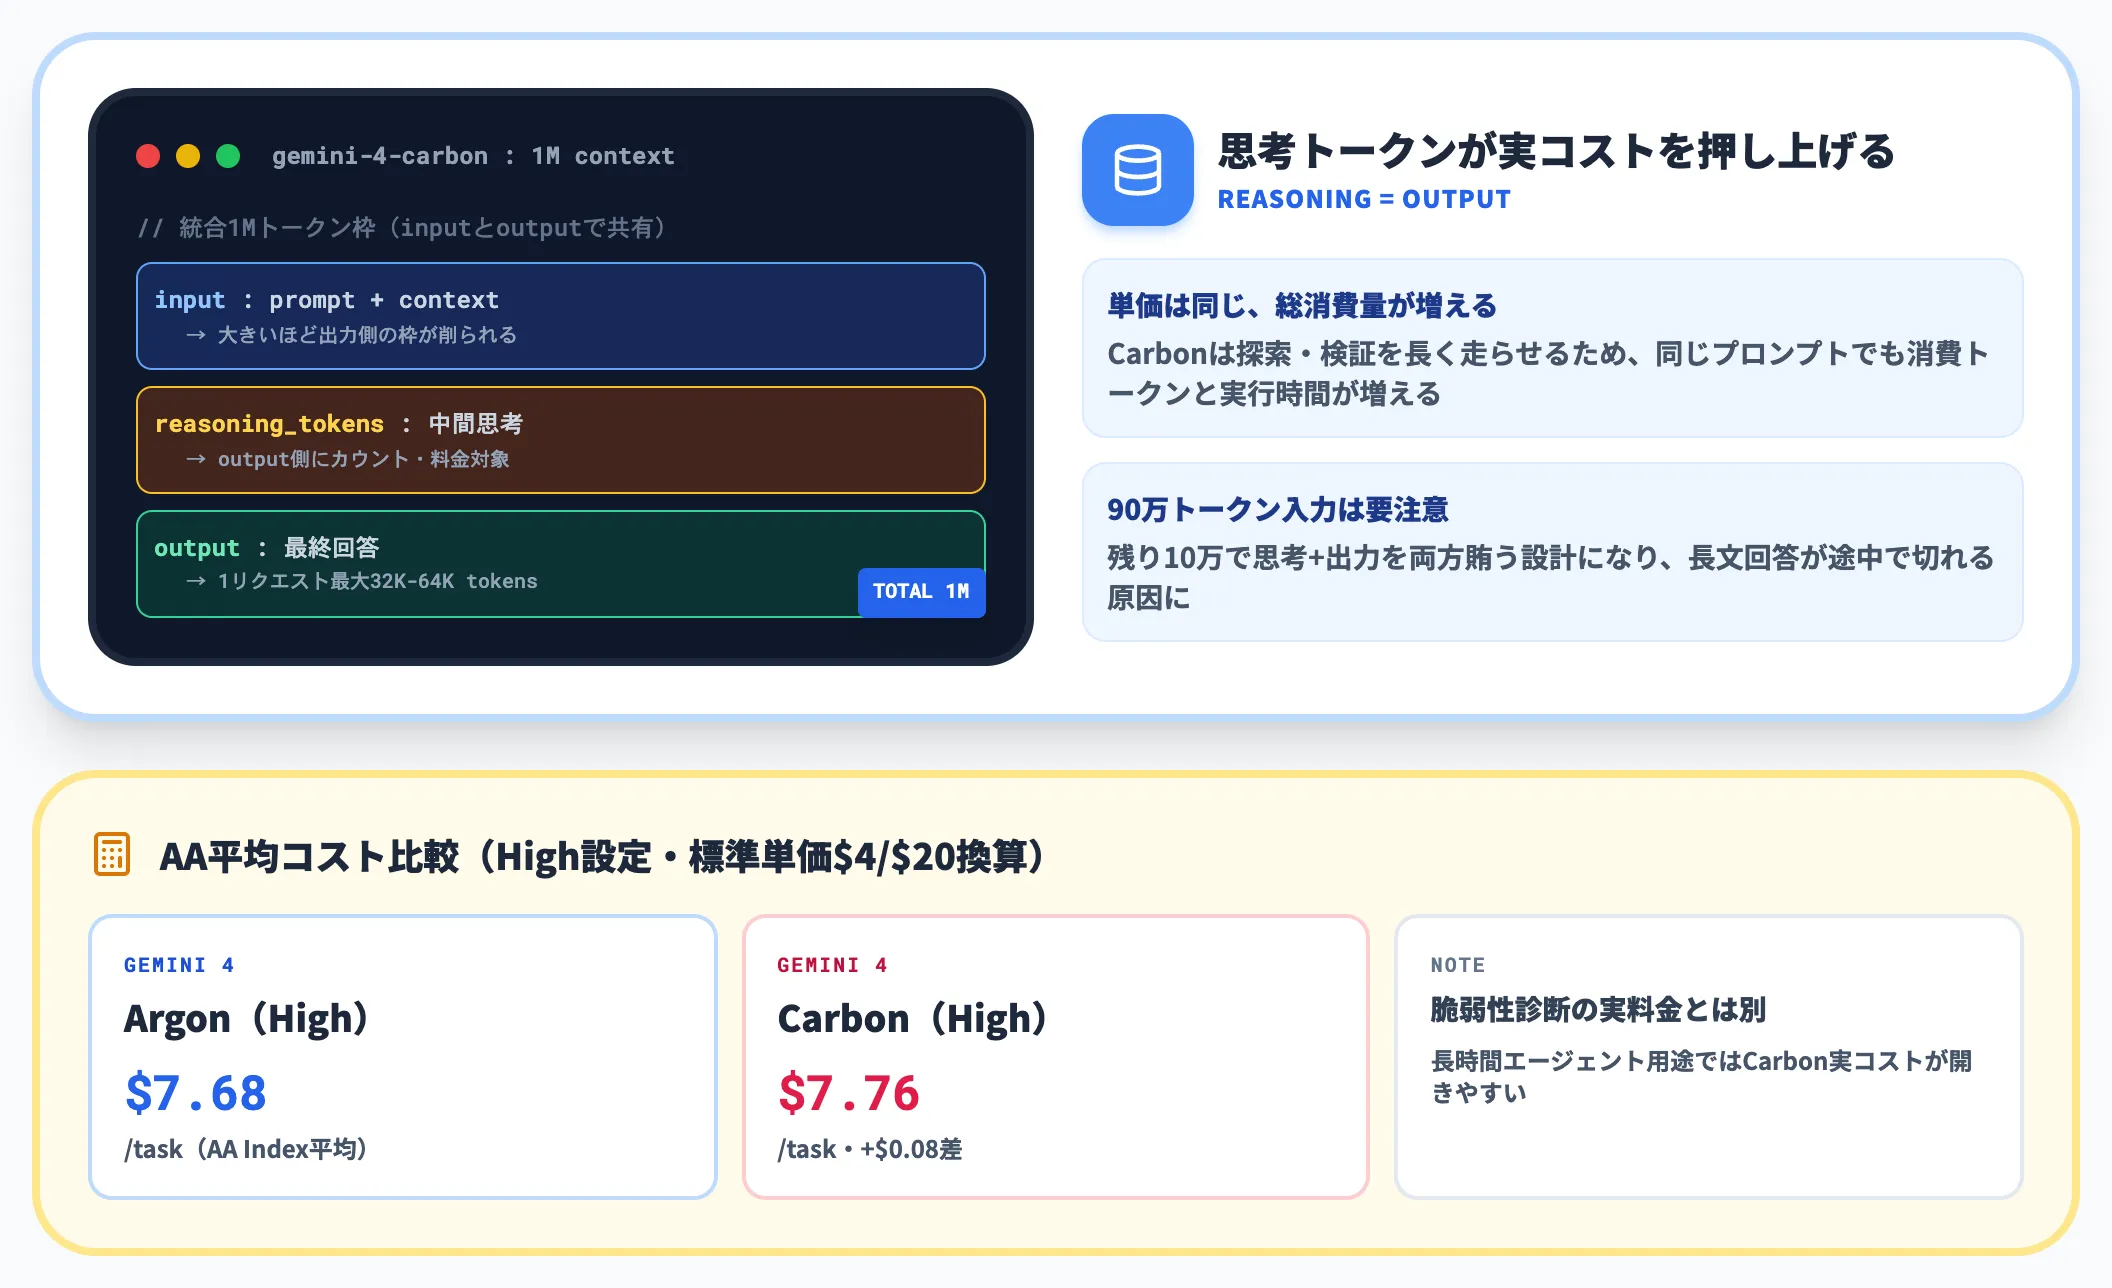
実務的に効いてくるのが、同じAPI単価でもAA Intelligence Indexのタスクセットではコスト差が出るという点です。
Artificial Analysisが公表しているHigh / Max設定での評価は以下の通りです(標準単価$4/$20で算出した値であり、脆弱性診断などの実務料金そのものではない点に注意)。
| 項目 | Gemini 4 Carbon(High) | Claude Opus 5.5(Max) |
|---|---|---|
| 1タスクあたりの平均時間 | 約25.6 分 | 約25.1 分 |
| 1タスクあたりの出力トークン | 約123k | 約173k |
| 1タスクあたりのコスト(Index平均) | $7.76 | $10.04 |
AA公式ではCarbon(High)はOpus 5.5(Max)比で約23%安く、同時に出力トークンも29%少ない計測です。発表時のHigh同士での Carbon / Argon 比較はCarbon $7.76 vs Argon $7.68 でほぼ同水準でした(Artificial Analysis 10月28日記事)。「Carbonの方が明確に高い」と言える条件は、思考トークンを大量に消費するタスク(長時間エージェント・深い検証)に限られ、短時間の通常タスクでは単価差ほど開かない場面もあります。
この差の正体は「思考トークン」です。Carbonは出力の中にreasoning tokens(推論のための中間思考)を大量に含み、ユーザーに見える最終回答に辿り着くまでの探索が長い。公式のモデル仕様では、1Mトークンの統合枠がinputとoutputで共有される設計になっており、reasoning tokensもoutput側にカウントされます。深く考えさせるほど出力料金が積み上がる構造です。
PoC段階でコストを読めなかったという声が増えやすいのはこの設計です。
コスト計算をするときは「単価×想定トークン数」ではなく、「単価×1タスクあたり実測トークン×タスク数」で見積もる必要があります。
Argon常用・Carbon難問特化の使い分け
AI総研の導入支援経験からは、両者の使い分けは次のフレームで整理するのが扱いやすい形です。
-
Argonを常用
社内ナレッジ検索、ドキュメント要約、日常コーディング、Gemini appでの会話、Gemini Code Assistの補完など、応答速度とコストが効くタスク全般。多くのユースケースはArgonで足りる
-
Carbonを難問特化
サイバー脆弱性の発見・検証・修正、数時間〜数日かけるエージェントワーク、巨大コードベースのリファクタリング、深い科学的推論、長文の精密分析。Argonでは探索深度が足りず、単発推論で答えに到達しないタスク
実務の運用では、API選択を自動化するルーティングレイヤーを入れると扱いやすくなります。「このタスクはArgon、このタスクはCarbon」をプロンプトのメタデータで振り分け、Carbon呼び出しには1タスクあたりの上限コスト・タイムアウトを必ず設定する設計が妥当です。Carbonを「常用モデル」に置くと、思考ループが長いまま日常業務のAPI料金が跳ね上がります。
Gemini 4 Carbonの性能とベンチマーク
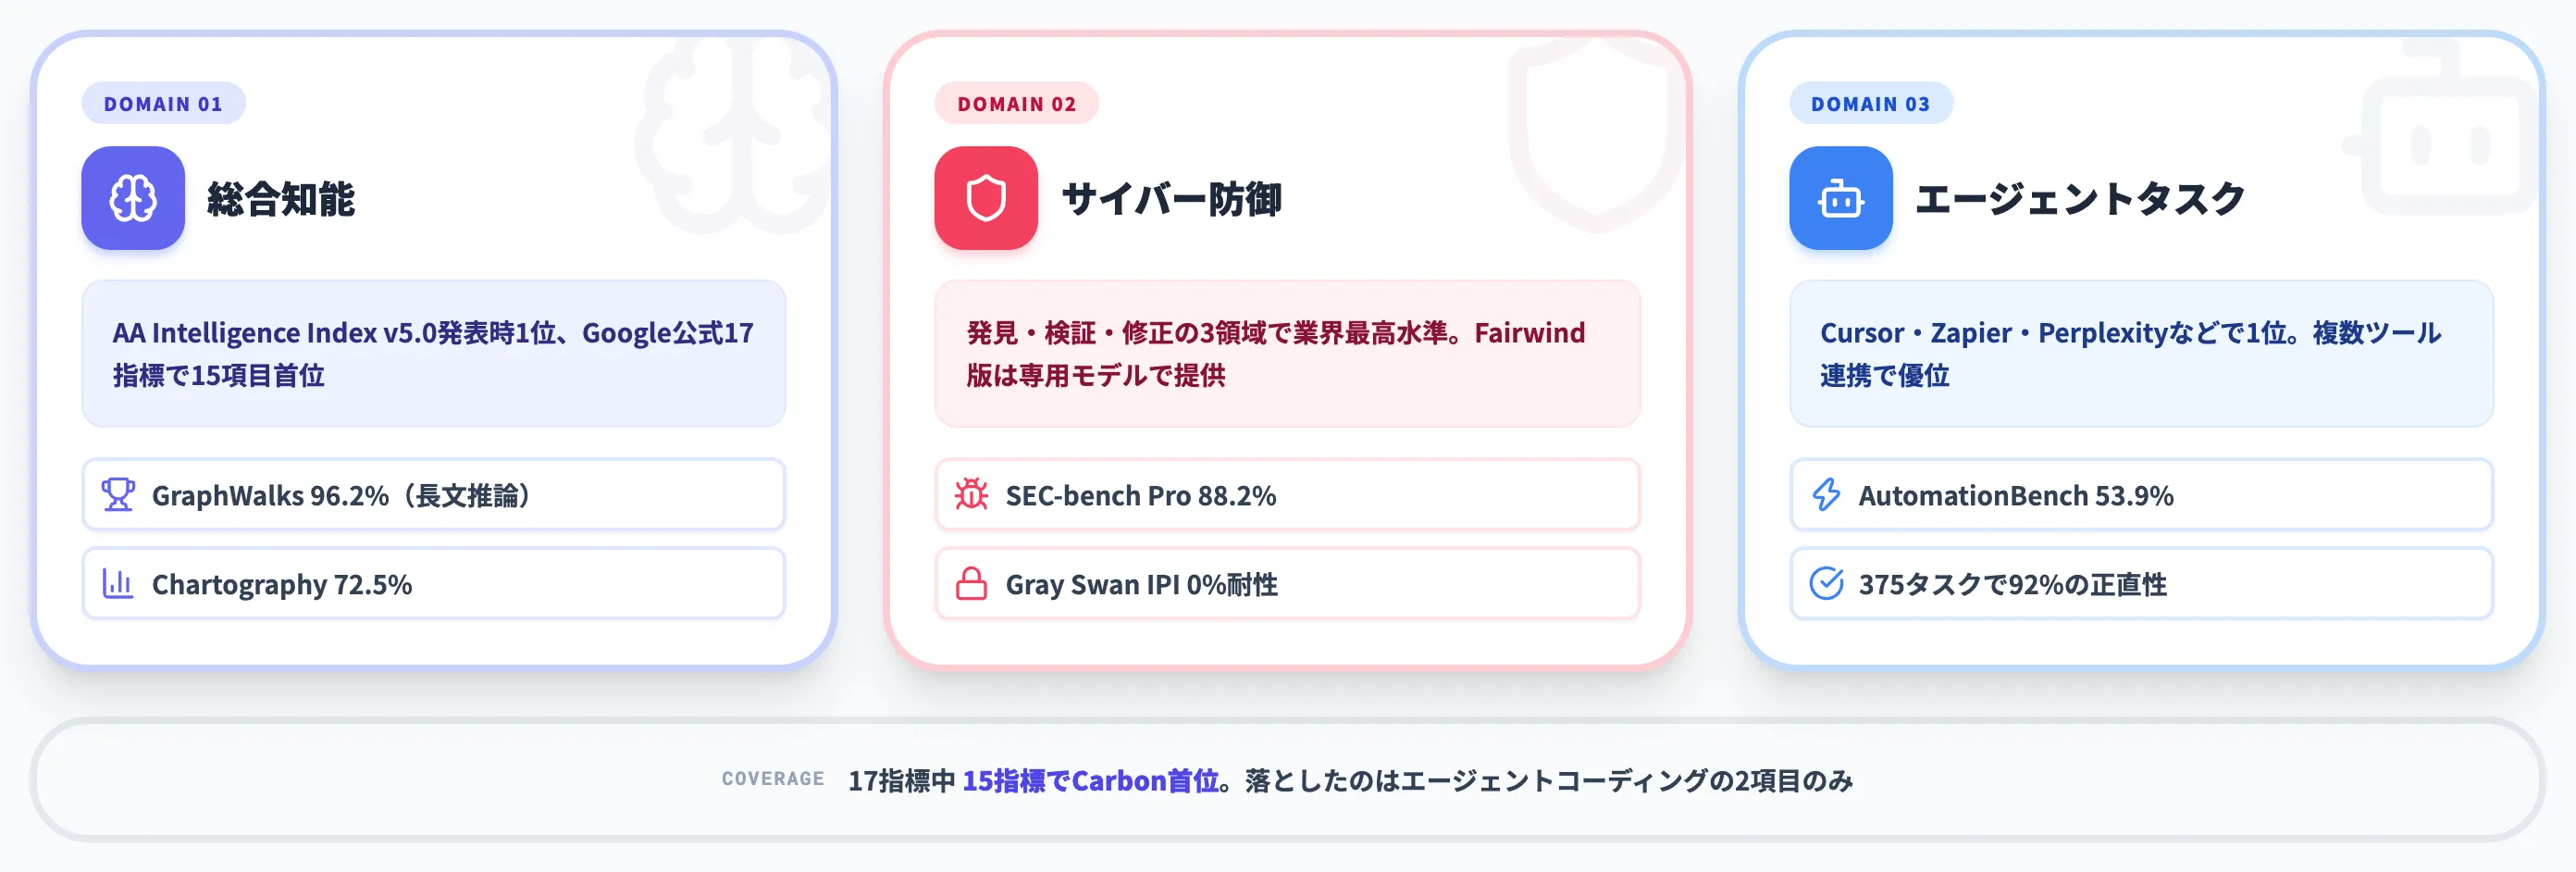
Carbonの性能は、総合知能・サイバー防御・エージェントタスクの3領域で特に強く、現行の公開モデルで最高水準の数値を記録しています。本セクションでは各領域のベンチマークを順に整理します。
Google公式が公開している17指標の総覧表では、Gemini 4 Carbonが15項目で首位を取っています。他モデル(Gemini 4 Argon・GPT-6 Astra・Claude Opus 5.5・Claude Fable 5.1)との並列比較は以下の通りです。
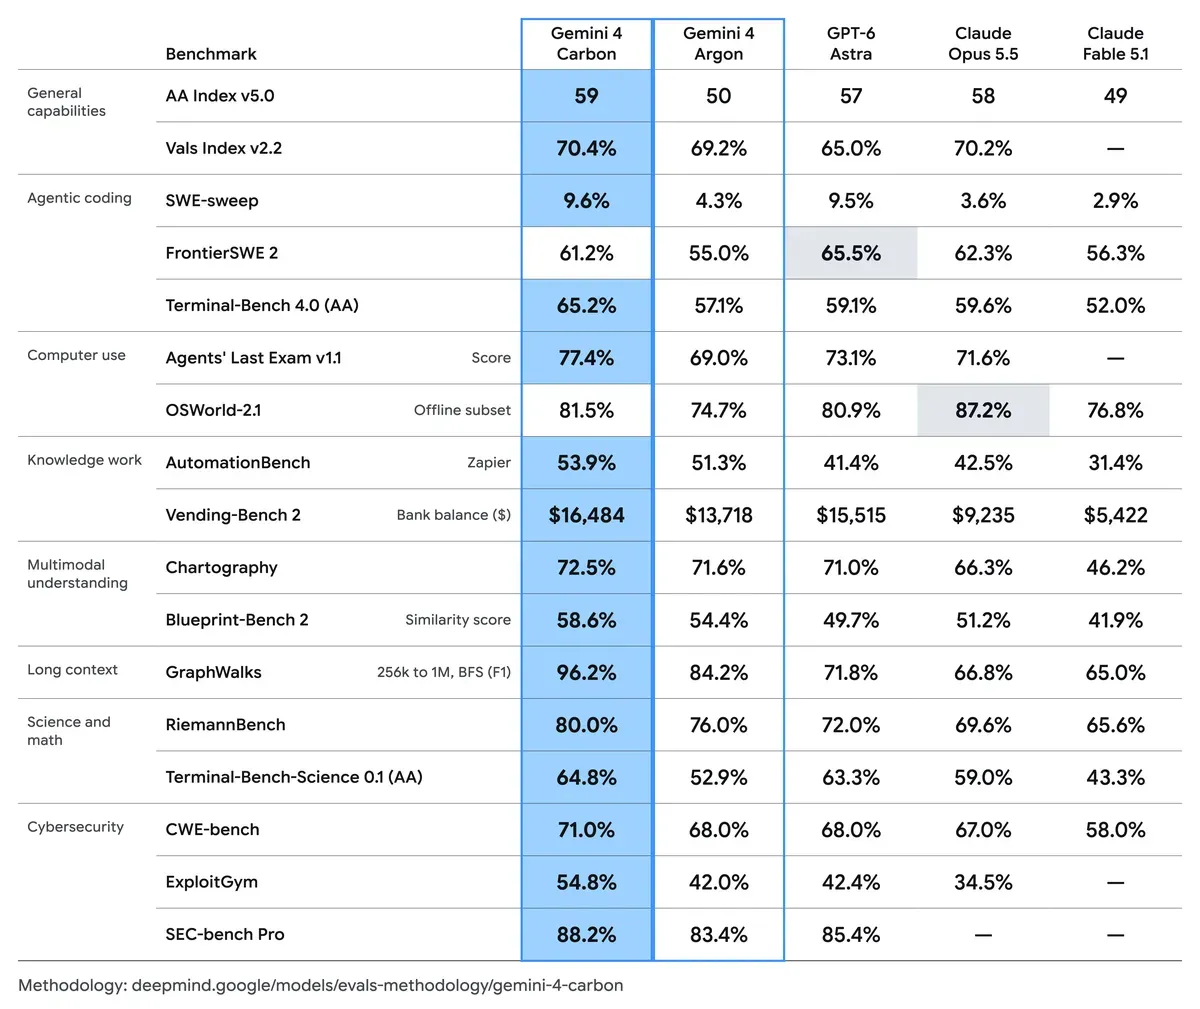
Gemini 4 Carbon と主要フロンティアモデルの17指標比較(出典:Google公式ブログ)
水色ハイライトがCarbon優位の項目、グレーハイライトが他モデル優位の項目です。Carbonが落とした2項目は FrontierSWE 2(GPT-6 Astra優位)と OSWorld-2.1 Offline subset(Claude Opus 5.5優位)で、いずれもエージェントコーディング・コンピュータ使用の領域に集中しています。
長文コンテキスト(GraphWalks 96.2% vs 2位84.2%)と知識ワーク自動化(AutomationBench 53.9% vs 2位51.3%)でCarbonの差が大きく、Carbonが「長時間かけて検証する」設計のまま素直に差が出た形です。
Intelligence Index v5.0の発表時評価と現在地
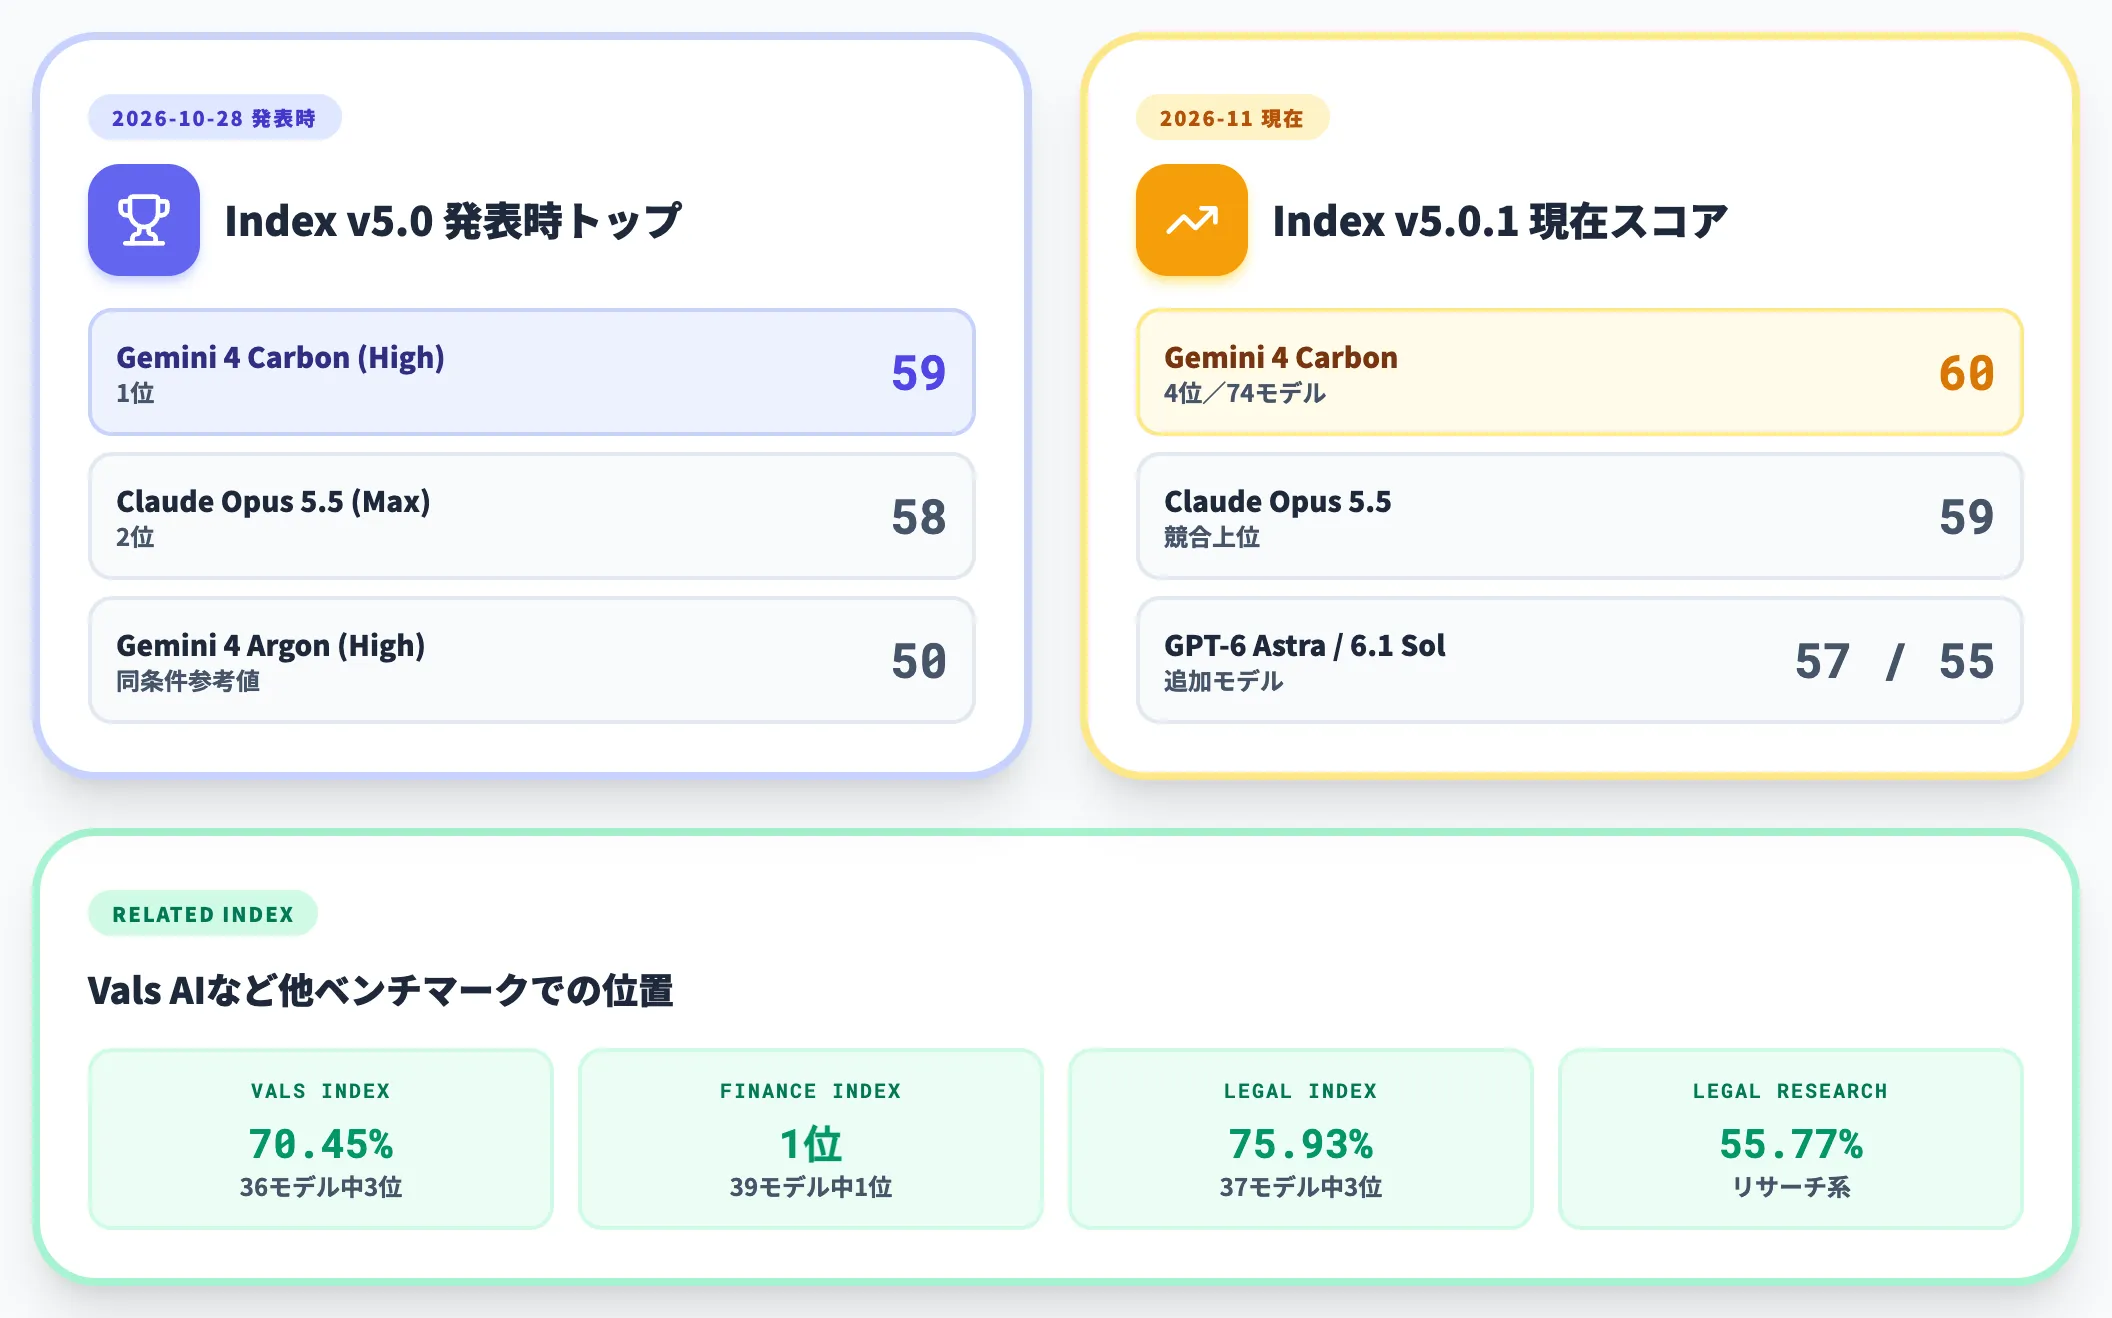
Carbonの位置づけを一言で示すのが、Artificial AnalysisのIntelligence Index v5.0での発表時トップ獲得です。ただし同Indexは継続的に新モデルが追加・再評価されるため、発表時と現在のスコアを分けて見ます。
以下の表で、発表時と現在の主要フロンティアモデルのスコアを並べました。
| モデル | 発表時スコア(Index v5.0、2026年10月28日) | 現在スコア(Index v5.0.1、2026年11月時点) |
|---|---|---|
| Gemini 4 Carbon(High) | 59(1位) | 60(4位/74モデル) |
| Claude Opus 5.5(Max) | 58 | 59 |
| GPT-6 Astra | — | 57 |
| GPT-6.1 Sol | — | 55 |
| Gemini 4 Argon(High) | 50 | 50 |
発表時のCarbonは59点で全モデル中トップでしたが、公開後に主要競合が追加・再評価されたことで、2026年11月時点では60点ながら順位は4位(v5.0.1)に下がっています。
Google公式のベンチマーク総覧表(前掲)は発表時点の数値であり、現行ランキングとは別に読み解く必要があります。
関連評価として、Vals AIが運営するVals Indexでは70.45%で36モデル中3位、Finance Indexでは39モデル中1位、Legal Indexでは75.93%で37モデル中3位、Legal Research Benchでは55.77%という評価です。
総合スコアは「全タスク平均」であって、個別タスクでは順位が入れ替わる点に注意が必要です。この非対称性は後述のH2「Gemini 4 Carbon vs Claude Opus 5.5 vs GPT-6.1 Sol」で詳しく扱います。
サイバー防御の3領域ベンチマーク
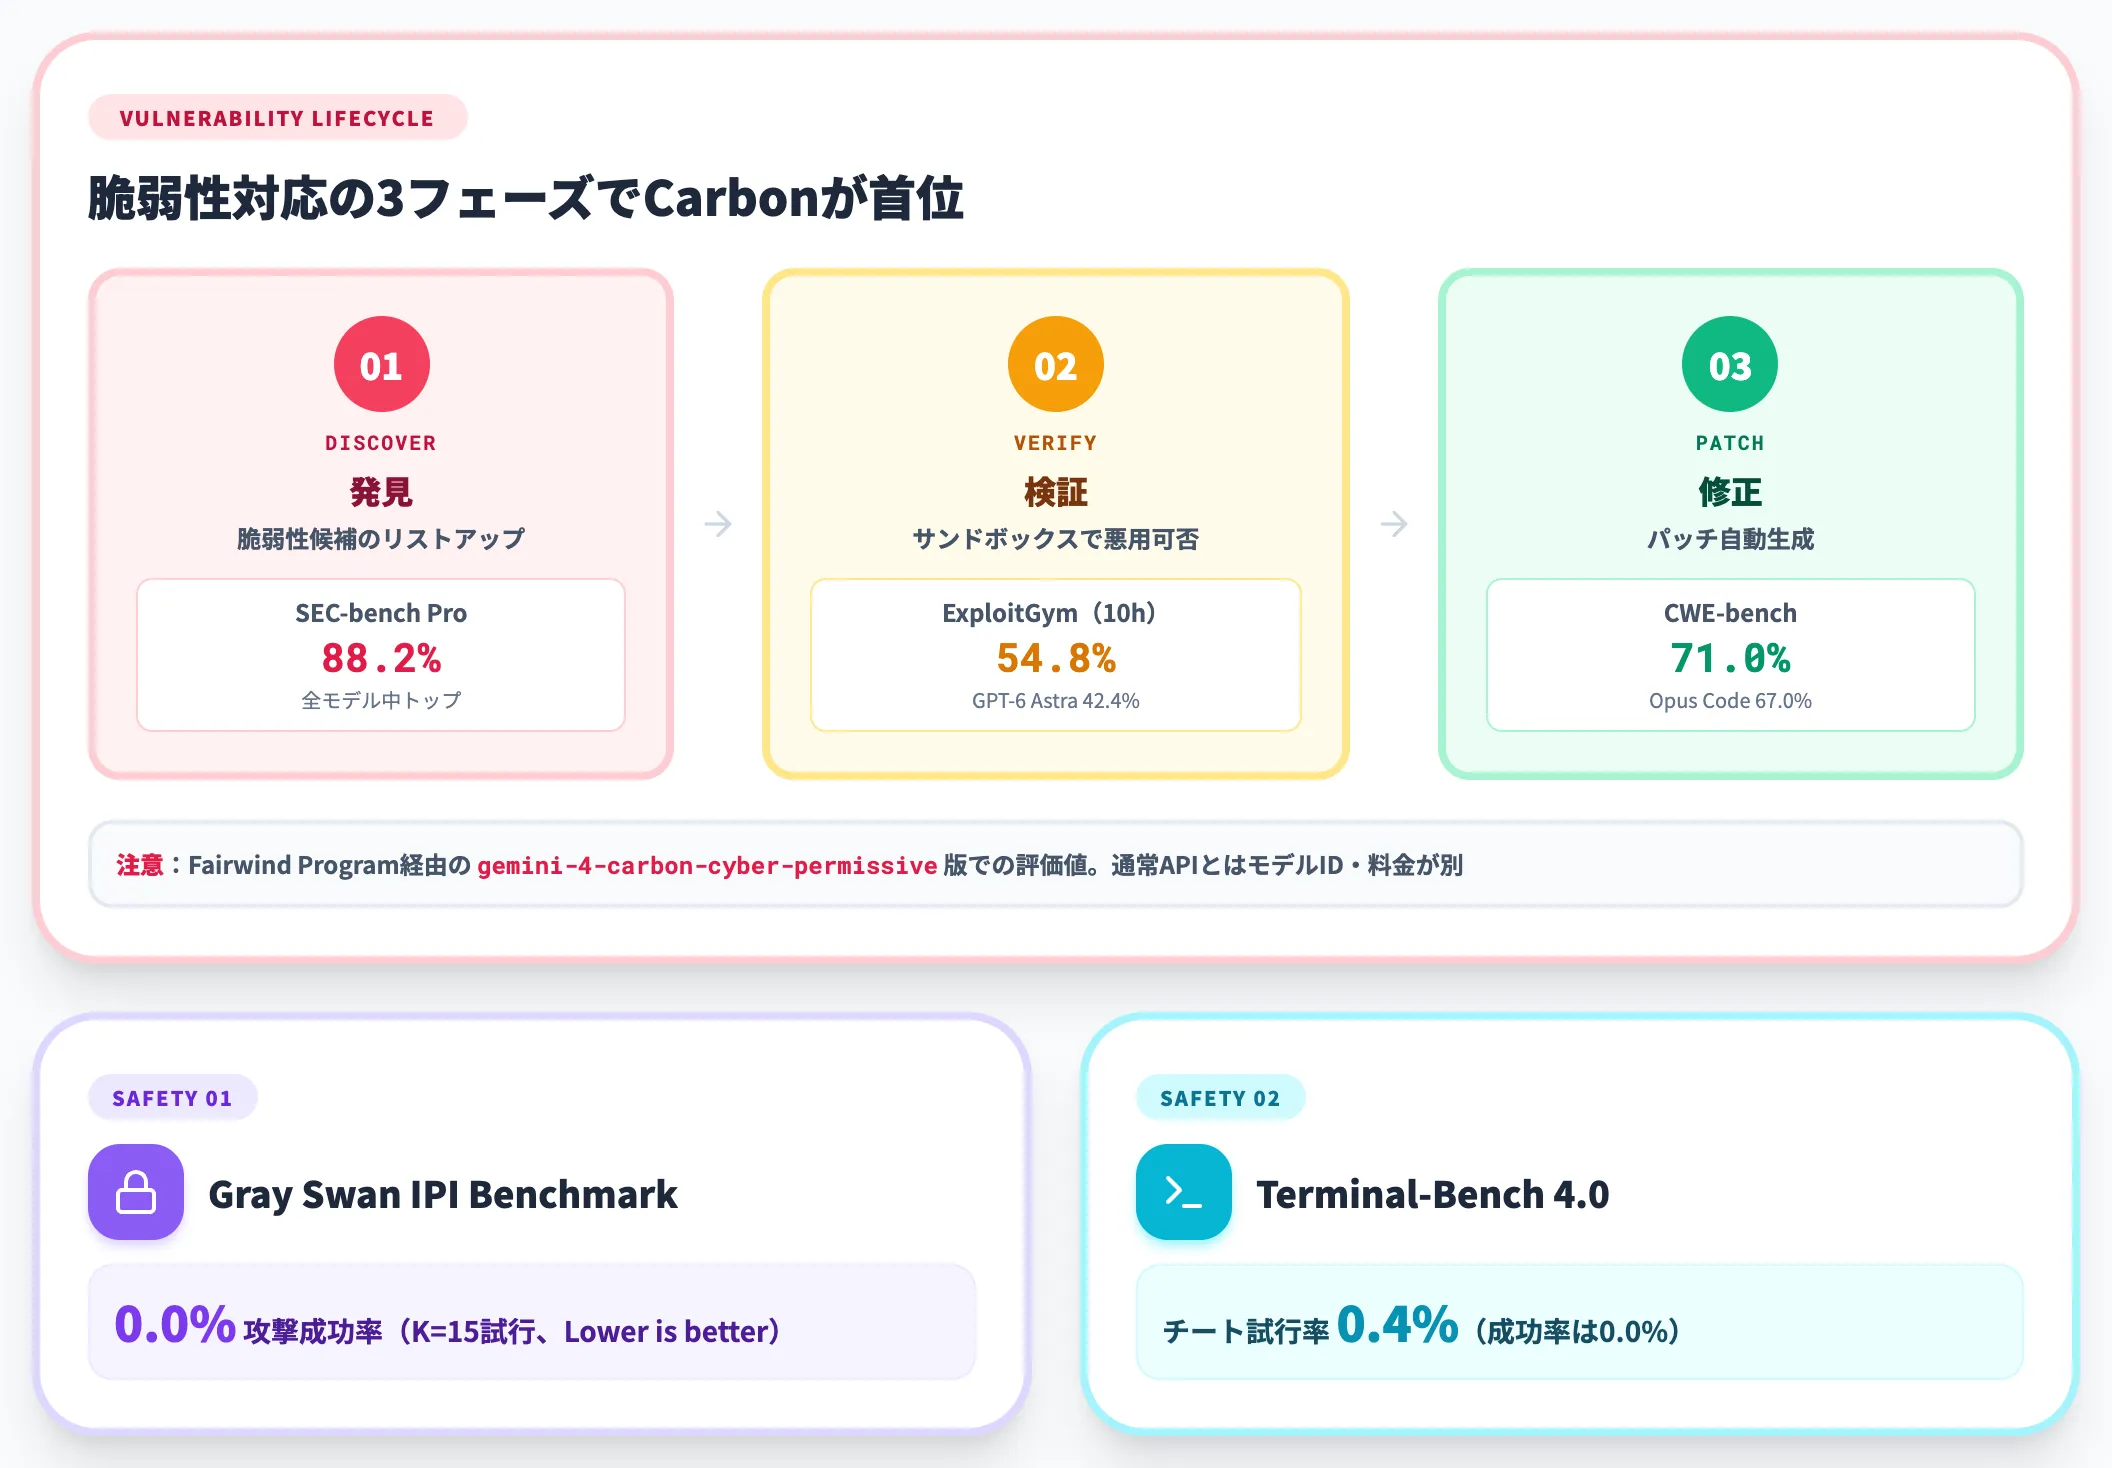
Carbonが「サイバー防御専用」と呼ばれる根拠は、脆弱性対応ライフサイクルの3領域すべてでトップスコアを出していることです。
なお以下のうちSEC-bench Pro・ExploitGym・CWE-bench の3指標は、Fairwind Program経由で提供されるサイバー専用版 gemini-4-carbon-cyber-permissive(Vertex AIでは別モデルIDとして公開・イントロ割引適用外)での評価結果です。
通常API版(gemini-4-carbon)とはアクセス経路・料金・補助ツールが異なります。Gray Swan IPI・Terminal-Bench 4.0 は通常API版の安全性評価範囲です。
以下の表で、Carbonのサイバー系ベンチマーク結果をまとめました。
| ベンチマーク | 役割 | Carbonスコア |
|---|---|---|
| SEC-bench Pro | 脆弱性発見 | 88.2% |
| ExploitGym | 脆弱性検証 | 54.8% |
| CWE-bench | パッチ生成 | 71.0% |
| Gray Swan IPI Benchmark | プロンプトインジェクション攻撃成功率 | 0.0%(K=15試行、Lower is better) |
| Terminal-Bench 4.0 | 評価でのチート試行率 | 0.4%(成功率は0.0%) |
各領域の具体的な比較グラフを順に見ていきます。脆弱性発見ベンチマークの SEC-bench Pro では、Carbonが88.2%で全モデル中トップを取っています。
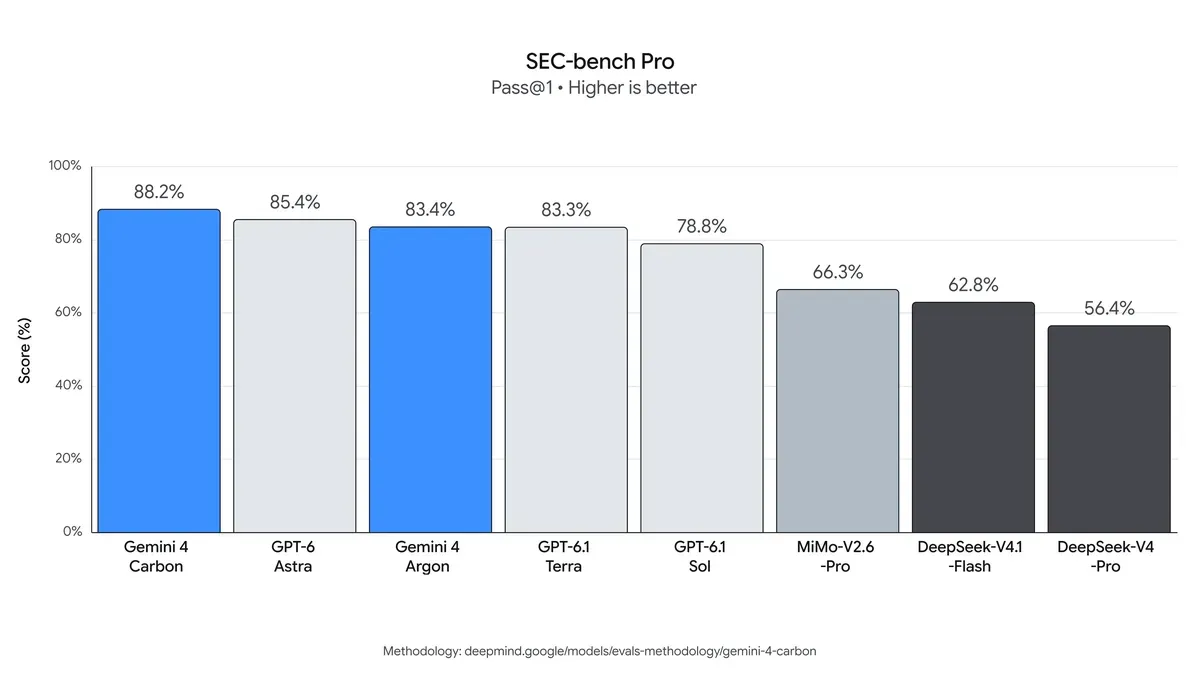
SEC-bench Pro の脆弱性発見スコア(Pass@1、出典:Google公式ブログ)
Carbon(88.2%)とGPT-6 Astra(85.4%)の差は2.8ポイントで、Pass@1評価ではわずかな差でも試行回数を重ねれば検出率に影響します。OpenAI系とGoogle系の上位5モデルが70%台後半〜80%台後半で競り合い、中国発の DeepSeek V4.1 Flash は62.8%、V4 Pro は56.4%と、フロンティア勢からは1段離れた水準です。
続いて脆弱性検証(発見した候補を実際に悪用できるかサンドボックスで試す)の ExploitGym では、Carbonがタスクあたり10時間の時間制限下で54.8%、6時間でも53.5%と、制限時間に左右されにくい安定した成績を出しています。
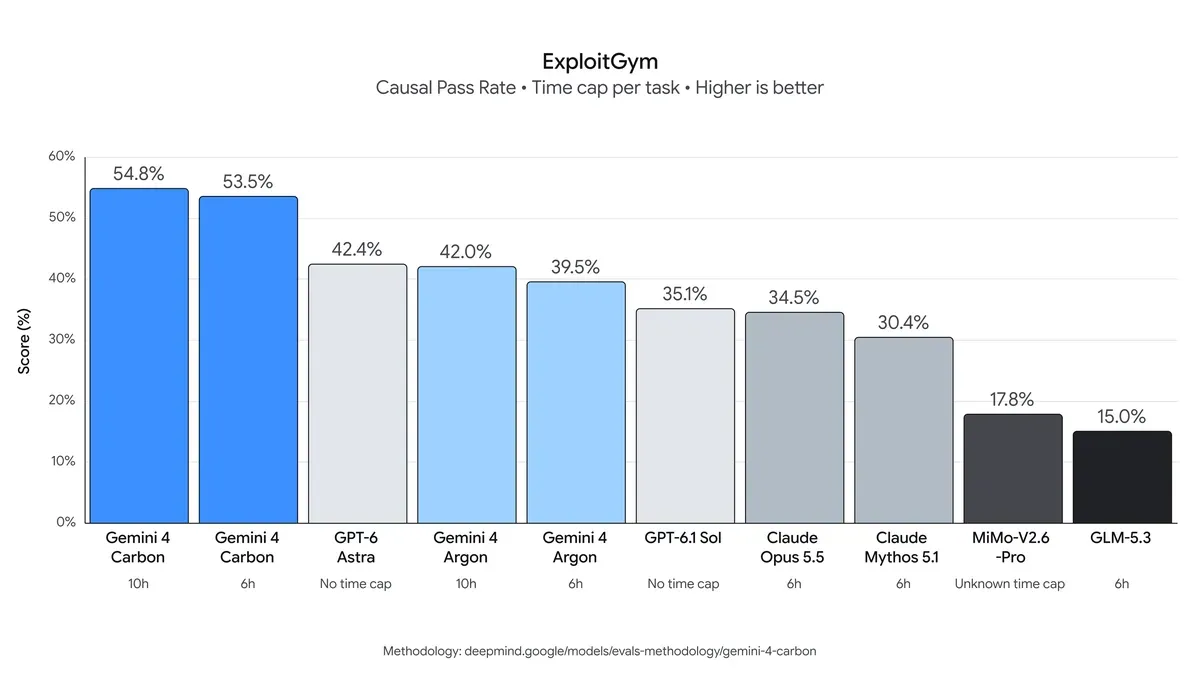
ExploitGym の Causal Pass Rate(Time cap per task、出典:Google公式ブログ)
競合の GPT-6 Astra は時間制限なしで42.4%、Claude Opus 5.5 は6時間設定で34.5%と、Carbon優位の差が10〜20ポイントと大きい領域です。「長時間かけて検証する」設計がそのまま結果に出ています。
最後にパッチ生成の CWE-bench では、Google Antigravity 上で動くCarbonが71.0%で首位。Claude Opus 5.5 を Claude Code 上で動かした場合の67.0%を4ポイント上回っています。
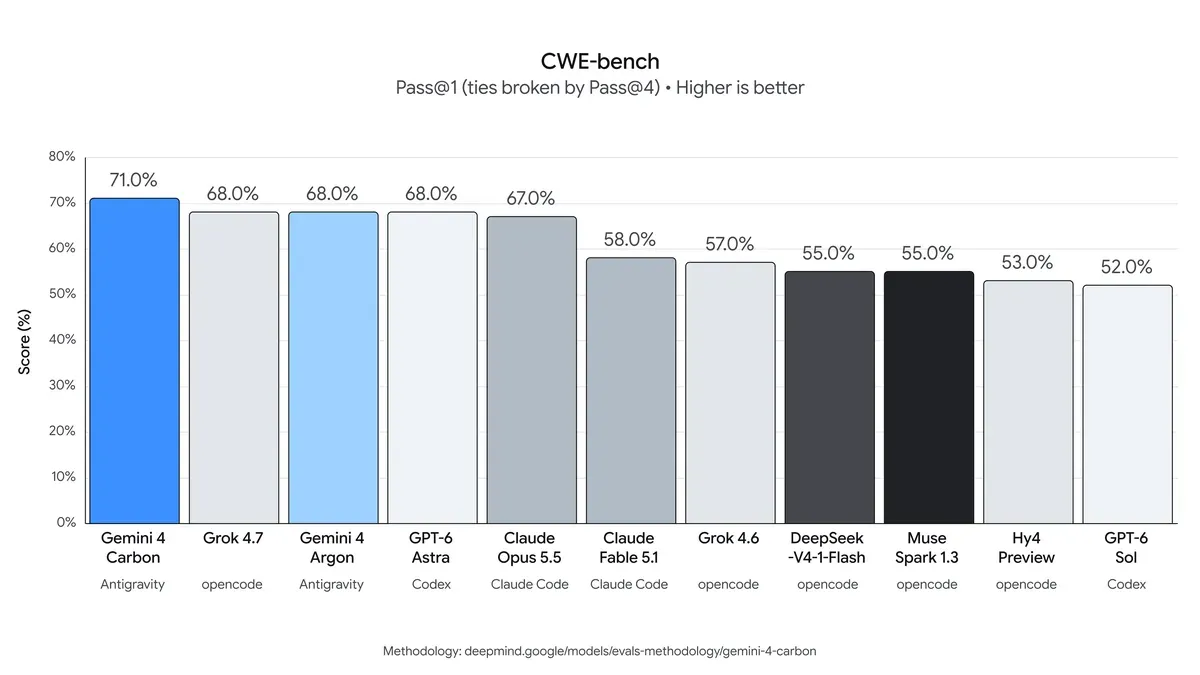
CWE-bench のパッチ生成スコア(Pass@1、出典:Google公式ブログ)
同じベンチマークでも実行ハーネスによって結果が変わる点に注意が必要です。Carbonは Antigravity との組み合わせで最高値、Argon は同じ Antigravity 上で68.0%、GPT-6 Astra は Codex 上で68.0%、Opus 5.5 は Claude Code 上で67.0%と、各社とも自社ハーネスで最高値を出す構図です。ベンチマーク比較は「モデル+実行環境のペア」で見る必要があります。
プロンプトインジェクション耐性の Gray Swan IPI Benchmark は「攻撃側の成功率」が指標なので低いほど良く、Carbonは0%を記録しています。
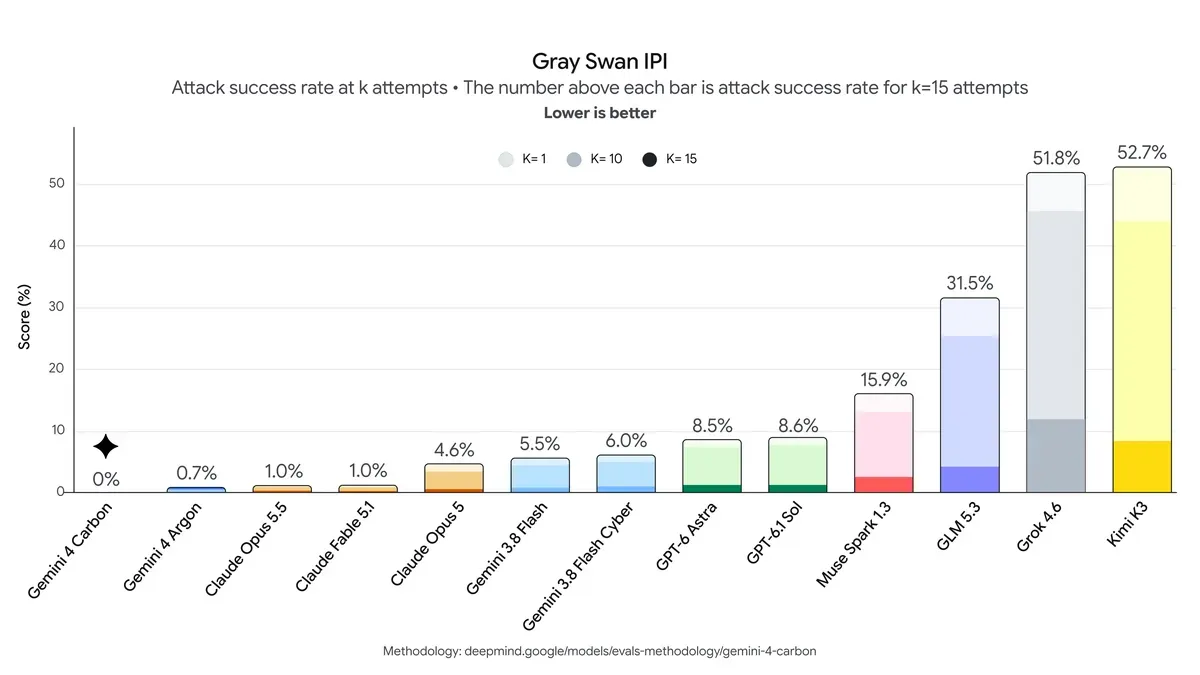
Gray Swan IPI の攻撃成功率(Lower is better、K=1/10/15試行、出典:Google公式ブログ)
Argon 0.7%、Claude Opus 5.5・Fable 5.1 が1.0%と、フロンティア上位勢は軒並み1%以下に収まっています。一方で Kimi K3(52.7%)や Grok 4.6(51.8%)のような中位モデルは、K=15回まで試行すると半数以上の攻撃が通る水準です。Carbonは間接プロンプトインジェクションへの耐性でも、この評価条件下ではArgonを下回る0%を記録しています。
Google Chromeチームの内部評価では、別の研究機関が公開している大規模フロンティアモデルと比べて、同じテスト条件で高品質なパッチを生成する性能が10倍以上と報告されています。脆弱性を見つけるだけでなく、修正コードを実際に書き切る点までを含めた評価です。
エージェントタスクの実務ベンチマーク
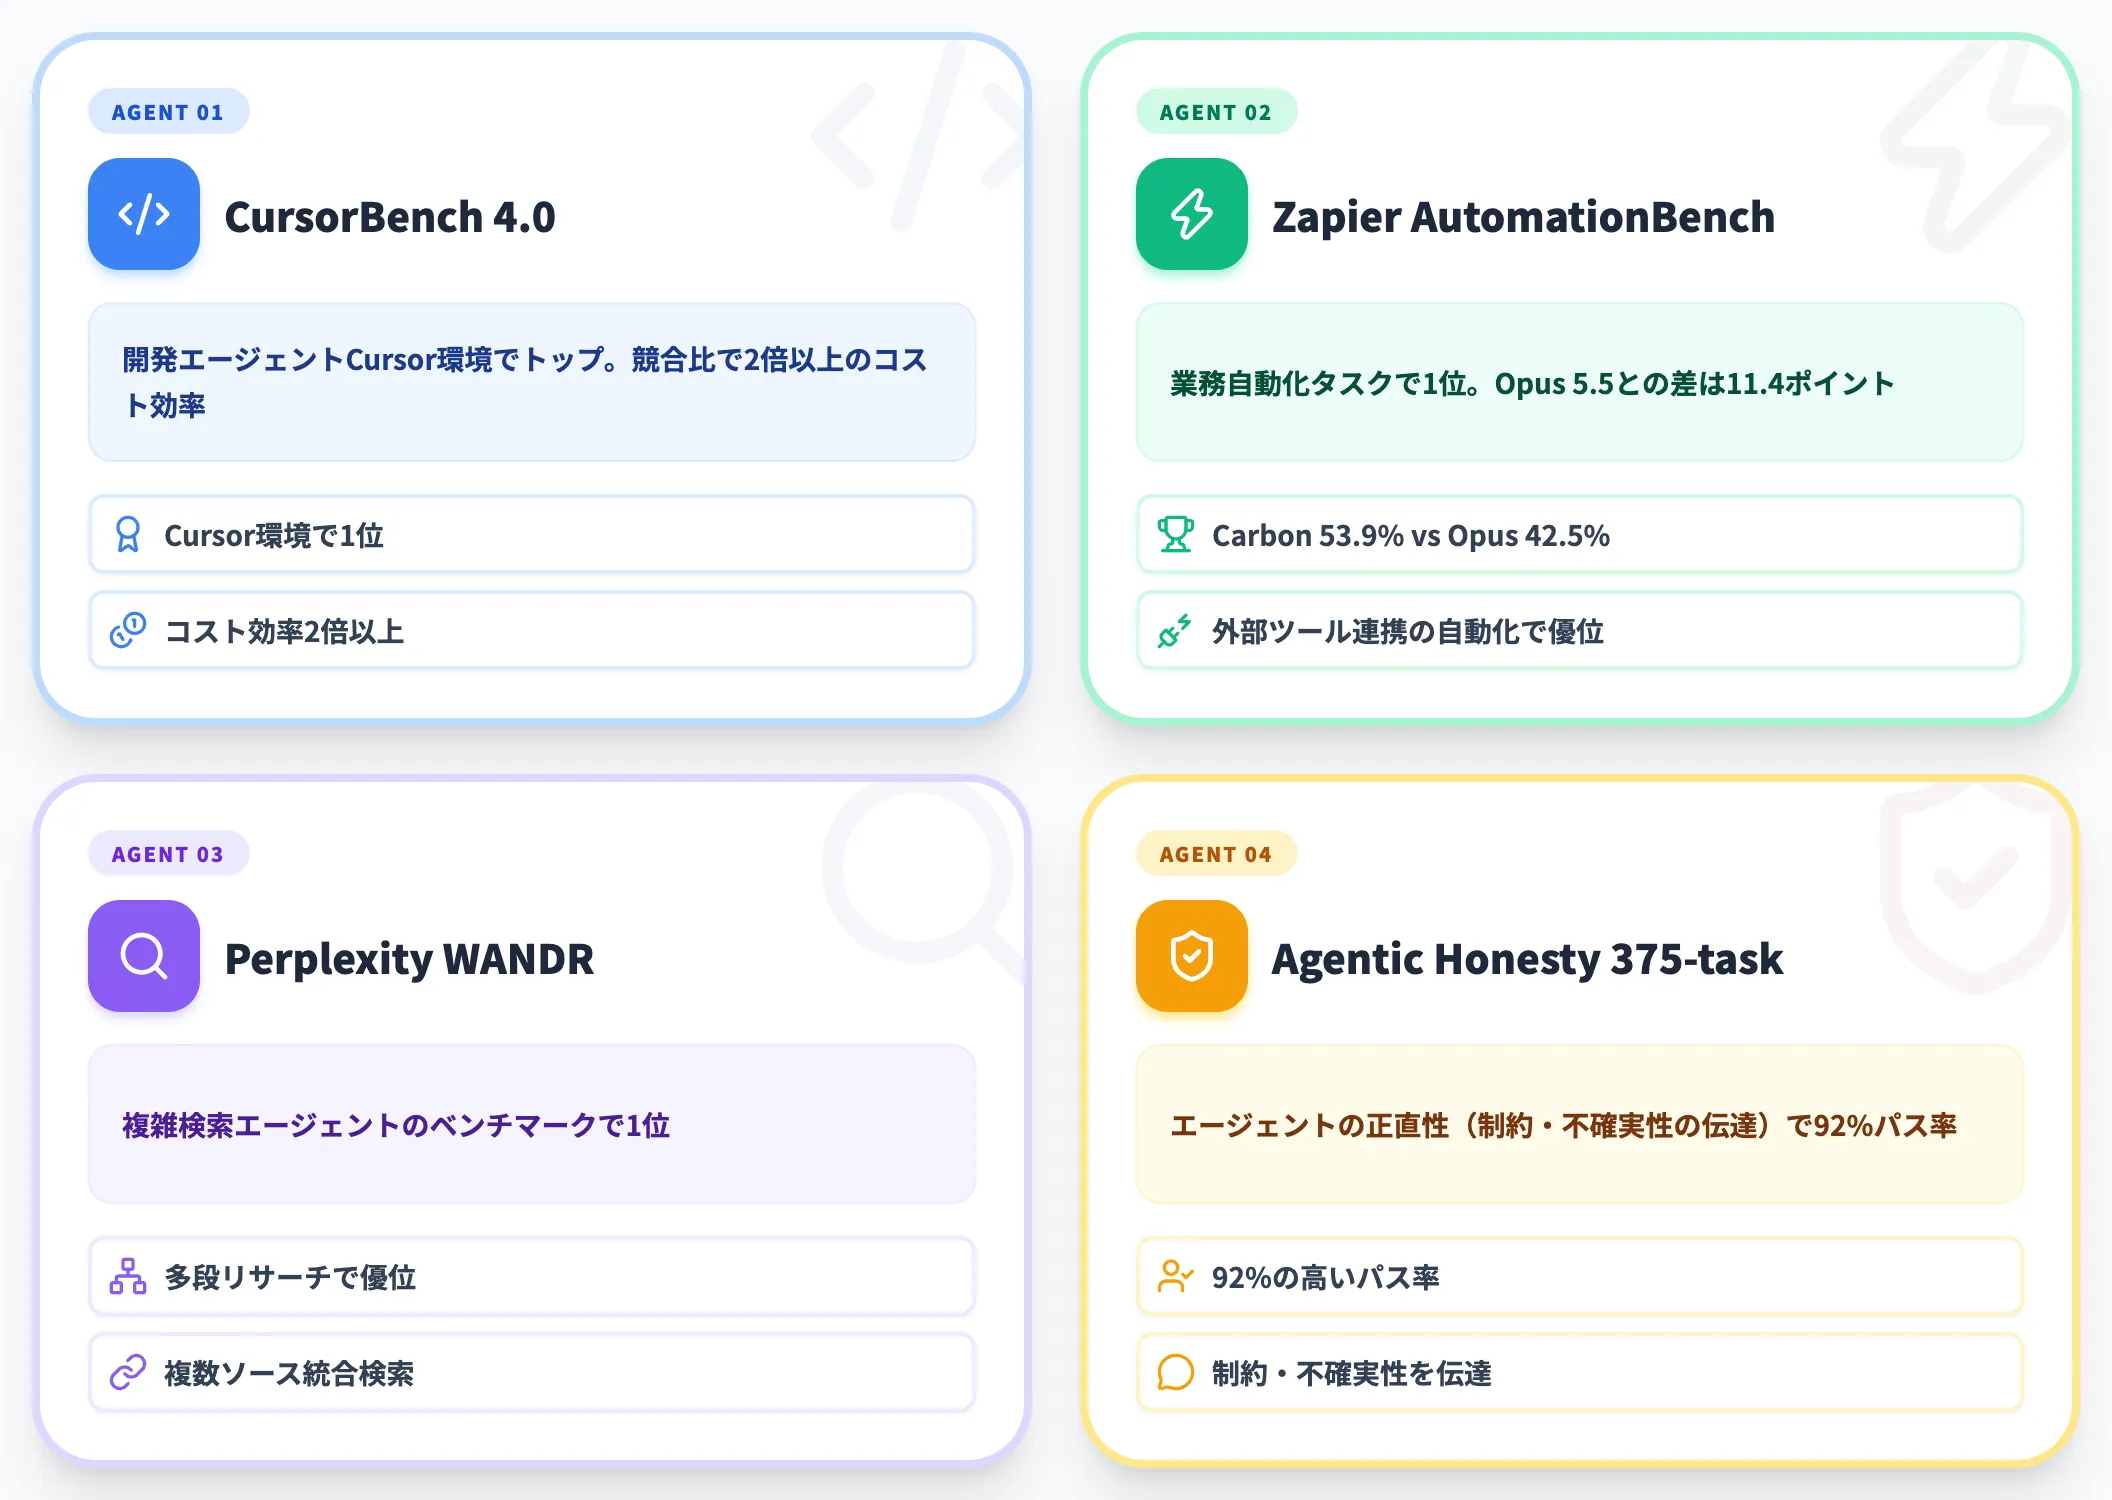
長時間エージェントの実力を測る3本のベンチマークでも、Carbonは上位を取っています。
-
CursorBench 4.0
開発エージェントCursorでの性能評価で1位。競合比で2倍以上のコスト効率
-
Perplexity WANDR
Perplexityが運営する複雑検索エージェントのベンチマークで1位
-
Zapier AutomationBench
業務自動化タスクで1位。スコア53.9%(Claude Opus 5.5は42.5%)
-
375-task agentic honesty benchmark
エージェントが自分の制約や不確実性を正直に伝える能力の評価で92%パス率
これらはいずれも「複数ステップ・複数ツール呼び出し・長時間稼働」が前提のタスクです。CursorやZapierのように外部ツールを呼びながら数分〜数十分かけて作業を完了するシーンでは、Carbonの徹底探索設計が素直に効いてきます。一方で、単発のコード補完や短い対話では Argon や後述のOpus 5.5が速度・コストで上回る場面があります。
このベンチマーク群を見れば、Carbonは「思考が重く遅いが、結果の質で勝つ」モデルだという設計意図がはっきり伝わってきます。
Gemini 4 Carbonの料金とコスト構造
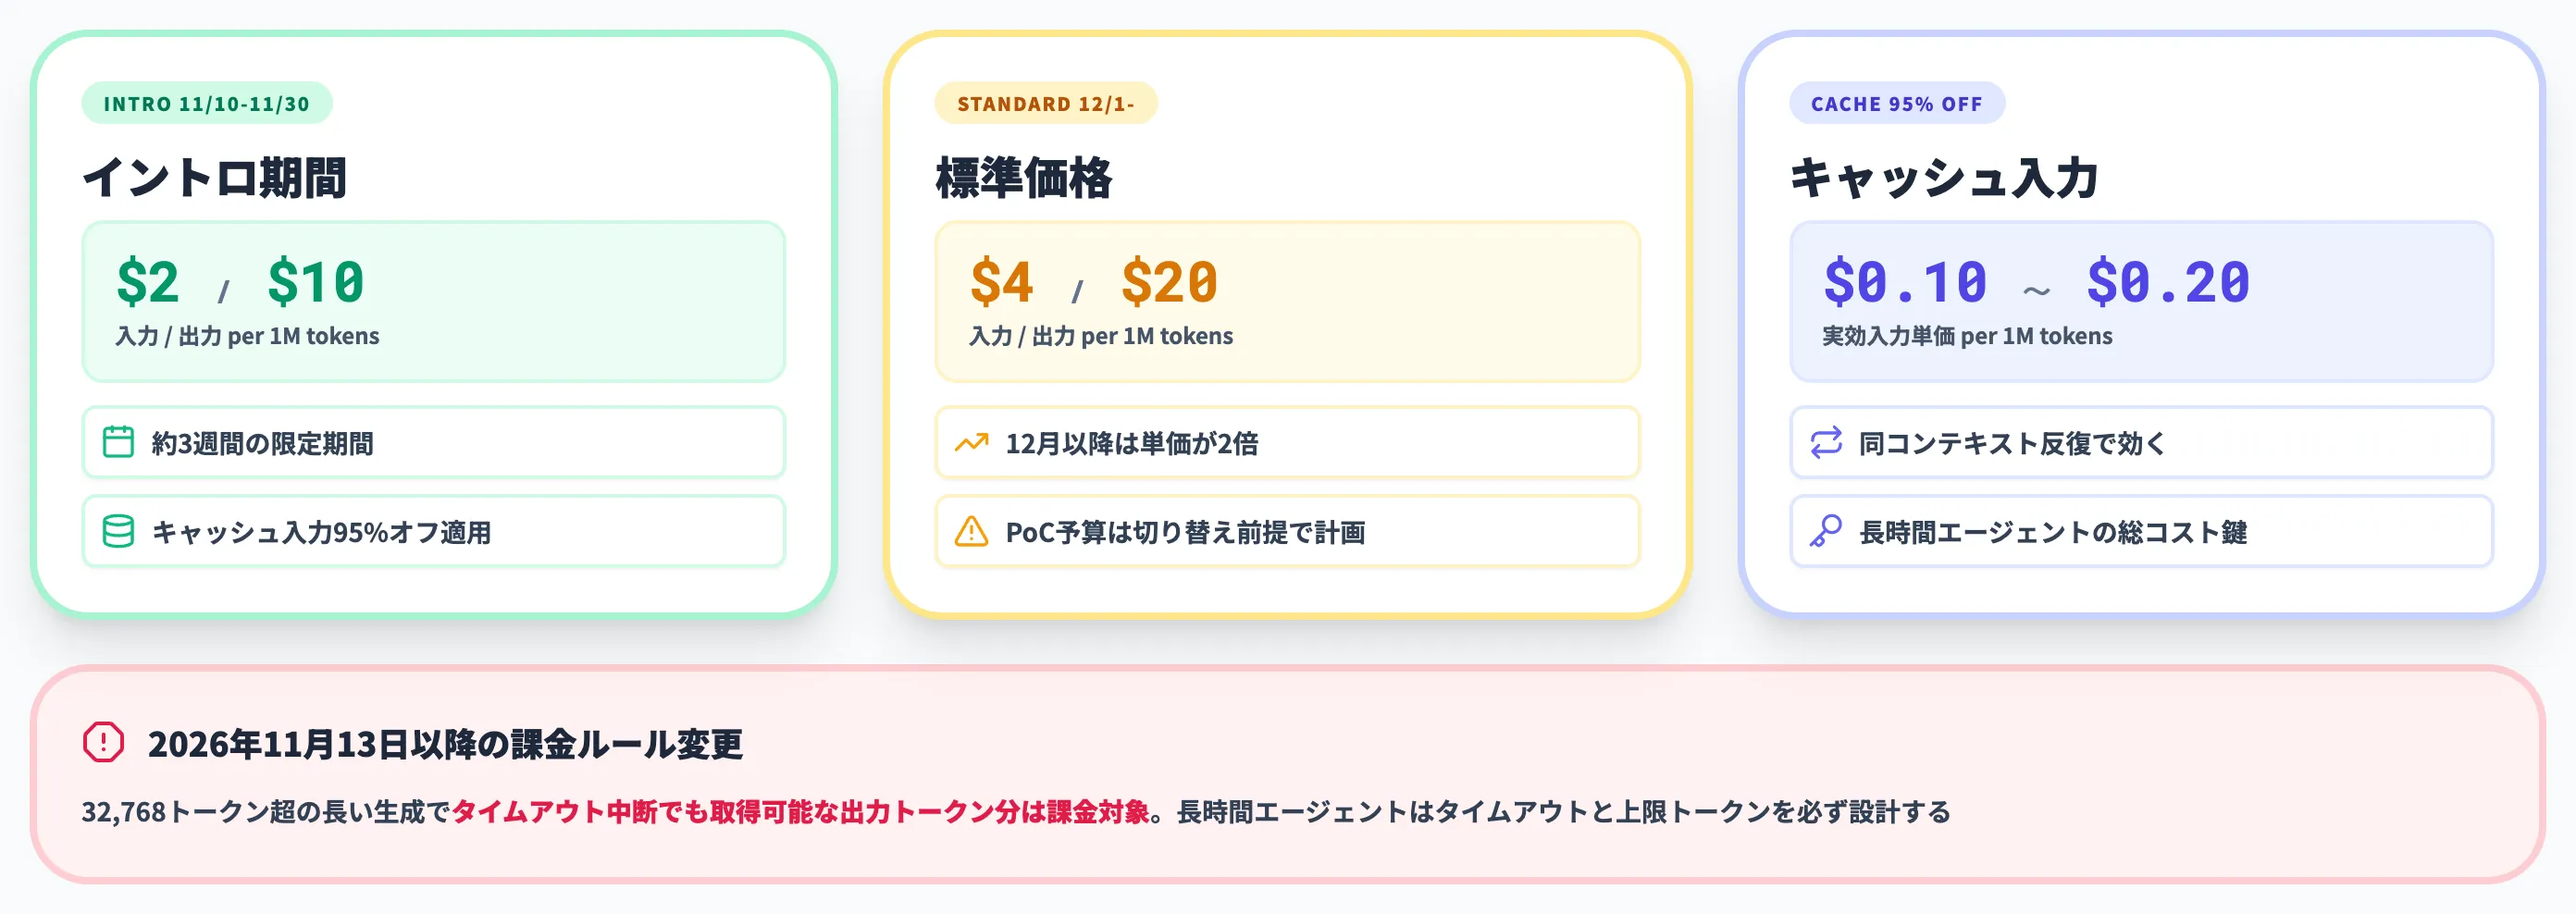
Carbonの料金は、API単価だけを見ると他社フロンティアと比べても競争的です。ただし前セクションで触れたとおり、1タスクあたりの実コストは単価では読み切れません。本セクションでは、料金表・統合トークン枠の挙動・実タスクコスト試算の3点で整理します。
API料金——イントロ期間と標準価格
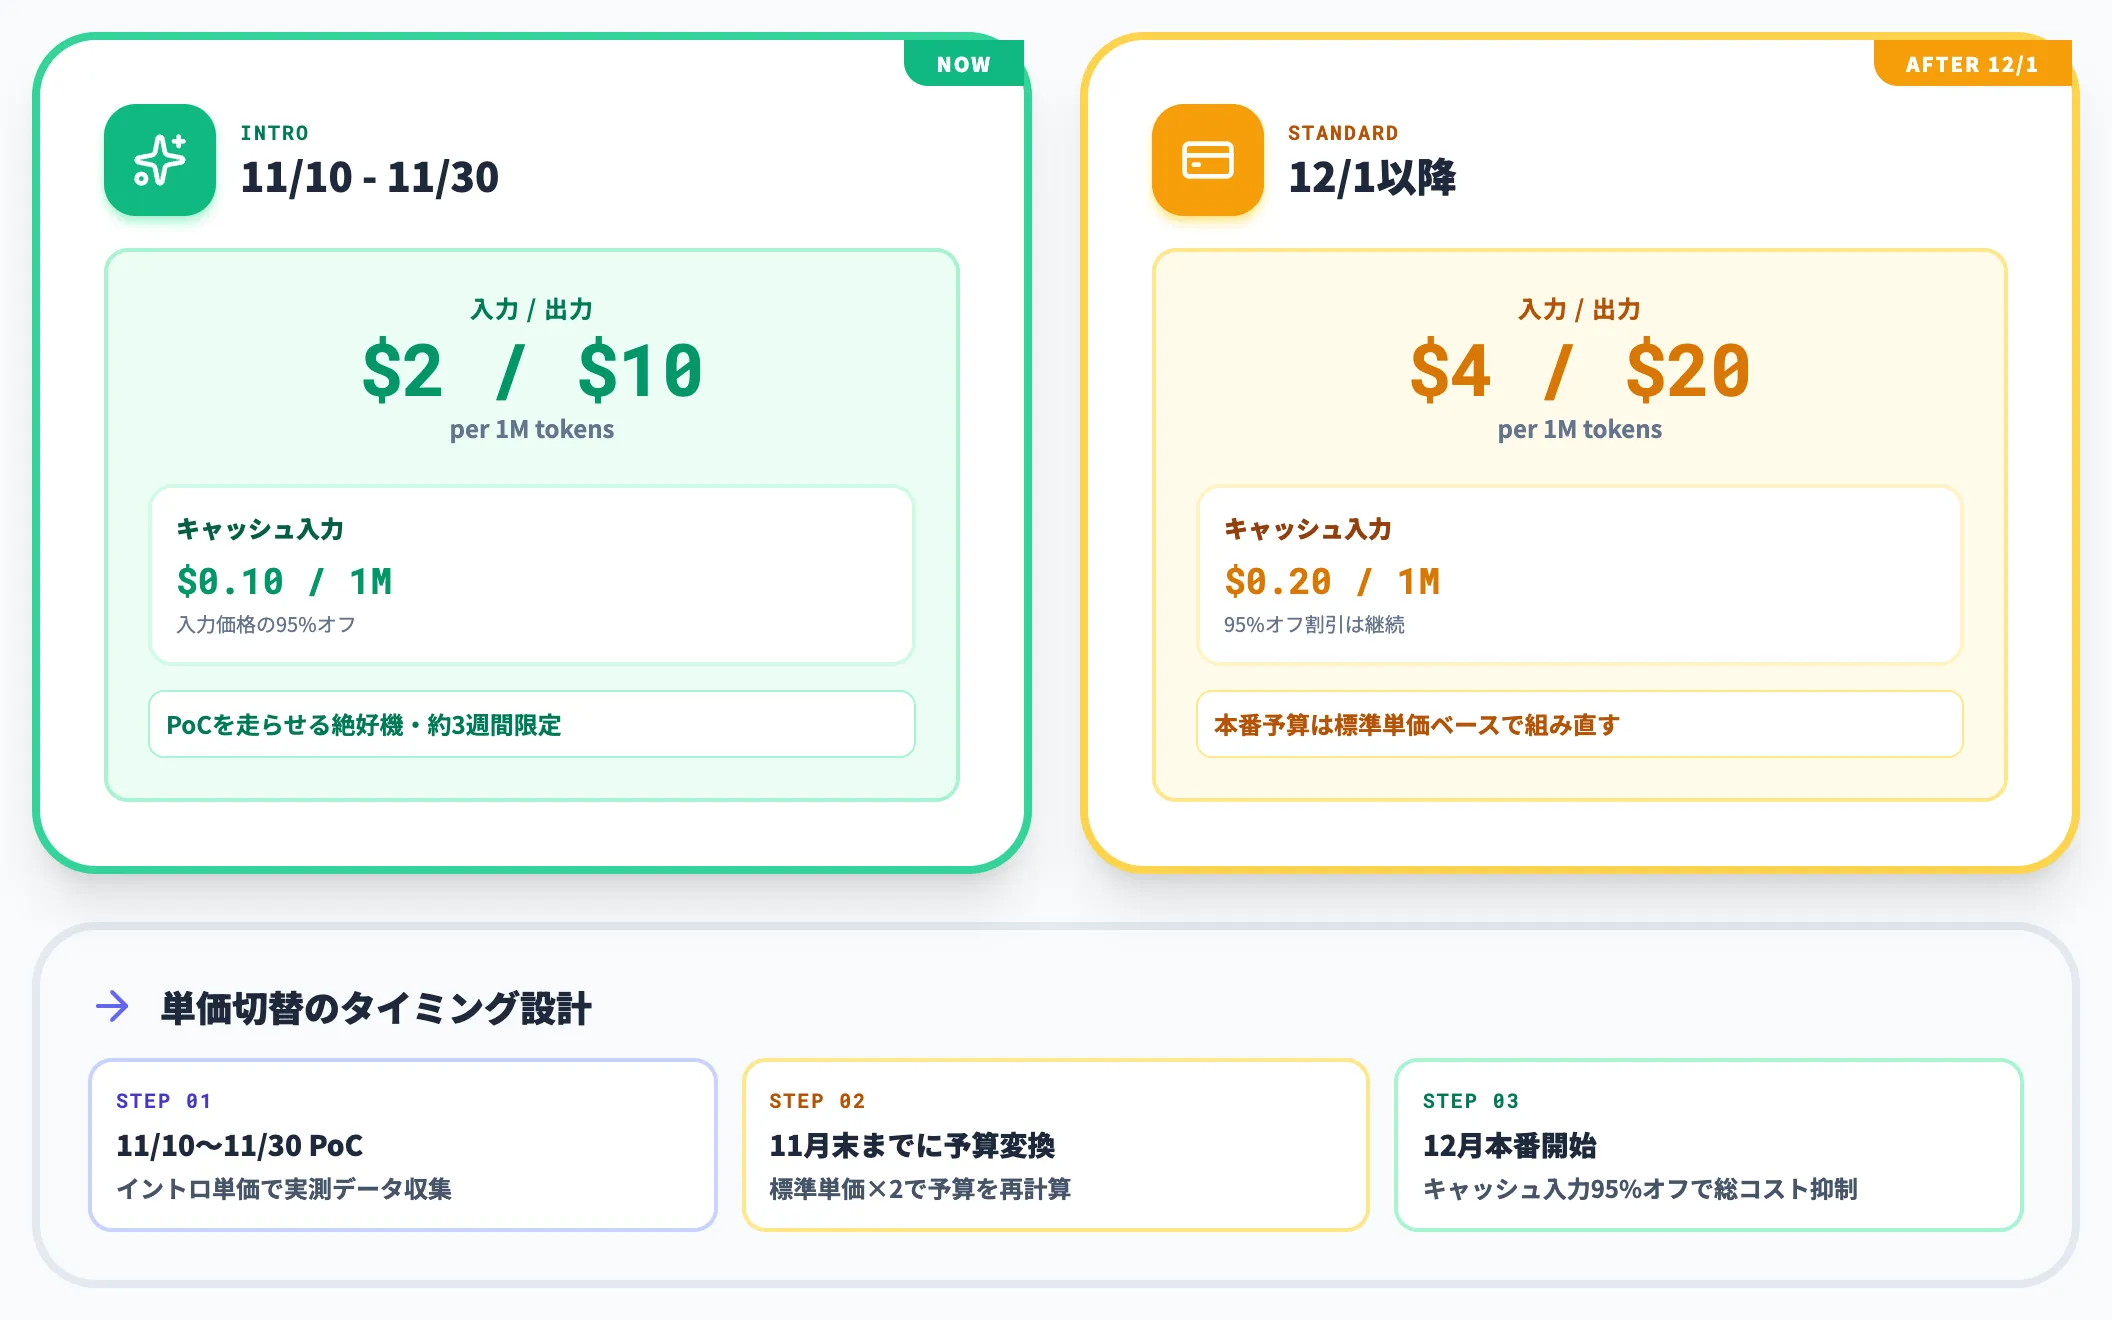
Carbonの料金体系は、2026年11月30日を区切りに大きく変わります。以下の表で、イントロ期間と標準価格を比較しました。
| 期間 | 入力 | 出力 | キャッシュ入力 |
|---|---|---|---|
| イントロ期間(2026/11/10〜11/30) | $2 / 1M tokens | $10 / 1M tokens | 入力価格の95%オフ |
| 標準価格(2026/12/1以降) | $4 / 1M tokens | $20 / 1M tokens | 入力価格の95%オフ |
イントロ期間は約3週間しかなく、PoCを回す期間としては短い設計です。11月30日を過ぎると単価が倍になるため、PoCをイントロ期間で走らせる計画にするか、12月以降の予算を標準価格ベースで組み直す必要があります。
キャッシュ入力95%オフは重要な割引です。同じコンテキスト(システムプロンプト・ドキュメント・事前情報)を繰り返し使うエージェントでは、入力トークンの大半がキャッシュ対象になり、実効単価は$0.10/1M(入力$2時)または$0.20/1M(入力$4時)まで下がります。長時間稼働のエージェントでは、プロンプトキャッシュをどう設計するかが総コストを決める最大のレバーになります。
加えて、Google Cloudでは2026年11月13日以降、32,768トークン超の長い生成についてタイムアウトで中断した場合でも、取得可能な出力トークンの使用量が課金対象となる変更が告知されています。PoCでCarbonを長時間エージェントに使う際は、思考ループが途中で切られても料金が発生する前提でタイムアウトと上限トークンを設計する必要があります。
統合トークン枠の実装——1Mを超える出力はどう処理されるか
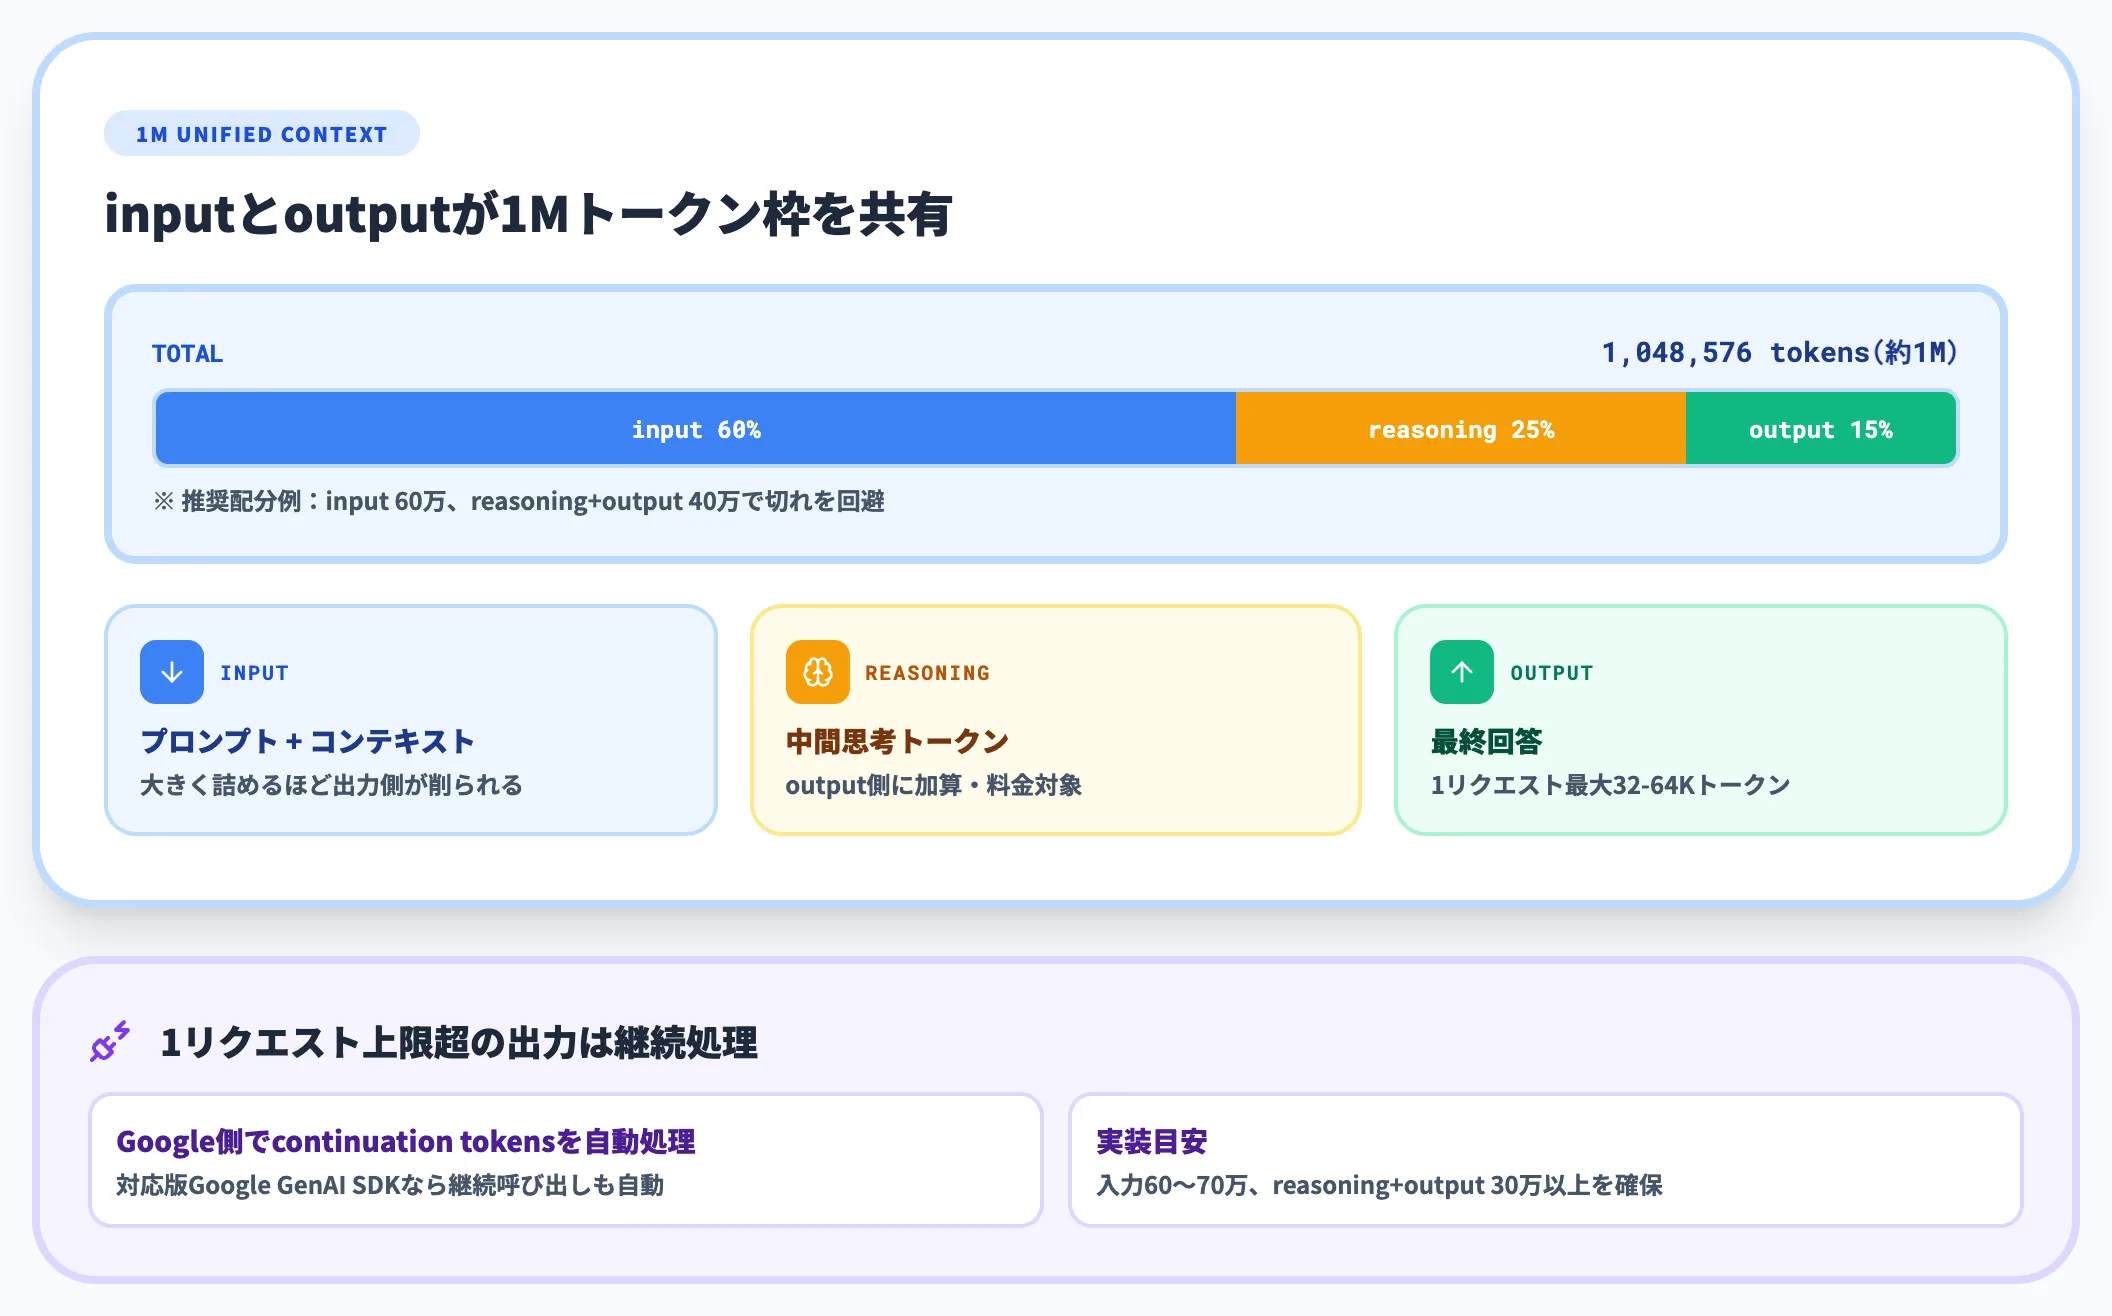
Carbonの仕様で見落とされやすいのが、1Mトークンの統合枠がinputとoutputで共有されるという点です。Google Cloudのモデル仕様では、以下の構造になっています。
- コンテキスト窓: 1,048,576トークン(約1M)
- 最大出力トークン: 通常デフォルトは65,536トークン。long decodeオプション利用時の上限が1,048,576トークン
- 既存設定が32K未満のアプリ向けの最低推奨: 32,768トークン(通常タスクはデフォルト65,536のまま)
- reasoning tokens(思考トークン)はoutput側にカウント
- 1リクエストあたりの前景出力は、ストリーミングで最大65,536トークン、非ストリーミングで最大32,768トークン
注意すべきは、入力を1Mトークン近くまで詰めると、出力側の枠が削られる点です。例えばシステムプロンプトと参照ドキュメントで90万トークン使うと、残り約10万トークンでreasoning tokensと最終出力を両方賄う必要があり、長文回答が途中で切れる原因になります。
1リクエスト制限(32,768〜65,536)を超える出力が必要な場合は、Google側でcontinuation tokensを自動処理する設計です。対応版の Google GenAI SDK を使えば継続呼び出しも自動処理されます。
実装時の目安として、「長文入力+長文出力」のタスクでは入力を60〜70万トークンに抑え、残り30万トークン以上をreasoning + outputに確保する設計にしておくと、途中切れを避けられます。
AA Intelligence Indexでのタスクコスト試算
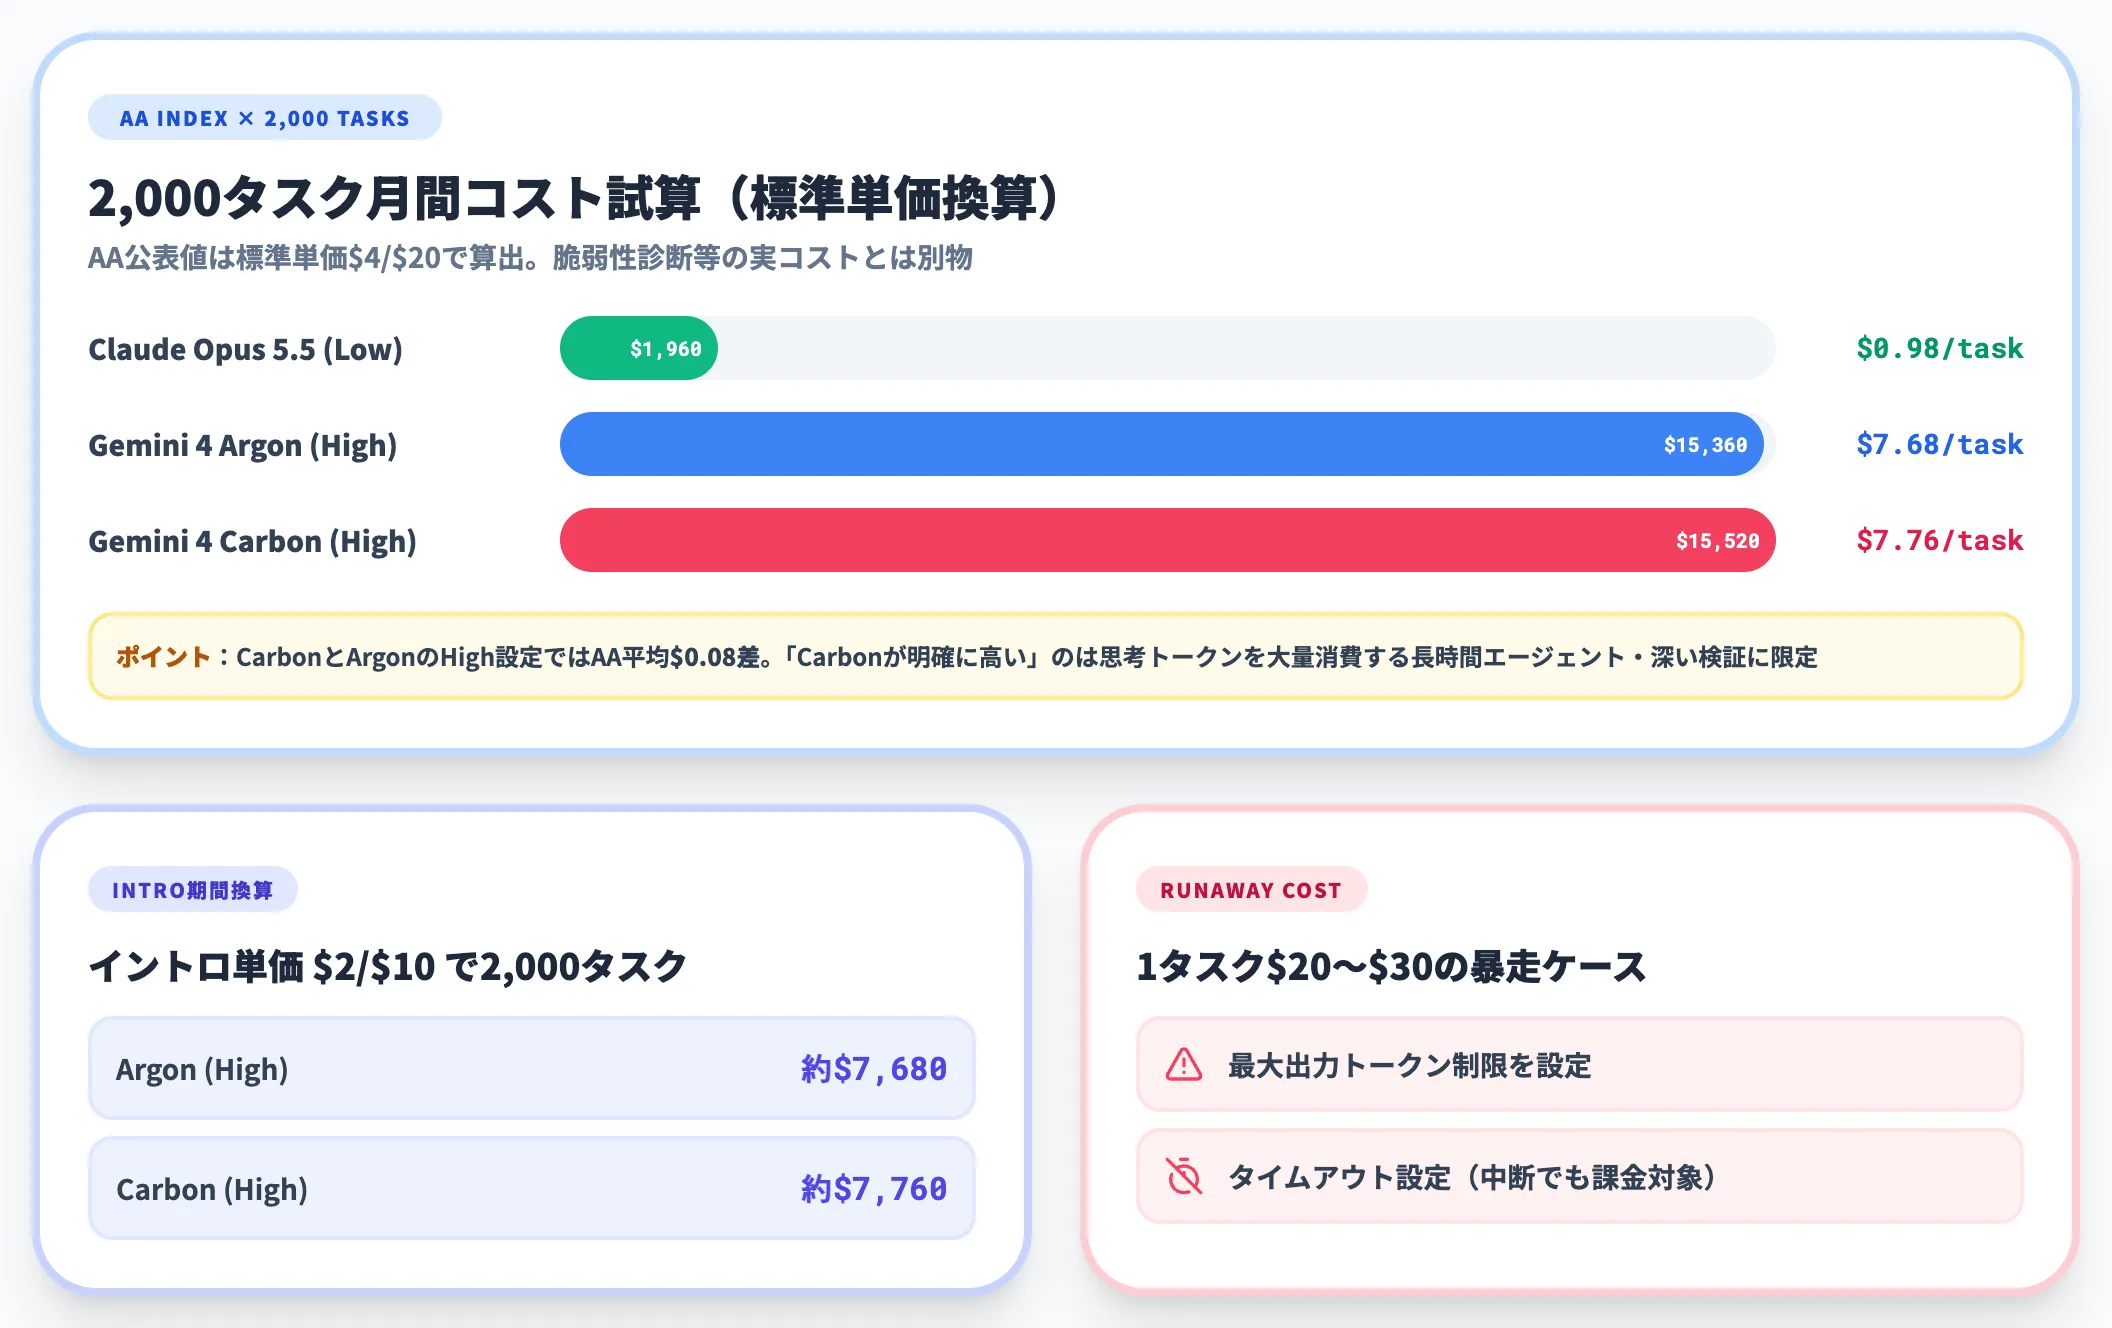
AA Intelligence Index v5.0の加重平均値を元に、2,000タスク走らせた場合の試算を並べます。この数値は Index評価タスクセットの加重平均であり、脆弱性診断や業務エージェントの実コストとは乖離する点に注意してください。実用途では、1タスクあたりの実測トークン消費を測ってから月間コストを見積もります。
以下の表で、Artificial Analysisの比較ページ掲載値から2,000タスクの試算を並べました(AA公表値は標準単価$4/$20で算出された数字です)。
| モデル | 1タスクコスト(AA平均) | 月間2,000タスク(標準単価) | 月間コスト目安(イントロ単価換算) |
|---|---|---|---|
| Claude Opus 5.5(Low) | 約$0.98 | 約$1,960 | — |
| Gemini 4 Argon(High) | 約$7.68 | 約$15,360 | 約$7,680 |
| Gemini 4 Carbon(High) | 約$7.76 | 約$15,520 | 約$7,760 |
Argon(High) の $7.68 はArtificial Analysis 2026年10月28日のCarbon #1記事で公表された発表時の値です。CarbonとArgonのHigh設定比較では、AA公表値ベースで1タスクあたり約$0.08の差しかありません。「CarbonがArgonより明確に高い」と言えるのは、Carbonが思考トークンを大量に消費する長時間エージェント・深い検証タスクに限定されます。短時間の通常タスクでは単価差ほど開かない場面もあります。
実務でのコスト管理のポイントは、Carbonを呼び出すタスクに単価上限を必ず設定することです。1リクエストあたりの最大出力トークンを絞る、1タスクあたりのタイムアウトを設定する、など、API側で思考ループの暴走を抑える仕組みを入れないと、1タスクで$20〜$30を使うケースも起きます。前述の通り、11月13日以降はタイムアウトで中断しても取得可能なトークン分は課金対象です。
Gemini 4 Carbonの提供経路と使い方
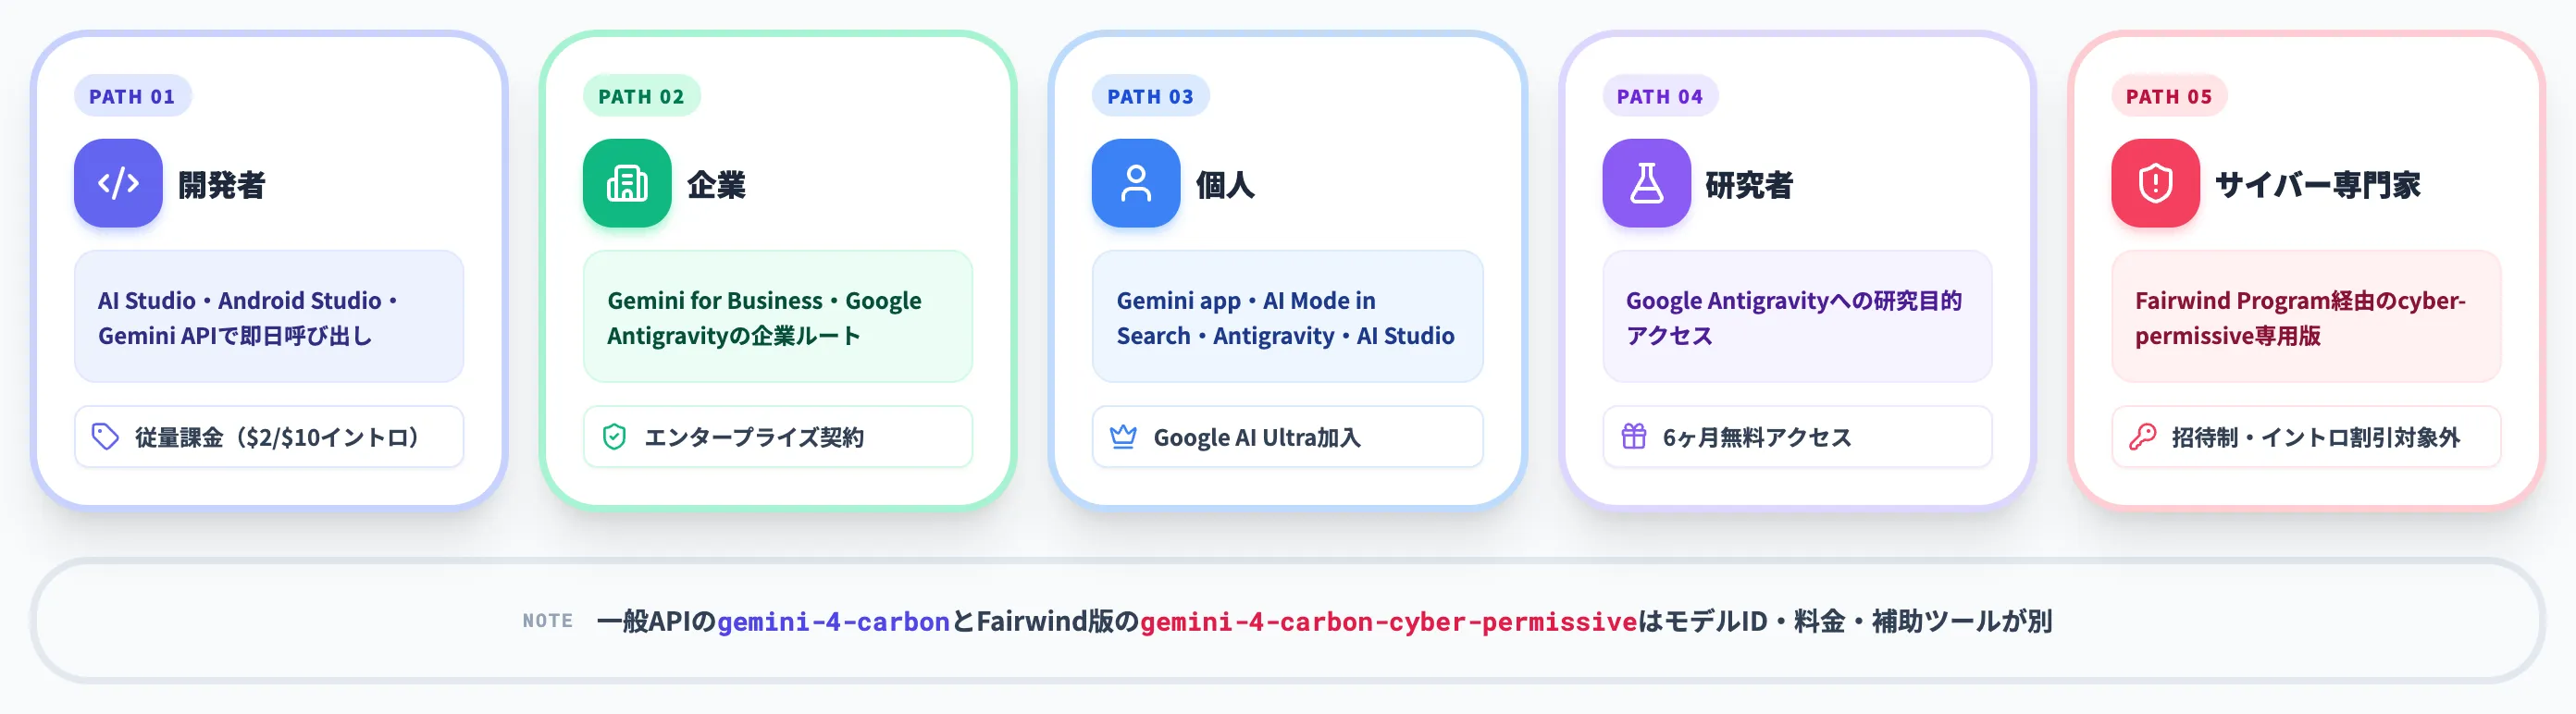
Carbonの利用経路は5つに分かれており、対象ユーザーごとに入口が違います。本セクションでは、開発者・企業・個人・研究者・サイバー専門家の各経路を順に整理します。
以下の表で、提供経路と対象ユーザーをまとめました。
| 対象 | 経路 | 料金 |
|---|---|---|
| 開発者 | Google AI Studio、Android Studio、Gemini API | 従量課金(イントロ$2/$10、12月以降$4/$20) |
| 企業 | Gemini for Business、Google Antigravity | エンタープライズ契約(APIは従量課金) |
| 個人 | Gemini app、AI Mode in Search、Antigravity、AI Studio | Google AI Ultraサブスクリプション |
| 研究者 | Google Antigravity | 6ヶ月無料アクセス |
| サイバー防御専門家 | Fairwind Program(gemini-4-carbon-cyber-permissive) | 招待制、イントロ割引適用外($4/$20) |
個人ユーザーもGemini APIを有料で契約できるため、開発・小規模運用は AI Studio / Antigravity 経由で即日利用可能です。Gemini app / AI Mode in Search / Antigravity / AI Studio でのCarbon利用は、個人向けサブスクリプションでは Google AI Ultra が対象として案内されています。サイバー防御の深い連携はFairwindが入口で、こちらはモデルIDも料金体系も別です。
開発者・企業向けAPIの始め方
開発者はGoogle AI StudioでCarbonのAPIを即日呼び出せます。モデル名は gemini-4-carbon で、認証キーを発行して通常のGemini APIと同じエンドポイントから呼び出します。
Android Studio内での開発支援経路としてもCarbonが案内されており、IDE上のコード生成・リファクタリング・デバッグ支援で使えます(Androidアプリ側へのAI機能実装は Firebase AI Logic など別経路の役割)。
企業向けの本番契約は、Google CloudのGemini Enterprise Agent Platform(旧Vertex AI)とGoogle Antigravityの2系統があります。Gemini Enterprise Agent Platformは既存のGoogle Cloudテナントに統合する形で、認証・監査・VPC・データレジデンシーなど企業要件を満たすルートです。Antigravityはエージェント開発に特化したプラットフォームで、CarbonとSwarmなどのエージェントオーケストレーション機能が組み合わせて使えます。
Google Antigravity 上での Gemini 4 Carbon 提供開始(出典:Google Antigravity ブログ)
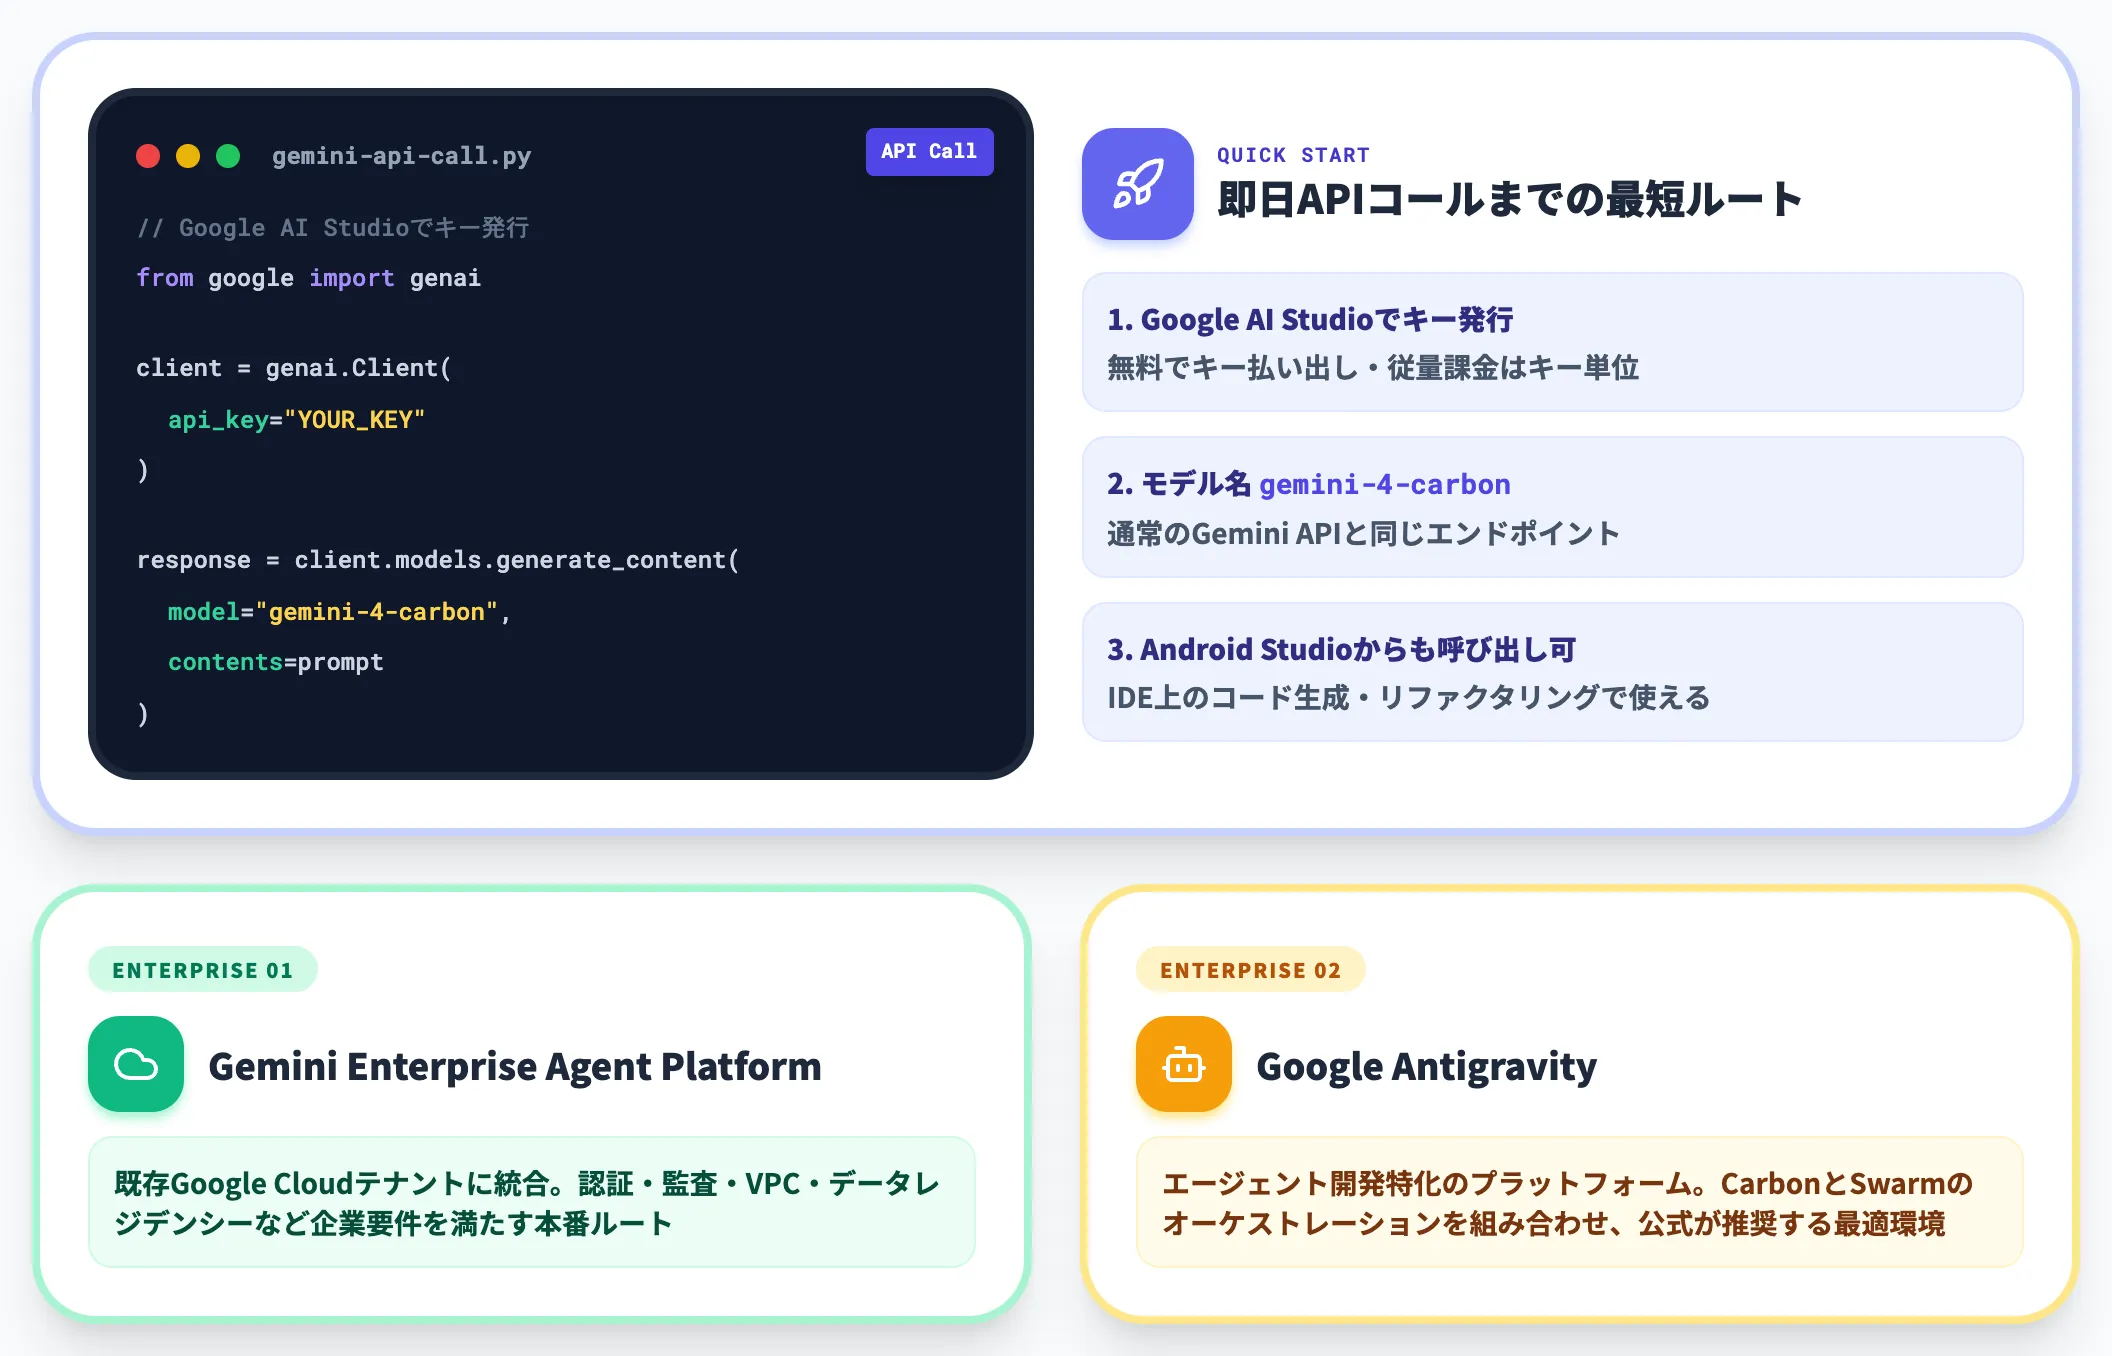
Antigravityは、エージェント開発特化型のプラットフォームとして、Carbonの徹底探索設計を最大限活かすツールチェーンを揃えています。CWE-bench のパッチ生成ベンチマークでトップを取った実行環境もこのAntigravityで、Google公式が「Carbonを最大限引き出す場所」として推奨する組み合わせです。
Gemini appとGoogle AI Ultra
個人ユーザーがCarbonを使う主要経路はGeminiアプリです。モデル選択でCarbonを選ぶには、Google AI Ultraサブスクリプションが必要になります。Ultra加入者には追加でAntigravityとAI Studioへの案内もあり、同じサブスクリプションで開発者向け経路にもアクセスできます。
Google AI UltraはGoogleの個人向け最上位プランで、Deep Research・Veo・Gemini Notebook・優先アクセスなどが束になっています。Carbonの思考ループは重いため、応答時間が数分単位になることを前提にした体験設計です。
AI Mode in Search経由では、検索結果の一部でCarbonの深い推論が差し込まれる形でも提供されています。
個人用途でCarbonを使うシーンとしては、長文の技術文書の深い分析、大規模な調査レポートの生成、複雑なコードベースのリファクタリング提案など、「数分待ってもいいから質の高い回答がほしい」場面に向きます。日常の素早い対話は従来どおりArgonやFlashが適しています。
Fairwind Programへの応募ルート
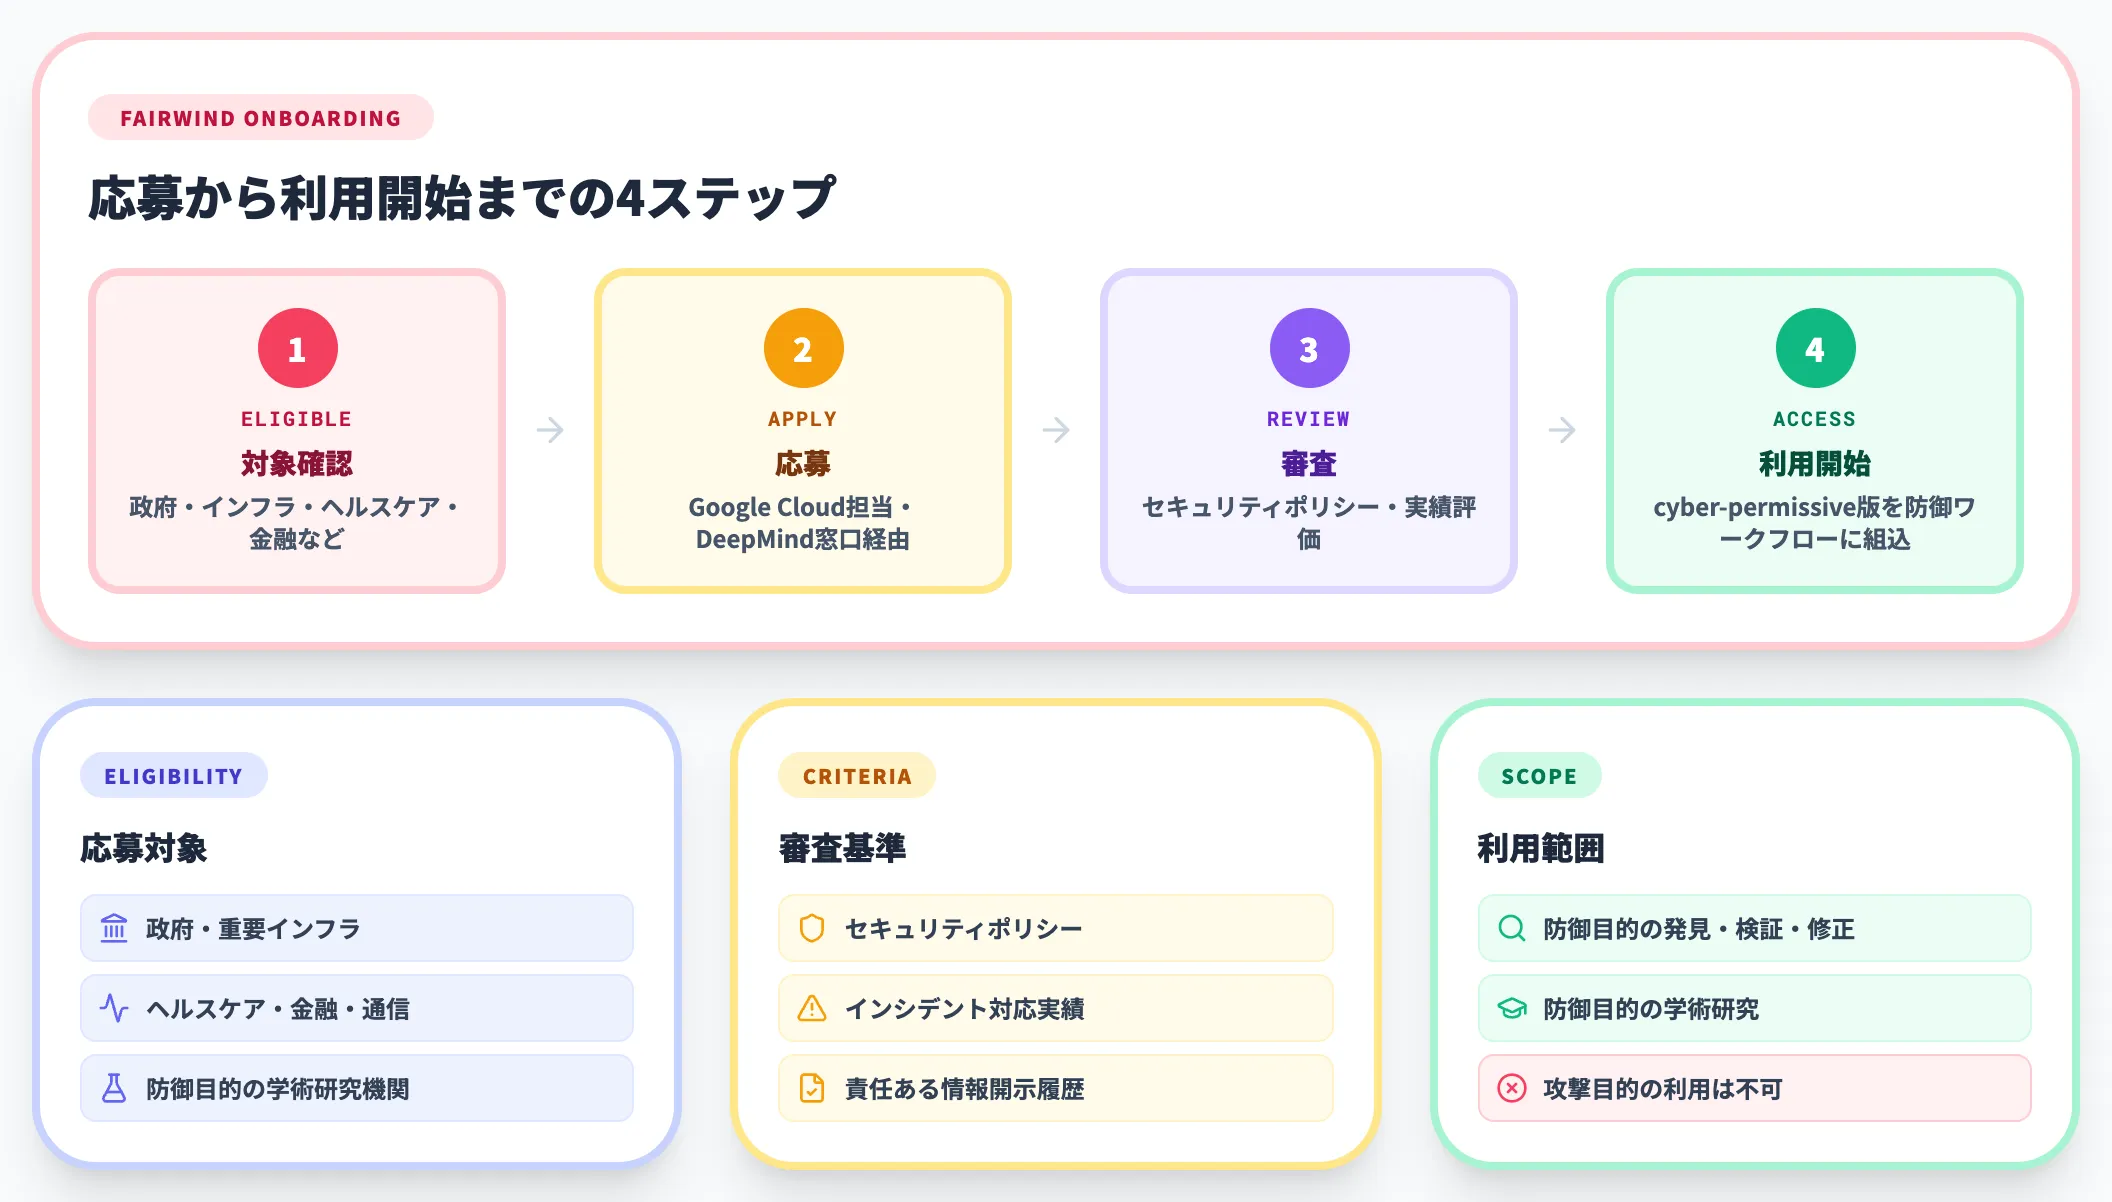
Fairwind ProgramはGoogle DeepMindがサイバー防御向けに運営している早期アクセスプログラムで、Carbonの一般提供開始前から運用されています。現在650以上のパートナーが参加しており、政府・重要インフラ運用者・ヘルスケア・テレコム・コア技術プラットフォームなどが対象です。
応募はGoogle Cloudの担当者への連絡、またはDeepMind側の窓口経由で進めます。審査に通ると、Carbonのサイバー専用モデル(Vertex AIでは gemini-4-carbon-cyber-permissive として公開される別IDのモデル。通常API版とは料金・補助ツールが異なり、イントロ割引は適用外)を使えるようになり、脆弱性発見・検証・パッチ生成の防御ワークフローに組み込めます。
-
応募対象
政府機関、重要インフラ事業者、ヘルスケア、金融、通信、主要テクノロジー企業、防御目的の学術研究機関のセキュリティチーム
-
審査基準
組織のセキュリティポリシー、過去のインシデント対応実績、責任ある情報開示の履歴など
-
利用範囲
防御目的の脆弱性発見・検証・修正、および防御目的の学術研究(攻撃目的の利用は不可)
-
既存事例
Wizの「Scan for Good」イニシアチブ(公的インフラの高リスク脆弱性を無料で修復・Carbonで運用開始)など。Isomorphic Labs の創薬R&D活用はArgon系の公開事例として知られていますが、Fairwind帰属は本記事執筆時点では未確認です
Carbonの一般提供が始まった後も、Fairwindは「サイバー防御専用」経路として継続します。一般APIで呼び出す gemini-4-carbon と、Fairwind経由の gemini-4-carbon-cyber-permissive は、モデルID・料金・補助ツール・運用ガイドラインがすべて別です。日本企業が応募する場合は、英語でのセキュリティ対応体制の説明と、組織のインシデント対応履歴を整えておくと審査がスムーズになります。
Gemini 4 Carbon vs Claude Opus 5.5 vs GPT-6.1 Sol——どのモデルを選ぶか
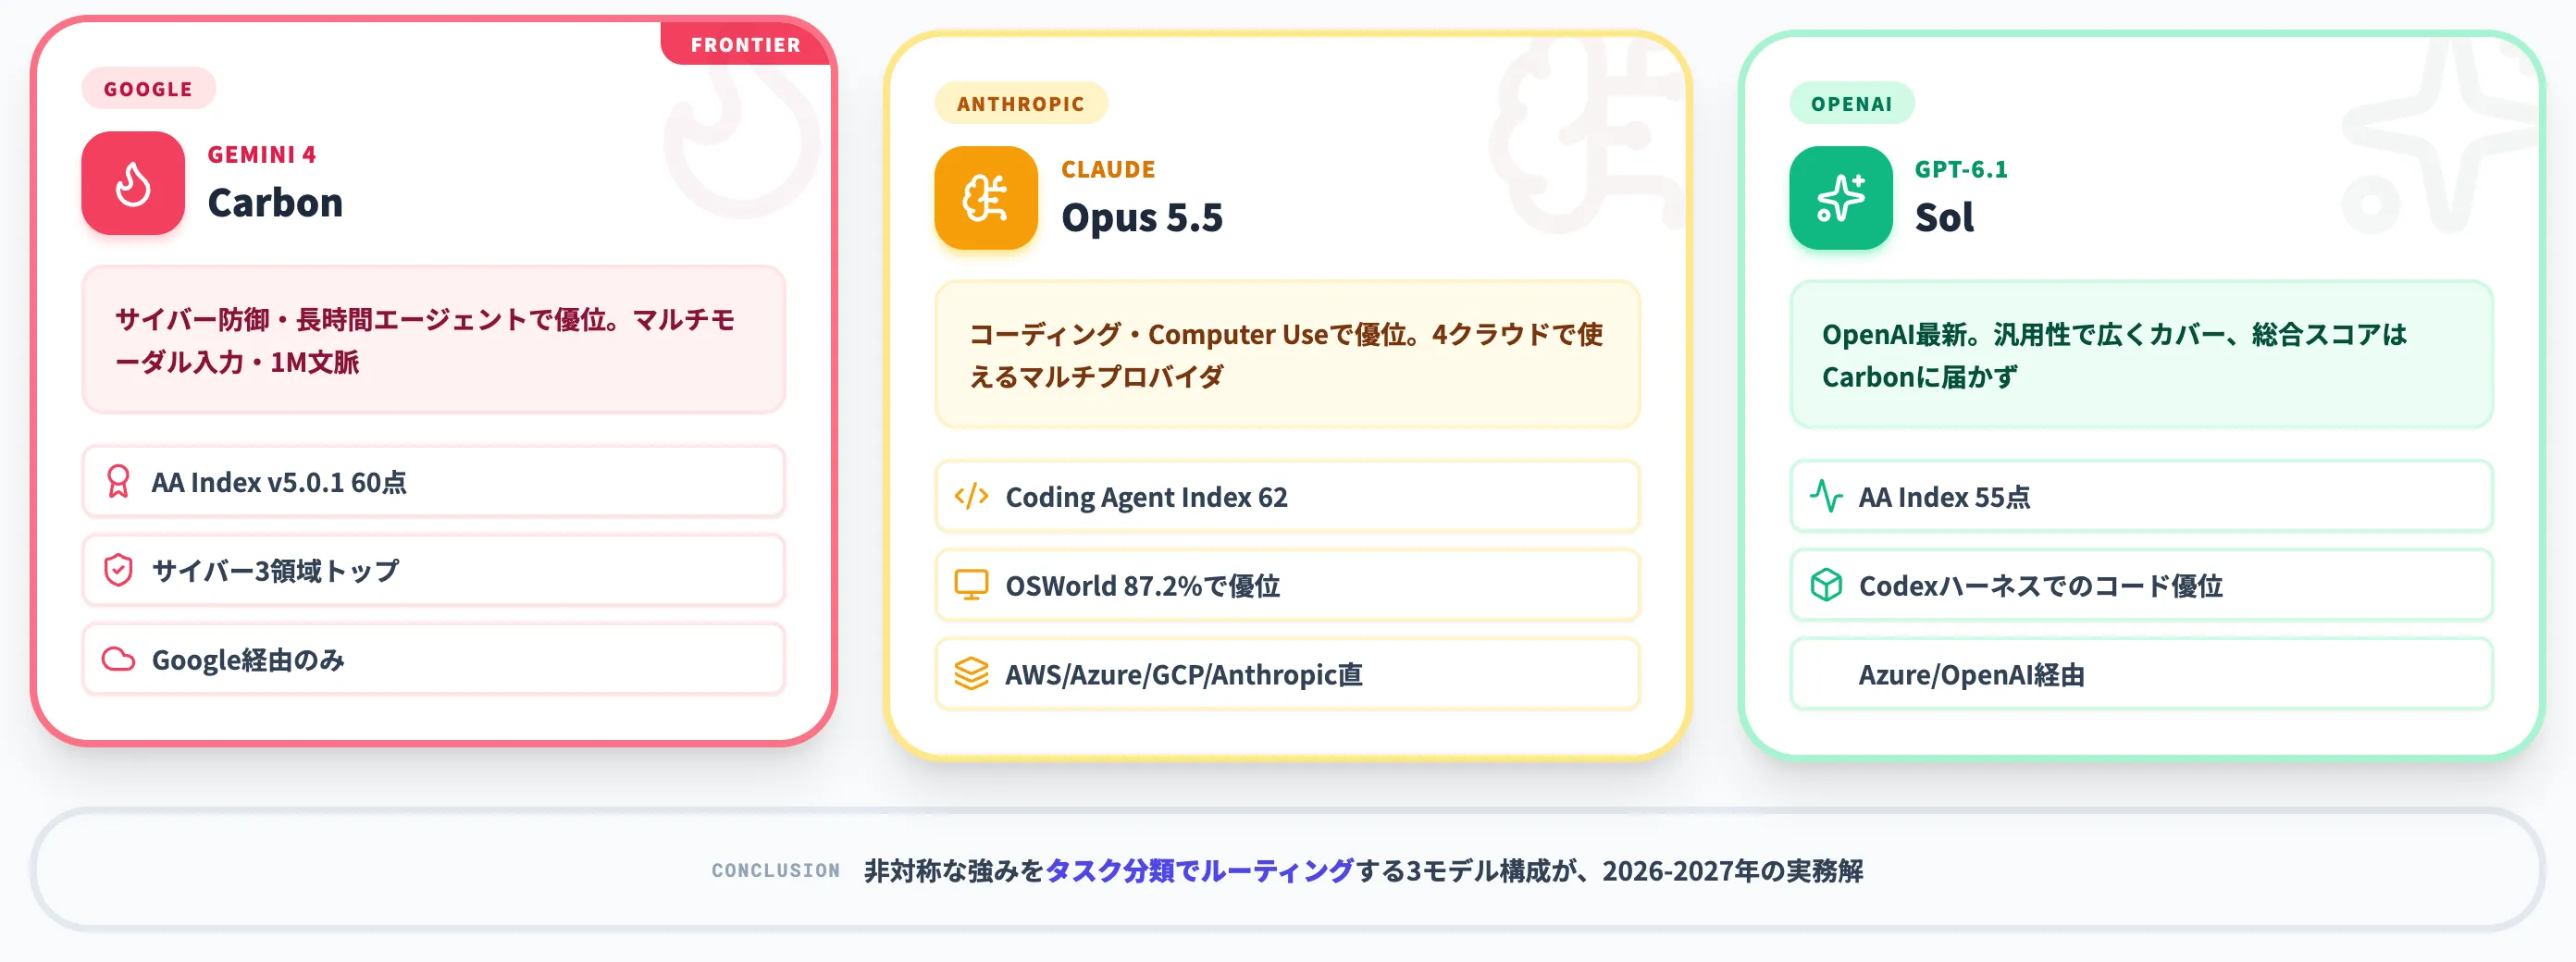
ここまでCarbon単独の性能を見てきましたが、実務の選定では他社フロンティアとの比較が不可欠です。本セクションでは、Claude Opus 5.5・GPT-6.1 Sol・2026年11月9日発表のClaude Fable 5.2 / Mythos 5.2を含め、非対称な強みを整理し選定軸を示します。
総合知能と長時間エージェント——Carbonが優位な領域
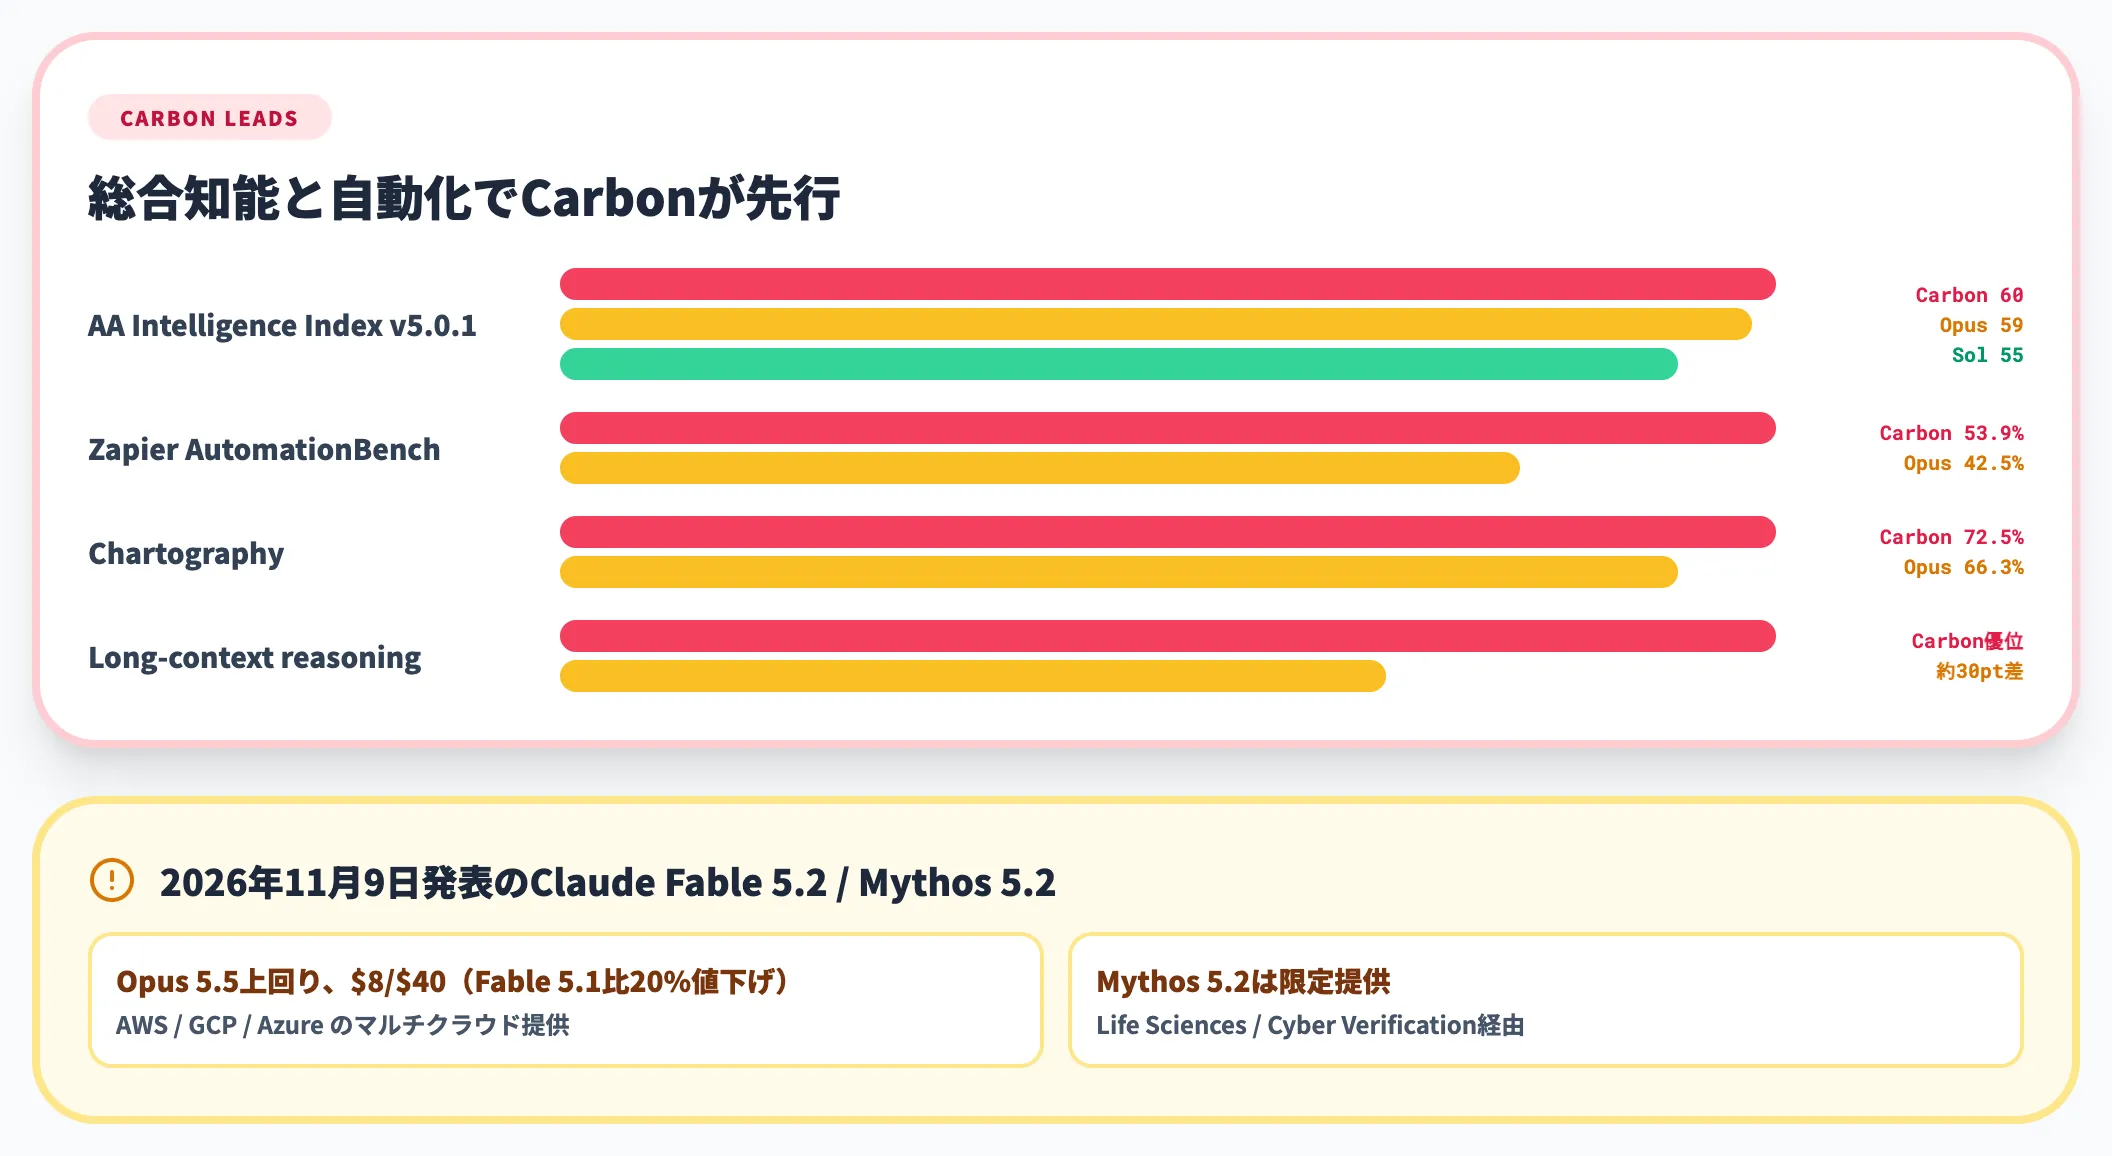
総合知能と長時間自動化タスクではCarbonが優位な指標が多い状態です。以下の表で、主要な総合ベンチマークを比較しました(Intelligence Indexは2026年11月時点の現行スコア)。
| ベンチマーク | Gemini 4 Carbon | Claude Opus 5.5 | GPT-6.1 Sol |
|---|---|---|---|
| Artificial Analysis Intelligence Index v5.0.1(現行) | 60(4位) | 59 | 55 |
| Zapier AutomationBench | 53.9%(1位) | 42.5% | — |
| Chartography(チャート理解) | 72.5% | 66.3% | — |
| Long-context reasoning | 優位(約30ポイント差) | — | — |
特に業務自動化(Zapier)、長文コンテキスト推論、チャート・ドキュメント理解で、Carbonが明確な差をつけています。これは「長時間かけて複数ステップを検証する」設計がそのまま効いた結果です。
ただしCarbon発表後の2026年11月9日に、Anthropicが Fable 5.2 / Mythos 5.2 を発表しました。Anthropic公式では「コンピュータ使用・ナレッジワーク・サイバーセキュリティ・エージェント型科学研究・エージェント型コーディング・複合推論などでOpus 5.5を上回る」と説明されており、料金は$8/$40 per 1M tokensでFable 5.1から20%値下げです。Fable 5.2 は AWS / Google Cloud / Azure のマルチクラウド提供、Mythos 5.2 は Life Sciences / Cyber Verification Programs 経由の限定提供です。難問特化・長時間推論の選定を直近の数字で詰めるなら、CarbonとFable / Mythos 5.2 を並べて評価する必要があります。
コーディングエージェント——ハーネス込みで競合が拮抗
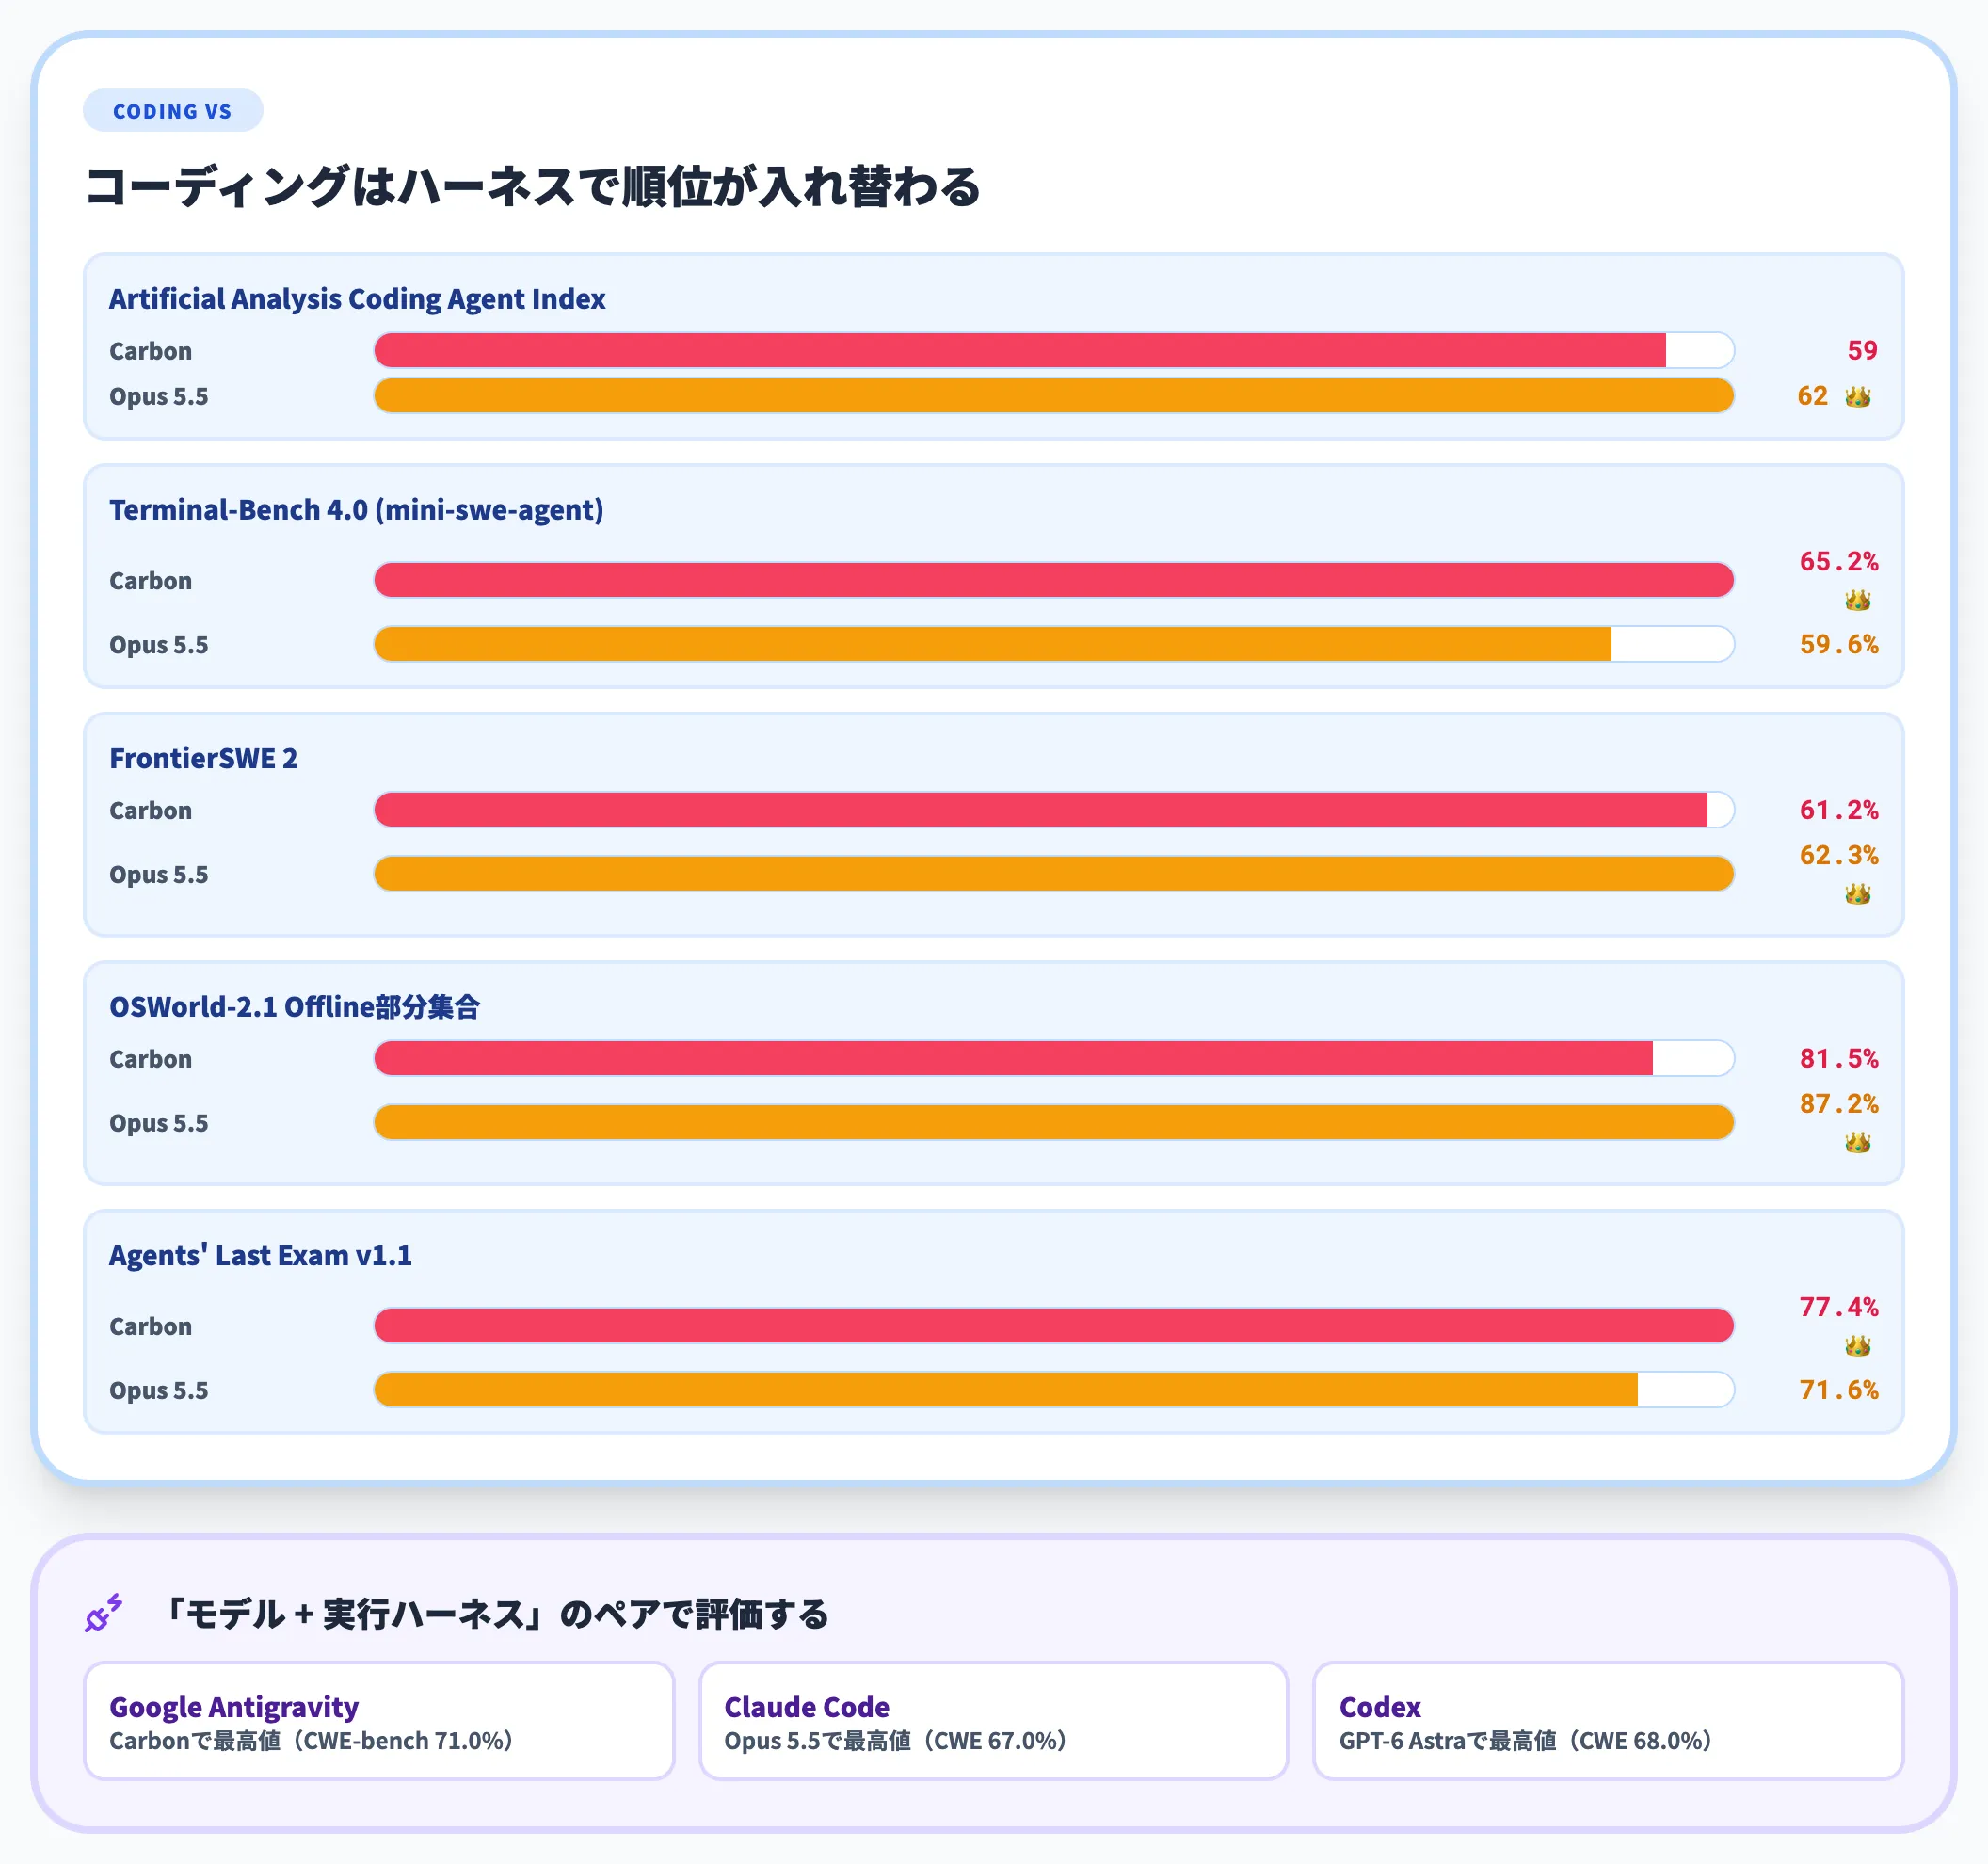
コーディング特化タスクは、モデル単体ではなく「モデル+実行ハーネス」の組み合わせで順位が変わります。以下の表で、コーディング系ベンチマークを比較しました(Google公式発表資料に基づく)。
| ベンチマーク | Gemini 4 Carbon | Claude Opus 5.5 | 補足 |
|---|---|---|---|
| Artificial Analysis Coding Agent Index | 59 | 62(上位) | Opusが優位 |
| Terminal-Bench 4.0 (AA, mini-swe-agent) | 65.2% | 59.6% | Carbonが上 |
| FrontierSWE 2 | 61.2% | 62.3% | Opusがわずかに上 |
| OSWorld-2.1 Offline部分集合 | 81.5% | 87.2% | Opusが約6ポイント上 |
| Agents' Last Exam v1.1 | 77.4%(1位) | 71.6% | Carbonが上 |
Coding Agent IndexではOpus 5.5が62で上位、Carbon(Antigravity上)が59です。一方、同じAAのTerminal-Bench 4.0(mini-swe-agentハーネスで評価)ではCarbon 65.2% > Opus 59.6% と逆転します。コーディングエージェントの優劣は「どのハーネスで動かすか」で入れ替わるため、「Opusが常に優位」とも「Carbonが常に優位」とも言い切れません。Computer Useで Opus 5.5 が優位になるのは OSWorld-2.1 Offline部分集合のような特定の評価範囲で、Agents' Last Exam v1.1 のような別評価では Carbon が上に出ます。
Claude Codeで開発ワークフローを組んでいるチームは、Opus 5.5 / Fable 5.2 の既存資産を無理にCarbonへ切り替える合理性は薄い状況です。ハーネス側の成熟度も含めて選ぶのが現実的です。
選定時の3つの判断軸
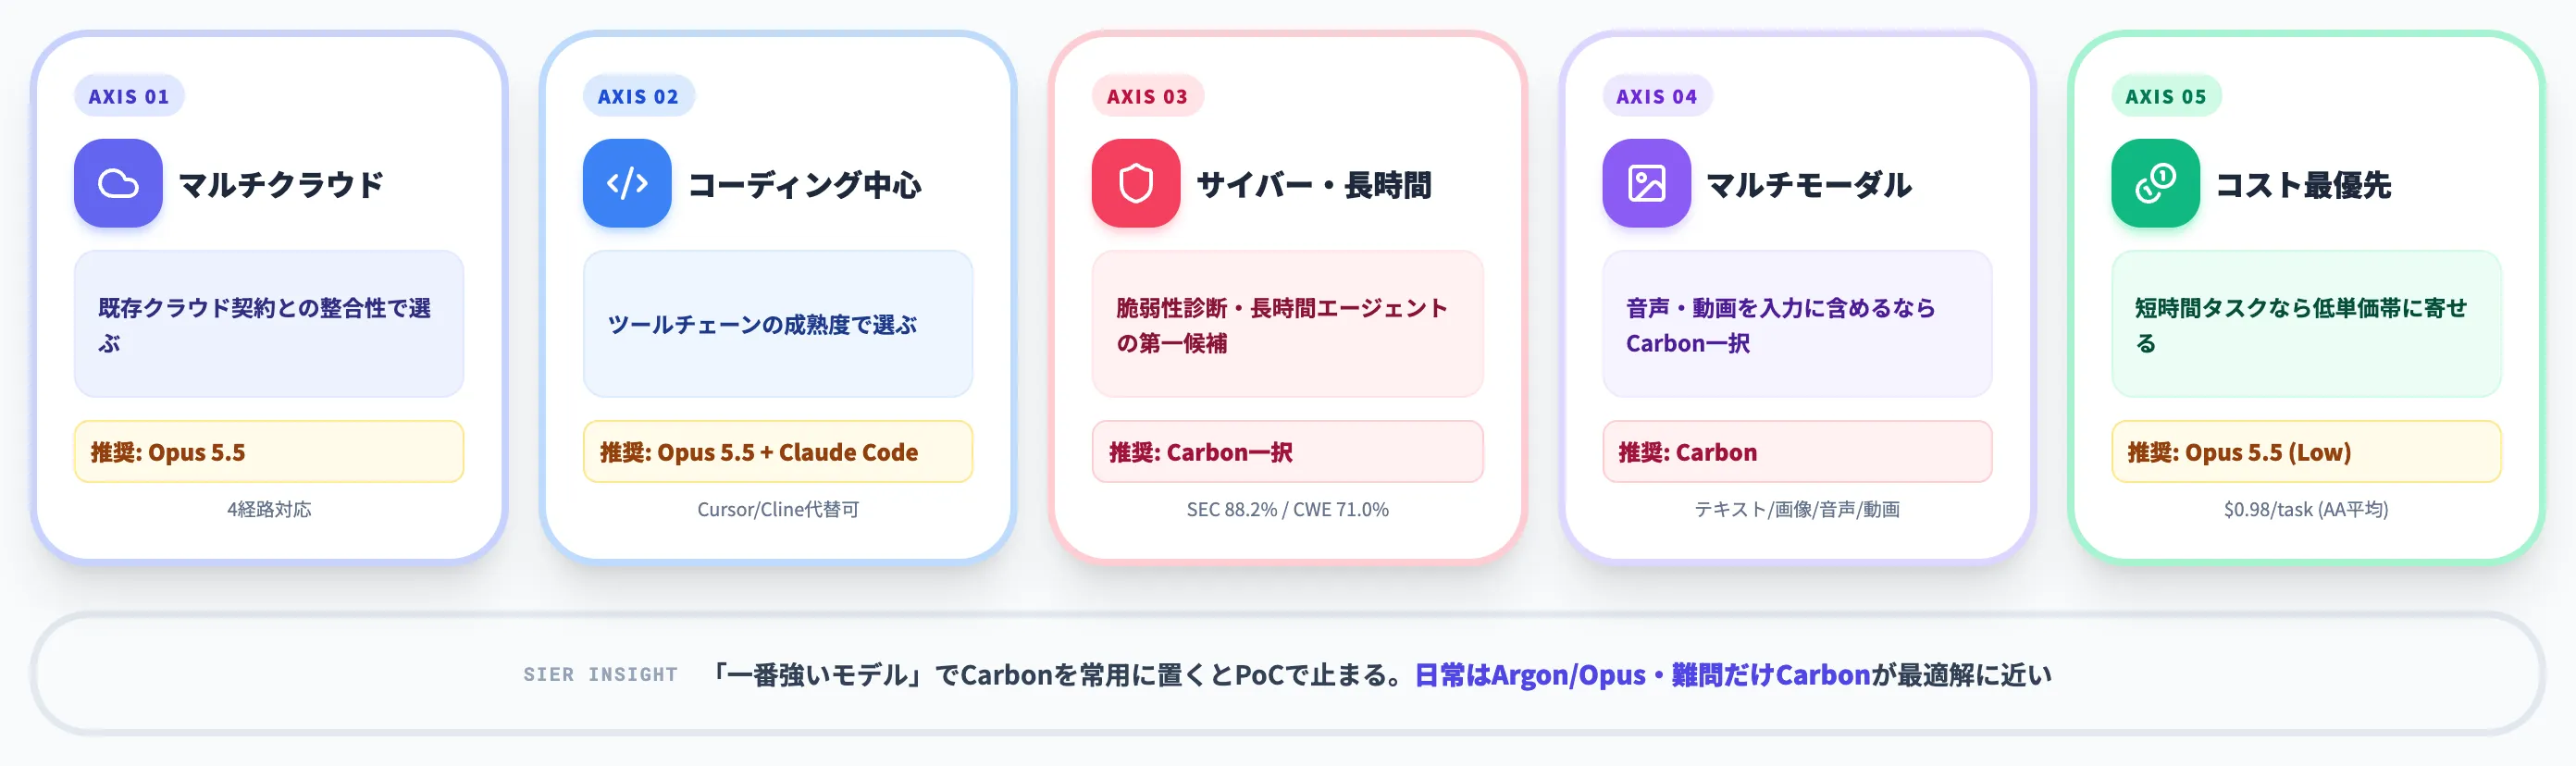
3モデルの選定を実務的に整理すると、以下の判断軸が有効です。
-
マルチクラウド要件がある
Claude Opus 5.5はAnthropic直契約、Amazon Bedrock、Microsoft Azure、Google Vertex AIの4経路で使える。Gemini 4 CarbonはGoogle経由のみ。既存クラウド契約との整合を取るなら、マルチクラウド対応が広いOpusが選定しやすい
-
コーディングエージェント中心
Claude Opus 5.5 + Claude Code、またはCline/Cursorなどのコーディング特化ツール。Carbonのコーディング性能は健闘しているが、ツールチェーンの成熟度でOpusがなお優位
-
サイバー防御・長時間エージェント中心
Gemini 4 Carbon一択。SEC-bench Pro 88.2%、CWE-bench 71.0%、Zapier AutomationBench 1位、長文コンテキスト推論でトップという組み合わせは他モデルでは出せない
-
マルチモーダル入力が必要
Carbonはテキスト・画像・音声・動画を入力可能。Opus 5.5はテキスト・画像のみ。音声・動画を含むエージェントを組むならCarbon
-
コスト最優先
短時間タスクなら Opus 5.5(Low)がAA平均で$0.98/task。Carbon・Argon(High)はAA平均で$7.68〜$7.76/task程度で、1タスクに費やす思考量で開くコストを許容できるかで判断する
SIerとして支援した案件の実感では、「とりあえず一番強いモデル」でCarbonを常用モデルに置くと、月間コストが読めなくなり、PoCの段階で止まる事例が多い。日常タスクはArgonまたはOpus 5.5、難問特化でCarbonという使い分けが、ほとんどのケースで最適解に近い構成です。
Gemini 4系の活用事例と業務適用パターン
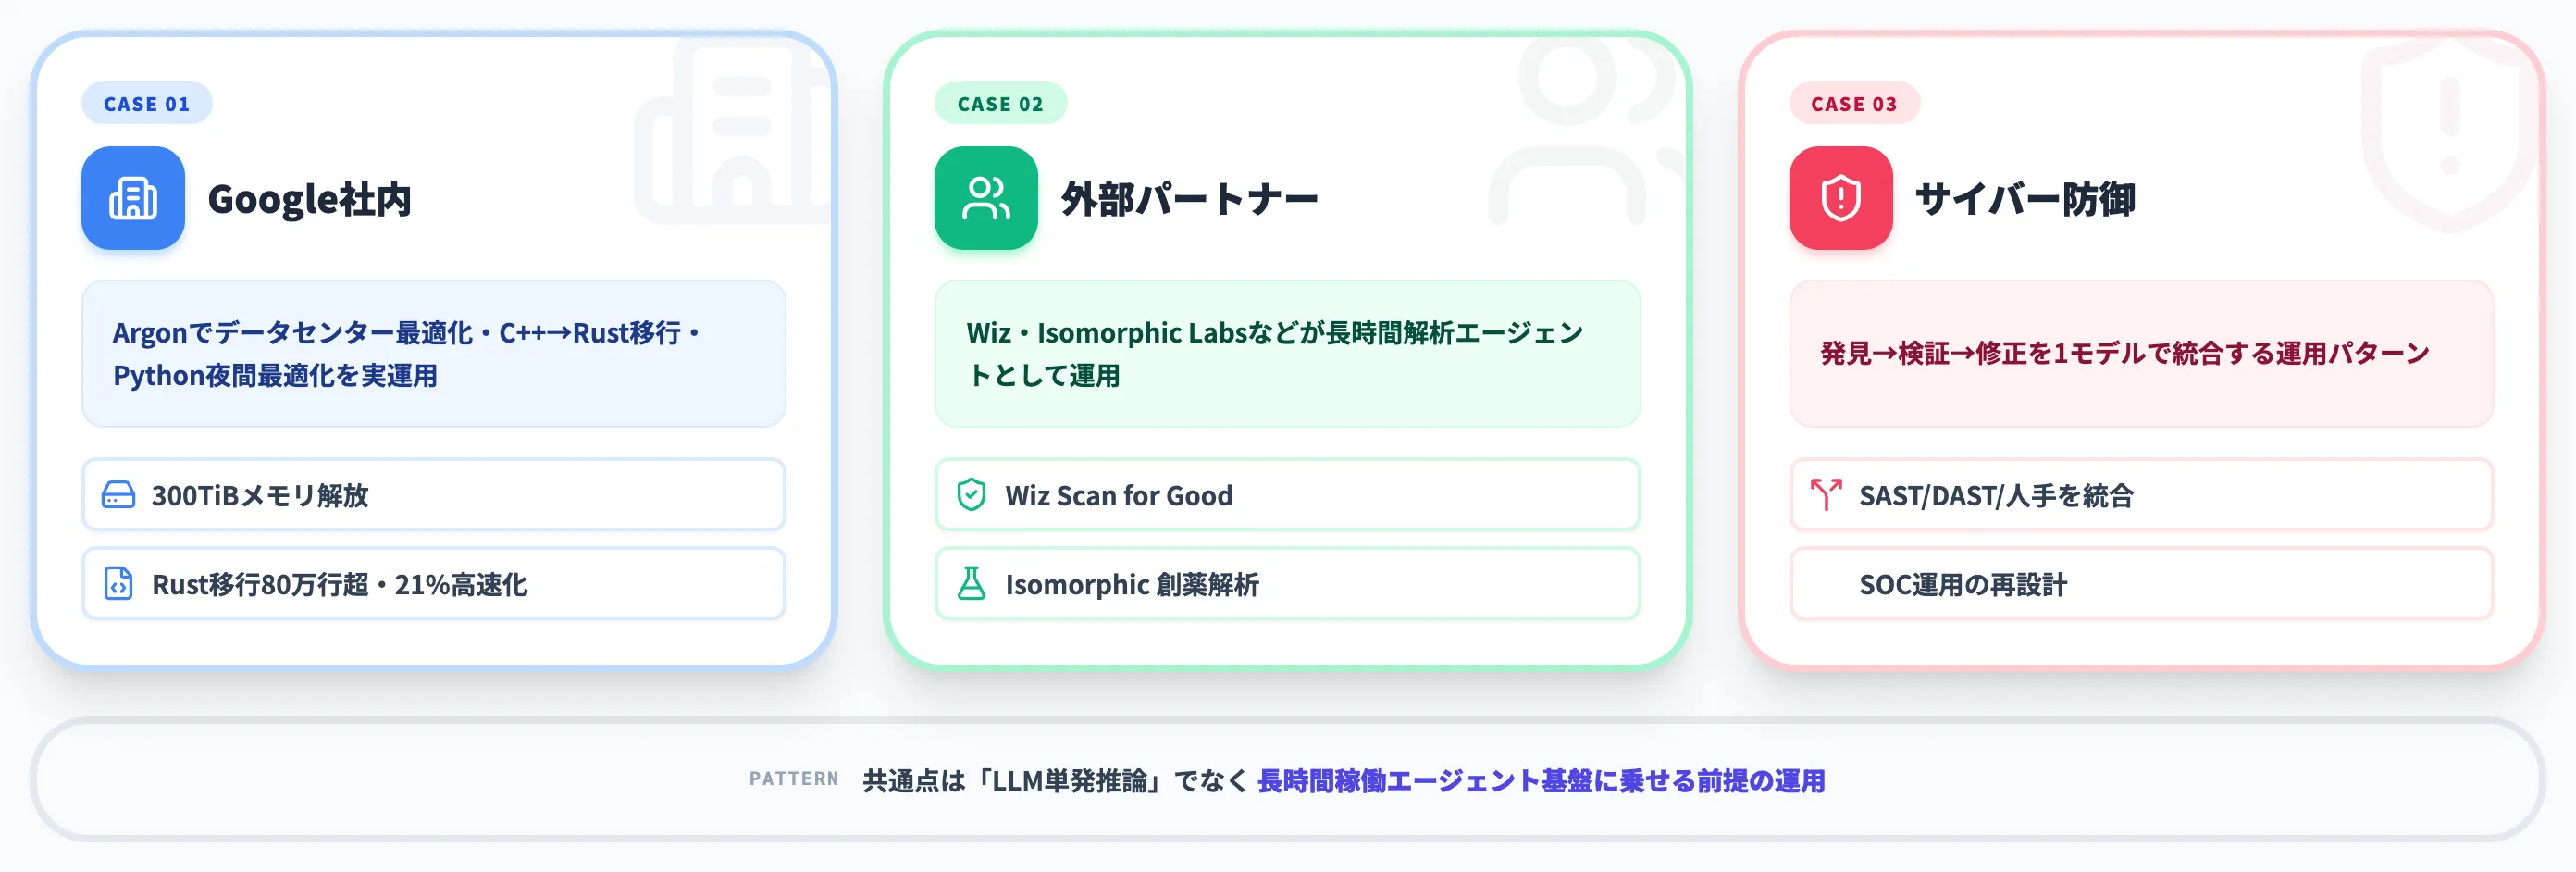
Carbonは一般提供を2026年11月10日に開始したばかりで、独自の大規模事例はまだ公表が少ない段階です。本セクションでは、同系統のArgonで既に公開されている事例と、Fairwind Program経由のCarbon運用パターンを整理します。これらは同じGemini 4系の設計を共有しており、Carbonでも応用可能なパターンです。
Google社内でのArgon実戦事例
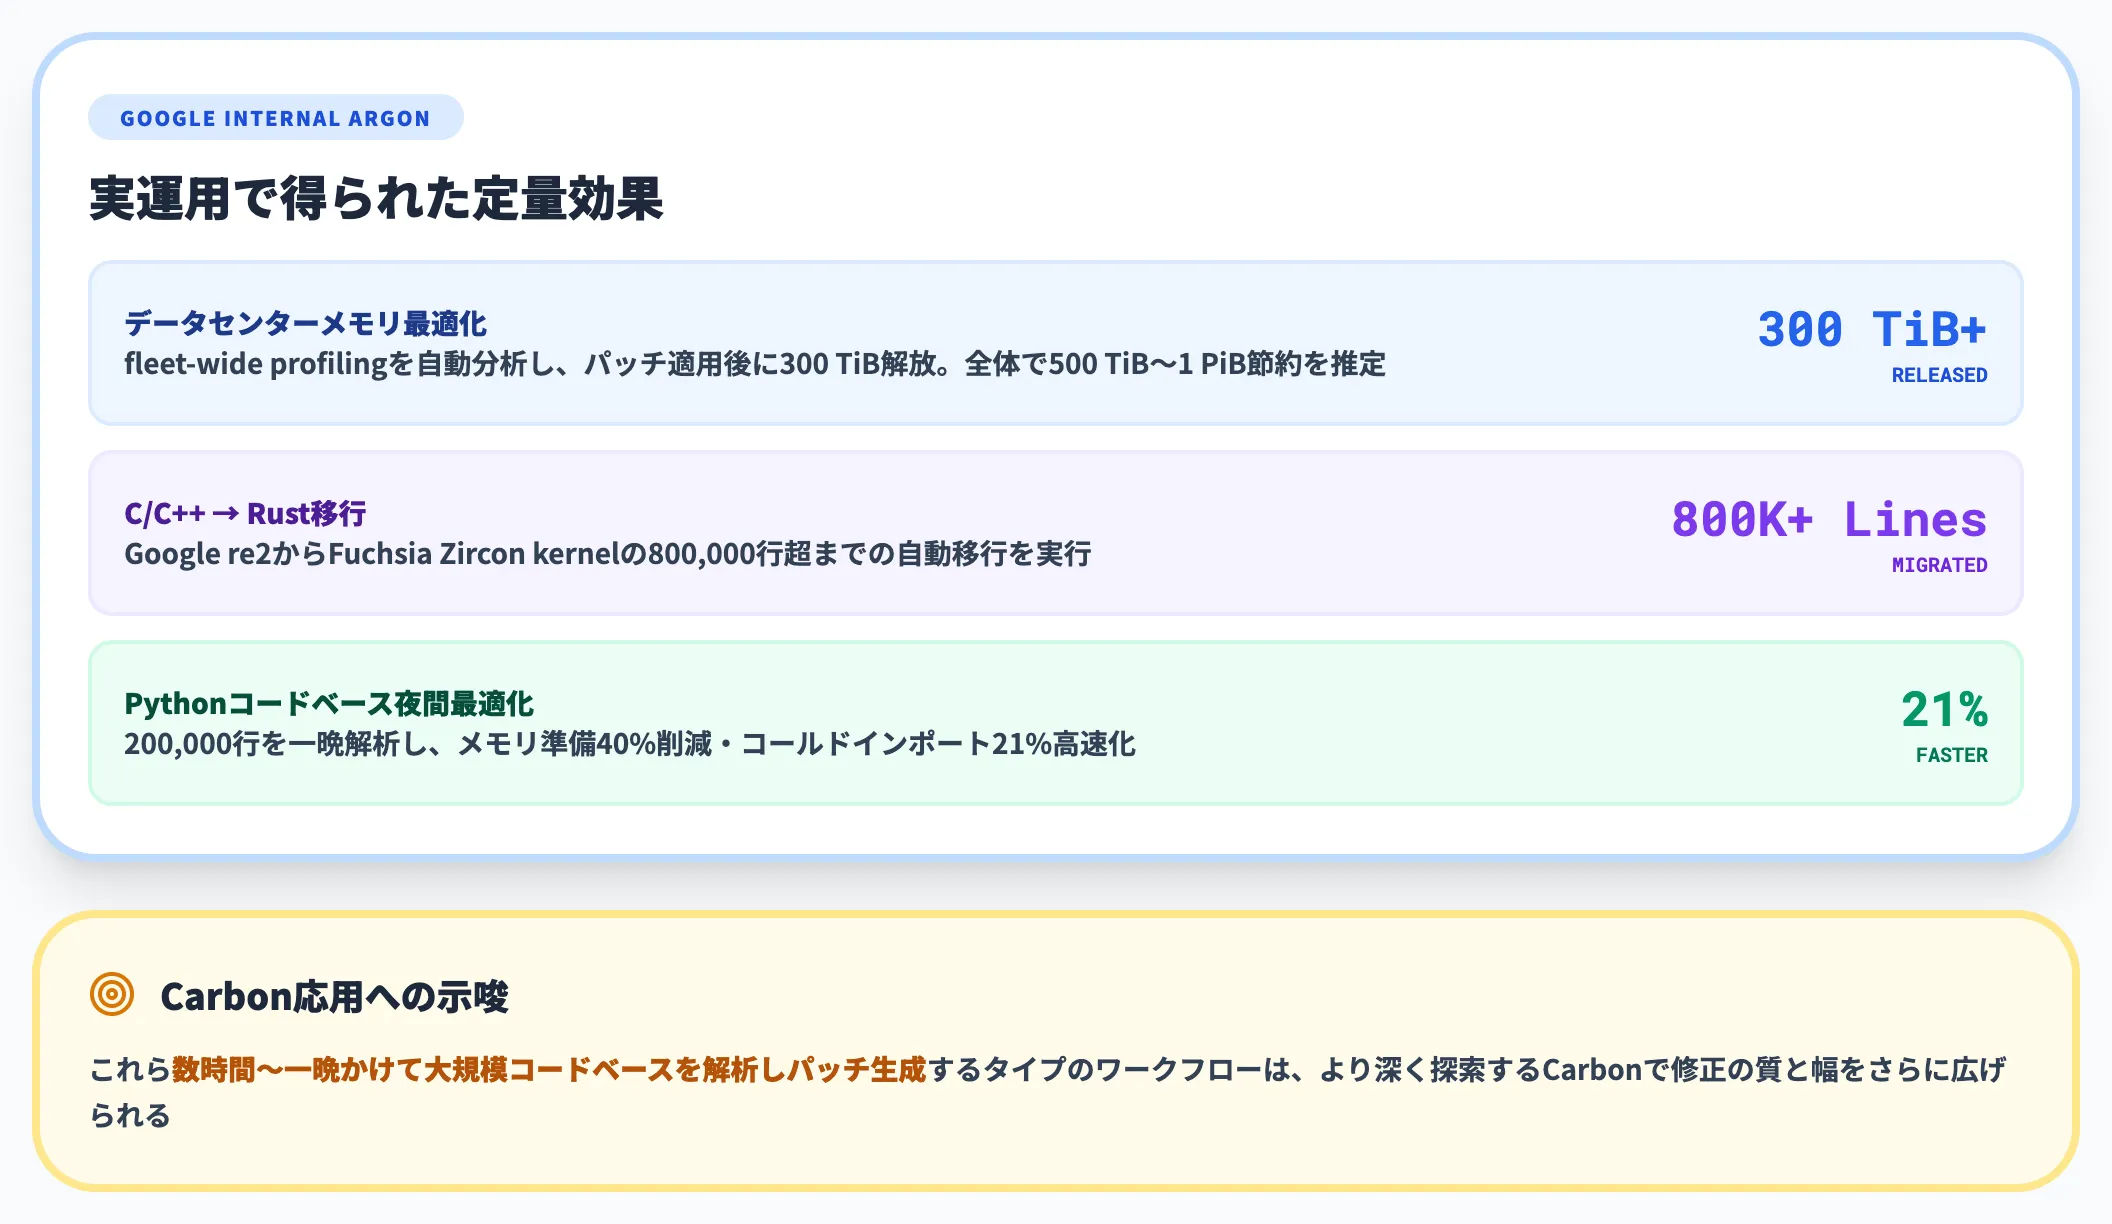
Google社内では、Argonを使った大規模な自動化がすでに運用されています。Google公式のArgon発表および Google Developers Blogで公開されている代表事例が以下の通りです。
-
データセンターのメモリ最適化
Argonエージェント群がfleet-wide profiling telemetryを自動分析し、メモリ最適化パッチを適用。ロールアウト後に300 TiBを解放、全体で500 TiB〜1 PiBの節約を推定(出典:Google 2026年9月30日Argon発表)
-
C/C++ → Rust移行
サイズの異なる複数のコードベースで自動移行を実行。Google re2から、Fuchsia Zircon kernelの800,000行超までが対象(出典:同上)
-
Pythonコードベース夜間最適化
200,000行のPythonコードベースを一晩で解析し、長セッションのメモリ準備オーバーヘッドを40%削減、コールドインポートを21%高速化(出典:Google Developers Blog)
これらは単発のコード補完ではなく、「数時間〜一晩かけて大規模コードベースを解析し、具体的なパッチを生成する」タイプのワークフローです。Argonでも既に実現しているため、より深い探索を行うCarbonを使えば、修正の質と幅をさらに広げられると見込まれます。
外部パートナーの先行事例
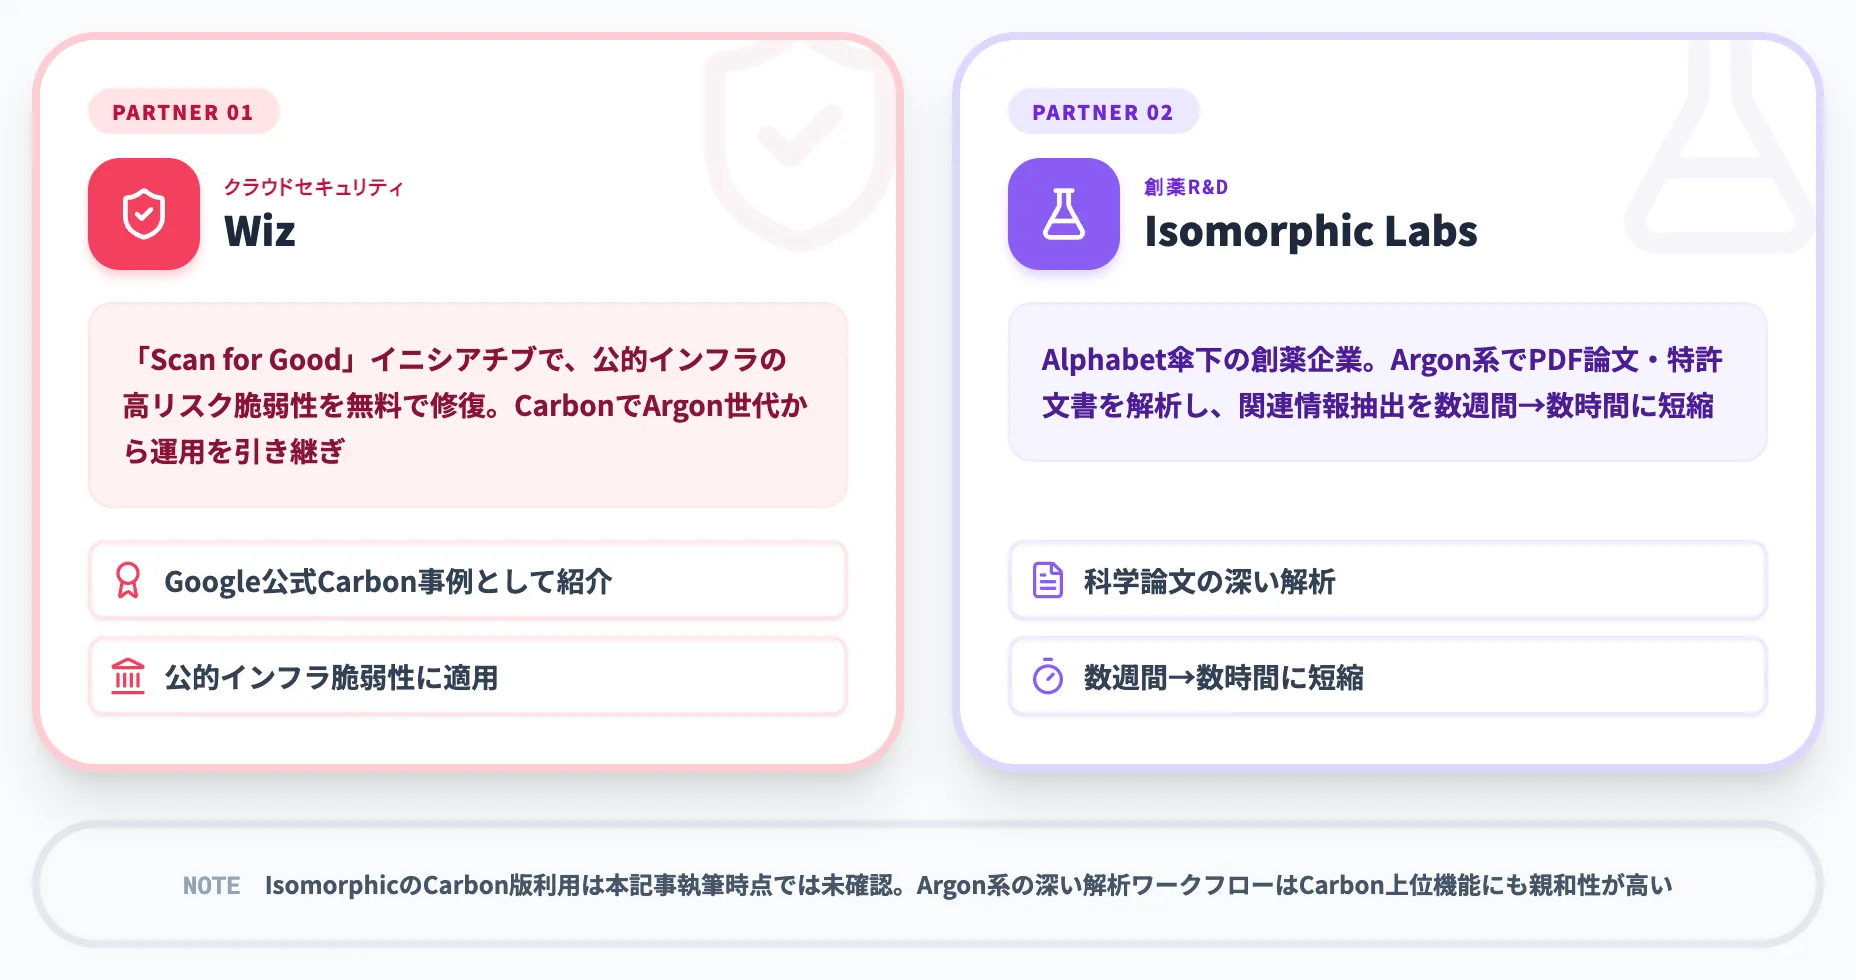
外部パートナー企業では、以下の事例がGemini 4系で公表されています。
-
Wiz(クラウドセキュリティ)
「Scan for Good」イニシアチブで、公的インフラの高リスクの脆弱性を無料で修復。Google公式のCarbon事例としても紹介されており、Argonで立ち上がった運用がCarbon世代に引き継がれています
-
Isomorphic Labs(創薬R&D)
Alphabet傘下の創薬企業。Argon系で複雑なPDF論文・特許文書を解析し、関連情報の抽出を数週間から数時間に短縮したと公表しています。深い科学的推論を長時間走らせるワークフローは、CarbonのArgon上位機能が活きる領域にも重なります(Carbon版での利用は本記事執筆時点では未確認)
これらの事例は「汎用LLMを呼ぶ」より「長時間かけて対象を解析する専用エージェント」として組まれています。LLMの単発推論ではなく、エージェント基盤に乗せて反復的に走らせる前提の設計です。
サイバー防御への適用パターン
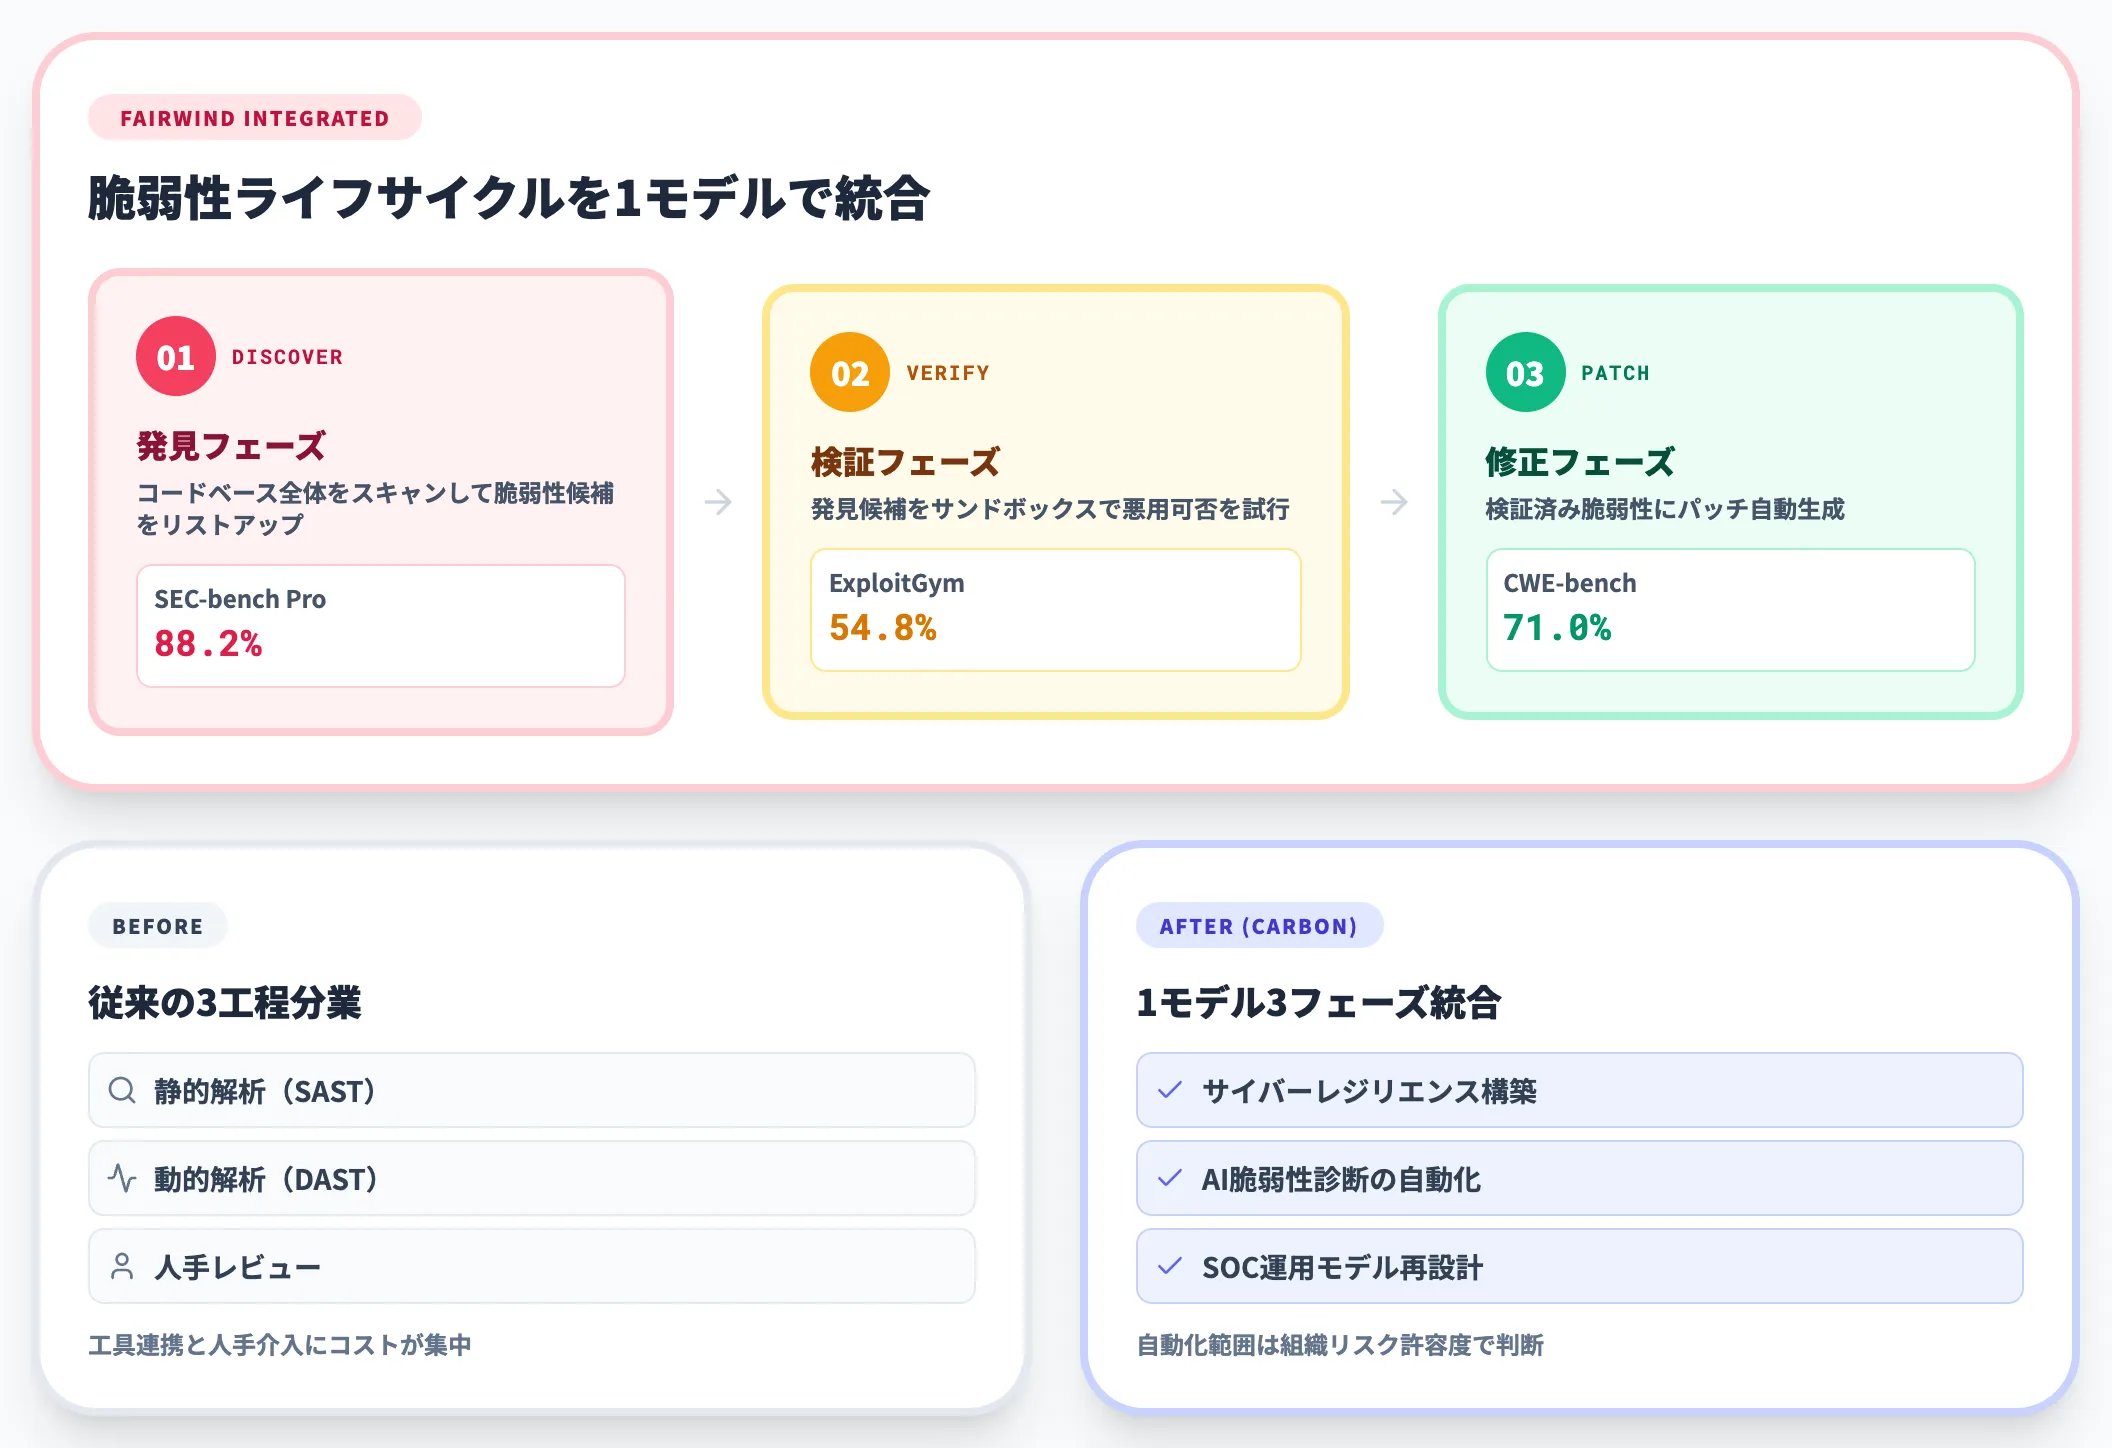
Fairwind Program経由のCarbon運用は、脆弱性対応ライフサイクルの3段を一気通貫で回す形に収束しています。
-
発見フェーズ
コードベース全体をスキャンし、脆弱性候補をリストアップ。SEC-bench Proで88.2%を記録しており、脆弱性発見ベンチマークとしては最高水準のスコア
-
検証フェーズ
発見した候補について、実際に悪用可能かをサンドボックス環境で検証。ExploitGym 54.8%は同ベンチマークで首位相当のスコア
-
修正フェーズ
検証済みの脆弱性に対し、修正パッチを自動生成。CWE-bench 71.0%、Chromeチーム評価で高品質パッチ生成性能が10倍の実績
従来、この3フェーズは静的解析ツール(SAST)→動的解析ツール(DAST)→人手レビューという分業で回されており、ツール間の連携と人手介入にコストがかかっていました。Carbonで1モデルが3フェーズを統合的に扱えるため、特にサイバーレジリエンスの構築やAIを活用した脆弱性診断の自動化で、従来の運用モデルを再設計する余地が出ています。
SIer視点で言えば、サイバー防御領域にAIを組み込むときは「発見だけ」「検証だけ」の部分適用で終わると、手前と後ろの工数が人手に残ります。Carbonは発見・検証・修正の3段を1モデルで扱える前提の設計なので、どこまで任せるか・どの工程に人手レビューを残すかを導入設計の段階で決めておくと、運用フェーズでの持て余しが減ります。全工程を自動化する必要があるかは、組織のリスク許容度と既存SOC運用の成熟度で判断するのが現実的です。
Gemini 4 Carbon導入判断のポイント
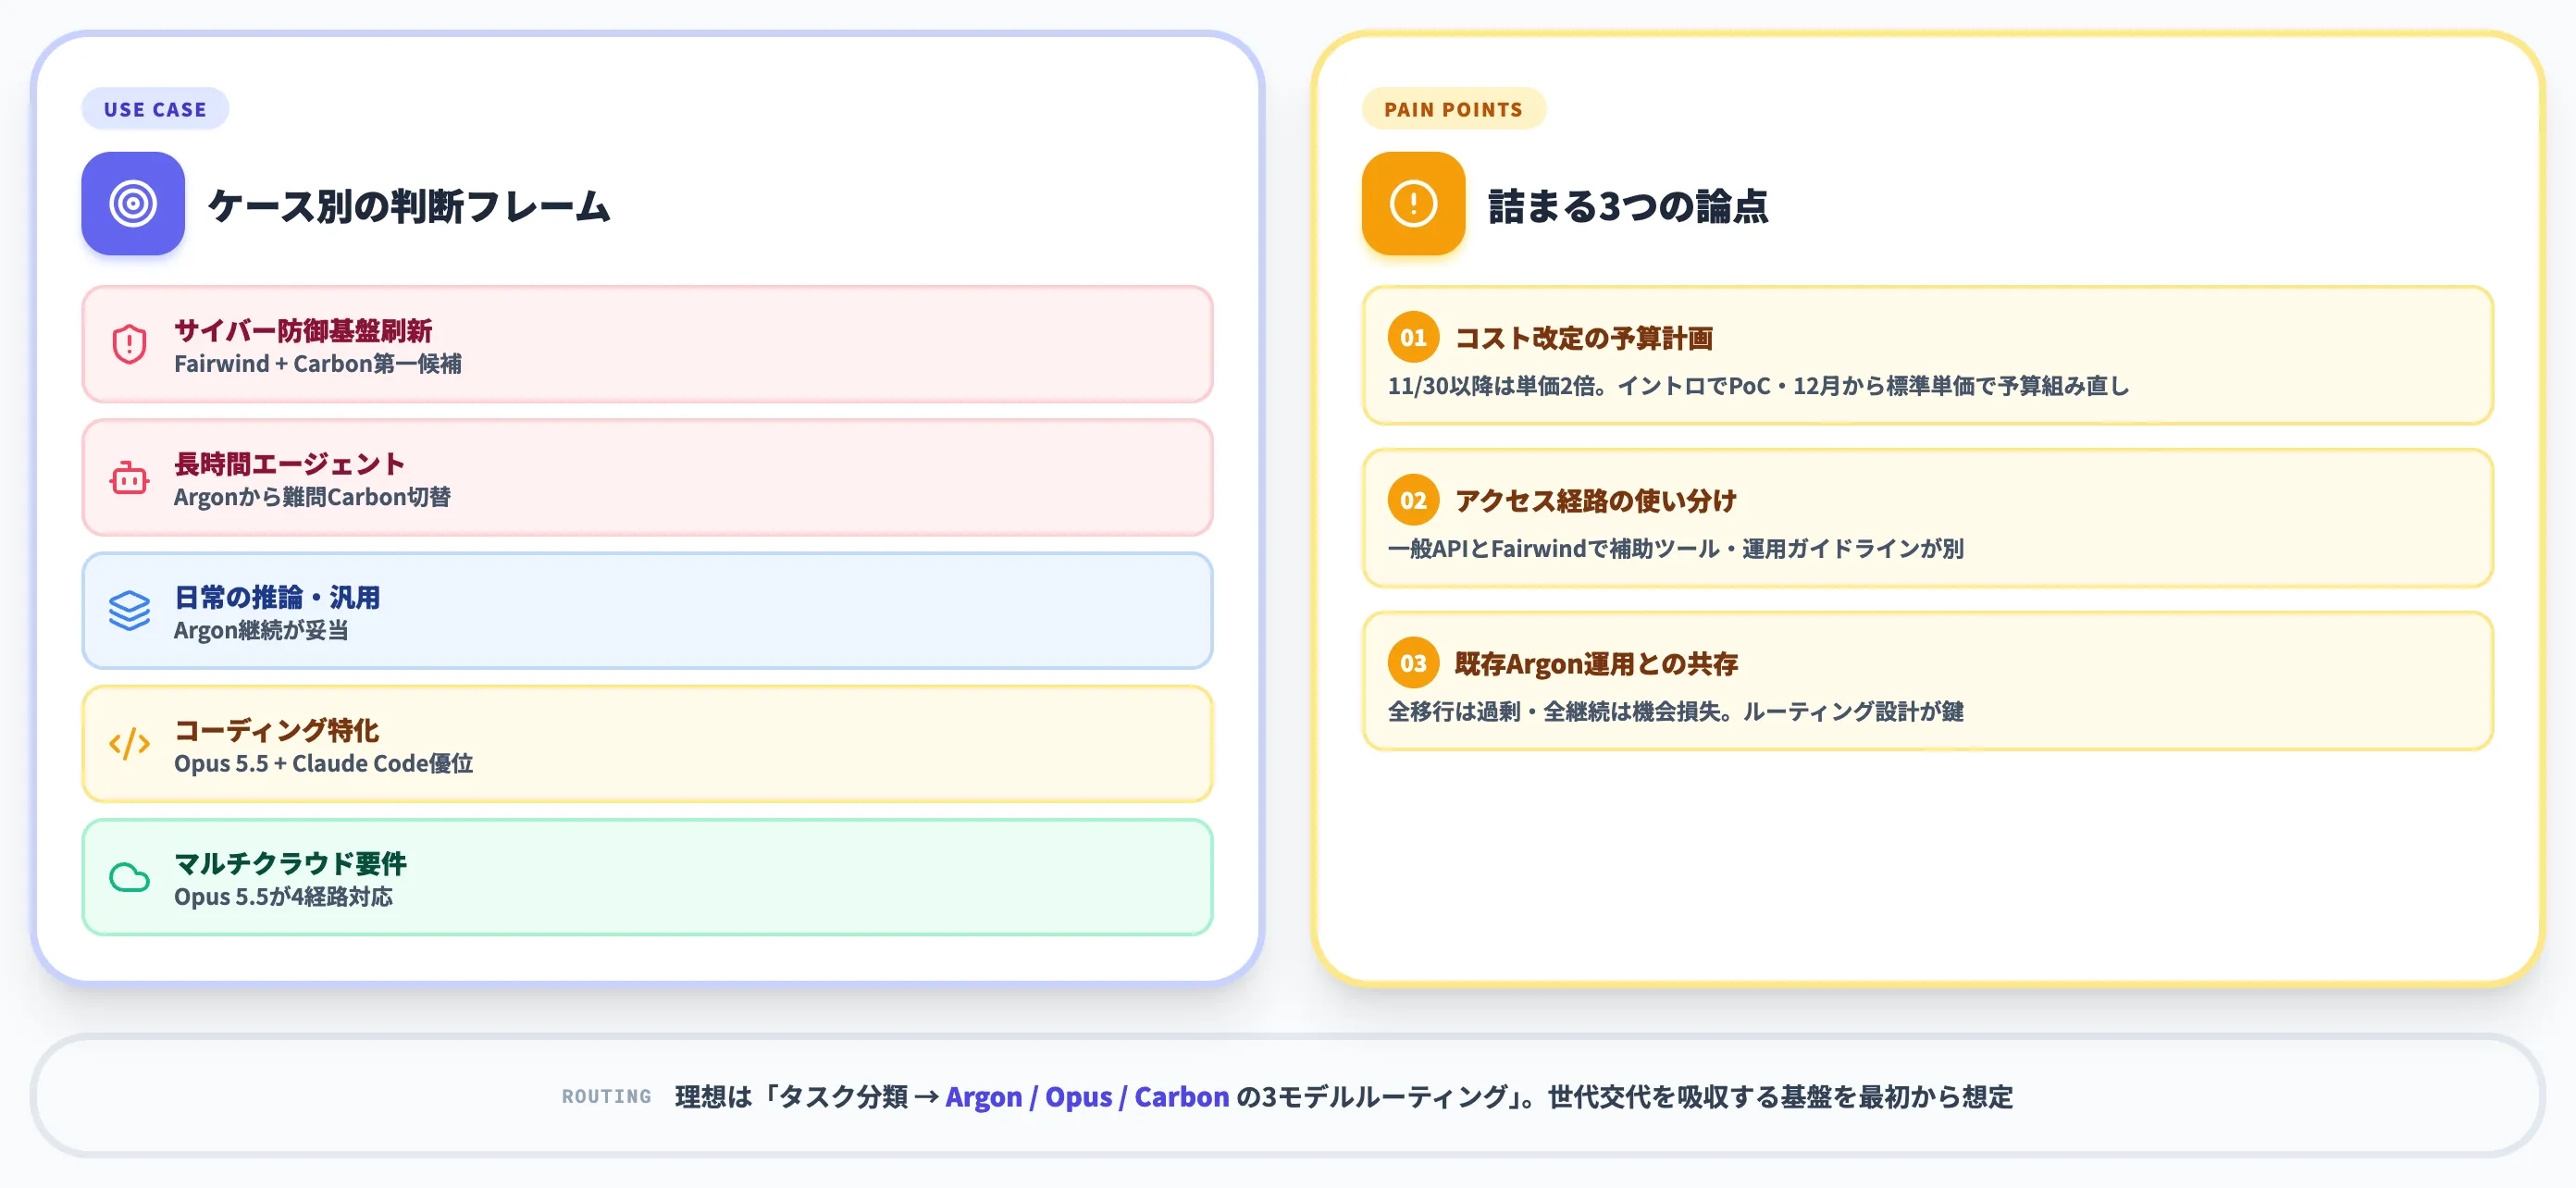
Carbonの導入判断は、「ケース別の推奨」と「詰まる論点」の2軸で整理すると扱いやすい形になります。本セクションでは、SIerの導入支援経験からケース別推奨と、判断で詰まる3つの論点を示します。
ユースケース別の推奨モデル
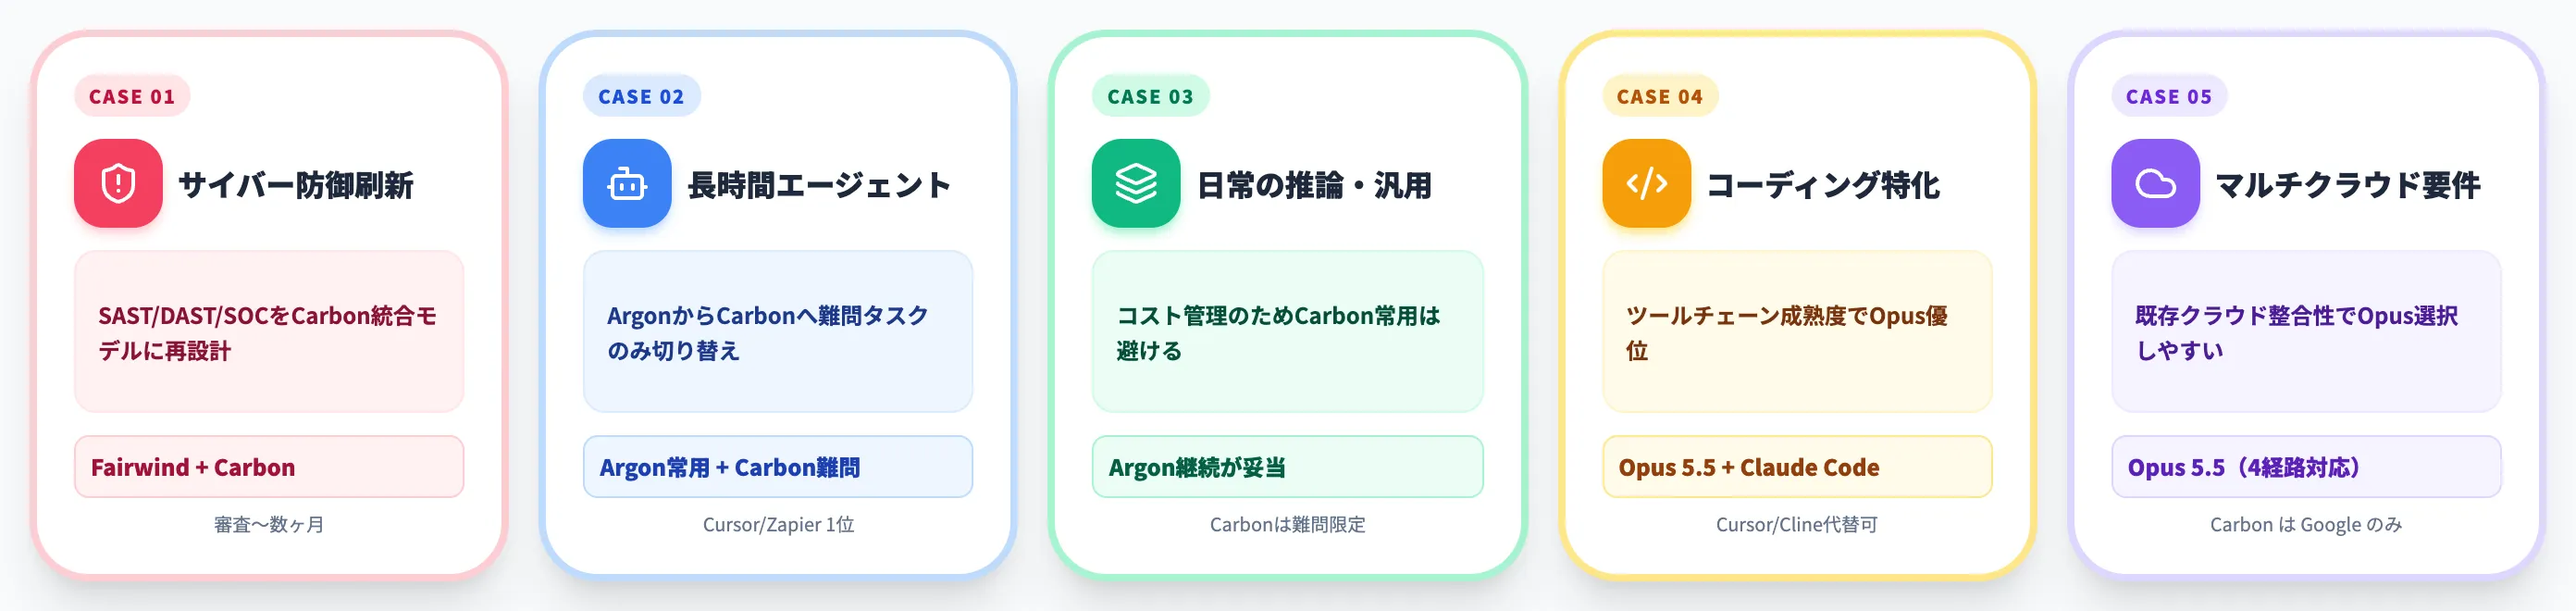
Carbonを「使うべきかどうか」は、ユースケースによってはっきり分かれます。以下のフレームで判断します。
-
サイバー防御基盤を刷新したい
Fairwind Program応募 + Carbon検討が第一候補。既存のSAST/DAST/SOC運用を、Carbonの発見・検証・修正統合モデルに再設計する価値がある。応募から審査完了まで数ヶ月見込む
-
長時間エージェント開発を進めている
Argonから Carbon へのアップグレード検討。CursorBench 1位・Zapier AutomationBench 1位の実績が効く領域。ただし常用はArgonに留め、難問タスクのみCarbonに振る設計が合理的
-
日常の推論・汎用タスク
Argon継続が妥当。Carbonは思考量が多く応答時間も長いため、常用に置くとコスト管理が難しくなる場面がある。Carbonを呼ぶのは明確に「難問」と分類できるタスクに限定する運用が扱いやすい
-
コーディング特化
Claude Opus 5.5 + Claude CodeやGitHub Copilot Code Review Max、Cursor/Clineの構成が現状優位。Carbonへの移行を急ぐ合理性は薄い。コーディングエージェント市場の次の更新を待つのが現実的
-
マルチクラウド要件がある
Opus 5.5がマルチクラウド対応(Anthropic・Bedrock・Azure・Google)。Carbonは Google 経由のみ。クラウド選定の制約を踏まえて選ぶ
実務では、「Carbonに全部任せる」構成ではなく、「タスク分類→Argon・Opus・Carbonの3モデルにルーティング」という多モデル構成が主流になると見込まれます。モデル世代交代に合わせてルーティングロジックを更新できる基盤を、最初から想定しておくと長持ちします。
導入判断で詰まる3つの論点
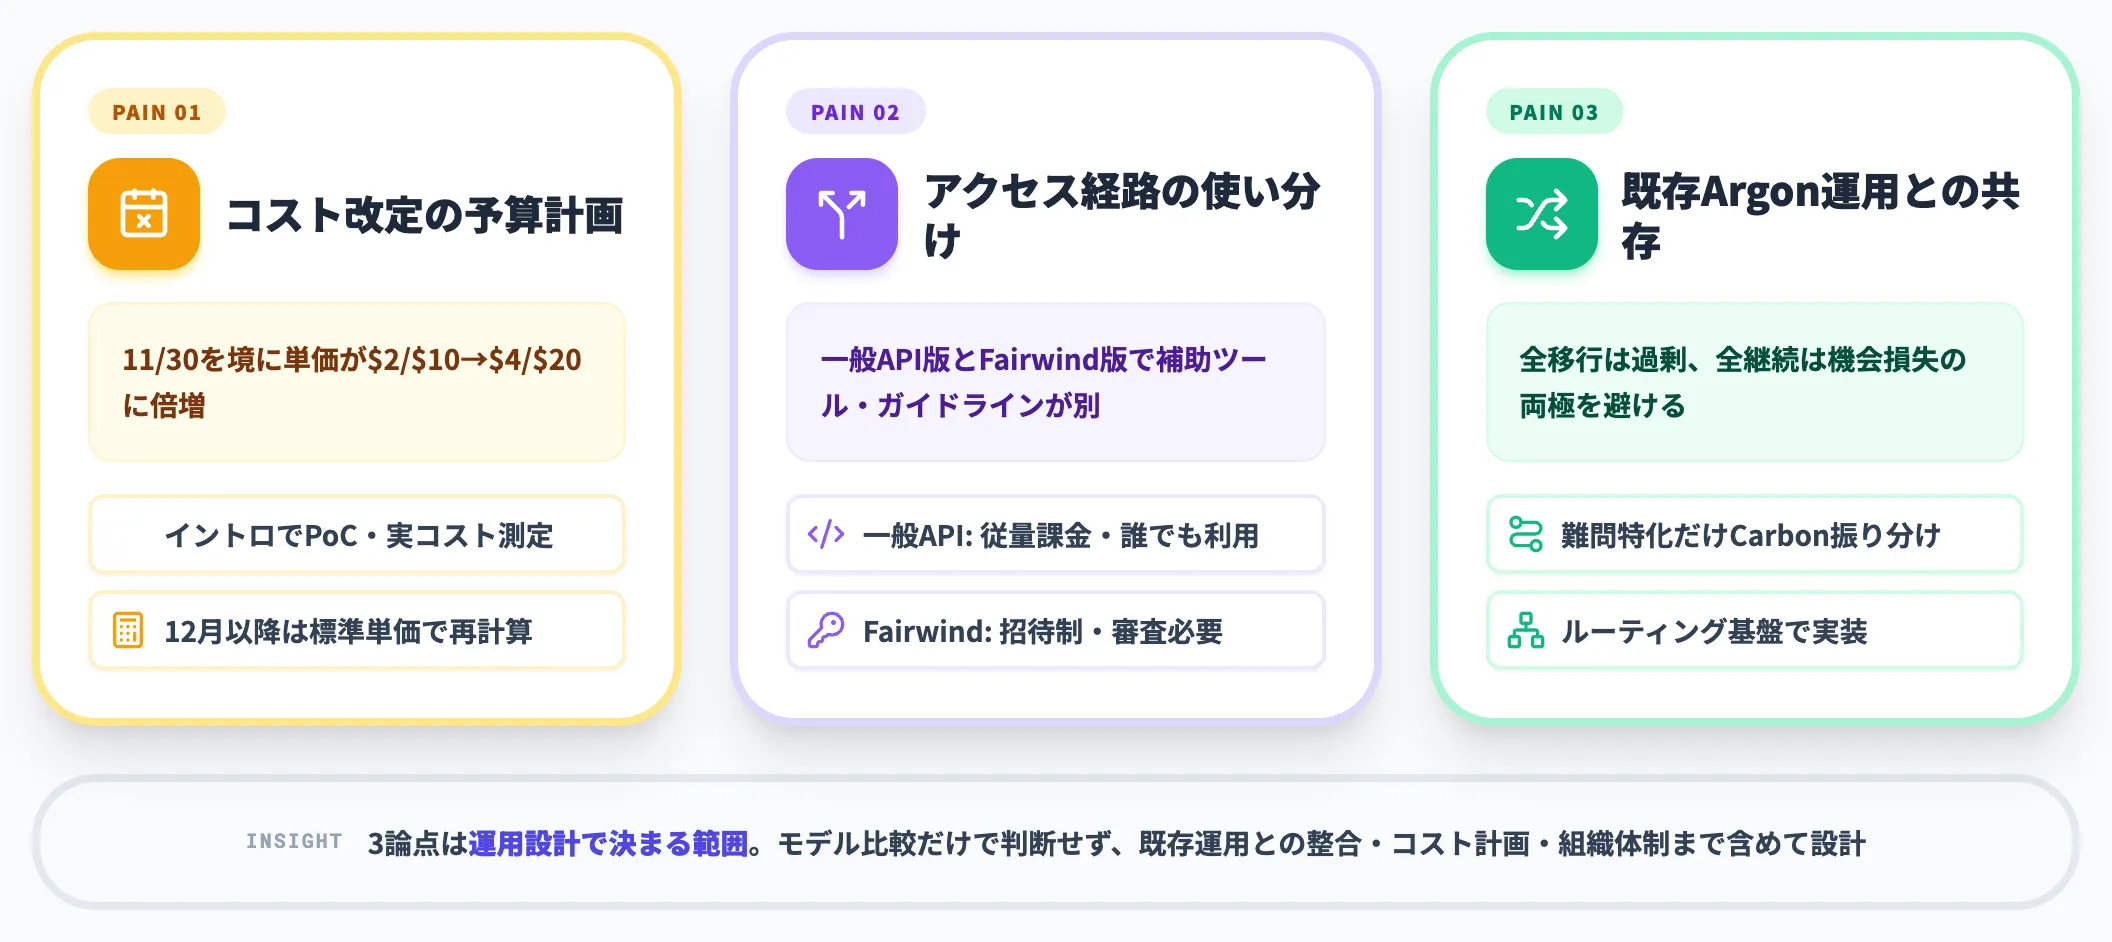
Carbonの導入判断で現場が詰まりやすいのが、以下の3論点です。
-
コスト改定の予算計画
2026年11月30日を境に単価が$2/$10 → $4/$20に倍増する。PoCをイントロ期間に走らせて実コストを測り、12月以降の予算を標準単価で再計算する必要がある。PoCの結果だけ見て判断すると、本番展開時に予算ショックが起きる
-
アクセス経路の使い分け
Carbonは一般APIとFairwind経由の2経路。一般APIは誰でも契約できるが、Fairwind経由は招待制で、使える補助ツールと運用ガイドラインが異なる。サイバー防御の深い連携を狙うなら、Fairwind応募と一般API契約を併走させる設計が妥当
-
既存Argon運用との共存
Argonで既に組んだワークフローを、どこまでCarbonに移すかの判断。全移行は過剰、全継続は機会損失。「難問特化タスクだけCarbon、他はArgon継続」という2モデル運用を、どうルーティング設計で実装するかがポイント
これら3論点は、Carbon単体の仕様ではなく「運用設計で決まる」範囲です。モデルの性能比較だけでなく、既存運用との整合・コスト計画・組織体制まで含めて設計する必要があります。
Gemini 4 Carbonを呼ぶ場面を絞り、1回ごとの上限を先に決める
Gemini 4 Carbonは、Argonと同じ単価で思考トークンを多く使い、探索と検証を重ねる設計のため、1タスクの料金と待ち時間が問題の難しさで大きく変わります。タイムアウトで止まった長い生成はそれまでの出力に料金がかかるうえ、12月には単価が倍になります。どの処理でCarbonを呼び、1回にどこまで許すかを本番の前に決めておかないと、月の費用が読めません。
その線引きをそのまま運用に移せるのが、AIに任せる段と人が引き取る段を、業務ごとのワークフローとして組み立てるAI Agent Hubです。
- Carbonに回すのは、手順で片づかない書類に限る
請求書の照合のように決まった手順で済む処理は既存のAgentで進め、稟議に添付された長い契約書の条項を社内規定と一つずつ照らすような、深い読み込みが要る書類だけを渡します。
- 1回の呼び出しに、待ち時間と出力の枠を設ける
待ち時間か出力のどちらかが上限に達した時点で打ち切り、担当者のTeamsへ回すため、思考が長引いた1回で料金が積み上がり続けずに済みます。
- 月の費用は、本番の前に流した結果から試算する
過去の稟議を数十件サンドボックス環境で通し、Carbonの段にかかった時間と出力の量を確かめておけば、標準単価と月の件数から費用を見通せます。
AI総合研究所の専任チームが、Carbonに回す書類の基準と1回あたりの枠を業務ごとに定め、Gemini Enterprise Agent Platformとの接続設計・構築まで一続きで支援します。
Carbonを上限つきで業務に組み込む

定型の照合と長い契約書を分けて流す
思考トークンを多く使うGemini 4 Carbonは、1タスクの料金と待ち時間が読みにくいため、呼ぶ処理を絞り、1回ごとの上限を決めてから本番に入るのが安全です。AI Agent Hubを使えば、手順どおりに済む処理は既存のAgentに任せ、時間をかけて読むべき書類だけをCarbonへ回す流れを組めます。
Gemini 4 Carbonに関するまとめ
本記事では、Gemini 4 Carbonを「長時間稼働するエージェントとサイバー防御を主な狙いとする、Gemini 4系の最上位モデル」として整理し、Argonとの違い・性能・料金・提供経路・他社フロンティアとの比較・活用事例・導入判断のポイントを解説しました。
2026年11月時点で押さえておくべきポイントは次の3つです。
- 脆弱性対応と長時間エージェントのベンチマークでは首位に立つが、Intelligence Indexの順位は競合の追加で発表時のトップから下がった
- コーディングの順位は組み合わせる実行ハーネスによって入れ替わり、Claude Codeで組んだ開発の流れをCarbonへ急いで移す理由は薄い
- Fairwind経由のサイバー専用版は招待制で、一般APIと別のモデルIDになり、料金と補助ツール、運用ガイドラインが異なる
AI総合研究所は、Carbonの評価にあたって、導入先の実行環境での比較と提供経路の見極めを柱に据えています。
まずは、普段使っているハーネスにCarbonを載せ、Opus 5.5やFable 5.2と同じ課題で結果を並べます。
続いて、サイバー防御に使うなら、一般APIでの検証と並行してFairwindへ応募し、英語でのセキュリティ対応体制の説明とインシデント対応の履歴を用意します。
入力と出力が一つのコンテキスト窓を分け合うため、長文を扱う設計では、参照資料を詰め込むほど思考と回答の余地が減る点に気を配る必要があります。
Gemini 4 Carbonの登場で、Gemini 4系は汎用の主力であるArgonの上に、難問に深く挑む層を加えた布陣になりました。