この記事のポイント
 動画からロボット動作ラベルを自動生成する3モデル構成で、ロボティクス訓練データのボトルネックを狙い撃ちする設計
- 1日20万時間のラベリング実績を持ち、NVIDIAの次世代基盤モデルGR00T-2の訓練データエンジンとして実運用されている
- API型モデル(GPT-6 Astra)比で約125分の1のコスト。人間動画キャプションでは汎用フロンティアモデルを上回る性能
- ライセンスは研究開発のみ対象の非商用で、商用利用はNVIDIAと別途契約が必要。ラベリングサービスの商用提供には不向き
- Qwen3.5ベースのオープンウェイトでHugging Faceから入手可能、再現性のある研究基盤として設計されている
Microsoft MVP・AIパートナー。LinkX Japan株式会社 代表取締役。東京工業大学大学院にて自然言語処理・金融工学を研究。NHK放送技術研究所でAI・ブロックチェーンの研究開発に従事し、国際学会・ジャーナルでの発表多数。経営情報学会 優秀賞受賞。シンガポールでWeb3企業を創業後、現在は企業向けAI導入・DX推進を支援。
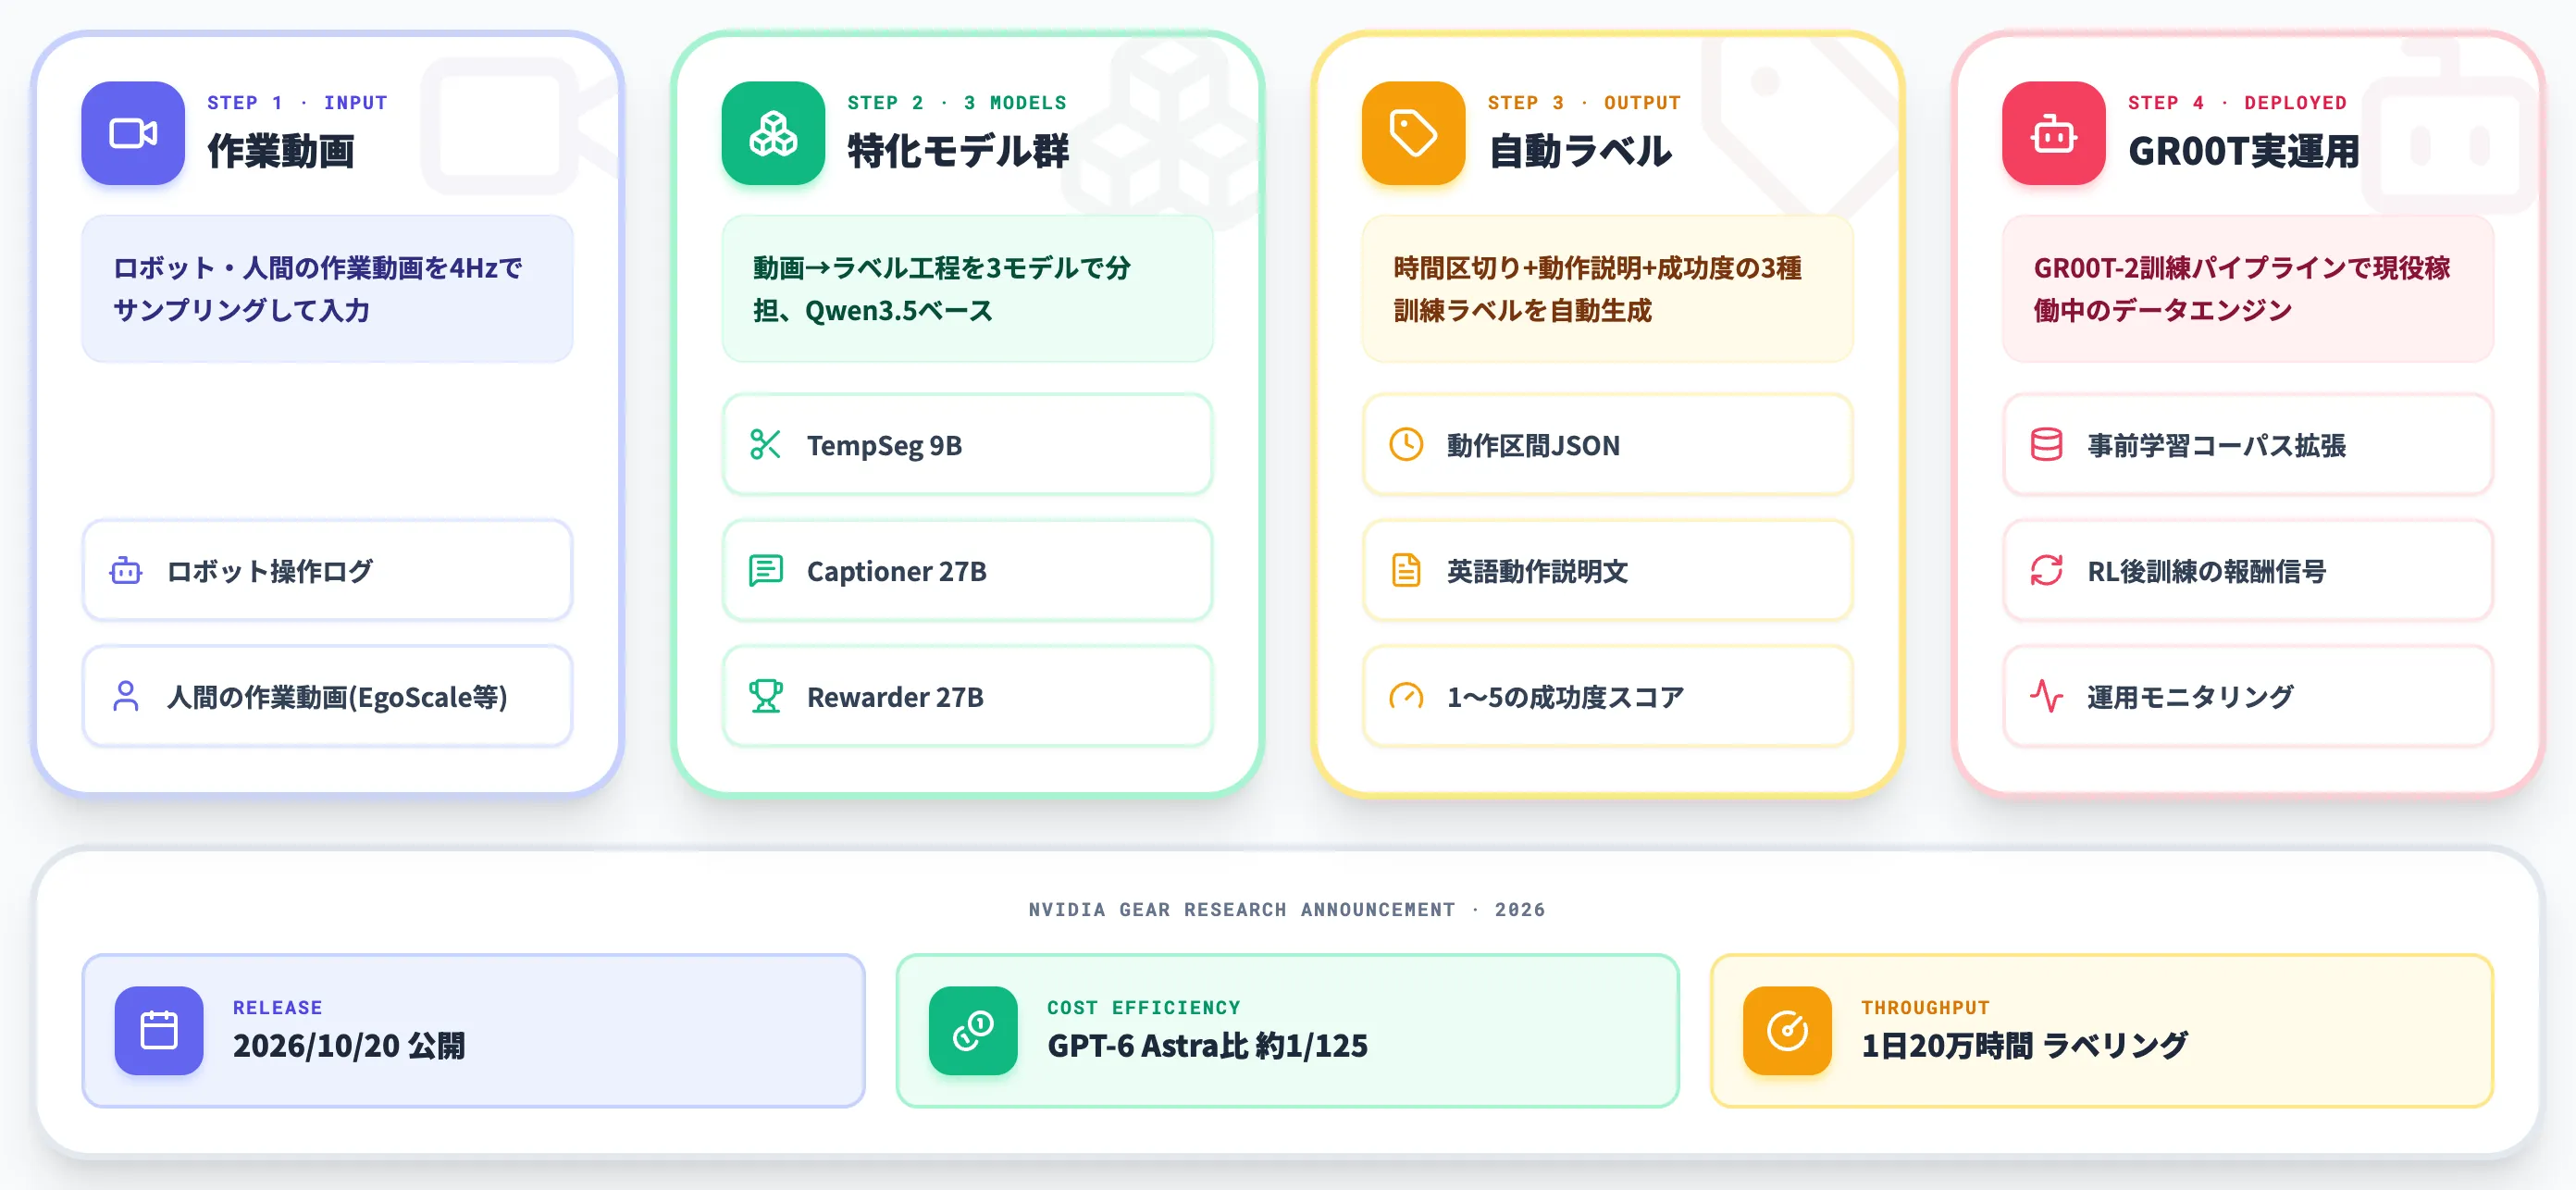
NVIDIA Flora(フローラ)とは、2026年10月20日にNVIDIAの研究チーム「GEAR」が公開した、ロボティクスAI訓練用のオープンデータエンジンです。
ロボットや人間の動画から、動作の切り分け・動作の説明文・成功度スコアを自動生成する3つのモデルで構成され、ヒューマノイドロボット基盤モデルGR00Tの訓練パイプラインで実際に使われています。
本記事では、3モデル構成(TempSeg・Captioner・Rewarder)、GPT-6 Astra比較のベンチマーク、125倍のコスト効率、非商用ライセンスの読み方、入手方法、日本企業への示唆までを、2026年10月時点の最新情報で体系的に解説します。
目次
NVIDIA Floraとは?ロボット動画から訓練ラベルを自動生成する基盤モデル群
Floraを構成する3モデル:TempSeg・Captioner・Rewarder
Flora-Captionerが動作を英語の指示文で説明する
NVIDIA Floraとは?ロボット動画から訓練ラベルを自動生成する基盤モデル群
NVIDIA Flora(フローラ)とは、2026年10月20日にNVIDIAの研究チーム「GEAR」が公開した、ロボティクスAI訓練用のオープンデータエンジンです。
ロボットや人間の作業動画を入力し、動作の時間的な区切り・各動作の説明文・成功度スコアの3種類のラベルを自動生成します。生成されたラベルは、ヒューマノイドロボット基盤モデルGR00Tの事前学習・強化学習・運用モニタリングで実際に利用されています。
Floraが際立つのは、単体の汎用マルチモーダルモデルではなく「ロボティクス訓練データ生成」という特定ワークロードに最適化された3モデル構成を取っている点です。NVIDIAはAPI型の汎用モデル(GPT-6 Astra)比で約125分の1のコスト水準で、1日あたり20万時間規模の動画ラベリングを実現したと発表しました。
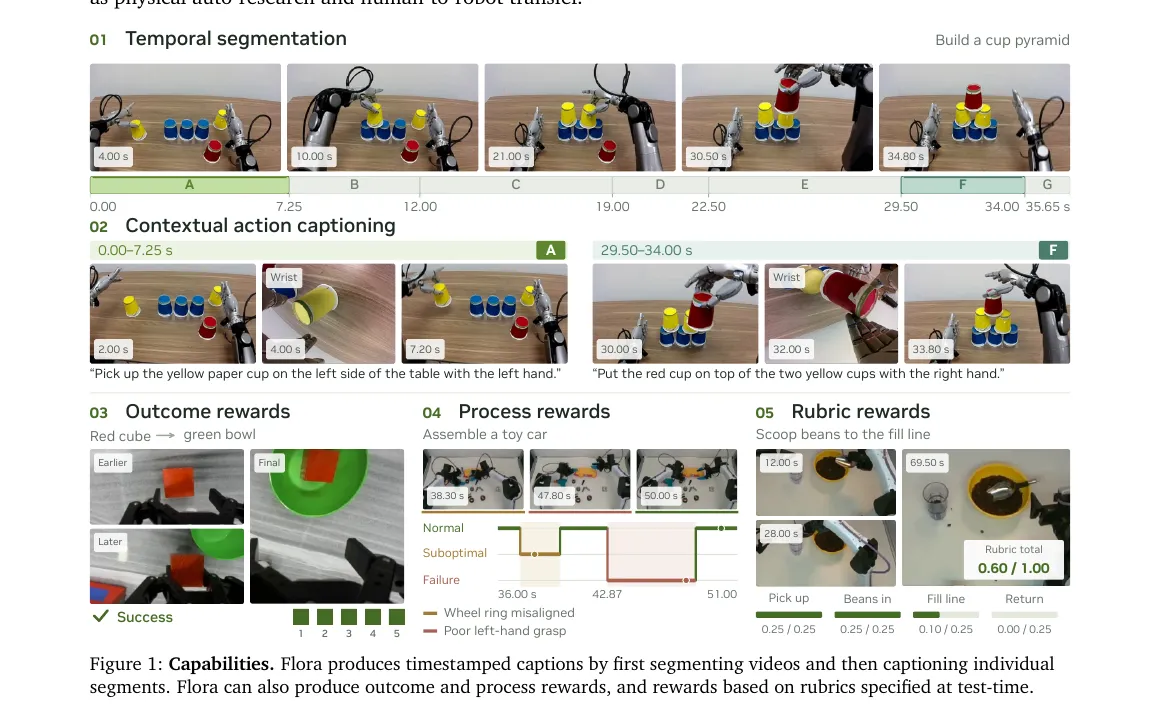
Floraが人間とロボットの作業動画に対して生成する5種類のラベル例(出典:Flora Paper (NVIDIA GEAR))
paperのFigure 1は、Floraの出力を5領域に整理した見取り図になっています。上段がTemporal segmentation(動作区間の切り分け)とContextual action captioning(周辺コンテキストを踏まえた動作説明)、下段がOutcome rewards(成功度の総合判定)、Process rewards(0.5秒刻みの行動品質)、Rubric rewards(ユーザー定義ルーブリックに沿った評価)です。この5領域が、記事後半で詳しく扱う3モデル(TempSeg・Captioner・Rewarder)の出力に対応しています。
ロボティクスAIが長く解けなかったデータ問題
Floraが解こうとしている課題を理解するには、まずフィジカルAI——物理世界で動くAI——が長らく直面してきたデータ構造の難しさを押さえる必要があります。
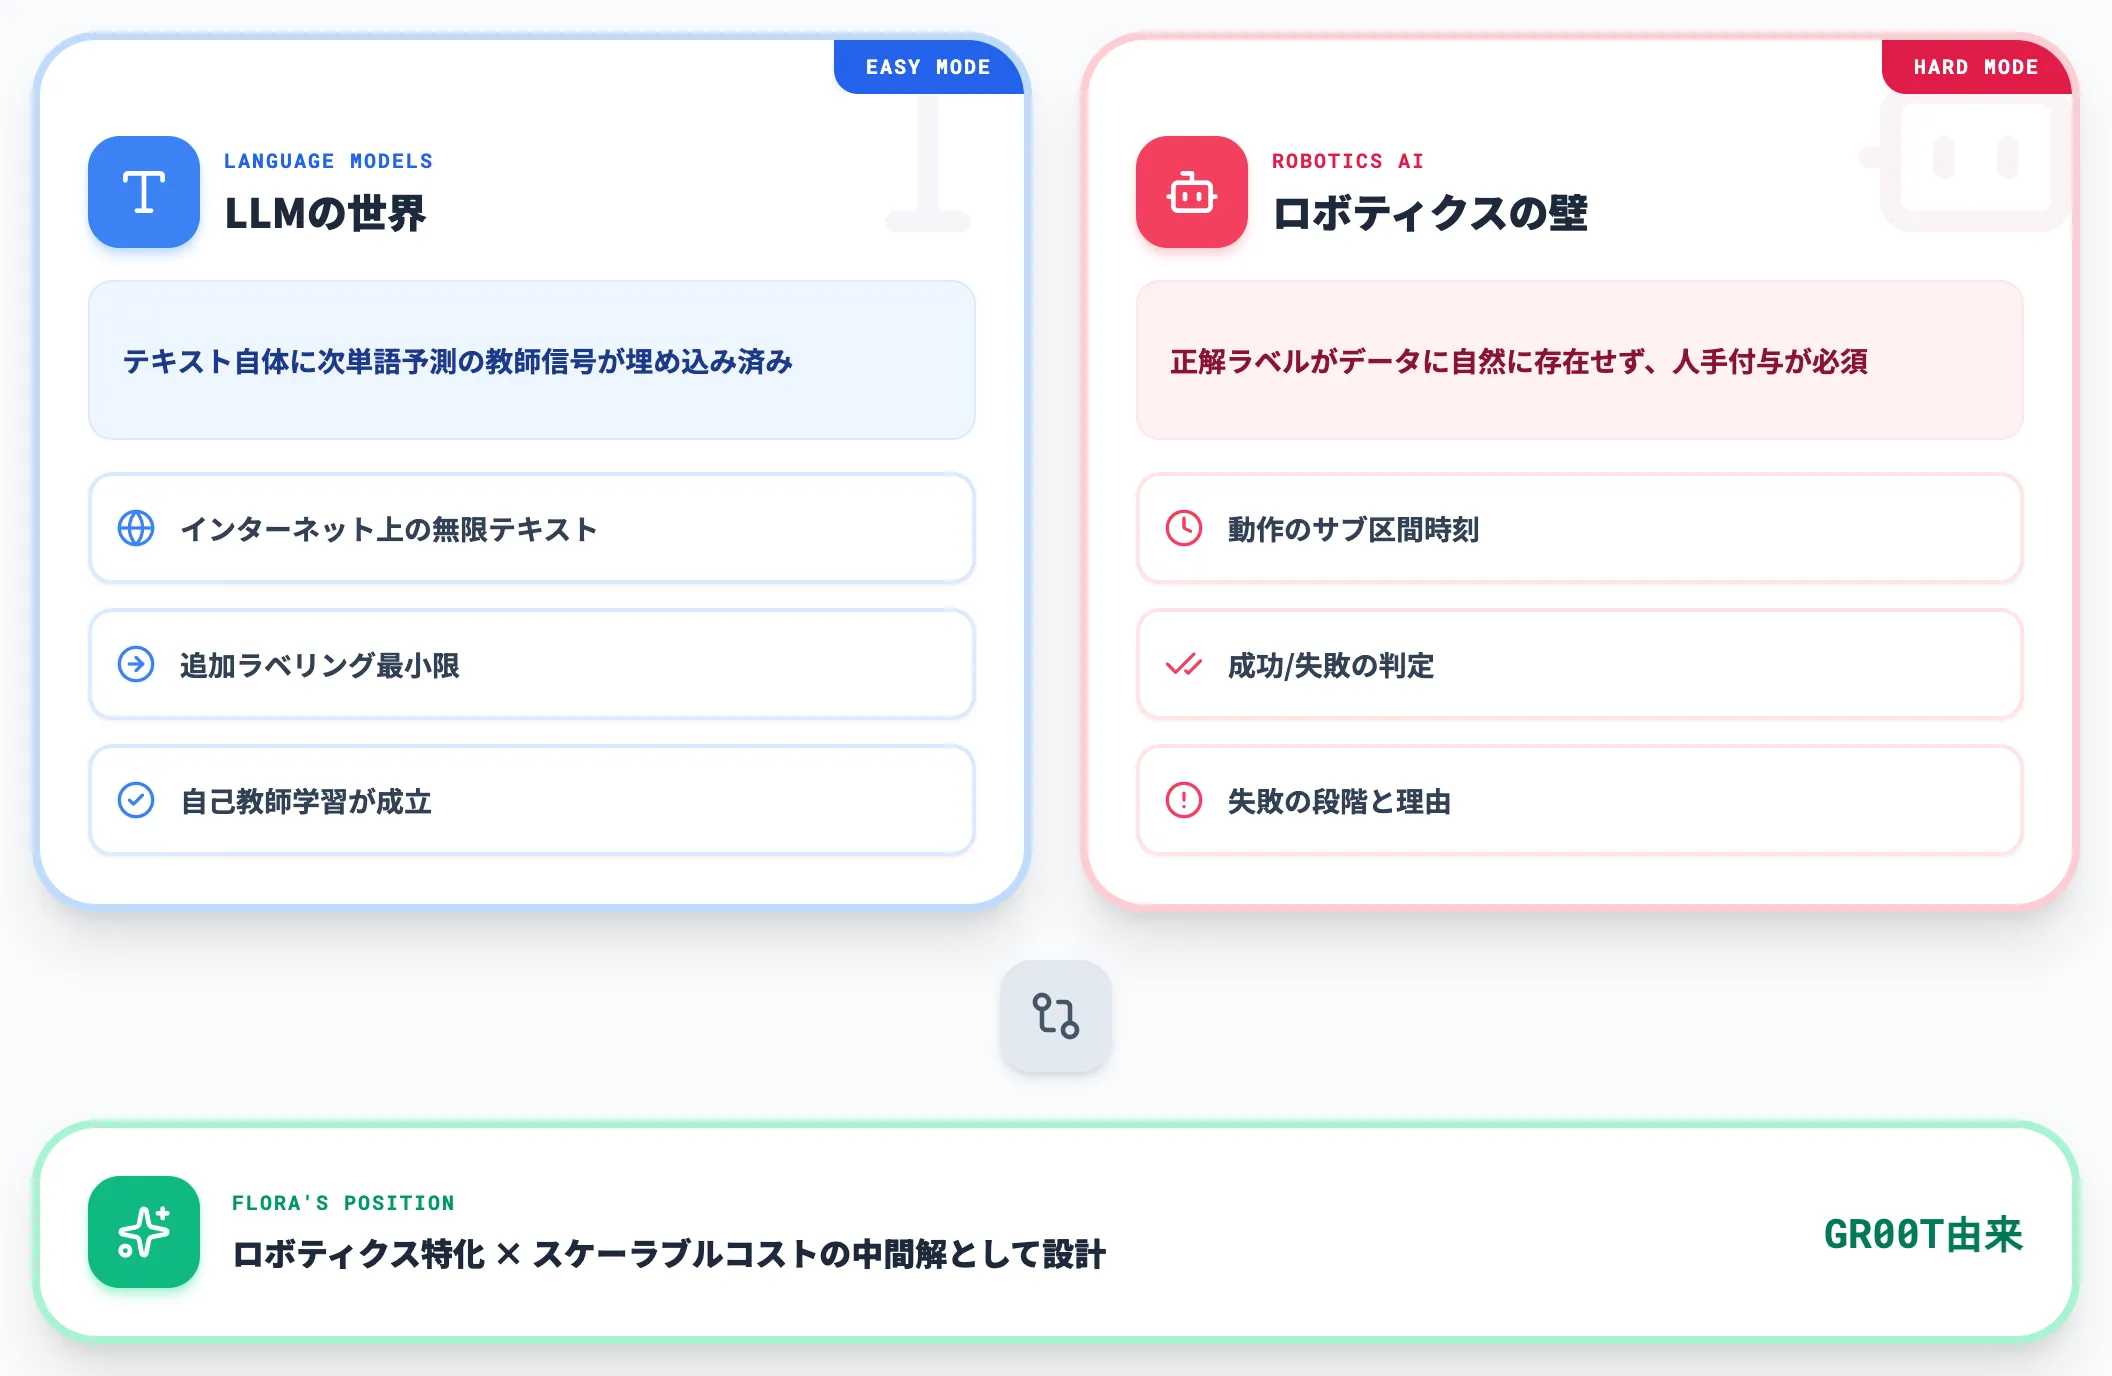
言語モデルや画像モデルがインターネット上に大量に存在するテキスト・画像を学習データとして使えたのに対し、ロボティクスAIにはそれに匹敵する「大規模で品質が揃った正解ラベル付きデータ」が存在しません。
LLMと決定的に異なる正解ラベルの性質
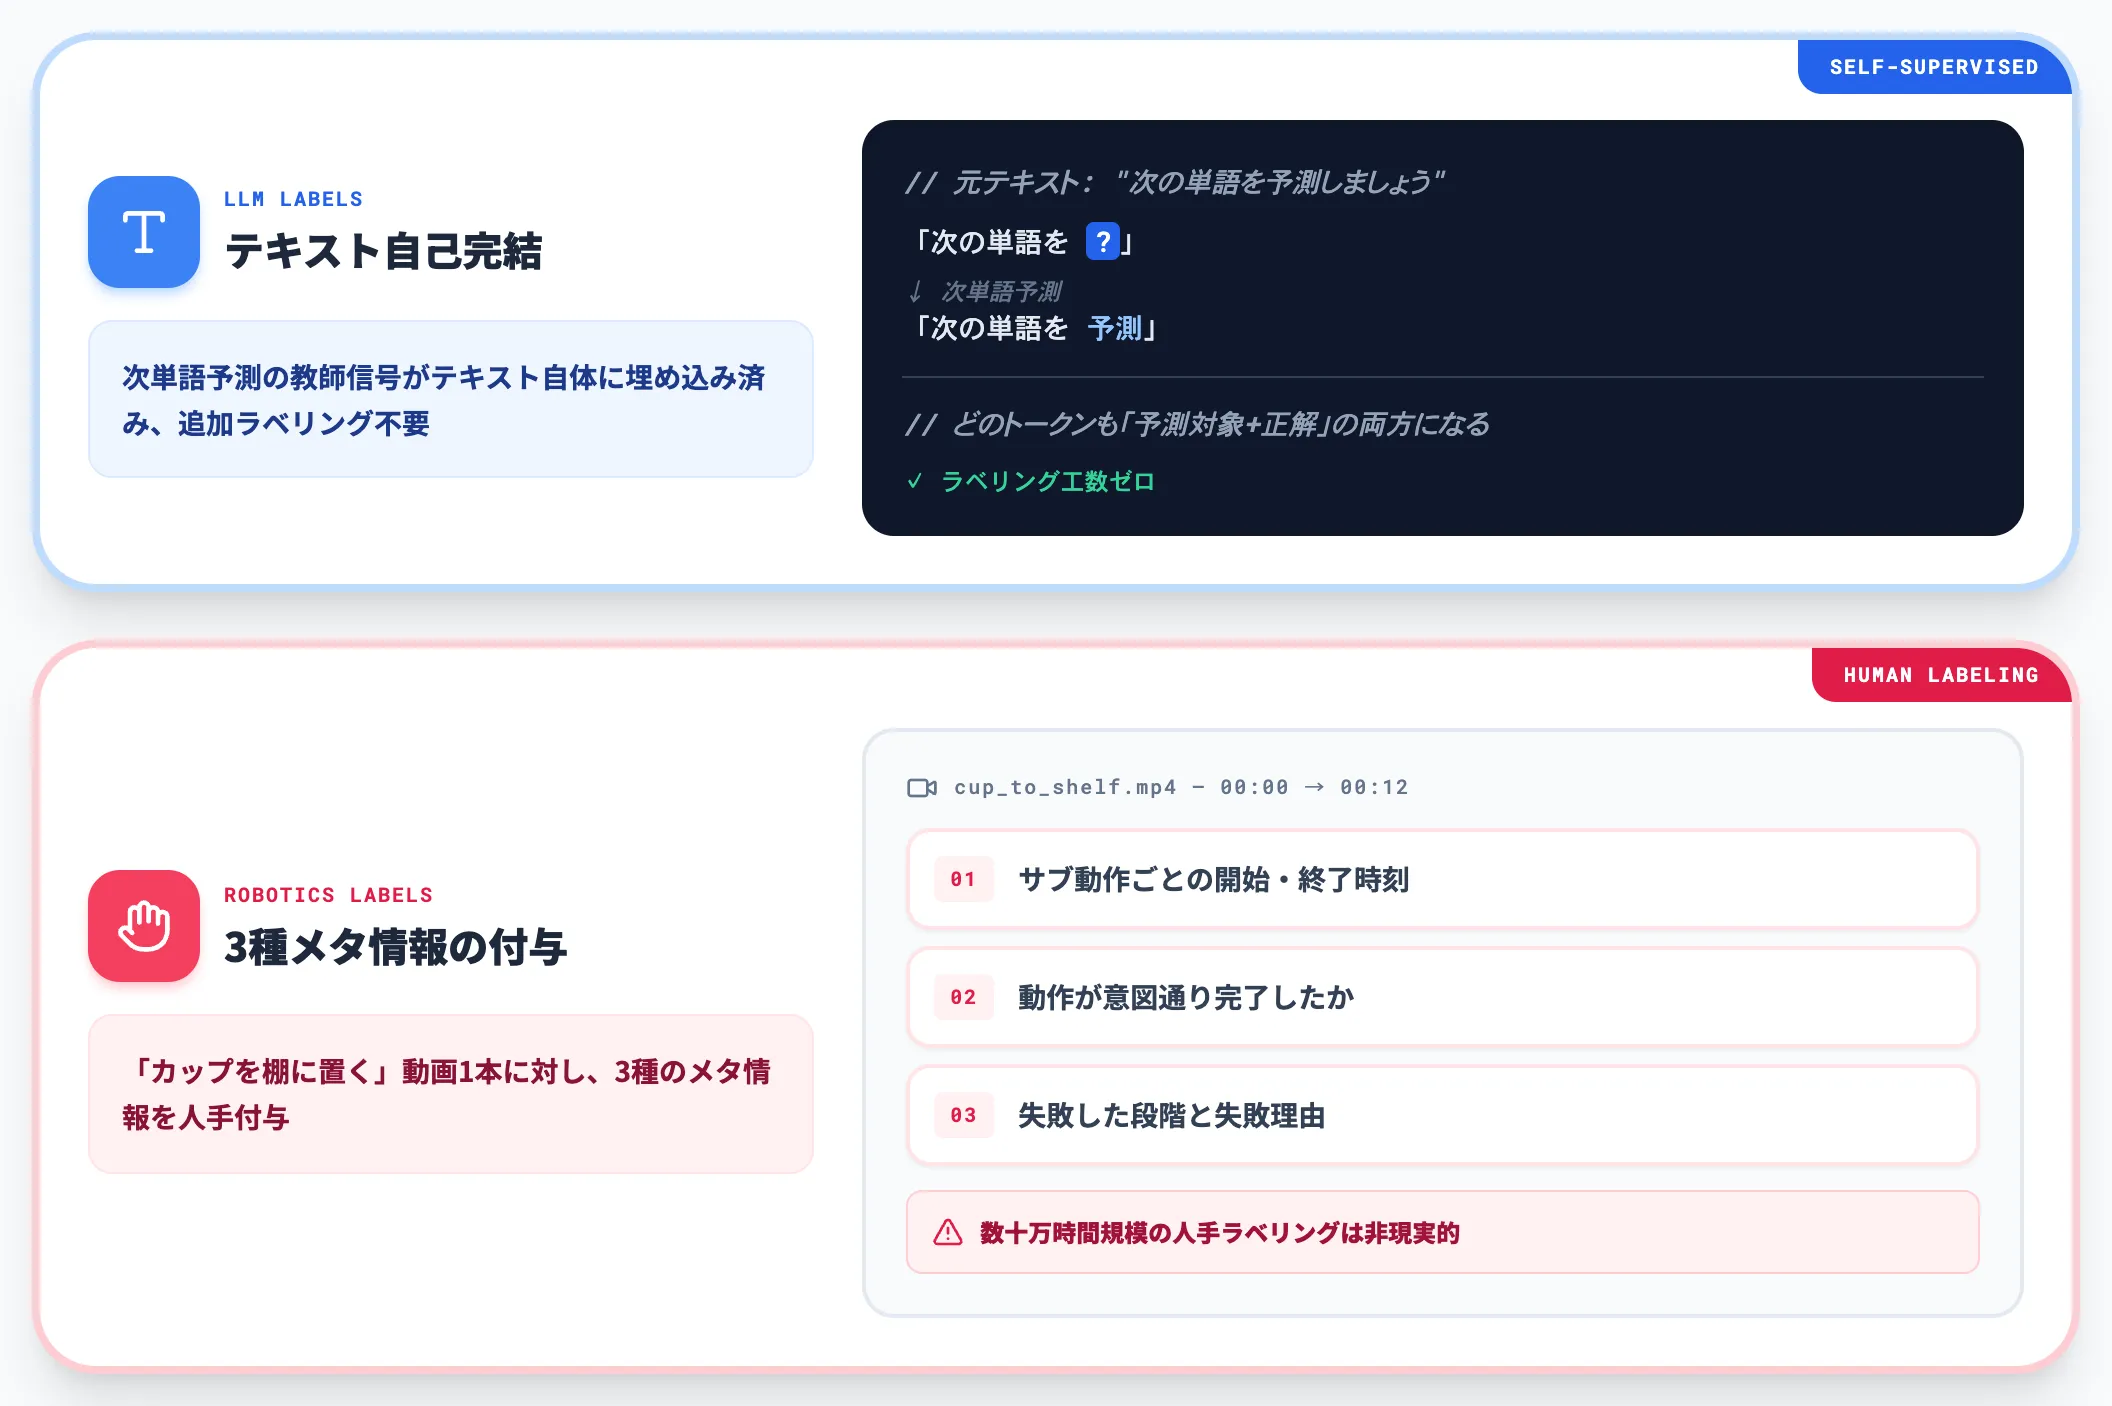
大規模言語モデル(LLM)の場合、次の単語を予測するという教師信号が自然言語テキスト自体に埋め込まれています。インターネット上のテキストをそのまま学習コーパスとして使えば、追加のラベリングは最小限で済みます。
対してロボティクスでは、「ある動作が成功したか失敗したか」「どの時間帯にどんなサブ動作を行ったか」といった正解ラベルがデータの中に自然に存在しないという問題があります。
具体的には、同じ「カップを棚に置く」という動作でも以下の情報を人手で付与する必要があります。
- 何秒から何秒まで、どのサブ動作(カップを掴む・持ち上げる・位置を調整する・置く)が行われたか
- その動作は意図通りに完了したか、途中で失敗したか
- 失敗した場合、どの段階でどんな理由で失敗したか
こうした粒度のラベルがあると、ロボット基盤モデルは「正しい動作」と「失敗パターン」をより細かく学習できます(エピソード単位の成否だけから学ぶRL手法もあり、必須条件ではありません)。ただし人手ラベリングを数十万時間規模で続けるのは現実的ではありません。
既存ソリューションの限界:人手ラベリングと汎用VLM
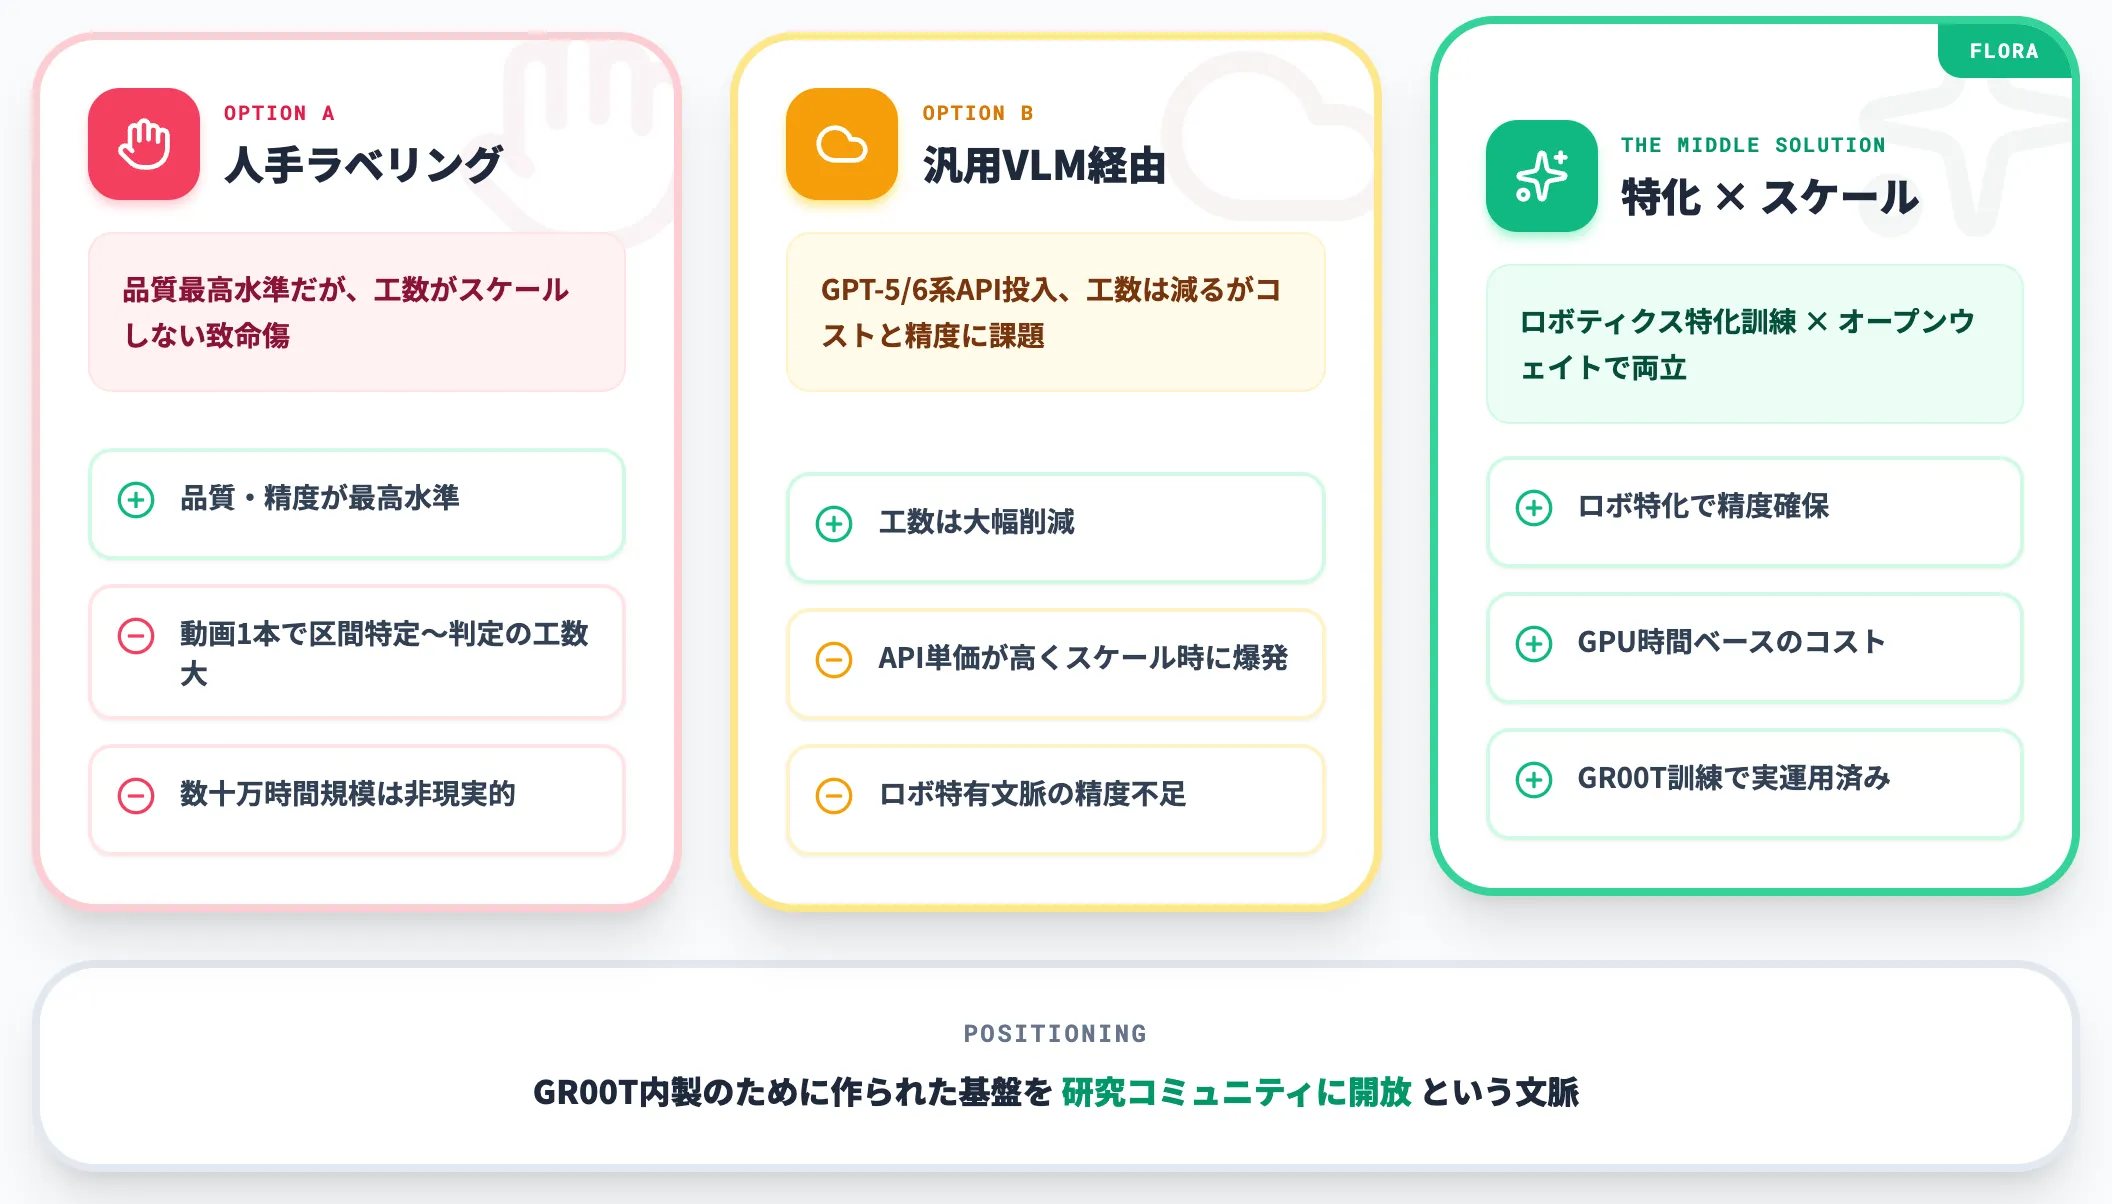
これまでロボティクス研究コミュニティは、2つの方向でこの問題に向き合ってきました。
-
人手による精密ラベリング
品質は高いが、動画1本に対して区間特定・動作記述・成功/失敗判定を人手で付与する工数がかかる。大規模な事前学習データセット構築には現実的でない
-
汎用VLM(GPT-5系・GPT-6系)による自動ラベリング
API経由で動画を送って説明文を生成させる方式。工数は削減できるが、API単価が高くスケール時のコストが問題。かつロボティクス特有の文脈(グリッパ・把持点・物体の相対位置)に対する精度が十分でない
Floraはこの2つの間に位置する「ロボティクスに特化しつつ、スケーラブルなコストで動く専用モデル」として設計されています。NVIDIA自身がGR00Tという内製の巨大基盤モデルを訓練するために必要になり、実用化したものを研究コミュニティに開放する——という文脈でリリースされました。
Floraを構成する3モデル:TempSeg・Captioner・Rewarder
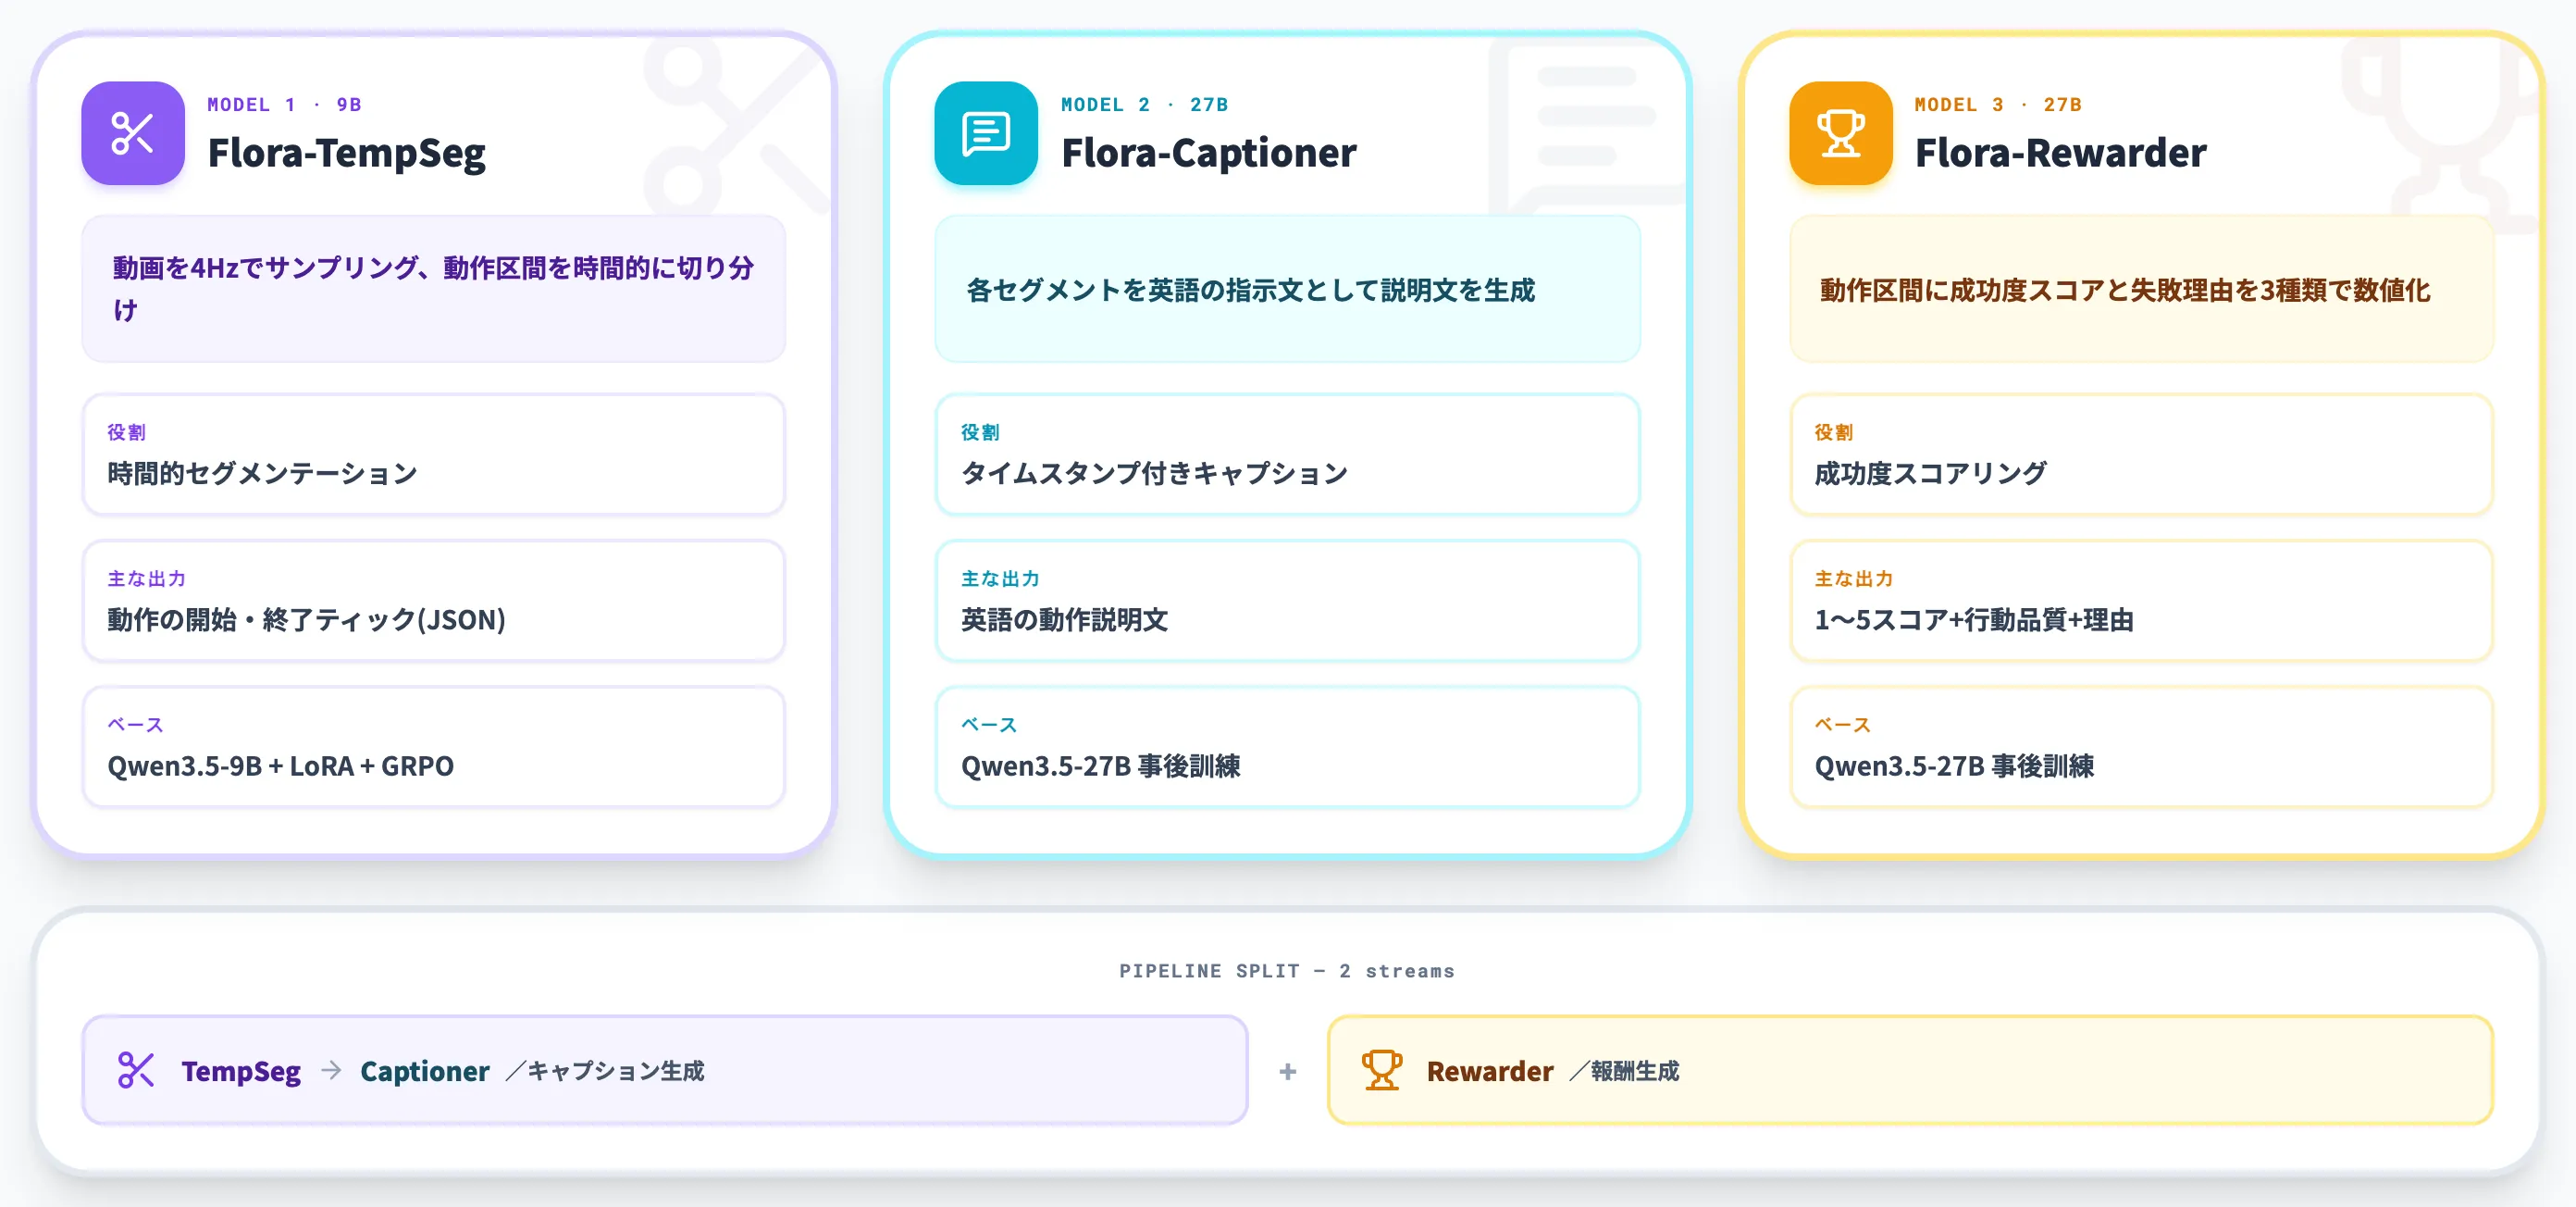
Floraは単一のモデルではなく、動画ラベリングパイプラインの各工程に特化した3つのモデルで構成されています。
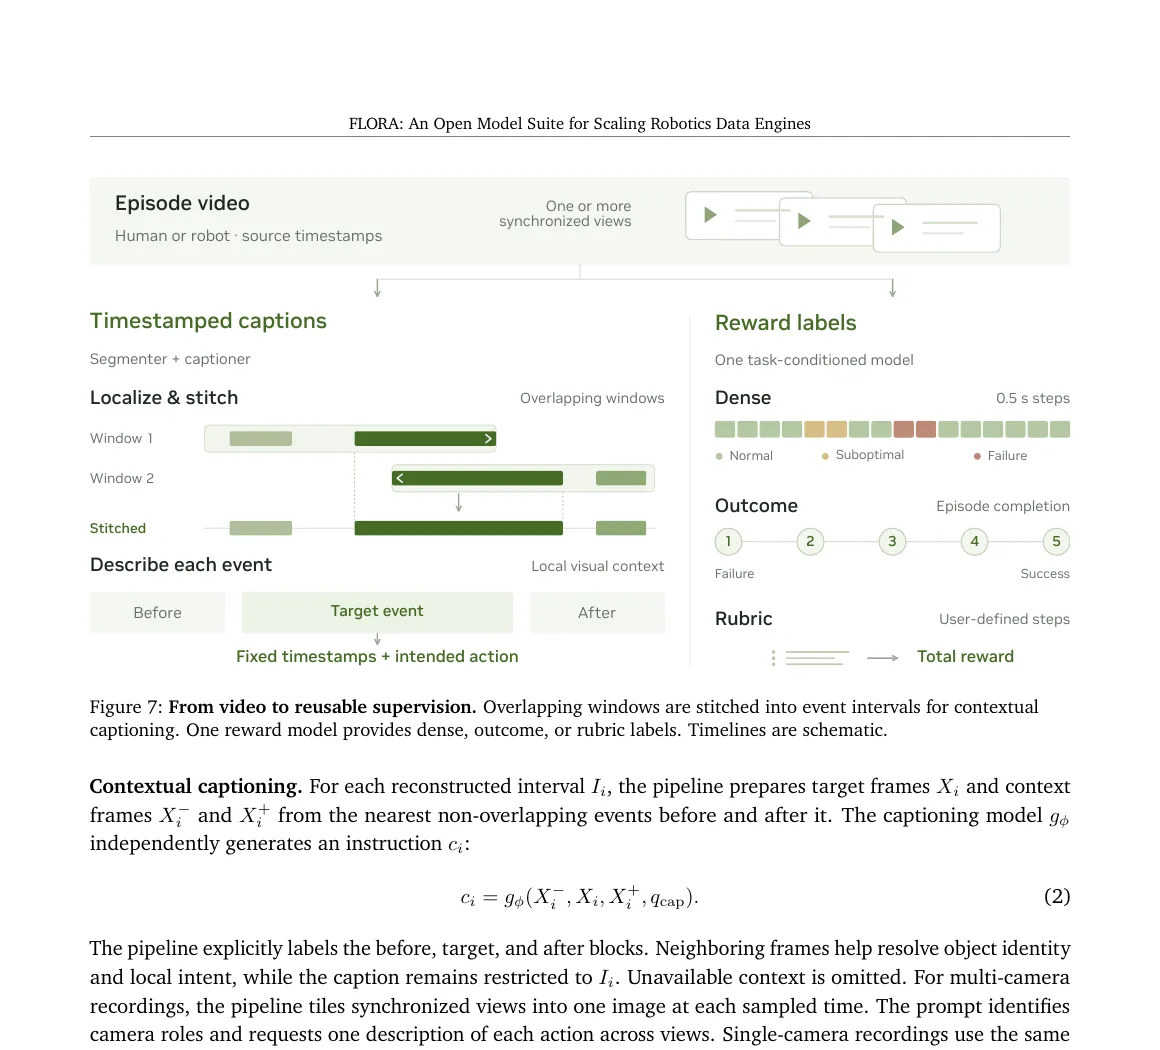
Floraのタイムスタンプ付きキャプションとリワードラベルの処理フロー(出典:Flora Paper (NVIDIA GEAR))
paperのFigure 7は、Floraが2系統のパイプラインで動画を処理する流れを示したものです。
左半分がTimestamped captions(動画の時間的区切り→区間特定→各動作の説明)、右半分がReward labels(Dense・Outcome・Rubricの3種類のスコアリング)に分かれています。TempSegがLocalize & stitchを、Captionerが各区間のdescribeを、Rewarderが3種類のリワード出力を担当するという役割分担が、この図で視覚的に理解できます。
以下の表で、3モデルの役割分担と仕様を整理しました。表の後で各モデルの詳細を順に解説します。
| モデル名 | パラメータ | 役割 | 主な出力 |
|---|---|---|---|
| Flora-TempSeg | 9B | 時間的セグメンテーション | 動作の開始・終了ティック(JSON形式) |
| Flora-Captioner | 27B | タイムスタンプ付きキャプション | 各セグメントの英語動作説明文 |
| Flora-Rewarder | 27B | 成功度スコアリング | 1〜5の総合スコア、0.5秒刻みの行動品質ラベル、推論理由 |
この構成から分かるのは、動画の区切り・動作説明・成功度評価という訓練データ生成の工程を、特化モデル群でカバーしている点です。
公式構成は、TempSeg→Captionerによるキャプション生成パイプラインと、Rewarderによる報酬生成パイプラインの2系統で分担しています。
Flora-TempSegが動画を動作ごとに切り分ける
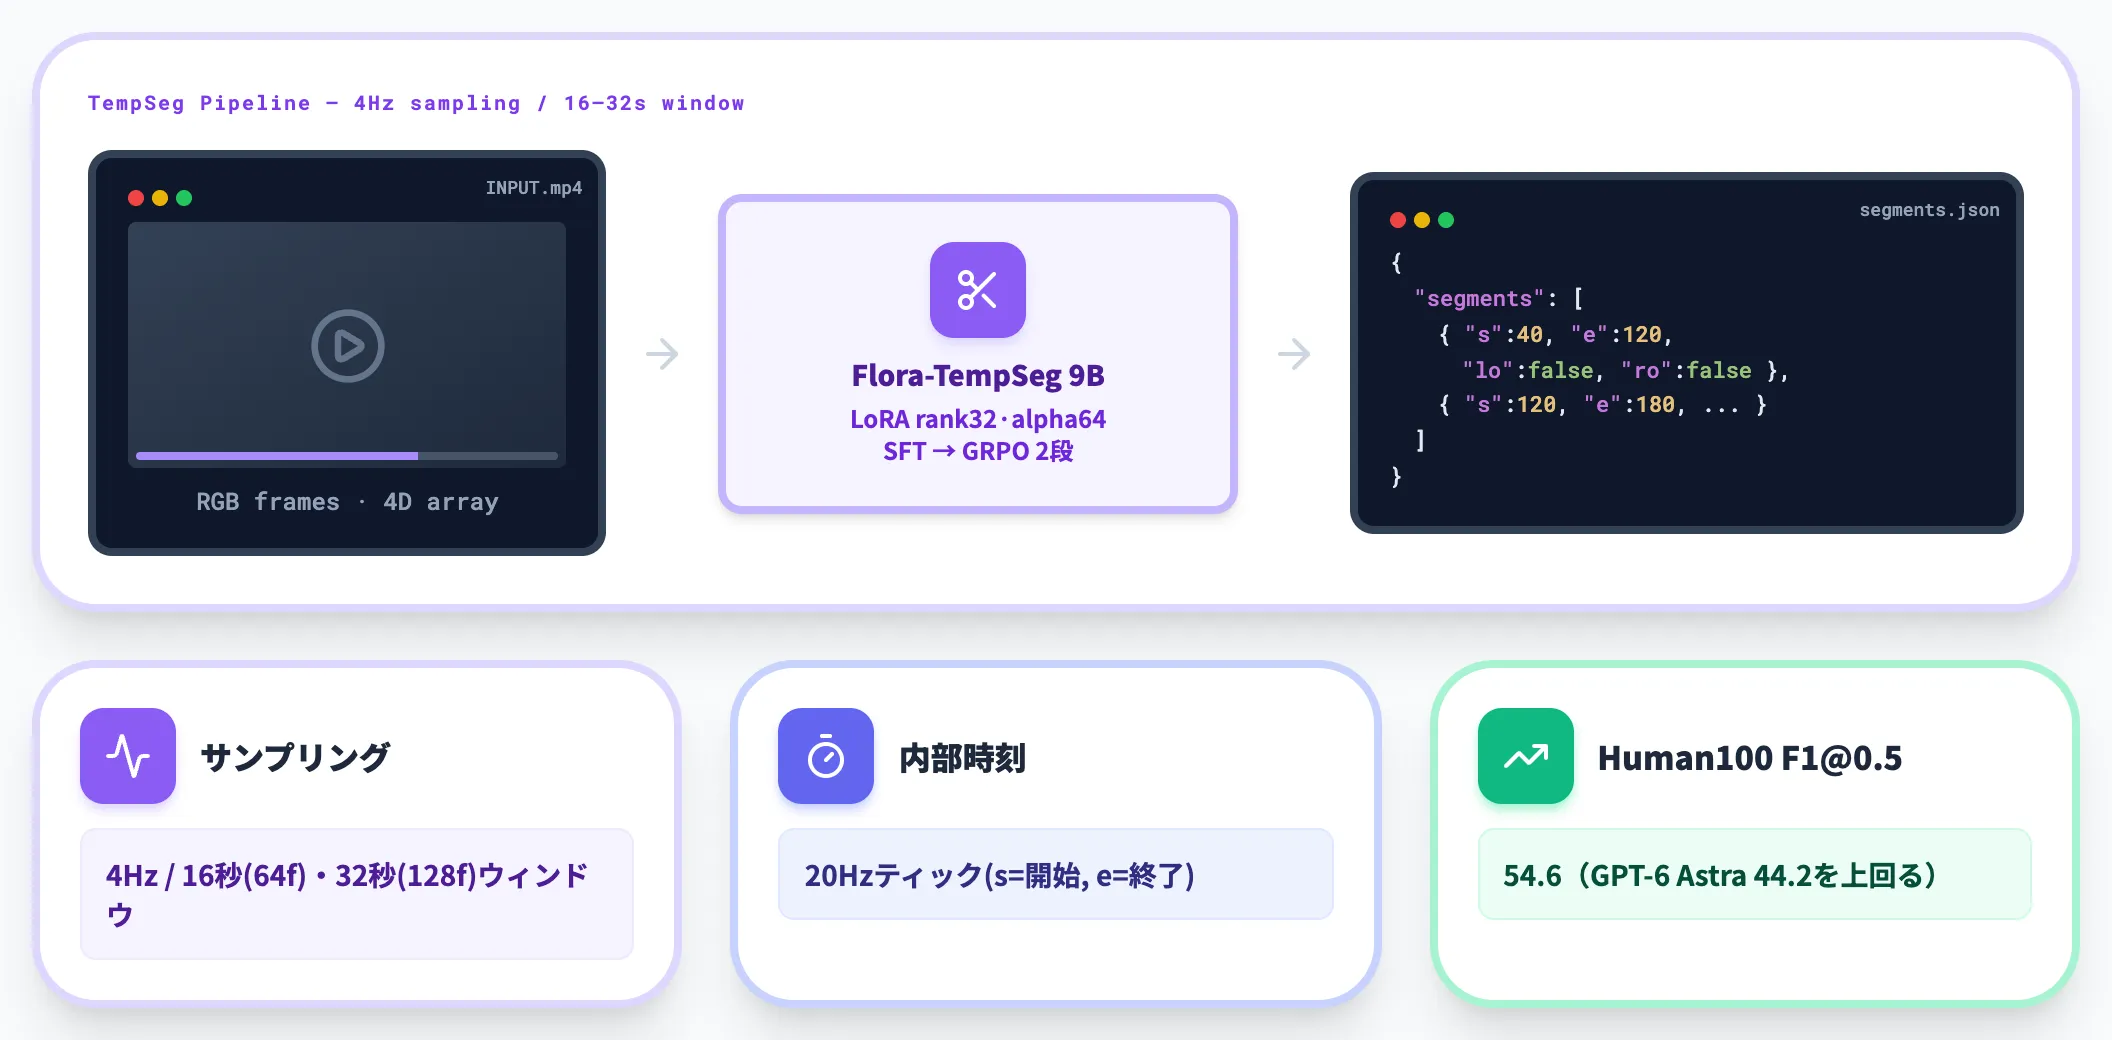
Flora-TempSegは、ロボットや人間の作業動画を4Hzでサンプリングし、どの時間帯にどんな動作区間が存在するかを検出するモデルです。
ベースモデルはAlibabaのQwen3.5(9B版)で、LoRA(rank 32・alpha 64)で追加訓練されています。
訓練は強化学習のGRPO(Group Relative Policy Optimization)を含む2段階構成で、Supervised Fine-Tuning後にGRPOで動画セグメンテーション精度を最適化しています。
入力・出力の仕様は以下のとおりです。
-
入力
RGB動画フレーム(4次元配列:frames × height × width × 3)+プロンプト。4Hzサンプリングで、16秒ウィンドウ(64フレーム)または32秒ウィンドウ(128フレーム)に対応
-
出力
JSONオブジェクト「{"segments": [{"s": 40, "e": 120, "lo": false, "ro": false}, ...]}」。「s」は開始ティック、「e」は終了ティック(20Hzの内部時刻)
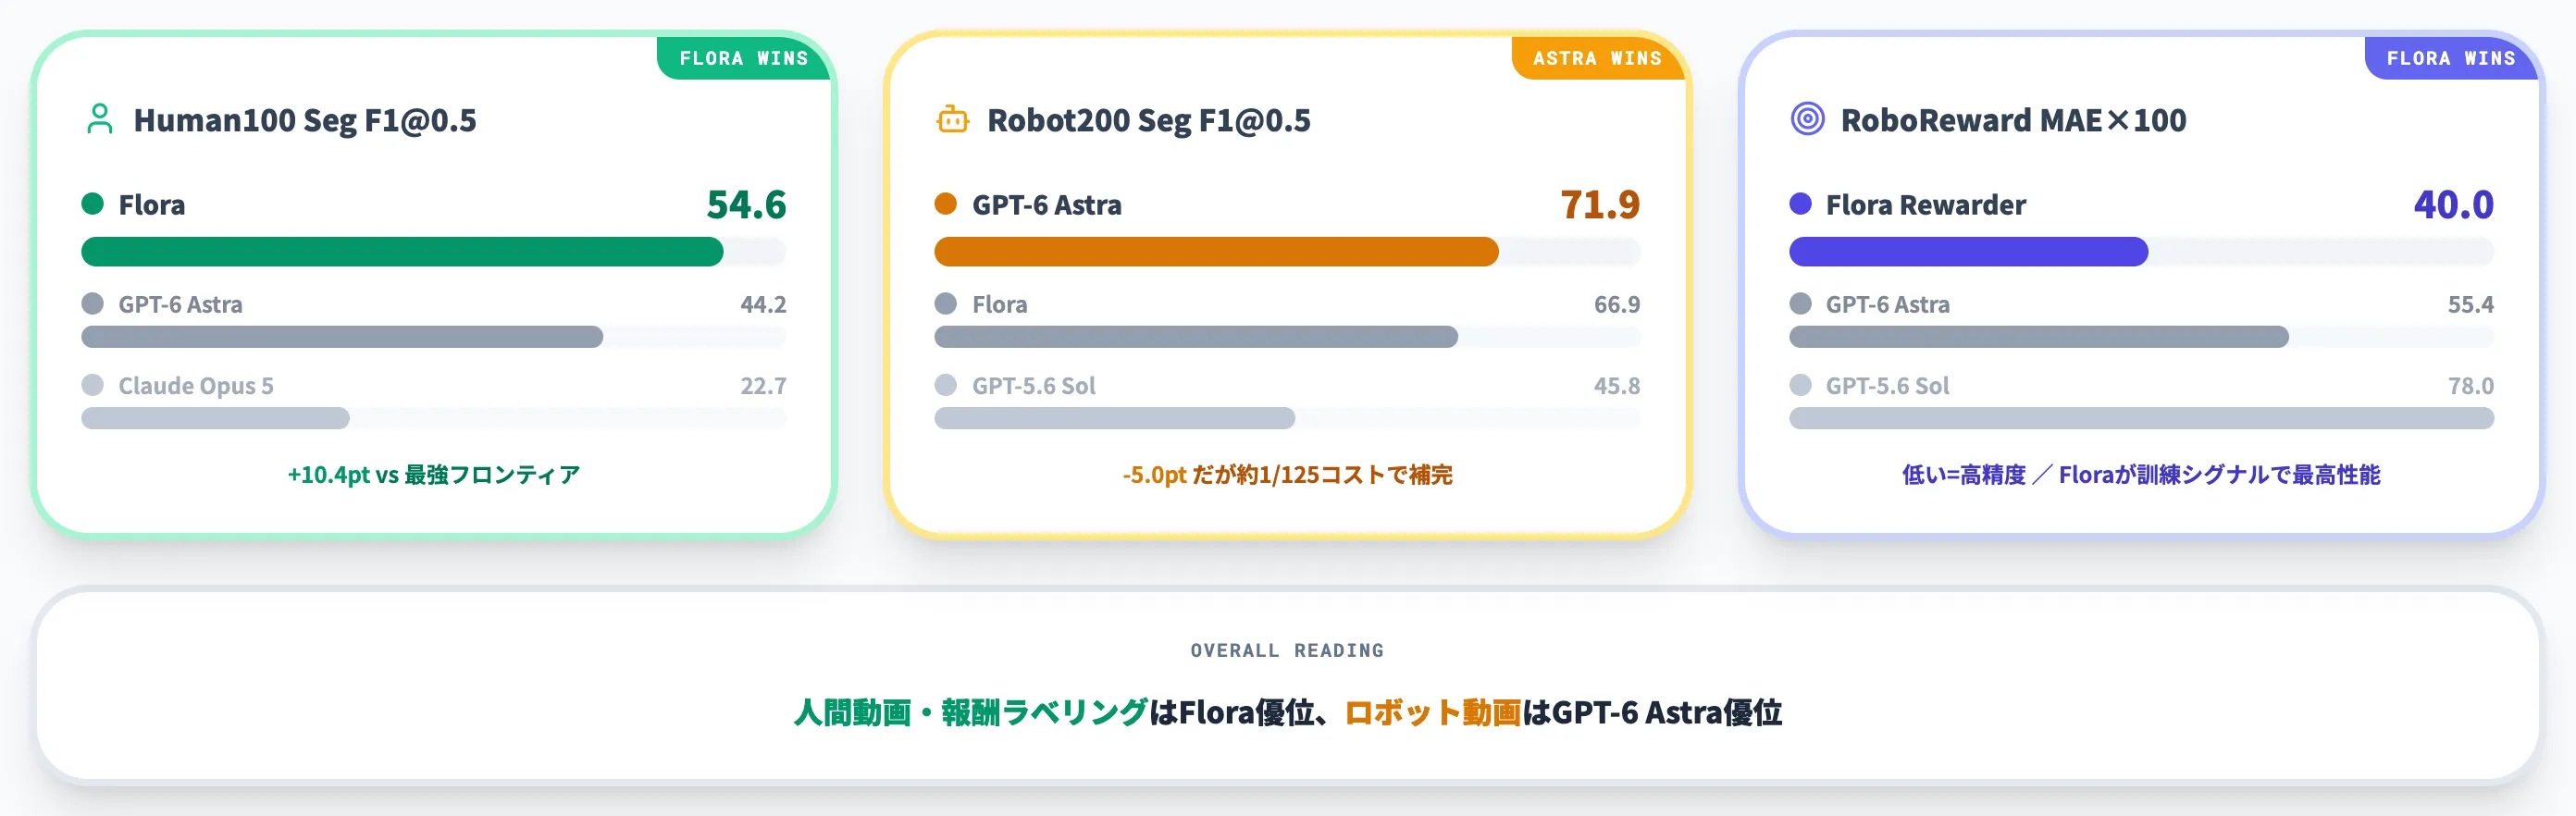
セグメンテーションのF1スコア(DenseCaptionBench Human100 Segmentation F1@0.5)は54.6で、GPT-6 Astraの44.2、Claude Opus 5の22.7を大きく上回っています。
Flora-Captionerが動作を英語の指示文で説明する
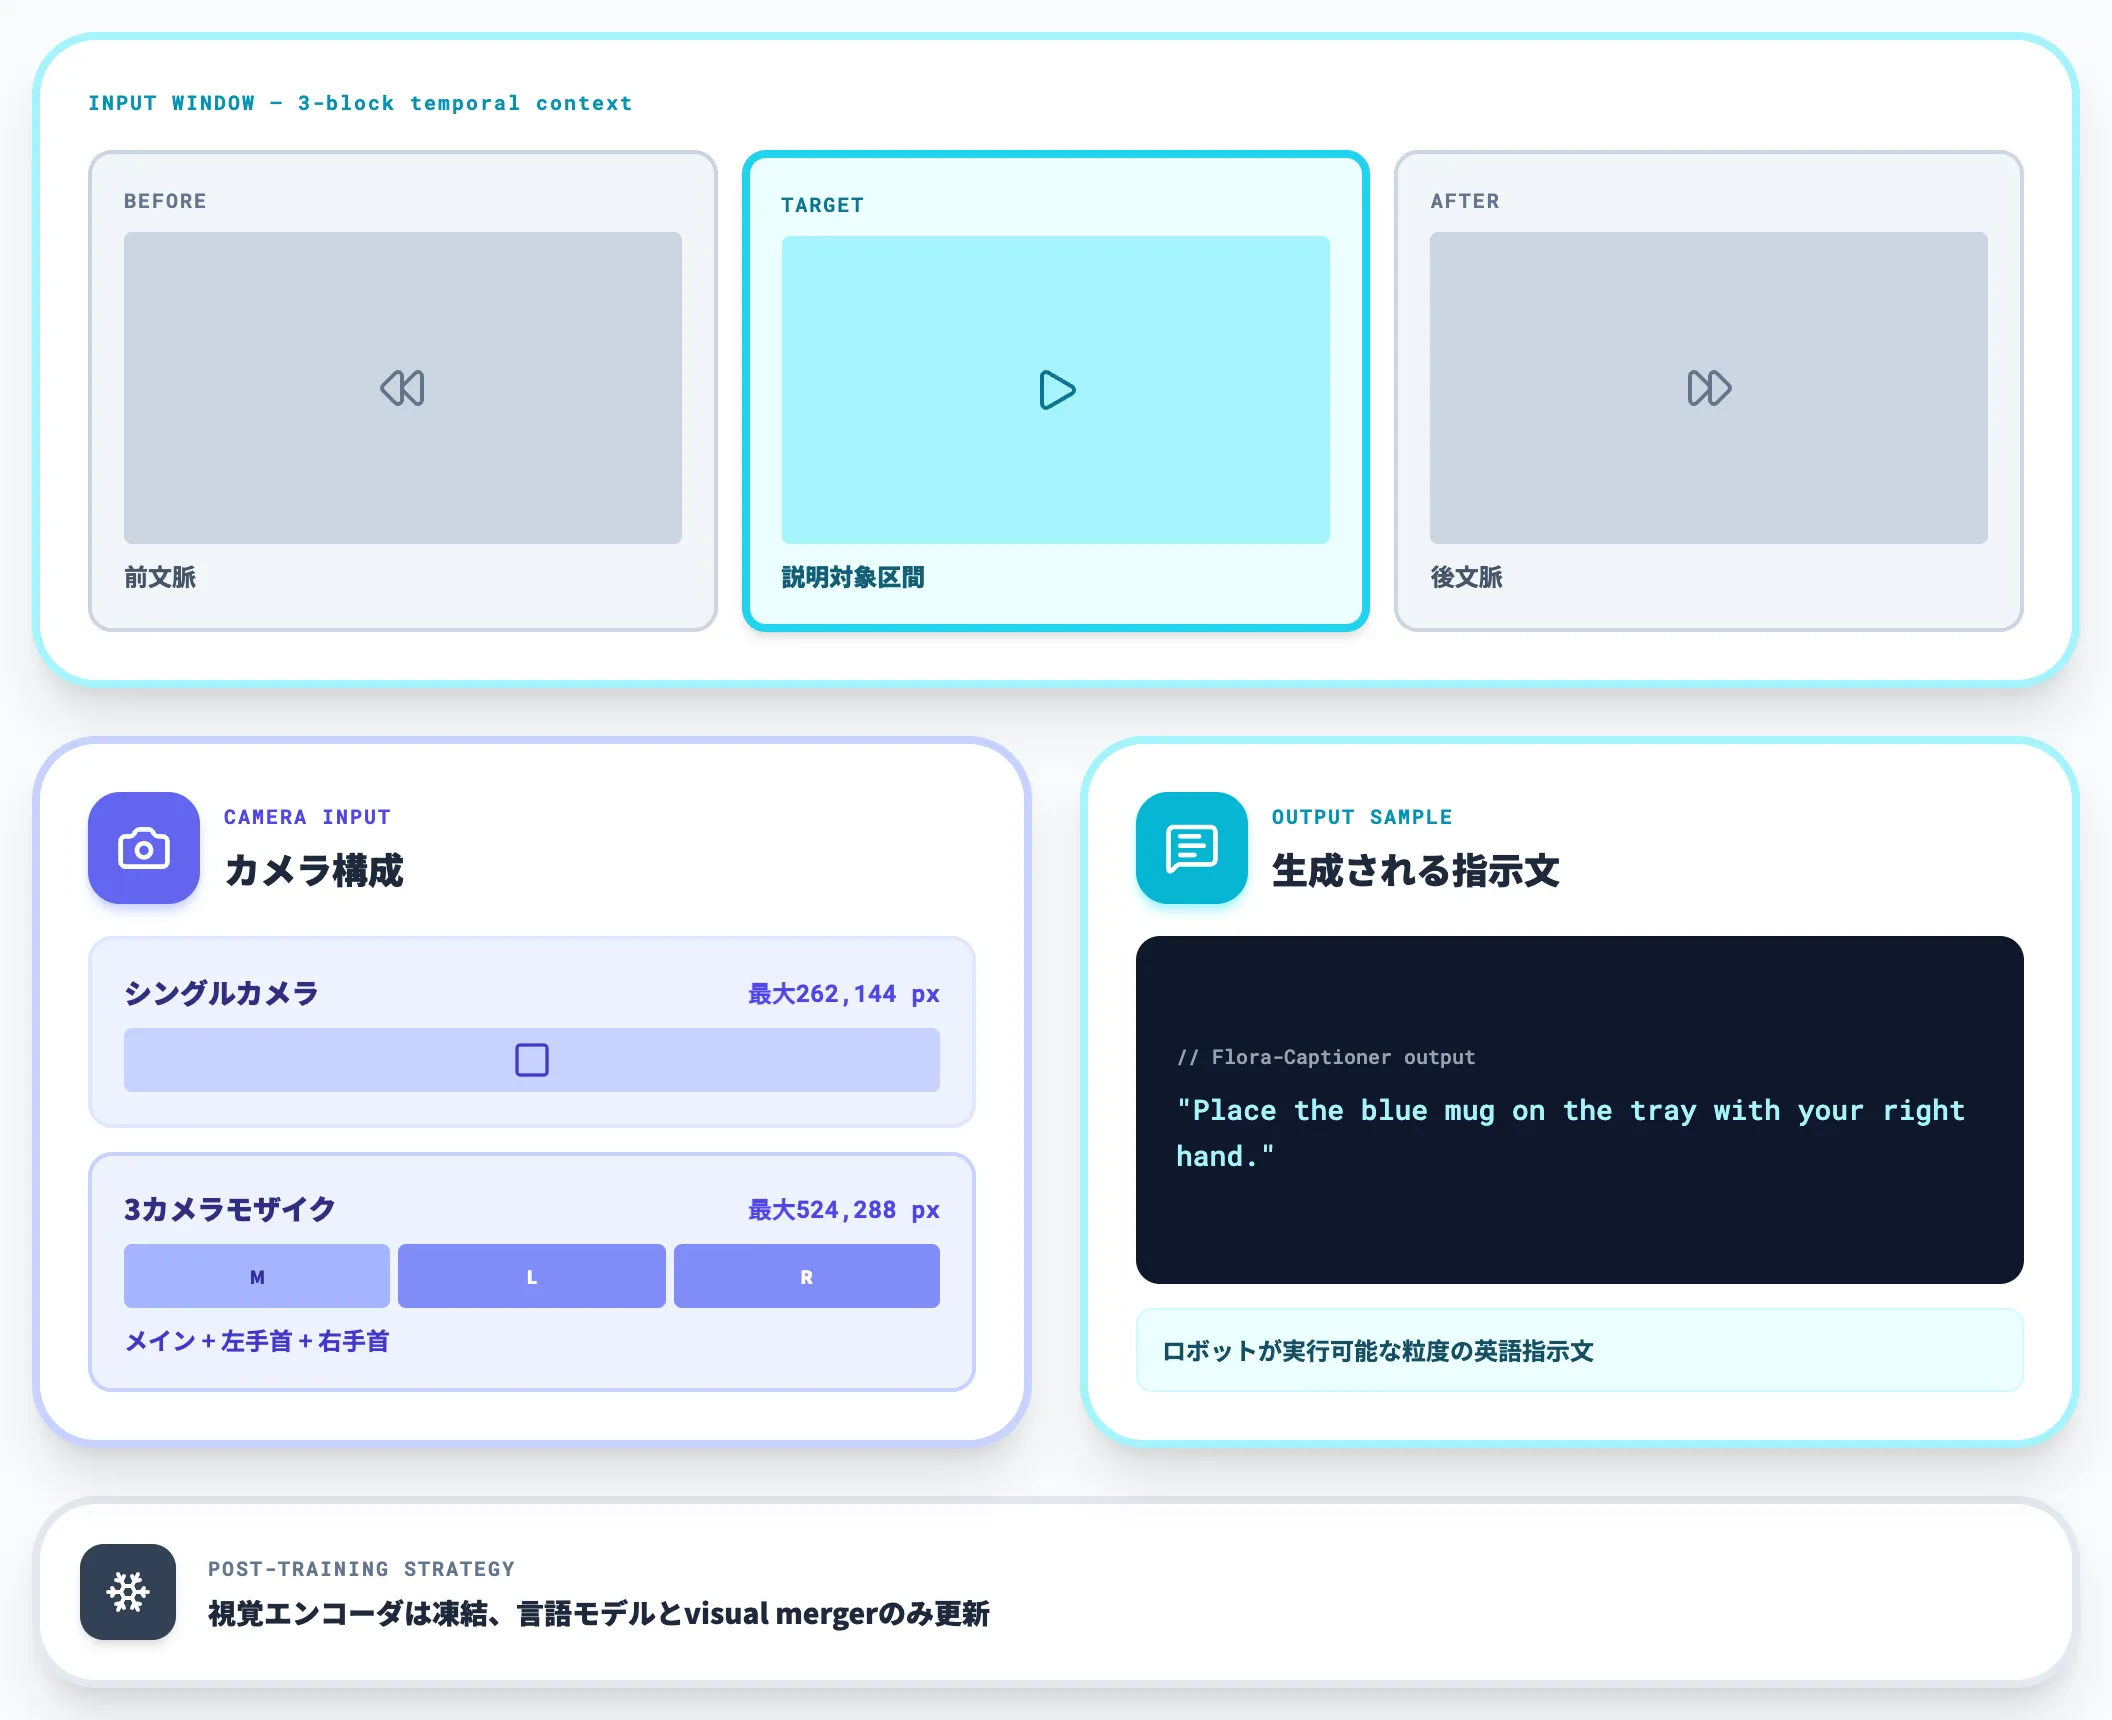
Flora-Captionerは、TempSegで切り出された動画区間に対して、1つの動作を英語の指示文として生成するモデルです。
パラメータ数は27B、ベースはQwen3.5-27Bのマルチモーダル版です。TempSegと異なり、LoRA追加訓練ではなく、視覚エンコーダーを凍結したうえで言語モデル部分とvisual mergerを更新する事後訓練で動作キャプションに特化させています。
特徴は、単一カメラだけでなく複数カメラのモザイク入力に対応している点です。
- シングルカメラ: 最大262,144ピクセル
- 3カメラモザイク: 最大524,288ピクセル(メインカメラ+左手首カメラ+右手首カメラ)
入力動画は「BEFORE」・「TARGET」・「AFTER」の3時間ブロックで構成され、TARGET区間に対して周辺コンテキストを踏まえた動作説明を生成します。出力例は「Place the blue mug on the tray with your right hand.」のような、ロボットが実行可能な粒度の英語指示文です。
Flora-Rewarderが動作の成功度を数値化する
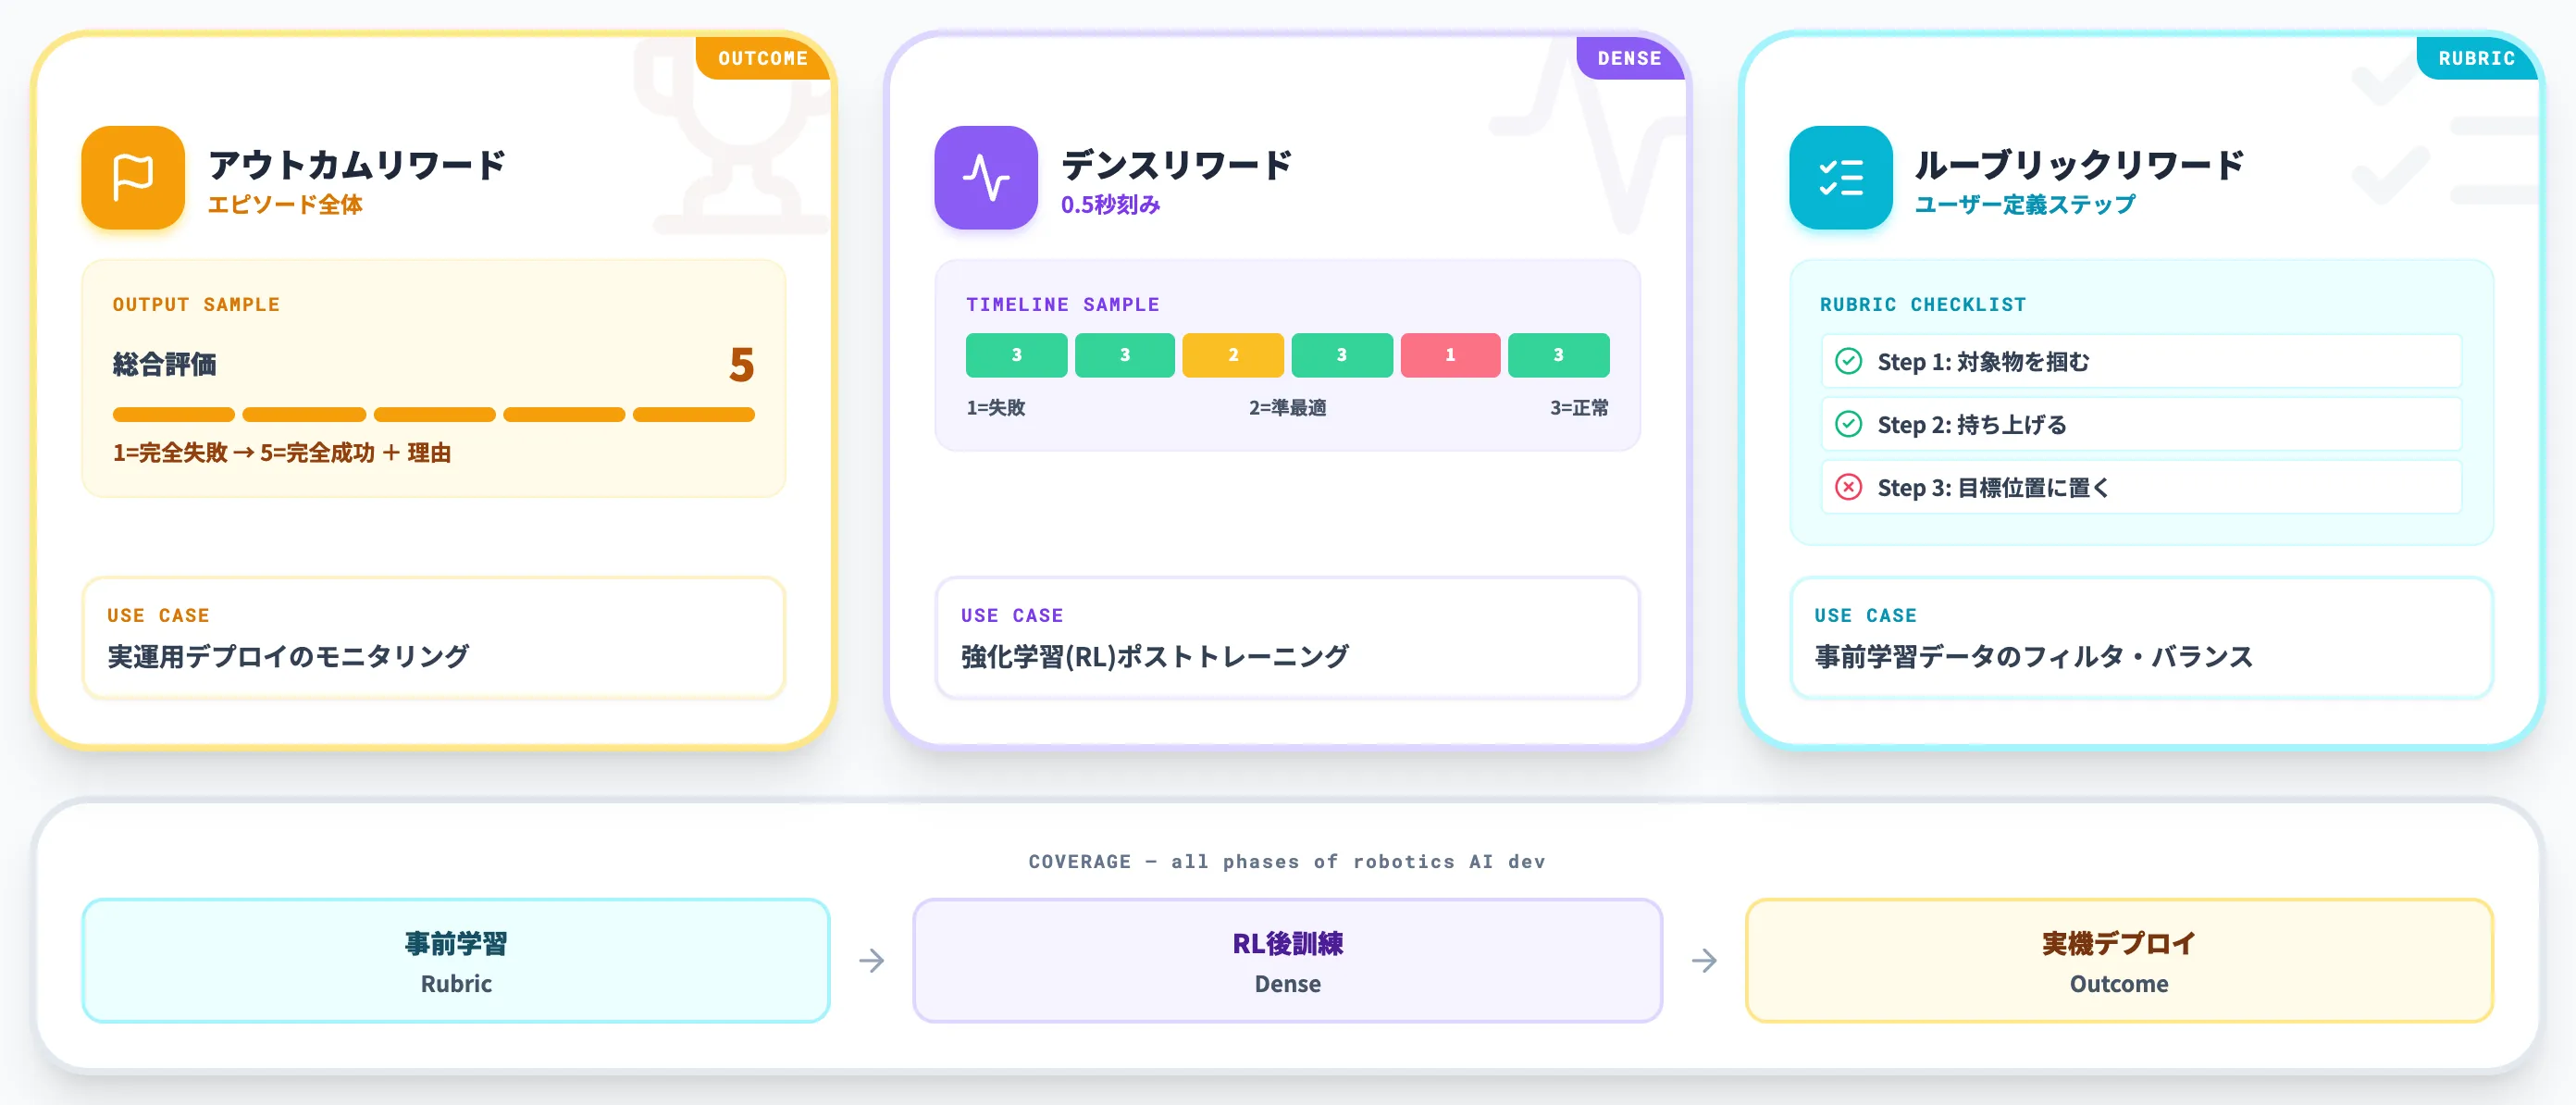
Flora-Rewarderは、動作区間に対して成功度や失敗理由を評価するモデルで、Floraの中で最も用途が複雑なモデルです。
ベースはCaptionerと同じQwen3.5-27B。出力は目的に応じて3種類を切り替えられます。
以下の表で、3種類のリワード出力を比較しました。この表の読み方を踏まえ、本セクション末尾で用途の使い分けを整理します。
| リワード種別 | 時間粒度 | 出力スコア | 想定用途 |
|---|---|---|---|
| アウトカムリワード | エピソード全体 | 1〜5の総合評価(1=完全失敗、5=完全成功)+理由 | 実運用デプロイのモニタリング |
| デンスリワード | 0.5秒刻み | 1=失敗 / 2=準最適 / 3=正常 + ウィンドウ最悪スコア + 理由 | 強化学習(RL)のポストトレーニング |
| ルーブリックリワード | ユーザー定義ステップ | 推論トレース+ルーブリックステップごとのスコア | 事前学習データのフィルタリング・バランス取り |
この3種類の使い分けは、ロボティクスAI開発の各段階(事前学習・RL後訓練・運用)に合わせたものです。デンスリワードはAgentic RLやGRPOのような強化学習フェーズで密な報酬信号として機能し、アウトカムリワードは実機デプロイ時の失敗検出に、ルーブリックリワードは大規模データ収集時の品質フィルタに対応します。
Qwen3.5をベースに採用した理由
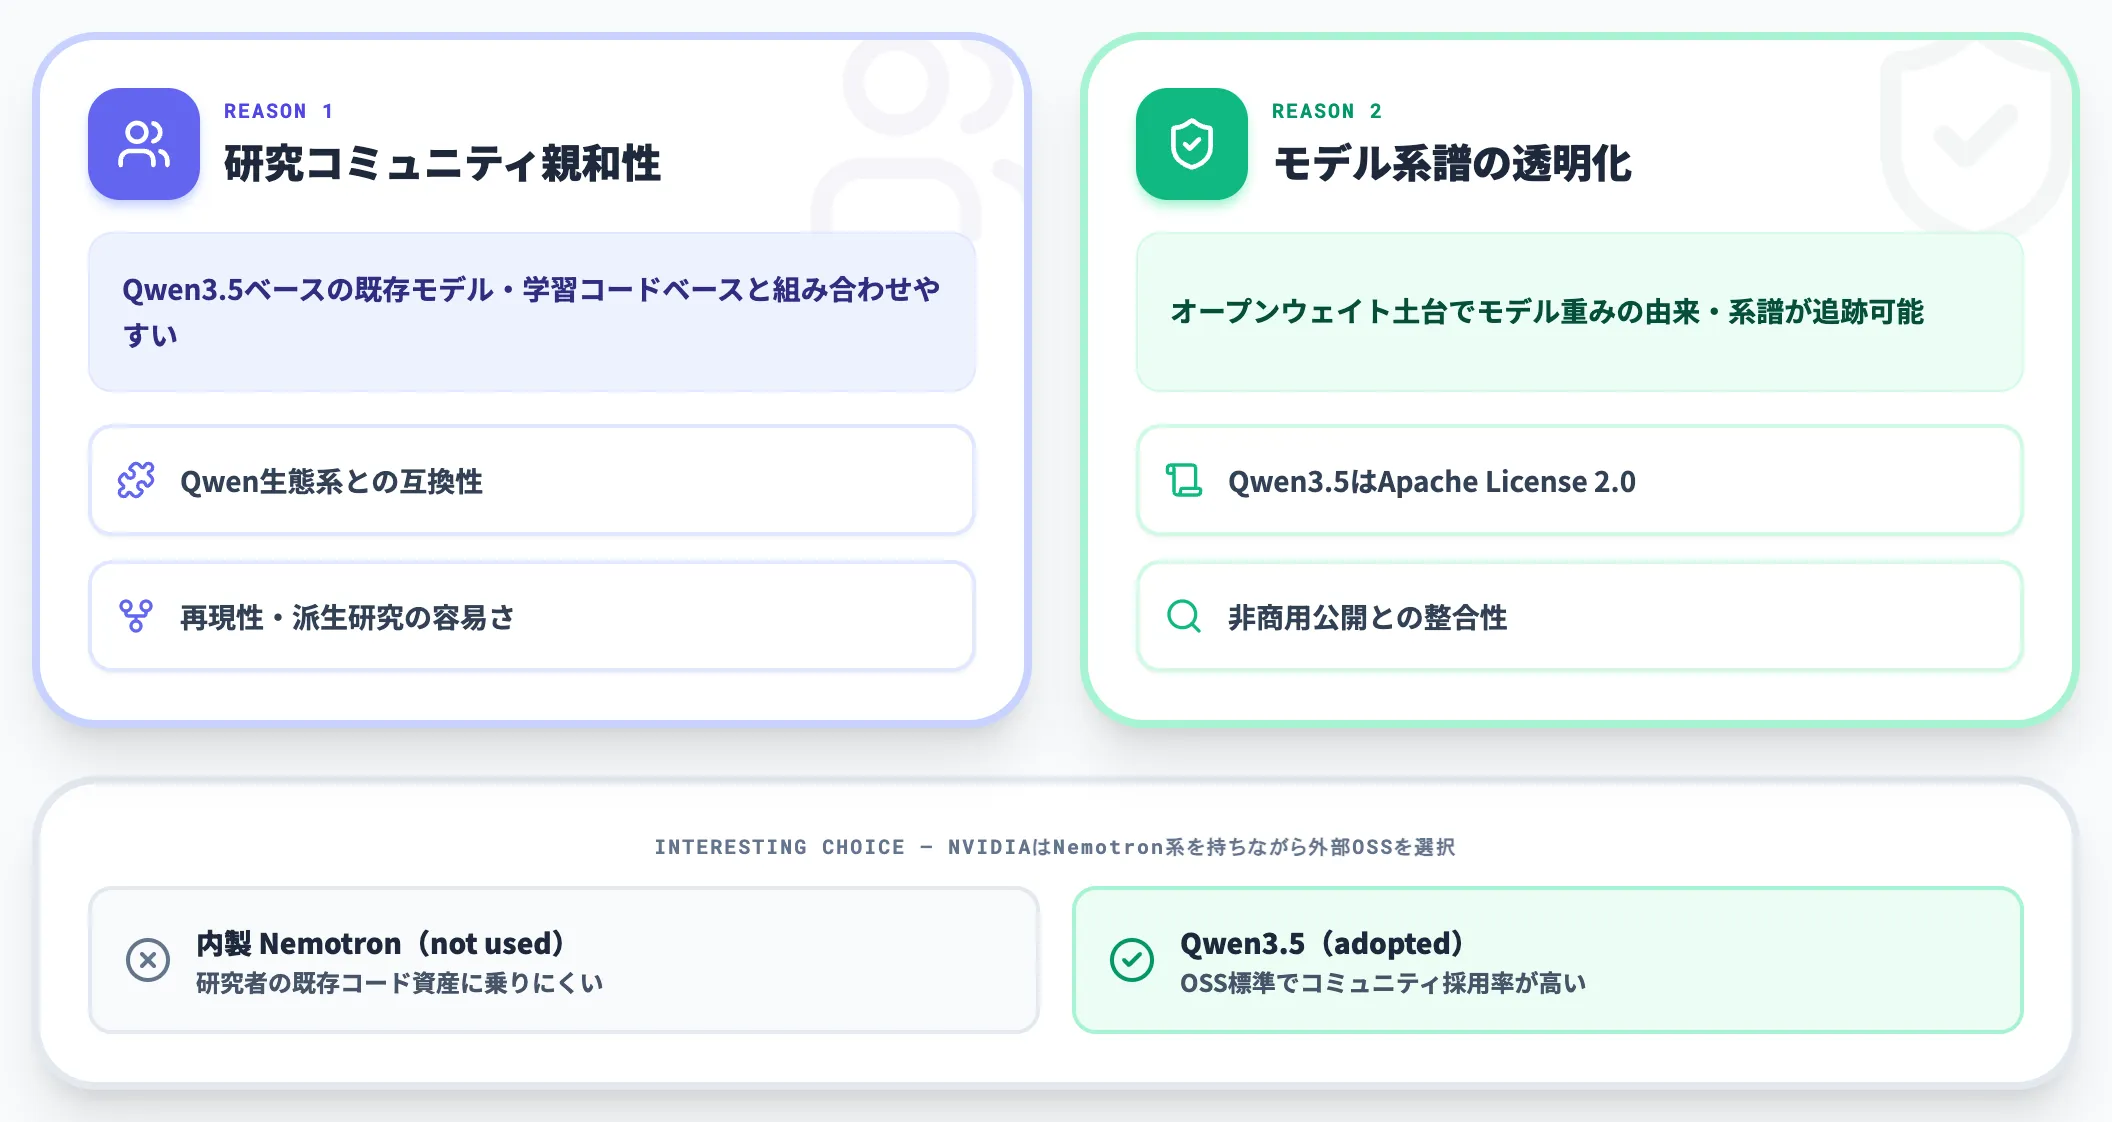
Flora 3モデルすべてが、Alibabaのオープンウェイト言語モデルQwen3.5をベースにしている点は、NVIDIAの技術選択として興味深い部分です。
NVIDIA自身はNemotronシリーズなど独自の言語モデル基盤を持っていますが、Floraではあえて外部のオープンウェイトモデルを採用しました。これにより、研究コミュニティがQwen3.5ベースの他のモデルや既存の学習コードベースとFloraを組み合わせやすくなるという利点があります。
また、研究用の非商用公開という性質上、オープンウェイトモデルを土台にすることでモデル重みの由来・系譜が透明化されます。
Qwen3.5はApache License 2.0で公開されており、ベースモデル部分には非商用限定の用途制限がない(再配布時のライセンス添付・表示保持などの条件は適用される)点も採用理由の1つと考えられます。
Floraのベンチマーク性能とGPT-6 Astra比較
Floraの性能評価は、2つの軸——タイムスタンプ付きキャプション(DenseCaptionBench)と報酬アノテーション(RoboRewardBench/DenseRewardBench)——で公開されています。
比較対象はGPT-6 Astra、GPT-5.6 Sol、Claude Opus 5、Kimi K3の4つのフロンティアモデルです。
Human100ではFloraが汎用VLMを超える
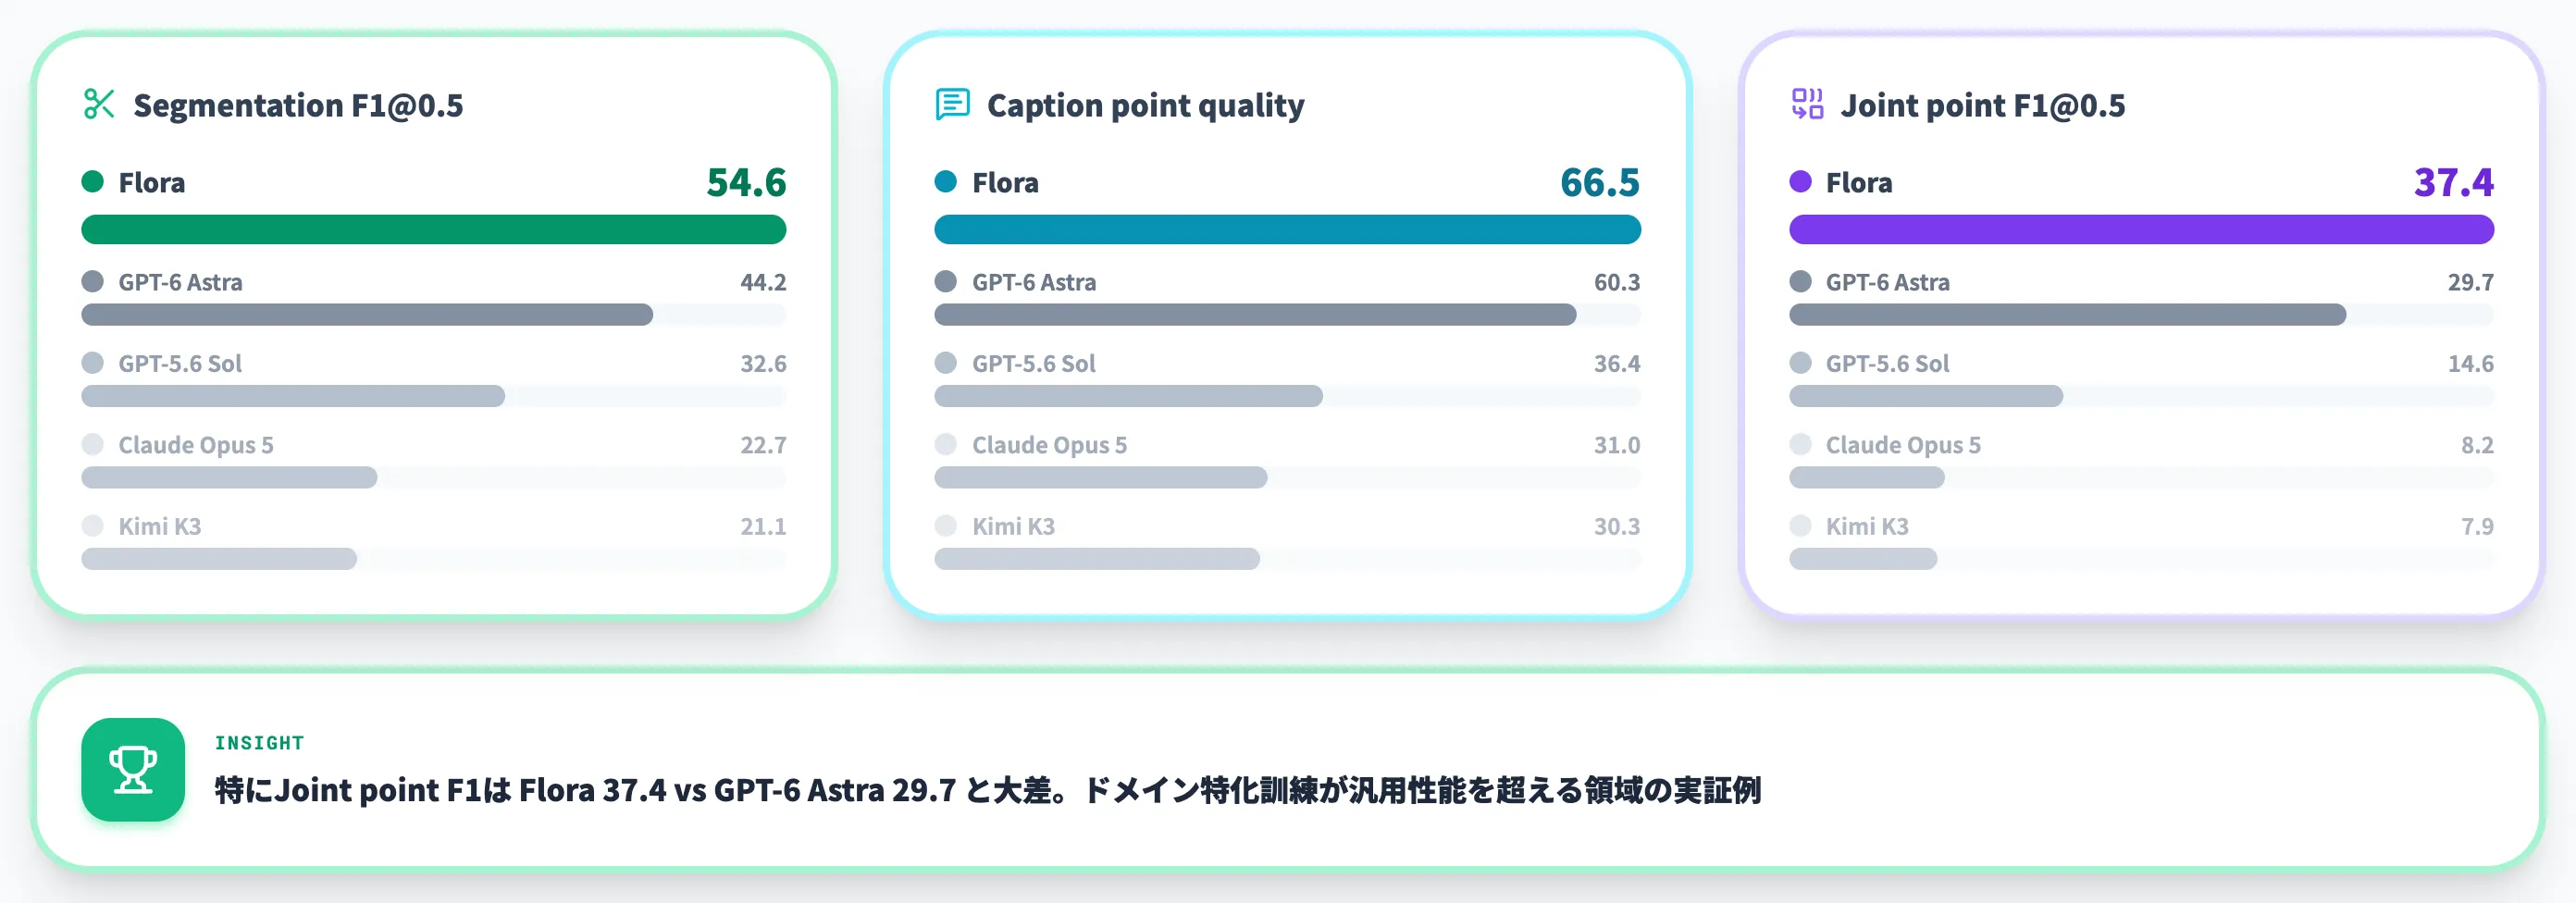
以下の表は、DenseCaptionBenchの人間動画サブセット「Human100」での比較結果です。この結果を読み解いた上で、次のサブセクションでロボット動画サブセットでの結果に進みます。
| モデル | Segmentation F1@0.5 | Caption point quality | Joint point F1@0.5 |
|---|---|---|---|
| Flora | 54.6 | 66.5 | 37.4 |
| GPT-6 Astra | 44.2 | 60.3 | 29.7 |
| GPT-5.6 Sol | 32.6 | 36.4 | 14.6 |
| Claude Opus 5 | 22.7 | 31.0 | 8.2 |
| Kimi K3 | 21.1 | 30.3 | 7.9 |
Floraは全3指標で最高スコアを記録し、GPT-6 Astraに対して10ポイント前後のリードを示しています。特にJoint point F1(セグメンテーションとキャプションの整合性)では、Floraの37.4がGPT-6 Astraの29.7を大きく引き離しています。
人間の作業動画は家庭内タスクや工場作業など多様で、学習コーパスの偏りが大きい領域です。ここでFloraが汎用フロンティアモデルを超えたことは、ロボティクス向けのドメイン特化訓練が汎用性能より効く領域が存在することを示しています。
Robot200ではGPT-6 Astraが優位
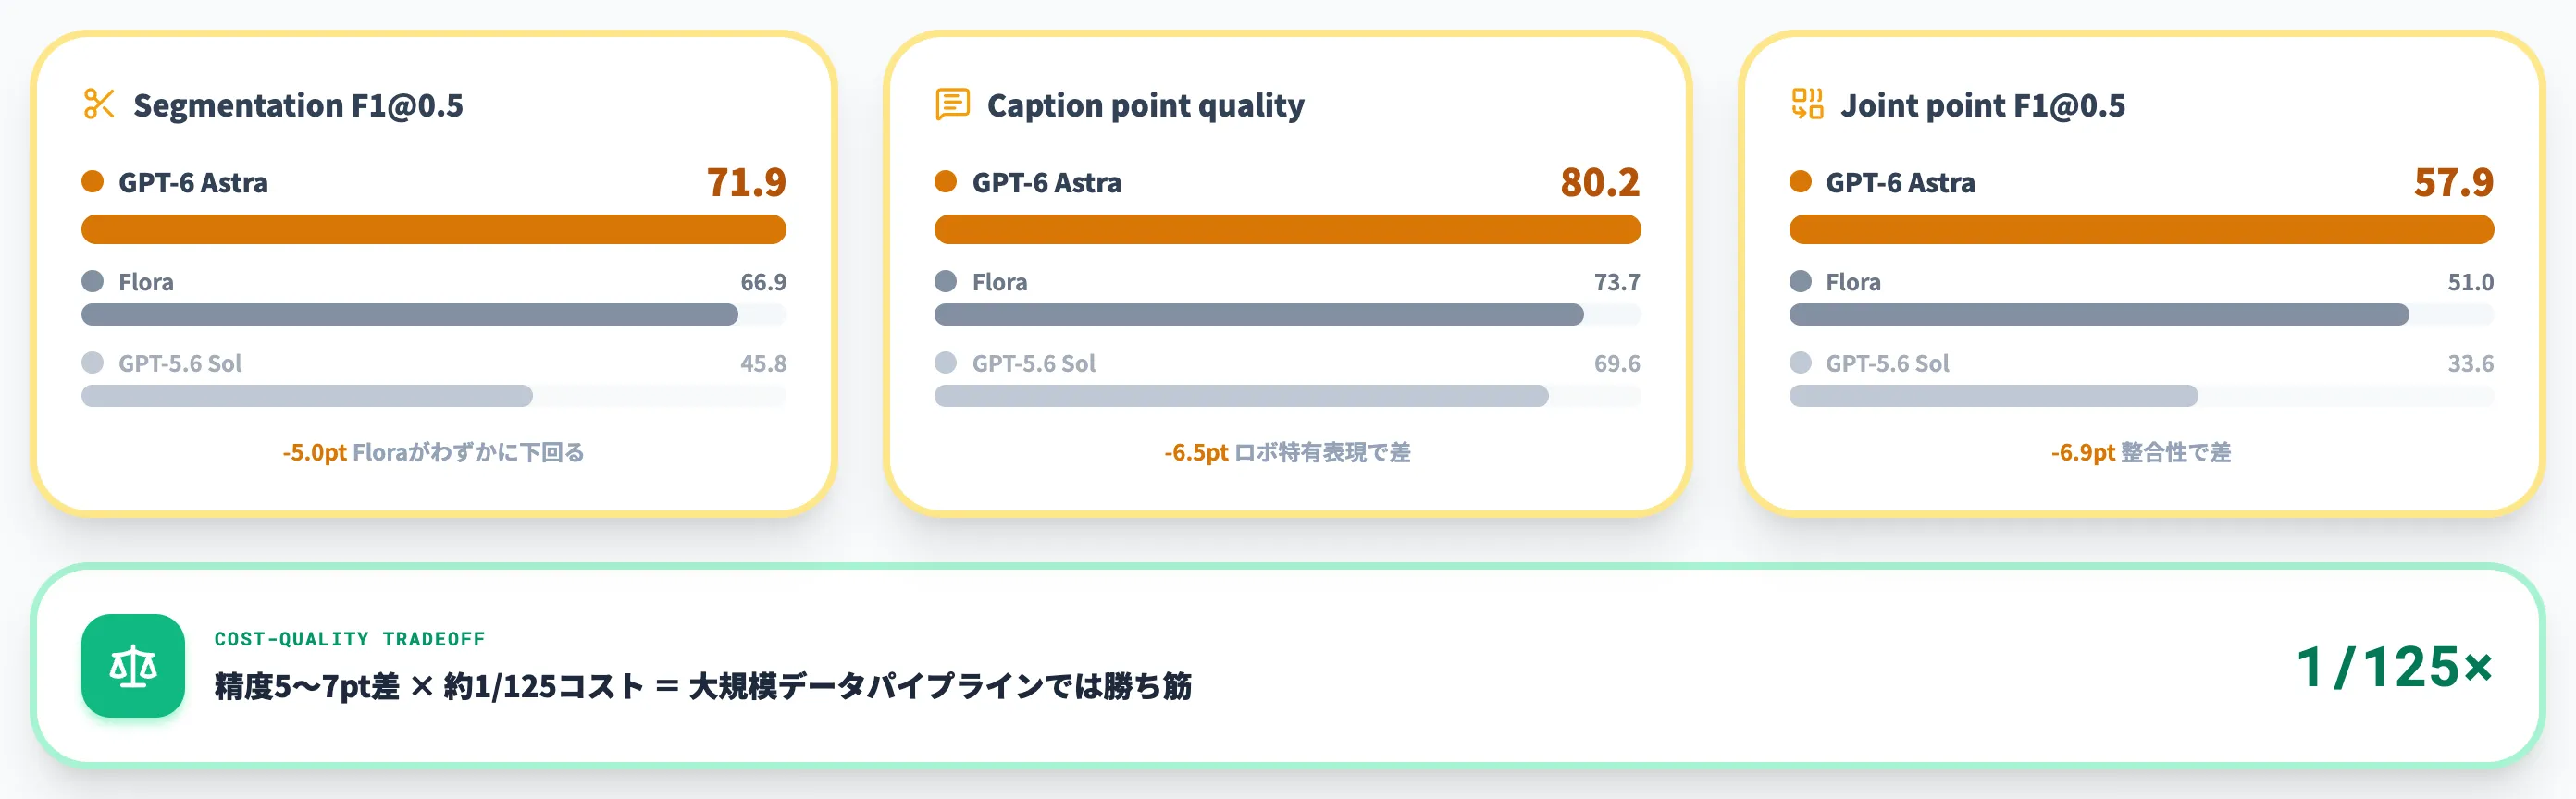
一方、ロボット動画サブセット「Robot200」での結果は、Floraの性能特性を正直に理解するうえで重要です。
| モデル | Segmentation F1@0.5 | Caption point quality | Joint point F1@0.5 |
|---|---|---|---|
| Flora | 66.9 | 73.7 | 51.0 |
| GPT-6 Astra | 71.9 | 80.2 | 57.9 |
| GPT-5.6 Sol | 45.8 | 69.6 | 33.6 |
ロボット動画ではGPT-6 Astraが全3指標でFloraを上回っています。差は5〜7ポイントで、特定ドメインの難易度の高さを示しています。
ただし、この差が実運用で致命的かどうかは別の判断軸が必要です。FloraはRobot200のような難易度の高いドメインではGPT-6 Astraに5〜7ポイント劣るが、ラベリング単価では約125分の1まで下げられるという設計思想です。費用側はNVIDIAの条件付き試算(paper付録D.1、人間・ロボット動画の50エピソード・$10/GPU時仮定)で、約125分の1のコスト比が示されています(この50エピソード区間では品質スコア自体もFlora 57.1%・Astra 53.7%とFloraが上)。精度の優劣はベンチマークのサブセット(Human100・Robot200・50エピソード区間)ごとに結論が変わる点、数十万時間規模のパイプラインまで同じコスト比が維持されるかは記事側の外挿であり実運用GPU時間や独立再現が確認されていない点に注意が必要です。
報酬アノテーションベンチマークではFloraがトップ
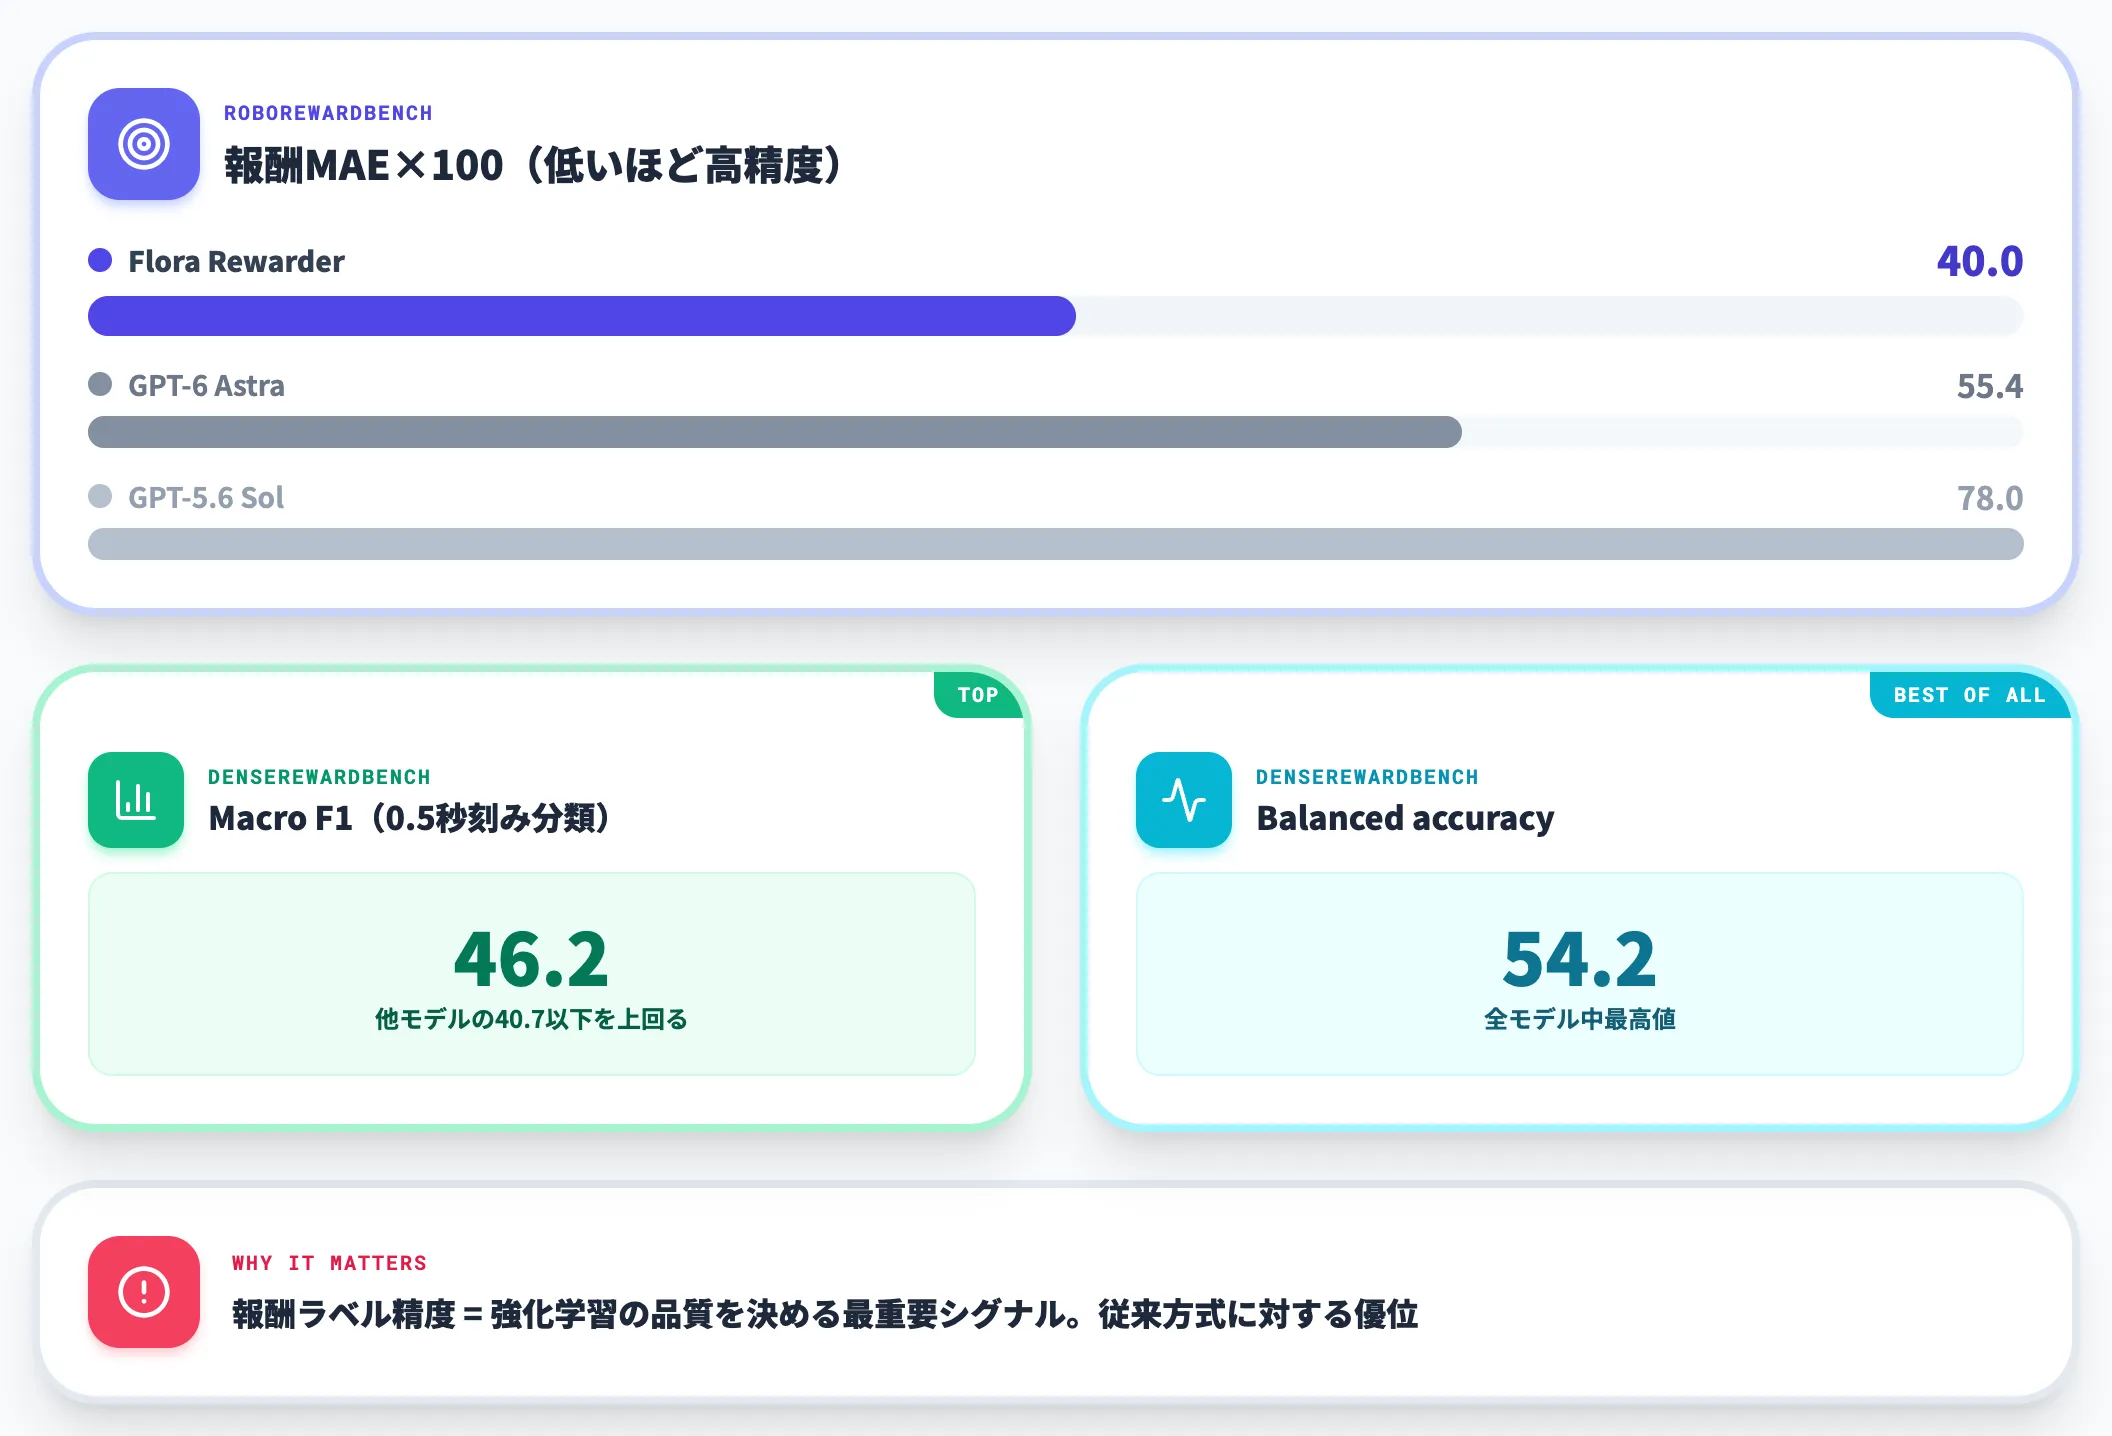
報酬ラベルの精度(RoboRewardBench)では、Floraが最高性能を示しています。
- Flora Rewarder: MAE × 100 = 40.0(低いほど高精度)
- GPT-6 Astra: 55.4
- GPT-5.6 Sol: 78.0
DenseRewardBench(0.5秒刻みの行動品質分類)でも、FloraのMacro F1は46.2で、他モデルの40.7以下を上回っています。Balanced accuracyは54.2で全モデル中最高値でした(出典:NVIDIA Flora Research Page)。
報酬ラベリングは、ロボティクスAIの訓練で最も価値の高い教師信号です。「どの行動が成功で、どの行動が失敗か」を正確にラベル付けできなければ、強化学習の品質そのものが決まりません。
Floraがこの軸でトップ性能を示している点は、汎用VLMをロボティクス訓練パイプラインで使ってきた従来方式に対する優位を意味します。
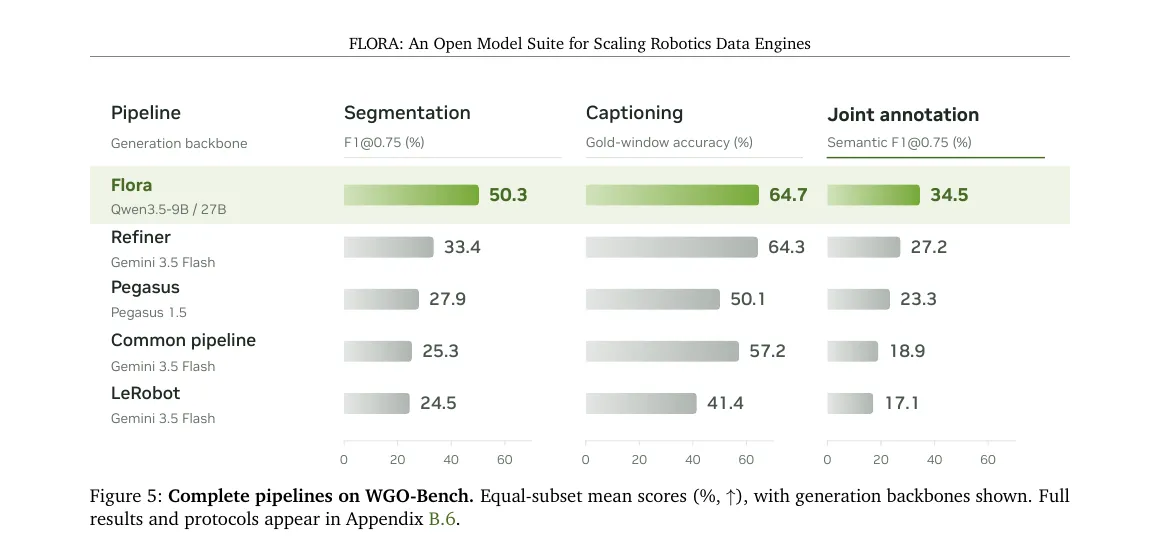
Floraと競合モデルのパイプライン総合スコア比較(WGO-Bench・Segmentation / Captioning / Joint annotation の3軸)(出典:Flora Paper (NVIDIA GEAR))
paperのFigure 5は、WGO-Benchの3軸——Segmentation F1@0.75・Captioning Gold-window accuracy・Joint annotation Semantic F1@0.75——で、FloraをRefiner・Pegasus・Common pipeline・LeRobotの既存ロボティクスパイプラインと比較したbar chartです。
Floraは全3軸で単独1位、特にSegmentationでは2位Refinerの33.4に対し50.3と17ポイント差を付けており、WGO-Bench総合でのパイプライン性能差が示されています。なお、paper付録B.6では「ワークフロー置き換え単独の寄与」までは実証していないと明記されており、どの要素が優位の主因かは本論文の範囲外です。
125倍コスト効率とGR00T訓練パイプラインでの実運用
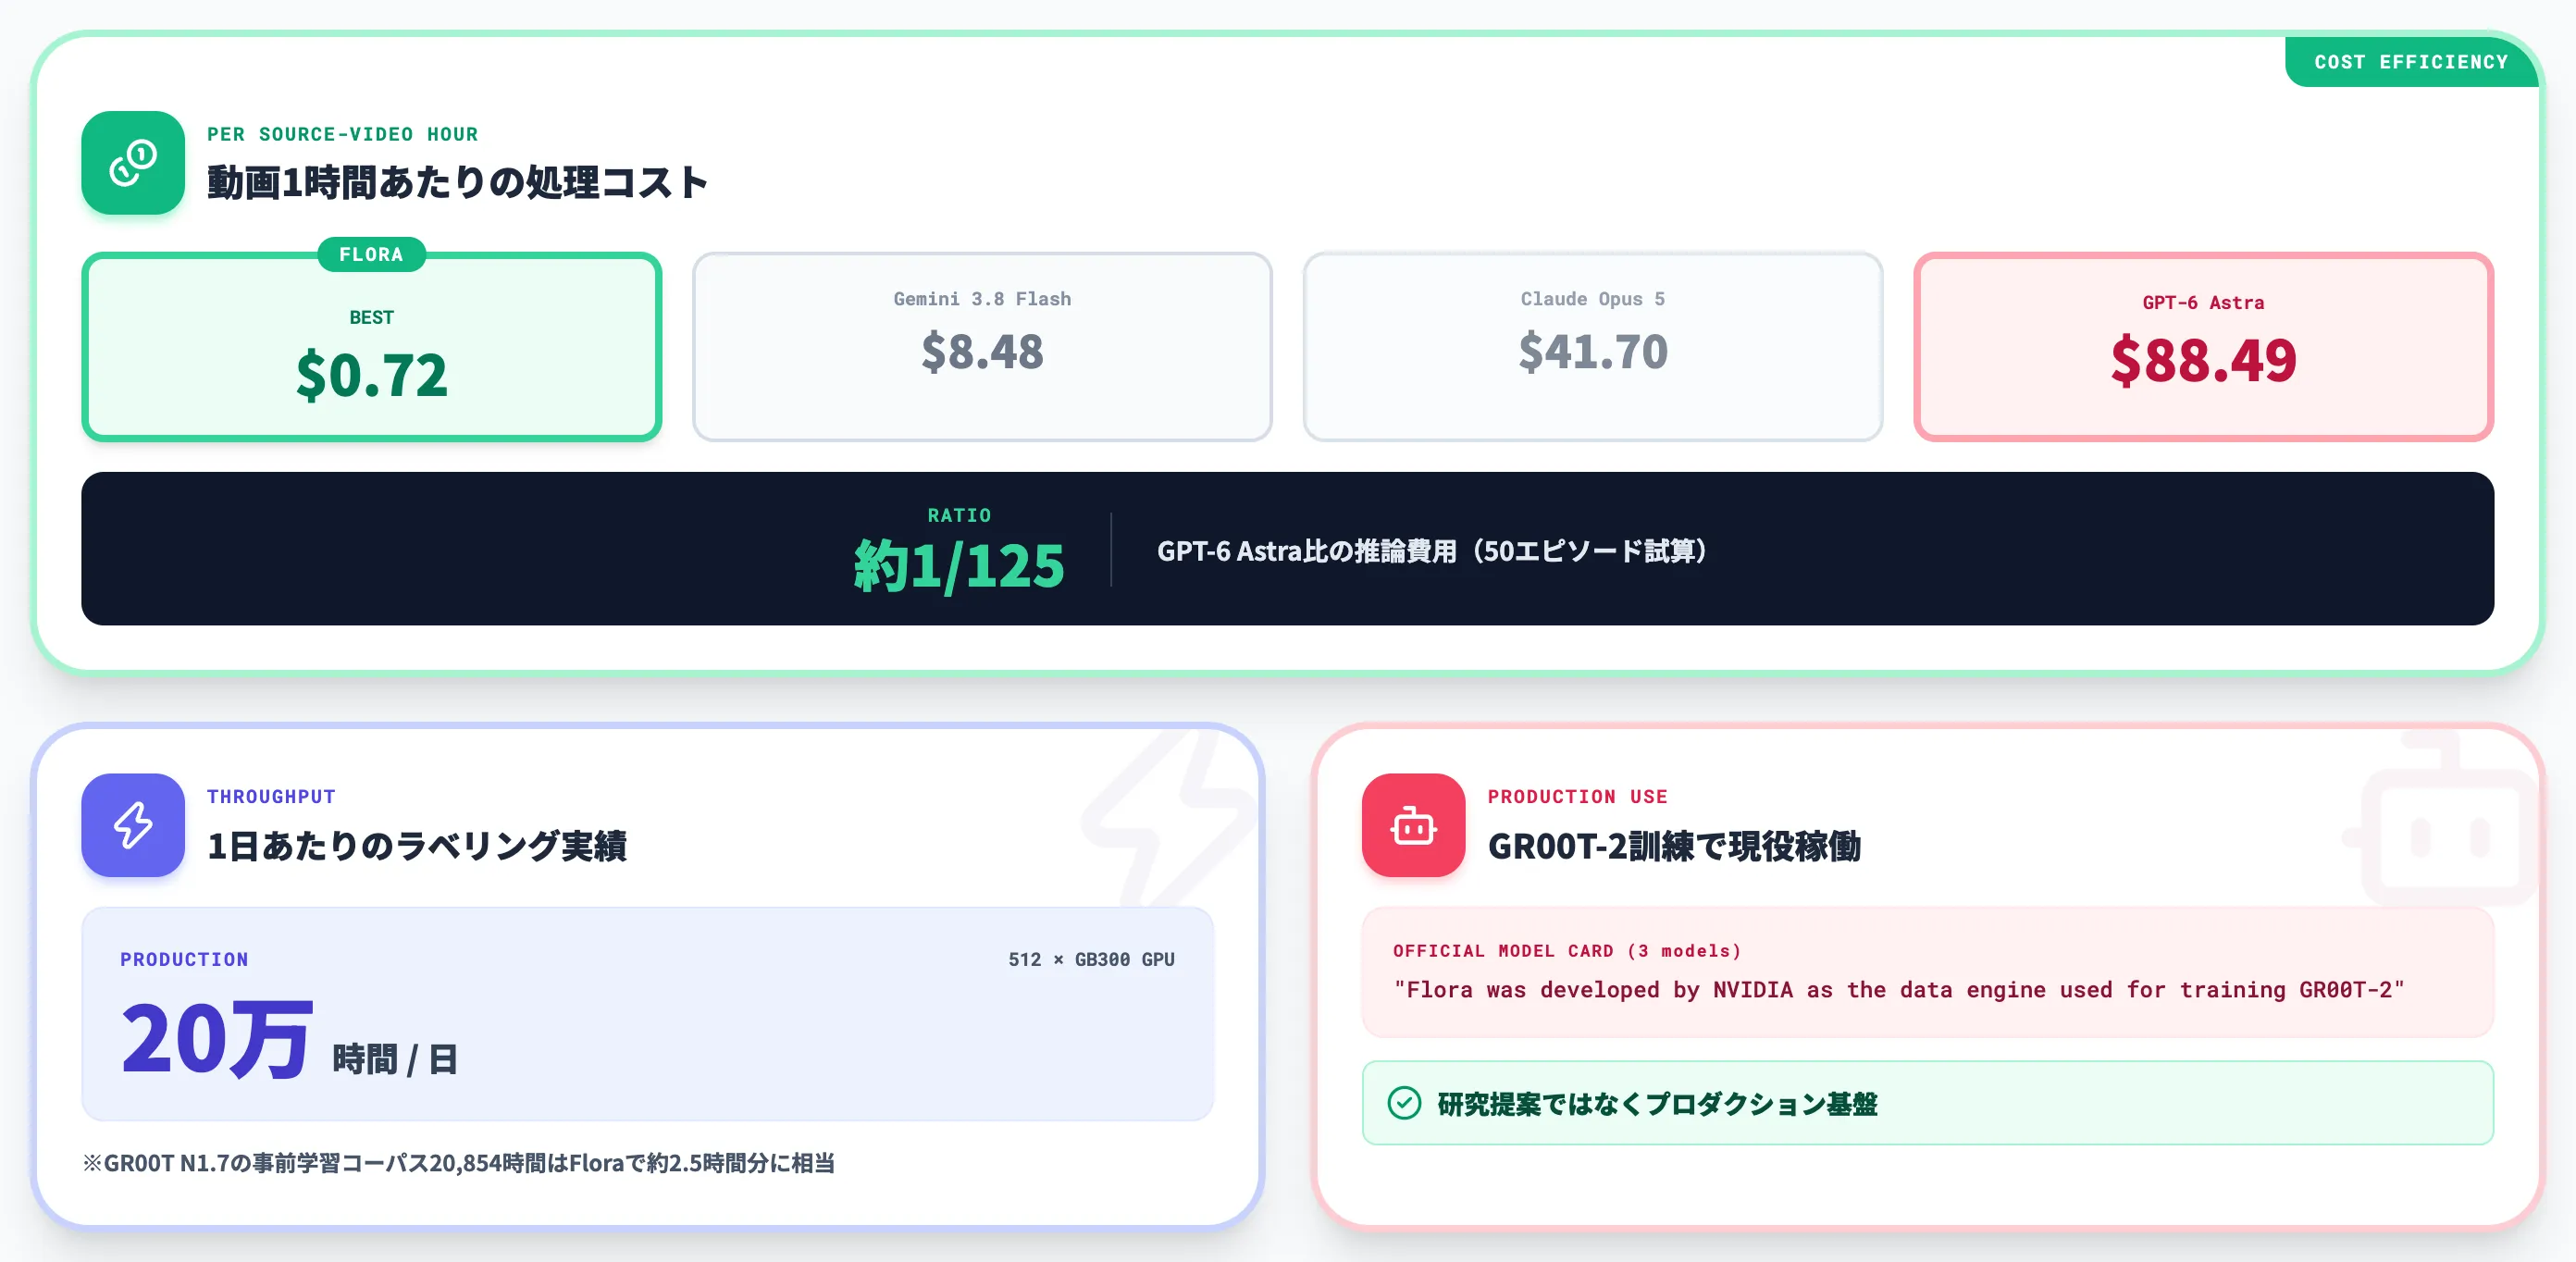
NVIDIAがFloraの発表で最も強調したのは「GPT-6 Astra比で約125分の1のコスト」という数字です。この主張の中身と、GR00T訓練パイプラインでの実運用規模を見ていきます。
API型モデルとのコスト構造の違い
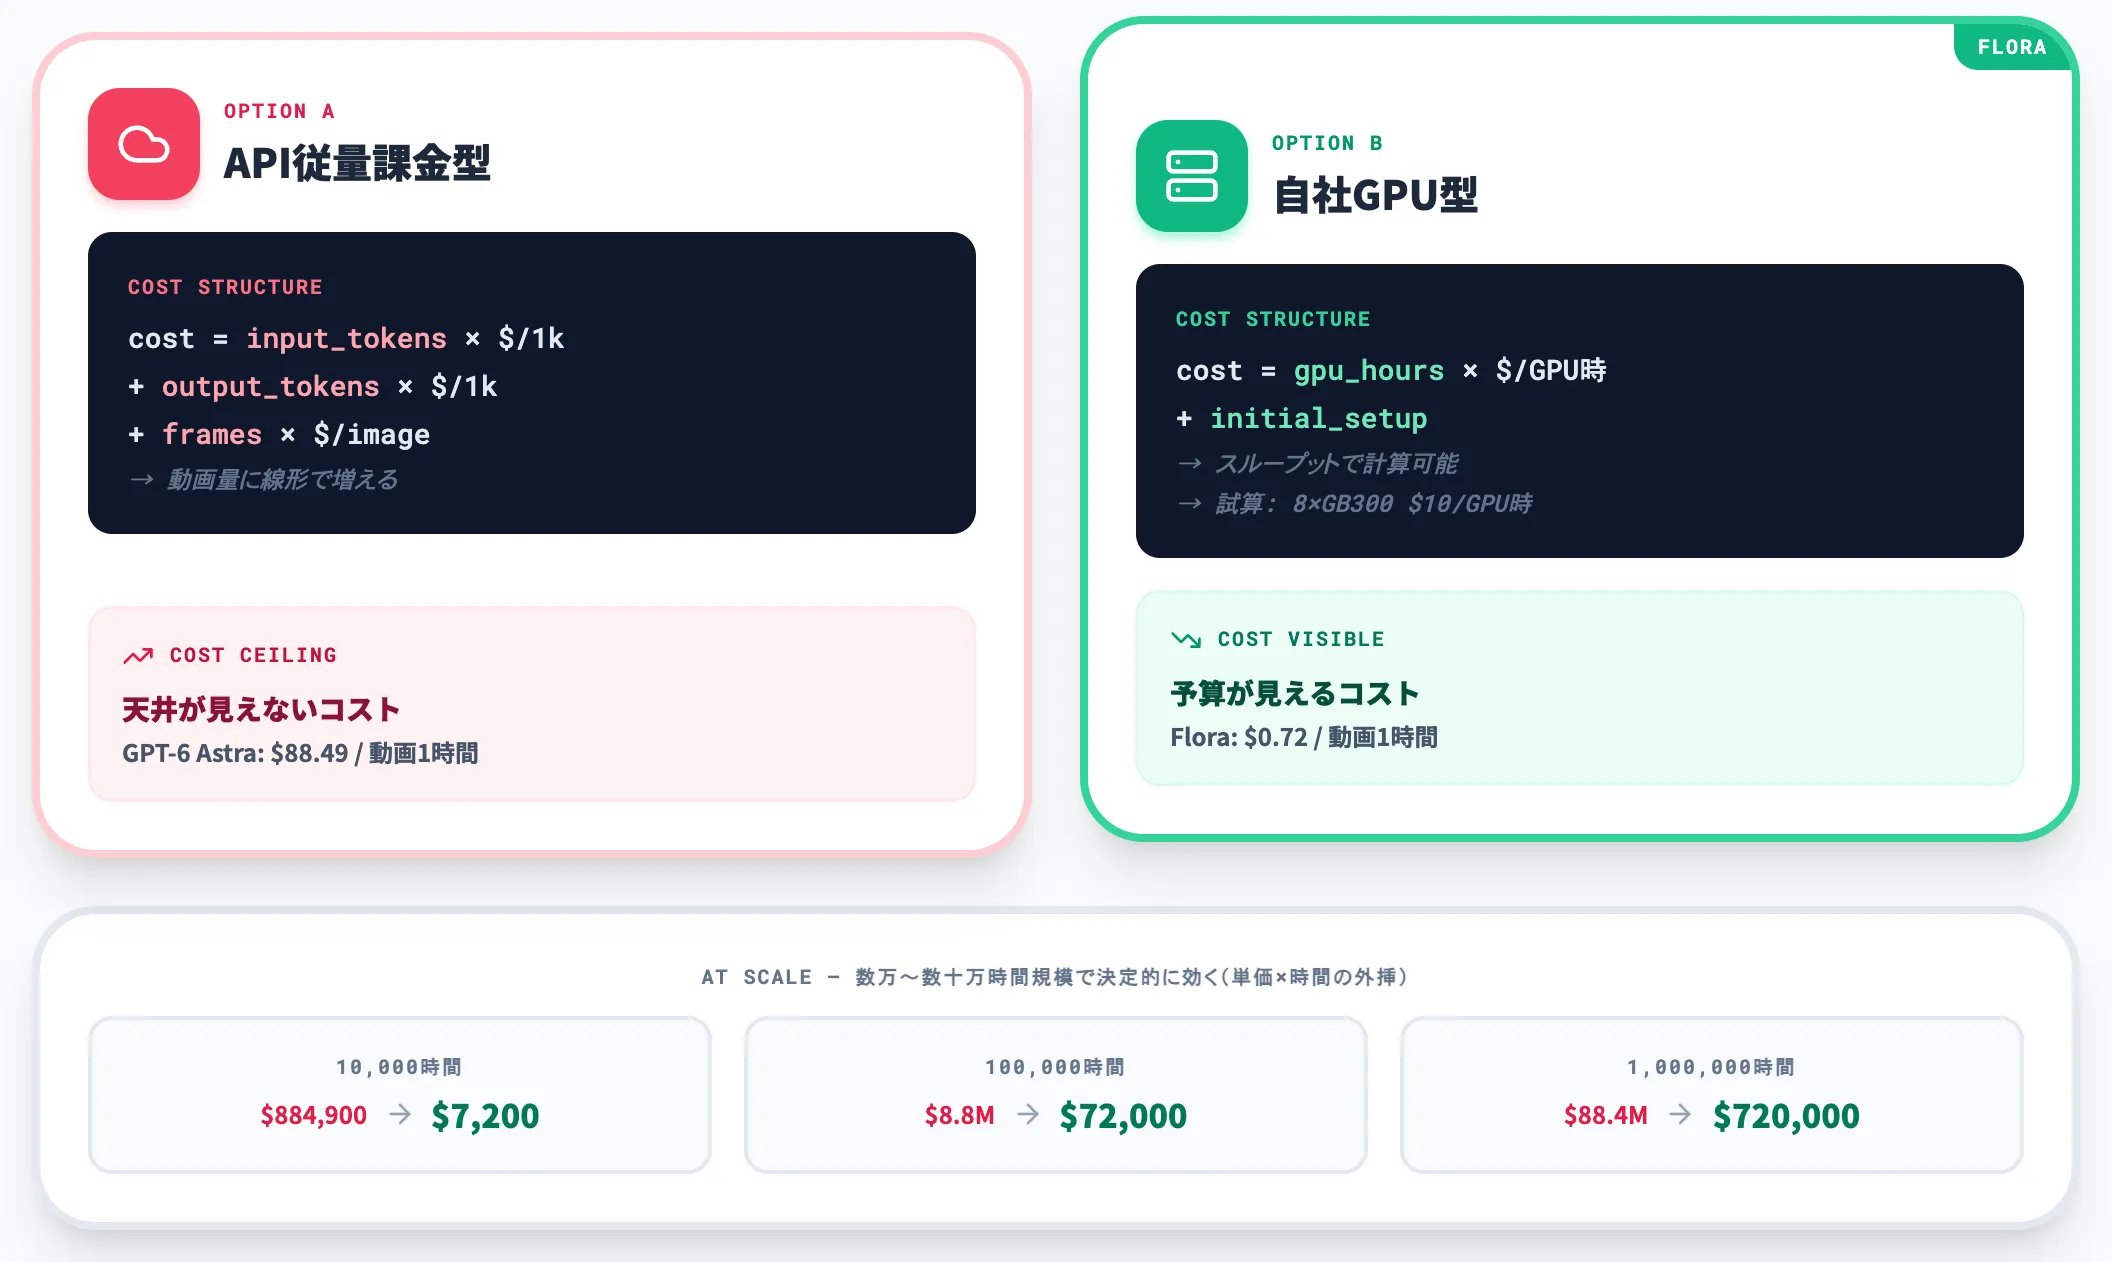
GPT-6 AstraやClaude Opus 5のような汎用フロンティアモデルを動画ラベリングに使う場合、入力トークン・出力トークンに対するAPI従量課金が発生します。
1時間の動画をAstraで処理する場合、動画フレームを画像トークンに変換した入力コストに加え、タイムスタンプ付きキャプションを出力するトークンコストがかかります。
対してFloraは、モデル重みそのものを自社GPU(またはGPUクラウド)にデプロイして動かす方式です。初期の推論基盤構築コストはかかりますが、ラベリング時間に対するAPI料金は発生しません。NVIDIAの試算(paper付録D)では、50エピソードの区間分割・キャプション生成を対象にした推論費用の比較で、GPT-6 Astra対比約125分の1になるとされています(8基のGB300・$10/GPU時を仮定した試算で、ストレージや導入オーバーヘッドは含まれません)。
この差が決定的に効くのは、ラベリング対象が数万時間〜数十万時間の規模になったときです。API型だと天井が見えないコストが、Floraだと「GPU時間 × GPU時間単価」で計算可能なコストに変わります。
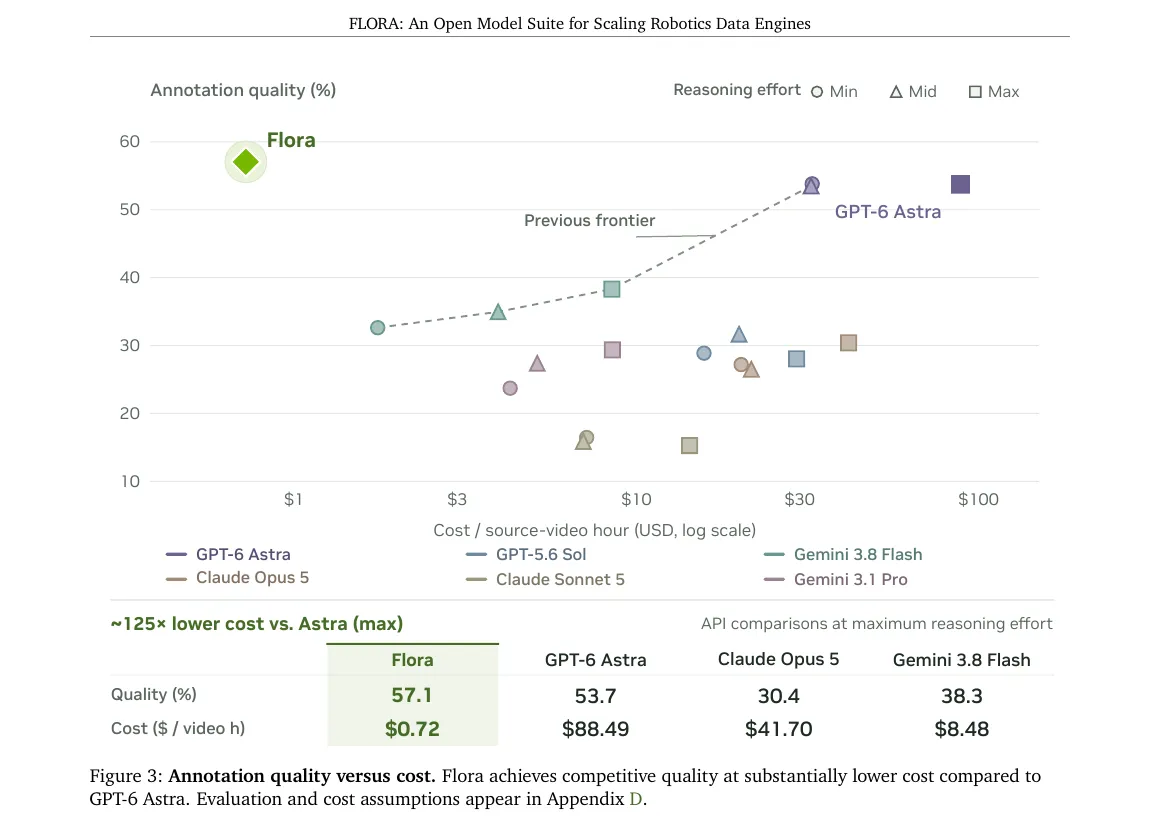
元動画1時間あたりの処理コストと品質の関係。Floraは「以前のフロンティア」ラインを左上へ更新した(出典:Flora Paper (NVIDIA GEAR))
paperのFigure 3は、縦軸にAnnotation quality(%)、横軸にCost per source-video hour(USD、対数軸)を取った散布図です。
従来のフロンティア——GPT-6 Astraの$88.49で品質53.7%——に対し、Floraは、$0.72で品質57.1%を達成しており、「品質を上げたままコストを大幅に下げた」構図が視覚的に示されています。
表下部の対比表(Flora $0.72 / GPT-6 Astra $88.49 / Claude Opus 5 $41.70 / Gemini 3.8 Flash $8.48)は、推論費用レベルでの対比を直感的に示していますが、これらはNVIDIAの条件付き推計(paper付録D、$10/GPU時仮定)であり、実運用のGPU時間や品質比較の参照ラベル版数も完全一致は保証されていません。
1日20万時間のラベリング実績
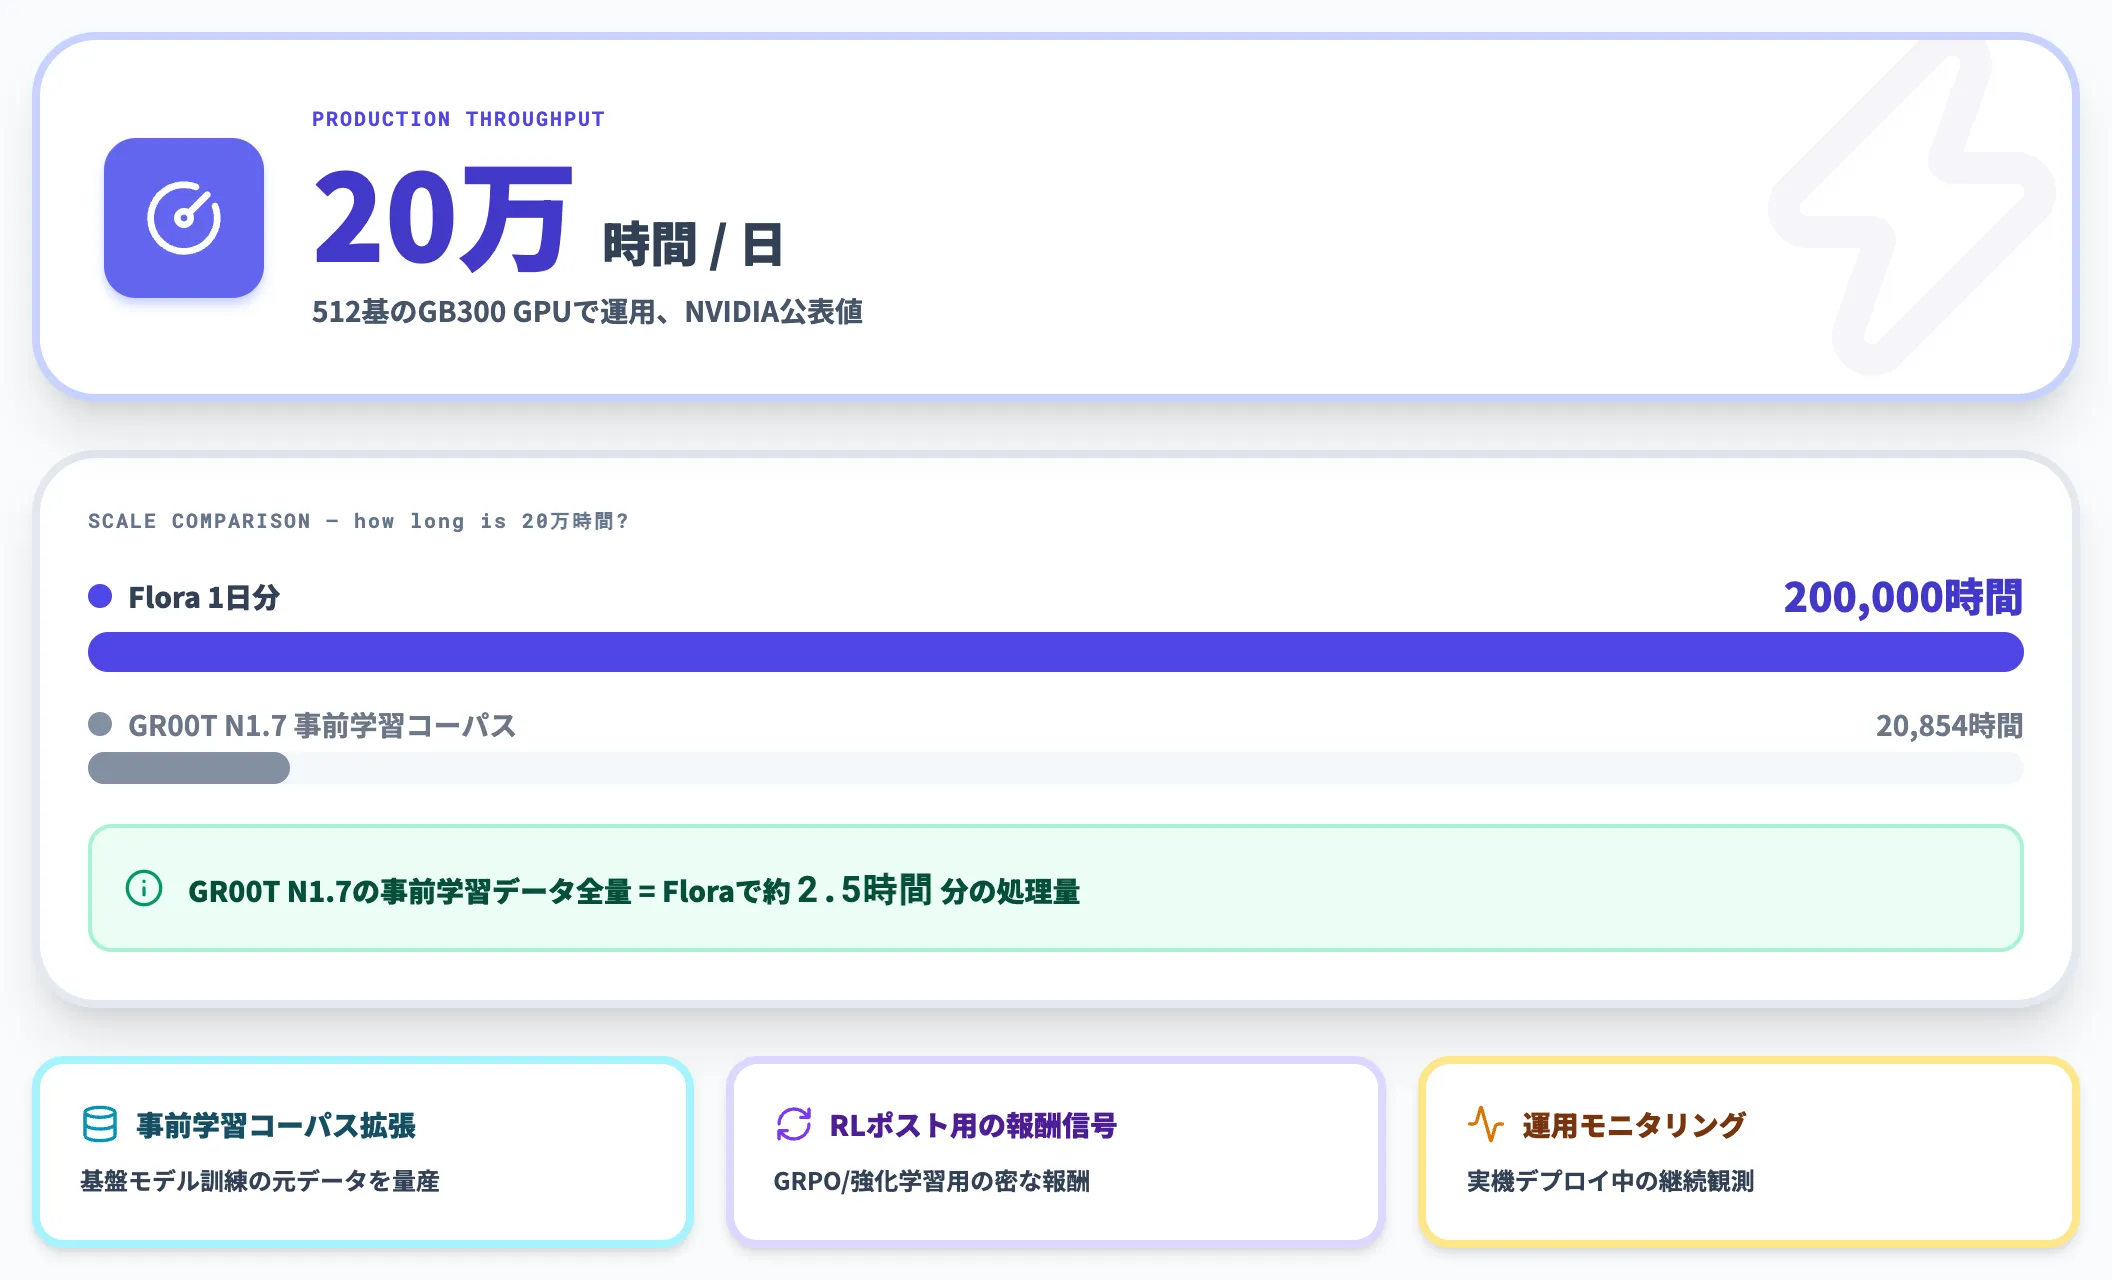
NVIDIAは、Floraを512基のGB300 GPUで運用し、1日あたり20万時間の動画ラベリングを達成していると公表しています。
これは、ロボティクス研究で求められるデータスケールを定量的に理解する手がかりになります。
たとえばGR00T N1.7は約20,854時間のEgoScale human videoで事前学習されていますが、これはFlora 約2.5時間分の処理量にすぎません。基盤モデルの訓練では事前学習コーパスの拡張・RLポストトレーニング用の報酬信号生成・運用モニタリング用のラベリングと複数の工程でラベル付きデータが必要になり、それぞれで動画規模が積み上がります。
Floraはこの要求を、API型モデルより大幅に低いコスト水準で満たせるよう設計されています。この「スケール可能なコスト」という性質こそが、Floraをロボティクスデータエンジンと呼ぶ理由です。
GR00T-2とFloraの関係
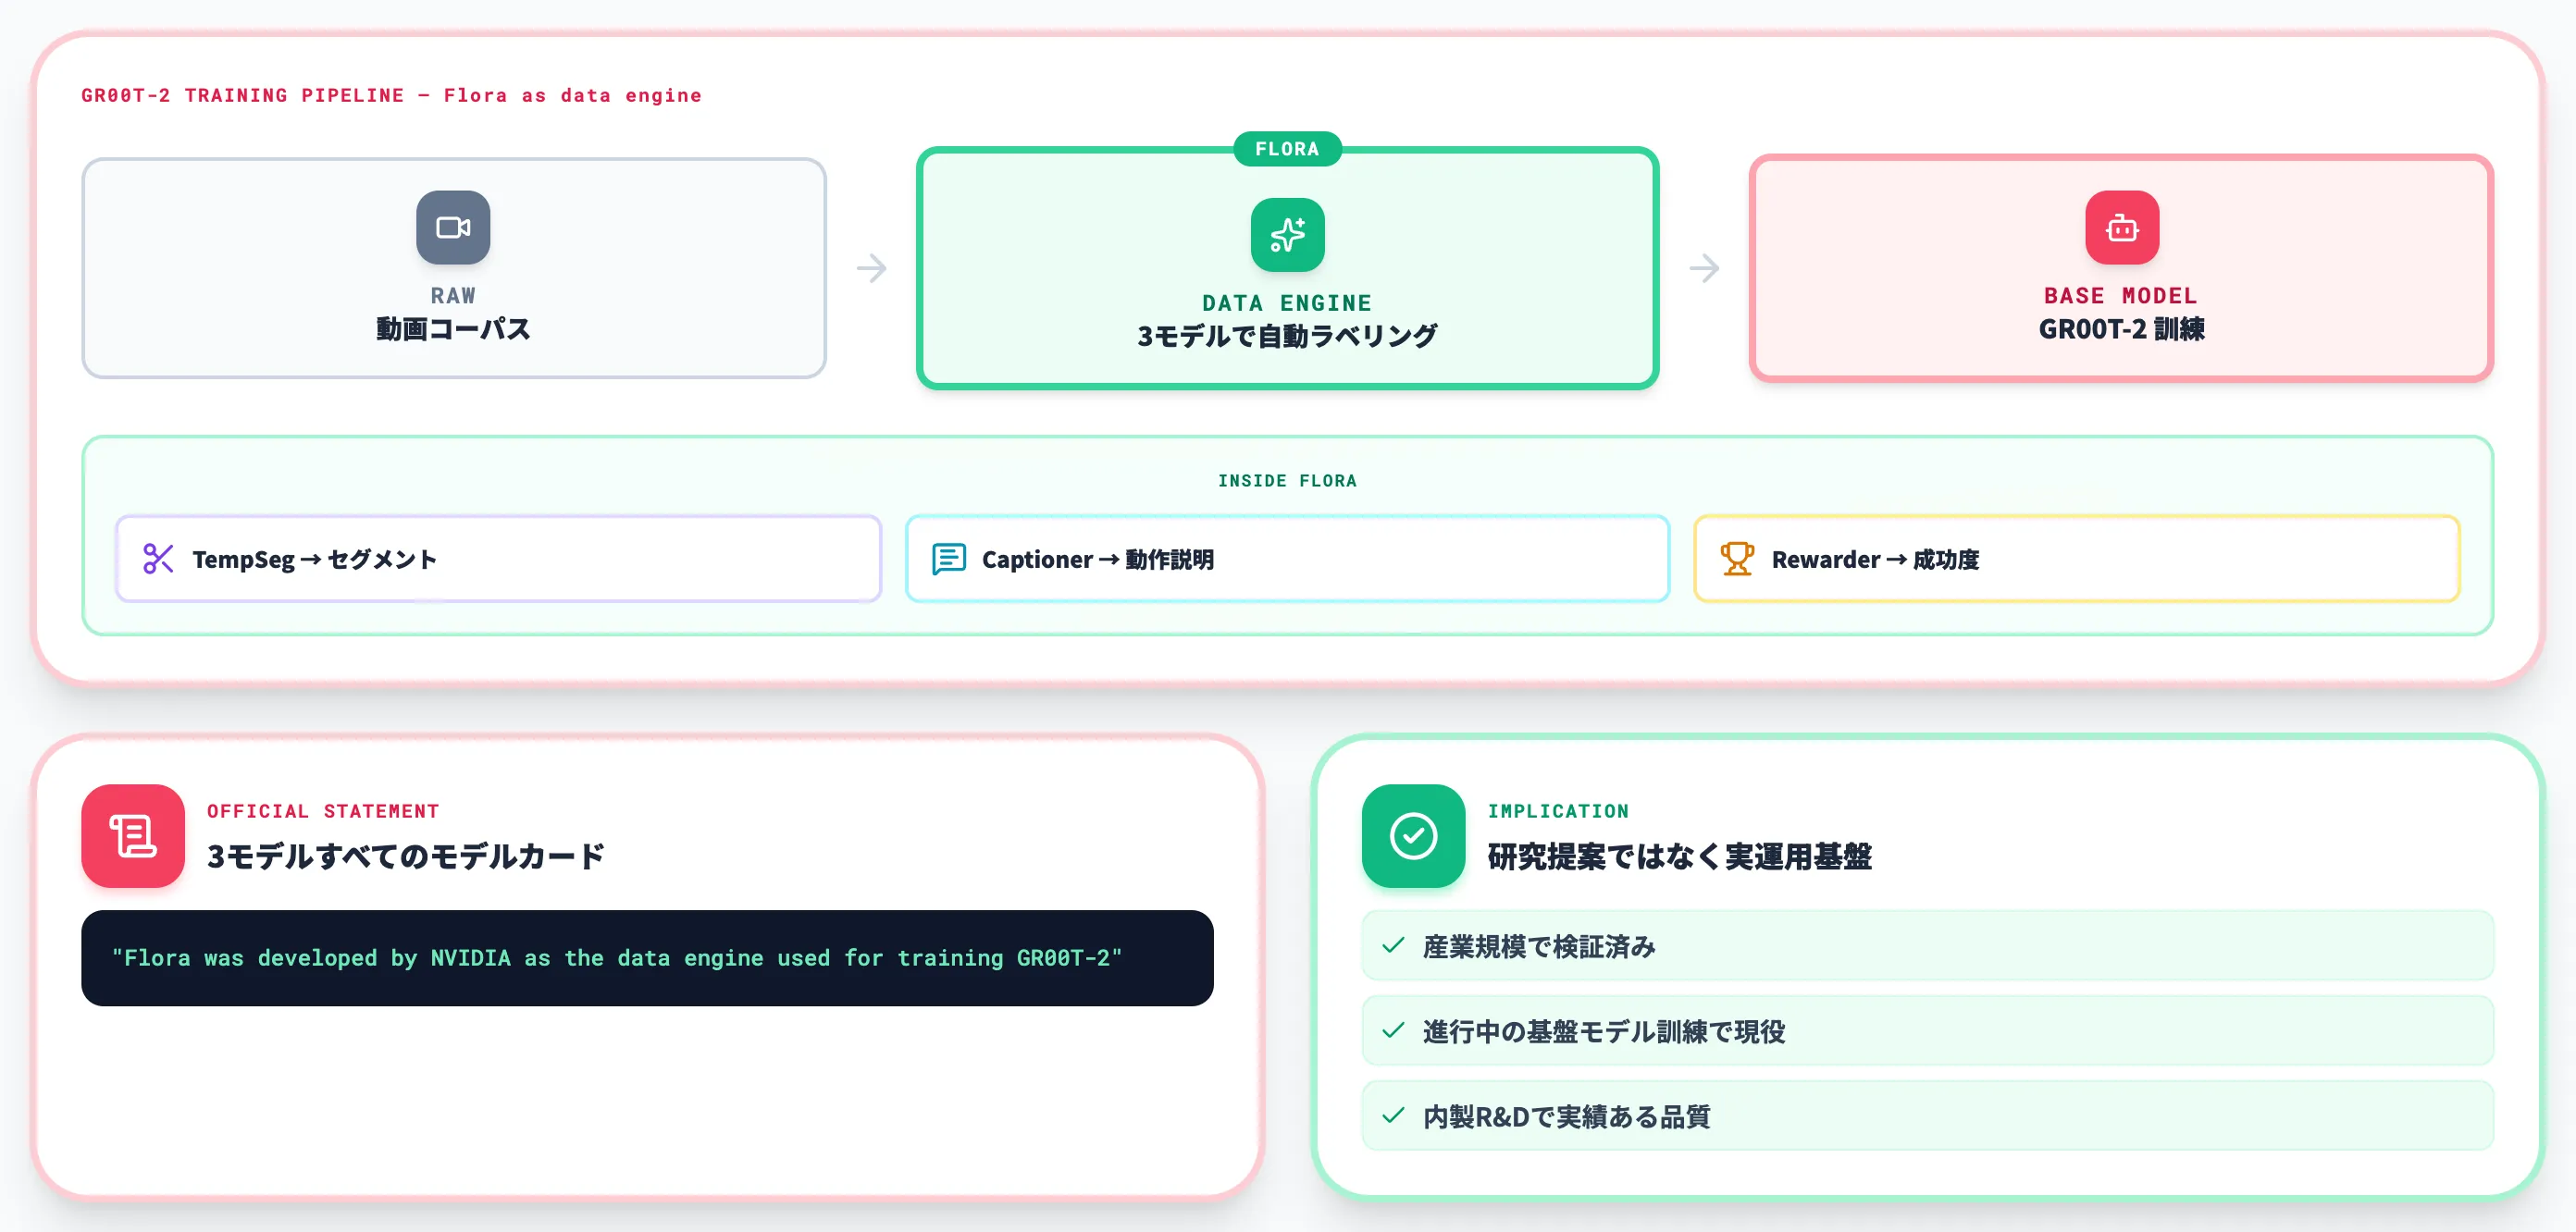
重要な事実として、FloraはNVIDIAが次世代ヒューマノイド基盤モデルGR00T-2の訓練用に開発したデータエンジンです。
Flora-TempSeg・Flora-Captioner・Flora-Rewarderの3モデルすべての公式モデルカードで「Flora was developed by NVIDIA as the data engine used for training GR00T-2」と明記されており、研究論文内の概念モデルではなく、進行中の基盤モデル訓練で使われている実運用パイプラインです。
これは、Floraが「研究提案」ではなく「産業規模で検証済みのプロダクション基盤」であることを意味します。
Floraのライセンスと入手方法
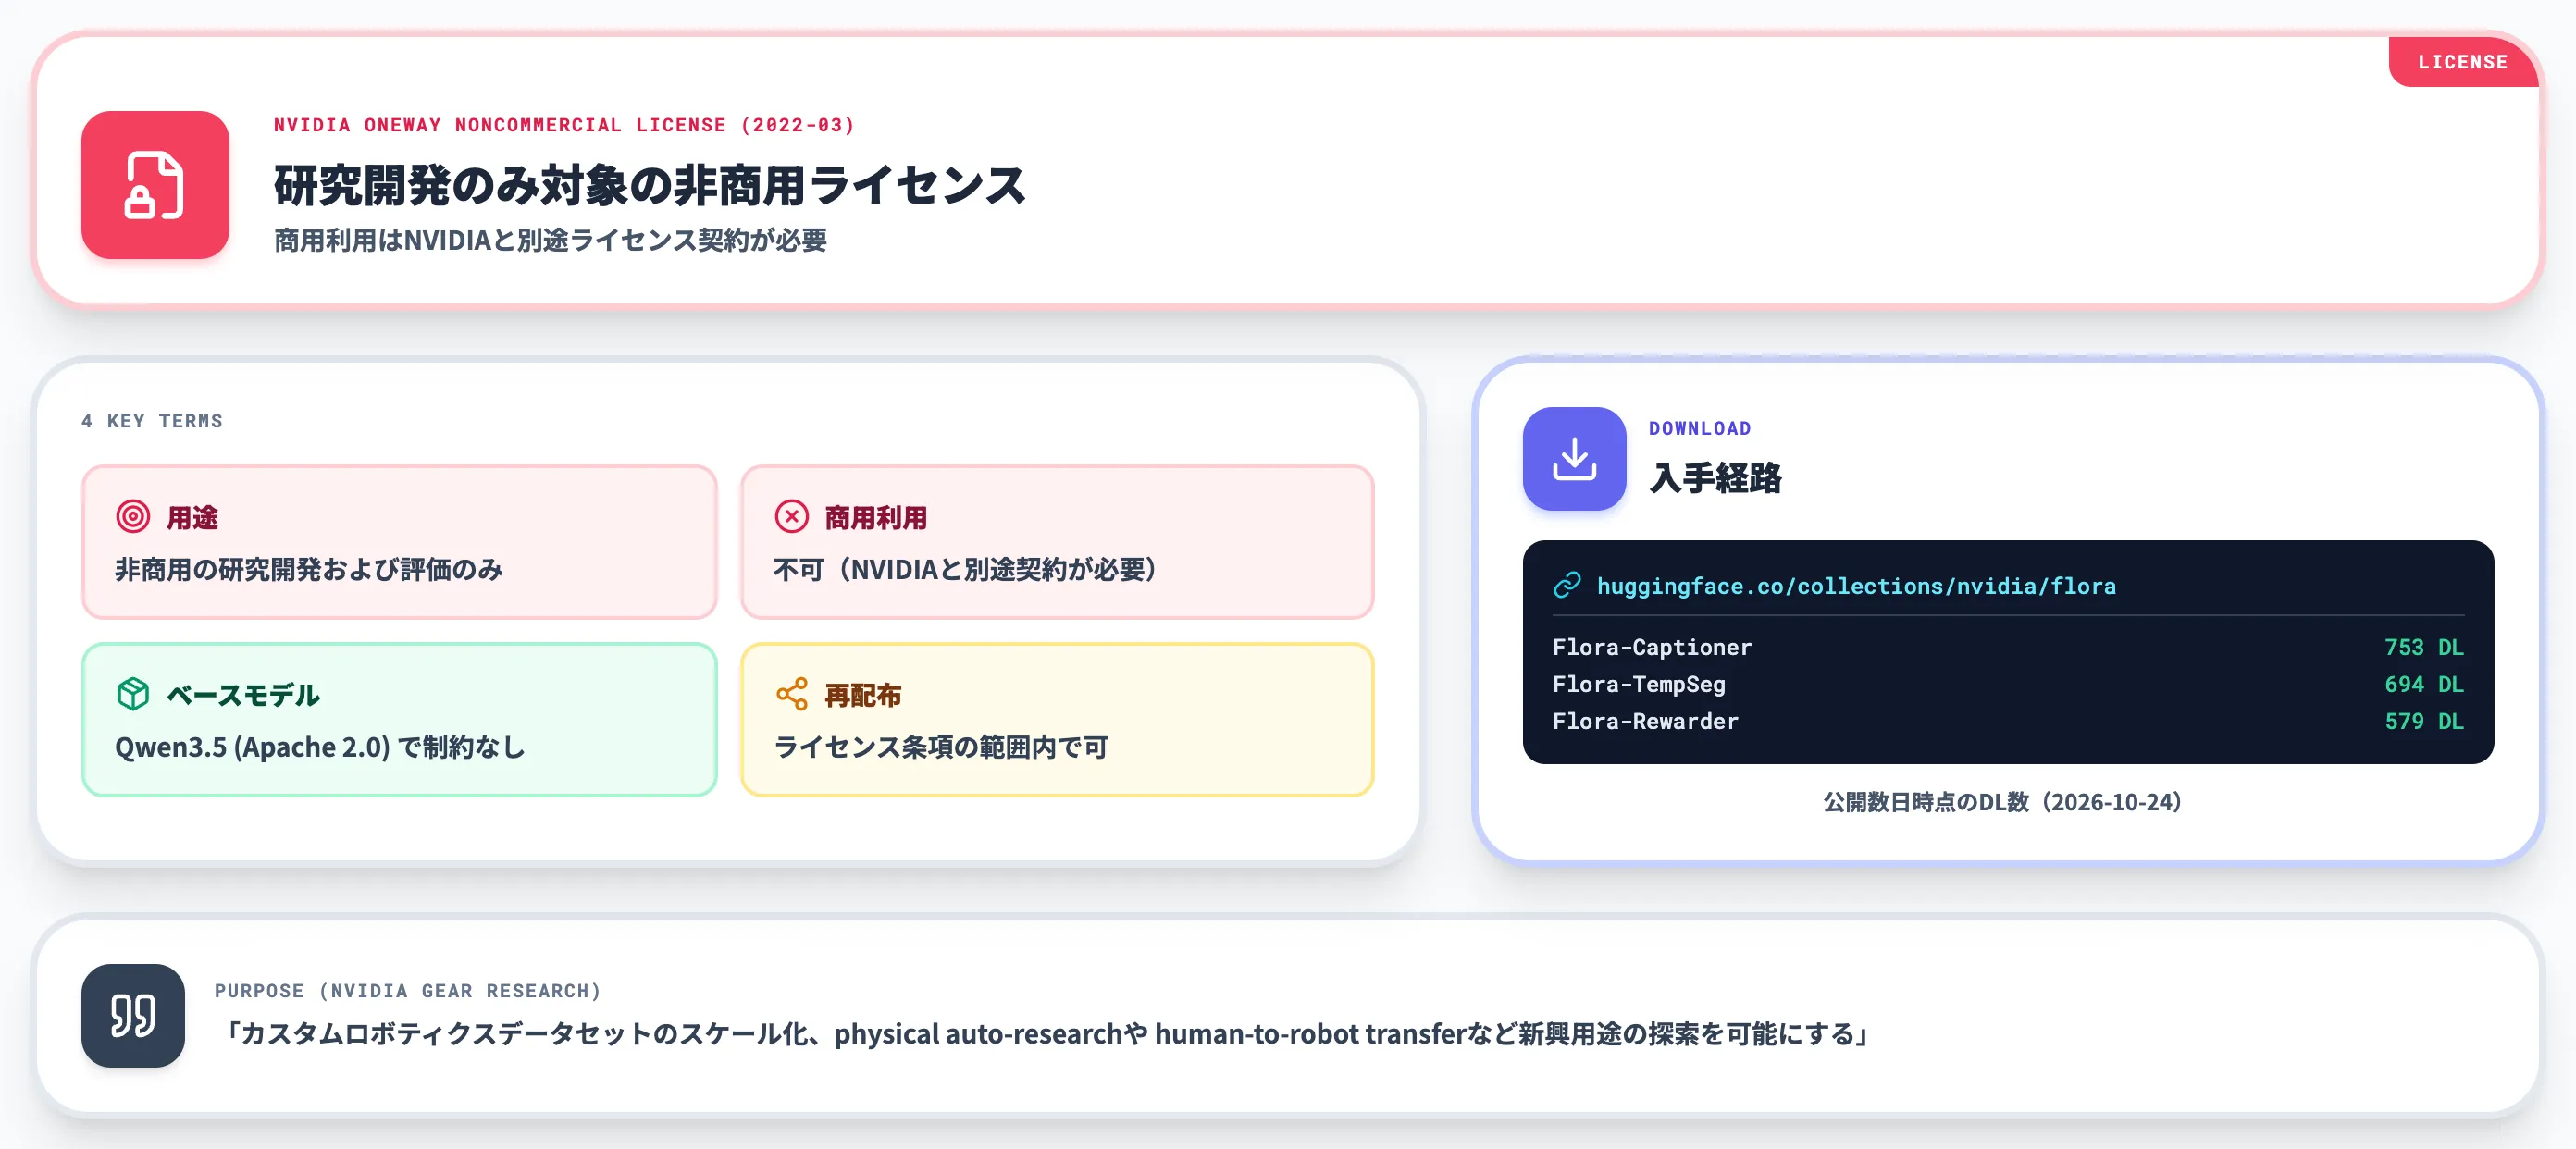
Floraの導入を検討する際、技術仕様と並んで重要なのがライセンスの読み方です。Floraは完全なオープンソースではなく、研究開発用途に限定された公開形態を取っています。
研究開発のみ対象の非商用ライセンス
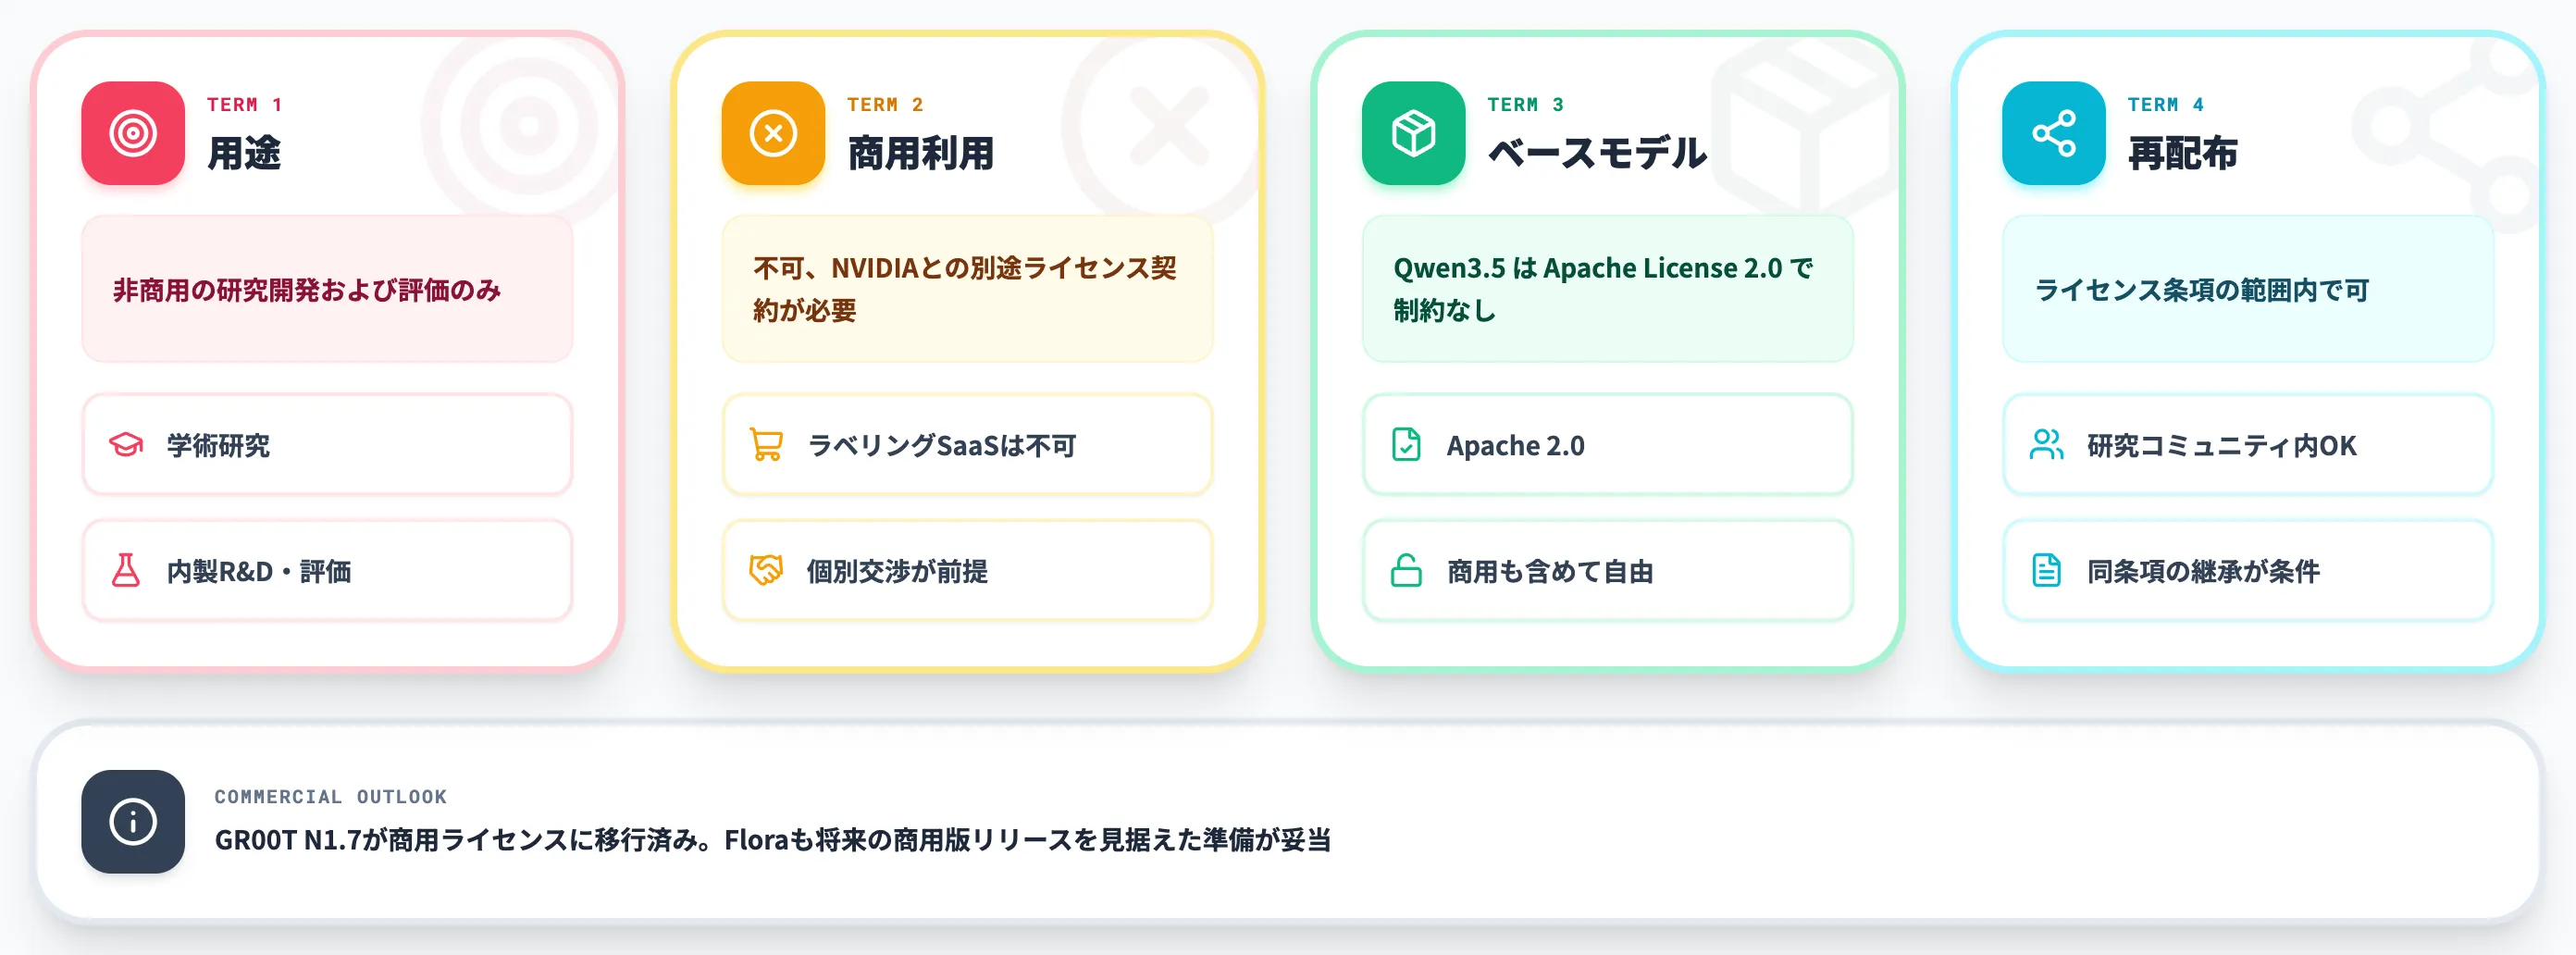
Flora 3モデルすべてに、NVIDIA OneWay Noncommercial License(2022年3月版)が適用されています。主要な条件は以下のとおりです。
-
用途
非商用の研究開発および評価のみ
-
商用利用
不可(NVIDIAとの別途ライセンス契約が必要)
-
ベースモデル
Qwen3.5はApache License 2.0で、ベースモデル部分には非商用限定の用途制限がない(再配布時のライセンス添付・表示保持などの条件は適用される)
-
再配布
ライセンス条項の範囲内で可
NVIDIA GEAR Researchの公式ページAbstractでは、「データエンジンをオープンソース化することで、研究者がカスタムのロボティクスデータセットをスケールし、physical auto-researchやhuman-to-robot transferのような新興用途を探索できるようにする」ことが公開目的として説明されています。
今回の公開モデルは非商用の研究開発用途に限定され、学術研究と内製R&Dの底上げが狙いという位置づけです。
Hugging Faceでの公開とPEFT使用例
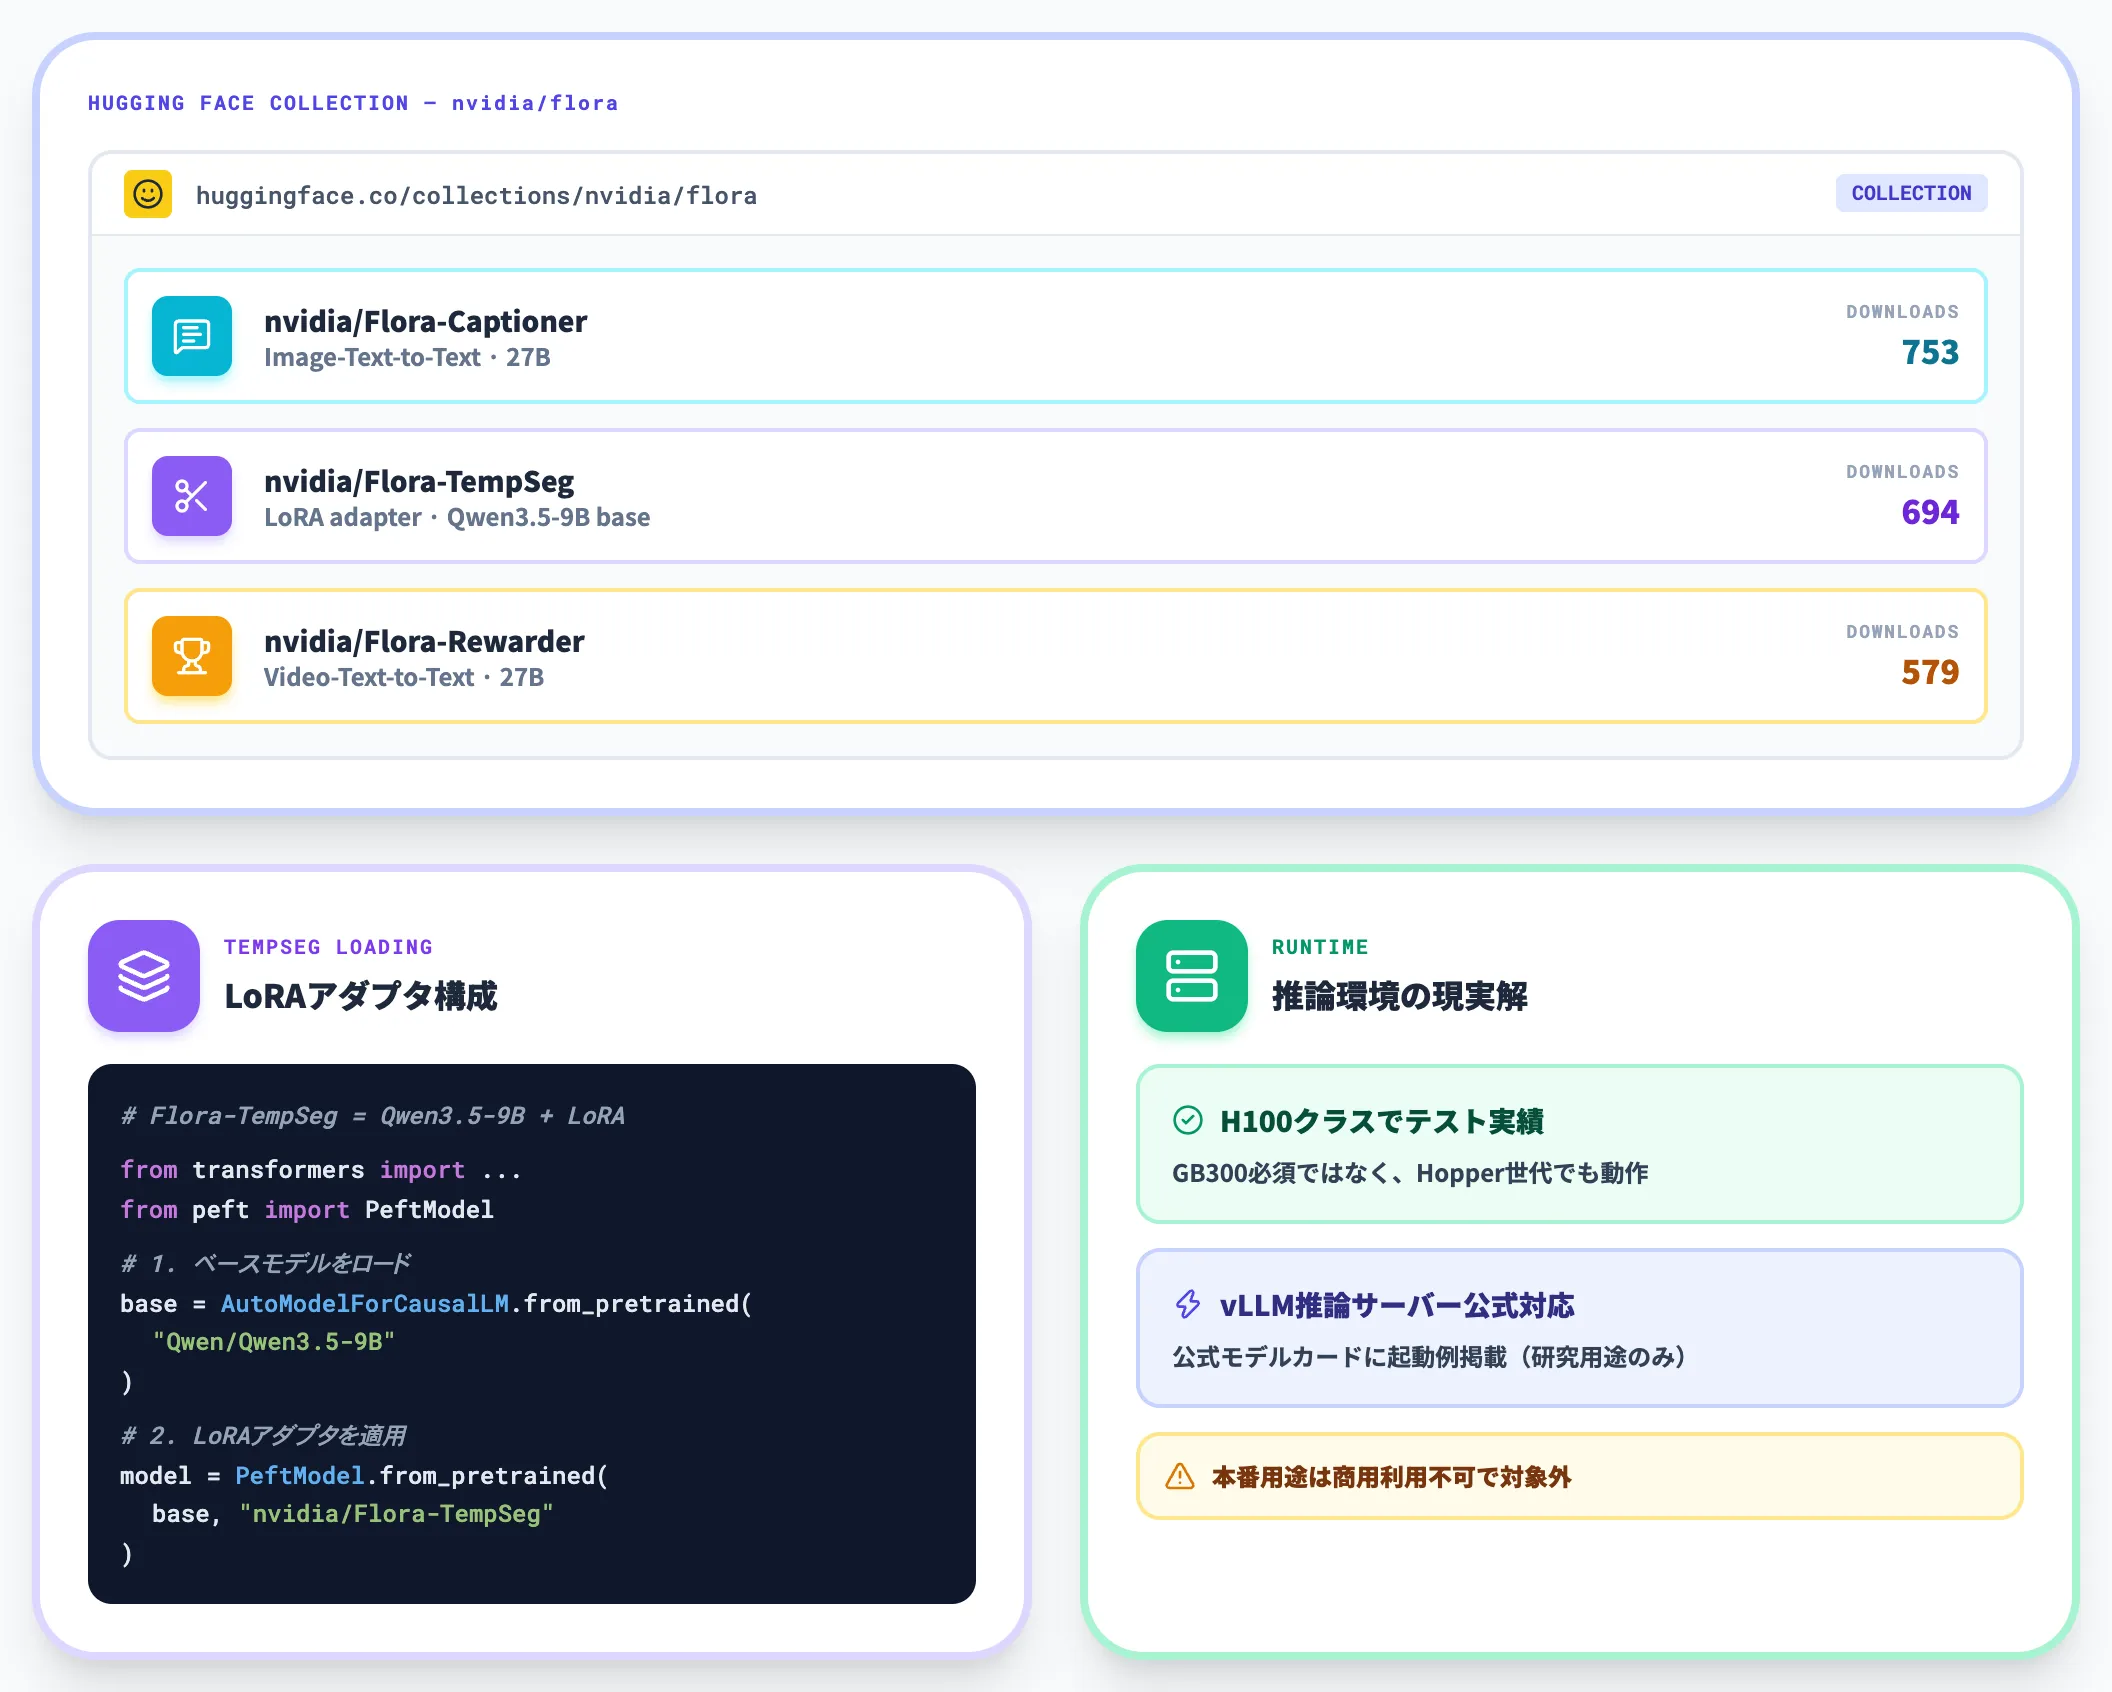
Floraの3モデルは、Hugging FaceのFloraコレクションから入手できます。
公開から数日経過時点で、Flora-Captionerが753、Flora-TempSegが694、Flora-Rewarderが579ダウンロードを記録しており(2026年10月24日時点のHugging Face画面)、研究コミュニティで即座に注目を集めたことが伺えます。
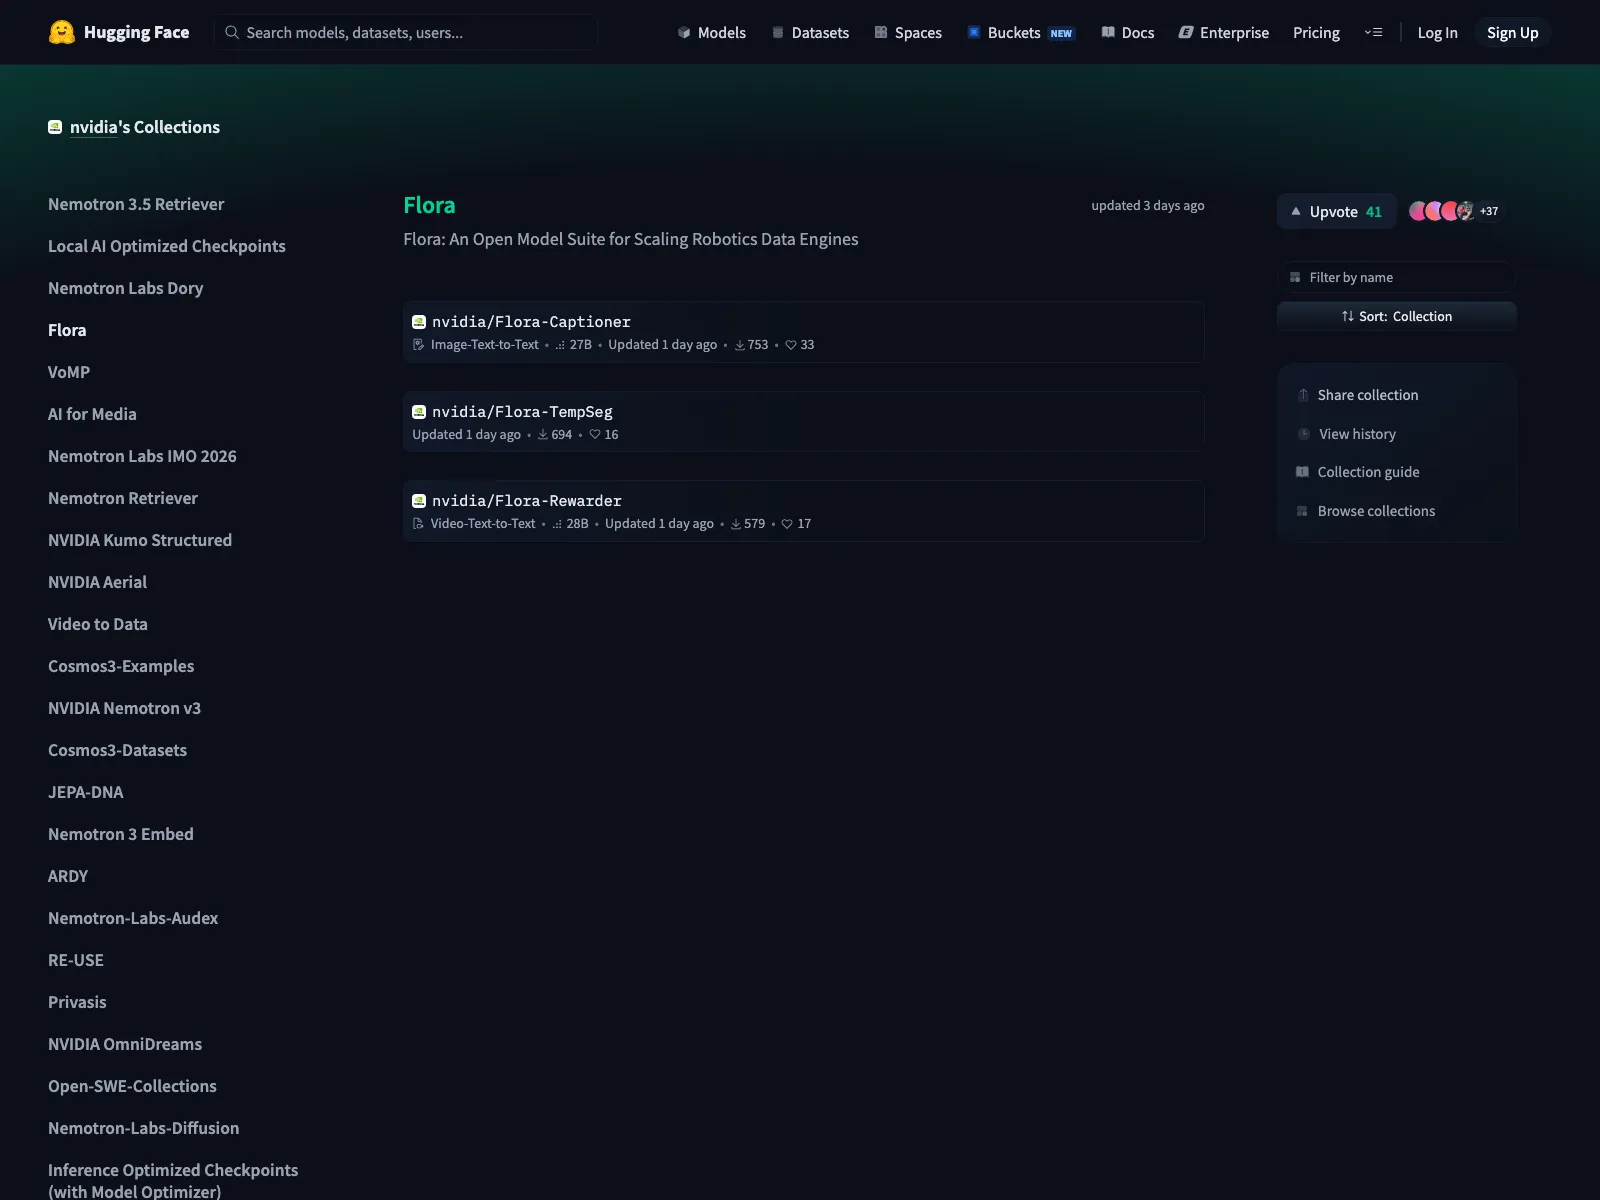
Hugging Faceで公開されているFlora公式コレクション——Captioner・TempSeg・Rewarderの3モデルがダウンロード数とともに並ぶ(出典:Hugging Face NVIDIA Flora Collection)
Flora-TempSegはQwen3.5-9BベースのLoRAアダプタとして配布されているため、オープンウェイトのQwen3.5-9Bを土台に動画対応のconditional generationクラスで読み込む構成になります。
Flora-Captioner・Flora-Rewarderはそれぞれ27Bのマルチモーダルモデルで、transformersライブラリから直接ロードする前提です。
具体的な読み込みクラス・推論設定・サンプリング条件(4Hz・16秒ウィンドウ等)は公式モデルカードを直接参照してください。
vLLMでの推論サーバー起動例も公式に掲載されていますが、公式モデルカードは本番用途を明示的に対象外(商用利用不可)と位置づけているため、推論基盤はあくまで研究環境向けの構築になります。
推論環境を構築する研究機関にとっては、NVIDIAのGB300のような最新GPU必須ではなく、Hopper世代のH100クラスでテスト実績が公表されている点は現実的な導入条件です。
Floraが向く用途と向かない用途
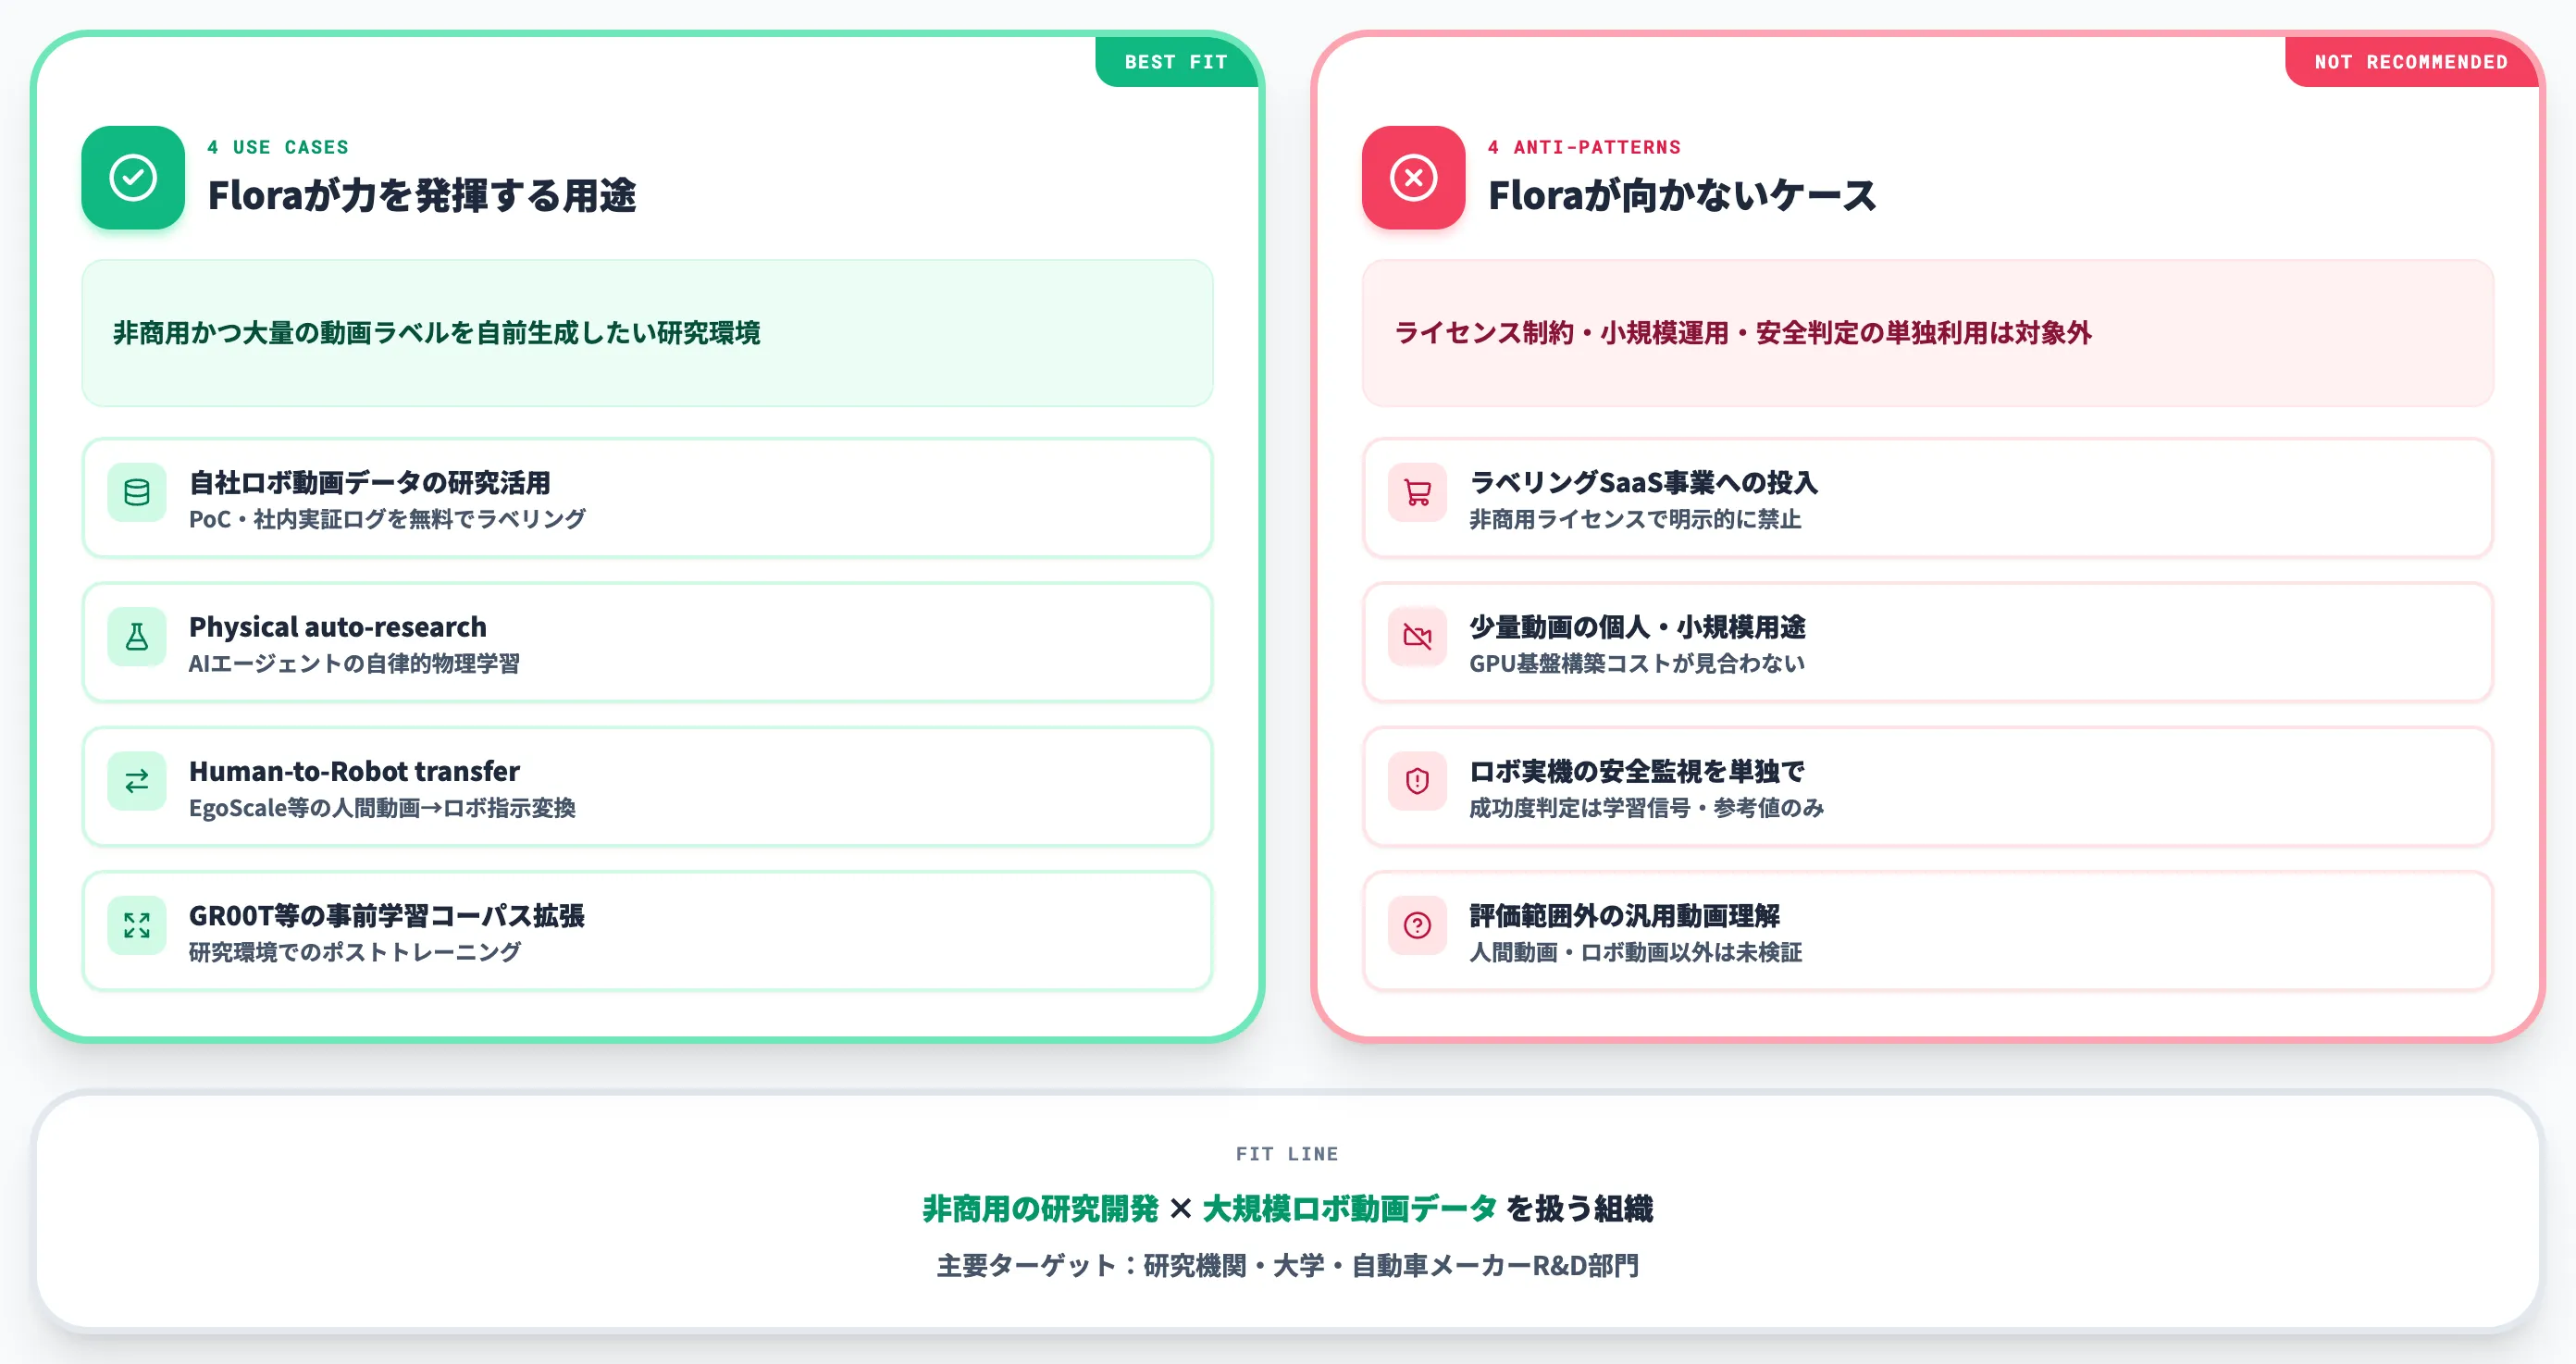
Floraをどこで使えば効くのか、逆にどこで使ってはいけないのかを整理します。NVIDIA GEARチームの意図と第三者レビューの判断を踏まえ、適合と不適合の線引きを示します。
Floraが力を発揮する4つの用途
Floraが力を発揮するのは、非商用の文脈で、大量の動画データから訓練ラベルを自前生成したいケースです。
-
自社保有のロボット動作データから訓練用ラベルを生成する研究
手持ちの動画データ(PoC・社内実証実験・大学研究室のロボット操作ログ等)を、API料金を気にせずラベリングパイプラインに流せる
-
物理オート研究(physical auto-research)
AIエージェントが自律的に物理環境を観察・実験・学習する研究で、ラベリング工程を自動化する基盤として機能する
-
人間動画からロボット動作への転移学習(human-to-robot transfer)
EgoScaleのような人間作業動画を解析し、ロボット向けの指示データに変換する前処理として使える
-
既存のロボティクス基盤モデルの事前学習コーパス拡張
研究環境でGR00TやEmbodied AI系モデルをポストトレーニングする場合、Floraでラベルを拡張したカスタムコーパスを使える
Floraが向かない4つのケース
一方、以下のような使い方はライセンス条件または技術特性の面で推奨されません。
-
ラベリングサービスを顧客に販売する事業
NVIDIA OneWay Noncommercial Licenseは商用利用を明示的に禁止している。有料のアノテーションサービスには別途契約が必須
-
数本〜数十本程度の少量動画しか持たない個人・小規模ユーザー
Floraは大規模データパイプラインでのスループットに最適化されている。API型モデルを数回叩くだけで済む用途では、Floraの推論基盤構築コストが見合わない
-
ロボット実機の機械安全を単独で監視する用途
Rewarderの成功度判定はあくまで学習信号・運用参考値であり、人命・設備に関わる安全判定の唯一の根拠にしてはいけない
-
ロボット特化訓練より汎用的な動画理解を優先するタスク
Floraの評価は人間作業動画とロボット動画中心のデータセット(DenseCaptionBenchのHuman100/Robot200・WGO-Bench・RoboRewardBench等)で行われており、評価範囲外の用途における性能は公表されていない。評価実績のない用途を扱う場合は、Floraが有利とは断言できない
適合ラインを一言で言えば、「非商用の研究開発で、大規模なロボティクス動画データを扱う組織」です。この条件に当てはまる研究機関・大学・自動車メーカーのR&D部門が主要なターゲットになります。
日本企業がFloraから読み取るべきこと
ここまでFloraの技術仕様と適合用途を見てきました。本セクションでは、日本の自動車メーカー・ロボット事業者・AI部門が、Floraというプロダクトから読み取るべき戦略的な意味を整理します。AI総研が導入支援で見てきた、日本企業の実務的な論点を踏まえた見解です。
Flora自体は直接使えないが、設計思想は参考になる
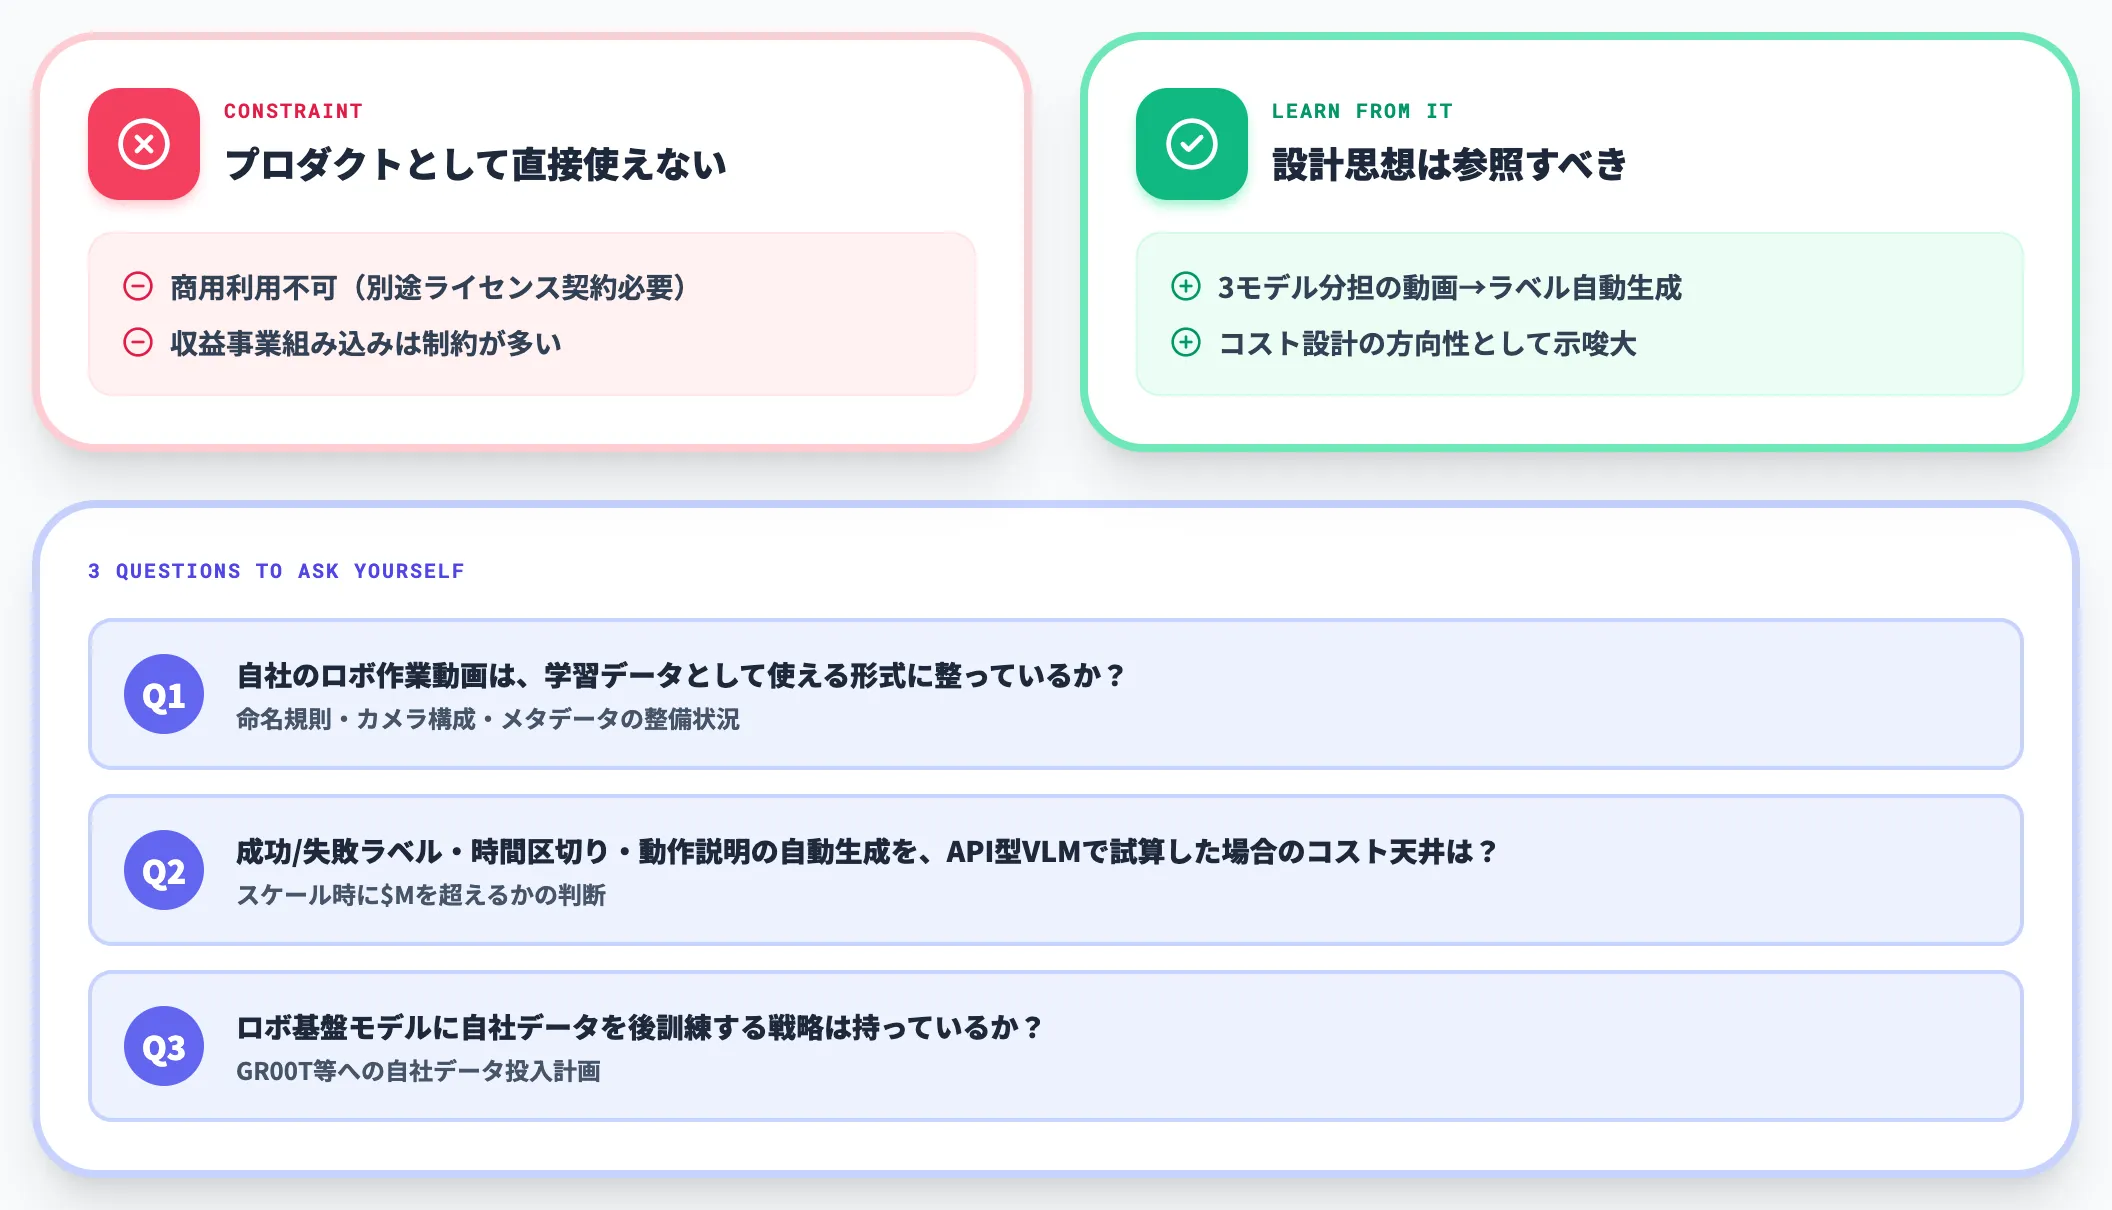
多くの日本企業にとって、Floraそのものは「直接業務に投入できないプロダクト」です。商用利用不可のライセンス条件を踏まえると、企業の収益事業に組み込むには別途ライセンス契約が必要になります。
しかし、Floraが示した「3モデルを組み合わせた動画からラベルへの自動生成パイプライン」という設計思想は、ロボティクス事業に関わるすべての企業が参照すべき方向性です。
特に以下のような問いに答えを持たない企業は、Floraのリリースを機に自社の立ち位置を再確認することになります。
- 自社のロボット運用で蓄積されている作業動画データを、学習データとして活用できる形式に整えているか
- 作業の成功/失敗ラベル・時間区切り・動作説明の自動生成を、API型VLMで試算した場合のコスト天井を把握しているか
- ロボット基盤モデルに自社データを後訓練する戦略を持っているか
ロボット事業者が今から準備すべきデータ戦略
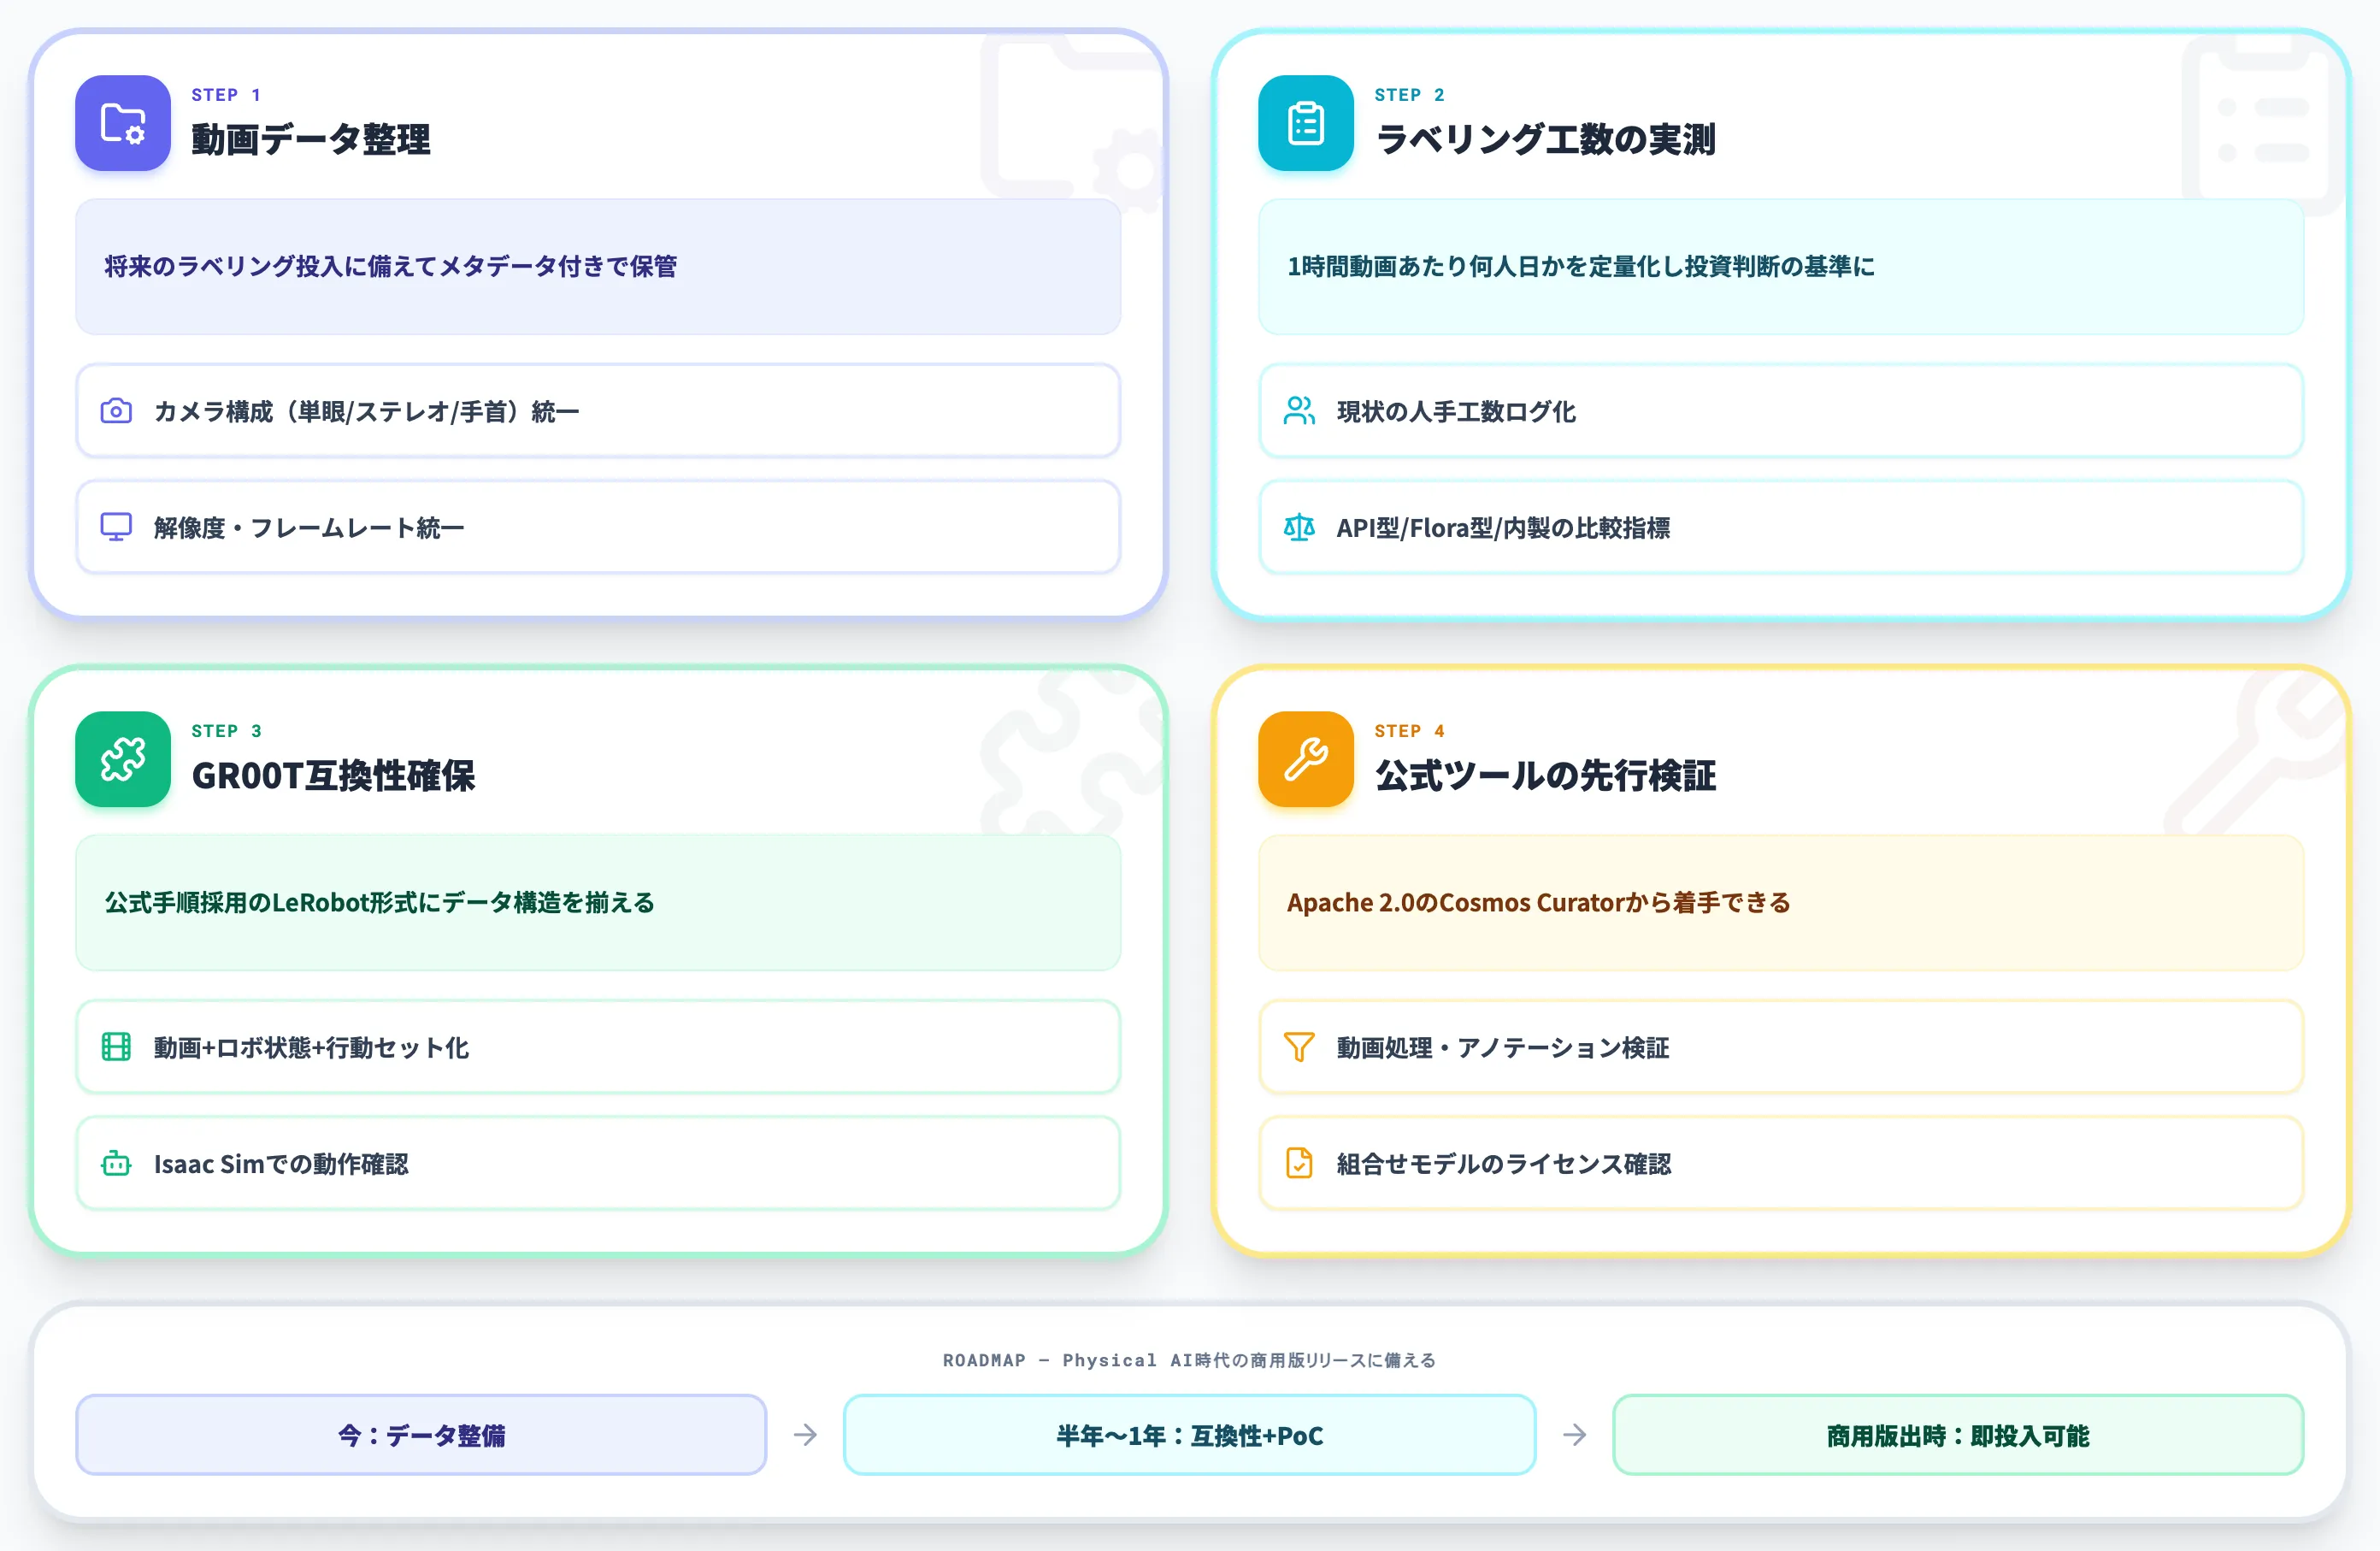
AI総研の支援現場では、日本の製造業・物流・サービス業がPhysical AI時代に対応する際、データパイプラインの先行構築が最大の差別化要因になると見ています。
Floraのような専用データエンジンが研究用途で公開されたことは、近い将来に商用版が出てくる兆候とも読めます。GR00T N1.7が商用ライセンスに移行したように、Floraも商用ライセンスの道筋が開く可能性を見据えて準備すべきです。
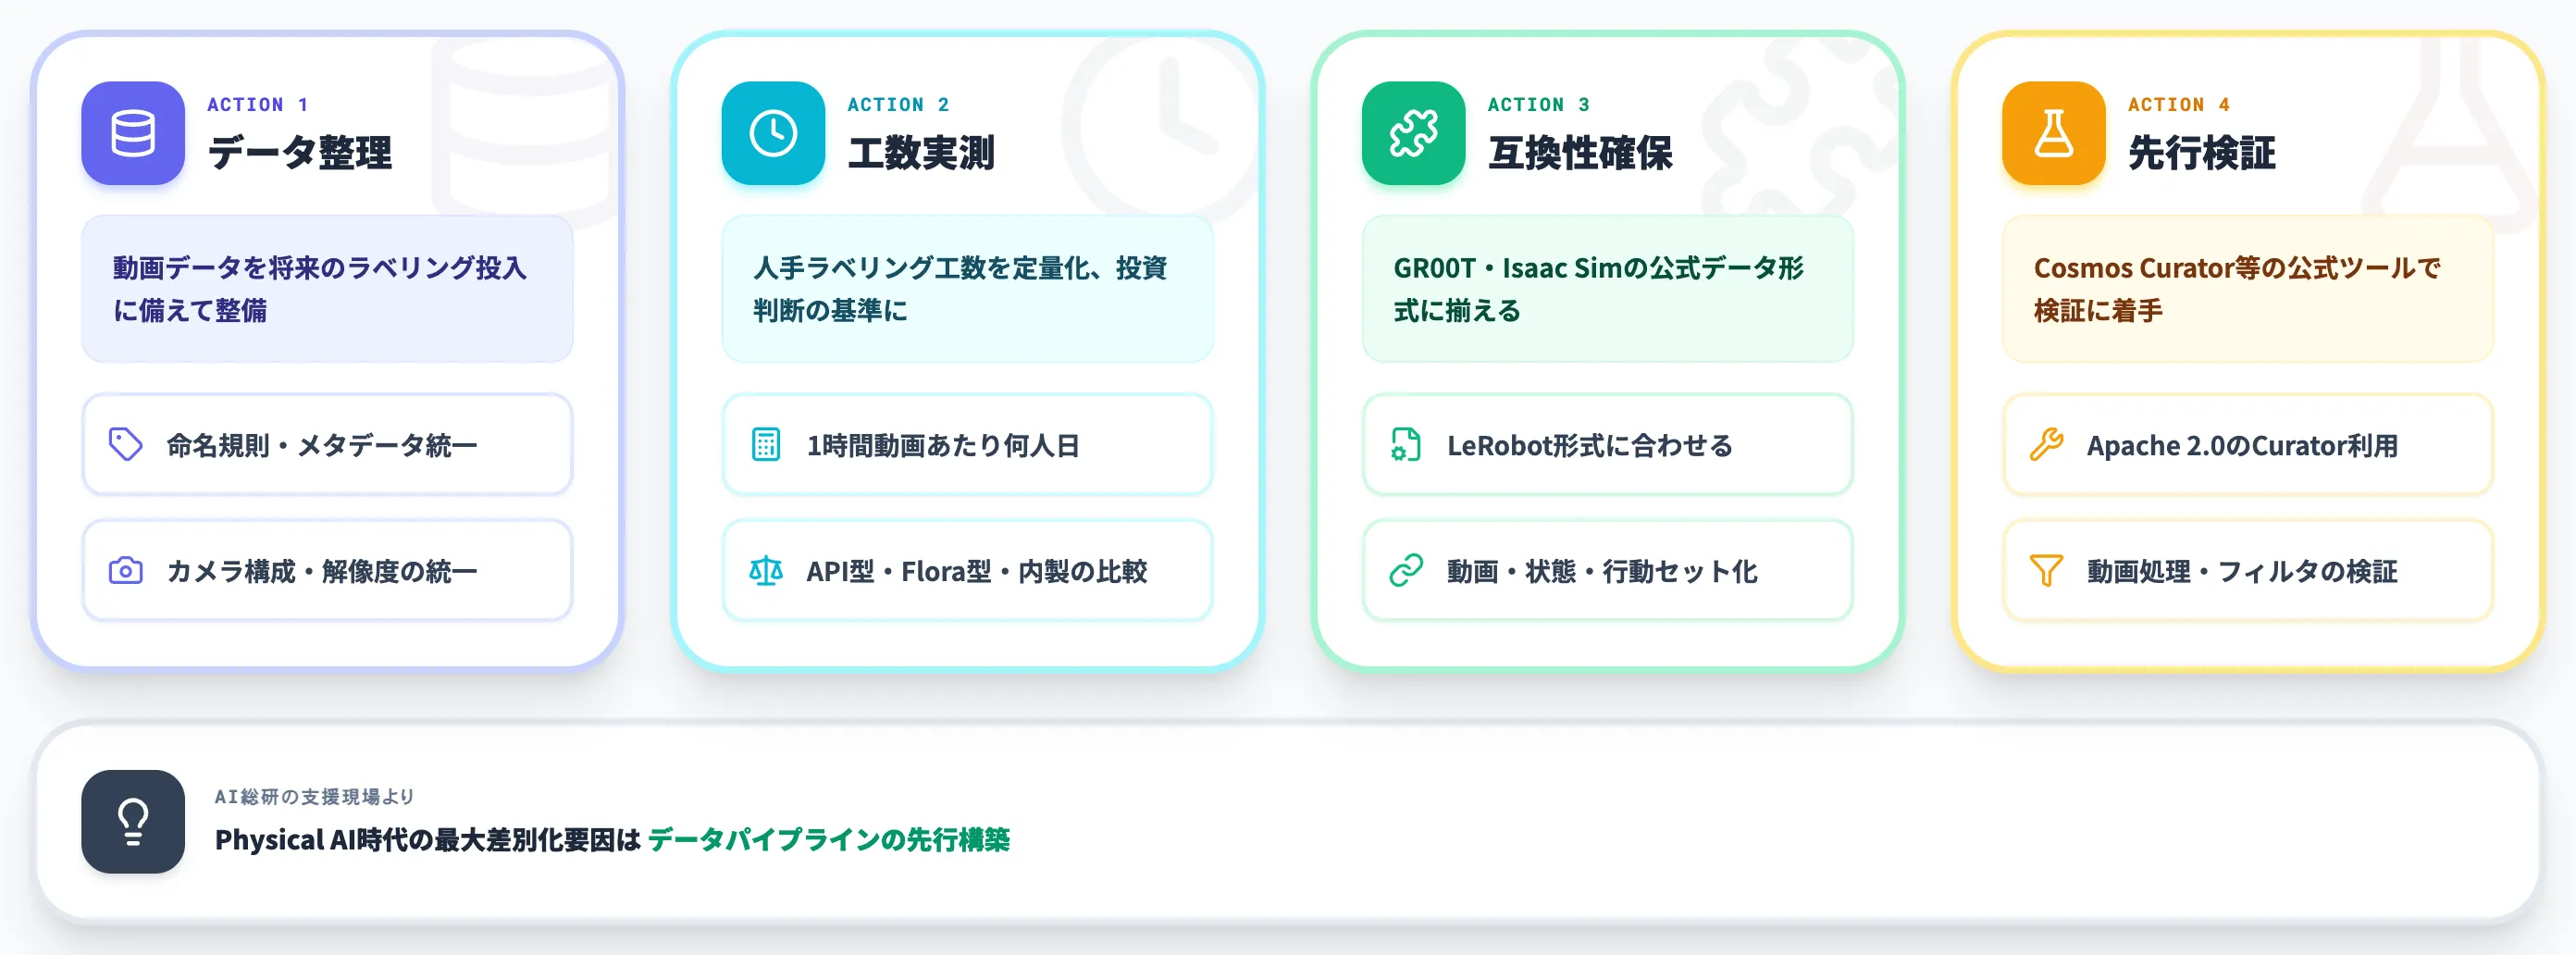
現段階で日本企業が取れる手は、以下の4つです。
-
動画データの整理と命名規則の統一
自社ロボットの作業動画を、将来のラベリング投入に備えてメタデータ付きで保管する。カメラ構成(単眼・ステレオ・手首カメラ)・解像度・フレームレートの統一も重要
-
ラベリング工数の実測
現状の人手ラベリングに1時間あたり何人日かかっているかを定量化する。これがAPI型・Flora型・内製型の投資判断の基準になる
-
GR00T・Isaac Simとの互換性確保
GR00Tをポストトレーニングするなら、公式手順で採用されているLeRobot形式(動画・ロボット状態・行動のセット)にデータ構造を合わせる
-
公式ツールチェーンの先行検証
動画パイプライン基盤として、Apache 2.0で公開されているNVIDIAのCosmos Curatorで動画処理・アノテーション・フィルタリングの検証に着手できる。ツール本体はApache 2.0だが、組み合わせるモデルのライセンスは別に確認する必要がある
Floraの商用化を待たずに、自社の作業動画を整えて現場の業務で使い始める
Floraは非商用ライセンスのため、収益事業に組み込むにはNVIDIAとの別途契約が必要ですが、自社の作業動画をカメラ構成や解像度をそろえてメタデータ付きで保管する準備には、今から着手できます。整えた動画をロボットの学習に回す日まで寝かせず、外観検査や技能伝承のような現場の業務で先に使い始めることが、データ整備の手間を回収する鍵になります。
その足がかりになるのが、作業動画や図面、センサーログといった現場のデータを整え、社員がTeamsから呼び出す業務エージェントで使えるようにする、製造業向けのAI Agent Hubです。
- 作業動画から手順と異常を読み取る
熟練者の作業動画を手順ごとにまとめた技能伝承の教材づくりや、検査映像から異常を見つける外観検査に、ロボットの学習とは別に映像を使えます。
- 現場のデータをAIが扱える形にそろえる
図面や帳票、センサーログ、現場写真の形式と品質を確かめ、重複や表記ゆれを整理してタグを付け、OneLakeに統合して、Agentが参照できる状態にします。
- 映像と図面を自社のテナント内で扱う
作業動画や図面は自社のAzureテナント内で扱うため、製造ノウハウが映った映像を社外のサービスに送らずに済み、閲覧できる社員はAgentごとのアクセス権限で区切れます。
AI総合研究所の専任チームが、手元にある作業動画と現場データの棚卸しから、1つの業務で使い始めるところまで伴走します。
手元の作業動画を現場の業務で生かす

動画と現場データをAIが扱える形に
Floraを収益事業に組み込むにはNVIDIAとの別途契約が要りますが、自社の作業動画や図面、センサーログをAIが扱える形に整えておくと、外観検査や技能伝承といった現場の業務で先に使い始めやすくなります。作業動画の活用例やデータ整備の進め方は、AI Agent Hubの製造業向けページでご覧いただけます。
まとめ
本記事では、NVIDIA Floraを「ロボット動画から訓練ラベルを自動生成するデータエンジン」として整理し、背景にあるデータ問題・3モデルの構成・ベンチマーク・コスト効率と実運用・ライセンスと入手方法・向く用途と向かない用途・日本企業への示唆を解説しました。
2026年10月時点で押さえておくべきポイントは次の3つです。
- 人間の作業動画や報酬ラベルの評価ではFloraが汎用フロンティアモデルを上回る一方、ロボット動画のRobot200ではGPT-6 Astraに届いていない
- 費用がAPI料金ではなくGPUの稼働時間で決まるため、扱う動画の量が増えるほど、汎用モデルとのコスト差が効いてくる
- Floraが合うのは、非商用の研究開発で大規模なロボット動画データを扱う組織で、ラベリングを有料サービスとして売る事業や、少量の動画しか持たない場合には向かない
ロボットの開発や運用に関わる日本企業に対して、AI総合研究所が今の段階で勧めている準備は、次の2段階です。
まずは、人手のラベリングに動画1時間あたり何人日かかっているかを実測し、API型・Flora型・内製型のどれに費用をかけるかを比べる基準を作ります。
続いて、NVIDIAがApache 2.0で公開しているCosmos Curatorで自社の動画の処理やアノテーションを試し、組み合わせるモデルのライセンスは個別に確かめます。
人手でも汎用モデルでも賄いきれなかったラベル作りが専用モデルで回り始め、ロボティクスAIでは動画を訓練データに変える仕組みそのものが競争力になりつつあります。
Floraはその仕組みをGR00T-2の訓練で実際に動かしている例であり、自社で同じ流れを組むときの設計の手本として読み込んでおきたいデータエンジンです。