この記事のポイント
 ロボット基盤モデルはVLA・世界モデル・制御モデルの3つのアーキテクチャで整理でき、採用スタックごとに組み合わせ方が異なる
- VLAは視覚と言語を直接アクションに変換する主流レイヤーで、GR00TやHelixでは内部にSystem 2のVLMとSystem 1の動作生成を持つ
- 2026年の新潮流はWorld Action Model(WAM)で、NVIDIA DreamZeroが2026年4月RoboArenaで1750 Eloを記録しπ0.5の1622を上回る
- 代表プレイヤーはNVIDIA(GR00T N1.7/Cosmos 3)、Google DeepMind(Gemini Robotics 2)、Physical Intelligence(π0.7+Pi API beta)、Figure AI(Helix 2.5)
- PoCならOpenVLA・LeRobot、量産前パイロットならGR00T N1.7・Pi API beta・Gemini Robotics 2が実務的な第一候補
Microsoft MVP・AIパートナー。LinkX Japan株式会社 代表取締役。東京工業大学大学院にて自然言語処理・金融工学を研究。NHK放送技術研究所でAI・ブロックチェーンの研究開発に従事し、国際学会・ジャーナルでの発表多数。経営情報学会 優秀賞受賞。シンガポールでWeb3企業を創業後、現在は企業向けAI導入・DX推進を支援。
ロボット基盤モデル(robotics foundation model)とは、ロボット単体のタスクを超えて、視覚・言語・身体動作を一つの大規模AIモデルで扱う汎用知能群の総称です。
従来の強化学習・模倣学習・ハードコード制御では、タスクごとに報酬関数や動作シーケンスを人が設計する必要がありました。基盤モデルは、インターネット規模の映像・言語データと実機ロボットの軌跡データを束ねて事前学習し、新しい指示や新しい環境へそのまま適用できる汎用性を獲得します。
2026年時点のロボット基盤モデルは、VLA(Vision-Language-Action)・世界モデル・制御モデルという3つのアーキテクチャで整理でき、NVIDIA GR00T N1.7・Physical Intelligence π系・Google Gemini Robotics 2・Figure Helix 2.5・NVIDIA Cosmos 3など複数の主要モデルが2026年に本格展開のフェーズへ入っています。
本記事では、3大アーキテクチャの関係、代表モデルと主要プレイヤーの最新動向、World Action Model(WAM)という2026年の新潮流、導入判断と課題までを俯瞰で解説します。
目次
ロボット基盤モデルとは?——ロボットの"頭脳"になる汎用AI
ロボット基盤モデルの3層構造——VLA・世界モデル・制御モデルの違い
デュアルシステム(System 1/System 2)という代表的な設計
制御モデル:Diffusion Policy・ACTが担う動作生成層
World Action Model(WAM)——VLAと世界モデルを融合する2026年の新潮流
ロボット基盤モデルとは?——ロボットの"頭脳"になる汎用AI
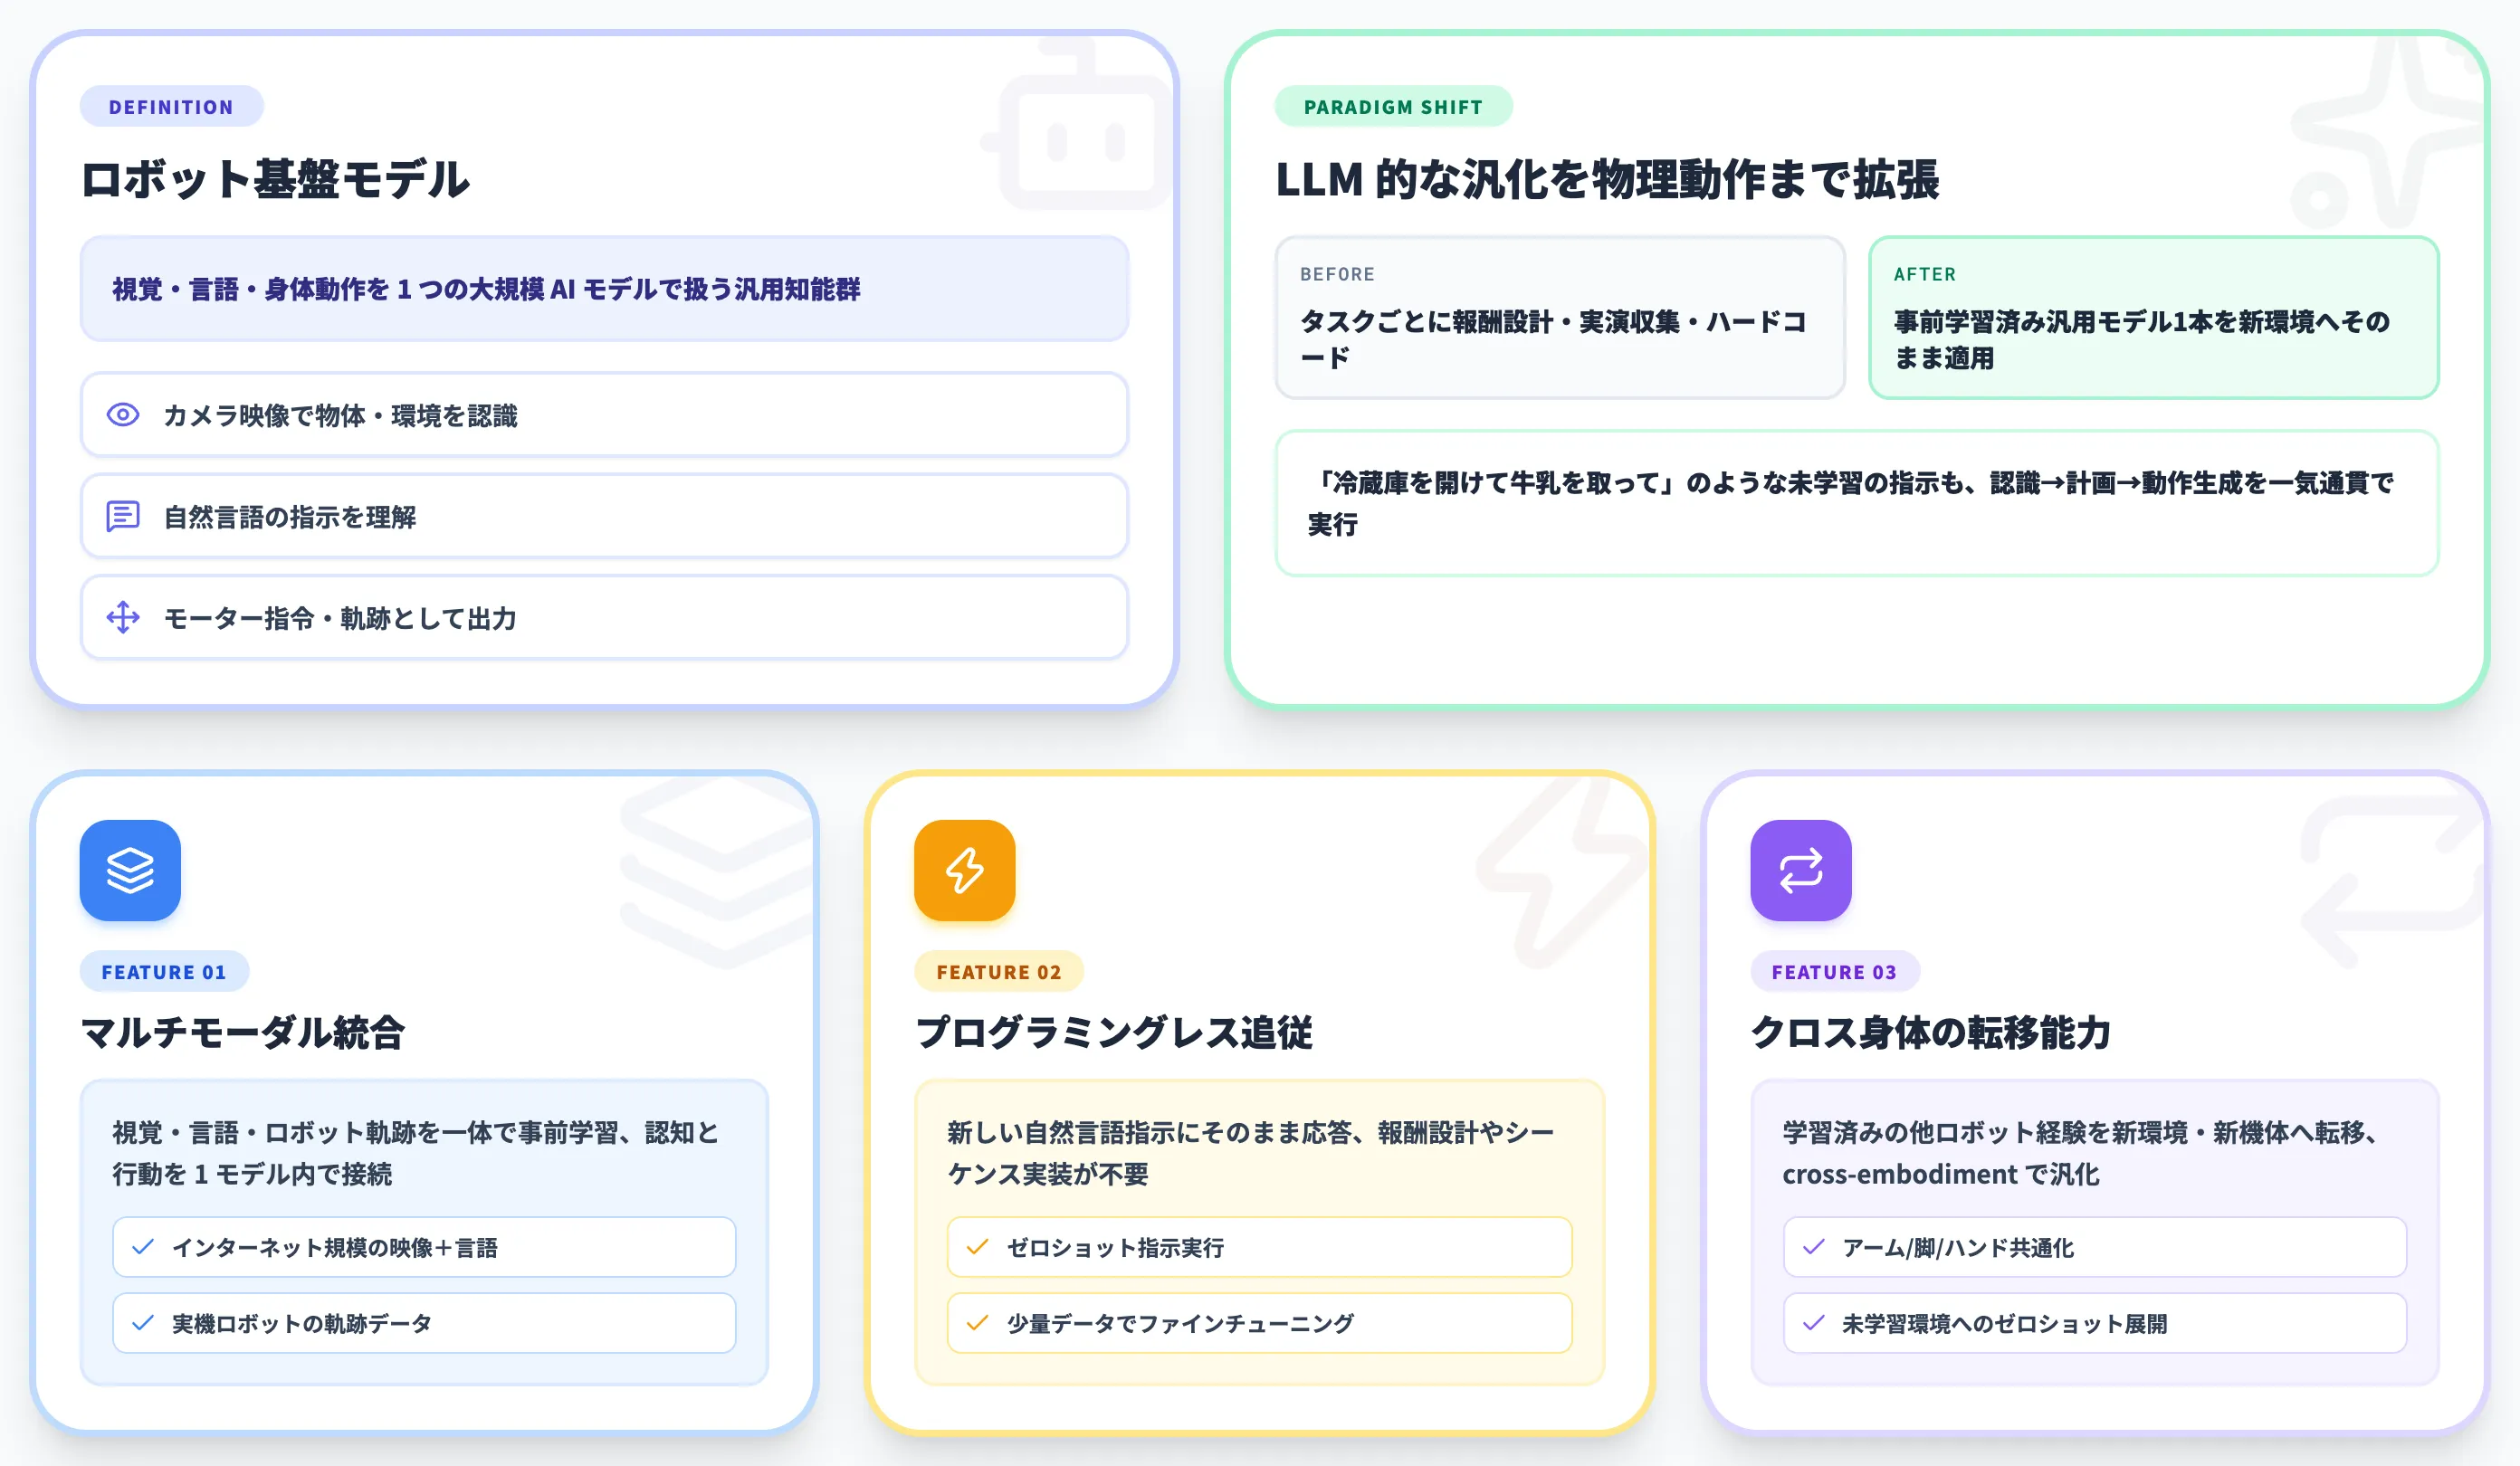
ロボット基盤モデル(robotics foundation model)とは、ロボット単体のタスクを超えて、視覚・言語・身体動作を一つの大規模AIモデルで扱う汎用知能群の総称です。
大規模言語モデル(LLM)が自然言語の広い範囲を1つのモデルで扱えるようになったのと同じ構図を、ロボットの物理動作まで広げたものと捉えると分かりやすい技術です。
従来のロボット制御では、タスクごとに報酬関数の設計・テレオペレーションでの実演収集・動作シーケンスのハードコードといった人手作業が必要でした。NVIDIA ResearchはIsaac GR00T N1 Whitepaperで、ロボット基盤モデルを「cross-embodimentで汎化する generalist humanoid foundation model」として整理しています。
ロボット基盤モデルが提供するのは、プログラミングレスで新しい指示に追従する能力と、学習済みの他ロボットの経験を転用して新環境に適応する転移能力の2つです。
汎用ロボット時代の頭脳にあたる基盤モデル
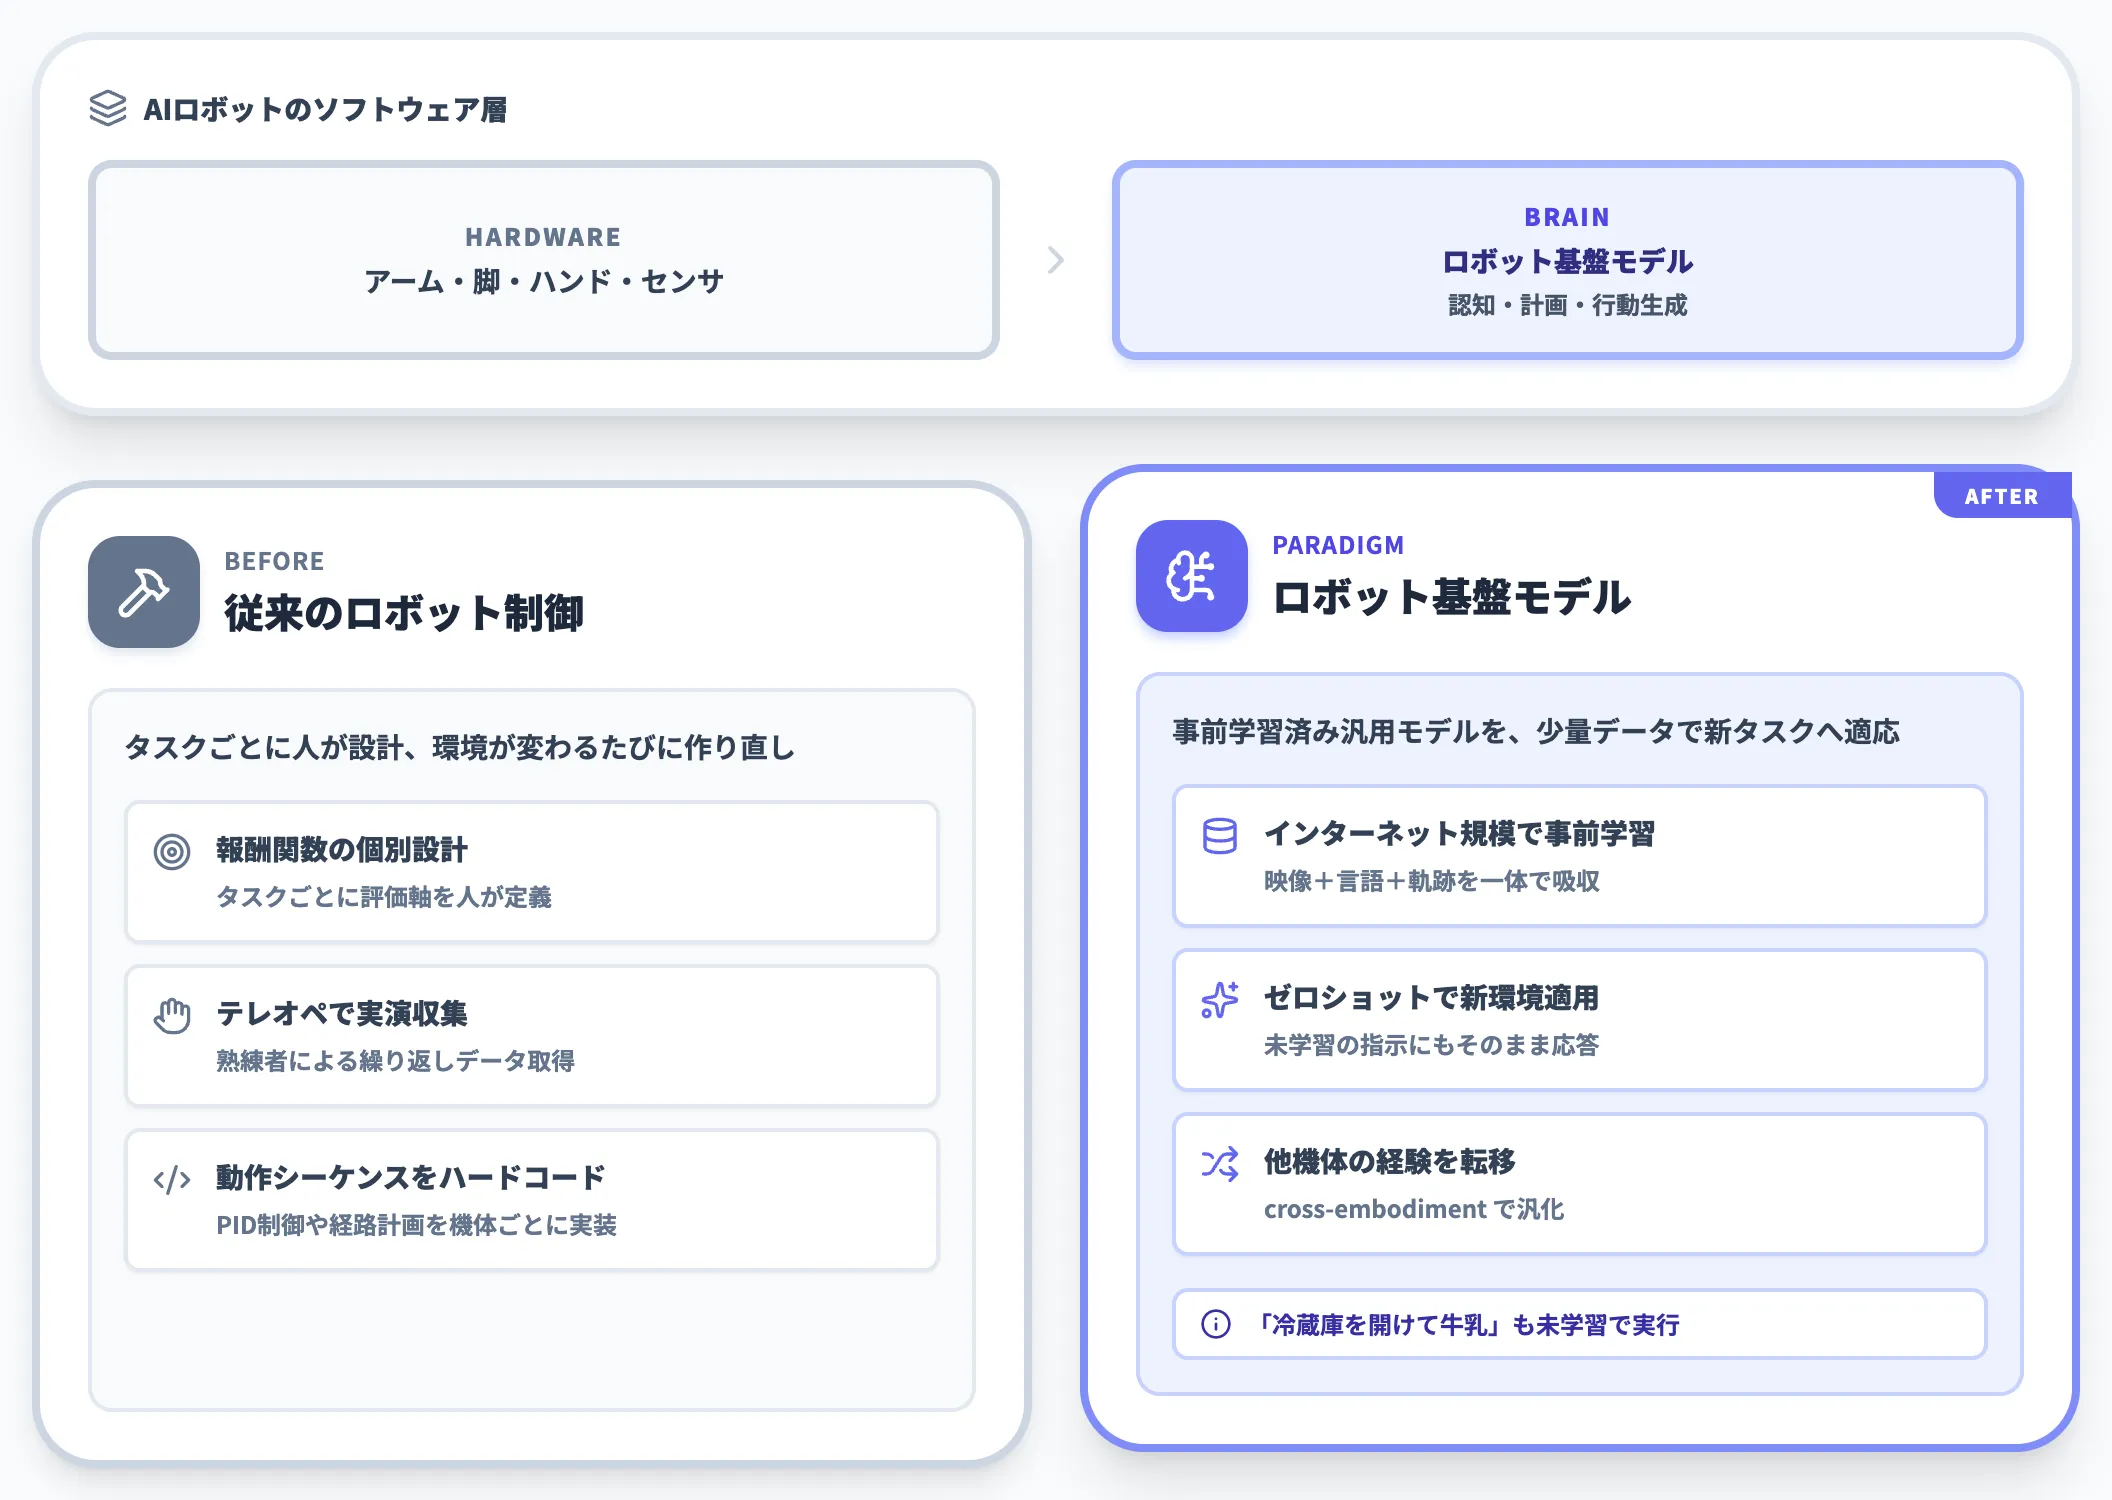
ロボット基盤モデルは、AIロボットのソフトウェア層に搭載される"頭脳"にあたります。
ハードウェア(アーム・脚・ハンド・センサ)と、低レイヤーの運動制御(モーター駆動・PID制御・力制御)の間に挟まる認知・計画・行動生成の層を、1つの大規模モデルで統一的に扱います。
-
従来
タスクごとに独立した学習パイプライン・個別のデータ収集・個別の報酬設計
-
ロボット基盤モデル
事前学習済みの汎用モデルを、新タスクには少量データでファインチューニング、新環境にはゼロショットで展開
視覚入力・自然言語指示・ロボットの軌跡データが一体で学習されることで、「冷蔵庫を開けて牛乳を取って」のような未学習の指示にも、物体認識・経路計画・動作生成を一気通貫で実行できるのが大きな転換点です。
ロボット基盤モデルの3層構造——VLA・世界モデル・制御モデルの違い
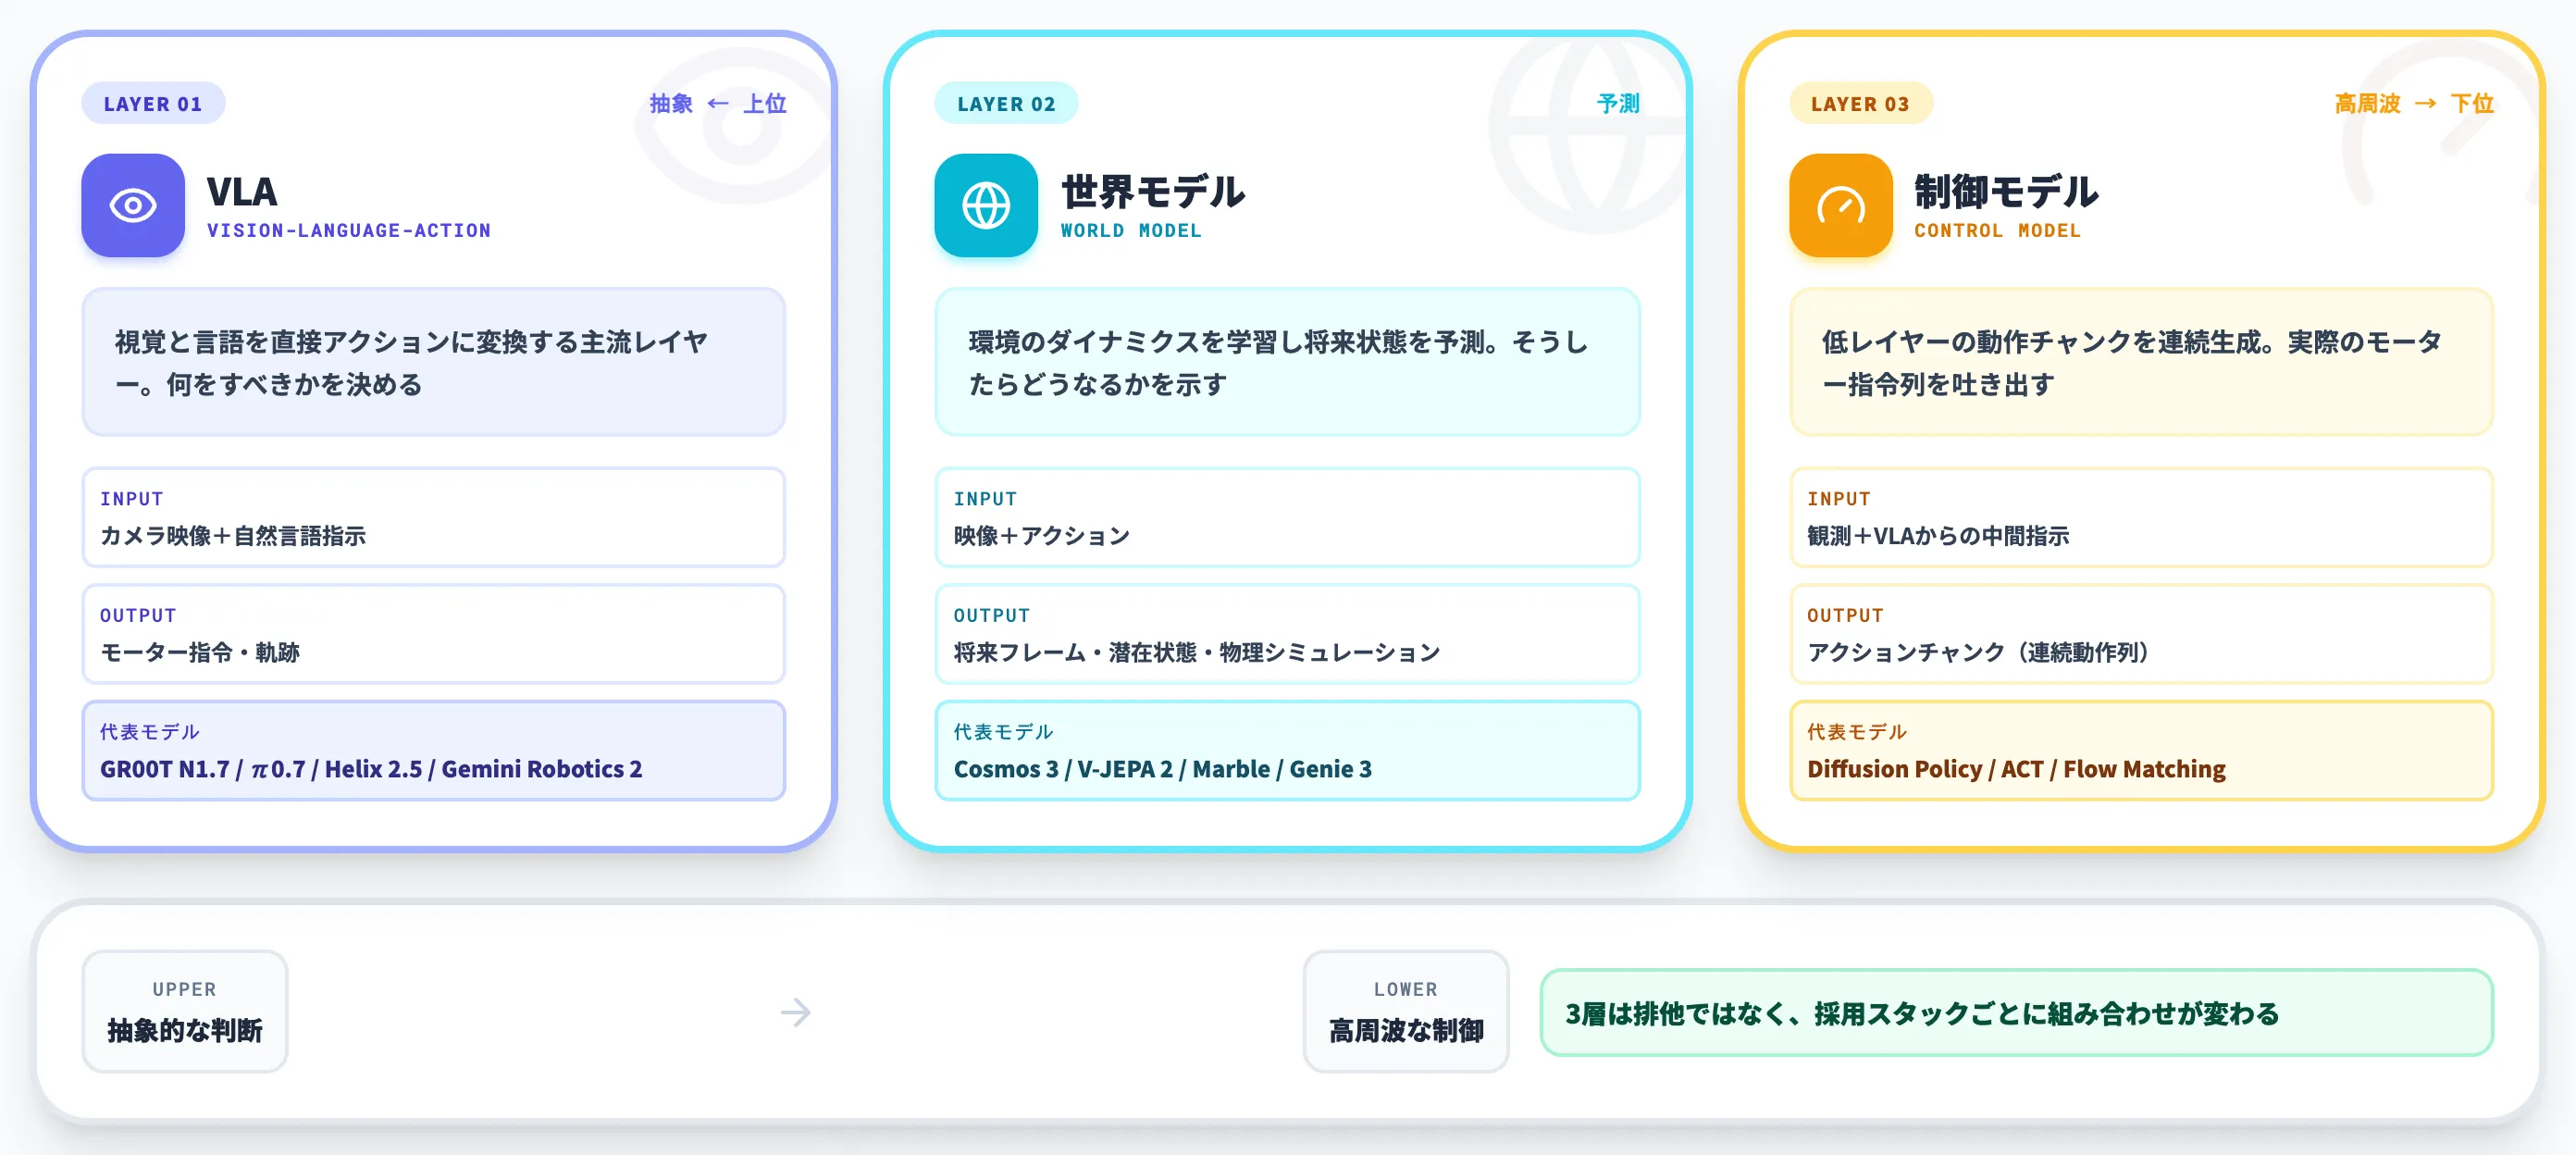
ロボット基盤モデルを単一の塊として扱うと、GR00TとCosmosとDiffusion Policyが同列に並んで見えてしまい、どれから使えばいいかが決められなくなります。実務的に押さえるべきは、ロボット基盤モデルは3つのレイヤーで役割分担しているという理解です。
本セクションでは、VLA・世界モデル・制御モデルの入出力と担当範囲、相互関係を整理します。
3層の役割分担
ロボット基盤モデルを機能で分けると、以下の3層に対応します。
| レイヤー | 役割 | 入力 | 出力 | 代表モデル |
|---|---|---|---|---|
| VLA(Vision-Language-Action) | 視覚と言語を直接アクションに変換する主流層 | カメラ映像+自然言語指示 | モーター指令・エンドエフェクタ軌跡 | GR00T N1.7/π0.7/Helix 2.5/Gemini Robotics 2/OpenVLA |
| 世界モデル(World Model) | 環境のダイナミクスを学習・将来状態を予測 | 映像+アクション | 将来フレーム・潜在状態・物理シミュレーション | NVIDIA Cosmos 3/Meta V-JEPA 2/World Labs Marble/Google Genie 3 |
| 制御モデル(Control Model) | 低レイヤーの動作チャンクを生成 | 観測+VLAからの中間指示 | アクションチャンク(連続した動作シーケンス) | Diffusion Policy/ACT/Flow Matching Policy |
この表から読み取れるのは、3つのレイヤーは排他ではなく、上位ほど抽象的な判断、下位ほど高周波な制御を担う役割分担として整理できるという点です。ただし、どのスタックでも3層が明示的に揃うわけではなく、GR00TやHelixのようにVLA 1つが上位判断と動作生成を内包する実装、世界モデルは学習データ生成に限って挟む実装など、組み合わせ方は採用例ごとに異なります。
デュアルシステム(System 1/System 2)という代表的な設計
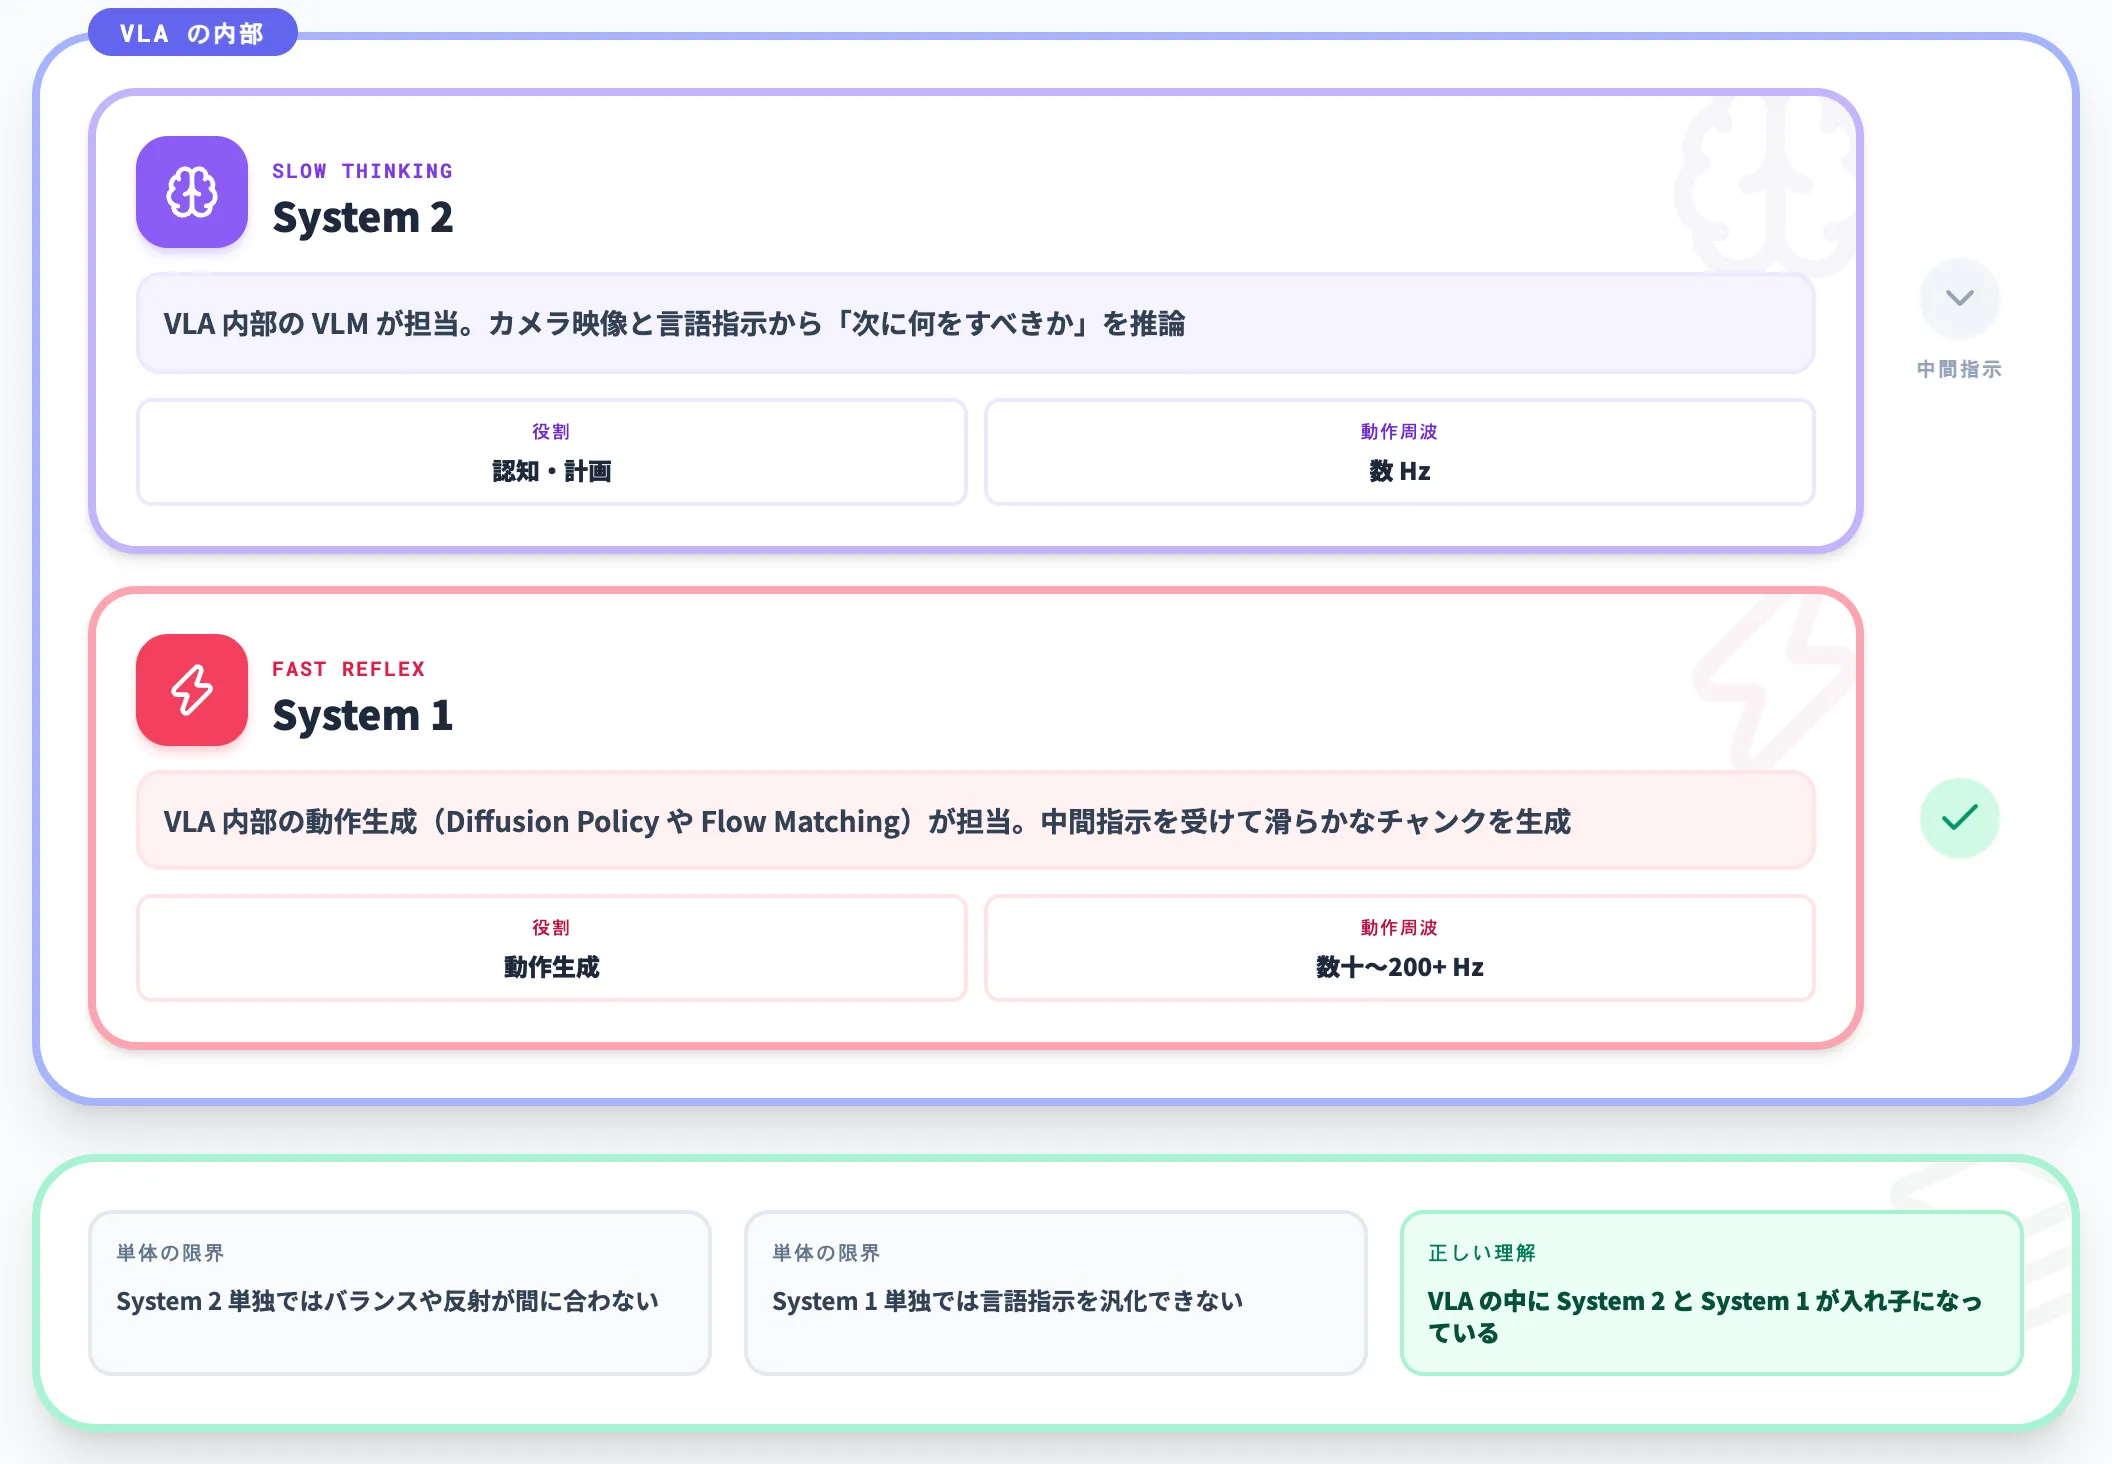
GR00TやHelixに代表されるVLAの実装では、「ゆっくり考える上位層」と「素早く反応する下位層」をVLA内部で2段構えにする設計が採られています。NVIDIAはGR00T N1 Whitepaperでこの Dual-System 構造を明示しており、Figure Helixも同じ階層分担で200Hz以上の上半身制御を実現しています。
-
System 2(遅い思考)
VLA内部のVLMが担当。カメラ映像と言語指示から「次に何をすべきか」を数Hzで推論する
-
System 1(速い反射)
VLA内部の動作生成(Diffusion PolicyやFlow Matching)が担当。中間指示を受けて数十〜数百Hzでなめらかな動作チャンクを生成する
つまり「VLA=System 2」ではなく「VLAの中にSystem 2とSystem 1が入れ子になっている」のが正確で、System 2単体ではバランスや反射が間に合わず、System 1単体では言語指示を汎化できないため、1つのVLAの中で両方を抱える構造になっています。世界モデルは、この構造の外側に合成データ生成やモデル予測制御の補助として差し込まれる形で登場します。
3層の実装レイアウト
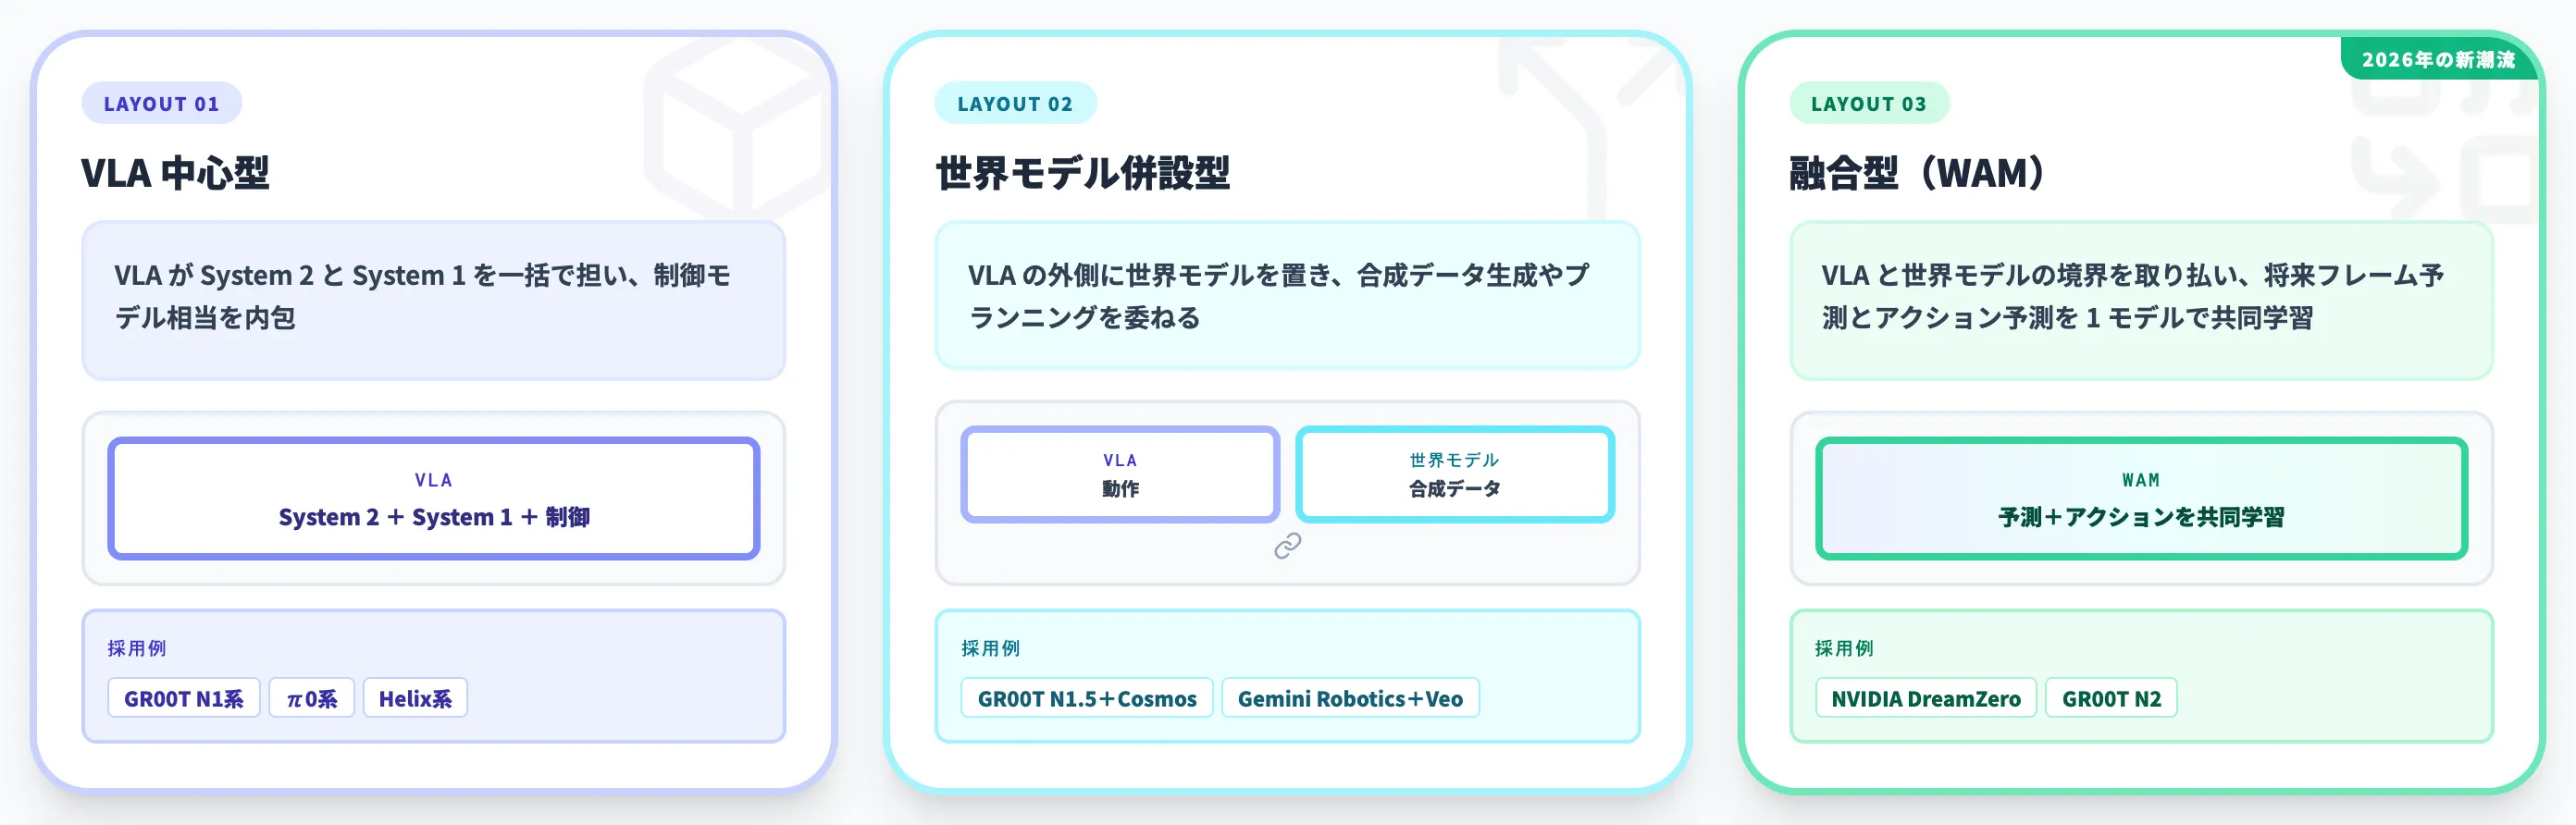
実際のロボット基盤モデルは、以下いずれかのレイアウトを取ります。
- VLA 中心型:VLAが System 2と System 1を一括で担い、制御モデル相当を内包する(GR00T N1 系・π0 系・Helix 系)
- 世界モデル併設型:VLAの外側に世界モデルを置き、合成データ生成やプランニングを委ねる(GR00T N1.5+Cosmos・Gemini Robotics+Veo)
- 融合型(WAM):VLAと世界モデルの境界を取り払い、将来フレーム予測とアクション予測を1つのモデルで共同学習(NVIDIA DreamZero/GR00T N2)
融合型(WAM)は、2023年のGoogle UniPiなど先行研究を含む一連の流れを、NVIDIA Developer Blogが2026年に"World-Action Model"という呼称で体系化・解説した概念です。
VLAモデル:視覚・言語・行動を直接結ぶ主流レイヤー
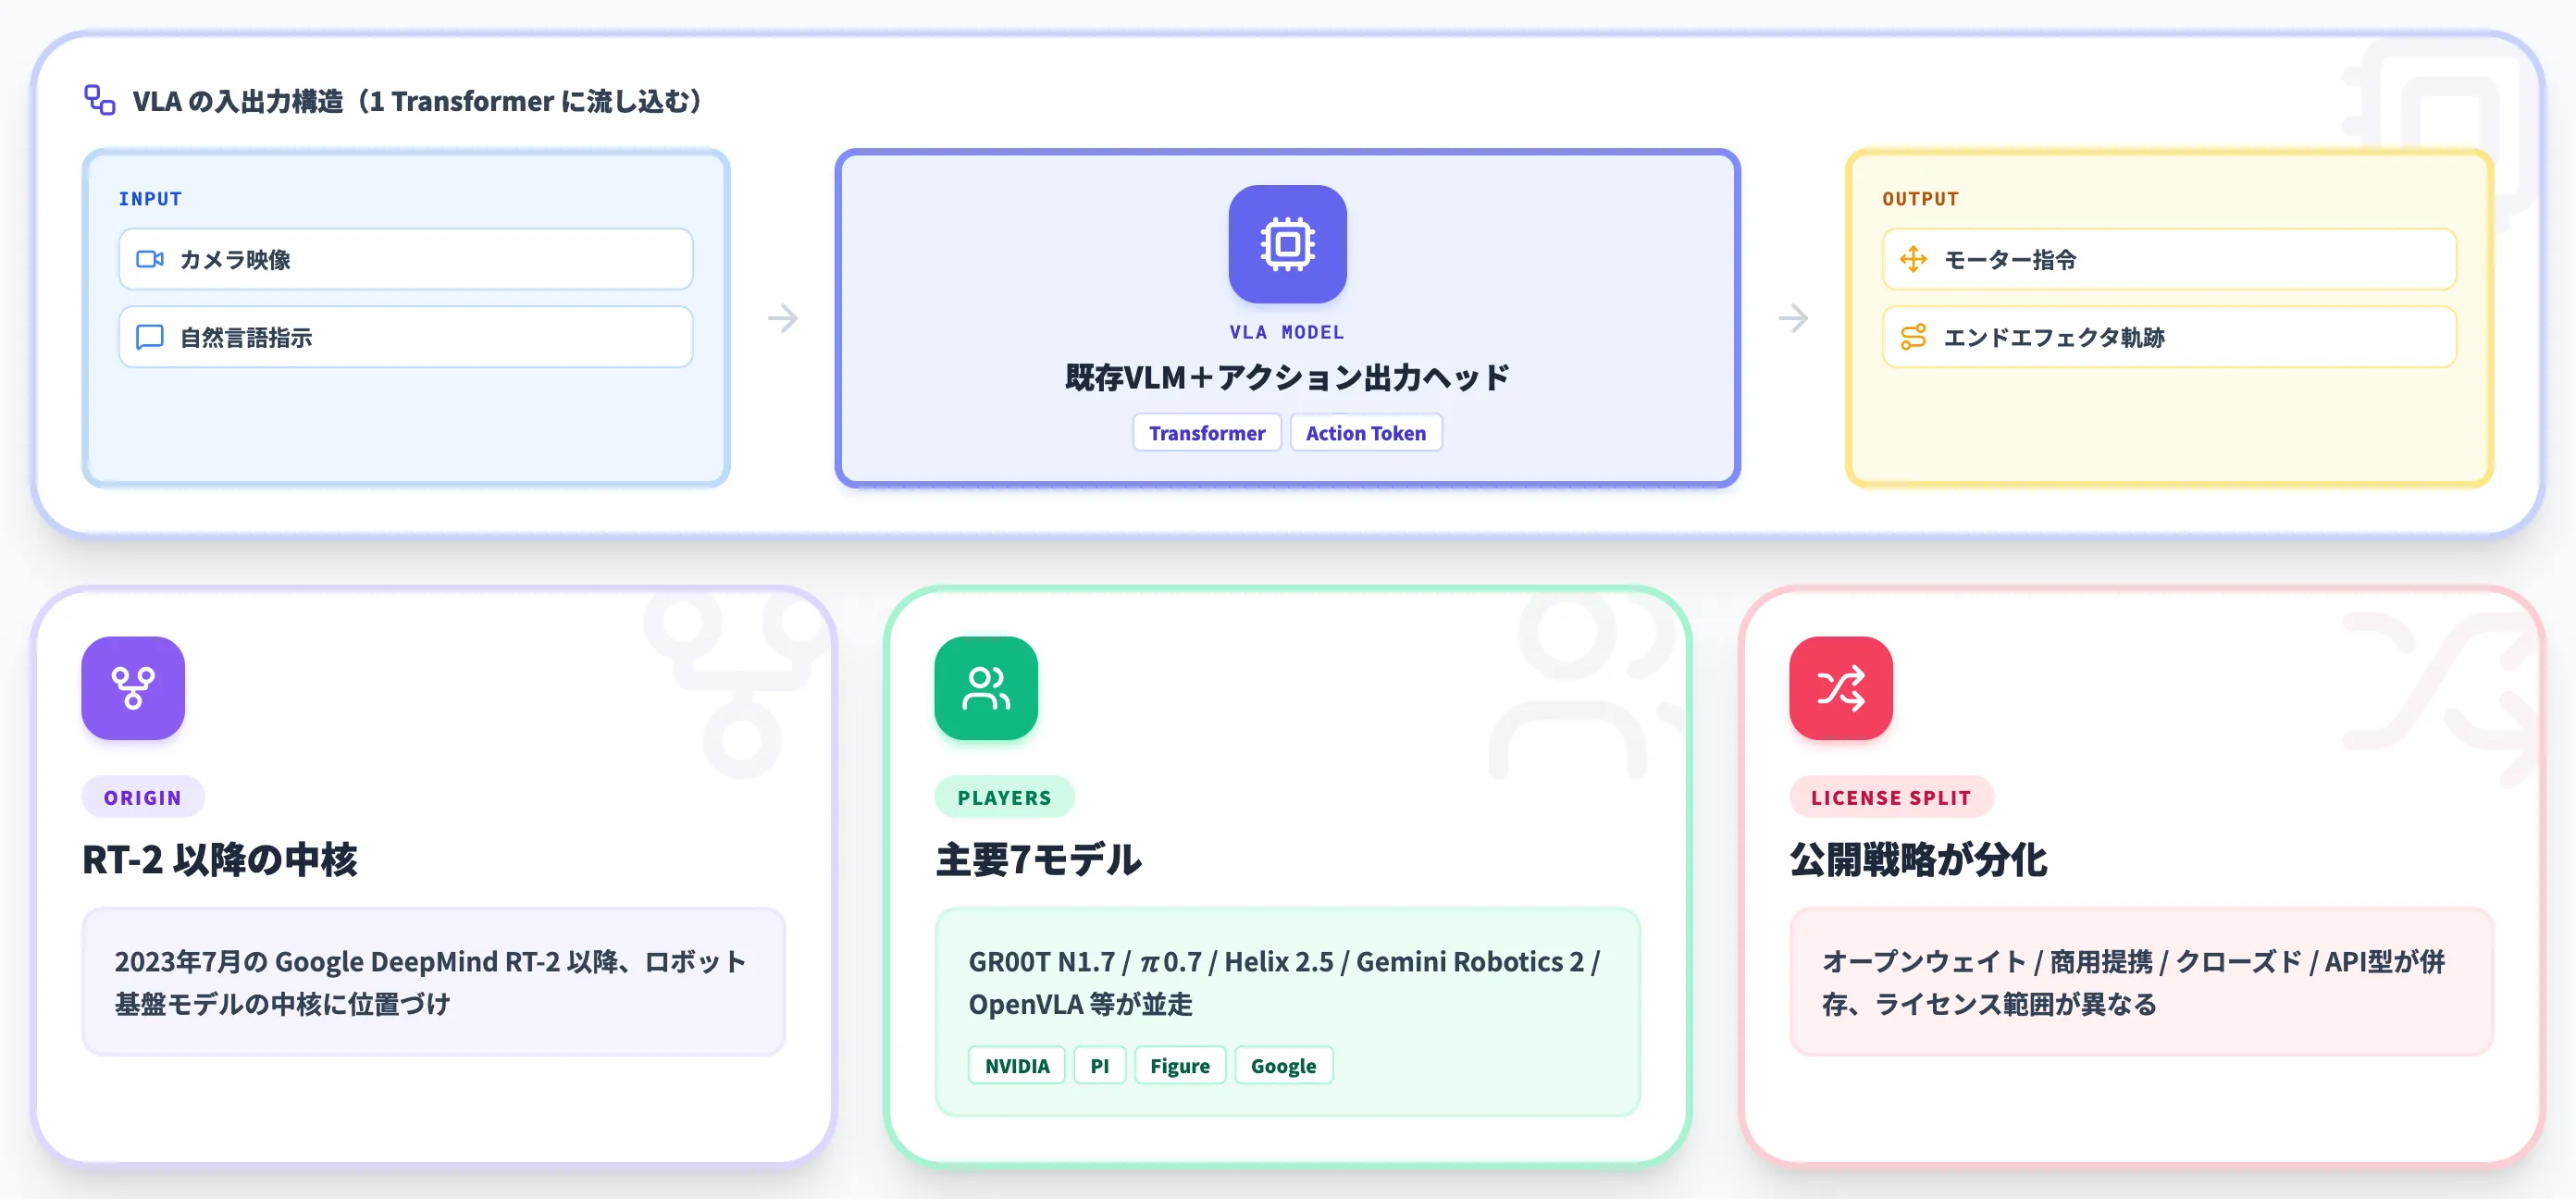
VLAモデル(Vision-Language-Action model)は、2023年7月のGoogle DeepMind RT-2以降、ロボット基盤モデルの中核に位置づけられているアーキテクチャです。
視覚入力と自然言語指示を1つのTransformerベースのネットワークに流し込み、出力をロボットのアクショントークン(モーター指令や軌跡)に変換します。
VLAの仕組みと代表モデル
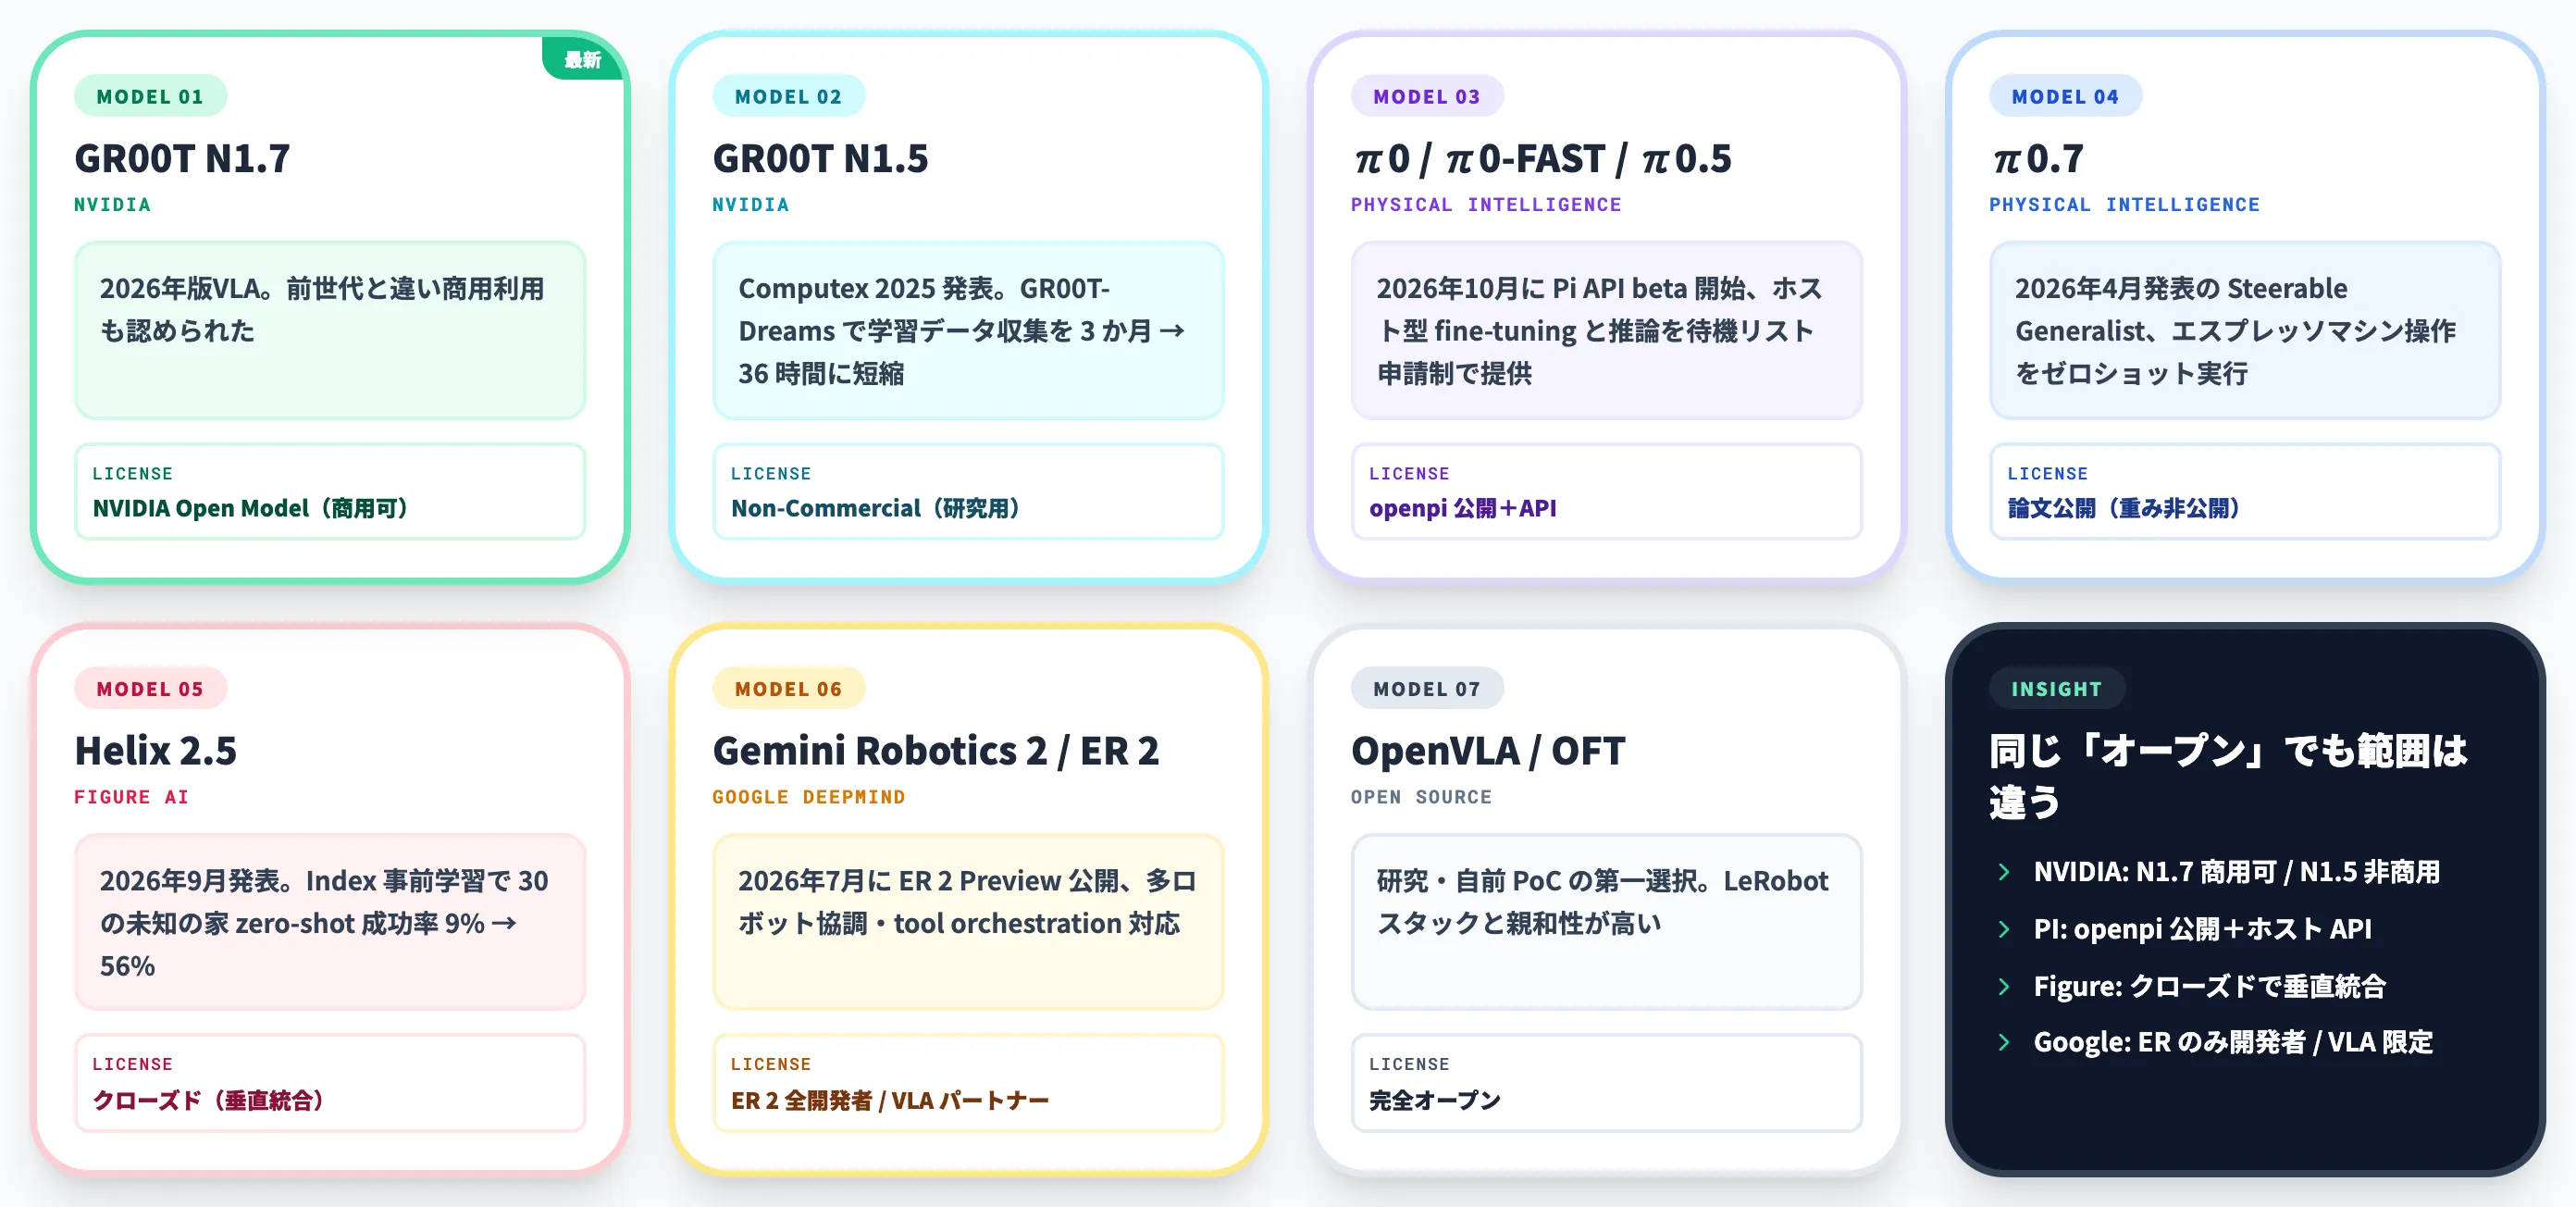
VLAの構造は、既存の視覚言語モデル(VLM)にアクション出力ヘッドを追加した設計が多数派です。2026年時点の主要VLAモデルは以下のとおりです。
| モデル | 開発元 | 公開形態 | 2026年の到達点 |
|---|---|---|---|
| GR00T N1.7 | NVIDIA | オープンウェイト・NVIDIA Open Model License(商用可) | 2026年版の最新VLA。商用利用も認められた点が前世代との大きな違い |
| GR00T N1.5 | NVIDIA | オープンウェイト・NVIDIA Non-Commercial License(研究・評価用途) | Computex 2025で発表。公式リリースによれば、GR00T-Dreamsにより3か月相当の学習データ収集を36時間の合成生成に短縮 |
| π0/π0-FAST/π0.5 | Physical Intelligence | 論文+openpiでチェックポイント公開(オープン) | 2026年10月にPi API betaが待機リスト申請制で開始、ホスト型fine-tuningと推論を提供 |
| π0.7 | Physical Intelligence | 論文公開(モデル重みはopenpi未収録) | 2026年4月にπ0.7 Steerable Generalist発表、エスプレッソマシン操作をゼロショット実行 |
| Helix 2.5 | Figure AI | クローズド | 2026年9月17日発表、Index事前学習で30の未知の家でzero-shot成功率9%→56%、タオル畳みやベッドメイキングなど全身操作が対象 |
| Gemini Robotics 2/ER 2 | Google DeepMind | API(Gemini Robotics-ER 2 Previewは全開発者向け、VLA本体はパートナー限定) | 2026年7月30日にER 2 Preview公開(多ロボット協調・進行分類・tool orchestration対応)。前世代の1.5は2026年4月に提供終了 |
| OpenVLA/OpenVLA-OFT | オープンソース | オープン | 研究・自前PoCの第一選択。LeRobotスタックと親和 |
この表の読み方として押さえておきたいのは、同じ「オープン」でもライセンス範囲が異なる点です。
NVIDIAはN1.7で商用利用も認めるライセンスまで広げた一方、N1.5は非商用向けのままで、Physical Intelligenceはopenpi経由のモデル配布に加えてPi API betaでホスト型fine-tuningまで提供し始めました。
Figure AIはHelixシリーズをクローズドで垂直統合、Google DeepMindはVLM部分(ER 2)だけ開発者公開しVLA本体は選定パートナー限定、という形で各社が公開戦略を使い分けています。
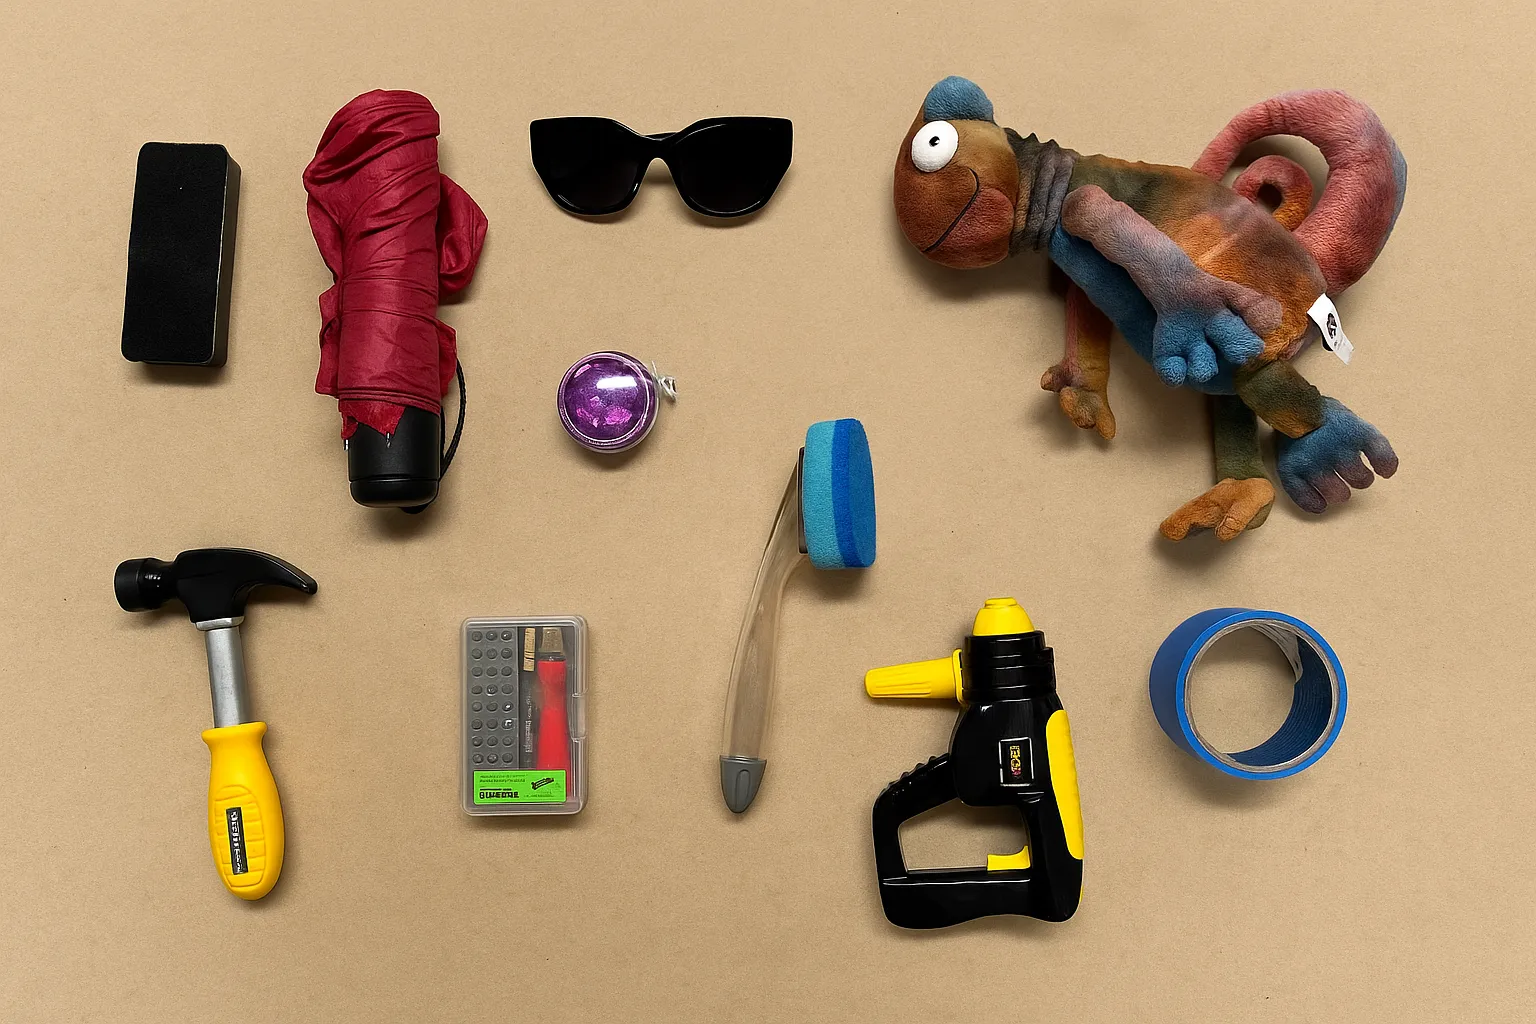
GR00T N1.5が未学習の物体にゼロショットで汎化できることを検証した実験で使われたオブジェクト群(出典:NVIDIA Research)
NVIDIAはGR00T N1.5の訓練時にこうした「見たことのない物体」への汎化を主要評価軸に据えており、ハードコード前提の制御モデルからロボット基盤モデルへパラダイム転換が進んでいる具体的な証拠として位置づけられます。
VLAの派生——VTLAと埋め込み身体推論
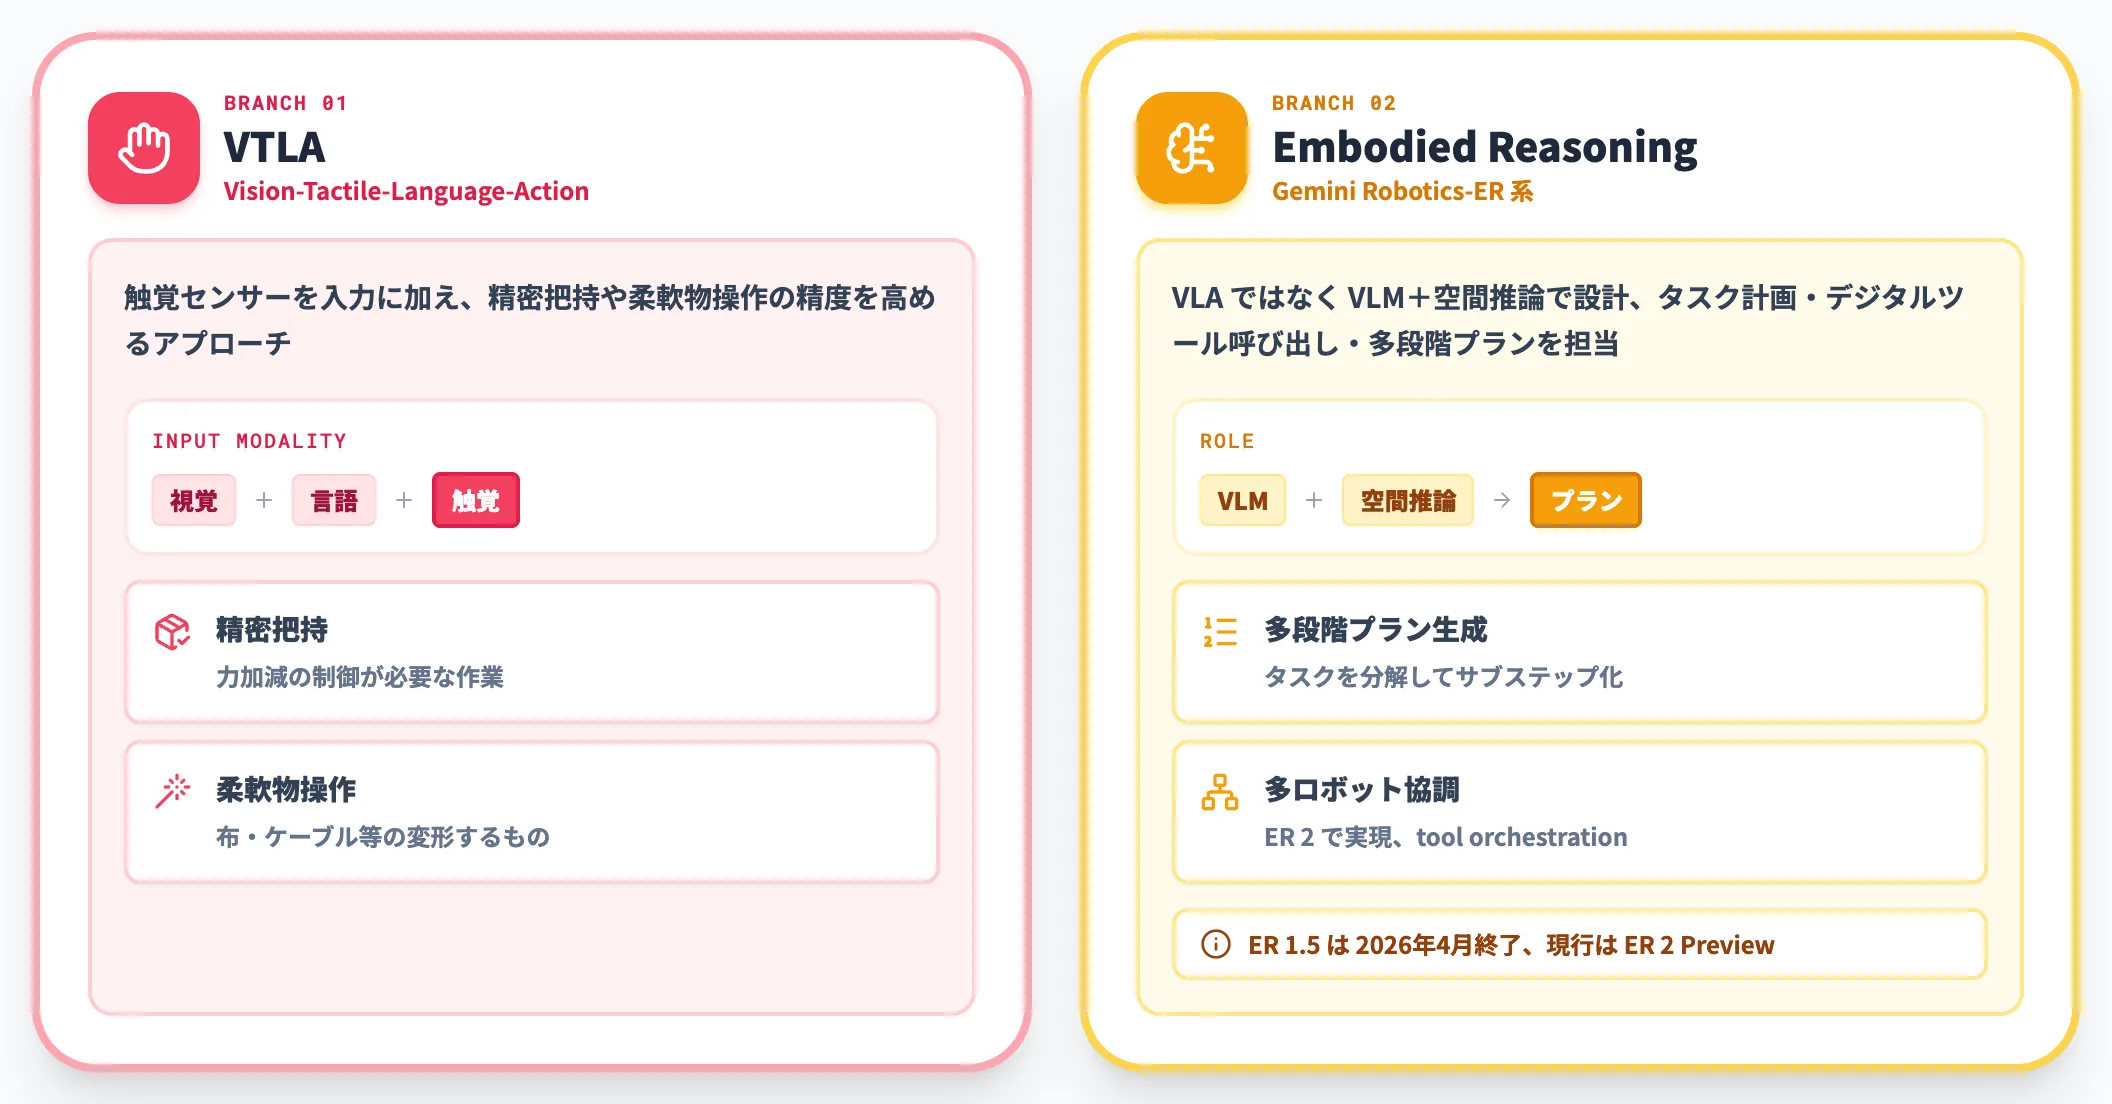
VLAの派生系も2026年に増えています。VTLAモデル(Vision-Tactile-Language-Action)は触覚センサーを入力に加え、精密把持や柔軟物操作の精度を高めるアプローチです。
Google DeepMindの Gemini Robotics-ERシリーズは、VLAではなくVLM+空間推論(Embodied Reasoning)として設計され、タスク計画・デジタルツール呼び出し・多段階プランを担います。初期のER 1.5は2026年4月に提供終了し、現行は2026年7月30日に公開されたGemini Robotics-ER 2 Previewで、多ロボット協調や進行分類まで扱えるようになりました。
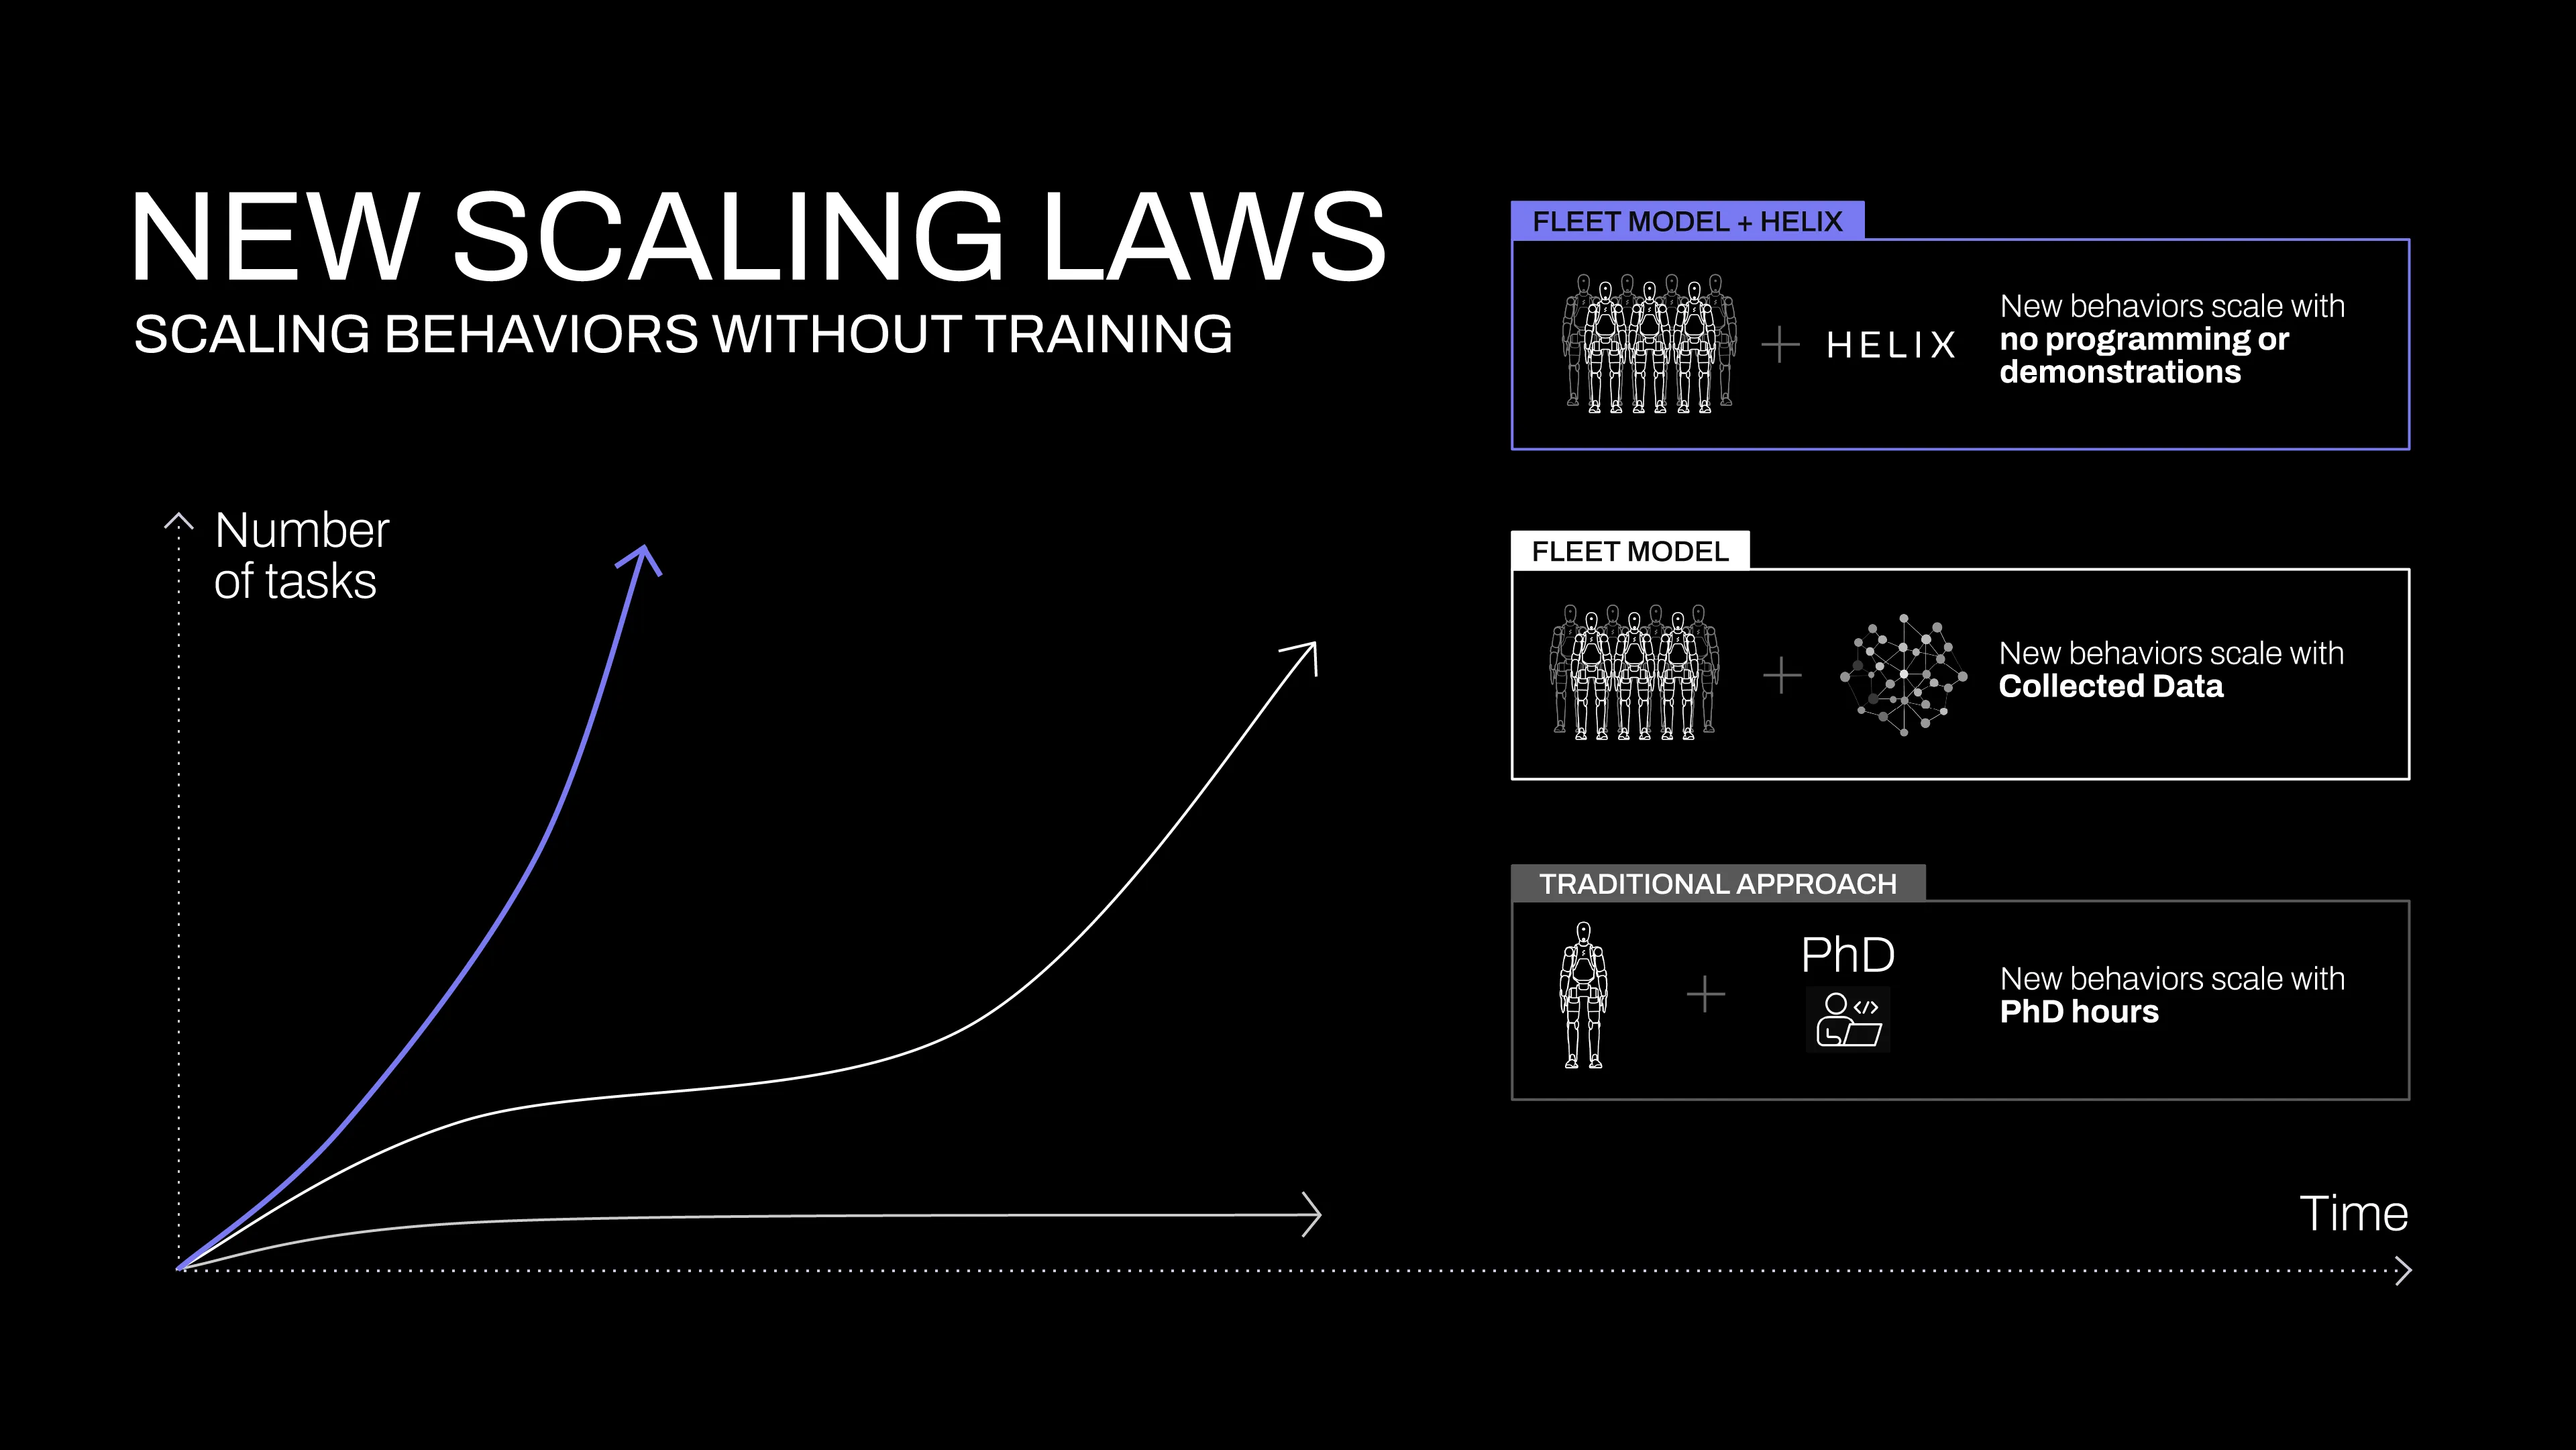
Figure Helix(初代)が示した「学習なしで新しい振る舞いが拡張する」スケーリング則(出典:Figure公式ブログ)
初代Helixが打ち出したのは、追加の学習なしに新しいタスクへ振る舞いが広がる"Fleet Model + Helix"型のスケーリング則で、従来の「PhDが時間をかけて個別訓練する」アプローチとの違いを強く主張しています。
2026年9月17日発表のHelix 2.5は、この路線をIndex事前学習で強化し、30の未知の家でのzero-shot成功率を9%→56%に引き上げました。VLA系モデルが単なる汎化性能競争を越え、「どう振る舞いを拡張するか」の設計思想競争に入っていることが読み取れます。
世界モデル:環境ダイナミクスを学習・予測する層
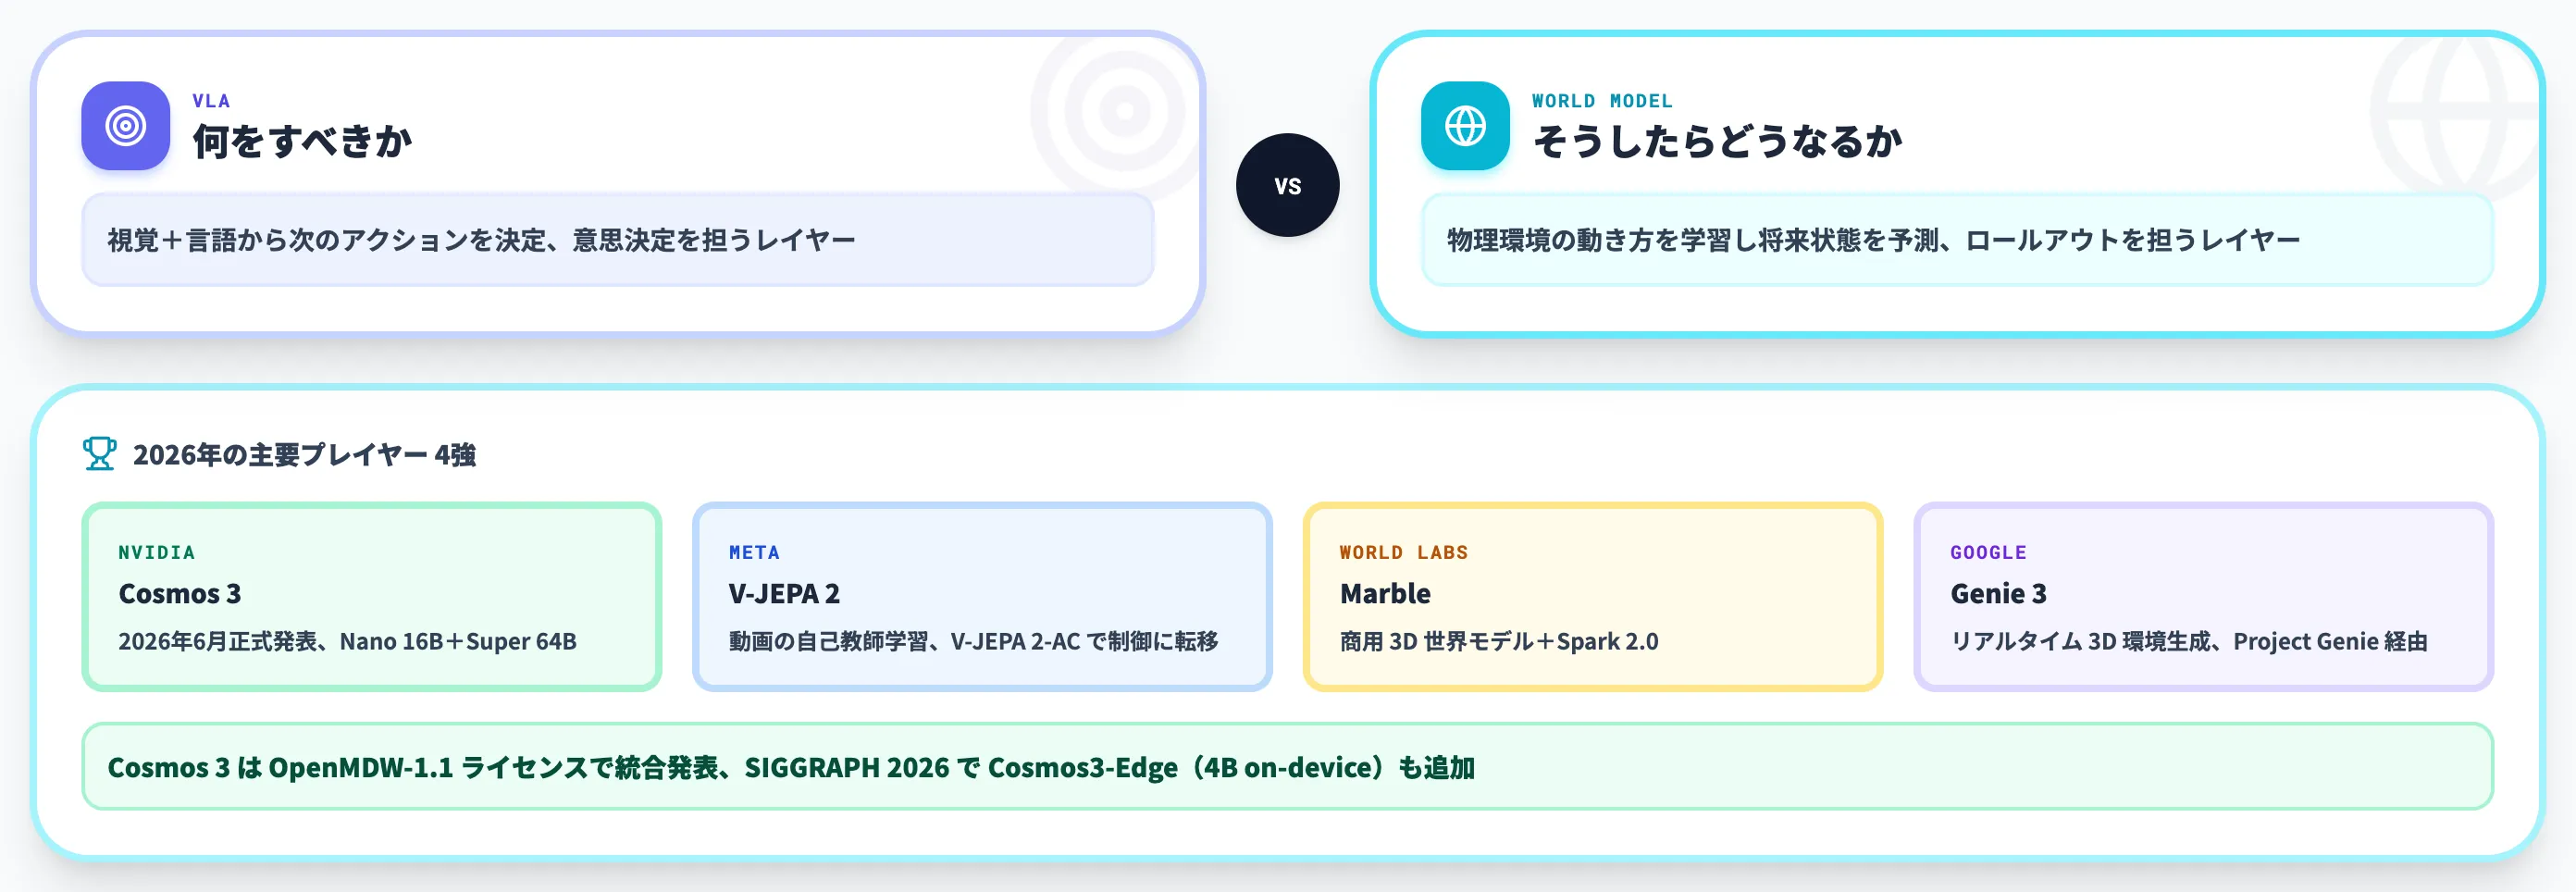
世界モデル(world model)は、ロボットが物理環境の「動き方」を学習し、将来状態を予測するためのモデルです。VLAが"何をすべきか"を決めるのに対し、世界モデルは"そうしたらどうなるか"を予測します。
世界モデルがロボットで担う3つの機能
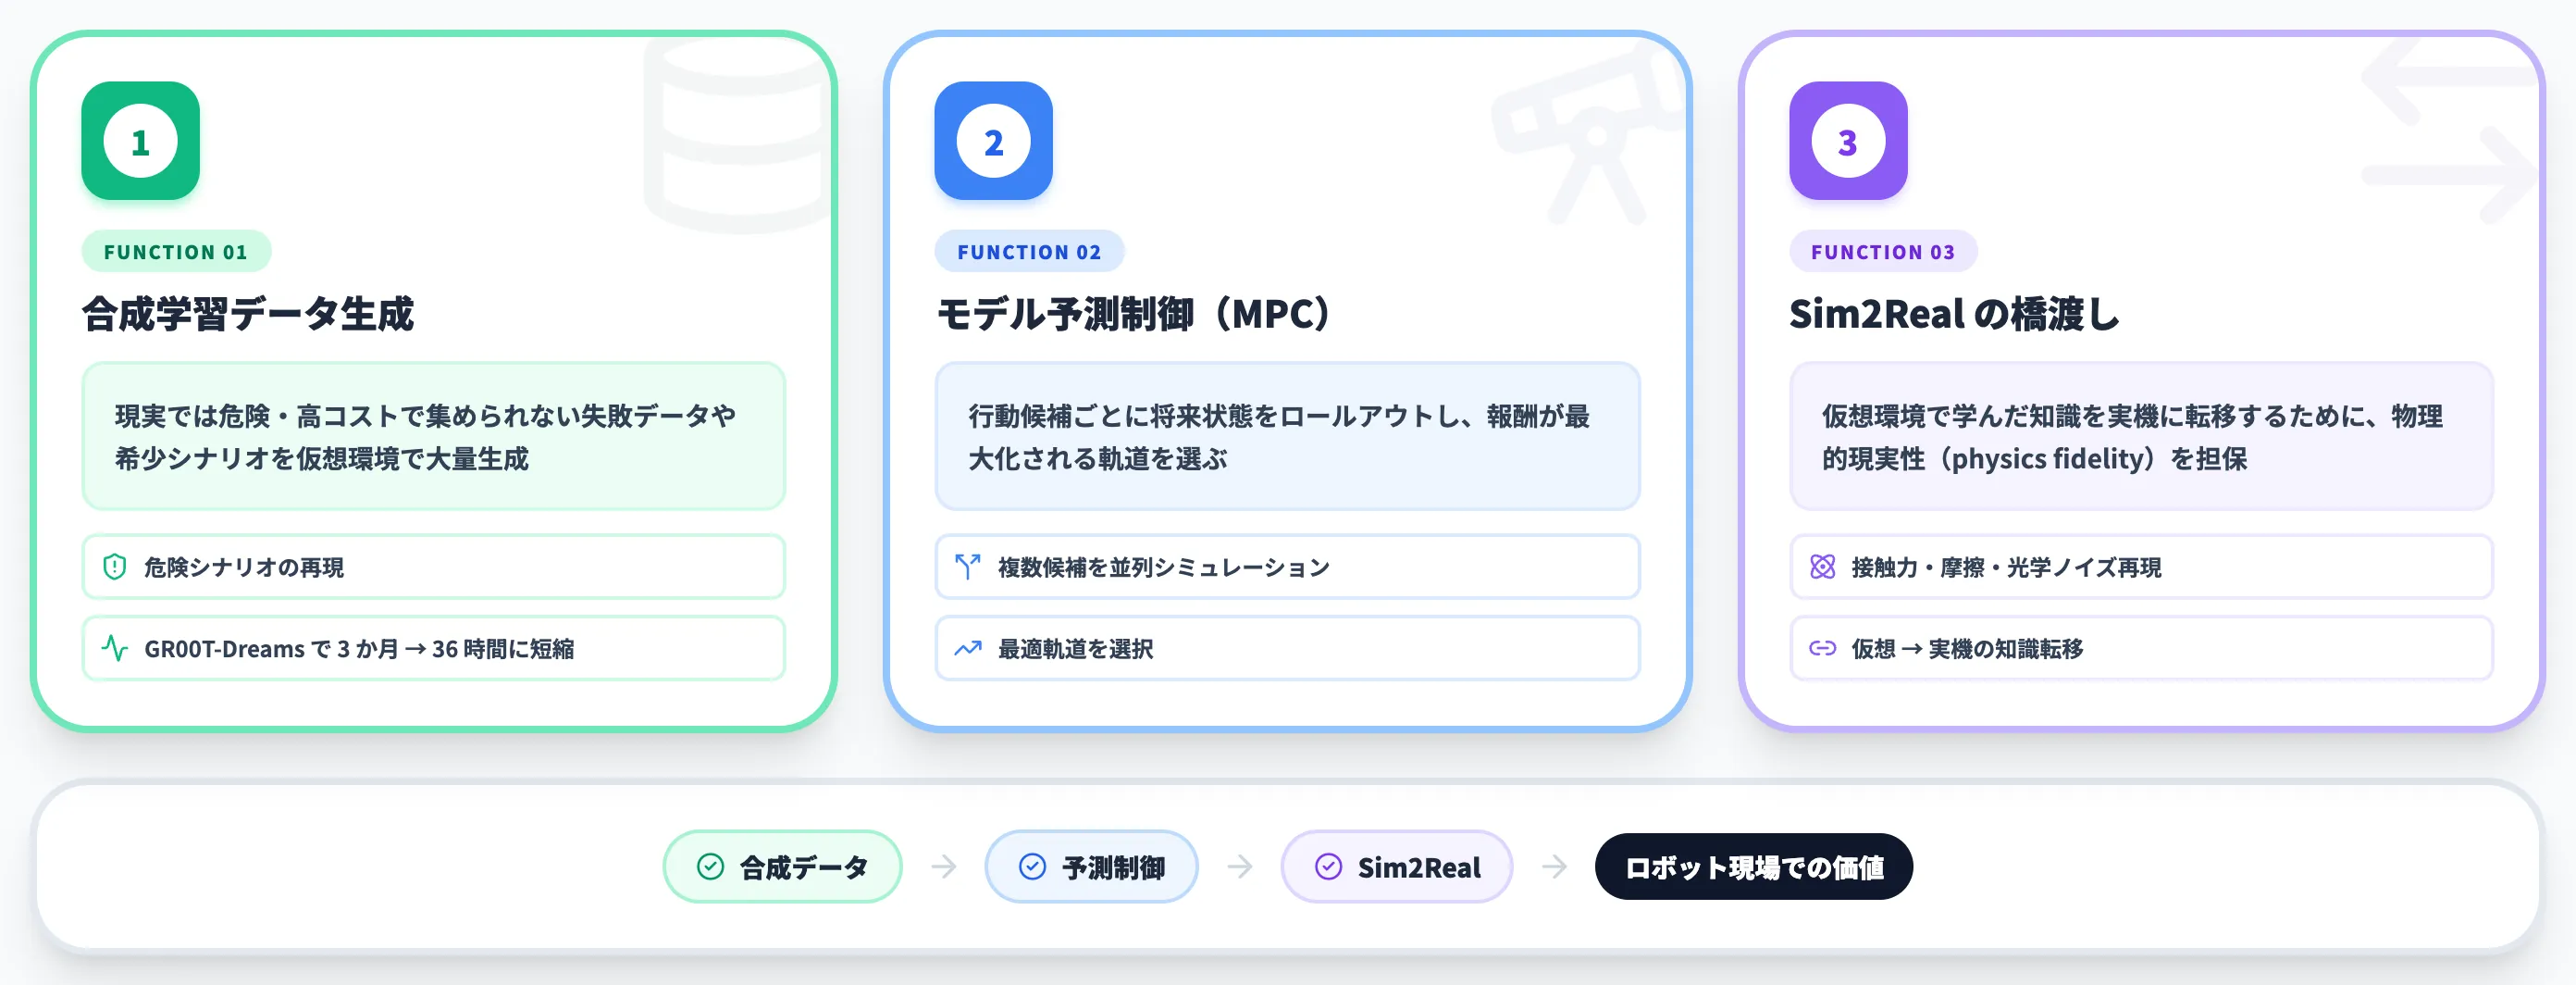
ロボット文脈で世界モデルが提供する価値は、大きく3つです。
-
合成学習データの生成
現実では危険・高コストで集められない失敗データや希少なシナリオを、仮想環境で大量生成する
-
モデル予測制御(MPC)
行動候補ごとに将来状態をロールアウトし、報酬が最大化される軌道を選ぶ
-
Sim2Real の橋渡し
仮想環境で学んだ知識を実機に転移するために、物理的な現実性(physics fidelity)を担保する
2026年の主要プレイヤーはNVIDIA Cosmos・Meta V-JEPA 2・World Labs Marble・Google Genie 3の4強です。NVIDIAは2026年6月1日にGTC TaipeiでCosmos 3を正式発表し、物理推論・世界シミュレーション・アクション生成を1つのオープンウェイトモデル群(OpenMDW-1.1ライセンス)に統合しました(Nano 16B+Super 64Bの2構成)。
さらに2026年7月20日のSIGGRAPH 2026でCosmos3-Edge(4B・on-device)が追加され、組み込み機器での現場推論まで射程に入れています。
2026年の世界モデル代表プレイヤー
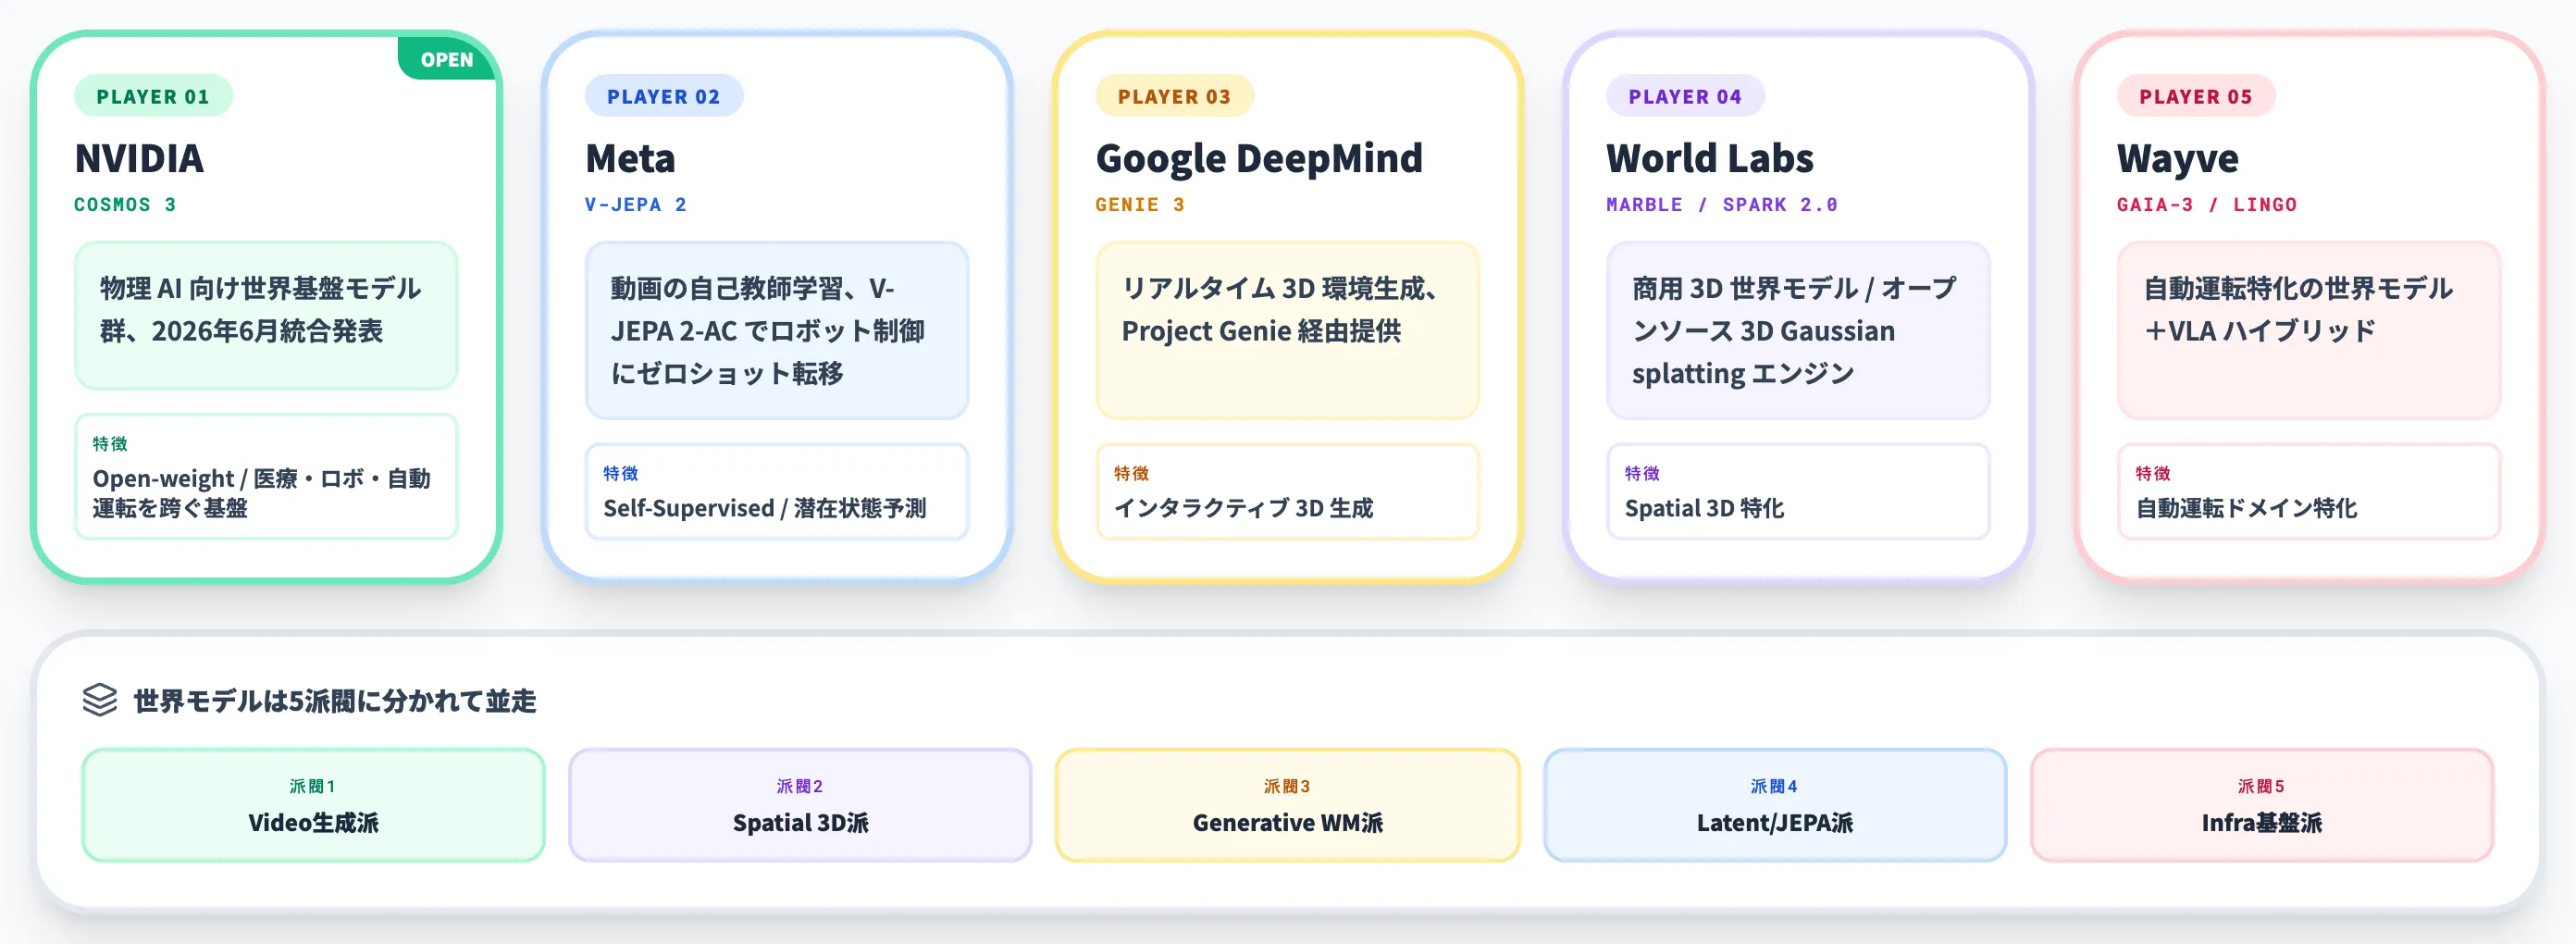
| プレイヤー | モデル/提供形態 | 特徴 |
|---|---|---|
| NVIDIA | Cosmos 3(Open-weight) | 物理AI向け世界基盤モデル群、2026年6月統合発表 |
| Meta | V-JEPA 2(self-supervised) | 動画の自己教師学習、V-JEPA 2-ACでロボット制御にゼロショット転移 |
| Google DeepMind | Genie 3 | リアルタイム3D環境生成、Project Genie経由提供 |
| World Labs | Marble・Spark 2.0 | 商用3D世界モデル/オープンソース3D Gaussian splattingエンジン |
| Wayve | GAIA-3・LINGO | 自動運転特化の世界モデル+VLAハイブリッド |
NVIDIAが2026年に拡張したAgentic・Physical・Healthcare向けオープンモデル群(Cosmos 3を含む)のキービジュアル(出典:NVIDIA Newsroom)
Cosmos 3は医療・ロボティクス・自動運転など物理AI全領域を跨ぐ基盤として位置づけられており、世界モデルが特定ドメインの道具から汎用インフラへ格上げされつつある流れを象徴しています。
制御モデル:Diffusion Policy・ACTが担う動作生成層
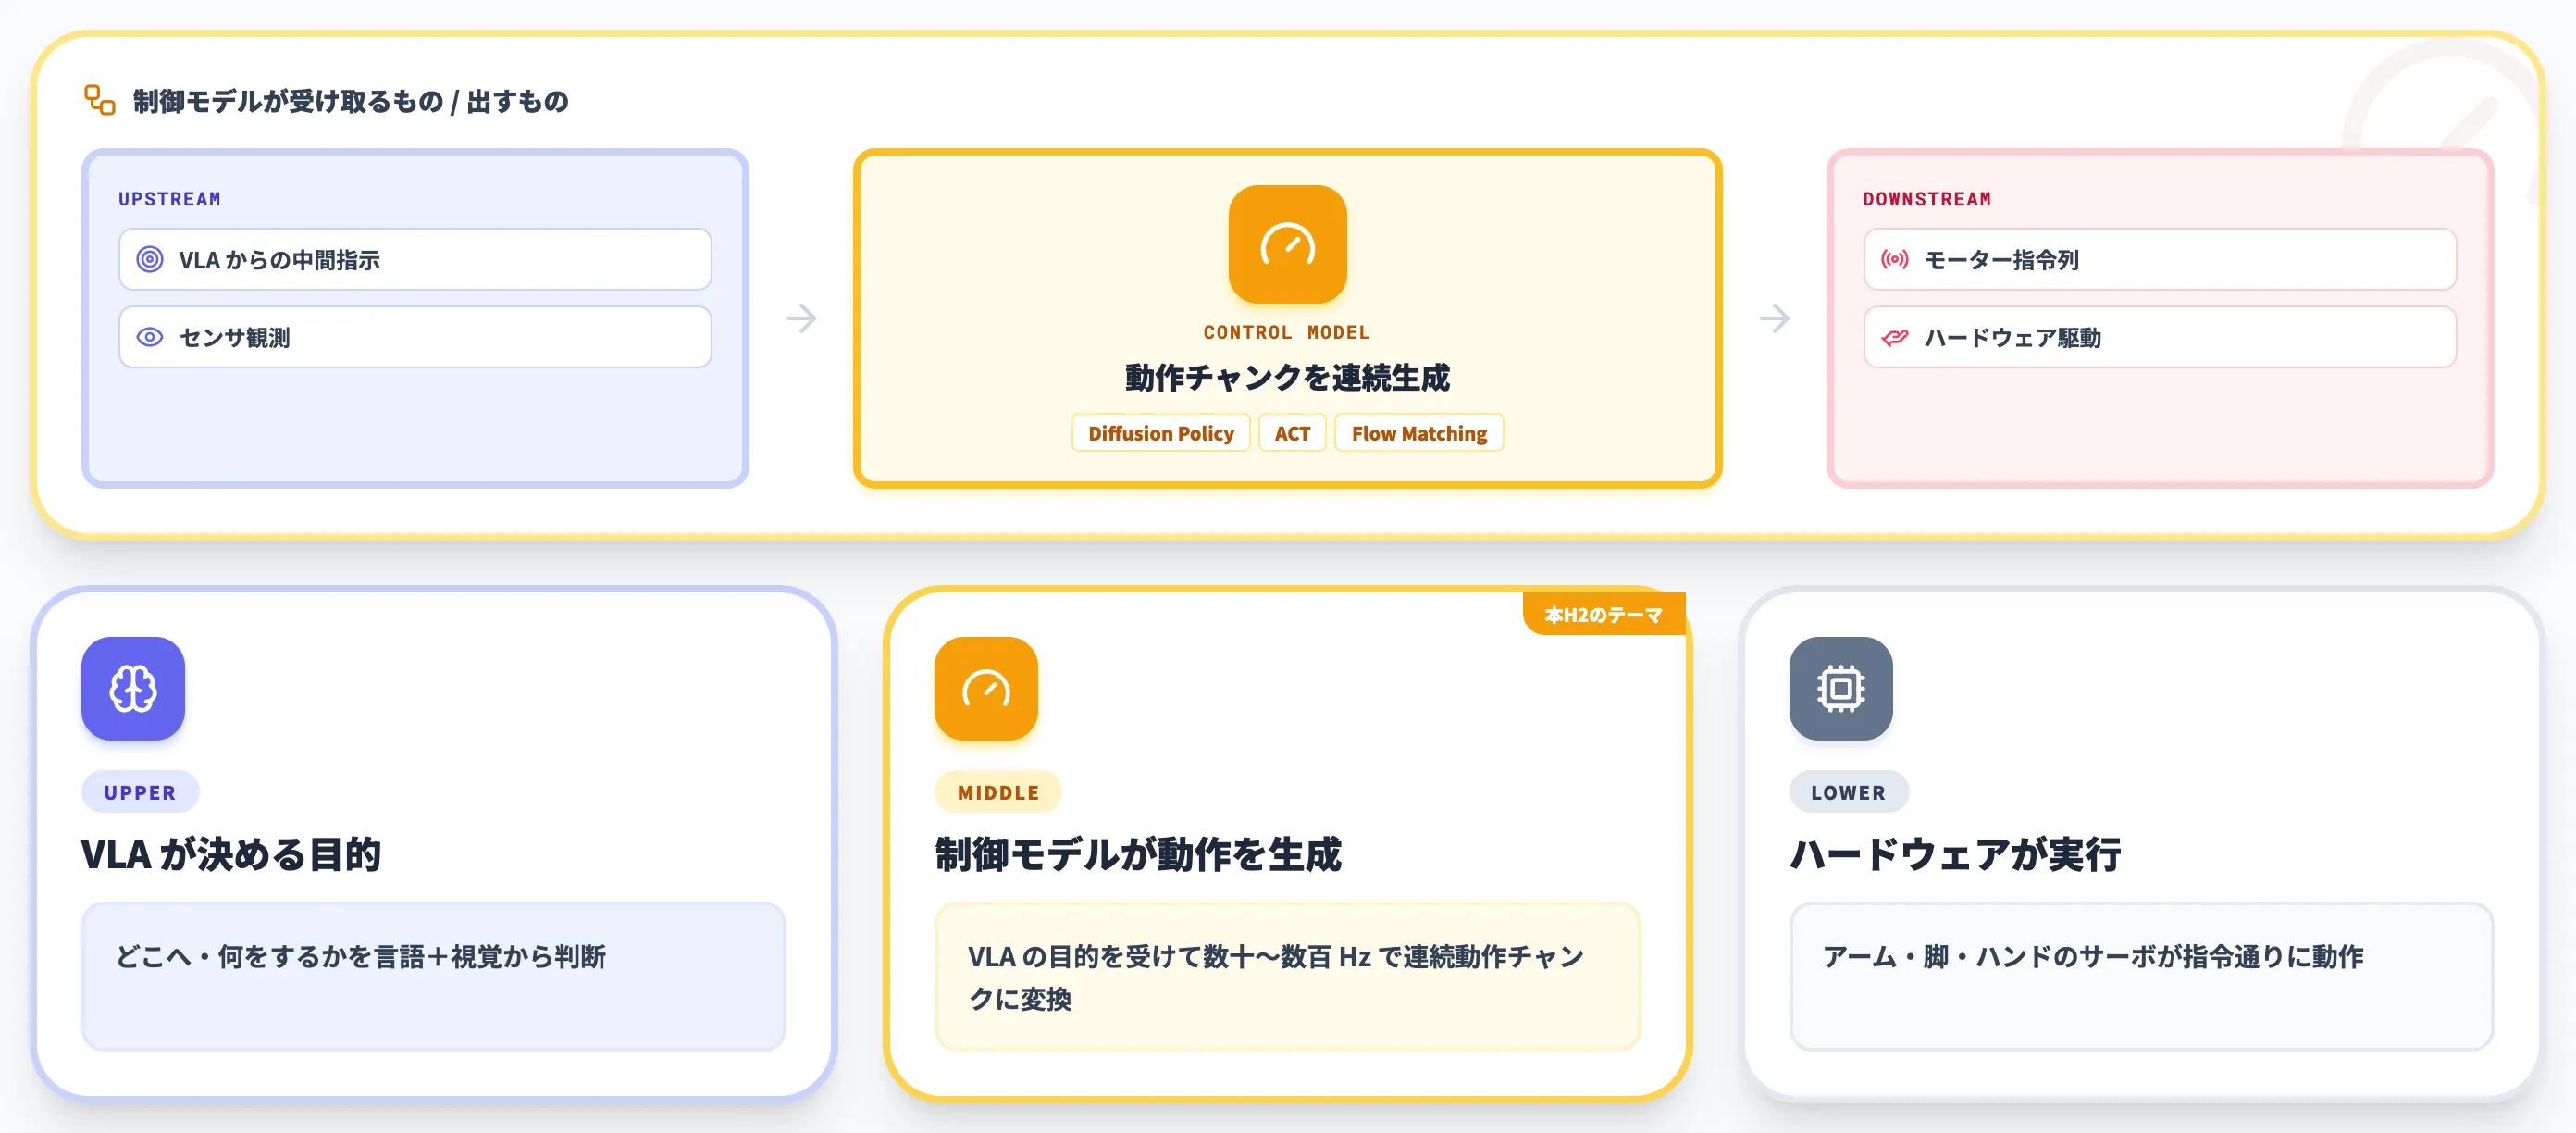
制御モデル(control model)は、ロボット基盤モデルの最下層にあたる動作生成の実装です。VLAが決めた目的や中間指示を受けて、実際のモーター指令列を連続的に吐き出します。
Diffusion PolicyとACTが標準パラダイム
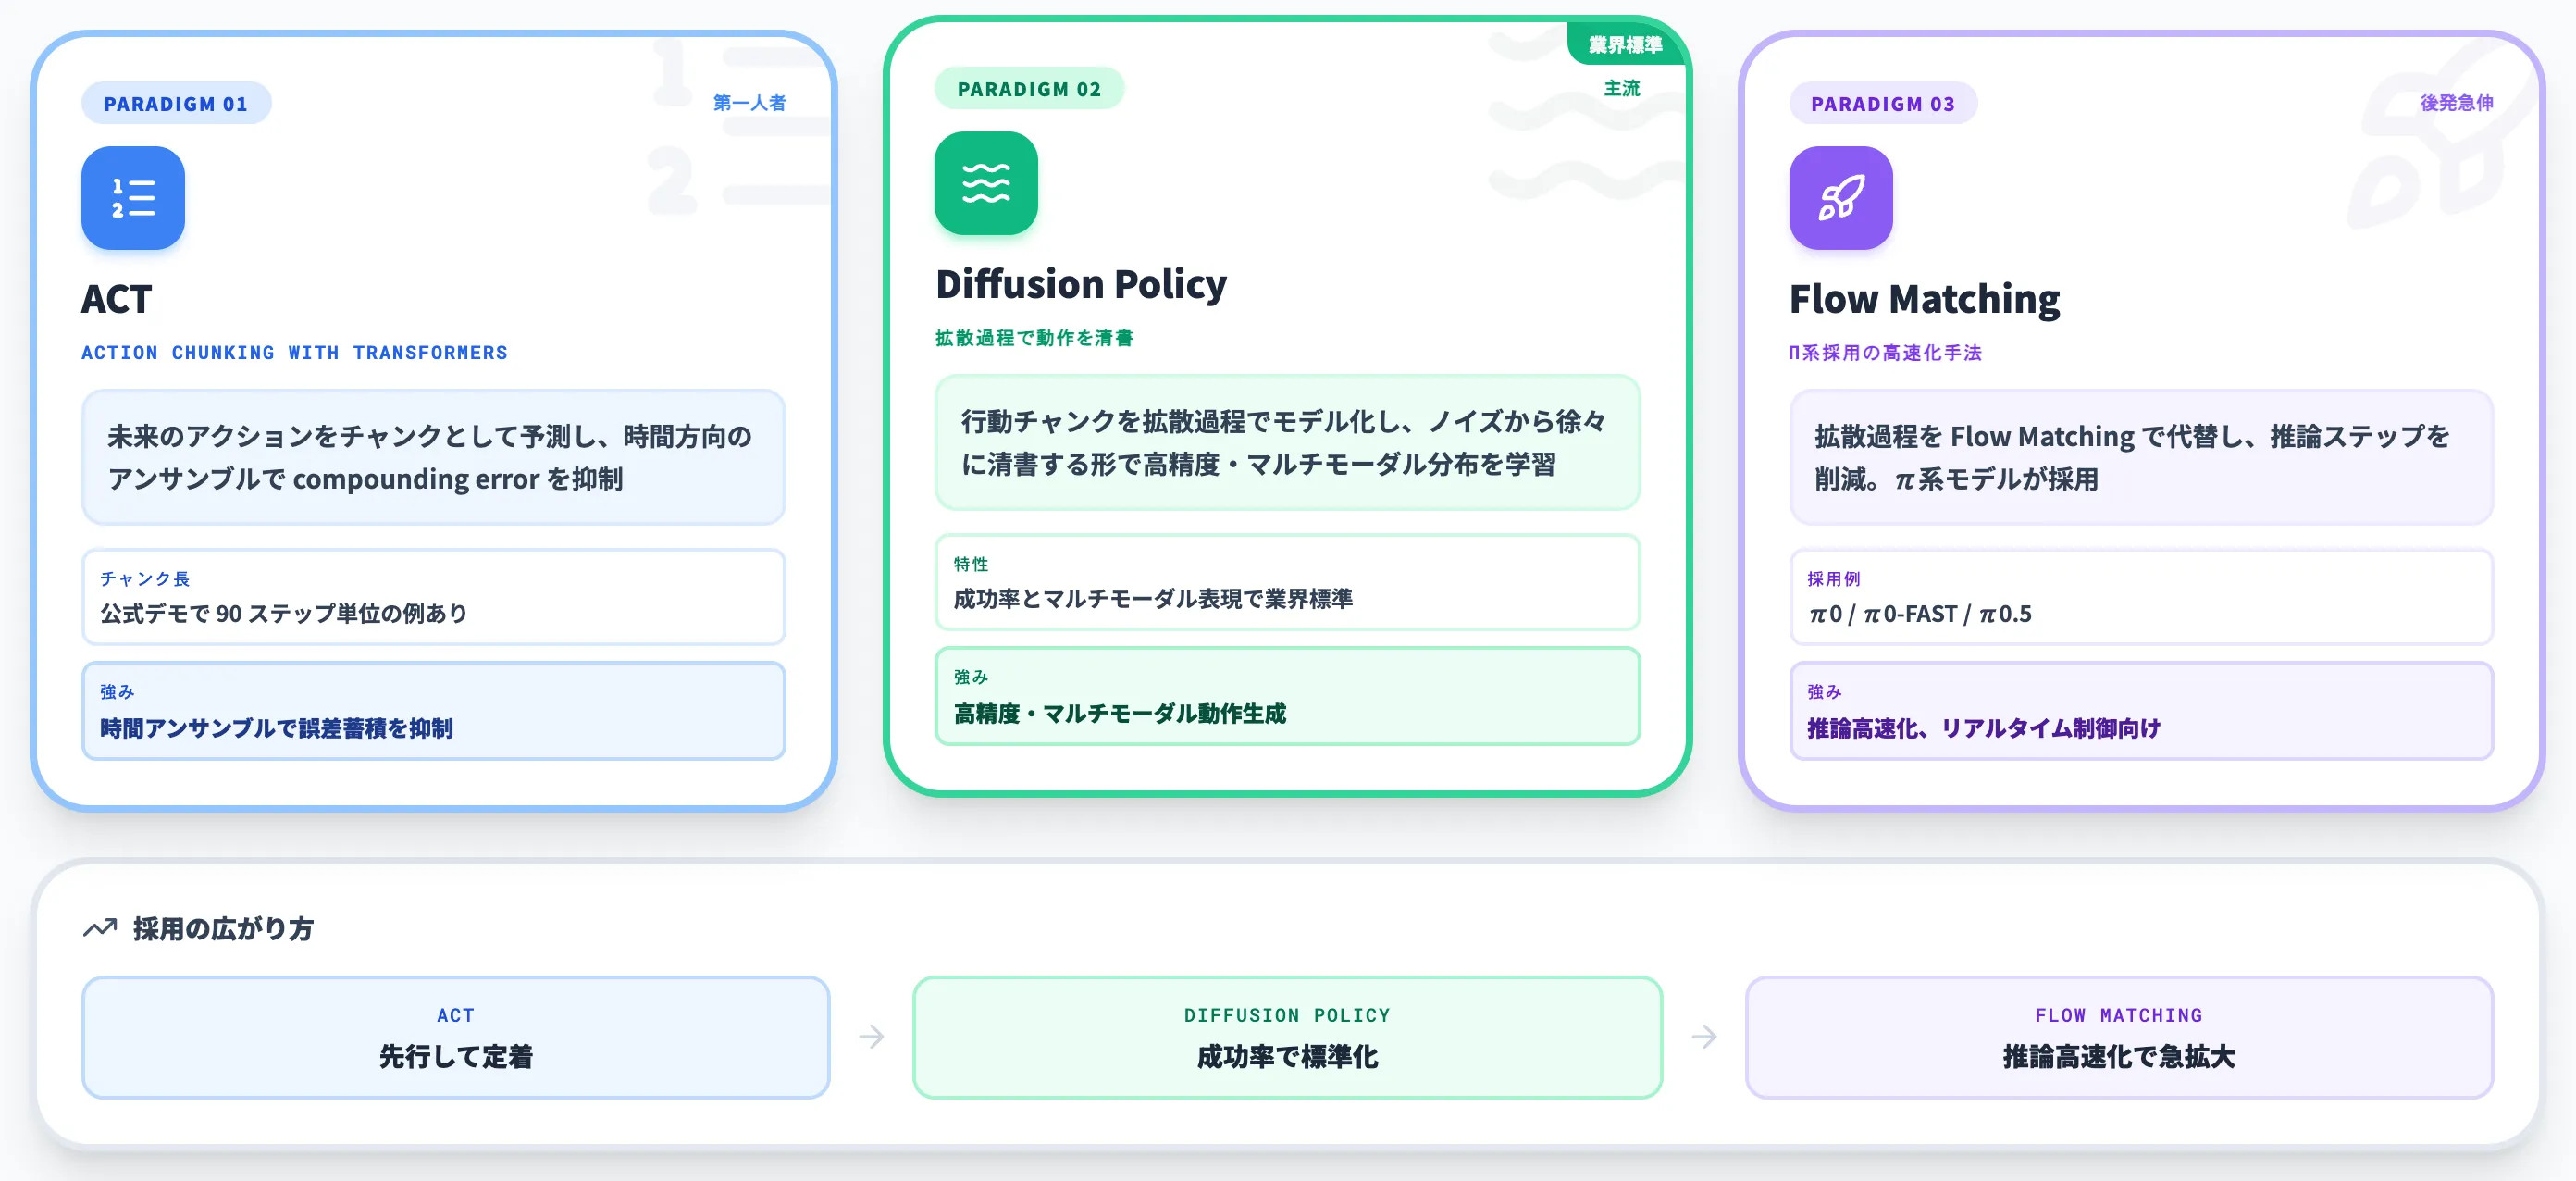
制御モデルの中心にあるのが、Diffusion PolicyとACT(Action Chunking with Transformers)です。
-
ACT(Action Chunking with Transformers)
未来のアクションをチャンクとして予測し、時間方向のアンサンブルで実行することでcompounding errorを抑制する。チャンク長は設定値で、公式プロジェクトのデモには90ステップ単位の例もある
-
Diffusion Policy
行動チャンクを拡散過程でモデル化し、ノイズから徐々に清書する形で高精度・マルチモーダルなアクション分布を学習
-
Flow Matching Policy
拡散過程を Flow Matching で代替し、推論ステップを削減。π系モデルが採用
ACTは第一人者的な存在、Diffusion Policyは成功率とマルチモーダル表現で業界標準に、Flow Matchingは推論高速化の観点で後発ながら急速に広がっています。
模倣学習との関係
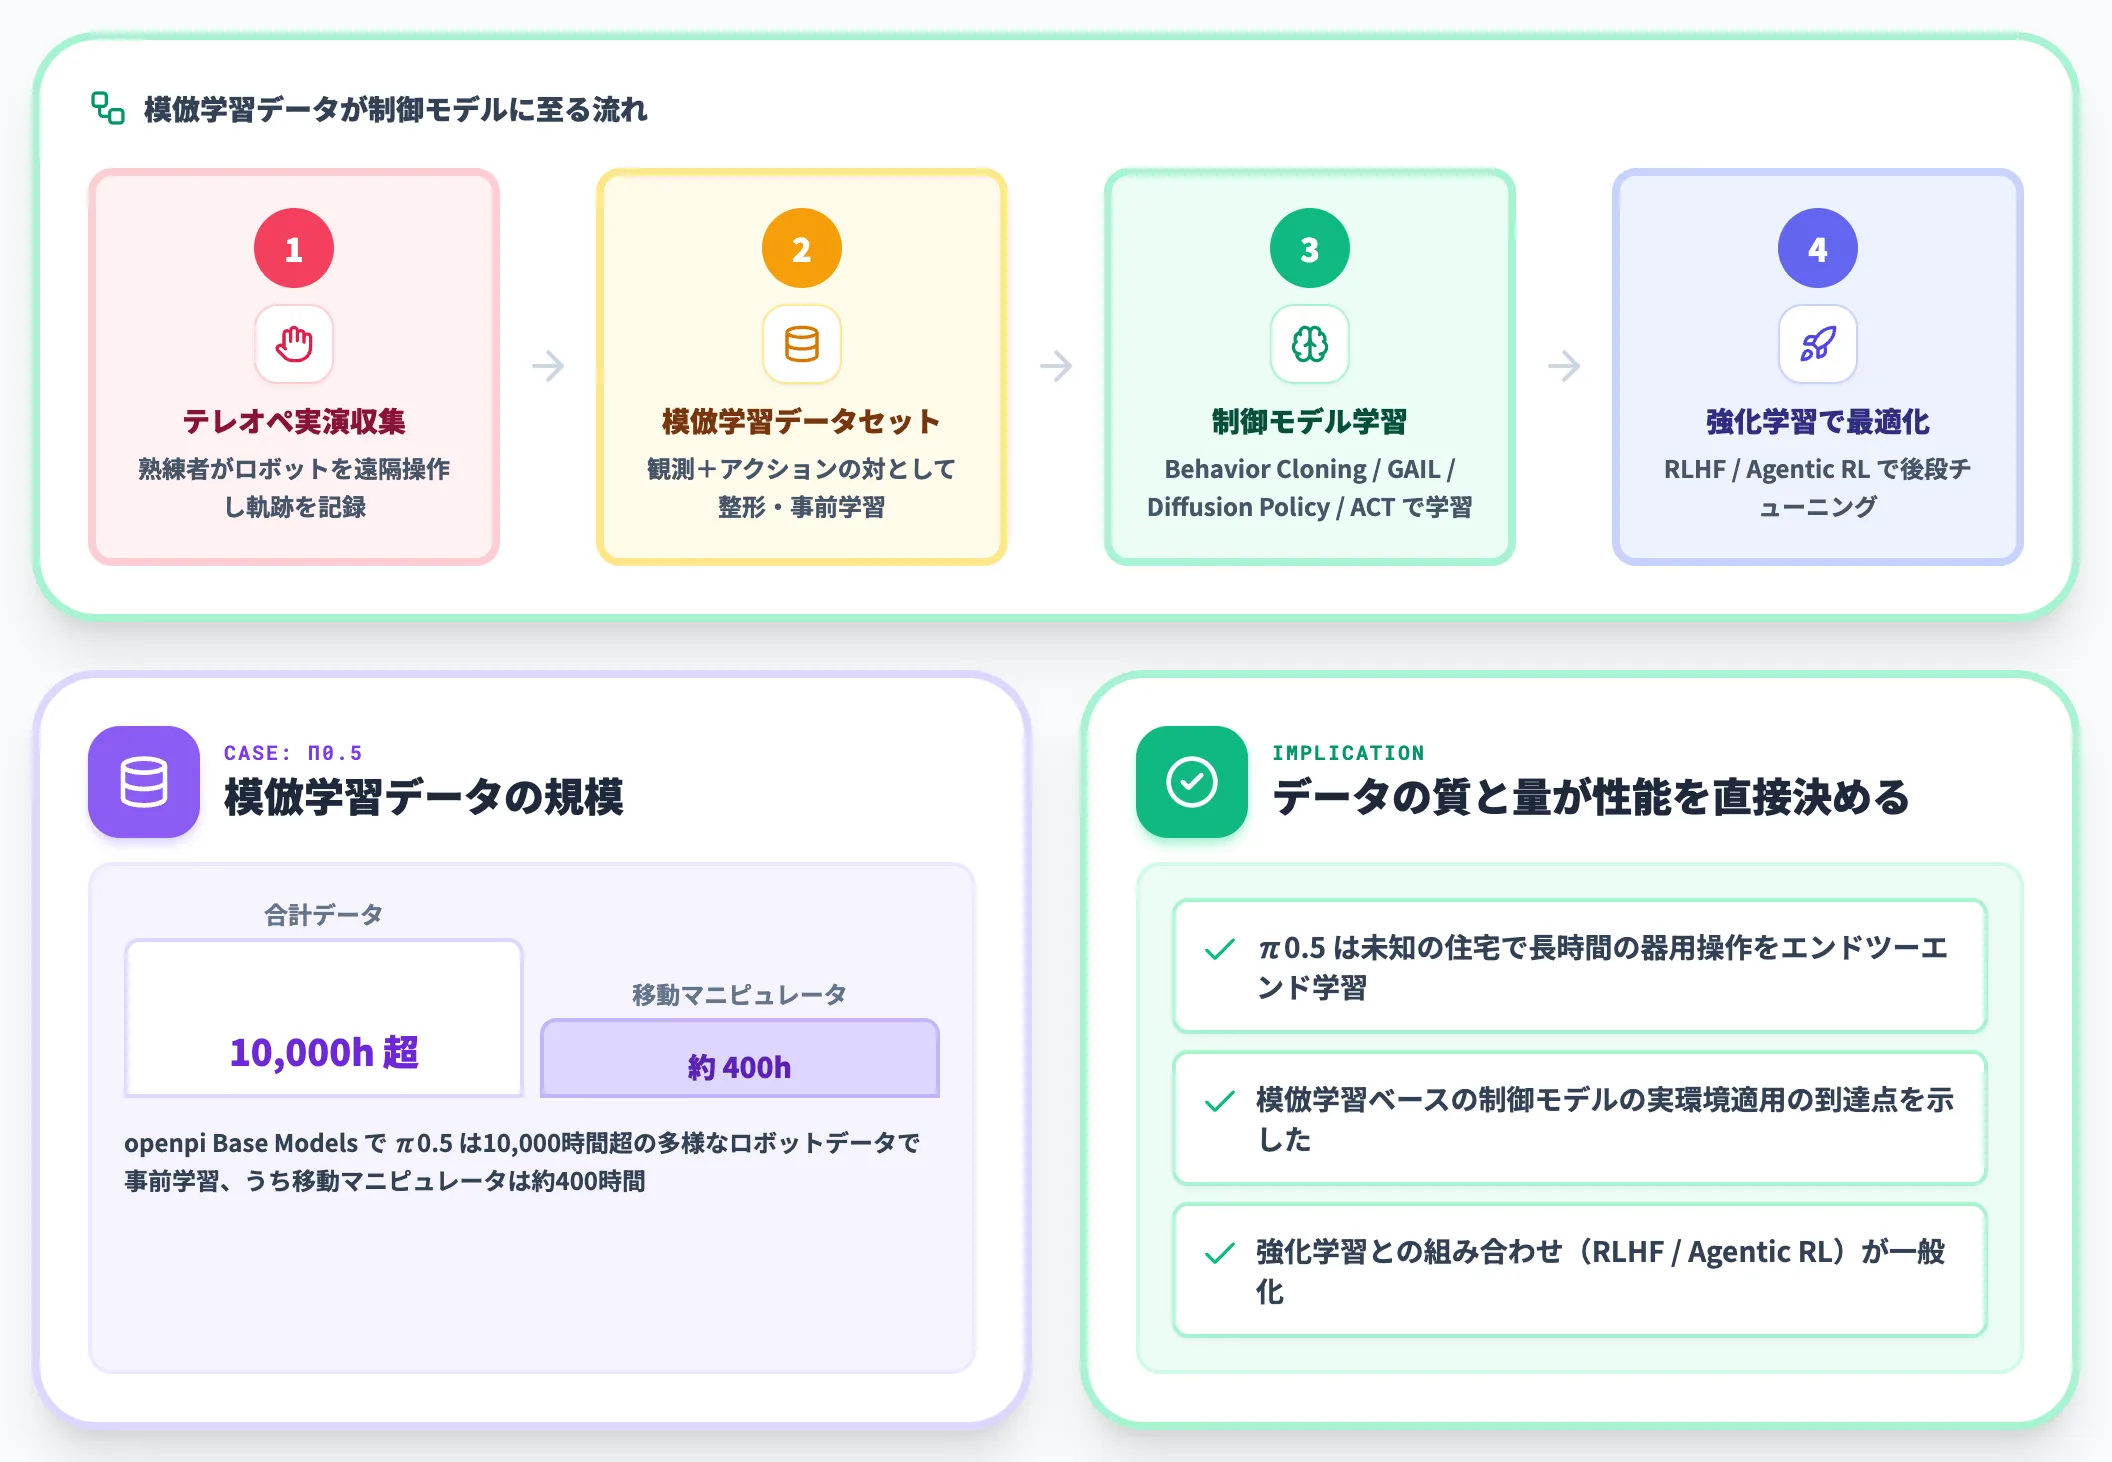
制御モデルの学習に不可欠なのが、人がロボットを操作した軌跡を正解として学ばせる手法群です。模倣学習はBehavior Cloning・逆強化学習・GAILなどを含み、Diffusion PolicyやACTの学習則としても使われます。
Physical Intelligenceはopenpi Base Modelsで、π0.5が10,000時間超の多様なロボットデータで事前学習された構成を公開しており、模倣学習データの質と量が制御モデルの性能を直接左右することが示されています(π0.5論文 p.6のPre-trainingセクションではこのうち移動マニピュレータの約400時間を含む内訳が説明されています)。
π0.5はOpen-World Generalizationを掲げるVLAで、Physical Intelligenceの代表モデルの一つ(出典:Physical Intelligence)
π0.5の論文は、未知の住宅で長時間かつ器用な操作をエンドツーエンドで学習したシステムとしての新規性を主張しており、模倣学習ベースの制御モデルがどこまで現実の非構造化環境に適用できるかを示した1つの到達点になっています。
強化学習との組み合わせ(RLHFや Agentic RL)で後段の最適化を加える構成も一般化してきました。
World Action Model(WAM)——VLAと世界モデルを融合する2026年の新潮流
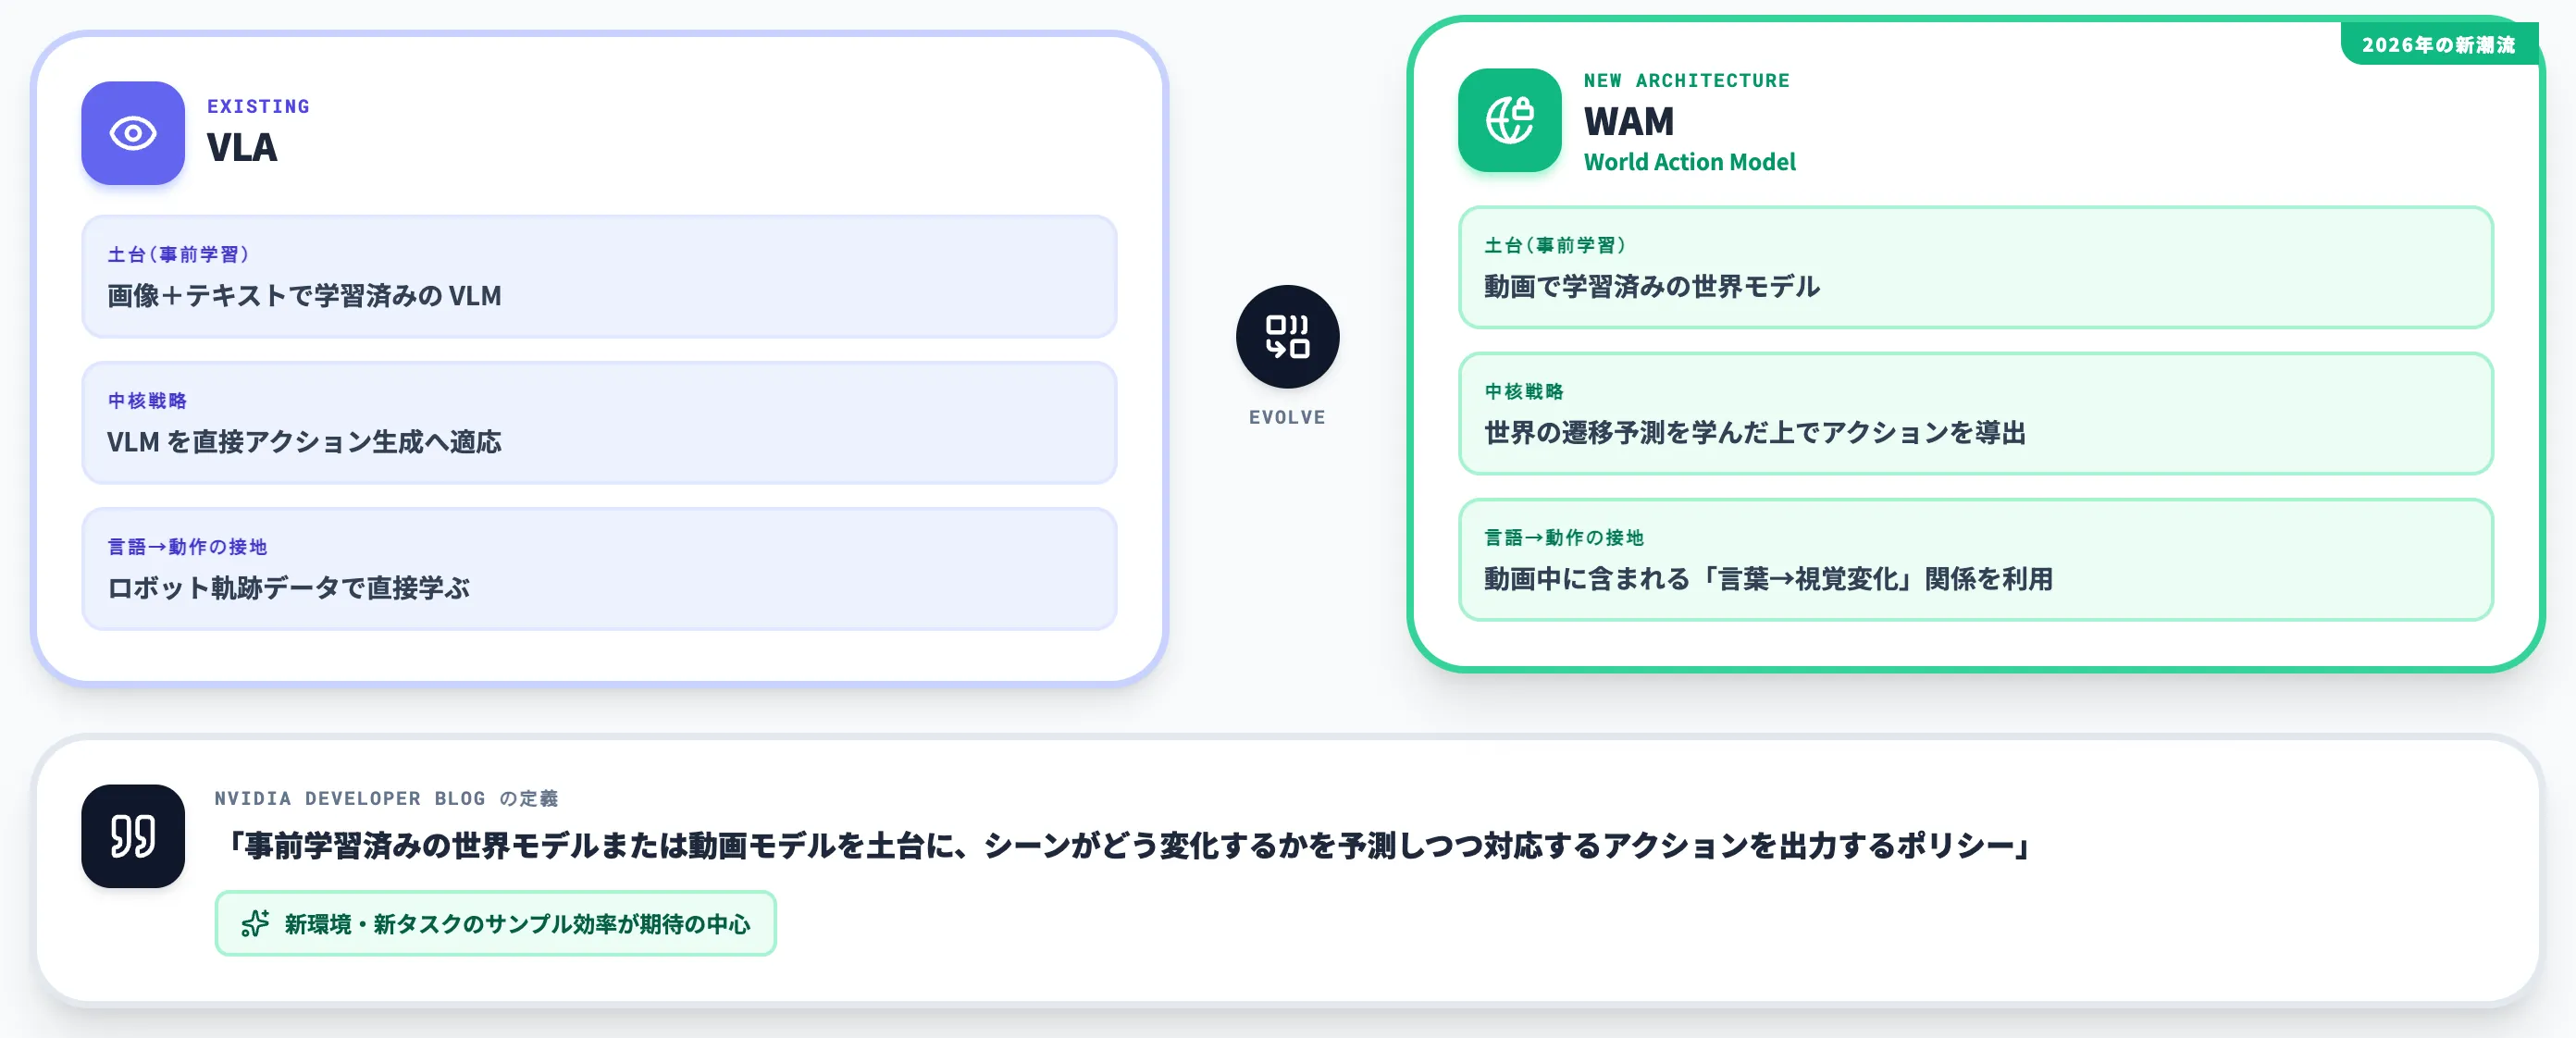
VLAと世界モデルを並列に置くのではなく、1つのモデルに融合するWorld Action Model(WAM)が2026年の新しいアーキテクチャ軸として台頭しています。
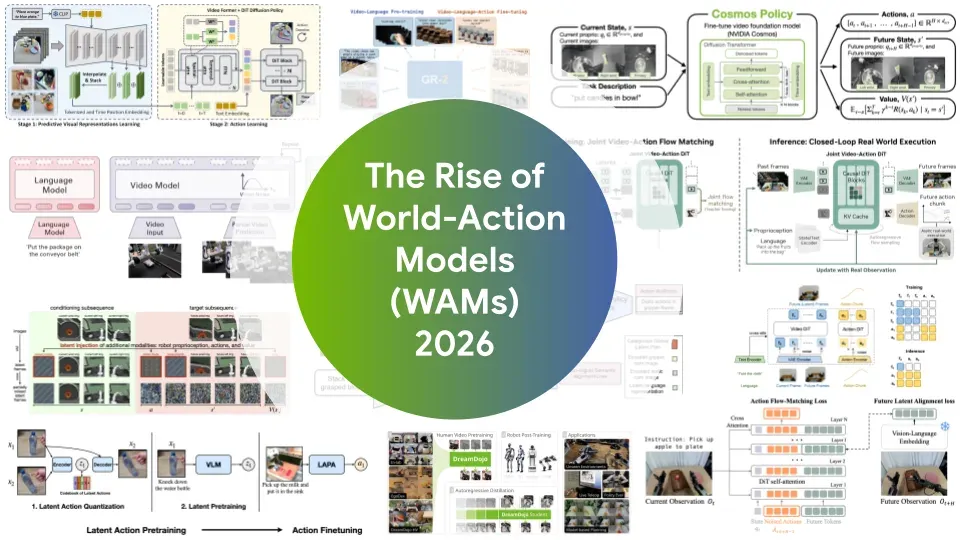
2026年に台頭したWorld Action Model(WAM)を体系的に解説するNVIDIA公式ブログ(出典:NVIDIA Developer Blog)
NVIDIA Developer Blogは、WAMをVLAと世界モデルを束ねる次世代のロボット基盤モデルとして位置づけ、DreamZeroをはじめ複数のWAM研究成果とアーキテクチャを並べて解説しています。
WAMとVLAの違い
NVIDIA Developer BlogはWAMを「事前学習済みの世界モデルまたは動画モデルを土台に、シーンがどう変化するかを予測しつつ対応するアクションを出力するポリシー」と定義しています。VLAとの対比は以下です。
| 観点 | VLA | WAM |
|---|---|---|
| 土台(事前学習) | 画像+テキストで学習済みのVLM | 動画で学習済みの世界モデル |
| 中核戦略 | VLMを直接アクション生成へ適応 | 世界の遷移予測を学んだ上でアクションを導出 |
| 言語→動作の接地 | ロボット軌跡データで直接学ぶ | 動画中にすでに含まれる"言葉→視覚変化"関係を利用 |
この違いが期待されるのは、新環境・新タスクでのサンプル効率です。世界モデル事前学習は動画データを広く吸収しているため、未知環境のダイナミクスをある程度推定でき、ロボット軌跡が少量でも汎化しやすくなる可能性があります。NVIDIAはこの効果を比較条件の揃った結論ではなく、初期結果に支えられた仮説として説明しています。
DreamZeroがRoboArenaで既存VLAを突き放す
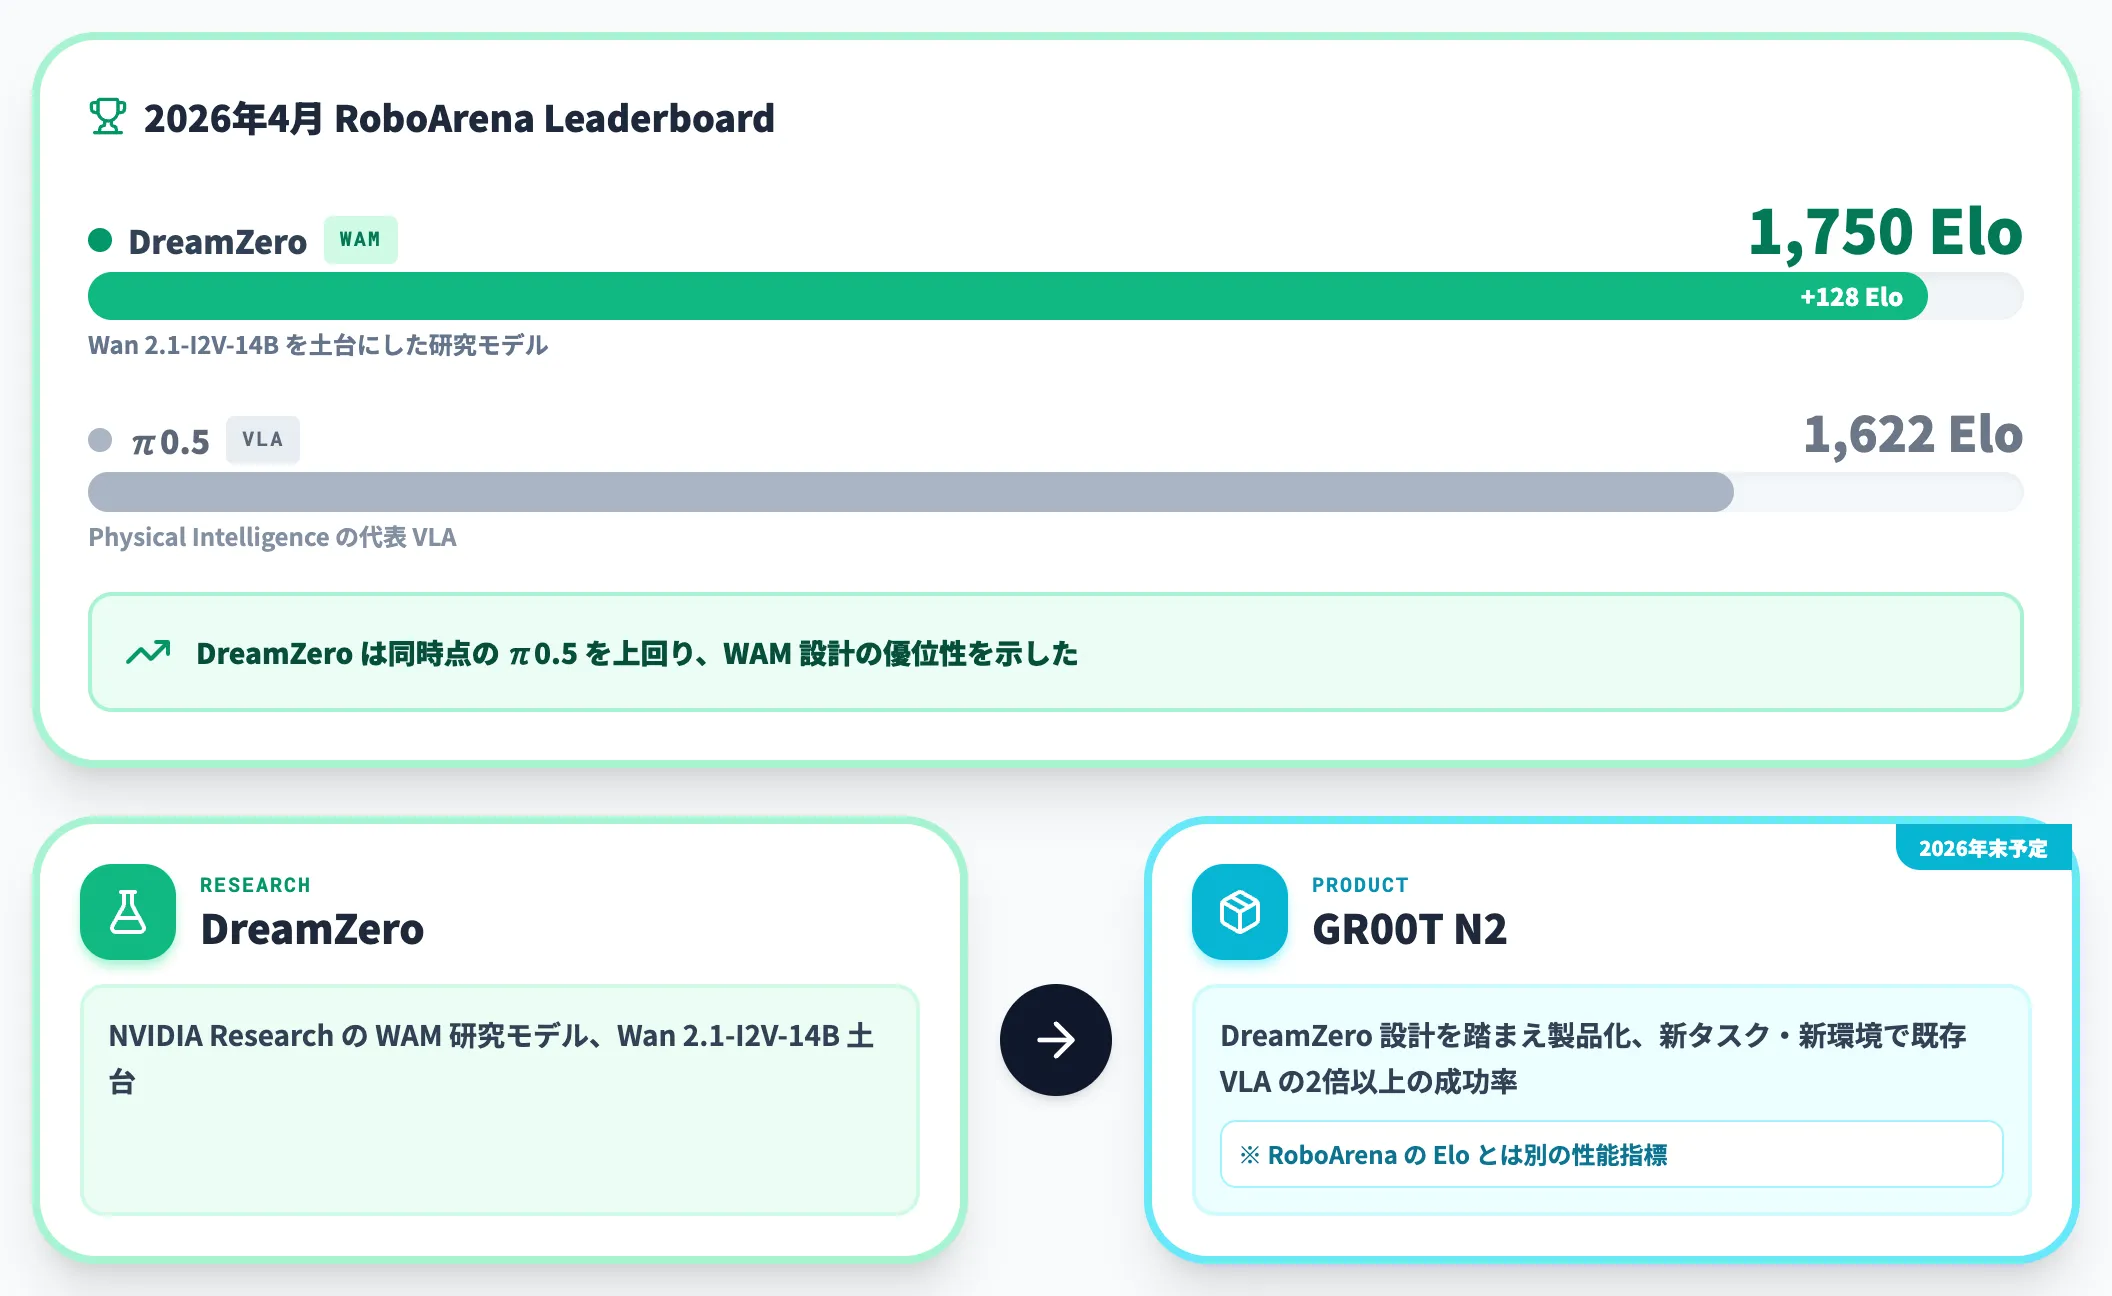
NVIDIA Research の DreamZero(WAM)は、Wan 2.1-I2V-14B を土台に構築された研究モデルで、2026年4月のRoboArena leaderboardで1750 Elo を記録し、同時点のπ0.5の1622を上回りました。この DreamZero の設計を踏まえて開発されるのが GR00T N2 で、2026年末のリリースが予告されています。
NVIDIA公式は GR00T N2 の性能について「新タスク・新環境で既存のVLAより2倍以上の成功率を示す」と説明しており、WAM設計を実製品に取り込むことで従来VLAより一段高いレイヤーの汎化を狙う方向です。この「2倍以上」は RoboArena の Elo とは別の性能指標です。
将来はハイブリッドが主流になる見通し
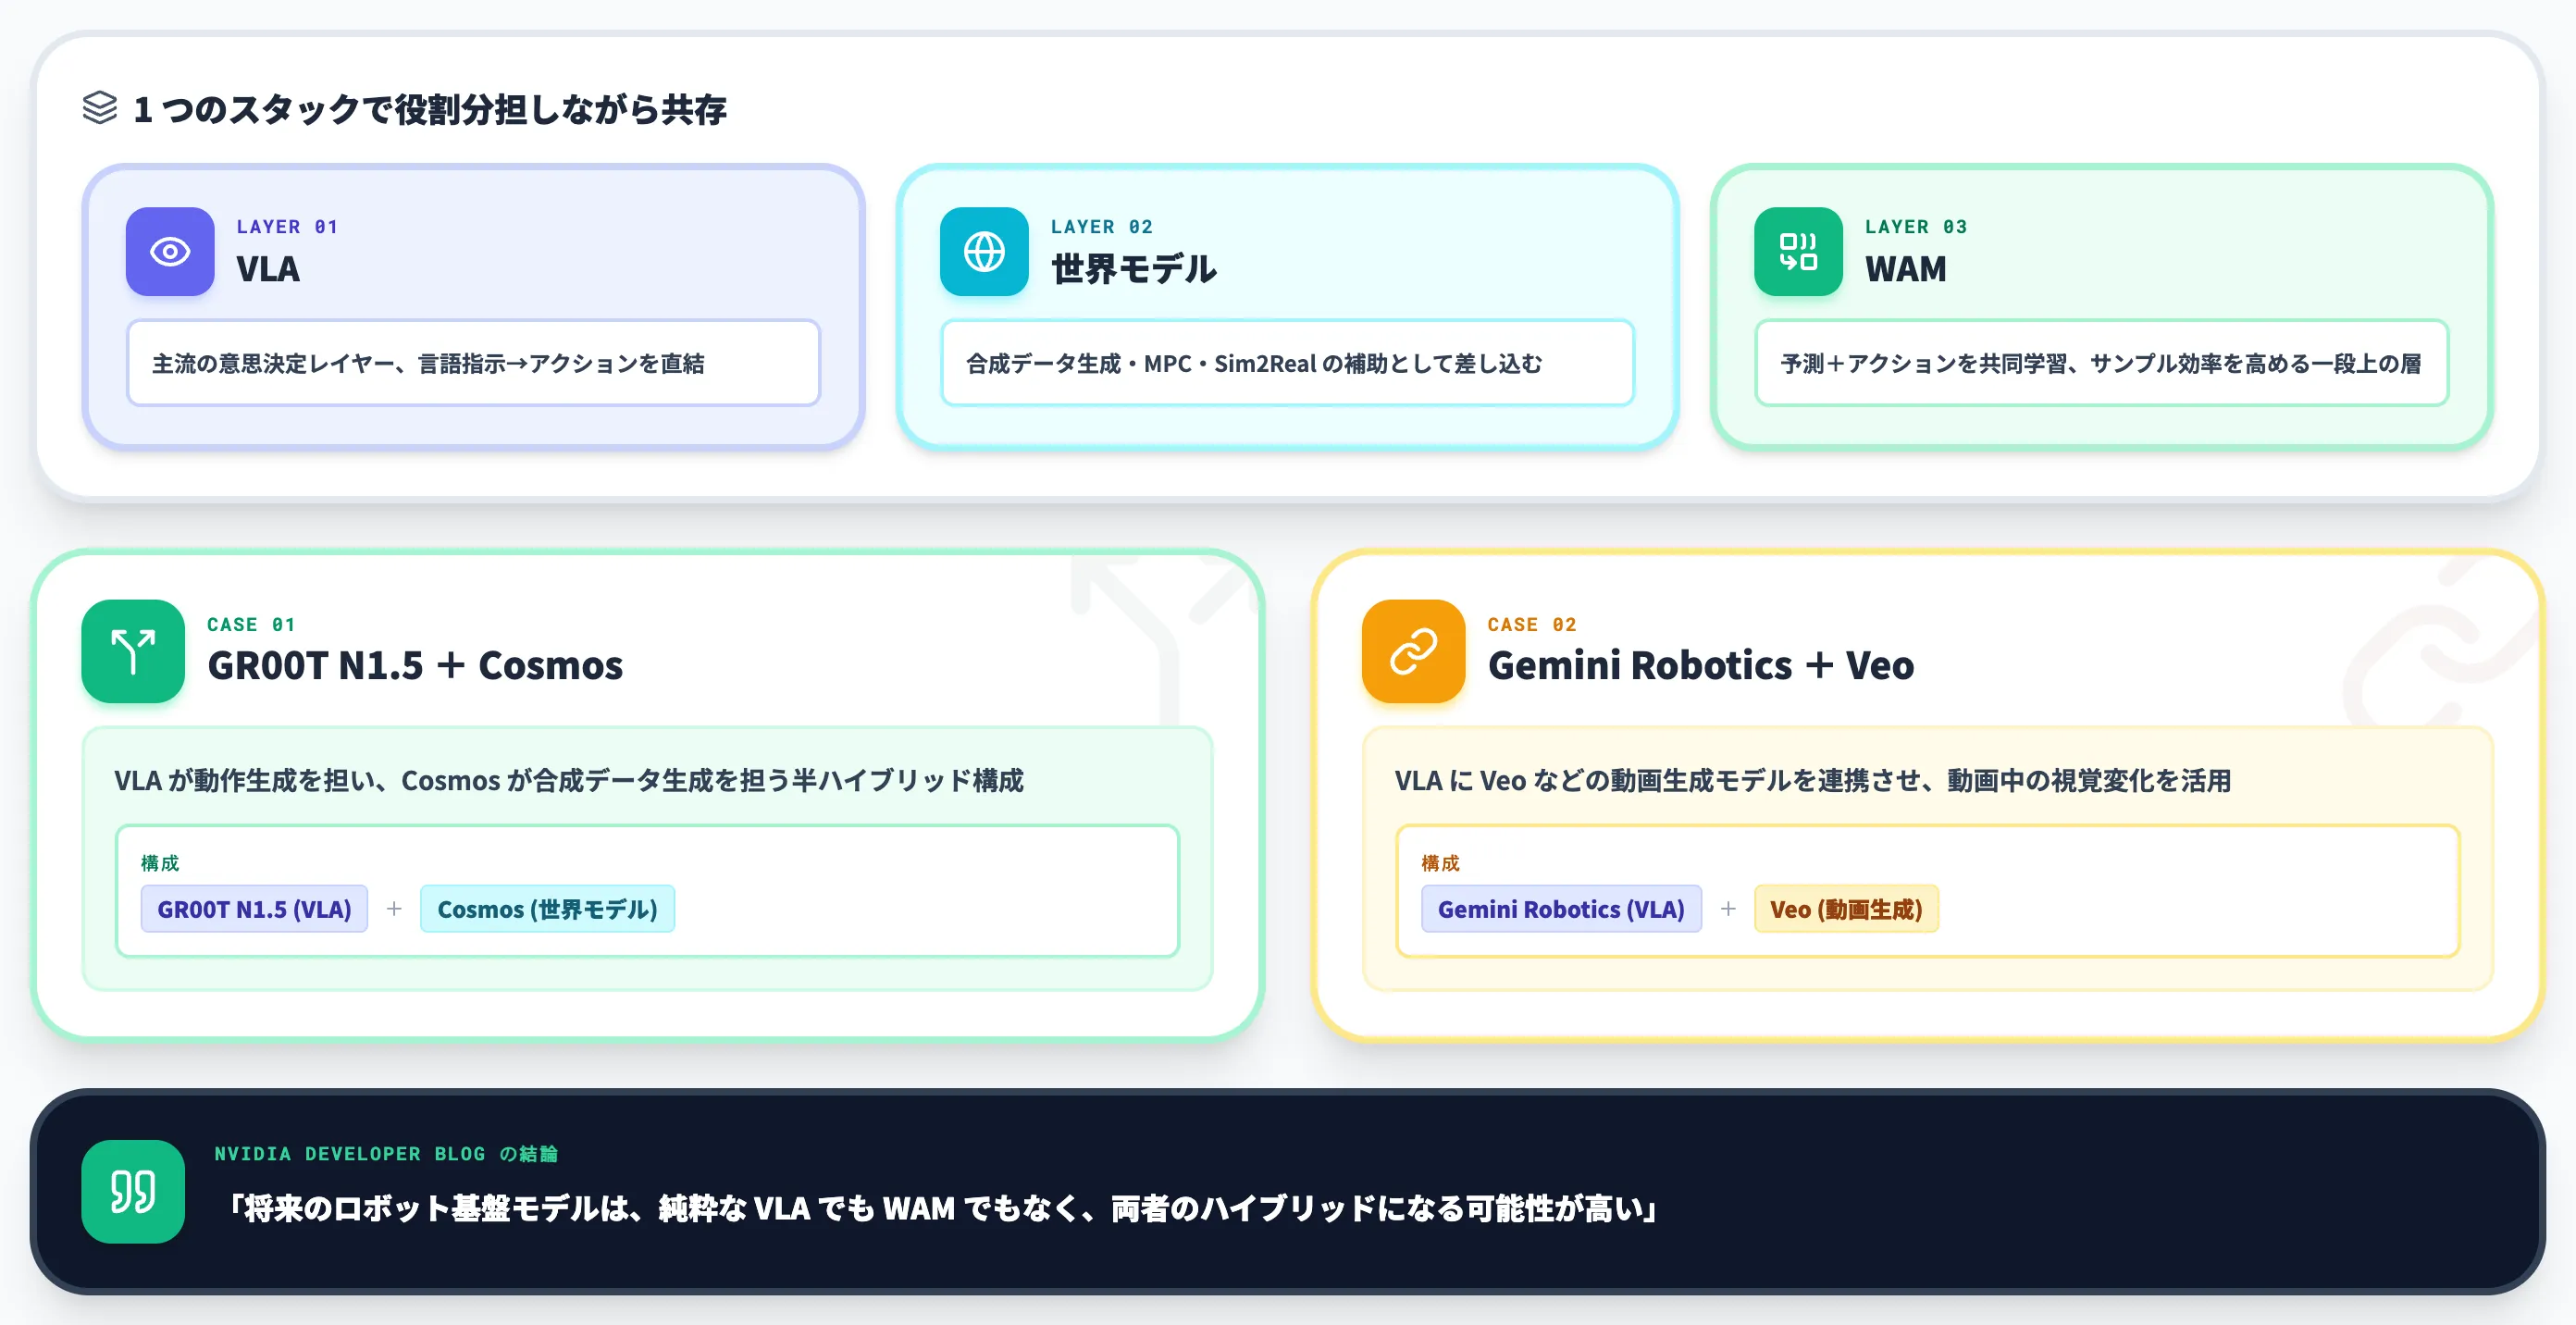
NVIDIA Developer Blogは記事末尾で「将来のロボット基盤モデルは純粋なVLAでもWAMでもなく、両者のハイブリッドになる可能性が高い」と結論づけています。
実際、GR00T N1.5は既にCosmosで合成データを生成している半ハイブリッドで、Gemini RoboticsもVeoなどの動画生成モデルと連携する方向を取っています。VLA/世界モデル/WAMは排他ではなく、1つのスタックの中で役割分担しながら共存する構図に収束しつつあります。
主要プレイヤーと代表モデルの最新動向
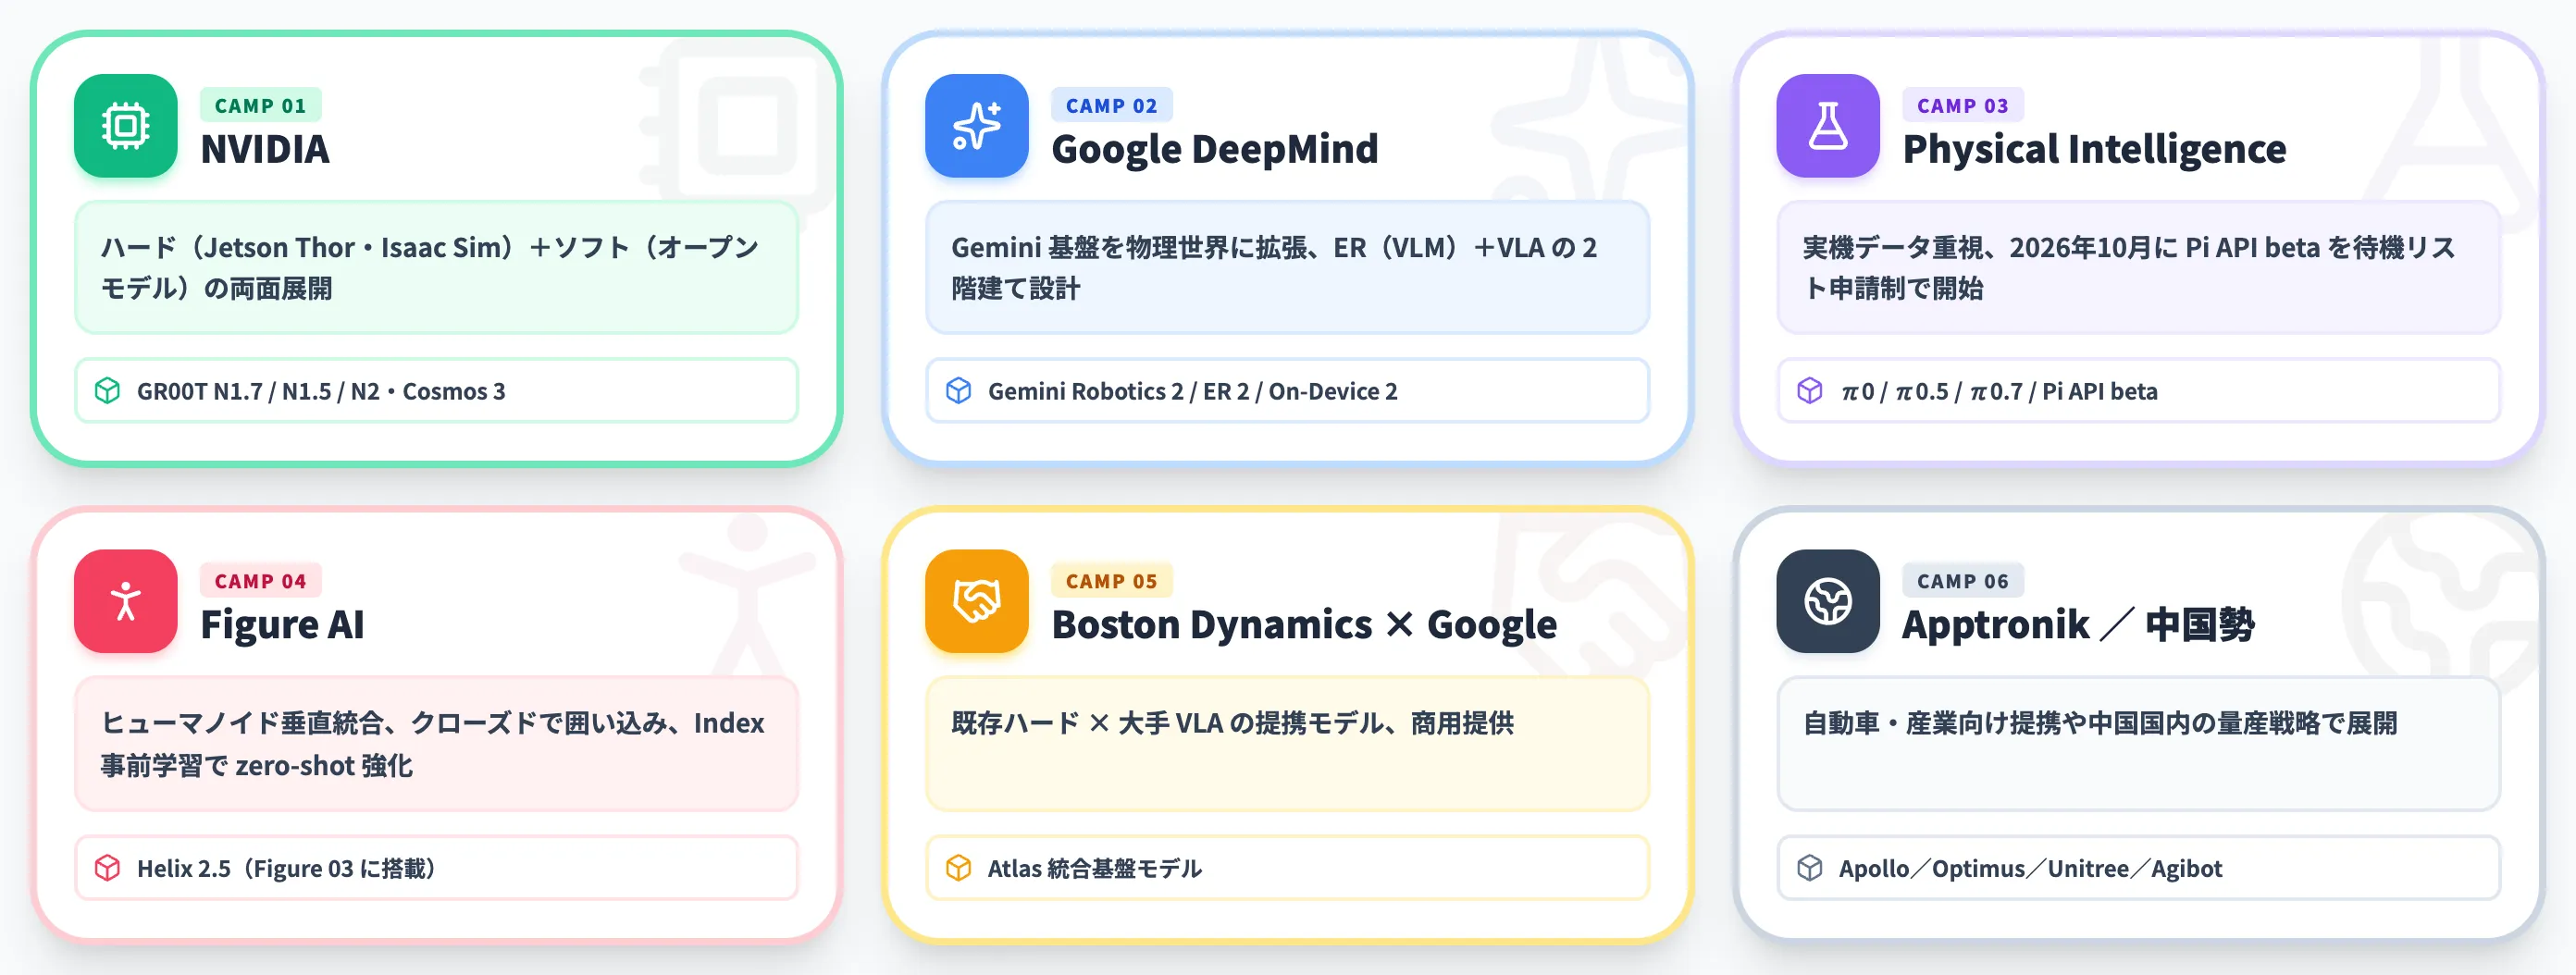
ロボット基盤モデルを開発している主要プレイヤーは、2026年時点でNVIDIA・Google DeepMind・Physical Intelligence・Figure AI・OpenAI系・中国勢の6陣営に大別できます。
2026年の代表プレイヤー比較
以下の表は、各社の主要モデルと戦略の違いを整理したものです。
| プレイヤー | 代表モデル | 戦略軸 | 公開形態 |
|---|---|---|---|
| NVIDIA | GR00T N1.7/N1.5/N2・Cosmos 3 | ハード(Jetson Thor・Isaac Sim)+ソフト(オープンモデル)の両面展開 | N1.7はNVIDIA Open Model License(商用可)、N1.5はNon-Commercial、Cosmos 3はOpenMDW-1.1 |
| Google DeepMind | Gemini Robotics 2・Gemini Robotics-ER 2・On-Device 2 | Gemini基盤を物理世界に拡張、ER(VLM)で高レベル計画、VLA本体で動作実行の2階建て設計 | VLAは選定パートナー、ER 2 Previewは全開発者向け |
| Physical Intelligence | π0・π0.5・π0.7 | 実機データ重視、Steerable Generalistで一般化、2026年10月にPi API betaを開始 | 論文+openpi(オープン、π0.7は論文のみ)+Pi API beta(待機リスト申請制) |
| Figure AI | Helix 2.5(Figure 03に搭載) | ヒューマノイド垂直統合、クローズドで囲い込み、Index事前学習でzero-shot汎化を強化 | クローズド |
| Boston Dynamics × Google DeepMind | Atlas統合基盤モデル | 既存ハード × 大手VLAの提携 | 商用 |
| Apptronik × Mercedes-Benz / Tesla / 中国勢(Unitree・Agibot) | Apollo/Optimus/各社ヒューマノイド | 自動車・産業向け提携や中国国内の量産戦略 | 混在 |
プレイヤー別の詳細は、NVIDIA GR00Tとは?ロボット基盤モデルの特徴や使い方を解説とPhysical Intelligence(π)とは?全モデル系譜やopenpi、競合比較を徹底解説で深掘りしています。
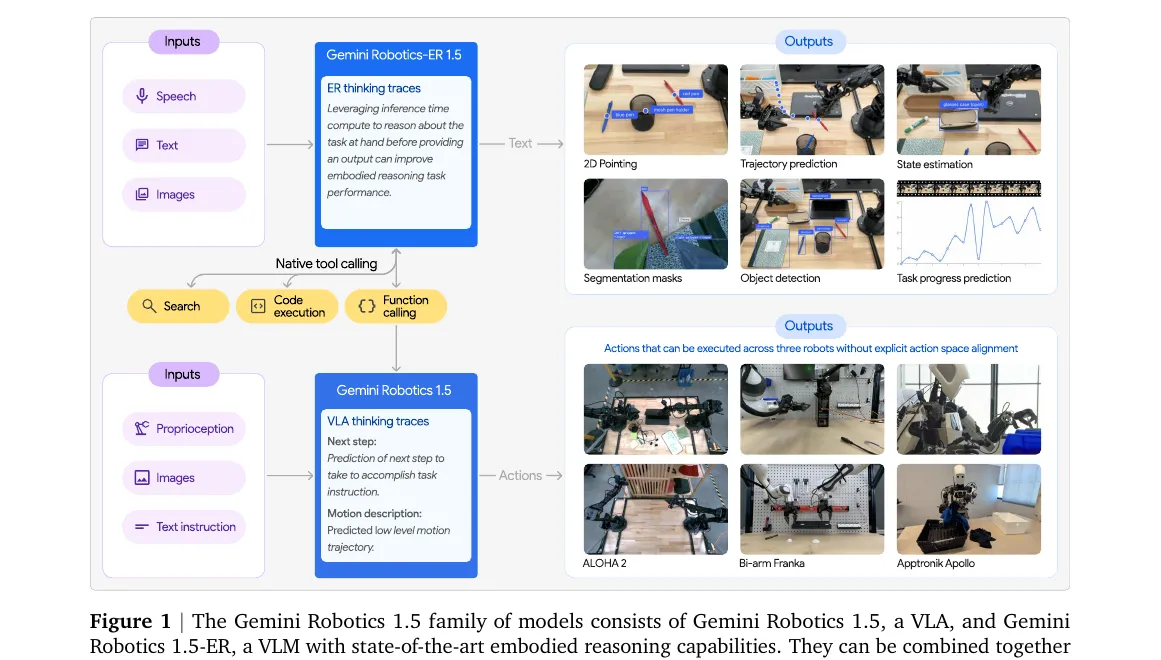
Gemini Robotics 1.5論文(2025年9月)のFigure 1。VLA本体+VLM+空間推論の2階建て設計は、2026年7月のER 2 Previewにも継承(出典:Google DeepMind)
Google DeepMindは「VLAが単独で全層を担う」のではなく、ER版VLMで高レベル計画を立て、VLA本体で動作を実行する2階建て設計を採用しており、ロボット基盤モデルが単一モデルから役割分担型の複合アーキテクチャに向かう流れを明示しています。2026年7月のER 2 Previewでも同じ構造が維持されています。
日本の動向——経産省・AIRoA・Turing・ファナック
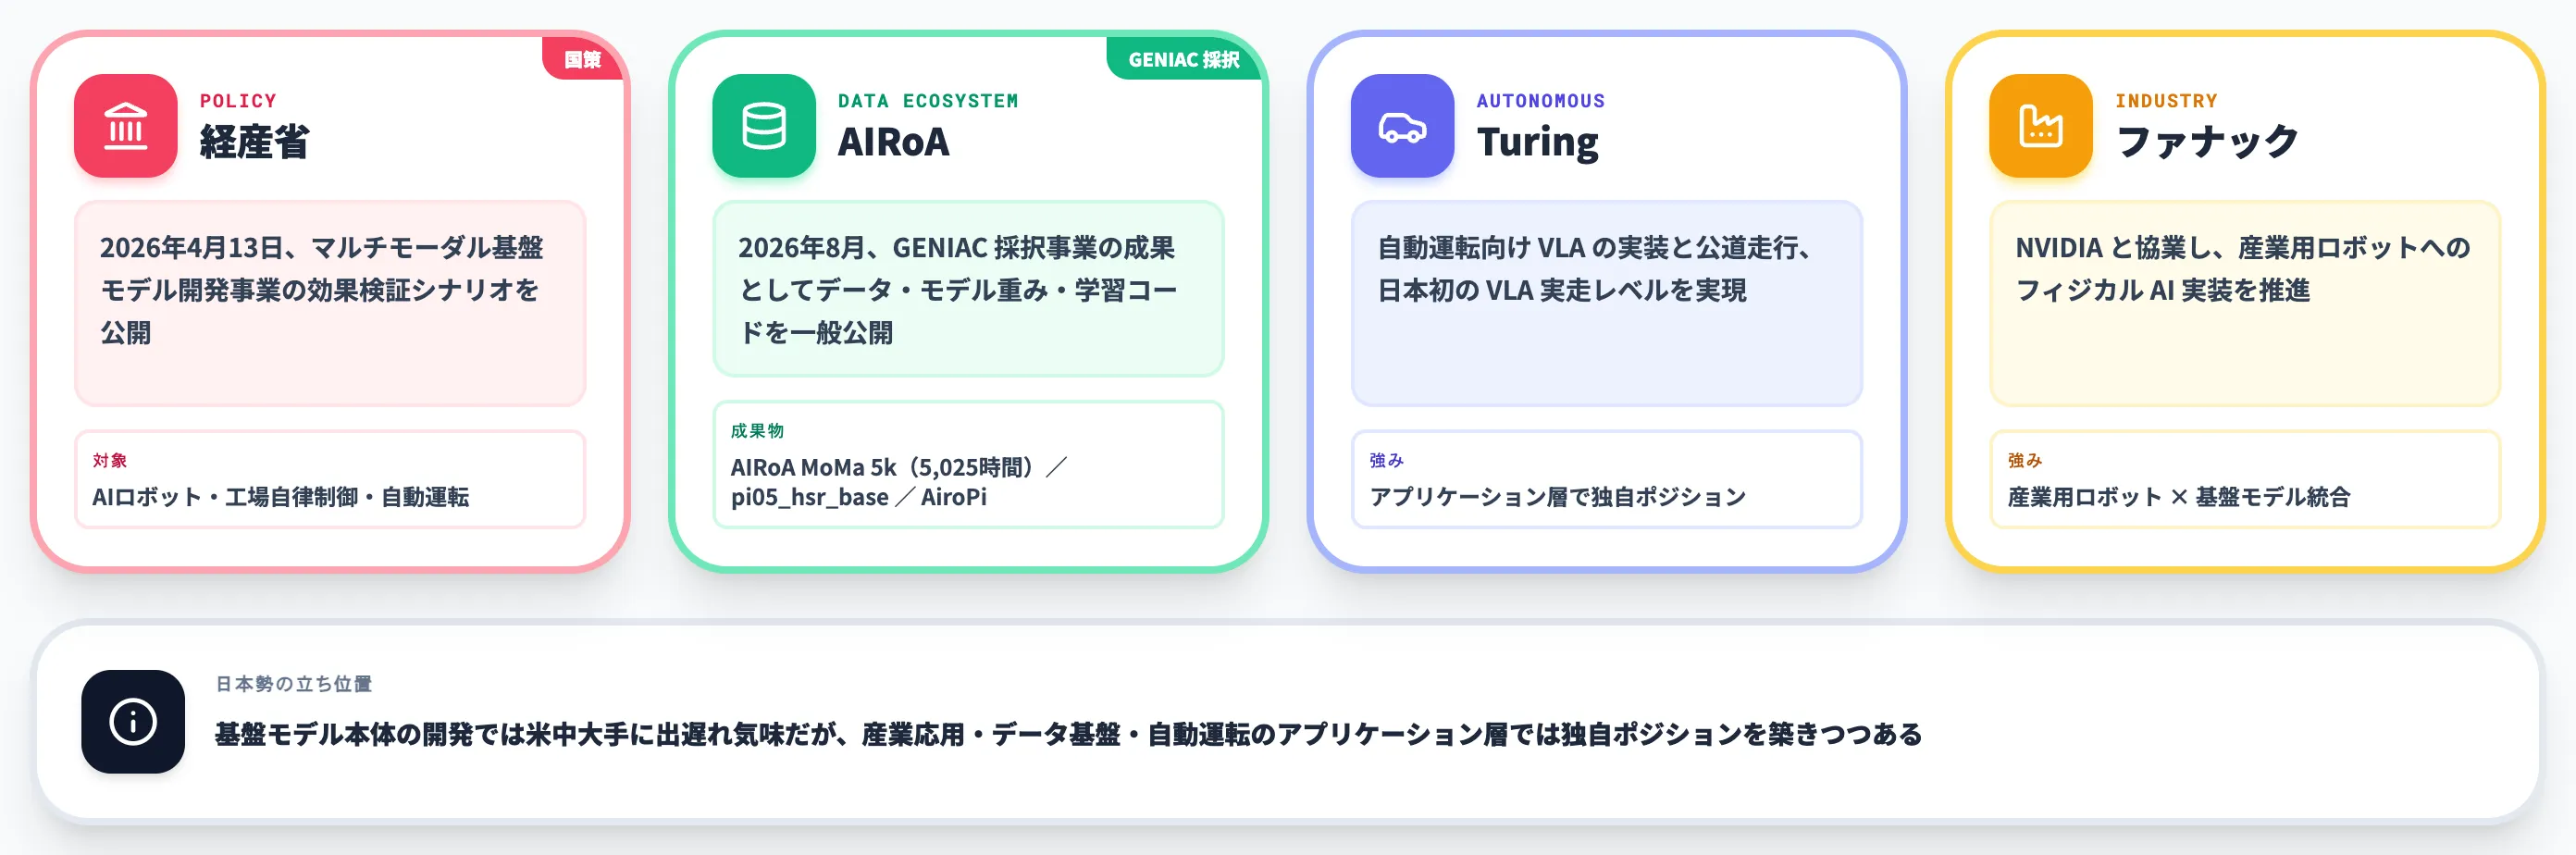
日本も2026年にロボット基盤モデル分野への国家的な取り組みを強化しています。
経済産業省は2026年4月13日にAIロボット・フィジカルAIを見据えたマルチモーダル基盤モデル開発事業の効果検証シナリオを公開し、AIロボット・工場の自律最適制御・自動運転等を見据えた国産基盤モデル開発を進める方針を打ち出しました。
-
AIRoA(AIロボット協会)
ロボットデータエコシステムの構築、業界横断のデータ共有を推進。2026年8月にはGENIAC採択事業の成果として、トヨタHSRで収集した5,025時間規模のデータセット「AIRoA MoMa 5k」、π0.5を土台に継続事前学習したモデル重み「pi05_hsr_base」、学習コード「AiroPi」を一般公開
-
Turing
自動運転向けVLAの実装と公道走行、日本初のVLA実走レベルを実現
-
ファナック
NVIDIAと協業し、産業用ロボットへのフィジカルAI実装を推進
国内勢は現時点で基盤モデル本体の開発では米中大手に対して出遅れ気味ですが、産業応用・データ基盤・自動運転のアプリケーション層では独自ポジションを築きつつあります。
ロボット基盤モデルの導入判断と開発コスト観
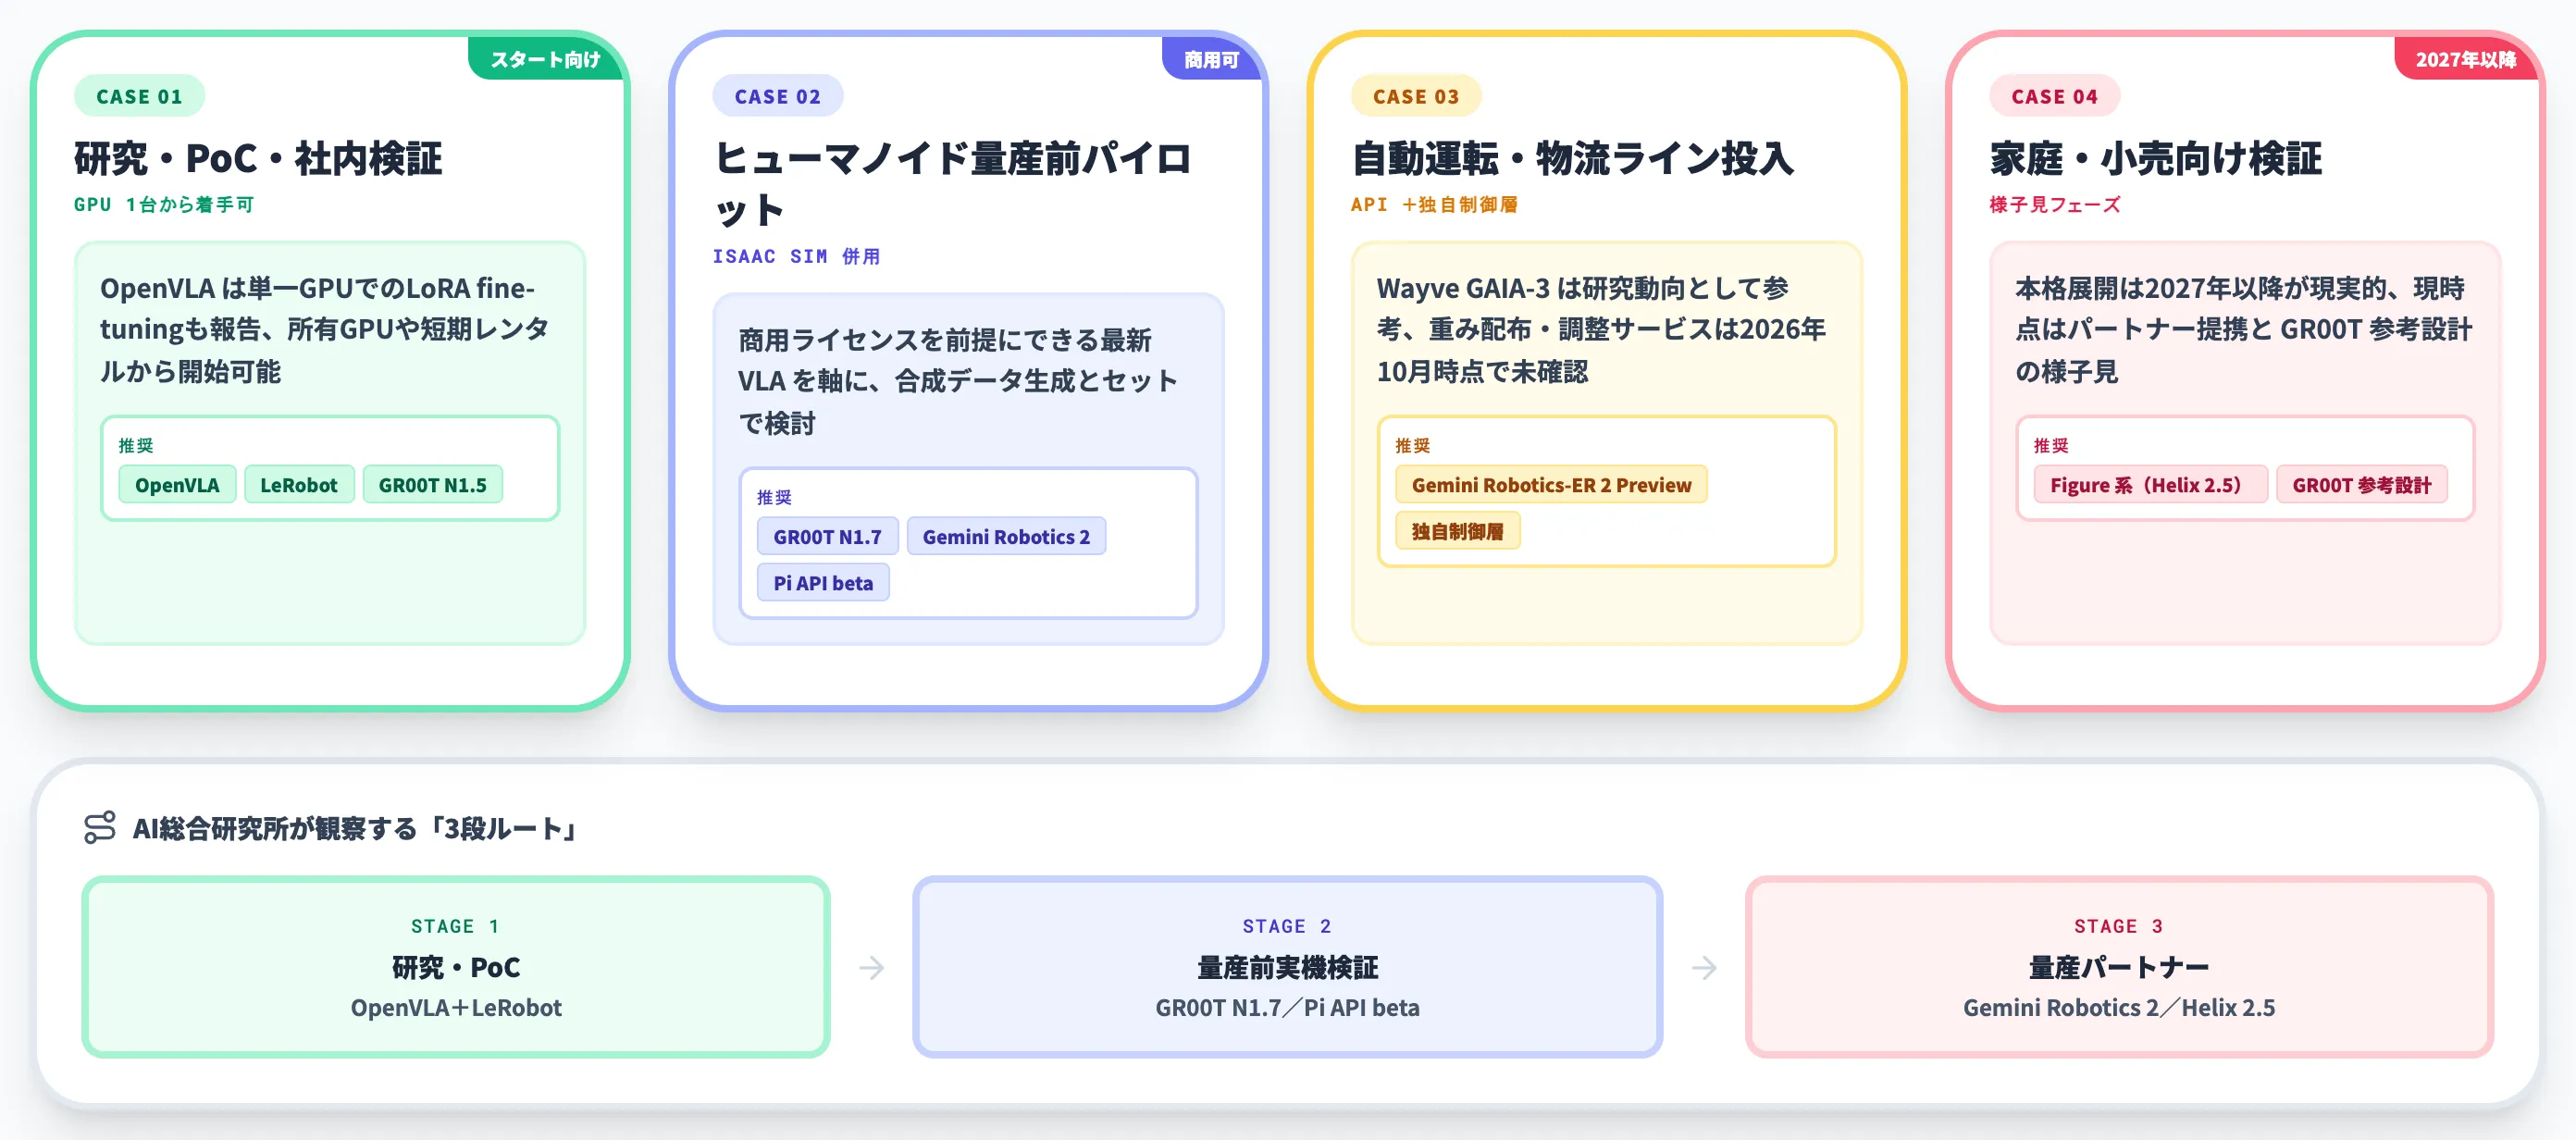
企業や研究機関がロボット基盤モデルを採用する際、「どのモデルから着手すべきか」の判断軸は目的と予算によって変わります。
導入ケース別の推奨モデル
AI総合研究所の支援・観察ベースで整理すると、以下のケース別推奨が実務的です。
-
ケース1:研究・PoC・社内検証段階
推奨は OpenVLA / LeRobot / GR00T N1.5(研究用途・非商用ライセンス)。OpenVLAは単一GPUでのLoRA fine-tuningも報告されており、所有GPUや短期レンタルから開始しやすい
-
ケース2:ヒューマノイド量産前のパイロット
推奨は GR00T N1.7(商用ライセンスを前提にできる最新VLA)/ Gemini Robotics 2(パートナー契約)/ Pi API beta(Physical Intelligenceが2026年10月に開始したホスト型fine-tuning)。Isaac Simでの合成データ生成とセットで検討
-
ケース3:自動運転・物流ライン投入
推奨は Gemini Robotics-ER 2 Preview(API)+独自制御層。自動運転評価用世界モデルのWayve GAIA-3は、研究動向として参考にする位置づけで、一般企業向けの重み配布・調整サービスは2026年10月時点で公開情報が確認できていない
-
ケース4:家庭・小売向け検証
推奨は Figure 系(Helix 2.5の提携)か GR00T 参考設計の様子見。本格展開は2027年以降が現実的
大まかな開発・運用コストの考え方
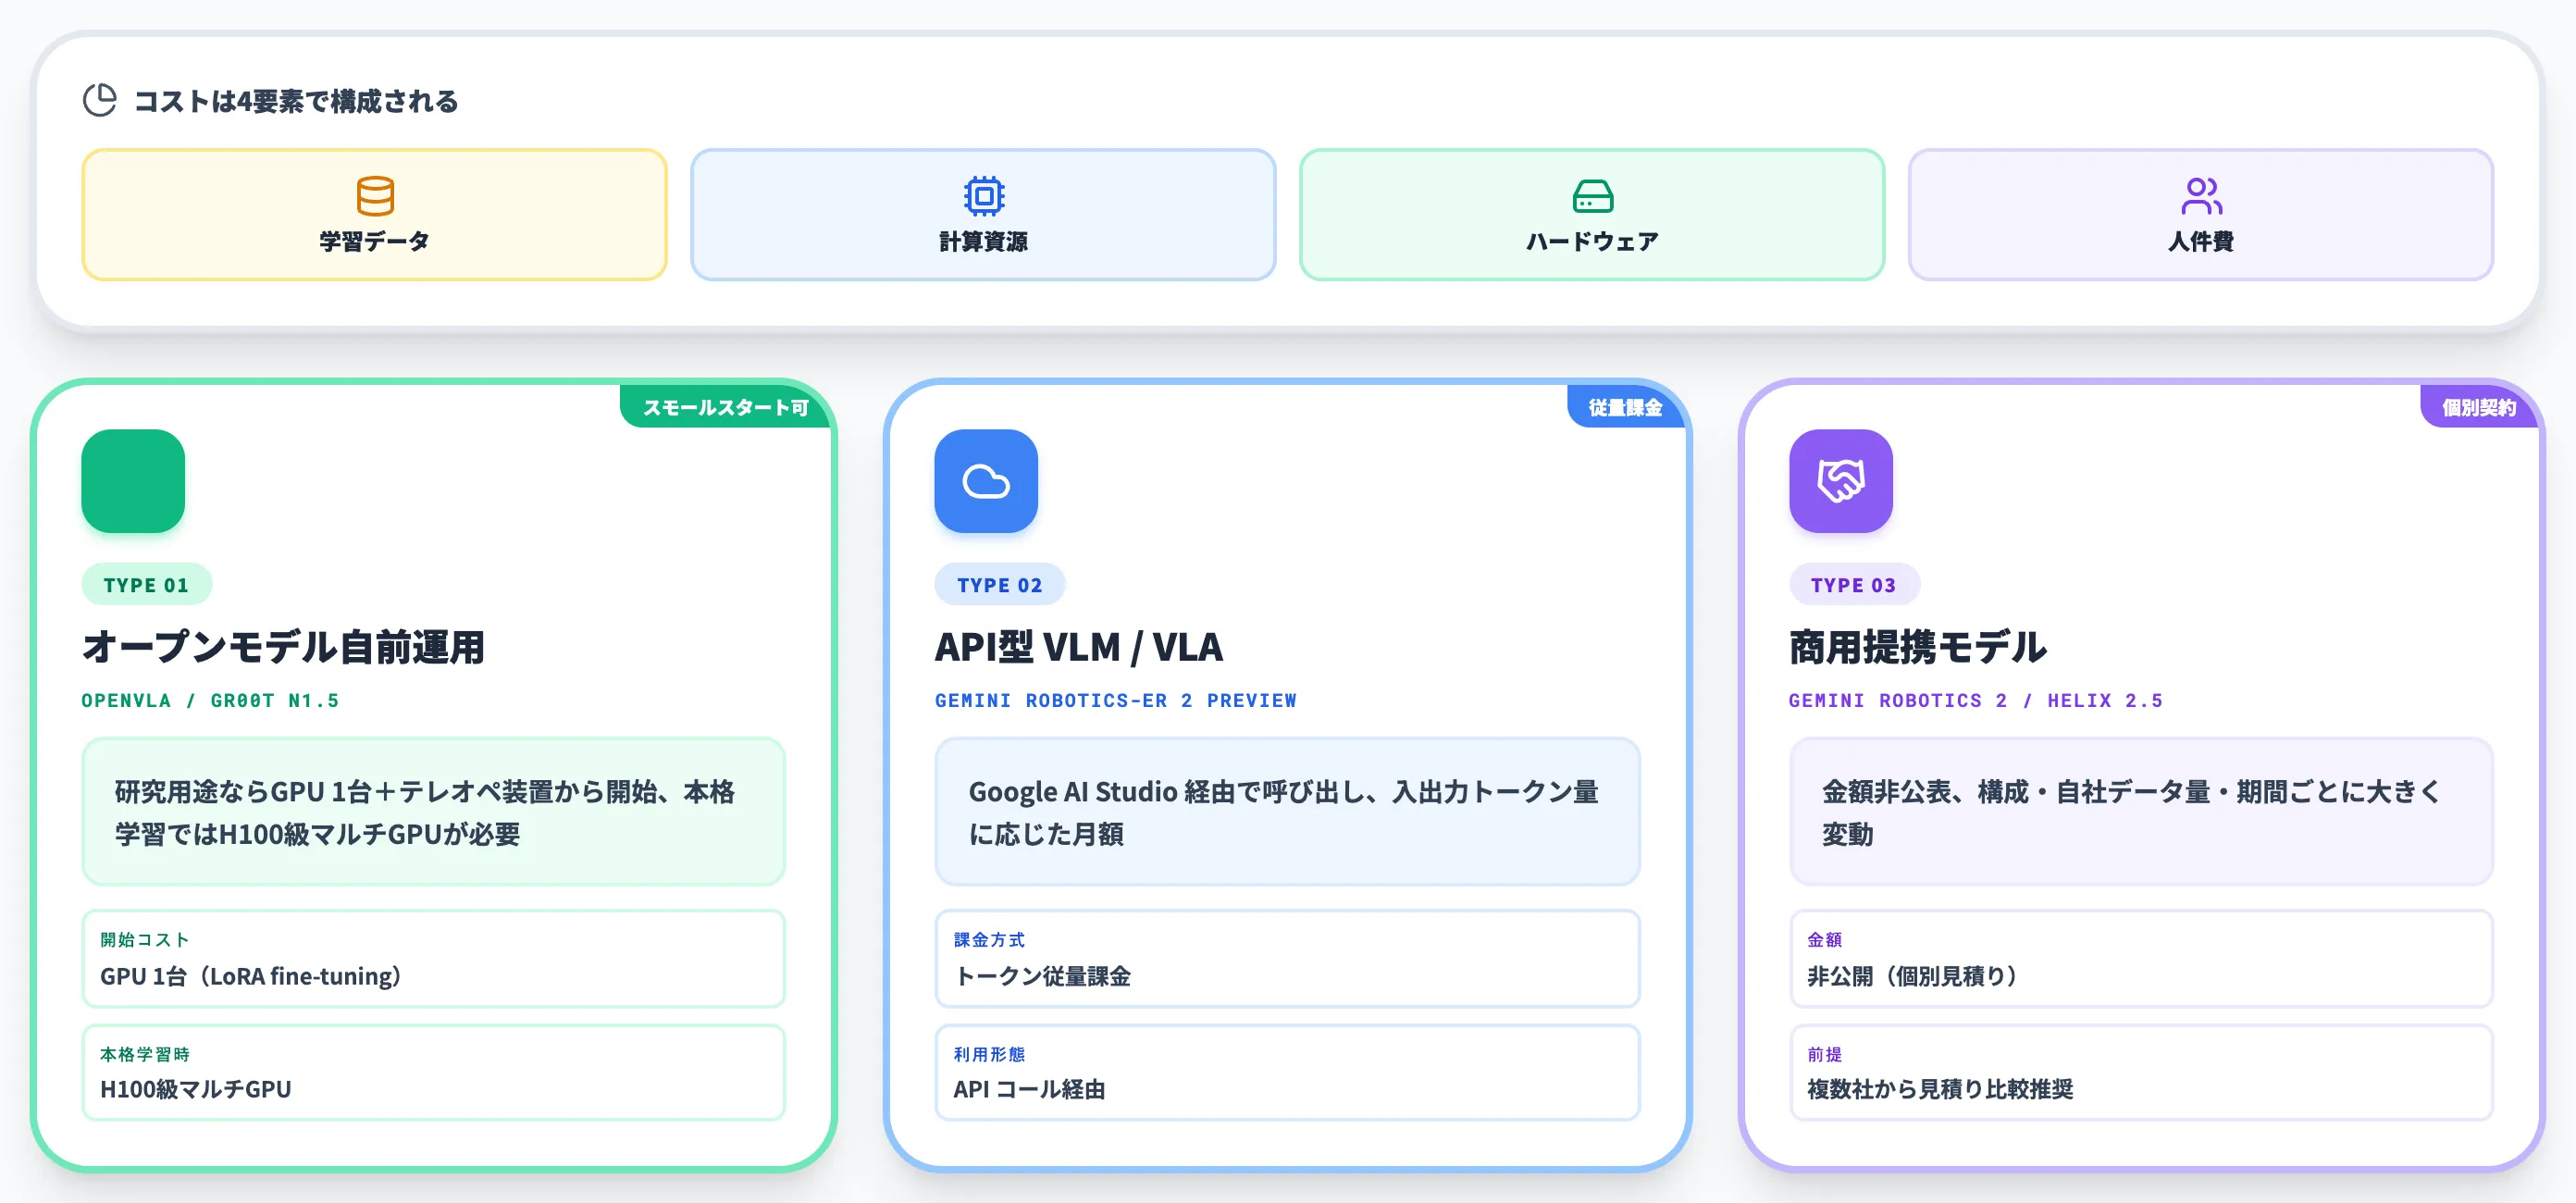
ロボット基盤モデルの開発コストは、学習データ・計算資源・ハードウェア・人件費の4要素で構成されますが、公開一次情報だけで"相場"と断言できるレンジは限定的です。公表情報から読み取れる傾向は次の通りです。
-
オープンモデル自前運用(OpenVLA/GR00T N1.5)
OpenVLAはLoRA fine-tuningなら単一GPUでも可能と報告されており、研究用途ならGPU 1台+テレオペ装置から開始できる。本格学習ではH100級マルチGPUが必要になる
-
API型VLM/VLA(Gemini Robotics-ER 2 Preview)
開発者がGoogle AI Studio経由で呼び出し。ER 2 Previewの料金は従量課金で、入出力トークン量に応じて月額が決まる
-
商用提携モデル(Gemini Robotics 2/Figure Helix 2.5)
個別契約で金額非公表。構成・自社データ量・期間ごとに大きく変動するため、見積りを取って比較する前提
VLAのトークン単価・GR00Tの自前運用コスト・API単価の詳細はVLAモデルとは?仕組み・主要モデル・2026年の産業実装を徹底解説の料金セクションで扱っています。
選定の実務的な着地点
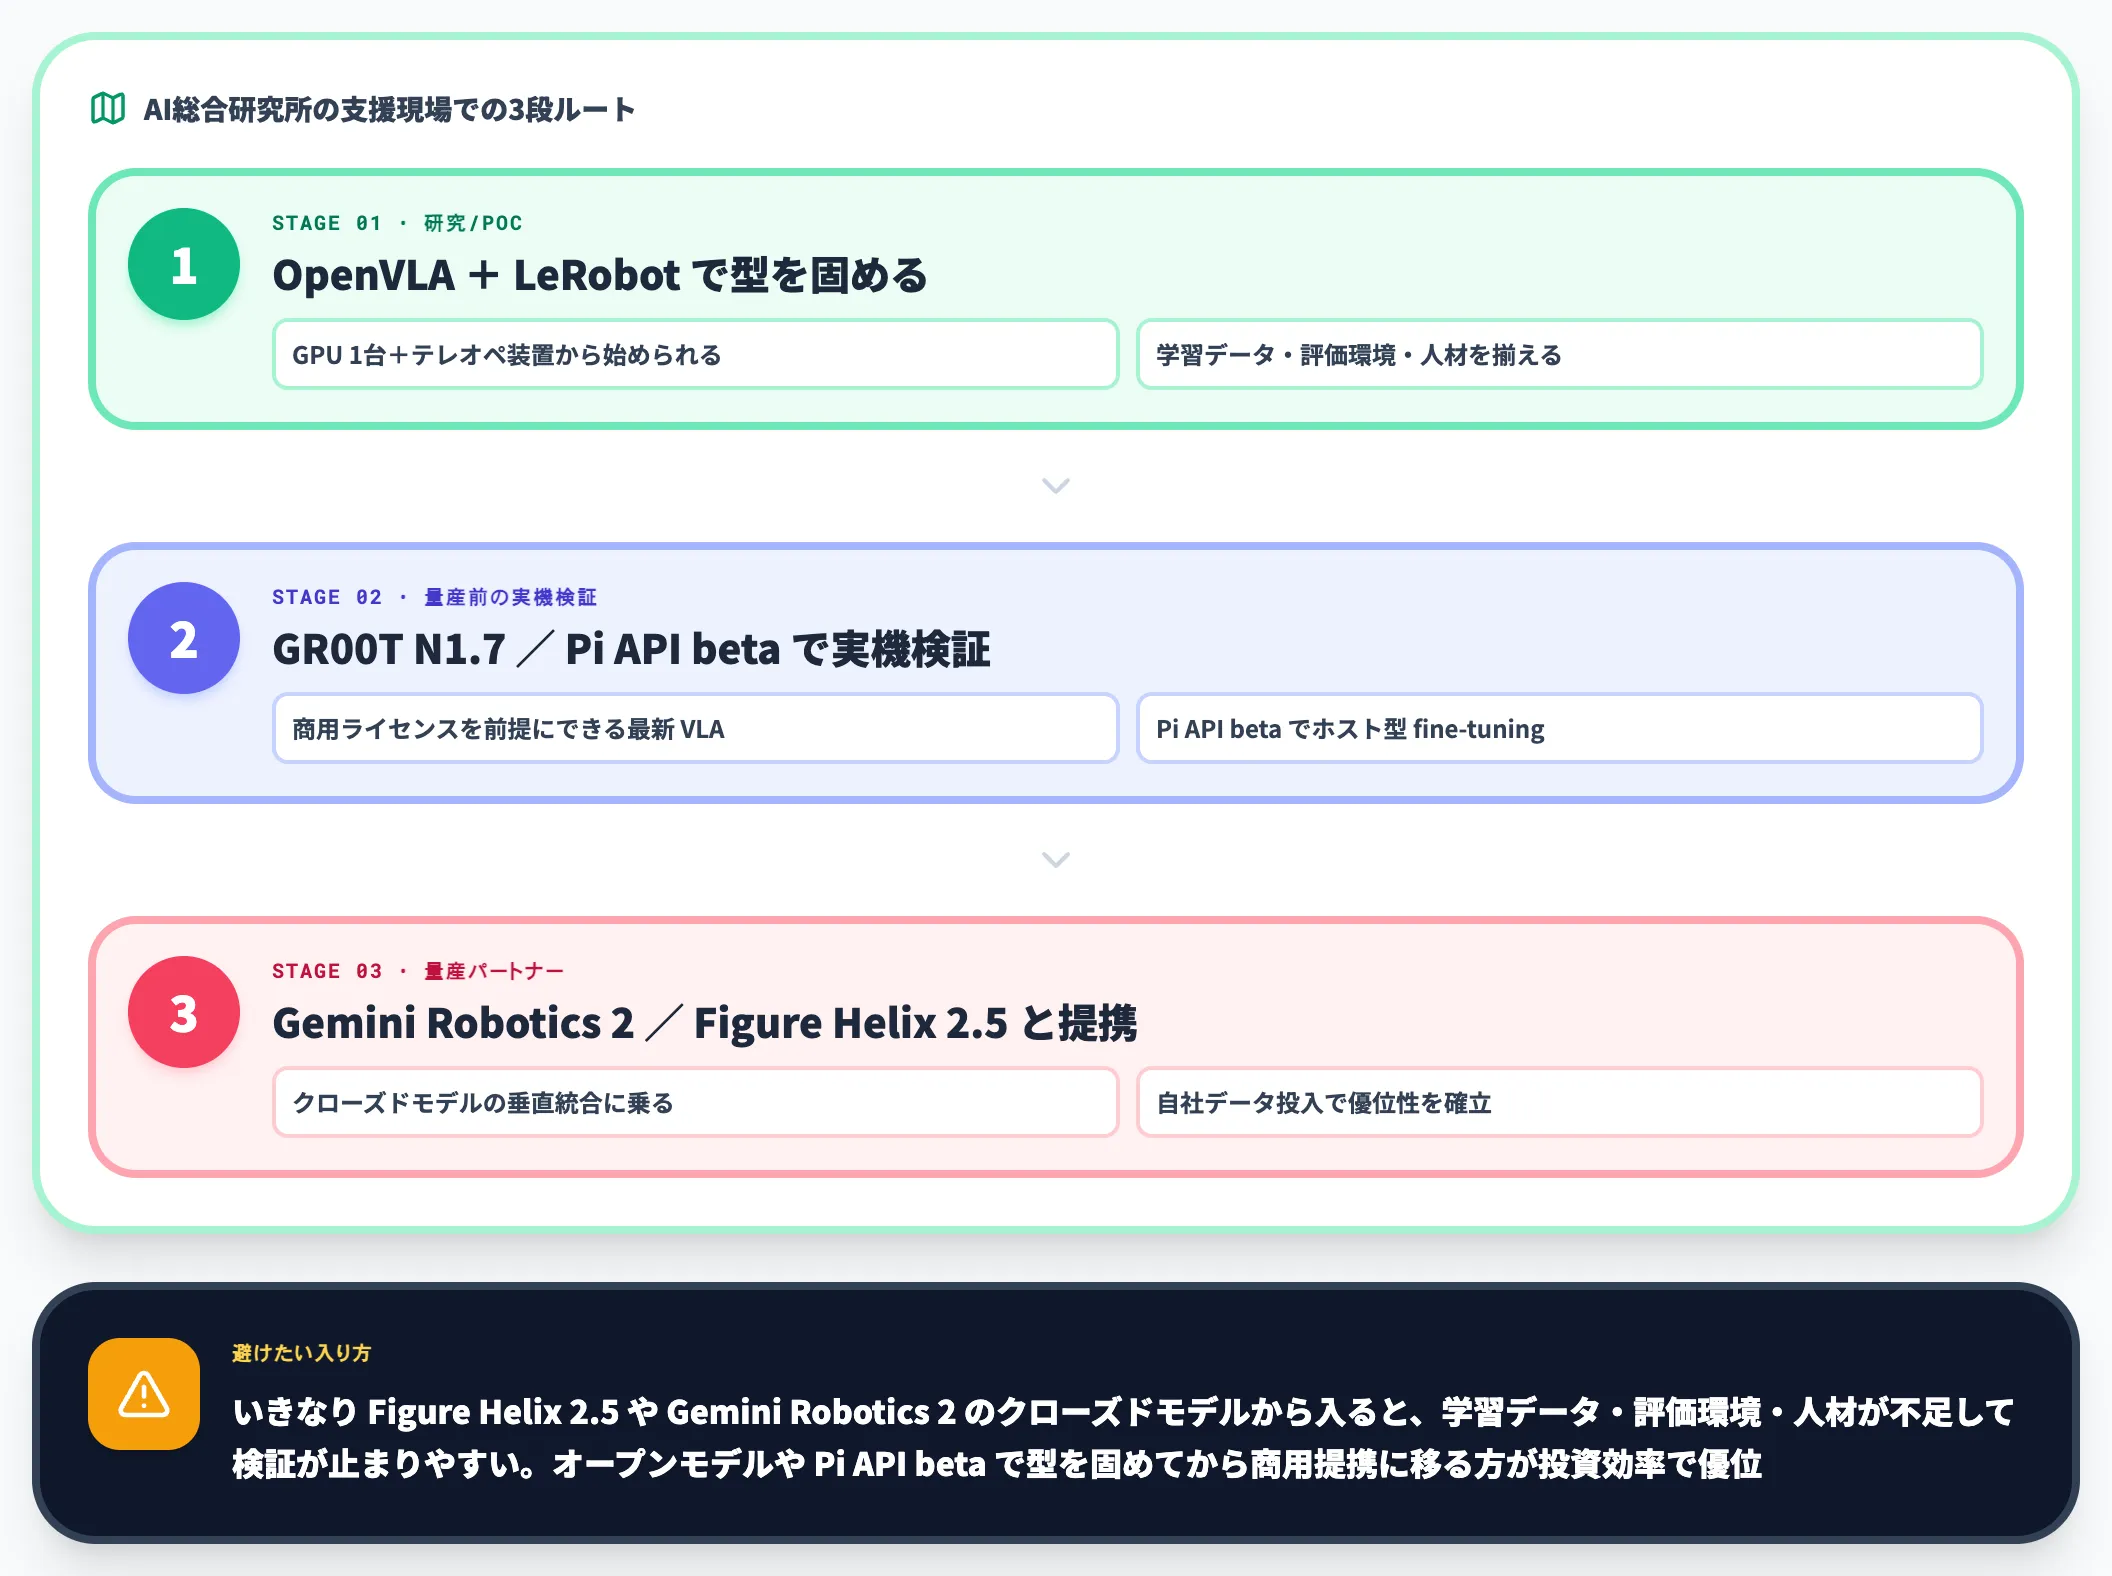
AI総合研究所の支援現場で観察する限り、SIer・研究機関のロボット基盤モデル着手は「研究・PoCならOpenVLA+LeRobot、量産前の実機検証ならGR00T N1.7やPi API beta、量産パートナーならGemini Robotics 2/Figure Helix 2.5」という3段ルートがもっとも採用しやすい流れです。
いきなり Figure Helix 2.5や Gemini Robotics 2のクローズドモデルから入ると、学習データ・評価環境・人材のいずれも不足して検証が止まりやすいため、オープンモデルやPi API betaのホスト型fine-tuningで型を固めてから商用提携に移る方が、投資効率で優位になります。
ロボット基盤モデルの課題と注意点
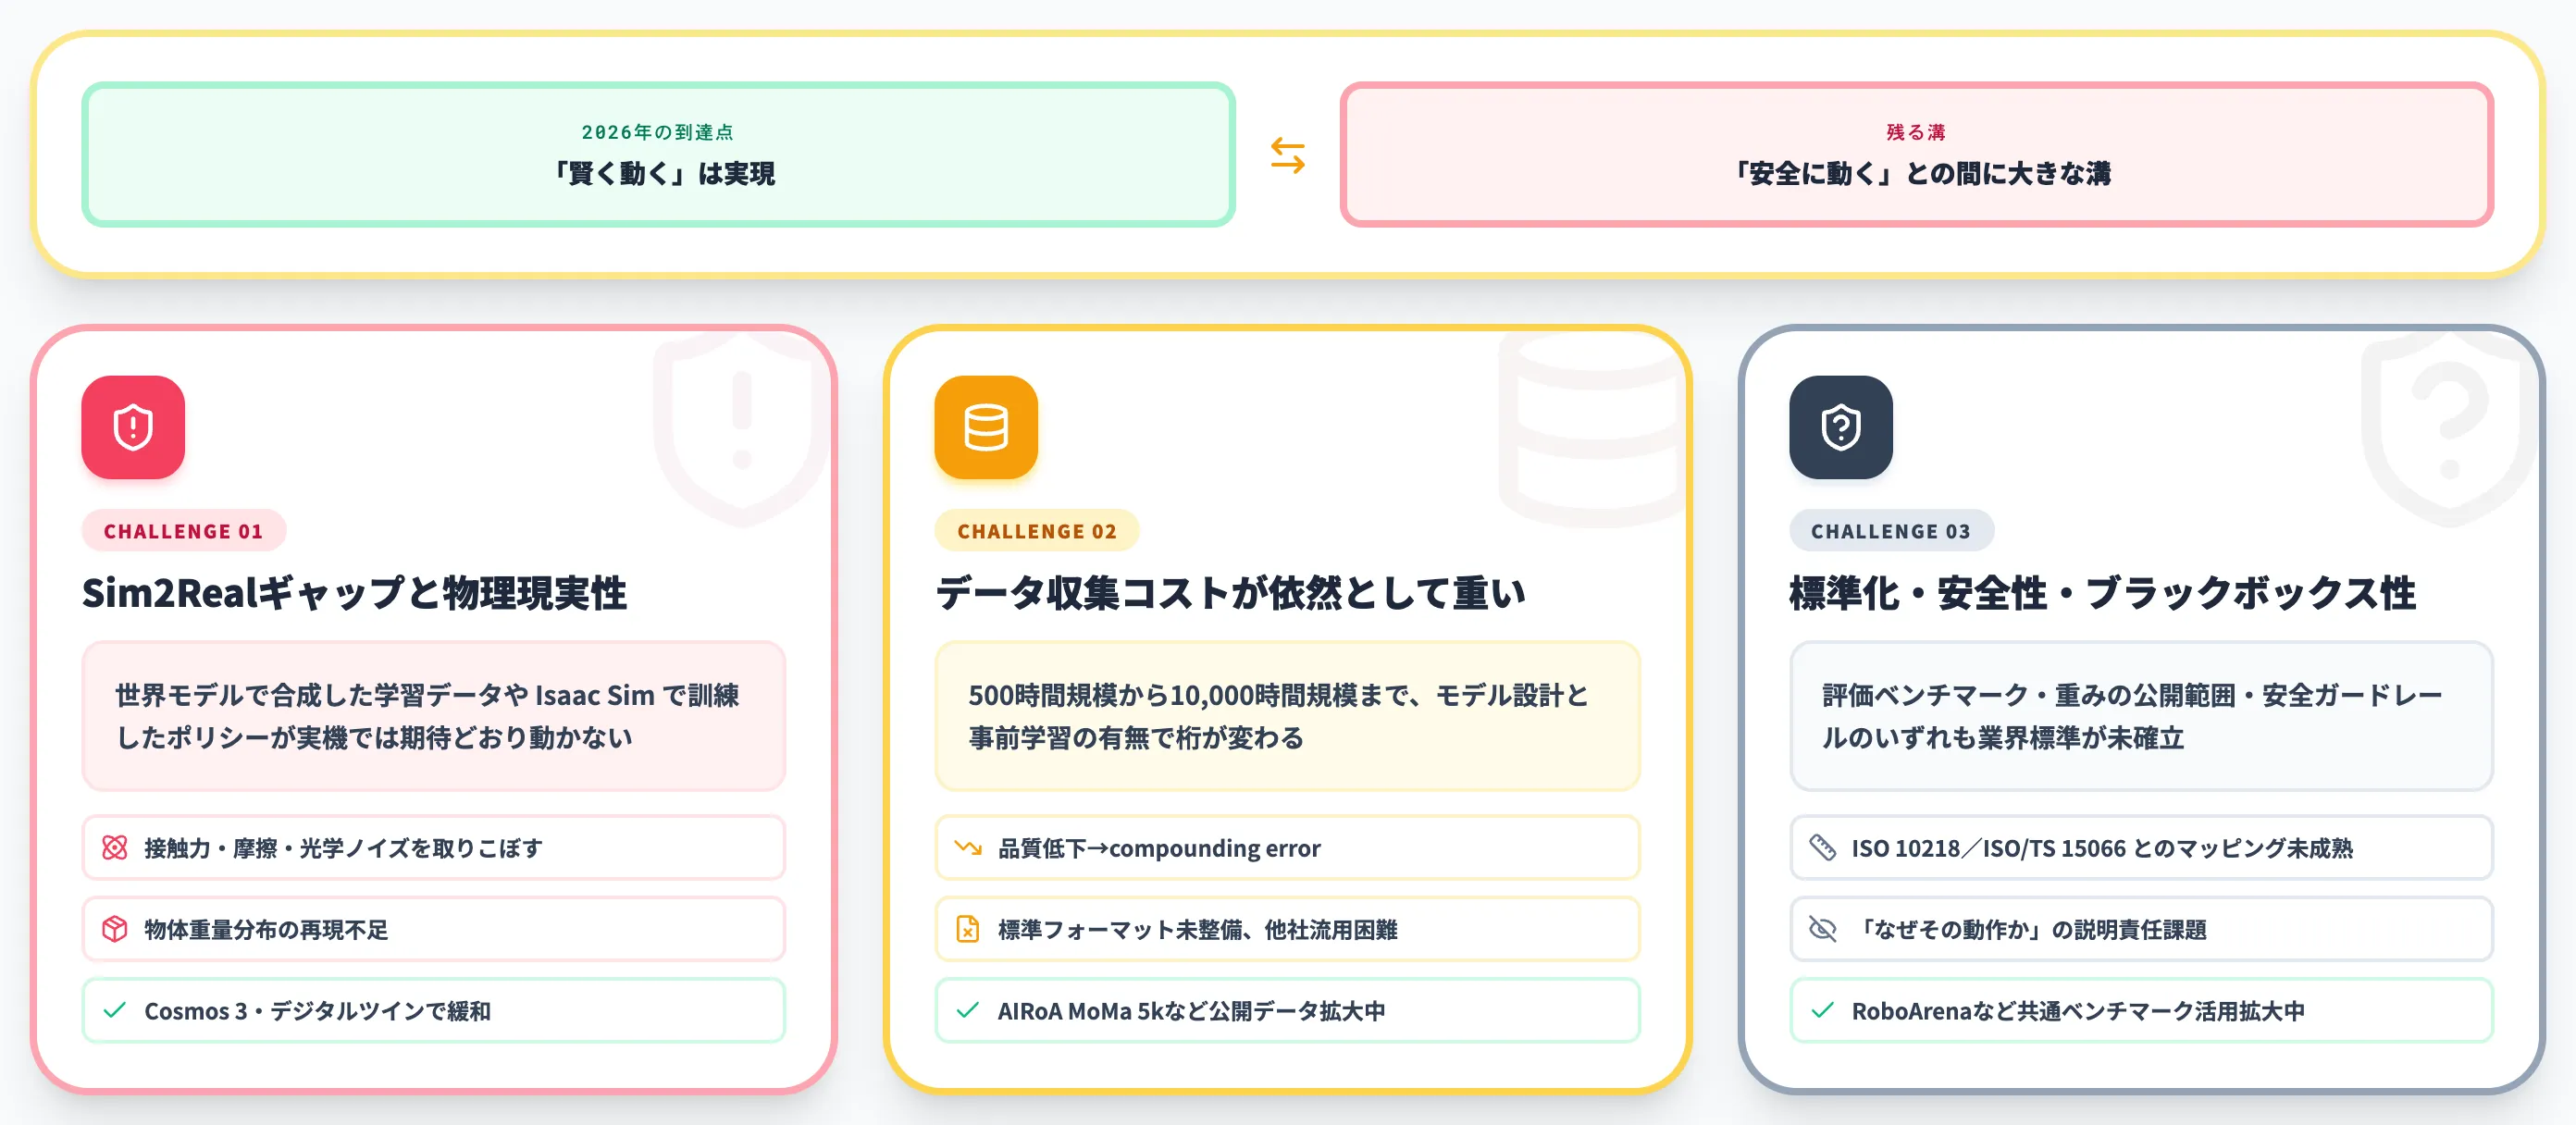
ロボット基盤モデルは2026年に商用展開のフェーズに入ったとはいえ、実機導入では「賢く動く」と「安全に動く」の間に大きな溝が残っています。
Sim2Realギャップと物理現実性
世界モデルで合成した学習データや、Isaac Simで訓練したポリシーが、実機では期待どおり動かないSim2Realギャップは依然として最大の壁です。
接触力・摩擦・光学ノイズ・物体の重量分布など、シミュレーションが取りこぼす物理要素が実機で予期せぬ失敗を生みます。Cosmos 3のような物理整合性を強化した世界モデルや、デジタルツインを使った段階的な検証が緩和策になりますが、完全解決には至っていません。
データ収集コストが依然として重い
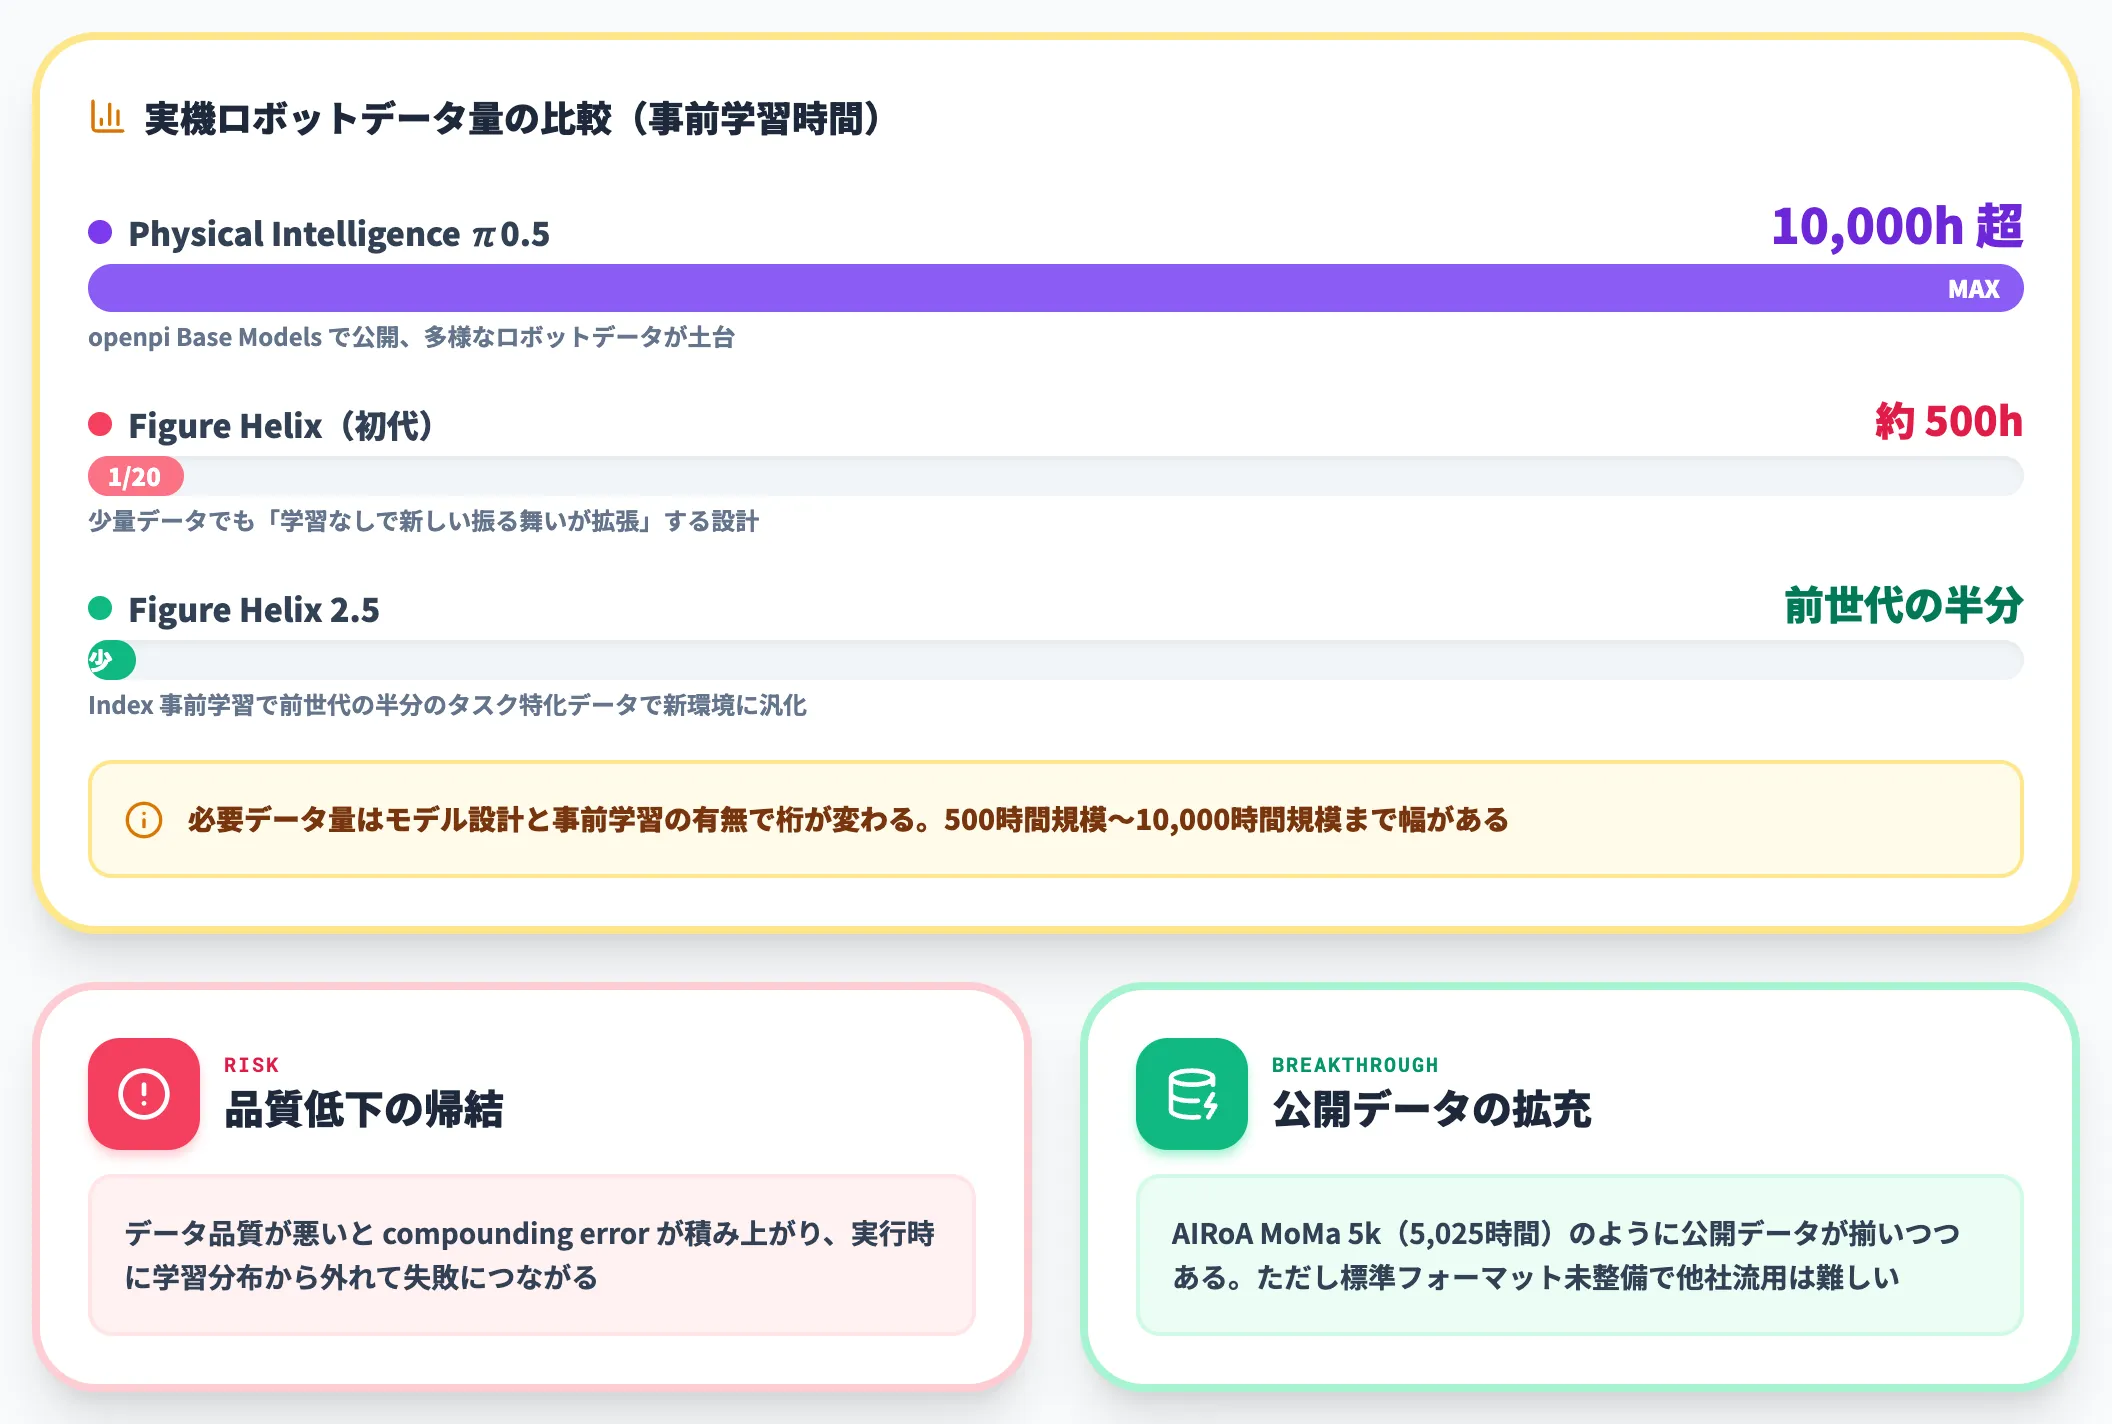
ロボット基盤モデルの学習に必要な実機ロボットデータの規模は、採用するモデルやアーキテクチャで大きく変わります。
Physical Intelligence π0.5は10,000時間超の多様なロボットデータを土台にしており、一方でFigure Helix(初代)は約500時間、Helix 2.5はIndex事前学習で前世代の半分のタスク特化データで新環境へ汎化しています。
- 必要データ量はモデル設計と事前学習の有無で桁が変わり、500時間規模から10,000時間規模まで幅がある
- データ品質が悪いとcompounding errorが積み上がり、実行時に学習分布から外れて失敗につながる
- 標準化されていないデータ形式が多く、他社データの流用も難しい(AIRoAのAIRoA MoMa 5kのように公開データが揃いつつある)
標準化・安全性・ブラックボックス性
ロボット基盤モデルは、評価ベンチマーク・モデル重みの公開範囲・安全ガードレールのいずれも業界標準が確立していません。
RoboArenaのような共通ベンチマークが2025年に提案され2026年に活用が広がってきましたが、産業用途で求められる安全性(ISO 10218・ISO/TS 15066)や、医療・介護向けの倫理要件とのマッピングはまだこれからです。
VLAモデルはAIの限界(フレーム問題)で指摘されているブラックボックス性も抱えており、「なぜその動作を選んだか」の説明責任は人手による検証や記録でカバーする運用が現実的です。
ロボット基盤モデルを業務に取り込む次の一歩
ロボット基盤モデルの導入は、OpenVLAやLeRobotでのPoCから、GR00T N1.7やPi API betaを使った量産前パイロットへと段階を踏んで進みます。ただ、実機の検証が進んでも、例外が起きたときに誰が判断し、作業の記録をどこに残し、業務システムにどう反映するかが決まっていなければ、現場の業務には組み込めません。ロボット側の検証と並行して、業務側の受け皿を整えておくことが欠かせません。
その受け皿として使えるのが、Teamsから呼び出せる業務エージェントを自社のAzureテナント内で一元管理するAI Agent Hubです。経費精算や請求書処理といったバックオフィス業務から動かし始められ、人の承認が必要な場面はTeamsに通知して担当者が判断します。SAP ConcurやDynamics 365などの業務システムとの連携も、同じ仕組みの上で扱えます。
AI総合研究所の専任チームが、ロボットの検証計画と並行して、どの業務からエージェントを動かすかを一緒に設計します。ロボット側のシステムとの接続も、要件に応じて設計・構築を支援します。
ロボット導入に備えて業務側を整える
バックオフィスから始める業務エージェント
ロボット基盤モデルの検証と並行して、例外時の判断や作業の記録、業務システムへの反映といった業務側の仕組みを整えておくと、実機を現場に組み込みやすくなります。AI Agent Hubのサービスページで、製造業やバックオフィスのユースケースと動くデモをご確認ください。
まとめ
本記事では、ロボット基盤モデルを「視覚・言語・身体動作を1つの大規模モデルで扱う、ロボットの頭脳にあたる汎用AI」として整理し、VLA・世界モデル・制御モデルの3層構造、WAMという2026年の新潮流、主要プレイヤーの動向、導入判断とコスト、残る課題を解説しました。
2026年10月時点で押さえておくべきポイントは次の3つです。
- VLA・世界モデル・制御モデルの3層で役割を分けて捉えると、乱立するモデルのどれから使うかを判断しやすくなる
- VLAと世界モデルを1つに融合するWAMが2026年の新潮流として台頭し、NVIDIAは将来の主流を両者のハイブリッドと見ている
- オープンモデルで型を固めてから商用提携に移るほうが、いきなりクローズドモデルから入るより検証が止まりにくく、投資効率もよい
自社で着手する場合は、AI総合研究所の支援現場で採用しやすい3段のルートが目安になります。
まずはOpenVLAやLeRobotで研究・PoCを回し、自社の作業でデータ収集と評価の型を作ります。
続いて、量産前の実機検証をGR00T N1.7やPi API betaで行い、手応えを確かめてからGemini Robotics 2やFigure Helix 2.5との商用提携に進みます。
どのモデルを選んでも、賢く動くことと安全に動くことの間にはSim2Realとデータ品質という溝が残っています。
ロボット基盤モデル分野は年単位で主役が入れ替わります。本記事で全体像をつかんだあとは、自社テーマに近い層から着手するのが最短ルートです。