この記事のポイント
 汎用LLMをロボット方策に直結する動きの中で、NVIDIAが3モードの性能・コストを横並びに測った初の体系的ベンチマーク
- Agentic PolicyがRoboLab-120で74.8%の成功率を記録し、Lakeside(LWM)比で23.8pt上回る数値を叩き出した
- ただしAgenticは成功エピソードの平均推計コスト約$36.40でDirectの約19倍。Orchestratedは3モード中で成功率とコストのバランスが取れた選択肢
- 既存VLAのπ0.5(28.0%)やWAMのCosmos3-Nano-Policy(36.8%)に対し、Astra経由の3モードはすべて上回った
- NVIDIA SRLは今回のテックレポートに加えCoRL 2026に10件採択、物理AI分野のアカデミックプレゼンスを強化中
Microsoft MVP・AIパートナー。LinkX Japan株式会社 代表取締役。東京工業大学大学院にて自然言語処理・金融工学を研究。NHK放送技術研究所でAI・ブロックチェーンの研究開発に従事し、国際学会・ジャーナルでの発表多数。経営情報学会 優秀賞受賞。シンガポールでWeb3企業を創業後、現在は企業向けAI導入・DX推進を支援。
Astranomy(アストラノミー)は、NVIDIA Seattle Robotics Labが2026年10月14日に公開した、OpenAIの汎用LLM「GPT-6 Astra」をロボットのネイティブ方策として評価する実証研究です。
専用学習したVLAやWAMを介さずAstra単体でロボットを動かす「Direct」、持続セッションでツール併用する「Agentic」、既存の方策モデルを監督する「Orchestrated」の3モードを、RoboLab-120ベンチマークで横並び比較しています。
本記事では、研究の位置づけ、3つのモードの機構差、性能・コスト・レイテンシの実測値、Stanford HomeBodyやRoboDojo評価論文との棲み分け、そして企業がこの技術をどう評価すべきかまでを、2026年10月時点の最新情報で整理します。
目次
Astranomyとは?NVIDIAがGPT-6 Astraを「素の方策」として評価した実証研究
Astranomyの命名——Astra + -nomy(天文学モチーフ)
Direct Policy——永続会話なしの行動チャンク呼び出し
Agentic Policy——Codex永続セッションで文脈を保持
Orchestrated Policy——Cosmos3-Nano-Policyの監督
評価基盤——RoboLab-120とDROID仕様のシミュレーション
Astranomyの実験結果——3モードの成功率とベースライン比較
既存VLA(π0.5)・WAM(Cosmos3-Nano)との差分
コストとレイテンシのトレードオフ——Agentic 約$36 vs Direct 約$2(成功エピソード平均)の実務インパクト
類似研究との差分——HomeBody・RoboDojo評価論文との棲み分け
Stanford HomeBody——スキルライブラリ経由型
Astranomyとは?NVIDIAがGPT-6 Astraを「素の方策」として評価した実証研究
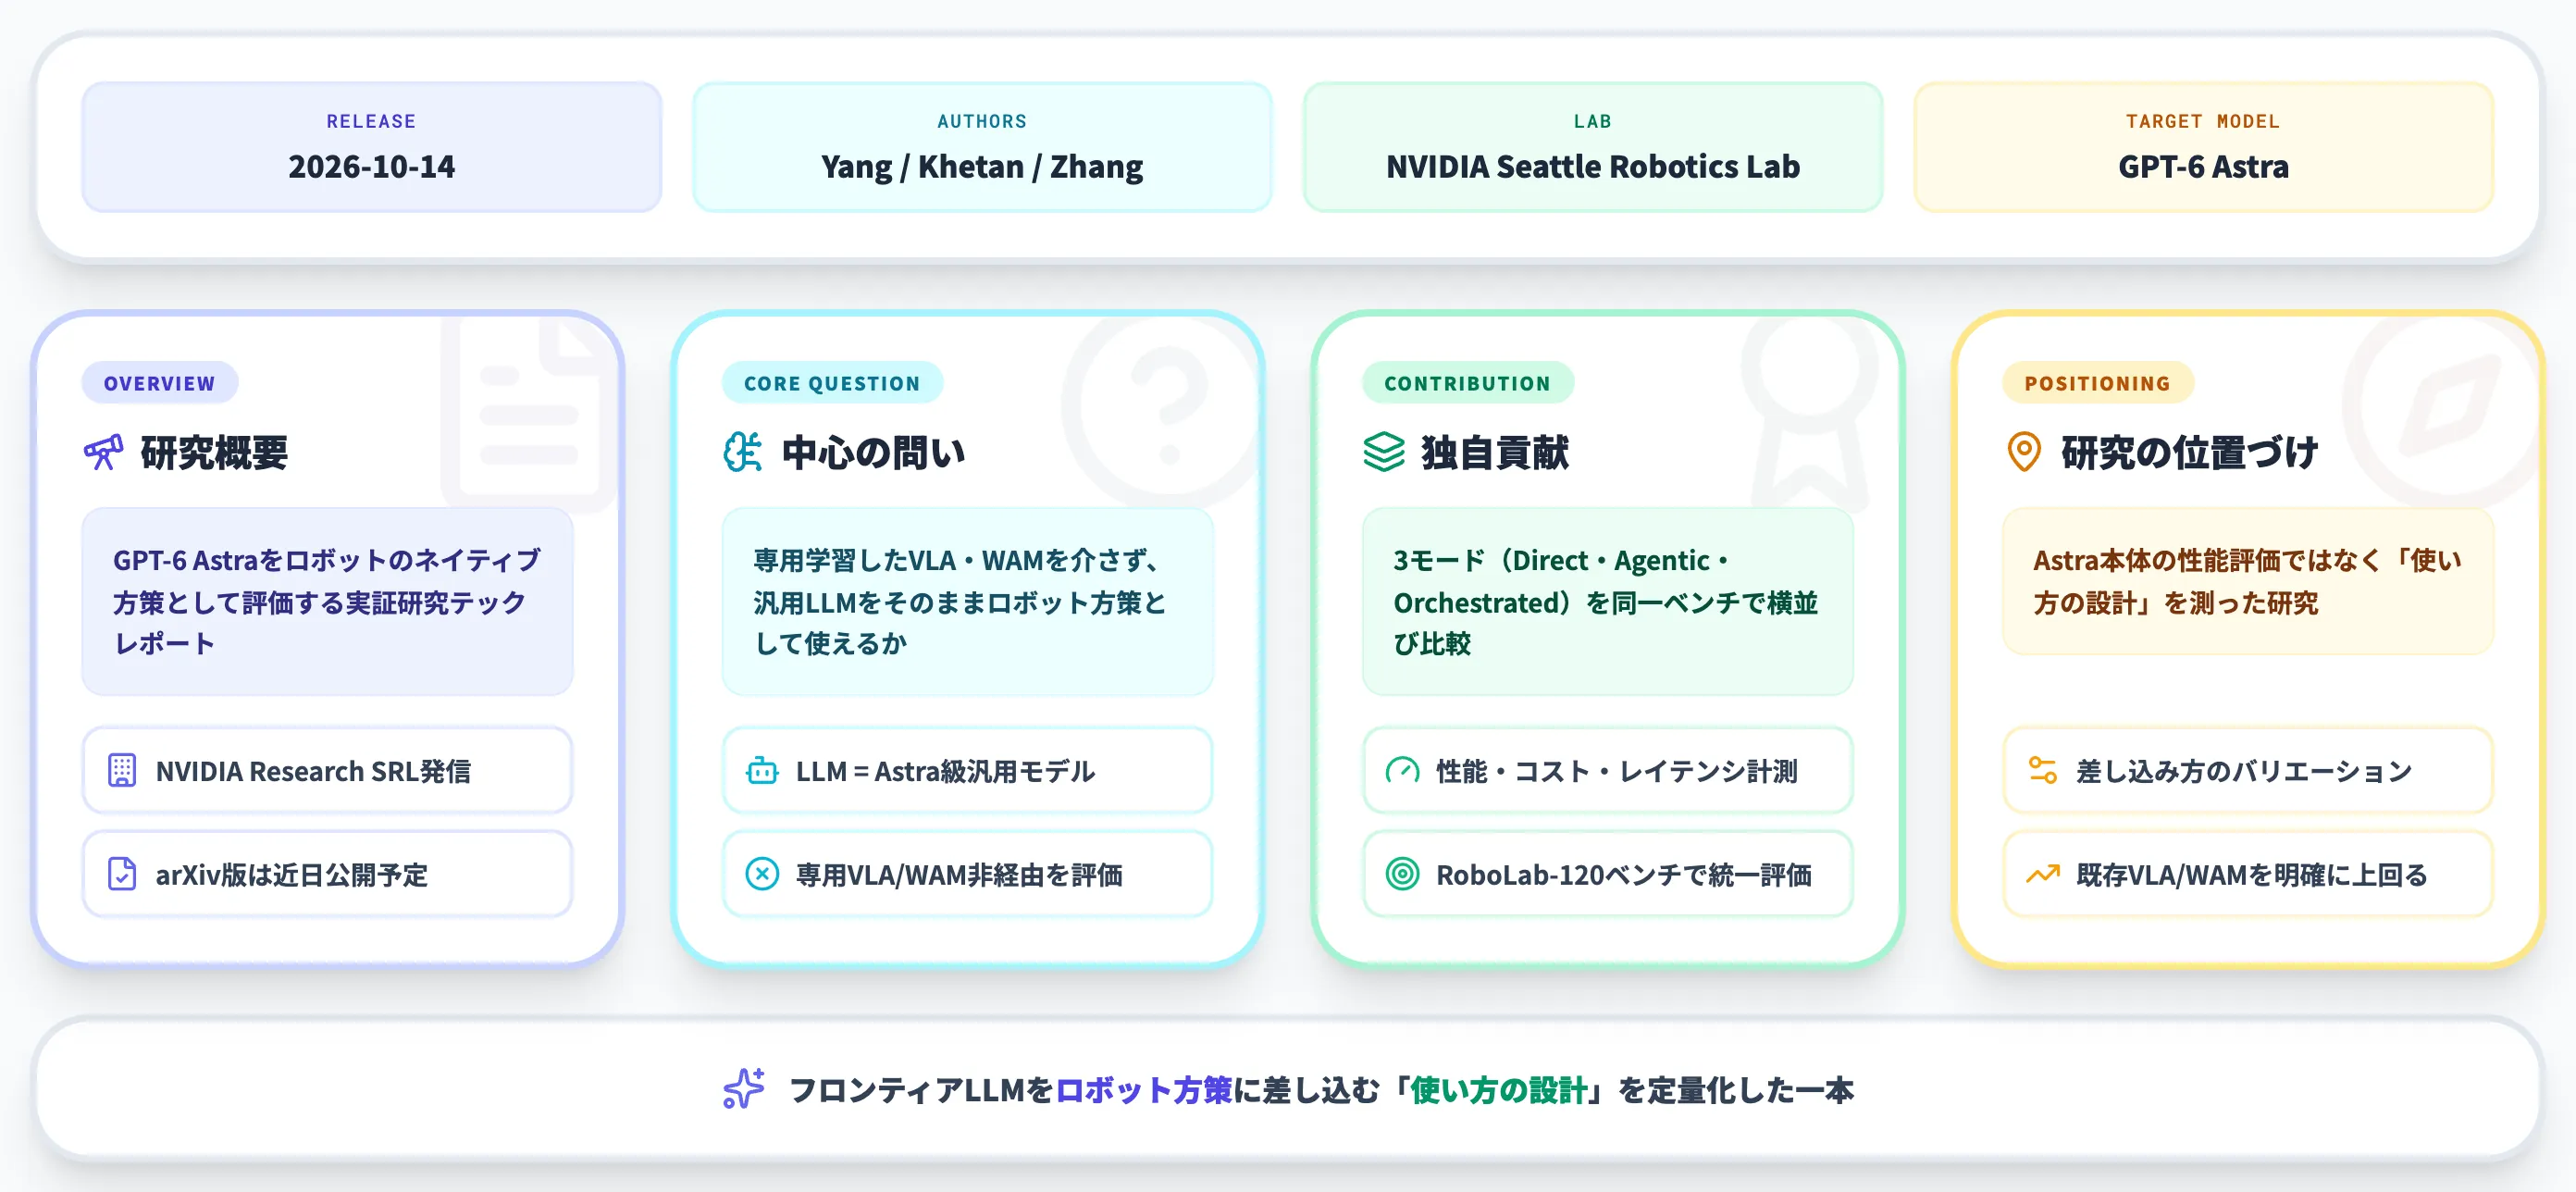
Astranomy(アストラノミー)とは、NVIDIA Seattle Robotics Labが2026年10月14日に公開したテックレポートで、OpenAIの汎用LLM「GPT-6 Astra」をロボットのネイティブ方策(native policy)として評価する実証研究です。
Astranomyの中心にある問いは「専用学習させたVLA・WAMを介さず、汎用LLMをそのままロボット方策として使えるか」です。これは2026年9月のGPT-6 Astra公開前後から急速に注目された論点で、Stanford HomeBodyやarXivの「An Unexpected Robot Policy」など複数研究が同時並行で走る状況になっています。
NVIDIA SRLはこの潮流の中で、「どう使うか」のバリエーションをDirect・Agentic・Orchestratedの3モードに切り分け、同一ベンチマーク上で性能・レイテンシ・コストを横並び比較した点が独自の貢献です。Astra本体の性能評価ではなく、フロンティアLLMをロボットに差し込むときの「使い方の設計」を測った研究と位置づけるのが正確です。
Astranomyの命名——Astra + -nomy(天文学モチーフ)
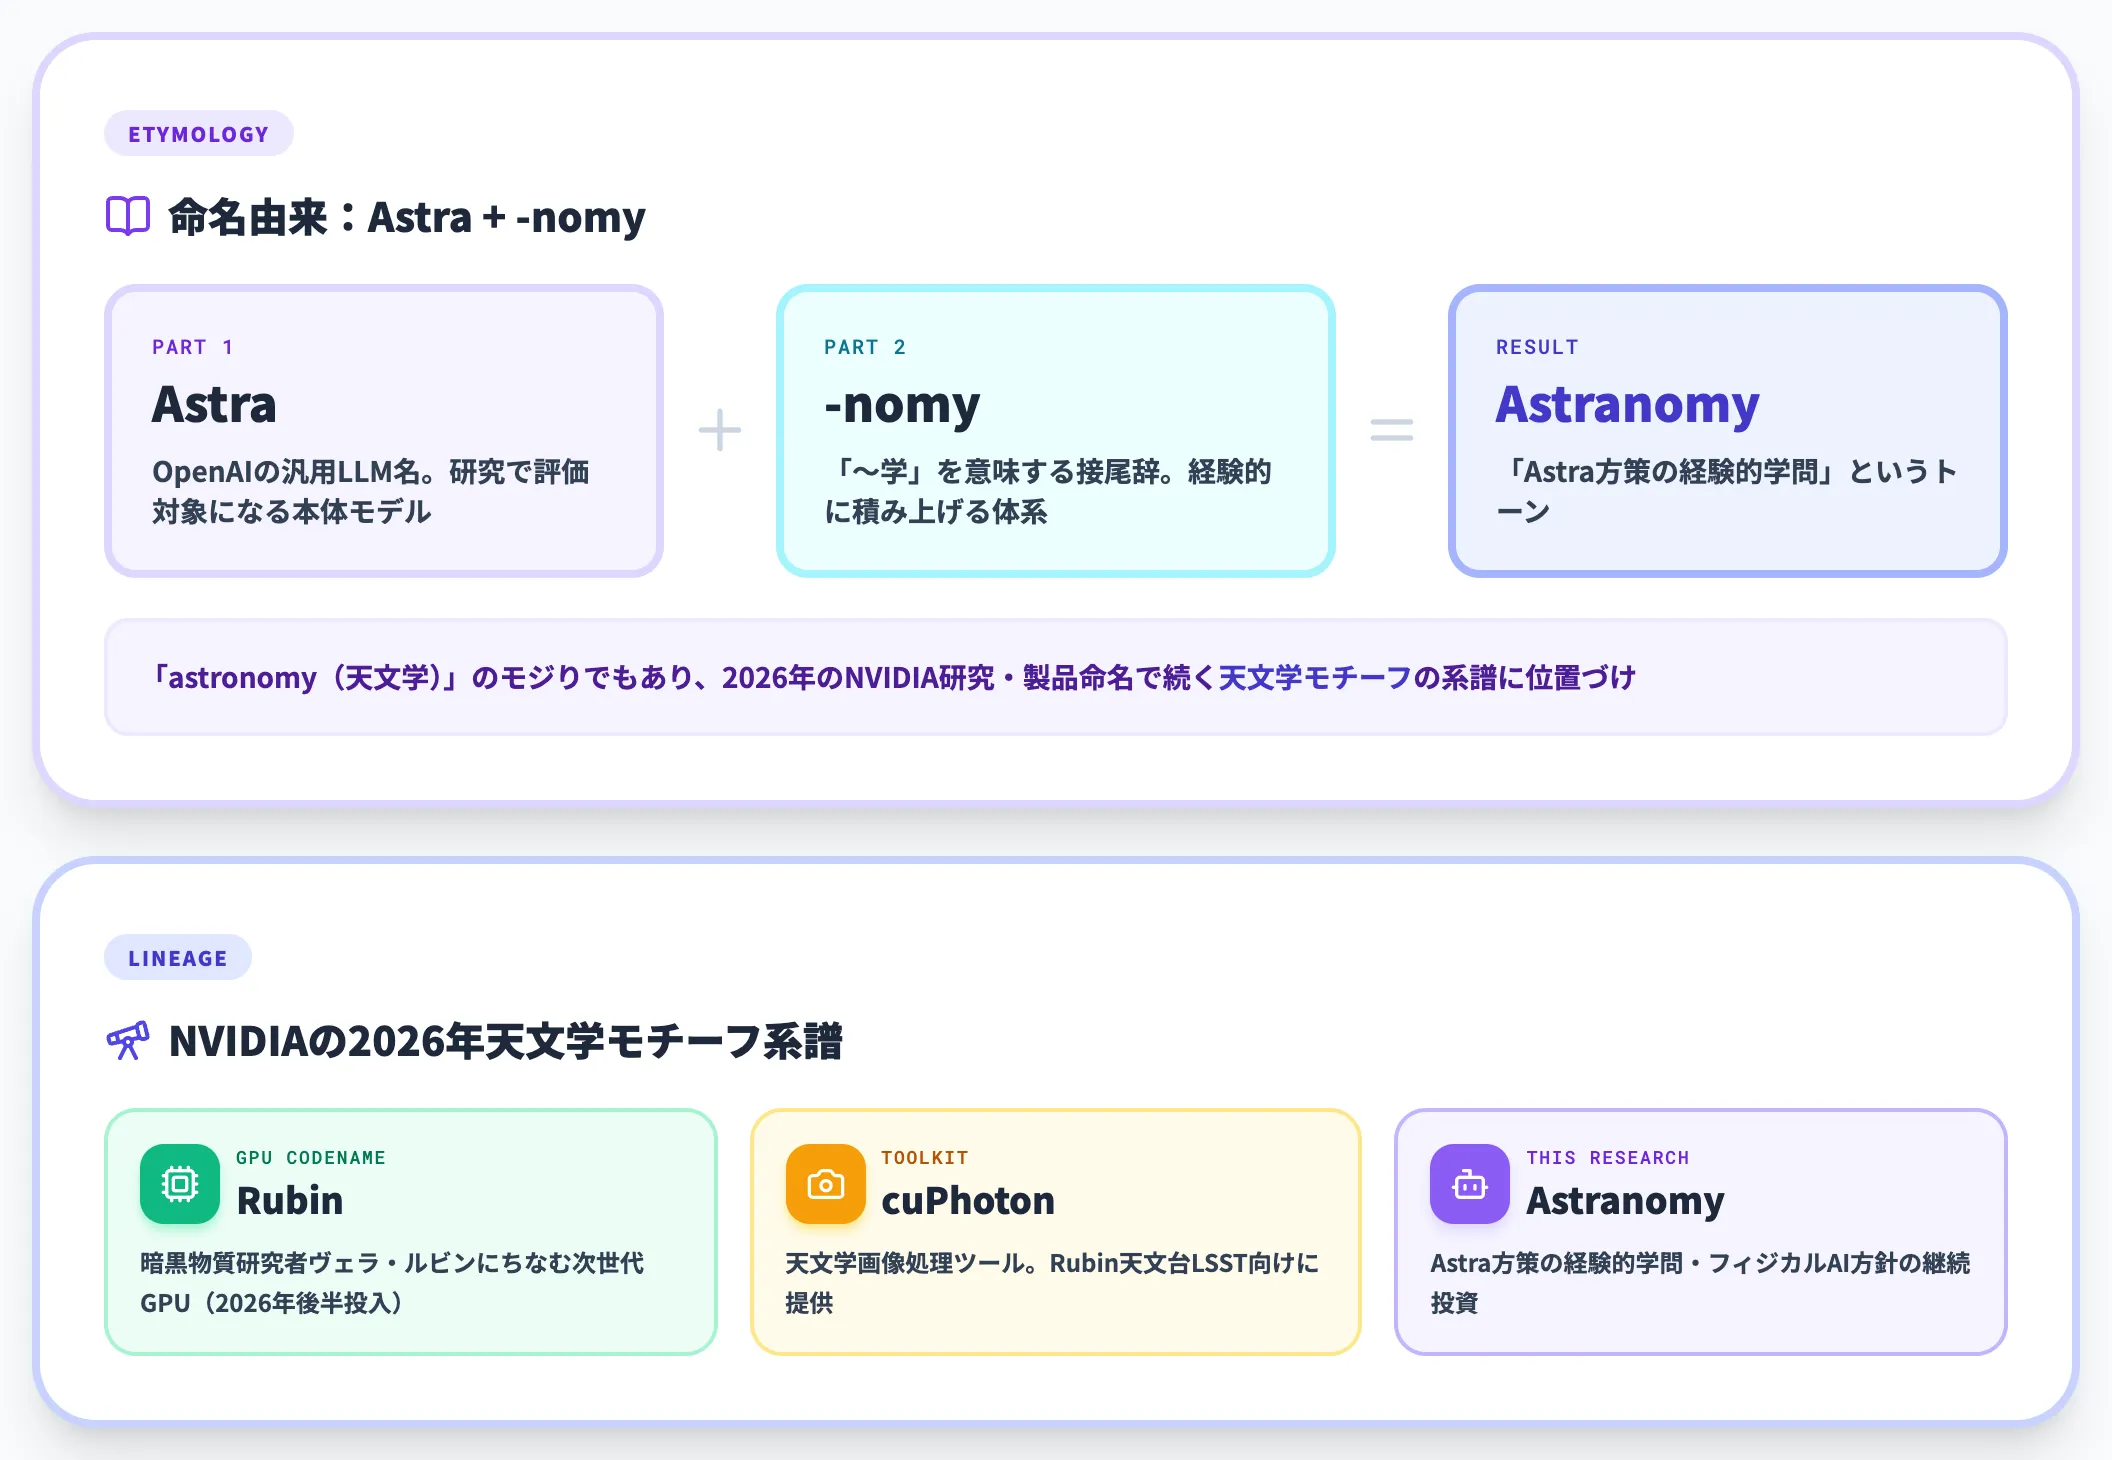
研究名は「Astra(OpenAIのモデル名)」と「-nomy(〜学)」を組み合わせた造語で、「Astra方策の経験的学問」というトーンを帯びています。
NVIDIAは2026年秋にBlackwell Ultra世代のフラッグシップ「DGX B300」を本格展開しつつ、天文学画像処理ツールキット「cuPhoton」を暗黒物質研究者ヴェラ・ルビンの名を冠するRubin天文台のLSST向けに提供しており、研究・ツール発信の文脈で天文学モチーフが重なって現れているのが特徴です。
Astranomyもこの系譜に位置し、フィジカルAI分野でNVIDIAが打ち出してきた一連の投資と地続きの発信です。
Astranomyが切り分けた3つのポリシーモード
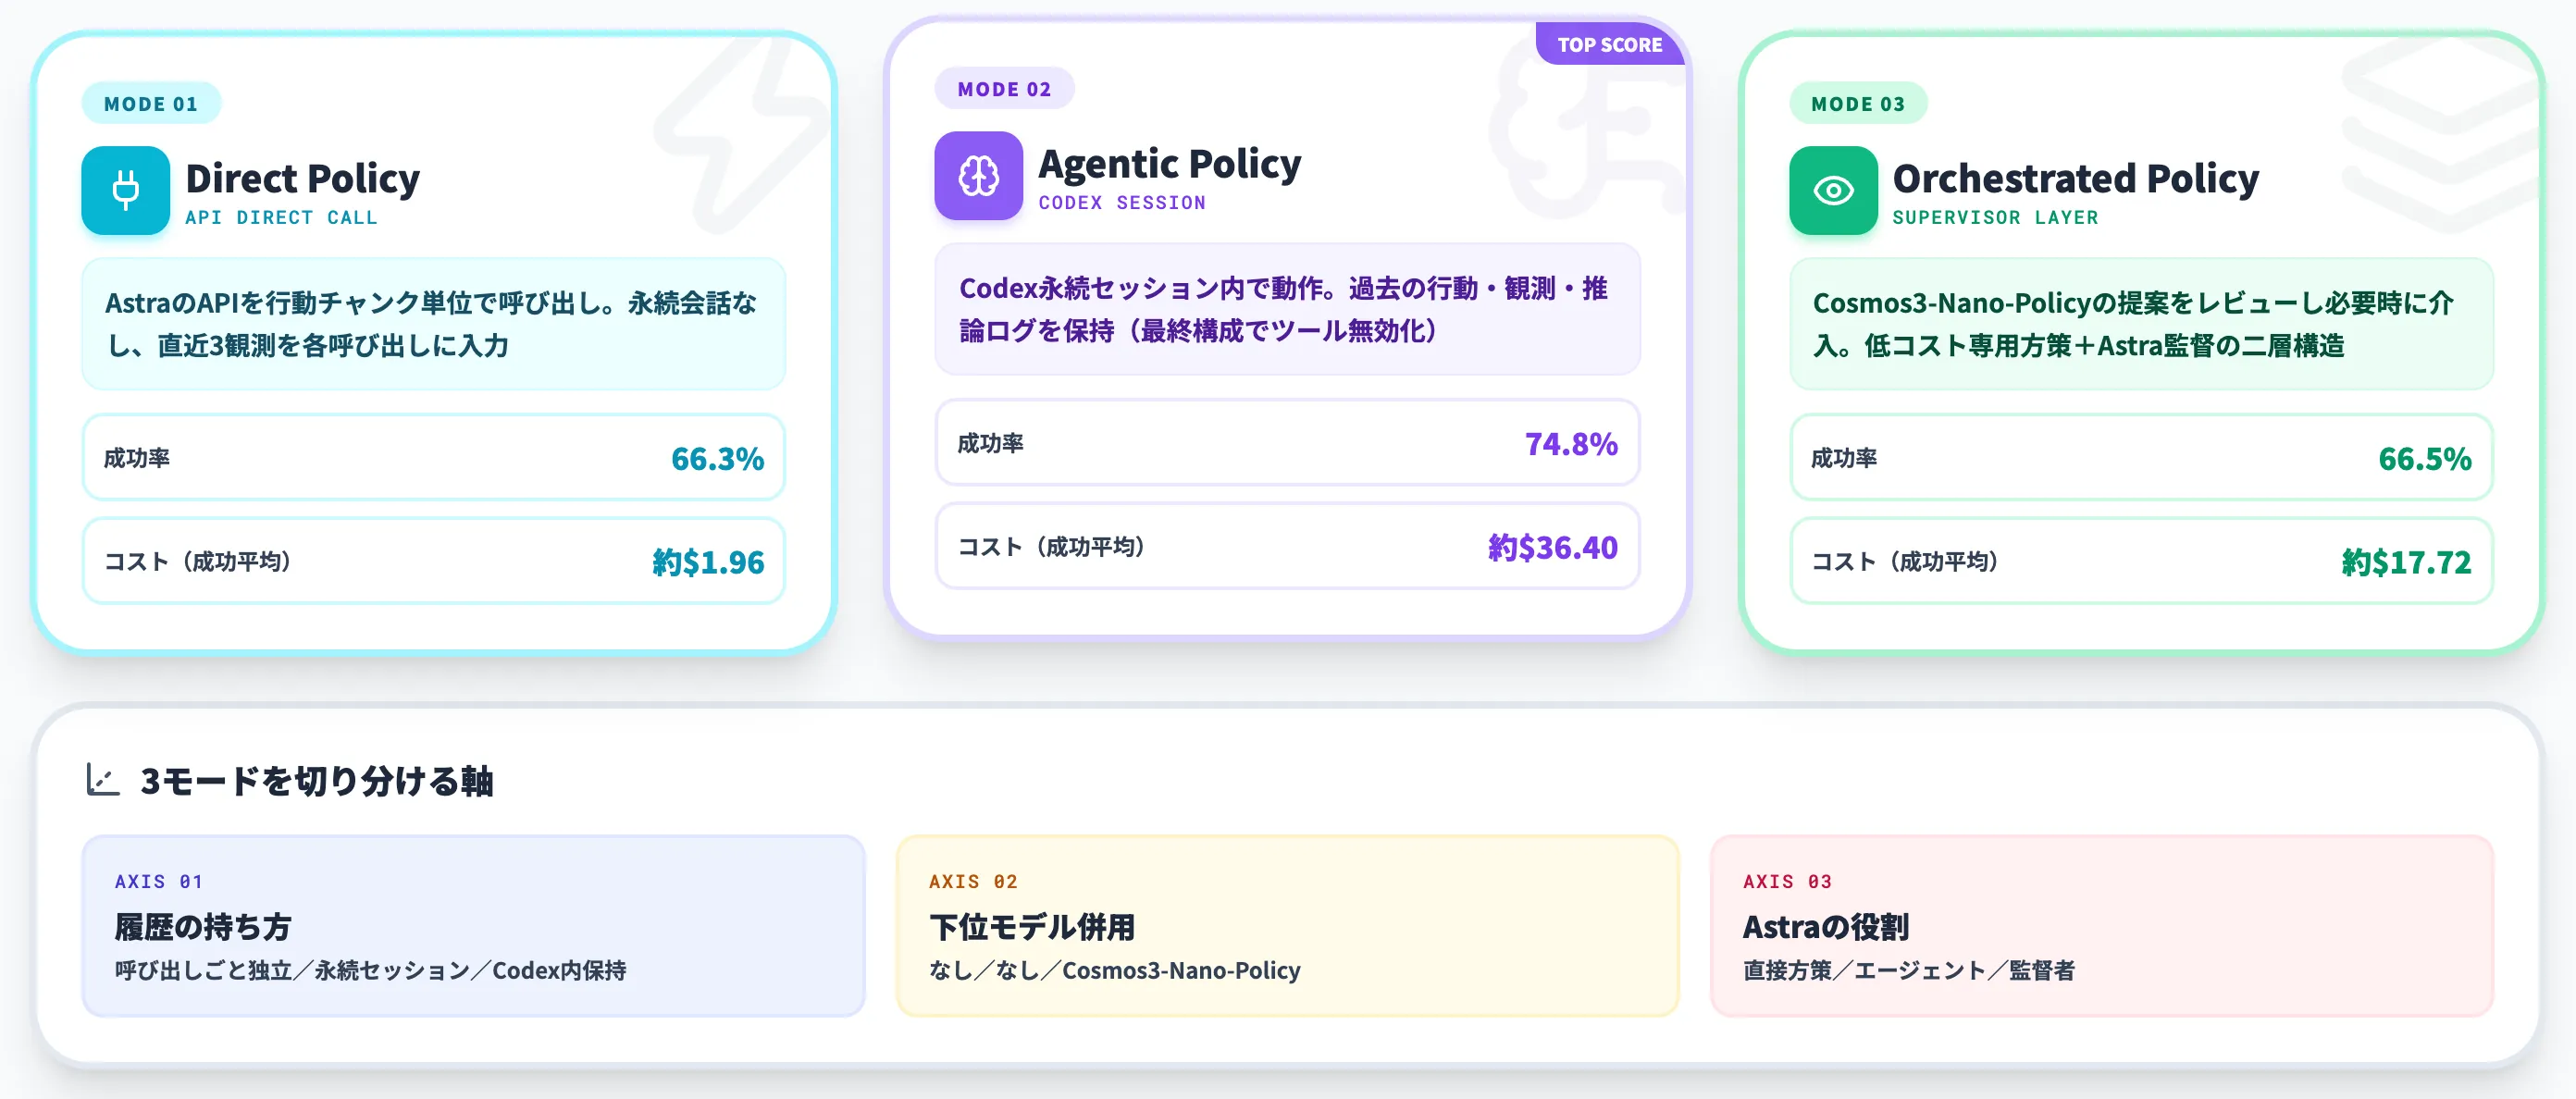
Astranomyの研究設計の中核は、GPT-6 Astraを「どの深さまでロボット制御に差し込むか」で3つのモードに切り分けた点です。
以下の表で、3モードの機構と情報保持の違いを整理しました。
| モード | Astraの役割 | 履歴保持 | 併用ツール |
|---|---|---|---|
| Direct Policy | APIで行動チャンクを生成 | 永続会話なし/直近3観測を各呼び出しに入力 | なし |
| Agentic Policy | Codex永続セッション内で動作 | あり(過去の行動・観測・推論ログ) | 公式§3.4・表2によれば、最終構成ではビジョンや計算の任意ツールは無効化(アブレーションでのみ有効化) |
| Orchestrated Policy | Cosmos3-Nano-Policyの提案をレビューし必要時に介入 | Codexセッション内で保持 | Cosmos3-Nano-Policy本体 |
この表が示すとおり、Astraをどこまでステートフルに使うか・下位の方策モデルと組み合わせるかが3モードの軸です。実務目線では「API直叩き」「エージェント化」「監督者化」と言い換えても構造が伝わります。
Direct Policy——永続会話なしの行動チャンク呼び出し
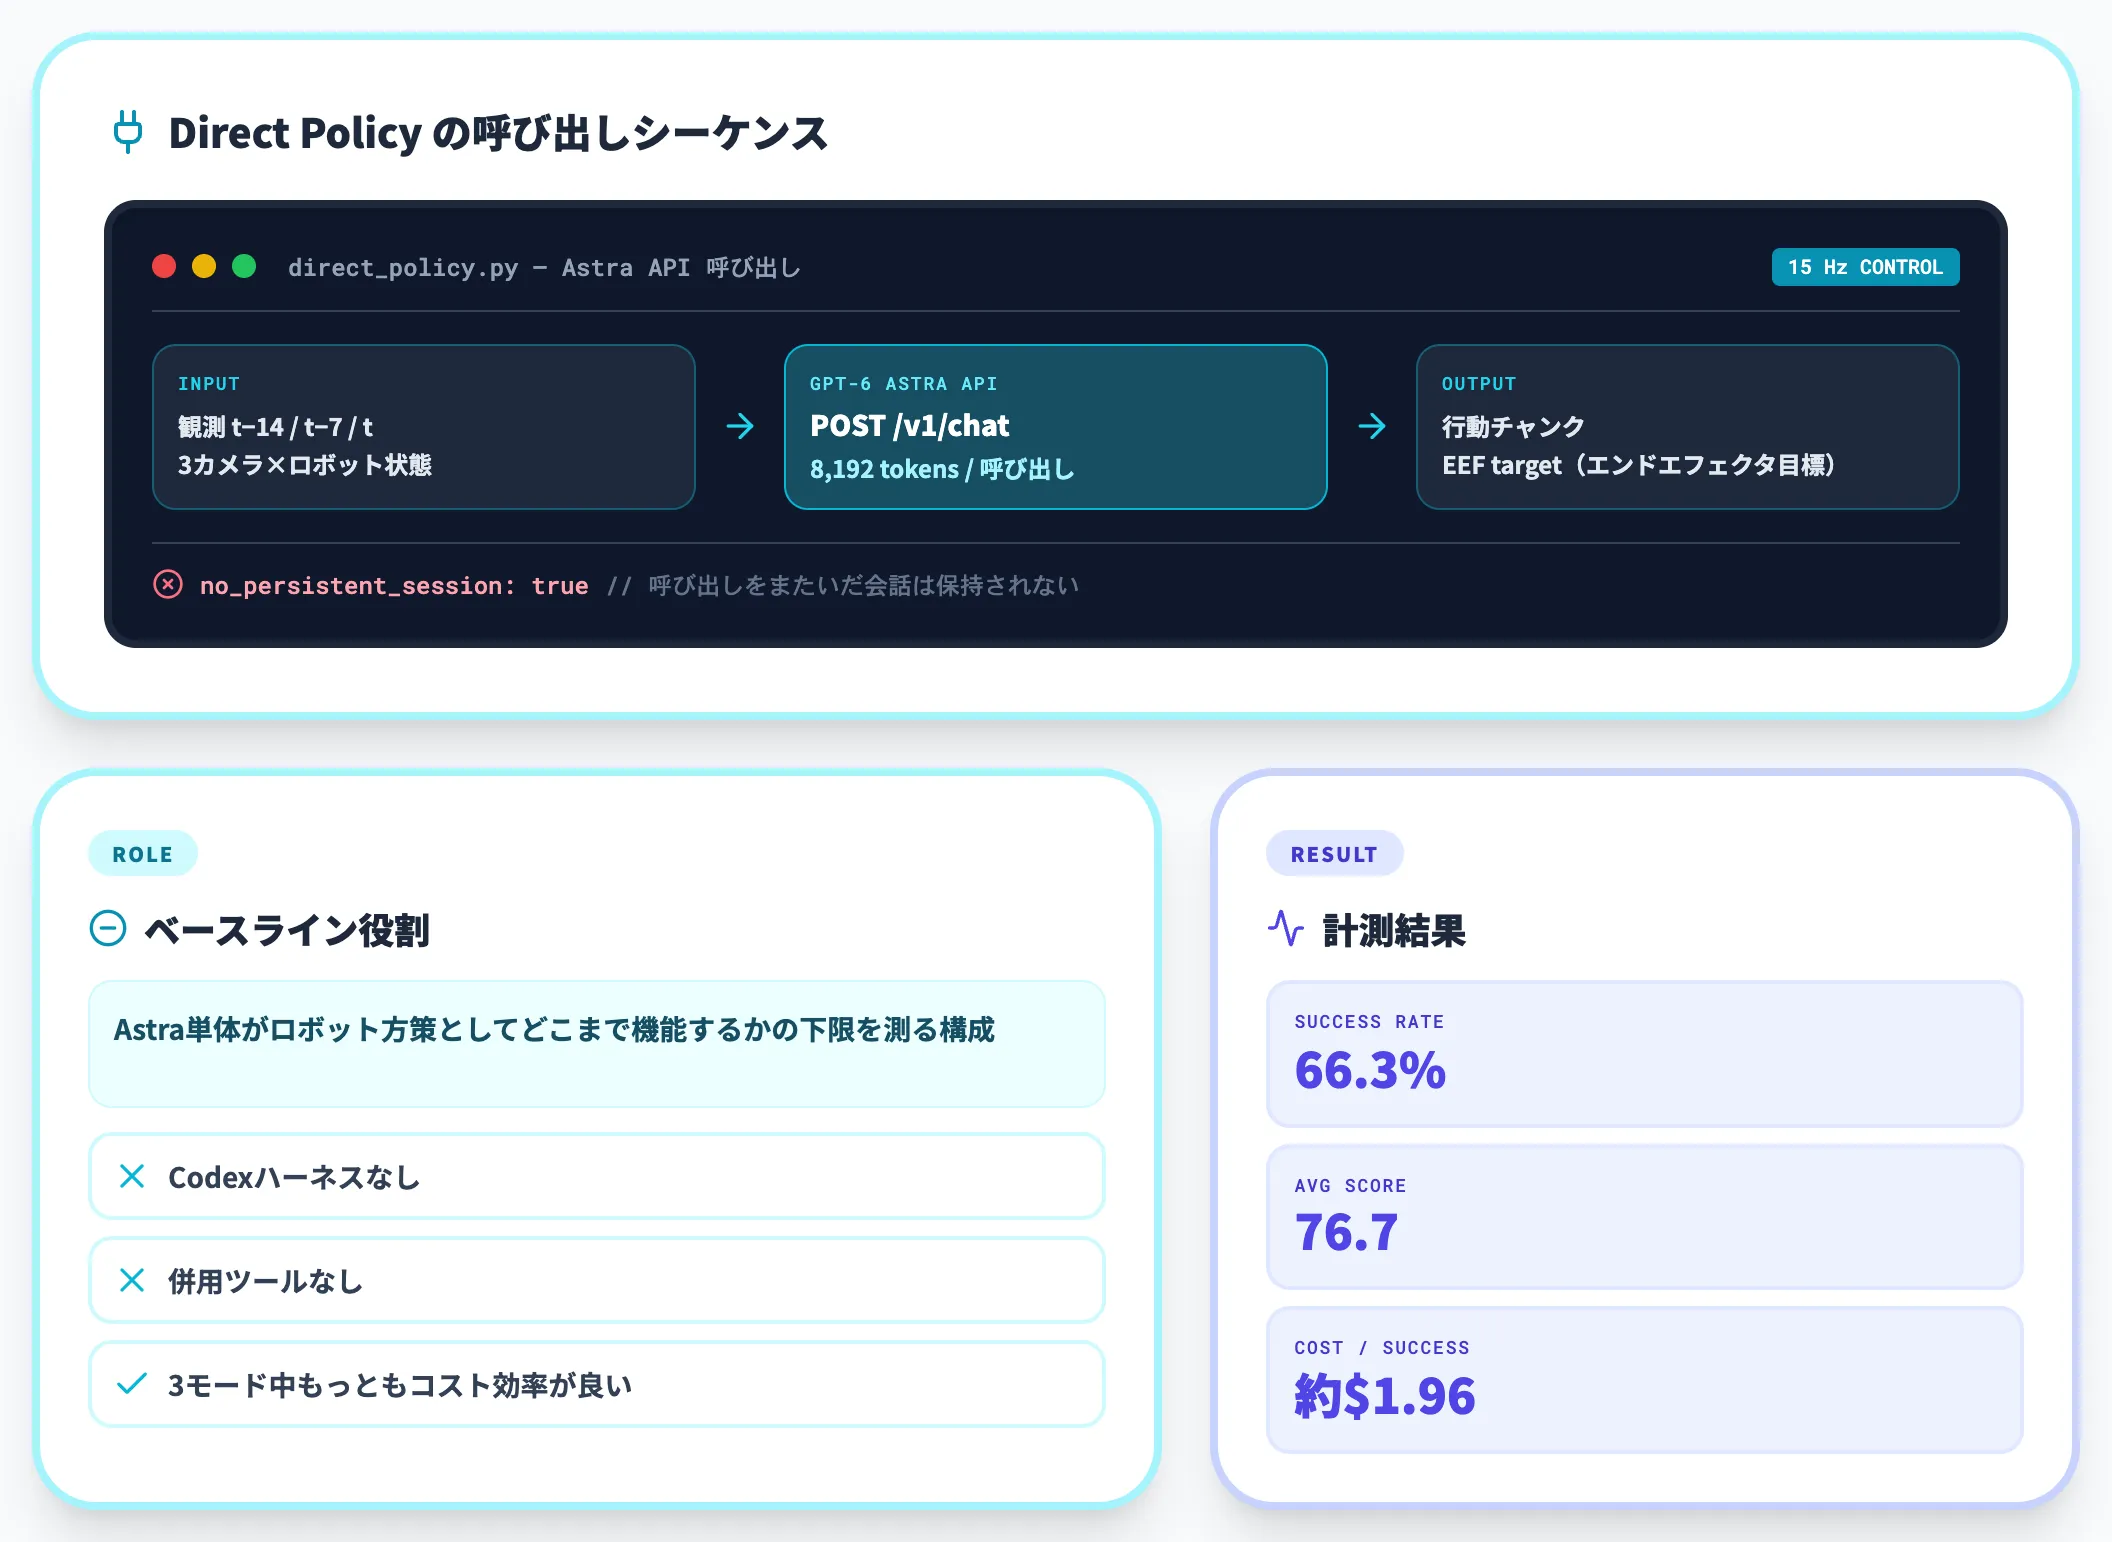
Direct Policyは最もシンプルな構成で、AstraのAPIを行動チャンク単位で呼び出し、エンドエフェクタ目標(EEF target)などを取得して実行します。各呼び出しには公式・表2によると直近3時点(t−14、t−7、t)の観測とロボット状態が入力され、Astraは次のチャンクを返す形です(各時点では3カメラ=左肩・右肩・リスト視点の画像を使用)。
Codexハーネスやツール併用は介在せず、呼び出しをまたいだ永続会話も保持されません。1チャンクが実行されるたびに新しい呼び出しとして独立に扱われるため、「Astra単体がロボット方策としてどこまで機能するか」の下限を測るベースライン的役割を担います。
Astranomyの計測ではDirect(EEF)が成功率66.3%・平均スコア76.7・成功エピソードあたり約$1.96で、最もコスト効率が良いAstra構成になっています。
Agentic Policy——Codex永続セッションで文脈を保持
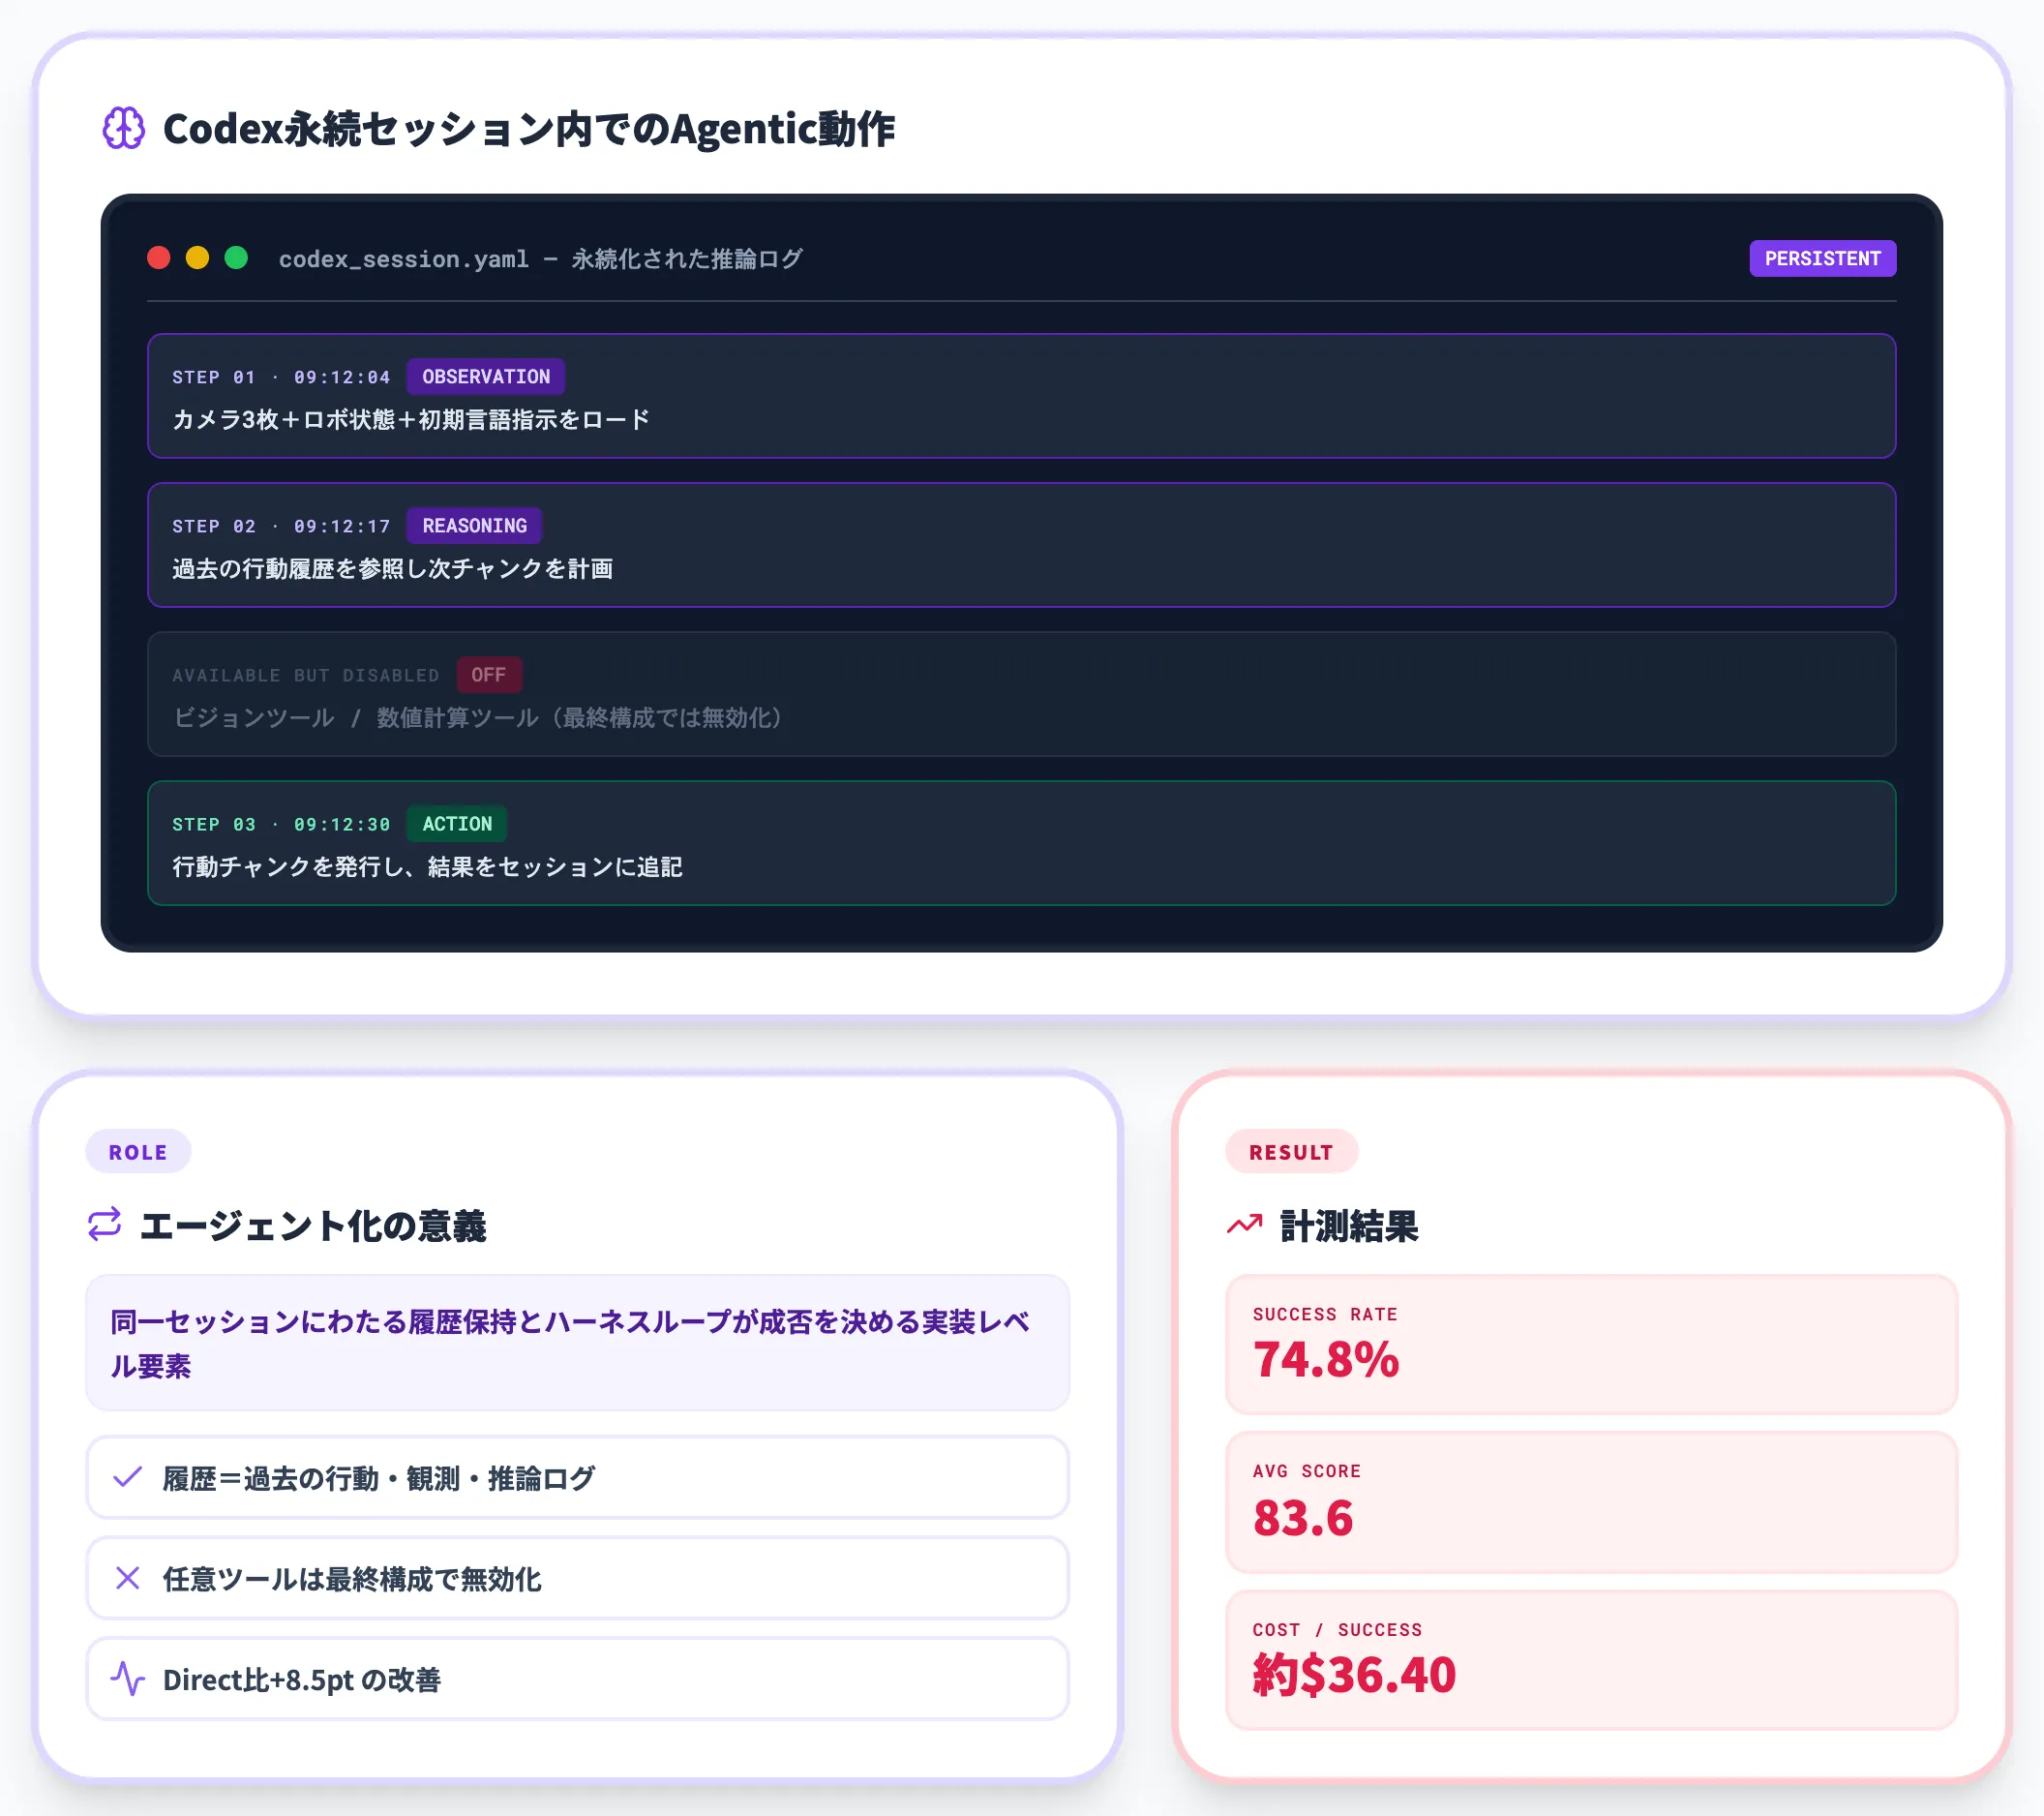
Agentic Policyは、OpenAIのCodexエージェントハーネス上でAstraを動かし、同一セッションにわたって過去の行動・観測・推論ログを保持します。
公式§3.4・表2によると、画像精査のビジョンツールや数値計算ツールにアクセスできる設計自体は用意されていますが、RoboLab-120での最終成績計測では任意ツールは無効化され、永続会話とハーネス側のループだけが有効になっています。ツール併用の効果はアブレーション実験で切り分け評価されており、74.8%の成功率をツール併用の効果として帰属するのは不正確です。
ベンチマーク結果はAgenticが成功率74.8%・平均スコア83.6で3モード中トップで、成功エピソードあたりの平均推計コストは約$36.40とDirectの約19倍に跳ね上がります(コスト計測の前提は後述「コストとレイテンシのトレードオフ」参照)。
Orchestrated Policy——Cosmos3-Nano-Policyの監督
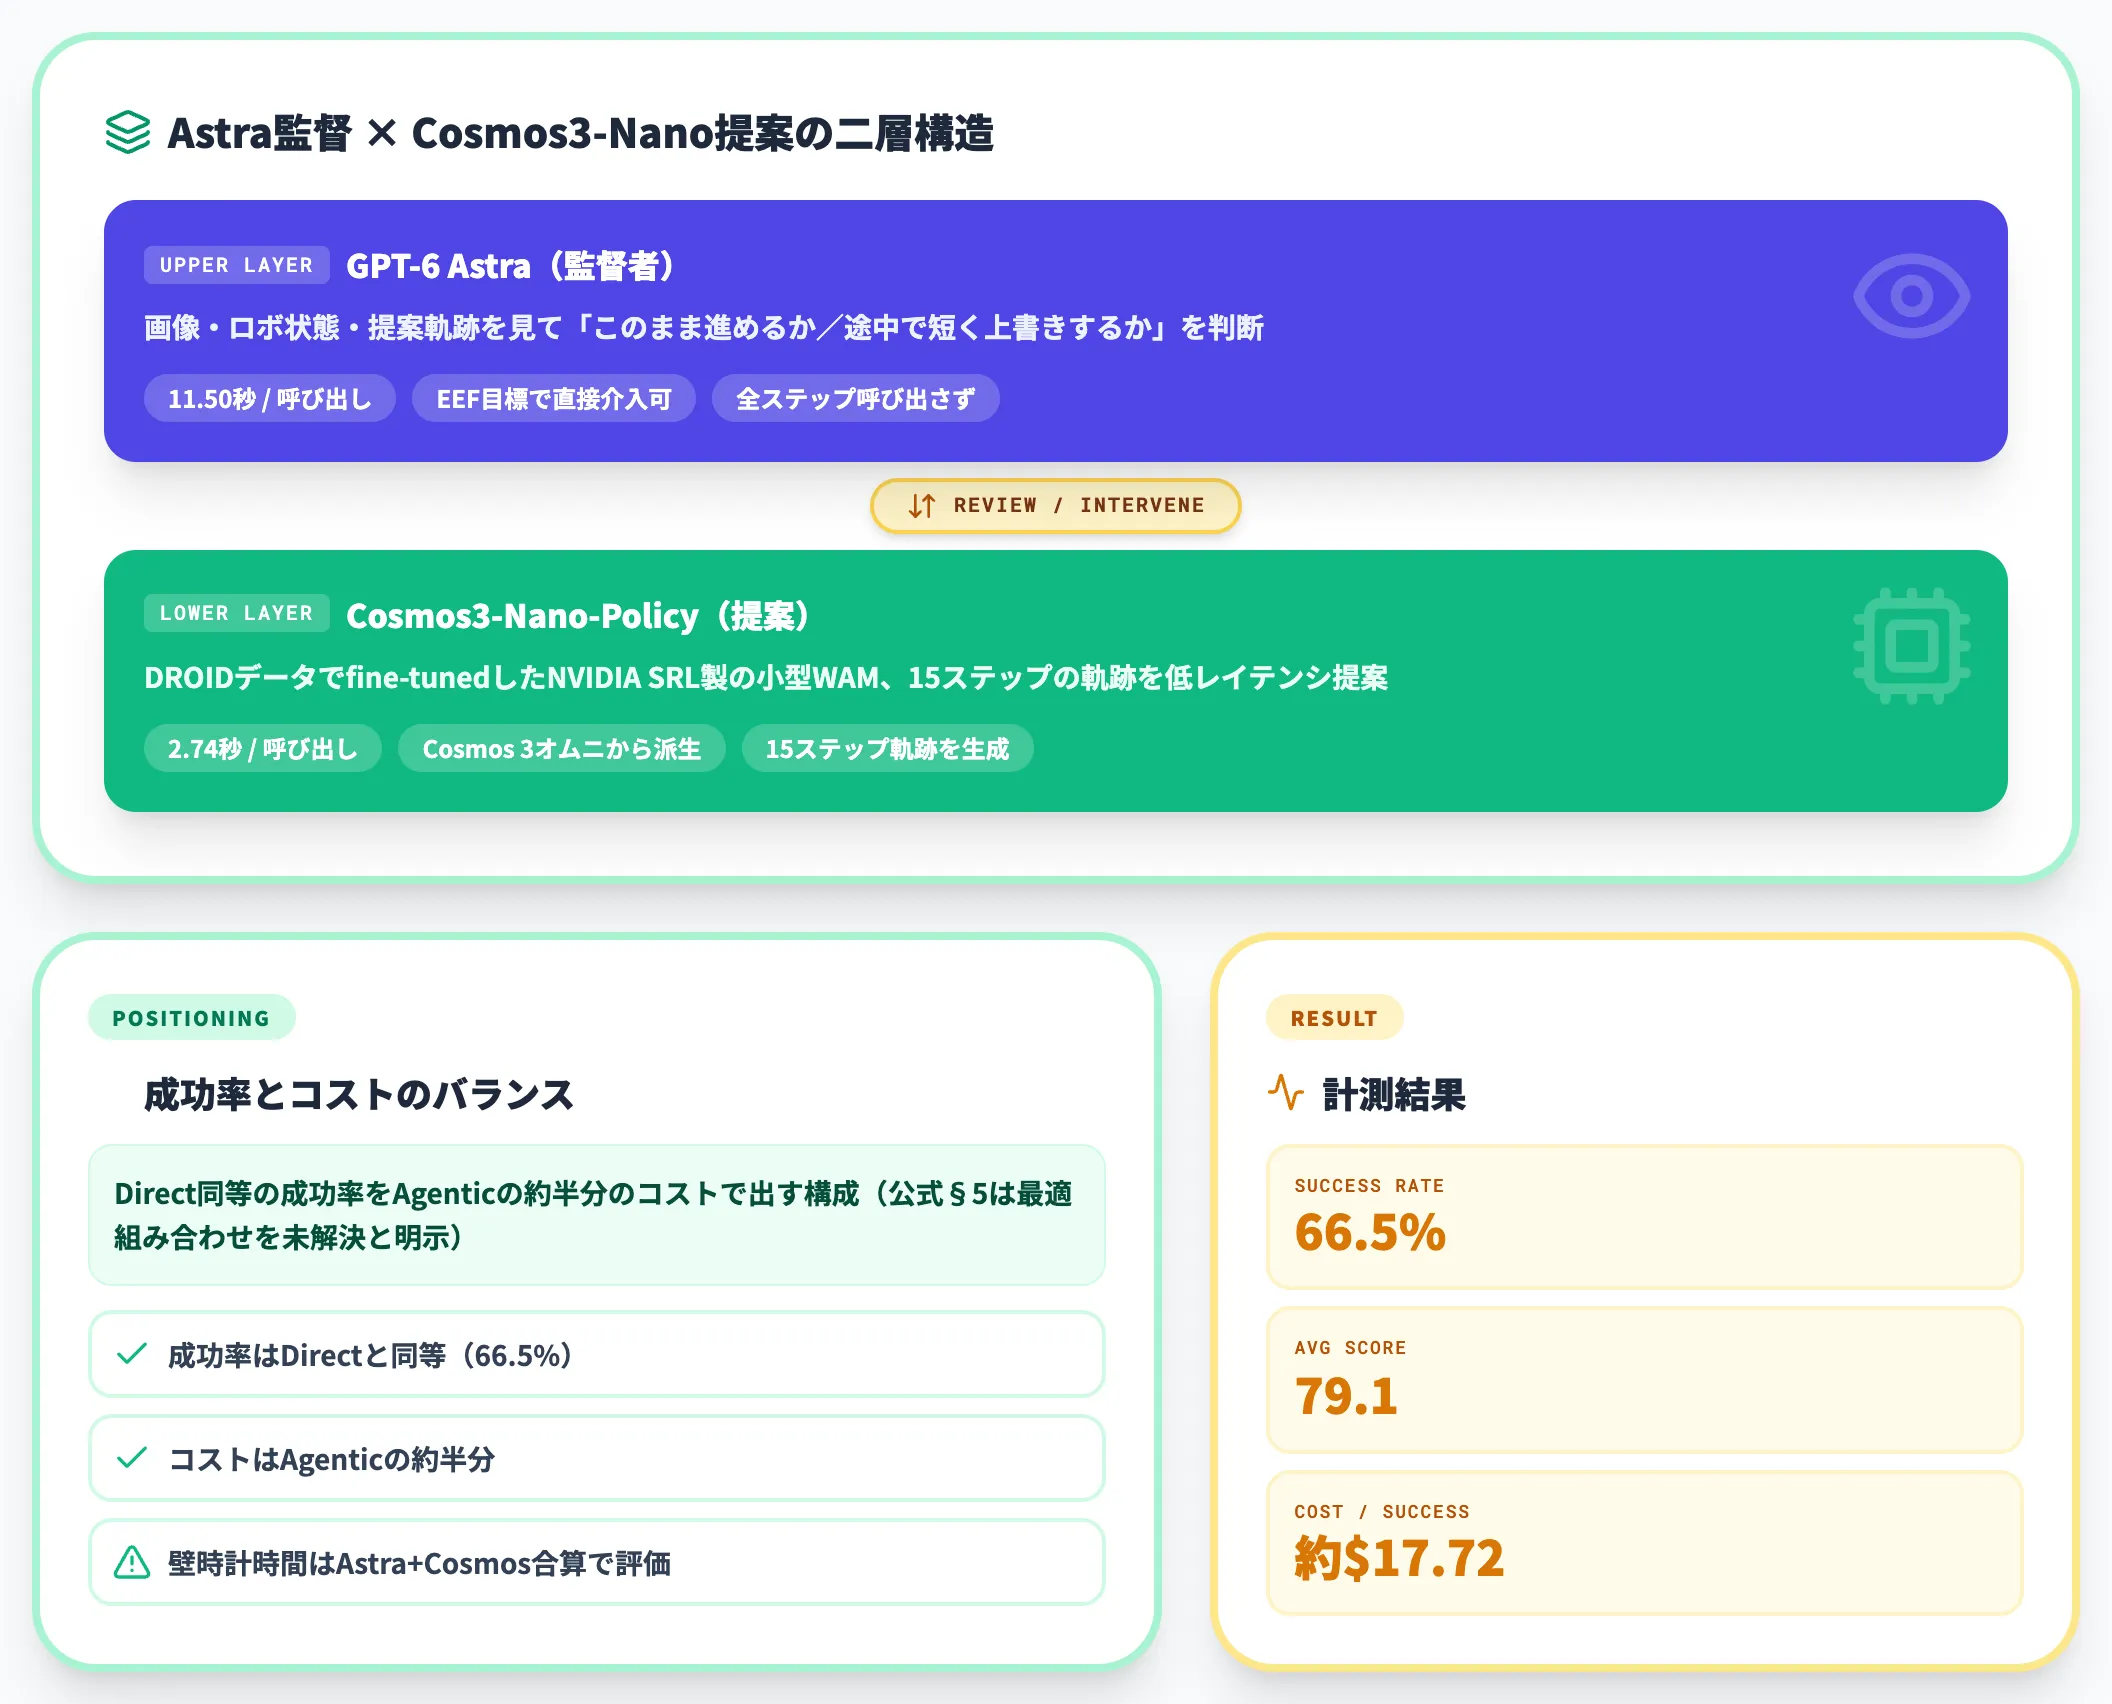
Orchestrated Policyは、専用学習した世界行動モデル(WAM)のCosmos3-Nano-PolicyにDROIDデータでfine-tunedしたNVIDIAの小型方策モデルを使い、Astraがその提案を監督して受容または介入編集する構成です。
Cosmos3-Nano-PolicyはNVIDIA Cosmosの方策系列として位置づけられ、エッジ向け小型世界モデルCosmos 3 Edgeと同じCosmos 3オムニモデル基盤から派生しています。
Cosmos3-Nano側が15ステップの軌跡を低レイテンシで提案し、Astraは画像・ロボット状態・提案軌跡を見て「このまま進めて良いか・途中で短く上書きするか」を判断します。
言わば、低コスト・高速な方策モデルの上に、Astraが高次の判断層を乗せる二層構造です。
Orchestratedは成功率66.5%・平均スコア79.1・成功エピソードあたり約$17.72で、Direct同等の成功率をAgenticの約半分のコストで出す結果になりました。
公式§5は専用方策との最適な組み合わせを未解決の論点として明示しており、ここでの数値は「3モードの中で成功率とコストのバランスが取れた構成が確認できた」範囲の結果として扱うのが正確です。
評価基盤——RoboLab-120とDROID仕様のシミュレーション
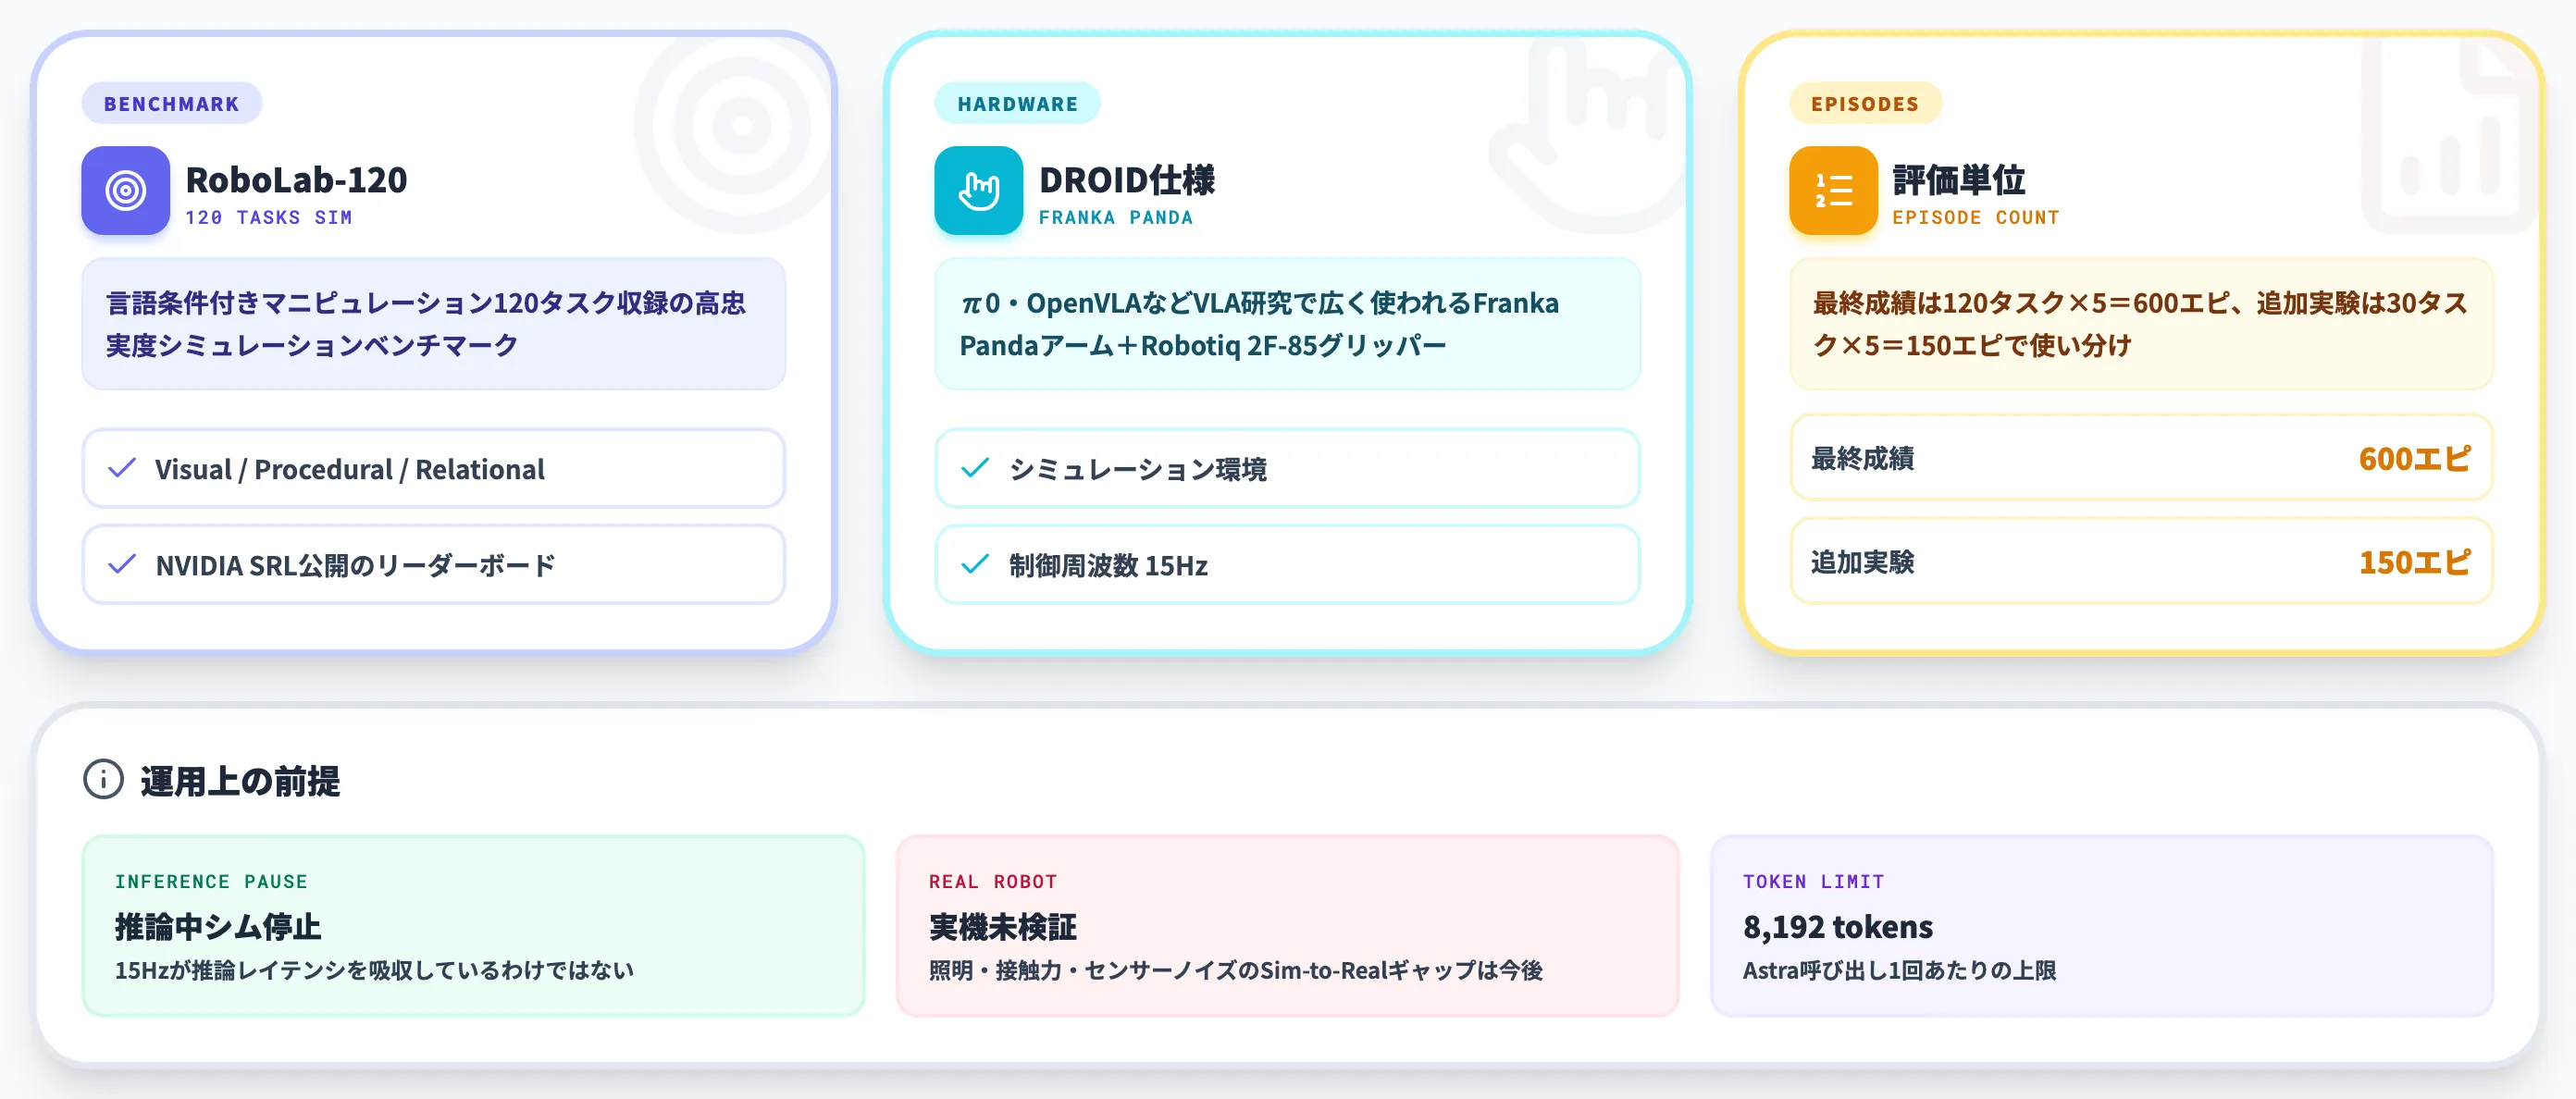
Astranomyの実験は、NVIDIAが同じく公開しているRoboLab-120というシミュレーションベンチマーク上で実施されています。
ロボットはFranka Pandaアームを用いたDROID仕様の構成で、物理環境ではなくシミュレータ内の挙動を評価する設計です。
RoboLab-120の構成——視覚・手続き・関係の3軸
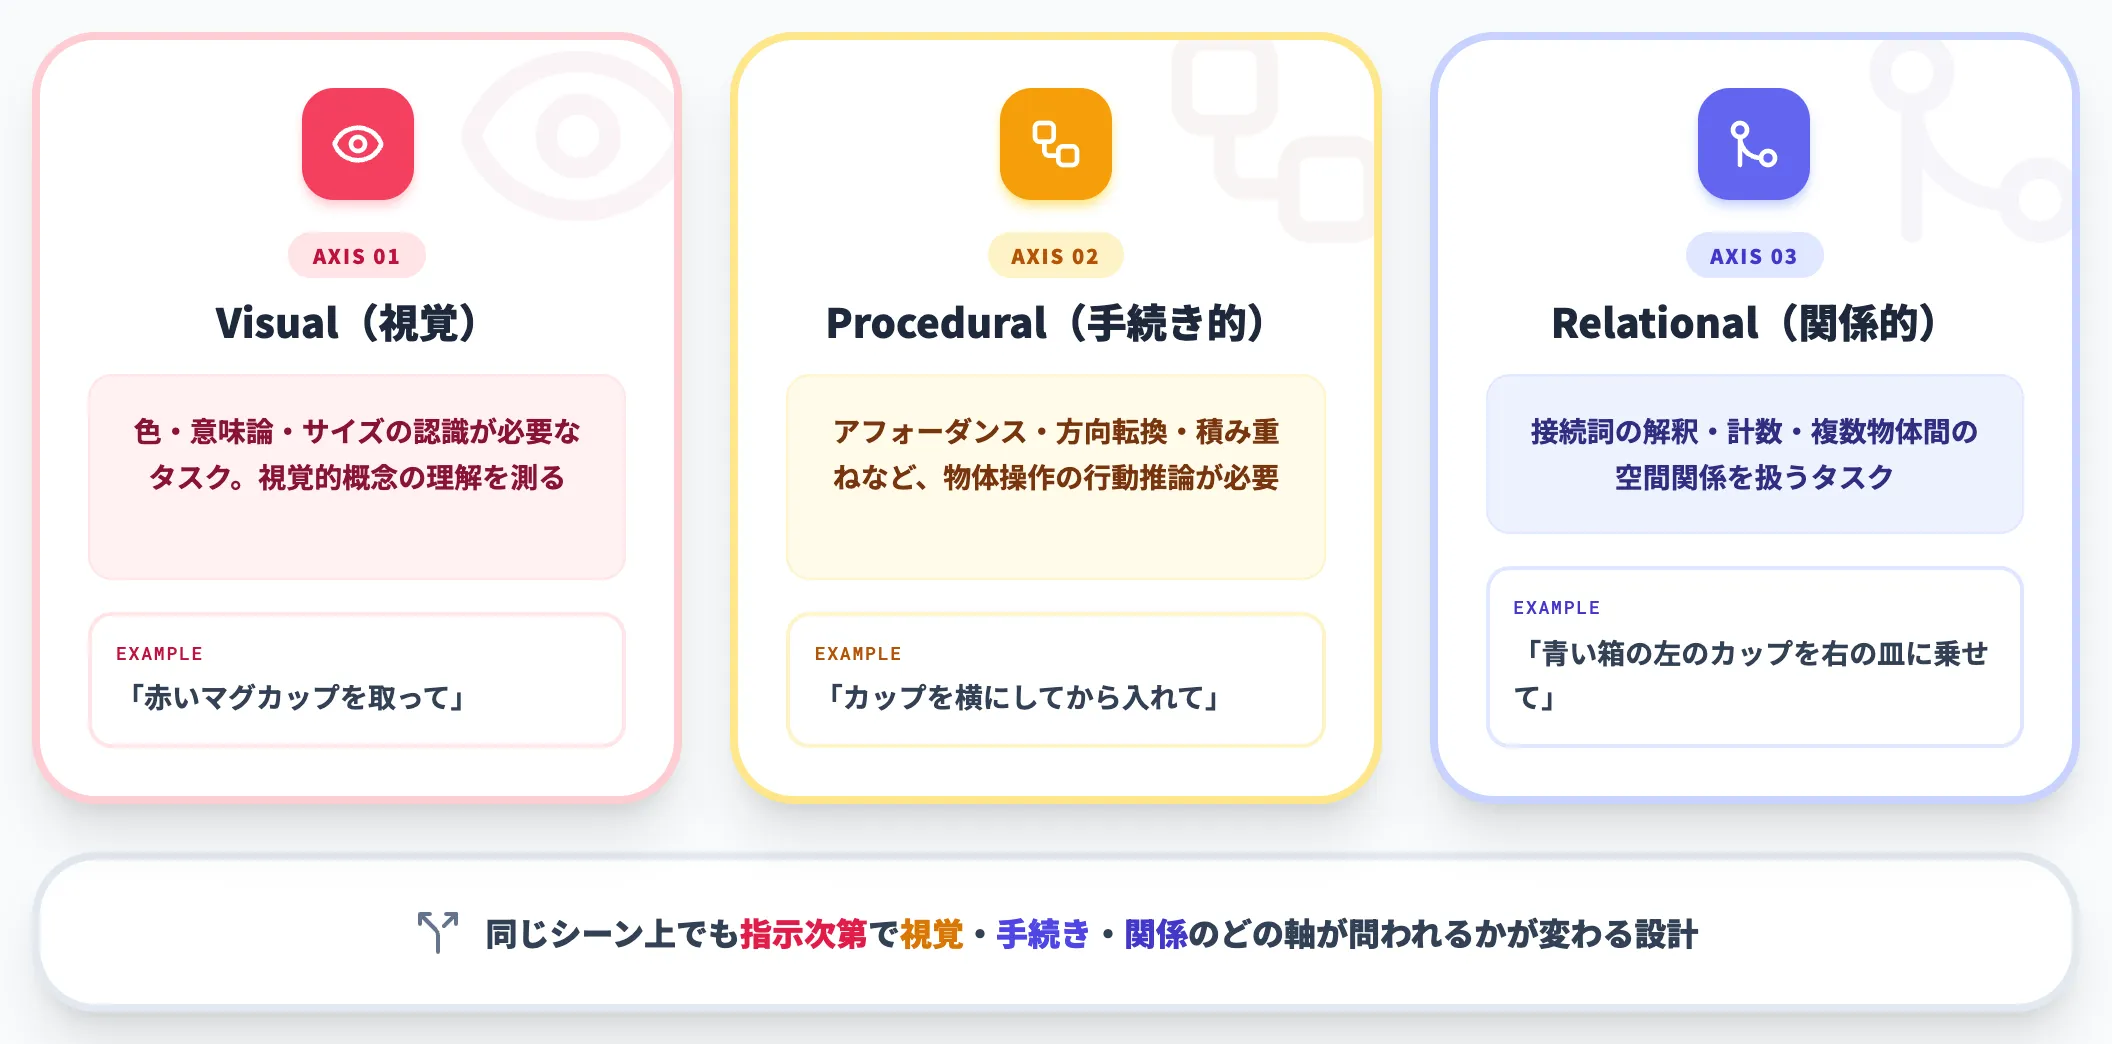
RoboLab-120は、言語条件付きマニピュレーション120タスクを収録した高忠実度シミュレーションベンチマークで、タスクの難しさを3つの能力軸で切り分けています。
-
Visual(視覚)
色・意味論・サイズの認識が必要なタスク。「赤いマグカップを取って」のような視覚的概念の理解を測る
-
Procedural(手続き的)
アフォーダンス・方向転換・積み重ねなど、物体操作の行動推論が必要なタスク
-
Relational(関係的)
接続詞の解釈・計数・複数物体間の空間関係を扱うタスク。「青い箱の左にあるカップを右の皿に乗せて」などが該当
公式§2によると、各ポリシーの最終成績は120タスク×5エピソード=600エピソードで測られています。
追加の切り分け実験(action horizon・観測履歴の長さ・ジオメトリ情報の有無など)は30タスクのサブセット×5エピソード=150エピソードで回しており、両者の母数を区別する必要があります。
推論コストが大きいため、全タスク評価と追加実験で評価単位を使い分ける設計です。
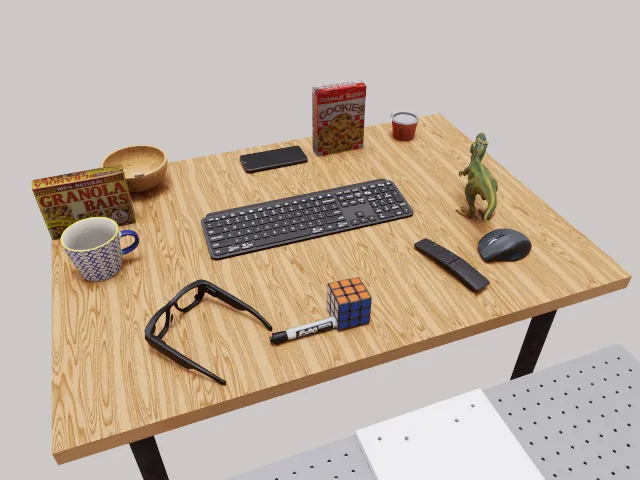
RoboLab-120に含まれるタスクシーンの一例「workdesk」。デスク上のキーボード・マグカップ・ドングル・置物など、同一シーン上で言語指示で操作対象を切り分ける構成(出典:NVIDIA Research — Astranomy)
このタスクシーンのように、RoboLab-120は同じ机上に複数の物体を置いて指示の曖昧度を変えることで、言語理解の難しさと物理実行の難しさを分離評価できる設計です。「赤いマグカップを取って」「鍵盤の左の黒い物を箱に入れて」など、同じシーン上でも指示次第で視覚・手続き・関係のどの軸が問われるかが変わります。
ハードウェアと制御仕様
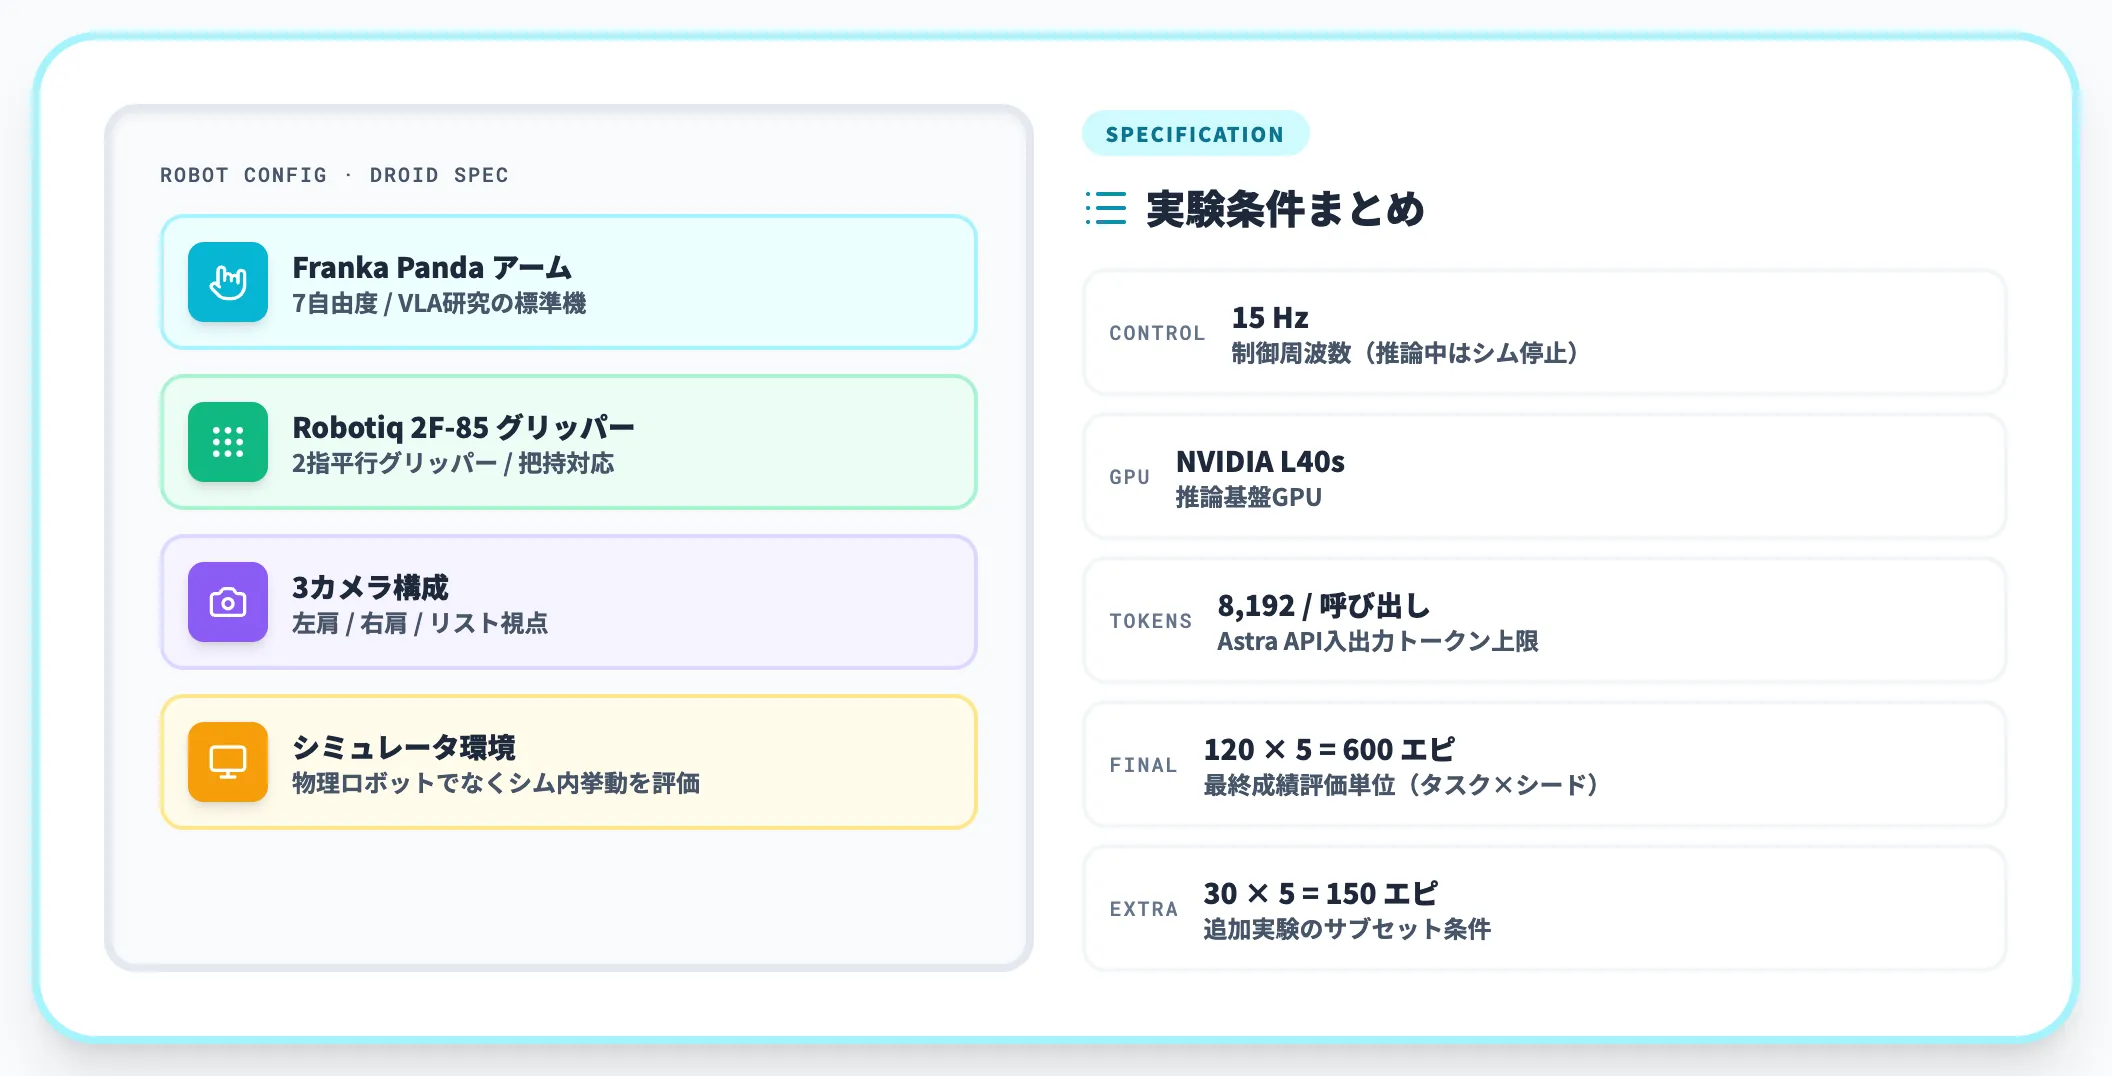
ロボット側は、Physical Intelligenceのπ0・OpenVLAなど多くのVLA研究で使われるDROID仕様のFranka Pandaアーム+Robotiq 2F-85グリッパーを採用しています。
以下の表で、Astranomyの実験条件をまとめます。
| 項目 | 仕様 |
|---|---|
| 環境 | シミュレータ(Franka Panda + Robotiq 2F-85のDROID仕様) |
| 制御周波数 | 15 Hz(推論中はシミュレーション停止) |
| GPU | NVIDIA L40s |
| トークン上限/呼び出し | 8,192トークン |
| 最終成績 | 120タスク × 5シード = 600エピソード/ポリシー |
| 追加実験 | 30タスクサブセット × 5シード = 150エピソード/条件 |
15Hz制御は精密マニピュレーションとしては控えめな周波数ですが、公式§2の記述では推論中はシミュレータを停止しており、15Hzが推論レイテンシを吸収しているわけではありません。
あくまでAstra呼び出しの合間に進む制御の周波数で、推論待ち時間は実時間上に別途積み重なります。
Astranomyの実験結果——3モードの成功率とベースライン比較
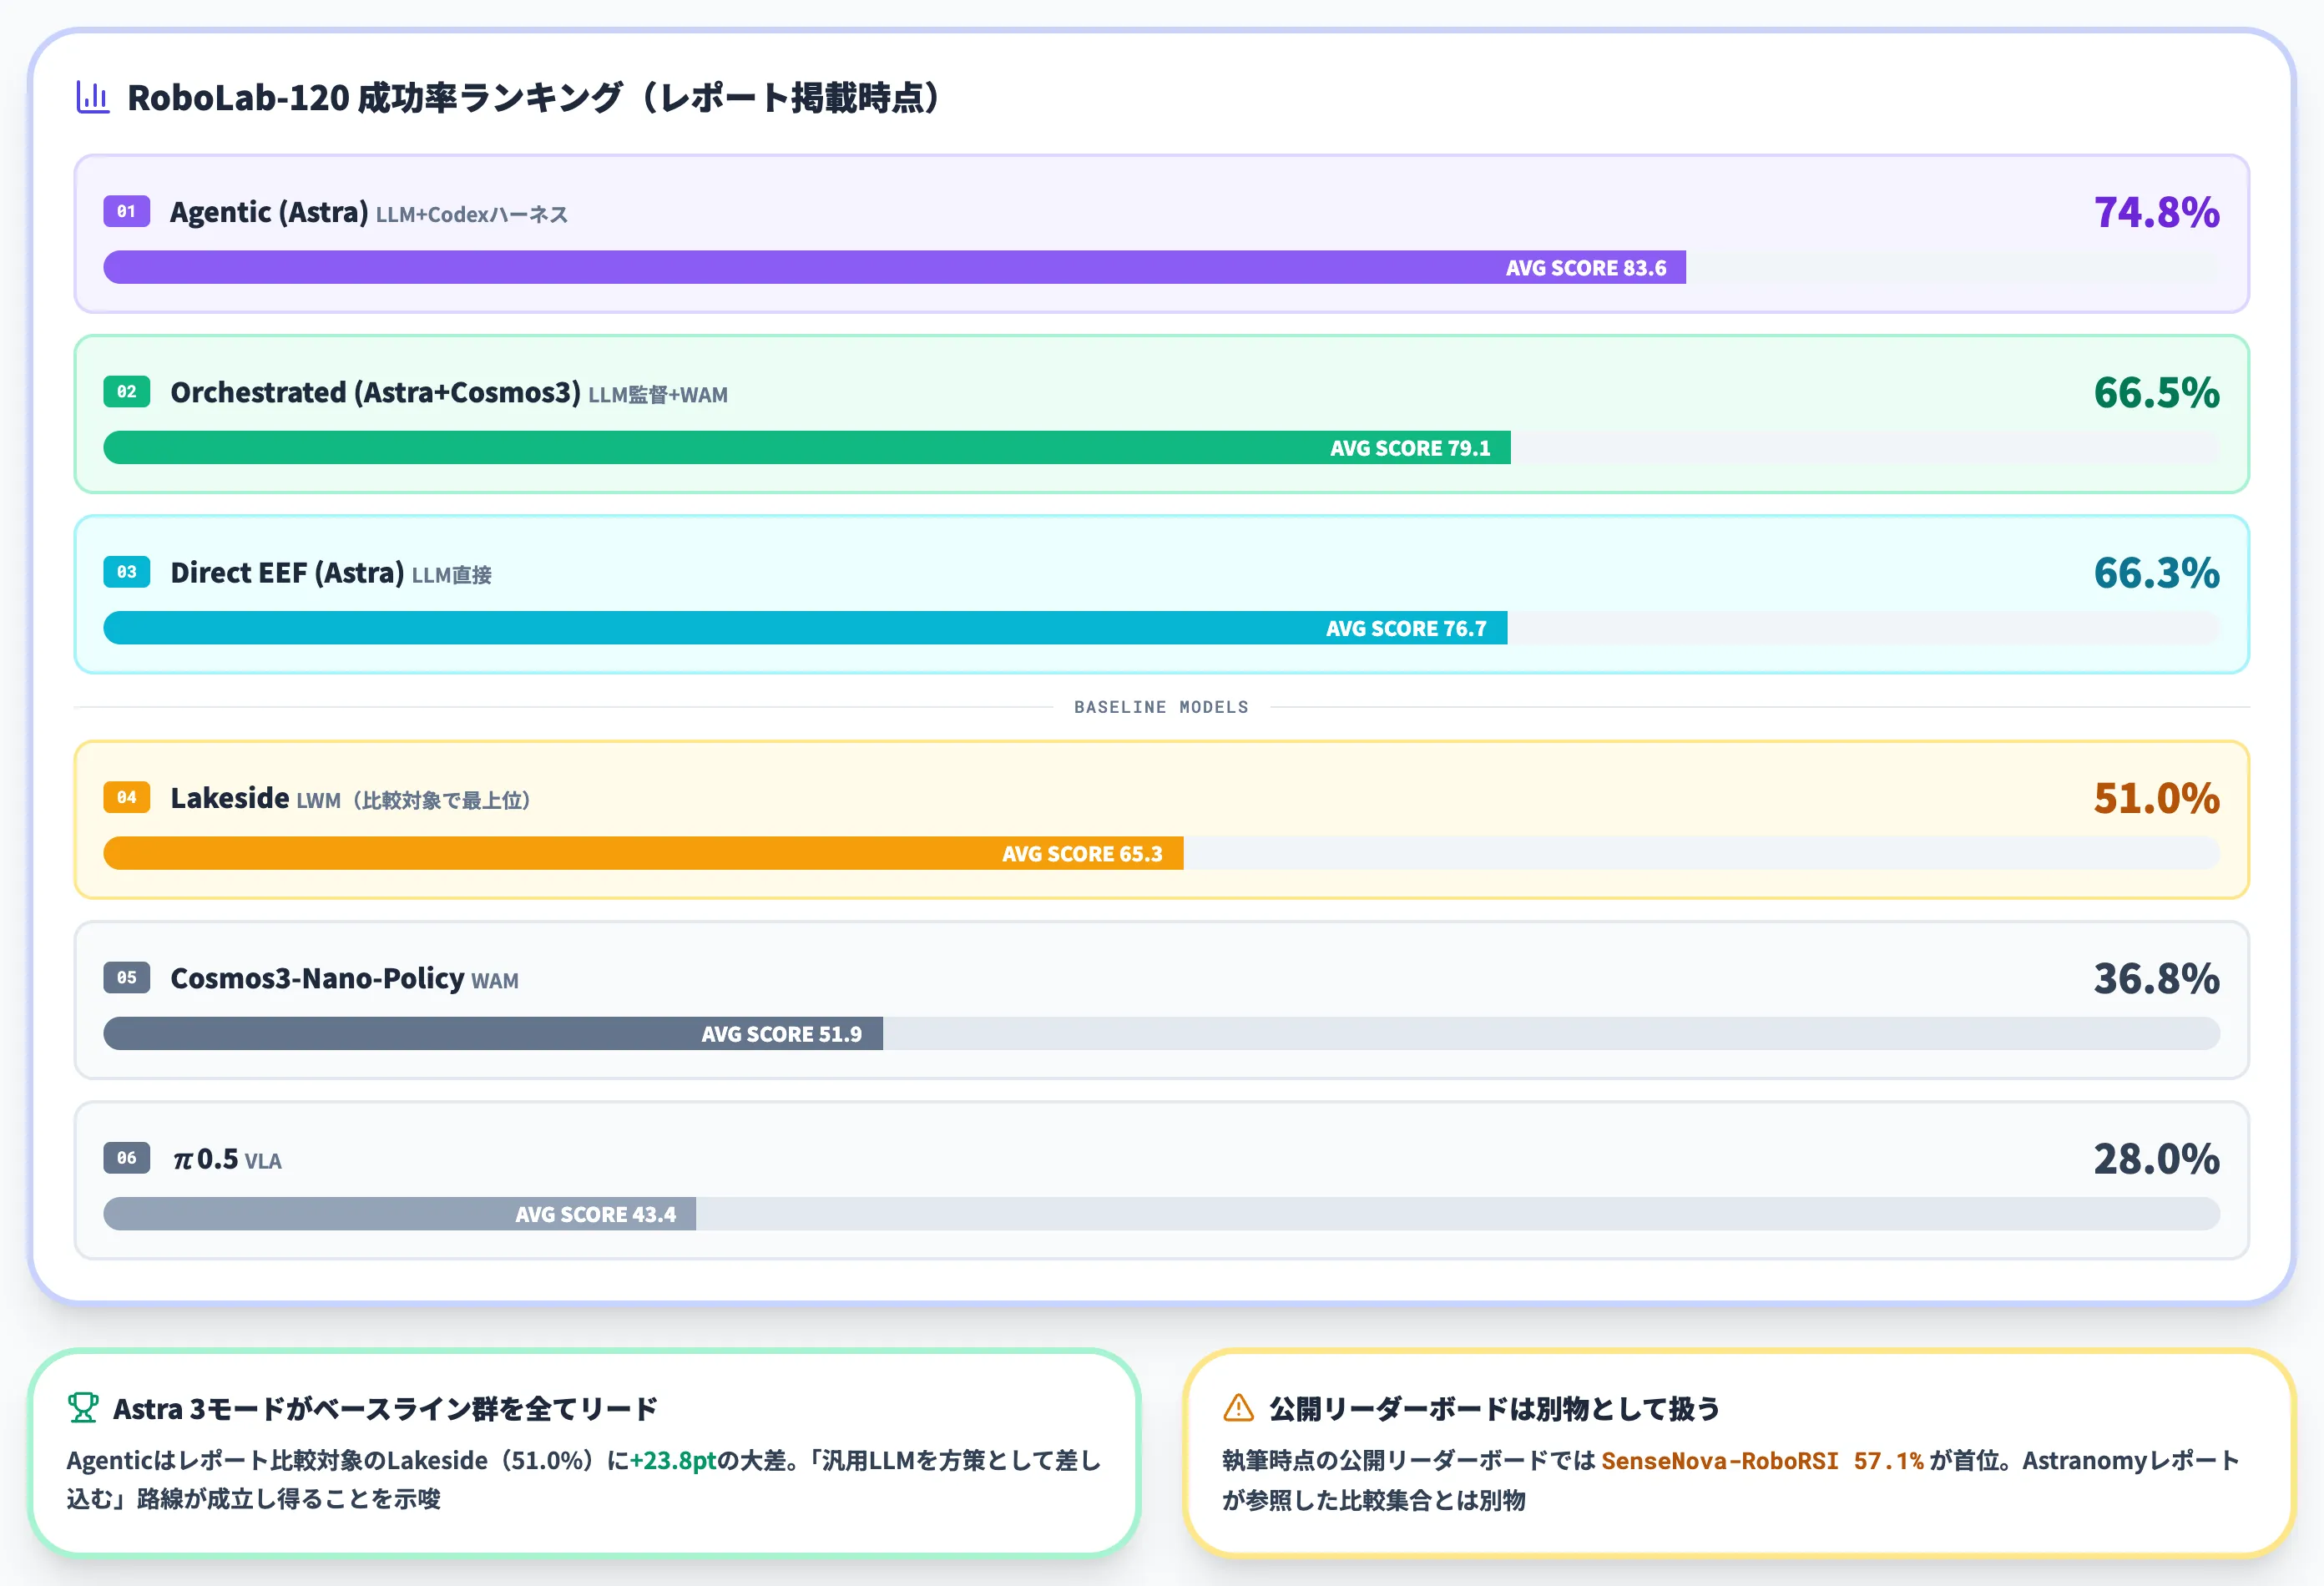
Astranomyが示した定量結果は、Astra経由の3モードがすべて既存VLA・WAMベースラインを上回るという明快な数値になっています。
Agentic Policyが74.8%で3モード中トップ
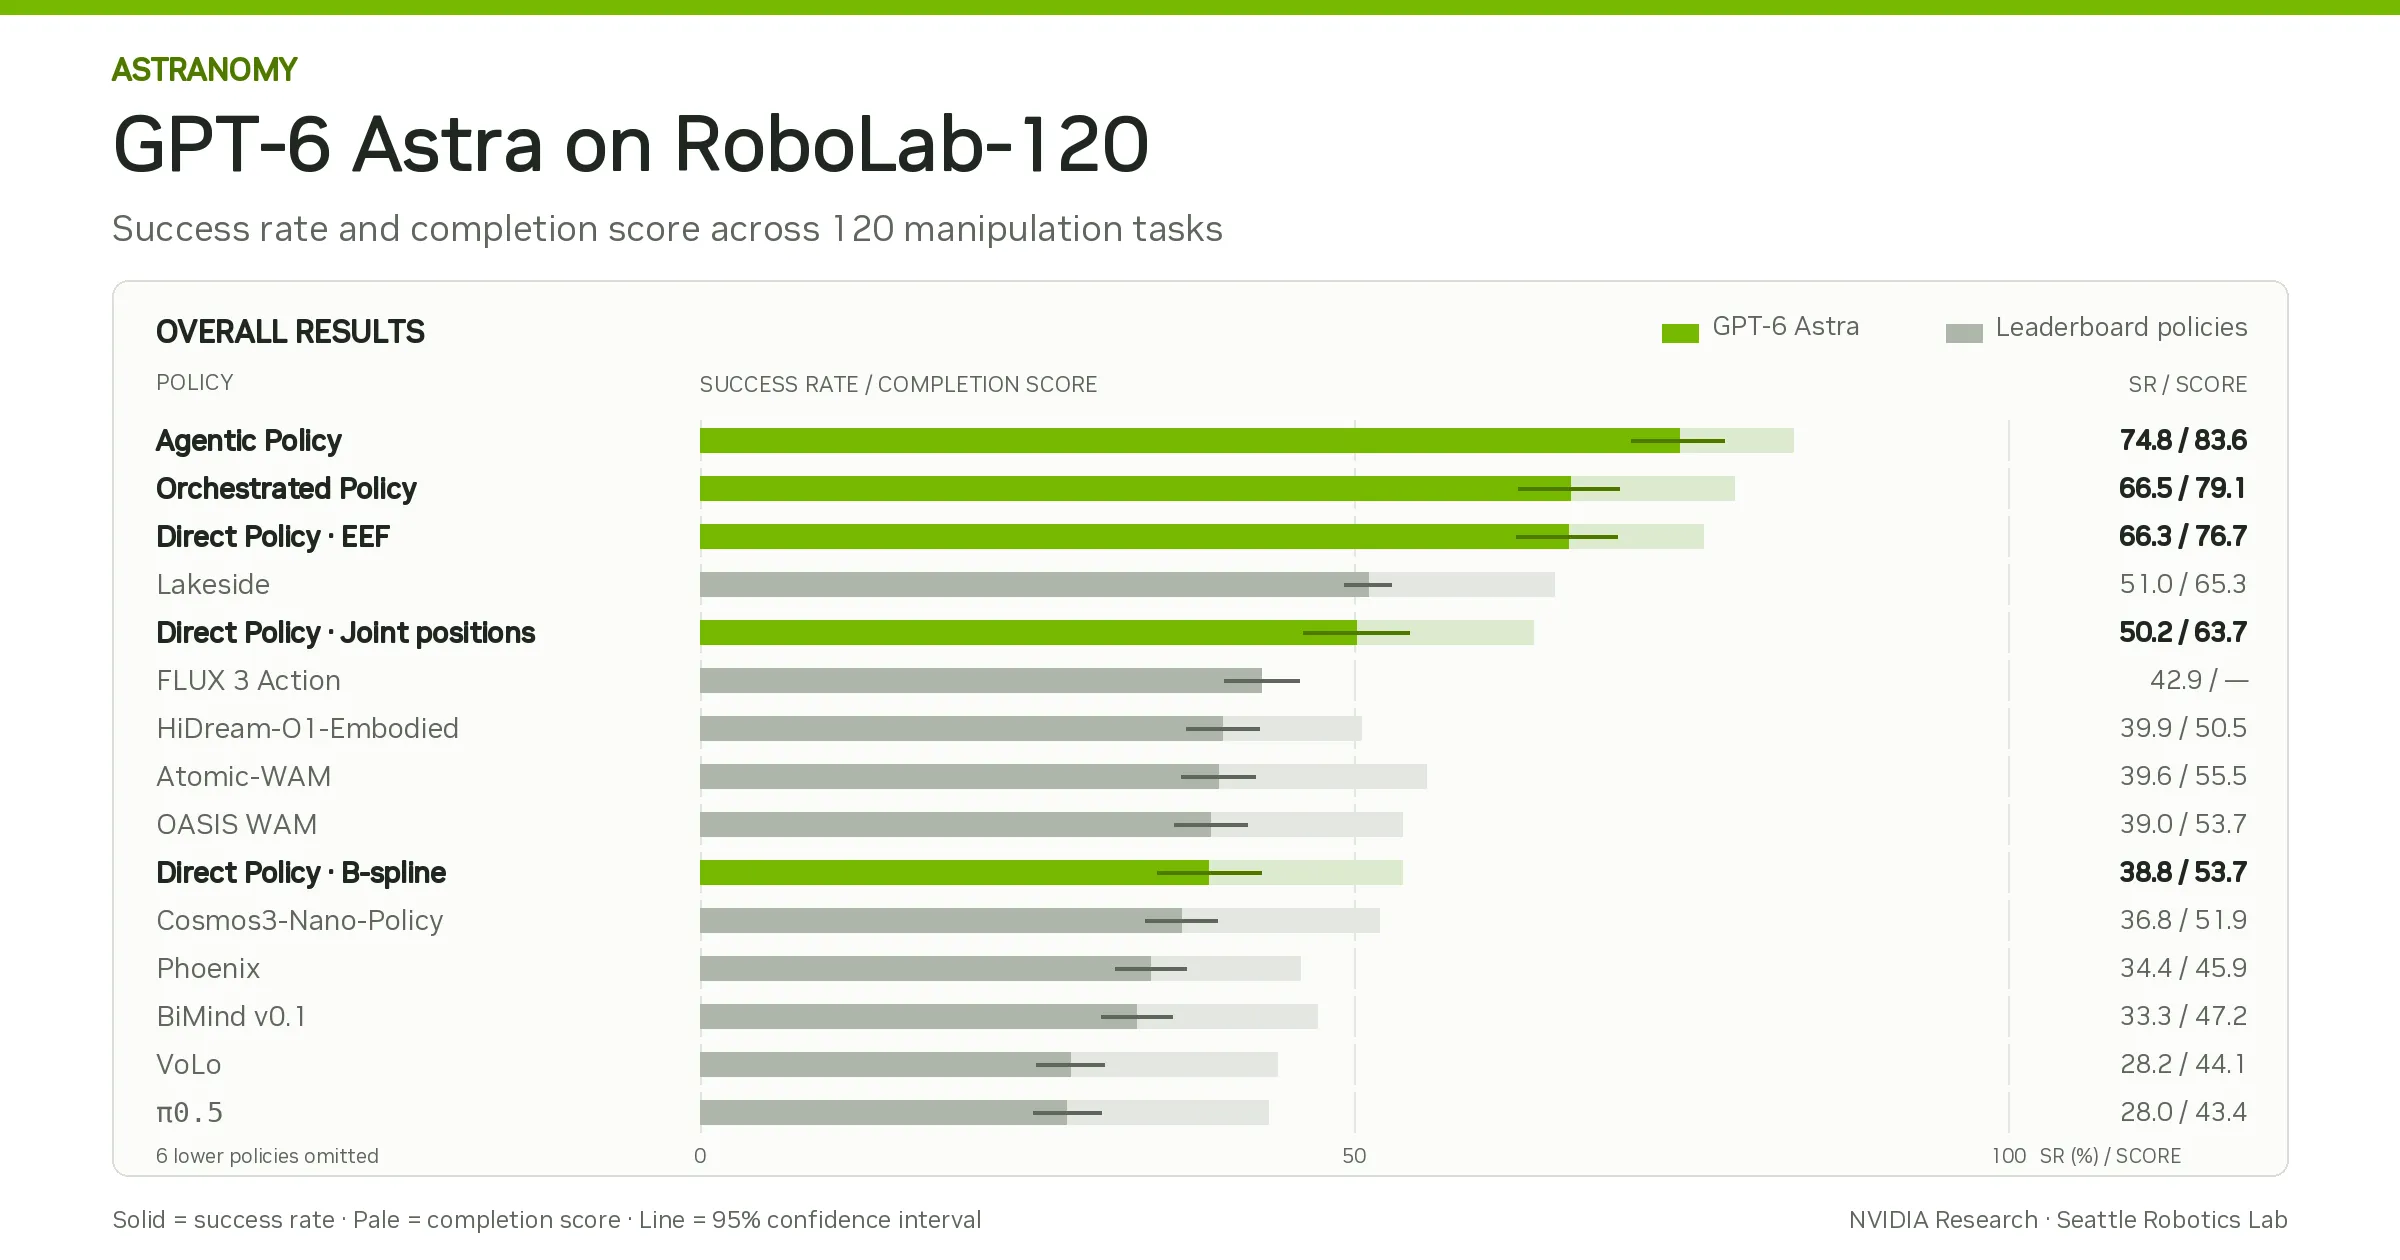
RoboLab-120での成功率と完了スコアの比較。Agentic Policyが74.8/83.6で最上位、Lakesideを23.8pt上回る(出典:NVIDIA Research — Astranomy)
グラフが示すとおり、Astra経由の3モード(Agentic・Orchestrated・Direct EEF)が揃って上位を占め、既存のRoboLab-120リーダーボード上位にあったLakeside・FLUX 3 Action・HiDream-O1-Embodied・Cosmos3-Nano-Policy・π0.5の各モデルを明確に引き離しています。
以下の表で、Astranomyの3モードと主要ベースラインの成績を数値で整理しました。
| ポリシー | タイプ | 成功率 | 平均スコア | 呼び出しレイテンシ |
|---|---|---|---|---|
| Agentic (Astra) | LLM+Codexハーネス | 74.8% | 83.6 | 13.37秒(Astra側) |
| Orchestrated (Astra+Cosmos3) | LLM監督+WAM | 66.5% | 79.1 | Astra 11.50秒/Cosmos 2.74秒を併用 |
| Direct EEF (Astra) | LLM直接 | 66.3% | 76.7 | 18.56秒(Astra側) |
| Lakeside | LWM(レポート比較対象で最上位) | 51.0% | 65.3 | — |
| Cosmos3-Nano-Policy | WAM | 36.8% | 51.9 | 713.76ms |
| π0.5 | VLA | 28.0% | 43.4 | 46.96ms |
この表が示す最大のポイントは、Astranomyの3モードがレポートの比較対象で最上位のLakeside(51.0%)をすべて上回っていることです。
なお、RoboLab-120の公開リーダーボードでは本記事執筆時点でSenseNova-RoboRSI(57.1%)が首位に表示されており、Astranomyレポートが掲載時点で参照した比較集合とは別物として扱う必要があります。
Agenticに至ってはLakesideに23.8ポイントという大差をつけており、「汎用フロンティアLLMを方策として差し込む」というアプローチが、少なくともレポート掲載時点の比較集合では専用学習モデル群の上に立ち得ることを示しています。
既存VLA(π0.5)・WAM(Cosmos3-Nano)との差分
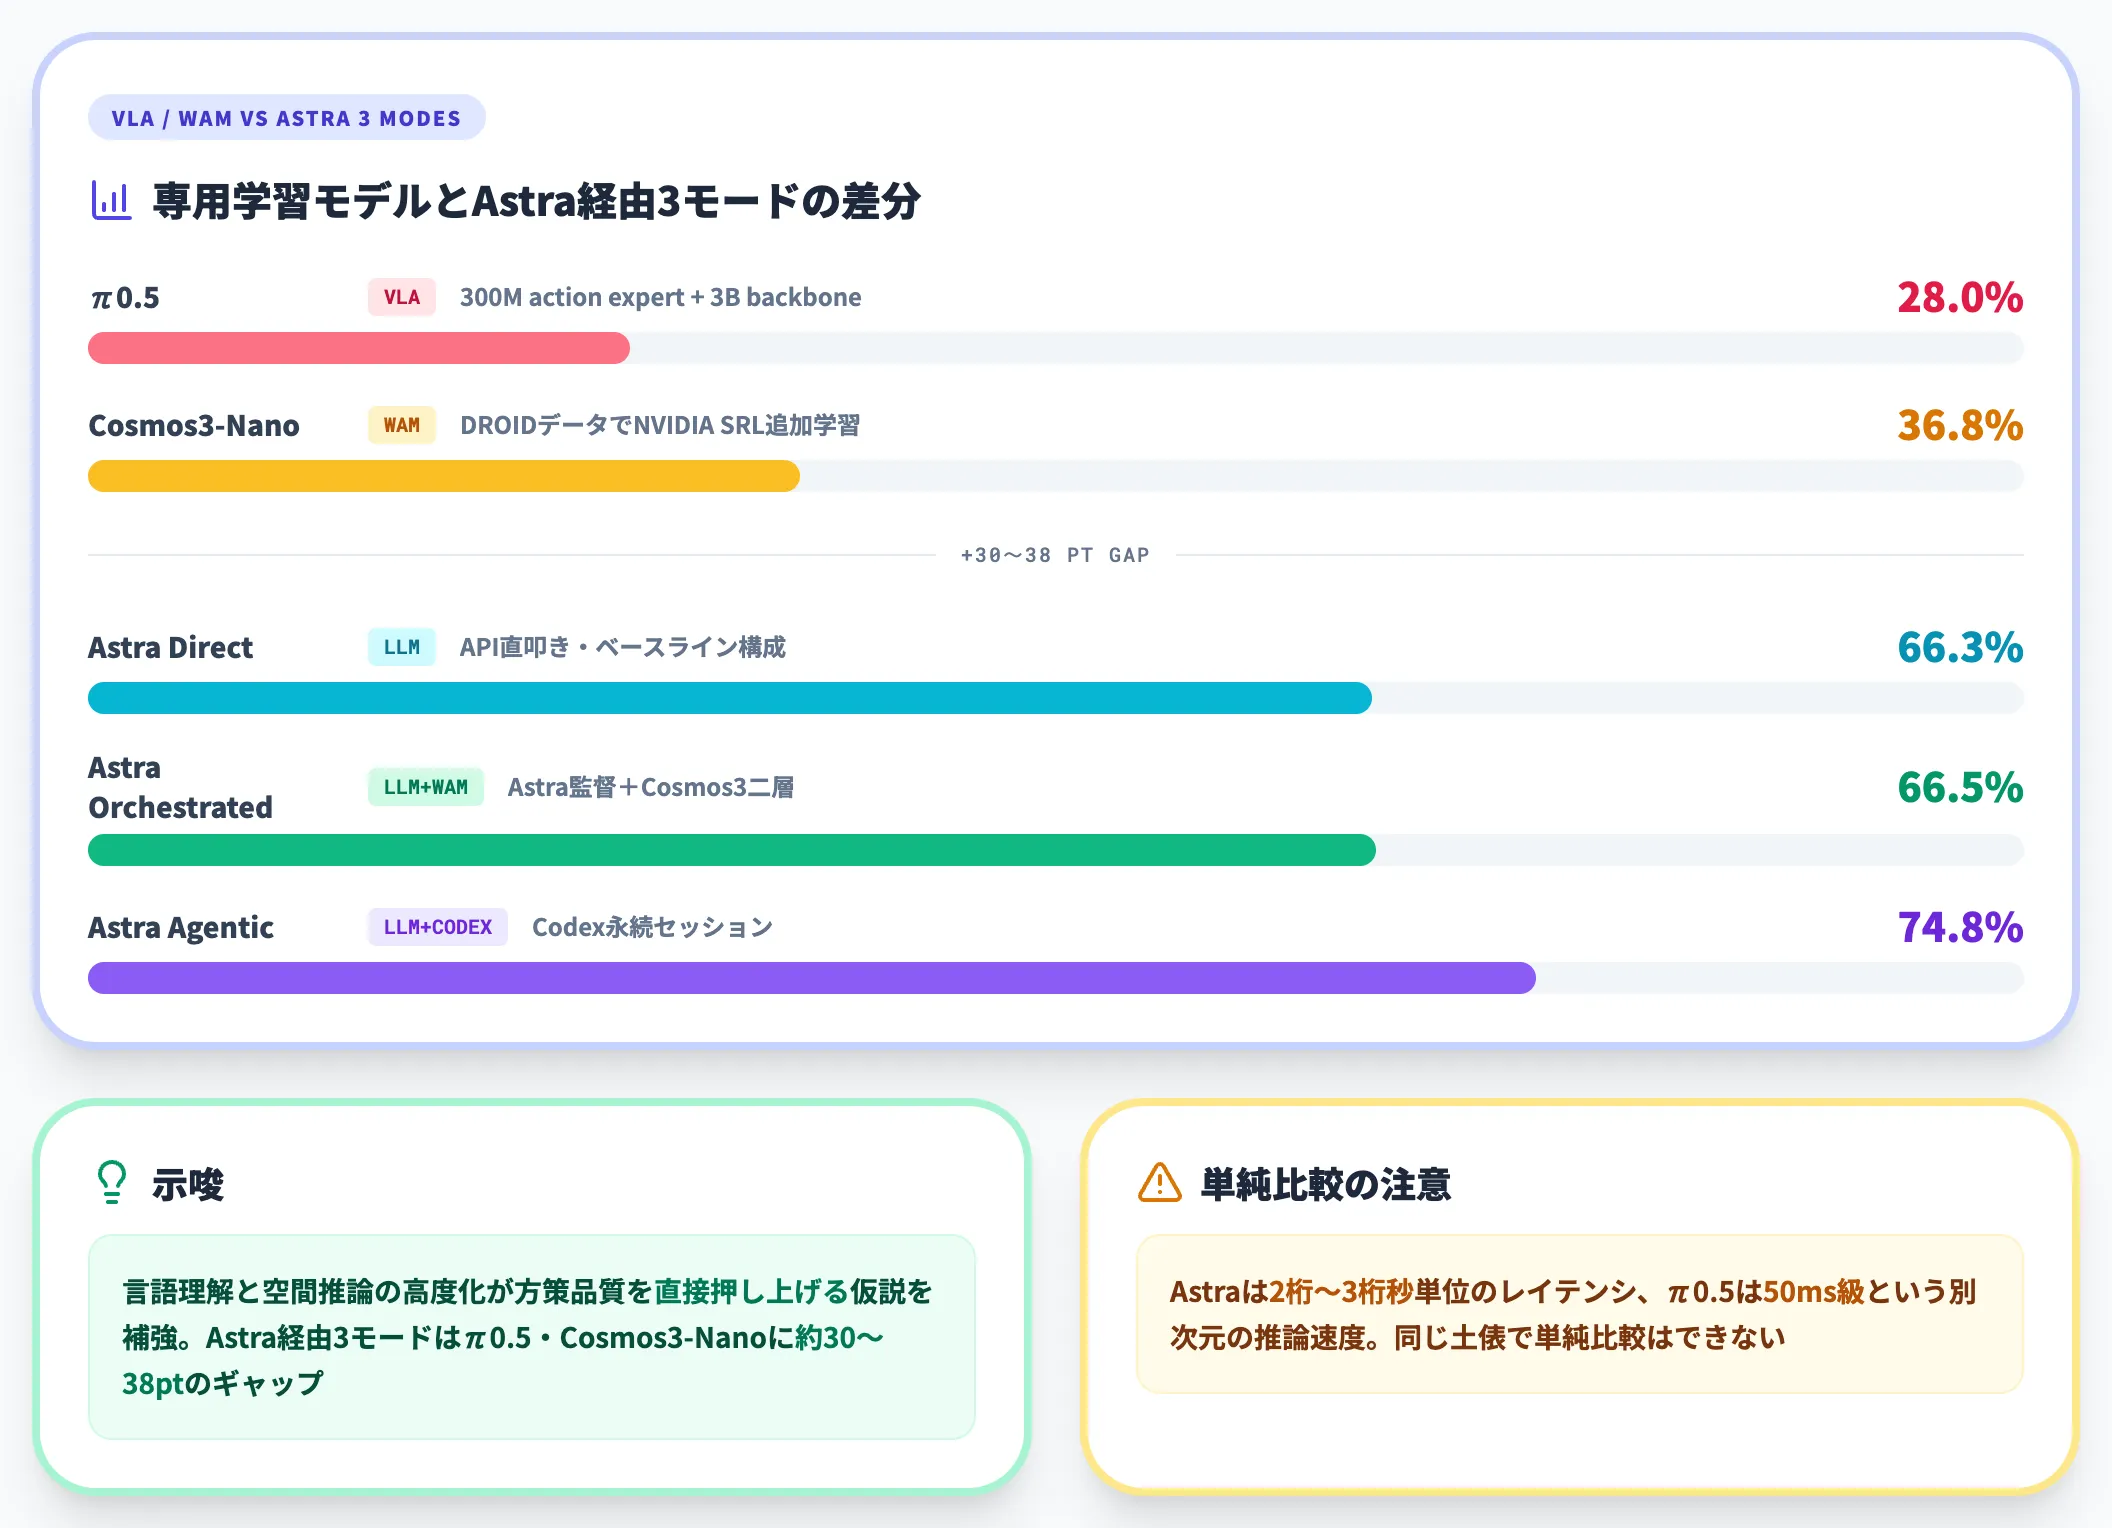
Astra経由3モードと、専用学習したVLA・WAM系の差分も明確です。
π0.5(28.0%)は300Mパラメータのaction expertを3Bバックボーンに乗せたVLAで、2025年時点の代表的な汎化方策モデルの一つです。
一方Cosmos3-Nano-Policy(36.8%)はDROIDデータで追加学習したNVIDIA SRL製の小型WAMで、Orchestrated Policyの下位モデルとして使われている方策モデル本体です。
Astra経由のDirect(66.3%)がこれらに対し約30〜38ポイントのギャップをつけている事実は、「言語理解と空間推論の高度化が方策品質を直接押し上げる」という仮説を補強しています。ただし後述するとおり、Astraはレイテンシが2桁〜3桁秒単位、π0.5は50ms級という別次元の推論速度で動いており、同じ土俵で単純比較することには注意が要ります。
Lakeside(LWM)比23.8ptの上積みが示す意味
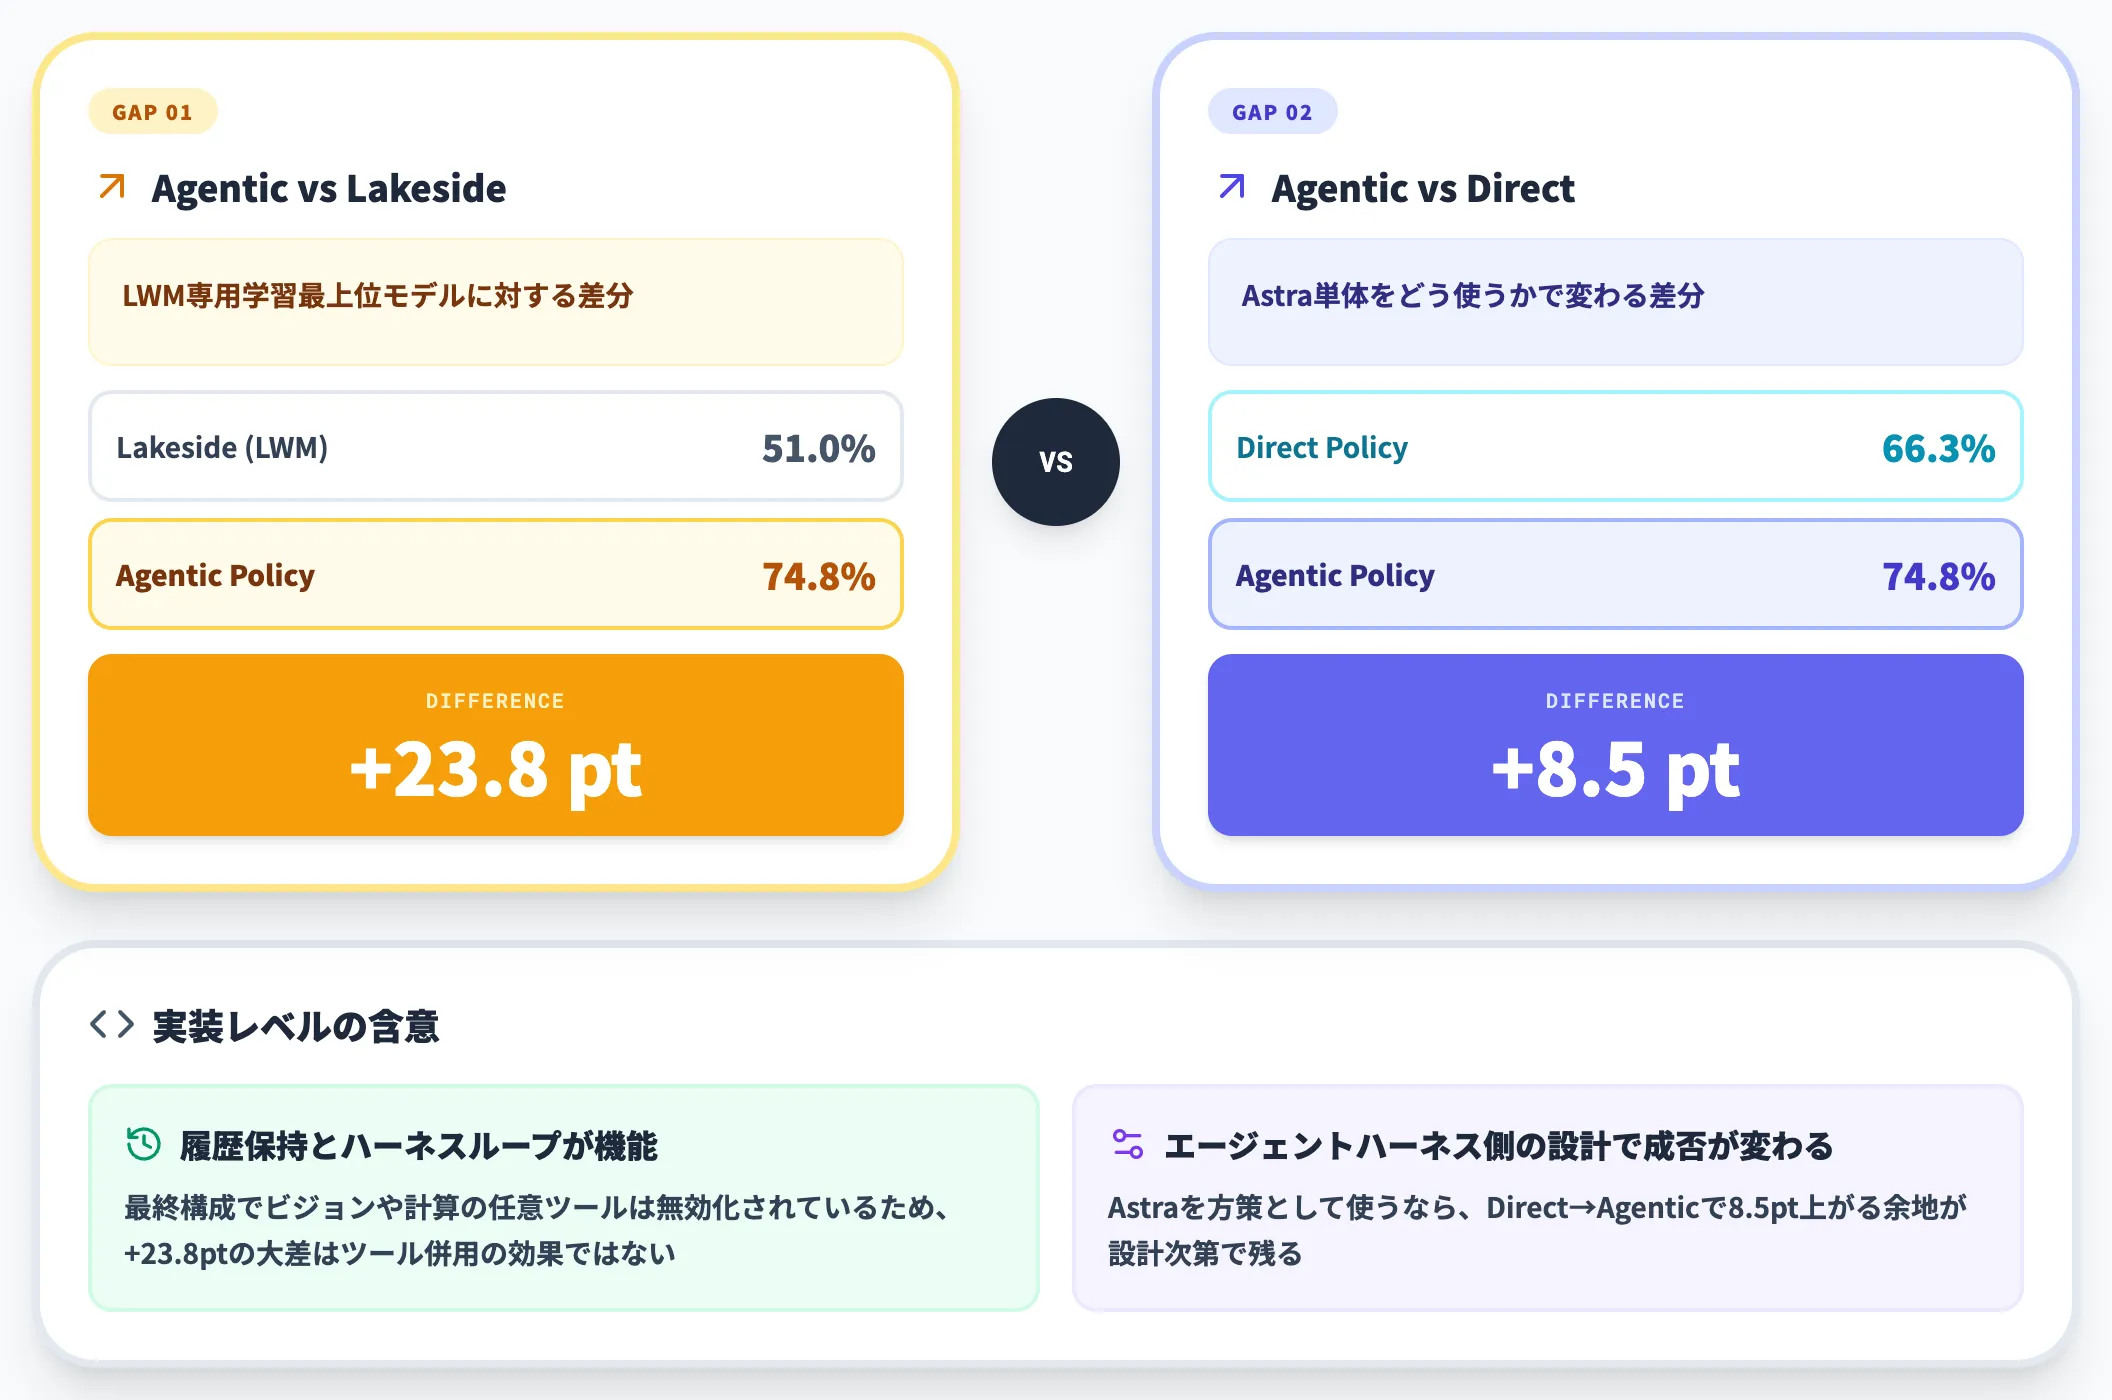
Lakesideはレポートの比較対象で最上位の方策モデル(言語世界モデル/LWM)です。
これに対しAgentic Policyが23.8ptの大差をつけた点は、Codex永続セッションでの履歴保持とハーネス側ループが機能したことを示唆します(最終構成ではビジョンや計算の任意ツールは無効化されているため、ツール併用の効果ではありません)。
Astra単体のDirect(66.3%)とAgentic(74.8%)の間に8.5ptの差が残っている点も重要で、「ロボット方策としてAstraを使うなら、エージェントハーネス側の設計で成否が変わる」という実装レベルの含意を持ちます。
コストとレイテンシのトレードオフ——Agentic 約$36 vs Direct 約$2(成功エピソード平均)の実務インパクト
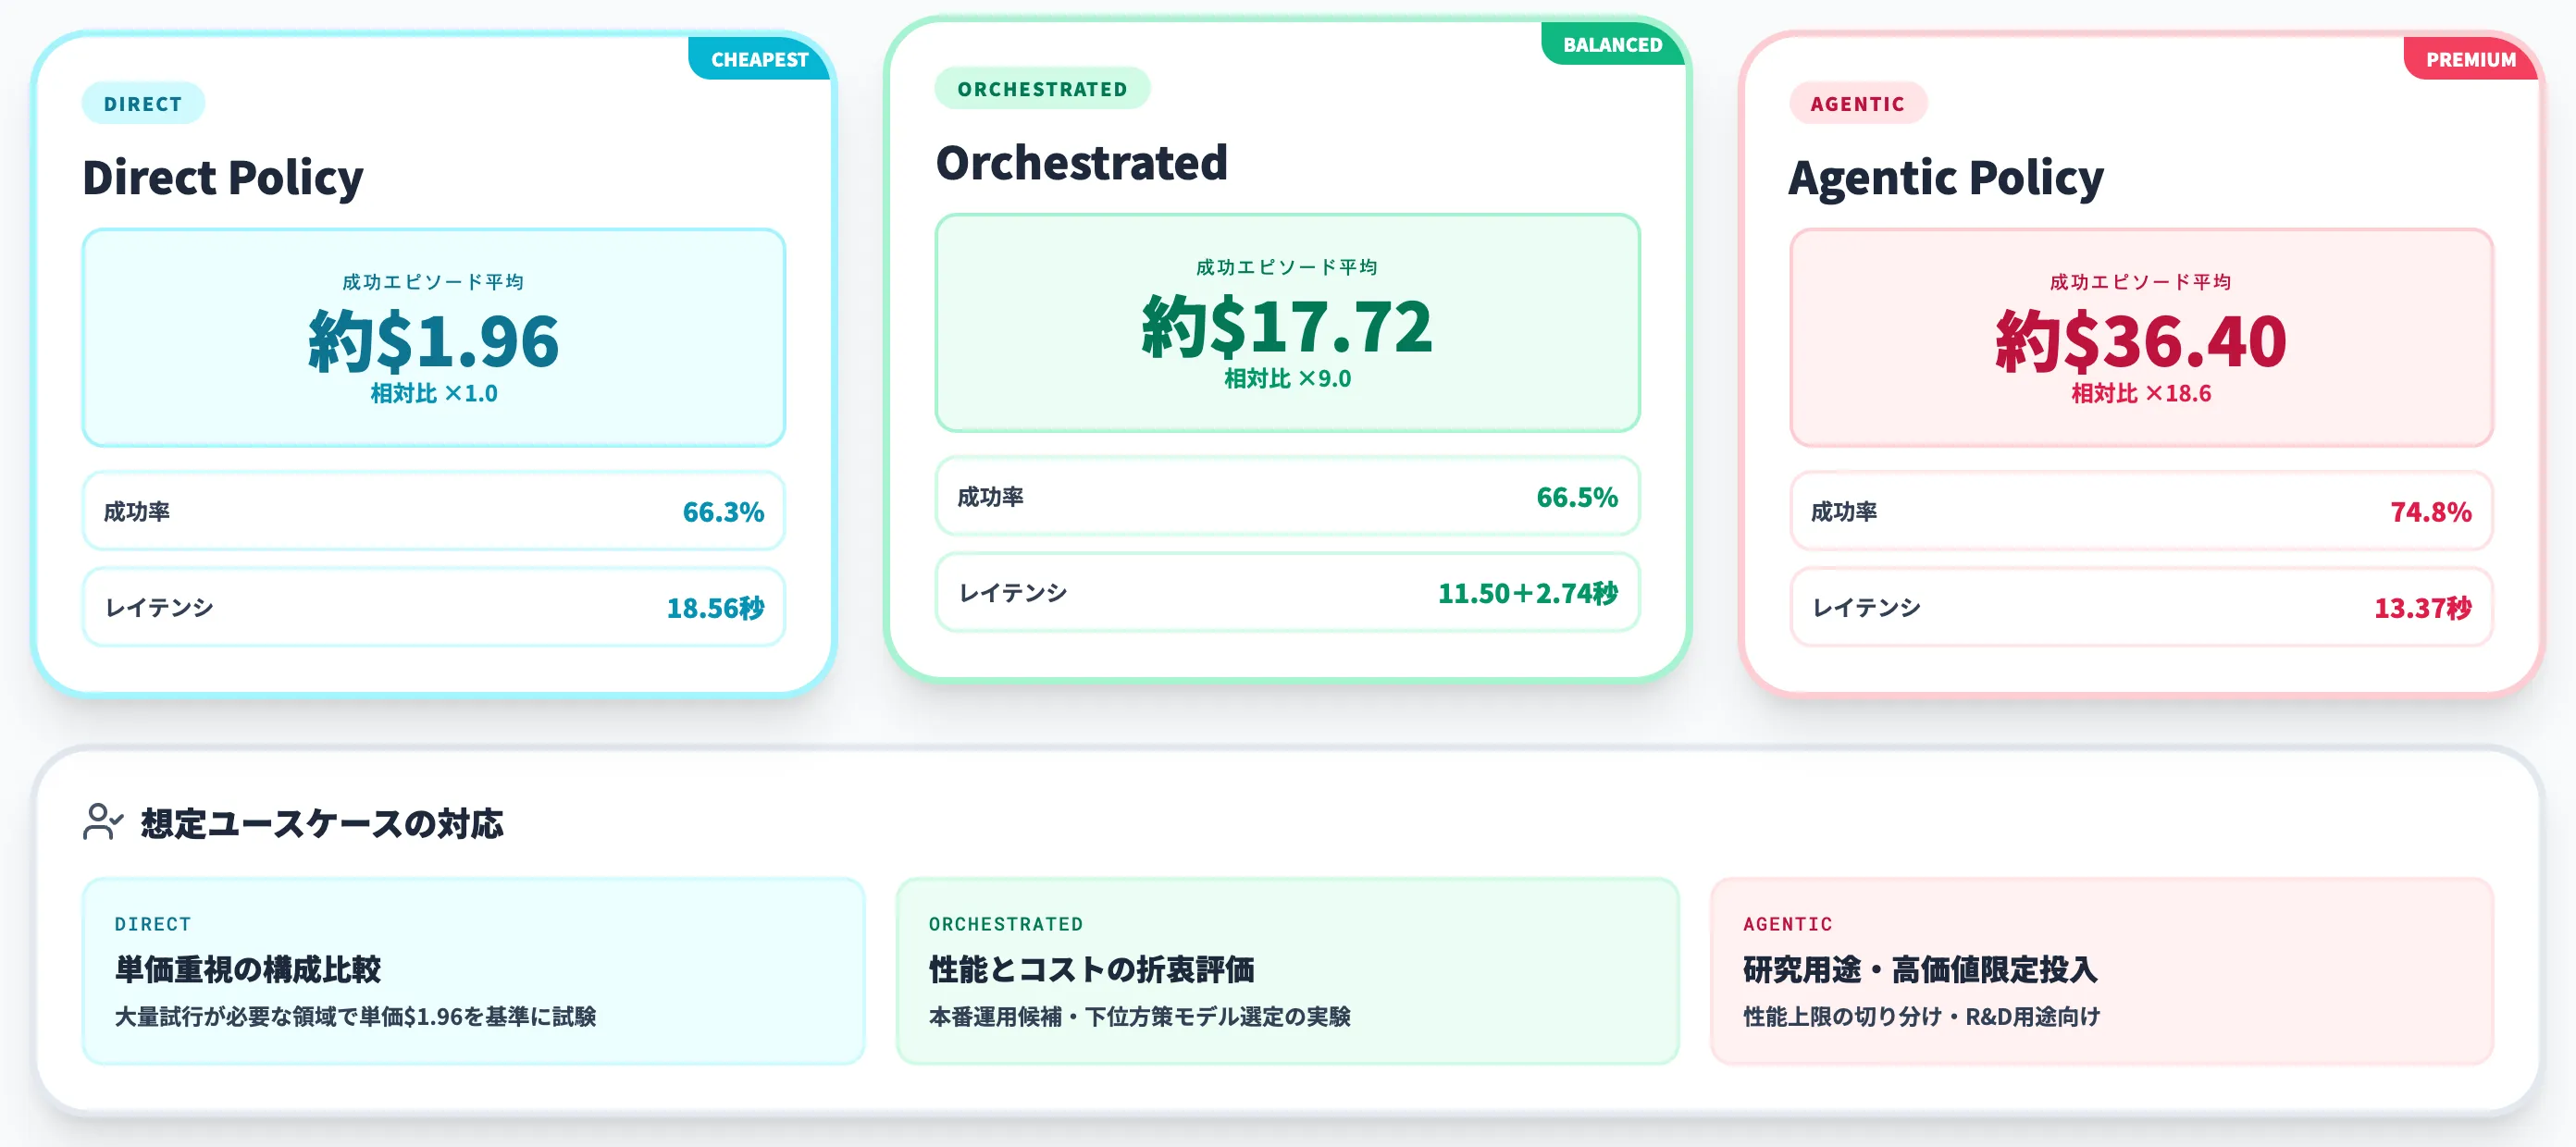
Astranomyの結果でもう一つ目を引くのが、成功率と推計コストのトレードオフが異常に大きいことです。性能順位とコスト順位が真逆に近い構造になっているため、企業がこの技術を評価する際の判断軸として扱う必要があります。
「成功エピソードあたり約$36」の読み方
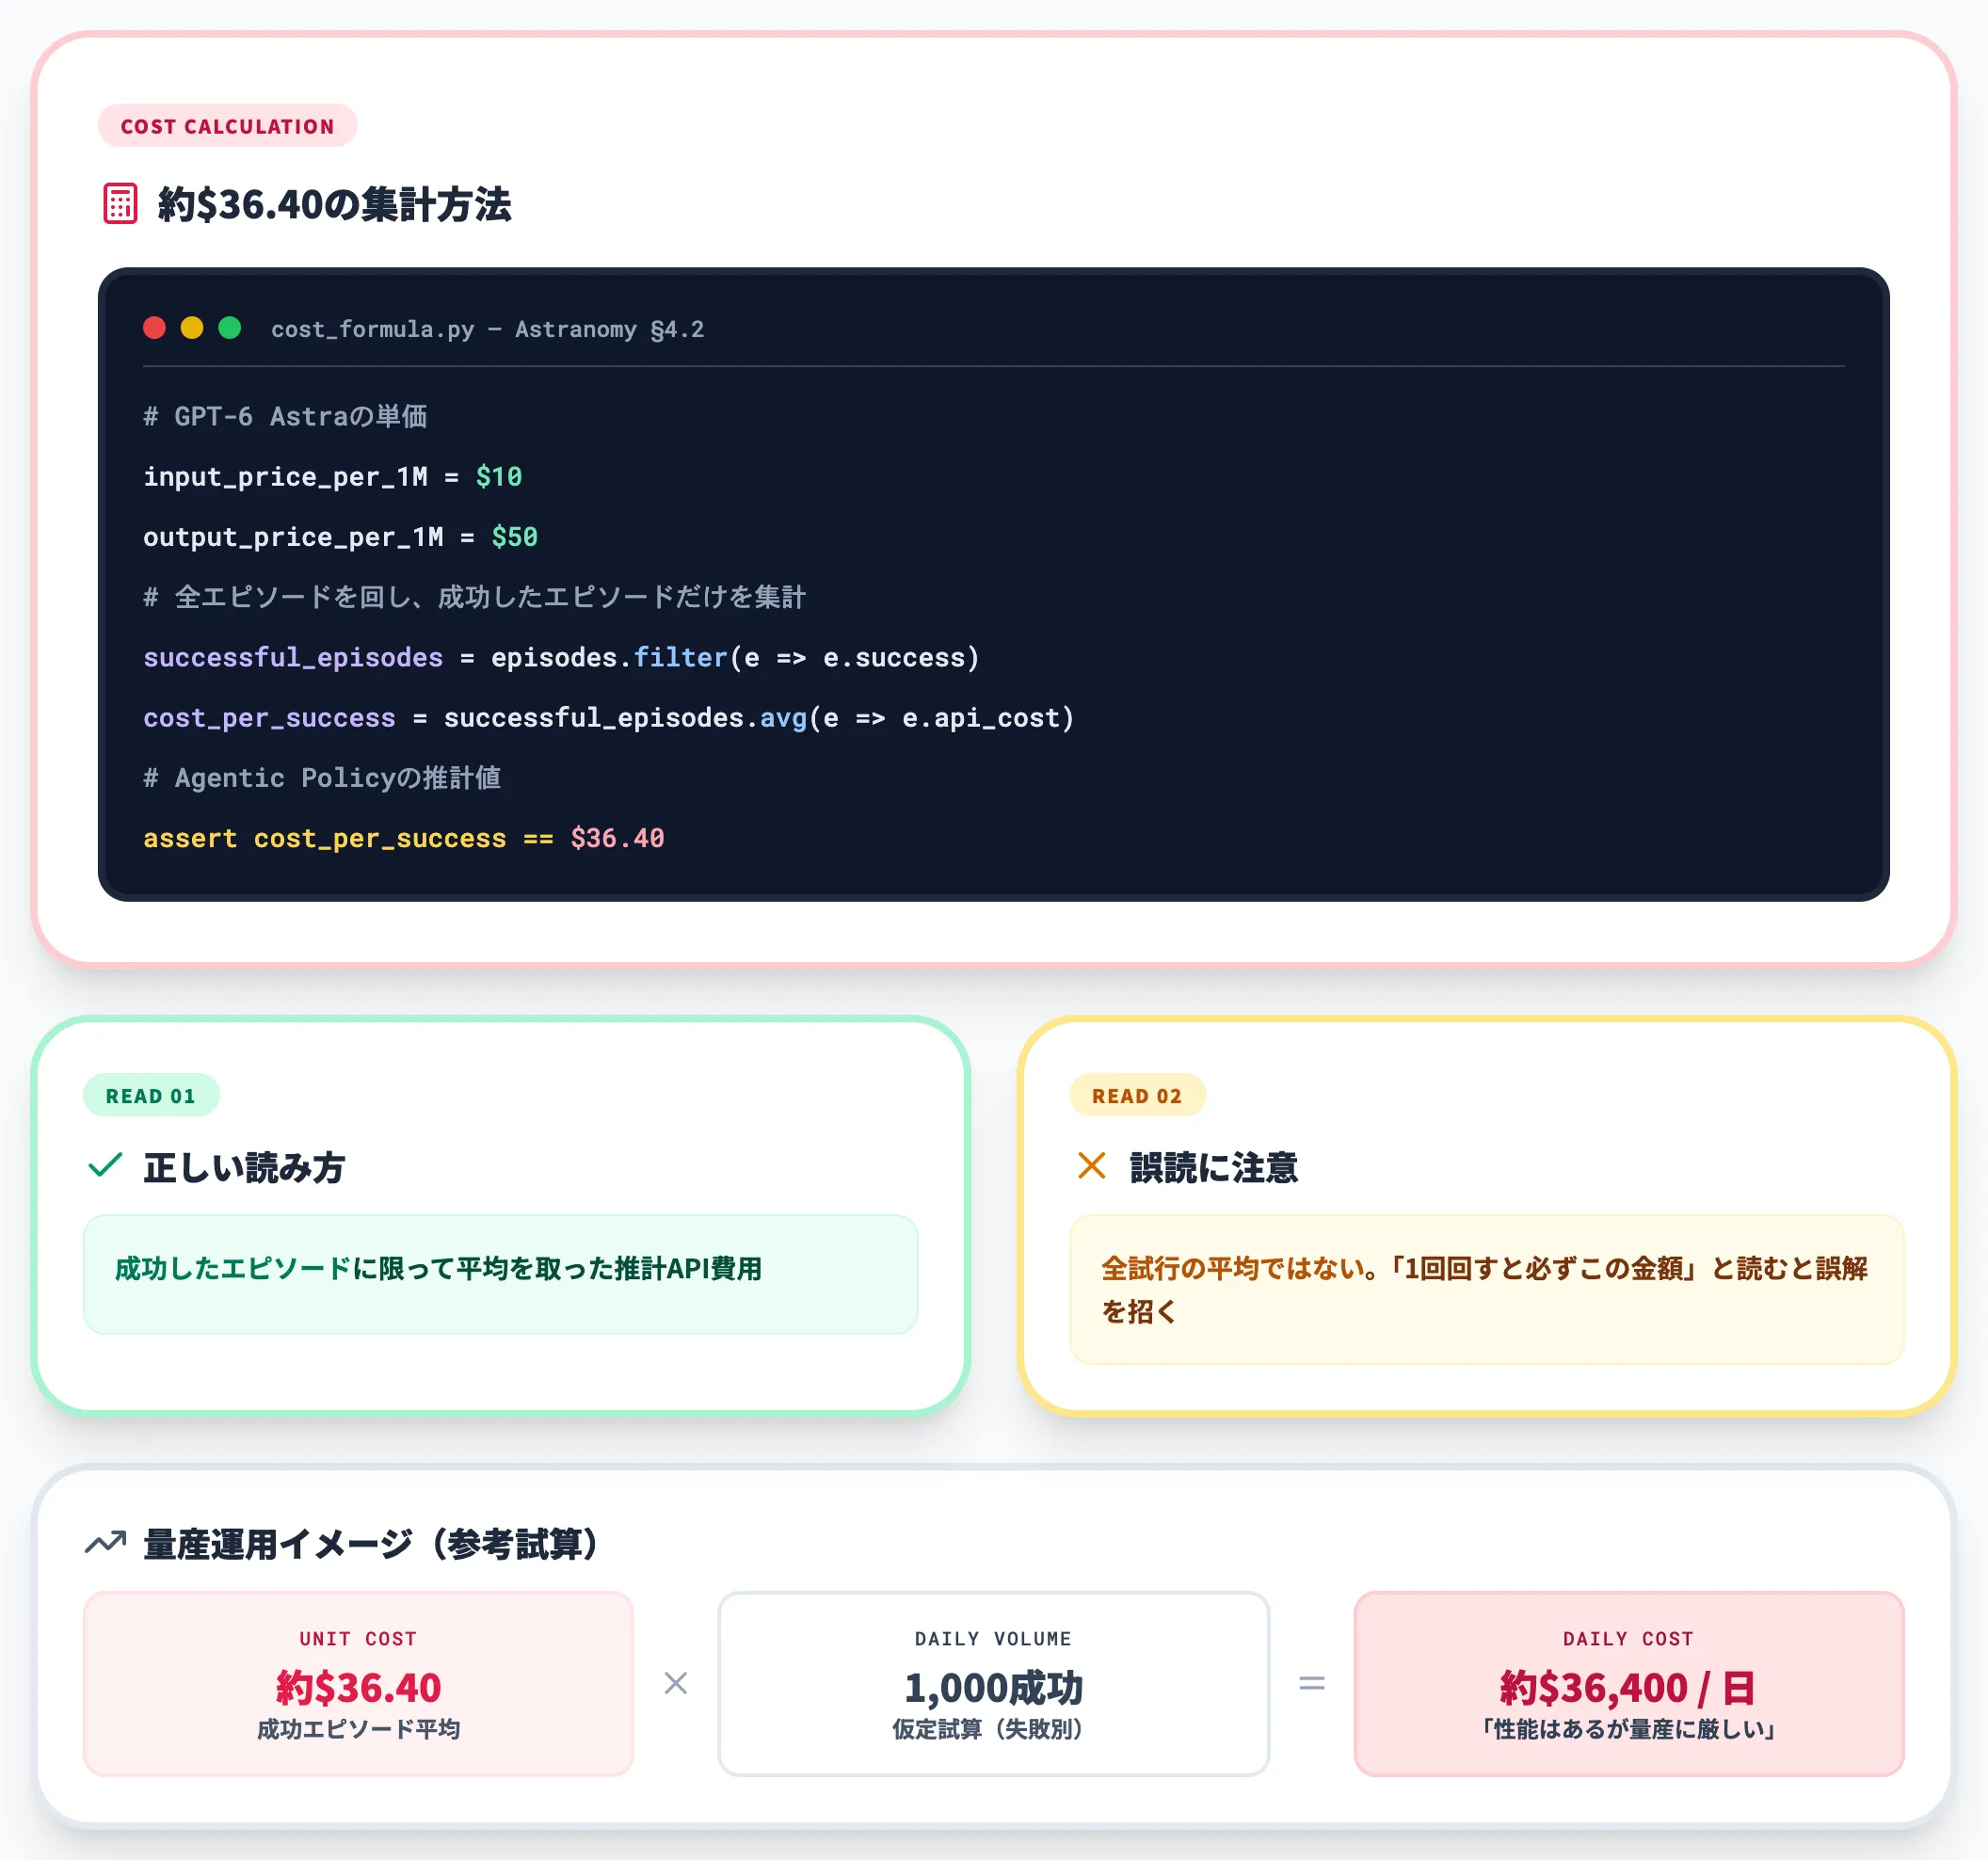
GPT-6 AstraのAPI料金は、OpenAIの公式ページによると入力$10/出力$50(100万トークンあたり)です。この単価がAgentic Policyのコスト数値を押し上げています。
公式§4.2によると、以下の表の値は成功したエピソードに限って平均を取った推計API費用です。全試行(成功+失敗)を均した単価ではないため、「エピソードを1回回すと必ずこの金額」と読むと誤解を生みます。
| モード | 成功エピソードあたり推計コスト | 相対比 | 想定ユースケース |
|---|---|---|---|
| Agentic | 約$36.40 | ×18.6 | 研究用途・高価値タスクの限定投入 |
| Orchestrated | 約$17.72 | ×9.0 | 性能とコストの折衷評価 |
| Direct (EEF) | 約$1.96 | ×1.0 | 単価重視の構成比較 |
Astranomyが示した推計値をそのまま量産運用に外挿することはできませんが、仮に成功率を一定と置いた参考試算として「1日1,000成功エピソードをAgenticで回す」と仮定すると**$36,400/日**規模となり、トークン課金とは別に失敗エピソードの消費も加わります。
「性能はあるがそのままでは量産に向かない」ことが、少なくとも推計レベルで読み取れる最初の制約です。
Orchestratedがコストと性能の折衷に見える構造
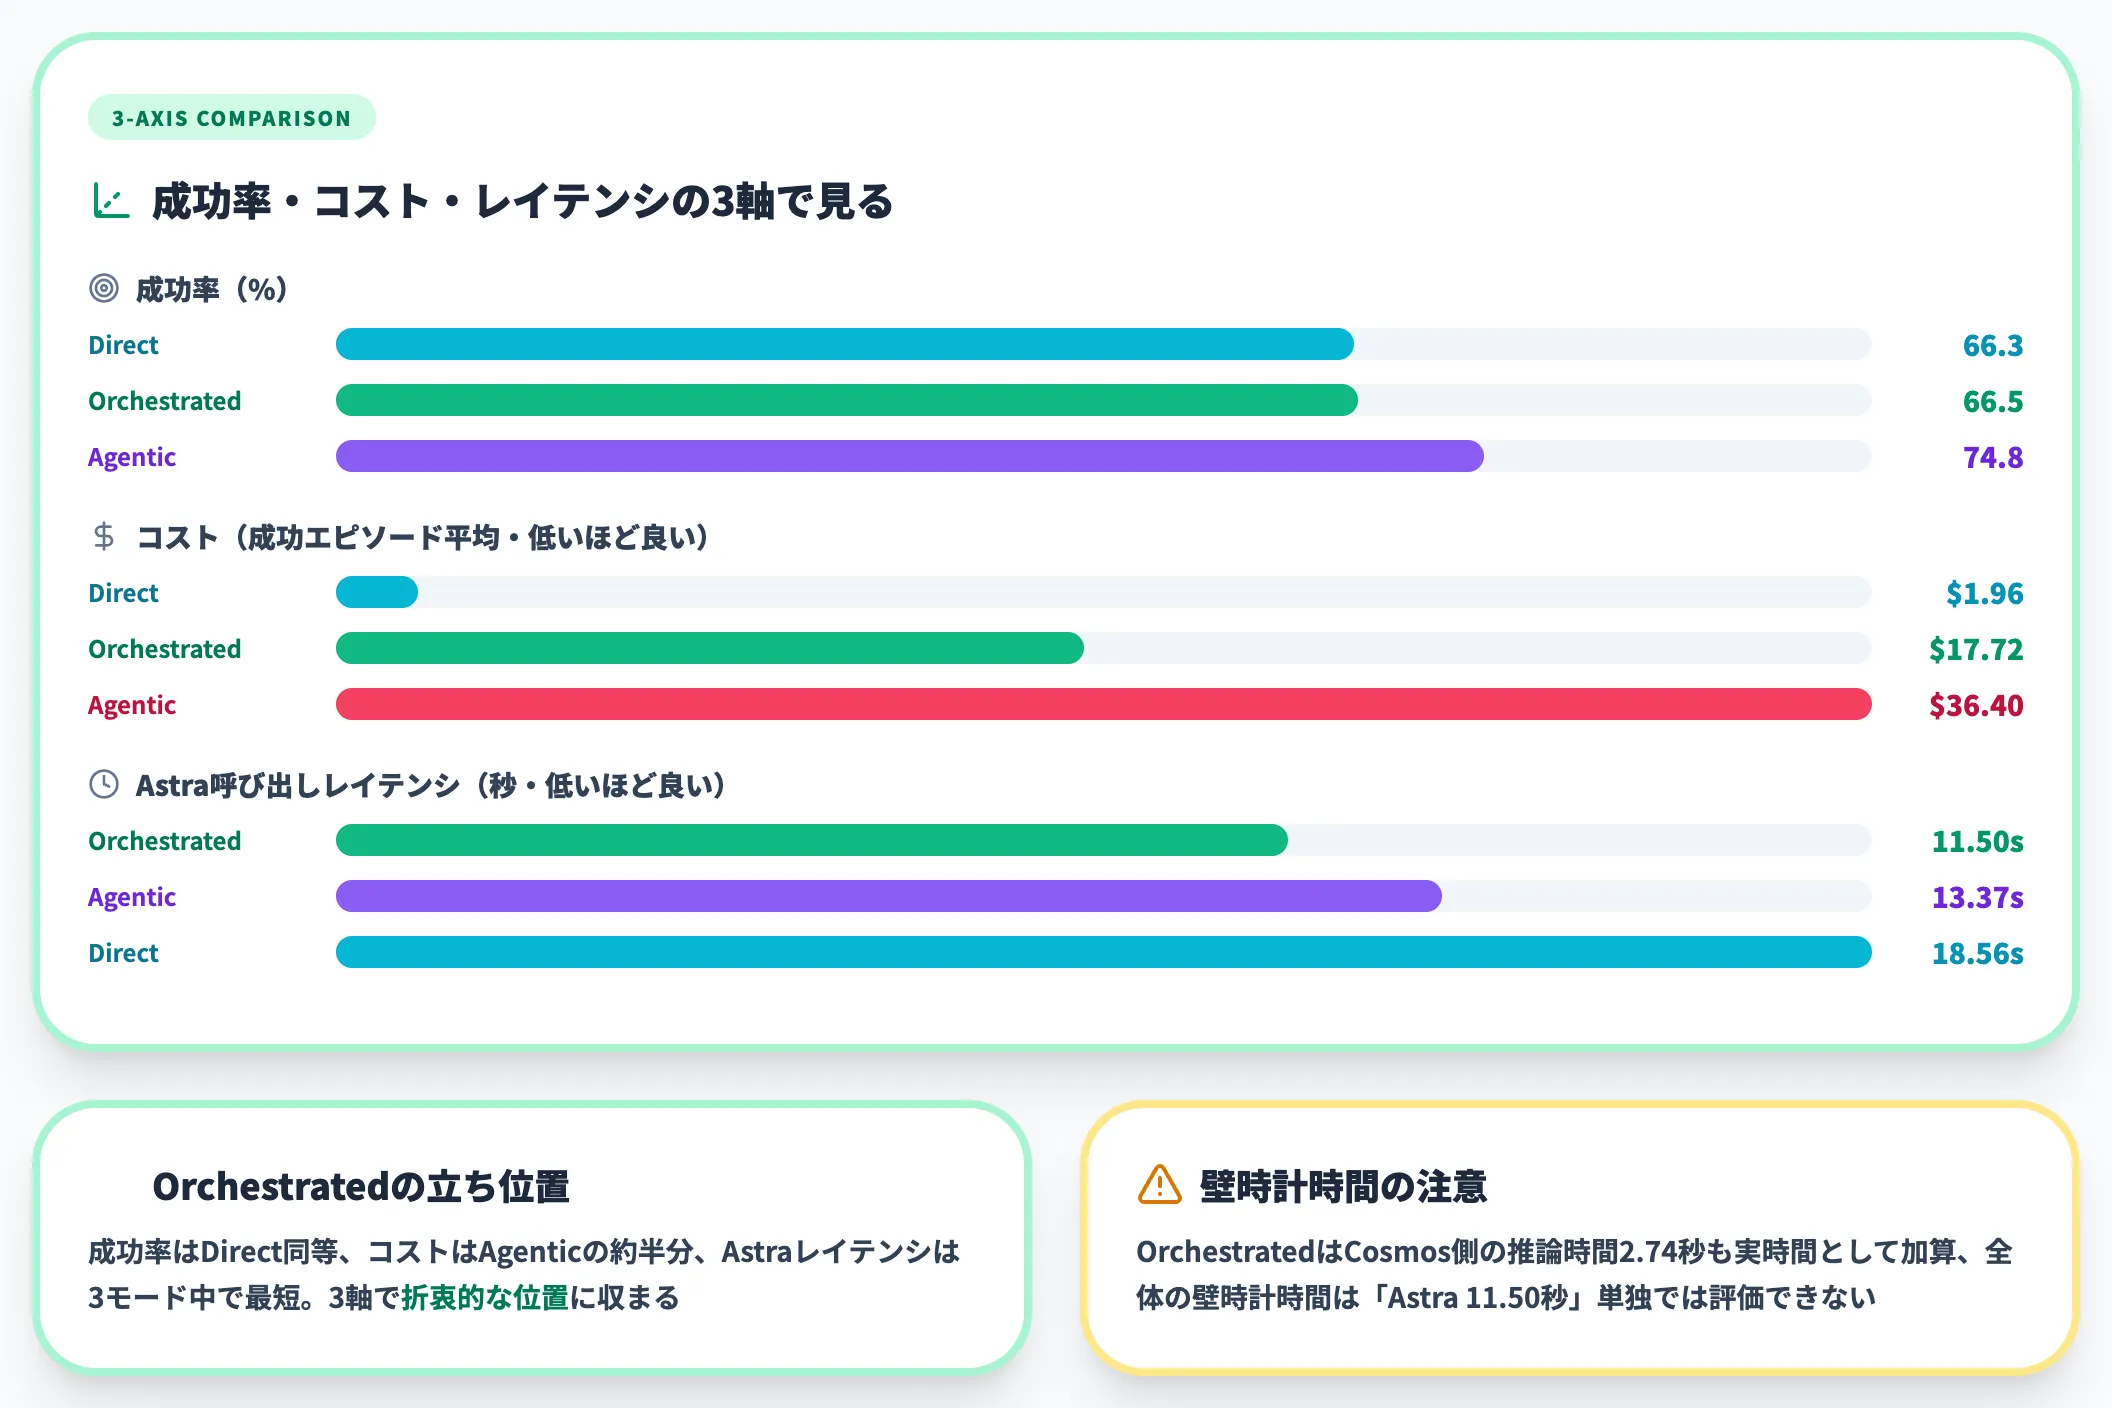
公式§4.1・表3の数値をコスト・性能・呼び出しレイテンシの3軸で見ると、OrchestratedはAgenticと比べてコストが小さく、Directと比べて成功率が高いという折衷的な位置に収まっています。
- 成功率はDirect(66.3%)と同等の66.5%
- 成功エピソードあたり推計コストはAgenticの約半分(約$17.72 vs 約$36.40)
- Astra側の呼び出しレイテンシは11.50秒(Direct 18.56秒・Agentic 13.37秒)/別途Cosmos側が1呼び出しあたり2.74秒
Astraは全ステップで呼び出されるわけではなく、Cosmos3-Nano-Policyの提案をレビューしたうえで必要時に行動へ介入する設計です。Astra側のトークン消費が抑えられる一方、Cosmos側の推論時間(2.74秒)も実時間として加算されるため、全体の壁時計時間は「Astra 11.50秒」単独では評価できません。
公式§5は専用方策との最適な組み合わせを未解決の論点として提示しており、「Orchestratedが現実解」と断定するよりも、低コスト専用方策モデル+LLMの監督という構成が、3モードの中では成功率とコストのバランスが取れた一例として確認できたと読むのが妥当です。
Action horizon拡張で呼び出し数を62%削減
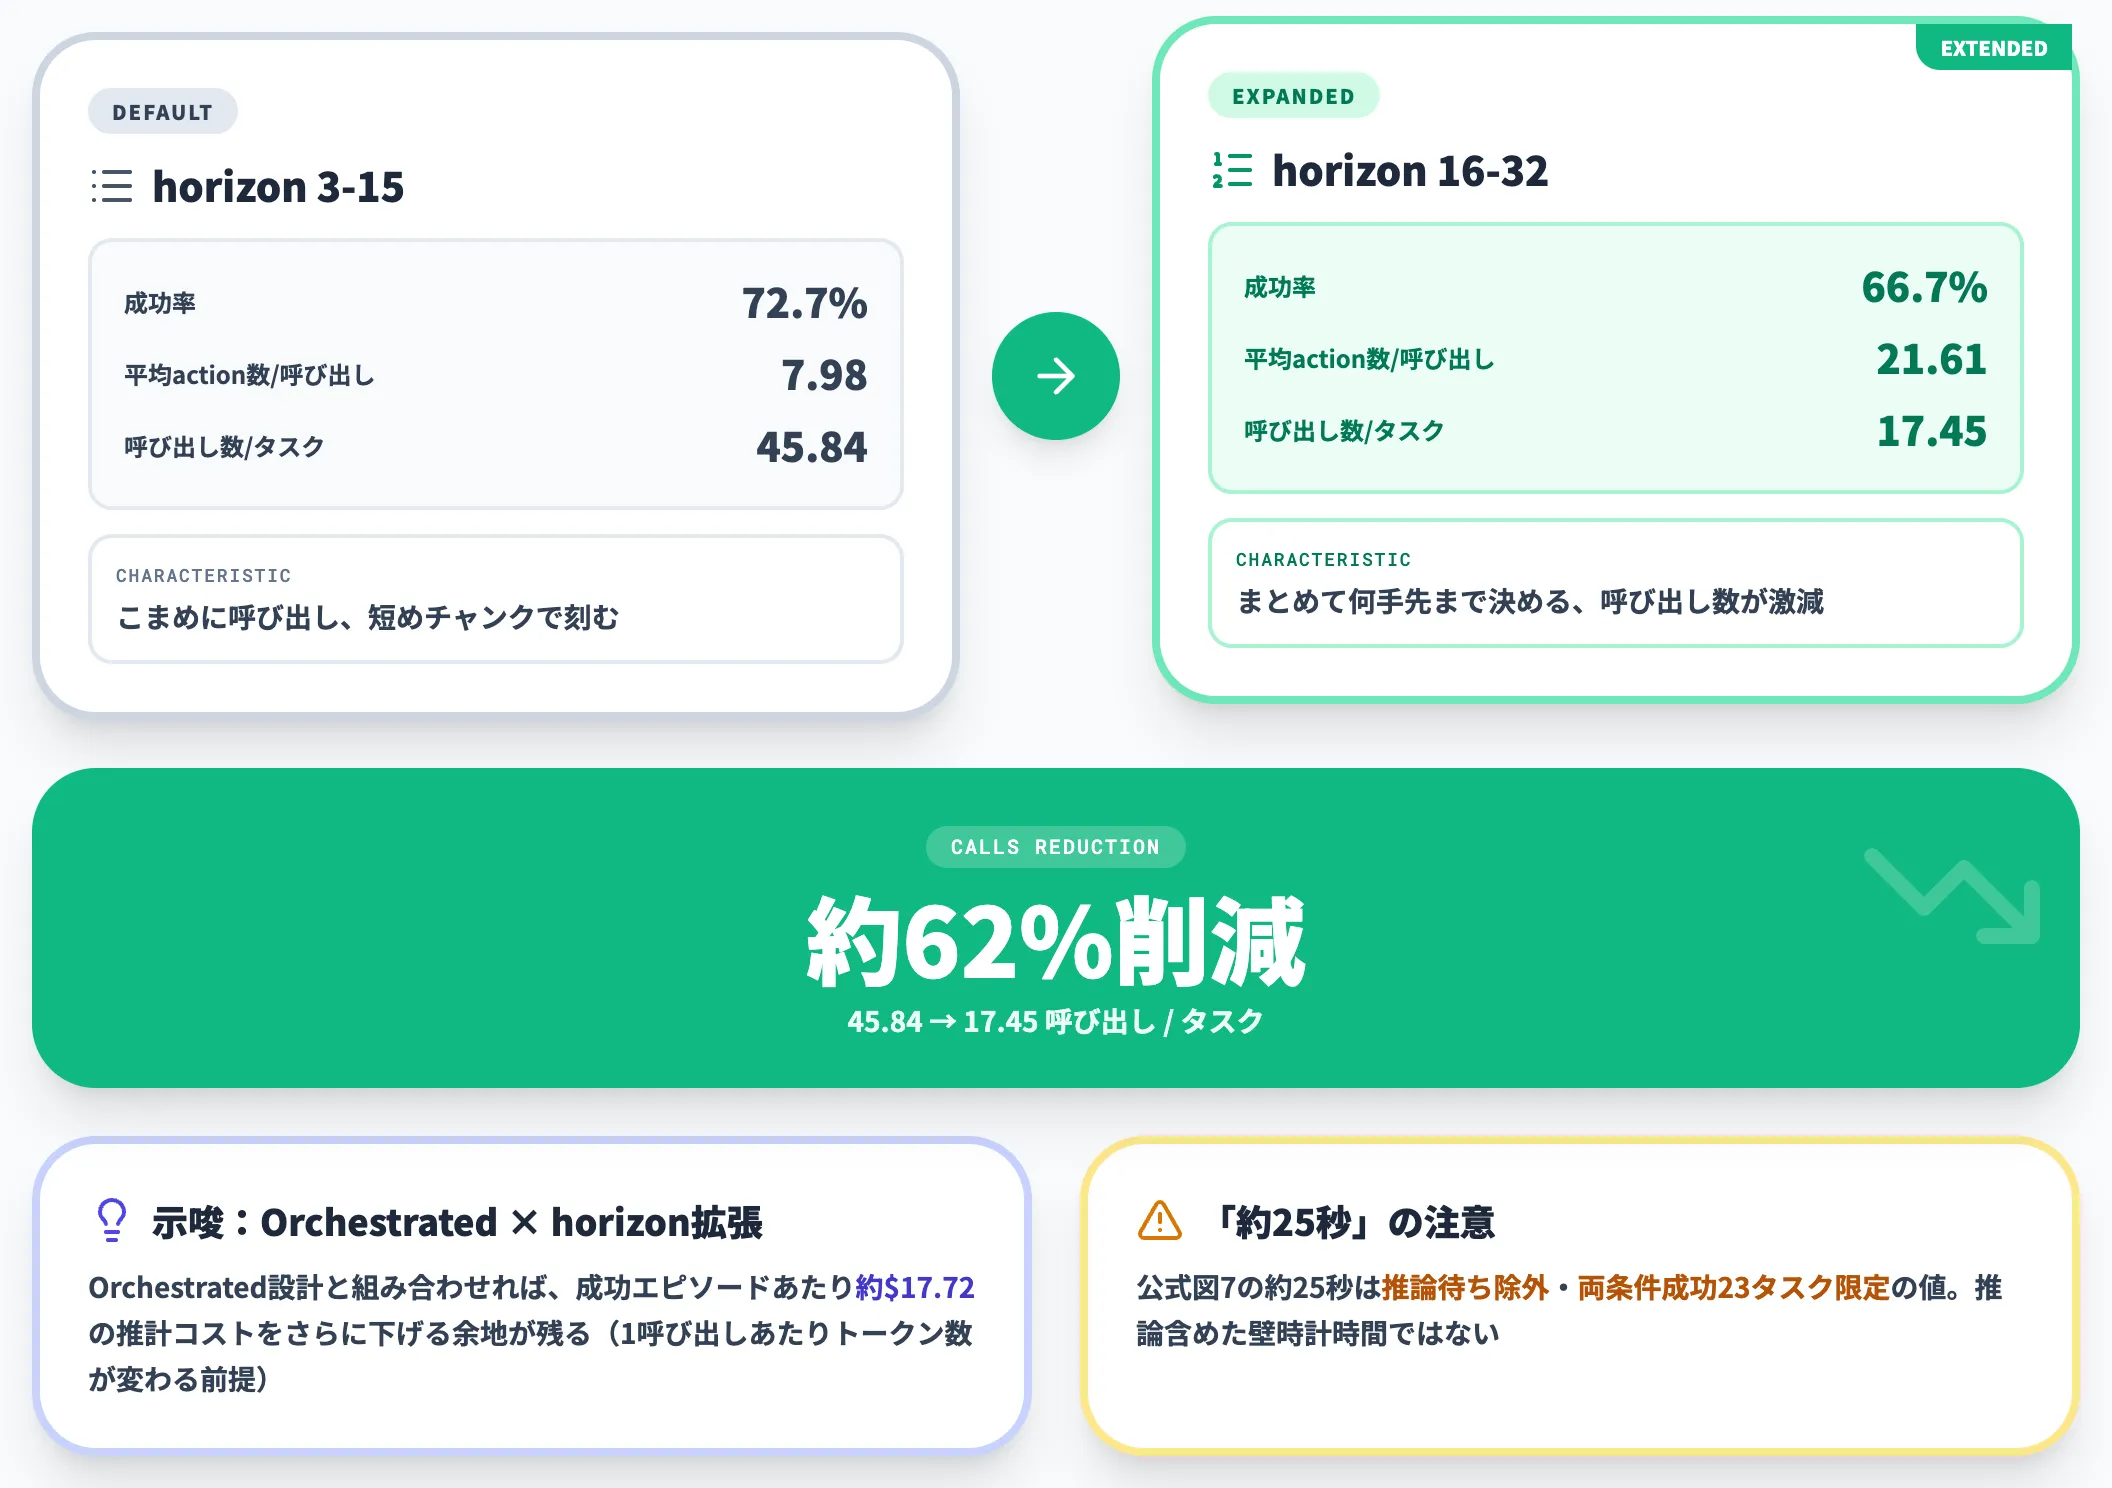
Astranomyは、Astraが1回の呼び出しでいくつのactionを提案するか(action horizon)を変えた追加実験も行っています。
| action horizon | 成功率 | 平均action数/呼び出し | 呼び出し数/タスク |
|---|---|---|---|
| 3-15(デフォルト) | 72.7% | 7.98 | 45.84 |
| 16-32 | 66.7% | 21.61 | 17.45 |
horizon拡張で呼び出し数が45.84→17.45に減少(約62%削減)する一方、公式・図7が示す「約25秒」は推論待ちを除いた動作時間で、かつ両条件で成功した23タスクの比較に限定された数値です。
推論時間を含めた壁時計時間や、未成功タスクも含めた平均ではない点に注意が必要です。成功率は6ポイント下がりますが、トークン課金のGPT-6 Astraでは呼び出し数の削減が推計コストの削減につながる可能性がある実用知見になります(1呼び出しあたりのトークン数が変わる前提で、削減幅はトークン消費次第)。
Astraが「自分でまとめて何手先まで決めるか」を適応的に判断できる余地が示されており、Orchestrated設計と組み合わせれば成功エピソードあたり約$17.72の推計コストをさらに下げる余地が残っていることになります。
類似研究との差分——HomeBody・RoboDojo評価論文との棲み分け
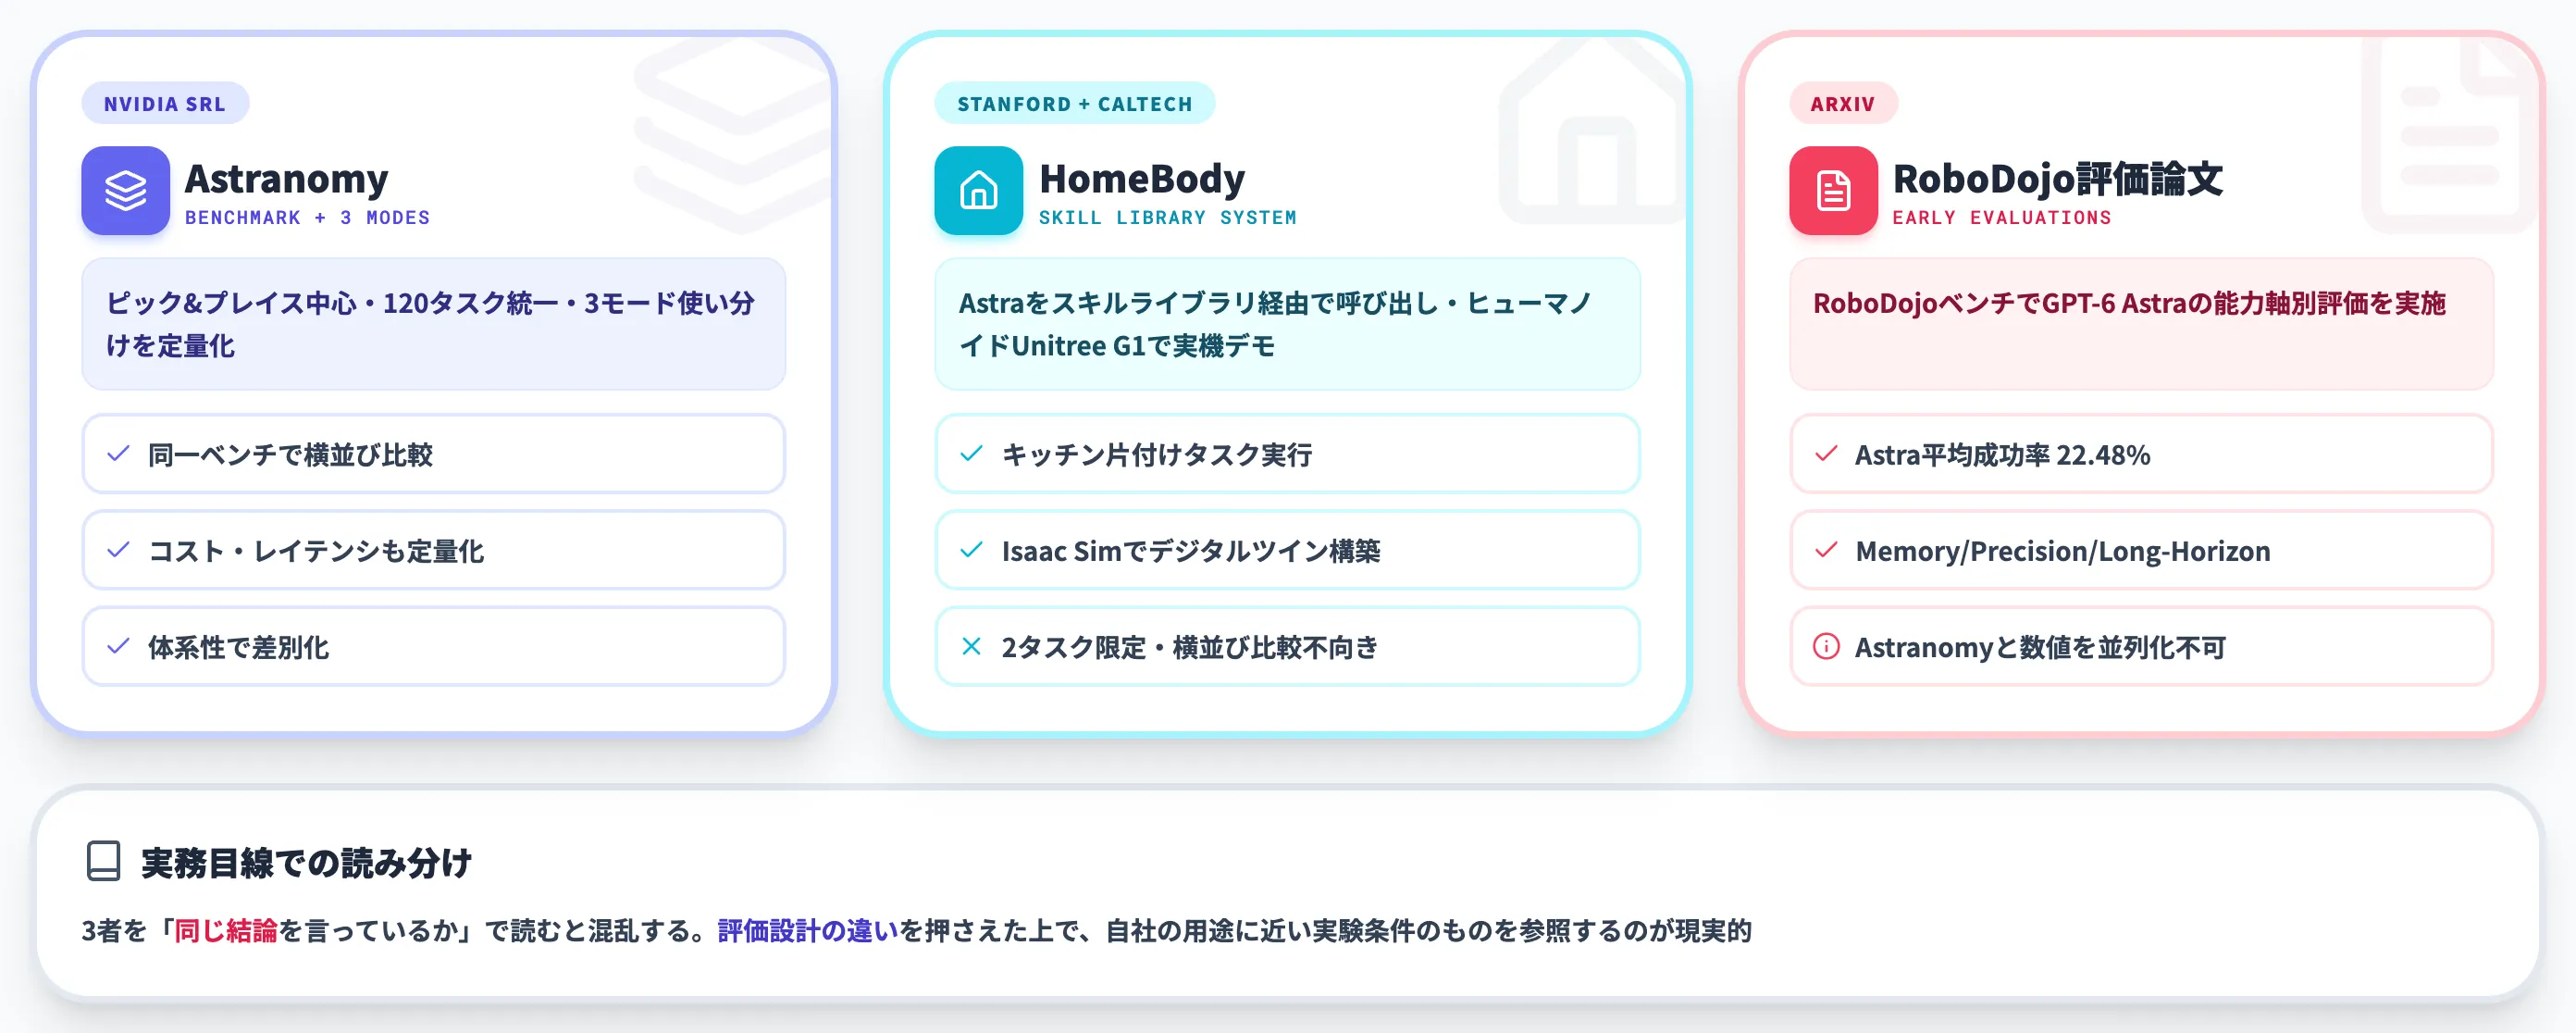
GPT-6 Astraをロボット方策として評価する研究はAstranomyだけではなく、2026年10月前後に複数のグループが同時並行で論文・プロジェクトを公開しています。棲み分けを押さえておくと、Astranomyが何を特異点として狙ったかが見えてきます。
Stanford HomeBody——スキルライブラリ経由型
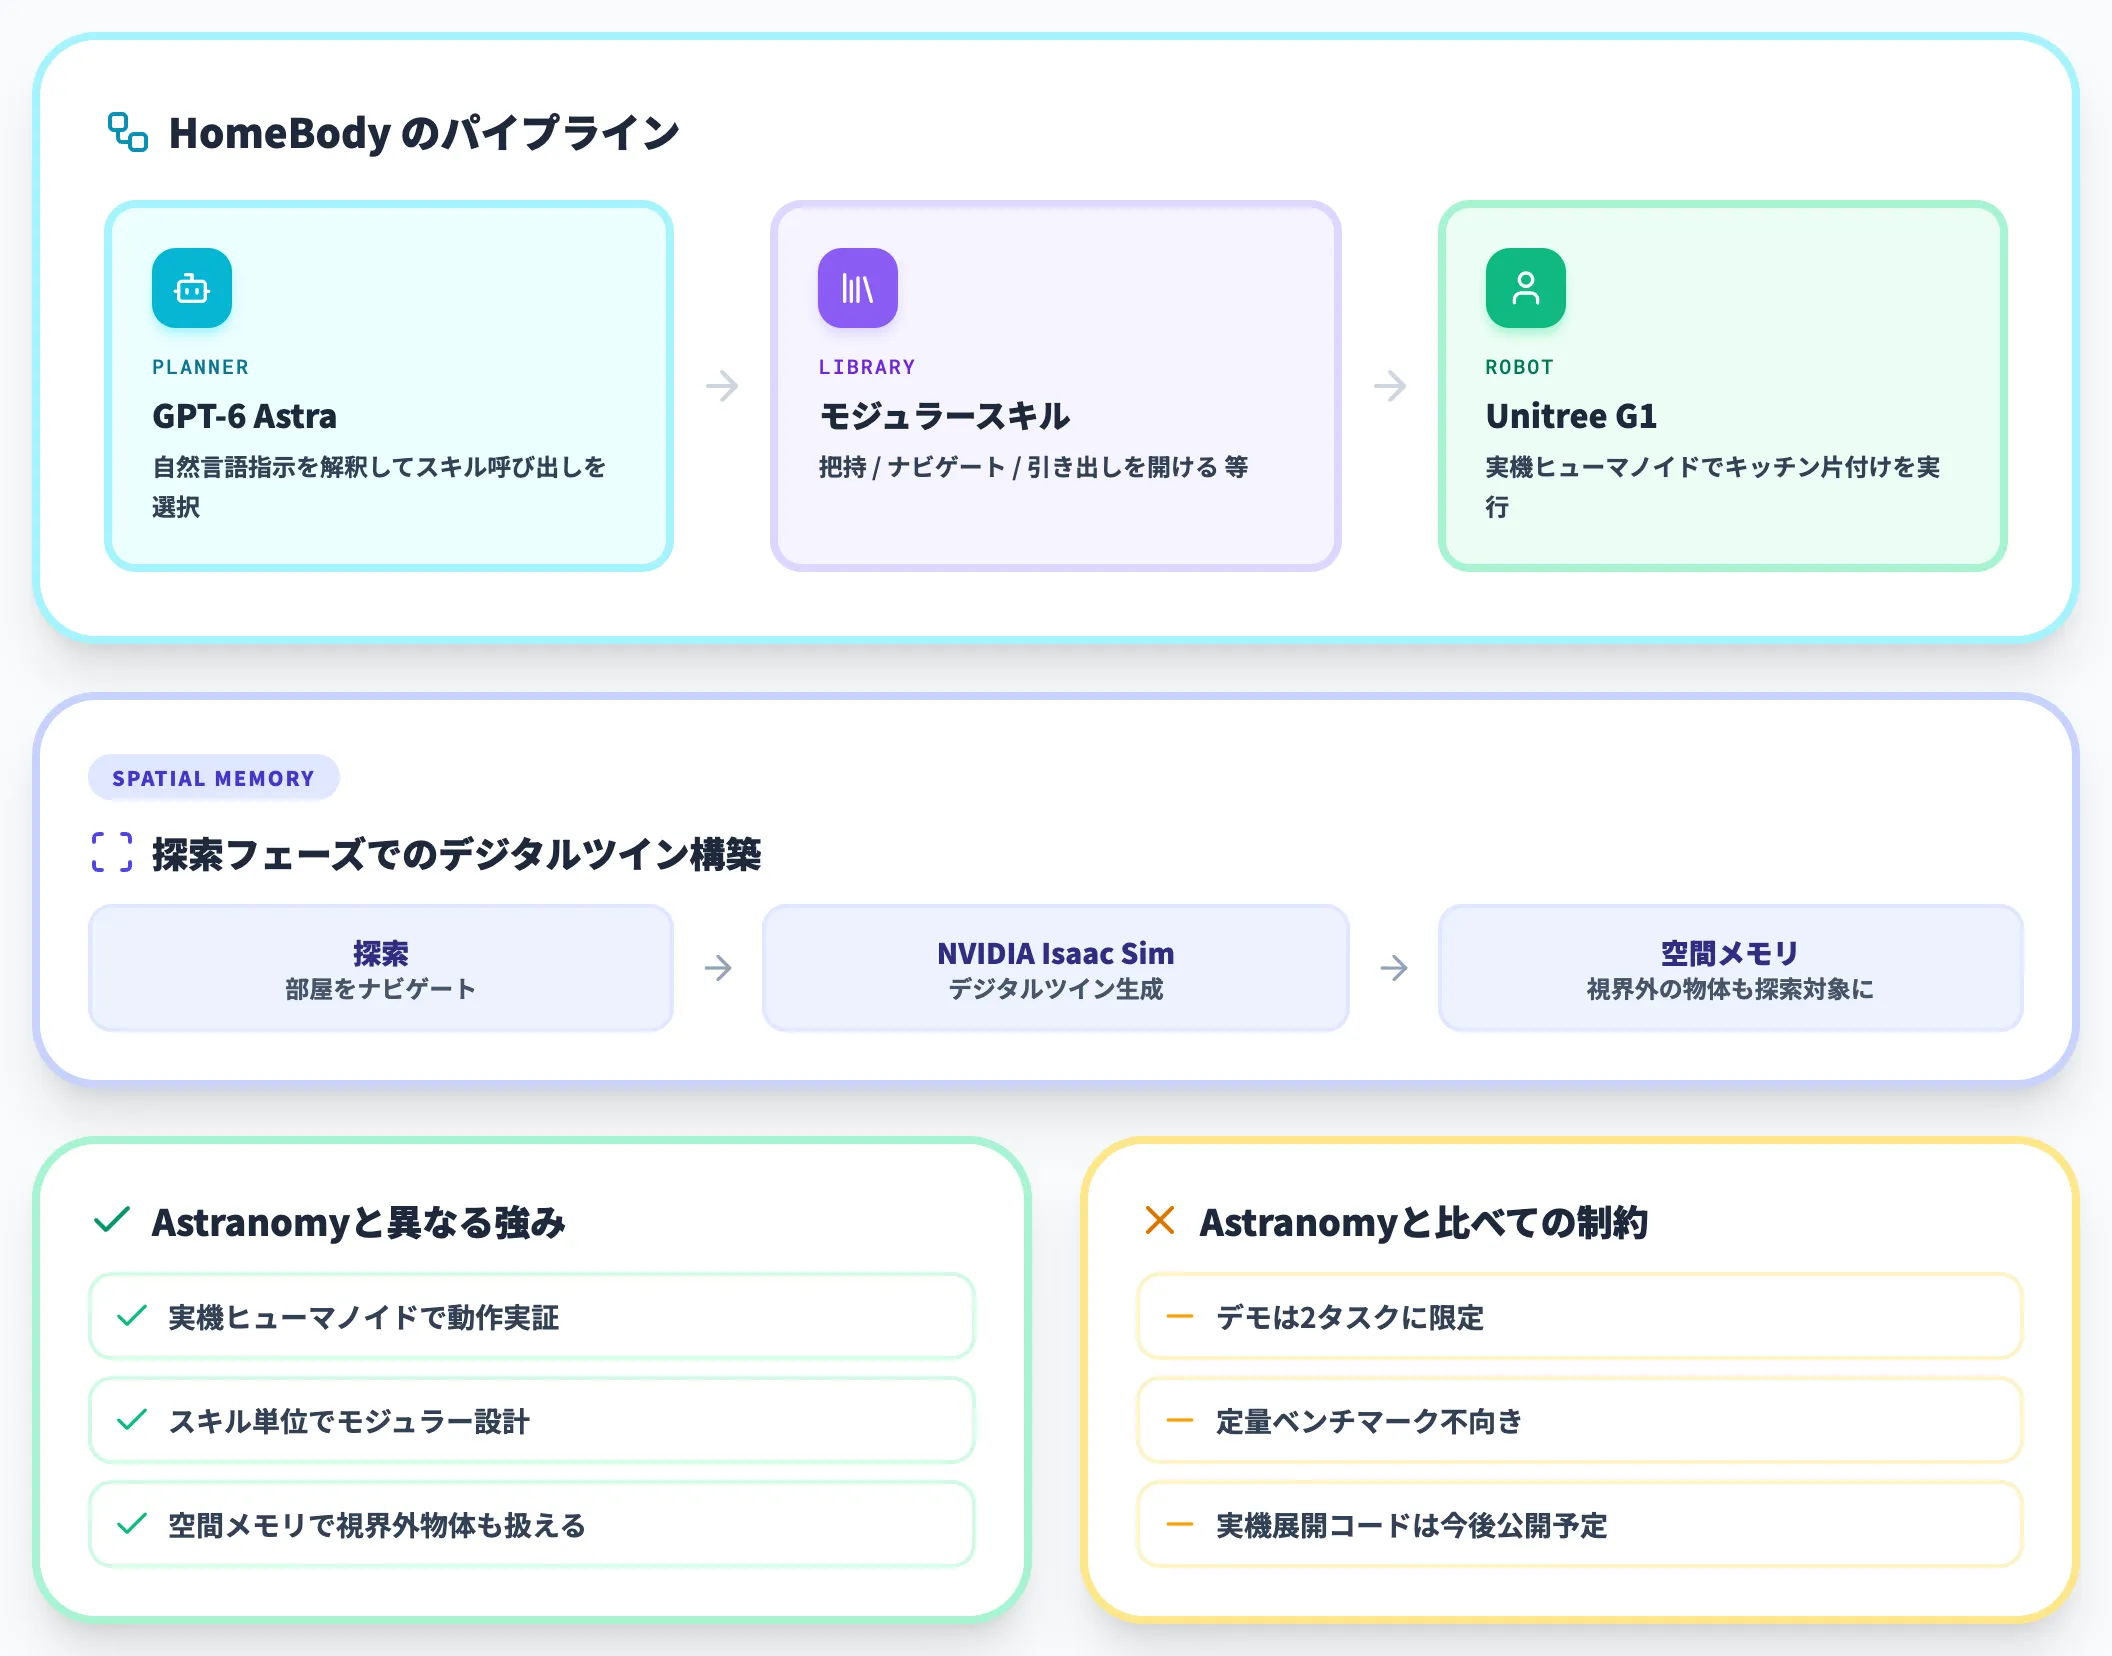
Stanford大学とCaltechのチームが公開したHomeBodyプロジェクトは、GPT-6 AstraをヒューマノイドUnitree G1に接続してキッチン片付けタスクを実行した事例です。
HomeBodyの特徴は、Astraの出力をモジュラーなスキルライブラリ(把持・ナビゲート・引き出しを開ける等)経由で呼び出す点です。ロボットは最初に部屋を探索してNVIDIA Isaac Simでデジタルツインを構築し、空間メモリを使って視界外の物体も探索対象にします。
公式リポジトリによると、HomeBodyはSIM・REAL2SIMのコードが公開済みで、実機展開コードは今後公開予定とされています。デモは2タスクに限定されており、Astranomyのように120タスク統一ベンチマークでの横並び比較には適さない位置づけです。Astranomyがベンチマーク統一・3モード切り分け・コスト定量化という体系性で差別化している構図が明確になります。
RoboDojo評価論文との棲み分け
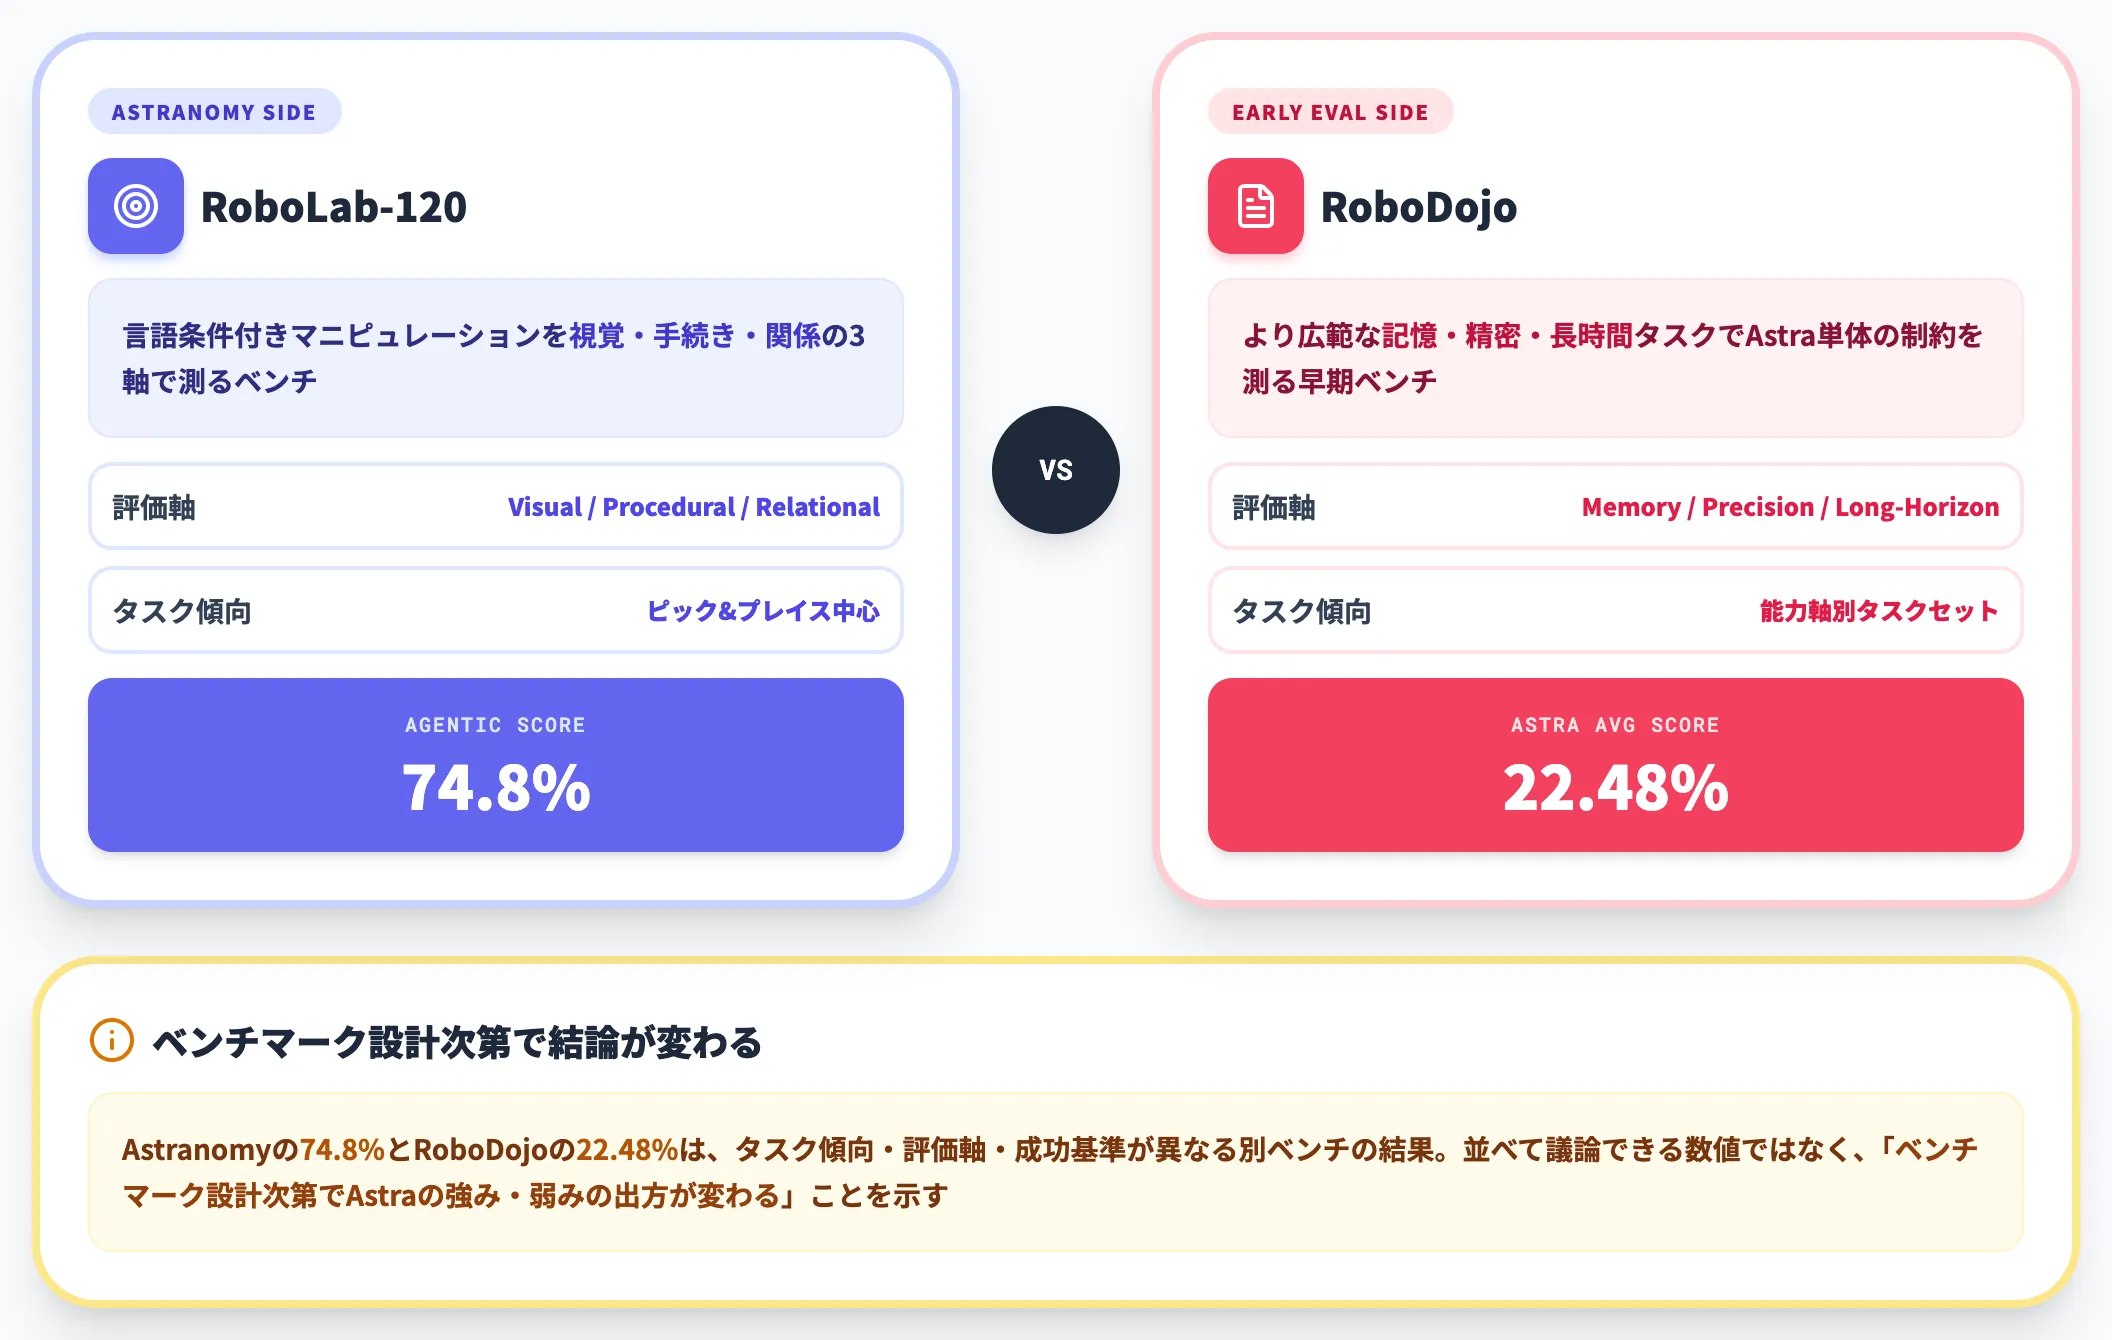
arXivに公開されている「An Unexpected Robot Policy: Early Evaluations of GPT-6 Astra on RoboDojo and Beyond」は、RoboDojoベンチマークという別の評価軸でGPT-6 Astraを計測した早期研究です。
RoboDojoではAstraの平均成功率が22.48%と報告されており、特にMemory・Precision・Long-Horizonタスクでは他の方策モデルより劣る結果になっています。
これはベンチマーク設計次第でAstraの強み・弱みの出方が変わることを示しており、Astranomyが得た74.8%とそのまま並べて議論できる数値ではありません。
実務目線での読み分けは次のとおりです。
- Astranomy: ピック&プレイス中心・言語条件付きタスク120本・3モードの使い分け定量化
- RoboDojo評価論文: より広範な能力軸(記憶・精密・長時間)で早期ベンチ、Astra単体の制約を明らかに
- HomeBody: スキルライブラリ経由の統合システム・実機ヒューマノイドの動作可能性実証
3者を「同じ結論を言っているか」で読むと混乱します。評価設計の違いを押さえた上で、自社の用途に近い実験条件のものを参照するのが現実的です。
より広いEmbodied AI分野の文脈では、「汎用LLMをそのまま方策にする」路線と「VLA/WAMを専用学習する」路線が併存しており、Astranomyはその分岐点を定量化した貢献として位置づけられます。
Astranomyの制限事項と今後の論点
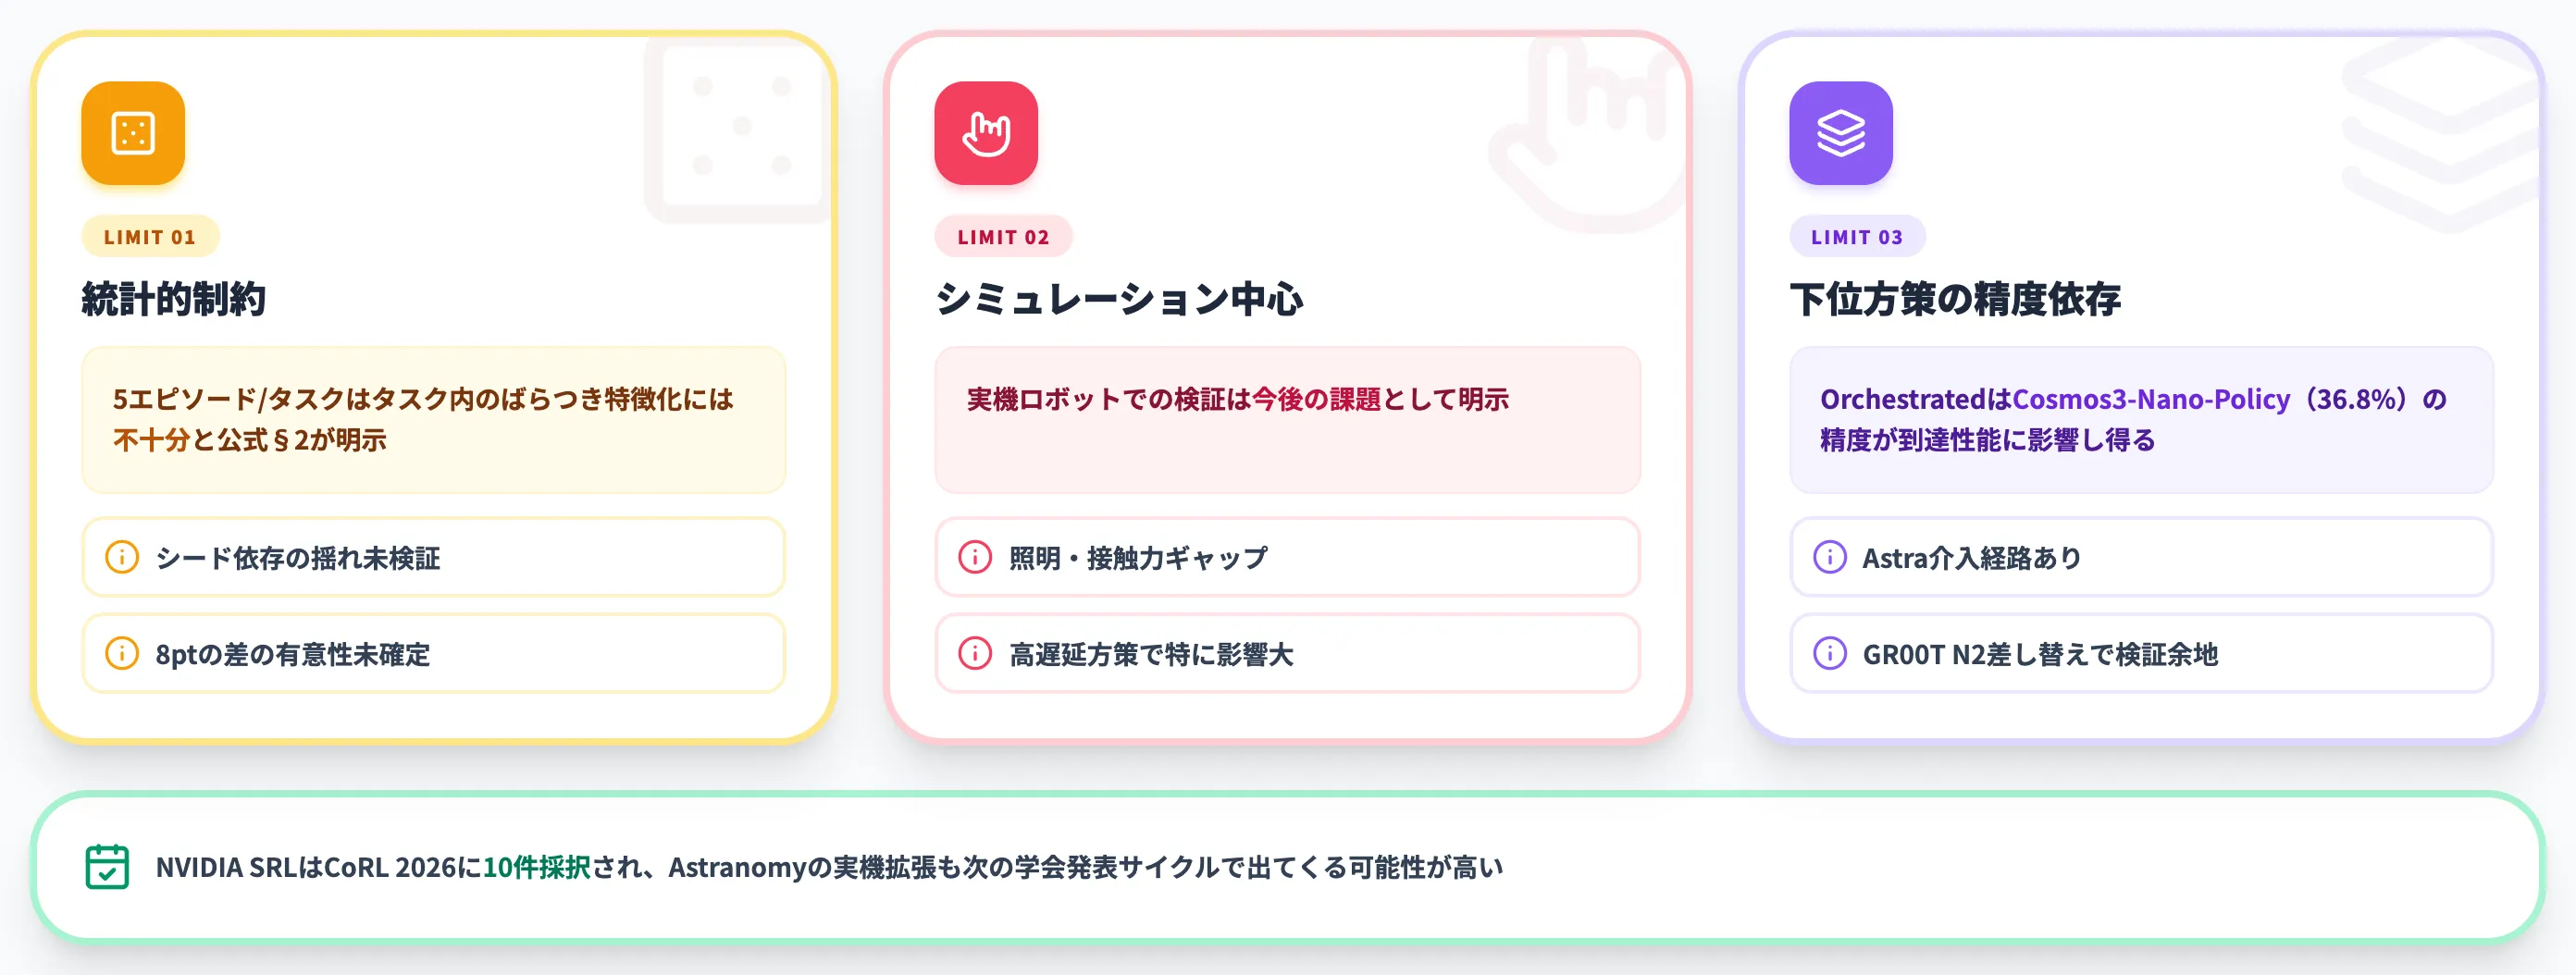
Astranomyのテックレポートは制限事項も率直に提示しており、過度な一般化を避けるためにも押さえておく必要があります。
5エピソード/タスクの統計的制約
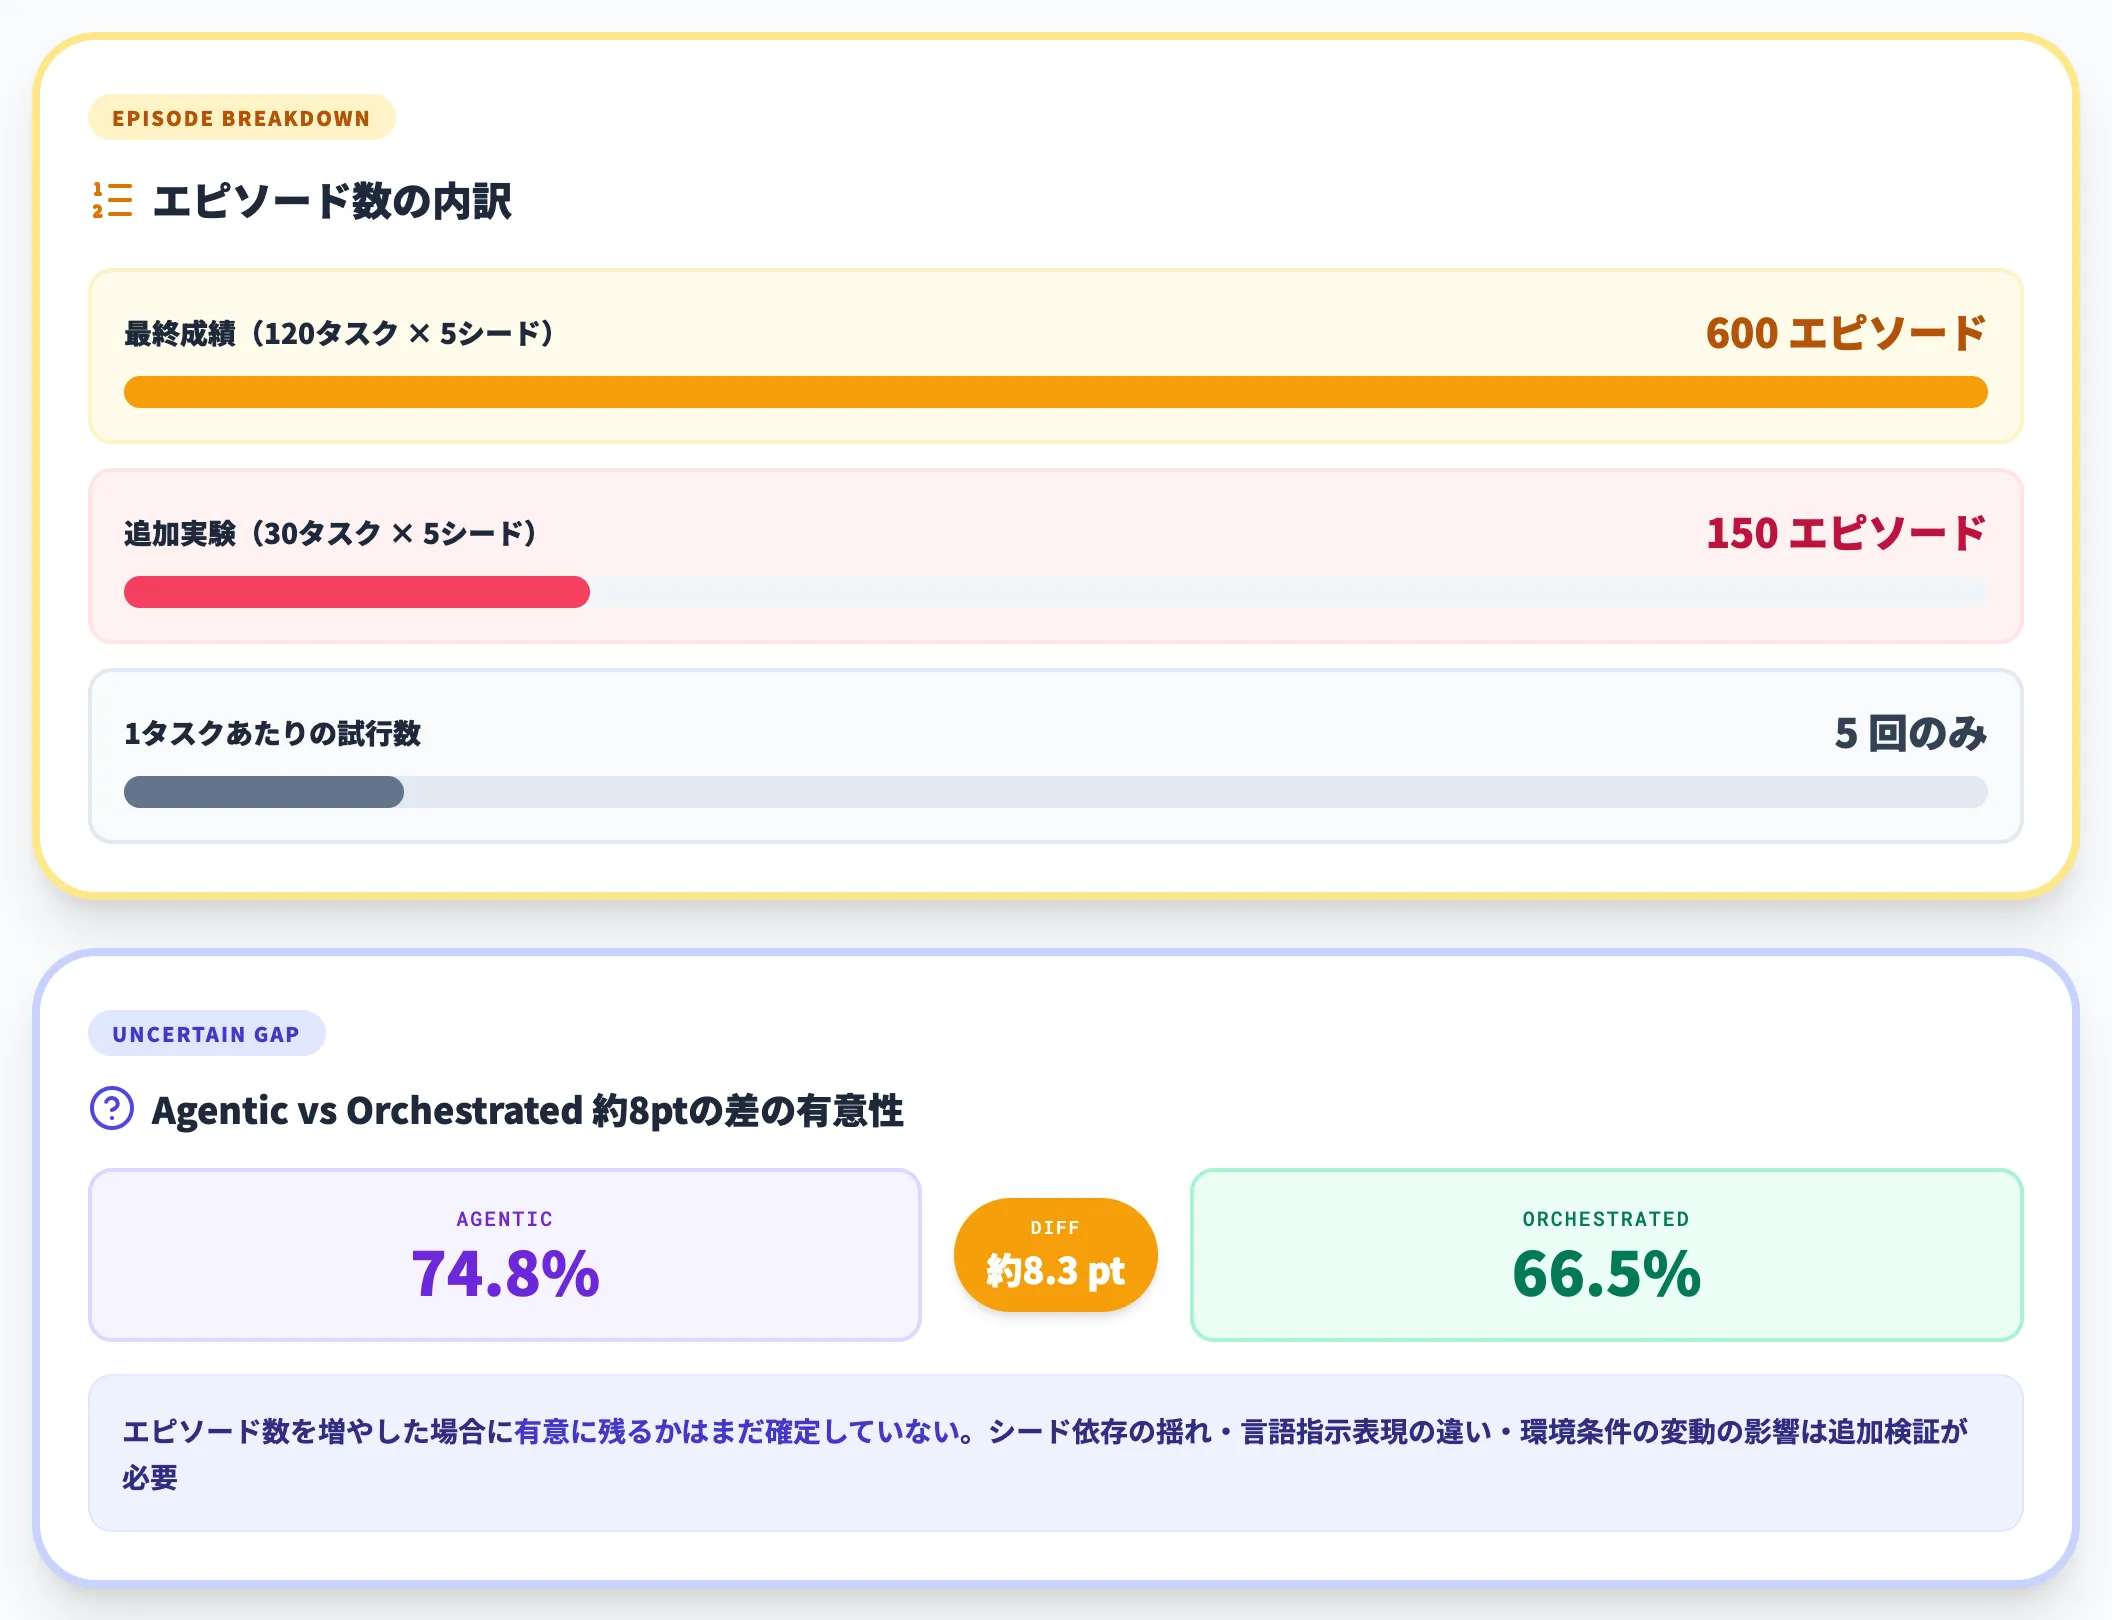
Astranomyは、各タスクの試行回数が5エピソード(固定シード0-4)に抑えられています。最終成績は120タスク×5=600エピソード、追加実験は30タスク×5=150エピソードで、母数自体は確保されていますが、公式§2が明示するとおりタスク内のばらつきを特徴づけるには1タスクあたり5回では不十分で、シード依存の揺れ・言語指示表現の違い・環境条件の変動が成功率にどこまで影響するかはより多数のエピソードで追加検証する必要があります。
Agentic Policyが74.8%、Orchestrated Policyが66.5%という約8ポイントの差も、エピソード数を増やした場合に有意に残るかはまだ確定していません。
シミュレーション中心・実機検証はこれから
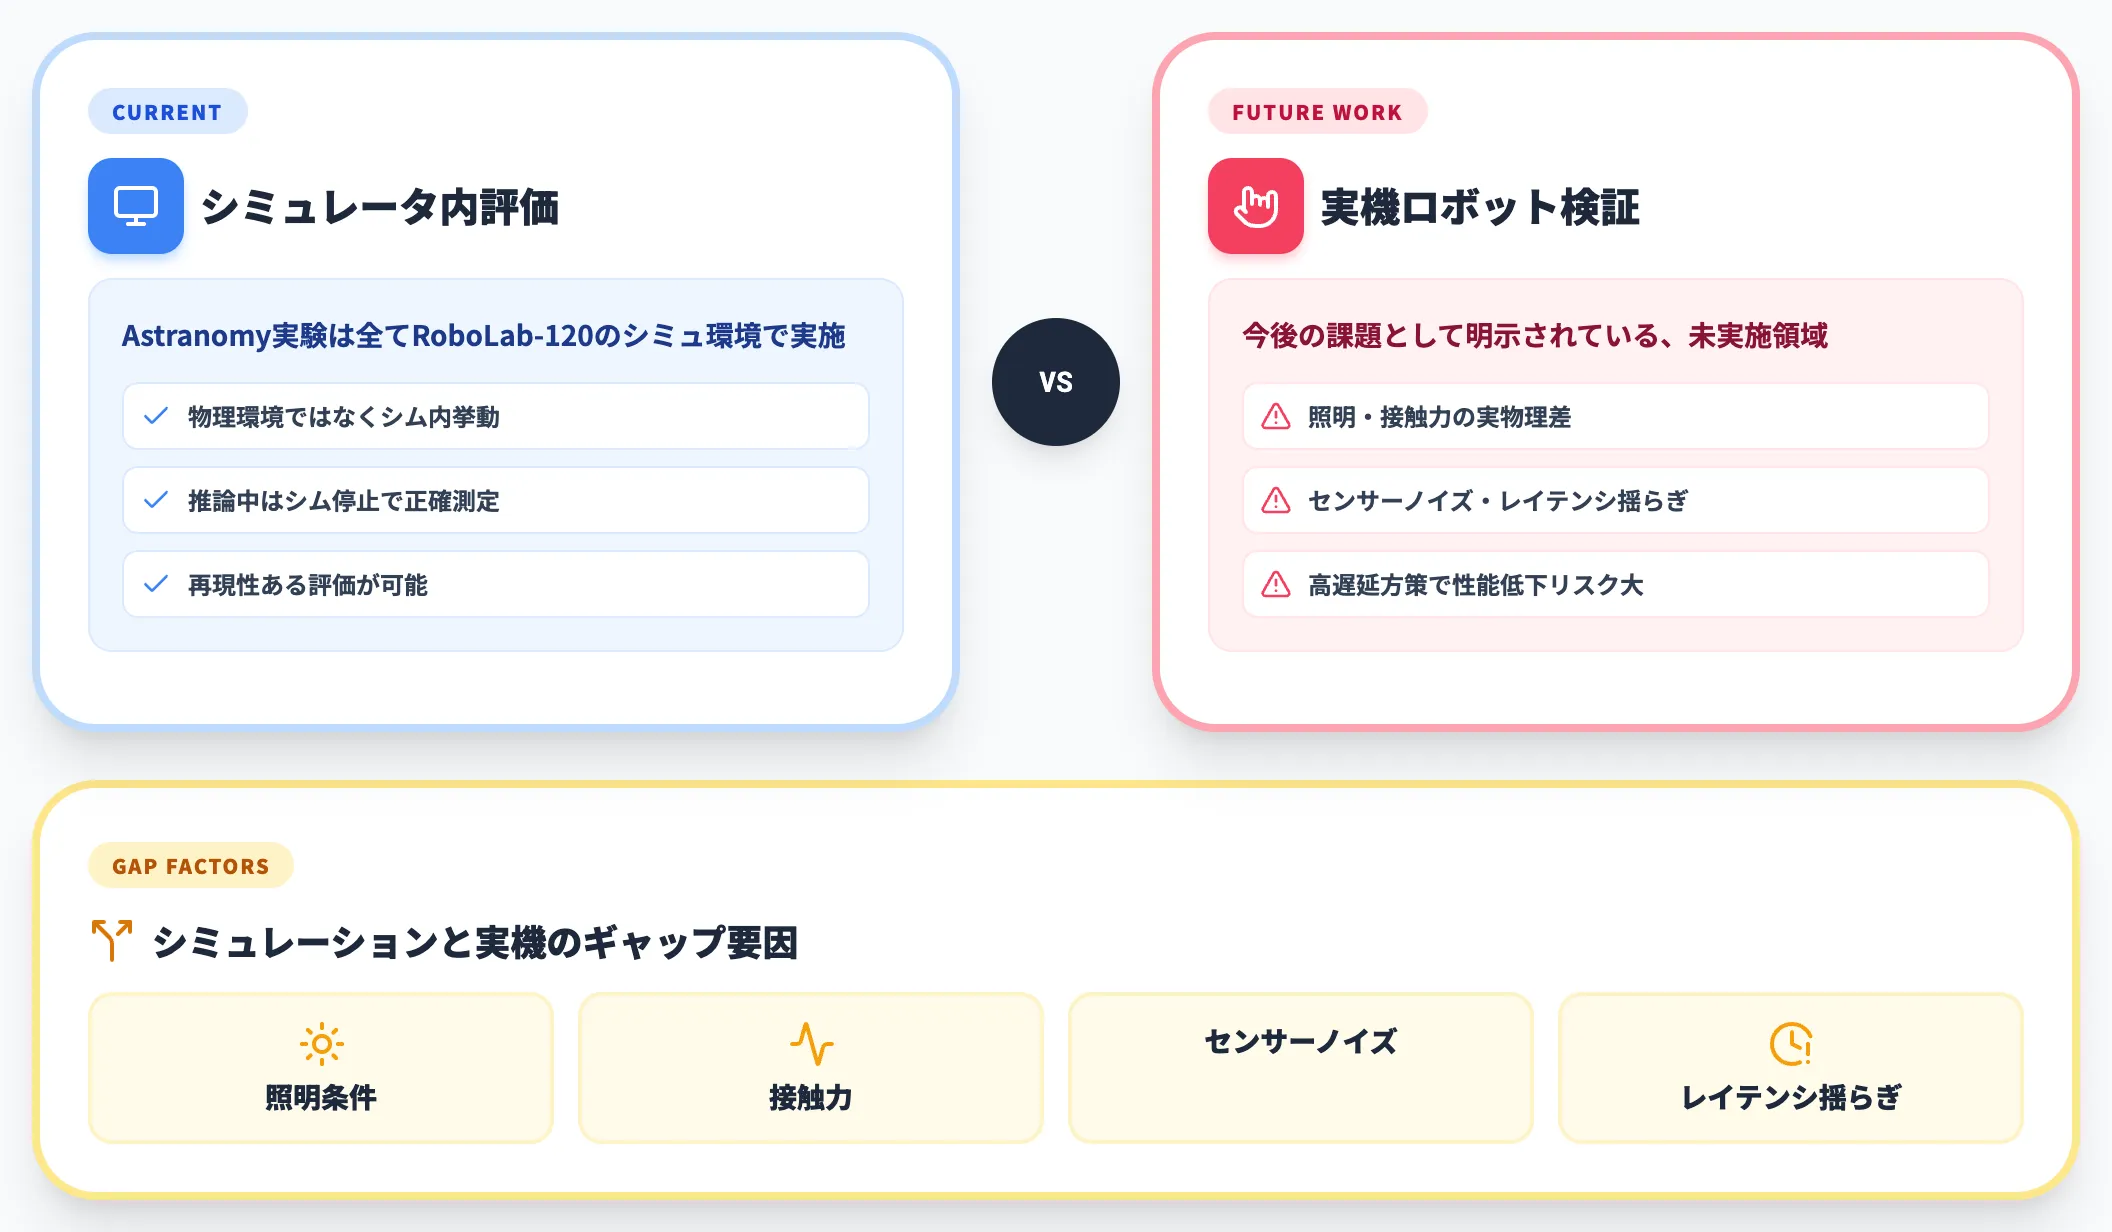
実験は全てRoboLab-120のシミュレーション環境で実施されており、実機ロボットでの検証は今後の課題として明示されています。
シミュレーションと実機の間には照明条件・接触力・センサーノイズ・レイテンシ揺らぎなどのギャップが存在し、Astraのような高遅延方策では特にこのギャップが性能を押し下げる可能性があります。
NVIDIA SRLは今回のテックレポートに加えCoRL 2026に10件採択されており、Astranomyの実機拡張も次の学会発表サイクルで出てくる可能性が高いと見ておく価値があります。
下位方策の精度がOrchestratedの性能に影響し得る
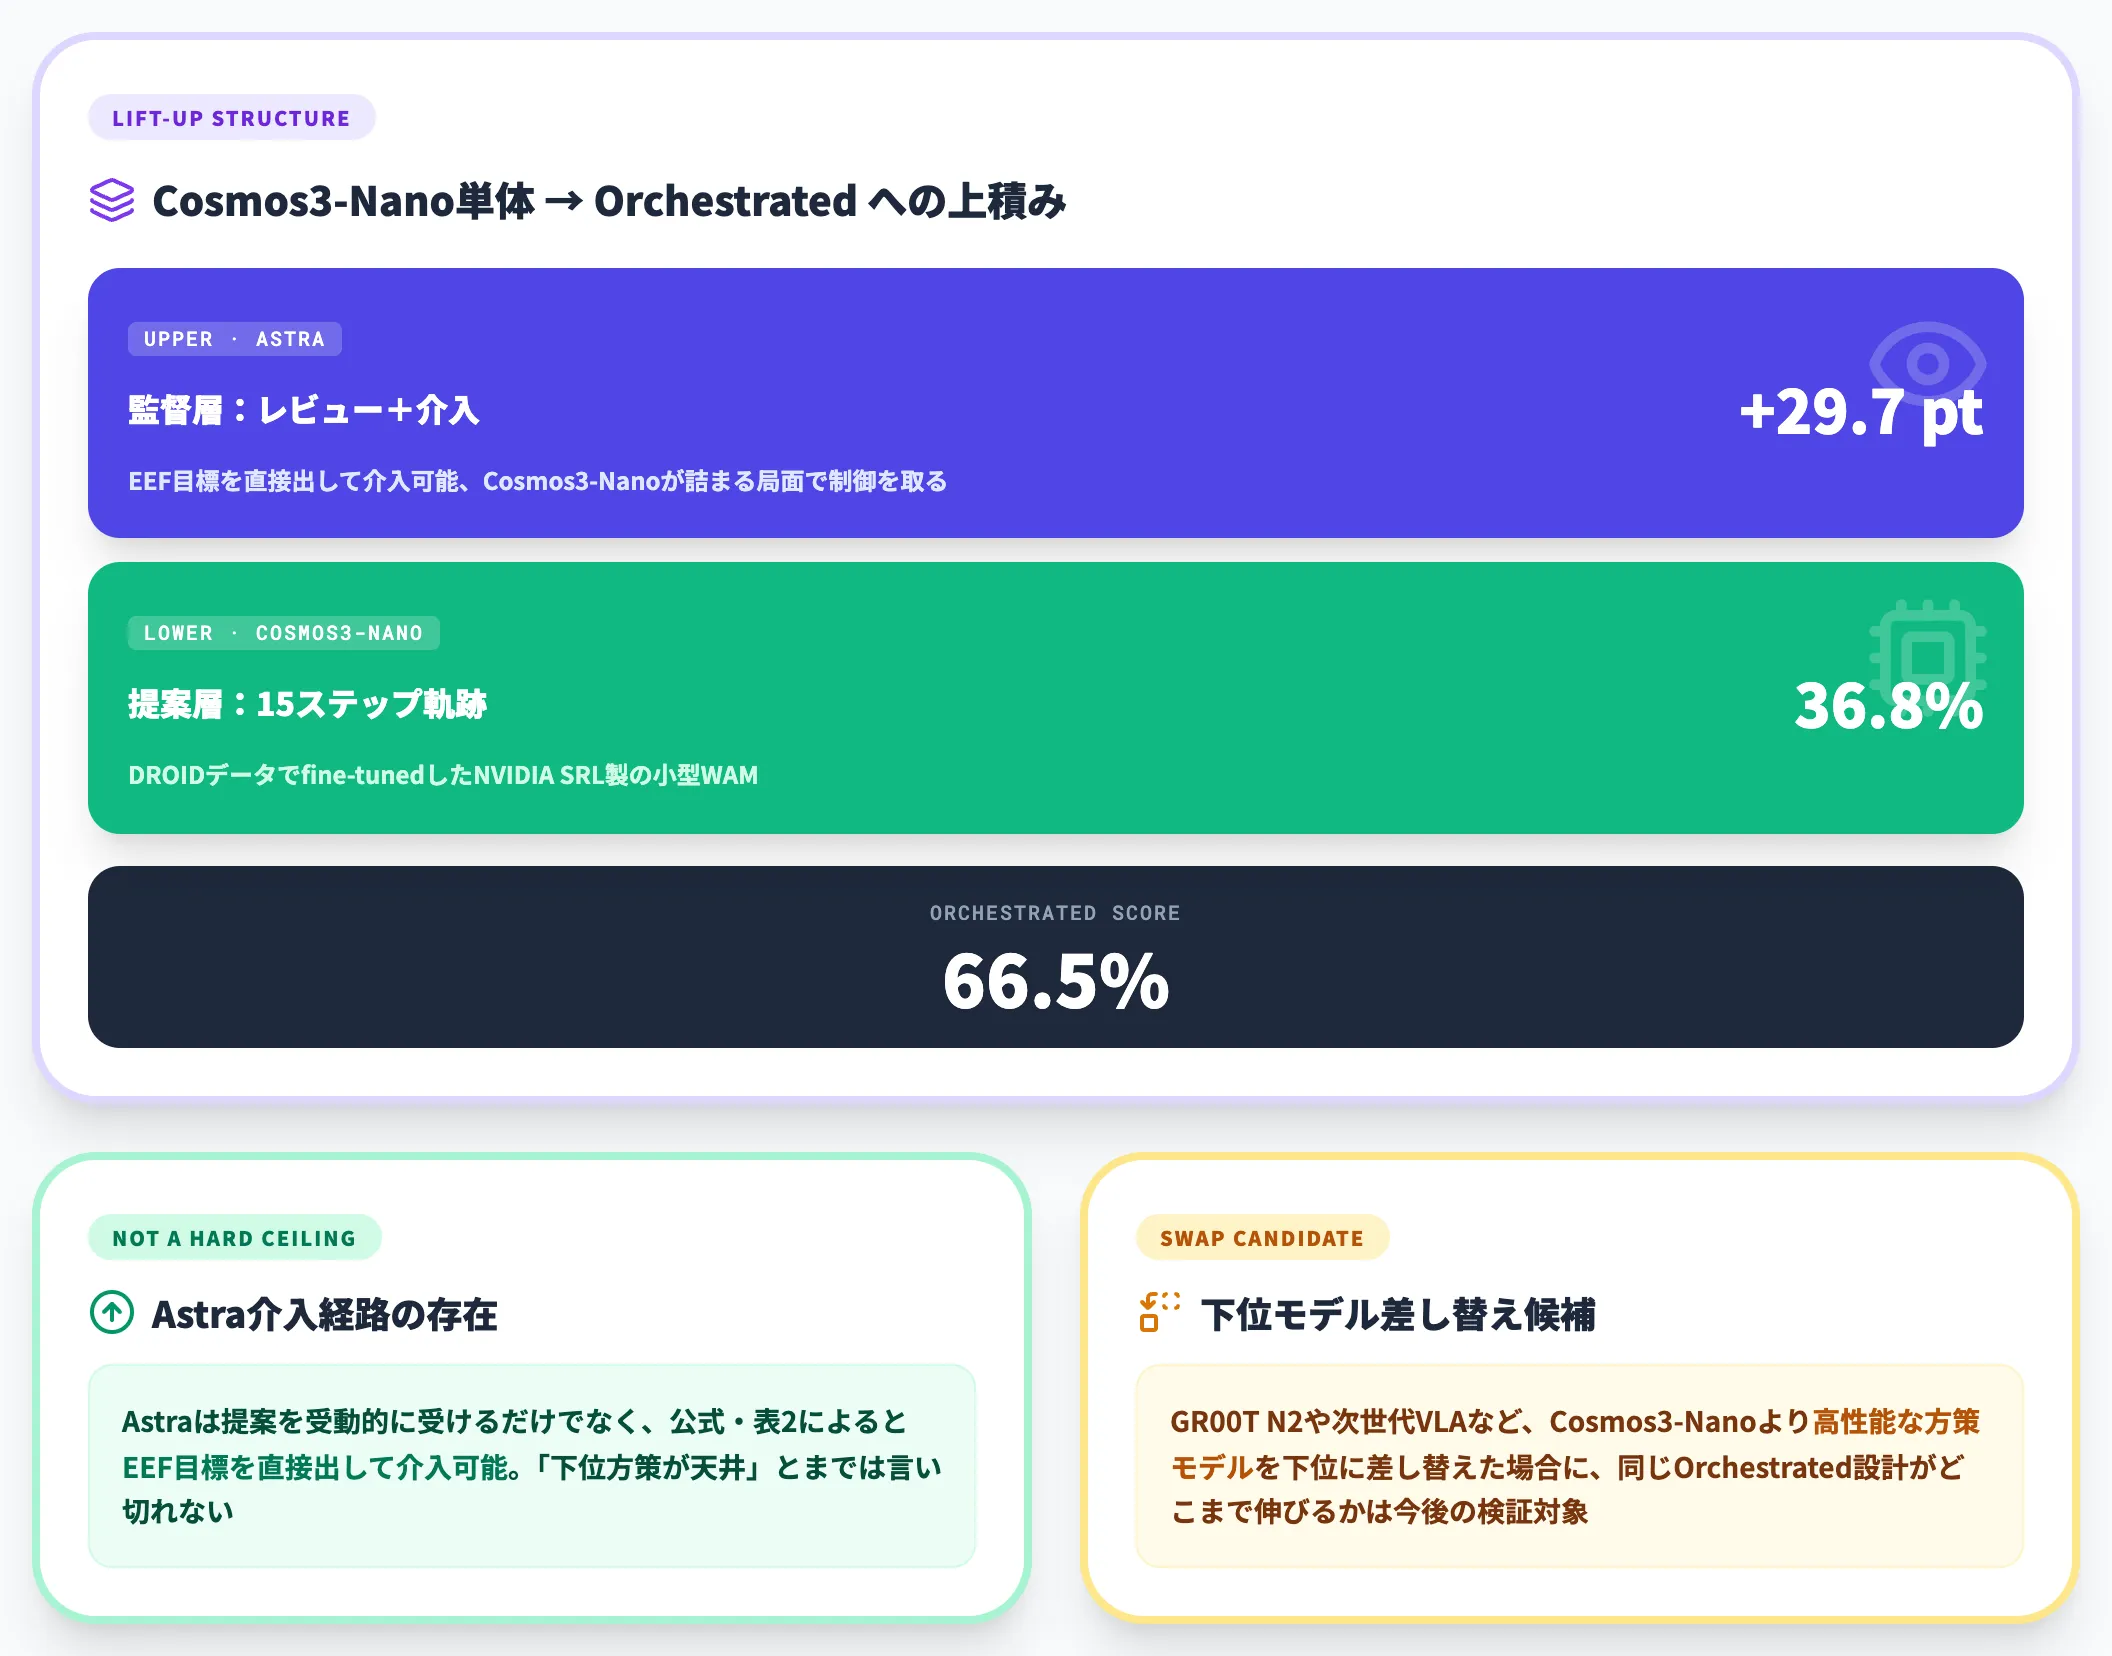
Orchestrated Policyは、下位方策モデルCosmos3-Nano-Policyの精度(36.8%)をベースに、Astraが監督層として入って66.5%まで引き上げる構成です。
Astraは提案を受動的に受けるだけでなく、公式・表2によるとEEF目標を直接出して介入することも可能で、Cosmos3-Nanoが詰まる局面でAstra側が制御を取ることもできます。この介入経路があるため「下位方策が天井を規定する」とまでは言い切れませんが、下位方策の精度がOrchestratedの到達性能に影響し得ることは確かです。
GR00T N2や次世代VLAなど、Cosmos3-Nanoより高性能な方策モデルを下位に差し替えた場合に、同じOrchestrated設計がどこまで伸びるかは今後の検証対象になります。
企業がAstranomy世代の技術をどう評価すべきか
Astranomyが示した結果は、企業がロボティクス×生成AIの投資判断を考える際の判断軸にも示唆を与えます。本セクションでは、AI総合研究所がB2B向けAI導入支援で得た感触も踏まえ、ケース別に整理します。
ロボ×AI投資の判断軸——Direct/Agentic/Orchestratedのどこから入るか
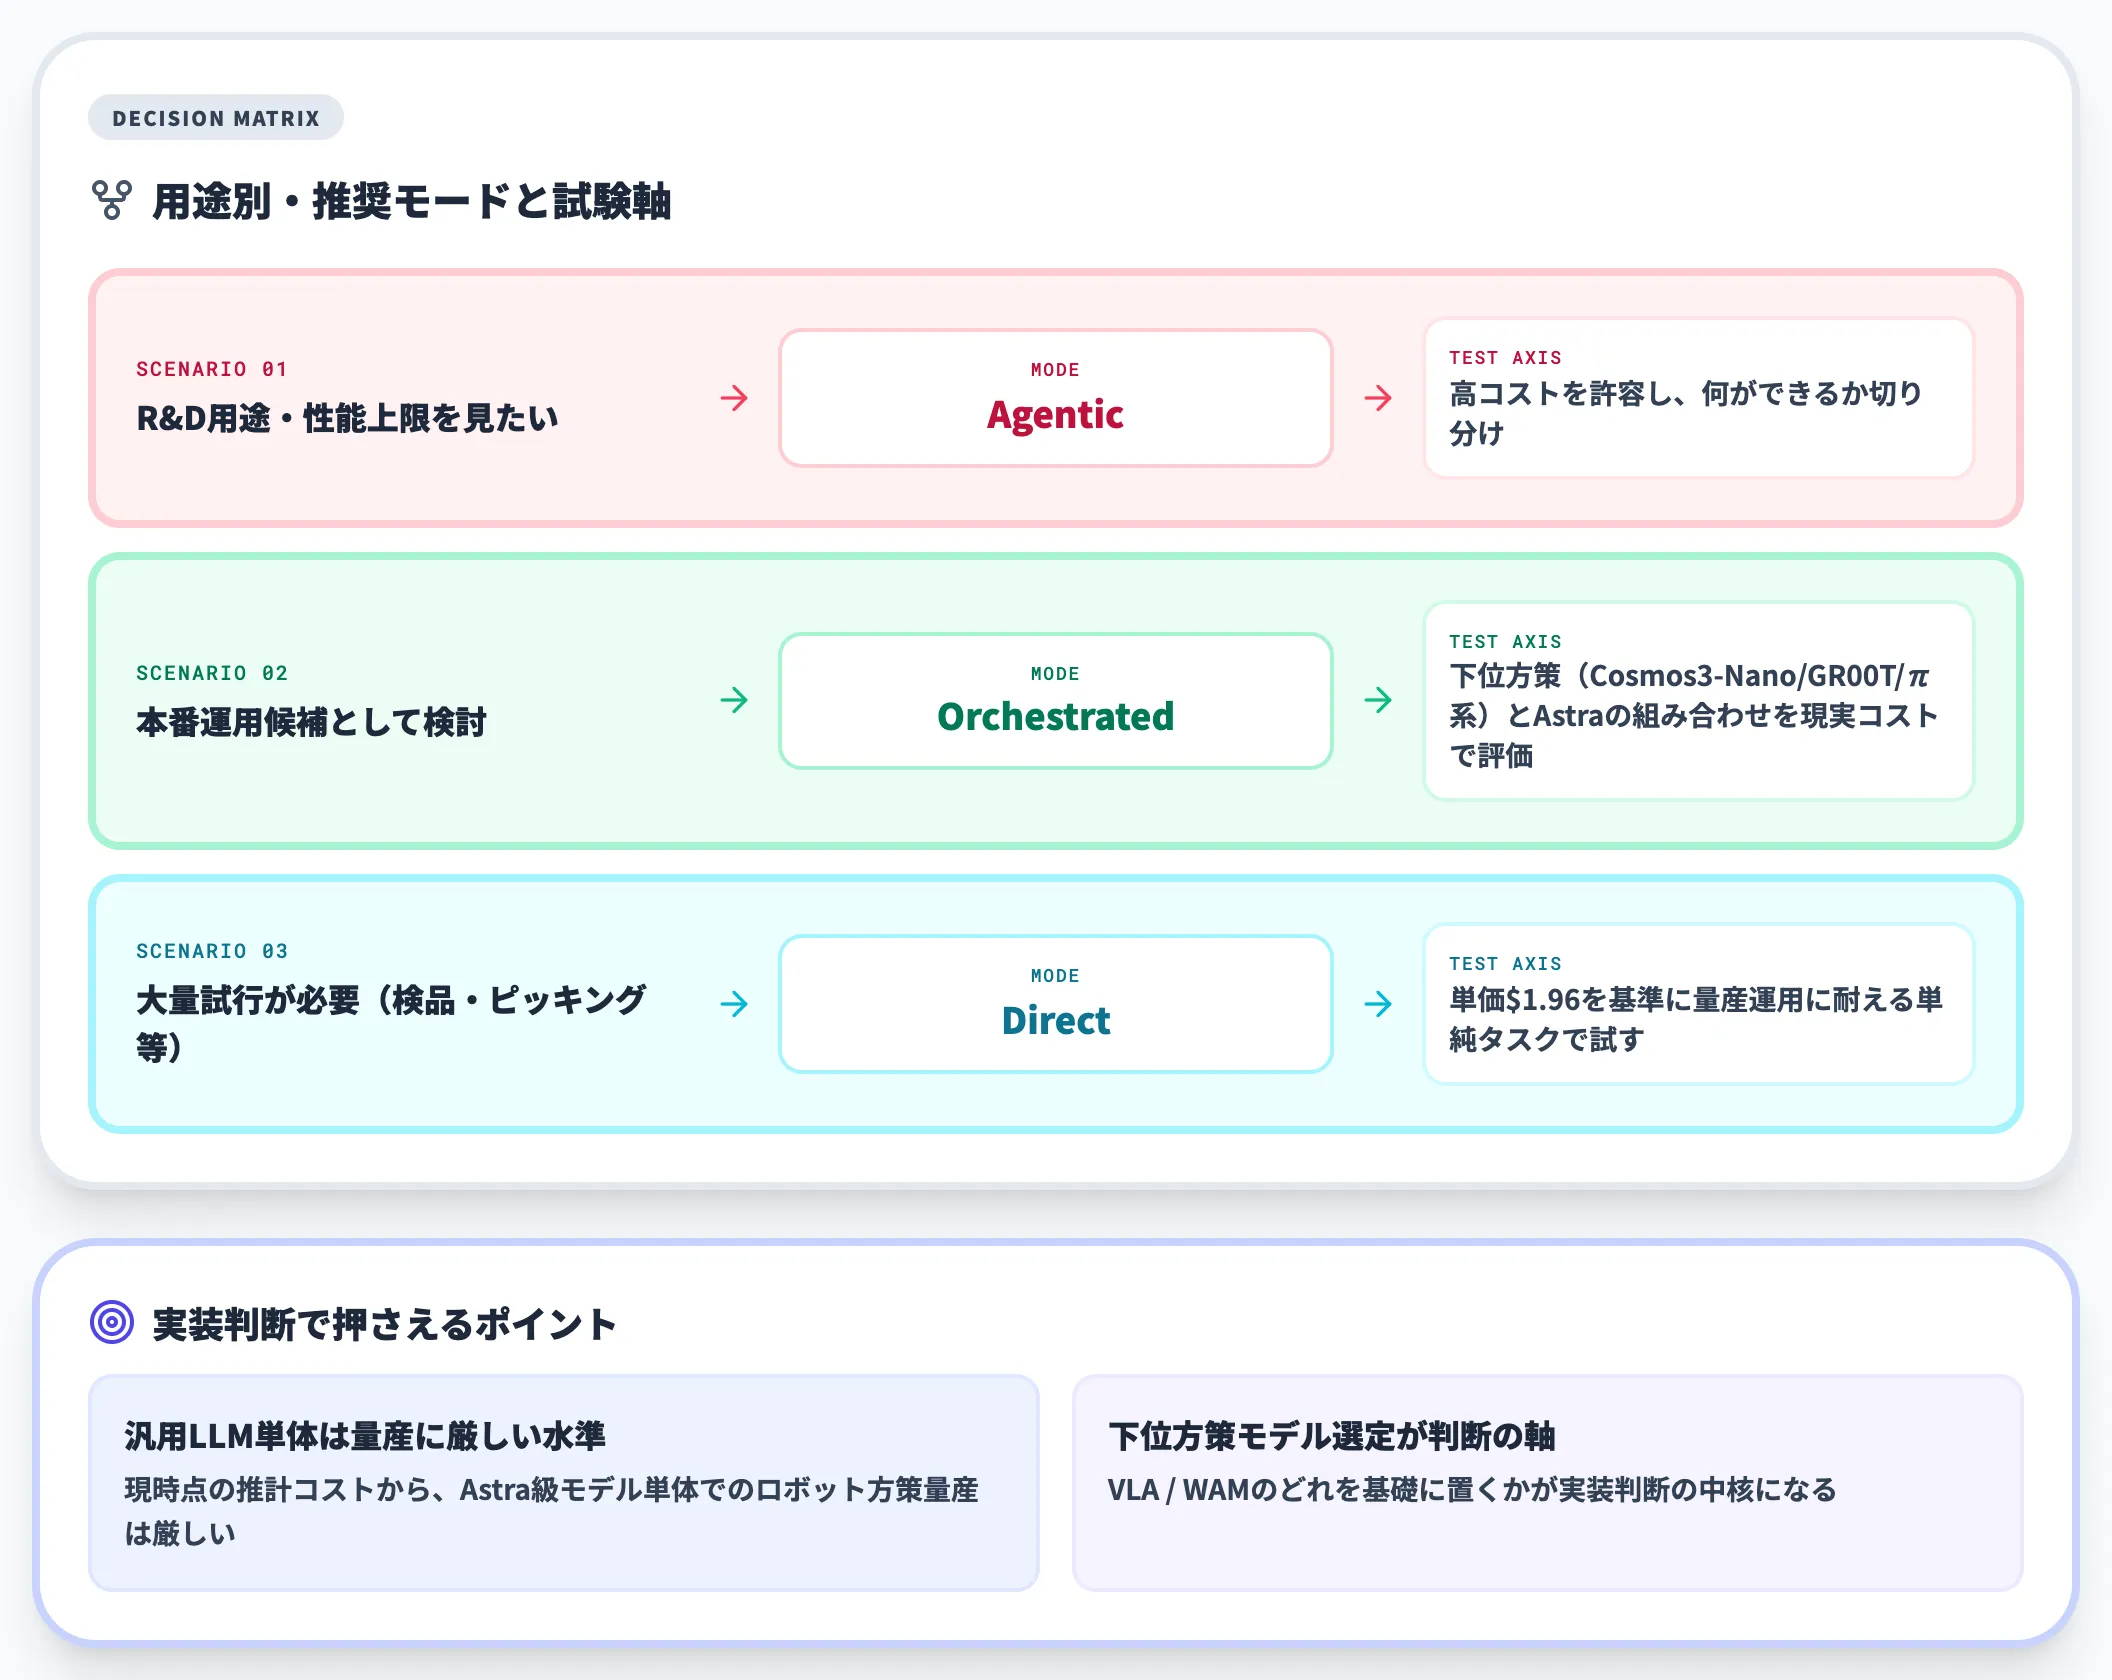
ロボット事業を抱える企業や、物理タスクの自動化を検討する企業がAstranomy世代のアプローチを評価する場合、3モードのどこから入るかを最初に決める価値があります。
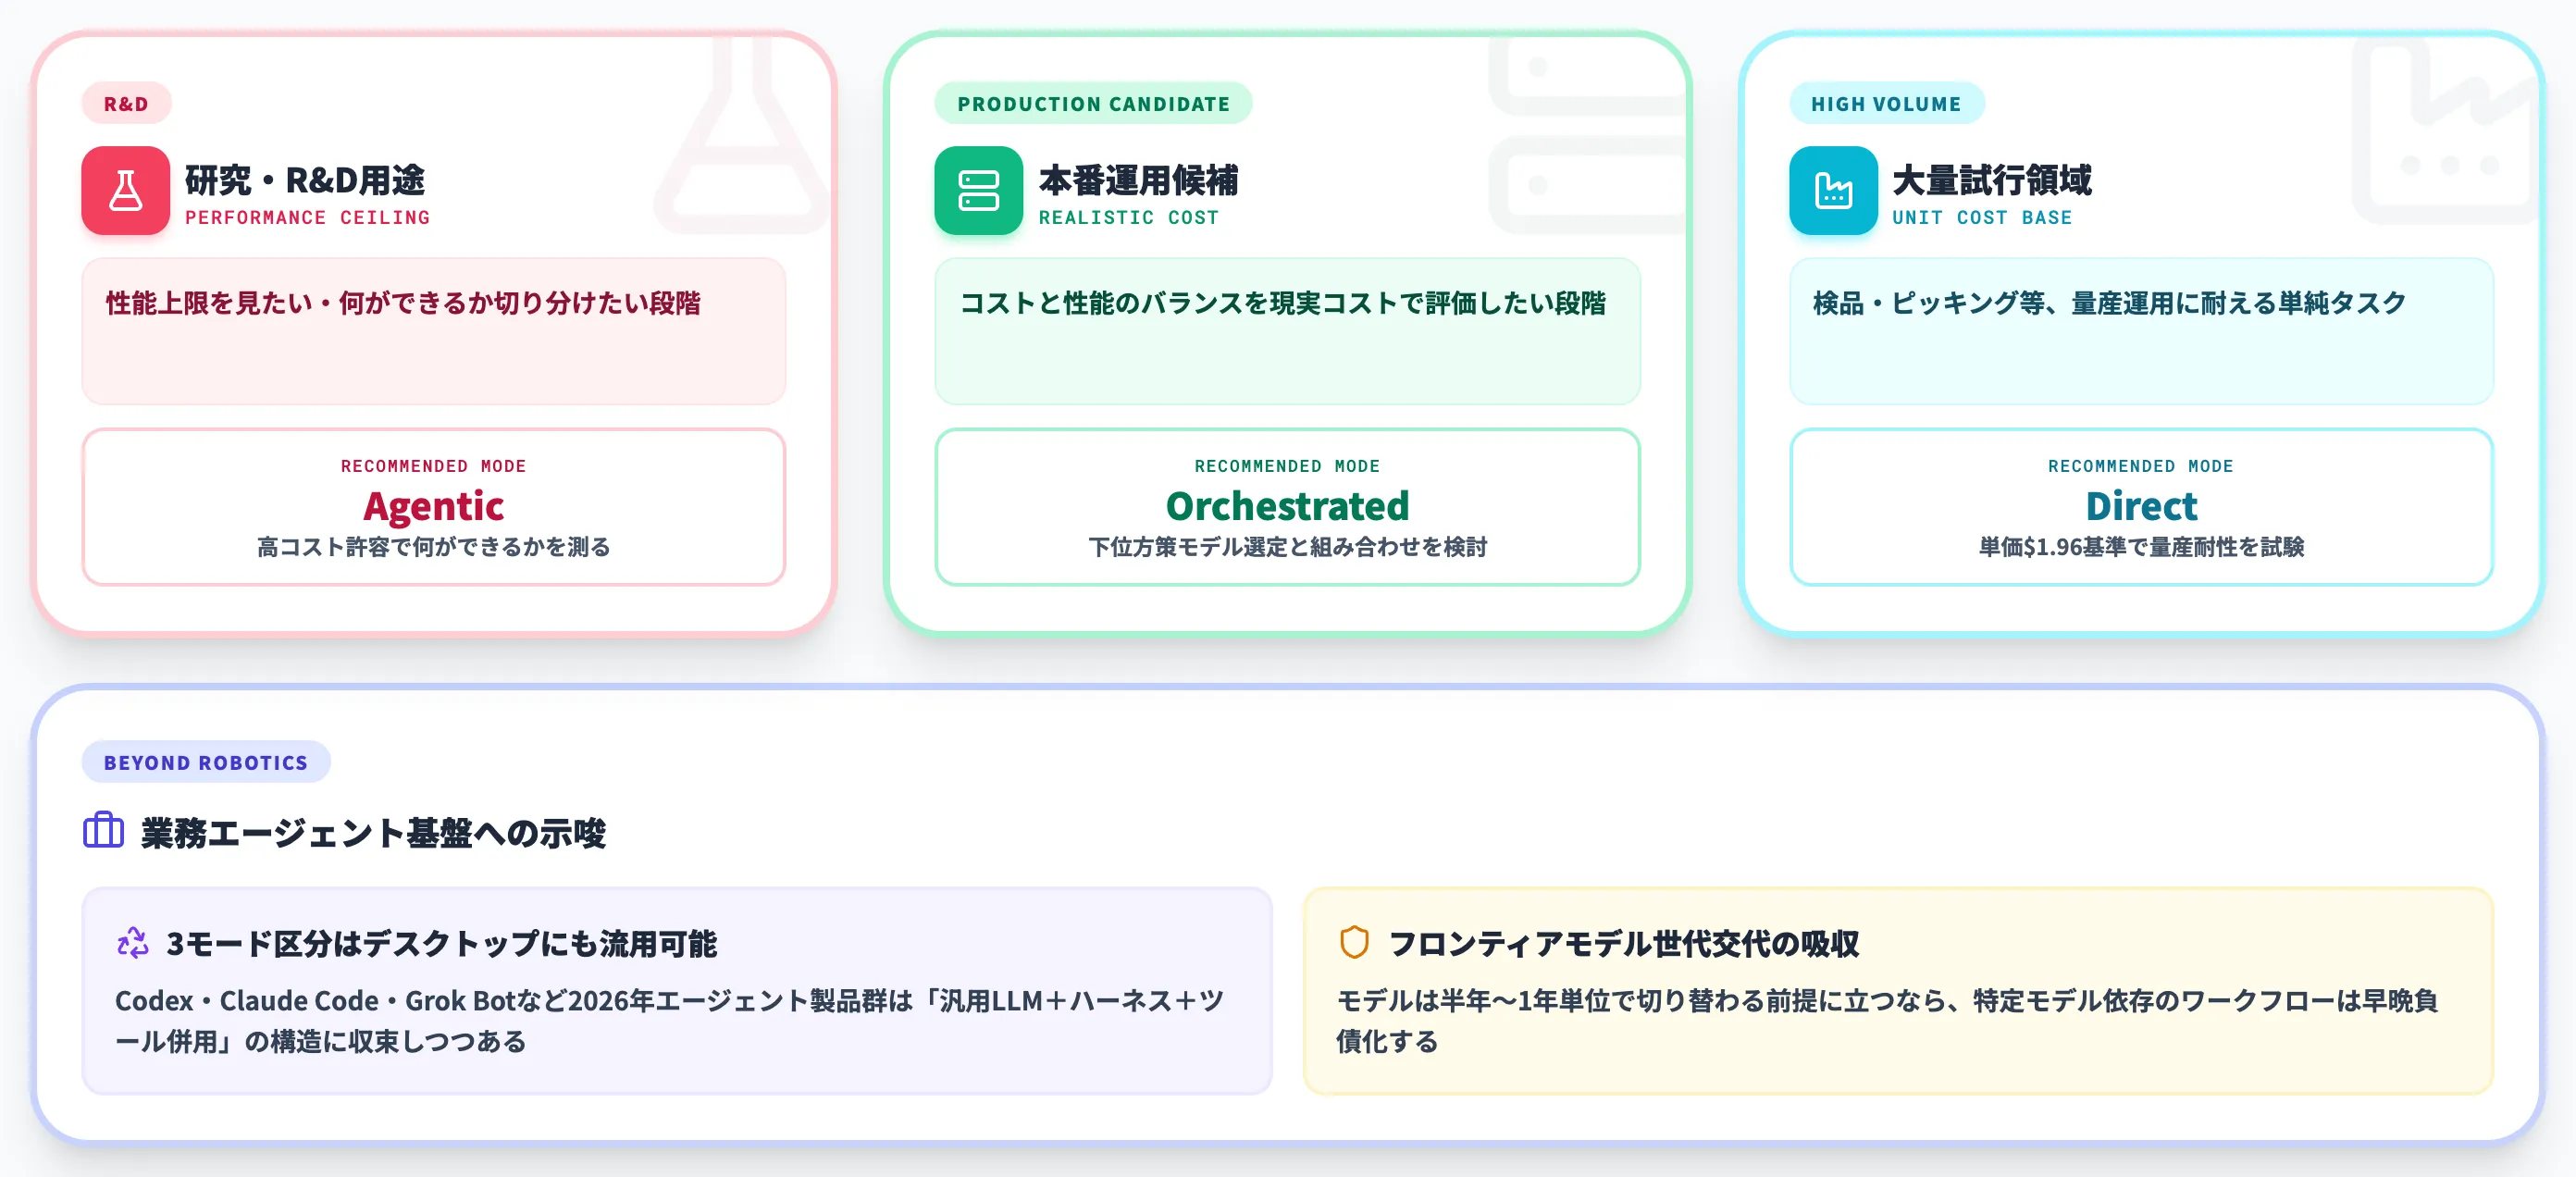
- 研究・R&D用途でまず性能上限を見たい → Agenticで高コストを許容し、何ができるか・できないかを切り分ける
- 本番運用候補として検討する → Orchestratedから入り、下位方策モデル(Cosmos3-Nano/GR00T/π系)とAstra級LLMの組み合わせを現実コストで評価
- 大量試行が必要な領域(検品・ピッキング等) → Directで単価$1.96を基準に、量産運用に耐える単純タスクで試す
汎用LLM単体でロボット方策を回すのは、推計コストから見ても現時点では量産運用に厳しい水準です。
公式§5は専用方策との最適な組み合わせを未解決としており、「主流」と断定できる段階ではありませんが、専用方策モデル+LLM監督という二層構造がAstranomyの3モード比較で成功率とコストのバランスが取れた選択肢として挙がってきているのは確かで、下位の方策モデル選定(VLA/WAMのどれを基礎に置くか)が実装判断の軸になります。
業務エージェント基盤への示唆
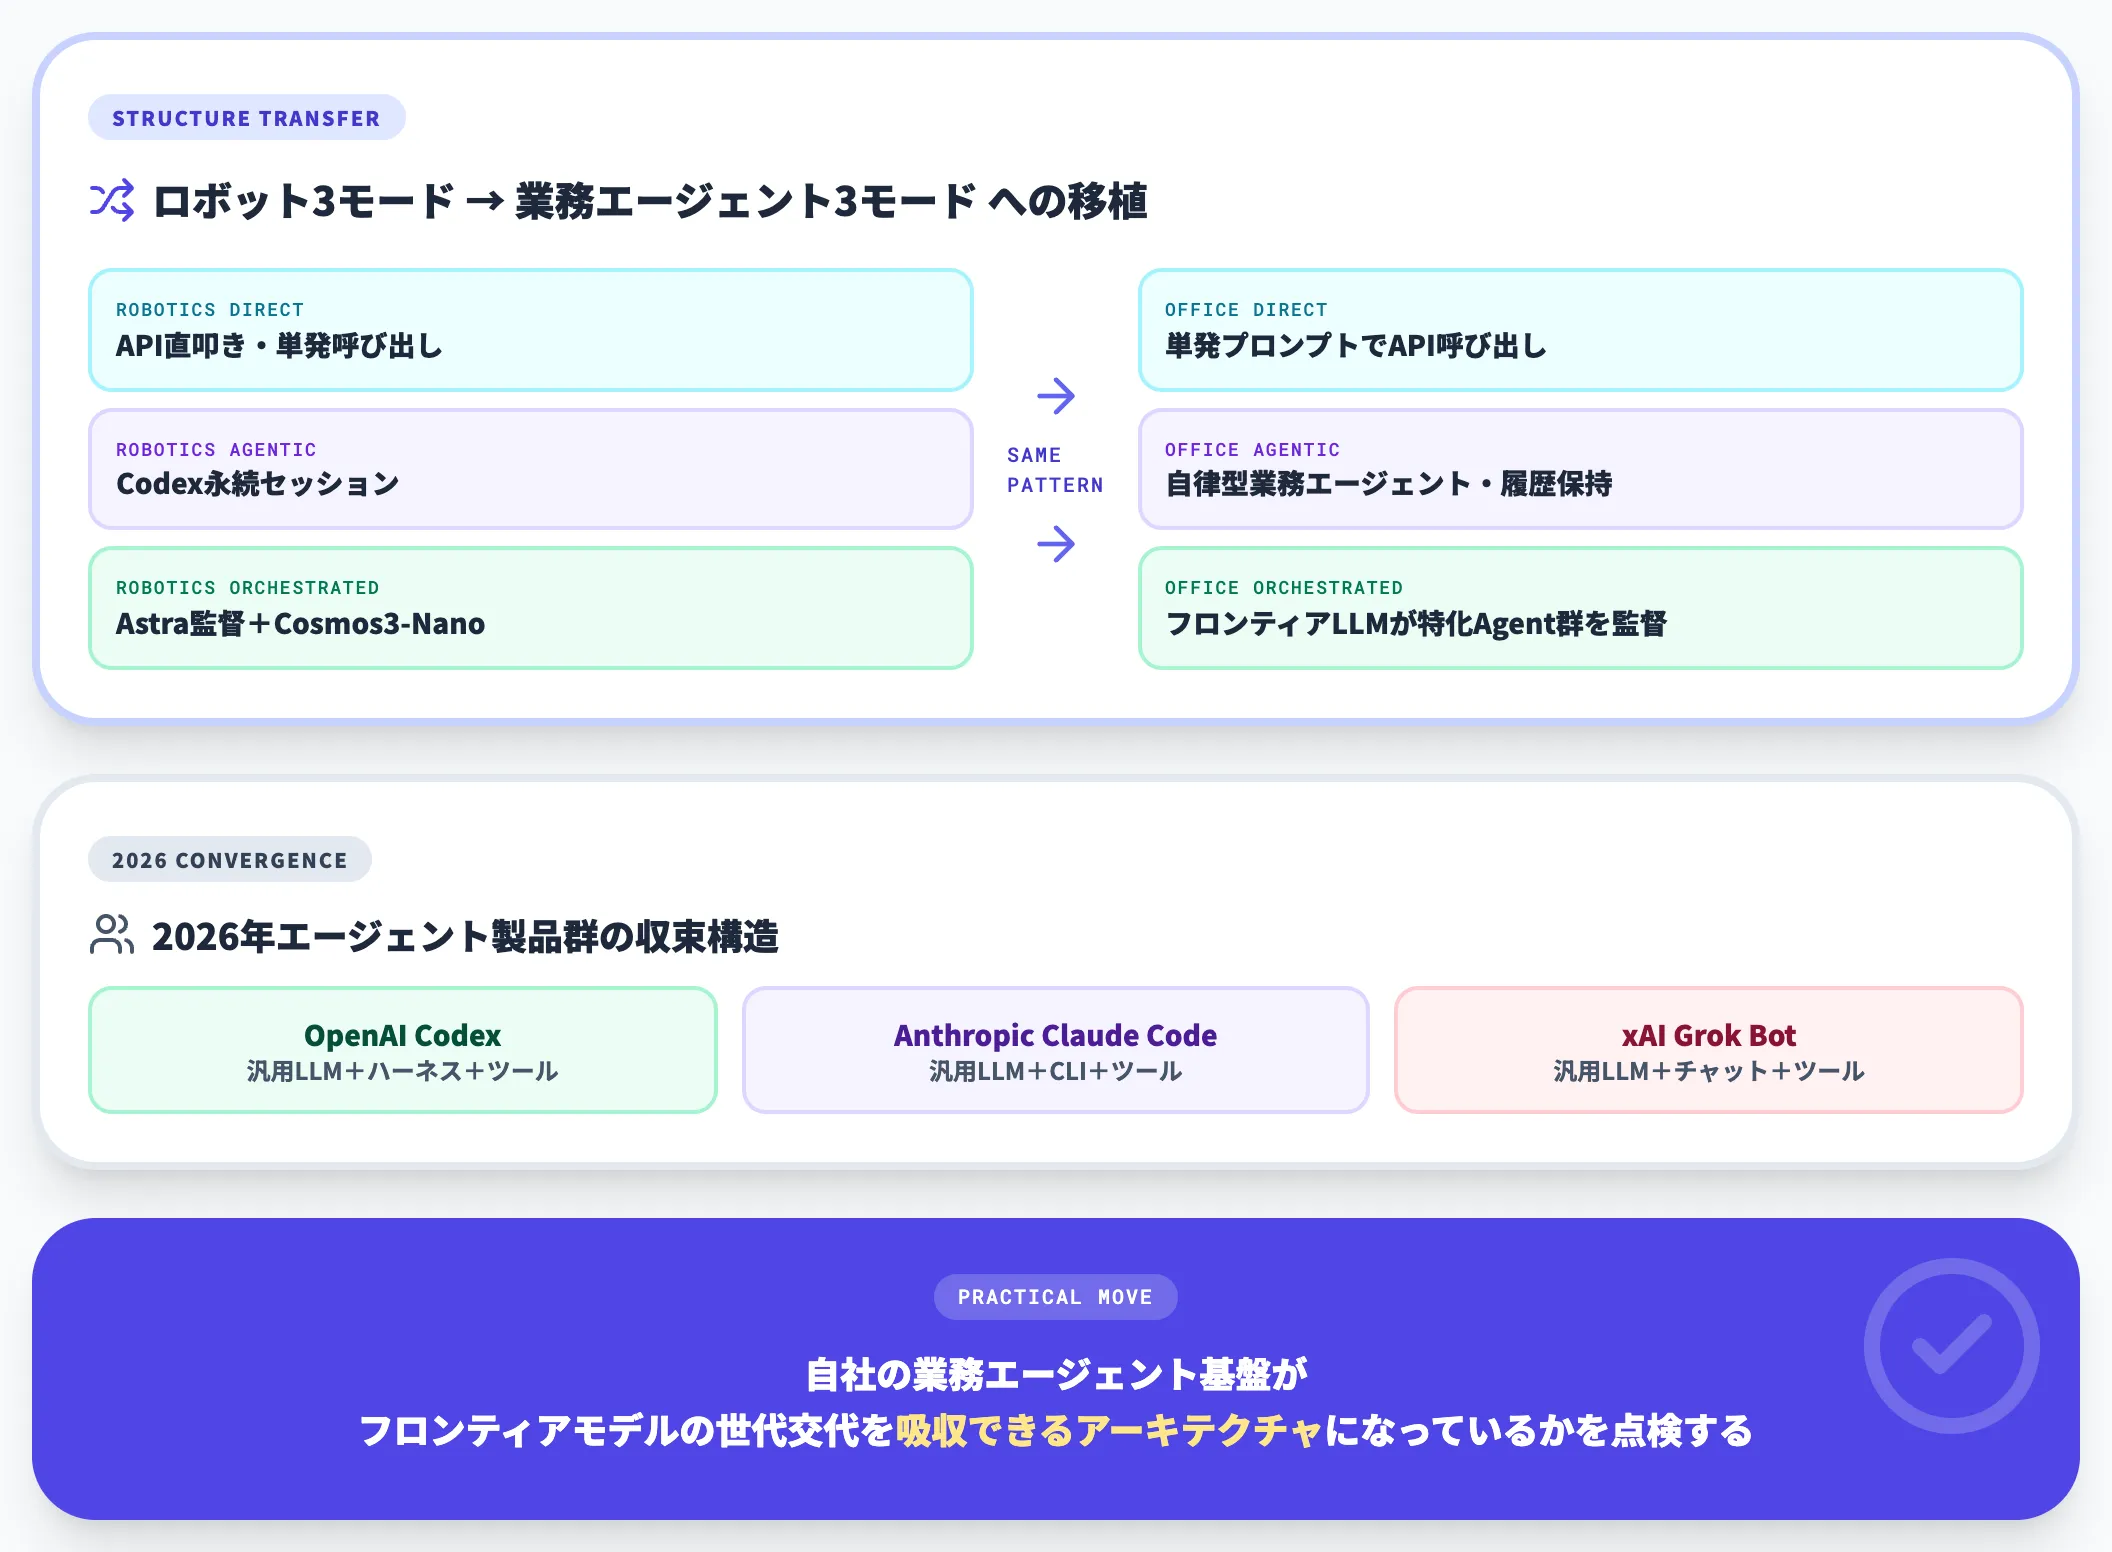
Astranomyが示した「汎用LLMをDirect・Agentic・Orchestratedと役割を切り替えて使う」設計は、物理ロボットに限らずデスクトップ業務エージェントにも適用可能な一般的なパターンです。
実際にOpenAIのCodex、AnthropicのClaude Code、xAIのGrok Botなど、2026年のエージェント製品群は汎用LLM+ハーネス+ツール併用の構造に収束しつつあります。
AIエージェントの設計を考える際、ロボット分野で定量化された3モード区分は、業務ドメインの判断にも流用できる視点です。
企業として現実的に取る打ち手は、「Astra級モデルが物理ロボット方策として機能することが実証された」という事実を踏まえ、自社の業務エージェント基盤がフロンティアモデルの世代交代を吸収できるアーキテクチャになっているかを点検することです。モデルは半年〜1年単位で切り替わる前提に立つなら、特定モデル依存のワークフローは早晩負債化します。
Astranomy世代の技術を業務に落とすなら
Astranomyが示したのは、「GPT-6 Astra級のフロンティアLLMをロボット方策に使える」という事実と、「ただし推計コスト構造的に、専用方策モデルとLLM監督の組み合わせが成功率とコストのバランス面で有力候補の一つになり得る」という設計示唆です(最適な組み合わせは公式§5でも未解決)。
物理ロボットだけでなく、デスクトップ業務エージェントでも同じ構造——Direct・Agentic・Orchestratedの切り替え——が成立します。
このレイヤーを担うのが、自社Azureテナント内で動くエンタープライズAIエージェント基盤です。AI総合研究所のAI Agent Hubは、Teamsから呼び出せる業務特化Agent群を1つのダッシュボードで統合管理し、フロンティアモデルの世代交代を吸収しながら業務プロセスに載せる運用基盤として機能します。
-
フロンティアLLMをAgentic/Orchestrated構造で業務に組み込む
Claude Opus・GPT-6系・Gemini系をバックエンドに据えた業務Agentを、Teams上から即起動。Astranomyが示した3モード設計の思想を、ロボット領域より先に業務ドメインで実装できます。
-
モデル世代交代を吸収する管理層
Astra→次世代モデル、Opus→次世代Opusのような短サイクル世代交代を、業務Agent側の設計を変えずに吸収。特定モデル依存のワークフロー陥落を回避できます。
-
Agent単位でセキュリティ統制を1画面統制
データ・業務情報を扱うAgentごとにアクセス範囲を設計。誰がどのAgentで何を照会したかを不変ログで残し、監査対応をそのまま提出できる形で保管します。
-
データは100%自社Azureテナント内に保持
業務データはAIの学習対象から完全除外。Azure Managed Applicationsとして自社テナント内で動作が完了する設計です。
AI総合研究所の専任チームが、フロンティアモデル選定から業務Agent基盤の統合設計まで一貫して支援します。AI Agent Hubのサービスページで、Astranomy世代の設計思想を業務エージェントに持ち込む実装例をご確認ください。
フロンティアLLM時代の業務エージェント基盤
モデル世代交代を吸収する運用基盤を整える
Astranomyが示すように、GPT-6 AstraのようなフロンティアLLMは方策・エージェント・監督者と役割を切り替えて使える段階に入っています。AI Agent Hubは業務特化Agent群を1つのダッシュボードで統合管理し、モデル世代交代を吸収しながら運用に載せる基盤として機能します。
まとめ
本記事では、NVIDIA Seattle Robotics Labが2026年10月14日に公開したAstranomyについて、研究の位置づけ、3つのポリシーモード、RoboLab-120ベンチマーク結果、コストとレイテンシのトレードオフ、類似研究との差分、企業の判断軸までを整理しました。
2026年10月時点で押さえておくべきポイントは次の3つです。
- Astranomyは「汎用LLMをロボット方策として使う」3モード(Direct・Agentic・Orchestrated)を、同一ベンチマーク上で性能・コスト・レイテンシを横並び比較した初の体系的研究
- Agentic Policyが成功率74.8%でレポート比較対象のLakesideを23.8pt上回る一方、成功エピソードあたり約$36.40の推計コストがかかり、Orchestratedがコストと性能のバランス面で有力候補として確認された
- Astra経由3モードはπ0.5・Cosmos3-Nano-Policyなど専用方策モデルを大きく上回り、「汎用LLM+専用方策モデルの監督」という二層構造の有効性が、少なくともRoboLab-120での比較で示された
Astranomyが突きつけるのは、ロボットだけでなく業務エージェント全般に対して「フロンティアLLMを方策・監督・ハーネスのどの層で使うか」を設計し直す段階に来ているという現実です。モデル単体の性能競争から、モデル×ハーネス×専用モデルの組み合わせ設計競争へと論点がシフトしつつあり、企業の生成AI投資もこの枠組みで検討する価値が高まっています。