この記事のポイント
 TimesFMは「時系列版のLLM」として学習不要のゼロショット予測を可能にした基盤モデル
- 2024年の1.0から3.0までの世代進化で、パラメータ削減と多変量対応が段階的に進んできた
- 3.0の事前学習済み重みは非商用ライセンスで、本番用途はBigQuery ML統合の2.5系(新規タスクのデフォルト)が実務推奨
- BigQuery MLのAI.FORECAST関数で、SQL数行だけで予測ジョブを組める
- Chronos-2は多変量が本命、Moirai 2.0はmasked encoderからデコーダーオンリーに移行、選定軸はデータ形式と運用経路
Microsoft MVP・AIパートナー。LinkX Japan株式会社 代表取締役。東京工業大学大学院にて自然言語処理・金融工学を研究。NHK放送技術研究所でAI・ブロックチェーンの研究開発に従事し、国際学会・ジャーナルでの発表多数。経営情報学会 優秀賞受賞。シンガポールでWeb3企業を創業後、現在は企業向けAI導入・DX推進を支援。
TimesFM(タイムズエフエム)は、Google Researchが開発した時系列予測のためのファウンデーションモデルです。大規模な実世界時系列データと合成データで事前学習されたデコーダーオンリーTransformerで、学習していない時系列に対しても追加学習なしで予測できる「ゼロショット予測」を実現します。
2024年5月の1.0公開以降、2.0(500M)→ 2.5(200M)→ 3.0(330M、多変量ネイティブ対応)と世代を重ね、最新のTimesFM 3.0はGIFT-Eval・fev-bench・TIMEの3大ベンチマークで事前学習済み基盤モデル中1位を記録しています。
本記事では、TimesFMシリーズの進化系譜、デコーダーオンリーTransformerの仕組み、Python・BigQuery ML・Vertex AIの3経路での使い方、料金・ライセンス構造、Chronos・Moirai・Lag-Llamaとの使い分けを、2026年9月時点の最新情報で体系的に解説します。
目次
TimesFMとは?Google Researchが公開した時系列予測ファウンデーションモデル
TimesFMシリーズの進化系譜——1.0から3.0までの世代変化
TimesFMの使い方——Python・BigQuery ML・Vertex AIの3経路
Vertex AI Model Gardenで本番エンドポイントとしてデプロイする
TimesFMとChronos・Moirai・Lag-Llamaの使い分け
TimesFMとは?Google Researchが公開した時系列予測ファウンデーションモデル
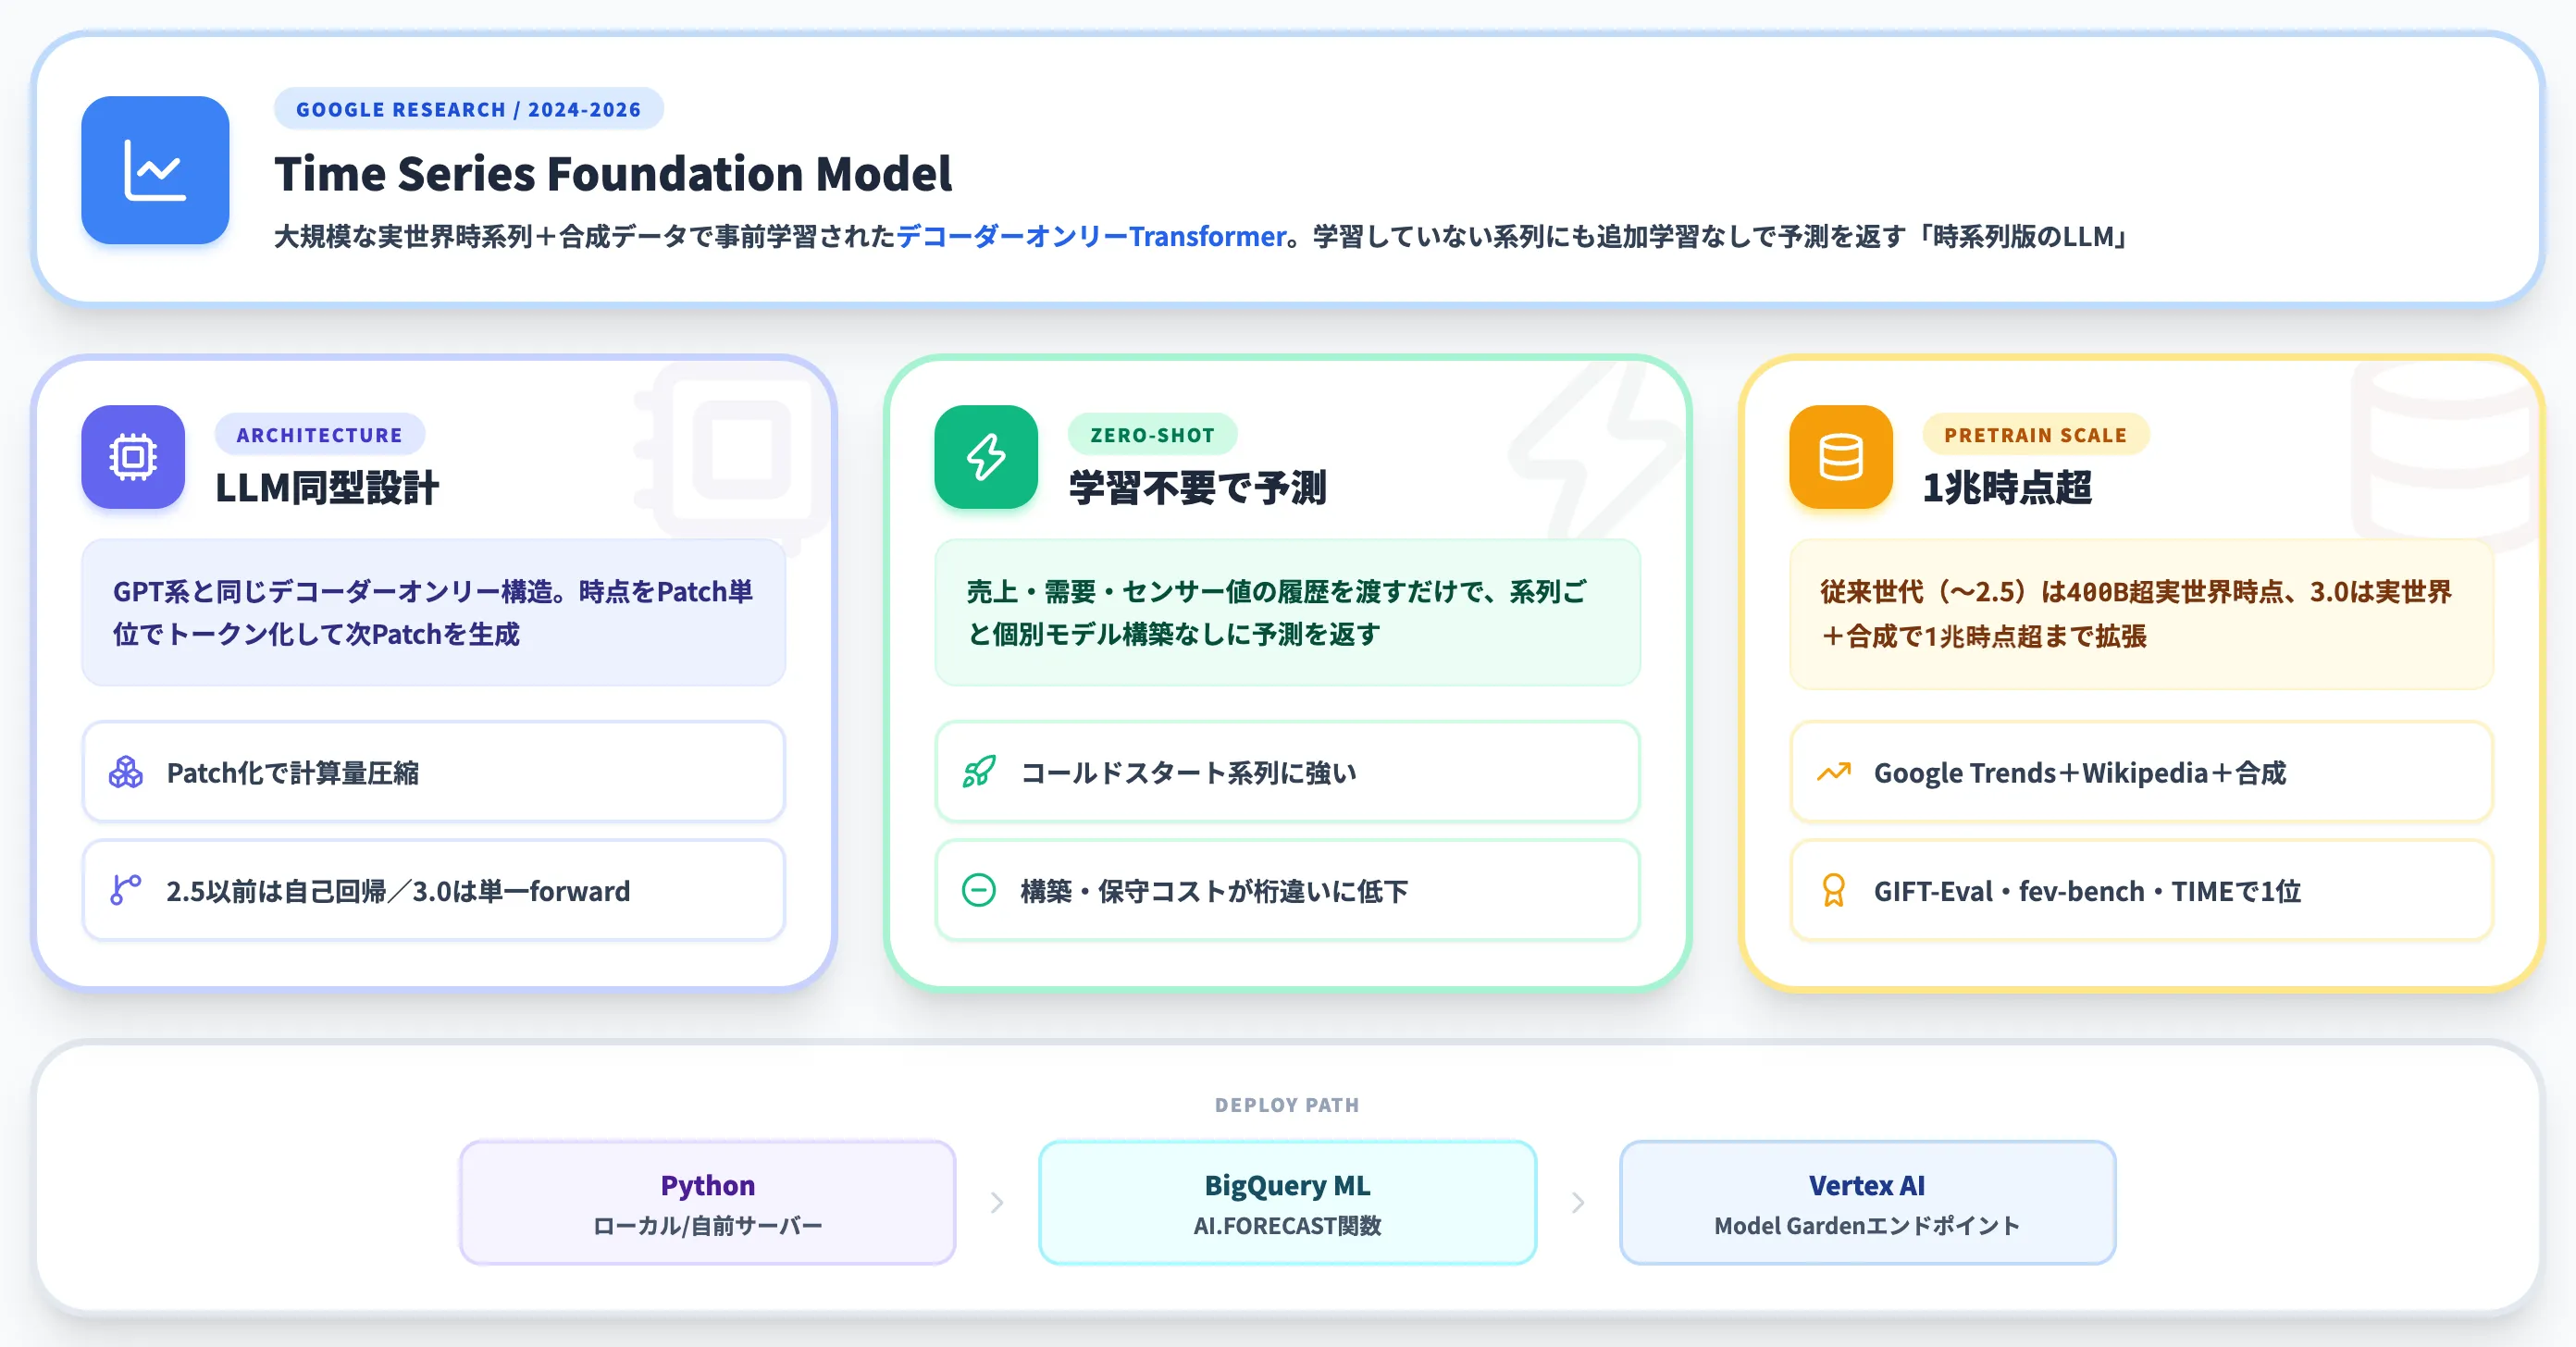
TimesFM(タイムズエフエム、Time Series Foundation Model)とは、Google Researchが開発した時系列予測のための事前学習済みファウンデーションモデルです。
TimesFMが他の時系列モデルと決定的に違うのは、大規模な実世界時系列データと合成データで事前学習されたデコーダーオンリーTransformerで、学習していない時系列に対しても追加学習なしで即座に予測できる点です。
売上・需要・トラフィック・センサー値のようなドメイン固有の系列に対しても、履歴を渡すだけでゼロショットで予測を返すため、系列ごとに個別モデルを構築してきた従来の運用と比べて構築コスト・保守コストが桁違いに下がります。
TimesFMとBigQuery・AlloyDBの統合構成
Google Cloud側のプロダクト統合を1枚で俯瞰すると、TimesFMは中央のファウンデーションモデルとして、BigQueryとAlloyDBの両方から呼び出せる構成に位置づけられています。
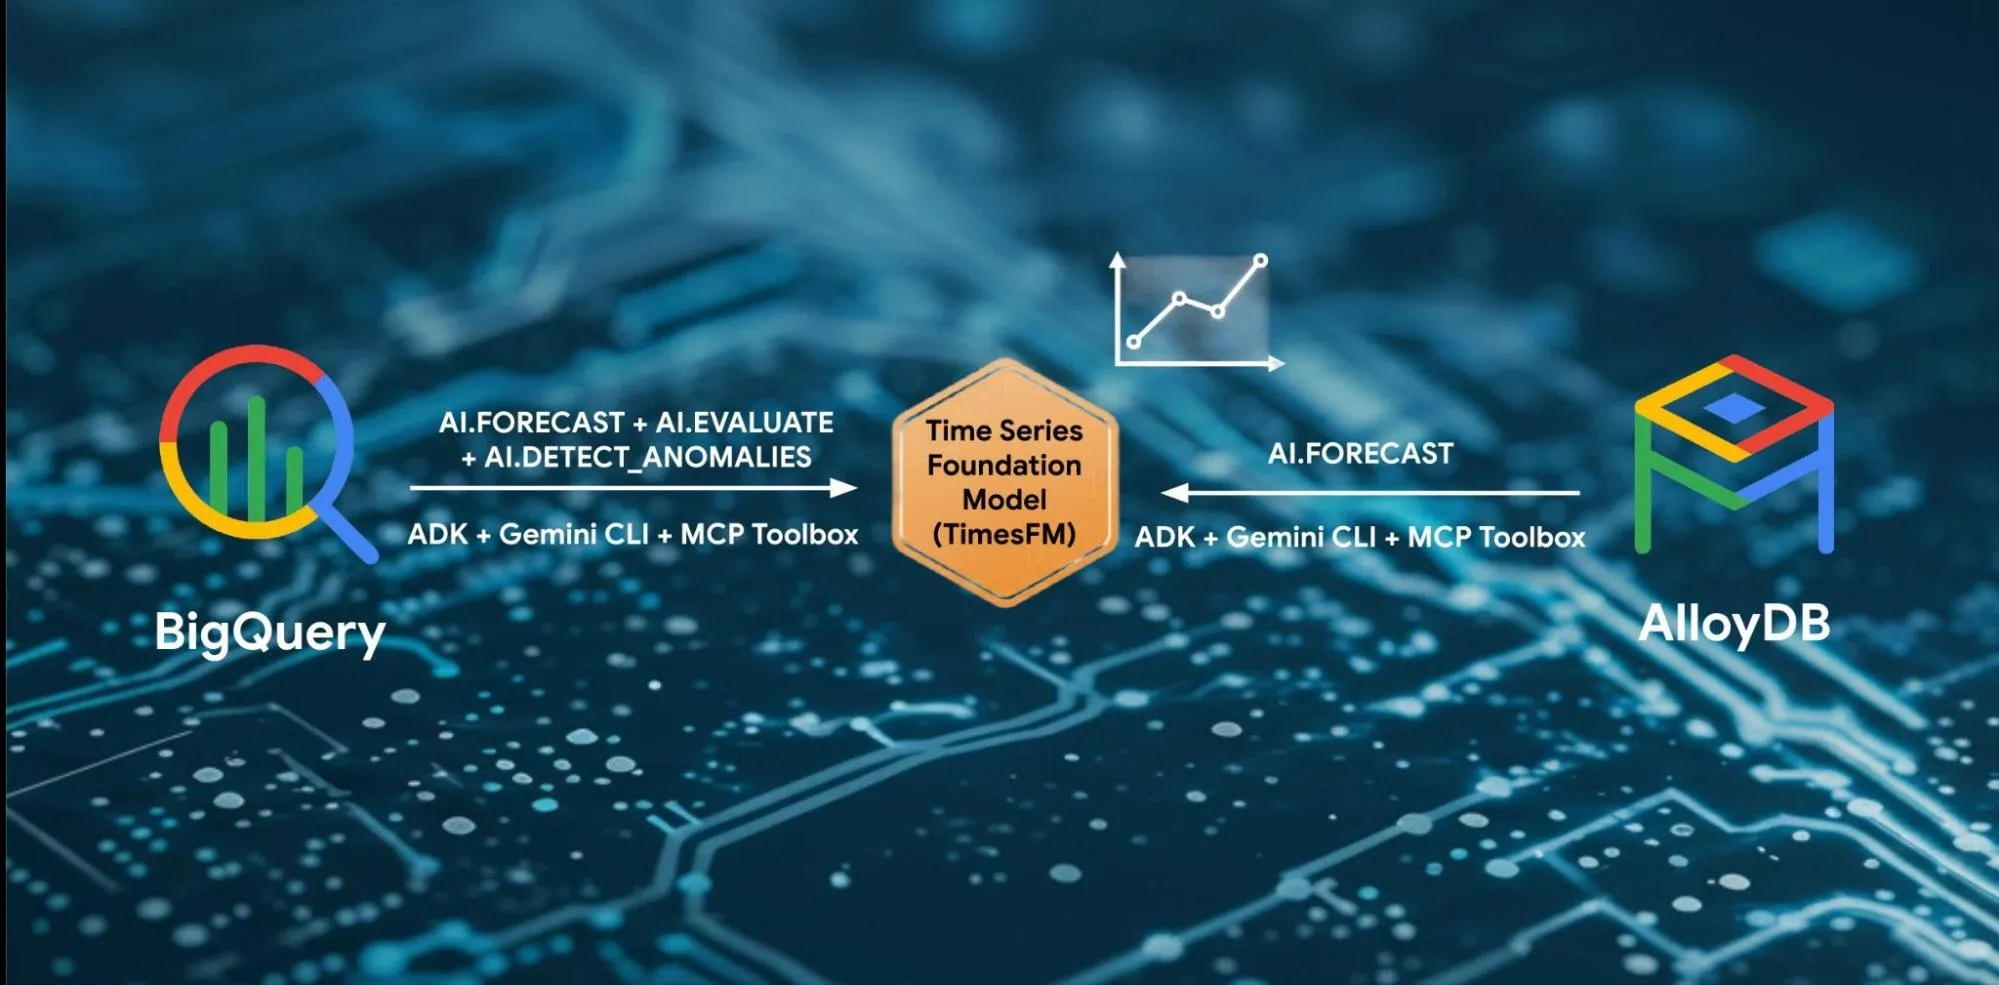
TimesFMを中核に置いたBigQuery・AlloyDBの統合構成(出典:Google Cloud Blog)
BigQuery側からは AI.FORECAST・AI.EVALUATE・AI.DETECT_ANOMALIESの3つのSQL関数と、ADK・Gemini CLI・MCP Toolboxを組み合わせてエージェント経由でも呼び出せます。
AlloyDB側からも同じ AI.FORECAST でTimesFMを叩けるため、分析基盤とトランザクションDBのどちらからでも予測ジョブを組める設計です。
TimesFMシリーズの進化系譜——1.0から3.0までの世代変化
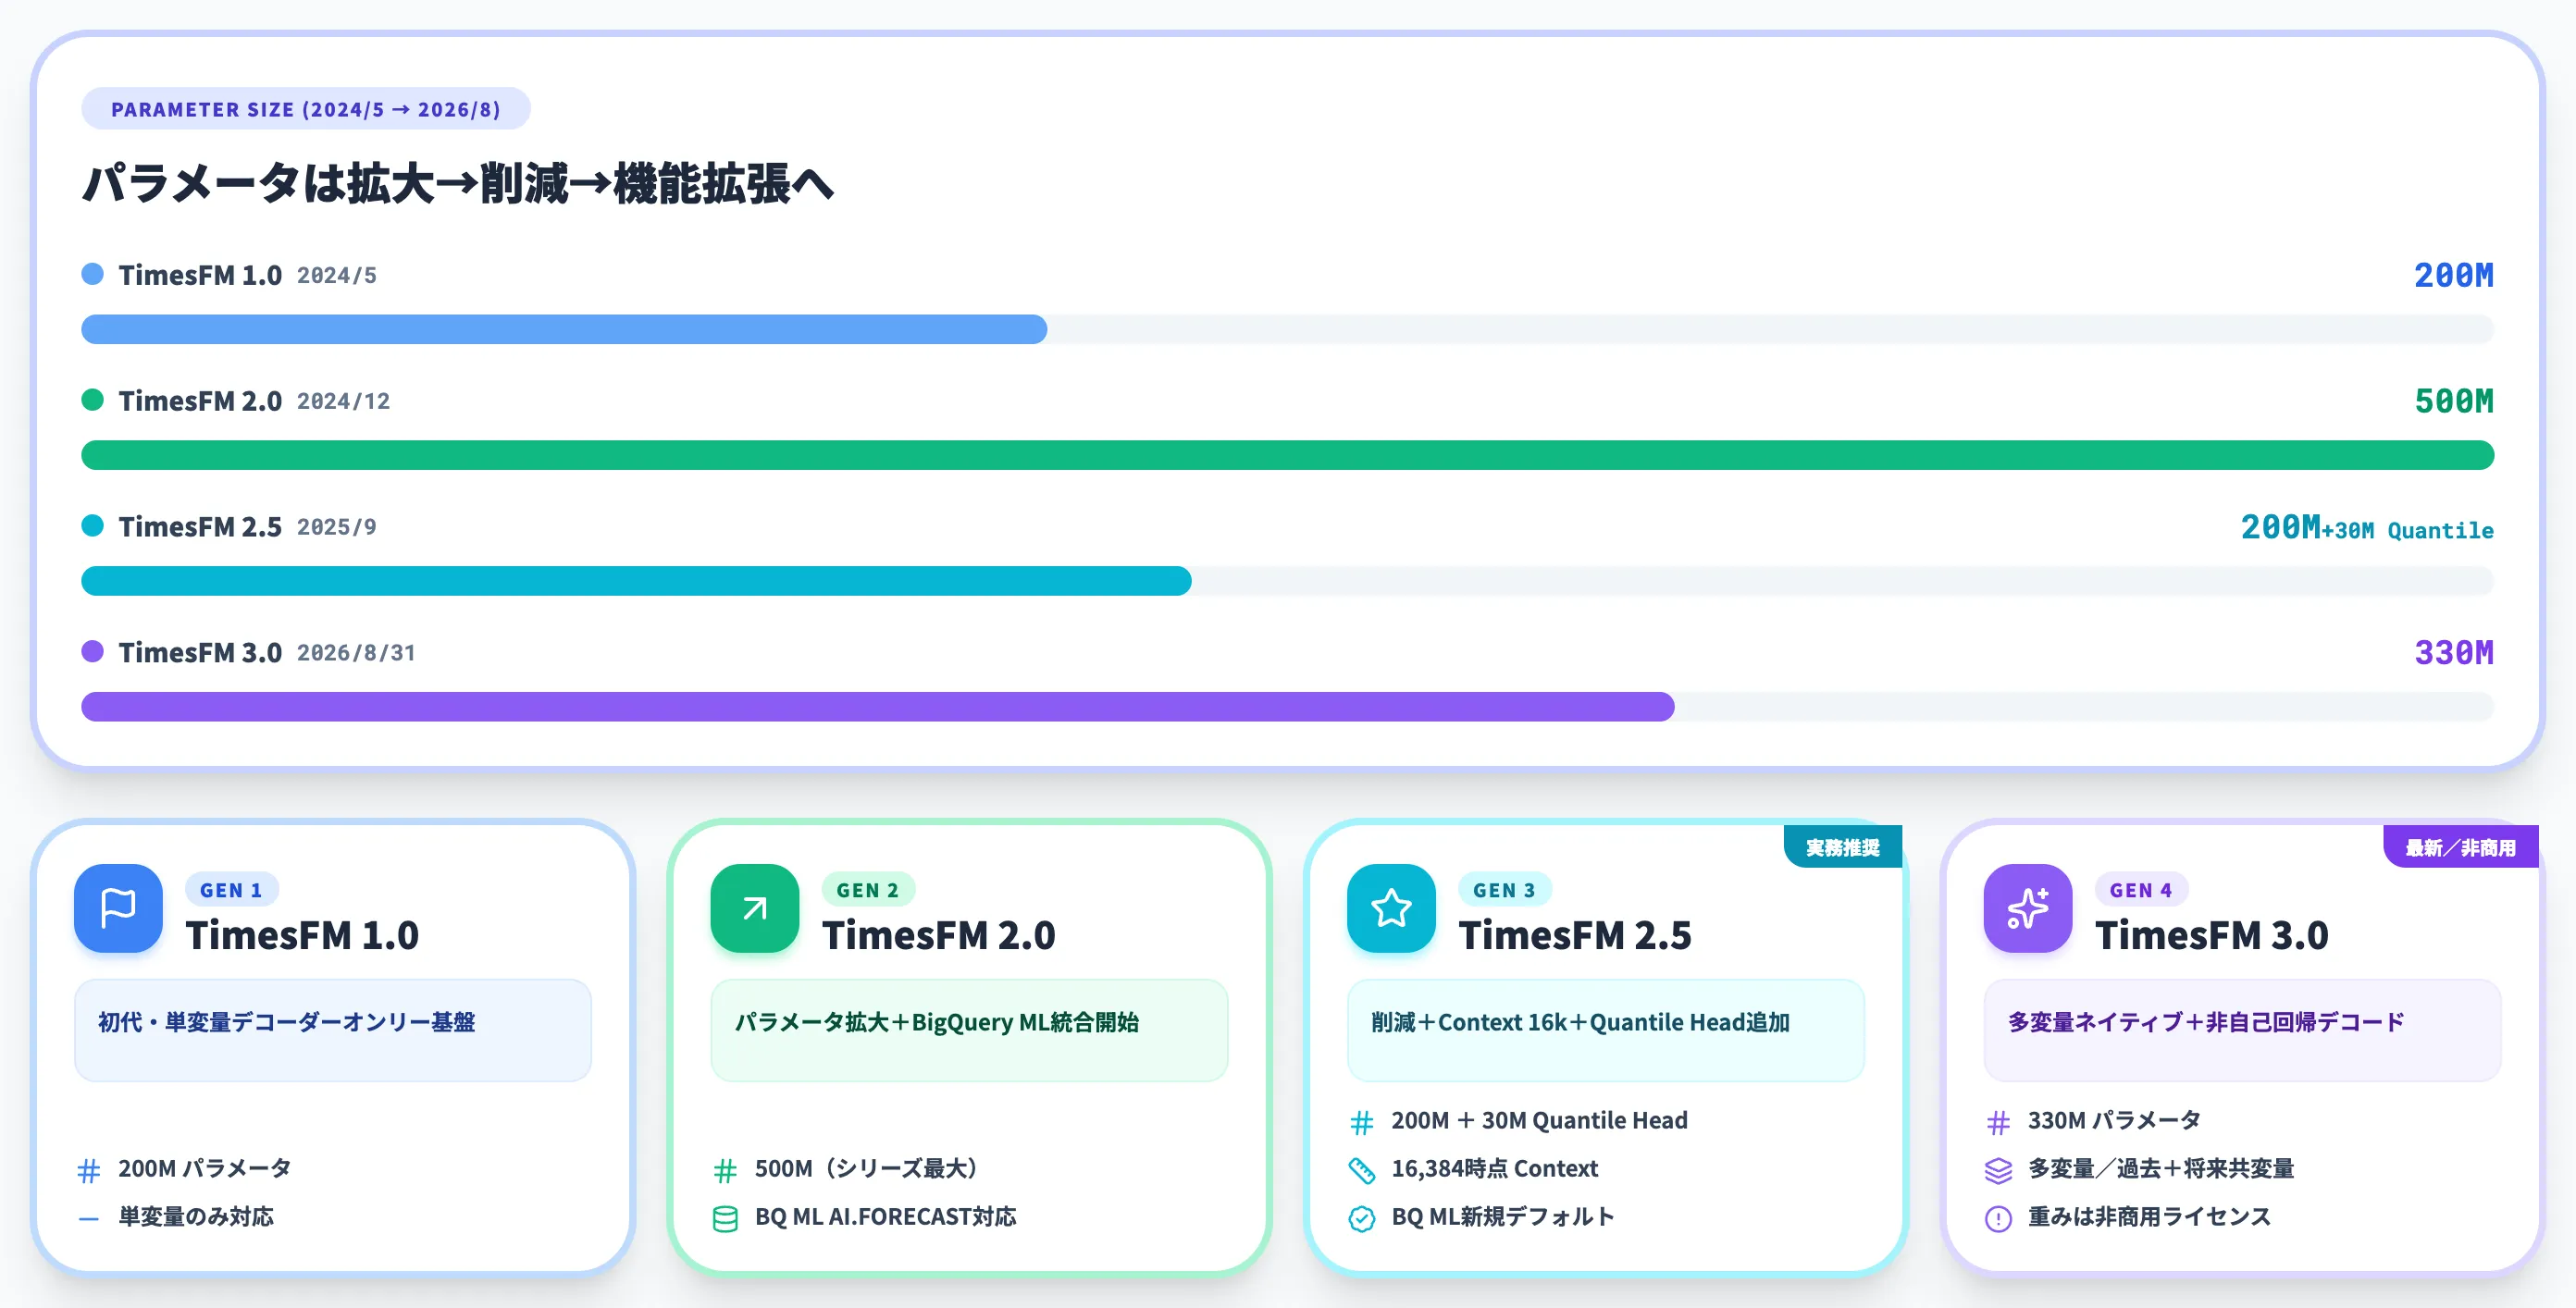
TimesFMは単発リリースのモデルではなく、2024年5月の1.0公開から2026年8月の3.0まで、約2年4か月で4世代の進化を重ねてきたシリーズプロダクトです。
各世代でパラメータ数と対応データ形式が段階的に変わっており、業務で採用するときは「どの世代を選ぶか」が実運用の可否を左右します。
4世代のスペック一覧
以下の表で、TimesFM各世代のスペックとリリース時期を整理しました。
| 世代 | リリース時期 | パラメータ数 | 対応データ形式 | 主要な追加機能 |
|---|---|---|---|---|
| TimesFM 1.0 | 2024年5月 | 200M | 単変量のみ | 初代・デコーダーオンリー基盤 |
| TimesFM 2.0 | 2024年12月 | 500M | 単変量のみ | パラメータ拡大・BigQuery ML統合 |
| TimesFM 2.5 | 2025年9月 | 200M(+30M Quantile Head) | 単変量のみ | パラメータ削減・16k Context・Quantile Head |
| TimesFM 3.0 | 2026年8月31日 | 330M | 多変量ネイティブ・過去/将来共変量 | 多変量対応・非自己回帰デコード・非商用ライセンス化 |
スペックだけを見ると3.0が最新かつ最強に見えますが、「業務でどの世代を選ぶか」の判断はもう1段細かい論点が入ります。次のH3で詳しく整理します。
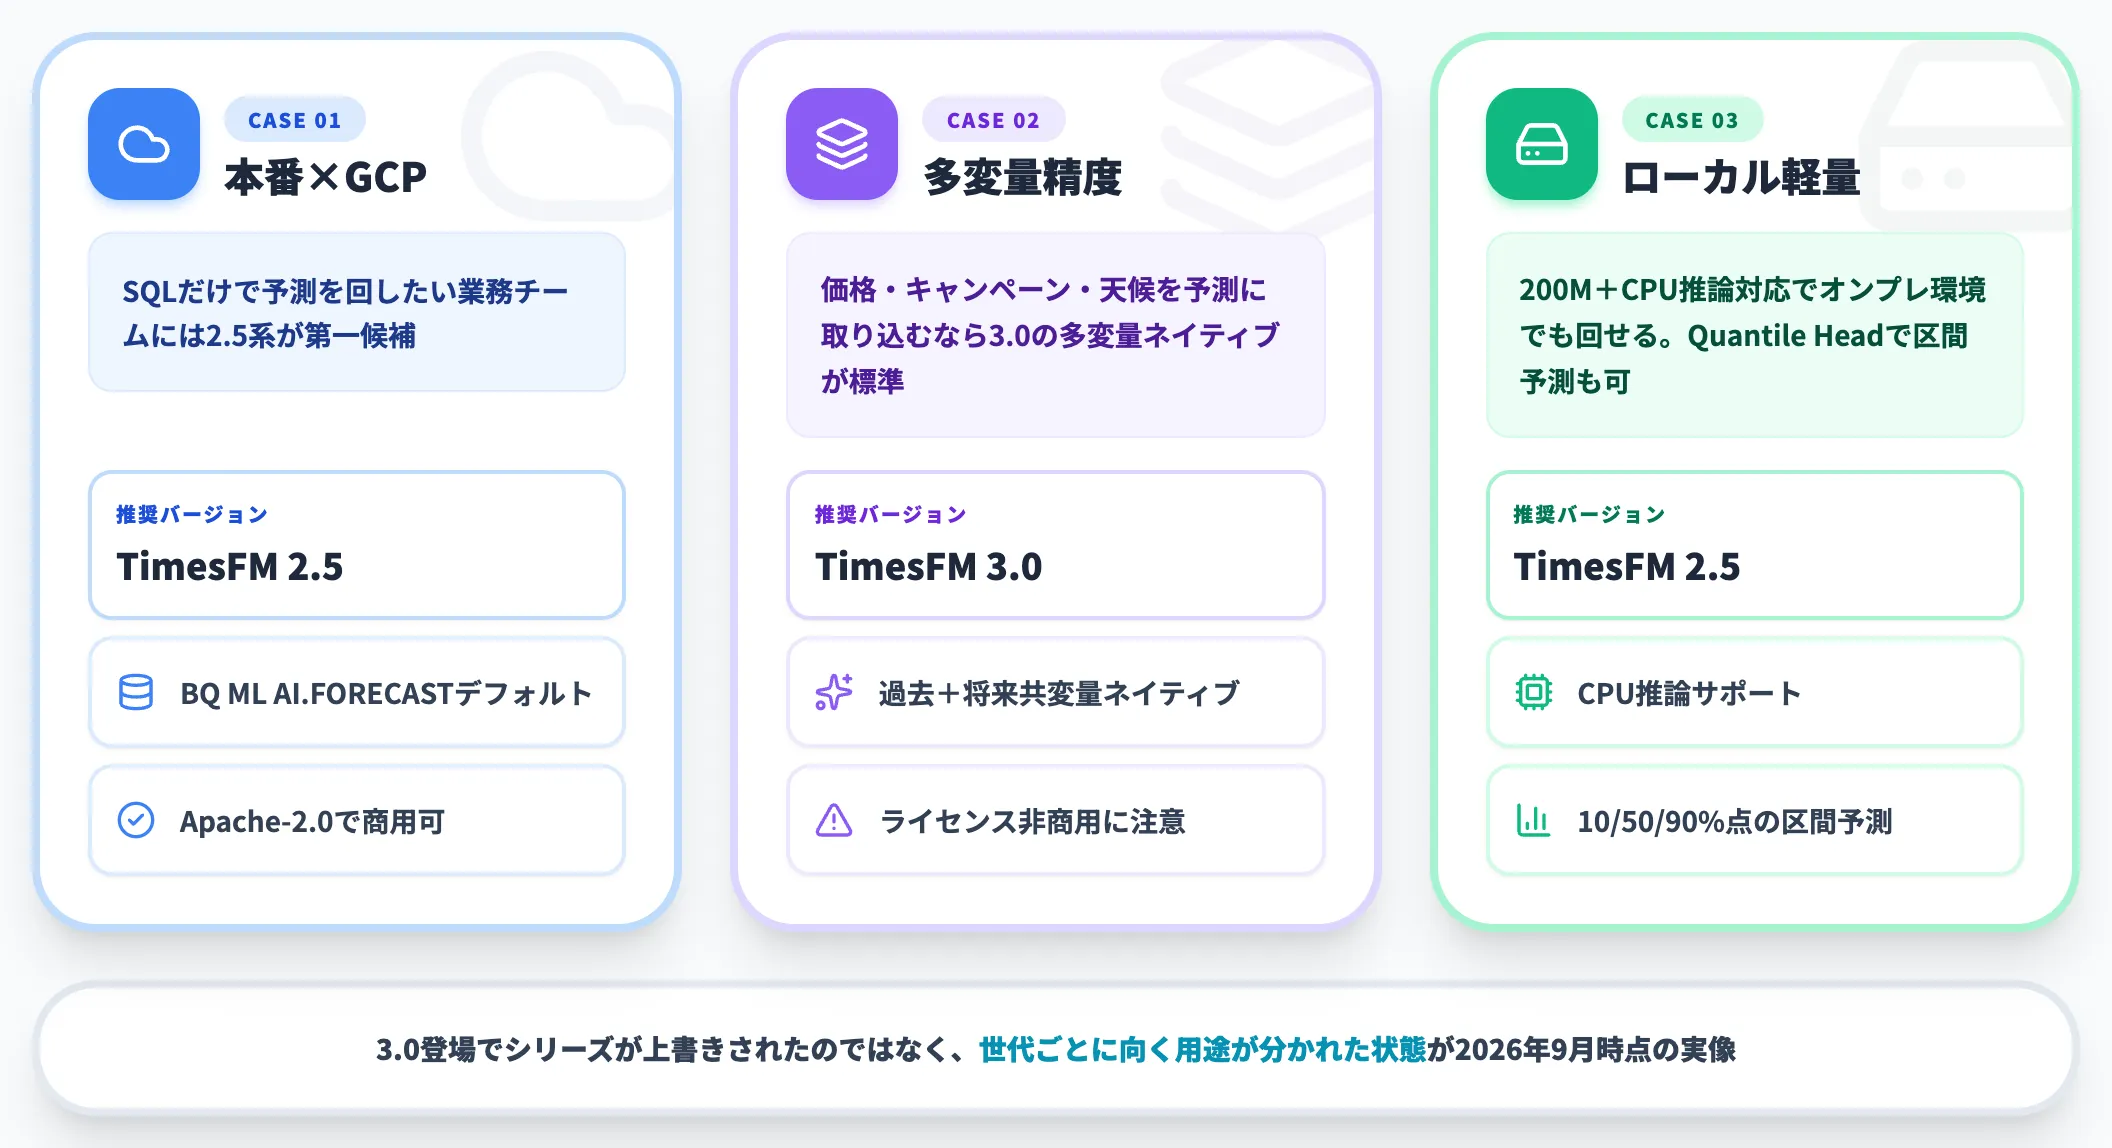
世代を選ぶときの実務判断
進化の方向性は明確です。パラメータを膨張させるのではなく、2.0で500Mまで拡大した後、2.5で200Mまで削減してレイテンシと可搬性を優先し、3.0で多変量対応という別軸の拡張に投資しました。
-
本番運用でGoogle Cloudから呼びたい場合
BigQuery MLのAI.FORECAST関数はTimesFM 2.5と2.0の両方をサポートしており、新規タスクのデフォルトはTimesFM 2.5です。SQLだけで予測を回したい業務チームには2.5系が実務推奨になります。
-
多変量・共変量を活かして精度を突き詰めたい場合
3.0の多変量ネイティブ対応は、価格・キャンペーン・天候といった外生変数を予測に取り込みたいときの標準選択になります。ただし後述のとおりライセンスが非商用限定です。
-
ローカル環境で軽く回したい場合
2.5系は200Mまで削減されており、CPU推論もサポートされます。Quantile Headによる予測区間も追加されているため、意思決定の下振れ・上振れを含めた運用に向きます。
3.0の登場でシリーズ全体が上書きされたわけではなく、世代ごとに「向く用途」がきれいに分かれた状態というのが2026年9月時点の実像です。
3.0で追加された「多変量ネイティブ対応」の意味
TimesFM 2.5までは1本の時系列を独立に予測する単変量モデルで、価格・在庫・天候といった外生変数を組み込みたい場合はXReg(追加の共変量入力)を別途扱う必要がありました。
3.0では、複数の時系列を同時に予測する多変量モードと、過去のみ既知の共変量(past covariates)・過去と将来ともに既知の共変量(past-future covariates)のネイティブ統合が実装されました。
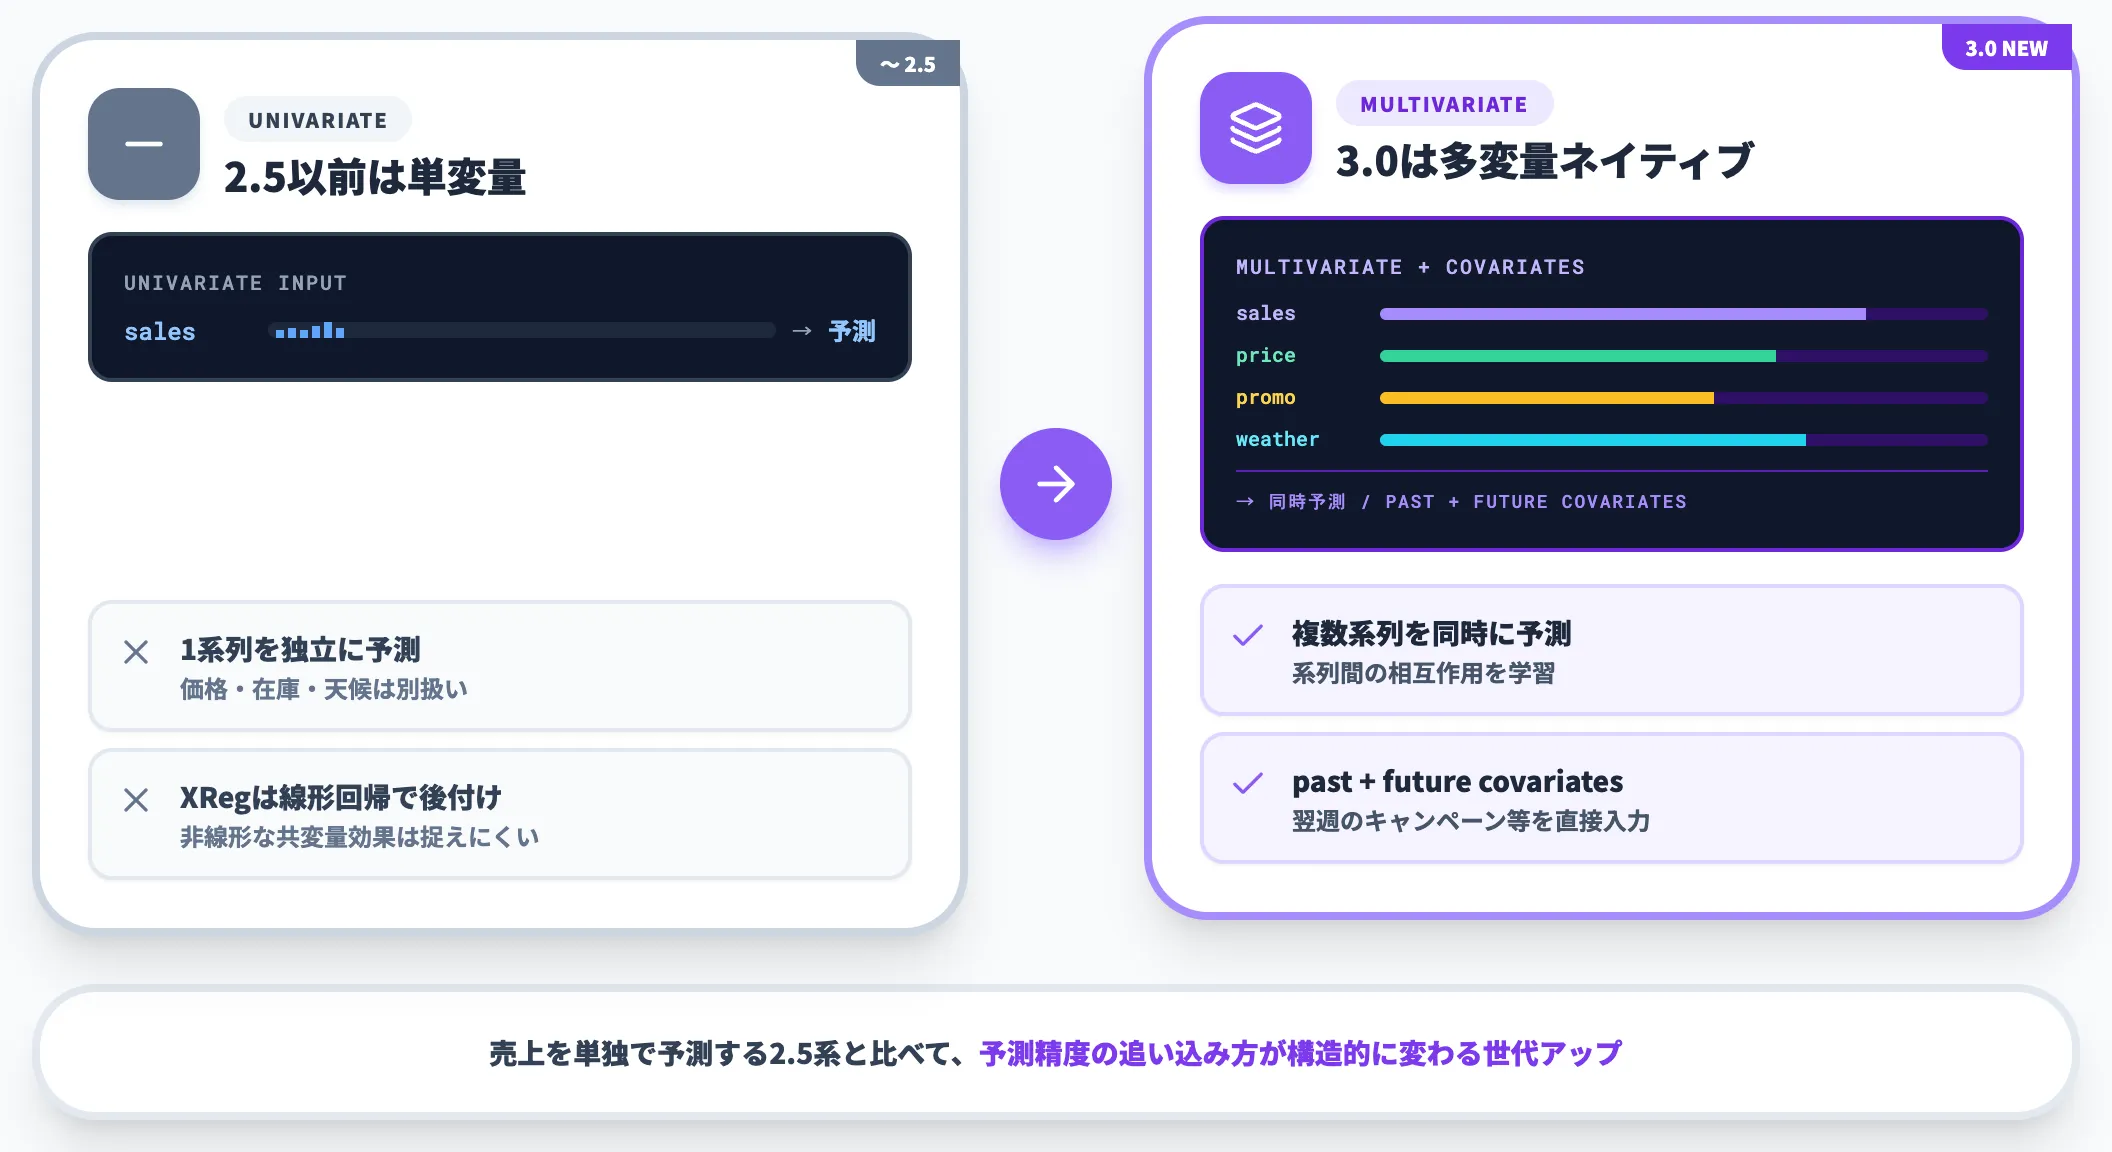
これによって、需要予測に「翌週のキャンペーン有無」「予定販売価格」「祝日フラグ」といった将来時点で既知の情報を直接入力できるようになります。
売上を単独で予測する2.5系と比べて、予測精度の追い込み方が構造的に変わる世代アップです。詳細はGoogle Research公式ブログで解説されており、多変量ネイティブ対応・Chronos-2との詳細比較を扱う個別記事は別途公開予定です。
TimesFMを支える技術的な仕組み
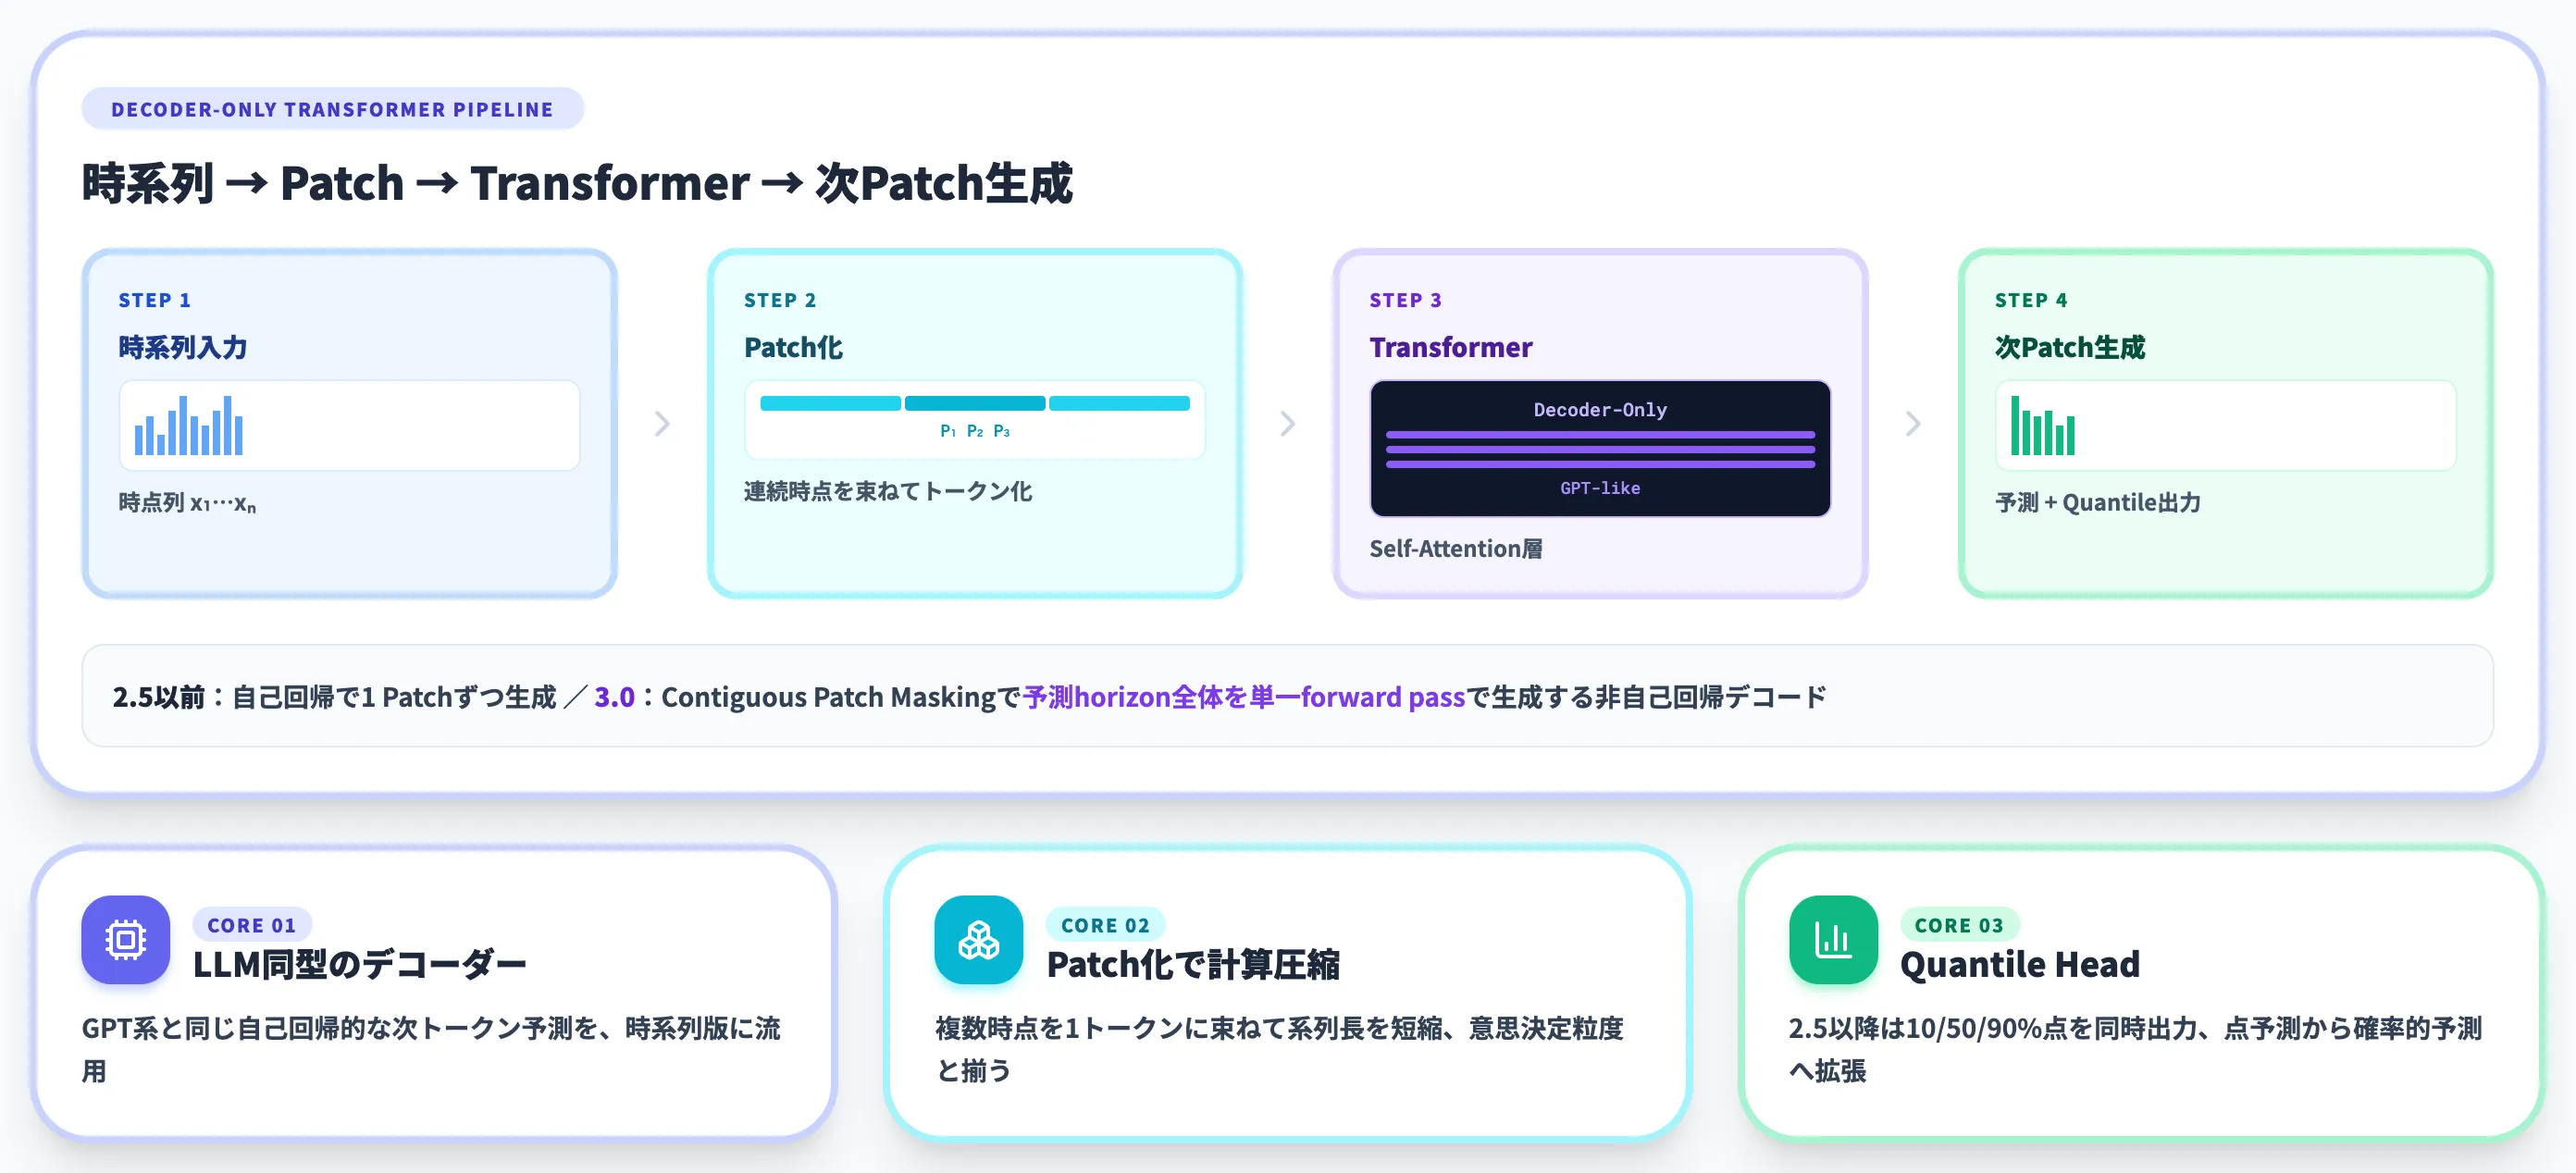
TimesFMがゼロショットで幅広い時系列に対応できる理由は、GoogleがICML 2024で発表した原論文で示されたアーキテクチャ設計にあります。
大規模言語モデル(LLM)が単語をトークン化して自己回帰的に次の単語を予測するのと同じ発想を、時系列データに持ち込んだのがTimesFMです。
デコーダーオンリーTransformerとパッチ化
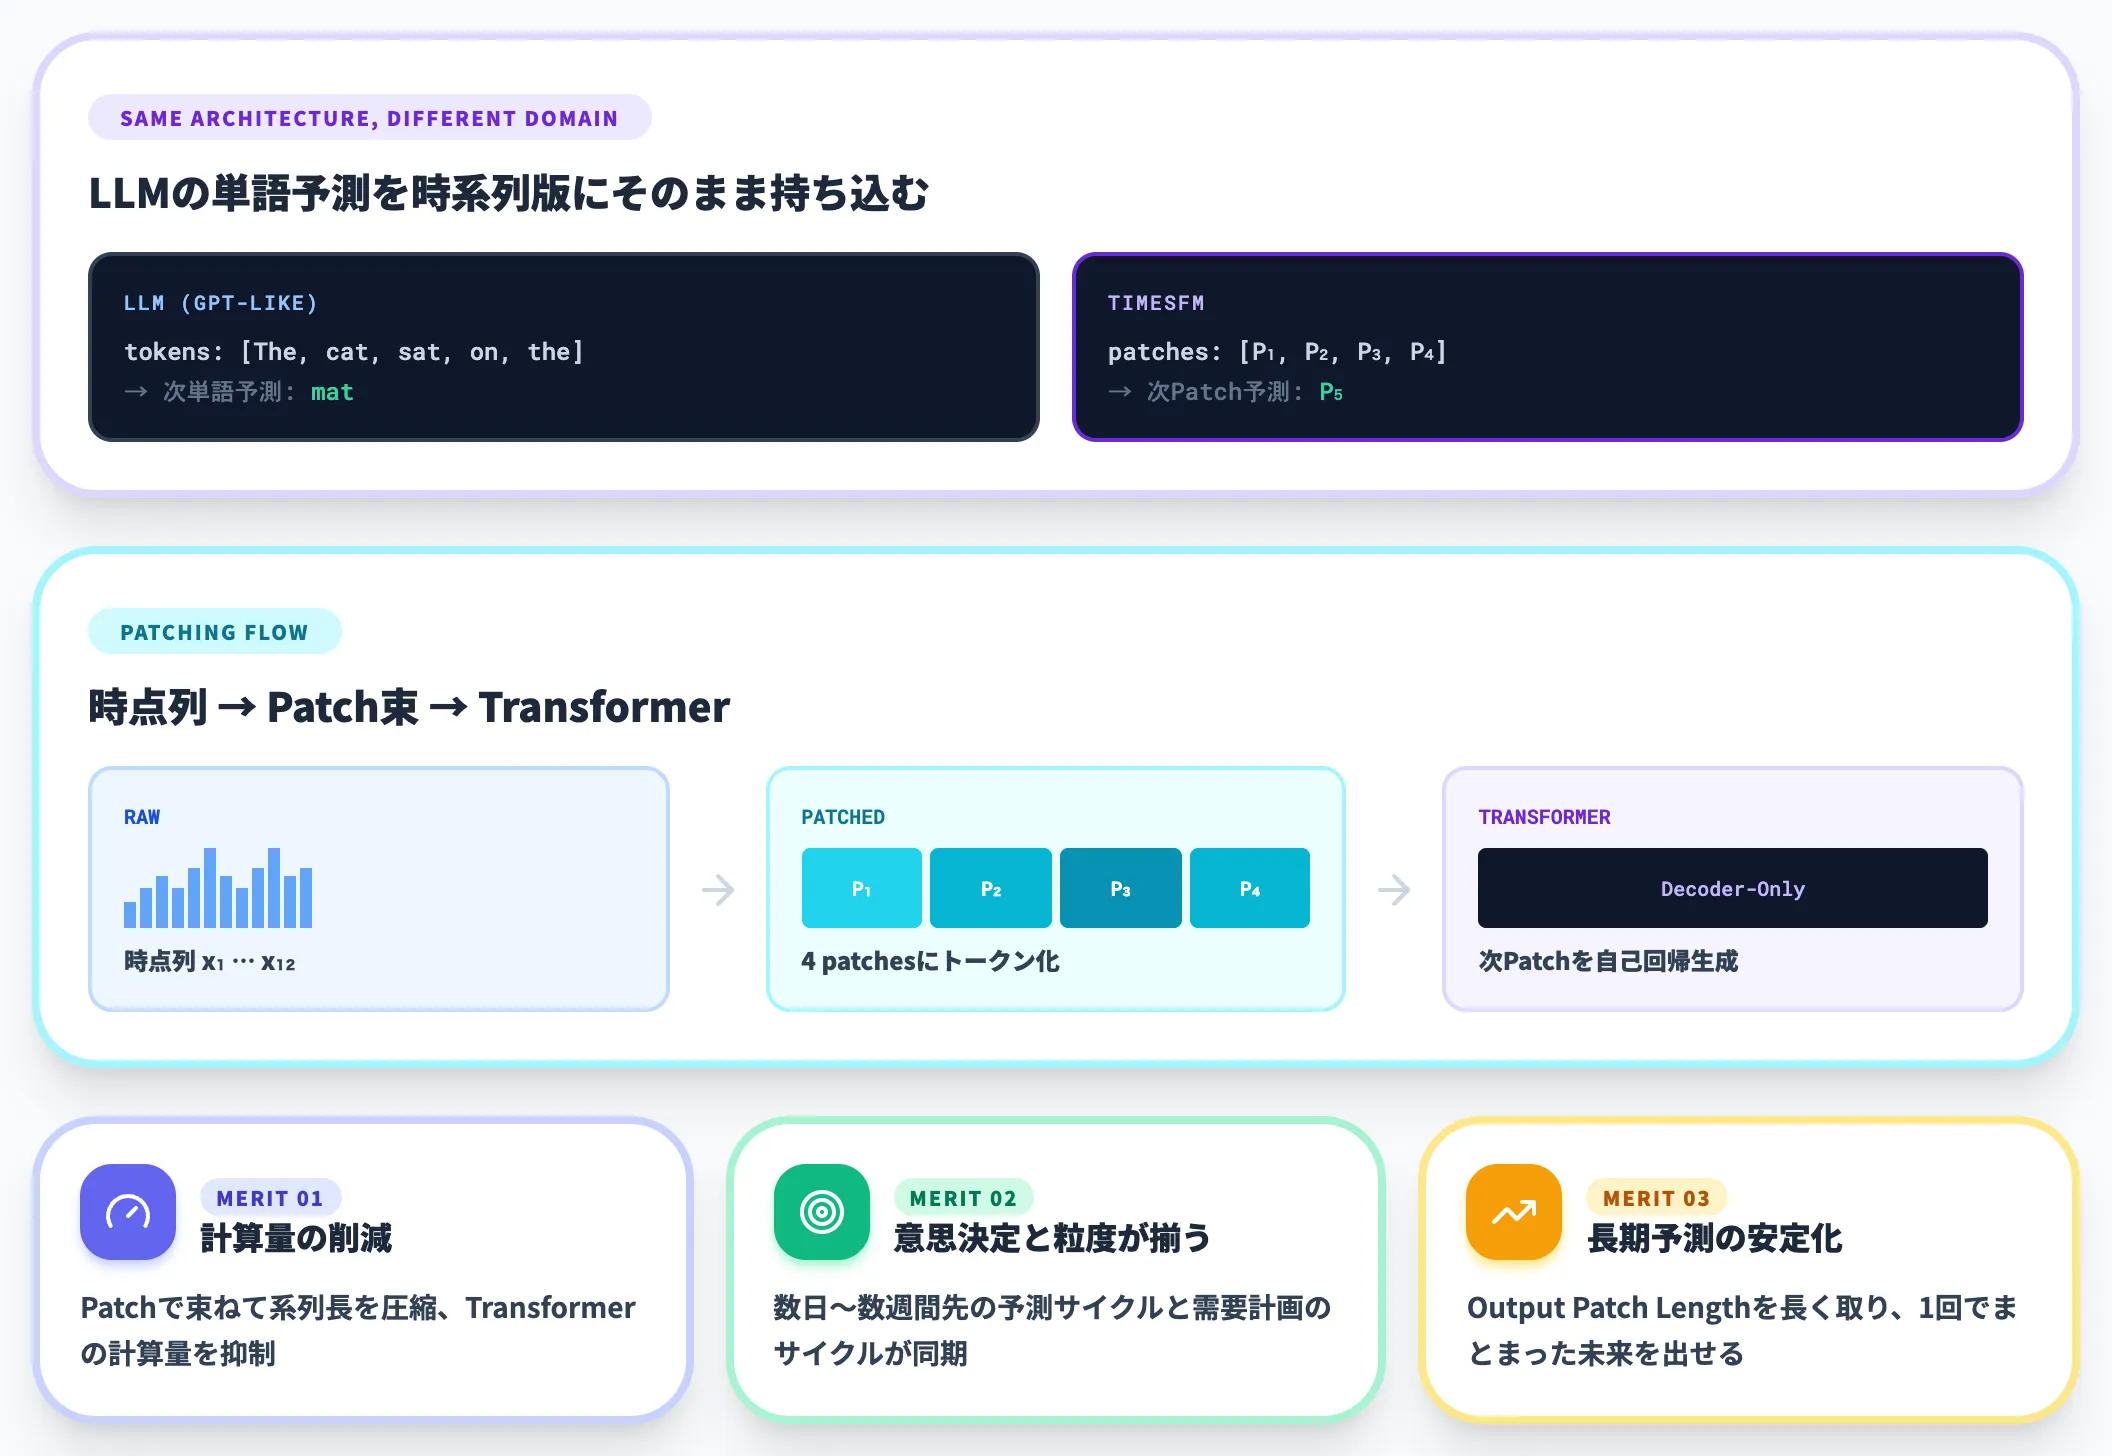
TimesFMのモデル本体は、GPT系のLLMと同じデコーダーオンリーのTransformerです。
時系列データをそのまま入力するのではなく、連続する複数の時点をひとまとまり(Patch)にトークン化してから、次のPatchを生成します。2.5以前はLLMと同じく自己回帰的に1 Patchずつ生成しますが、3.0ではContiguous Patch Maskingにより予測horizon全体を単一forward passで生成する非自己回帰デコードに切り替わっています。
Patch化のメリットは主に3つあります。
-
計算量の削減
1時点ずつを1トークンとして扱うと入力長が爆発しますが、Patchで束ねることで系列長を圧縮し、Transformerの計算量を抑えられます。
-
予測の粒度が意思決定に馴染む
需要予測や在庫計画のような実務では、1時点先ではなく数日〜数週間先を一度に見たいケースが多く、Patch単位で予測することで意思決定サイクルと粒度が揃います。
-
長期予測の安定化
自己回帰で1時点ずつ生成するとエラーが蓄積しますが、Output Patch Lengthを長く取ることで、1回の推論でまとまった未来を出せます。
このPatch化は、SalesforceのMoiraiやPatchTSTにも共通する時系列基盤モデルの標準アプローチで、TimesFMもこの系譜の延長線上にあります。
ゼロショット予測を成立させる事前学習データ
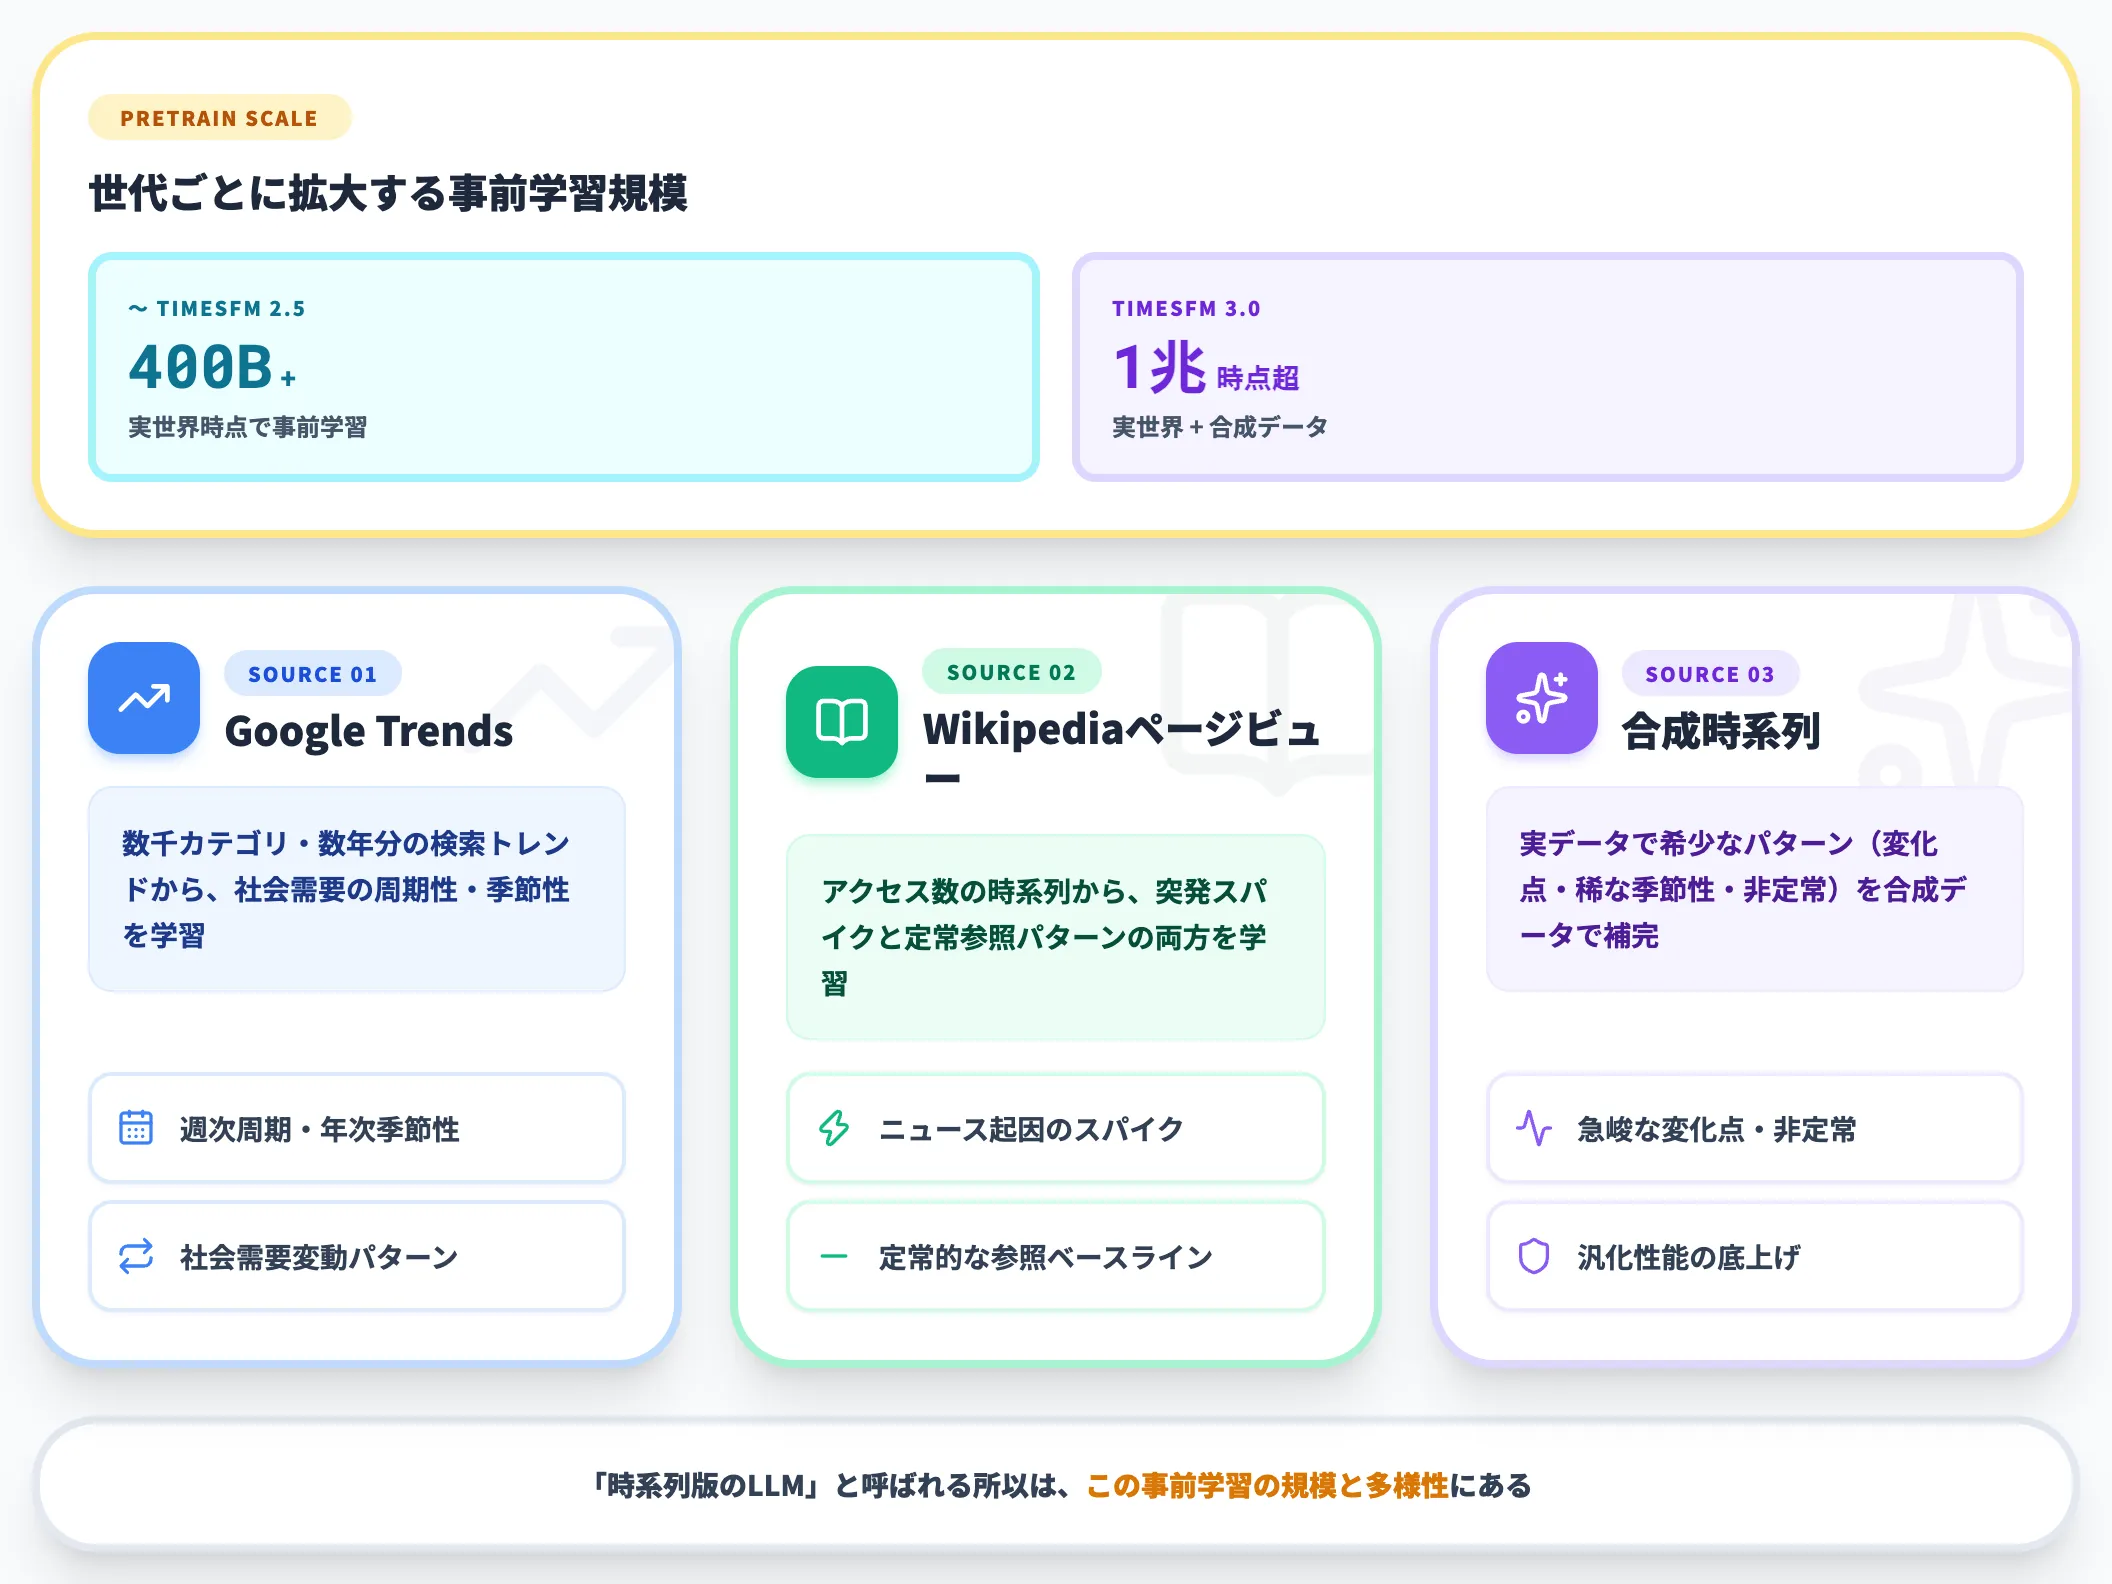
TimesFMがゼロショットで動くのは、事前学習に使ったデータの多様性と規模のおかげです。
Googleは実世界の公開データと合成データを組み合わせて事前学習しています
。Google Cloudの公式ブログによれば、BigQueryに統合された従来世代(〜2.5)は400Bを超える実世界時点で事前学習されており、最新のTimesFM 3.0では実世界+合成データで1兆時点超まで規模が拡大しました。
事前学習データの主な内訳は次のとおりです。
-
Google Trendsの検索トレンドデータ
数千カテゴリ・数年分の検索トレンドから、社会的な需要変動の周期性・季節性を学習しています。
-
Wikipediaのページビューデータ
アクセス数の時系列から、突発的なスパイク(ニュース起因)と定常的な参照パターンの両方を学習しています。
-
合成時系列データ
実データでは希少なパターン(急峻な変化点、稀な季節性、非定常な振る舞い)を合成データで補完し、汎化性能を底上げしています。
「時系列版のLLM」と呼ばれる所以は、この事前学習の規模と多様性にあります。LLMがWebコーパスの言語パターンを学習しているのと同様に、TimesFMは実世界の時系列パターンを学習しているため、業種を問わず初手で使える汎化力を持ちます。
自己回帰予測とQuantile Head
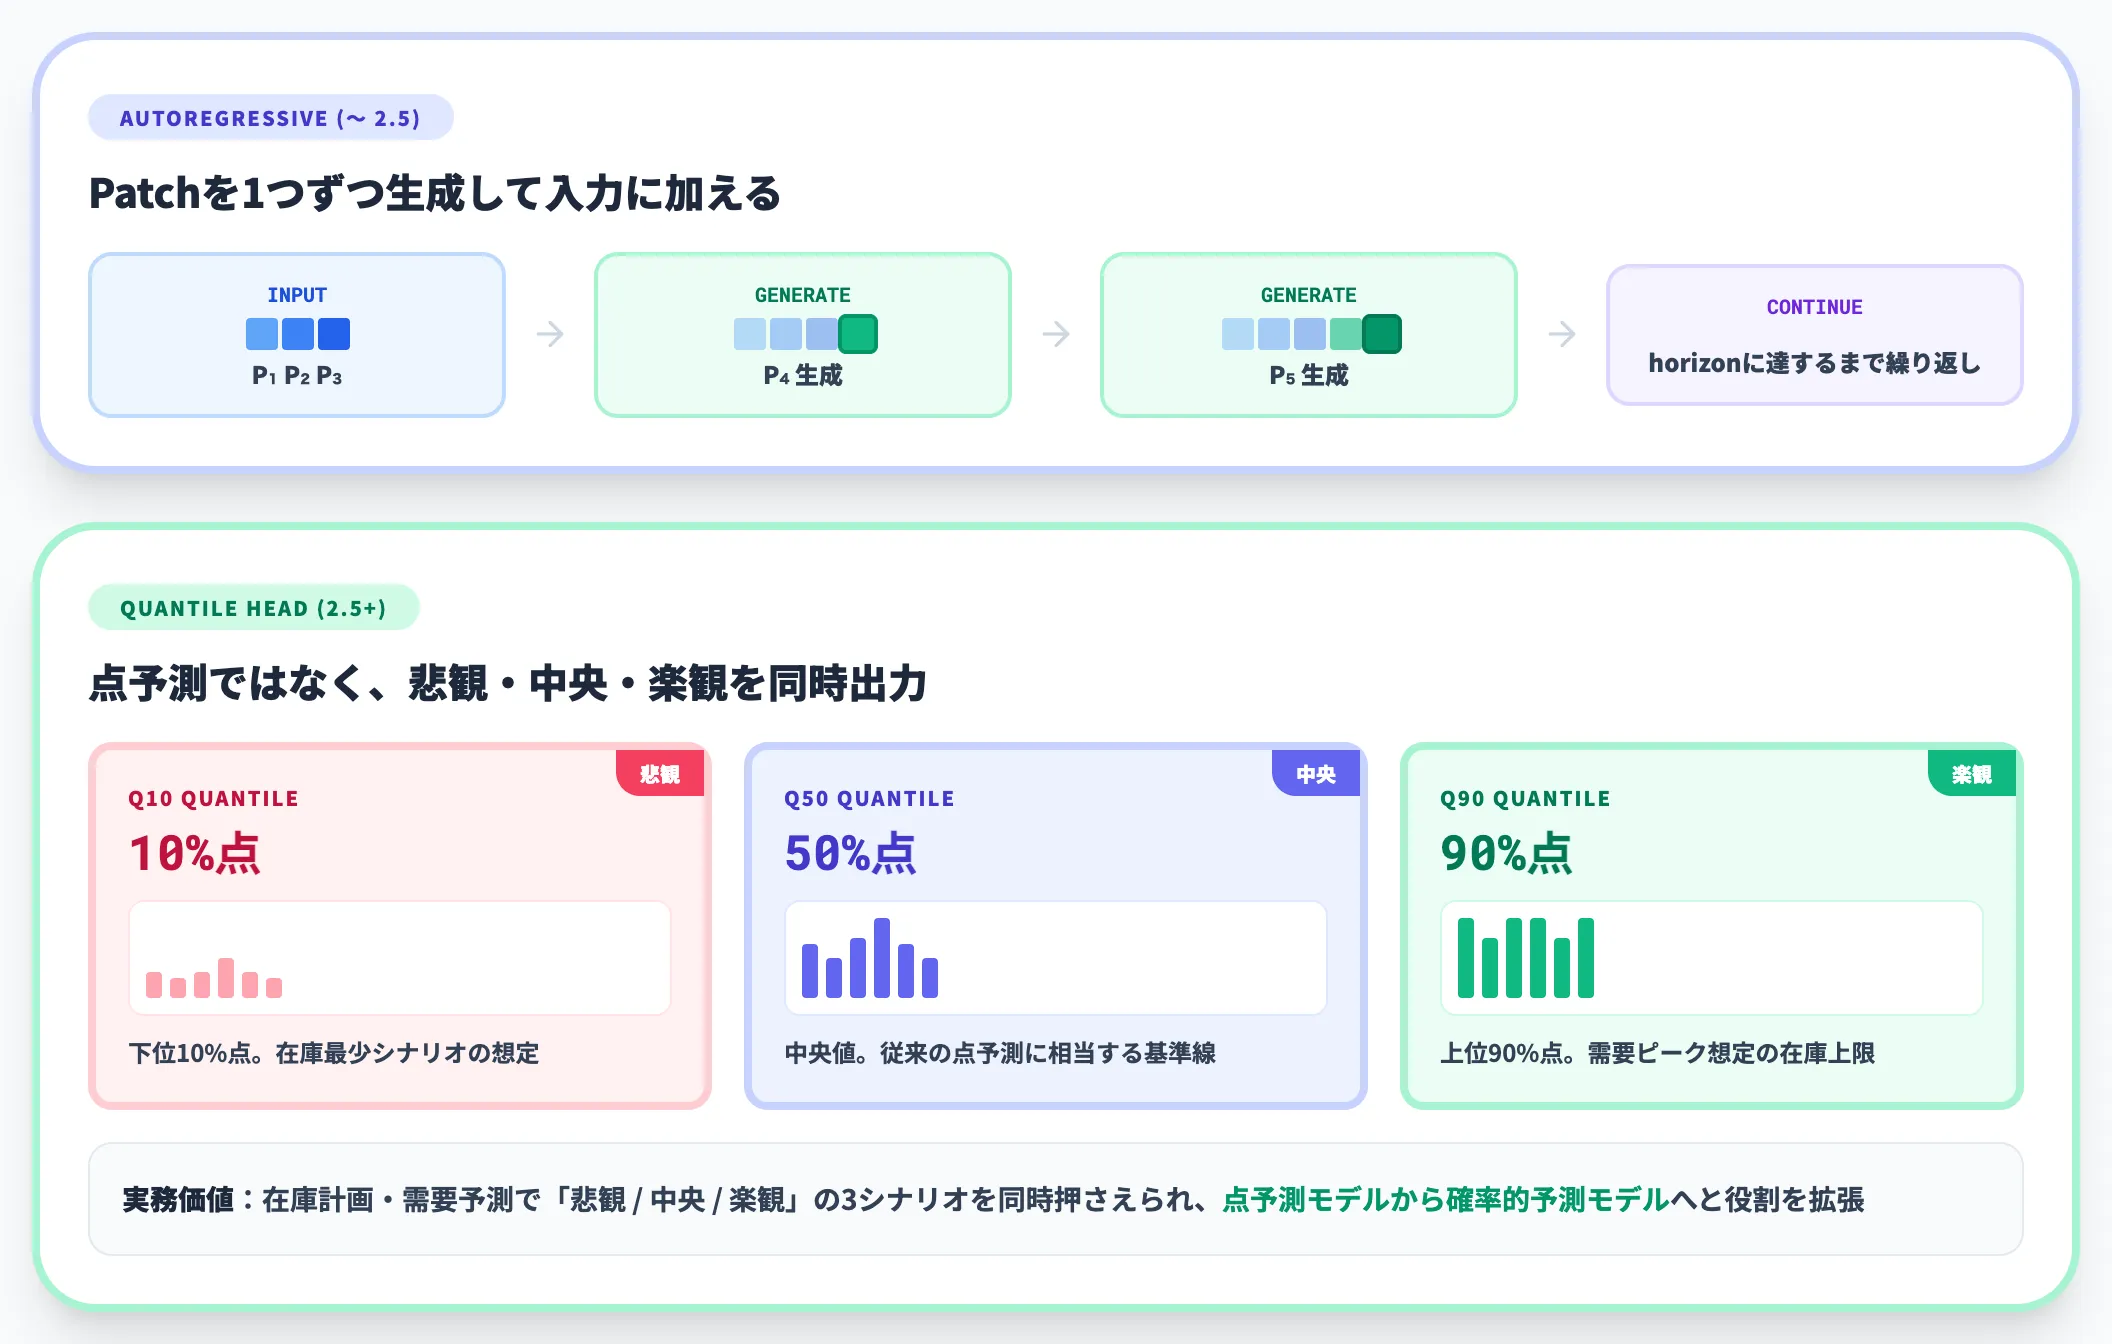
TimesFM 2.5以前の推論は、入力された過去のPatchから次のPatchを生成し、それを入力に加えてさらに次のPatchを生成する、というLLM同様の自己回帰プロセスで未来を出します(3.0は前述のとおり非自己回帰デコードに変更されています)。
2.5系以降では、単一の点予測(中央値予測)だけでなく、Quantile Headによって複数の分位点(10%点・50%点・90%点など)を同時に出力できるようになりました。
これは実務では大きな意味を持ちます。在庫計画や需要予測では、「一番ありそうな値」だけでなく、「悲観シナリオ(下位10%点)」と「楽観シナリオ(上位90%点)」を同時に押さえて意思決定するのが基本だからです。
Quantile Headの実装で、TimesFMは点予測モデルから確率的予測モデルへと役割を広げた形になります。
TimesFMの使い方——Python・BigQuery ML・Vertex AIの3経路
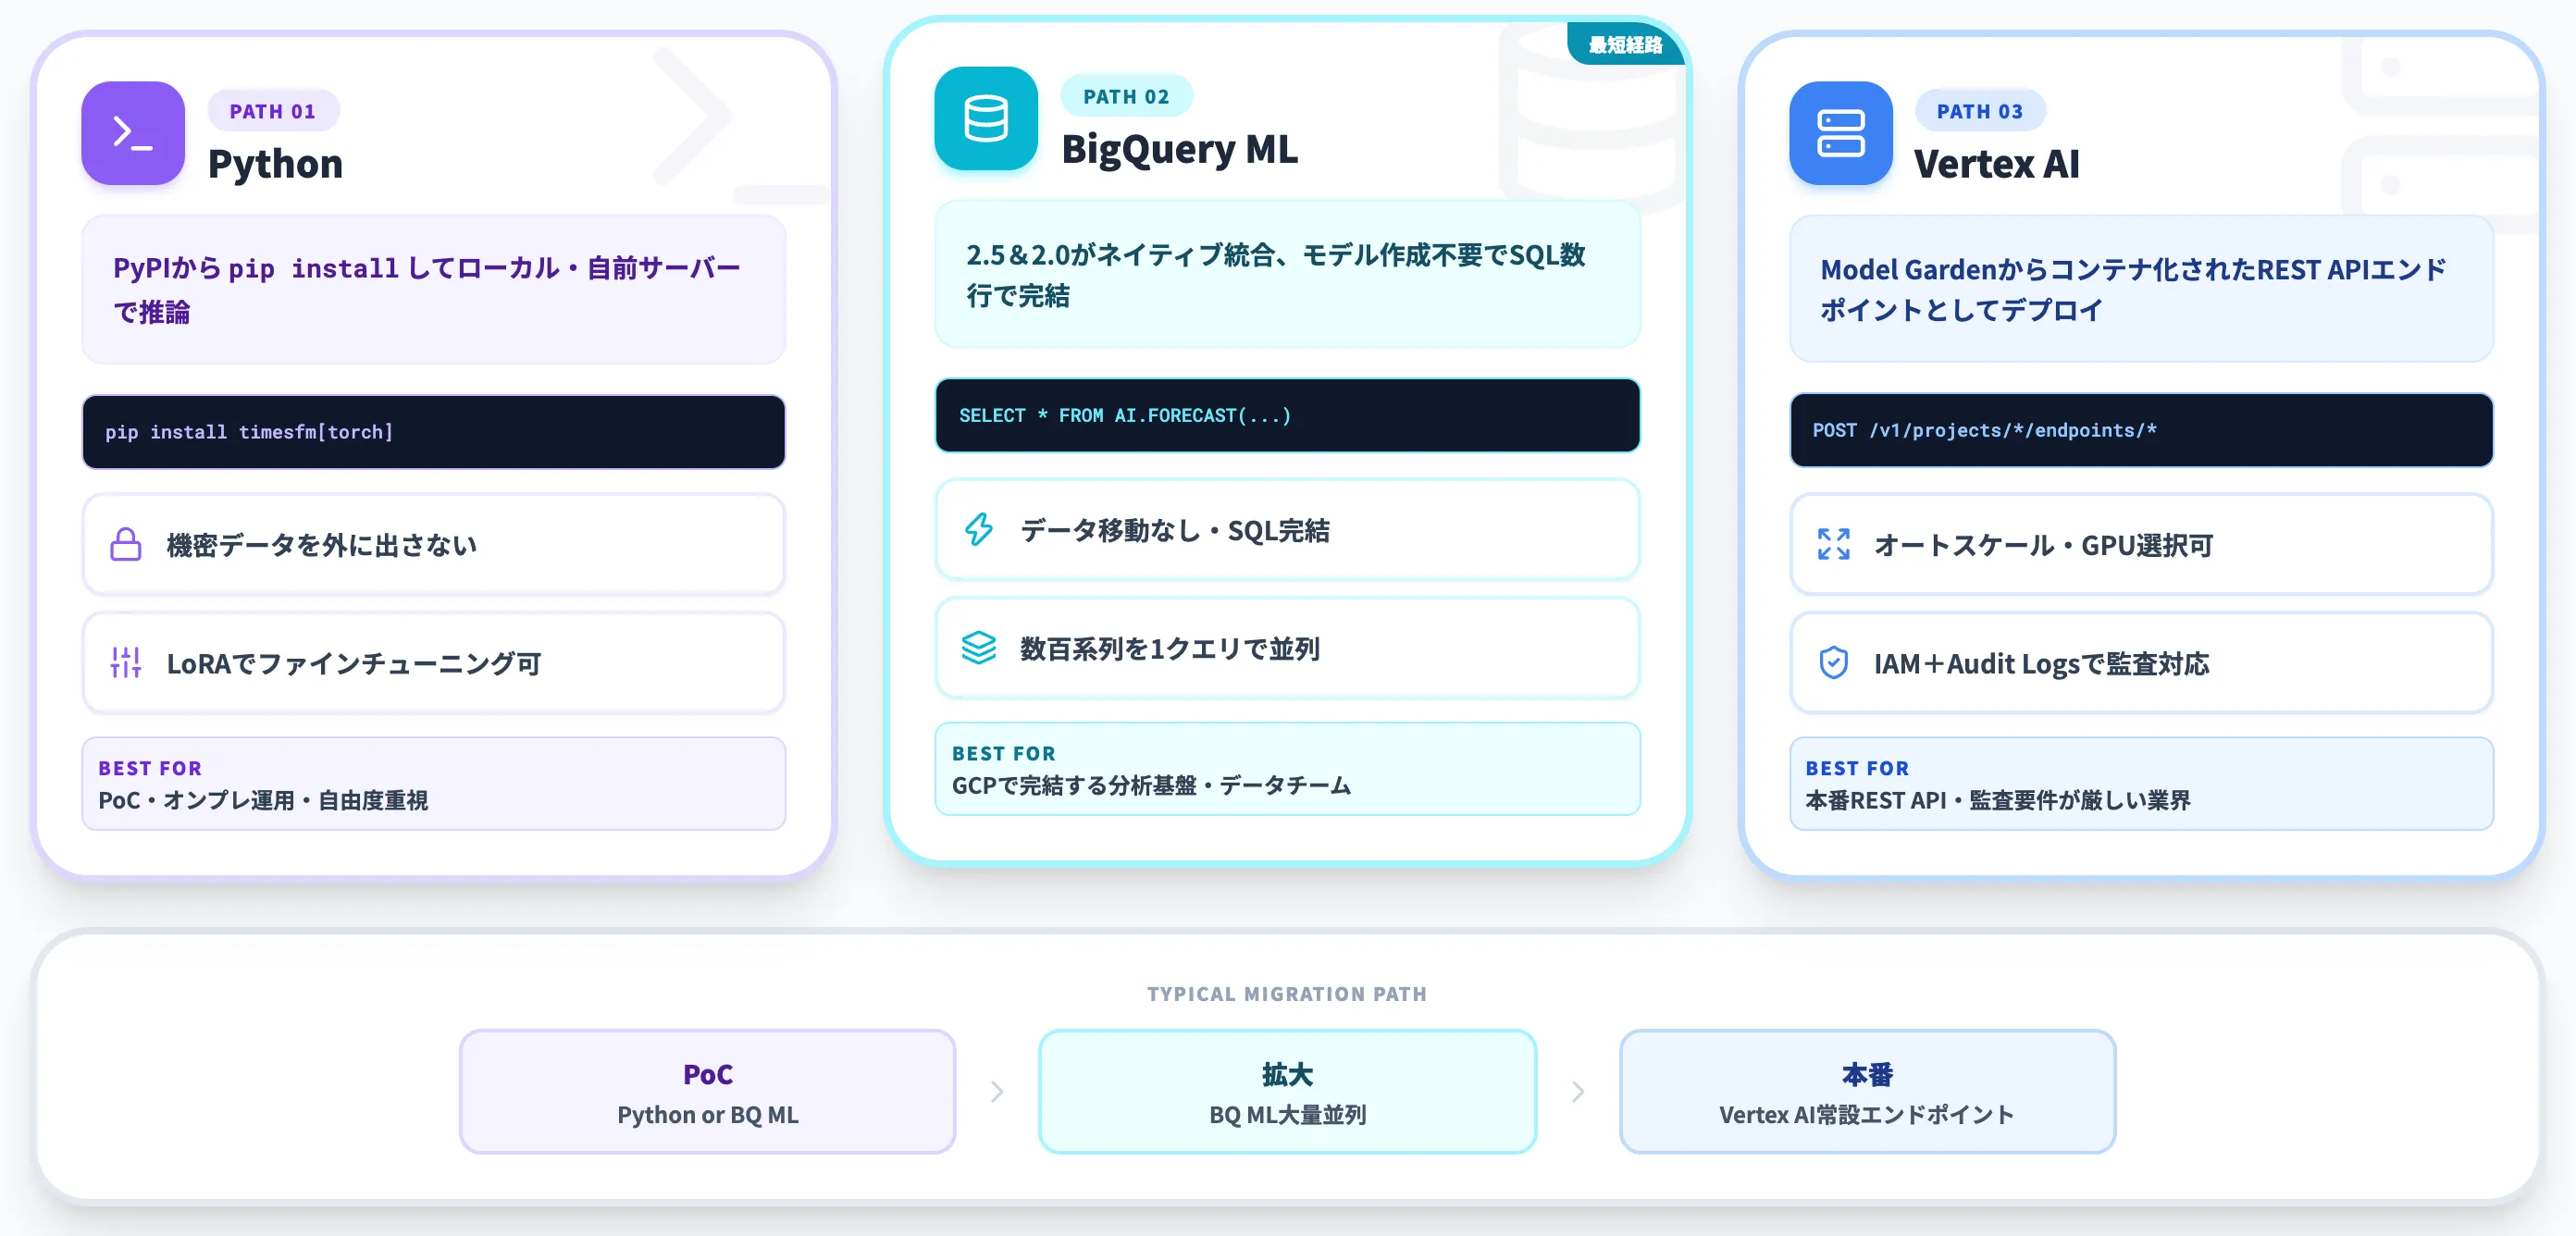
TimesFMを業務で使う経路は、大きく3つに分かれます。
ローカル・自前サーバー系(Python)、Google Cloudのマネージド分析基盤系(BigQuery ML・AlloyDB)、**Google Cloudのマネージド推論系(Vertex AI)**の3つで、それぞれ想定ユーザーと運用コストが異なります。
Pythonパッケージからローカル推論する
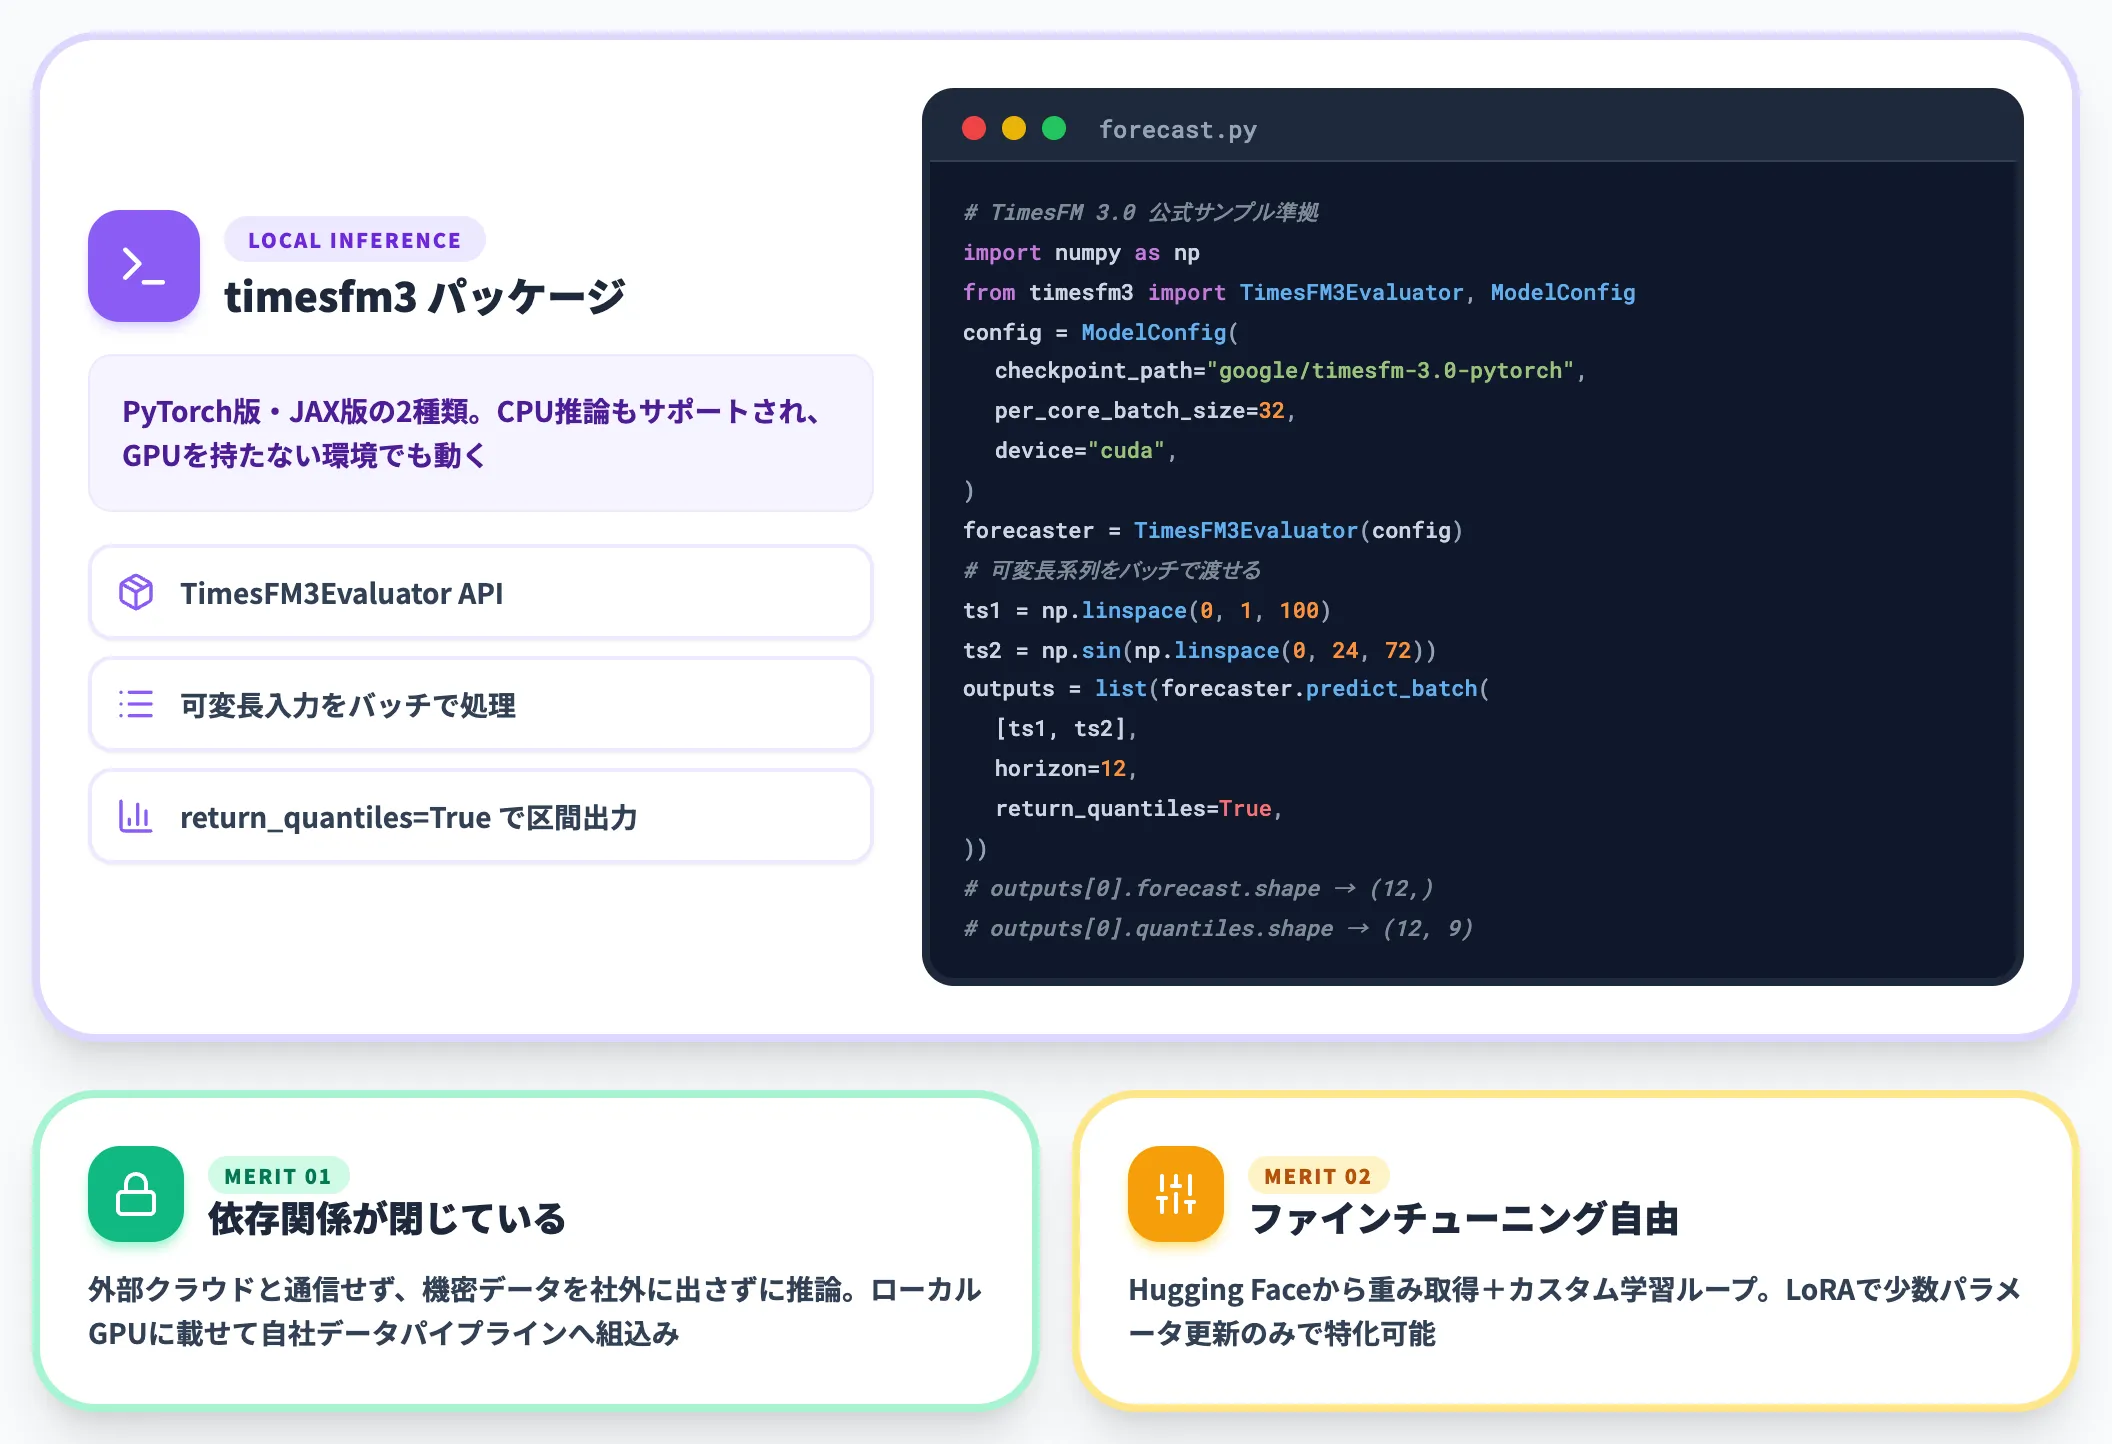
最小構成で試したい場合は、PyPIパッケージ経由でローカルにインストールするのが最速です。
インストールはPyTorch版と JAX版の2種類が提供されており、GPUを持たない環境でもCPU推論でひとまず動きます。
# PyTorch版のインストール
pip install timesfm[torch]
TimesFM 3.0 は timesfm3 パッケージで、ModelConfig を作成して TimesFM3Evaluator を初期化し、predict_batch() で推論する公式APIです。
# 単変量予測の最小コード例(TimesFM 3.0公式サンプル準拠)
import numpy as np
from timesfm3 import TimesFM3Evaluator, ModelConfig

config = ModelConfig(
    checkpoint_path="google/timesfm-3.0-pytorch",
    per_core_batch_size=32,
    device="cuda",
)
forecaster = TimesFM3Evaluator(config)

# 長さの異なる系列をバッチで渡せる(可変長入力)
ts1 = np.linspace(0, 1, 100).astype(np.float32)
ts2 = np.sin(np.linspace(0, 24, 72)).astype(np.float32)

outputs = list(forecaster.predict_batch(
    [ts1, ts2],
    horizon=12,
    return_quantiles=True,
))
# outputs[0].forecast.shape   → (12,)
# outputs[0].quantiles.shape  → (12, 9)
このアプローチの利点は複数あります。
-
依存関係が閉じている
外部クラウドとの通信が発生しないため、機密データを社外に出さずに推論できます。ローカルGPUに載せて自社データパイプラインに組み込む構成が最も自由度が高くなります。
-
ファインチューニングの自由度が高い
自社データで追加学習してドメイン特化させたい場合、Hugging Faceのモデルカードから重みをダウンロードしてカスタム学習ループを回せます。LoRA(Low-Rank Adaptation)を使えば、少数パラメータの更新だけで特化させることも可能です。
BigQuery MLからSQLで呼び出す
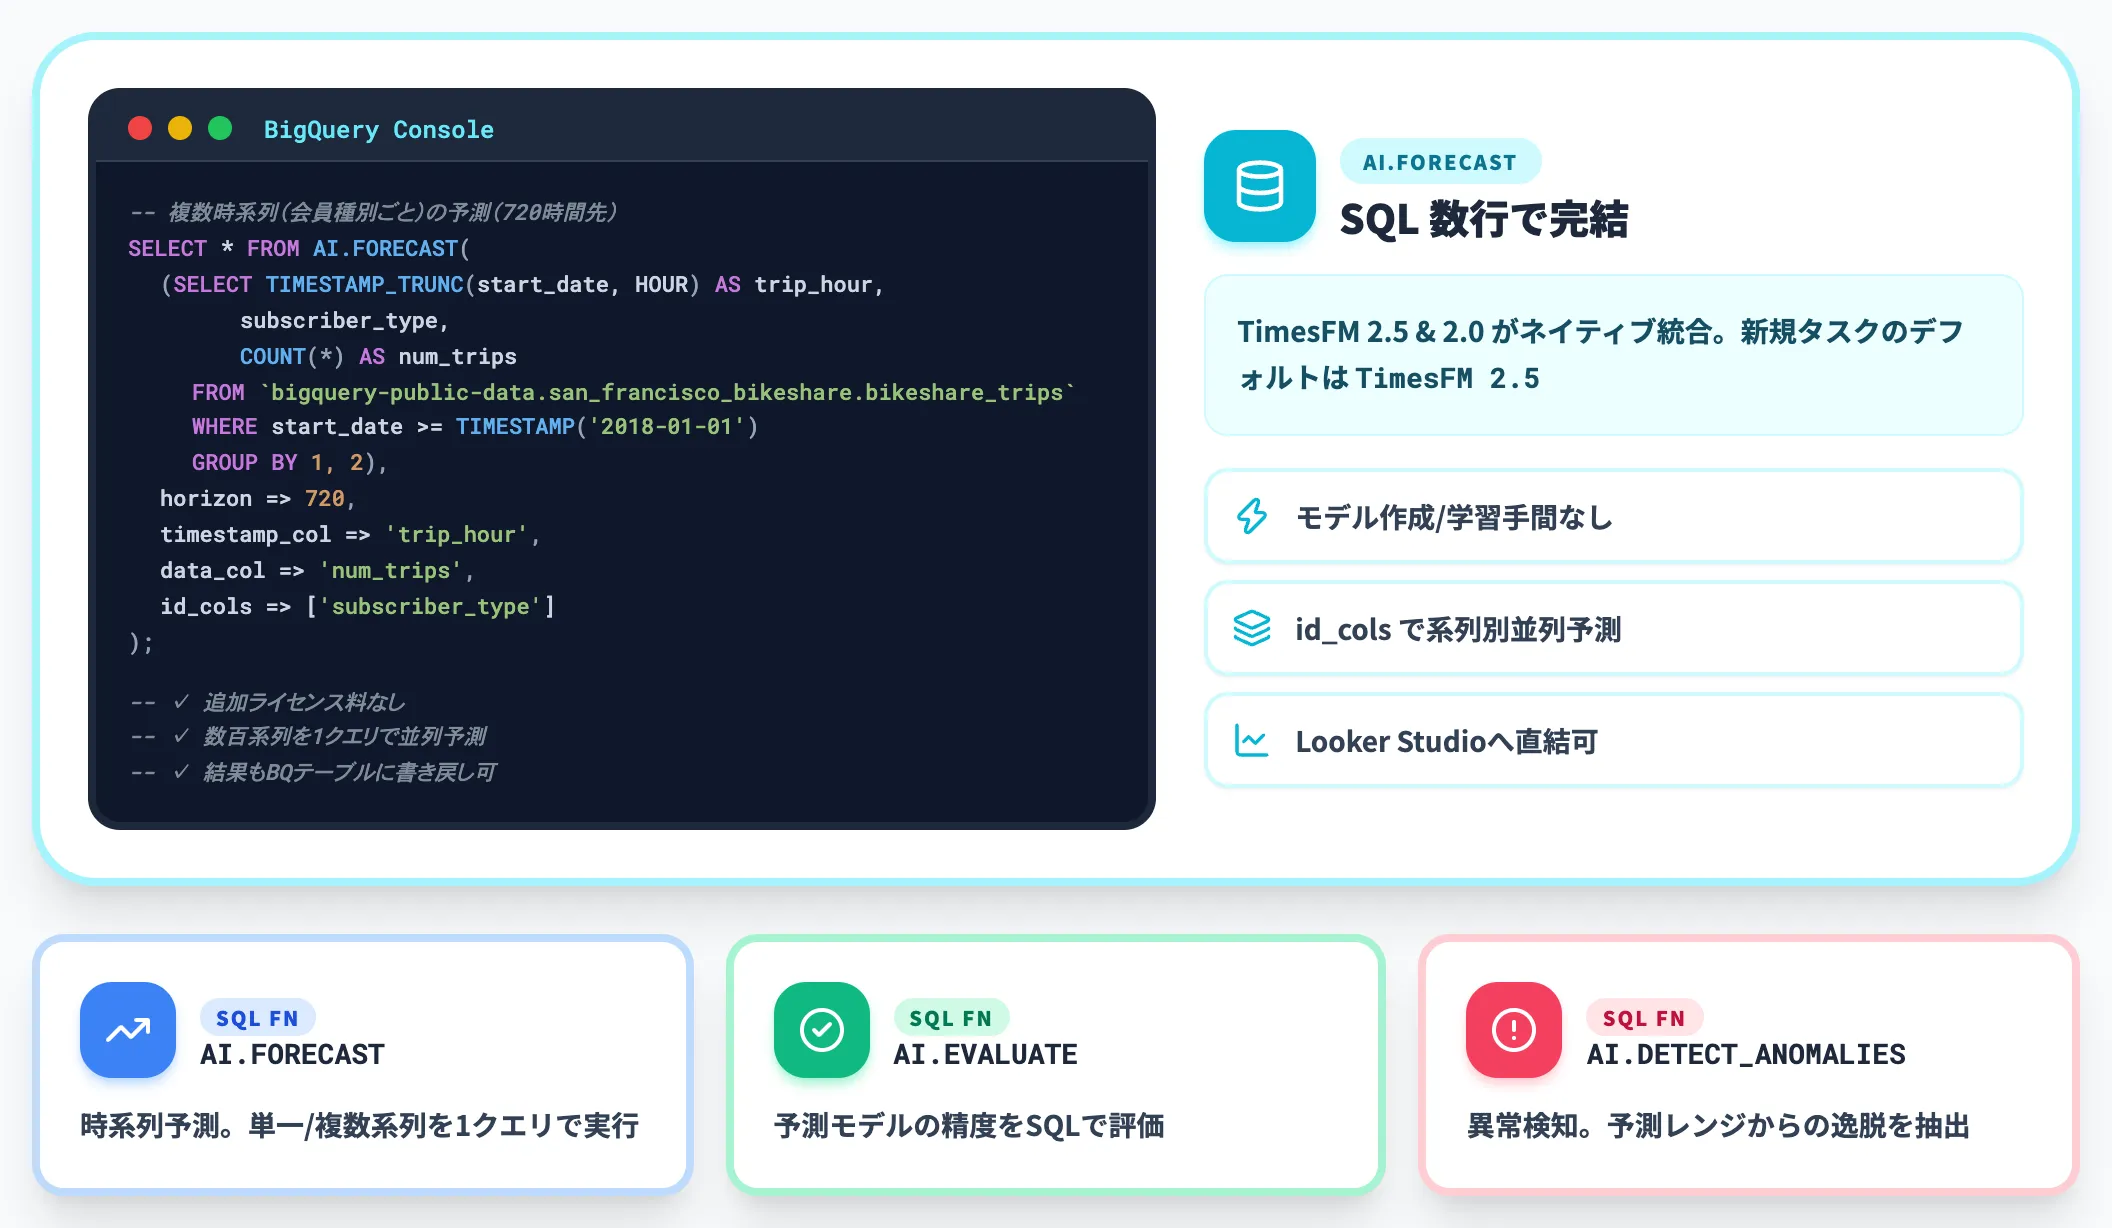
データ分析部門や業務チームでSQLだけで予測を回したい場合は、BigQuery MLのAI.FORECAST関数がもっとも短経路です。
BigQuery MLにはTimesFM 2.5と2.0がネイティブ統合されており(公式ドキュメント。新規タスクのデフォルトはTimesFM 2.5)、モデルを自分で作成・学習する手間なしで、SQL数行だけで予測ジョブを組めます。
-- 単一時系列の予測(10日先まで)
SELECT * FROM AI.FORECAST(
  (SELECT TIMESTAMP_TRUNC(start_date, DAY) AS trip_date,
          COUNT(*) AS num_trips
   FROM `bigquery-public-data.san_francisco_bikeshare.bikeshare_trips`
   GROUP BY 1),
  timestamp_col => 'trip_date',
  data_col => 'num_trips'
);

-- 複数時系列(会員種別ごと)の予測(720時間先まで)
SELECT * FROM AI.FORECAST(
  (SELECT TIMESTAMP_TRUNC(start_date, HOUR) AS trip_hour,
          subscriber_type,
          COUNT(*) AS num_trips
   FROM `bigquery-public-data.san_francisco_bikeshare.bikeshare_trips`
   WHERE start_date >= TIMESTAMP('2018-01-01')
   GROUP BY 1, 2),
  horizon => 720,
  timestamp_col => 'trip_hour',
  data_col => 'num_trips',
  id_cols => ['subscriber_type']
);
クエリ結果の可視化タブに切り替えると、過去の履歴データと未来予測が1本の折れ線で連続表示されます。
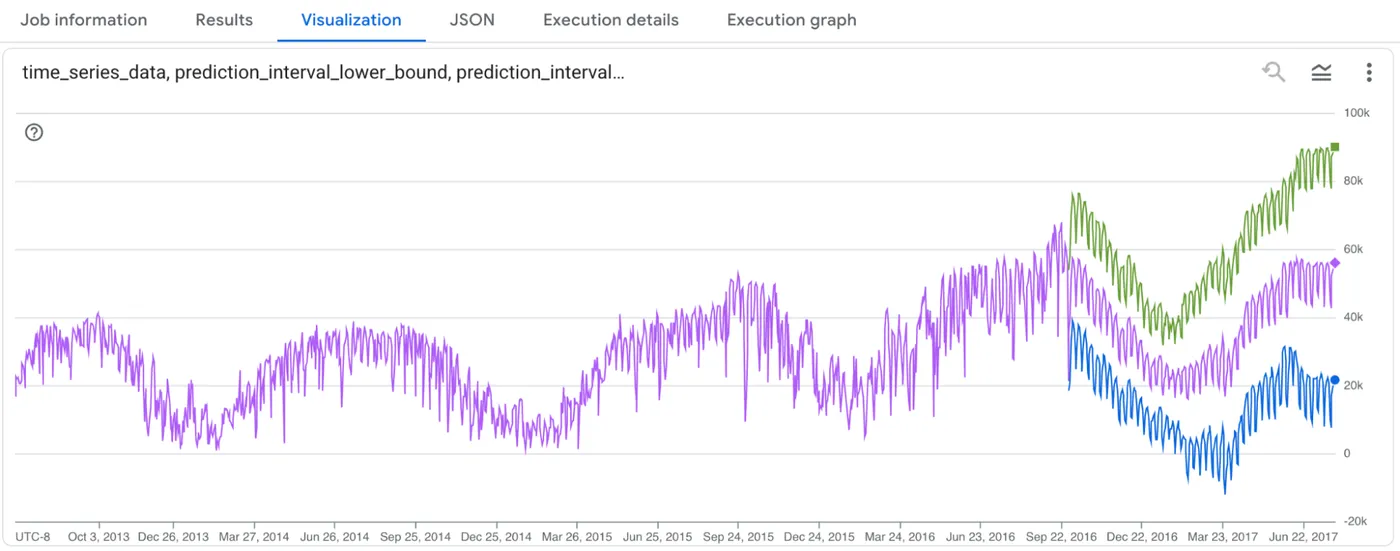
BigQuery ML AI.FORECASTによる時系列予測のVisualization出力(出典:Google Cloud Blog)
紫の帯が過去の実測値、右端で分岐している青と緑の折れ線が予測値と予測区間の上下限です。
過去数年の周期性を学習した上で、未来720時間先までの予測レンジをまとめて返してくれる点が、Prophet/ARIMAでは自前実装が必要だったUXの差になります。
複数系列を同時に予測した場合、「id_cols」 に指定した系列ごとに色分けされた予測結果が並列で表示されます。
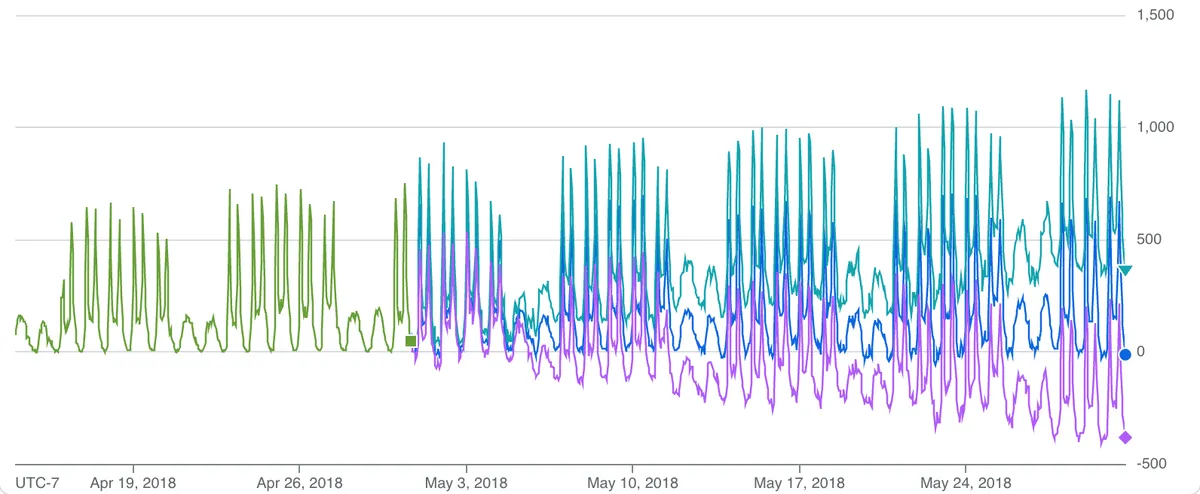
BigQuery ML AI.FORECASTで会員種別3系列を同時に予測した例(出典:Google Cloud Blog)
このように系列数が数十〜数百に増えても、SQLの1クエリで並列に予測を回せます。系列ごとに個別モデルを構築していた従来の運用と比べて、開発・保守の工数が大幅に削減されます。
SQLで直接呼べるメリットは、分析基盤の外にデータを出す必要がない点にも表れます。BigQueryに集約済みの売上・アクセス・センサーデータをそのままAI.FORECAST関数に渡せば、予測結果もBigQueryのテーブルに書き戻せるため、Looker/Looker Studioからのダッシュボード化までワンストップで完結します。
TimesFM 3.0のBigQuery ML対応もGoogle Researchが近日中に予定と発表しており、多変量対応のマネージド利用は近い将来にリリースされます。
AlloyDBでは、Vertex AI上のTimesFM v2エンドポイントを登録してAI.FORECASTから呼び出す構成がプレビュー提供されており、トランザクションDBから直接予測を呼び出す経路も選べます。
Vertex AI Model Gardenで本番エンドポイントとしてデプロイする
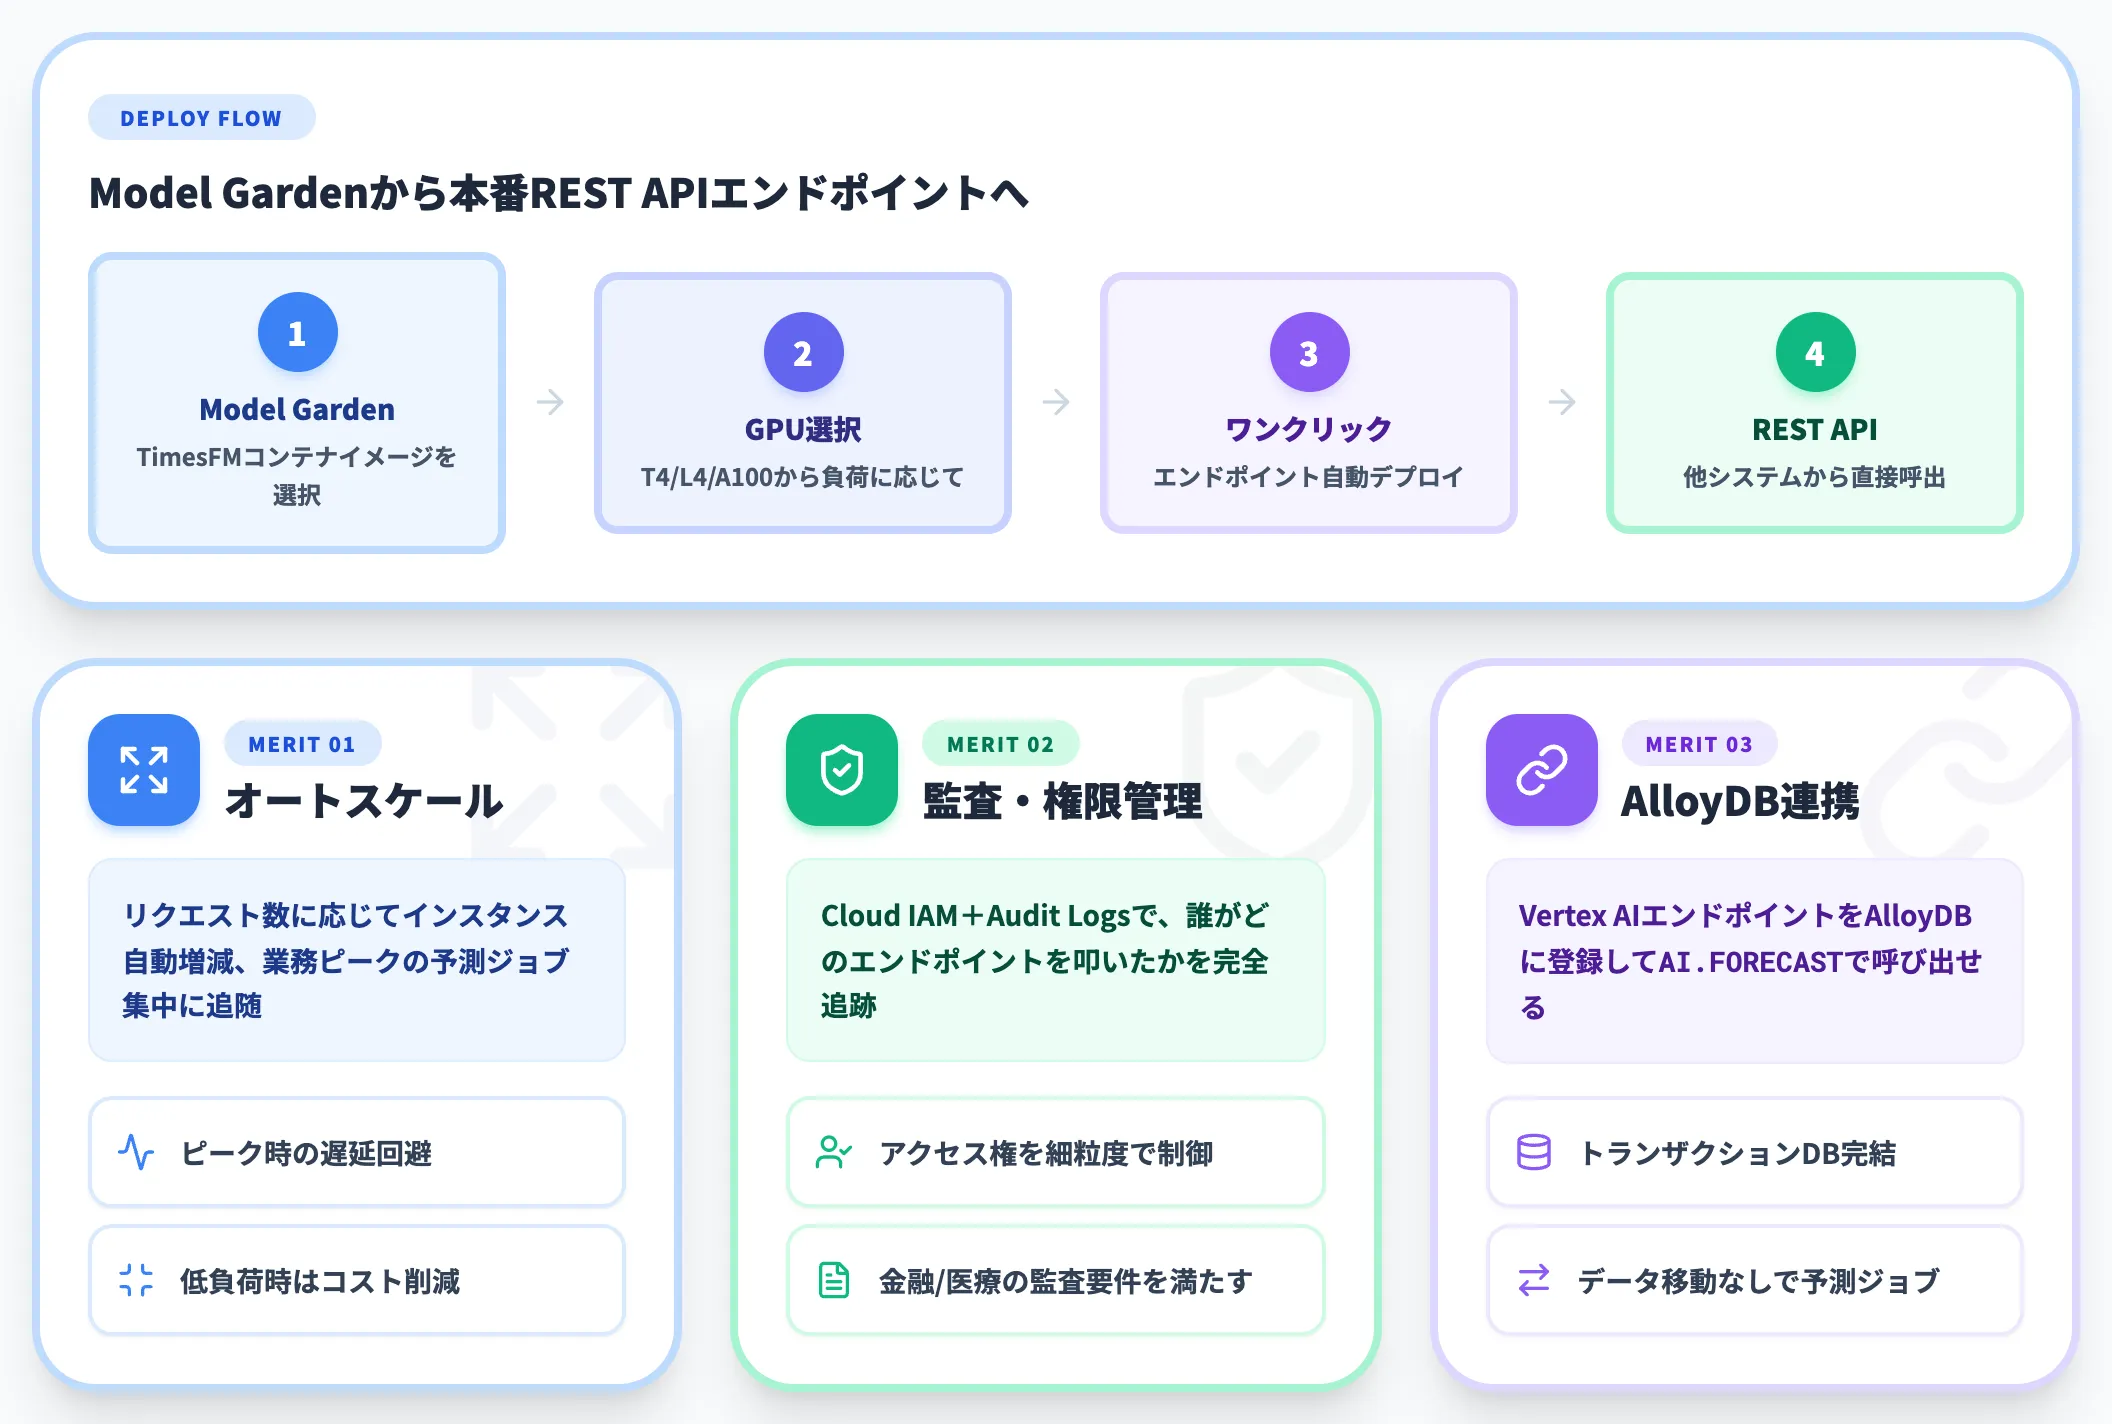
推論をREST APIとして他システムから呼び出したい場合は、Vertex AI Model Gardenのコンテナ化エンドポイントを使います。
TimesFMのコンテナイメージがModel Gardenに登録されており、GPUインスタンス(NVIDIA T4/L4/A100等)を選んでワンクリックでデプロイできます。
Vertex AI経由のメリットは主に3つです。
-
スケーリング自動化
リクエスト数に応じてインスタンスを自動増減できるため、業務ピーク時の予測ジョブ集中に対応できます。
-
監査・権限管理
Google Cloud IAMの権限体系で、誰がどのモデルエンドポイントを叩いたかをCloud Audit Logsに残せます。金融・医療のように監査要件が厳しい業界で標準的な運用ができます。
-
AlloyDB連携でSQLからも呼べる
Vertex AIにデプロイしたエンドポイントをAlloyDBのModel Endpoint Managementに登録すれば、AlloyDBからSQLで推論を呼び出せます。トランザクションDBの中で完結する予測パイプラインを構成可能です。
実務では「PoC段階はPython・BigQuery MLで簡易実装 → 本番はVertex AI」という段階的な組み方をするケースが多く、AI総研の支援現場でも同じ移行パスをよく採用しています。AlloyDBは、既にトランザクションDB側で系列データを持っているケースで、データ移動なしに予測を回せる選択肢として押さえておく価値があります。
TimesFMの料金とライセンス構造
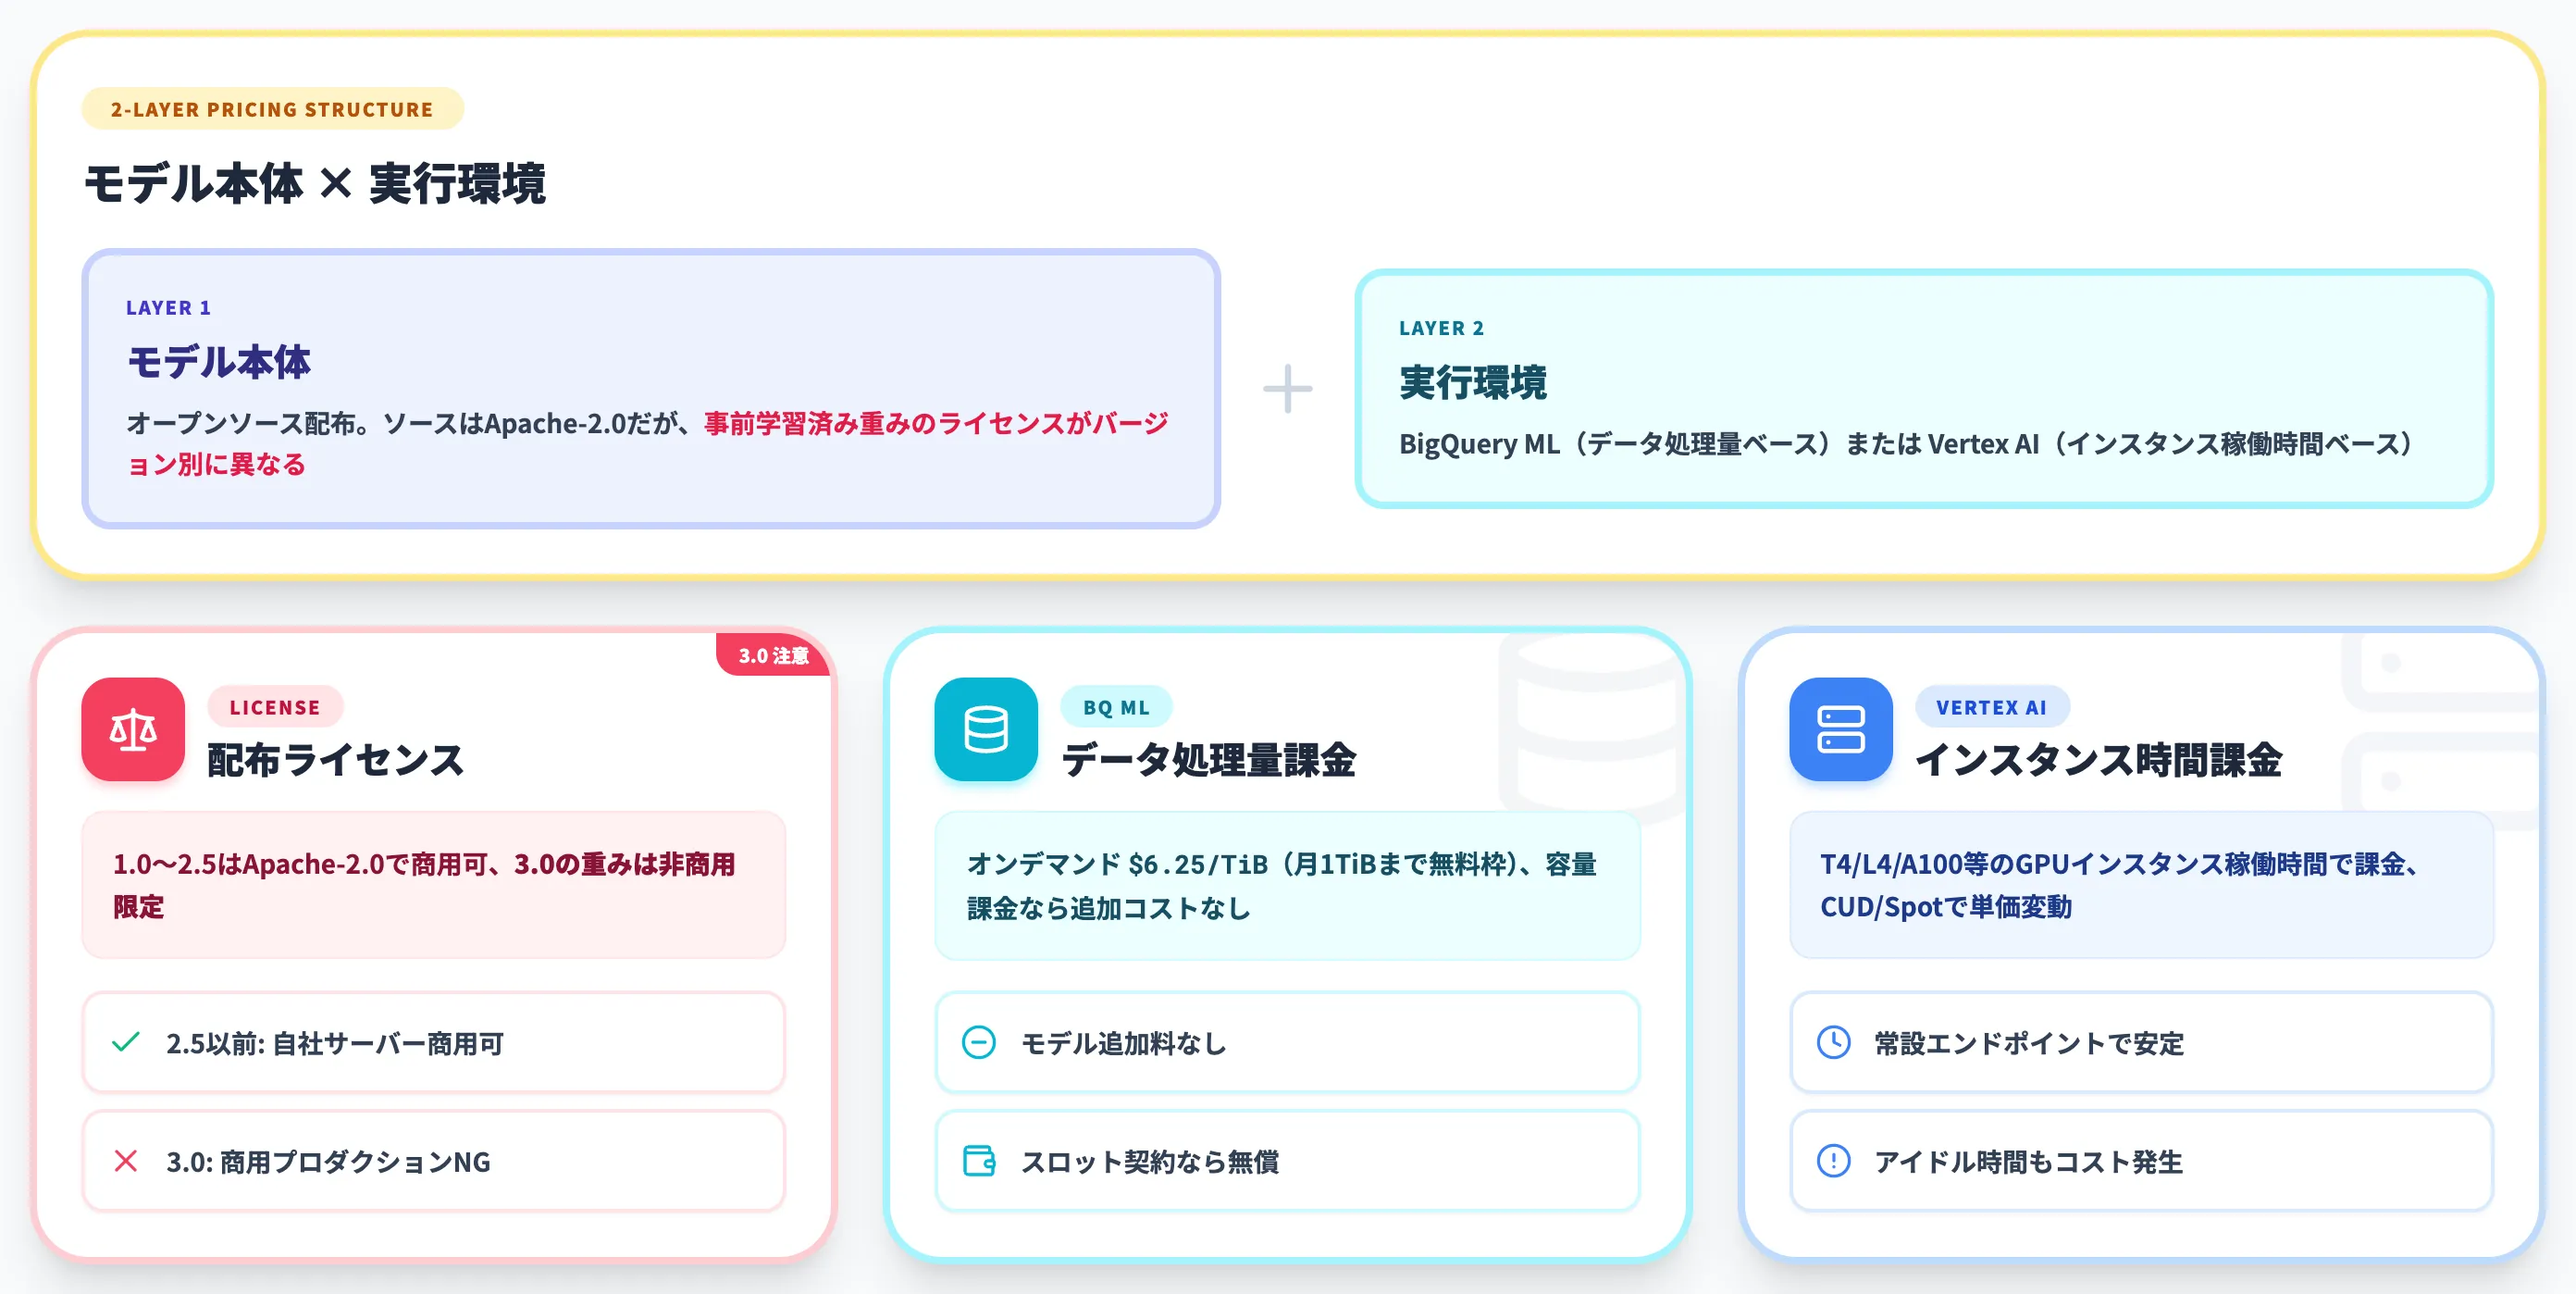
TimesFMは「モデル本体」と「実行環境」の2階建てで料金が発生します。
モデル本体はオープンソース配布ですが、バージョンごとにライセンス条件が異なる点が2026年最大の注意点です。
モデル本体の配布ライセンス
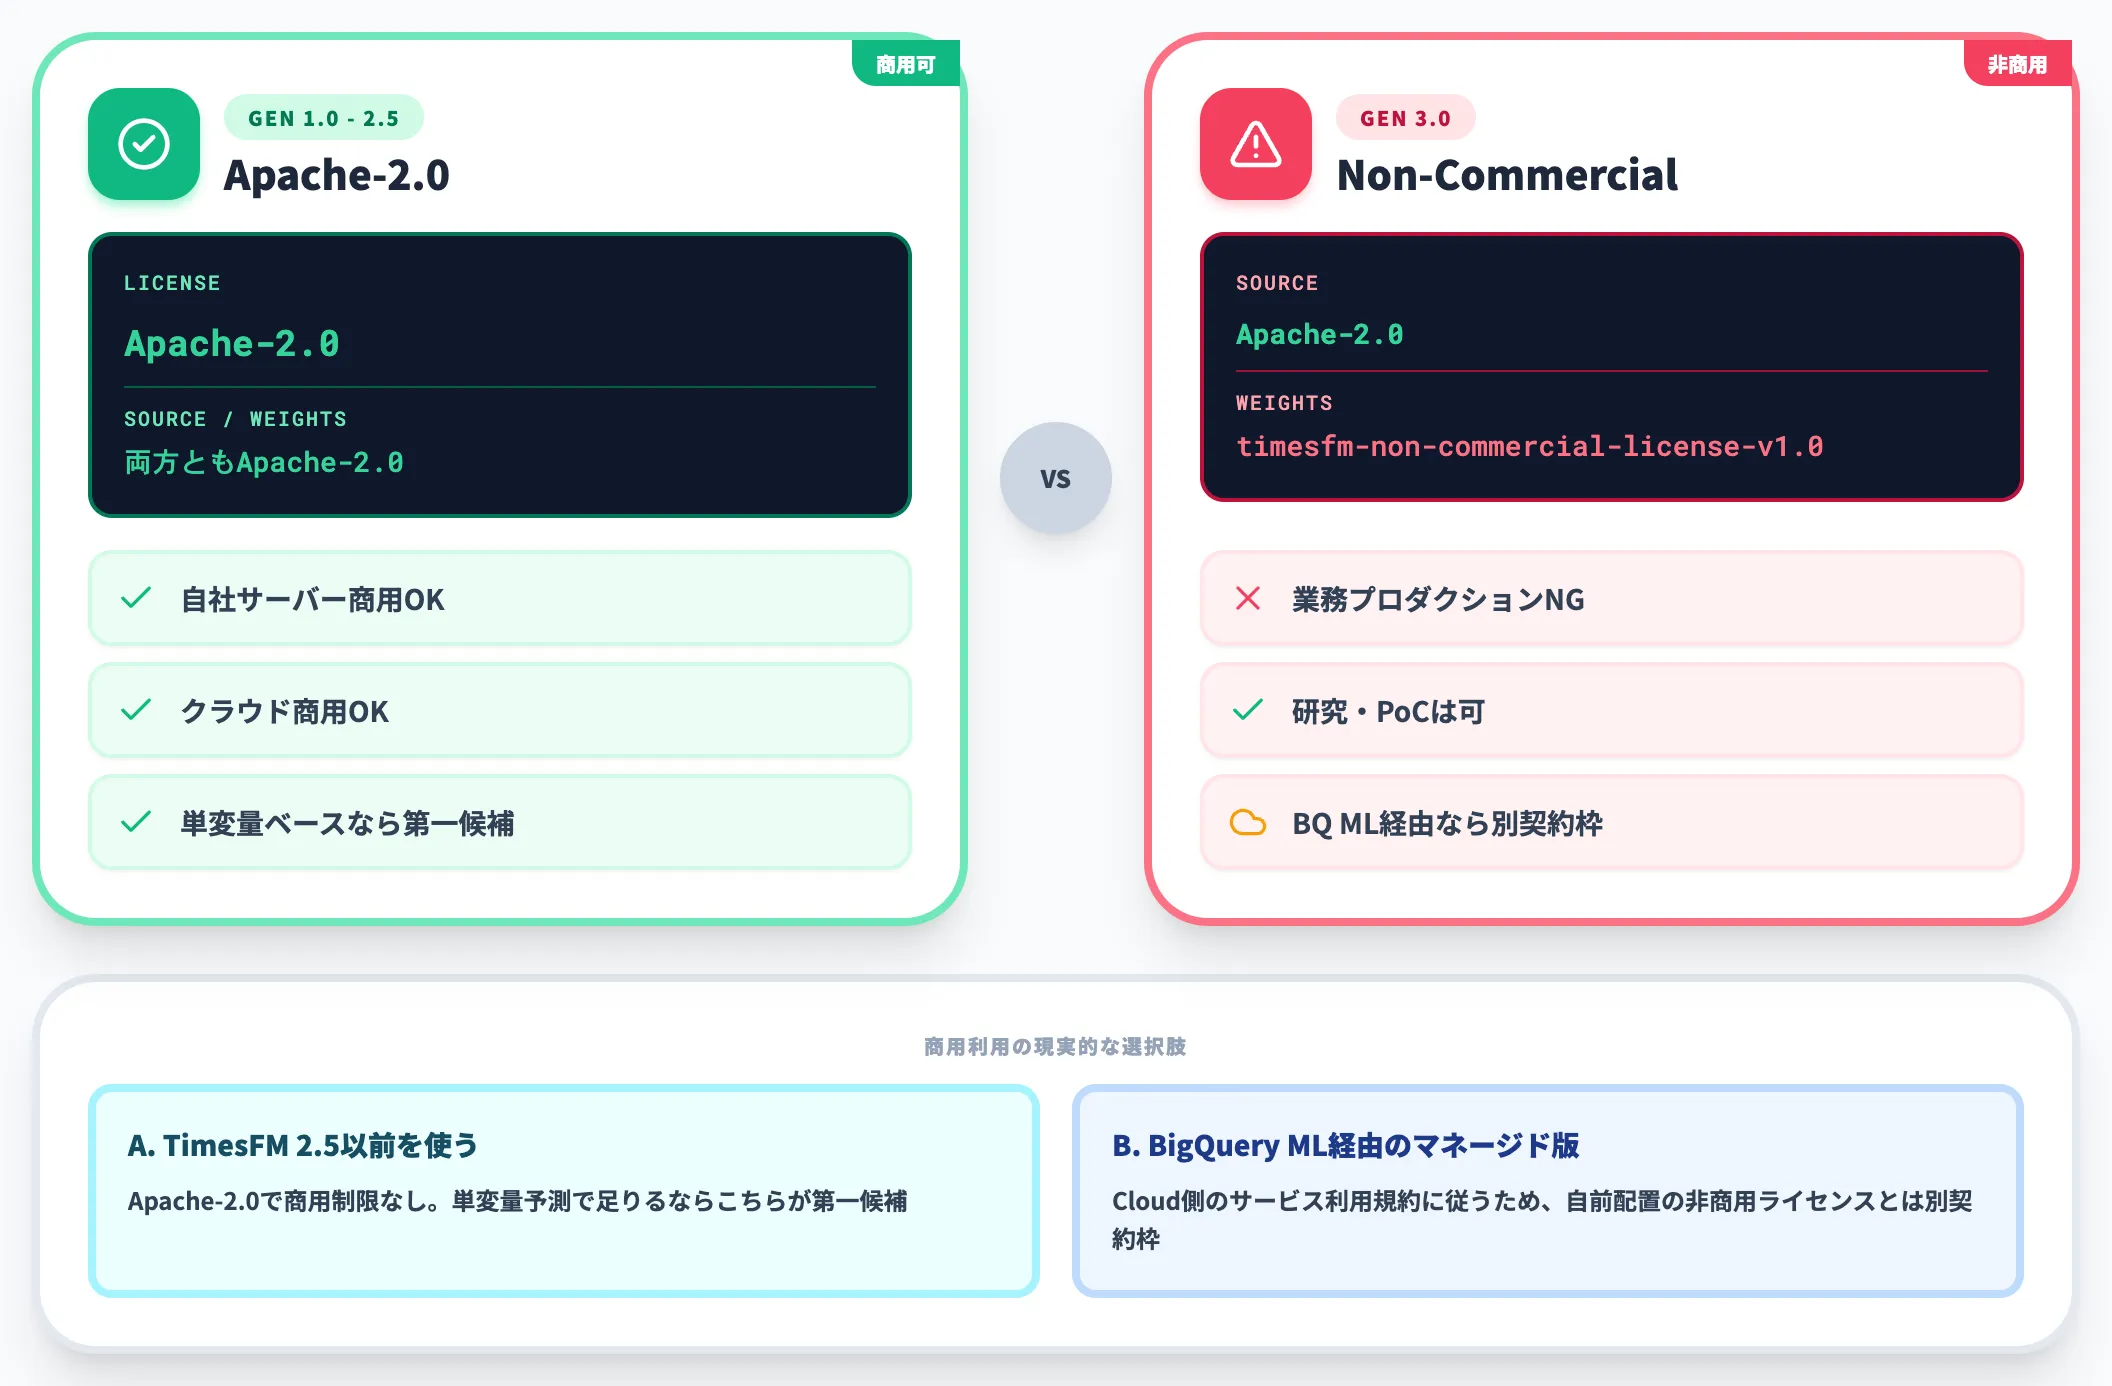
TimesFMのソースコード自体はApache-2.0で配布されていますが、事前学習済み重み(pretrained weights)のライセンスはバージョンで大きく異なります。
以下の表で、各バージョンのライセンス条件を整理しました。
| バージョン | ソースコード | 事前学習済み重み | 商用利用 |
|---|---|---|---|
| TimesFM 1.0 / 2.0 / 2.5 | Apache-2.0 | Apache-2.0 | 可 |
| TimesFM 3.0 | Apache-2.0 | timesfm-non-commercial-license-v1.0 | 不可(非商用・非本番用途に制限) |
この差の意味は実務的に非常に大きいです。TimesFM 3.0を業務プロダクションに載せるには、Google公式のGitHubリポジトリでも明記されているように、非商用ライセンスの制約を回避する必要があります。
商用利用したい場合の現実的な選択肢は次の2つです。
-
TimesFM 2.5以前を使う
Apache-2.0で配布されており、自社サーバーでもクラウドでも商用利用に制限がありません。単変量予測で足りるならこちらが第一候補になります。
-
BigQuery ML経由のマネージド版を使う
Google Cloudのマネージド機能として提供されている場合は、Cloud側のサービス利用規約に従うため、自前で重みを配置する場合の非商用ライセンスとは別の契約枠になります。
BigQuery ML経由の課金モデル
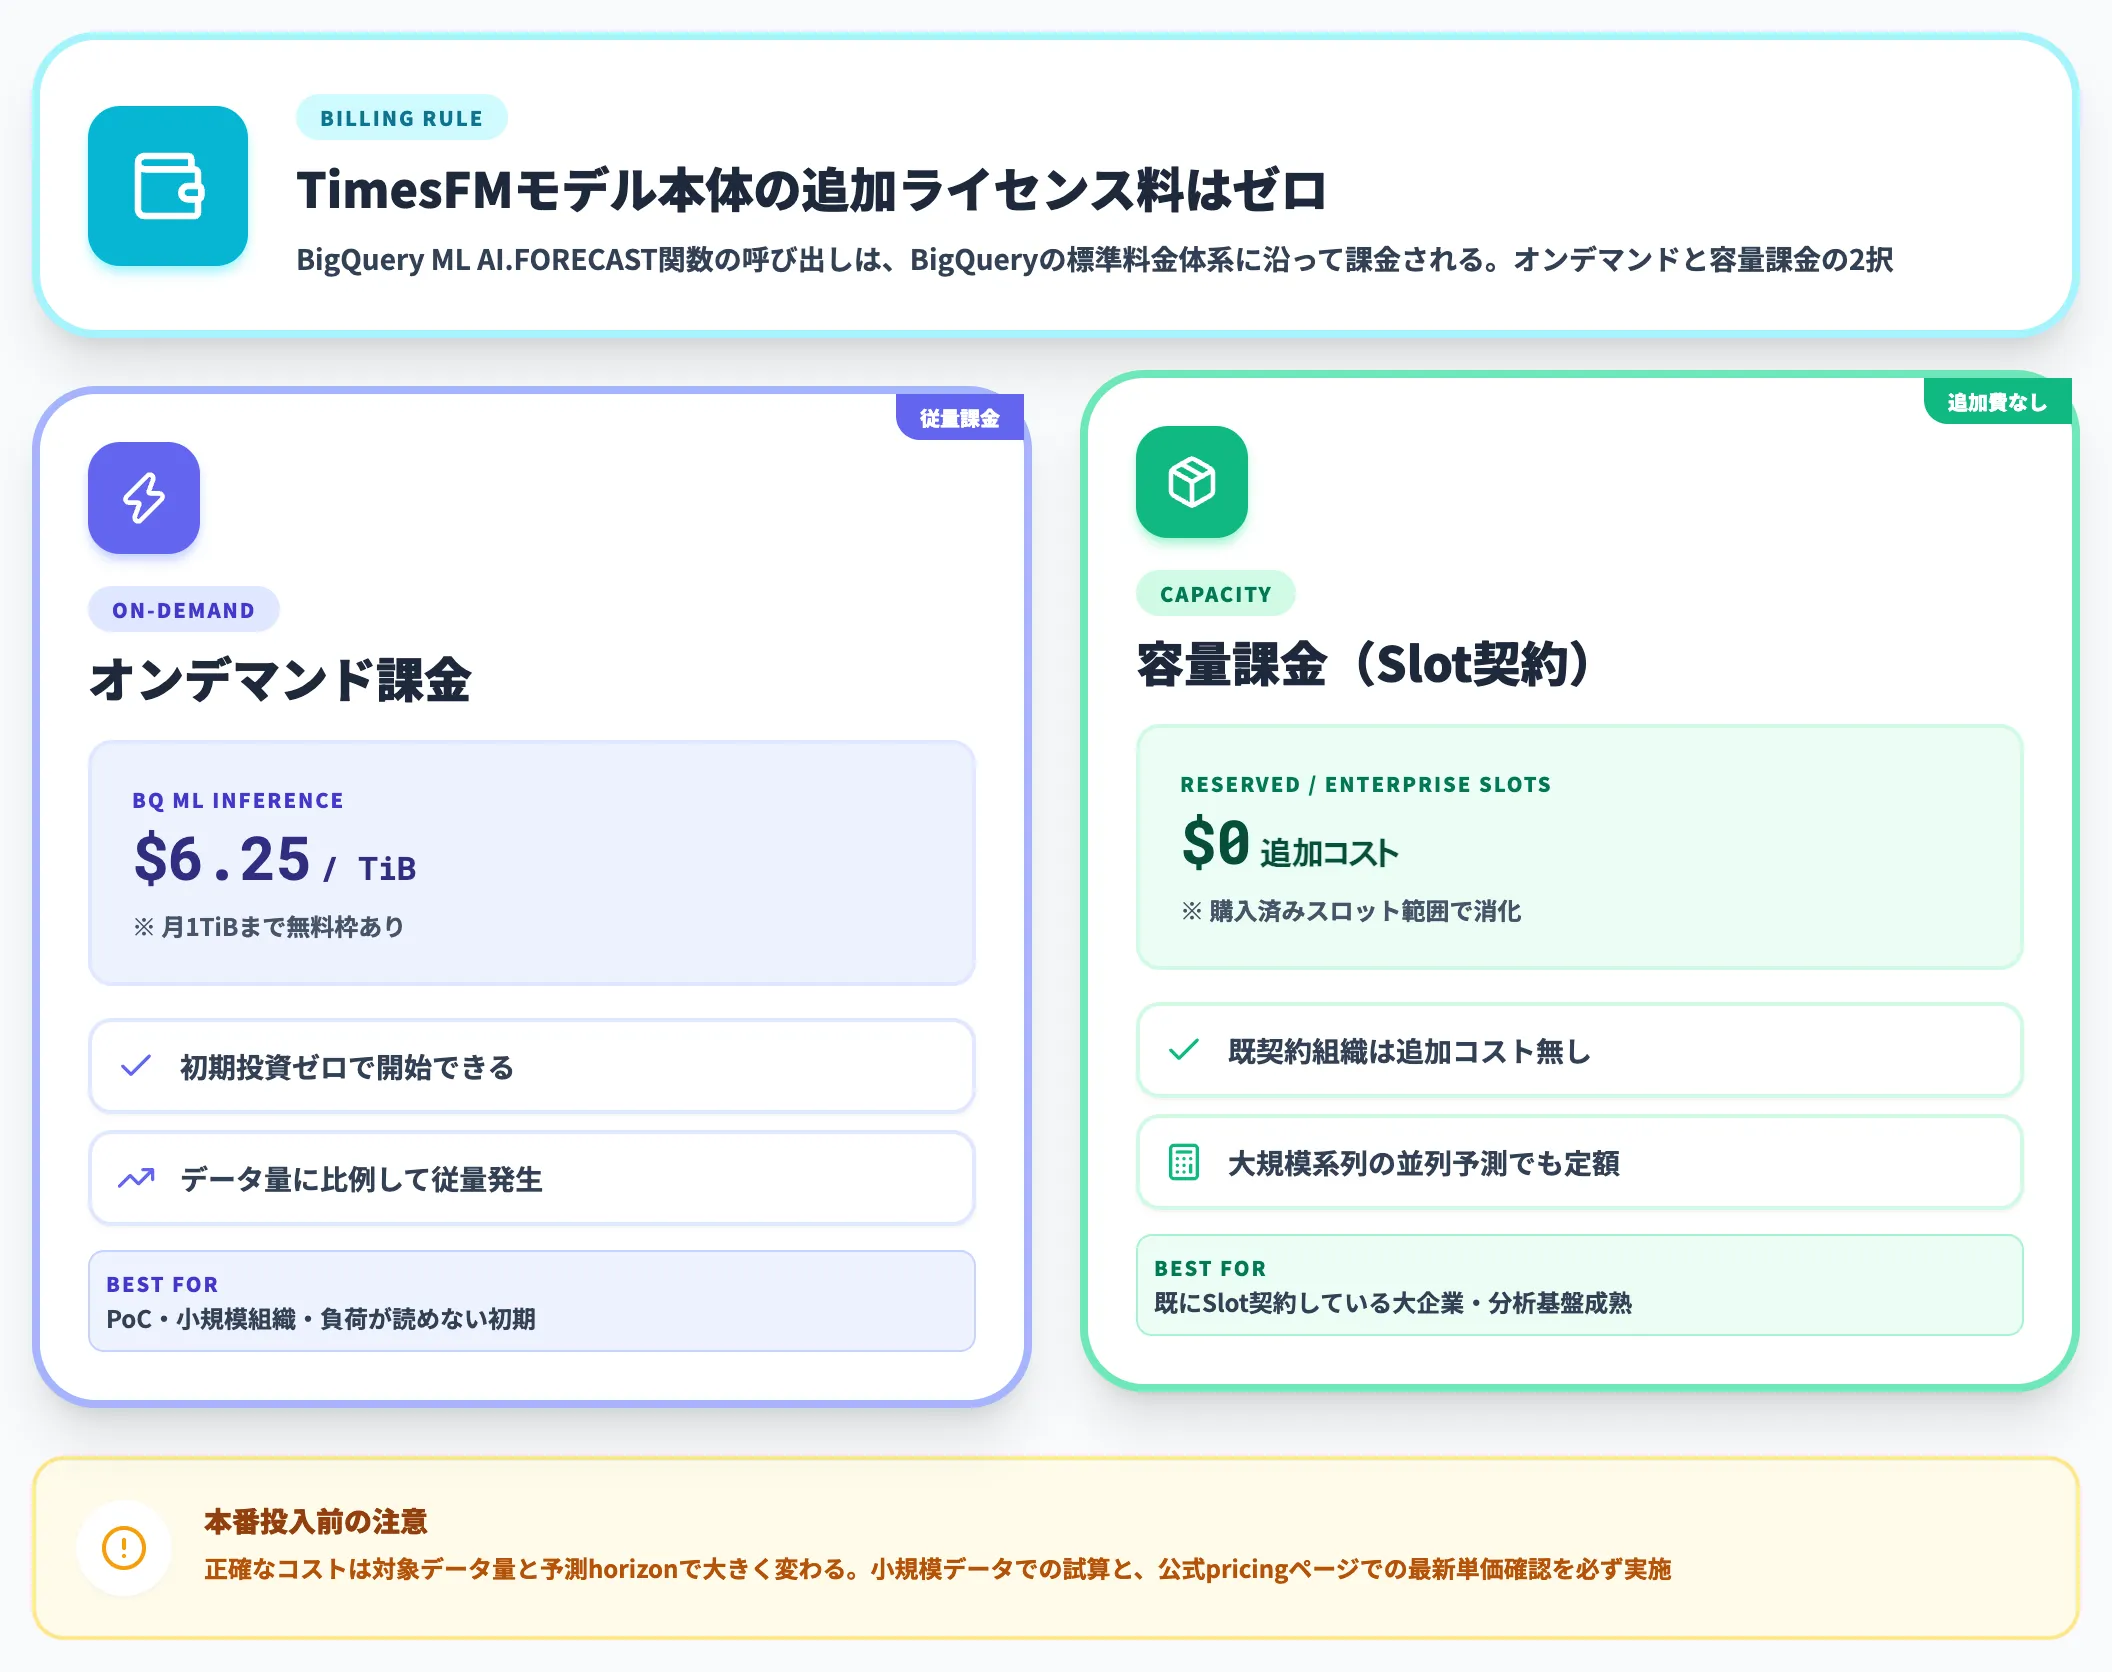
BigQuery MLでAI.FORECAST関数を呼び出す場合、課金はBigQueryの標準料金体系に沿って発生します。TimesFMモデル自体の追加ライセンス料はかかりません。
-
オンデマンド課金
BigQuery MLの推論(inference)料金として、公式pricingでは現行 $6.25/TiB(月1TiBまでの無料枠あり)で表示されています。処理データ量に応じた従量課金です。
-
容量課金(Reserved / Enterprise Slot契約)
購入済みスロットの範囲で消化されるため、追加課金は発生しません。既にスロット契約している組織はこちらで完結します。
正確なコストは対象データ量と予測horizonで大きく変わるため、本番投入前に小規模データでの試算と、公式pricingページでの最新単価確認を必ず実施してください。
Vertex AIエンドポイント経由の課金モデル
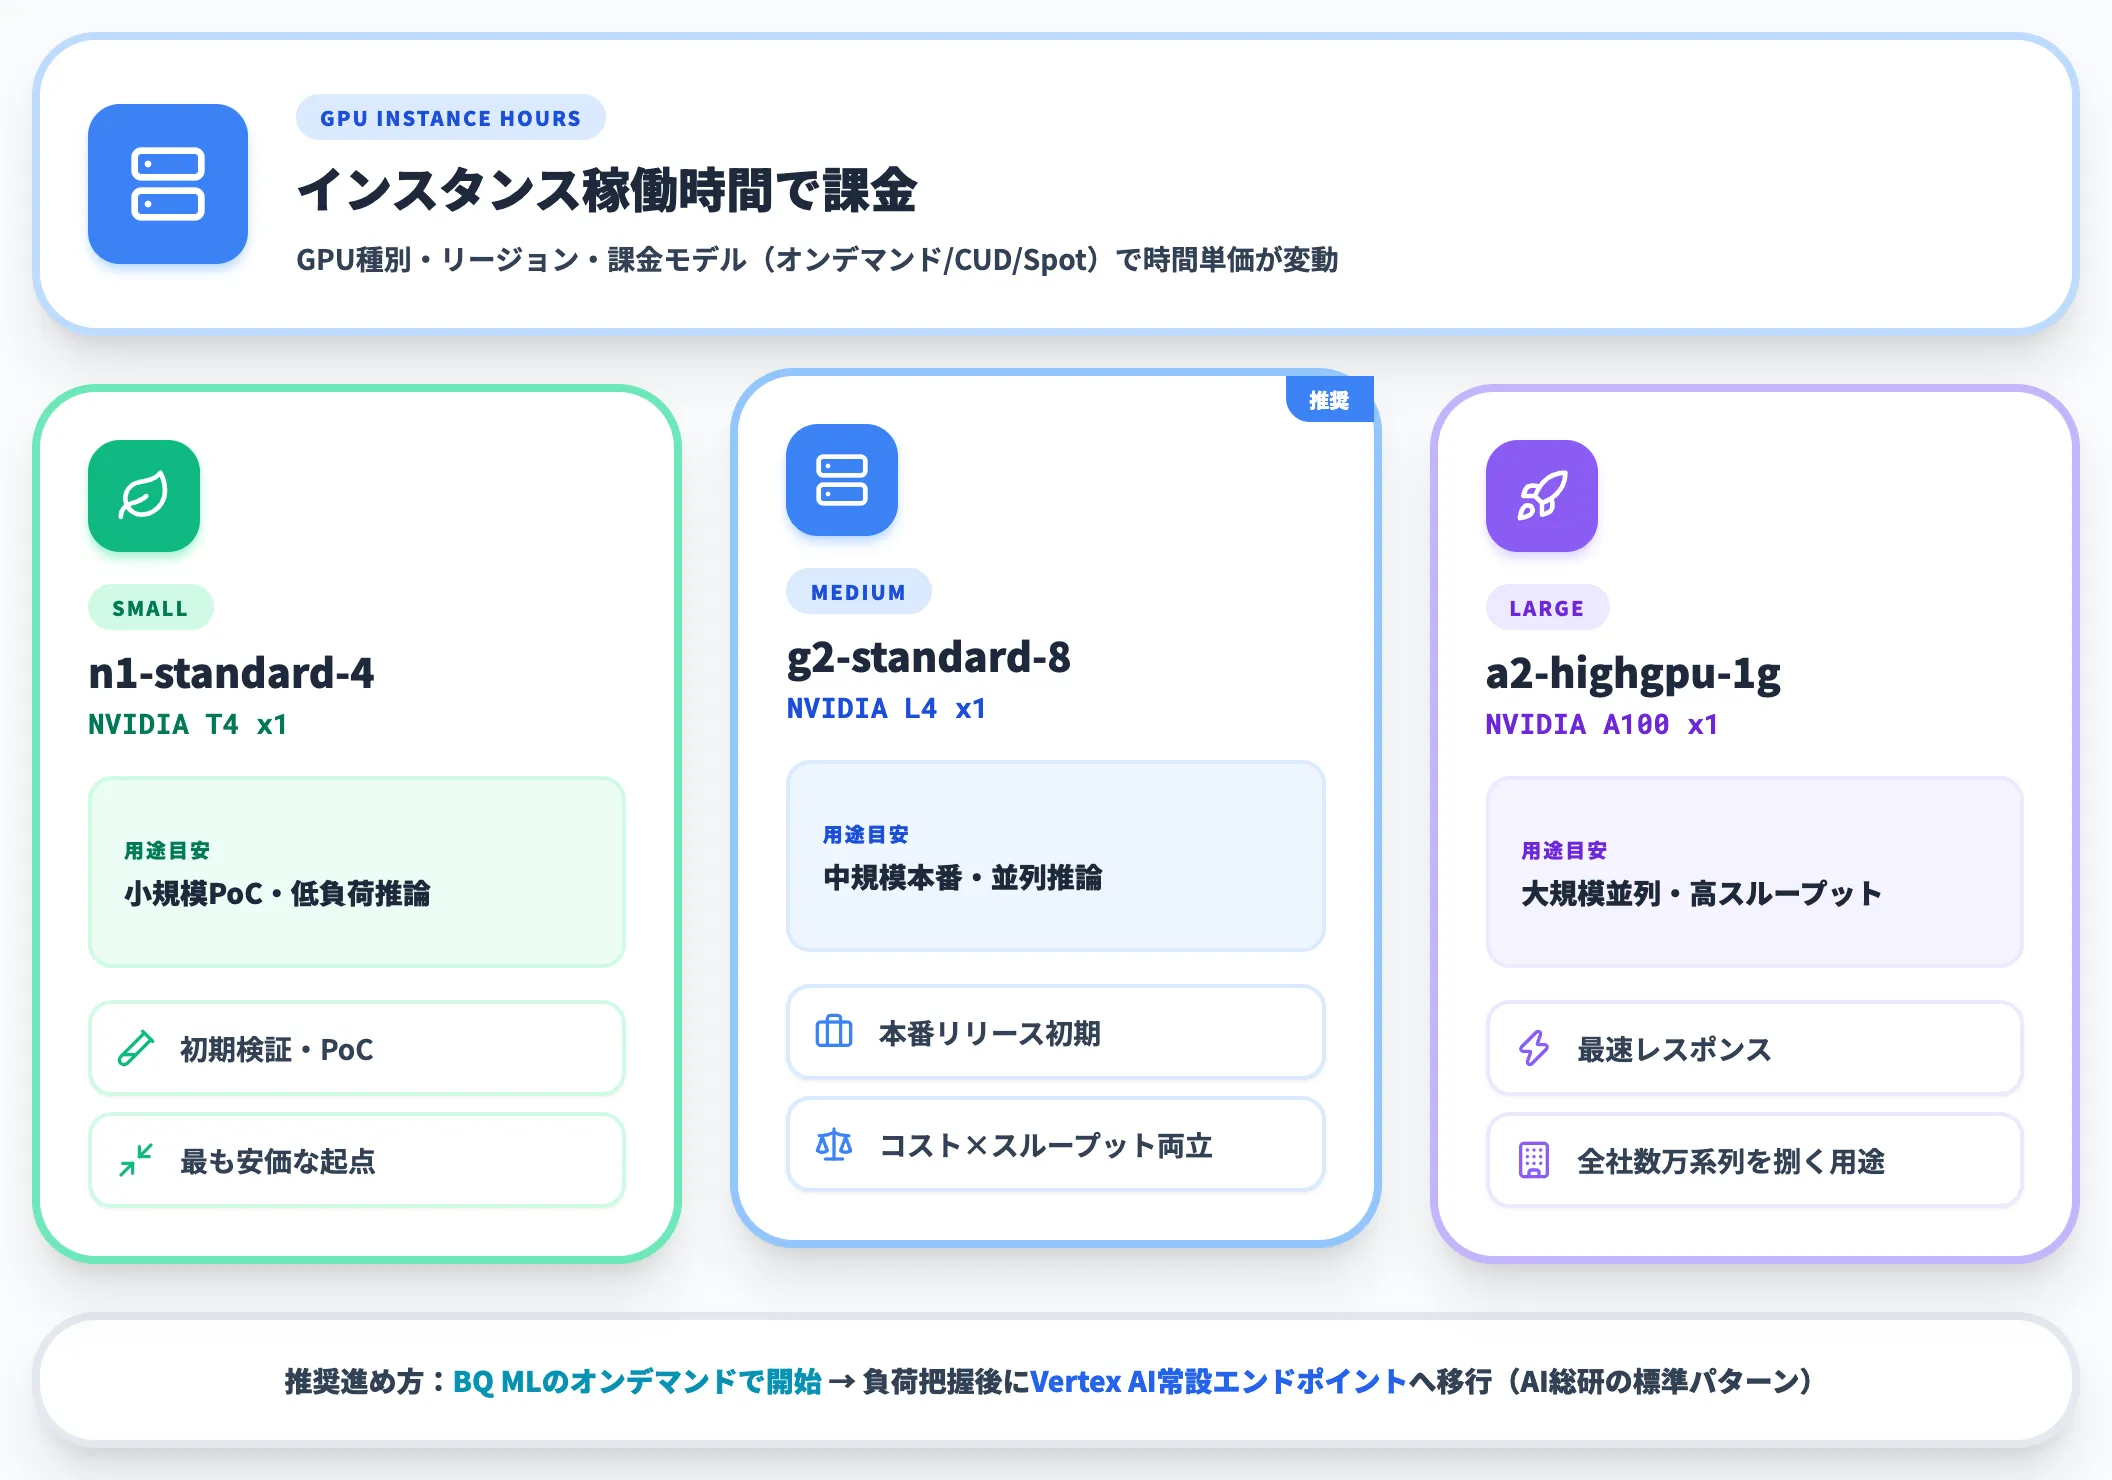
Vertex AI Model GardenでTimesFMをデプロイする場合の料金は、インスタンスの稼働時間ベースで発生します。
代表的なGPUインスタンス構成の目安を、以下の表にまとめました。
| インスタンス種別 | 用途目安 |
|---|---|
| n1-standard-4 + NVIDIA T4 x1 | 小規模PoC・低負荷推論 |
| g2-standard-8(NVIDIA L4 x1) | 中規模本番・並列推論 |
| a2-highgpu-1g(NVIDIA A100 x1) | 大規模並列・高スループット |
時間単価はリージョン・課金モデル(オンデマンド/CUD/Spot)で大きく変動するため、実際の見積はVertex AI料金ページとGPU料金ページで必ず最新値を確認してください。
推論負荷が読めない初期フェーズでは、BigQuery MLのオンデマンド課金で開始し、負荷が読めてきたタイミングでVertex AIの常設エンドポイントに移行するのが、AI総研の支援現場で採用している標準的な進め方です。
TimesFMとChronos・Moirai・Lag-Llamaの使い分け
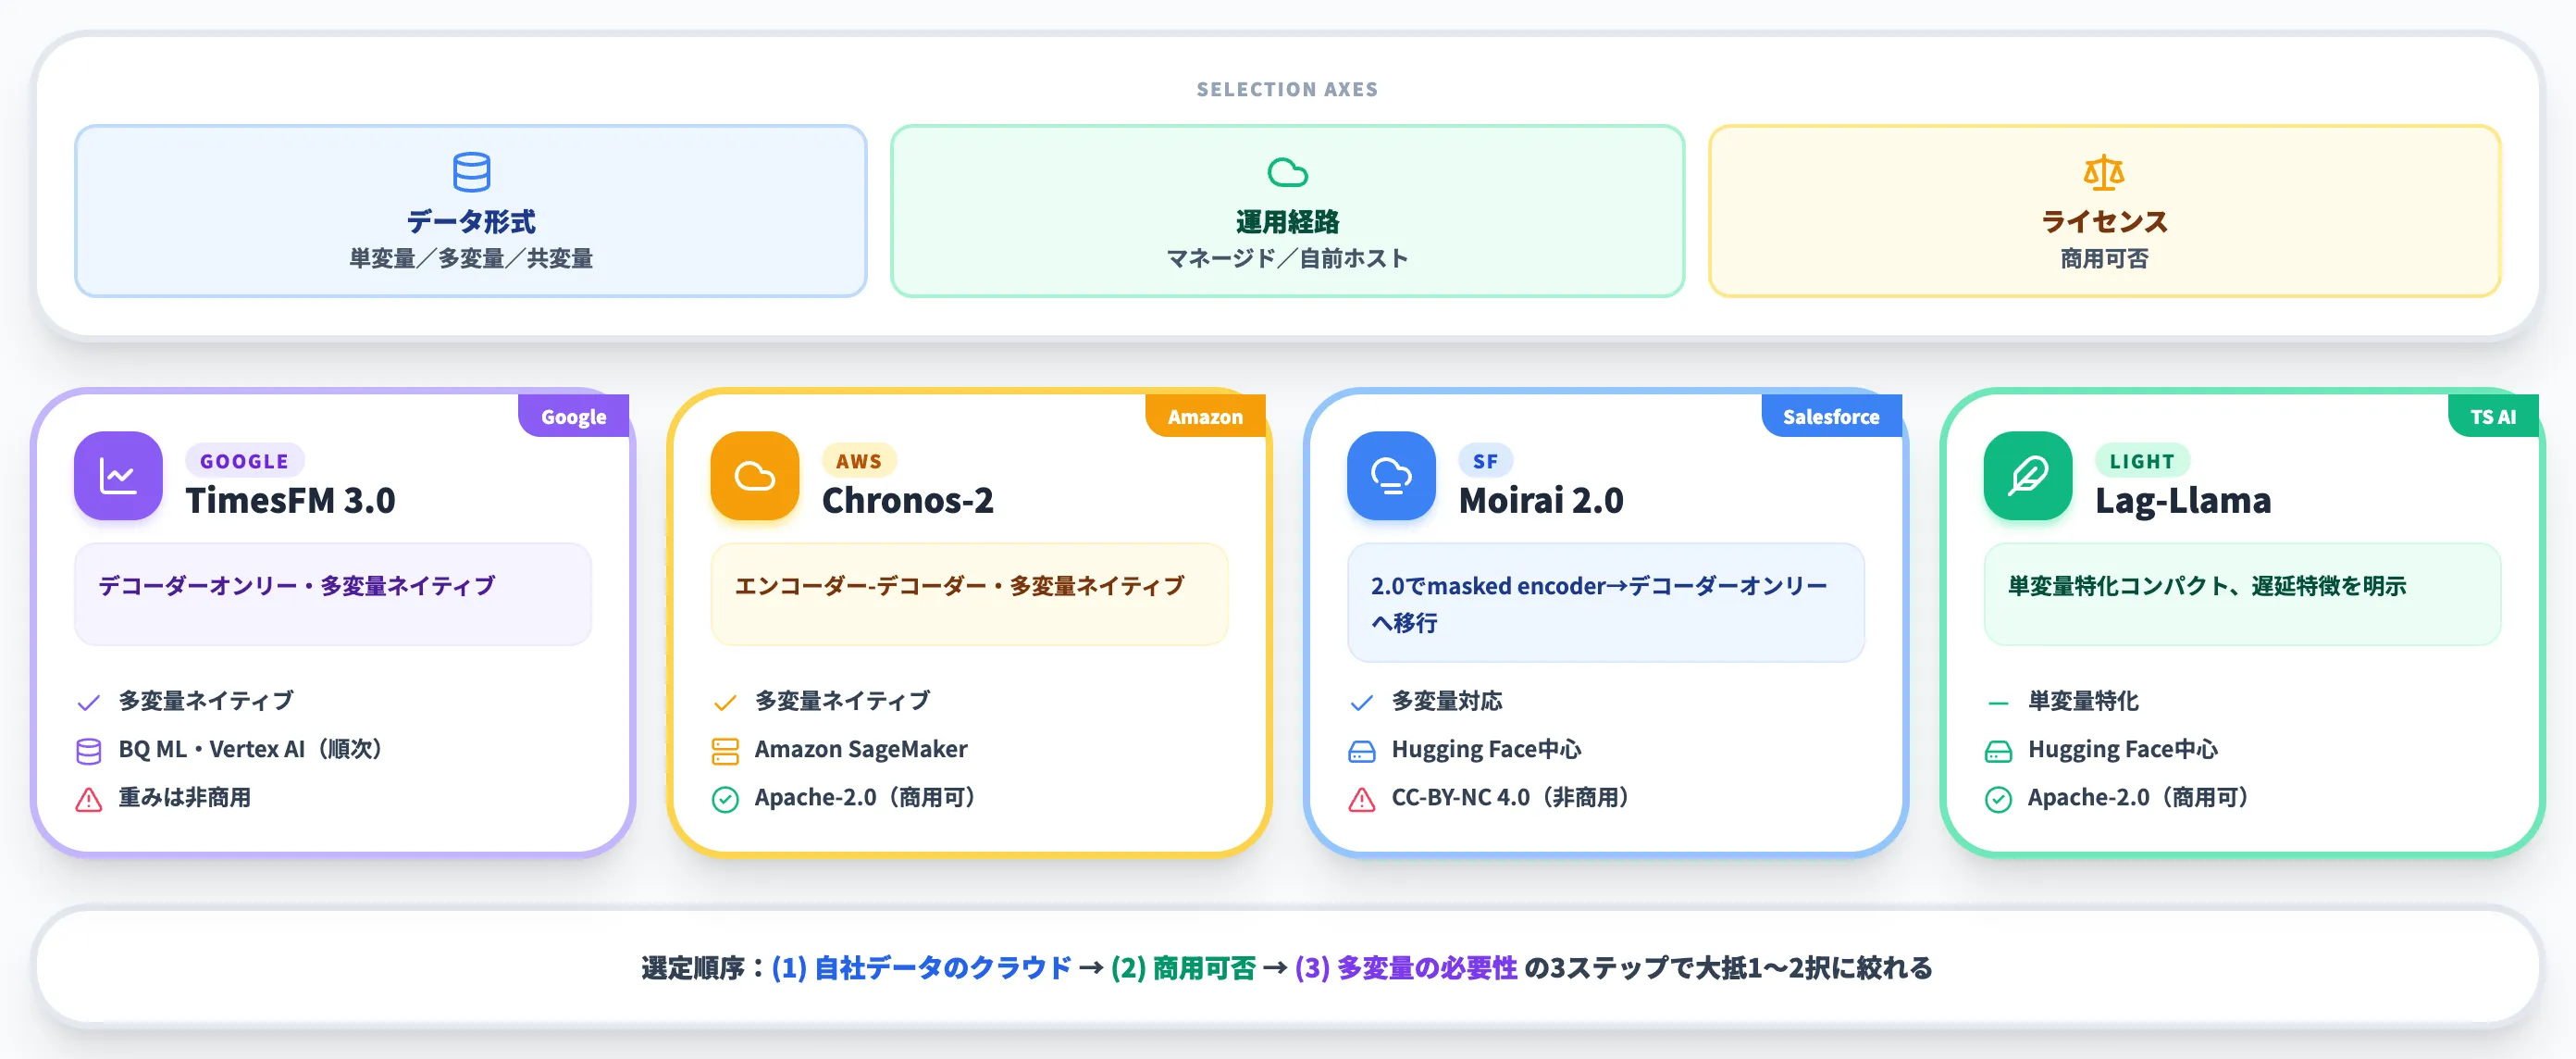
TimesFMは時系列基盤モデル(TSFM)の代表格ですが、Amazon ScienceのChronos、SalesforceのMoirai、Time Series AI社のLag-Llamaといった有力な競合が並走しています。
「どれを選ぶか」は、データ形式・運用経路・ライセンスの3軸で決まります。
4モデルの基本特性一覧
以下の表で、TimesFM 3.0を含む主要4モデルの2026年9月時点の特性を整理しました。
| モデル | 提供元 | アーキテクチャ | 多変量対応 | 主なマネージド経路 | ライセンス |
|---|---|---|---|---|---|
| TimesFM 3.0 | Google Research | デコーダーオンリー | ネイティブ | BigQuery ML・Vertex AI(順次対応) | 非商用 |
| Chronos-2 | Amazon Science | エンコーダー-デコーダー | ネイティブ | Amazon SageMaker | Apache-2.0(商用可) |
| Moirai 2.0 | Salesforce | デコーダーオンリー(2.0でmasked encoderから移行) | 多変量対応 | Hugging Face中心 | CC-BY-NC 4.0(非商用) |
| Lag-Llama | Time Series AI | デコーダーオンリー | 単変量特化 | Hugging Face中心 | Apache-2.0(商用可) |
特に差が出るのが「マネージド経路」と「ライセンス」の組み合わせです。Google Cloudにデータ基盤があるならTimesFM、AWS環境ならChronos、というインフラ側の選択がまず前提になります。
選定軸ごとの推奨
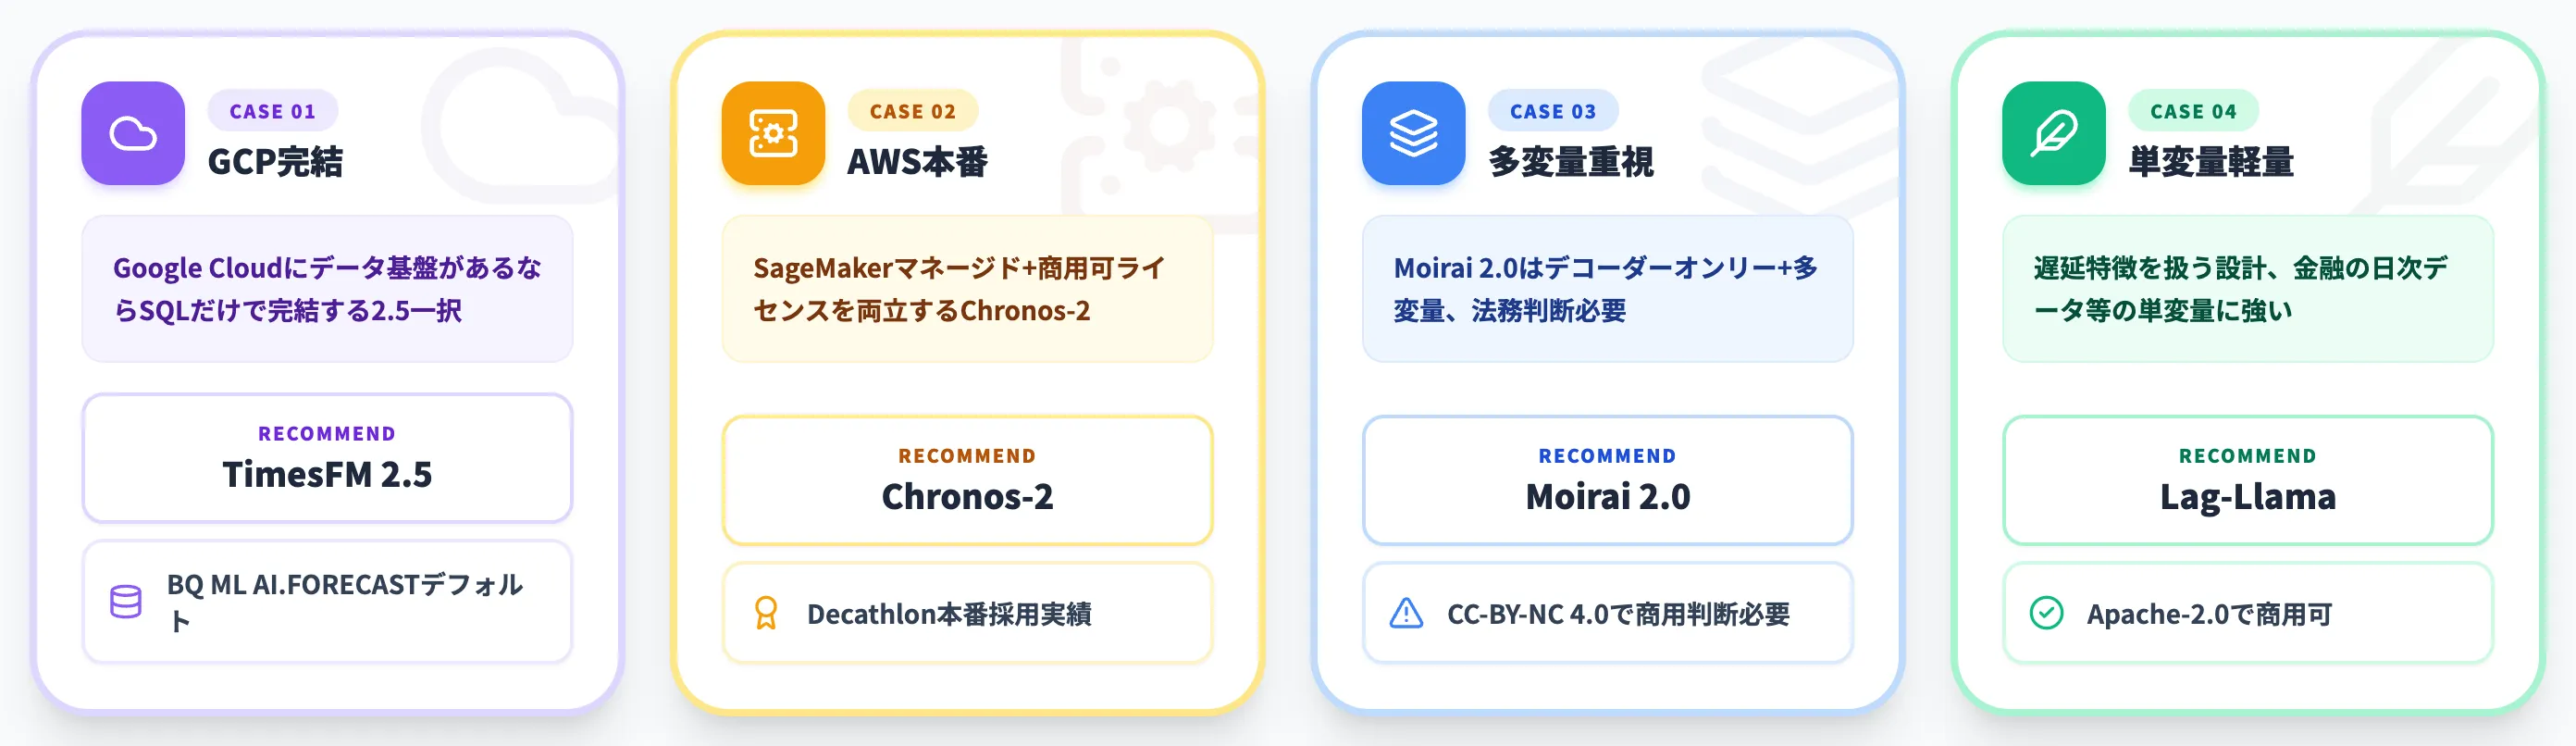
同じ「時系列基盤モデル」というカテゴリでも、実際の使い所は次のように分かれます。
Google Cloudでデータ基盤が完結している場合
TimesFM 2.5がBigQuery MLの新規タスクデフォルトとしてネイティブ統合されているため、SQLだけで予測を回せる利便性が圧倒的です。
3.0の多変量対応が近日BigQueryにも来る予定なので、Google Cloudユーザーは実質的にTimesFM一択に近い状況です。
AWS環境で本番運用する場合
Amazon SageMakerでのマネージド提供と商用可ライセンスを両立しているのはChronos-2です。Decathlonの本番採用事例のように、大規模需要予測でも実績があります。
多変量+複雑な依存構造を扱いたい場合
Moirai 2.0は2.0でmasked encoderからデコーダーオンリーへ移行し、多変量にも対応しました。ただし公開重みは CC-BY-NC 4.0(非商用) で配布されているため、商用利用可否は自社の法務判断が必要です。
単変量特化で軽量に回したい場合
Lag-Llamaは単変量に絞ったコンパクト設計で、遅延特徴(過去のラグ値)を明示的に扱う設計になっています。金融系の日次データのような単変量ユースケースでは有力な候補です。
選定の実務的な優先順位は、「(1)自社データがどのクラウドにあるか → (2)商用利用可能か → (3)多変量が必要か」の順番で見ていくと、大抵の場合1〜2択に絞り込めます。
ARIMA・Prophetといった従来モデルとの位置づけ
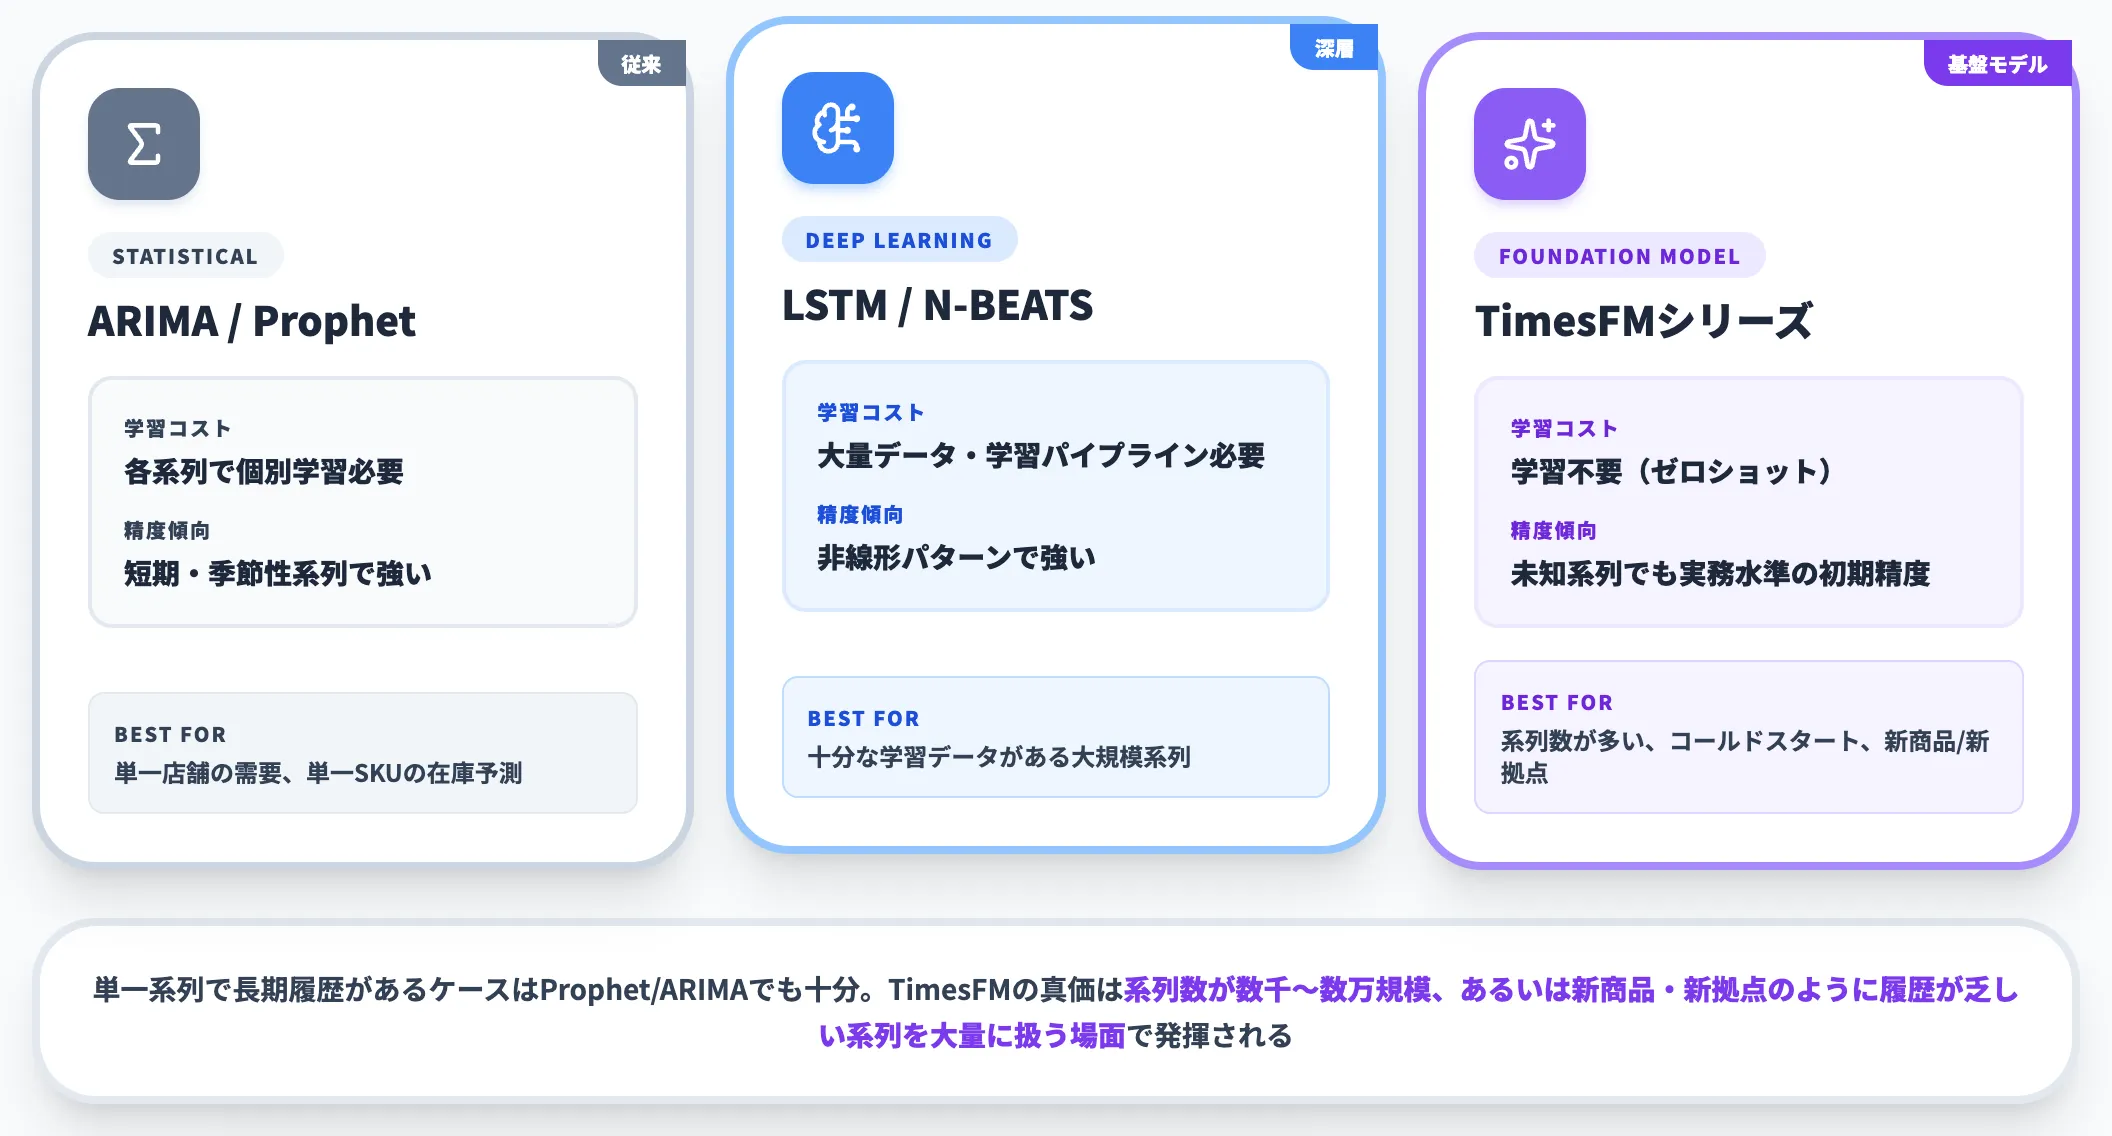
時系列基盤モデルの登場で、ARIMA・Prophet・LSTM・N-BEATSといった従来の時系列予測手法がすぐに不要になるわけではありません。
以下の表で、従来モデルとTimesFMの棲み分けを整理しました。
| 手法 | 学習・準備コスト | 精度傾向 | 向く用途 |
|---|---|---|---|
| ARIMA / Prophet | 各系列で個別学習必要 | 短期・季節性のある単純系列で強い | 単一店舗の需要、単一SKUの在庫予測 |
| LSTM / N-BEATS | 大量データと学習パイプラインが必要 | 系列固有の非線形パターンで強い | 十分な学習データがある大規模系列 |
| TimesFMシリーズ | 学習不要(ゼロショット) | 未知系列でも実務水準の初期精度 | 系列数が多い、コールドスタート、新商品/新拠点 |
つまり、単一系列で長期の履歴があり、統計的に安定したパターンを持つケースではProphet/ARIMAでも十分な精度が出ることも多いです。
TimesFMの真価が発揮されるのは、系列数が数千〜数万規模、あるいは新商品・新拠点のように履歴が乏しい系列を大量に扱う場面です。
TimesFM導入で見落としやすい実装上の制約
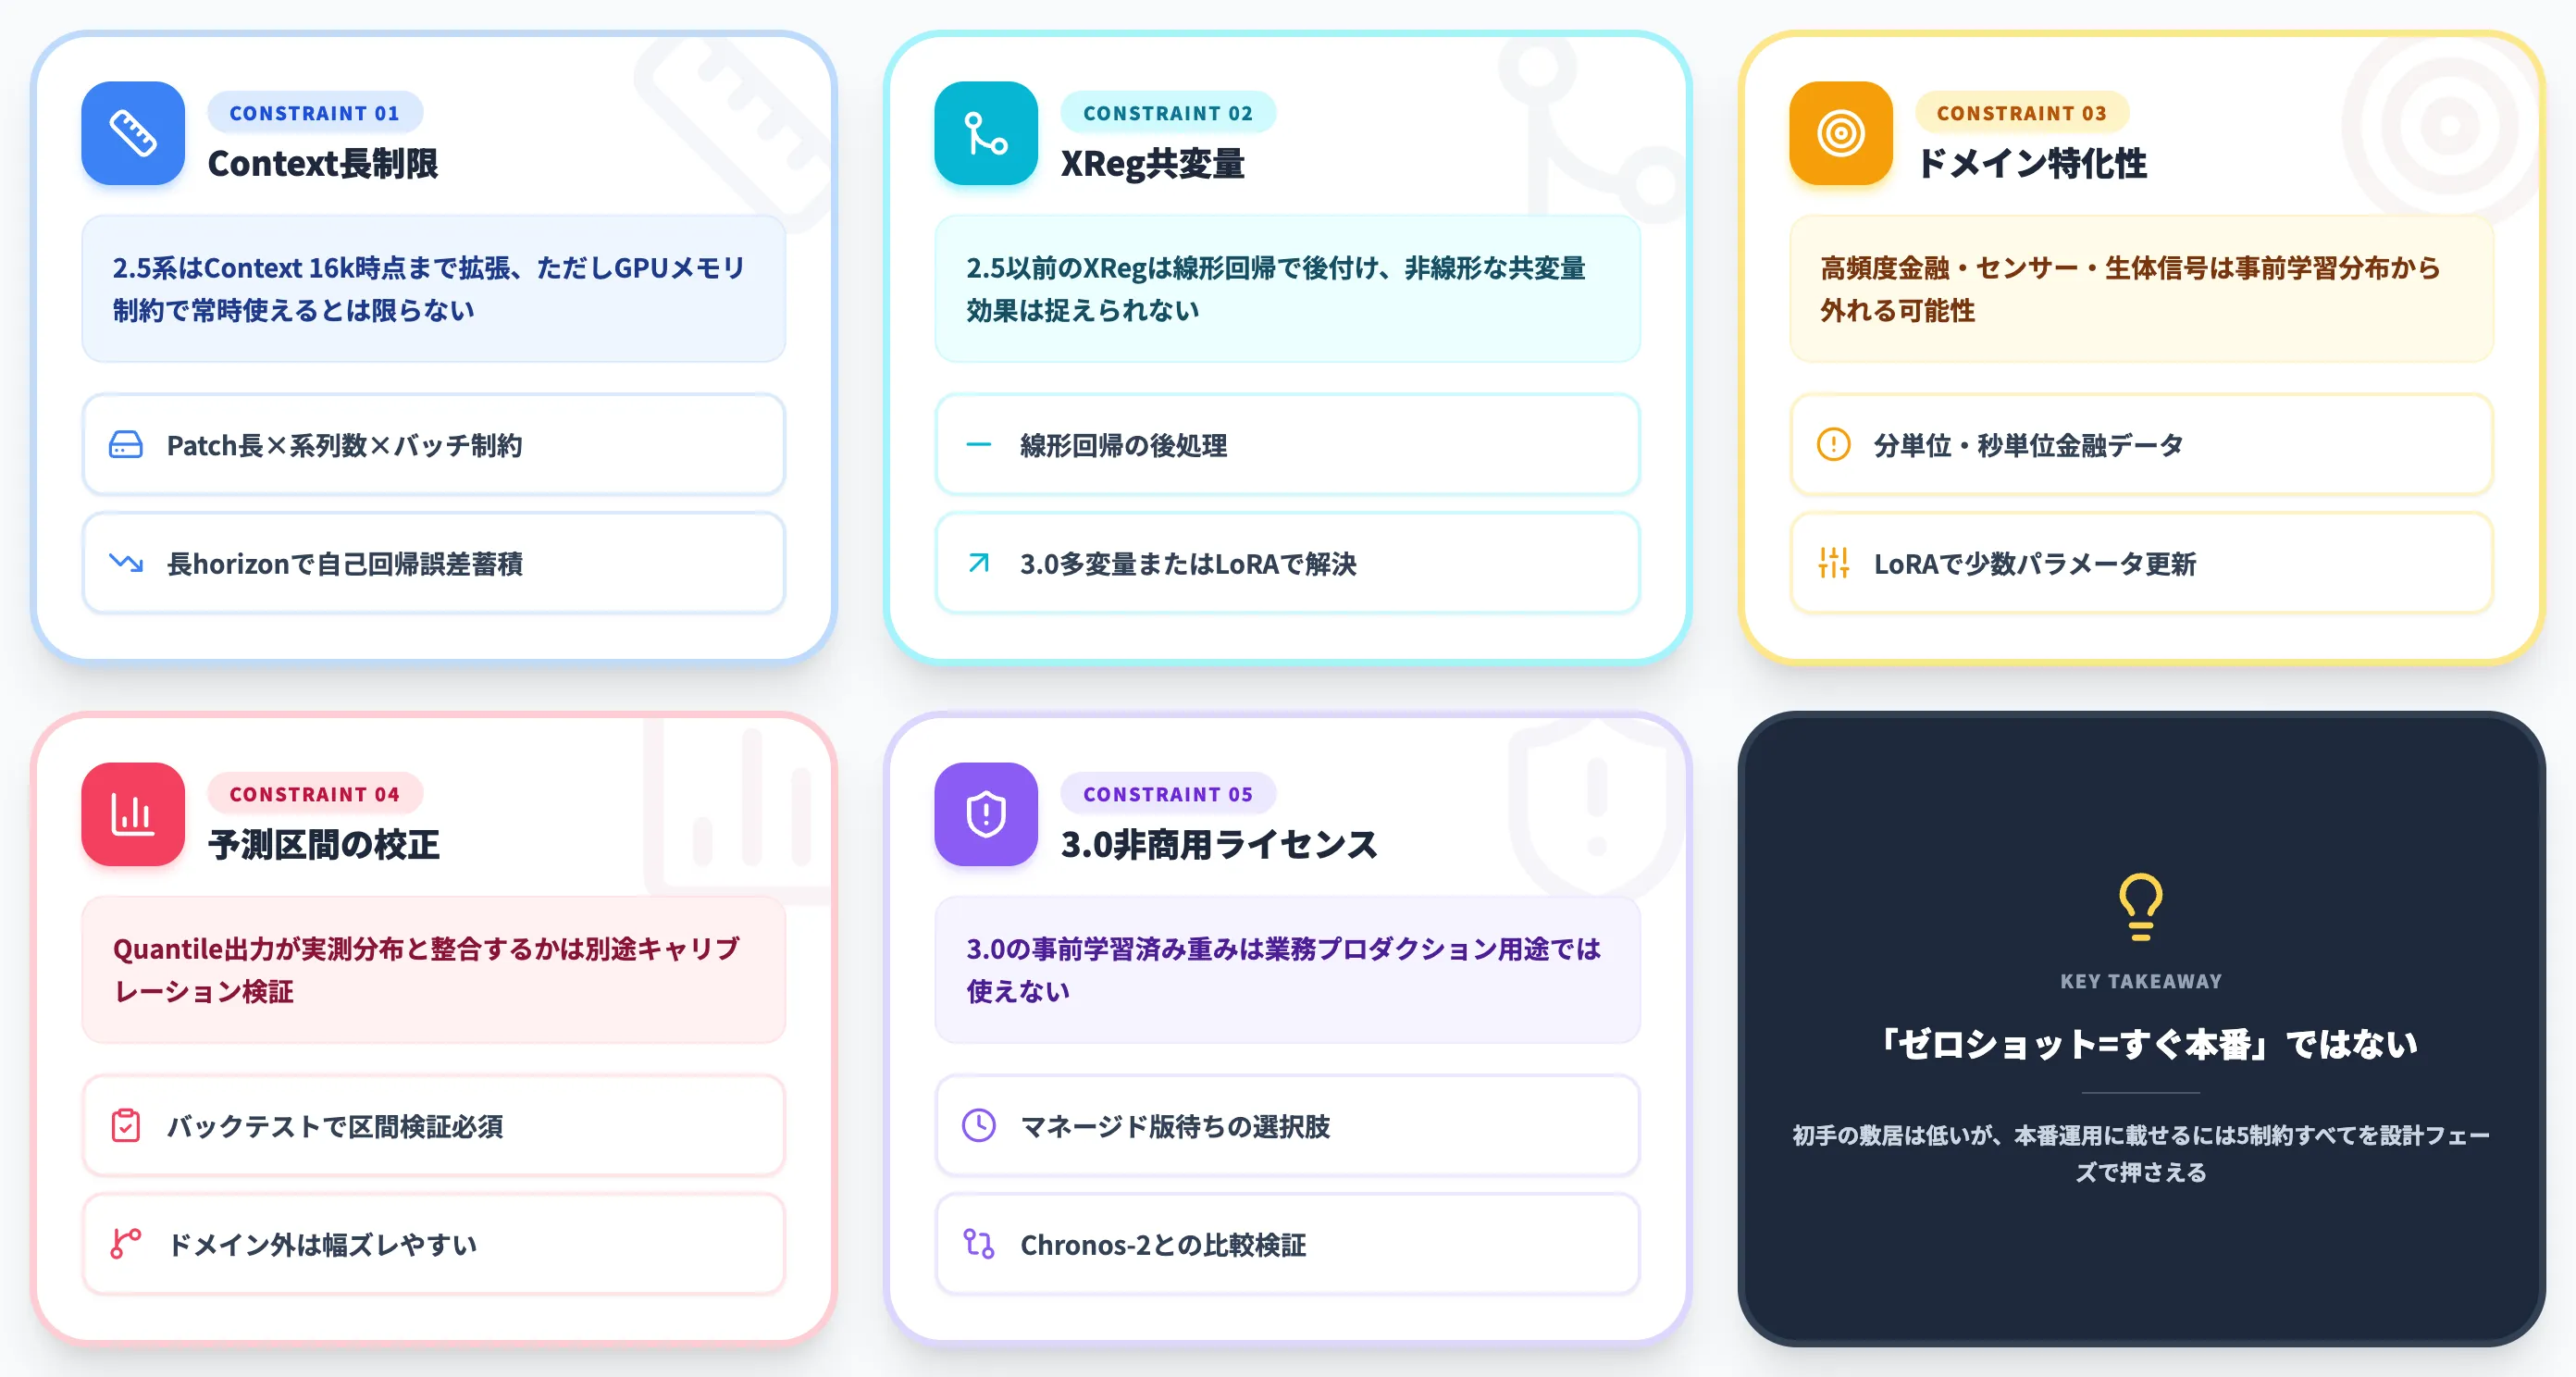
TimesFMは「ゼロショットで動く」がゆえに、初手の敷居が低い一方で、本番運用に載せるときに引っかかる制約がいくつか存在します。
導入検討フェーズで押さえておくべき5つの実装ポイントを整理します。
Context長制限とhorizonの関係
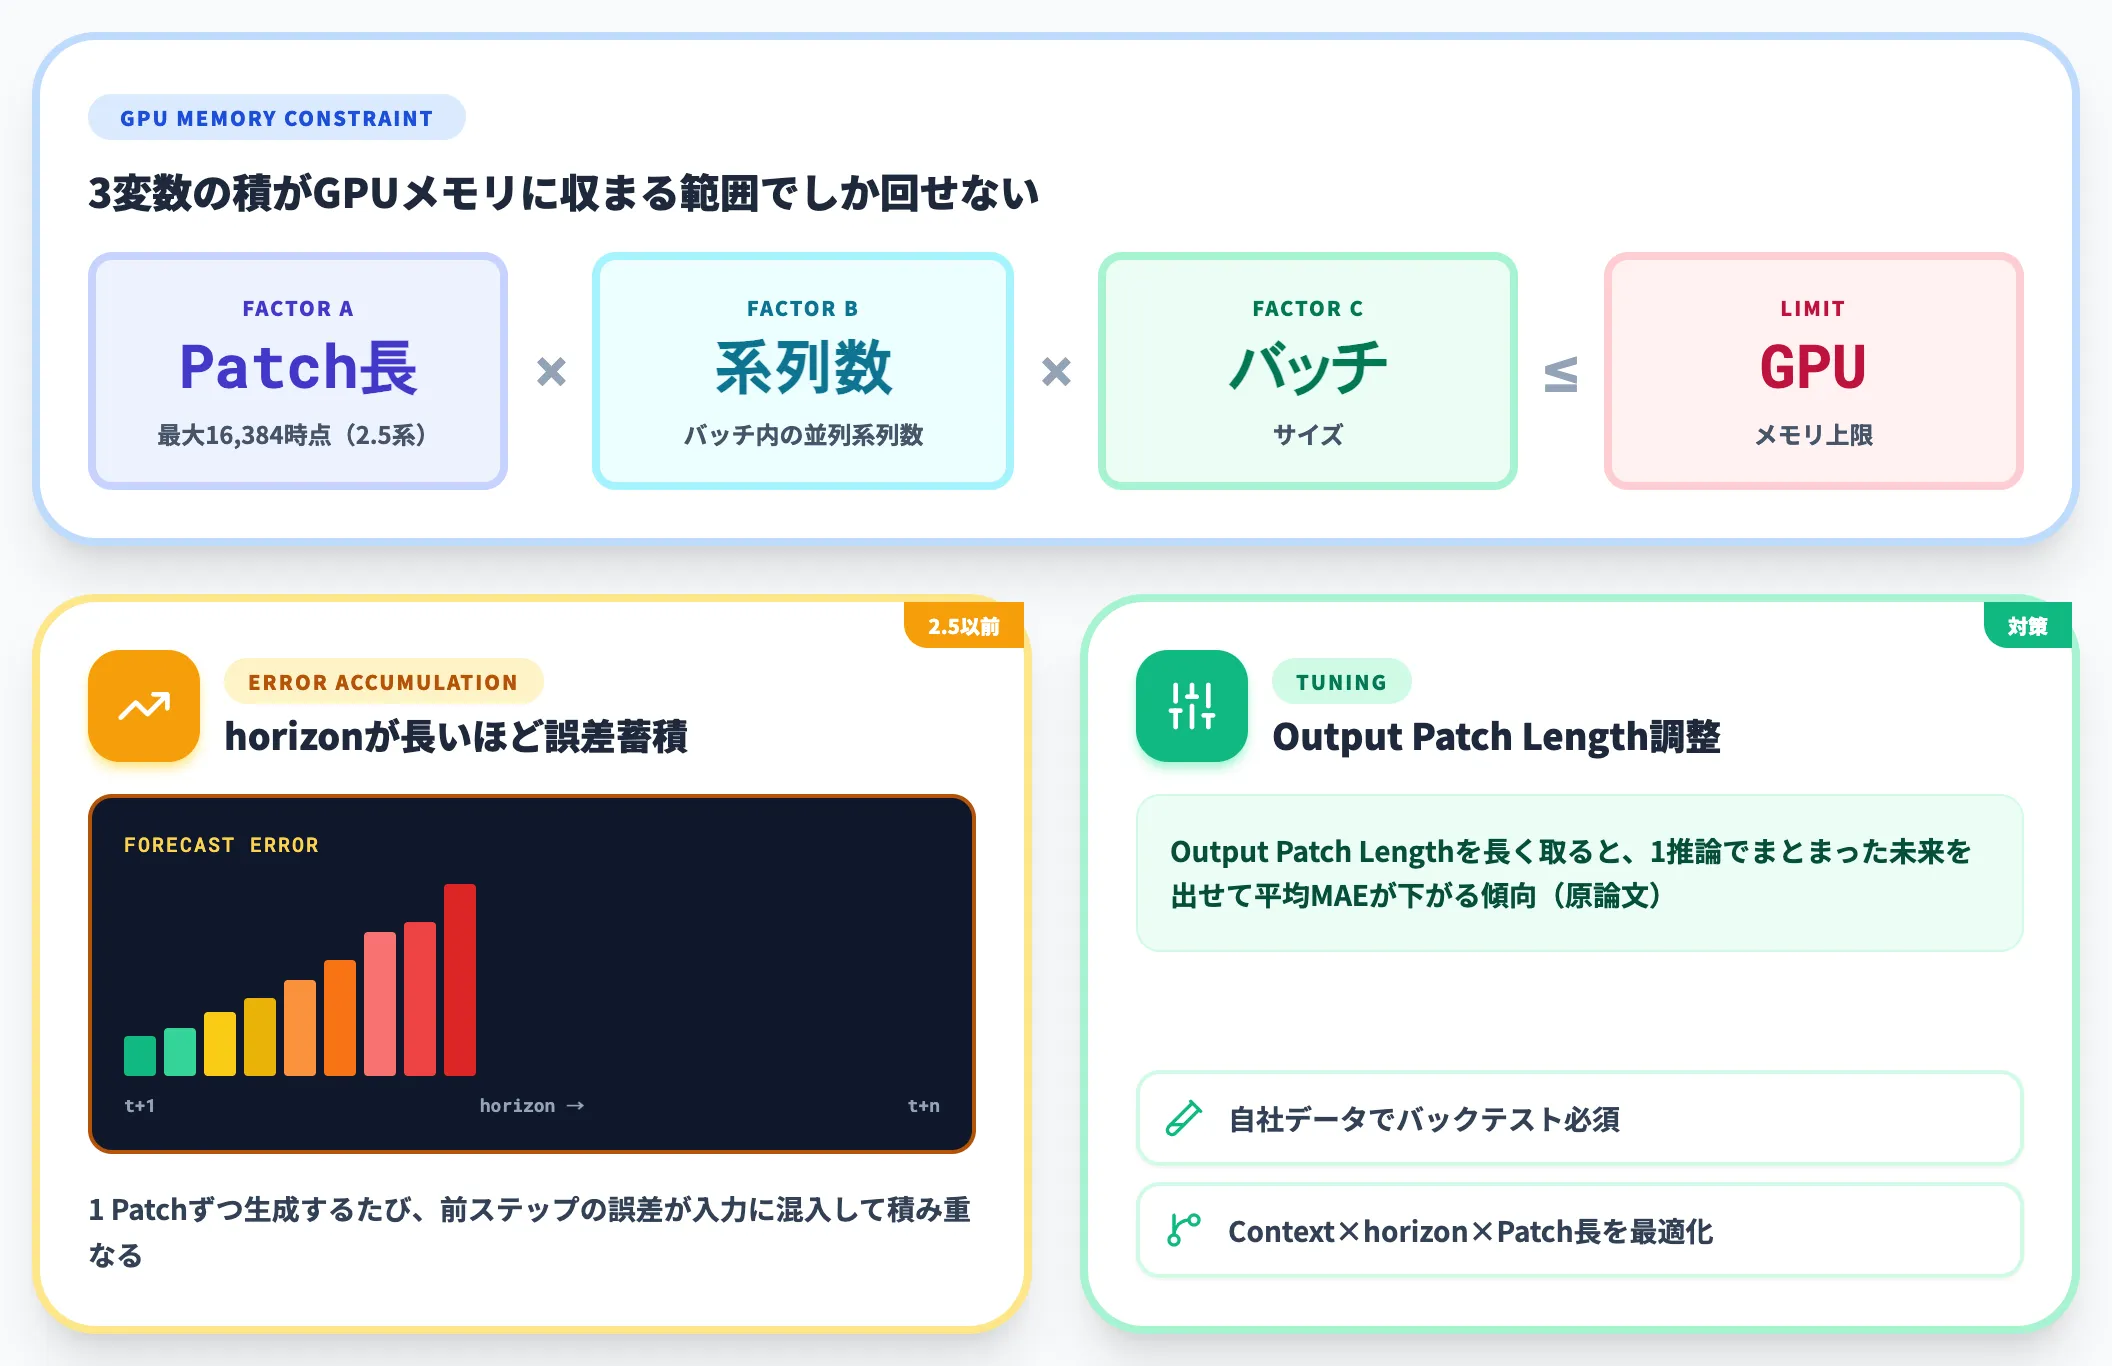
TimesFM 2.5系ではContext長が最大16,384時点まで拡張されましたが、これは「常に16,384時点を履歴として使える」という意味ではありません。
実際の推論では、入力Patch長 × バッチ内の系列数 × バッチサイズの積がGPUメモリに収まる範囲内でしか回せません。日次データで数年分の履歴を数千系列同時に予測する場合、Context長を絞る調整が必要になります。
また、horizonが長くなるほど(2.5以前の)自己回帰デコードでは誤差が蓄積しやすいため、Context長やOutput Patch Lengthの調整が精度を保つ勘所になります。
XReg(共変量入力)の位置づけ
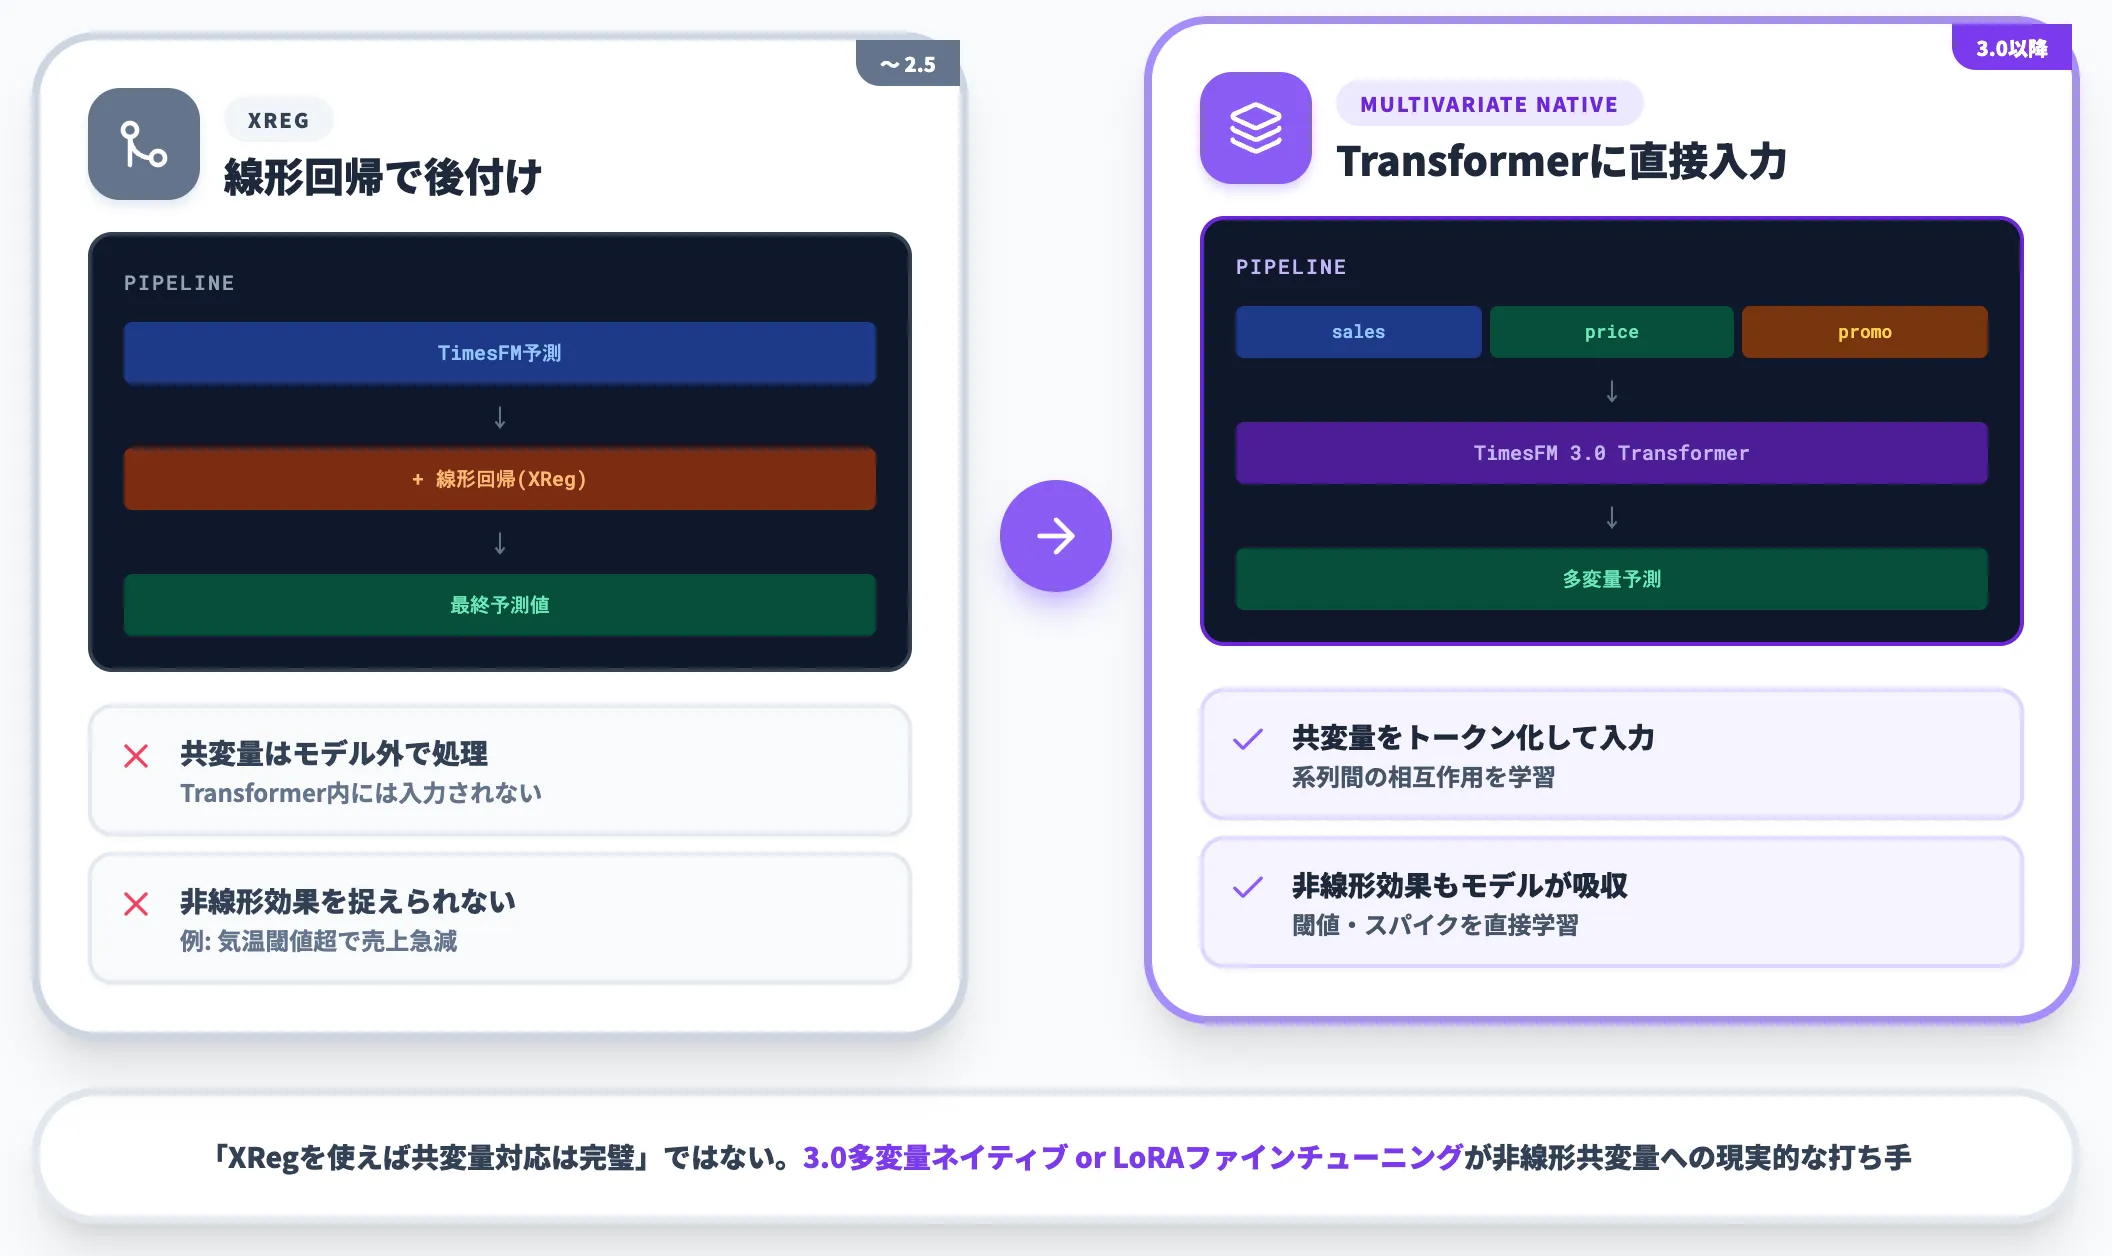
TimesFM 2.5以前のXReg機能は、「共変量をトークンとして直接モデルに入力する」ものではなく、予測結果に対して線形回帰で共変量の影響を後付けするアプローチでした。
このため、非線形な共変量効果(例:気温が閾値を超えると急激に売上が減る)はうまく捉えられません。
共変量を非線形にモデル本体に組み込みたい場合は、TimesFM 3.0の多変量ネイティブ対応、あるいは自社データでのLoRAファインチューニングを検討する必要があります。
「XRegを使えば共変量対応は完璧」ではない点は、原論文にも明記されている構造上の制約です。
ドメイン特化性——事前学習データに含まれないパターン
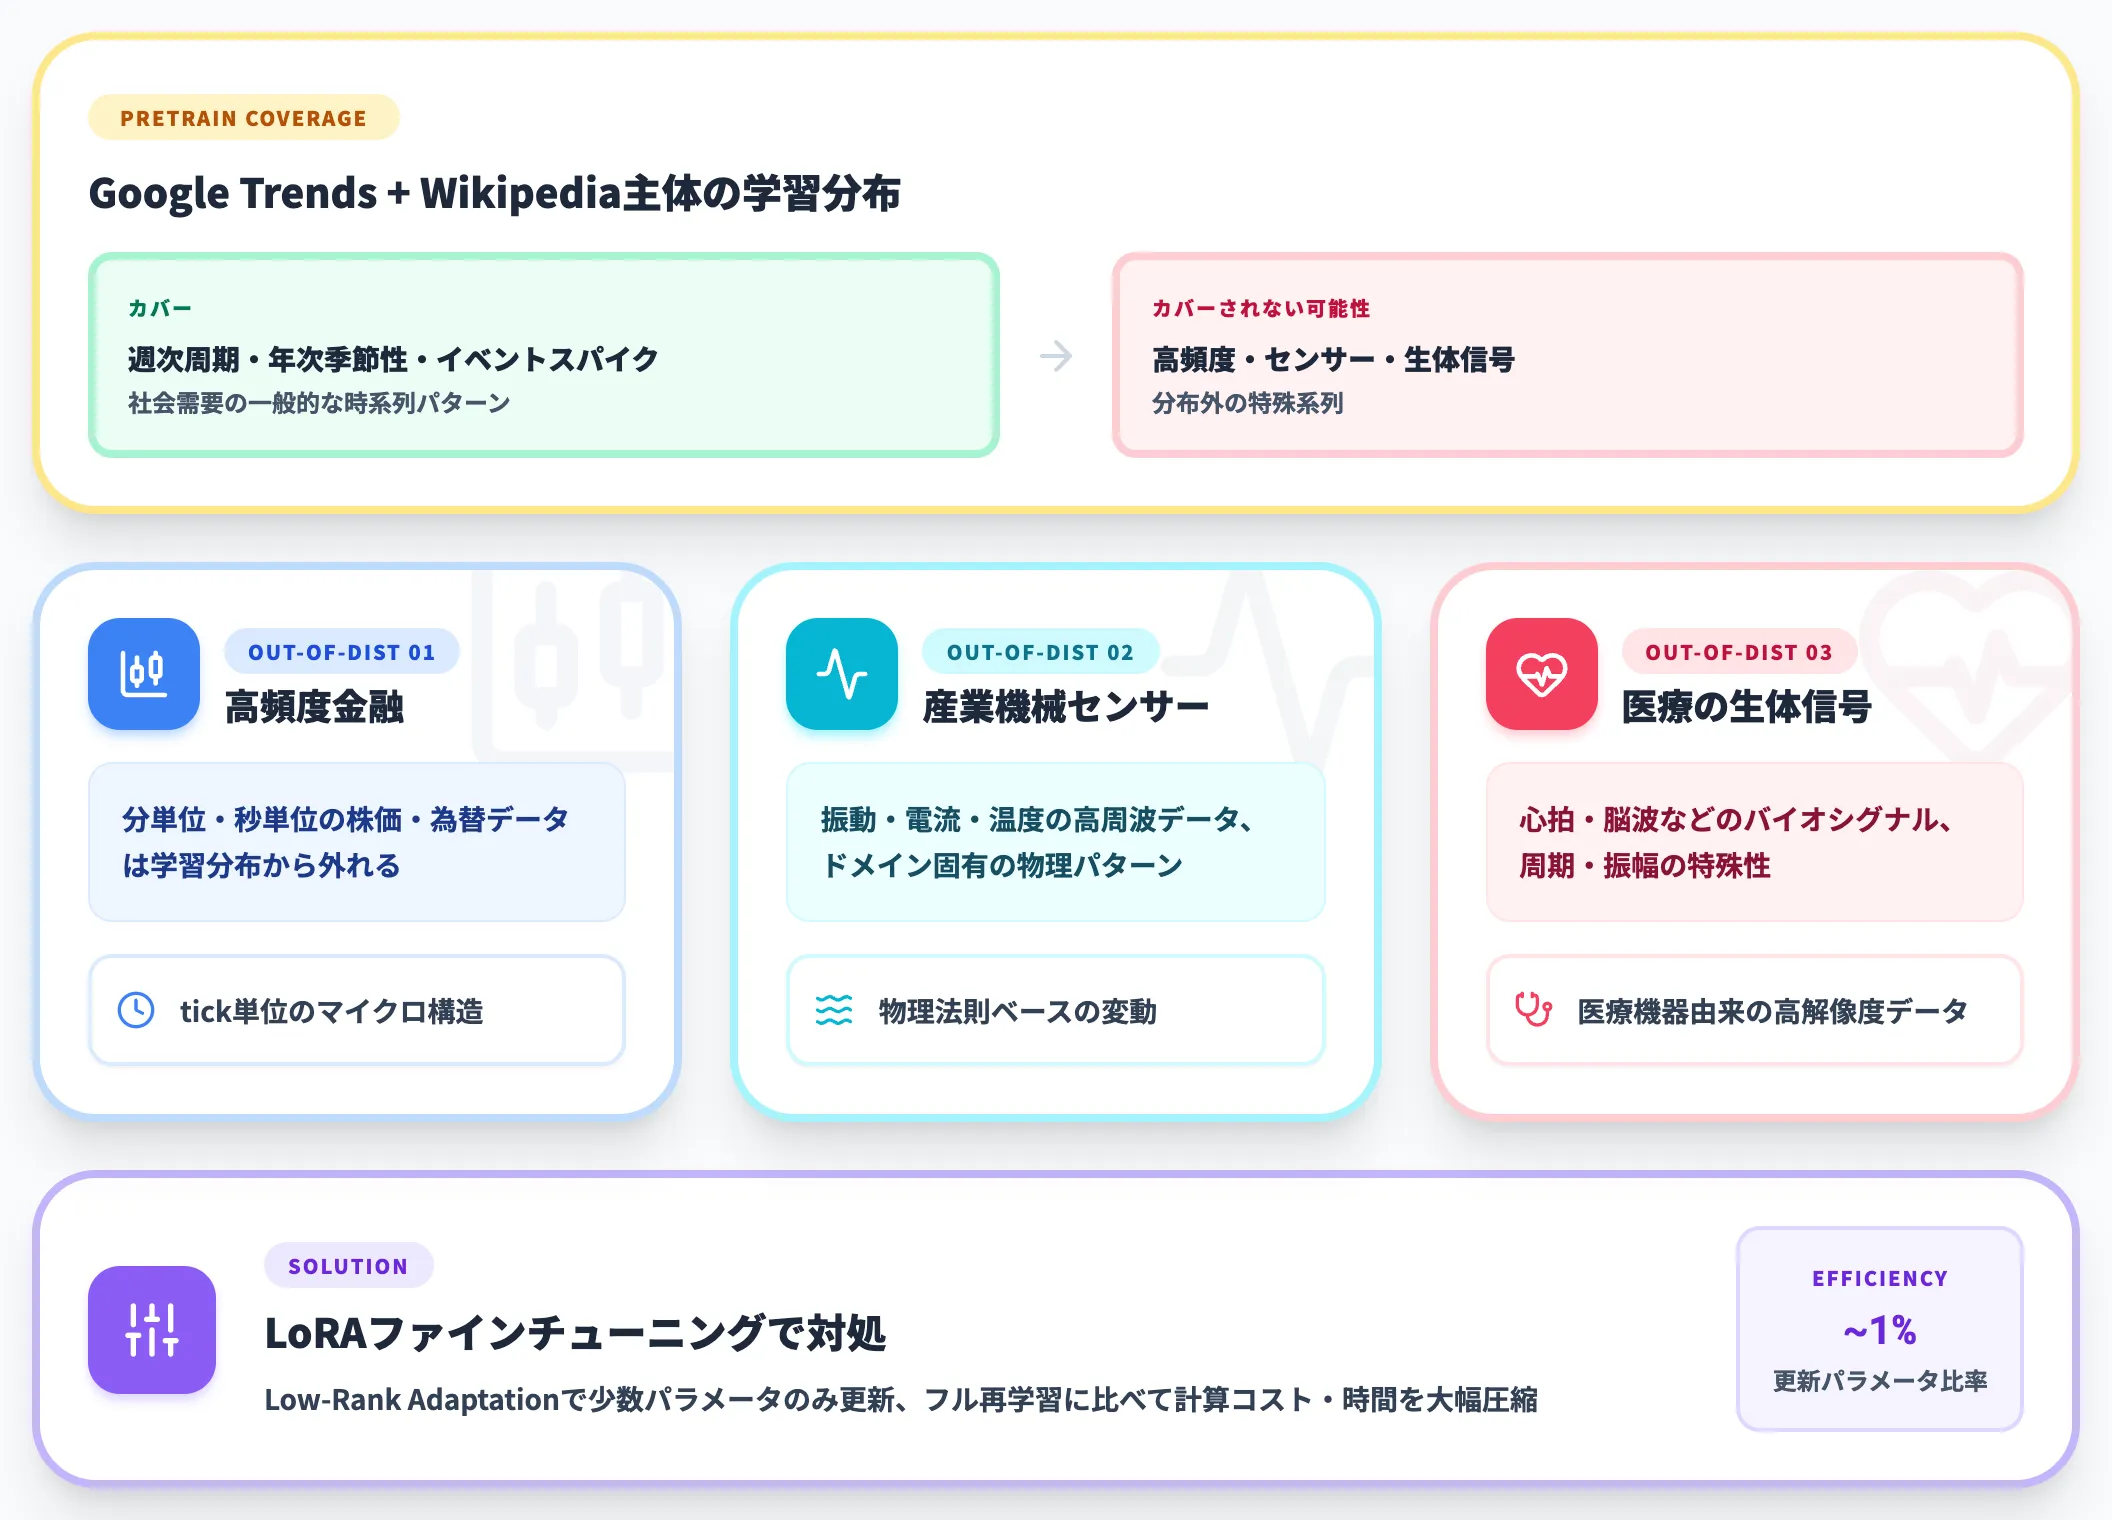
TimesFMの事前学習データは、Google Trendsの検索トレンドとWikipediaページビューが主体です。
これらは一般的な社会需要の時系列パターン(週次周期・年次季節性・イベントスパイク)を広くカバーしますが、以下のような特殊系列は事前学習分布から外れている可能性があります。
- 分単位・秒単位の高頻度金融データ
- 産業機械のセンサーデータ(振動・電流・温度)
- 医療の生体信号(心拍・脳波)
このような系列でゼロショット精度が出ない場合、自社データでのLoRAファインチューニングが現実的な対処策です。LoRAは少数パラメータだけを更新するため、フル再学習と比べて計算コスト・時間を大幅に抑えられます。
予測区間(Quantile)の校正
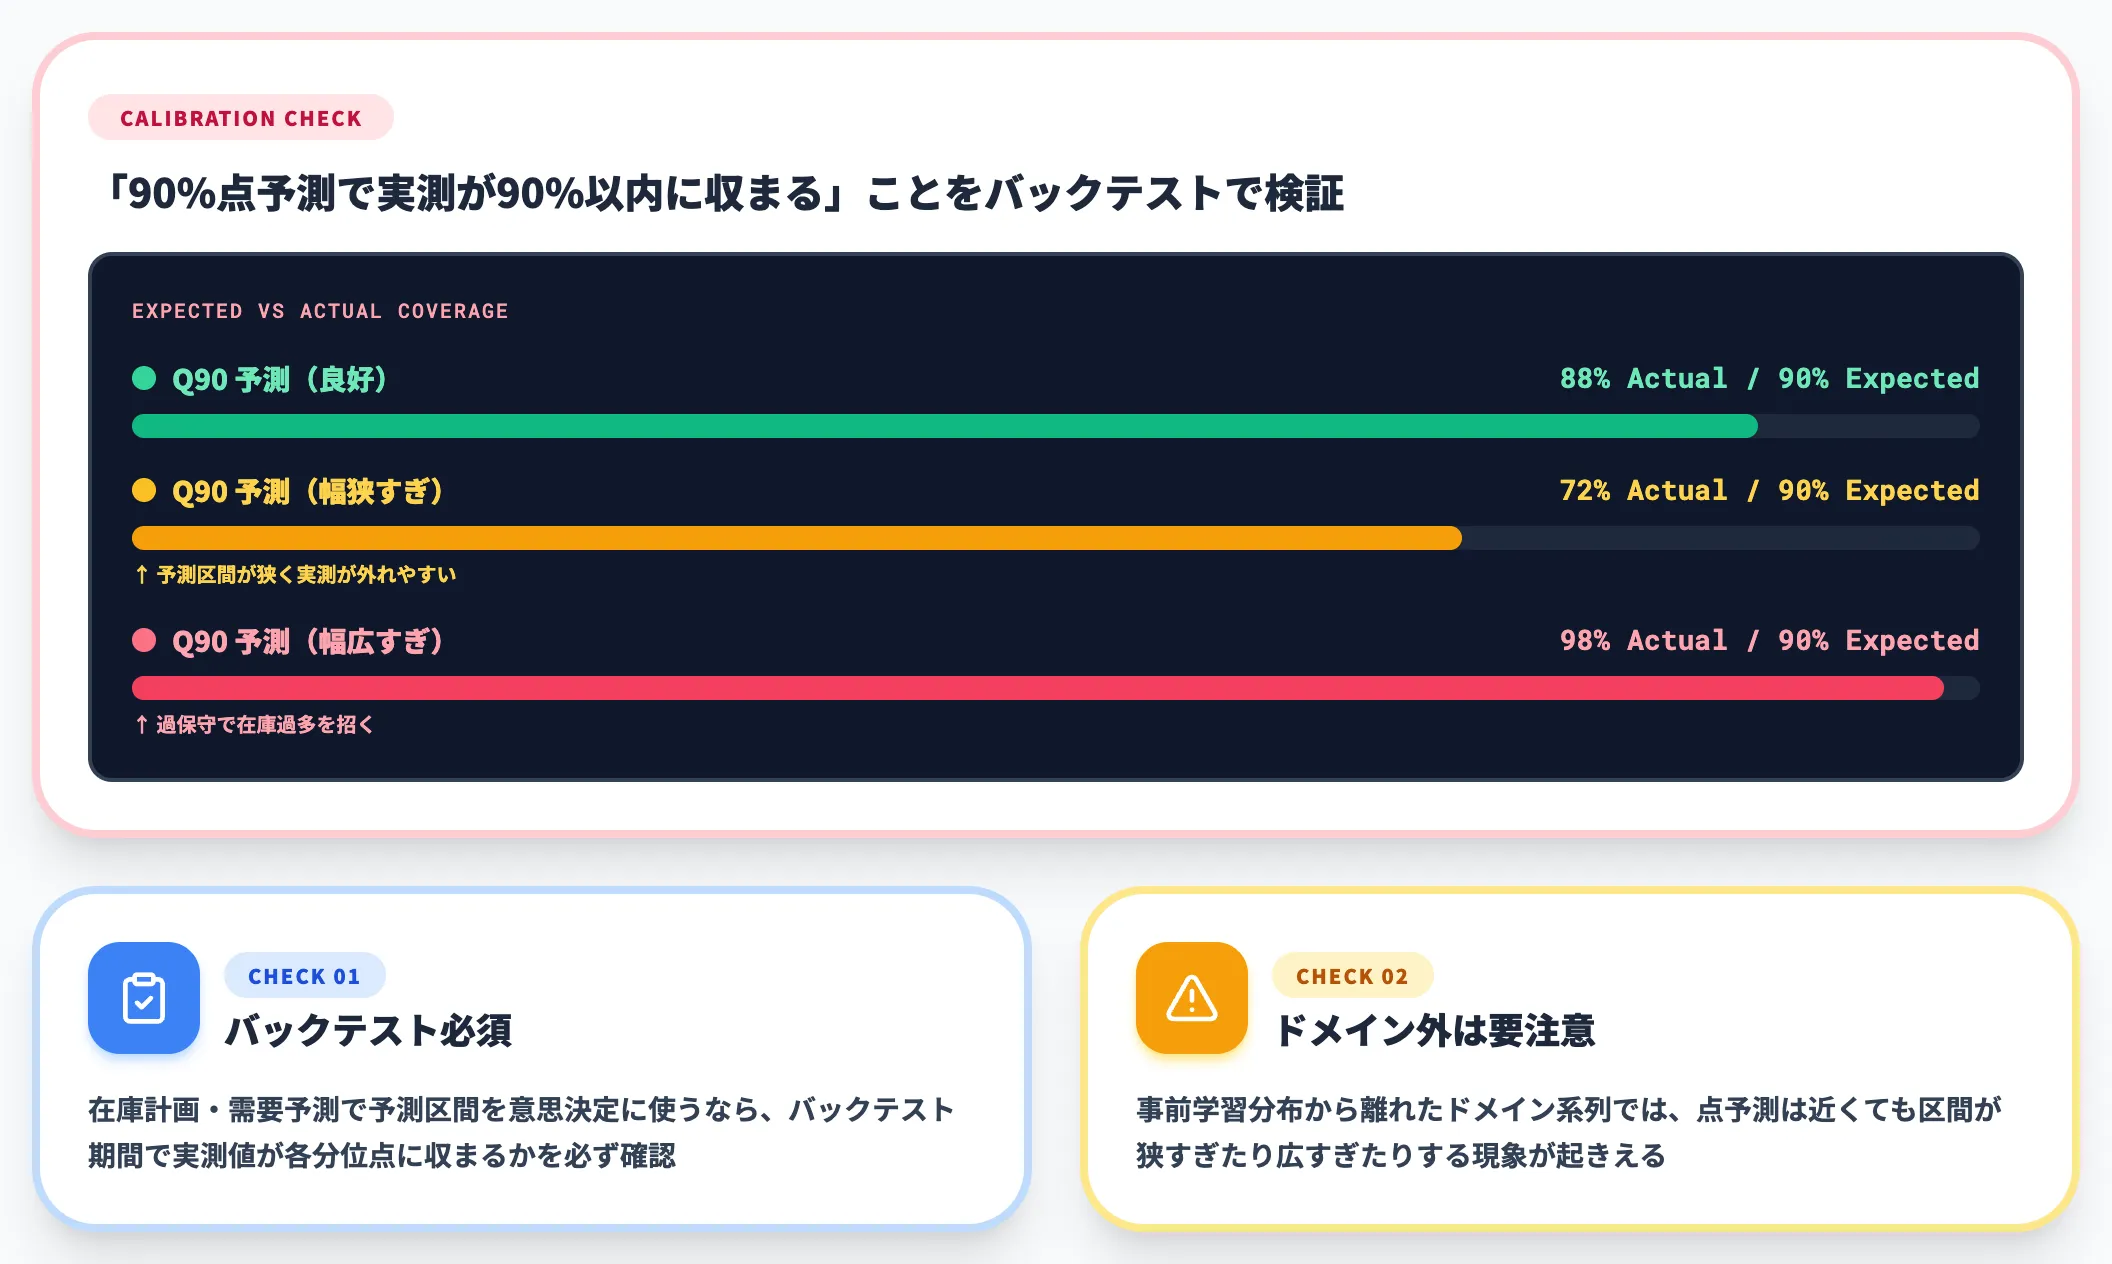
TimesFM 2.5以降のQuantile Headは、10%点・50%点・90%点などの分位点を同時に出力できますが、出力される予測区間が実測分布と整合しているかは別途検証が必要です。
在庫計画や需要予測で予測区間を意思決定に使う場合、バックテスト期間で実測値が各分位点に正しく収まっているか(例:90%点予測なら実測の90%が下回っているか)を確認するキャリブレーションチェックを必ず入れてください。
特に、事前学習分布から離れたドメイン系列では、点予測は近くても区間が狭すぎたり広すぎたりする現象が起きえます。
3.0の非商用ライセンス制約と回避策
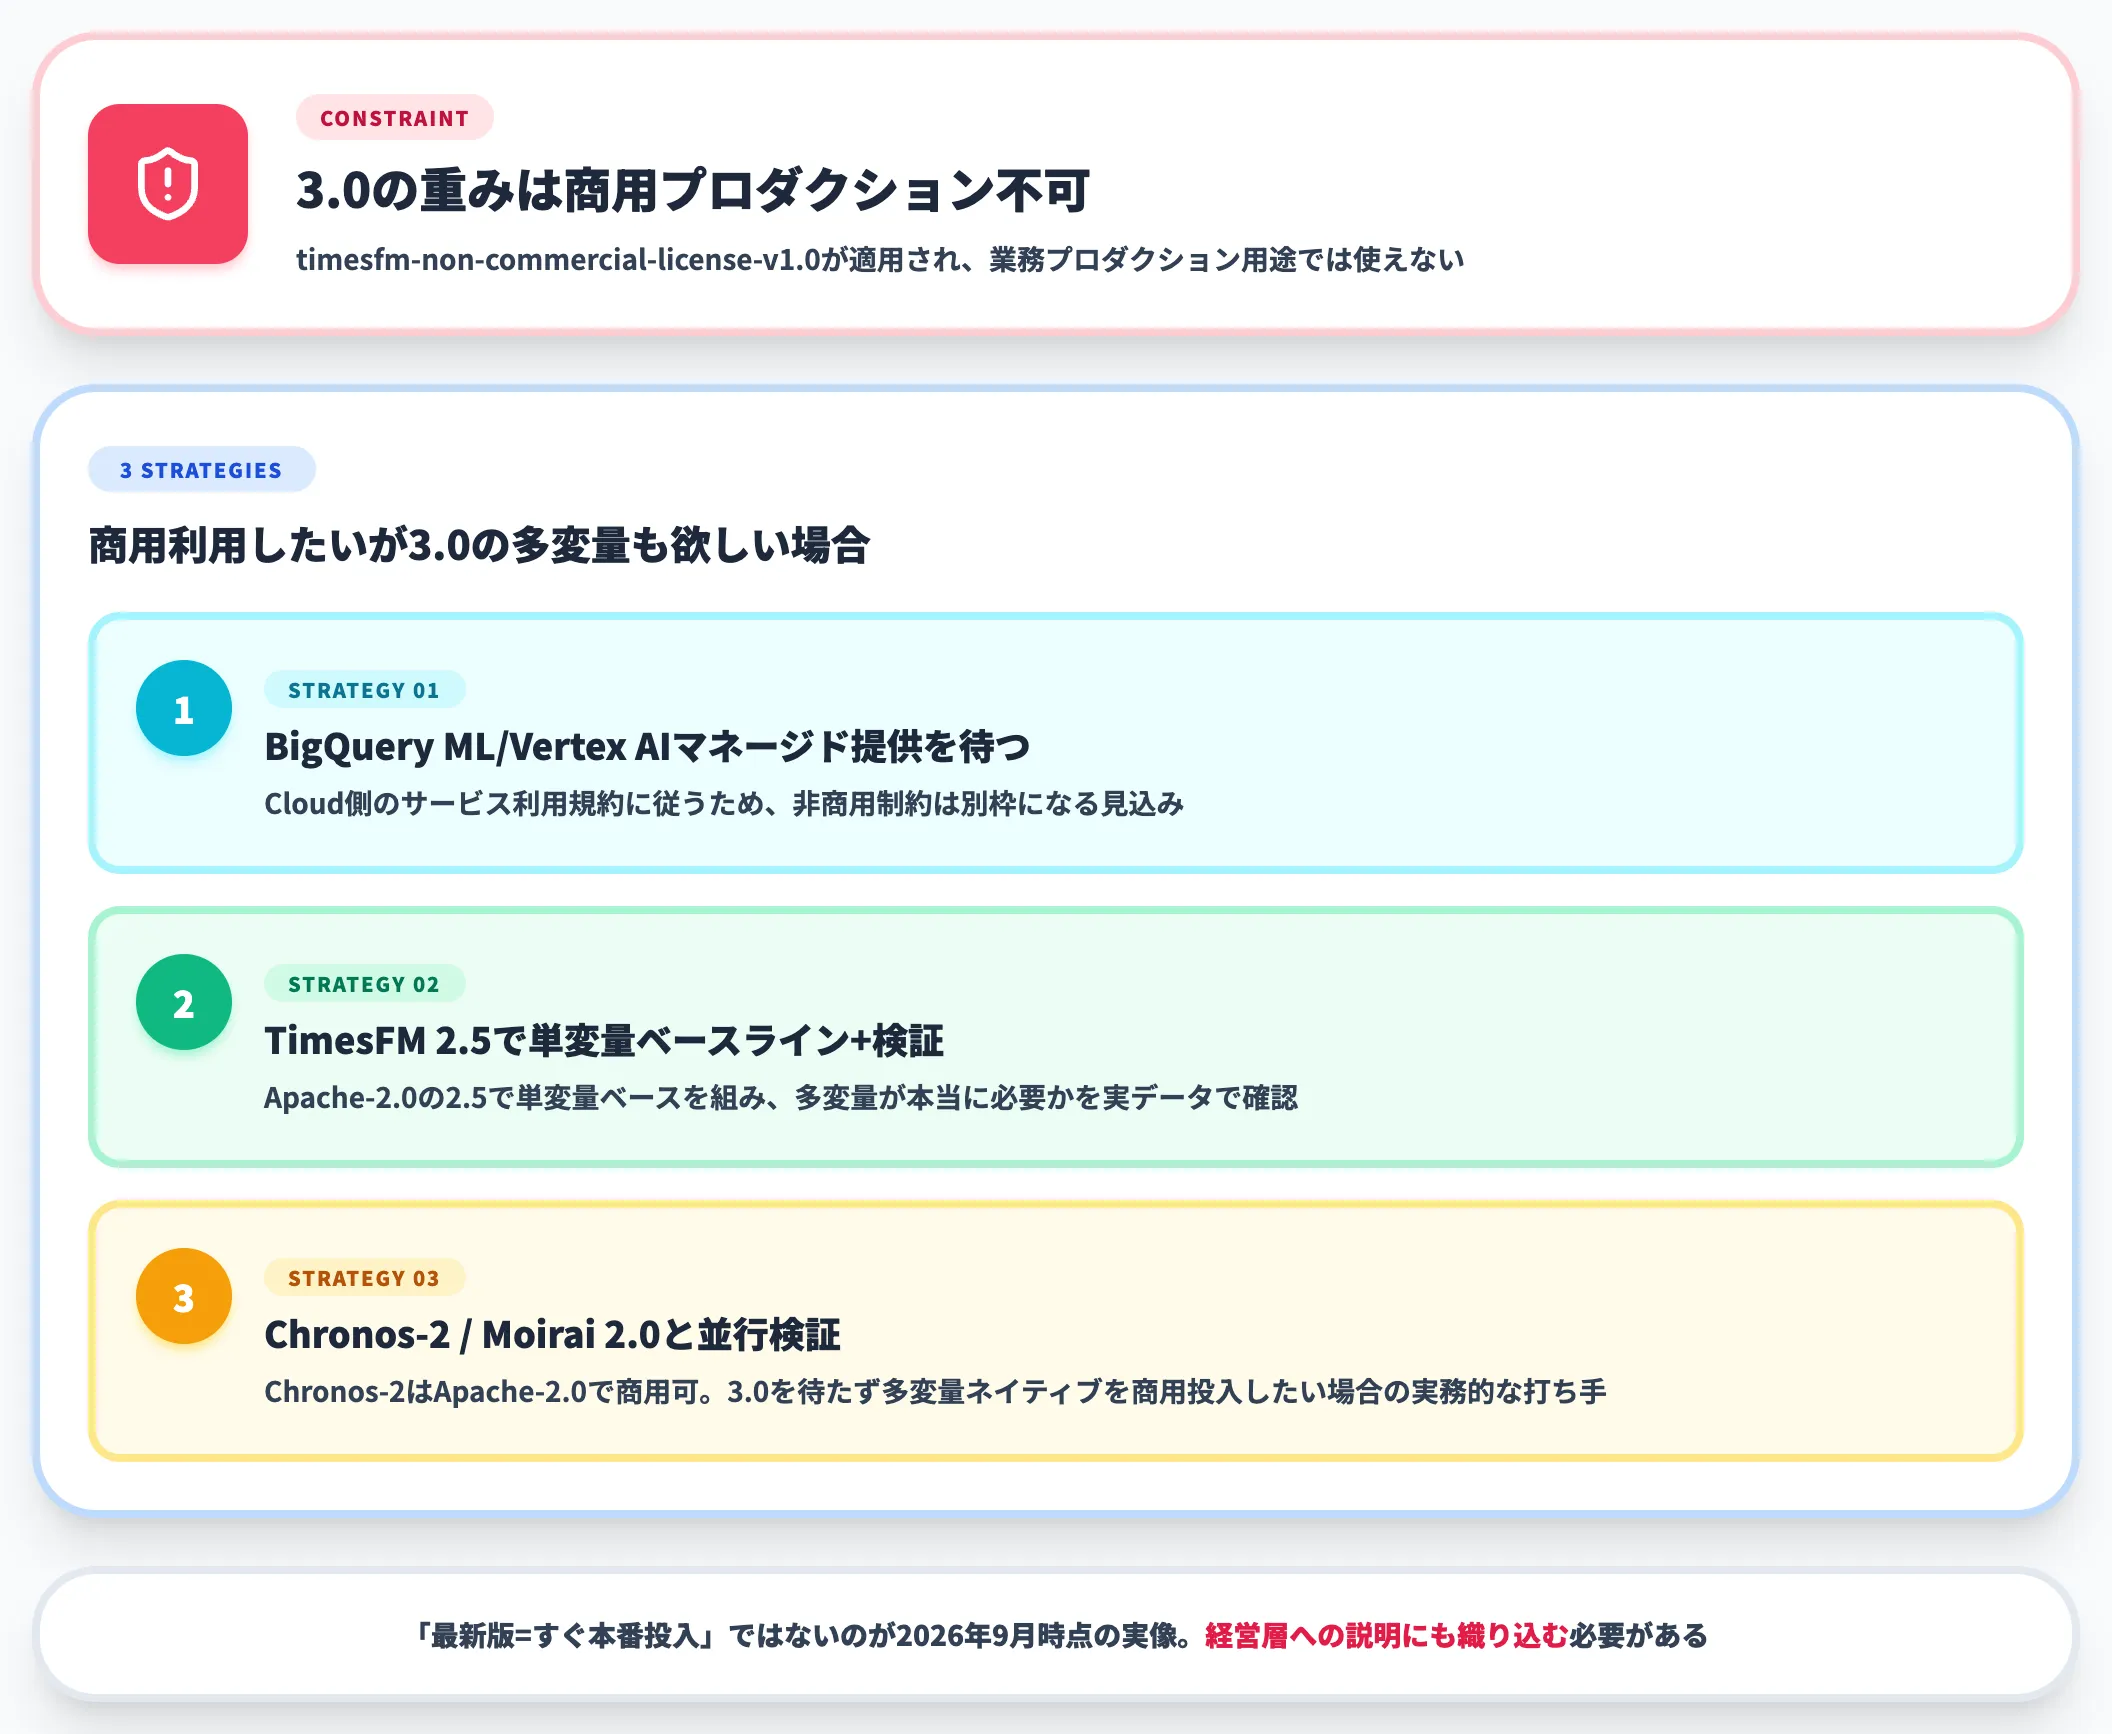
先述のとおり、TimesFM 3.0の事前学習済み重みは非商用ライセンスで、業務プロダクション用途では使えません。
商用利用したいが3.0の多変量対応も欲しい場合、選べる打ち手は次の3つです。
-
BigQuery ML/Vertex AI経由のマネージド提供を待つ
Google Cloudのマネージド機能として提供される場合、Cloud側の利用規約に従うため非商用制約は別枠になる見込みです。
-
TimesFM 2.5 + Chronos-2/Moirai 2.0との比較検証
2.5系(Apache-2.0)で単変量ベースラインを組み、多変量が本当に必要かを実データで検証してから3.0待ちか他モデルかを決めます。
-
他モデル(Chronos-2/Moirai 2.0)と並行検証する
Chronos-2はApache-2.0で商用可、Moirai 2.0はCC-BY-NC 4.0(非商用)です。3.0を待たずに多変量ネイティブ対応を商用で入れたい場合、Chronos-2との精度比較を実施するのが実務的です。
「最新版=すぐ本番投入」ではないのが2026年9月時点のTimesFM 3.0の実像で、この点は経営層への説明にも織り込んでおく必要があります。
TimesFMを業務にどう活かすか——バージョン選定とPoC設計
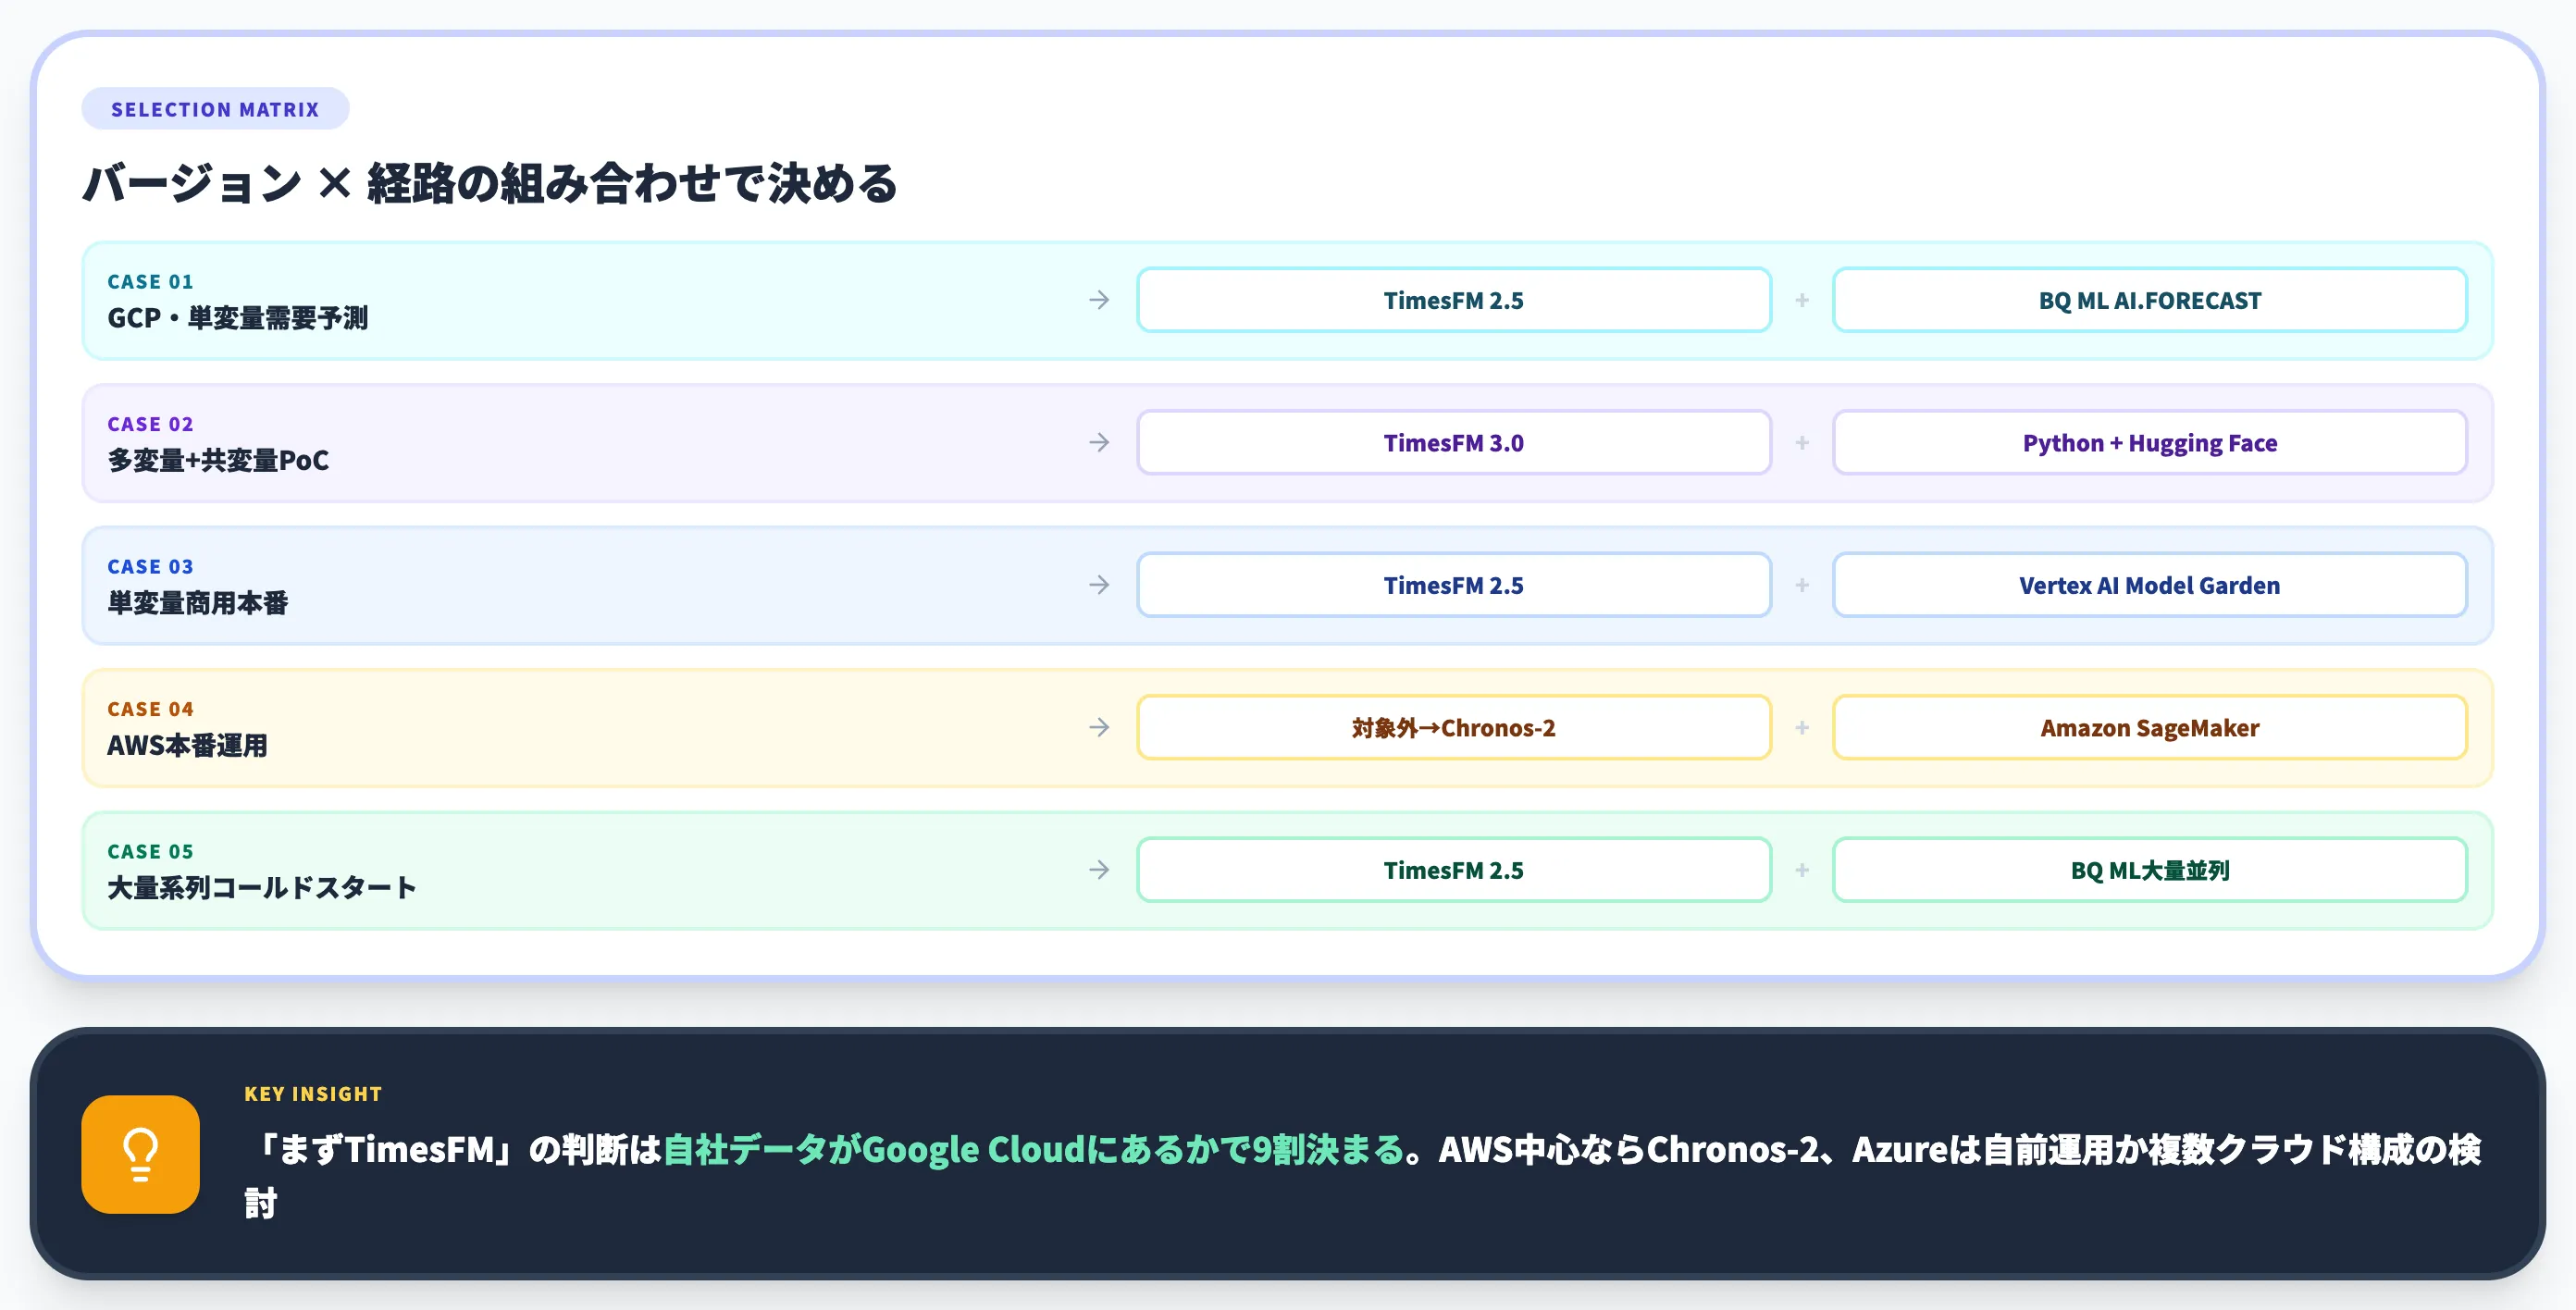
TimesFMシリーズを業務で活かすには、「どのバージョンを選ぶか」と「どの経路で回すか」の組み合わせを、自社の業務要件から逆算して決めるのが最短ルートです。
AI総研の需要予測PoC支援でも、この2軸の切り分けが最初の設計判断になります。
バージョン×経路のケース別推奨
以下の表で、代表的な業務要件別のバージョン・経路の推奨組み合わせをまとめました。
| 業務要件 | 推奨バージョン | 推奨経路 | 理由 |
|---|---|---|---|
| Google Cloud基盤で単変量の需要予測を回したい | TimesFM 2.5(新規タスクのデフォルト) | BigQuery ML AI.FORECAST | SQL数行で完結、追加ライセンス料なし |
| 多変量+共変量で精度を突き詰めたいPoC段階 | TimesFM 3.0 | Python + Hugging Face | 3.0の多変量ネイティブ対応を非商用範囲で検証 |
| 単変量で本番運用したい(商用利用) | TimesFM 2.5 | Vertex AI Model Garden | Apache-2.0で商用可、GPU推論で高スループット |
| AWS環境で本番運用したい | 対象外(Chronos-2推奨) | Amazon SageMaker | Google Cloud外ならChronos-2が第一候補 |
| 大量系列(数万〜)でコールドスタート運用 | TimesFM 2.5 | BigQuery ML | ゼロショット×SQL大量並列でスループット確保 |
この表から見えるのは、「まずTimesFM」の判断は自社データがGoogle Cloudにあるかで9割決まるということです。
AWS中心ならChronos-2、Azureならまだ標準的なマネージド提供が薄いため、Python自前運用かVertex AI経由でのマルチクラウド構成を検討します。
PoC設計の3ステップ
TimesFMを本格導入するかの判断は、次の3ステップで進めるのが実務的です。
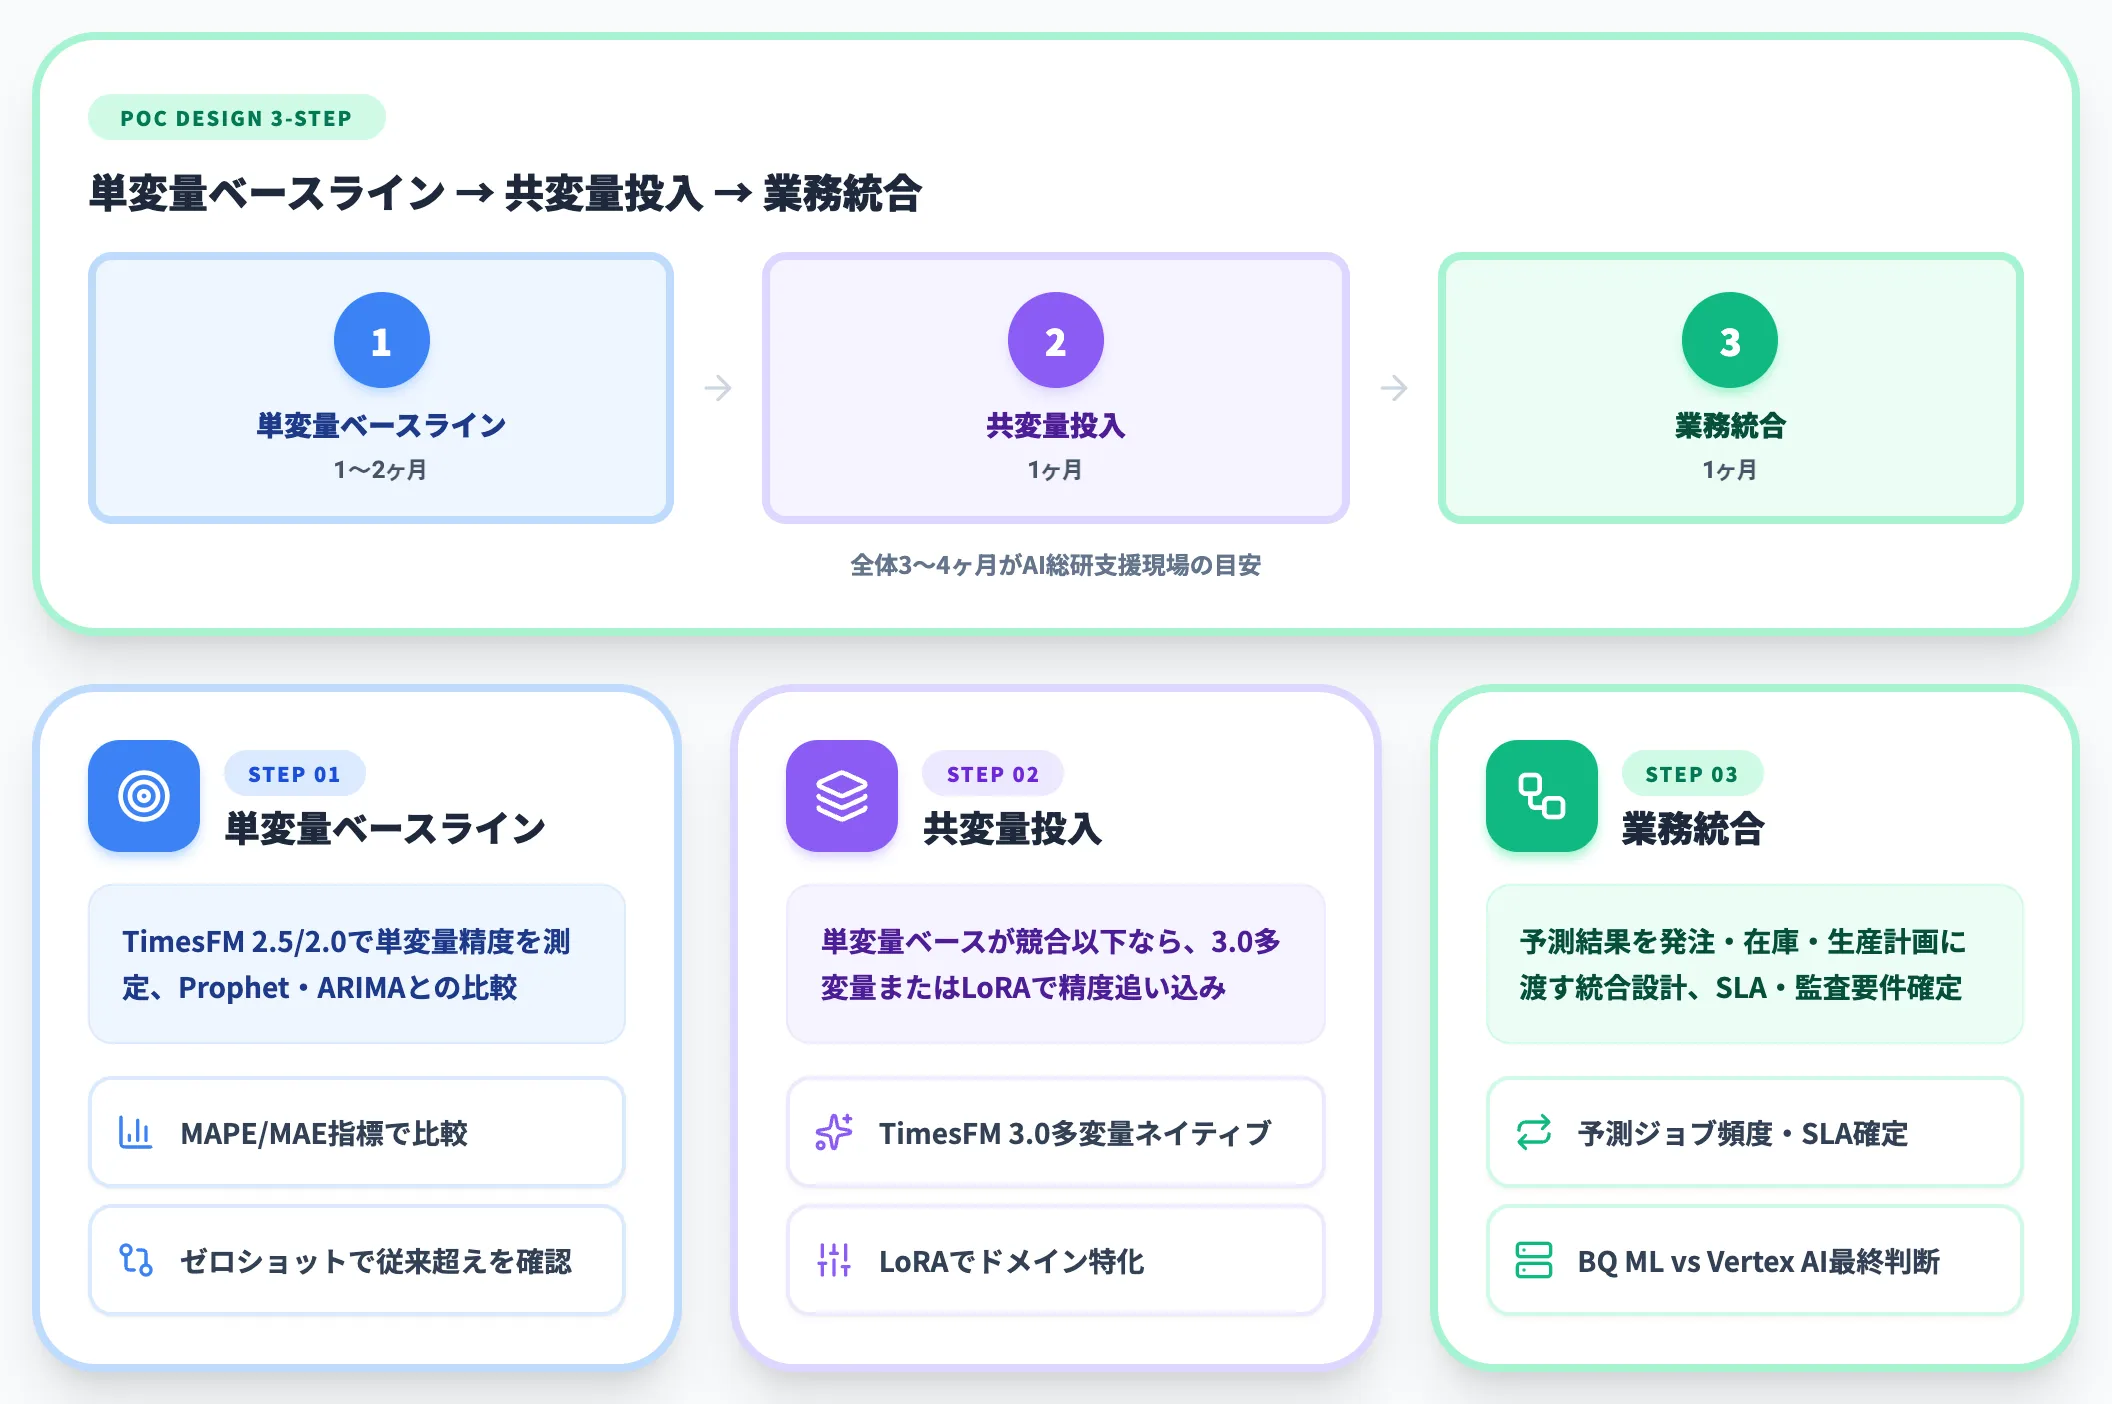
- ステップ1:単変量ベースラインの構築
まずTimesFM 2.5または2.0で、対象系列の単変量ベースライン精度(MAPE/MAEなど)を測ります
。Prophet・ARIMAといった従来モデルとの比較も同じデータで実施し、ゼロショット単変量で従来モデルを上回れるかを確認します。
-
ステップ2:共変量投入と多変量化の効果測定
単変量ベースラインが競合手法と同等以上ならプロダクション経路を検討、下回るなら共変量投入(TimesFM 3.0の多変量、あるいは自社データでのLoRAファインチューニング)で精度を追い込みます。
-
ステップ3:業務プロセスへの統合検証
モデル精度が業務要件を満たしたら、予測結果を業務システム(発注・在庫・生産計画)にどう渡すかの統合を検証します。ここで予測ジョブの実行頻度・SLA・監査要件を確定させ、BigQuery ML運用かVertex AI運用かの最終判断を下します。
ステップ1〜2で1〜2ヶ月、ステップ3を含めて全体で3〜4ヶ月というのが、AI総研の支援現場で多いPoC期間の目安です。「ゼロショットだからすぐ使える」の裏側で、業務統合まで含めた設計が本当の勝負どころになります。
予測モデル導入で詰まる論点
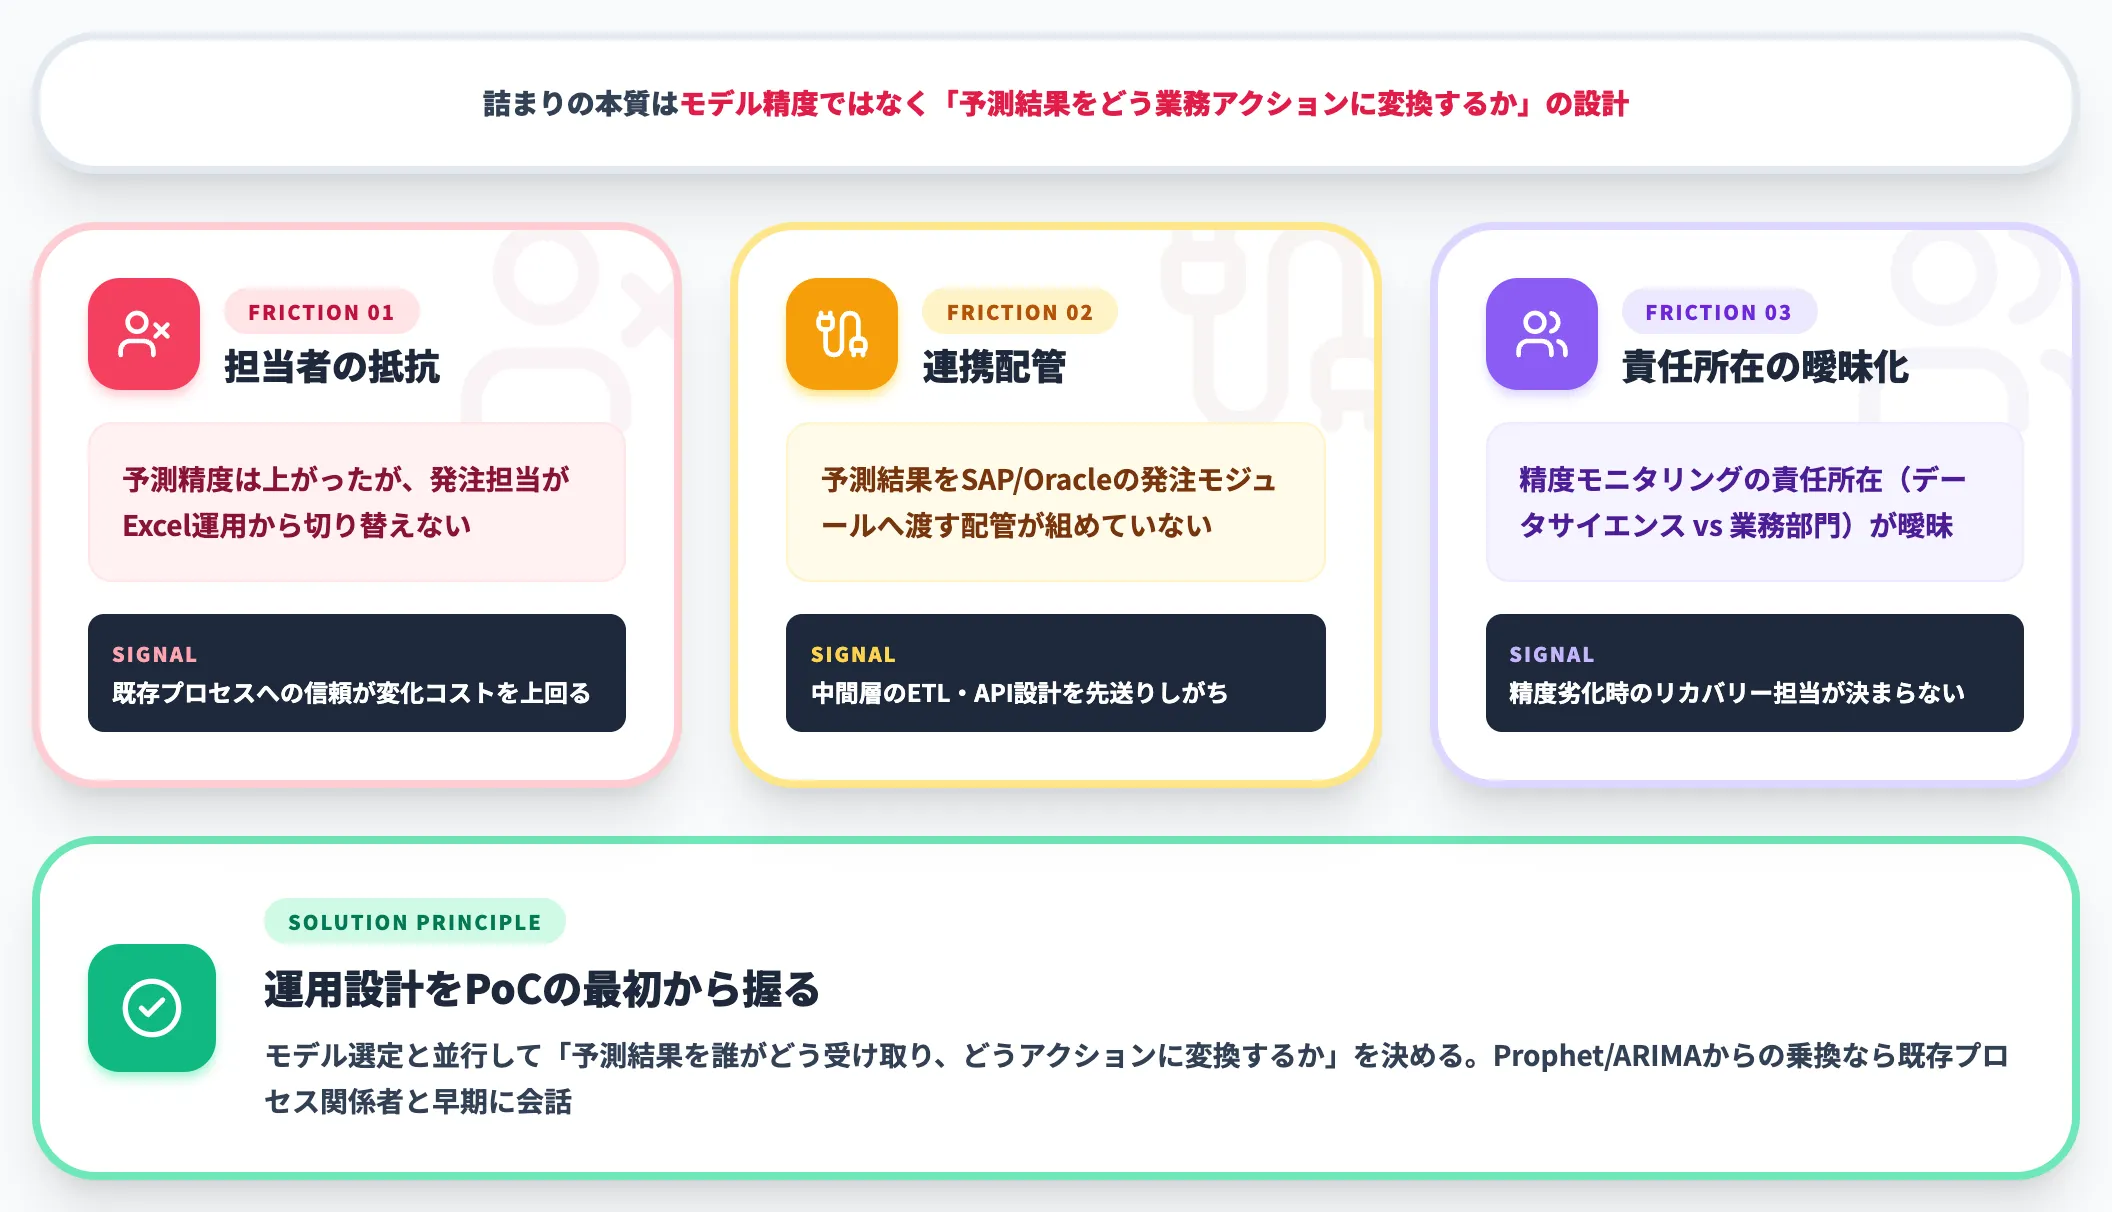
TimesFMに限らず、時系列基盤モデルを業務に組み込む際に詰まりやすいのは、モデル精度ではなく「予測結果をどう業務アクションに落とすか」の設計です。
- 予測精度は上がったが、発注担当がExcelから発注を切り替える気にならない
- 予測結果をSAP/Oracleの発注モジュールに渡す配管が組めていない
- 精度モニタリングの責任所在(データサイエンス vs 業務部門)が曖昧
これらは技術論というより組織設計の話で、モデル選定と並行して「予測結果を誰がどう受け取り、どうアクションに変換するか」の運用設計をPoCの最初から握っておくのがコツです。
Prophet/ARIMAから乗り換える場合は、既存の予測プロセスに関わる人と早期に会話するのが特に大事で、モデル精度が上がっても運用側の合意が取れないと採用が止まります。
TimesFMを組み込んだ業務Agent基盤を整えるなら
TimesFMのゼロショット予測は「精度の高い数値を出す」ところまでは短経路で到達できます。
ただし、需要予測・在庫最適化・売上シミュレーションを業務プロセスに組み込むには、予測結果をアクション(発注・生産計画・キャンペーン判断)に変換するAgent層と、権限・監査・ログを統合する運用基盤が必要です。
このレイヤーを担うのが、自社Azureテナント内で動くエンタープライズAIエージェント基盤です。AI総合研究所のAI Agent Hubは、TimesFMのような予測モデルを業務特化Agentとして統合し、Teams上から呼び出せる形で運用できる基盤として機能します。
-
予測モデルを業務Agentとして組み込み
TimesFMをVertex AI・BigQuery ML経由でエンドポイント化し、AI Agent Hubの需要予測Agent・在庫最適化Agentのバックエンドとして統合。Teams上から「来月の需要予測を出して」といった業務チャットで即実行できます。
-
モデル世代交代を吸収する管理層
TimesFM 2.0 → 2.5 → 3.0のような世代交代が起きても、業務Agent側の設計は変わりません。Chronos-2などへの切り替えも吸収でき、特定モデル依存のワークフロー陥落を回避できます。
-
Agent単位でセキュリティ統制を1画面統制
需要データ・売上データを扱うAgentごとにアクセス範囲を設計。誰がどのAgentで何を照会したかを不変ログで残し、監査対応をそのまま提出できる形で保管します。
-
データは100%自社Azureテナント内に保持
売上・在庫・顧客データはAIの学習対象から完全除外。Azure Managed Applicationsとして自社テナント内で動作が完了する設計です。
AI総合研究所の専任チームが、TimesFMを含む時系列基盤モデルの選定から業務Agent基盤の統合設計まで一貫して支援します。AI Agent Hubのサービスページで、時系列予測×業務Agentの実装例をご確認ください。
時系列予測を業務Agentとして運用する
TimesFM推論を業務プロセスに載せる
TimesFMのゼロショット予測を導入しても、需要予測結果を発注・在庫・生産計画のアクションにつなげるレイヤーがないと、精度改善は数字で止まってしまいます。AI Agent Hubは予測モデルをTeams上の業務Agentとして統合し、実行ログ・権限・監査を1画面に集約する運用基盤です。
まとめ
本記事では、TimesFMについて、シリーズの進化系譜・技術的な仕組み・使い方・料金とライセンス・他モデルとの使い分け・導入上の制約・業務活用の設計指針までを、2026年9月時点の最新情報で解説しました。
2026年時点で押さえておくべきポイントは次の3つです。
- TimesFMは大規模時系列で事前学習されたデコーダーオンリーTransformer(従来世代は400B超、3.0は実世界+合成で1兆時点超)で、ゼロショット予測により系列数が多い/コールドスタート系列を大量に扱う用途で構築・保守コストを桁違いに下げる
- 1.0→2.0→2.5→3.0の進化で、単変量特化から多変量+共変量ネイティブ対応へと段階的に拡張されたが、3.0の重みは非商用ライセンスで本番用途はBigQuery ML統合の2.5系(新規タスクのデフォルト・Apache-2.0)が実務推奨
- Google Cloud基盤ならBigQuery ML AI.FORECASTで最短経路、AWSならChronos-2(商用可)、多変量モデルはライセンスと運用経路(Chronos-2は商用可・Moirai 2.0はCC-BY-NC 4.0で研究用途中心)で選ぶ
TimesFMを業務で活かす鍵は、モデル選定そのものよりも**「予測結果をどう業務アクションに変換するか」の運用設計を最初から握ること**です。Prophet/ARIMAからの乗り換えを検討している段階なら、単変量ベースラインでの精度比較→共変量投入の効果測定→業務システム統合の3ステップで進めるのが、AI総研の支援現場で標準的な進め方です。
時系列予測が「モデル訓練問題」から「モデル選択問題」へと変わりつつある2026年、TimesFMシリーズは選択肢の中心として押さえておく価値のあるプロダクトです。