この記事のポイント
 SynthIDは画像・音声・動画・テキスト4形式に対応するGoogle DeepMindの不可視電子透かしで、生成時に自動付与される
- 2026年5月Google I/OでSearch・Chrome統合を発表、同日OpenAIもC2PA Conforming Generator認定+SynthID採用+Verify公開で足並みを揃えた
- 主な確認経路はGemini質問/SynthID Detector Portal/Search・Chrome統合/OpenAI Verifyの4系統(OpenAI VerifyはOpenAI由来コンテンツ限定)
- スクリーンショットや大幅な再圧縮で透かしは弱まり、除去研究も進行中で「検出されない=本物」ではない
- 企業判断は「発信側で埋め込む」「受信側で検証する」「外注クリエイティブに来歴要件」の3方向で設計する
Microsoft MVP・AIパートナー。LinkX Japan株式会社 代表取締役。東京工業大学大学院にて自然言語処理・金融工学を研究。NHK放送技術研究所でAI・ブロックチェーンの研究開発に従事し、国際学会・ジャーナルでの発表多数。経営情報学会 優秀賞受賞。シンガポールでWeb3企業を創業後、現在は企業向けAI導入・DX推進を支援。
SynthID(シンスID)は、Google DeepMindがAI生成物に埋め込む「不可視の電子透かし」を扱う識別技術です。
2026年5月19日、Google I/O 2026がSearch・Chromeへの検証統合を発表、同日OpenAIもC2PA Conforming Generator認定+SynthID採用+Verify公開を打ち出し、AI生成物の来歴・生成経路の検証は業界横断のコンテンツ来歴インフラへと軸足を移し始めました。
本記事では、対応コンテンツ形式と対応プロダクトの全体像、透かしの仕組み、Gemini/SynthID Detector/Search・Chrome統合/OpenAI Verifyの4経路での確認方法、C2PAとの関係、限界と除去攻撃の実態、そして企業実務での判断軸までを、2026年9月時点の最新情報で体系的に解説します。
目次
SynthIDとは?AI生成物に不可視の電子透かしを埋め込む識別技術
SynthIDが対応するコンテンツ形式と対応プロダクトの全体像
SynthIDとC2PAの関係——来歴・生成経路検証の二層設計
SynthIDとは?AI生成物に不可視の電子透かしを埋め込む識別技術
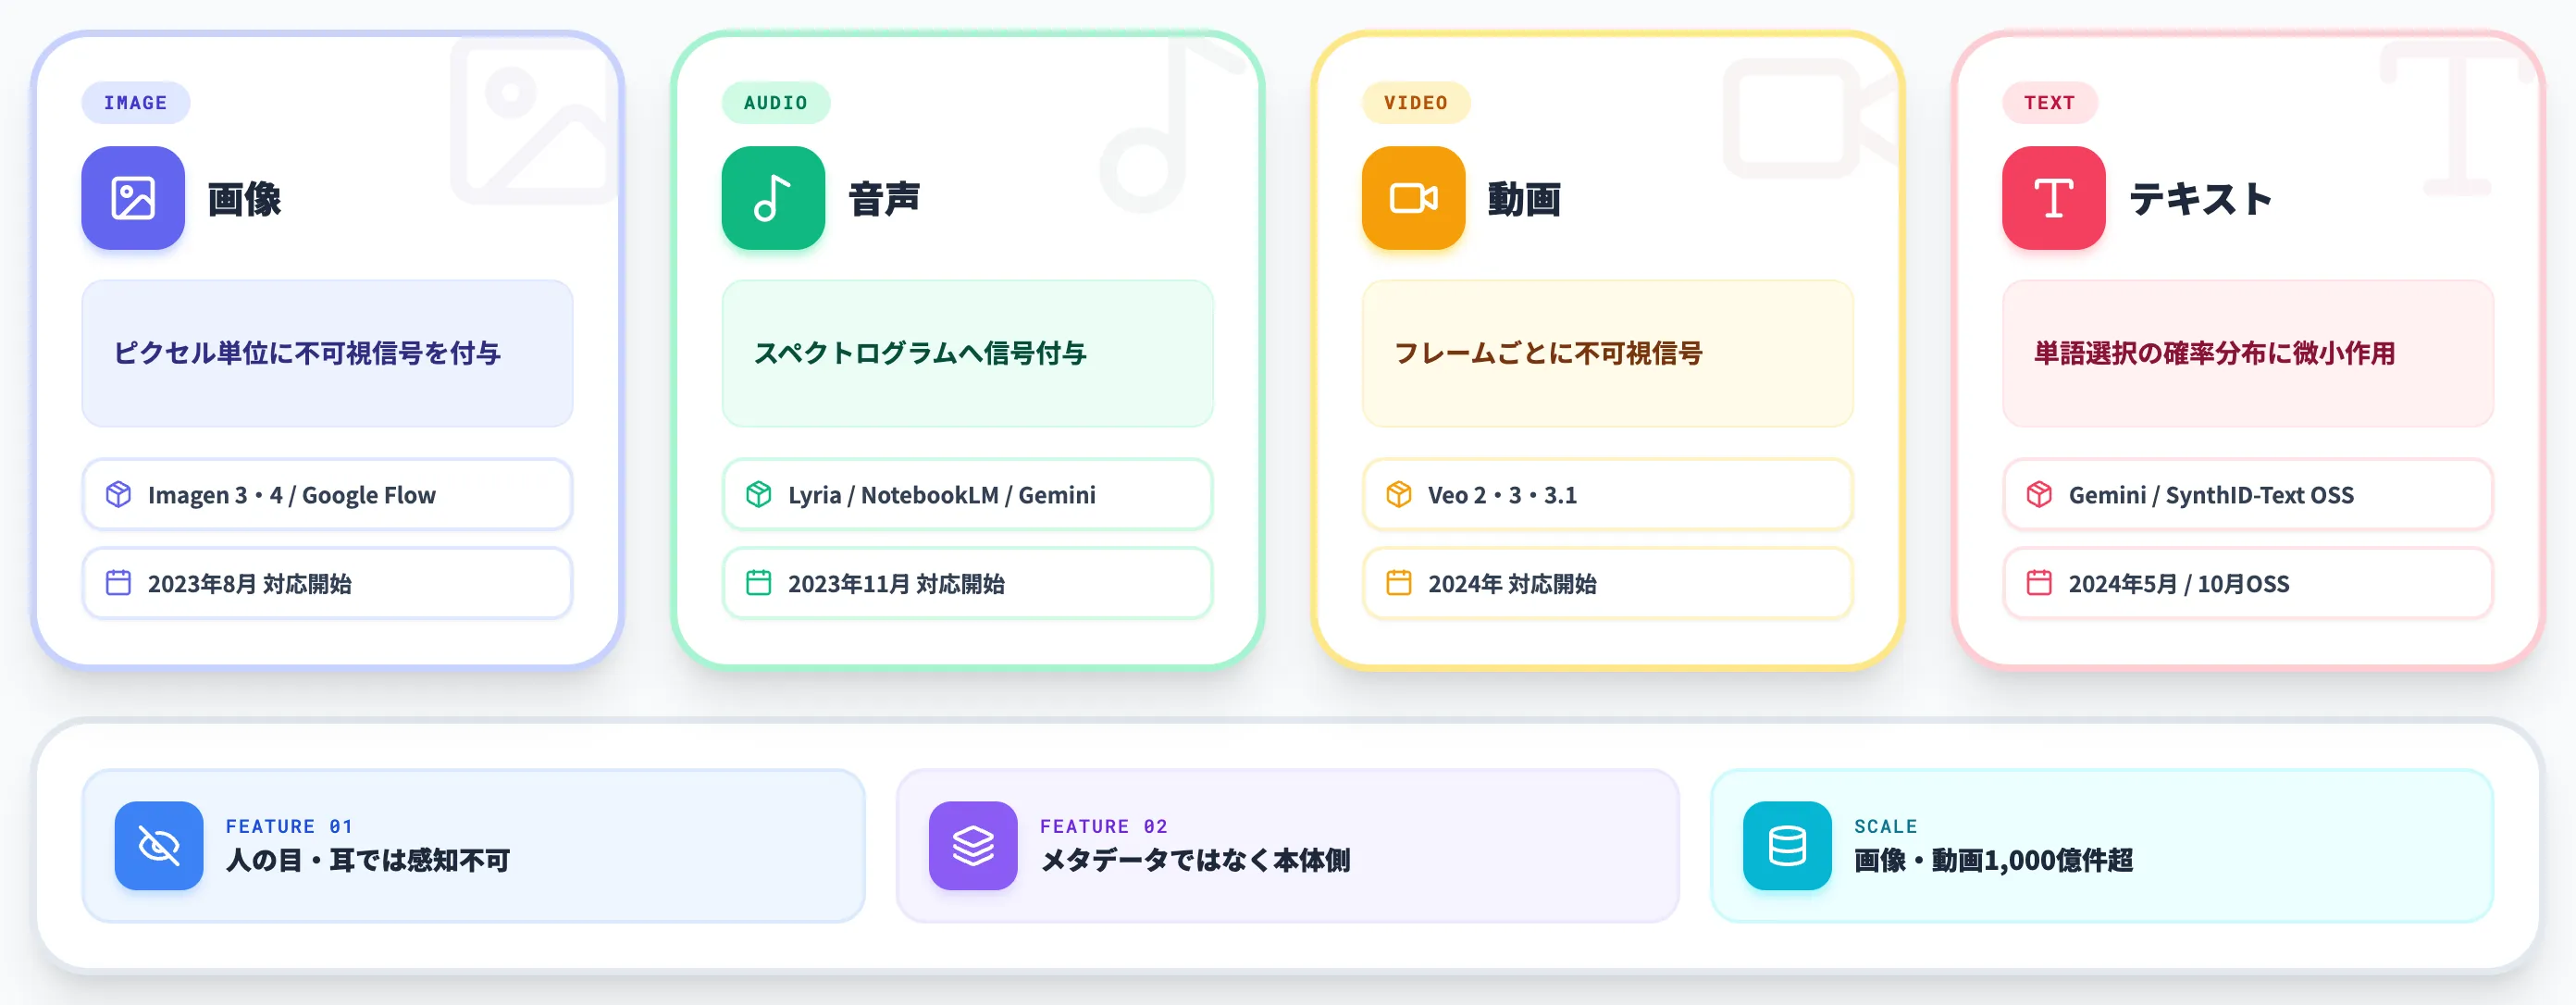
SynthID(シンスID)は、Google DeepMindが2023年8月に発表した、AI生成物に不可視の電子透かしを埋め込むための識別技術です。
画像・音声・動画・テキストの4形式に対応し、ファイルのメタデータではなくコンテンツ本体側に識別子を埋める点が特徴です。
2026年に入って、Google I/O 2026でのSearch・Chrome検証統合やOpenAI・ElevenLabs・Kakao等の採用公表を機に、Google内部技術から業界横断のコンテンツ来歴インフラの一角へと拡大しつつあります。
SynthIDが対応する画像・音声・動画・テキストの4形式を象徴するキービジュアル(出典:Google Blog)
コンテンツ来歴インフラでの位置づけ
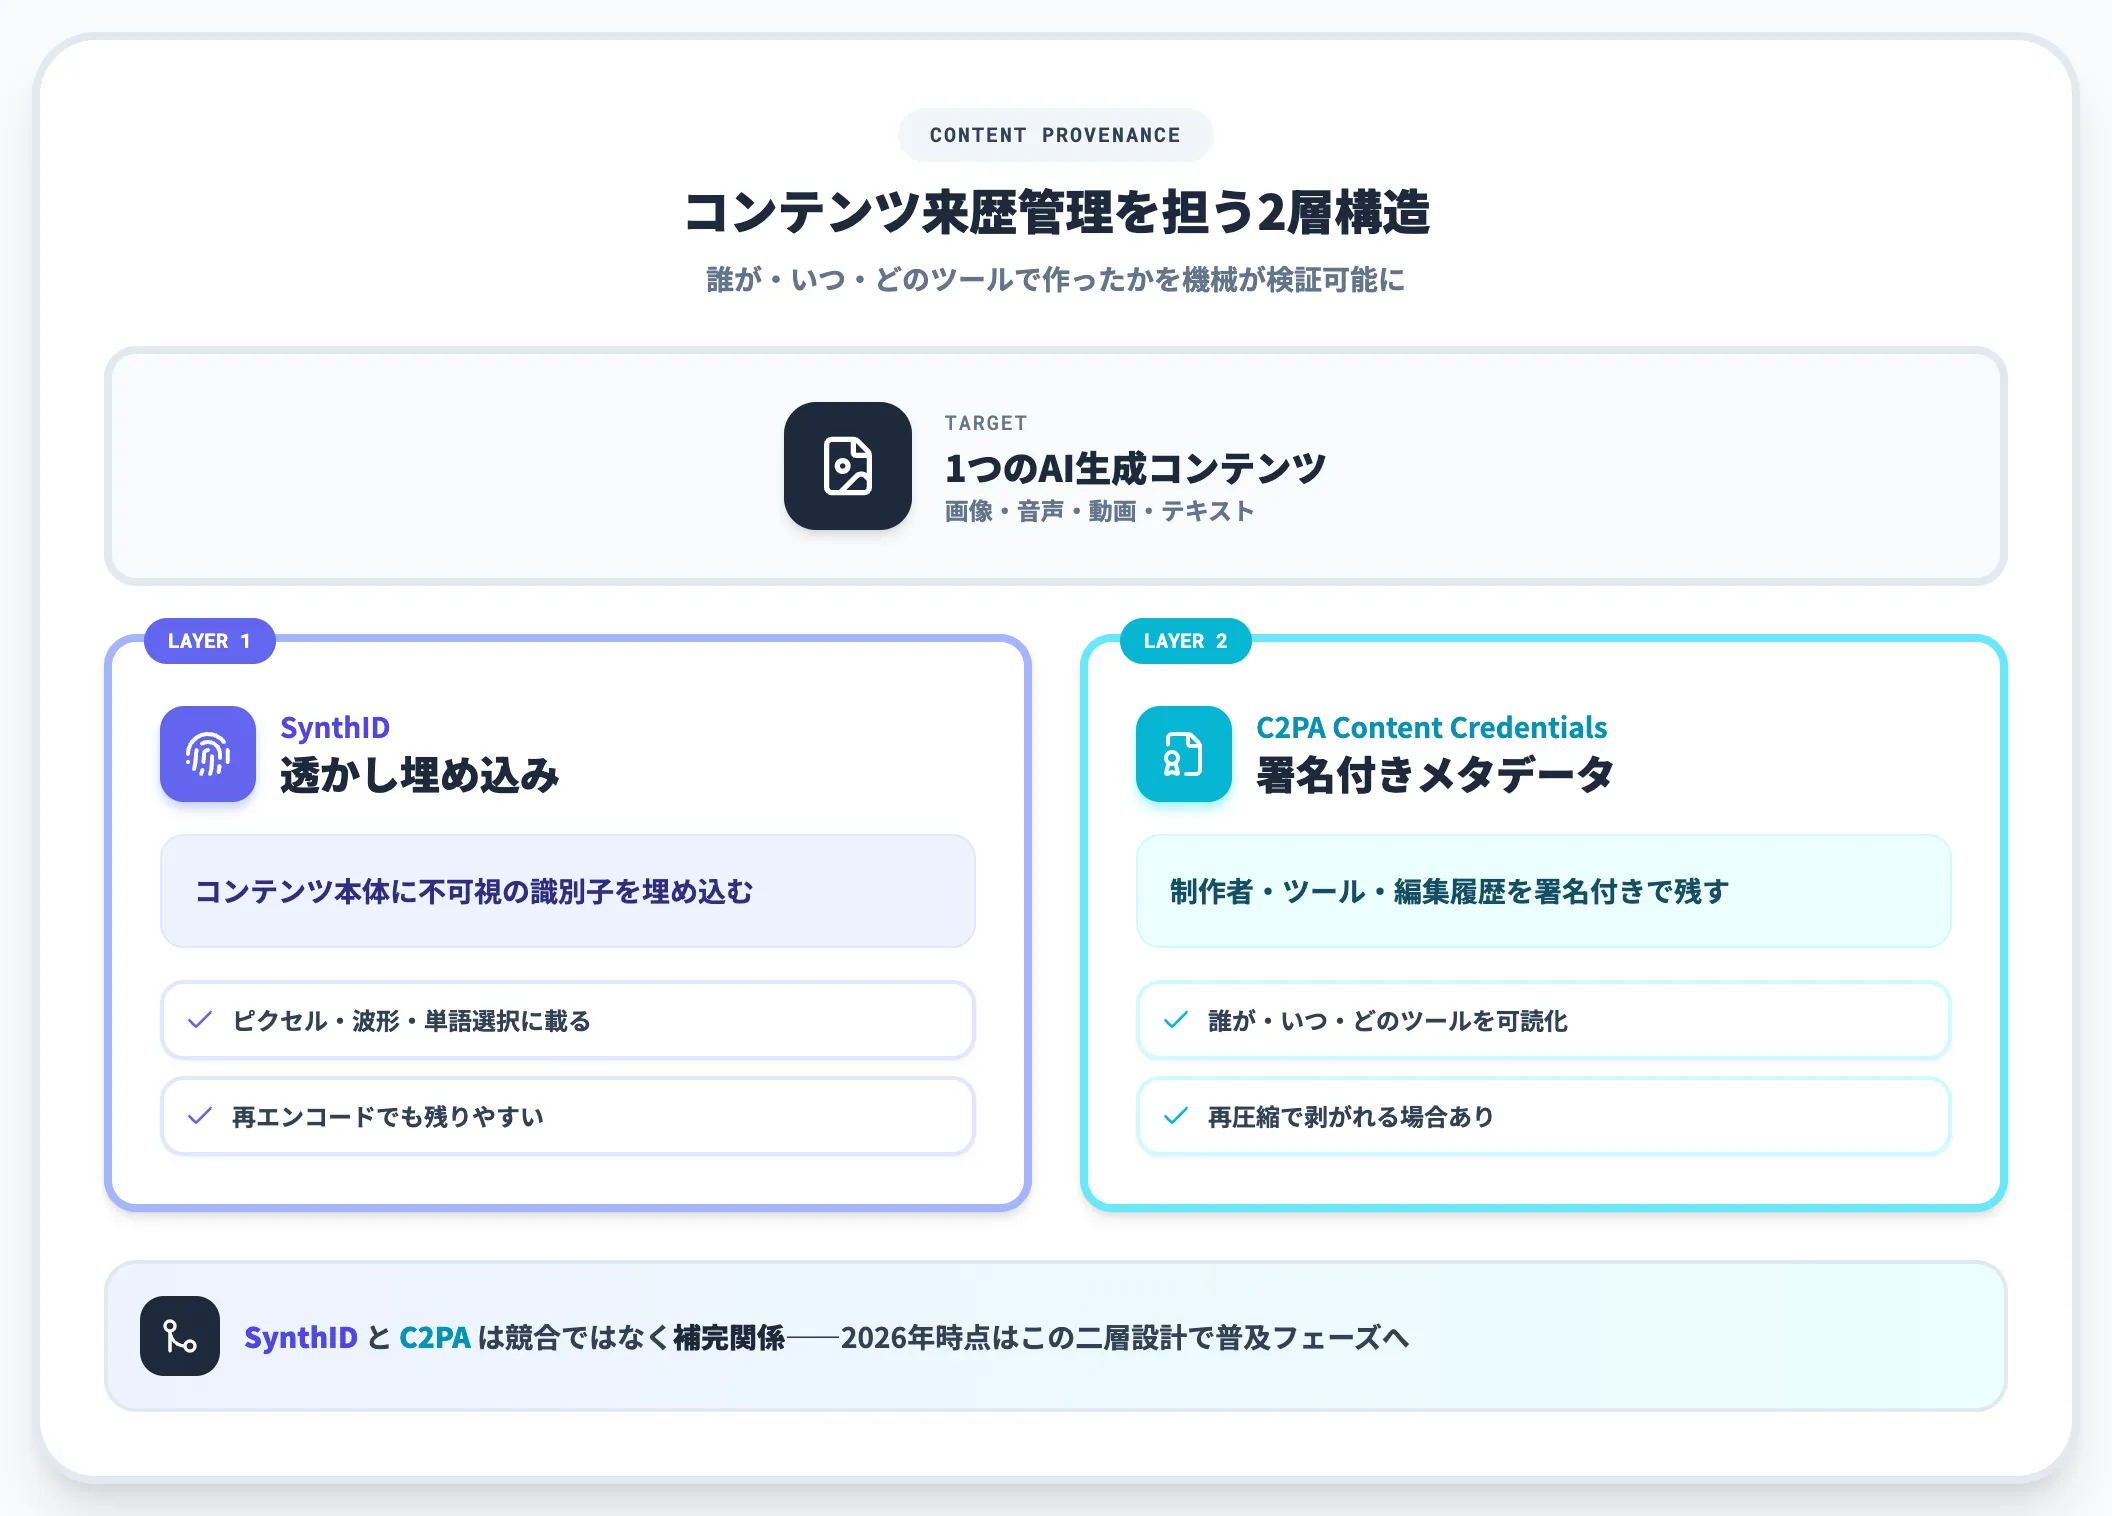
Content Provenance(コンテンツ来歴)とは、あるコンテンツがいつ・どのツールで・誰の手で作られたかを、機械が検証できる形で追跡可能にする仕組みです。生成AIの普及で「見た目では本物と区別がつかないコンテンツ」が急増したことで、コンテンツ来歴は2020年代後半のインフラ論点として一気に前景化しました。
SynthIDはこの来歴管理を「コンテンツ本体に透かしを埋める」レイヤーで担い、後述のC2PAは「暗号署名付きメタデータでコンテンツの制作履歴を残す」レイヤーを担います。2026年時点で両者は競合ではなく補完関係として設計されており、後段のセクションで詳しく整理します。
Google DeepMindによれば、SynthID発表以降にウォーターマークが埋め込まれた画像・動画は1,000億件を超え、音声は累計60,000年分に到達しています。
この規模は、SynthIDが単発の研究プロジェクトではなく、Googleの生成AIプロダクト群の標準機能として定着していることを示します。
SynthIDが対応するコンテンツ形式と対応プロダクトの全体像
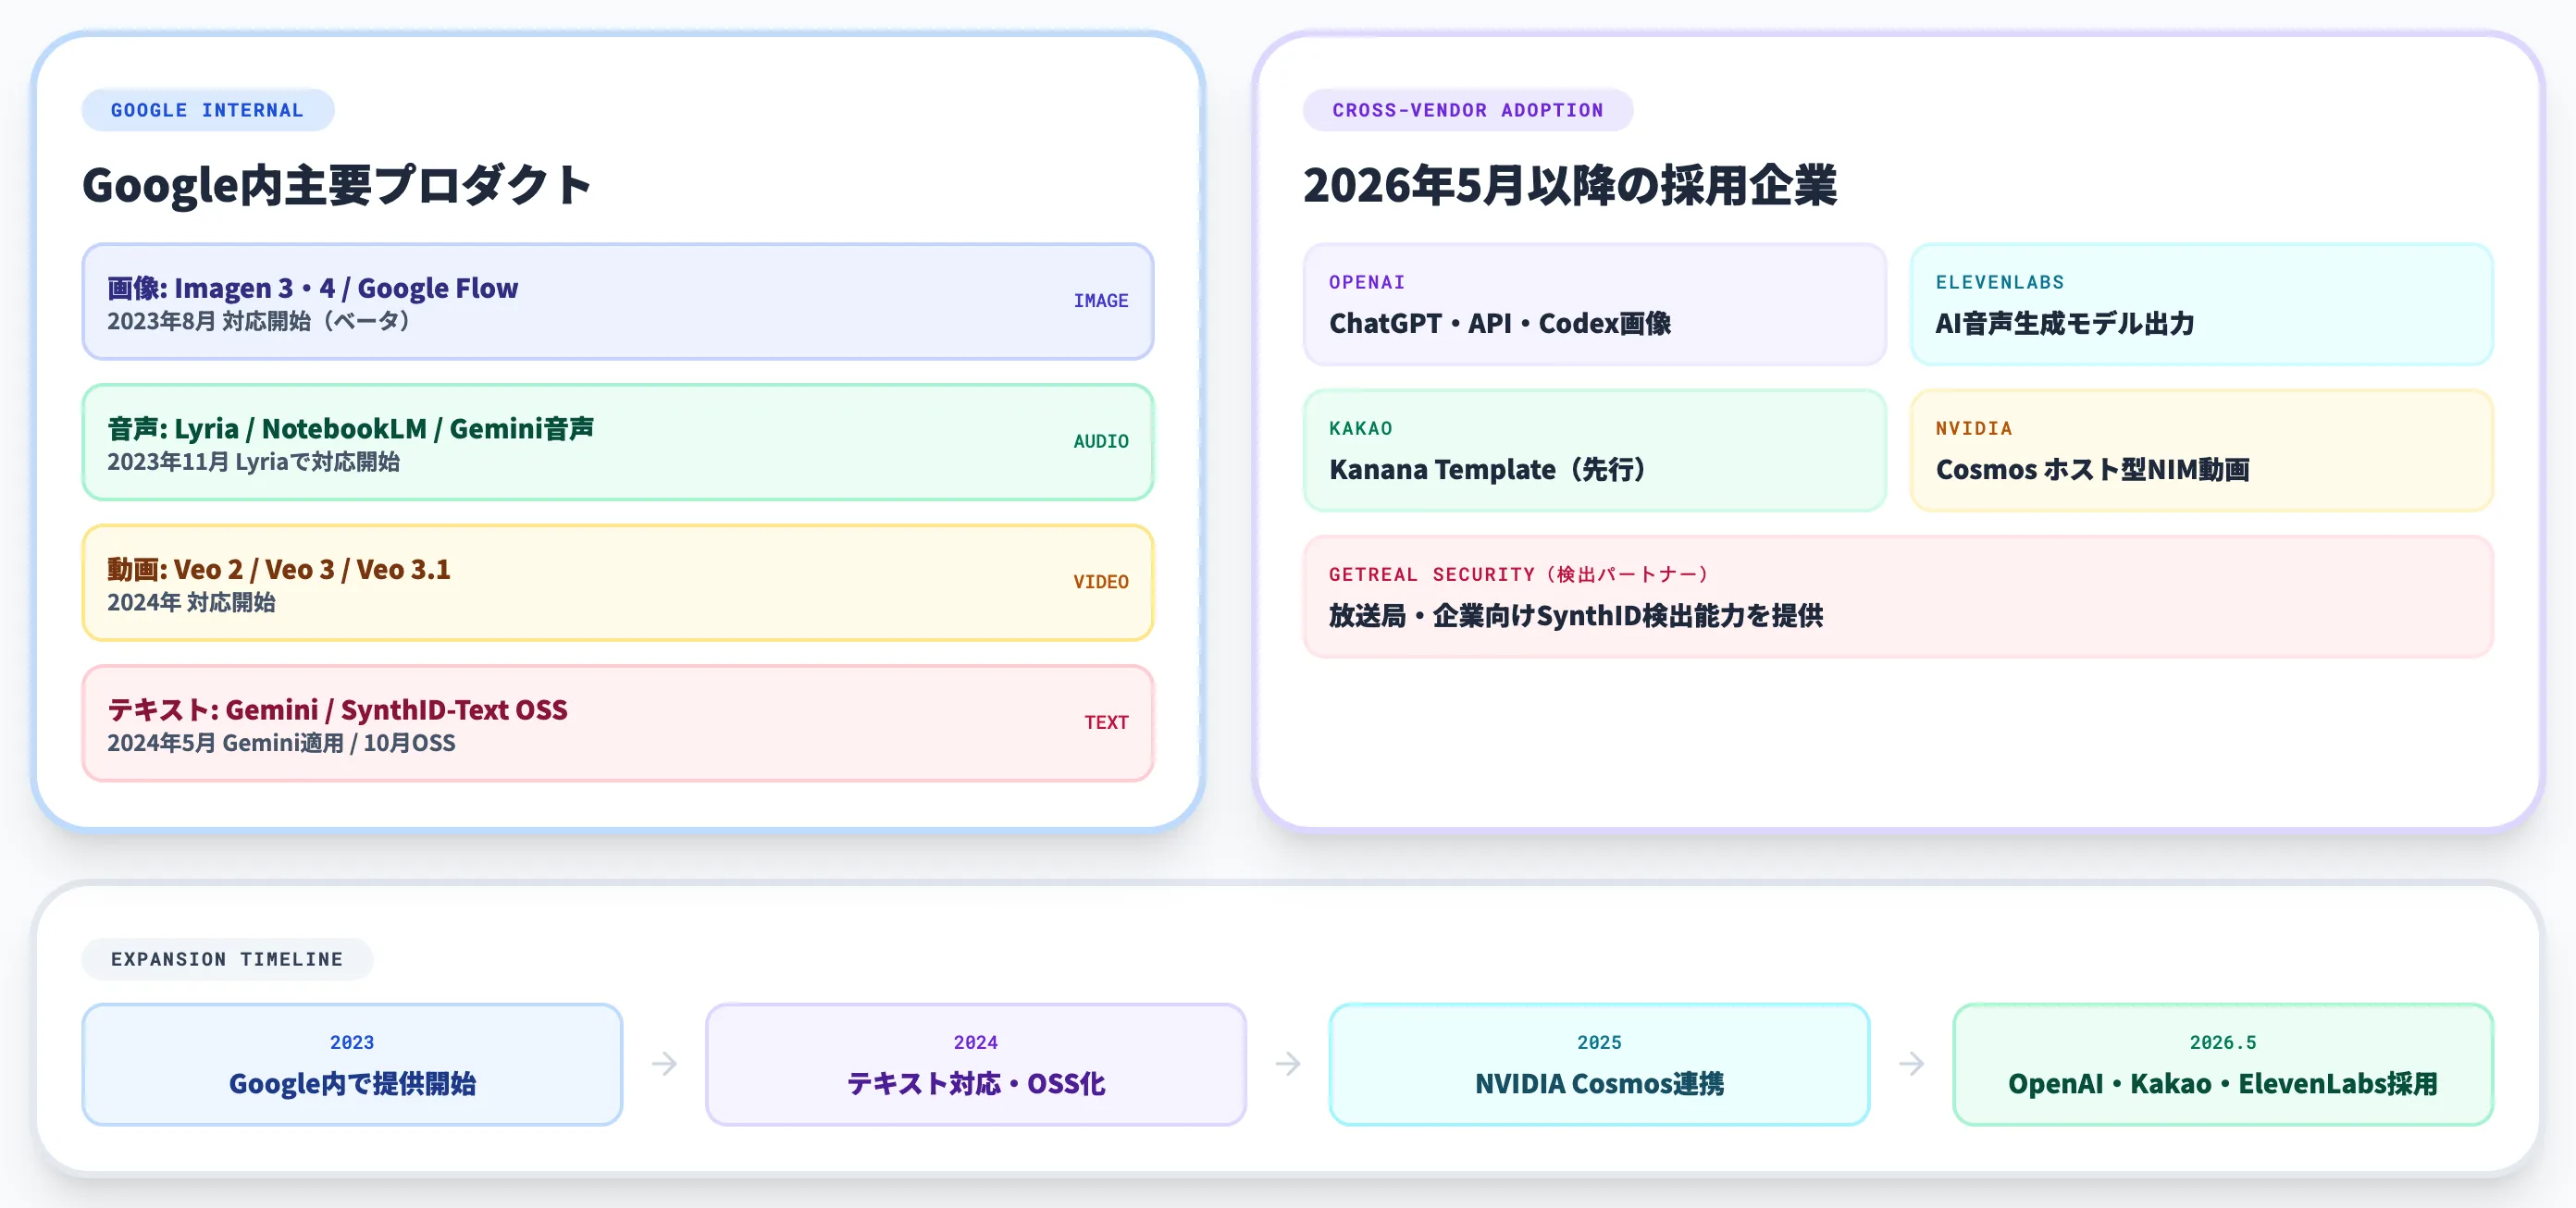
ここからは、SynthIDが具体的にどのコンテンツ形式・どの生成プロダクトに組み込まれているのかを、Google内プロダクトと外部パートナーの両面から整理します。
対応範囲は2023年8月の画像から始まり、2023年11月に音声(Lyria)、2024年5月にテキスト(Geminiへの適用)、その後動画への拡大と続き、テキストは2024年10月にOSS公開されました。
NVIDIAとのCosmos連携は2025年に、OpenAI・ElevenLabs・Kakaoによる新規採用は2026年5月にそれぞれ公表されています。全体像を掴んでおくと、後段の「どこで検出できるか」「どこに透かしが乗っているか」の判断が早くなります。
4つのコンテンツ形式への対応状況
以下の表で、SynthIDが対応する4形式と、それぞれのGoogle内主要プロダクトを整理しました。
| コンテンツ形式 | 主なGoogleプロダクト | 対応開始時期 |
|---|---|---|
| 画像 | Imagen 3・Imagen 4、Google Flow | 2023年8月(ベータ) |
| 音声 | Lyria、NotebookLMポッドキャスト機能、Gemini音声出力 | 2023年11月(Lyria) |
| 動画 | Veo 2・Veo 3・Veo 3.1 | 2024年 |
| テキスト | Geminiアプリ・Web、SynthID-Text(OSS) | 2024年5月(Gemini適用)/10月(OSS公開) |
4形式のうち、テキストのみ2024年10月にオープンソース化されており、自社の言語モデルにも組み込めます。画像・音声・動画については現時点でGoogle AIプロダクトおよび公式パートナー経由での埋め込みに限定されます。
Google内ではImagen 3・Veo・Lyria・NotebookLM・Geminiが標準搭載しているため、上記の対応プロダクトから出力されるコンテンツにはユーザーが意識しなくても透かしが乗っている状態です。
クロスベンダーで広がる採用企業
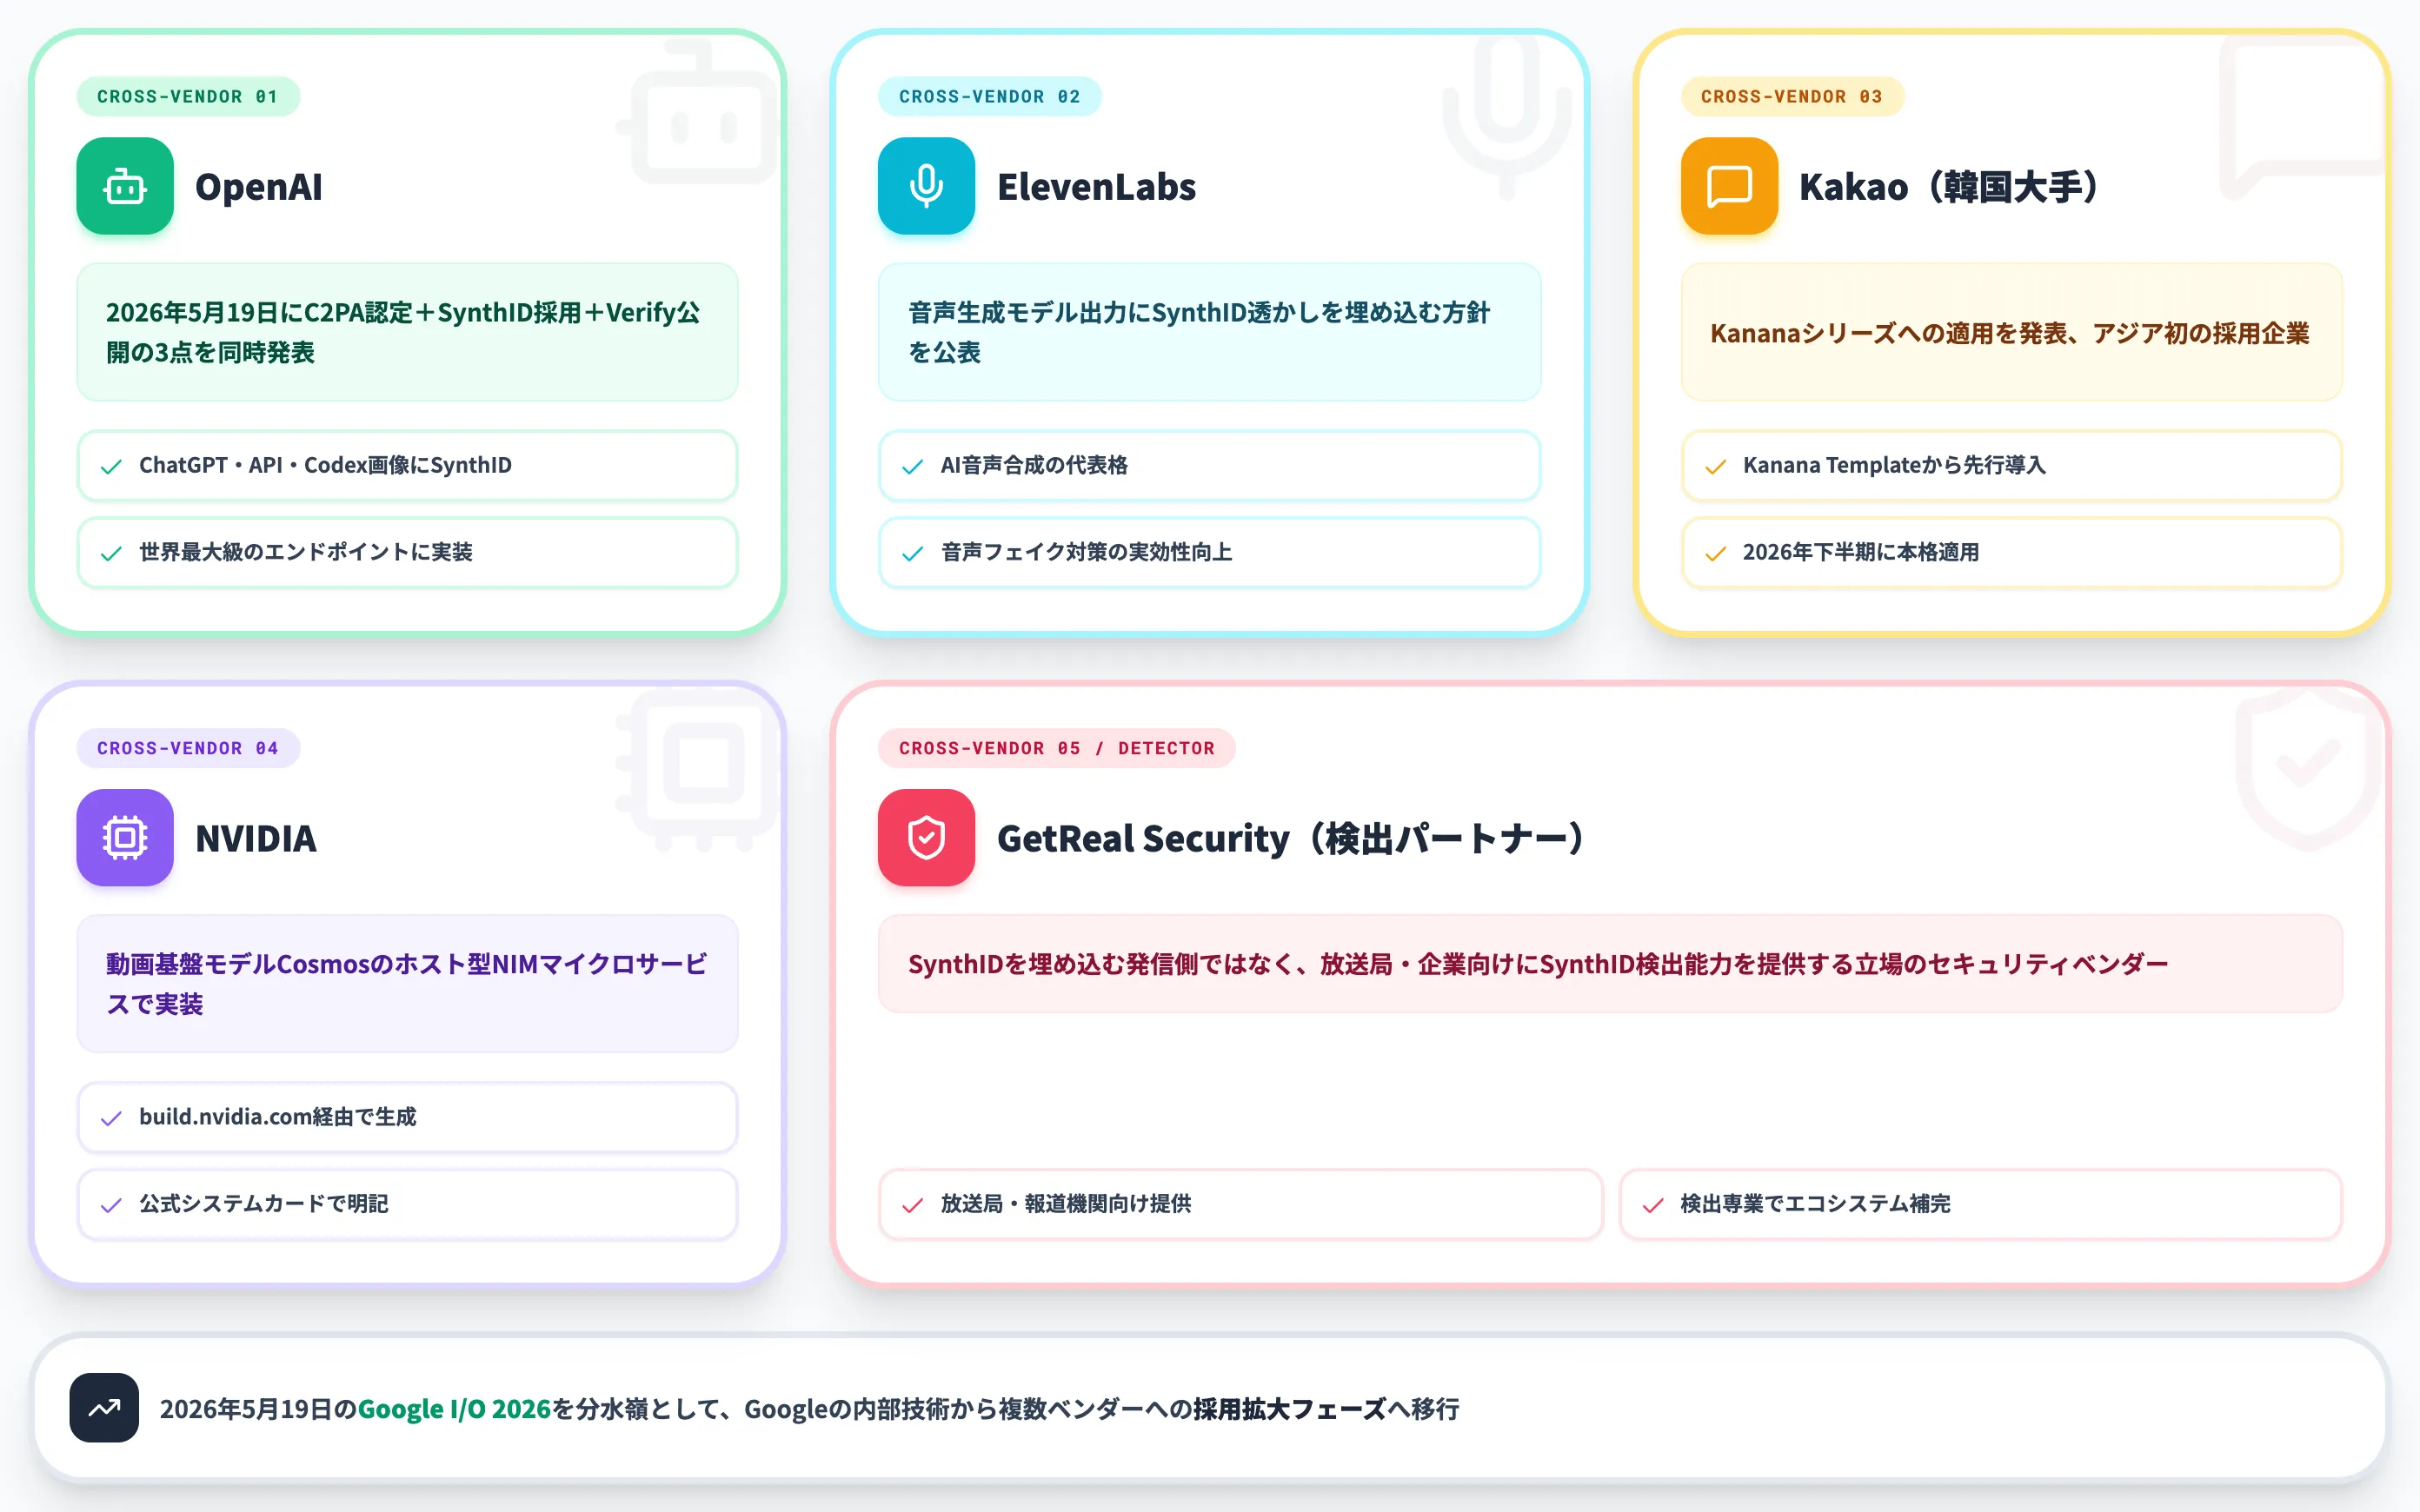
2026年5月19日のGoogle I/O 2026を分水嶺として、SynthIDはGoogleの内部技術から複数ベンダーへの採用が拡大するフェーズに入りました。以下の企業が採用を公表しています。
-
OpenAI
OpenAIは2024年5月にC2PA運営委員会(Steering Committee)に加入済みで、2026年5月19日にはC2PA Conforming Generator認定+SynthID採用+Verify公開の3点を同時発表。ChatGPT・OpenAI API・Codex経由で生成される画像にSynthID透かしが載る
-
ElevenLabs
音声生成モデル出力にSynthID透かしを埋め込む方針を公表。AI音声合成の代表格である同社の参加は、音声フェイク対策の実効性を大きく引き上げる
-
Kakao
韓国大手IT企業。自社AIモデル「Kanana」シリーズへのSynthID適用を発表し、KakaoTalk向けのAI動画生成「Kanana Template」から先行導入、画像モデル「Kanana Collage」と動画モデル「Kanana Kinema」への本格適用は2026年下半期以降の計画
-
NVIDIA
動画基盤モデル「NVIDIA Cosmos」のホスト型NIMマイクロサービス(build.nvidia.com経由)が生成する動画にSynthIDを埋め込む点が公式のシステムカードで示されている
-
GetReal Security
セキュリティベンダー側の検出パートナー。SynthIDを埋め込む発信側ではなく、放送局・企業向けにSynthID検出能力を提供する立場
特に重要なのはOpenAIの参加です。ChatGPT・DALL-E系画像生成は世界で最も広く使われているエンドポイントの一つで、この経路にSynthIDが乗ることで、来歴が付いたまま流通するAI生成画像の割合が増えていく見通しです。
OpenAIの姿勢転換——独自検出器から透かし+来歴へ
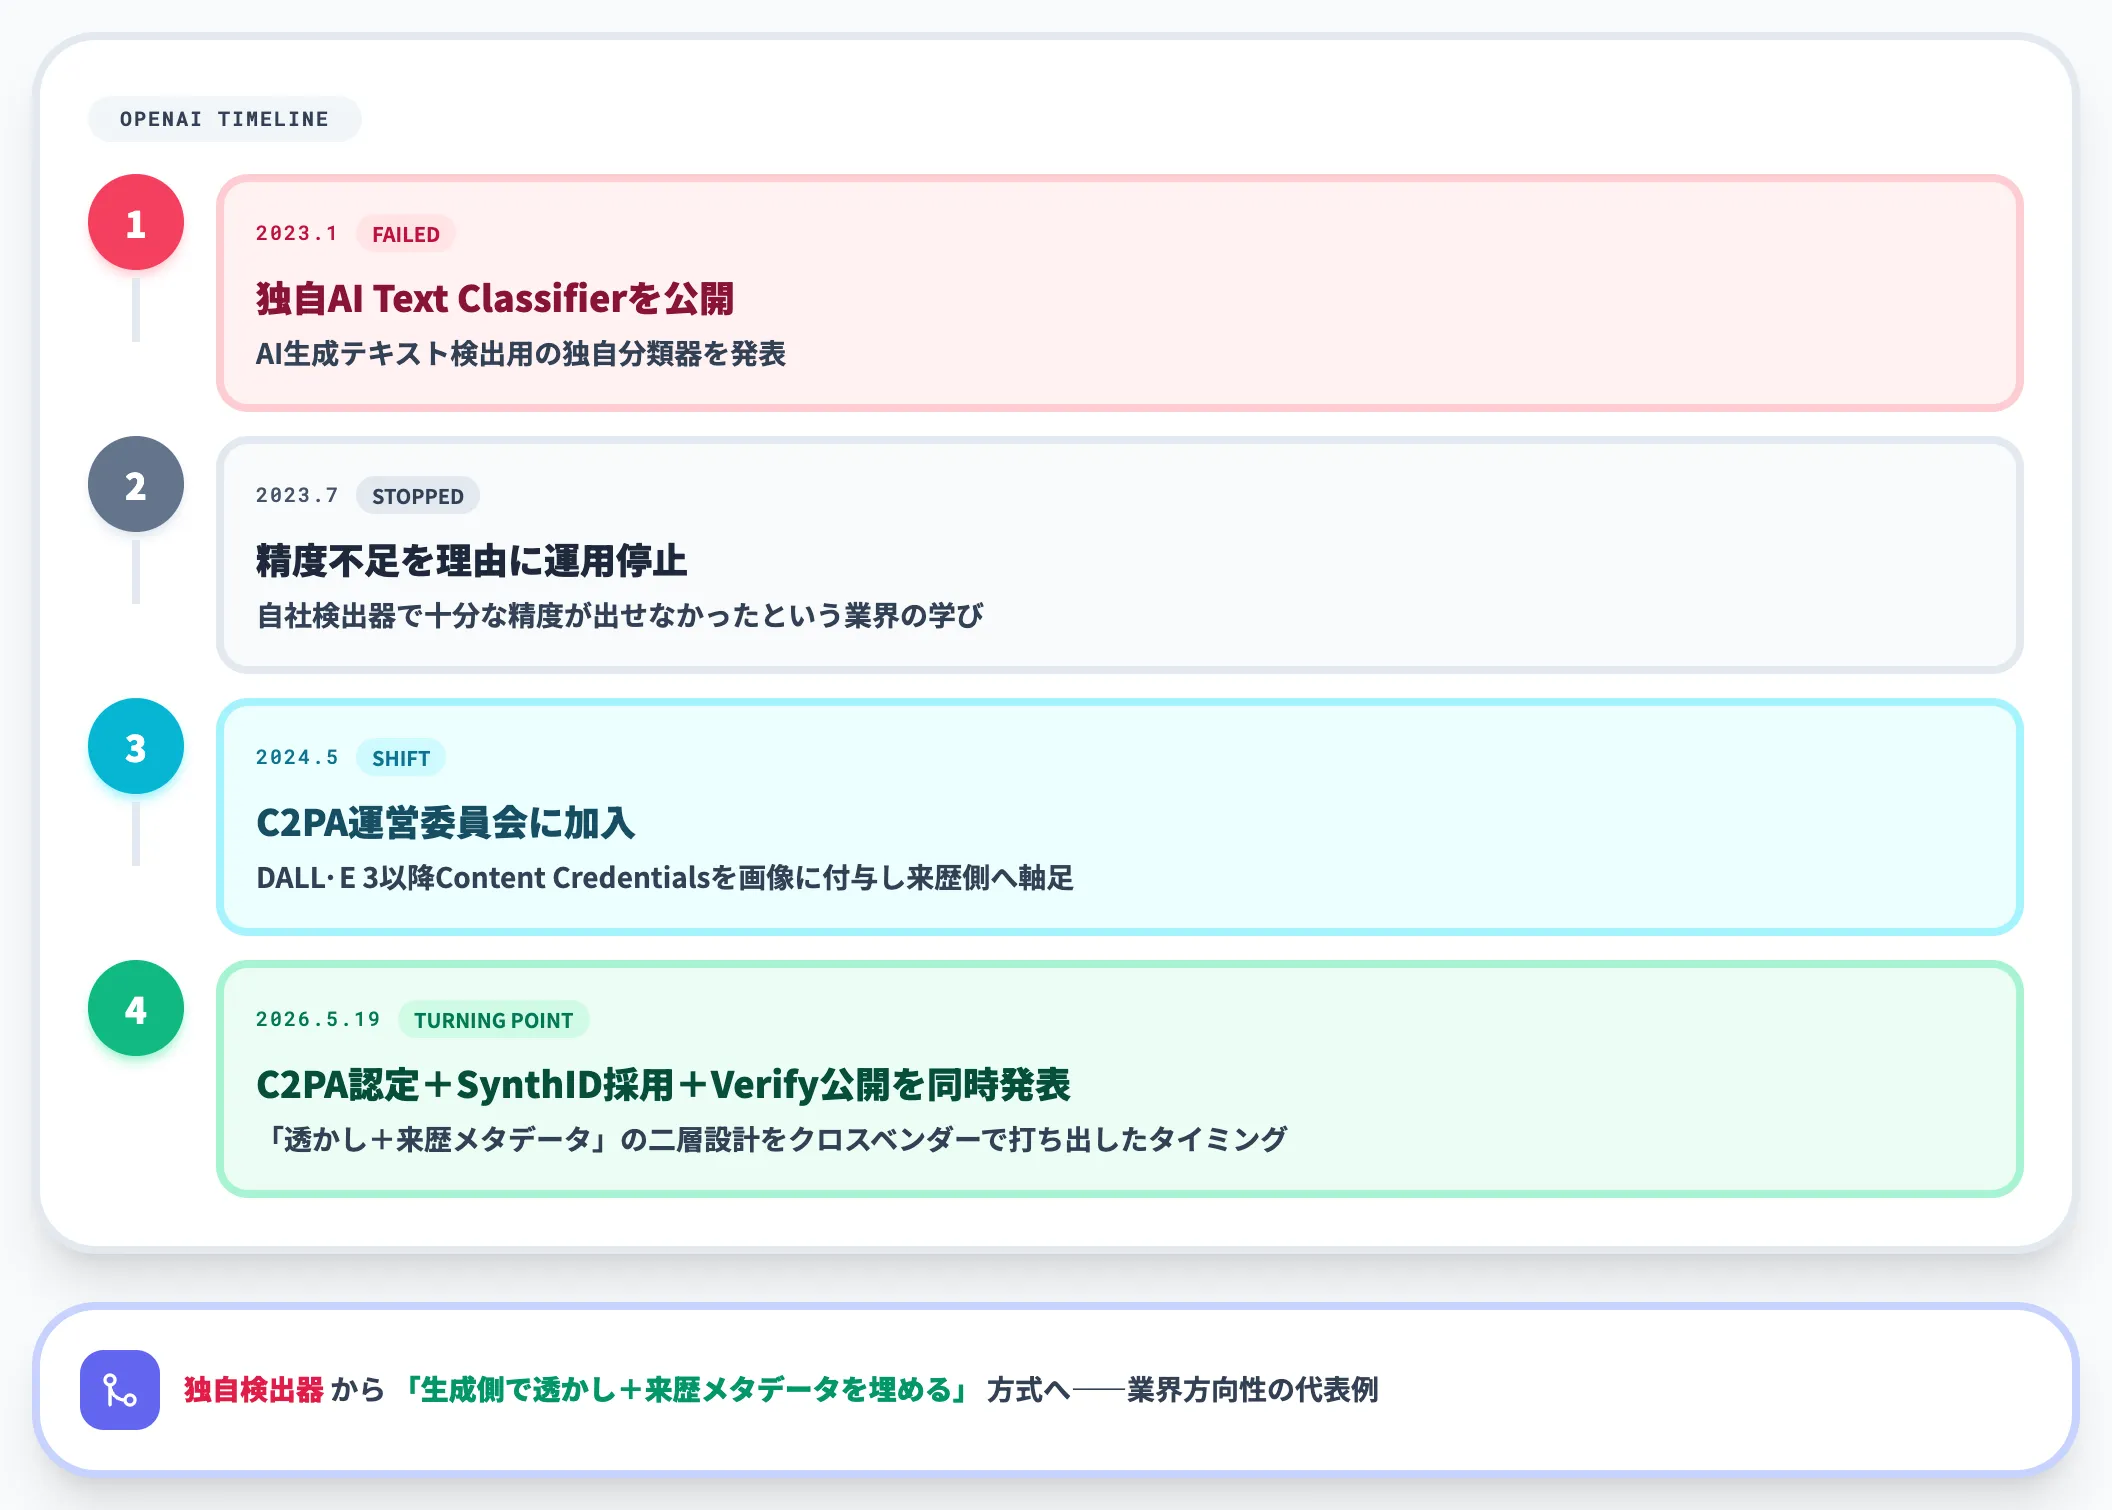
OpenAIは2023年1月に独自のAI Text Classifierを公開しましたが、精度不足を理由に2023年7月に運用停止しています。以降OpenAIは公開検出器を出さず、「text provenanceは研究中」という姿勢を続けてきました。
OpenAIはC2PA運営委員会には2024年5月に加入しており、DALL·E 3以降はContent Credentialsによる来歴メタデータを画像に付けてきました。
2026年5月19日はその延長線上で「C2PA Conforming Generatorとしての正式認定+SynthID採用による透かしレイヤー追加+公開検証ツールVerifyの公開」を一斉に打ち出したタイミングです。
自社検出器では十分な精度が出せなかったという業界の学びを踏まえ、生成側で透かしと来歴メタデータを埋める方式が2026年時点で採用が広がる方向性の一つになっている、という文脈で理解しておくと、後段のC2PA二層設計の話が繋がりやすくなります。
SynthIDの仕組み——埋め込みと検出のアーキテクチャ
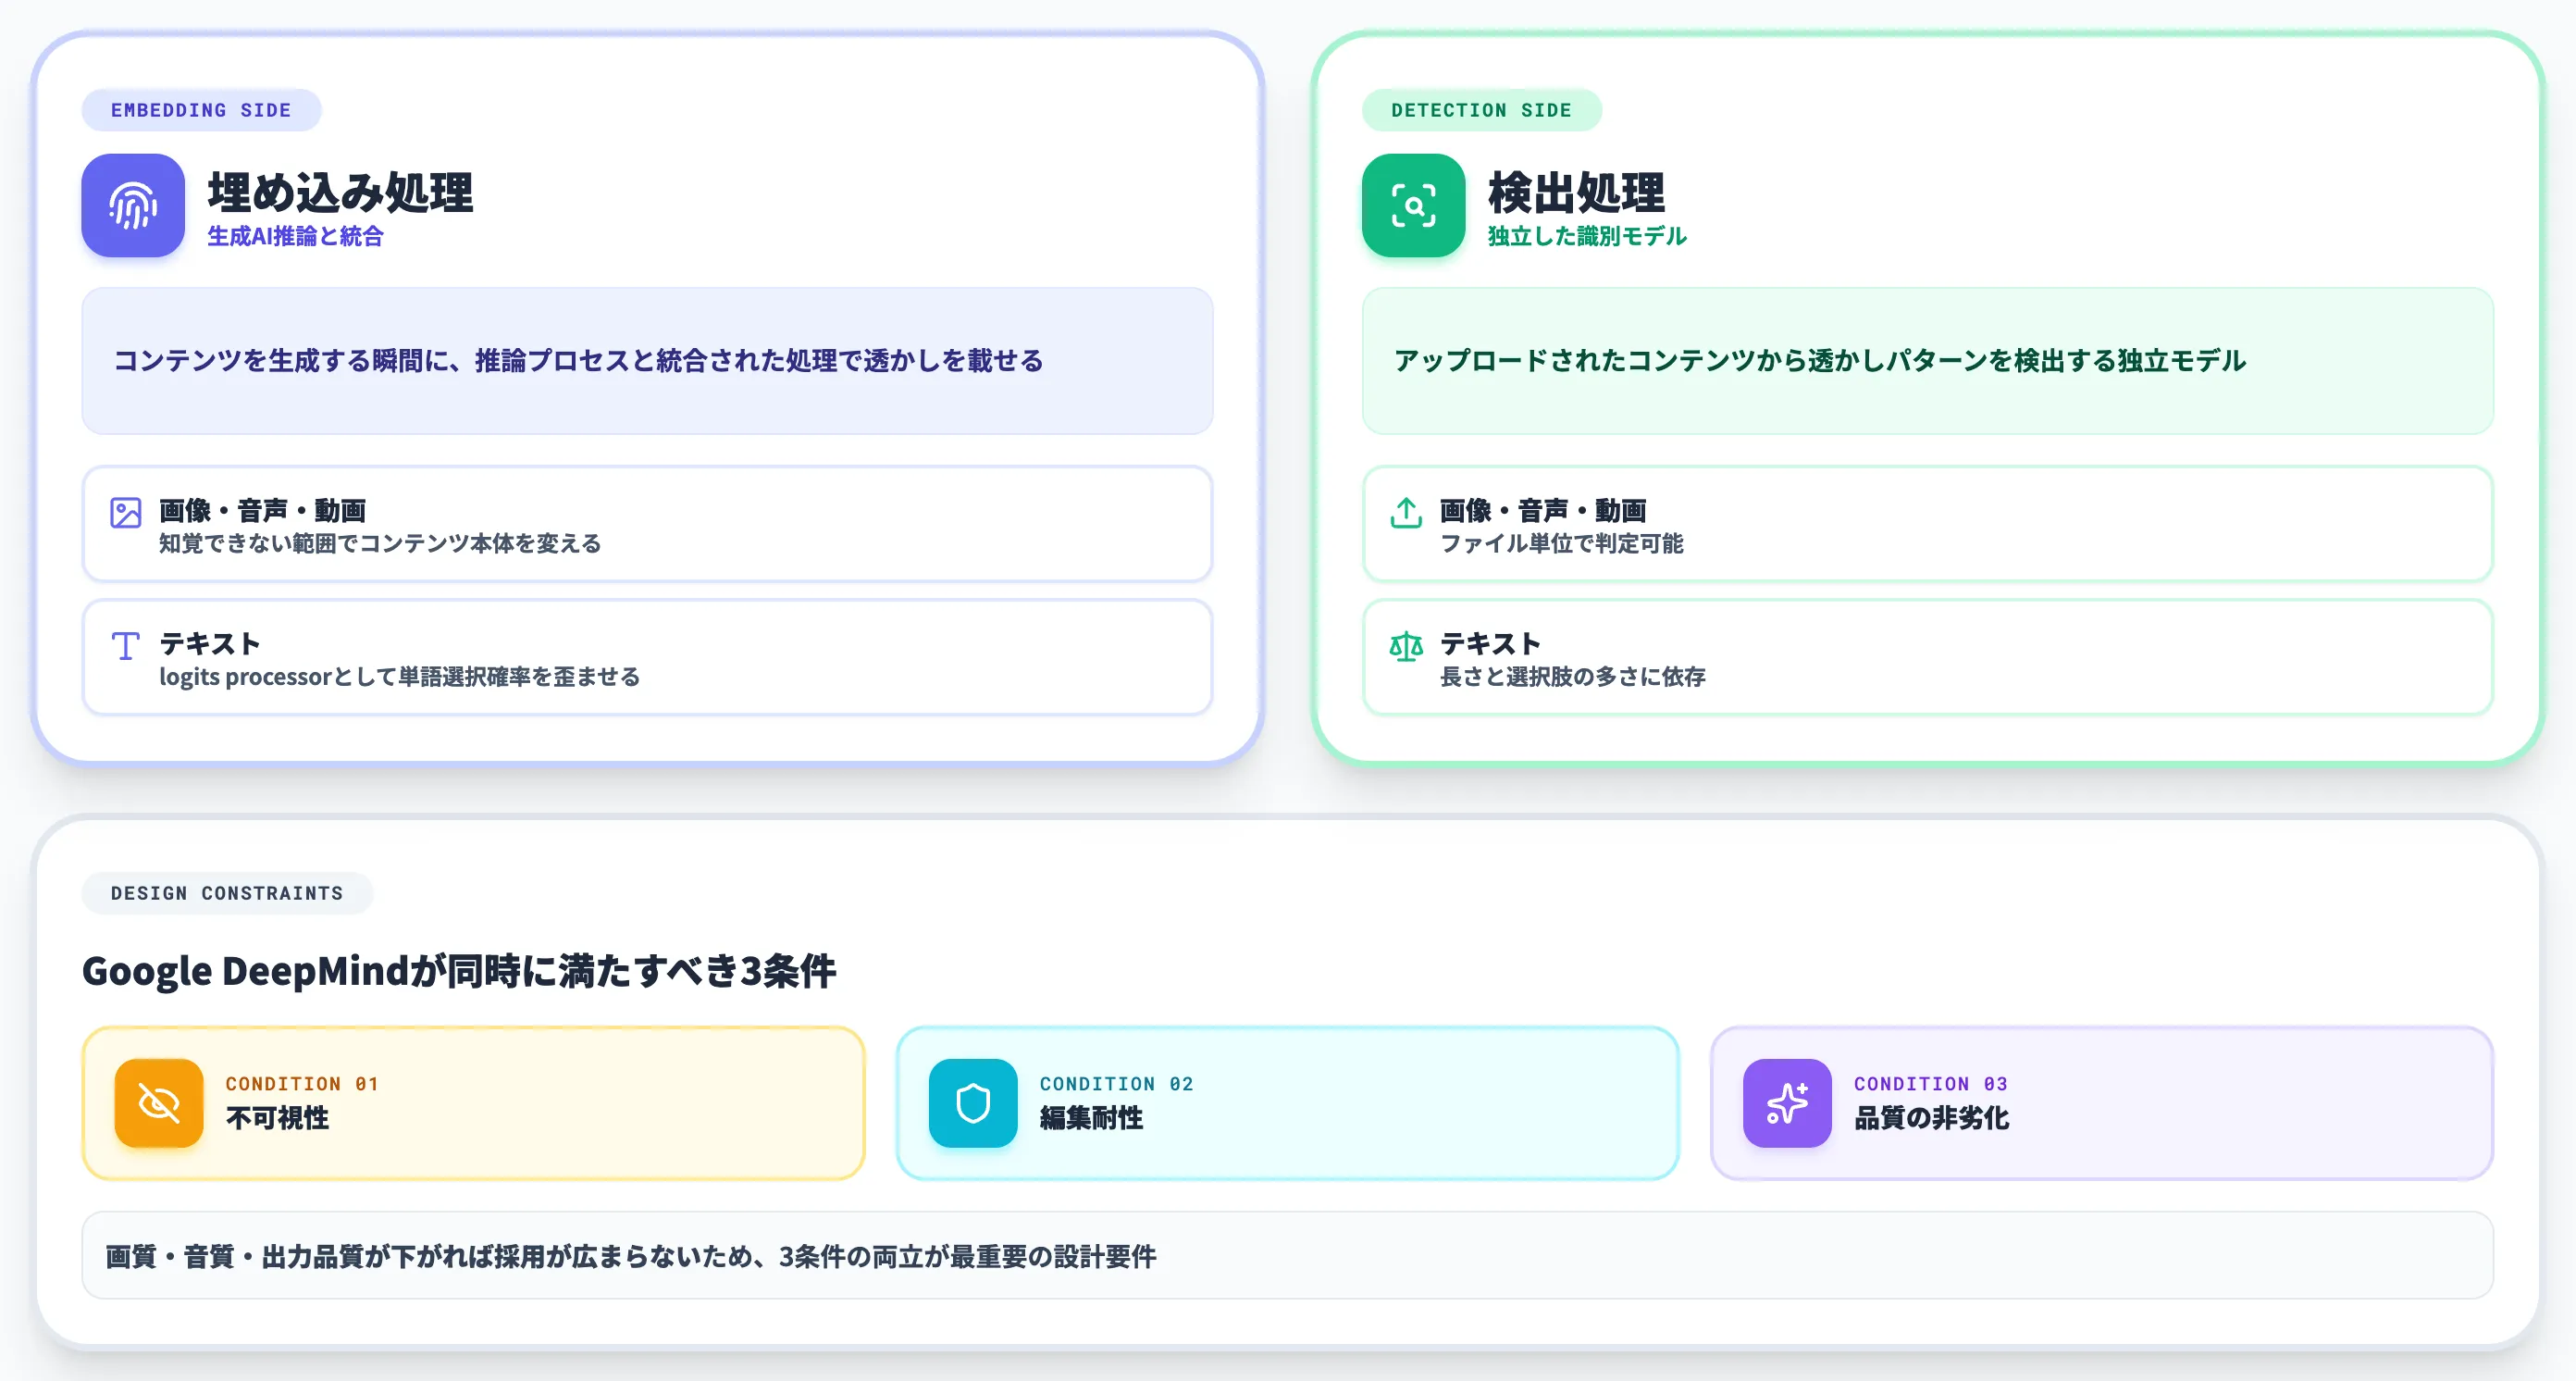
SynthIDの技術的な骨格は、生成時に不可視の識別子を埋め込む処理と、アップロードされたコンテンツを解析して識別子を読み取る処理の2段で構成されています。
ただしモダリティ(形式)によって埋め込み方が根本的に違うため、「1つの技術」というより「4つのアプローチを束ねた技術群」に近いのが実態です。
モダリティ別の埋め込み方式
以下の表で、4形式それぞれで透かしがどう埋め込まれるかを整理しました。
| 形式 | 公式が説明する埋め込みレイヤー | 耐えられる編集 | 苦手な編集 |
|---|---|---|---|
| 画像 | ピクセルへの不可視な信号付与 | クロップ・色調補正・非可逆圧縮・軽度のノイズ付加 | スクリーンショットの繰り返し・大幅な再構築 |
| 音声 | スペクトログラム(時間×周波数)への信号付与 | MP3圧縮・ノイズ・区間切り出し | 大幅な音源加工・別音源への差し替え |
| 動画 | 各フレームのピクセルへの信号付与 | フレームレート変更・部分編集 | 大幅リエンコード・別動画への合成 |
| テキスト | 単語選択時のトークン確率分布への微小な作用 | 一部の言い換え・十分な長さのある引用 | 全文の翻訳・大幅な書き換え |
この表が示すように、透かしの物理的な載り方は形式ごとに全く違います。画像・音声・動画は「人間の知覚では捉えられない範囲でコンテンツ本体を変える」ことで透かしを残し、テキストは「生成AIが次の単語を選ぶ確率をわずかに歪める」ことで統計的な痕跡を残します。
つまり画像・音声・動画のSynthID透かしはファイル単位の検出処理で判定できるよう設計されていますが、テキストは長さと選択肢の多さに依存するため、短文・大幅編集後のテキストは判定困難になる場合があります。
埋め込み処理と検出処理の2段構成
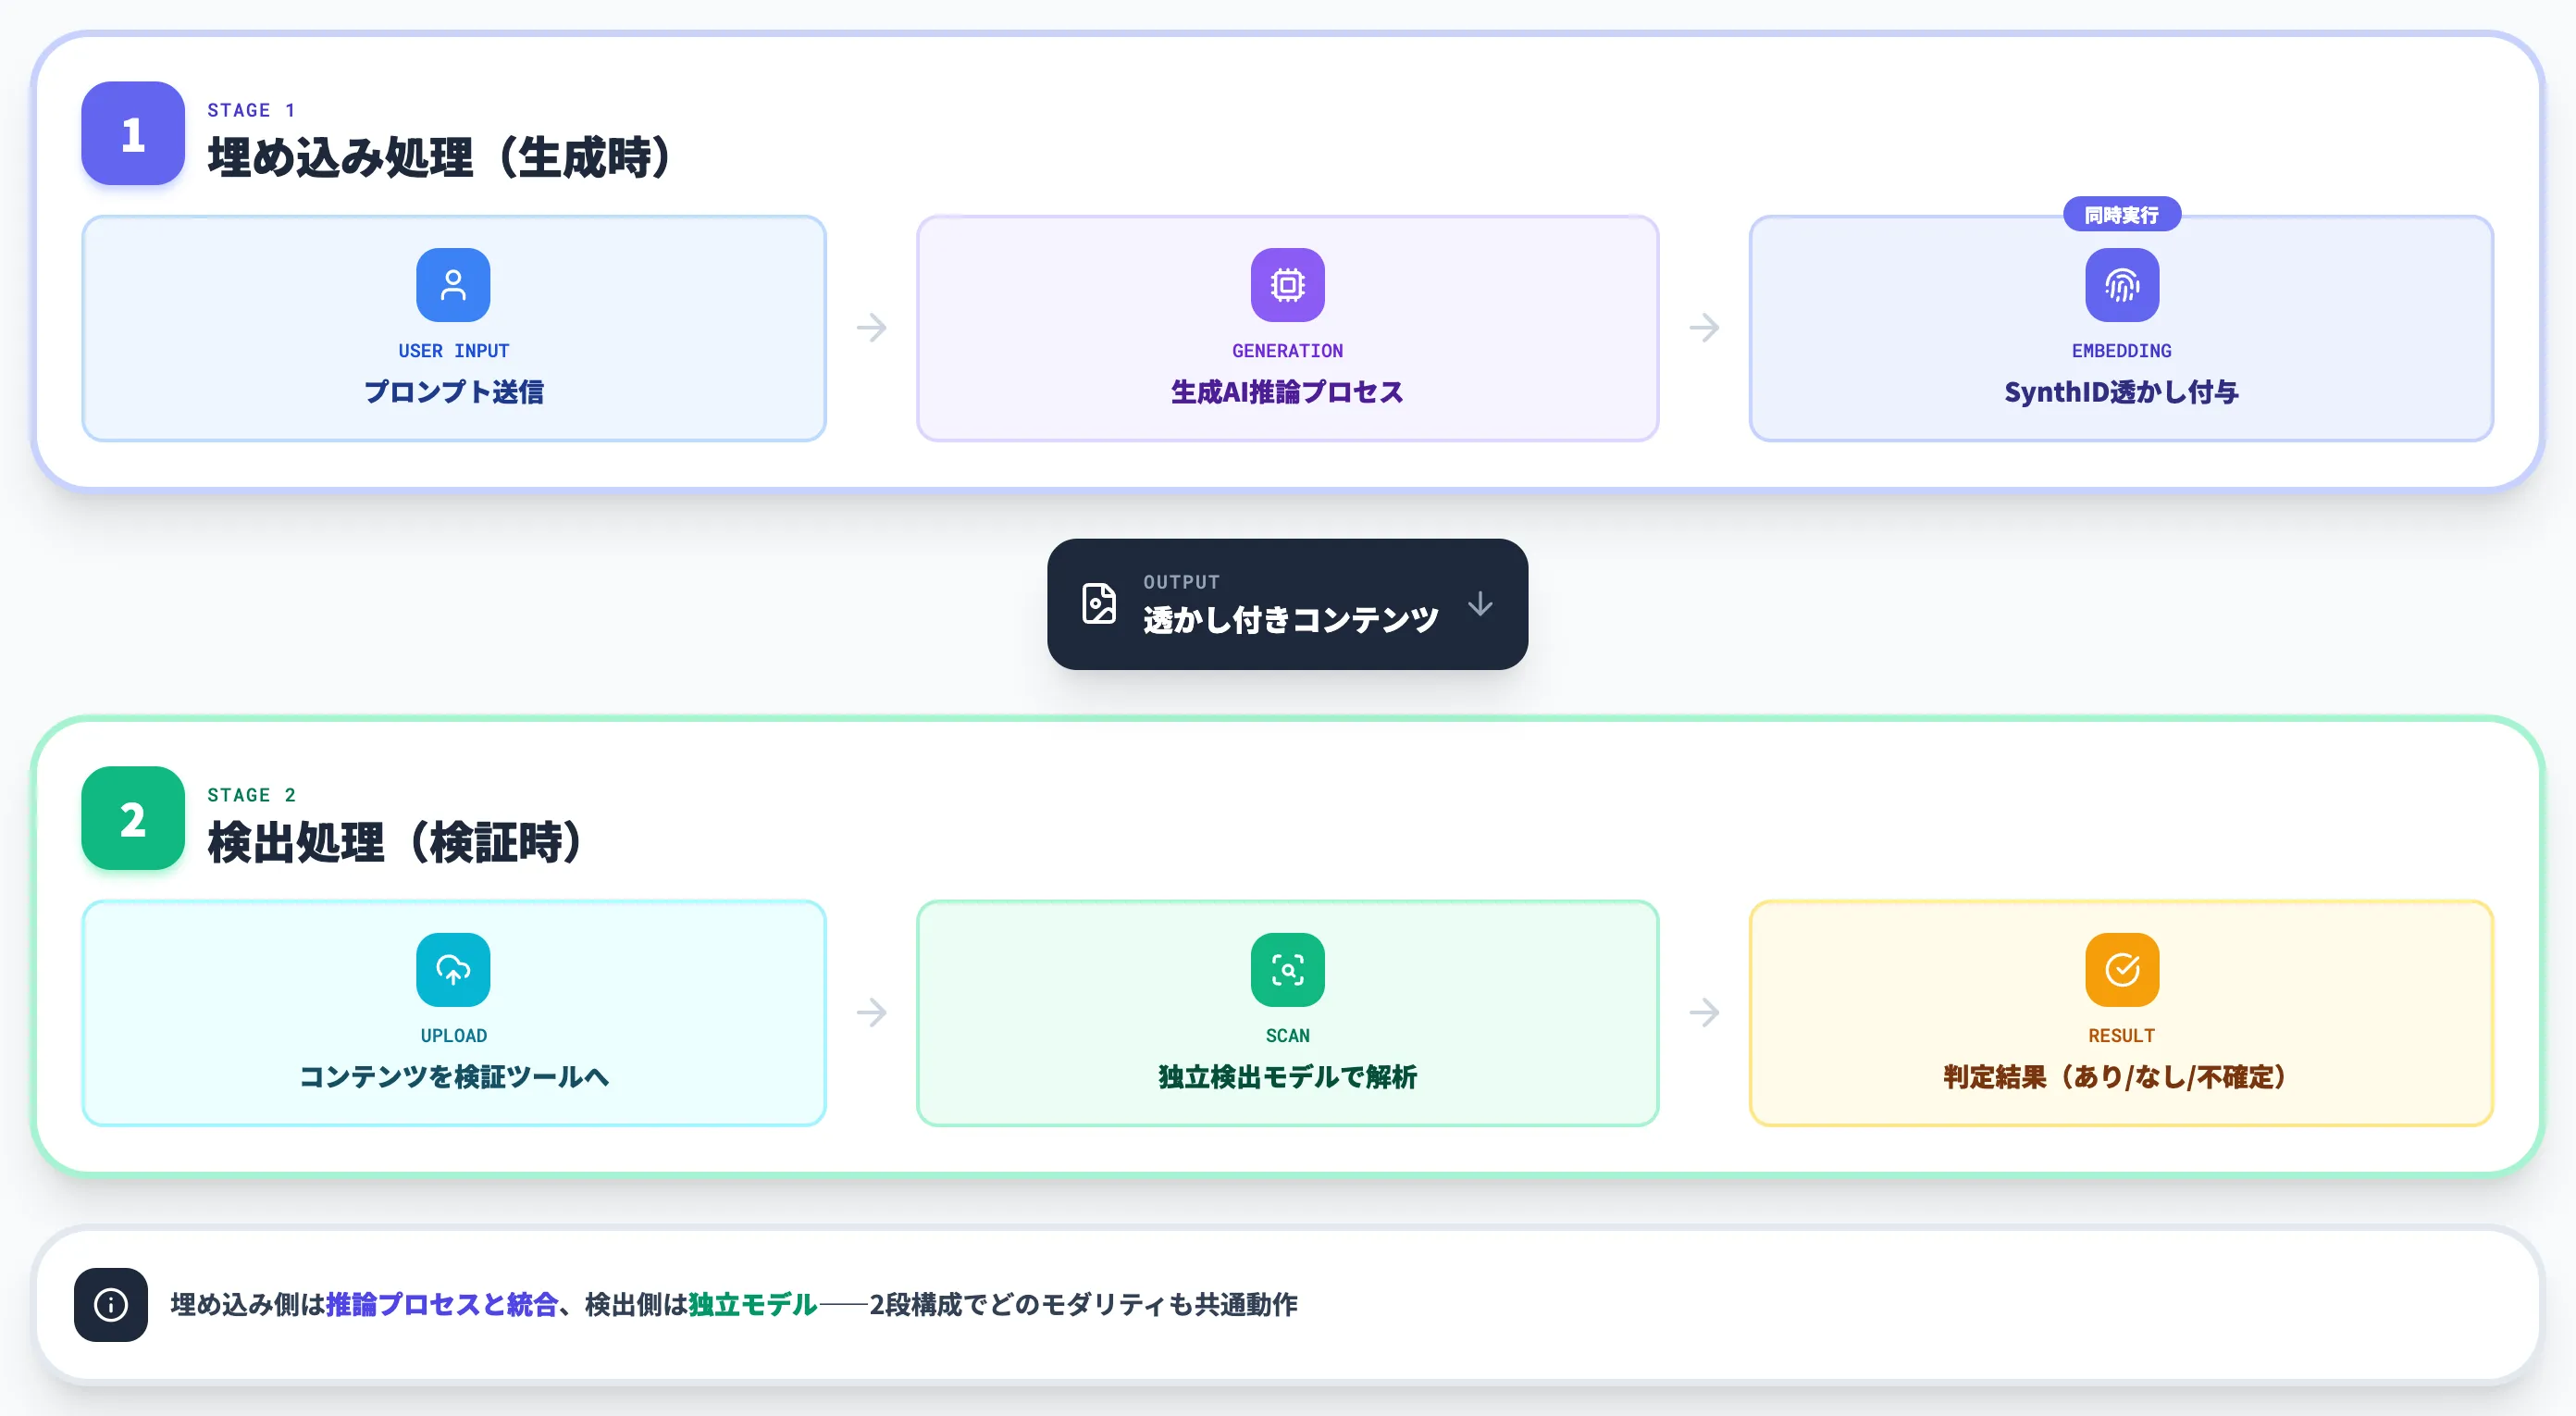
SynthIDはどの形式でも、埋め込み処理と検出処理の2段で動きます。埋め込み側は生成AI本体の推論プロセスと統合され、コンテンツを生成する瞬間に透かしを載せます(テキストの場合はモデルではなく、単語選択時のlogits processorとして実装されます)。
検出側は独立した識別モデルで、アップロードされたコンテンツから透かしパターンを検出します。
Google DeepMindによれば、SynthIDは「不可視性」「編集耐性」「コンテンツ品質の非劣化」の3条件を同時に満たすよう設計されています。透かしを入れることで画質・音質・出力品質が下がると採用が広まらないため、この3条件の両立が最重要の設計要件になっています。
テキスト透かしはOSS化——自社モデル組み込み可
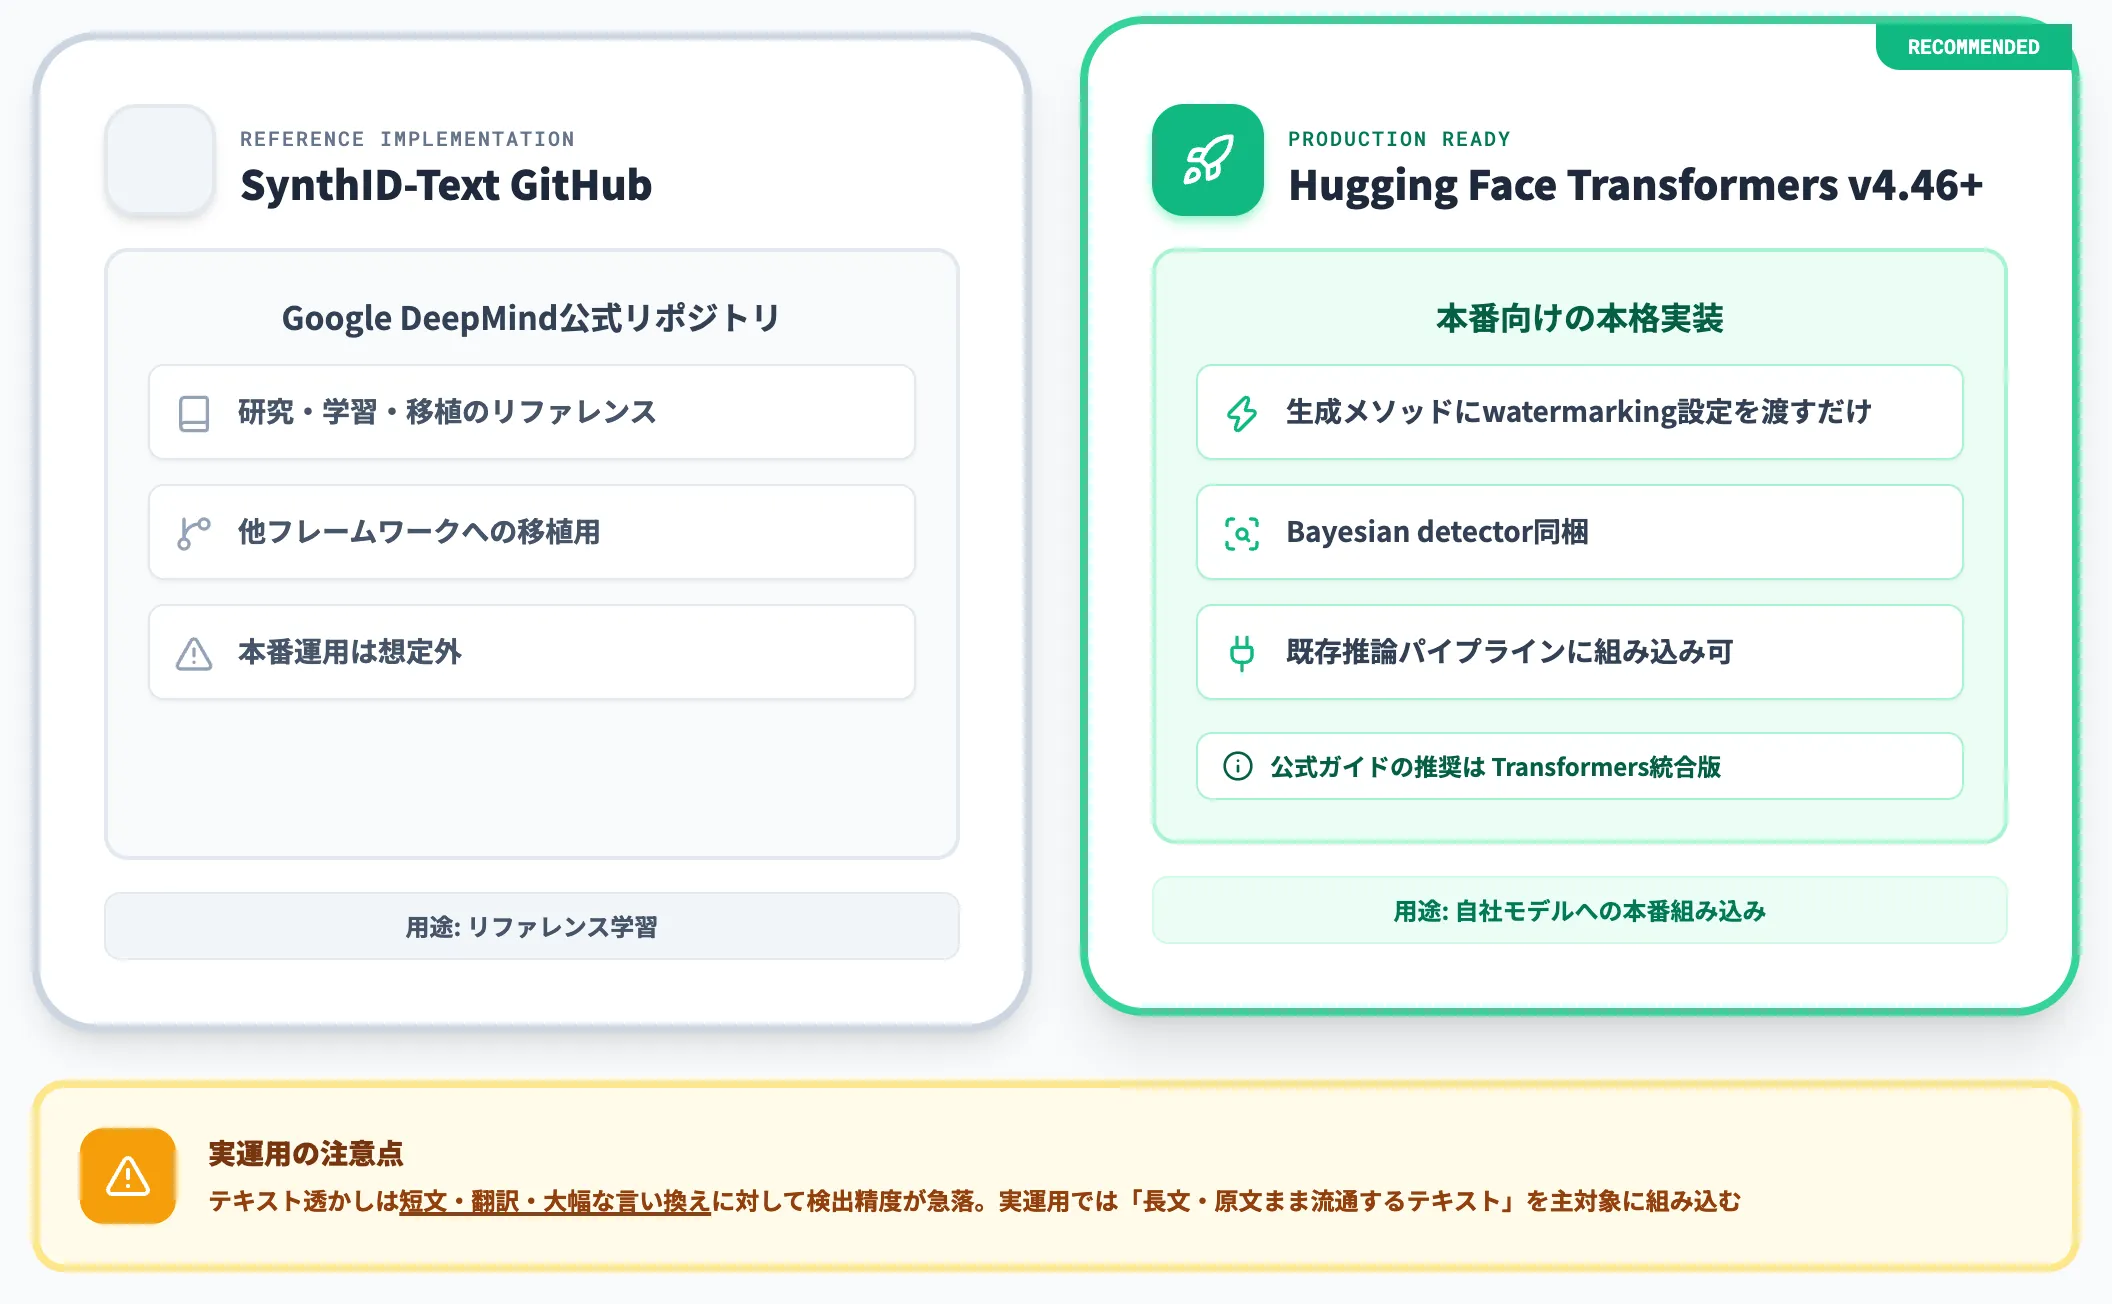
画像・音声・動画のSynthIDは現時点でGoogle AIおよび公式パートナー経由での埋め込みに限定されますが、テキスト透かしは2024年10月23日にオープンソース化されています。実装は2系統に分かれる点を押さえておくと選定を誤りません。
-
SynthID-Text GitHubリポジトリ
Google DeepMindが公開する参照実装(reference implementation)。本番運用を想定した実装ではなく、他フレームワークへの移植・学習用途に位置づけられている
-
Hugging Face Transformers v4.46.0+への統合
本番向けの本格実装はHugging Face Transformers側に組み込まれており、既存推論パイプラインの生成メソッドにwatermarking設定を渡すだけで追加できる。検出用のBayesian detectorも同梱
本番投入するなら参照実装ではなくTransformers統合版を使う、というのが公式ガイドの推奨です。自社モデルの出力にもSynthID透かしを埋め込めば、外部から「これは自社モデルが出したものか」を検証できる仕組みを作れます。
ただしテキスト透かしは短文・翻訳・大幅な言い換えに対しては検出精度が大きく落ちるため、実運用では「長文・原文まま流通するテキスト」を主対象に組み込むのが現実的です。
SynthIDの確認方法——主な4つの経路
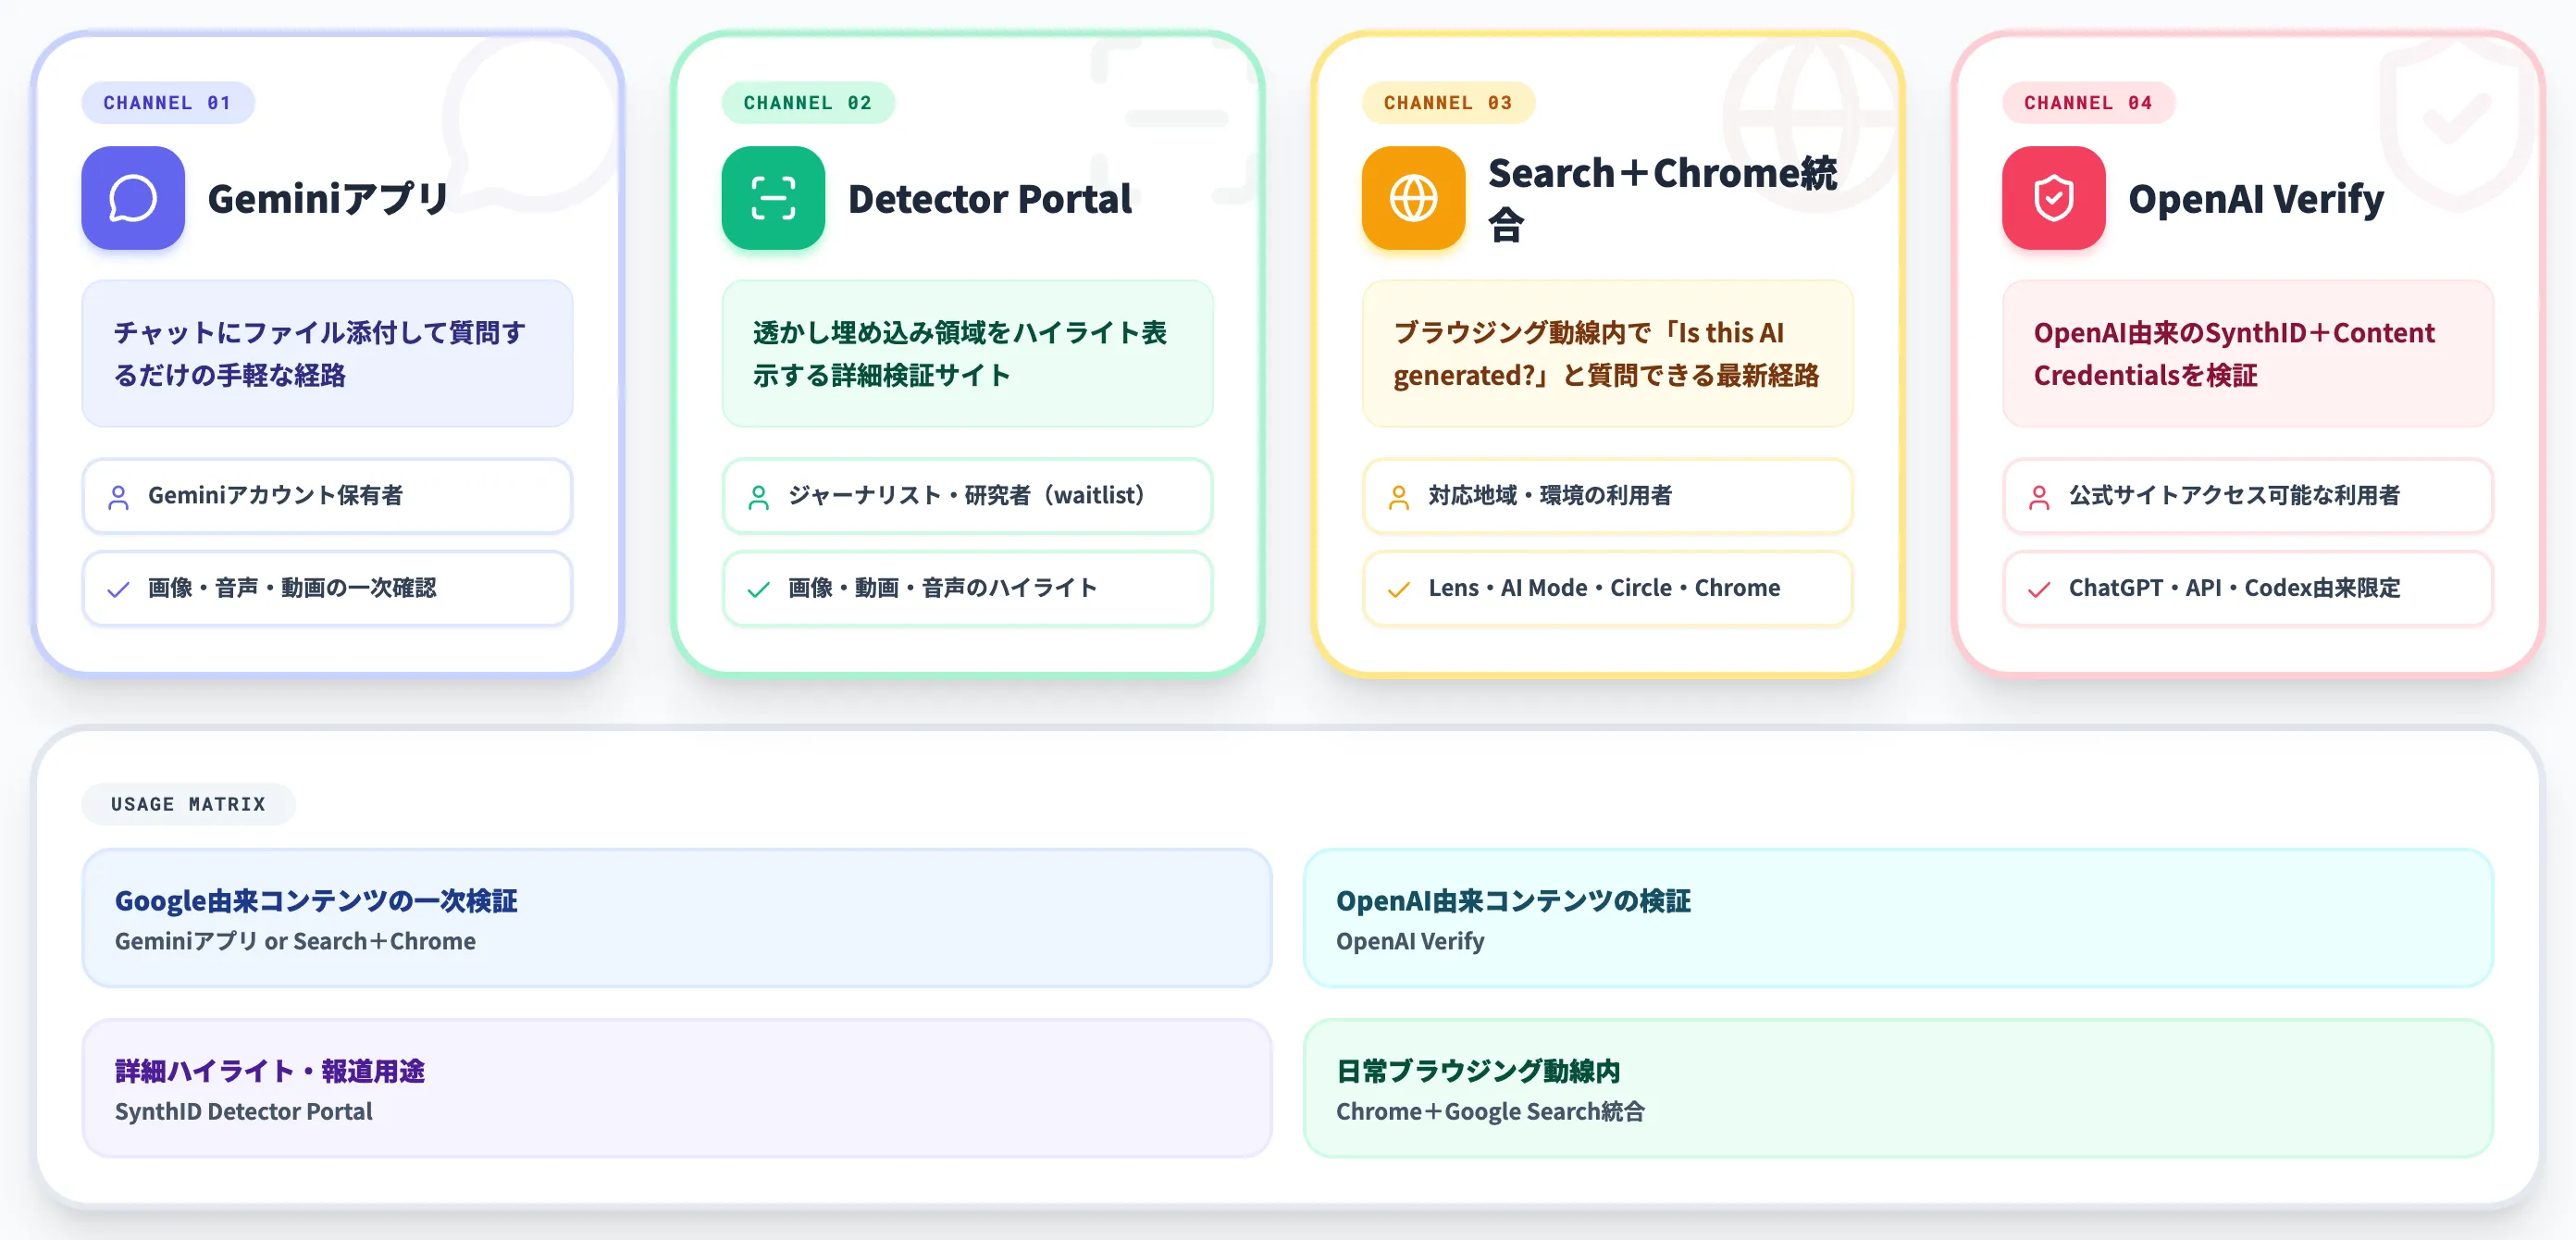
ここまでSynthIDが何に載っているかを整理してきましたが、実際に「このコンテンツにSynthIDが入っているか」を検証するには主に4つの経路があります(ElevenLabs Audio Detector・Anthropicのテキスト検出APIなど採用企業各社の限定提供経路もあります)。誰でもすぐに使える経路と、ジャーナリスト・研究者に限定されている経路が混在しているので、用途に応じて使い分けます。
Geminiアプリで質問する
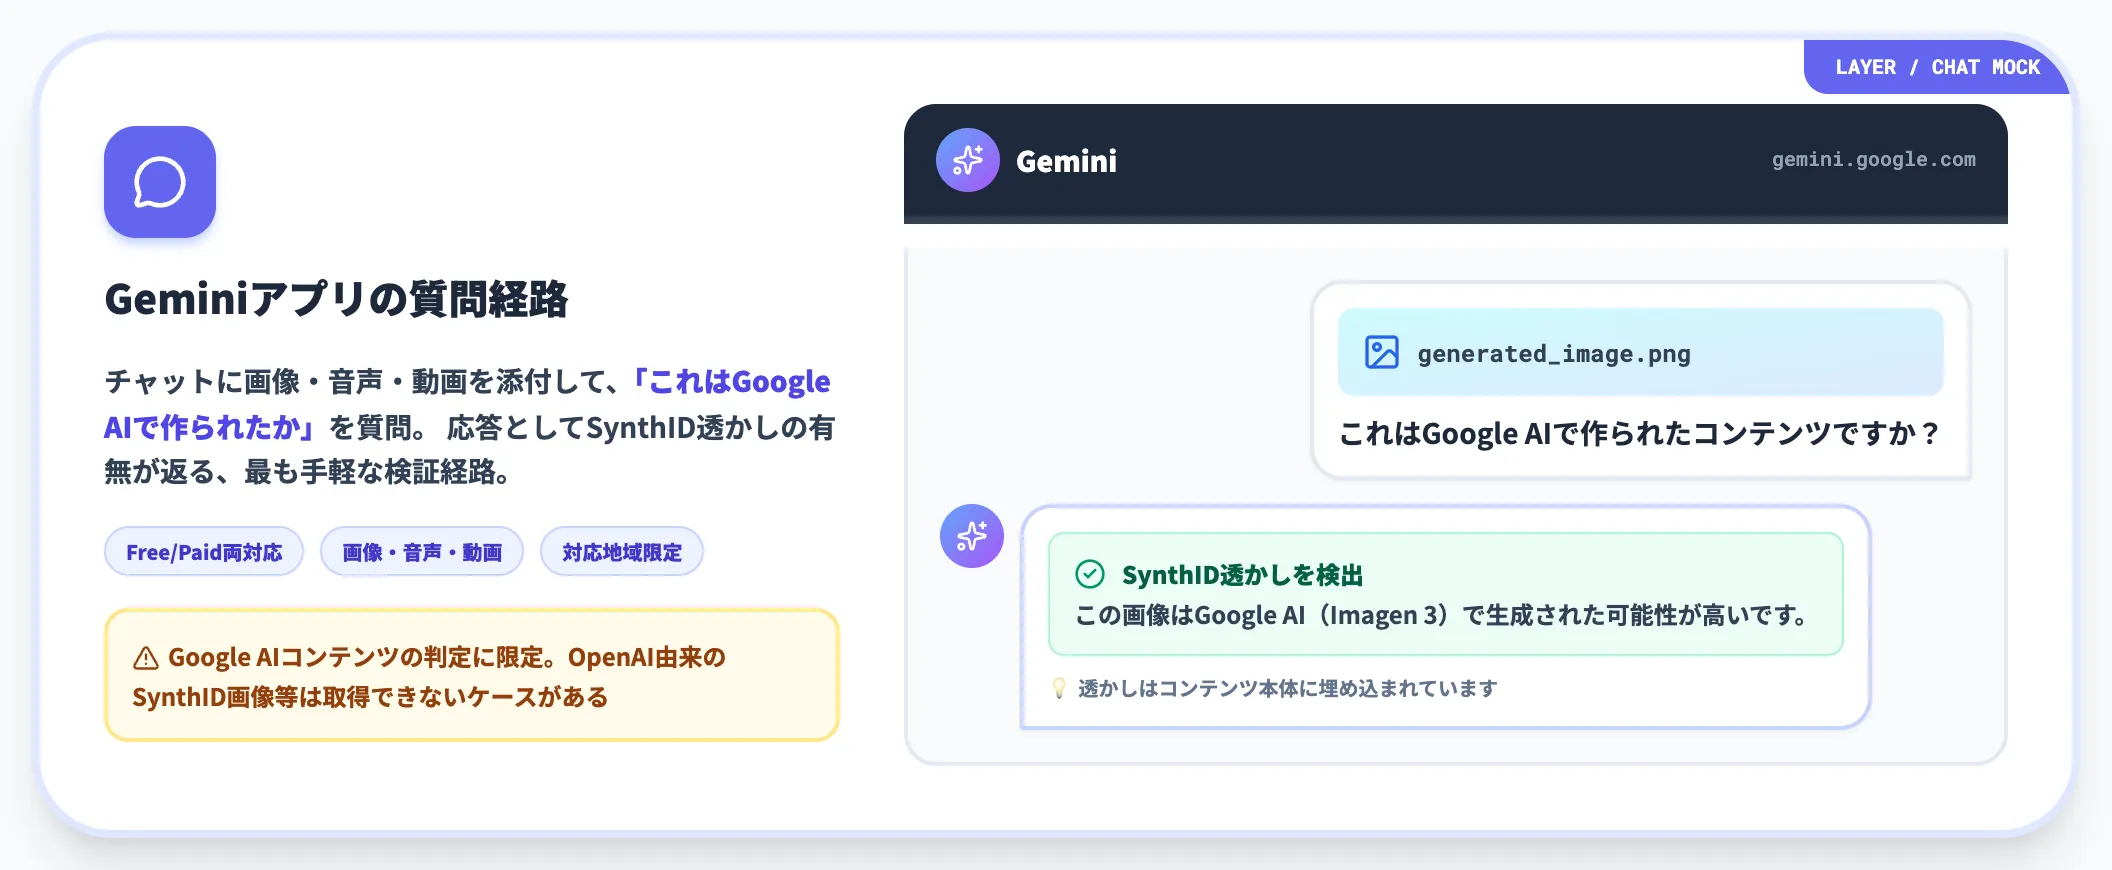
最も手軽な経路が、Geminiアプリの画像・音声・動画検証機能を使う方法で、チャットにファイルをアップロードして「これはGoogle AIで作られたコンテンツか」と質問すると、Geminiの応答としてSynthID透かしの有無が返ります。
利用にはGeminiにサインインできる個人アカウント、または対象のGoogle Workspaceアカウントが必要で、対応地域・言語・機能ロールアウト状況によって使える範囲が変わります。
ただしGemini経由の確認は「SynthIDが載っているGoogle AIコンテンツかどうか」の判定に限られ、OpenAI経由でSynthIDが載った画像や、他モダリティの詳細な位置情報は取得できないケースがあります。
SynthID Detector Portal
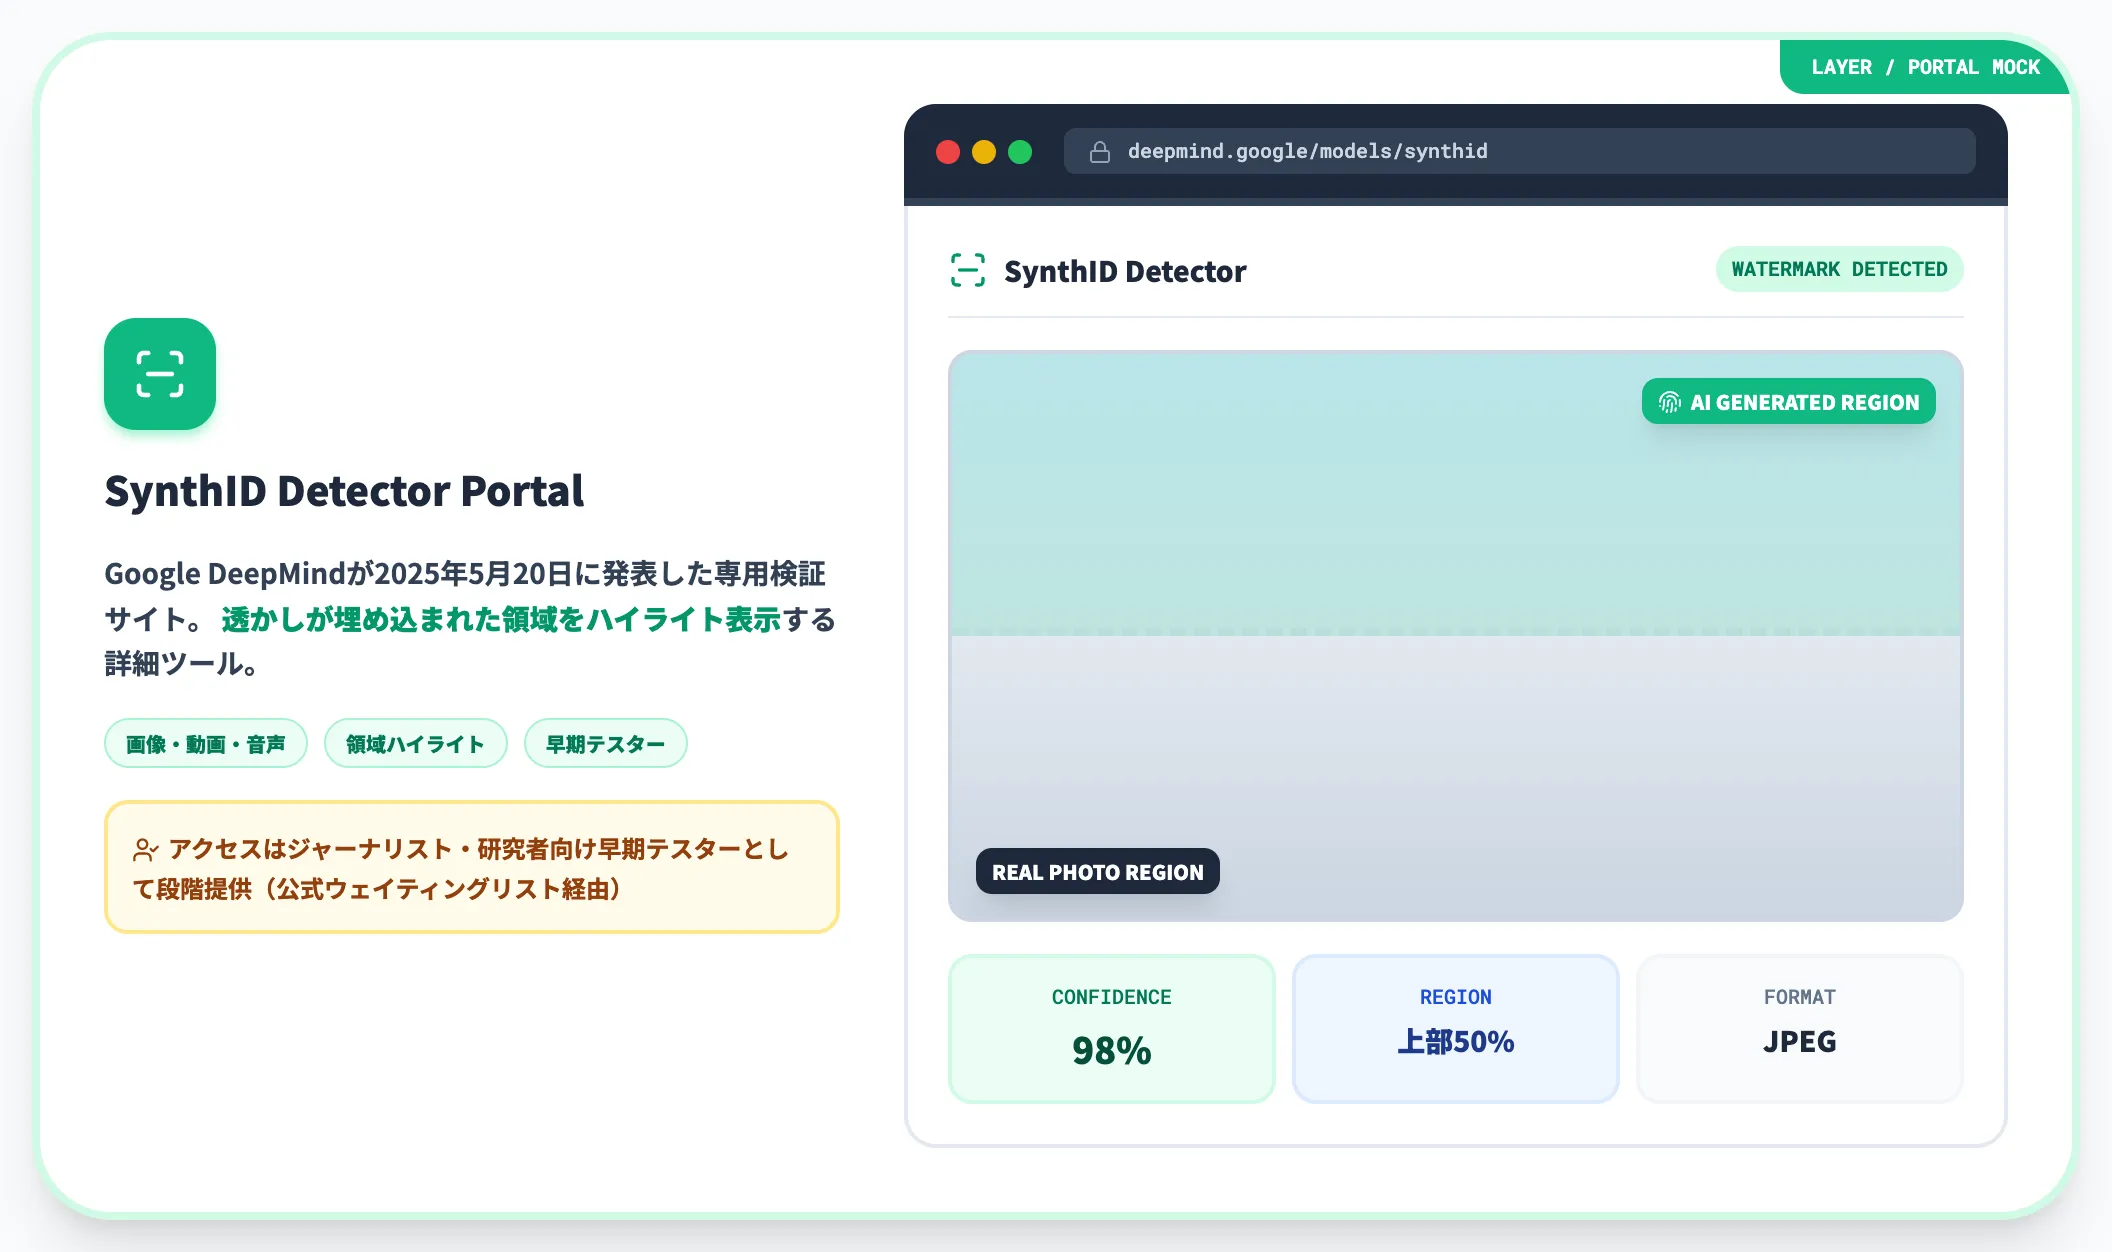
Google DeepMindが2025年5月20日に発表した専用検証サイトが「SynthID Detector」です。
画像・動画・音声ファイルをアップロードすると、SynthID透かしが埋め込まれた領域をハイライト表示します。2025年の発表時点ではテキストも対象として言及されていましたが、現行の公式ページでは画像・動画・音声のみが案内対象で、テキストの検証を公開消費者向けに提供する公式ツールは記事執筆時点では見当たりません。
-
判定結果の粒度
音声なら透かしが埋め込まれている特定セグメント、画像なら透かしが存在すると推定される領域を示す。AI生成の空と実写の前景を組み合わせた画像なら、AI生成部分だけがハイライトされる
-
アクセス方式
ジャーナリスト・メディア関係者・研究者向けの早期テスターとして段階提供。利用希望者は公式ウェイティングリスト(Googleフォーム)から申請する
Detector Portalは記事執筆時点でも早期テスター段階で、ジャーナリスト・メディア関係者・研究者を軸に段階提供されています。
バッチ処理・PDFレポート出力・企業向けの正式なコンプライアンスプランなどは現時点で公式には案内されていないため、実務導入を検討する場合は最新の公式アナウンスを都度確認する形になります。
Chrome+Google Search統合
2026年5月19日のGoogle I/O 2026で発表された最新経路が、Search側のLens・AI Mode・Circle to Searchと、Chrome側のGemini in ChromeへのSynthID検証機能統合です。ユーザーは画像に対して「Is this made with AI?」「Is this AI generated?」と質問することで、そのコンテンツがAI生成かどうかを確認できます。
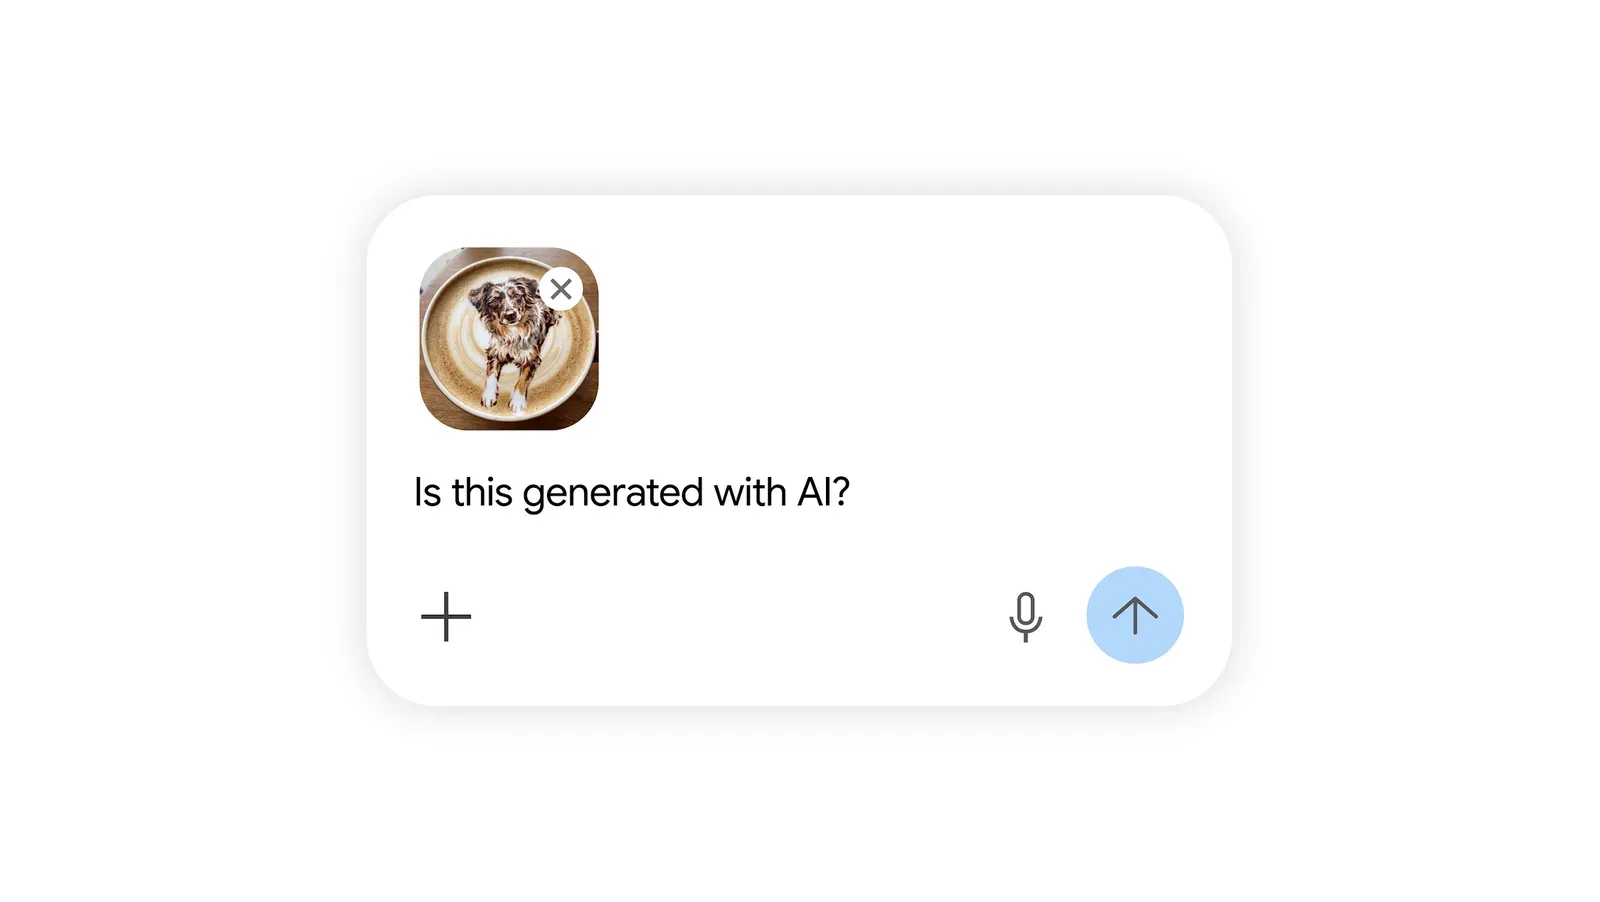
Google Search・Chrome・Gemini in Chromeで画像をアップロードして「Is this generated with AI?」と質問する動線(出典:Google Blog)
動線の主役は入力欄の上に貼られたラテアート犬の画像で、その下に「Is this generated with AI?」の1文を投げるだけで検証がスタートします。専用の検証ポータルに移動する必要はなく、SearchのLens・AI Mode・Circle to SearchあるいはChrome上のGemini in Chromeから、同じ質問形式で判定を呼び出せる設計になっています。
提供時期はSynthIDとC2PAで分かれており、SynthID検証はGeminiアプリで先行提供済み、SearchはGoogle I/O 2026当日(2026年5月19日)から、Chromeはその後「数週間かけて」段階展開する計画が示されました。
C2PA Content Credentialsの検証はGeminiアプリで発表当日から利用可能で、Search・Chromeへの展開は「今後数か月かけて」拡げる方針が示されています。
Detector Portalとの最大の違いは、専用サイトに移動せずブラウジング動線の中で検証できる点です。企業のメディア担当者やSNS運用者にとって、ワークフローに組み込みやすい経路になります。
OpenAI Verify
2026年5月19日、Google I/O 2026と同じ日にOpenAIが公開したのが「OpenAI Verify」です。画像をアップロードすると、その画像にOpenAI由来のSynthID透かしとContent Credentials(C2PA)が含まれているかを検証します。
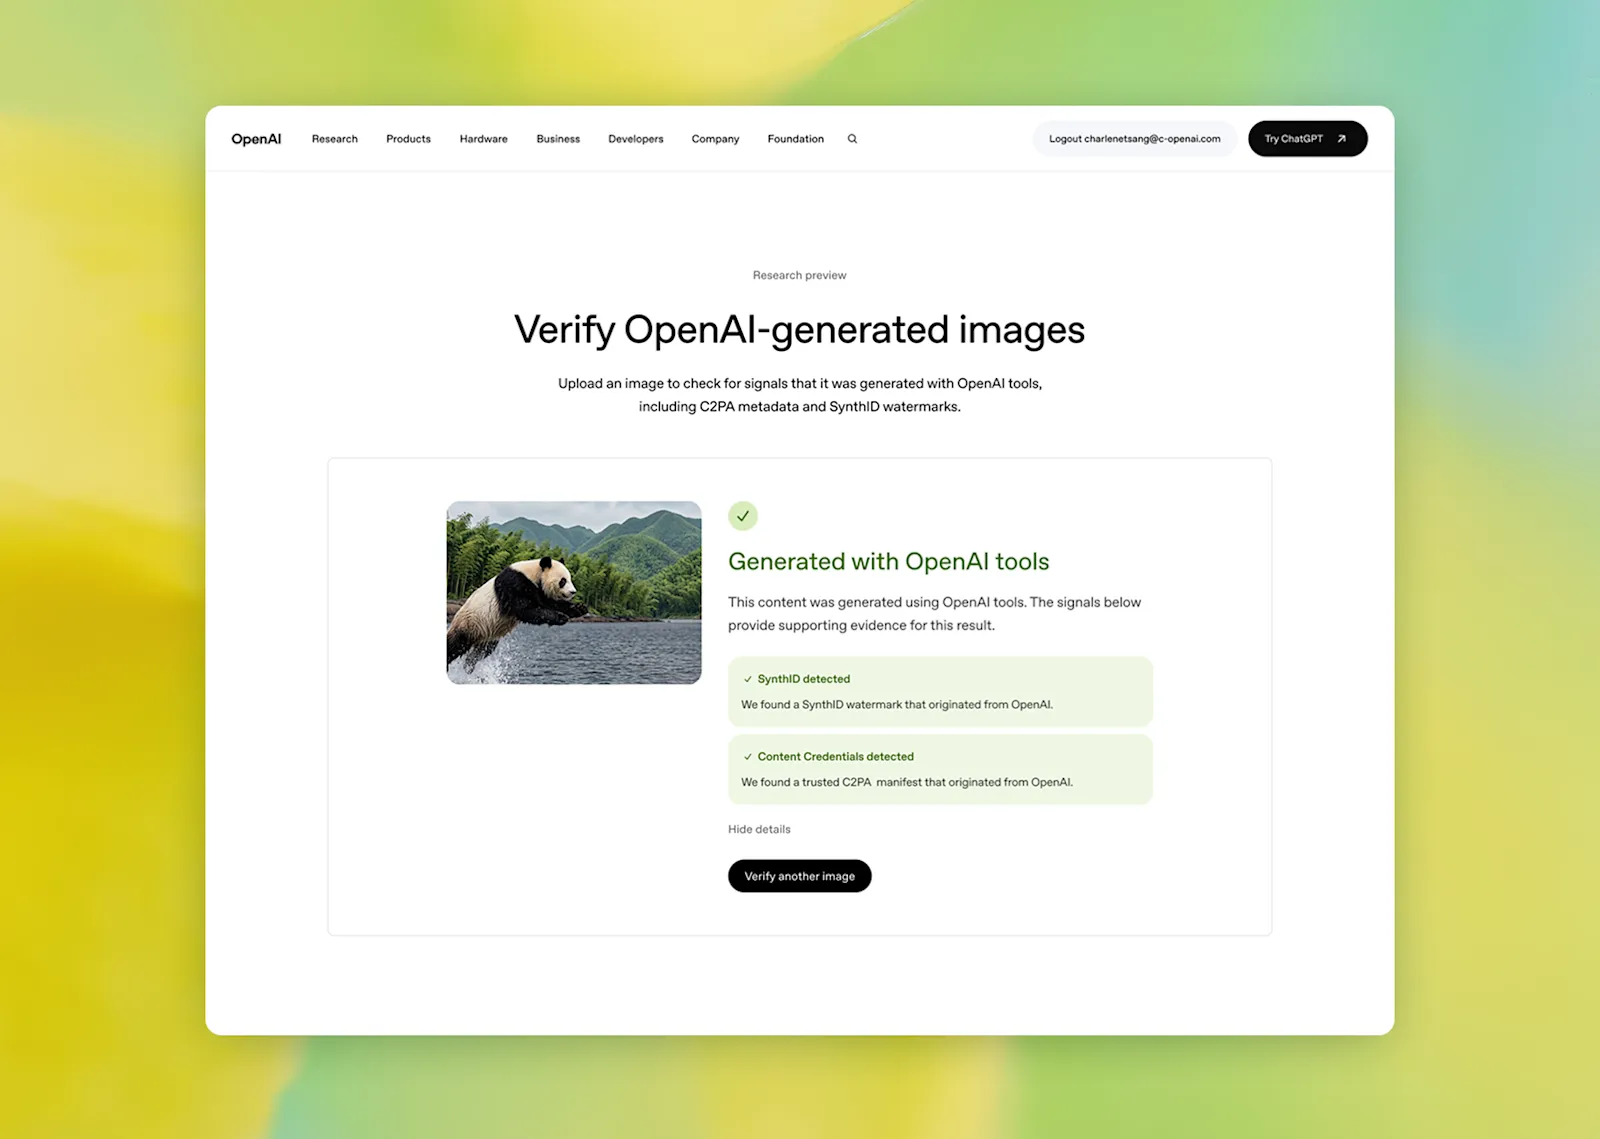
OpenAI Verifyの検証結果画面。SynthID watermarkとContent Credentialsの両方が検出された状態を表示(出典:OpenAI)
検証結果画面の中央には「Generated with OpenAI tools」の判定と、その根拠として「SynthID watermark detected」「Content Credentials detected」の2行が並びます。
1つのファイルに対してSynthIDとContent Credentialsの両方の検出結果を返す構造なので、片方が剥がれた場合でももう片方の情報が来歴の手掛かりとなり得る点が、Verifyの設計思想です。
重要なのは対象範囲で、OpenAIは公式に「At launch, the tool is limited to content generated by OpenAI」と明記しています。つまりChatGPT・OpenAI API・Codex経由で作られた画像・音声を検証するツールであり、他社SynthID/他社C2PAコンテンツを汎用的に判定する仕組みではありません。
将来的にはクロスプラットフォーム対応を目指す方針も示されていますが、現時点ではOpenAI由来コンテンツ限定と理解しておく必要があります。
続くアップデートも押さえておきます。2026年7月31日にOpenAI Verifyは音声対応と検証APIを追加し、ChatGPT・OpenAI API経由のOpenAI音声にもSynthIDが載るようになりました。API化により、企業側の検証ワークフローに組み込む選択肢が広がっています。
Google側のDetector PortalとOpenAI Verifyが並存することで、GoogleコンテンツはGoogle側、OpenAIコンテンツはOpenAI側というように発信元ベンダーごとの一次検証が可能になった、というのが2026年5月19日の同日発表が持つ実務的な意味です。
4経路の使い分け早見表
以下の表で、4経路の対象ユーザーと得意用途を整理しました。
| 経路 | 対象ユーザー | 得意な用途 |
|---|---|---|
| Gemini質問 | Geminiに対応したアカウントの利用者 | 画像・音声・動画の一次確認 |
| SynthID Detector Portal | ジャーナリスト・研究者(waitlist経由) | 画像・動画・音声の詳細ハイライト |
| Search・Gemini in Chrome | 対応地域・環境の利用者 | ブラウジング動線内での質問形式検証 |
| OpenAI Verify | 公式サイトにアクセス可能な利用者 | OpenAI由来の画像・音声のSynthID/Content Credentials検証 |
企業内での運用を設計するなら、日常のブラウジングはSearch・Gemini in Chrome経路、対象コンテンツの一次確認はGeminiアプリ、OpenAI生成物のセカンド検証はOpenAI Verify、そしてジャーナリスト向けの詳細判定はDetector Portal、というように発信元ベンダーとコンテンツ種別で経路を使い分けるのが実務的です。
SynthIDとC2PAの関係——来歴・生成経路検証の二層設計
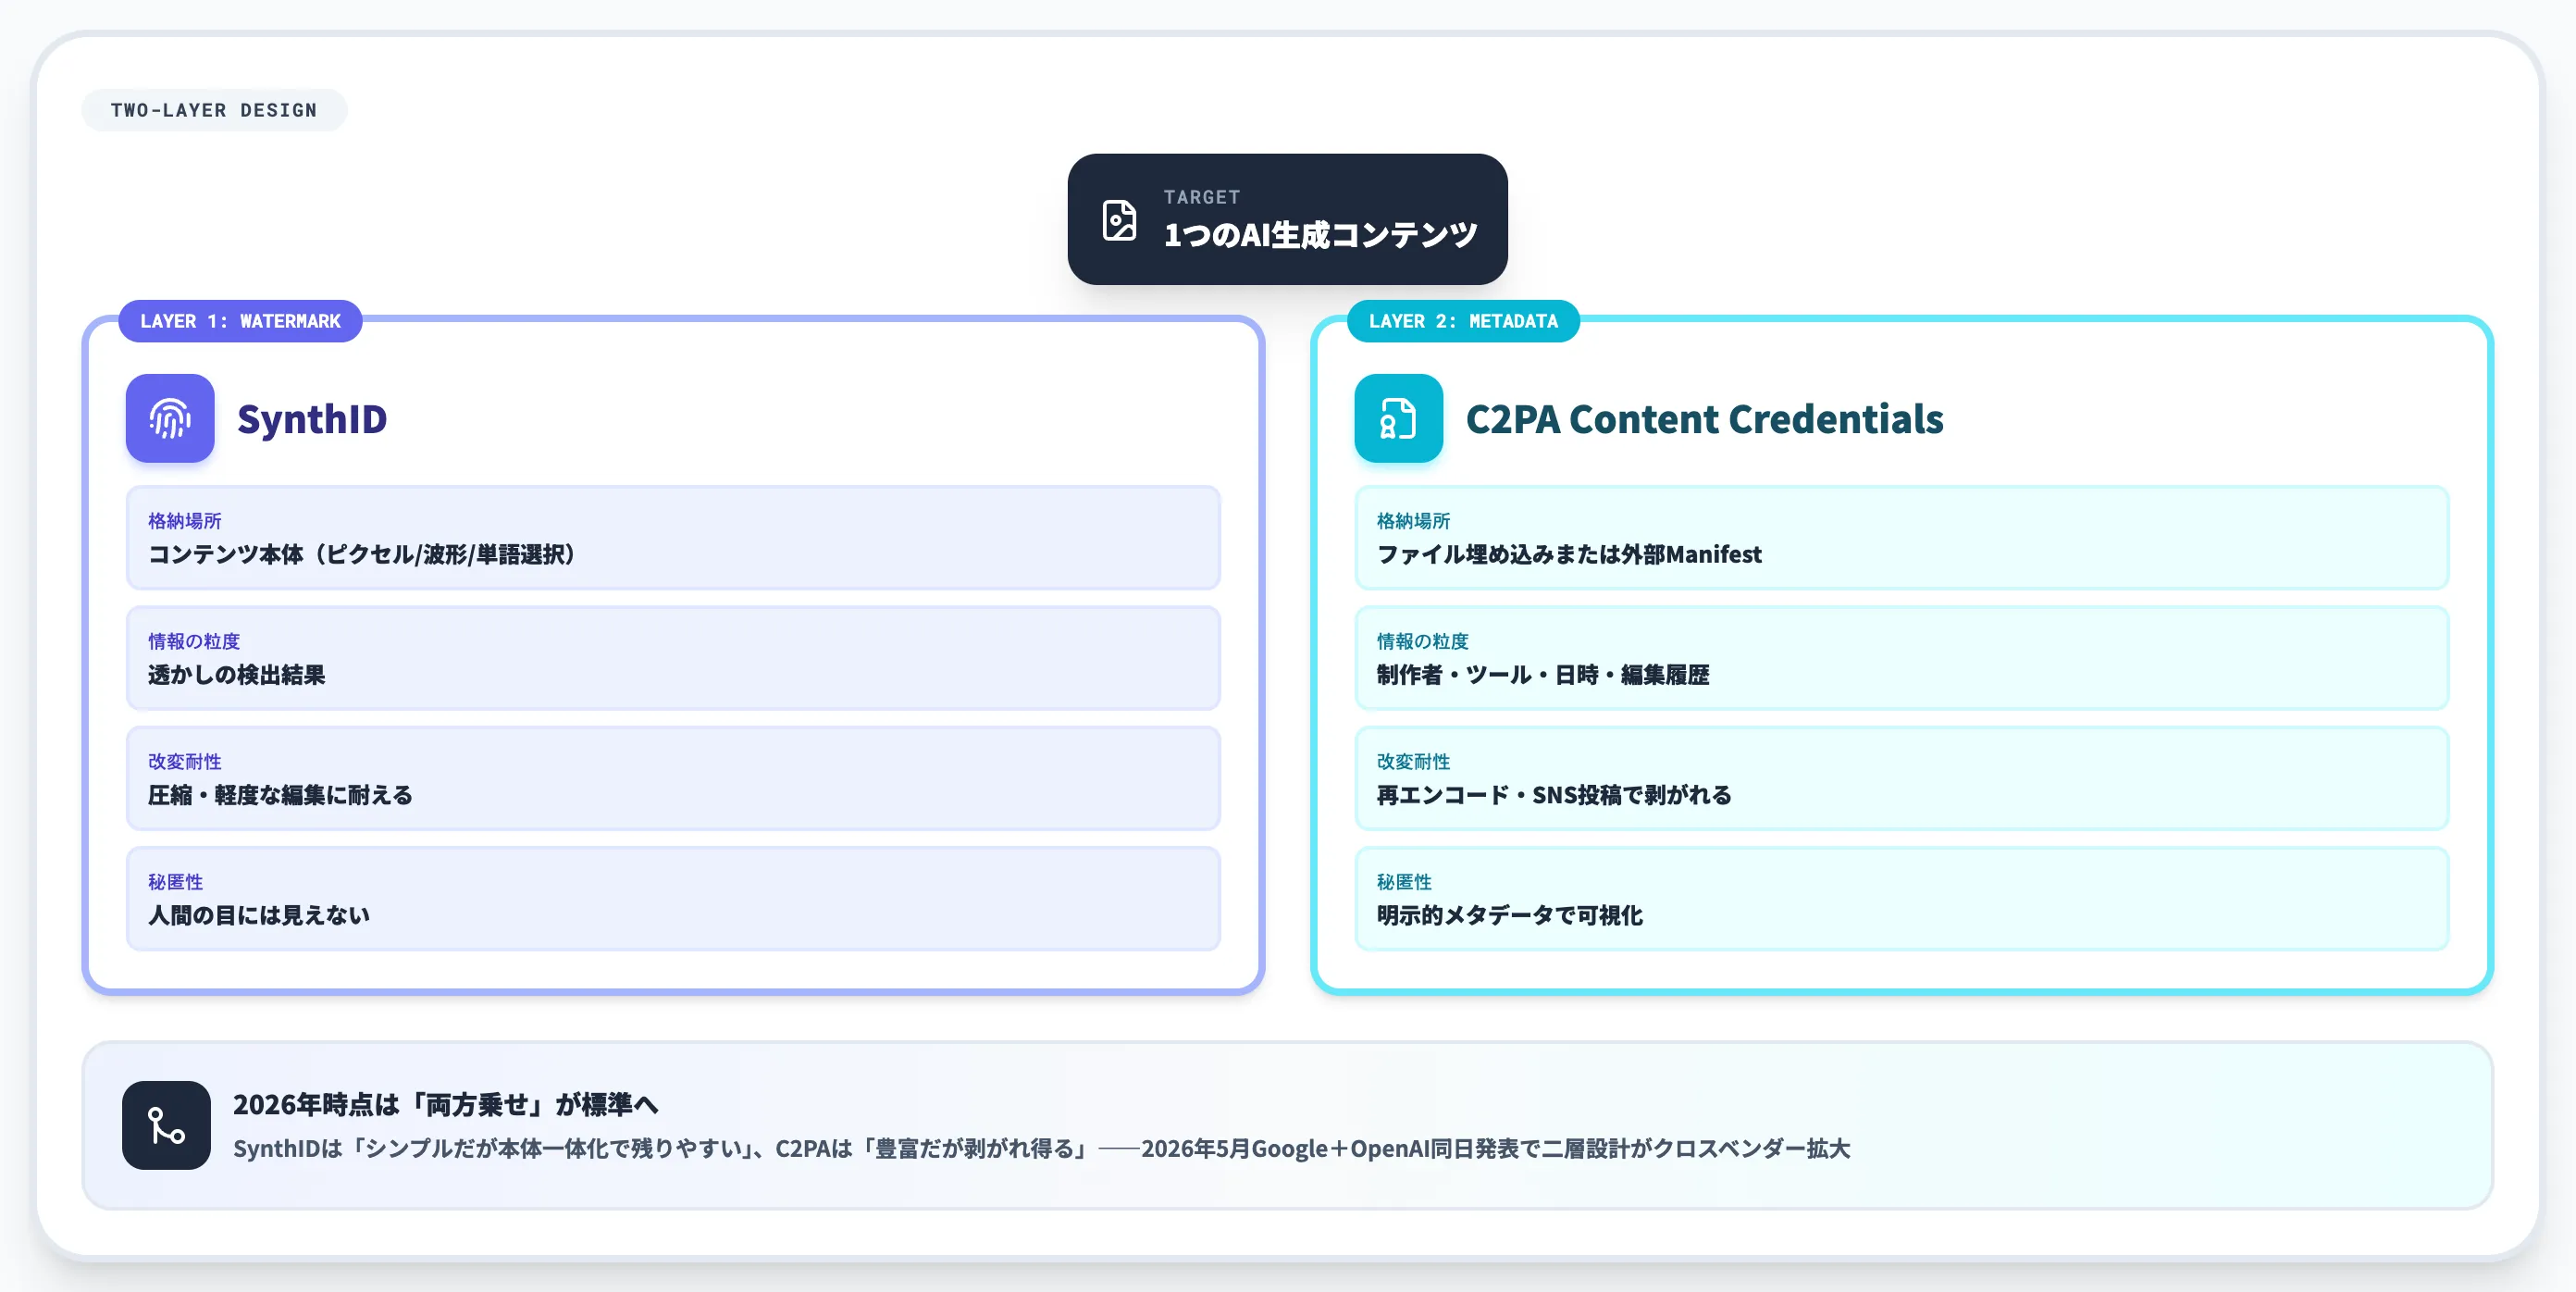
SynthIDと並んで頻繁に登場する規格がC2PA(Coalition for Content Provenance and Authenticity)です。
両者は競合ではなく、AI生成物の来歴管理を担う「二層設計」として補完関係にあります。企業の来歴ガバナンスを設計するときは、この二層の役割分担を理解しておく必要があります。
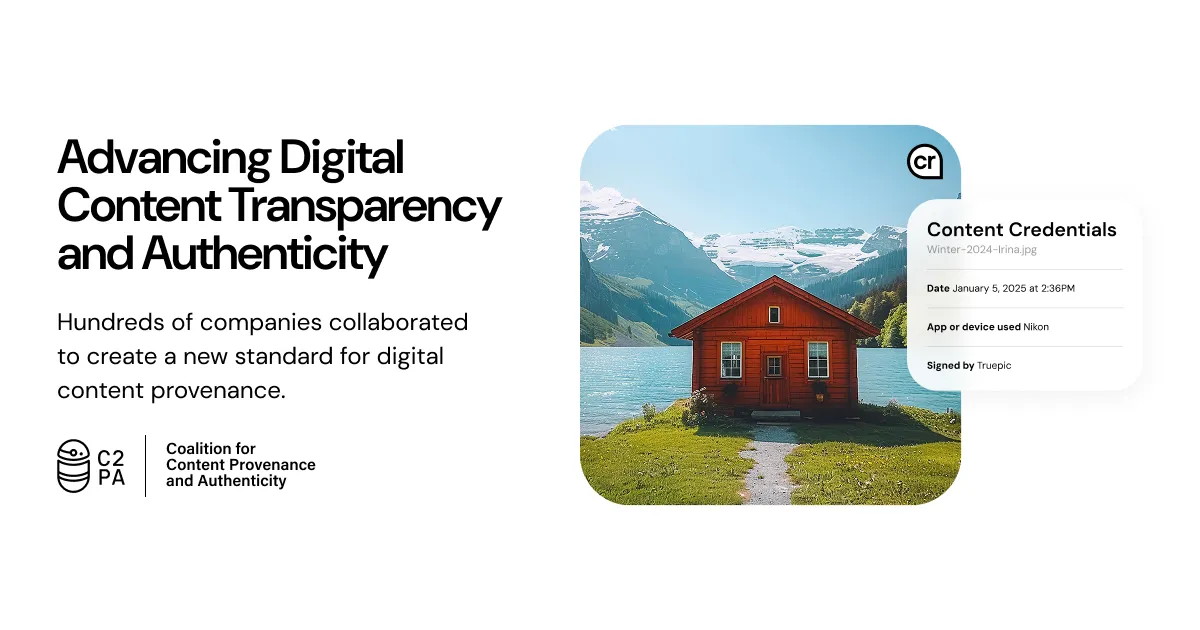
C2PAが提供するContent Credentialsメタデータ(撮影日・使用デバイス・署名者)が画像に紐づく仕組みを示す公式キービジュアル(出典:C2PA)
右側のポップアップに並ぶのは、Content Credentialsが1コンテンツに紐づける情報の表示例です。ここでは撮影日(Date)・使用デバイス(App or device used)・署名者(Signed by)の3項目が例示されており、画像本体とは別レイヤーで暗号署名付きで保持されます。
左側の家の写真右上に付いている「cr」アイコンが、Content Credentialsが付与されていることを示すマークです。
C2PAとは——暗号署名付きの来歴メタデータ標準
C2PAは、Adobe・Microsoft・BBC・Google・OpenAI・Meta・Sony・TikTok・Amazon・Publicis Groupe・Truepic等が運営委員会に参画するオープン標準団体で、コンテンツの制作履歴を暗号署名付きのメタデータとして扱います。誰が・いつ・どのツールで作り、その後どんな編集が加わったかを、機械が検証できる形で追跡します。
採用エコシステムを見るときは、標準策定を担うC2PAと、Adobeが主導する採用推進コミュニティ「Content Authenticity Initiative(CAI)」を切り分けておくとズレません。よく引用される「6,000超のメンバー」はCAI側のコミュニティ規模で、C2PA運営委員会自体は上記のコアメンバー中心に構成されます(Intelは運営委員会ではなくContributor Memberに位置します)。
仕様は継続的にアップデートされており、2026年2月9日にC2PAが発表したContent Credentials 2.3(仕様履歴上は2025年12月付)ではプレーンテキスト・OGG Vorbis音声・ライブ動画などの新フォーマット対応と編集履歴の可読性向上、および外部リファレンスAssertion・細粒度なウォーターマーキングアクション・仕様バージョン明示などが加わり、2026年4月のContent Credentials 2.4ではJSON表現「crJSON」、Repository Receipt Assertion、Environmental Sustainability Assertion、AI Disclosure Assertion、HTML文書へのC2PA Manifest埋め込みなどが追加されました。
SynthIDとC2PAの役割分担
以下の表で、SynthIDとC2PAが何を担い、何を担わないかを整理しました。
| 観点 | SynthID | C2PA Content Credentials |
|---|---|---|
| 情報の格納場所 | コンテンツ本体(ピクセル/波形/単語選択) | ファイル埋め込みまたは外部Manifest |
| 情報の粒度 | 透かしの検出結果(AI生成の可能性を示す) | 制作者・ツール・日時・編集履歴などの構造化情報 |
| 改変耐性 | 圧縮・軽度な編集に耐える | 再エンコード・SNS投稿でしばしば剥がれる |
| 秘匿性 | 人間の目には見えない | 明示的なメタデータとして可視化される |
| 検証の必要環境 | 専用の識別モデルが必要 | C2PA準拠ビューア(Content Credentials対応ブラウザ・公式Verifyツール等)で読める |
この整理から分かるのは、C2PAは「豊富な文脈情報を運べるが再エンコード等で失われることがある」、SynthIDは「透かしの検出結果というシンプルな出力だがコンテンツ本体と一体化して残りやすい」という補完関係です。片方だけでは弱点が残るため、「両方乗せる」設計をGoogleとOpenAIが同時に打ち出したことで、この方向性がクロスベンダーで広がっています。
なぜ「両方乗せ」の採用が広がっているのか
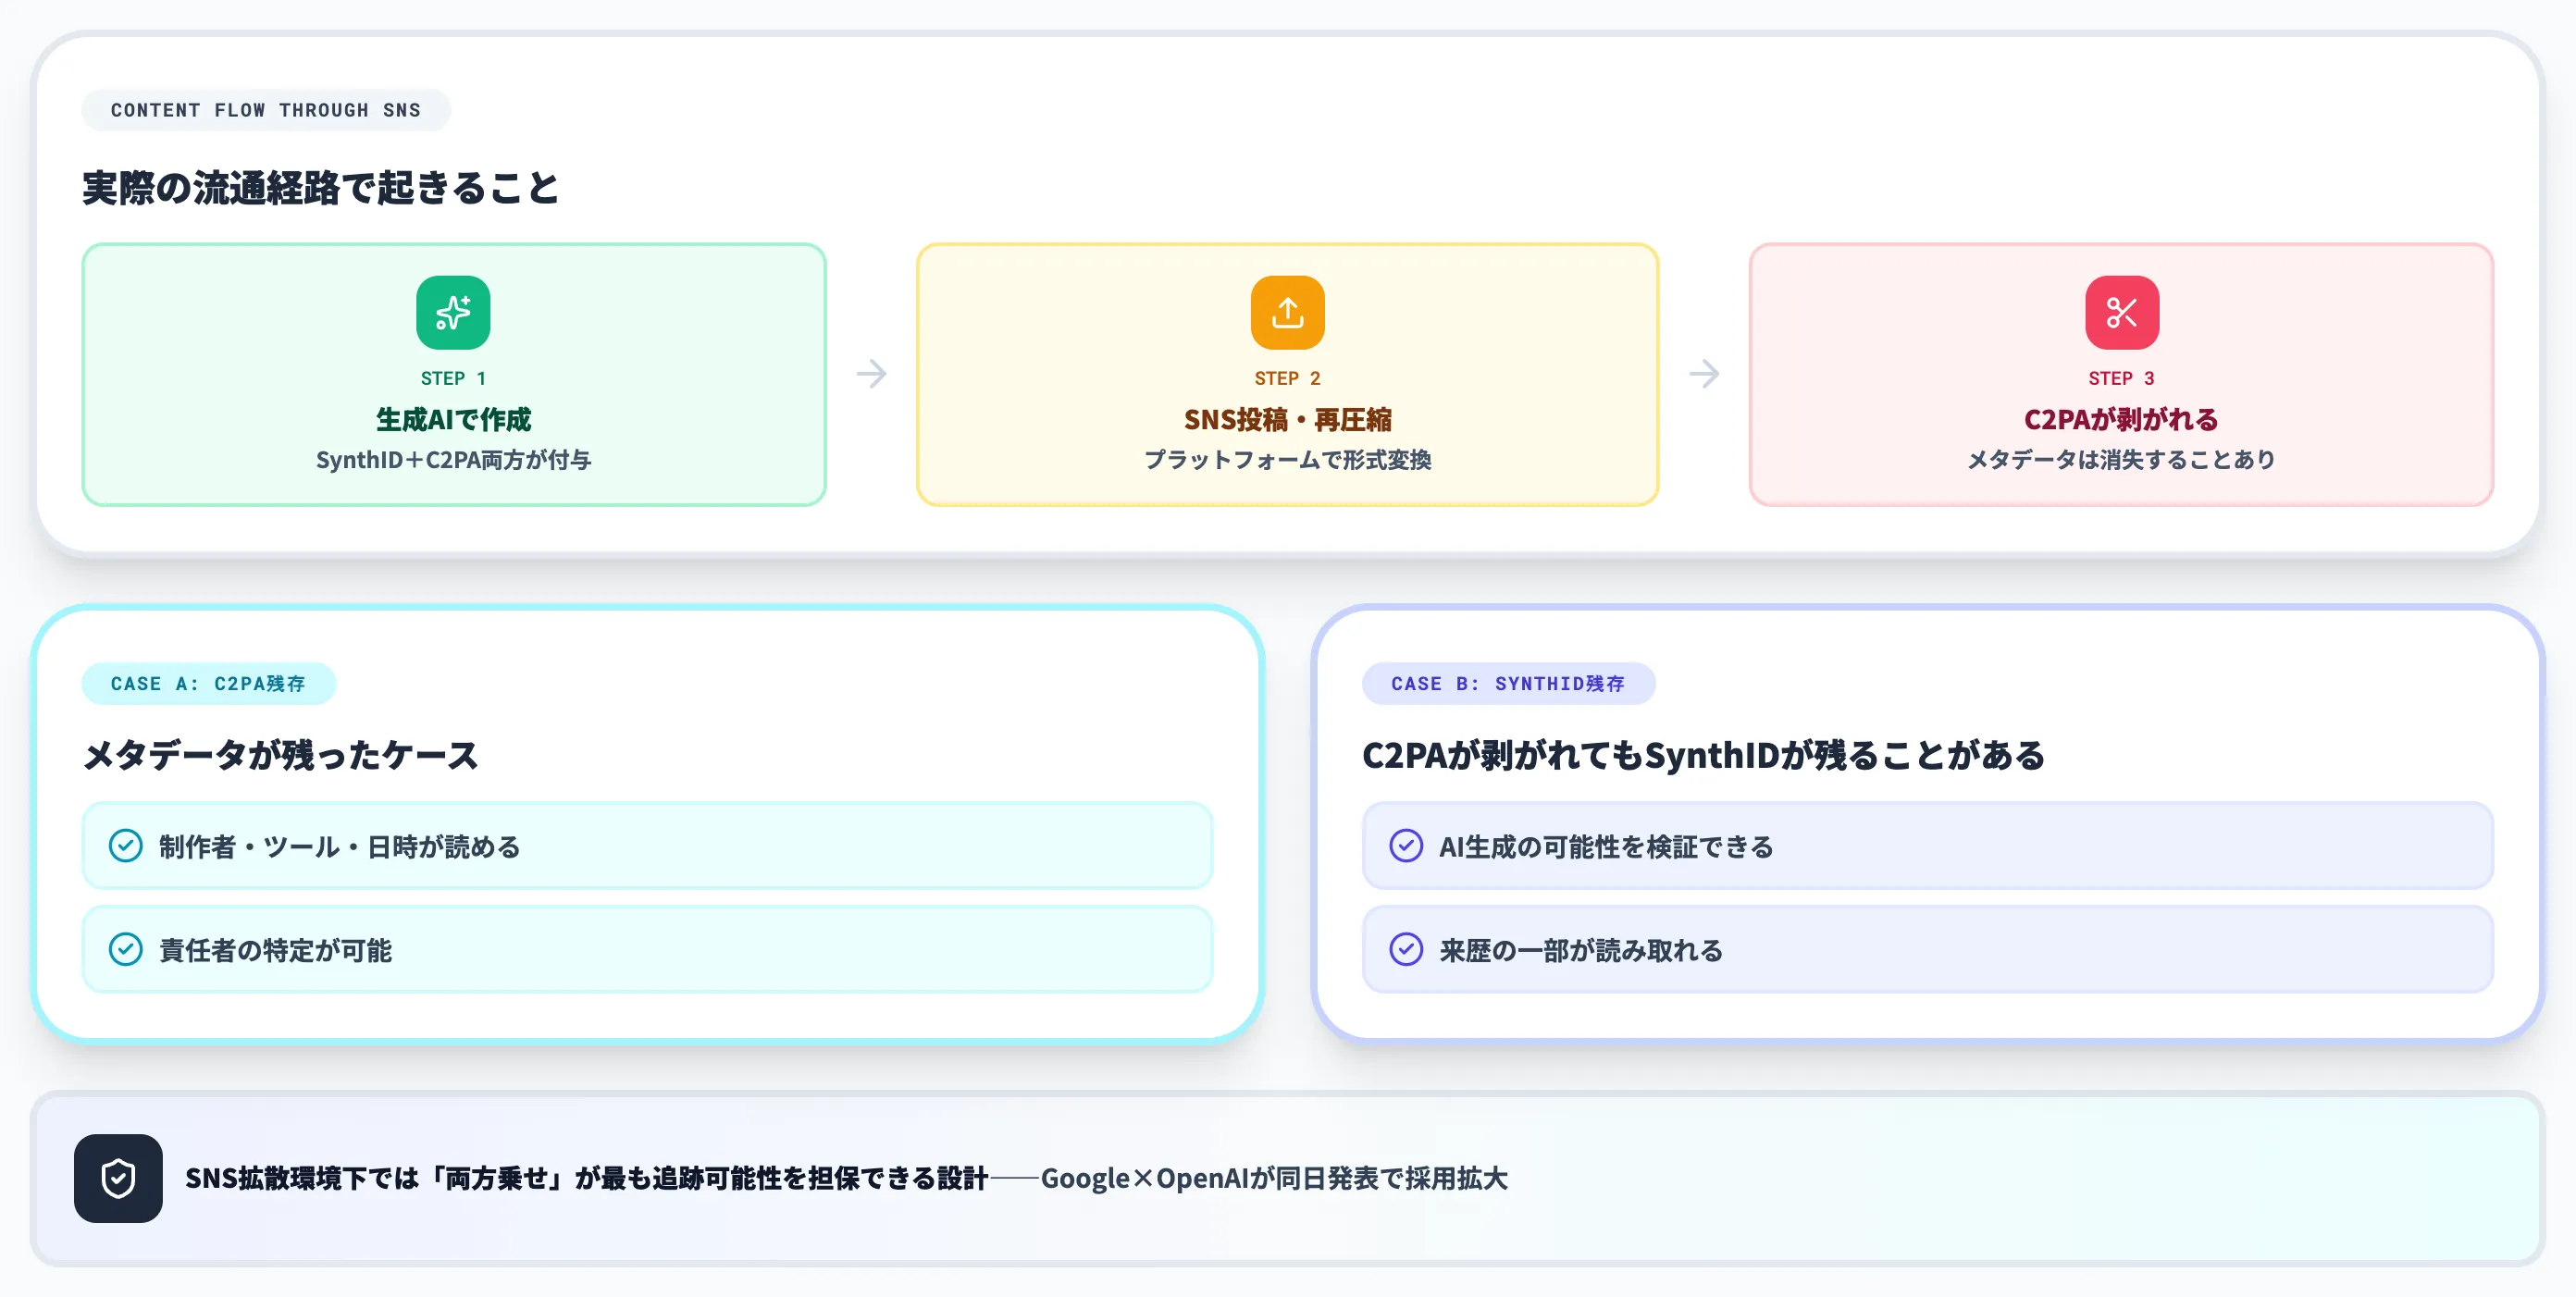
2026年5月19日にGoogleとOpenAIが同日で「C2PA+SynthID」の二層設計を発表したことは、単なる技術発表ではなく、クロスベンダー採用が加速したターニングポイントとして扱われています。
背景には、SNSやコンテンツ配信プラットフォーム上でのアップロード・再圧縮・形式変換という現実的な制約があります。プラットフォーム側で画像・動画が変換されると、C2PAメタデータは失われることがあります。一方SynthIDはコンテンツ本体に載っているため、変換を経ても残りやすい設計です。
つまり「C2PAが剥がれてもSynthIDが残る場合がある/SynthIDのない他社生成物でもC2PAが残っていれば来歴を追える」という補完設計が、コンテンツが広く流通する現代のAI生成物追跡において重要な構造になっているわけです。
二層設計が欠けた時に起きること
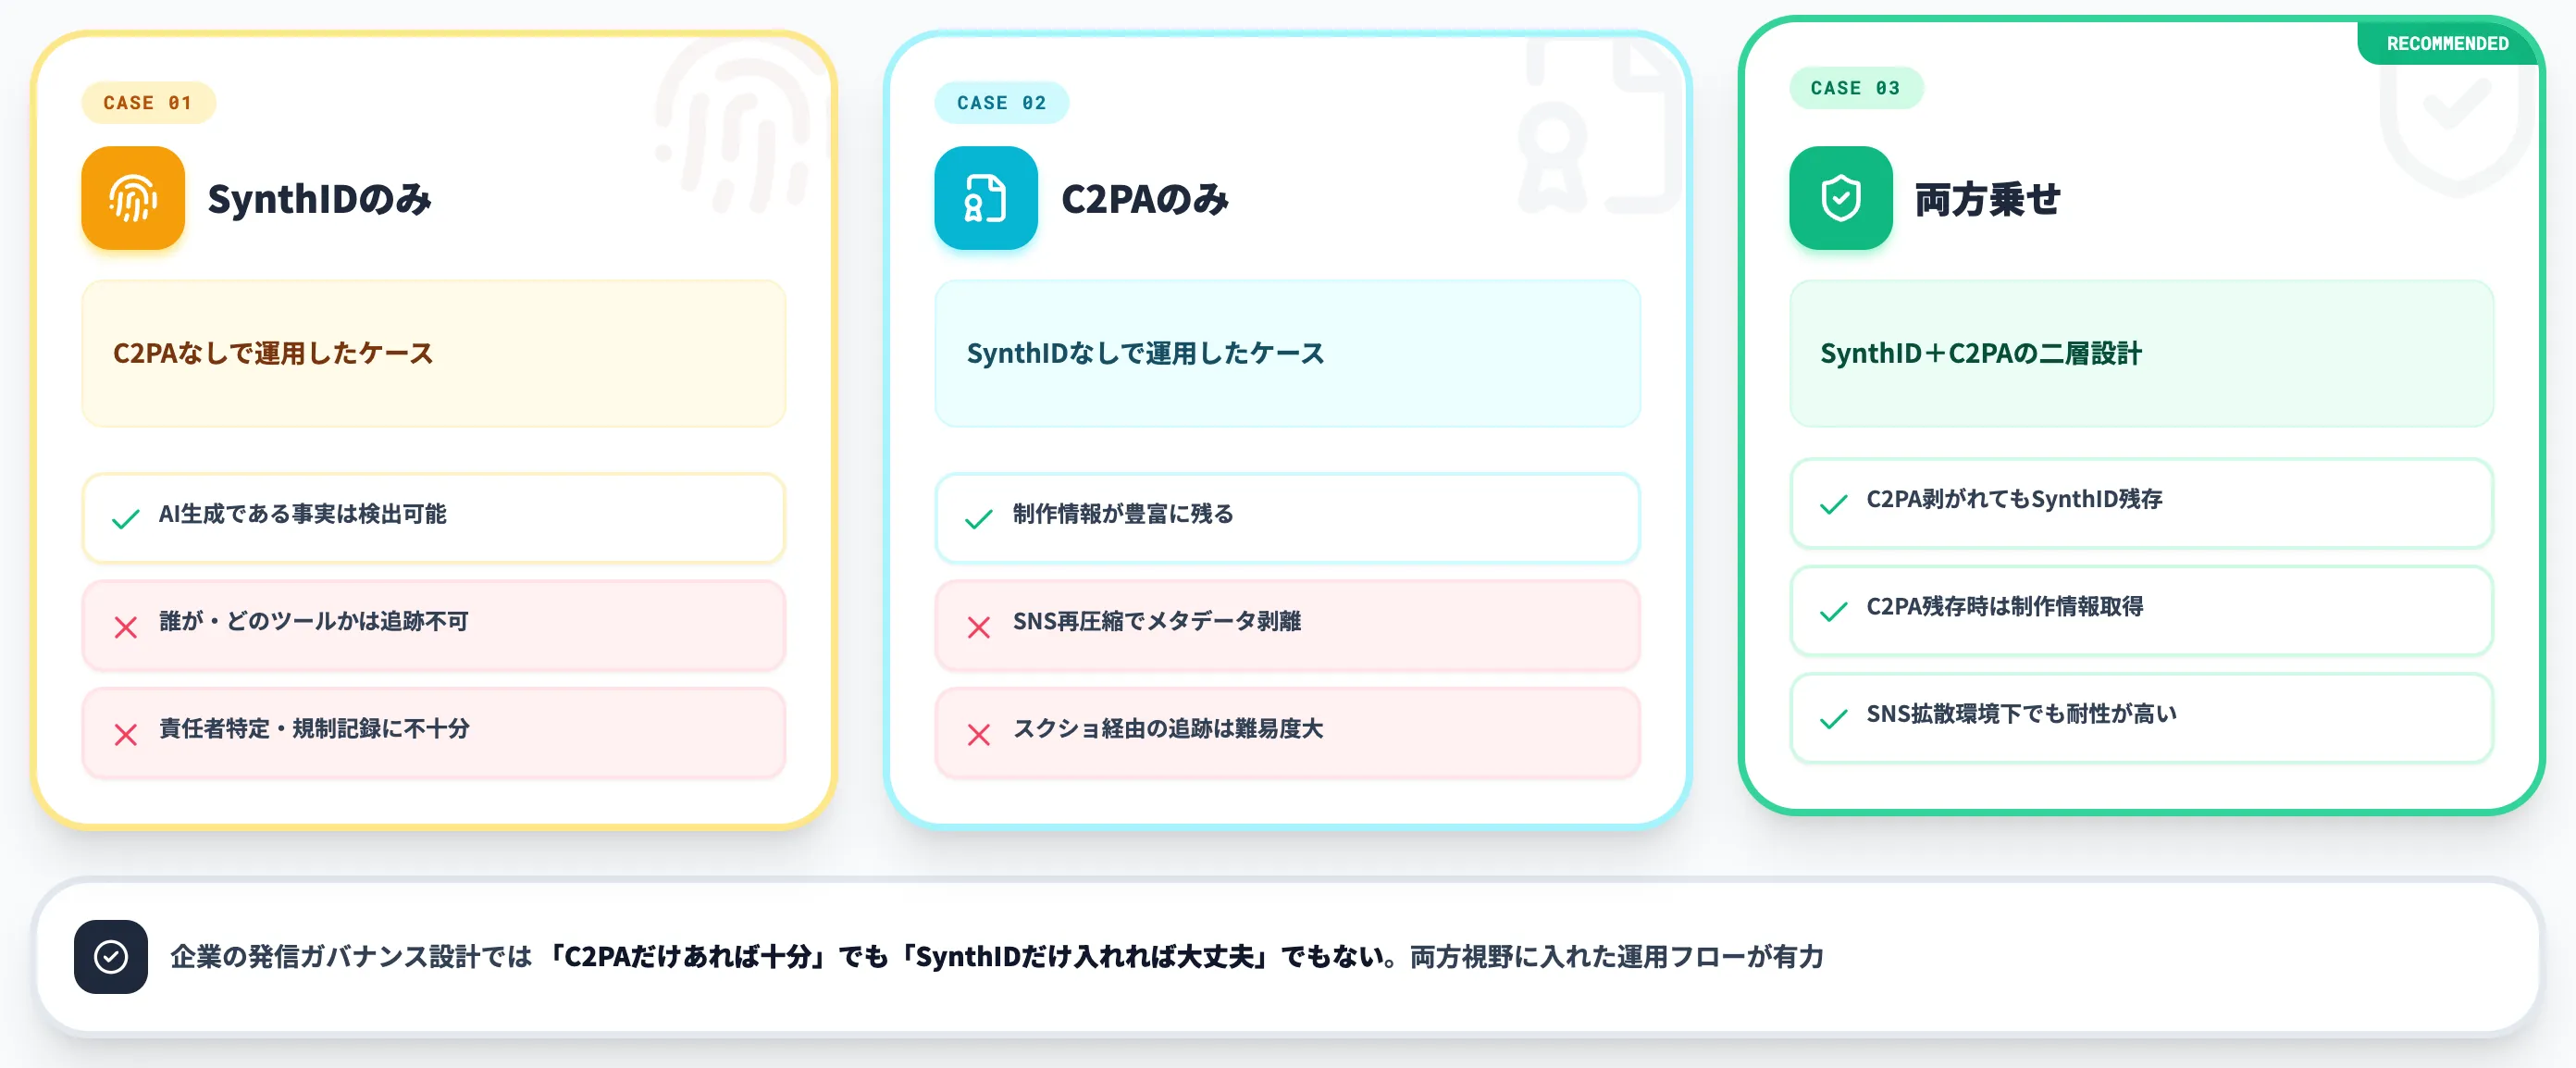
片方だけで運用した場合の失敗パターンを整理しておくと、なぜ両方を組み合わせる利点があるかが実感しやすくなります。
-
SynthIDのみ・C2PAなしの場合
「AI生成である」ことは検出できても、誰が・どのツールで作ったかまでは追跡不可。責任者の特定や規制対応の記録には不十分
-
C2PAのみ・SynthIDなしの場合
SNS再圧縮でファイル内のメタデータが剥がれると、そのファイル単体からは制作情報を直接読めなくなる。C2PAには外部マニフェスト・マニフェストリポジトリ・ソフトバインディングによる復元経路も規定されているが、SNS拡散後・スクショ経由の追跡は難易度が跳ね上がる
-
両方乗せの場合
SNS再圧縮でC2PAが剥がれても、SynthIDでAI生成の可能性を検証できる余地が残る。C2PAが残っていれば制作情報も取得できる
この構造を踏まえると、企業の発信ガバナンス設計では「C2PAだけあれば十分」でも「SynthIDだけ入れれば大丈夫」でもなく、両方を視野に入れた運用フローが有力な選択肢になります。
SynthIDの限界——検出できないケースと除去攻撃の実態
SynthIDはクロスベンダー採用が広がりつつありますが、万能ではありません。むしろ「万能ではないという前提で運用する」ことが、来歴管理を実務で回すための出発点です。
ここでは、SynthID透かしが検出できない典型ケースと、除去技術の現状を整理します。
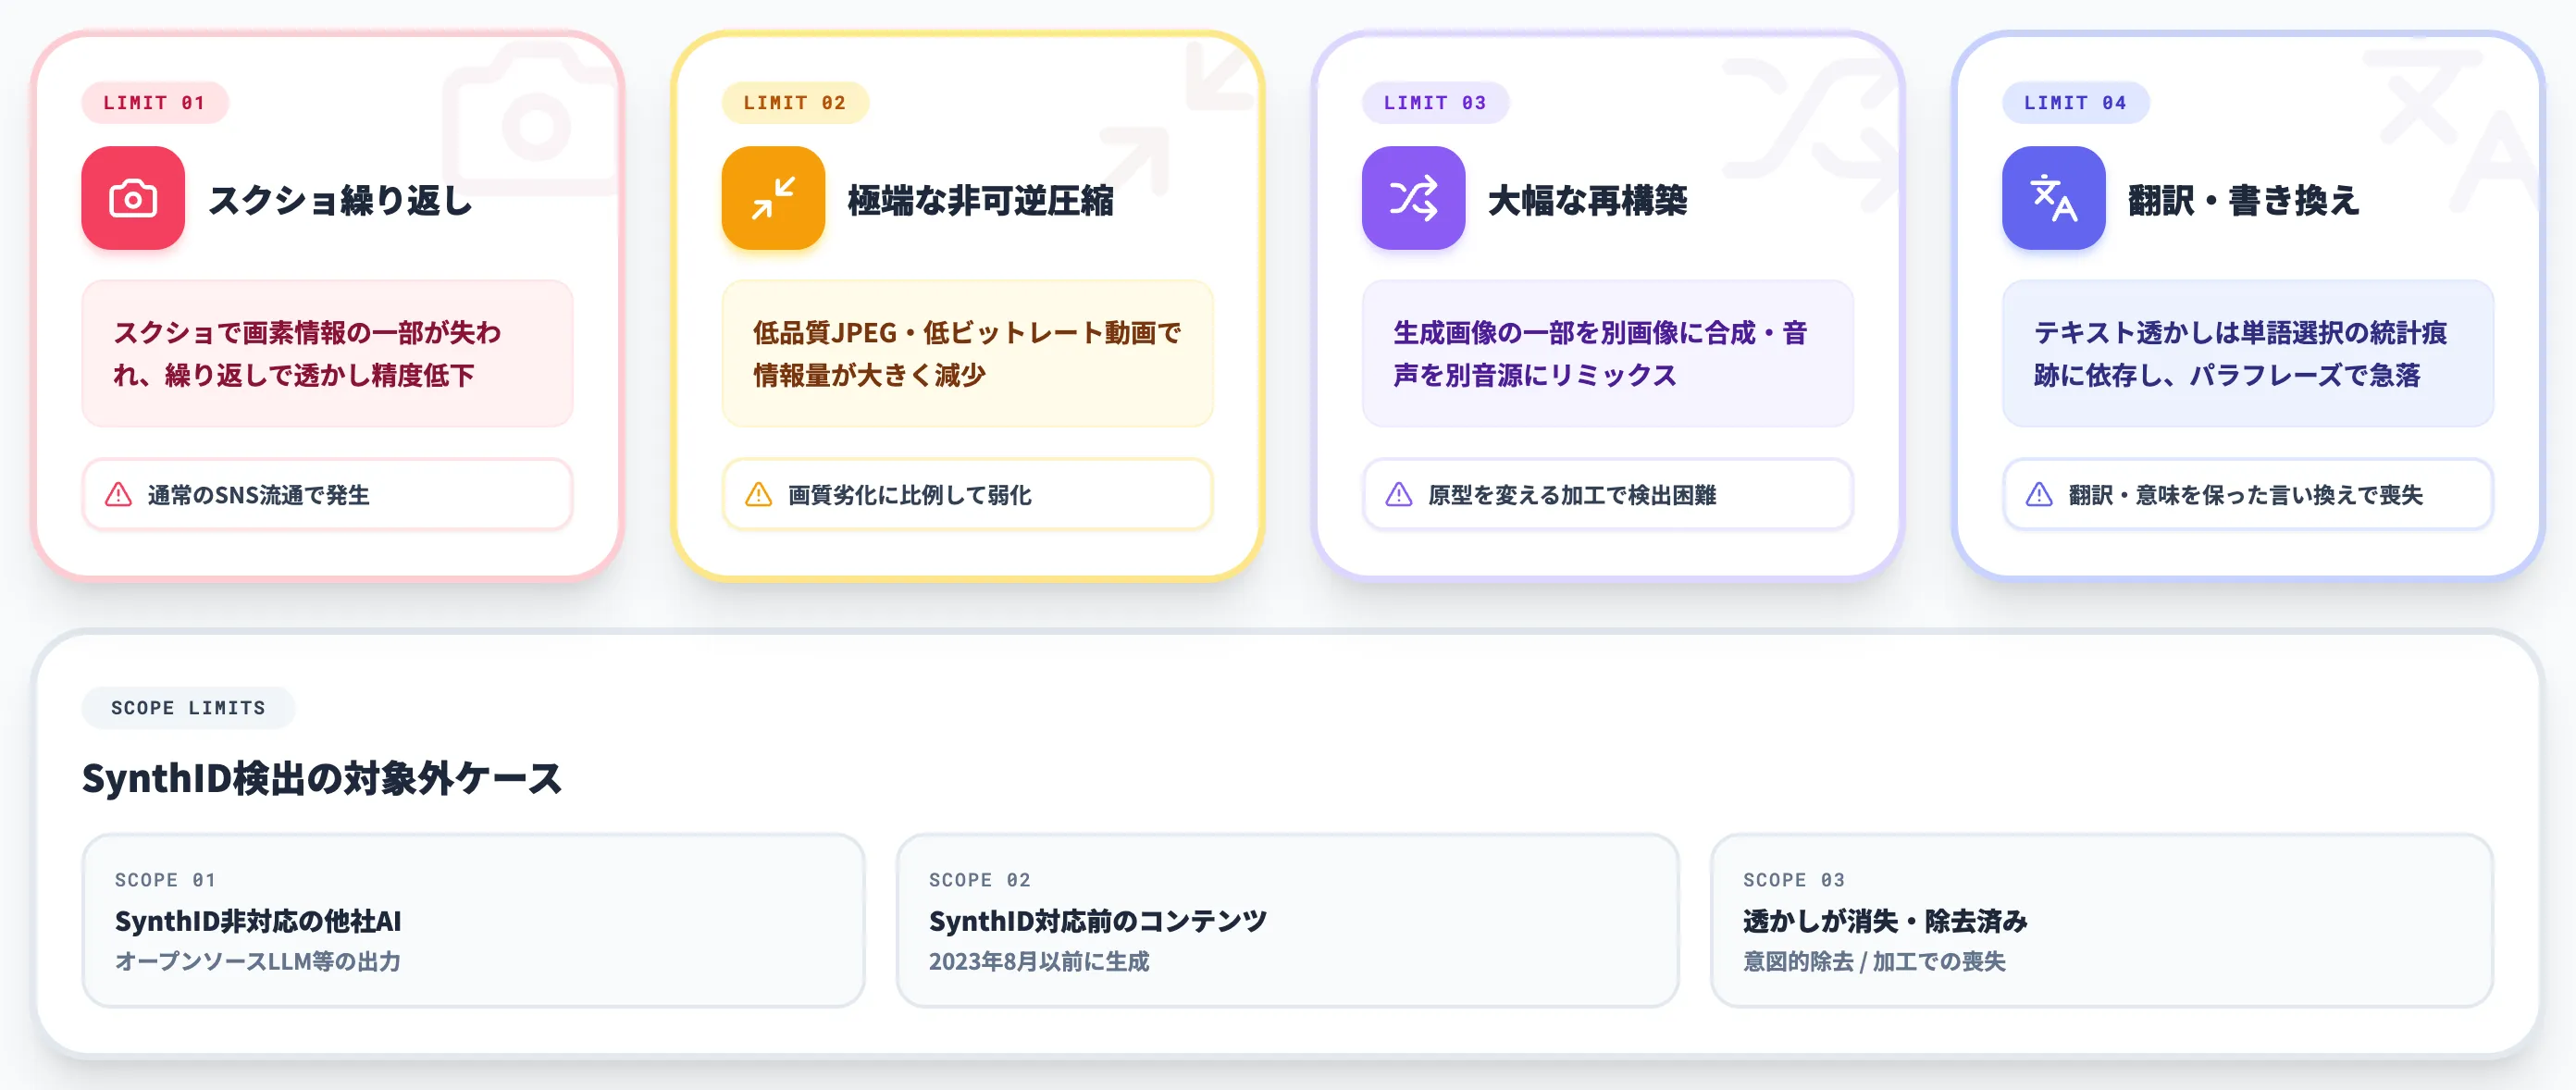
弱化・検出困難になる典型パターン
以下のパターンでは、SynthID透かしの検出精度が大きく落ちるか、検出困難になる場合があります。
-
スクリーンショットの繰り返し
画像をスクショで撮り直す度に画素情報の一部が失われる。何度もスクショサイクルを重ねると透かしの検出精度が落ちる場合がある
-
極端な非可逆圧縮
JPEG品質を極端に下げる・低ビットレートでの動画再エンコードなど、コンテンツの情報量そのものを大きく減らす加工に弱い
-
大幅な再構築・別コンテンツ合成
生成画像の一部だけを別画像に合成、生成音声を別音源にリミックスするなど、原型を大きく変える加工では透かしの検出が困難になる場合がある
-
テキストの翻訳・大幅な書き換え
テキスト透かしは単語選択の統計的痕跡に依存するため、翻訳や意味を保ったまま言い換えるパラフレーズで検出精度が急落する
これらの弱化パターンは、いずれも「悪意ある除去」というより通常のコンテンツ運用で発生するものです。SNSに画像を投稿して他ユーザーがスクショで拡散、といった一般的な流通経路でも透かしが弱くなる場合があります。
除去技術の研究とオープンソース公開
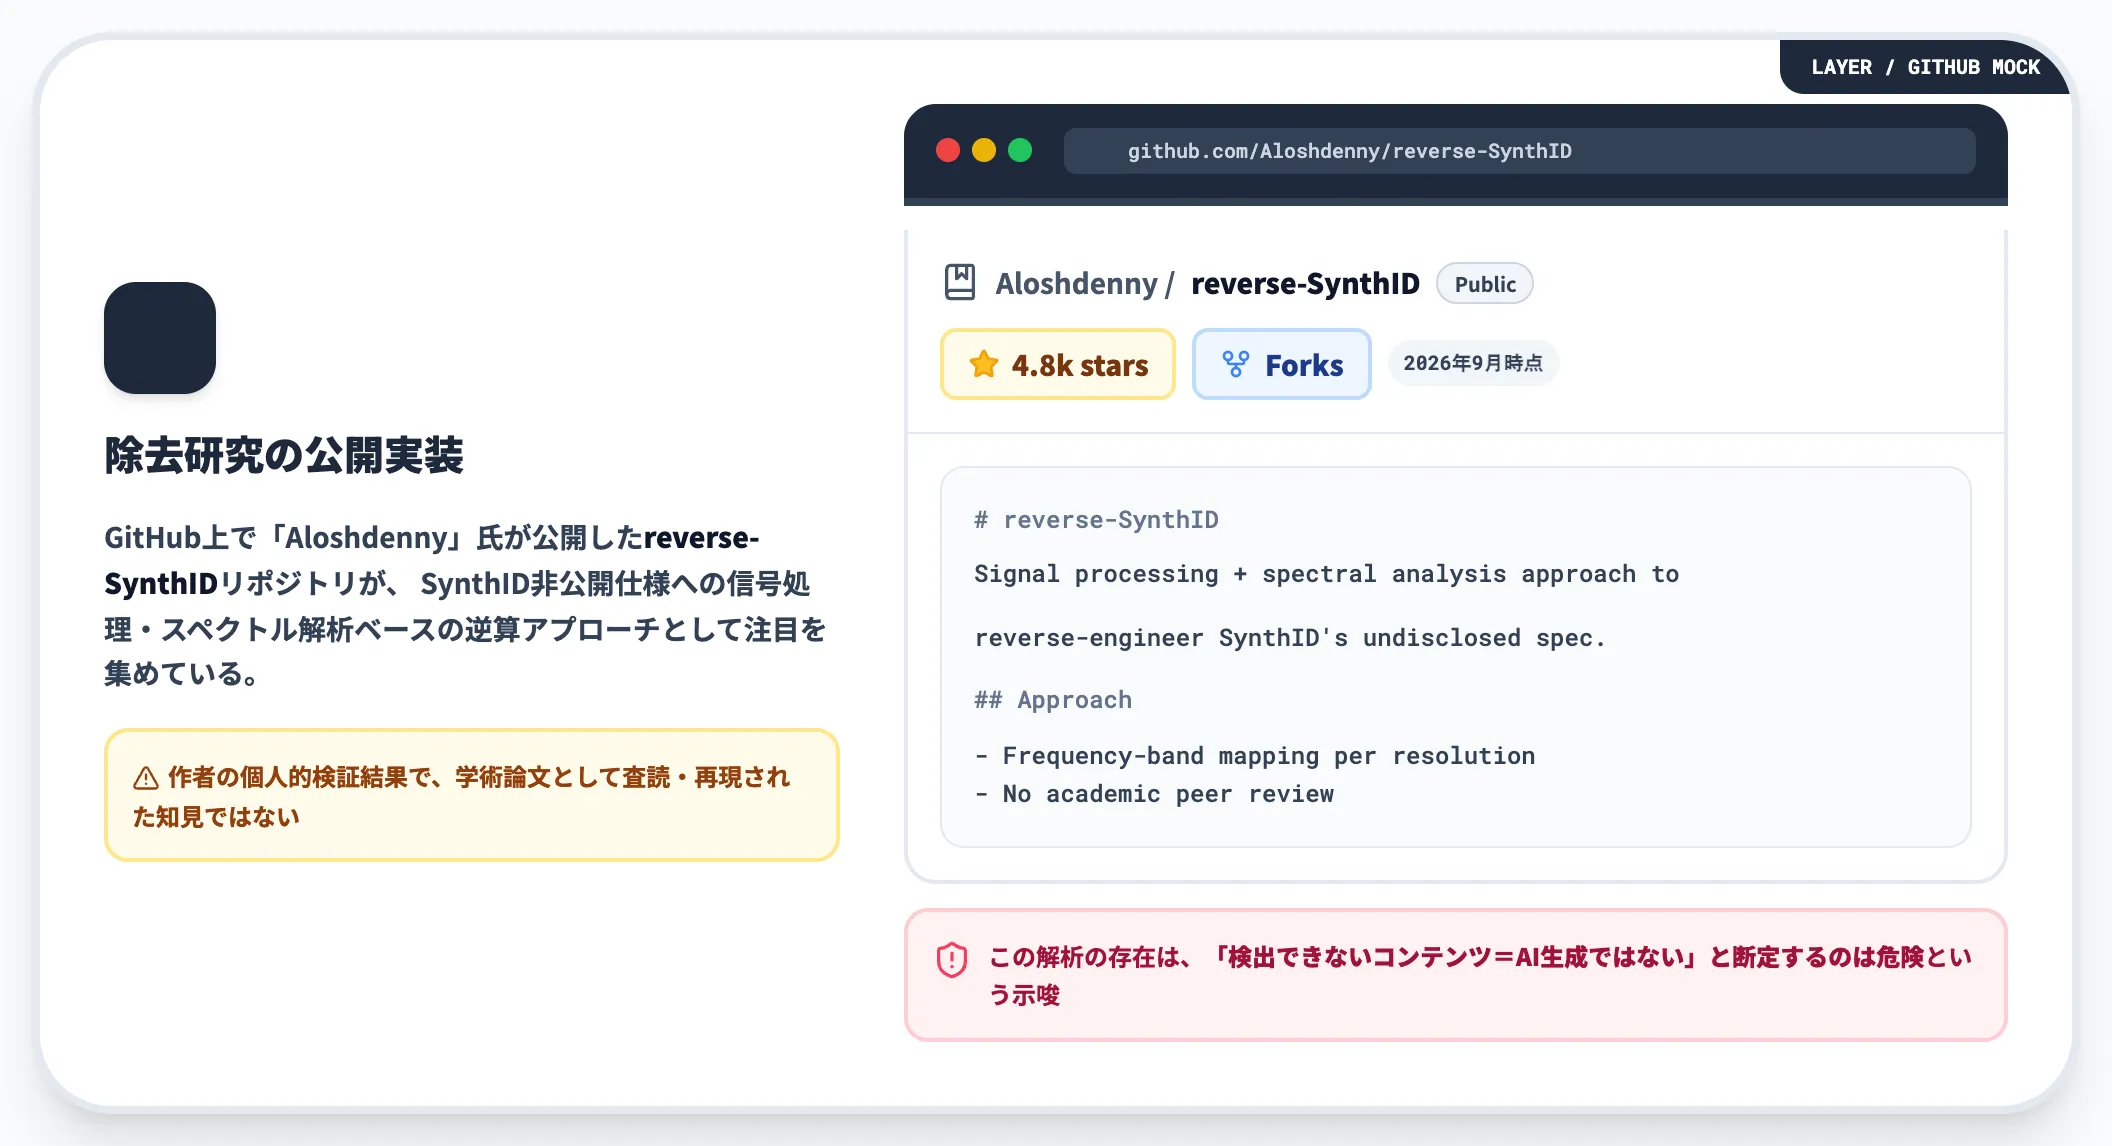
GitHub上では「Aloshdenny」というハンドルの開発者が公開したreverse-SynthIDというリポジトリが約4,800(4.8k)のスターを集めています(2026年9月時点)。SynthID非公開仕様に対して信号処理とスペクトル解析だけで逆算するアプローチを取り、画像解像度ごとの周波数帯マッピングを特定したと作者は説明しています。
ただしこの解析はリポジトリ作者による個人的な検証結果であり、学術論文として独立に査読・再現された知見ではありません。「除去できる」と即断せず、「そう主張する公開実装があり、透かし技術の限界を示唆する」レベルで扱うのが妥当です。
一方で、こうした試みが公開されている以上、SynthID透かしを検出できないコンテンツを「AI生成ではない」と断定するのは危険です。
「検出されない=本物」とは限らないという原則
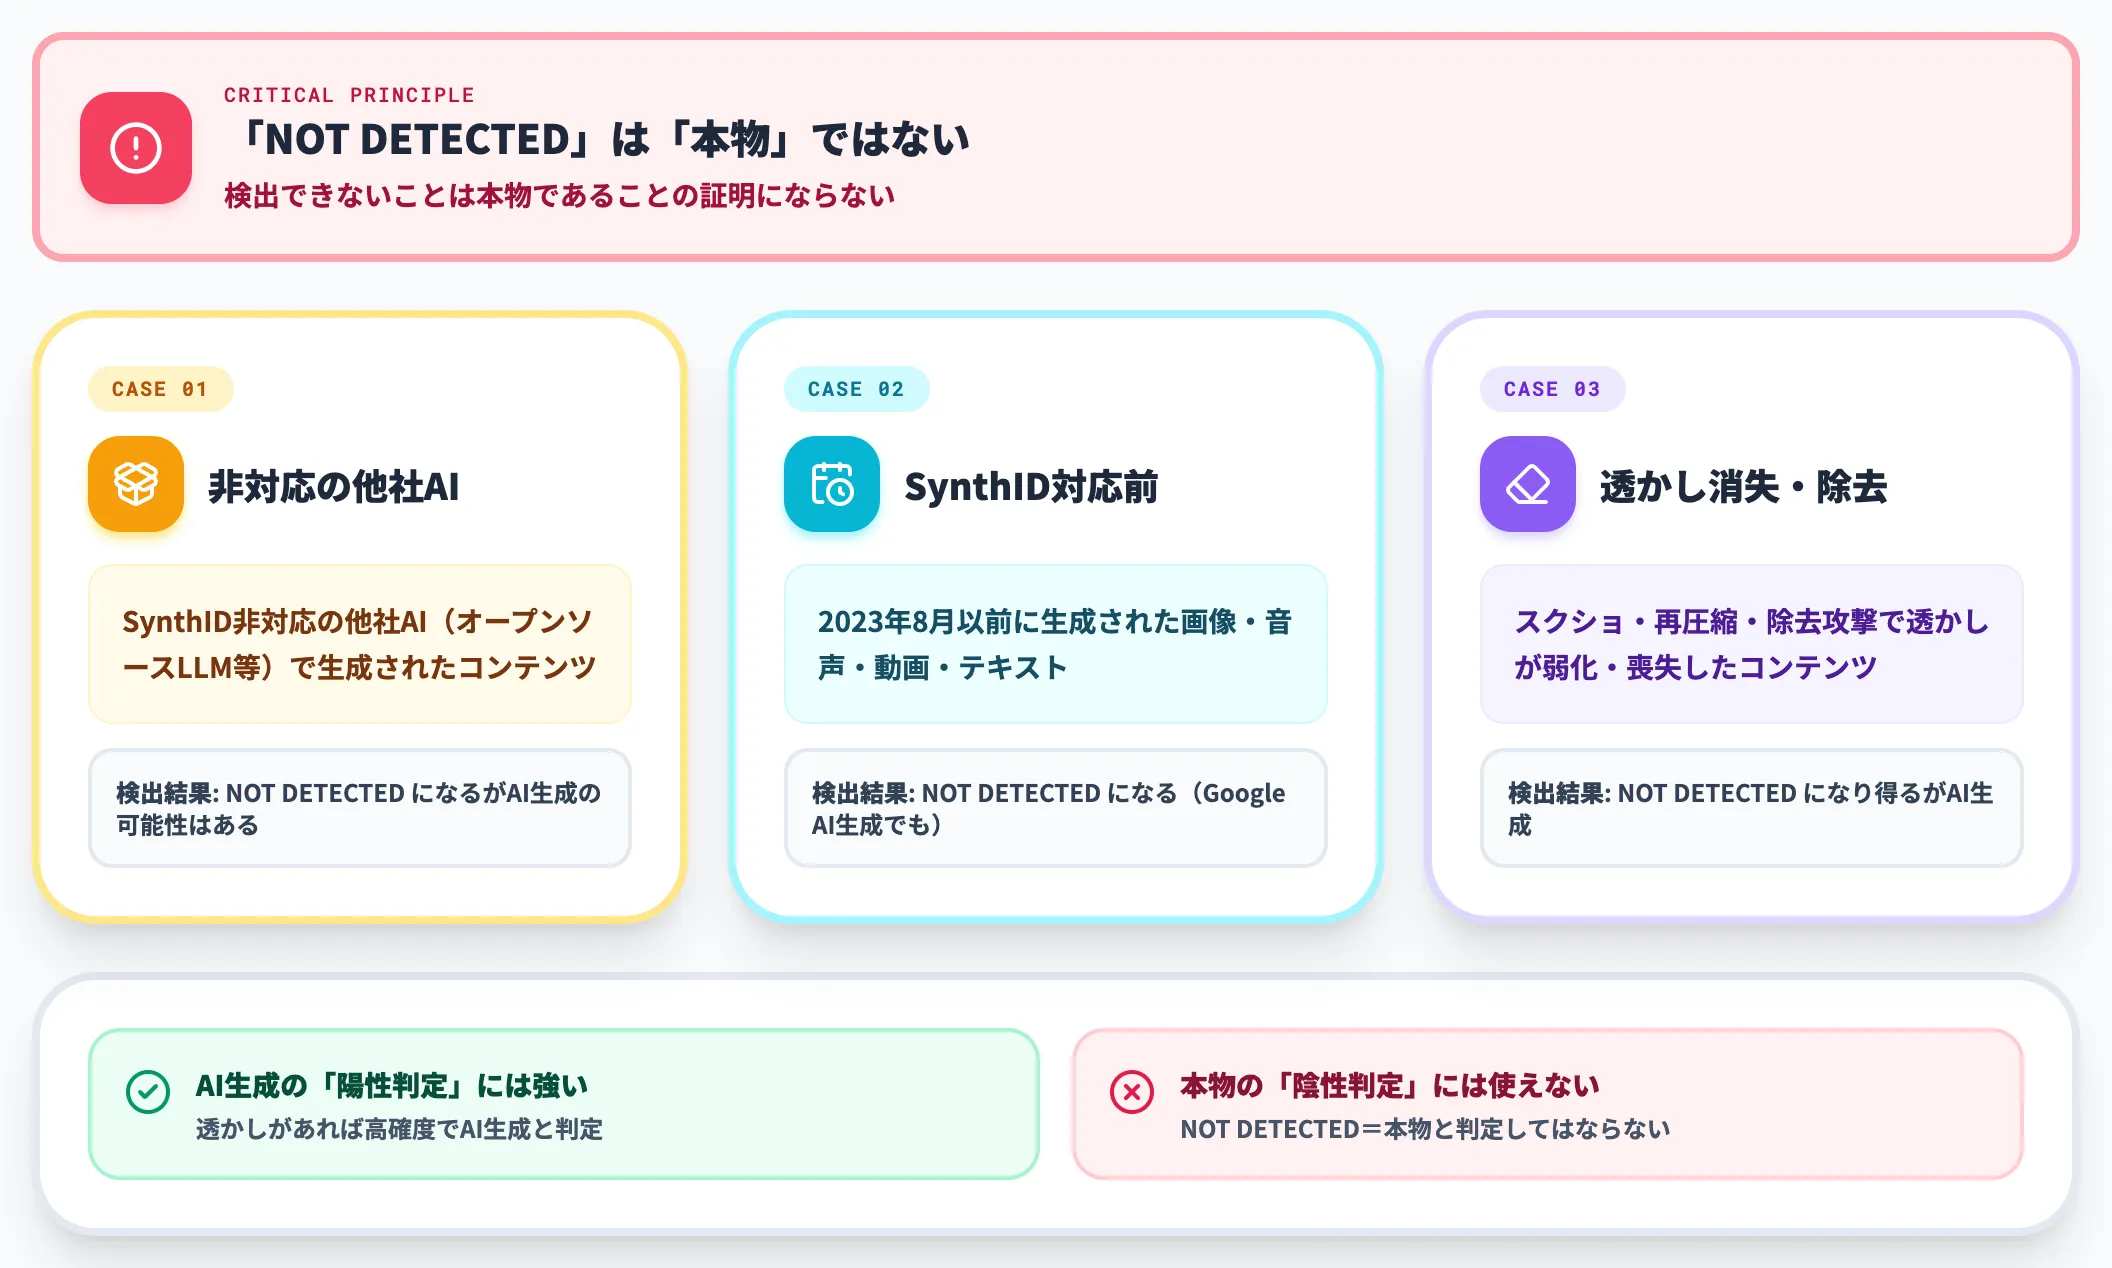
SynthID運用で最も重要な原則が、検出されないことは本物であることの証明にならないという点です。SynthIDが検出できるのは「SynthIDを埋め込んで生成されたコンテンツ」に限られ、以下のケースは検出対象外になります。
- SynthID非対応の他社AI(オープンソースLLM等)で生成されたコンテンツ
- SynthID対応前(2023年8月以前)に生成されたコンテンツ
- SynthID透かしが消失・除去されたコンテンツ
つまりSynthID検出は「AI生成の陽性判定」には強いが「本物の陰性判定」には使えません。
企業が来歴管理ポリシーを組む際、「Detector PortalでNOT DETECTEDが出たから本物」という運用フローを組んでしまうと、上記3ケースをすべて誤判定するリスクを負います。
False negative/positiveの扱い
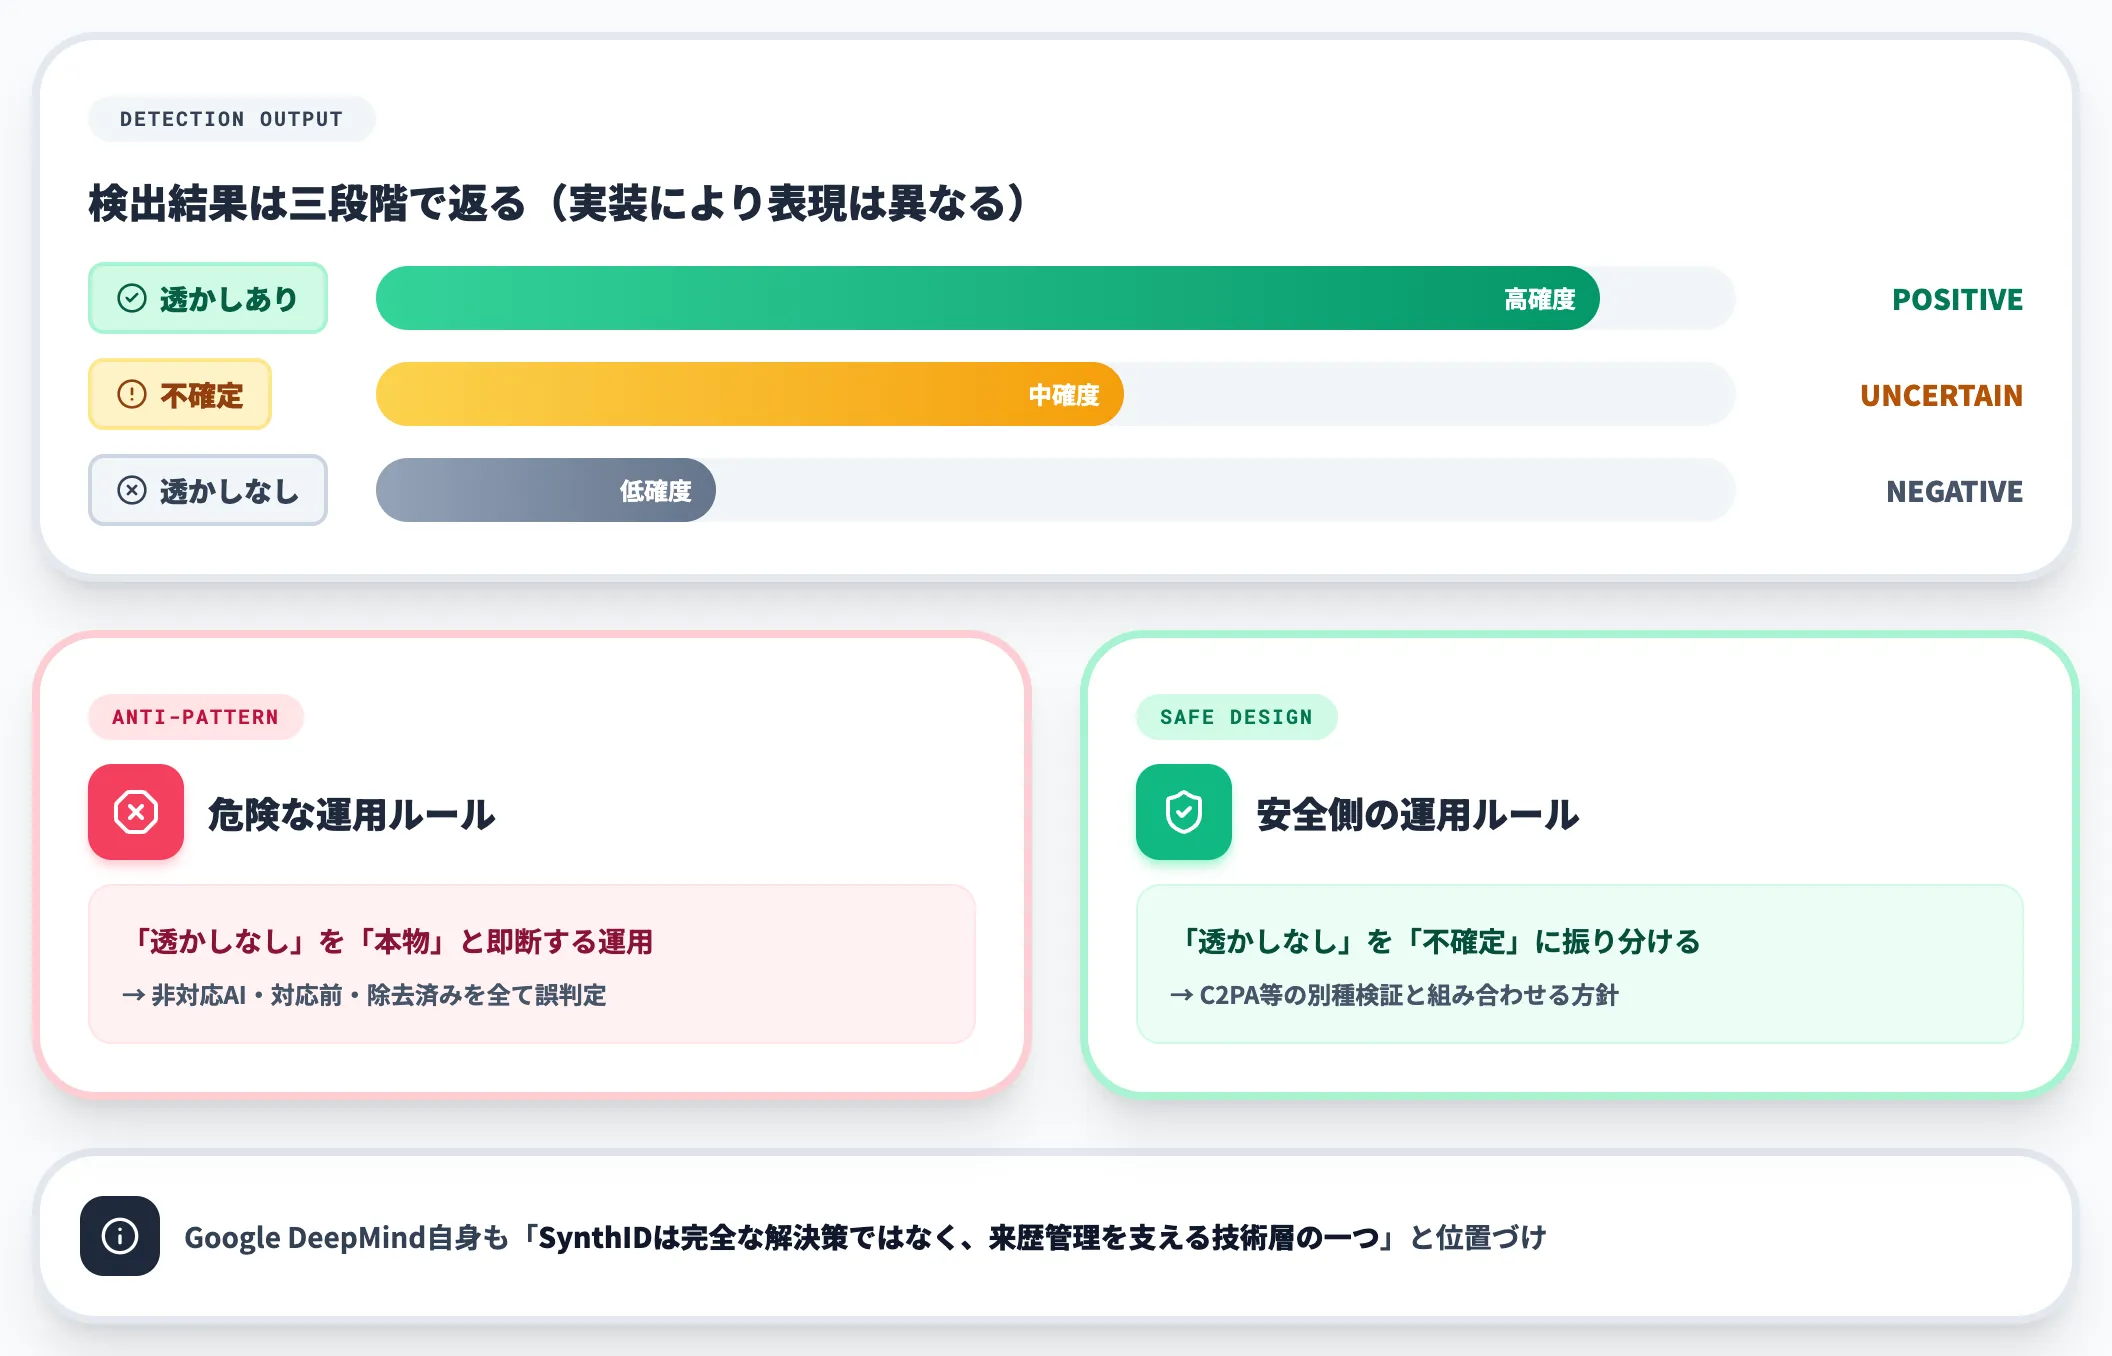
判定結果は「透かしあり/透かしなし/不確定」の三段階で返る形式が採用されているツールが多く見られます(実装により表現は異なります)。「透かしなし」を「本物」と即断せず「不確定」に振り分ける運用ルールが安全側の設計です。
Google DeepMind自身も、SynthIDを「AI生成物識別の完全な解決策ではなく、コンテンツ来歴管理を支える技術層の一つ」と位置づけています。
導入企業側もこの認識に合わせ、SynthID単独に依存せずC2PAや別種の検証手段と組み合わせる方針を明示することが、後々のトラブル回避につながります。
企業がSynthIDを扱うときの実務判断
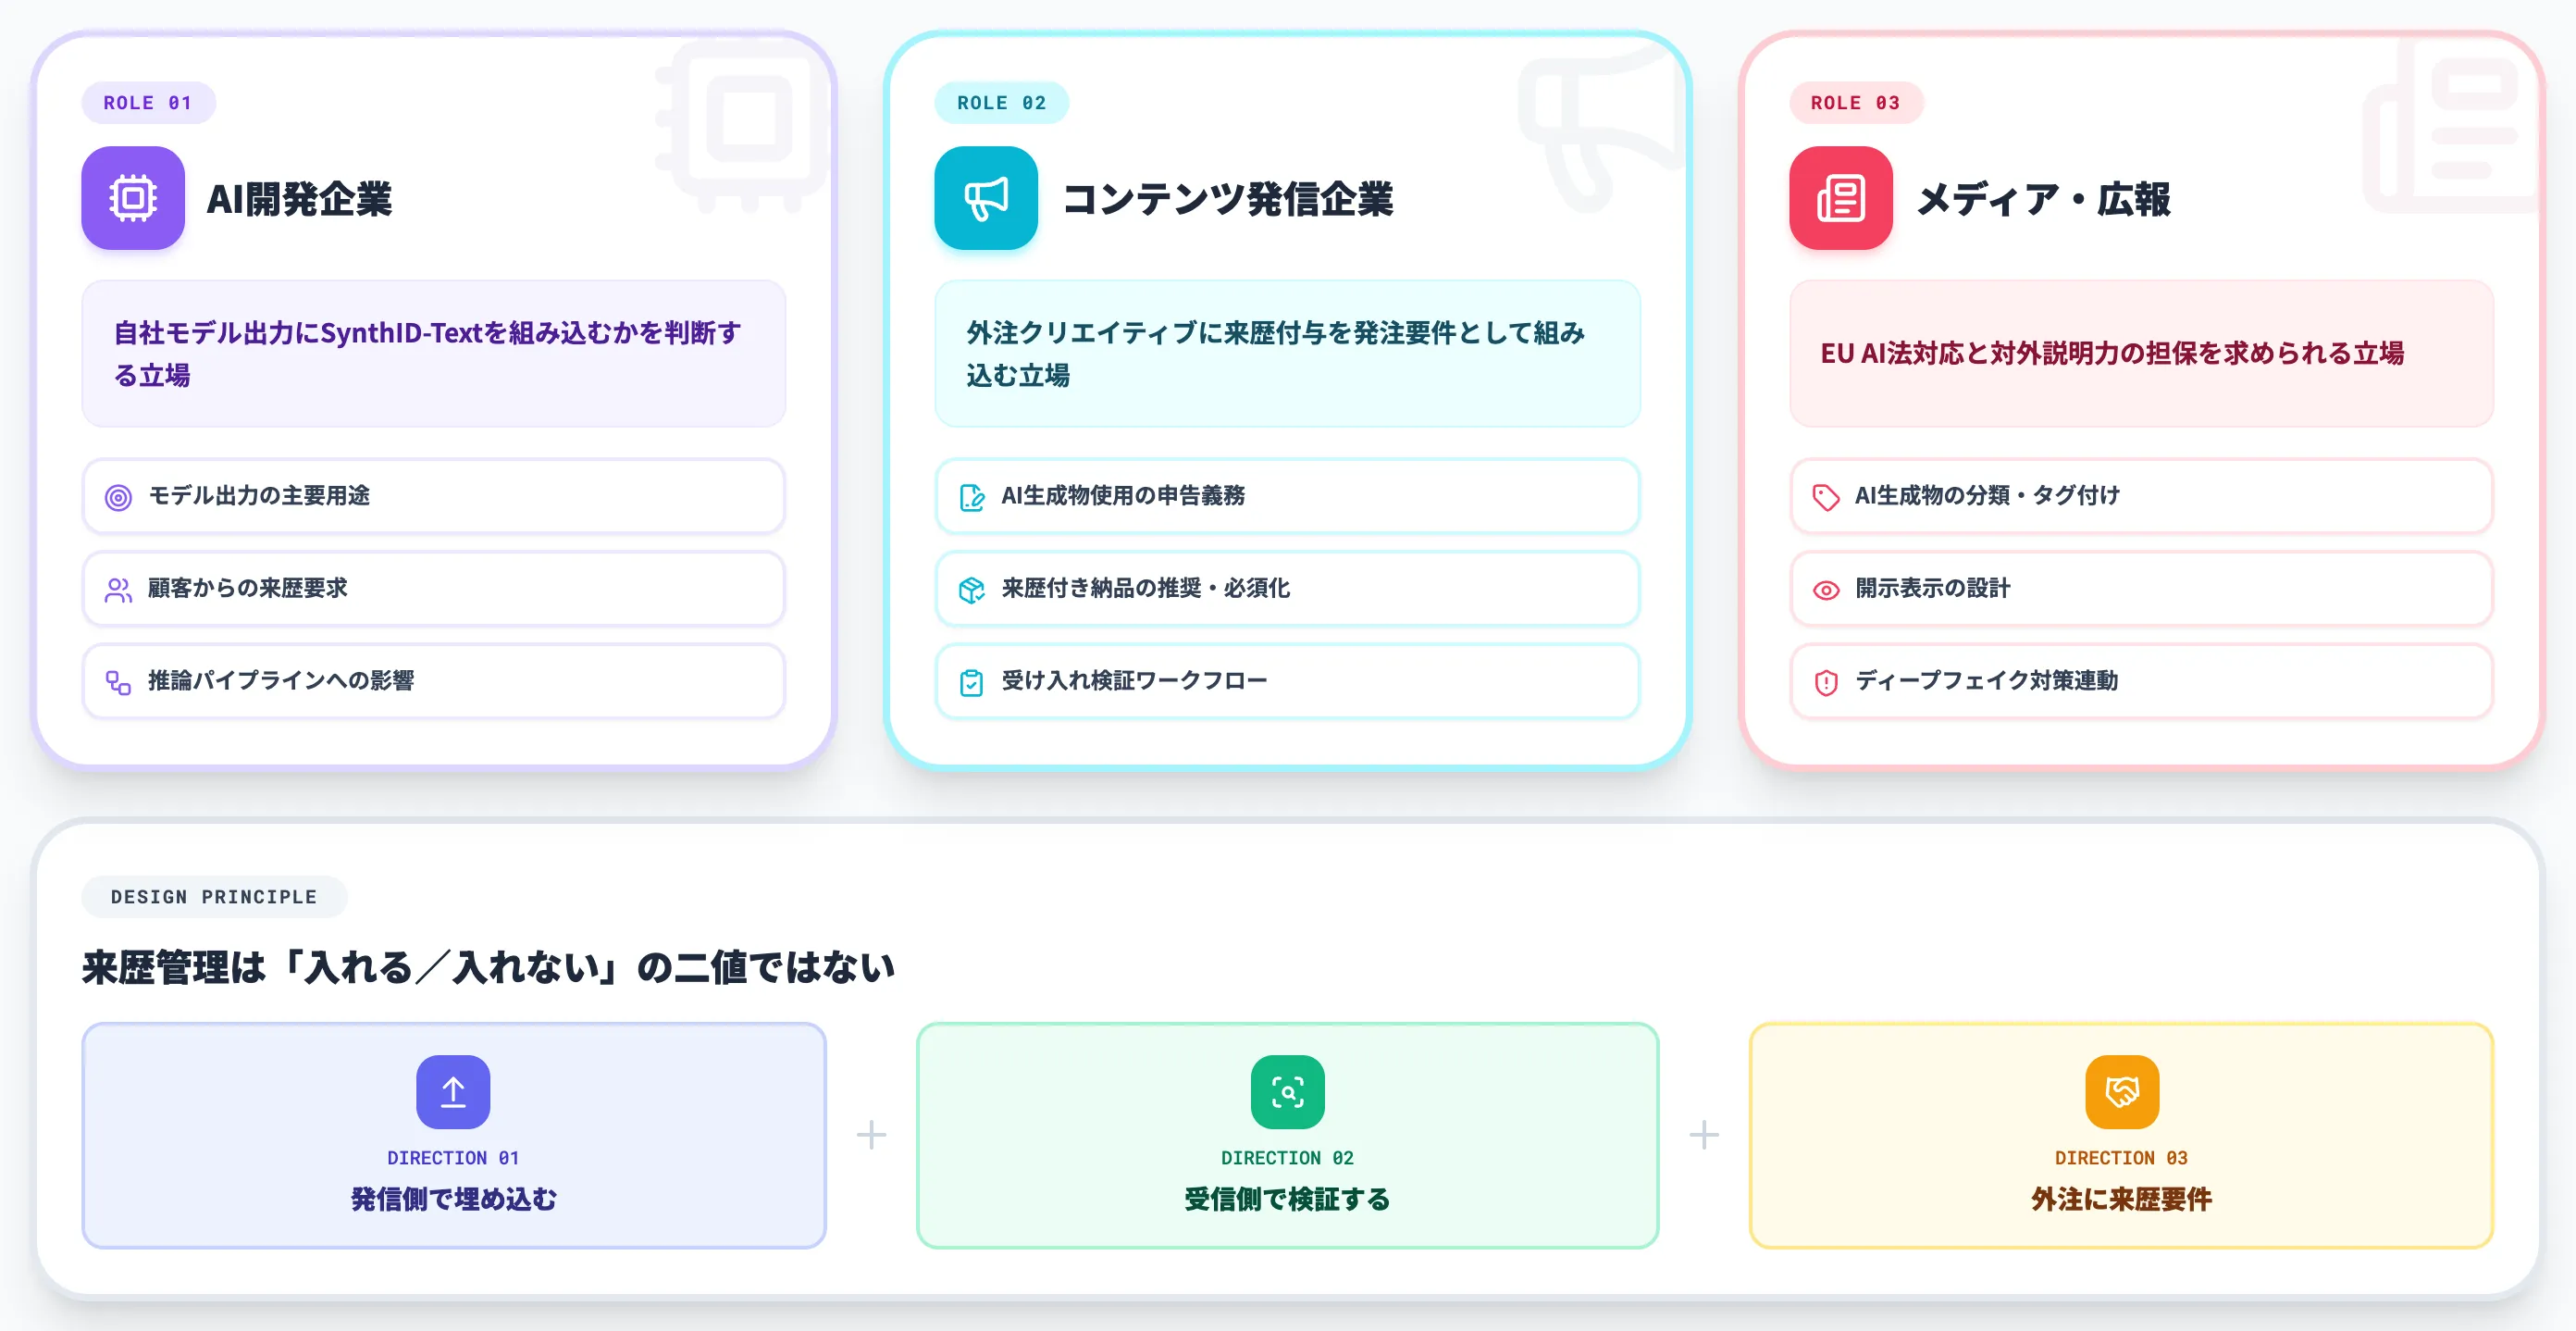
ここまで技術・エコシステム・限界を整理してきましたが、最後に企業側でSynthIDをどう扱うべきかを立場別に整理します。AI開発企業・コンテンツ発信企業・メディア広報の3つの立場で判断軸が変わるため、それぞれのケースで押さえるべきポイントを示します。
AI総研の支援現場でも、来歴管理は「入れる/入れない」の二値ではなく「発信側で埋め込むか・受信側で検証するか・外注クリエイティブに要件化するか」の3方向で設計するケースが増えています。
AI開発企業——OSS透かしの組み込み判断
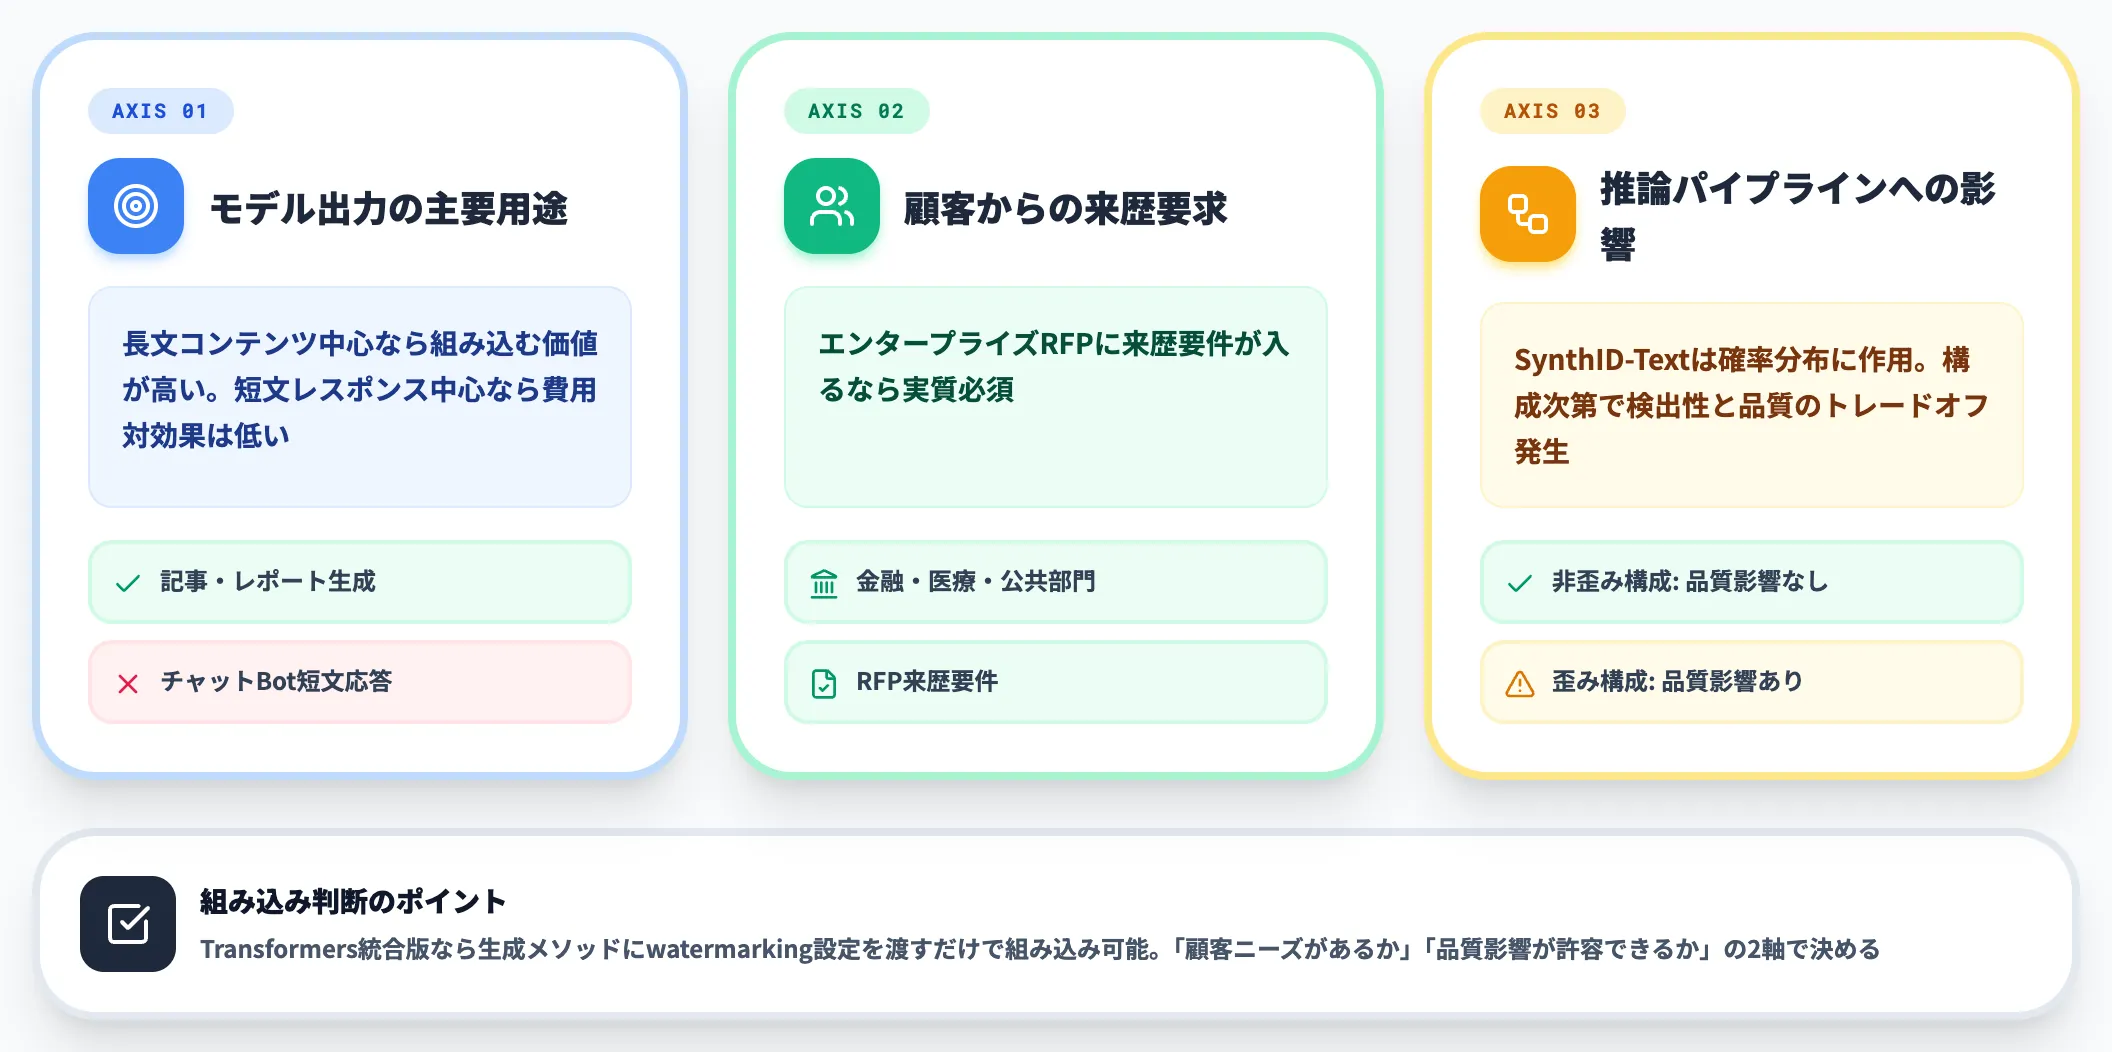
自社で言語モデルを開発・提供している企業は、Hugging Face Transformers統合版のSynthID-Textを自社モデルに組み込む選択肢があります(GitHub版は参照実装で本番想定外)。判断軸は以下の通りです。
-
モデル出力の主要用途
長文コンテンツ(記事・レポート)が中心なら透かしの検出精度が確保しやすく、組み込む価値が高い。短文レスポンス中心(チャットBot応答等)なら透かしが弱く、費用対効果が低い
-
顧客からの来歴要求の有無
金融・医療・公共部門の顧客からは「AI生成物であることを証明できる仕組み」を要求される場合がある。エンタープライズ顧客のRFPに来歴要件が含まれるなら組み込みは実質的な必須要件
-
既存の推論パイプラインへの影響
SynthID-Textはトークン選択時の確率分布に作用するため、構成によって検出性と品質のトレードオフがある。非歪み構成については有意な品質低下は確認されていないとGoogleが説明しているが、検出性を高める歪み構成では品質影響が発生し得るため、品質評価のベンチマークで自社ユースケースの許容範囲を事前検証しておく
Transformers統合版なら生成メソッドにwatermarking設定を渡すだけで組み込めますが、「顧客ニーズがあるか」「品質影響が許容できるか」の2軸で判断することが重要です。
コンテンツ発信企業——外注への来歴要件化
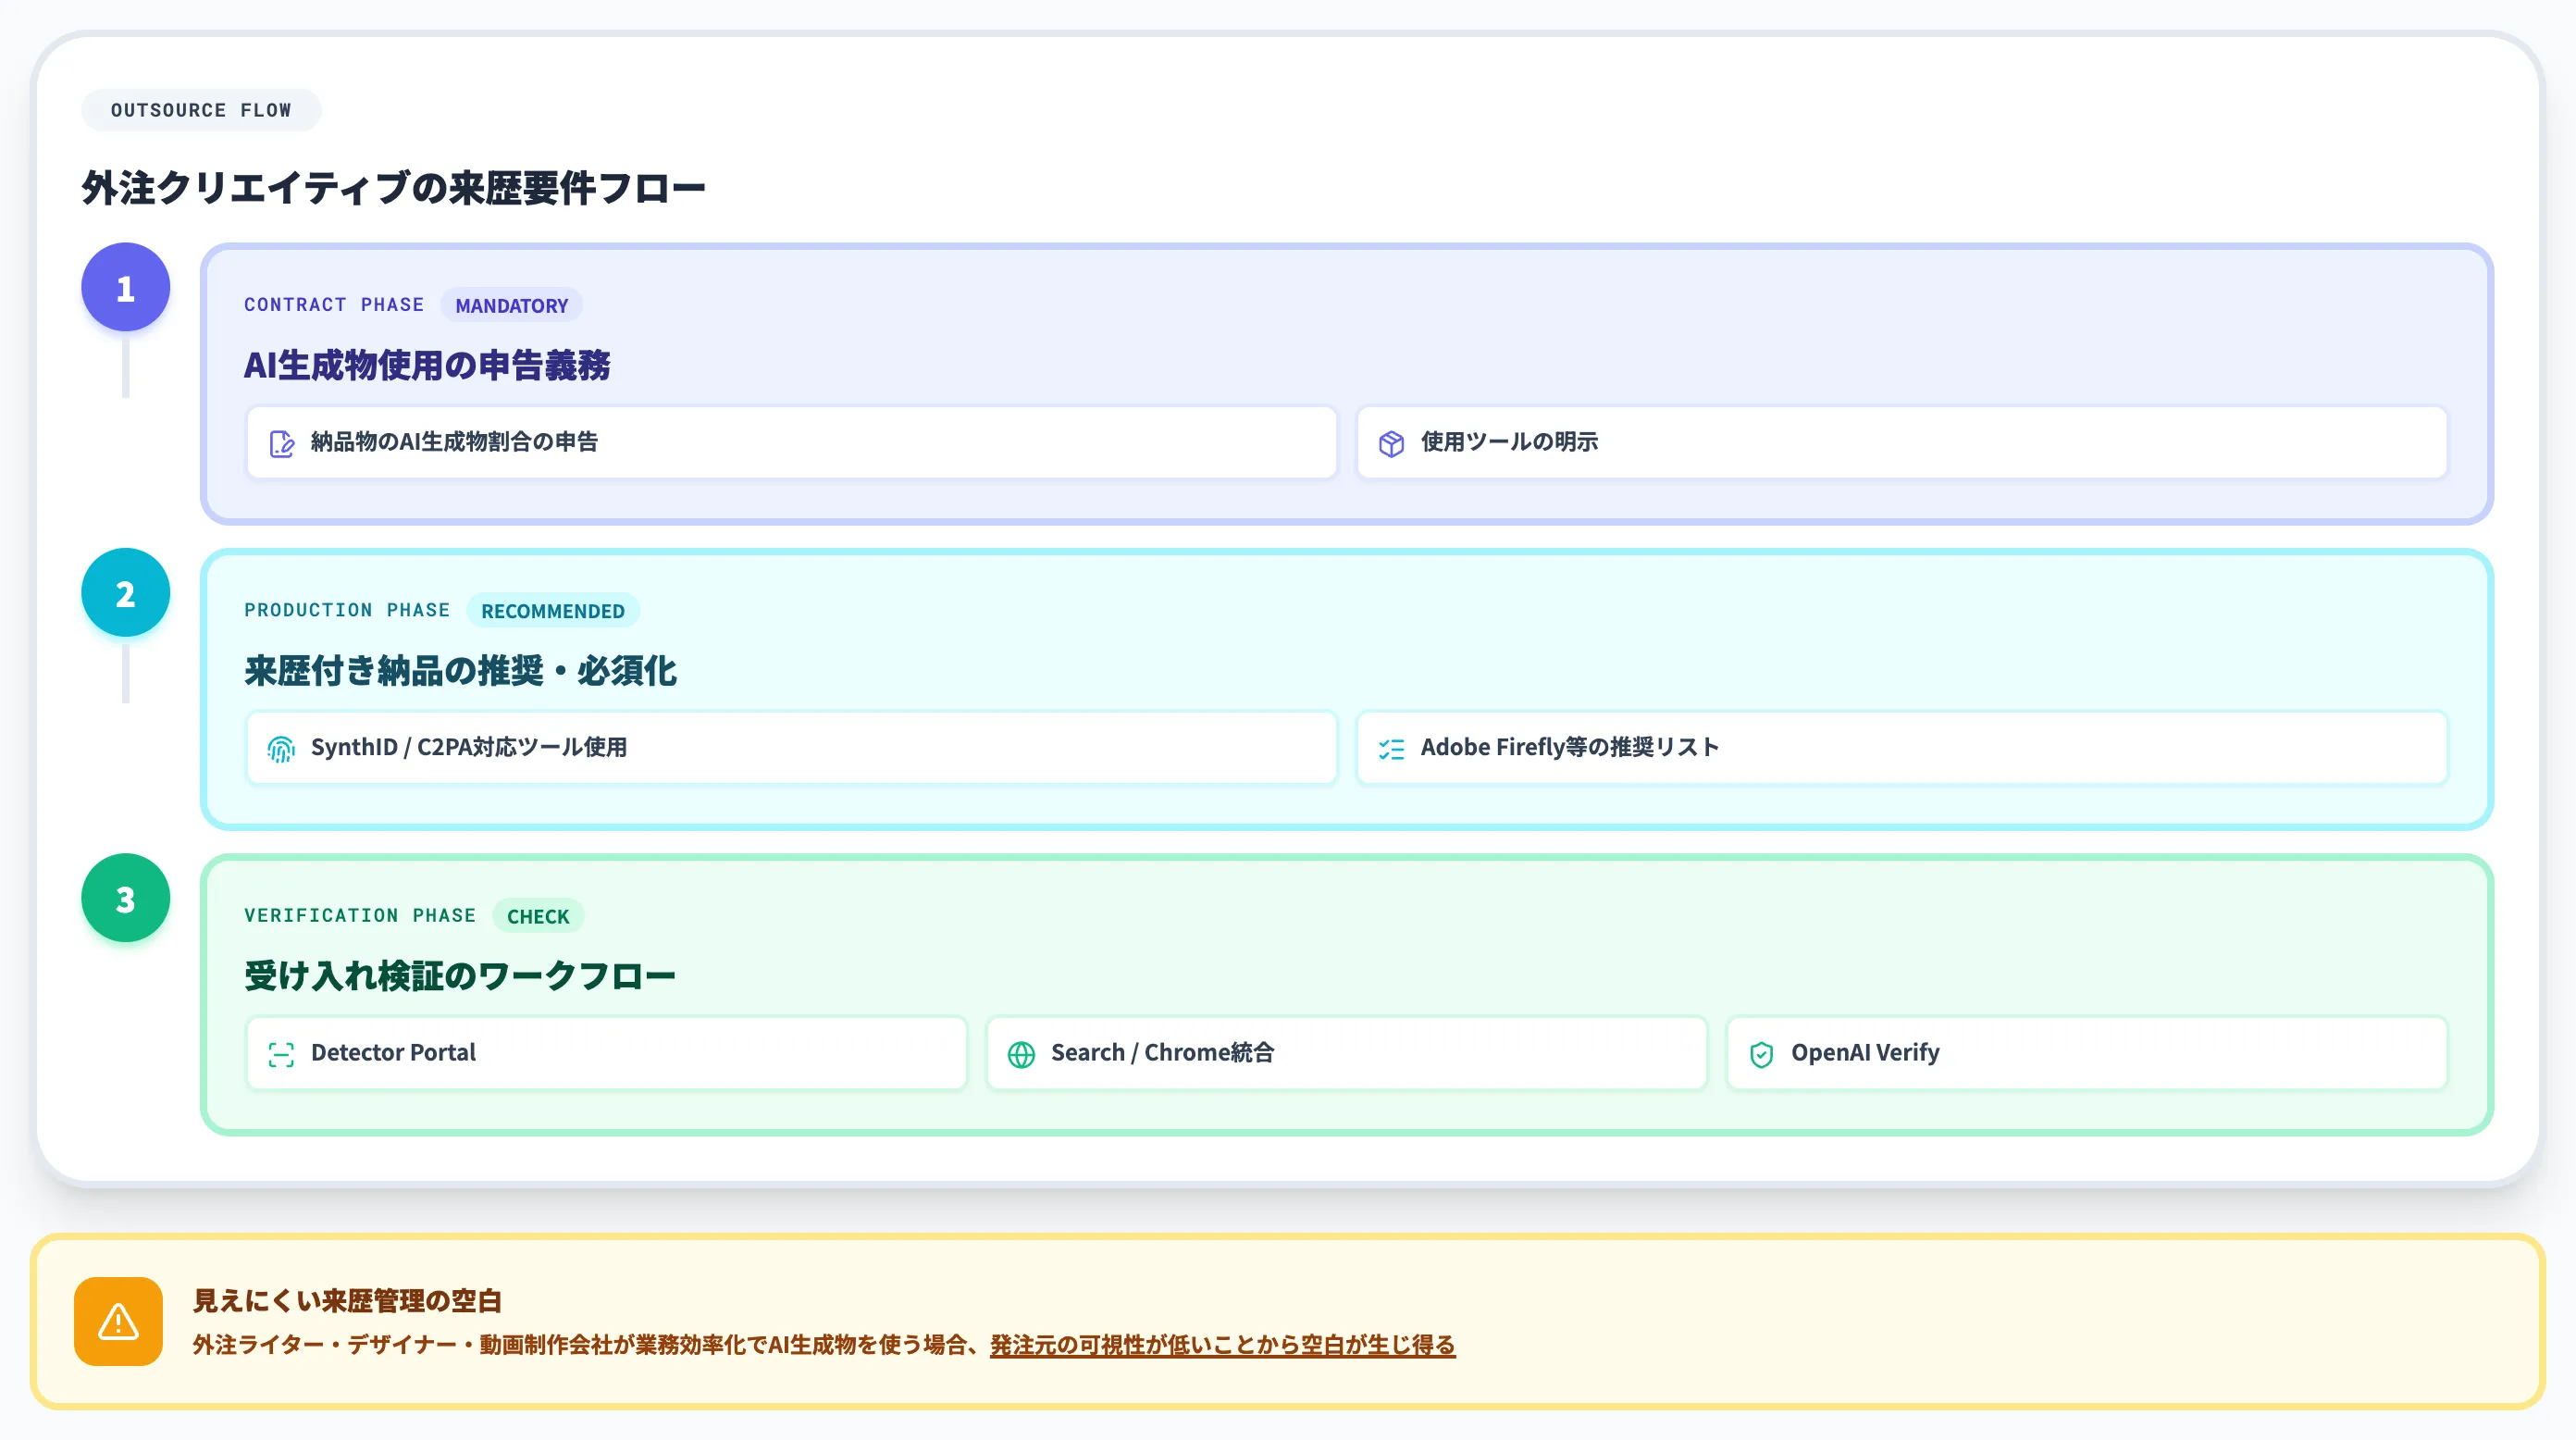
自社ブランドでコンテンツを発信している企業(メディア・EC・広告主)は、社内制作物だけでなく外注クリエイティブに来歴付与を発注要件として組み込む判断が問われます。
外注ライター・デザイナー・動画制作会社が業務効率化のためにAI生成物を使う場合、発注元の可視性が低いことから来歴管理の空白が生じ得ます。以下を発注契約書に盛り込むことが実務的な対応になります。
-
AI生成物使用の申告義務
納品物にAI生成物を含む場合、その割合と使用したツールを申告する義務を発注時に明記する
-
来歴付き納品の推奨・必須化
可能な限りSynthID/C2PA対応ツールで生成し、来歴情報を残した状態で納品してもらう。C2PA Content Credentialsに対応する生成ツール(Adobe Firefly等)の使用を推奨リストとして提示する
-
受け入れ検証のワークフロー
納品物を受領した際、SynthID Detector Portal・Search/Gemini in Chrome・OpenAI Verifyの経路のうち発信元に合うものを選んで検証するステップを社内フローに組み込む
メディア・広報——EU AI法対応と対外説明力
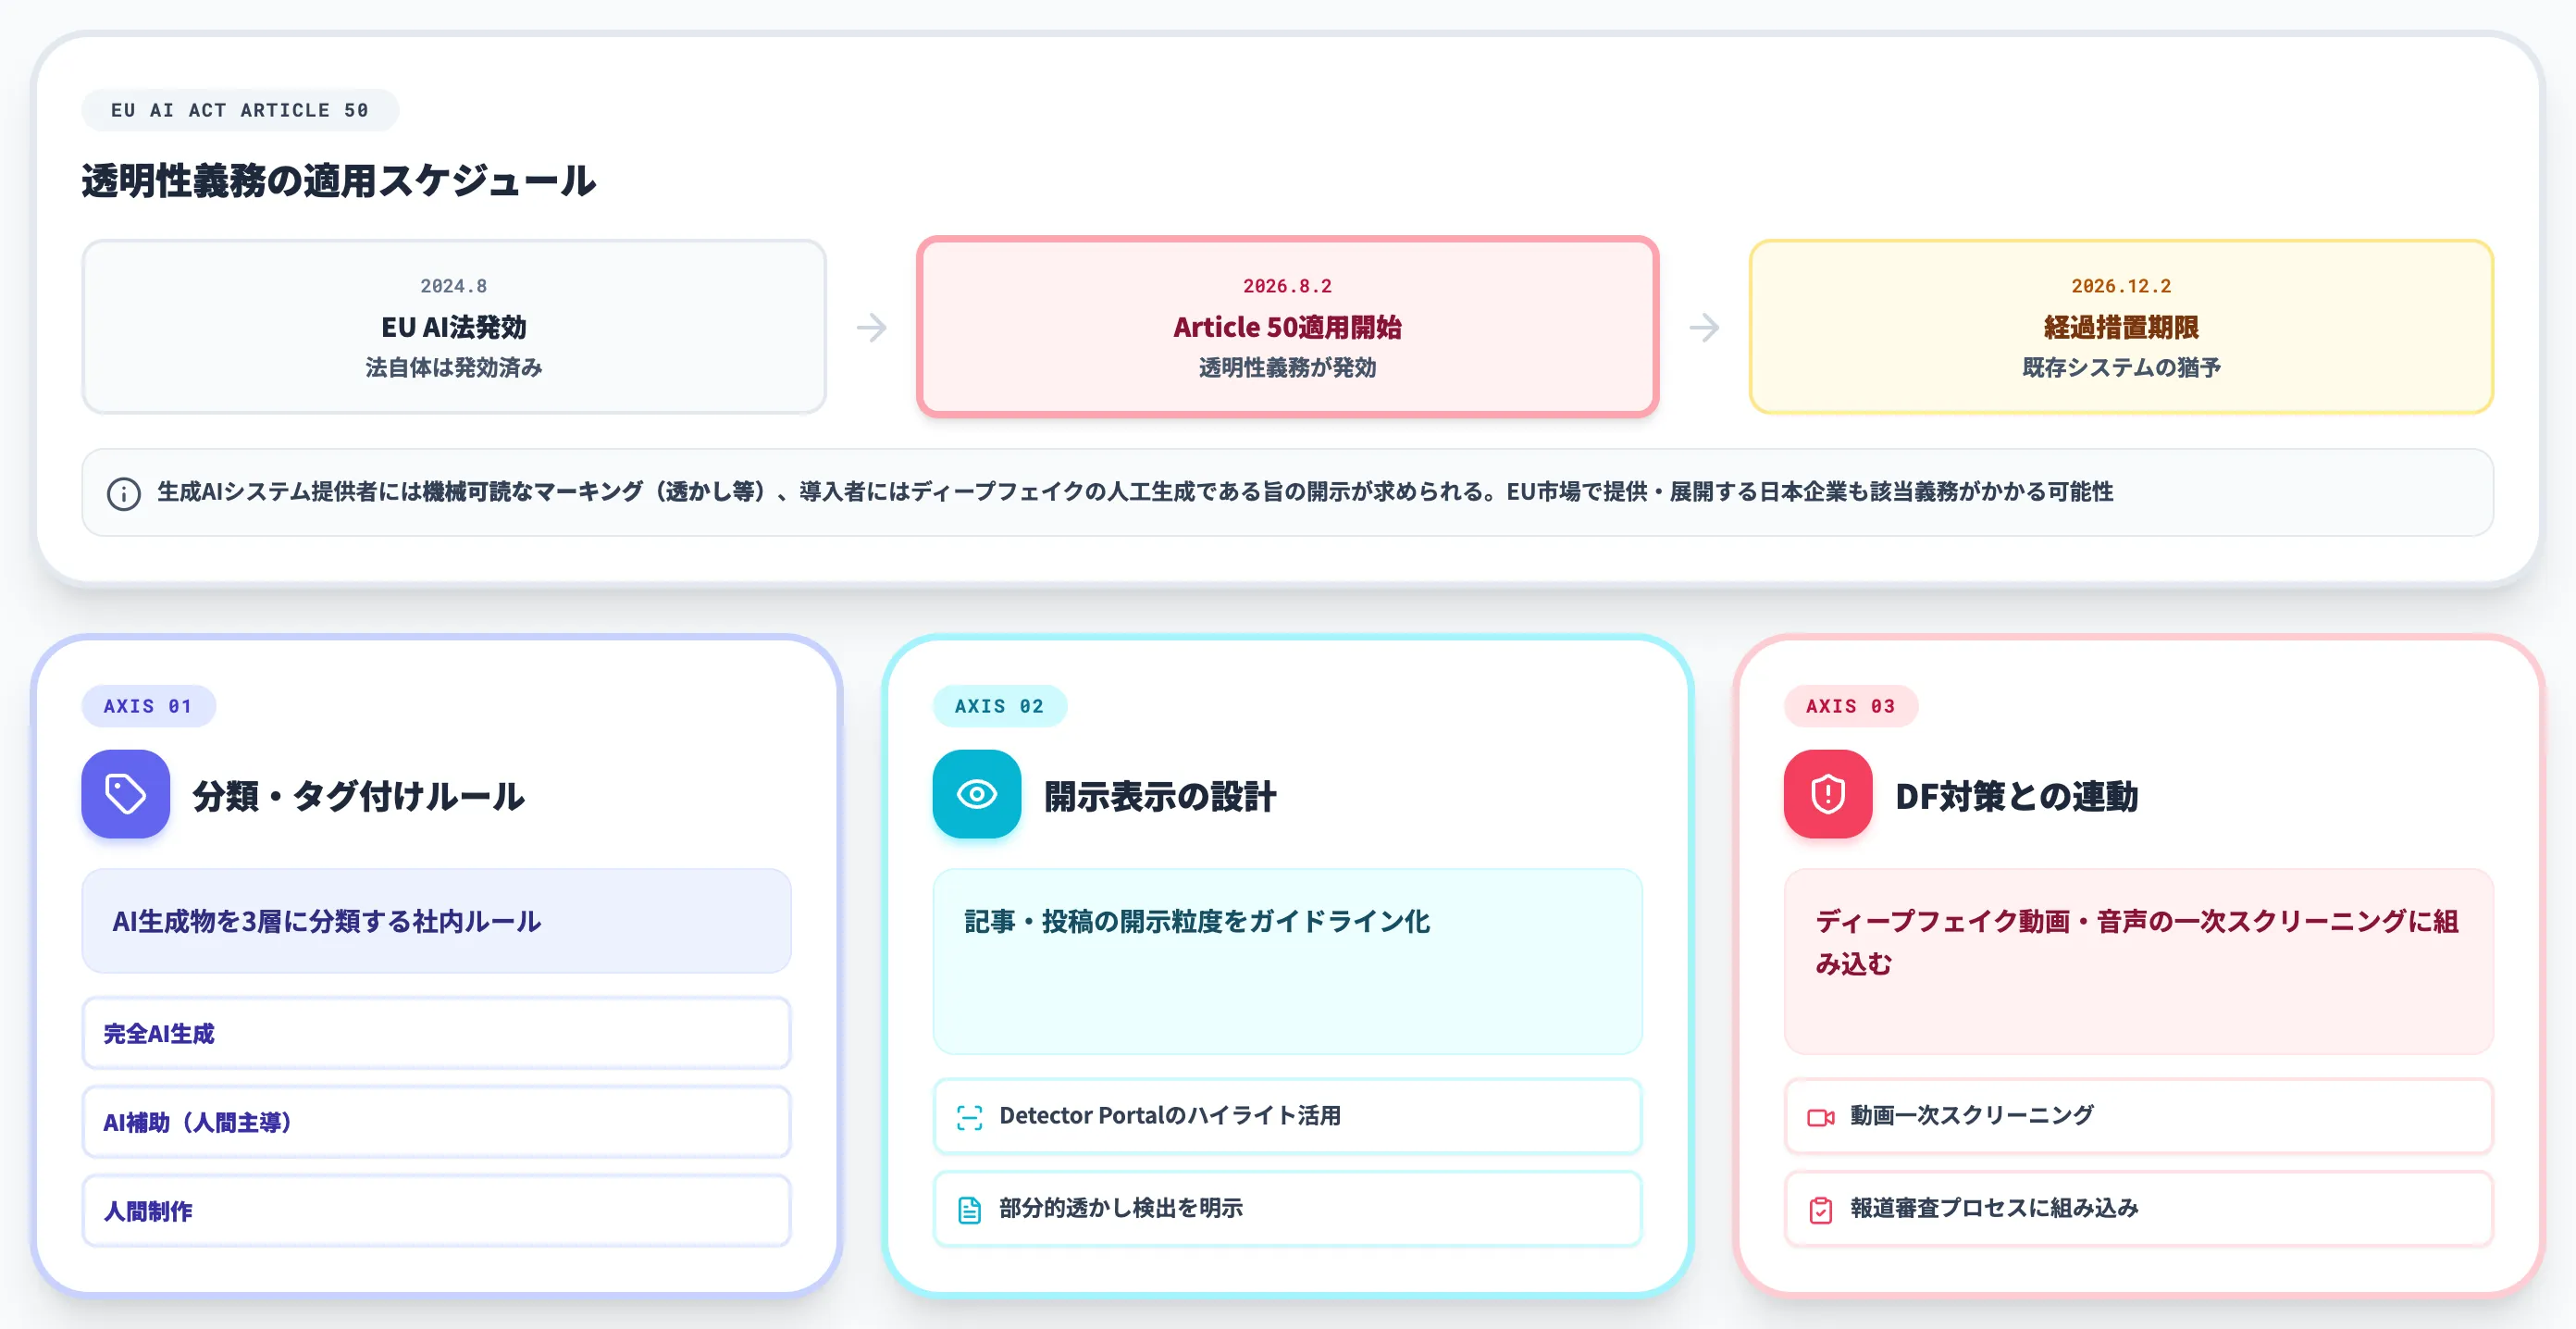
報道機関・広報部門は、SynthIDを「対外的にAI生成であることを開示できる仕組み」として活用する立場になります。EU AI法自体は2024年8月に発効済みで、透明性義務を定めるArticle 50は2026年8月2日から適用開始となります。
生成AIシステムの提供者には機械可読なマーキング(透かし等)の付与、導入者にはディープフェイクの人工生成である旨の開示が求められます。公益事項に関するAI生成テキストの表示義務は、人間による実質的レビューまたは編集管理を経たうえで自然人または法人が公開への編集責任を負う場合には例外が認められます。
また、2026年8月2日以前に市場投入された生成AIシステムには、Article 50(2)の機械可読なマーキング・検出義務に限り、2026年12月2日までの限定的な経過措置があります(導入者側の開示義務は当日から適用)。EU市場で生成AIを提供・展開する日本企業には該当義務がかかる可能性があります。
実務ではSynthIDだけで開示義務を果たせるわけではなく、AIガバナンスの一部として組み込む必要があります。判断軸は以下の通りです。
-
AI生成物の分類・タグ付けルール
社内でAI生成物を「完全AI生成」「AI補助(人間主導)」「人間制作」の3層に分類し、SynthID/C2PA検証結果と付き合わせる社内ルールを整備する
-
開示表示の設計
記事・投稿にAI生成物が含まれる場合、どの粒度でどう開示するかをガイドライン化する。SynthID Detector Portalのハイライト機能を使い、「画像の一部で透かしが検出された(AI生成の可能性が高い)」と開示できるようにする
-
ディープフェイク対策との連動
SynthIDによる検証を、ディープフェイク動画・音声の一次スクリーニングに組み込む。誤情報対策の観点から報道審査プロセスに組み込む
導入で詰まる論点——実務でぶつかる3つの選択
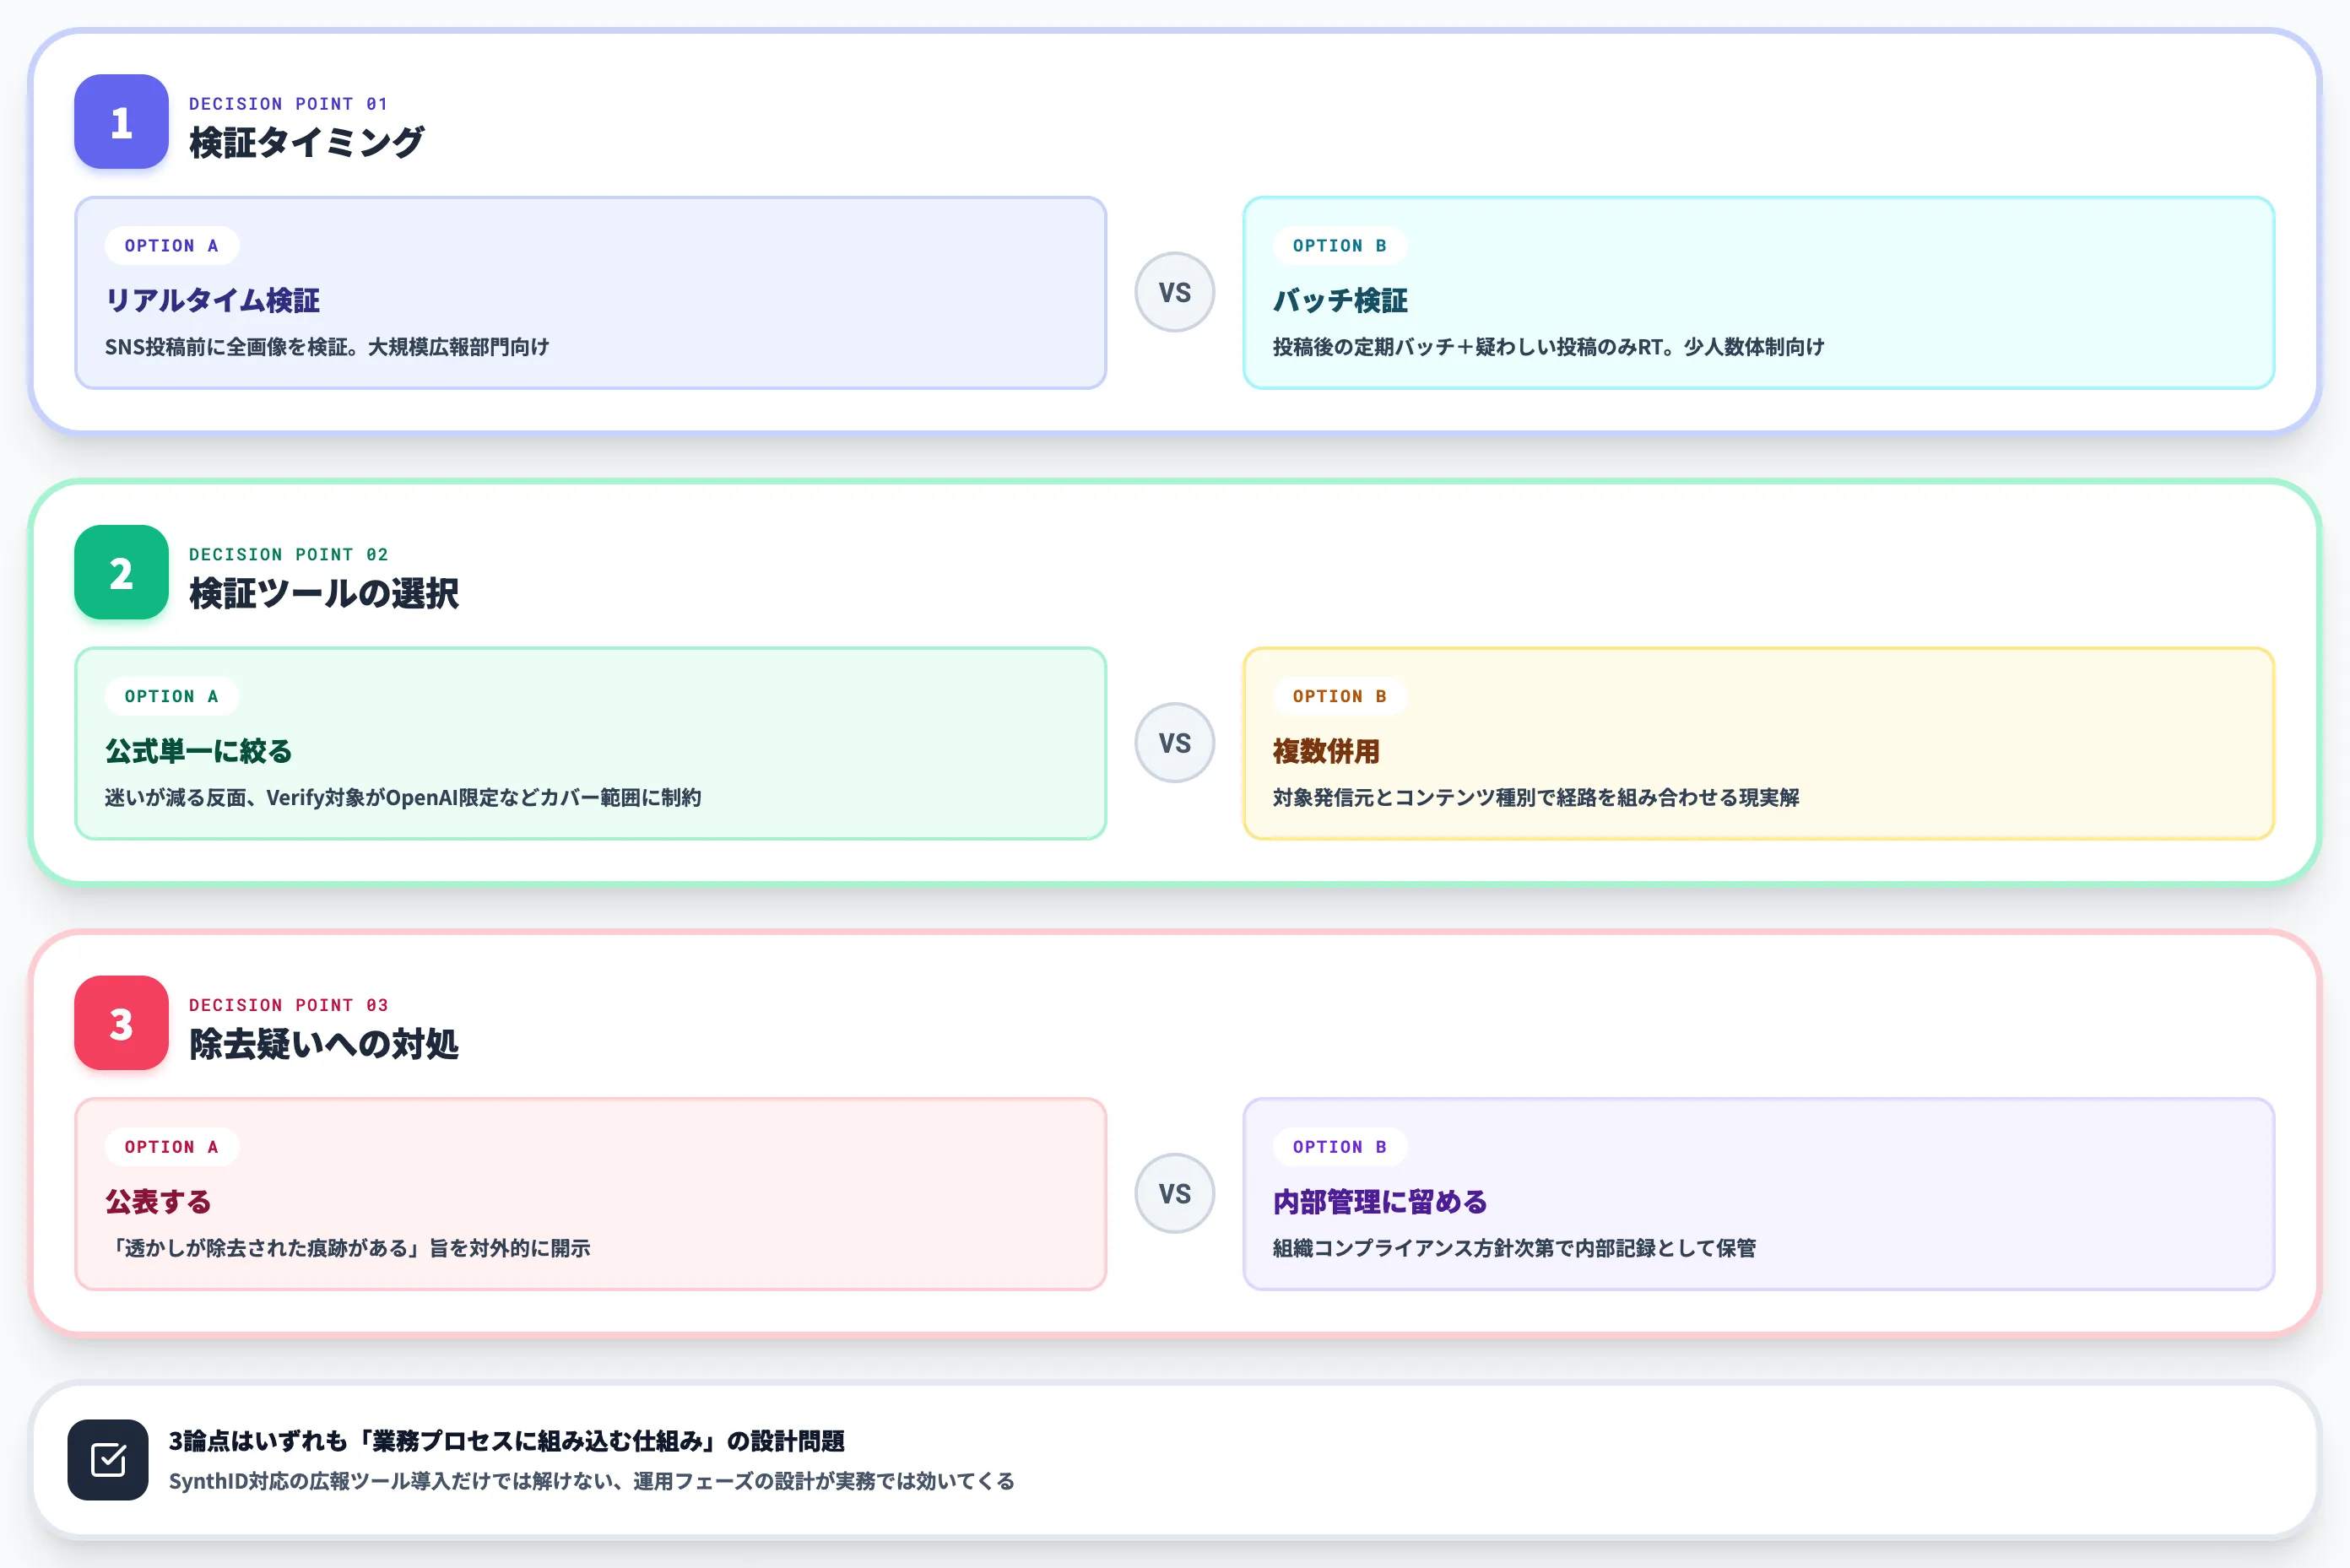
企業の来歴管理設計で実際に判断に迷うポイントを3つ挙げておきます。
- ① 検証タイミング——リアルタイム vs バッチ
SNS投稿前に全画像を検証するか、投稿後に定期バッチで検証するかは運用リソース次第です。
少人数体制ならバッチ検証+疑わしい投稿のみリアルタイム検証、大規模な広報部門ならリアルタイム検証を全件に適用する形が現実的です。
- ② 検証ツールの選択——公式単一 vs 複数併用
SynthID Detector Portal・OpenAI Verify・Search/Gemini in Chromeの3経路のうち、どれを一次判定にするか。
単一に絞ると迷いが減りますが、Verifyの対象がOpenAI由来限定である点、SearchとChrome側の対応状況が段階展開である点を踏まえ、対象コンテンツの発信元ベンダーとコンテンツ種別で経路を組み合わせる形が現実的です。
- ③ 除去疑いへの対処——公表するか内部管理か
外部から受信したコンテンツに「透かしが除去された痕跡」が疑われた場合、それを公表するか内部管理に留めるかは組織のコンプライアンス方針次第です。
公表基準を事前に明文化しておかないと、事件発生時にアドホックな判断に追われます。
3つの論点はいずれも、SynthIDを「入れる技術」ではなく「業務プロセスに組み込む仕組み」として設計することの必要性を示しています。
SynthID対応の広報ツール導入だけでは解けない、運用フェーズの設計が実務では効いてきます。
届いたコンテンツはSynthIDで確かめ、社内で生成AIを使った分は記録で示す
SynthIDやOpenAI Verifyで確認できるのは、届いたコンテンツに透かしが載っているかどうかで、検出されなかったからといって人が作ったものとは限りません。自社が発信する側では、完全AI生成・AI補助・人間制作の3層に分けて開示するために、どの業務で生成AIを使い、誰が内容を確かめてから外に出したかを、社内の記録として残しておく必要があります。
その記録を日々の業務の中で残す役割を担うのが、社内のAIエージェントをまとめて動かす基盤です。AI総合研究所のAI Agent Hubは、Teamsから呼び出す社内のAgentを、自社のAzureテナント内に置いた1つの管理画面で管理します。
- 生成AIを使う入口をTeamsにそろえる
業務で使うAgentはTeamsから呼び出し、管理画面に一覧でまとまるため、部署ごとに別の生成AIツールが使われて、どこでAIを使ったかを追えなくなる状態を避けやすくなります。
- どのAgentを使ったかを記録に残す
Agentの実行は、誰がいつどのAgentを使ったかとあわせて不変の実行ログに残るため、AI補助で作ったものかどうかを分類するときの根拠になります。
- 社外に出す前に人の確認を挟む
Agentが作った文書を社外に出す前に、担当者がTeams上で承認する段階を組み込めるため、人の確認を経たものかどうかを、承認と差し戻しの履歴で示せます。
AI総合研究所の専任チームが、発信・受信・外注の3方向のうち、社内で生成AIを使う発信側の記録の残し方から設計を支援します。
社内で使う生成AIを記録に残す
人の確認を経たかを履歴で示す
SynthIDで届いたコンテンツを確かめる一方で、自社が発信するものは、どこで生成AIを使い、誰が確認したかを社内で示せる形に整えておくと、開示の判断がぶれにくくなります。AI Agent Hubのサービスページのよくある質問では、AIの処理と人の手作業のステップを組み合わせてワークフローを作れることをご紹介しています。
まとめ
本記事では、SynthIDを「AI生成物に不可視の透かしを埋め込む識別技術」として整理し、対応形式と対応プロダクト・埋め込みと検出の仕組み・確認方法・C2PAとの関係・検出できないケース・企業の実務判断を解説しました。
2026年9月時点で押さえておくべきポイントは次の3つです。
- SynthIDはGoogleの内部技術から他社も採用する仕組みへ広がり、OpenAIなどのツールで生成した画像や音声にも透かしが載り始めている
- 透かしを確かめる経路は発信元のベンダーごとに分かれており、OpenAI Verifyは現時点でOpenAIのツールで生成したコンテンツしか判定できない
- 透かしは悪意ある除去がなくても、スクショの繰り返しや翻訳で弱まることがあるため、透かしなしの結果は「不確定」として扱う必要がある
SynthIDによる確認を業務に取り入れる企業に向けて、AI総合研究所が勧めている進め方は次のとおりです。
まずは、自社で扱う画像・音声・動画をどの経路で一次確認するかを決め、投稿前に全件を検証するか、投稿後にまとめて検証するかを、運用できる人数に合わせて選びます。
続いて、外注先との発注契約にAI生成物の使用申告を盛り込み、納品物を受け取るたびに透かしを確かめる手順を加えておくと、出どころの分からない素材が紛れ込みにくくなります。
GoogleとOpenAIが同じ日にSynthIDとC2PAの併用を打ち出したことで、AI生成物の見分け方は、単独の技術に頼らず透かしと来歴情報を重ねて確かめる方向へ進んでいます。
SynthIDはこのうちコンテンツ本体に残る透かしを受け持つ技術であり、単発の検証ツールとしてではなく、来歴管理を支える仕組みの一部として扱うのが妥当です。