この記事のポイント
 NVIDIA NOOAは2026年7月20日 UTCにGitHubで初回公開されたApache 2.0のPythonフレームワーク(NVIDIA公式ブログでの発表は7月27日)。エージェントを1つのクラスで記述する設計
- メソッド=行動・フィールド=状態・docstring=プロンプト・型注釈=契約の4要素マッピングでプロンプト・ツール・グラフを1つに畳む
- SWE-bench Verified 82.2%(GPT-5.5 xhigh)を投稿時点SOTA 79.2%を上回るスコアで達成、PI・OpenCodeを上回る精度をトークン量がPI比で半減(OpenCode比では約15%減)で実現
- Alpha段階の研究ソフトウェアでAST検査と拒否リストだけでは本番投入不可、公式はOSレベル隔離手段としてOpenShellとの併用を案内
- LangGraph運用チームはモデルAPI費用が組織予算に効く規模か新規プロジェクト評価枠での部分導入が現実的、Pydantic AI併用チームは学習コスト低め
Microsoft MVP・AIパートナー。LinkX Japan株式会社 代表取締役。東京工業大学大学院にて自然言語処理・金融工学を研究。NHK放送技術研究所でAI・ブロックチェーンの研究開発に従事し、国際学会・ジャーナルでの発表多数。経営情報学会 優秀賞受賞。シンガポールでWeb3企業を創業後、現在は企業向けAI導入・DX推進を支援。
NVIDIA NOOA(NVIDIA Object-Oriented Agents)は、NVIDIA Labsが2026年7月20日 UTCにGitHubで初回公開し、7月27日にNVIDIA公式ブログで発表した、AIエージェントを1つのPythonクラスとして記述するApache 2.0のオープンソースフレームワークです。
プロンプトテンプレート・ツール定義・ワークフローグラフが別々に散らばる従来型の設計を、メソッド=行動・フィールド=状態・docstring=プロンプト・型注釈=契約という4要素マッピングでクラス1つに畳み込む点が特徴で、公開直後からSWE-bench Verifiedで82.2%の実測性能とPI比でトークン量半減(OpenCode比では約15%減)という数字で注目を集めています。
本記事では、NOOAの中心思想と6つの機能、ベンチマーク実測の中身、LangGraph・CrewAI・Pydantic AIとの位置づけ、インストールから最初のAgent実装までの手順、料金構造、alpha段階での本番投入の注意点までを、2026年8月時点の一次情報で体系的に解説します。
目次
「NVIDIA double-O Agents」——著者による別称
4要素マッピング:メソッド・フィールド・docstring・型注釈
ベンチマーク実測:SWE-bench 82.2%とPI比トークン半減の中身
SWE-bench Verified——GPT-5.5 xhighで82.2%、投稿時点SOTAを上回る
Terminal-Bench 2.0——モデル組み合わせによっては負ける
CyberGym L1とARC-AGI-3——脆弱性PoC生成86.8%と抽象推論85.1%
LangGraph・CrewAI・Pydantic AIから乗り換えるか
インストール——pipまたはuv、Python 3.12〜3.13必須
MCP対応——Anthropic発のツールプロトコルをオプションで
「Research Software」の明記——安定版ではない
OSレベル隔離——コンテナ・OpenShellでのサンドボックス
OpenShellとの組み合わせ——公式が案内するOSレベル隔離構成
NVIDIA NOOAとは何か
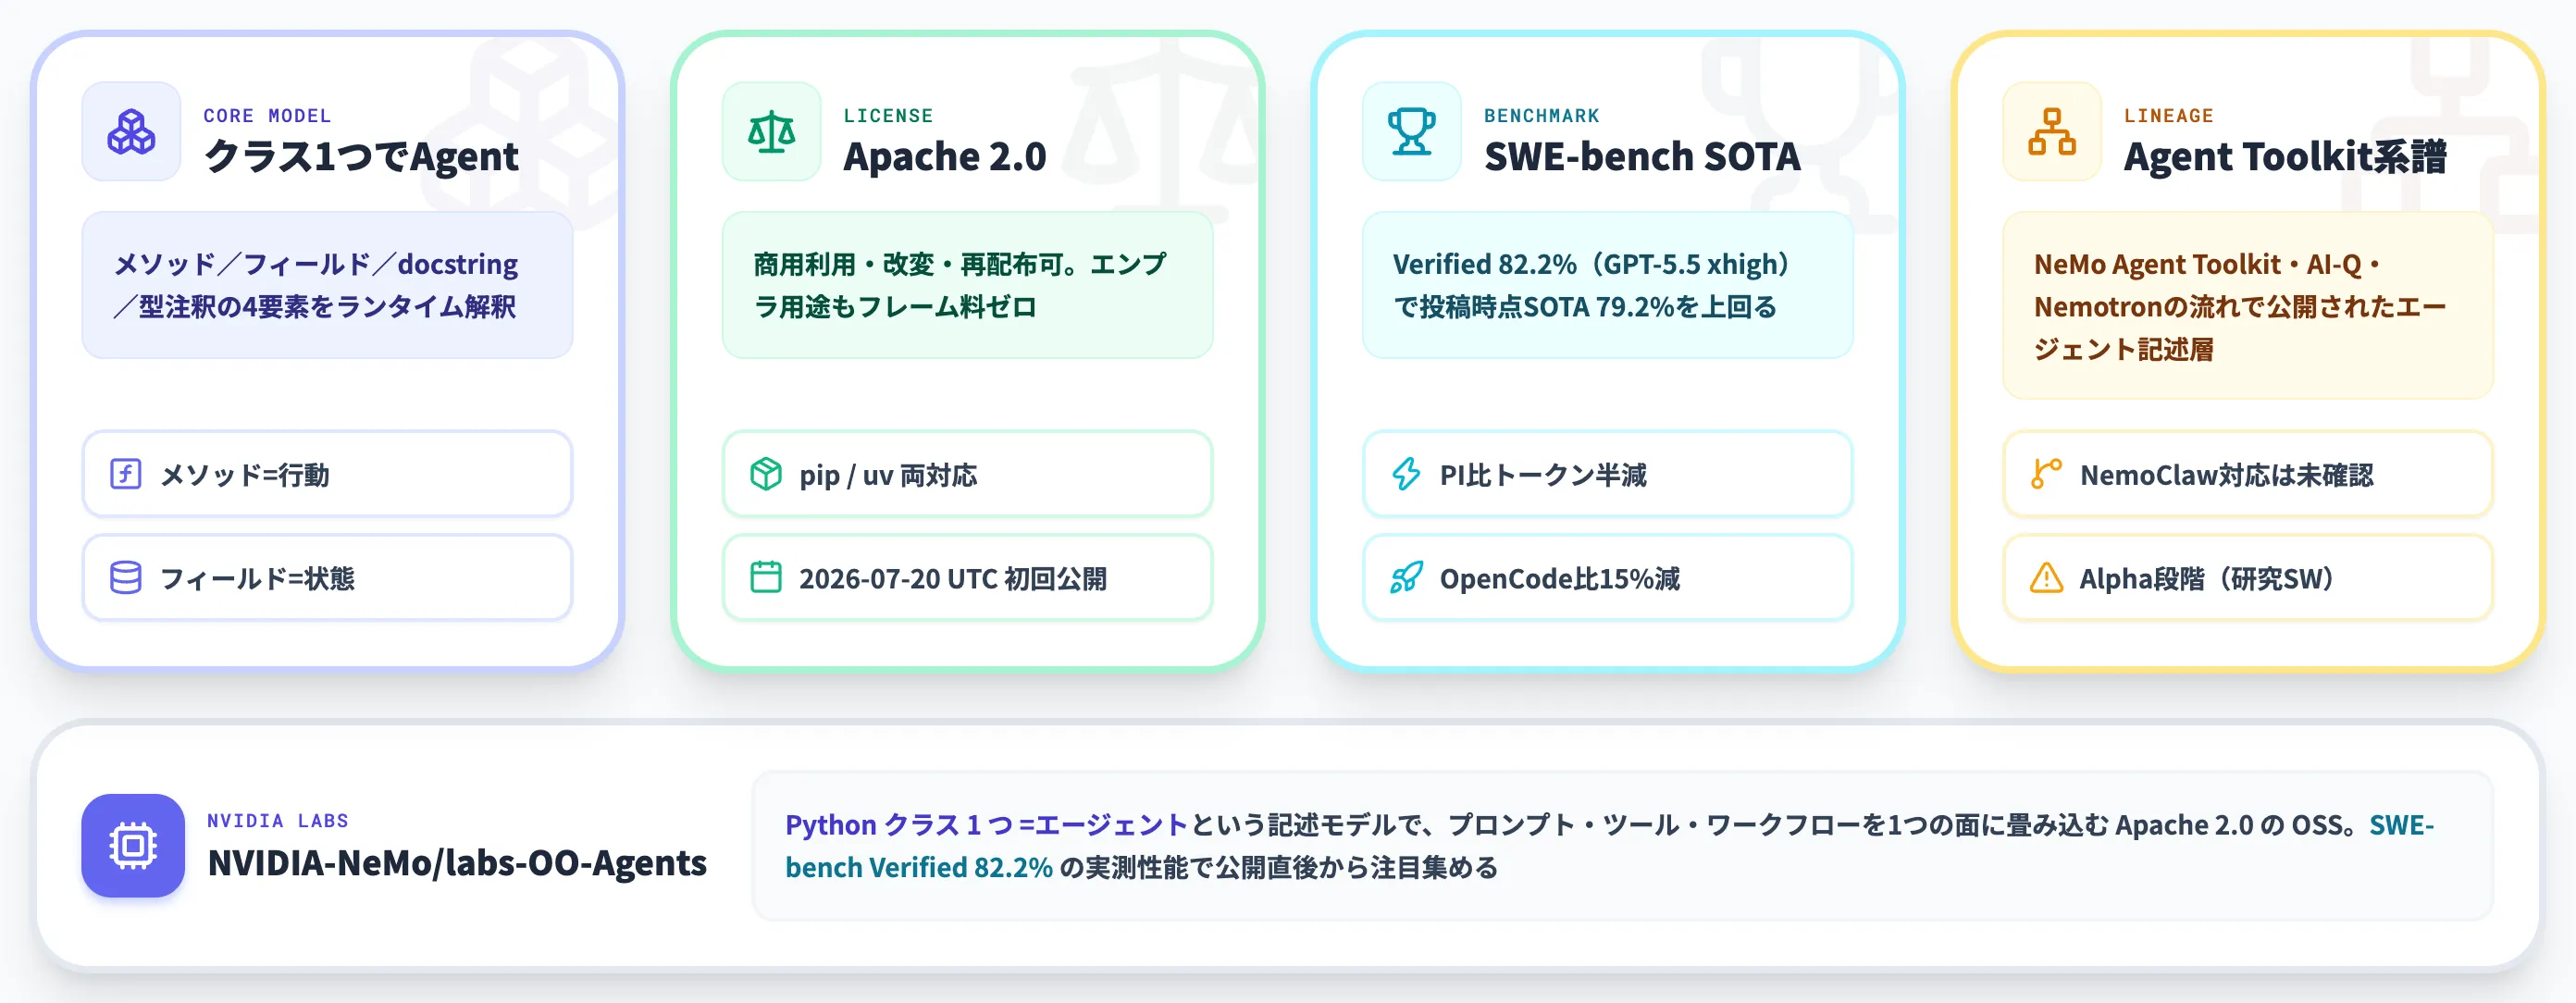
NVIDIA NOOA(NVIDIA Object-Oriented Agents/NVIDIA "double-O" Agents)は、NVIDIA Labsが2026年7月にGitHubで公開した、AIエージェントを1つのPythonクラスとして記述するApache 2.0のオープンソースフレームワークです。
NOOAが従来のエージェントフレームワークと根本的に違うのは、プロンプトテンプレート・ツール定義・コールバックコード・ワークフローグラフが別々に散らばる従来設計を、Pythonクラス1つに畳み込む点です。
NVIDIA NOOA公式リポジトリ(NVIDIA-NeMo/labs-OO-Agents)(出典:GitHub)
「NVIDIA double-O Agents」——著者による別称
NOOAの正式名称は「NVIDIA-labs Object Oriented Agents」ですが、著者ら(Paul Furgale氏ら15名のNVIDIA研究者)は技術報告書内で自ら「NOOA or NVIDIA double-O Agents」とダブル・オー呼びを併記しています。
技術報告書「NVIDIA-labs OO Agents: Native Python Object-Oriented Agents」の1ページ目(出典:arxiv 2607.20709)
NVIDIAのエージェント関連OSS公開は2025年から進んできた流れの延長で、NOOAはその中でエージェント記述層の位置づけとして公開されました。ただし、公式に公開されているNemoClaw対応ランタイム一覧にNOOAは含まれておらず、NVIDIA Agent Toolkitの正式構成要素としての位置づけは現時点で未確認です。
中心の発想:Pythonクラスがそのままエージェント
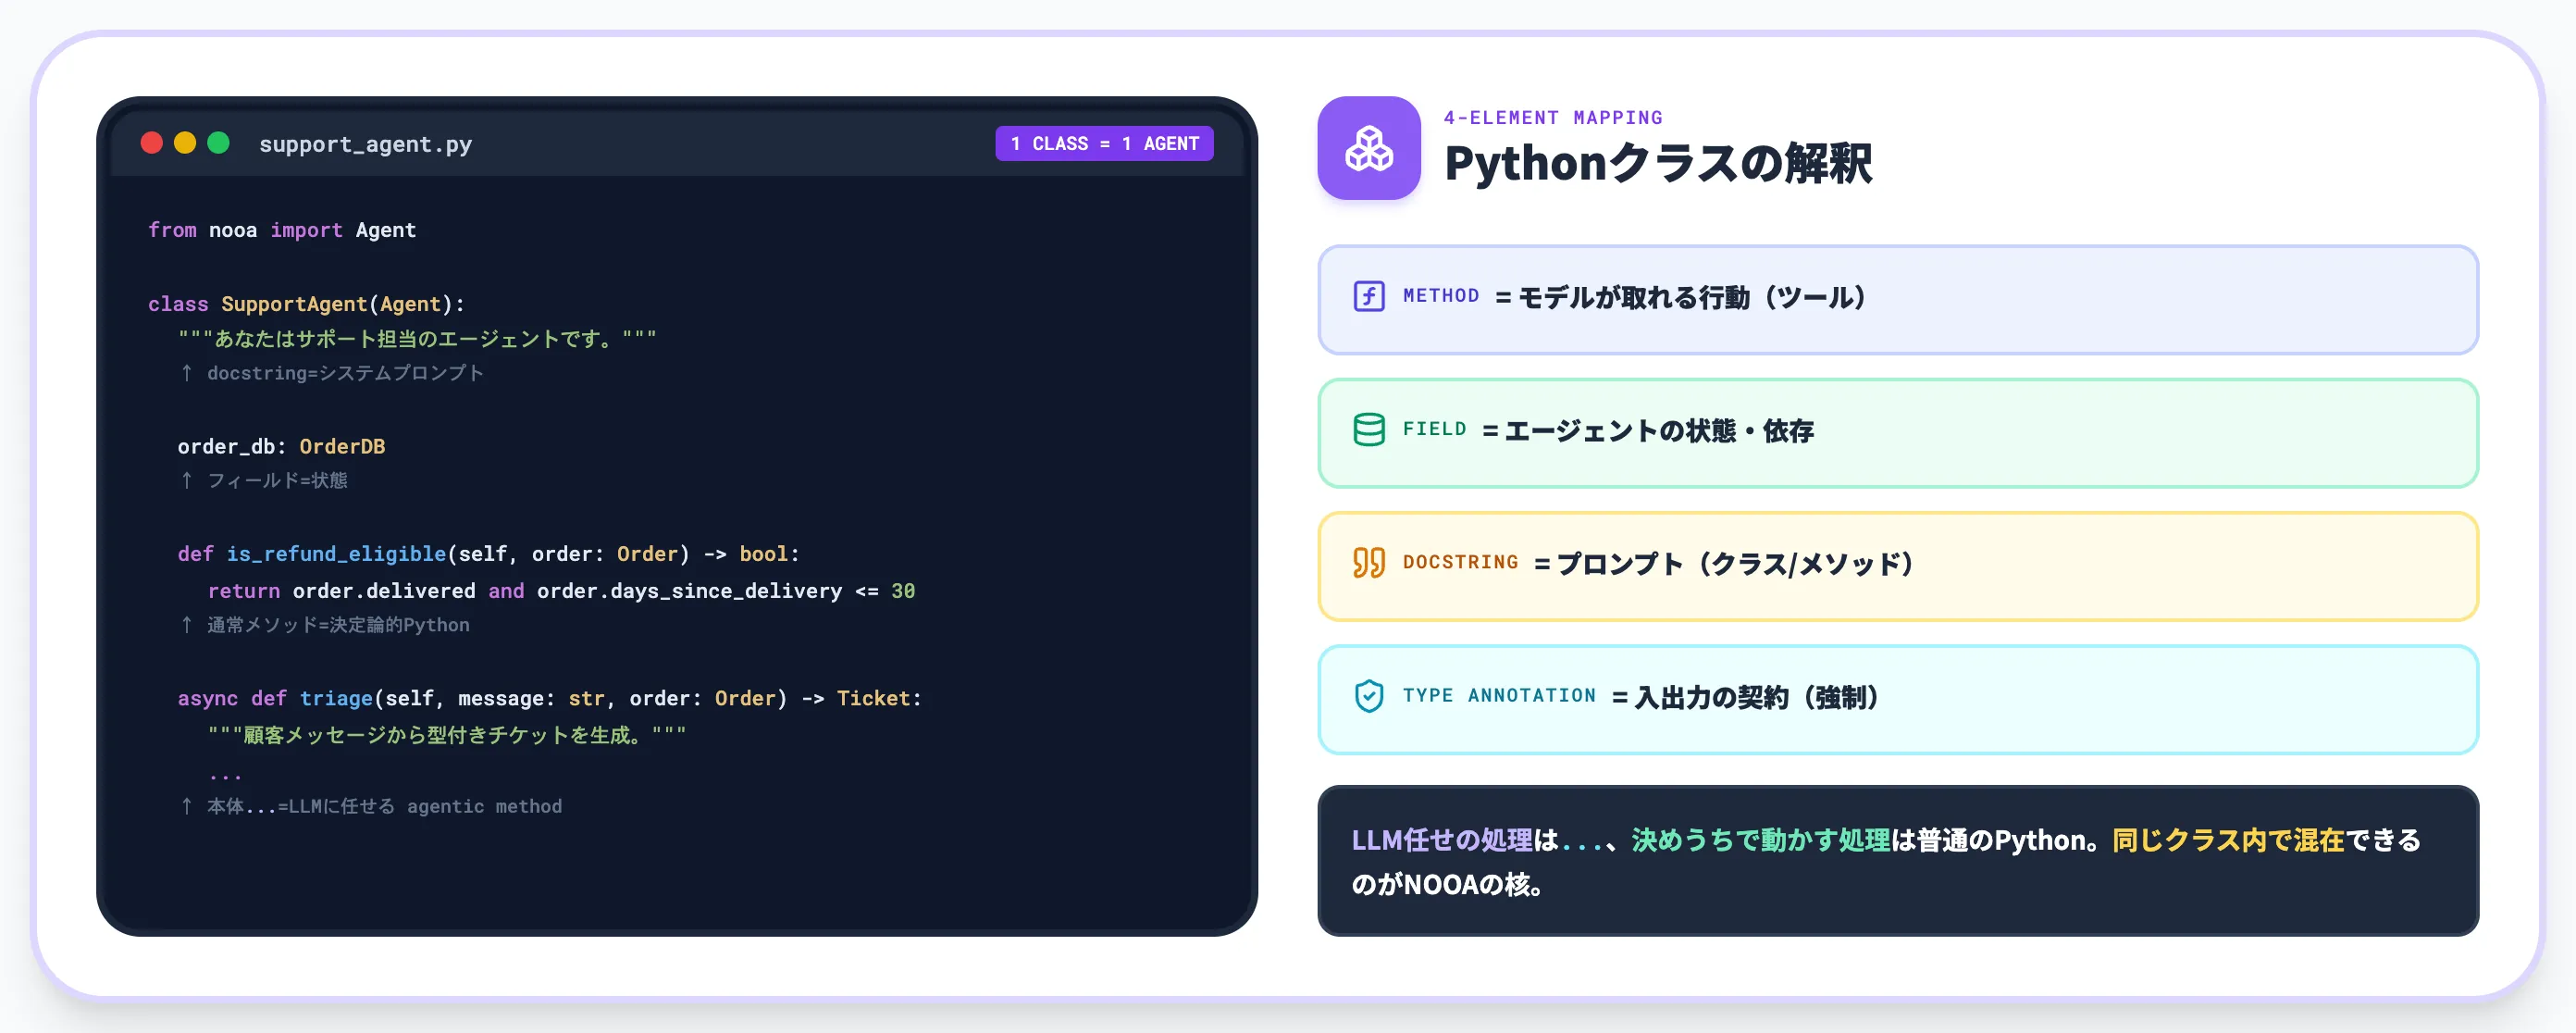
ここからは、NOOAの設計思想を1つのコード例と、4要素マッピングの側から整理します。
クラス=エージェントの記述モデル
NOOAでエージェントを書く最小の姿は、以下のようになります(公式GitHubリポジトリのquickstart例をベースに調整)。
from nooa import Agent

class SupportAgent(Agent):
    """あなたはサポート担当のエージェントです。"""

    order_db: OrderDB

    def is_refund_eligible(self, order: Order) -> bool:
        return order.delivered and order.days_since_delivery <= 30

    async def triage(self, message: str, order: Order) -> Ticket:
        """顧客メッセージから型付きサポートチケットを生成する。"""
        ...
このコードのポイントは3つあります。
-
クラスのdocstring
"""あなたはサポート担当のエージェントです。"""がエージェント全体のシステムプロンプトとして扱われる
-
is_refund_eligibleメソッド
本体が普通のPythonなので、決定論的に動く通常メソッドとして呼ばれる
-
triageメソッド
本体が...(省略記法)だけで、docstringがプロンプト・型注釈が入出力契約になり、ランタイムがLLMを呼んで結果を型付きオブジェクトで返す
「LLMに任せたい処理は...」「決めうちで動かしたい処理は普通のPython」という同じクラス内での混在が、NOOAの記述モデルの核です。ツールと本体ロジックを別レイヤーに分ける従来型の面倒がなく、既存のPython資産をそのまま持ち込みやすくなっています。
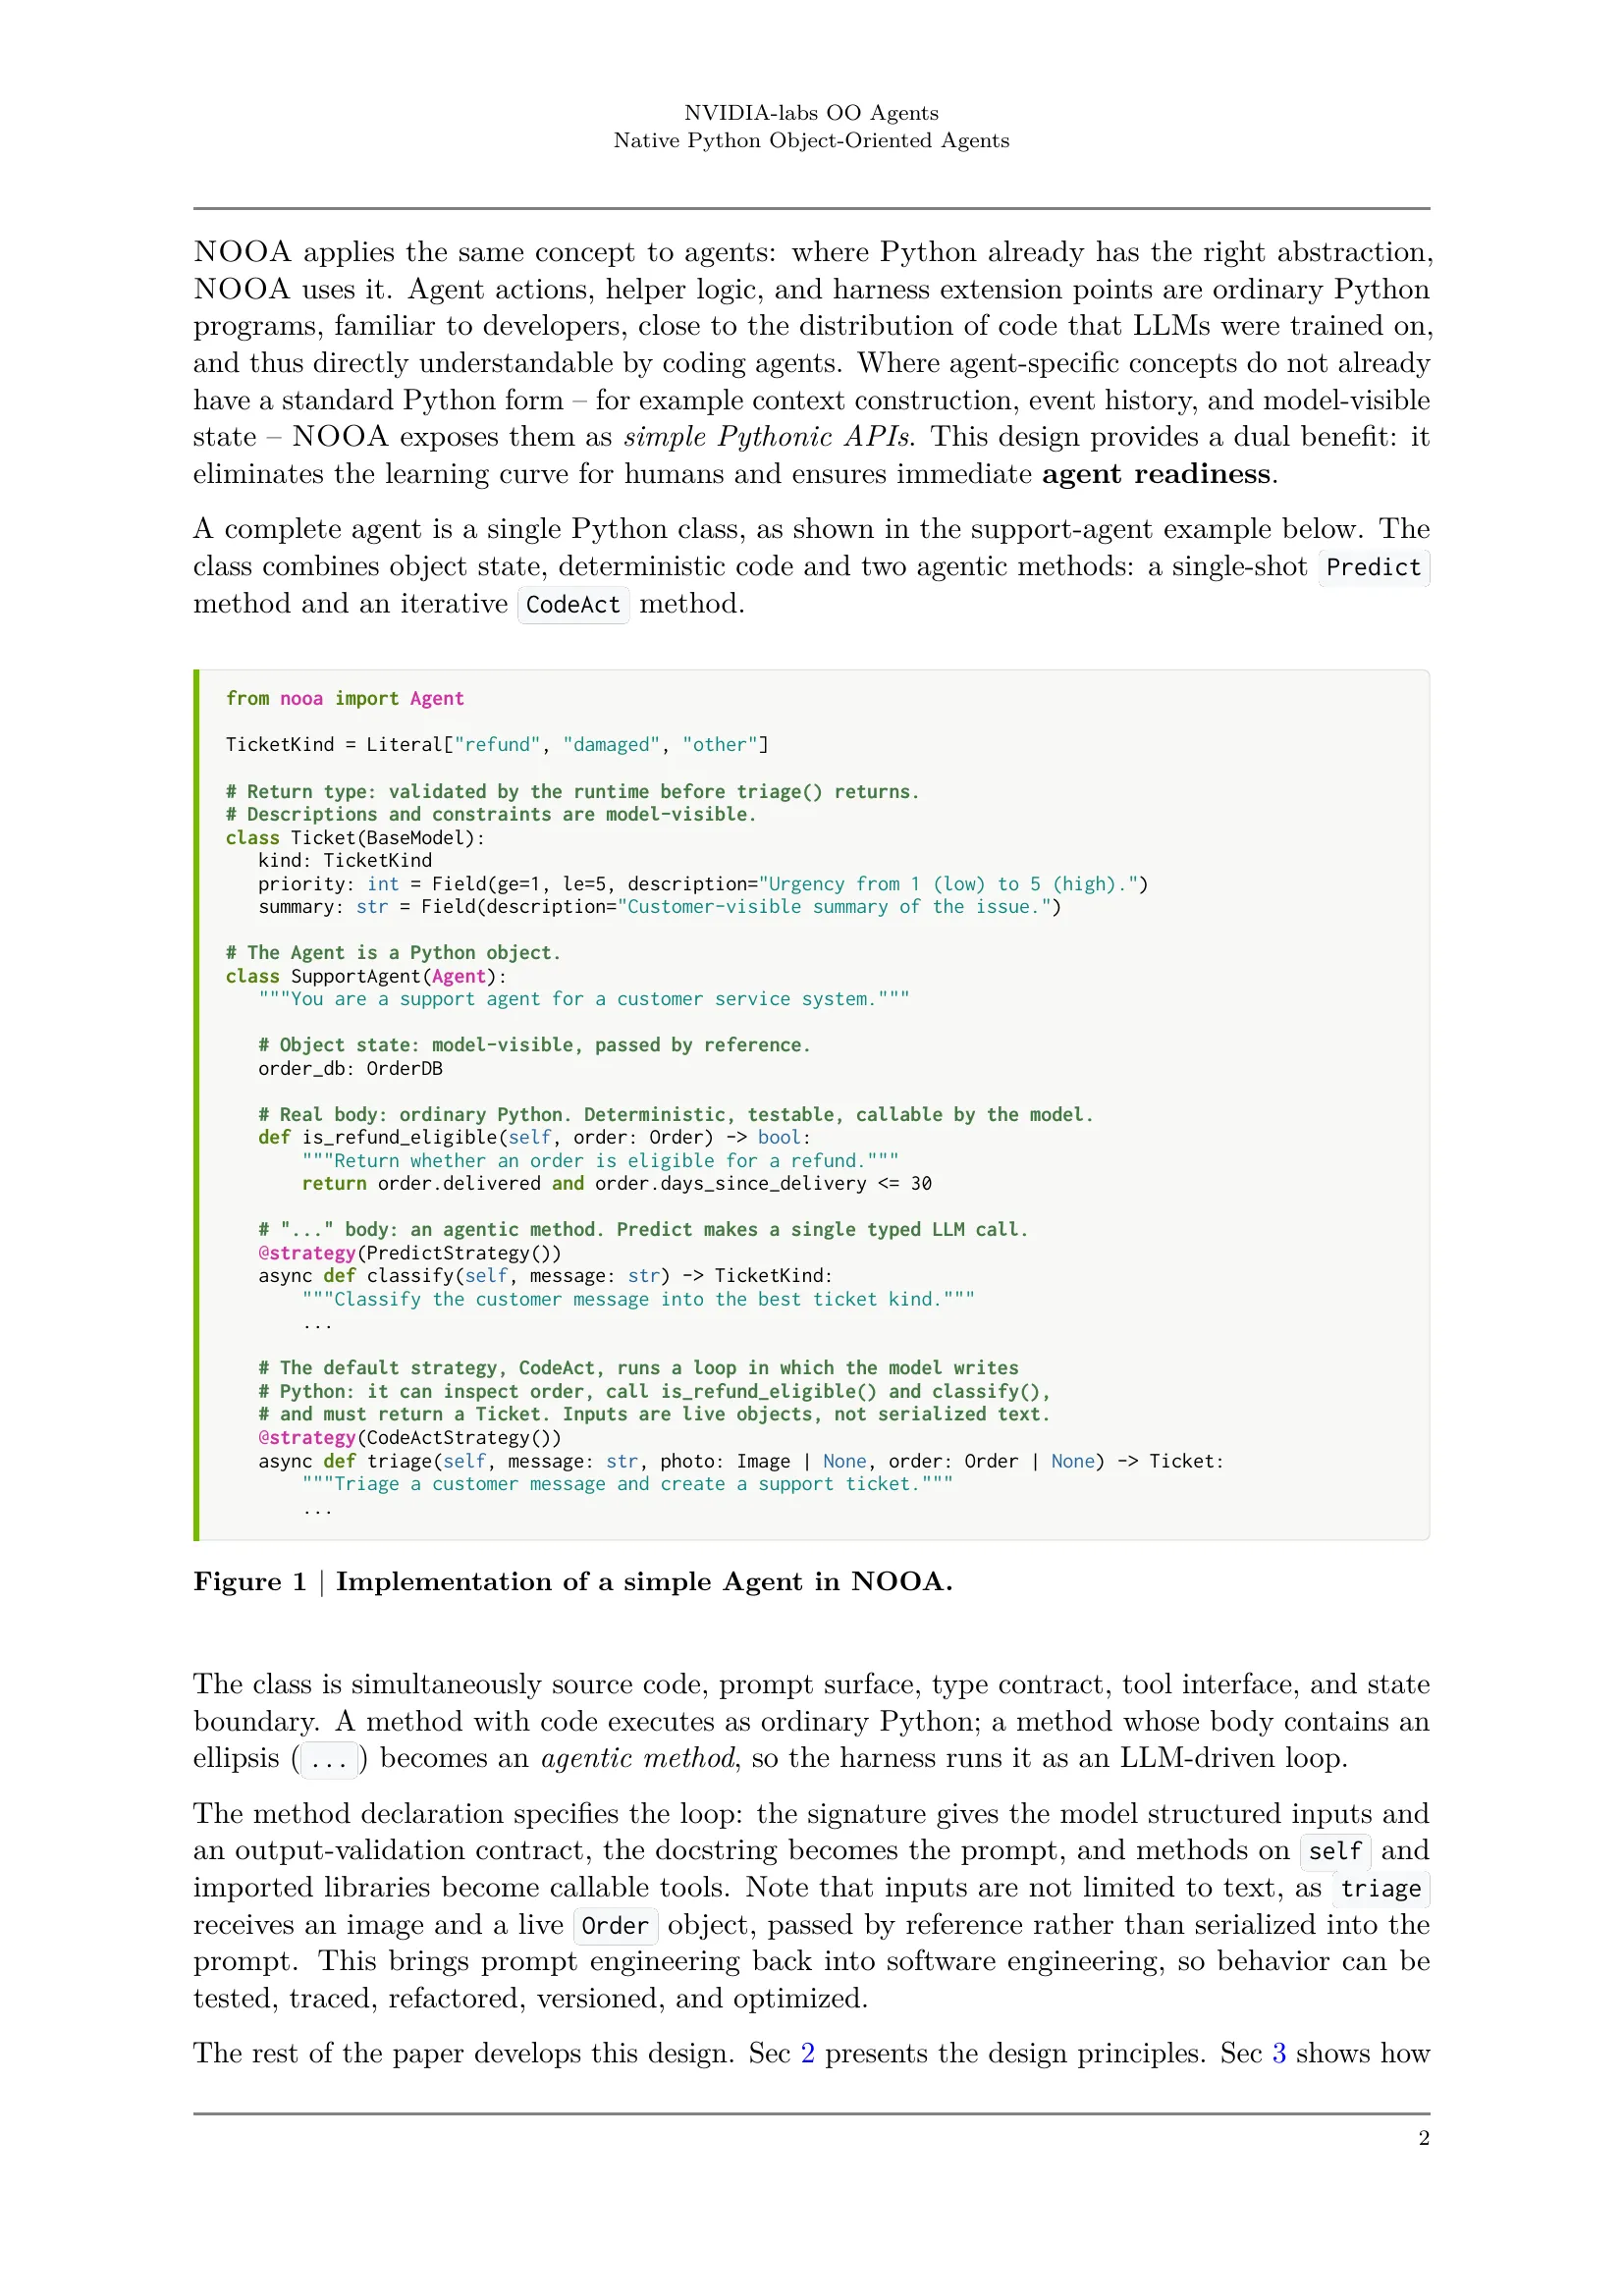
論文Figure 1:SupportAgentの実装例(PredictStrategy/CodeActStrategyの2つのagentic methodと通常メソッドが同じクラス内に混在。TicketKindは戻り値のLiteral型)(出典:arxiv 2607.20709 p.2)
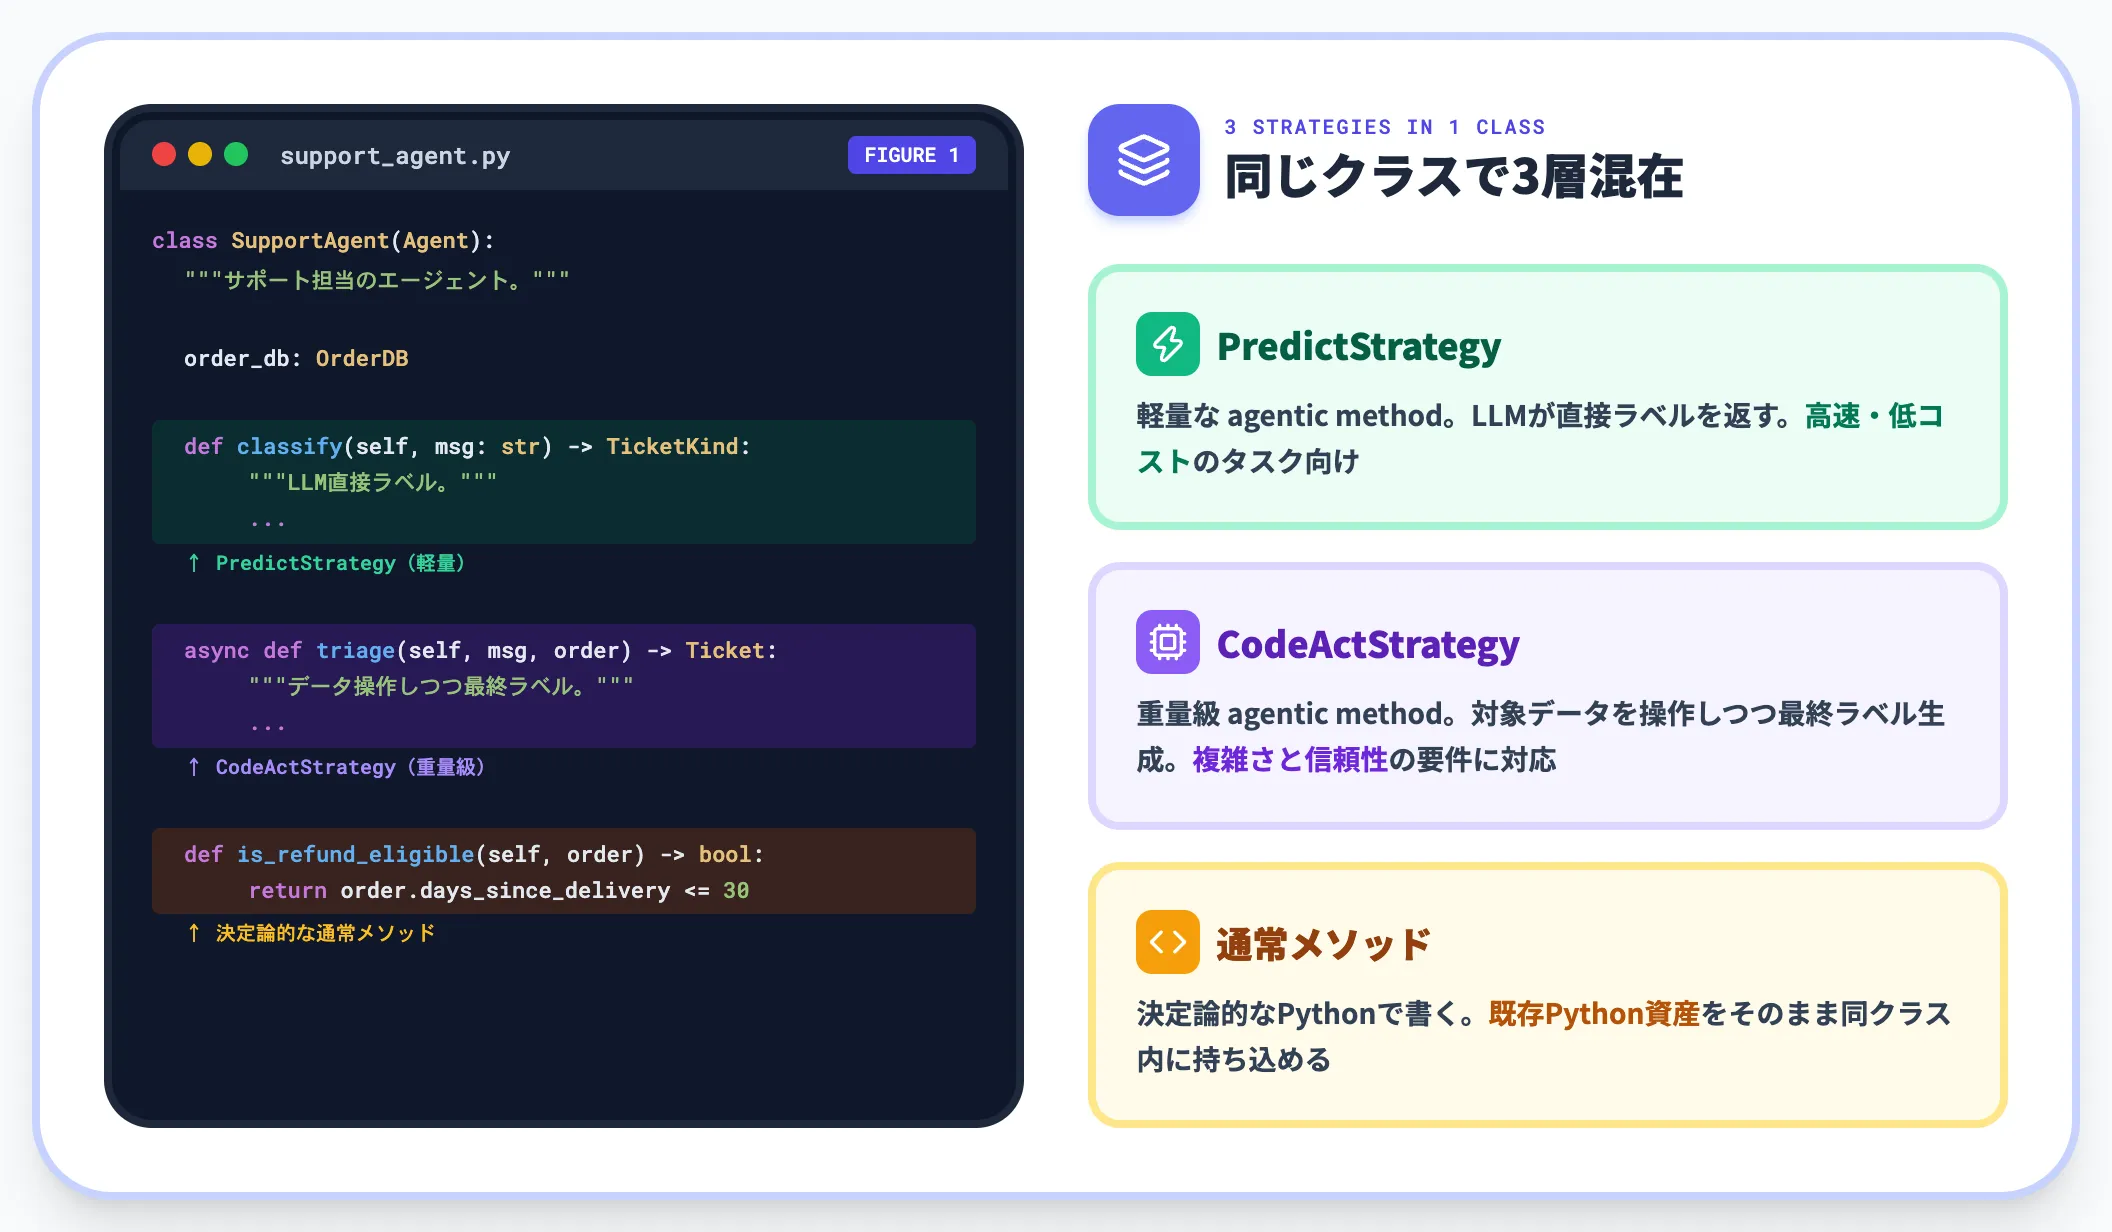
論文Figure 1が示すのは、上記のSupportAgentをさらに拡張した完全な実装例です。SupportAgentはclassify(LLMが直接ラベルを返す軽量な agentic method・PredictStrategy)とtriage(CodeActStrategyで対象データを操作しつつ最終ラベルを返す重量級の agentic method)の2つのagentic methodを持ち、さらにis_refund_eligibleという決定論的な通常メソッドが同じクラスに同居しています。
同じ「サポートチケット分類」タスクを、複雑さと信頼性の要求に応じて2つの戦略で書き分けられる、というのがNOOAのクラス設計の柔軟性を示す典型例です。
4要素マッピング:メソッド・フィールド・docstring・型注釈
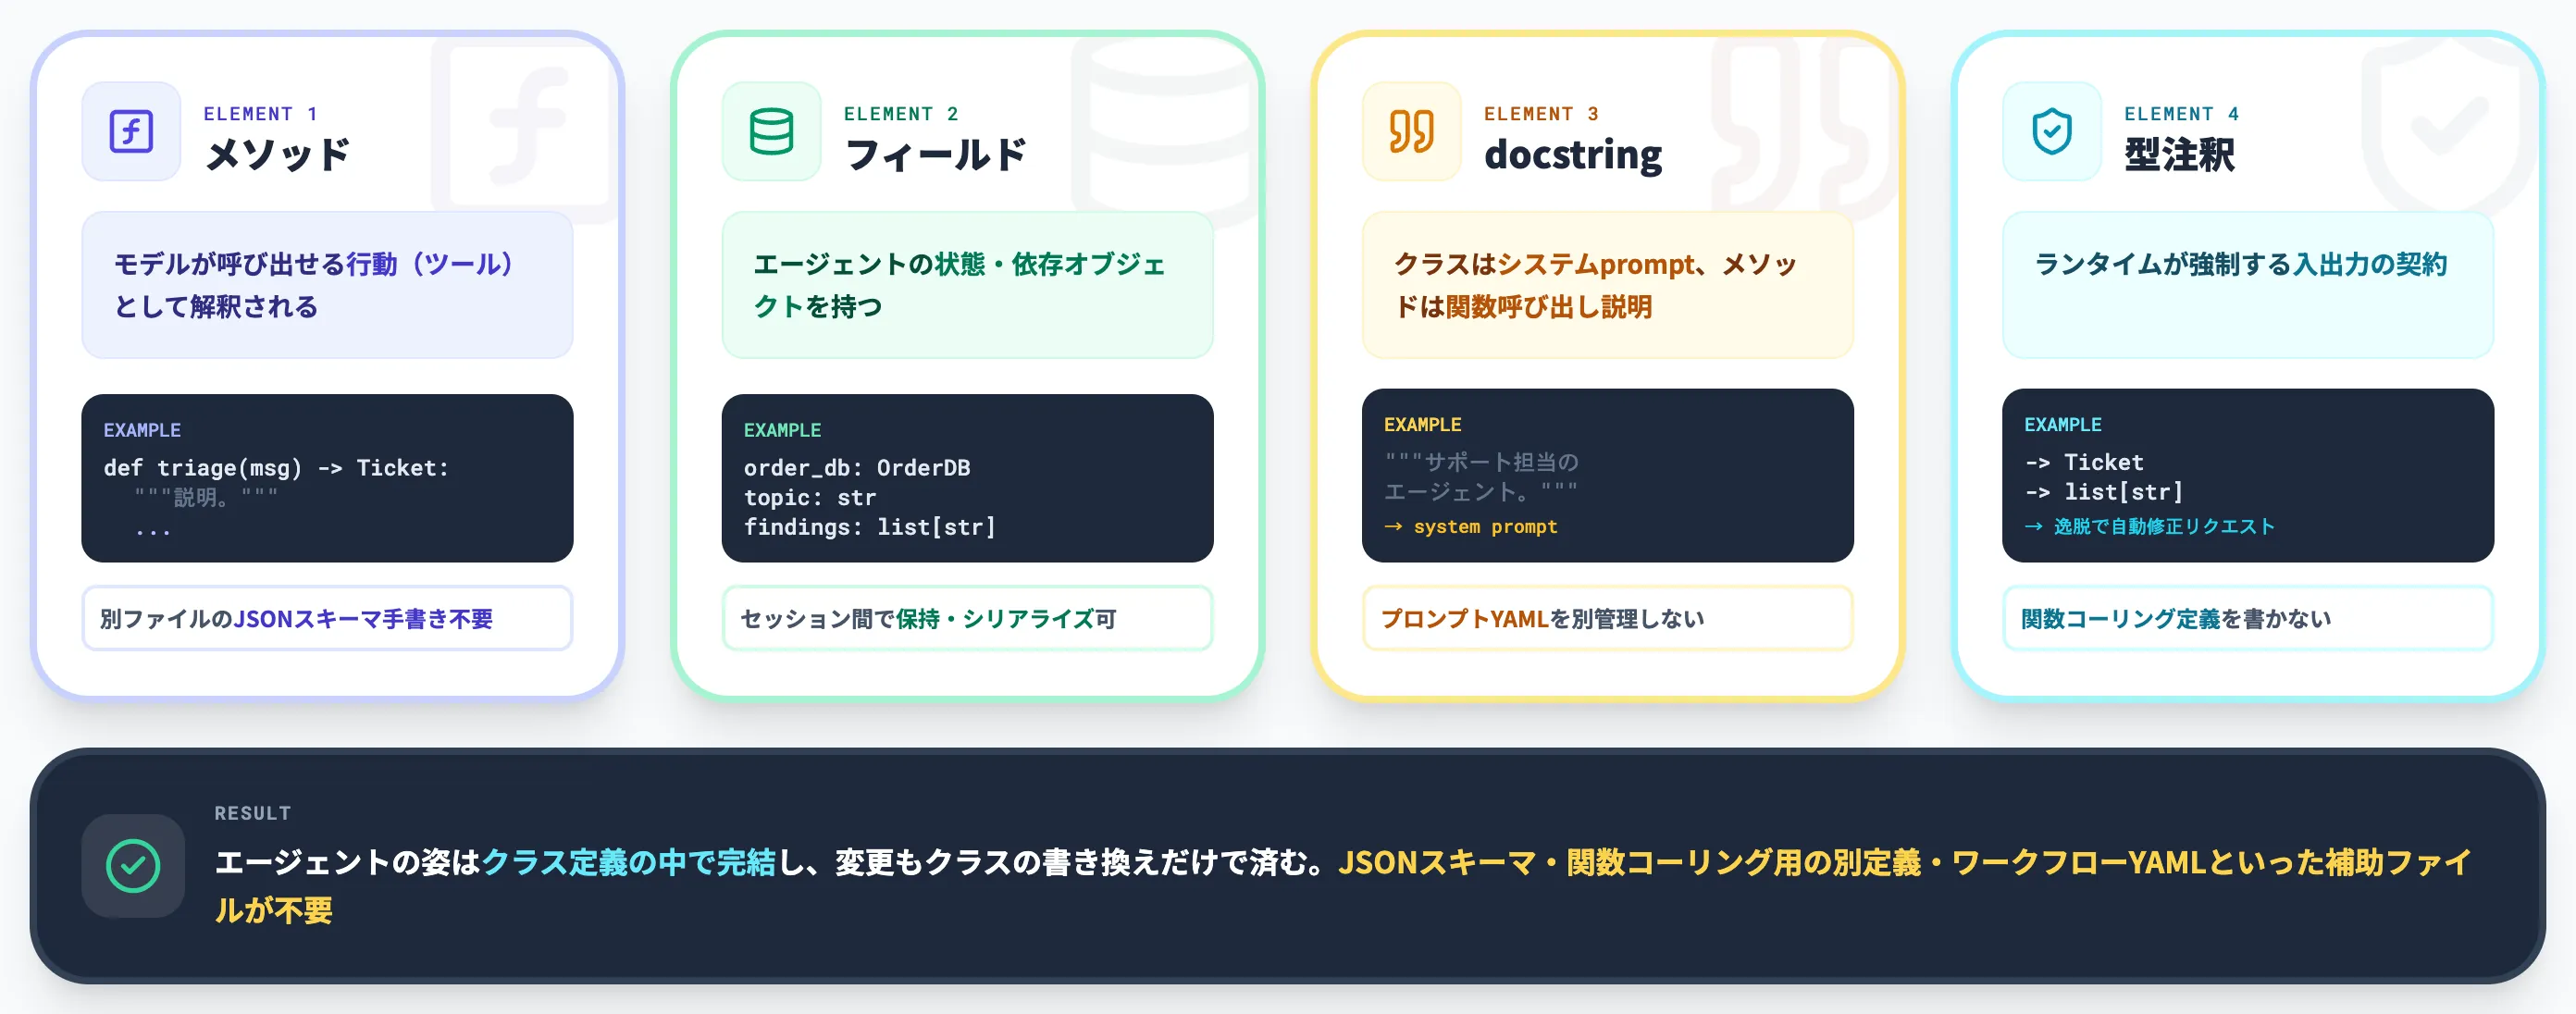
以下の表で、Pythonクラスの4要素がNOOAランタイムでどう解釈されるかを整理しました。
| Pythonクラスの要素 | NOOAランタイムでの意味 |
|---|---|
| メソッド | モデルが呼び出せる行動(ツール) |
| フィールド | エージェントの状態・依存オブジェクト |
| docstring | クラスならシステムプロンプト、メソッドなら関数呼び出し用の説明 |
| 型注釈 | ランタイムが強制する入出力の契約 |
この4要素マッピングが決まっているため、JSONスキーマの手書き・関数コーリング用の別定義・ワークフローYAMLといった補助ファイルが不要になります。
エージェントの姿はクラス定義の中で完結し、変更もクラスの書き換えだけで済みます。
Pydantic AIはAgentクラスに型安全を組み込む点でNOOAと近い思想を持ちますが、フレームワーク提供のAgent(...)をインスタンス化して構成する方式のため、ユーザー定義クラスのメソッド・フィールドがそのままエージェントになるNOOAとは記述モデルが異なります。
NOOAは加えて「メソッド本体を...にしてLLMに任せる/通常のPythonコードで書いて決定論に振る」の二択を同じクラス内で切り替えられる点が独自です。
他フレームで揃わない6つの機能
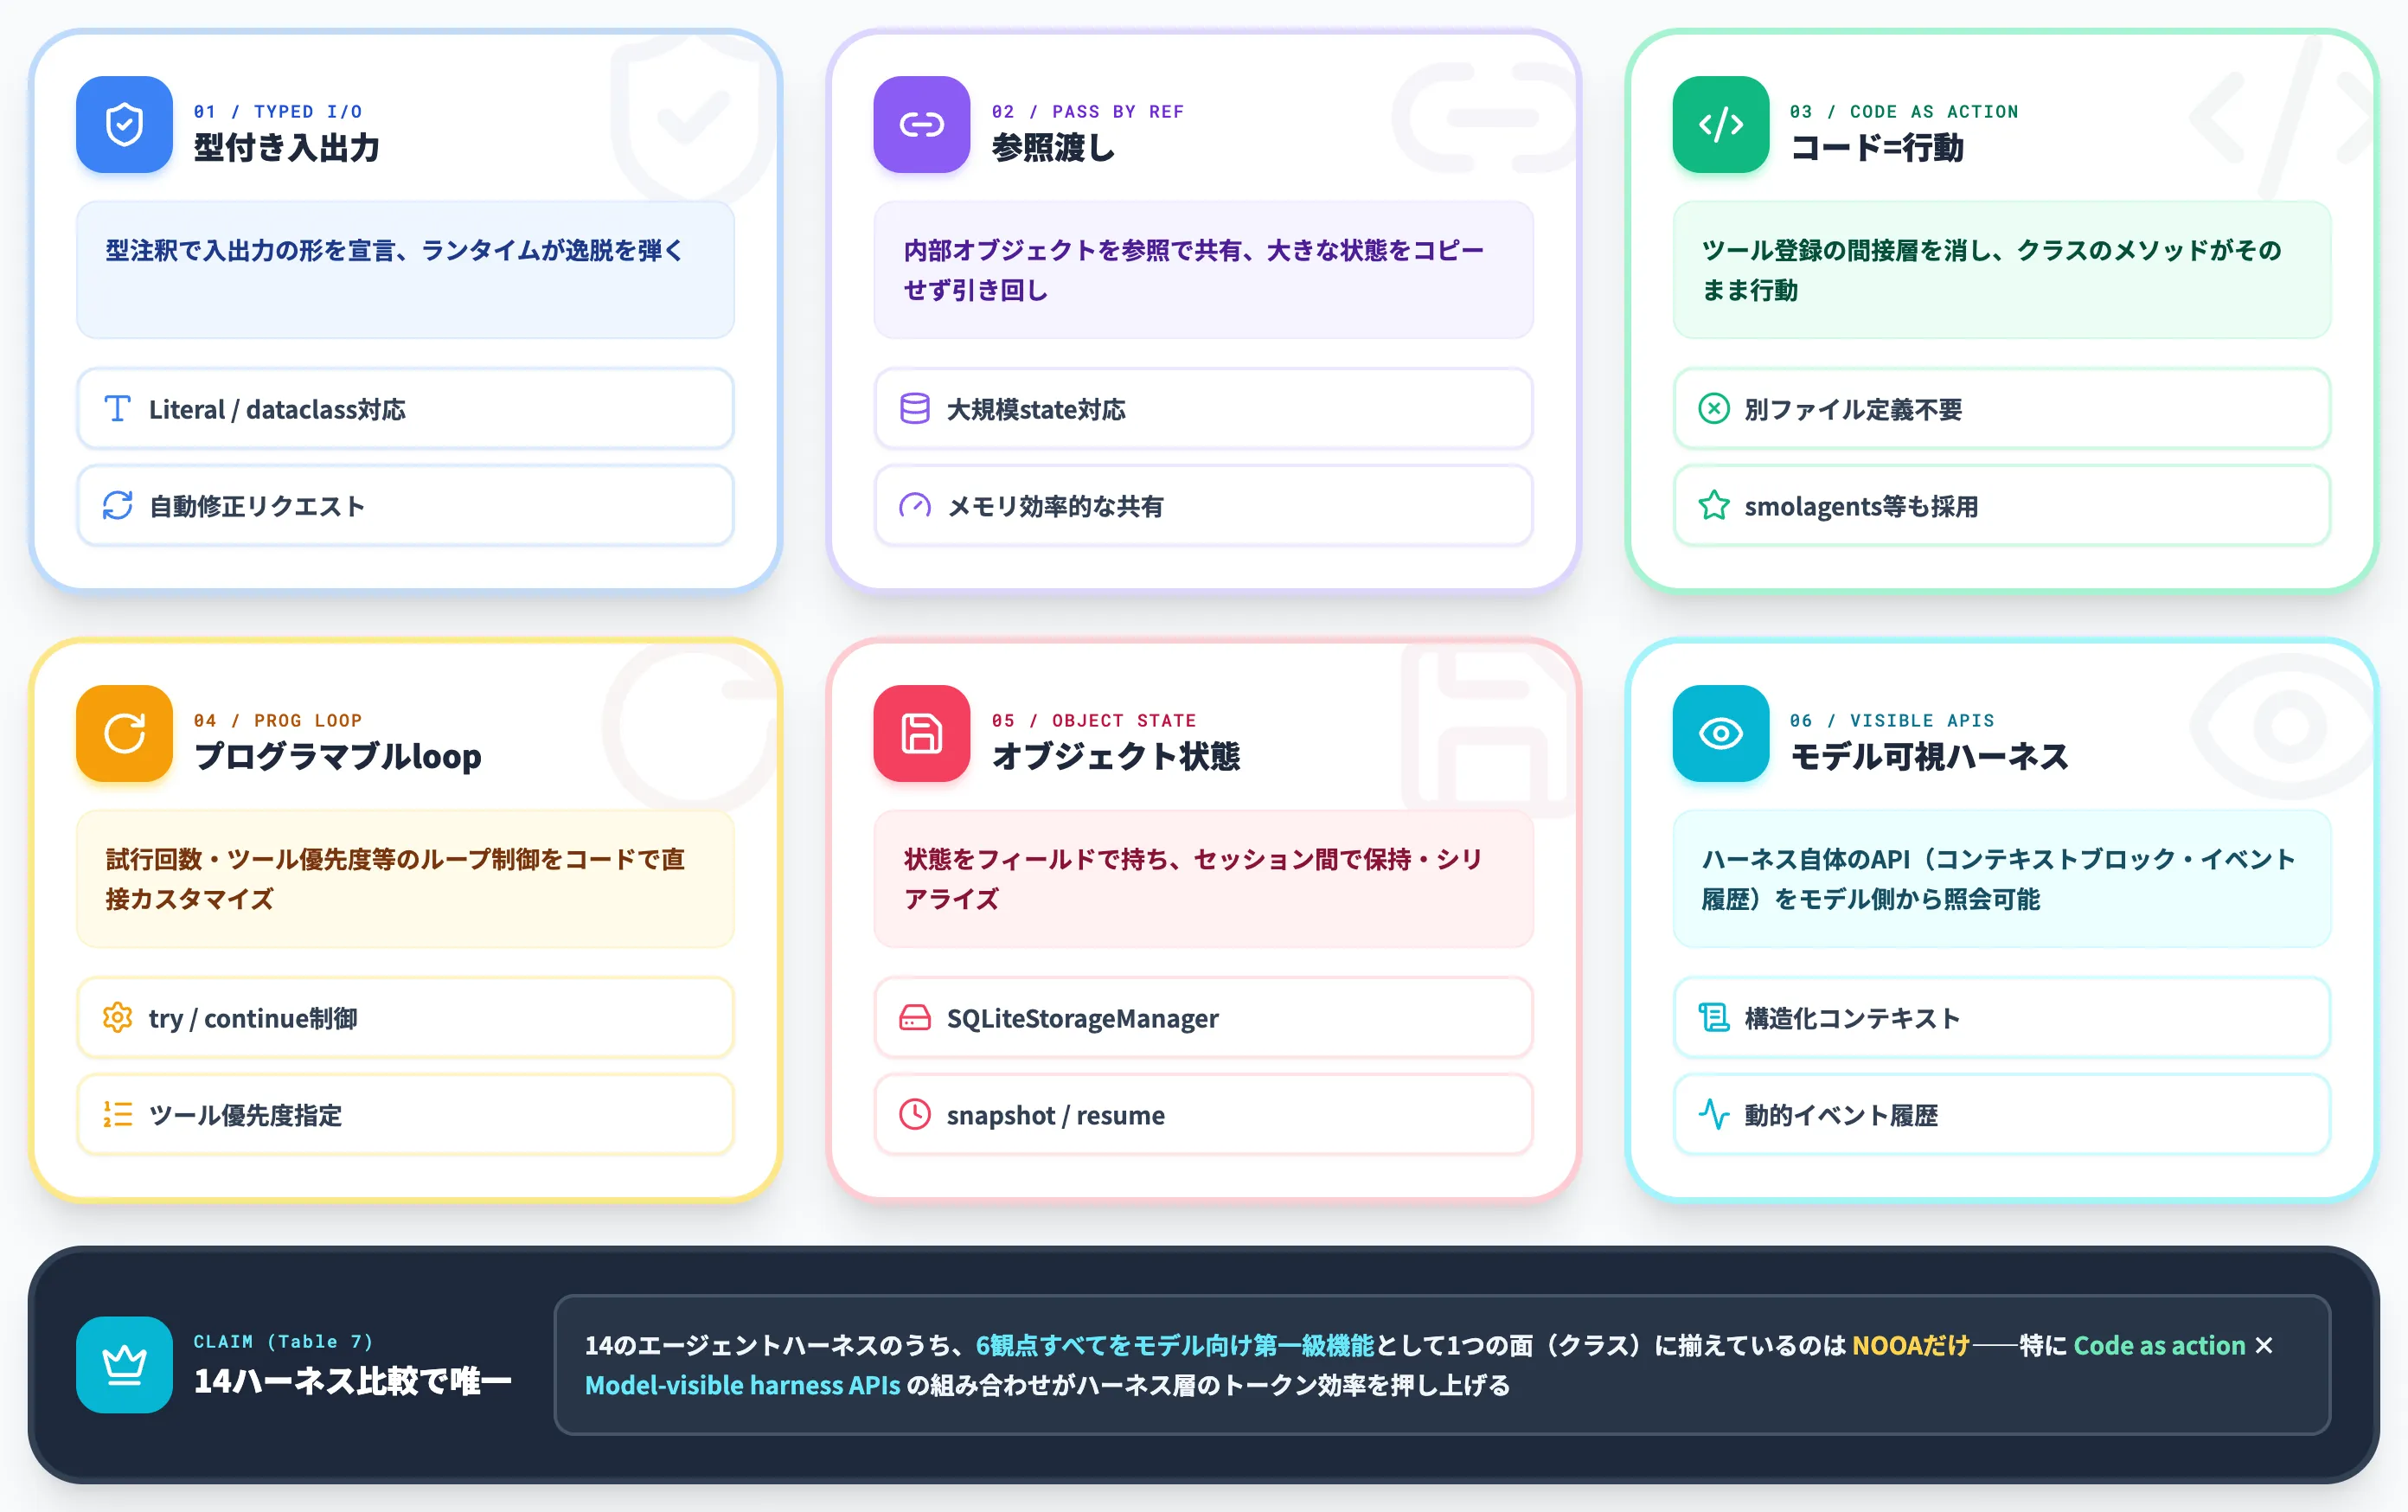
NOOA技術報告書のSection 5は、14のエージェントフレームワーク(=エージェントハーネス:モデルとツール・状態・履歴・ループ制御を束ねる周辺システム層)を6つの観点で採点する比較を掲載しています。
そこで打ち出されているのが、「他システムも一部の観点は採用しているが、6つ全部を1つの面(クラス)に露出しているのはNOOAだけ」という主張です。以下の表で、6つの機能とその実務的な意味を整理しました。
| # | 機能 | 実務的な意味 |
|---|---|---|
| 1 | Typed I/O(型付き入出力) | 型注釈で入出力の形を宣言し、ランタイムが逸脱を弾く |
| 2 | Pass by reference(参照渡し) | エージェントの内部オブジェクトを参照で共有し、大きな状態をコピーせず引き回せる |
| 3 | Code as action(コード=行動) | ツールを別ファイルで登録せず、クラスのメソッドがそのままモデル側から呼べる行動になる |
| 4 | Programmable loop engineering(プログラマブルなループ設計) | ループ制御(試行回数・ツール優先度等)をコードで直接カスタマイズできる |
| 5 | Object state(オブジェクト状態) | エージェントの状態をクラスのフィールドで持ち、セッション間で保持・シリアライズできる |
| 6 | Model-visible harness APIs(モデルから見えるハーネスAPI) | ハーネス自体のAPI(構造化コンテキストブロック・動的コンテキスト・イベント履歴等)をモデルから直接照会できる |
論文Section 5では、この6つの設計パターンが14の主要フレームワーク・ハーネスで採用されているかを一覧表にまとめています。
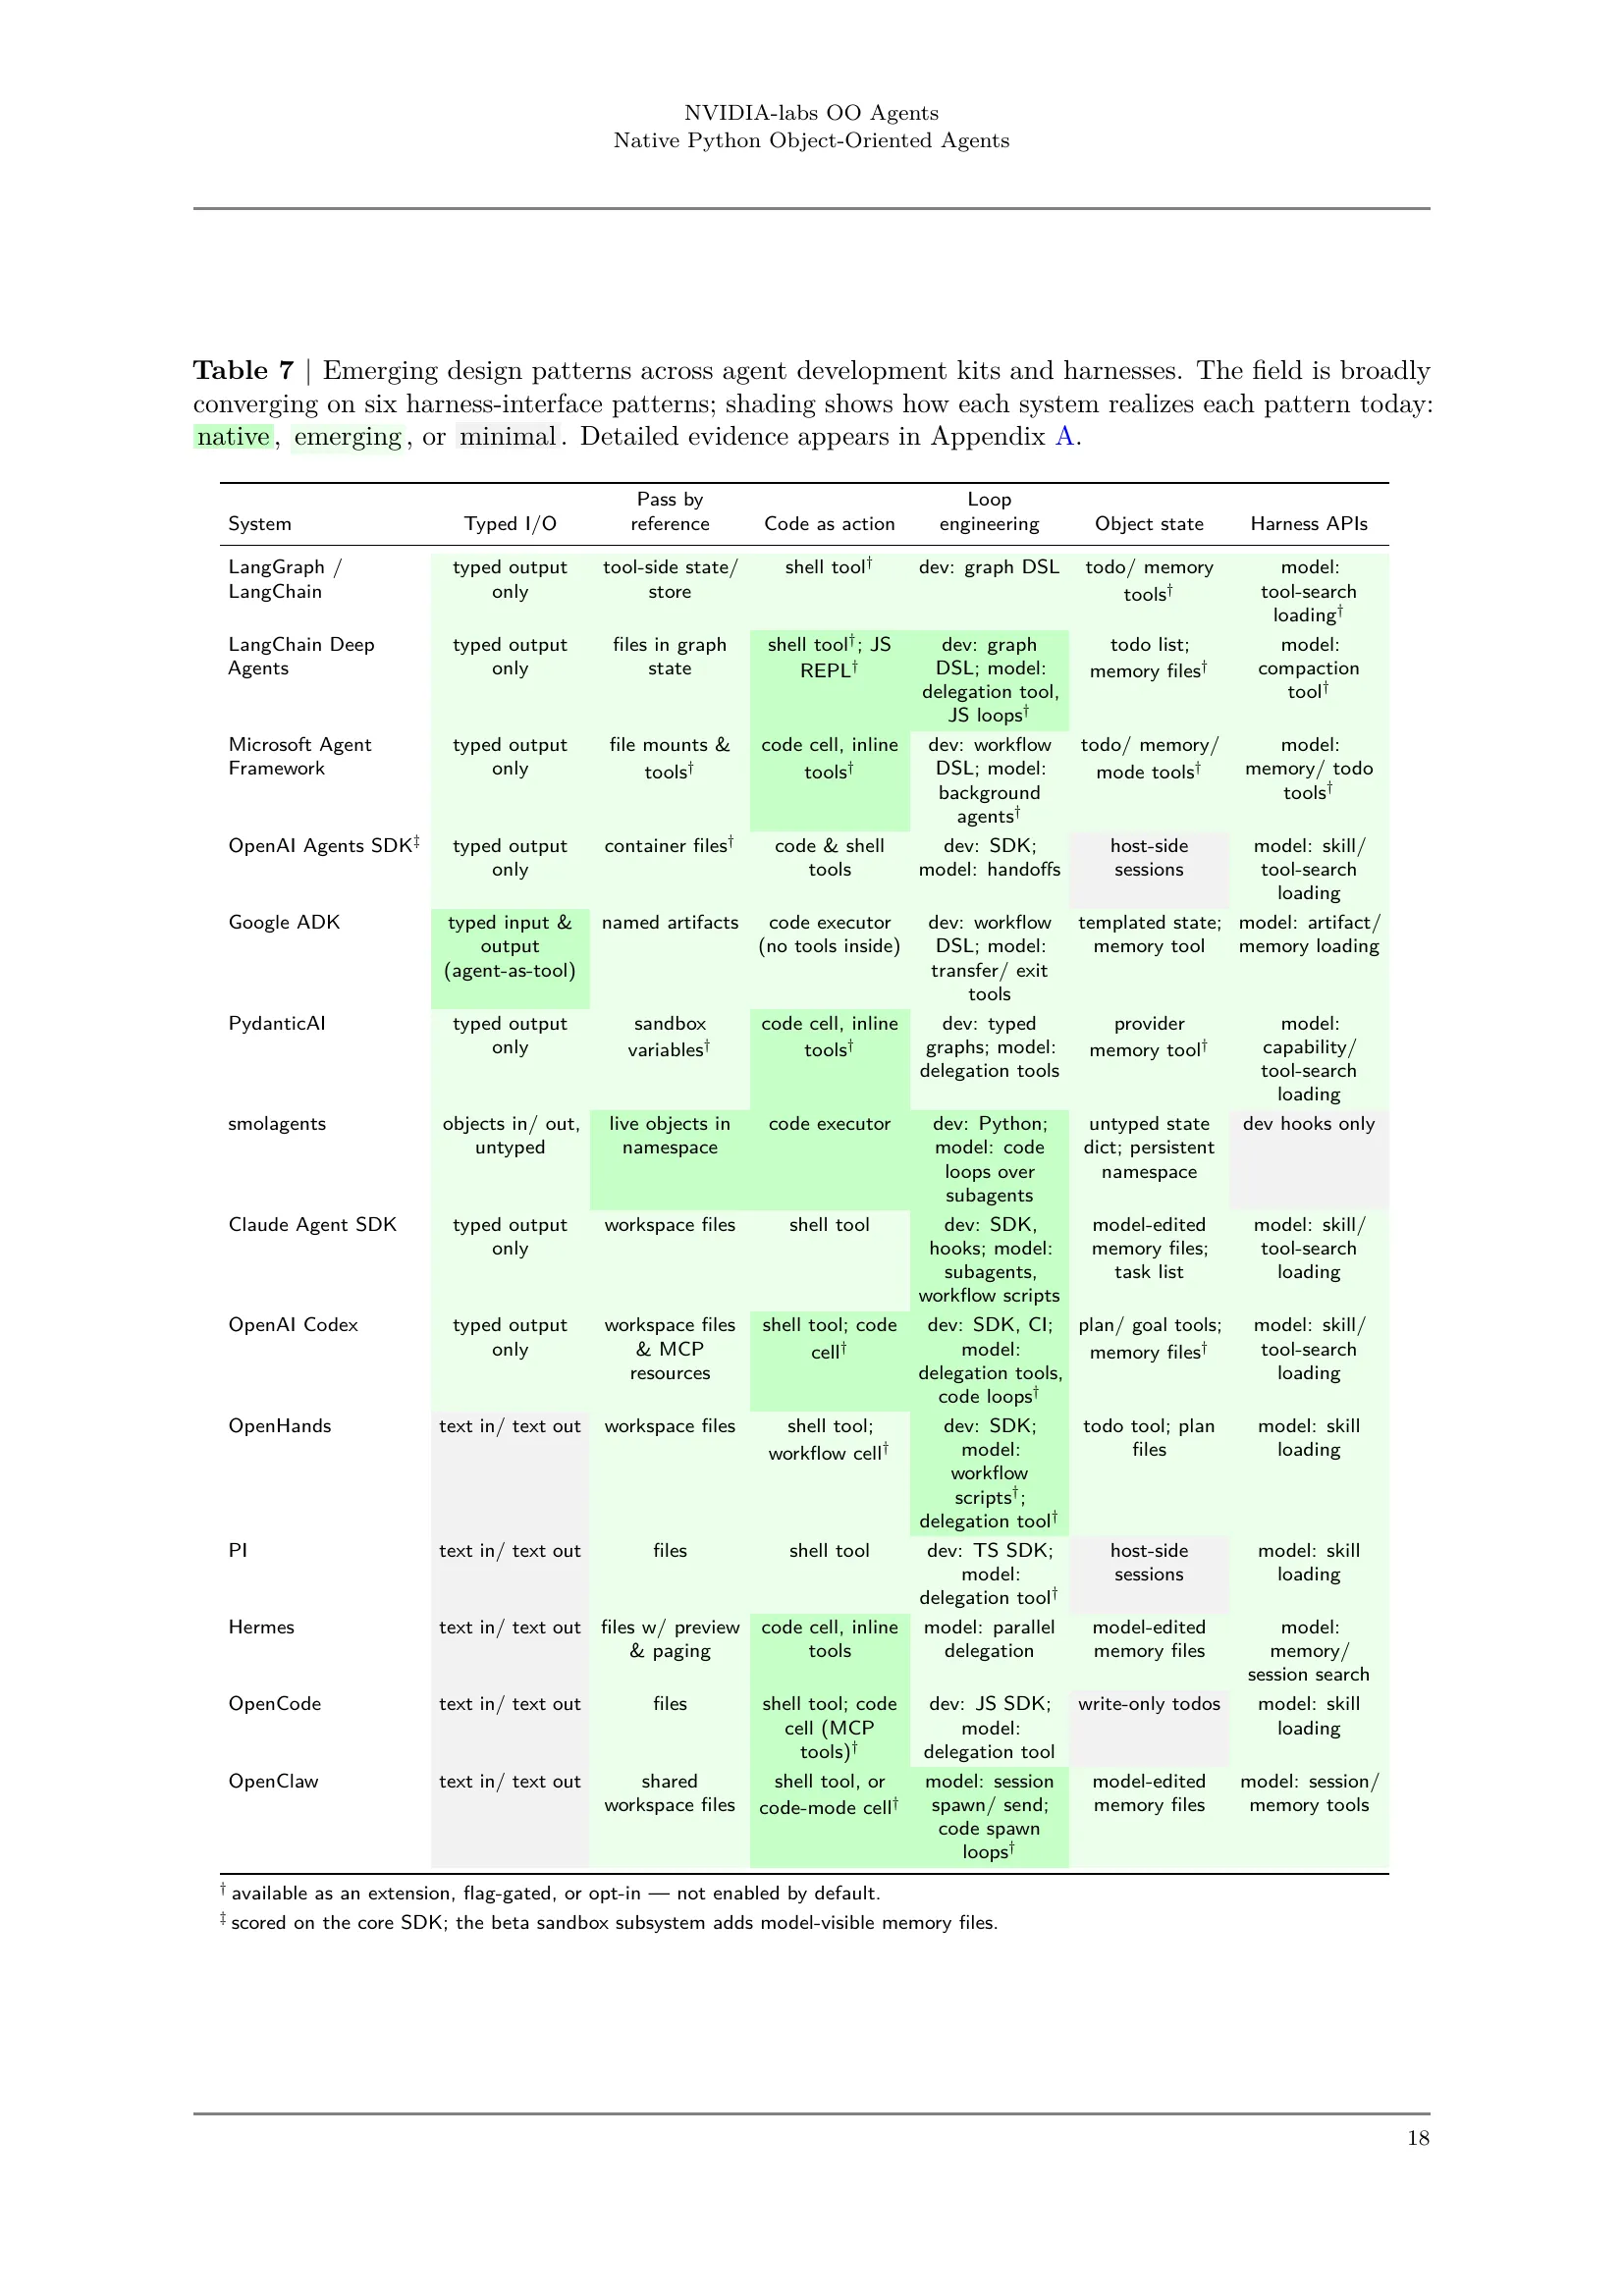
論文Table 7:14のエージェント開発キット・ハーネスにおける設計パターン採用状況(出典:arxiv 2607.20709 p.18)
表を横断して見ると、各システムは6観点をnative/emerging/minimalの3段階で異なる水準で実現していますが、6つすべてをモデル向けの第一級機能として1つの面(クラス)に揃えているのはNOOAだけ、というのが論文の評価です。「Code as action」(コード=行動)は smolagents や OpenHands にも native の採用例があり、「Model-visible harness APIs」も多くのシステムに部分実装がある中で、NOOAは6観点をすべて第一級で束ねている構図として読めます。
この6つのうち特に効くのが、3のCode as actionと6のModel-visible harness APIsの組み合わせです。前者でツール登録の間接層が消え、後者でハーネスの状態がモデル側にも渡ることで、モデルが「自分がどこにいて、どんなAPIが使えるか」を自然に把握できるようになります。
結果として、余計なプロンプト誘導なしにモデルが適切な次アクションを選びやすくなる、というのが技術報告書の主張です。
NOOAが目指しているのは、「モデルとハーネスの間の情報段差を減らす」設計です。この段差を減らせた分だけ、次のセクションで見るベンチマーク上のトークン効率が上がる、という理屈になっています。
ベンチマーク実測:SWE-bench 82.2%とPI比トークン半減の中身
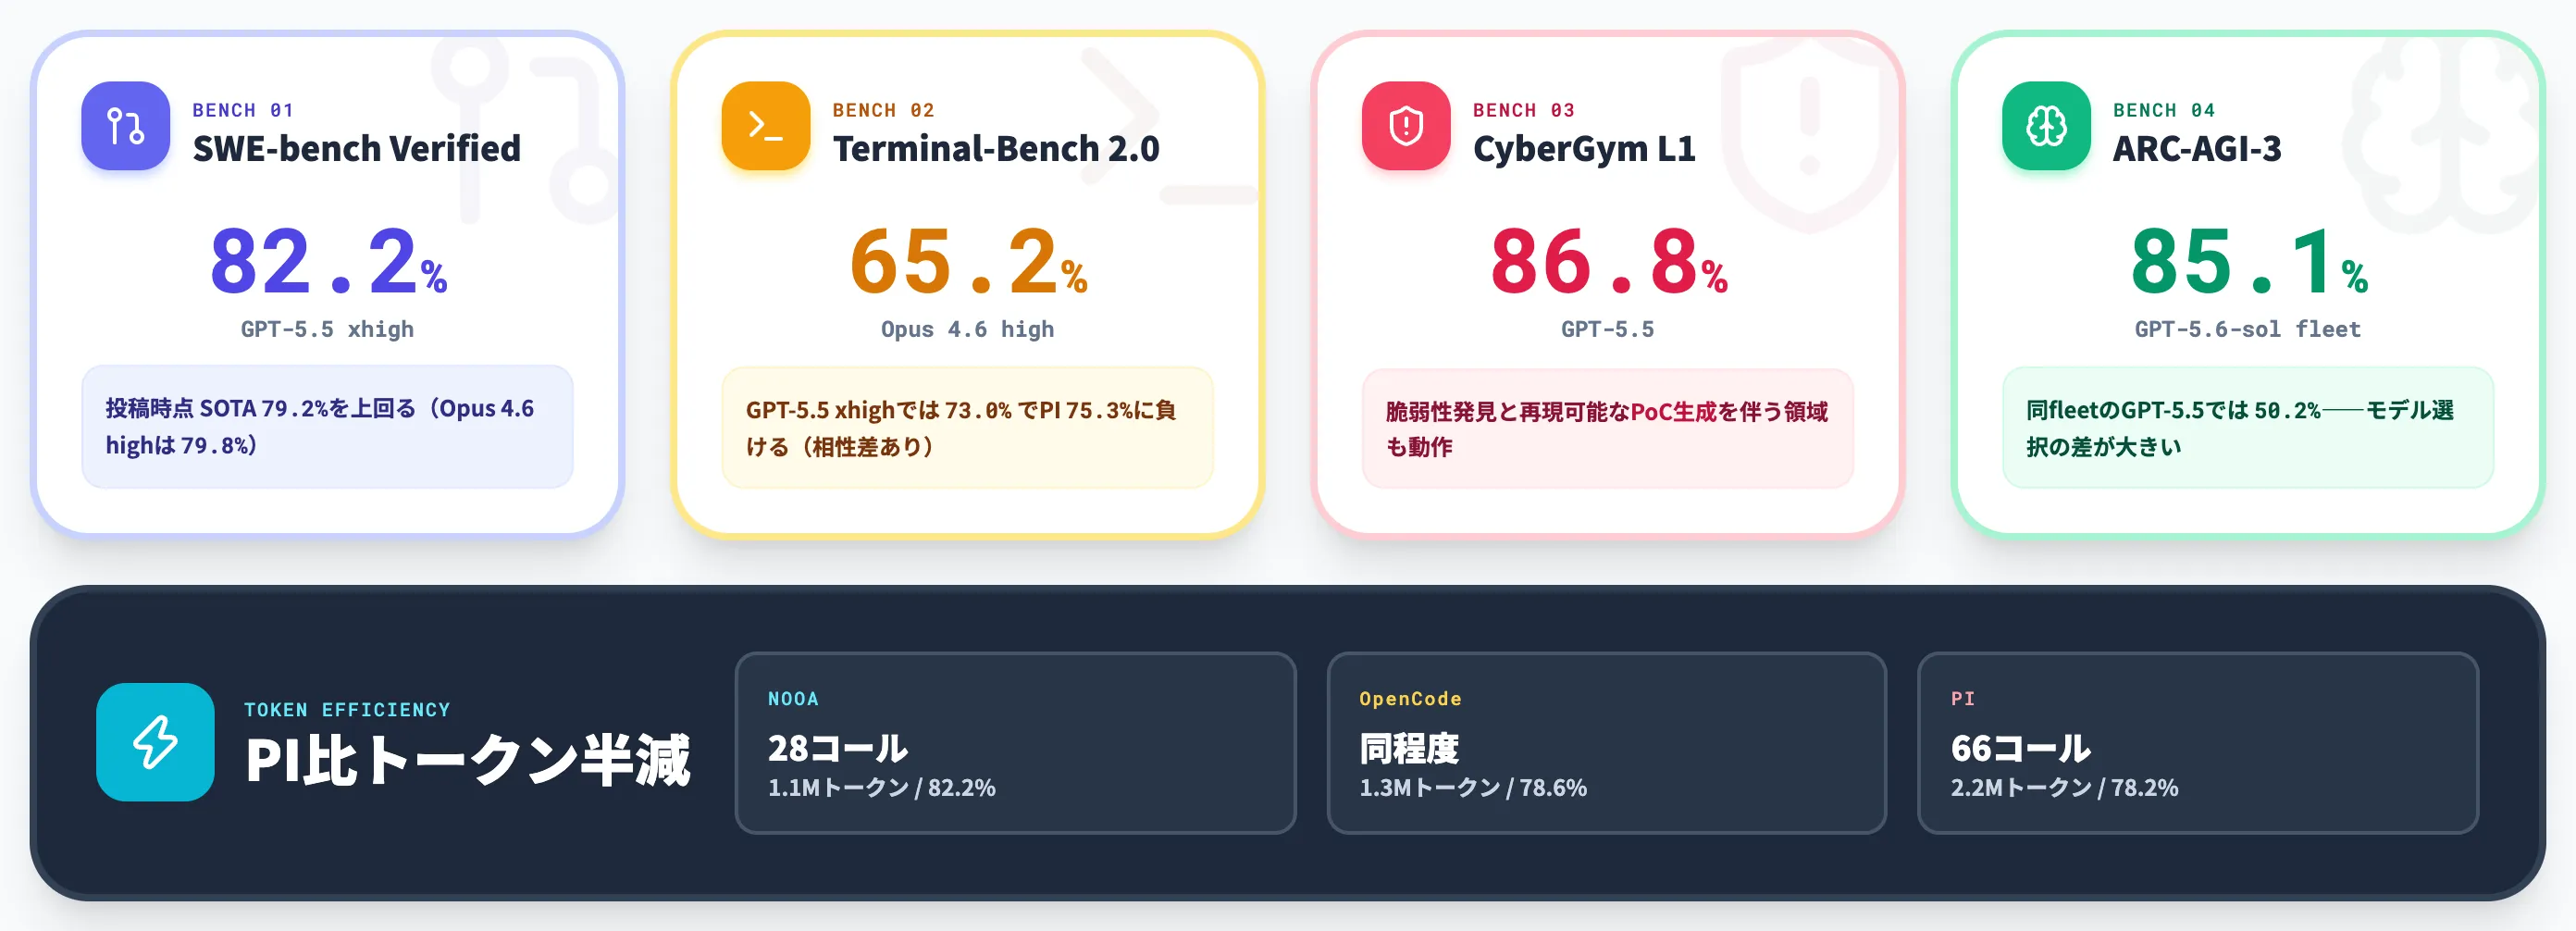
ここからは、NOOA技術報告書が示したベンチマーク結果を、SWE-bench Verified・Terminal-Bench 2.0・CyberGym L1・ARC-AGI-3の4本立てで見ていきます。
SWE-bench Verified——GPT-5.5 xhighで82.2%、投稿時点SOTAを上回る
SWE-bench Verifiedは、実際のGitHubリポジトリから収集したソフトウェア工学タスクを解けるかを測る、コード修正エージェント評価の標準ベンチマークです。
以下の表は、技術報告書Table 3から抜粋した、NOOA・OpenCode 1.14.33・PI v0.72.1の3ハーネスをGPT-5.5とOpus 4.6の推論深度違いで比較したものです。
| ハーネス | GPT-5.5 (off) | GPT-5.5 (high) | GPT-5.5 (xhigh) | Opus 4.6 (off) | Opus 4.6 (high) |
|---|---|---|---|---|---|
| NOOA | 67.2% | 78.8% | 82.2% | 76.8% | 79.8% |
| OpenCode 1.14.33 | 59.2% | 75.0% | 78.6% | 76.0% | 75.2% |
| PI v0.72.1 | 60.8% | 73.6% | 78.2% | 75.6% | 75.8% |
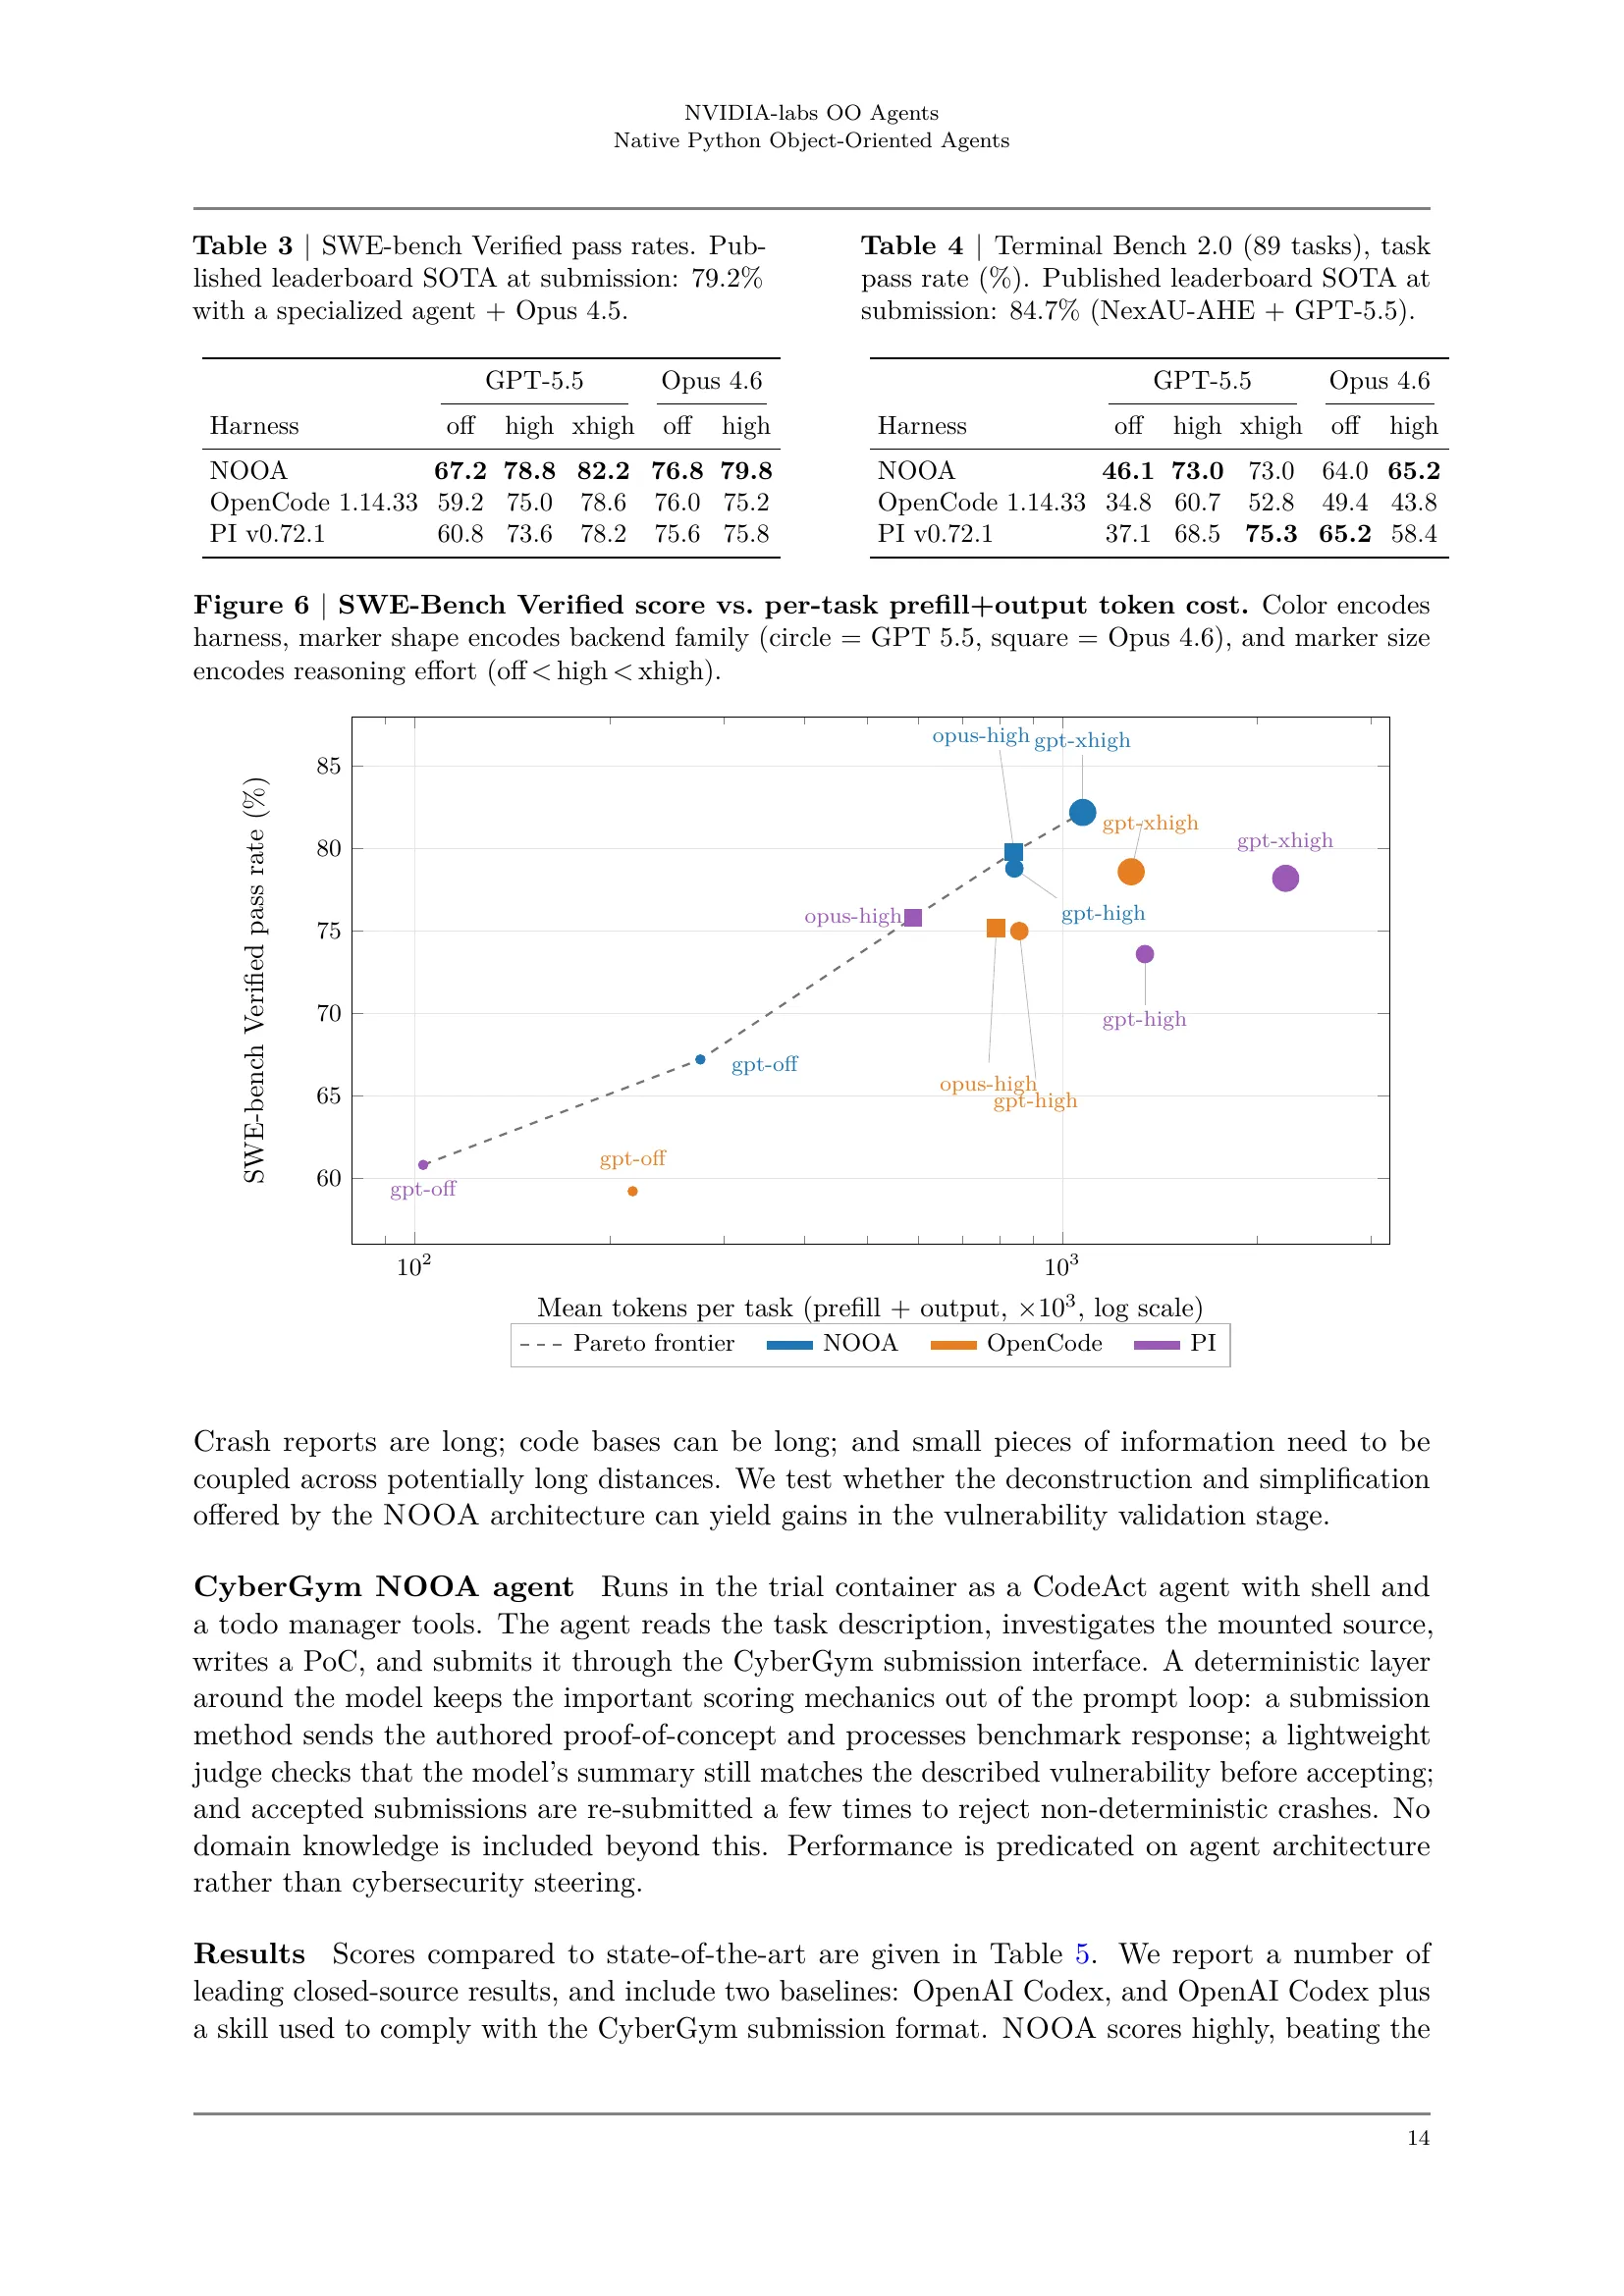
論文Table 3・Table 4・Figure 6:SWE-bench Verified・Terminal-Bench 2.0のスコアと、SWE-benchスコア vs 1タスクあたりトークンコストの散布図(出典:arxiv 2607.20709 p.14)
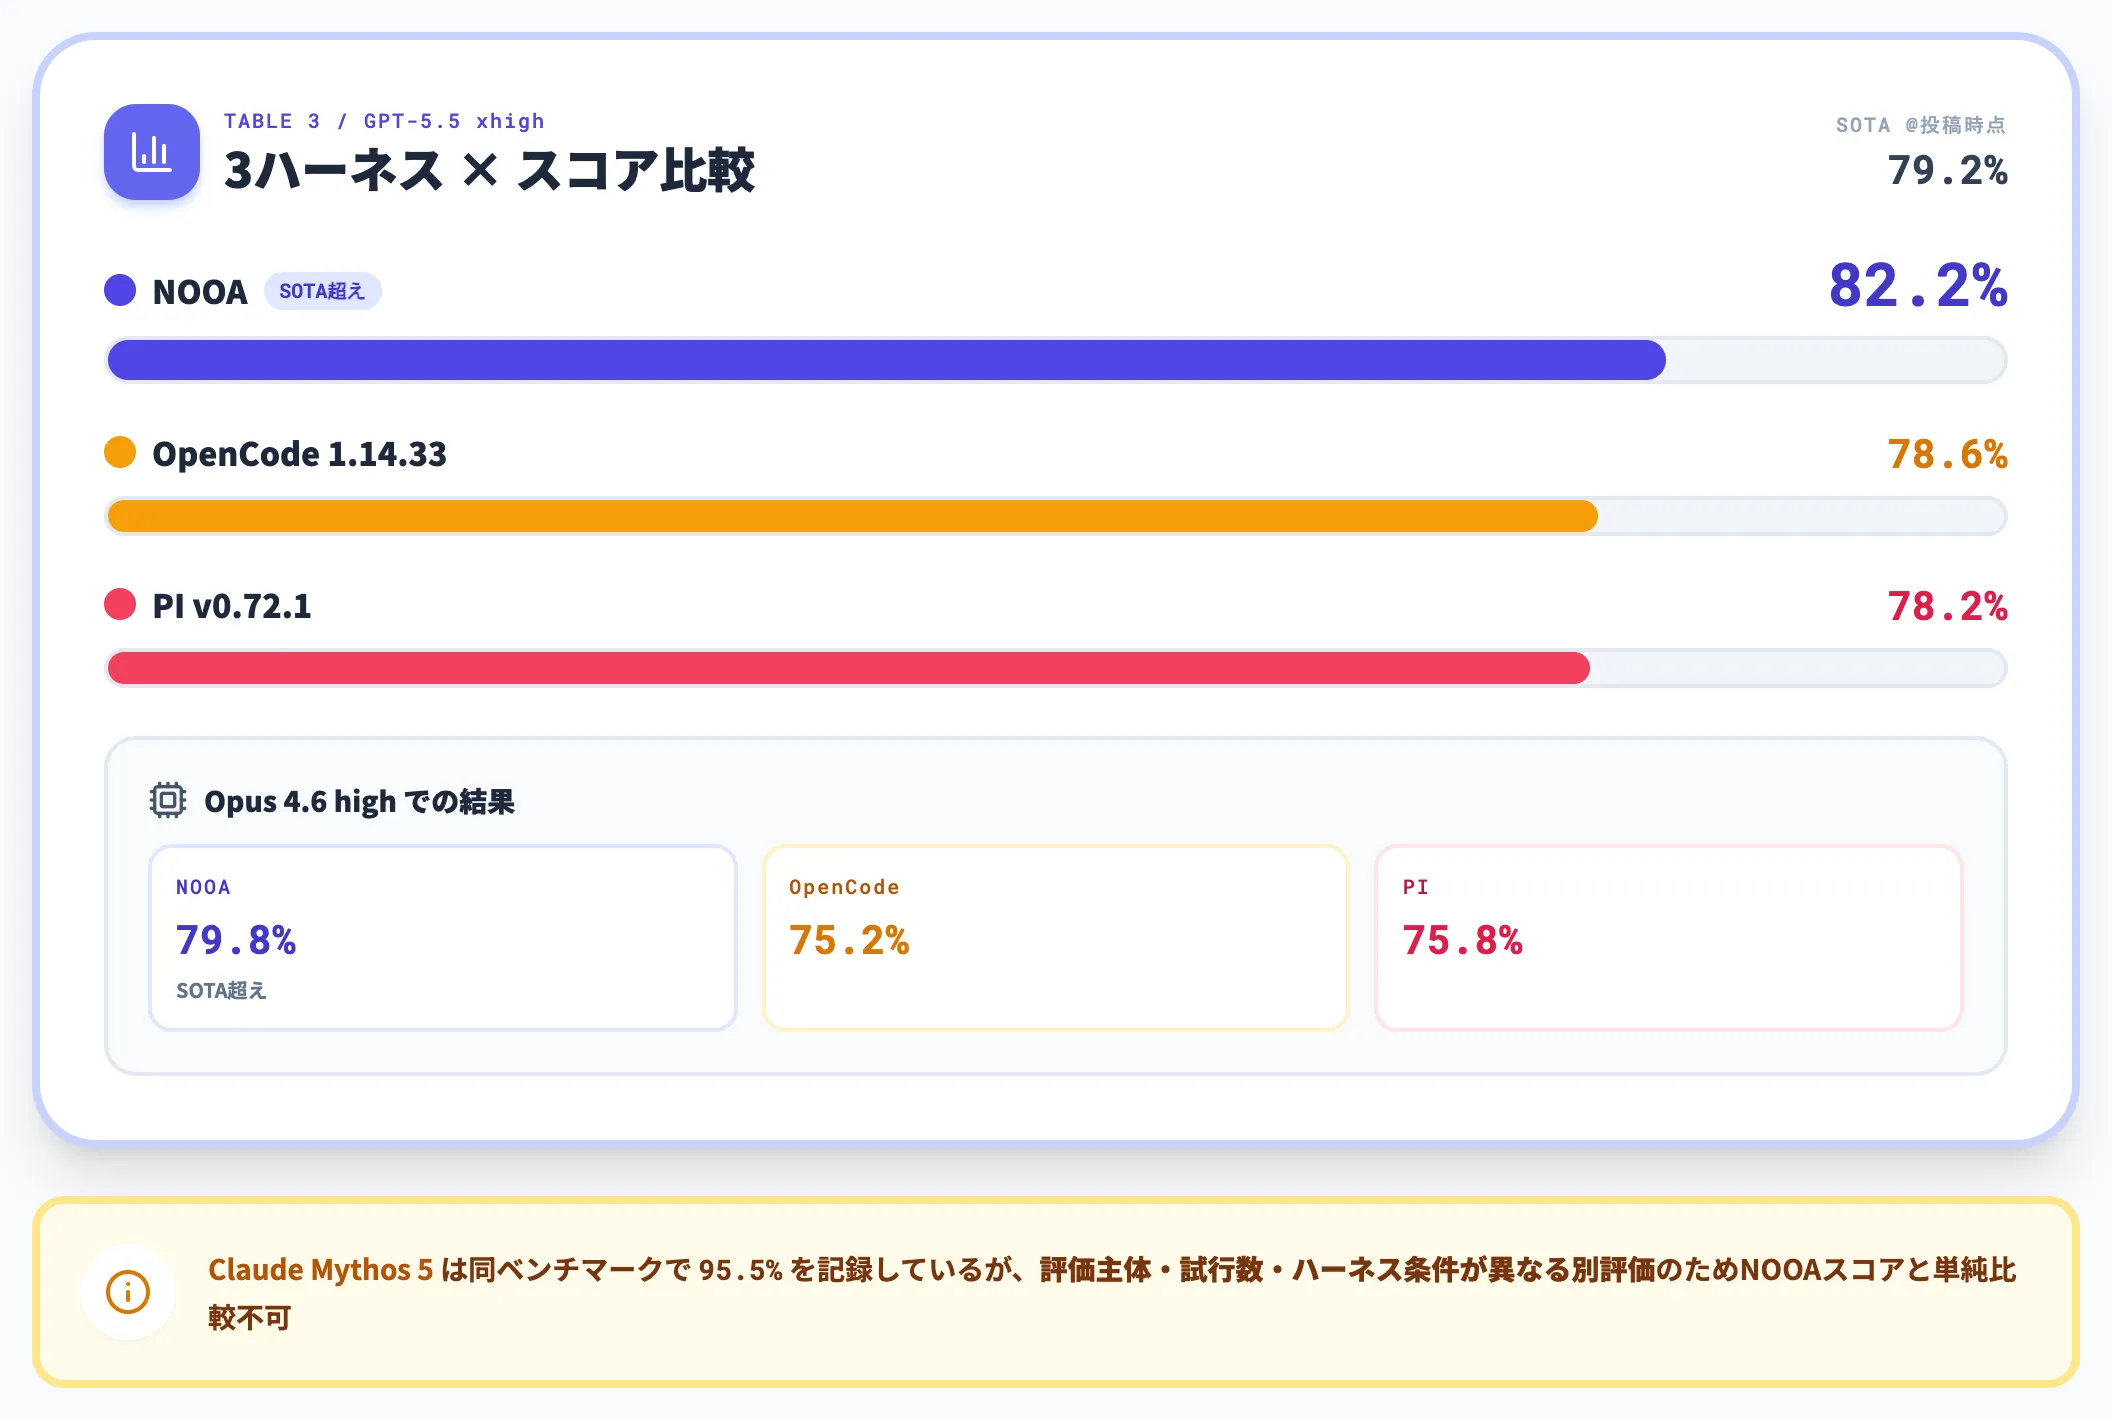
Figure 6の散布図では、横軸が1タスクあたりの入出力トークン量(log scale)、縦軸がSWE-bench Verified合格率です。
散布図の左上(低トークン・高精度)にNOOAの各データポイントが固まり、右方向(高トークン)にPI・OpenCodeが伸びている構図が、「PIより高い精度を約半分のトークン量で達成する」という主張の視覚的裏付けになっています。
技術報告書は投稿時点の公開リーダーボードSOTAを「79.2%(Opus 4.5+特化型エージェント)」とし、NOOA + GPT-5.5 xhighの82.2%とNOOA + Opus 4.6 highの79.8%がこれを上回った、と位置づけています。
同ベンチマークではClaude Mythos 5が95.5%を記録していますが、これは同じSWE-bench Verifiedであっても評価主体・試行数・ハーネス条件が異なる別評価のため、NOOAのスコアと単純に比較はできません。
トークン効率——PIより高い精度を約半分のトークン量で達成
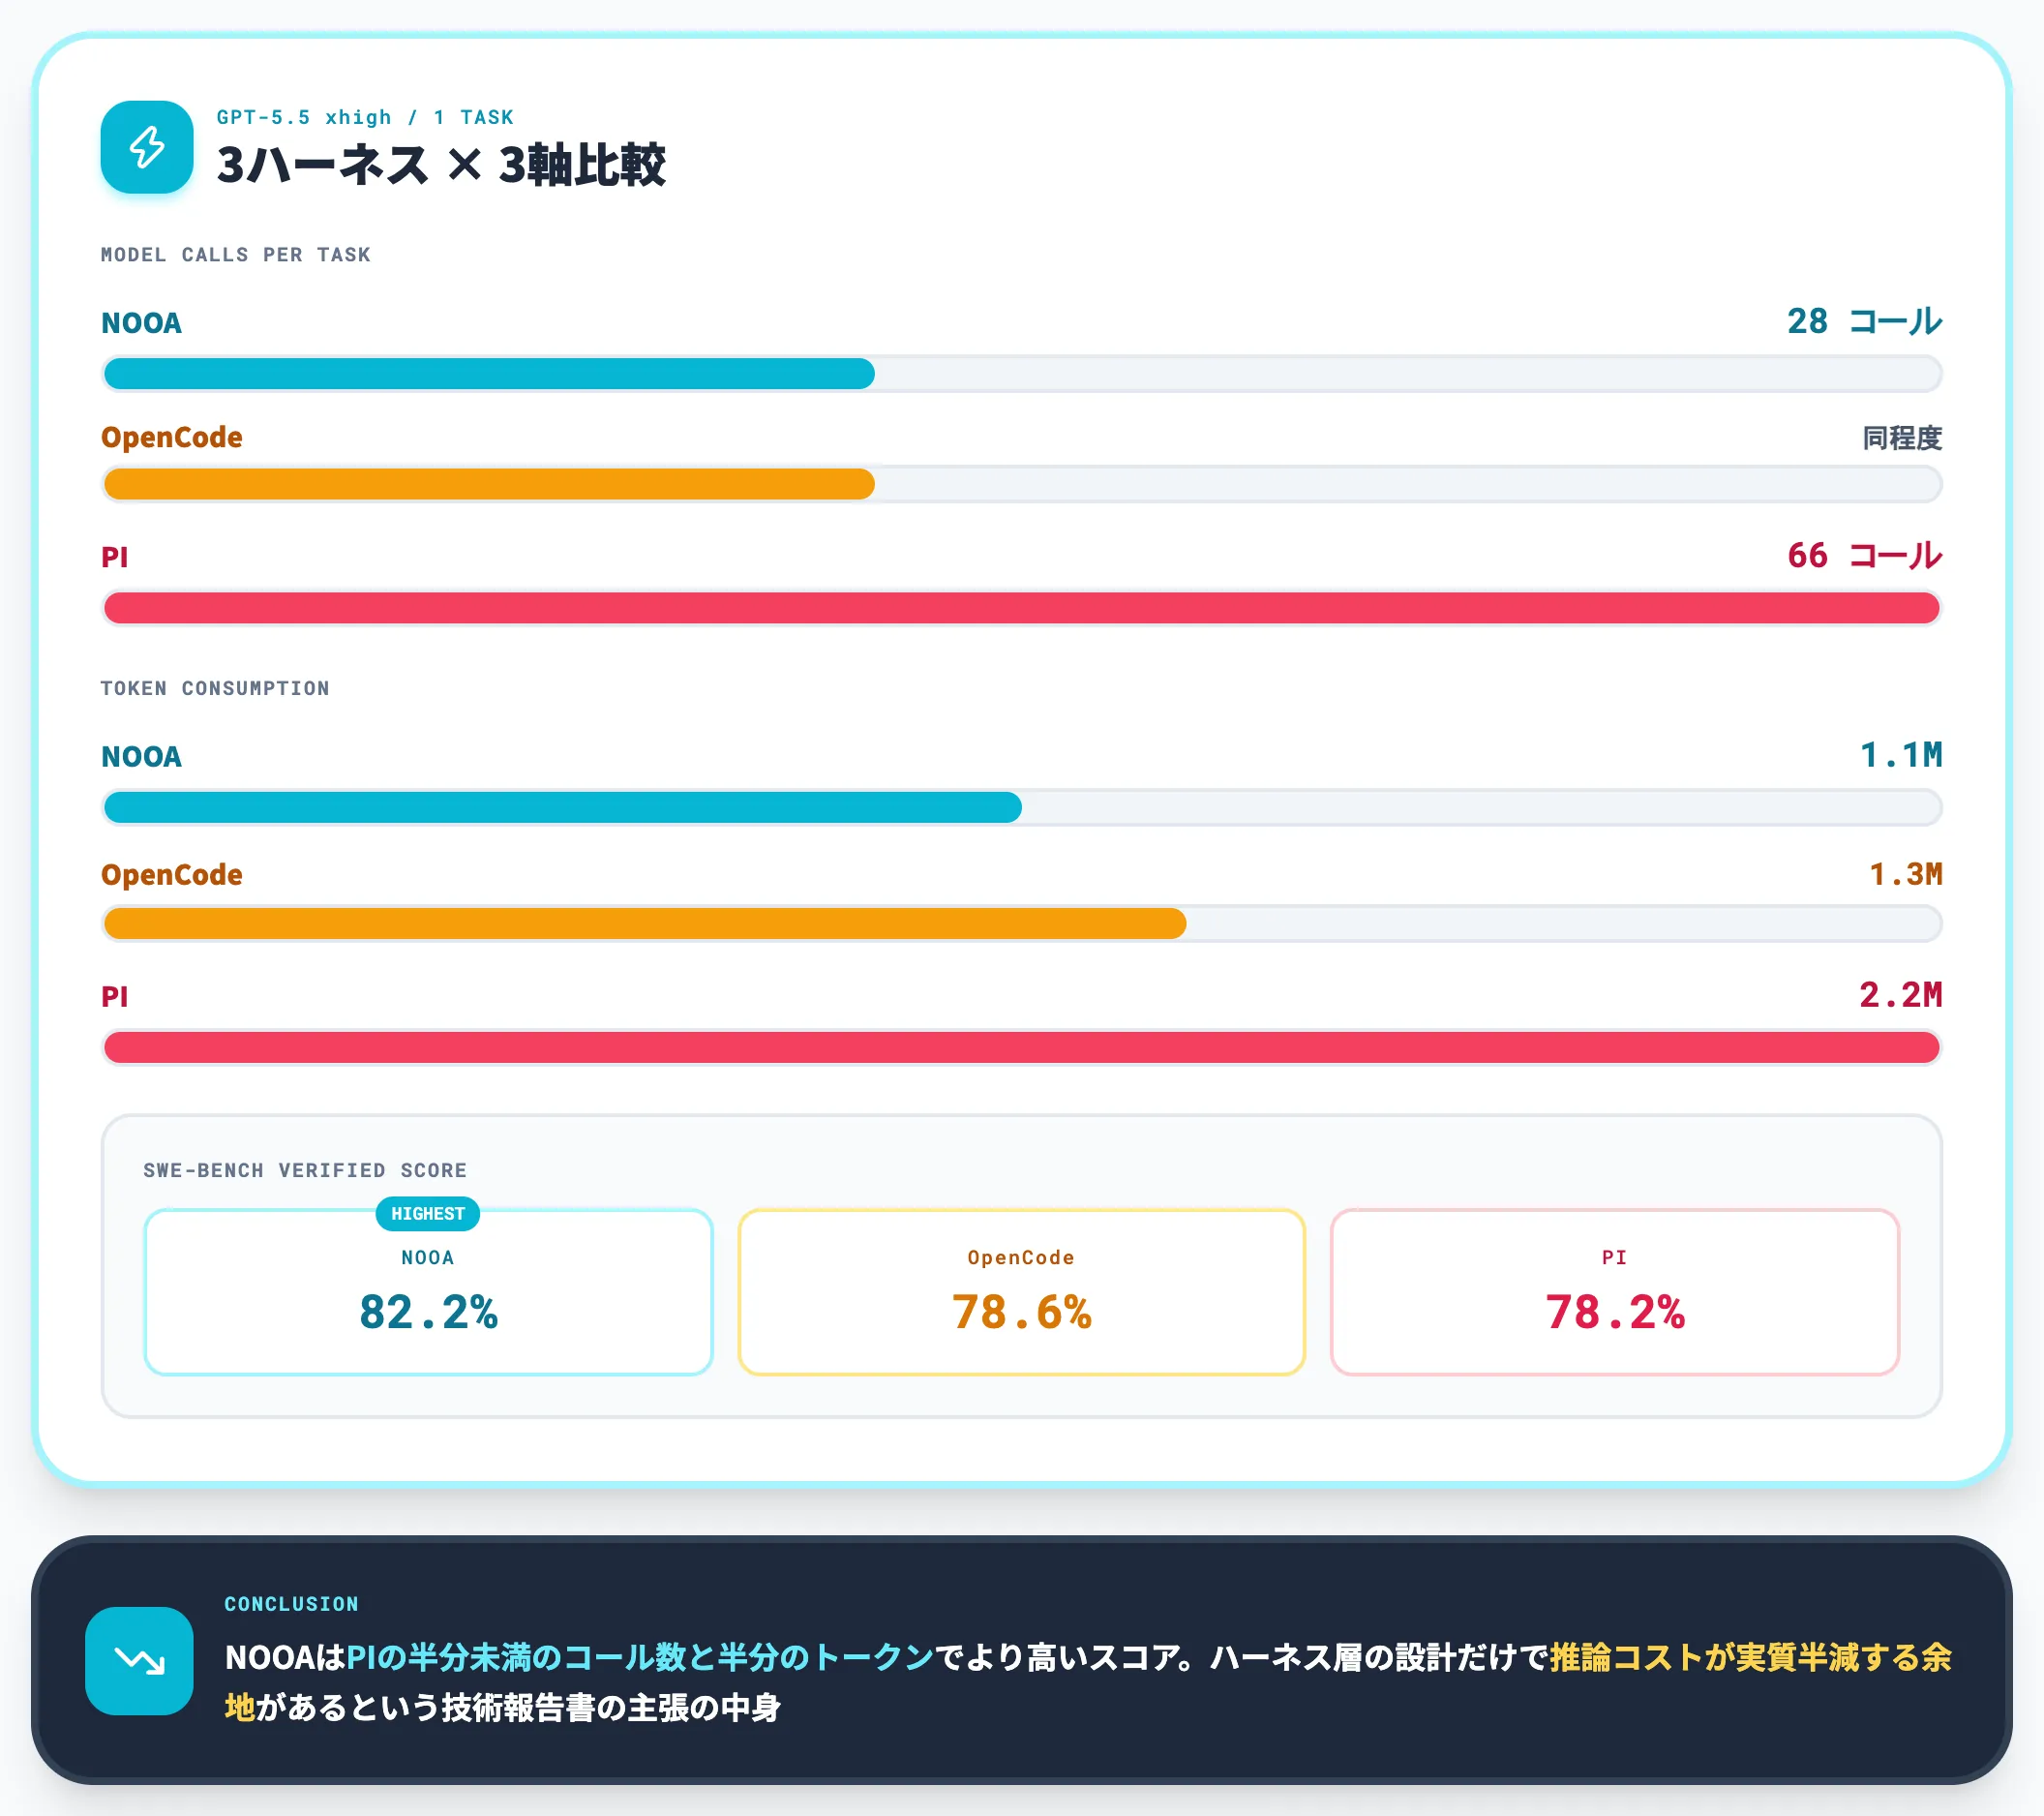
さらに注目すべきは、精度そのものよりも3ハーネスのモデル呼び出し回数とトークン消費です。GPT-5.5 xhighでの1タスクあたりの消費を、3ハーネスで比較すると以下のようになります。
-
NOOA
約28コール/1.1Mトークン/82.2%
-
OpenCode
NOOAと同程度のコール数/1.3Mトークン/78.6%
-
PI
66コール/2.2Mトークン/78.2%
NOOAはPIの半分未満のコール数と半分のトークンで、より高いスコアを出しています。ハーネス層の設計だけで推論コストが実質半減する余地がある、というのが技術報告書の一番強いメッセージです。
エージェント運用のコストがモデルAPI利用料で決まるいまの構造だと、トークン量の差は月間の請求書に直接効いてきます。
実際の削減額は各モデルの入力・キャッシュ入力・出力の内訳と単価に依存するため、自社の運用ボリュームと採用モデルの公式pricingで試算する必要があります。
Terminal-Bench 2.0——モデル組み合わせによっては負ける
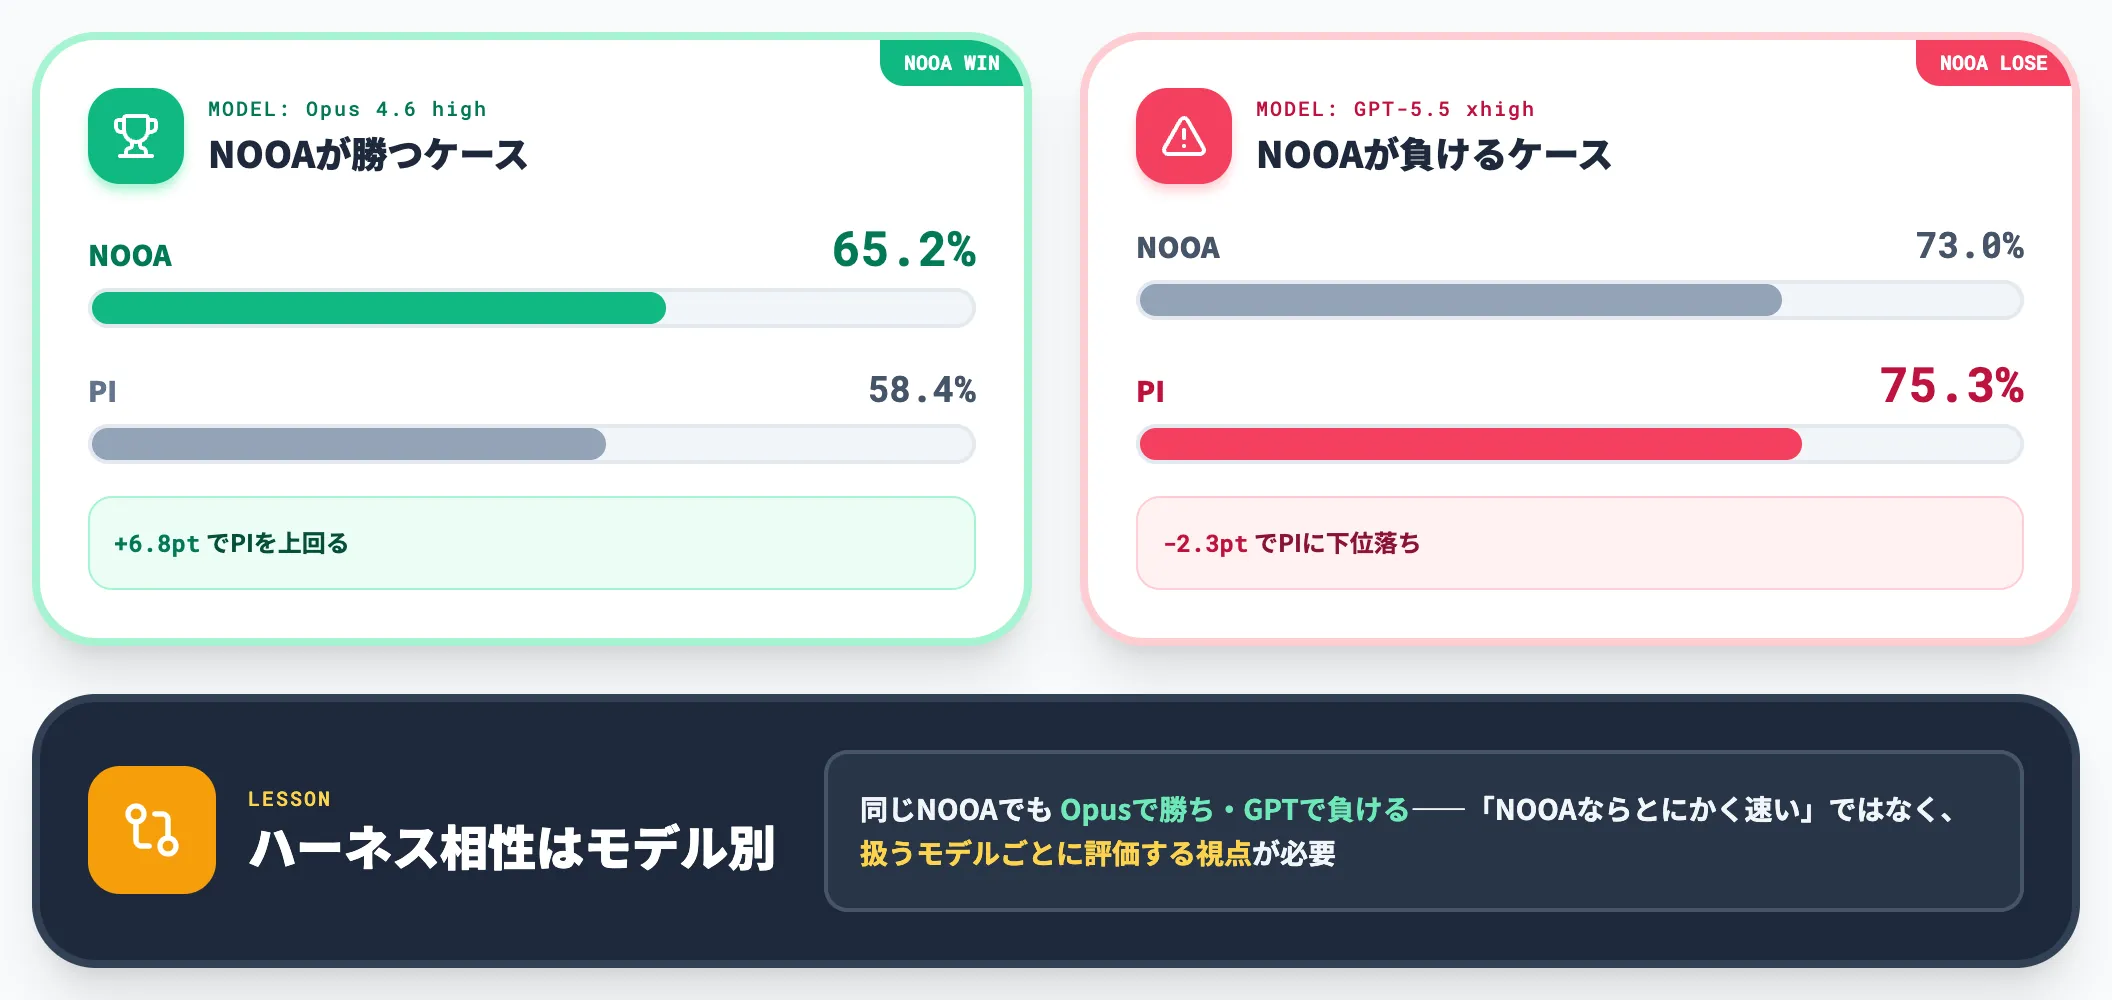
SWE-benchほど話題にならない領域では、NOOAが全戦全勝ではありません。ターミナル操作を含む89タスクを収録したTerminal-Bench 2.0では、NOOAはOpus 4.6 highで65.2%(PI 58.4%を上回る)ですが、GPT-5.5 xhighではNOOA 73.0%に対してPI 75.3%と、モデル組み合わせによっては下位に落ちます。
この負けは軽視すべきではない材料です。ハーネスの相性はモデルごとに違う——同じフレームワークでも、扱うモデルが変われば向き不向きが出る、という事実がここに表れています。
「NOOAならとにかく速い・強い」ではなく、モデル別に評価する視点が要ります。
CyberGym L1とARC-AGI-3——脆弱性PoC生成86.8%と抽象推論85.1%
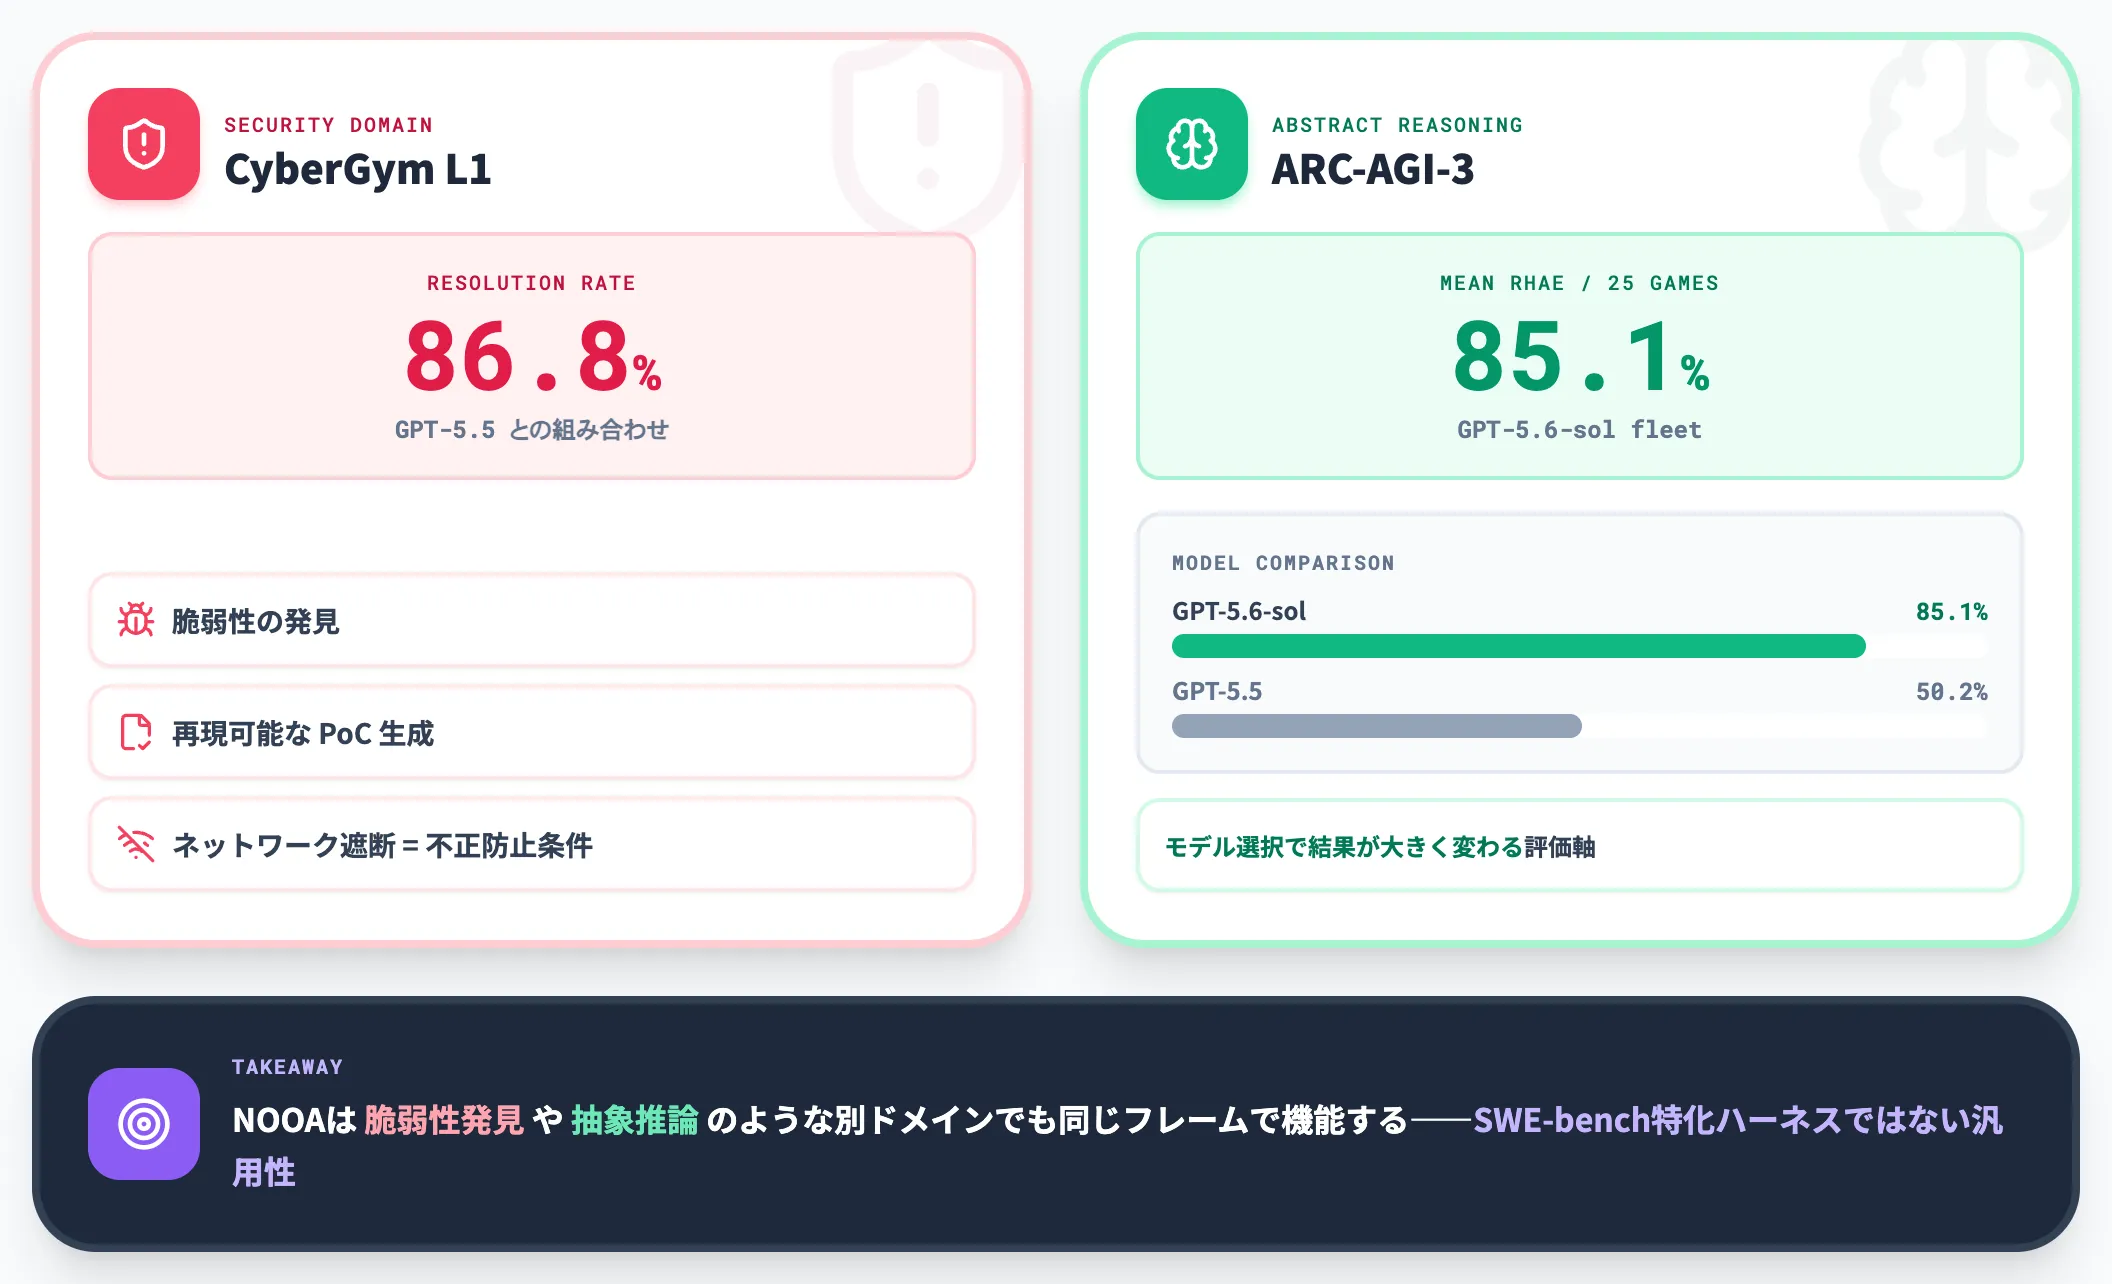
技術報告書は、コード修正以外の領域でも実測データを公開しています。
-
CyberGym L1(コードベース内の脆弱性を発見し、再現可能なPoCを生成するタスク・ネットワーク遮断は不正防止条件)
GPT-5.5との組み合わせで86.8%の解決率。脆弱性の再発見とPoC検証を伴う領域でも動くことを示す実測値
-
ARC-AGI-3(抽象推論タスクの新世代版)
GPT-5.6-solを使った25ゲームのfleet構成で mean RHAE 85.1%(同fleetのGPT-5.5では50.2%)。モデル選択で結果が大きく変わる評価軸
これらの数値が意味するのは、NOOAが「SWE-benchのようなコード修正だけに特化したハーネス」ではなく、脆弱性発見や抽象推論のような別ドメインでも同じフレームで機能する、汎用性のある設計だという点です。
LangGraph・CrewAI・Pydantic AIから乗り換えるか
ここからは、既にLangGraph・CrewAI・Pydantic AIなどの主要フレームワークで開発を回しているチームが、NOOAに乗り換える価値があるかをケース別に整理します。
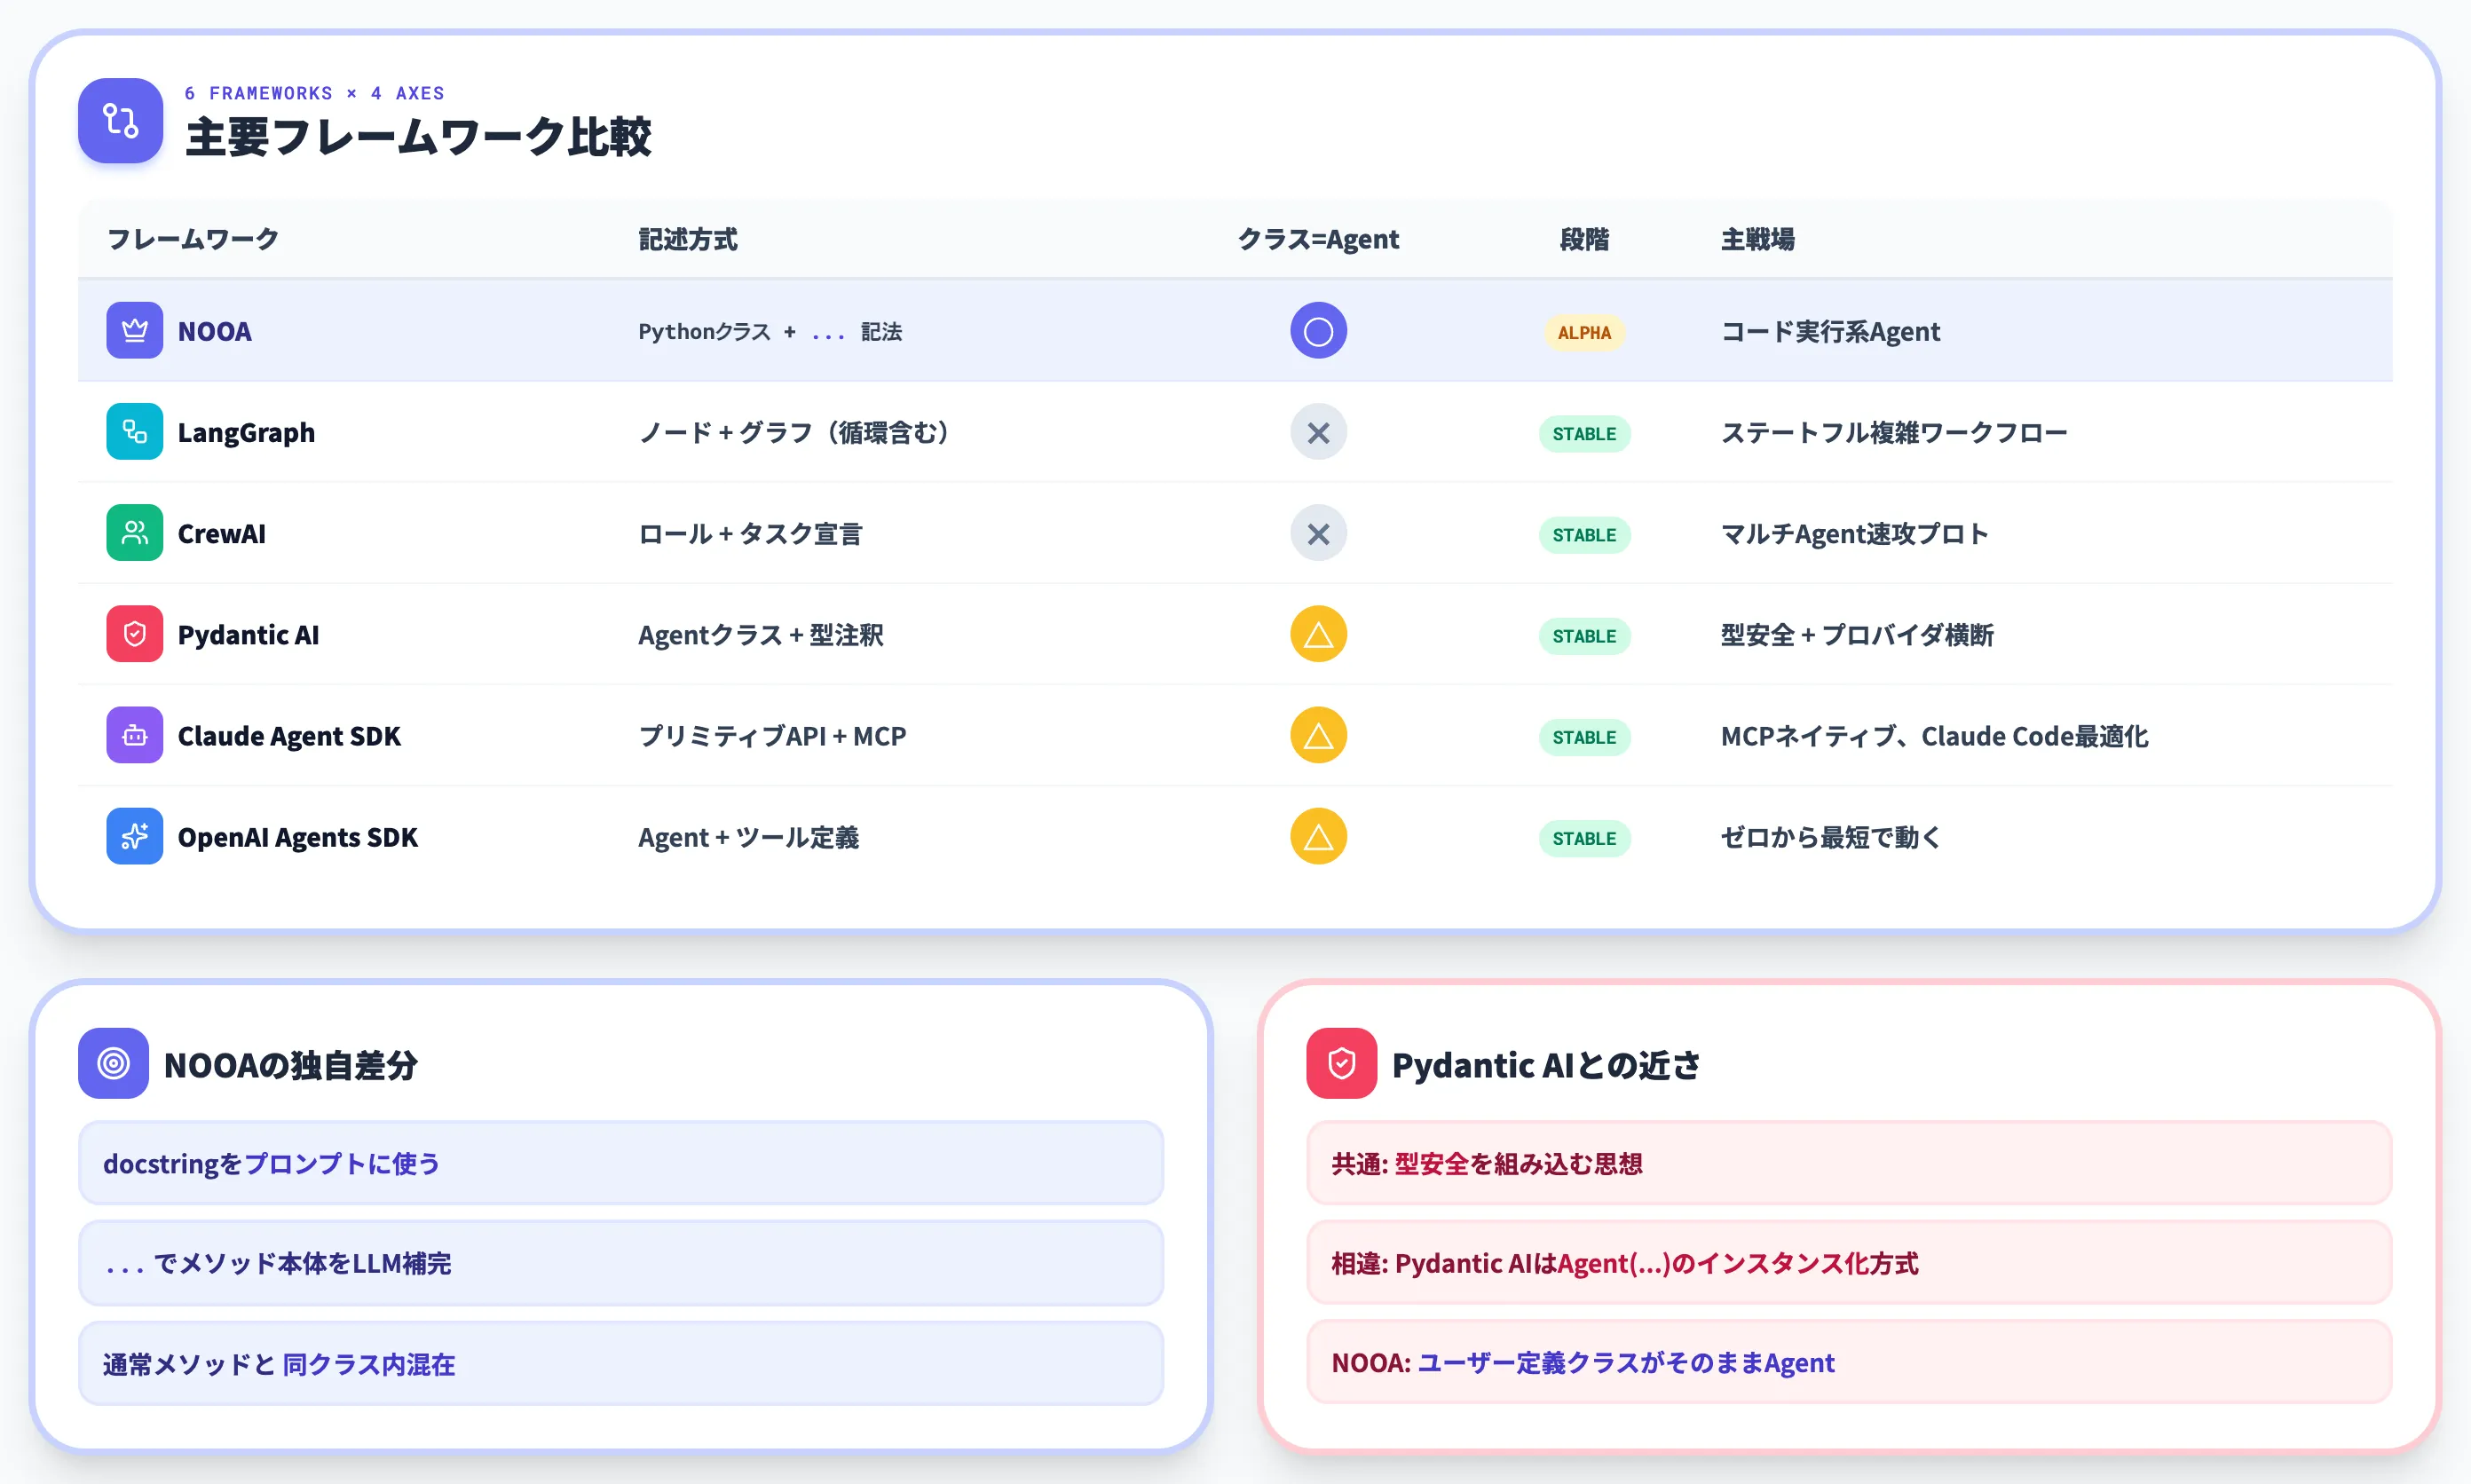
まず静的な比較を1枚にまとめます。以下の表は、主要6フレームワークをNOOAとの対比で並べたものです。
| フレームワーク | 記述方式 | クラス=エージェント | 段階 | 主戦場 |
|---|---|---|---|---|
| NOOA | Pythonクラス+...記法 | ○ | Alpha(研究SW) | コード実行系エージェント |
| LangGraph | ノード+グラフ(ループ・循環含む) | × | 安定版 | ステートフルな複雑ワークフロー |
| CrewAI | ロール+タスク宣言 | × | 安定版 | マルチエージェント速攻プロト |
| Pydantic AI | Agentクラス+型注釈 | △(Agentオブジェクト+型注釈) | 安定版 | 型安全+LLMプロバイダ横断 |
| Claude Agent SDK | プリミティブAPI+MCP | △ | 安定版 | MCPネイティブ、Claude Code最適化 |
| OpenAI Agents SDK | Agent+ツール定義 | △ | 安定版 | ゼロから最短で動く |
ここで見えるのは、Pythonクラス=エージェントという記述モデルの代表例はNOOAで、Pydantic AIは型安全設計の点で近いという点です。Pydantic AIはフレームワーク提供のAgent(...)をインスタンス化する構成のため、ユーザー定義クラスがそのままエージェントになるNOOAとは記述モデルが異なります。NOOA独自の差分は、docstringをプロンプトに使う点・...でメソッド本体をLLM補完する点・クラスにis_refund_eligibleのような通常メソッドを混在させられる点にあります。
LangGraph運用チームが判断に迷う3つの分岐
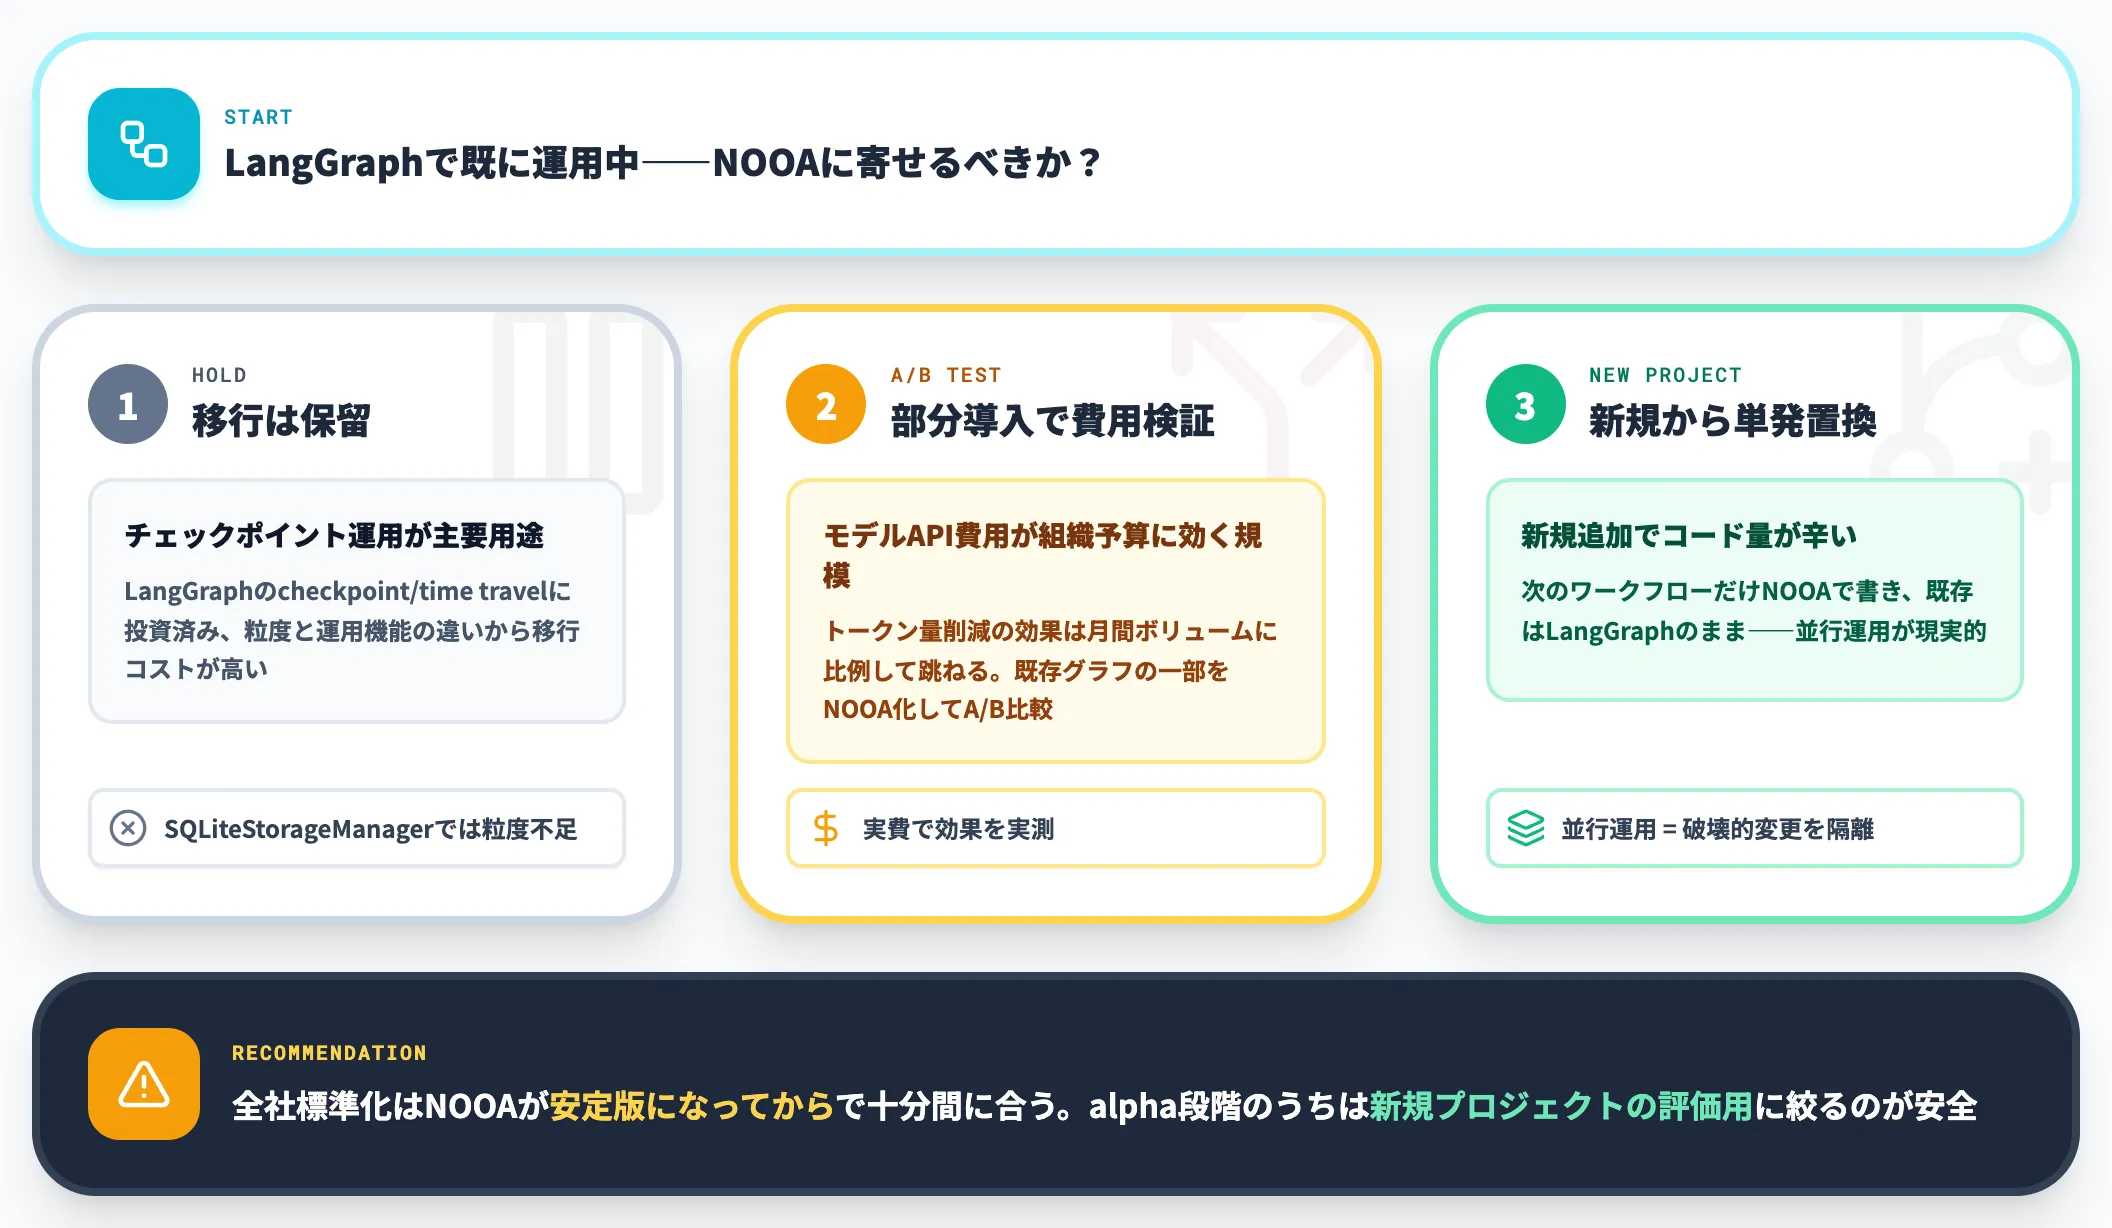
LangGraphで既にステートフルな長期ワークフローを組んでいるなら、以下の3点で移行の意義が変わります。
-
チェックポイント運用が主要用途なら、移行は保留
LangGraphは各グラフステップのチェックポイントやtime travelが充実。NOOAにもSQLiteStorageManagerによるsnapshot/resumeはあるが、粒度と運用機能が異なるため、既存のチェックポイント運用に投資してきたチームは移行コストが高い
-
モデルAPI費用が組織予算に効く規模なら、部分導入で費用対効果を実測
トークン量削減の効果は月間ボリュームに比例して跳ねる。既存グラフの一部をNOOA化してA/B比較する価値がある
-
新規ワークフロー追加時にコード量が増えて辛いなら、単発置換から
LangGraphの記述量は要件が増えるほど跳ね上がる。次の新規ワークフローだけNOOAで書き、既存はLangGraphのまま残す並行運用が現実的
移行の全社標準化は、NOOAが安定版になってからで十分間に合います。alpha段階のうちは新規プロジェクトの評価用に絞るのが安全です。
CrewAIプロトタイピング中のチームは軽く触れる程度で
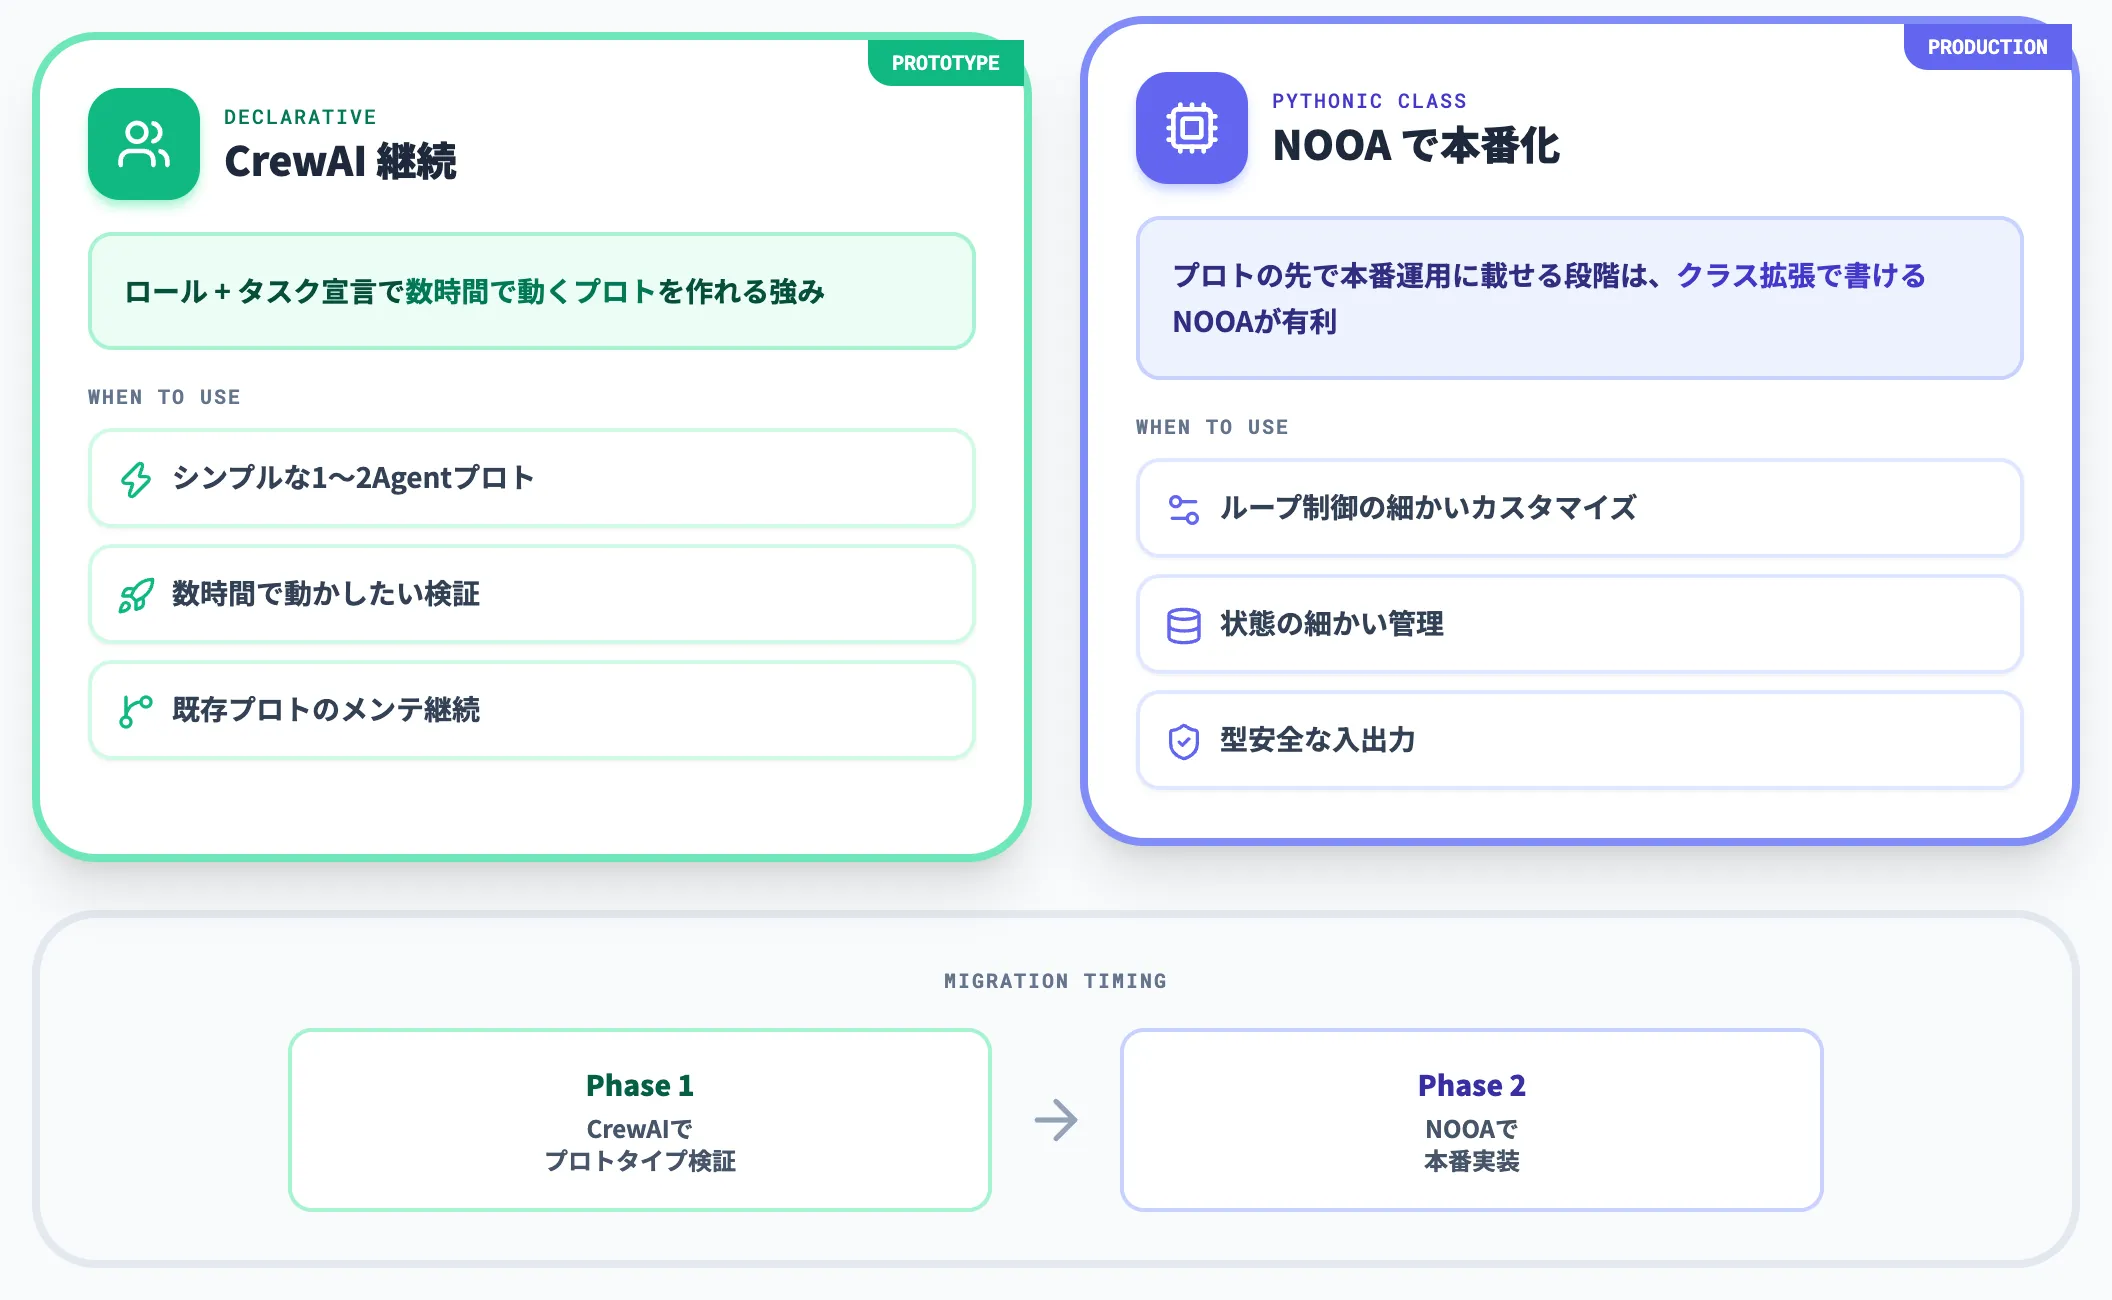
CrewAIは「ロール+タスク」の宣言で数時間で動くプロトを作れる強みがあります。NOOAのクラス記法は、シンプルな1〜2エージェントのプロトを作るだけならCrewAIの方が速い場面が多いです。
CrewAIチームがNOOAを見るとしたら、プロトの先で本番運用に載せる段階でしょう。CrewAIの宣言記法だとカスタマイズしにくい部分(ループ制御・状態の細かい管理・型安全な入出力)が、NOOAならクラスの拡張だけで書けます。
Pydantic AI併用チームは記述モデルの棲み分けで
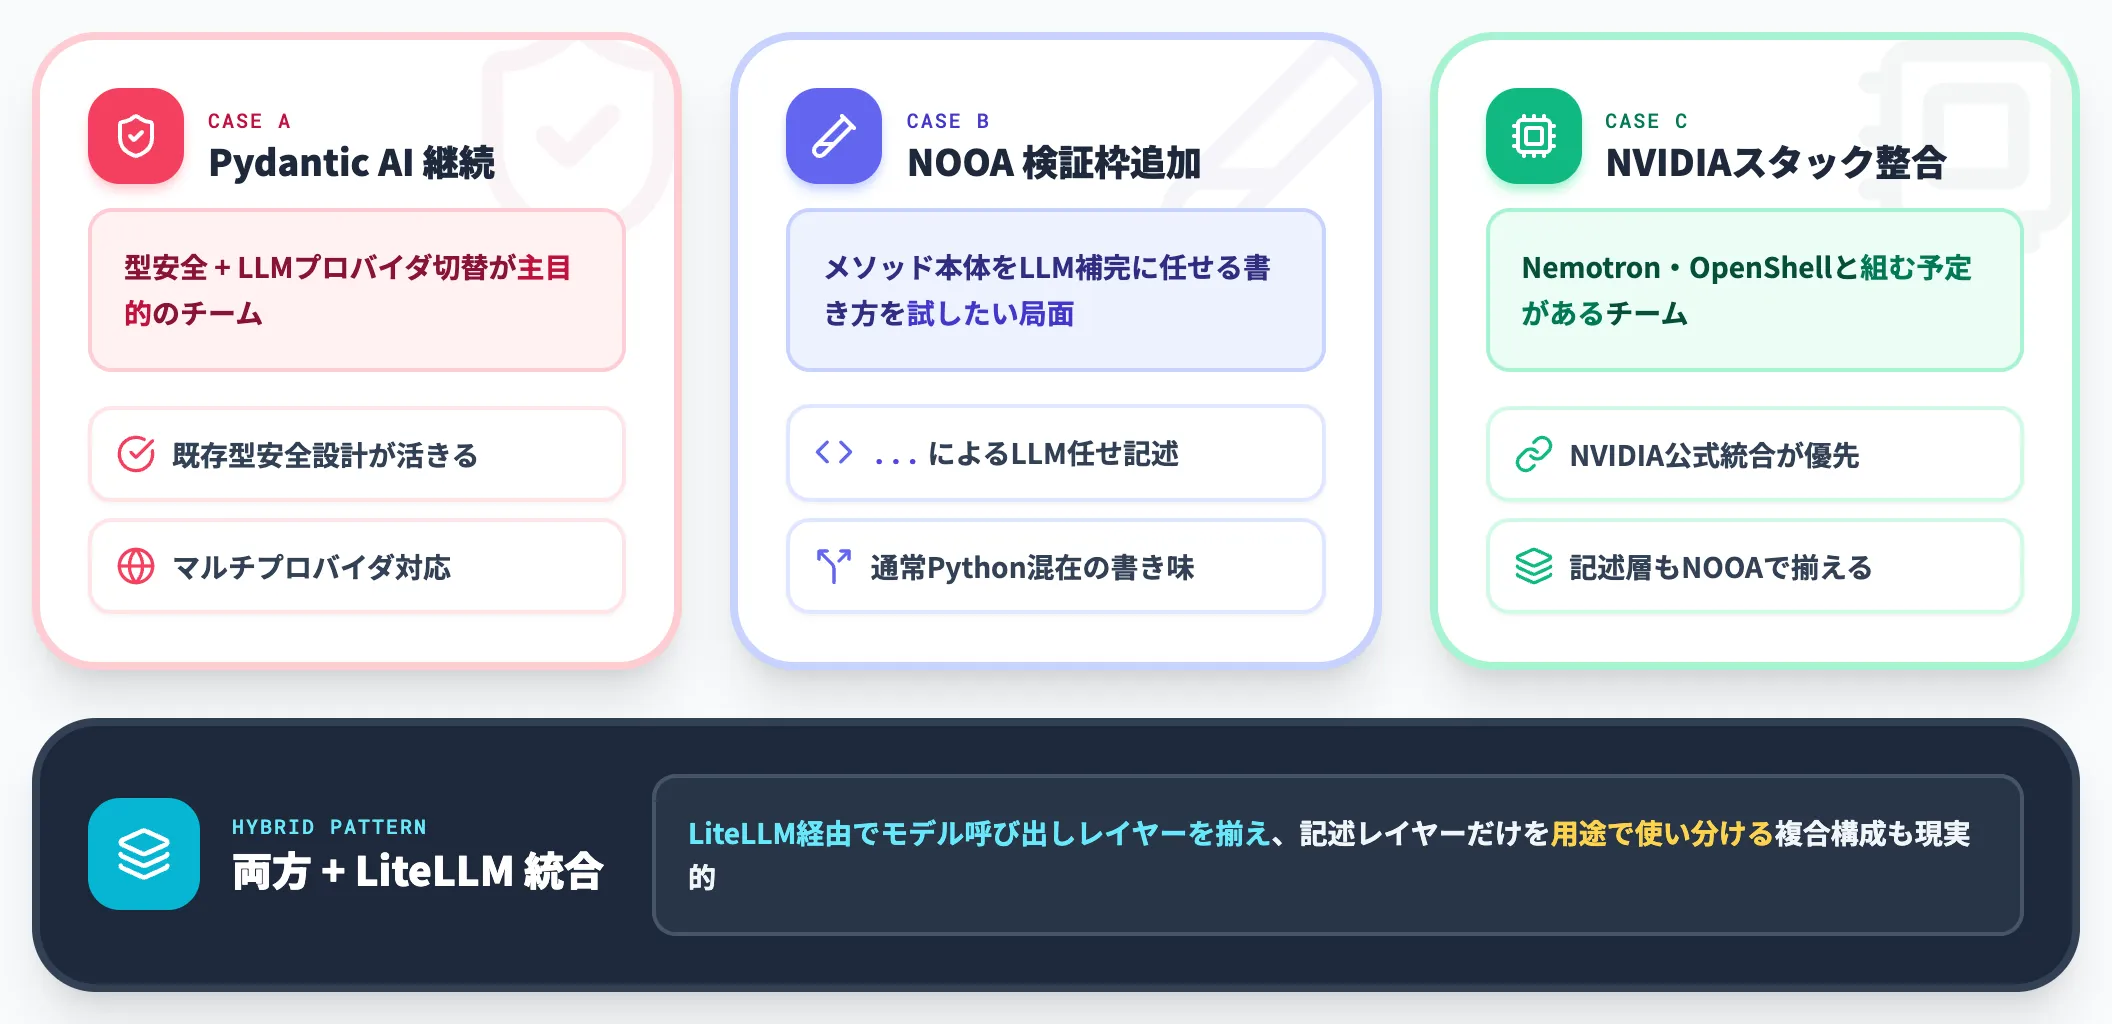
Pydantic AIをすでに使っているなら、記述モデルは近いため学習コストは低いです。棲み分けの目安は次のとおりです。
-
型安全+LLMプロバイダ切替が主目的なら、Pydantic AIを継続
既存の型安全設計とマルチプロバイダ対応がそのまま活きる
-
メソッド本体をLLM補完に任せる書き方をしたいなら、NOOAを検証枠で追加
...によるLLM任せの記述と通常Pythonの混在がやりたい局面で採用する
-
NVIDIAスタック(Nemotron・OpenShell)と組む予定があるなら、NOOAが第一候補
NVIDIA公式の統合を優先するなら記述層もNOOAで揃える方が自然
実務的には、両方をLiteLLM経由でモデル呼び出しレイヤーを揃え、記述レイヤーだけを用途で使い分けるという構成も現実的です。
インストールから最初のAgent実装まで
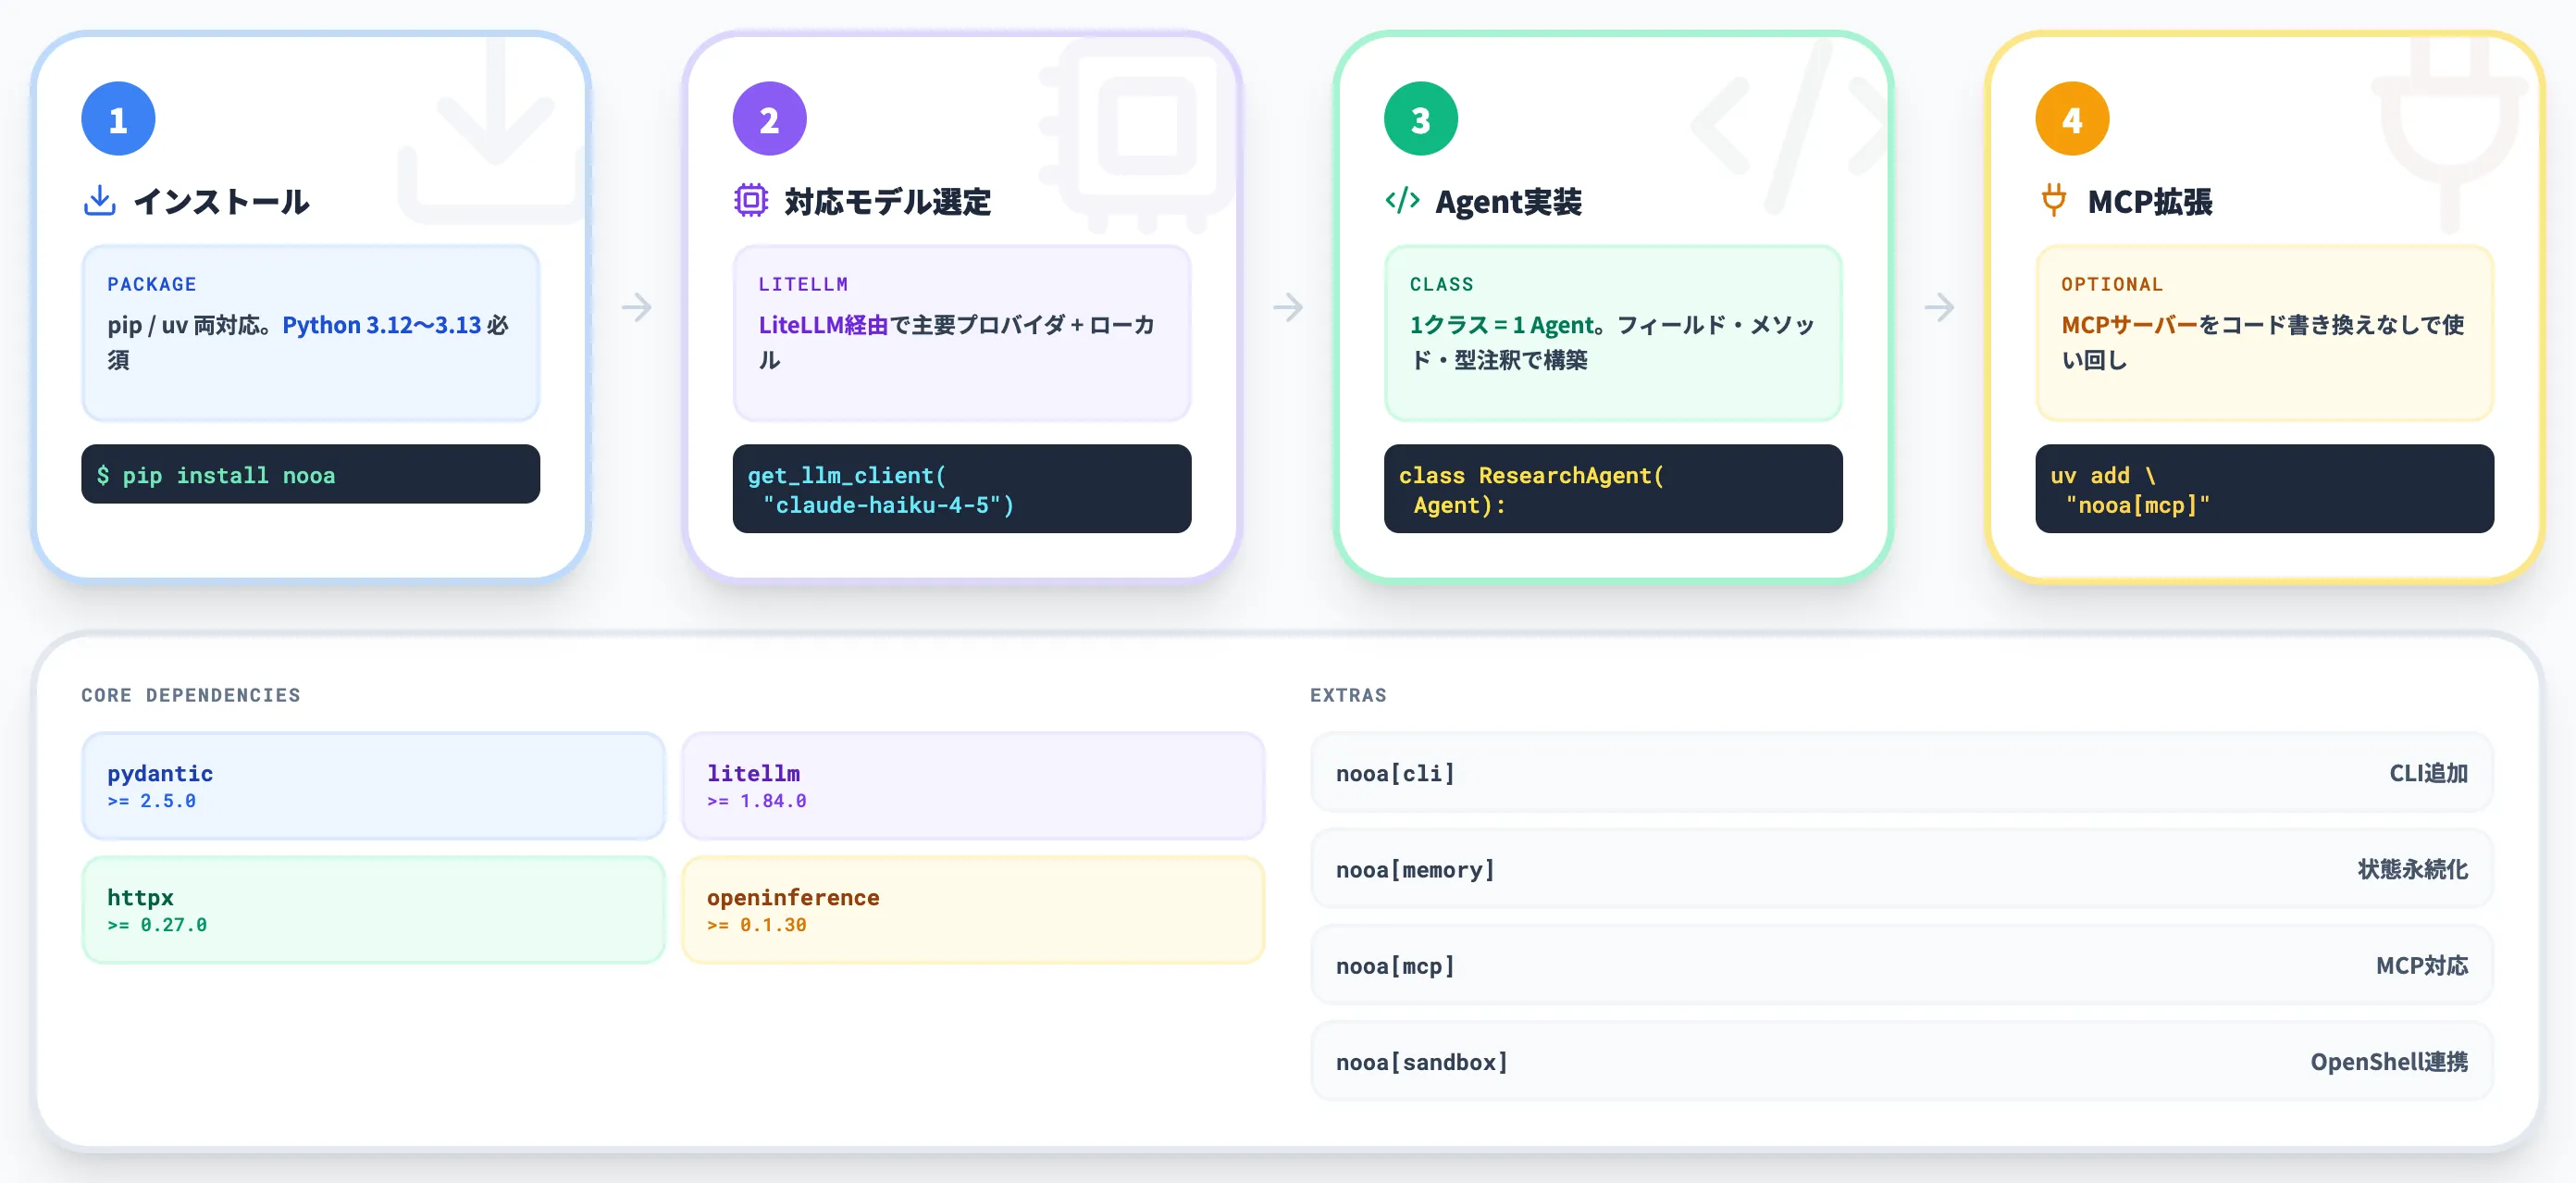
ここからは、NOOAを実際に触るための最短ルートを、インストール→対応モデル選定→最初のエージェント実装の順で整理します。
インストール——pipまたはuv、Python 3.12〜3.13必須
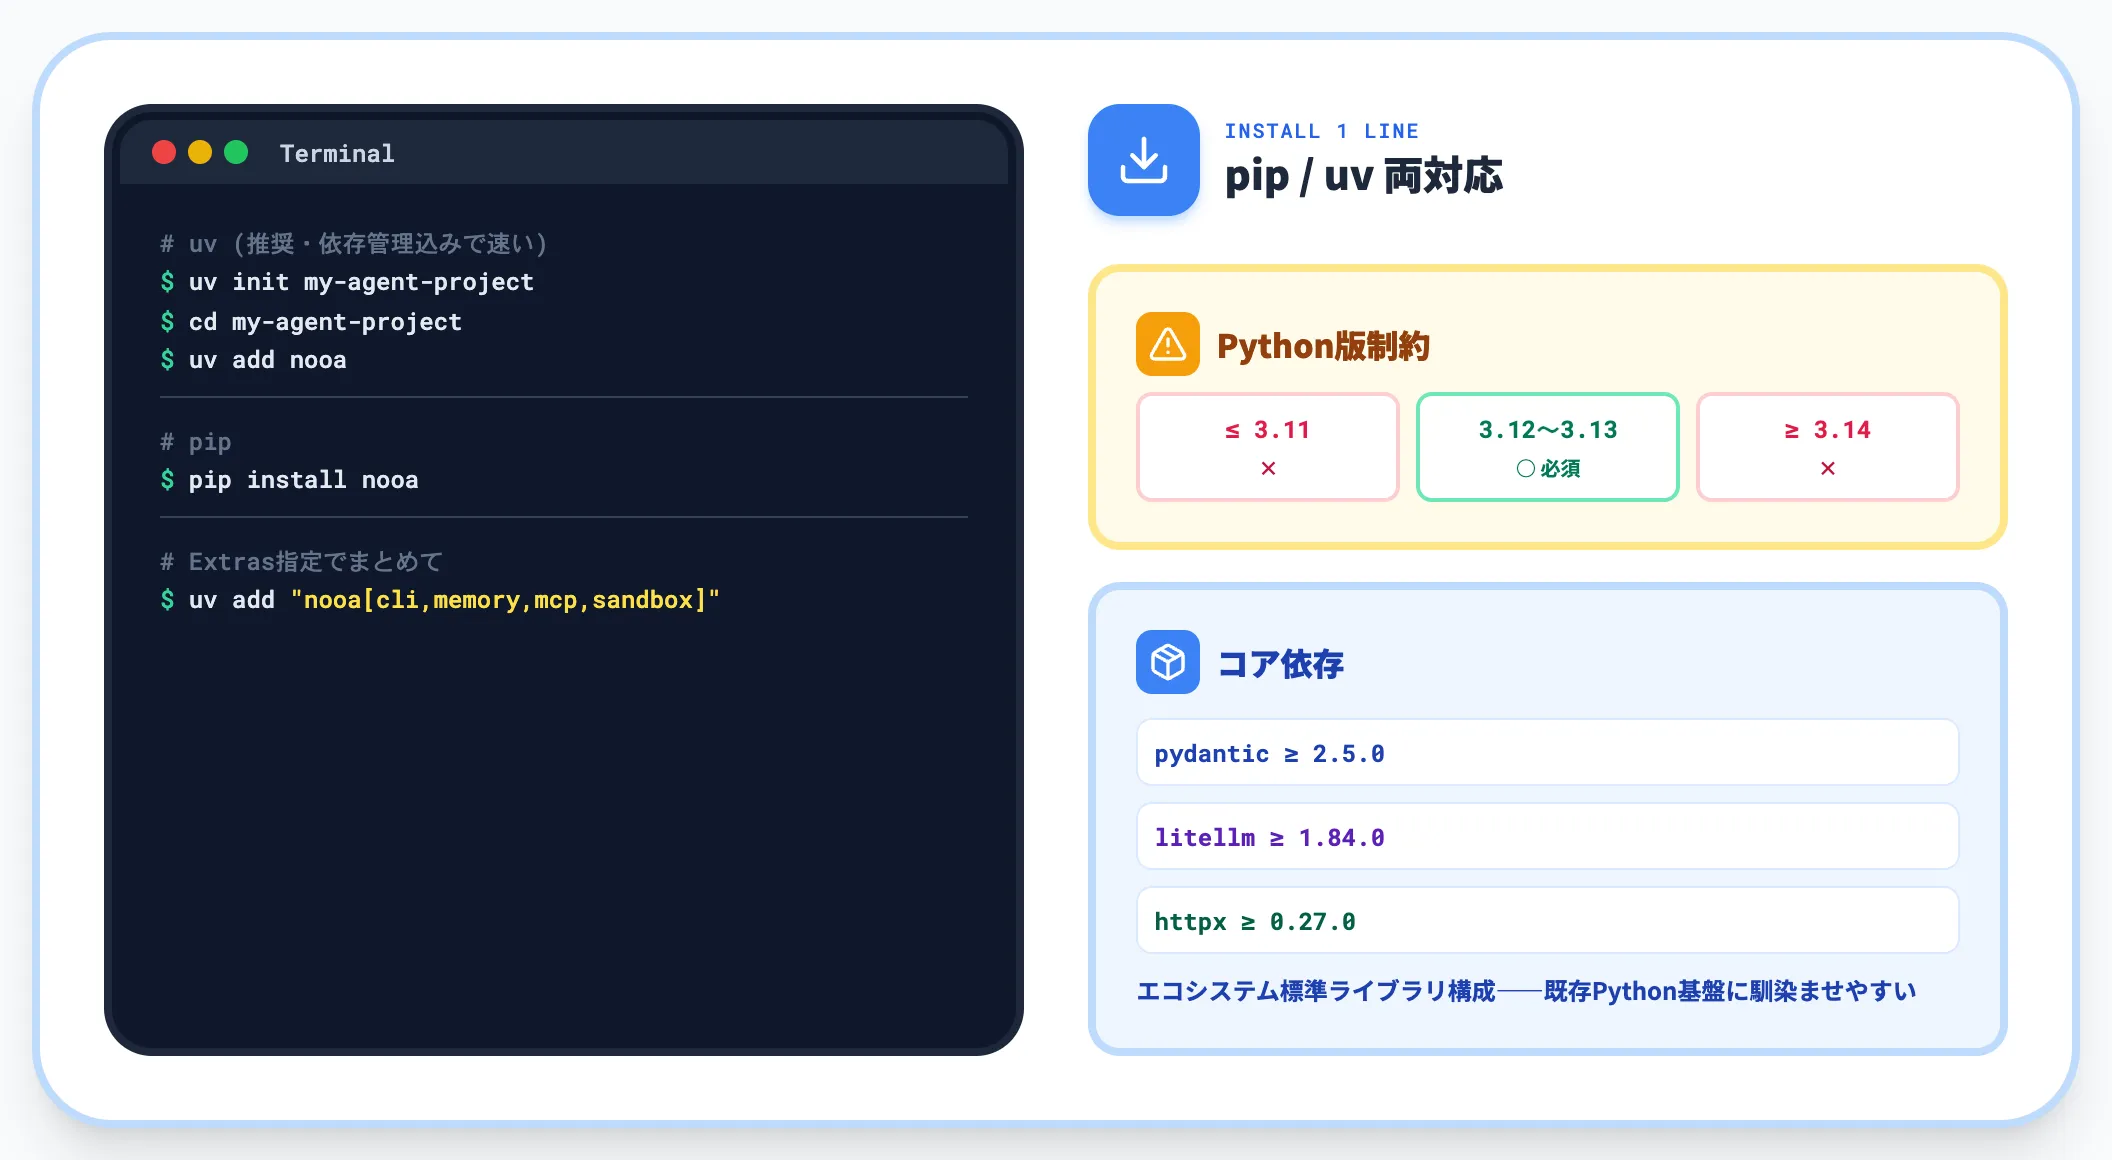
NOOAはpipとuvの両方で提供されています。プロジェクト新規作成なら、uvの方が依存管理を含めて速いです。
# uvの場合
uv init my-agent-project
cd my-agent-project
uv add nooa

# pipの場合
pip install nooa
拡張機能を含める場合は、Extras指定でまとめて入れます。
uv add "nooa[cli,memory,mcp,sandbox]"
パッケージのバージョン・依存関係・Star数などのメタ情報は libraries.io で確認できます。
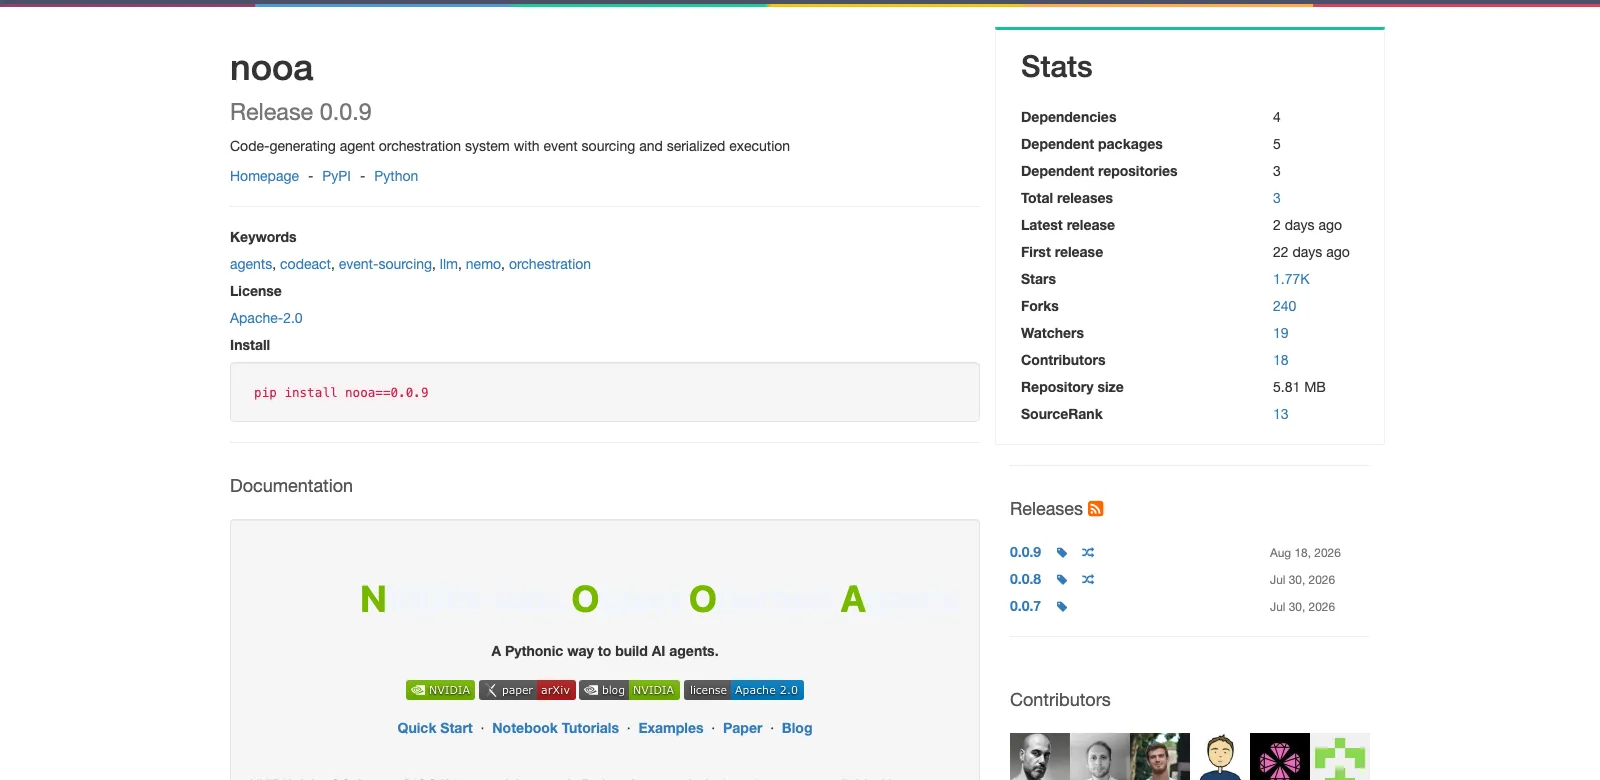
nooaパッケージのメタ情報(Latest v0.0.9・2026年8月18日リリース・Apache-2.0・Stars 1.77K)(出典:libraries.io)
Python版は3.12以上・3.14未満が必須で、3.11以前や3.14以降では動きません。既存プロジェクトのPython版制約は事前に確認してください。
主なコア依存はpydantic>=2.5.0・litellm>=1.84.0・httpx>=0.27.0・openinference-instrumentation-litellm>=0.1.30と、いずれもエコシステム標準のライブラリで構成されており、既存のPython基盤に馴染ませやすい設計です。
対応モデル——LiteLLM経由で主要プロバイダ全部
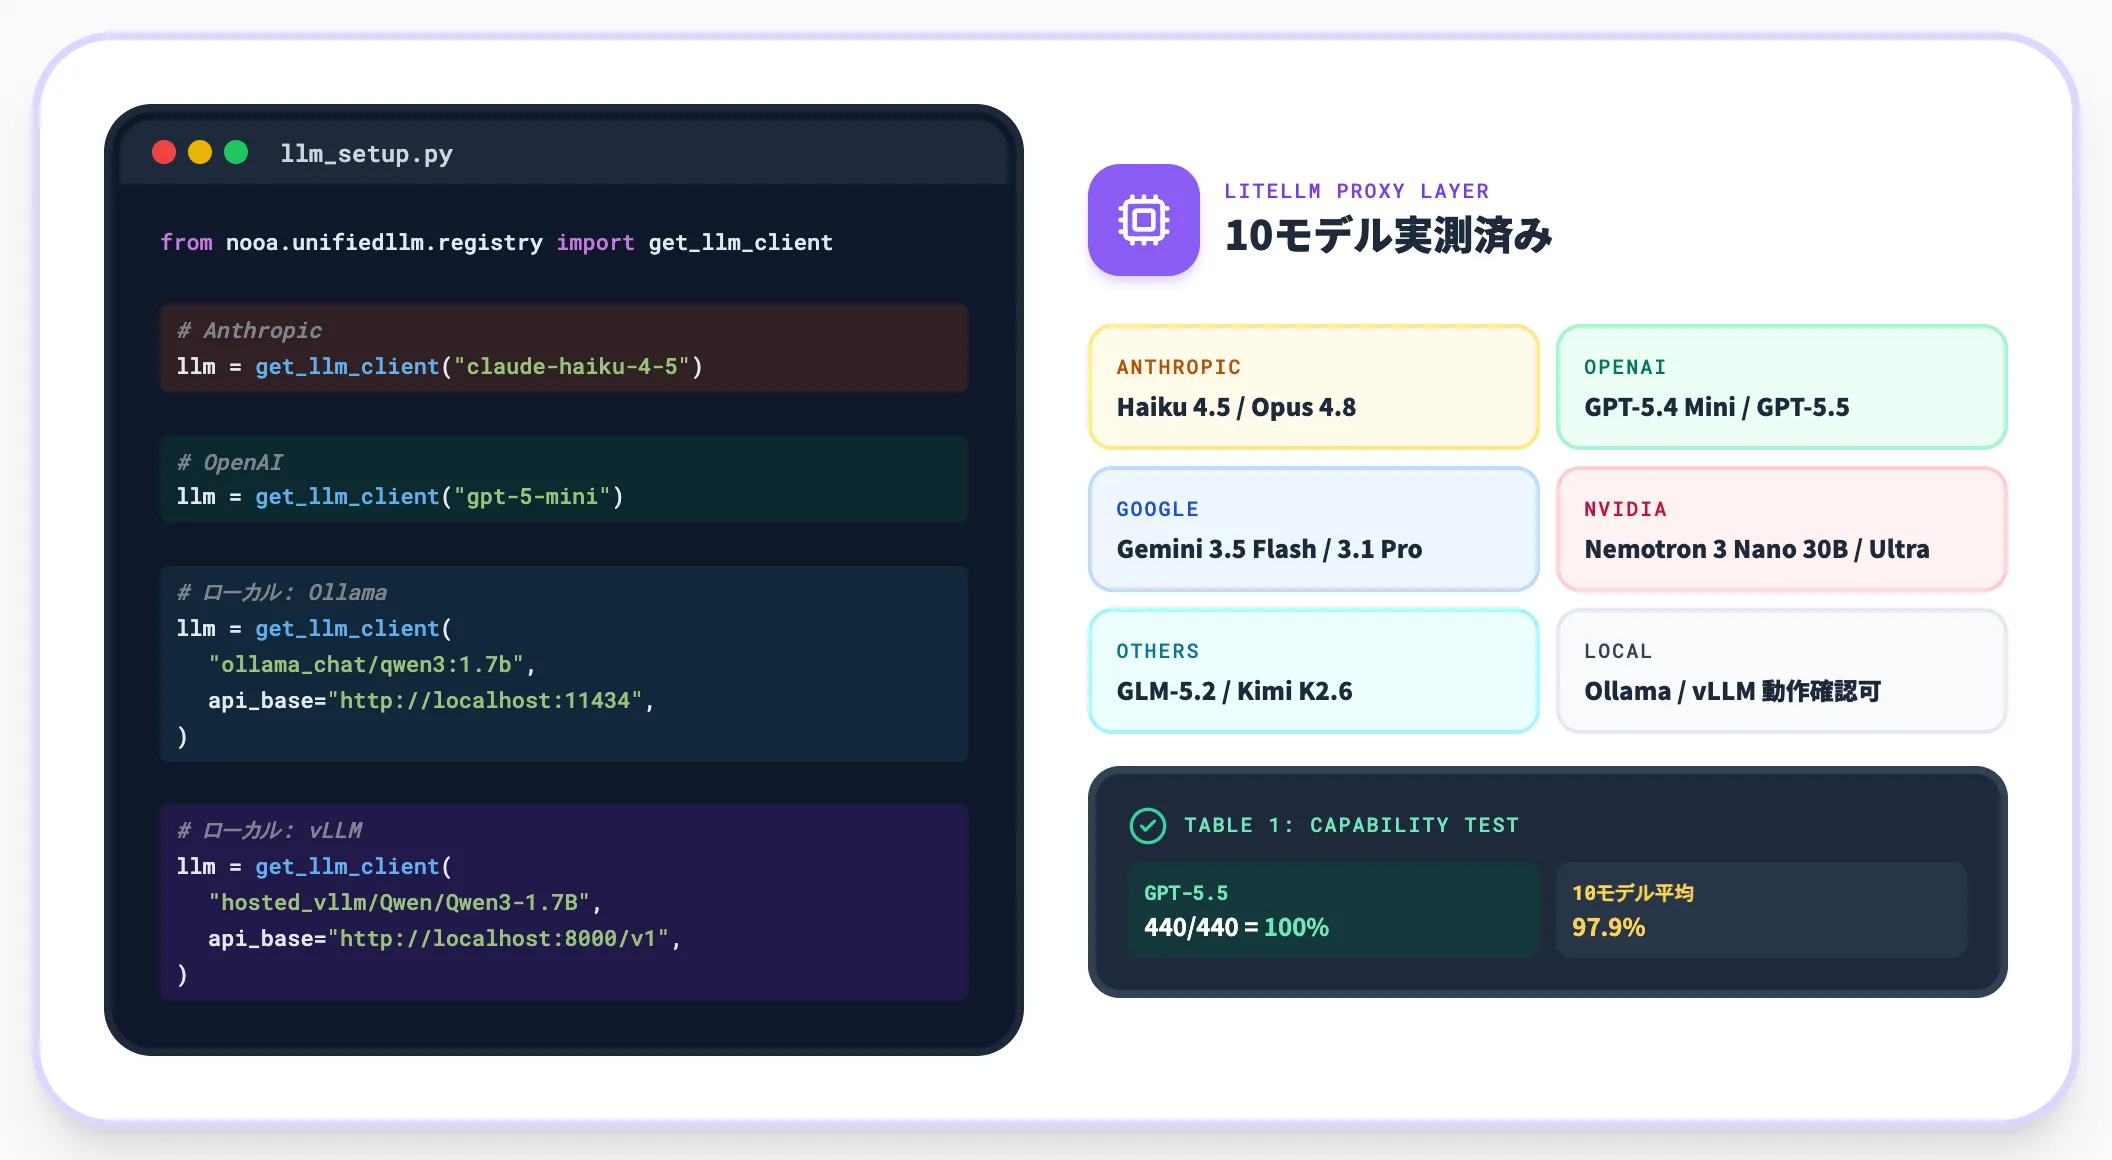
NOOAはLiteLLM経由でモデルを呼ぶ設計のため、LiteLLMがサポートするプロバイダはそのまま使えます。公式READMEに掲載されている例は以下のとおりです。
from nooa.unifiedllm.registry import get_llm_client

# Anthropic
llm = get_llm_client("claude-haiku-4-5")

# OpenAI
llm = get_llm_client("gpt-5-mini")

# ローカル:Ollama
llm = get_llm_client(
    "ollama_chat/qwen3:1.7b",
    api_base="http://localhost:11434",
)

# ローカル:vLLM
llm = get_llm_client(
    "hosted_vllm/Qwen/Qwen3-1.7B",
    api_base="http://localhost:8000/v1",
)
技術報告書のCapability Testsでは、Claude Haiku 4.5・Claude Opus 4.8・Gemini 3.5 Flash・Gemini 3.1 Pro・GLM-5.2・Kimi K2.6・Nemotron 3 Nano 30B・Nemotron 3 Ultra・GPT-5.4 Mini・GPT-5.5と、主要な10モデルで実測しています。手元で試すだけならOllama経由の小型モデルで動作確認できます。
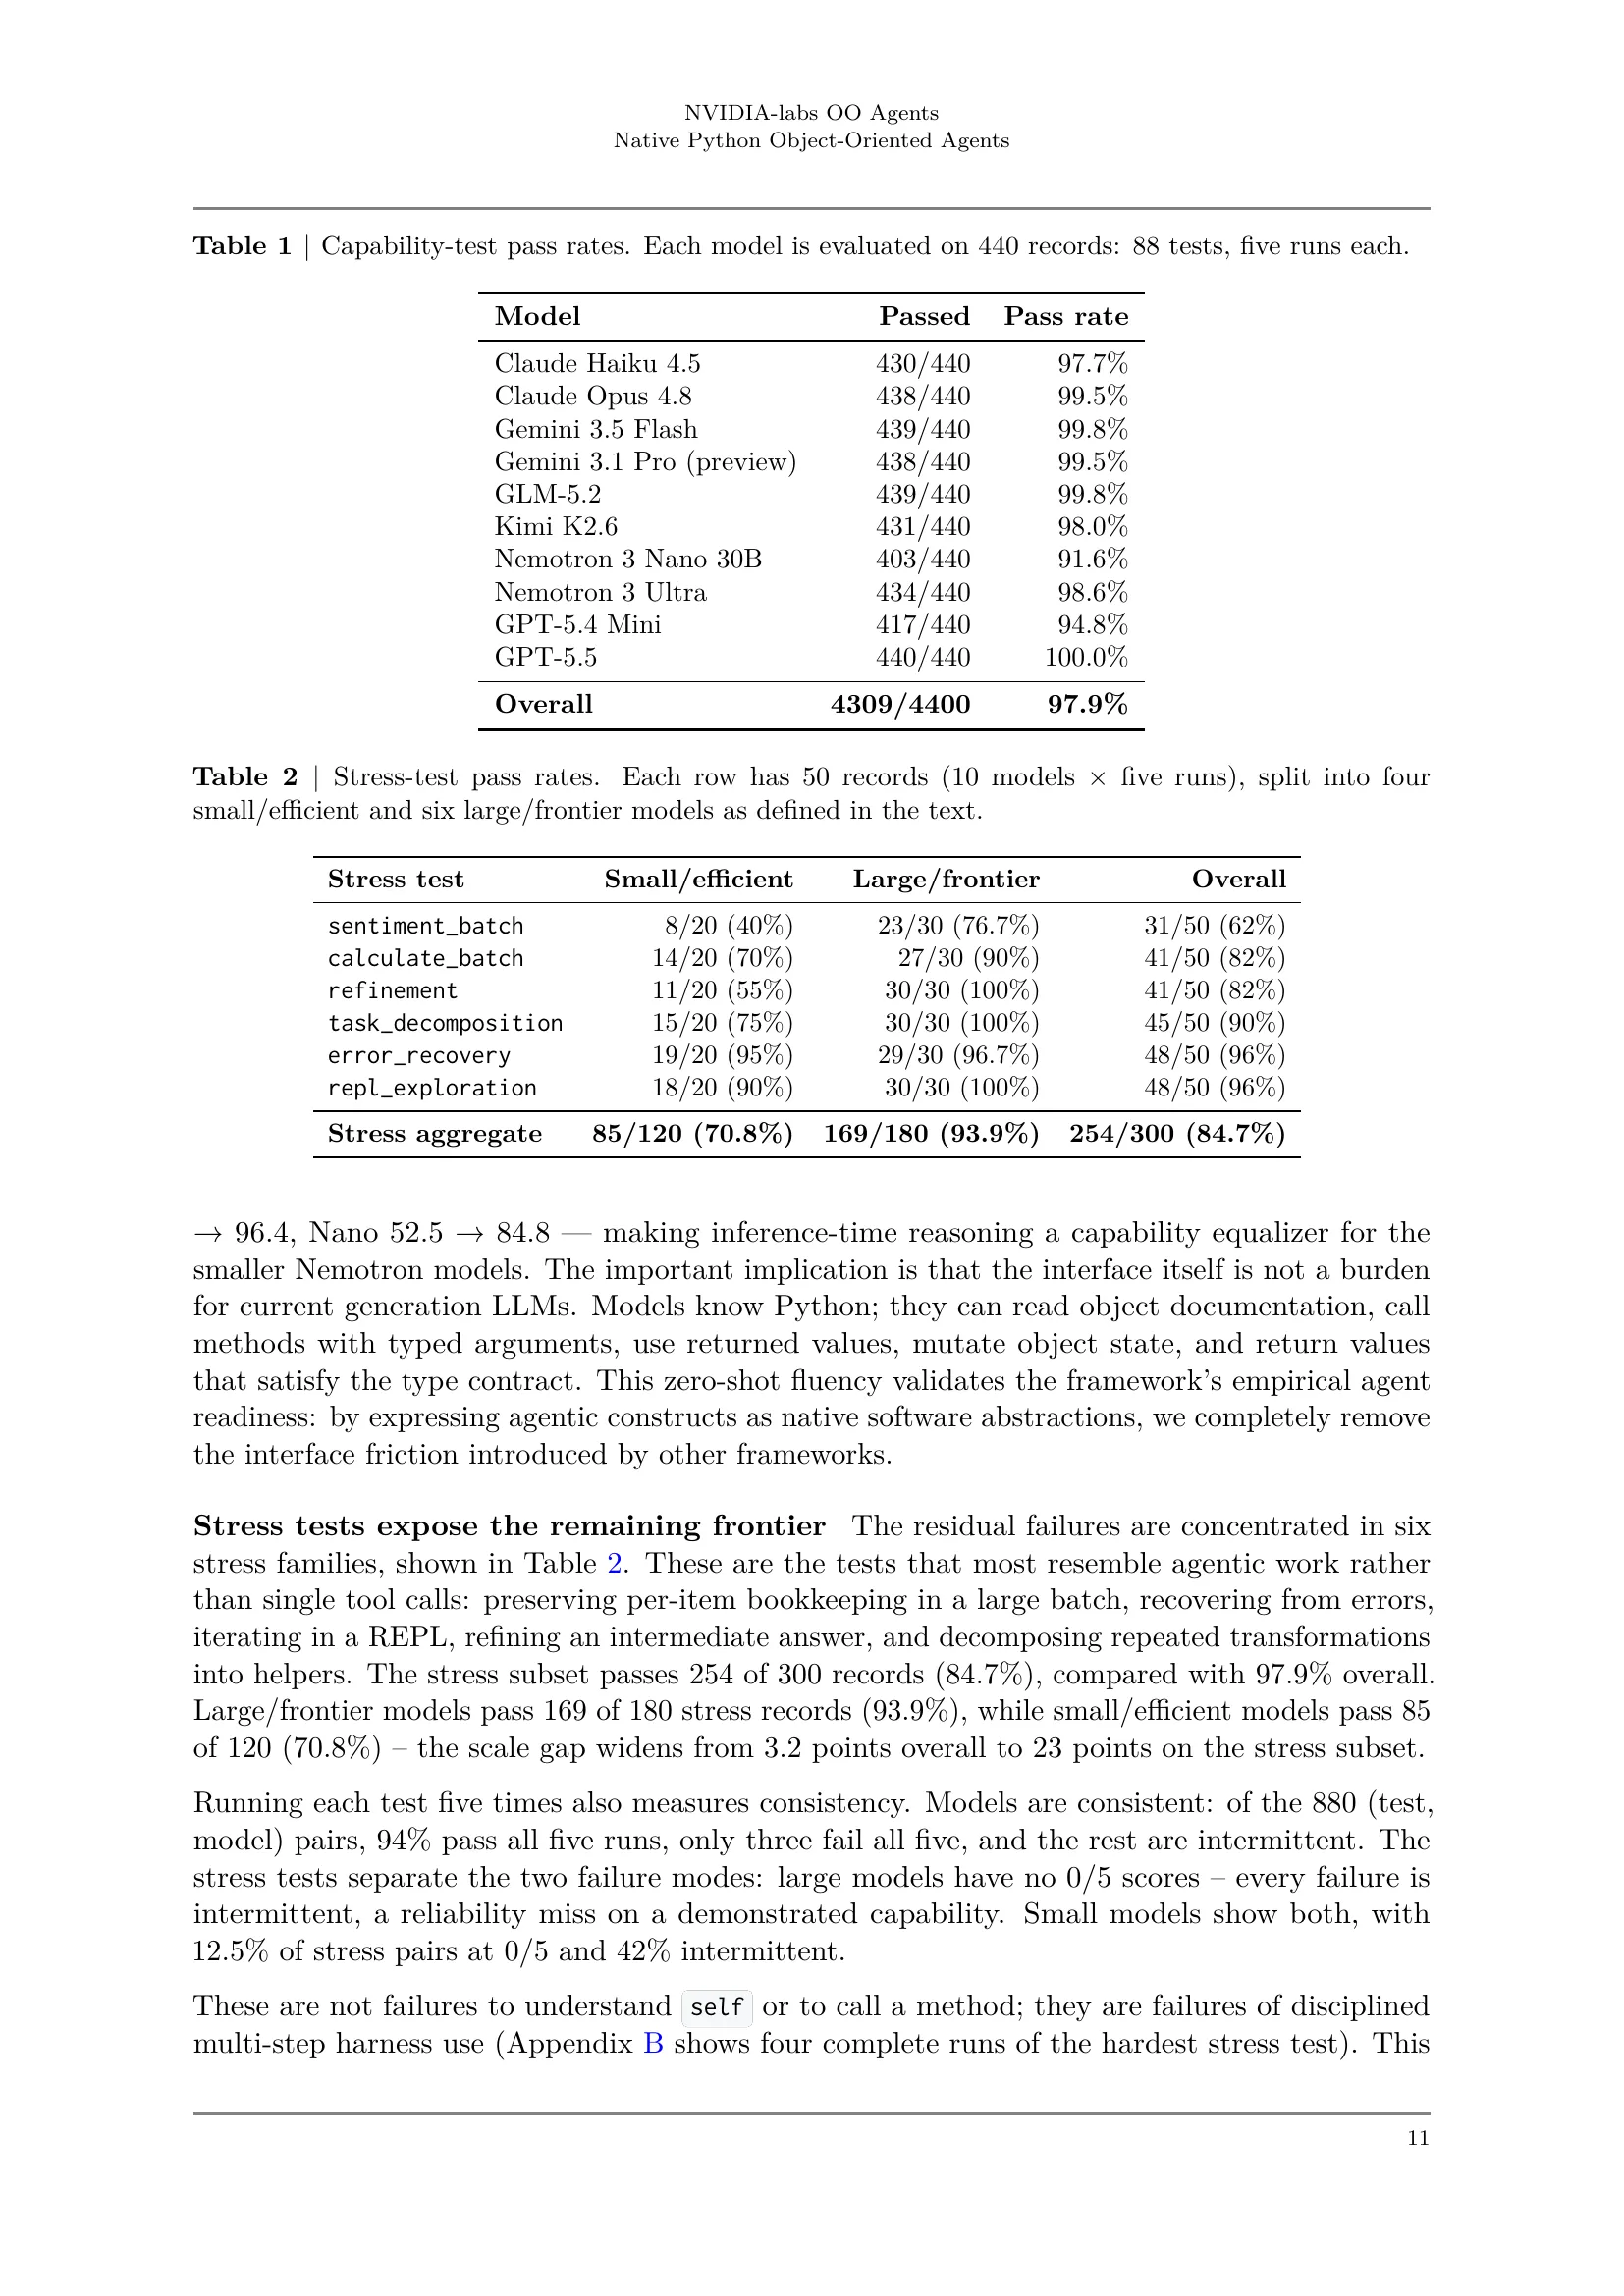
論文Table 1・Table 2:10モデルのCapability-test合格率とStress-test結果(出典:arxiv 2607.20709 p.11)
Table 1で目を引くのは、GPT-5.5が440件の評価レコード(88テスト×5回)すべてに合格し、合格率100%を記録している点と、Nemotron 3 Nano 30Bの91.6%が10モデル中最低で、それでも90%を超えている点です。
全モデルで平均97.9%を出しており、NOOAの型付き契約がモデル横断で安定して機能することが確認できます。
最初のAgent実装——ResearchAgentの骨格
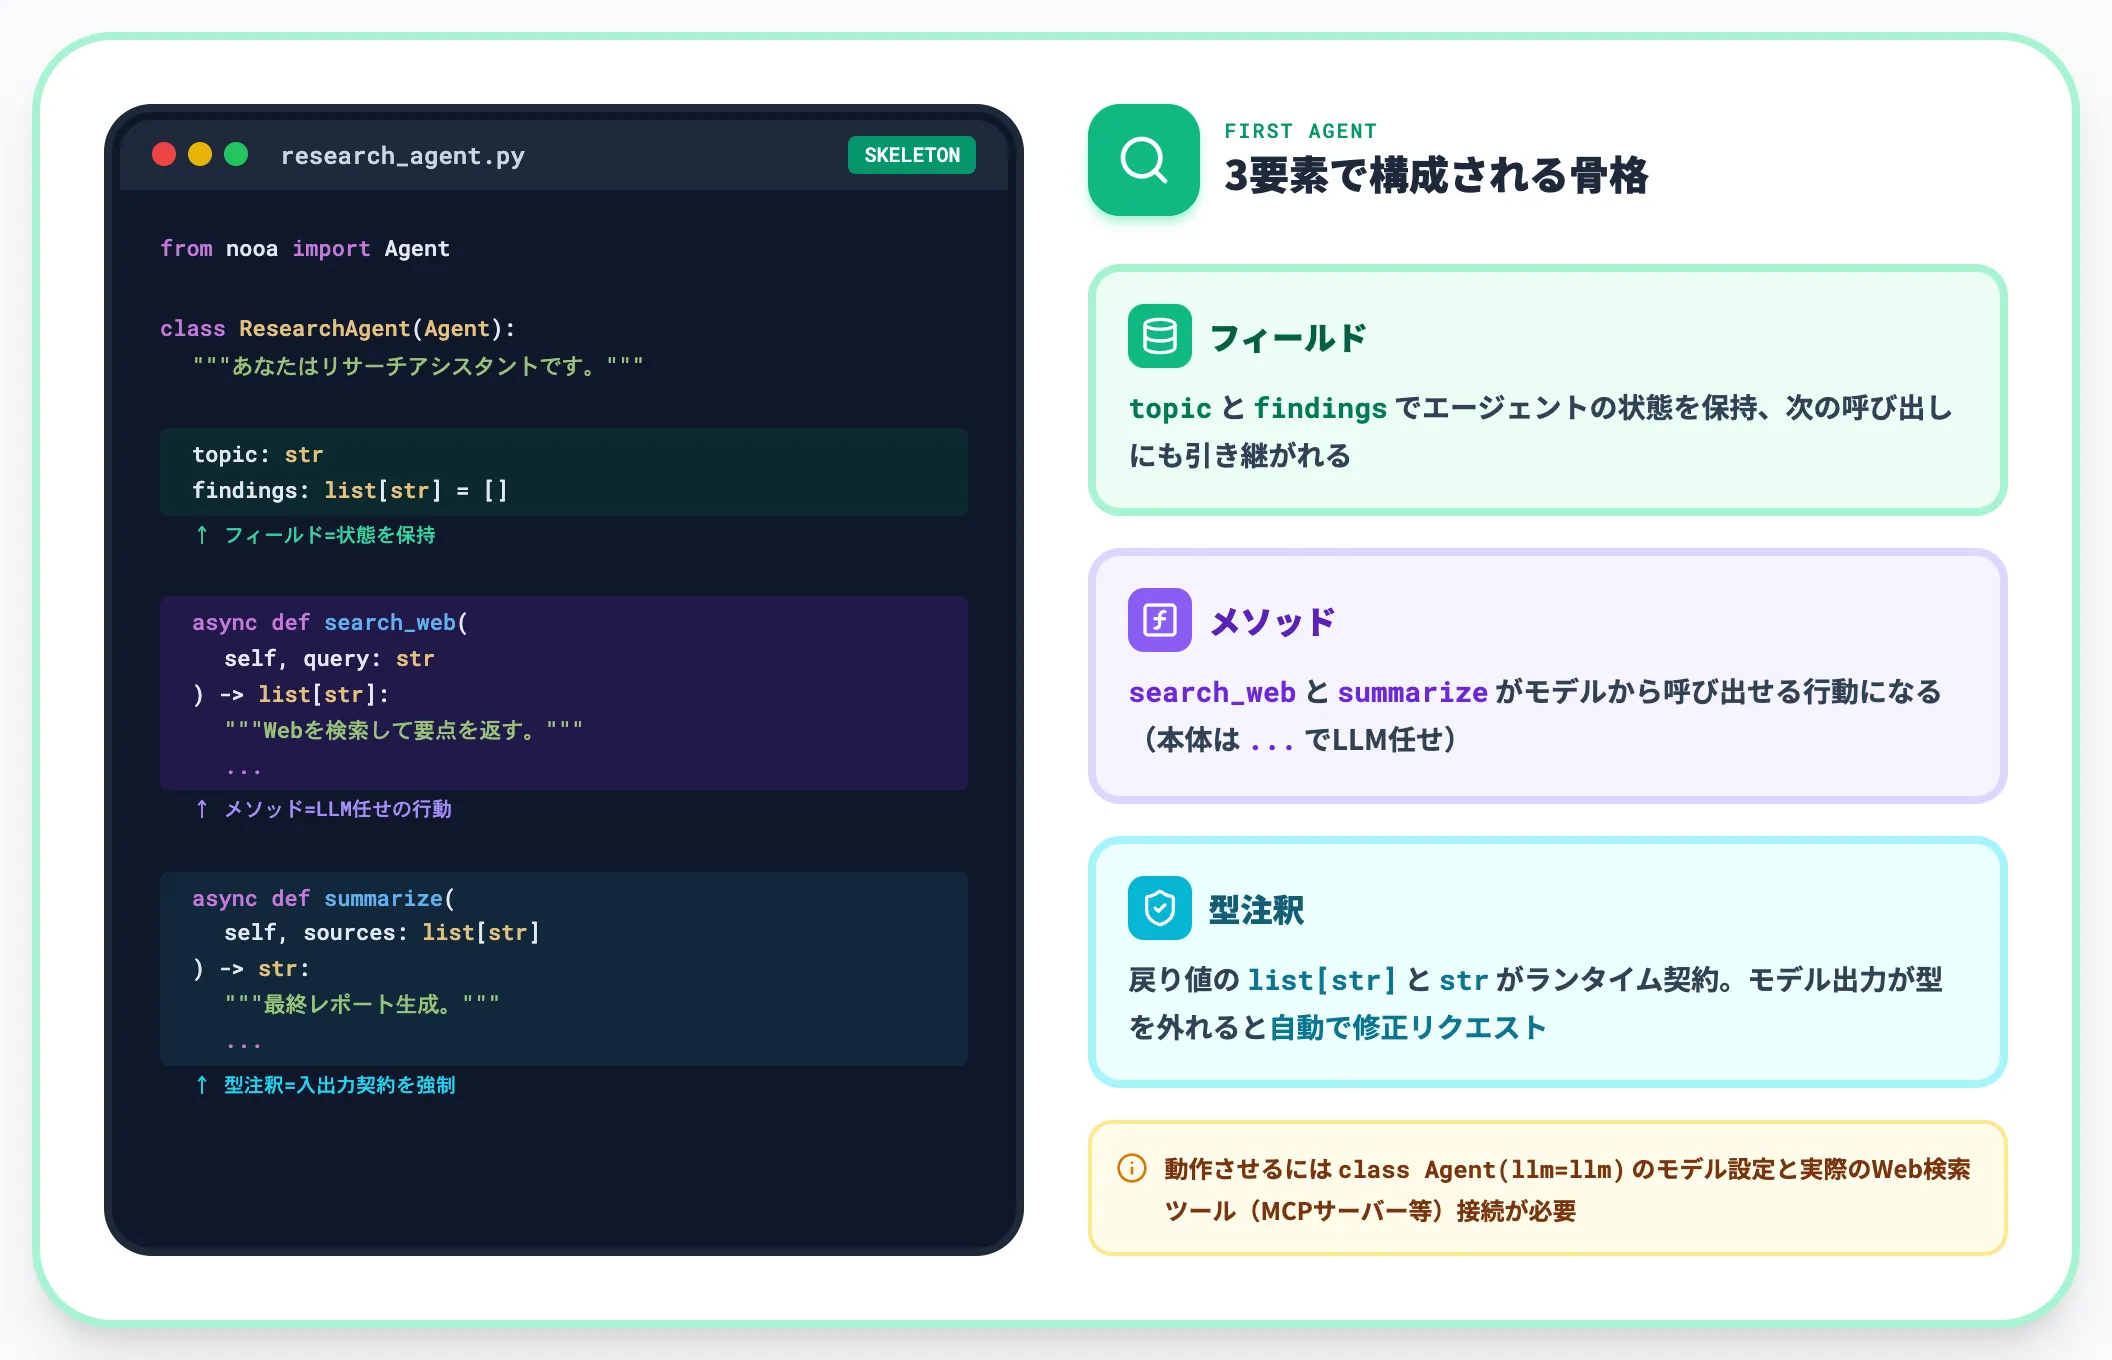
以下は、Web検索とサマリ生成を1クラスで書く場合のResearchAgentの骨格(未実行の構造例)です。
from nooa import Agent

class ResearchAgent(Agent):
    """あなたはリサーチアシスタントです。"""

    topic: str
    findings: list[str] = []

    async def search_web(self, query: str) -> list[str]:
        """Webを検索して要点を返す。"""
        ...

    async def summarize(self, sources: list[str]) -> str:
        """収集したソースから最終レポートを生成する。"""
        ...
このコードで注目すべきは3点あります。
-
topicとfindings
フィールドとしてエージェントの状態を保持し、次の呼び出しにも引き継がれる
-
search_webとsummarize
メソッドとしてモデルから呼び出せる行動になる(本体は...でLLM任せ)
-
戻り値の型注釈(list[str]とstr)
ランタイムが強制する契約になり、モデル出力が型を外れると自動で修正リクエストが飛ぶ
骨格レベルでは、フィールド・メソッド・型注釈だけでエージェントの姿が定義できるのがNOOAの特徴です。
実際に動作させるには、class ResearchAgent(Agent, llm=llm)のようなモデル設定、実際のWeb検索ツール(MCPサーバー等)の接続、インスタンス化とawaitによる実行フローの追加が必要になります。公式Quick Startのサンプル実装はGitHubリポジトリを参照してください。
MCP対応——Anthropic発のツールプロトコルをオプションで
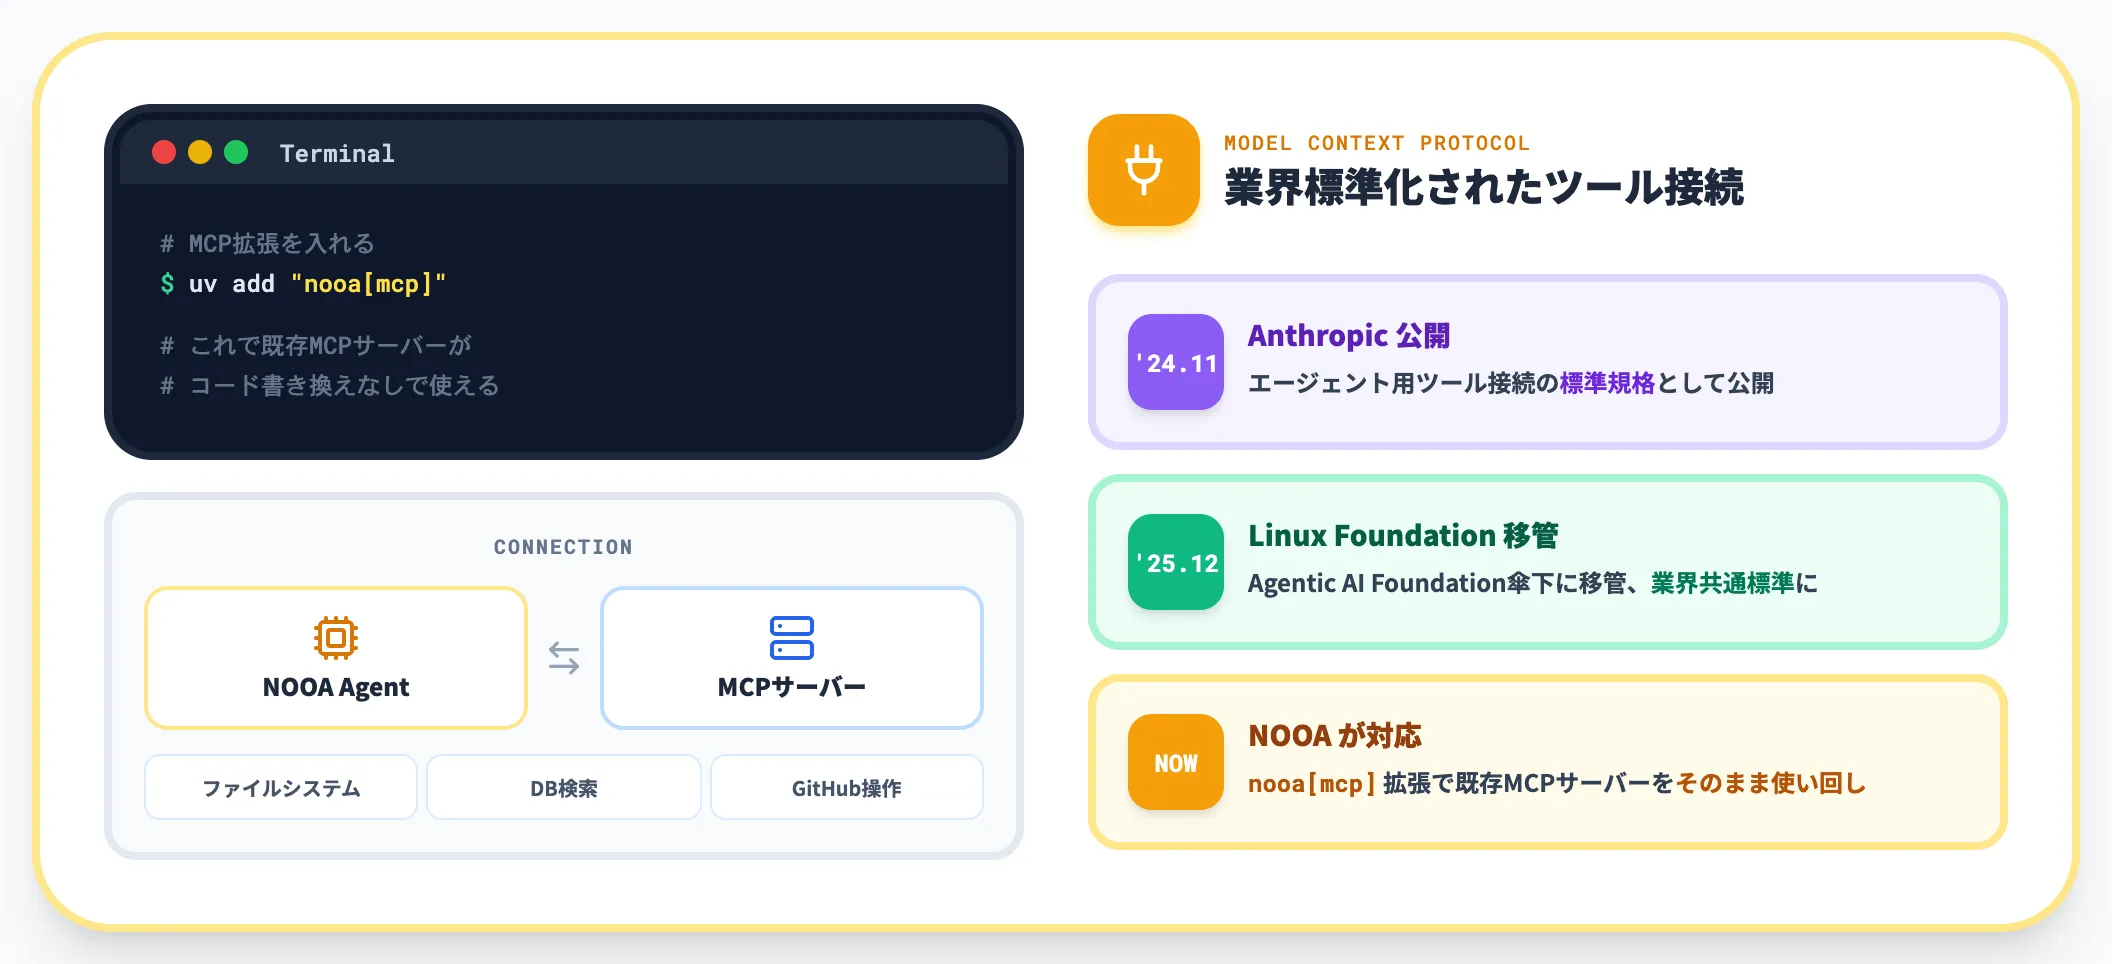
NOOAはModel Context Protocol(MCP)に対応しています。uv add "nooa[mcp]"でMCP拡張を入れると、MCP準拠のツールサーバーをNOOAエージェントから呼び出せるようになります。
MCPは2024年11月にAnthropicが公開したエージェント用ツール接続の標準規格で、2025年12月にはLinux Foundation傘下のAgentic AI Foundationに移管され、業界共通の標準になりました。NOOAがMCP対応することで、既存のMCPサーバー(ファイルシステム操作・DB検索・GitHub操作等)をコード書き換えなしで使い回せます。
フレームワークは無料・モデルAPI費用が本コスト
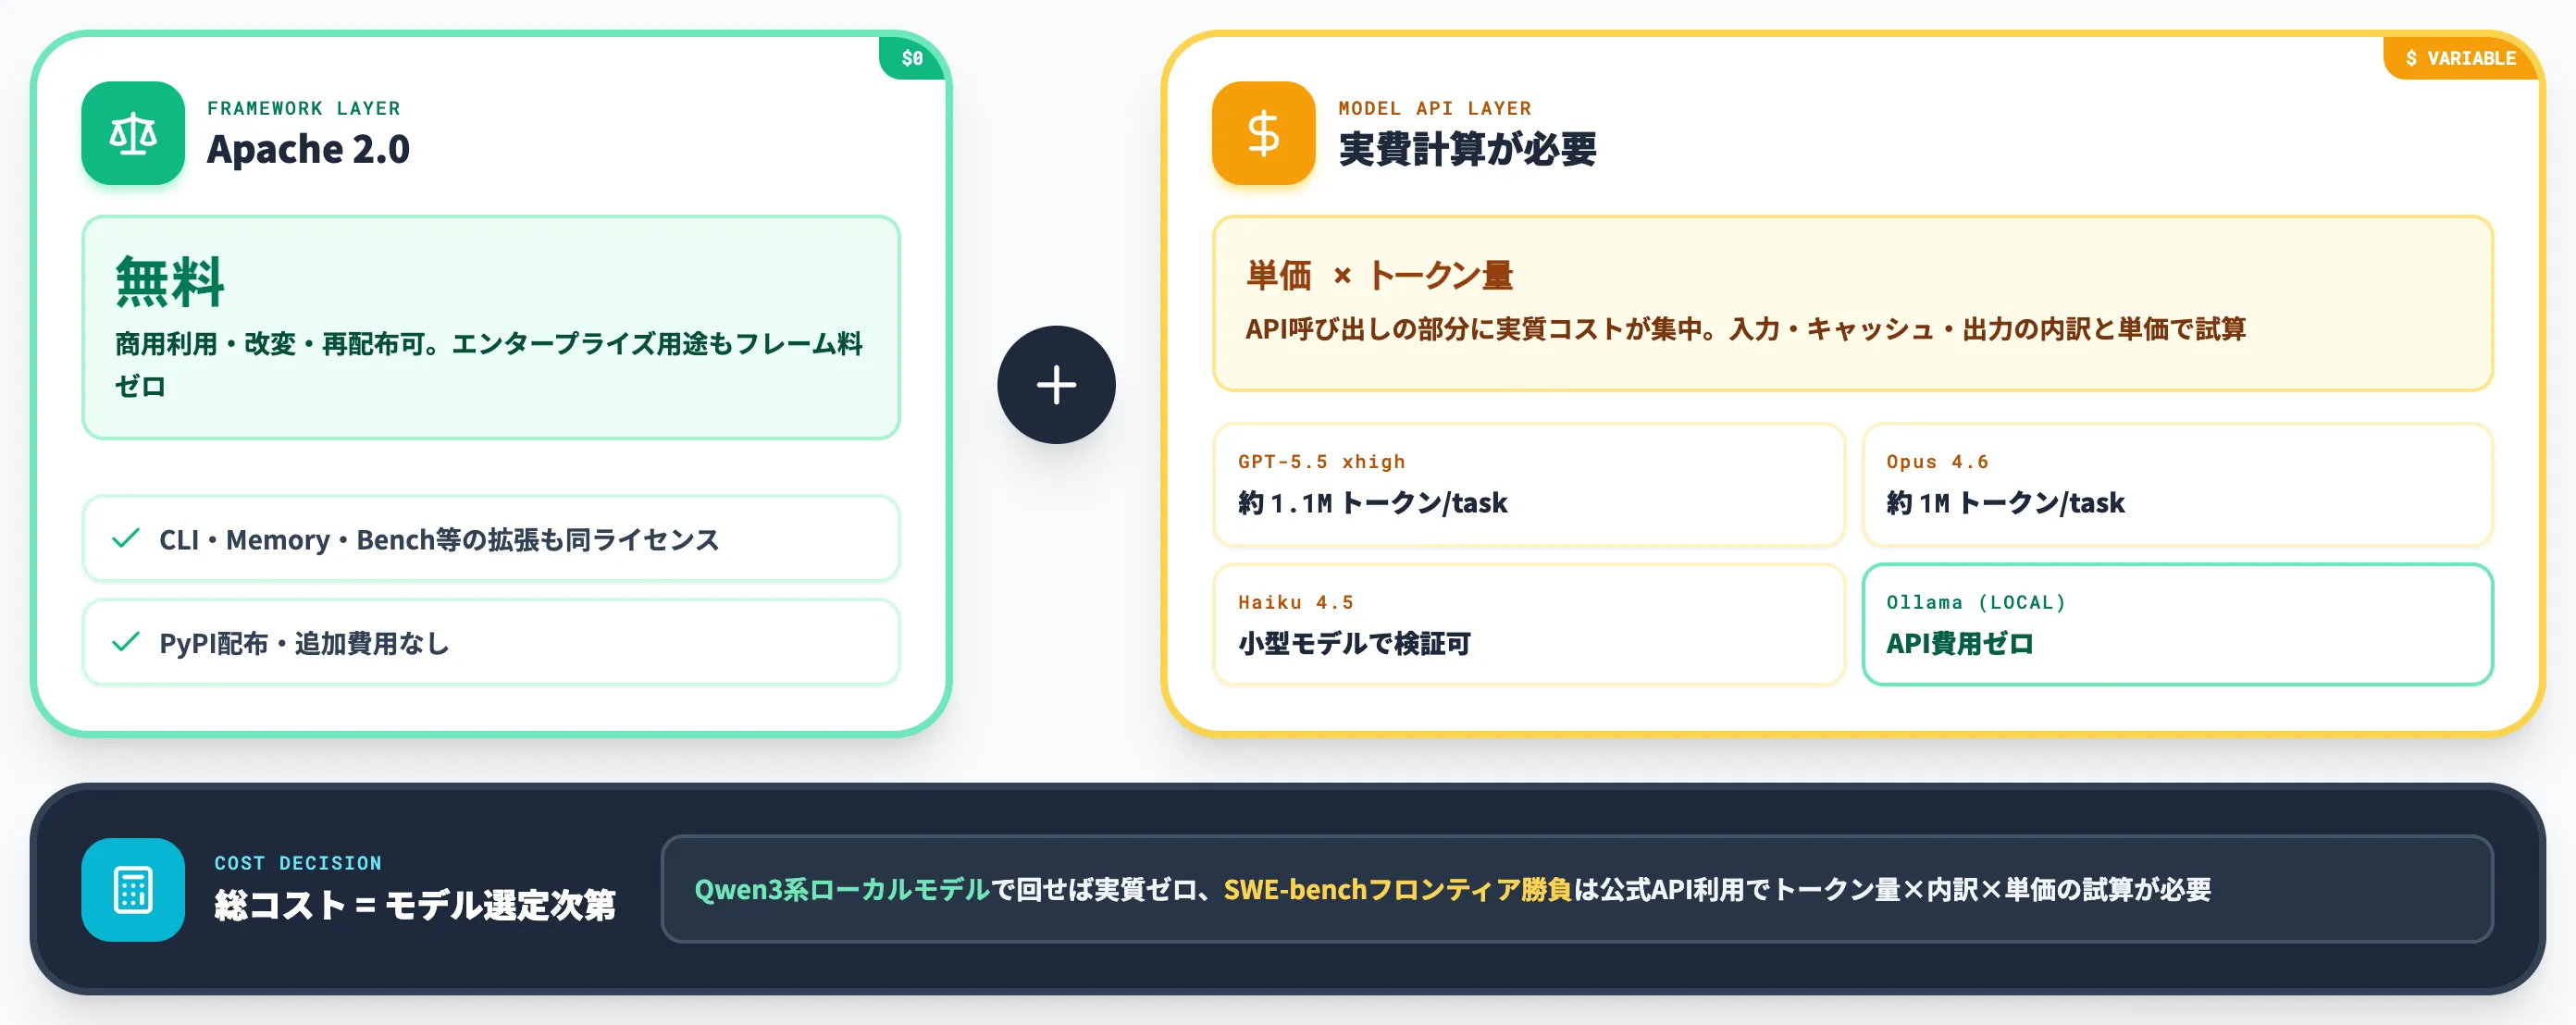
NOOAはApache 2.0ライセンスで公開されており、フレームワーク自体の利用料はありません。実質的なコストはモデルAPI呼び出しの部分に集中します。
フレームワーク:Apache 2.0で商用利用も無料
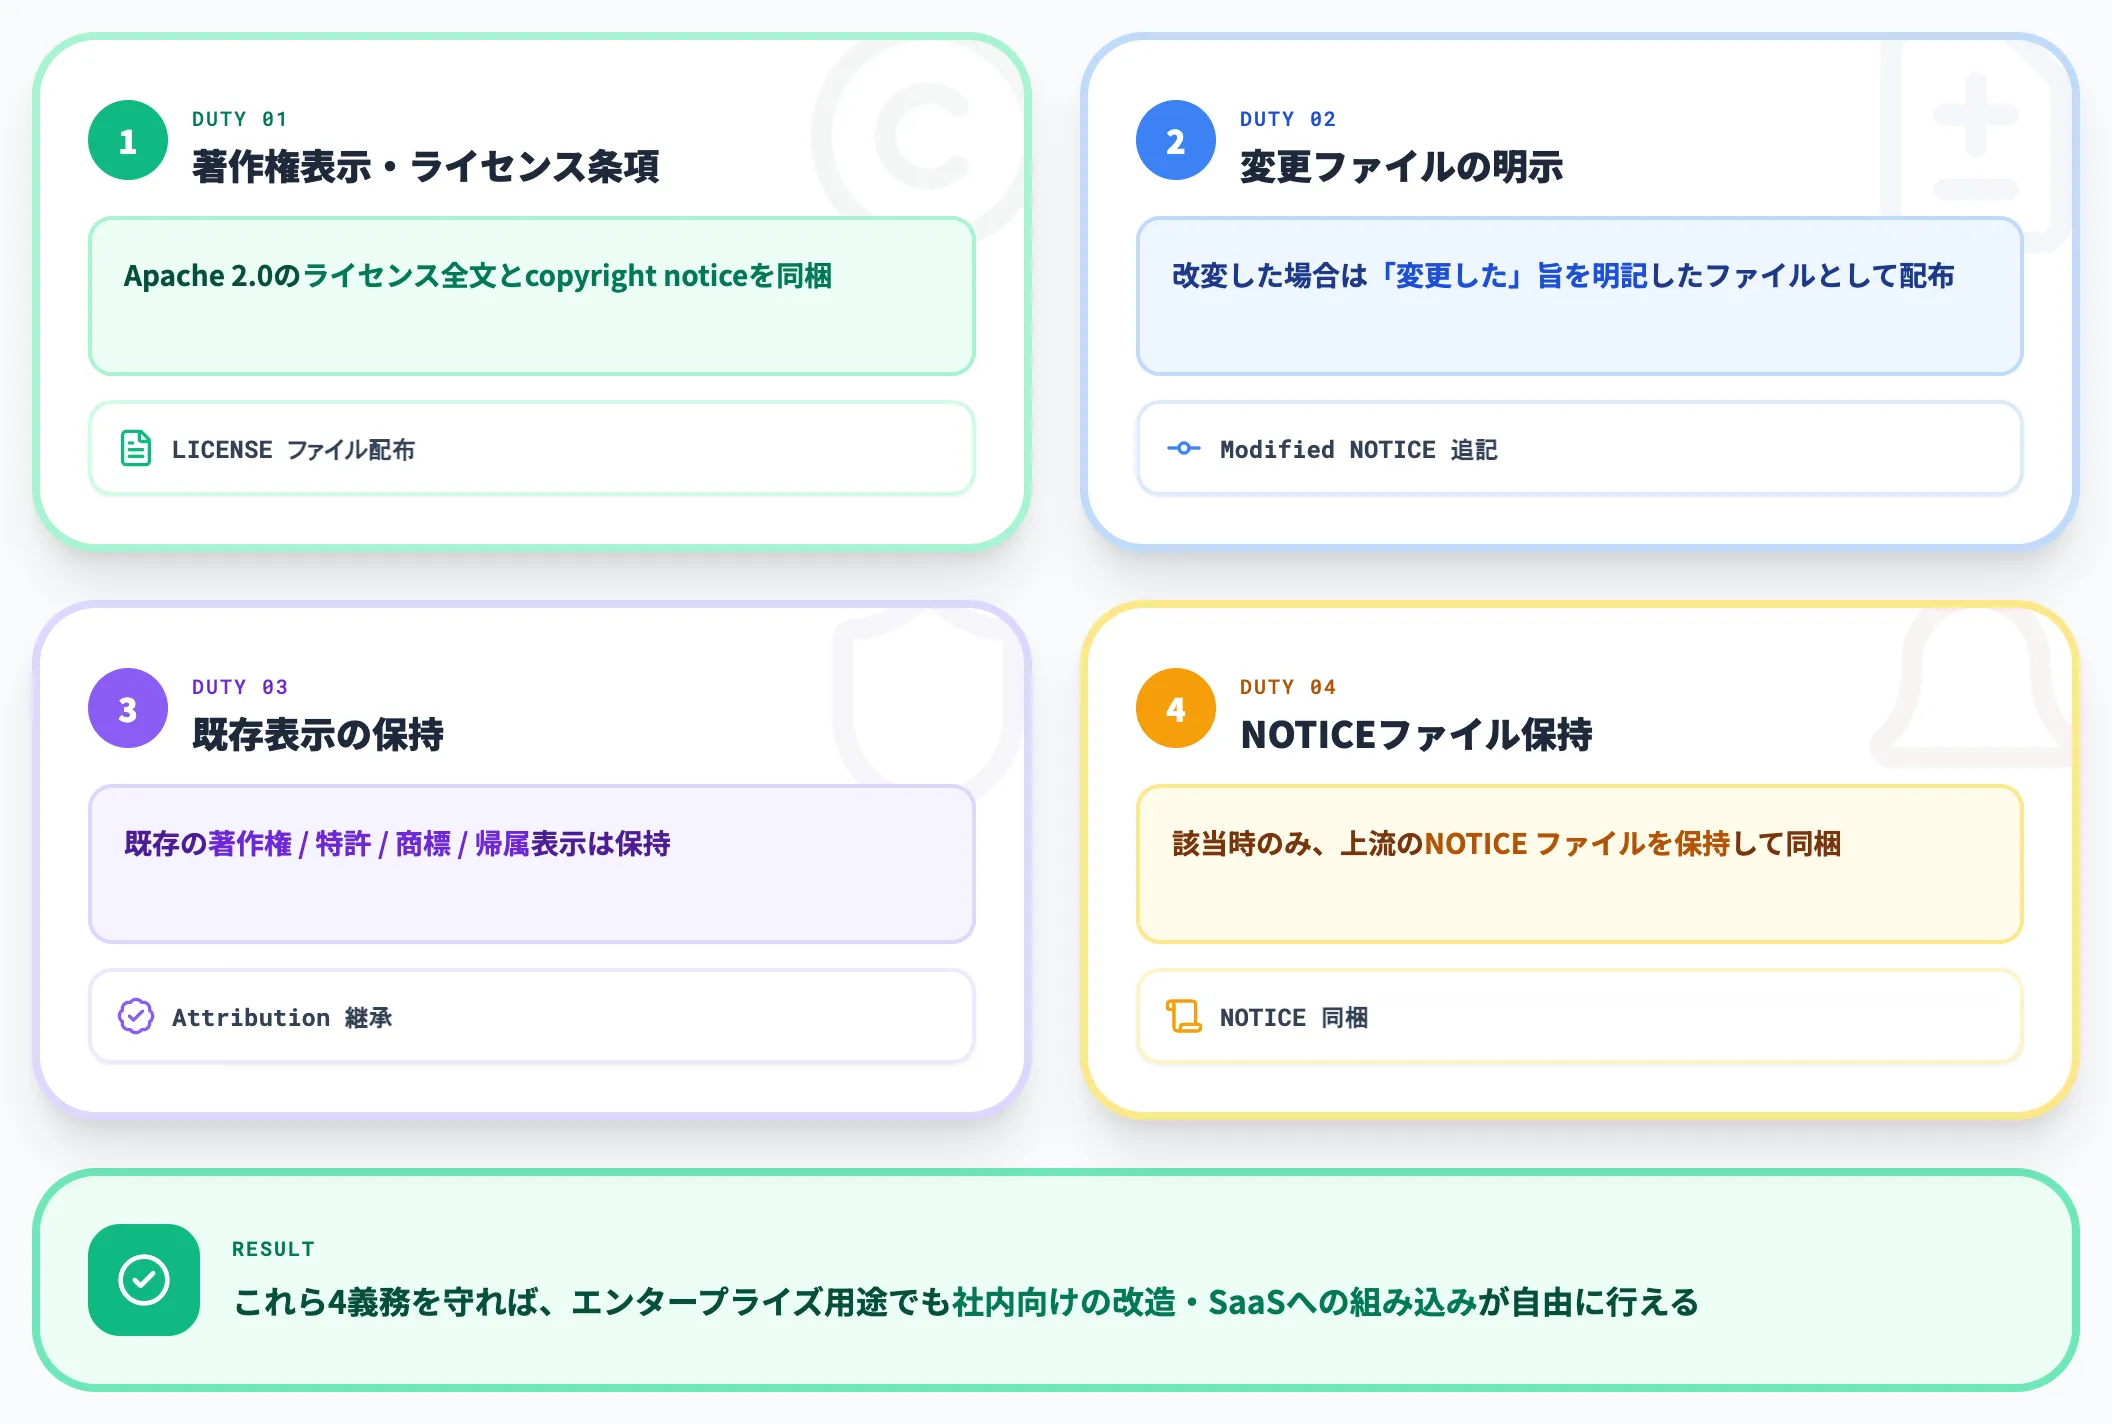
Apache 2.0は商用利用・改変・再配布が可能で、著作権表示とライセンス条項の同梱・変更ファイルの明示・既存の著作権/特許/商標/帰属表示の保持・(該当時)NOTICEファイルの保持といった義務を守れば、エンタープライズ用途でも社内向けの改造やSaaSへの組み込みが自由に行えます。
拡張機能(CLI・Memory・Bench・Tracing・Sandbox等)も同じライセンスでPyPIから配布されており、追加費用は発生しません。
実コスト:モデルAPI単価×トークン量(実費は要試算)
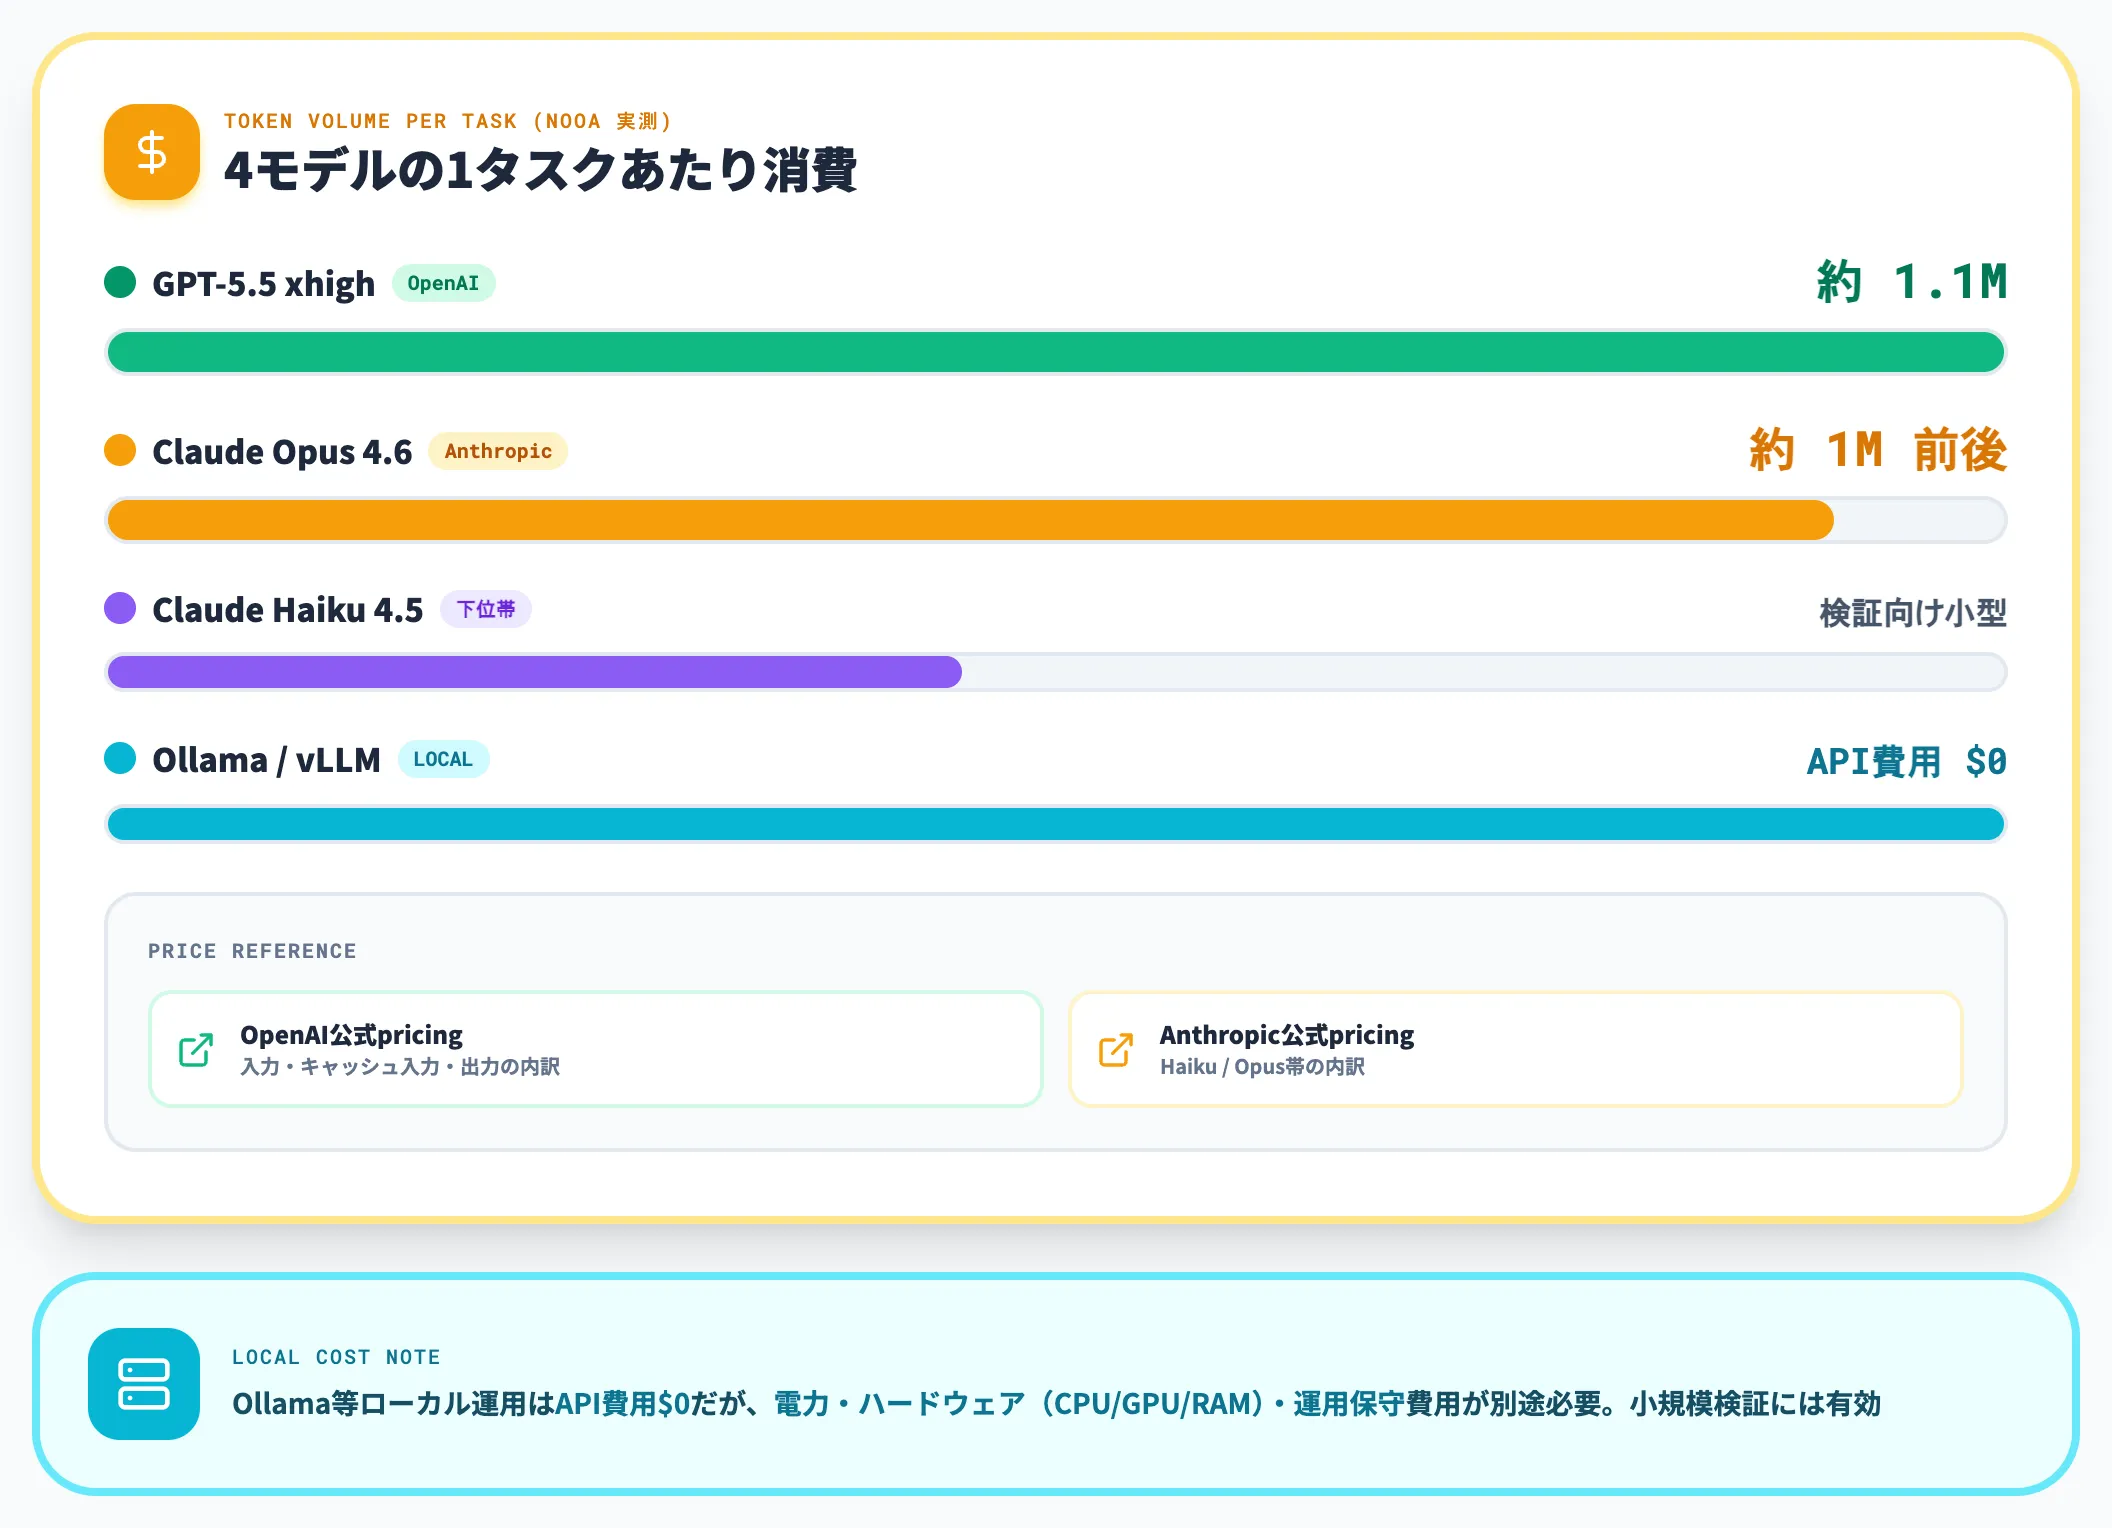
コスト構造の中心はモデル呼び出しです。技術報告書の実測から得られる1タスクあたりのトークン量と、実費計算の前提を並べると、以下のようになります。
| モデル | 1タスクあたりのトークン量(NOOA実測) | 実費計算の前提 |
|---|---|---|
| GPT-5.5 xhigh | 約1.1M | OpenAI公式pricingで入力・キャッシュ入力・出力の単価内訳を確認 |
| Claude Opus 4.6 | 約1M前後 | Anthropic公式pricingで内訳を確認 |
| Claude Haiku 4.5 | 小型モデルで検証可 | 同上(Anthropic下位帯) |
| Ollama(ローカル) | ローカル実行のためAPI費用ゼロ | 電力・ハードウェア(CPU/GPU/RAM/ストレージ)・運用保守費用が別途必要 |
この表から分かるのは、ローカルモデル(Ollama・vLLM)で回せば、API利用料はゼロになるという点です。
別途、電力・ハードウェア・運用保守費用は必要ですが、社内ワークフローの検証や小規模タスクなら、Qwen3系の小型モデルをローカルで動かして十分に実装確認できます。
SWE-benchのようなフロンティア勝負ではモデル差が出るため、公式APIを使う場合の実費は、トークン量×入力/キャッシュ/出力の内訳×モデル別単価で算出する必要があります。
ベンチマーク再現の準備
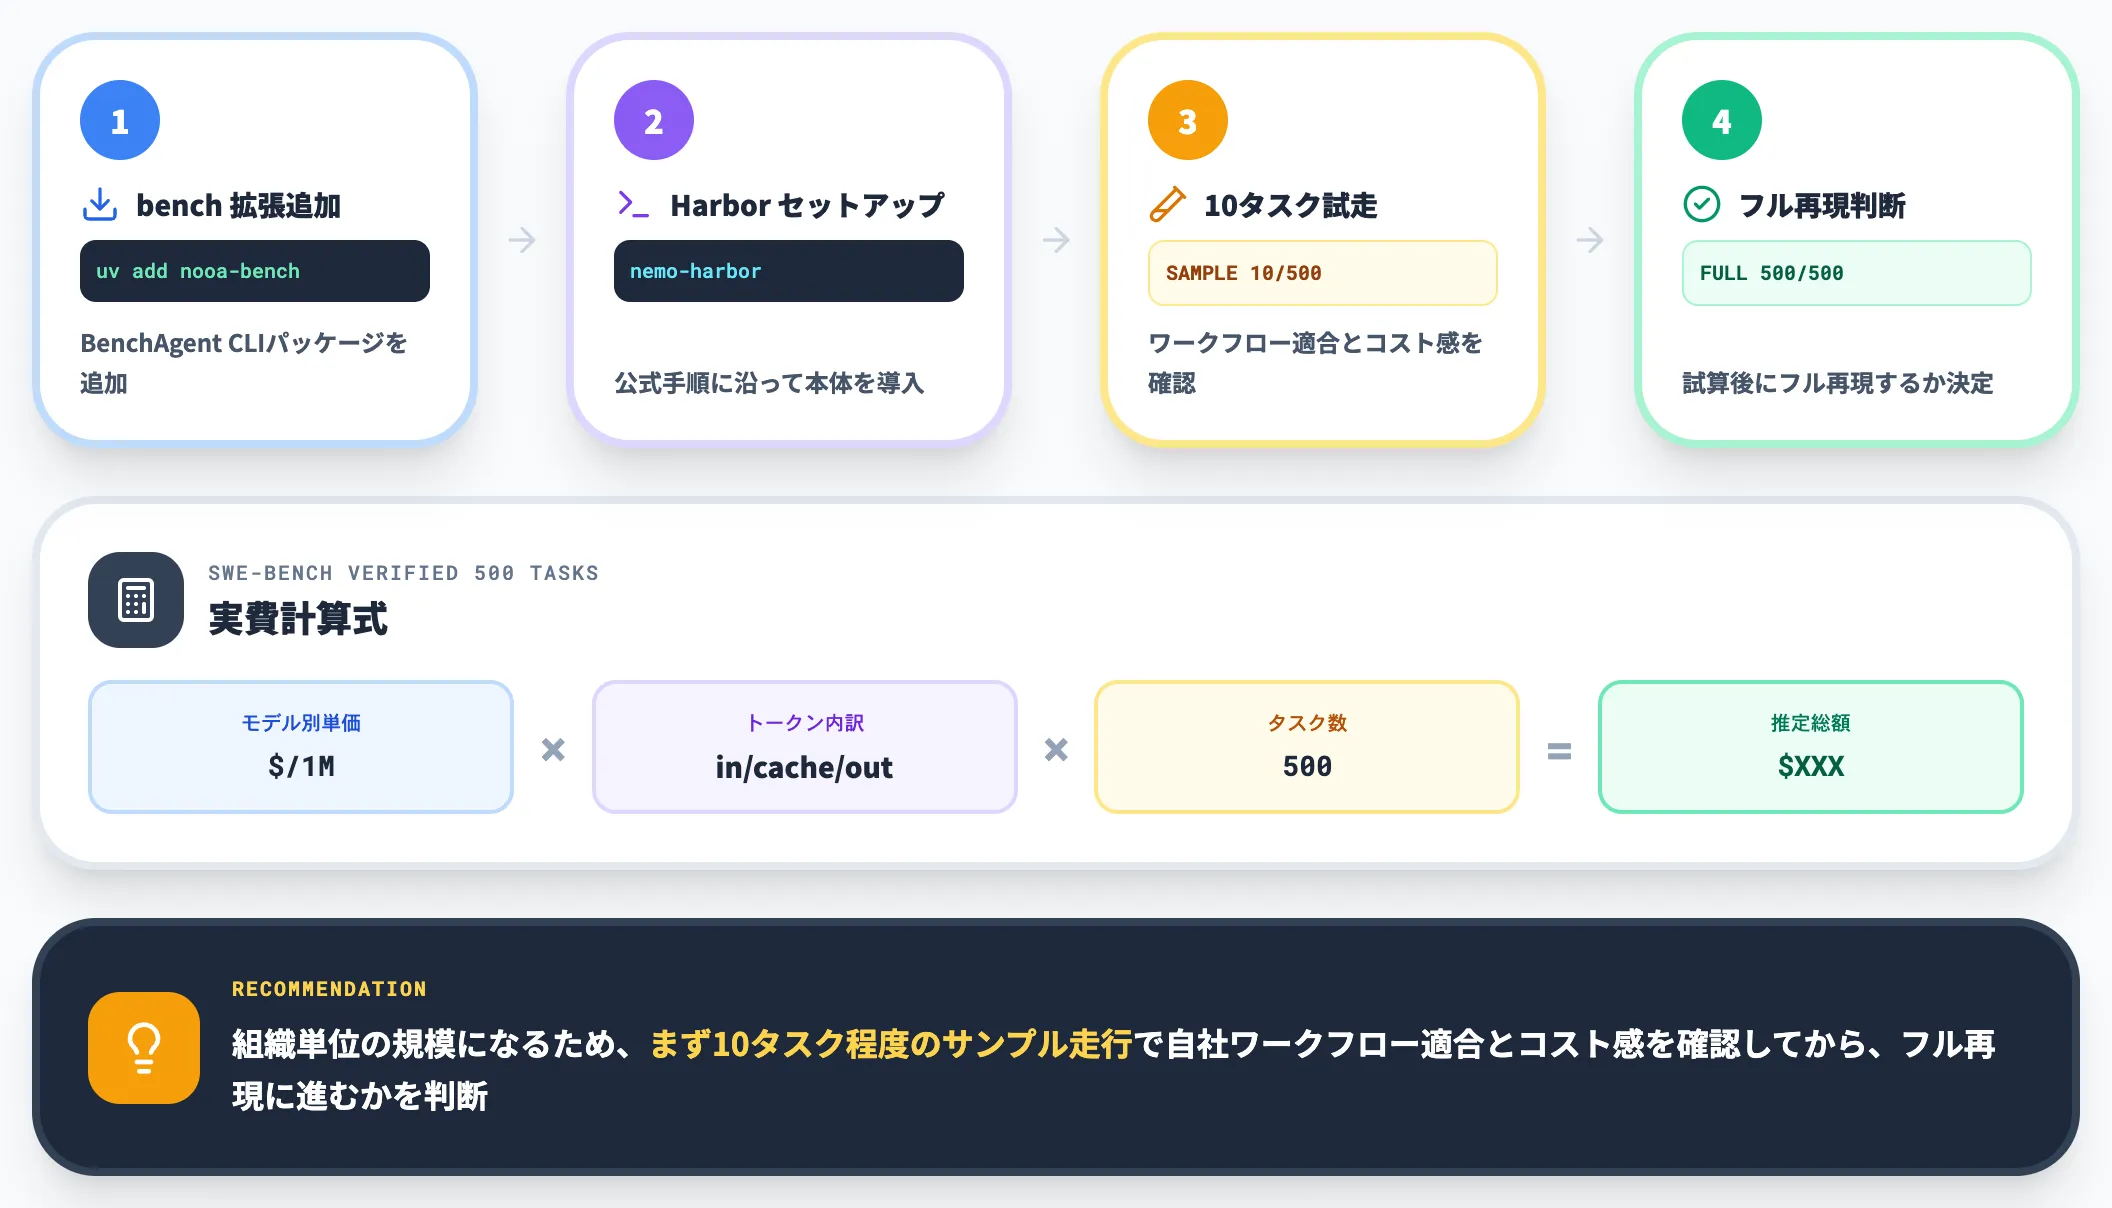
技術報告書の結果を自前で再現したい場合、基本はuv add nooa-benchでBenchAgentのCLI(nemo-harborエントリポイントを含む)が導入できます。Harbor本体の詳細セットアップは公式ベンチマーク手順を参照してください。S
WE-bench Verifiedの500タスク全走破にかかるAPI費用は、モデル別単価×トークン内訳×タスク数で試算する必要があります。
組織単位で走らせる規模になりやすいため、まずは10タスク程度のサンプル走行で自社のワークフロー適合とコスト感を確認してから、フル再現に進むか判断するのが現実的です。
Alpha段階のNOOAを本番投入する前に押さえる注意点
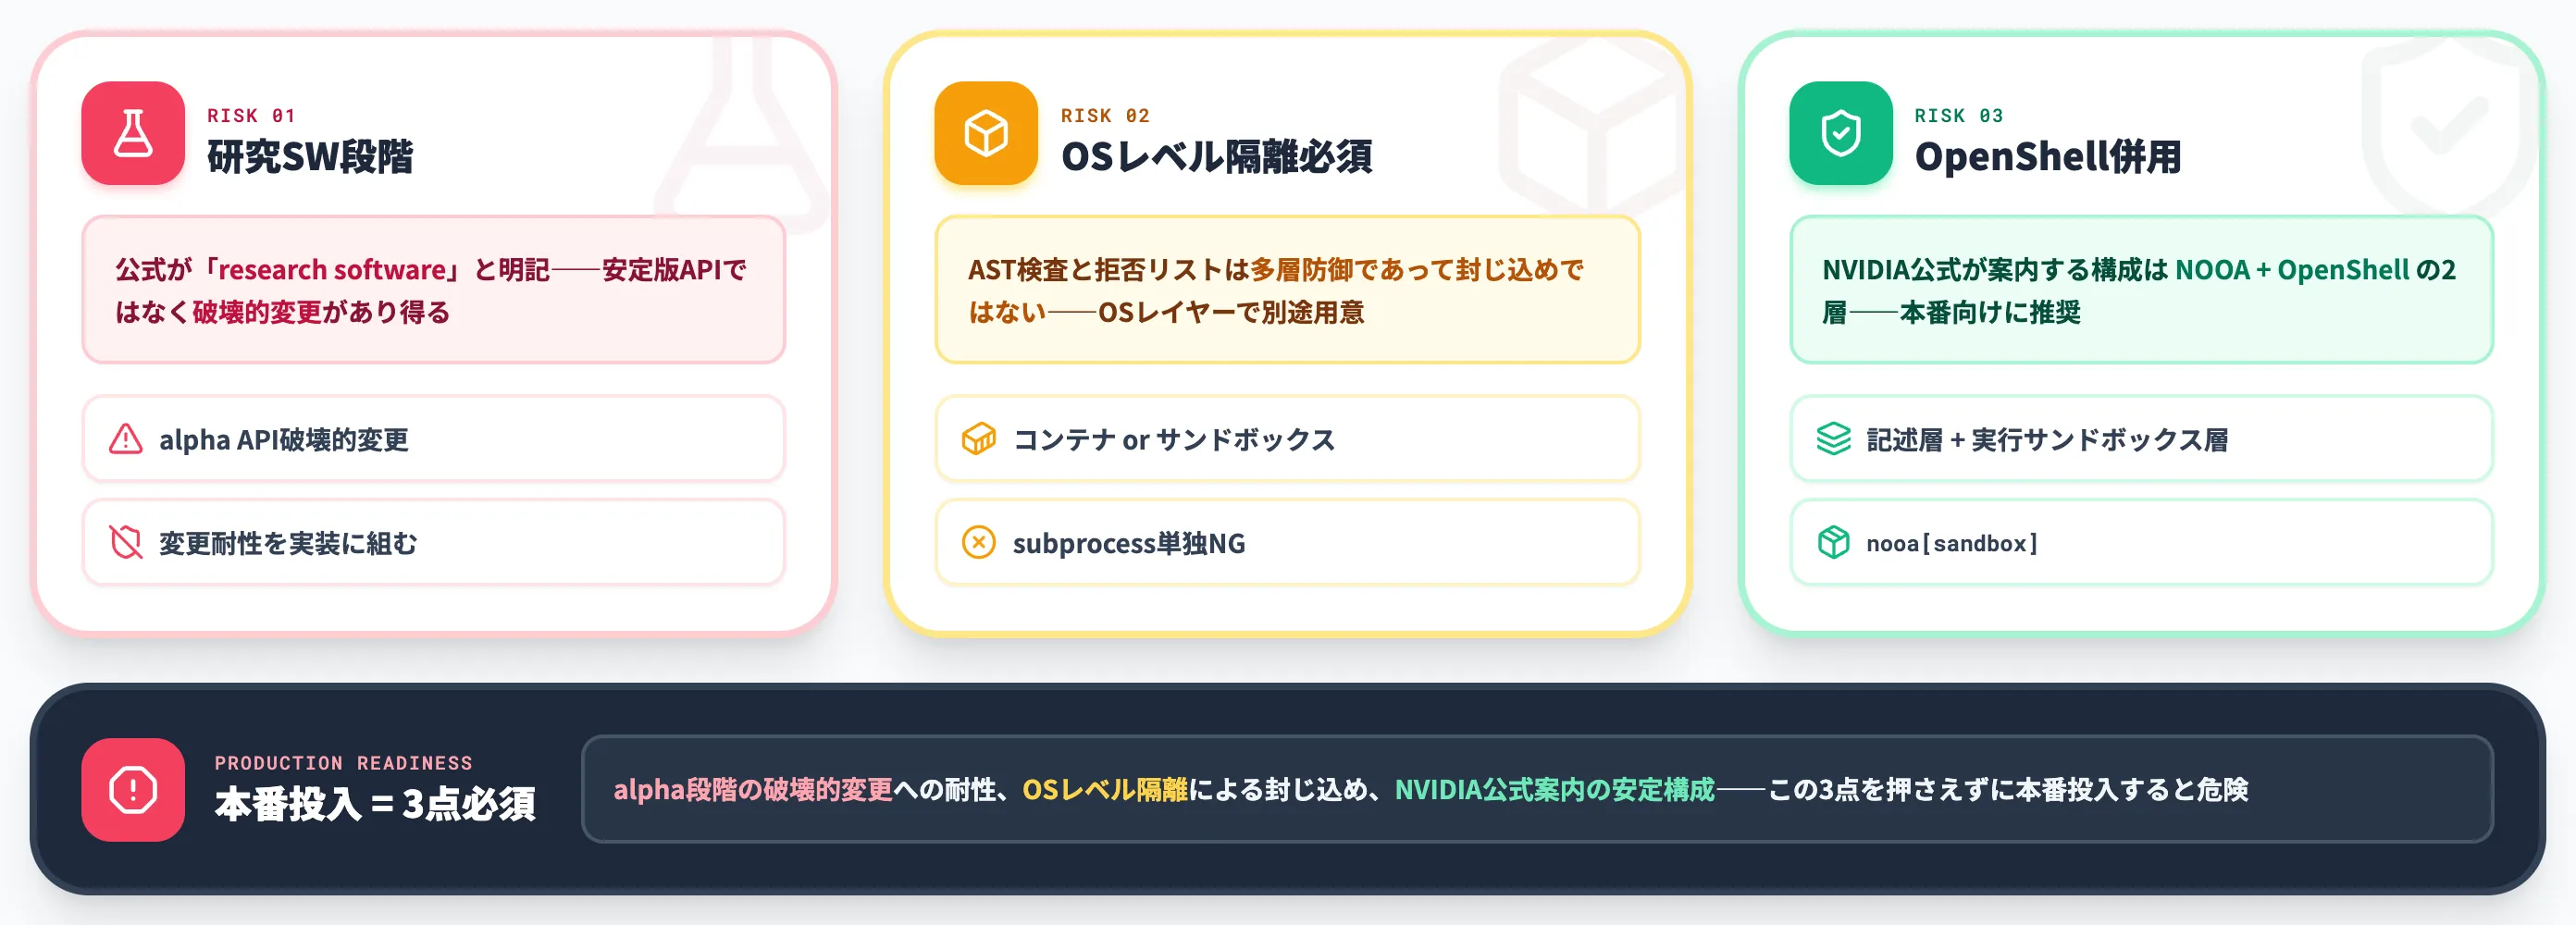
NOOAは強力ですが、公式が明記しているとおりresearch software(研究ソフトウェア)の段階にあります。本番運用に載せる前に、以下の3点は必ず押さえる必要があります。
「Research Software」の明記——安定版ではない
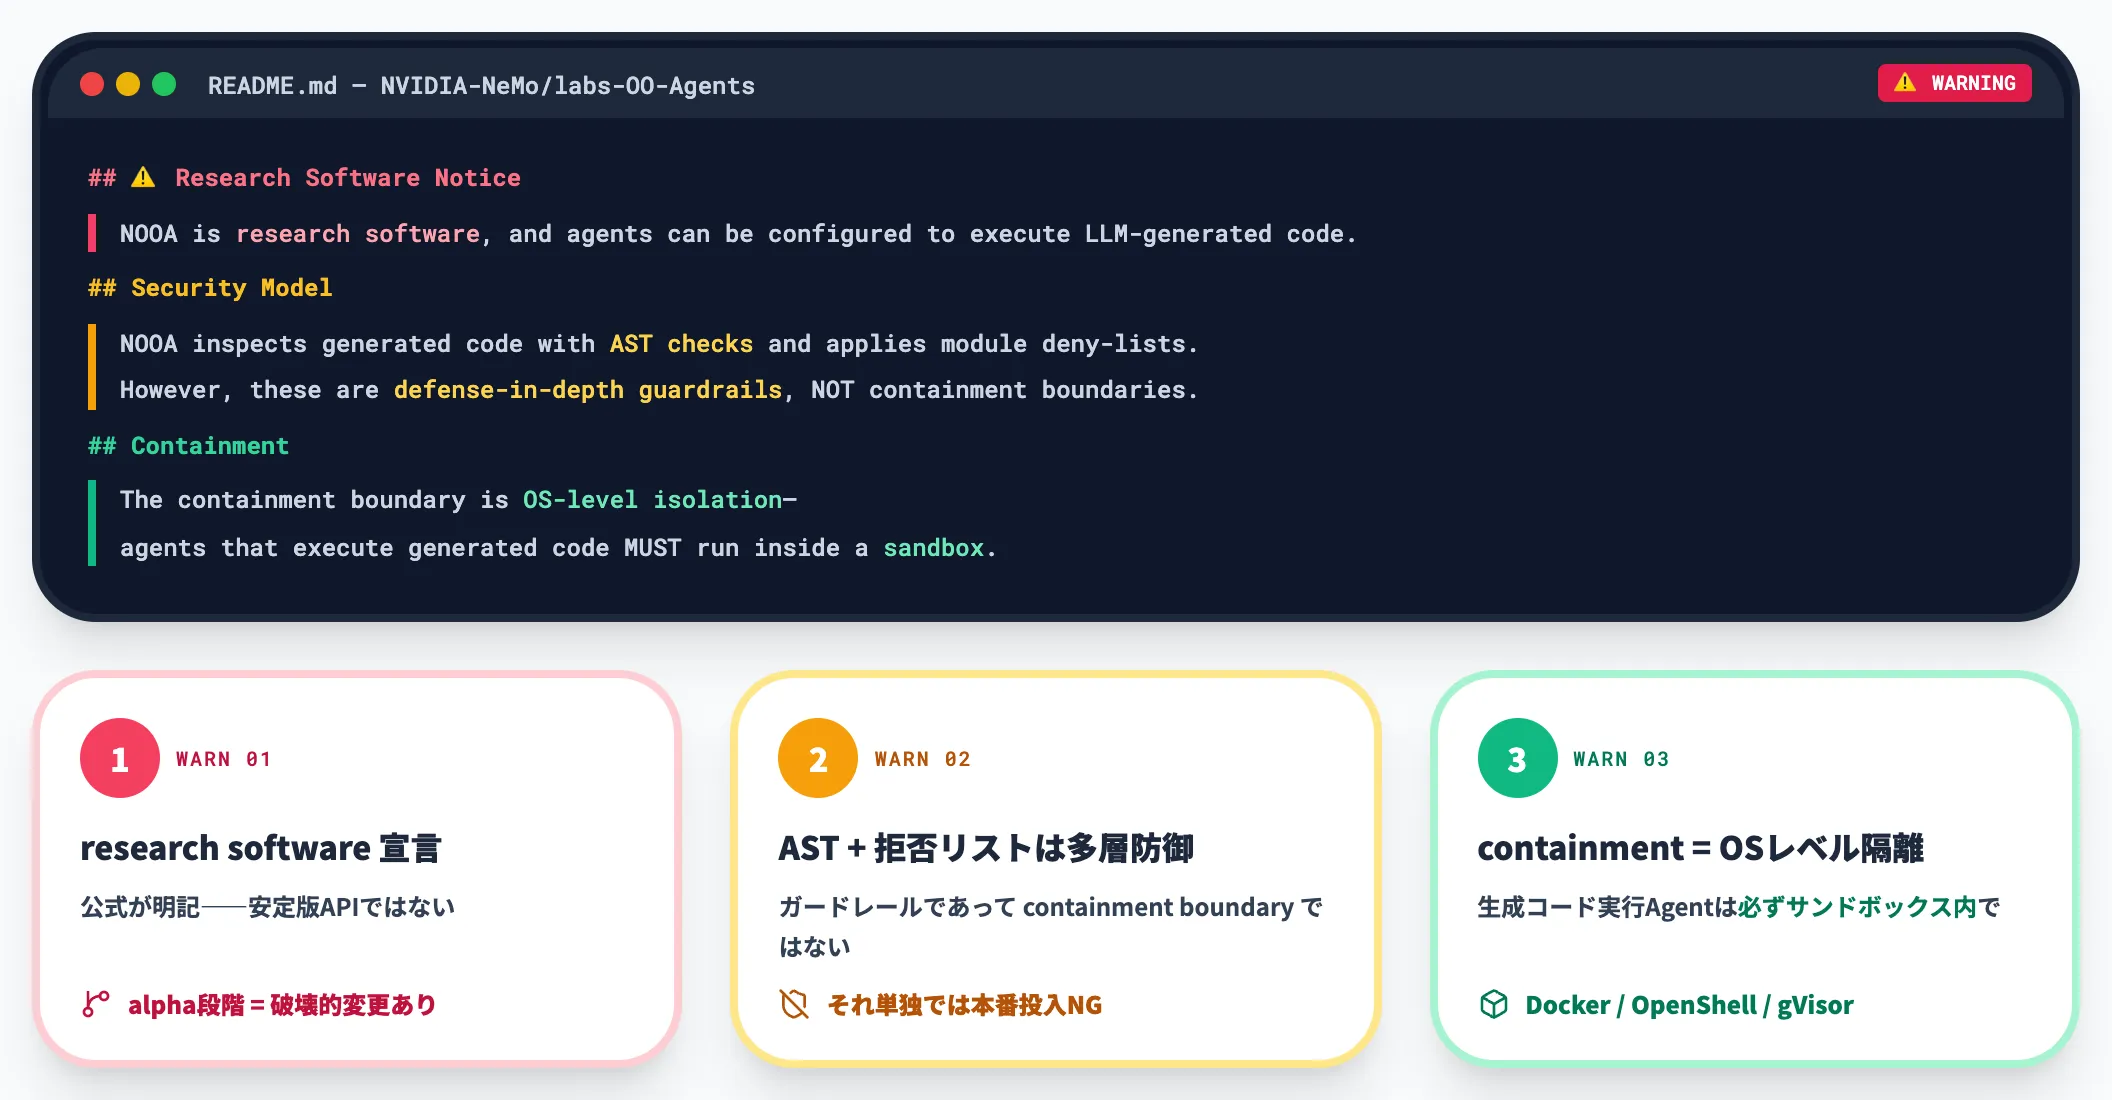
NOOAのREADMEには、以下の警告が明記されています。
- 「NOOAはresearch softwareであり、エージェントはLLMが生成したコードを実行するように設定できる」
- 「NOOAは生成コードをAST(抽象構文木)検査し、モジュール拒否リストを適用する。ただしこれらは多層防御のガードレールであって、containment boundary(封じ込め境界)ではない」
- 「containment boundaryはOSレベルの隔離である——生成コードを実行するエージェントは必ずサンドボックスの中で動かすこと」
つまり、AST検査と拒否リストだけを頼りにNOOAを本番投入するのは、公式が明示的に推奨しない構成です。alpha段階のAPIは今後の破壊的変更もあり得るため、変更耐性を持たせた実装にする必要があります。
OSレベル隔離——コンテナ・OpenShellでのサンドボックス
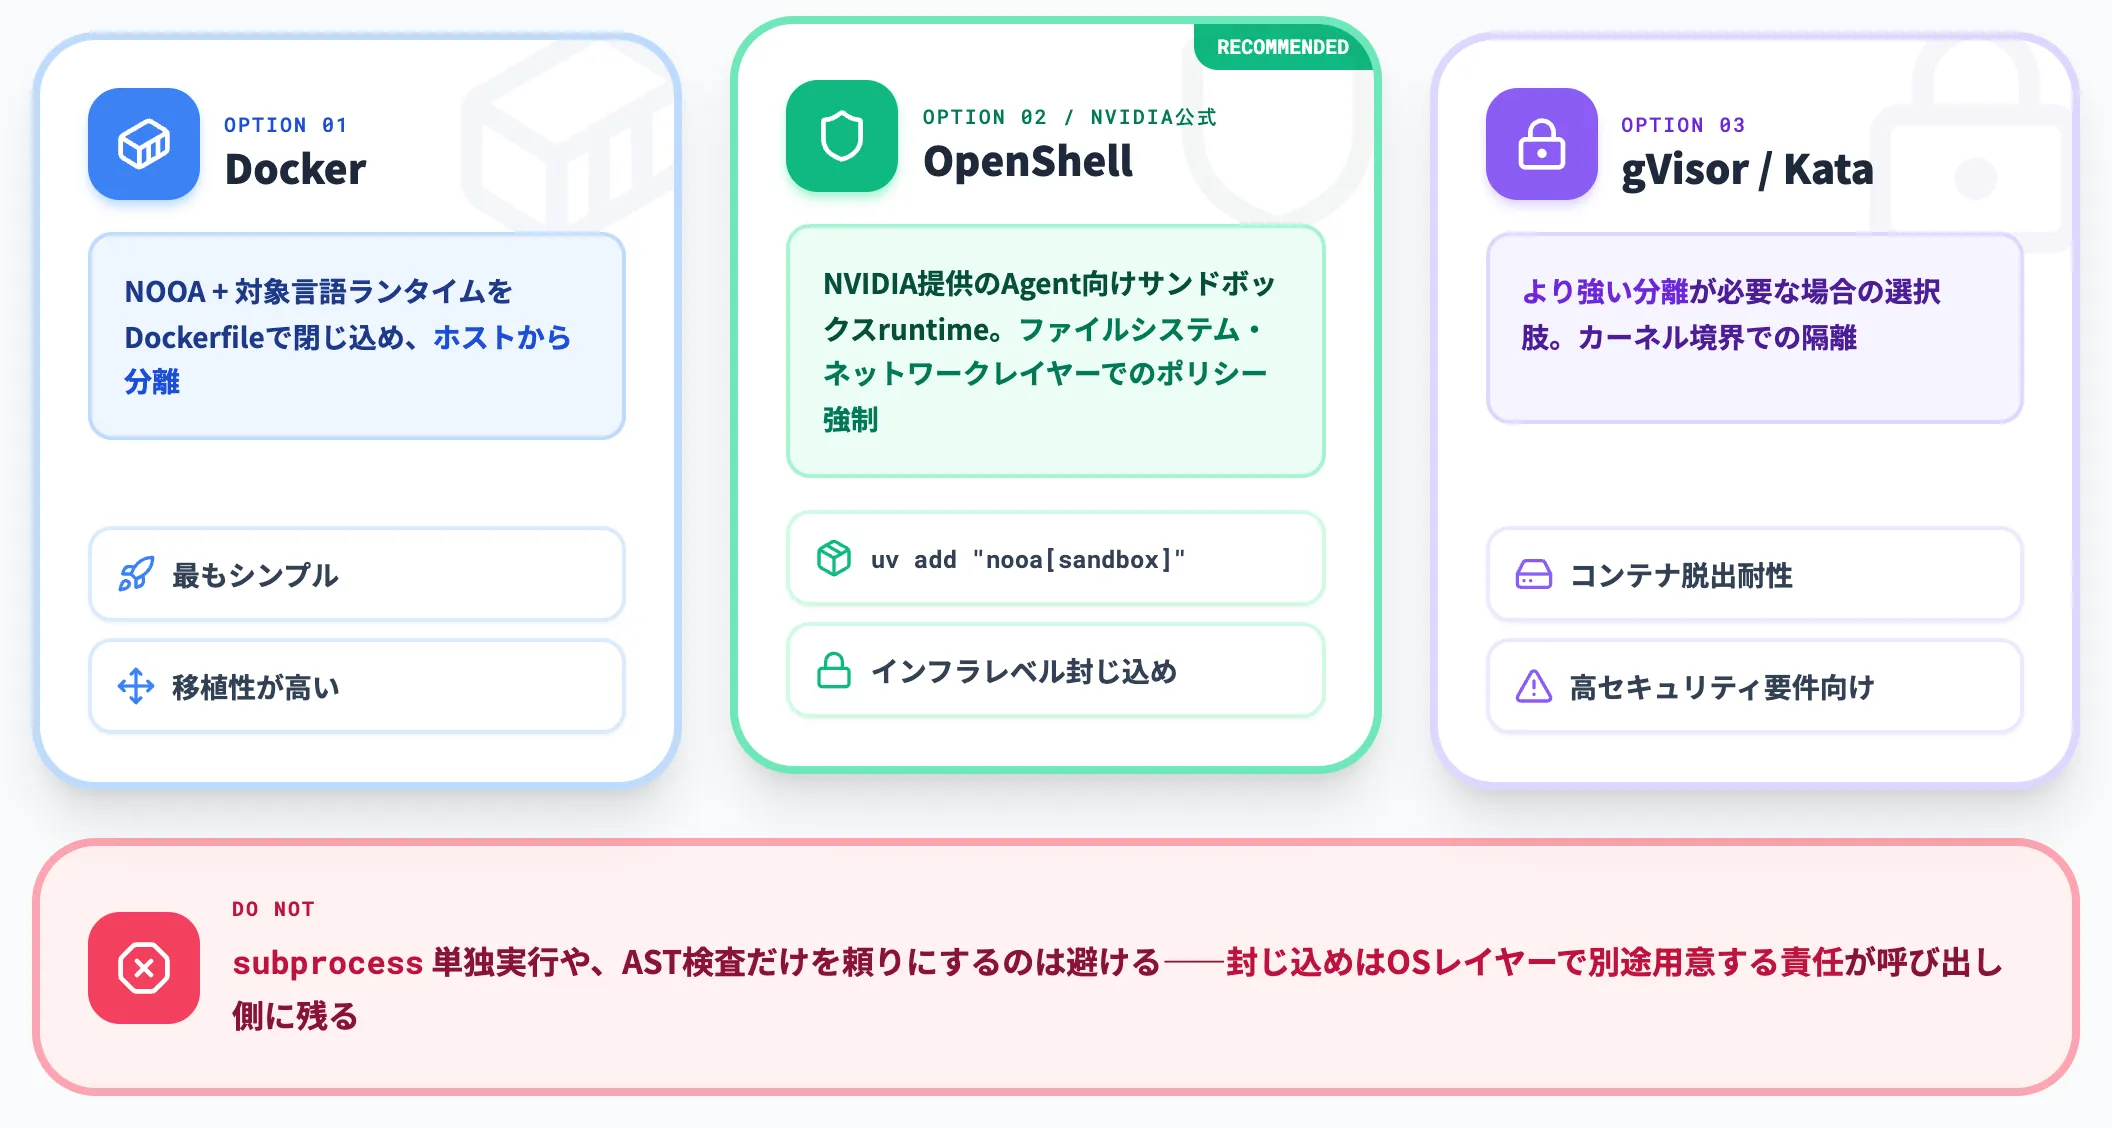
生成コードを実行するエージェントは、必ずOSレベルの隔離環境で動かします。標準的な選択肢は3つあります。
-
Dockerコンテナ
DockerfileでNOOA + 対象言語ランタイムだけを閉じ込め、ホストから分離する。最もシンプルで移植性が高い
-
NVIDIA OpenShell
NVIDIAが提供するエージェント向けサンドボックスruntime。ファイルシステム・ネットワークレイヤーでのポリシー強制、インフラレベルでの封じ込めを備える。uv add "nooa[sandbox]"で連携できる
-
gVisor / Kata Containers
より強い分離が必要な場合の選択肢。カーネル境界での隔離を提供し、コンテナ脱出への耐性が高い
単なるsubprocess実行や、AST検査だけを頼りにするのは避けてください。公式が「これらは多層防御であって封じ込めではない」と明記している以上、封じ込めはOSレイヤーで別途用意する責任が呼び出し側に残ります。
OpenShellとの組み合わせ——公式が案内するOSレベル隔離構成
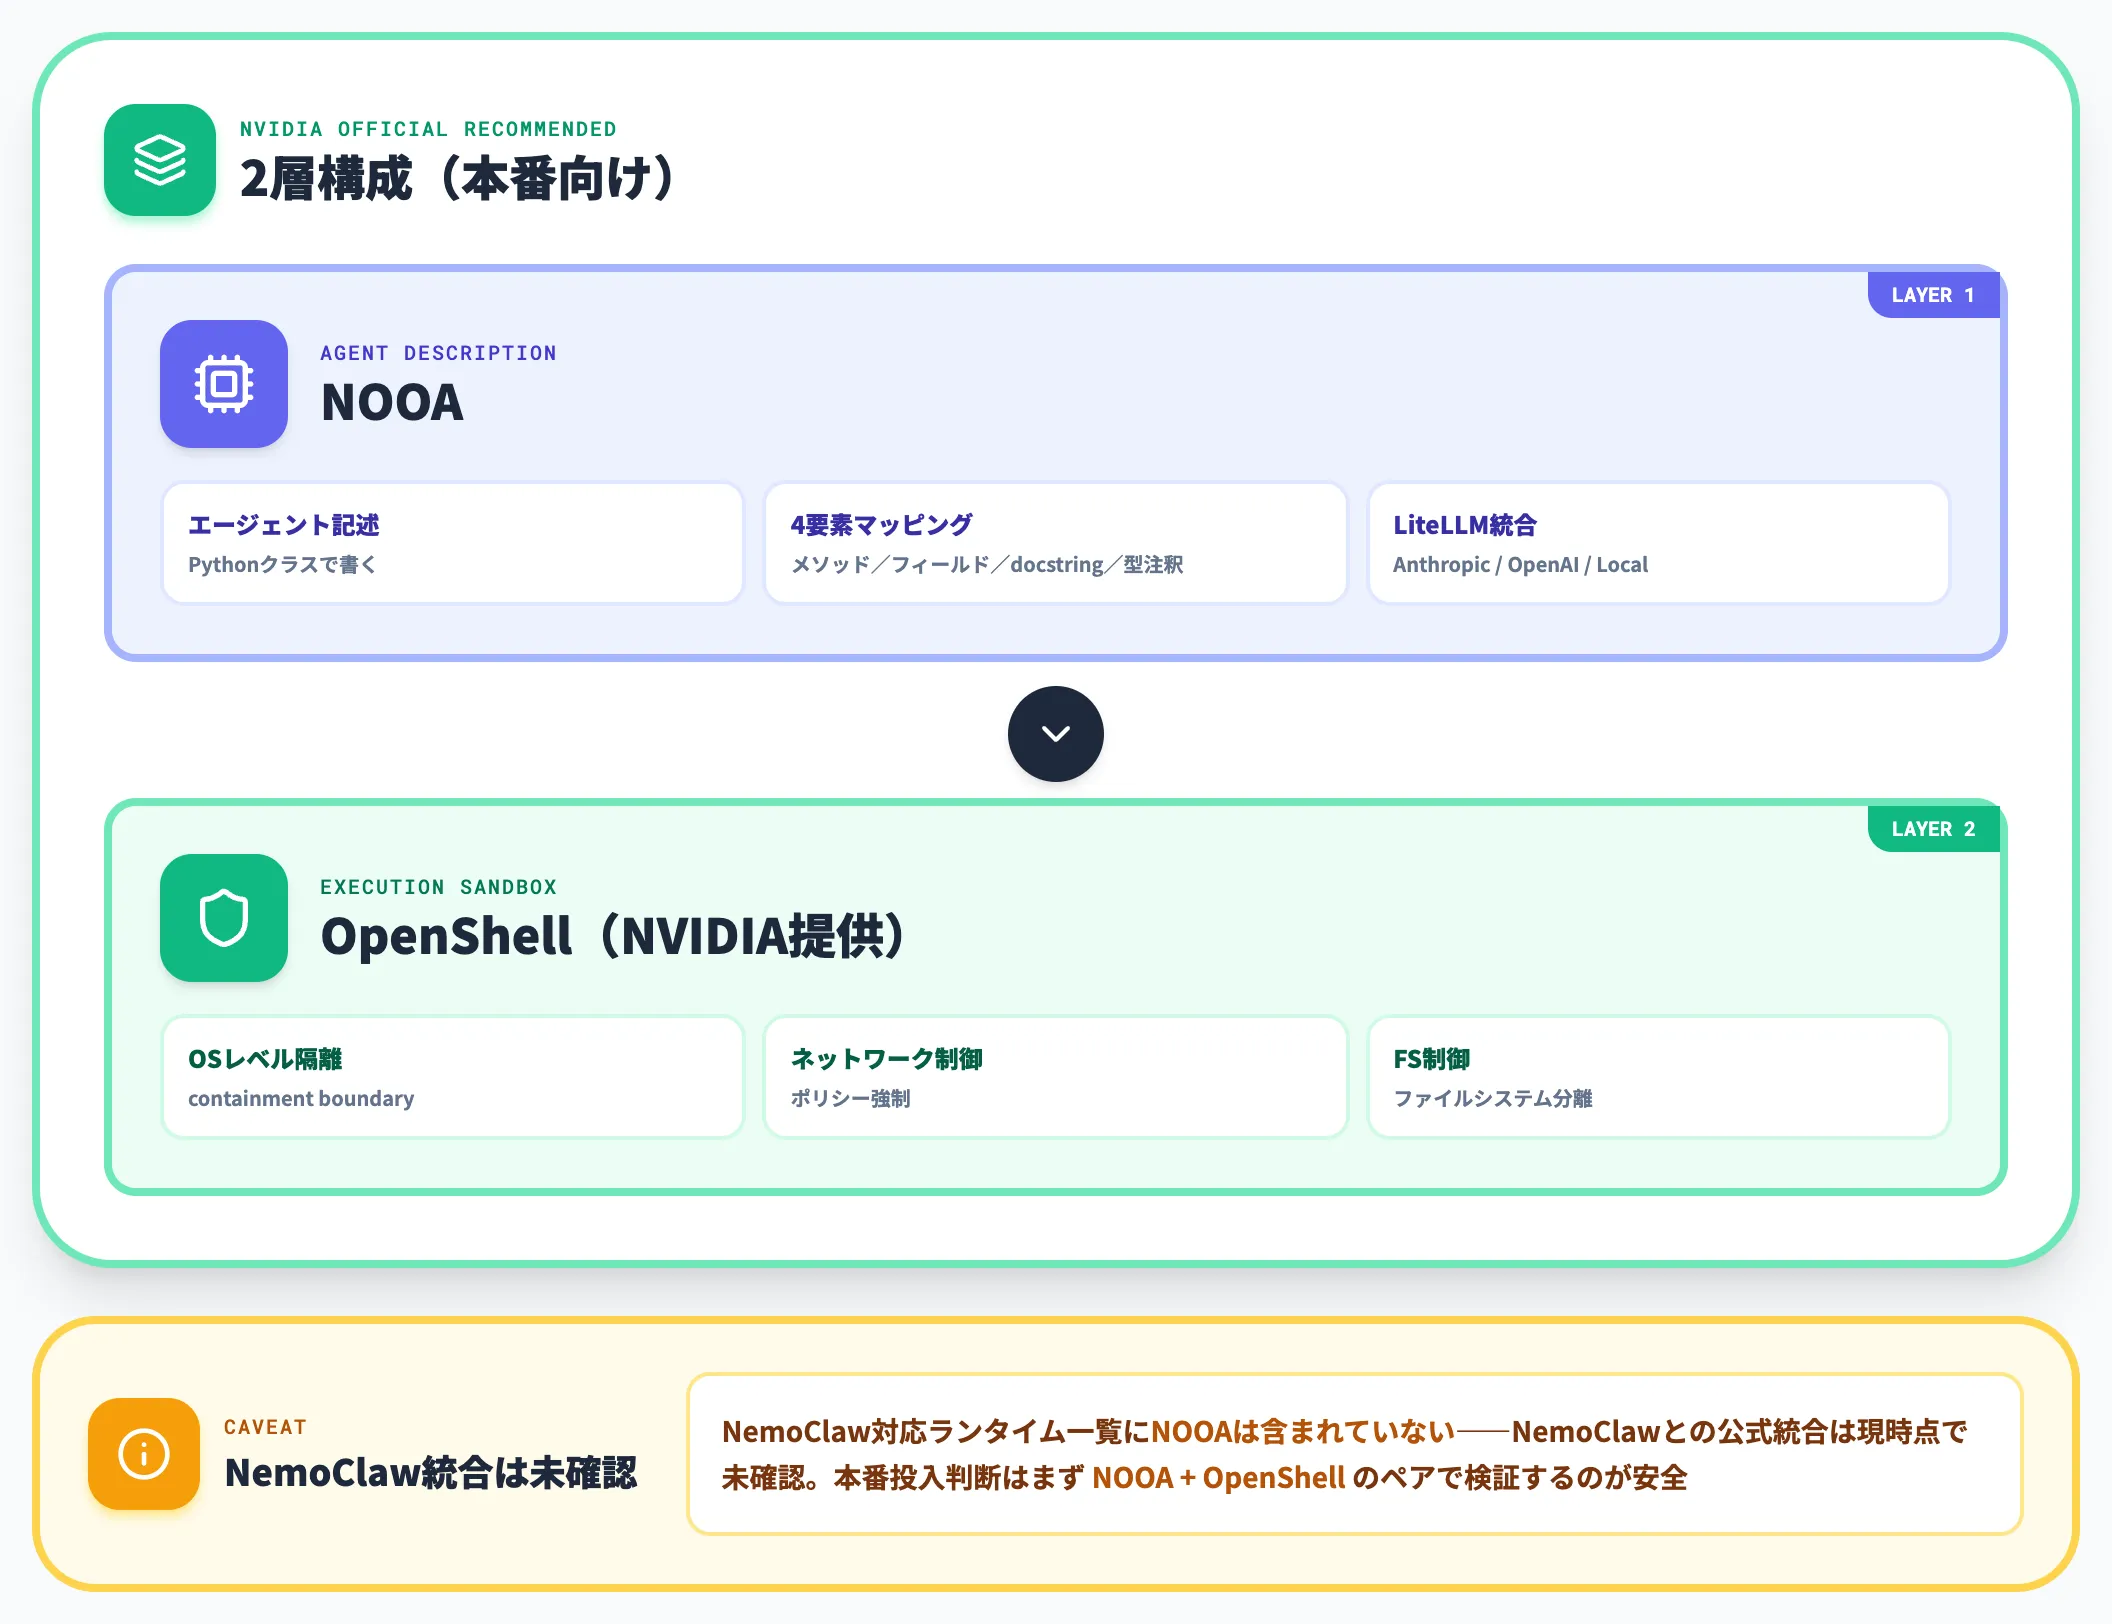
NOOA公式記事が本番向けに明記している構成は、NOOA + OpenShellの2層です。
-
NOOA
エージェント記述層(Pythonクラスで書く)
-
OpenShell
コード実行のサンドボックス層(NVIDIA提供・OSレベル隔離)
NemoClaw自体は産業ソフト各社(Cadence・Dassault Systèmes・Siemens・Synopsys等)が構築・統合・協業を進めており、産業ソフト分野で採用が広がっています。ただし現時点でNemoClaw対応ランタイム一覧にNOOAは含まれておらず、NOOAとNemoClawの公式統合は確認できていません。本番投入の判断は、まずNOOA + OpenShellのペアで検証するのが安全です。
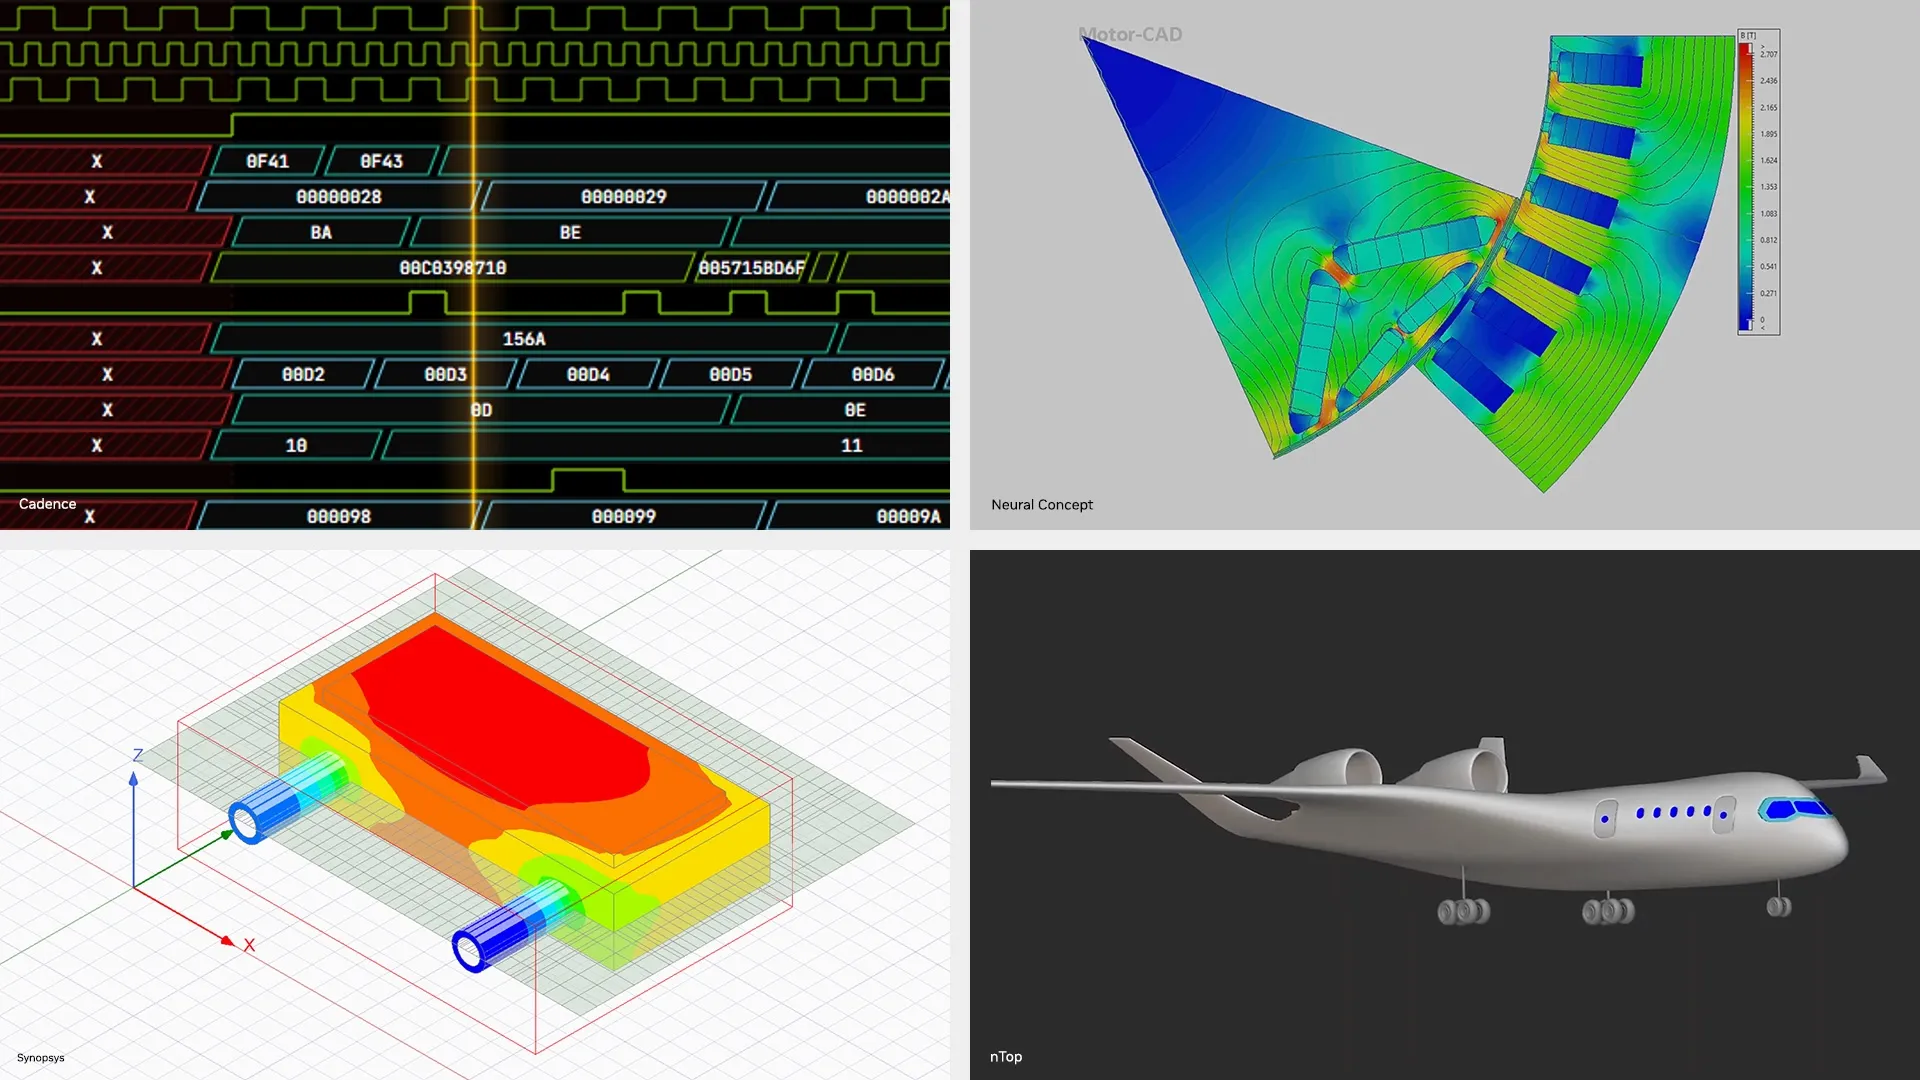
NVIDIA NemoClawで自律AIエンジニアを構築する産業ソフト各社(Cadence・Neural Concept・Synopsys・nTop)の実装例(出典:NVIDIA Blog)
なお、ホスト型のマネージドサービスとして展開する予定はNVIDIAから発表されていません。自社インフラ or 自社クラウドテナント内で運用する前提の設計思想です。
モデルとハーネスが短い周期で替わるなら、業務プロセスは別の層で受け止める
NOOAはalpha段階の研究ソフトウェアで、APIの破壊的変更があり得るうえ、Terminal-Bench 2.0のようにモデルの組み合わせ次第で順位が入れ替わります。記述層やモデルを試しながら社内で使うなら、規定の判定や承認の手順、会計システムへの登録を、ハーネスの入れ替えに左右されない層に分けておくと、試すたびに作り直さずに済みます。
その層に当たるのが、社員の入口と仕事の手順を、Agentを組む道具から切り離して持つ土台です。AI総合研究所のAI Agent Hubは、承認の流れと基幹システムへの接続を、Agentの作り方とは別に基盤の側で受け持ちます。
- 決めうちの判定は、LLMに任せない段に残す
経費の上限や支払条件のように答えが決まる判定は規定チェックAgentの段として切り出し、LLMには申請文の読み取りや分類を任せる、という分け方を業務の流れの中で組めます。
- NOOAで書くのは、次の業務の1本から
既存のAgentはそのまま動かし、NOOAで書いた新しいAgentは接続を設計したうえで、同じTeamsの入口と承認の流れに並べておけます。
- トークン量の差を、業務ごとの利用件数から試算する
Agentごとの実行回数が管理画面に残るため、PI比で半分というトークン削減が自社でどれだけの金額になるかを、件数の多い処理から順に計算できます。
AI総合研究所の専任チームが、NOOAで試す処理の候補を選び、評価用のAgentと今の業務の流れをつなぐ部分の設計と構築を、要件に合わせて受け持ちます。
業務の手順をハーネスから切り離す

評価中のフレームと本番の手順を分ける
NOOAのようなalpha段階の記述層やモデルを試すほど、規定の判定や登録の手順をハーネスから切り離しておく意味が増します。AI Agent Hubは社員がTeamsで使うAgentと人の確認の流れを基盤の側で持ち、新しいフレームで書いたAgentとつなぐ部分は、要件に合わせてAI総合研究所が設計・構築します。
まとめ
本記事では、NVIDIA NOOAを「NVIDIA Labsが公開した、Pythonのクラス一つでAIエージェントを記述するオープンソースのフレームワーク」として整理し、設計思想・他のフレームワークにない機能・性能の実測・乗り換えの判断・導入の手順・料金・本番投入の注意点を解説しました。
2026年8月時点で押さえておくべきポイントは次の3つです。
- クラスのメソッドやフィールド、型注釈をそのまま行動・状態・契約として扱い、プロンプトやツール定義、ワークフローの記述をPythonのクラス一つに畳み込む
- ハーネスの状態とAPIをモデルから直接見える形で渡し、モデルが次に取るべき行動を余計な誘導なしで選びやすくしている
- AST検査と拒否リストは多層防御の一枚にすぎず、生成コードを実行させるならコンテナやOpenShellのようなOSレベルの隔離の中で動かす
AI総合研究所がNOOAの試用に付き添うときは、手元で完結する検証を入口にします。
まずは、Ollamaで小型のモデルを動かし、API費用をかけずにクラスの書き方と型の契約の効き方をつかみます。
続いて、社内で使っているMCPサーバーをNOOAから呼び出し、ツールを書き直さずにつながるかを試します。
SWE-benchの数字ばかりが目を引きますが、脆弱性の発見や抽象推論のような別の領域で、同じクラスの書き方のまま結果を出している点に、設計の汎用性が表れています。
NOOAは、普段どおりのPythonの書き方でエージェントを組める点で、安定版を待つ間に手になじませておきたいフレームワークです。
※本記事は2026年8月20日時点・NOOA v0.0.9(2026年8月18日リリース)を対象に執筆しています。NOOAは alpha 段階の研究ソフトウェアのため、API仕様・importパス・依存構成の破壊的変更が発生する可能性があります。実装時は必ず最新の公式READMEと技術報告書を確認してください。