この記事のポイント
 Muse Emberは$0.10/$0.50で1Mコンテキストと画像・音声・動画対応を備える、エージェント実行層に特化した最軽量モデル
- Artificial Analysis Intelligence Indexで36点、Claude Haiku 5.5と同点ながら1タスクあたりコストは$0.14 vs $0.41で約1/3
- 入力が200Kを超えると単価は$0.30/$1.50に跳ね上がる「200K Catch」があり、長文処理では設計での制御が必須
- エージェント実行・ツール呼び出し・抽出・ルーティングではHaiku 5.5を上回るが、知識質問は21.1%と弱くスタンドアロンQ&A用途には不向き
- OpenAI互換のResponses APIとAnthropic Messages互換APIの両方を提供しており、既存のOpenAI・Anthropic SDKからbase_urlの差し替えで移行できる
Microsoft MVP・AIパートナー。LinkX Japan株式会社 代表取締役。東京工業大学大学院にて自然言語処理・金融工学を研究。NHK放送技術研究所でAI・ブロックチェーンの研究開発に従事し、国際学会・ジャーナルでの発表多数。経営情報学会 優秀賞受賞。シンガポールでWeb3企業を創業後、現在は企業向けAI導入・DX推進を支援。
Muse Ember(ミューズ・エンバー)は、Meta Superintelligence Labsが2026年11月9日に発表した、同ラボ史上最軽量・最安のエージェント実行向けモデルです。
基本単価は入力$0.10・出力$0.50(100万トークンあたり)で、Claude Haiku 5.5と同じIntelligence Index 36のスコアを1タスクあたり約1/3のコストで実現します。
Muse Wonderが計画を立て、Muse Emberが量をさばく——このハイブリッド設計を前提とした、エージェント量産時代の新しい主力候補です。
本記事では、Muse Emberの性能ベンチマーク・料金体系(200Kを境に3倍跳ね上がる「200K Catch」を含む)・使い方と対応プラットフォーム・Wonder+Emberの2段構え運用パターン・Claude Haiku 5.5との使い分け・制限と注意点を、2026年11月時点の最新情報で体系的に解説します。
目次
Muse Emberとは?Meta Superintelligence Labsの最軽量エージェント実行モデル
Muse Emberの性能ベンチマーク——Claude Haiku 5.5と同点ながら用途が偏る
Muse WonderとEmberの2段構え運用——公式の実装例から見る設計パターン
Muse Emberとは?Meta Superintelligence Labsの最軽量エージェント実行モデル
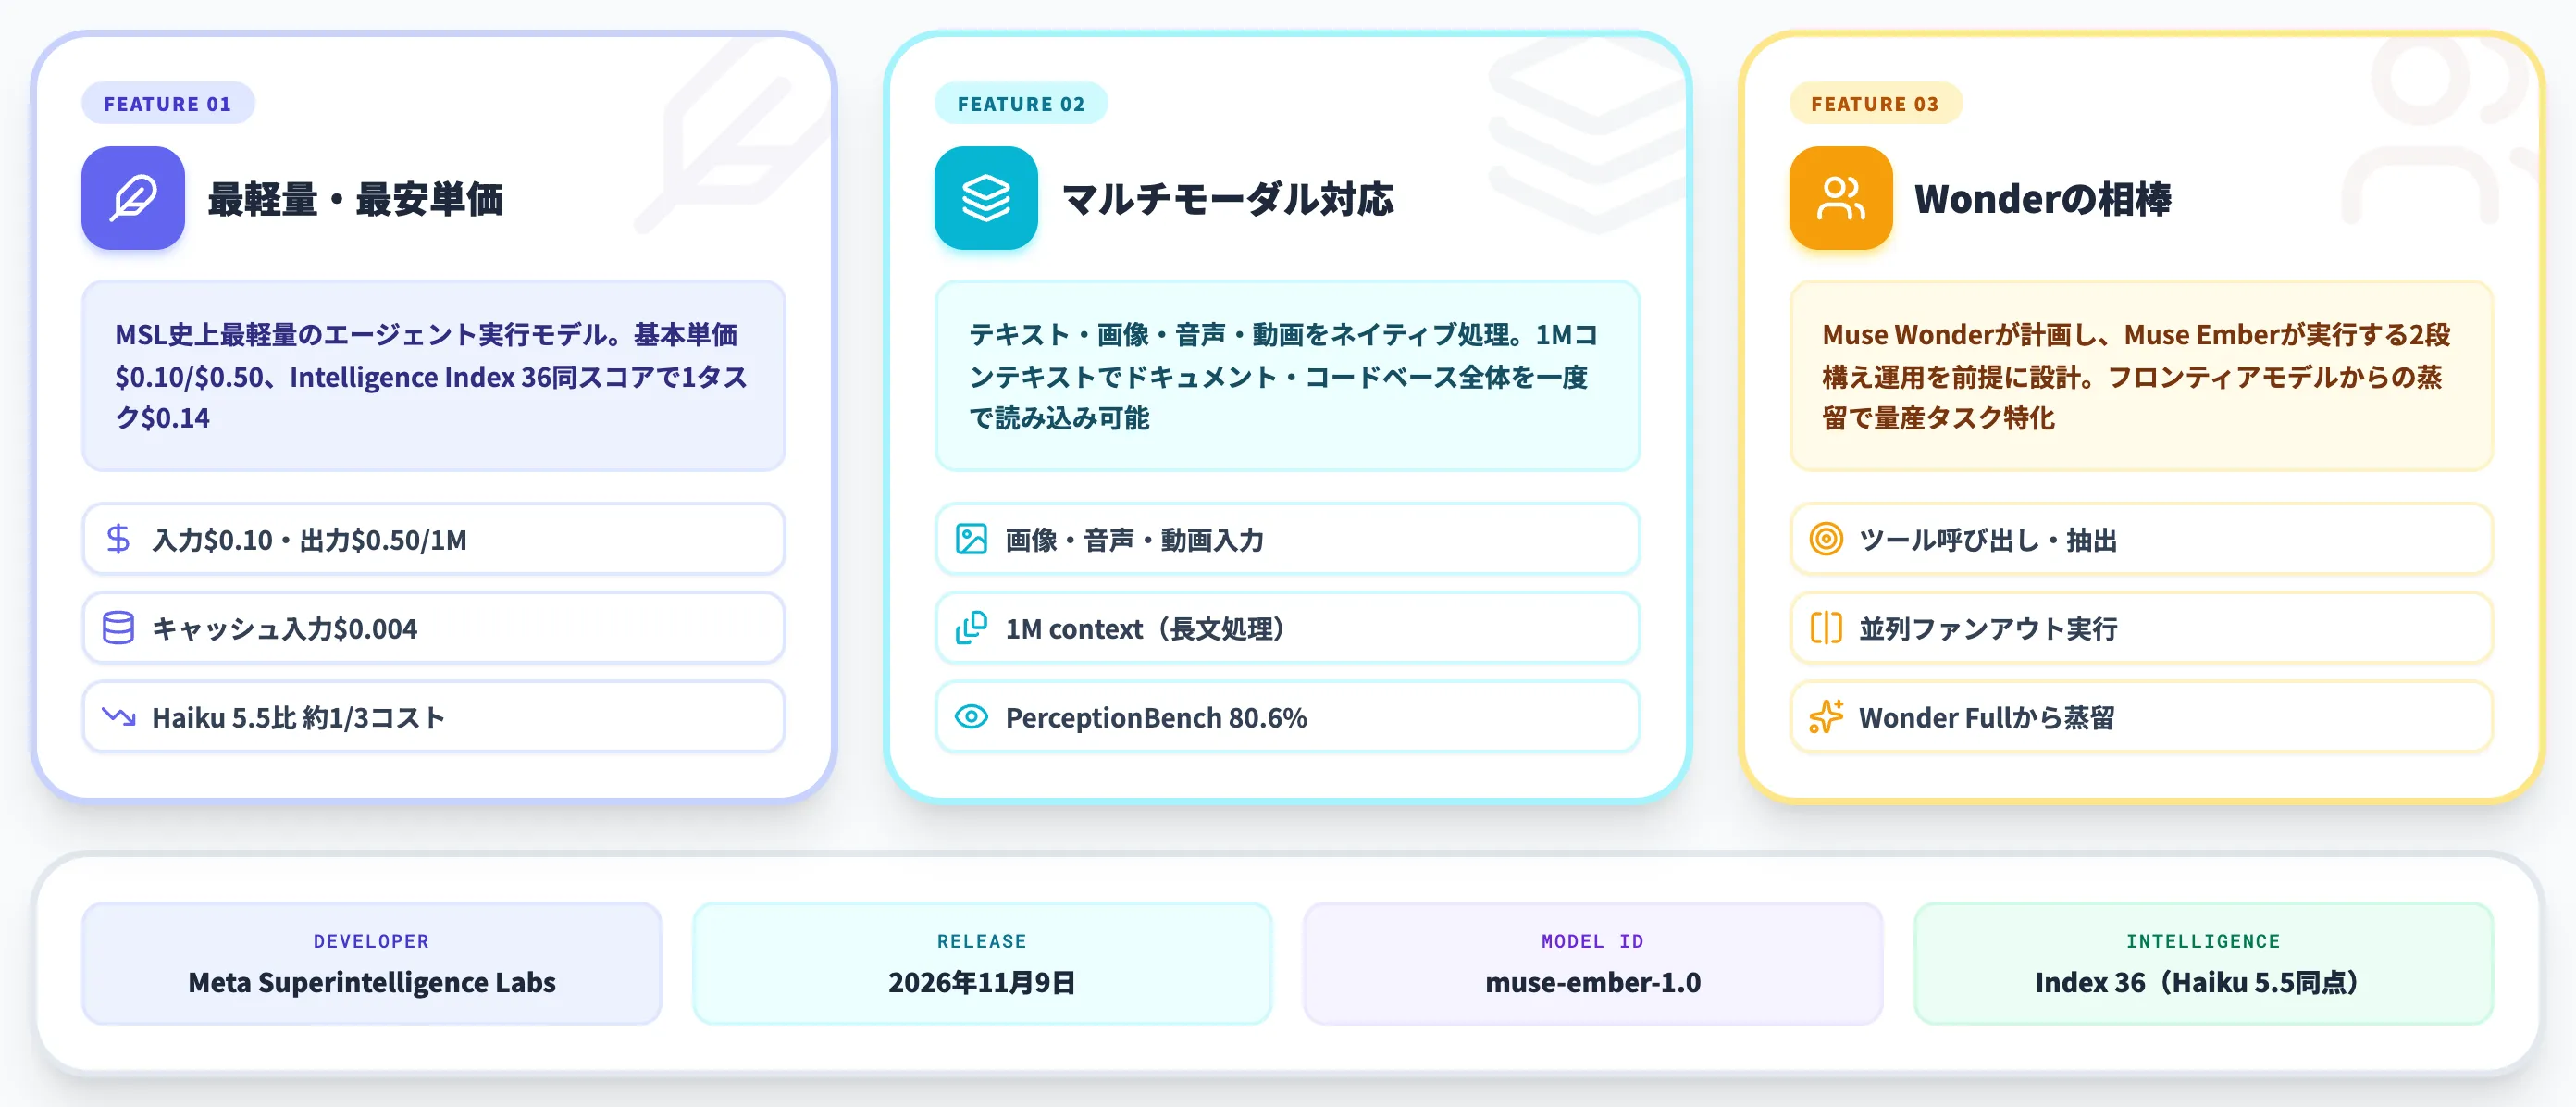
Muse Emberは、Meta Superintelligence Labs(MSL)が2026年11月9日に発表した、同ラボ史上最軽量かつ最もコスト効率の高いエージェント実行向けAIモデルです。
Meta公式ブログでは、Muse Emberを「複雑な推論の実行や、エージェントが1日中繰り返す作業——ツール呼び出し、コーディングのサブタスク、ルーティング、情報抽出、長文ドキュメントのパース——に設計したモデル」と説明しています。
ベースの料金は入力$0.10・出力$0.50(100万トークンあたり)で、フロンティアモデルと比べて一桁から二桁安い価格帯に位置します。
Meta自身は「Muse Wonderが計画を立て、Muse Emberが量をさばく」("Muse Wonder plans, Muse Ember handles the volume")という2段構えの運用を前提に設計しており、単独で使うよりも上位モデルとのペアで本領を発揮する立ち位置です。
Muse Emberローンチキービジュアル(出典:Meta公式blog Build with Muse Ember)
Muse系モデルの中での位置づけ
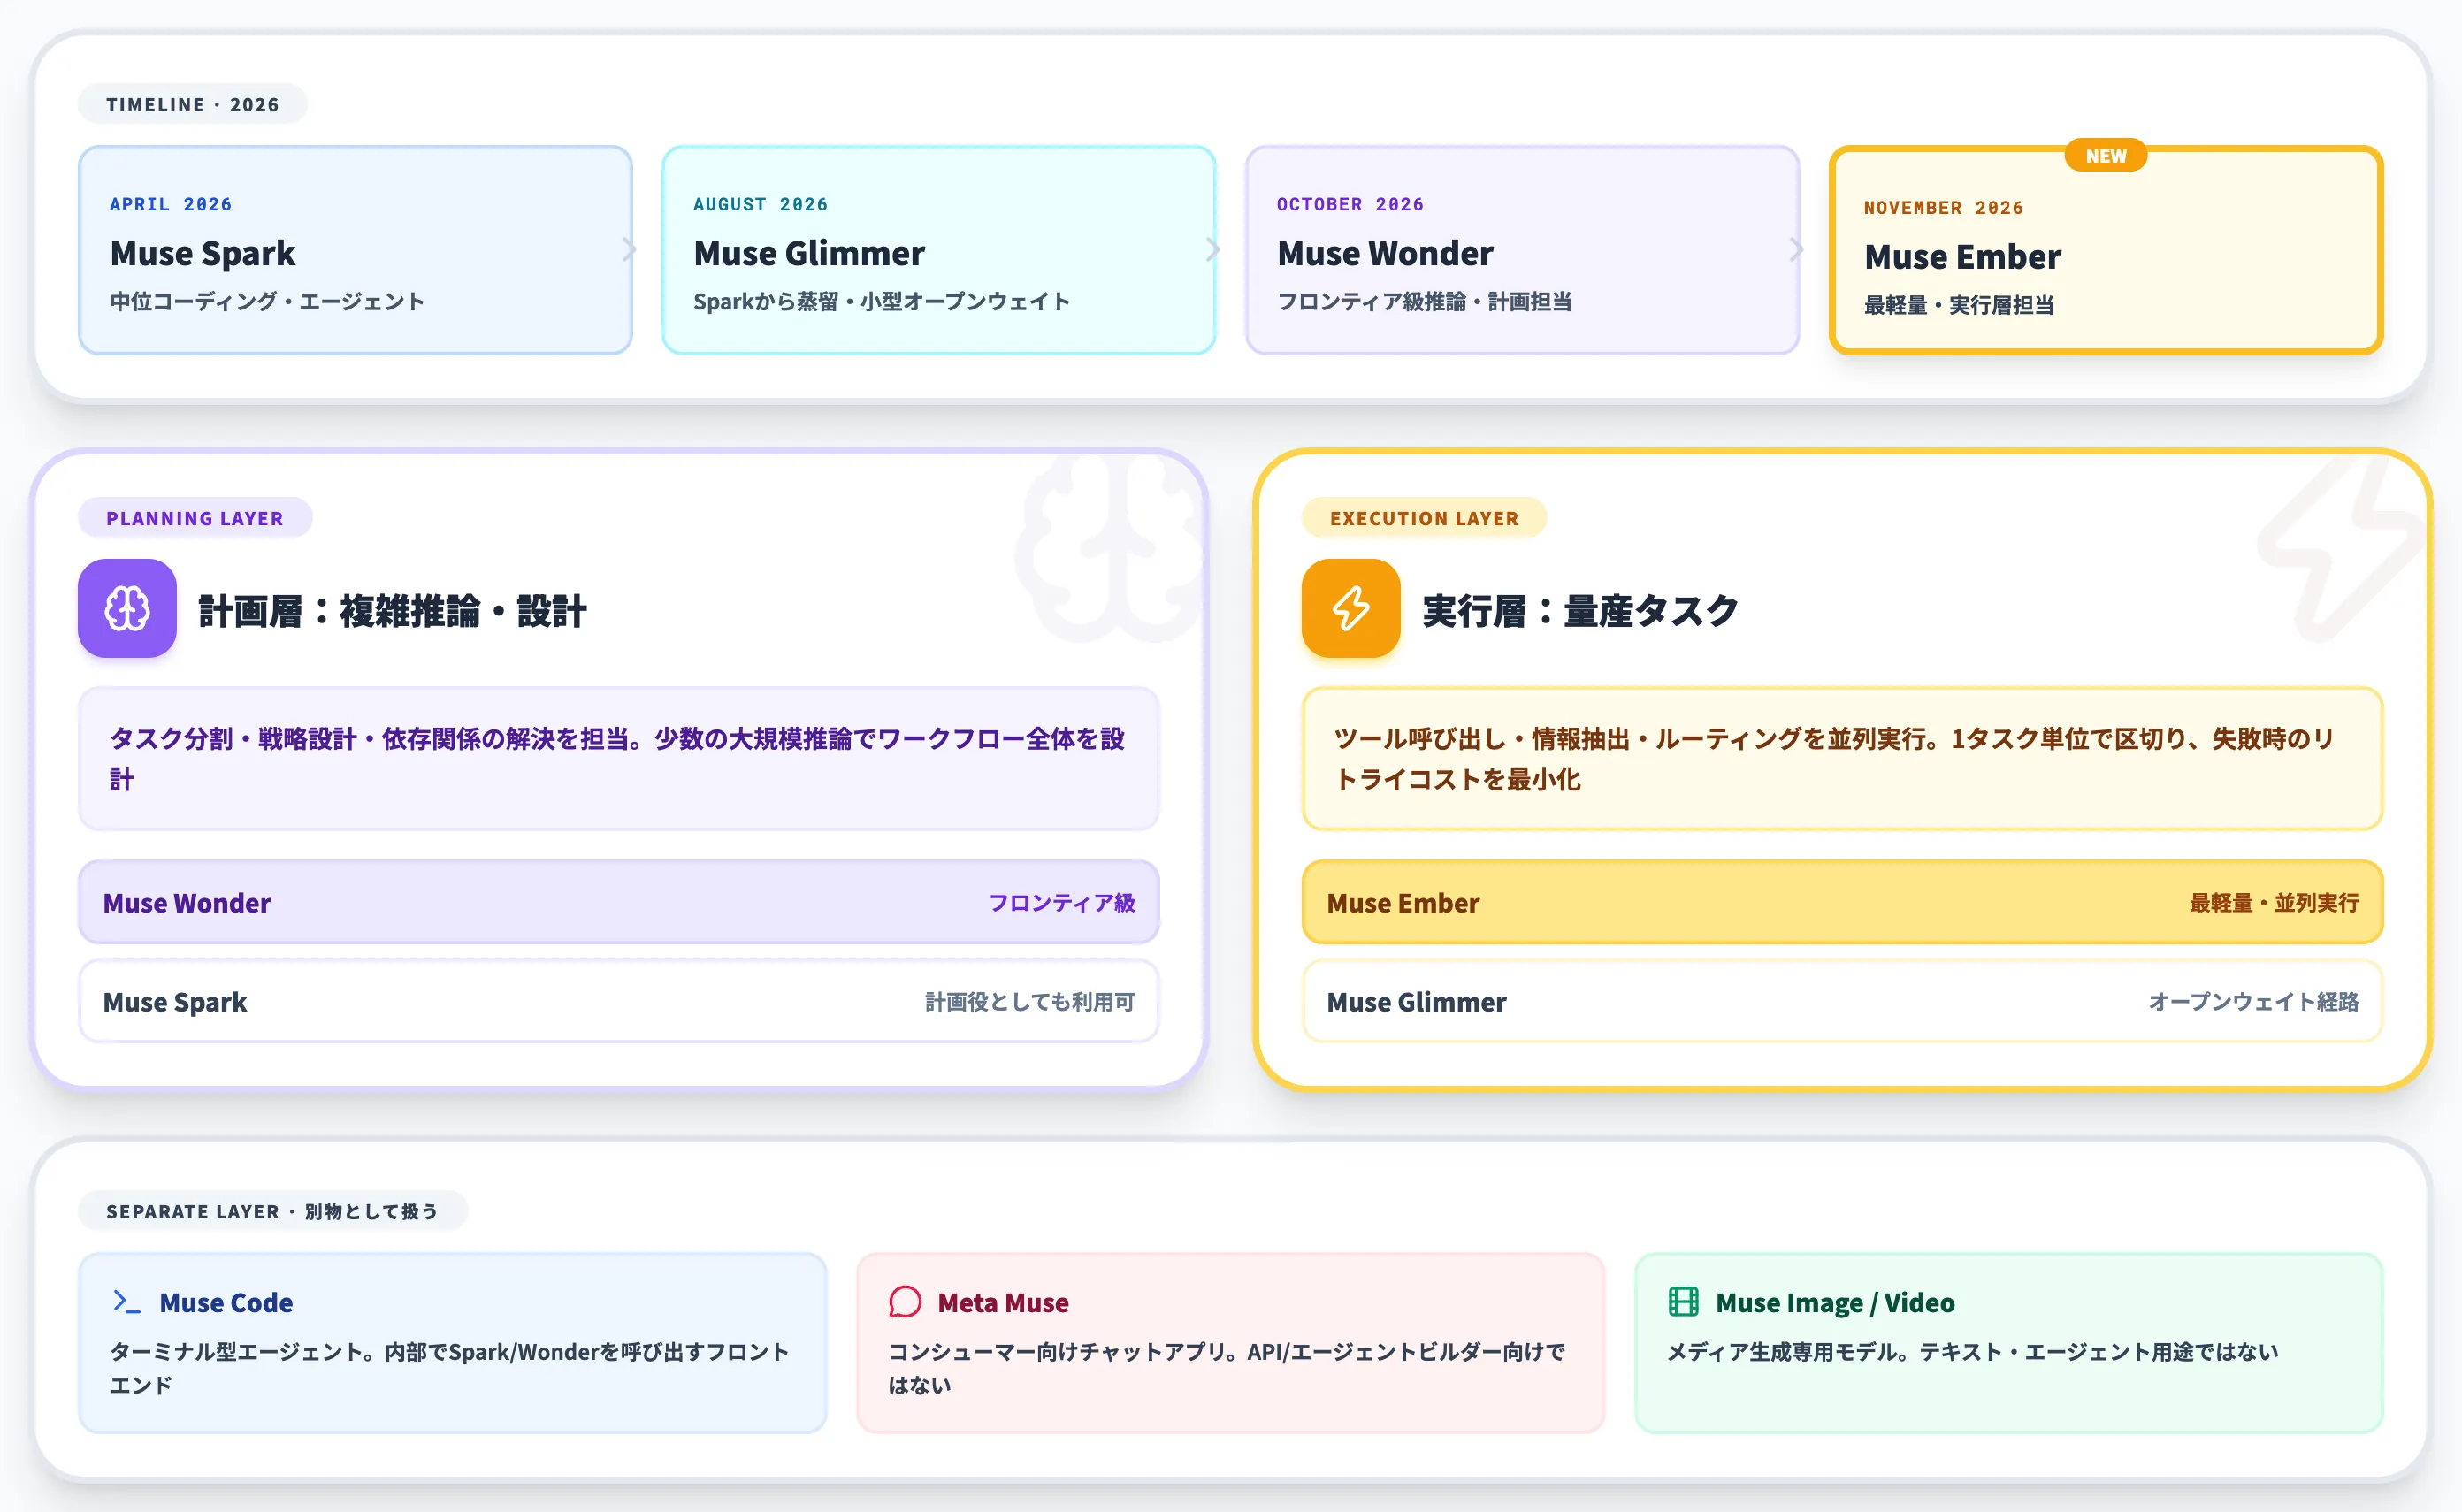
Muse Emberを理解するうえで最初に押さえるべきは、Metaが2026年中に段階的に拡張してきたMuse系モデル群の中で、量産タスク実行を担うポジションという点です。
以下の表で、本記事と関連の深い主要Museモデルの系譜と担当領域を整理しました。
| モデル | 発表 | 位置づけ | 主要用途 |
|---|---|---|---|
| Muse Spark | 2026年4月 | 中位のコーディング/エージェント向けモデル | 日常的なコード生成・エージェントタスク |
| Muse Glimmer | 2026年8月 | Sparkから蒸留した小型モデル | 軽量な推論・コスト抑制用途 |
| Muse Wonder | 2026年10月 | フロンティア級の推論モデル | 複雑な計画・設計・長尺推論 |
| Muse Ember | 2026年11月 | 最軽量の実行モデル | ツール呼び出し・抽出・ルーティング・量産タスク |
この表から分かるのは、Muse Emberが「Sparkより下、Glimmerとは別軸、Wonderの相棒」という役割で位置づけられている点です。
Metaは軽量モデルを単に追加したのではなく、フロンティア級のWonderで計画層を厚く担い、Emberで実行層の量を一気にさばく設計を強く押し出しています。
公式ブログでは、WonderとEmber以外にSparkも計画役として利用できると紹介されており、計画と実行の線引きは厳格ではなく、タスクに応じた組み合わせが前提です。Muse Emberは「Muse Wonder Fullを使って訓練した最初のモデル」とも説明されており、フロンティアモデルからの蒸留という技術的な位置づけが明確になっています。
Muse Emberの性能ベンチマーク——Claude Haiku 5.5と同点ながら用途が偏る
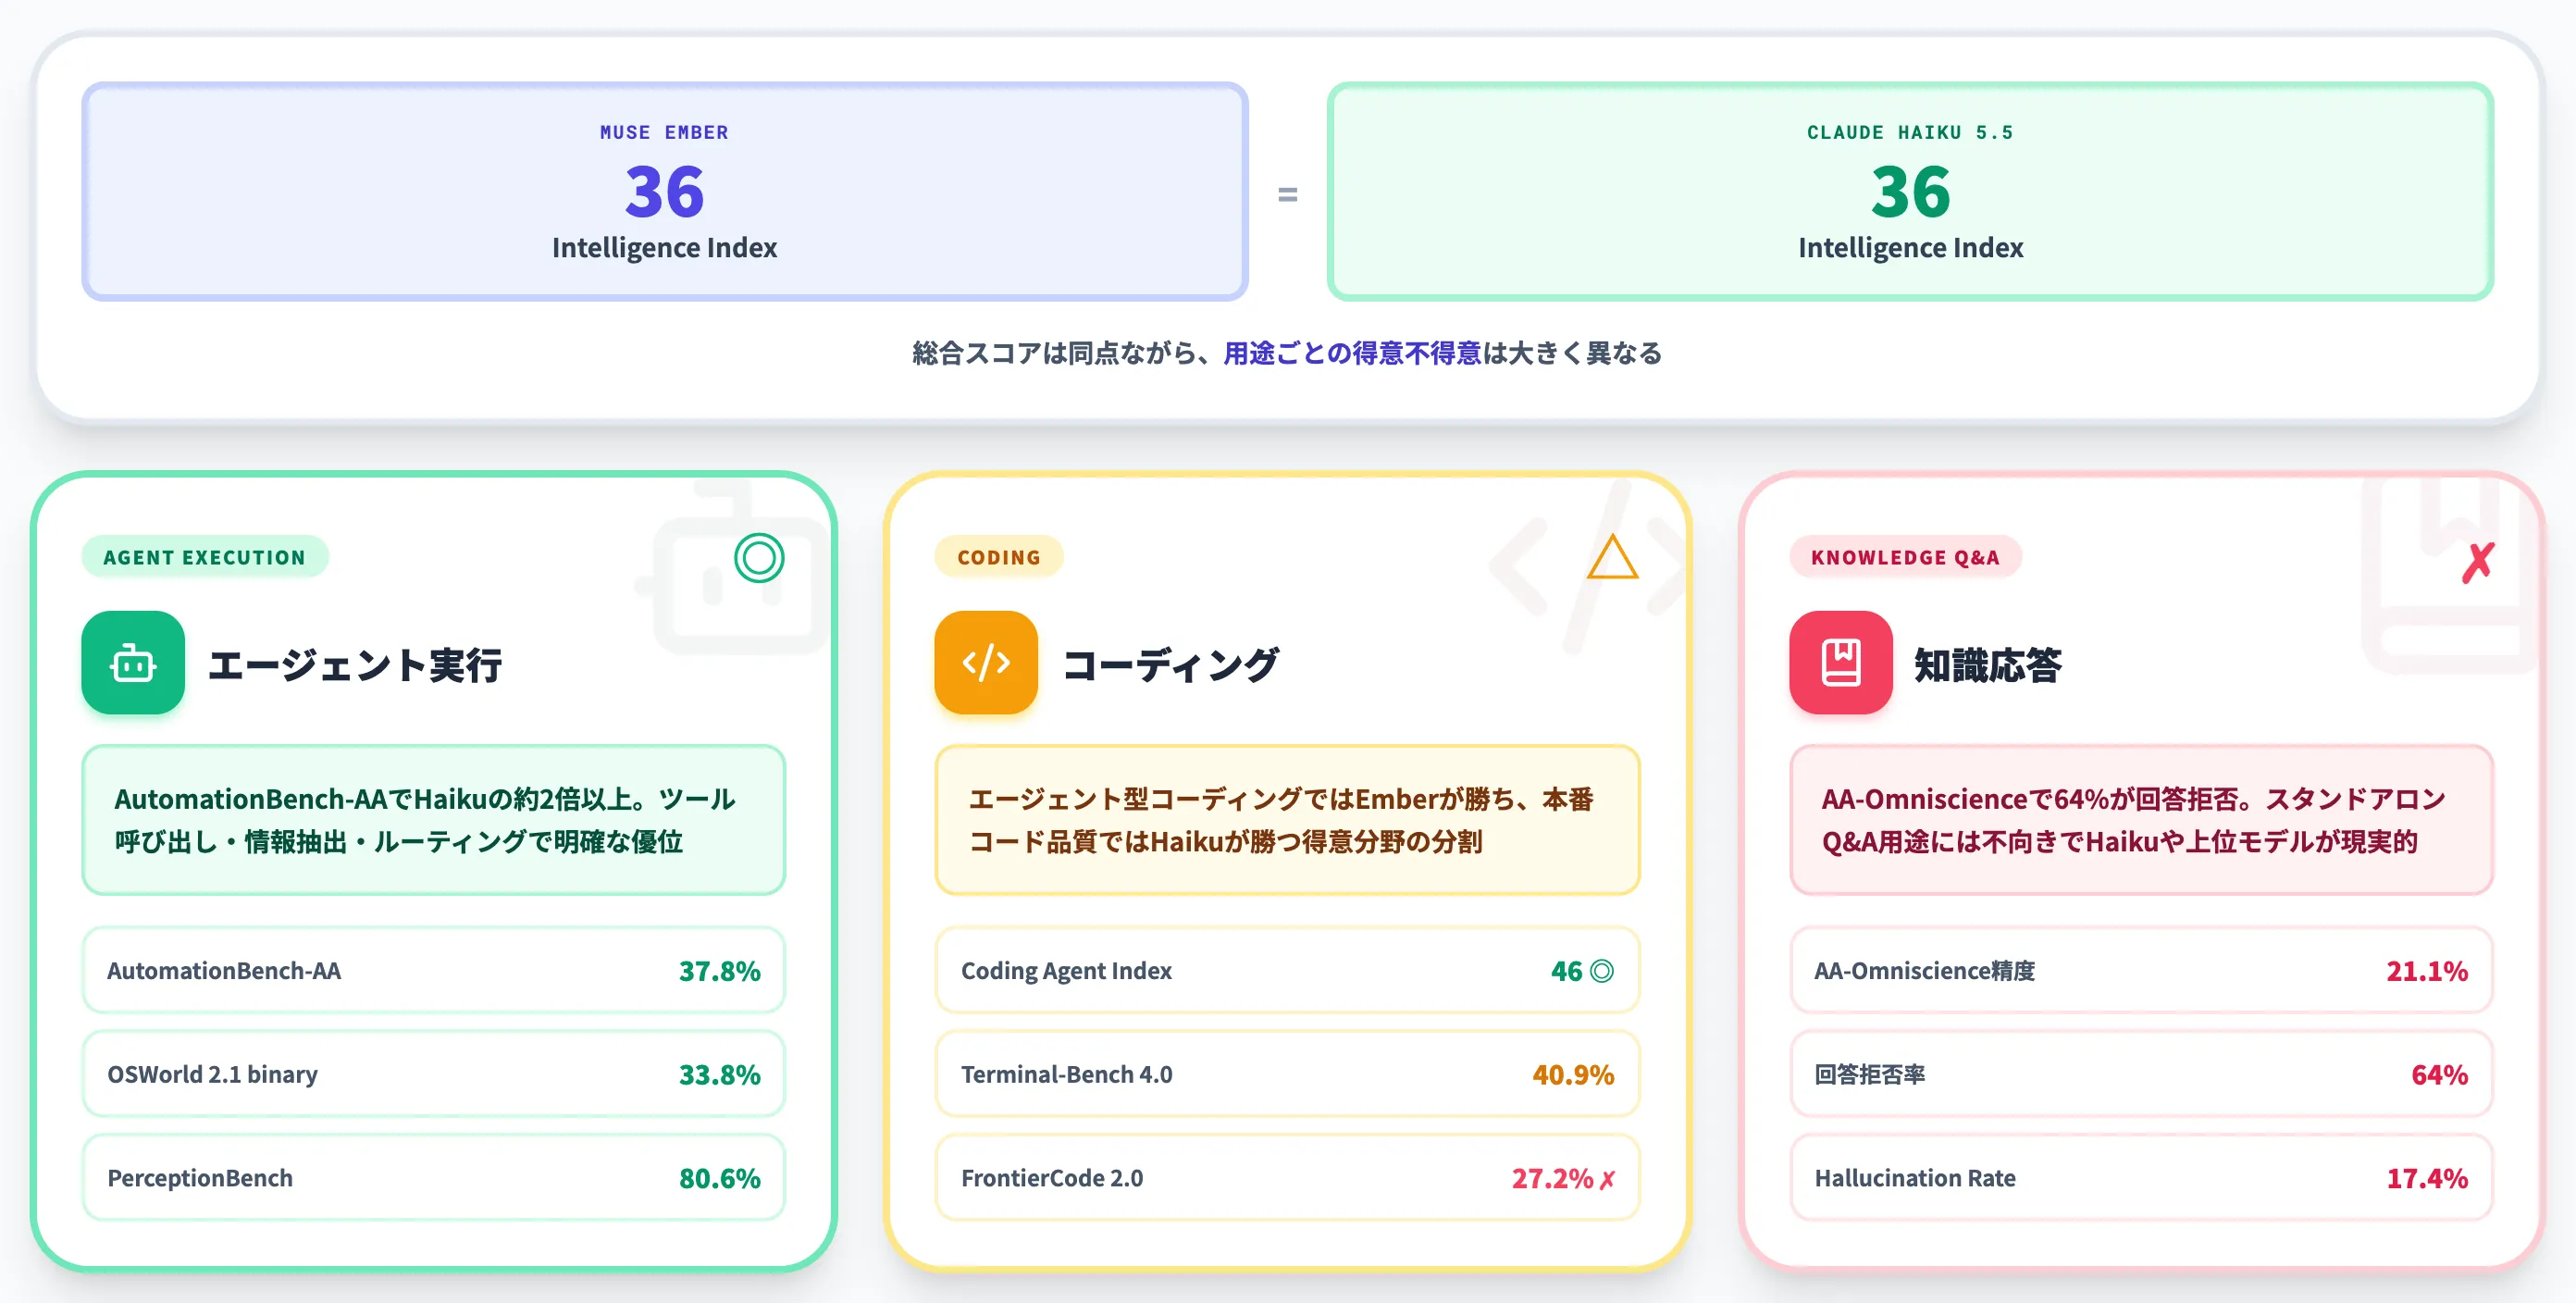
Muse EmberはArtificial Analysis Intelligence Indexで36点を記録し、Claude Haiku 5.5(36点)と同点に並びました。
ただし、総合点が同じでも用途ごとの得意不得意は大きく異なります。
本セクションでは、Metaと第三者の公開しているベンチマーク数値を軸に、Muse Emberが「どこで強く、どこで弱いか」を整理します。
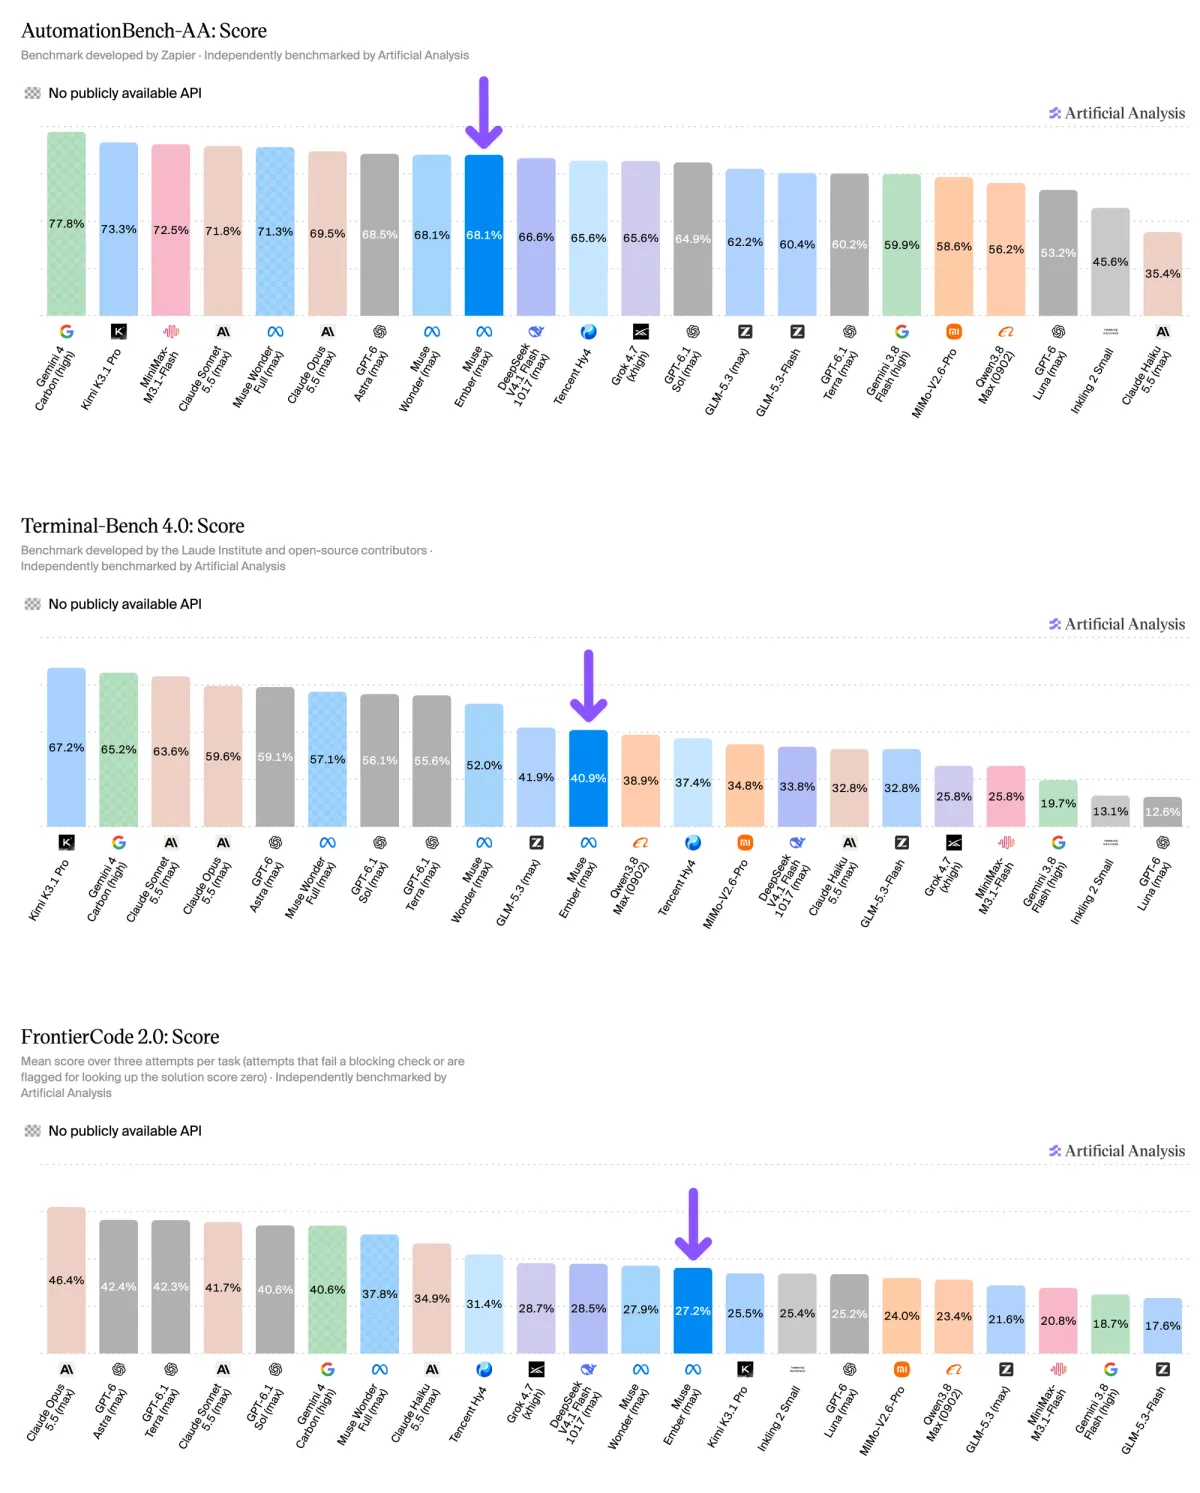
Muse Emberの主要ベンチマーク3指標・AutomationBench-AA / Terminal-Bench 4.0 / FrontierCode 2.0(出典:Artificial Analysis)
3段グラフの上段はエージェント自動化能力、中段はターミナル環境での実行力、下段は本番コード品質を示しています。
紫矢印の位置を見ると、Muse EmberがAutomationBench-AAではトップ帯に食い込み、Terminal-Benchは中位安定、FrontierCode 2.0では下位に沈むという「エージェント実行に特化・プロダクションコード生成は不得意」という得意領域の偏りが一目で読み取れます。
エージェント実行タスクでは明確な優位
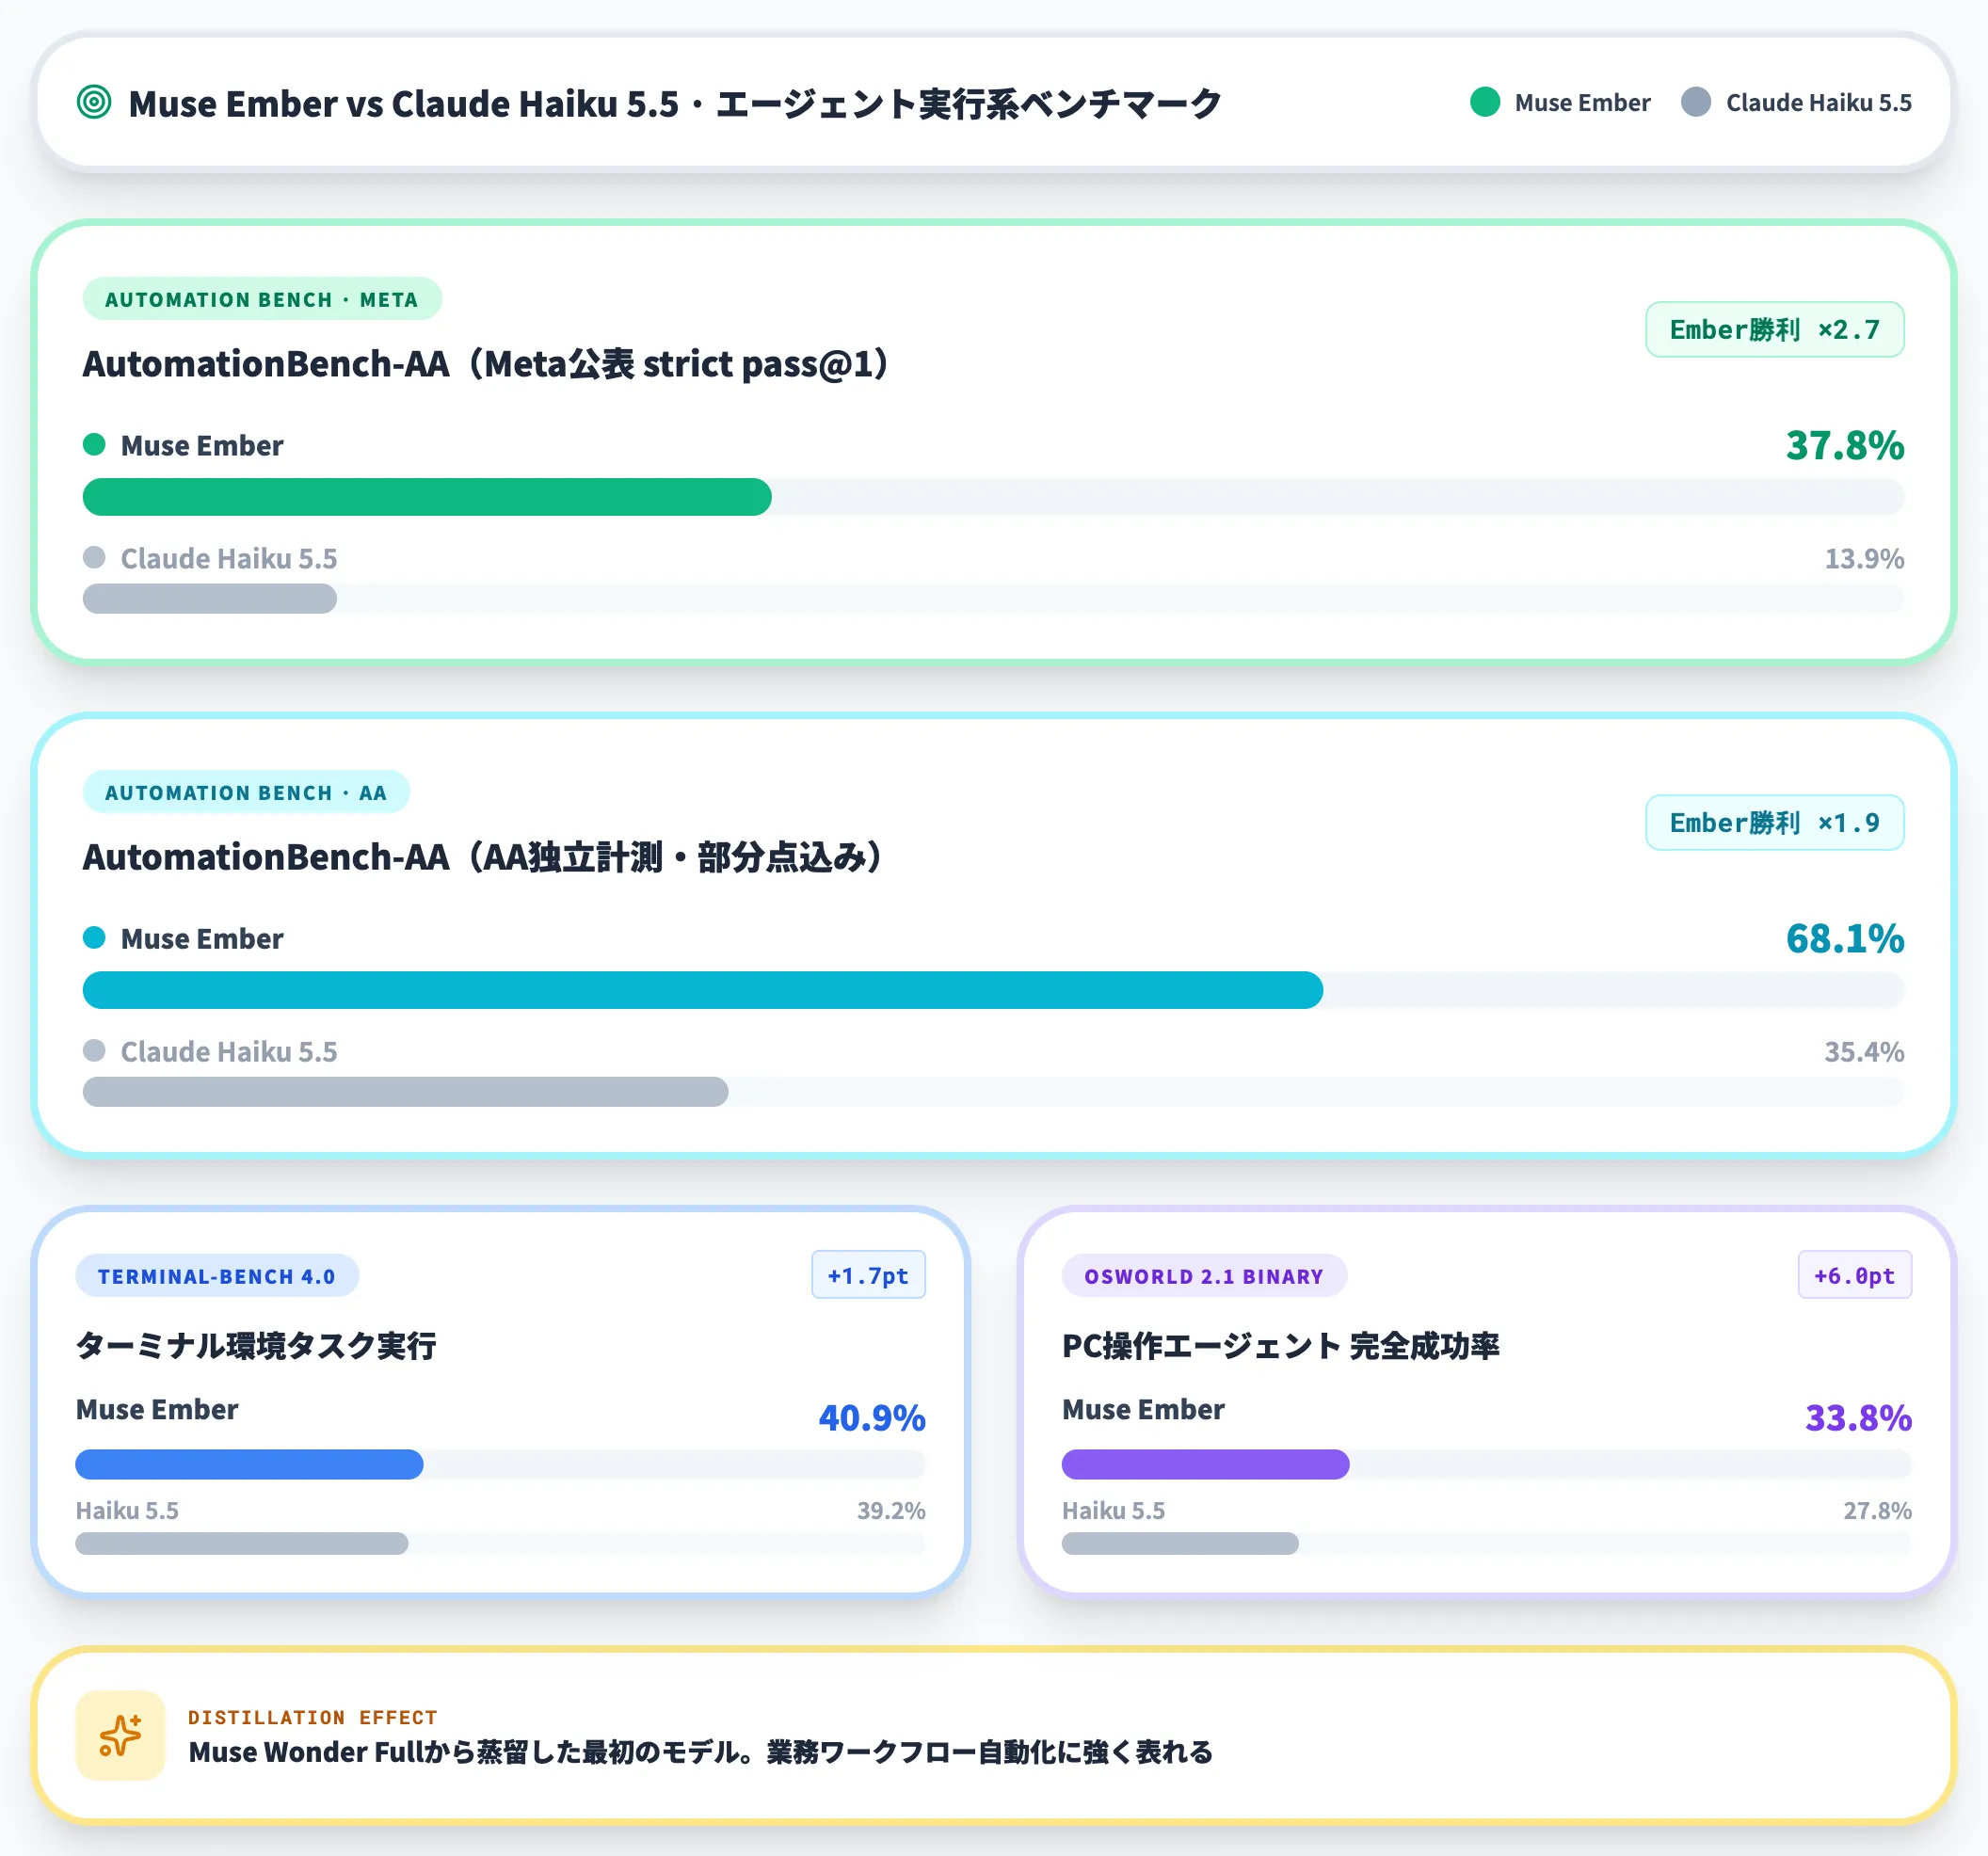
まず、Muse Emberが設計目的としているエージェント実行系のベンチマークでは、同じ軽量帯のClaude Haiku 5.5に対して多くの指標で優位に立つことが確認されています。
以下の表で、エージェント実行関連の主要ベンチマークを比較しました。採点方式やハーネス条件によって数値の桁が変わるため、各行の出典・測定条件を併記しています。
| ベンチマーク | 測定内容・採点方式 | Muse Ember | Claude Haiku 5.5 | 出典 |
|---|---|---|---|---|
| AutomationBench-AA | 業務ワークフローの自動化成功率・Meta公表のstrict pass@1 | 37.8% | 13.9% | Meta公式blog |
| AutomationBench-AA | 目標達成度の部分点評価(ガードレール違反時は0点)・AA独立計測 | 68.1% | 35.4% | Artificial Analysis |
| Coding Agent Index-AA | コーディングエージェントの総合力・AA独立計測 | 46 | 37 | Artificial Analysis |
| Terminal-Bench 4.0 | ターミナル環境でのタスク実行・Meta公表値 | 40.9% | 39.2% | Meta公式blog |
| Terminal-Bench 4.0 | ターミナル環境でのタスク実行・AA独立計測 | — | 32.8% | Artificial Analysis |
| OSWorld 2.1(partial採点) | PC操作エージェントの部分点込み成功率 | 69.5% | 68.9% | Meta公式blog |
| OSWorld 2.1(binary採点) | PC操作エージェントの完全成功率 | 33.8% | 27.8% | Meta公式blog |
| PerceptionBench | マルチモーダル認識 | 80.6% | — | Meta公式blog |
この表から読み取れるのは、Muse EmberがAutomationBench-AAではMeta計測・AA計測ともにClaude Haiku 5.5の約2倍以上のスコアを示す一方、OSWorld 2.1ではpartial採点ではほぼ横並び(69.5% vs 68.9%)、binary採点で約6ポイントのリード(33.8% vs 27.8%)にとどまる、という点です。
「約2倍」のリードはAutomationBench側の話で、OSWorldでは差が限定的だと分けて捉える必要があります。
これはMetaが公式ブログで「Muse Wonder Fullで訓練した最初のモデル」と紹介している通り、フロンティアモデルからエージェント特化のパターンを蒸留した効果が、特に業務ワークフロー自動化系で強く表れていると考えられます。
コーディング用途は得意分野が割れる
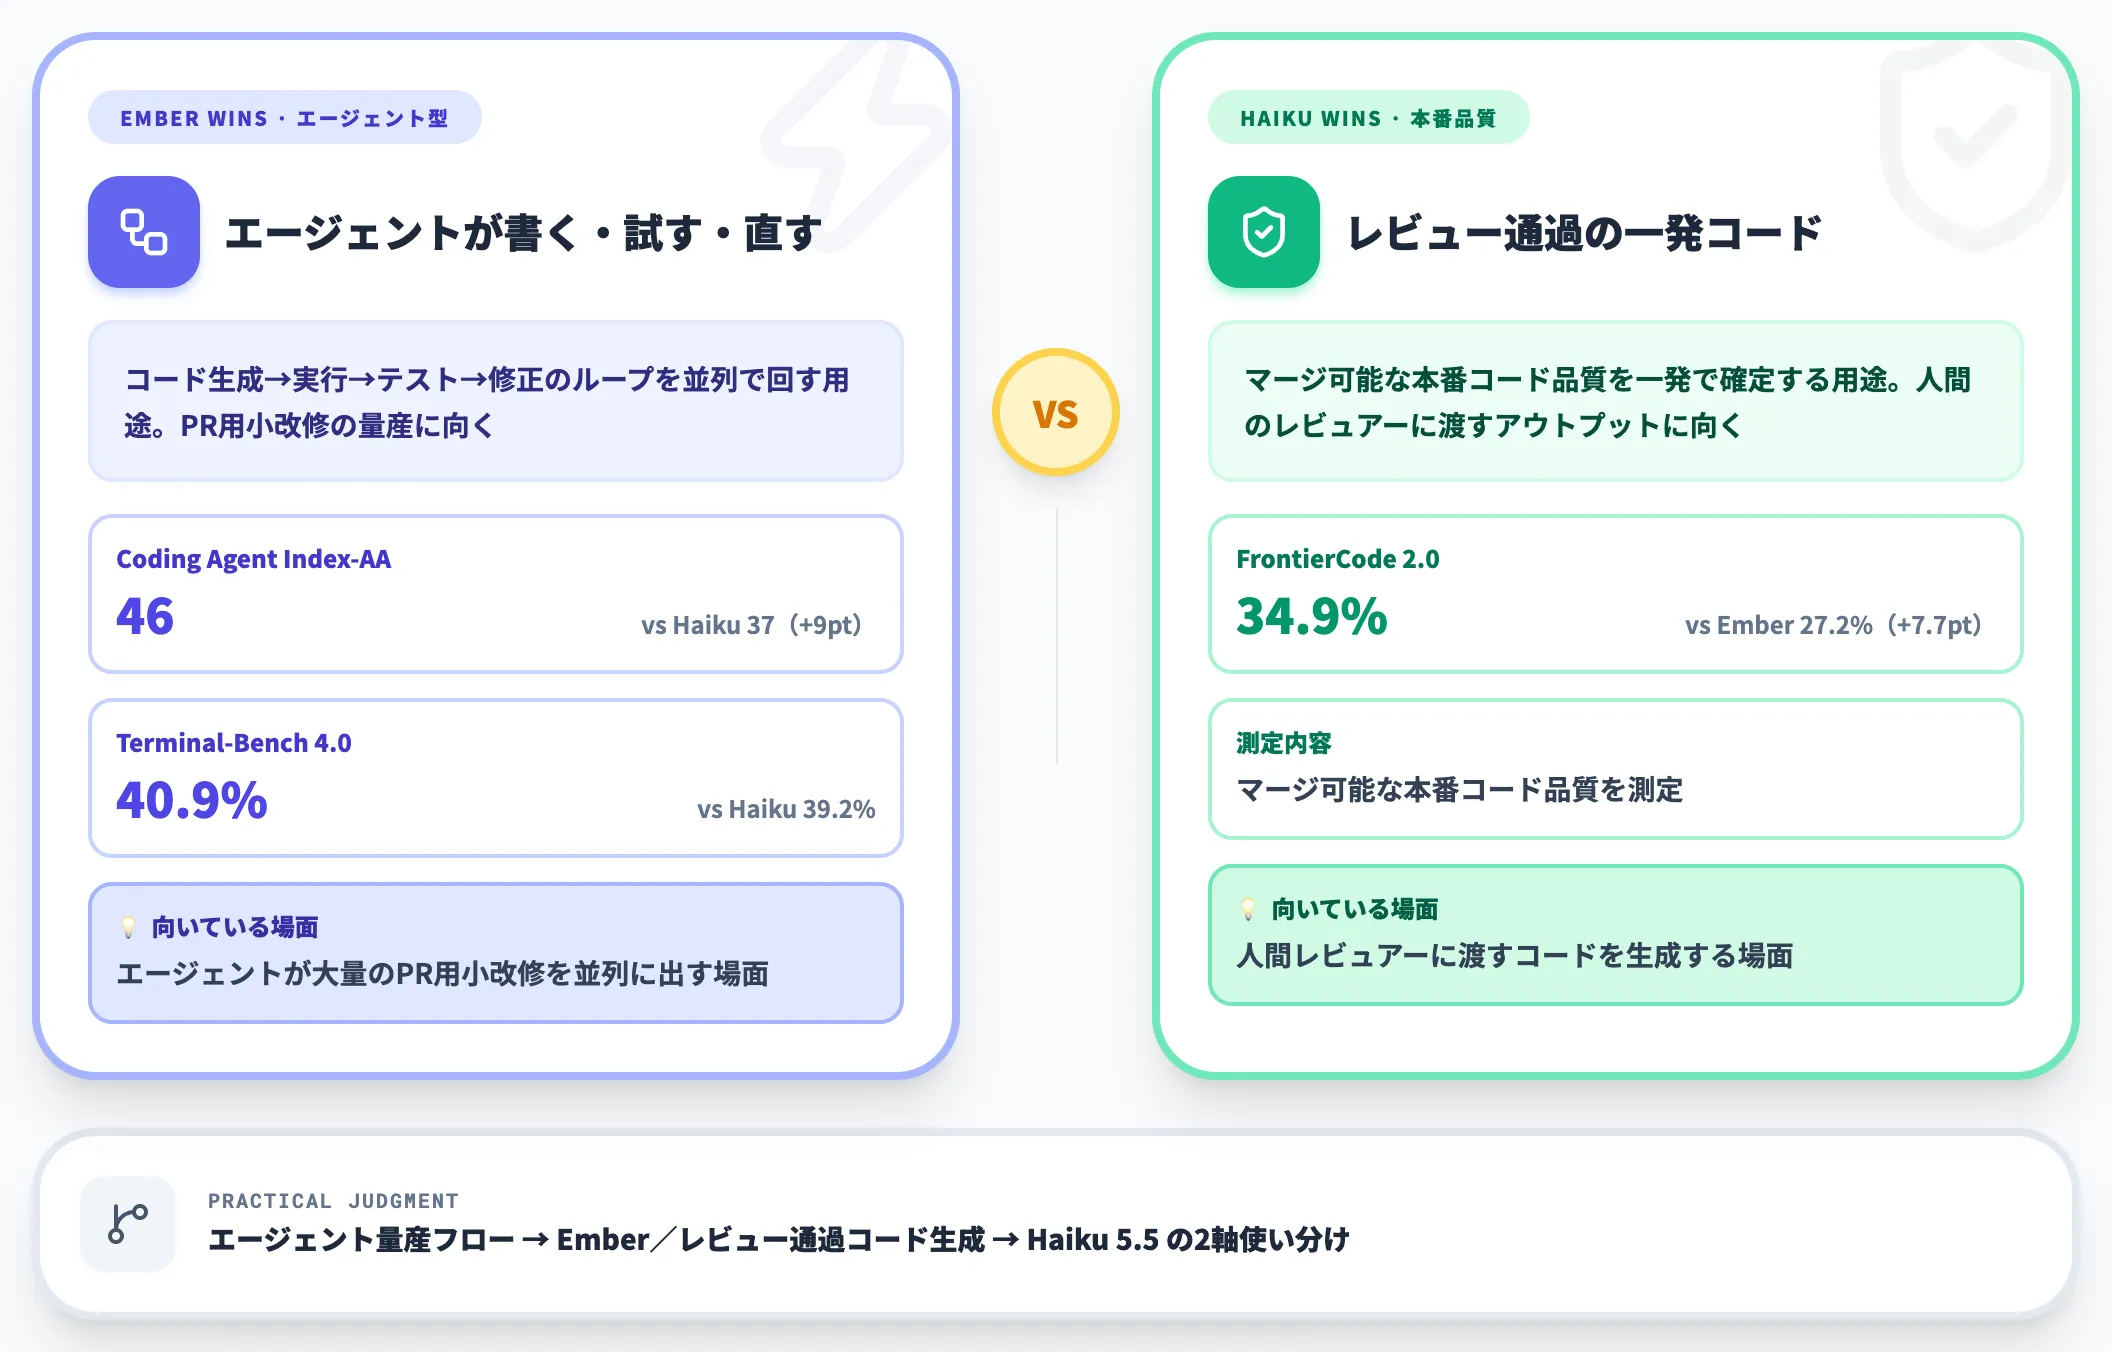
コーディング関連ではやや複雑で、ベンチマークの種類によって勝ち負けが入れ替わります。
- Coding Agent Index-AA
Muse Code経由のコーディングエージェントで測定。Muse Ember 46 vs Haiku 5.5 37で、Emberが明確に優位
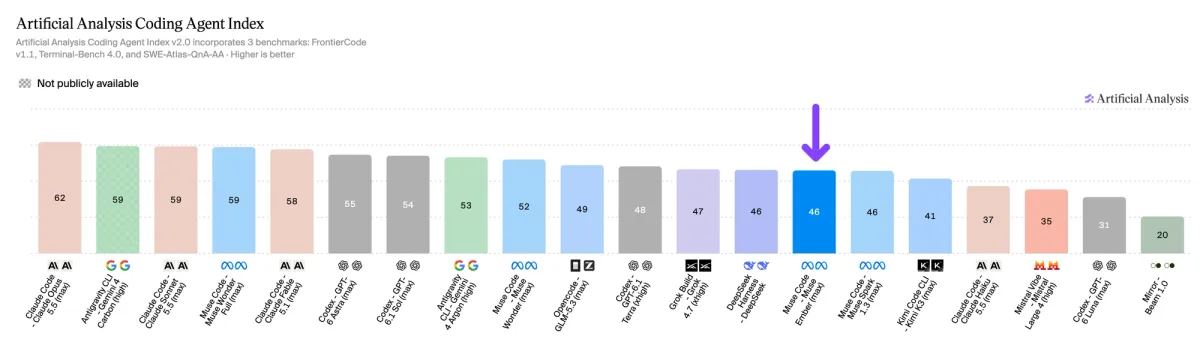
Artificial Analysis Coding Agent IndexでのMuse Code経由Muse Emberのスコア46(出典:Artificial Analysis)
バーの中央に単独で強調されている「Muse Code - Muse Ember(max)」の46は、同じ指標で測ったClaude Haiku 5.5の37を9ポイント上回り、Grok Code CLI(41)やClaude Haiku(37)を明確にリードします。
トップのClaude Code系やCodex系(50点台後半〜60点台)には届かないものの、同価格帯の軽量モデルでは頭ひとつ抜けたコーディングエージェント性能を示しています。
-
Terminal-Bench 4.0
ターミナル環境での一連の操作。Muse Ember 40.9% vs Haiku 5.5 39.2%で、ほぼ拮抗
-
FrontierCode 2.0
マージ可能な本番コード品質を測るベンチマーク。Muse Ember 27.2% vs Haiku 5.5 34.9%で、Haiku 5.5が優位
つまり、「エージェントとしてコードを書き・実行し・テストする」フローではEmberが強いが、「レビューを通過するプロダクションコードを一発で生成する」用途ではHaiku 5.5に軍配が上がるという傾向です。
実務的には、エージェントが大量のPR用小改修を並列に出す場面ではEmber、人間のレビュアーに渡すコードを生成する場面ではHaiku 5.5、という使い分けが現実的な判断軸になります。
知識質問は弱点で64%は回答拒否
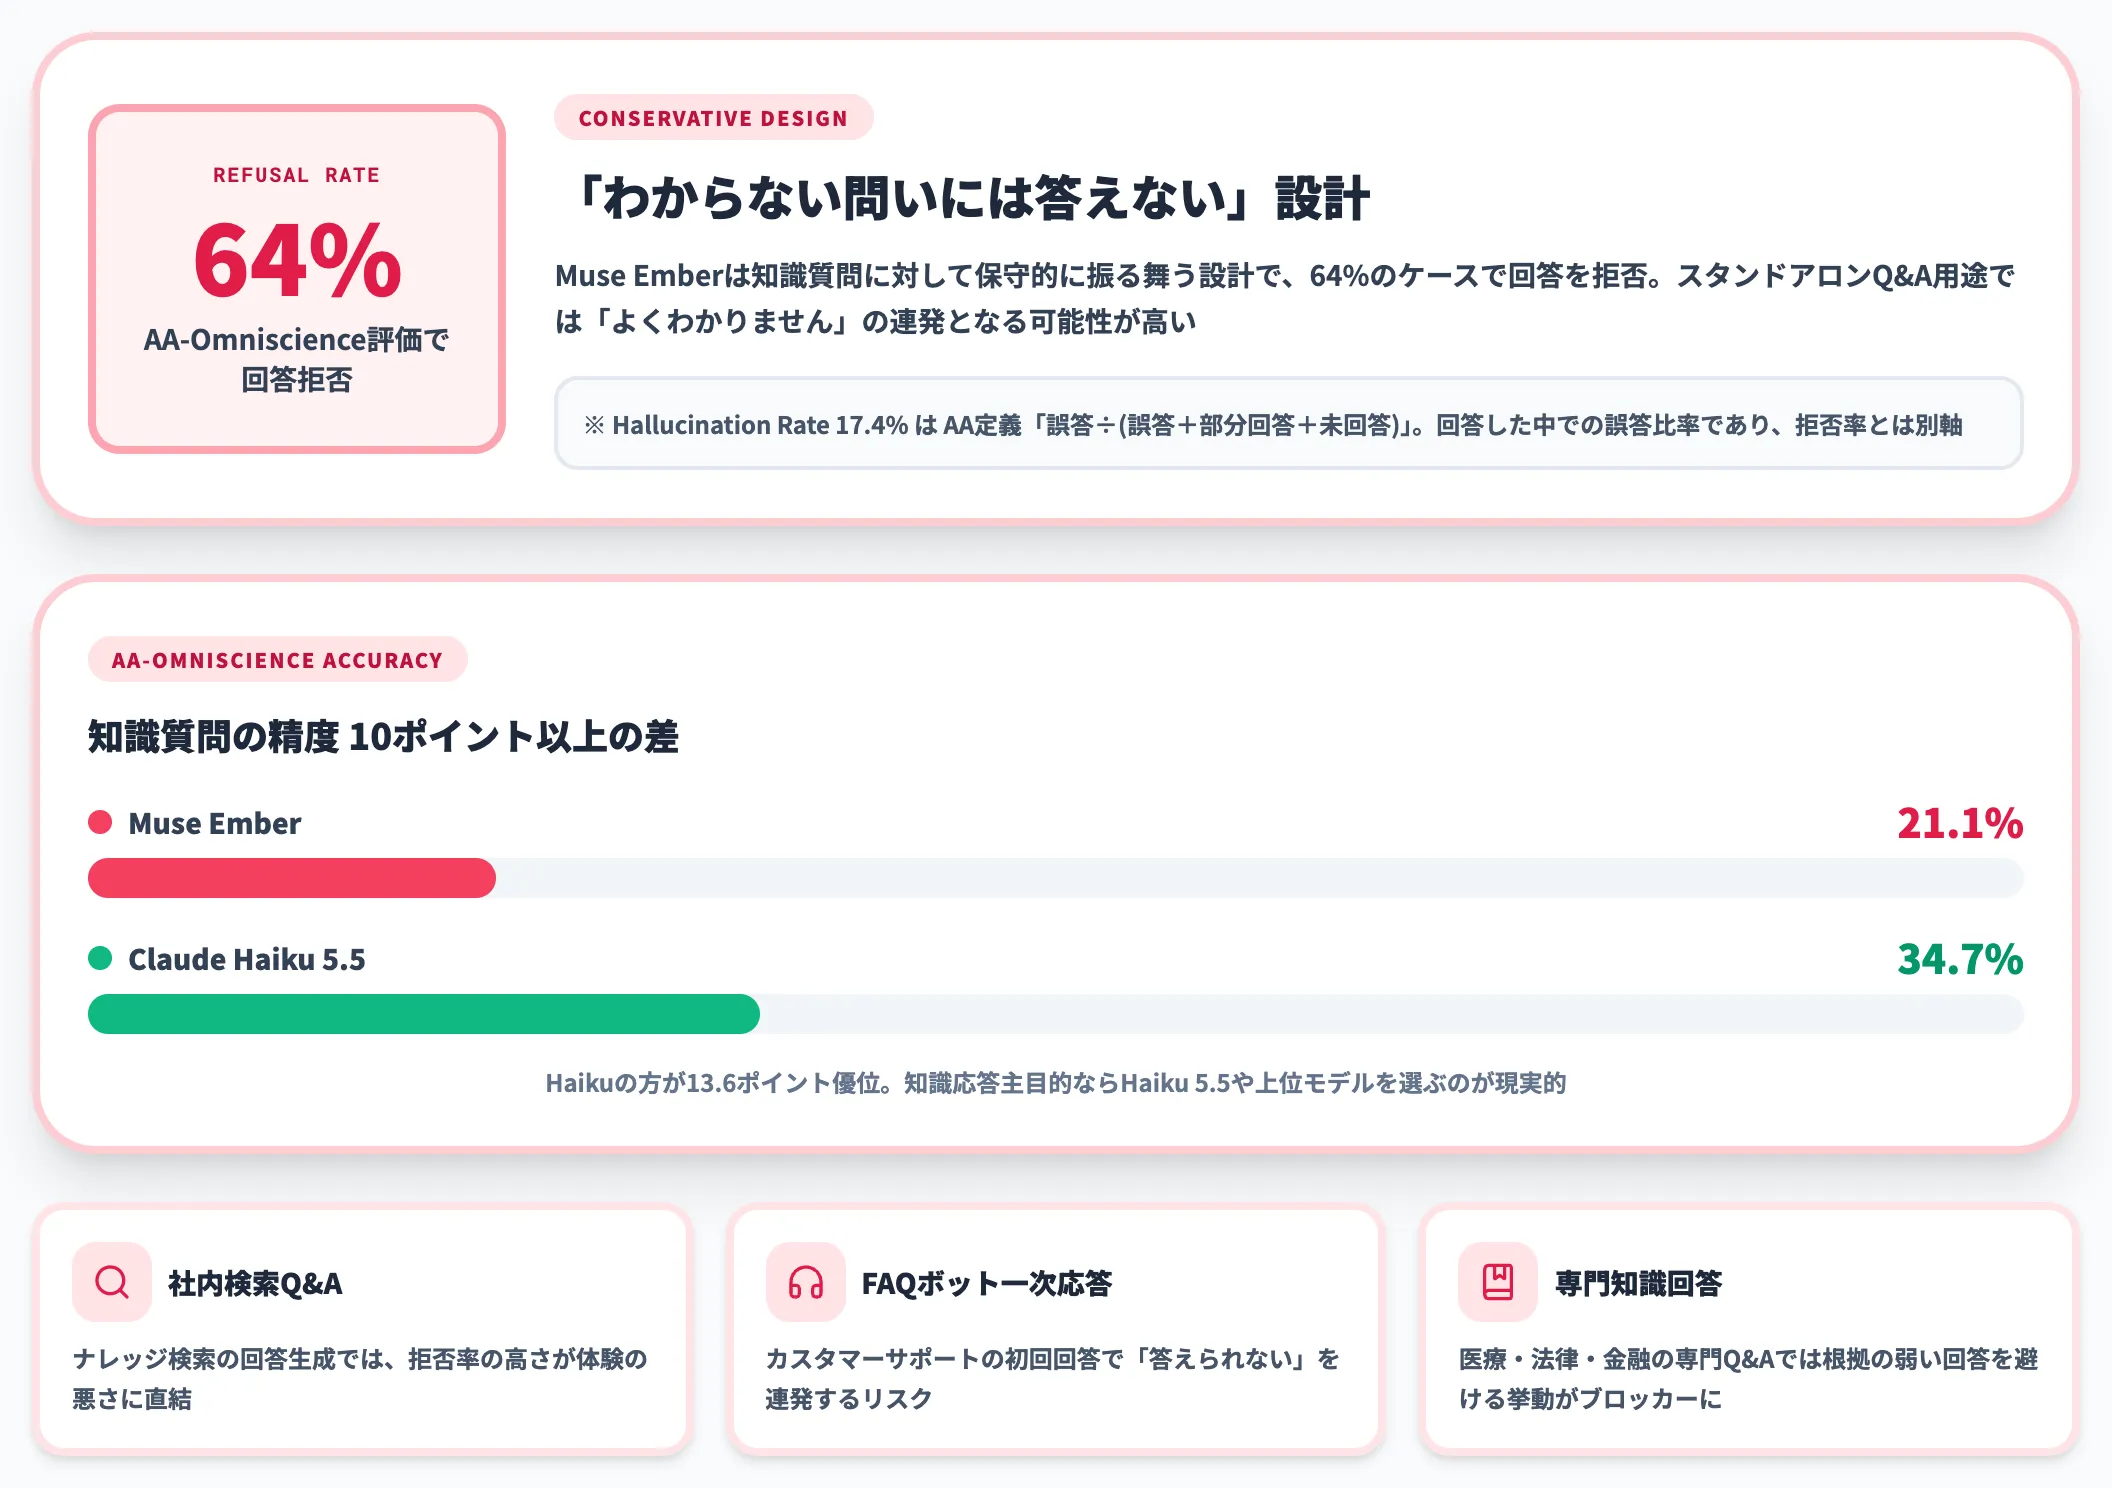
一方で、Muse Emberの明確な弱点がAA-Omniscienceという知識質問の精度ベンチマークです。
Artificial Analysisの検証によれば、Muse EmberのAA-Omniscience精度は21.1%で、Claude Haiku 5.5の34.7%と比べて10ポイント以上の差があります。
さらに特徴的なのが、Muse EmberがAA-Omniscience評価において質問の64%で回答を拒否するという挙動です。Hallucination Rate 17.4%は Artificial Analysis の定義で「誤答を(誤答+部分回答+未回答)で割った値」であり、残り36%の中での比率ではありません。評価上は「わからない問いは答えない」保守的な設計が反映された数値です。
AA-Omniscienceは特定の知識質問データセットでの評価であり、この回答拒否率がエージェントのツール呼び出しや情報抽出ループの挙動へそのまま横展開できるわけではない点には注意が必要です。
それでも、スタンドアロンの知識Q&A用途(FAQボット・社内検索の回答生成など)でMuse Emberを使うと、回答率の低さがそのまま体験の悪さに直結する可能性が高いという示唆は十分に読み取れます。
知識応答が主目的の場面は、Haiku 5.5や、Claude Sonnet 5.5のような上位モデルを選ぶのが現実的です。
Muse Emberの料金体系と「200K Catch」
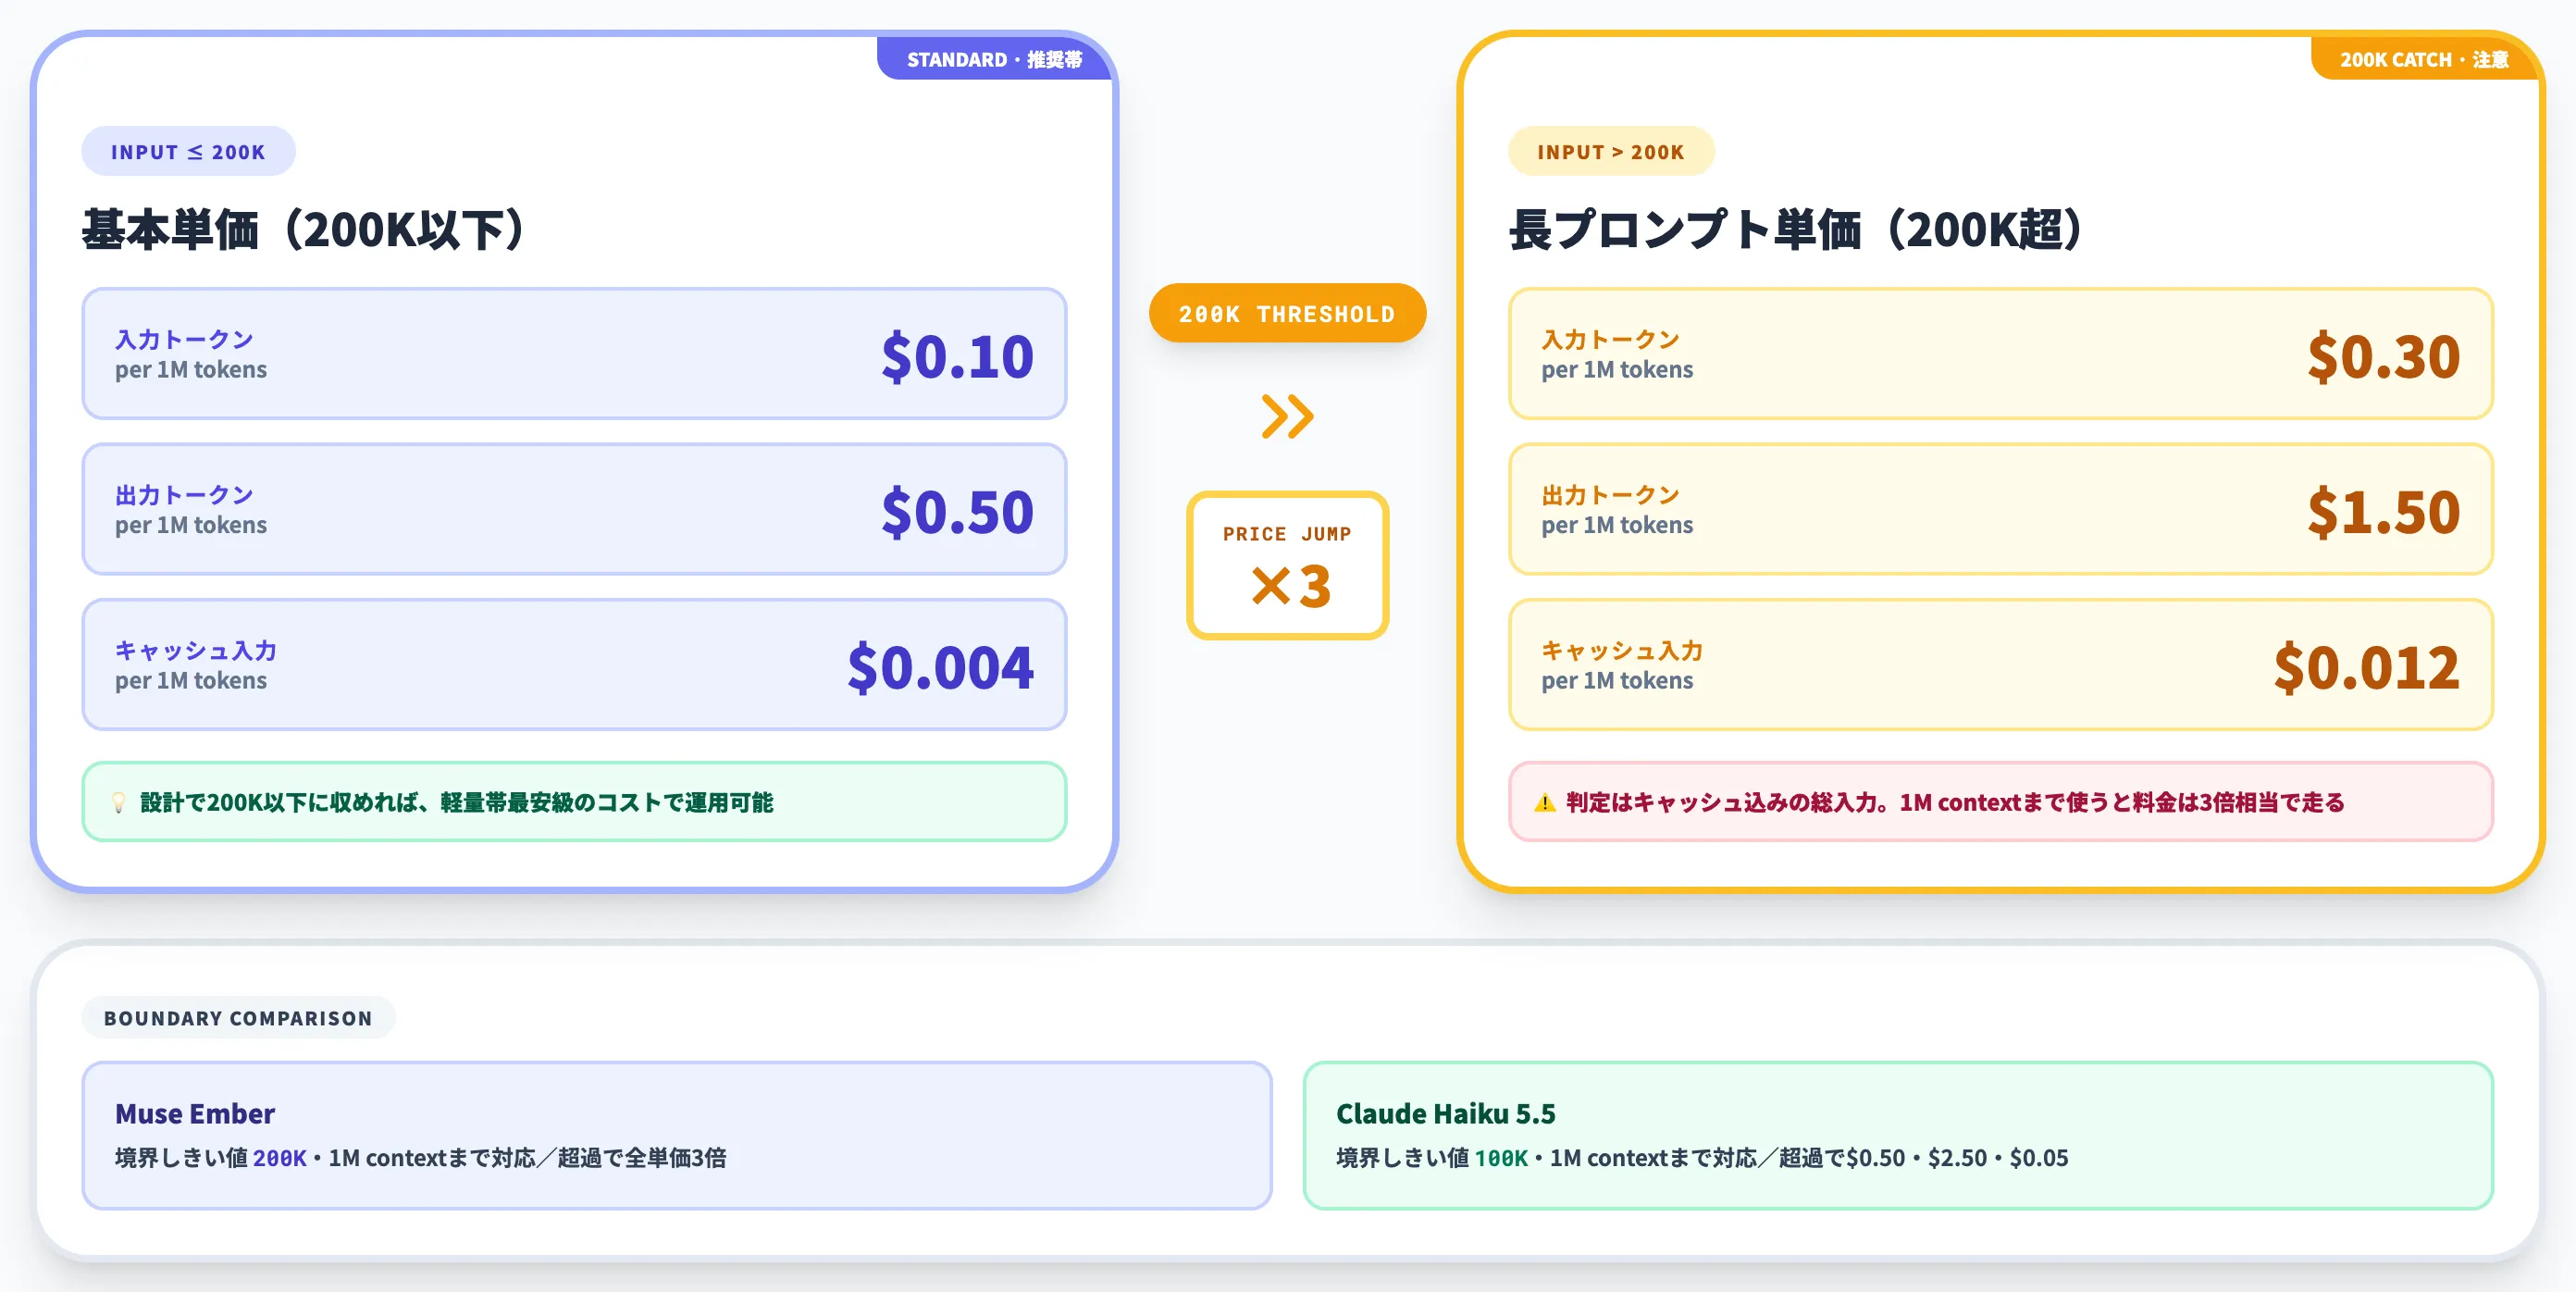
Muse Emberの料金で最も注目すべきは、基本単価と「200K Catch」の2段階構造です。
本セクションでは、基本単価・200K超えの跳ね上がり・キャッシュ入力の優位性・1タスクあたりの実勢コストを順に整理します。
基本単価と200Kしきい値
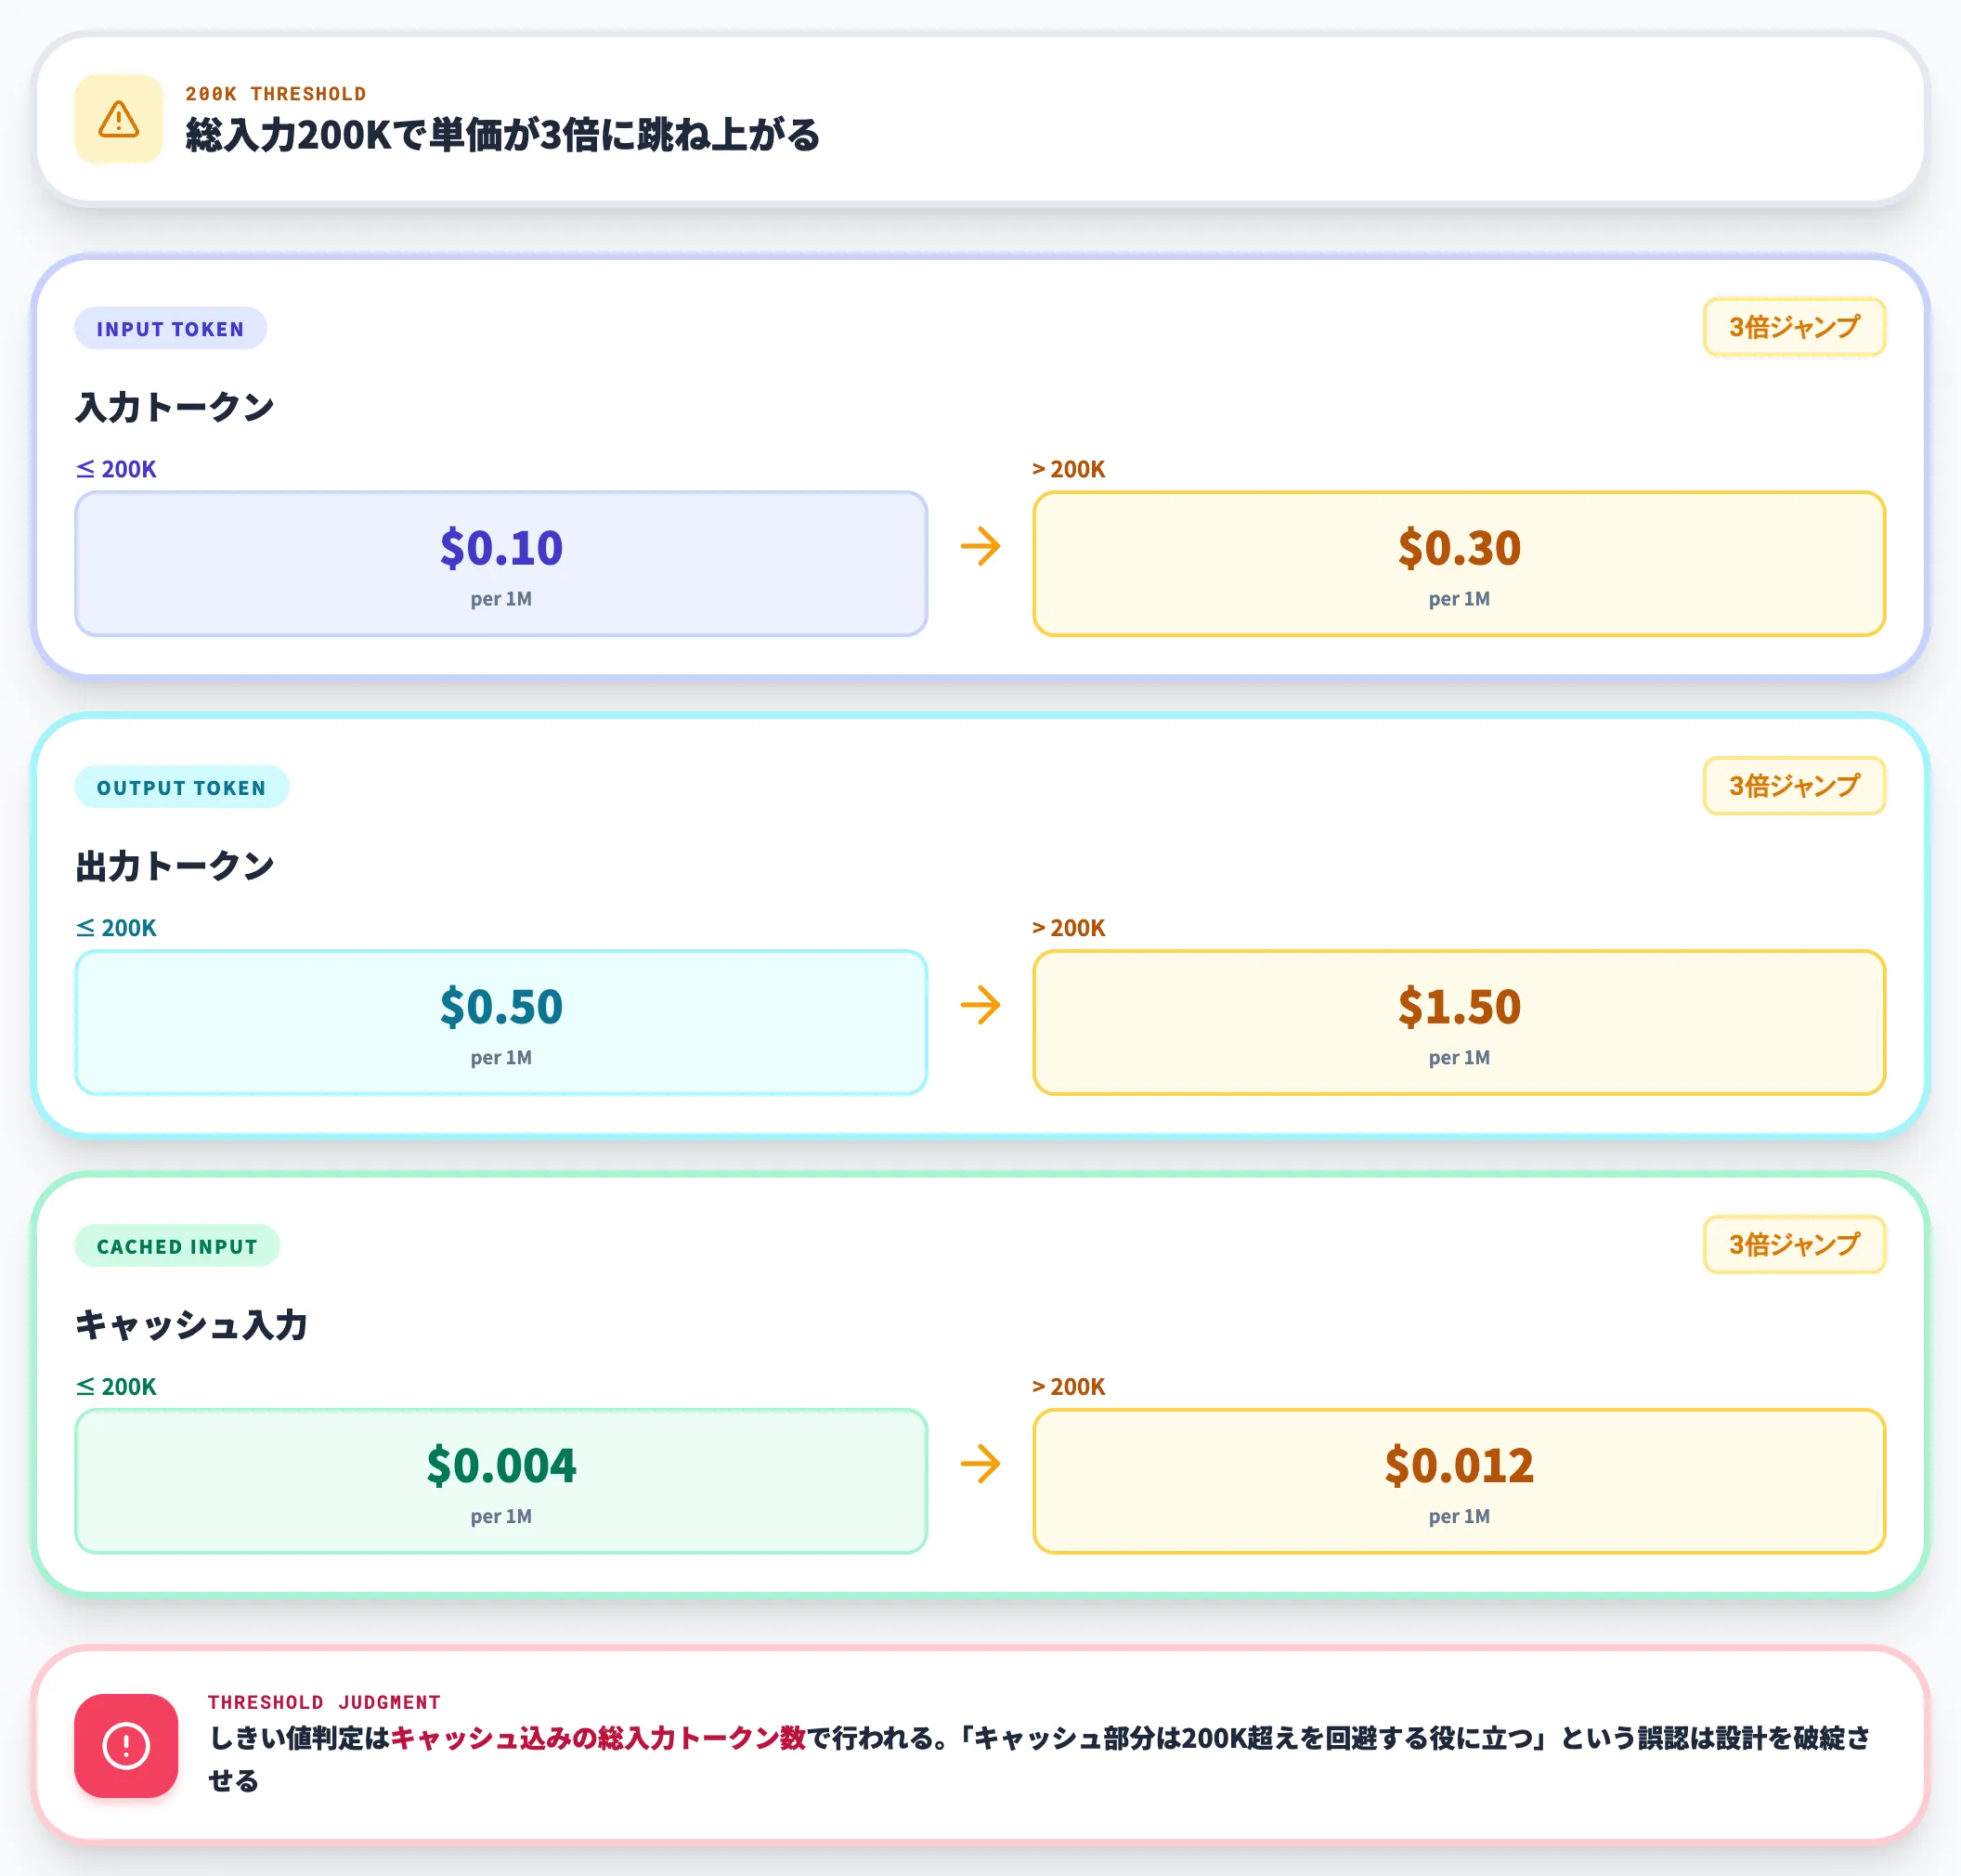
以下の表で、Muse Emberの料金体系を整理しました。
| 項目 | 料金(100万トークンあたり) | 条件 |
|---|---|---|
| 入力トークン | $0.10 | 総入力が200K以下の場合 |
| 出力トークン | $0.50 | 総入力が200K以下の場合 |
| キャッシュ入力 | $0.004 | 総入力が200K以下の場合 |
| 入力トークン(長プロンプト) | $0.30 | 総入力が200Kを超える場合 |
| 出力トークン(長プロンプト) | $1.50 | 総入力が200Kを超える場合 |
| キャッシュ入力(長プロンプト) | $0.012 | 総入力が200Kを超える場合 |
この表が示すのは、総入力が200Kを超えた瞬間に、入力・出力・キャッシュ入力すべてが3倍の単価に跳ね上がるという構造です。
しきい値の判定はフレッシュ入力だけではなく、キャッシュを含む総入力トークン数で行われる点が重要です。「キャッシュ部分は200K超えを回避する役に立つ」と誤認すると、設計が成立しません。
200Kは決して非現実的な数字ではありません。契約書の全文、中規模のソースコードリポジトリ全体、長尺の技術ドキュメント群などは容易に200Kを超えます。
1Mコンテキスト対応と宣伝されていても、実際に1Mまで使うと料金は3倍相当で走ることを前提に設計する必要があります。
これに対してClaude Haiku 5.5はコンテキスト上限が1Mで、100Kは料金の境界になっています。100Kを超えると入力$0.50・出力$2.50・キャッシュ入力$0.05に切り替わるため、軽量帯の2モデルはそれぞれの境界しきい値を前提に設計を使い分ける必要があります。
キャッシュ入力の価格優位性
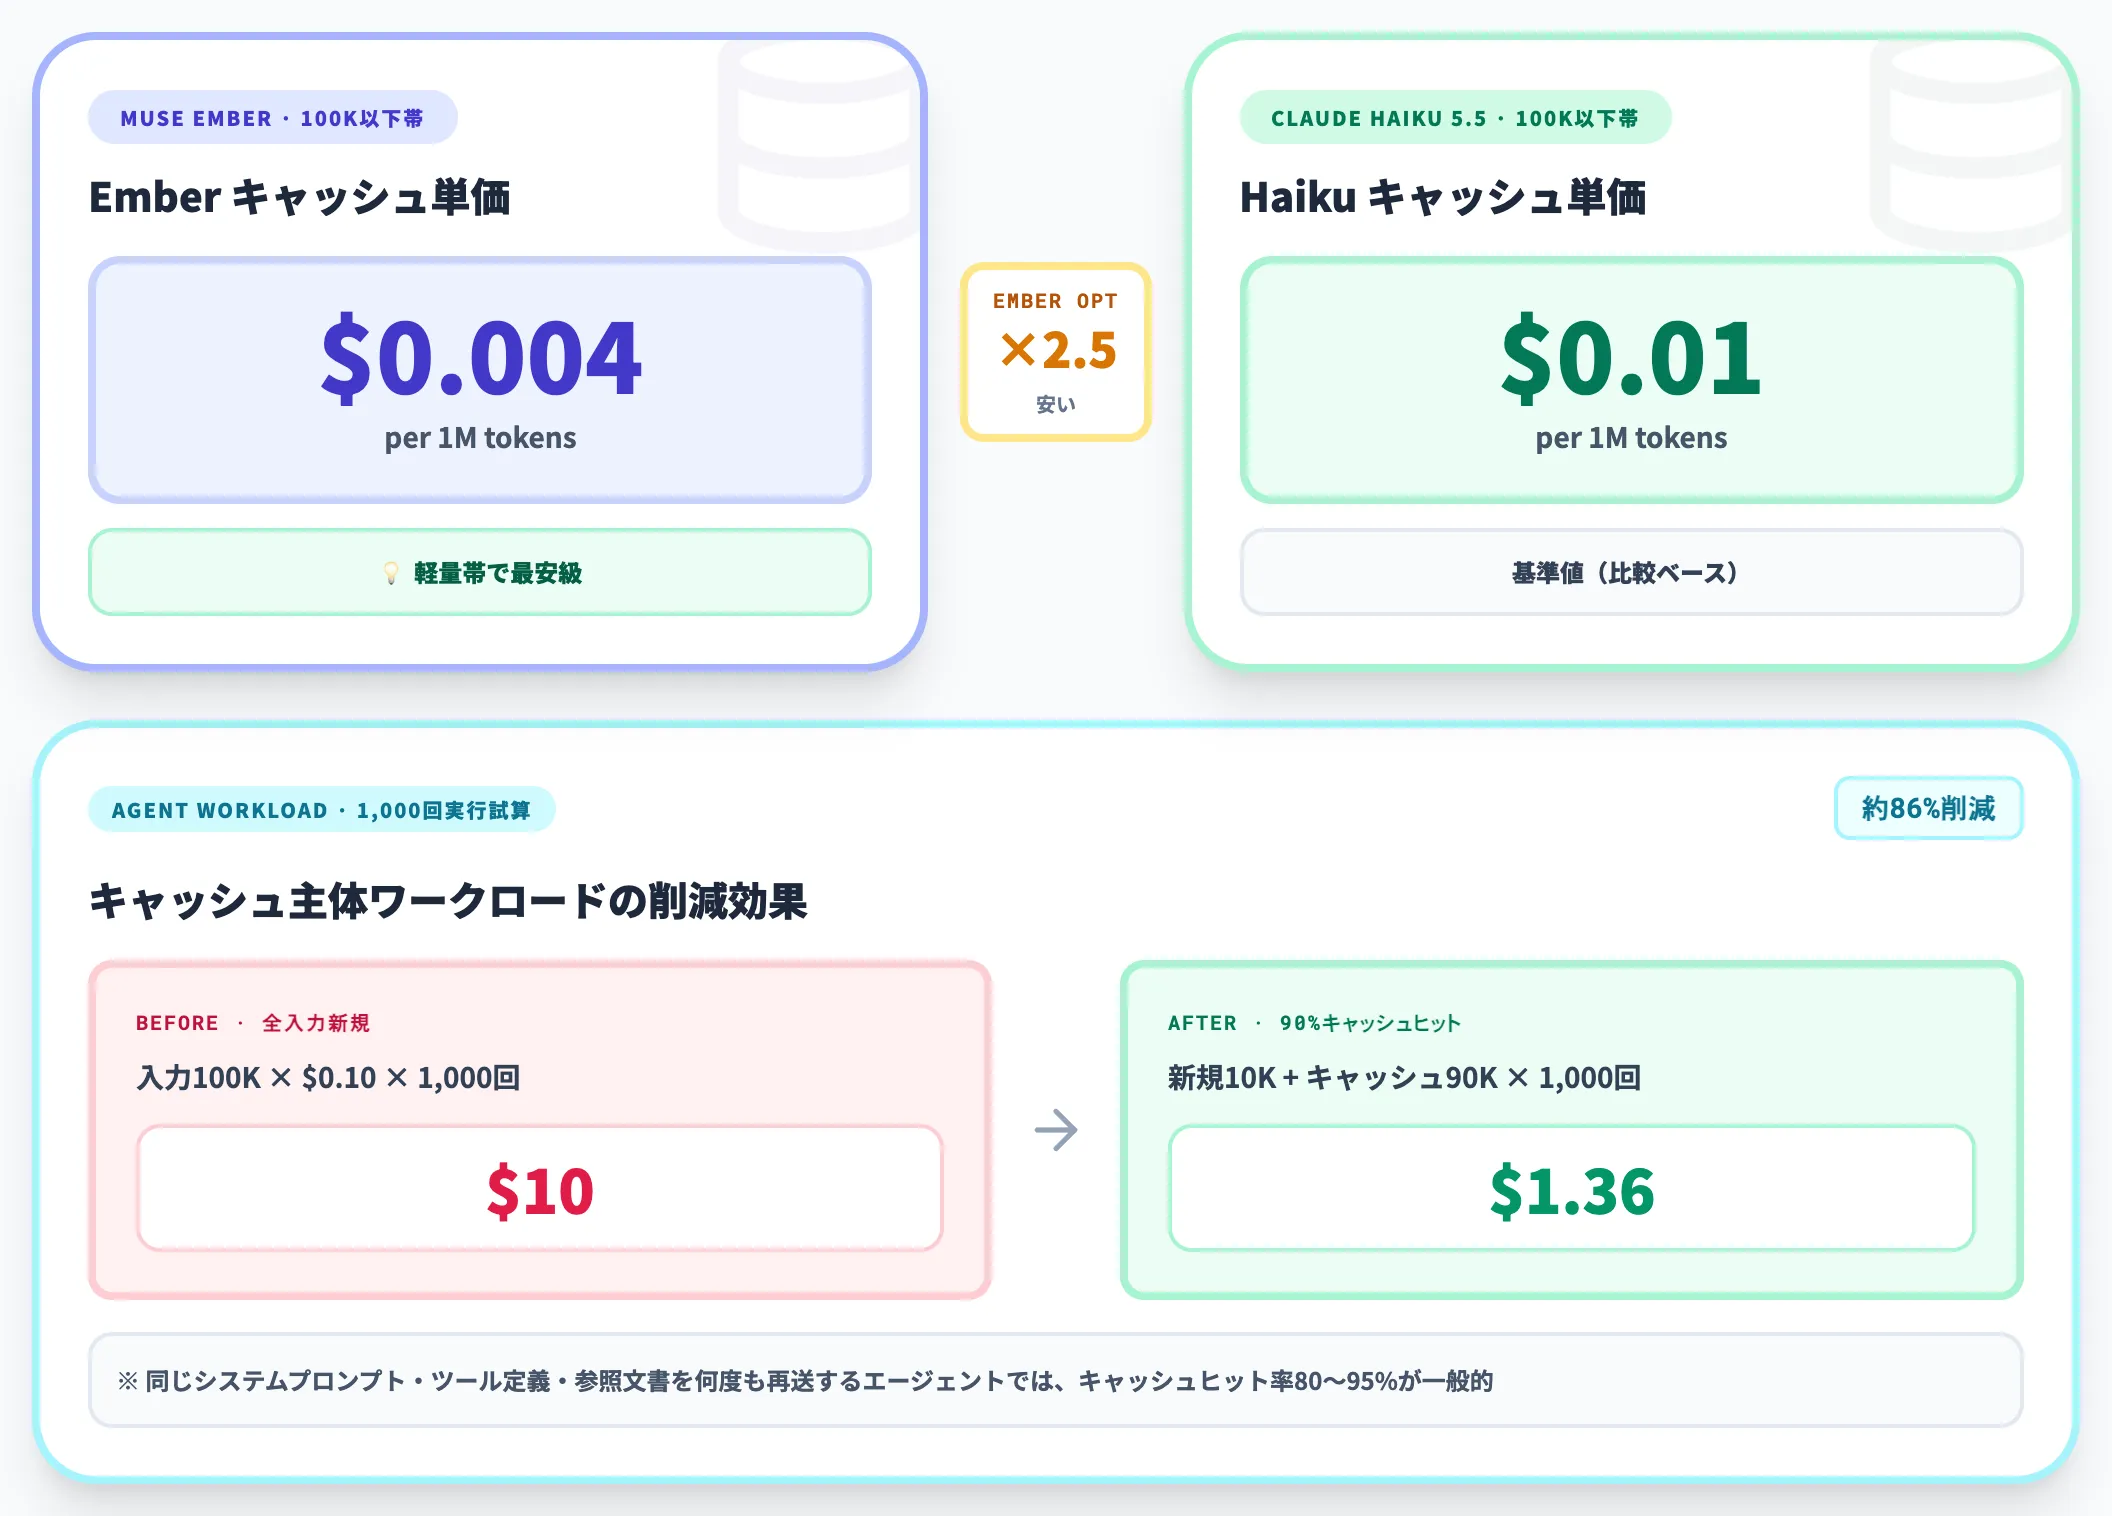
Muse Emberのもう一つの差別化ポイントが、キャッシュ入力の$0.004という単価です。
エージェントのワークロードでは、同じシステムプロンプト・同じツール定義・同じ参照文書を何度も再送する場面が多く、全入力に占めるキャッシュヒット率が80〜95%に達することも珍しくありません。
以下は、エージェント1,000回実行時の概算コストの違いを整理したものです。
-
全入力が新規の場合
入力100K × $0.10 × 1,000回 = $10
-
入力90%がキャッシュヒットの場合
新規10K × $0.10 × 1,000回 + キャッシュ90K × $0.004 × 1,000回 = $1 + $0.36 = $1.36
-
削減率
約86%($10 → $1.36)
このキャッシュ入力$0.004は、Claude Haiku 5.5の100K以下区分のキャッシュ単価($0.01)と比べて約2.5倍安い水準です。
短文条件では桁違いの差ではなくなりますが、キャッシュ主体のワークロードでは依然として軽量帯最安級で、Muse Emberが「Haikuと同じ総合スコアで約1/3のCost per task」を実現する一因になっています。
1タスクあたりの実勢コスト
Artificial Analysisの検証では、Intelligence Indexで36点を取るのに必要な1タスクあたりの実勢コストが明確に測定されています。
| モデル | 1タスクあたりコスト | 出力トークン量 | 位置づけ |
|---|---|---|---|
| Muse Ember | $0.14 | 1.15億トークン(検証総量) | 同スコア帯で最安 |
| Claude Haiku 5.5 | $0.41 | 2.98億トークン(検証総量) | 性能同等だが約3倍のコスト |
この表で特に重要なのは、出力トークン量の差です。Muse EmberはHaiku 5.5の約39%の出力量で同じスコアを達成しており、「必要な思考だけ短く出力して、余計な説明を省く」訓練が効いていることを示唆しています。
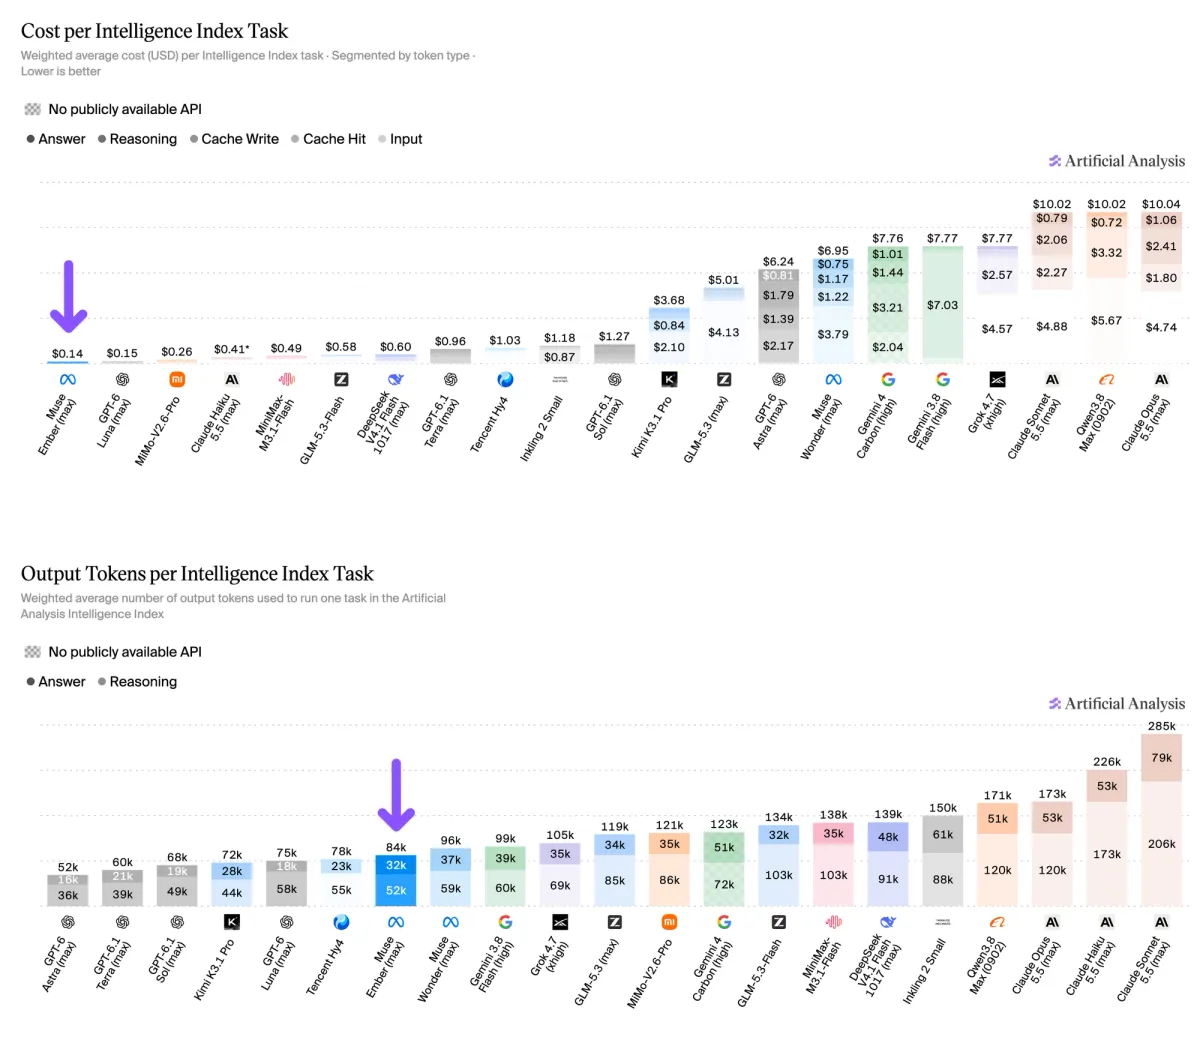
Intelligence Index 1タスクあたりのコスト(上段)と出力トークン量(下段)の全モデル比較(出典:Artificial Analysis)
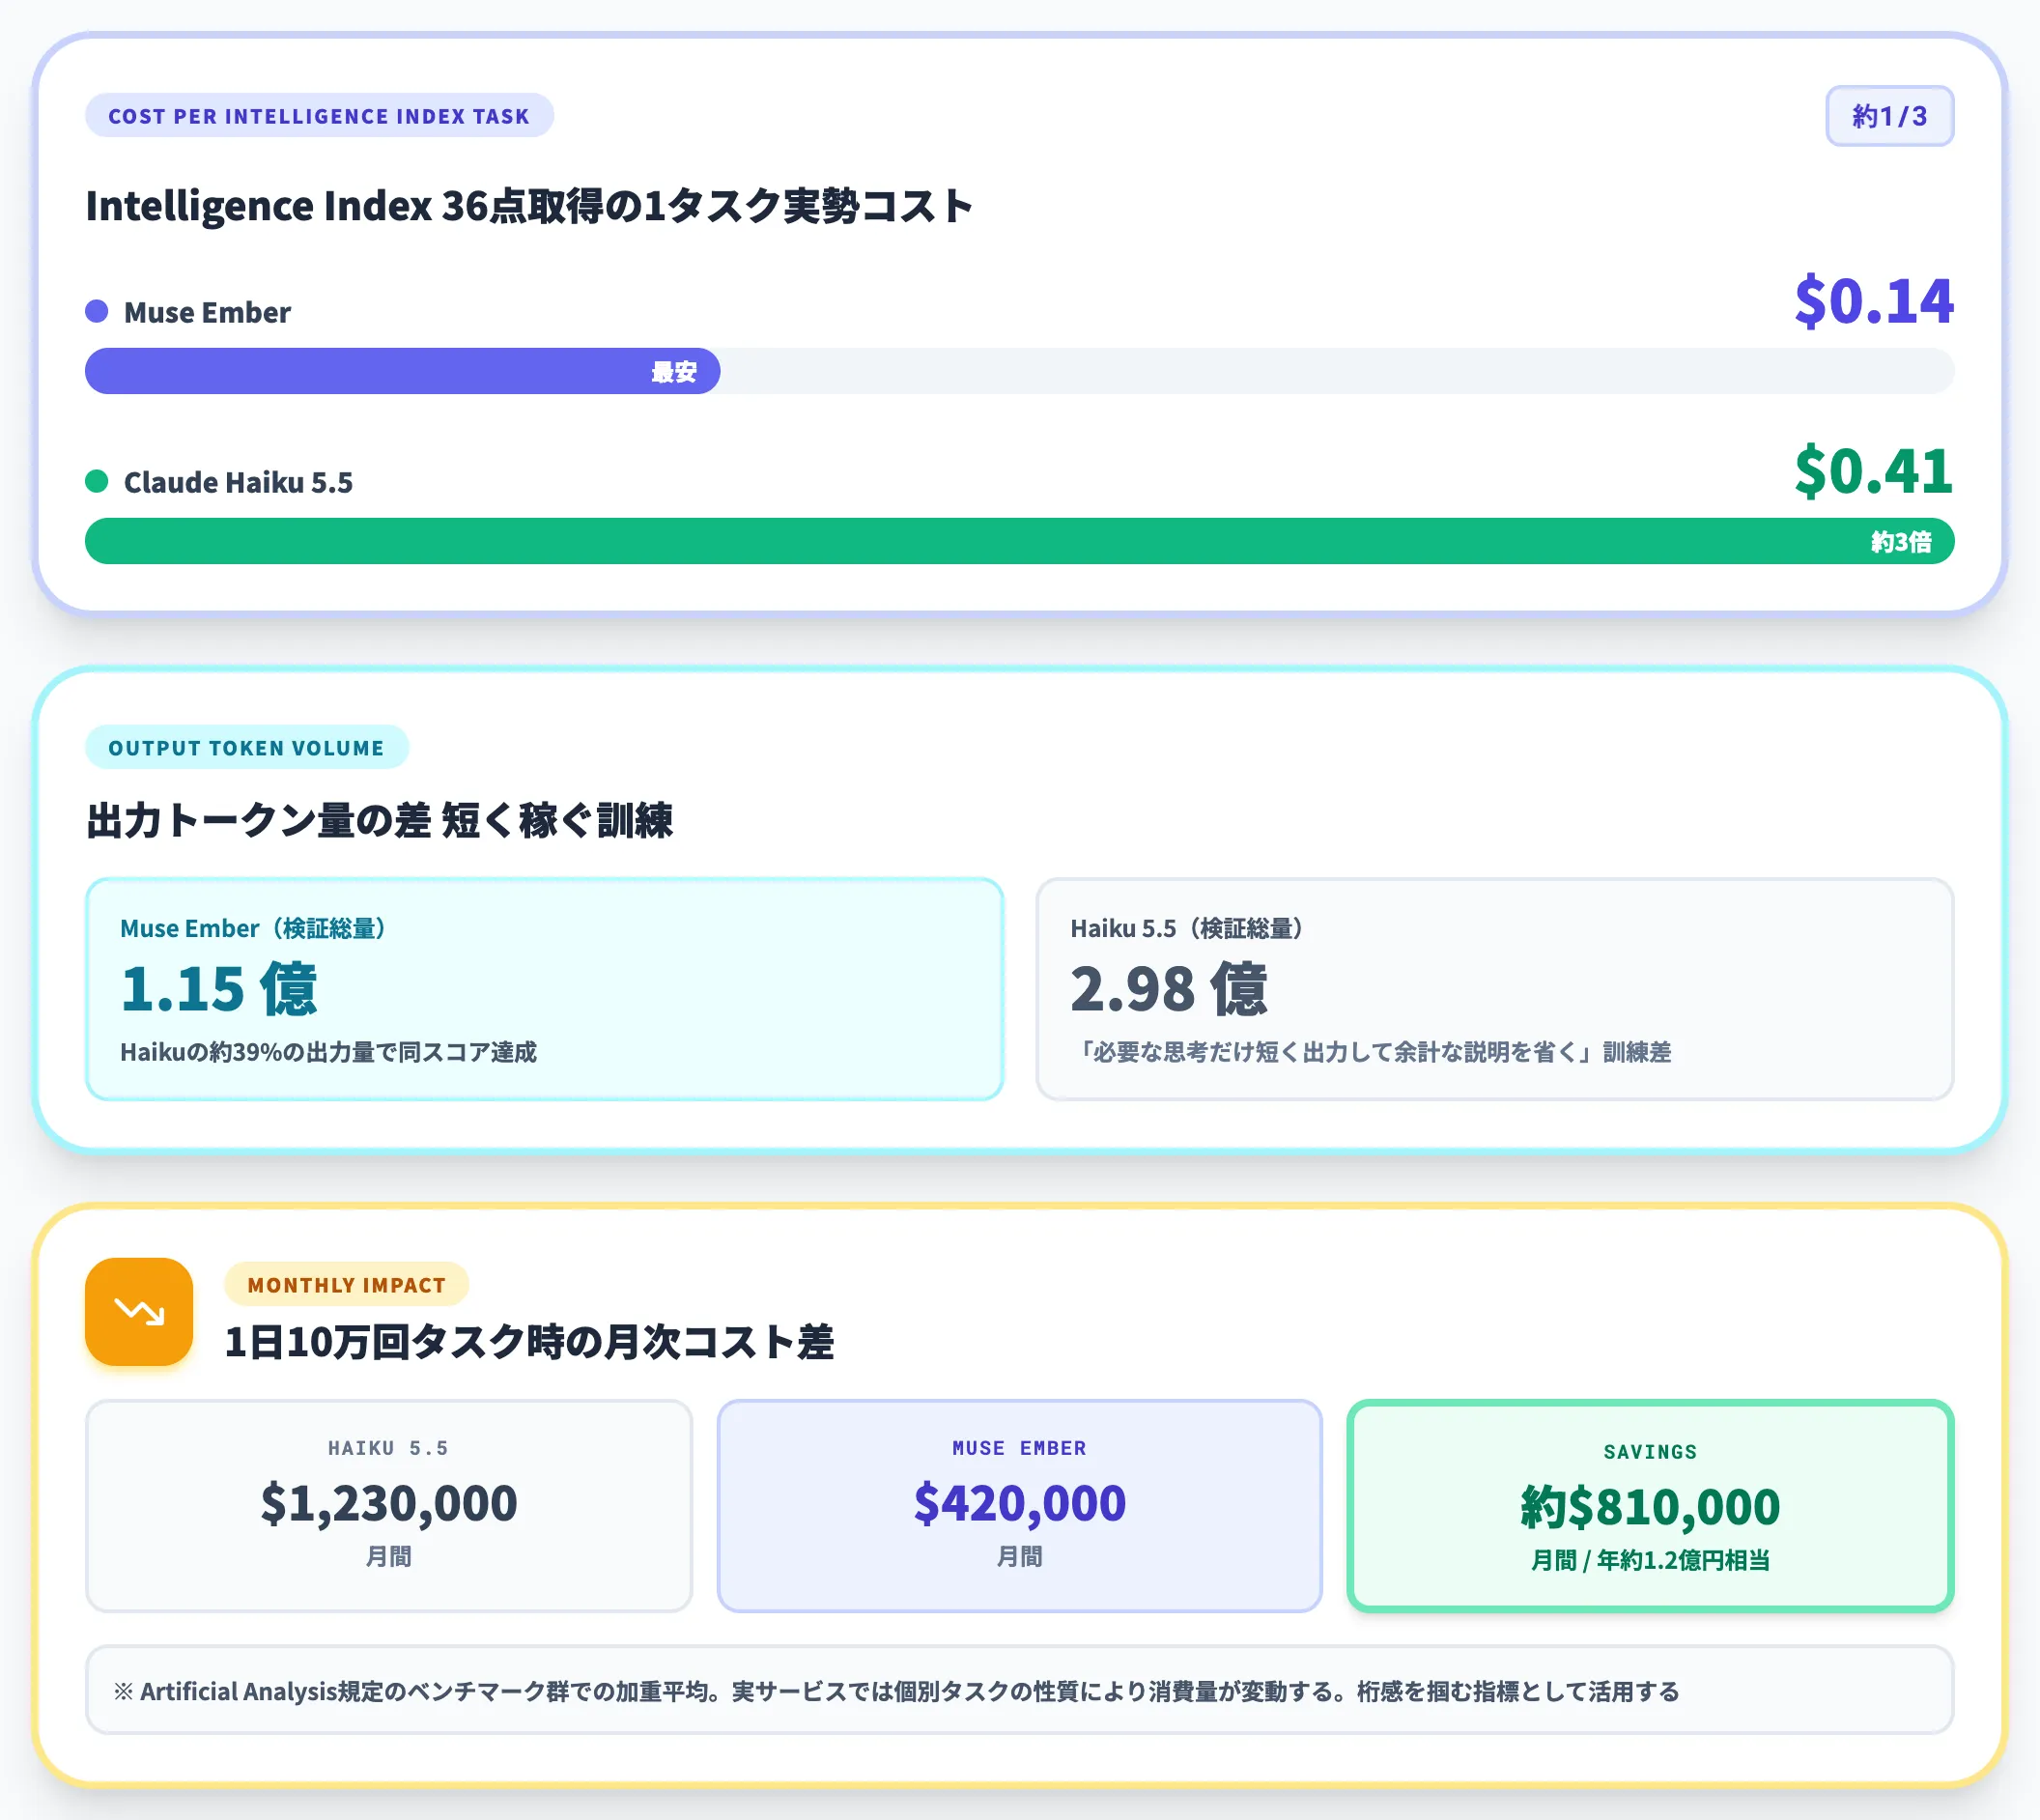
上段のCost per Intelligence Index Taskを見ると、Muse Emberは紫矢印が左端寄りにあり、1タスク$0.14で軽量帯最安水準に位置します。
Haiku 5.5は$0.41で、同じ総合スコア36点に対してMuse Emberの約3倍のコストがかかることが確認できます。下段の出力トークン量もEmberが抑えめで、短い応答で同スコアを稼ぐ訓練方針が数値に表れています。
このCost per Taskは、Artificial Analysisが規定するベンチマーク群での加重平均であり、実サービスに適用する際は「個別タスクの性質によって1タスクあたりの消費量が変動する」という前提で読む必要があります。
その前提を置いたうえで、エージェント量産のワークロードでは「1タスクあたりコスト」が月次請求額に直結します。
たとえば1日10万回のタスクを回すサービスで、同じ平均費用プロファイルを仮定すると、Muse Emberに切り替えることで月間約$810,000(約1.2億円相当)のコスト差が理論上出る規模感です。実運用では長文処理の頻度や並列度で数値が上下しますが、桁感を掴む指標としては十分活用できます。
もちろん200Kを超える入力を日常的に扱う場合は、長プロンプト単価で優位が崩れる可能性もあります。設計段階での入力長見積もりが、そのまま月次コストの桁を決める構造だと認識しておくべきです。
Muse Emberの使い方と対応プラットフォーム
Muse Emberの大きな特徴として、既存のOpenAI SDK・Anthropic SDKユーザーがほぼ無改修で移行できる設計が公式に提示されています。
Metaは2系統のAPI(OpenAI互換のResponses APIと、Anthropic互換のMessages API)を同時に提供しているため、既存の実装資産を活かしたまま切り替えできます。
本セクションでは、Meta Model APIでの直接利用、各SDKからの移行手順、対応プラットフォームの選択肢を整理します。
Meta Model APIでの基本利用
Muse Emberは、モデルID 「muse-ember-1.0」としてMeta Model API経由で呼び出せます。Responses APIに対応しており、OpenAI SDKを使う場合は以下のような実装で動作します。
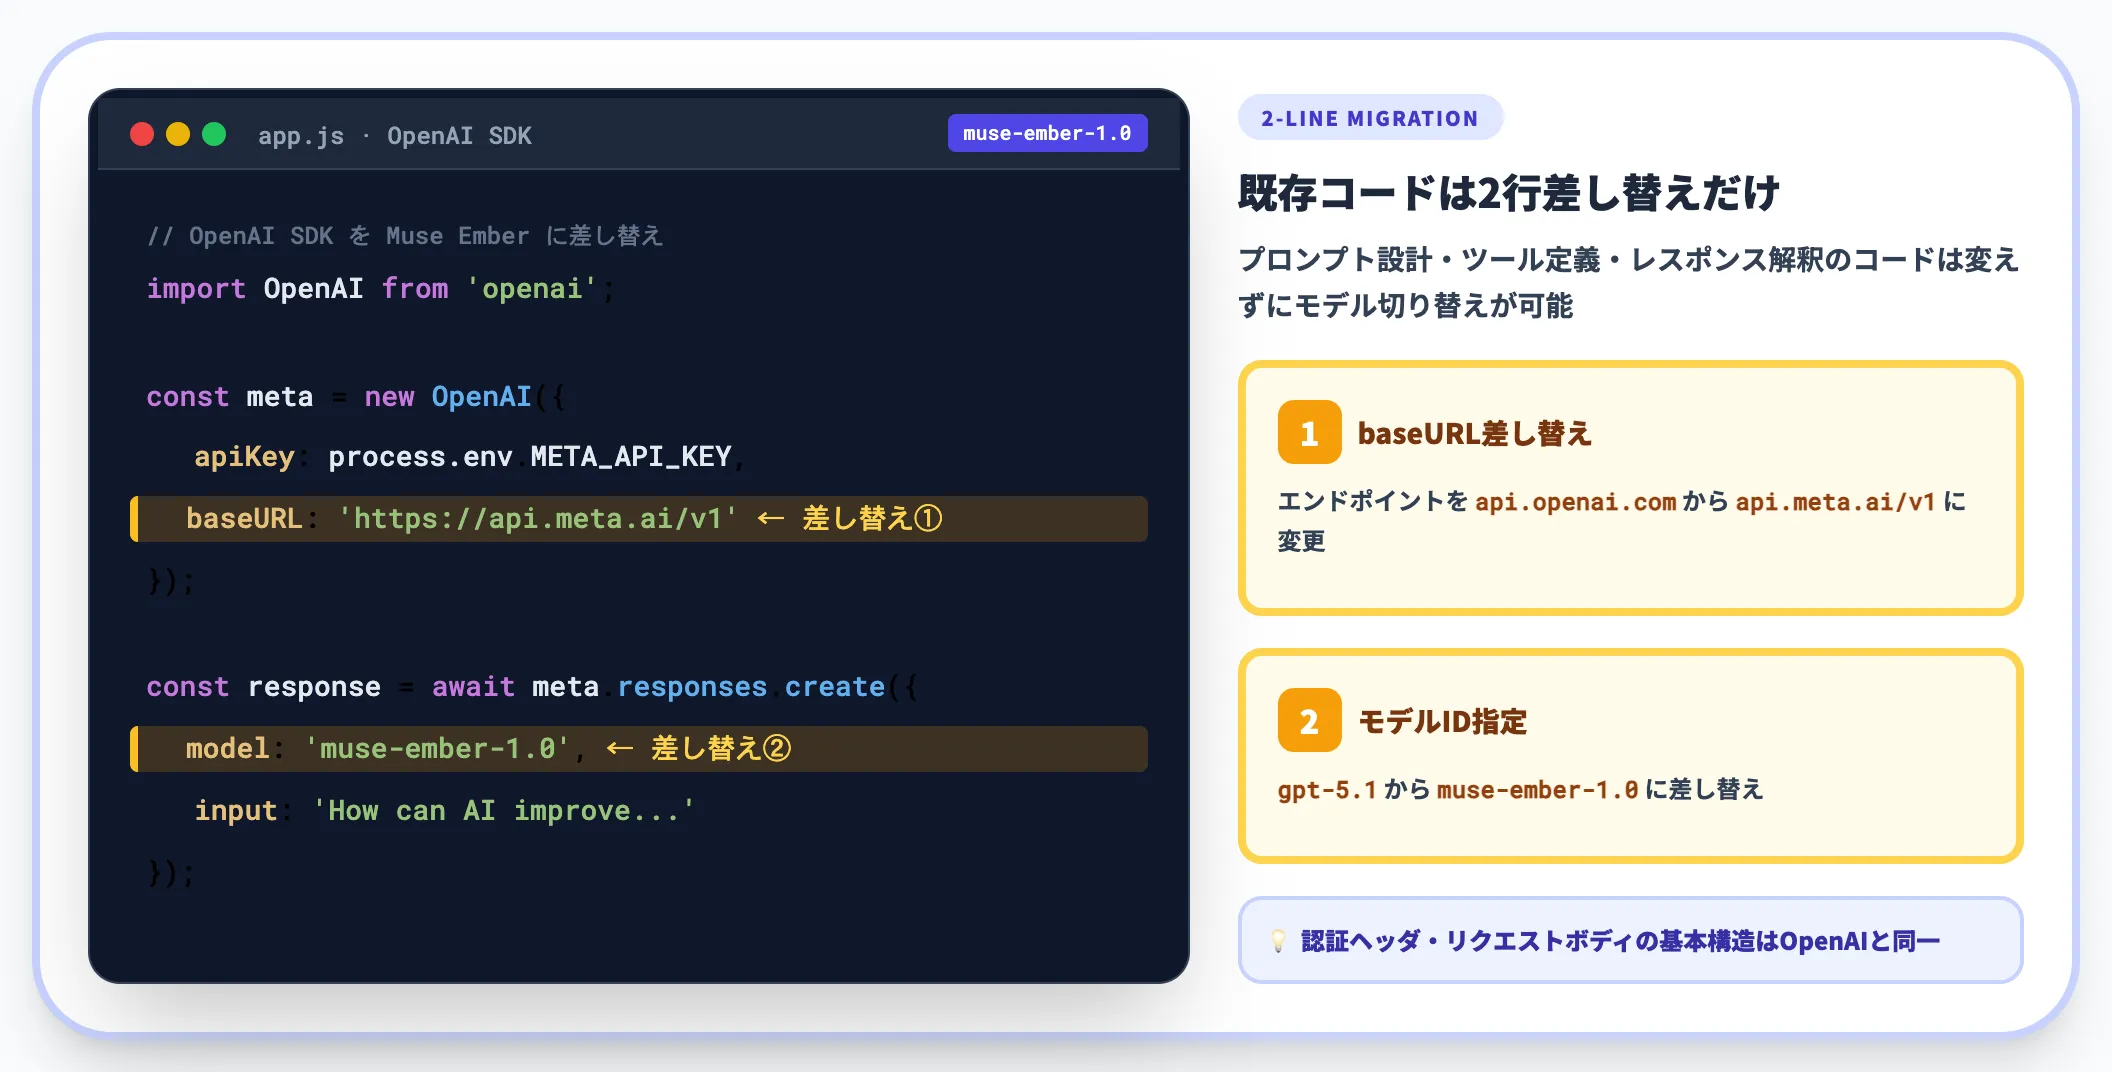
import OpenAI from 'openai';

const meta = new OpenAI({
  apiKey: process.env.META_API_KEY,
  baseURL: 'https://api.meta.ai/v1'
});

const response = await meta.responses.create({
  model: 'muse-ember-1.0',
  input: 'How can AI improve my coding?'
});
このコード例が示すように、OpenAI SDKを流用する場合はエンドポイントとモデルIDの差し替えだけで動作する設計です。
認証ヘッダやリクエストボディの基本構造はOpenAIと同一で、「baseURL」と「model」だけを差し替えれば動作します。
これはエージェントビルダーにとって非常に大きな意味を持ちます。プロンプト設計・ツール定義・レスポンス解釈のコードを一切変えずに、モデルの選択肢だけを切り替えられるためです。
各SDKからの移行手順
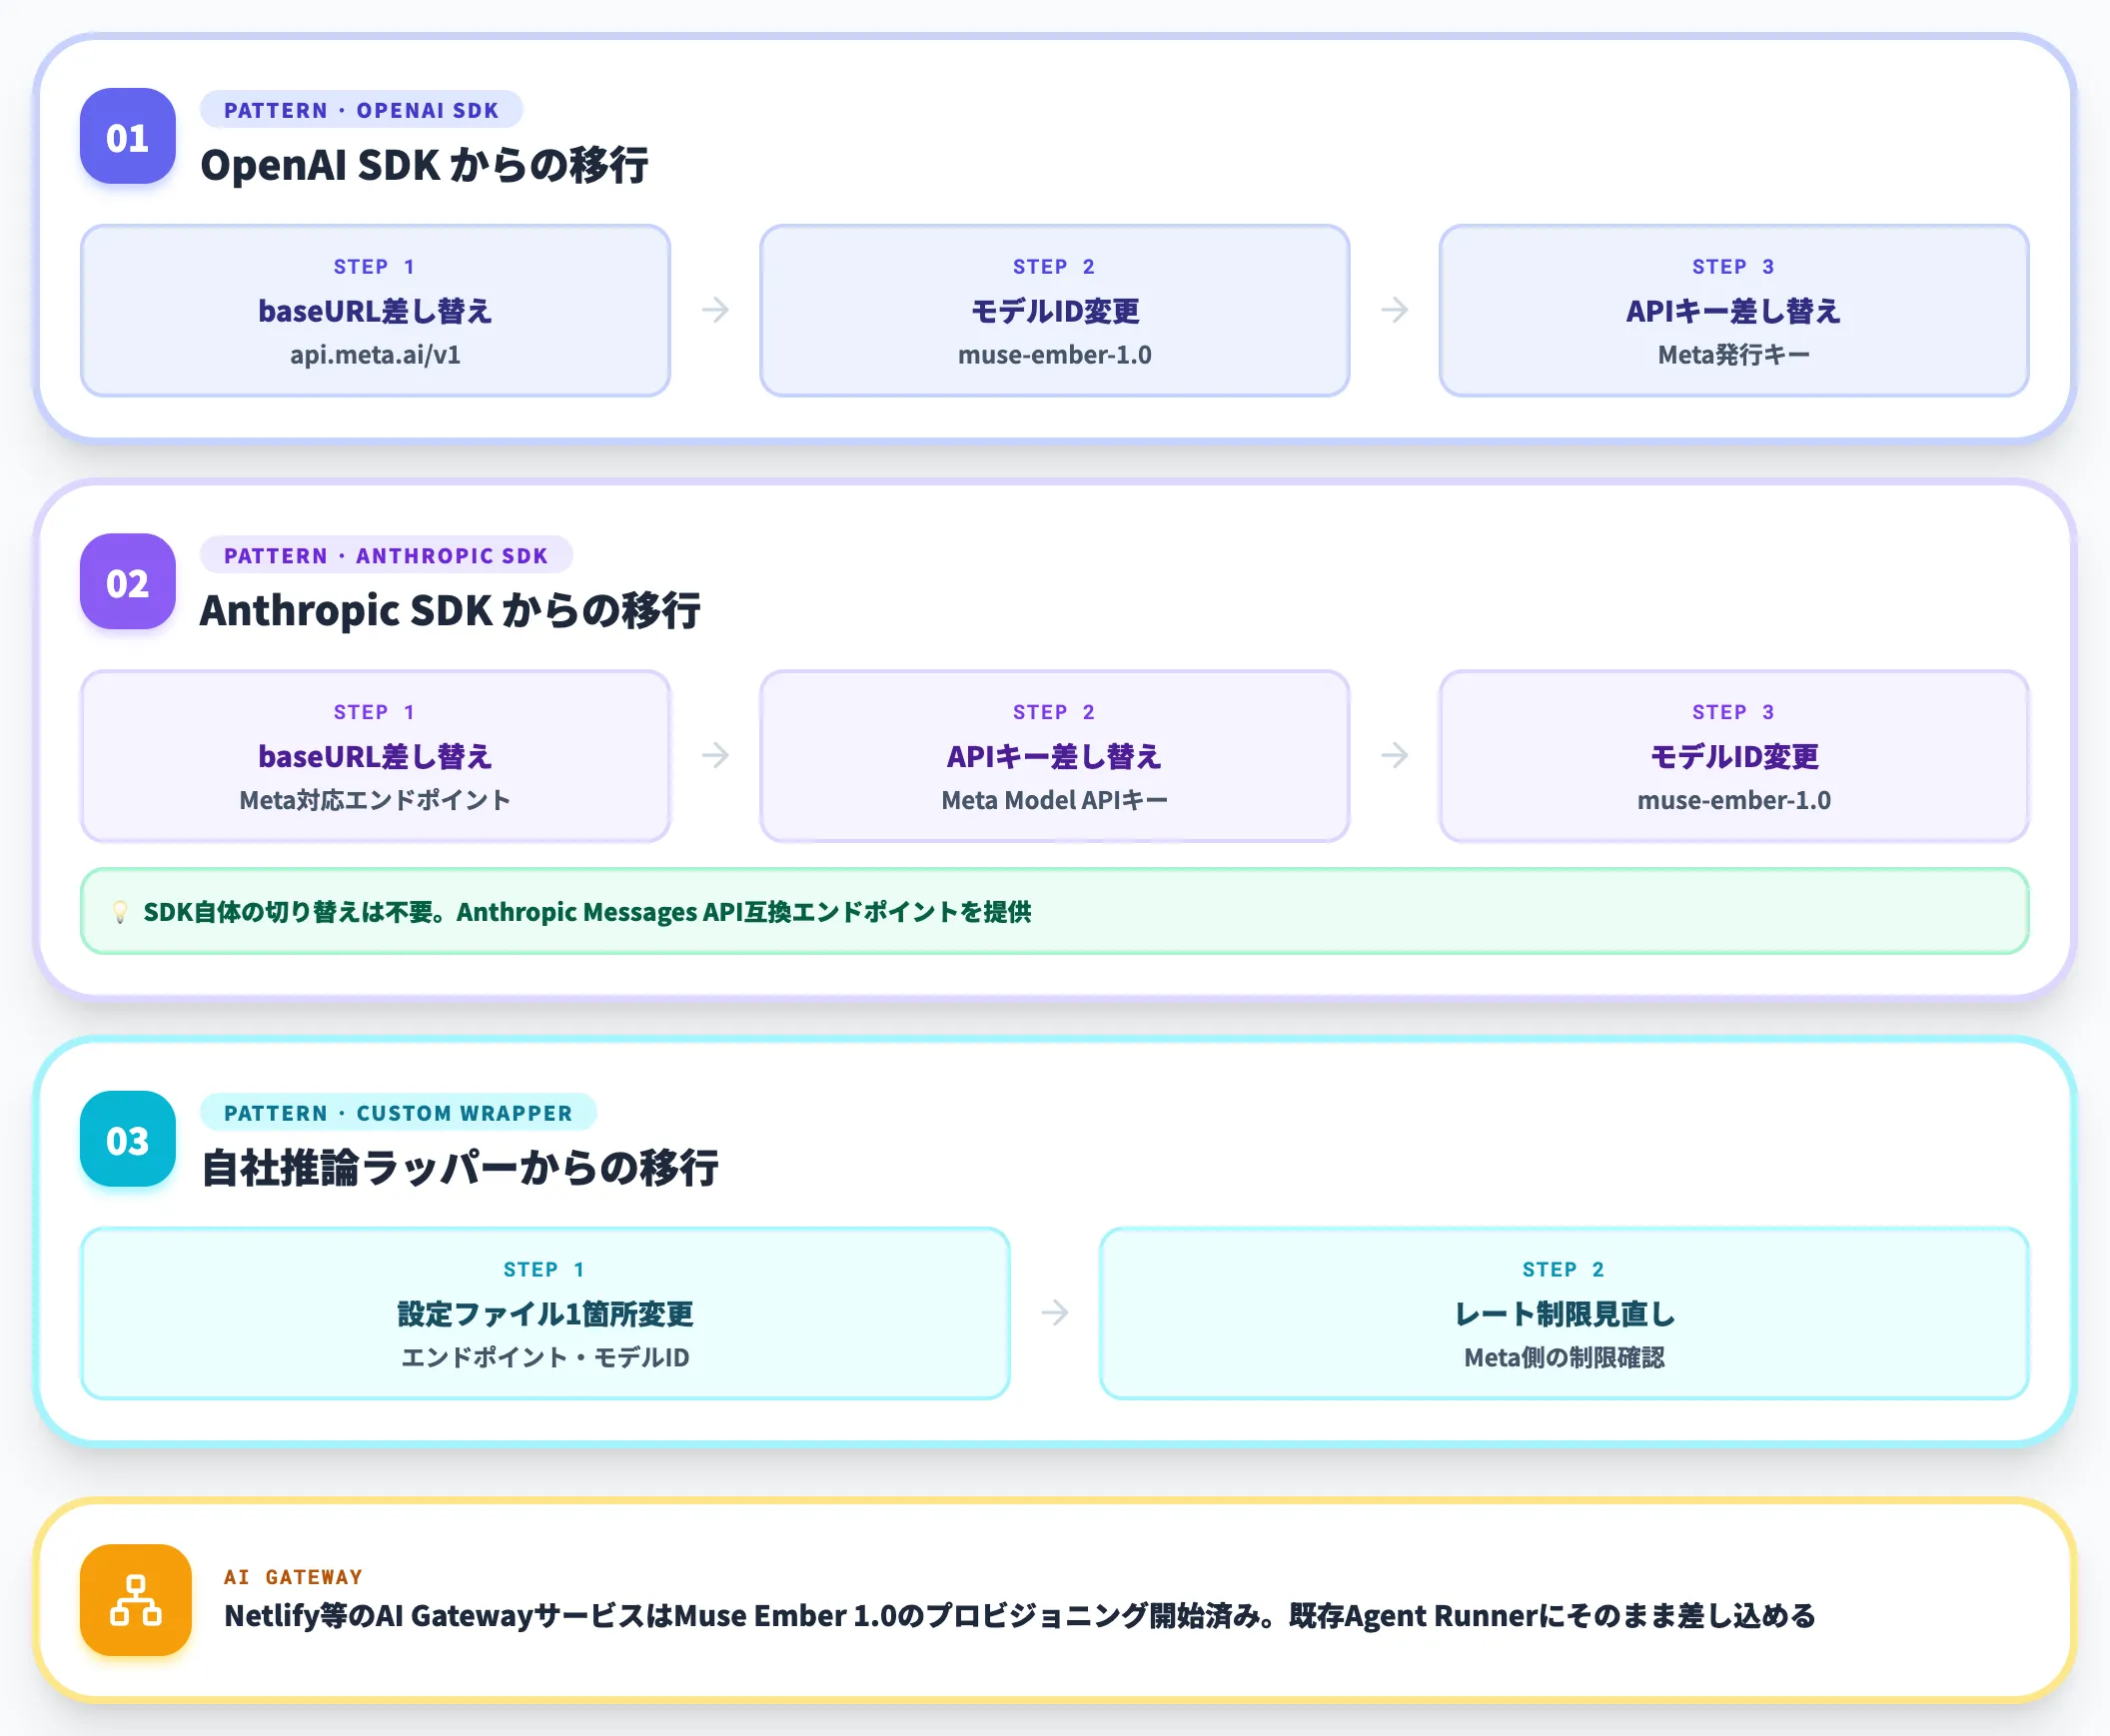
既存のアプリケーションからMuse Emberへの移行は、以下のパターンに整理できます。
-
OpenAI SDKを使っている場合
「baseURL」を「https://api.meta.ai/v1」に差し替え、モデルIDを「muse-ember-1.0」に変更。APIキーはMeta側で新規発行したものに差し替える
-
Anthropic SDK(Claude SDK)を使っている場合
MetaはAnthropic Messages API互換のエンドポイントも提供しているため、SDK自体の切り替えは不要。Anthropic SDKの「baseURL」をMetaの対応エンドポイントに差し替え、APIキーをMeta Model APIで発行したキーに変更し、モデルIDを「muse-ember-1.0」に変えれば動作する
-
自社の推論ラッパーを経由している場合
エンドポイントとモデルID、レート制限の見直しのみ。多くの場合、設定ファイル1箇所の変更で対応可能
AI Gateway系のサービス(Netlifyなど)は既にMuse Ember 1.0のプロビジョニングを開始しており、既存のAgent Runnerにそのまま差し込める形で提供されています。
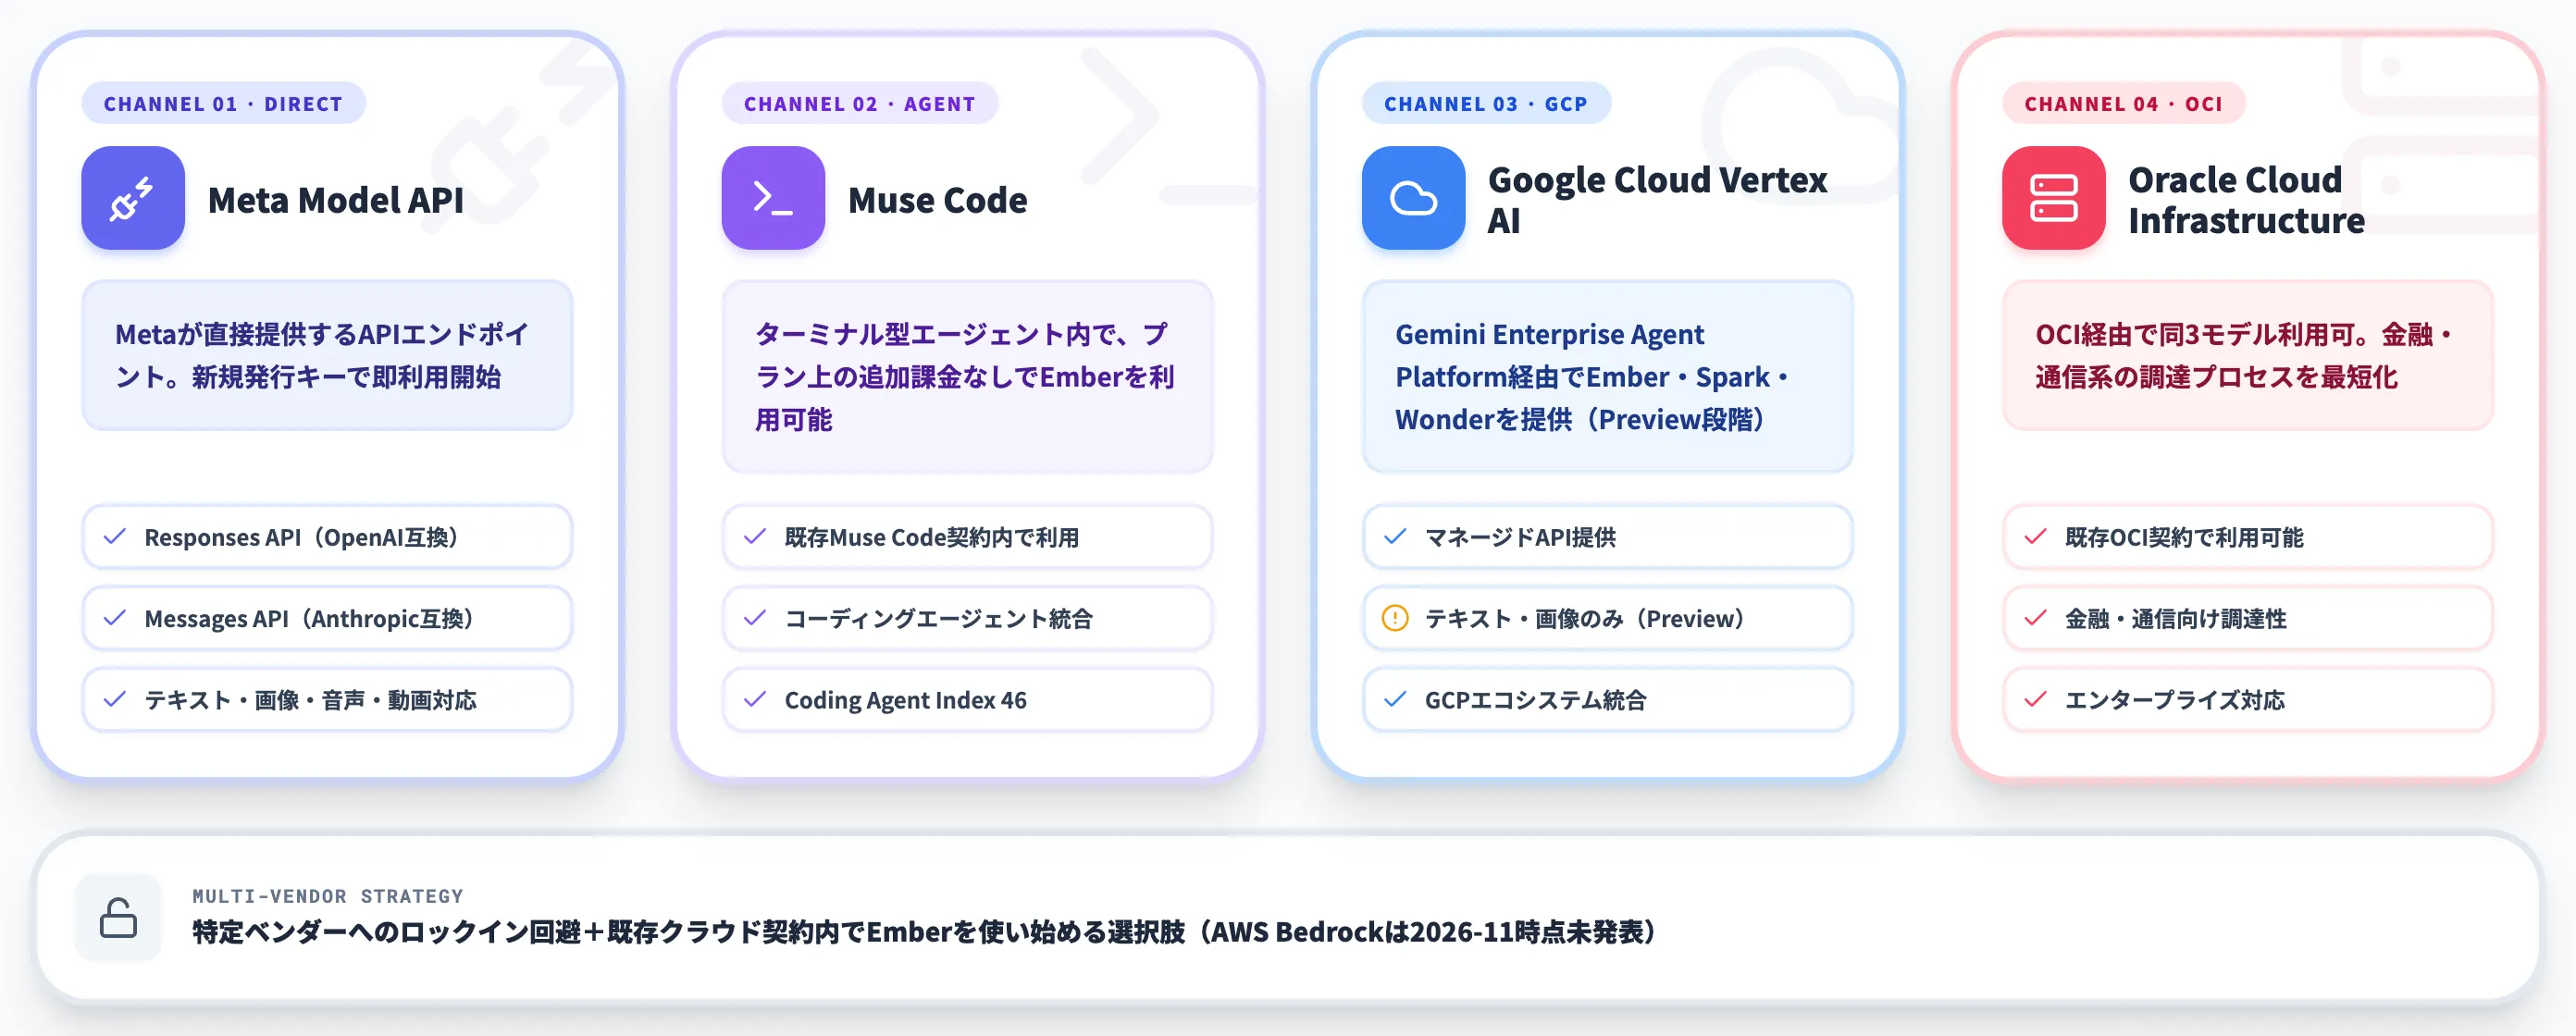
対応プラットフォームの4経路
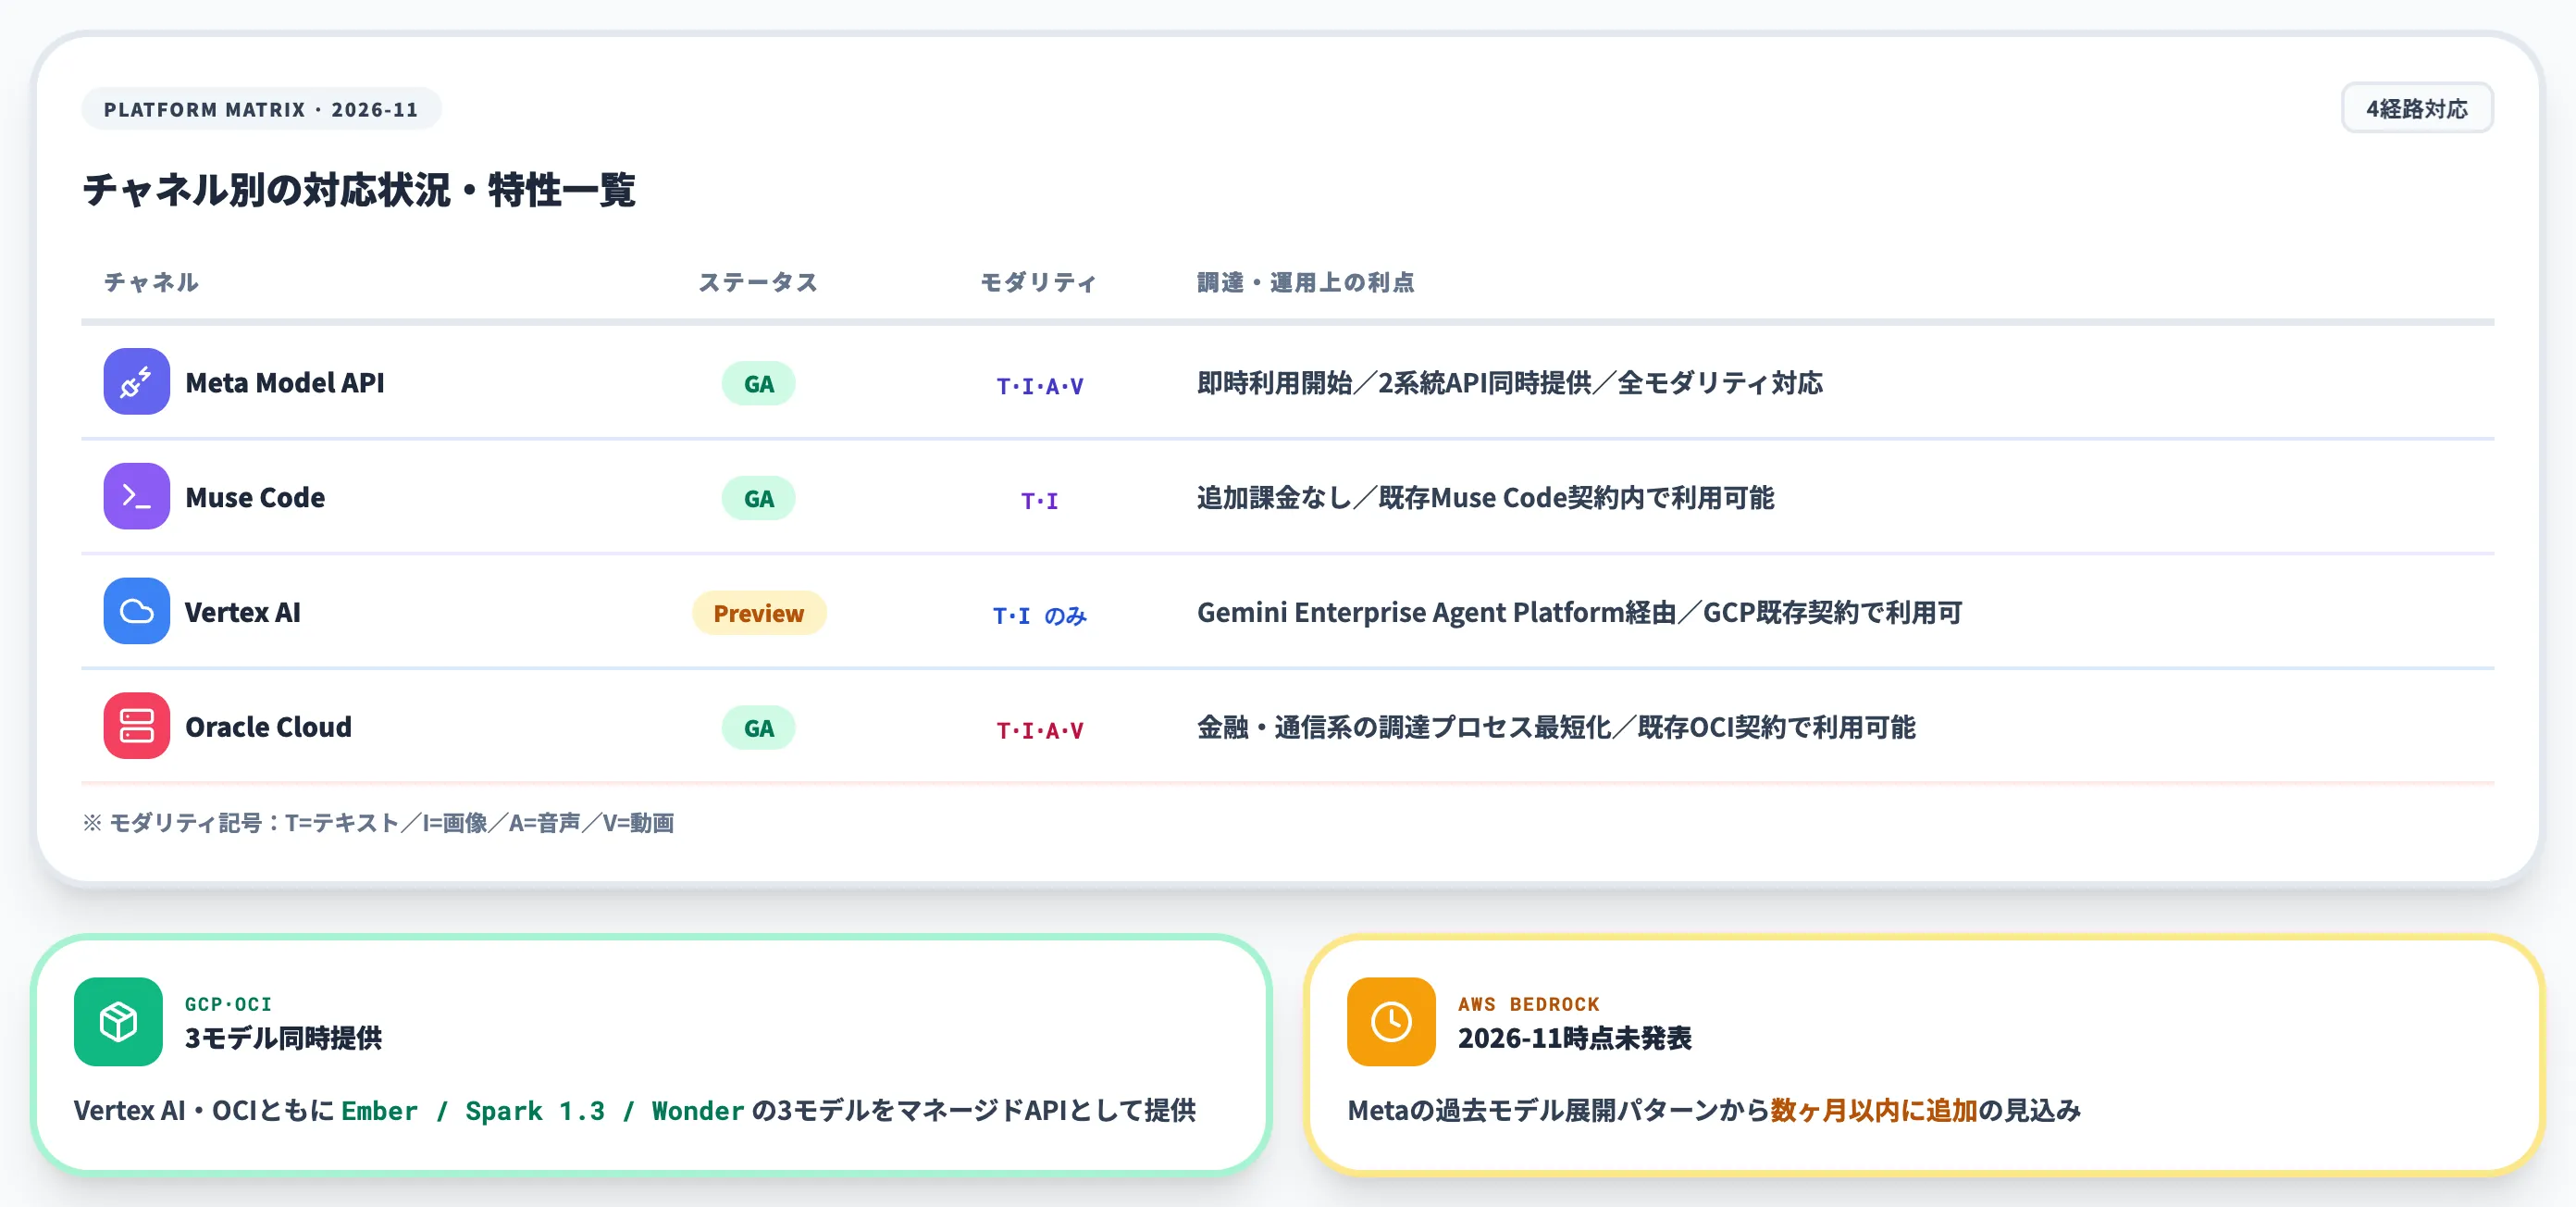
Muse Emberは、以下の4チャネル経由で提供されています。
-
Meta Model API
Metaが直接提供するAPIエンドポイント。最もシンプルで、新規発行したAPIキーで即座に利用可能
-
Muse Code
前述のターミナル型エージェント内で、プラン上の追加課金なしで利用できる。既にMuse CodeのサブスクリプションがあるチームはそのままEmberを使い始められる
-
Google Cloud Vertex AI
Gemini Enterprise Agent Platform経由でMuse Ember・Spark 1.3・Wonderの3モデルがマネージドAPIとして提供されている(2026年11月時点ではPreview段階で、入力はテキスト・画像に限定されるため、音声・動画を扱う用途は別経路の検討が必要)
-
Oracle Cloud Infrastructure
OCI経由でも同3モデルが利用可能。既にOCIをインフラ基盤にしている金融・通信系の企業にとって、調達プロセスを最短化できる
この4チャネル対応により、特定ベンダーへのロックインを避けながら、既存のクラウド契約内でMuse Emberを使い始める選択肢が複数用意されています。AWSのBedrockへの展開は2026年11月時点では未発表ですが、Metaの過去のモデル展開パターンから、数ヶ月以内の追加が予想されます。
Muse WonderとEmberの2段構え運用——公式の実装例から見る設計パターン
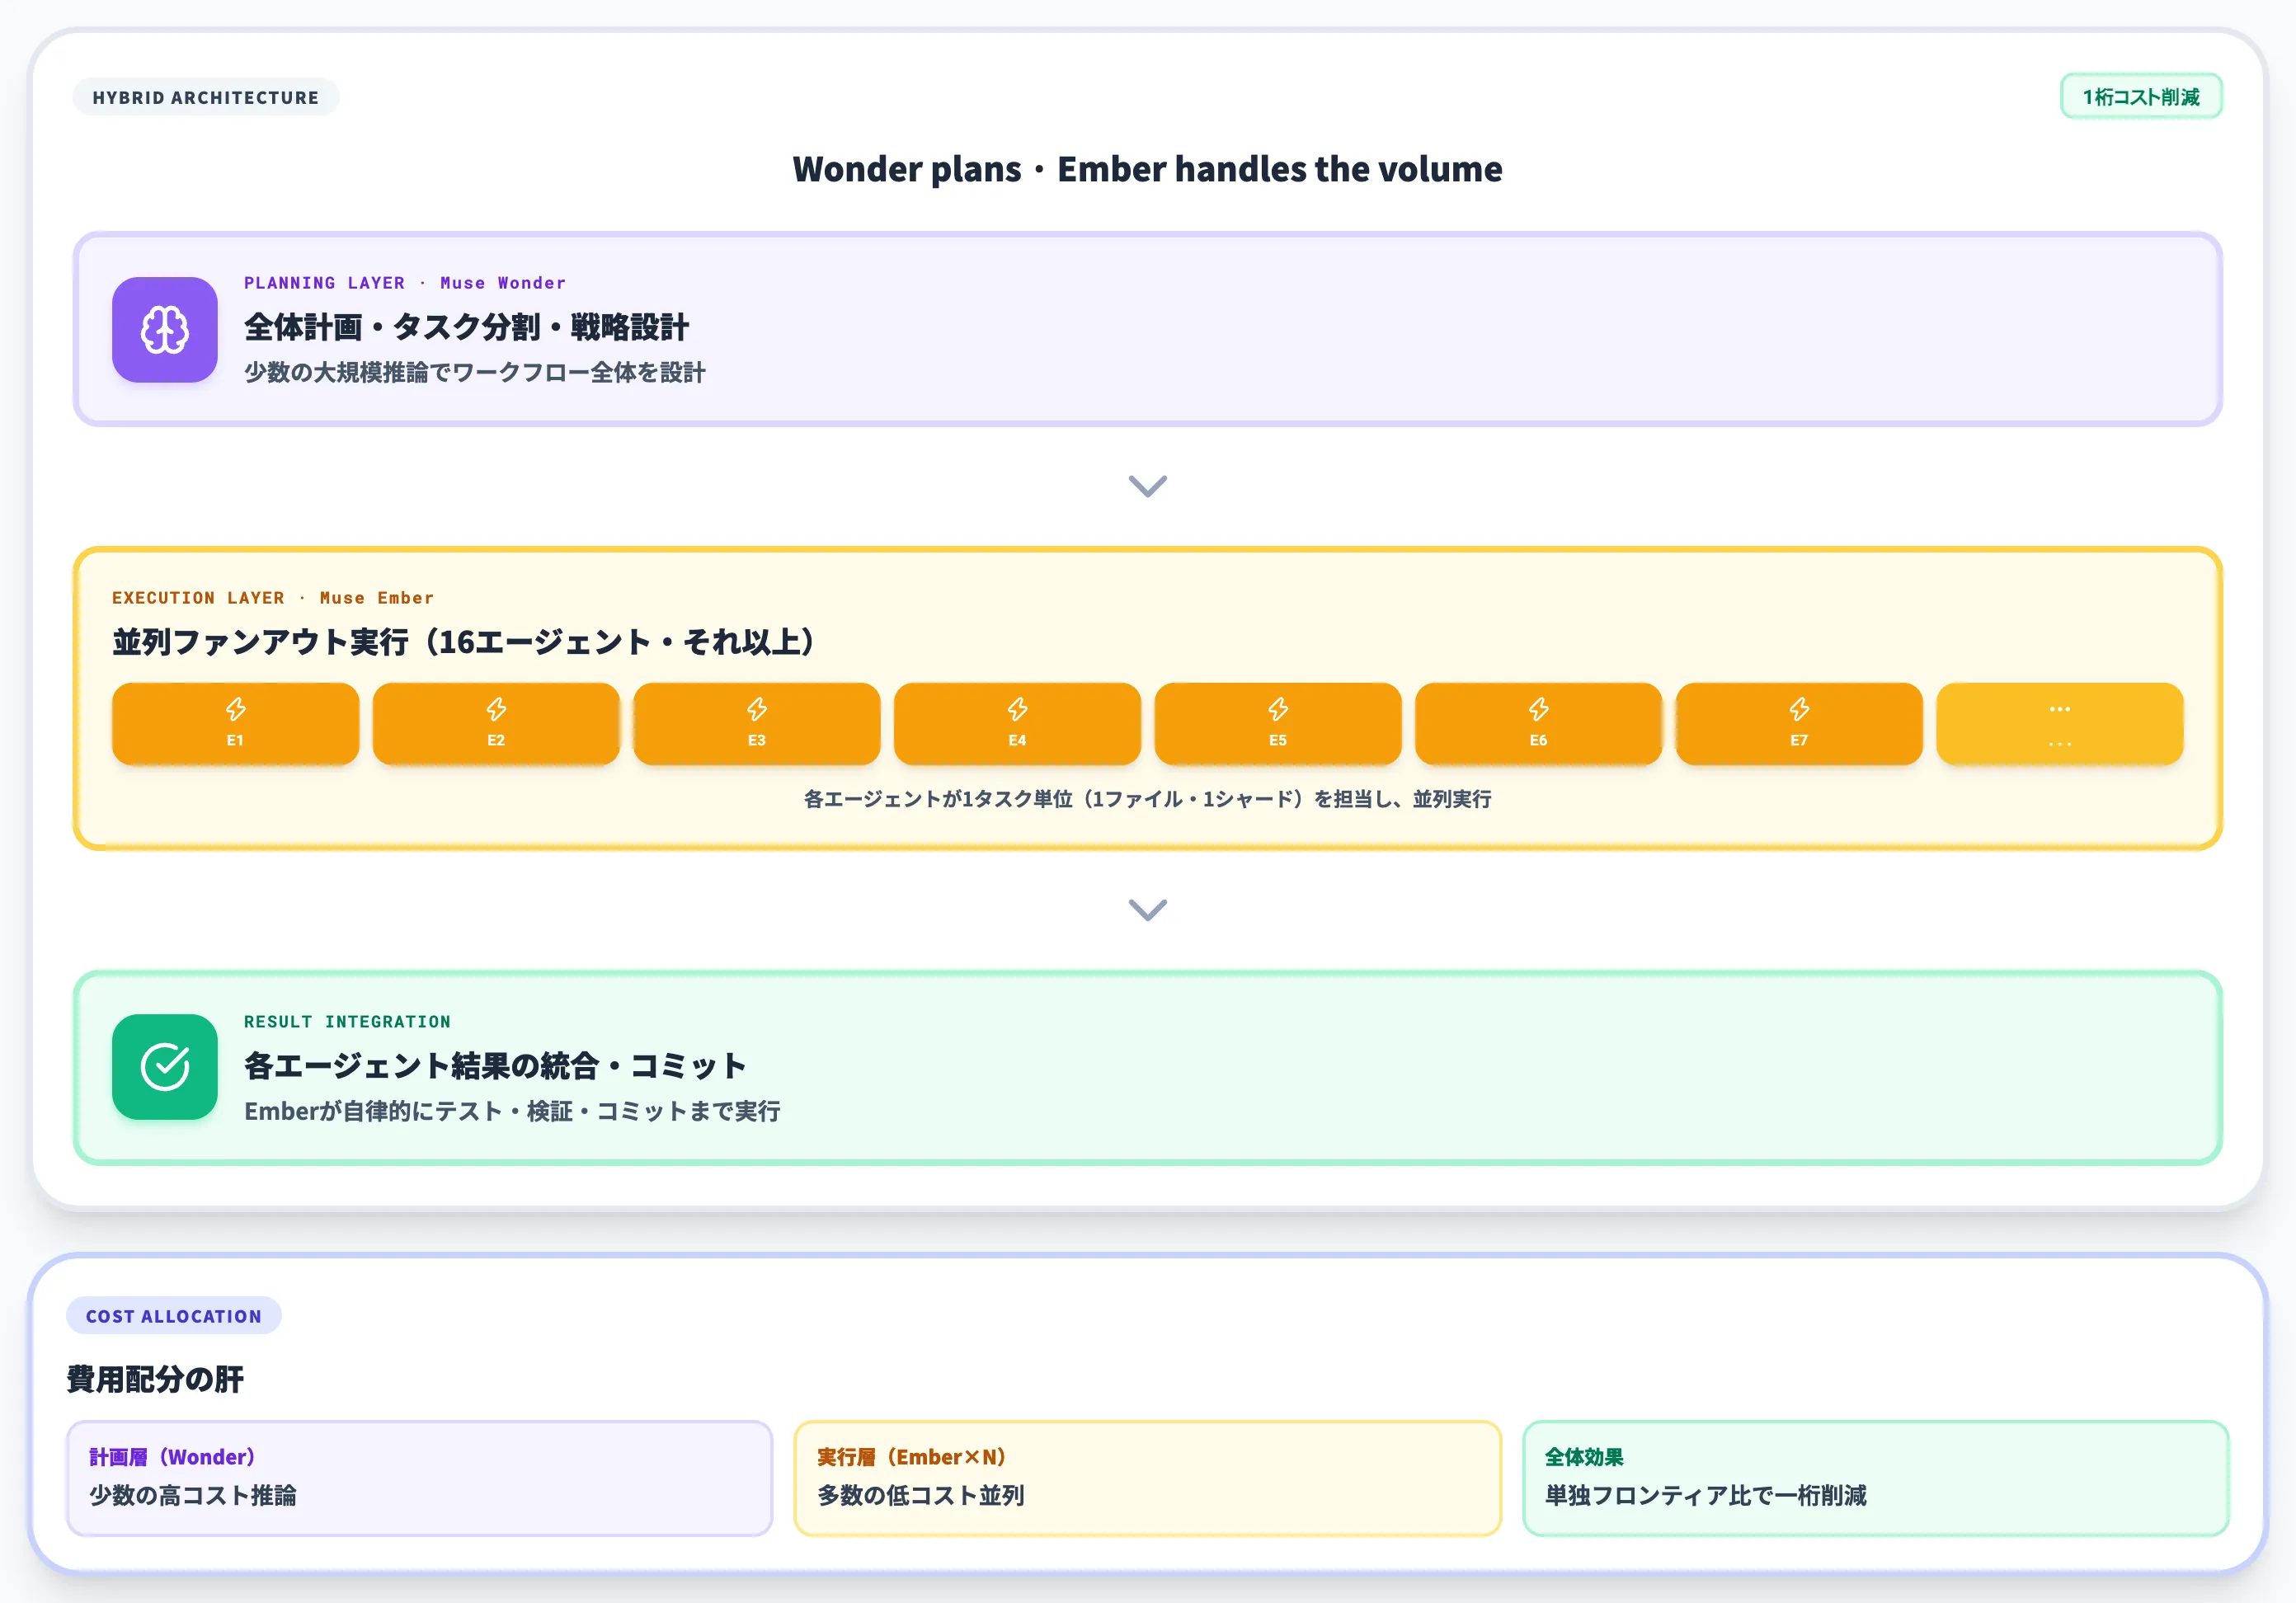
Muse Emberを単独で使っても安い軽量モデルの一つにしかなりませんが、Muse Wonderとペアで運用すると、エージェントの実行コストを一桁下げる設計パターンが成立します。
Meta公式のdevブログでは、具体的な実装例2本が実コスト付きで公開されています。本セクションでは、その2つのパターンを軸に、並列ファンアウト設計のポイントを整理します。
Python→Rustコードマイグレーションの例
1本目の実装例は、Pythonで書かれたレキサー(字句解析器)実装をRustに移植するタスクです。
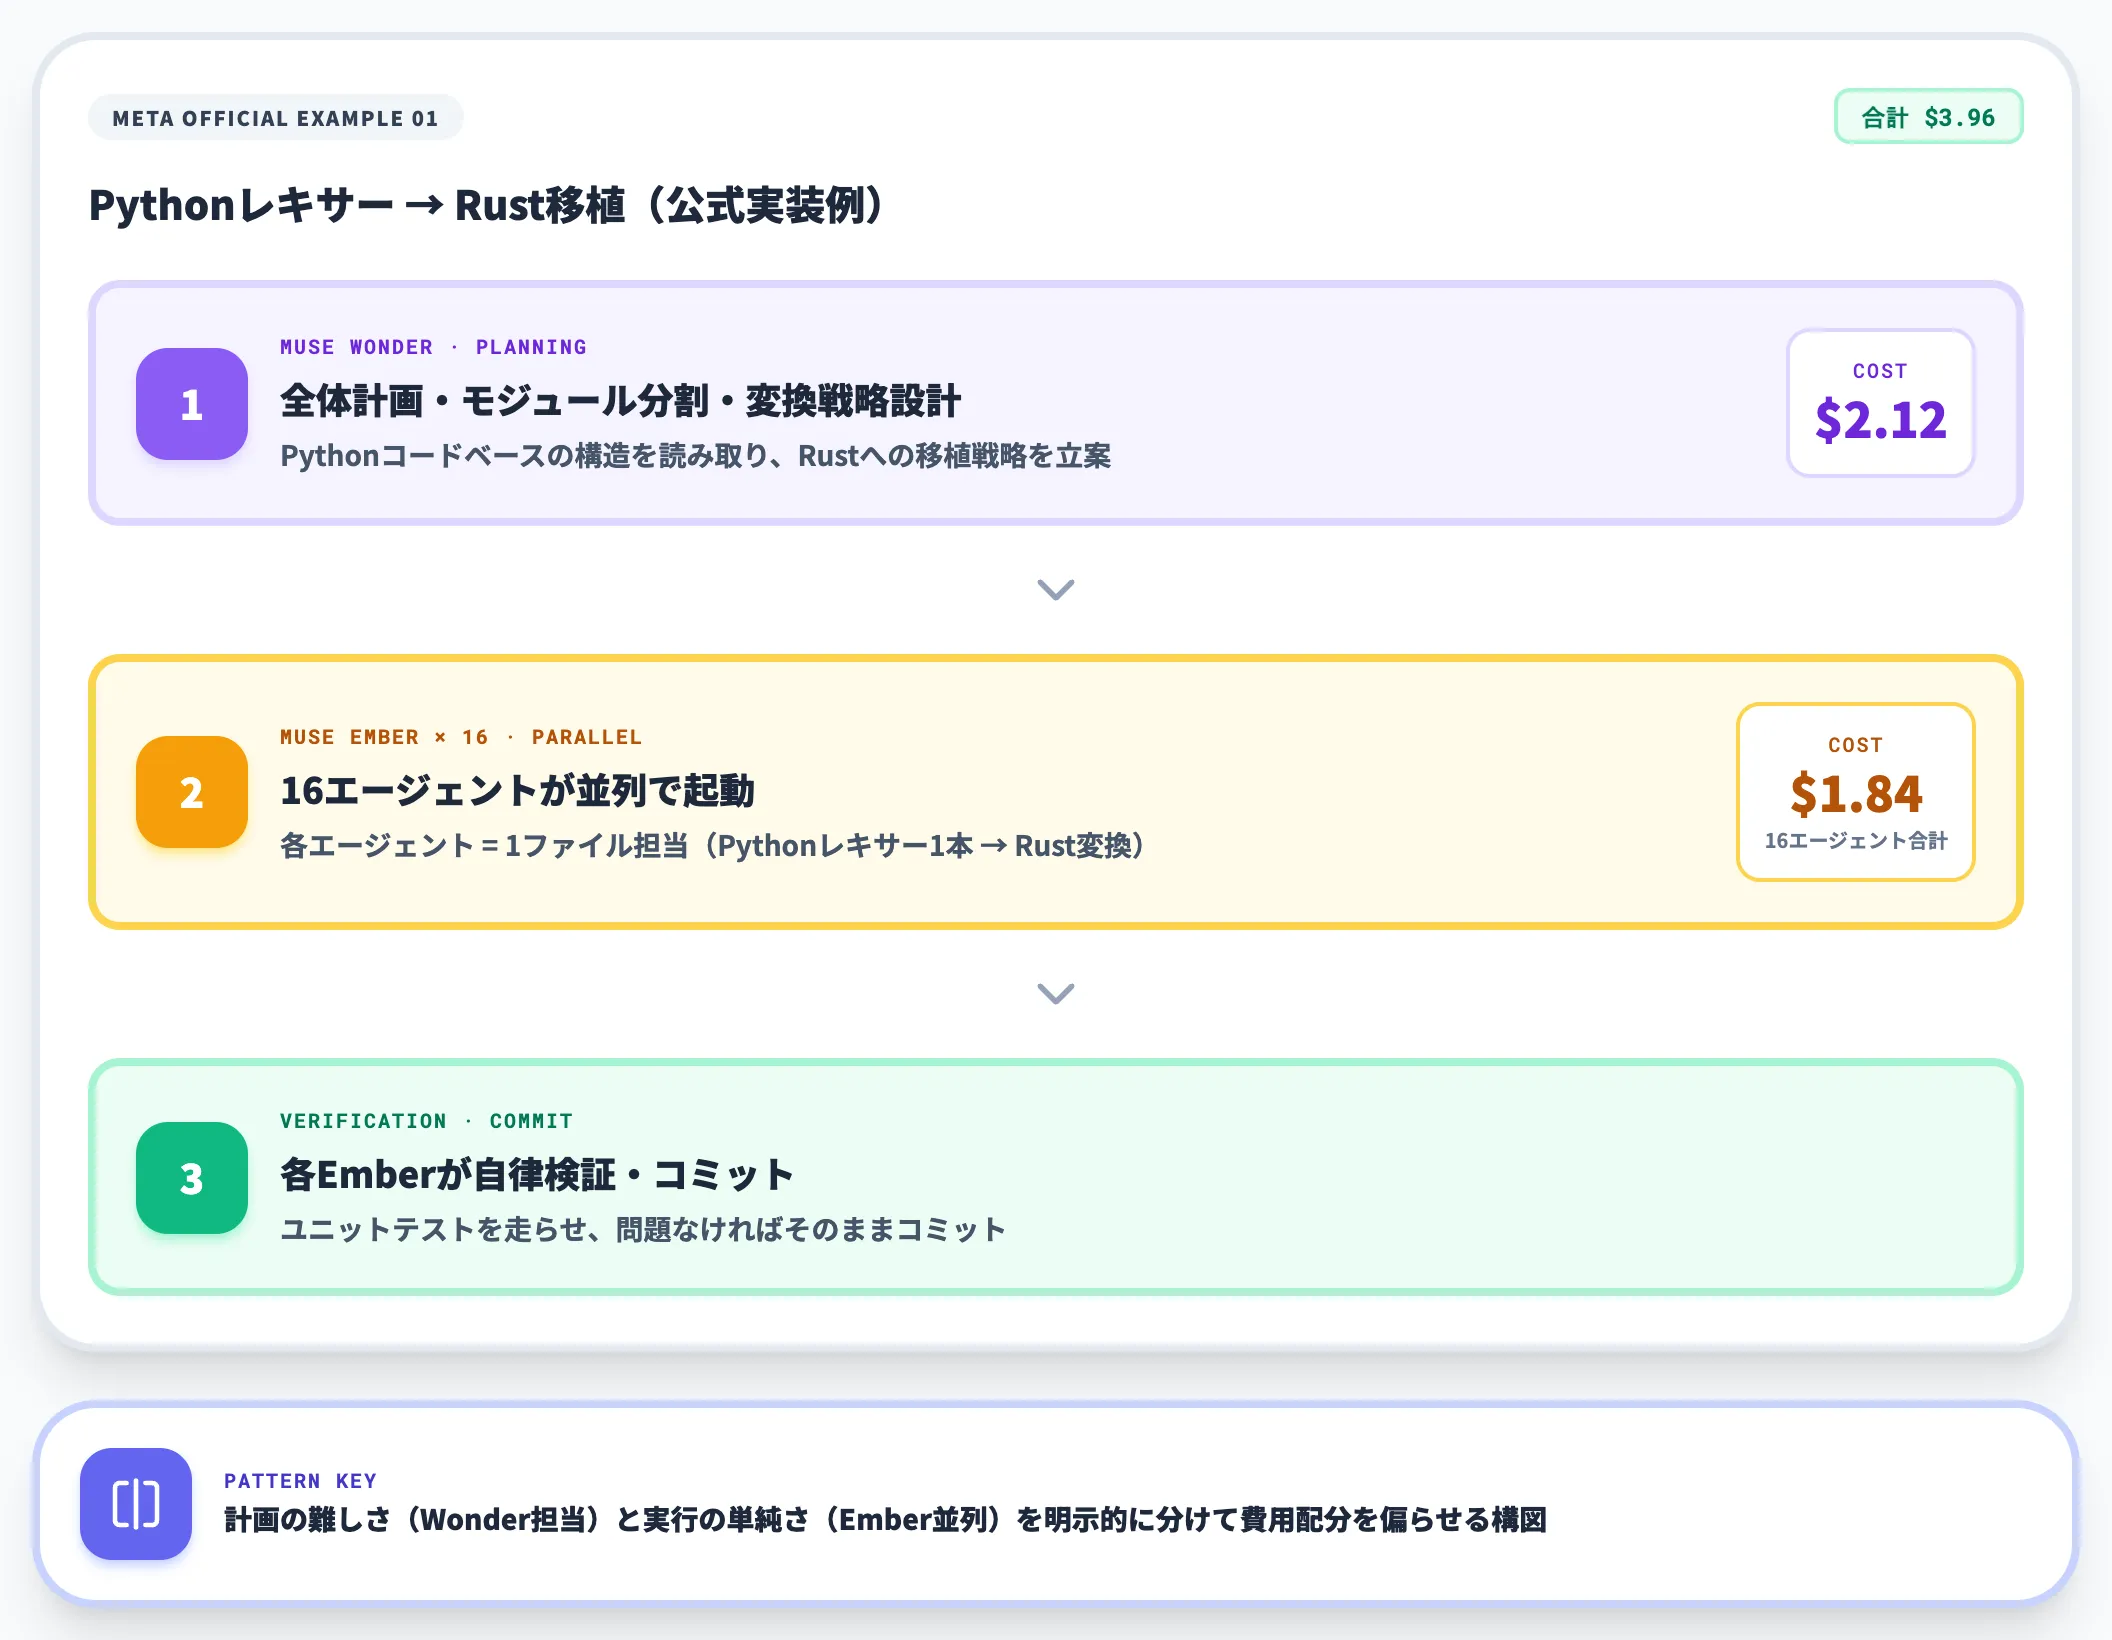
-
構造
Muse Wonderが全体の計画を立て、モジュール分割と変換戦略を設計。その後、16個のMuse Emberエージェントが並列で起動し、各々が1つのレキサーファイルを担当
-
各Emberエージェントの動作
担当ファイルのPythonコードを読み、Rustに変換し、ユニットテストを走らせて結果を検証。問題なければそのままコミットする
-
実コスト
合計約$3.96。内訳はMuse Wonderが$2.12、Muse Ember 16エージェント合計で$1.84
このパターンの肝は、計画の難しさ(Wonderが担当)と実行の単純さ(Emberが並列で担当)を明示的に分けている点です。計画は少数の大規模推論、実行は多数の軽量推論、という組み合わせで費用配分が偏る構図がそのまま数値に出ています。
10,000枚の写真整理の例
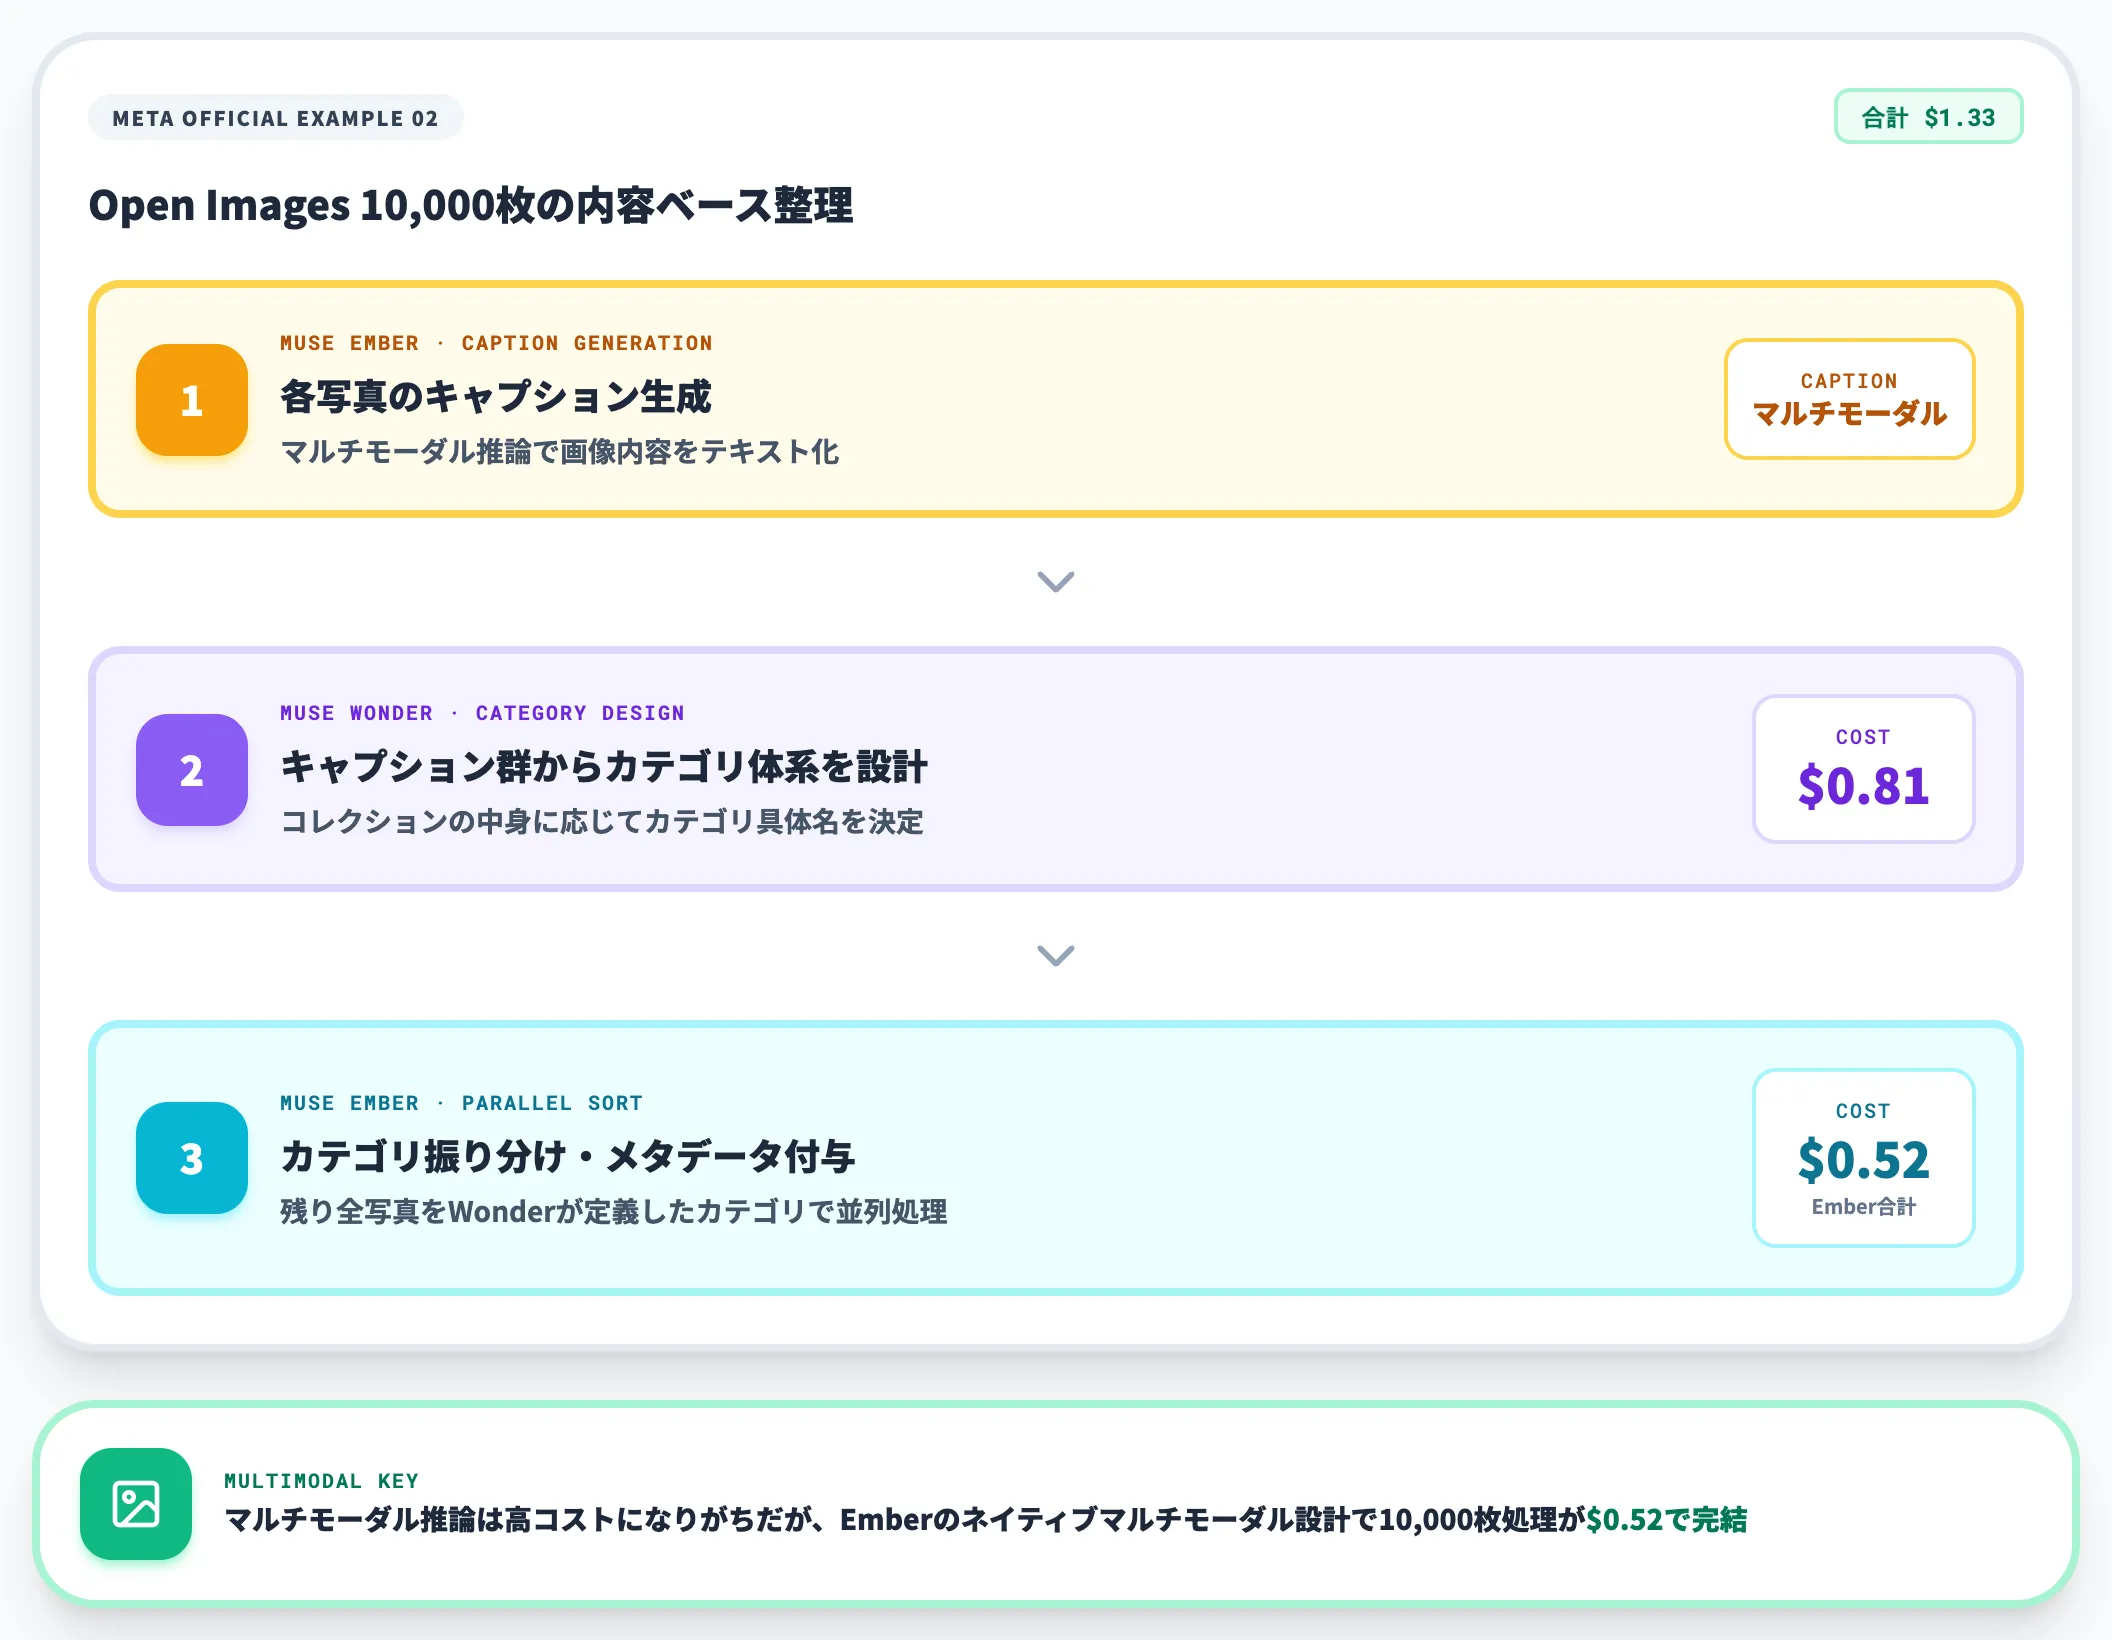
2本目は、Open Imagesデータセットの10,000枚の写真を内容ベースで整理するタスクです。
-
構造
Muse Emberが各写真のキャプションを生成し、Muse Wonderがそのキャプション群を読んでカテゴリ体系を設計。カテゴリの具体名はコレクションの中身に応じて決まる
-
並列処理
Muse Emberのエージェント群が、残り全写真に対してWonderが定義したカテゴリで振り分けとメタデータ付与を実施
-
実コスト
合計$1.33。Muse Wonderが$0.81、Muse Ember合計で$0.52
このケースで特筆すべきは、マルチモーダル(画像入力)タスクでもEmberが十分に機能している点です。マルチモーダル推論は一般的にテキストのみのタスクより高コストになりがちですが、Emberのネイティブマルチモーダル設計により、大量画像処理が$0.52で完結しています。
並列ファンアウト設計の3つのポイント
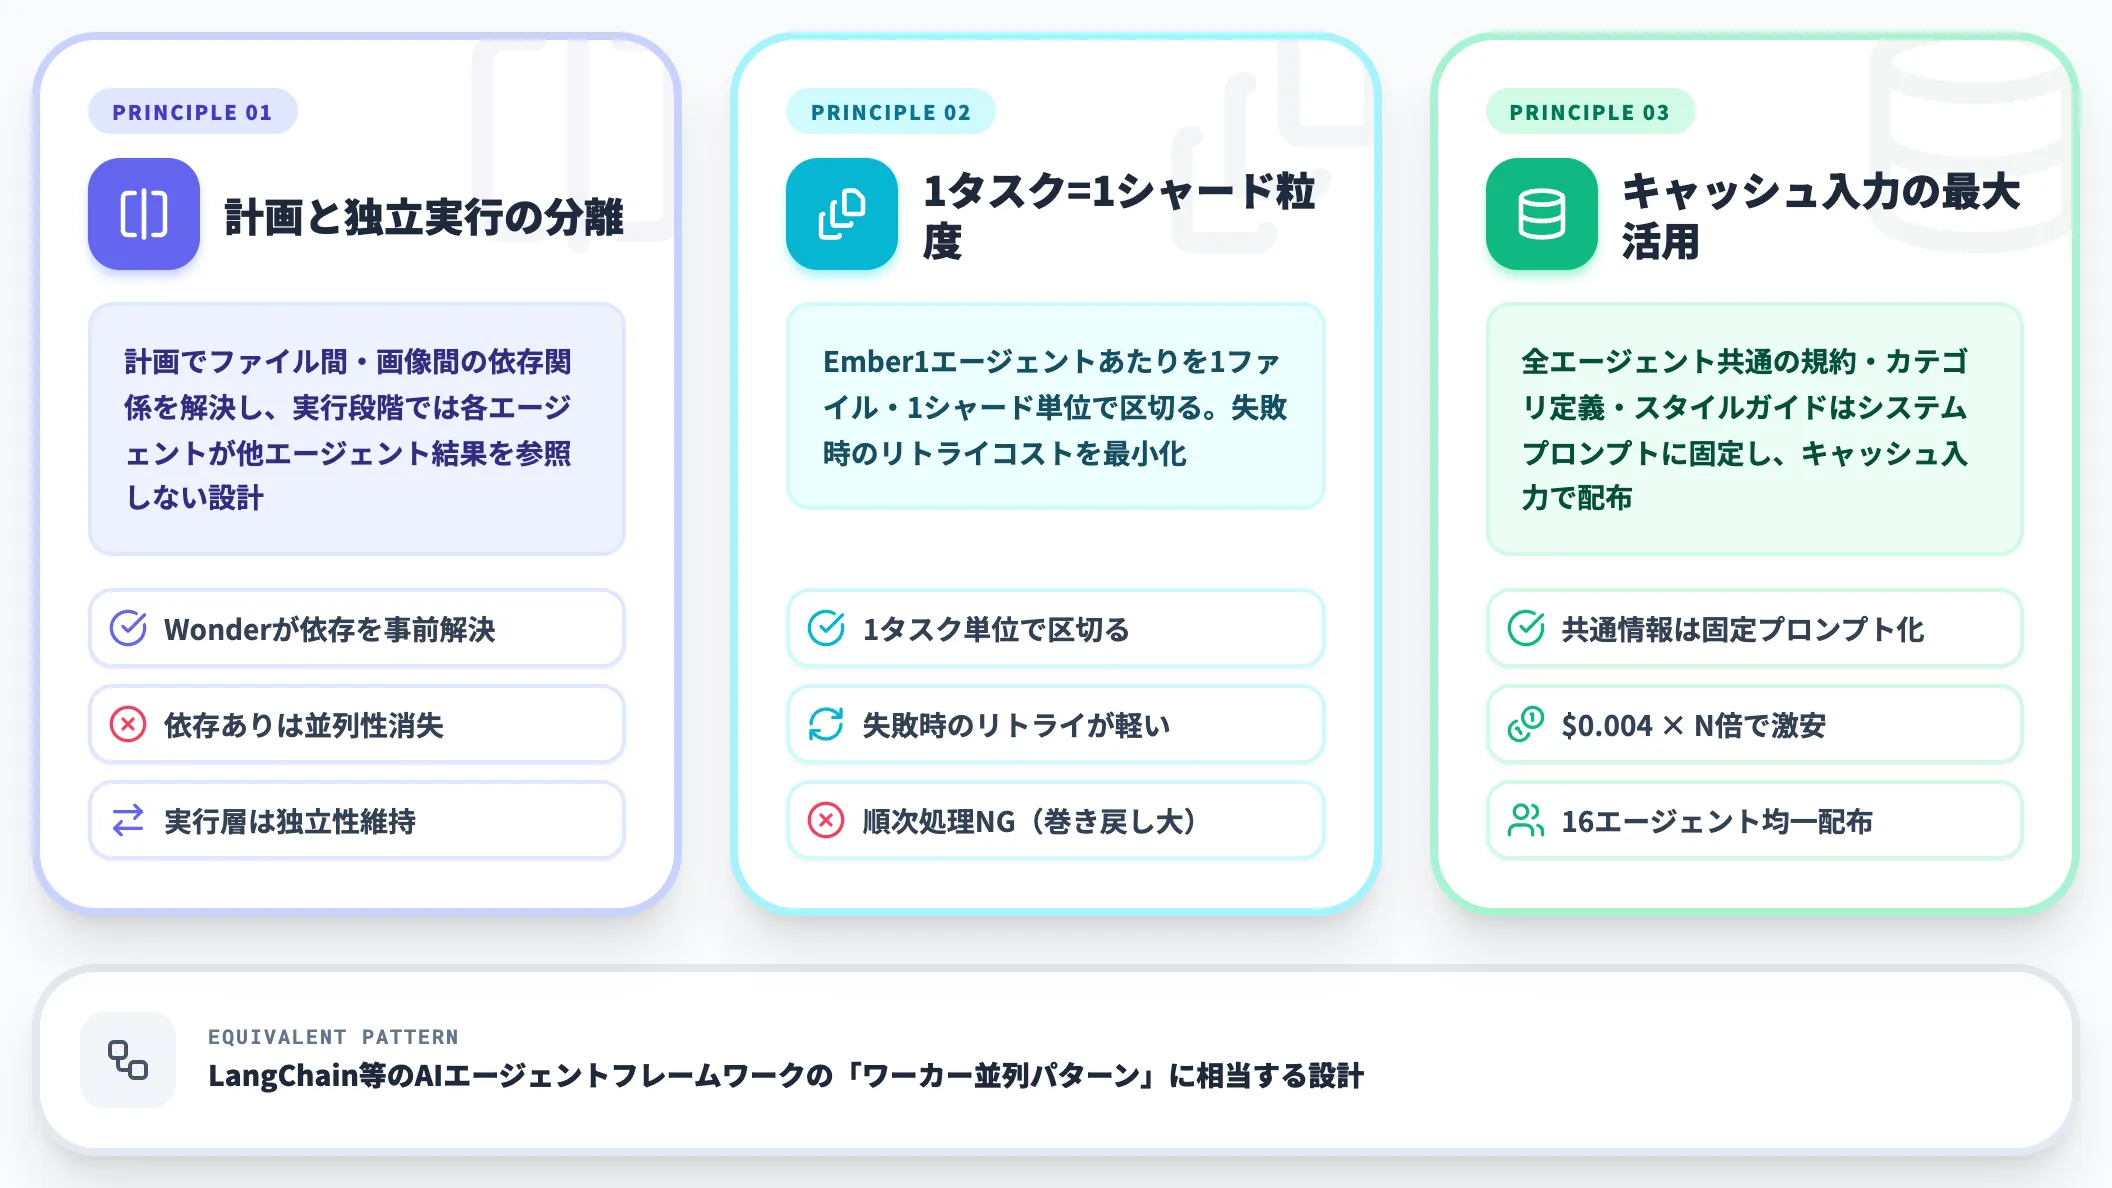
公式の実装例2本から読み取れる、WonderとEmberの2段構え設計のポイントは以下の3点です。
-
タスクを「計画」と「独立実行」に分離する
計画段階ではファイル間・画像間の依存関係を解決し、実行段階では各エージェントが他エージェントの結果を参照しない設計にする。依存があるとEmber側の並列性が消え、Wonderで全部やるのと変わらなくなる
-
Ember1エージェントあたりのタスクを「1ファイル・1シャード」単位で区切る
1エージェントが複数タスクを順次処理すると、エラー時の巻き戻しコストが大きくなる。1タスク単位なら失敗時にそのエージェントだけリトライすれば済む
-
キャッシュ入力を最大限活用する
全エージェントに共通する「プロジェクト全体の規約」「カテゴリ定義」「スタイルガイド」はシステムプロンプトに固定し、キャッシュ入力として送る。16エージェント分で$0.004 × 16 × 固定コンテキスト、という低コストで共通知識を配れる
この設計は、LangChainのようなAIエージェントフレームワークで言うところのワーカー並列パターンに相当します。公式blogの2例(Python→Rust移植で合計$3.96、写真整理で合計$1.33)は、WonderとEmberの組み合わせで到達した絶対額の実例であり、他モデル単独との倍率比較は提示されていません。
自社環境で既存のフロンティア単独構成と比較する場合は、同条件のPoCで倍率を実測するのが安全です。
Claude Haiku 5.5との使い分け
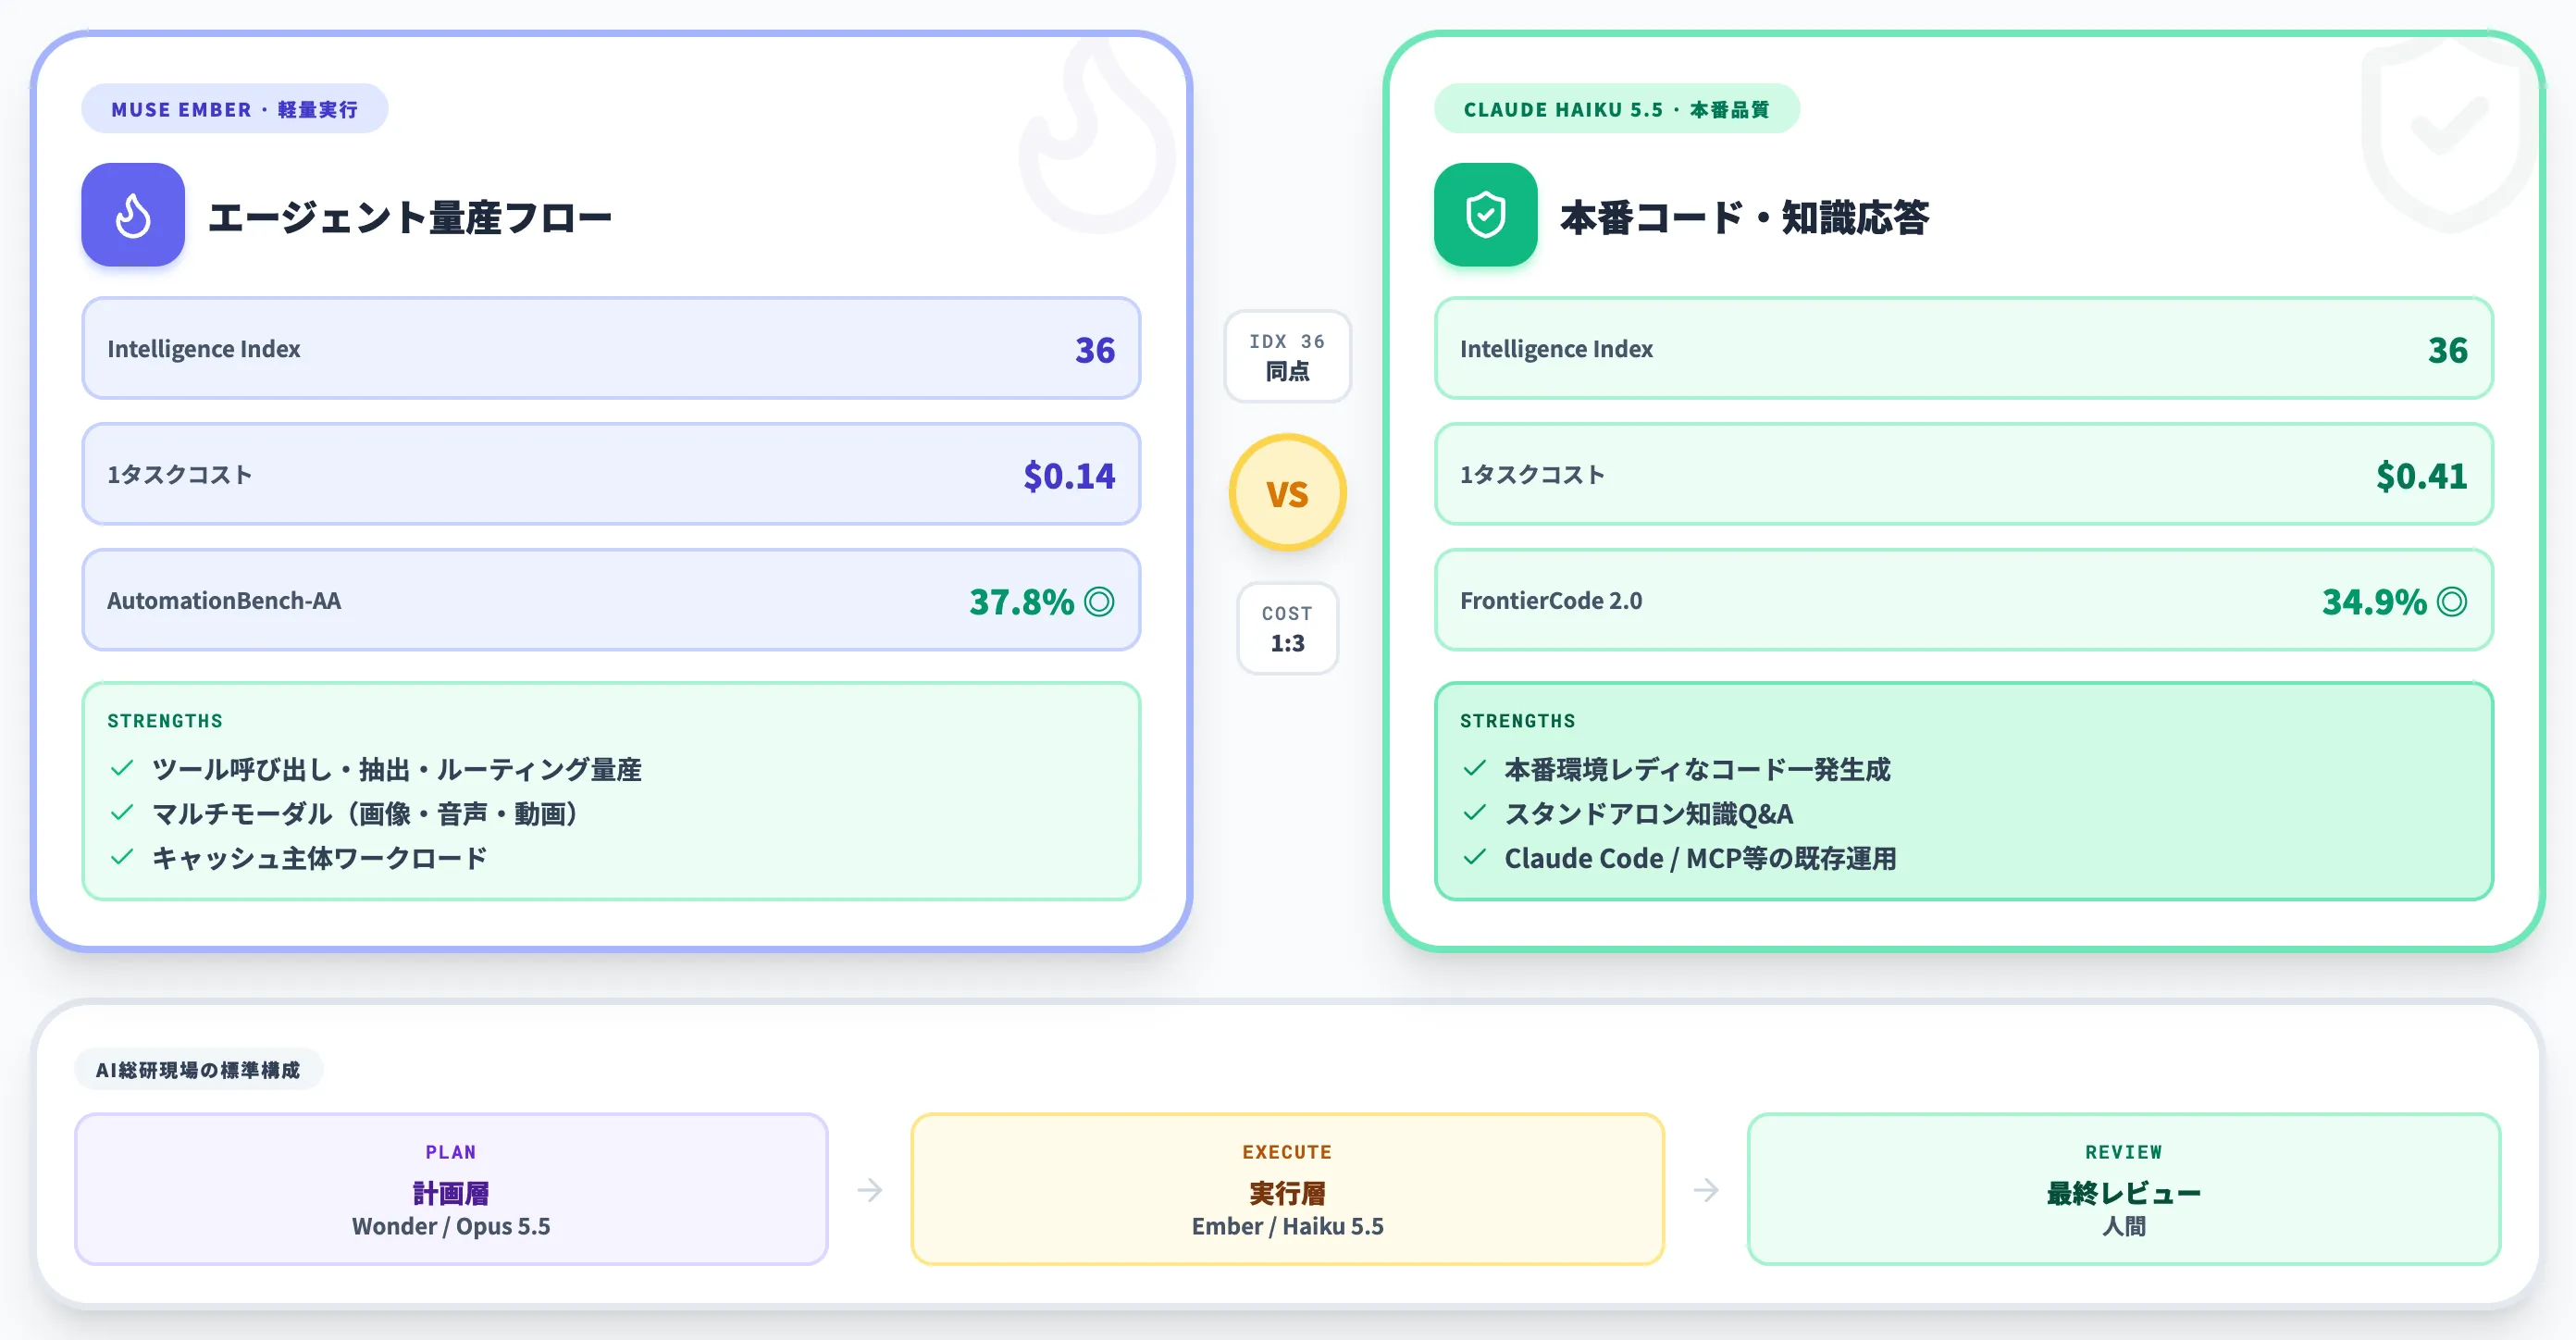
Muse EmberとClaude Haiku 5.5は、Artificial Analysis Intelligence Indexで両者36点と同点で、同じ価格帯(基本単価$0.10/$0.50)の直接の競合関係にあります。
ただし、ベンチマーク別の得意領域が大きく異なるため、用途によって明確に使い分ける判断軸が存在します。
既にClaude 4ファミリーの比較記事で軽量モデルの選び方は整理していますが、2026年11月時点でMuse Emberが加わったことで判断軸が1つ増えた形です。
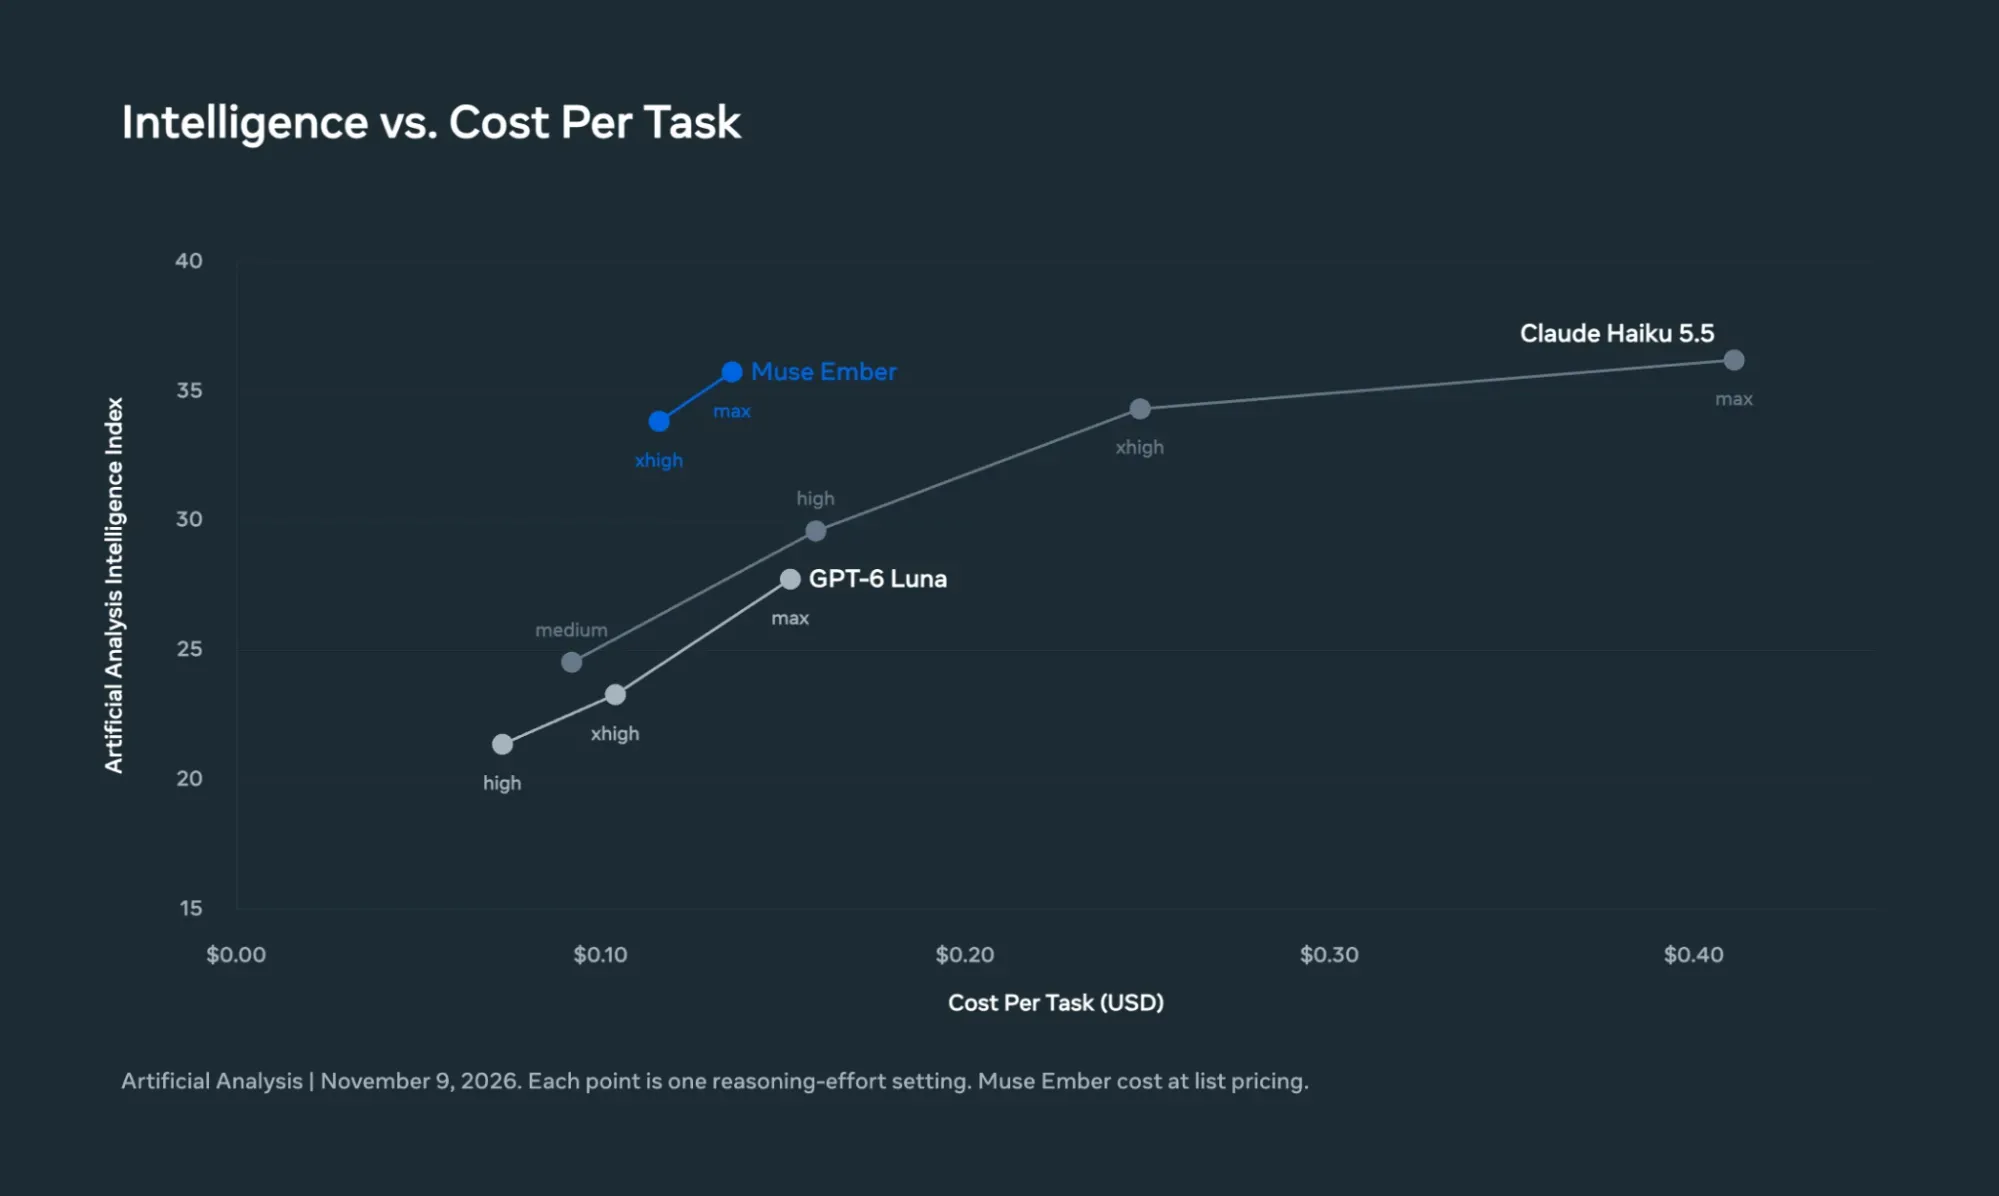
Muse Ember(青)・Claude Haiku 5.5・GPT-6 Lunaの性能/コスト分布・各reasoning-effort設定別にプロット(出典:Meta公式blog Build with Muse Ember)
散布図を見ると、縦軸のIntelligence Index 35〜36付近でMuse Ember(青点)とClaude Haiku 5.5(右端のmax点)はほぼ横並びです。
ところが横軸のCost Per Taskを見ると、Muse Emberは$0.14前後、Haiku 5.5は$0.41前後で、同じ性能ラインに到達するために3倍のコスト差が生じていることが視覚的に確認できます。
GPT-6 Luna は Intelligence Index 28前後の別スコア帯にプロットされており、Muse Ember・Haiku 5.5とは比較するスコアラインが異なります。
Muse Emberを選ぶケース
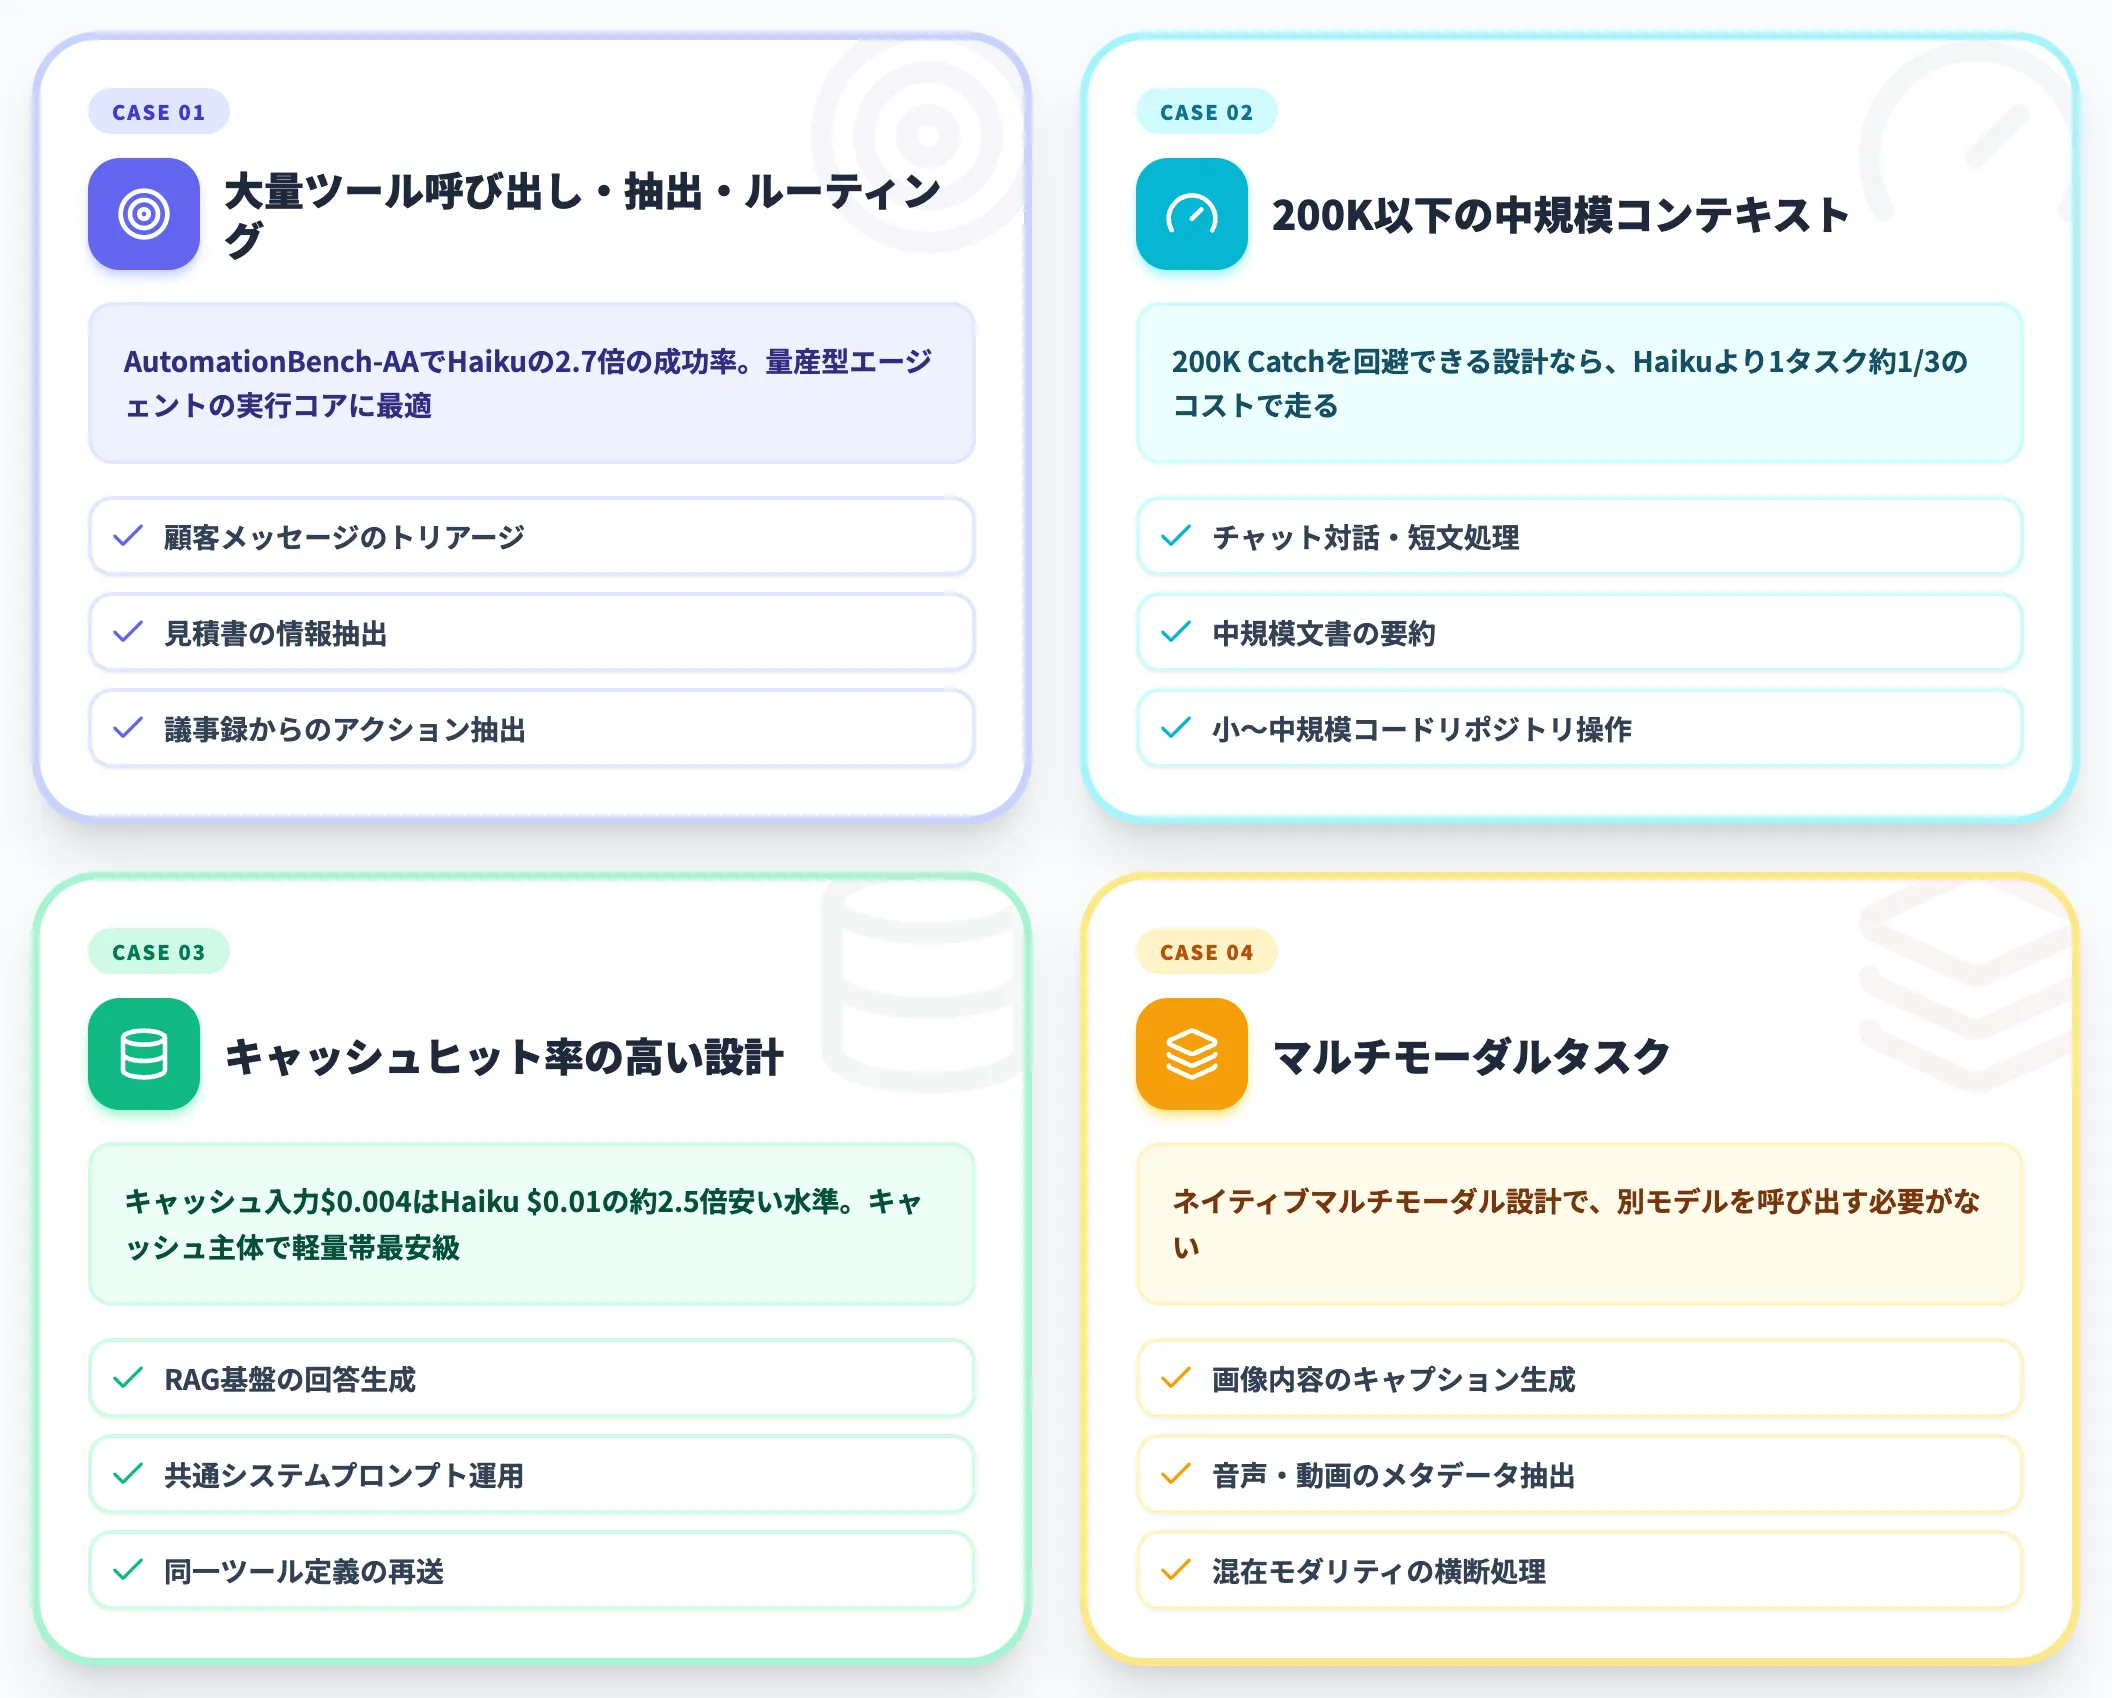
以下のいずれかに該当するなら、Muse Emberが第一候補になります。
-
エージェントが大量のツール呼び出し・抽出・ルーティングを繰り返す
AutomationBench-AAでHaikuの2.7倍の成功率を示しており、量産型エージェントの実行コアとして最適
-
200Kを超えない中規模のコンテキストを前提にしている
200K Catchを回避できる設計なら、Haiku 5.5より1タスクあたり約1/3のコストで走る
-
キャッシュヒット率が高いシステム設計(RAG・共通プロンプト運用)
キャッシュ入力$0.004は、100K以下区分のHaiku 5.5キャッシュ単価$0.01と比べて約2.5倍安く、キャッシュ主体のワークロードでは軽量帯最安級
-
画像・音声・動画を混ぜたマルチモーダルタスクを扱う
ネイティブマルチモーダル設計で、別モデルを呼び出す必要がない
Claude Haiku 5.5を選ぶケース
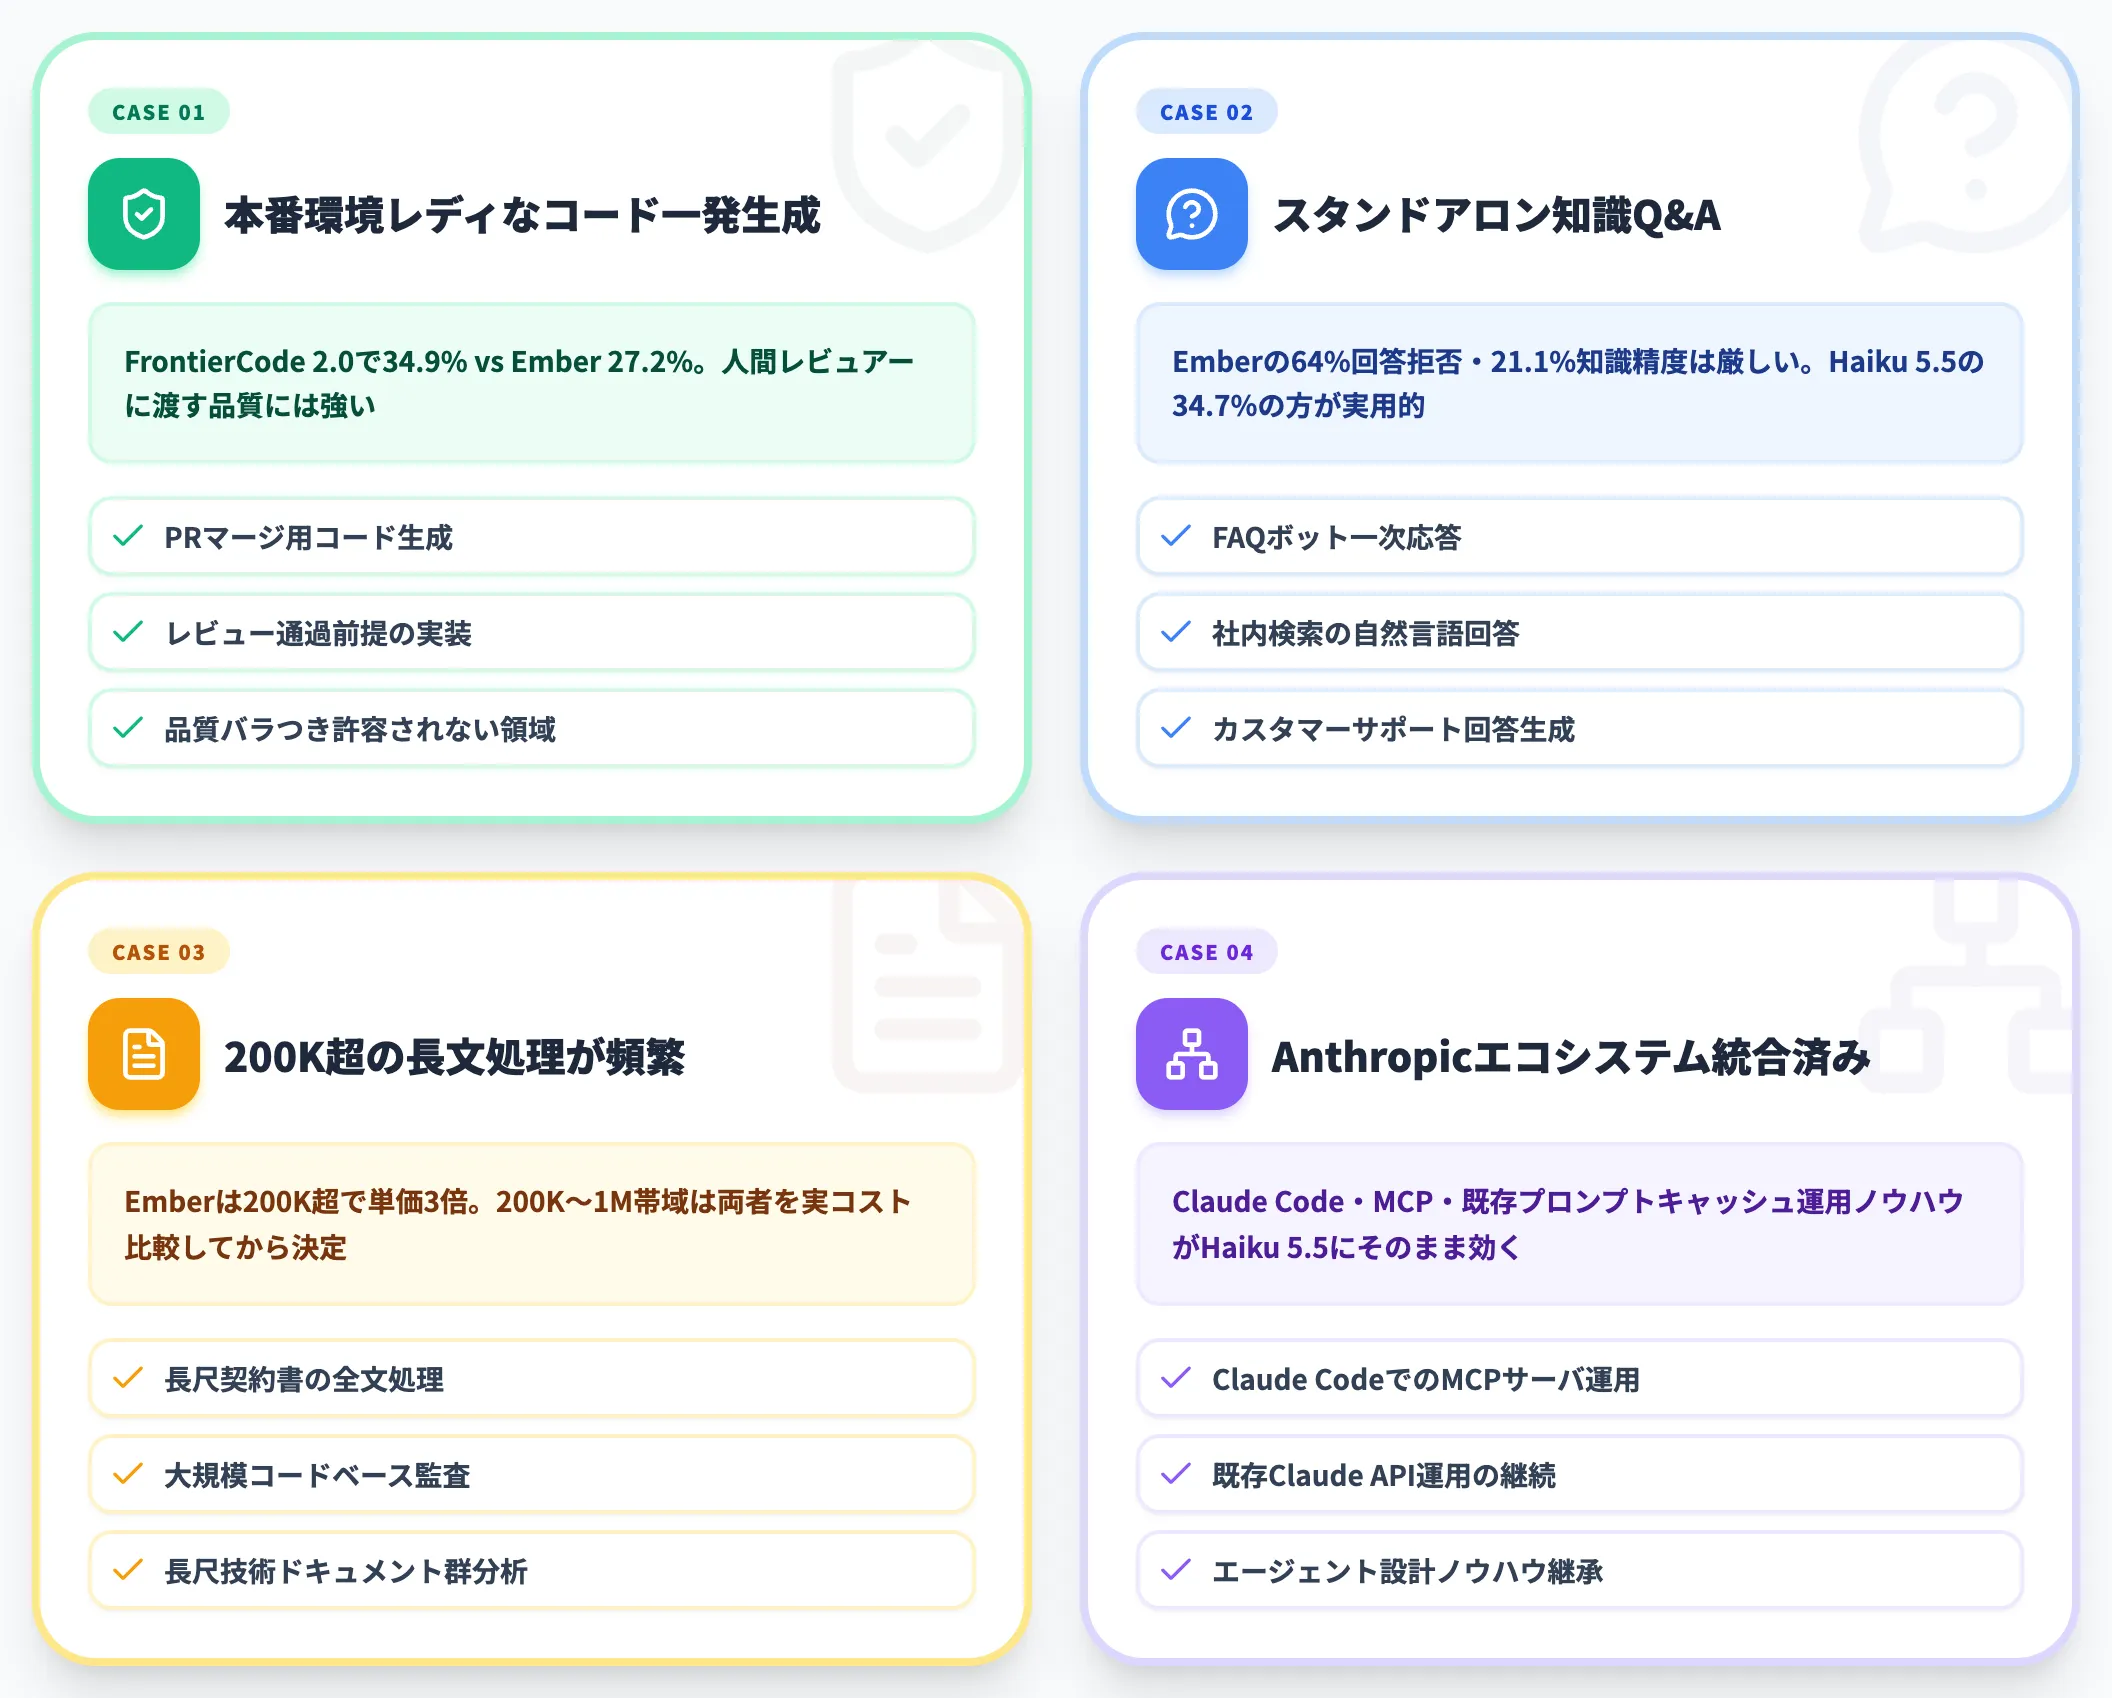
逆に、以下のいずれかに該当するなら、Claude Haiku 5.5が引き続き現実的な第一候補です。
-
本番環境レディなコードを一発で生成する用途
FrontierCode 2.0で34.9% vs Ember 27.2%と、Haikuが約28%優位。人間レビュアーに渡す品質を求める場面では強い
-
スタンドアロンの知識Q&A(FAQボット・社内検索の回答生成)
Muse Emberの64%回答拒否と21.1%の知識精度は、Q&A用途には厳しい。Haiku 5.5の34.7%の方が実用的
-
200Kを超える長文処理が頻繁に発生する
Muse Emberは200K超で入力・出力・キャッシュのすべてが3倍に跳ね上がる。Haiku 5.5は100K超で入力$0.50・出力$2.50・キャッシュ$0.05となるため、200K〜1Mの帯域で使うワークロードは両者を実コストで比較してから決めるのが安全
-
Anthropicエコシステム(Claude Code・MCP・既存のClaude API運用)に深く統合済み
Metaは Anthropic Messages互換APIも提供しているためSDK自体はそのまま使えるが、Claude Codeで動くMCPサーバやプロンプトキャッシュの運用ノウハウ・エージェント設計はHaiku 5.5側にそのまま効く
用途別の判断軸
実務的な使い分けの軸は、突き詰めれば2つに集約されます。
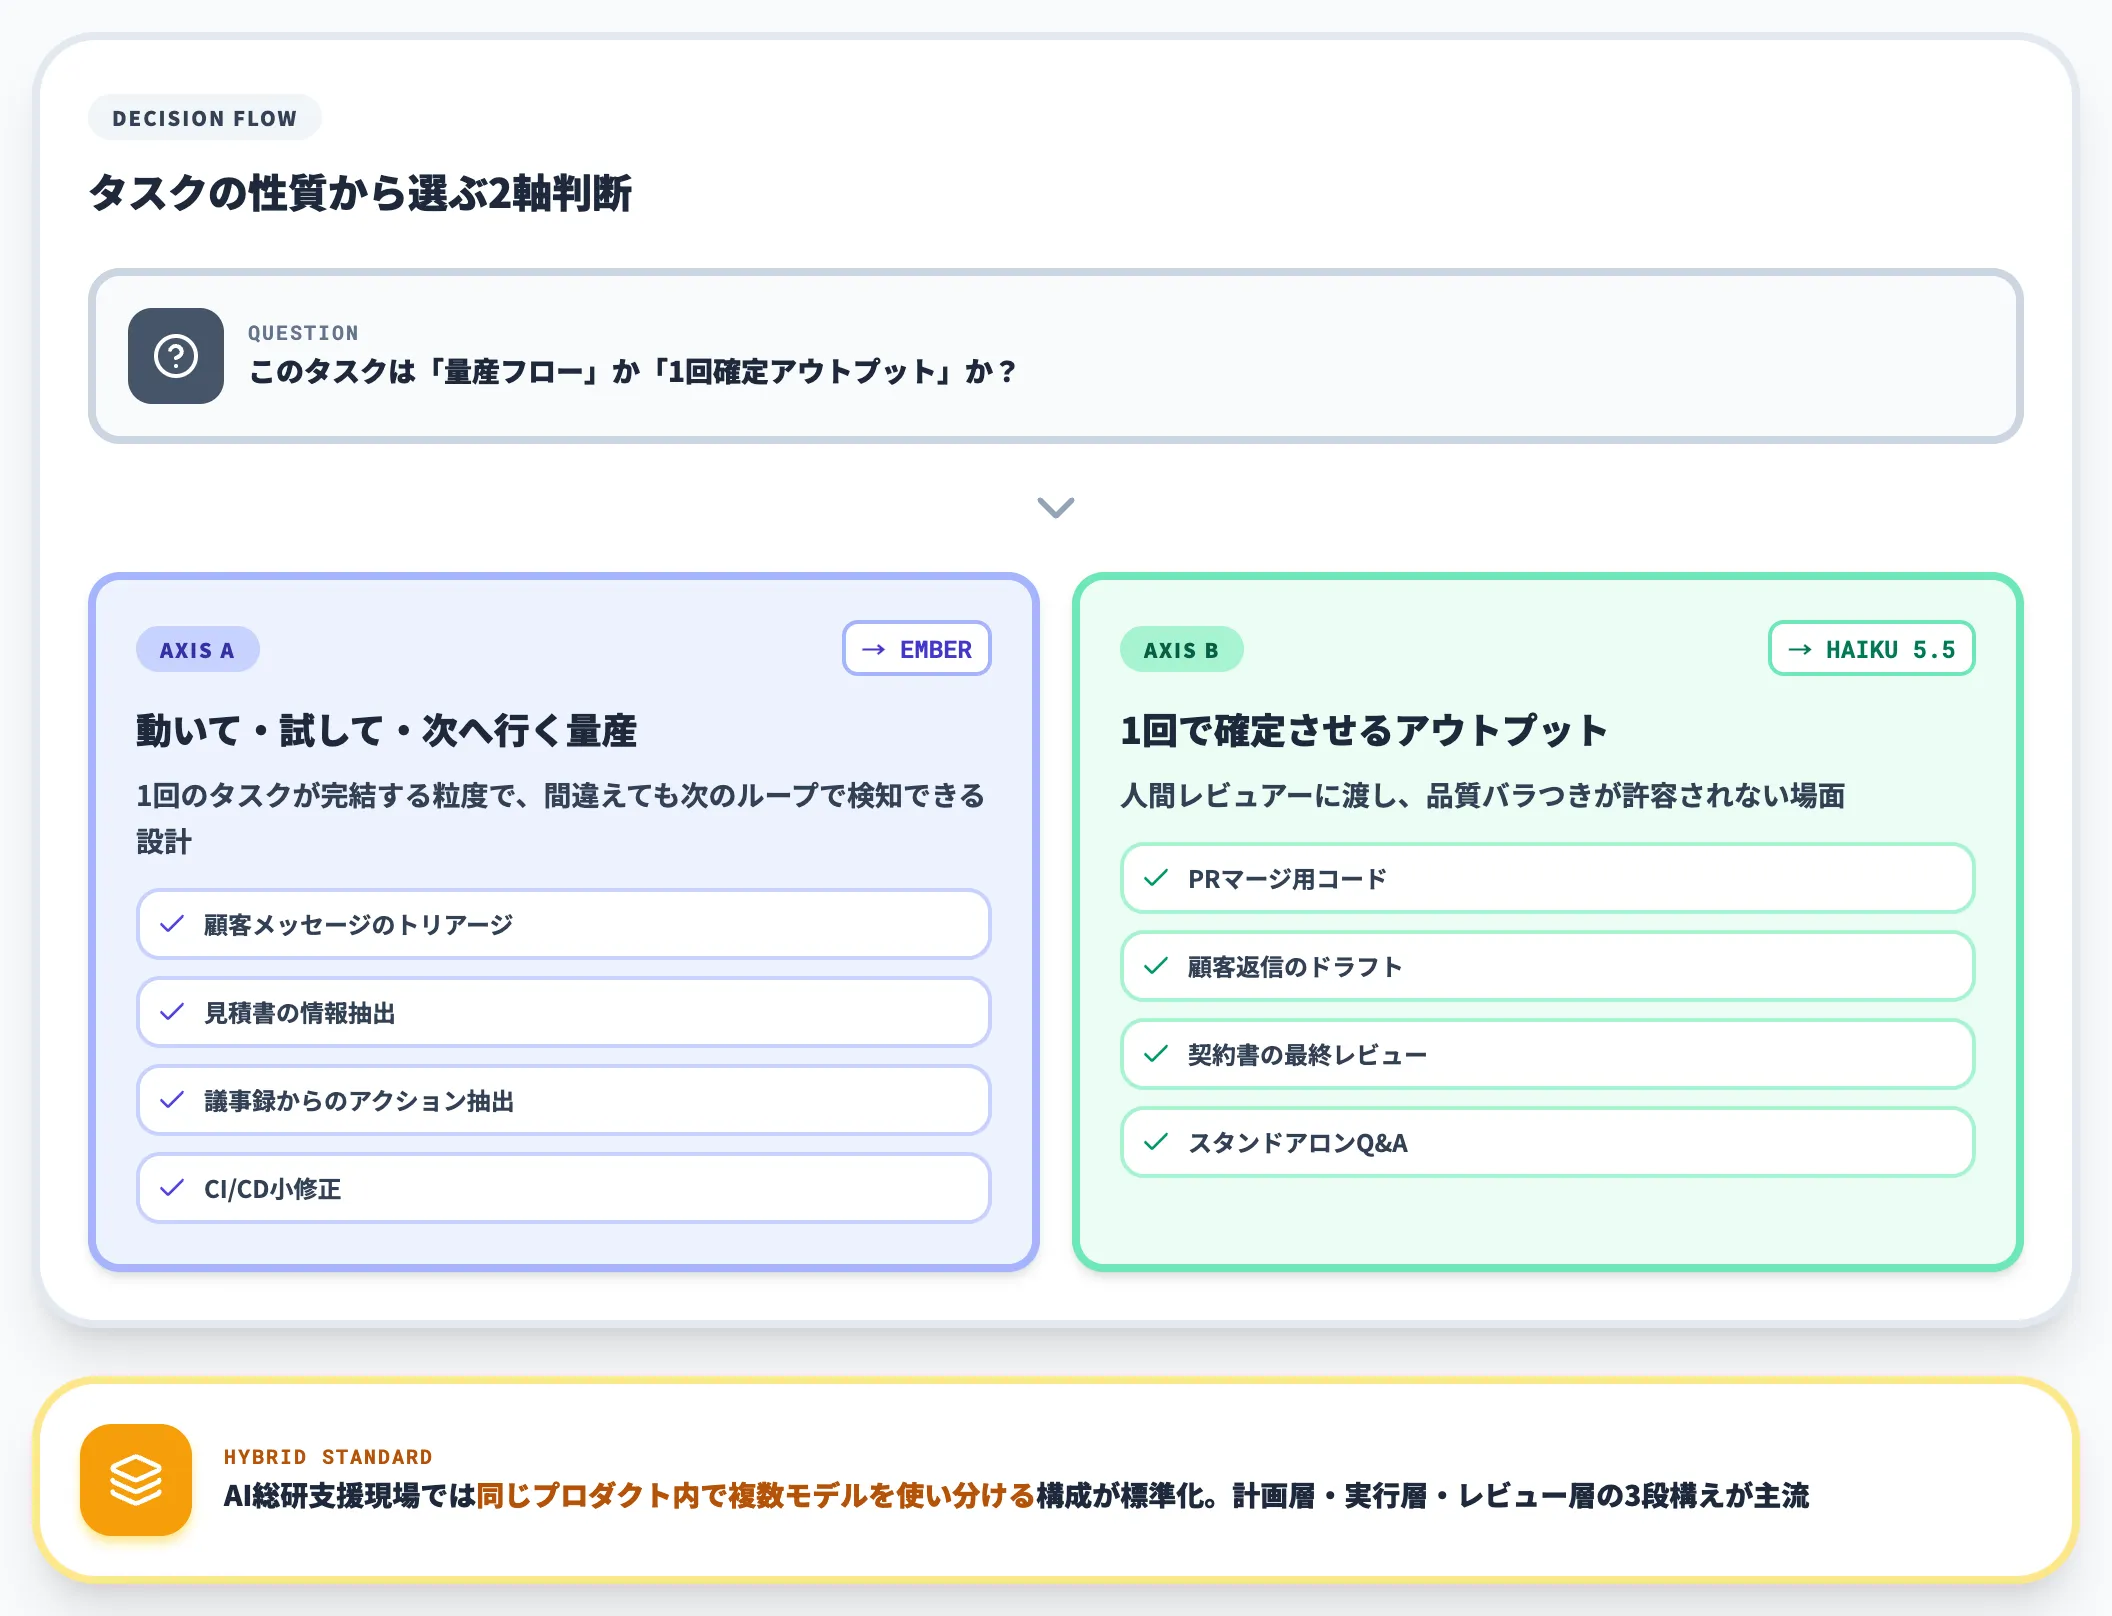
エージェントが『動いて・試して・次へ行く』フローを量産する用途——顧客メッセージのトリアージ、見積書の情報抽出、議事録からのアクション抽出、CI/CDパイプラインの小修正——ではMuse Emberが向きます。これらは1回のタスクが完結する粒度で、間違えても次のループで検知できる設計になっているためです。
一方、人間のレビュアーに渡すアウトプットを1回で確定させたい用途——PRマージ、顧客返信のドラフト、契約書の最終レビュー——ではHaiku 5.5やClaude Sonnet 5.5が引き続き現実的です。品質のバラつきが許容されない場面では、Emberの保守的な回答拒否が逆にブロッカーになります。
AI総研の支援現場でも、同じプロダクト内で複数モデルを使い分けるハイブリッド構成が標準的になっています。計画層にWonderまたはClaude Opus 5.5、実行層にEmberまたはHaiku 5.5、最終レビューに人間、という3段構えで運用するケースが増えているのが実情です。
Muse Emberの制限と注意点
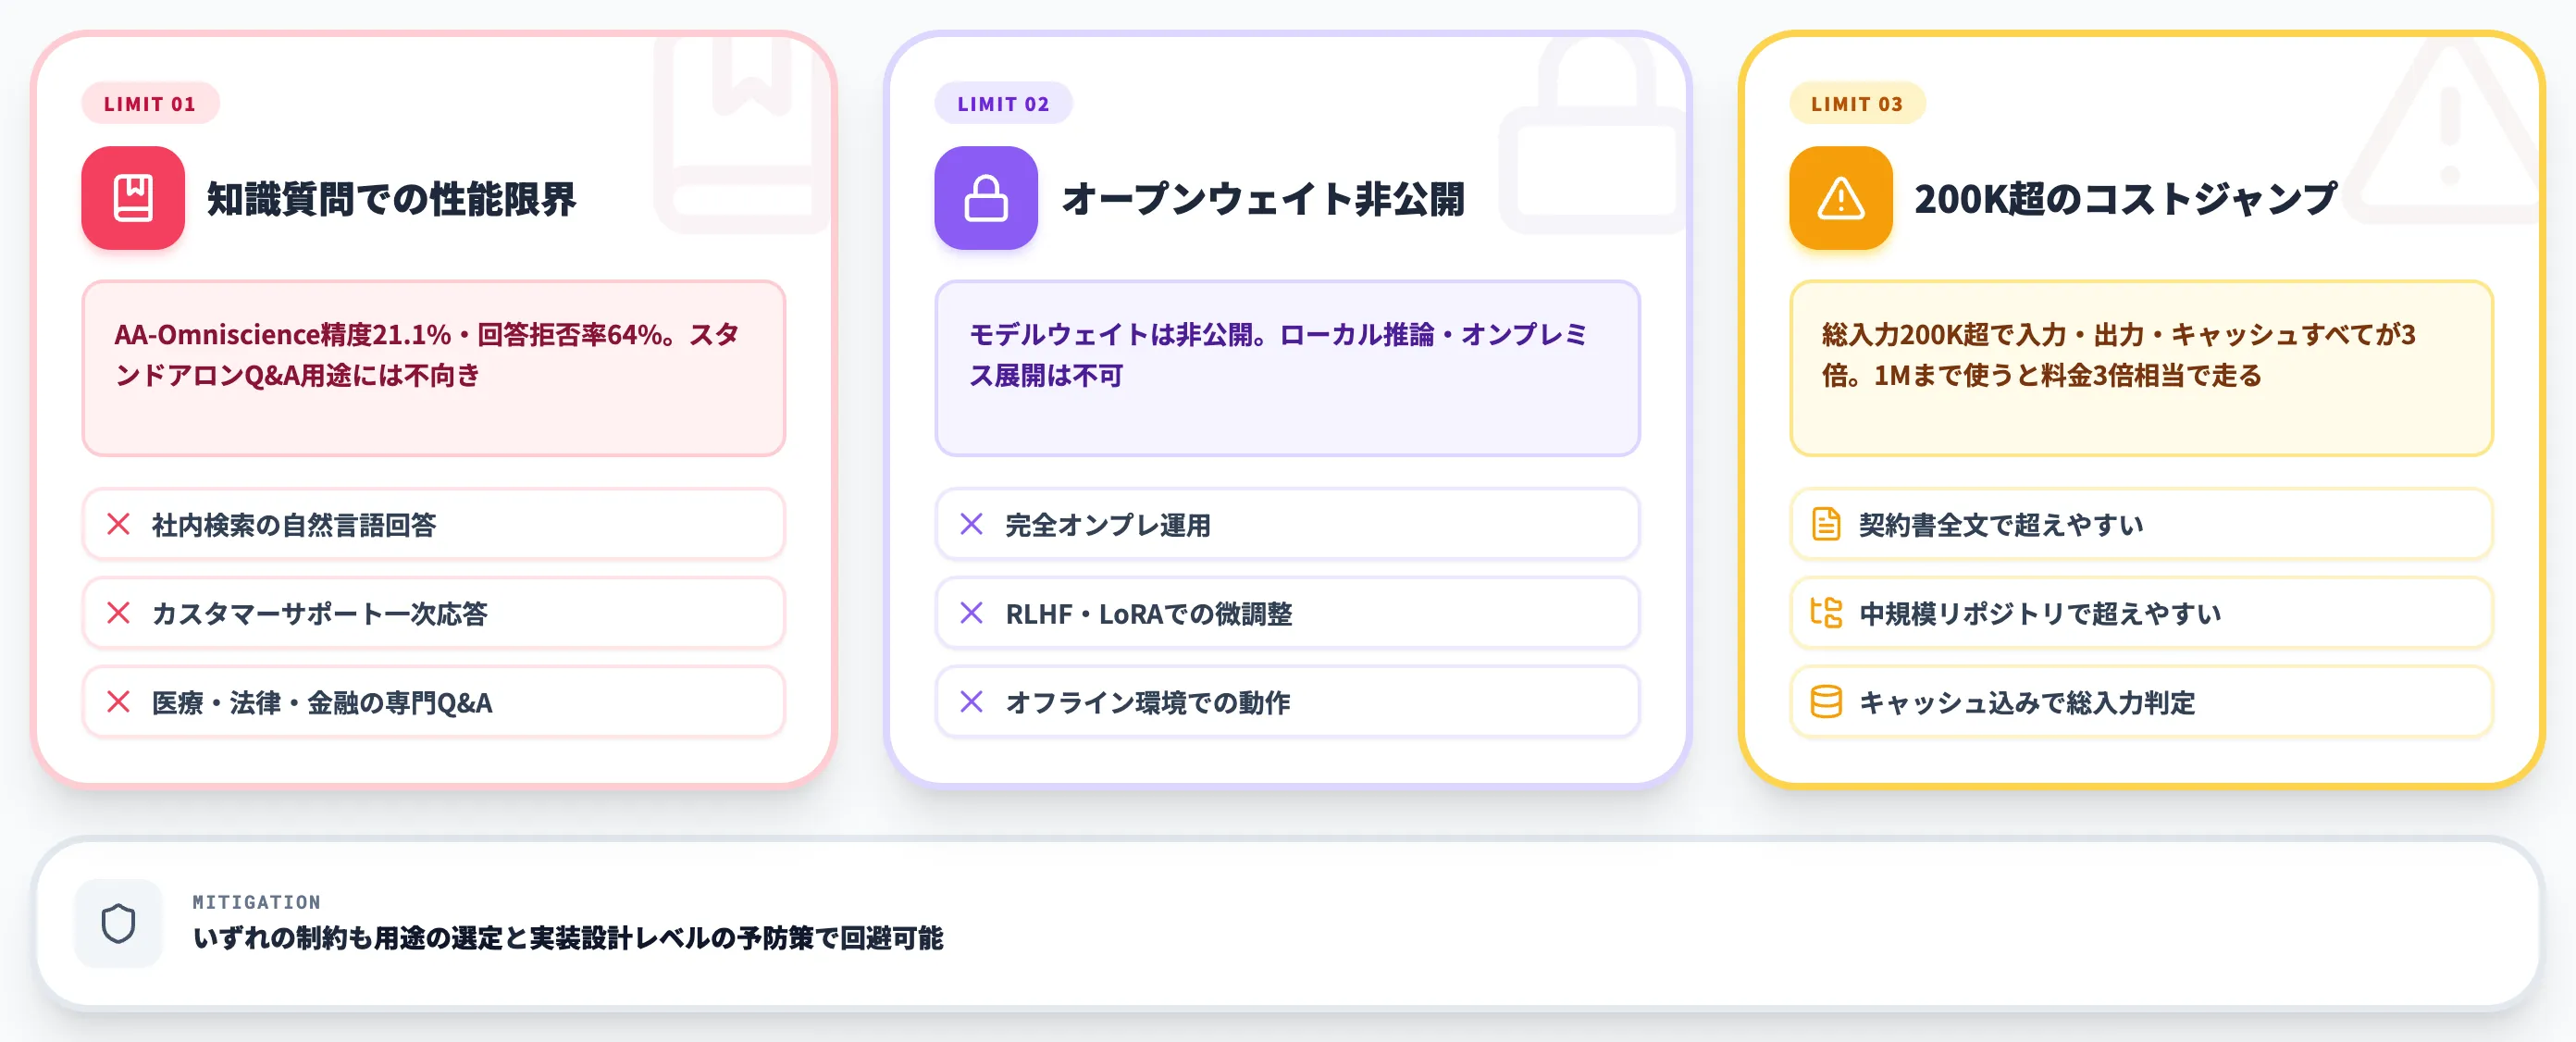
Muse Emberは価格・性能・マルチモーダル対応のバランスで優れたモデルですが、2026年11月時点ではいくつかの制約があります。本セクションでは、導入判断で見落としやすい3つの論点を整理します。
知識質問での性能限界
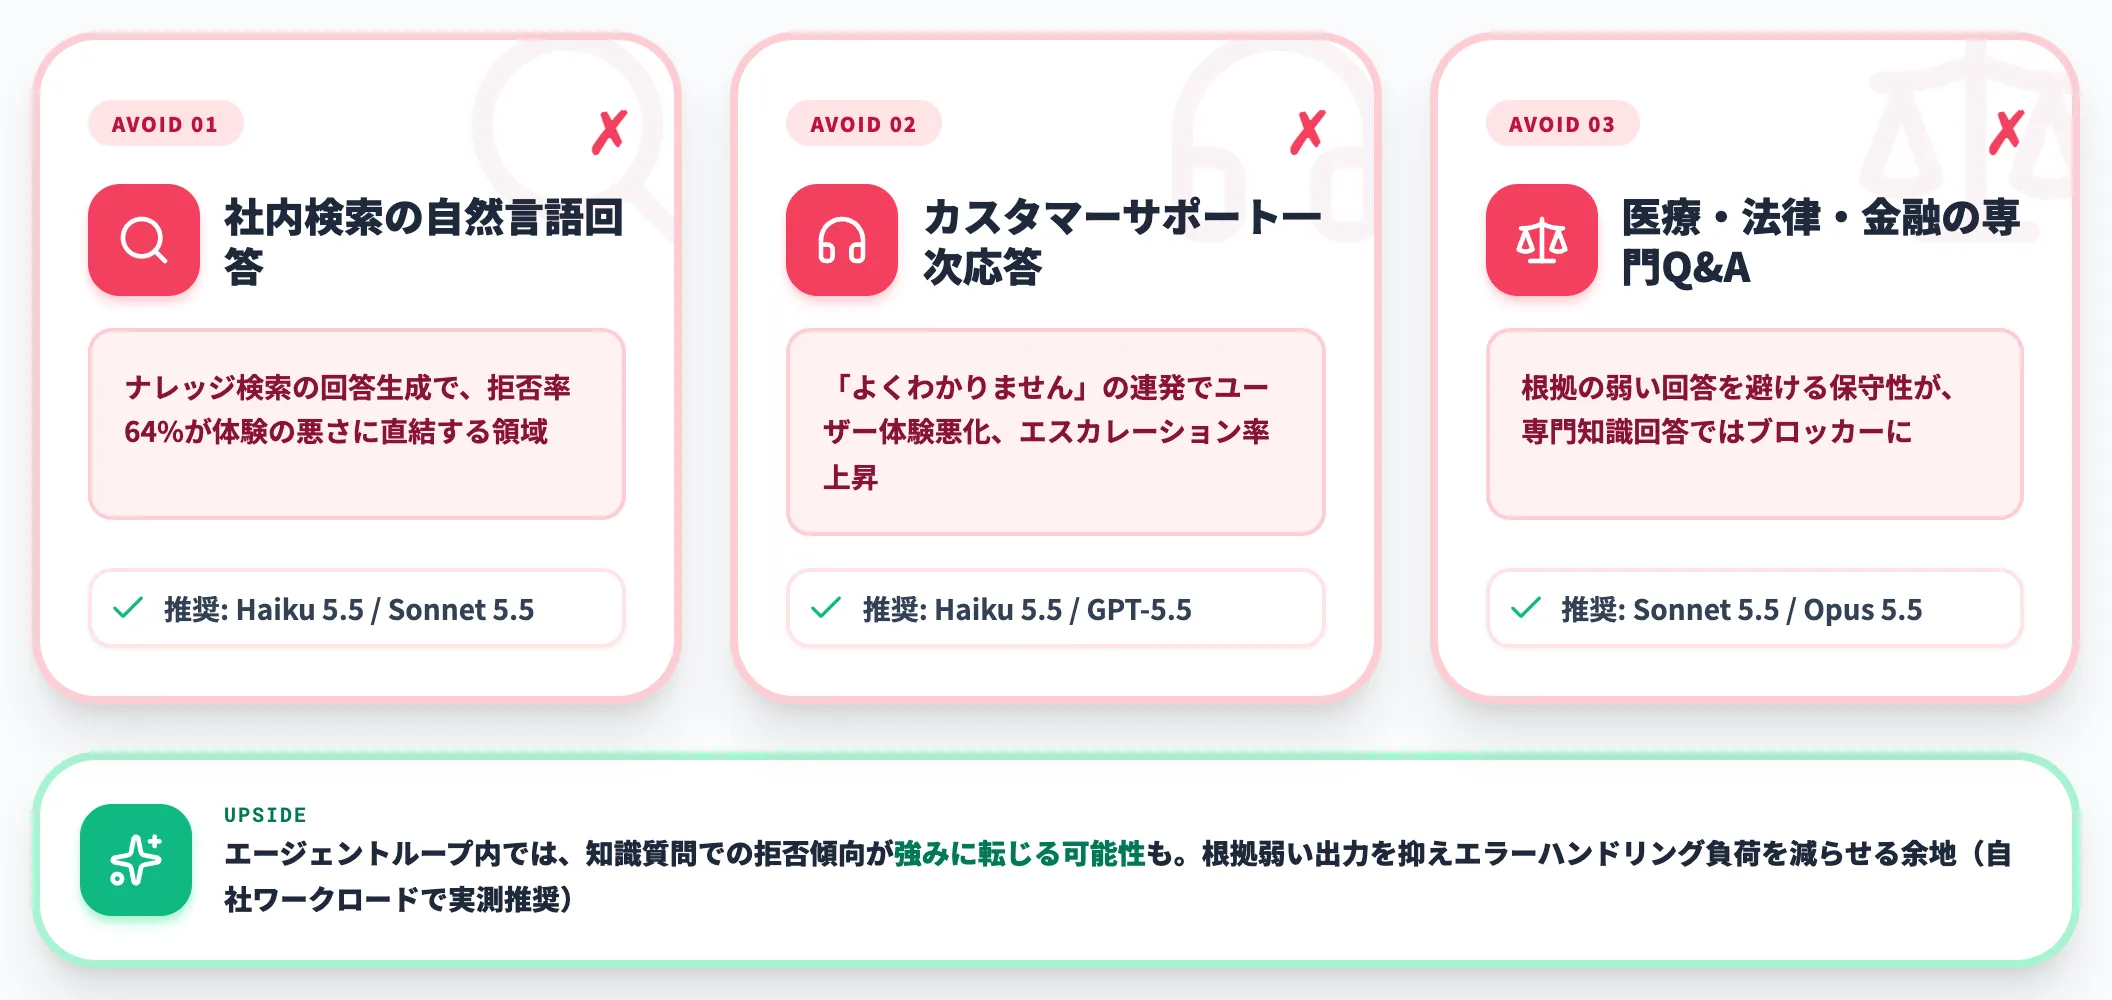
繰り返しになりますが、Muse Emberは知識質問の精度が低く、64%で回答を拒否するという保守的な設計を採用しています。
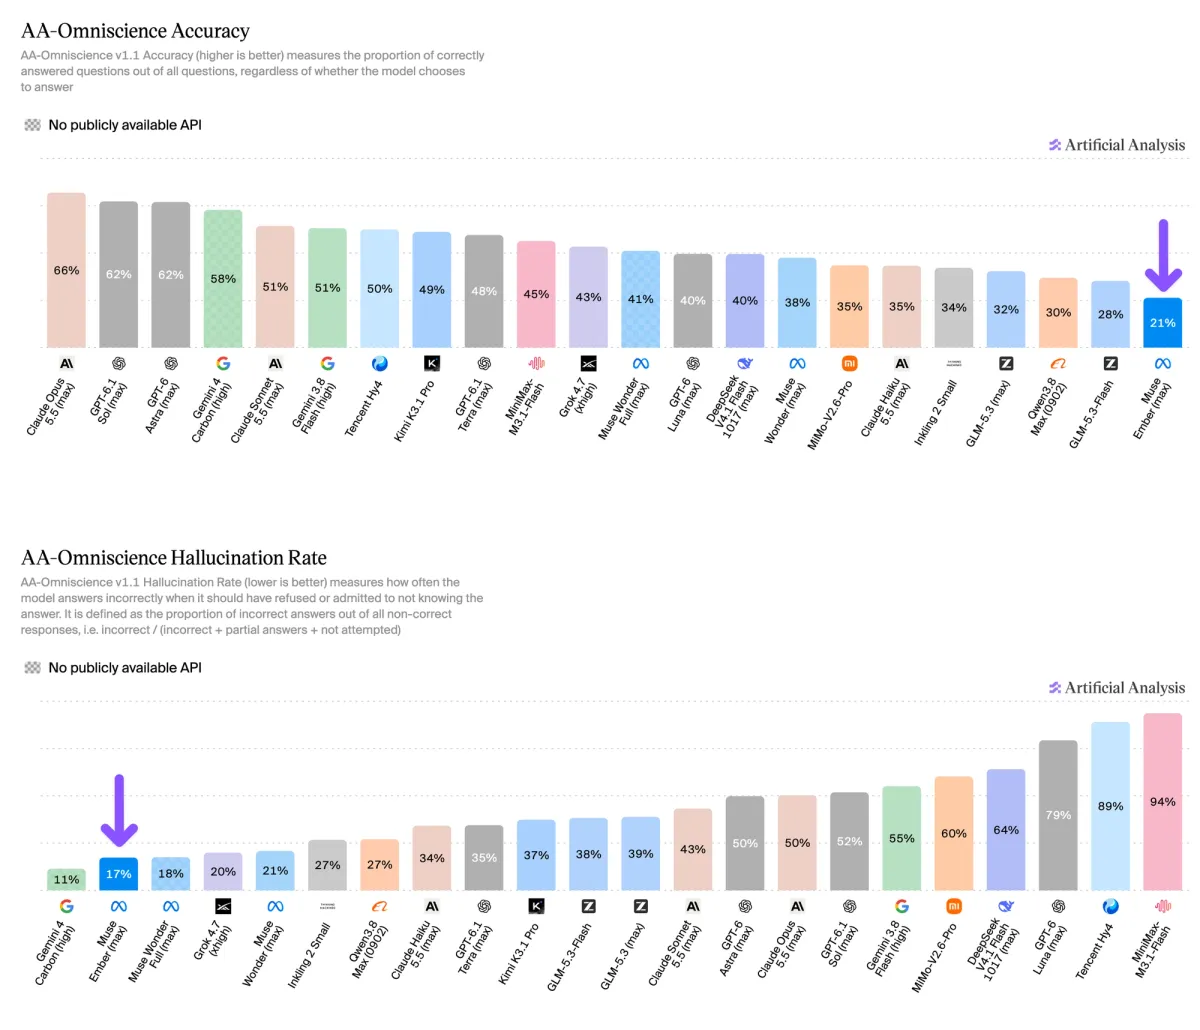
Muse EmberのAA-Omniscience知識精度(上段)と幻覚率(下段)の全モデル比較(出典:Artificial Analysis)
上段のAccuracyグラフでは、Muse Ember(紫矢印・右端付近)が21.1%とプロットされており、主要モデルの30〜50%帯と比べて知識精度が低いことが分かります。
下段のHallucination Rateでは、Muse Emberの17.4%は上位モデルより低い水準にとどまります。この数値はAA-Omniscience評価の定義(誤答÷(誤答+部分回答+未回答))に基づく値で、知識質問では回答そのものを避ける傾向が強い挙動を反映した結果です。
- 社内検索の自然言語回答
- カスタマーサポートの一次応答
- 医療・法律・金融の専門知識回答
これらの用途では、Muse Emberをスタンドアロンで使うと、ユーザー体験が「よくわかりません」の連発になりかねません。
知識Q&A用途はClaude Sonnet 5.5・Haiku 5.5・GPT-5.5のような、知識応答に最適化されたモデルを選ぶのが現実的です。
一方で、エージェントのループ内でMuse Emberを使う場合、この保守性が強みに転じる可能性もあります。
知識質問での回答拒否傾向が、ツール呼び出しや情報抽出のループでも同じ方向に効くなら、根拠の弱い出力を抑えてエラーハンドリング側の負荷を減らせる余地があります。ただしこれはAA-Omniscienceの評価結果からの類推であり、ツール実行時の実挙動は自社ワークロードで実測して確認するのが確実です。
オープンウェイト非公開による制約
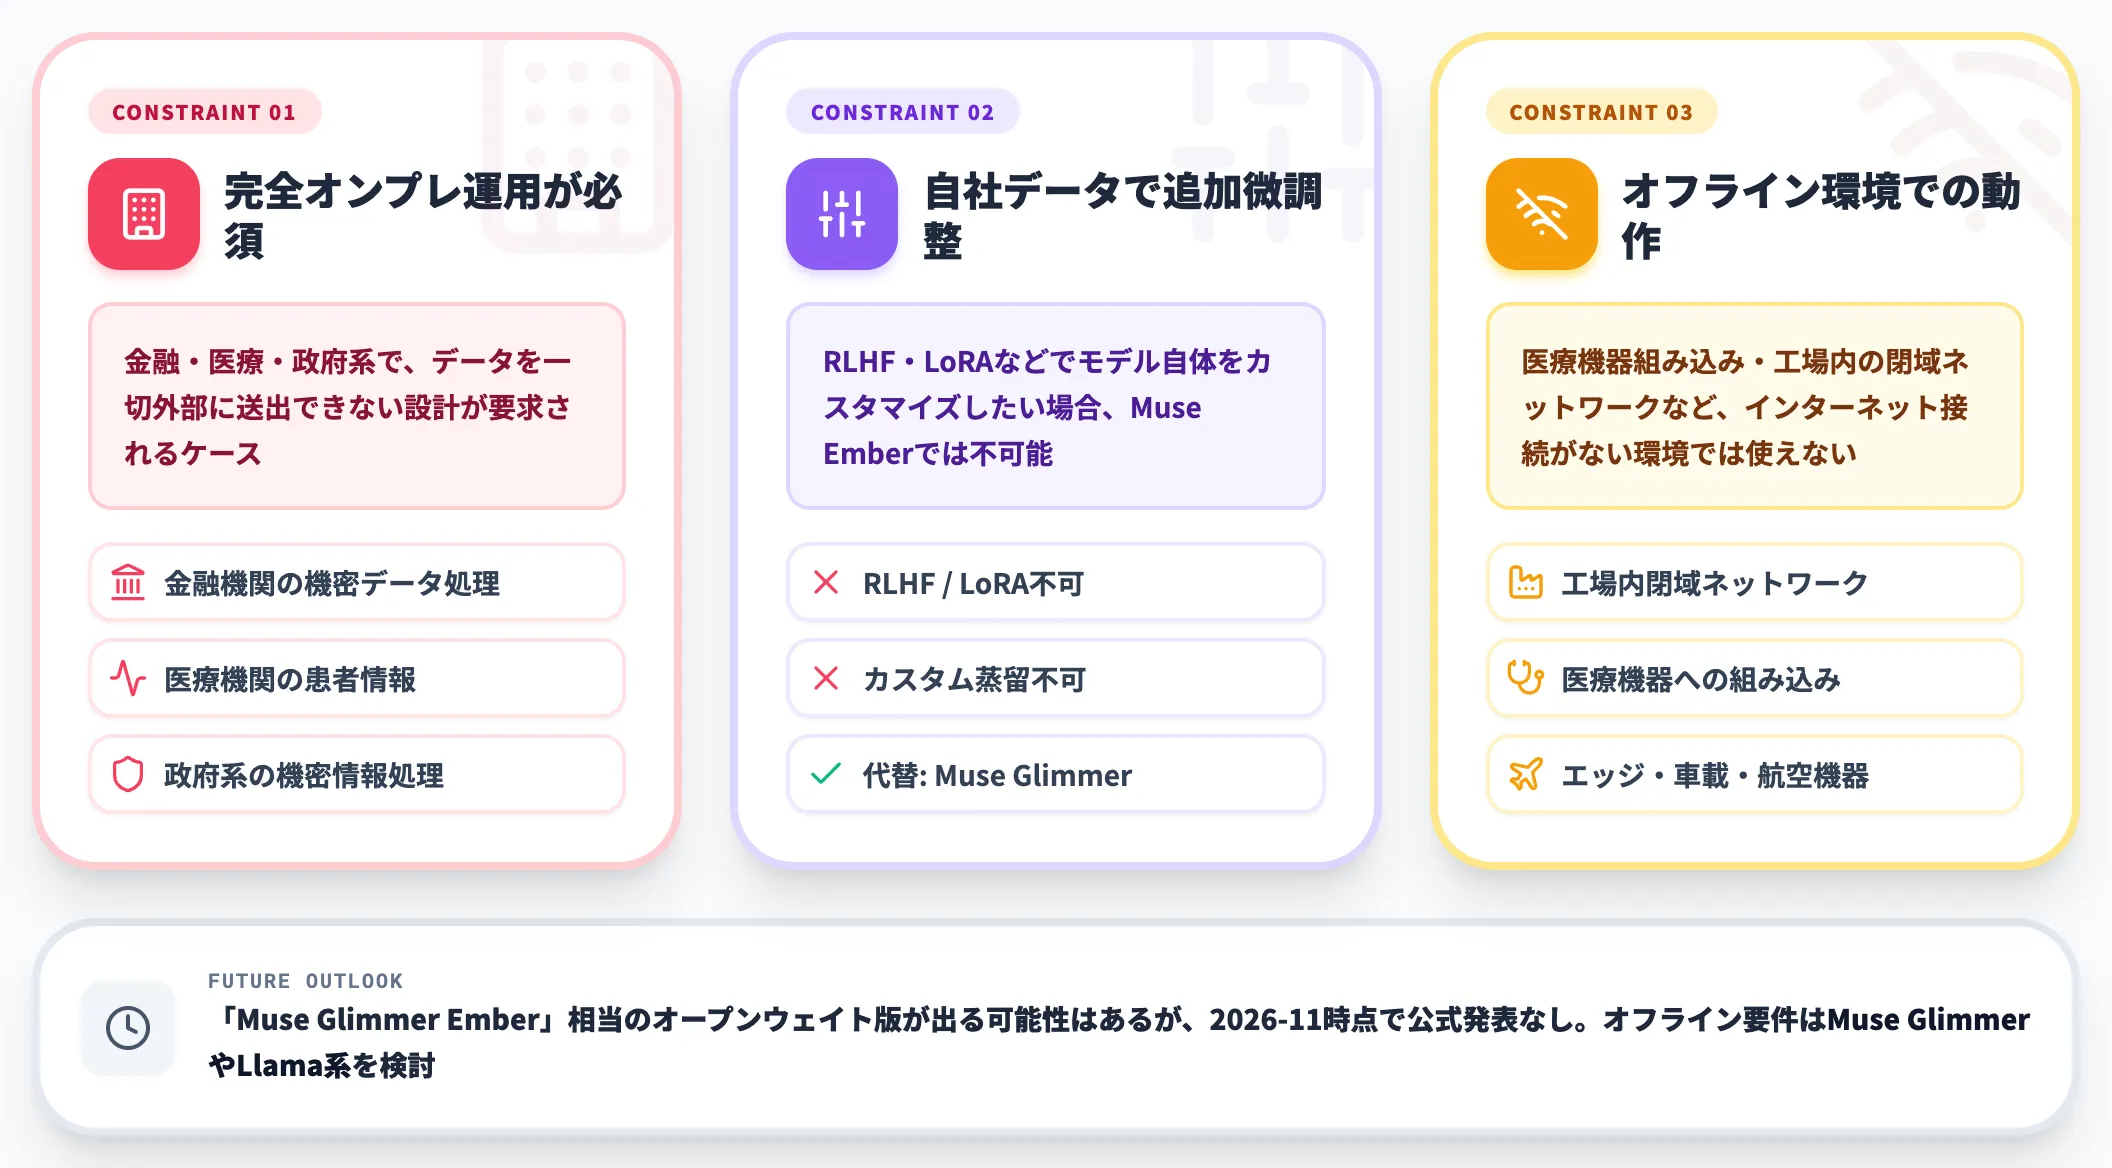
Muse Emberは、Muse Glimmerのようなオープンウェイト版が提供されていません。モデルウェイトは非公開で、ローカル推論・オンプレミス展開は現時点では不可能です。
これは以下のような要件を持つケースで制約になります。
-
完全オンプレ運用が必須な業界
金融・医療・政府系で、データを一切外部に送出できない設計が要求されるケース
-
自社データで追加微調整したい
RLHF・LoRAなどでモデル自体をカスタマイズしたい場合、Muse Emberでは不可能。Muse Glimmer(Spark系のオープンウェイト)を代替候補にする必要がある
-
オフライン環境での動作
医療機器組み込み・工場内の閉域ネットワークなど、インターネット接続がない環境では使えない
Metaの過去のモデル展開パターンから、Muse Emberのオープンウェイト相当(「Muse Glimmer Ember」のような名称)がリリースされる可能性はありますが、2026年11月時点で公式発表はありません。オフライン運用が要件なら、Muse GlimmerやLlama系の既存モデルをベースに検討する必要があります。
200K超のコストジャンプへの運用対応
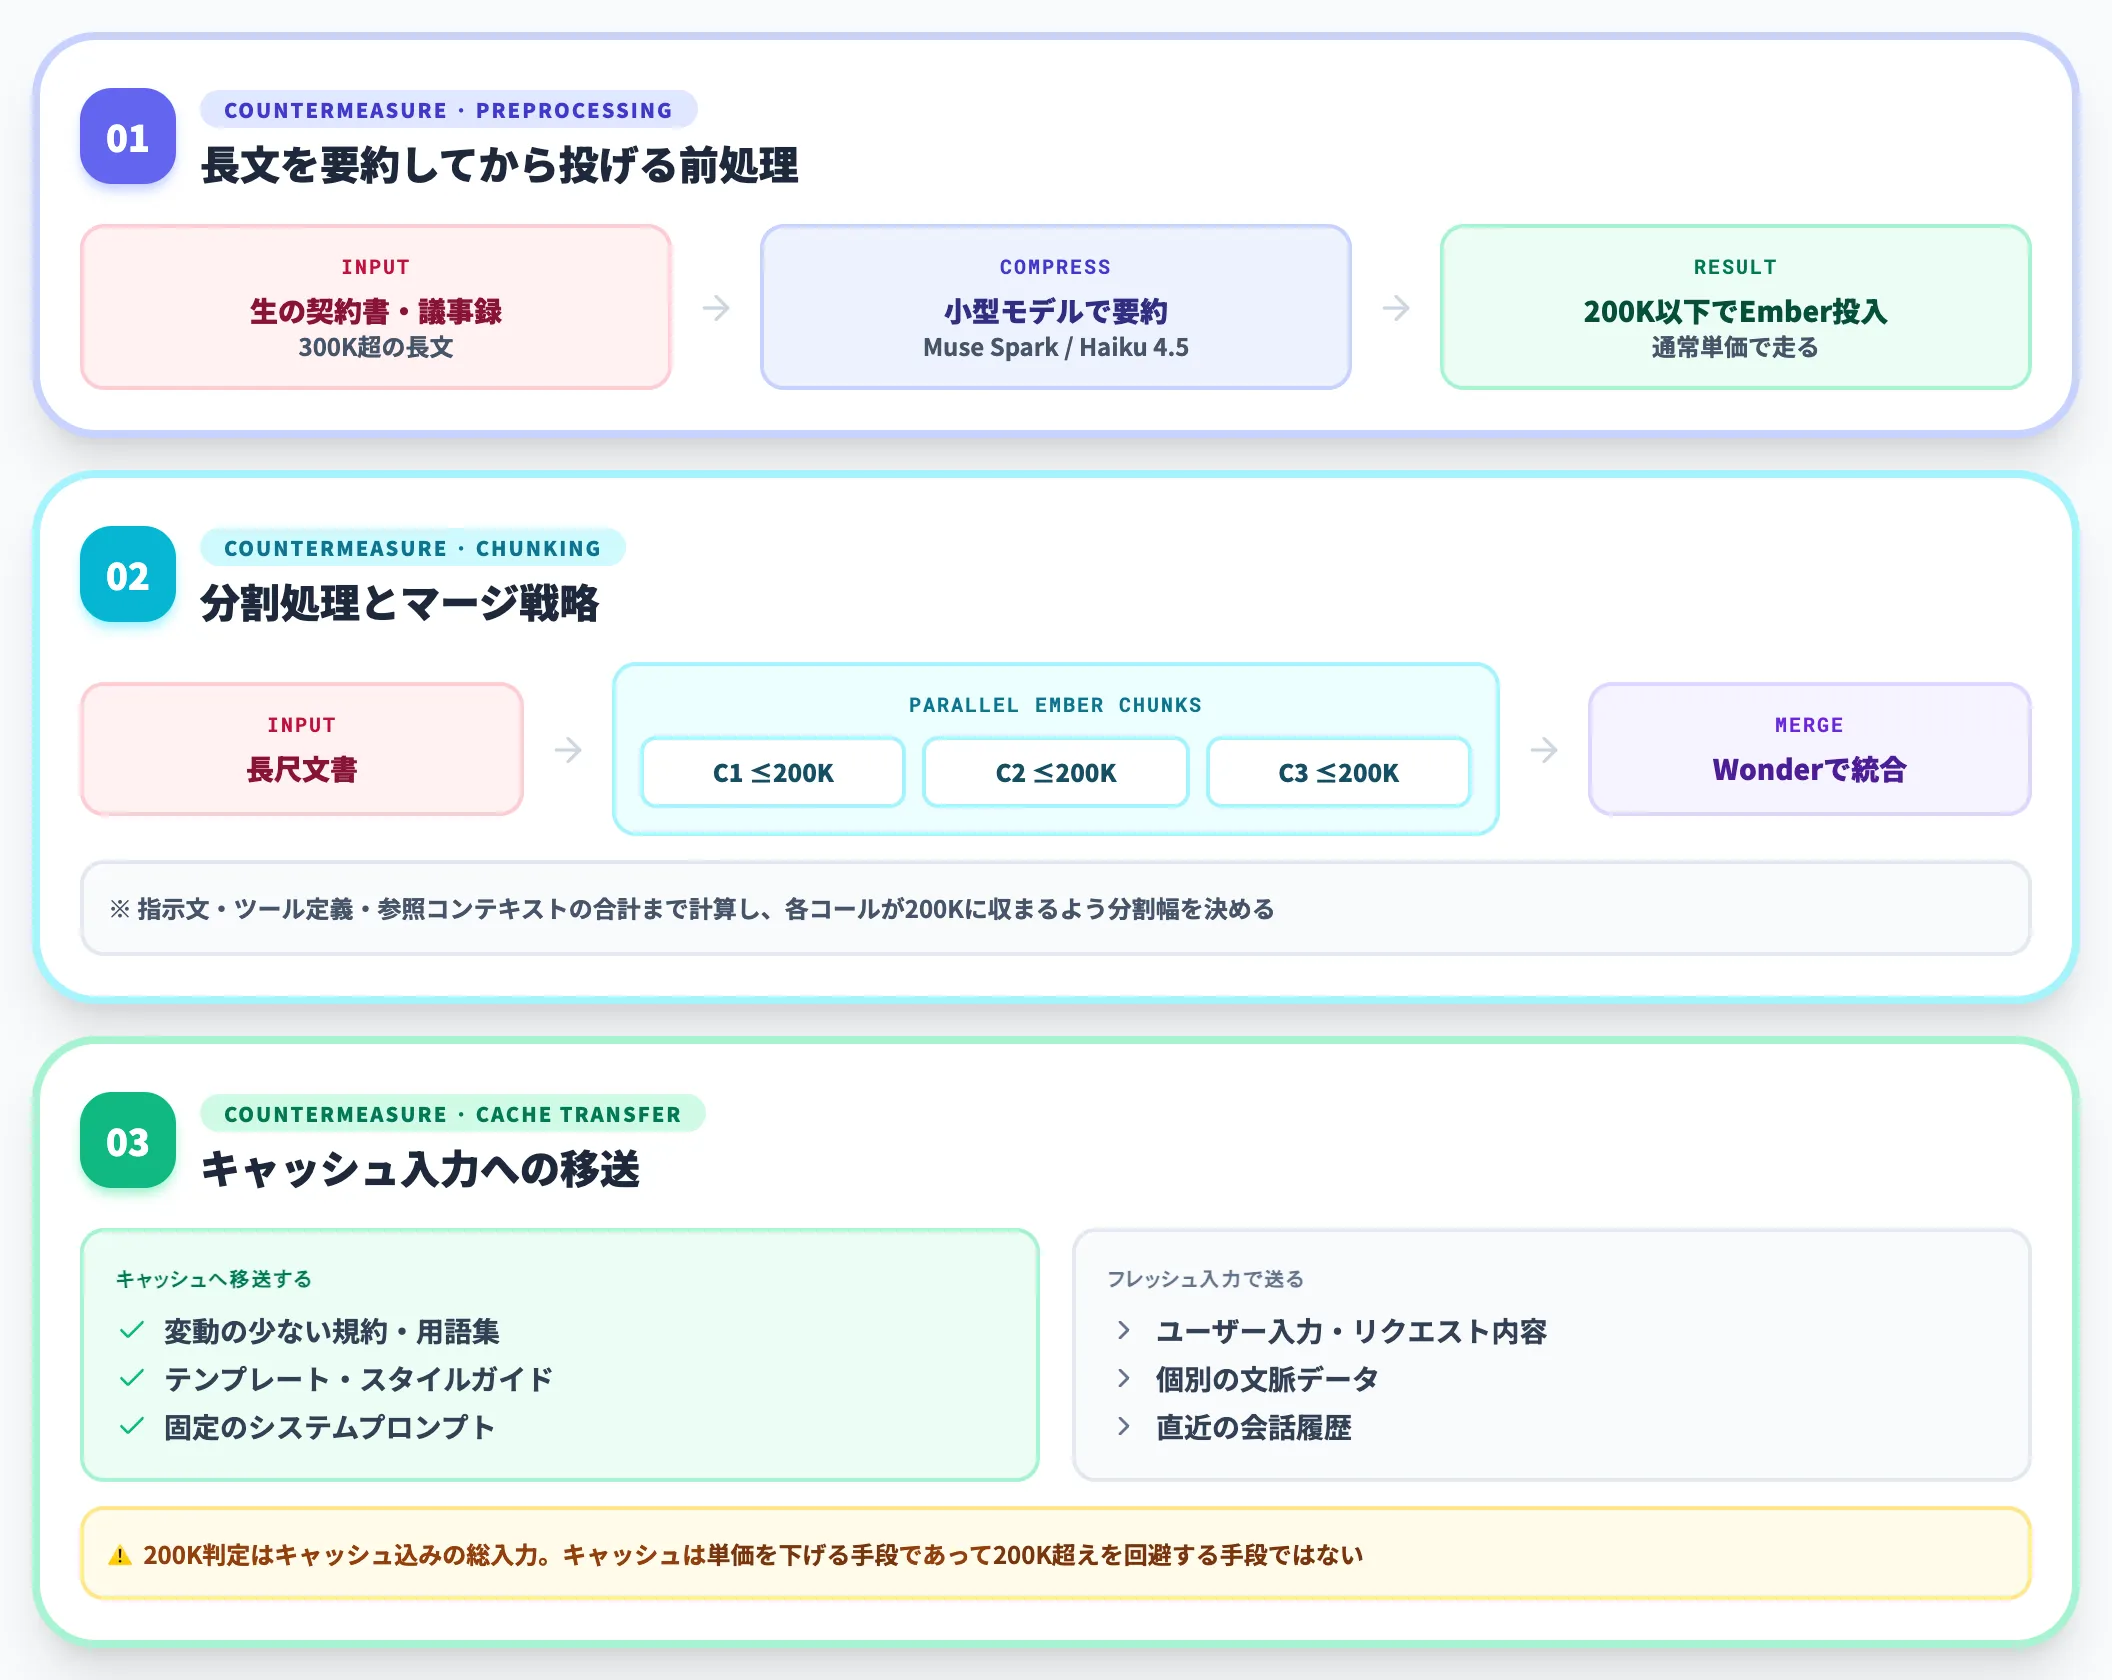
既に料金セクションで触れた200K Catchは、実装設計レベルで予防策を組み込む必要があります。
-
長文を要約してから投げる前処理
生の議事録・契約書を全文送るのではなく、小さい要約モデル(Muse Spark・Haiku 4.5)で200K以下に圧縮してからMuse Emberに渡す
-
分割処理とマージ戦略
長尺の文書を複数チャンクに分けて処理する。Emberの料金判定はキャッシュを含む総入力トークン数で行われるため、各コールが200Kに収まるように、指示文・ツール定義・参照コンテキストの合計まで計算して分割幅を決める。最後にWonderで統合する設計なら、各Emberコールの実コストを通常単価に抑えつつ、品質を保てる
-
キャッシュ入力への移送
変動が少ない参照情報(規約・用語集・テンプレート)はキャッシュ入力に移送し、変動部分だけをフレッシュ入力で送る。ただし200K判定はキャッシュ込みの総入力で行われるため、キャッシュは単価を下げる手段であって200K超えを回避する手段ではない点に注意する
これらの設計は、長文を日常的に扱うエージェント(契約書レビュー・コード監査・会議議事録抽出)では必須の工夫です。設計段階でこれを織り込めるかどうかで、月次コストの桁が変わります。
Muse Emberで量をさばく処理を、次の段で誤りを拾える流れに載せる
Muse Emberは、Claude Haiku 5.5と同じIntelligence Indexの36点を約1/3の1タスクコストで出す一方、知識質問の精度は21.1%にとどまります。向いているのは、見積書からの情報抽出や問い合わせの振り分けのように1件ごとに完結し、誤りが出たときに次の段で気づける処理です。業務で量をさばかせるなら、モデルを選ぶより先に、Emberの出力を受け取って確かめる側の手順を決めておく必要があります。
こうした手順を組み込めるのが、AIが進めるステップと人が目を通すステップを1本のワークフローに並べる、業務AIのプラットフォームです。AI総合研究所のAI Agent Hubは、請求書の受領や経費の申請を、読み取り、照合、担当者の確認の順に進めます。
- 請求書や見積書は、1件ずつ区切って渡す
AI-OCR Agentが書類ごとに読み取るため、1回の入力が200Kを超えにくく、誤りのあった件だけをやり直せば済みます。
- 抜き出した値は、次のステップで規定と突き合わせる
金額や勘定科目は規定チェックAgentが社内の決まりと照らし合わせるため、合わない値は基幹システムへ登録する前に止まります。
- 読み切れない件は、担当者に回す
Emberが値を返さなかった件や照合で引っかかった件は担当者のTeamsに届くため、人が中身を見たうえで次の処理へ進めます。
AI総合研究所の専任チームが、要件に応じてMuse Emberとの接続を設計・構築し、どの作業からEmberに切り替えるかを、今のClaudeやGPTの構成と比べて決める段階から支援します。
軽量モデルの抽出結果を照合してから使う

読み切れない件は担当者が確かめる
1タスクあたりのコストがClaude Haiku 5.5の約1/3で済むMuse Emberは、出力を後の工程で点検できる抽出や振り分けに強い一方、知識を問う質問への回答は苦手です。AI Agent Hubでは、読み取った請求書を社内規定と照合し、人の確認を経て基幹システムへ登録するまでを、Agentの組み合わせで進めます。
まとめ:Muse Emberが開くエージェント量産時代の実務設計
本記事では、Muse Emberを「Meta Superintelligence Labsが発表した、エージェントの実行役に特化した最軽量モデル」として整理し、性能・料金体系・使い方・Muse Wonderとの分業・Claude Haiku 5.5との使い分け・制限と注意点を解説しました。
2026年11月時点で押さえておくべきポイントは次の3つです。
- 定型業務を自動で回す力ではClaude Haiku 5.5を大きく引き離すが、レビューに通す本番向けのコードを一度で書き上げる用途では後れを取る
- キャッシュ分を含めた入力の総量が一定のしきい値を超えると、入力・出力・キャッシュの単価がそろって跳ね上がる
- 重みが公開されていないため、自社のサーバーでは動かせず、閉域網での運用や自社データでの微調整が要件ならMuse GlimmerやLlama系が候補になる
Metaが公開した実装例を自社のエージェントに当てはめるとき、AI総合研究所が設計の土台に置くのは次の2点です。
まずは、タスクを、上位モデルが担う計画の工程と、各エージェントが互いの結果に頼らずに進む実行の工程とに分けます。
続いて、全エージェントに共通する規約やカテゴリの定義はシステムプロンプトに固定し、キャッシュ入力で配ります。
軽量帯のモデルどうしで請求額を分けるのは、単価表に並ぶ数字に加えて、同じ水準の答えに届くまでに出力するトークンの量です。
Muse Emberは、エージェントを量産する時代に、実行の側で積み上がる費用を削る役目を担います。