この記事のポイント
 NVIDIA GPUが選択肢の中心だったAIインフラに、TPUが企業採用の現実的な第2軸として浮上している
- Anthropicは数百億ドル規模のTPU契約を2025年10月に締結、2026年4月には複数GW級の追加契約を発表した
- TPU料金はv5e $1.20/chip-hourから第7世代Ironwood $12/chip-hourまで、性能特性に応じて10倍の幅がある
- Ironwood(v7)以降はTensorFlow対応を外し、JAX/PyTorch前提に移行。TorchTPUが2026年10月にOSS公開された
- 第8世代TPU 8t/8iで「訓練用と推論用の設計分離」というパラダイム転換が示された
Microsoft MVP・AIパートナー。LinkX Japan株式会社 代表取締役。東京工業大学大学院にて自然言語処理・金融工学を研究。NHK放送技術研究所でAI・ブロックチェーンの研究開発に従事し、国際学会・ジャーナルでの発表多数。経営情報学会 優秀賞受賞。シンガポールでWeb3企業を創業後、現在は企業向けAI導入・DX推進を支援。
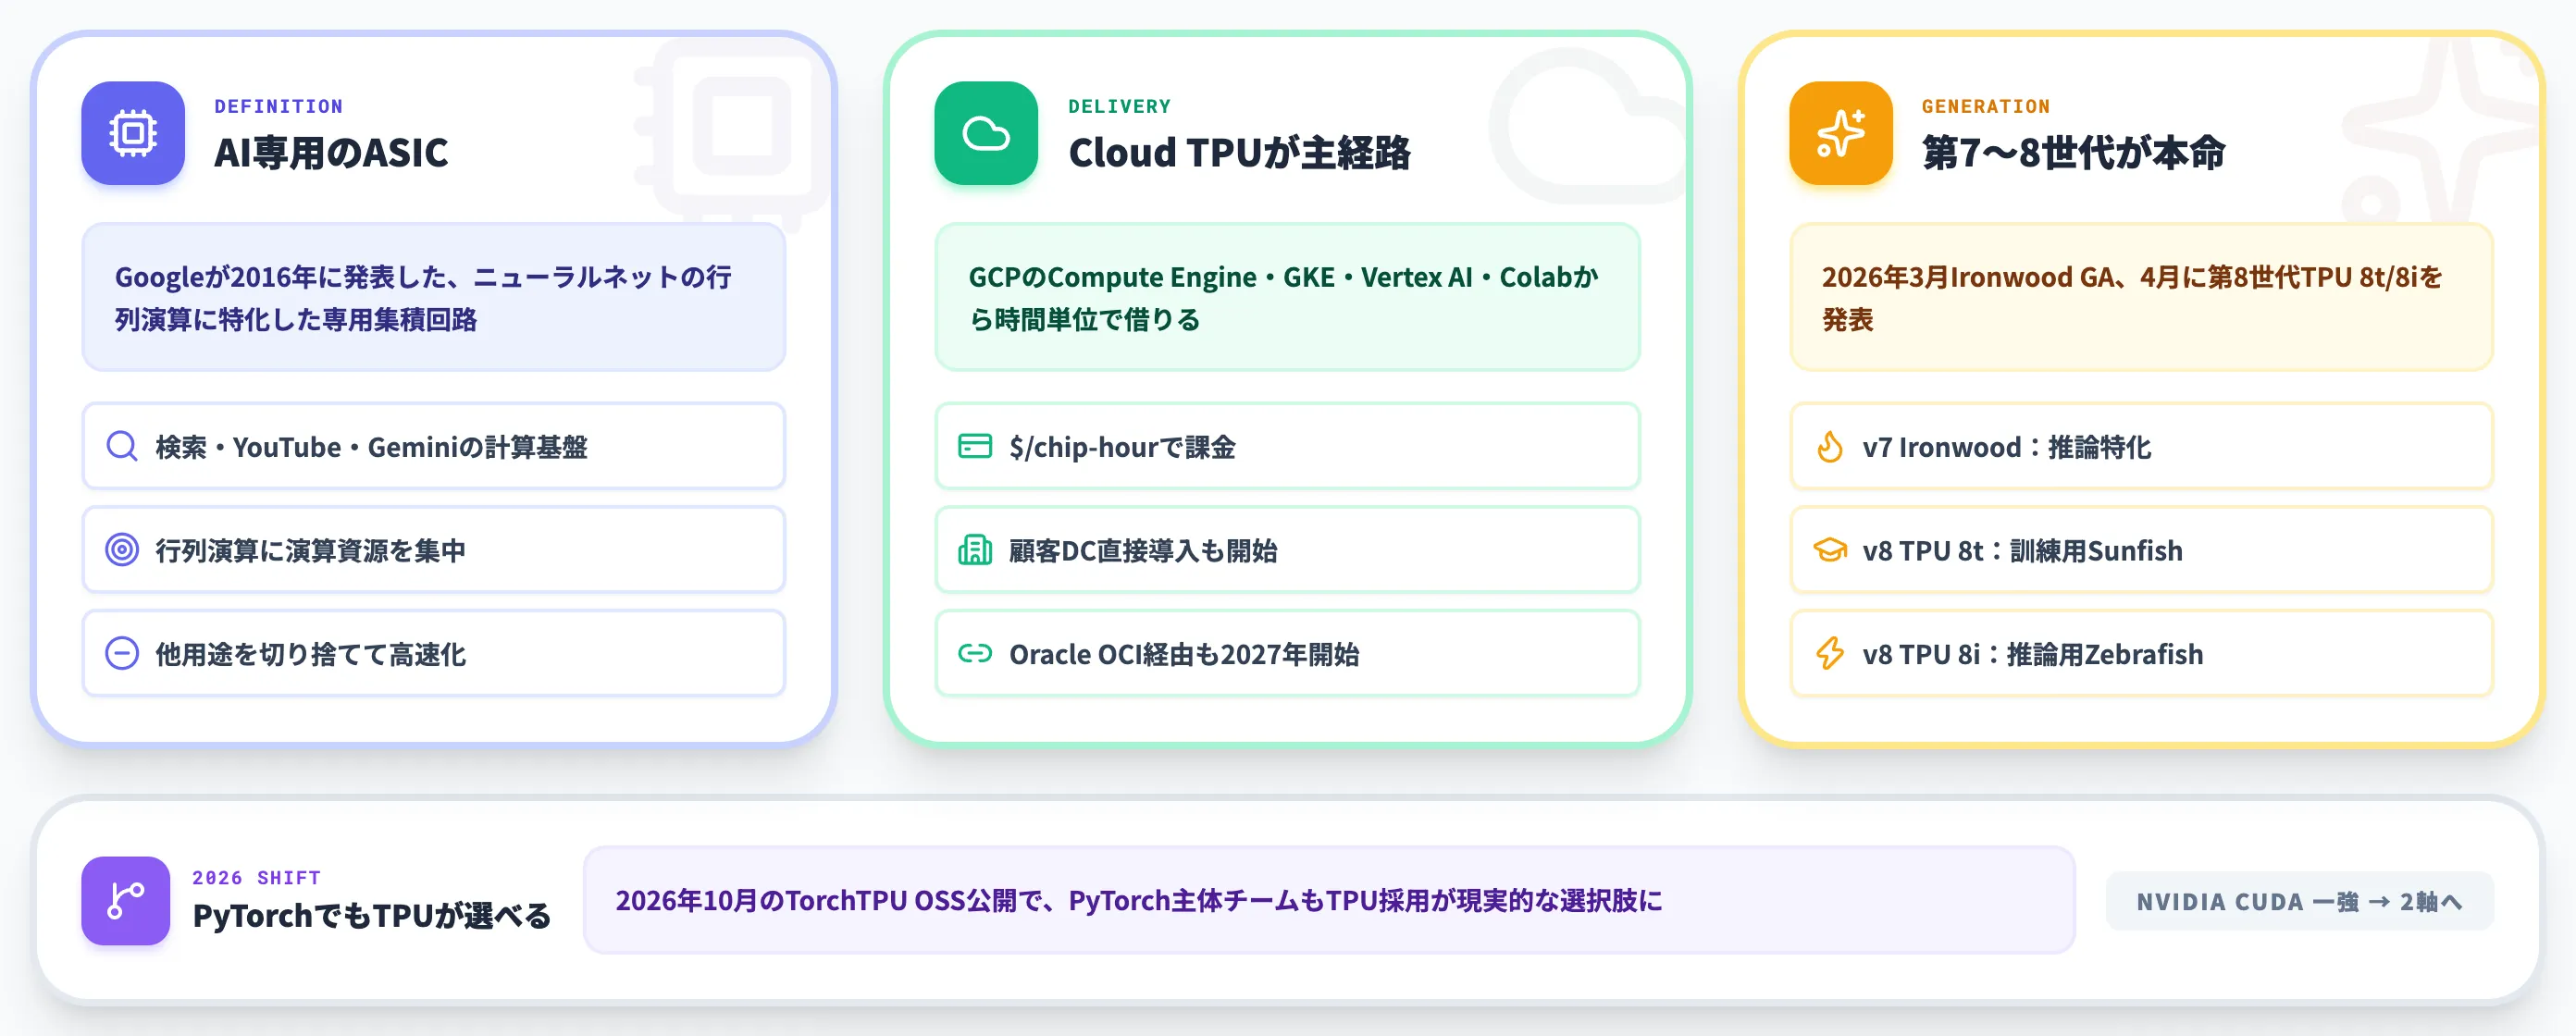
TPU(Tensor Processing Unit)は、Googleが機械学習向けに自社設計したAI専用プロセッサです。CPUやGPUが汎用計算向けに設計されているのに対し、TPUはニューラルネットワークの中核をなす行列演算に特化した専用回路を備え、学習と推論を高いワットパフォーマンスで実行します。
2026年に入りGoogleは第7世代「Ironwood」を3月に一般提供し、第8世代として訓練用「TPU 8t」と推論用「TPU 8i」に初めて設計を分離しました。NVIDIA GPUが選択肢の中心だったAIインフラの外側でも、Anthropic・Midjourney・SalesforceなどTPUを並列の選択肢として採用する企業が増えています。
本記事では、TPUの定義、GPU・CPUとの違い、仕組み、世代別ロードマップ、料金、活用事例、選定判断軸、導入で詰まる論点を2026年11月時点の最新情報で解説します。
目次
TPUとGPU・CPUの違い——設計思想と得意ワークロードの差
MXU(Matrix Multiply Unit)とシストリックアレイ
ICI(Inter-Chip Interconnect)とスーパーポッド
TPUの世代別ロードマップ——v5eから第8世代8t/8iまで
Ironwood(v7)——初の推論特化世代、Anthropicが数百億ドル規模の契約
第8世代——TPU 8t/8iで訓練と推論を分離、派生の8tx・8i Max
TPUの活用事例——Google自社、Anthropic、Midjourney、Salesforce
Google自社——Gemini・検索・YouTube・広告の計算基盤
Anthropic——数百億ドル規模の契約と複数GWの追加容量
Salesforce・Safe Superintelligence・Citadel Securities
PyTorch対応——TorchTPUのOSS公開で移行コストが下がりつつある
フレームワーク移行工数——PyTorch/XLAからTorchTPUへの切り替え
独自カーネルの移植コスト——CUDAからTPU向けカーネル群へ
TPUとは?Googleが自社開発したAI向けのASIC
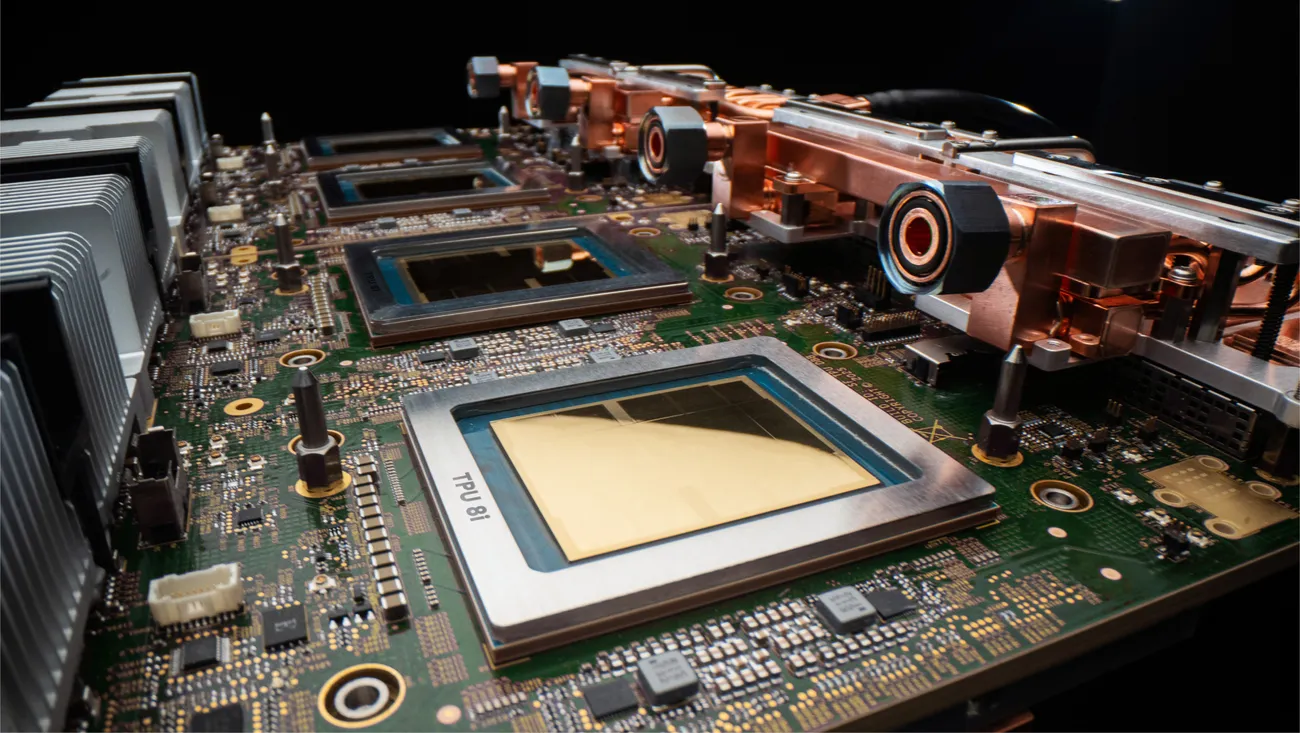
TPUのハードウェア実物——基板上に並ぶ金色のチップとヒートシンク(出典:Google Blog)
TPU(Tensor Processing Unit)とは、Googleがニューラルネットワークの計算を効率化するために自社設計したAI専用のASIC(Application-Specific Integrated Circuit:特定用途向け集積回路)です。2016年のGoogle I/Oで初代が発表されて以来、世代を重ねながら社内の検索・翻訳・YouTubeレコメンド、そしてGeminiなどのフロンティアLLMの学習と推論を支えてきました。
CPUやGPUが「汎用計算で幅広い処理をこなす前提」で設計されているのに対し、TPUはディープラーニングの中核にある行列演算(matrix multiplication)に演算リソースの大半を割り当て、他の用途を切り捨てる形で高速化しています。
NVIDIA GPU一強の外側に立ち上がったTPU
第7世代「Ironwood」は2026年3月31日にGA(TPU7xとして公式リリースノートに記載)となり、4月のCloud Nextで広く紹介されました。
同イベントで第8世代として訓練用「TPU 8t」と推論用「TPU 8i」が発表され、2026年内の一般提供が予告されています。
10月のPyTorch ConferenceではPyTorchをTPUでそのまま動かすTorchTPUがOSS公開され、「NVIDIA CUDA一強」だったAIインフラの外側にTPUが現実的な選択肢として立ち上がりつつあります。
TPUとGPU・CPUの違い——設計思想と得意ワークロードの差
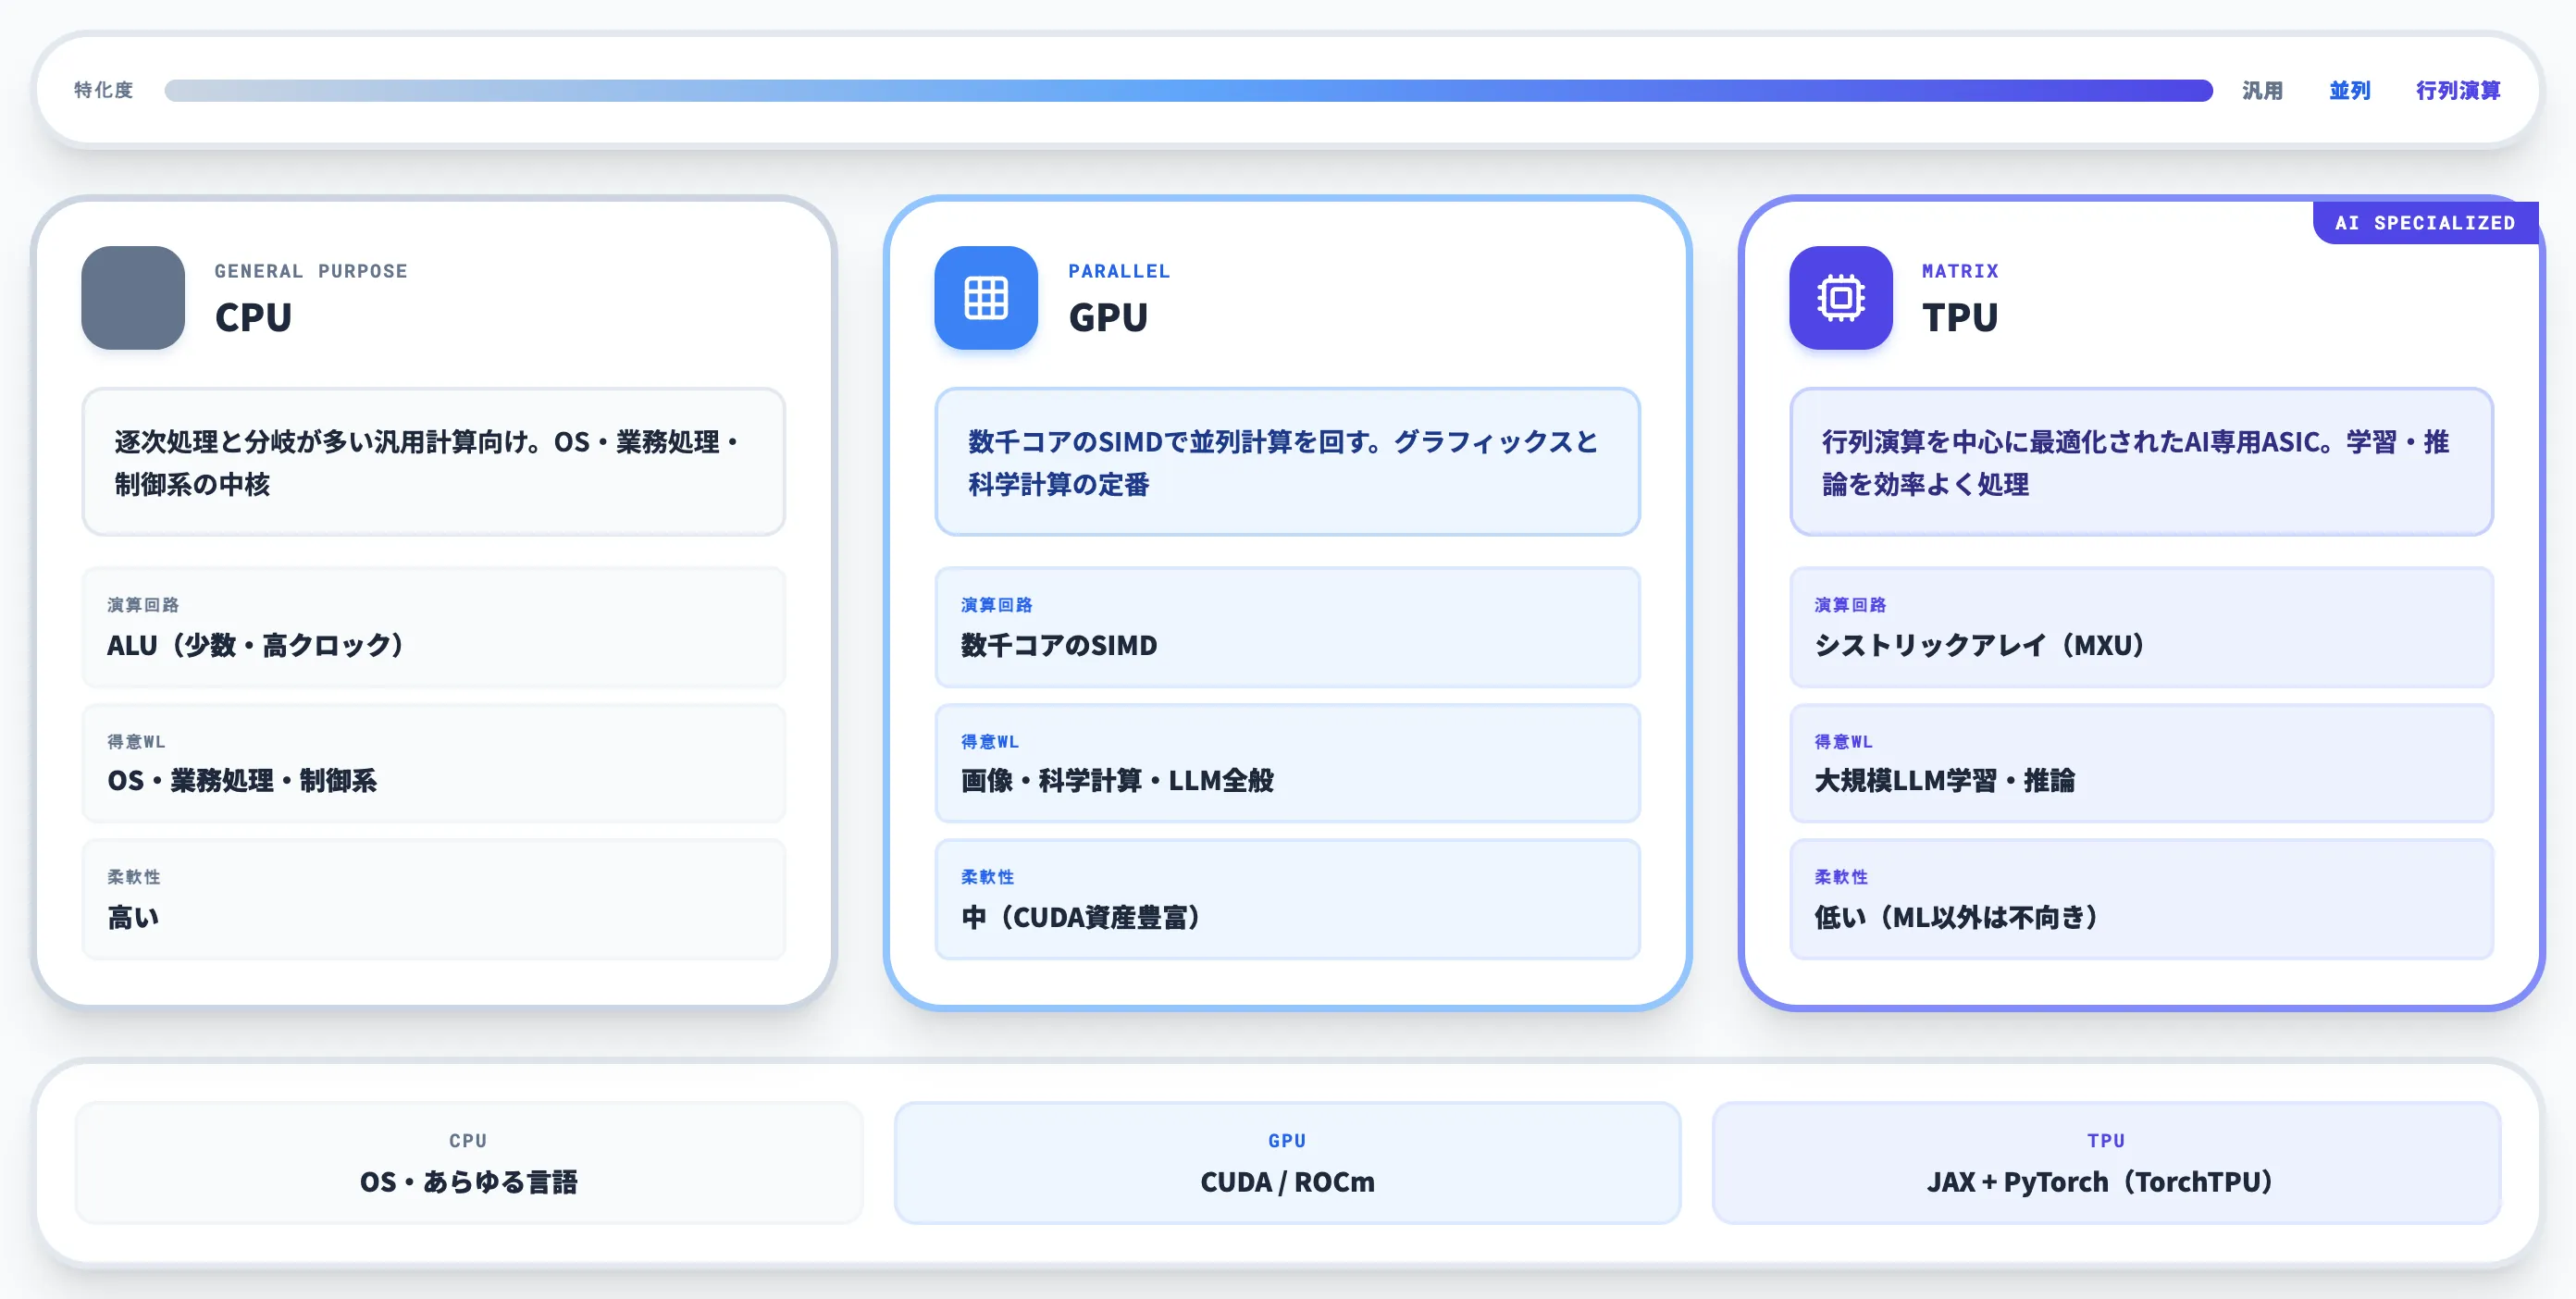
TPUの位置づけを掴むうえで、CPU・GPU・TPUがそれぞれ想定しているワークロードと設計思想の差を押さえておくと、選定判断が一気に楽になります。
以下の表で、CPU・GPU・TPUの設計特性を整理しました。
| 項目 | CPU | GPU | TPU |
|---|---|---|---|
| 設計目的 | 逐次処理・分岐が多い汎用計算 | 並列計算・グラフィックス処理 | ニューラルネットワーク(行列演算) |
| 主要演算回路 | ALU(少数・高クロック) | 数千コアのSIMD | シストリックアレイ(MXU) |
| 得意なワークロード | OS・業務処理・制御系 | 画像処理・科学計算・LLM推論・訓練 | 大規模LLM学習、推論 |
| 柔軟性 | 高い | 中 | 低い(機械学習以外は不向き) |
| 入手経路 | PC・サーバーに標準搭載 | GPUカード単品・クラウド | Cloud TPU(GCP)が主経路、顧客DC導入・OCI経由(2027〜)も予定 |
| 対応フレームワーク | OS・あらゆる言語 | CUDA/ROCm(PyTorch・TensorFlow他) | JAX中心+PyTorch(2026年10月〜TorchTPU)。TensorFlowは第7世代Ironwood以降は非対応 |
この比較で読み取るべき最大のポイントは、TPUは「捨てたぶんだけ強い」設計だという点です。
入力テンソルの形が頻繁に変わる処理や独自演算を多用するモデルはTPUの苦手領域ですが、形状が安定した大規模行列演算が計算量の大半を占めるTransformer系LLMの学習・推論では、ワット当たり性能と単価の両面で有力な選択肢になります(GPUとの優劣は規模・モデル特性・契約条件で変動するため、記事後半の選定判断軸で条件別に整理します)。
TPUが得意なワークロード
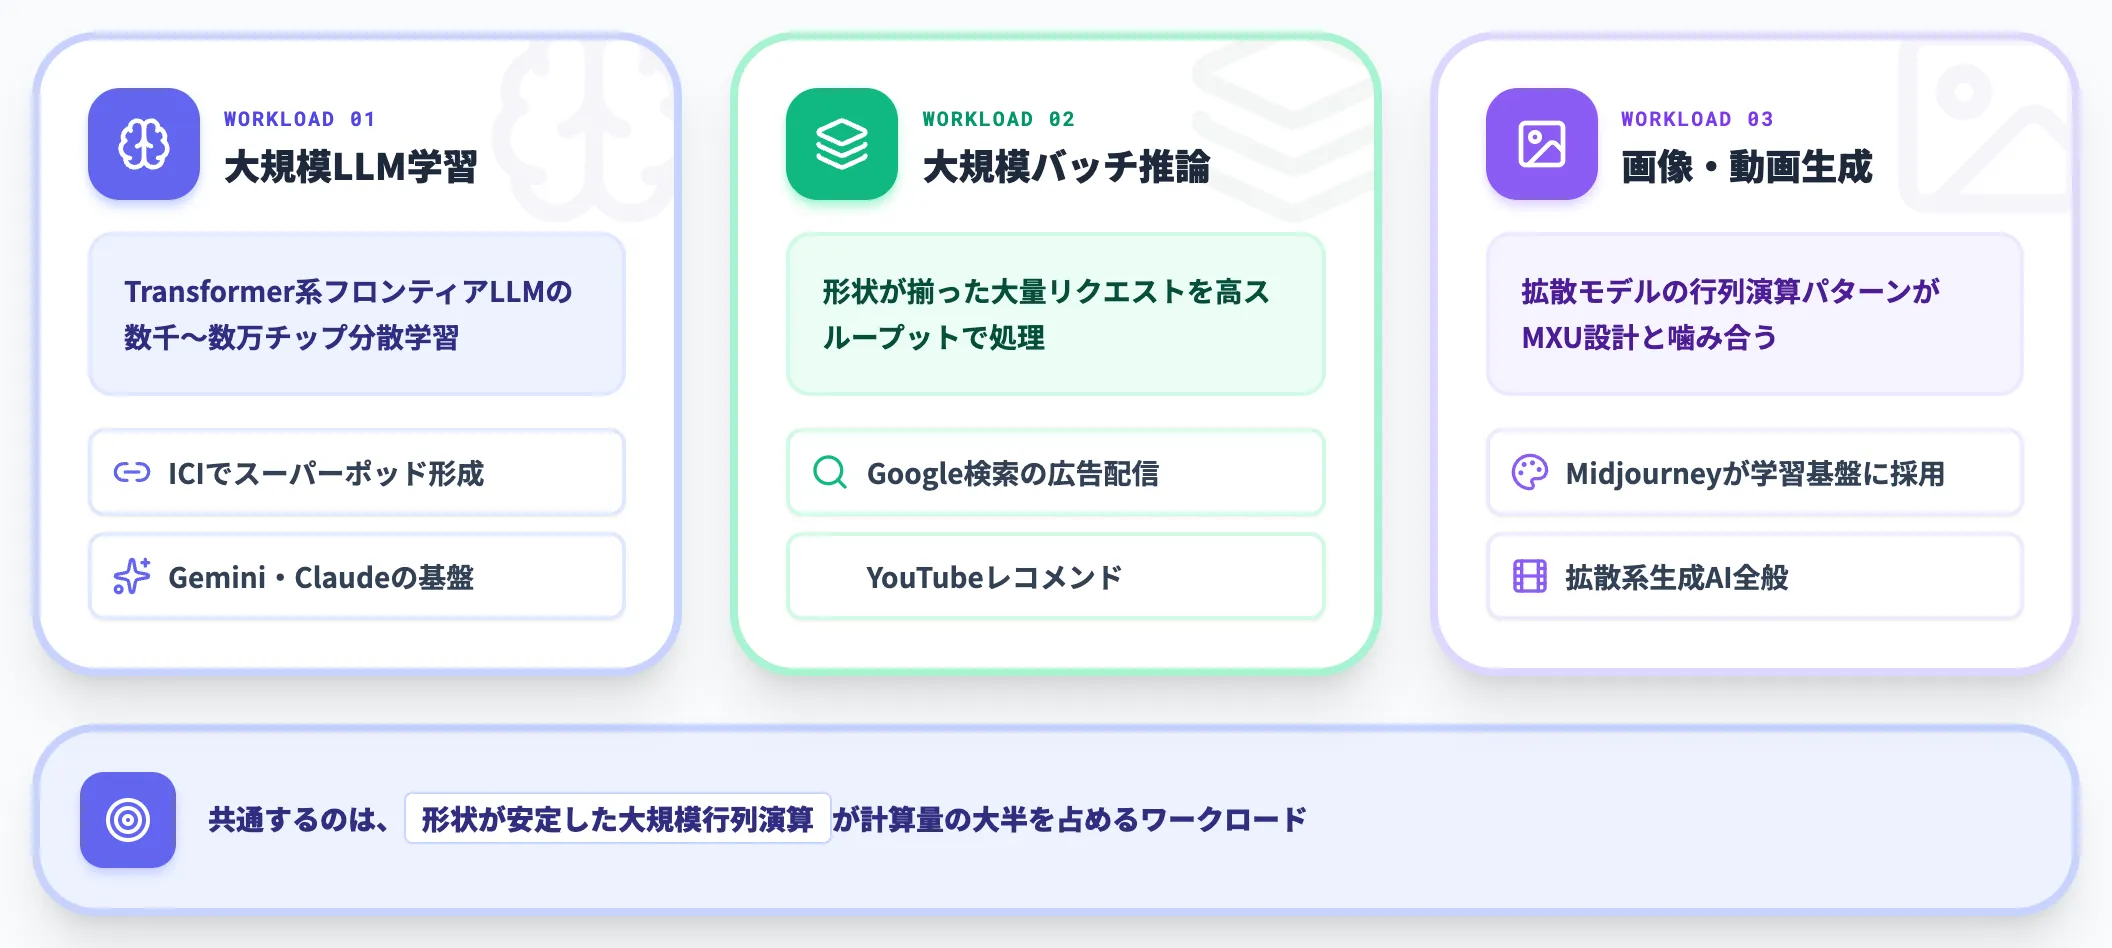
TPUの設計特性が刺さるのは、以下のようなワークロードです。
-
Transformer系の大規模言語モデル学習
GeminiやClaudeのようなフロンティアLLMは、数千〜数万チップを束ねた分散学習が前提になるため、チップ間接続(ICI)とスーパーポッド設計を持つTPUが本領を発揮します。
-
大規模バッチ推論・レコメンド
Google検索の広告配信やYouTubeのレコメンデーションのように、形状が揃った大量リクエストを処理する用途は、TPUの高スループット設計と相性が良いワークロードです。
-
画像・動画生成系の拡散モデル
拡散モデルの行列演算はTPUのMXUが得意とするパターンに近く、Midjourney はGoogle Cloud TPUを学習基盤に採用しています(推論側はGoogle CloudのGPUも併用)。
GPUを先に検討すべきワークロード
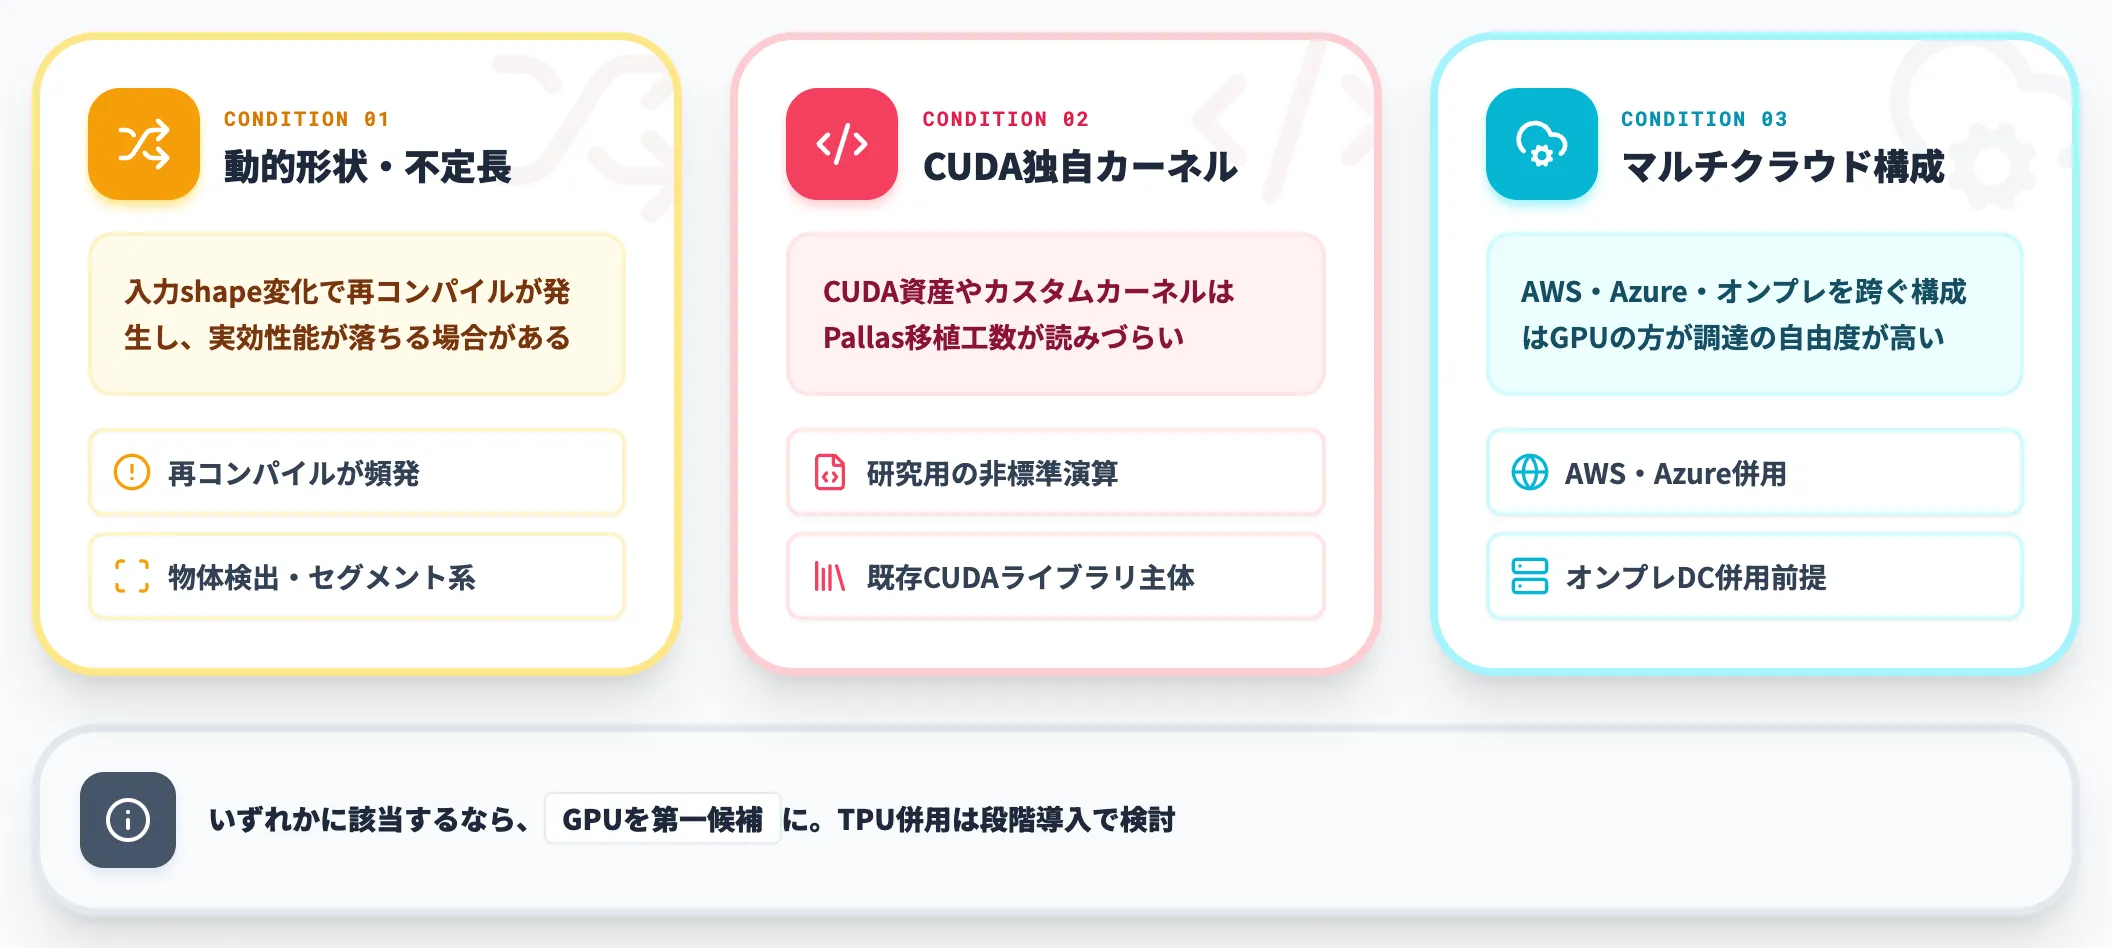
一方で、GPUを優先した方が実務で収まりやすいのは次のような条件です。
-
動的形状・不定長入力が多いモデル
入力のshapeが毎回変わるワークロードでは、実行経路によっては再コンパイルが発生し、そのオーバーヘッドで実効性能が落ちる場合があります。
-
CUDA独自カーネルや研究用の非標準演算
NVIDIA CUDA向けに書かれた独自カーネルが多い研究コードは、Pallas(TPU向けカスタムカーネル)への移植工数が無視できません。
-
マルチクラウド・オンプレ併用を前提とする構成
TPUの主な提供経路はGoogle Cloud経由で、顧客データセンターへの直接導入やOracle OCI経由の提供(2027年開始予定)も段階的に広がっていますが、AWS・Azure・既存の自社DCをまたぐ構成では引き続きGPUの方が調達の自由度は高い状態です。
TPUの仕組み——MXU・HBM・ICIで決まる演算速度
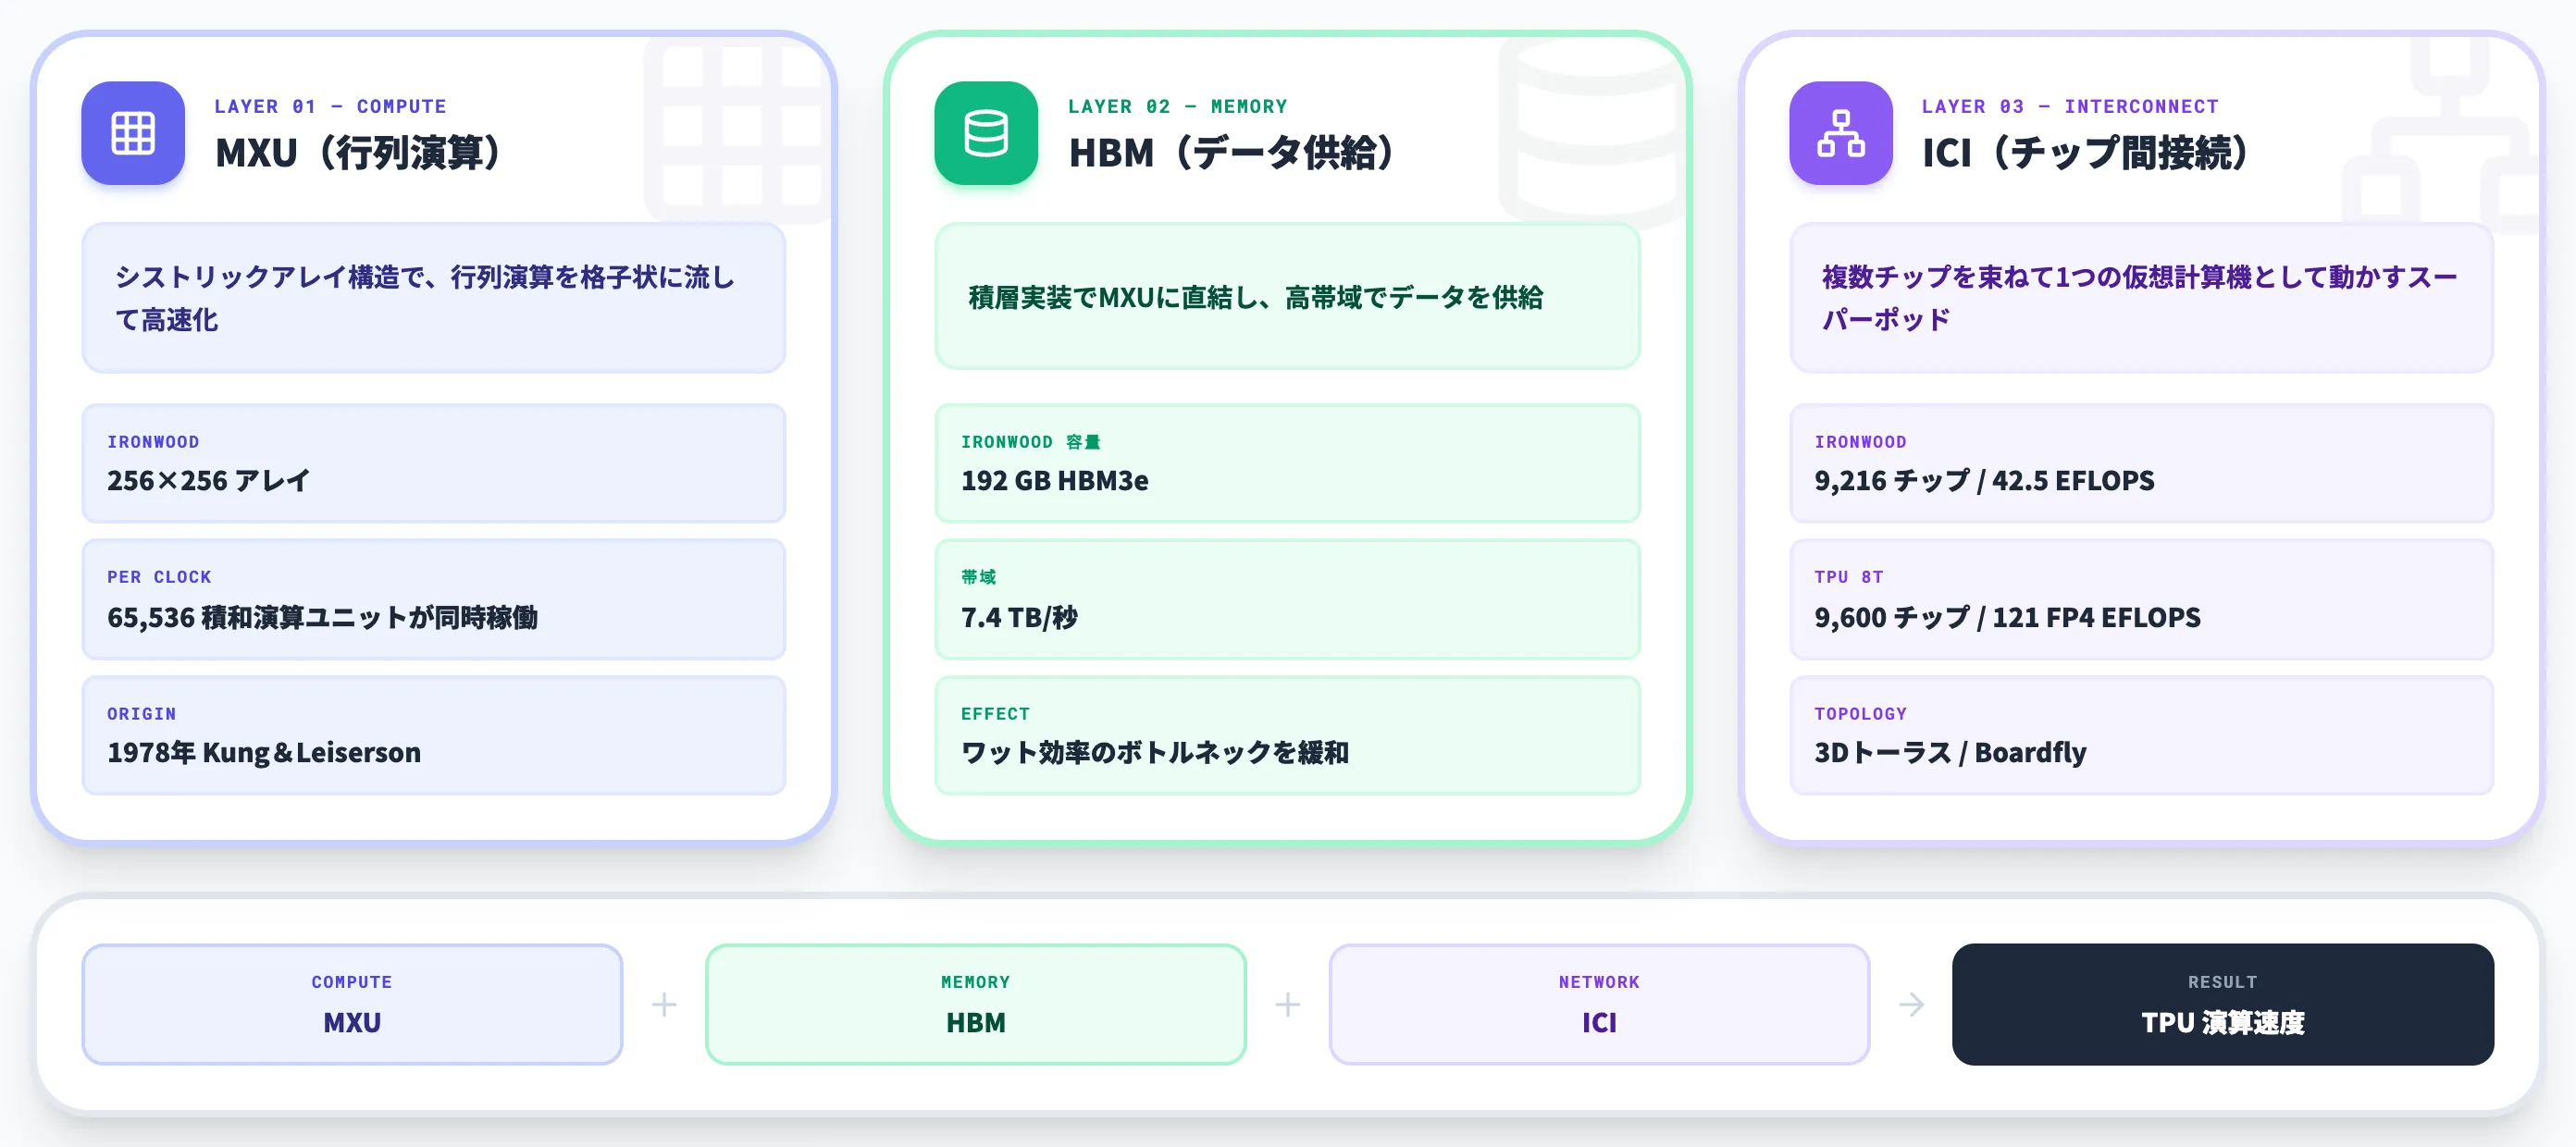
TPUの性能は、①行列演算を担うMXU、②データ供給を担うHBM、③チップ間接続を担うICIの3層でほぼ決まります。
各世代の進化もこの3層のどこを伸ばしてきたかで読み解けます。
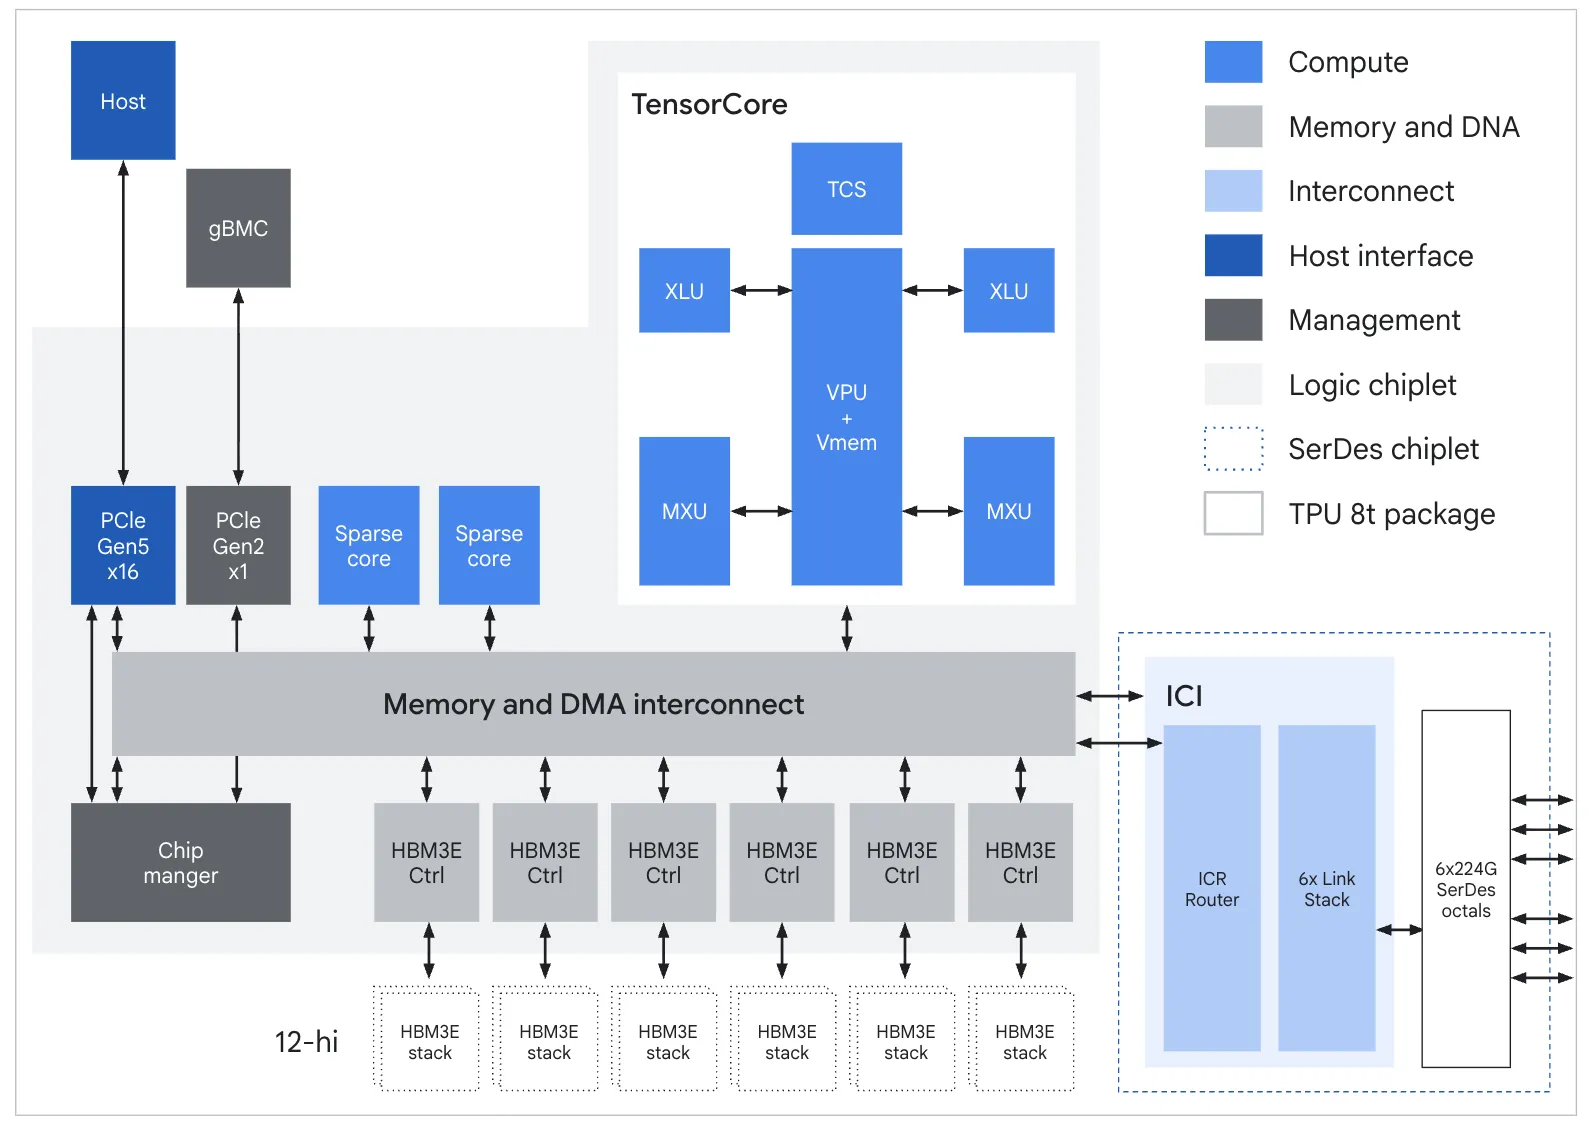
TPU 8tの内部アーキテクチャブロック図(出典:Google Cloud Blog)
Google Cloudが公開した第8世代TPU 8tのブロック図を見ると、チップの中央にTensorCore(TCS・XLU・VPU+Vmem・2基のMXU)が1基置かれ、その周囲に6基のHBM3Eコントローラ、2基のSparse core、Memory and DMA interconnect、右端にICI(Inter-Chip Interconnect)と SerDes chiplet が配置されています。
ホストとの接続はPCIe Gen5 x16、管理系はgBMC経由。この構造がTPUの演算速度を規定する骨格です。
MXU(Matrix Multiply Unit)とシストリックアレイ
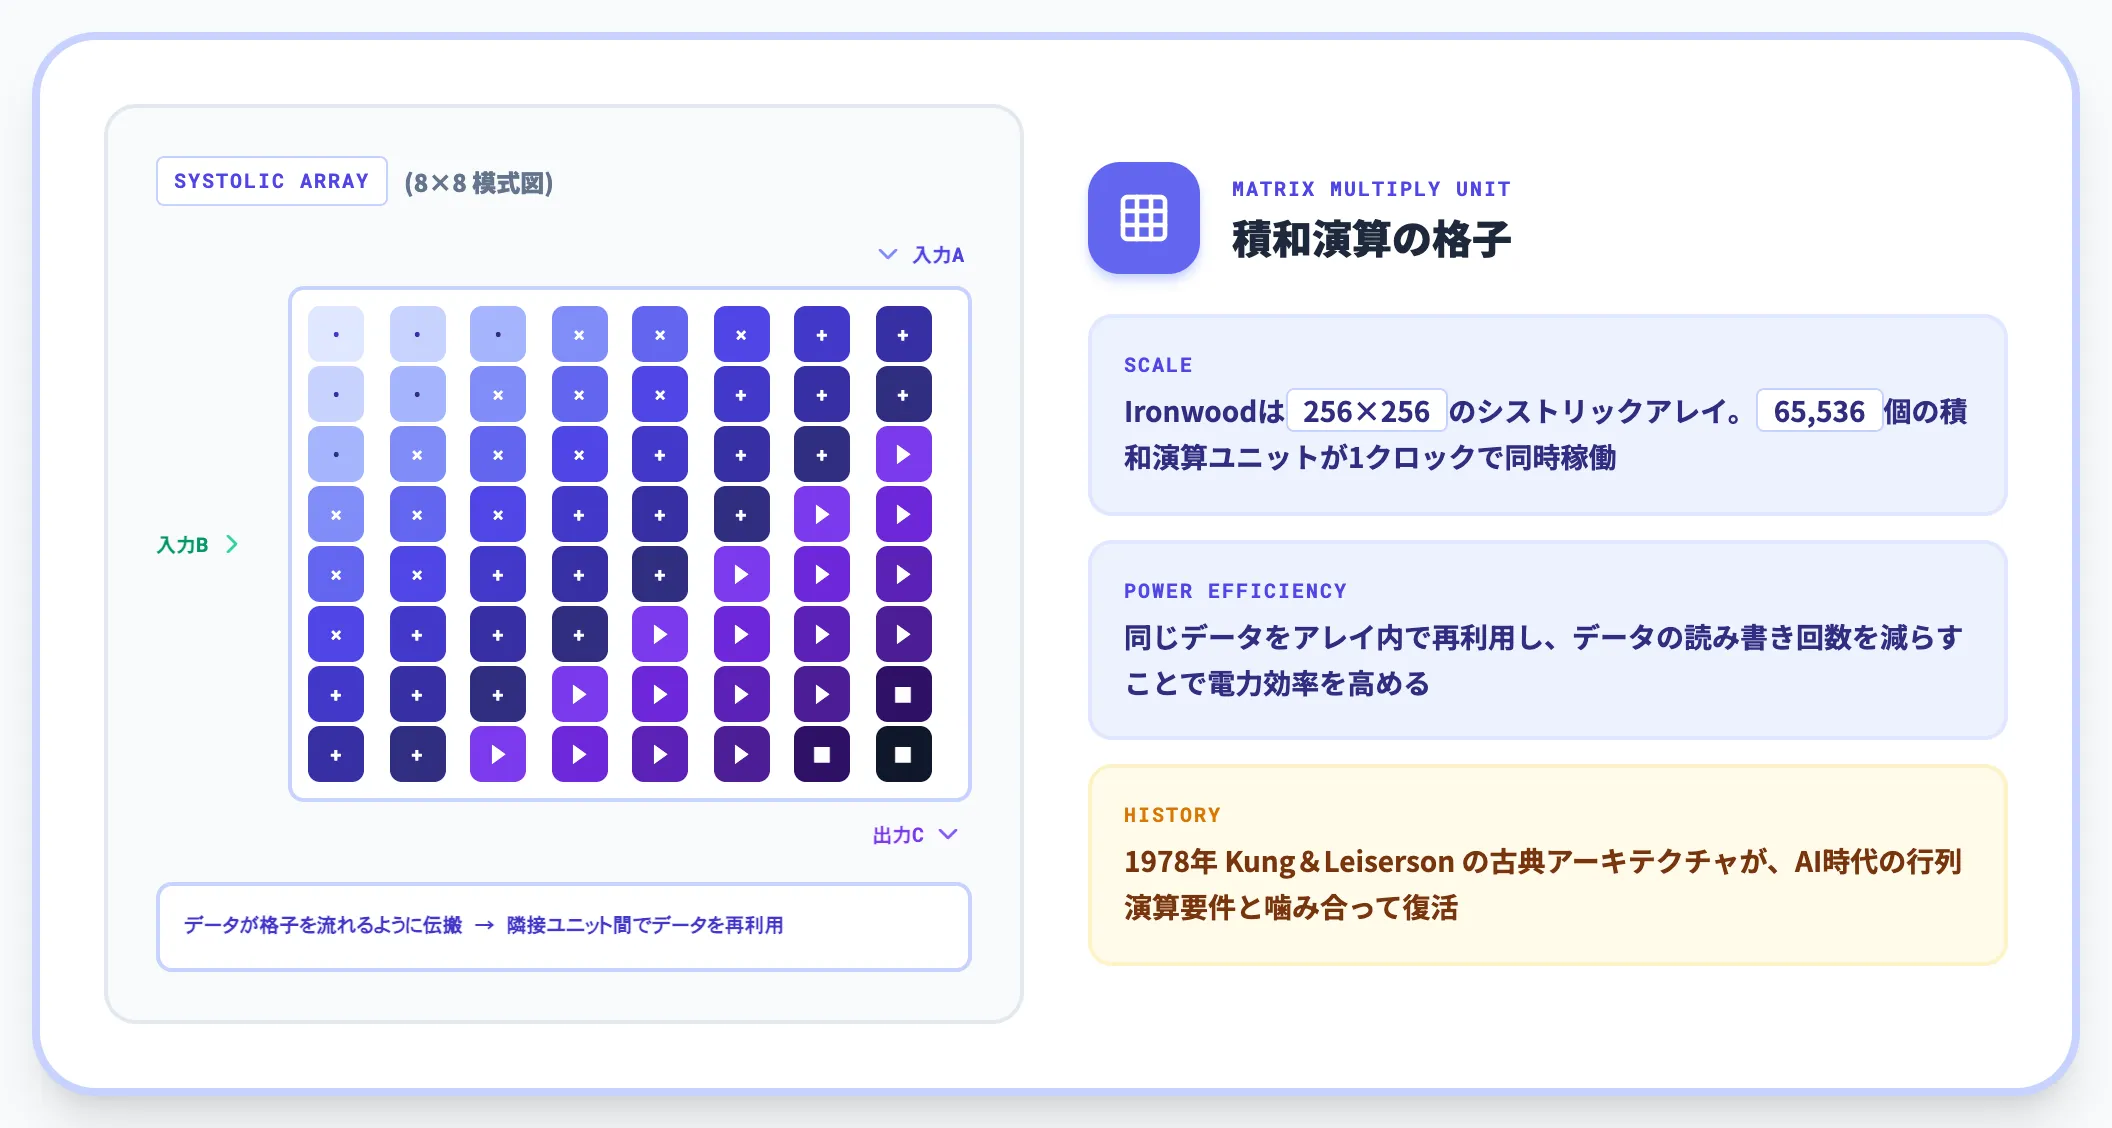
MXUはTPUの心臓部で、シストリックアレイと呼ばれる格子状の演算ユニット配列です。Ironwoodでは256×256のシストリックアレイが搭載されており、65,536個の積和演算ユニットが1クロックで同時に動きます。
シストリックアレイは1978年にCarnegie MellonのH. T. KungとCharles E. Leisersonが共著論文「Systolic Arrays for (VLSI)」で提案した古典的アーキテクチャですが、「行列演算だけを徹底して速く回したい」というAI時代の要件と噛み合い、TPUの設計思想の核になっています。
HBM(High Bandwidth Memory)
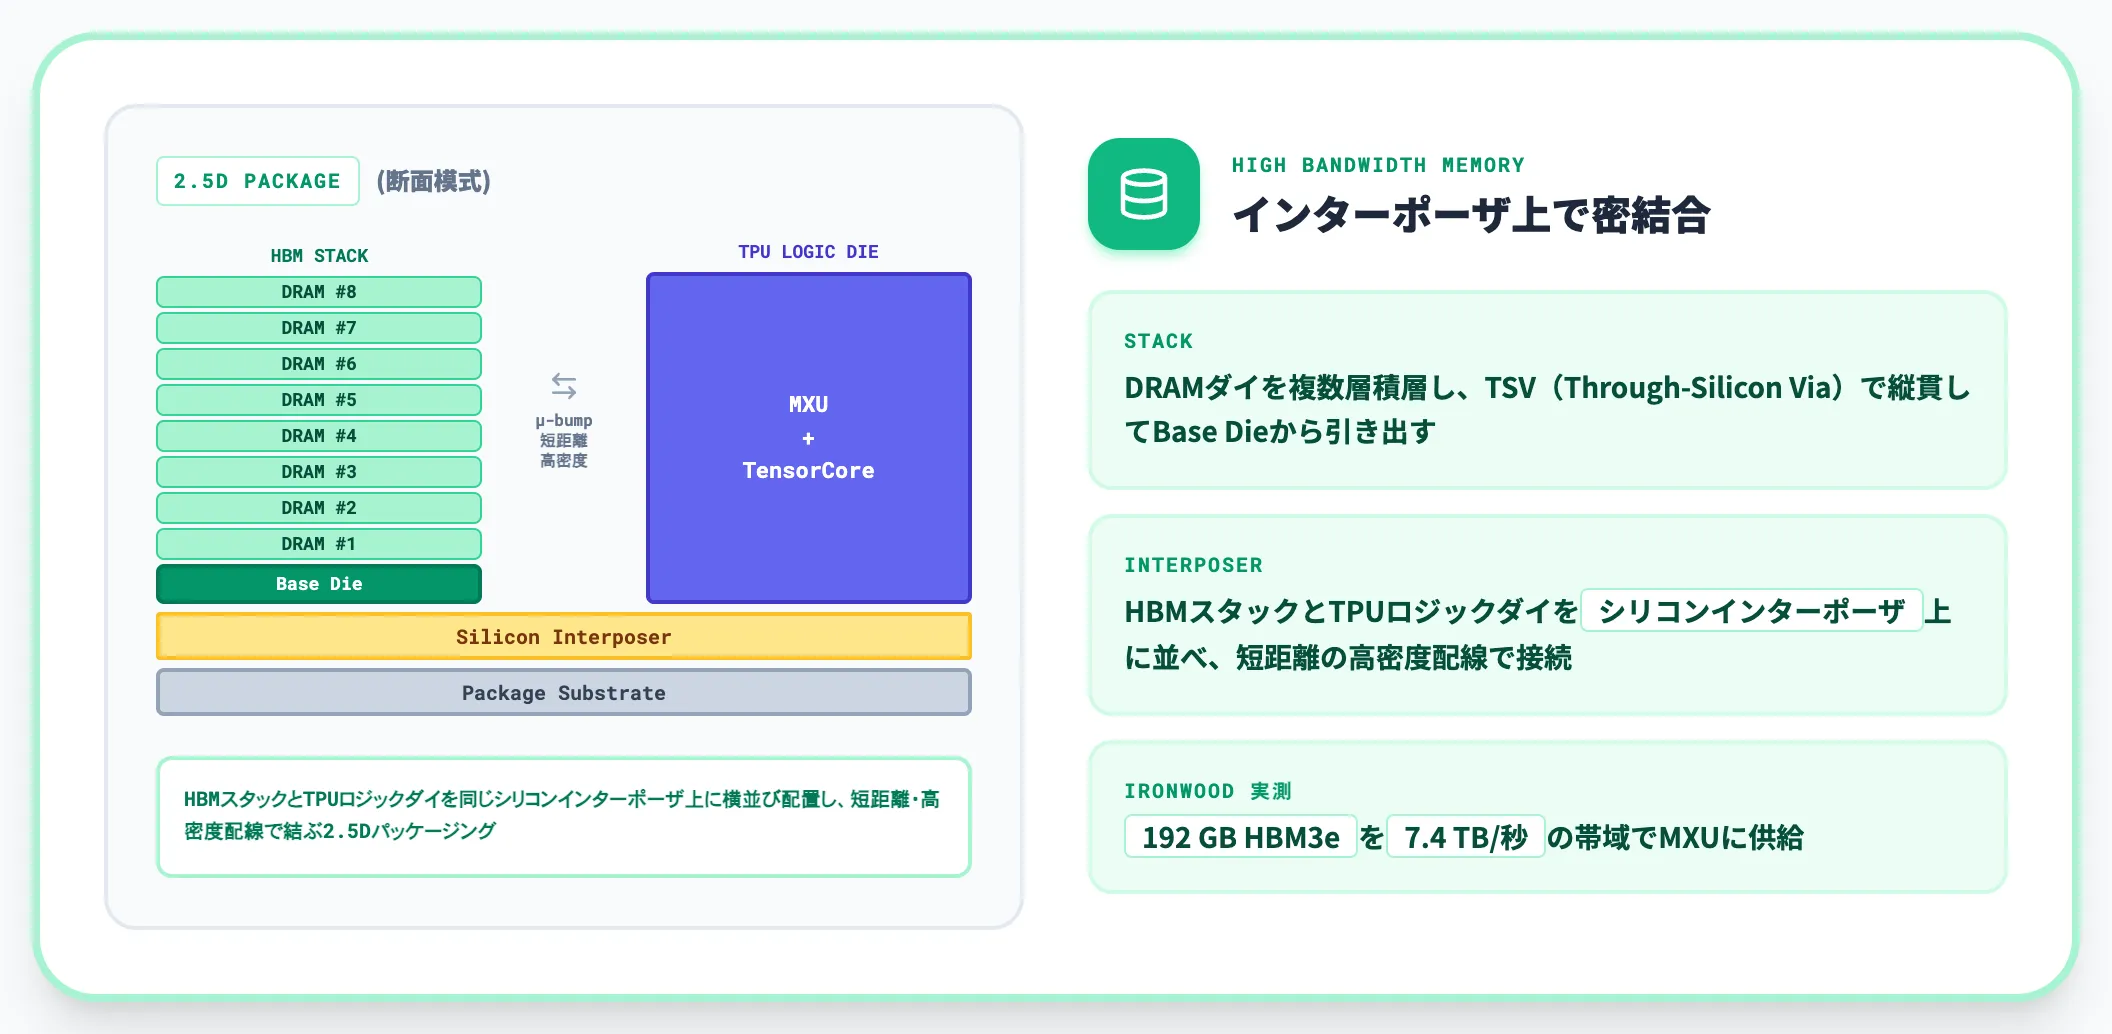
MXUをフル稼働させるには、演算と同じ速度でデータを供給できるメモリが必要です。
TPUはこのため、容量と帯域の両方が大きなHBMをチップに直結しています。世代ごとのHBM容量は後述の世代別ロードマップで整理しますが、Ironwoodでは192GBのHBM3eが7.4TB/秒の帯域でMXUに接続される設計です。
HBMは半導体基板に積層して配線を短くする実装のため、通常のDRAMと比べて電力あたりの帯域が桁違いに大きく、ワット効率のボトルネックを緩和します。
ICI(Inter-Chip Interconnect)とスーパーポッド
単一チップで賄えない大規模学習では、複数チップを束ねて1つの仮想的な計算機として動かす必要があります。
TPUはICIという独自のチップ間接続で、スーパーポッドを構成します。世代によってトポロジは異なり、v5pとIronwood(TPU7x)は3Dトーラス型(間のv6e Trilliumは2Dトーラス)、第8世代の訓練用TPU 8tも引き続き3Dトーラス、推論用TPU 8iはBoardfly(Dragonfly系の3階層構造)で設計されています。
Ironwoodは最大9,216チップを1つのスーパーポッドとして束ね、42.5 ExaFLOPSのピーク性能を実現します。
第8世代のTPU 8tではこれを9,600チップ・121 FP4 ExaFLOPSへとさらに拡張します。NVIDIA側のNVLink/NVSwitchと比較しても、1つの論理計算機として扱えるチップ数の規模が大きいのがTPUスーパーポッドの特徴です。
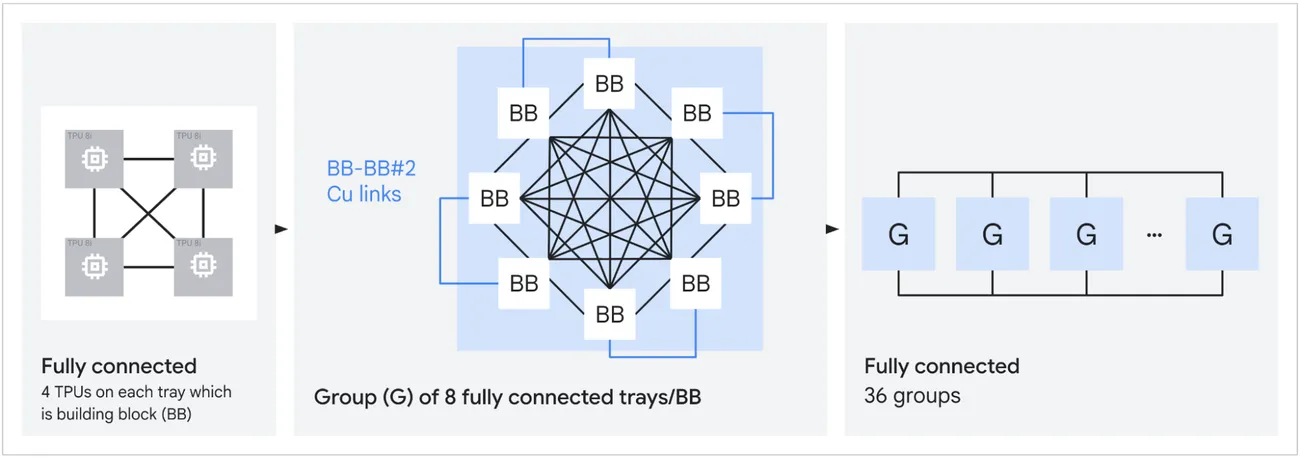
TPU 8i Boardflyトポロジ:4 TPU/tray=Building Block → 8 BB/Group → 最大36 Groups(最大1,024アクティブチップ/出典:Google Cloud Blog)
TPU 8iのスーパーポッドはBoardflyと呼ばれる階層型トポロジを採用しています。4 TPUをフルコネクトしたtrayを最小単位(Building Block)とし、8 Building Blockを銅配線で密結合して1 Groupを構成、Groupを最大36個をOptical Circuit Switchで束ねて最大1,024アクティブチップのポッドを形成します。
all-to-all通信のホップ数を削減することで、MoE(Mixture of Experts)や推論ワークロードの通信レイテンシを抑える設計です。
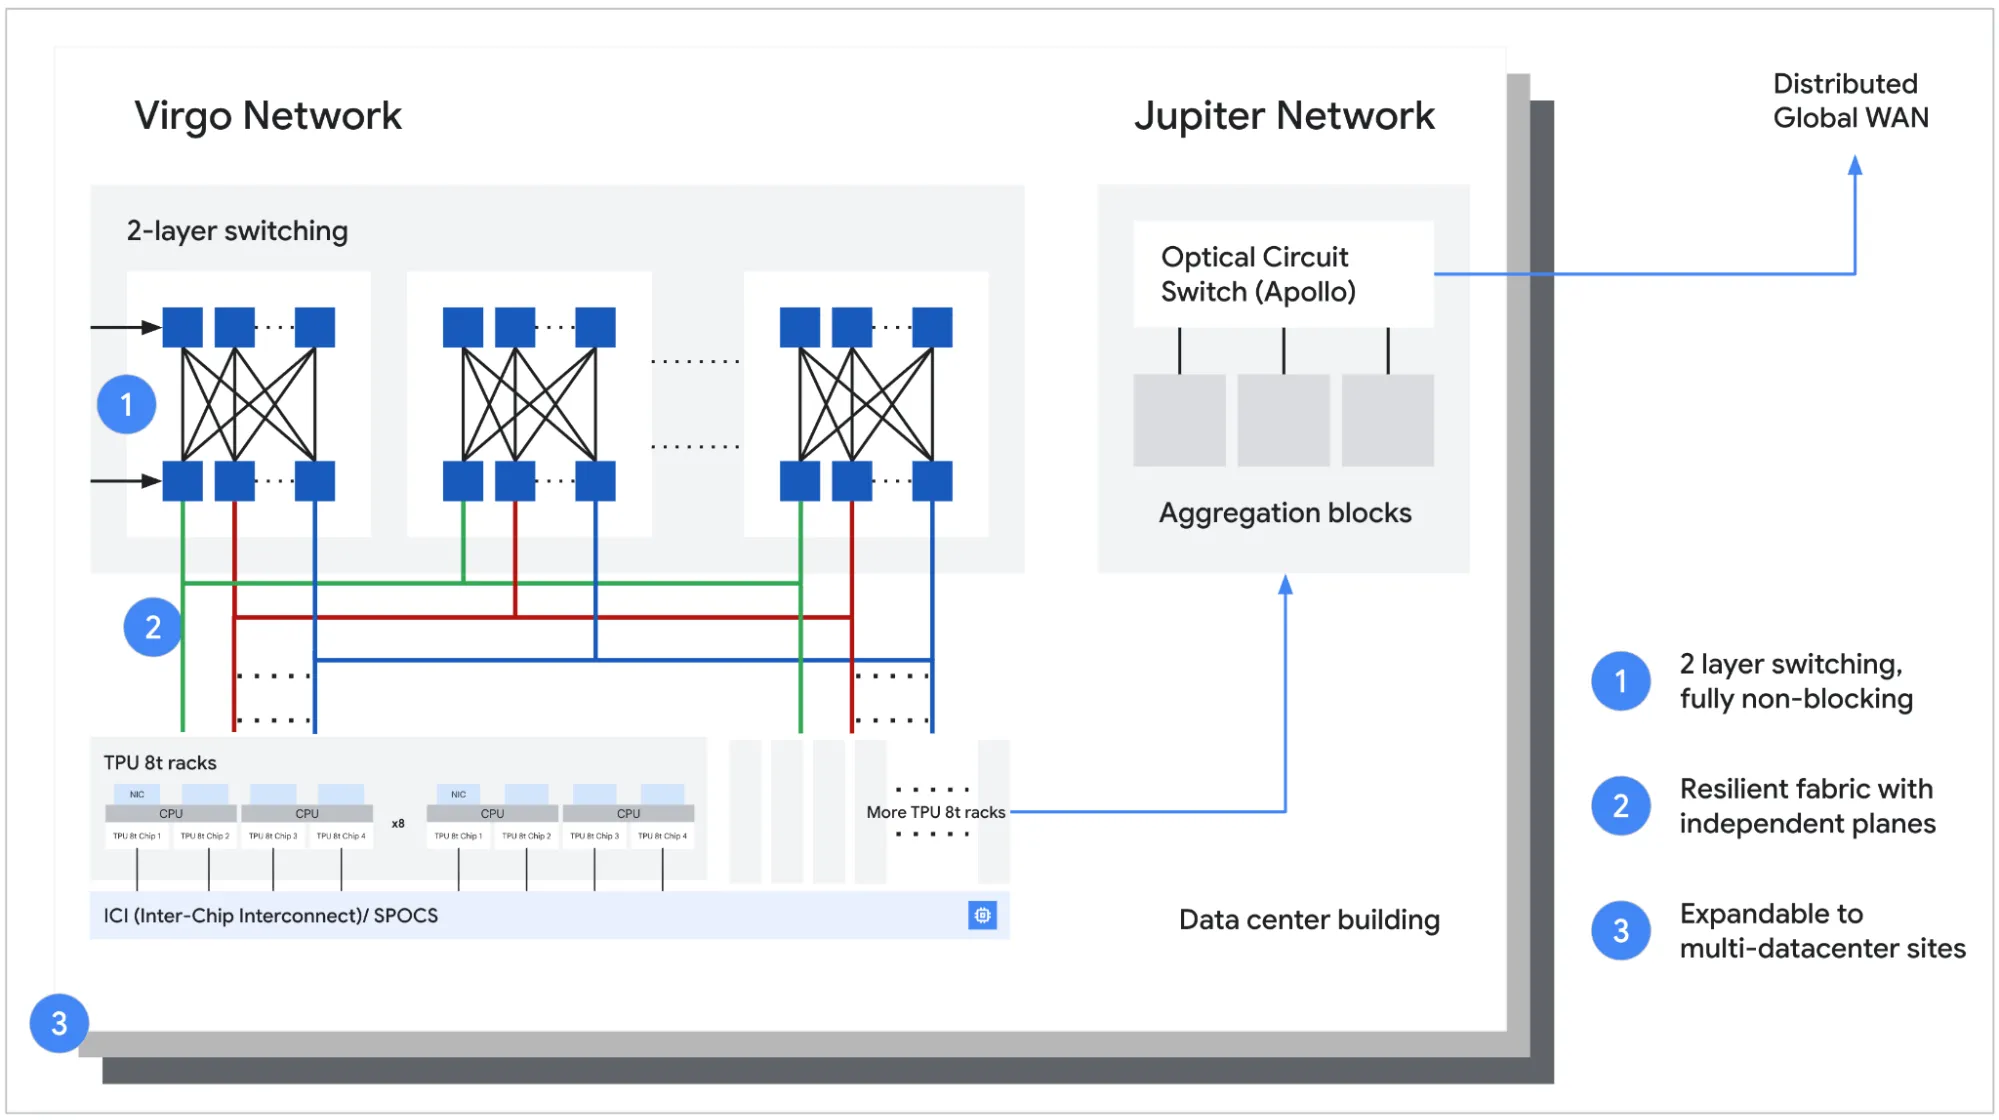
TPU 8tのラックネットワーク:ICI(ポッド内)+Virgo(ポッド間スケールアウト)+Jupiter・OCS(Apollo)+WANを組み合わせる階層構成(出典:Google Cloud Blog)
ICI自体はスーパーポッド内のチップ間接続で、ポッドを越える経路は別のネットワーク層が受け持ちます。ポッド間を接続するスケールアウト用ファブリックが Virgo Network(最大134,000 TPUを単一ファブリックで接続、2層ノンブロッキング構成)、データセンター内の集約と光回線切替は Jupiter Network と Optical Circuit Switch(Apollo)、さらにDistributed Global WANを跨いで複数データセンターへ拡張できる階層構成です。
AnthropicやGoogle自社の兆パラメータ級モデル学習が実現できている背景には、このICI+Virgo+Jupiter+WANの組み合わせがあります。
TPUの世代別ロードマップ——v5eから第8世代8t/8iまで
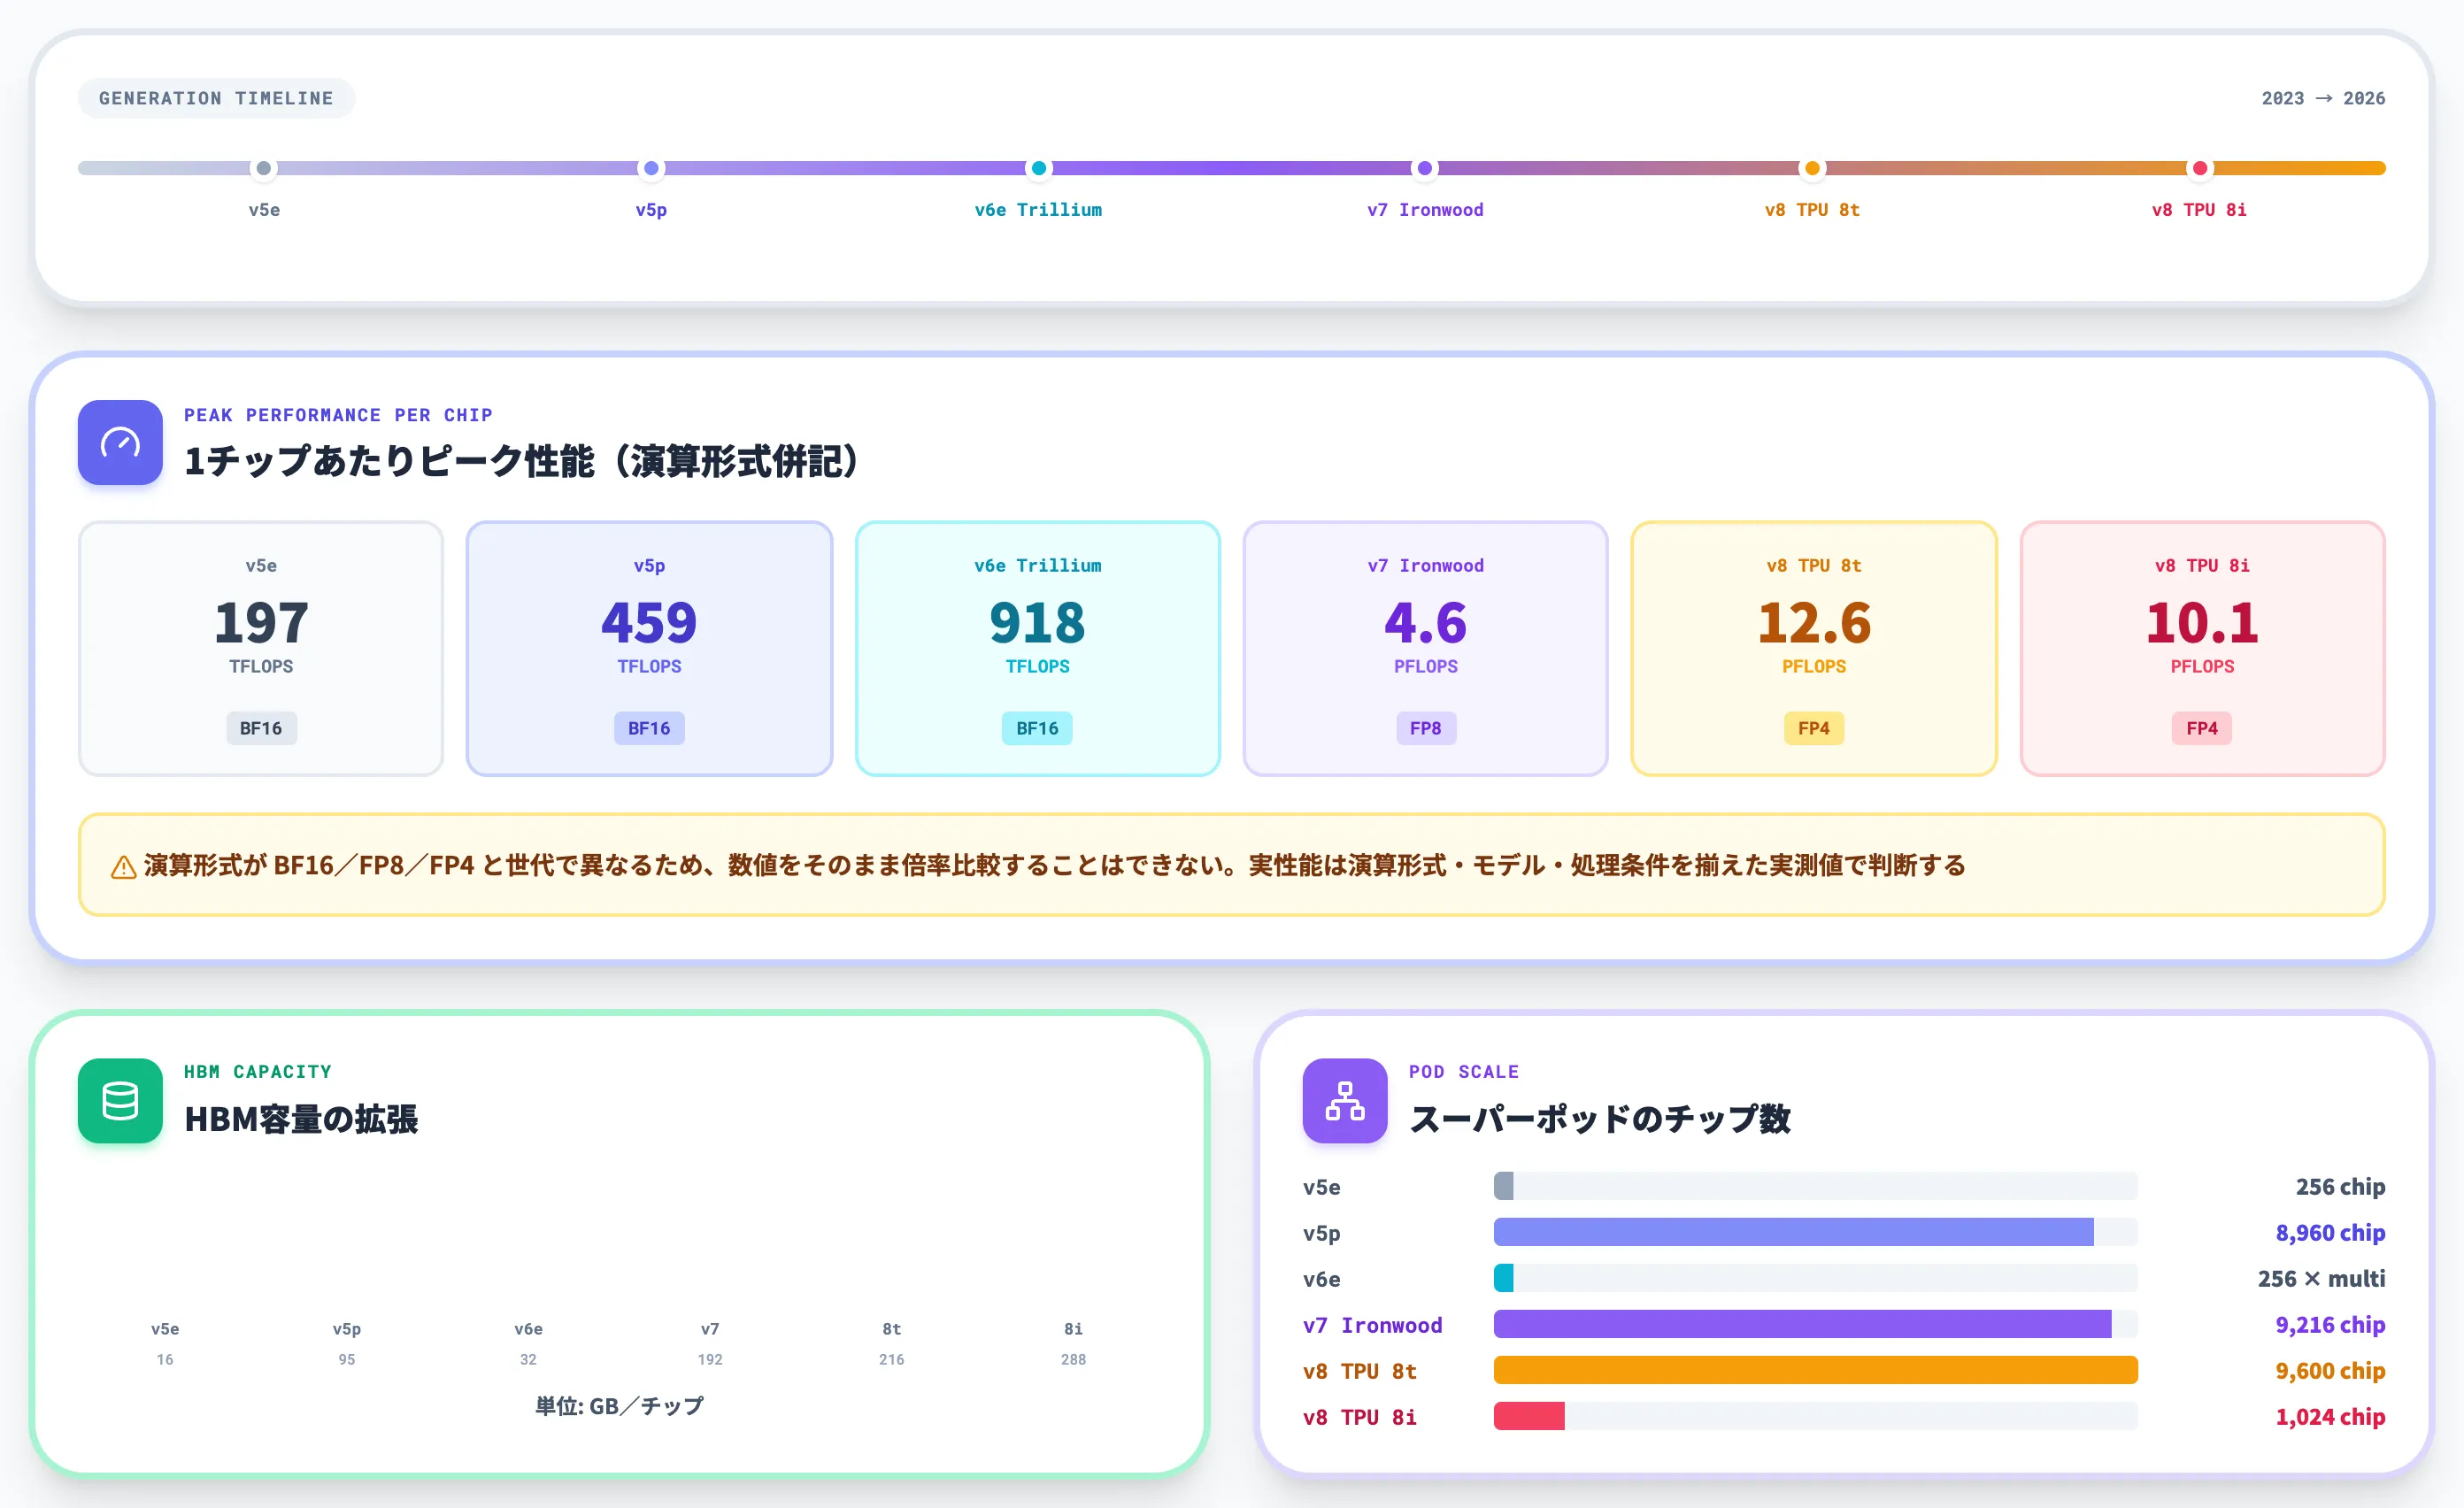
TPUは2016年の初代から数えて、2026年11月時点で第8世代まで到達しています。実務で目にするのはv5e以降の最近4世代なので、ここではその4世代の特性と性能変遷を整理します。
v5e / v5p——コスト特化と性能特化の2系統
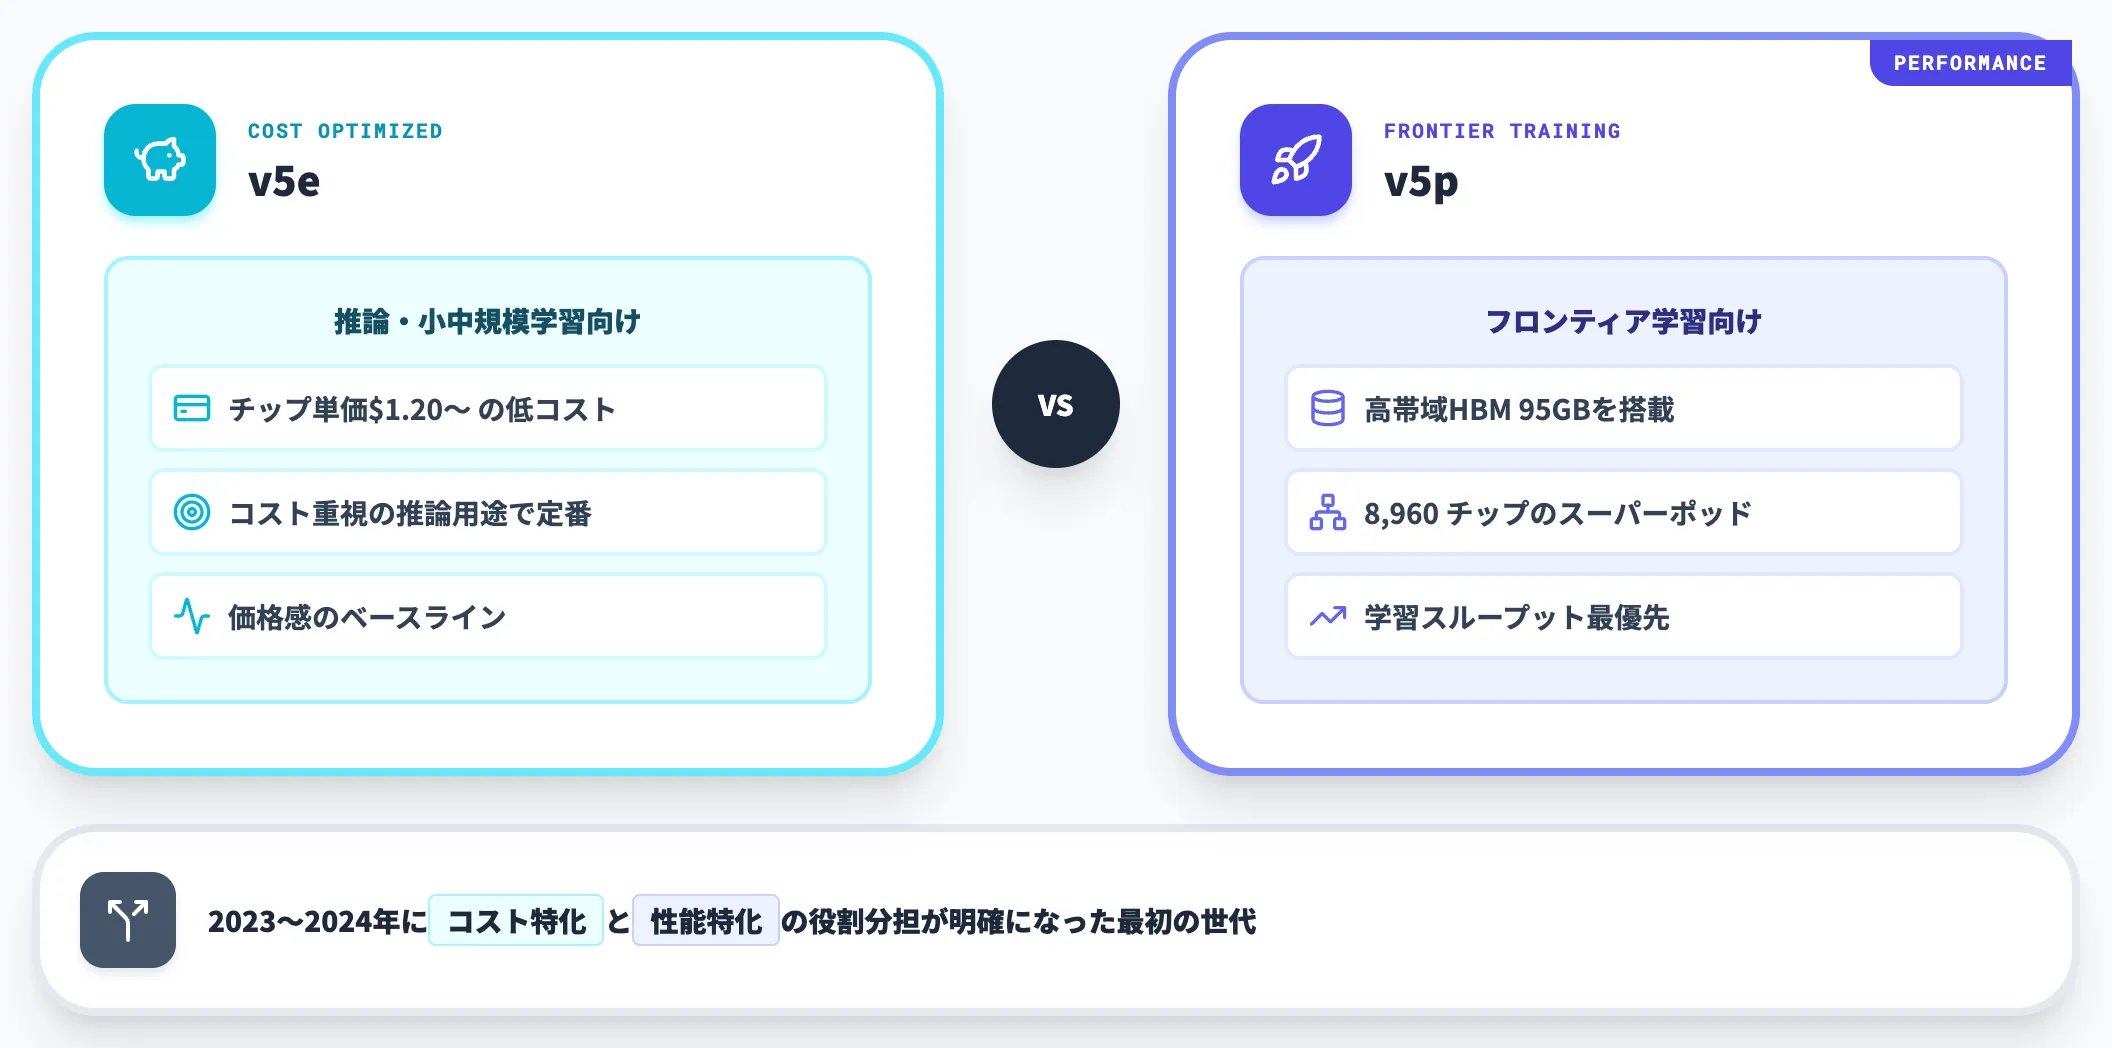
v5eはコスト最適化系の推論・小中規模学習向け、v5pはフロンティア学習向けとして、2023〜2024年に提供されました。v5eは1チップあたりのピーク性能と価格を抑え、v5pは高帯域HBMと大規模ICIで学習性能を伸ばす、という役割分担が明確になった最初の世代です。
v5eは現在もコスト重視の推論用途で選ばれることが多く、価格感を測るベースラインとして位置づけられています。
v6e(Trillium)——1世代で4.7倍のMXU性能
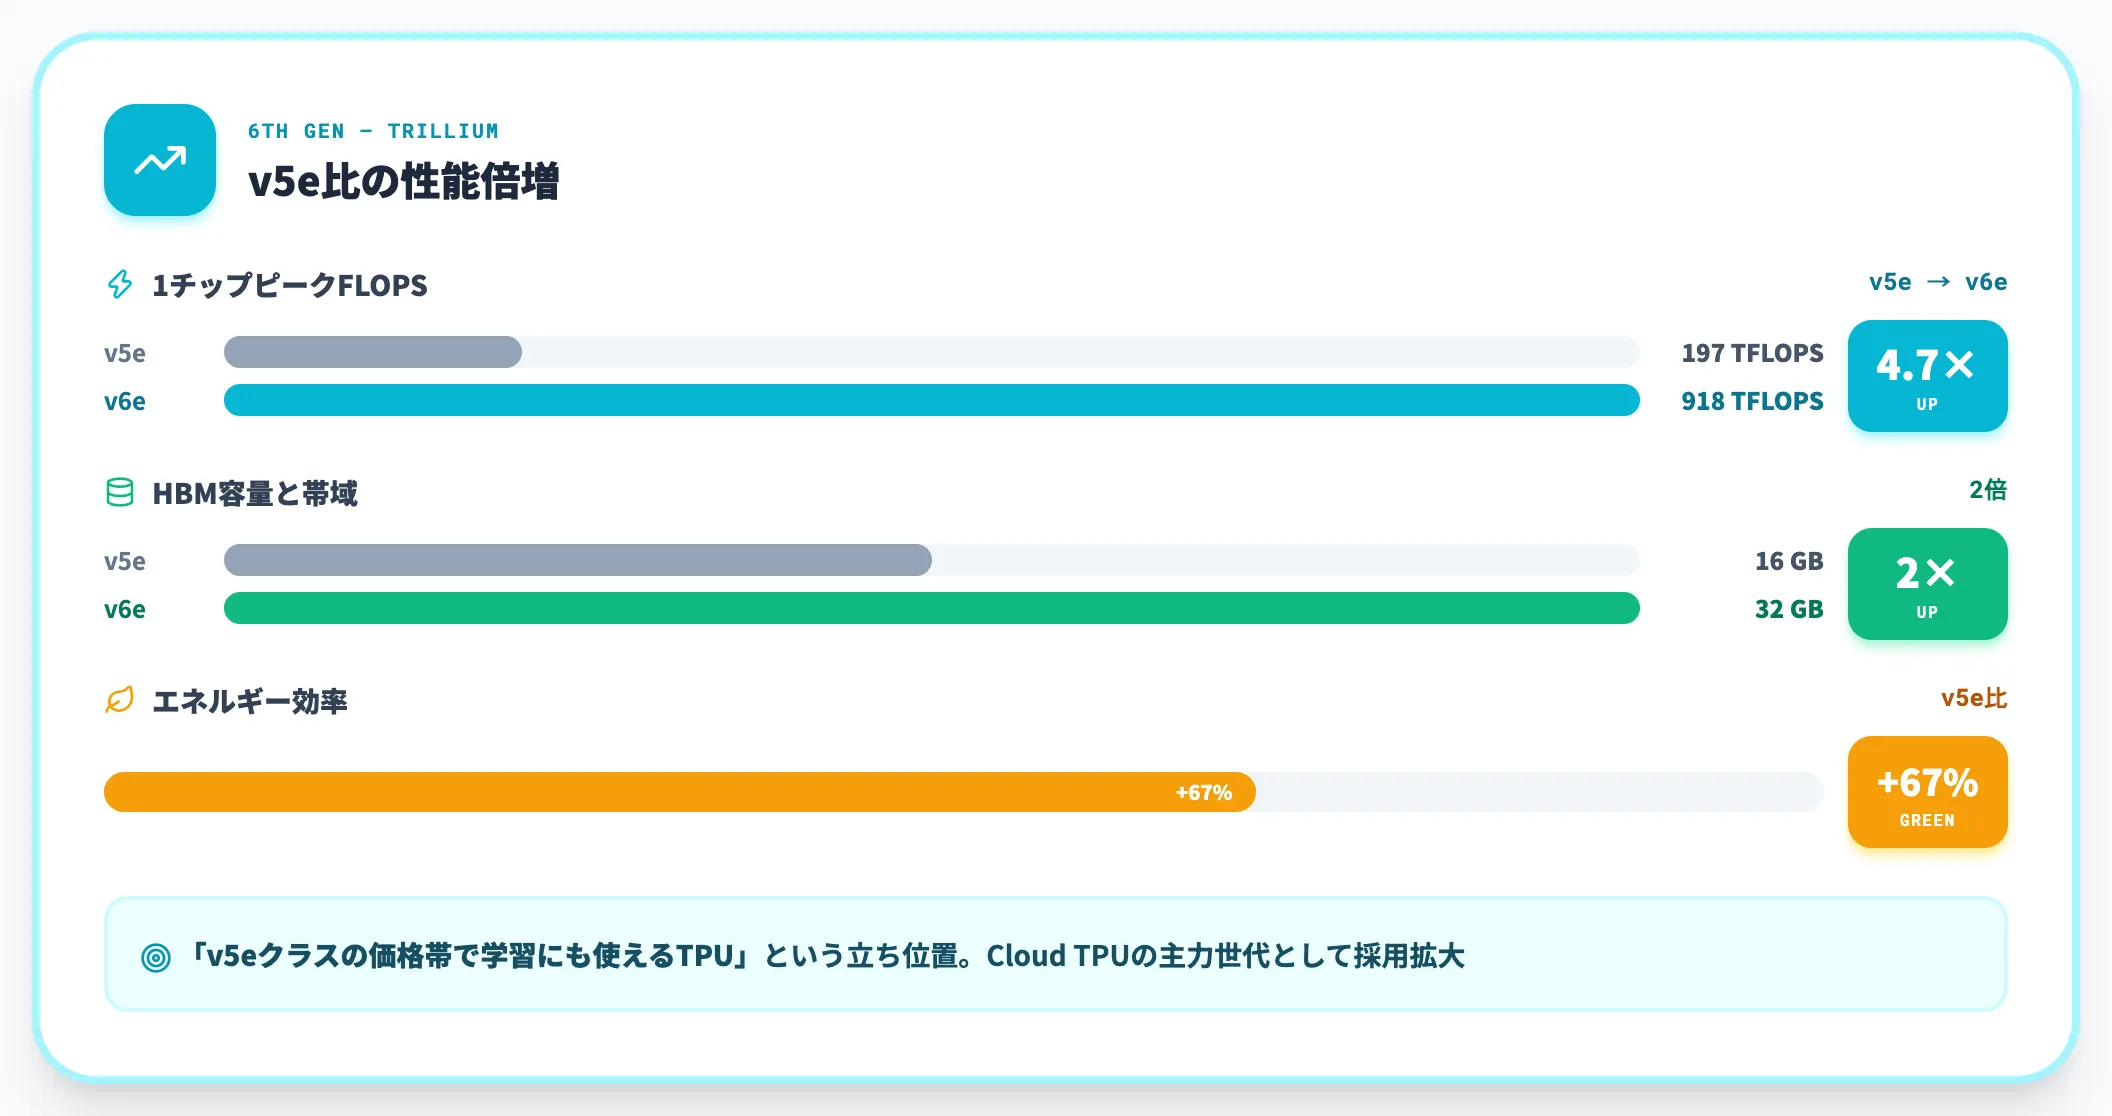
v6eのコードネーム「Trillium」は、2024年に発表された中堅世代です。1チップあたりのピークFLOPSはv5eの4.7倍、HBM容量と帯域は倍増、ICI帯域も倍増しており、「v5eクラスの価格帯で学習にも使えるTPU」という立ち位置を取りました。
GoogleはTrillium公式発表でv5e比67%以上のエネルギー効率改善を謳っており、推論・学習の双方で使いやすい汎用性と電力効率の改善を両立したことで、v6eはCloud TPUの主力世代として採用が広がりました。
Ironwood(v7)——初の推論特化世代、Anthropicが数百億ドル規模の契約
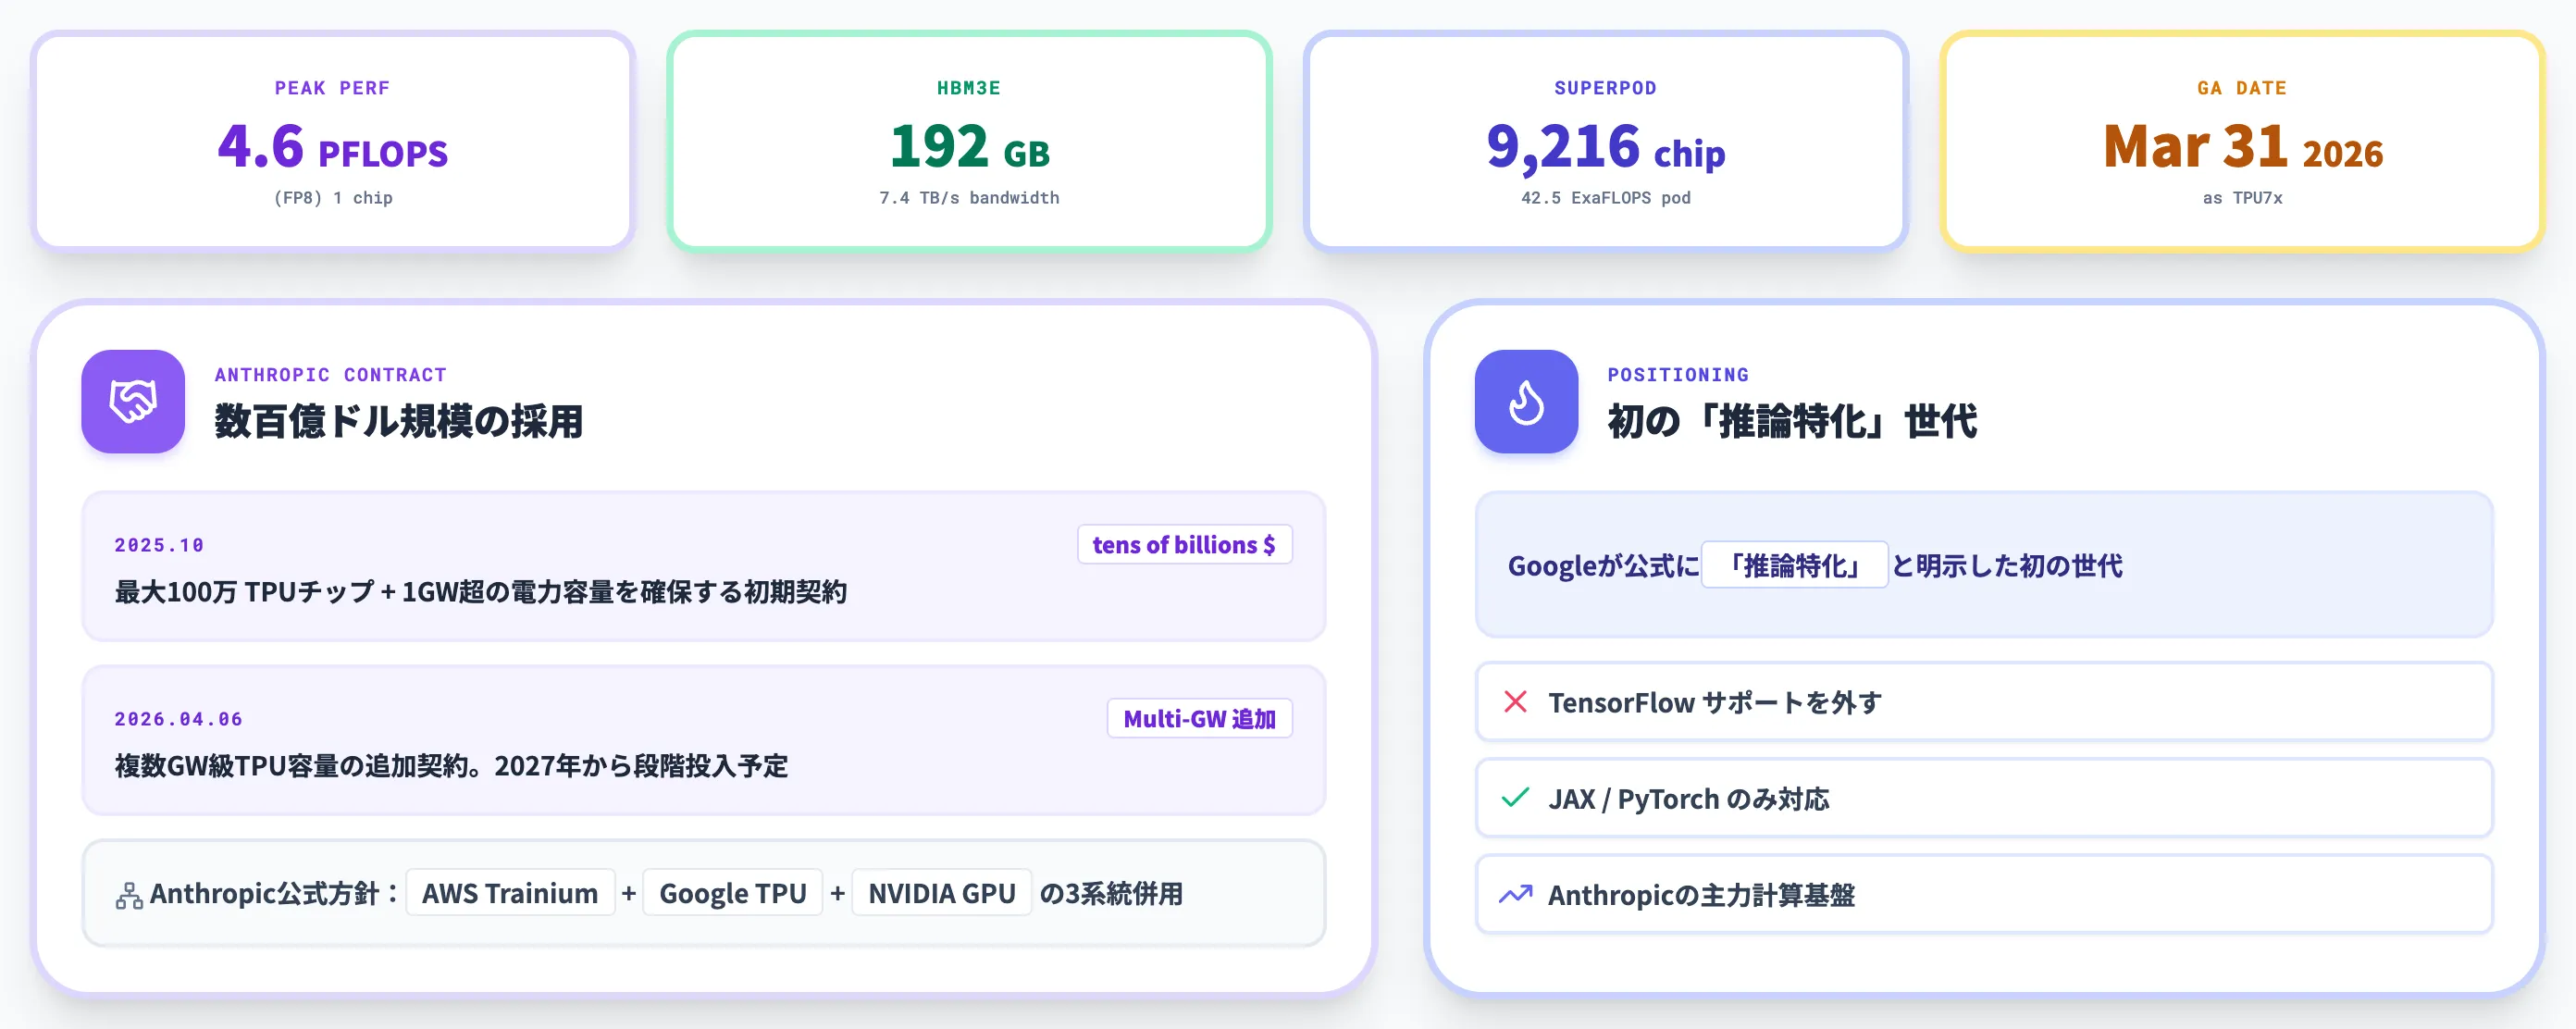
第7世代Ironwood(TPU7x)は2026年3月31日に正式GAとなり、4月のCloud Nextでも大きく紹介されました。1チップあたり4.6 PFLOPS(FP8)、192GBのHBM3e、9,216チップで42.5 ExaFLOPSのスーパーポッドというスペックで、Googleが初めて「推論特化」と明示した世代になります。
Anthropicは2025年10月に数百億ドル規模(tens of billions of dollars)のTPU契約をGoogle Cloudと締結し、2026年4月6日には追加の複数GW級TPU容量を確保する契約を発表しました(追加容量は2027年から段階的に投入予定)。
Anthropicは公式にAWS Trainium・Google TPU・NVIDIA GPUの3系統を併用する方針を表明しており、TPUはそのうち推論・学習の両方を支える主要な計算基盤の1つに位置づけられています。
第8世代——TPU 8t/8iで訓練と推論を分離、派生の8tx・8i Max
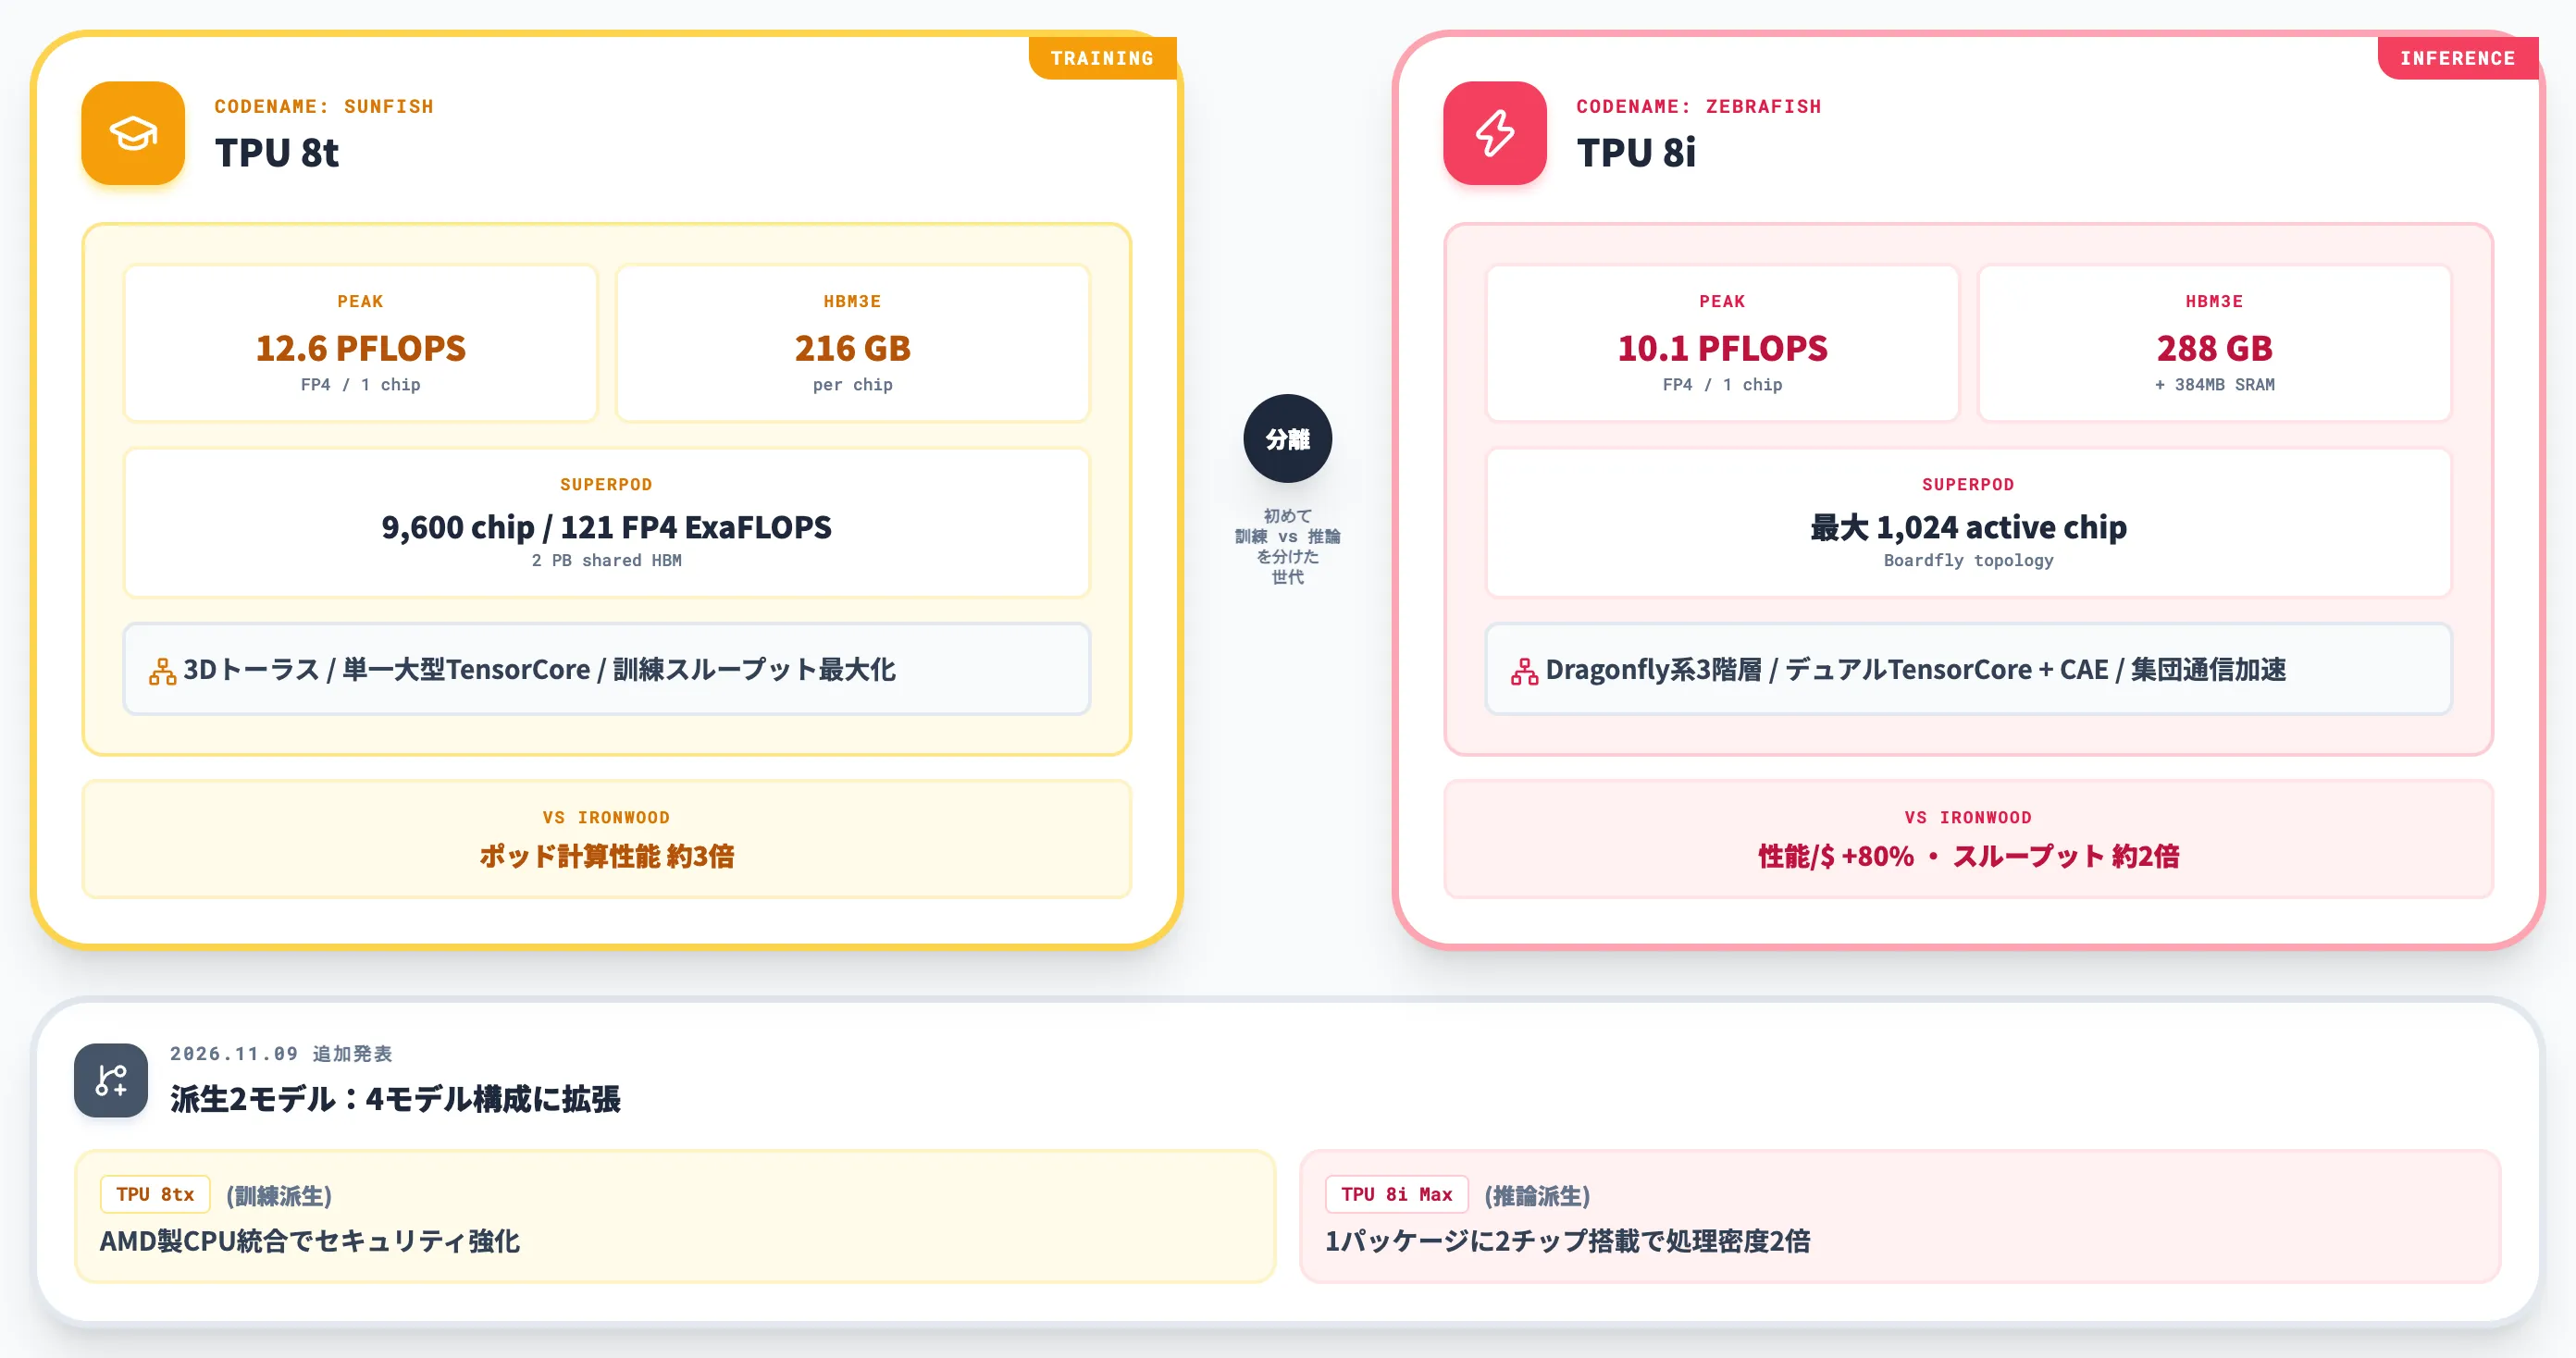
同じCloud Next 2026で発表された第8世代は、TPUの歴史で初めて訓練用と推論用の設計を分けたアーキテクチャです。
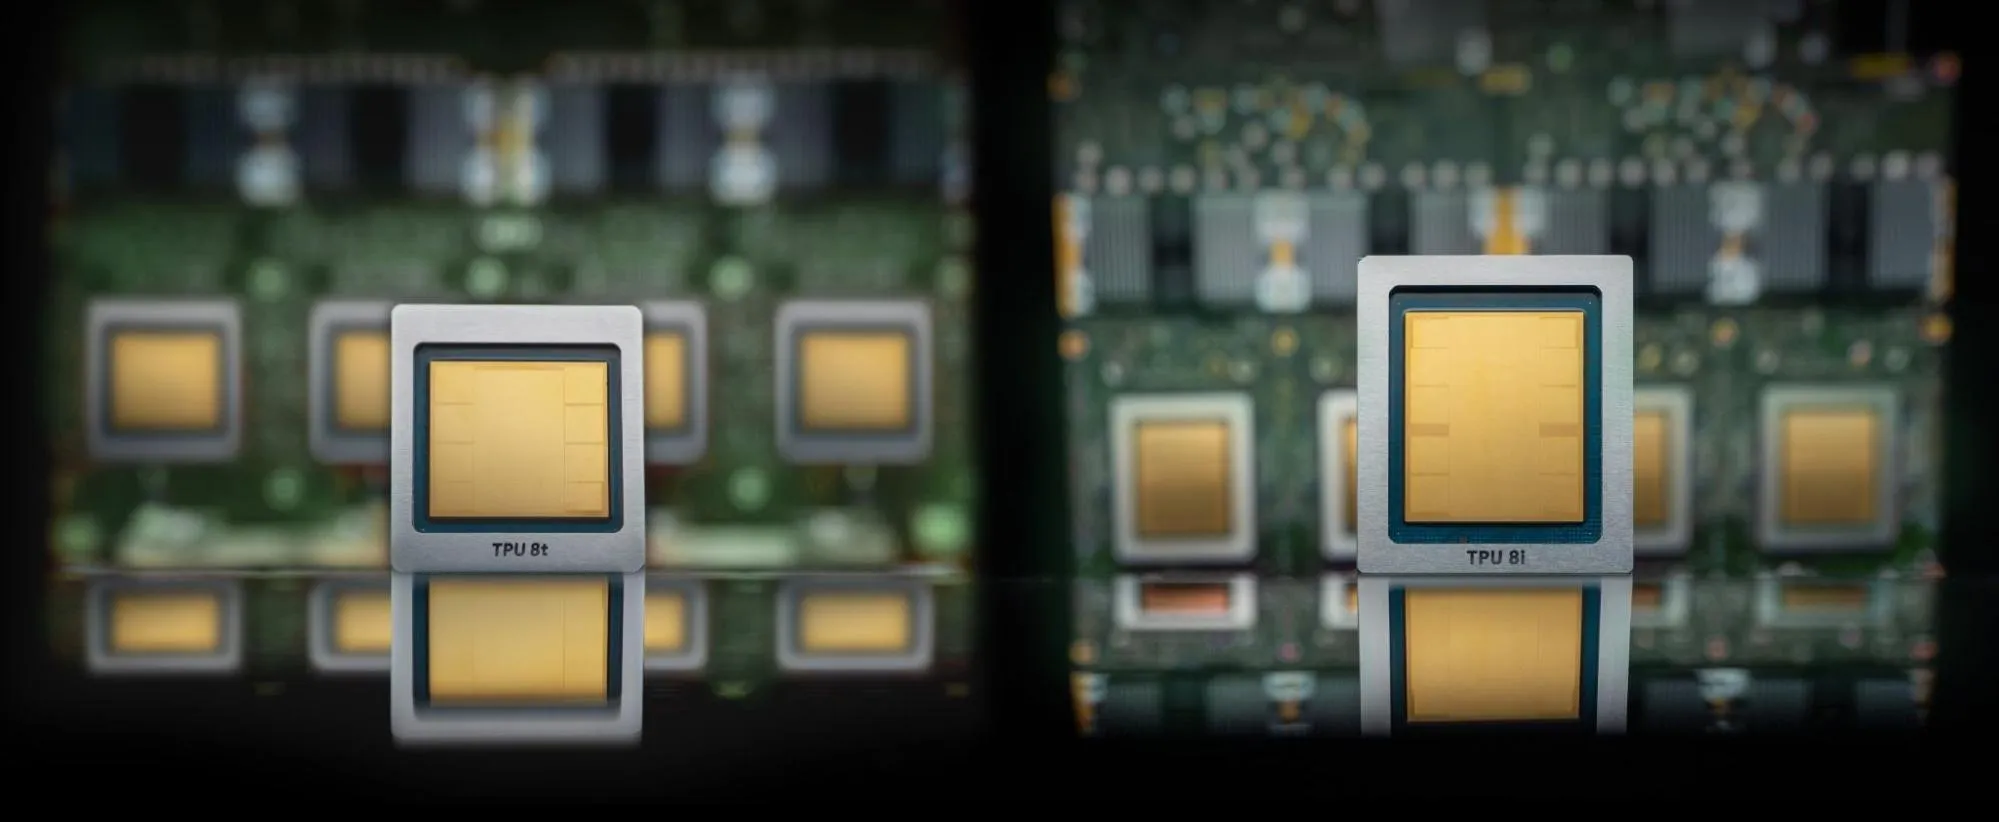
第8世代TPUの2チップ:訓練用TPU 8t(左)と推論用TPU 8i(右)(出典:Google Cloud Blog)
-
TPU 8t(訓練用・コードネーム「Sunfish」)
1チップあたり12.6 FP4 PFLOPS、216GB HBM3eを搭載し、9,600チップのスーパーポッドで121 FP4 ExaFLOPS・2ペタバイトの共有HBMというスペックで、Ironwood比のポッド計算性能を約3倍に引き上げる設計です。
-
TPU 8i(推論用・コードネーム「Zebrafish」)
1チップあたり10.1 FP4 PFLOPS、288GB HBM3e、384MB SRAMを搭載し、最大1,024アクティブチップのスーパーポッドを構成します。Ironwood世代比で性能/ドル最大80%向上・スループット約2倍、という推論特化のバランスを取っています。
両チップともTSMCの先端プロセスで製造され、Ironwood比で最大2倍のワットパフォーマンスを実現する計画です。提供時期は「2026年中(later this year)」と予告されています。
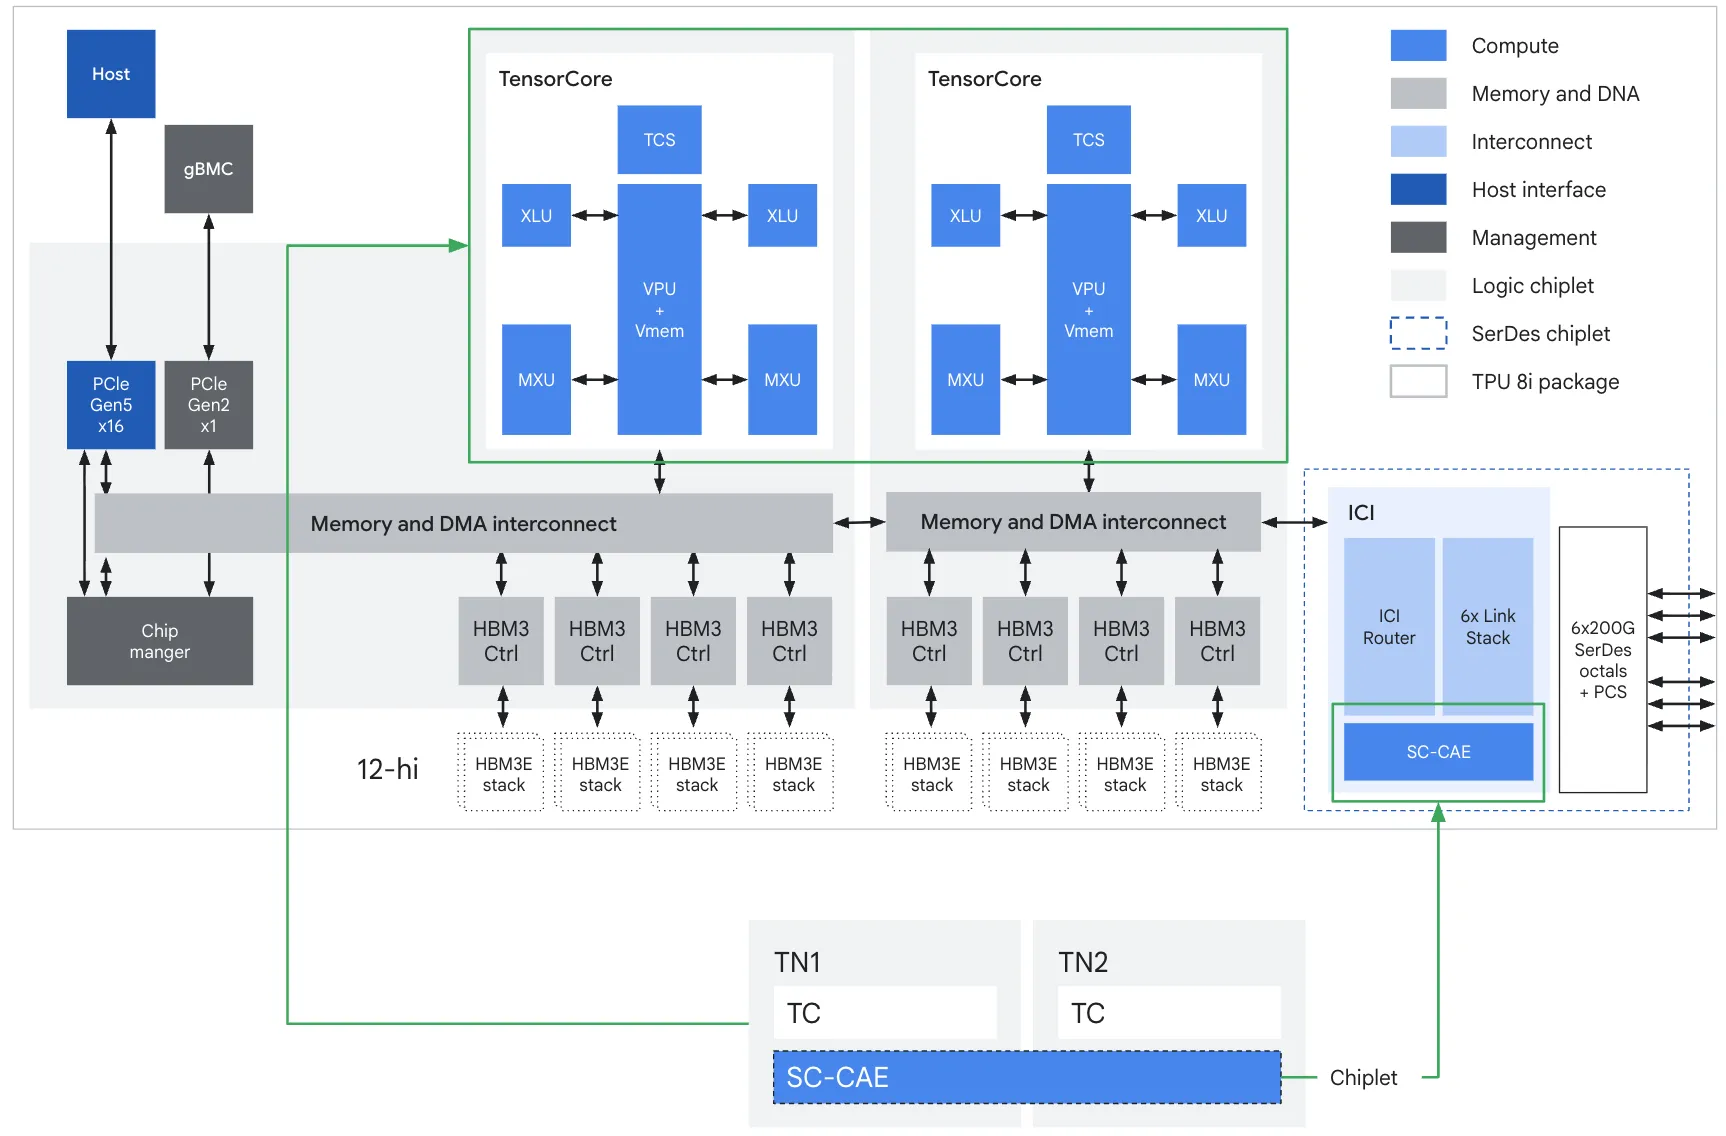
TPU 8iの内部アーキテクチャ:デュアルTensorCore+SC-CAEチップレット構成(出典:Google Cloud Blog)
TPU 8iのブロック図で目を引くのは、チップ内にTensorCoreが2基置かれている点と、同一パッケージ内にSC-CAE(Sparse Core + Collectives Acceleration Engine)チップレットが組み合わされている構成です。
CAEはall-to-allなどの集団通信をハードウェアでオフロードする専用エンジンで、MoE・推論系の通信ボトルネックを緩和する役割を担います。
TPU 8tが単一の大型TensorCoreで訓練スループットを最大化する設計なのに対し、TPU 8iはデュアルコア化とCAEによる集団通信加速で、推論レイテンシと同時並列セッション数の両方を伸ばす方向に振られています。
さらに2026年11月9日には、TPU 8tx(AMD製CPUとの統合でセキュリティを強化したモデル)とTPU 8i Max(1パッケージに2チップを搭載して処理密度を2倍に引き上げたモデル)が派生版として発表され、第8世代のラインナップは4モデル構成になりました。
世代別の主要スペックを一覧で整理します。
| 世代 | 世代名 | ピーク性能/chip | HBM容量 | ポッド構成 | 主用途 |
|---|---|---|---|---|---|
| v5e | TPU v5e | 197 TFLOPS(BF16)/393 TOPS(INT8) | 16 GB | 256チップ | コスト重視の推論・小中規模学習 |
| v5p | TPU v5p | 459 TFLOPS(BF16) | 95 GB | 8,960チップ | フロンティア学習 |
| v6e | Trillium | 918 TFLOPS(BF16) | 32 GB | 256チップ×マルチスライス | 学習・推論の主力世代 |
| v7 | Ironwood | 4.6 PFLOPS(FP8) | 192 GB | 9,216チップ=42.5 ExaFLOPS | 推論特化、Anthropicの主力 |
| 8t | Sunfish | 12.6 PFLOPS(FP4) | 216 GB | 9,600チップ=121 FP4 ExaFLOPS | 大規模訓練 |
| 8i | Zebrafish | 10.1 PFLOPS(FP4) | 288 GB | 最大1,024アクティブチップ | 大規模推論・強化学習 |
確かな傾向として言えるのは、HBM容量が世代ごとに大きく拡張されており、モデルパラメータ数の増加に合わせてメモリ側の律速緩和が進んでいる点です。
TPUの料金——世代別単価と購入経路の選び方
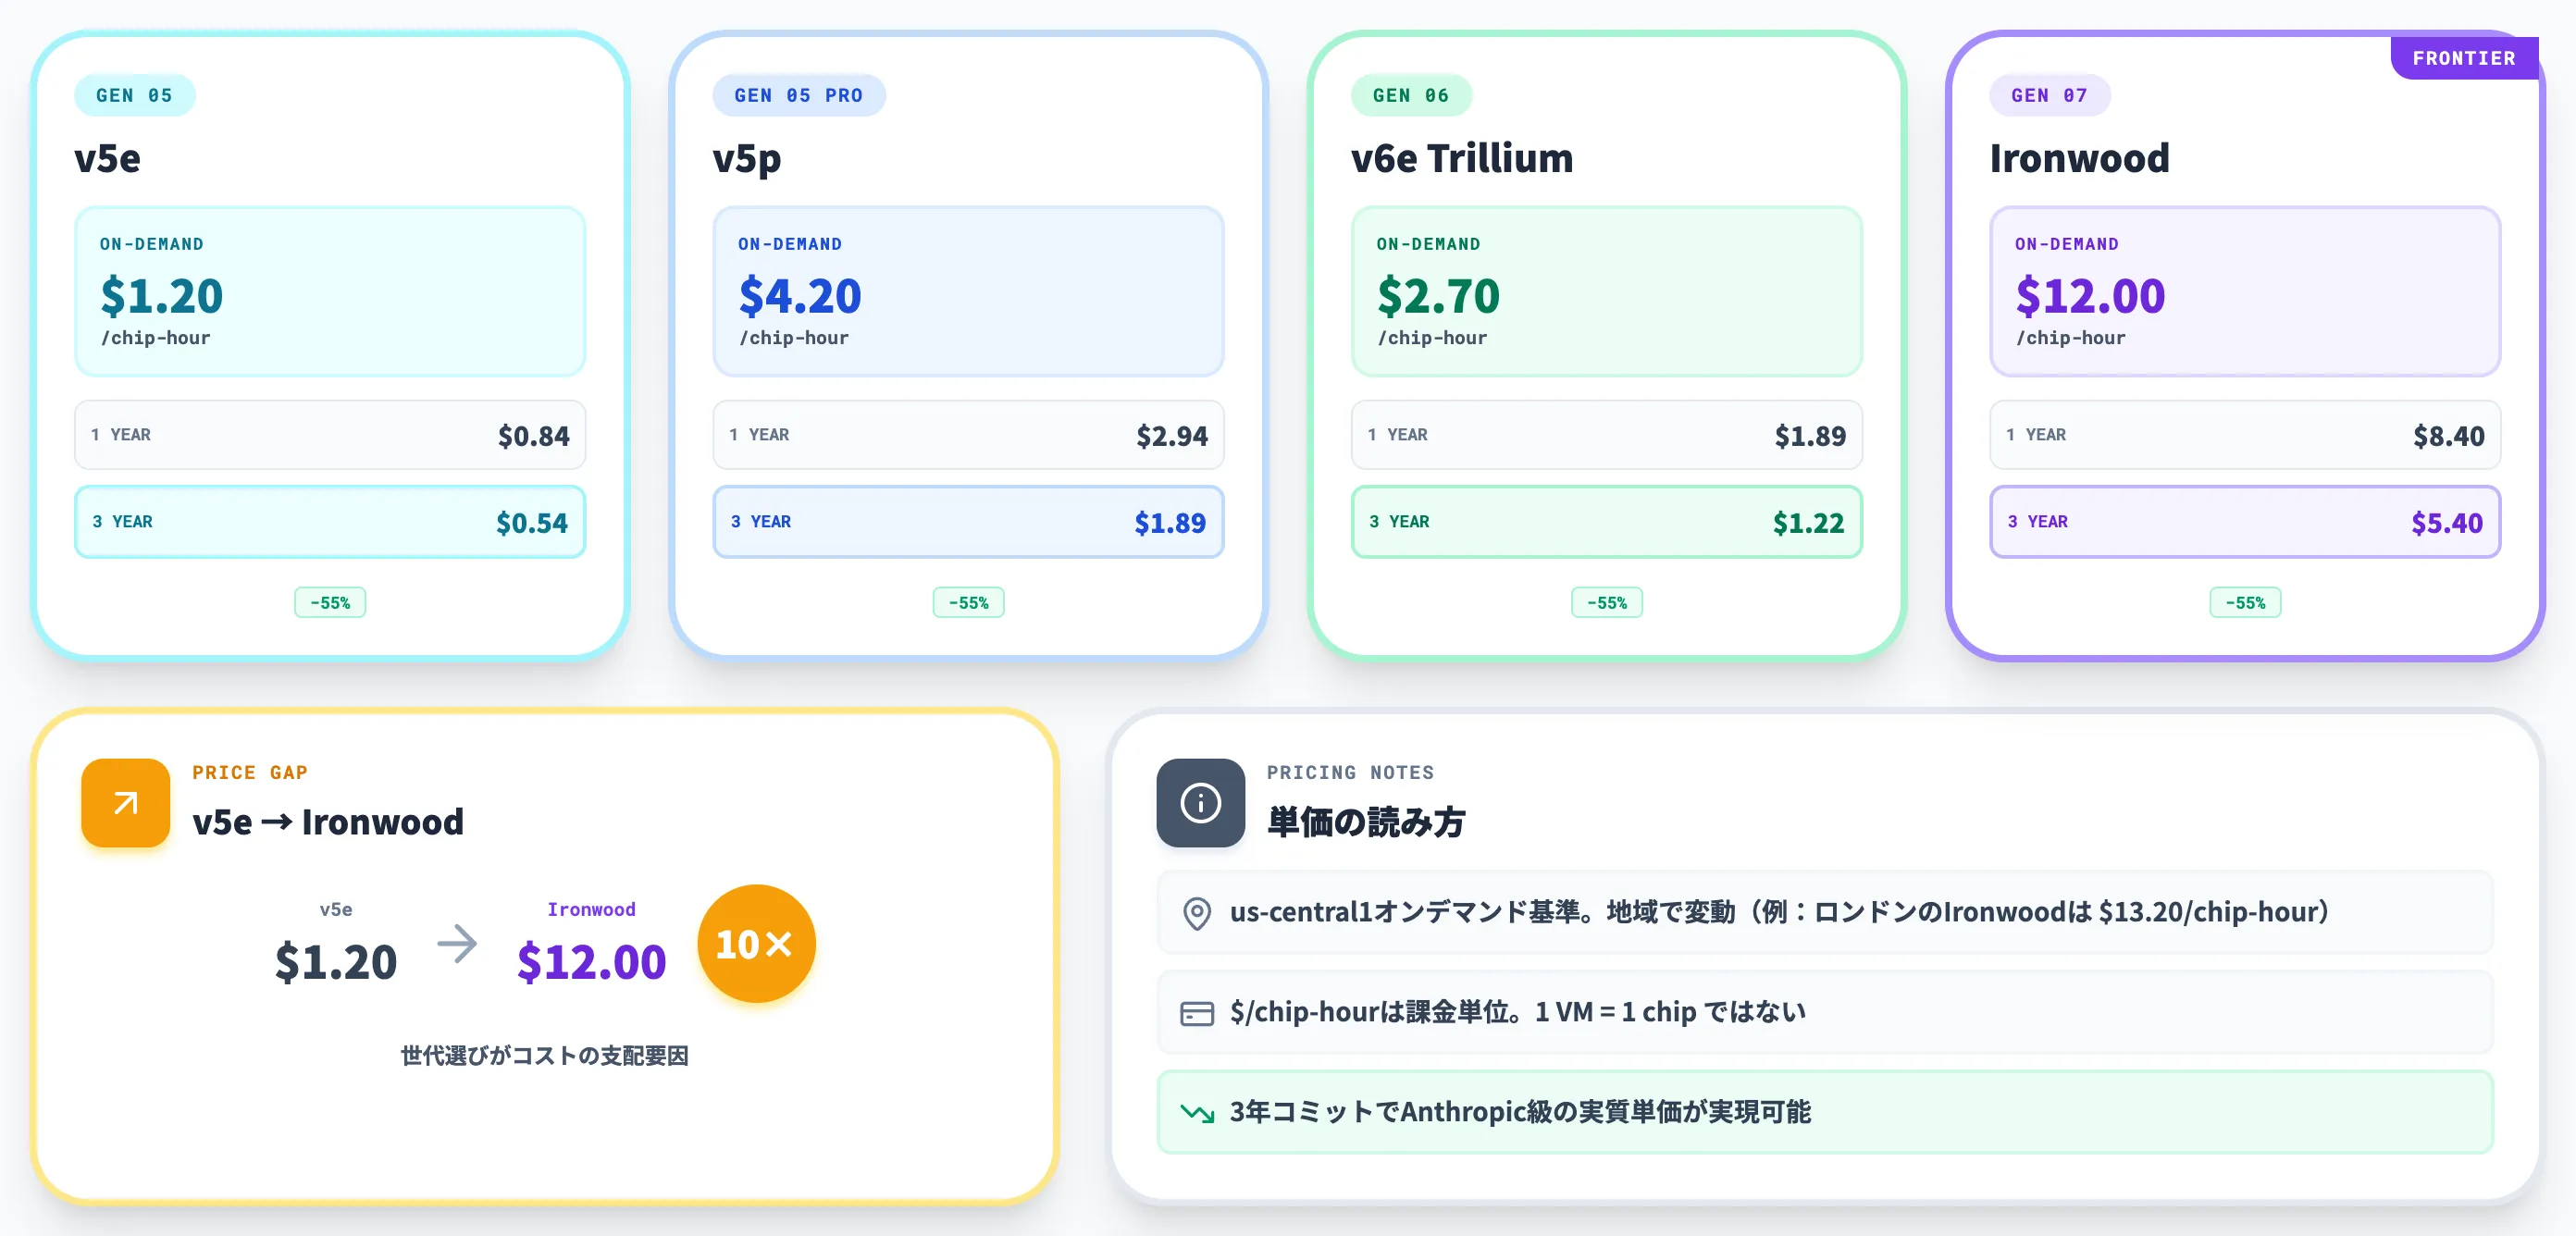
TPUの料金は、世代ごとのチップ時間単価×利用時間で決まります。公開されている単価は 「$/chip-hour」 で表示されますが、実際に起動するTPU VMが持つチップ数は世代・構成(スライス形状)で決まり、「1 VM = 1チップ」を意味するものではありません。
世代別のオンデマンド単価
2026年11月時点の米国リージョン(us-central1など)のオンデマンド単価は、Google Cloud公式Cloud TPU pricing の定義に基づき次のとおりです。
地域によって単価は変動し、Ironwood(v7)はたとえばロンドンでは $13.20/chip-hourが掲載されています。
| 世代 | オンデマンド単価($/chip-hour) | 1年コミット($/chip-hour) | 3年コミット($/chip-hour) |
|---|---|---|---|
| v5e | $1.20 | $0.84 | $0.54 |
| v5p | $4.20 | $2.94 | $1.89 |
| v6e(Trillium) | $2.70 | $1.89 | $1.22 |
| Ironwood(v7) | $12.00 | $8.40 | $5.40 |
単価表から分かる実務的なポイントは、世代が変わると単価も1桁変動するという点です。
v5eとIronwoodでは10倍の差があり、「どの世代を選ぶか」そのものがコストの支配要因になります。性能1 FLOPSあたりに換算するとIronwoodの単価は決して高くないため、モデル規模とスループット要件で世代を選ぶことが実務の第一歩です。
コミット割引は現行の主要世代で公開されており、3年コミットを選ぶとv5eで $0.54/chip-hour(割引率55%)、Ironwoodで $5.40/chip-hour(同55%)まで下がります。Google Cloud Committed Use Discounts による長期契約が、Anthropicのような大規模ユーザーの実質単価を支える仕組みです。
購入経路と選び方
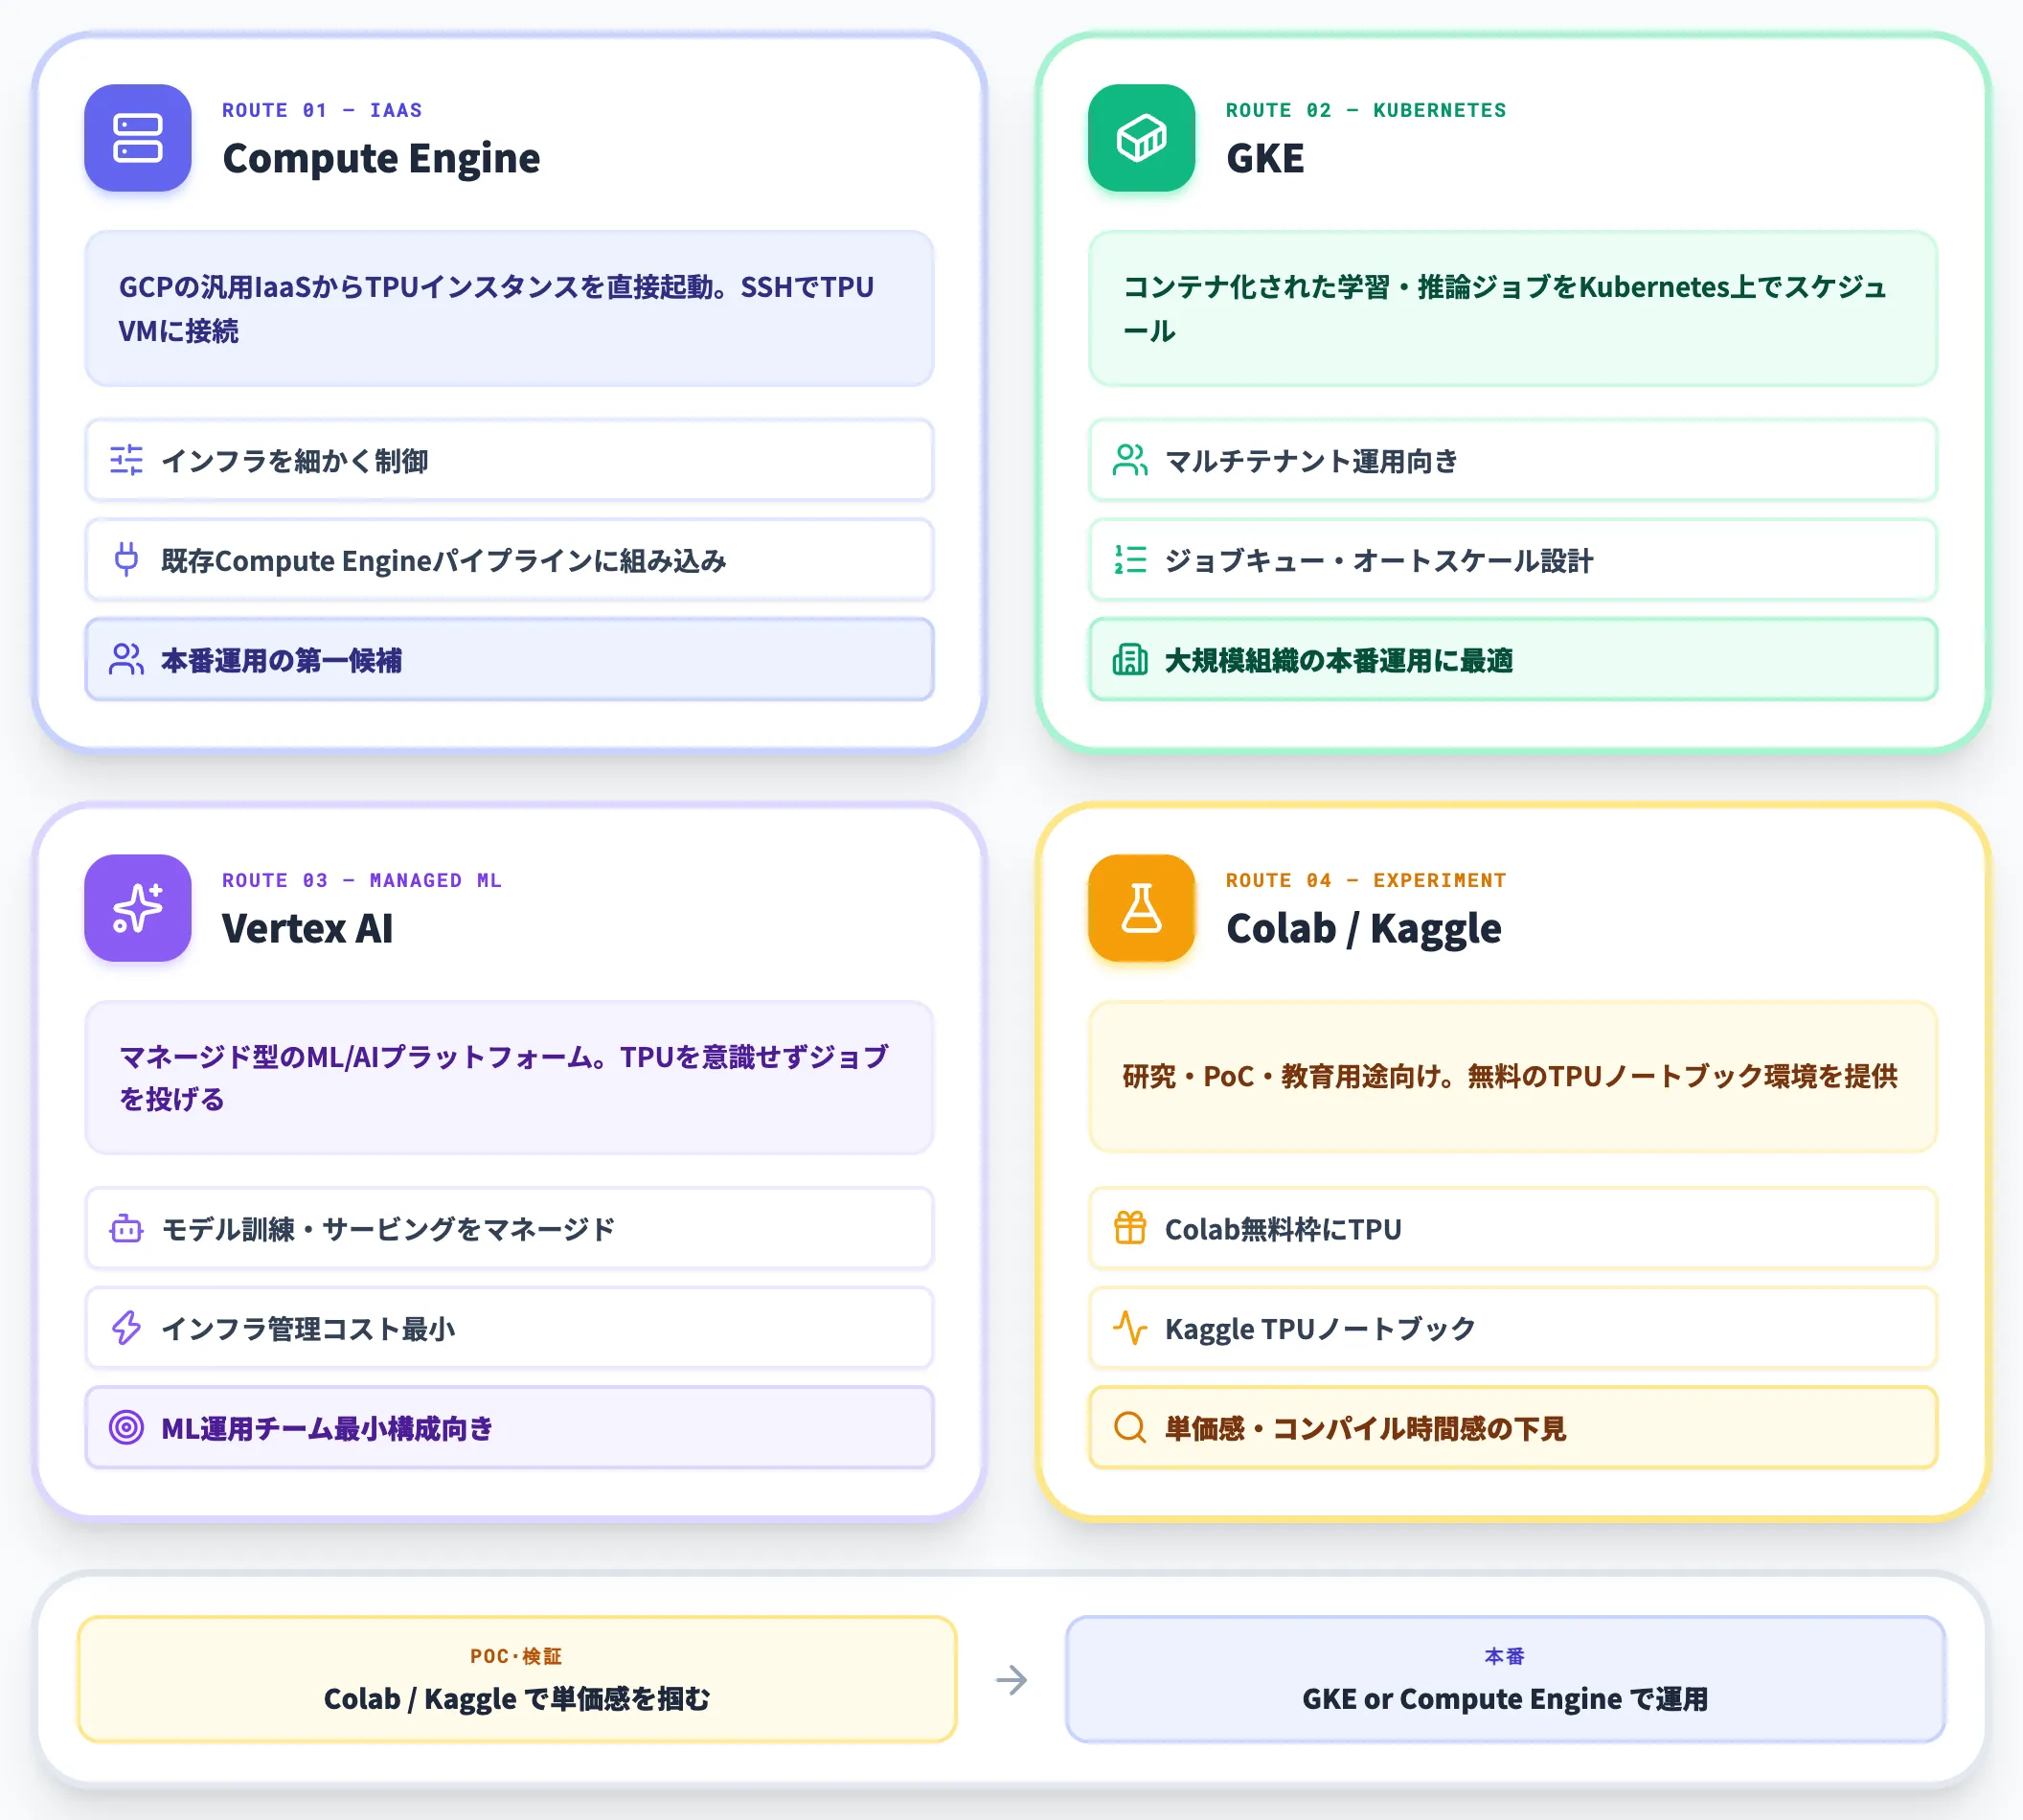
Cloud TPUの利用経路は、ワークロードと運用スタイルに応じて次の4系統から選びます。
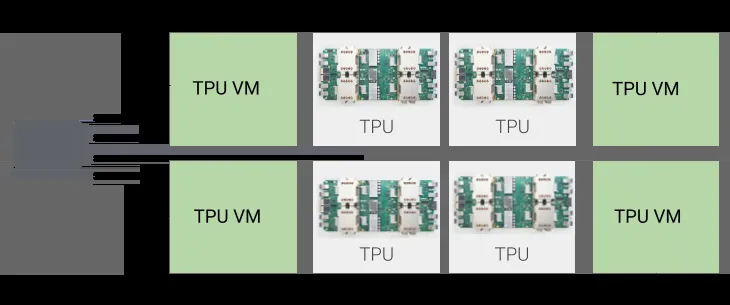
Cloud TPUのTPU VMアーキテクチャ:手元からSSHでTPU VMに接続する(出典:Google Cloud TPU Docs)
Compute EngineからTPUを使う場合の基本構造は、SSHでTPU VMに接続するマネージドVMモデルです。1 VMが持つチップ数は世代・構成で異なり(たとえばIronwoodでは1ホストに4チップ接続する構成があります)、価格表の 「$/chip-hour」 はあくまで課金の表示単位で、「1 VM = 1チップ」を意味しません。ユーザー視点ではごく普通のLinux VMとして扱え、その中から 「tpu」 などのデバイス指定でTPU演算をディスパッチする、というレイヤリングになっています。
-
Compute Engine
Google Cloudの汎用IaaSからTPUインスタンスを直接起動する経路。インフラを細かく制御したい場合や、既存のCompute Engineパイプラインに組み込みたい場合の第一候補。
-
GKE(Google Kubernetes Engine)
コンテナ化された学習・推論ジョブをKubernetes上でスケジュールする経路。マルチテナント運用や、ジョブキュー・オートスケール設計をコードで扱いたい組織に向きます。
-
Vertex AI
マネージド型のML/AIプラットフォーム。モデル訓練・サービングをマネージドで回したい場合に、TPU利用を意識せずジョブを投げられます。
-
Colab / Kaggle
研究・PoC・教育用途向けの経路。通常のGoogle Colabには無料で使えるTPU枠があり(提供されるTPU世代・リソースは時期によって変動)、Kaggleも無料のTPUノートブック環境を提供しています。小規模な試用にはこの経路が低摩擦です。
本番運用はGKE or Compute Engineが実務の定番で、PoCや性能評価の段階ではColabやKaggleで試して単価感・コンパイル時間感を掴む流れが現実的です。
TPUの活用事例——Google自社、Anthropic、Midjourney、Salesforce
TPUの実採用は、2026年に入って急速に広がっています。Google自社利用に加えて、外部企業の大規模採用がフロンティアAI各社から相次いで発表されたのが直近1年の大きな変化です。
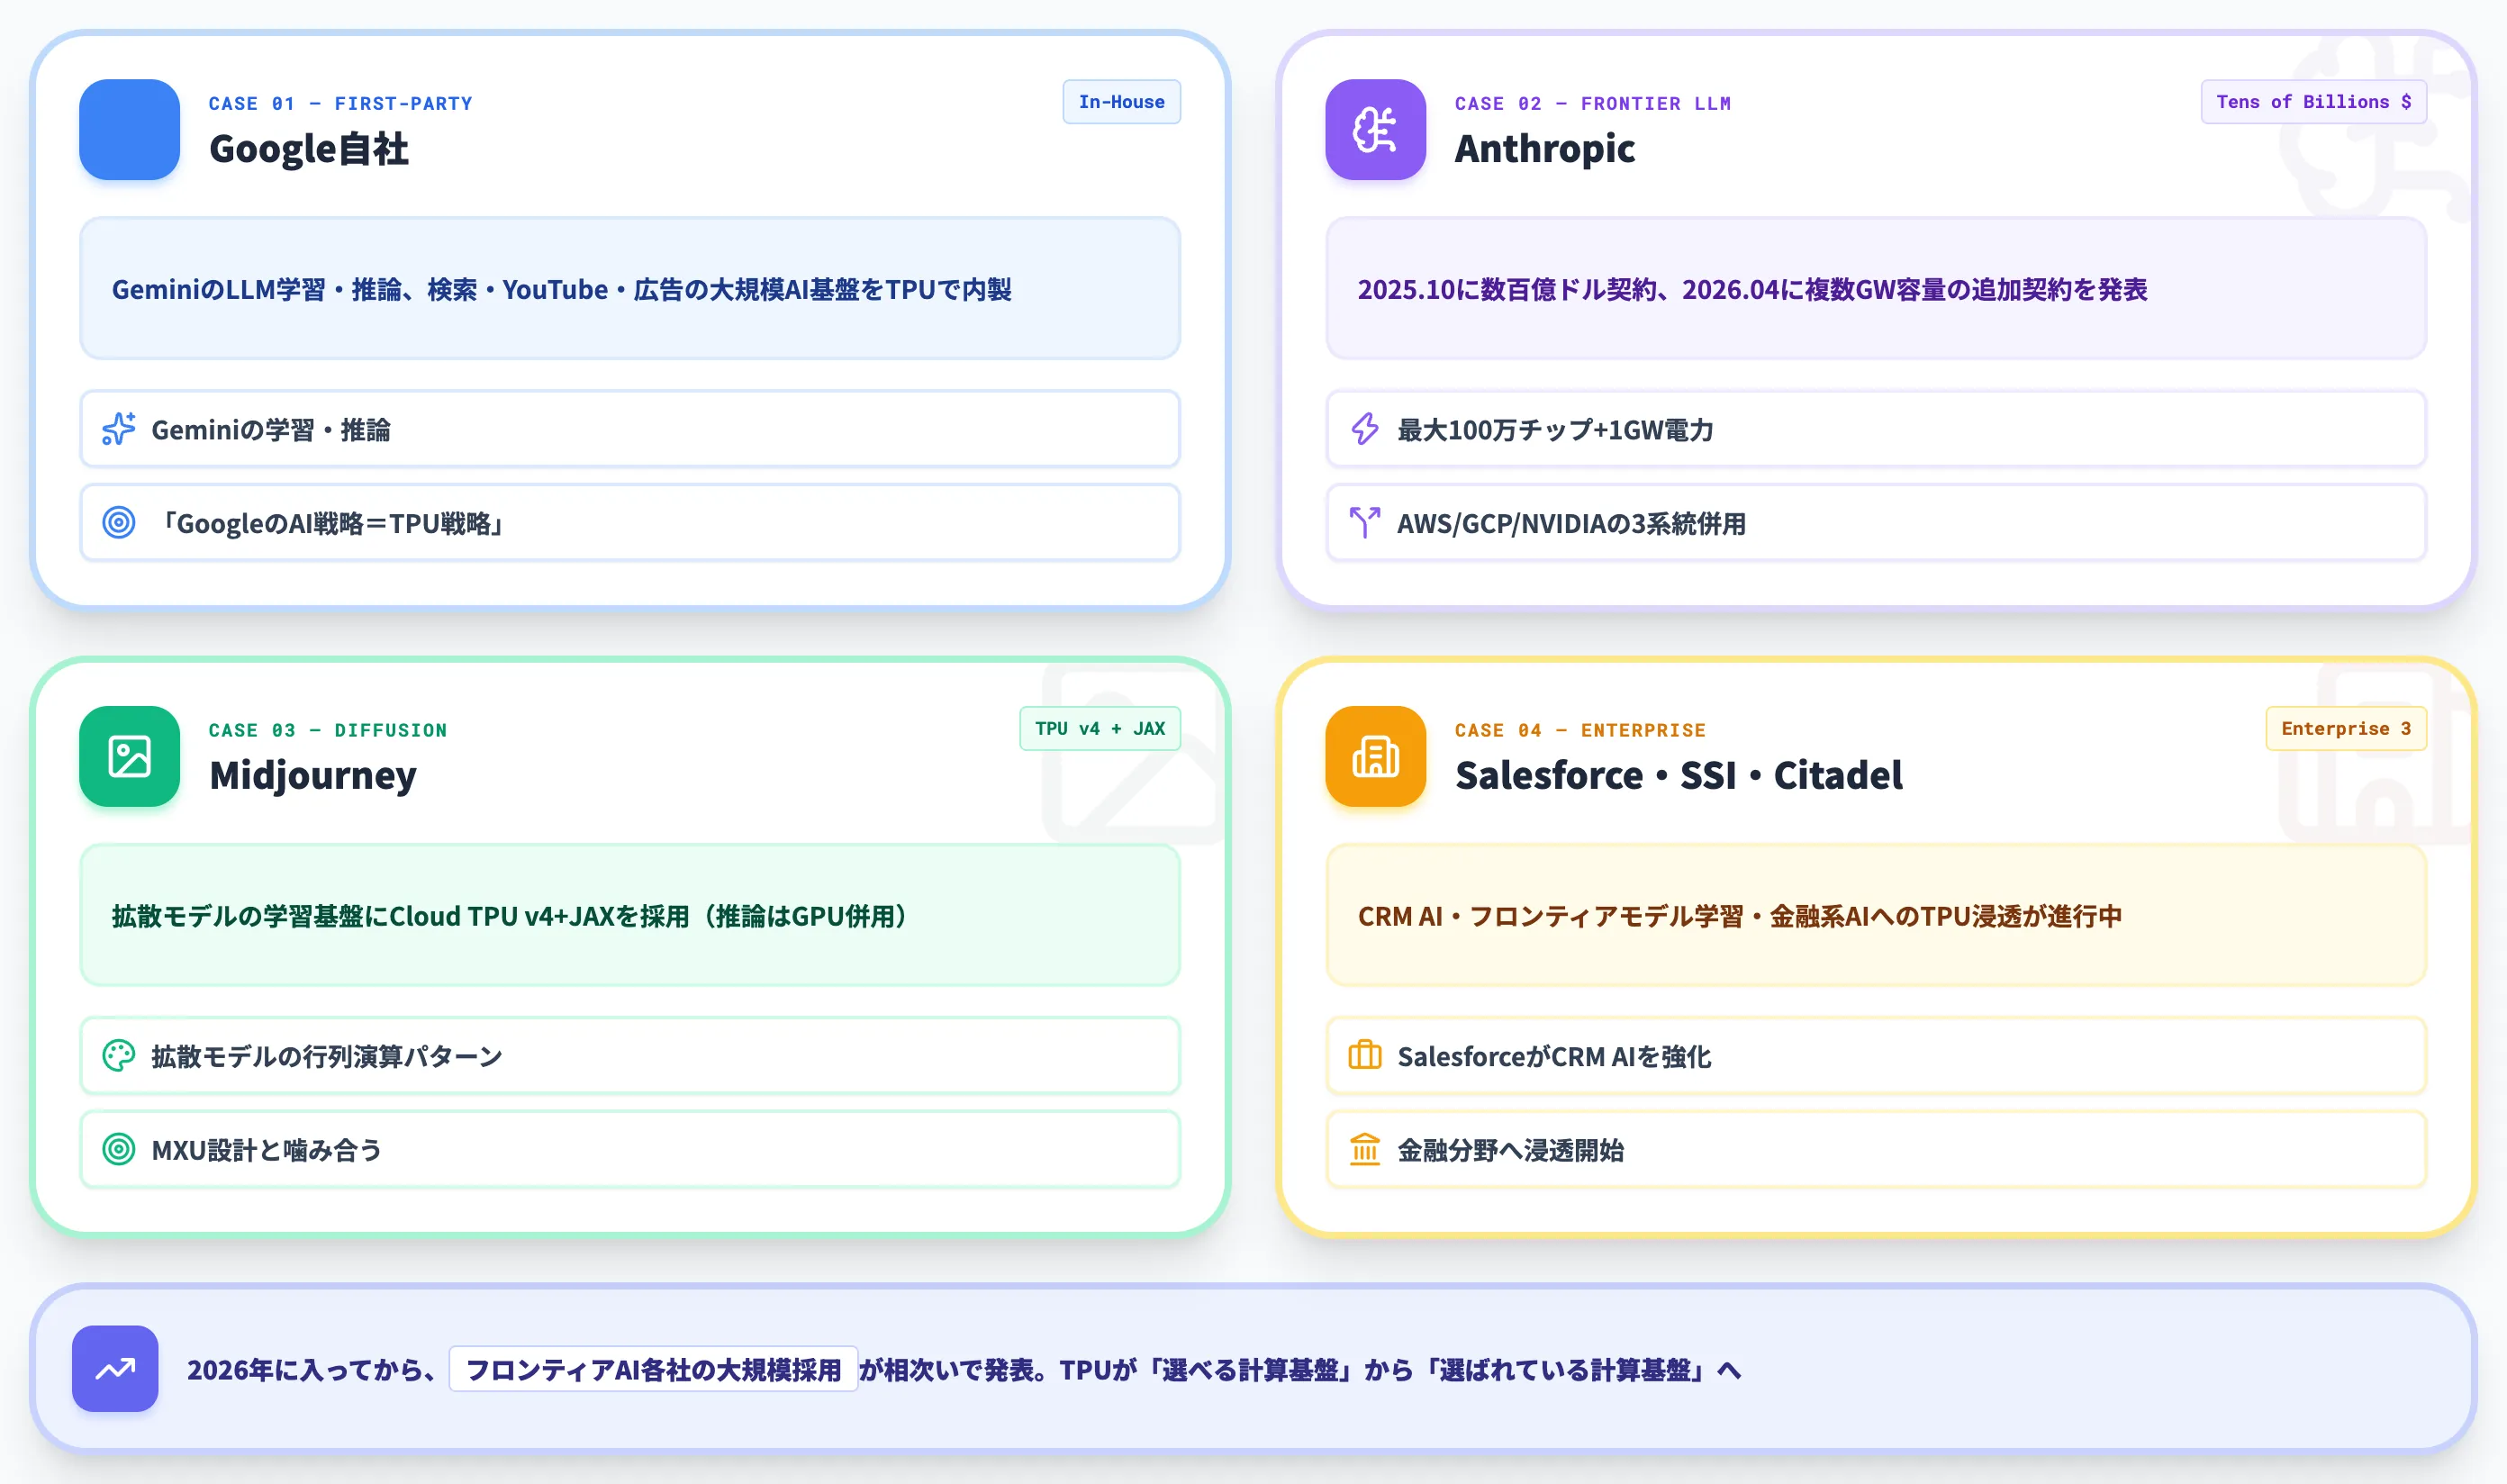
Google自社——Gemini・検索・YouTube・広告の計算基盤
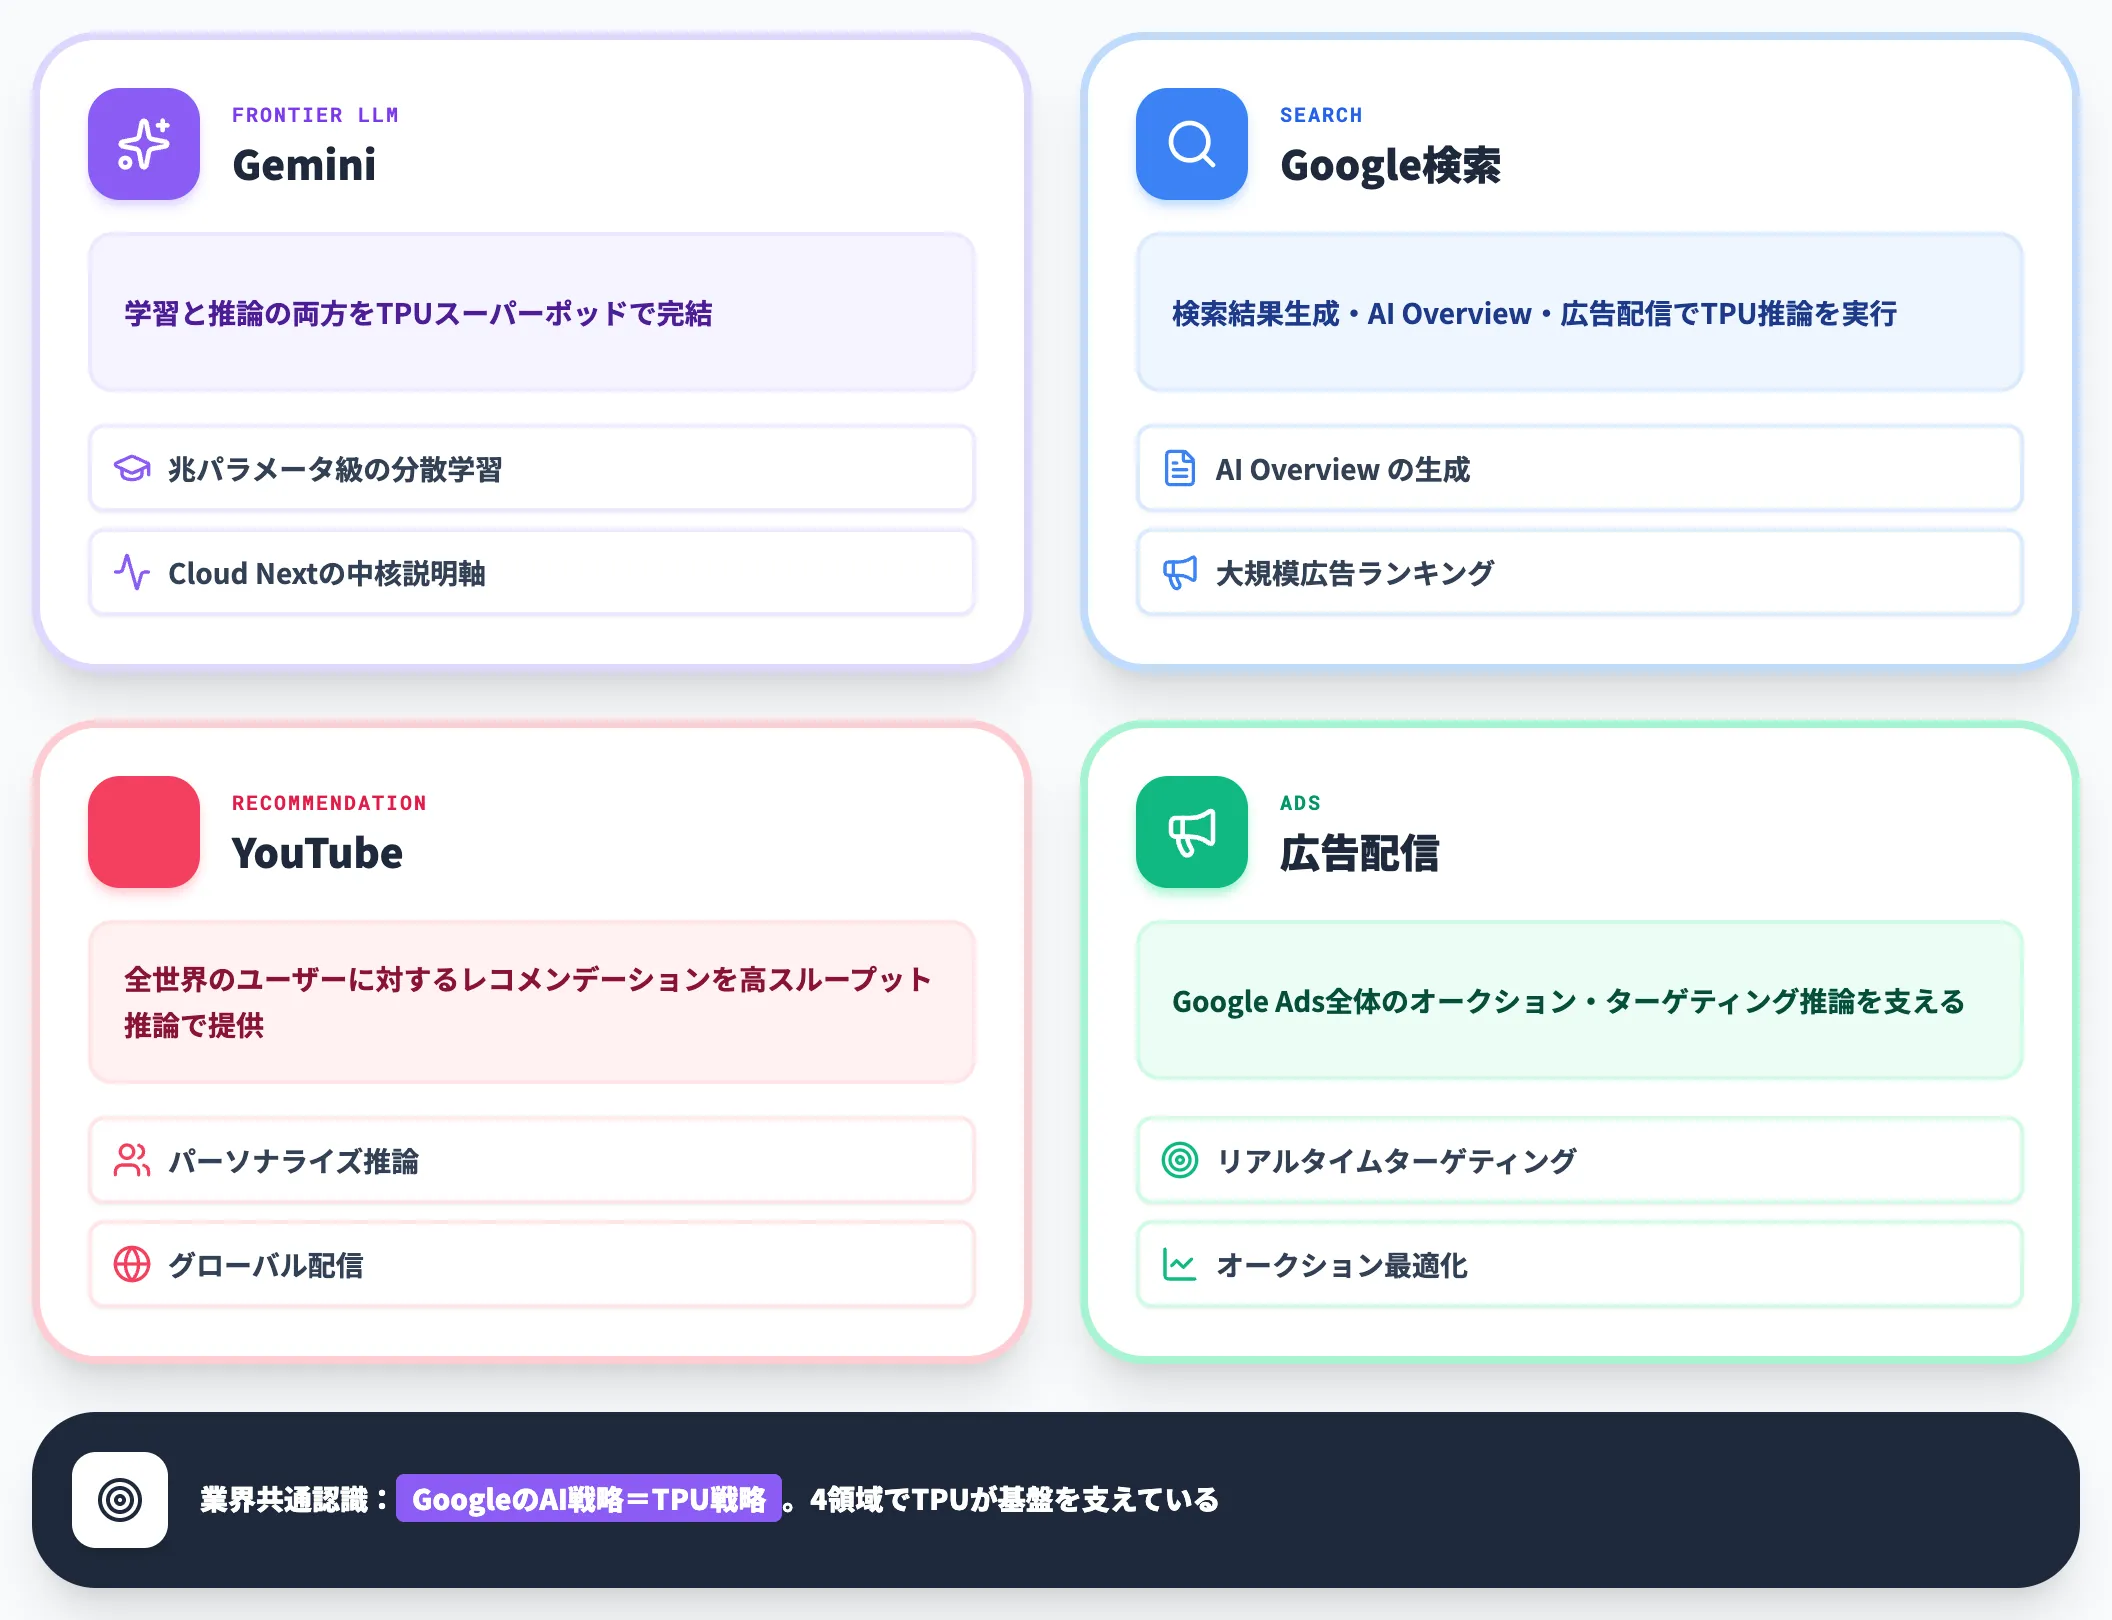
Googleは自社のフロンティアLLMGeminiの学習と推論、検索結果生成、YouTubeのレコメンデーション、広告配信などの大規模AI基盤を、TPUで内製しています。
Google Cloud Next 2026の基調講演でも、Geminiの学習と提供をTPUが支える構造は中核的な説明軸として扱われており、「GoogleのAI戦略=TPU戦略」という見方が業界共通の認識になっています。
Anthropic——数百億ドル規模の契約と複数GWの追加容量
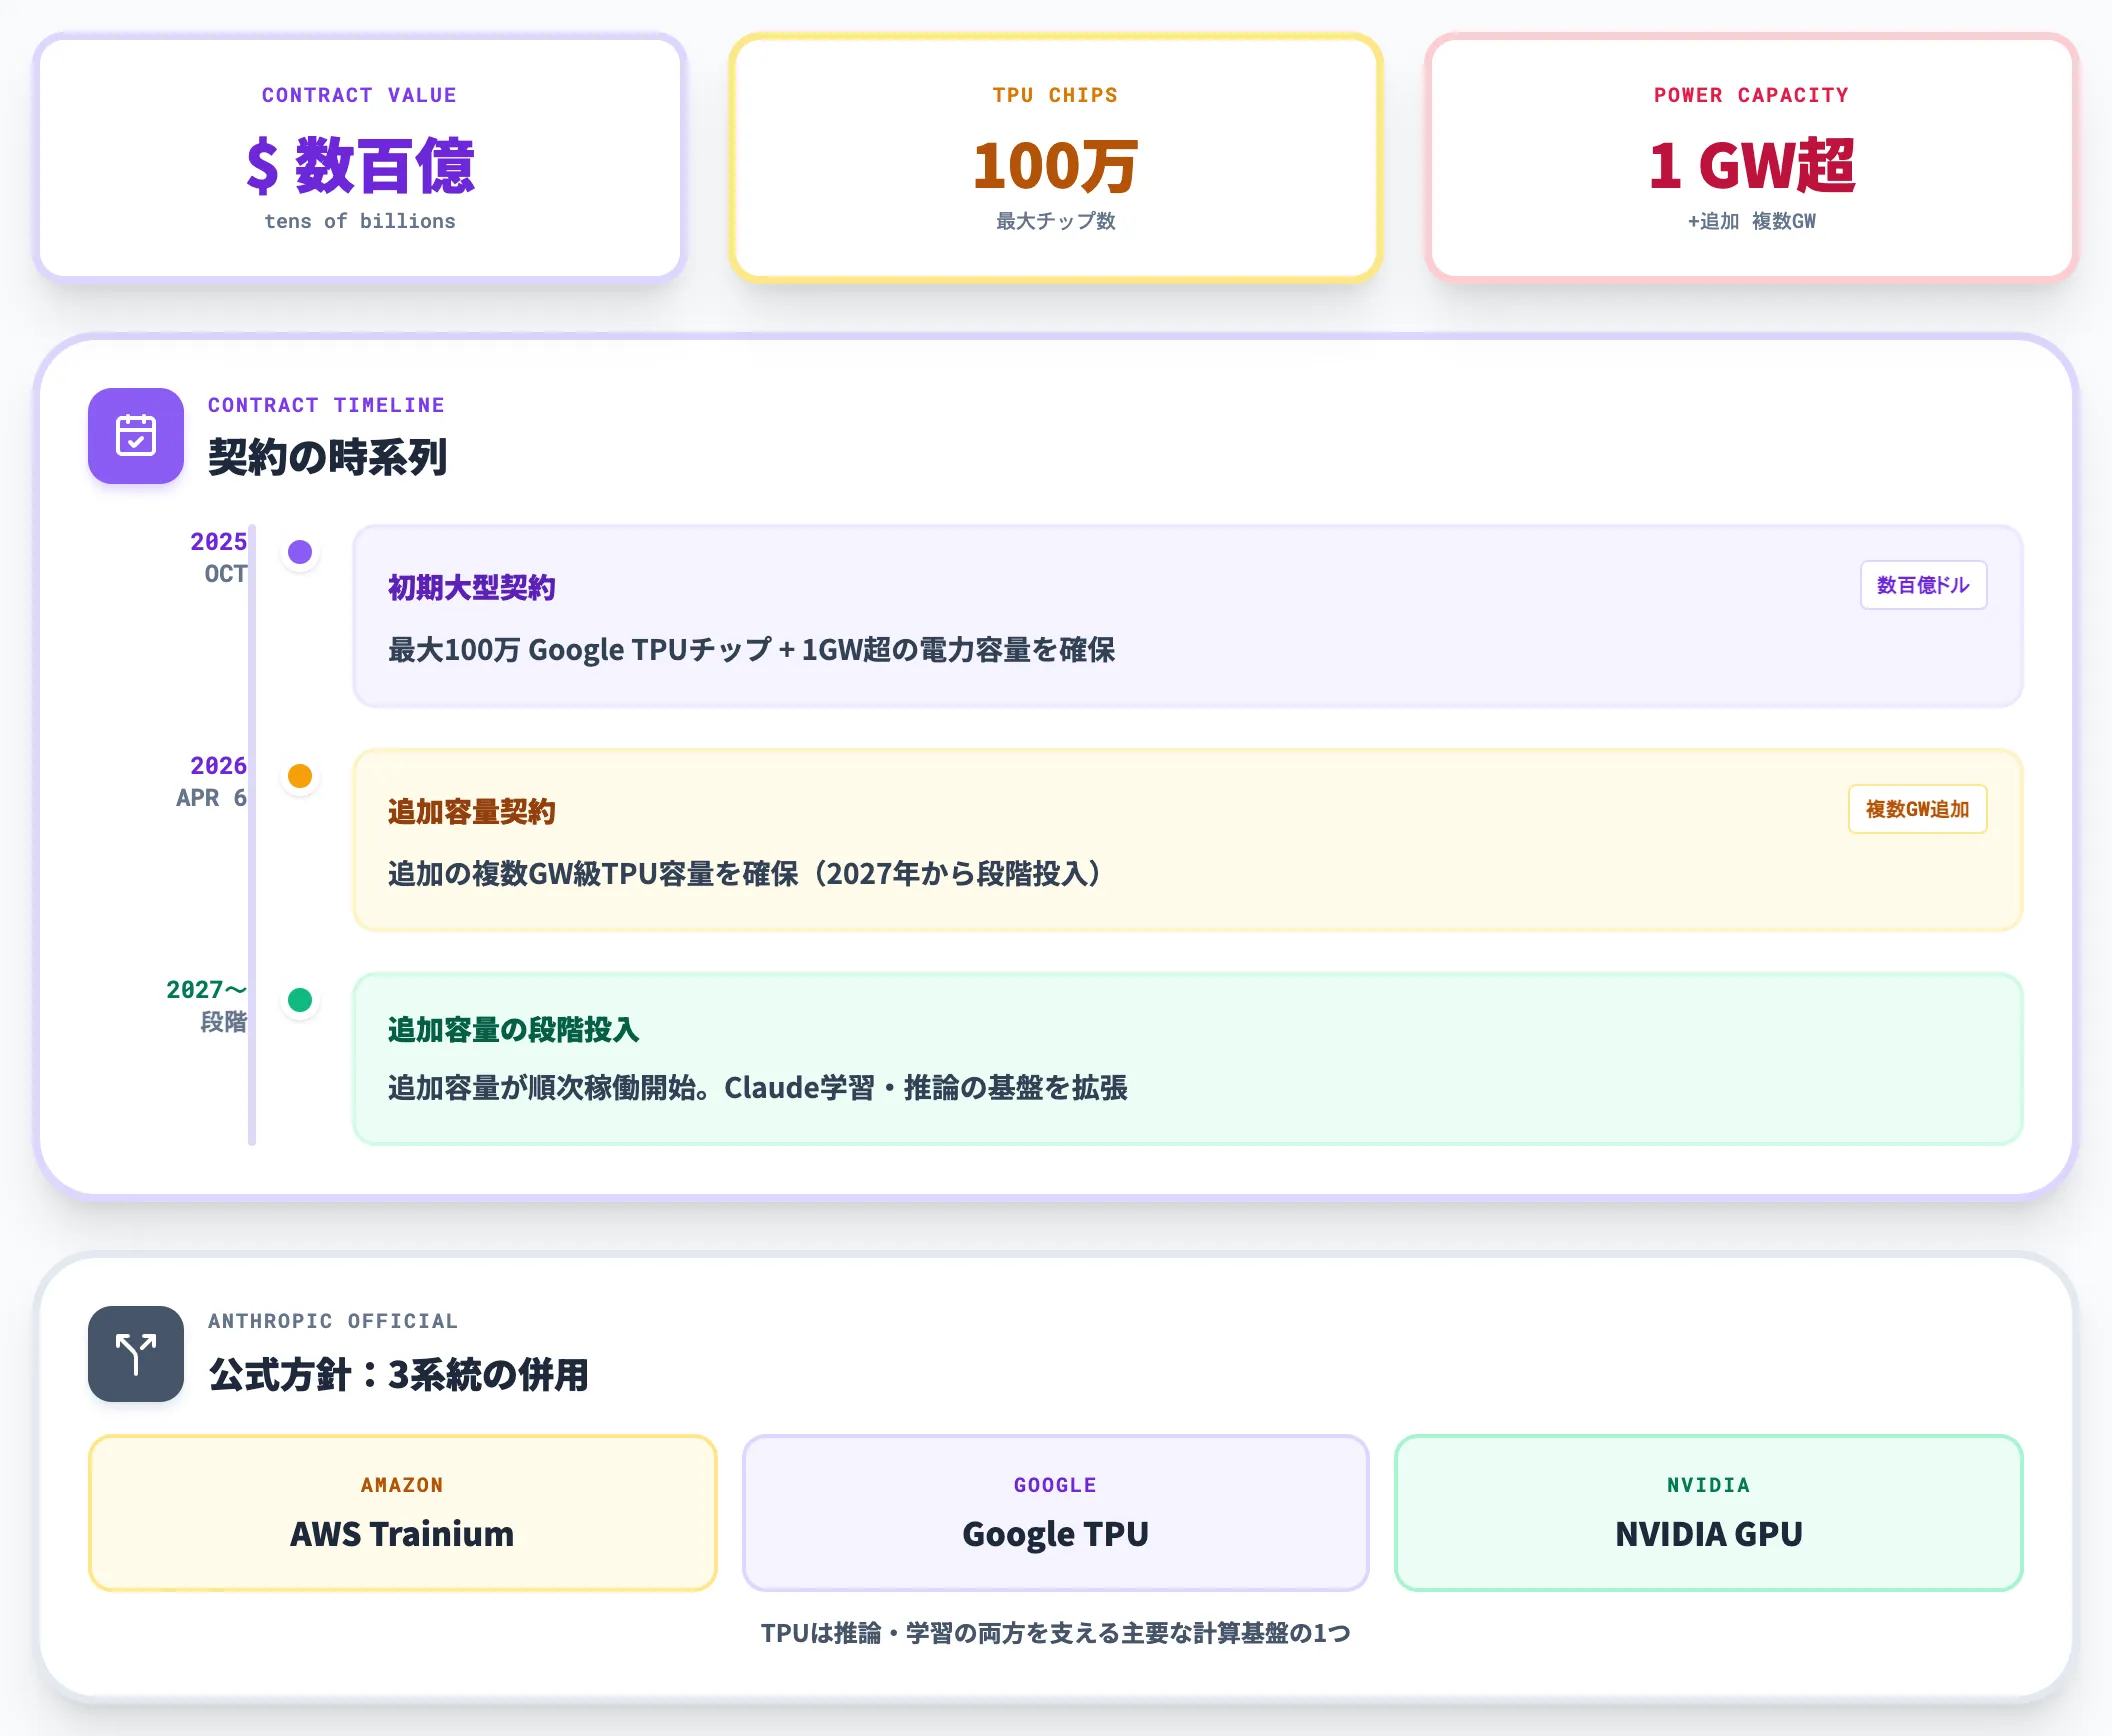
Anthropicは2025年10月に、最大100万のGoogle TPUチップと1GW超の電力容量を確保する「数百億ドル規模(tens of billions of dollars)」の契約をGoogle Cloudとの間で締結しました。
2026年4月6日には追加の複数GW級TPU容量を確保する契約(2027年から段階的に投入予定)が追加で発表されています。
Anthropicは公式に、AWS Trainium・Google TPU・NVIDIA GPUの3系統を併用する方針を表明しており、TPUはその中で推論・学習の両方を支える主要な計算基盤の1つとして位置づけられています。
Midjourneyなどの画像生成サービス
画像生成サービスのMidjourneyは、公式発表でGoogle Cloud TPU(v4 + JAX)を学習基盤に採用したことを明らかにしています(推論はGoogle CloudのGPUも併用)。
拡散モデルの学習では行列演算が計算量の大半を占めるため、TPUのMXU設計と噛み合う画像生成系は、TPUが学習基盤の選択肢として浮上しやすい領域です。
Salesforce・Safe Superintelligence・Citadel Securities
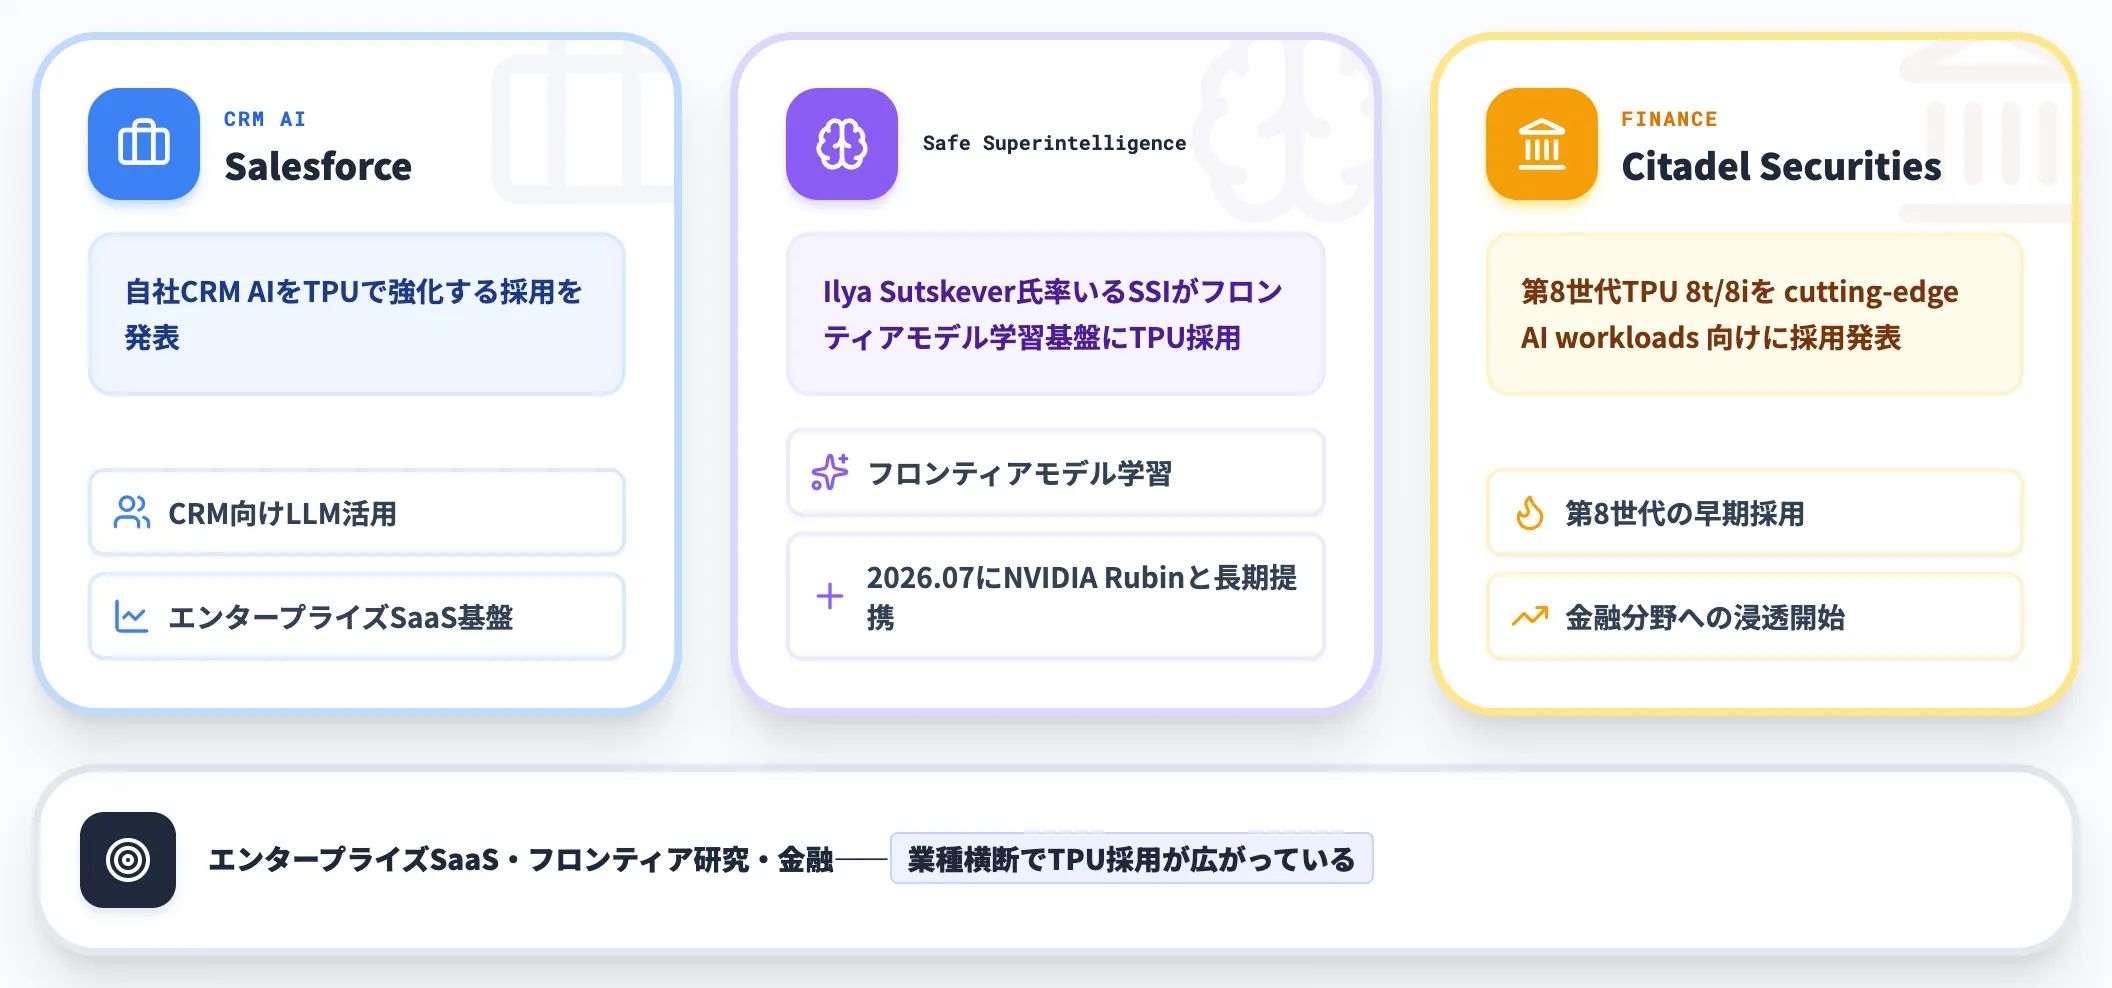
外部TPU顧客はこの3社以外にも広がっており、Salesforceは自社のCRM AIをTPUで強化、Ilya Sutskever氏が率いるSafe Superintelligence(SSI)はフロンティアモデル学習基盤としてTPUを採用してきました(2026年7月27日にはNVIDIA Vera Rubin GPUの長期戦略パートナーシップも発表されています)。
Citadel Securitiesは第8世代TPU 8t/8iを「cutting-edge AI workloads」向けに採用すると発表しており、金融分野への浸透も始まっています。
TPUの選定判断軸——どんなワークロードで刺さるか
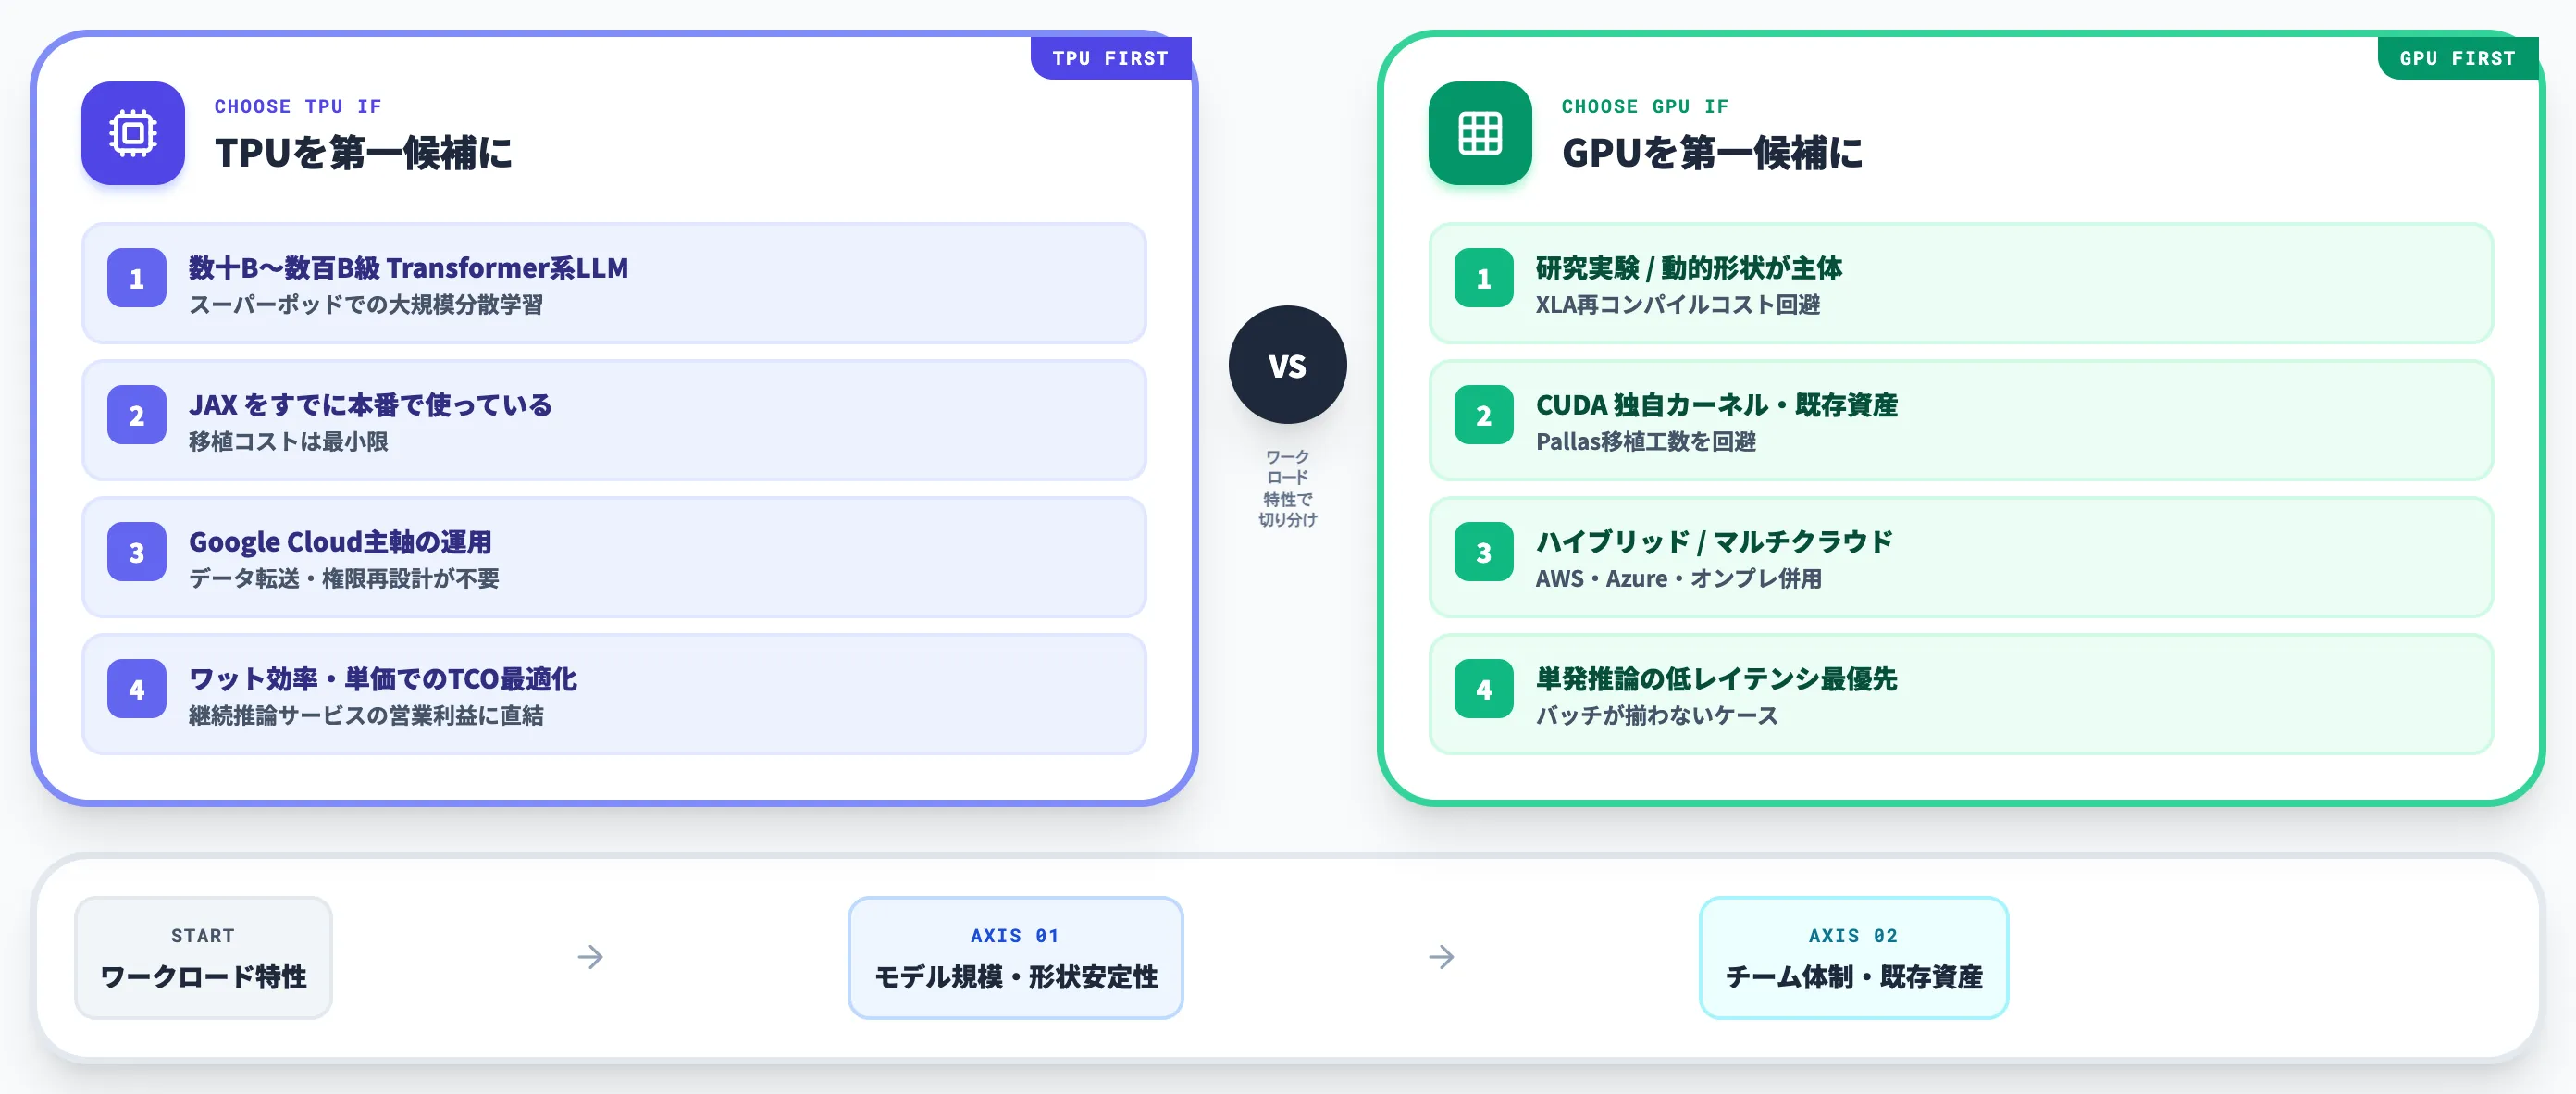
ここまでの仕組み・世代・料金・事例を踏まえると、TPUを選ぶべきか、GPUを選ぶべきかの判断はワークロードとチーム体制の2軸で切り分けられるようになります。
TPUを第一候補にすべき条件
-
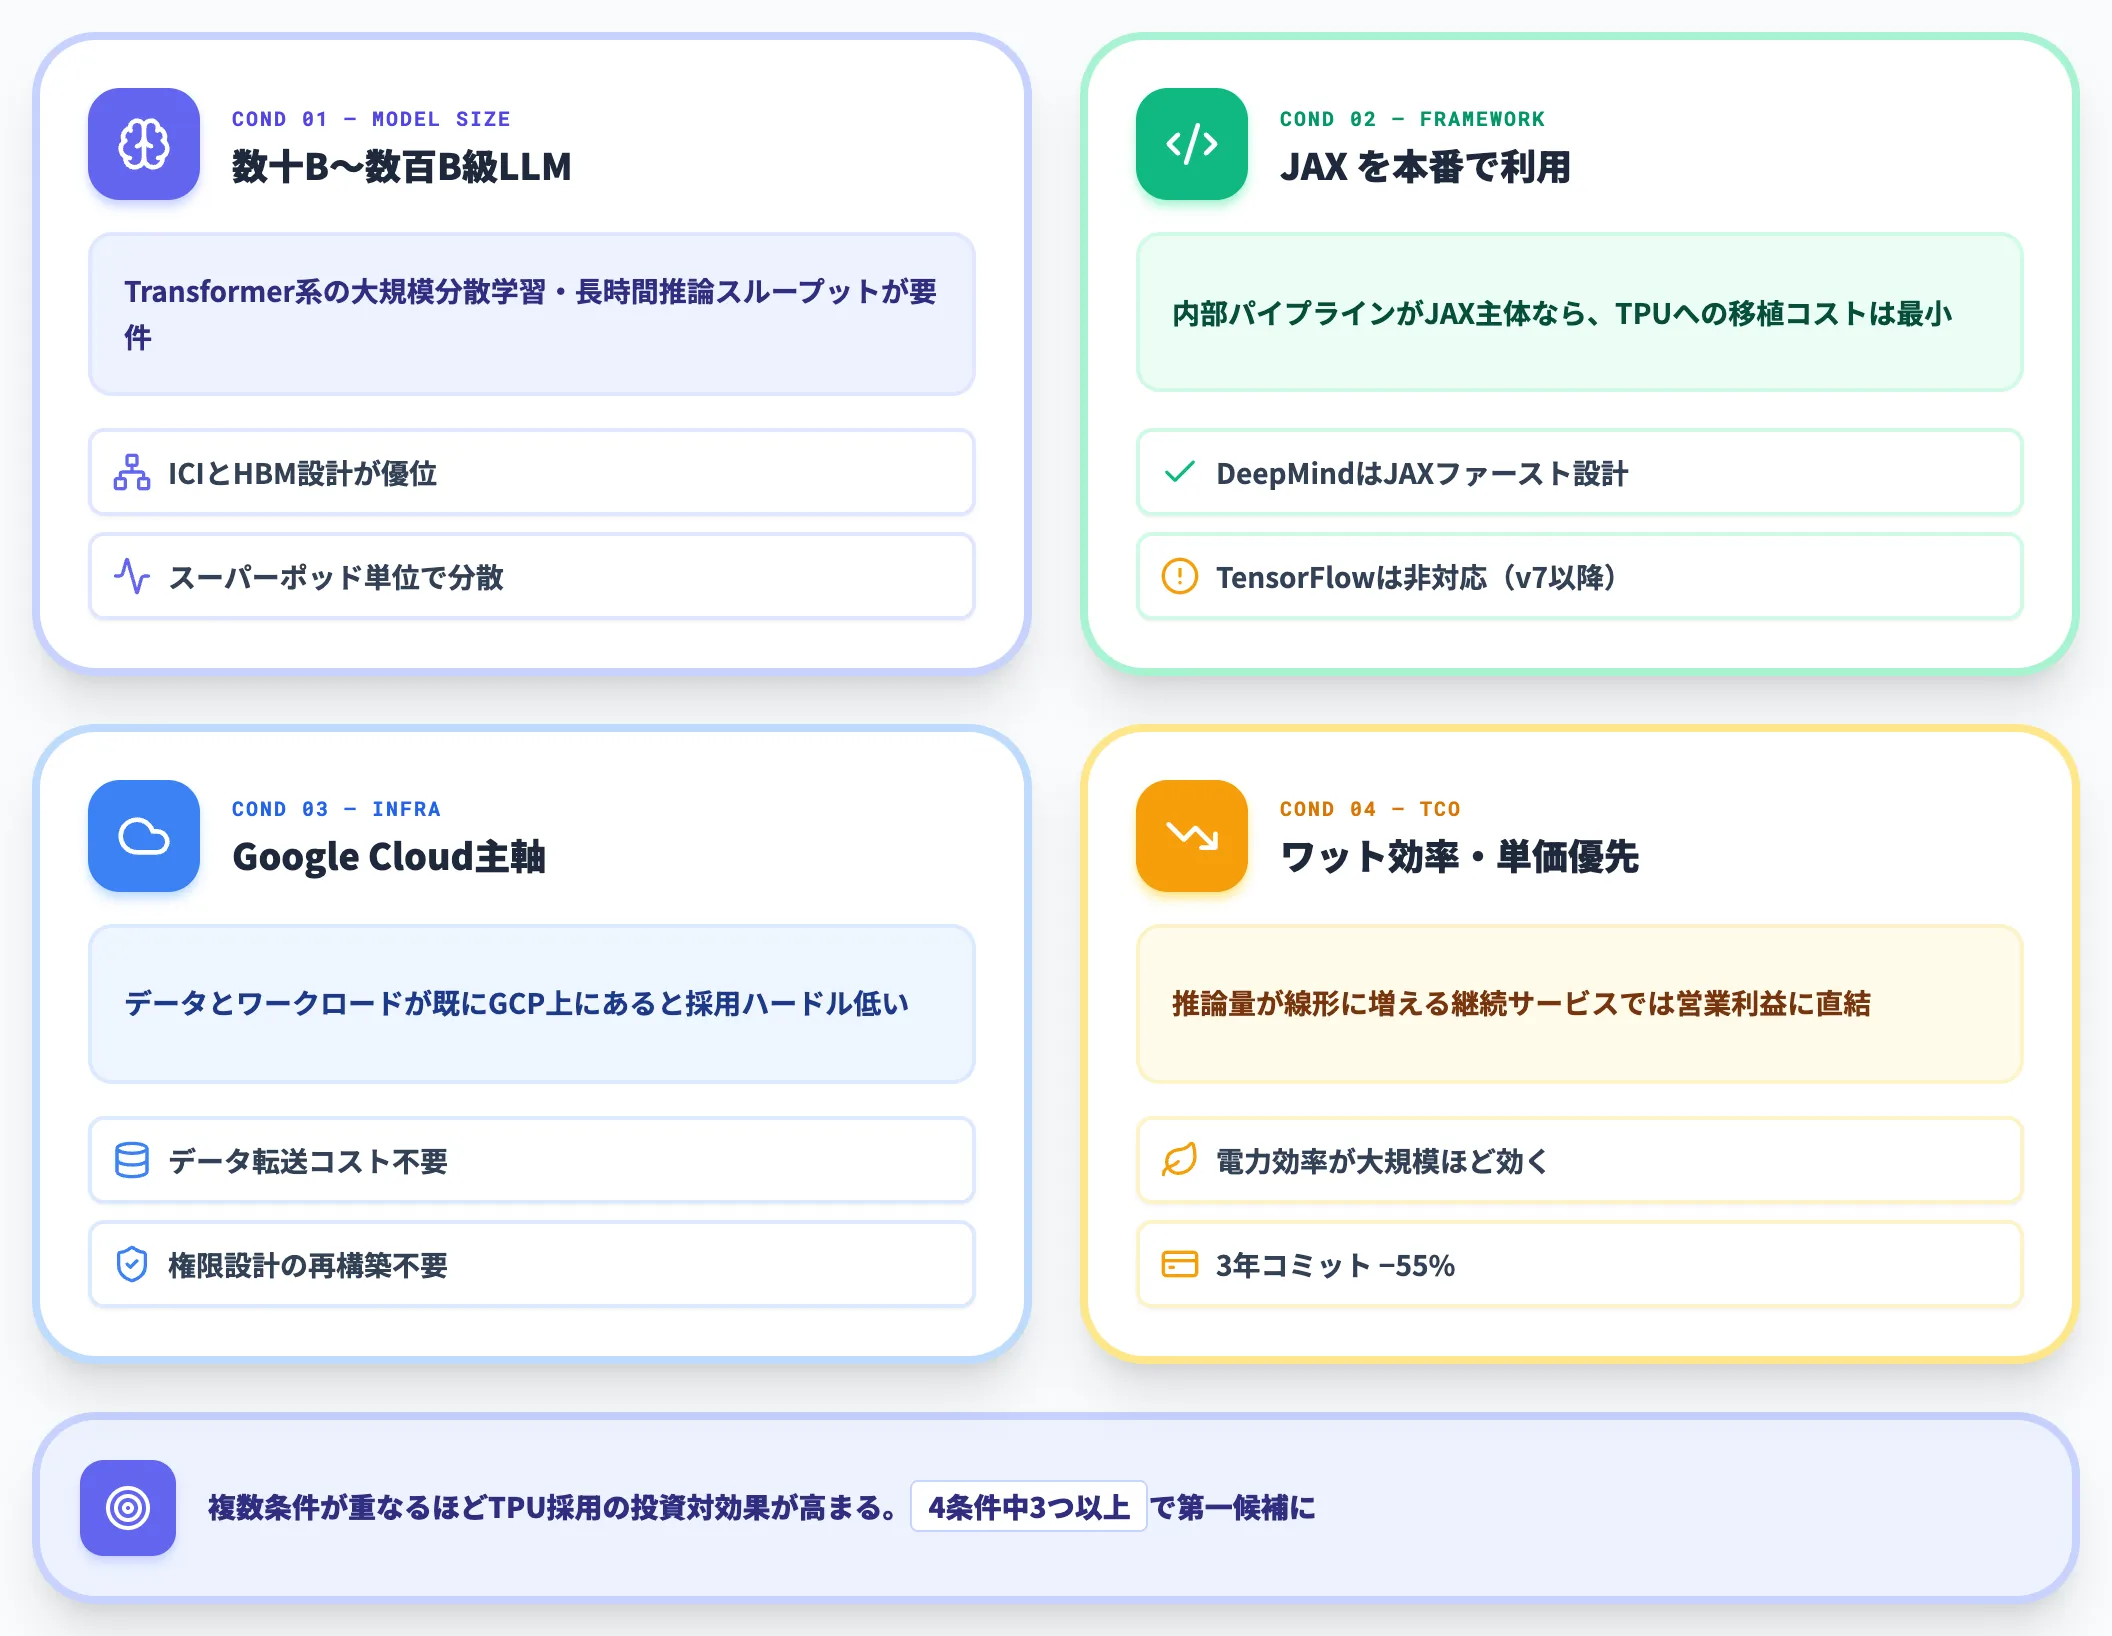
モデル規模が数十B〜数百B以上のTransformer系LLMを学習・推論する
スーパーポッド単位での大規模分散学習、長時間の推論スループットが要件になるほど、TPUのICIとHBM設計の優位が効いてきます。
-
JAXをすでに本番で使っている
内部パイプラインがJAXで組まれているなら、TPUへの移植コストは最小限で済みます。
DeepMindのようにJAXファーストで設計されているチームは、TPU以外の選択肢を取る理由があまりありません。
Ironwood(TPU7x)の公式仕様ではJAXとPyTorchのみがサポート対象(TensorFlow非対応)となっており、TensorFlow依存のパイプラインはIronwood以降の世代採用時にJAX/PyTorchへの移植計画が必要です(旧世代向けのCloud TPU APIランタイム等では対応経路が残っていますが、利用経路ごとに対応状況が分かれます)。
-
Google Cloudを主クラウドとして使っている
データとワークロードがすでにGoogle Cloudに乗っている場合、データ転送コストと権限設計の再構築が不要なため、TPU採用のハードルが大きく下がります。
-
ワット当たり性能・単価でのTCO最適化が最優先
Midjourneyのように推論量が線形で増える継続サービスでは、TPUの電力効率と大規模コミット割引が営業利益に直結します。
GPUを第一候補にすべき条件
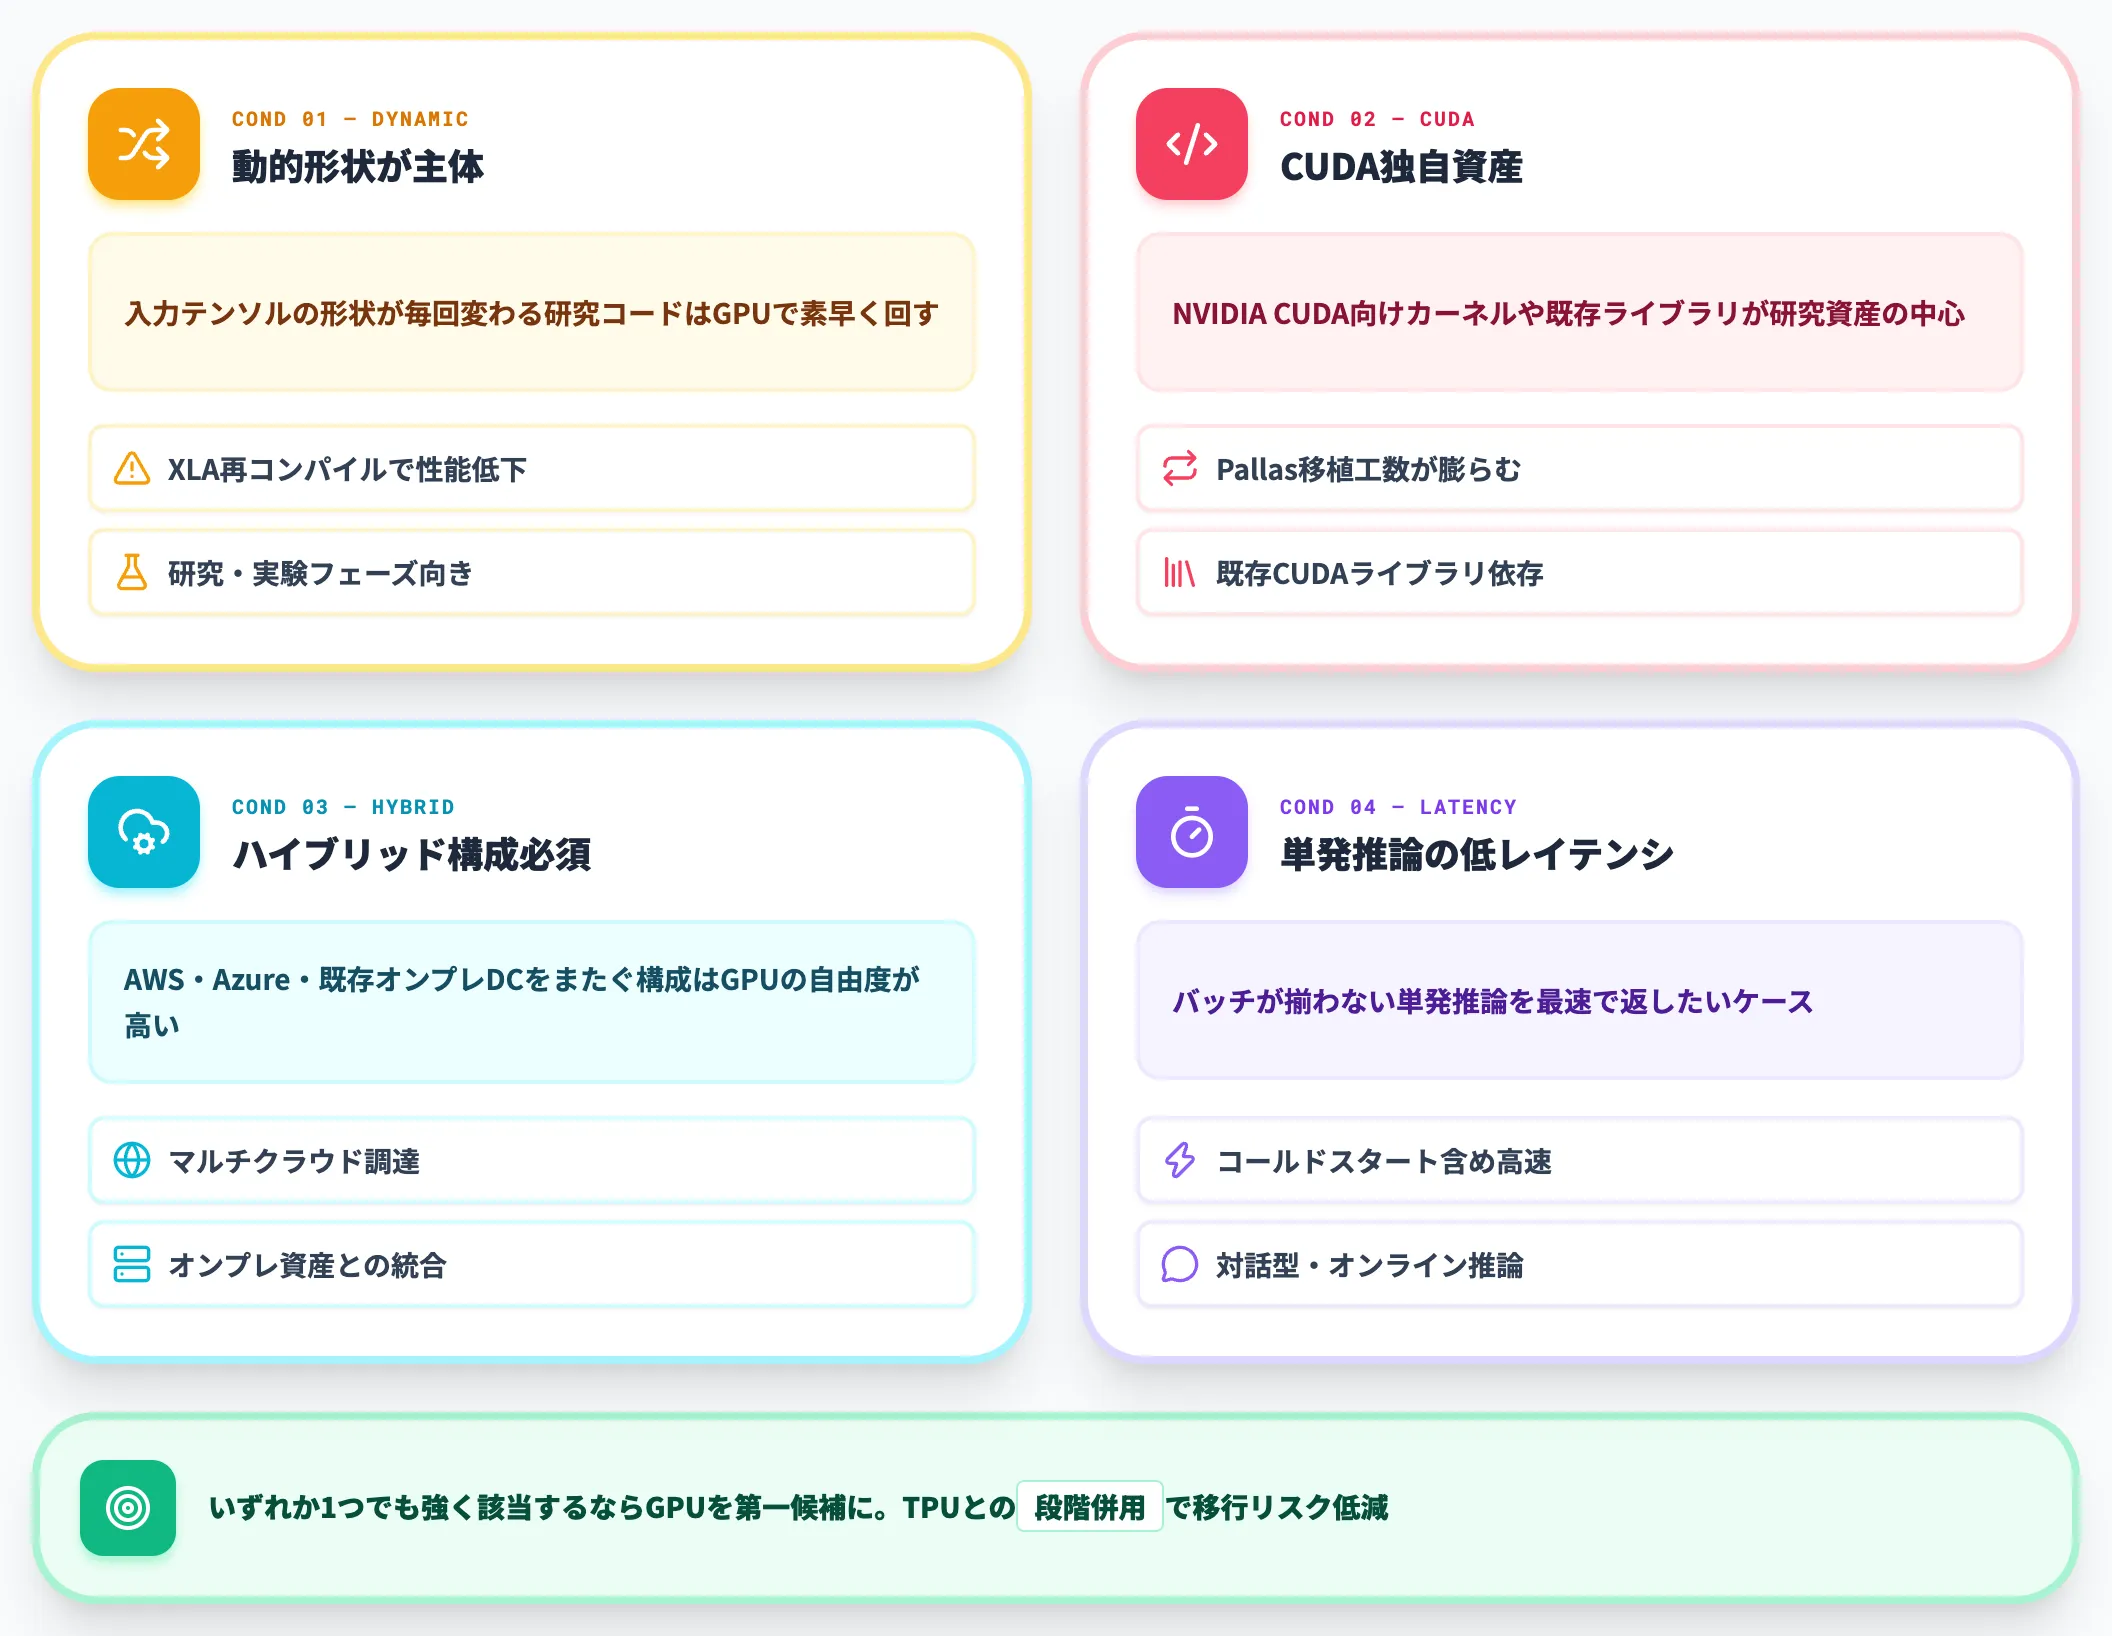
-
モデル研究・実験フェーズでshapeが動的に変わる
入力テンソルの形状が毎回変わる研究コードは、XLA再コンパイルのオーバーヘッドでTPUの性能を引き出しにくいため、GPUで素早く回したほうが現実的です。
-
CUDA独自カーネル・CUDA資産を多用している
NVIDIA CUDA向けに書かれたカーネルや既存ライブラリが研究資産の中心にある場合、Pallas(TPU向けカスタムカーネル)への移植工数が膨らみます。
-
オンプレミスを含むハイブリッド構成を必須にしたい
TPUの主な提供経路はGoogle Cloud経由で、顧客DC導入やOracle OCI経由(2027年開始予定)も段階的に広がる見込みですが、現時点でAWS・Azure・既存の自社DCをまたぐ構成では、GPUのほうが構成の自由度と調達の柔軟性が高くなります。
-
推論レイテンシを最優先し、単発リクエストを最速で返したい
バッチが揃わない単発推論では、GPUのほうがコールドスタート含め低レイテンシを実現しやすいケースがあります。
PyTorch対応——TorchTPUのOSS公開で移行コストが下がりつつある
従来、TPU対応フレームワークはTensorFlow / JAXが中心で、PyTorchユーザーはPyTorch/XLA 経由でTPUを扱う必要がありました。コードの書き換え工数と動的形状の制約が、PyTorch主体チームにとってTPU採用の実質的な障壁になっていました。
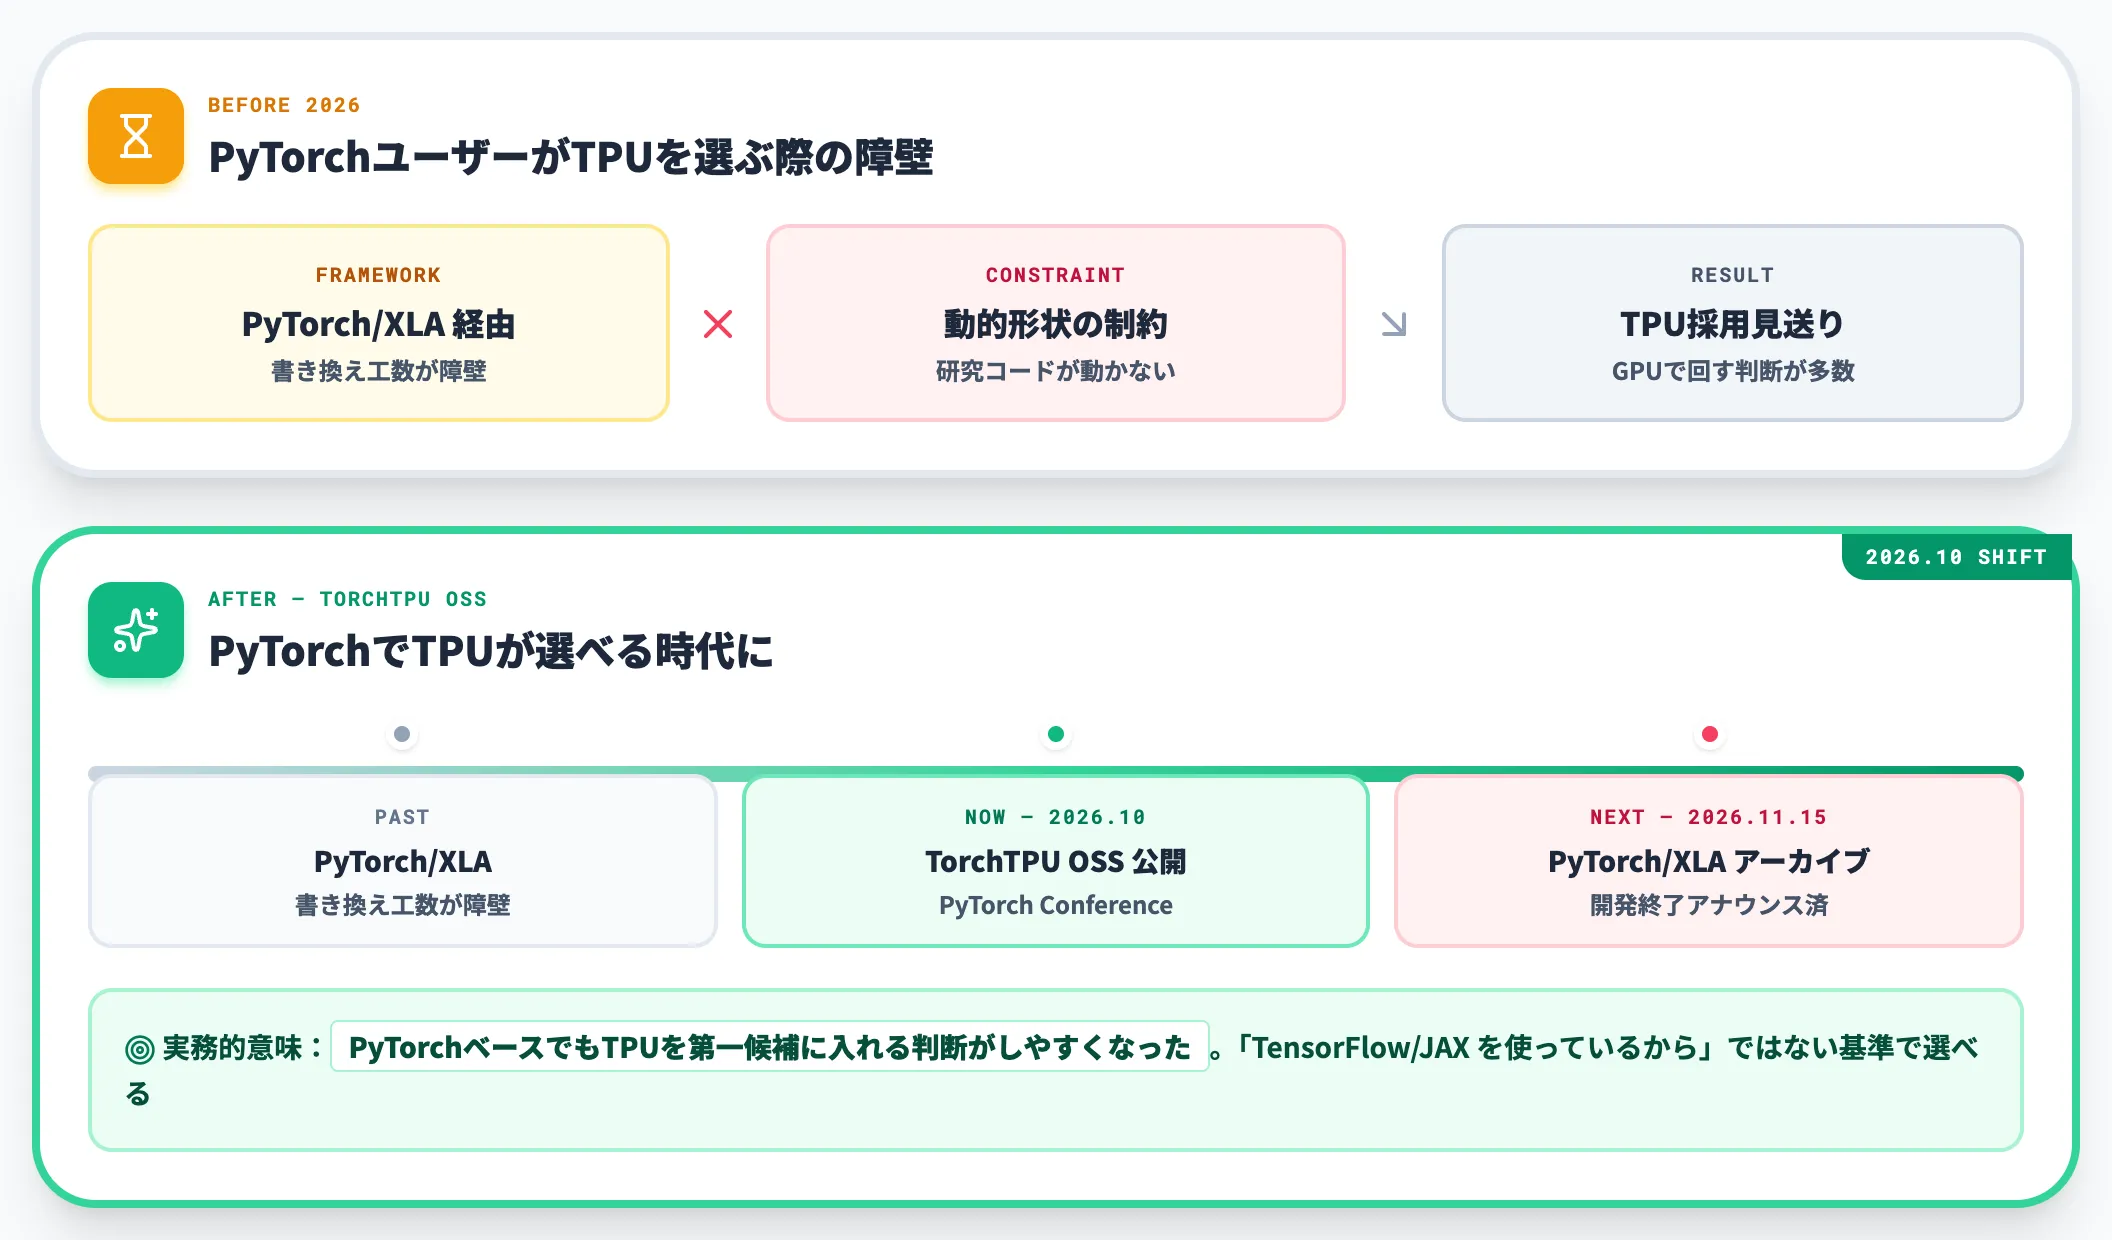
2026年10月のPyTorch Conferenceで、GoogleはPyTorchをTPUでそのまま動かす「TorchTPU」をOSSとして公開しました。同時にPyTorch/XLAは開発終了がアナウンスされ、リポジトリは2026年11月15日にアーカイブ化される予定です。これにより、PyTorchユーザーがTPUを選ぶハードルは2026年後半を境に下がりつつあります。
実務的な意味は、「TensorFlow/JAXを使っているから」ではなく、「PyTorchでTPUを使う選択肢が公式に用意された時代に入った」という点です。PyTorchベースのワークロードでも、ワークロード特性が噛み合えばTPUを第一候補に入れる判断がしやすくなっています。
TPU導入で詰まる3つの論点
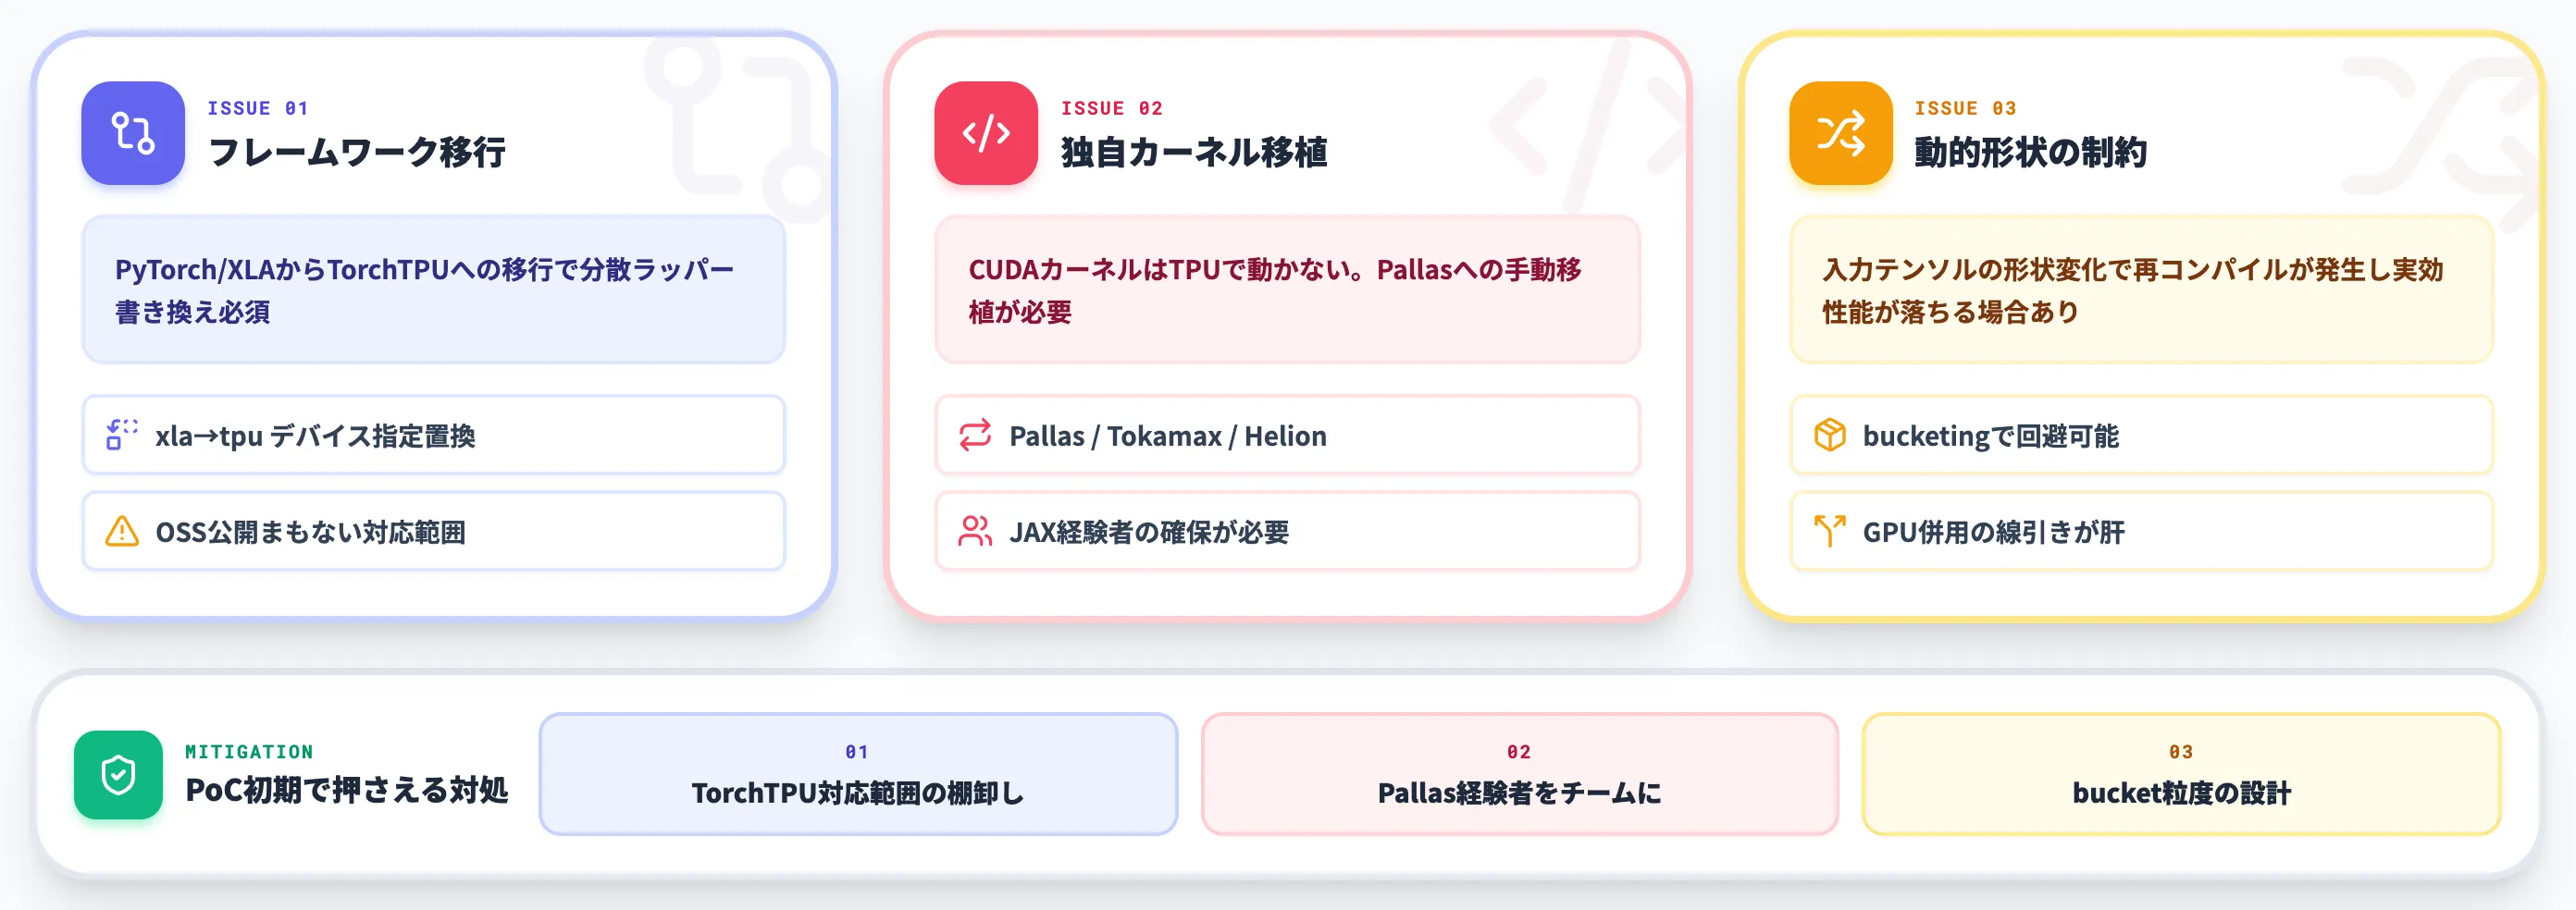
TPU採用を決めた後、実装・運用のフェーズで現場が詰まりやすい論点が3つあります。構成設計の段階で押さえておくと、PoCの手戻りを大幅に減らせます。
フレームワーク移行工数——PyTorch/XLAからTorchTPUへの切り替え
PyTorch/XLAで動いているパイプラインをTorchTPUに移行する場合、「xla」デバイス指定を「tpu」デバイスに置き換える基本パターンは単純ですが、分散学習のラッパーや「torch_xla.distributed」依存コードは書き換えが必要です。
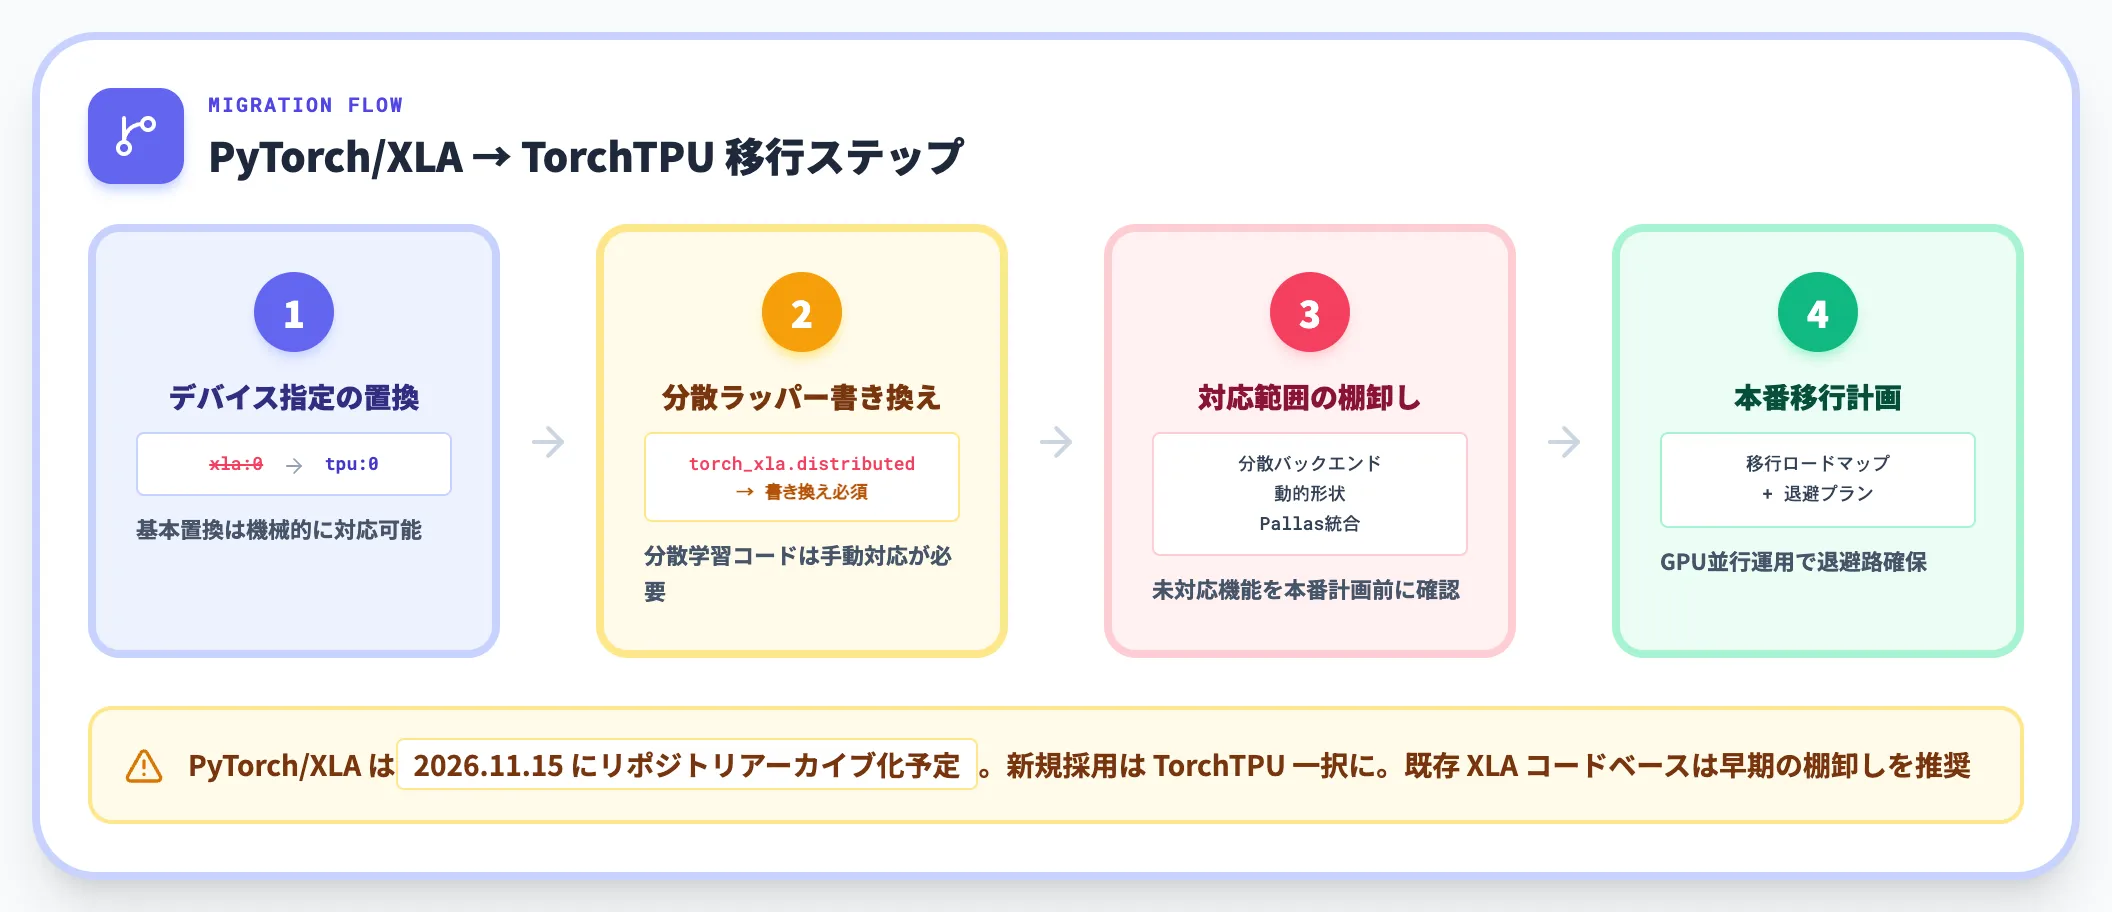
OSS公開まもない時期は、分散学習・動的形状・独自カーネル周辺で未対応機能が残ることがあります。本番移行前には、TorchTPUの対応範囲(分散バックエンド・動的形状サポート・Pallas統合)を一度棚卸ししてから計画を立てることをお勧めします。
独自カーネルの移植コスト——CUDAからTPU向けカーネル群へ
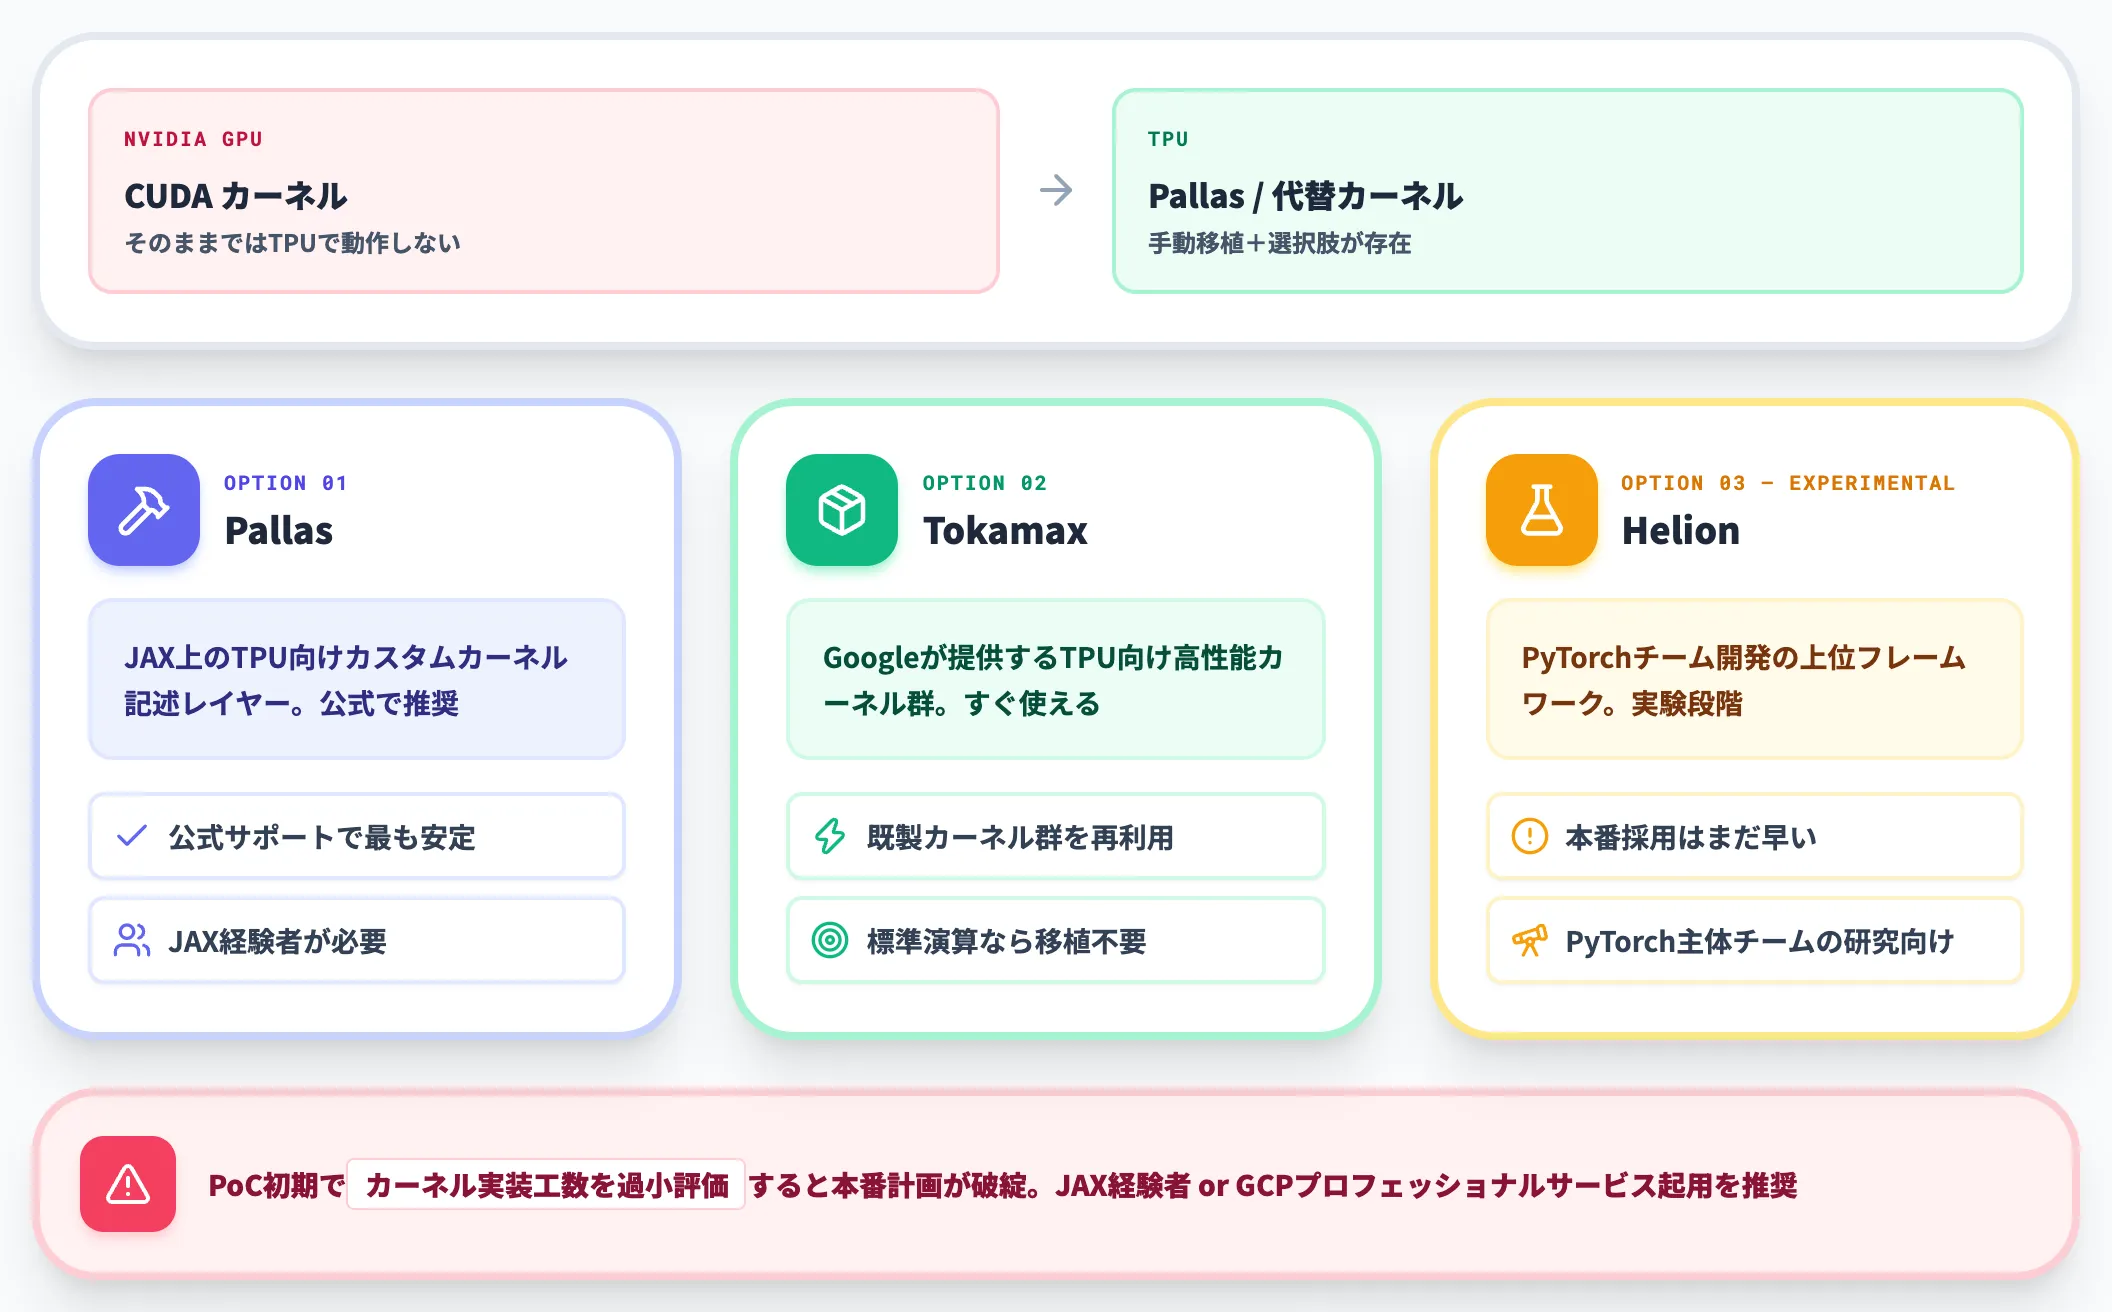
NVIDIA GPU向けのCUDAカーネルをそのままTPUで動かすことはできません。非標準演算を扱う場合は、Pallas(JAX上のTPU向けカスタムカーネル記述レイヤー)に手動移植する選択肢に加えて、Googleが提供するTokamaxカーネル群や、実験段階のHelion のような上位フレームワークを利用する選択肢もあります。
CUDA資産が中心のチームでは移植工数の見積もり精度が低くなりがちで、PoC初期でカーネル実装の時間を過小評価したまま本番計画を組むと後段で破綻します。
TPU採用を検討する段階で、Pallas/JAXの経験者を1人以上チームに入れるか、Google Cloudのプロフェッショナルサービスに相談するほうが現実的です。
動的形状・不定長入力の制約
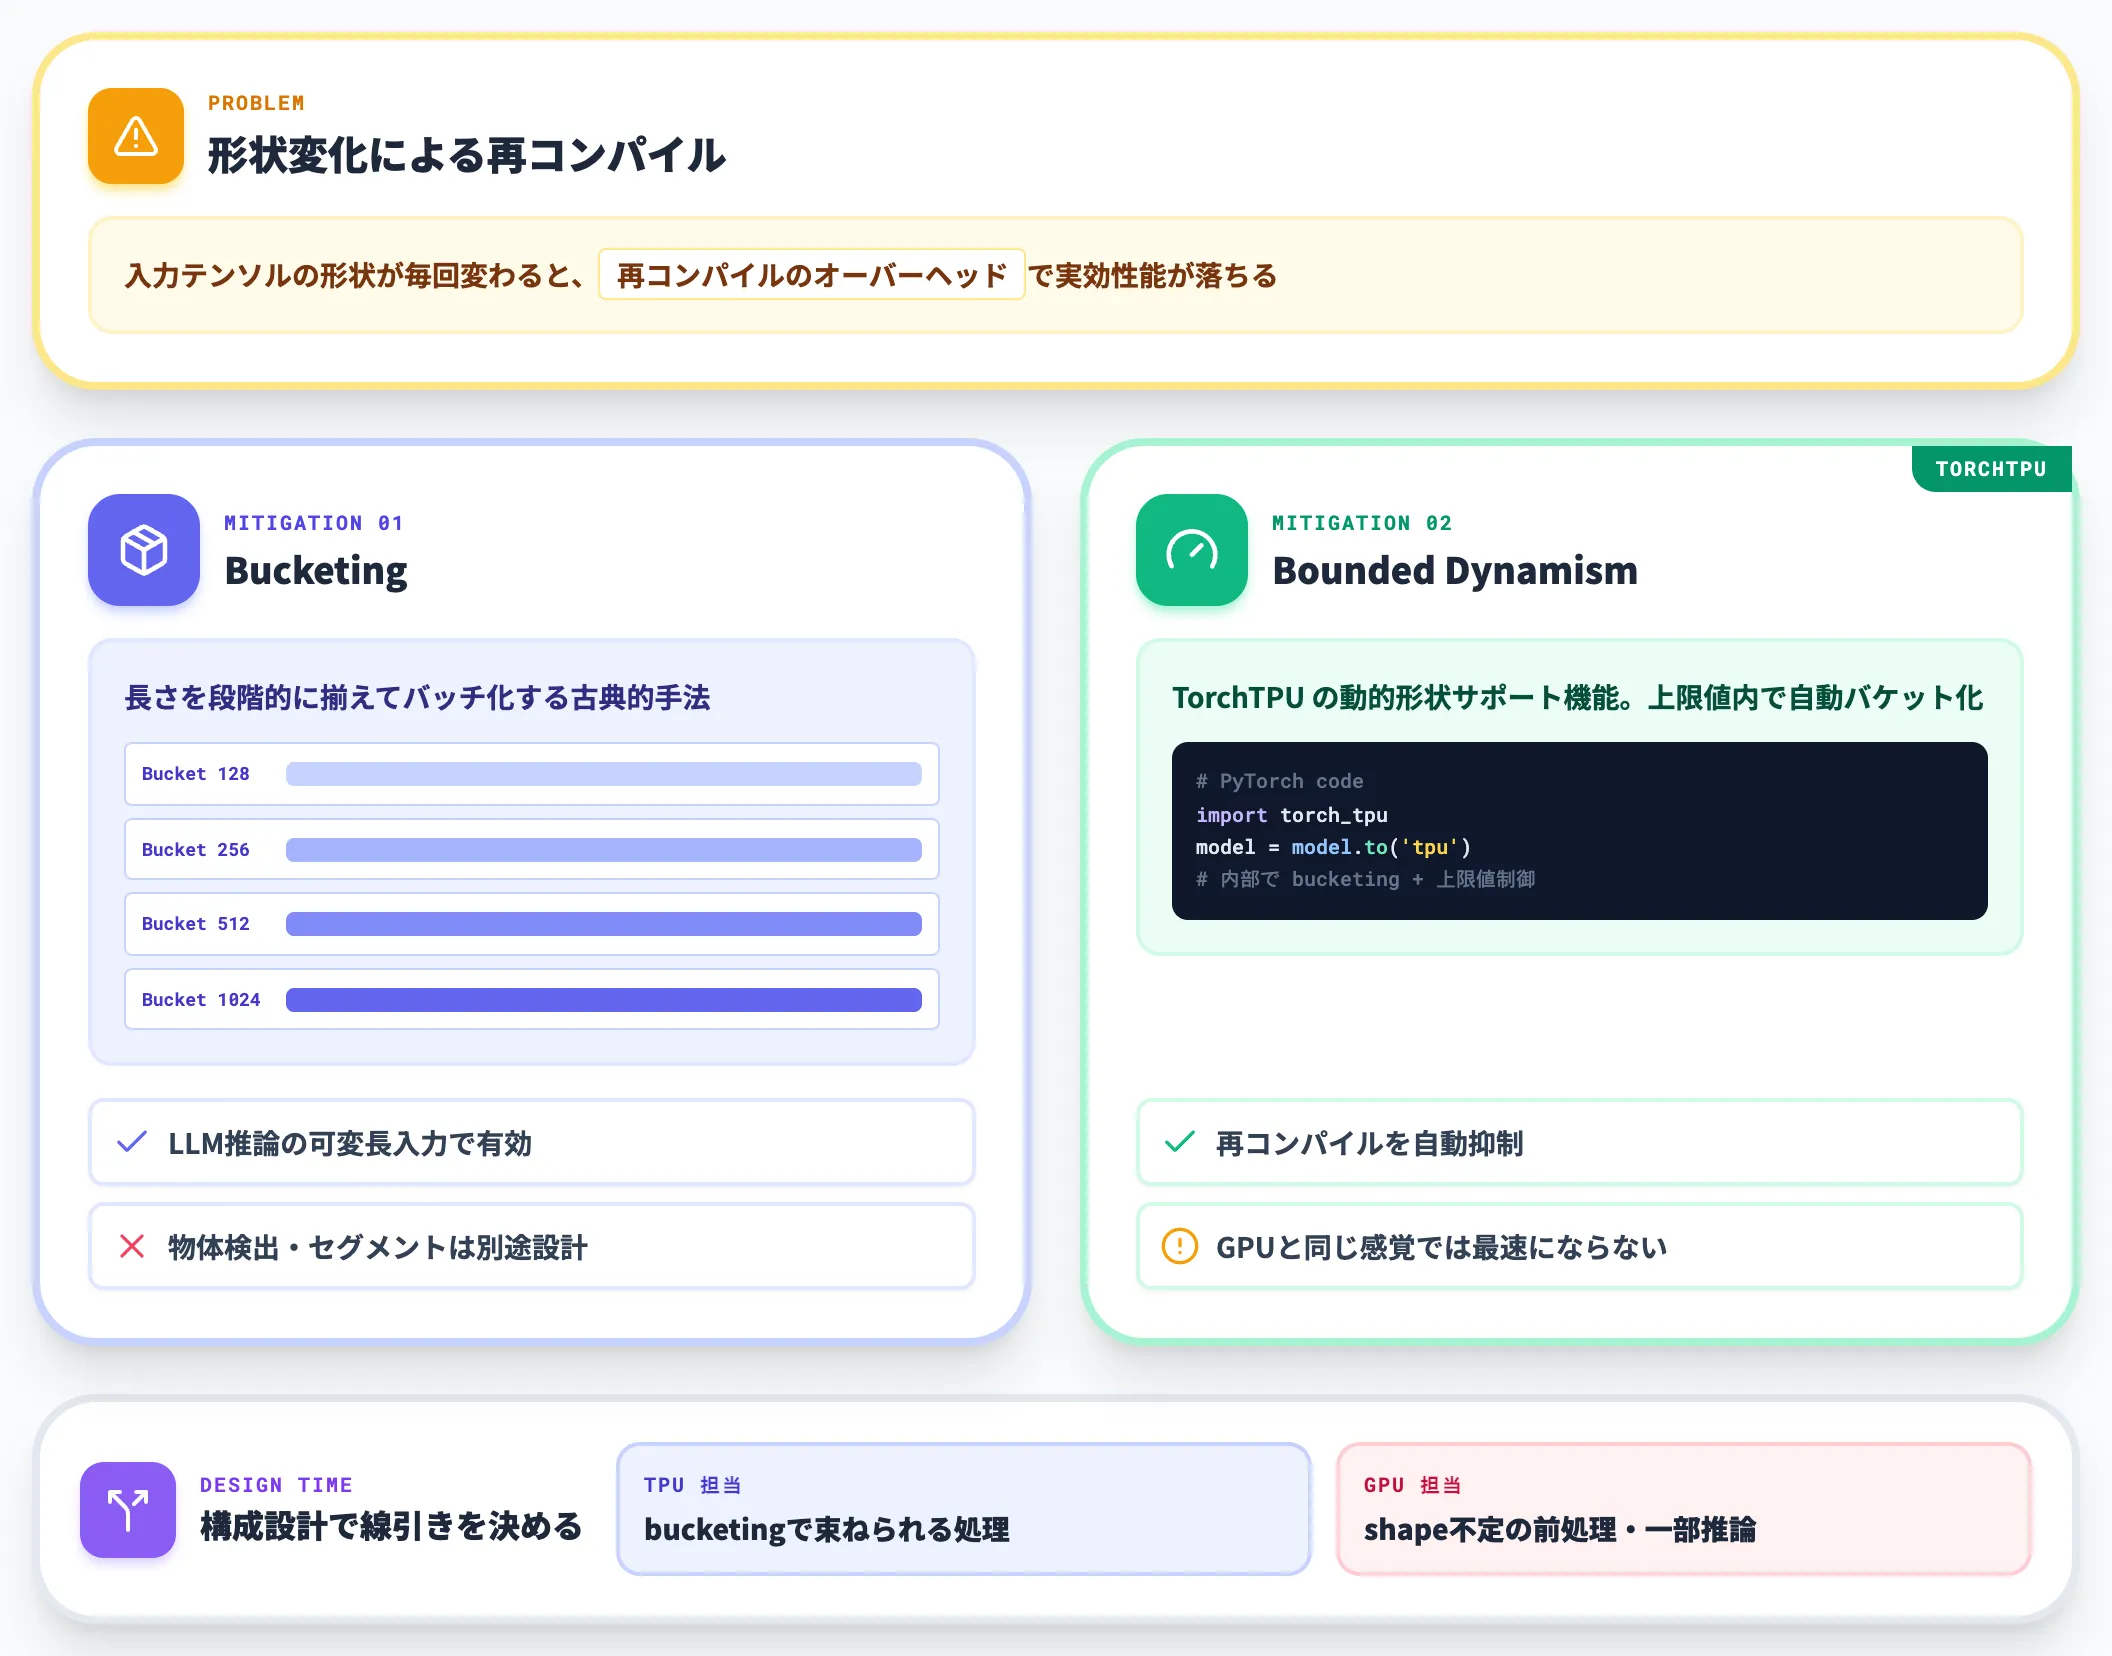
入力テンソルの形状が変わると、実行経路によっては再コンパイルが発生し、そのオーバーヘッドで実効性能が落ちる場合があります。
LLM推論の可変長入力は「bucketing」(長さを段階的に揃えてバッチ化する手法)で回避できますが、画像セグメンテーションや物体検出のようにshapeが毎回変わる系統は、TPU向けに前処理を再設計する必要があります。
TorchTPUはBounded Dynamism と呼ばれる動的形状サポートを提供し、内部的にはバケット分けと上限値を用いて再コンパイルを抑える仕組みを備えています。
ただし「動的形状をそのまま投げても最速で動く」というGPUと同じ感覚で設計すると性能が出ない前提は変わりません。構成設計の時点で、どのワークロードを「bucketing」でまとめるか、どの部分はGPUに残すかの線引きを決めておくことが重要です。
TPUを第2軸に持つなら、モデルの置き場所と業務データの間を先に設計する
TPUの採用ハードルは、データとワークロードがすでにGoogle Cloudにある企業ほど下がります。業務データがMicrosoft 365やAzureにある企業がTPUを推論の第2軸に持つなら、Google Cloud上のモデルに何を渡し、どの処理をTPU側に回すかを、チップや世代の選定と同じ段階で決める必要が出てきます。
その振り分けを業務の側に置けるのが、業務データとAgentをAzureの自社環境に集めたまま使えるAI Agent Hubです。
- TPU側のモデルに渡す項目を、Agentの段で絞る
請求書や申請のデータはAzure側に置いたまま、推論に要る項目だけをAgentが取り出してGoogle Cloud側のモデルに送る形で組めるため、データ転送の量と権限設計の範囲を絞り込めます。
- 件数のそろう処理を、まとめてTPU側に回す
月末に集中する請求書の処理のように形のそろった大量の依頼はまとめてTPU側へ送り、社員がTeamsで1件ずつ尋ねる問い合わせは低レイテンシの経路で返すという分け方を、Agentごとに組めます。
- 推論の基盤を移すときに、社員の使い方を変えない
GPUからTPUへ、あるいはIronwoodから第8世代へ移すときに、Agentが呼び出す先を差し替える形にしておけば、Teamsの入口と業務の手順はそのまま残せます。
AI総合研究所の専任チームが、TPUに回す候補の処理を業務の中から洗い出し、Vertex AIやGKEで動かす推論とAgentのあいだの接続を、要件に応じて設計し、構築まで受け持ちます。
TPUの推論と業務データの間を設計する

渡す項目と回す処理をAgentで分ける
TPUを推論の第2軸に持つと、Microsoft 365やAzureにある業務データとの間で、何を渡しどの処理を回すかの設計が加わります。AI Agent Hubは業務データとAgentを自社のAzureテナントに置く基盤で、Google Cloud側のモデルとの接続はAI総合研究所が要件に応じて組み立てます。
まとめ|TPUはAI基盤の第2軸として本格的に立ち上がった
本記事では、TPUを「Googleがニューラルネットワークの行列演算に特化して自社設計したAI専用のASIC」として整理し、GPU・CPUとの違い・仕組み・世代別のロードマップ・料金・採用事例・選定の判断軸・導入時に手間取る論点を解説しました。
2026年11月時点で押さえておくべきポイントは次の3つです。
- TPUは行列演算に資源を集めて他の用途を切り捨てた設計で、形の安定した大規模なTransformerの学習・推論では、電力当たりの性能と単価に強みが出る
- 最新の世代で訓練用と推論用に設計が分かれ、PyTorchをそのまま動かせるTorchTPUの公開で、GPUと並べて検討できる選択肢になった
- 動的に形が変わる入力やCUDA独自のカーネルを多く抱えるチームは、再コンパイルや移植の工数が膨らむため、GPUを第一候補に残すほうが収まりやすい
AI総合研究所の検証支援では、TPUとGPUのどちらを選ぶかを決める材料を、2つの検証で集めます。
まずは、ColabやKaggleの無料のTPU枠で検証したいモデルを動かし、単価の感覚とコンパイルにかかる時間をつかみます。
続いて、PyTorch/XLAやTensorFlowに依存している箇所を拾い出し、TorchTPUかJAXへ移す計画を立てます。
TPUの費用は世代ごとのチップの時間単価と使う時間の掛け算なので、世代選びがそのまま予算の設計を兼ねます。
TPUは、Googleが自社のGeminiや検索のために磨いてきた計算基盤で、Cloud TPUを通じて外部の企業が同じ仕組みを借りて使えます。