この記事のポイント
 5モデル構成(E2B/E4B/12B/26B MoE/31B)で、スマホからサーバーGPUまで環境に応じて選べる
- シリーズ初のApache 2.0採用で、ライセンス料ゼロで商用利用・改変・再配布が可能
- 31B DenseはAIME 2026で89.2%、2026年4月1日時点のArena AIオープンモデル部門3位の性能水準
- Vertex AI・Cloud Run・GKE・ローカル実行の4系統から、コストとデータ主権で使い分けできる
- 2026年7月のサイレント更新でFA4対応・tool calling・vision処理が改善済み
Microsoft MVP・AIパートナー。LinkX Japan株式会社 代表取締役。東京工業大学大学院にて自然言語処理・金融工学を研究。NHK放送技術研究所でAI・ブロックチェーンの研究開発に従事し、国際学会・ジャーナルでの発表多数。経営情報学会 優秀賞受賞。シンガポールでWeb3企業を創業後、現在は企業向けAI導入・DX推進を支援。
Gemma 4は、Google DeepMindが2026年4月2日に発表したオープンAIモデルファミリーです。
シリーズで初めてApache 2.0ライセンスが採用され、同ライセンスの条件下で商用利用・改変・再配布・派生モデル配布ができるようになりました。
2026年6月には12B Unifiedが追加され、スマートフォンからサーバーGPUまでを5サイズでカバーする体制に拡張されています。
本記事では、5モデル構成、機能面の進化、実行環境ごとの使い分け、料金と実運用の注意点を、2026年7月時点の最新情報で体系的に解説します。
目次
Gemma 4とは — Google DeepMindのオープンAIモデル
12B Unified — ノートPCで動く新型マルチモーダル
Gemma 4の使い方 — ローカル/AI Studio/Vertex AI/Cloud Run
Gemma 4とは — Google DeepMindのオープンAIモデル
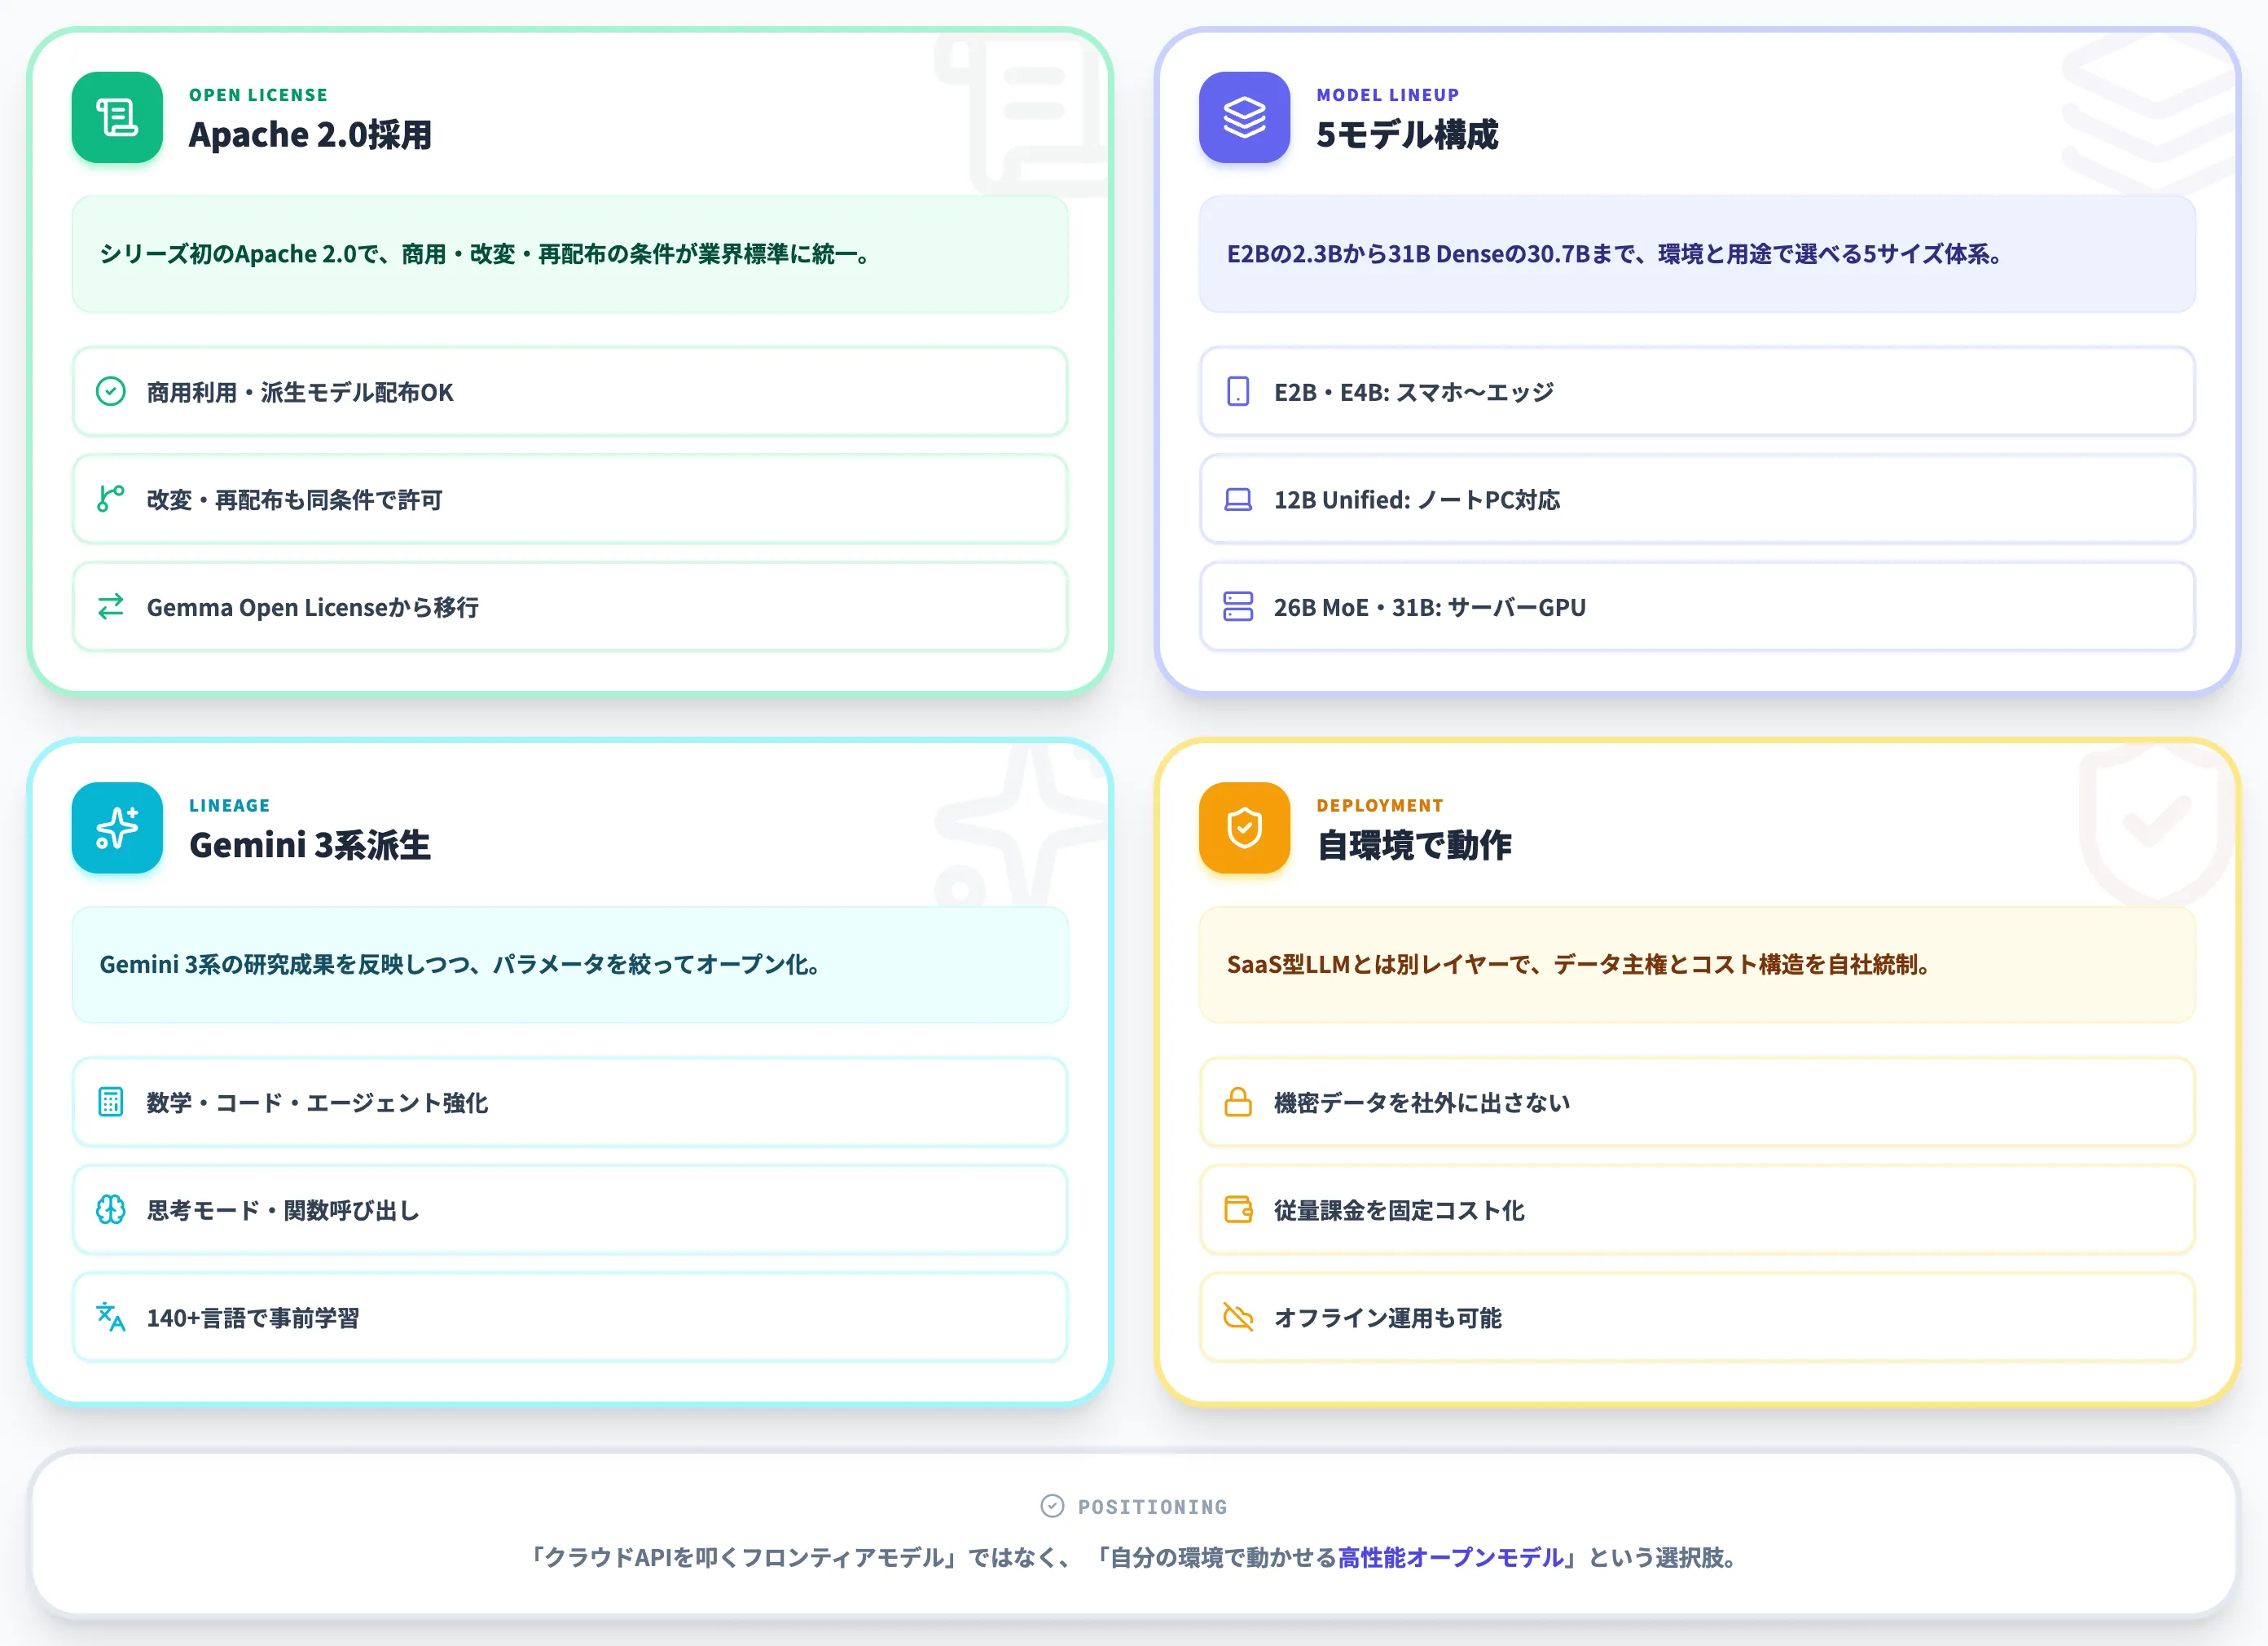
Gemma 4は、Google DeepMindが2026年4月2日に公開したオープンAIモデルファミリーで、同社のフロンティアモデルGemini 3と同じ研究基盤から派生した軽量オープン版という位置づけにあたります。
最大の転換点は、シリーズで初めてApache 2.0ライセンスを採用した点です。従来の「Gemma Open License」独自ライセンスから乗り換わり、ライセンス表示さえ満たせば商用利用・改変・再配布・派生モデル配布までが標準の枠内で認められるようになりました。
「クラウドAPIを叩くフロンティアモデル」ではなく「自分の環境に持ってきて動かせる高性能モデル」という選択肢を、データ主権とコスト構造の両面から企業に届ける存在と言えます。
GeminiとGemmaのシリーズ内での位置づけ
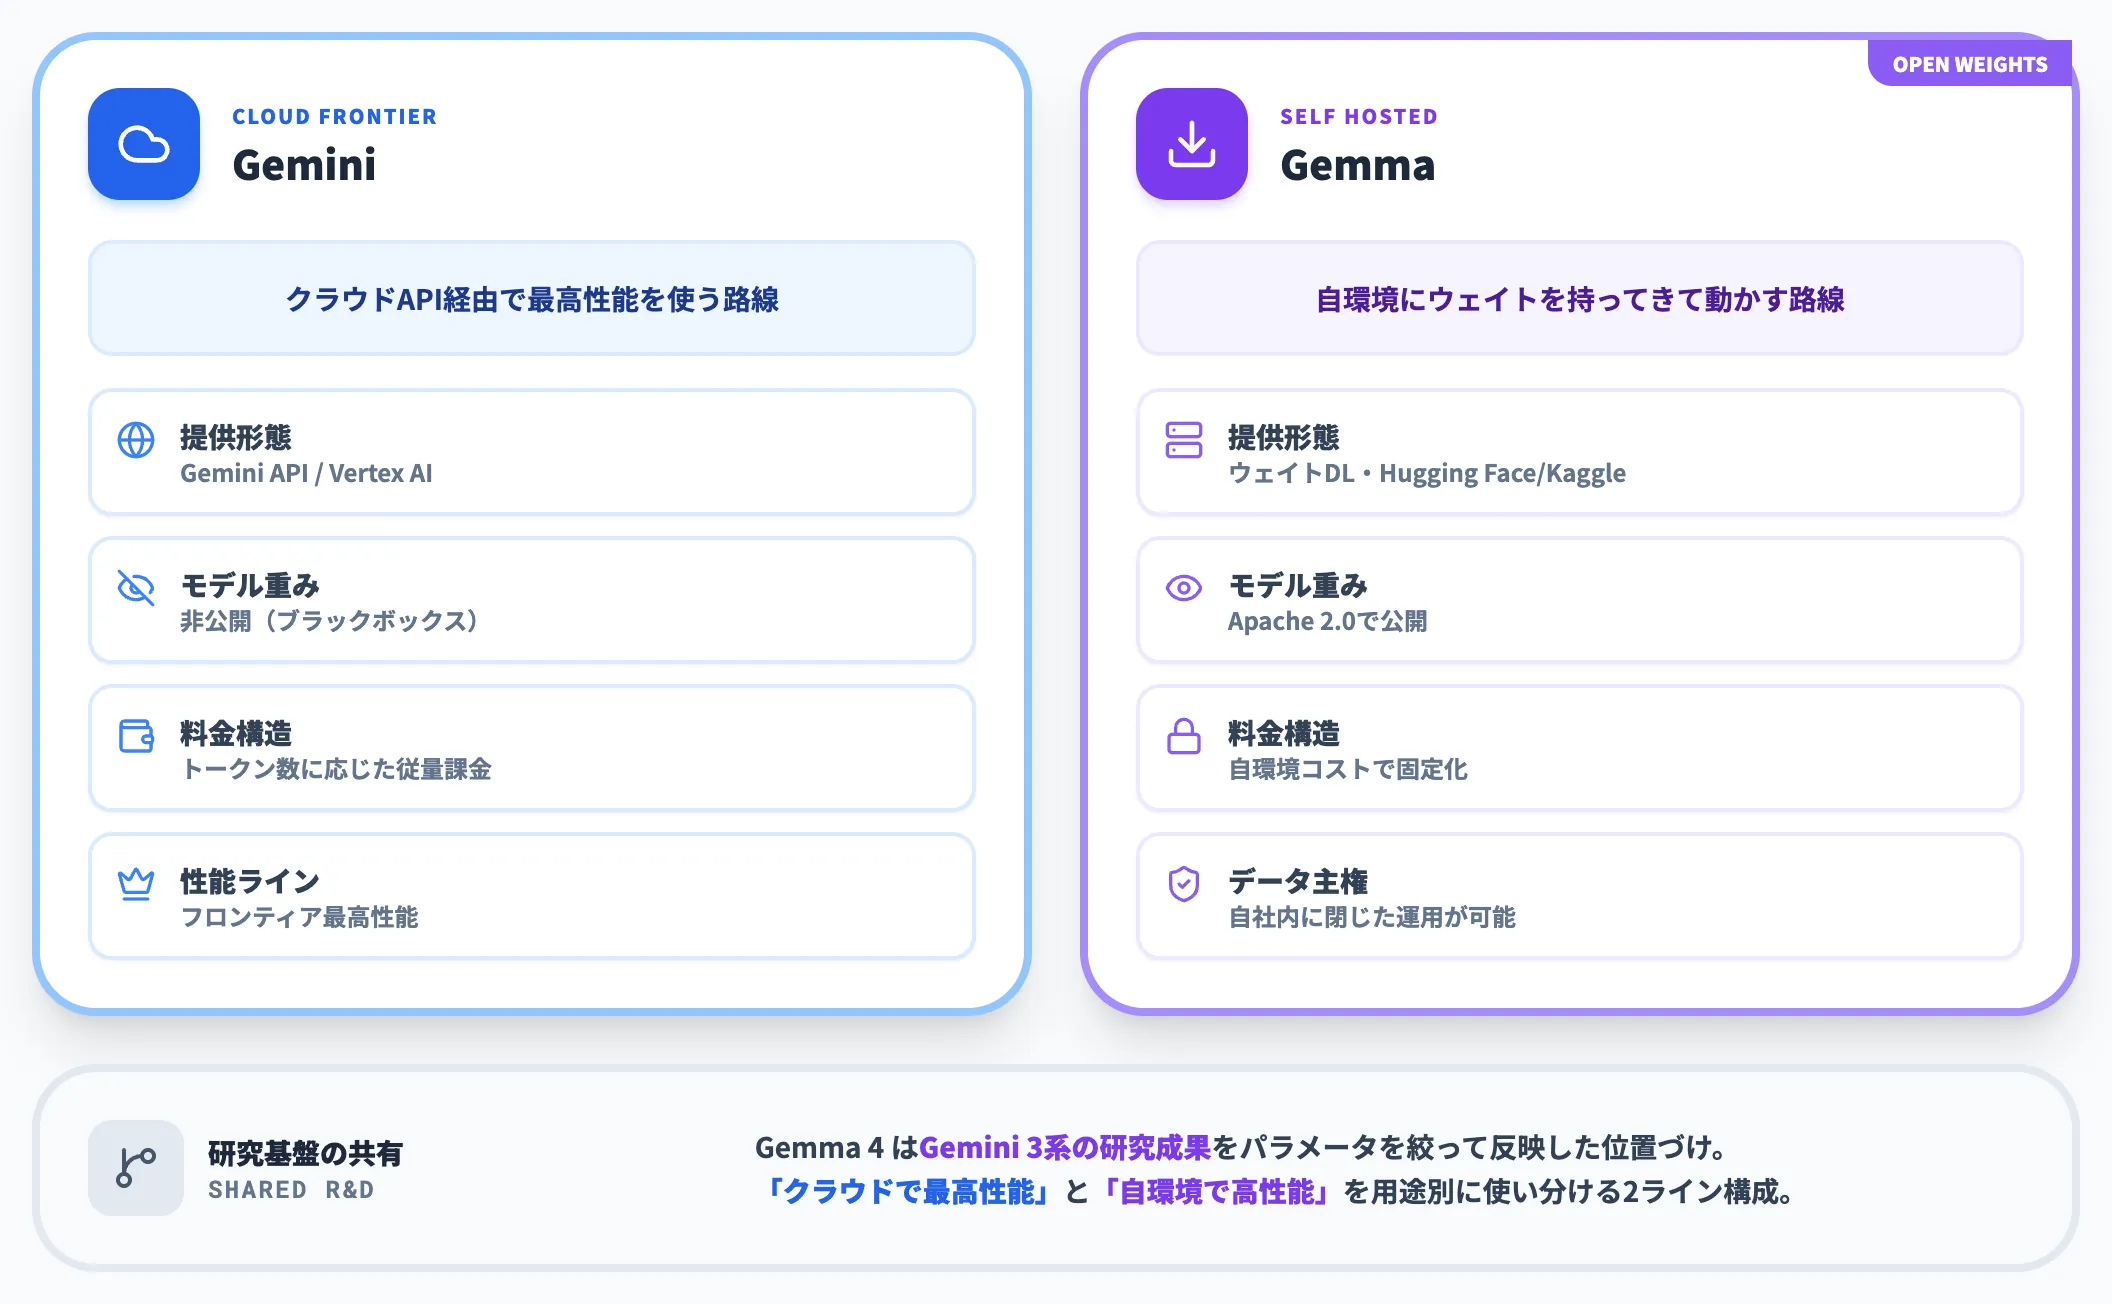
Google DeepMindのモデル群はフロンティア系の「Gemini」とオープン系の「Gemma」の2ライン構成で、Gemma 4はGemini 3系の研究成果をパラメータ数を絞ってオープン化した位置づけにあたります。
- Gemini(クローズド系):Gemini API・Vertex AI経由の商用APIで提供、モデル重み非公開のフロンティア系
- Gemma(オープン系):ウェイトをHugging Face等からダウンロードして自環境で動かせる、Apache 2.0のオープン系
ポイントは、GeminiとGemmaは競合ではなく、「クラウドAPI」と「自環境実行」の使い分けを前提とした2ライン構成、という点です。
「Gemini世代のノウハウをオープンモデルとしてローカルで動かしたい」ニーズと「クラウドAPIのランニングコスト・従量課金を避けたい」ニーズの両方に応える設計になっています。
Gemma 4の5モデル構成と選び方
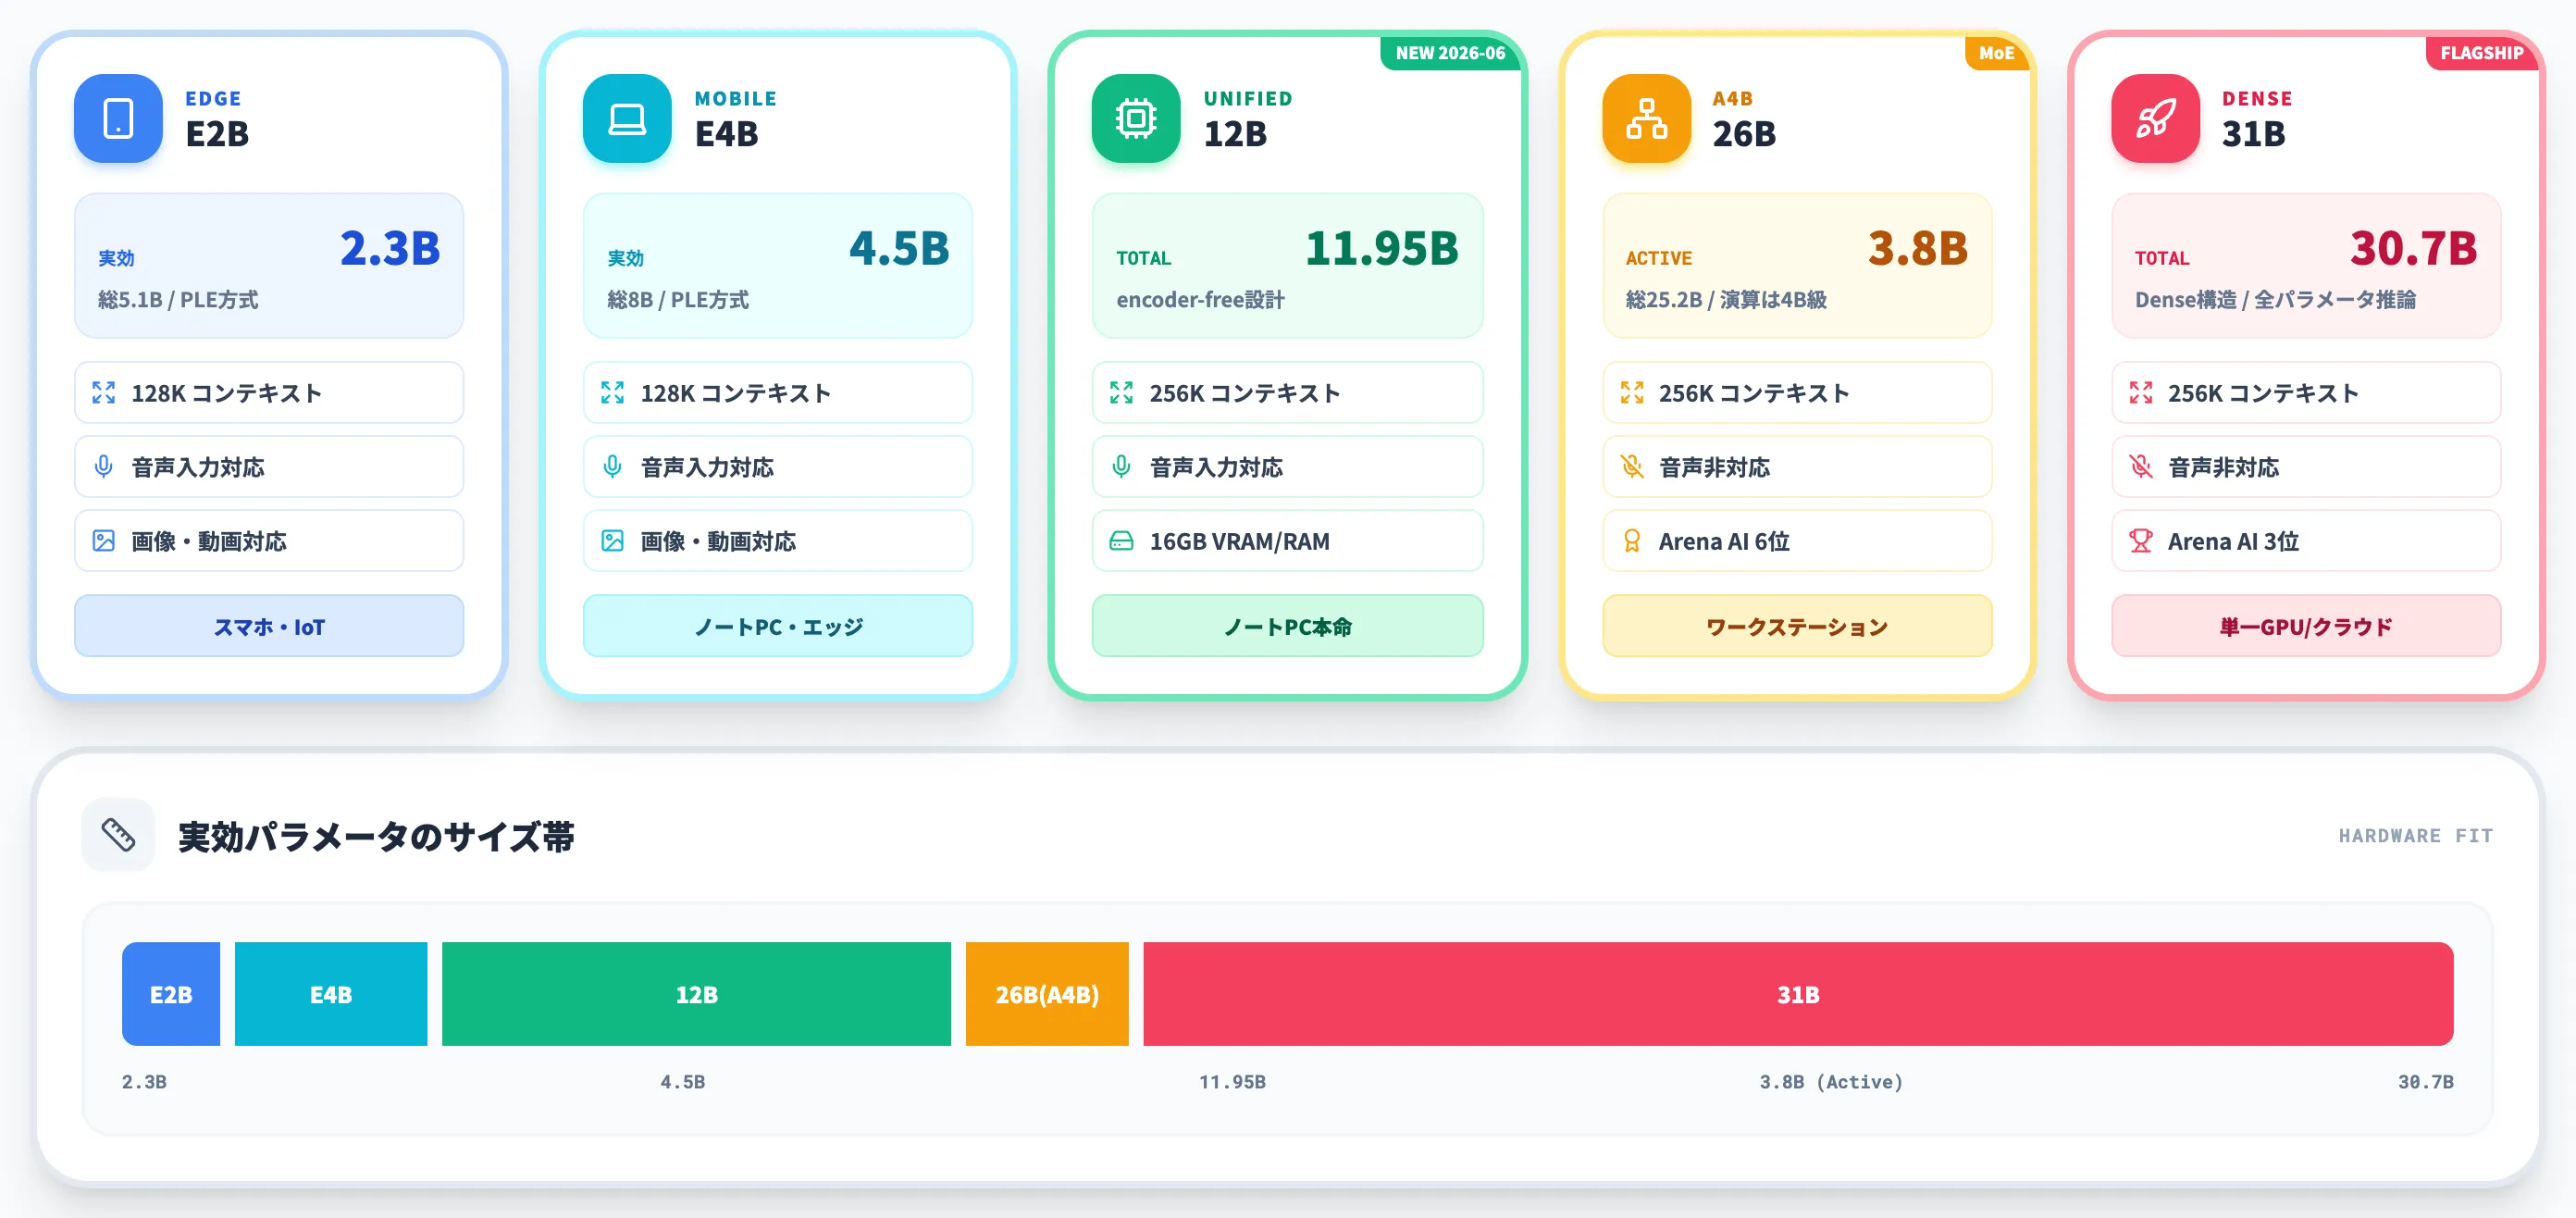
Gemma 4は、用途とハードウェア要件に合わせて5つのバリエーションから選べる構成です。
以下の表で、5モデルのスペックと想定デプロイ環境を整理しました。
| モデル | 総パラメータ | 実効/アクティブ | コンテキスト | 音声入力 | 想定環境 |
|---|---|---|---|---|---|
| E2B | 5.1B | 2.3B | 128K | ○ | スマホ・IoT |
| E4B | 8B | 4.5B | 128K | ○ | ノートPC・エッジデバイス |
| 12B Unified | 11.95B | 11.95B | 256K | ○ | ノートPC(16GB VRAM以上) |
| 26B A4B MoE | 25.2B | 3.8B(アクティブ) | 256K | ✗ | ワークステーション |
| 31B Dense | 30.7B | 30.7B | 256K | ✗ | 単一GPU/クラウド |
以下で、それぞれのモデルについて詳しくみていきます。
E2B・E4B — エッジ・モバイル向けのEシリーズ
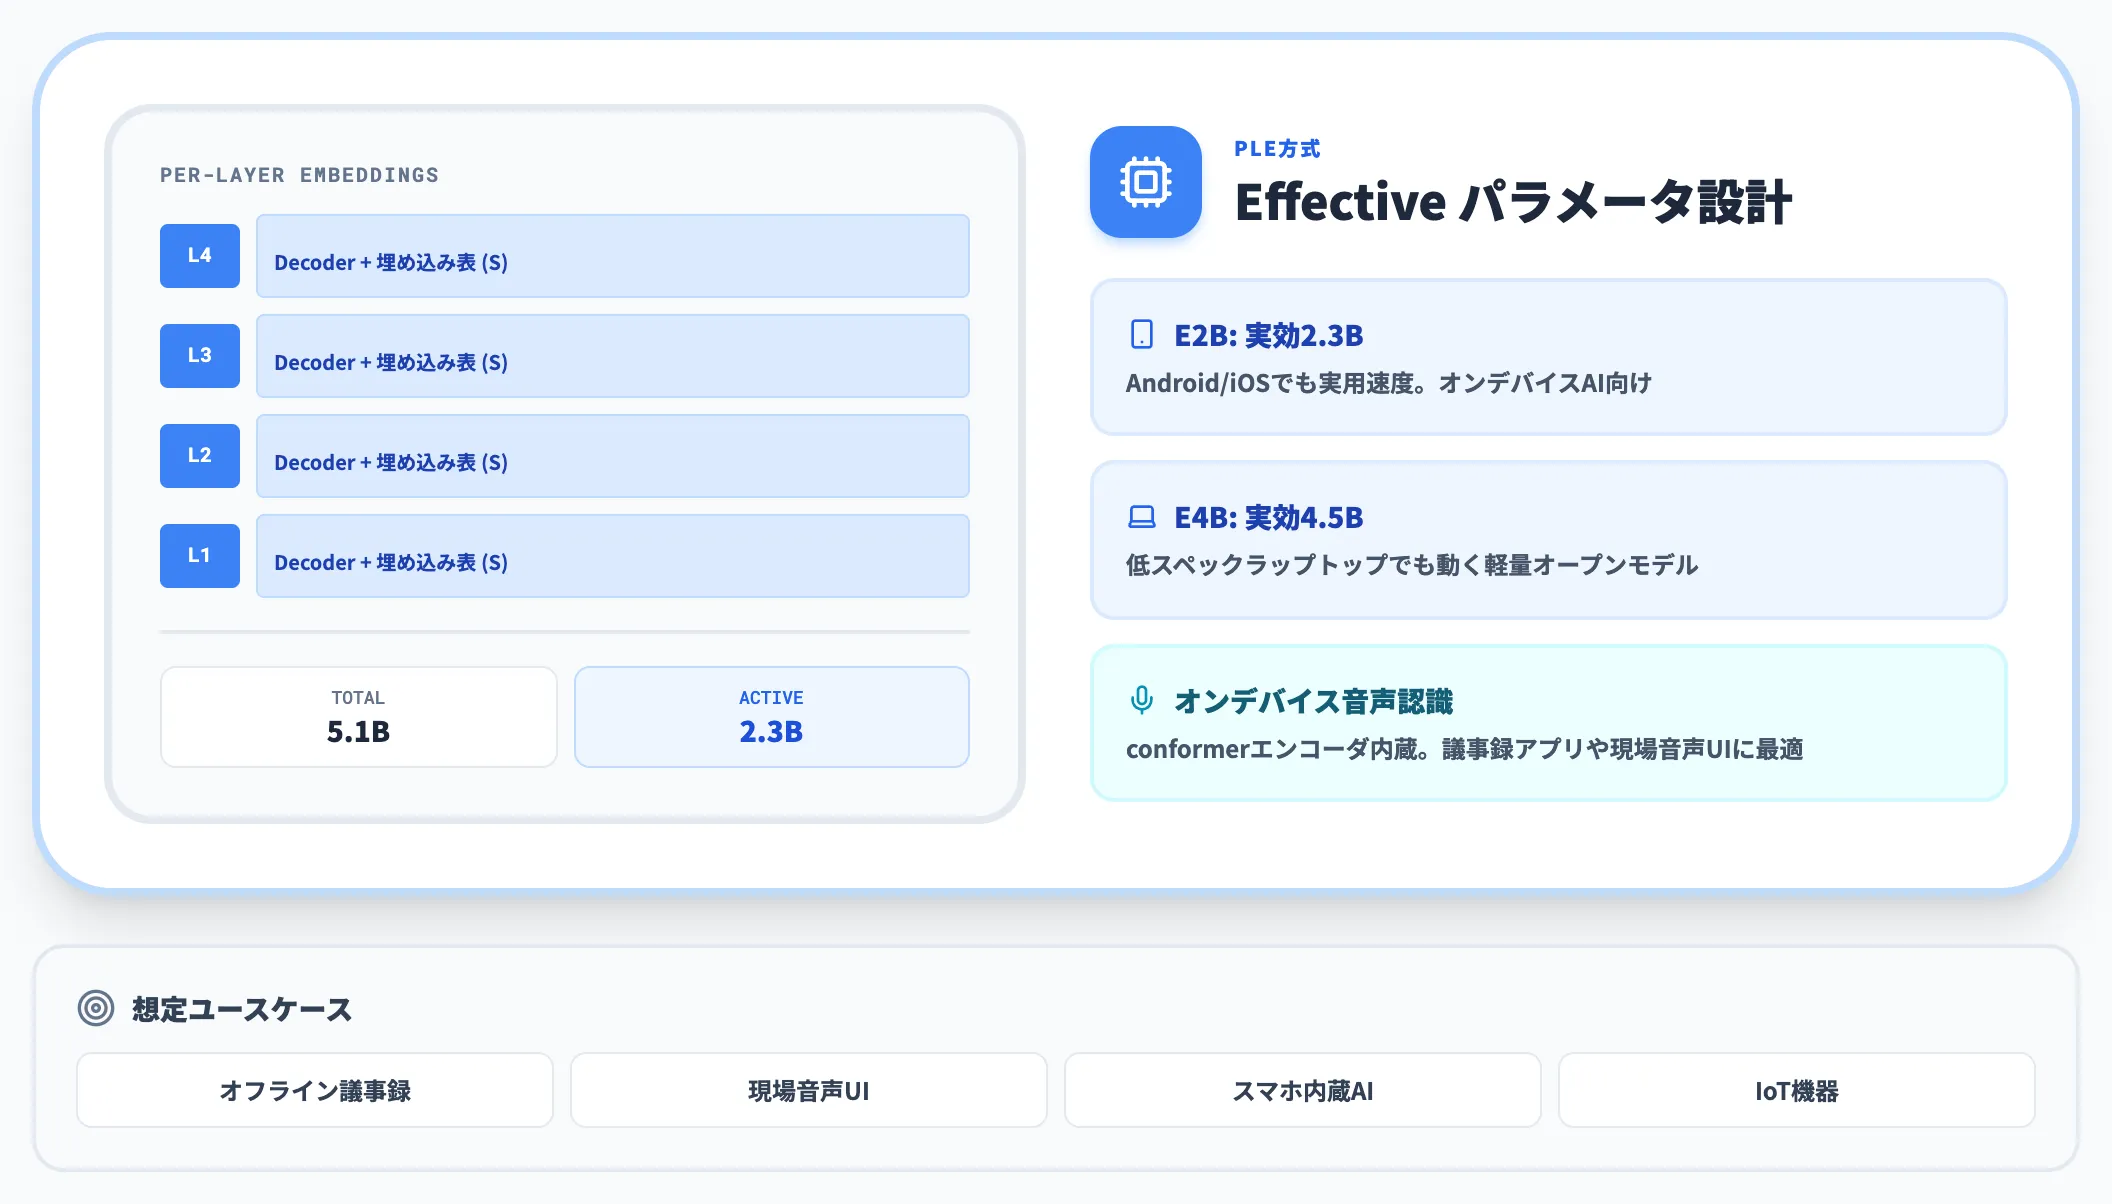
E2BとE4Bの「E」は「Effective(実効)」の頭文字で、Per-Layer Embeddings(PLE)方式により各デコーダーレイヤーが独自の小さなトークン埋め込み表を持つ設計です。
ルックアップ中心の処理に切り替えることで、総パラメータ数よりも実効パラメータ数を小さく抑えられるのが特徴で、実効値はE2Bで2.3B、E4Bで4.5B。Android/iOSや低スペックのラップトップでも実用速度が出ます。
両モデルはさらに音声入力にも対応します。
conformerベースのエンコーダを内蔵し、オンデバイスで音声認識までワンストップで完結する構成のため、オフラインで動く議事録アプリや、データを外に出せない現場向けの音声UIといったユースケースがそのまま射程に入ります。
12B Unified — ノートPCで動く新型マルチモーダル
12B Unifiedは2026年6月に追加された比較的新しいバリエーションで、他の4モデルと大きく違うのは、テキスト・画像・音声を単一のLLMバックボーンで処理する「encoder-free」設計を採っている点です。
従来のマルチモーダルモデルは画像や音声を専用エンコーダで前処理してからLLMに渡す構造が主流でしたが、12B Unifiedは視覚を軽量な埋め込みモジュールで、音声を生信号ごと、直接トークン空間に流し込むアーキテクチャに切り替えています。
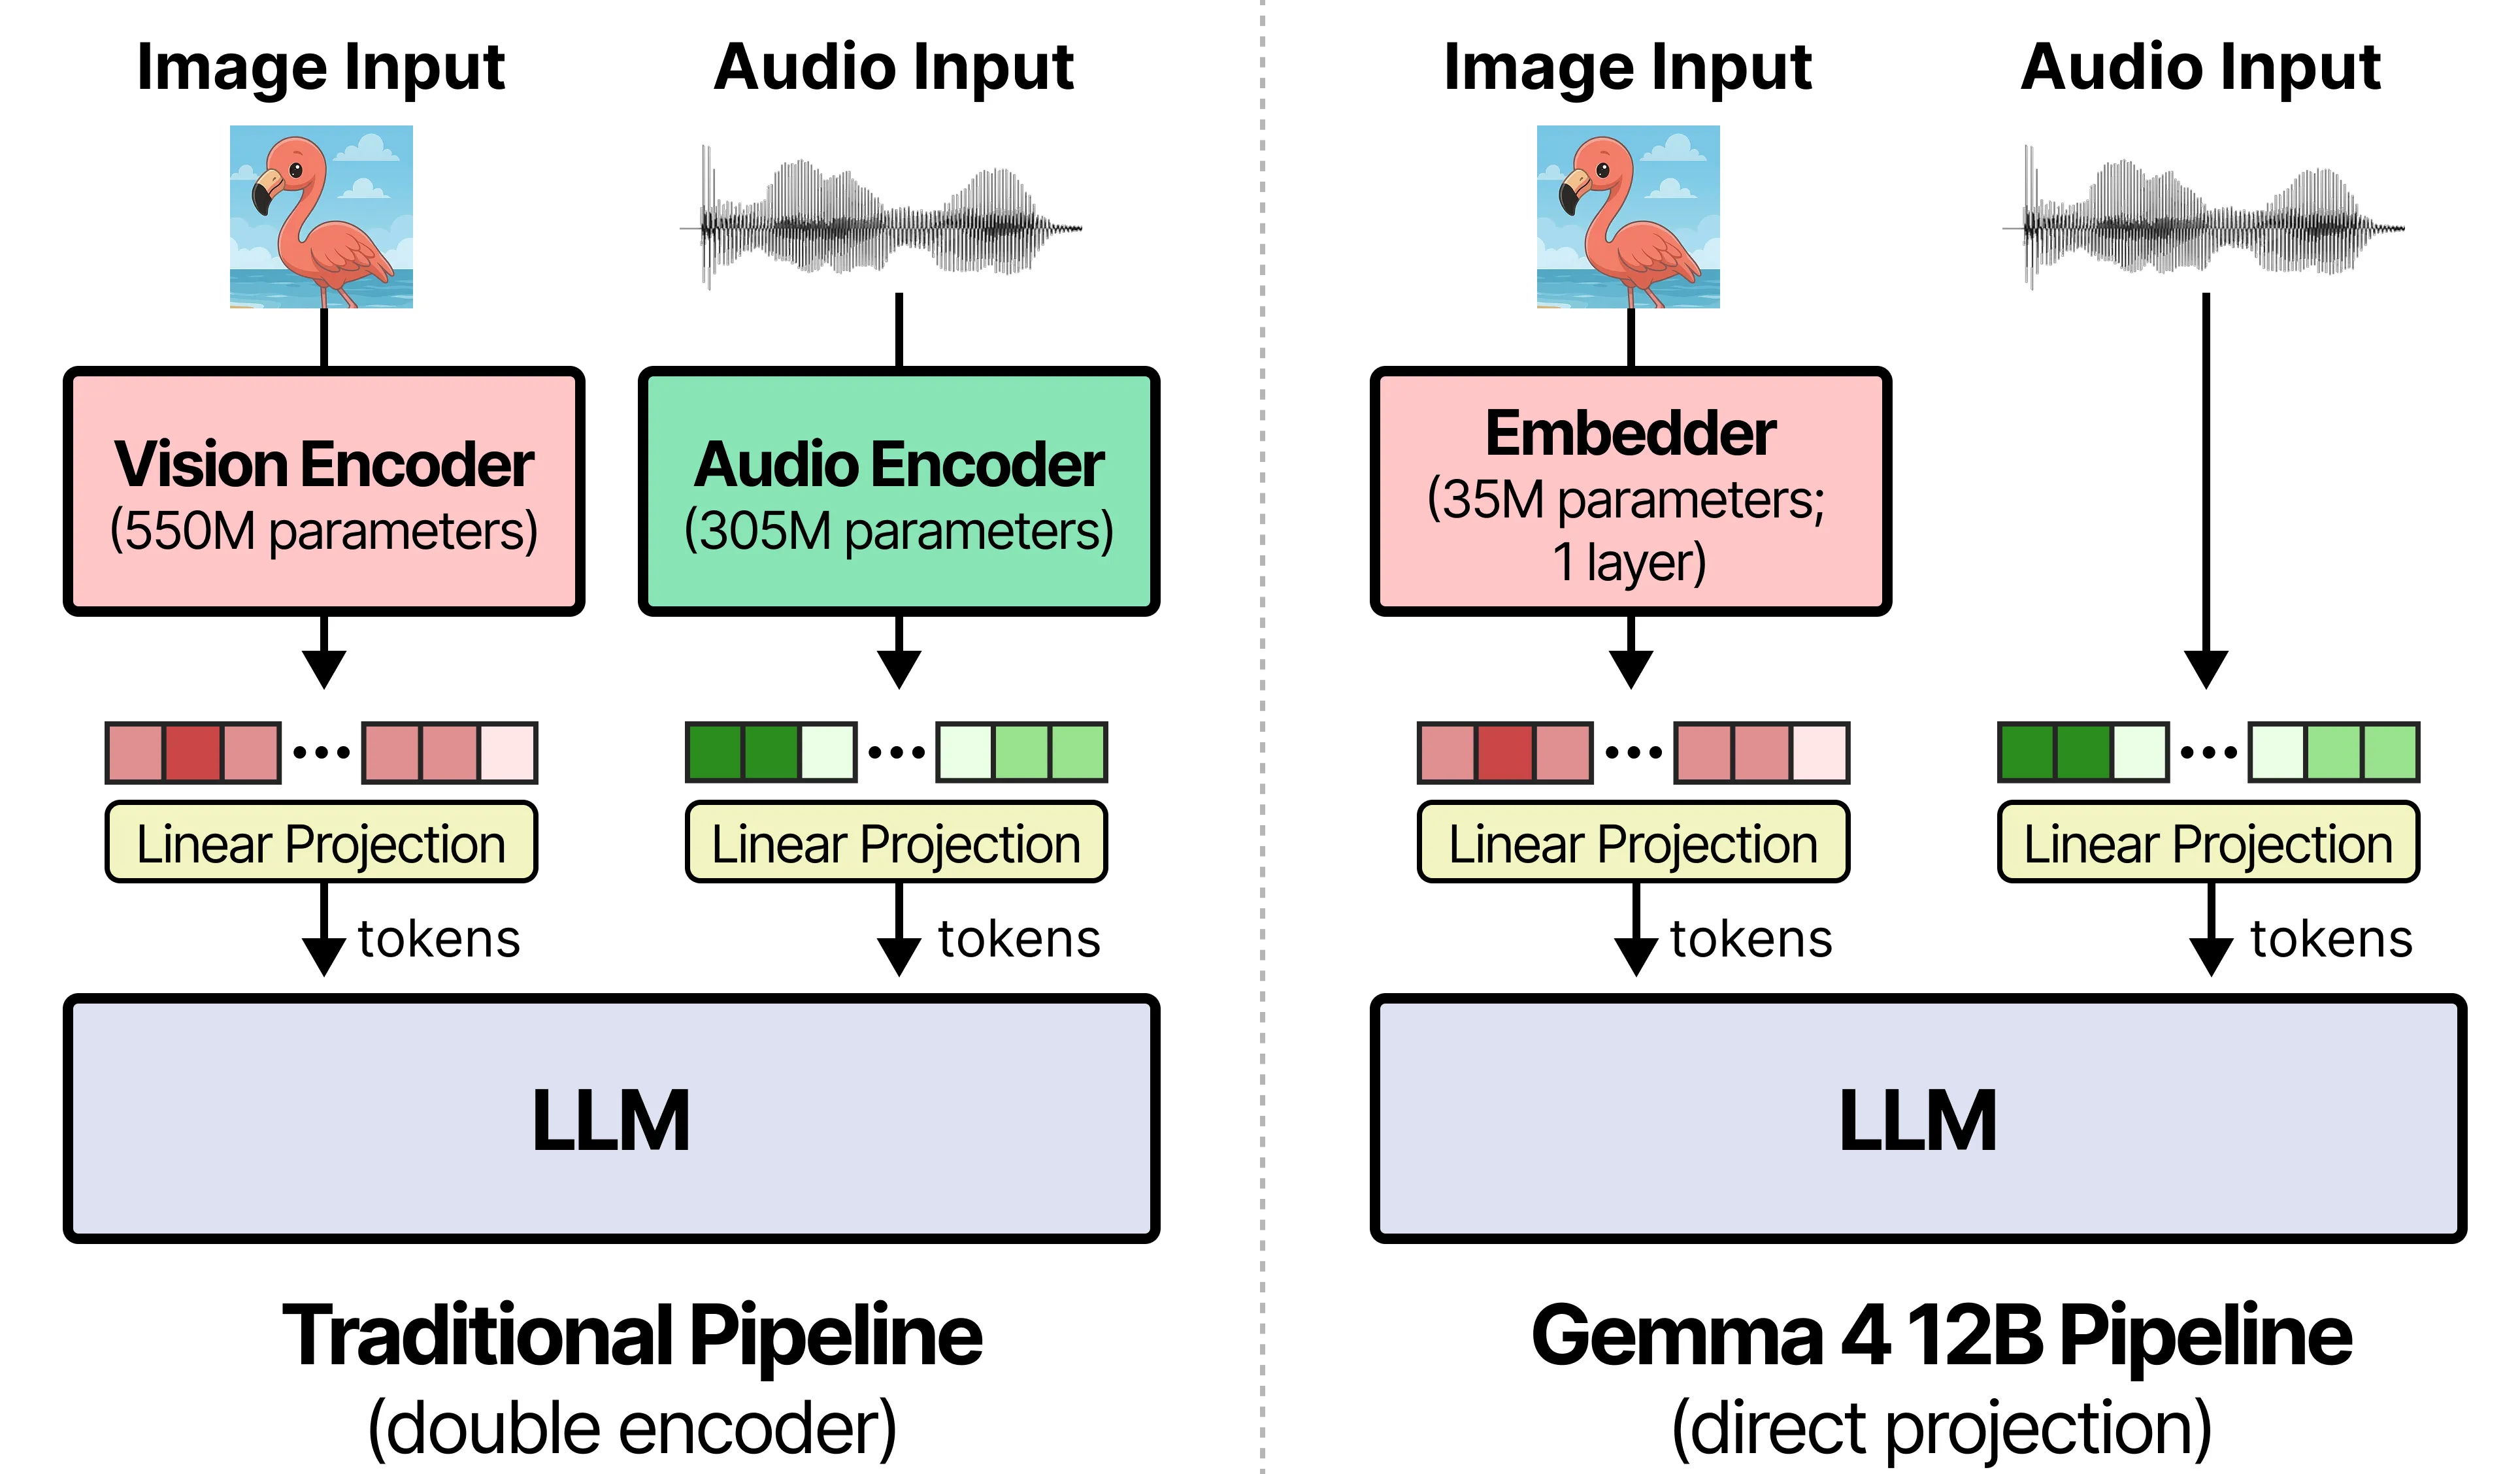
従来のマルチモーダルパイプライン(左)と、Gemma 4 12Bのencoder-free設計(右)の対比(出典:Google Developers Blog)
図の左側が従来型で、Vision Encoder(550Mパラメータ)とAudio Encoder(305Mパラメータ)という重い専用エンコーダが独立して動く構成です。一方の右側、Gemma 4 12Bでは、これがEmbedder(35Mパラメータ・1レイヤー)に置き換わり、画像も音声も直接LLMのトークン空間に接続されます。差し引きで約8.2億パラメータ相当(550M+305M−35M)を削り落とせるため、ラップトップ相当のメモリでも26B級モデルに近い精度が出せる、というのがこの設計の勘所です。

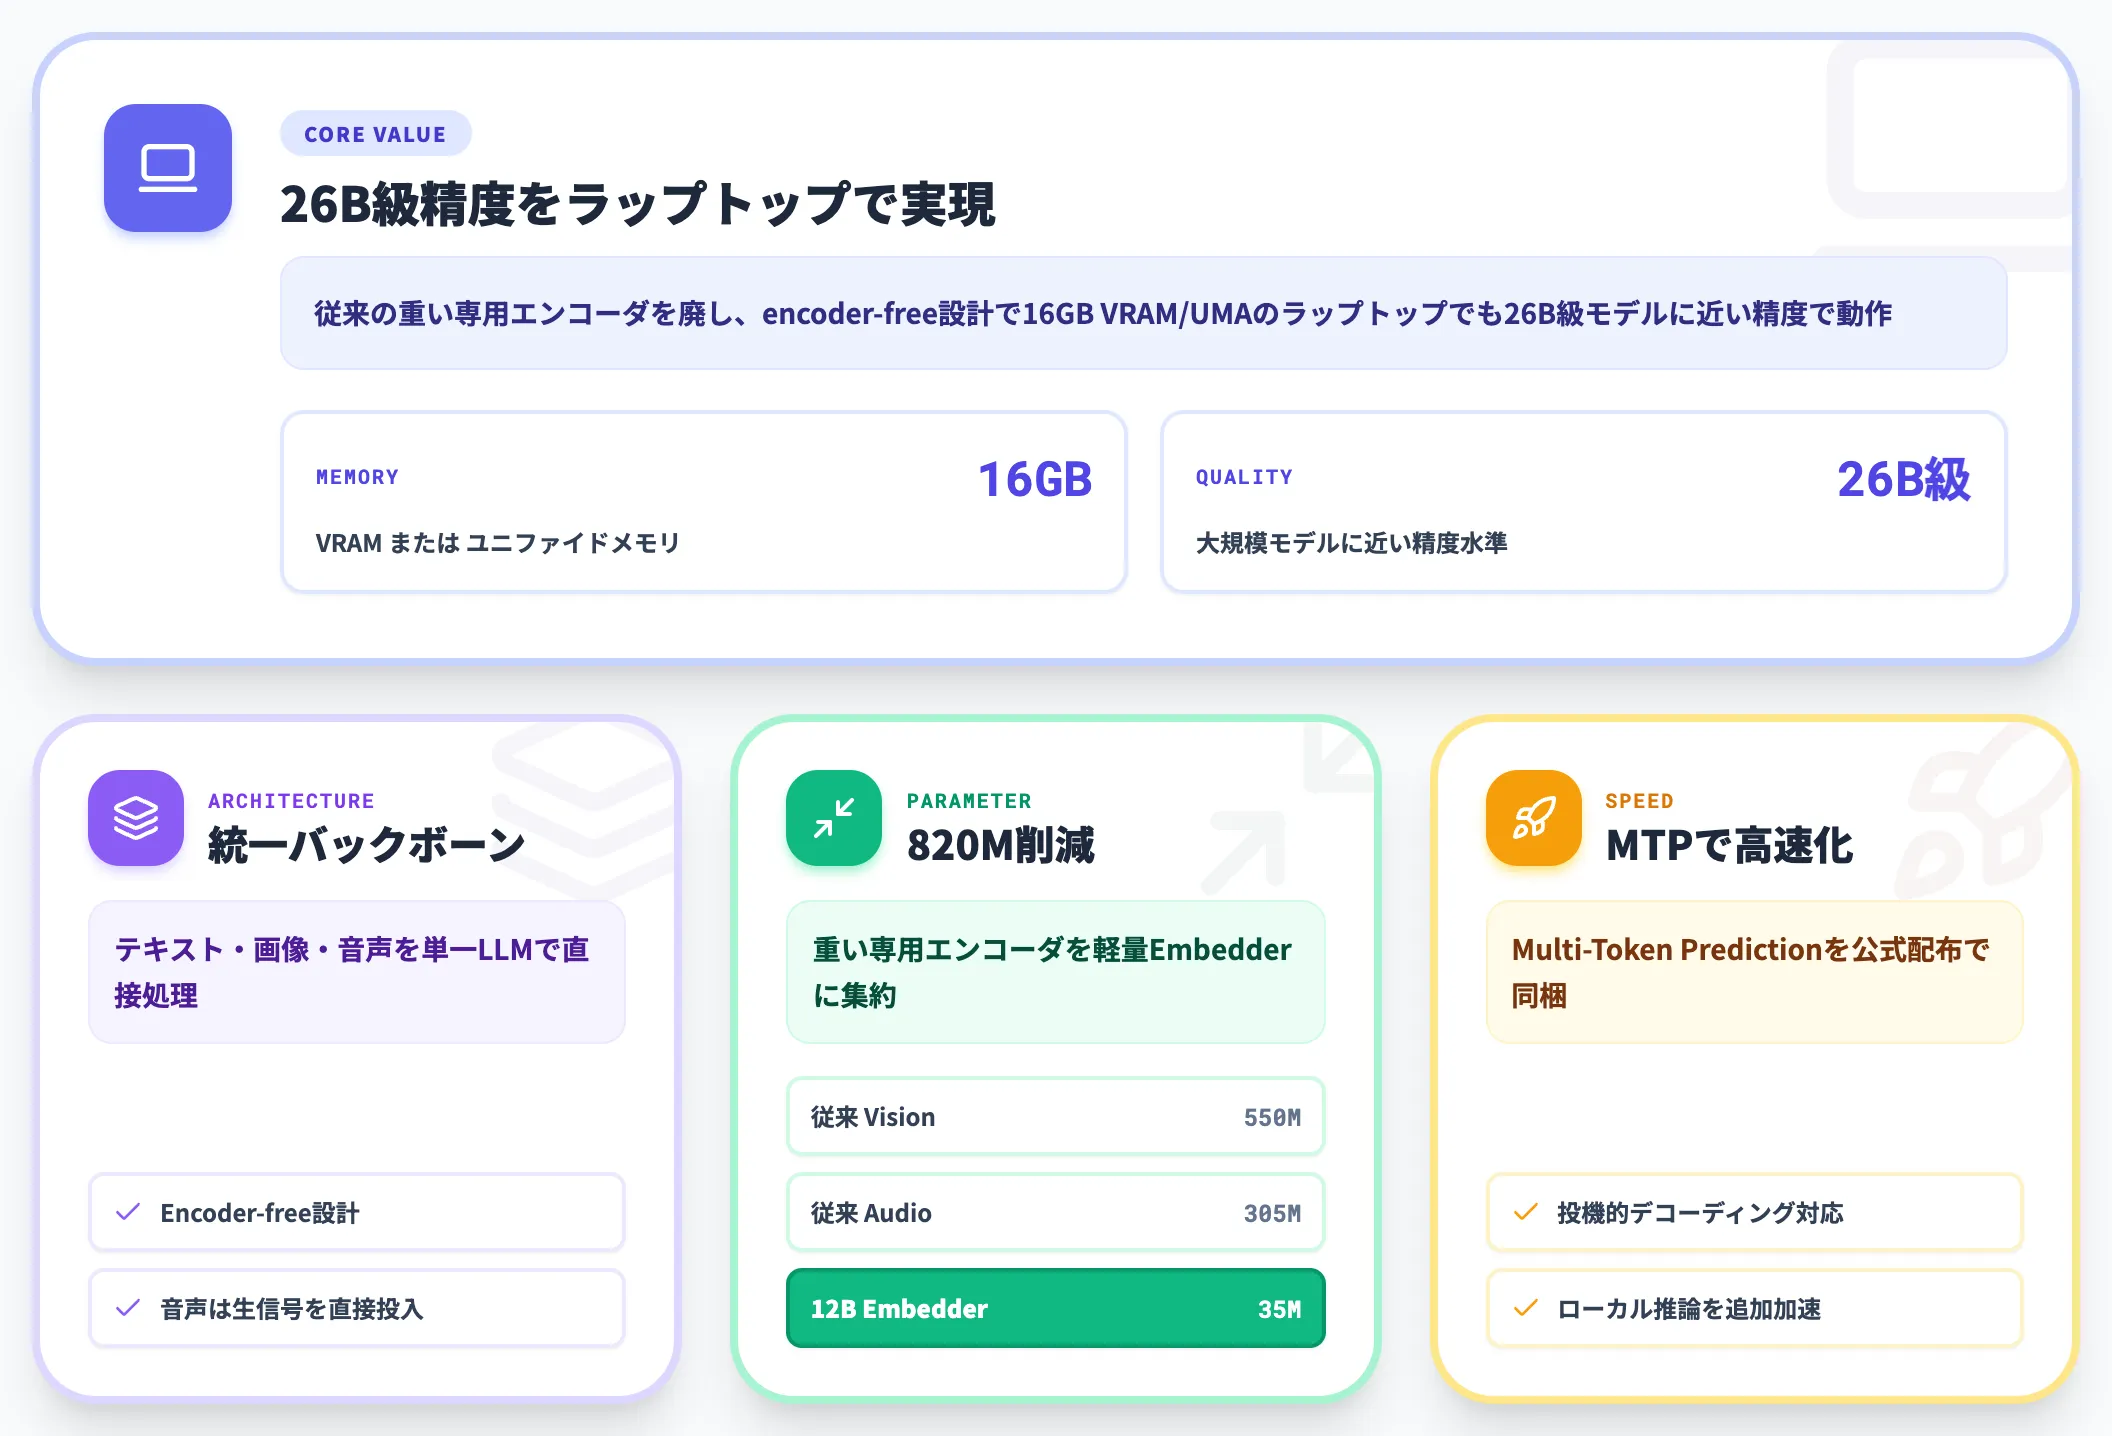
また、Gemma 4 12Bの公開と同時に、ローカル推論を高速化する専用のMulti-Token Prediction(MTP)モデルも配布されており、投機的デコーディングで推論速度をさらに引き上げられます。
その結果、16GB VRAMまたはユニファイドメモリを持つラップトップで、26Bに近い性能を出せるようになりました。個人開発者や中規模チームが「クラウドに出せないデータを扱う」場面で第一候補になるモデルです。
26B A4B — MoEで単一GPUに載せる
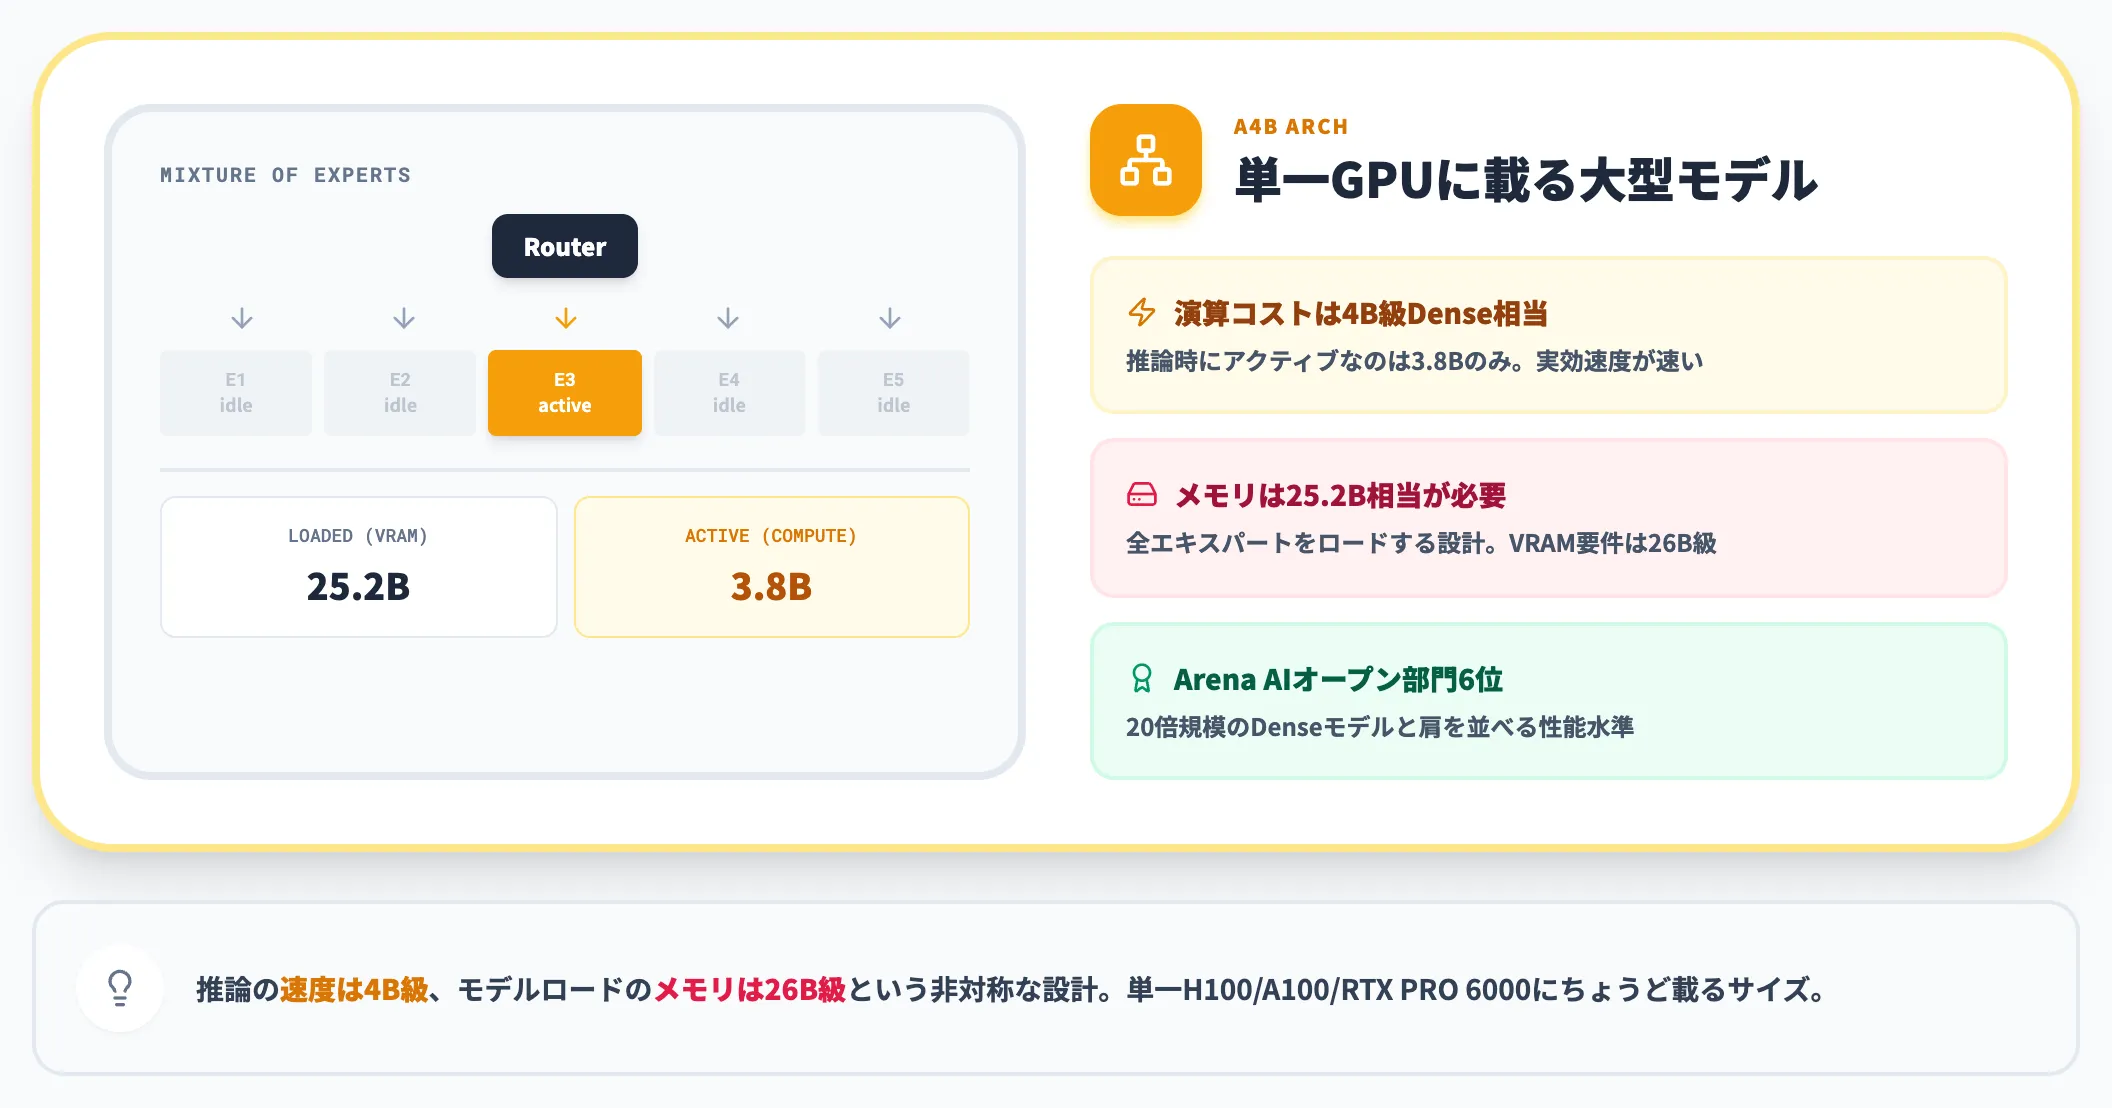
26B A4Bは、Mixture of Experts(MoE)構造を採用したモデルです。「A4B」は「Active 4B」の略で、25.2Bの総パラメータのうち推論時にアクティブになるのは3.8Bだけという設計になっています。
つまり演算速度は4B級Denseモデルに近づく一方、モデルのロードには全25.2B相当のメモリが要ります。「速度は軽量モデル並み、メモリだけは大型モデル並み」という非対称なリソース要求が特徴で、実際にArena AIリーダーボードのオープン部門で6位(2026年4月1日時点)に入り、自分より20倍規模のモデルと肩を並べる性能を叩き出しました。
31B Dense — サーバーGPU向けのフラッグシップ
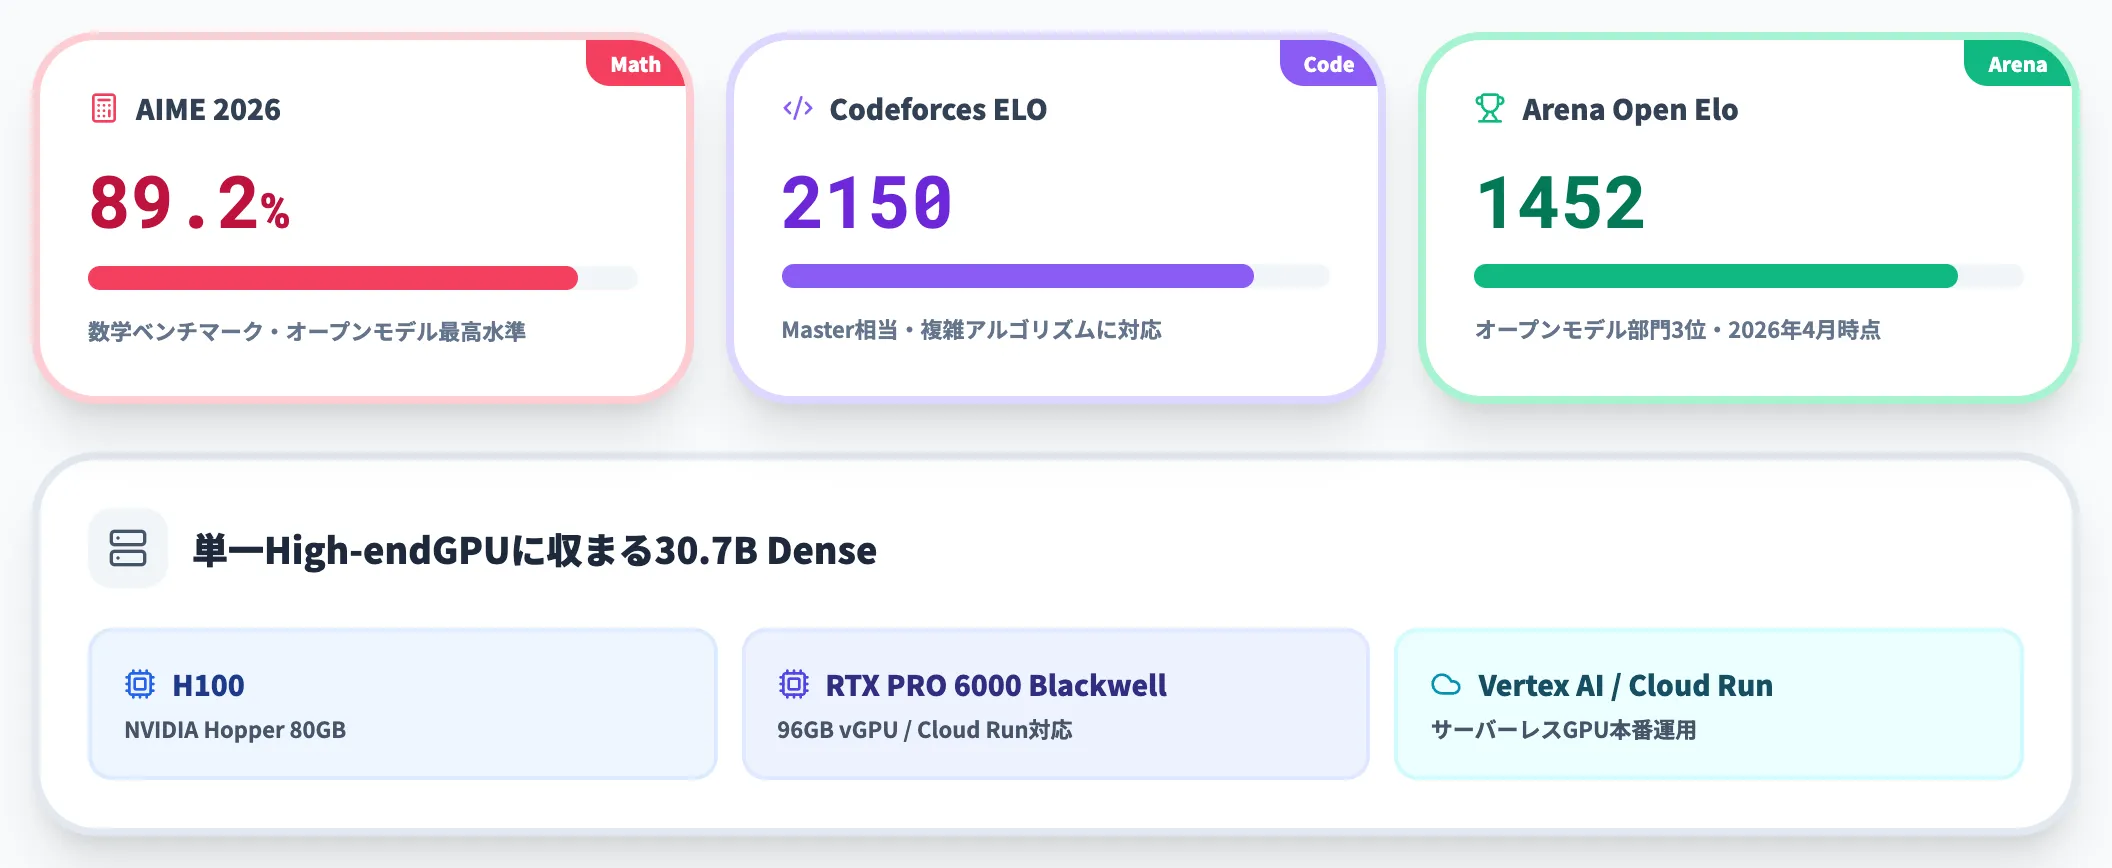
31B Denseは、Gemma 4シリーズで最も高性能な密なモデルです。総パラメータ30.7Bを全て推論に使うDense構造で、AIME 2026で89.2%、Codeforces ELOで2150(Master相当)というスコアを記録しました。
サイズ的にはHigh-endGPU(H100・RTX PRO 6000 Blackwell等)1枚に載る範囲に収まりながら、Arena AIのオープンモデル部門で3位(Elo 1452・2026年4月1日時点)に食い込み、クラウド提供のフロンティアモデルに次ぐ位置にランクインしています。
ワークステーションでの検証からVertex AIやCloud RunのサーバーレスGPUに乗せた本番運用まで、同じ重みで通せるのが実務上の強みです。
モデル選定の判断軸
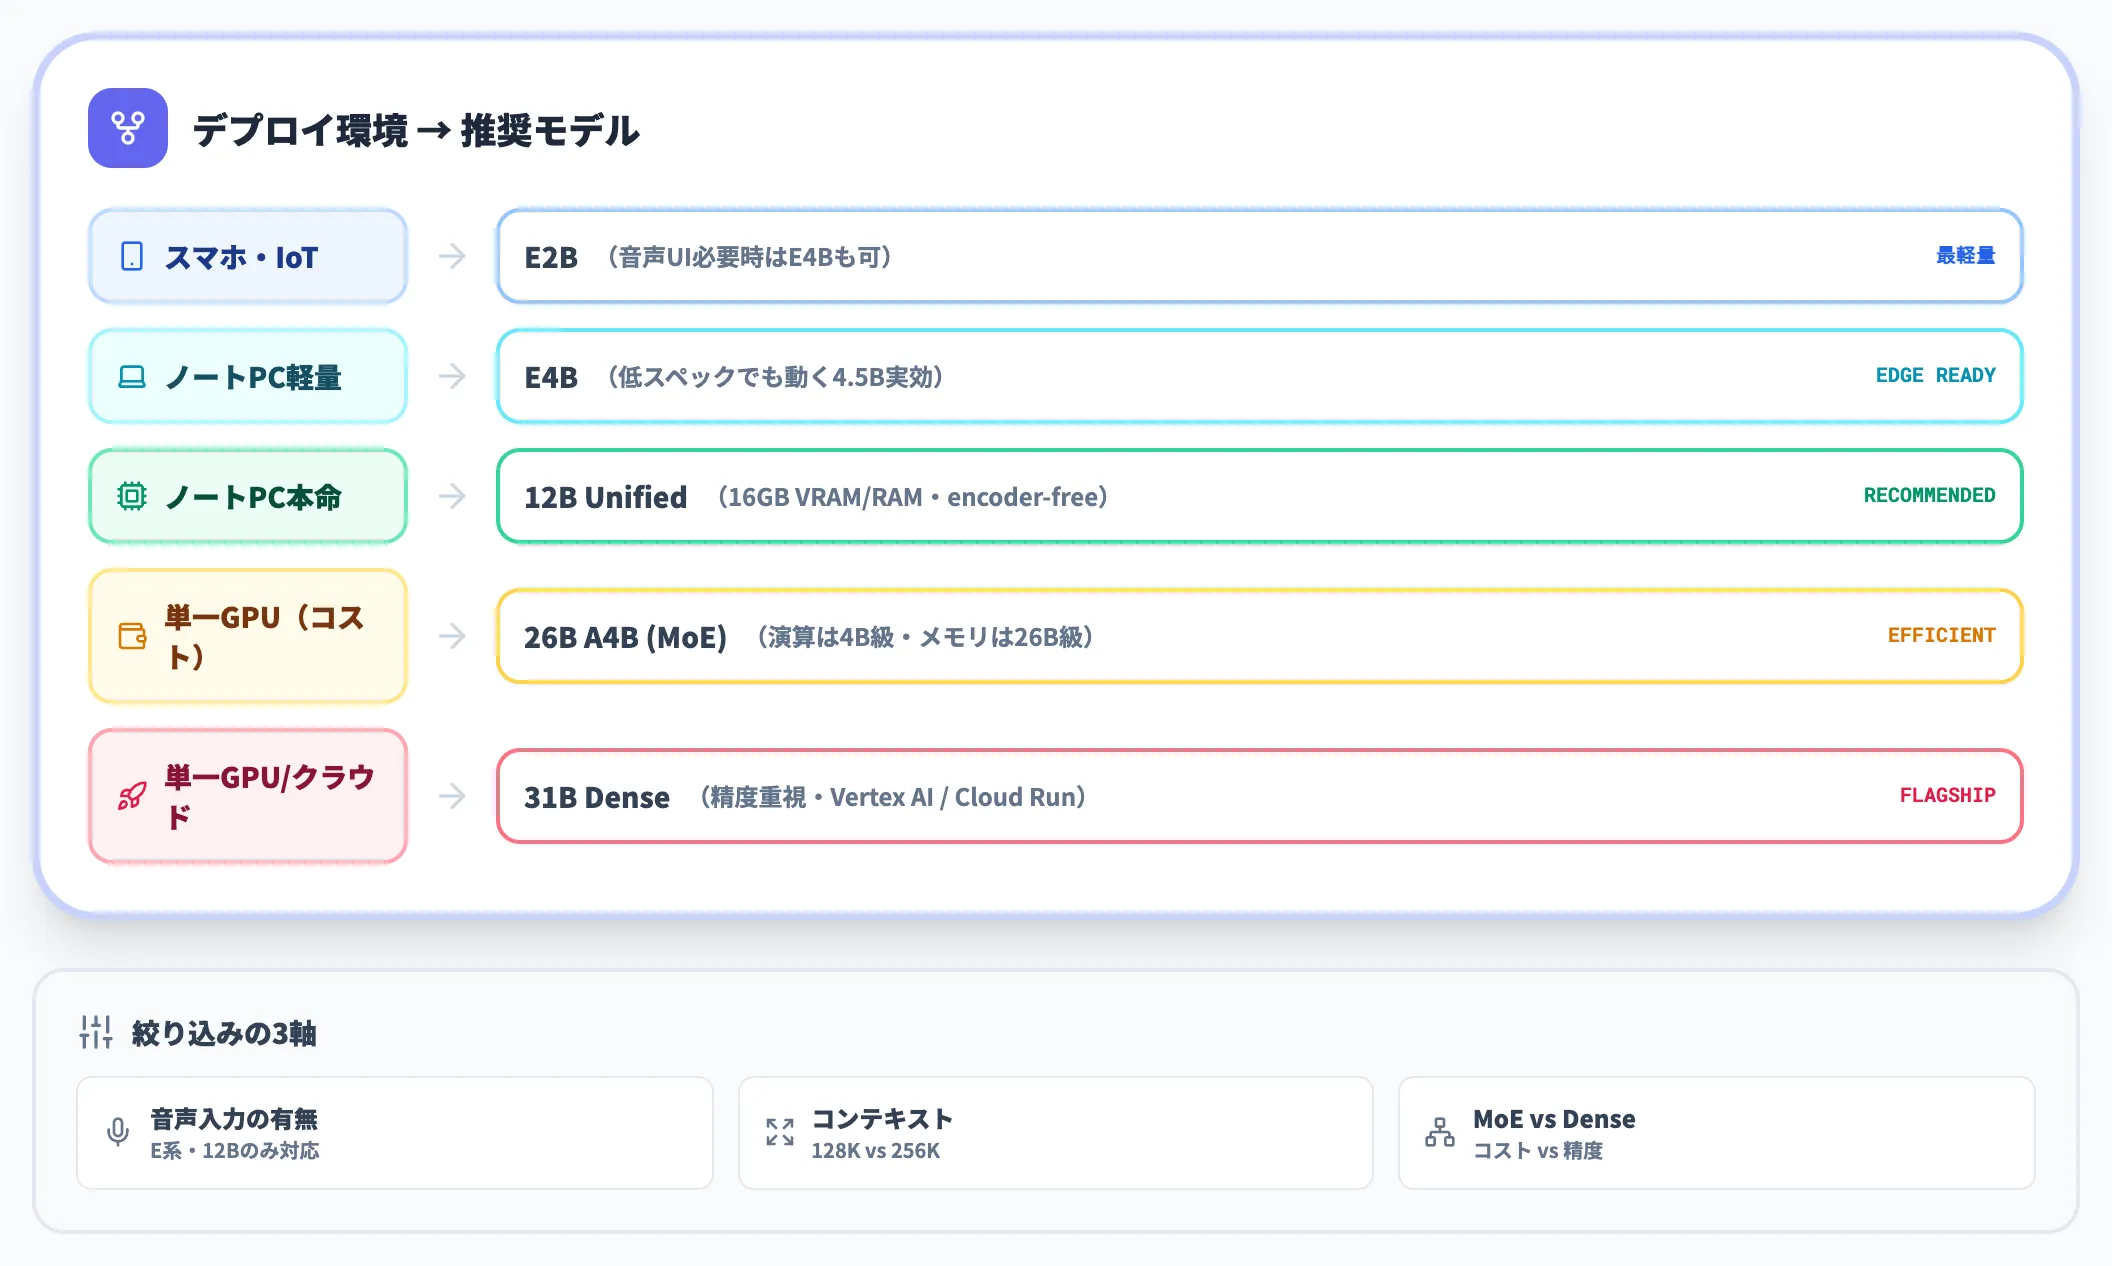
5モデルから何を選ぶかは、デプロイ環境と処理する情報量で決まります。実務での選び方は以下のように整理できます。
-
スマートフォン・IoTデバイスで動かす
E2Bが第一候補。音声UIを組みたい場合はE2B/E4Bのオンデバイス音声認識が使えます
-
ノートPCで社内文書処理を回す
16GB以上のVRAMやユニファイドメモリがあれば12B Unifiedが最適。より軽く動かすならE4B
-
単一GPUで社内AI基盤を構築する
コスト重視なら26B A4B(MoE)、精度重視なら31B Dense
-
Vertex AI・Cloud Runでスケーラブルに提供する
31B Denseがサーバーレス構成でもマネージド構成でも使いやすい
-
音声入力を含むマルチモーダル処理
E2B・E4B・12B Unifiedのいずれか。26B・31Bは音声非対応
音声入力の有無、コンテキスト長(128K vs 256K)、MoEかDenseかの3軸で分岐すれば、自社の要件に合うモデルが絞り込めます。
Gemma 4の主要機能とGemma 3からの進化
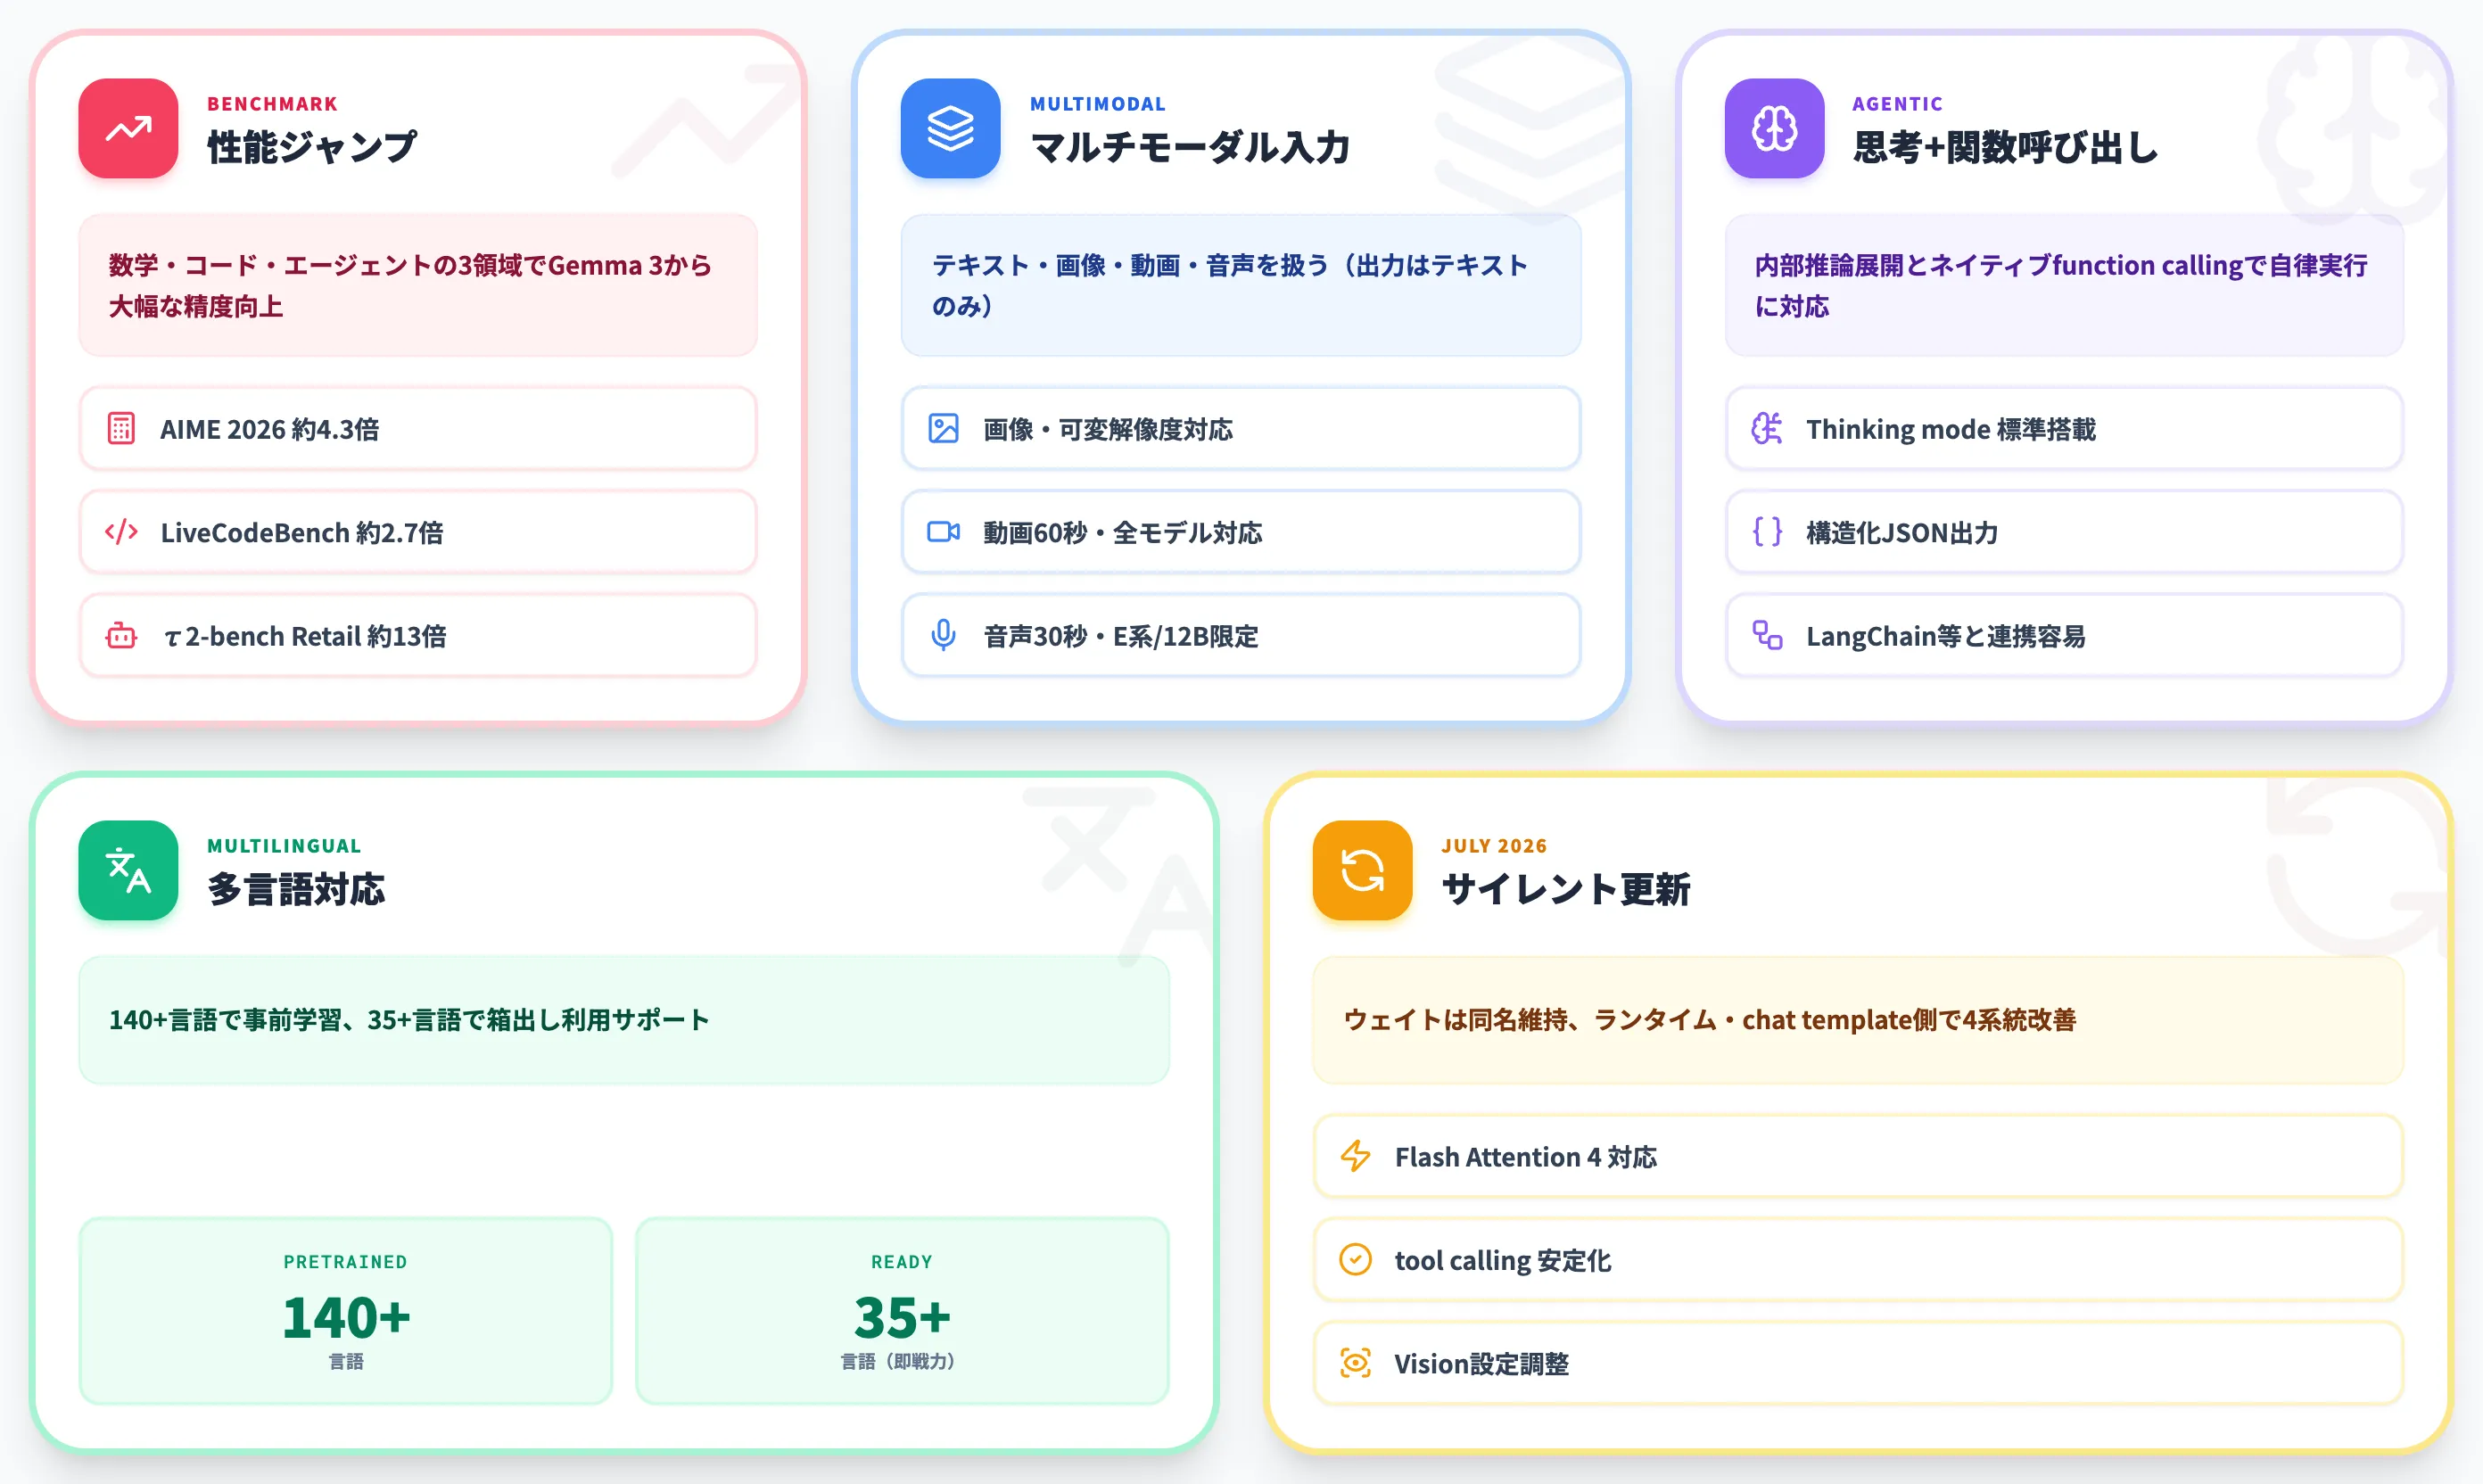
Gemma 4は、Gemma 3までの「軽量オープンモデル」路線を大きく拡張し、フロンティアモデルに近い機能を盛り込んでいます。ここではGemma 3からの性能ジャンプと、代表的な機能を整理します。
Gemma 3から4への性能ジャンプ
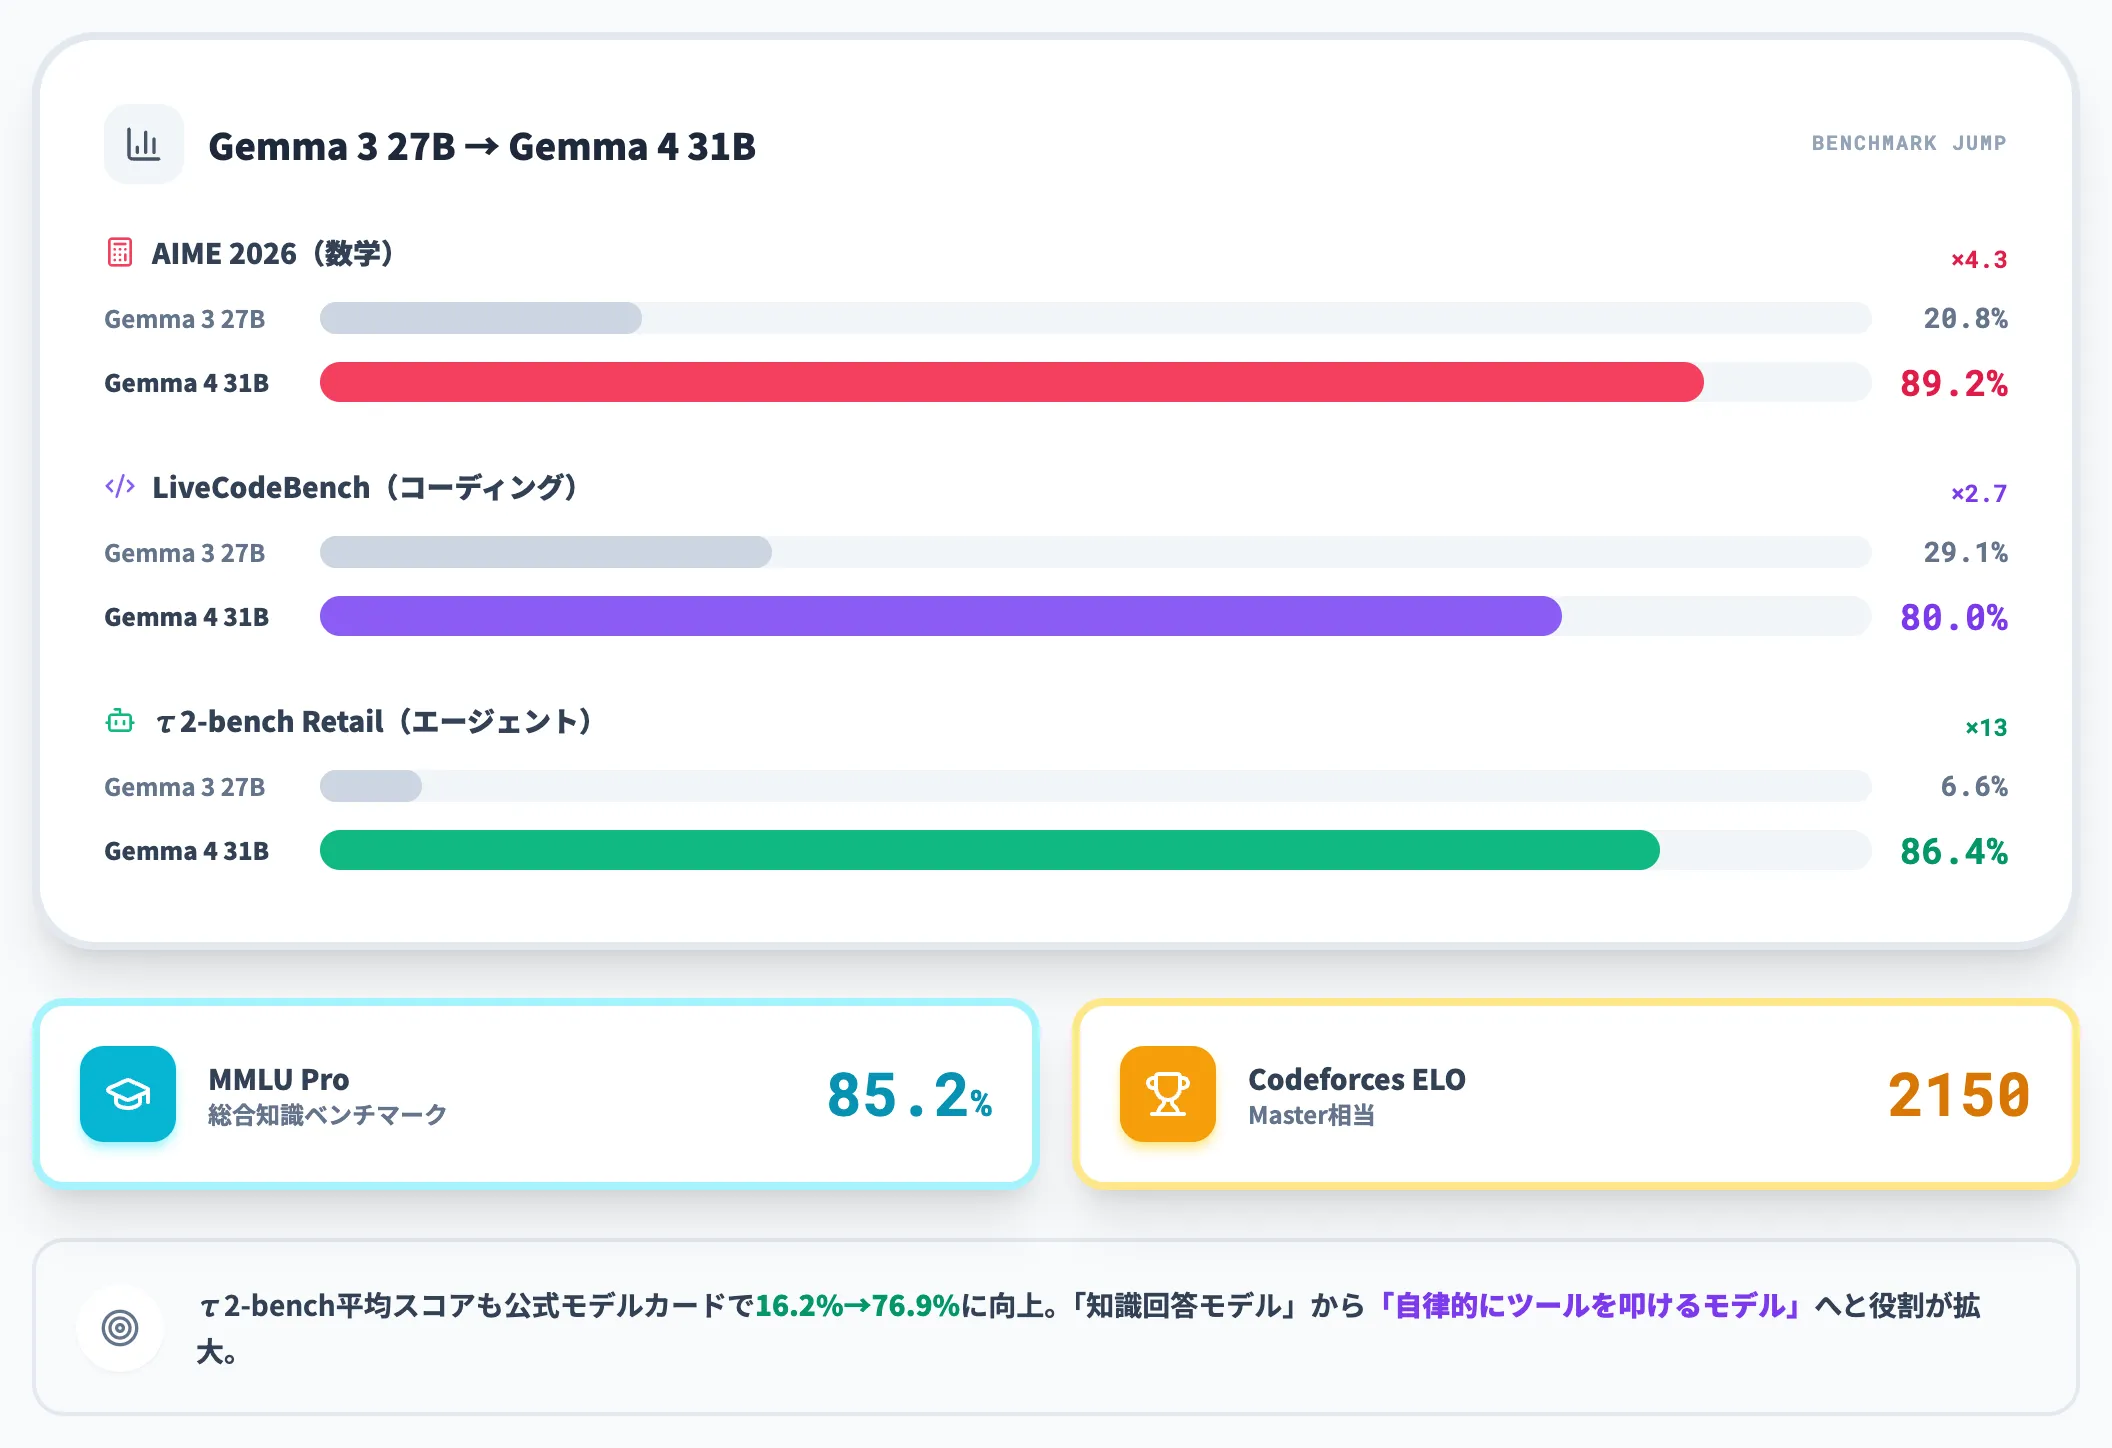
Gemma 4公式ブログによれば、数学・コーディング・エージェンティックなツール使用の3領域で大幅なジャンプが確認されています。以下の表で、代表的なベンチマークの比較を整理しました。
| ベンチマーク | Gemma 3 27B | Gemma 4 31B | 伸び |
|---|---|---|---|
| AIME 2026(数学) | 20.8% | 89.2% | 約4.3倍 |
| LiveCodeBench(コーディング) | 29.1% | 80.0% | 約2.7倍 |
| τ2-bench Retail(エージェント) | 6.6% | 86.4% | 約13倍 |
| MMLU Pro | — | 85.2% | — |
| Codeforces ELO | — | 2150 | Master相当 |
特に伸びが目立つのはエージェント領域で、Gemma 4を単なる「知識回答モデル」から「自律的にツールを叩けるモデル」へ引き上げた最大の要因になっています。
公式モデルカードのτ2-bench平均スコアも16.2%→76.9%へと跳ね上がっており、業務自動化の候補として検証テーブルに載せる価値が明確に高まったと言えます。
マルチモーダル対応 — 画像・動画・音声
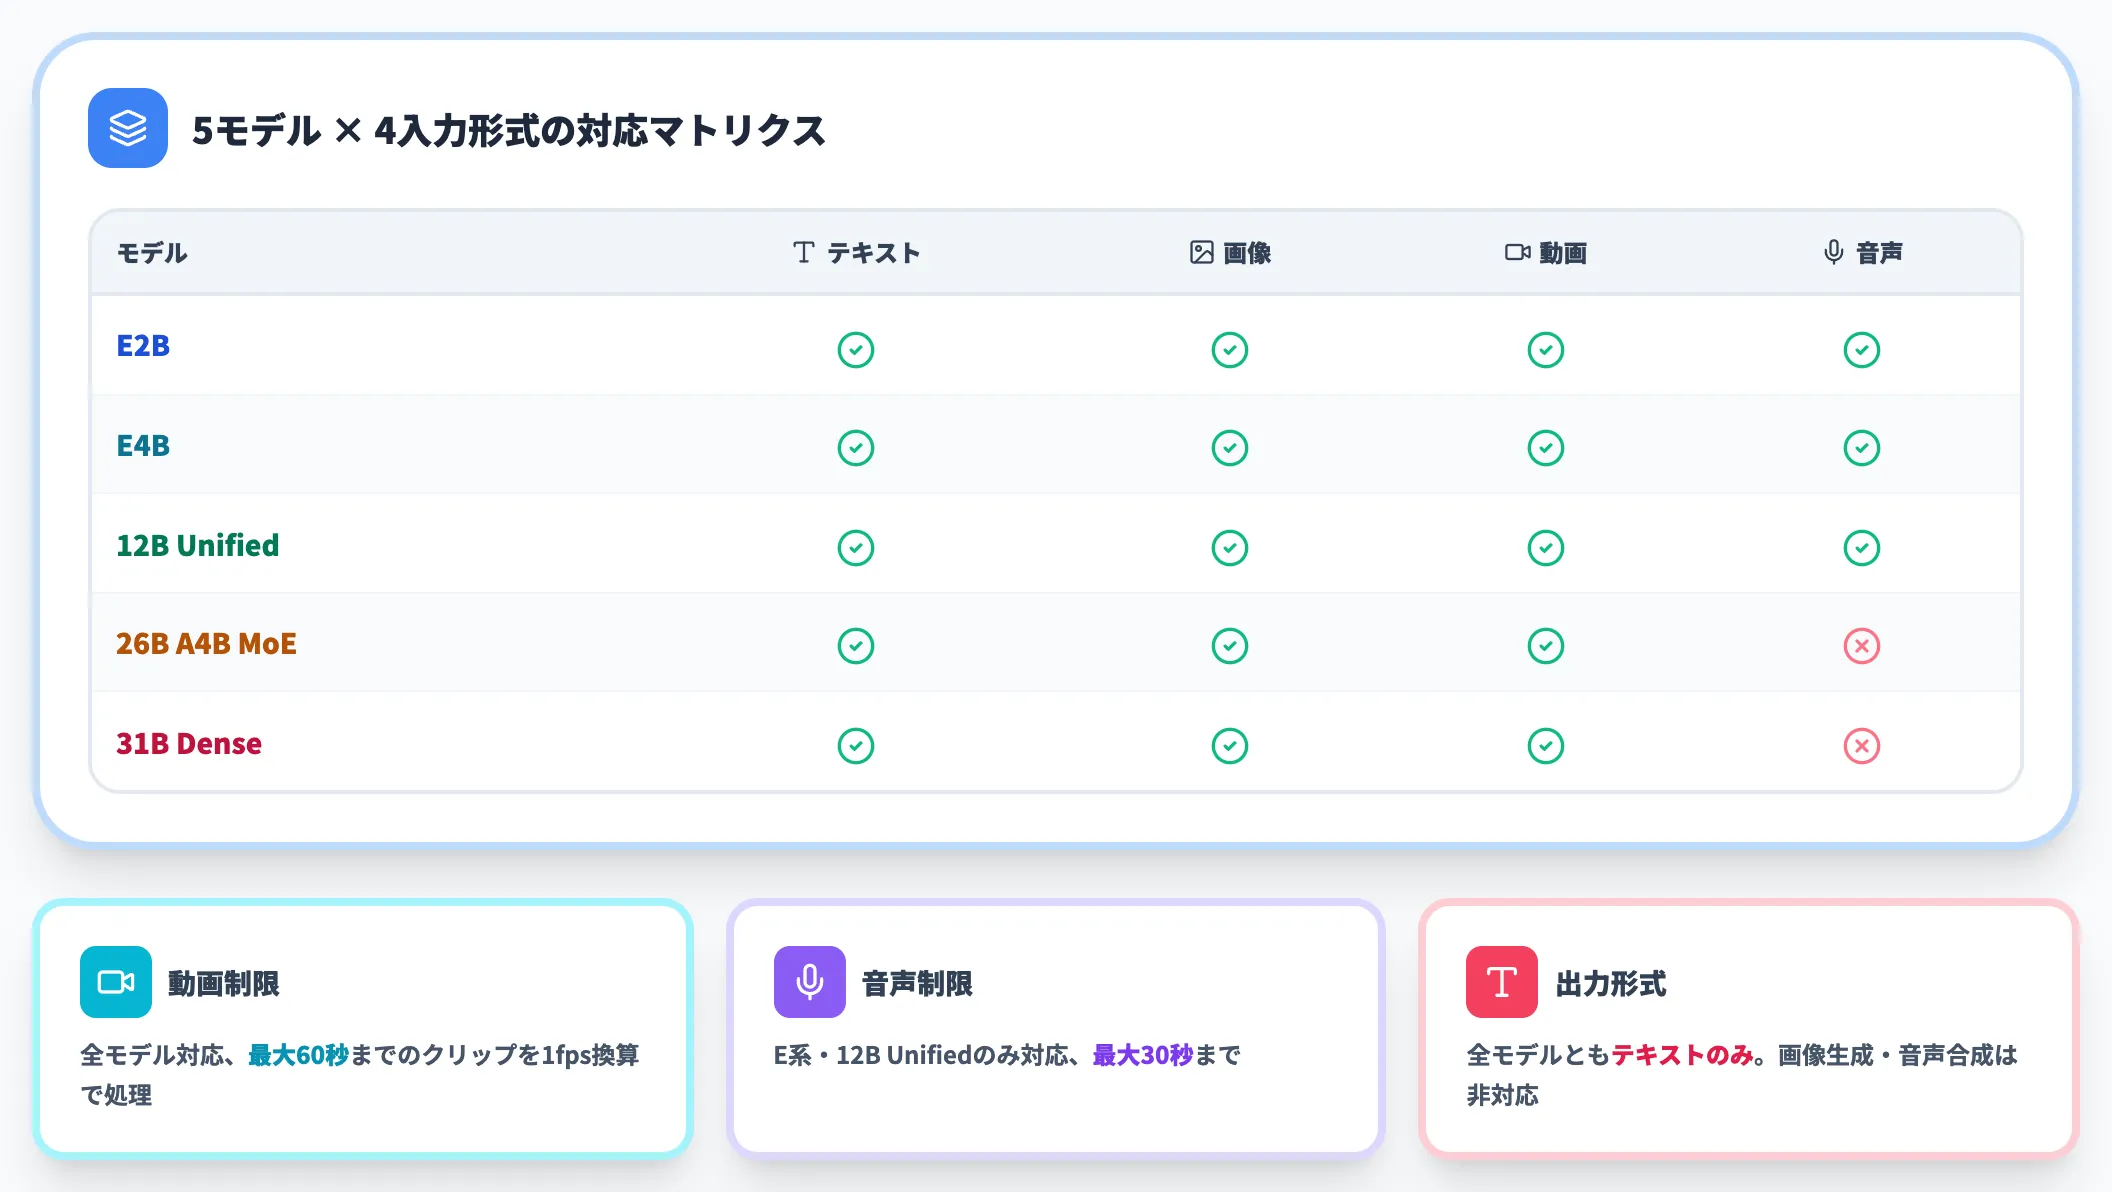
Gemma 4は、5モデルすべてでテキストと画像入力を扱えます。
可変解像度・可変アスペクト比の画像もそのまま渡せるため、スクリーンショットや図面の解析をそのまま業務に載せられるレベルです。
動画入力は26B・31Bを含む全モデルで対応し、1fps換算のフレーム処理で最大60秒までのクリップを解釈できます。
音声入力はE2B・E4B・12B Unifiedの3モデルに限られ、こちらは最大30秒までがサポート範囲です。裏を返すと26B MoEと31B Denseは音声非対応で、テキスト・画像・動画の3モードでの利用が前提となります。
一方で、出力は全モデルともテキストのみという制約があります。
画像生成や音声合成はサポート範囲外なので、生成側のマルチモーダルを組みたい場合はGeminiやGemini Omniといった別モデルと組み合わせる設計になります。
思考モードとエージェンティック機能
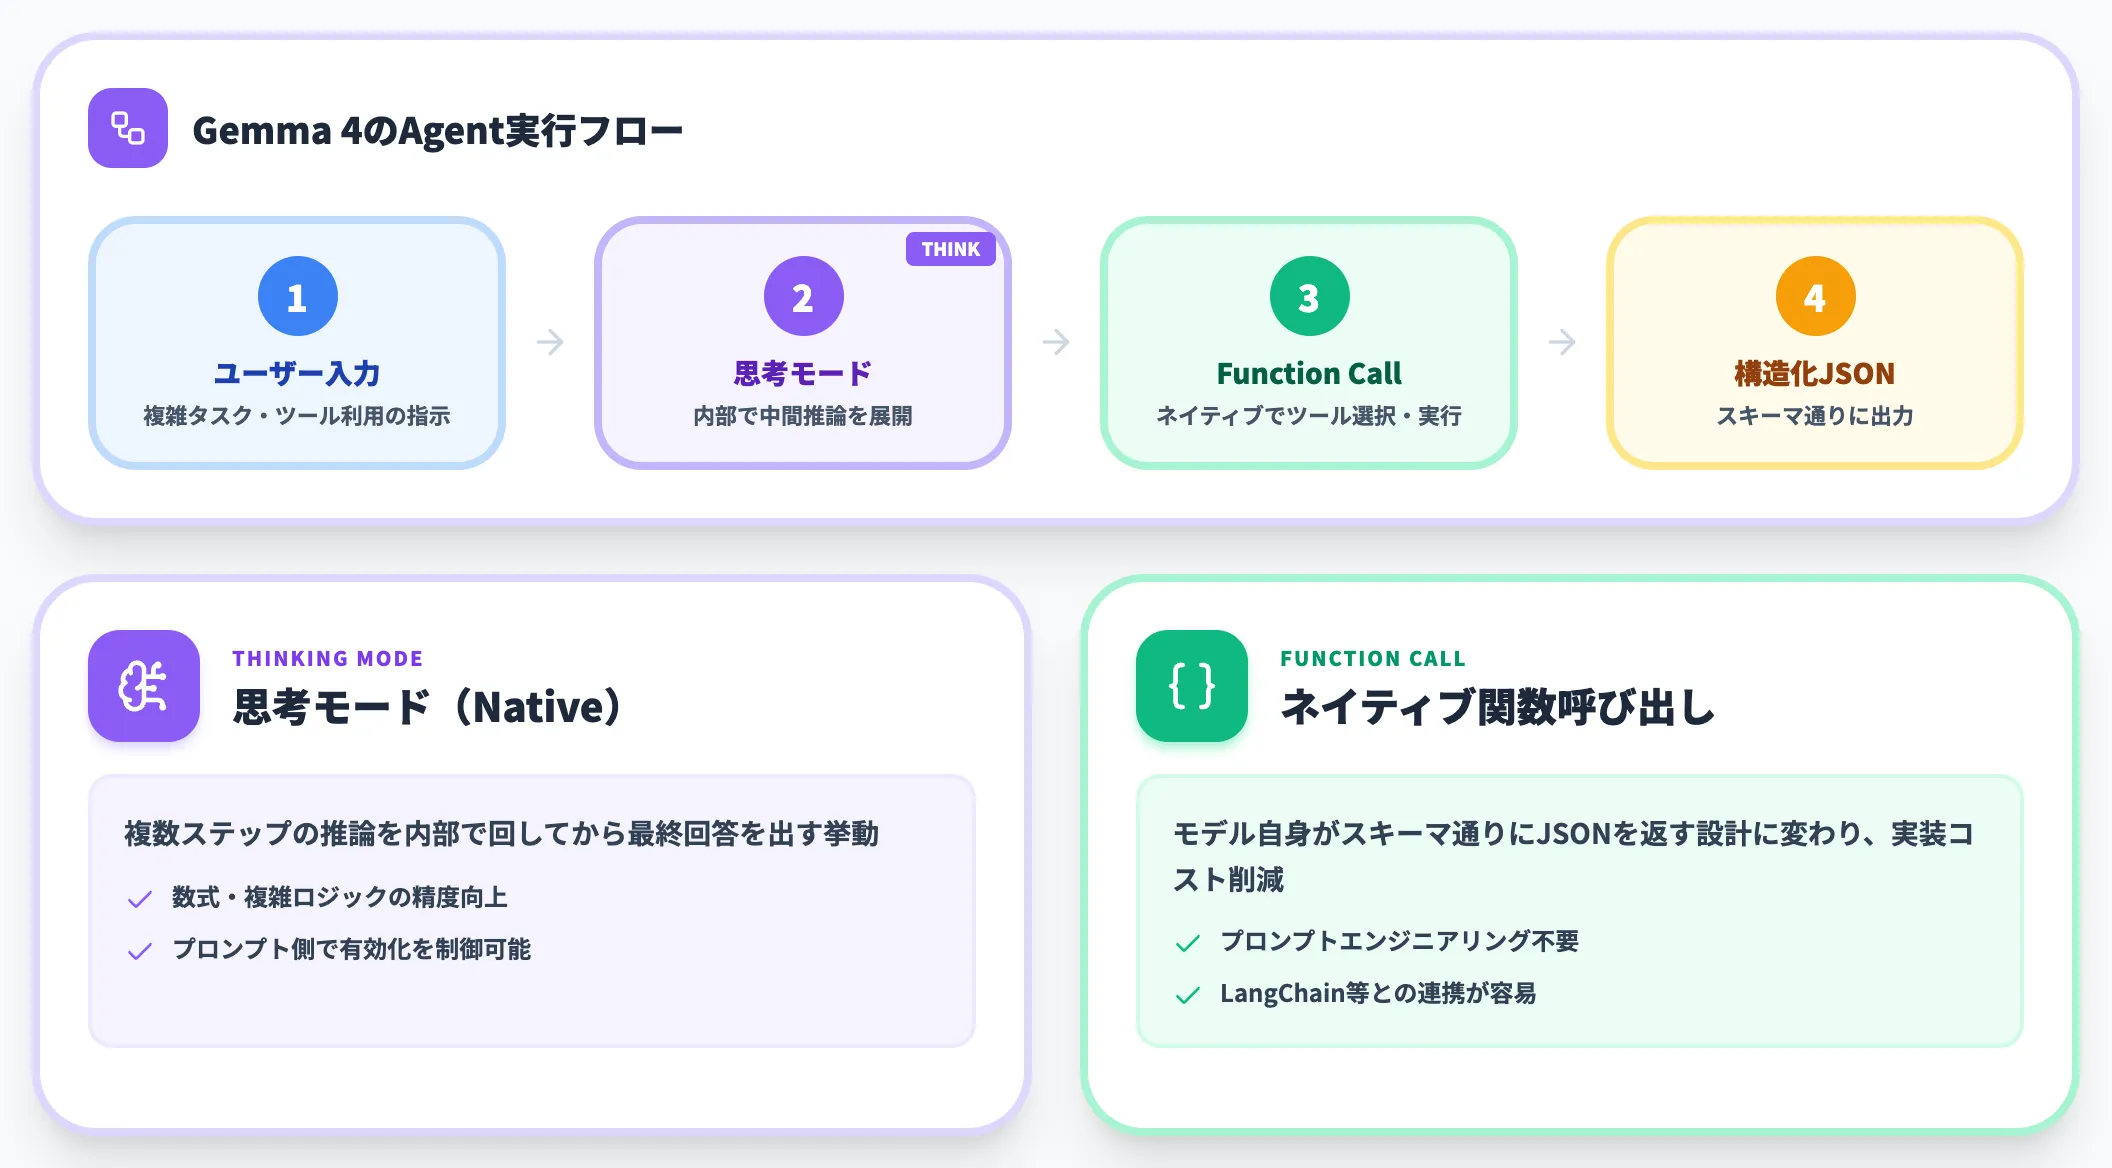
Gemma 4は、複数ステップの推論を内部で回す「思考モード(Thinking mode)」をネイティブサポートします。
数式や複雑なロジックを含むタスクで、モデル内部で中間推論を一度展開してから最終回答を返す挙動です。
もう一つの中核が、ネイティブ関数呼び出しと構造化JSON出力です。
従来はプロンプトエンジニアリングやライブラリ側のパースで補っていた部分を、モデル自身がスキーマ通りのJSONで返すように設計が置き換わっています。LangChainなどのエージェントフレームワークとの噛み合わせがよく、実装コストがそのまま削れるのが実務側のメリットです。
Gemma 4はGoogle AI Edge上でAgent Skillsとしてエッジデバイスに配布できる(出典:Google Developers Blog)
多言語対応 — 140言語で事前学習、35言語で即戦力
Gemma 4は、公式モデルカードによると140を超える言語で事前学習され、うち35を超える言語で「箱出し利用」がサポートされています。
この多言語カバレッジは、翻訳や要約に留まらず、多言語カスタマーサポート・多国籍拠点の議事録処理・非英語ドキュメントのRAGといった業務にそのまま効いてきます。
オープンモデルの中でも横に広い言語対応が取れている点は、Gemma 4の実務的な選定理由になりやすいポイントです。
2026年7月のサイレントアップデート
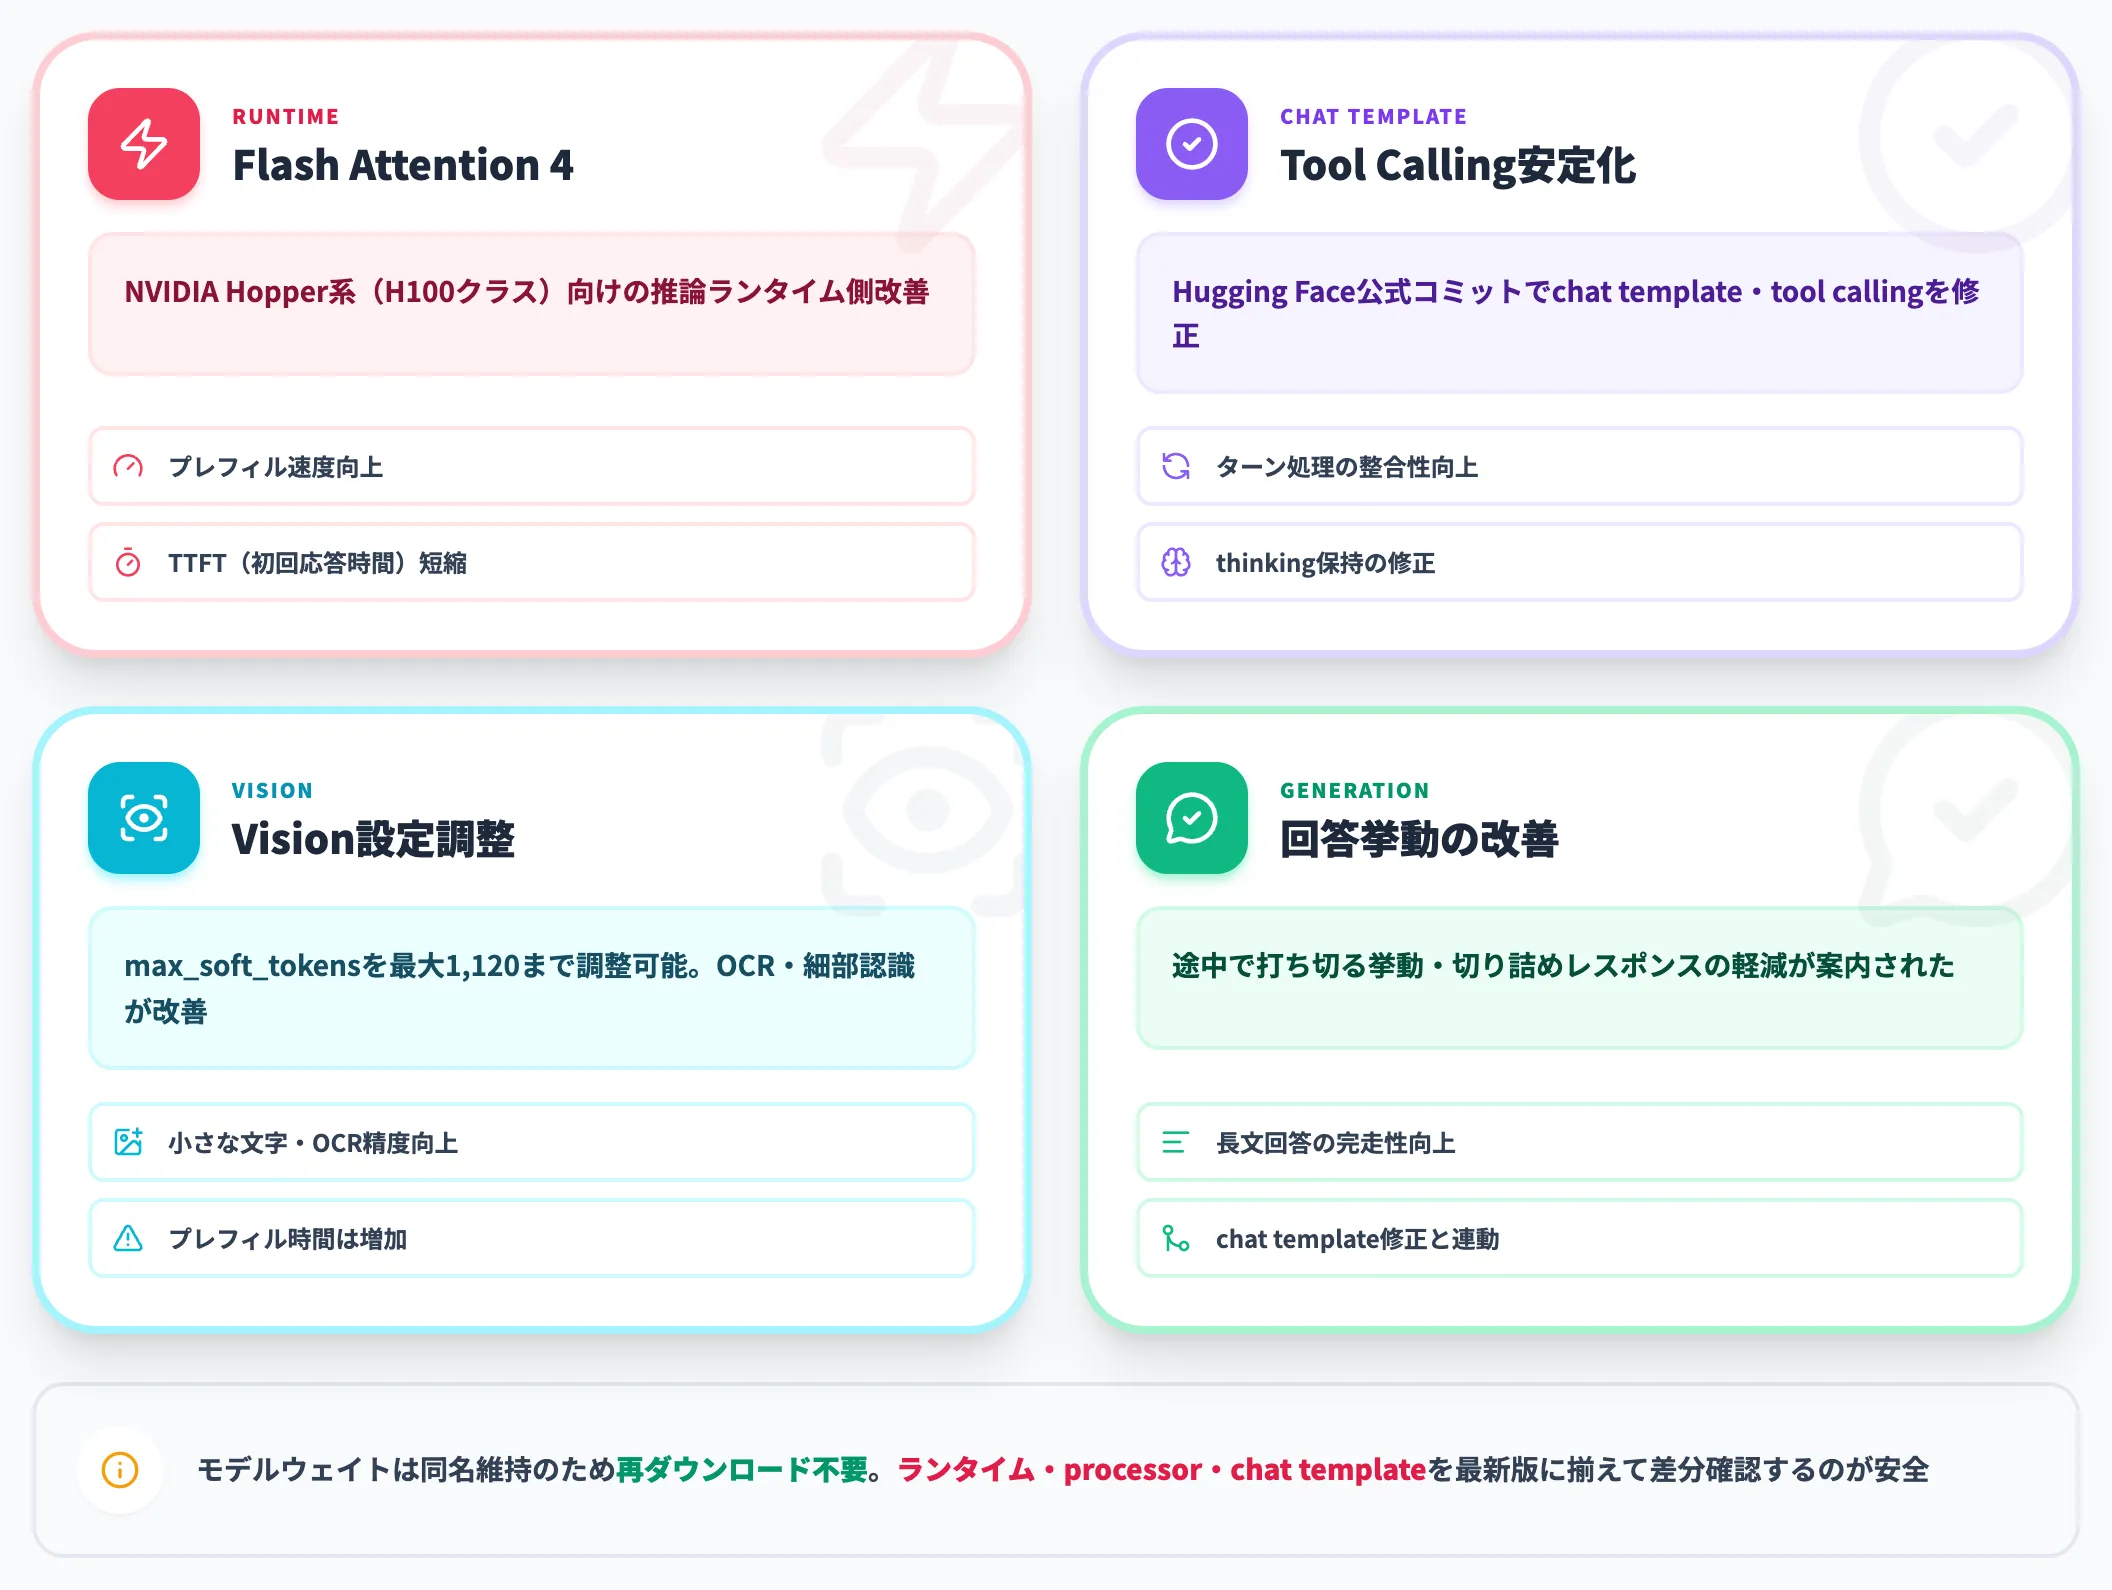
Gemma 4は、2026年7月にGoogleが公式X(旧Twitter)投稿で複数の改善を案内しました。
ただしモデルウェイトそのものは同名のまま維持されており(Hugging Faceのファイル履歴でconfig.jsonとprocessor_config.jsonが未更新である点から確認できます)、実際に手が入ったのはランタイム・chat template・vision設定・回答挙動という4系統の周辺レイヤーです。
-
Flash Attention 4(FA4)対応
NVIDIA Hopper系(H100クラス)向けの推論ランタイム側の対応で、プレフィル速度の向上とTTFT短縮の効果が報告されています
-
ツール呼び出しの安定化
Hugging Face公式コミットでchat template・tool callingのターン処理・thinking保持を修正
-
Vision設定の調整
max_soft_tokensを最大1,120まで調整可能。値を上げるとOCRや小さな文字など細部の認識が向上する一方、計算量とプレフィル時間は増える
-
回答挙動の改善
Googleが「途中で回答を打ち切る挙動」や切り詰めレスポンスの軽減を案内。chat templateの修正と連動して効果が出る領域
2026年4月〜6月に環境を組んだチームは、モデルウェイトの再ダウンロードは基本的に不要ですが、利用中のランタイム・processor・chat templateを最新版に揃え、差分を確認しておくと安全です。
Gemma 4と競合オープンモデルの比較
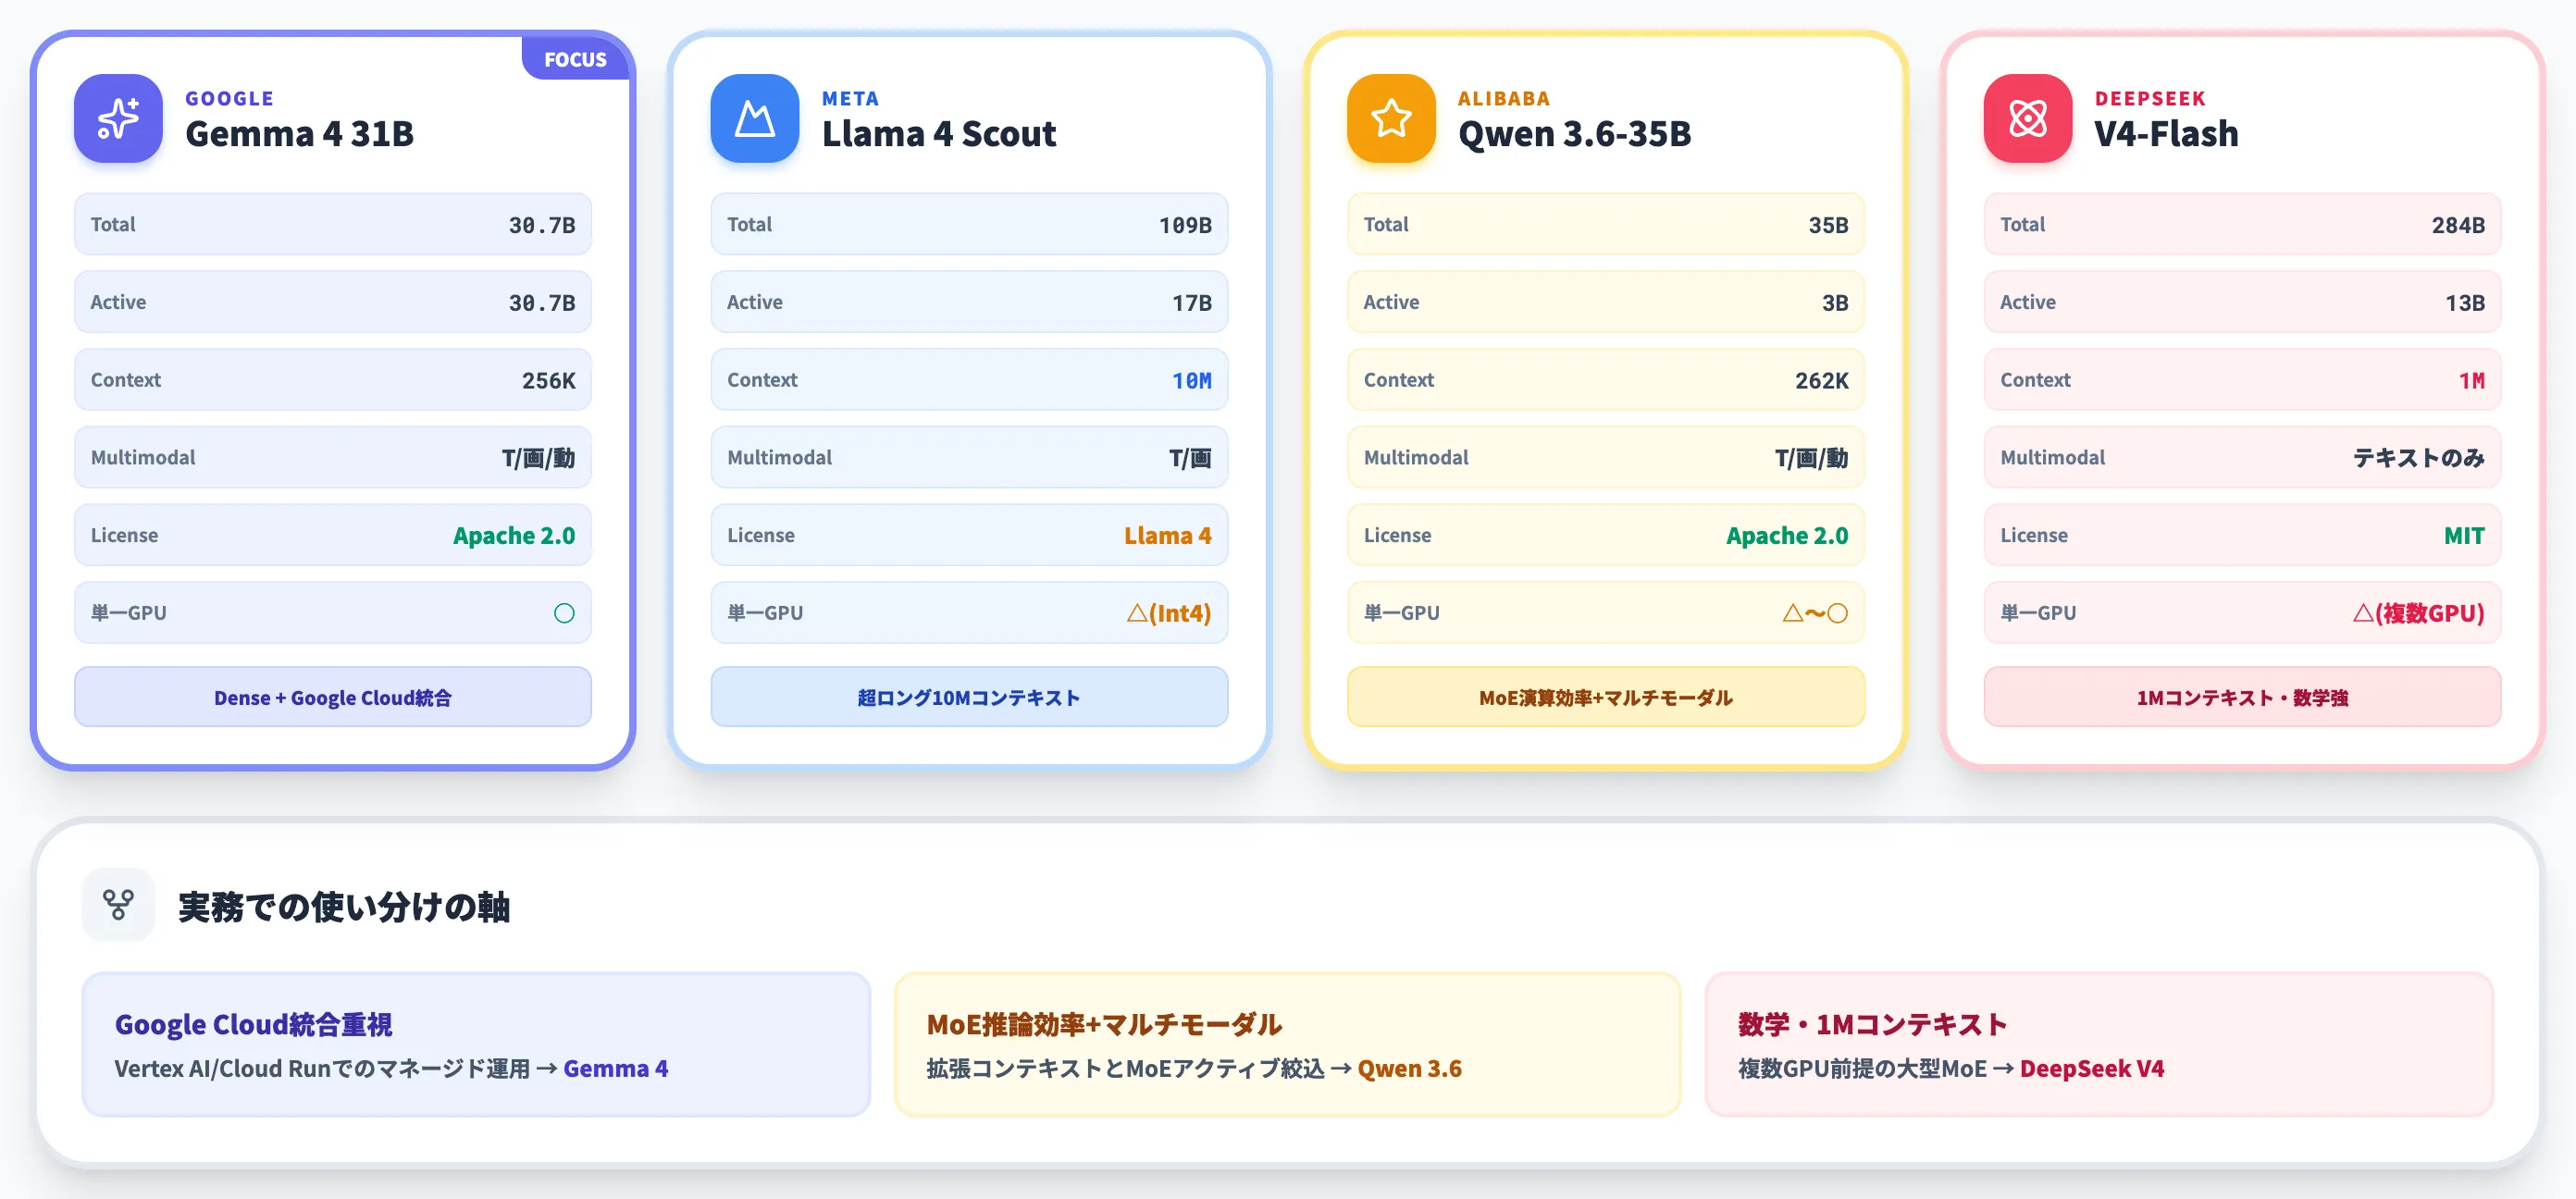
Gemma 4を評価するときの比較対象は、Meta Llama 4系、Alibaba Qwen 3.6系、DeepSeek V4系の3系統になります。
以下の表で、2026年7月時点の代表的な差分を整理しました。
| 項目 | Gemma 4 31B | Llama 4 Scout | Qwen 3.6-35B-A3B | DeepSeek V4-Flash |
|---|---|---|---|---|
| 総パラメータ | 30.7B | 109B | 35B(MoE) | 284B(MoE) |
| アクティブ/実効 | 30.7B | 17B | 3B | 13B |
| コンテキスト | 256K | 10M | 262K(約1M拡張可) | 1M |
| マルチモーダル | テキスト/画像/動画 | テキスト/画像 | テキスト/画像/動画 | テキストのみ |
| ライセンス | Apache 2.0 | Llama 4 Community License | Apache 2.0 | MIT |
| 商用利用 | Apache 2.0条件下で可 | リリース日時点の前月MAU7億超は別途許諾要 | Apache 2.0条件下で可 | MIT条件下で可 |
| 単一GPU適合 | ○ | △(Int4量子化・H100 1基) | △〜○(量子化・コンテキスト短縮時) | △(80〜96GB級では複数GPUが必要) |
| 主な強み | 31B Dense+公式Google Cloud提供 | 超ロング10Mコンテキスト | マルチモーダル+MoEによる推論時の演算効率 | 1Mコンテキスト・数学 |
Gemma 4 31Bの直接競合として存在感を強めているのがQwen 3.6-35B-A3Bで、マルチモーダル入力への対応でも強みが接近しています。
ただしQwen 3.6は総パラメータ35Bを丸ごとロードする必要があり、公式の262Kコンテキスト実行例も8GPUのテンソル並列構成が前提です。
したがって実務的な使い分けは、Google Cloud(Vertex AI・Cloud Run)でのマネージド運用や公式提供の運用統合を優先するならGemma 4、MoEによる推論時の演算効率や拡張コンテキストを重視するならQwen 3.6、という切り分けが現実解になります。
Llama 4はLlama 4 Community Licenseにより「Llama 4リリース日時点で、ライセンシーと関連会社の対象製品・サービスが前月MAU7億人を超えている場合」に別途許諾が必要になるため、該当規模の大企業サービスへ組み込む際は要注意です。
DeepSeek V4-Flashはテキスト専用で、一般的な80〜96GB級GPUでは複数GPU構成を前提にする必要があります。
Gemini 3系との使い分け
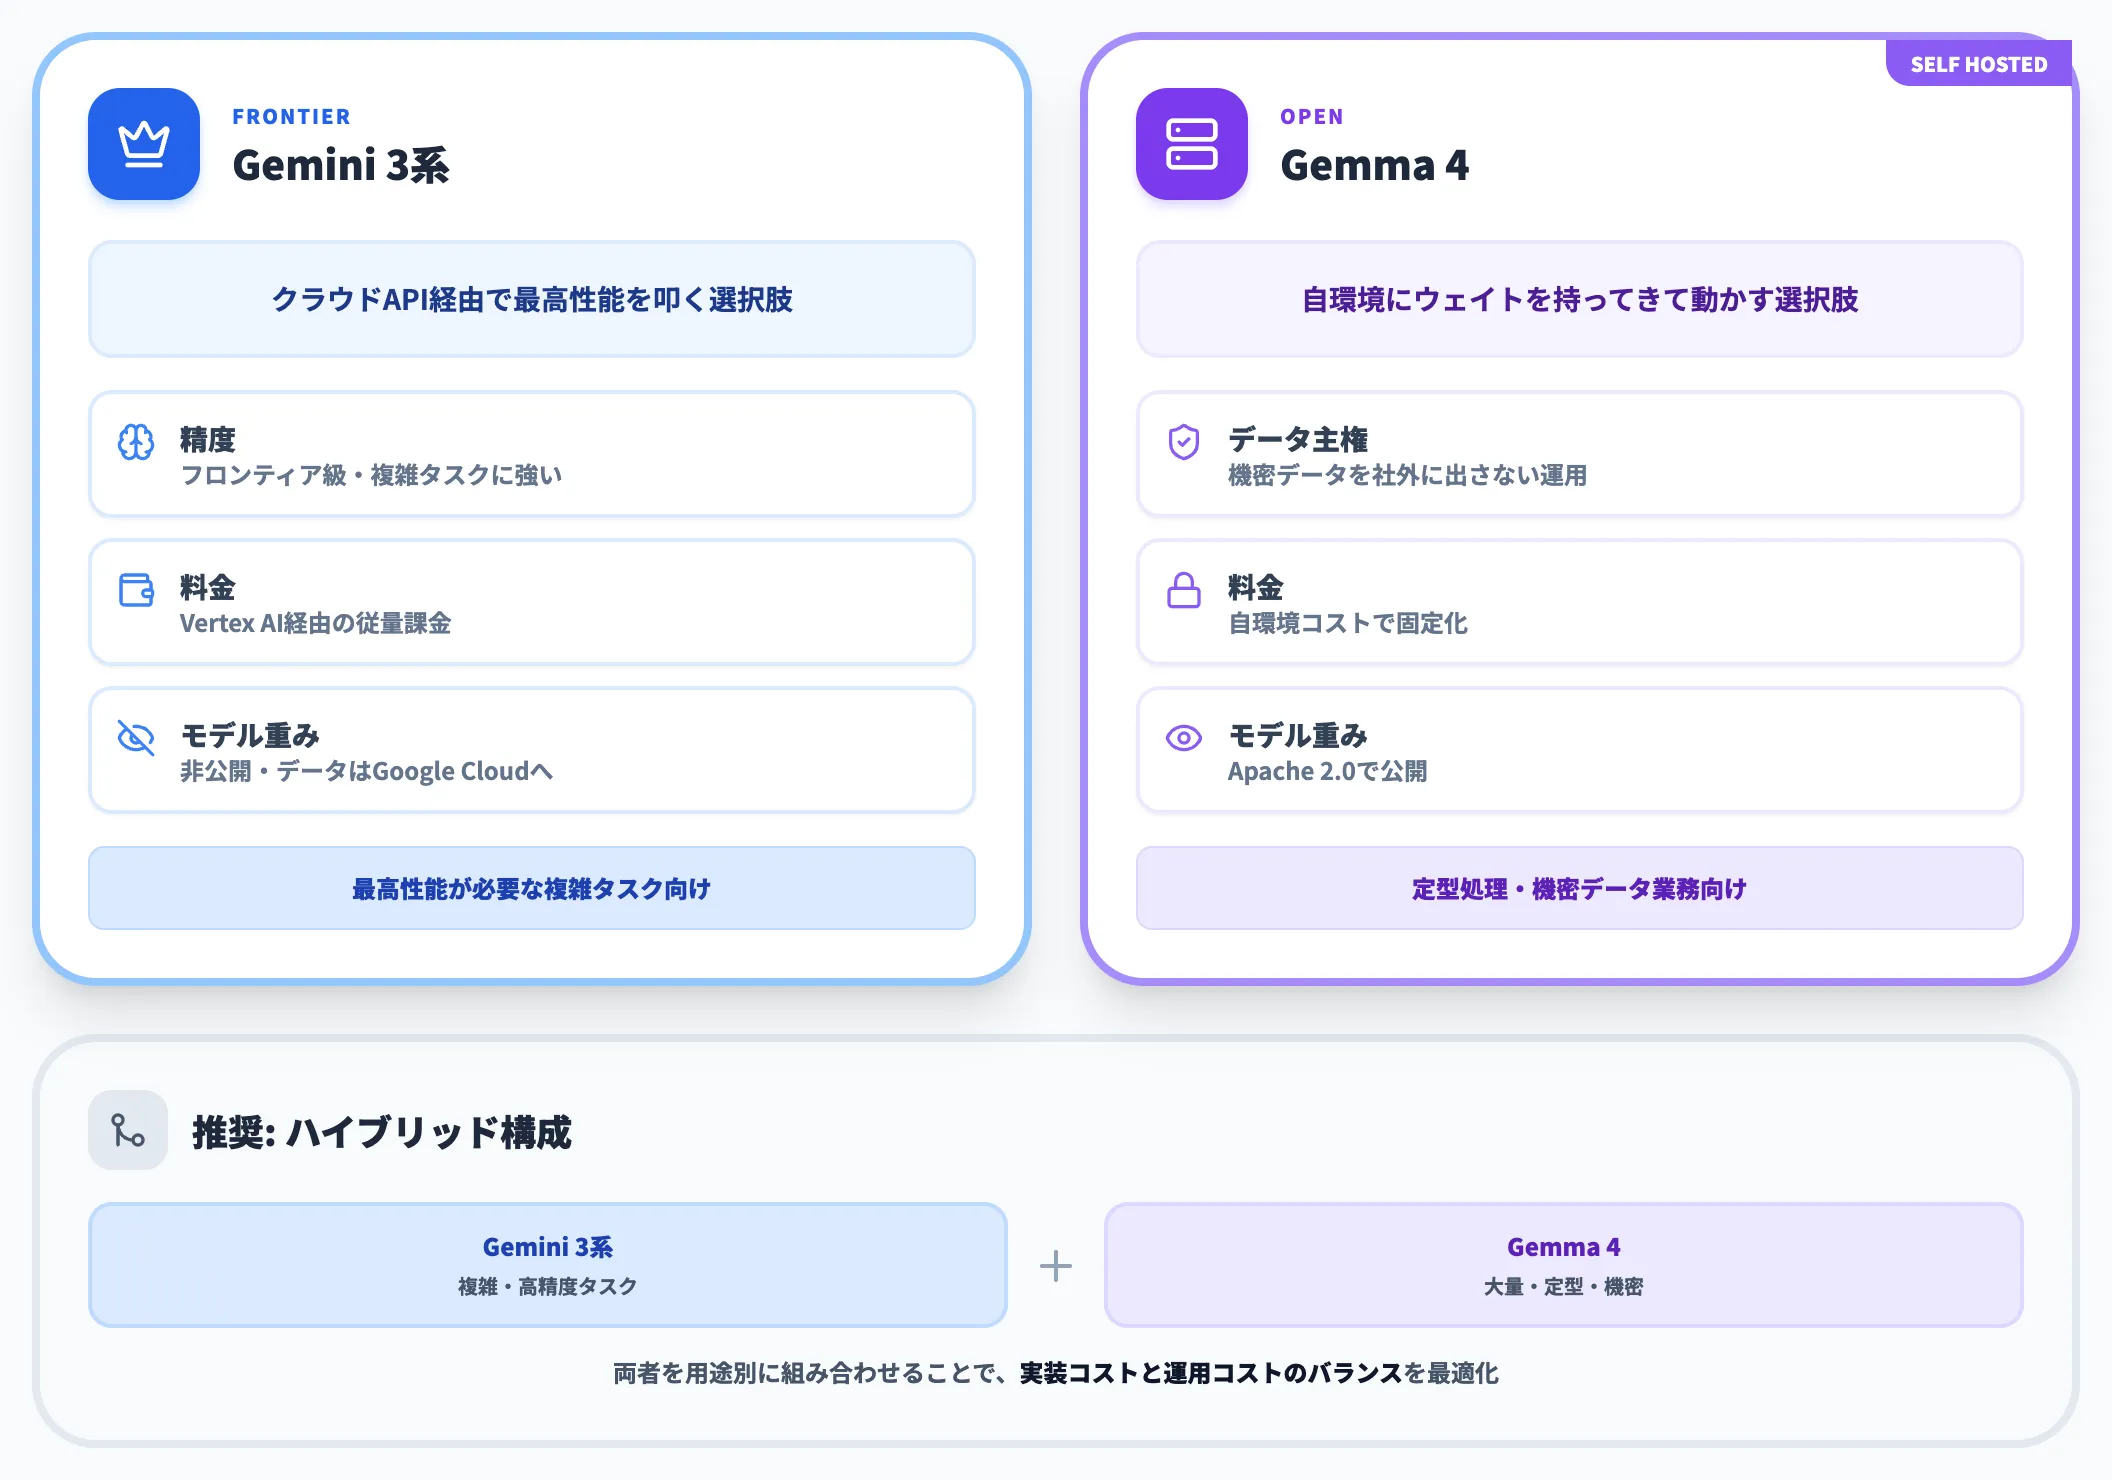
同じGoogle DeepMind内でも、Gemini 3系(Gemini 3・Gemini 3.1 Pro・Gemini 3 Flash)とGemma 4は役割が明確に分かれています。Gemini 3系は「クラウドAPI経由で最高性能を使う」路線で、モデル重みは非公開のままVertex AI経由の従量課金が主な提供形態です。
一方のGemma 4は「自分の環境にウェイトを持ってきて動かす」路線で、データ主権を守りたい用途やコストを固定したい用途で選ばれます。
実務での棲み分けとしては、フロンティア級の精度が必要な複雑タスクはGemini 3、大量に低コストで回したい定型処理や機密データを社外に出せない業務はGemma 4、というのが自然な線引きです。
両者を用途別に組み合わせるハイブリッド構成が、実装コストと運用コストの両方でバランスの取りやすい選択肢になります。
Gemma 4の使い方 — ローカル/AI Studio/Vertex AI/Cloud Run
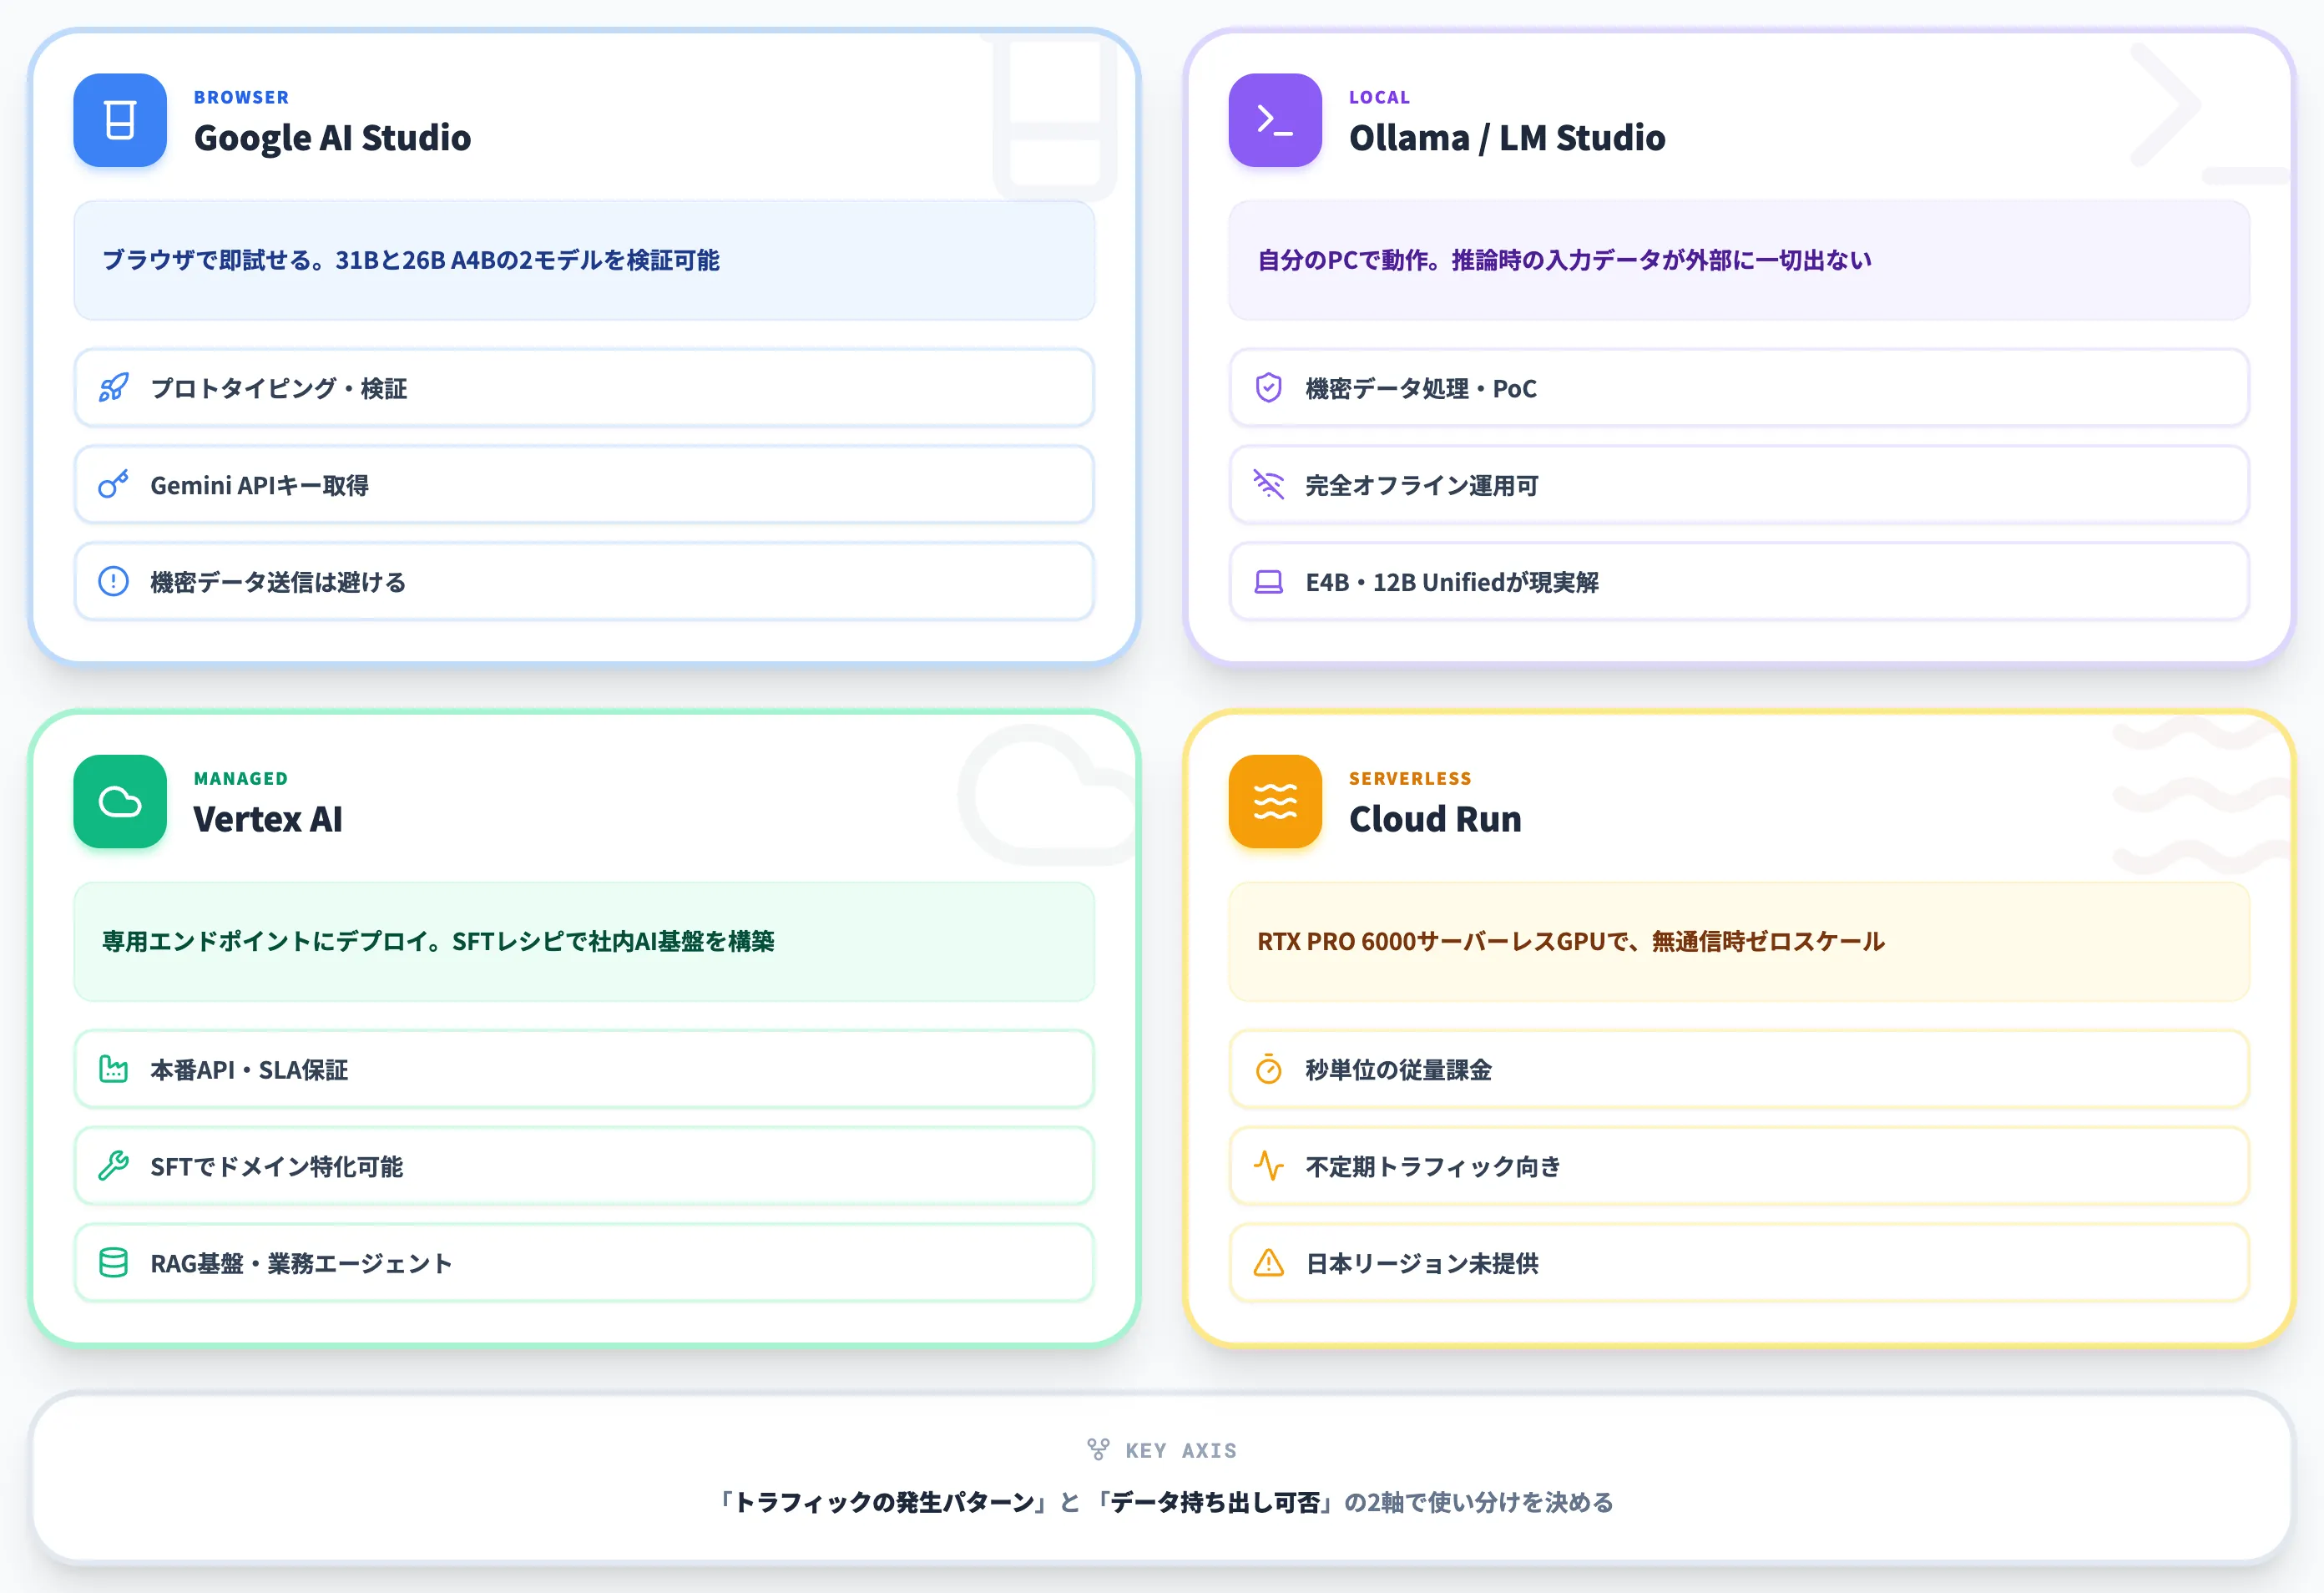
Gemma 4は、実行環境の選択肢が多いことが特徴です。ここでは代表的な4系統を、コスト・レイテンシ・データ主権の観点で使い分けられるように整理します。
Google AI Studio — 最短で挙動を確認
Gemma 4を最も手軽に触れる入口は、Google AI StudioのブラウザUIです。Googleアカウントでログインするだけで31B Denseと26B A4Bの2モデルを試せるうえ、自作アプリからGemini API経由でGemma 4を呼びたい場合もAI Studio上でAPIキーを発行して使い回せます。
注意しておきたいのは、無料サービス側では入出力データがGoogle製品の改善に利用される場合があるという点です。
機密データを扱うなら有料サービス(Gemini API有料枠)に切り替えるか、そもそも企業データを送らない前提で運用を組む必要があり、AI Studioの立ち位置としてはプロトタイピングやプロンプト検証、モデル選定の一次判断用途に置くのが素直です。
Ollama・LM Studioでローカル実行
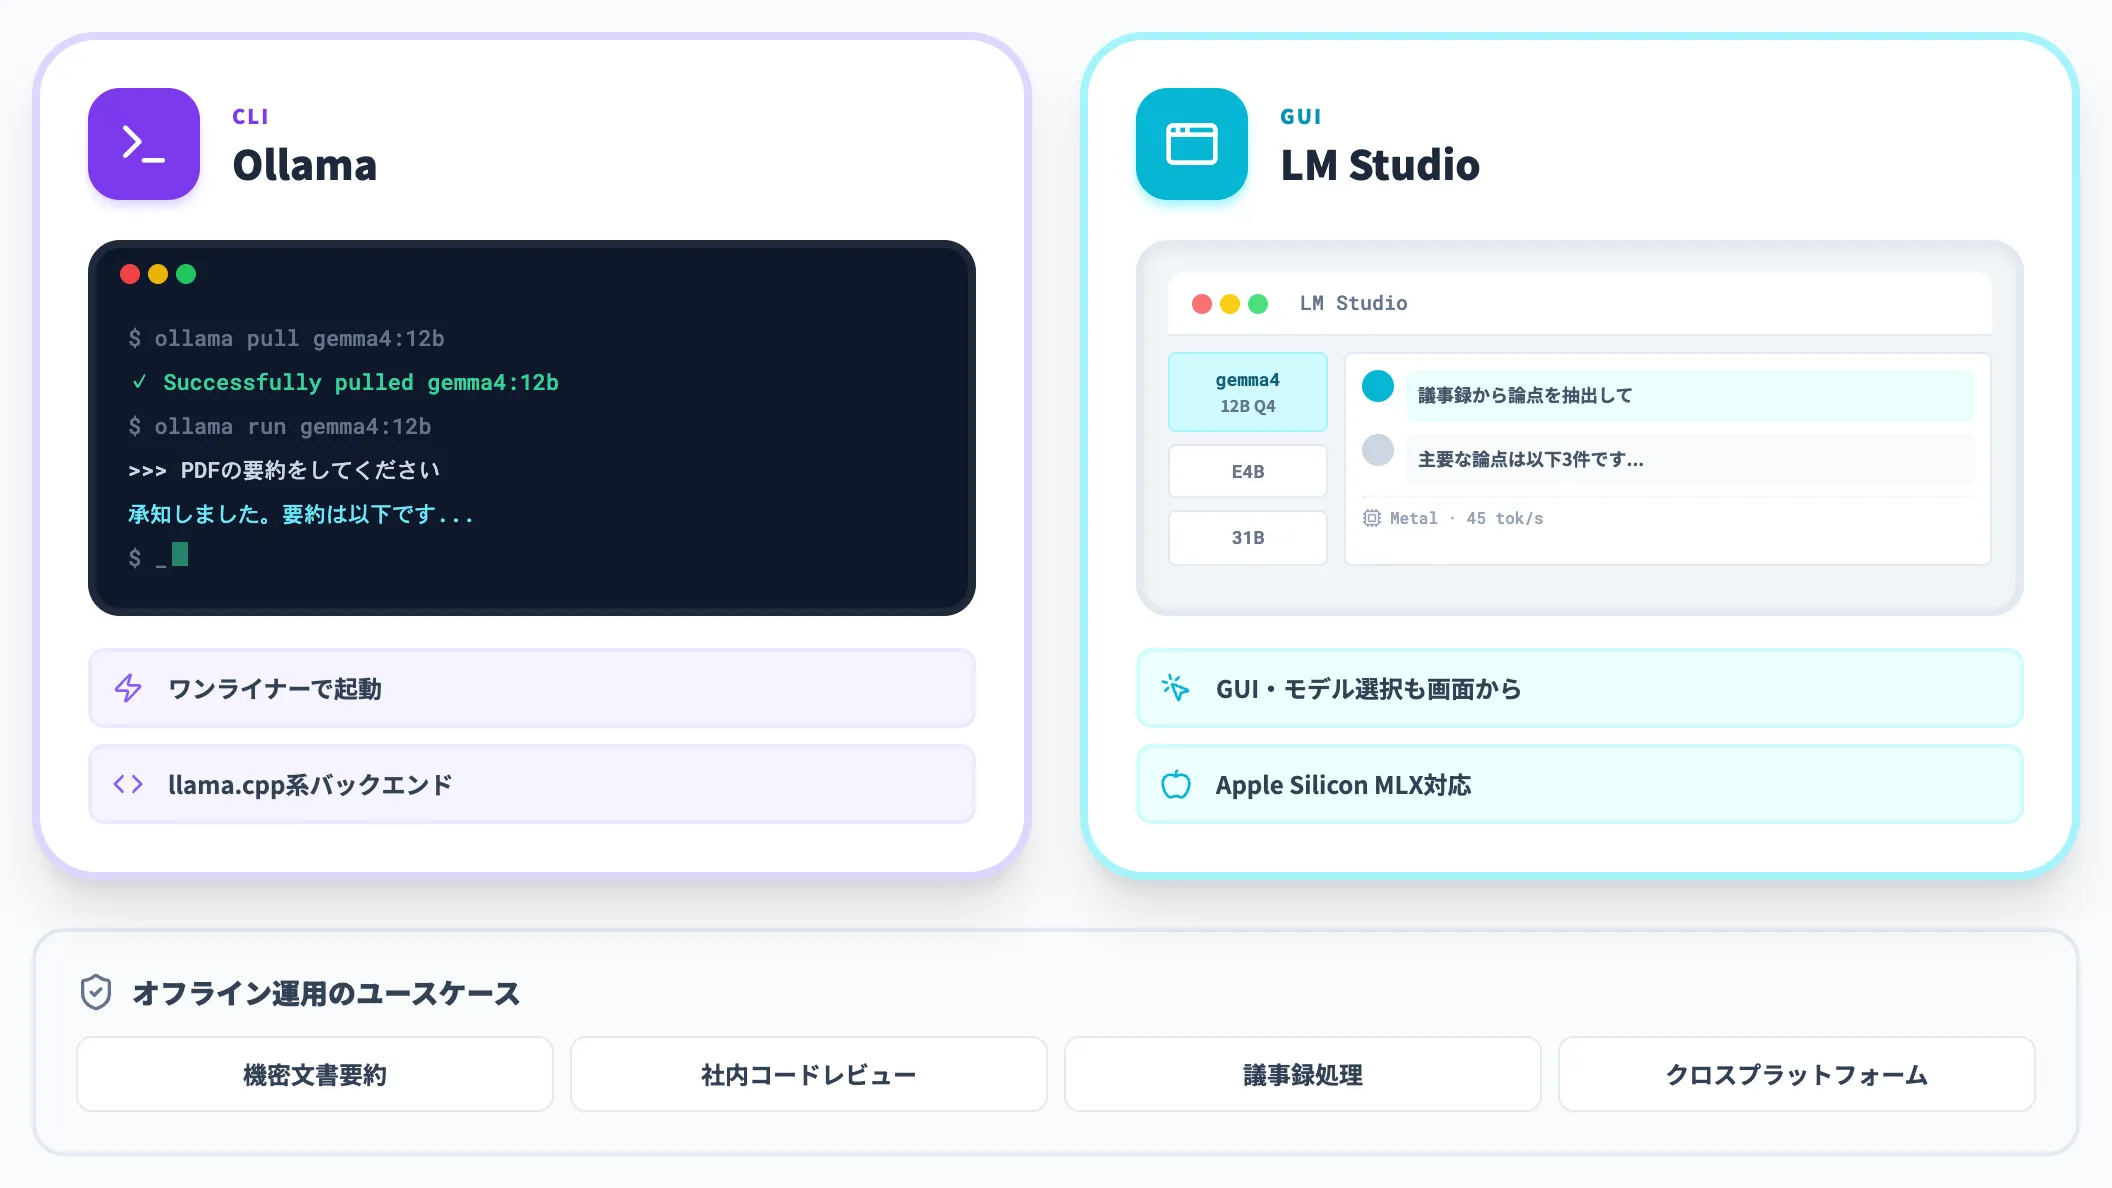
自分のPCやサーバーで動かす場合、公式発表ではllama.cpp・MLX・LiteRT-LM・vLLMなど多数のバックエンドが案内されています。
中でも個人開発者やチームが手軽にローカル実行する現実的な選択肢がOllamaとLM Studioです。Ollamaはコマンドラインベースで、「ollama run gemma4:12b」のようにワンライナーで起動できる手軽さが売り。
LM StudioはGUIベースで、モデル選択から実行、チャットUIまで一体で使えるのが強みです。
両方ともmacOS・Windows・Linuxに対応しており、内部的にはOllamaがllama.cpp系、LM Studioがllama.cppに加えてApple SiliconのMLX等の量子化推論バックエンドをサポートしています。
このルートの最大の利点は、外部APIや拡張機能を使わない完全オフライン構成であれば推論時の入力データが外部に一切出ないことです。
機密文書の要約、社内コードのレビュー、外部にアップロードできない議事録の処理といった、データが外に出せない業務にそのまま噛み合います(モデル取得・アップデートの通信だけは別途必要)。
裏返せば、大型モデルほど高スペックGPUを要求される点は避けられず、ラップトップ運用の現実解はE4B・12B Unifiedあたりになります。
Vertex AIで本番運用
Vertex AI Model Gardenからは、Gemma 4の各モデルを自分の専用エンドポイントにデプロイできます。
26B A4B ITは実験提供のマネージドAPIとして直接叩ける一方、他のモデルはセルフデプロイで運用する棲み分けになっていて、加えてVertex AI Training Clusters(VTC)とNVIDIA NeMo Megatron統合による最適化済みSFT(Supervised Fine-Tuning)レシピも公式に用意されています。
つまり、ドメイン特化のGemma 4を作ってから社内のRAG基盤や業務エージェントに組み込む、といった実装が現実的な選択肢に入ってきます。
Cloud RunサーバーレスGPUで従量運用
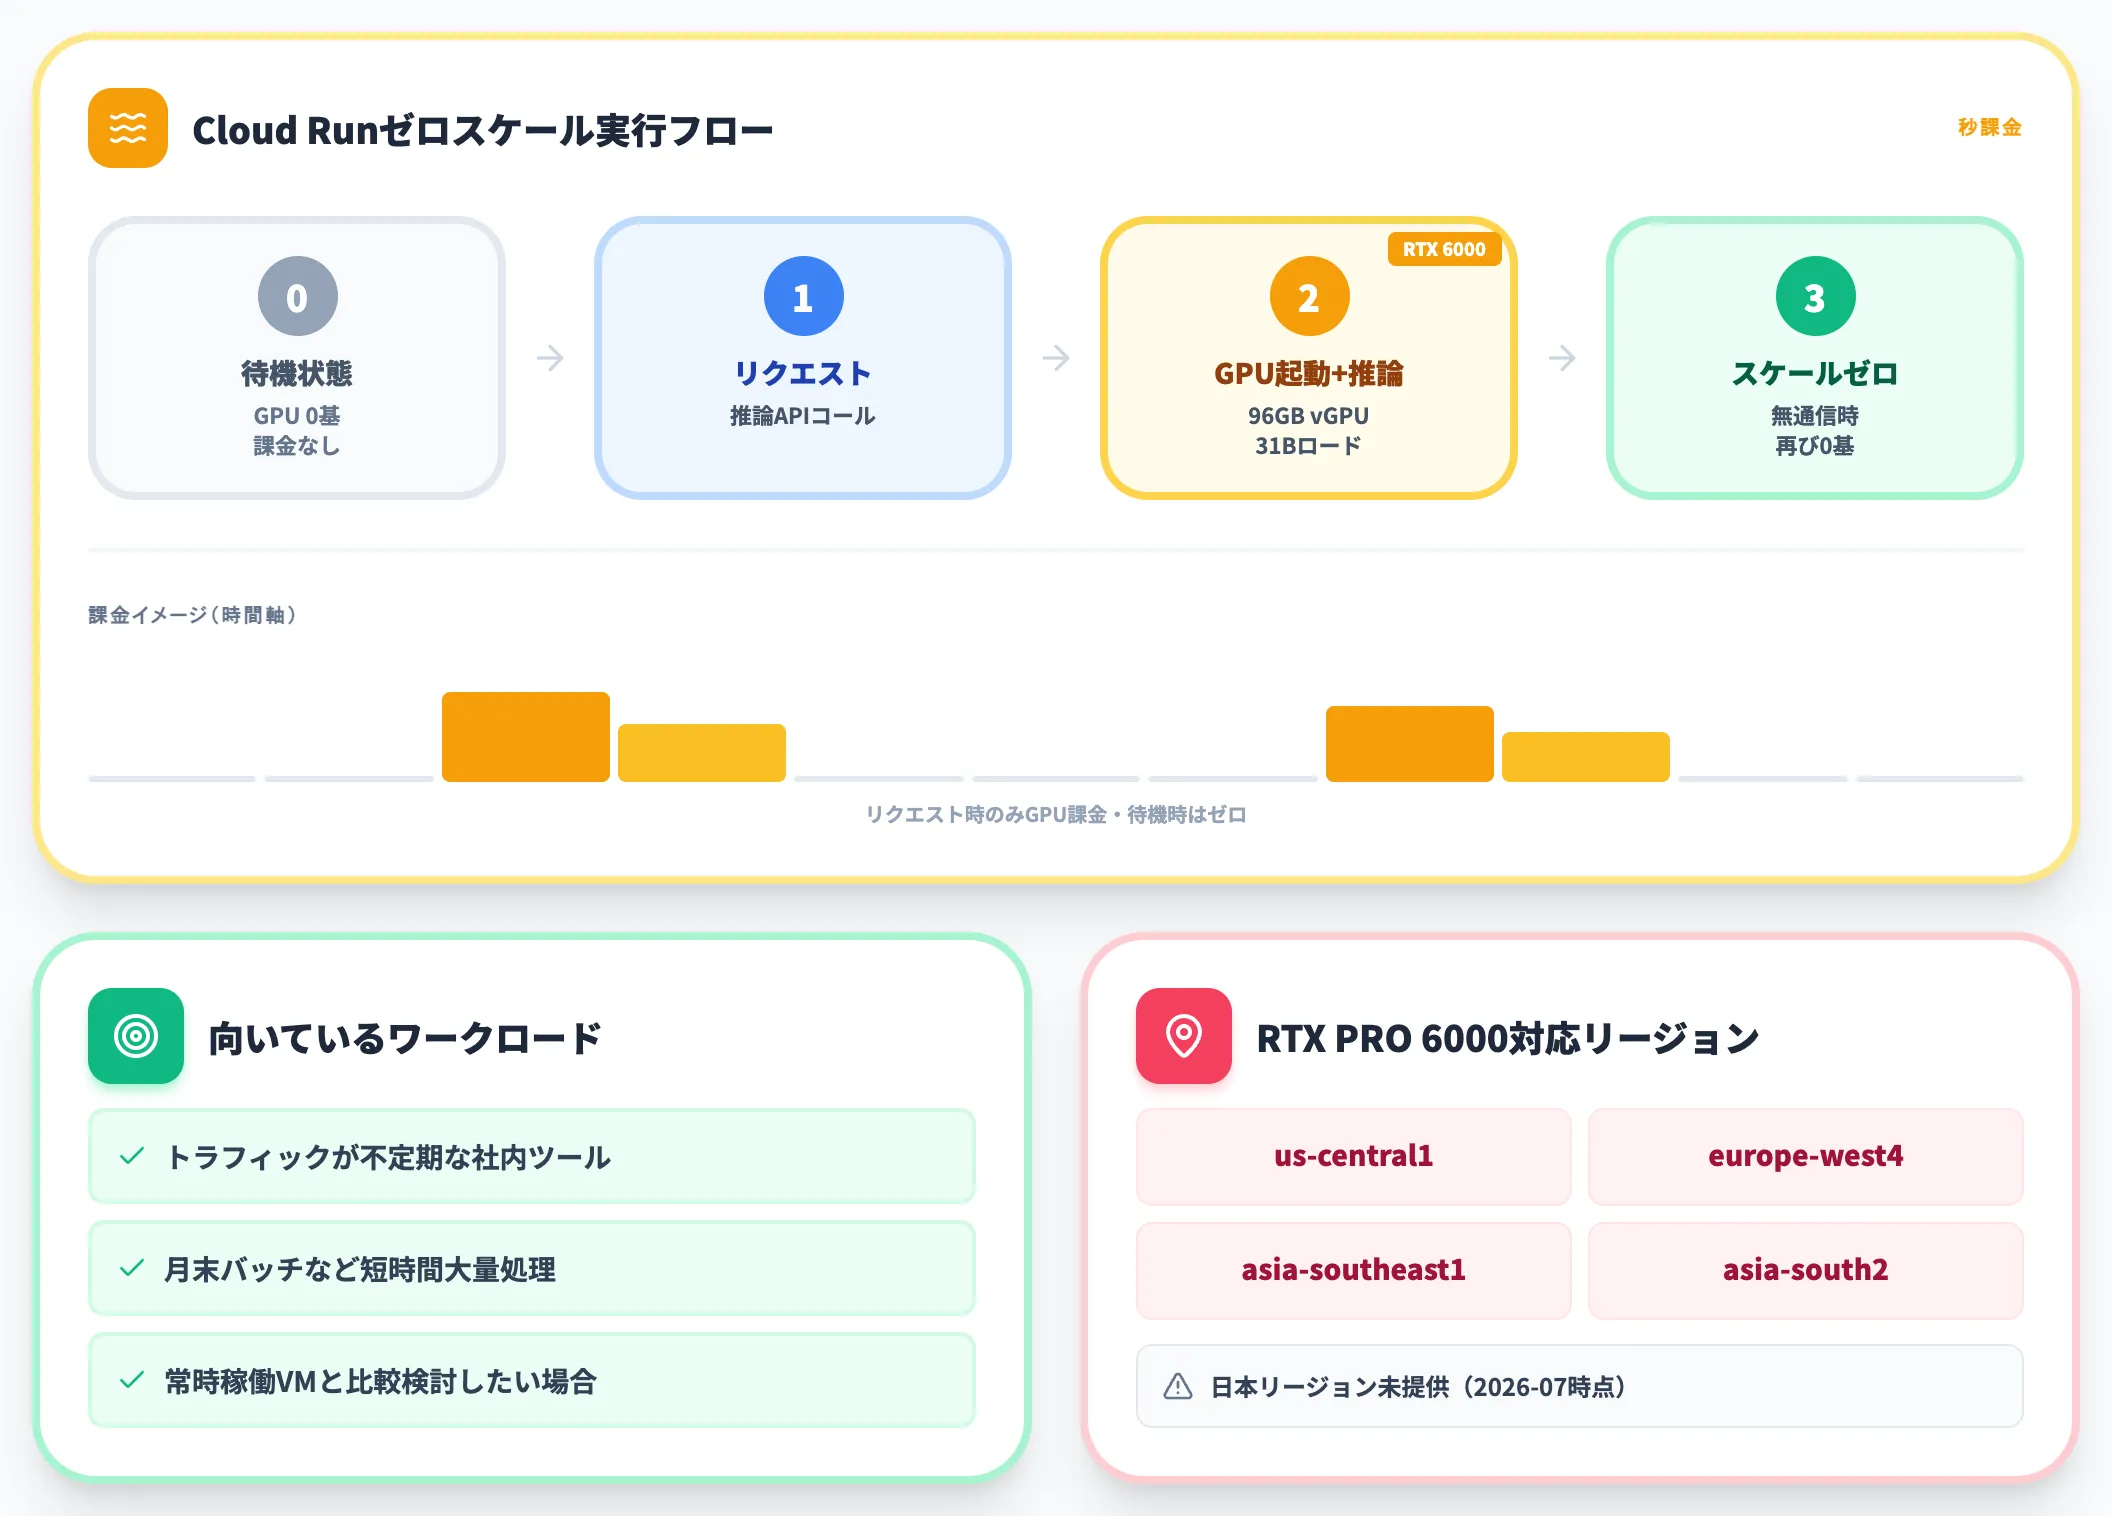
2026年にはCloud RunのサーバーレスGPU(RTX PRO 6000 Blackwell)が一般提供され、Gemma 4を回せる場所が一気に広がりました。vGPUメモリ96GBのインスタンスに31B Denseがそのまま載ります。
Cloud Runの特徴は、リクエストがないときにゼロスケールする点にあります。
待機中のGPU課金を抑えやすいため、トラフィックが不定期な社内ツールや、月末バッチ処理のように短時間だけ大量に叩きたいワークロードで、常時稼働のVMと天秤にかけやすい選択肢になります。
実際、公式コードラボには無通信時にスケールゼロとなる構成例が具体的に示されています。
4系統の使い分け
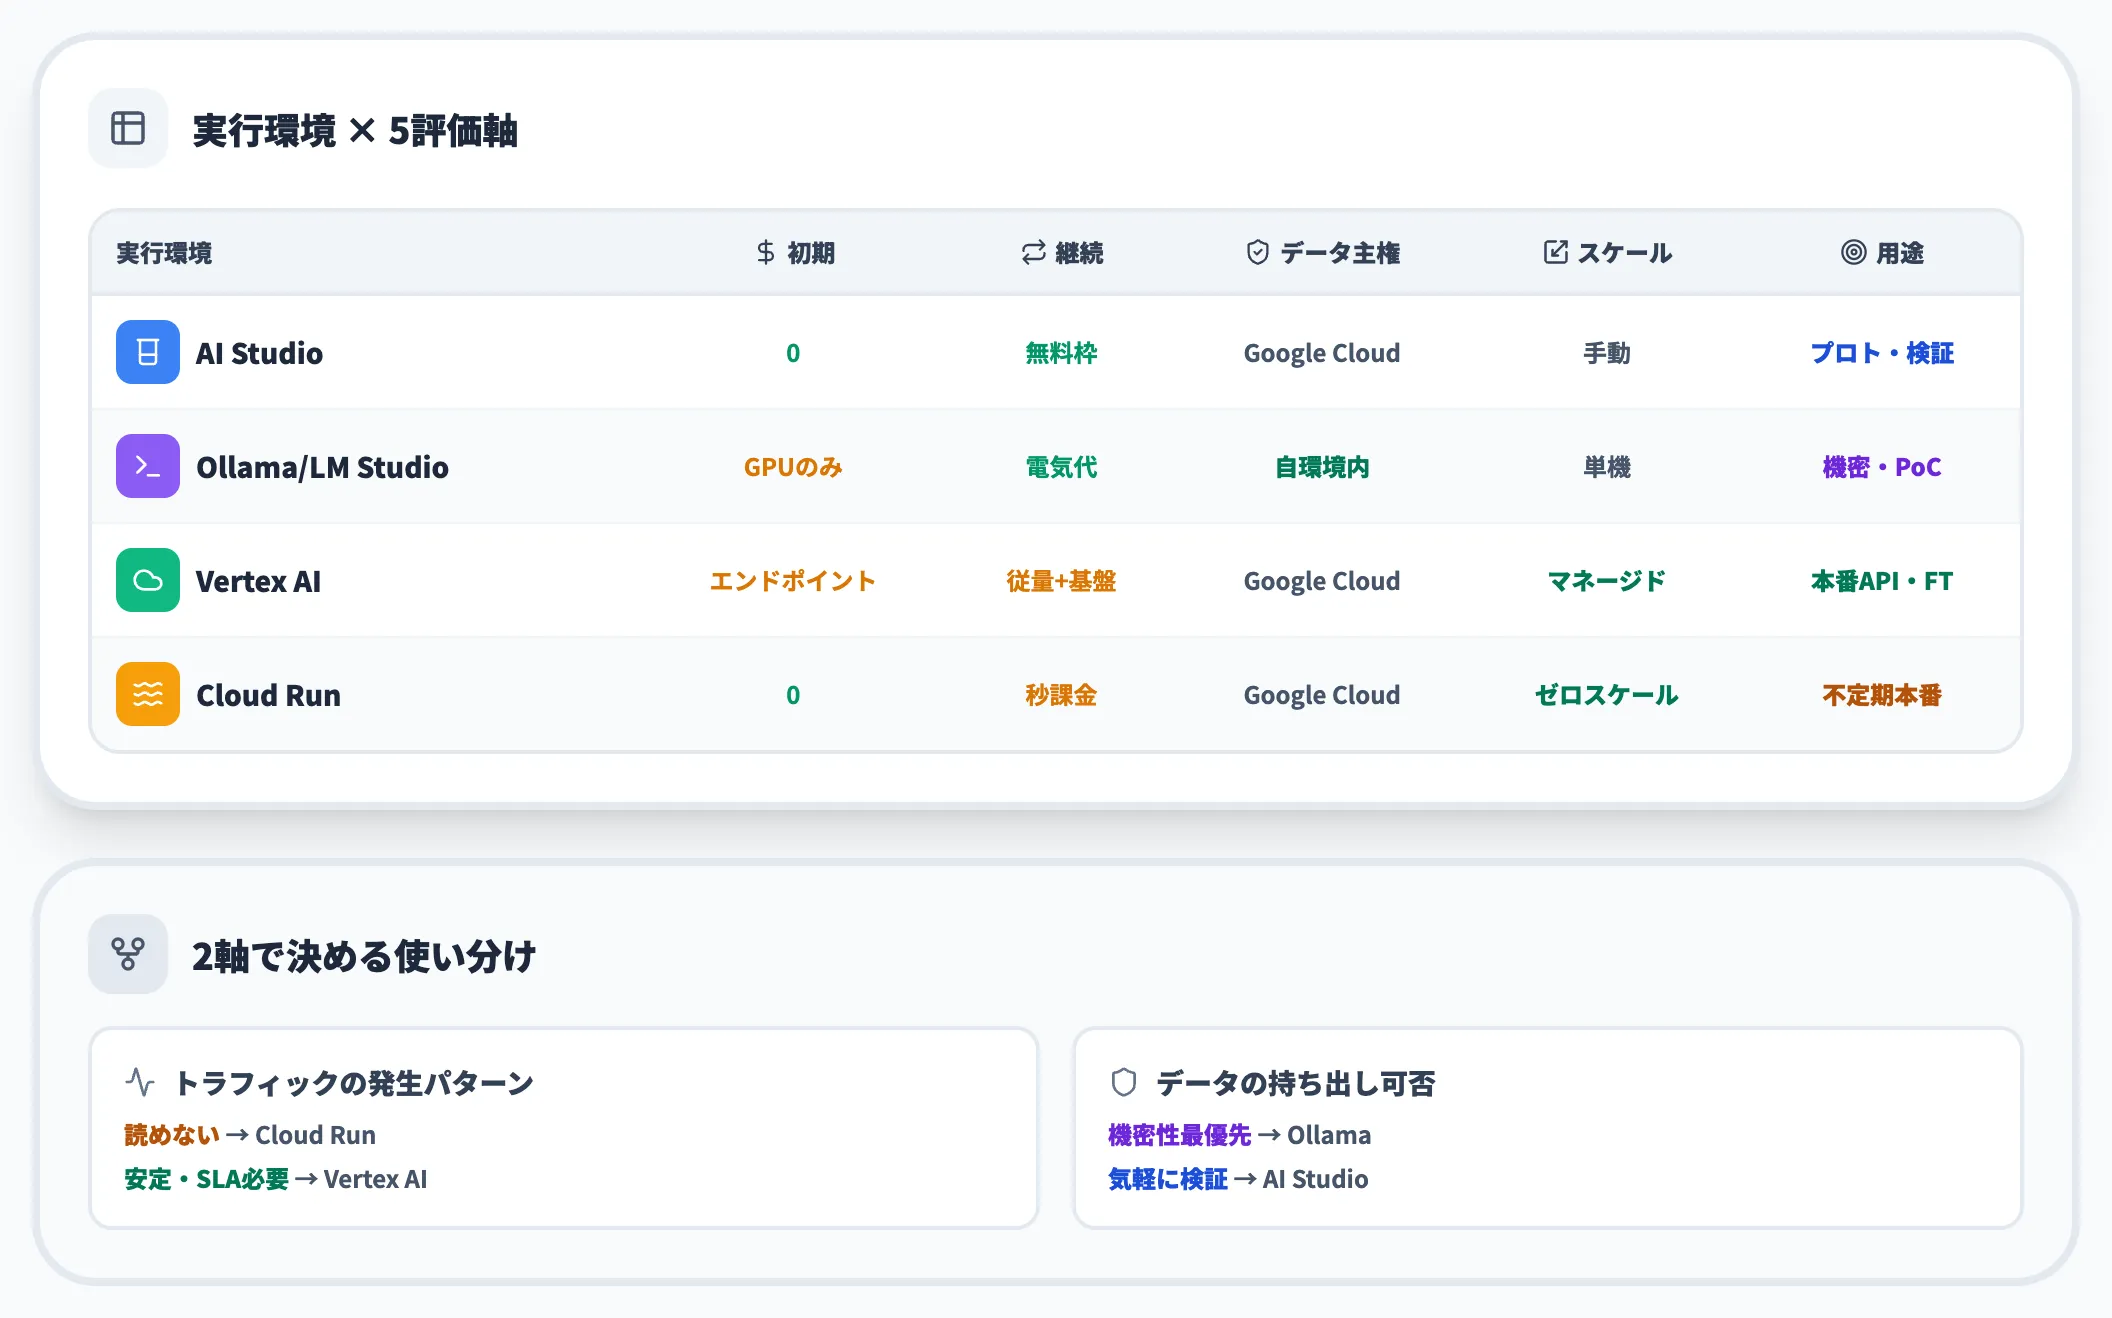
同じGemma 4でも、実行環境で得られる特性が変わります。以下のマトリクスで整理しました。
| 実行環境 | 初期コスト | 継続コスト | データ主権 | スケール | 向いている用途 |
|---|---|---|---|---|---|
| AI Studio | 0 | 無料枠 | Google Cloud | 手動 | プロトタイピング・検証 |
| Ollama/LM Studio | GPUのみ | 電気代 | 自環境内 | 単機 | 機密データ処理・PoC |
| Vertex AI | エンドポイント維持 | 従量+基盤 | Google Cloud | マネージド | 本番API提供・ファインチューニング |
| Cloud Run | 0 | 従量(秒課金) | Google Cloud | ゼロスケール | 不定期トラフィックの本番運用 |
実務で選ぶ際に効いてくる軸は、「トラフィックの発生パターン」と「データの持ち出し可否」の2つに集約できます。
トラフィックが読めない業務ならCloud Run、機密性が最優先なら自環境のOllama、本番SLAが必要ならVertex AI、という具合に軸を切り分けて当てはめると、選択で迷いにくくなります。
Gemma 4の料金・コスト構造
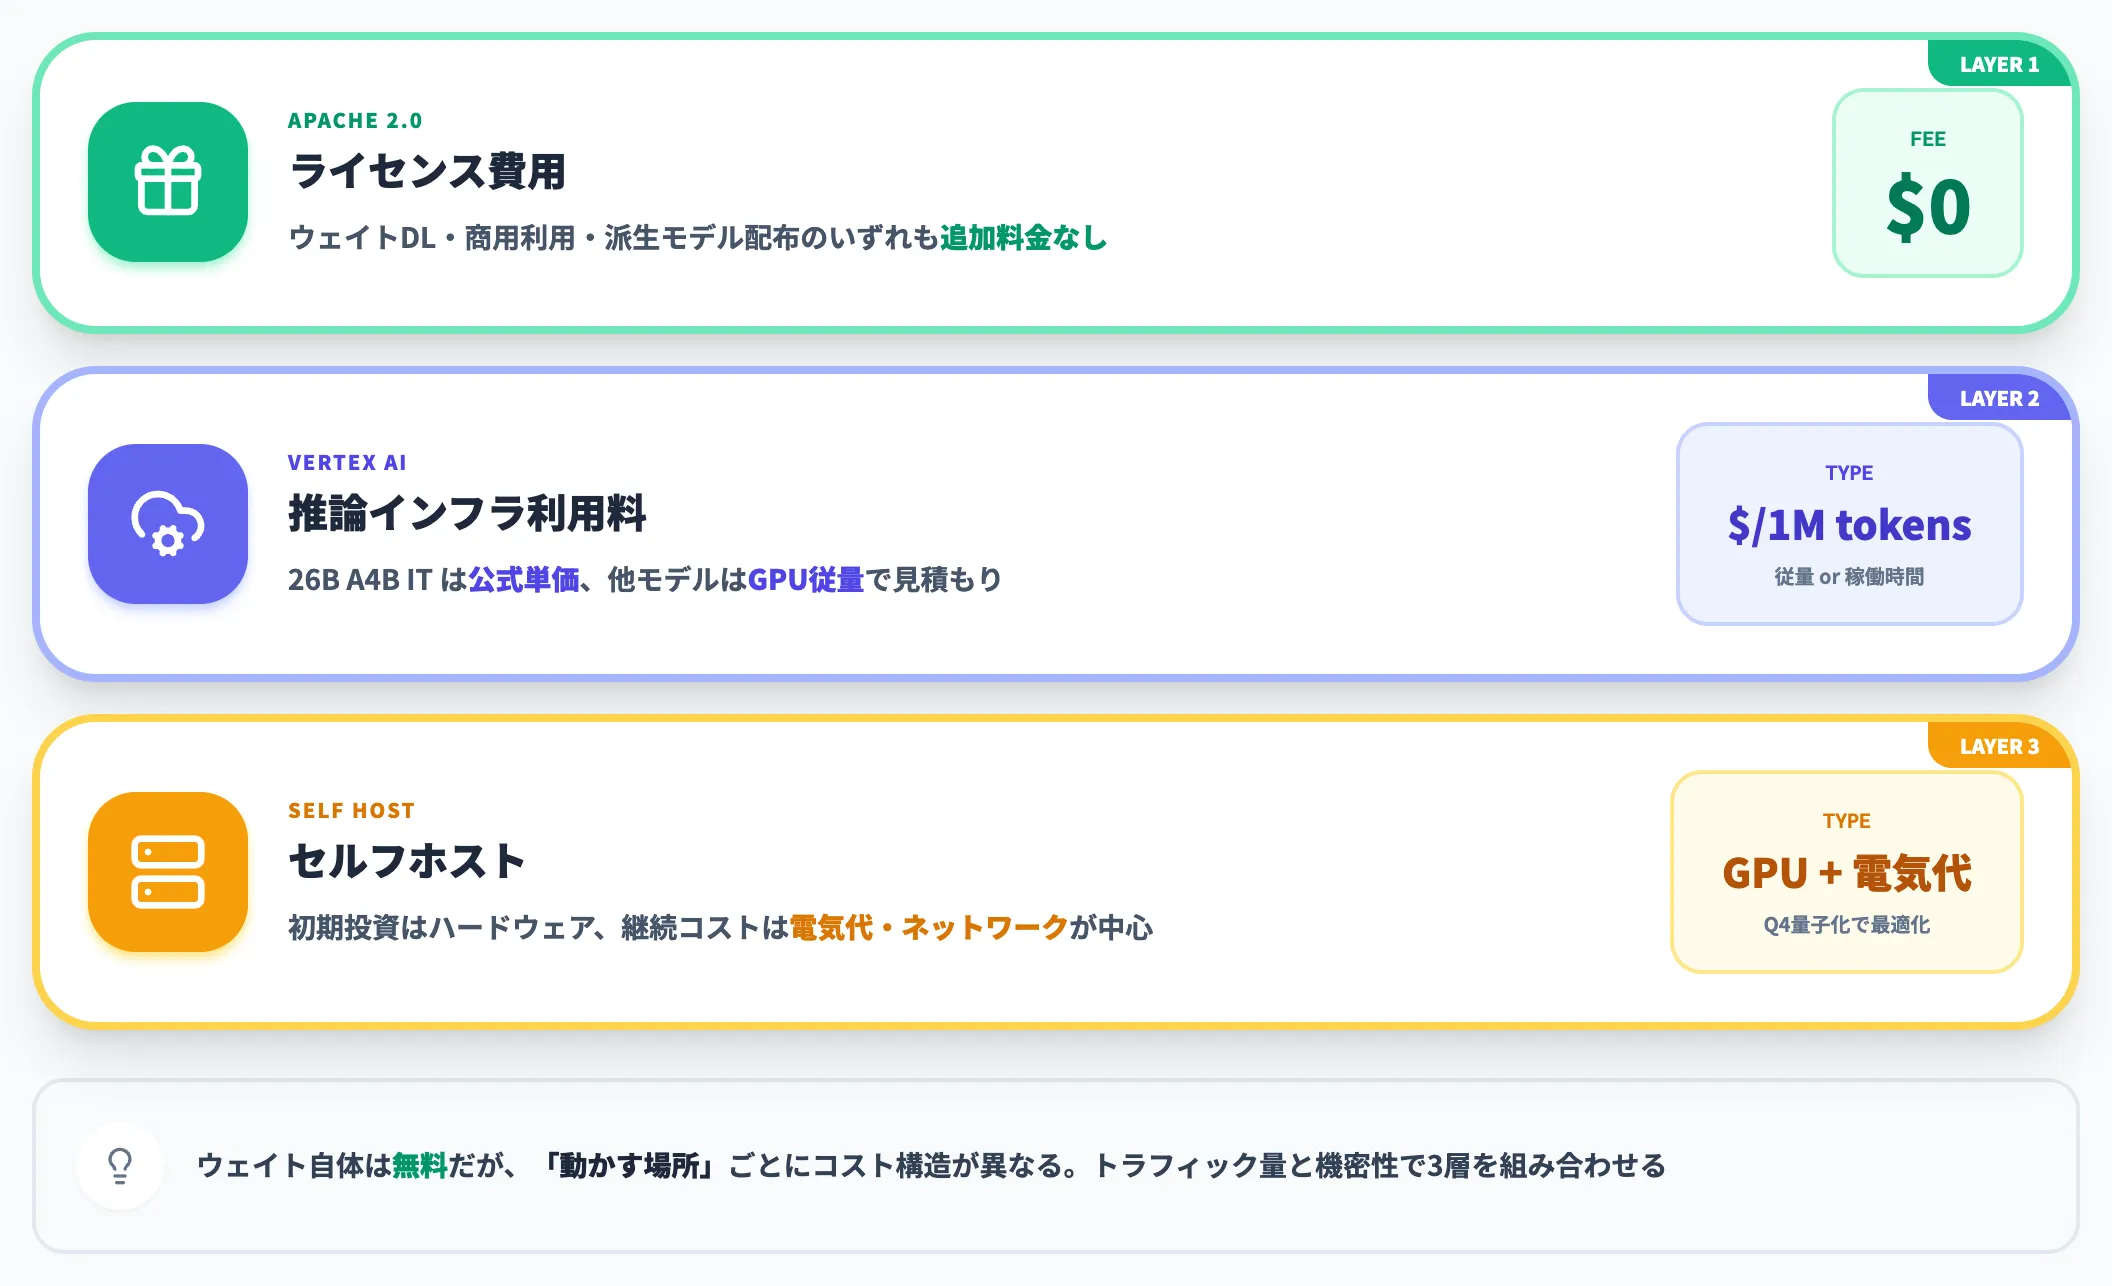
Gemma 4はウェイト自体は無料ですが、実運用では「動かす場所」に応じたコストが発生します。ここでは3層構造でコスト構造を整理します。
ライセンス費用 — 完全無料
Gemma 4のウェイトダウンロードとApache 2.0ライセンスでの利用は、完全無料です。Hugging Face・Kaggle・Ollama Registryのいずれからも、5モデルすべてを取得できます。商用サービスへの組み込み、ファインチューニング後の派生モデル配布、SaaSプロダクトの内部利用――どのケースでも追加ライセンス費用は発生しません。従来の独自ライセンスから、広く使われているApache 2.0に土台が乗り換わった格好です。
Vertex AIの従量料金
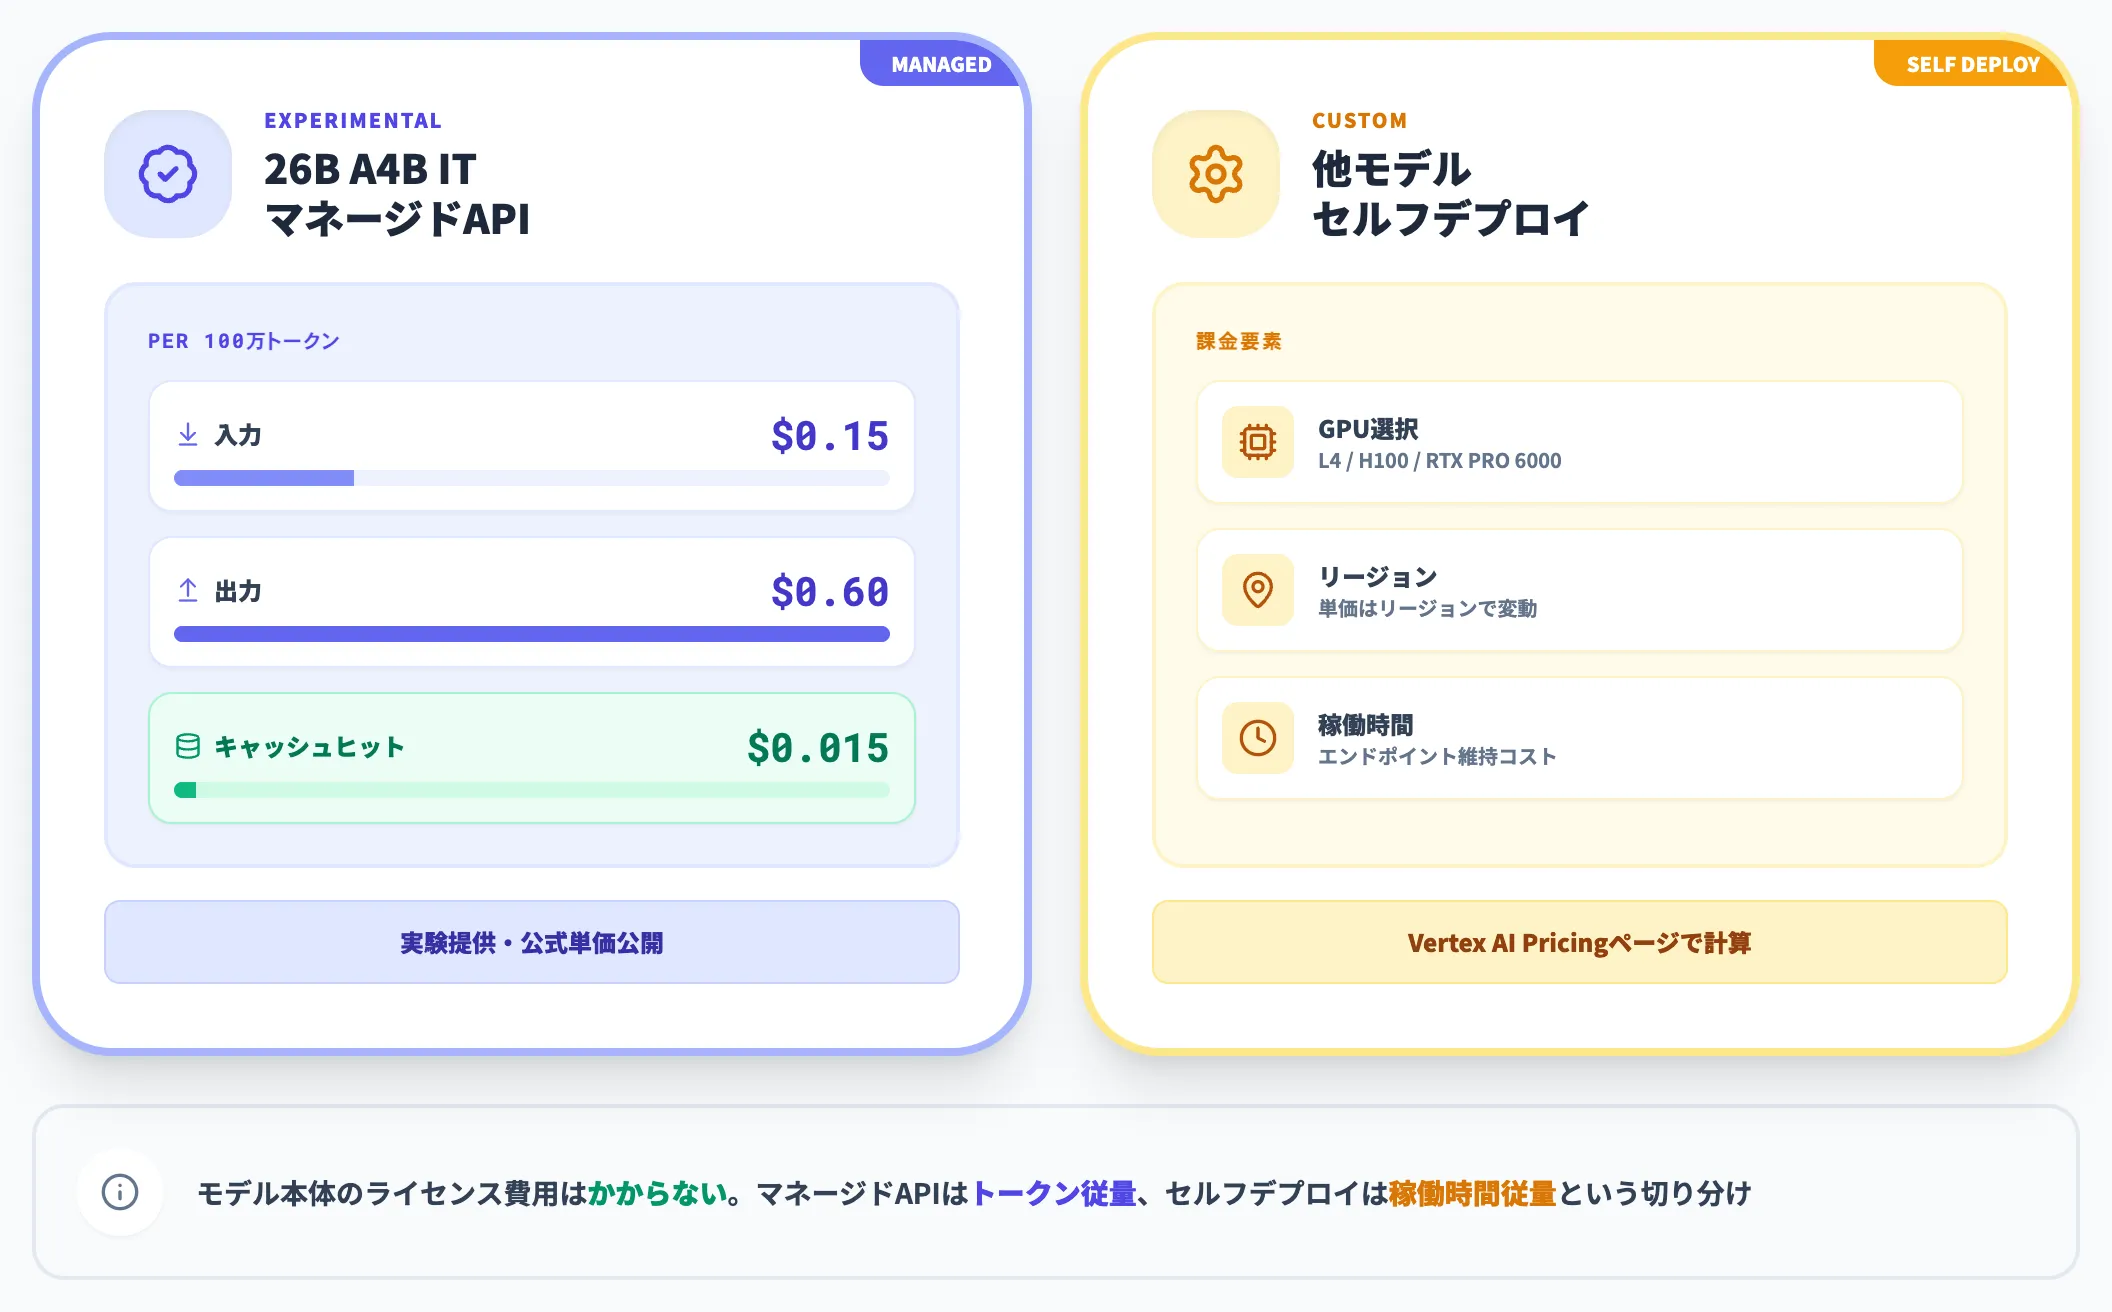
Vertex AI経由でGemma 4を叩く場合、モデル本体のライセンス費用はかからず、発生するのは推論インフラの利用料だけです。
マネージド提供の26B A4B ITについては、公式料金ページで単価が明示されています(2026年7月時点:入力$0.15/100万トークン、出力$0.60/100万トークン、キャッシュヒット$0.015/100万トークン)。
一方、セルフデプロイで動かす他モデルはVertex AIの料金ページベースになり、選ぶGPU(NVIDIA L4・H100・RTX PRO 6000等)・リージョン・稼働時間の掛け算で見積もる従量課金という形です。
セルフホストのコスト目安
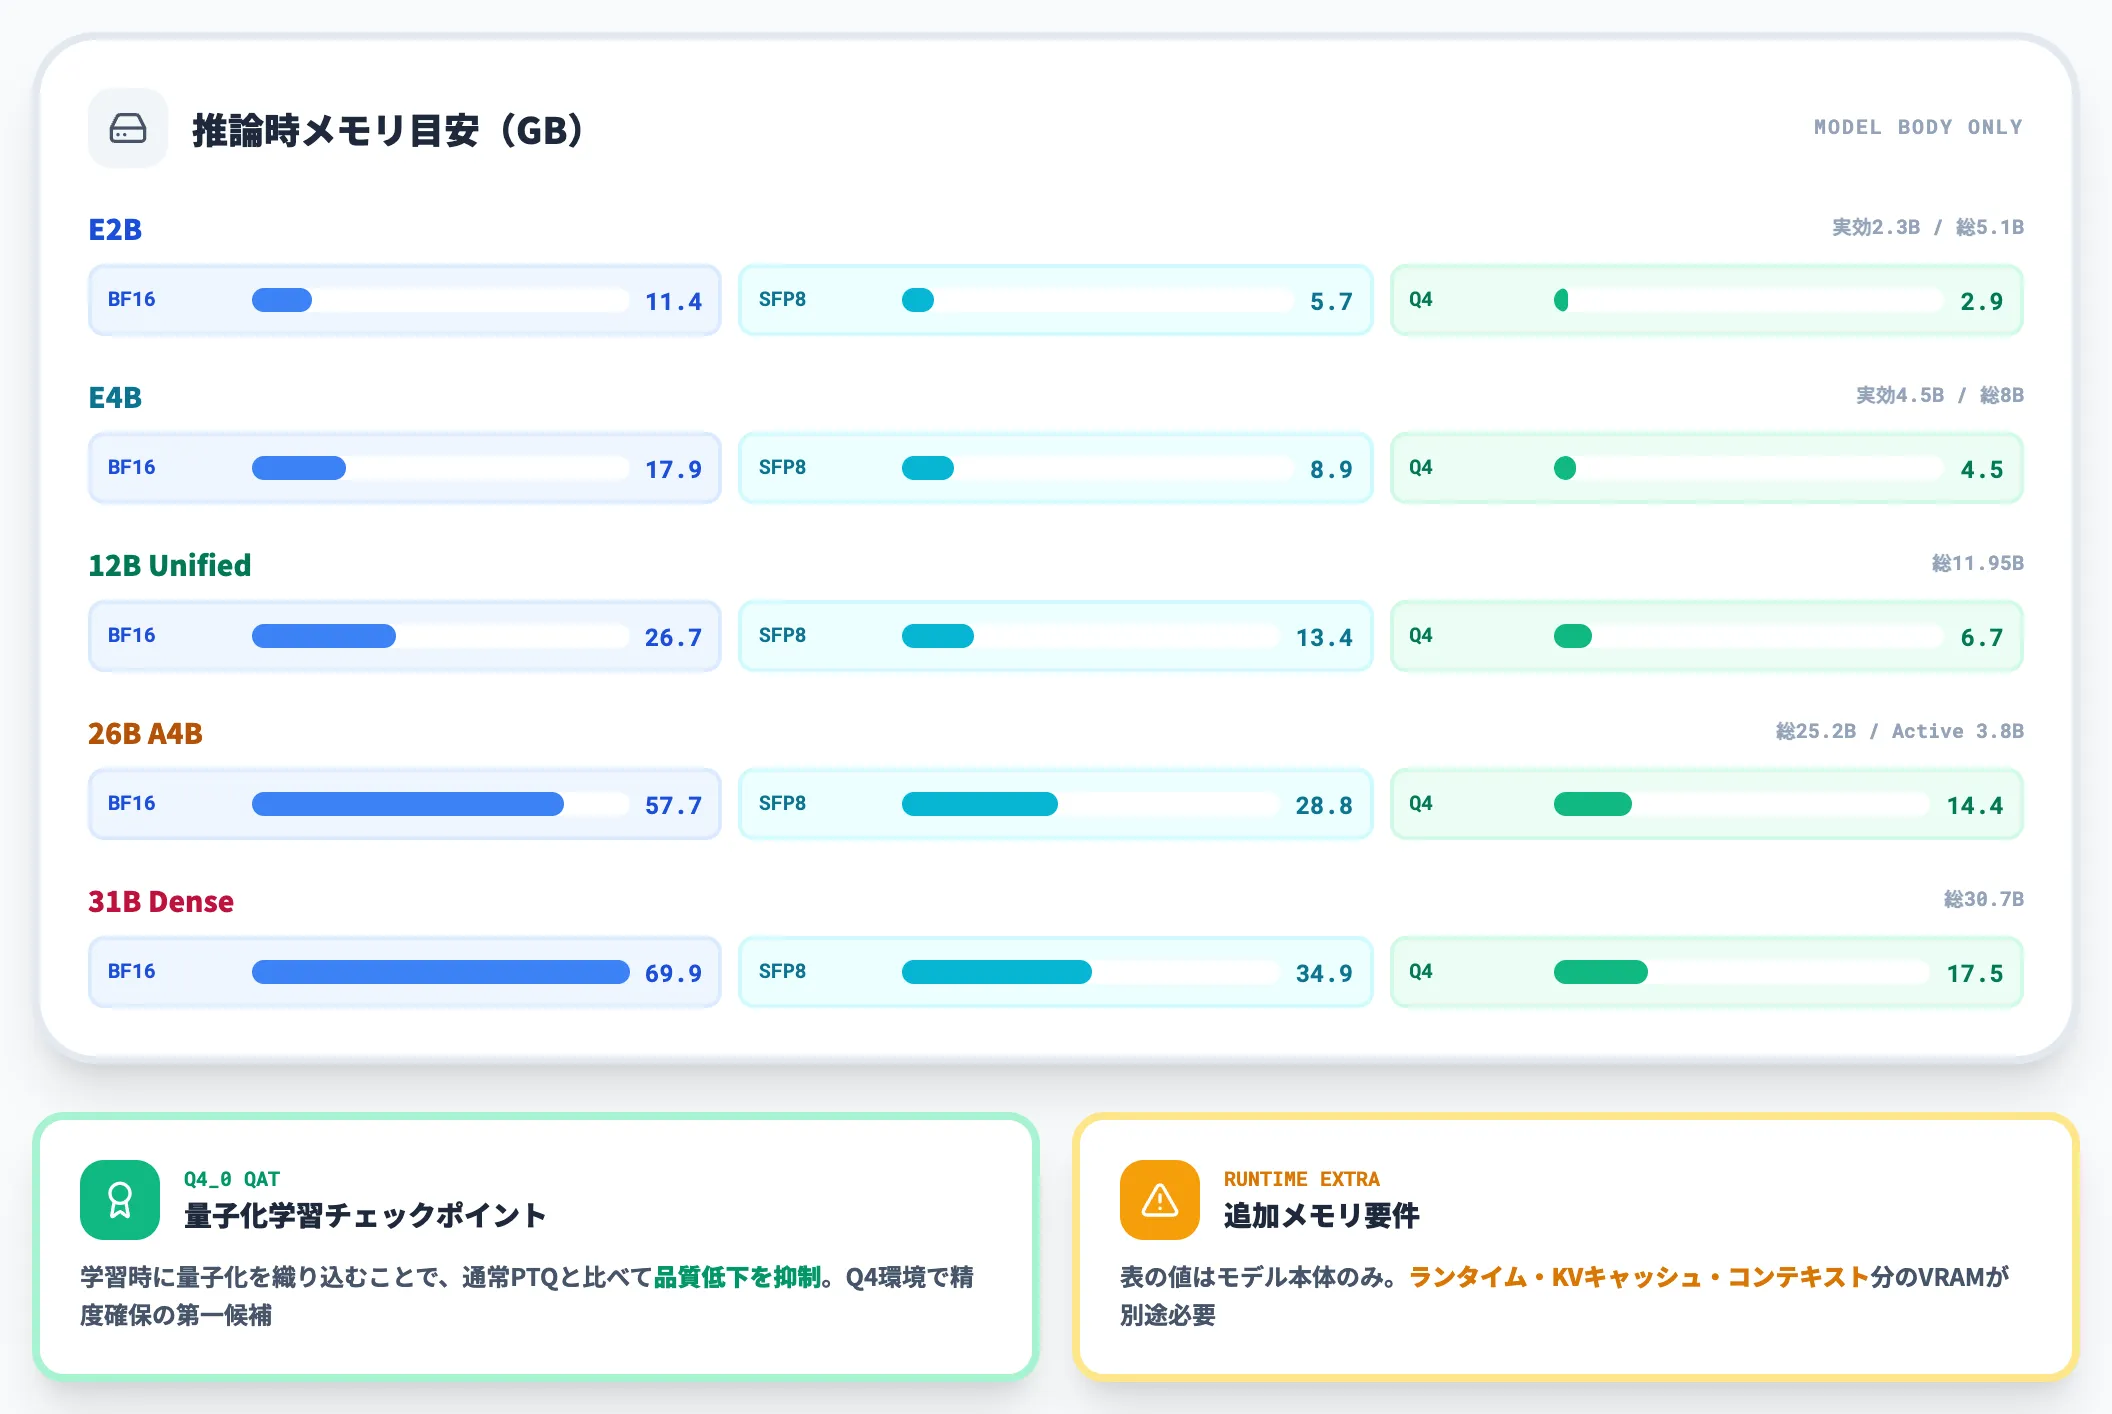
自分のGPUで運用する場合、初期投資はハードウェア、継続コストは電気代とネットワークが中心です。公式モデル概要によると、推論時メモリの目安は量子化方式によって以下のように変わります。
| モデル | BF16 | SFP8 | Q4 |
|---|---|---|---|
| E2B | 11.4GB | 5.7GB | 2.9GB |
| E4B | 17.9GB | 8.9GB | 4.5GB |
| 12B Unified | 26.7GB | 13.4GB | 6.7GB |
| 26B A4B | 57.7GB | 28.8GB | 14.4GB |
| 31B Dense | 69.9GB | 34.9GB | 17.5GB |
表の値はあくまでモデル本体のロード目安で、ランタイム・KVキャッシュ・実行時のコンテキスト分までは含まれていない点に注意が要ります。
実運用ではQ4量子化を選ぶことで31B DenseをRTX 4090(24GB)1枚で扱う構成も組めますが、長いコンテキストや同時リクエストが増えれば24GBを容易に超えてきます。
逆に精度重視でBF16を選んだ場合、31B Denseには80GB VRAM級のGPU(H100・A100・RTX PRO 6000 Blackwell等)が必要になります。結局のところ、用途とハードウェア予算に合わせて量子化方式・コンテキスト長・バッチサイズを組み合わせて見積もる、というのがGemma 4の実運用の作法です。
2026年6月には、Q4_0 QAT(Quantization-Aware Training)チェックポイントとモバイル向けQATチェックポイントも公式に配布されました。学習時点で量子化を織り込むアプローチのため、通常のポストトレーニング量子化(PTQ)に比べて品質低下が抑えられており、Q4環境で精度を確保したいケースでは第一候補に置きやすい選択肢です。
インフラ側では、Cloud RunのRTX PRO 6000 Blackwell(96GB vGPU)で31Bを動かす構成が公式コードラボで示されており、無通信時にスケールゼロさせられるため待機中のGPU課金を抑えられます。
オンプレGPUの継続運用と、Cloud Runの秒課金・ゼロスケールを並べて比較し、トラフィック量に応じてどちらを主軸に据えるかを決めるのが現実的な運用方針です。
Gemma 4を実運用に載せる際の注意点
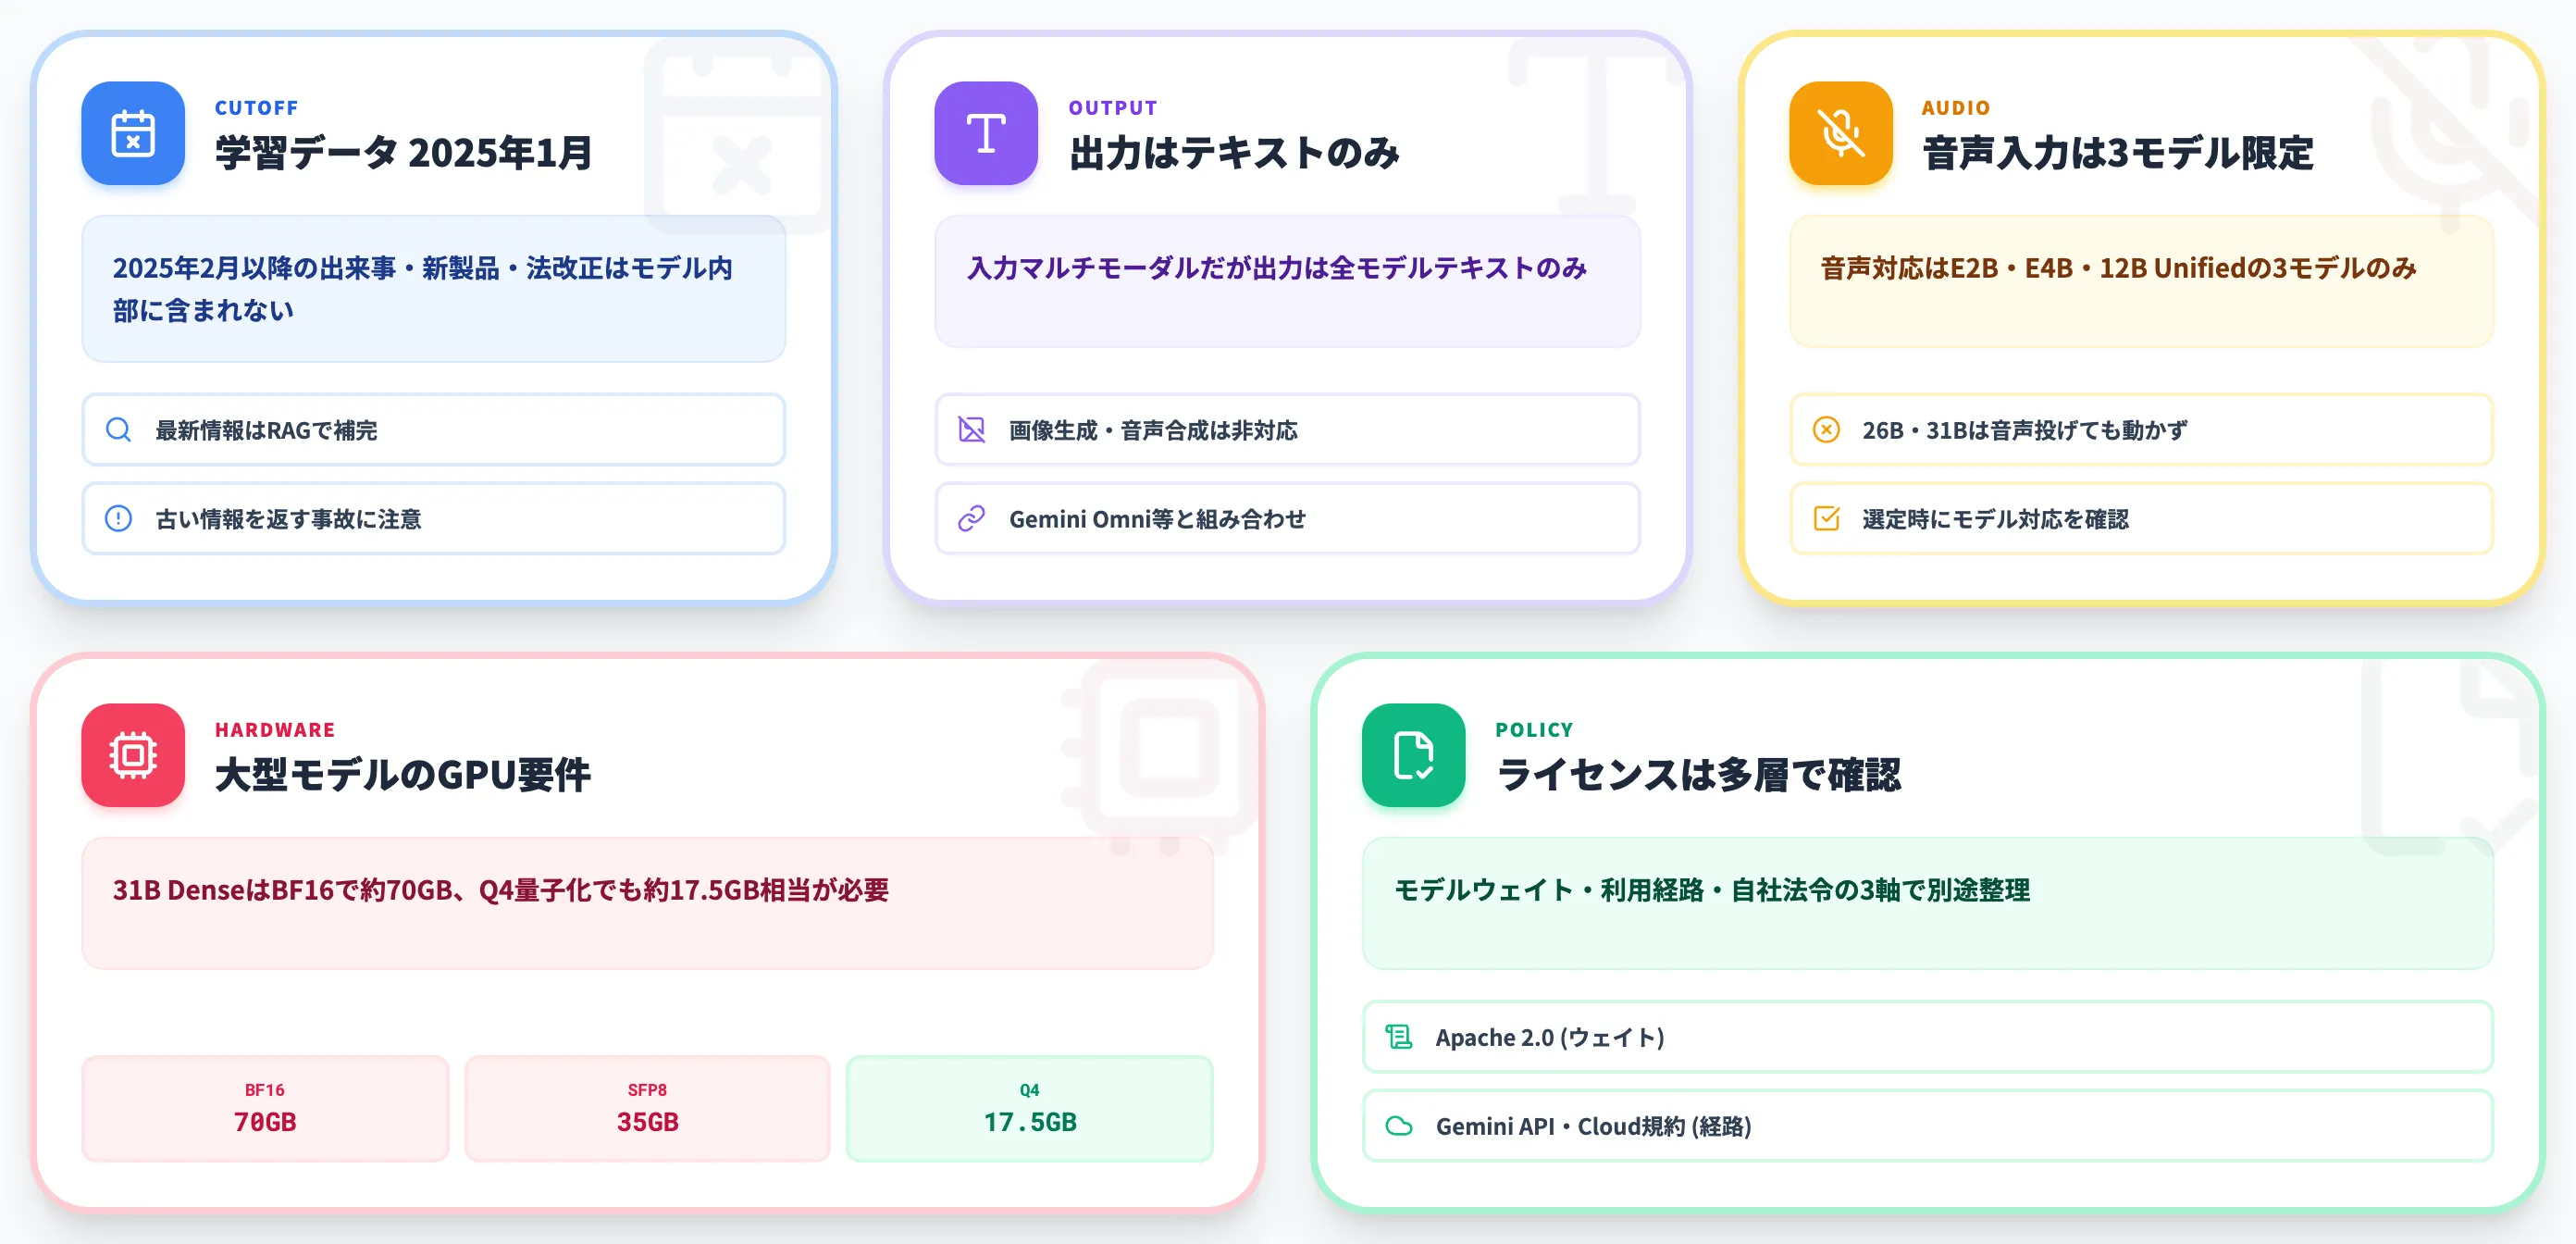
高性能なオープンモデルですが、実運用には固有の制約があります。特にPoC段階で見落とされやすい5点を整理します。
学習データのカットオフは2025年1月
Gemma 4の学習データは、公式モデルカードによれば2025年1月でカットオフされています。したがって2025年2月以降の出来事、新製品情報、法改正、市場動向といった話題は、原則としてモデル内部の学習対象には含まれず、正確性は保証されません。
このため、最新情報を扱う業務では、RAG(外部知識検索)や関数呼び出しで最新データを外から取り込む設計が前提になります。逆に「Gemma 4に聞けば最新の話も分かる」という前提でプロダクトを組んでしまうと、初日から古い情報を返す事故に直結します。
出力はテキストのみ
Gemma 4は入力側こそマルチモーダル対応ですが、出力はどのモデルもテキストのみという設計です。画像生成・音声合成・動画生成は範囲外になっています。
「マルチモーダルAI」という肩書きで紹介されることが多いため、生成側までマルチモーダルだと誤解されがちですが、絵を描かせたり音声を返させたりしたい場合は別モデルとの組み合わせが必須です。生成側のマルチモーダルが必要なら、Gemini OmniやNano Bananaといった別ラインが受け皿になります。
音声入力は3モデルのみ
音声入力に対応しているのは、E2B・E4B・12B Unifiedの3モデルだけです。26B MoEと31B Denseは音声非対応となっています。
「大型モデルほど音声も強いはず」という直感で選ぶと、31B Denseに音声を投げて動かない、という事故になりがちなポイントです。音声処理を含むアプリケーションでは、モデル選定の時点で音声対応モデルに候補を絞り込んでおく必要があります。
大型モデルは相応のGPU要件
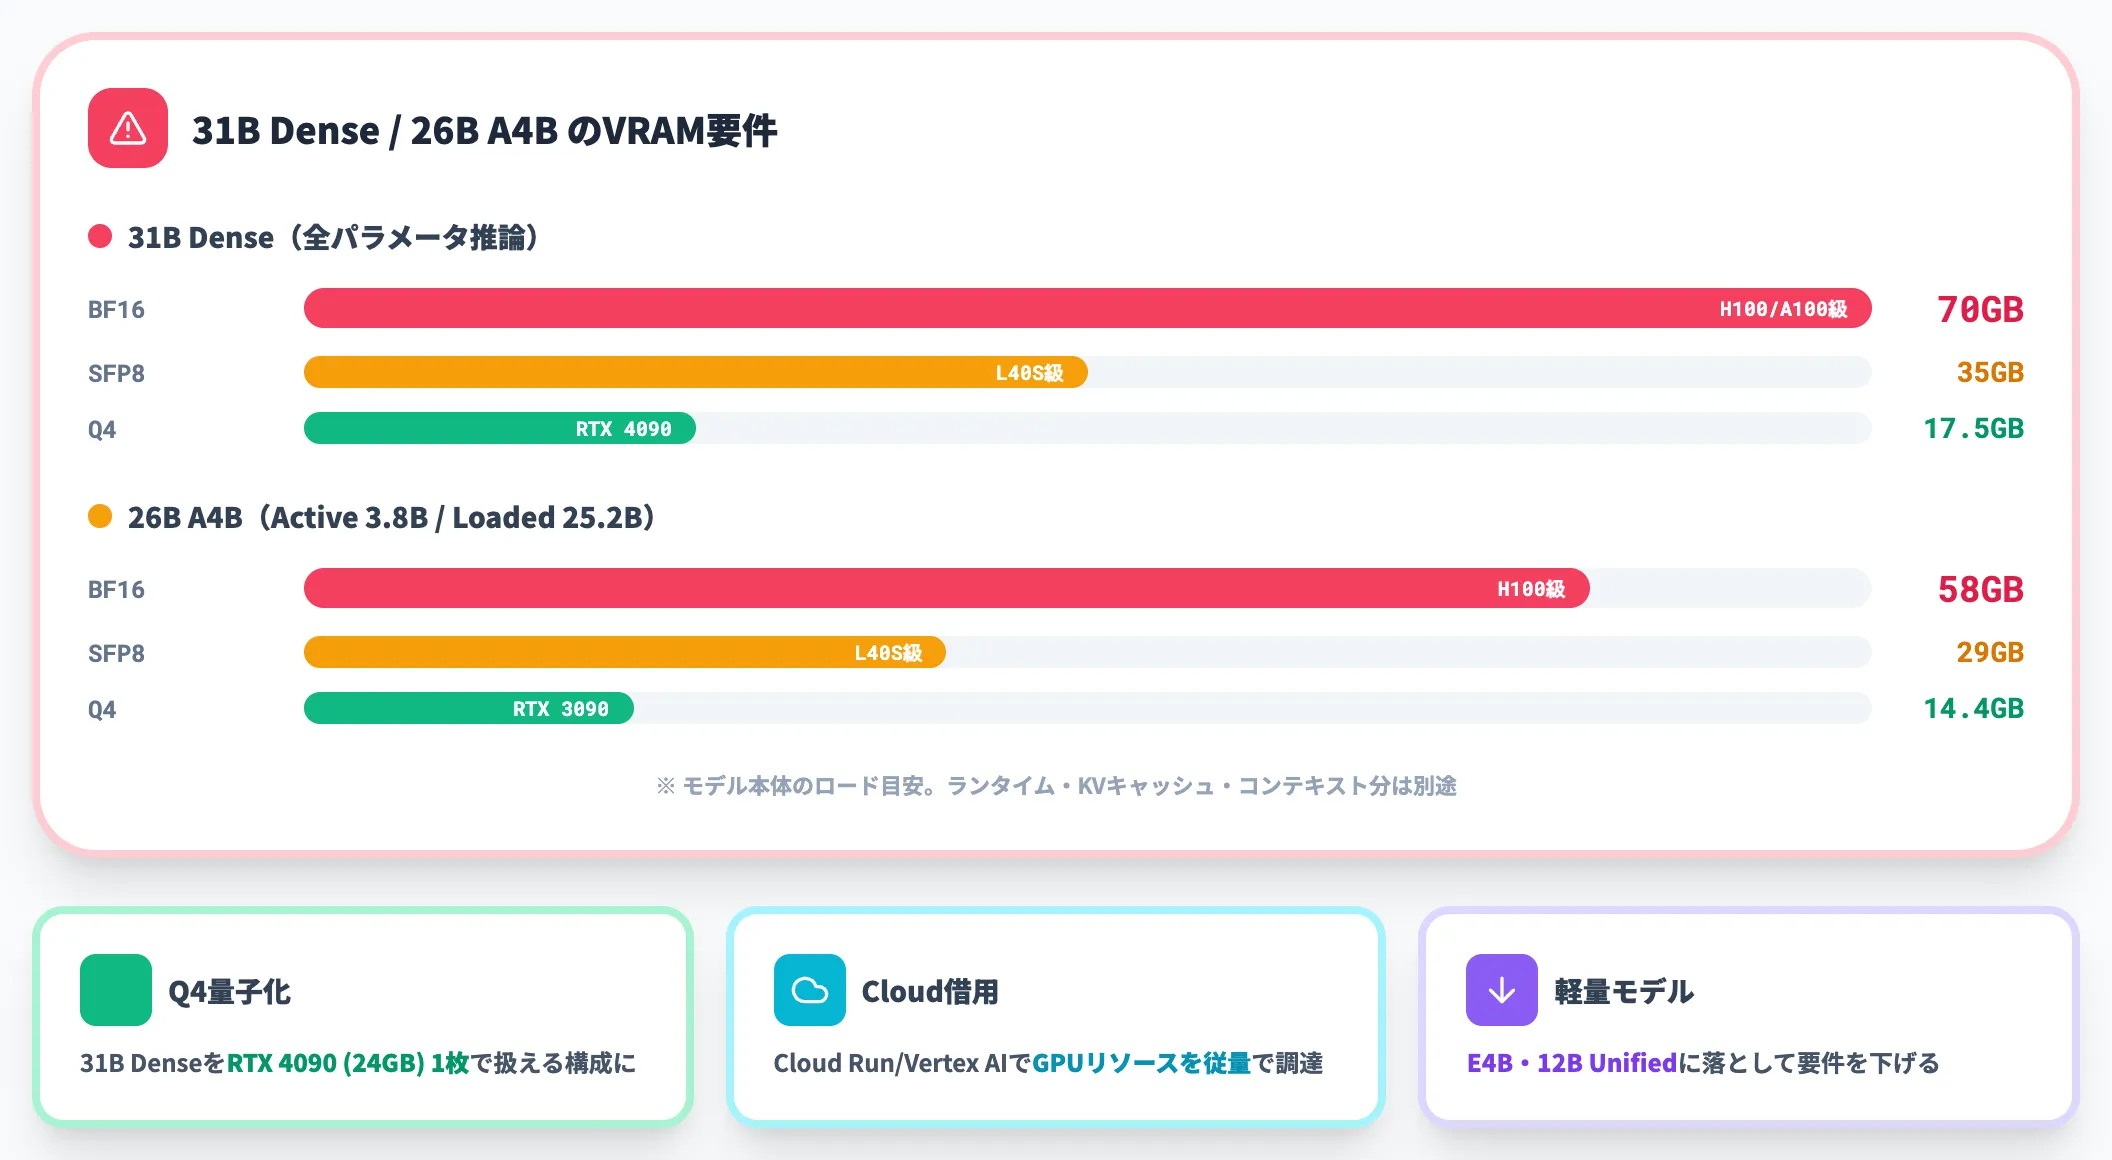
31B Denseはモデル本体のロード目安がBF16で約70GB、SFP8で約35GB、Q4量子化でも約17.5GB相当で、これに加えてランタイム・KVキャッシュ・コンテキスト分のVRAMが上乗せで必要になります。
26B A4Bも同様で、MoEでアクティブは3.8Bとはいえ、モデルロード時には全25.2Bパラメータ分(BF16で約58GB)のメモリを積む必要があります。
つまり「オープンモデル=誰でもすぐ動く」というのは事実ではありません。手元にH100やA100級のGPUがないなら、Q4量子化を選ぶ/Cloud RunやVertex AIでリソースを借りる/E4B・12B Unifiedといった軽量モデルに落とす――といった選択肢を組み合わせて詰めていく判断になります。
ライセンスと運用ポリシーは別軸で確認する
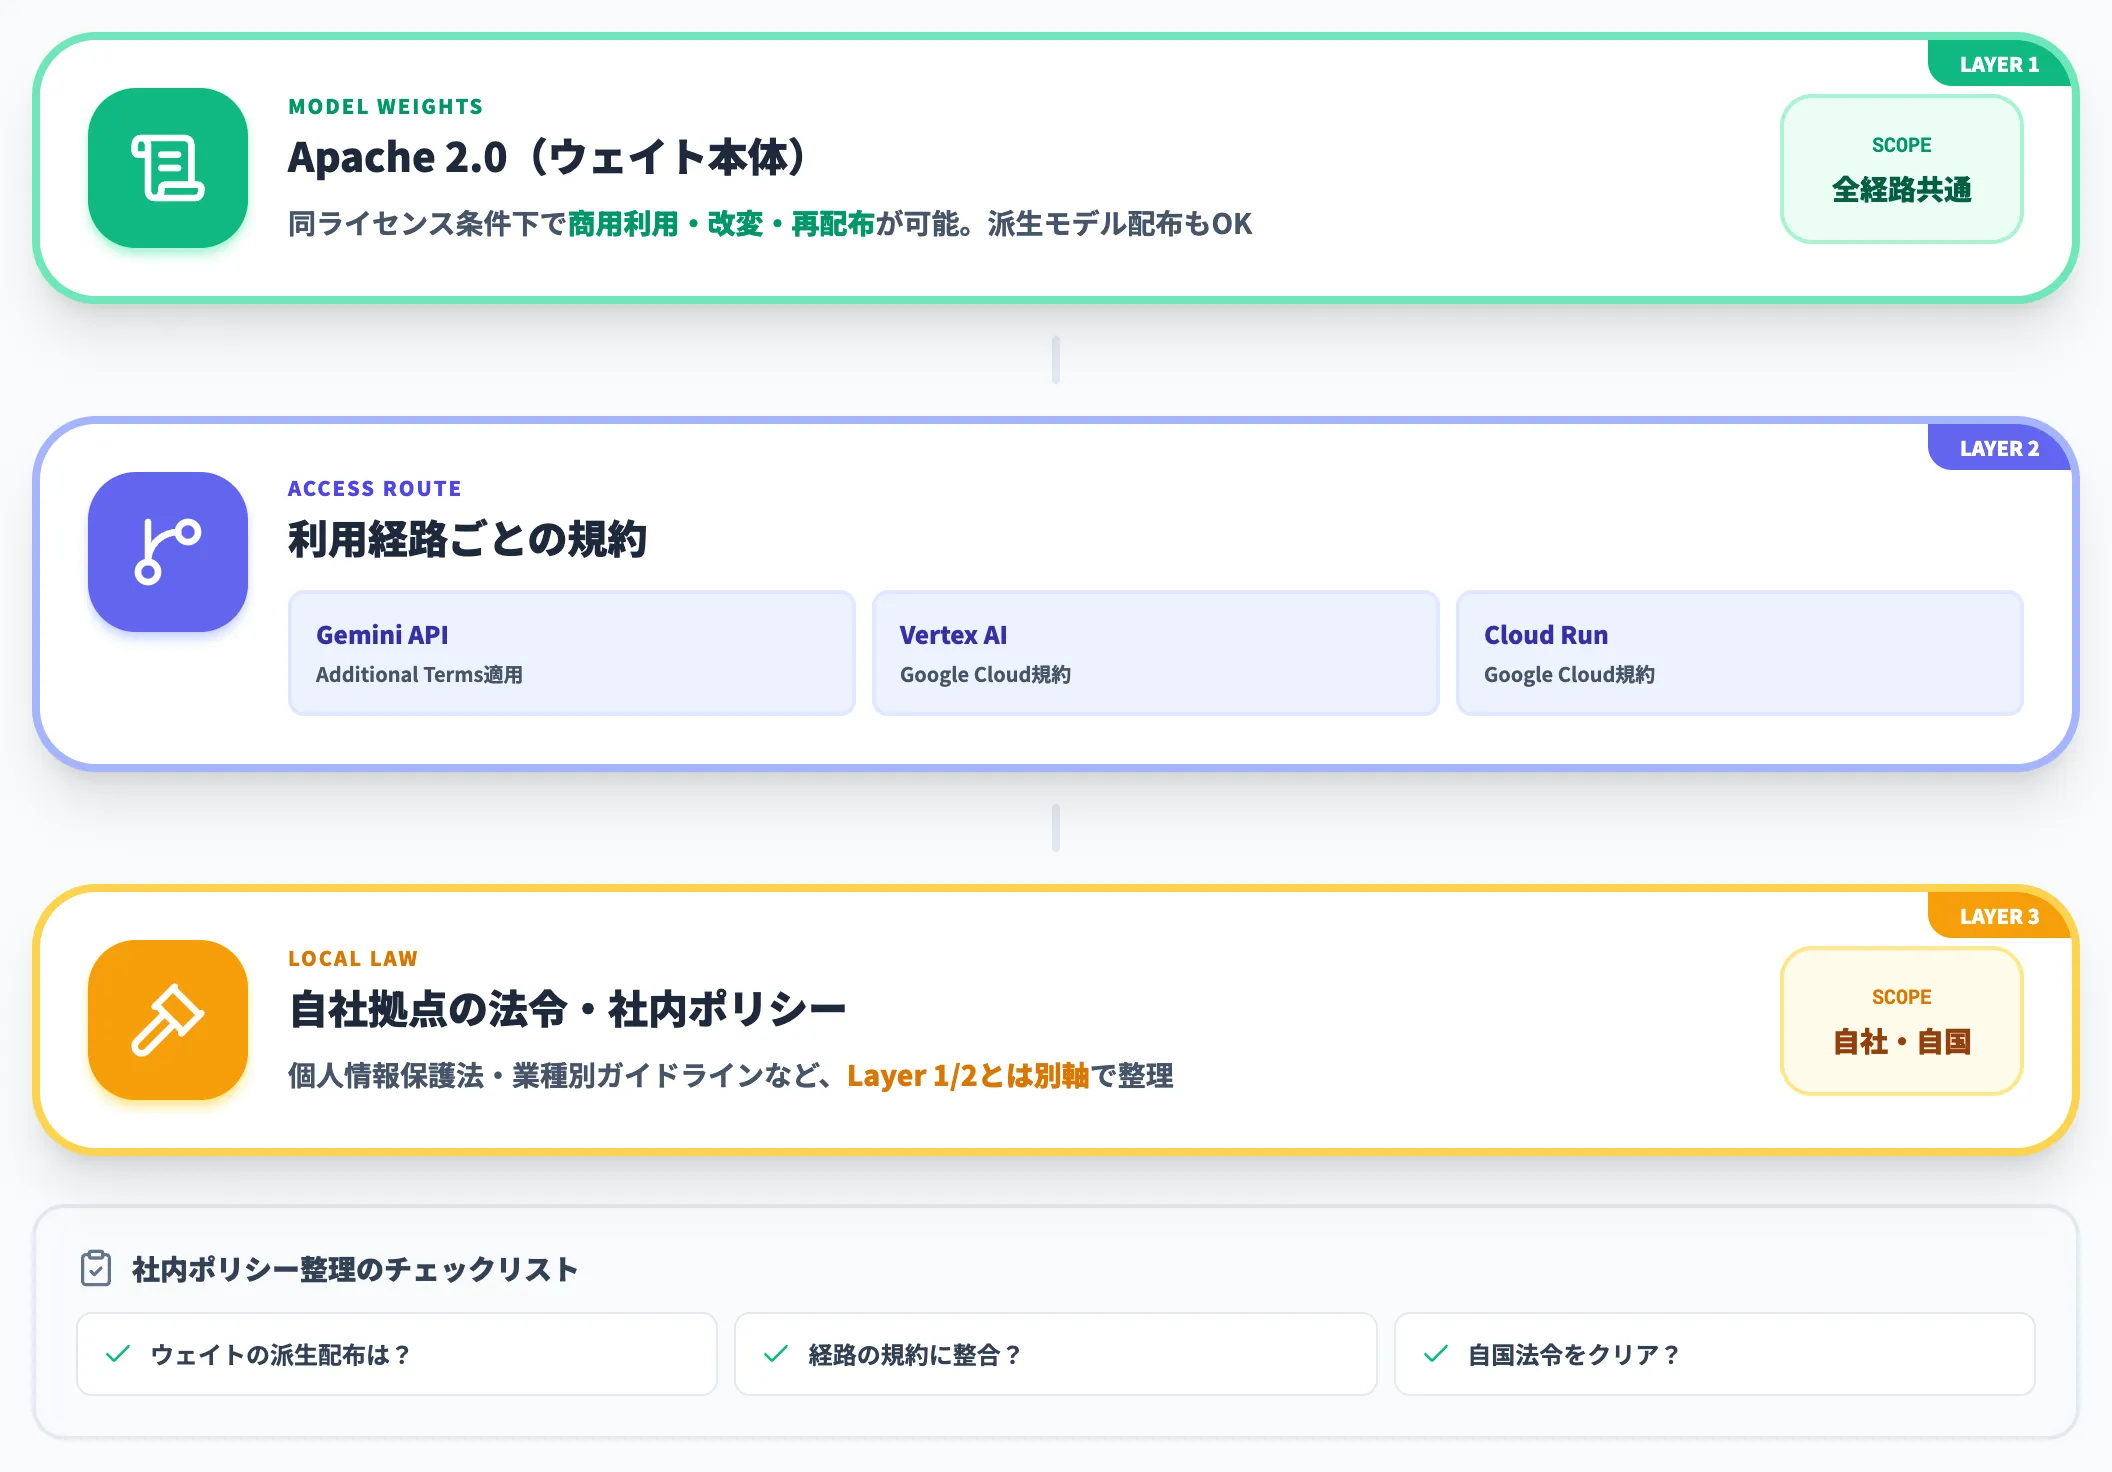
Gemma 4のモデルウェイトにはApache 2.0が適用され、同ライセンスの条件を満たせば商用利用・改変・再配布が可能になっています。
ただし、利用する経路によっては別レイヤーの規約が追加で乗ってきます。例えばGoogle AI StudioやGemini API経由の利用にはGemini API Additional Termsが、Vertex AIやCloud Runなどへ展開する場合は各Google Cloudサービスの利用規約が別途適用されます。
そのため企業導入の際は、①モデルウェイトのライセンス条件、②利用経路ごとの提供元規約、③自社が拠点を置く国の法令、この3点を別軸として社内ポリシーに落とし込んでおくのが安全です。
Gemma 4を自社Azureテナント内の業務Agent基盤に載せるなら
Gemma 4のようなApache 2.0オープンモデルは、E2Bのスマホ実行から31B DenseのサーバーGPUまで幅広く動かせる強みがあります。
ただしローカル/Vertex AI/Cloud Runで検証しただけでは業務は動かず、業務Agent層・実行ログ・権限管理・データ主権までを含めた運用設計が並行して必要です。
このレイヤーを担うのが、自社Azureテナント内で動くエンタープライズAIエージェント基盤です。AI総合研究所のAI Agent Hubは、Teamsから呼び出せる業務特化Agent群を1つのダッシュボードで統合管理し、Gemma 4のようなオープンモデルをバックエンドに据えても業務プロセス側の設計を守れる運用基盤として機能します。
- オープンモデルを自社テナント内で運用
Gemma 4を自社Azureテナント内にデプロイし、業務Agent層と接続。データは100%自社テナント内に保持され、AIの学習対象から完全除外されます。
- モデルサイズを機密度と用途で使い分け
非機密・大量処理はE2B/E4B/12B、重要判断は26B/31Bクラス、といったポリシーベースのモデルルーティングを設計段階から支援。オープンモデルの料金優位と品質を両立できます。
- 構築基盤が違っても管理は1つ
Copilot Studio・n8n・Microsoft Foundryなど複数の構築基盤で作ったAgentを1つのダッシュボードに集約。実行ログ・アクセス権限・セキュリティスキャンを一元管理します。
- Teams入口で業務プロセスに直結
Gemma 4で検証したモデルをTeams上のAgentから呼び出し、社内DB・基幹システムを更新するフローまで一気通貫で実装できます。
AI総合研究所の専任チームが、オープンモデル選定から業務Agent基盤の統合設計まで一貫して支援します。AI Agent Hubのサービスページで、Gemma 4を業務に載せる実装例をご確認ください。
Gemma 4を業務Agent基盤に載せる

オープンモデルを自社テナント内で運用
Gemma 4のようなオープンモデルを技術検証しただけでは、業務のBefore/Afterは動きません。AI Agent Hubは、業務特化Agent群を1つのダッシュボードで統合管理し、Gemma 4を含むオープンモデルを自社Azureテナント内で業務プロセスに載せる運用基盤として機能します。
まとめ
本記事では、Gemma 4について、5モデル構成、Gemma 3からの進化、競合オープンモデルとの違い、4系統の実行環境、料金構造、実運用の制約までを、2026年7月時点の最新情報で解説しました。
2026年時点で押さえておくべきポイントは次の3つです。
- Gemma 4はE2B/E4B/12B Unified/26B MoE/31B Denseの5モデルで、スマホからサーバーGPUまで環境別に選び分けられる
- Gemma 3比でAIME約4倍・τ2-bench Retail約13倍と大幅性能向上、Apache 2.0で商用利用可・Vertex AI/Cloud Runの公式提供が競合との差別化ポイント
- 実行環境はAI Studio/ローカル/Vertex AI/Cloud Runの4系統で、データ主権とトラフィック特性で選び、カットオフ2025年1月・音声3モデル限定・GPU要件の制約に注意
Gemma 4は、「Gemini 3系の研究成果を自分の環境で動かす」という選択肢を、コスト・データ主権・スケーラビリティの各観点で現実的な水準まで押し上げたモデルファミリーだと言えます。SaaS型LLMとオープンモデルの棲み分けが進んでいる今、社内AI基盤の選定候補として最初に検証テーブルに載せておく価値のあるモデルです。