この記事のポイント
 Fable 5.1比で出力最大30%高速・料金20%値下げの$8/$40を実現し、フロンティアタスクの単価が実運用レンジに入った
- FrontierCode 2.0のXhighで49.1%・FrontierSWE v2で69.9%とOpus 5.5を上回り、長時間エージェント指標Remote Labor Indexは5.1比2.3倍に伸長
- Opus 5.5で足りる案件はOpus 5.5が第一候補、Fable 5.2は長時間エージェントや1000サブエージェント並列などOpusで息切れする局面での上位置
- AdvisorとOrchestratorの2パターンでHaiku・Sonnet・Opusと組み合わせて使う設計がAnthropic公式の推奨
- Mythos 5.2は同じ基盤モデルでサイバー・生物化学ドメインの安全制限を緩和した提供形態で、認定を受けた組織や個人向け、通常企業はFable 5.2を使う
Microsoft MVP・AIパートナー。LinkX Japan株式会社 代表取締役。東京工業大学大学院にて自然言語処理・金融工学を研究。NHK放送技術研究所でAI・ブロックチェーンの研究開発に従事し、国際学会・ジャーナルでの発表多数。経営情報学会 優秀賞受賞。シンガポールでWeb3企業を創業後、現在は企業向けAI導入・DX推進を支援。
Claude Fable 5.2は、Anthropicが2026年11月9日に発表した最新のフロンティアモデルです。
Fable 5.1から出力が最大30%高速化し、料金は入力$8・出力$40(100万トークンあたり)と20%値下げされた最上位帯のモデルで、Anthropic IPOのロードショー開始を翌日に控えたタイミングで公開されました。
本記事では、Fable 5.1からの変更点、料金とFast mode、ベンチマーク性能、Opus 5.5との使い分け、Mythos 5.2との違い、利用プランと制約事項までを2026年11月時点の情報で解説します。
目次
Claude Fable 5.2とは?Opus 5.5の上に積まれた最上位フロンティアモデル
Claude Fable 5.2のベンチマーク結果と性能向上
Remote Labor Index 17.9%→41.3%が示す意味
Terminal-Bench・RoboDojo・Humanity's Last Exam
Claude Fable 5.2とOpus 5.5の使い分け
Claude Fable 5.2を活かすAdvisor/Orchestratorパターンと活用事例
Advisorパターン——難所だけFable 5.2に相談する
Orchestratorパターン——Fable 5.2が小型モデルを指揮する
Claude Fable 5.2とMythos 5.2の違い
Cyber/Life Sciences Verification Programの対象
自社がFable 5.2とMythos 5.2のどちらを使うべきか
Claude Fable 5.2の利用プラン・API経路と制約事項
Claude API・Bedrock・Google Cloud・Microsoft Foundryでの利用
30日データ保持・サンプリング制約・Forced tool useの挙動
Claude Fable 5.2とは?Opus 5.5の上に積まれた最上位フロンティアモデル
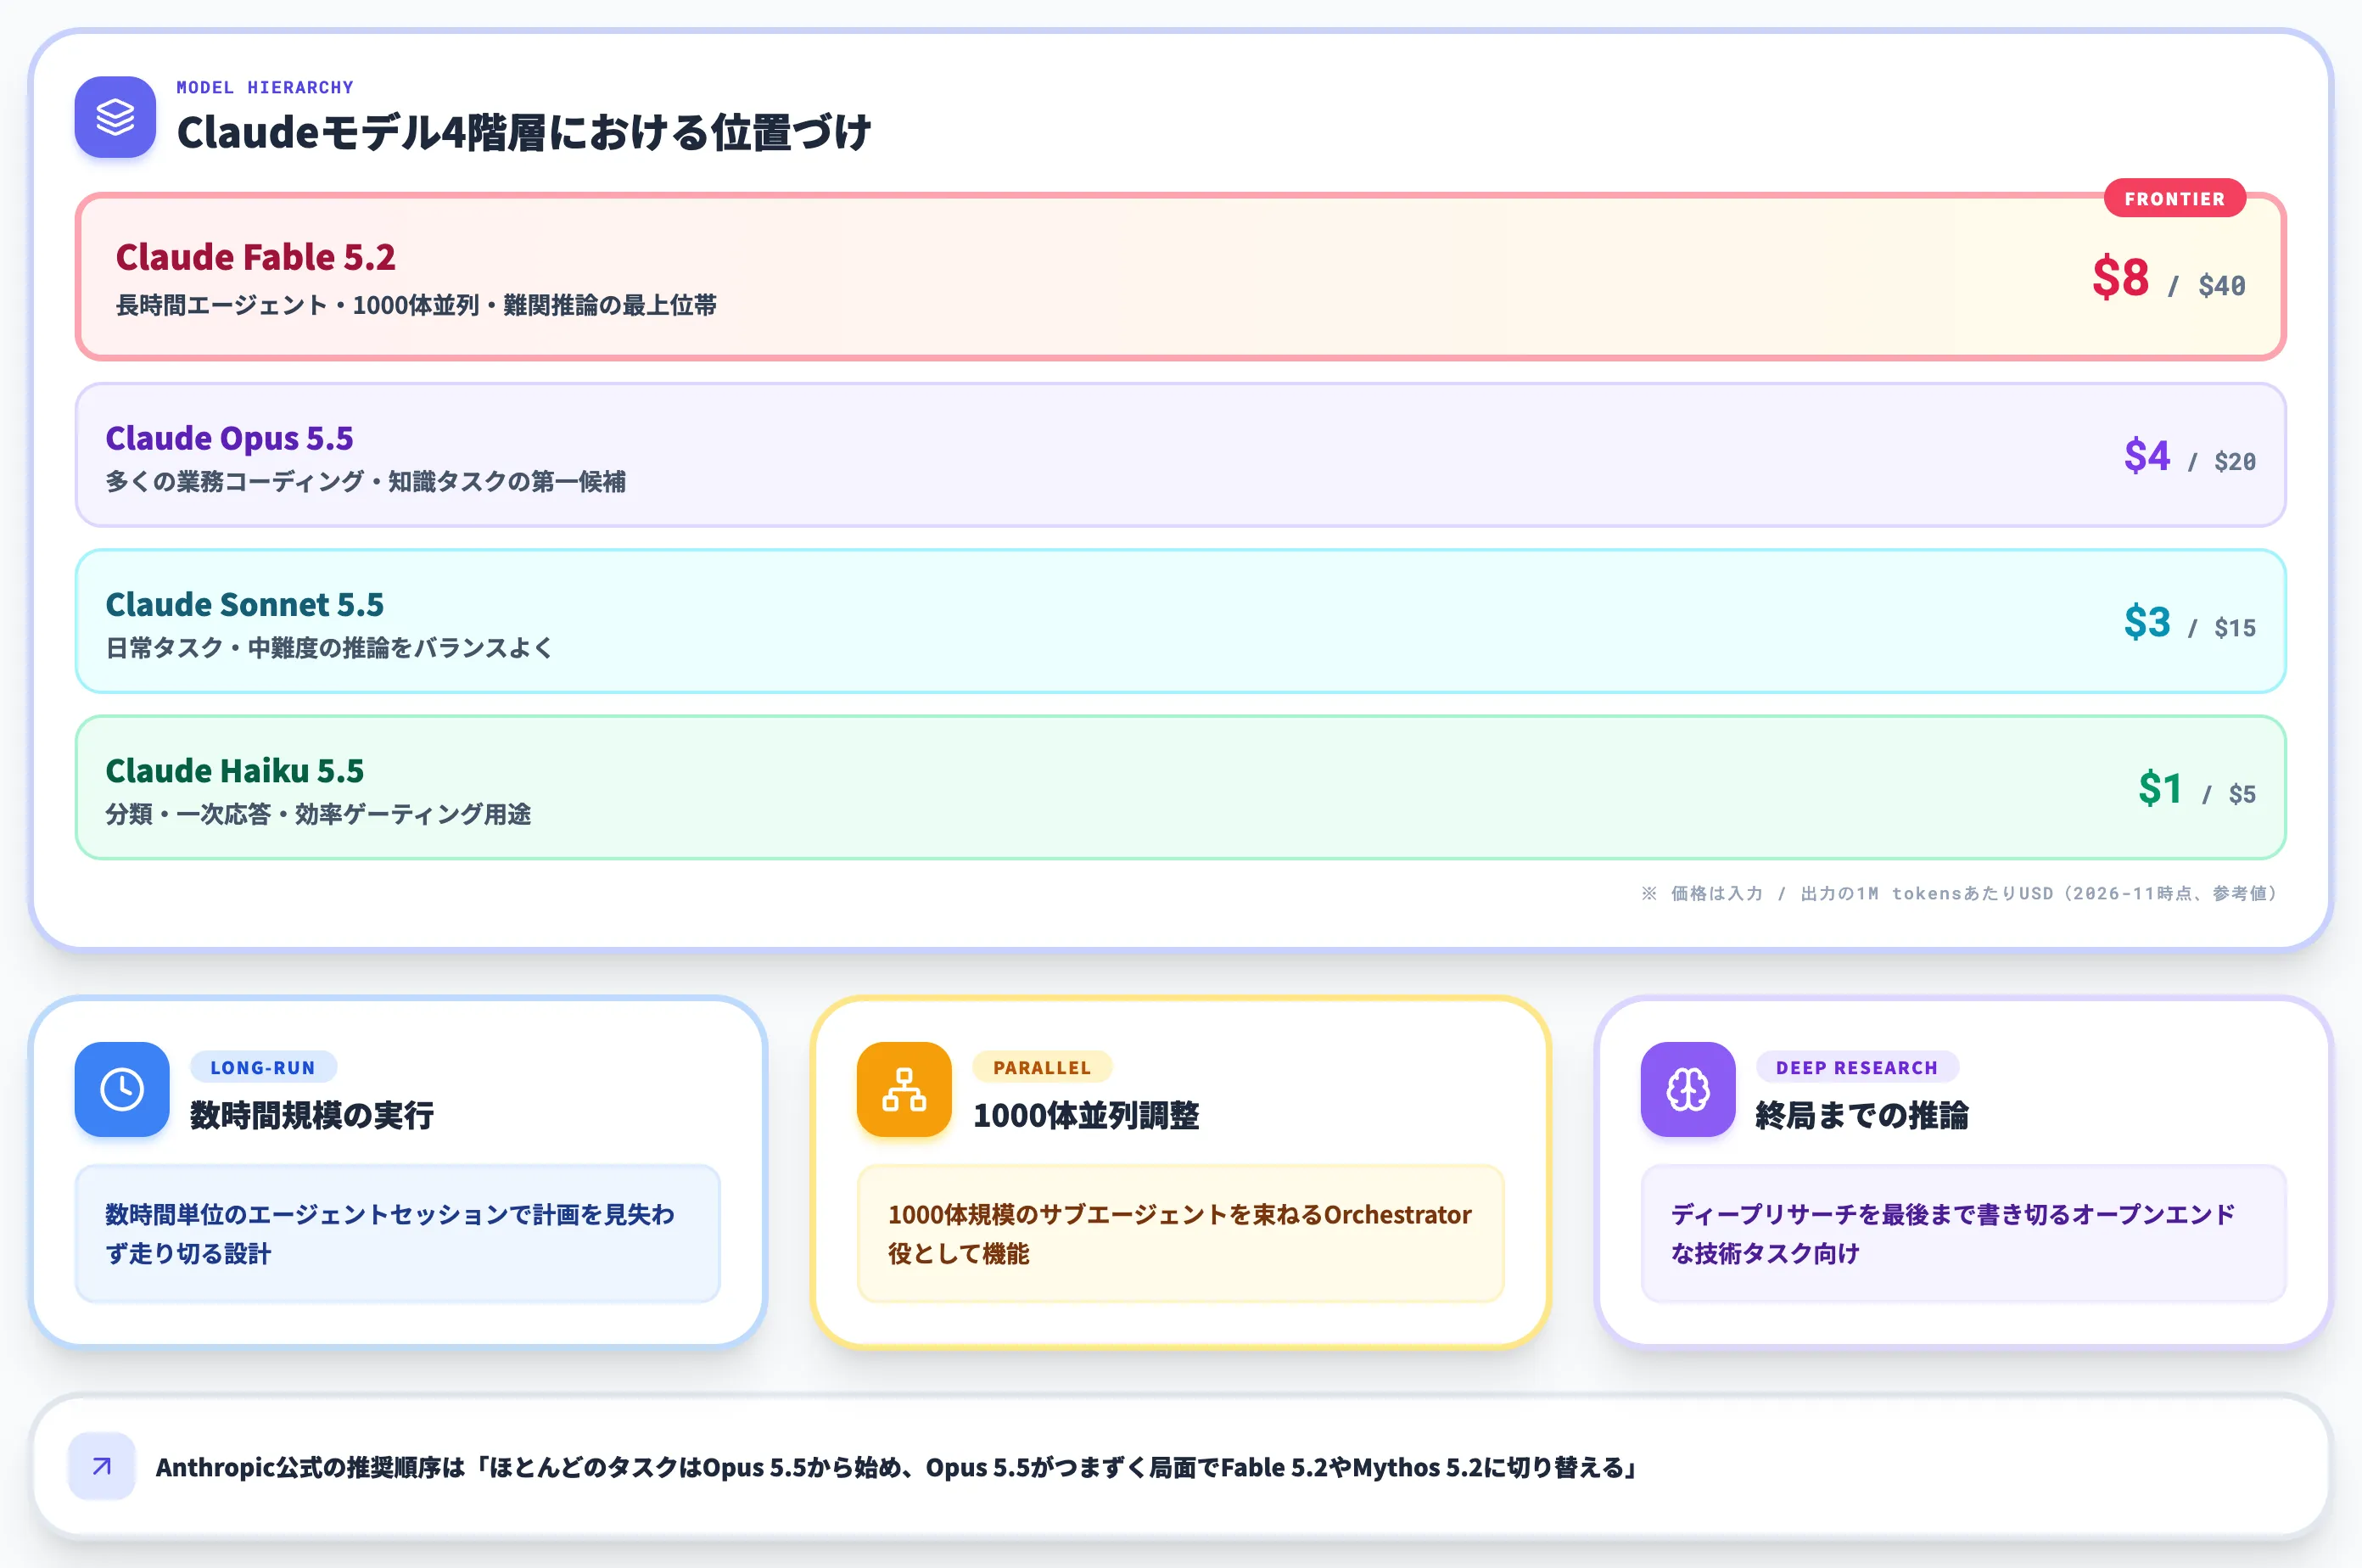
Claude Fable 5.2は、Anthropicが2026年11月9日に公開した、長時間のエージェント実行と難関推論に照準を合わせたフロンティアモデルです。
Fable 5.1から出力が最大30%高速化し、料金は入力$8・出力$40(100万トークンあたり)と20%値下げされました。AnthropicのIPOロードショー開始を翌日に控えたタイミングでの公開で、最上位帯の単価がFable 5.1の$10/$50から$8/$40まで引き下げられる価格改定となっています。
Fable 5.2が担うのは、Opus 5.5・Sonnet 5.5・Haiku 5.5の3階層で足りなくなる領域です。
Anthropic公式は「ambitious, open-ended technical work」(野心的でオープンエンドな技術タスク)を想定用途として挙げており、数時間単位のエージェントセッション、1000体規模のサブエージェント調整、終わりまで書き上げるディープリサーチ、といった従来は人間の長時間労働に紐付いていた作業が主戦場です。
2026年11月9日発表のClaude Fable 5.2とMythos 5.2のローンチキービジュアル(出典:Anthropic)
Anthropicが同時に発表した指針では、「ほとんどのコーディングや知識タスクはOpus 5.5から始め、Opus 5.5がつまずく局面でFable 5.2やMythos 5.2に切り替える」順序が推奨されています。
Fable 5.1からの進化とFable 5.2の立ち位置
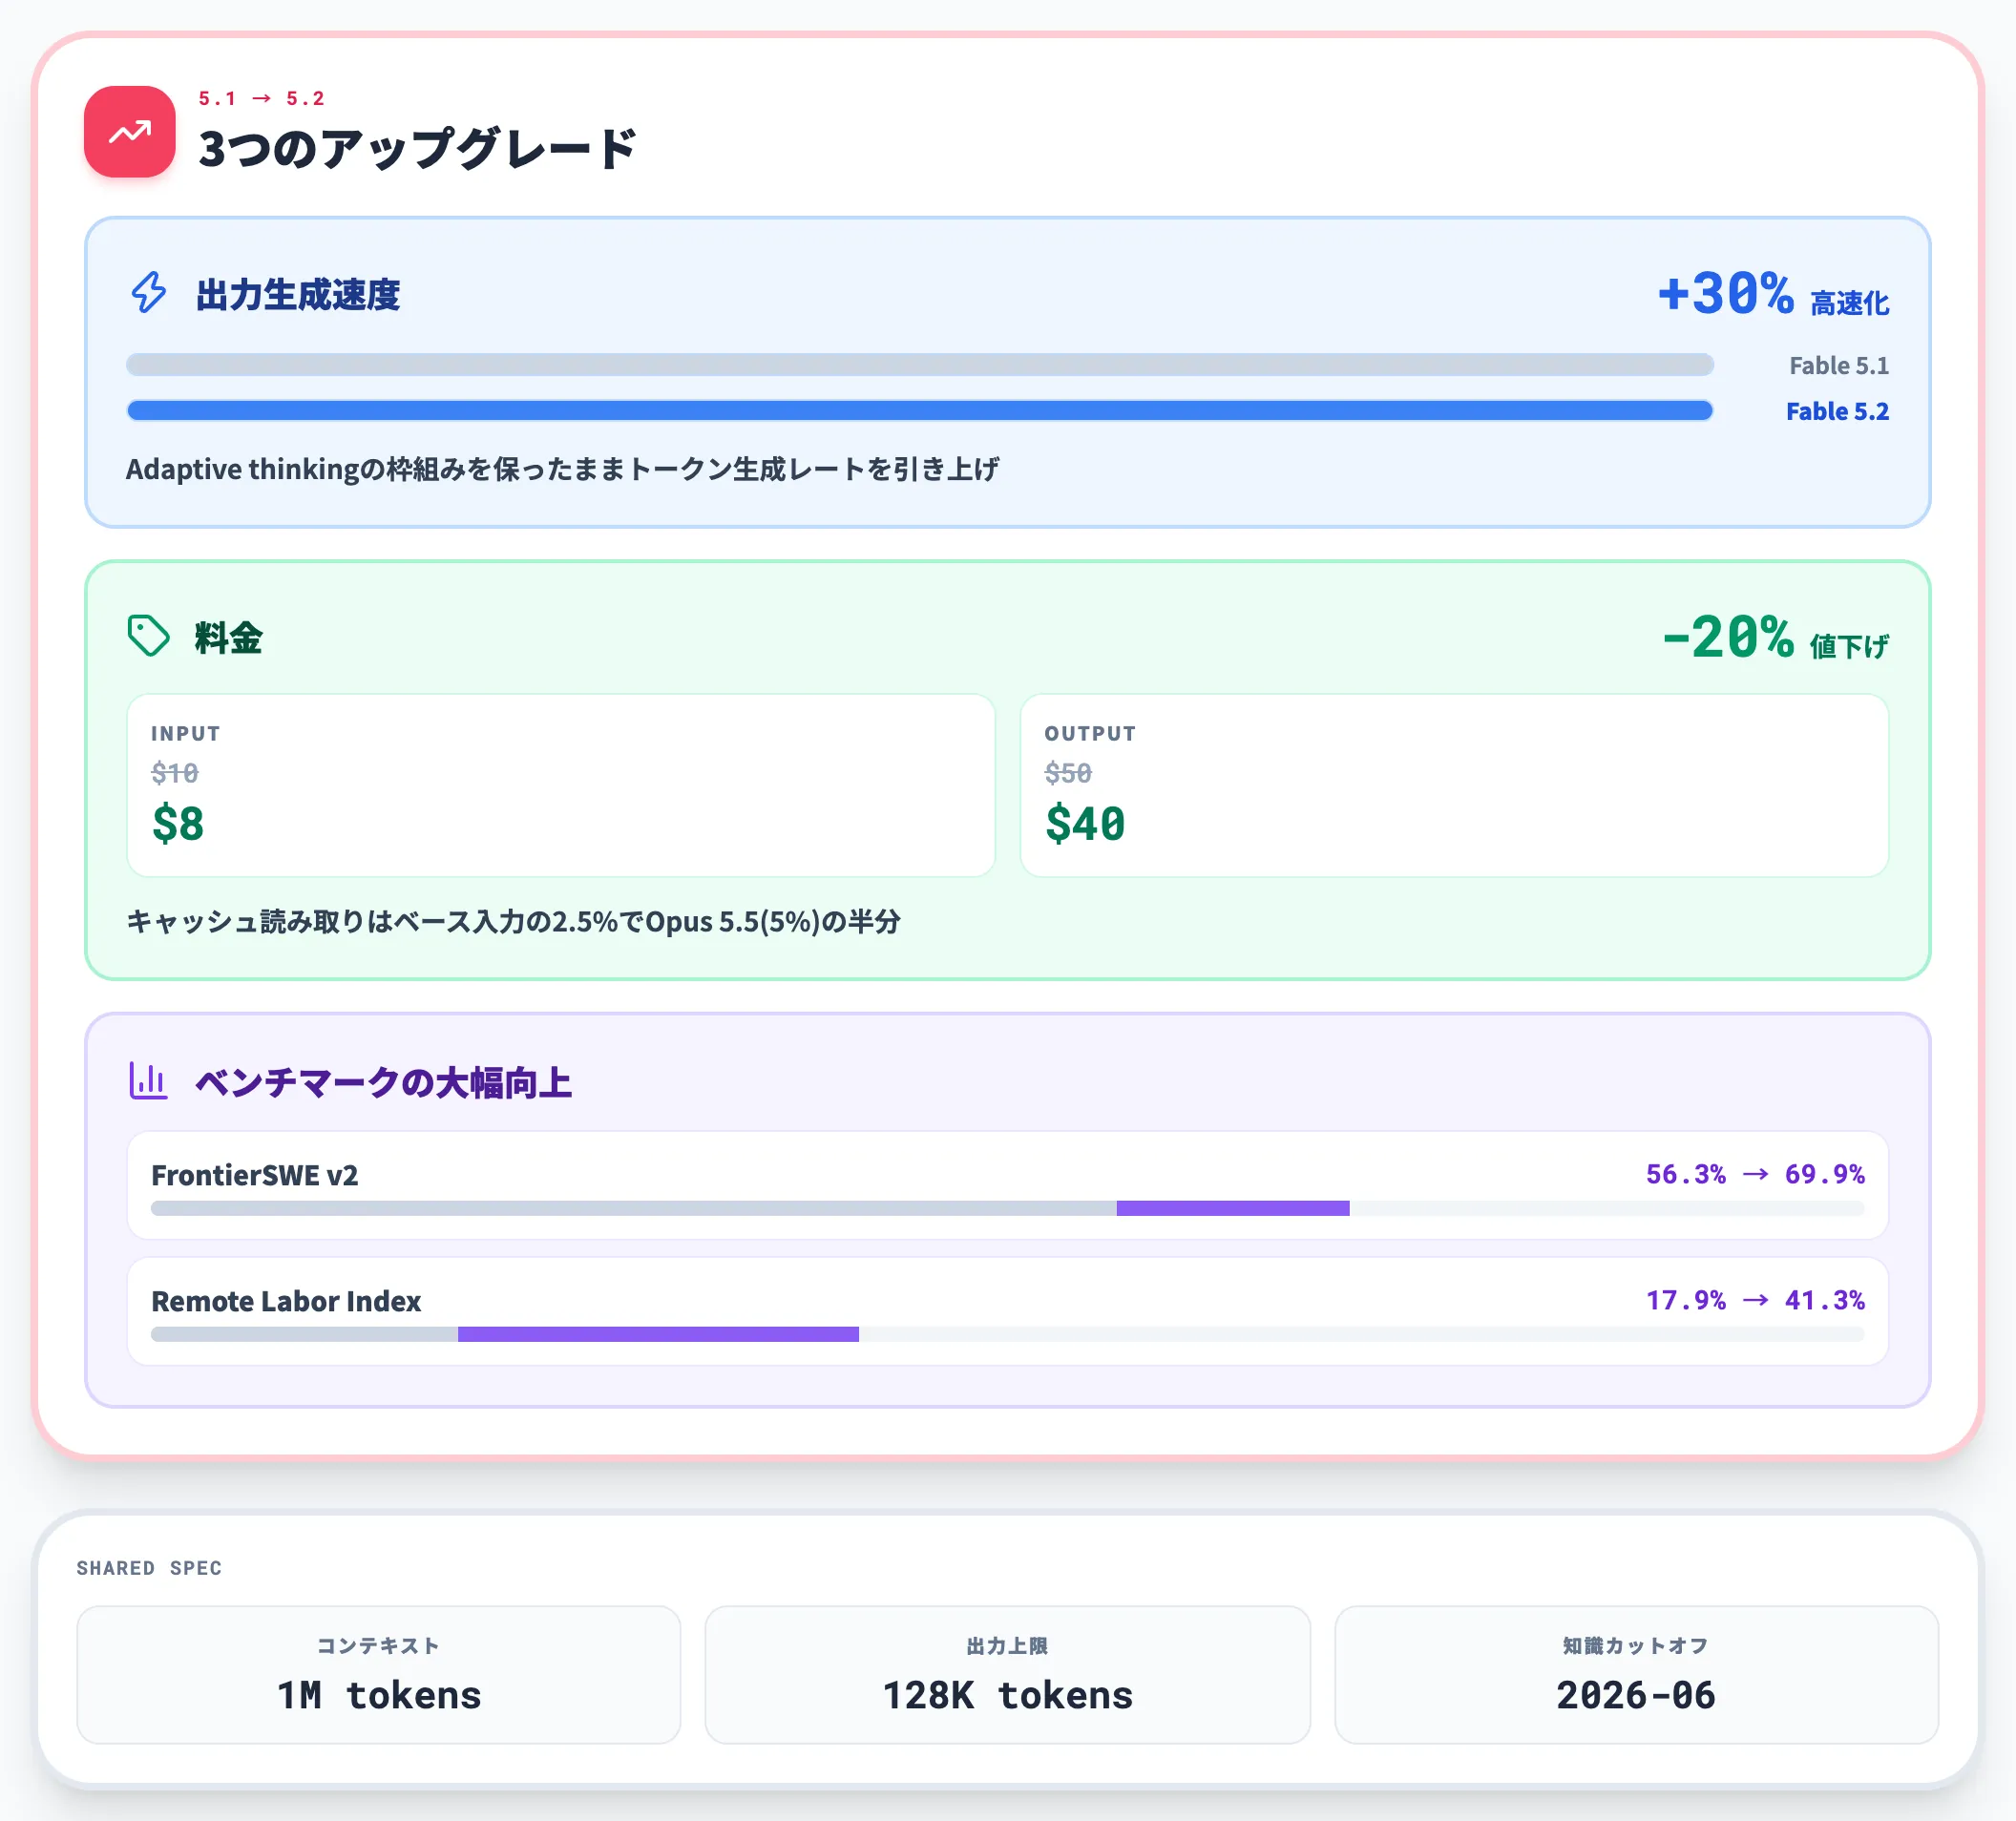
Fable 5.2は、2026年9月公開のFable 5.1の後継として、長時間エージェント能力の底上げと単価の実運用化を同時に進めたバージョンです。
主なアップグレード点は次の3つに集約されます。
- 出力生成の最大30%高速化
Fable 5.1と同じAdaptive thinkingの枠組みを保ったまま、トークン生成レートが引き上げられました
- 料金の20%値下げ
入力$10→$8・出力$50→$40へと引き下げられ、プロンプトキャッシュ読み取りはベース入力の2.5%(Opus 5.5は5%)に設定されています
- ベンチマークの大幅向上
FrontierSWE v2は56.3%→69.9%、Remote Labor Indexは17.9%→41.3%と、長時間エージェント指標で顕著な改善を示しています
フロンティア帯の単価が下がった意味は大きく、従来は1タスク$10〜$50単位を覚悟しないと回せなかった長時間推論が、Opus 5.5ベースライン比較でも実運用の射程に入ってきました。
モデル世代としてはOpus 5.5の上に位置づけられ、同じ1M tokensコンテキスト・128K tokens出力上限・2026年6月知識カットオフを共有しています。
Claude Fable 5.2の料金とFast mode
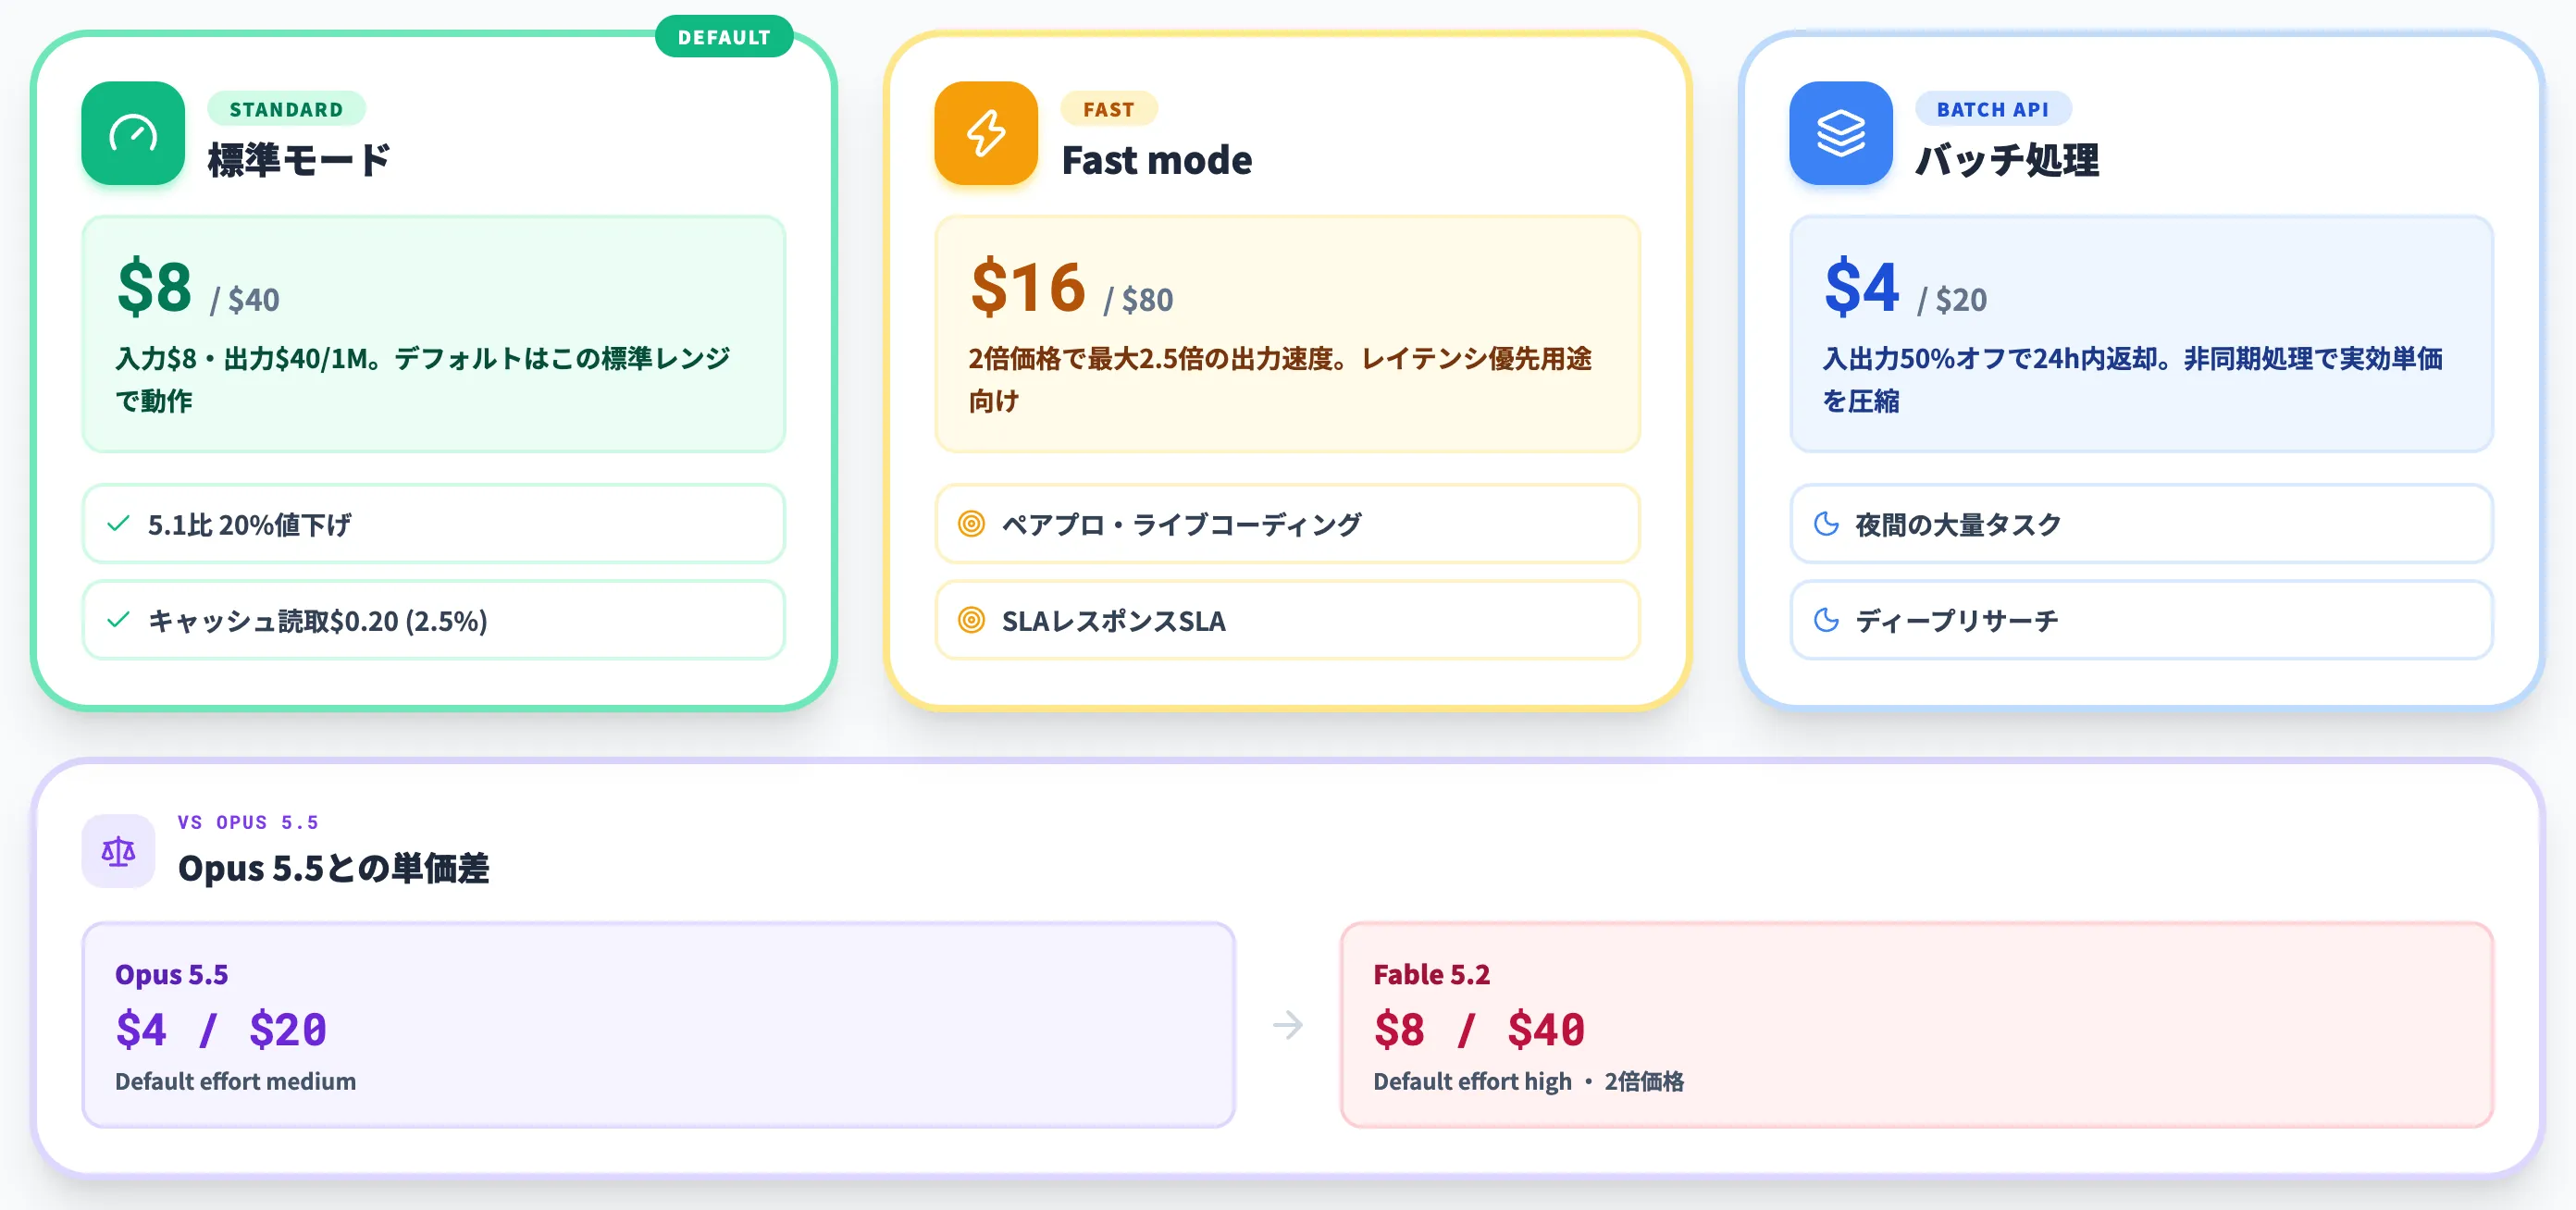
Claude Fable 5.2の料金は、標準モードが入力$8・出力$40(100万トークンあたり)、Fast modeは入力$16・出力$80です。本セクションでは、標準料金・プロンプトキャッシュ・Fast mode・Batch APIの4つを順に見ていきます。
標準価格とプロンプトキャッシュ
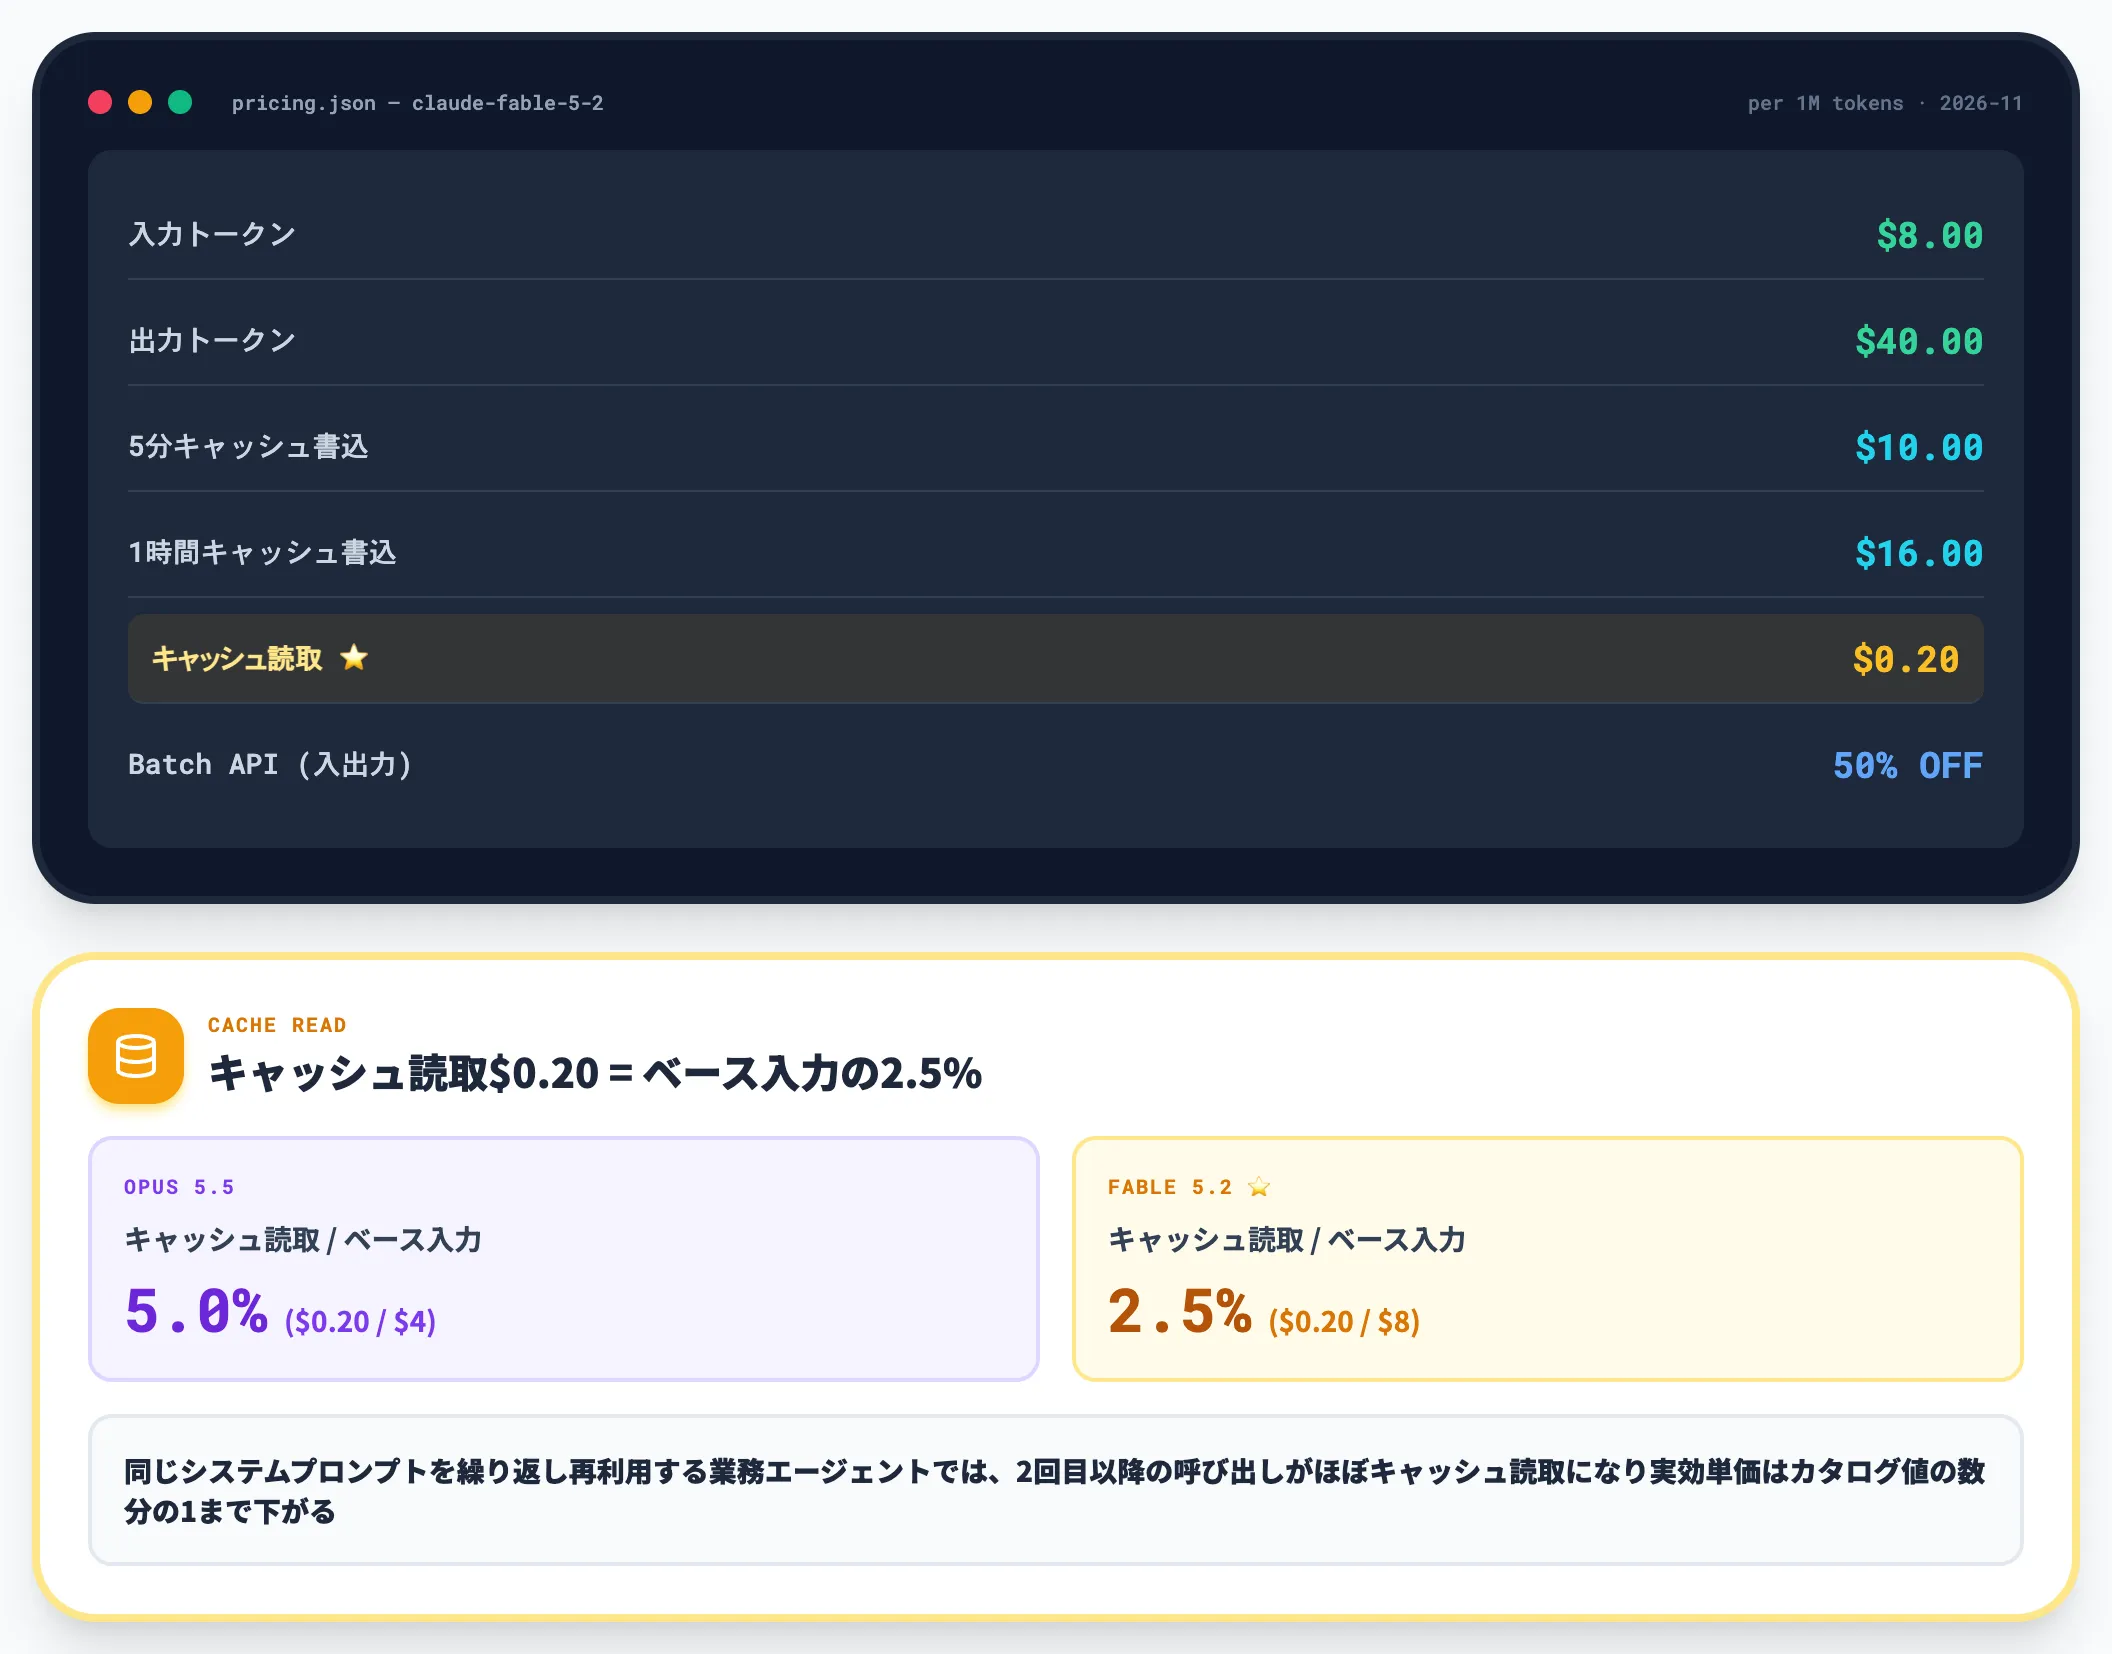
標準モードの基本単価は、公式pricingで以下のように設定されています(2026年11月時点)。
| 項目 | 価格(100万トークンあたり) |
|---|---|
| 入力トークン | $8 |
| 出力トークン | $40 |
| 5分間キャッシュ書き込み | $10 |
| 1時間キャッシュ書き込み | $16 |
| キャッシュ読み取り | $0.20 |
| Batch API | 入出力ともに50%オフ |
注目すべきは、キャッシュ読み取りの$0.20という単価です。これはベース入力価格の2.5%にあたり、Opus 5.5のキャッシュ読み取り(ベース入力の5%)と比べても半分の比率で設計されています。
同じシステムプロンプトや大規模なドキュメントを何度も読み込ませる業務エージェントでは、2回目以降の呼び出しがほぼキャッシュ読み取りになるため、実効単価はカタログ値の数分の1まで下がります。
Fable 5.1が入力$10・出力$50だったことを踏まえると、同じ入出力トークン数と同じ課金条件が前提なら、単純に乗せ替えるだけで単価ベースで20%の削減が入る計算です。
Fast modeの$16/$80をどう使うか
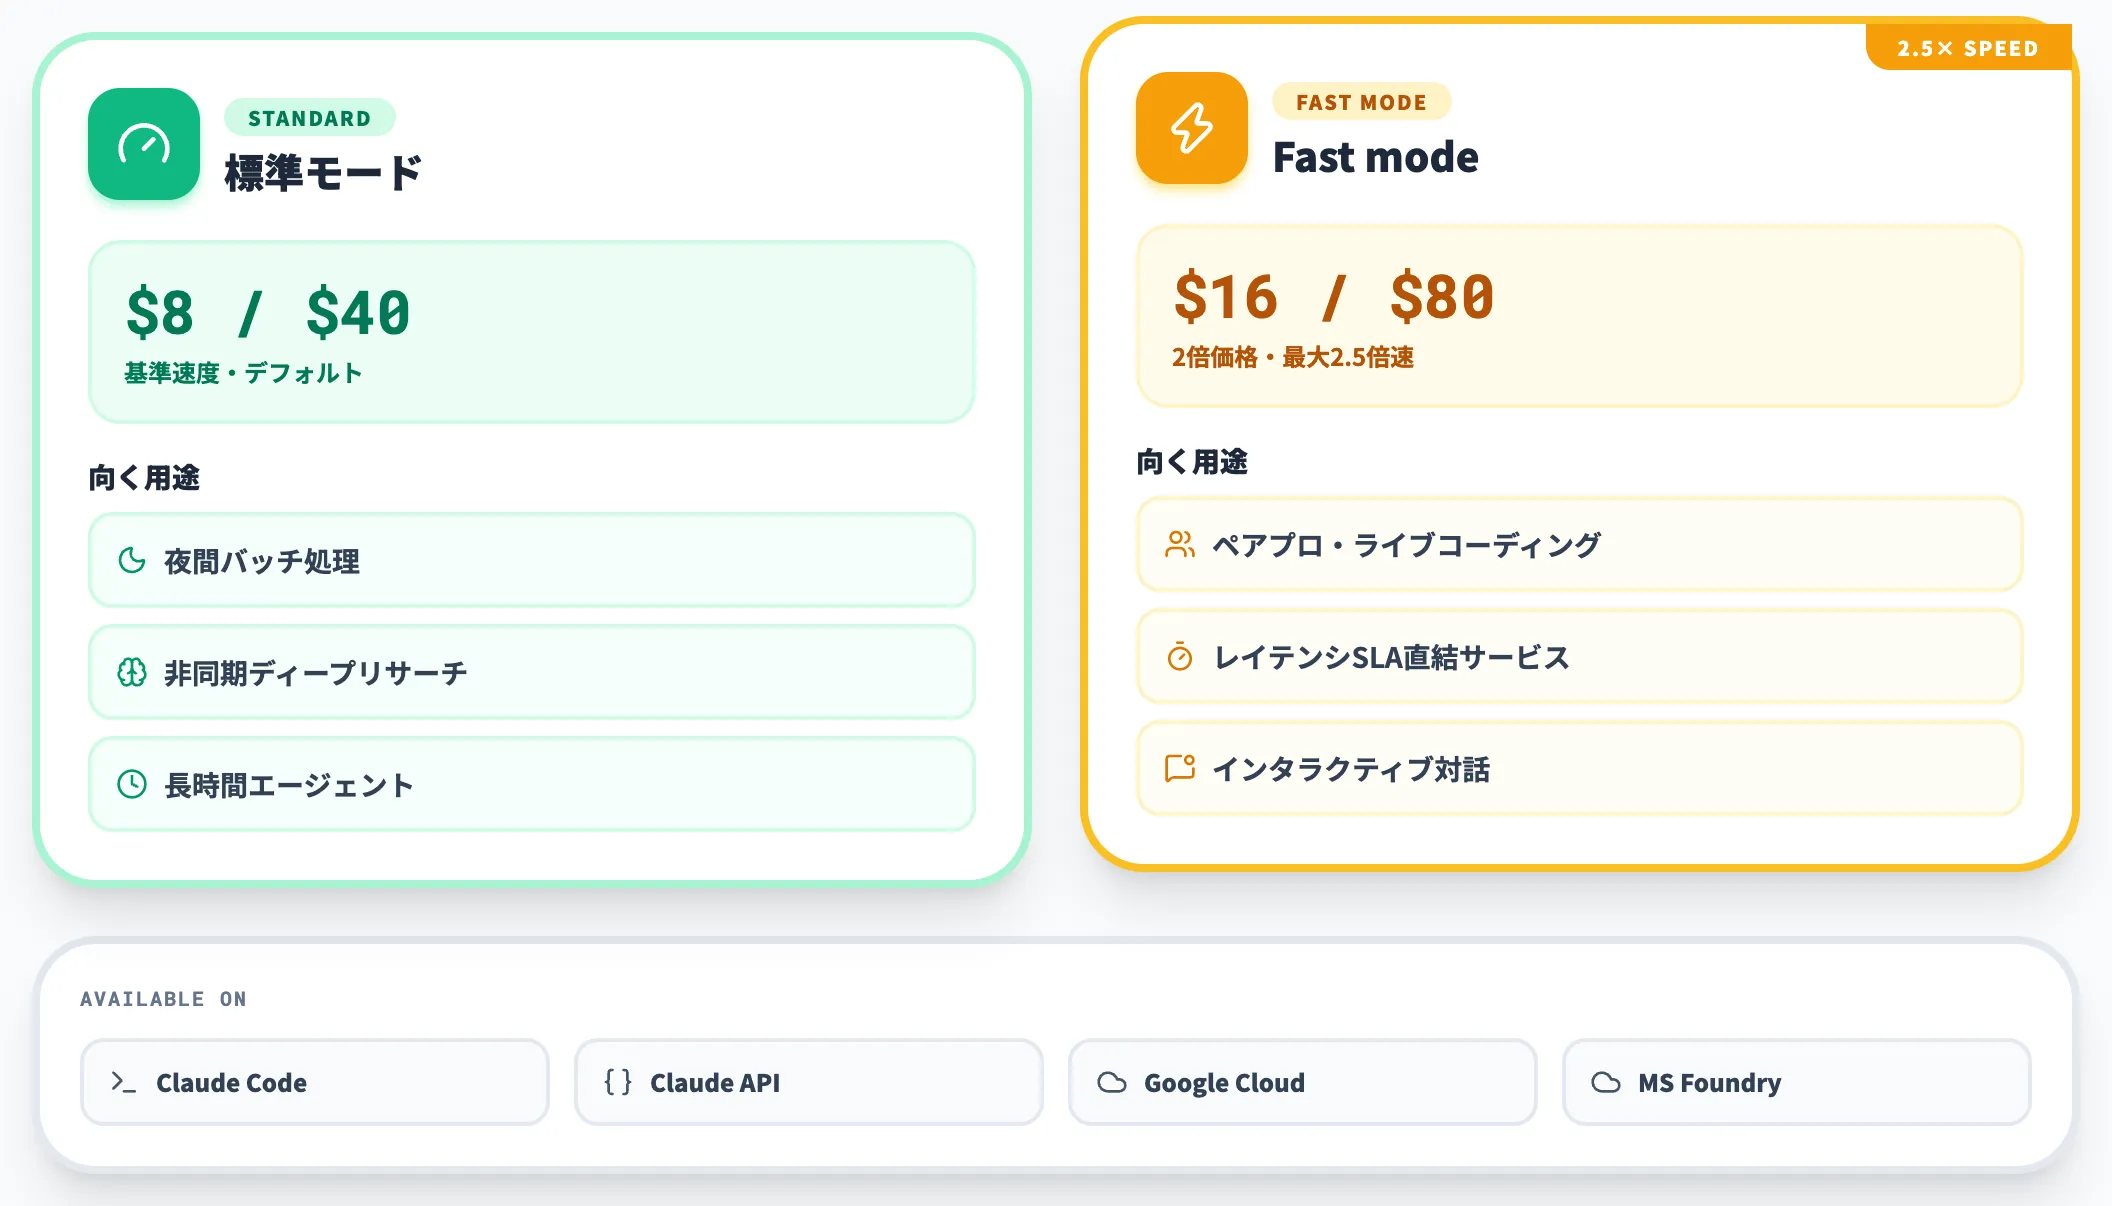
Fast modeは標準モードの2倍価格で最大2.5倍の出力速度を提供するオプションです。
Fast modeが向くのはレイテンシが主要制約になるケースに限られます。具体的には、インタラクティブなエージェント操作でユーザーが待つ場面(ペアプログラミング・ライブコーディング)、または1トークンあたり遅延がSLAに直結するリアルタイムサービスです。
逆に、バッチ処理・夜間のディープリサーチ・非同期の長時間エージェントでは、2倍のコストを払ってまで待ち時間を縮める意味は薄くなります。
Fast modeはClaude Code・Claude API・Google Cloud・Microsoft Foundryの各経路で利用可能で、Messages APIのパラメータで切り替える設計です。デフォルトは標準モードなので、意図的に指定しない限り$8/$40レンジで動きます。
Batch APIとキャッシュで実効単価をさらに下げる
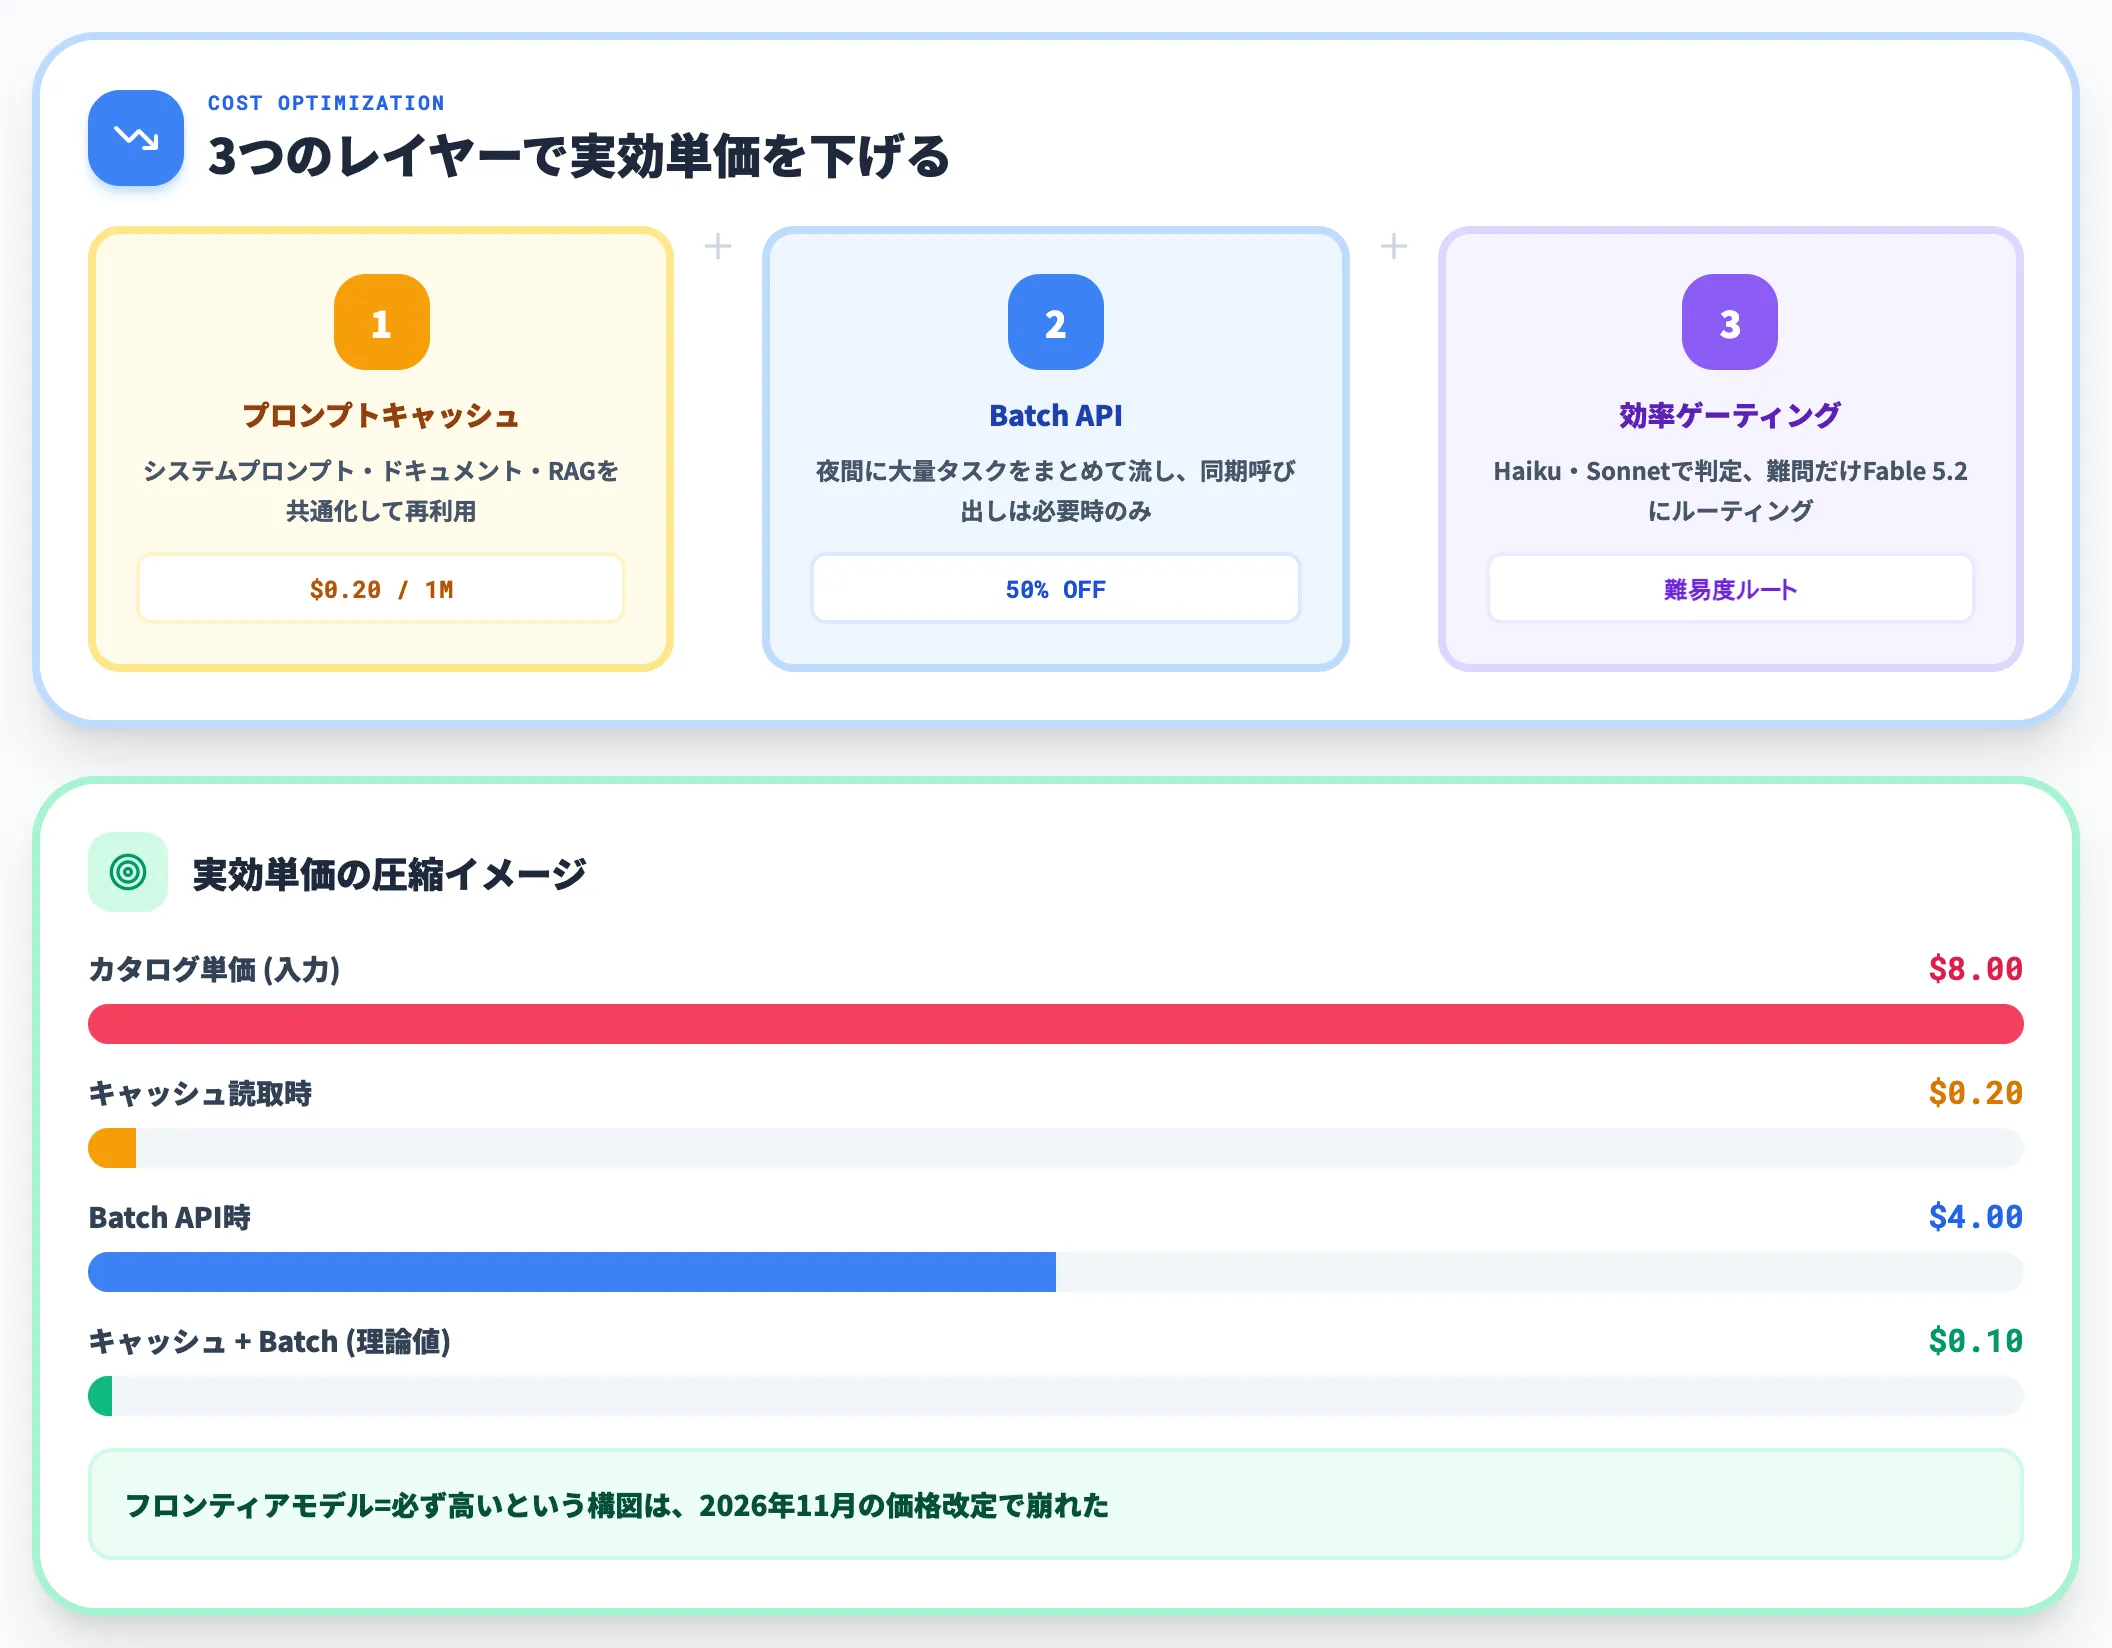
Batch APIを併用すると、入出力ともに50%オフが適用されます。入力$4・出力$20まで下がり、24時間以内に結果が返る非同期処理ならOpus 5.5の標準単価と並ぶ水準です。
実運用でコストを最適化する典型的な組み合わせは次の3点に集約されます。
- プロンプトキャッシュを前提に、システムプロンプト・ドキュメント・RAGコンテキストを共通化して再利用する
- Batch APIで夜間に大量タスクをまとめて流し、同期呼び出しを本当に必要な局面に絞る
- 効率ゲーティングとして、まずHaiku 5.5・Sonnet 5.5で判定し、難易度の高い入力だけFable 5.2にルーティングする
キャッシュ読み取り$0.20・Batch API 50%オフを組み合わせると、長文入力をFable 5.2で何度も扱うワークロードでも実効単価はOpus 5.5標準単価に近づきます。
「フロンティアモデル=必ず高い」という構図は、2026年11月の価格改定で崩れました。
Claude Fable 5.2のベンチマーク結果と性能向上
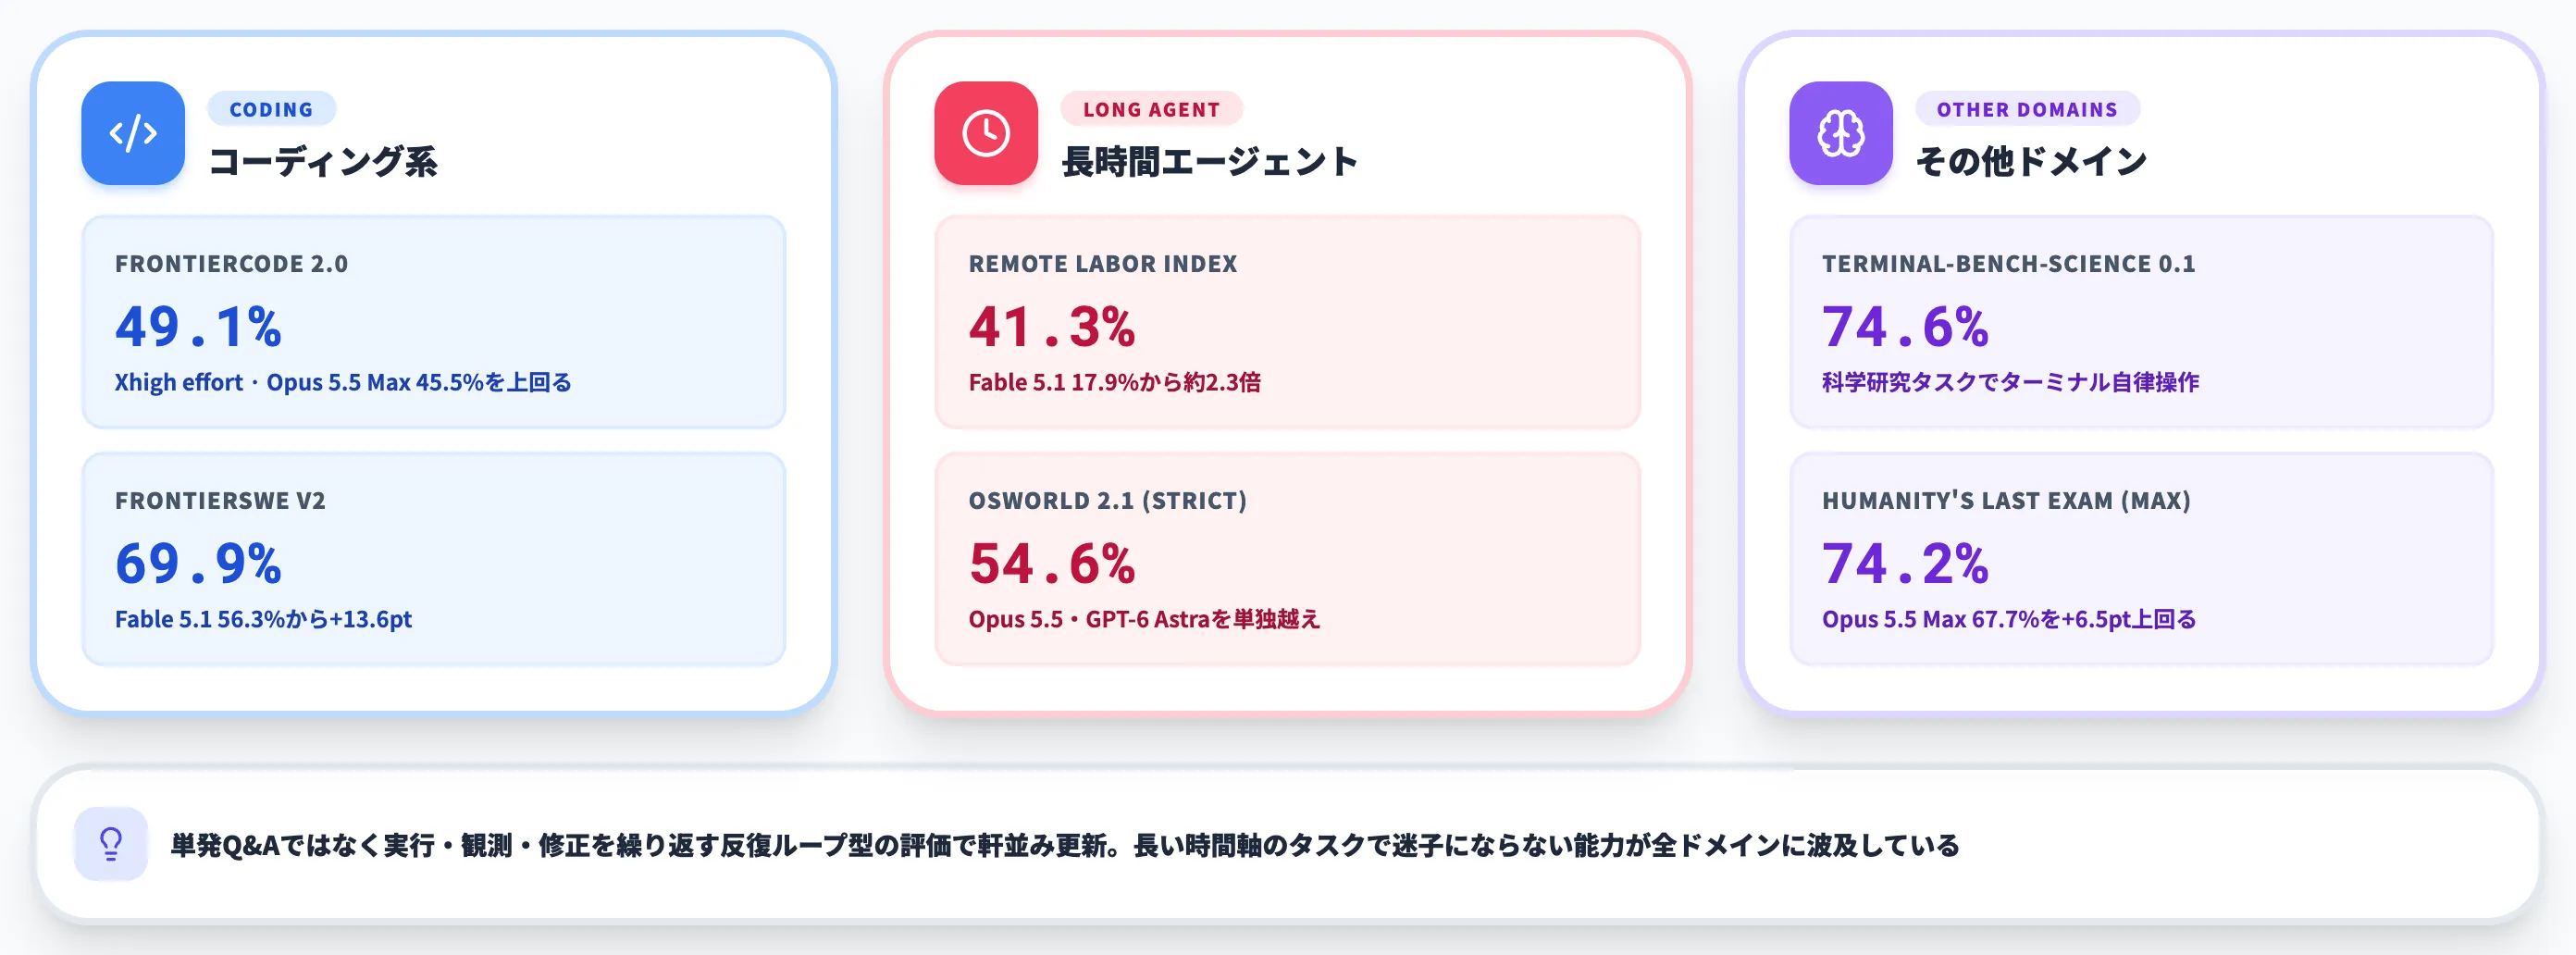
Claude Fable 5.2は、Anthropic公式発表で複数の難関ベンチマークを更新しています。
本セクションでは、コーディング・長時間エージェント・その他ドメインの3カテゴリに分けて、Fable 5.1・Opus 5.5・競合モデルとの位置関係を整理します。
コーディングとエージェンティック系の性能
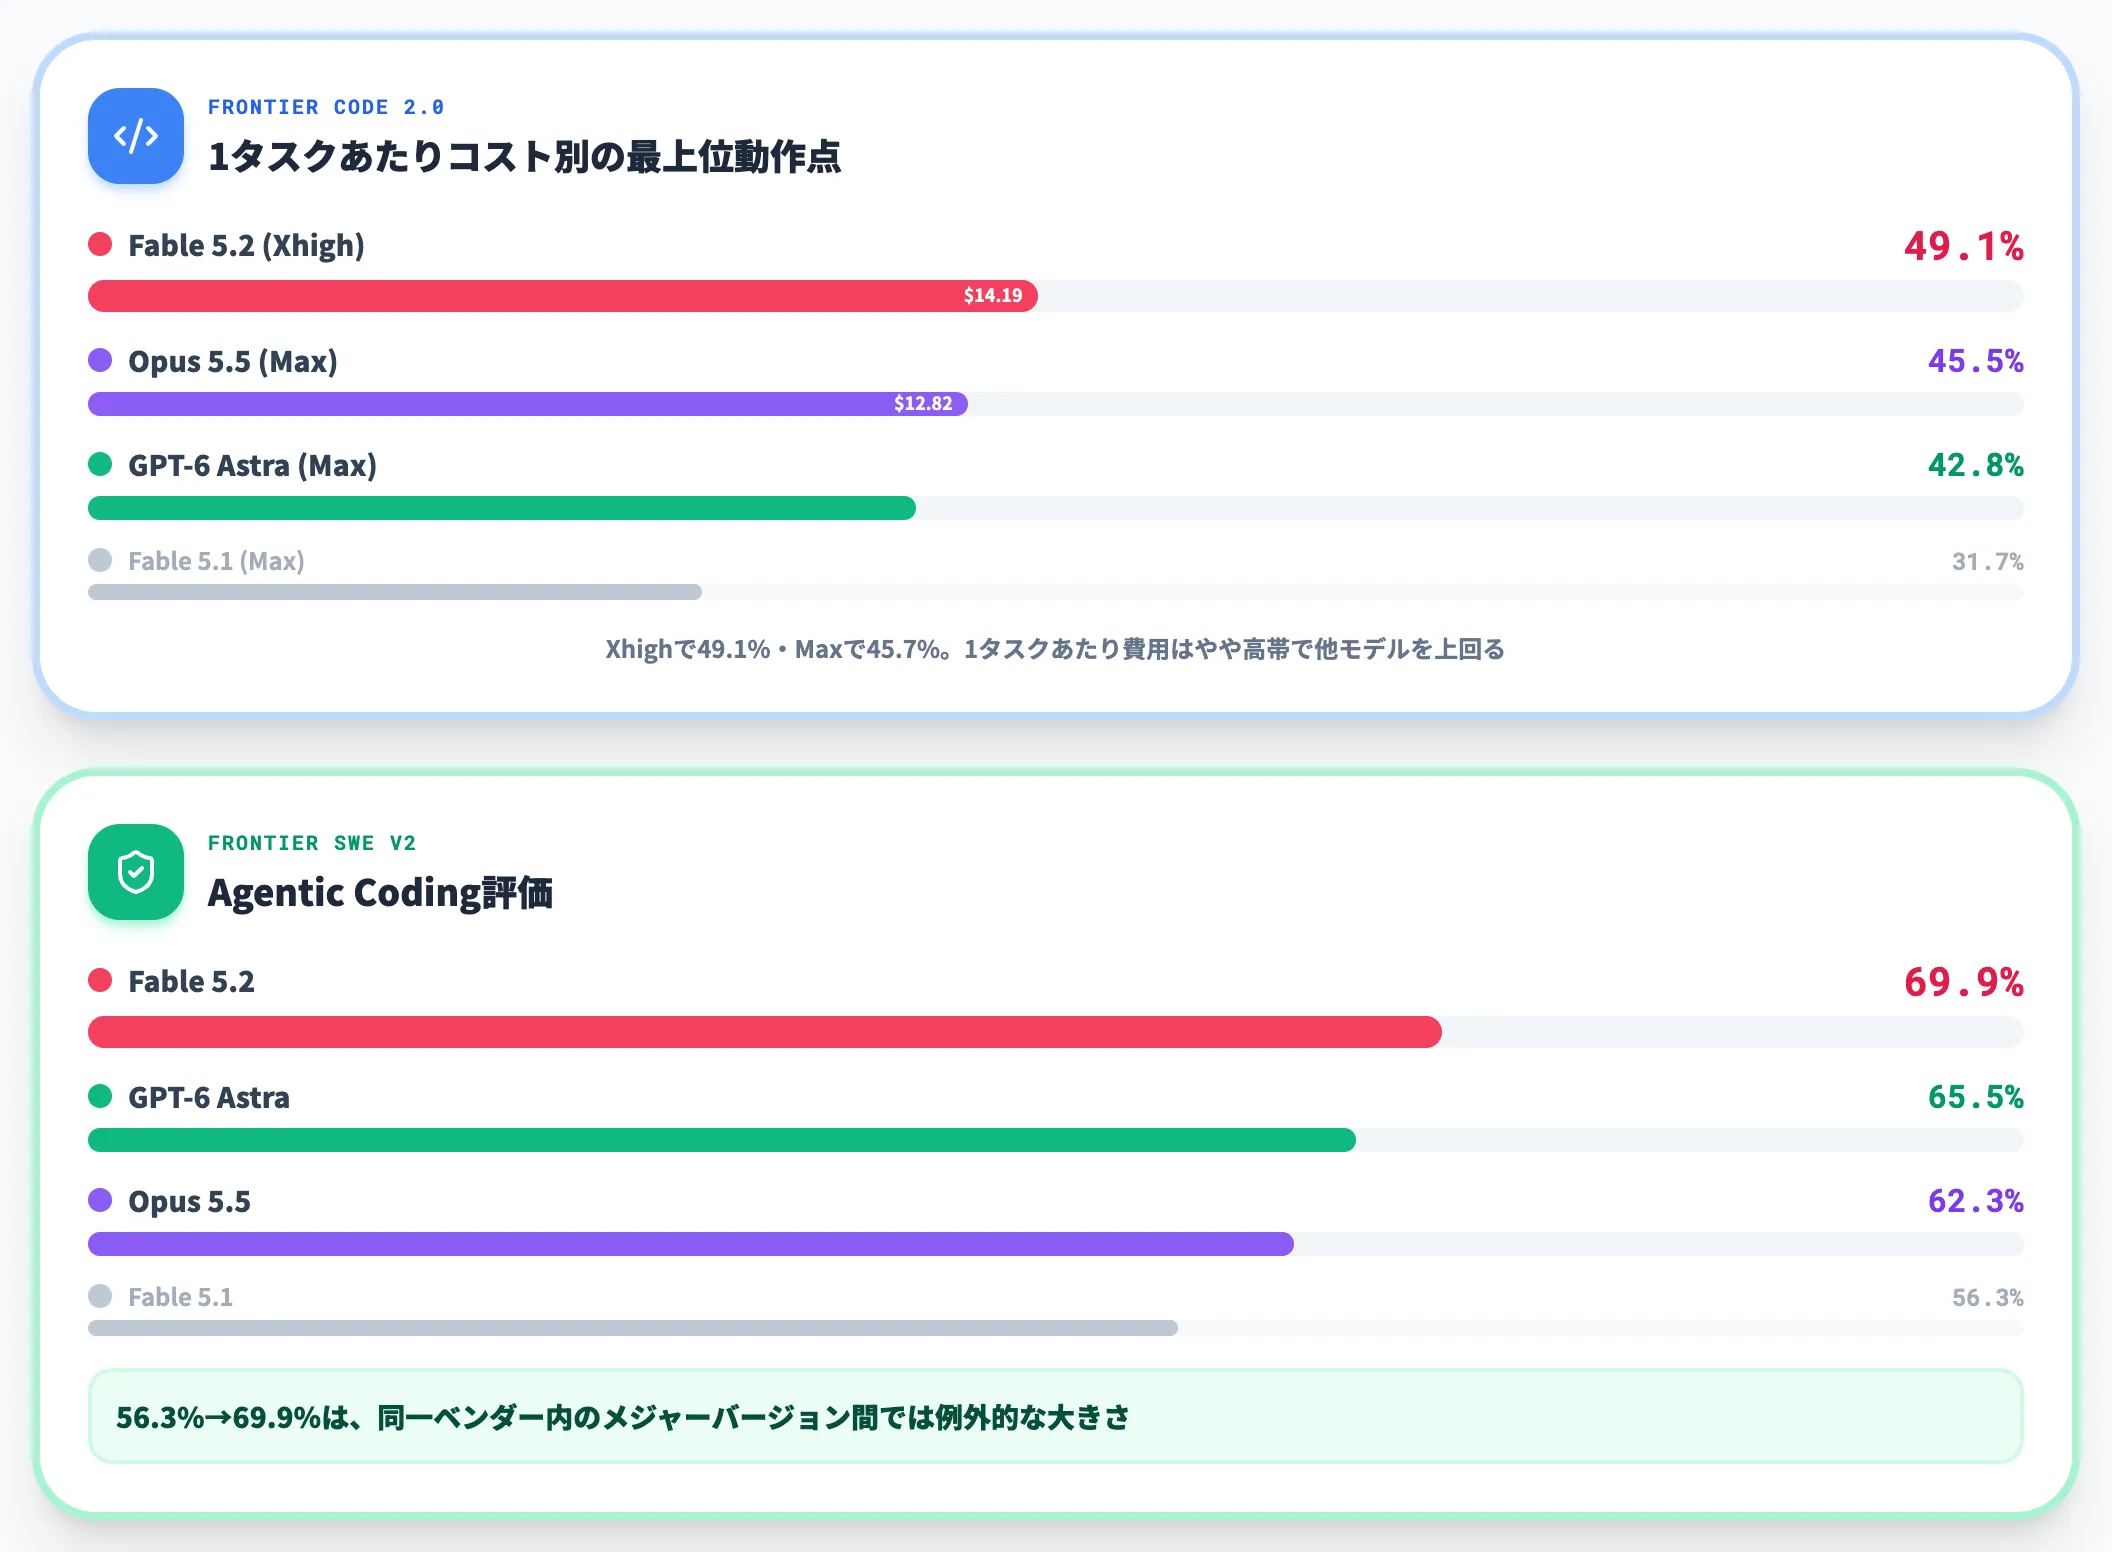
コーディング系・エージェンティック系のベンチマークは、Fable 5.2の存在意義を最も直接的に示す指標です。以下の表で、Fable 5.2のスコアをFable 5.1・Opus 5.5・GPT-6 Astraと並べました。
| ベンチマーク | Fable 5.2 | Fable 5.1 | Opus 5.5 | GPT-6 Astra |
|---|---|---|---|---|
| FrontierCode 2.0 | 49.1%(Xhigh) | — | 45.5%(Max) | 42.8%(Max) |
| FrontierSWE v2(agentic coding) | 69.9% | 56.3% | 62.3% | 65.5% |
| Terminal-Bench-Science 0.1 | 74.6% | — | — | — |
FrontierCode 2.0を効率レンジごとに並べた公式グラフを見ると、高スコア帯のパレートフロンティアでFable 5.2が最上位の動作点を取り、同帯の他モデルを上回っている構図が読み取れます。
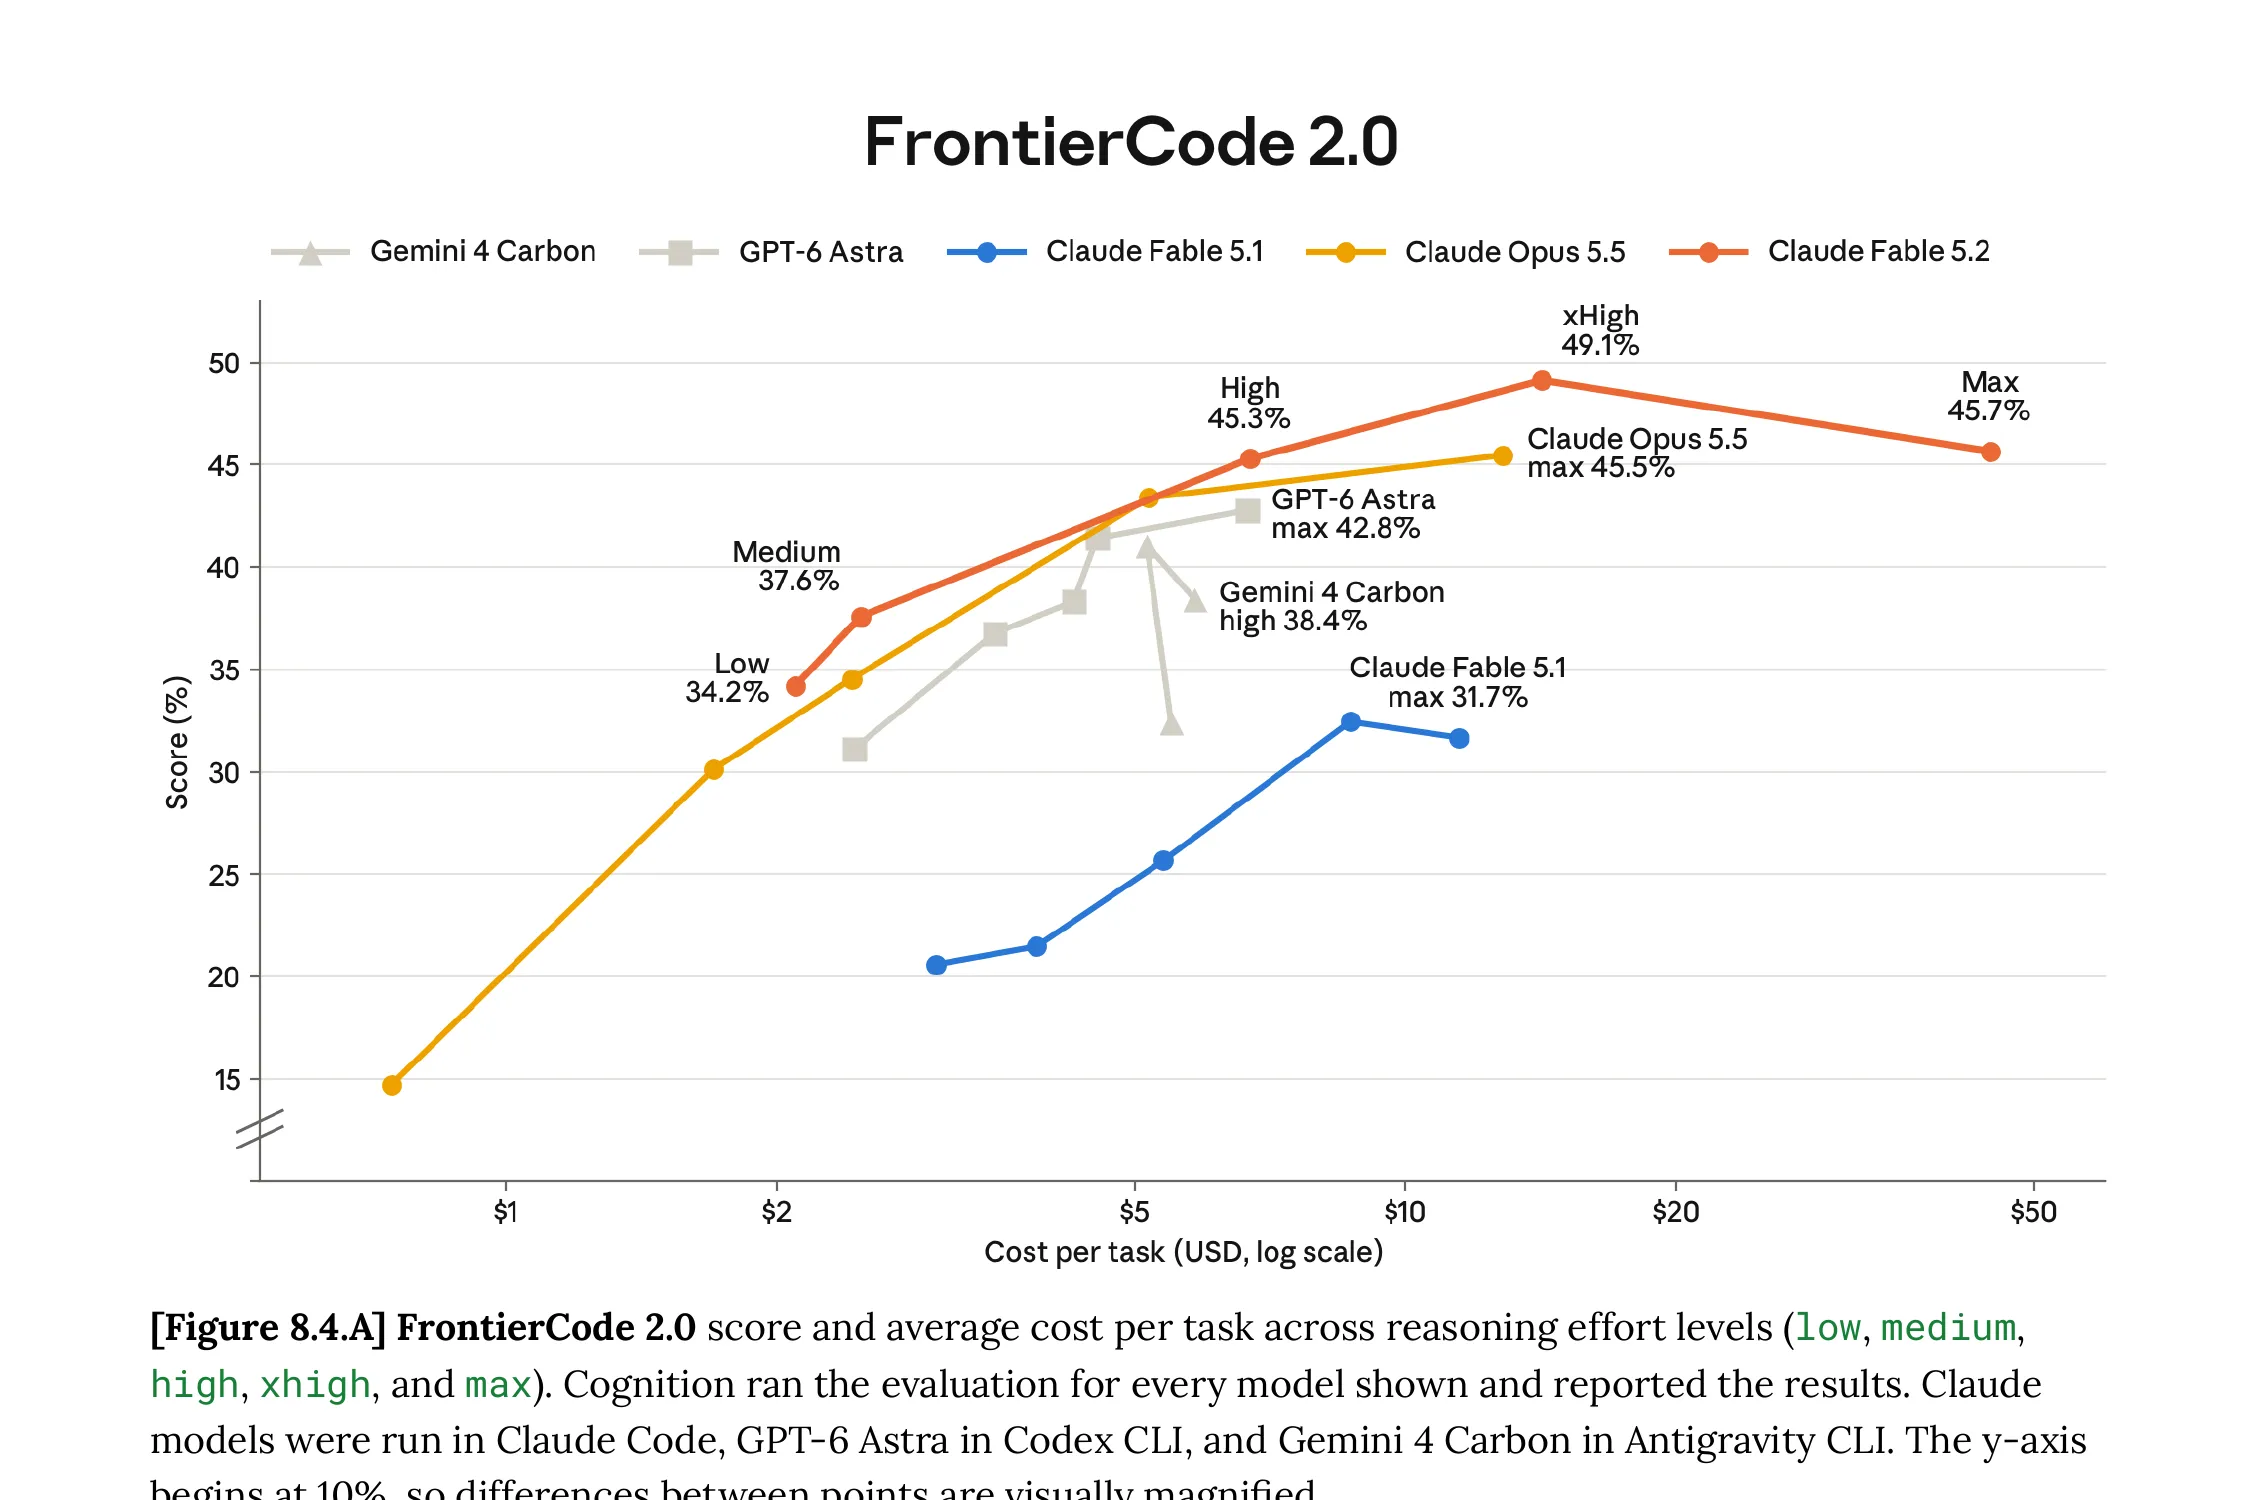
FrontierCode 2.0スコアと1タスクあたり平均コスト。Fable 5.2のXhigh effort 49.1%が、Opus 5.5のMax effort 45.5%・GPT-6 AstraのMax effort 42.8%を上回る(出典:Anthropic System Card)
Fable 5.2はXhigh effortで49.1%、Max effortで45.7%です。公式散布図ではFable 5.2のXhigh(1タスク$14.19)が、Opus 5.5のMax effort 45.5%(1タスク$12.82)・GPT-6 AstraのMax 42.8%を上回る形で描かれており、1タスクあたりの費用はFable側がやや高い帯で勝ち切っています。
Fable 5.1のMax 31.7%との差はさらに大きく、本評価の対象モデルの範囲ではコーディング系で単独トップの序列となっています。
FrontierSWE v2の56.3%→69.9%という伸びは、同一ベンダー内のメジャーバージョン間では例外的な大きさです。
FrontierSWE v2はエージェントが自力でテストを書き、失敗を修正し、仕様外のケースを潰すところまで含めて評価する設計で、タスク評価スコアが1世代前より大幅に向上したことを示します。
Remote Labor Index 17.9%→41.3%が示す意味
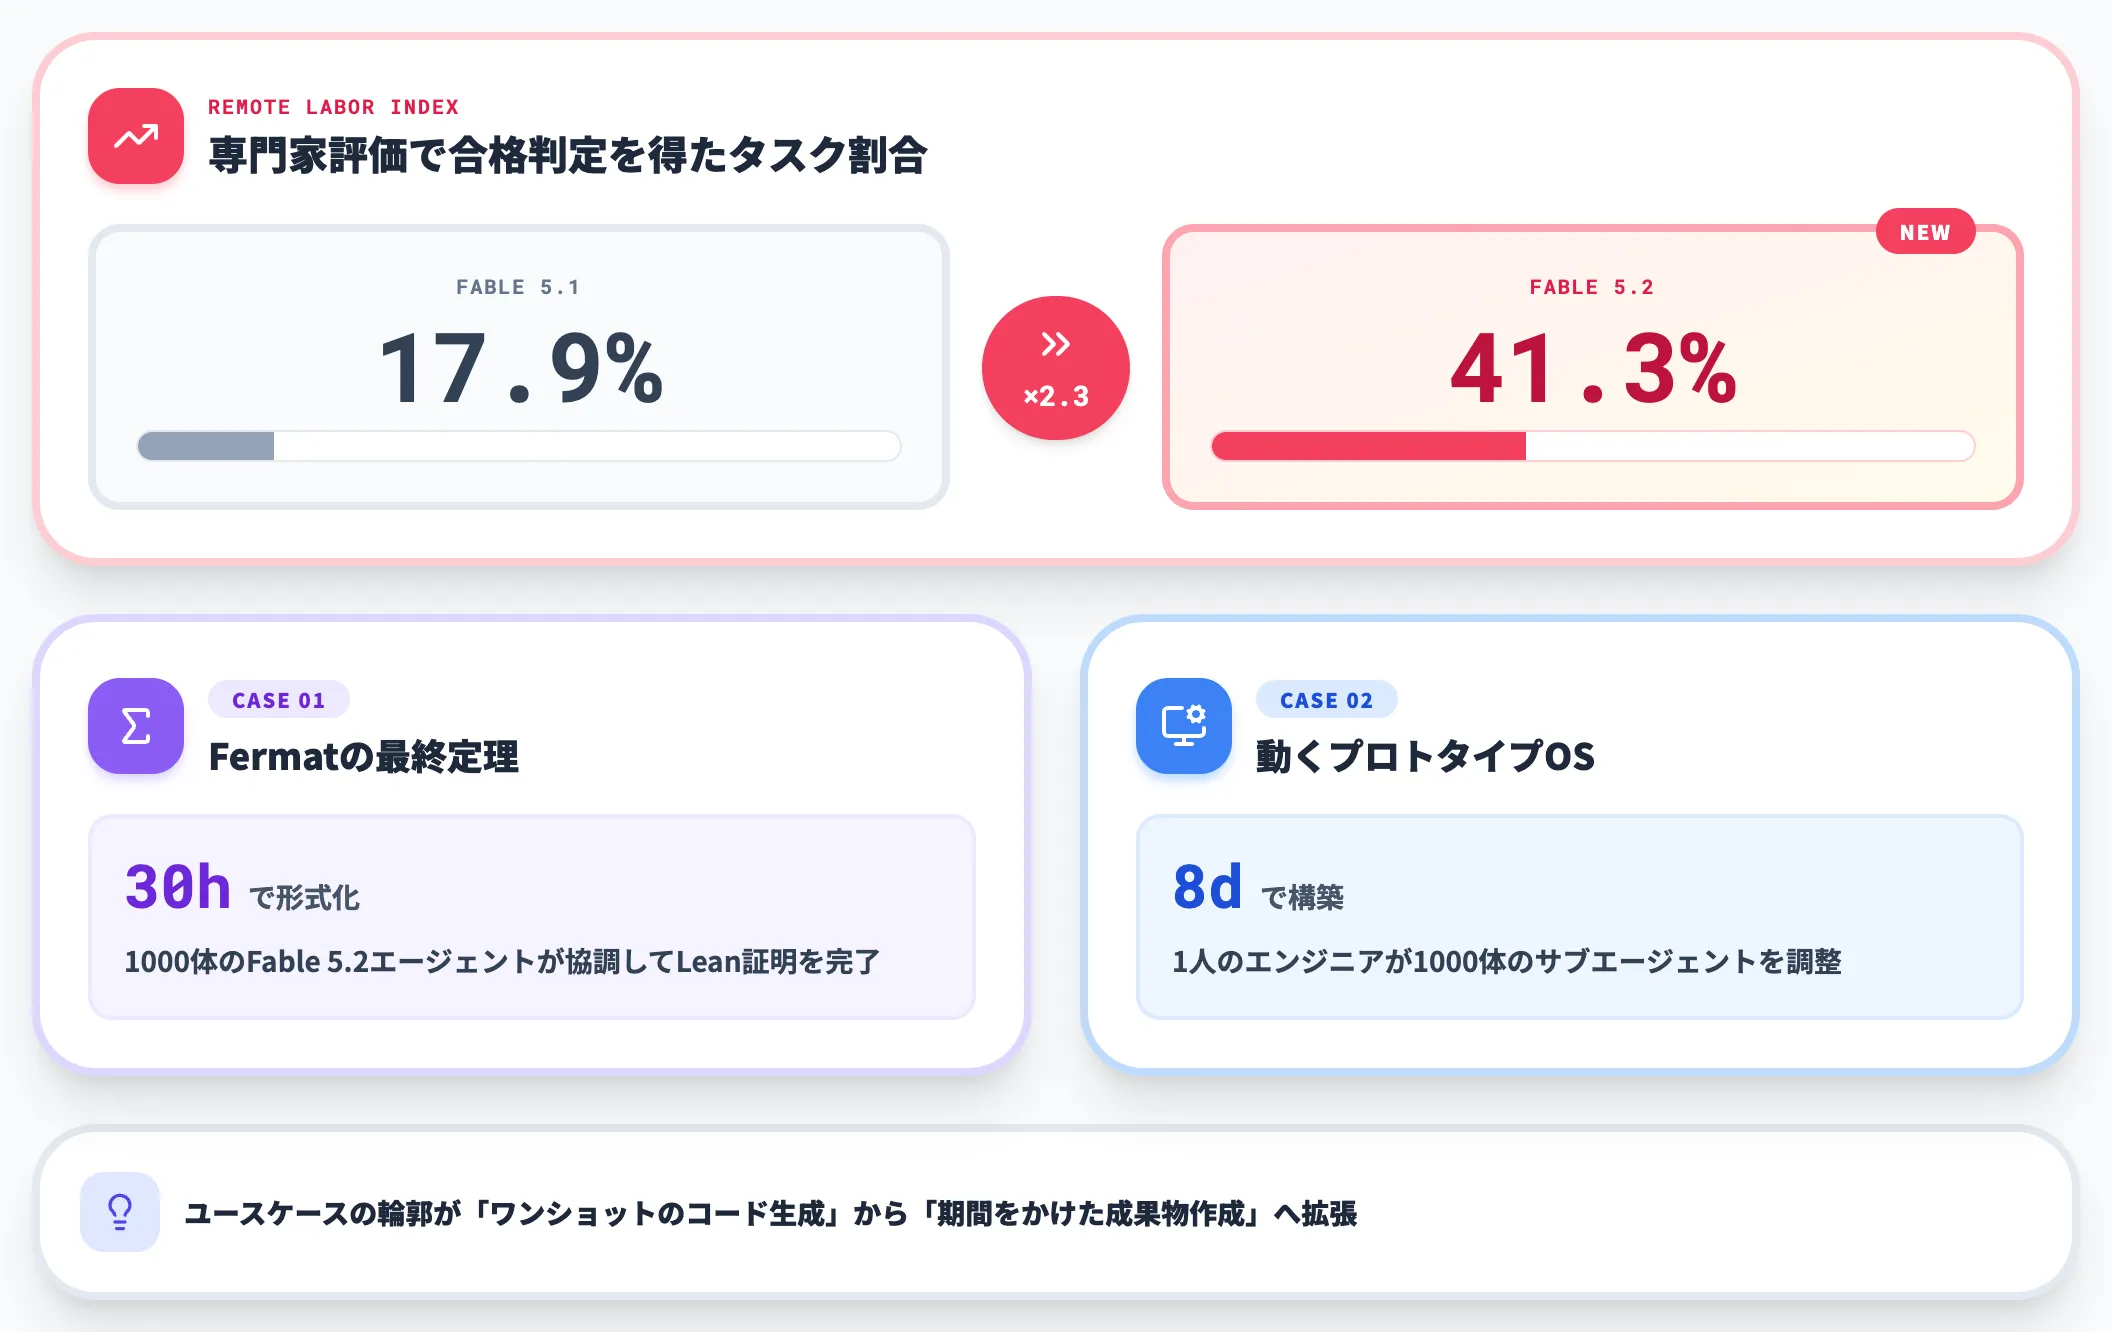
長時間エージェント能力の指標として注目されているのが、Remote Labor Indexです。
| モデル | Remote Labor Index |
|---|---|
| Fable 5.1 | 17.9% |
| Claude Fable 5.2 | 41.3% |
Remote Labor Indexは、数時間から数日にわたる「人が在宅勤務で扱う現実のタスク」をAIが仕上げた成果物を人間の専門家が評価し、専門家と同等以上と判定された案件の割合を測るベンチマークです。17.9%→41.3%という約2.3倍の伸びは、長時間タスクでも成果物の水準を専門家レベルで保てる案件が広がったことを示しています。
実例として、Anthropicが発表の裏側で紹介した社内実験では、1000体のFable 5.2エージェントがFermatの最終定理の証明を30時間で形式化し、別のエンジニアは1000体のサブエージェントを8日間調整して動作するプロトタイプOSを構築したと報告されています。
長時間走れるエージェントが実在するなら、ユースケースの輪郭が「ワンショットのコード生成」から「期間をかけた成果物作成」へ広がります。
Terminal-Bench・RoboDojo・Humanity's Last Exam
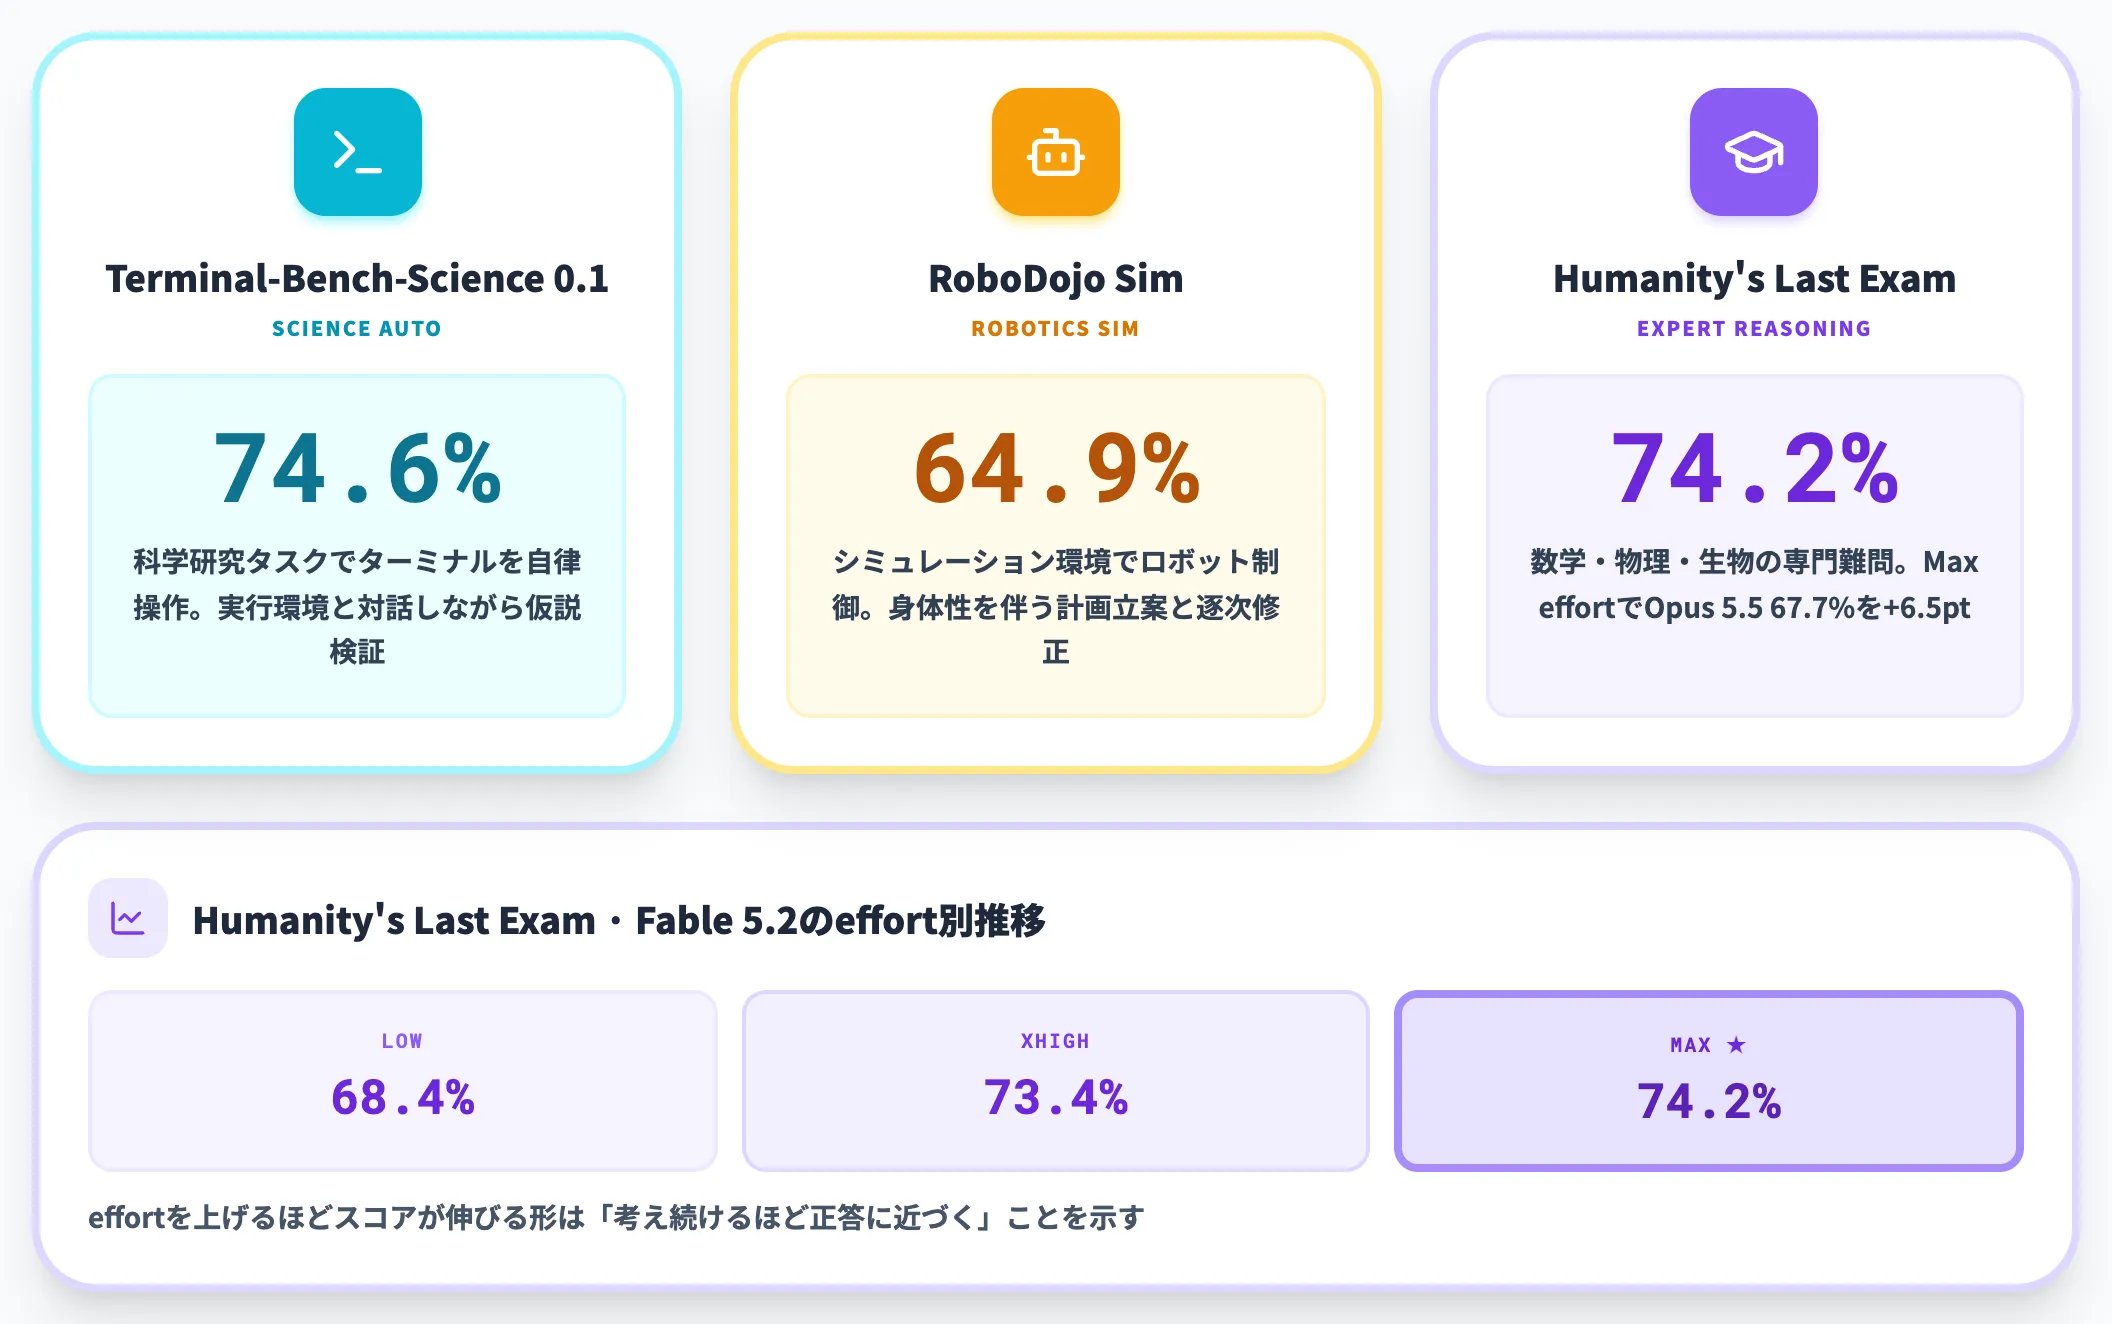
Fable 5.2は、コーディング以外のドメインでも複数の難関ベンチマークを更新しています。
- Terminal-Bench-Science 0.1:74.6%
科学研究タスクでターミナルを自律操作する能力を測る評価。実行環境と対話しながら仮説検証を回せるかを見る
- RoboDojo Sim:64.9%
シミュレーション環境でのロボット制御タスク。身体性を伴う計画立案と逐次修正を評価する
- Humanity's Last Exam:74.2%
数学・物理・生物学など専門領域の難問に対する推論能力。知識カットオフ(2026年6月)内の問題を幅広くカバーする
Humanity's Last Examを公式のreasoning effort別に並べた折れ線を見ると、同じcostレンジでFable 5.2が他モデルの上側に一貫して位置していることが分かります。
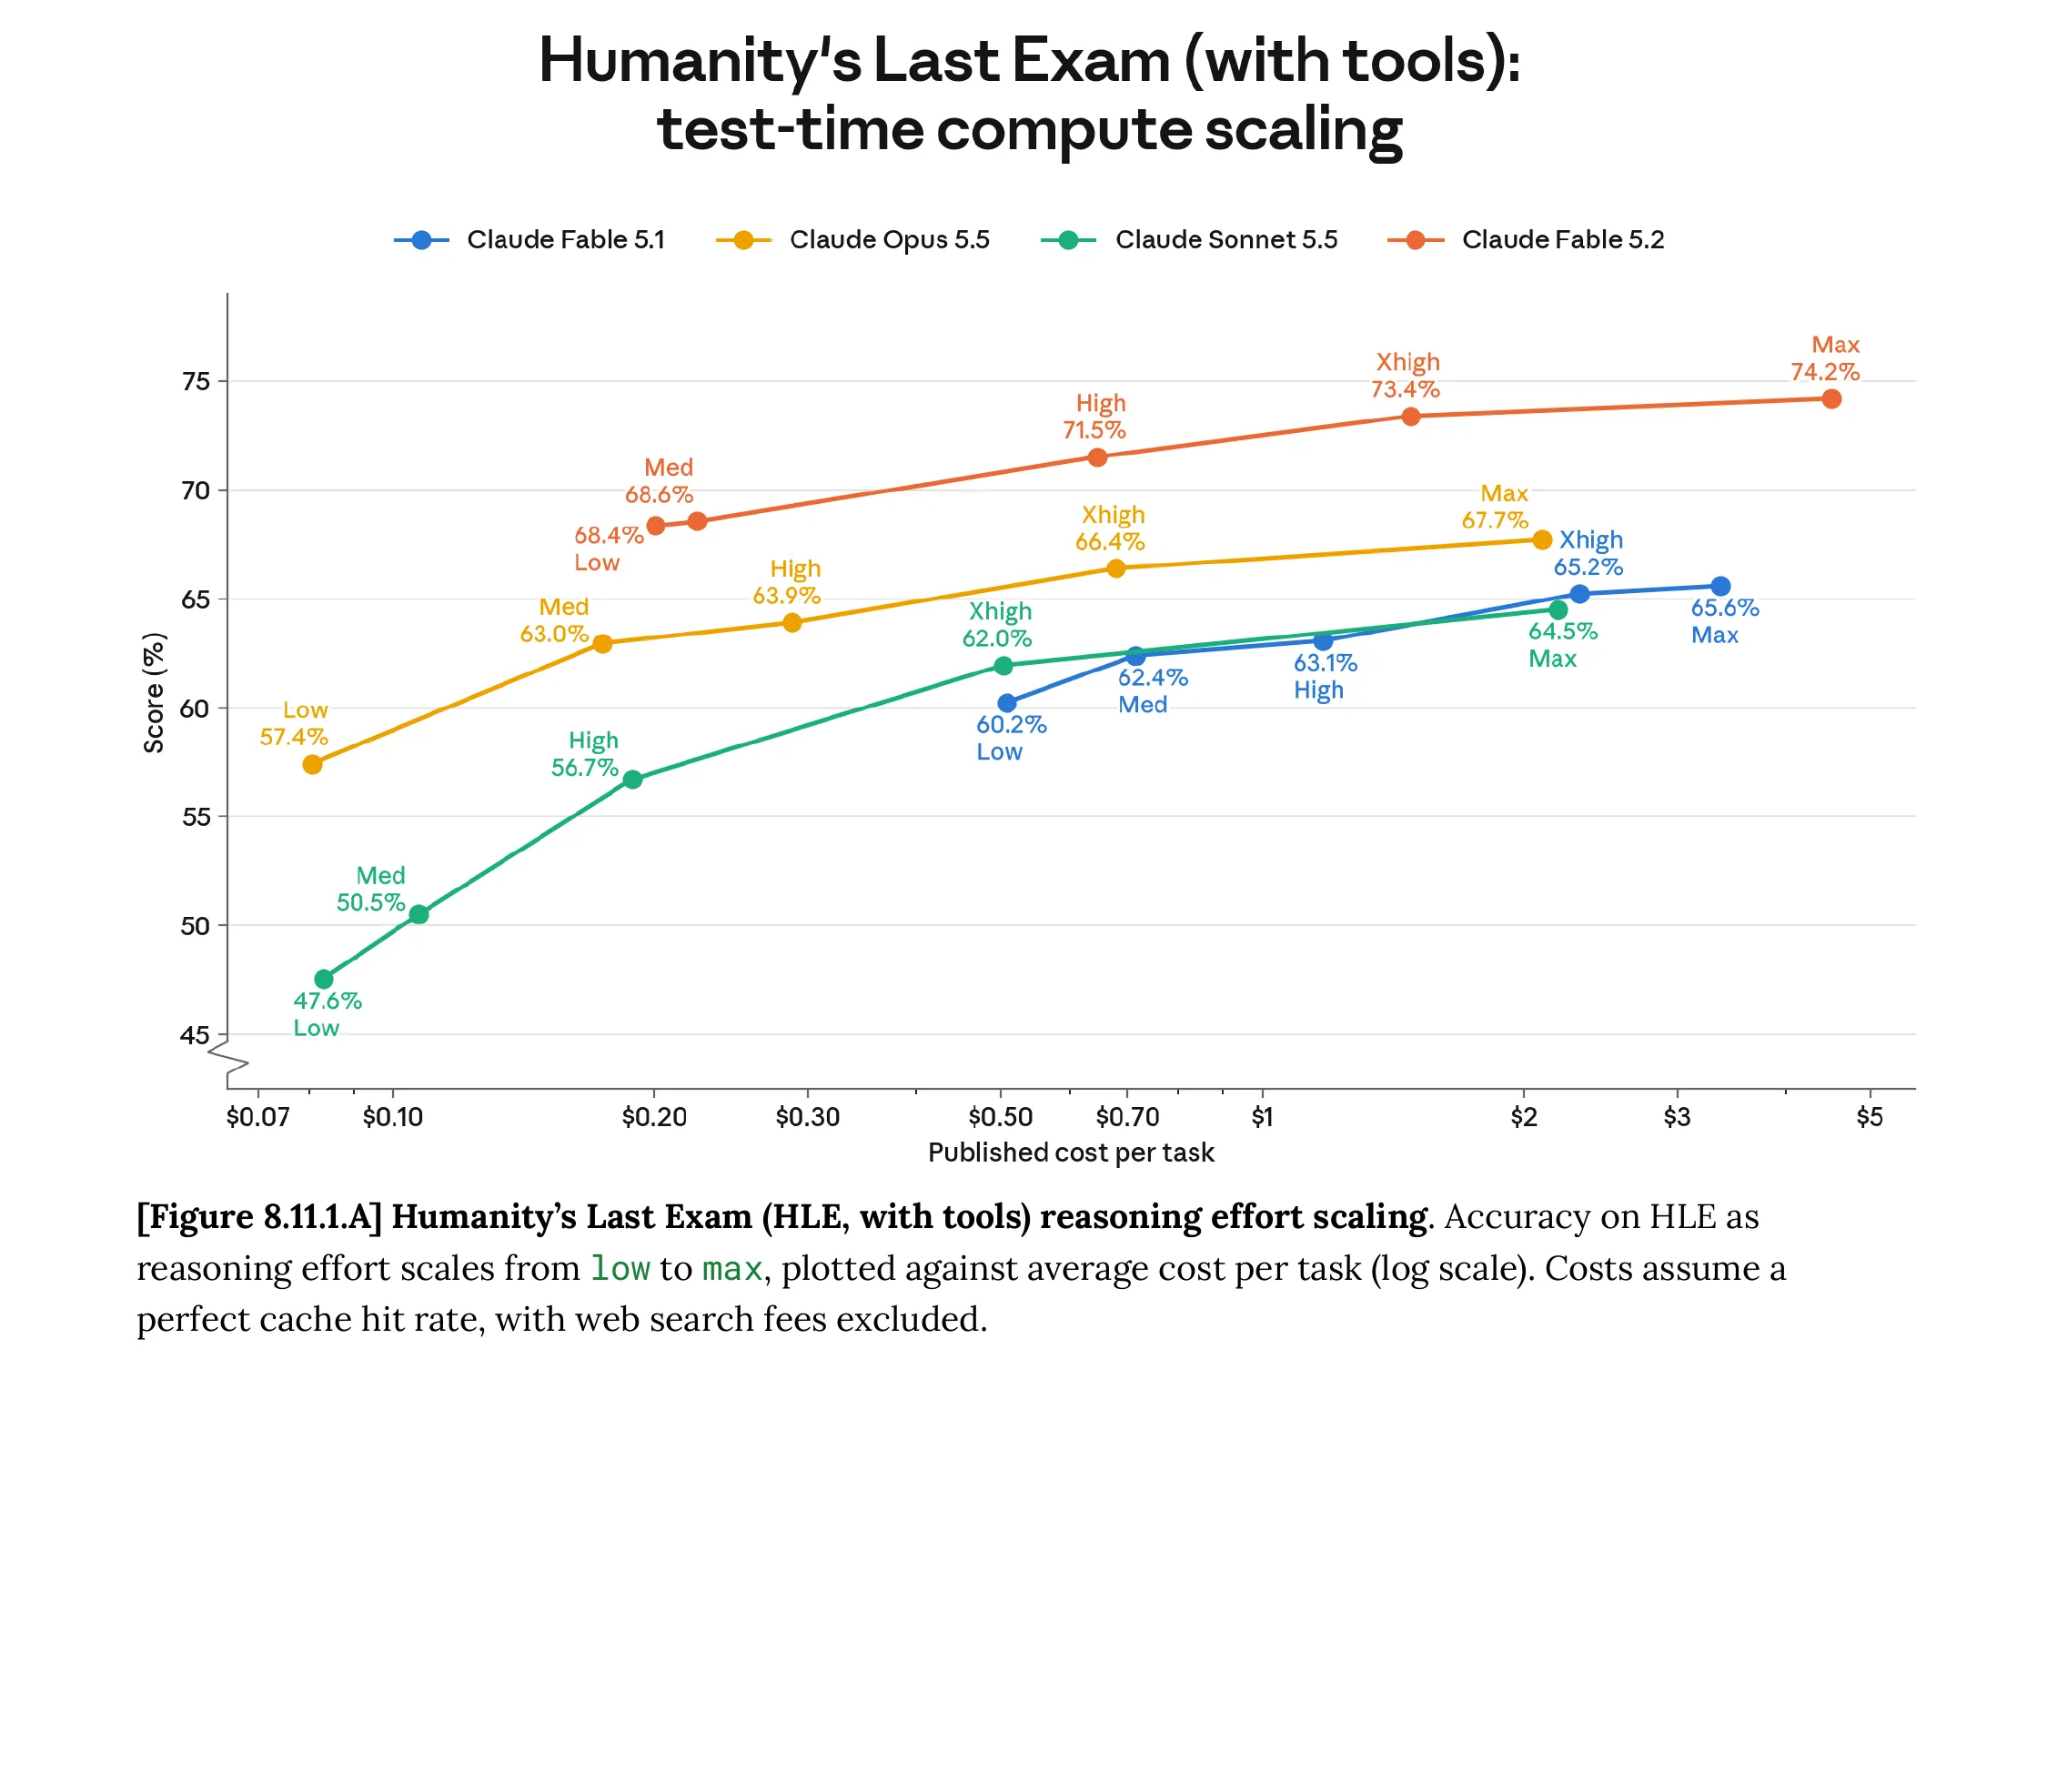
Humanity's Last Exam(tools使用)のreasoning effort別スコア。Fable 5.2のMax 74.2%は、Opus 5.5のMax 67.7%・Sonnet 5.5のMax 64.5%・Fable 5.1のMax 65.6%を大きく上回る(出典:Anthropic System Card)
Fable 5.2はLow effortで68.4%、Xhighで73.4%、Maxで74.2%という推移で、effortを上げるほどスコアが伸びる形は能動的に「考え続ける」ほど正答に近づくことを示しています。
Opus 5.5がMax effortで67.7%の頭打ちを見せるのに対し、Fable 5.2は同じeffort段階間で5.6〜11.0ポイント上に線が走っています。
さらに、同じシステムカードで公開されているagentic computer use(OSWorld 2.1)では、Fable 5.2がpartialスコア89.3%・strictパス率54.6%で、Opus 5.5・GPT-6 Astra・Fable 5.1をすべて上回る単独トップに立ちました。
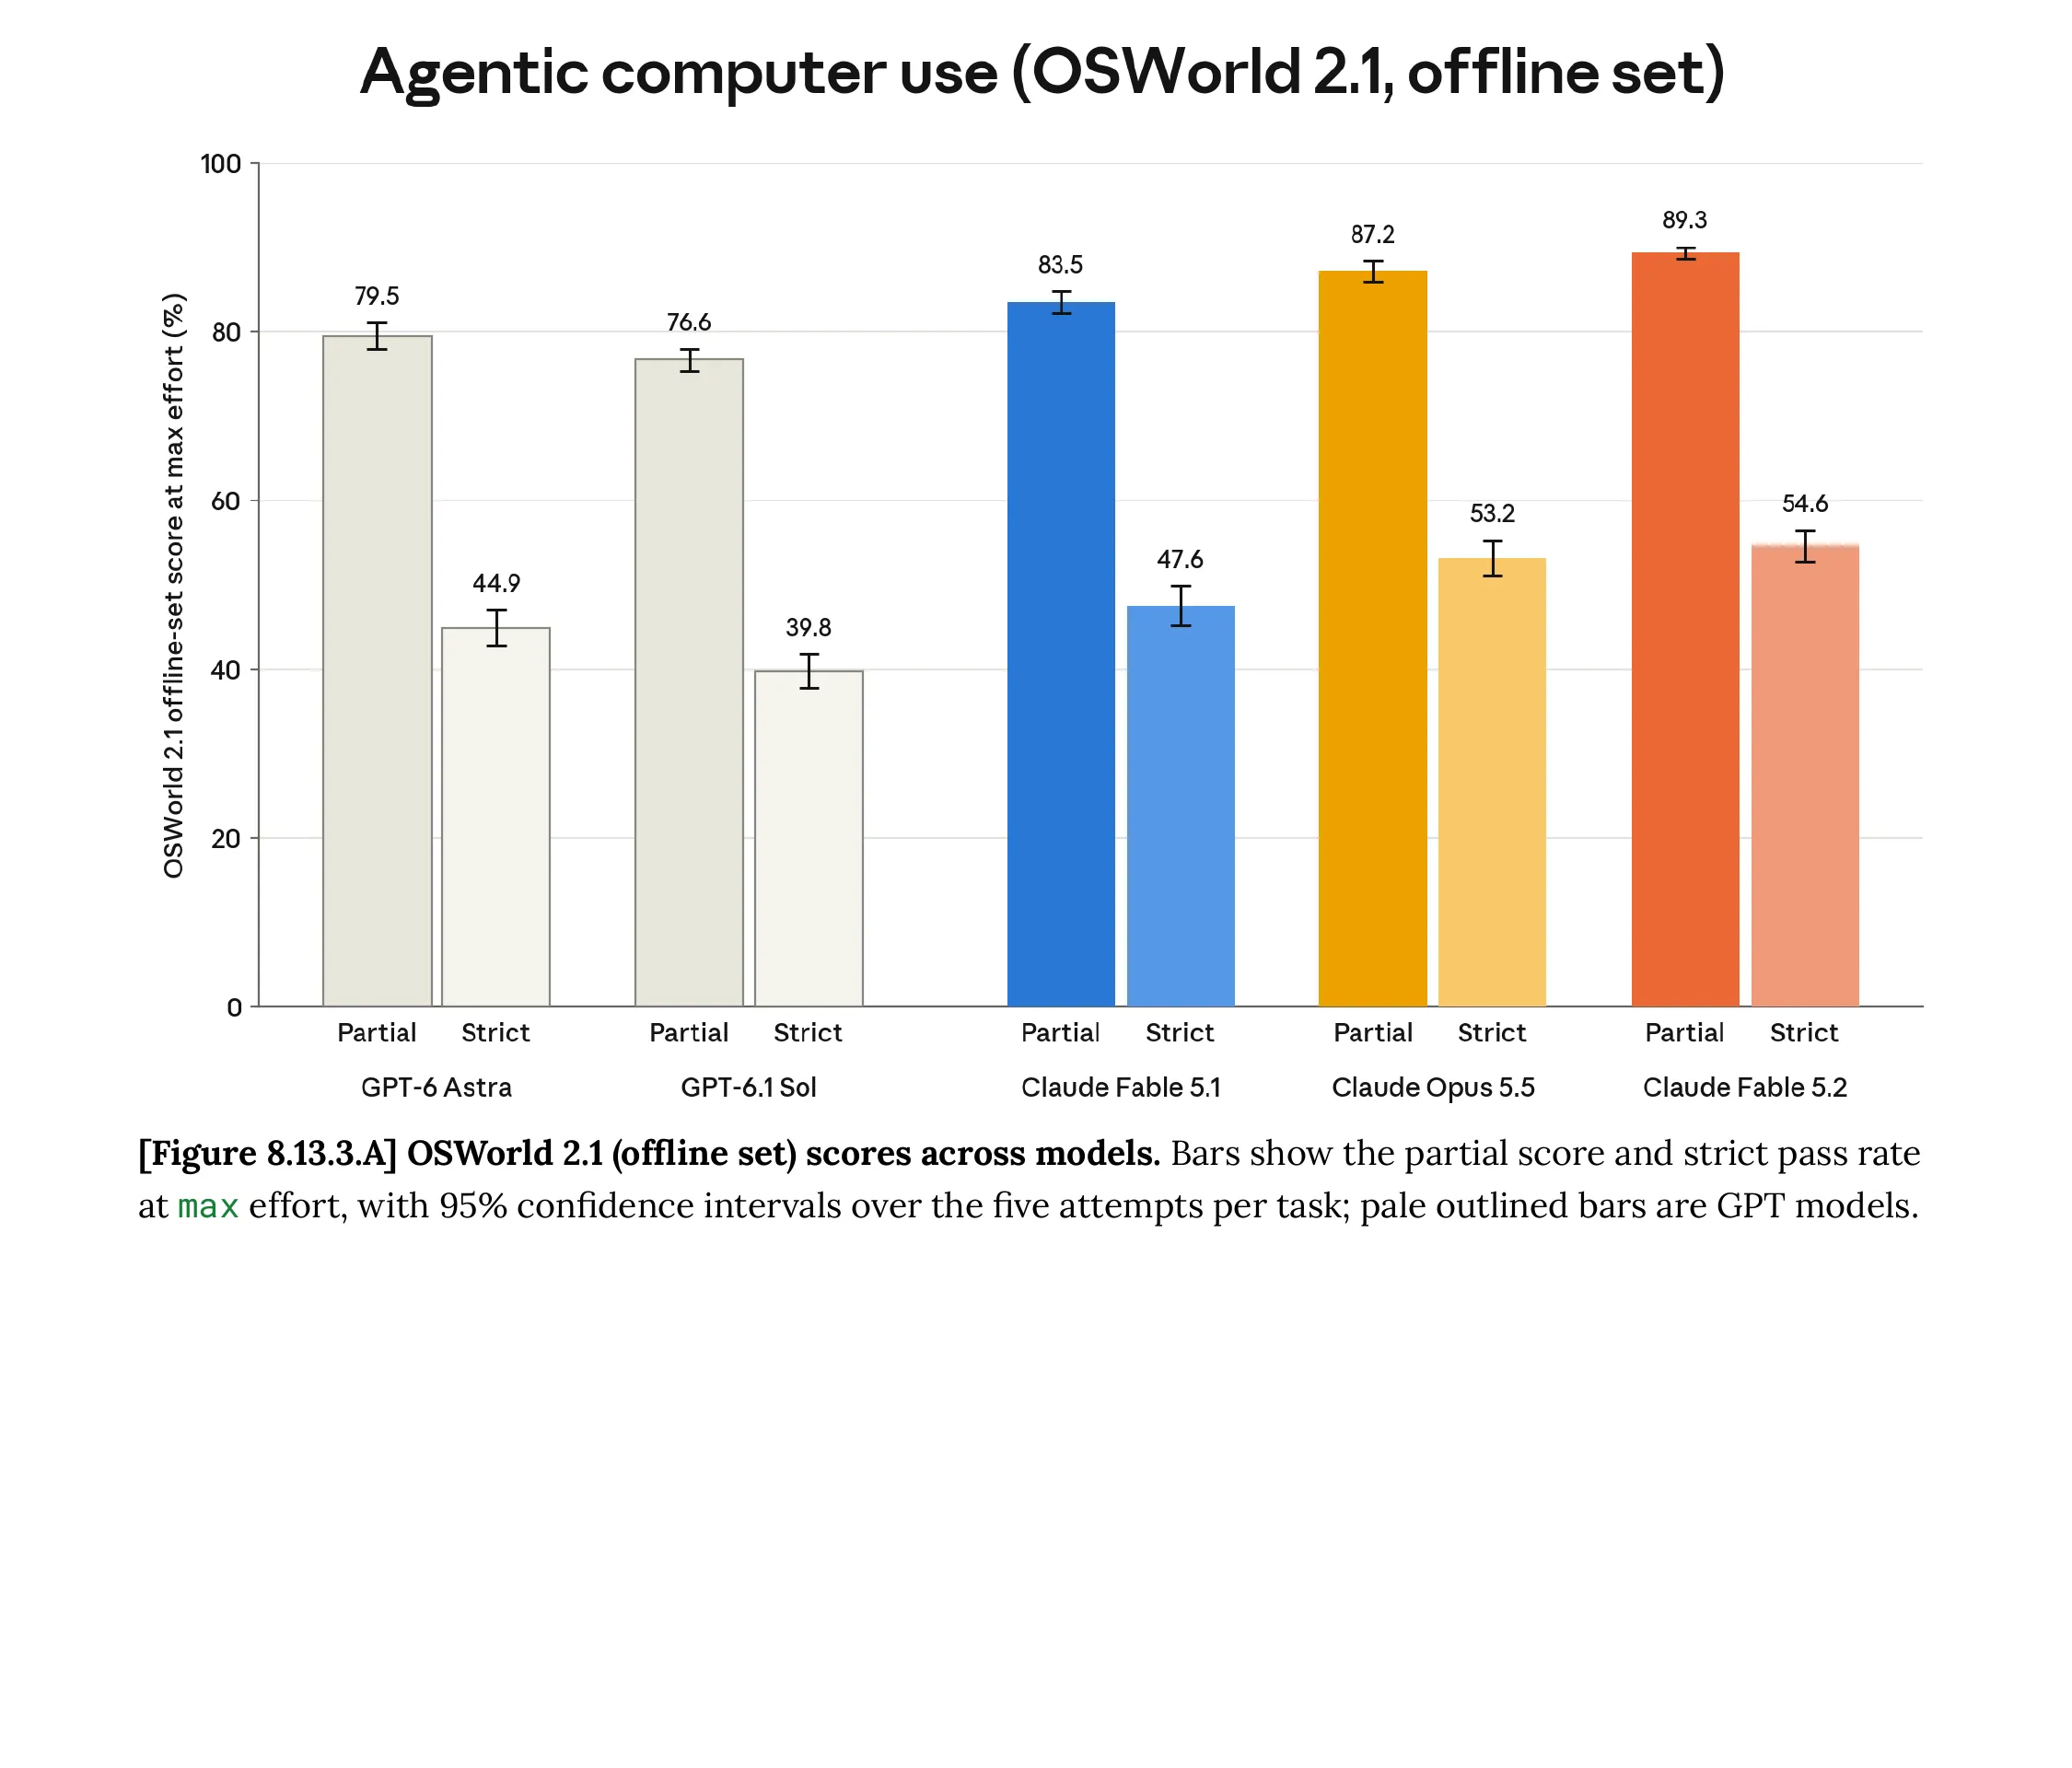
OSWorld 2.1(offline set)のpartialスコアとstrictパス率。Fable 5.2 89.3%/54.6%、Opus 5.5 87.2%/53.2%、GPT-6 Astra 79.5%/44.9%(出典:Anthropic System Card)
OSWorld 2.1は、AIがファイル操作・アプリ切替・設定変更といったコンピュータ画面上のタスクを自律実行できるかを測るベンチマークで、業務エージェントが現場のPCで動くときの実能力に直結する指標です。
Fable 5.2がここでも上回っている事実は、長時間推論の強さがコーディング以外のオペレーション領域にも波及していることを示しています。
これらは単発のQ&Aではなく、実行・観測・修正を繰り返す反復ループ型の評価です。
Fable 5.2が苦手だった局面が全方位で改善されているというより、「長い時間軸のタスクで迷子にならない能力」が全ドメインに波及している、と読み解くのが実態に近いかたちです。
Claude Fable 5.2とOpus 5.5の使い分け
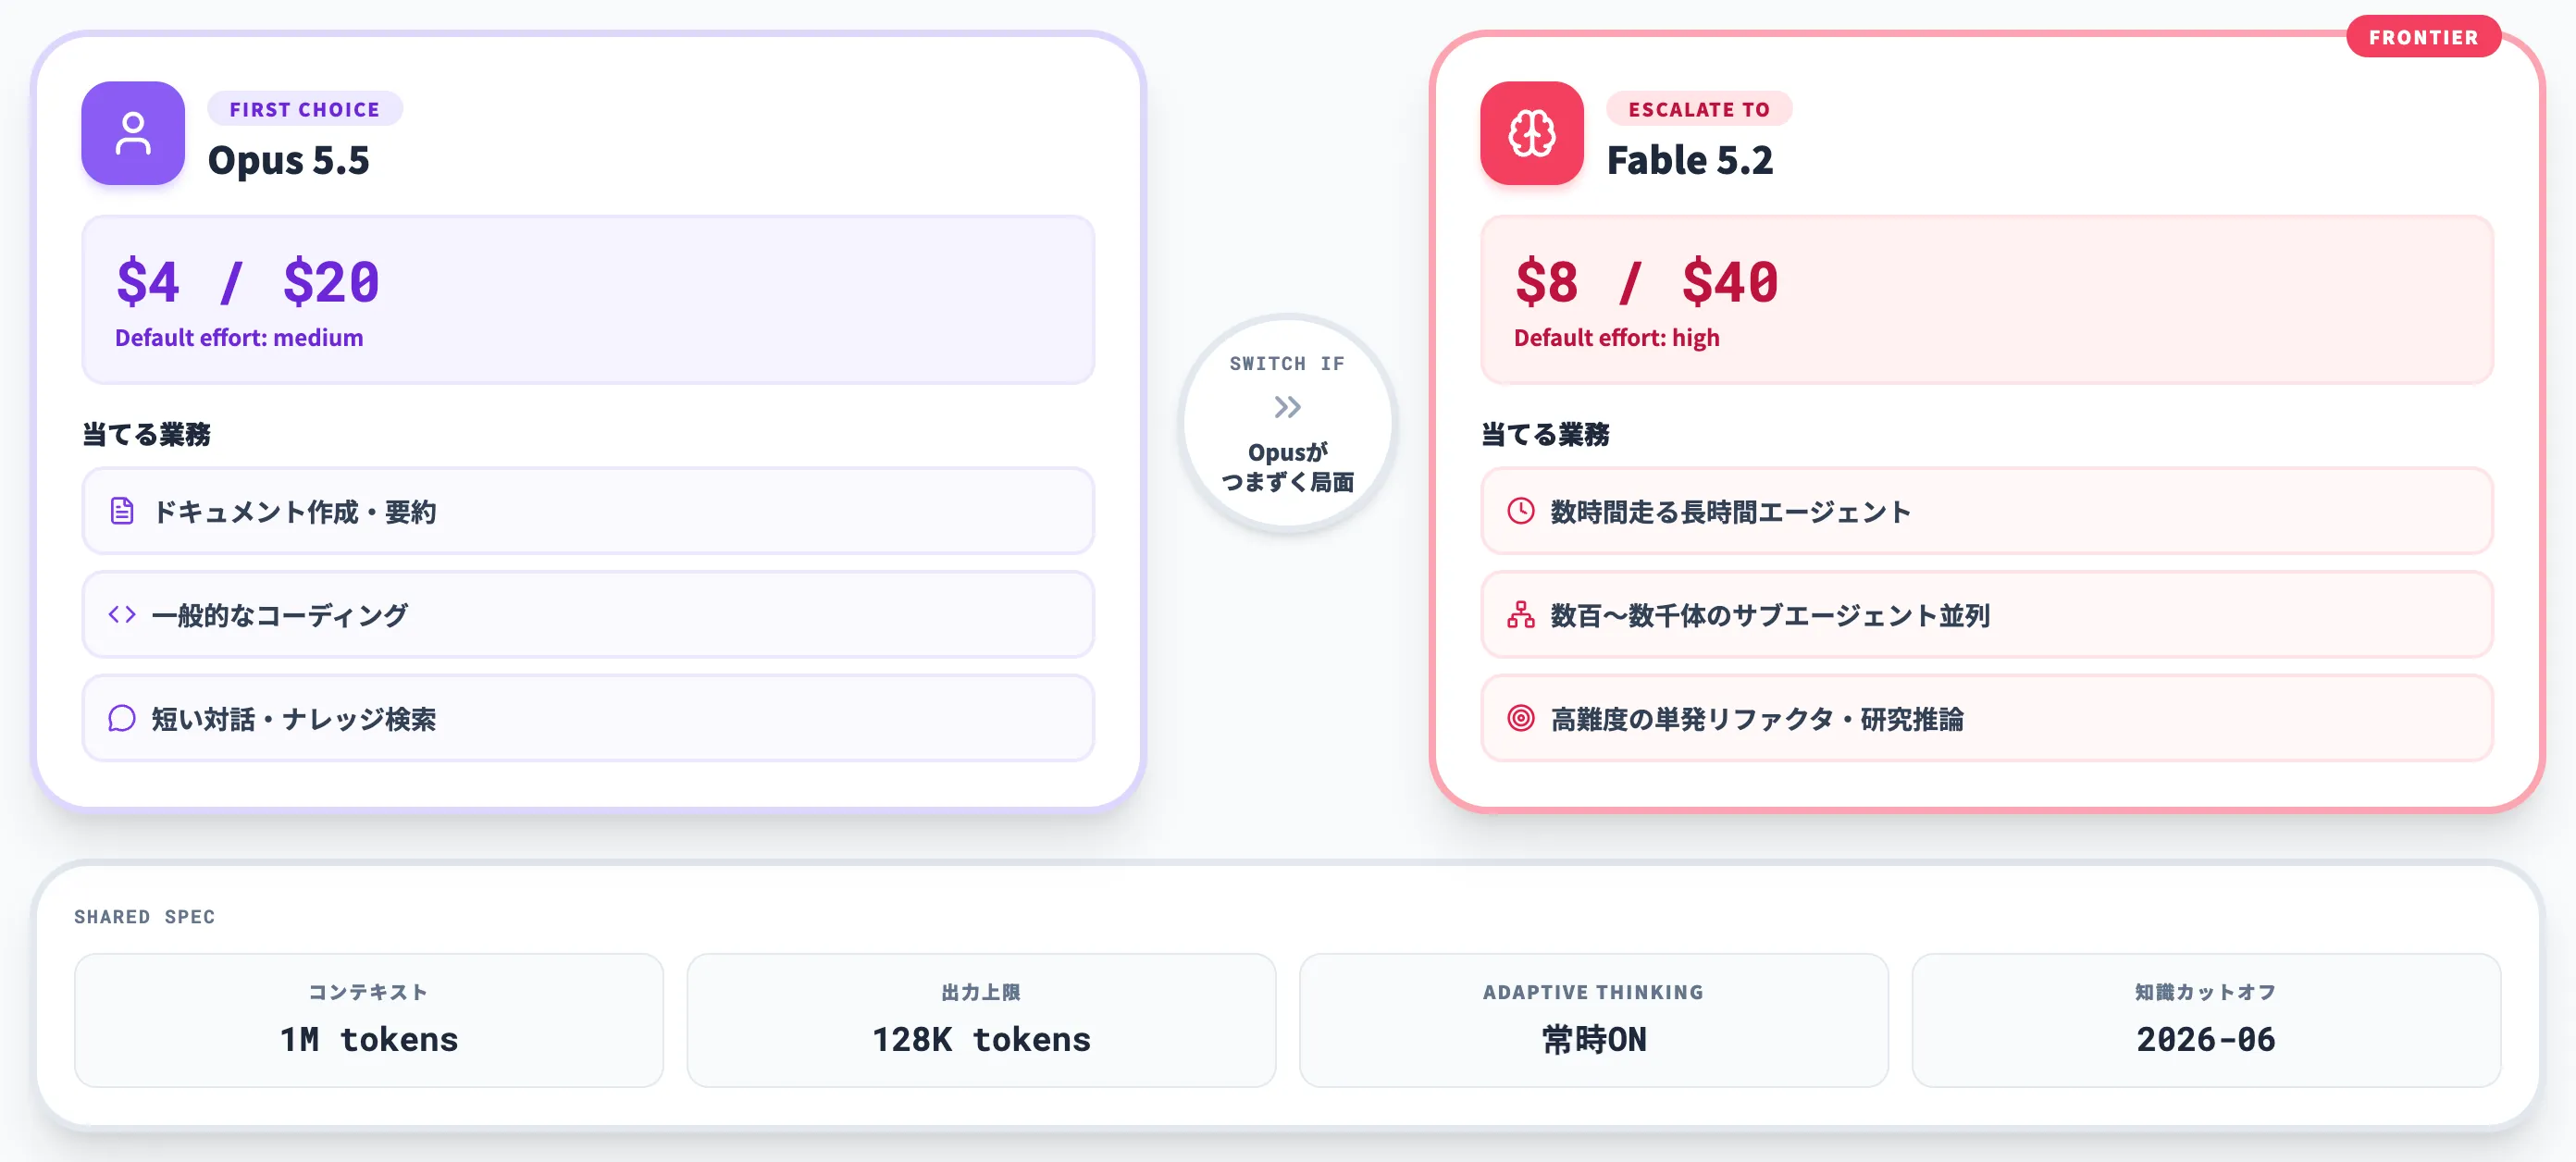
Claude Fable 5.2とClaude Opus 5.5は、どちらも1M tokensコンテキスト・128K tokens出力のフロンティア帯で、価格差は2倍(Opus 5.5が入力$4/出力$20、Fable 5.2が入力$8/出力$40)です。
本セクションでは、コスト精度トレードオフ・ワークロード別の判断・AI総研の実務推奨の3つに分けて、使い分けの軸を整理します。
価格と精度のトレードオフ
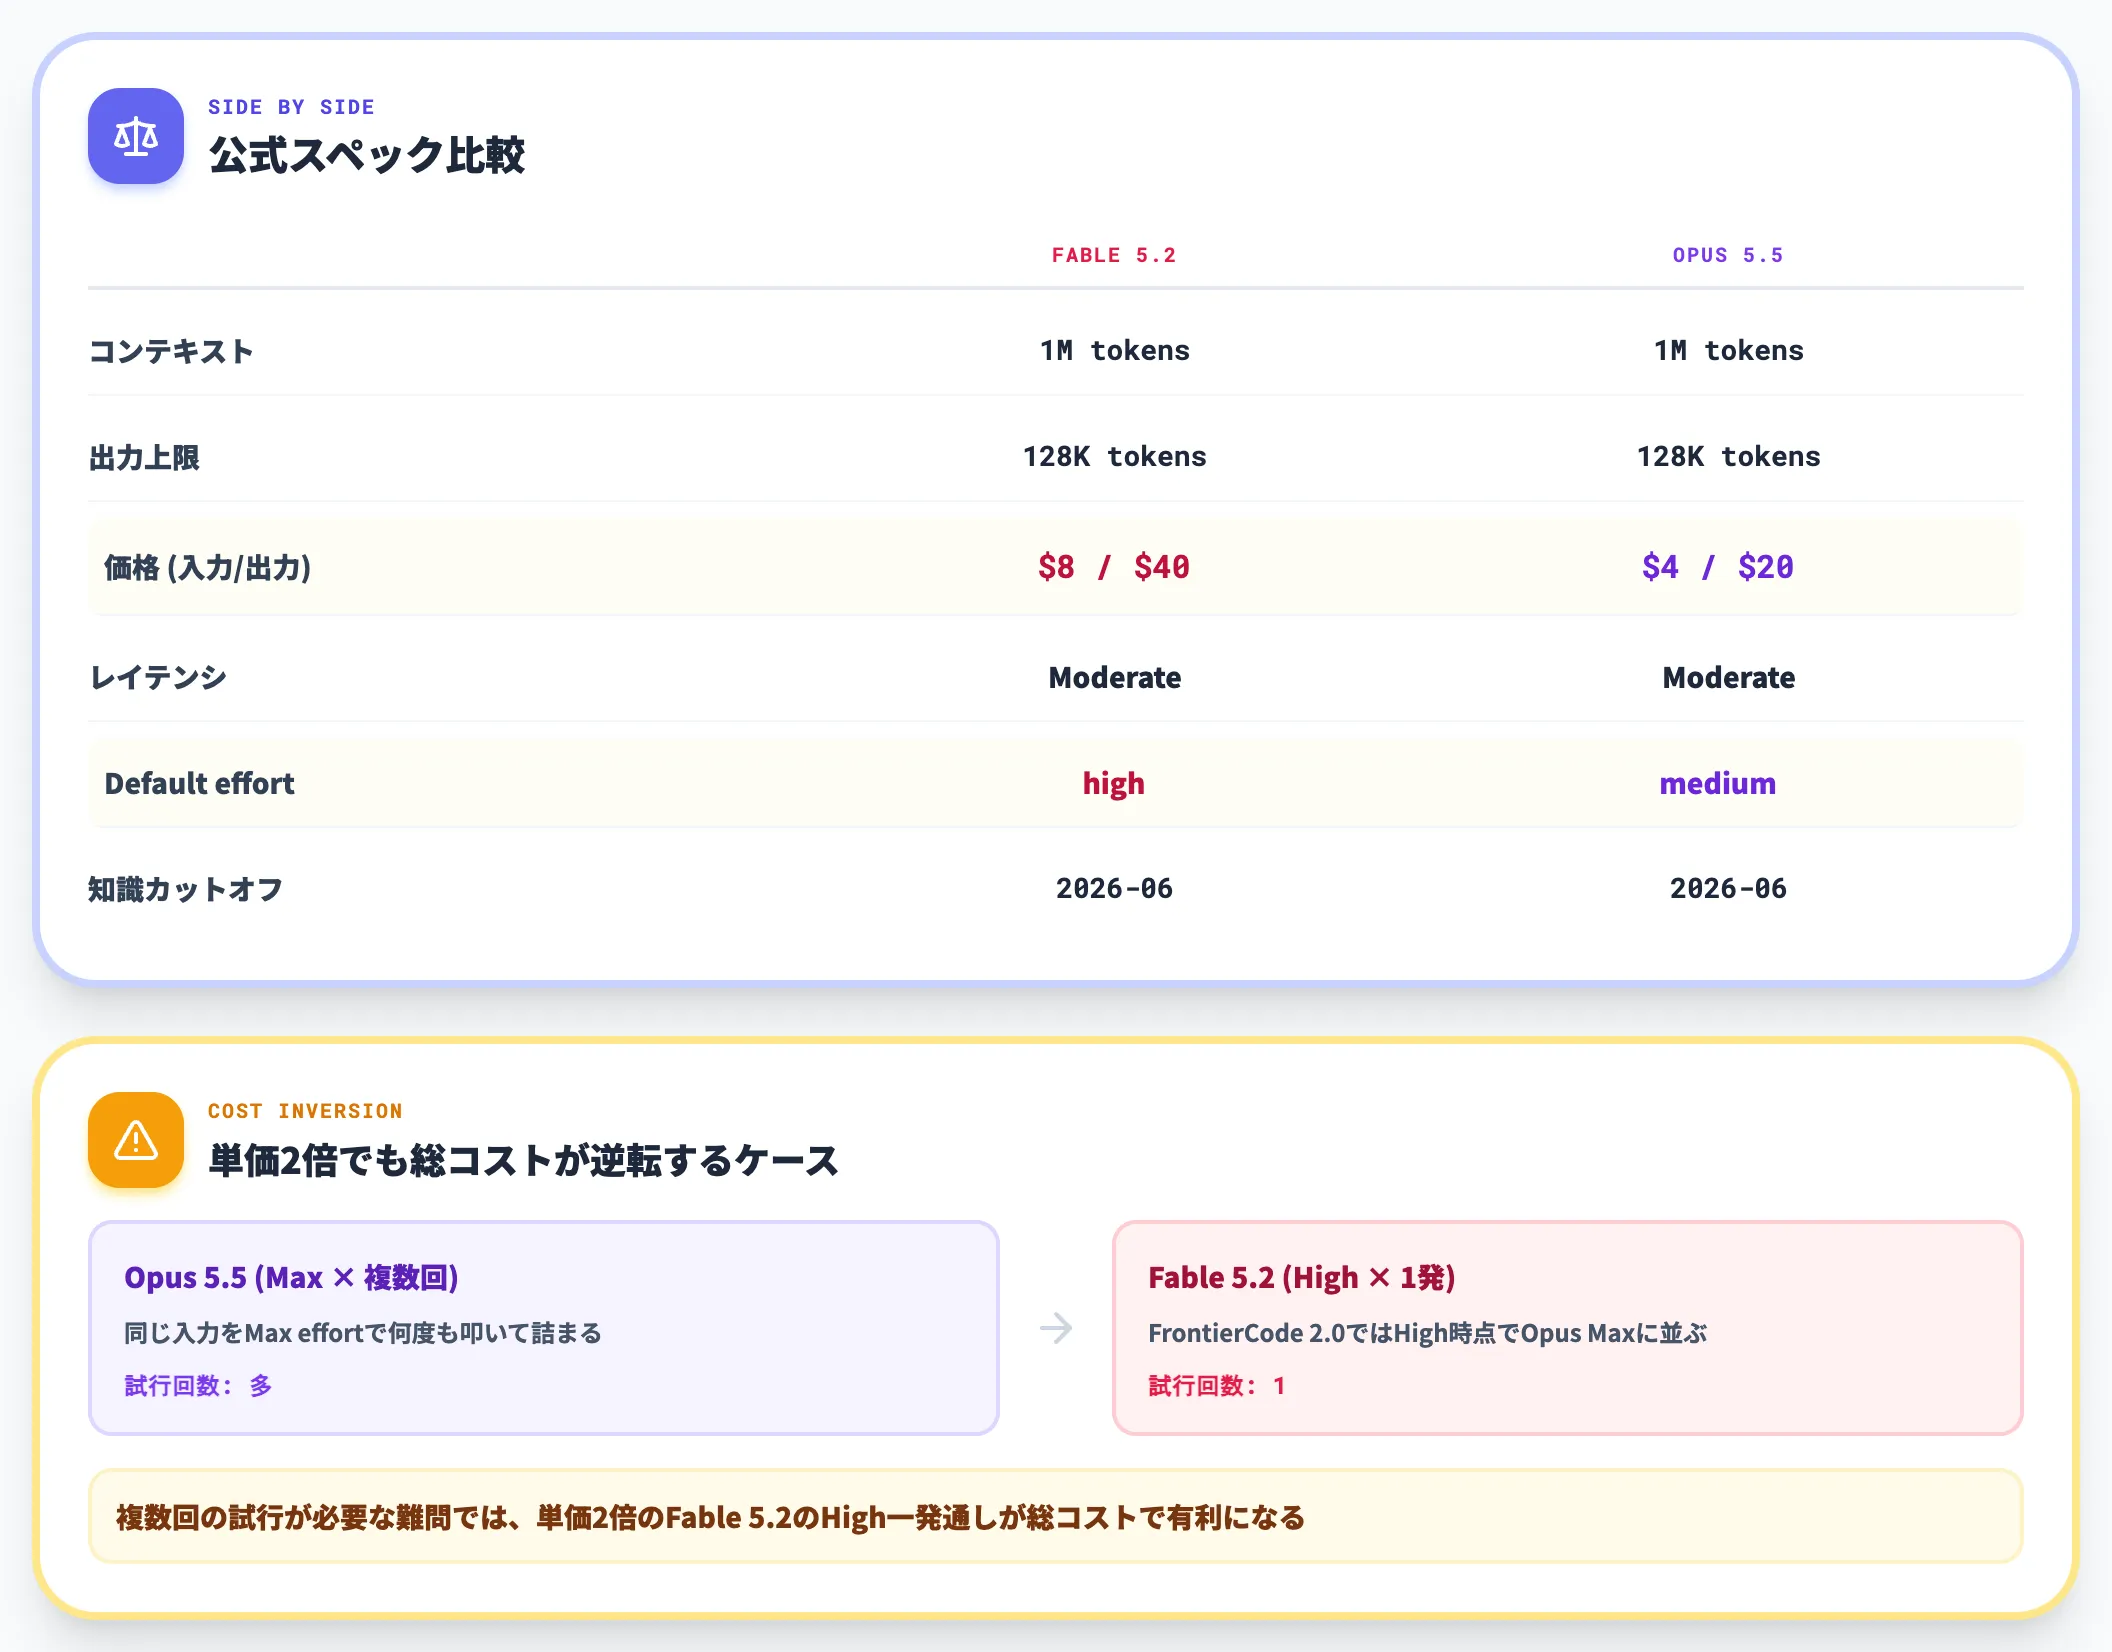
公式比較における両モデルの位置づけをまとめます。
| 項目 | Fable 5.2 | Opus 5.5 |
|---|---|---|
| コンテキスト | 1M tokens | 1M tokens |
| 出力上限 | 128K tokens | 128K tokens |
| 価格(入力/出力) | $8 / $40 | $4 / $20 |
| レイテンシ | Moderate | Moderate |
| Adaptive thinking | 常時オン(切断不可) | 常時オン |
| Default effort | 「high」 | 「medium」 |
| 知識カットオフ | 2026年6月 | 2026年6月 |
注意すべきは、Default effortが「high」と「medium」で異なる点です。
同じ入力でもFable 5.2はより多くの思考トークンを消費する設計になっているため、単純な「2倍の価格」よりも実効差が広がる場合があります。
一方、FrontierCode 2.0ではFable 5.2がHigh effort時点でOpus 5.5のMax effort相当に並ぶため、Opus 5.5をMax effortで繰り返し叩くよりFable 5.2のHighで一発通した方が総コストが下がる、という逆転現象も報告されています。
どのワークロードでFable 5.2に切り替えるか
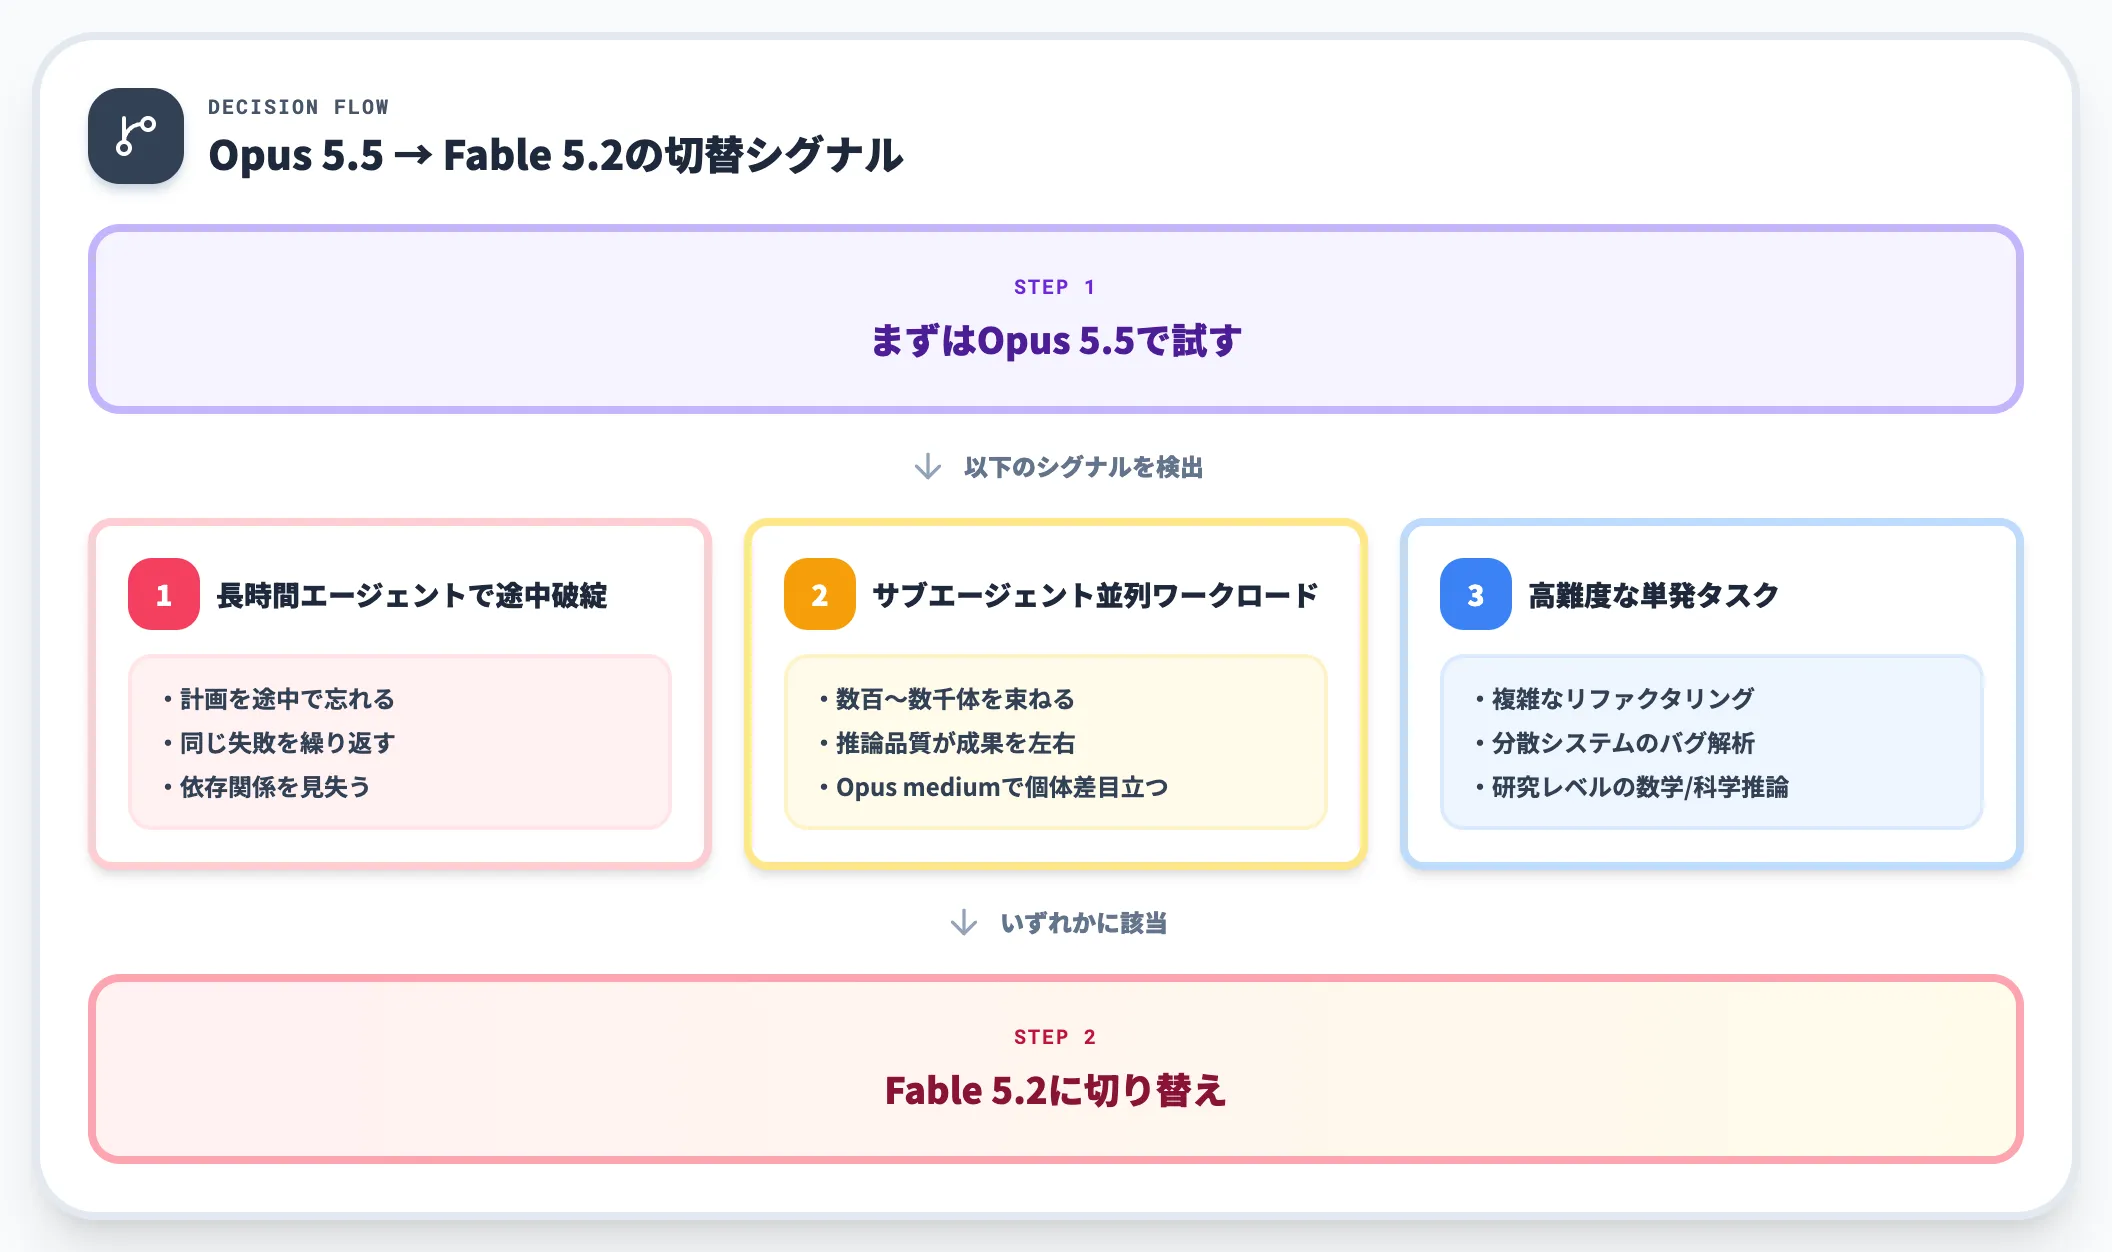
Anthropic公式が推奨する判断フローはシンプルで、Opus 5.5から始めてOpus 5.5がつまずく局面でFable 5.2に切り替える、です。実務で「Opus 5.5がつまずく局面」を見極めるシグナルは、次の3点が代表的です。
- 数時間以上かかる長時間エージェントで途中破綻
計画を途中で忘れる、同じ失敗を繰り返す、依存関係を見失う。Remote Labor Indexの差が最も効く領域
- サブエージェントを数百〜数千体束ねる並列ワークロード
各サブエージェントの推論品質が全体の成果を左右し、Opus 5.5の「medium」設定では個体差が目立つ
- 高難度な単発タスク
複雑なリファクタリング、分散システムのバグ解析、研究レベルの数学・科学推論。ワンショットで仕上げる必要があり、Opus 5.5を複数回叩いても詰まる
逆に、ドキュメント作成・一般的なコーディング・要約・短い対話では、Opus 5.5以下の階層で十分というケースが多く、Fable 5.2に乗せ替えてもコスト増ほどの精度向上は見込みにくくなります。
AI総研の実務観点でのケース別判断
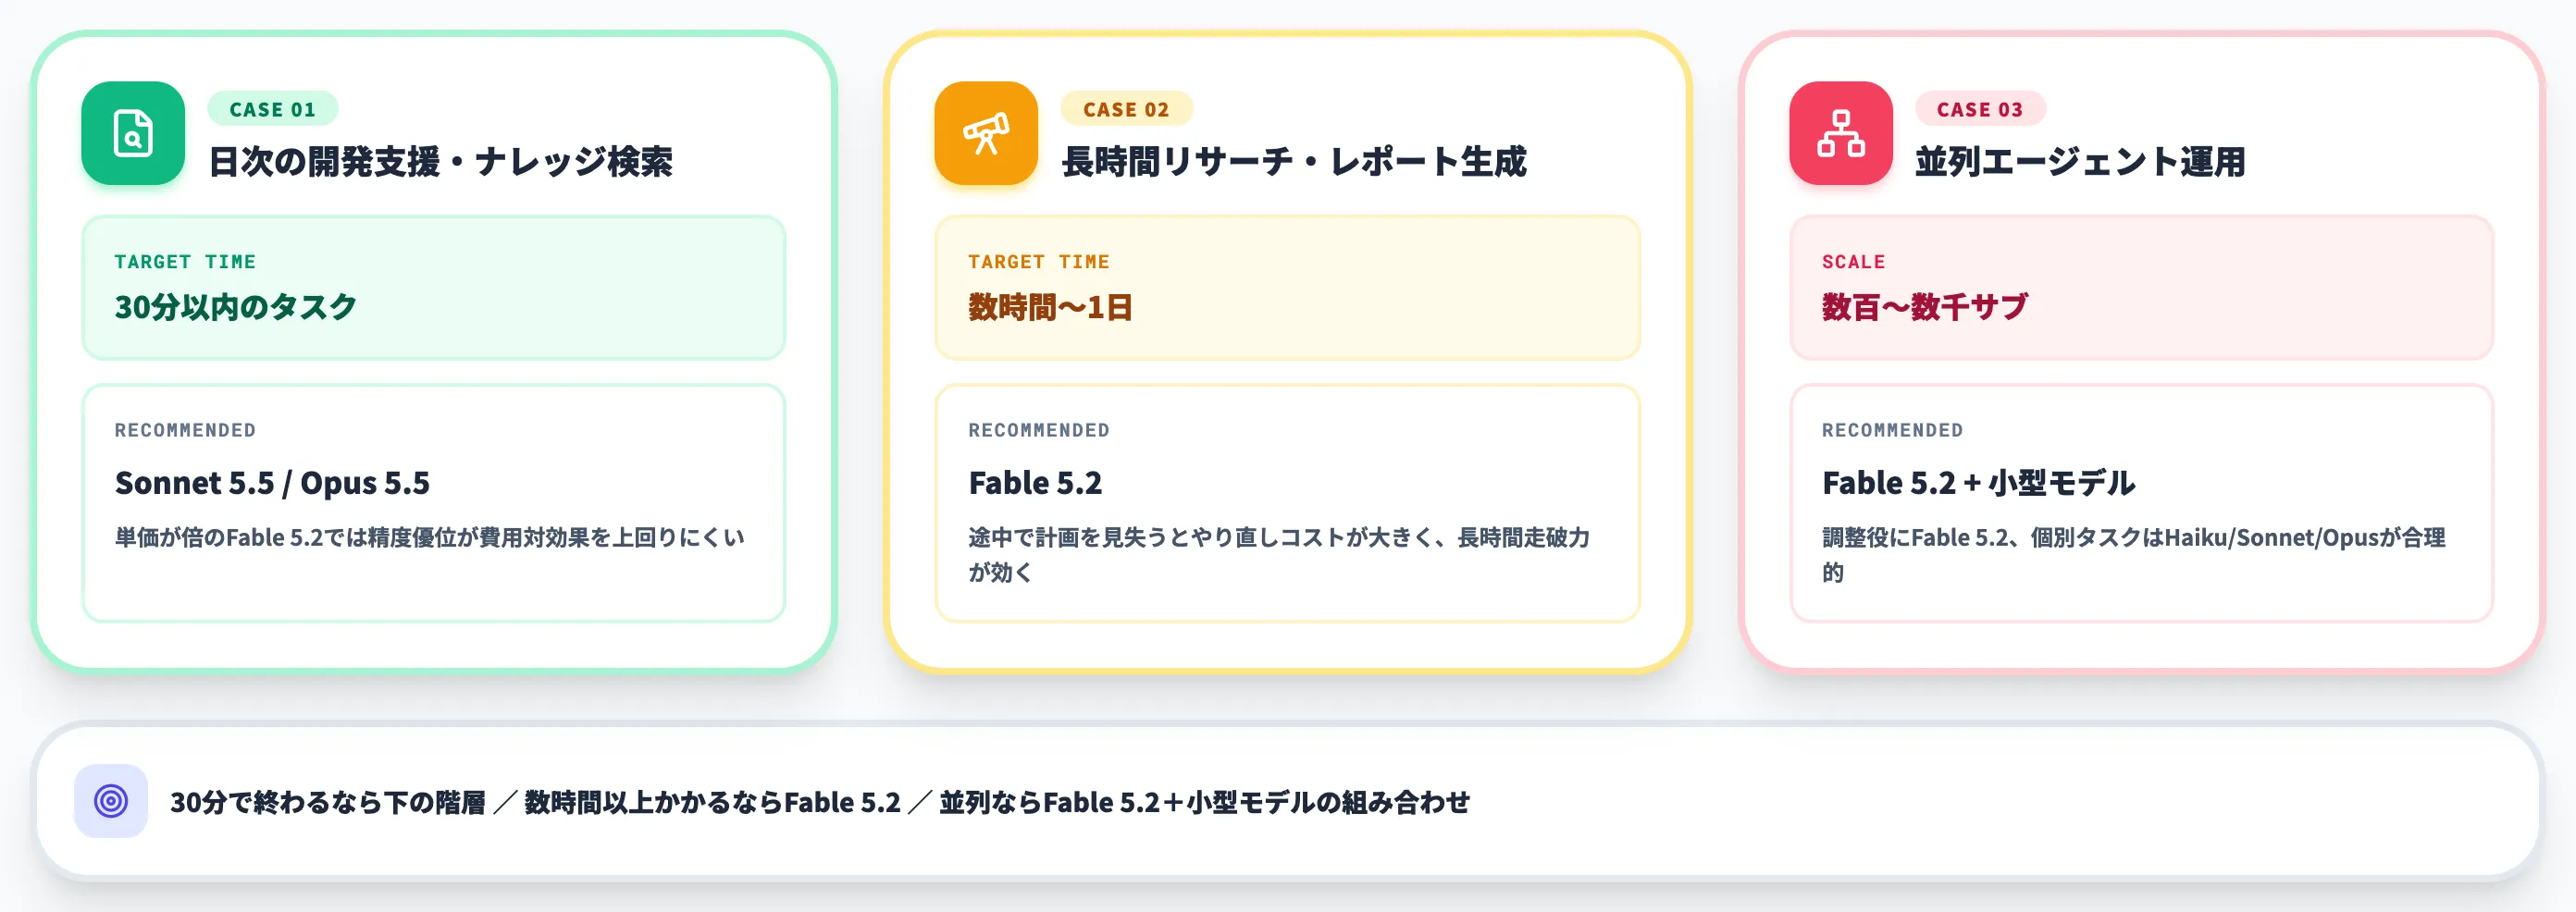
実務での使い分けとしては、以下の3ケースで整理するのが現実的です。
-
ケース1:日次の開発支援・ナレッジ検索
対象業務が「30分以内で終わるタスク」の場合、Sonnet 5.5もしくはOpus 5.5を第一候補にします。Fable 5.2は単価が倍で、短時間タスクでは精度優位が費用対効果を上回りにくいためです。
-
ケース2:長時間走らせるリサーチ・レポート生成
数時間〜1日単位で走らせる深いリサーチや、複数の情報源を横断して成果物を書き上げるタスクはFable 5.2の射程です。
途中で計画を見失うとやり直しコストが大きくなるため、Opus 5.5で試して失敗が目立つならFable 5.2に切り替える判断軸が立ちます。
-
ケース3:並列エージェント運用
数百〜数千のサブエージェントを束ねるワークロードは、Advisor/Orchestratorパターンと組み合わせてFable 5.2を活用します。
全エージェントをFable 5.2で動かすのではなく、調整役にFable 5.2を据え、個別タスクはHaiku 5.5・Sonnet 5.5・Opus 5.5に委ねる構成が合理的です。
ワークロード別の判断を1枚絵にすると、「30分で終わるなら下の階層/数時間以上かかるならFable 5.2/並列ならFable 5.2+小型モデルの組み合わせ」というかたちになります。
Claude Fable 5.2を活かすAdvisor/Orchestratorパターンと活用事例
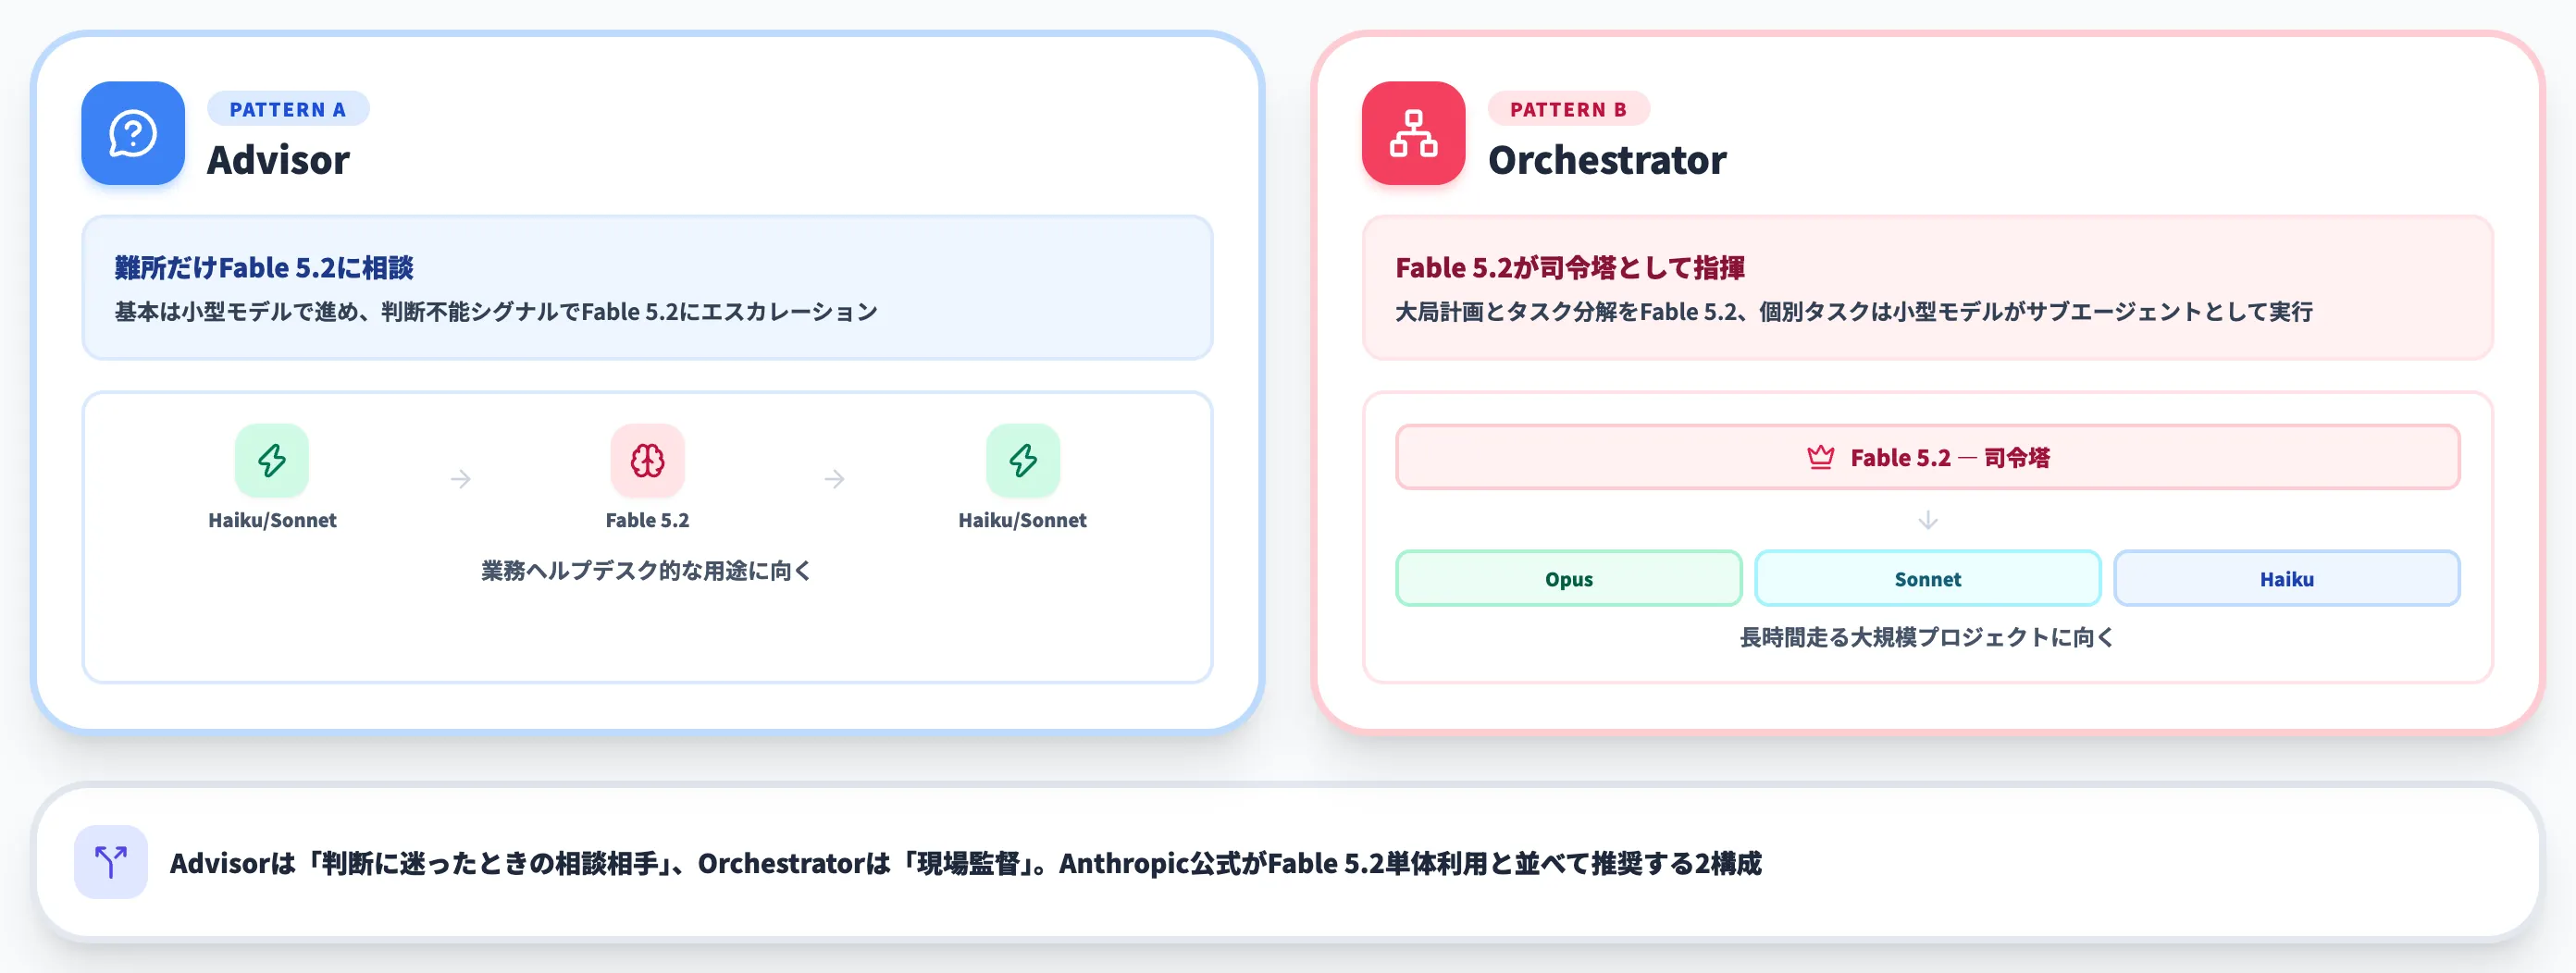
Anthropicは、Claude Fable 5.2単体での使用に加えて、他のClaudeモデルと組み合わせた2つの運用パターンを公式に提示しています。本セクションでは、Advisor・Orchestratorの2パターンの設計と、実際に動いた1000エージェント規模の活用事例を扱います。
Advisorパターン——難所だけFable 5.2に相談する
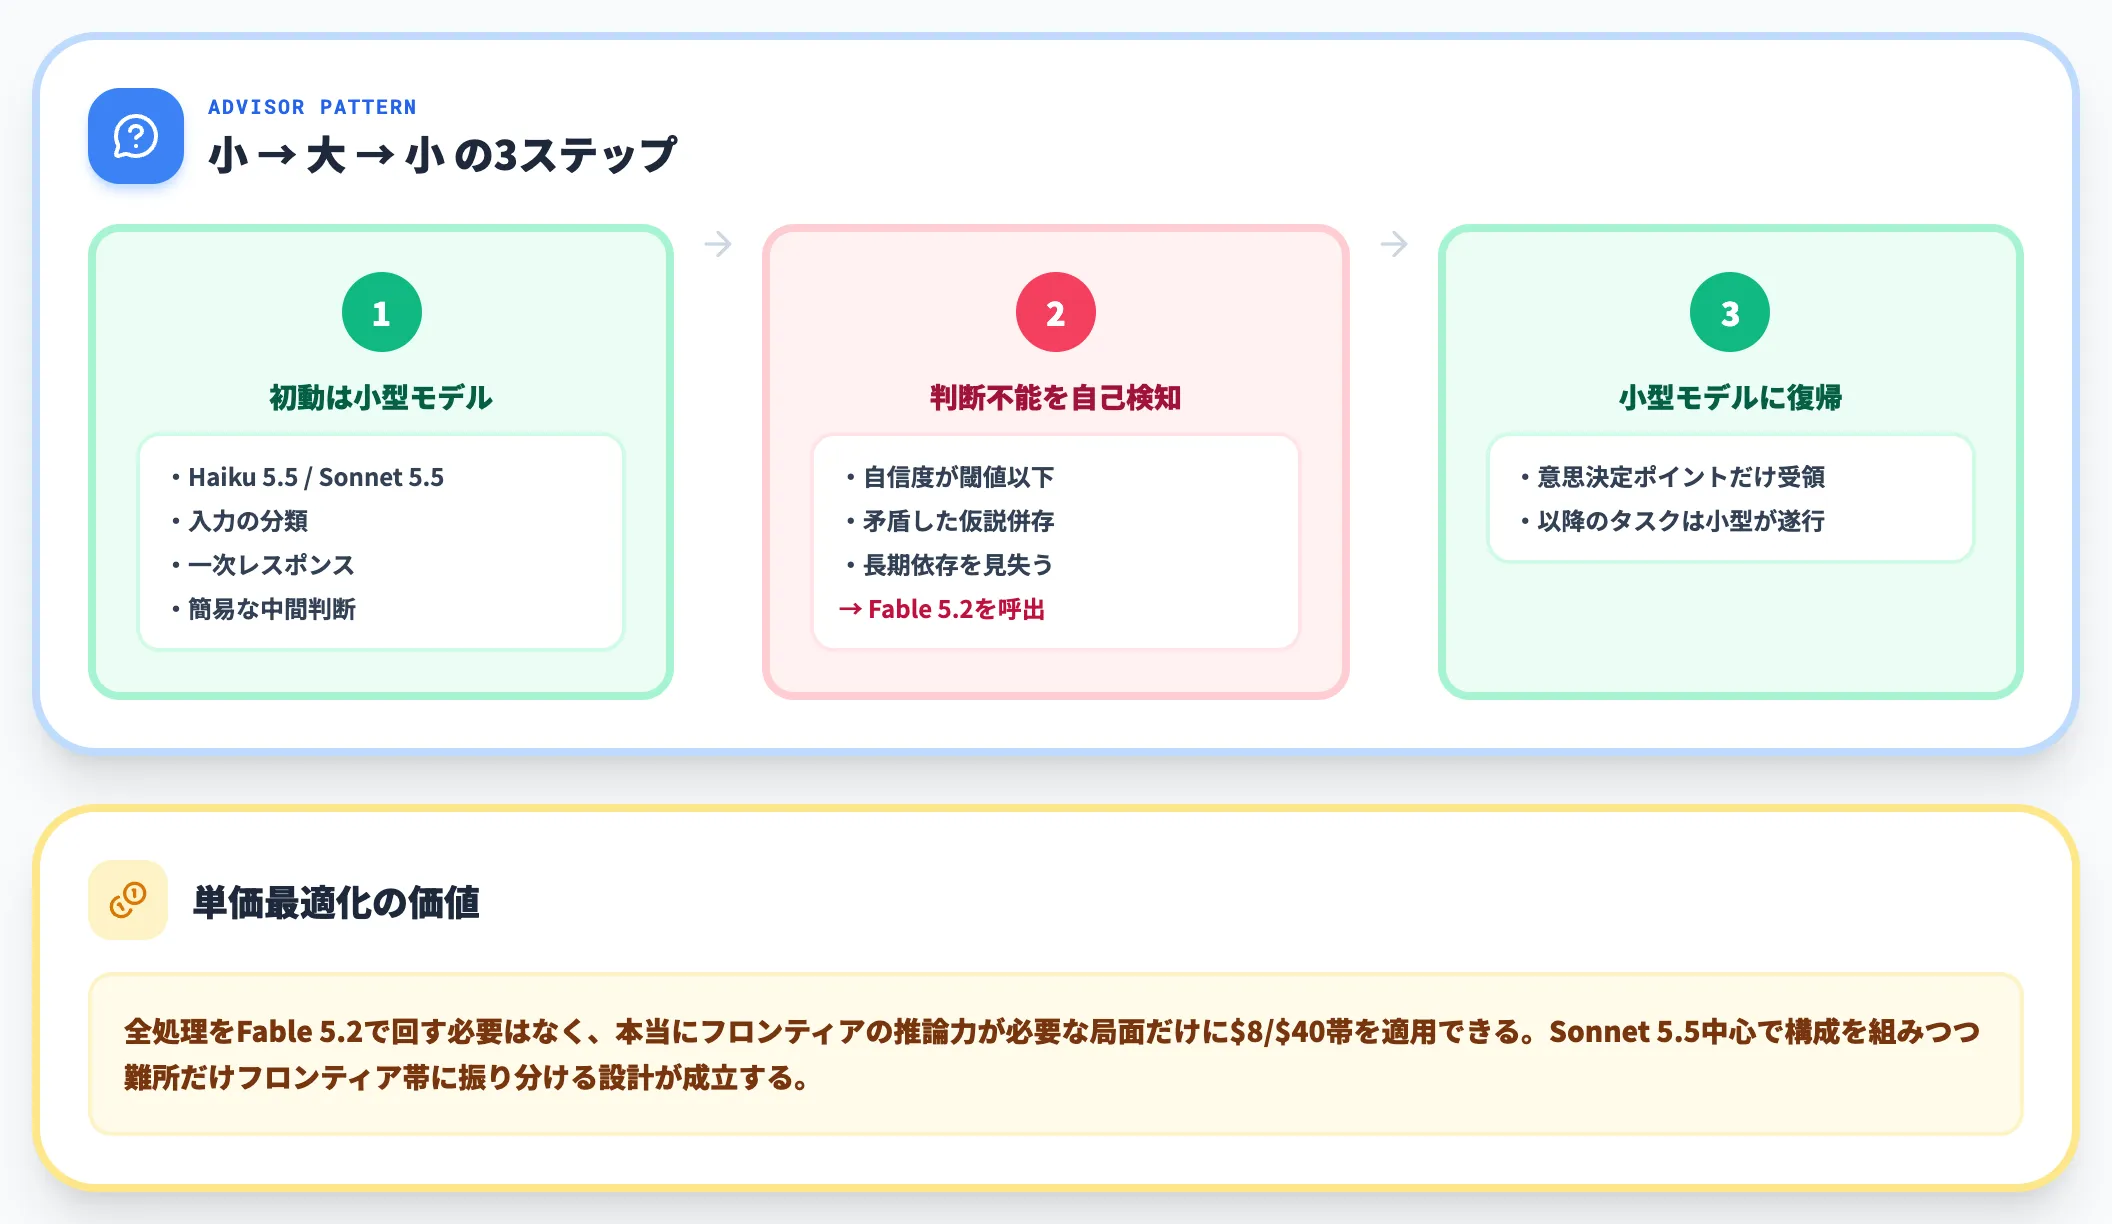
Advisorパターンは、Haiku 5.5・Sonnet 5.5・Opus 5.5が基本処理を担当し、難しい局面だけFable 5.2に相談する構成です。
実装イメージは次のようになります。
- 初動は小型モデル
Haiku 5.5やSonnet 5.5がタスク全体を進め、入力の分類・一次レスポンス・簡易な中間判断を担う
- 判断不能を自己検知してエスカレーション
「自信度が閾値を下回る」「複数の矛盾した仮説が併存する」「長期的依存関係を見失っている」といったシグナルを検出し、Fable 5.2を呼び出す
- アドバイス受領後に小型モデルに復帰
Fable 5.2は意思決定ポイントだけを示し、以降のタスク遂行は再びHaiku 5.5・Sonnet 5.5が引き継ぐ
この構成の価値は単価の最適化にあります。全処理をFable 5.2で回す必要はなく、本当にフロンティアの推論力が必要な局面だけに$8/$40帯を適用できるため、Sonnet 5.5中心で構成を組みつつ難所だけフロンティア帯に振り分ける設計が成立します。
Orchestratorパターン——Fable 5.2が小型モデルを指揮する
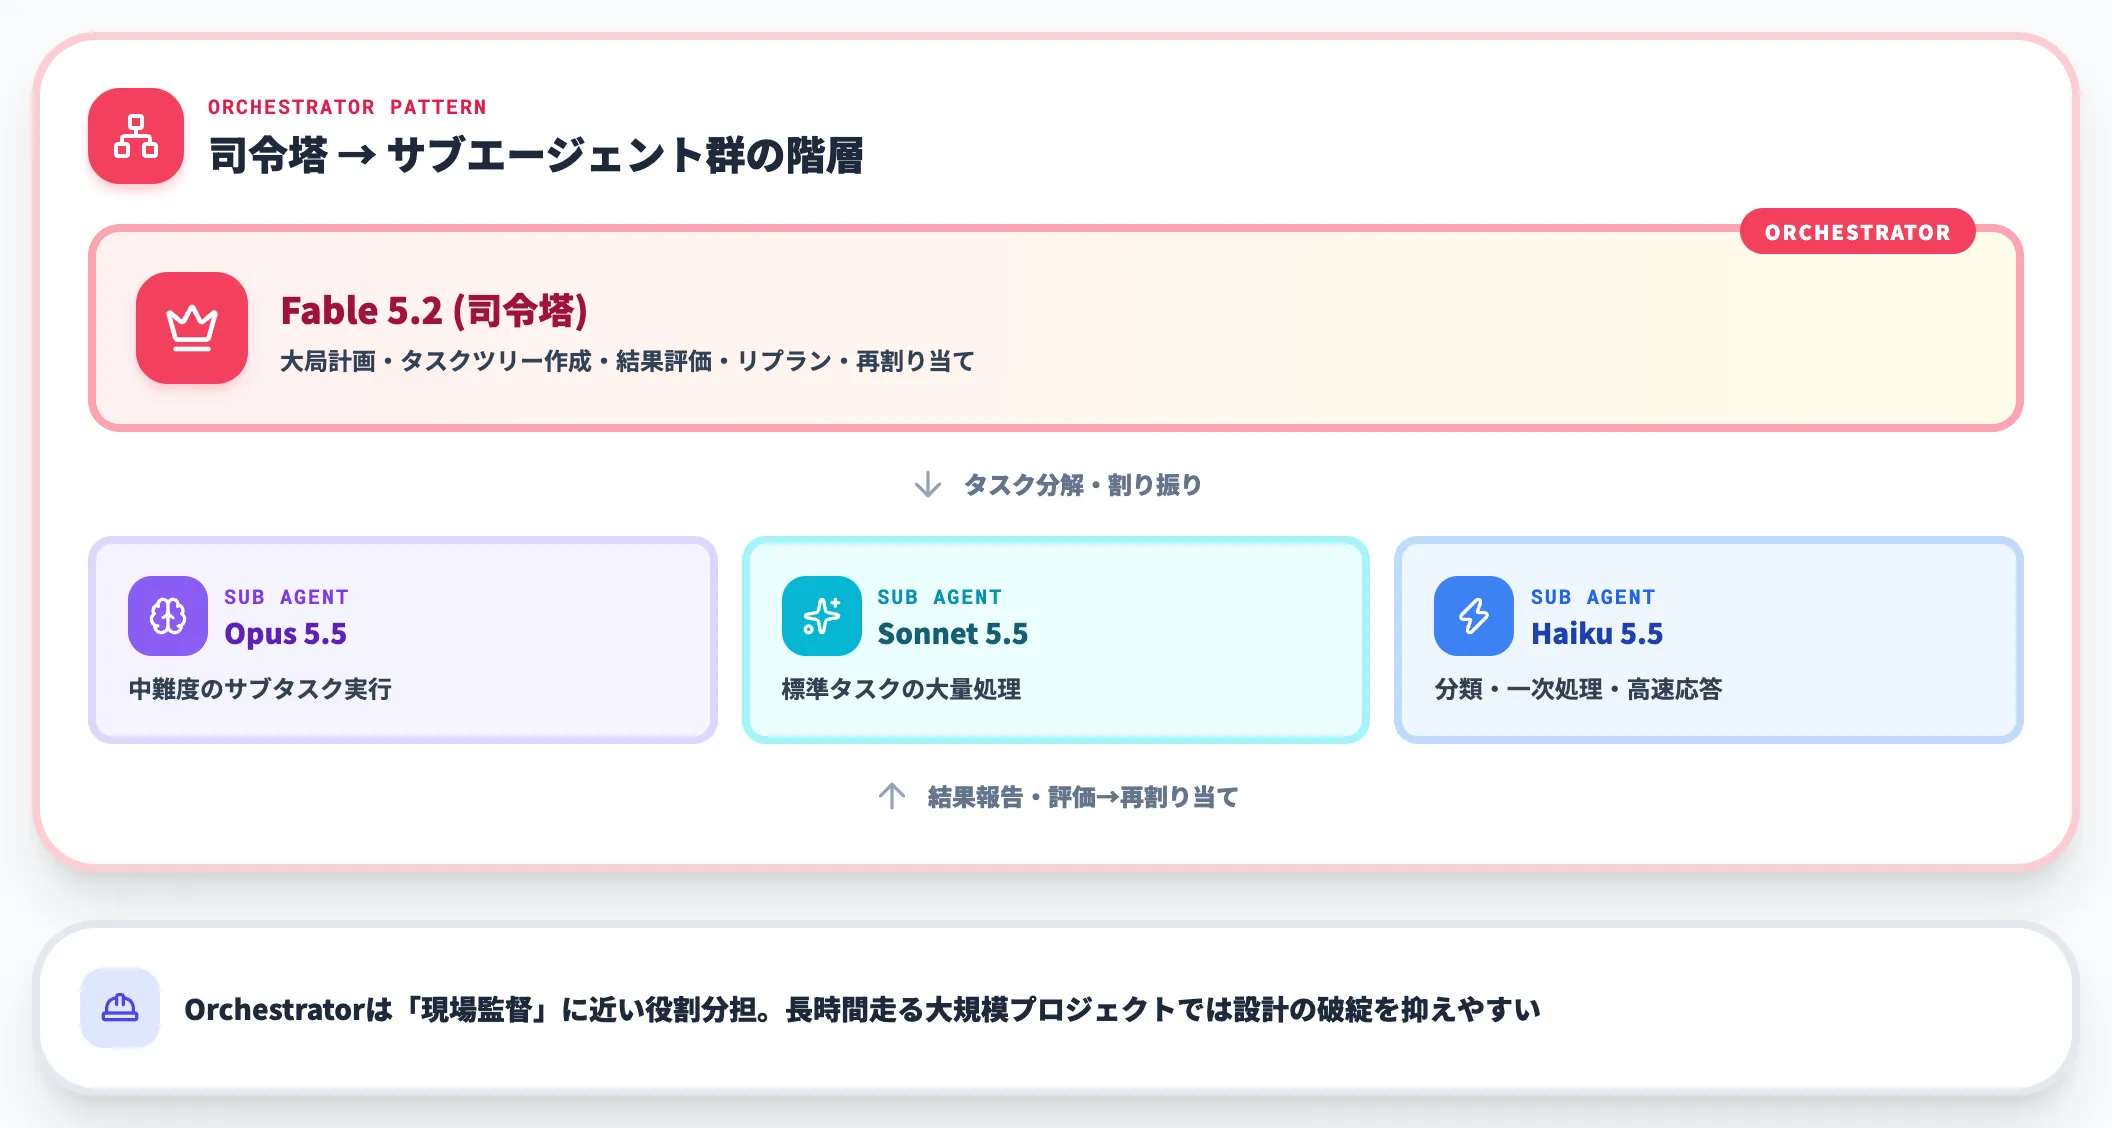
Orchestratorパターンはその逆で、Fable 5.2が司令塔として大局計画とタスク分解を担当し、Haiku 5.5・Sonnet 5.5・Opus 5.5がサブエージェントとして実タスクをこなす構成です。
実装イメージとしては、Fable 5.2がプロジェクト全体のゴールを受け取り、タスクツリーを作成し、個別のノードを小型モデルに割り振ります。小型モデルからの結果を受けて評価・リプラン・再割り当てを繰り返し、全体の進行を管理する役回りです。
Advisorが「判断に迷ったときの相談相手」なら、Orchestratorは「現場監督」に近い役割分担です。長時間走る大規模プロジェクトではOrchestrator構成の方が設計の破綻を抑えやすく、逆に多数のユーザーが散発的に相談してくる業務ヘルプデスク的な用途ではAdvisor構成が運用コストに優しい、という使い分けになります。
1000エージェントの実例——Fermat証明とOS開発
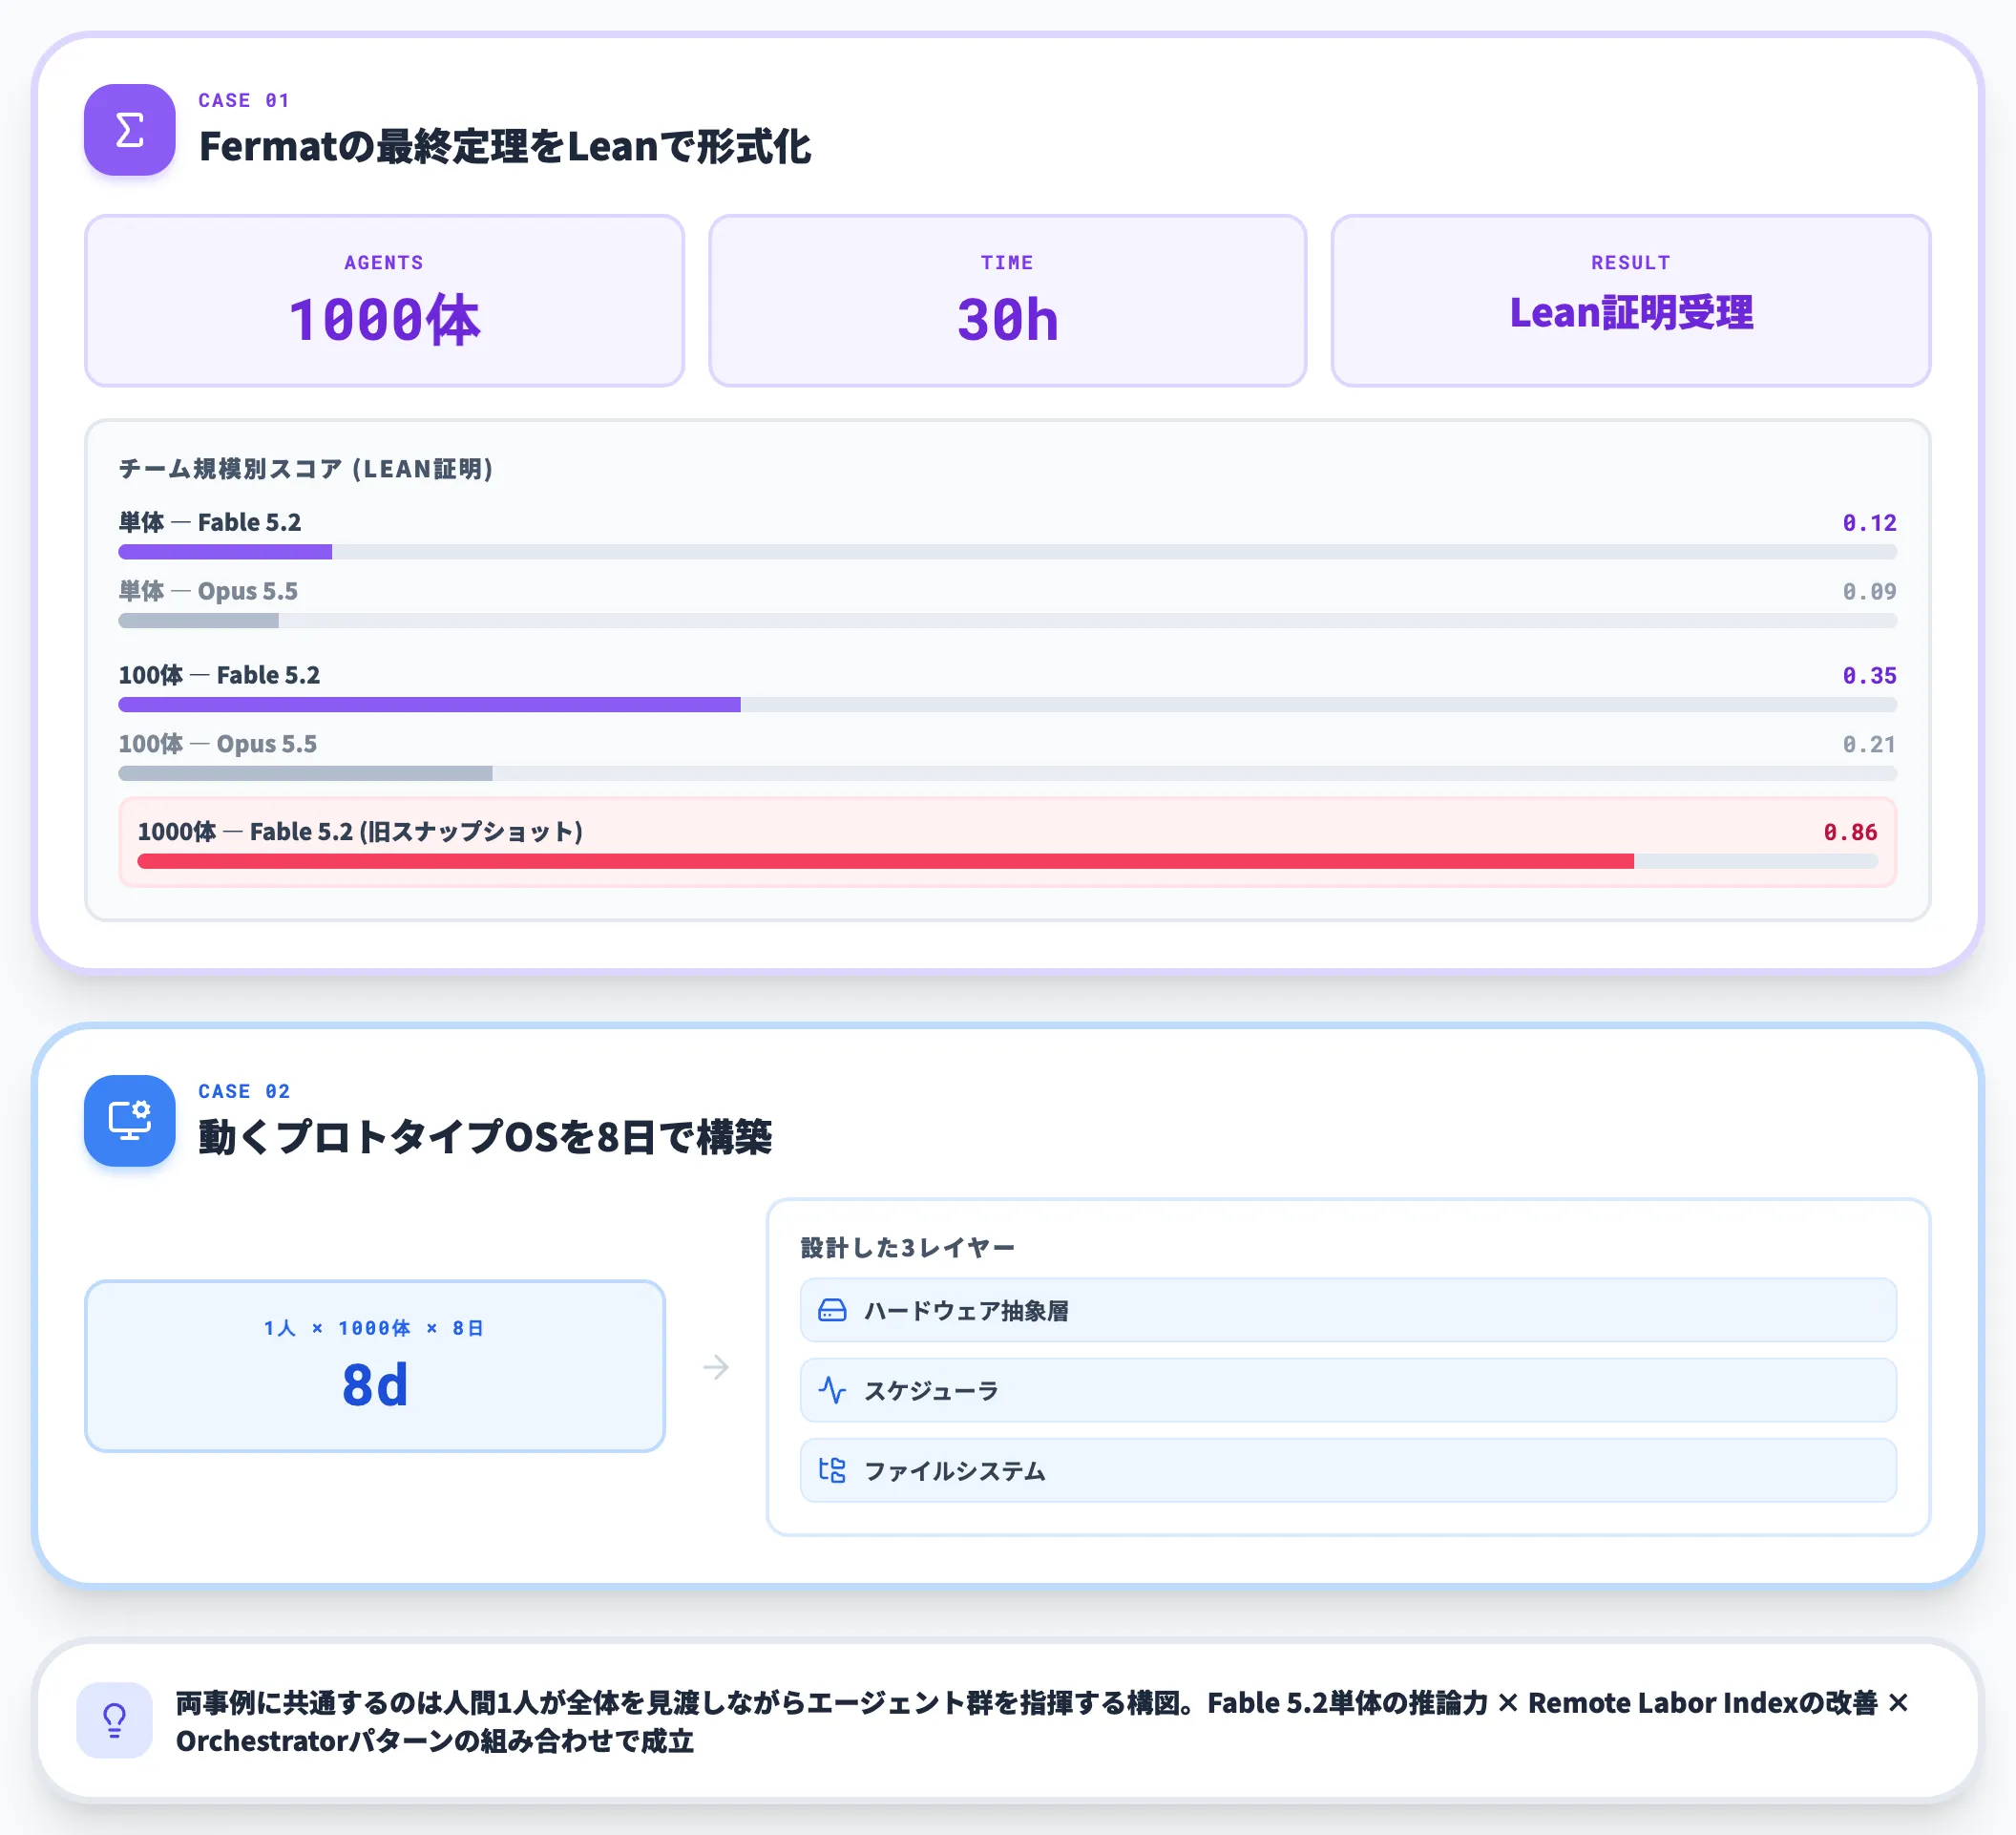
Fable 5.2の長時間エージェント能力を示す具体例として、Anthropicが発表資料で紹介したのは以下の2件です。
- Fermatの最終定理を30時間で形式化
1000体のFable 5.2エージェントが協調して、Fermatの最終定理の形式的証明を30時間で組み上げた実験。人間の数学者チームが数年かけた作業の形式化に相当する
- 動作するOSを8日で構築
1人のエンジニアが1000体のサブエージェントを8日間調整して、動くプロトタイプOSを構築。ハードウェア抽象層・スケジューラ・ファイルシステムの各レイヤーを分担させた
Fermat証明の実験はエージェント数とスコアの関係を公式データでも追えます。以下のグラフは、1体から100体までのチーム規模別にLeanによる定理証明のスコアを比較したものです。
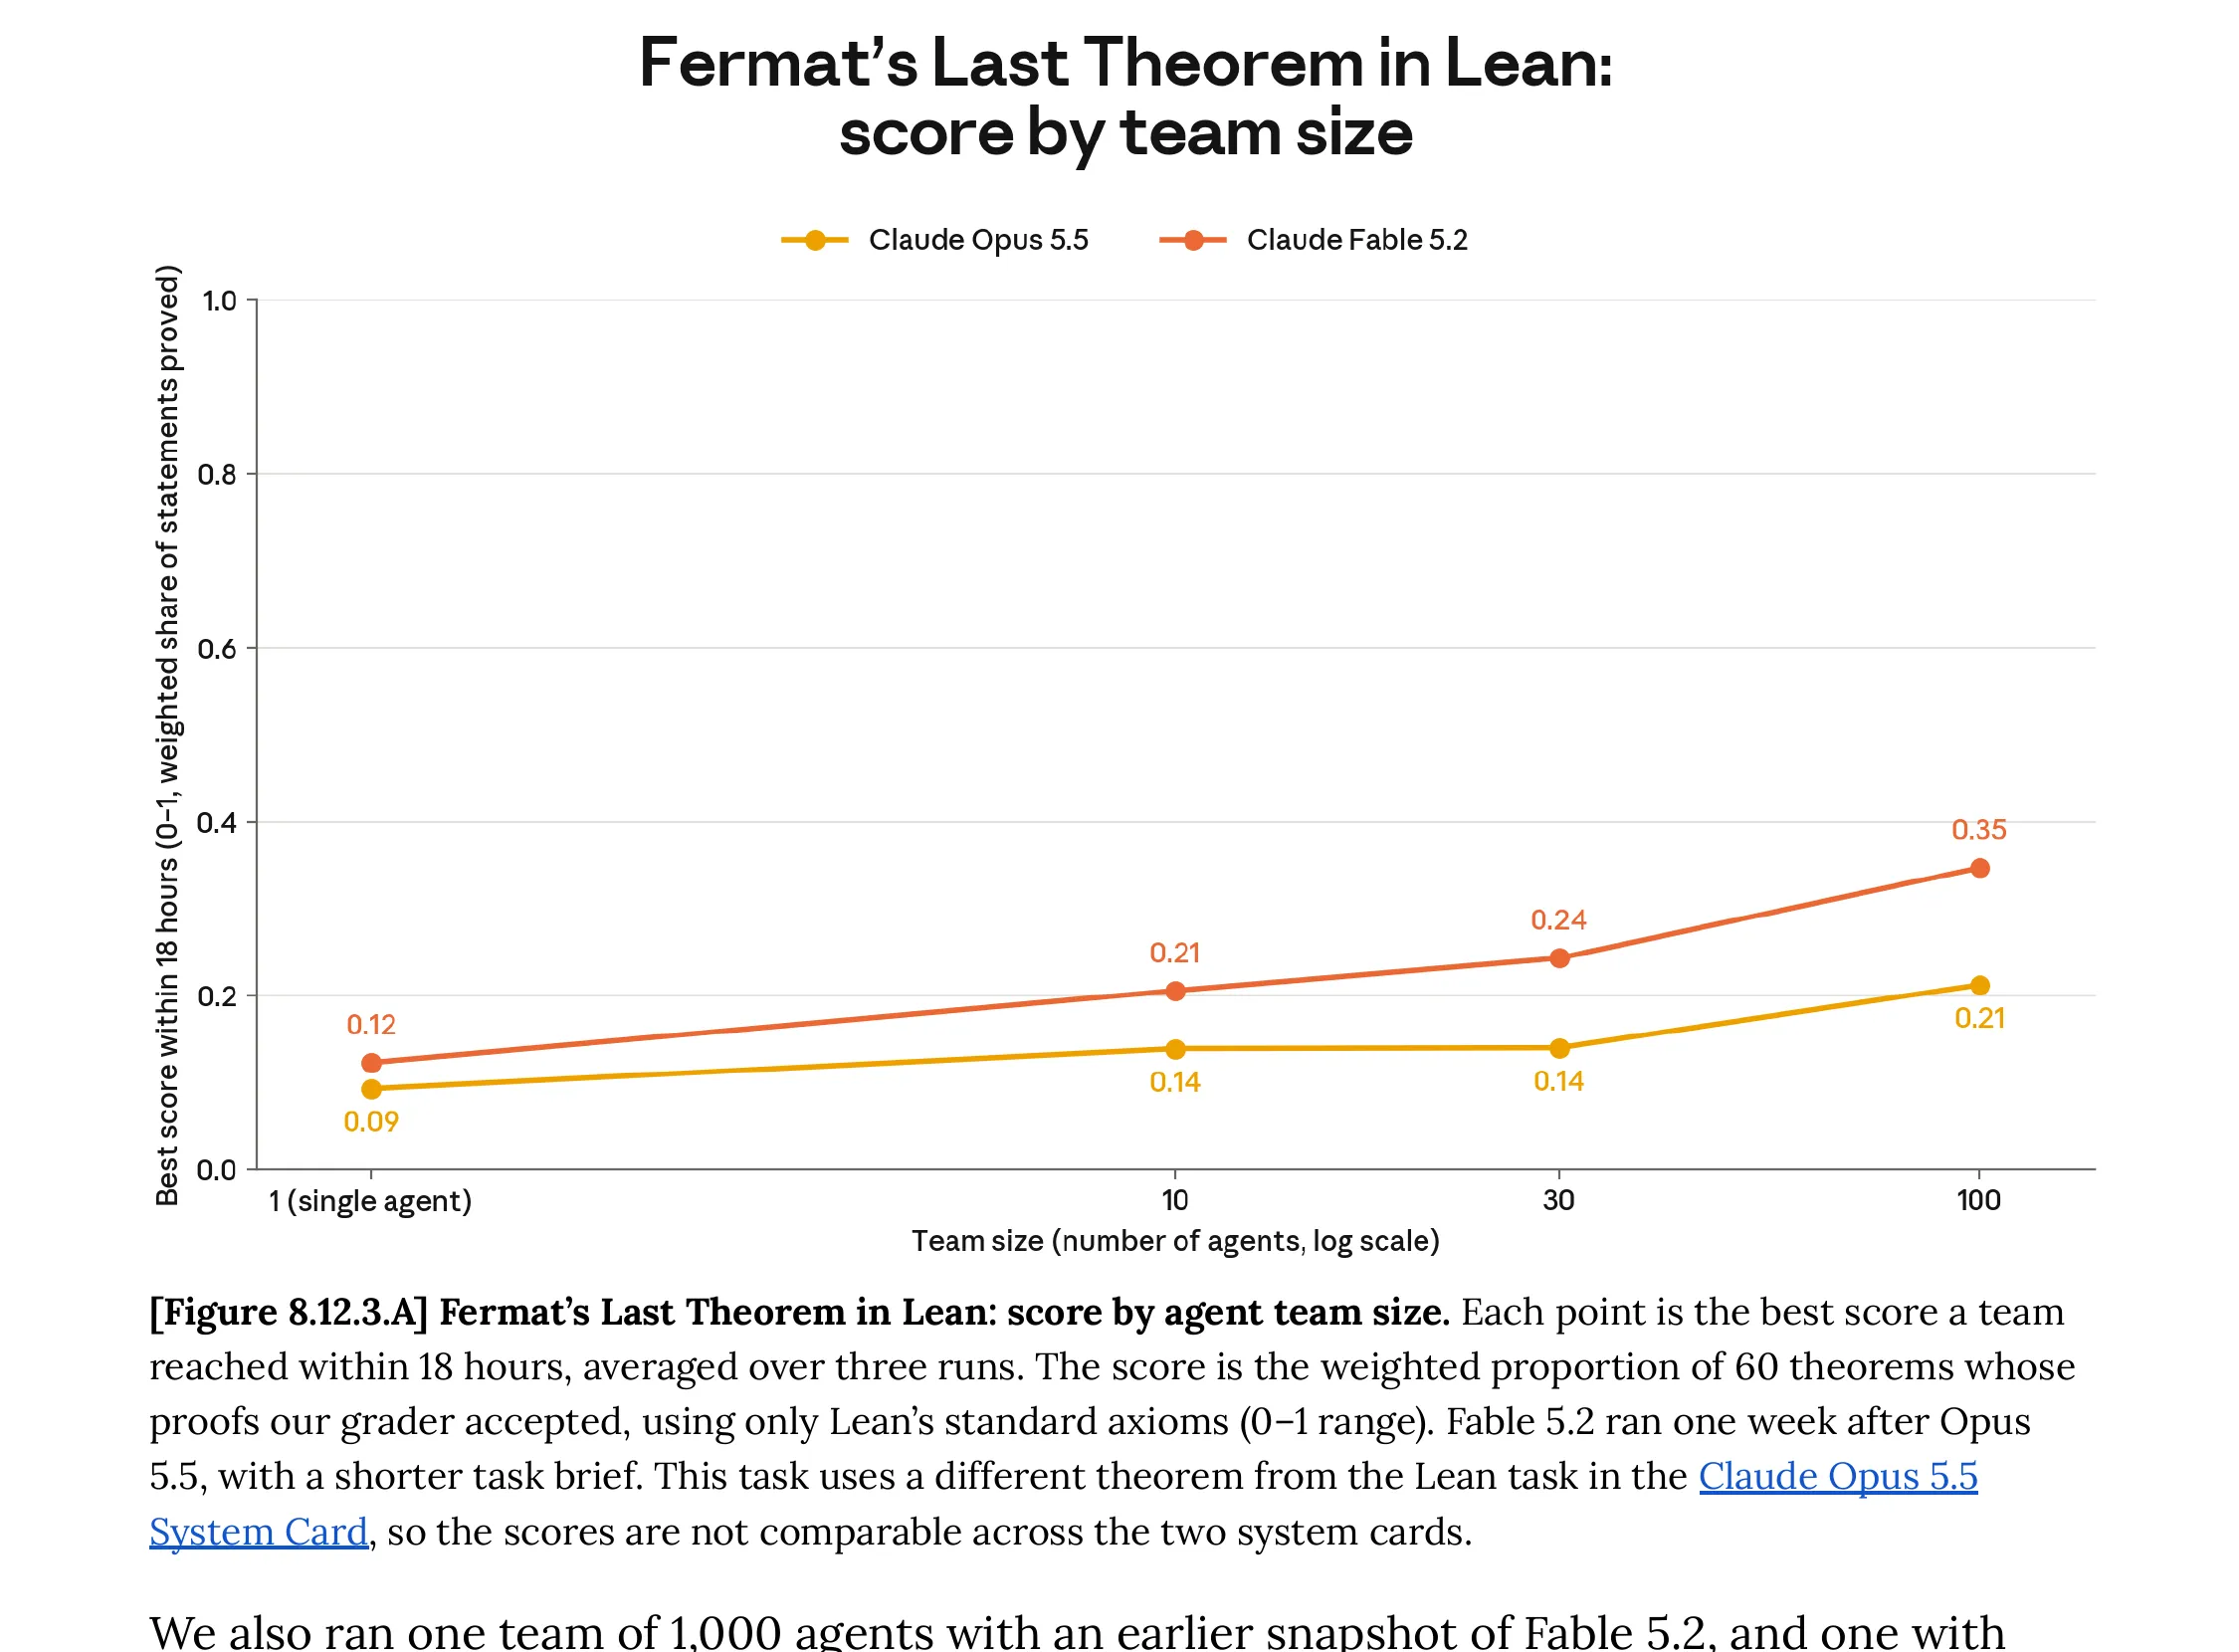
Fermat's Last Theorem in Lean: チーム規模別スコア。Fable 5.2は単体で0.12・100体で0.35に到達し、Opus 5.5の0.09/0.21を一貫して上回る(出典:Anthropic System Card)
グラフが示しているのは、エージェント数を増やすほどスコアが伸びる傾きが、Opus 5.5よりFable 5.2のほうが大きいという点です。
単体では0.12対0.09とほぼ並びに見えますが、100体規模ではFable 5.2が0.35、Opus 5.5が0.21で差が1.7倍に広がります。1000体まで並列を伸ばしたチームは、Fable 5.2の旧スナップショットを使っても18時間時点で0.86まで到達し、その後12時間延長して30時間時点で「Fermatの最終定理のLean証明が受理」される完全完了に至った、と公式システムカードに記載されています。
両事例に共通するのは、人間1人が全体を見渡しながらエージェント群を指揮する構図です。
Fable 5.2単体の推論力に加えて、長時間タスクで成果物の水準を保てる案件の割合(Remote Labor Index)が底上げされたことと、Orchestratorパターンによる階層設計が組み合わさって成立しています。
Fable 5.2の長時間エージェント能力はソフトウェアだけに閉じません。Anthropicが公開した電子機器設計の公式ケーススタディでは、Fable 5.2単体が回路図・基板レイアウト・エンクロージャを組み合わせて3つの電子デバイス(USBスピーカーフォン・家庭用音声アシスタントハブ・バッテリー駆動のバーチャルペット)を一貫設計しています。
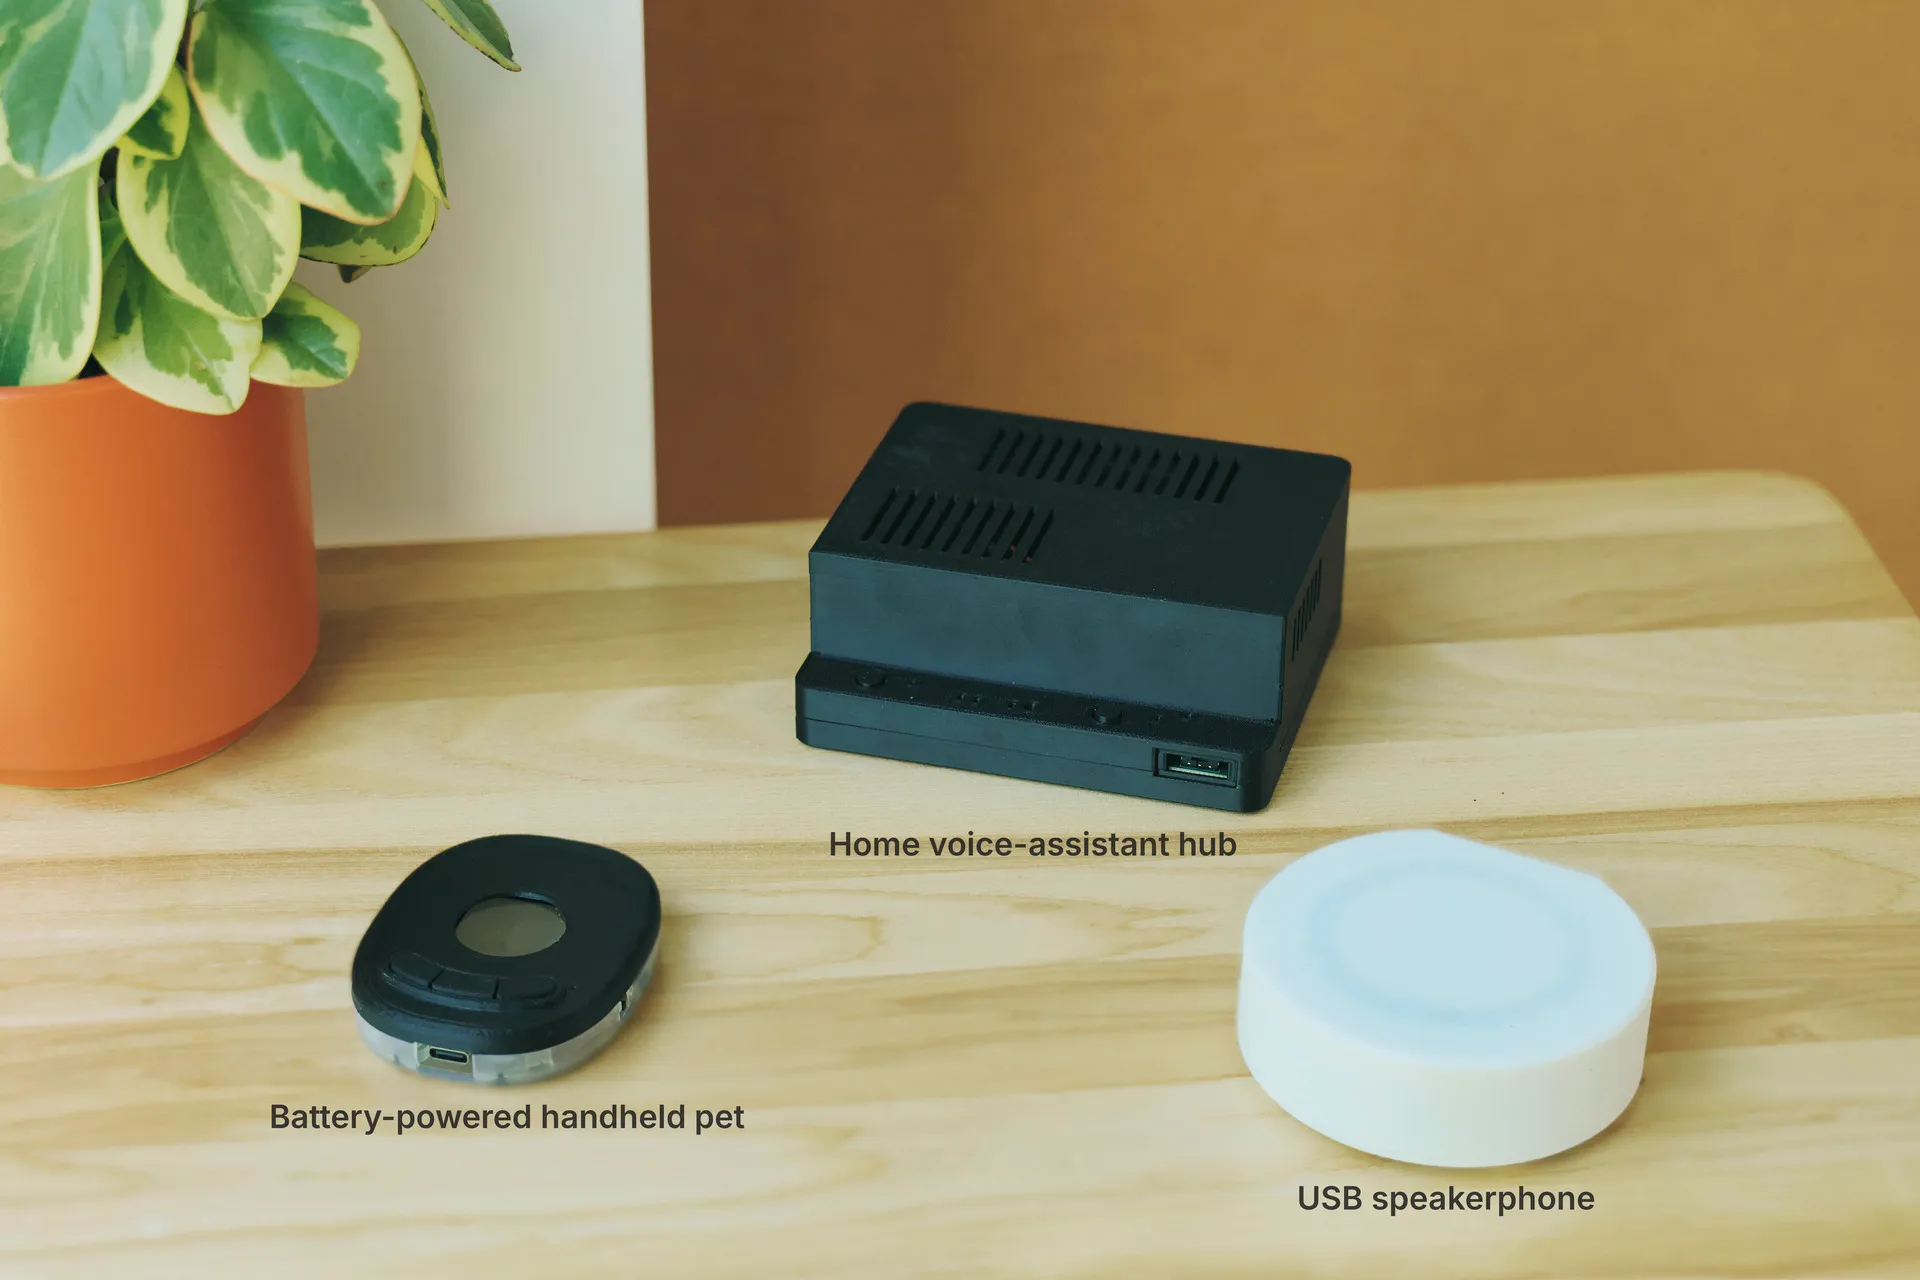
Fable 5.2が設計・プロトタイプ化した3つのデバイス(左:バッテリー駆動のバーチャルペット、中央:家庭用音声アシスタントハブ、右:USBスピーカーフォン)(出典:Anthropic Research: Claude Electronics Design)
同ケーススタディで報告されているDiode PCB Gym(電子回路設計特化のベンチマーク)では、Fable 5.2が69%、Fable 5が25%で、わずか2世代で2.7倍以上に伸びています。
「コードを書く」能力の延長で物理設計までカバーし始めたことが、2026年11月時点でFable 5.2がフロンティア帯にいる根拠の1つです。
企業実用の文脈で言えば、CursorはFable 5.2をCursorBenchで評価して公表しており、Stripeは前世代のFable 5で既に50M行規模のRuby移行を1日で完了させた実績を公開しています。Enterprise Frontier Safeguardsの私的ベータにはBridgewater・Salesforce・Stripeが参加しており、金融・CRM・決済の各領域で業務組み込みが先行している段階です。
Claude Fable 5.2とMythos 5.2の違い
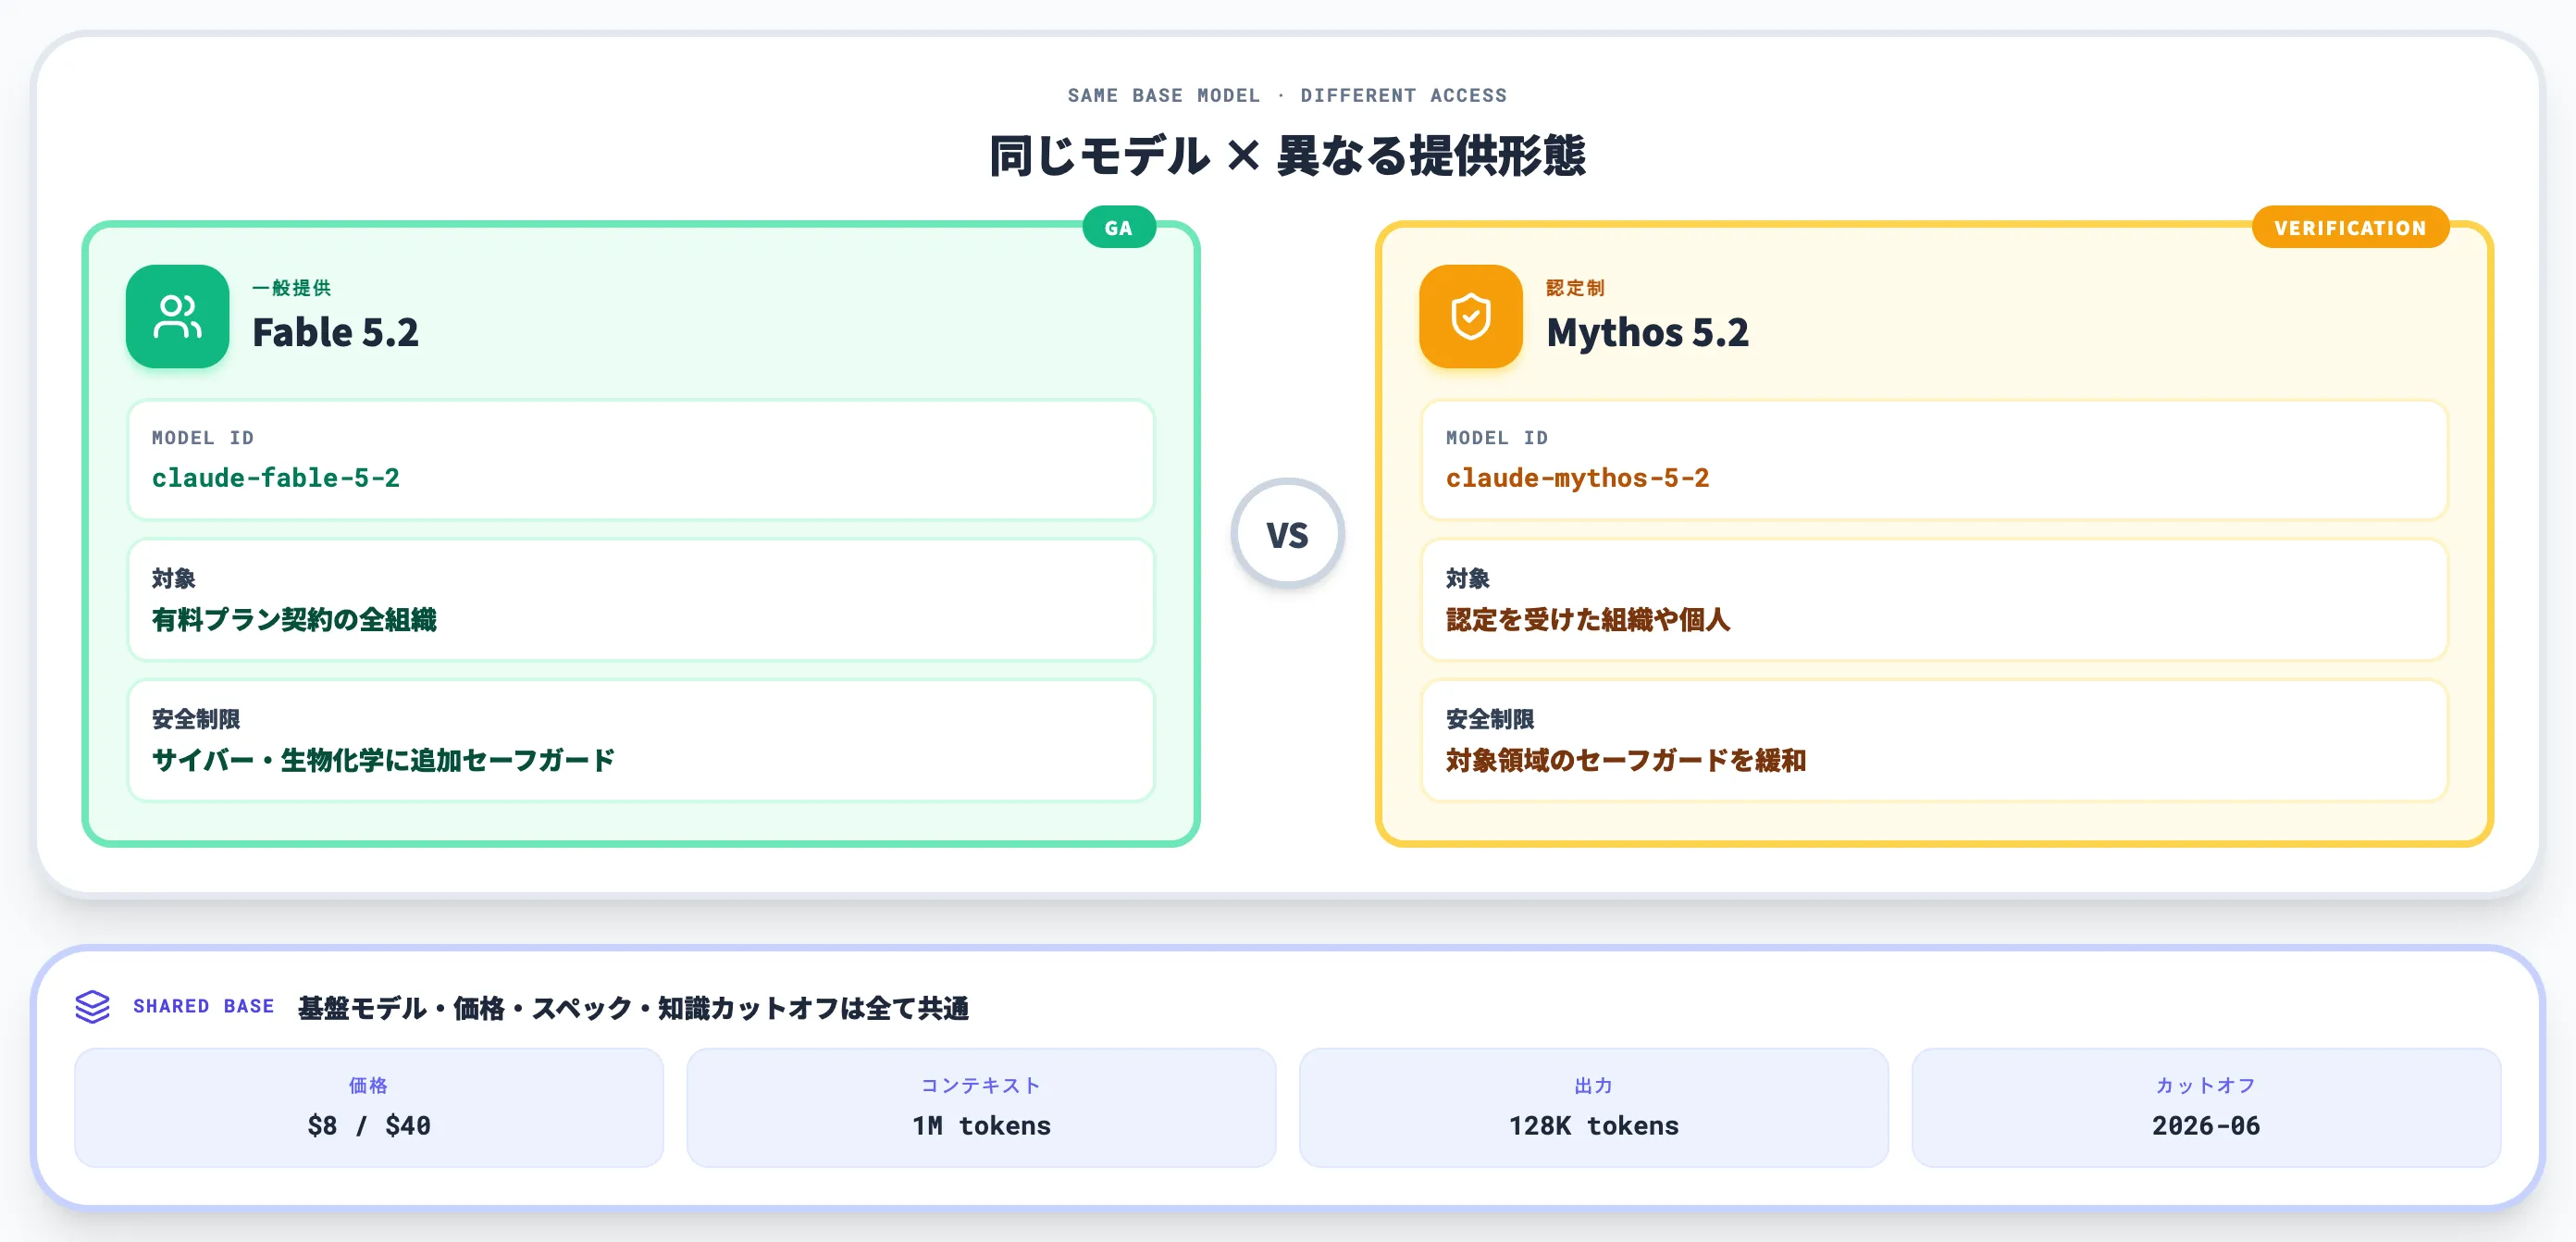
Claude Fable 5.2と同時に発表されたClaude Mythos 5.2は、中身は同じモデルですが、提供対象と安全制限の設定が異なります。
本セクションでは、FableとMythosの関係・Verification Programの対象・自社がどちらを使うべきかの判断を整理します。
同じモデル、違う対象ユーザー
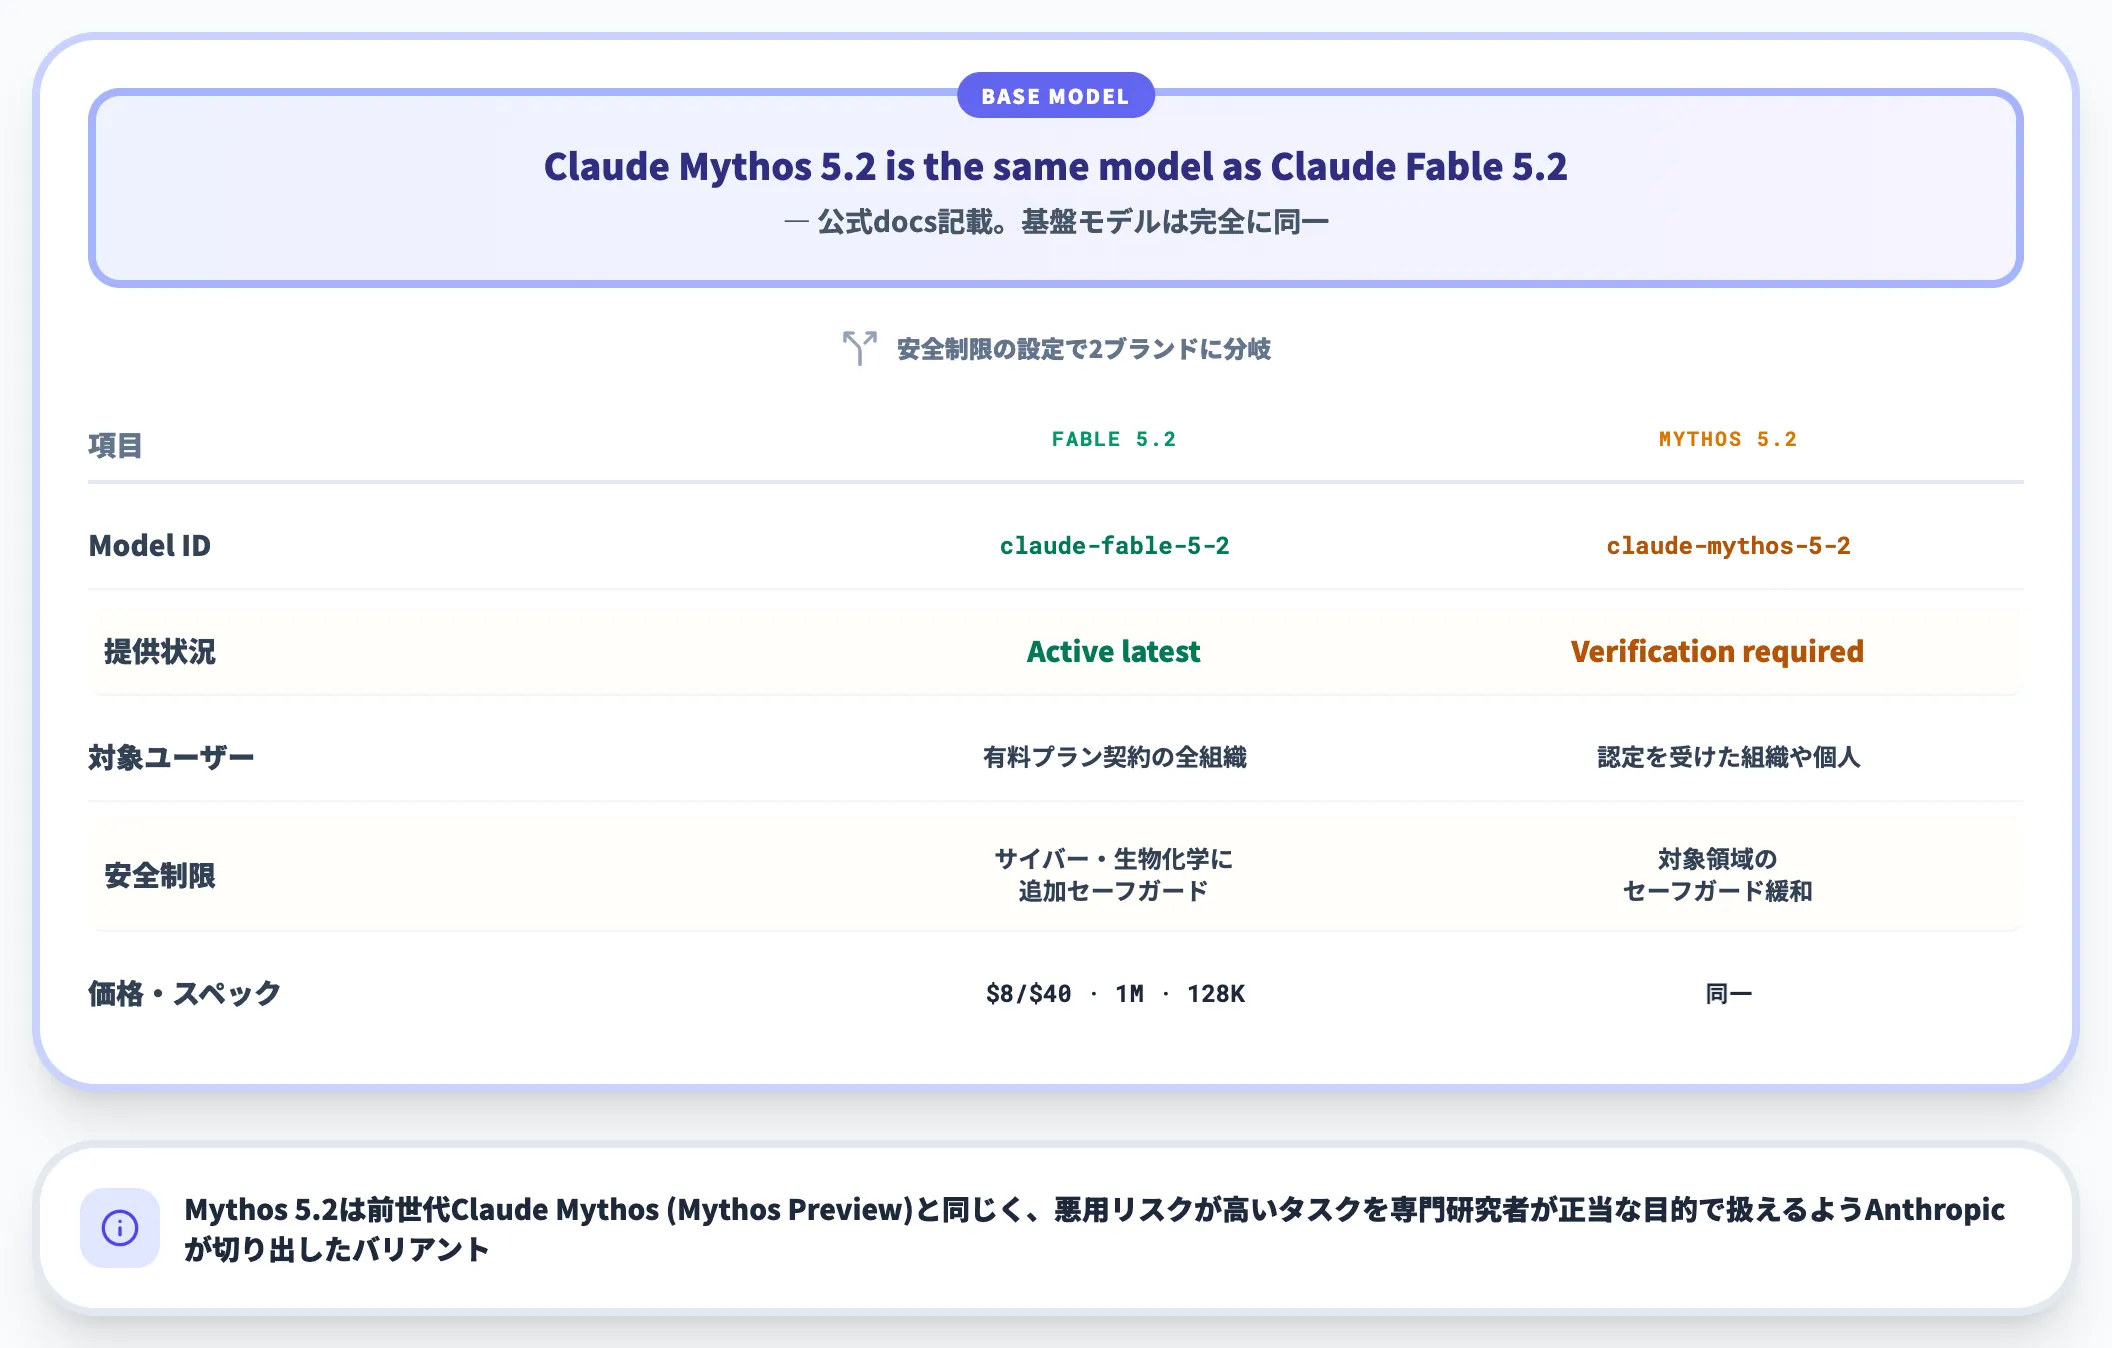
Mythos 5.2の公式docsには「Claude Mythos 5.2 is the same model as Claude Fable 5.2」と明記されています。
基盤モデル・スペック・価格・レイテンシ・知識カットオフは共通で、違うのはサイバー・生物化学といった高リスク領域に対する安全制限の強弱です。
| 項目 | Fable 5.2 | Mythos 5.2 |
|---|---|---|
| Model ID | claude-fable-5-2 | claude-mythos-5-2 |
| 提供状況 | 一般提供(Active latest) | Verification required |
| 対象 | 有料プラン契約の全組織 | 認定を受けた組織や個人 |
| 安全制限 | サイバー・生物化学に追加セーフガード | 対象領域のセーフガードを緩和 |
| 価格・スペック | 入力$8/出力$40/1M context/128K output | 同一 |
Mythos 5.2は前世代のClaude Mythos(Mythos Preview)と同じく、サイバー攻撃・バイオ脅威など悪用リスクが高いタスクを専門研究者が正当な目的で扱えるようAnthropicが別ブランドに切り出したバリアントです。
基盤は同じですが、refusalガードの挙動や許可されるユースケースが異なる契約関係を結ぶ格好になっています。
Cyber/Life Sciences Verification Programの対象
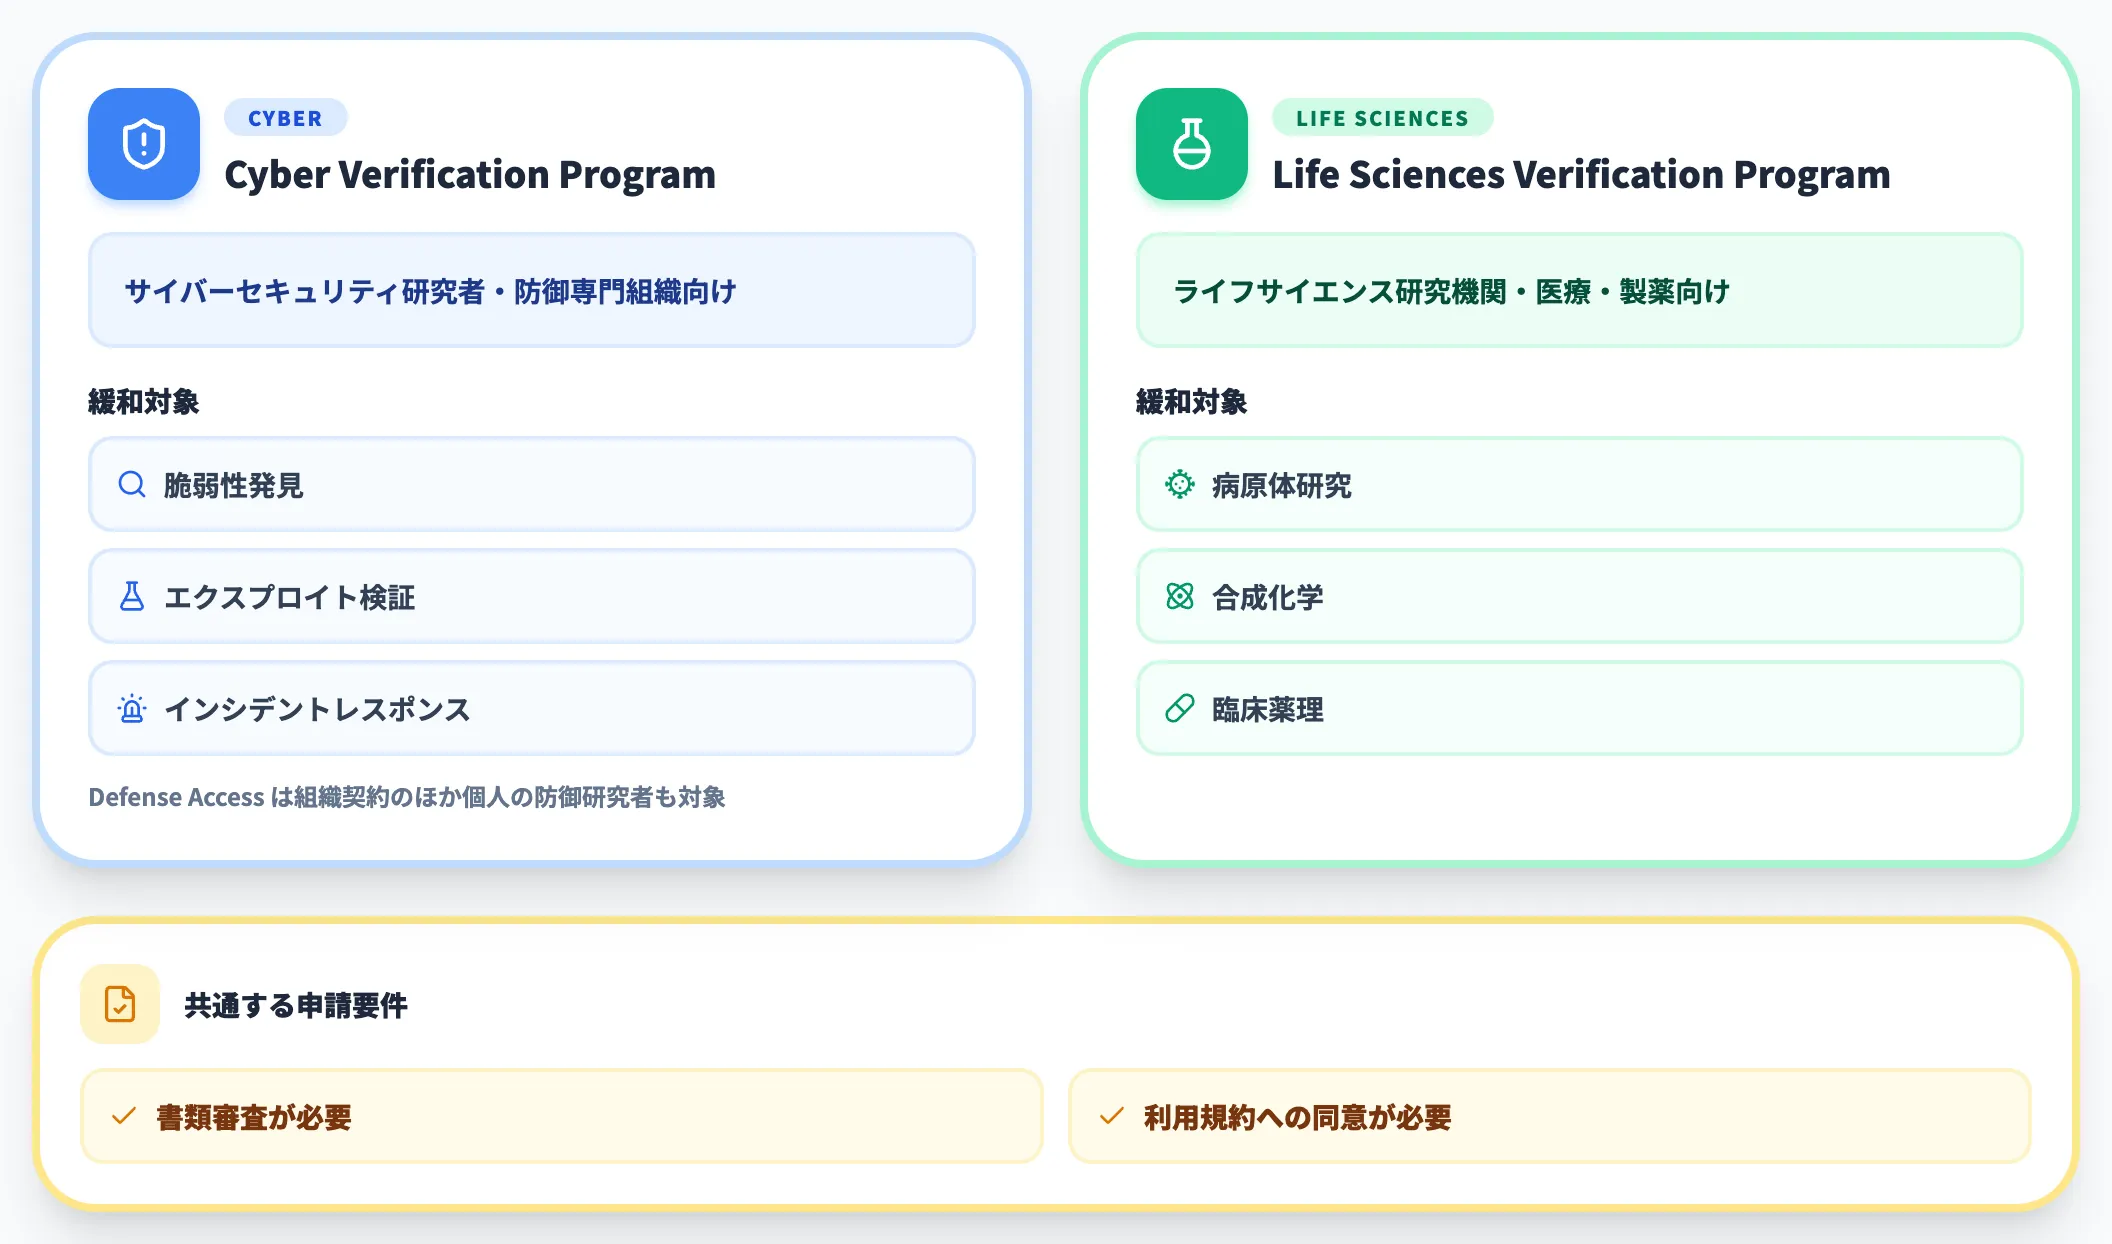
Mythos 5.2にアクセスするには、Anthropicが運営する2つのVerification Programのいずれかに認定される必要があります。
-
Cyber Verification Program
サイバーセキュリティ研究者・防御専門組織向け。脆弱性発見、エクスプロイト検証、インシデントレスポンスなど、通常のrefusalで止まる依頼を正当な防御目的で実行できる
-
Life Sciences Verification Program
ライフサイエンス研究機関・医療・製薬向け。病原体研究、合成化学、臨床薬理など、生物化学系の高リスクトピックを研究目的で扱える
どちらも書類審査と利用規約への同意が必要で、一般の有料プラン契約だけでは認定されません。
Cyber Verification ProgramのDefense Accessは組織契約だけでなく個人の防御研究者も対象で、その他の経路も含めて「組織限定」ではない運用になっています。前世代のClaude Fable 5・Mythos 5の利用停止事件で示されたように、Verification Program外で機微な要求が通ってしまうとAnthropic側からモデルアクセスが止められる事態もあり得る領域です。
自社がFable 5.2とMythos 5.2のどちらを使うべきか
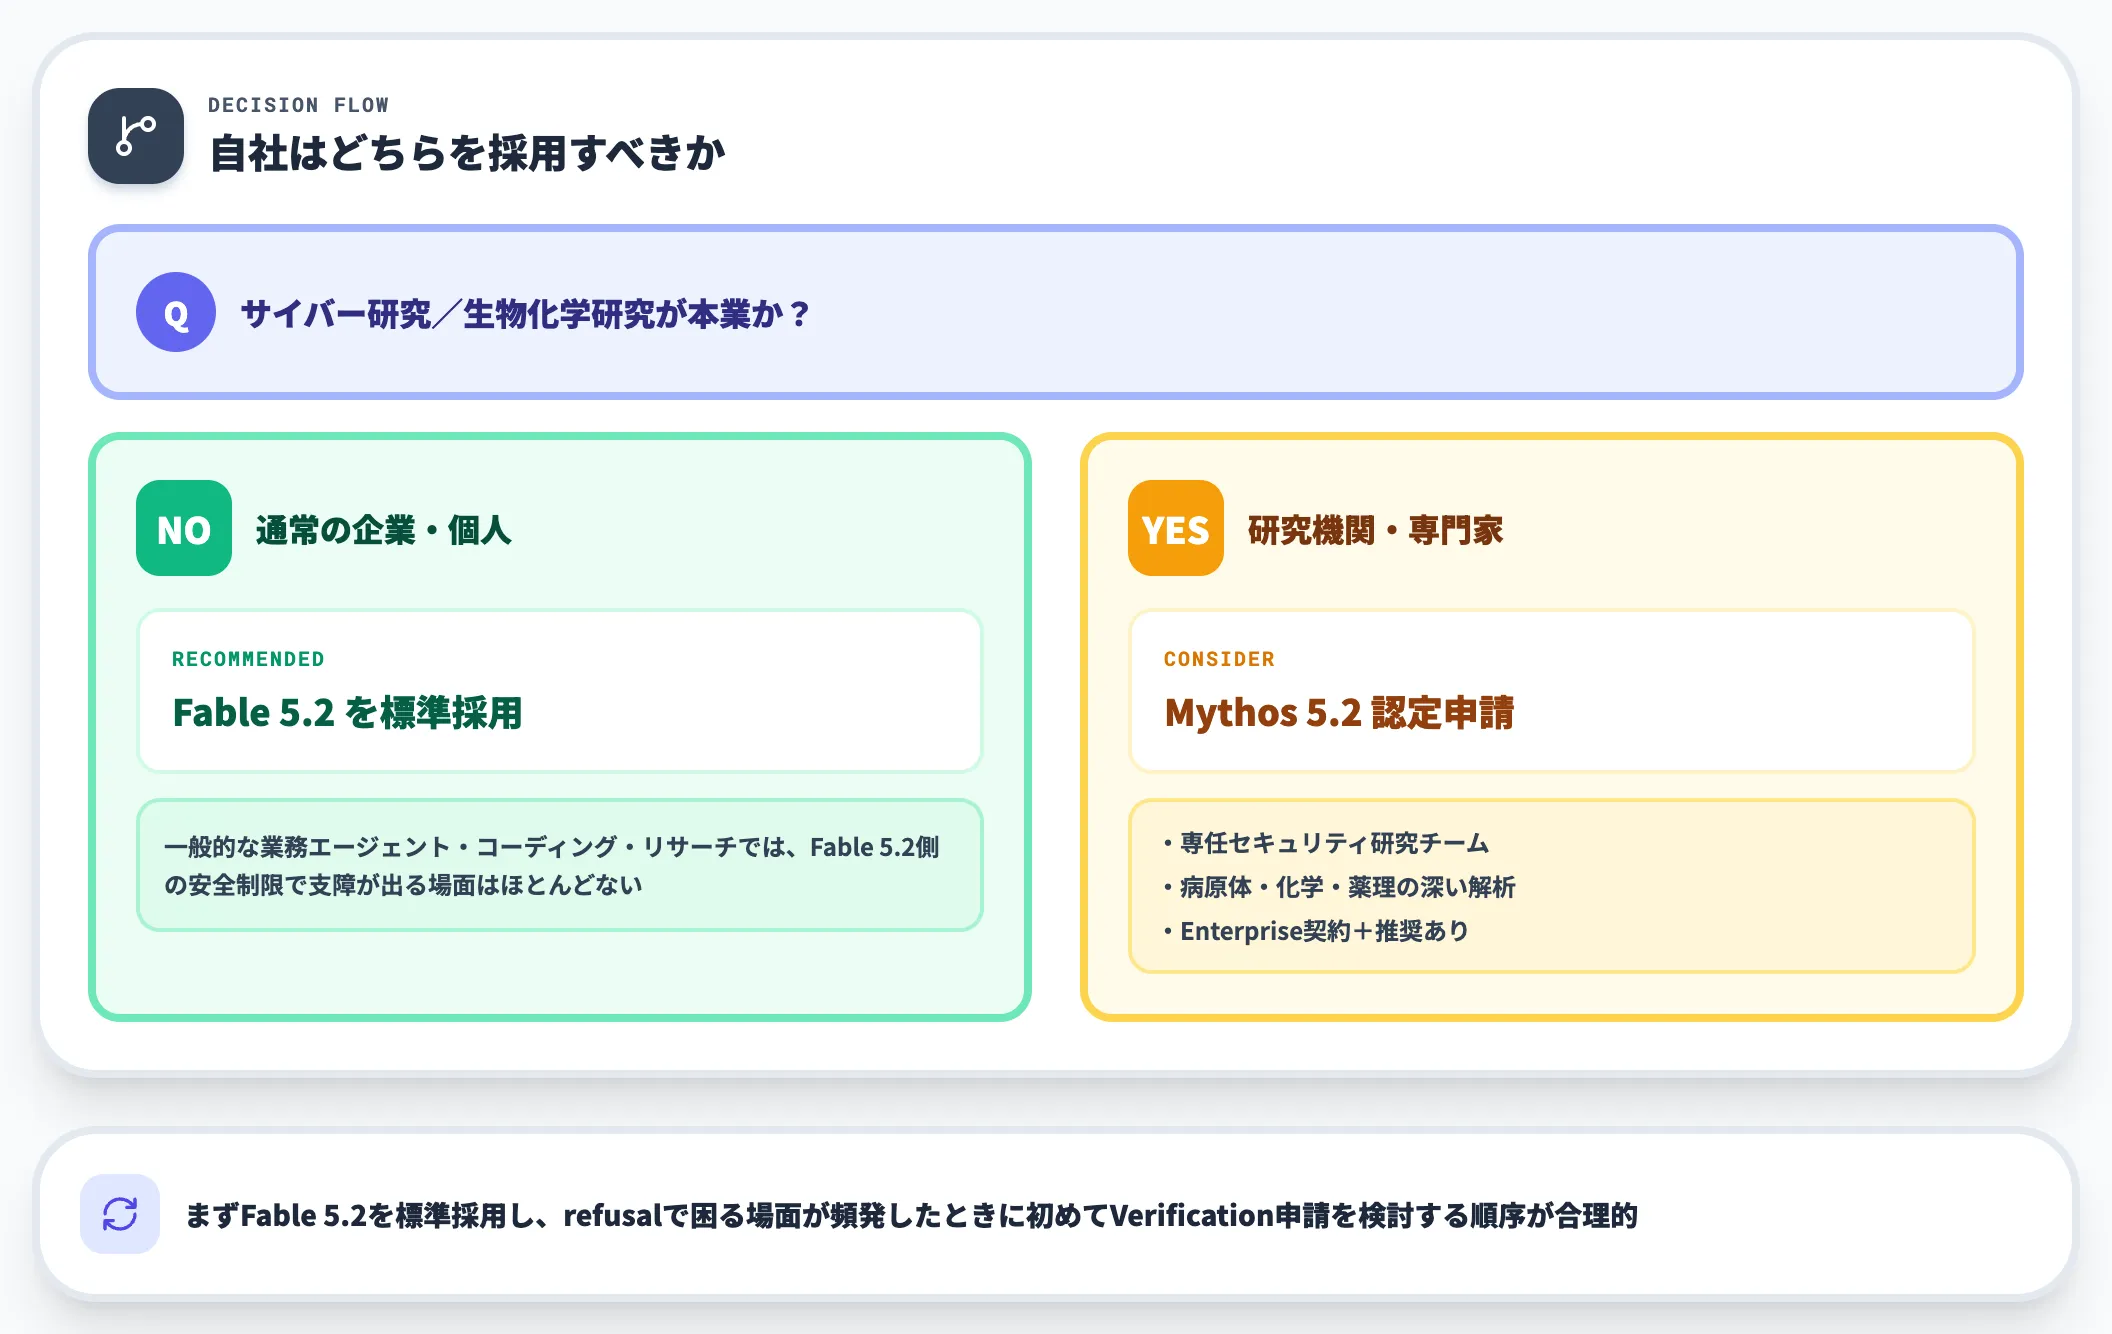
実務的な判断軸は明快で、サイバー研究/生物化学研究が本業でなければFable 5.2を使う、です。
一般的な業務エージェント・コーディング・リサーチでは、Fable 5.2側の安全制限で支障が出る場面はほとんどなく、Mythos 5.2の認定手続きを踏むメリットが見合いません。
Verification Programへの申請を検討するのは、以下のいずれかに該当する組織や個人です。
- 専任のセキュリティ研究チームや個人の防御研究者として、脆弱性発見・レッドチームを業務/研究の中心にしている
- ライフサイエンス研究機関として病原体・化学物質・薬理の深い解析を行う
- AnthropicのEnterprise契約を既に持ち、アカウントチームからVerification推奨を受けている
これらに該当しない場合、Fable 5.2を標準として採用し、refusalで困る場面が頻発したときに初めてVerification申請を検討する順序が合理的です。
Claude Fable 5.2の利用プラン・API経路と制約事項
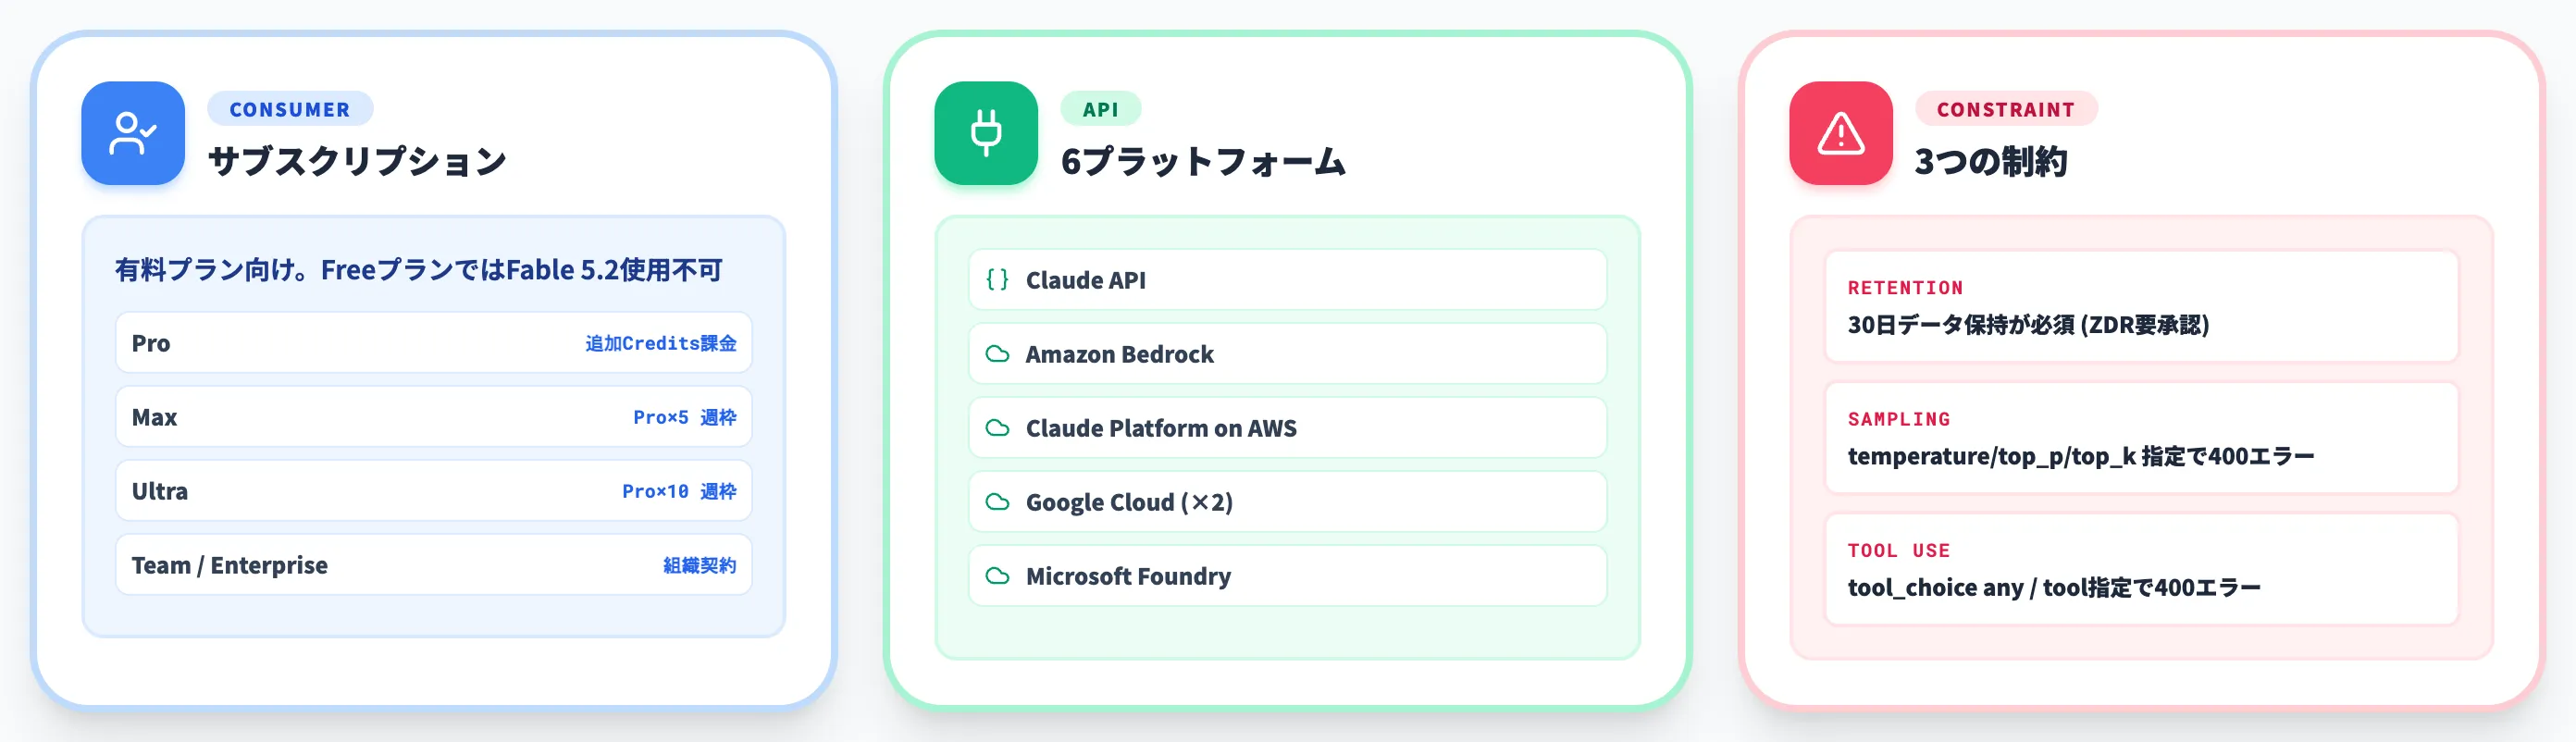
Claude Fable 5.2はConsumer向けサブスクリプションとAPI経路の両方で提供されており、同時に扱う上で押さえるべき制約がいくつか存在します。本セクションでは、Consumerプランでの提供・API経路・利用上の制約の3つを整理します。
Pro/Max/Team/Enterpriseでの提供
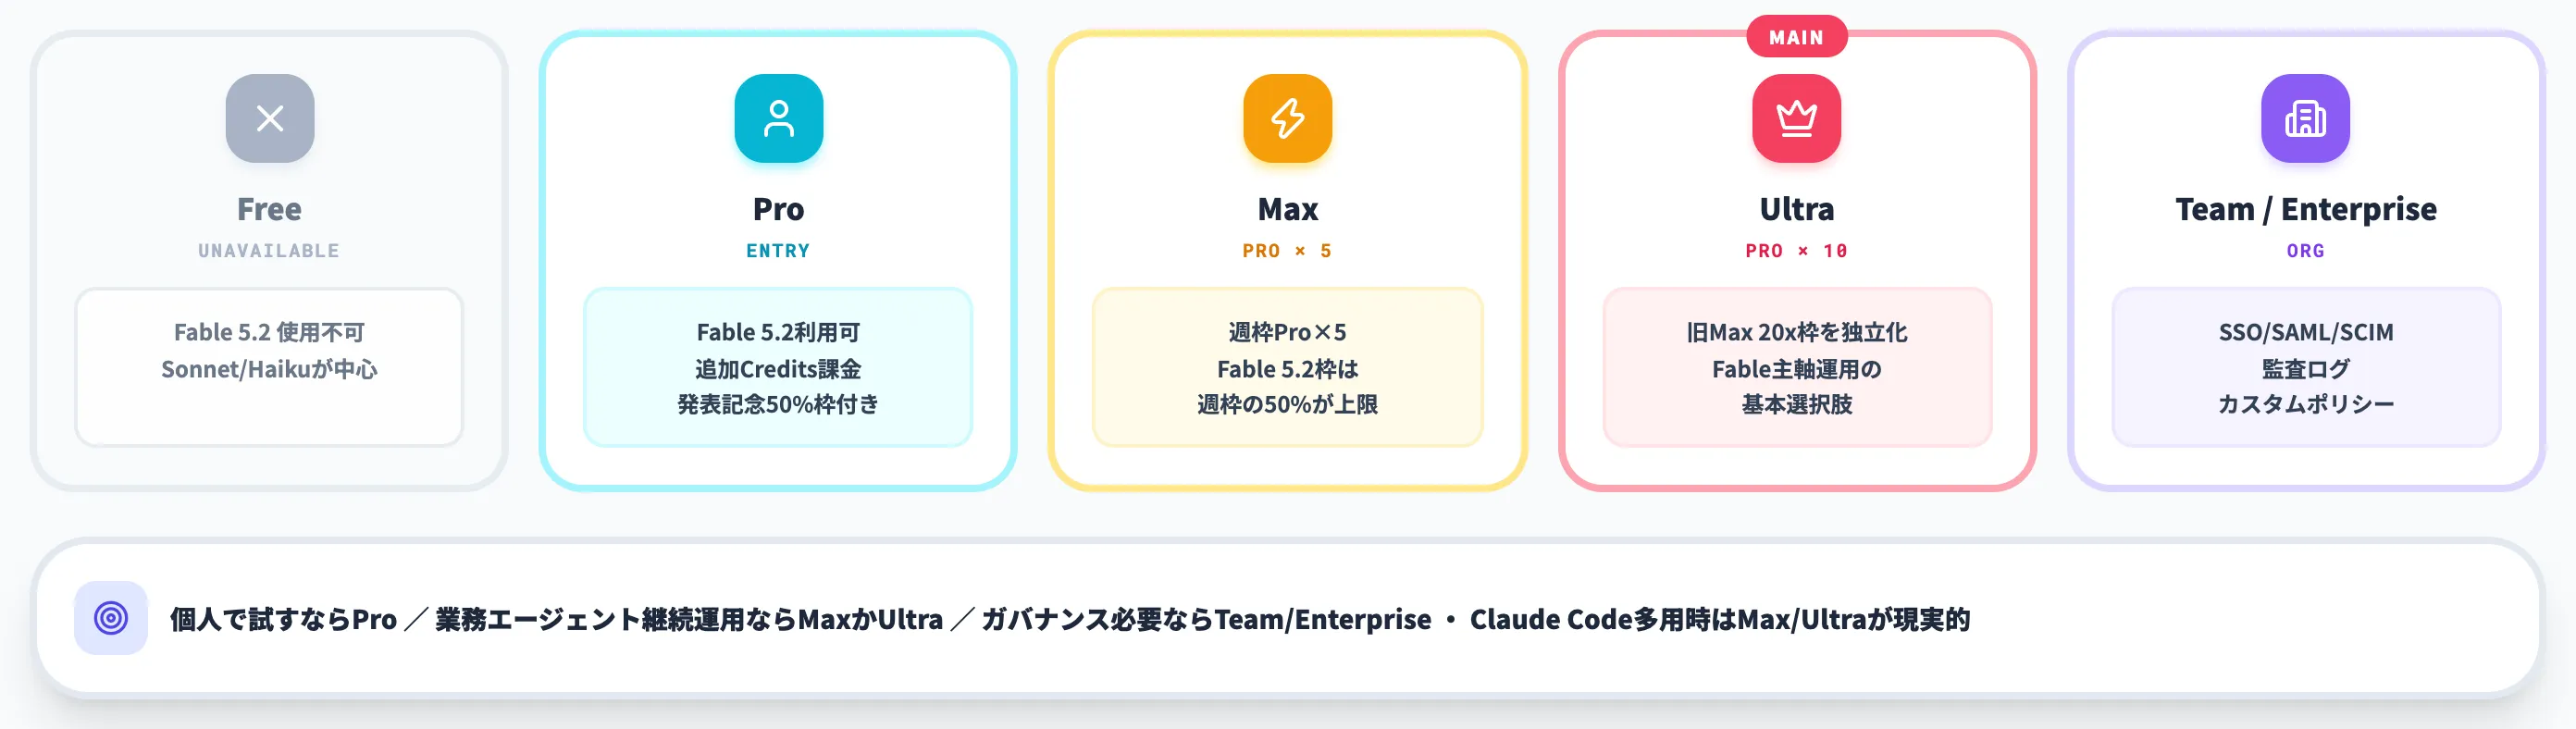
Consumerサブスクリプション側では、Fable 5.2は有料プラン向けとして提供されています。
- Freeプラン
Fable 5.2は使用不可。Sonnet 5.5・Haiku 5.5など下の階層が中心
- Claude Pro
Fable 5.2を利用可能。ただしFable 5.2の呼び出しは追加のCredits課金が基本で、2026年11月16日まではFable発表記念として週枠50%相当の特典付きで利用できる
- Claude Max
Proの5倍の週枠でFable 5.2を扱える(Fable 5.2への利用枠は週枠の50%が上限)。長時間エージェントやサブエージェント並列の継続運用に向く
- Ultra
旧Max 20x枠が独立したプランとなり、Proの約10倍(週枠)でFable 5.2を扱える(Fable 5.2への利用枠は同じく週枠の50%が上限)。業務でFable 5.2を主軸に据えて継続運用する場合の基本選択肢
- Team
組織契約でFable 5.2をメンバーに展開可能。SSO・SAMLなどのID連携が付随する
- Enterprise
Teamの機能に加え、SCIMによるユーザー自動連携・監査ログ・カスタムポリシー設定など法人向け統制が揃う
個人で試す段階ならProで十分ですが、業務エージェントを継続運用するならMaxかUltra、ガバナンスも必要な組織運用ではTeam/Enterpriseが現実的な選択肢です。
Claude Codeの料金プランはConsumerプランのレート枠を共有する設計のため、Claude CodeでFable 5.2を多用する場合はMaxかUltraが必要になるケースが多くなります。
Claude API・Bedrock・Google Cloud・Microsoft Foundryでの利用
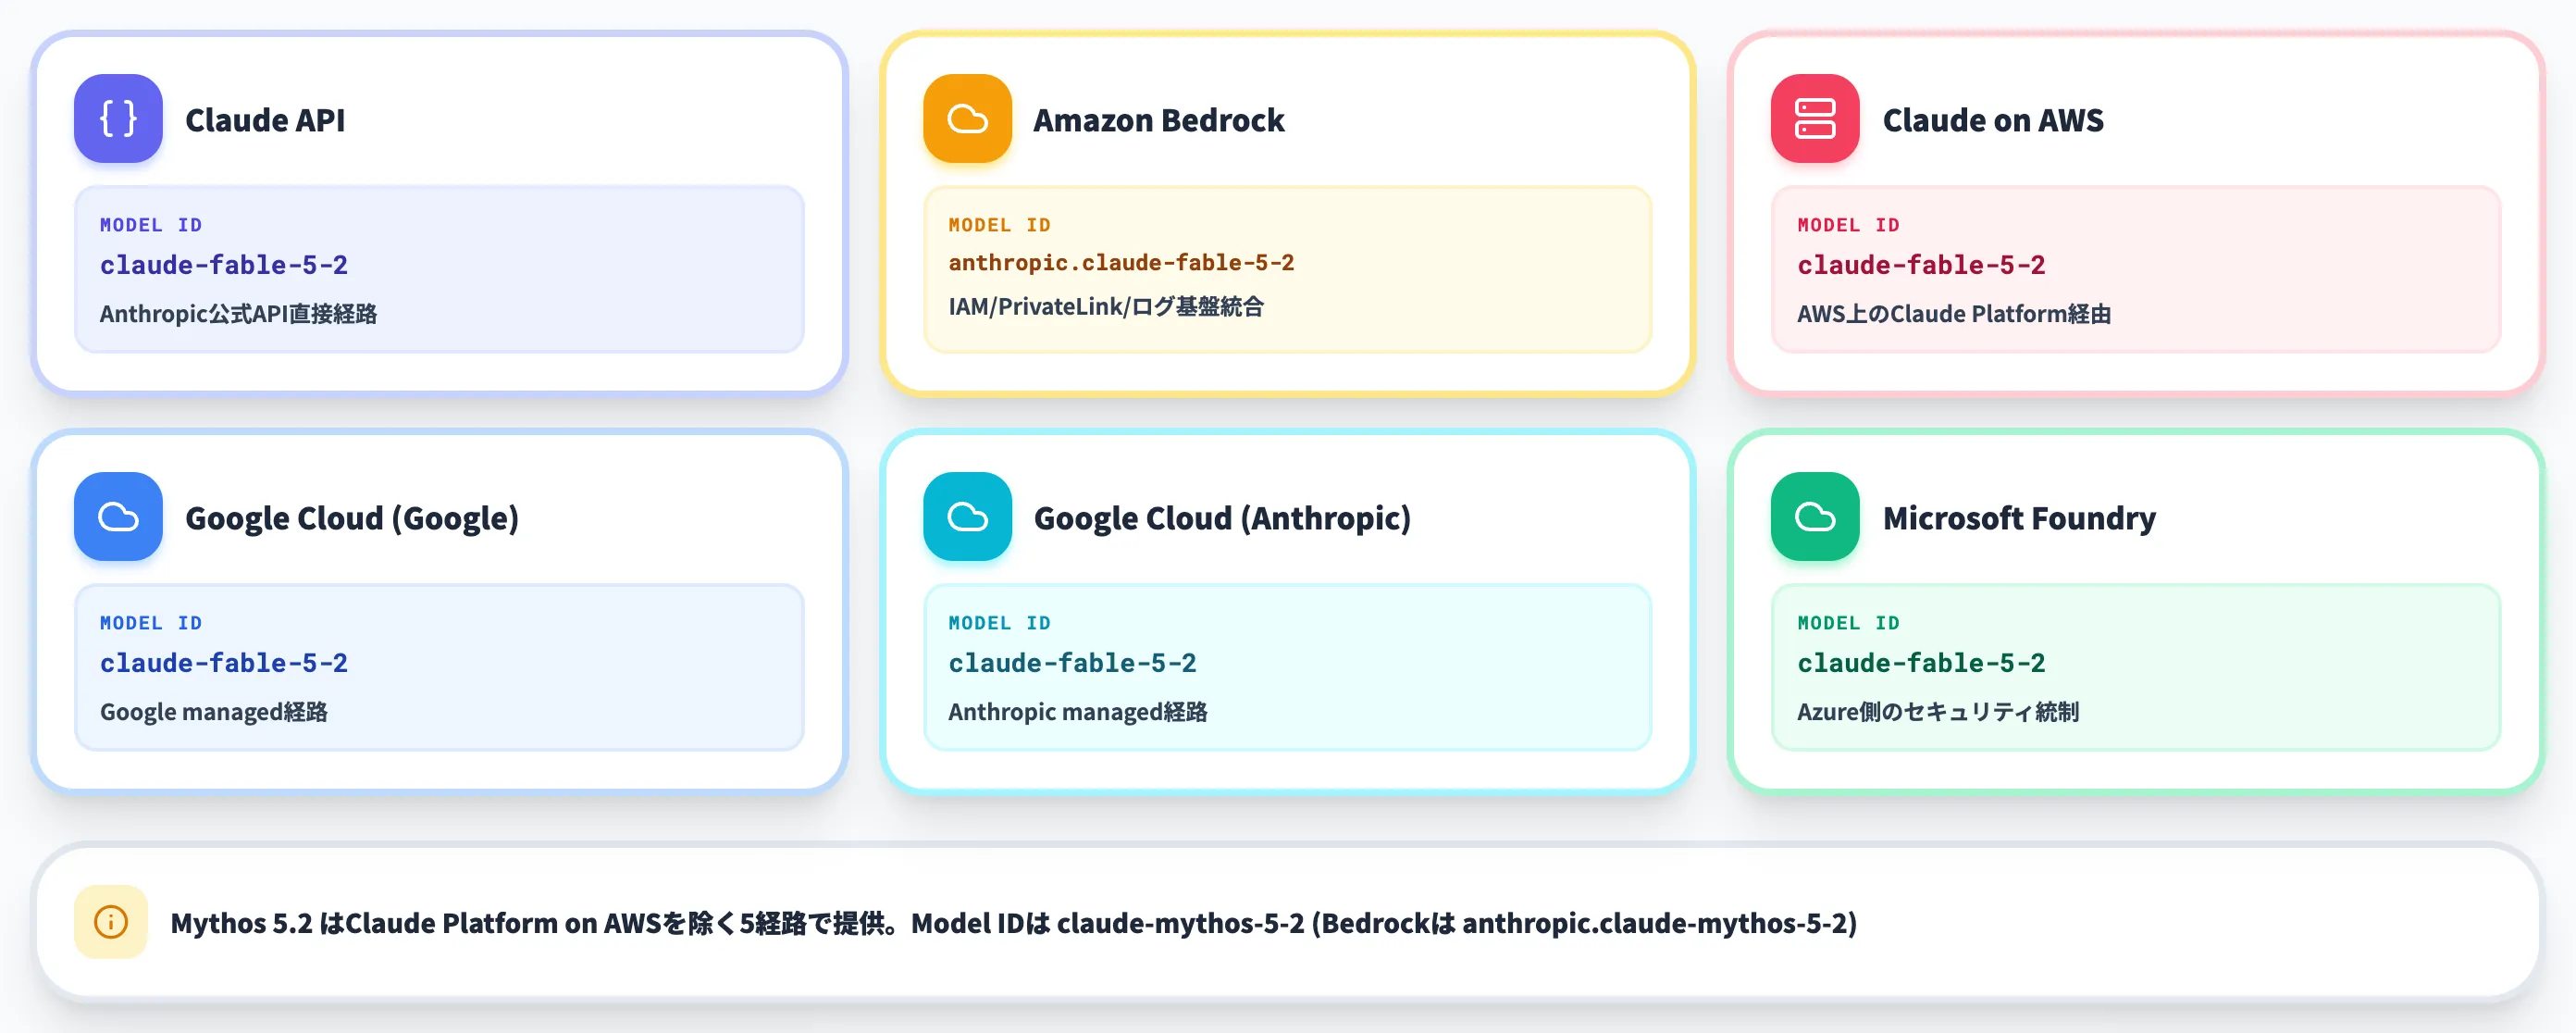
API経路では、Fable 5.2は6つのプラットフォームで提供されています。
| プラットフォーム | Model ID |
|---|---|
| Claude API | claude-fable-5-2 |
| Amazon Bedrock | anthropic.claude-fable-5-2 |
| Claude Platform on AWS | claude-fable-5-2 |
| Google Cloud(Google managed) | claude-fable-5-2 |
| Google Cloud(Anthropic managed) | claude-fable-5-2 |
| Microsoft Foundry | claude-fable-5-2 |
既存のクラウド契約内でFable 5.2を扱えるため、調達の手続きを増やさずに導入できる点がメリットです。Bedrock経由であればAWSのIAM・PrivateLink・ログ基盤と統合でき、既存のAWSアカウント内で完結します。Google Cloud/Microsoft Foundry経由も同様に、それぞれのクラウド側のセキュリティ統制とログ基盤に乗せられます。
Mythos 5.2は公式docsに記載のClaude API・Amazon Bedrock・Google Cloud(Anthropic managed/Google managed)・Microsoft Foundryの5経路で提供されており、Claude Platform on AWSはAWS側の提供モデル一覧にも掲載されていません。API Model IDはclaude-mythos-5-2(Bedrockはanthropic.claude-mythos-5-2)で、認定手続きを経てからの利用が前提になります。
30日データ保持・サンプリング制約・Forced tool useの挙動
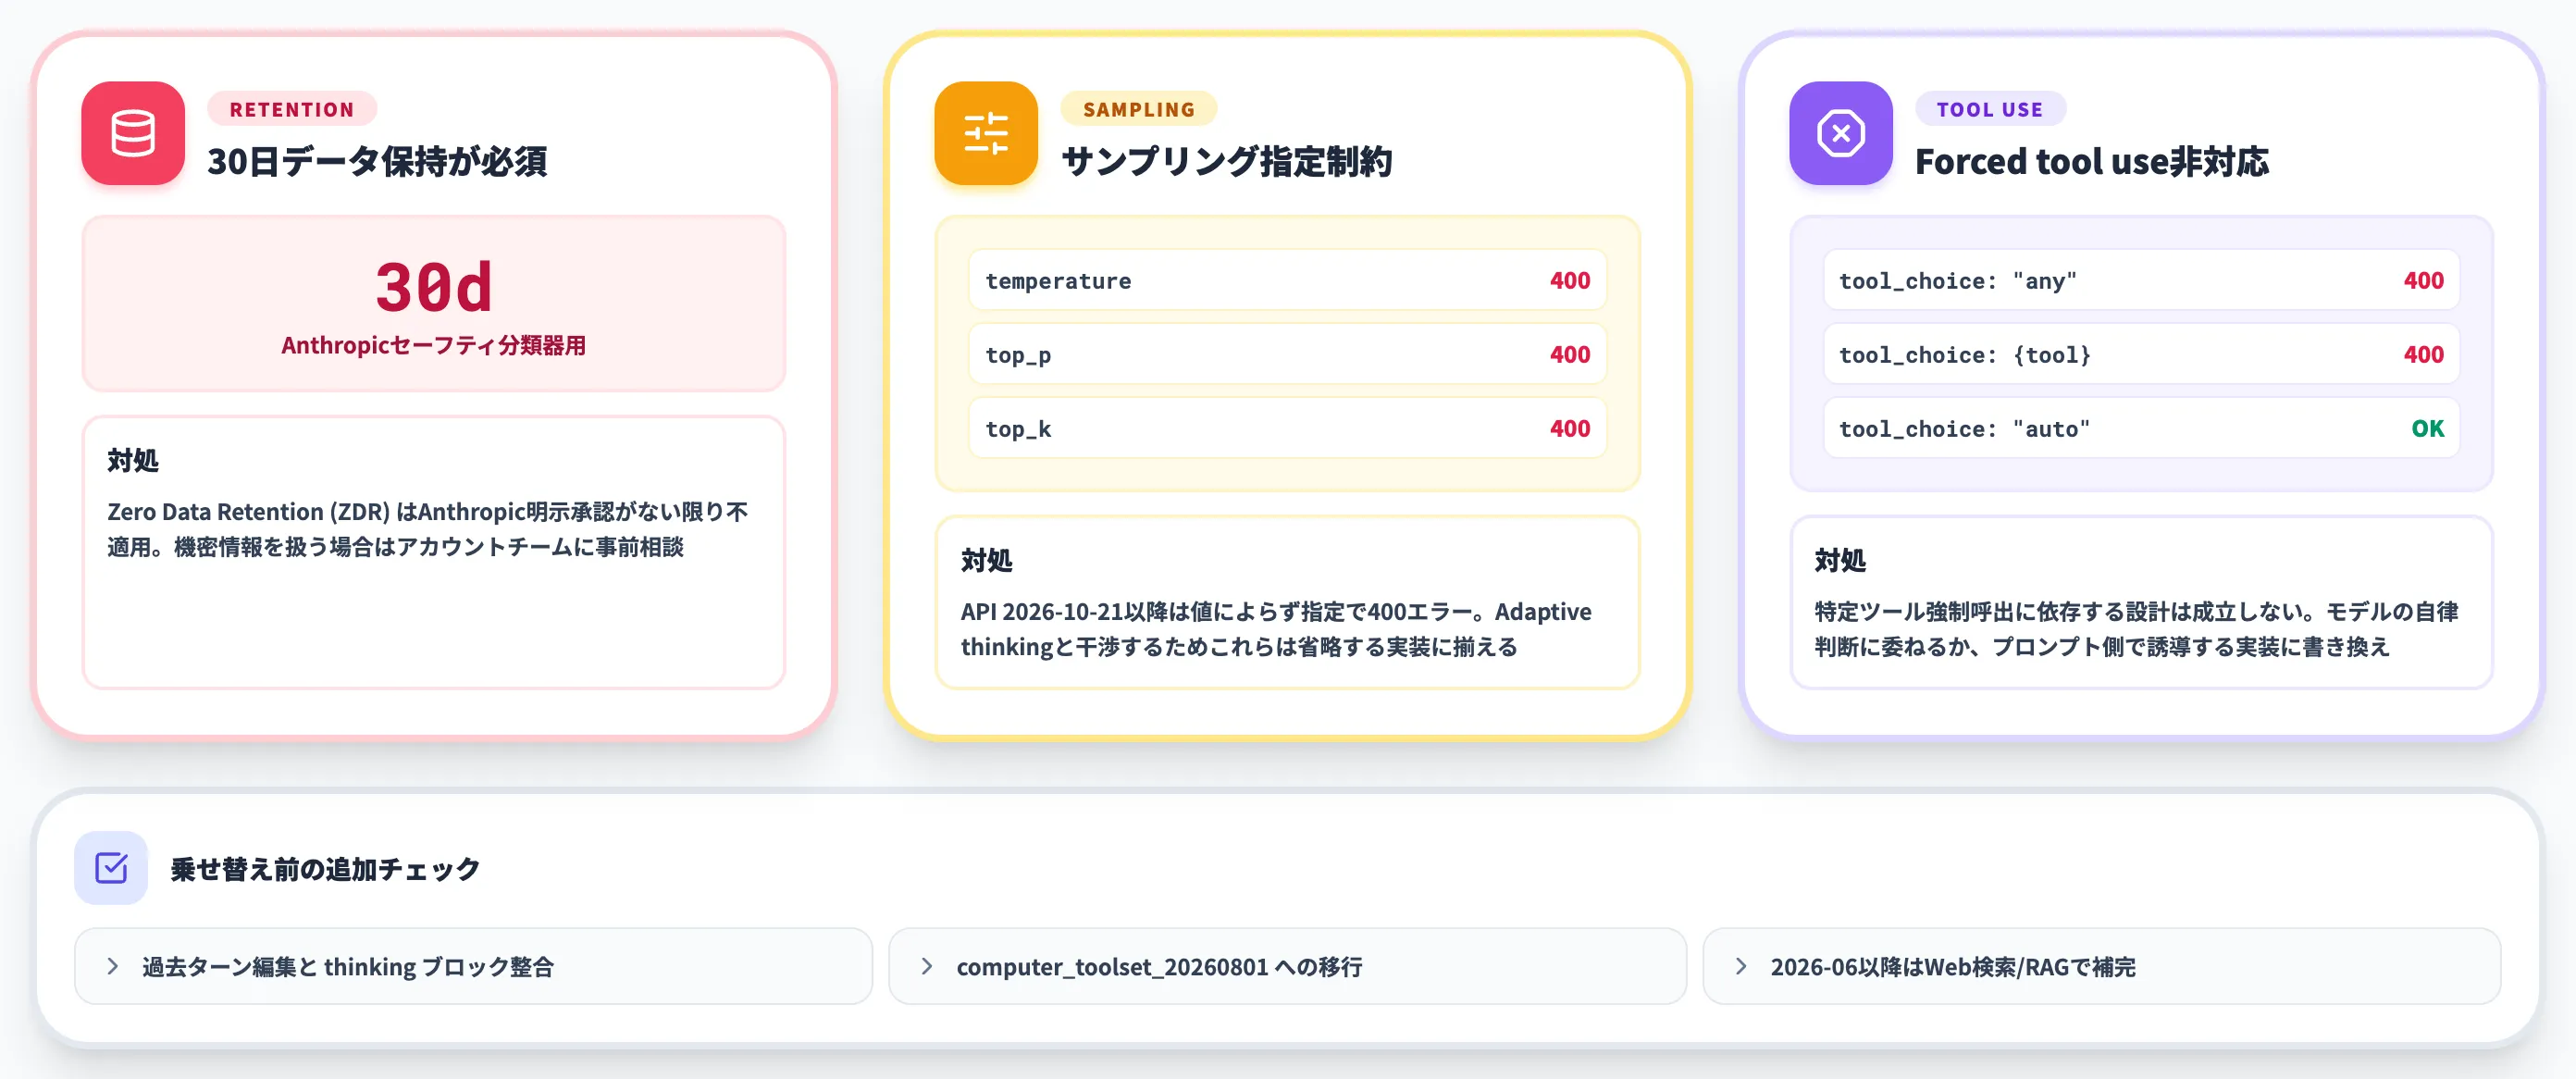
Fable 5.2を実装する際に注意すべき3つの制約があります。
-
30日のデータ保持が必須
Fable 5.2はAnthropicのセーフティ分類器を動かすためにデフォルトで30日間のリクエスト保持を要求します。
Zero Data Retention(ZDR)契約は、Anthropic側の明示的承認がない限り適用されません。機密情報・個人情報を扱う場合は事前にAnthropicのアカウントチームに相談が必要です
-
サンプリングパラメータの指定制約
APIバージョン2026-10-21以降では、temperature・top_p・top_kを値によらず指定すると400エラーを返します。
それ以前のAPIバージョンでは非デフォルト値の指定時に拒否される挙動で、Adaptive thinkingの内部制御と干渉するため、これらのパラメータは省略する実装に揃える必要があります
-
Forced tool useの非対応
tool_choiceのany・tool指定も400エラーになります。特定ツールの強制呼び出しに依存する設計は、Fable 5.2では成立しません。ツール選択はモデルの自律判断に委ねるか、プロンプト側で誘導する実装への書き換えが必要です
既存のOpus 5.5・Sonnet 5.5向けコードベースからFable 5.2に乗せ替える際は、まず上記3項目を確認した上で試験投入する段取りが安全です。あわせて、過去ターンを編集すると、以降のthinkingブロックの前提が崩れて既定ではそのまま再送すると400エラーになる点と、旧コンピュータ操作ツールが新しいcomputer_toolset_20260801へ移行している点も、Fable 5.2側の公式変更点として実装前に確認しておく必要があります。知識カットオフも2026年6月のため、それ以降の事実・最新APIについてはWeb検索ツールまたはRAG側で補完する運用が前提になります。
Fable 5.2を業務に組み込む前に、登録の経路と処理の順番を固める
Fable 5.2はOSWorld 2.1でpartialスコア89.3%と画面操作の力を伸ばしましたが、条件どおりに最後まで終えたstrictパス率は54.6%です。tool_choiceでツールを強制できない点と合わせると、基幹システムへの登録や承認の回付のように、毎回同じ順番で通したい処理をモデルの判断だけに預けるには、確実さが足りません。推論力は判断の難しい段階に充て、登録の経路と処理の順番はモデルの外で固めておく必要があります。
その外側を受け持つのが、AIの判断と決まった手順をワークフローに組み合わせる、業務エージェントの基盤です。AI総合研究所のAI Agent Hubは、n8nやCopilot StudioでAgentを組み立て、社員はTeamsから呼び出して使います。
- 基幹システムへの登録は、画面ではなく連携で通す
経費の仕訳は、自動入力Agentがfreee会計や勘定奉行クラウドへ連携で書き込むため、画面の変更で入力が止まりません。
- 処理の順番は、ワークフローの手順で決めておく
規定の確認だけをAIのステップにして、回付と登録は決まった手順に置くため、ツールの選び方で処理が抜けません。
- モデルに渡す項目を、判断に要る範囲に絞る
Fable 5.2はリクエストを30日保持するため、氏名や振込先の口座のように判断に使わない項目は、モデルを呼ぶ前に外してから渡します。
AI総合研究所の専任チームが、業務ごとにOpus 5.5で足りる段階とFable 5.2に回す段階を見極め、Microsoft Foundry経由の接続を要件に応じて設計・構築します。
登録と処理の順番をワークフローで固める

判断の難所だけFable 5.2に任せる
Fable 5.2はOSWorld 2.1のstrictパス率が54.6%で、ツールの強制呼び出しに対応しないため、基幹システムへの登録や処理の順番はワークフローで固め、難しい判断に絞って呼ぶ構成が向いています。経費精算や請求書処理のユースケースは、動くデモとあわせてAI Agent Hubのサービスページで紹介しています。
まとめ
本記事では、Claude Fable 5.2を「Opus 5.5の上に位置する、長時間のエージェント実行に向けたフロンティアモデル」として整理し、Fable 5.1からの変更点・料金・性能・Opus 5.5との使い分け・活用パターン・Mythos 5.2との違い・利用プランと制約を解説しました。
2026年11月時点で押さえておくべきポイントは次の3つです。
- 長時間のタスクで専門家並みの成果物を出せる案件が大きく増え、数時間から数日かかる仕事をエージェントで回しやすくなった
- 値下げ後の単価にキャッシュとBatch APIを重ねれば、長文を繰り返し扱う処理の実効単価はOpus 5.5の標準単価に近づく
- サイバーや生物化学の研究が本業でない限りMythos 5.2は不要で、同じモデルのFable 5.2を標準に据えれば足りる
Fable 5.2を既存のClaude活用に足すときの段取りとして、AI総合研究所は次の2つの手順を提案しています。
まずは、Opus 5.5で回している長時間のタスクのうち、途中で計画を見失うものを選び、同じ条件でFable 5.2に流して成果を比べます。
続いて、Opus 5.5をMax effortで繰り返し回すより、Fable 5.2のHighで一度に通す方が総額の下がる処理を絞り込みます。
人が全体を見渡しながらエージェント群を指揮する構図は、長い時間軸のタスクで迷子にならないモデルがあって初めて成り立ちます。
Fable 5.2は考える時間を長く取るほど答えの質が上がるモデルで、すぐに返す必要のない夜間のリサーチや数日がかりの開発でこそ持ち味が出ます。