この記事のポイント
 MAIAは個人用AIエージェントの延長ではなく、チーム共有・組織メモリ・ソブリン展開を前提に設計し直した新カテゴリの製品
- 推論にはAnthropic Claude・OpenAI GPT・Google Geminiをオーケストレート、バックエンドはAWSで動くアプリケーション層製品
- Mac appとSlackアプリで提供、ベータ期間中はアクセス申請ベースで無料(日次利用上限あり)。エンタープライズはソブリン展開オプションあり
- ChatGPT Team TasksやMicrosoft Facilitator/Channel Agentなど既存製品にも共有機能は出ているが、MAIAはCompany Memoryで組織の意思決定根拠まで積む点が差分
- 日本語対応・ベータ段階の仕様変更リスク・既存ナレッジSaaSとの共存が、国内企業の導入検討で詰まる3つの観点
Microsoft MVP・AIパートナー。LinkX Japan株式会社 代表取締役。東京工業大学大学院にて自然言語処理・金融工学を研究。NHK放送技術研究所でAI・ブロックチェーンの研究開発に従事し、国際学会・ジャーナルでの発表多数。経営情報学会 優秀賞受賞。シンガポールでWeb3企業を創業後、現在は企業向けAI導入・DX推進を支援。
Zyphra MAIA(ザイフラ・マイア)は、個人用に閉じていたAIエージェントを「チームの同僚」として設計し直した初期の製品のひとつです。
2026年11月6日にベータ公開され、同じエージェントを複数人で同時操作でき、組織の意思決定とその根拠を「Company Memory」として記憶する点が従来のAIエージェントと大きく異なります。
本記事では、Zyphra MAIAの主要機能、Anthropic・OpenAI・Googleの各モデルをオーケストレートする技術構成、料金と提供条件、ChatGPT・Claude Duet・Microsoft 365 Copilot・Devinとの違い、導入検討で見落とされやすい論点までを2026年11月時点の最新情報で整理します。
目次
Dynamic Apps:チーム用のダッシュボードを動的生成
Zyphraの研究プロダクトとIBM・AMD提携——ZAYA1学習基盤
ChatGPT Business / ChatGPT Enterprise
Zyphra MAIAとは
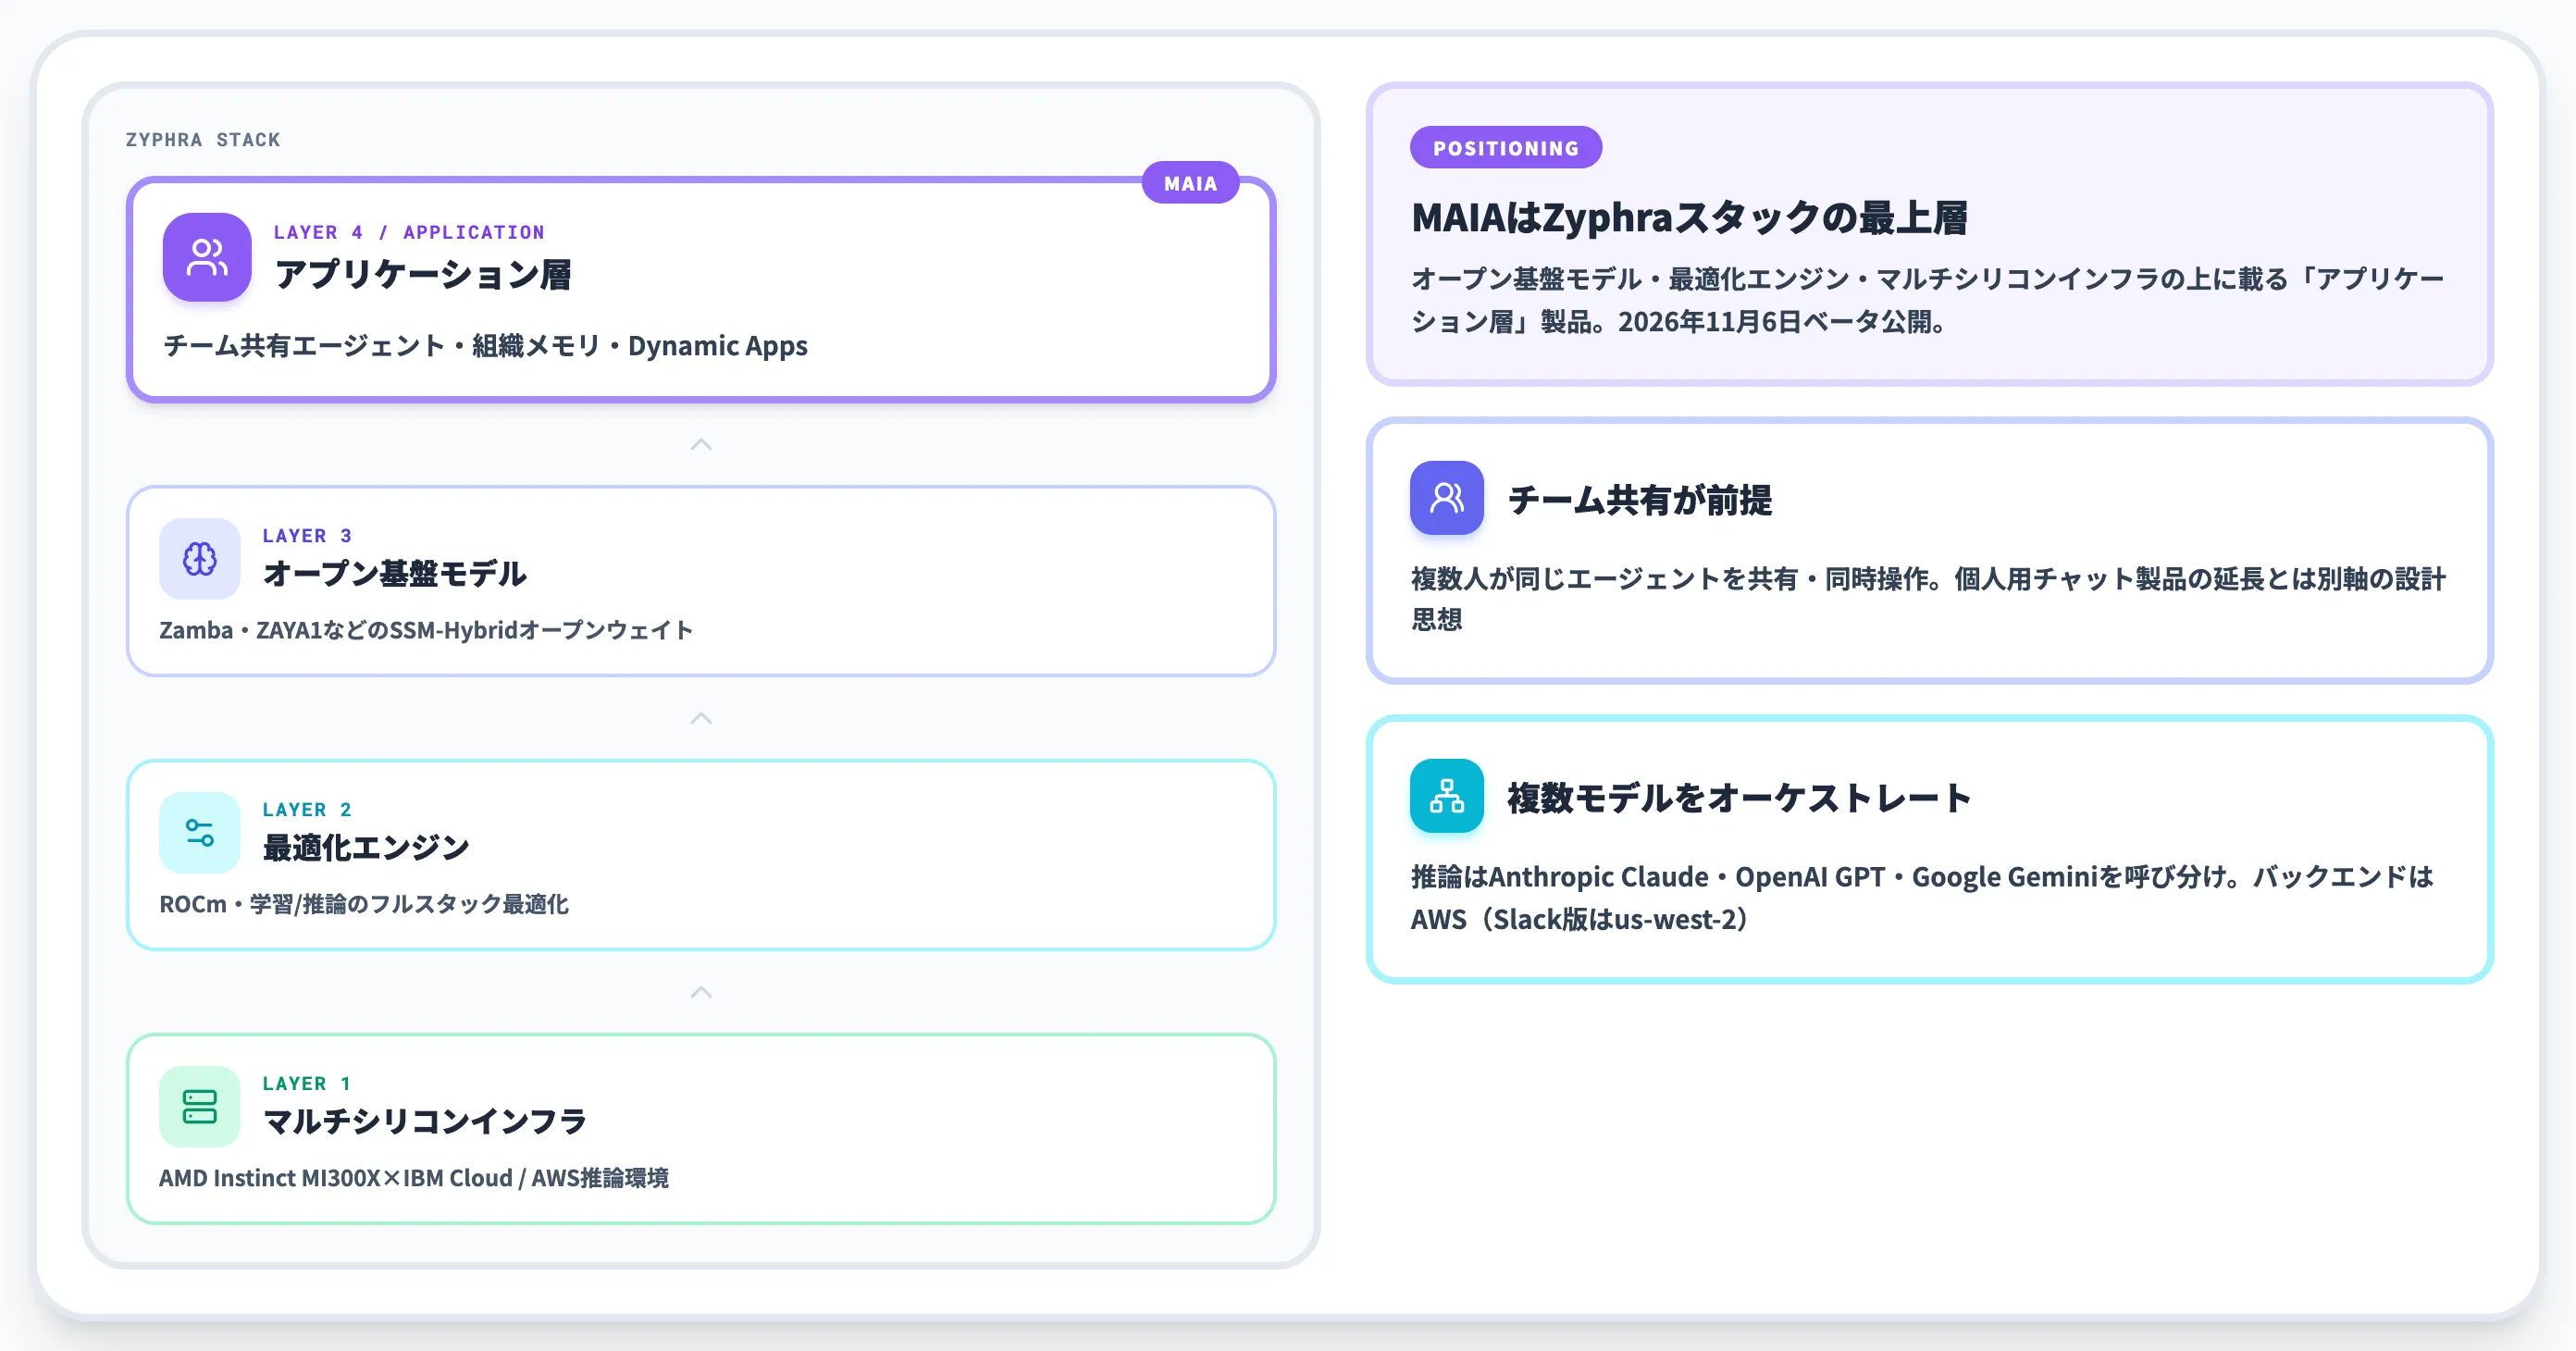
Zyphra MAIAとは、Zyphra Technologiesが提供する個人用に閉じていたAIエージェントを「チームの同僚」として設計し直したチーム共有型のAIエージェント製品です。
従来のAIエージェントが「ユーザー1人がチャット画面で呼び出す」前提で作られてきたのに対し、MAIAは最初から複数人が同じエージェントを共有し、同時に操作しながら使うことを前提にアーキテクチャが組まれています。同
社のオープンモデル・最適化エンジン・インフラスタック全体のうち、「アプリケーション層」に位置づけられるプロダクトです。
「The colleague you've been waiting for.」をキャッチに、MAIAをチームの同僚として位置づけるMAIA公式ページ(出典:Zyphra MAIA)
個人用AIエージェントが抱える3つの運用問題
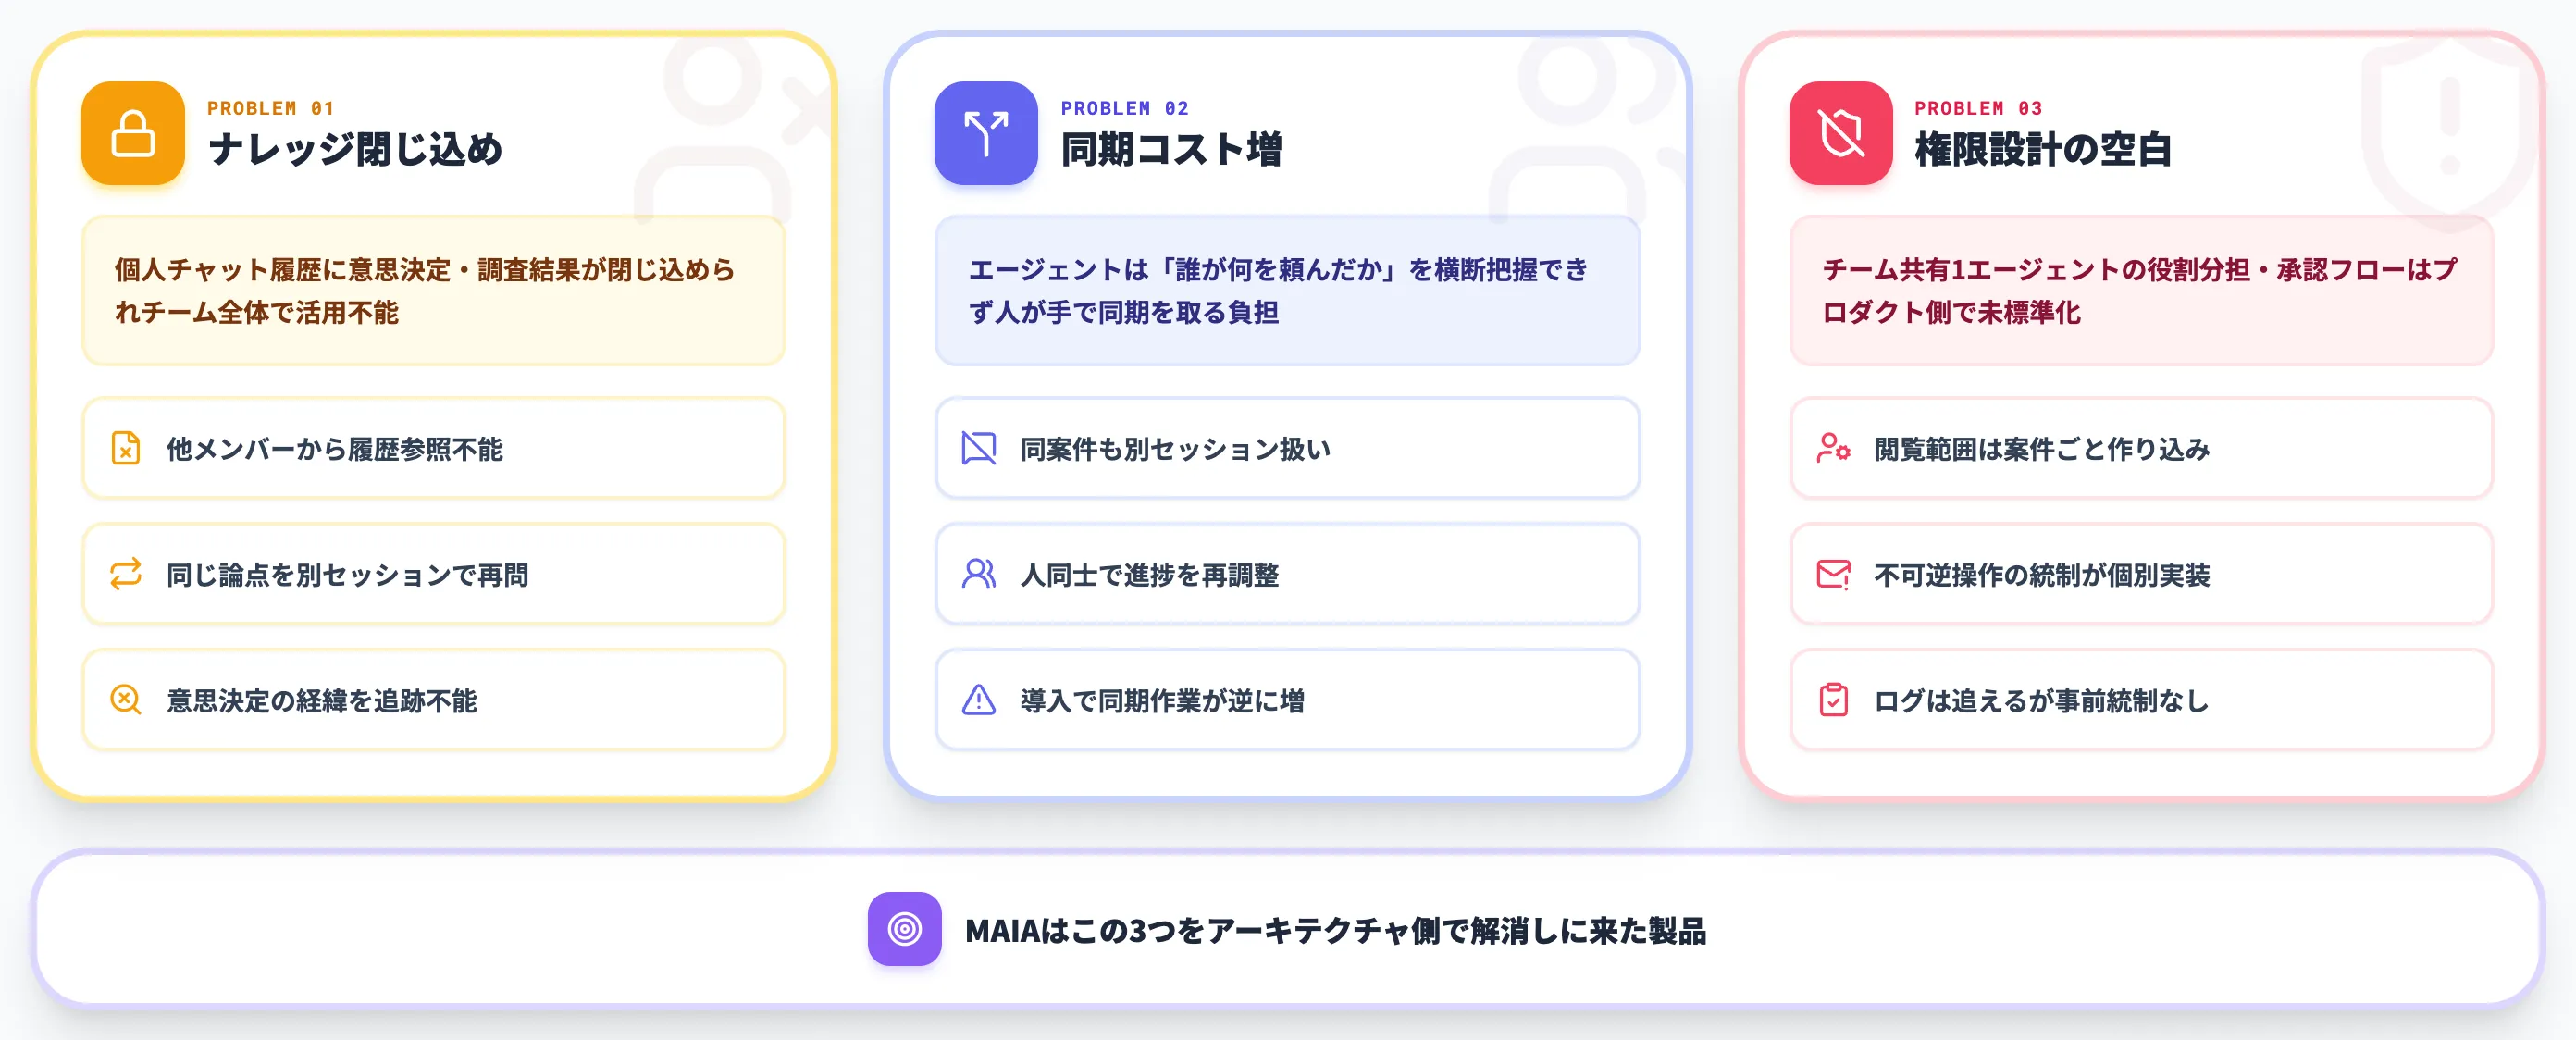
MAIAの設計意図を理解するには、既存の「個人用AIエージェント」をチームで使ったときに何が起きるかを押さえる必要があります。
ChatGPT・Claude・Microsoft 365 Copilot Chatといった主要製品は、いずれも「1人のユーザーが自分のアカウントで呼び出す」モデルで作られています。
本セクションでは、MAIAが解こうとしている3つの構造問題を整理します。
ナレッジが個人の会話に閉じ込められる
現行の主流エージェントでは、組織の意思決定・方針・調査結果はそれぞれのメンバーのチャット履歴に残ります。
Aさんが昨日ChatGPTで整理した競合分析は、Bさんのアカウントからは原則見えません。管理者ダッシュボードで会話内容を全文検索する運用も一部存在しますが、エージェント自身が「チーム全体のナレッジとして」活用する設計ではありません。
結果として、同じ論点を別メンバーが別のセッションで何度も聞き直し、意思決定の経緯が追えなくなります。
複数人同時作業の同期コストが高い
同じ仕事を複数人で進めるとき、現在のエージェントは「誰が何を頼んだか」を横断的に把握しません。
PMがエージェントに「来週の提案書たたき」を依頼し、別メンバーが同じ案件で「競合比較」を依頼しても、エージェントは2つを別のセッションとして扱います。進捗を揃えるためには、人間同士がSlackやドキュメントで補完する必要があり、エージェントを入れたことで同期作業が逆に増えるケースも珍しくありません。
権限設計がプロダクトレベルで整わない
チーム利用が広がると「どのメンバーに何を見せるか」「誰が不可逆な操作(メール送信・ファイル移動・外部API発火等)を許されるか」が運用上の論点になります。
既存の個人用エージェントは、プラン単位でモデル・連携ツールを配布する設計が中心で、個別機能として事前承認(Claude Duetなど)やテナント内の監査ログは整ってきていますが、チーム共有の1エージェントに対する役割分担・承認フローを汎用的に組み込む設計は、プロダクト側で標準化されていません。管理者側は「ログは追えるが、個々の操作を事前統制できる仕組みは案件ごとに作り込みになる」状態に置かれがちです。
MAIAはこの3つを「エージェントのアーキテクチャに最初から組み込む」アプローチで解こうとしています。次節で主要機能を整理します。
Zyphra MAIAの主要機能
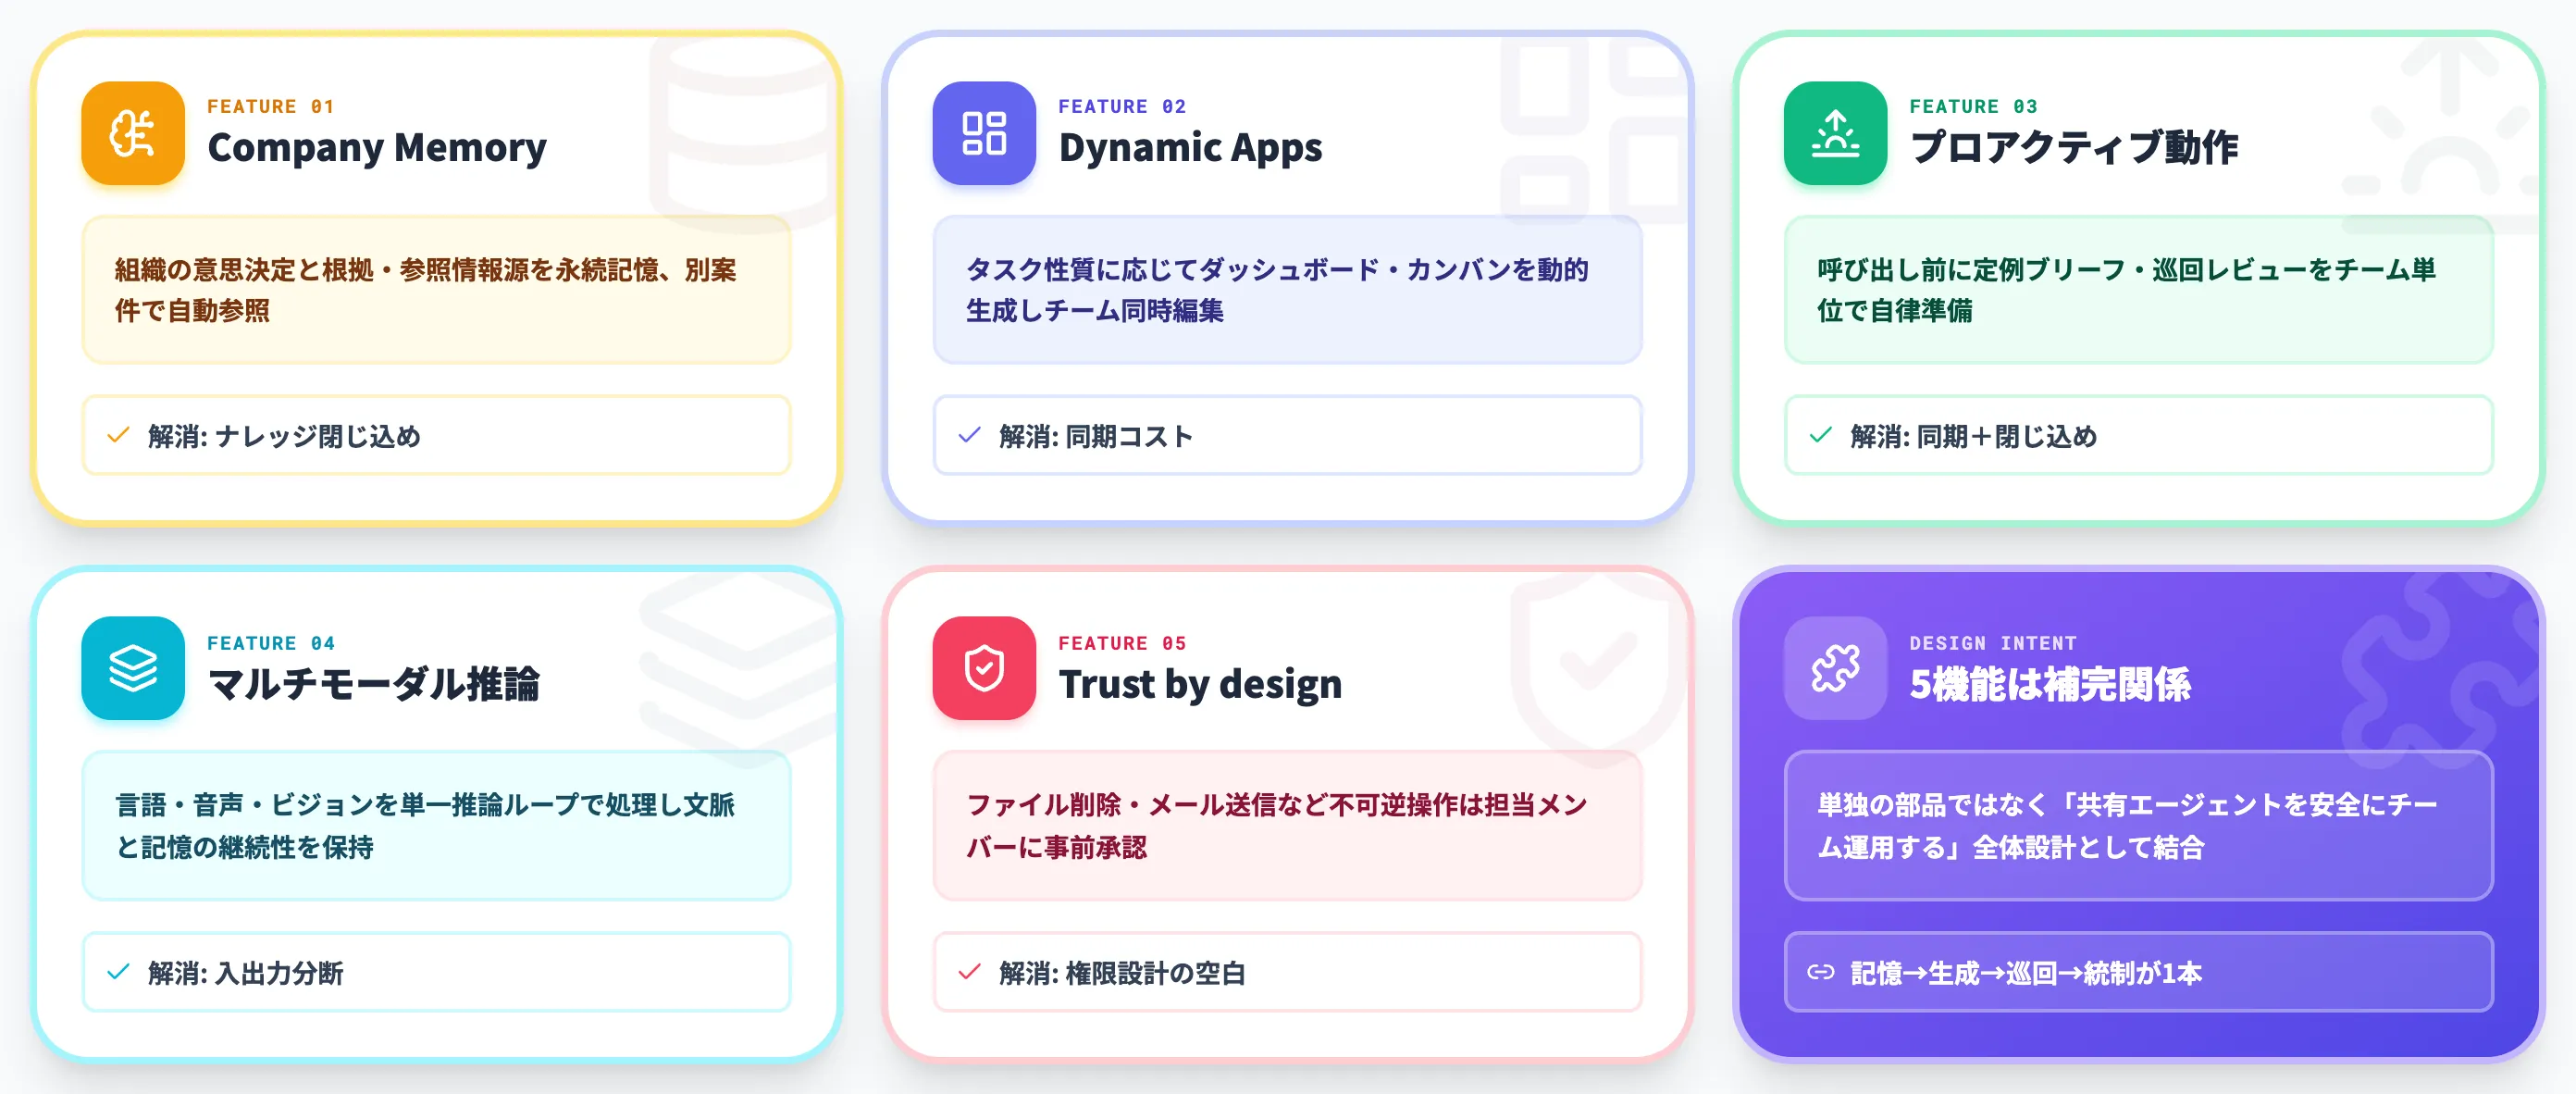
MAIAの機能群は、前節で整理した3つの運用問題にそれぞれ対応する形で設計されています。
公式ページでは「Company Memory」「Dynamic Apps」「プロアクティブ動作」「マルチモーダル推論」「Trust by design」の5つが主要機能として提示されています。
以下の表で、各機能と解こうとしている問題の対応関係を整理しました。
| 機能 | 概要 | 解こうとしている問題 |
|---|---|---|
| Company Memory | 組織の意思決定・その根拠・情報源を永続記憶 | ナレッジの個人閉じ込め |
| Dynamic Apps | チーム用のダッシュボード・カンバンを動的生成 | 複数人作業の同期コスト |
| プロアクティブ動作 | 定例ブリーフ・リマインドを先回りで準備 | 同期コスト+ナレッジ閉じ込め |
| マルチモーダル推論 | 言語・音声・ビジョンを単一の推論ループで処理 | 入出力チャネルの分断 |
| Trust by design | 不可逆操作前の確認と沈黙の作法 | 権限設計の空白 |
5機能はそれぞれが単独で動く部品ではなく、「共有エージェントを安全にチーム運用する」ための補完関係にあります。以下で1つずつ見ていきます。
Company Memory:組織の意思決定を記憶する
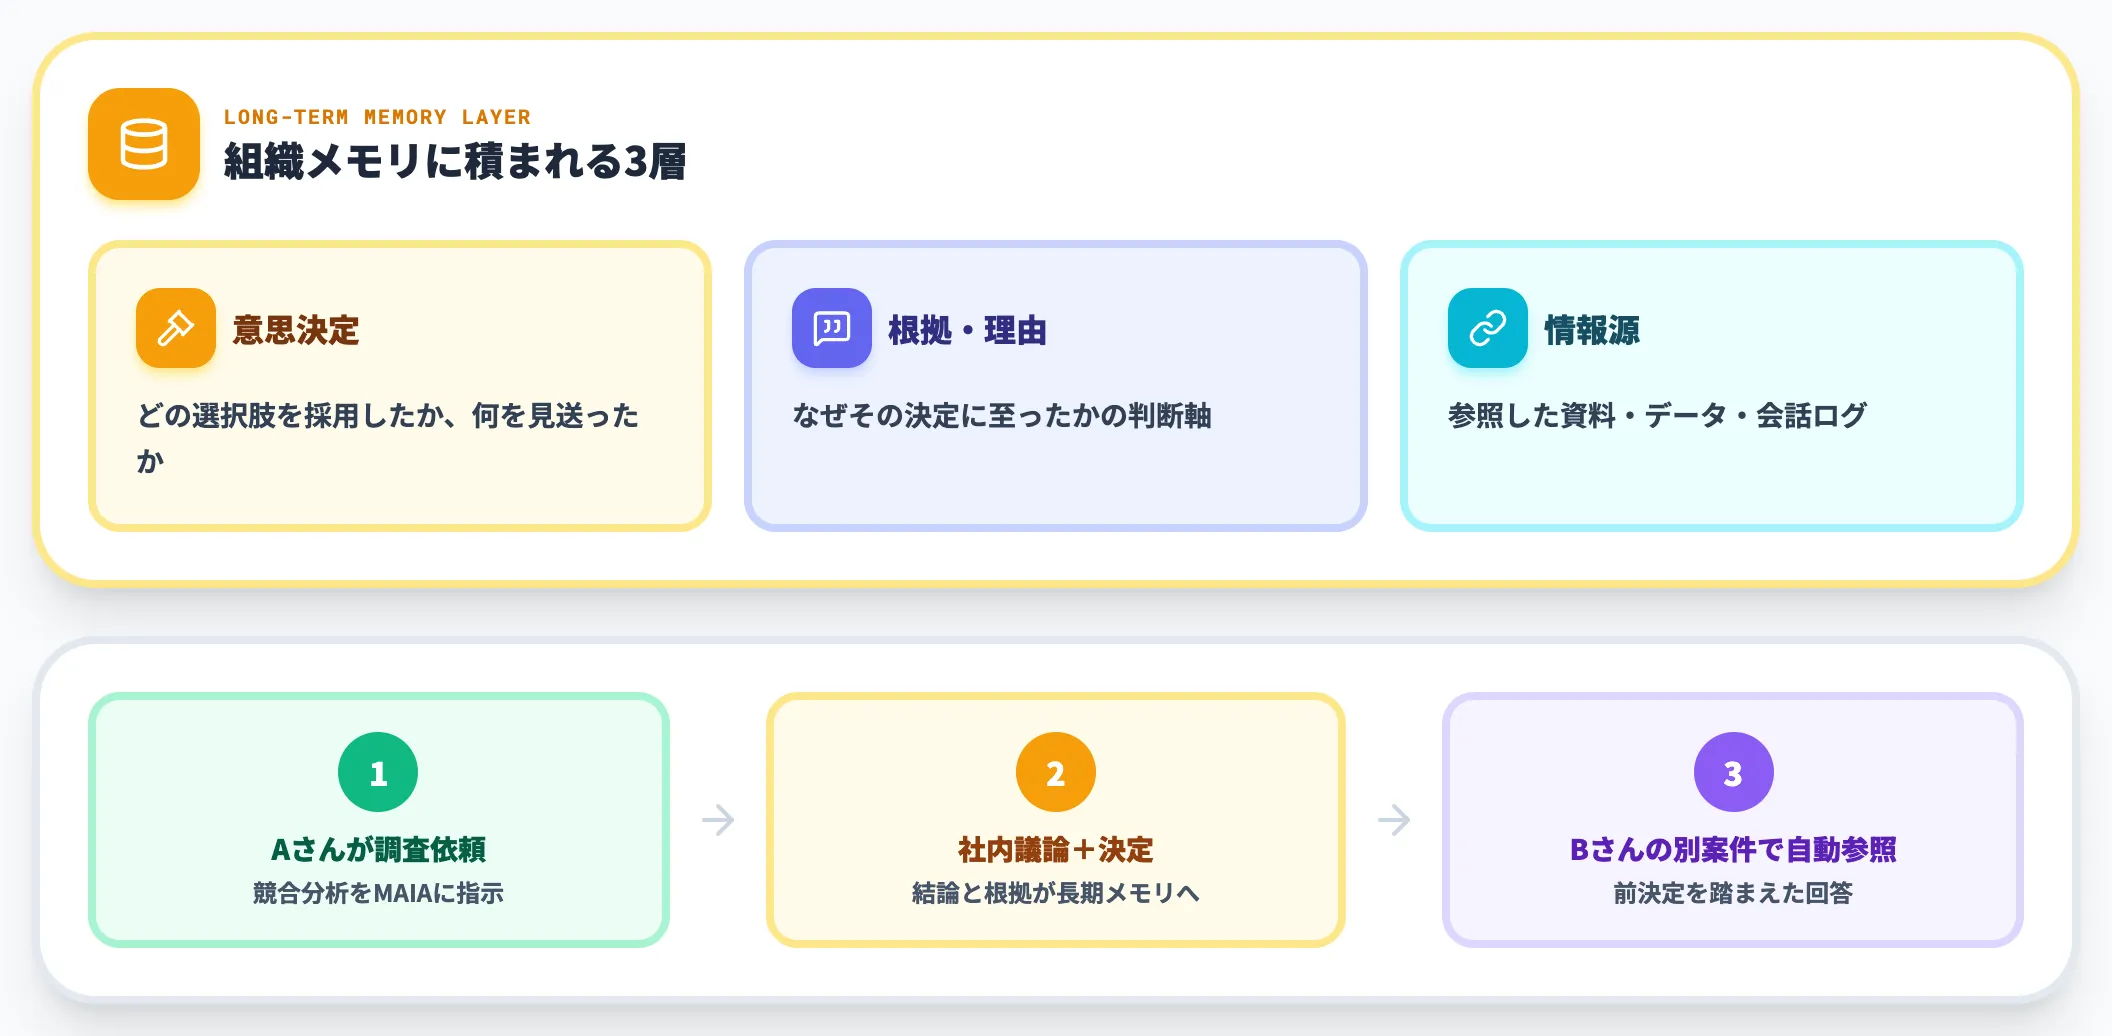
Company Memoryは、MAIAが意思決定とその理由・参照した情報源を永続的に記憶する仕組みです。
公式は「新しい仕事は、組織がすでに知っていることの上に積み上がる」と説明しています。あるメンバーがエージェントに依頼した調査内容と、その後の社内議論で下された結論は、エージェント自身の長期メモリに残り、別メンバーが別の案件を進めるときに自動で参照されます。
Dynamic Apps:チーム用のダッシュボードを動的生成
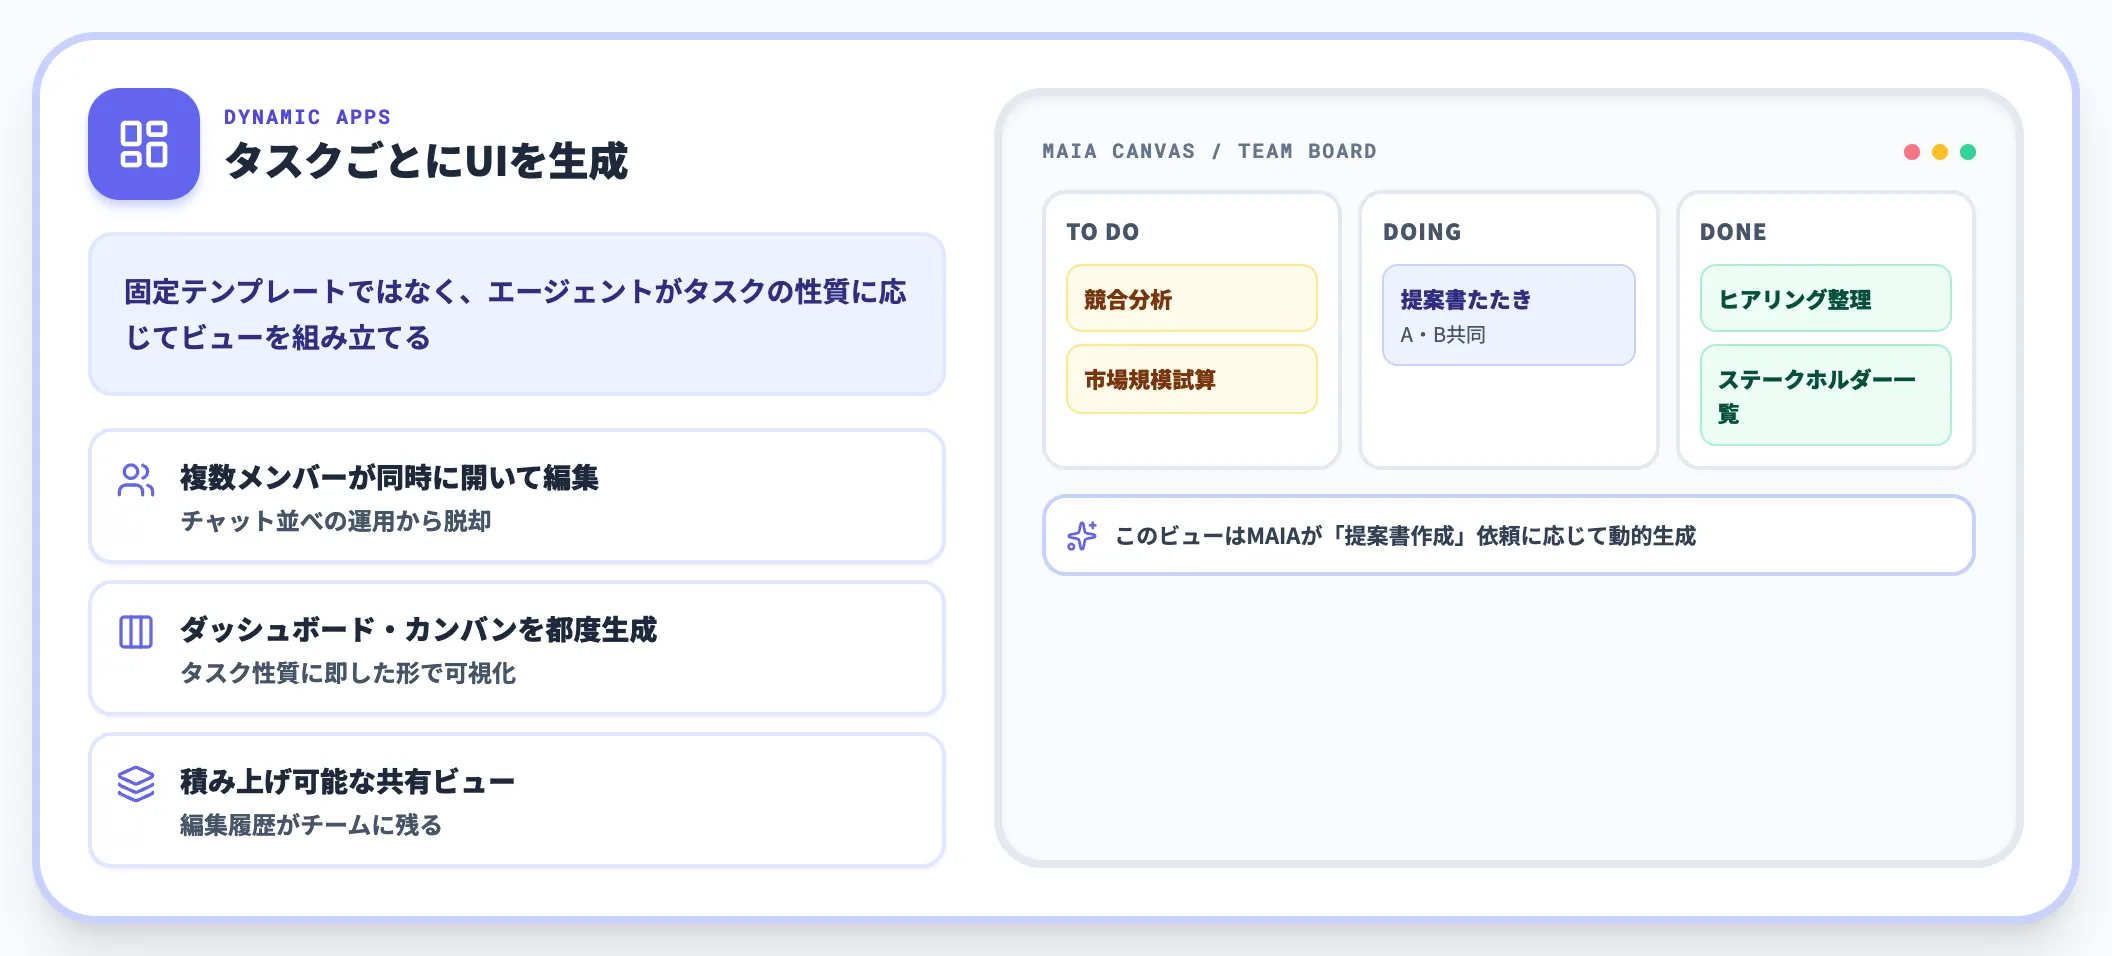
Dynamic Appsは、チームの作業ごとに必要なUI(ダッシュボード・カンバン式タスクリスト等)をMAIAがその場で生成・共有する機能です。
公式ページでは「あなたとチームのために作るアプリ」と位置づけられており、固定テンプレートを選ぶのではなく、エージェントがタスクの性質に応じてビューを組み立てます。生成されたビューは複数メンバーが同時に開き、編集し、積み上げていけるため、個別エージェントのチャット画面を並べる運用から踏み出せます。
プロアクティブ動作:先回りで定例ブリーフを準備
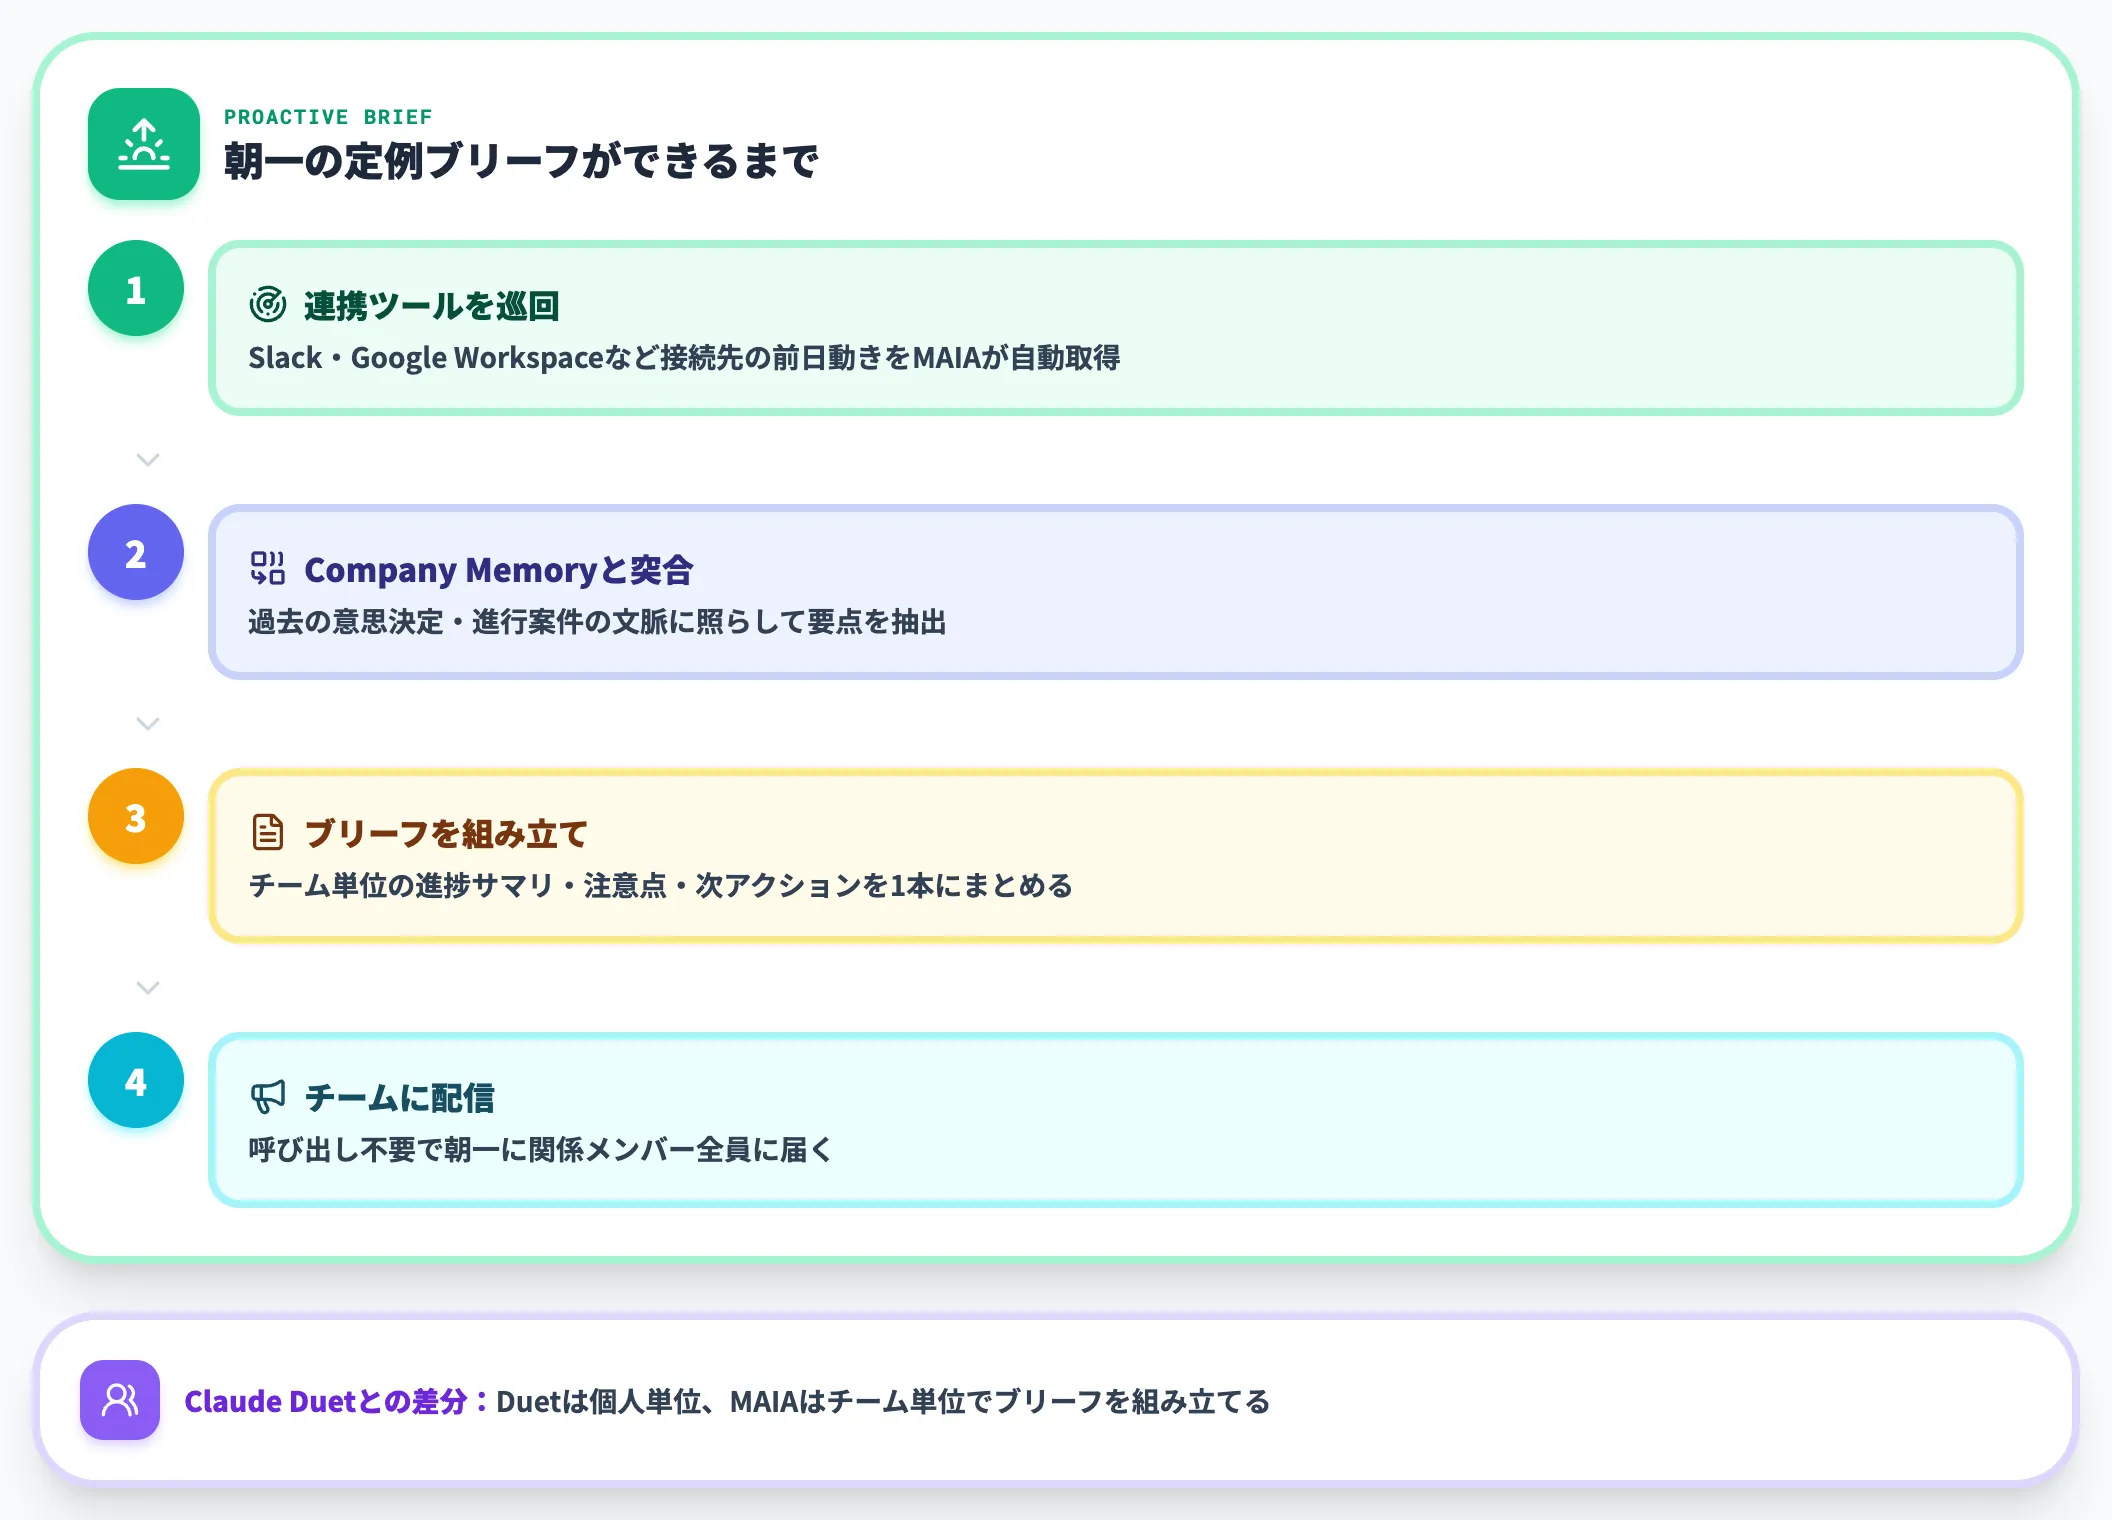
MAIAはユーザーが呼び出さなくても、定例のブリーフや巡回レビューを自律的に準備します。
朝一番に前日の進捗サマリを届け、連携ツール(Slack・Google Workspace等)で何か動きがあれば要点を先回りで整理します。
Claude Duetが同じ「プロアクティブ型エージェント」を個人向けに実装しているのに対し、MAIAはチーム単位でブリーフを組み立てる点が異なります。
マルチモーダル推論:言語・音声・ビジョンを単一ループで
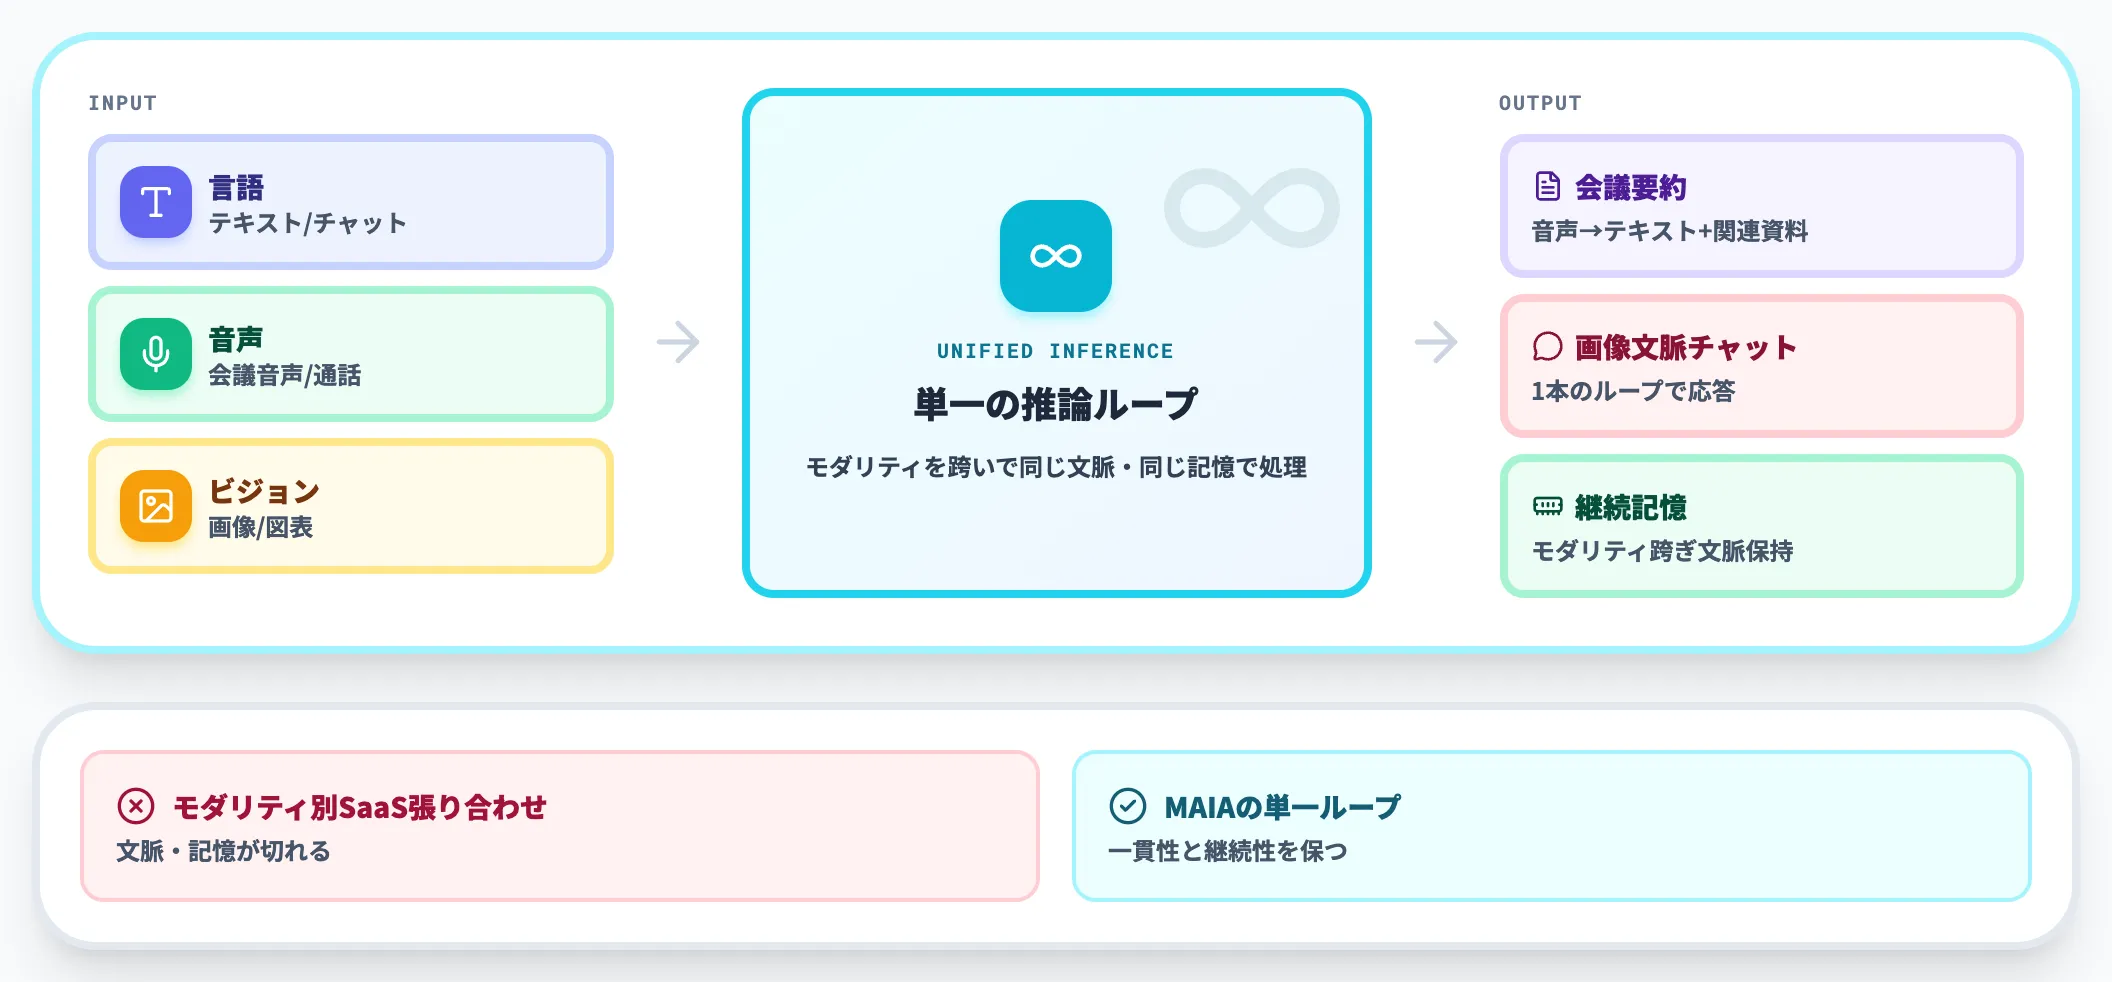
MAIAは言語・音声・ビジョンの入力を、単一の推論ループで処理すると公式で説明されています。
会議音声の要約と関連ドキュメントの参照、画像入りチャットでの文脈処理を1本のループで回せるため、モダリティ別のSaaSを張り合わせる構成と比較して、会話の一貫性と記憶の継続性を保ちやすくなります。
Trust by design:不可逆操作前の確認
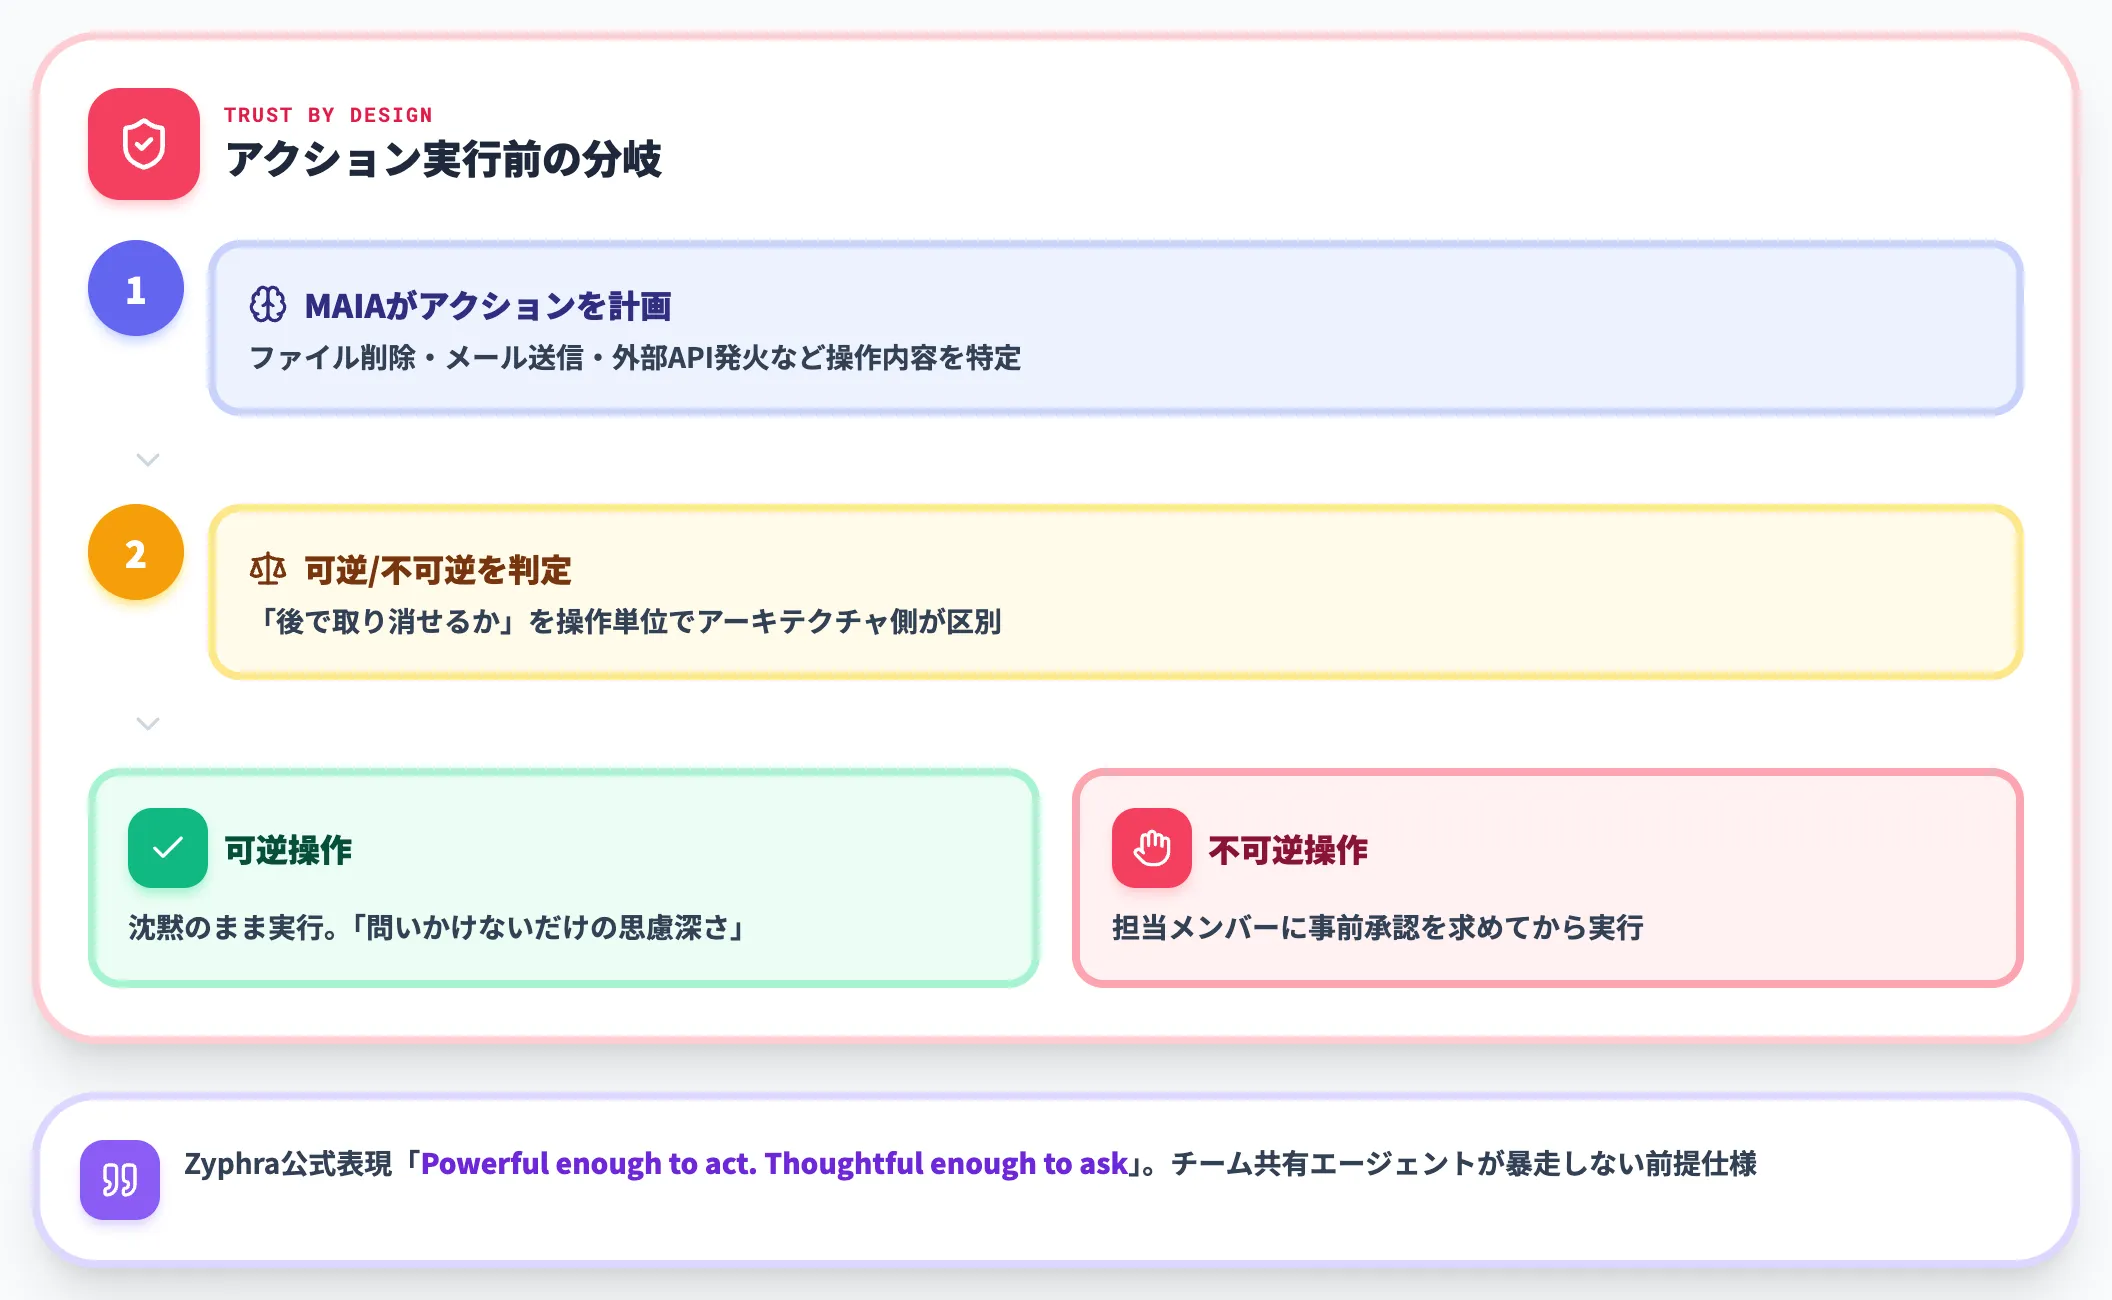
Trust by designは、不可逆な操作の前に確認を取り、不要なときは沈黙するという設計思想です。
公式は「Powerful enough to act. Thoughtful enough to ask(行動できるだけ強く、問いかけられるだけ思慮深い)」と表現しており、ファイル削除・メール送信・外部API発火といった操作をエージェントが単独で実行する前に、担当メンバーに承認を求める仕様になっています。チーム共有エージェントが暴走しないための前提仕様として、アーキテクチャ側で持っている点が特徴です。
Zyphra MAIAを支える技術基盤とインフラ戦略
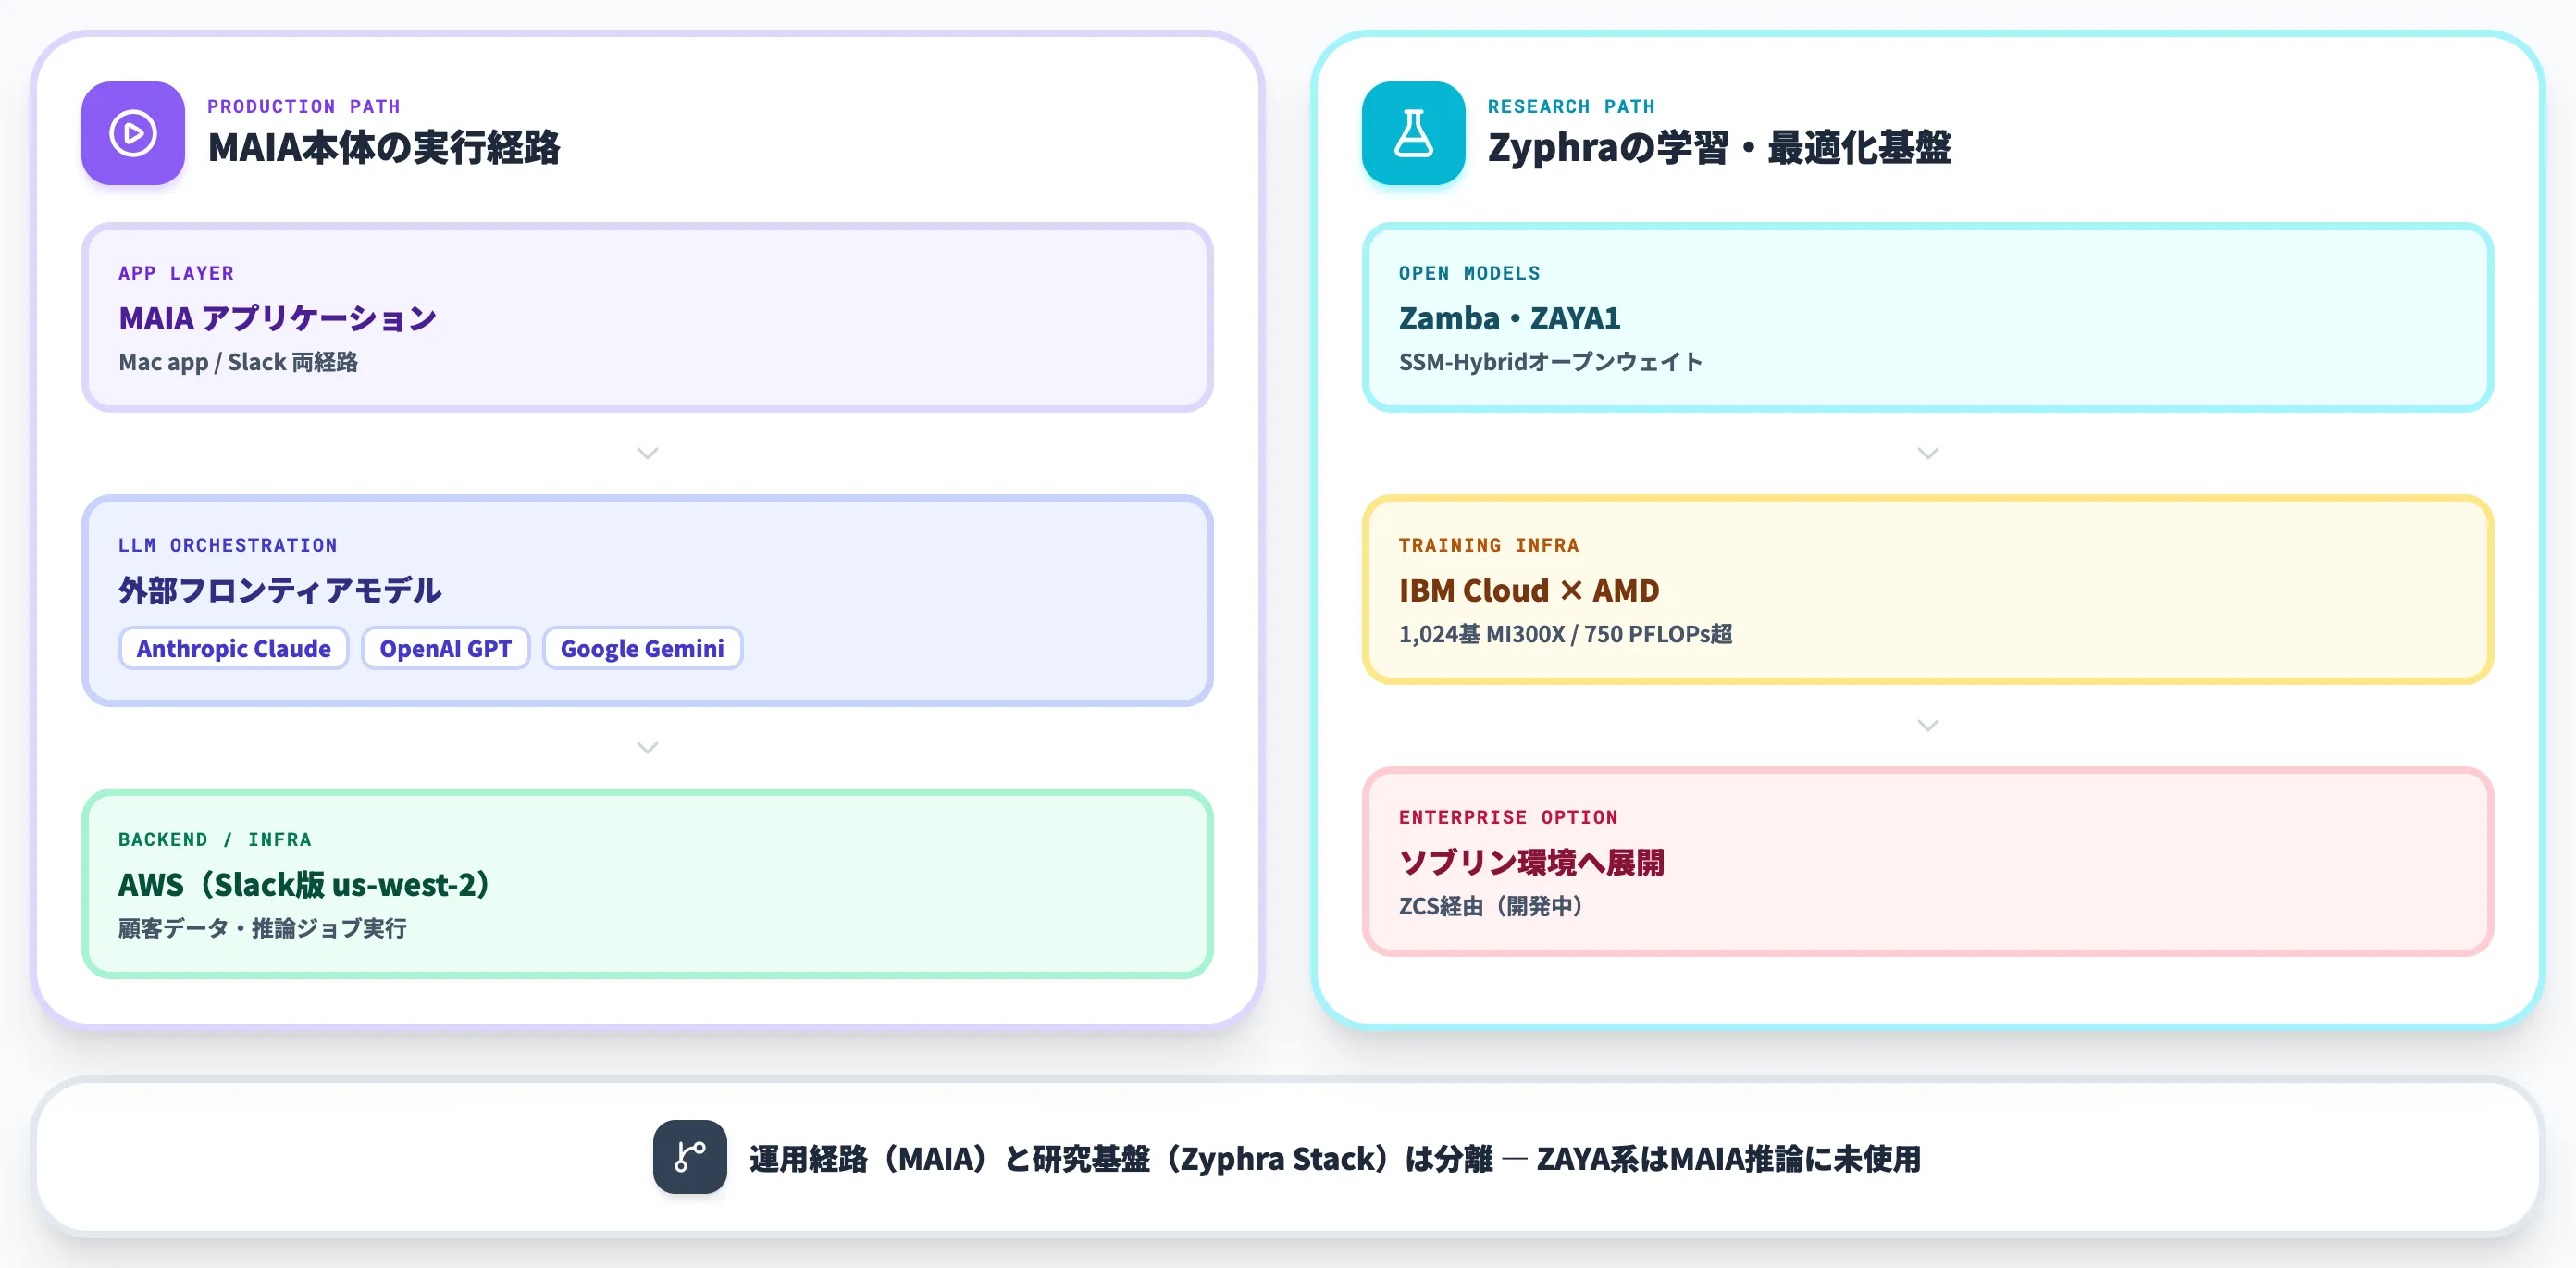
MAIAは「自社ですべてを作る」のではなく、外部LLMのオーケストレーション層とZyphra自身の学習・最適化基盤を分けて設計しています。
Zyphra公式トップで掲げる「Open Superintelligence — Open models. Multisilicon infrastructure. Intelligence you control.」の戦略メッセージ(出典:Zyphra)
評価の軸は、「MAIA本体がどのモデルを呼んでいるか」「Zyphraが研究用途で持っている学習基盤は何か」「エンタープライズ展開時に自社環境へ持ち込めるか」の3つに分かれます。順に見ていきます。
MAIAが呼び出すフロンティア基盤モデル
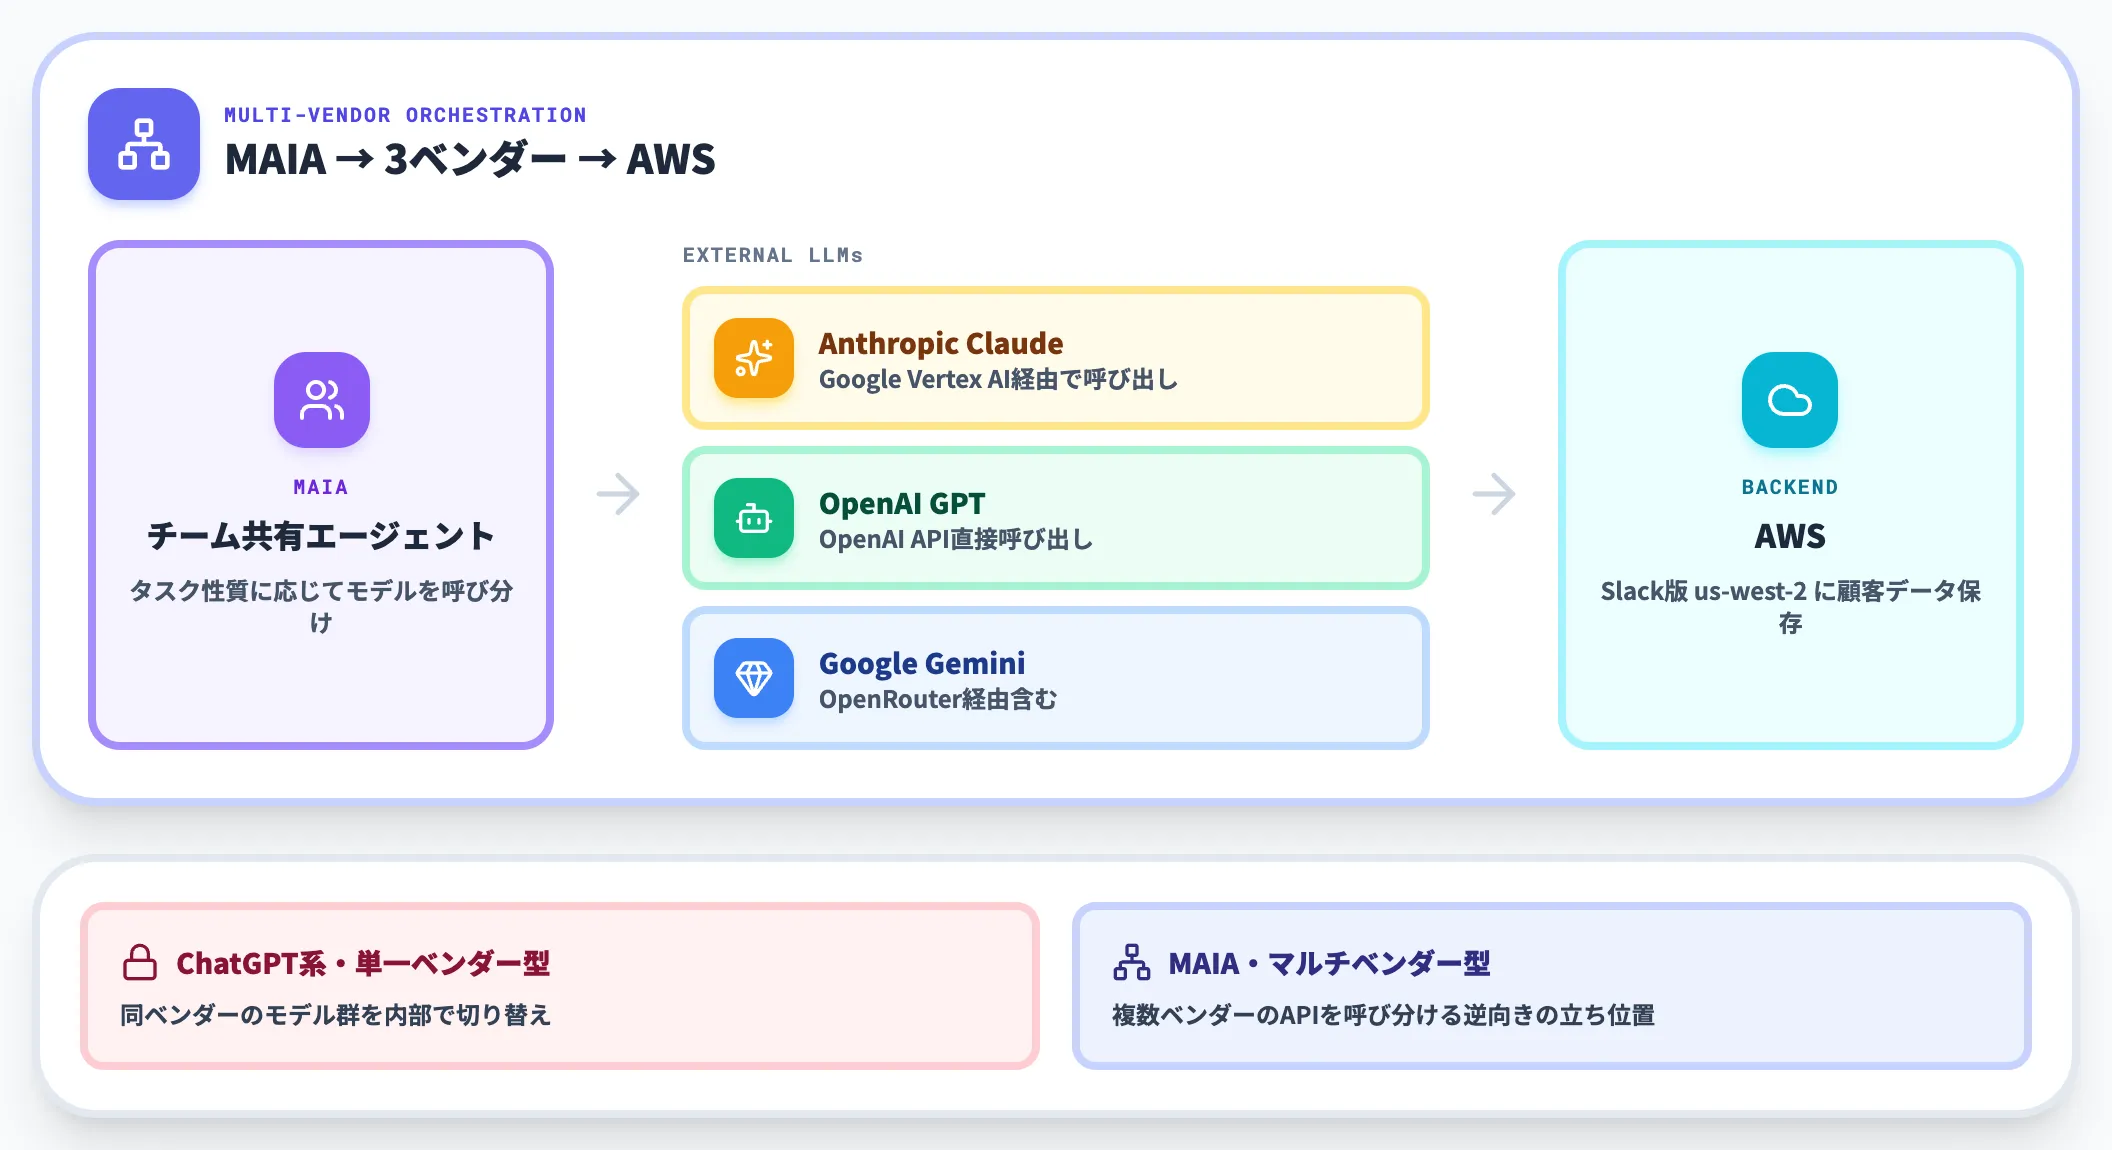
MAIAの推論はAnthropic Claude(Google Vertex AI経由)・OpenAI GPT・Google Geminiを外部LLMとして呼び出す構成です。Zyphra公式のSubprocessors一覧で、Anthropic・OpenAI・Google・OpenRouterが明記されています。
バックエンドはAWSで動き、Slack版の顧客データ保存先はAWS us-west-2です。現行ベータのこの構成は、単一ベンダーのクローズドモデルに縛られず複数ベンダーのAPIを呼び分ける設計になっており、ChatGPT系のように「同じベンダーのモデル群を自製品内で切り替える」構成とは逆の立ち位置を取っています。
公式が「最先端のオープン基盤モデルをオーケストレートし、透明性・深いカスタマイズ・主権的なコントロールを可能にする」と説明している「オープン基盤モデル」の活用は、Enterpriseページ側で示されているカスタマイズ・ソブリン展開の文脈で主に提示されており、現行ベータの推論経路とは区別して理解する必要があります。
Zyphraの研究プロダクトとIBM・AMD提携——ZAYA1学習基盤
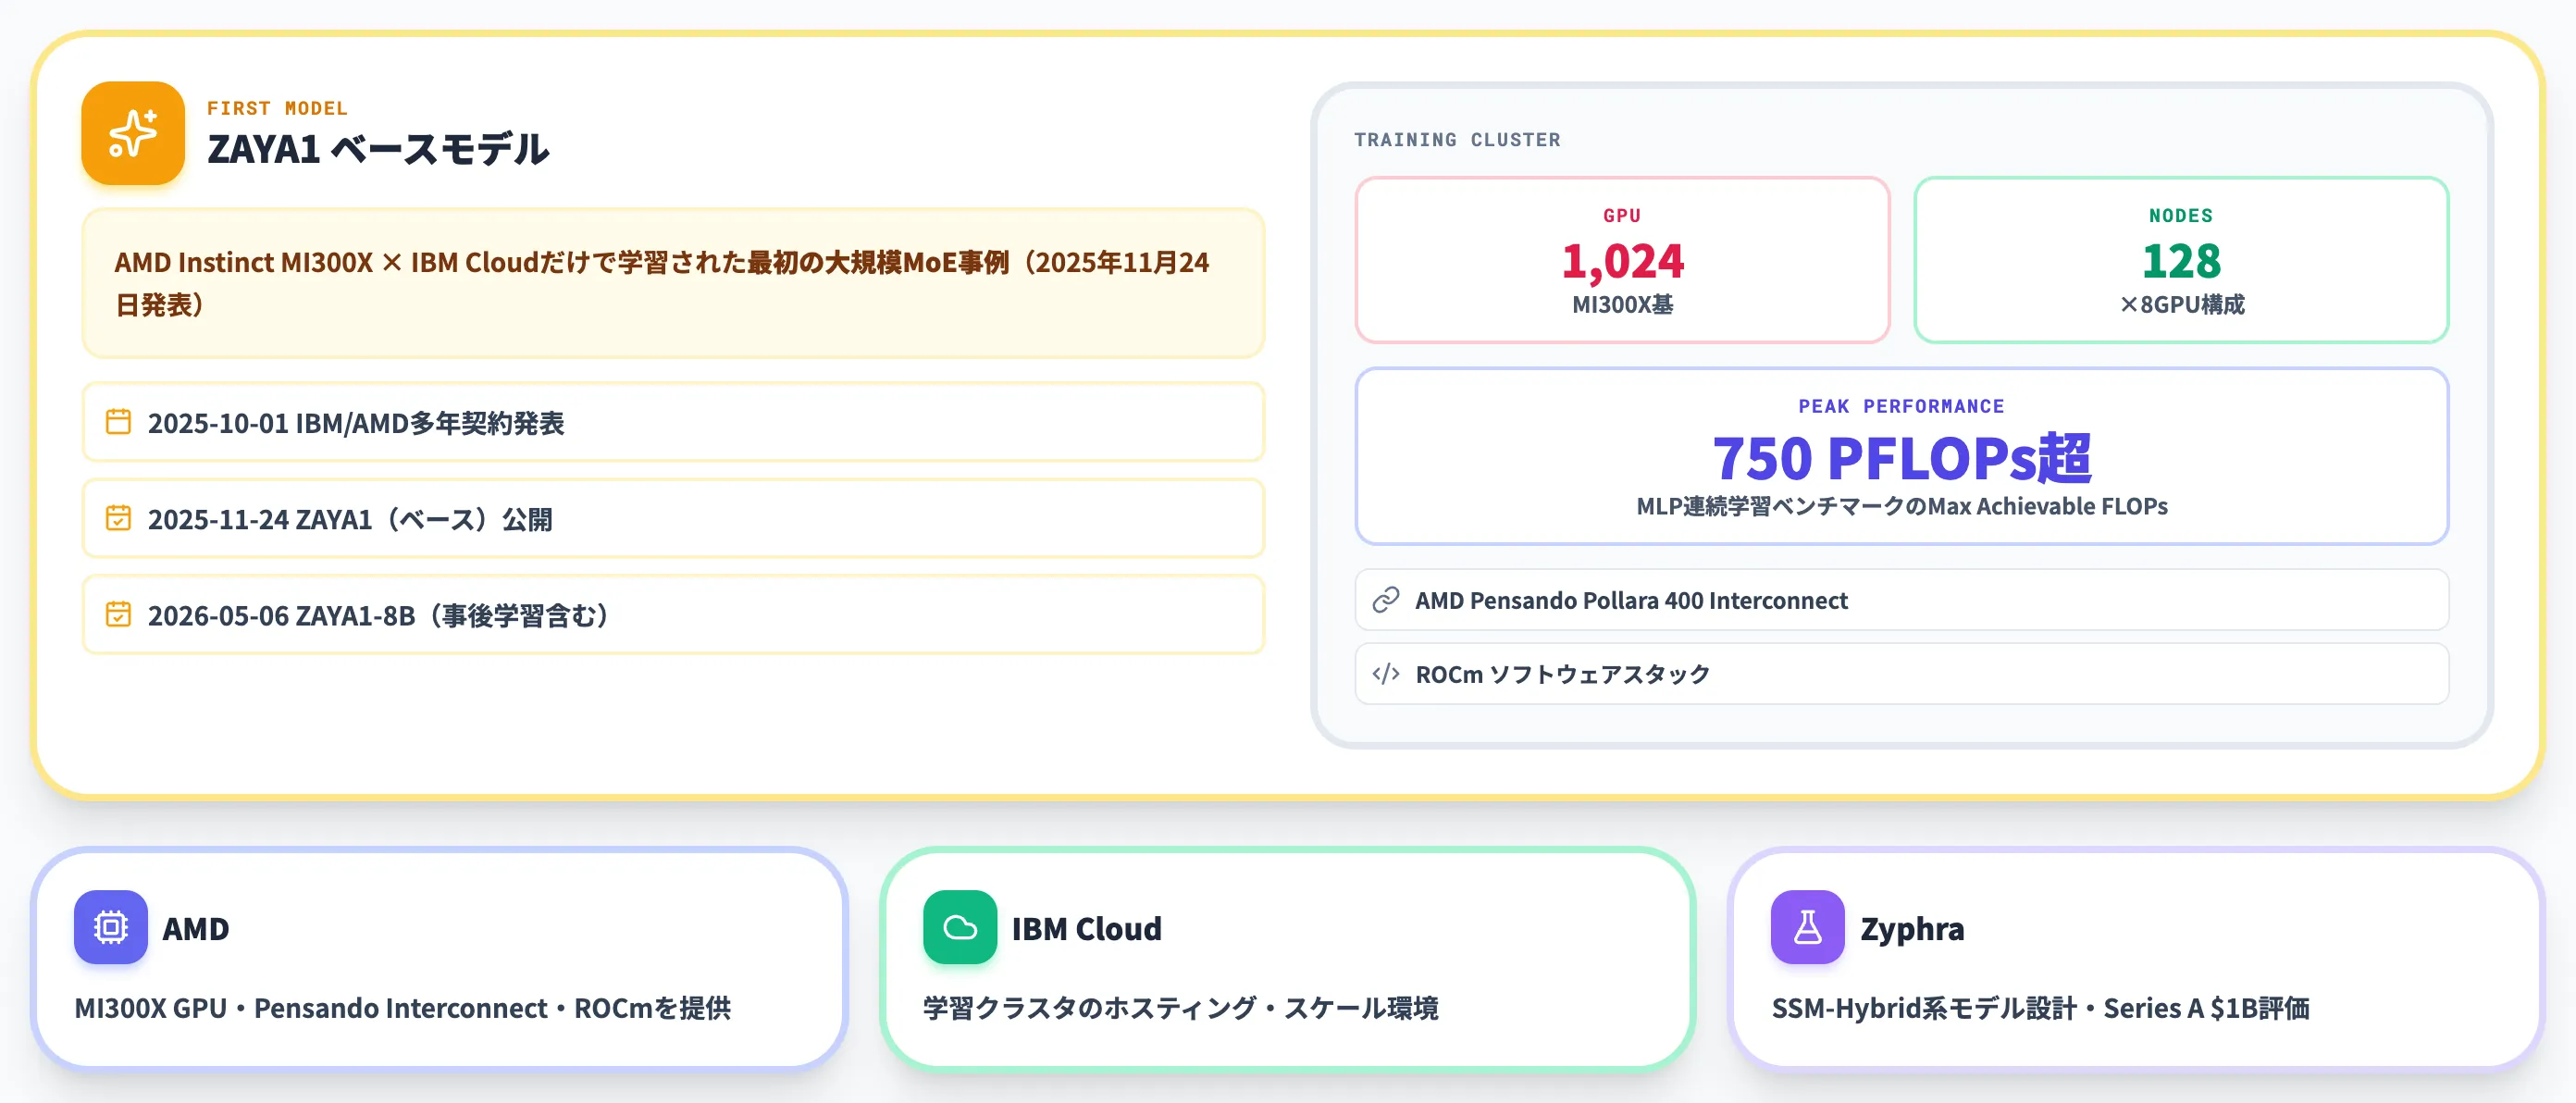
Zyphra自身は、ZambaというSSM-HybridのオープンウェイトLLM群を研究プロダクトとして開発してきました。
Zamba2-7BはMistral・Google Gemma・Meta Llama 3の同規模オープンモデルを上回ると公表されています(Zamba/Zamba2自体は128基のNVIDIA H100で学習されたモデル)。
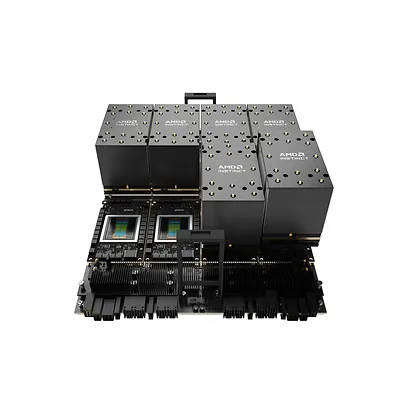
IBM・AMD・Zyphra提携で採用されたAMD Instinct MI300X搭載ユニバーサルベースボード(出典:IBM Newsroom)
このインフラを支えるのが、2025年10月1日に発表されたIBMおよびAMDとの多年契約("for training frontier multimodal foundation models" と明記)です。
この基盤で学習された初の実モデルが、2025年11月24日発表のZAYA1(ベースモデル)——AMD Instinct MI300XとIBM Cloudだけで学習された最初の大規模MoEモデル事例となりました(事後学習まで含めたZAYA1-8Bは2026年5月6日に別途発表)。
-
学習クラスタ
IBM Cloud上の1,024基のAMD Instinct MI300X GPU(128ノード×8GPU)+AMD Pensando Pollara 400 Interconnect+ROCmソフトウェアスタック。AMD公式ブログによれば、クラスタ全体で連続したMLPを学習させるベンチマークで750 PFLOPs超のMax Achievable FLOPsを記録
-
資金調達
Zyphraは2025年にSeries A($1B評価)を完了済み。IBMとAMDは本契約でインフラ提供者として関与しており、Series Aのリード投資家名はIBMプレスでは明示されていません
-
MAIAとの関係
Zyphraの基盤モデル学習に使われるクラスタで、MAIA本体の推論・実行環境はAWS側にあります
ソブリン環境へのカスタム展開
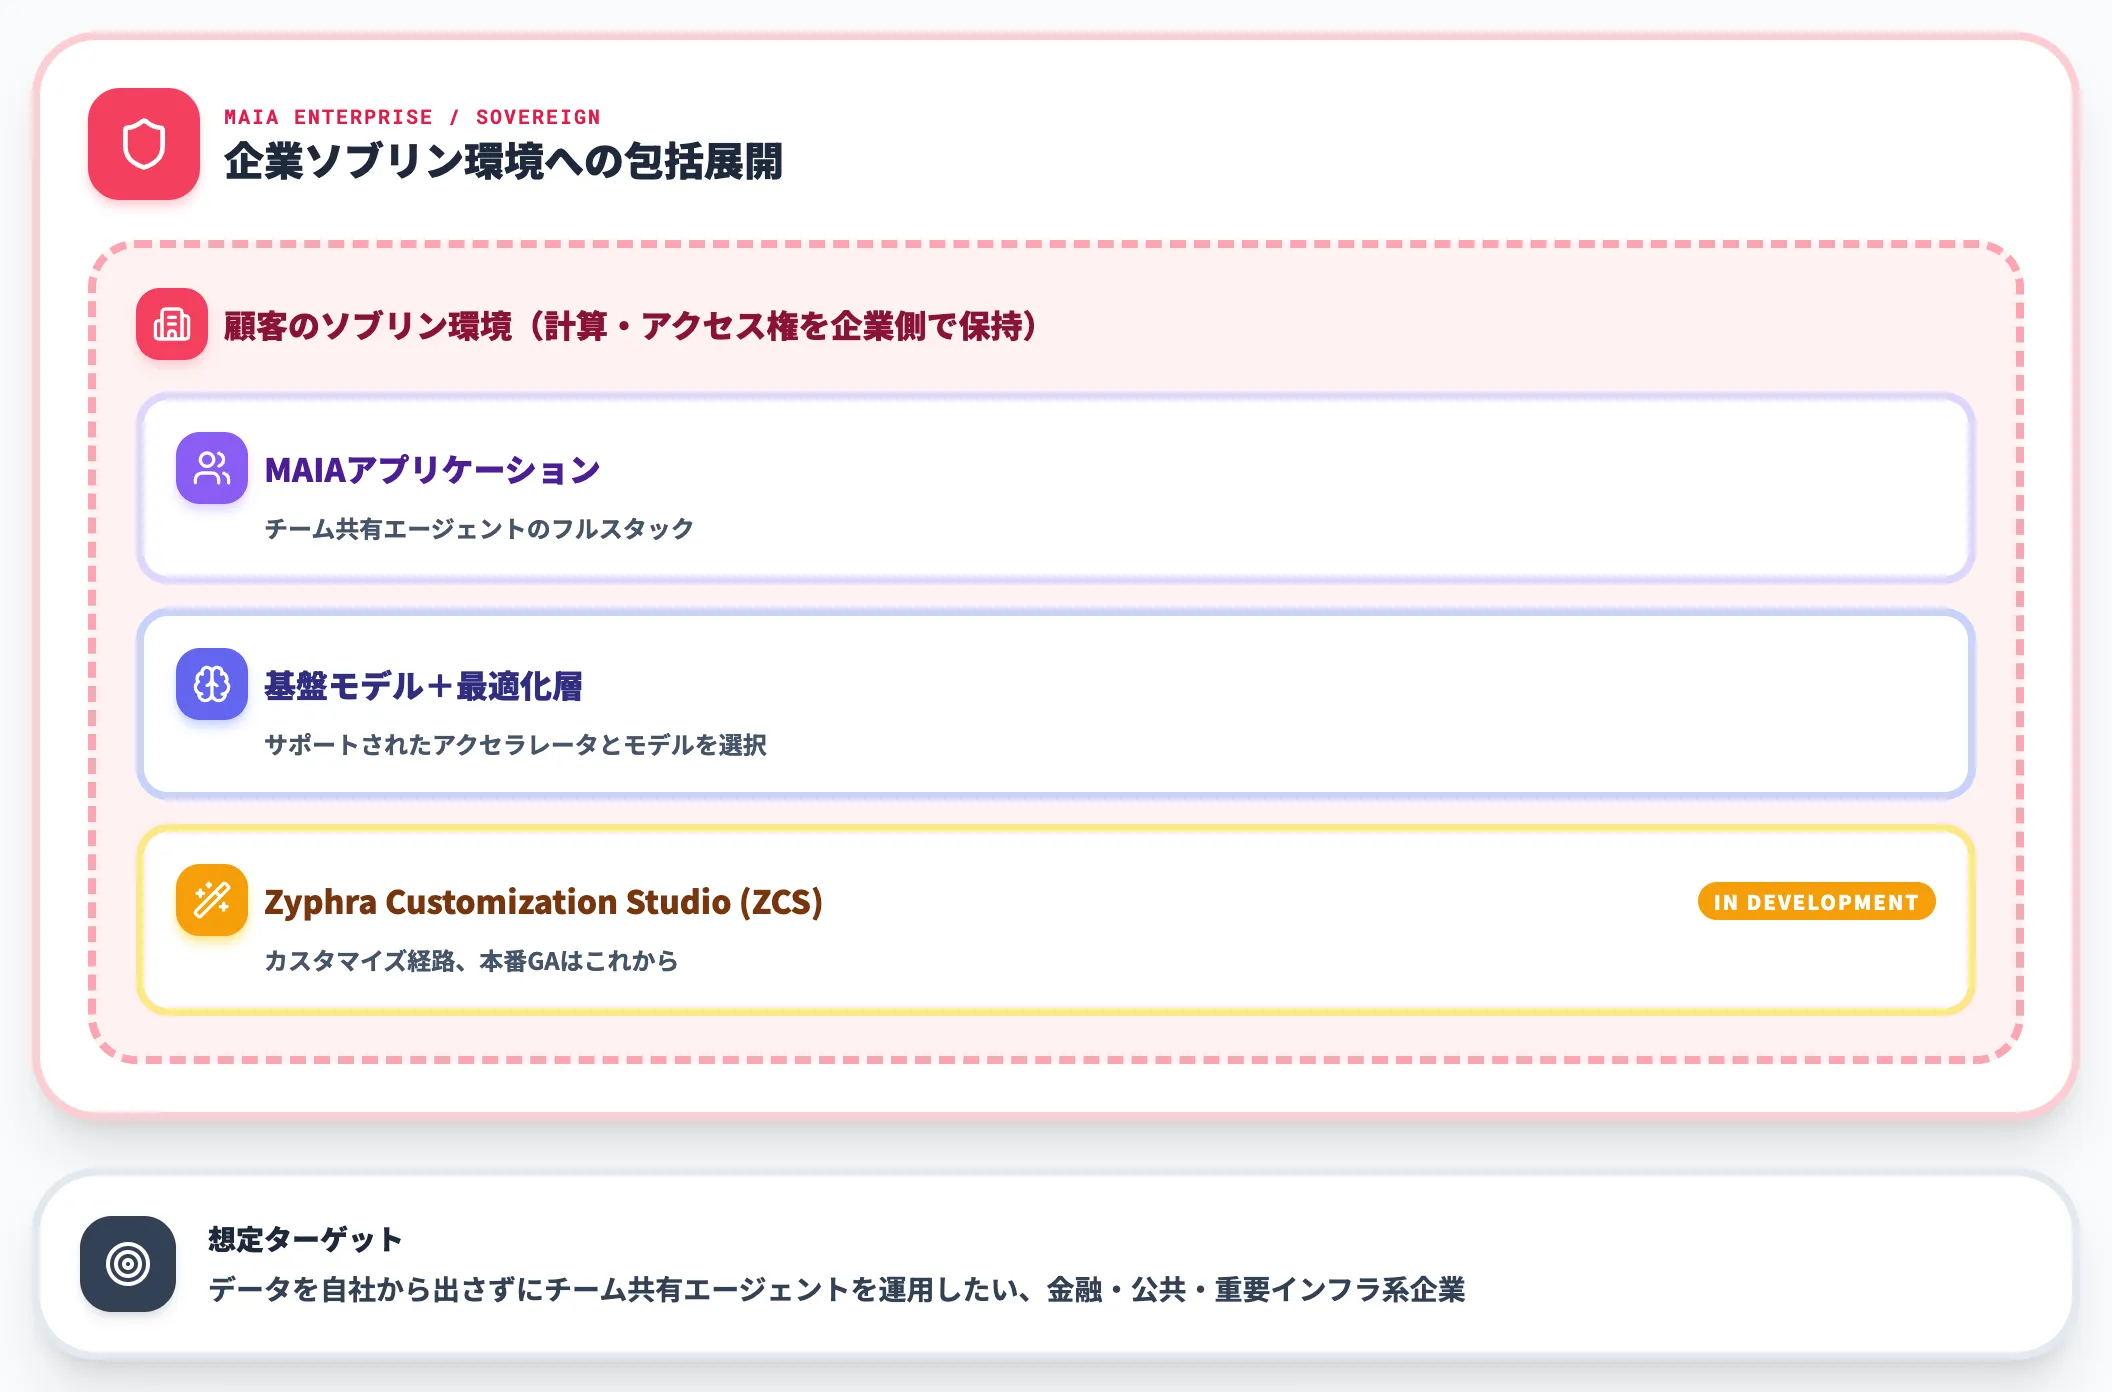
MAIA Enterpriseでは、MAIAと基盤モデル・最適化層をまとめて、企業のソブリン環境にデプロイできるオプションが提示されています。
公式Enterpriseページでは「計算環境とアクセス権の管理、サポートされたアクセラレータとモデルの選択、カスタマイズされたインテリジェンスの配置」までを企業側で握れる設計だと説明されています。カスタマイズ経路として用意されているZyphra Customization Studio(ZCS)は、公式ページ上で現時点「In development(開発中)」と明示されており、本番GAはこれから進む段階です。
この設計は、「データを自社から出さずにチーム共有エージェントを運用したい」という要件を持つ金融・公共・重要インフラ系企業にとって、将来の選択肢として注視する価値があります。
Zyphra MAIAの料金と提供形態
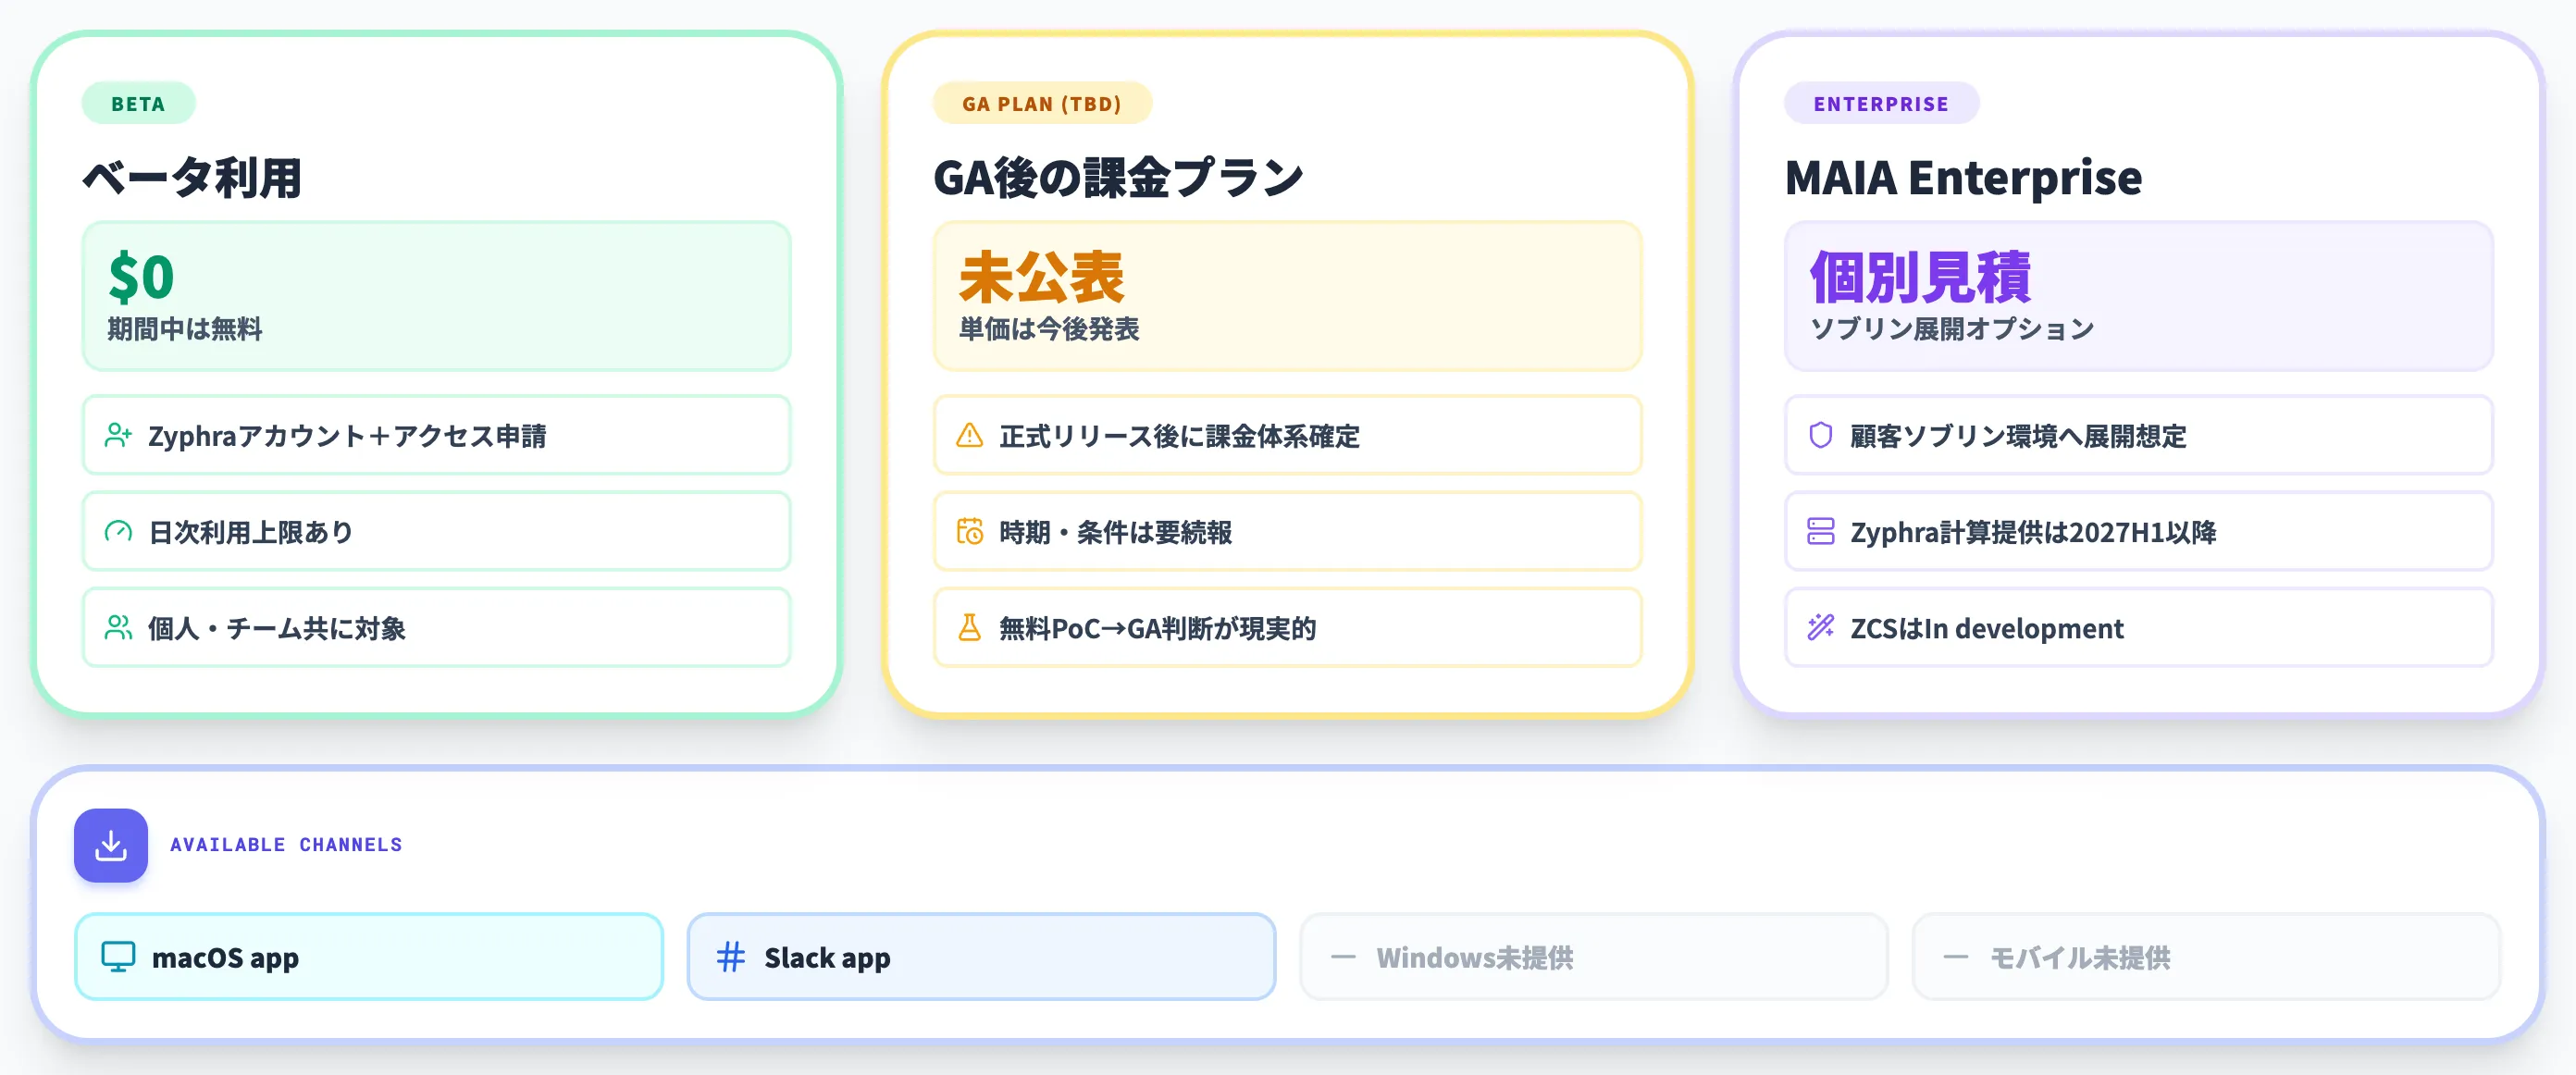
MAIAはベータ段階のため、正式リリース後の課金体系は未公表です。
ここでは2026年11月時点で確認できる提供形態と、エンタープライズ利用で発生するコスト構造を整理します。
ベータ期間中は無料
MAIAはベータ期間中、個人・チームとも無料で利用できます。
公式ページおよびSlackマーケットプレイスではダウンロードが案内されており、Zyphraアカウントを作成してベータアクセスを申請するか、一般提供向けのウェイトリストに登録する運用です。
ベータ期間中は無料ですが、日次の利用上限が設定されている点と、ベータ終了後の課金プラン・単価が未公表な点は押さえておく必要があります。
Mac appとSlackアプリの2形態
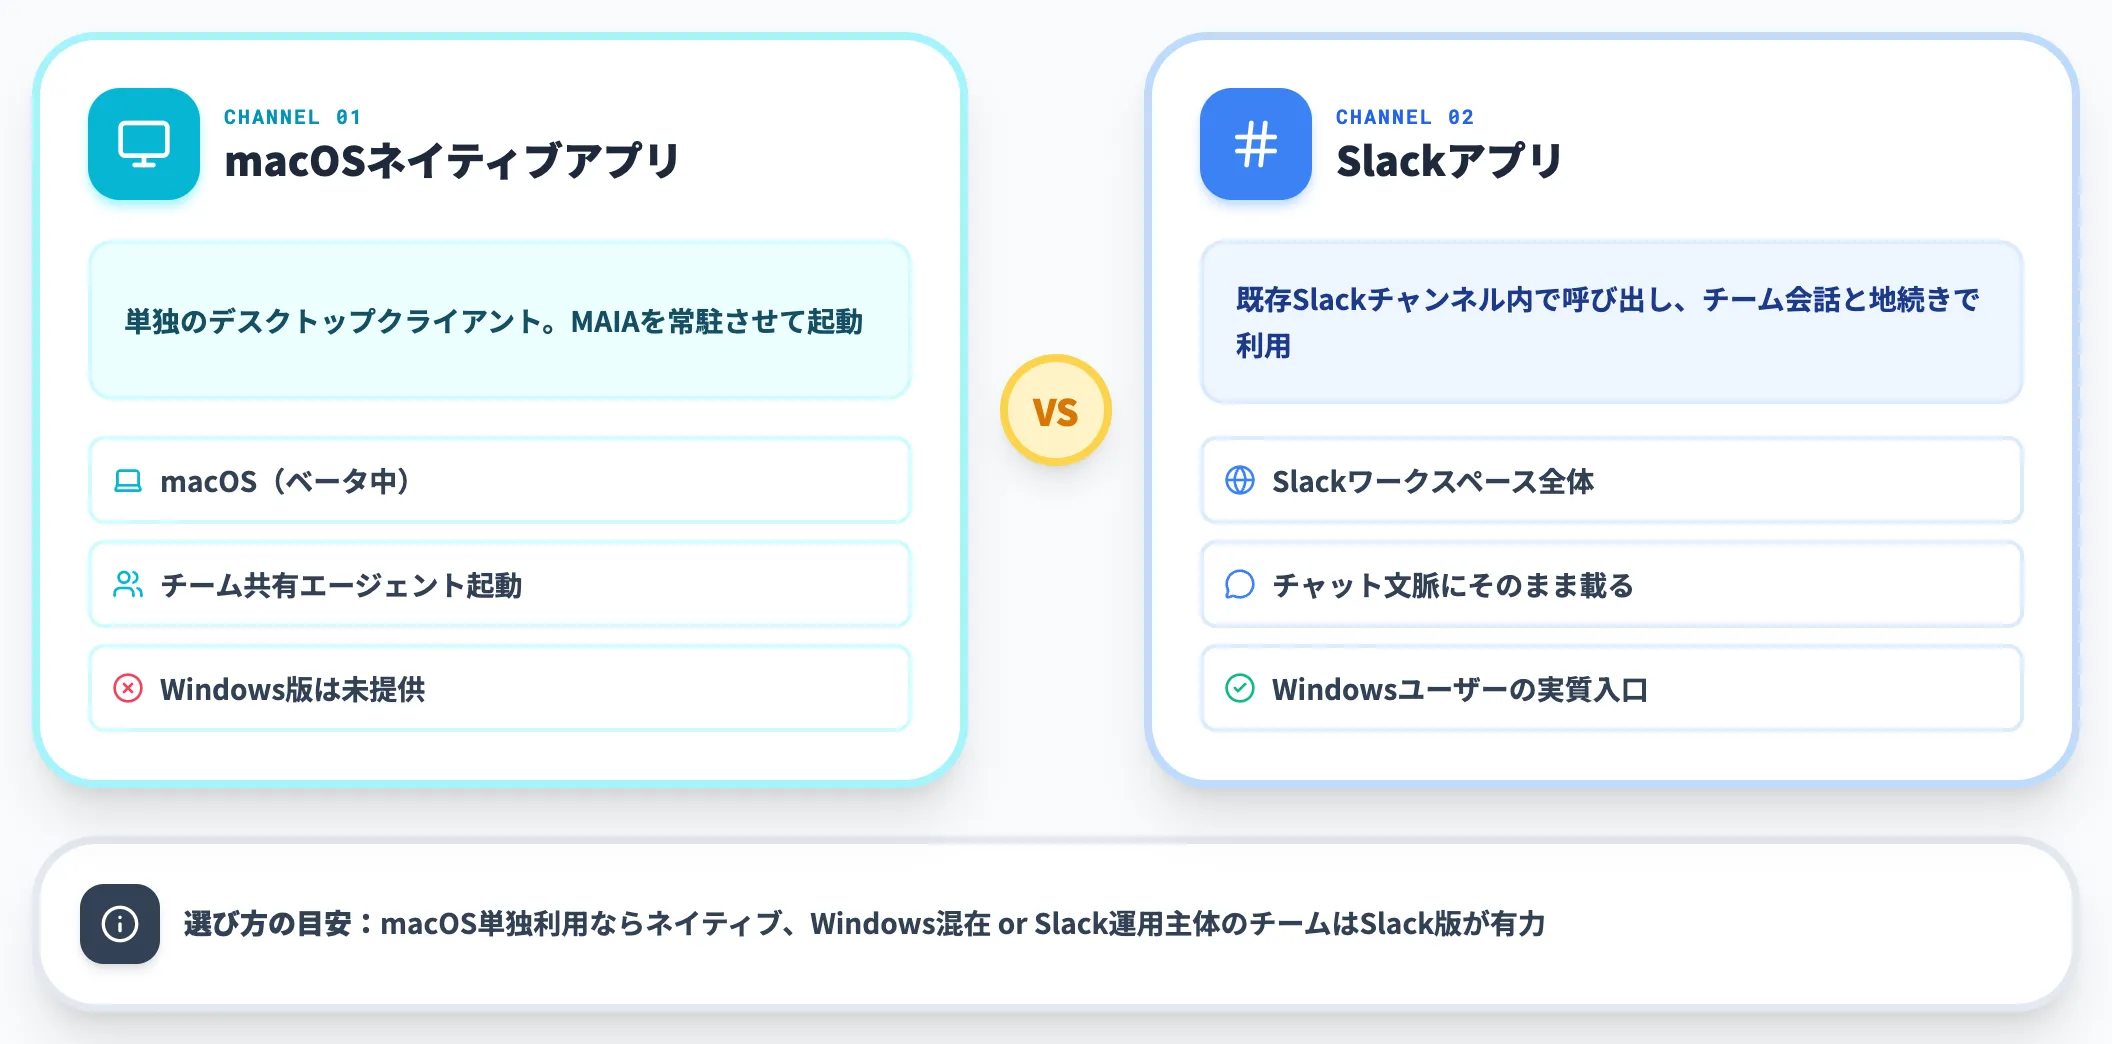
ベータ時点でMAIAは2つの経路で提供されています。1つはmacOSネイティブアプリ、もう1つはSlack上で動くアプリです。
以下の表で、2形態の違いを整理しました。
| 提供形態 | 対応OS/環境 | 主な使い方 |
|---|---|---|
| macOS ネイティブアプリ | macOS(ベータ中) | 単独のデスクトップクライアントとして、チーム共有エージェントを起動 |
| Slack アプリ | Slackワークスペース | 既存Slackチャンネル内でMAIAを呼び出し、チーム会話と地続きで利用 |
WindowsクライアントやモバイルアプリはベータGAアナウンス時点では確認できず、既存のSlack経由利用がWindowsユーザーの実質的な入口になります。
エンタープライズ版のカスタマイズ
企業導入向けにはMAIA Enterpriseが用意されています。
公式Enterpriseページでは「現在ベータで、組織と協業しながらフルスタックを主権環境に展開していく」と記載されており、料金体系は個別見積り方式です。
Zyphraの計算リソース提供は2027年上半期から順次予定とも案内されています。
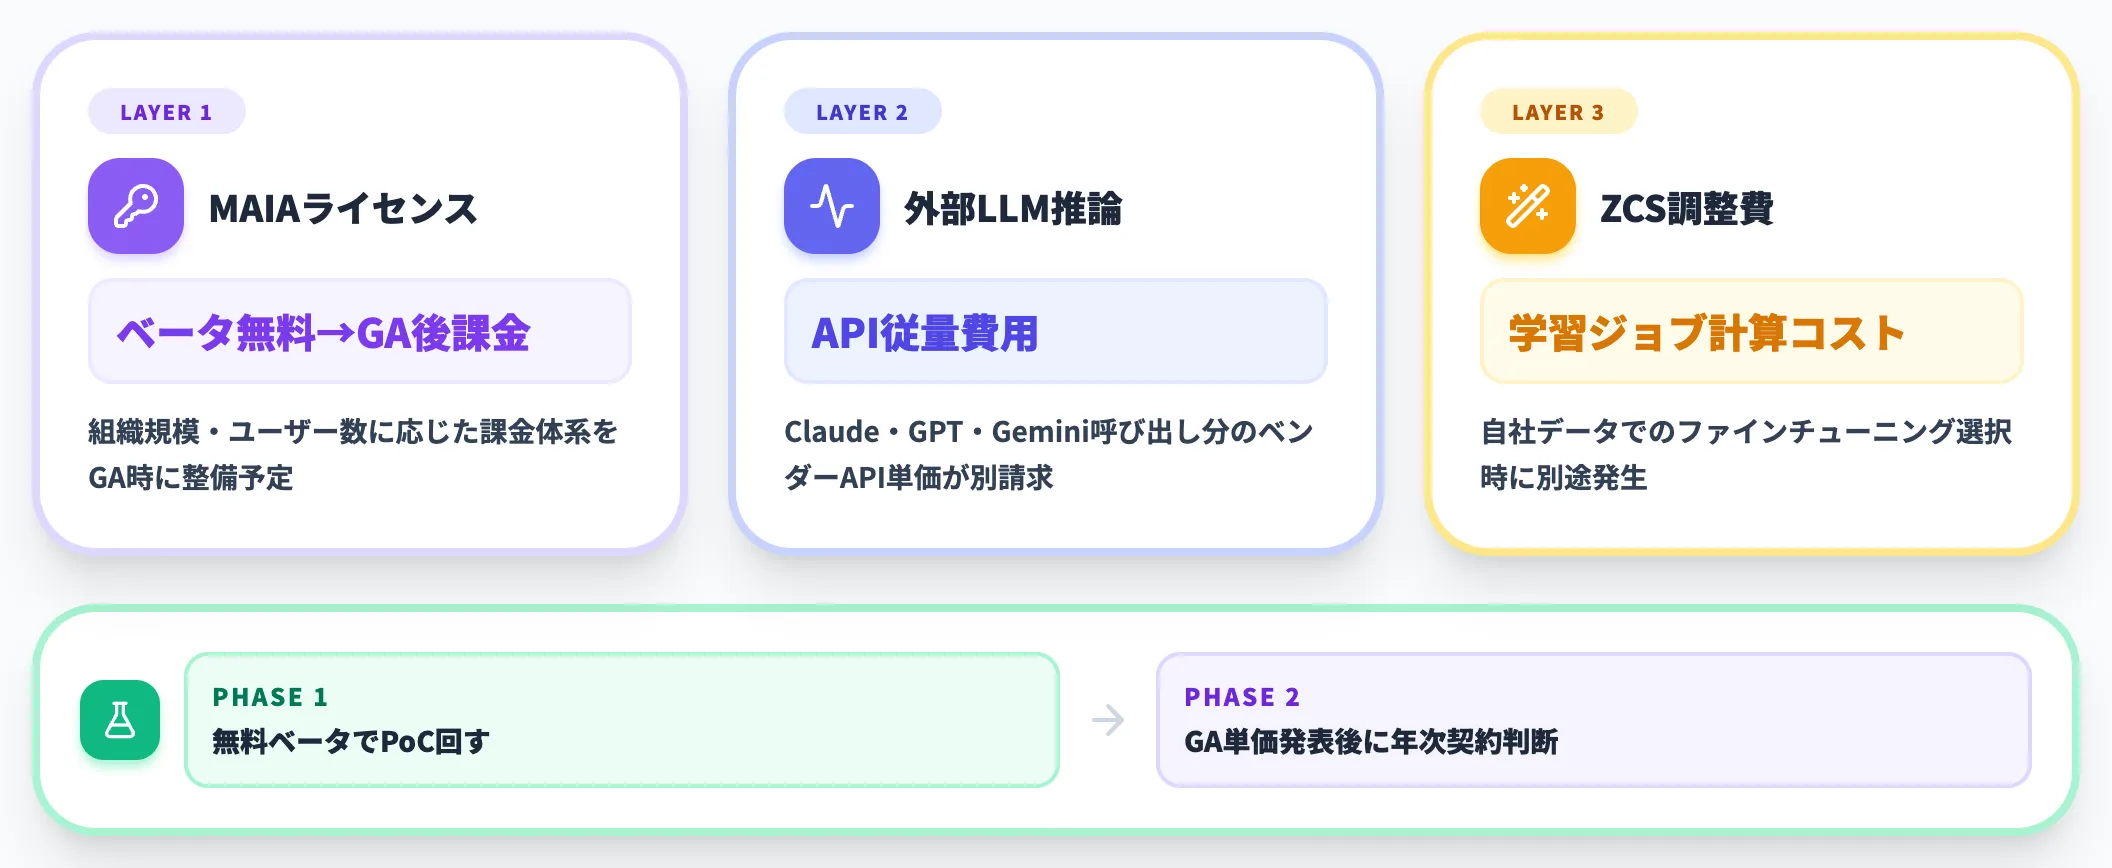
Enterprise利用時に発生するコストは、以下のレイヤーに分かれる想定です。
-
MAIAライセンス
現行はベータで無料、GA後は組織規模・ユーザー数に応じた課金体系が整備される見込み
-
外部LLMの推論コスト
Anthropic Claude・OpenAI GPT・Google Geminiなど、MAIAが呼び出すフロンティアモデルのAPI従量費用
-
Customization Studioによるファインチューニング費用
自社データでのモデル調整を選ぶ場合は、学習ジョブ分の計算コストが別途発生
GA後の料金プラン確定前に導入検討を進める企業では、無料ベータ期間中にPoCを回し、GA時の単価が発表され次第、年次契約の判断に移るという進め方が現実的です。
他のチーム向けAIエージェントとの違い
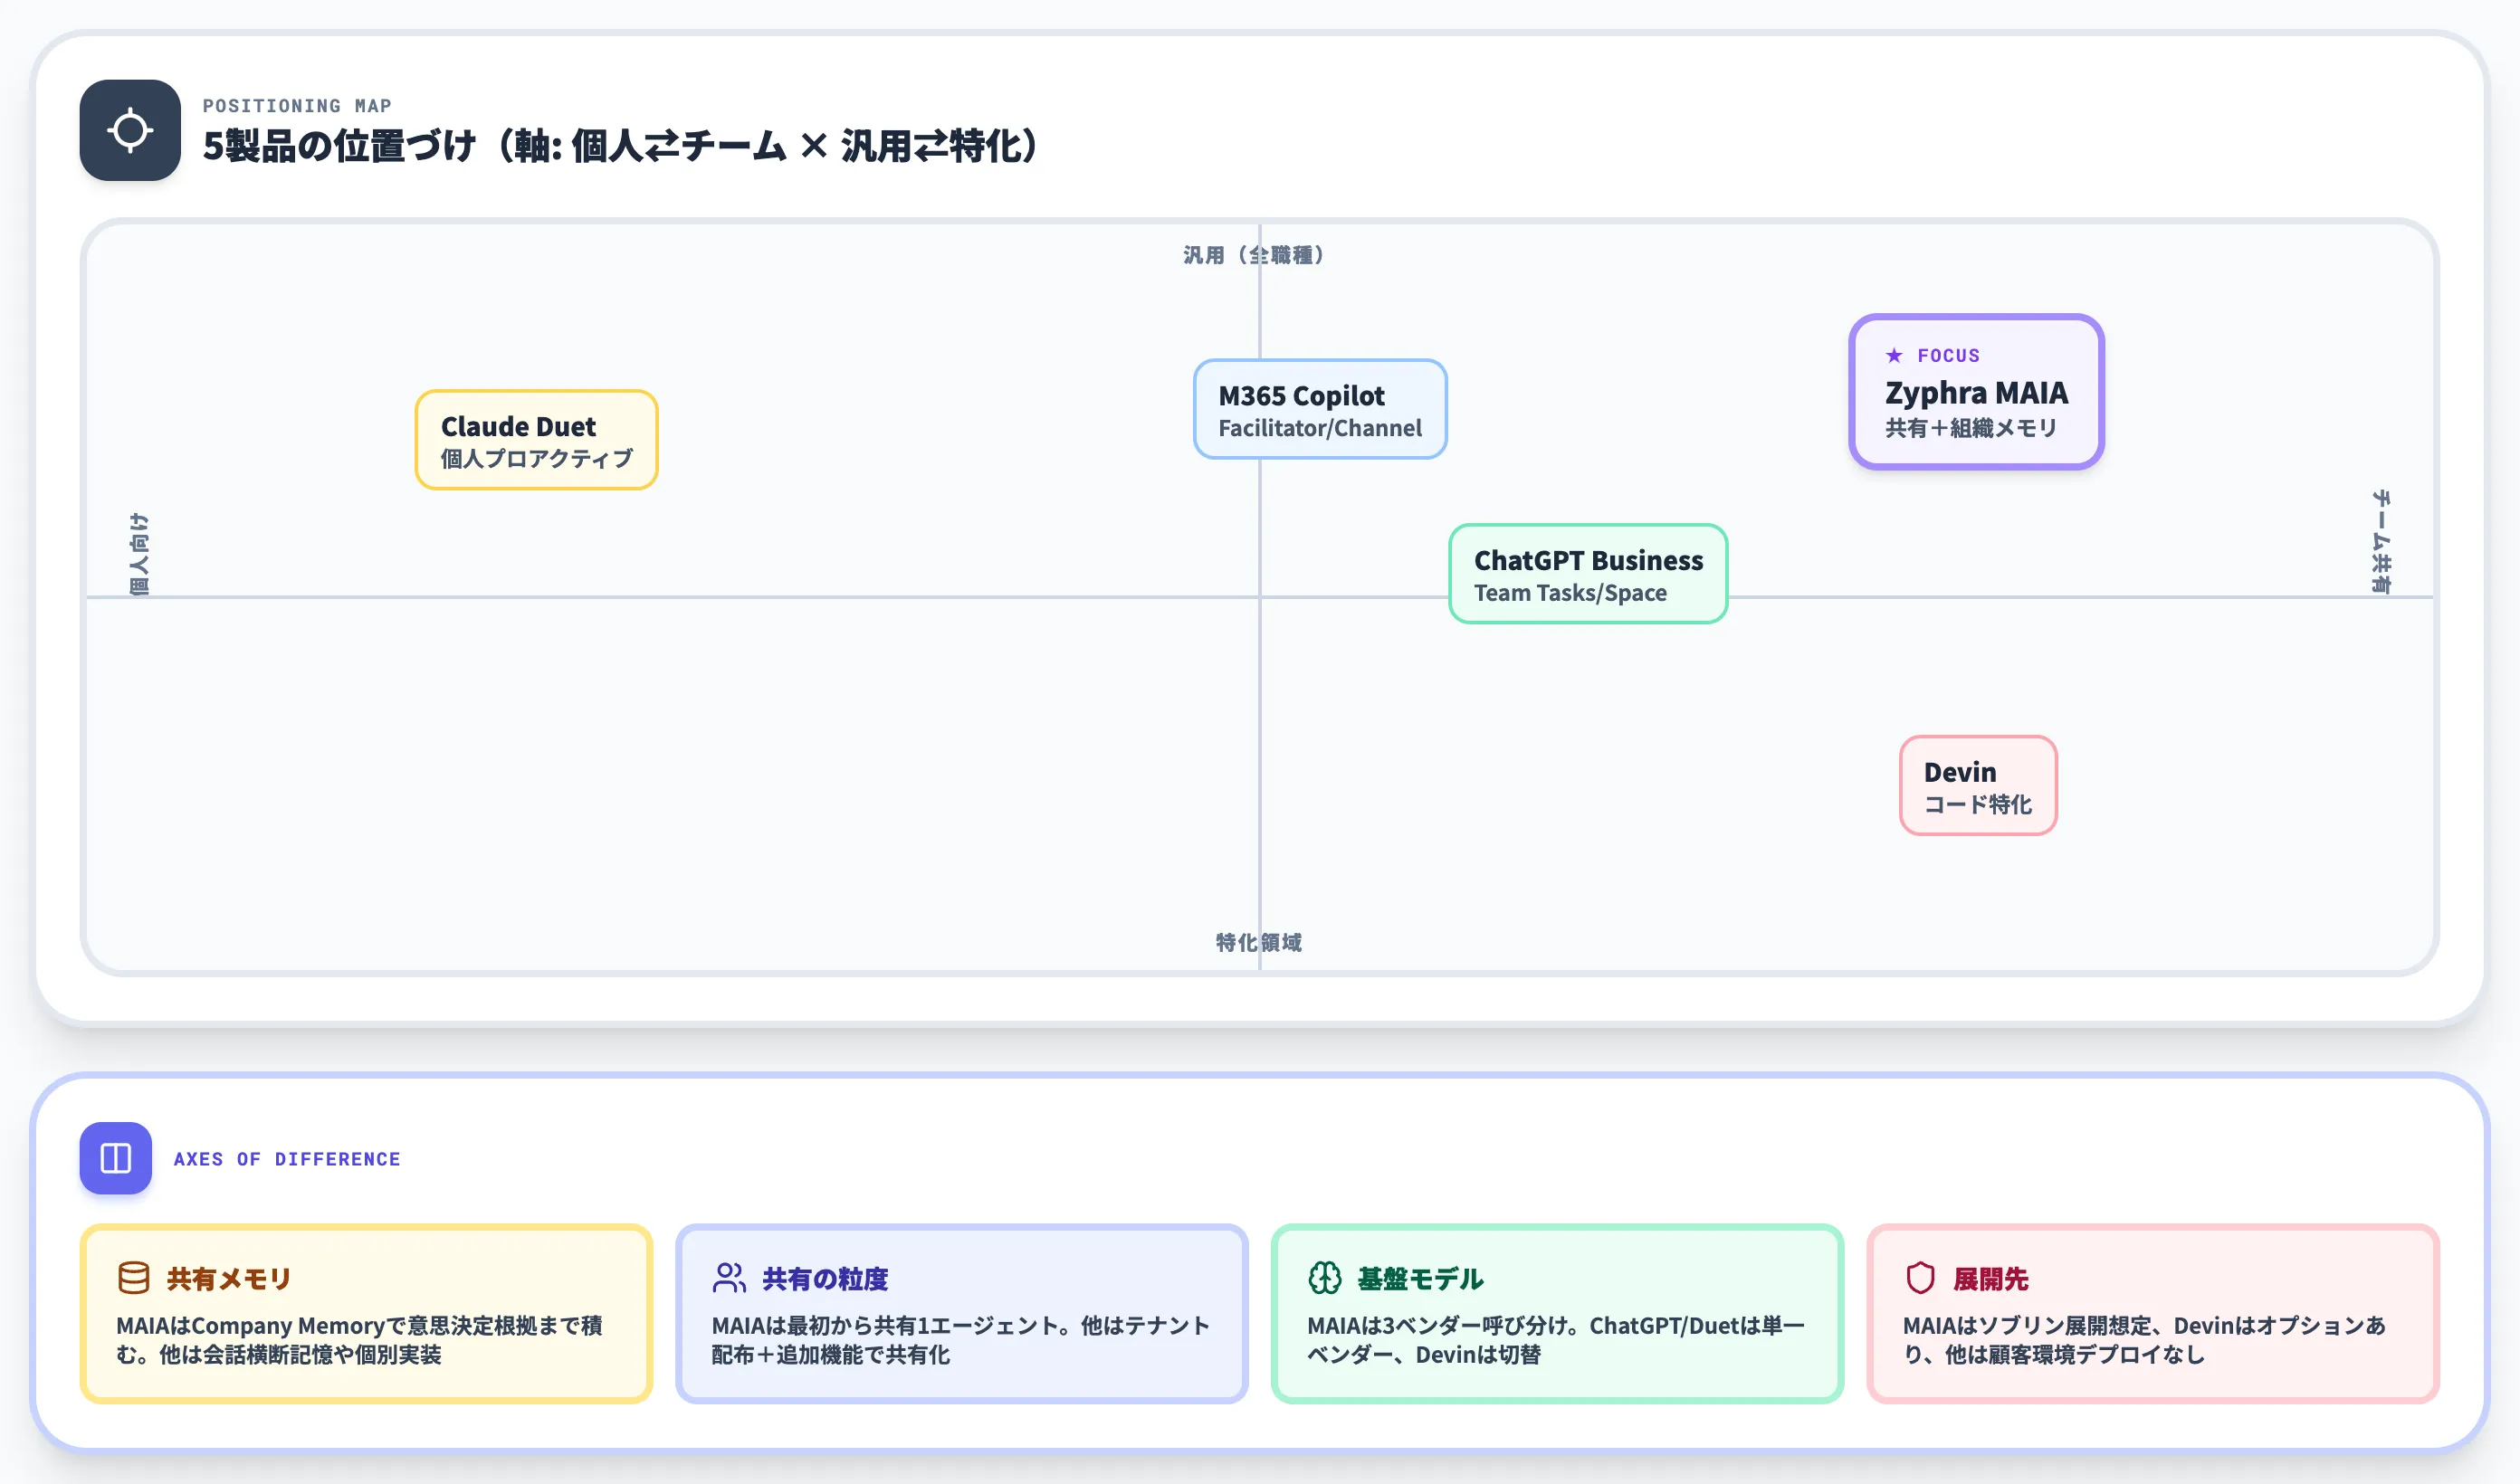
MAIAと似たポジションを狙う製品はすでに複数あります。ここでは主要4製品との違いを整理します。
先に全体像をまとめた比較表を示します。
| 項目 | Zyphra MAIA | ChatGPT Business/Enterprise | Claude Duet | Microsoft 365 Copilot | Devin |
|---|---|---|---|---|---|
| 設計思想 | 1エージェントをチームで共有+組織メモリ | 個人チャット+Team Tasksで共有自動化 | 個人向けプロアクティブ | 個人Copilot+Facilitator/Channel Agent | コーディング特化チームエージェント |
| 共有メモリ | Company Memoryで組織単位(意思決定の根拠まで) | ChatGPT Spaceとチーム共有タスク | 個人向け | ユーザー個別+共有エージェント範囲 | チームコードベース学習 |
| プロアクティブ | 定例ブリーフ・巡回レビュー | Team Tasksでスケジュール/イベント起動 | 本機能として実装 | 共有エージェント経由で定例化可能 | タスク継続実行 |
| 基盤モデル | Anthropic/OpenAI/Googleを外部呼び出し | OpenAIクローズド | Claude Opus 5.5固定 | GPT系+Microsoft独自モデル | 複数LLMの切替 |
| インフラ | AWS(Slack版は us-west-2) | Microsoft Azure中心 | Anthropicの運用環境 | Microsoft Azure | 複数クラウド |
| 顧客環境デプロイ・データ統制 | Enterpriseで顧客ソブリン環境へ展開想定(ZCSは開発中) | 顧客環境へのデプロイなし、SSO/SCIM/監査統制で対応 | Pro/Max/Ultraのみ、Team/Enterprise未提供 | Microsoft Azureテナント内のアクセス境界分離、顧客環境デプロイなし | 顧客環境デプロイのオプションあり |
| 料金(2026/11時点) | ベータ無料(アクセス申請+日次上限) | Business 年払い$20/月払い$25、Enterprise要問合せ | Pro/Max/Ultra内に含む | $30/ユーザー/月(Microsoft 365上乗せ) | Teams $80/月+$40/dev seat、上限200名 |
比較で見えるのは、MAIAと他4製品は「同じエージェント製品カテゴリ」だが前提が別物という点です。順に見ていきます。
ChatGPT Business / ChatGPT Enterprise
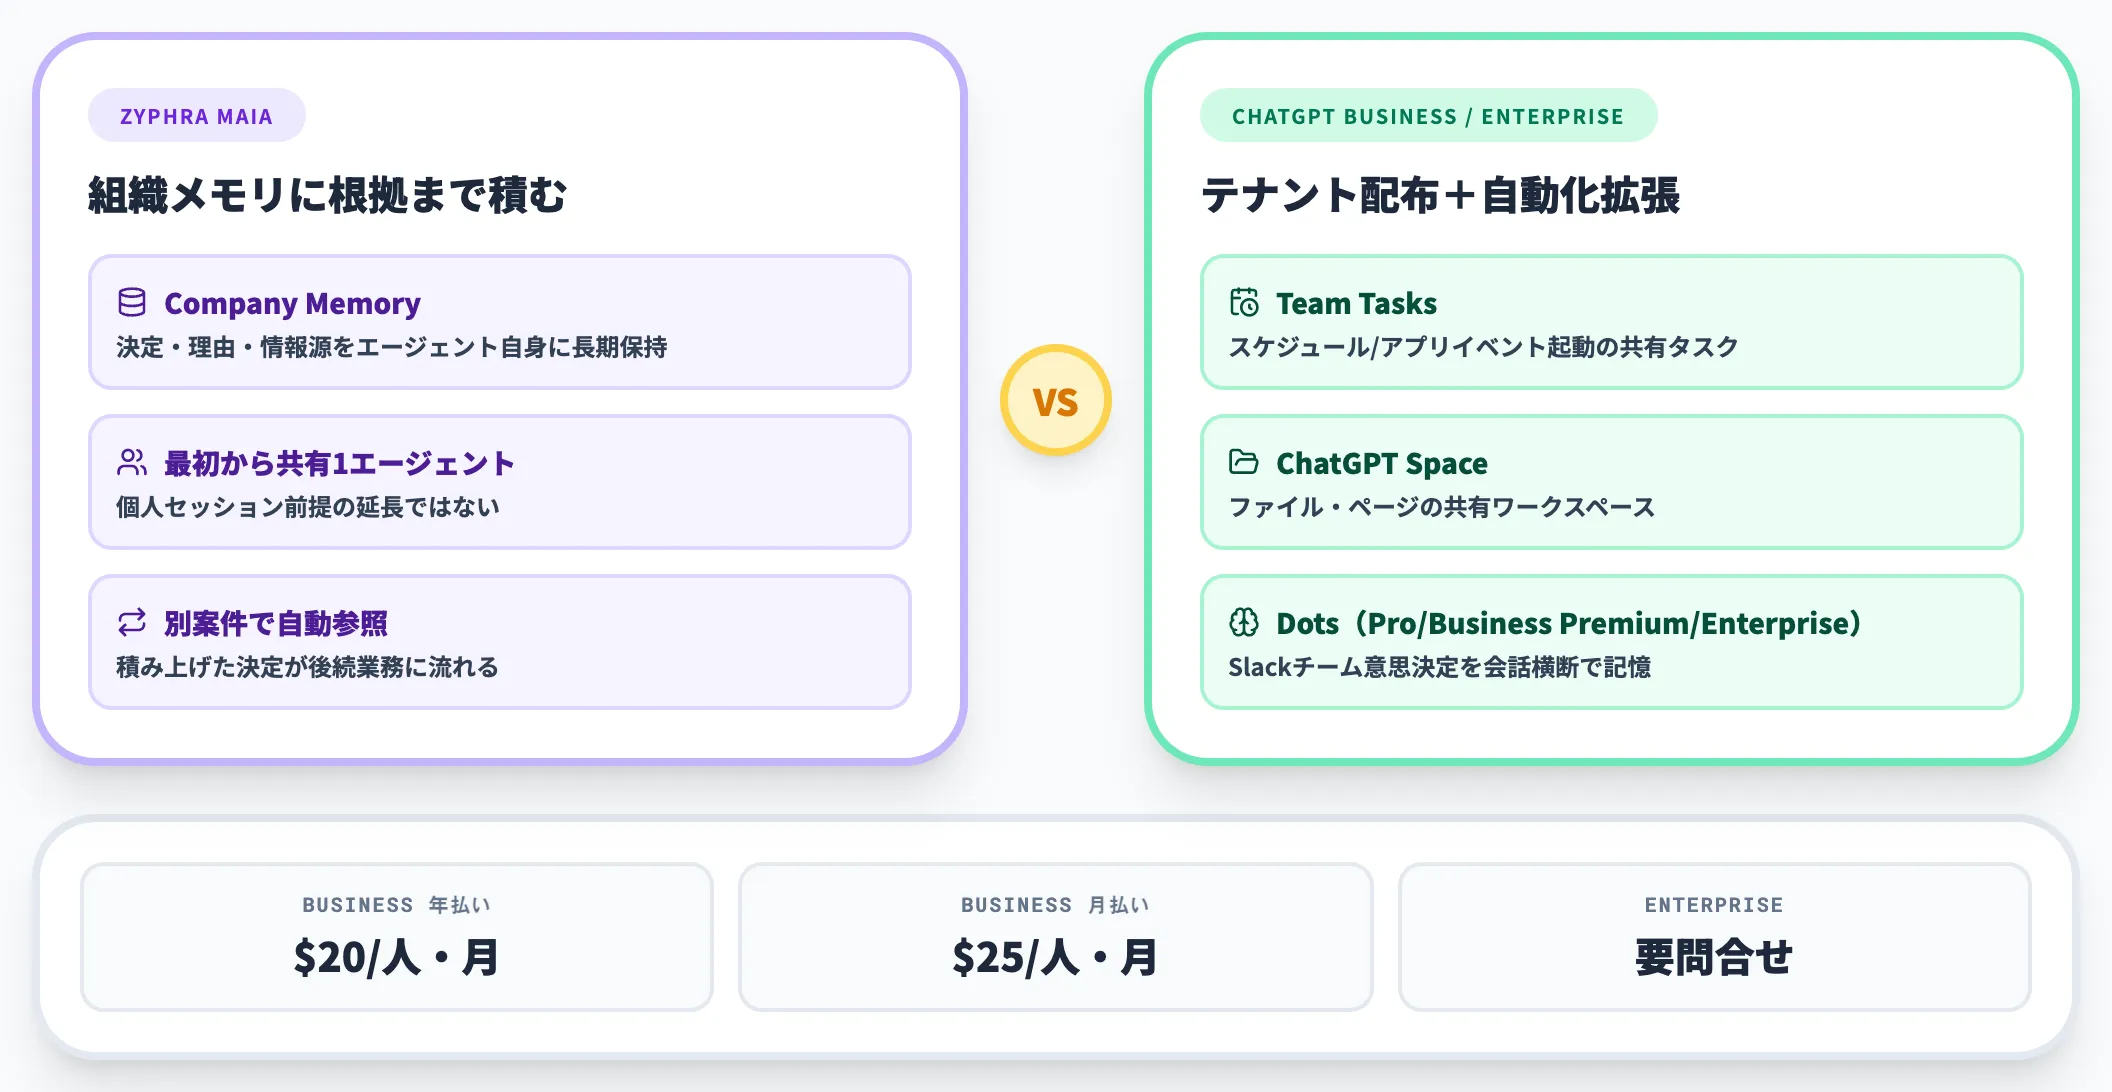
ChatGPT Business・ChatGPT Enterpriseは、個人ユーザー向けのChatGPTに「組織管理・SSO・データ分離・コネクタ連携」を加えたテナント配布型です。
2026年9月のOpenAI DevDayでTeam Tasks(チーム共有のスケジュール/アプリイベント起動タスク)とChatGPT Space(ファイル・ページの共有ワークスペース)が加わり、個人セッションだけに閉じていた従来構造から、チームでの自動化・情報共有へ機能が拡張されています。
料金はChatGPT Business年払い換算$20/人・月払い$25/人、Enterpriseは営業問い合わせです。
MAIAとの違いは、共有メモリが「意思決定の根拠と情報源まで保持するか」という深さにあります。
ChatGPT側もPro・Business Premium・Enterprise向けのDotsなどでSlack上のチーム意思決定を会話横断で記憶する機能を広げていますが、MAIAのCompany Memoryは組織の決定・その理由・参照情報源をエージェント自身の長期メモリに積み上げ、別メンバーが別案件を進めるときに自動参照させることを前提に設計している点で軸が違います。
Claude Duet
Claude 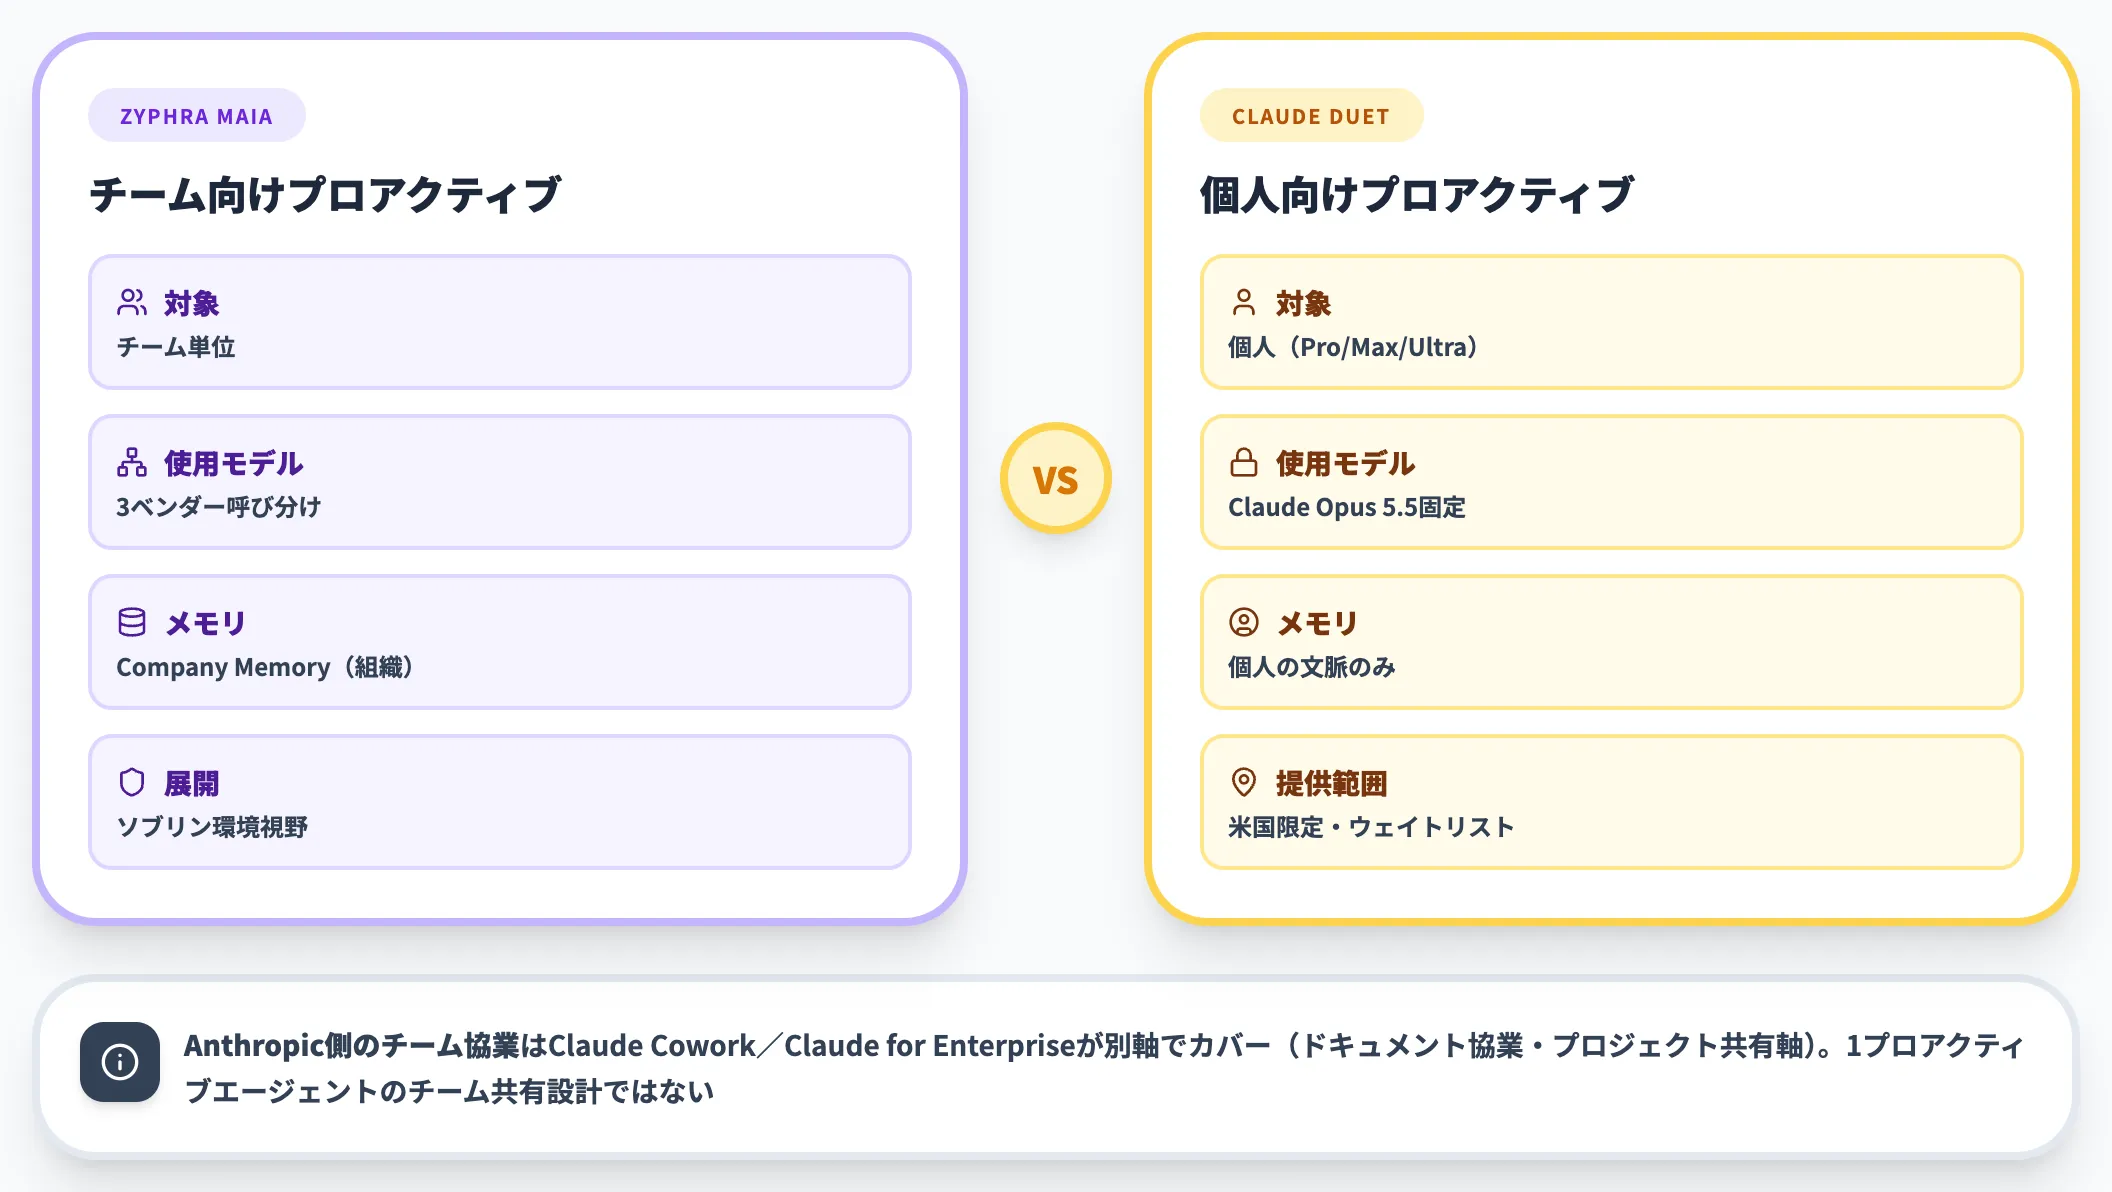
Duetは、Anthropicが2026年10月に発表したプロアクティブ型エージェントで、朝のブリーフや連携アプリの巡回を自律的に行う点ではMAIAと似たポジションを取ります。
ただしClaude Duetは個人向けとして設計されており、2026年11月時点の対象はClaude.aiのPro・Max・Ultra契約者、米国限定、ウェイトリスト経由。
使用モデルはClaude Opus 5.5固定で選択不可、Team/Enterpriseプランへの提供はありません。チーム共有メモリ・Dynamic Apps・ソブリン展開もDuetのプロダクトスコープには含まれません。
Anthropicのチーム協業はClaude CoworkやClaude for Enterprise側でカバーされますが、これらはドキュメント協業・プロジェクト共有の軸で、「1つのプロアクティブエージェントをチーム全員で操作する」設計ではありません。
Microsoft 365 Copilot
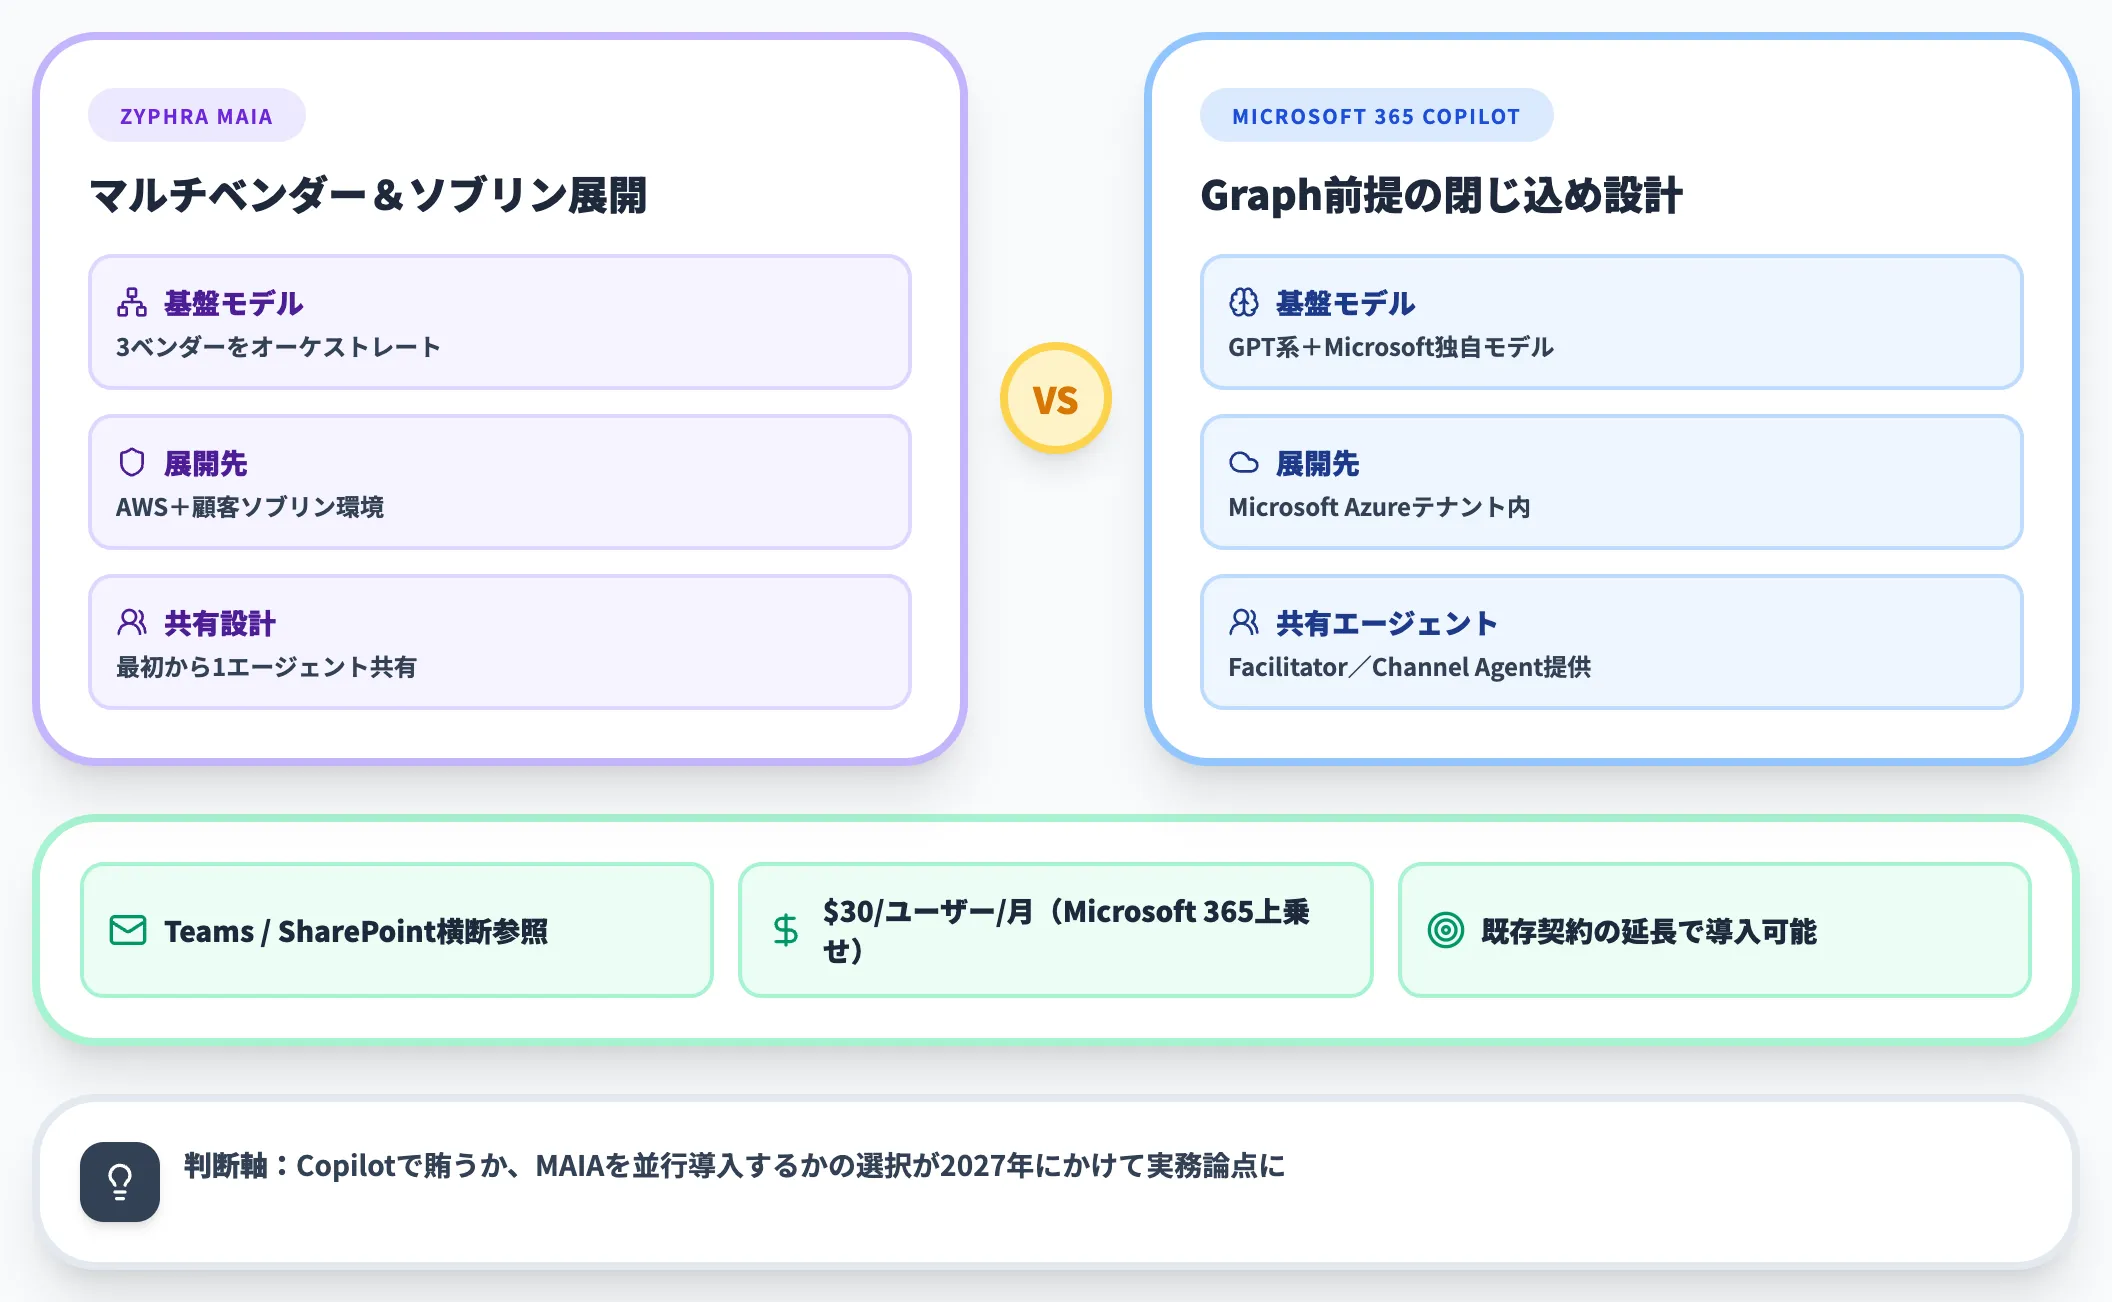
有料ライセンス付きのMicrosoft 365 CopilotはMicrosoft 365アプリに統合され、Microsoft Graphデータ(メール・ドキュメント・会議)を横断参照できます。
チーム共有エージェントについても、会議全員で同じエージェントとやり取りするFacilitator Agent、チャンネル全員が共有してプロジェクト管理・状況報告まで担うChannel Agentが公式に提供されており、「1エージェントをチームで操作する」軸自体はCopilot側にも存在します。
テナント内の情報統合という点ではMAIAより一歩進んでいる一方、Microsoft 365 Copilotの共有エージェントはGraph/Teams/SharePointを前提とした閉じ込め設計です。MAIAは単一ベンダーのクラウド・モデルに縛られず複数ベンダーのフロンティアモデルをオーケストレートする設計で、ソブリン展開まで視野に入れる点で立ち位置が違います。
Microsoft 365との既存契約がある企業にとっては、Copilotの共有エージェントで賄うか、MAIAのような別軸エージェントを並行導入するかの判断論点が、2027年にかけて出てきます。
Devin
Devinは、Cognition社が提供するコーディング特化のチーム向けAIエージェントです。
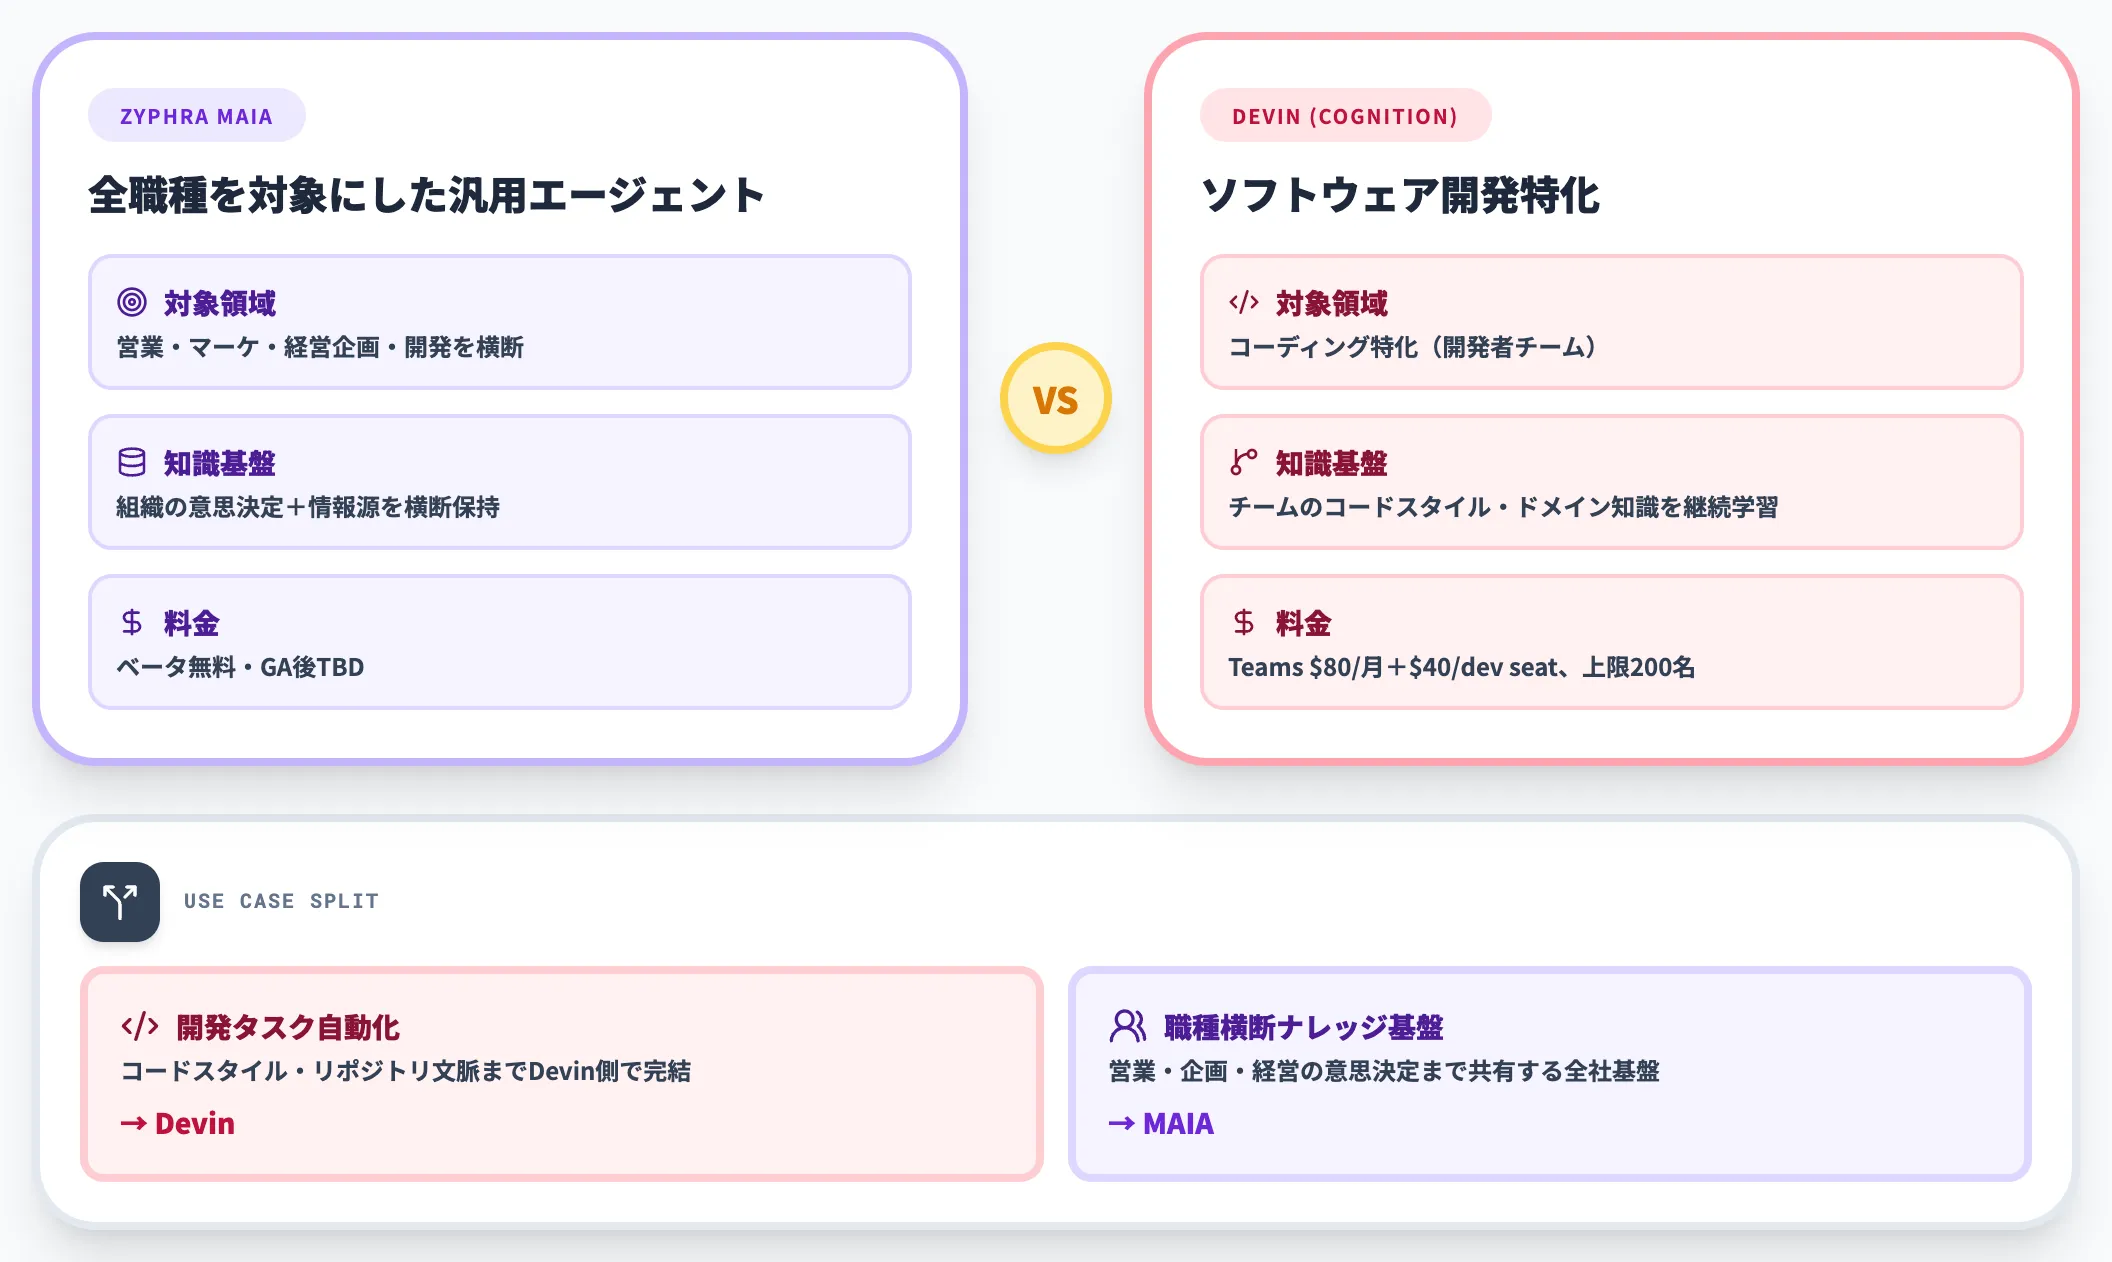
Devinの現行Teamsプランは月$80のチーム基本料金+フル開発者席あたり$40/月、上限200ユーザーまで(Pro全機能+共有・協業・一元管理・分析・優先サポート付き)。継続学習でチームのコードスタイル・ドメイン知識を蓄積し、MultiDevin機能で複数エージェントを並行稼働させる仕組みも持っています。
ただしDevinはソフトウェア開発タスクに特化した設計で、営業・マーケ・経営企画などの一般業務には寄せていません。MAIAは汎用スーパーエージェントとして全職種を対象にしているため、利用シーンの重なりは「開発チームのナレッジ管理」などに限定されます。開発タスクの自動化だけが目的ならDevin、職種横断のチームナレッジ基盤を狙うならMAIA、という使い分けになります。
比較の結論を一言でまとめると、MAIAは「1つのエージェントをチームで共有+組織の意思決定根拠まで永続記憶」という軸でアーキテクチャを組んだ製品です。
既存契約(Microsoft 365 Copilot・ChatGPT Business等)にもチーム共有機能は広がっており、設計思想の違いを把握した上で、既存契約の延長で済ませるか、別軸のMAIAを並行検討するかの判断軸が現時点では実務的です。
Zyphra MAIA導入検討で見落とされやすい3つの観点
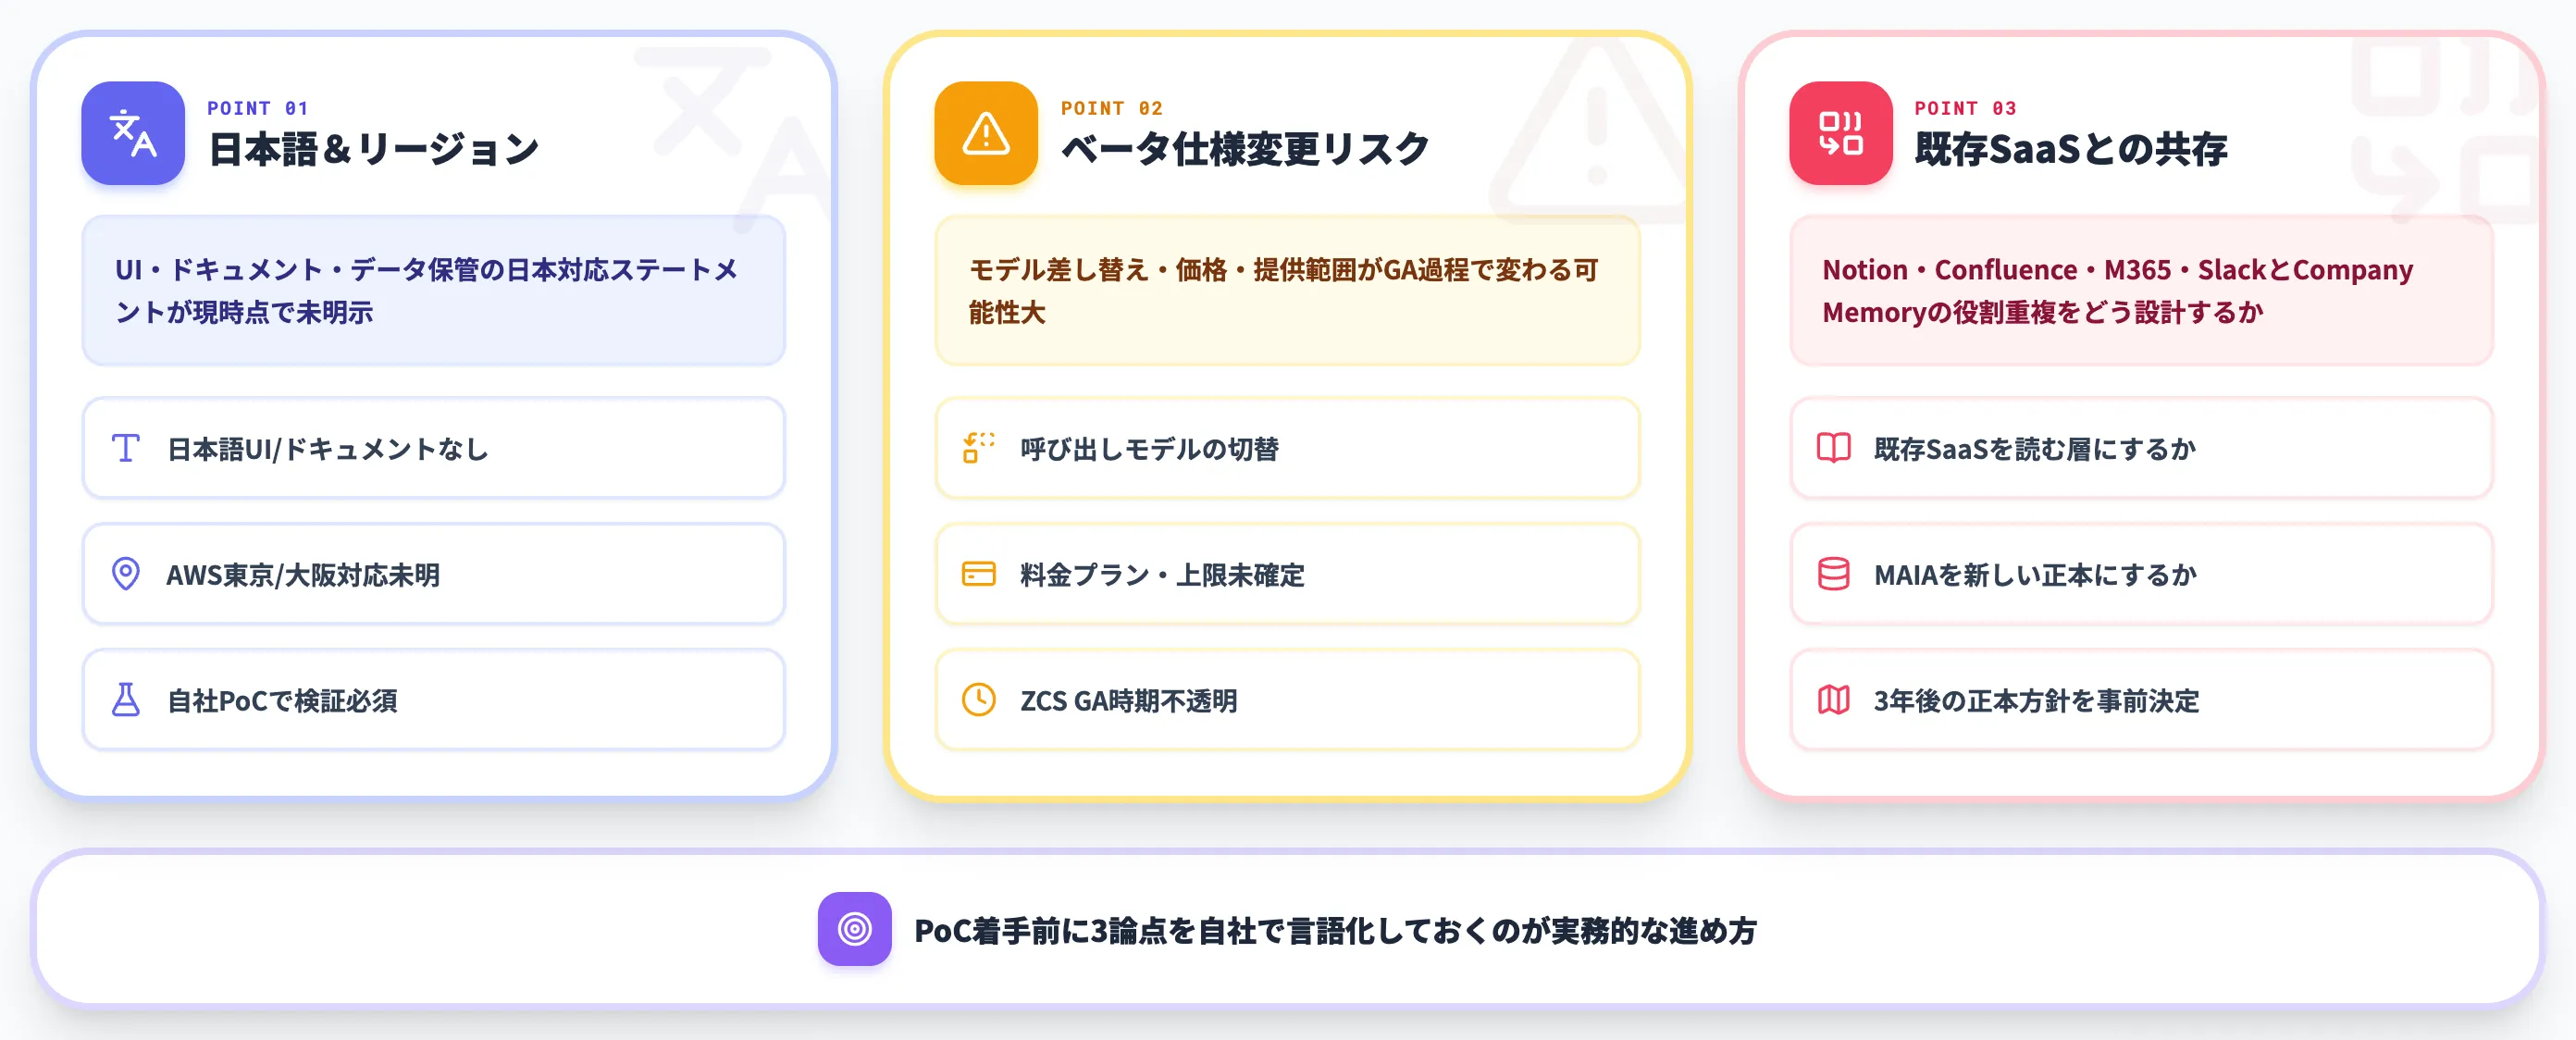
ここまで機能・技術・比較を見てきましたが、実際の導入検討に入ると公式ページには明記されていない論点が複数出てきます。
国内企業がPoC段階で詰まるポイントは、主に次の3つに集約されます。
日本語対応と日本リージョンの状況
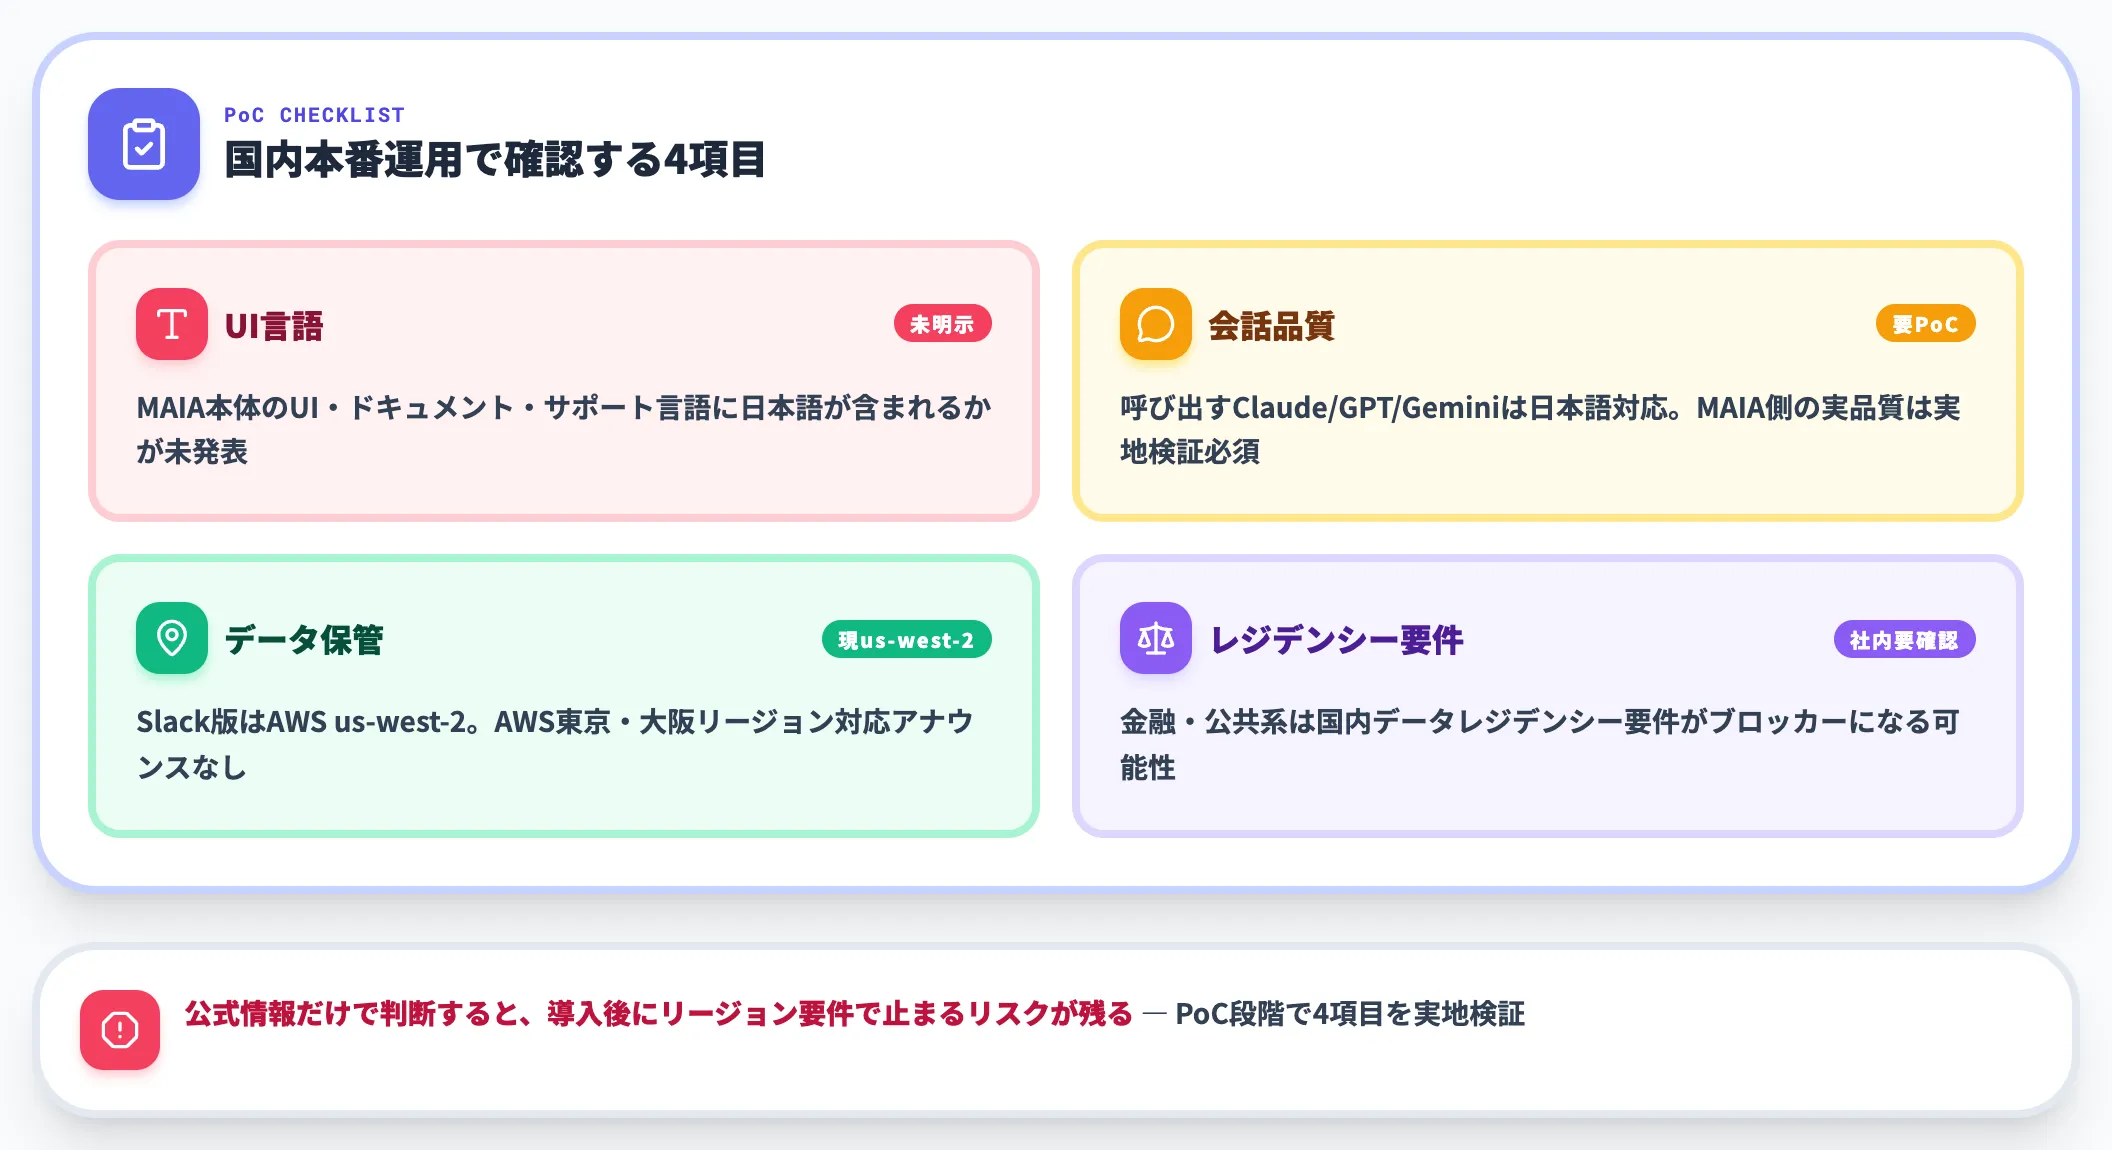
MAIAは英語インターフェースでベータ公開されており、日本語対応の公式ステートメントは2026年11月時点で見当たりません。
MAIAが呼び出すAnthropic Claude・OpenAI GPT・Google Gemini自体は日本語に対応していますが、MAIAのUI・ドキュメント・サポート言語に日本語が含まれるかは公式に明記されていません。バックエンドはAWSで動く設計で、Slack版のデータ保存先はAWS us-west-2。AWSの東京・大阪など日本国内リージョン対応や国内データレジデンシーに関するアナウンスは出ていません。
国内企業でMAIAを本番運用に載せる場合、日本語での会話品質と、データ保管リージョンの要件を自社でPoC検証することが前提になります。公式情報だけで判断すると、導入後にリージョン要件で止まるリスクが残ります。
ベータ段階の仕様変更リスク
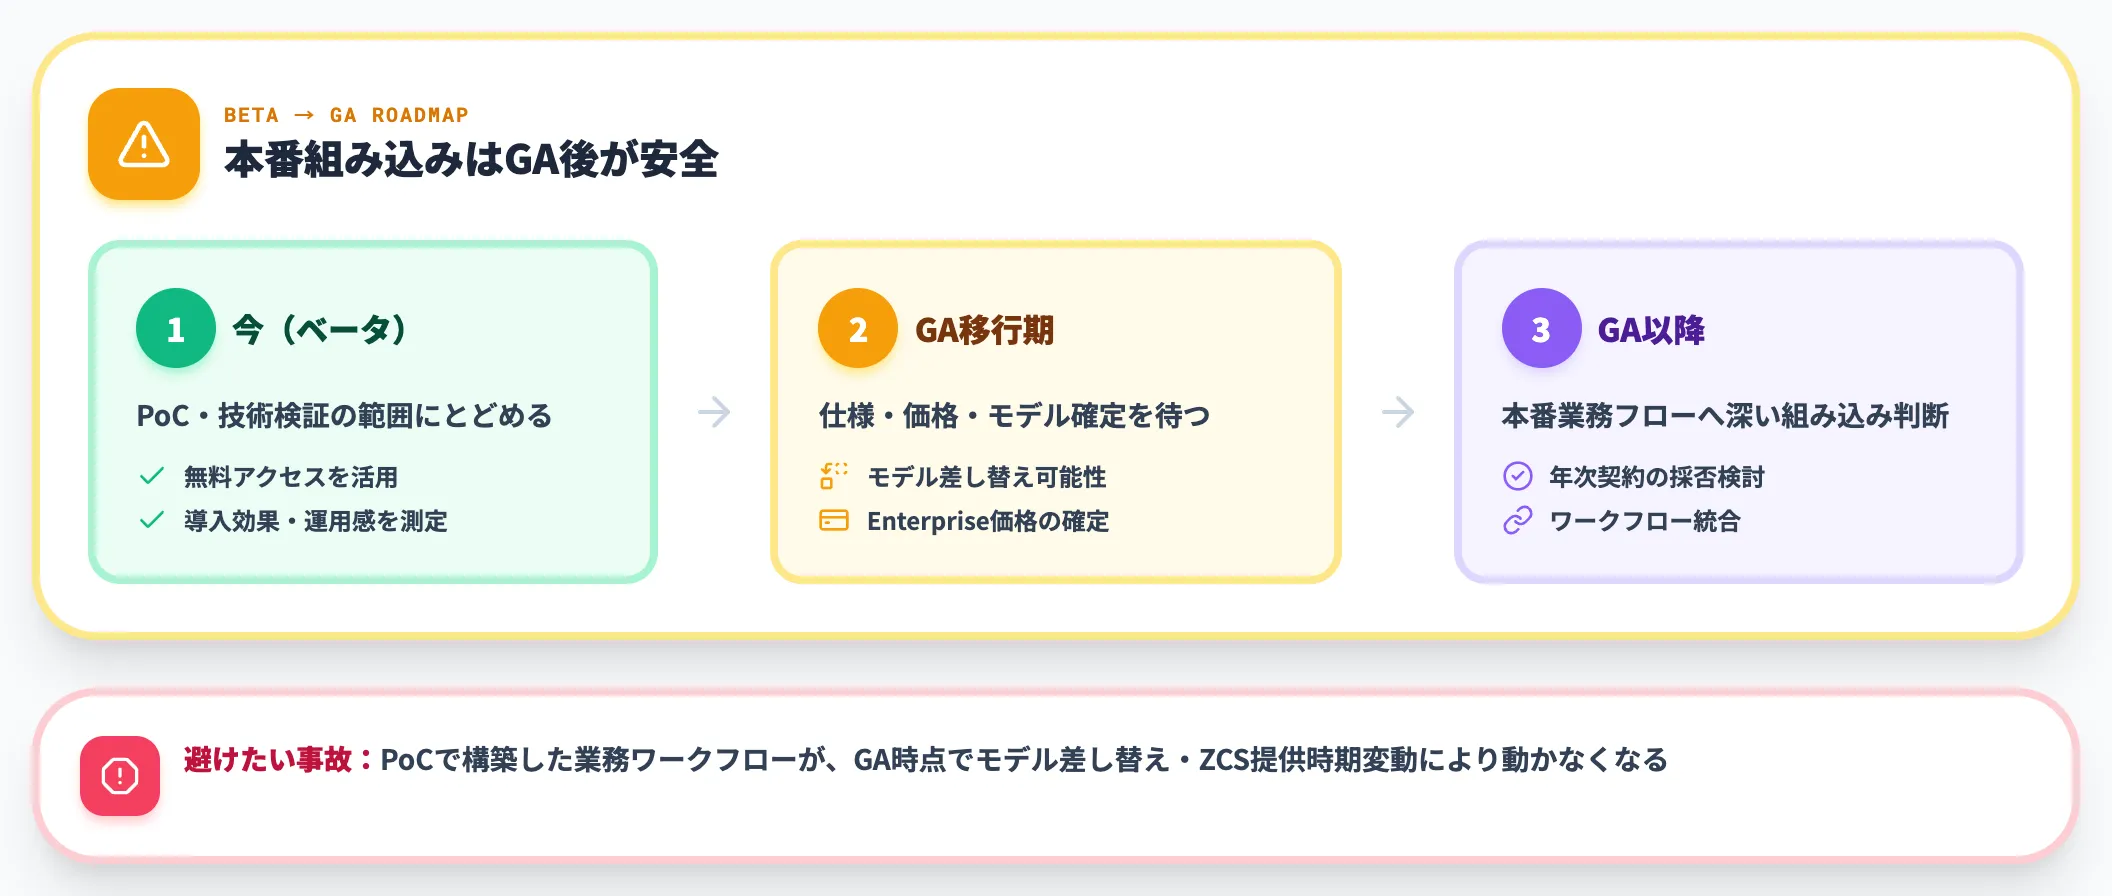
MAIAはベータ製品で、仕様・料金・提供範囲の変更が今後起こり得ます。
特に注意したいのはモデル差し替えのリスクです。MAIAは外部LLM(Anthropic/OpenAI/Google)を呼び出す構成のため、バックエンド側のモデル版アップデートや呼び出し先ベンダーの切り替えがGA過程で入る可能性があります。日次利用上限・Enterprise価格・ソブリン展開のZCS提供時期(現時点「In development」)も、今後の発表次第で変わります。
PoCで構築した業務ワークフローがGA時点で動かなくなる事故を避けるには、ベータ期間中の運用はPoC・技術検証の範囲にとどめ、本番業務フローへの深い組み込みはGA後に判断する設計が安全です。
既存のナレッジSaaSとの共存
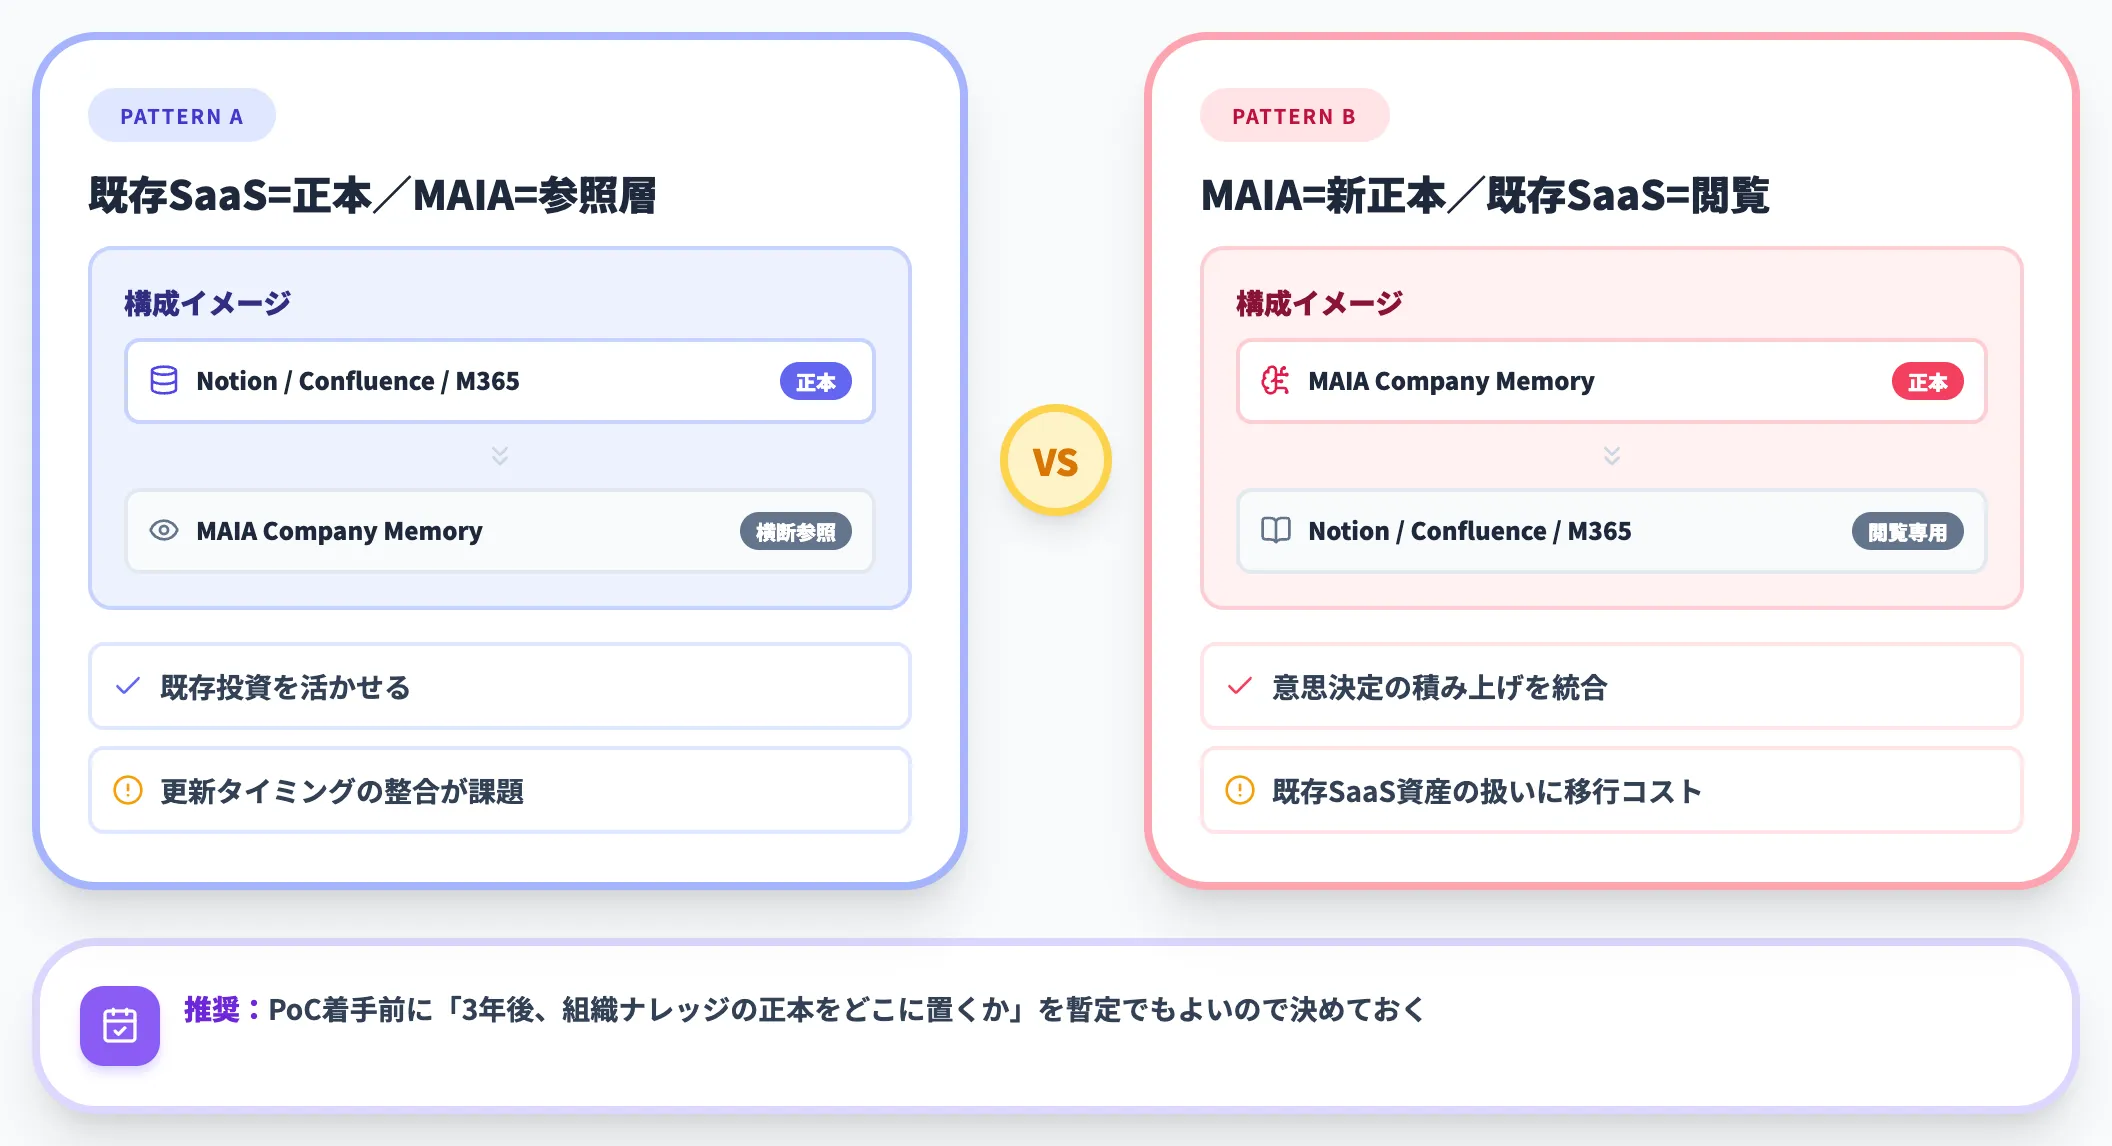
MAIAのCompany Memoryは、組織の意思決定を保持する新しい層を作り出します。これが既存のNotion・Confluence・Microsoft 365・SlackといったナレッジSaaSと役割が重なる領域です。
導入検討で見落としやすいのは、「既存SaaSの情報をMAIAが読む」運用にするのか、「MAIAが新しい正本になる」運用にするのかという正本設計です。前者ならMAIAはあくまで横断参照の層、後者なら既存SaaSは閲覧専用に落とす必要が出てきます。
AI総研の支援現場でも、エージェント導入時に既存ナレッジ基盤との役割分担を言語化できていない組織では、PoCの成果が本番運用で再現しないケースが散見されます。MAIA PoCに着手する前に、「3年後、組織ナレッジの正本をどこに置くか」の方針を暫定でもよいので決めておくことを推奨します。
MAIAで問われる正本の置き場所を、申請や請求書では基幹システムに据える
MAIAのCompany Memoryは組織の決定を記憶する新しい層になるため、組織ナレッジの正本を既存のSaaSとMAIAのどちらに置くかは、PoCに入る前に詰めておきたい論点です。経費の申請や請求書のように、元の記録がすでに基幹システムにある業務なら、エージェントには別の保管先を持たせず、今のシステムを読み書きする層として組み込めます。
同じエージェントを部署の全員がこの形で使えるようにするのが、Agentを自社のAzureテナントの中に置き、今ある業務データとつなぐ基盤です。AI総合研究所のAI Agent Hubでは、バックオフィスの業務特化Agentに、社員がTeamsから仕事を頼めます。
- データは写しを作らずに読む
ERPやSharePointのデータはFabric OneLakeで仮想統合して参照するため、エージェント用の写しが二つ目の正本になる心配がありません。
- 処理の結果は基幹システムに書き込む
申請の内容は自動入力Agentが登録まで済ませるため、処理の結果がエージェントの側だけに残ることはありません。
- 判断の経緯を個人のチャットに閉じ込めない
Agentの処理と承認の履歴は自社のFabricにたまるため、どの申請がどの判断を経て通ったかを、部署の中で同じ記録から確認できます。
AI総合研究所の専任チームが、正本を動かさずにAgentへ渡せる業務を洗い出し、接続の設計から本番での運用まで支えます。
業務の正本を動かさずにAIへ渡す

データは写さず、経緯は自社に集める
MAIAの検討では組織ナレッジの正本をどこに置くかが問われますが、申請や請求書のように元の記録が基幹システムにある業務は、エージェントを読み書きの層として組み込めます。AI Agent Hubのサービスページでは、Fabric OneLakeでデータをつなぎ、Teamsから頼めるAgentが処理を進める仕組みを紹介しています。
まとめ
本記事では、Zyphra MAIAを「個人用に閉じていたAIエージェントを、複数人で共有して同時に操作する同僚として設計し直した製品」として整理し、個人用エージェントの運用問題・主要機能・技術構成・料金と提供形態・他のチーム向け製品との比較・国内企業が検討で詰まりやすい点を解説しました。
2026年11月時点で押さえておくべきポイントは次の3つです。
- 推論は外部のClaude・GPT・Geminiに任せる構成で、同じベンダーのモデルを切り替えるChatGPTとは逆の立ち位置をとる
- 日本語対応と国内リージョンについて公式の発表はなく、国内で本番に載せるには、会話の品質とデータを保存するリージョンの要件を自社で検証することが前提になる
- ベータ期間中は無料だが日次の利用上限があり、正式リリース後の課金プランと単価の発表はまだない
AI総合研究所では、MAIAの評価を、既存の共有機能で埋まらない部分に限って行います。
まずは、手元のChatGPTやCopilotの共有機能で、定例のブリーフや進み具合の共有が回っている業務と、回っていない業務を分けます。
続いて、回っていない業務を選び、無料のベータでDynamic Appsやプロアクティブ動作を少人数のチームで試します。
裏側のモデルの版や呼び出し先がGAまでに入れ替わる場合に備え、業務の流れに深く組み込むかどうかは、正式版の仕様を見てから決めるのが安全です。
一人ずつにエージェントを入れると、依頼の重なりを人どうしで埋める同期の手間がかえって増えるという課題に、MAIAはアーキテクチャの段階から答えようとした先駆けです。