この記事のポイント
 Fable 5.1並みの性能を単価$4/$20(Opus 5比20%減)で提供するAnthropicの新フラグシップ
- キャッシュ読み出し$0.20(Opus 5比60%減)で長時間動くエージェントほどコスト圧縮が効く構造
- コーディング常用の主軸はOpus 5.5、超長時間の自律運用はFable 5.1、Opus 5は移行整理が3世代の役割分担
- 拡張思考は常時オンで固定、サイバー領域はOpus 4.8・生物学と先端LLM領域はOpus 5へフォールバックし、Claude APIでは拒否処理またはフォールバック設定が必要
- モデルIDは「claude-opus-5-5」、Pro/Max/Team/EnterpriseとAWS Bedrock・Vertex・Foundryで即日利用可
Microsoft MVP・AIパートナー。LinkX Japan株式会社 代表取締役。東京工業大学大学院にて自然言語処理・金融工学を研究。NHK放送技術研究所でAI・ブロックチェーンの研究開発に従事し、国際学会・ジャーナルでの発表多数。経営情報学会 優秀賞受賞。シンガポールでWeb3企業を創業後、現在は企業向けAI導入・DX推進を支援。
Claude Opus 5.5(クロード・オーパス 5.5)は、Anthropicが2026年9月22日に投入したOpus 5の後継となる新フラグシップです。
Fable 5.1並みの性能を単価$4/$20(Opus 5比20%減)で提供し、コーディング・エージェント常用の主軸に据えやすい位置に落とし込まれました。
本記事では、性能・料金体系・拡張思考の常時オン化・Fable 5.1やOpus 5との使い分け・主要3クラウドでの使い方・移行で詰まる論点を、2026年9月時点の公式一次情報で整理します。
目次
Claude Opus 5.5とは?Fable 5.1並みの性能を4割安く提供する新フラグシップ
サイバーはOpus 4.8・生物学と先端LLMはOpus 5にフォールバック
Claude Opus 5.5とは?Fable 5.1並みの性能を4割安く提供する新フラグシップ
Anthropicが2026年9月22日に発表したClaude Opus 5.5(出典:Anthropic)
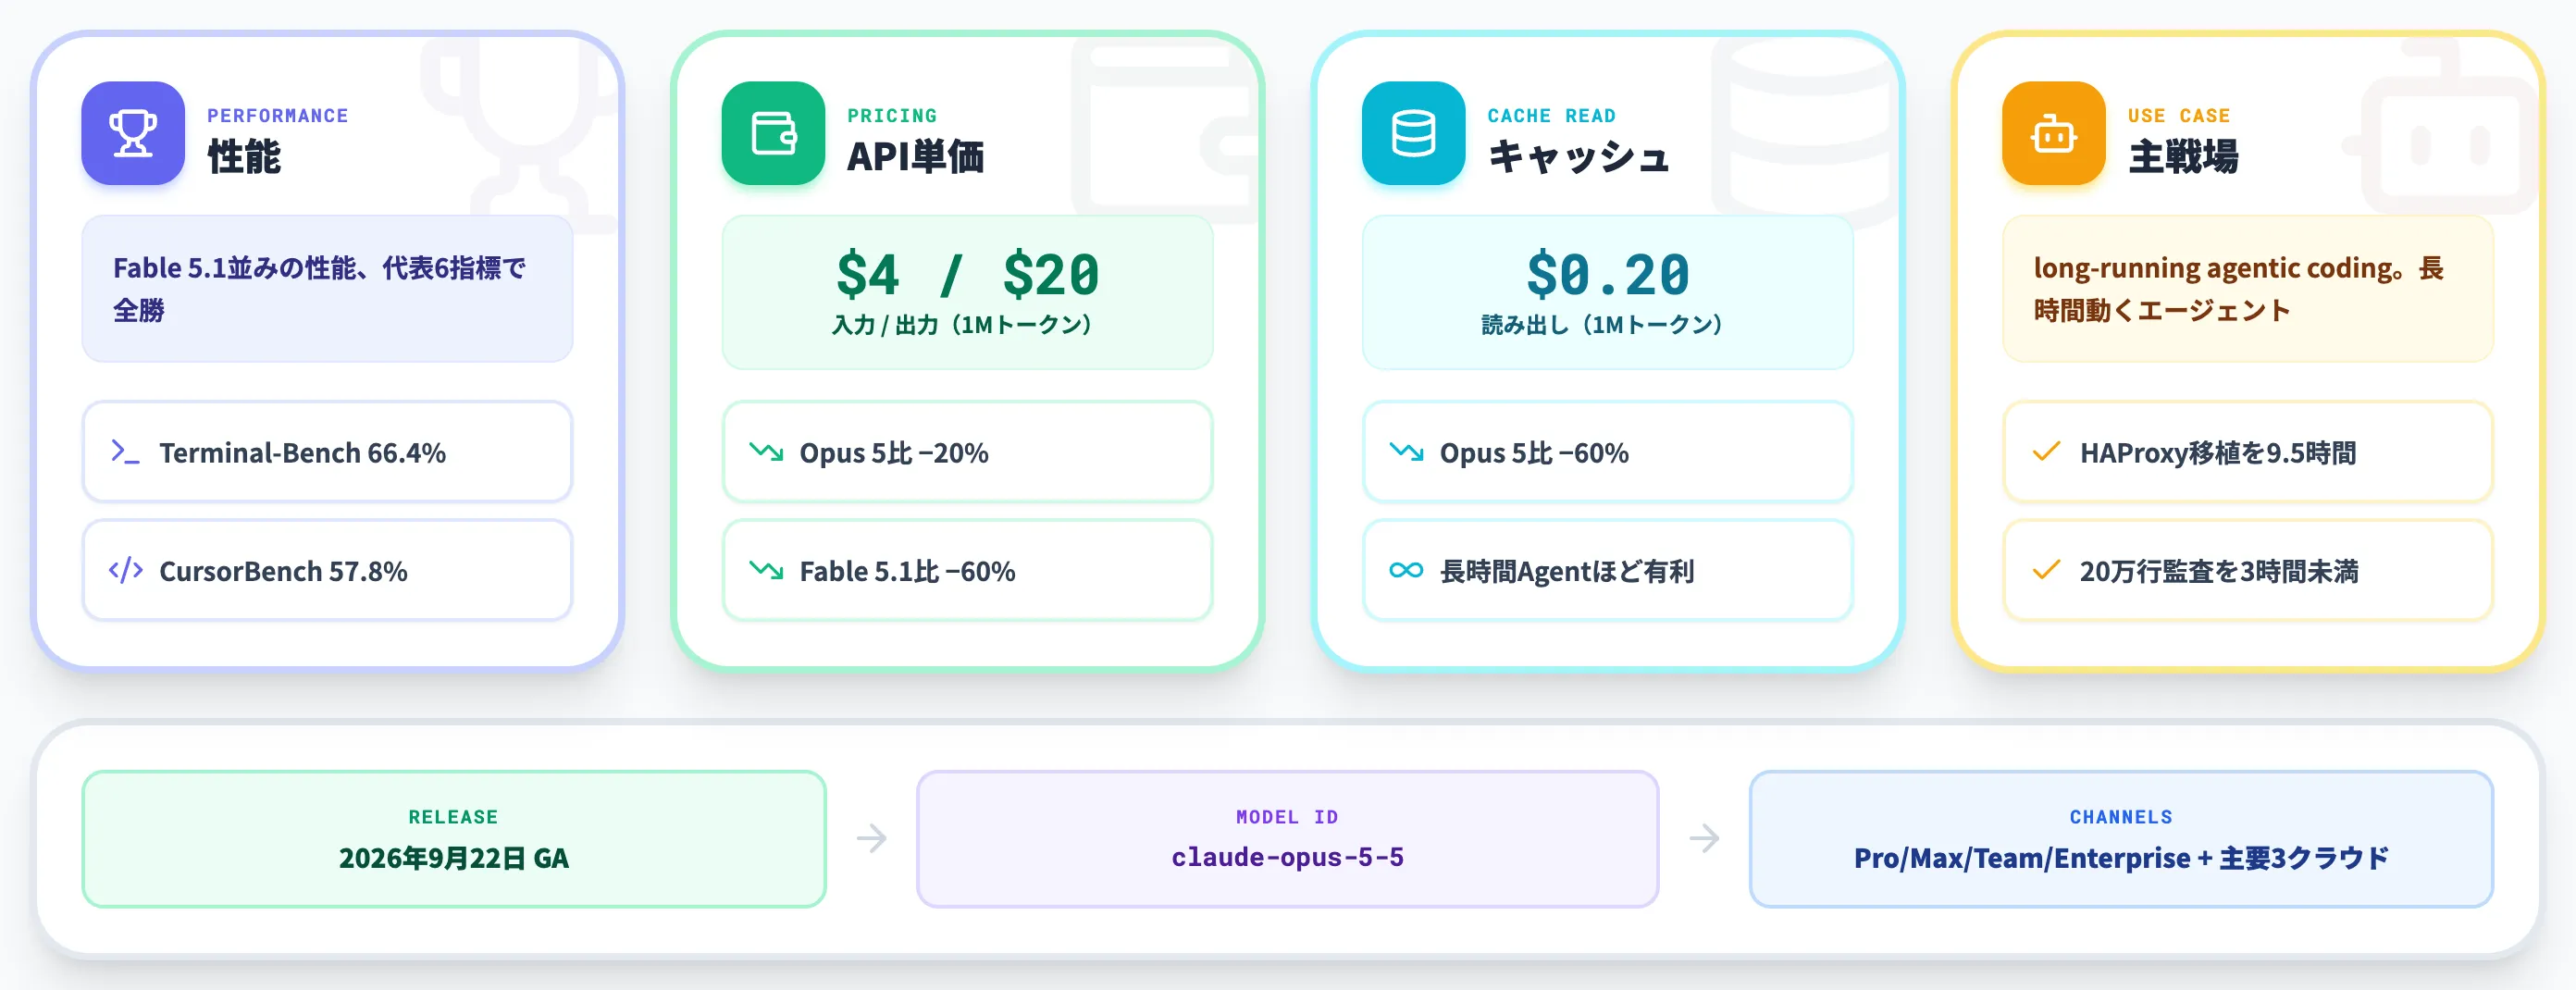
Claude Opus 5.5は、Anthropicの主力ライン「Opus」の最新世代です。2026年9月22日に公開され、AnthropicのフラグシップClaude Fable 5.1と同等の性能を、前世代Claude Opus 5から大幅に下げた単価で提供する位置づけです。
Opus 5.5は、「Fable 5.1に迫る知性を常用しても耐えられる単価に寄せてきた」1本で、長時間動くエージェントを主戦場とする世代交代となっています。
Claude Opus 5.5の料金体系
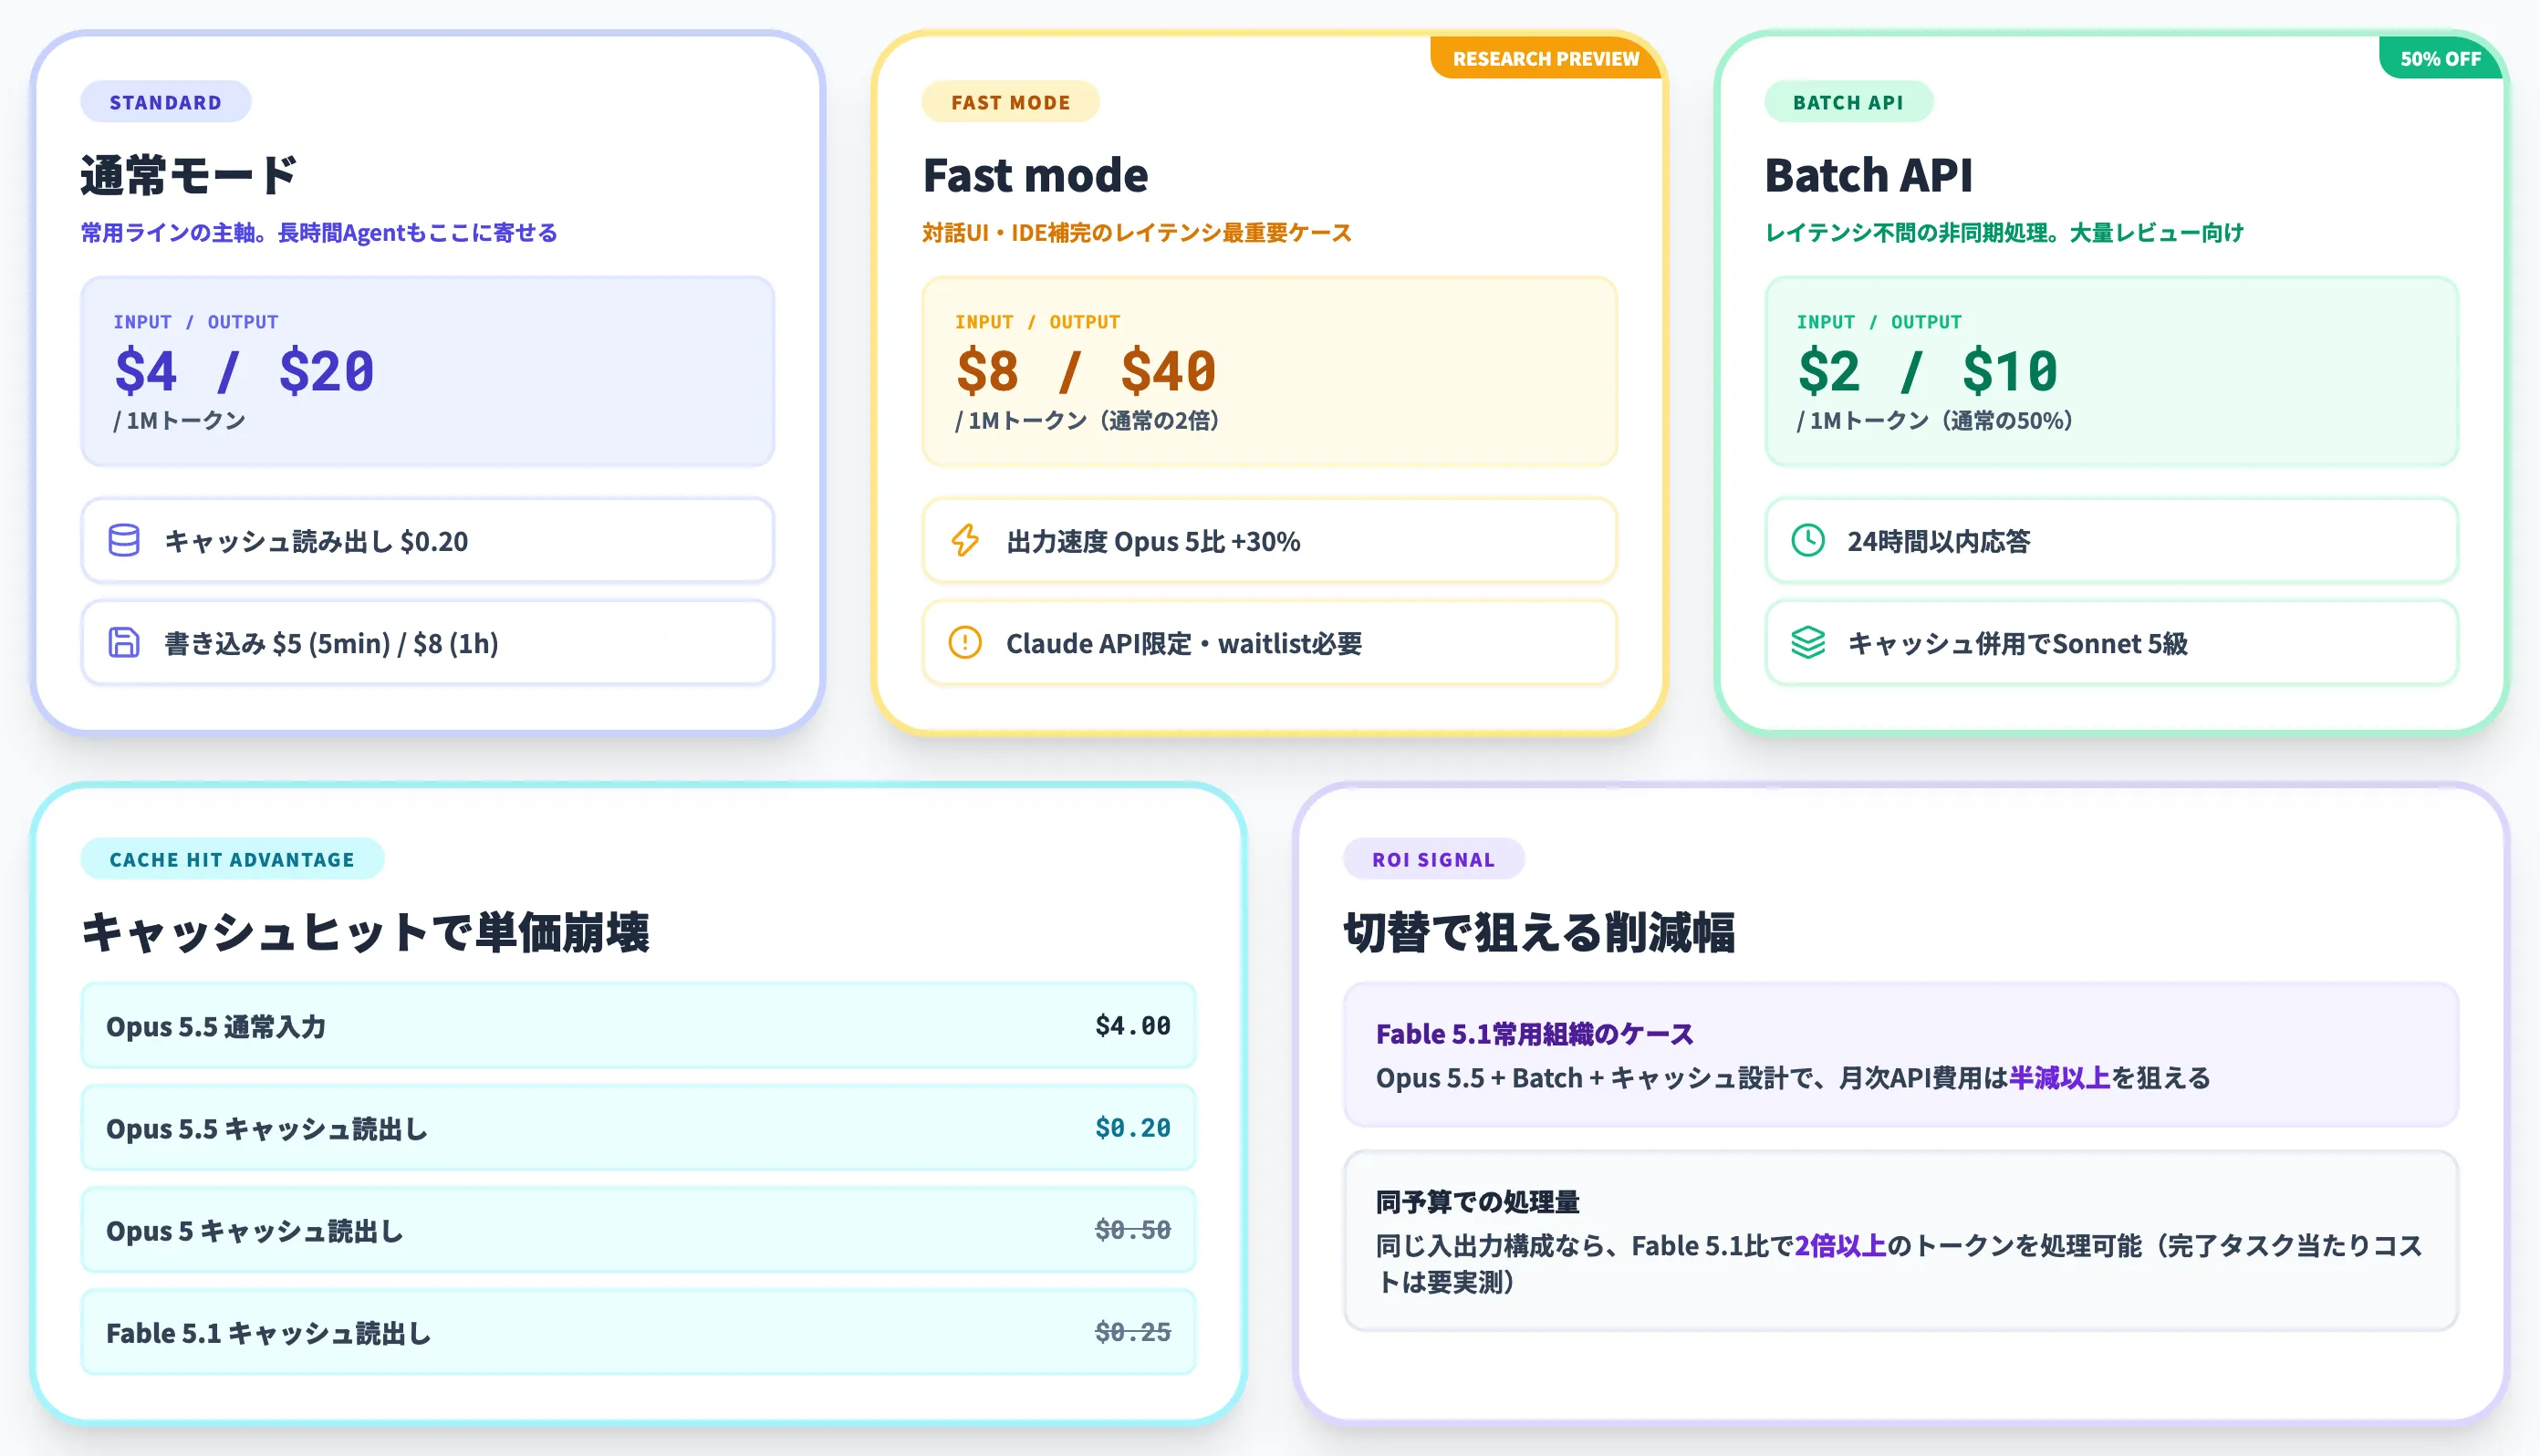
Claude Opus 5.5の料金は、Fable 5.1並みの性能を「常用可能な単価」に落とし込んだ点が最大の変化点です。本セクションでは、単価・キャッシュ・Fast mode・Batch APIまでAnthropic公式pricingの数値ベースで整理します。
基本単価はOpus 5から2割減、キャッシュは6割減
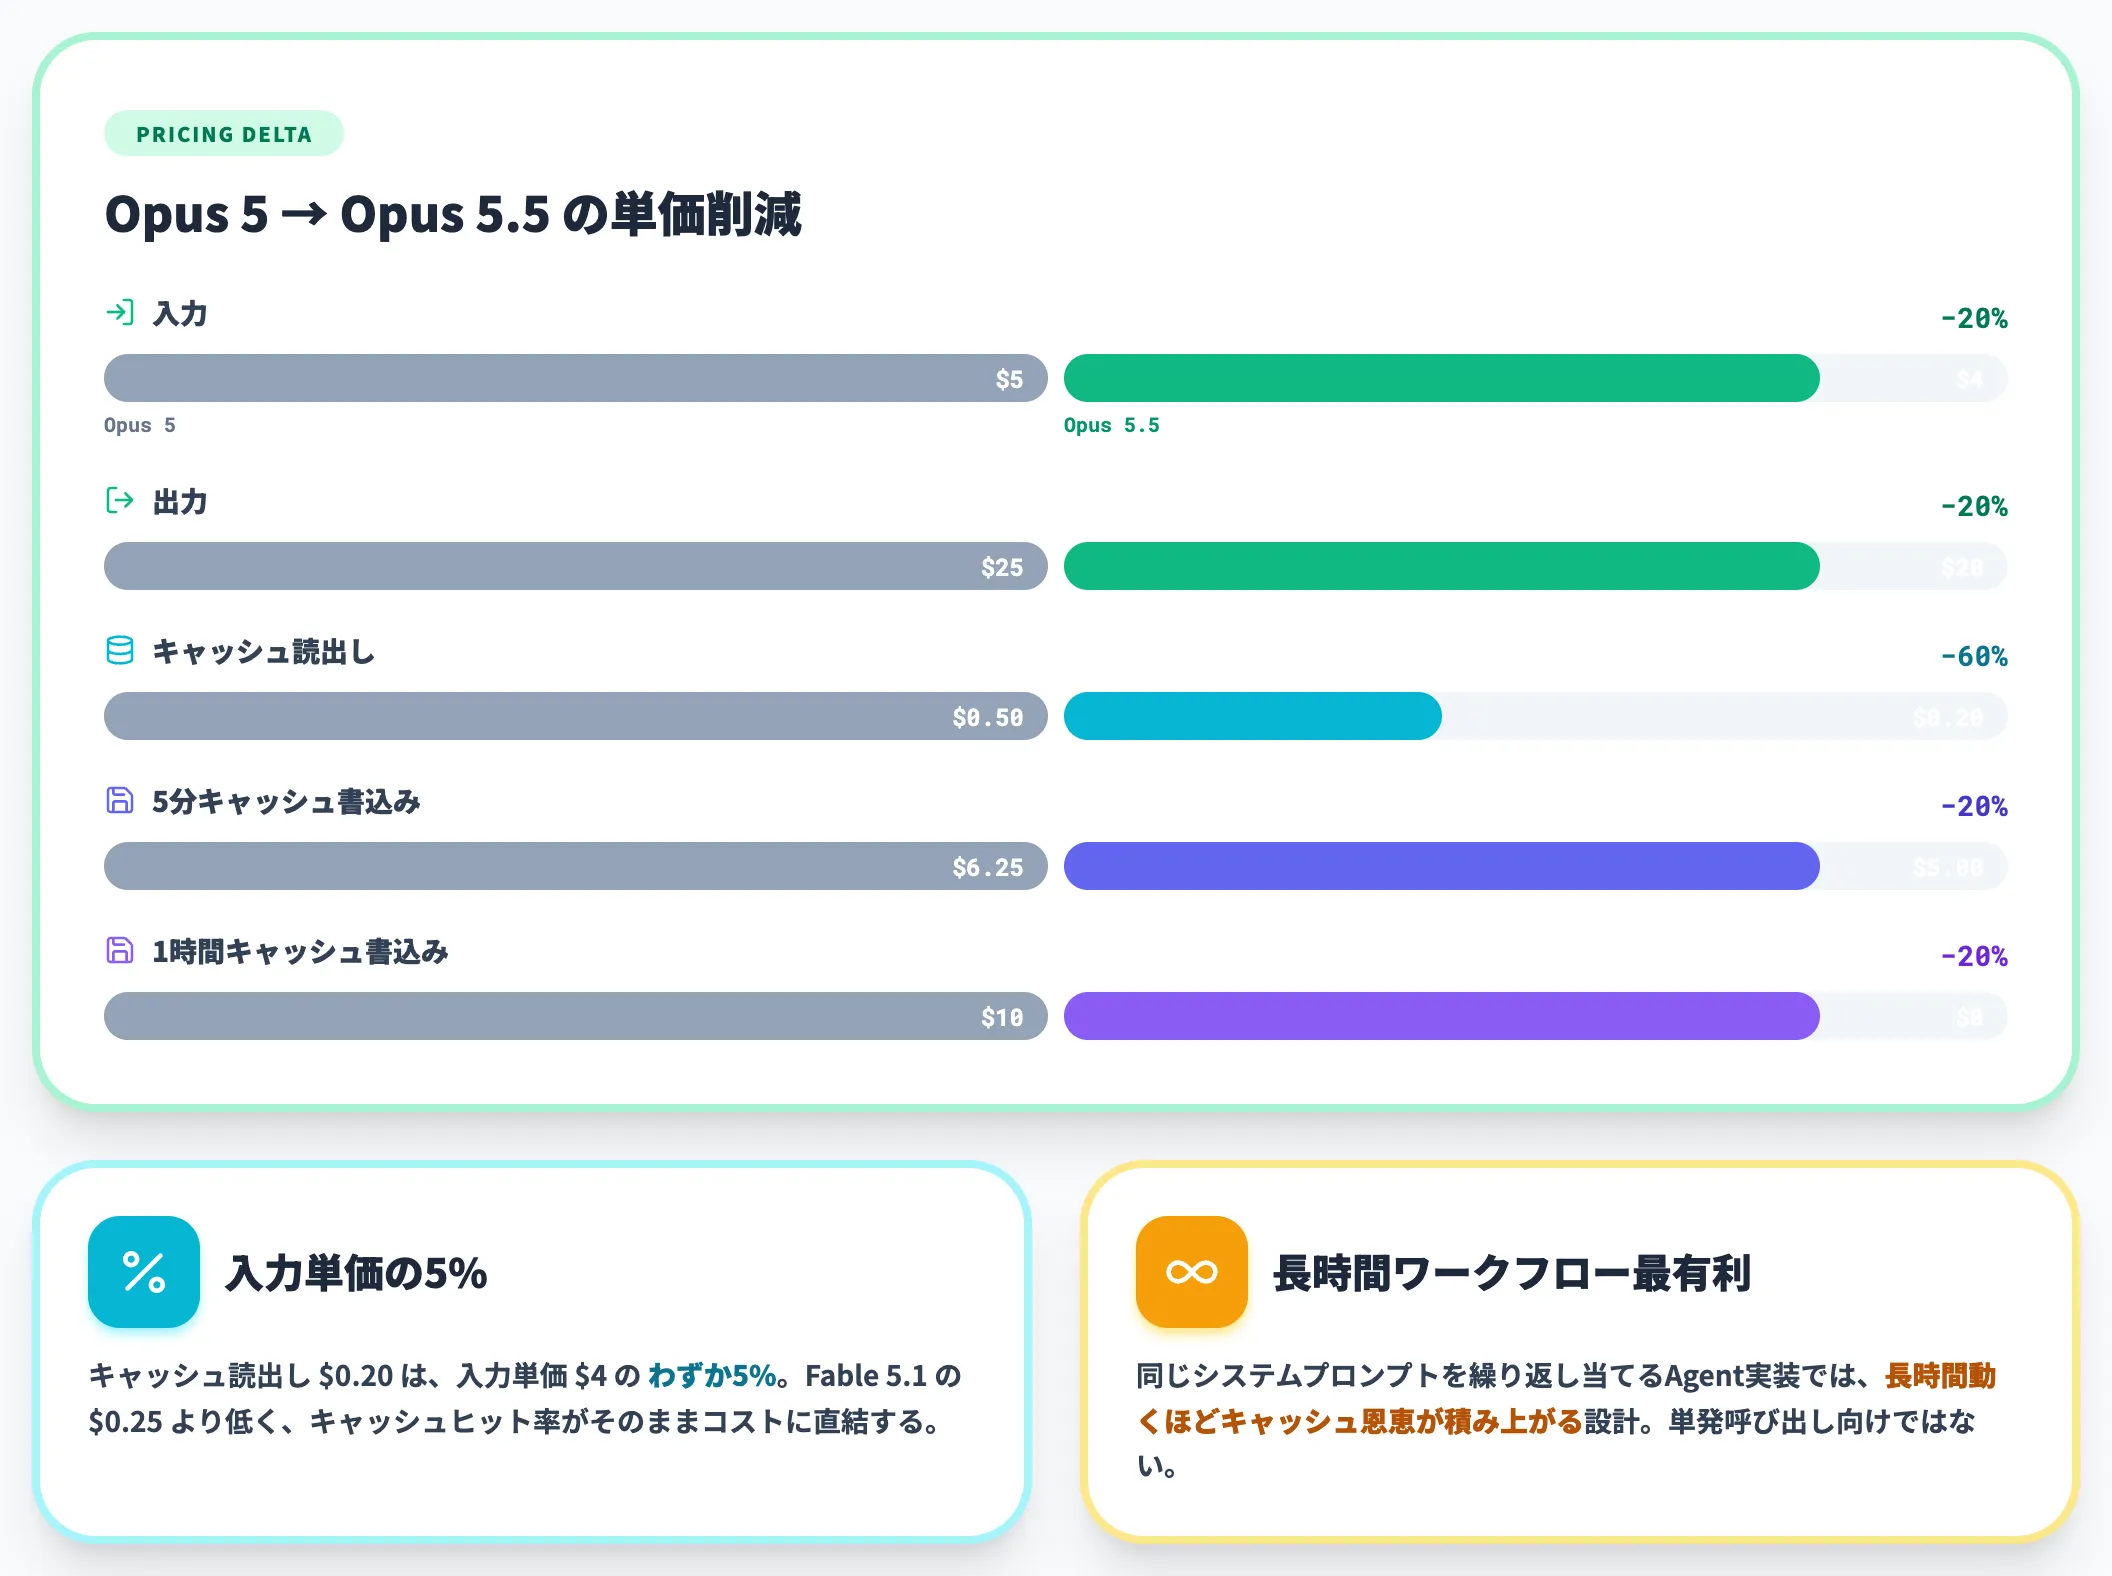
Anthropic公式pricing上、Claude Opus 5.5のAPI単価は以下のとおりです。
| 種別 | 単価(100万トークンあたり) | Opus 5との差分 |
|---|---|---|
| 入力 | $4 | -20%($5→$4) |
| 出力 | $20 | -20%($25→$20) |
| プロンプトキャッシュ読み出し | $0.20 | -60%($0.50→$0.20) |
| 5分プロンプトキャッシュ書き込み | $5 | -20%($6.25→$5) |
| 1時間プロンプトキャッシュ書き込み | $8 | -20%($10→$8) |
Claude Opus 5.5のキャッシュ読み出しは、入力単価の5%に相当する$0.20と、Opus 5からもFable 5.1($0.25)からも低い水準です。同じシステムプロンプトを繰り返し当てるエージェント実装ではキャッシュヒットの割合がそのままコストに直結するため、長時間動くワークフローほど恩恵が大きい構造になっています。
速度優先のFast modeは2倍単価
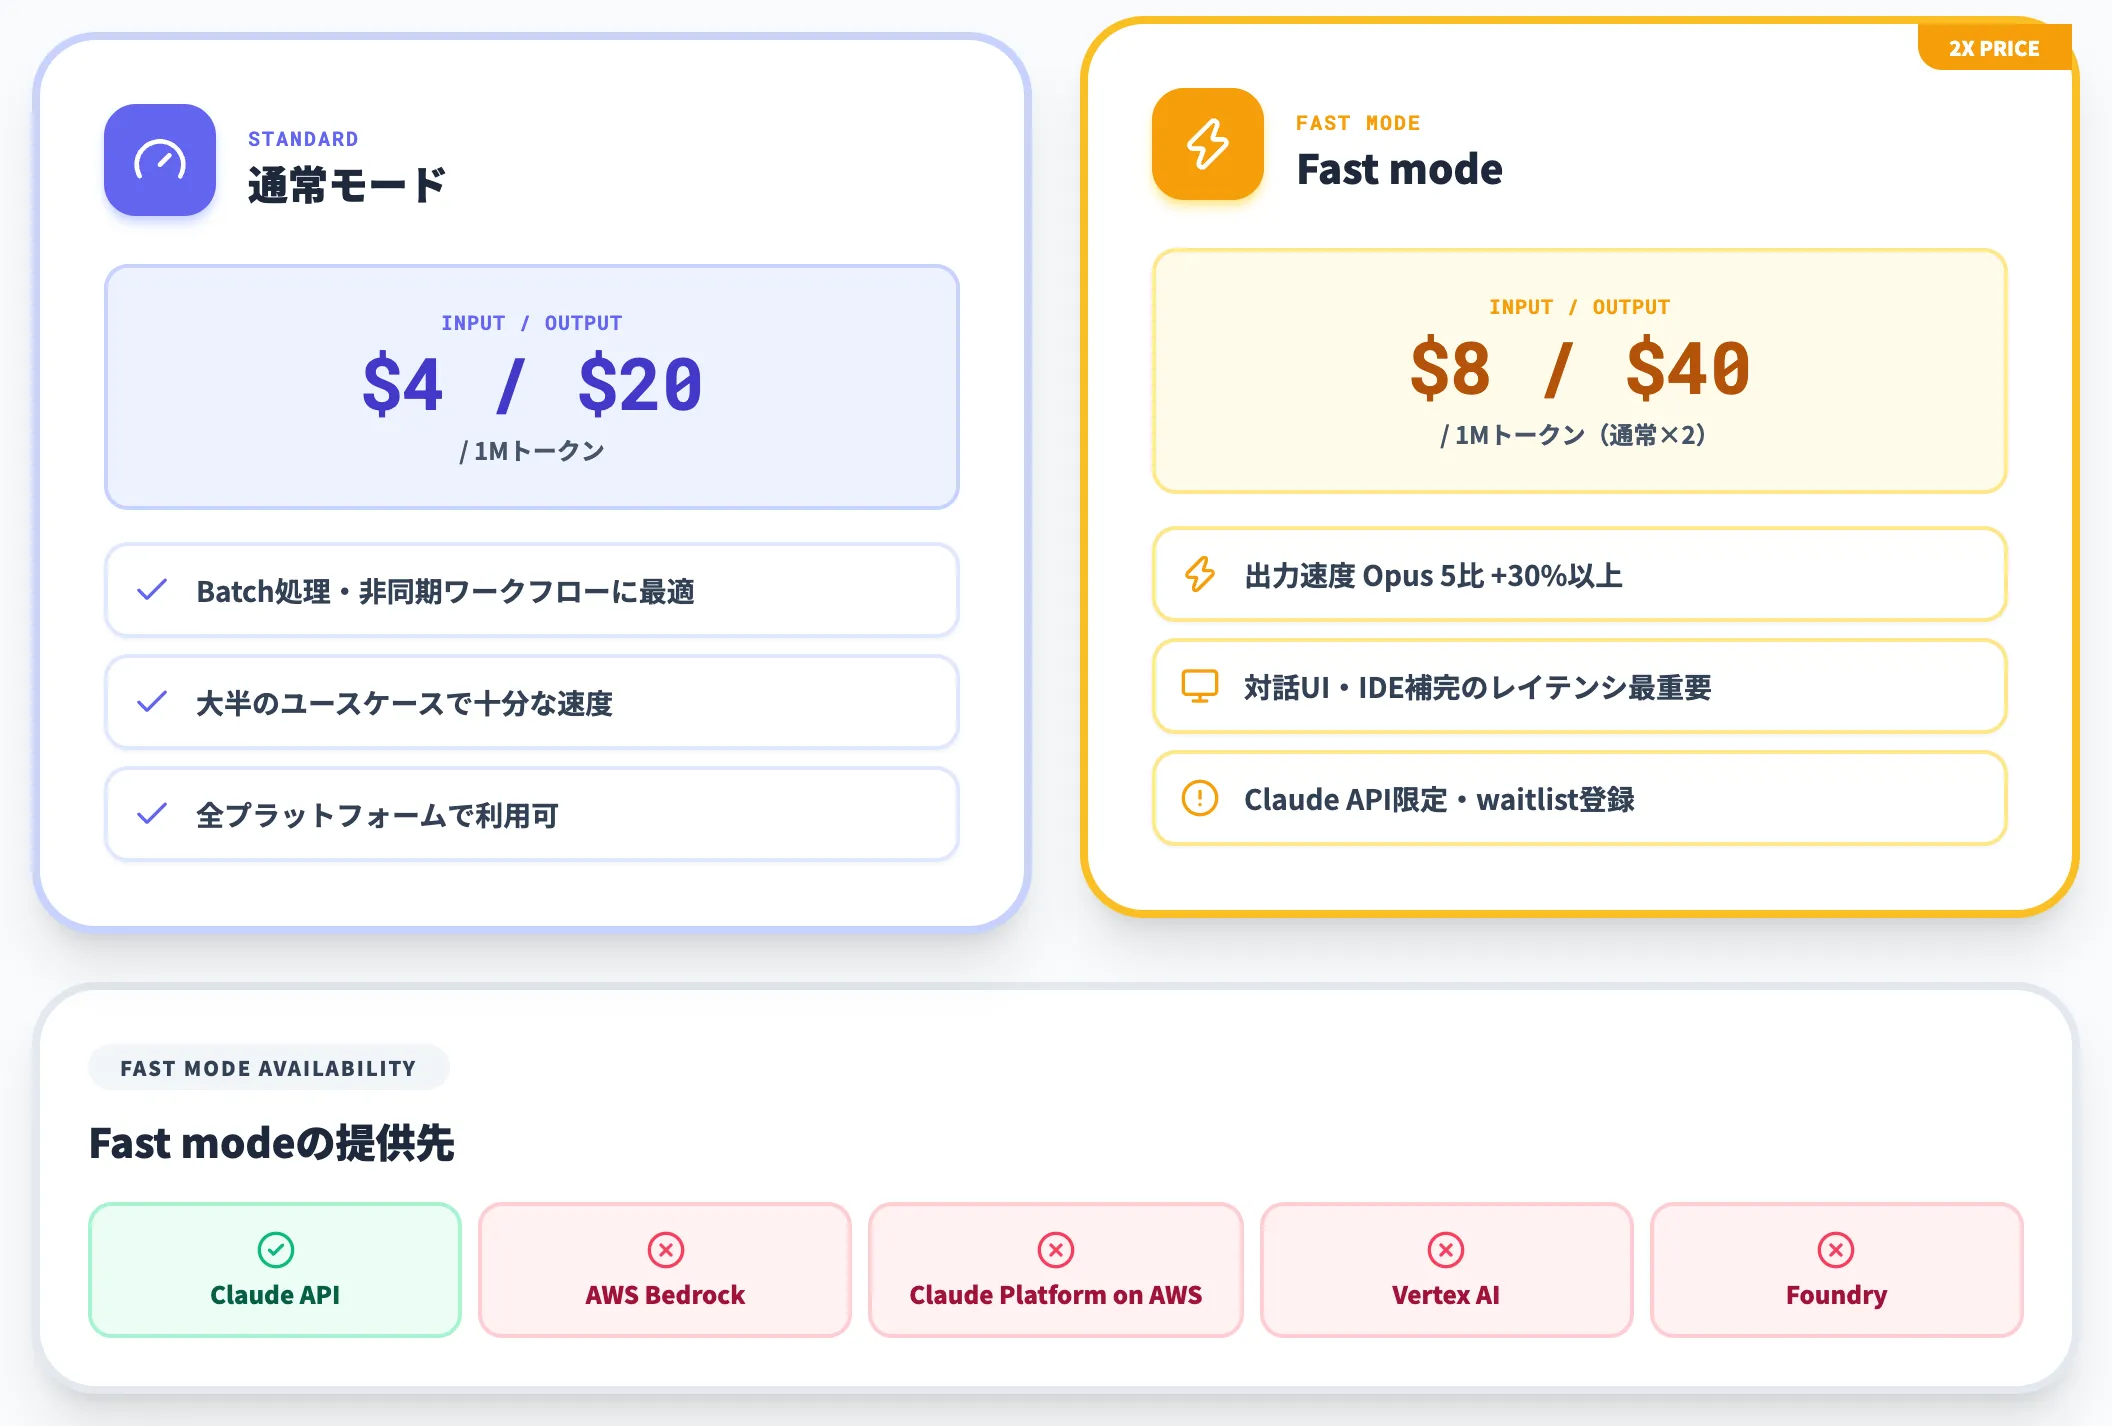
Claude Opus 5.5には、応答生成を高速化する「Fast mode」がresearch preview(限定プレビュー)として用意されています。利用にはAnthropicへの申請またはwaitlist登録が必要で、提供対象はClaude API限定です。Amazon Bedrock・Claude Platform on AWS・Google Cloud・Microsoft Foundryでは利用できません。
Fast modeの単価は入力$8/出力$40と、通常モードのちょうど2倍です。バッチ処理ではなく対話UI・IDE補完のように「レイテンシがユーザー体験を左右する場面」で使う想定です。
実測ベンチマークではOpus 5比で出力速度が30%以上向上しており、通常モードでも大半のユースケースは対応できます。Fast modeの2倍単価を払うか通常モードで受けるかは、ユースケースが対話寄りか非同期寄りかで判断するのが現実的です。
Batch API併用で最大50%オフ
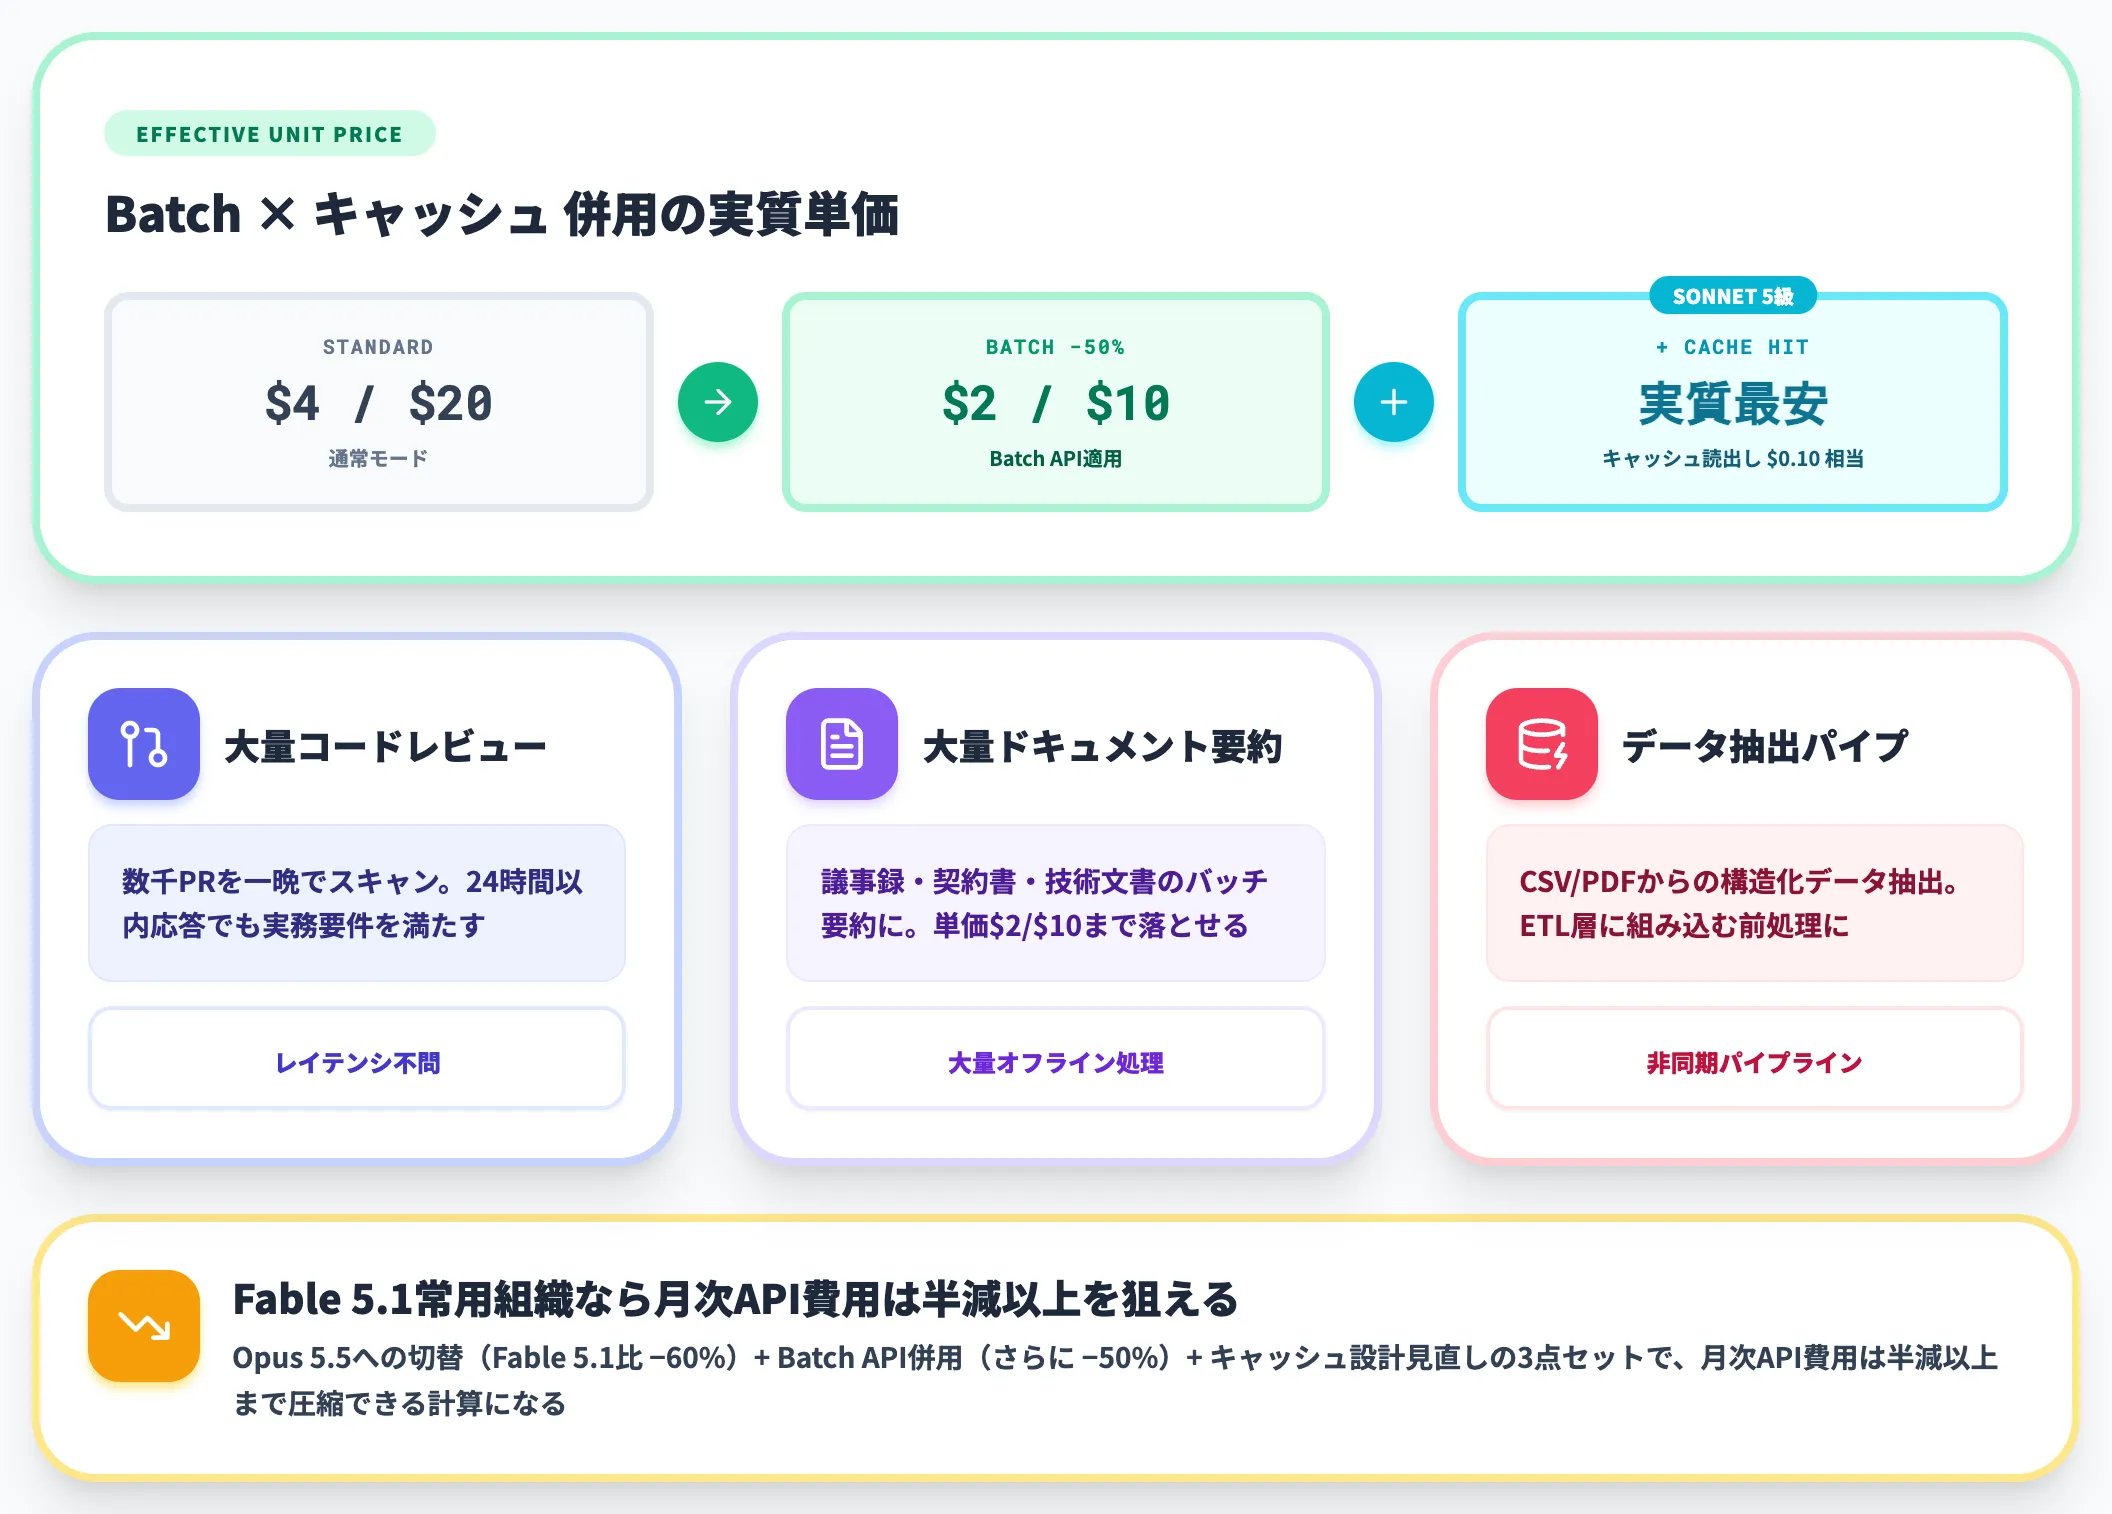
非同期処理向けのMessage Batches APIを使う場合、単価はさらに50%オフになります。
Batch APIは応答が24時間以内という条件付きですが、大量のコードレビュー・ドキュメント要約・データ抽出のような「レイテンシを問わない業務」で単価を$2/$10相当まで落とせます。
キャッシュとの併用も可能で、キャッシュヒット付きBatch実行なら実質的にOpus 5.5をSonnet 5並みの単価で回すこともできます。
常時Fable 5.1でエージェントを回していた組織なら、Opus 5.5への切り替えとBatch API+キャッシュ設計の見直しを組み合わせれば、月次のAPI費用は半減以上を狙える計算になります。
Claude Opus 5.5のベンチマークと実測性能
Claude Opus 5.5の性能を測る材料は、Anthropicが公式blogで公開した9指標のベンチマーク(本記事では代表6指標を抜粋)と、実験レポートに載った実測タスク4件、そして第三者集計のSWE-bench Pro結果に整理できます。本セクションではそれぞれを順に見ていきます。
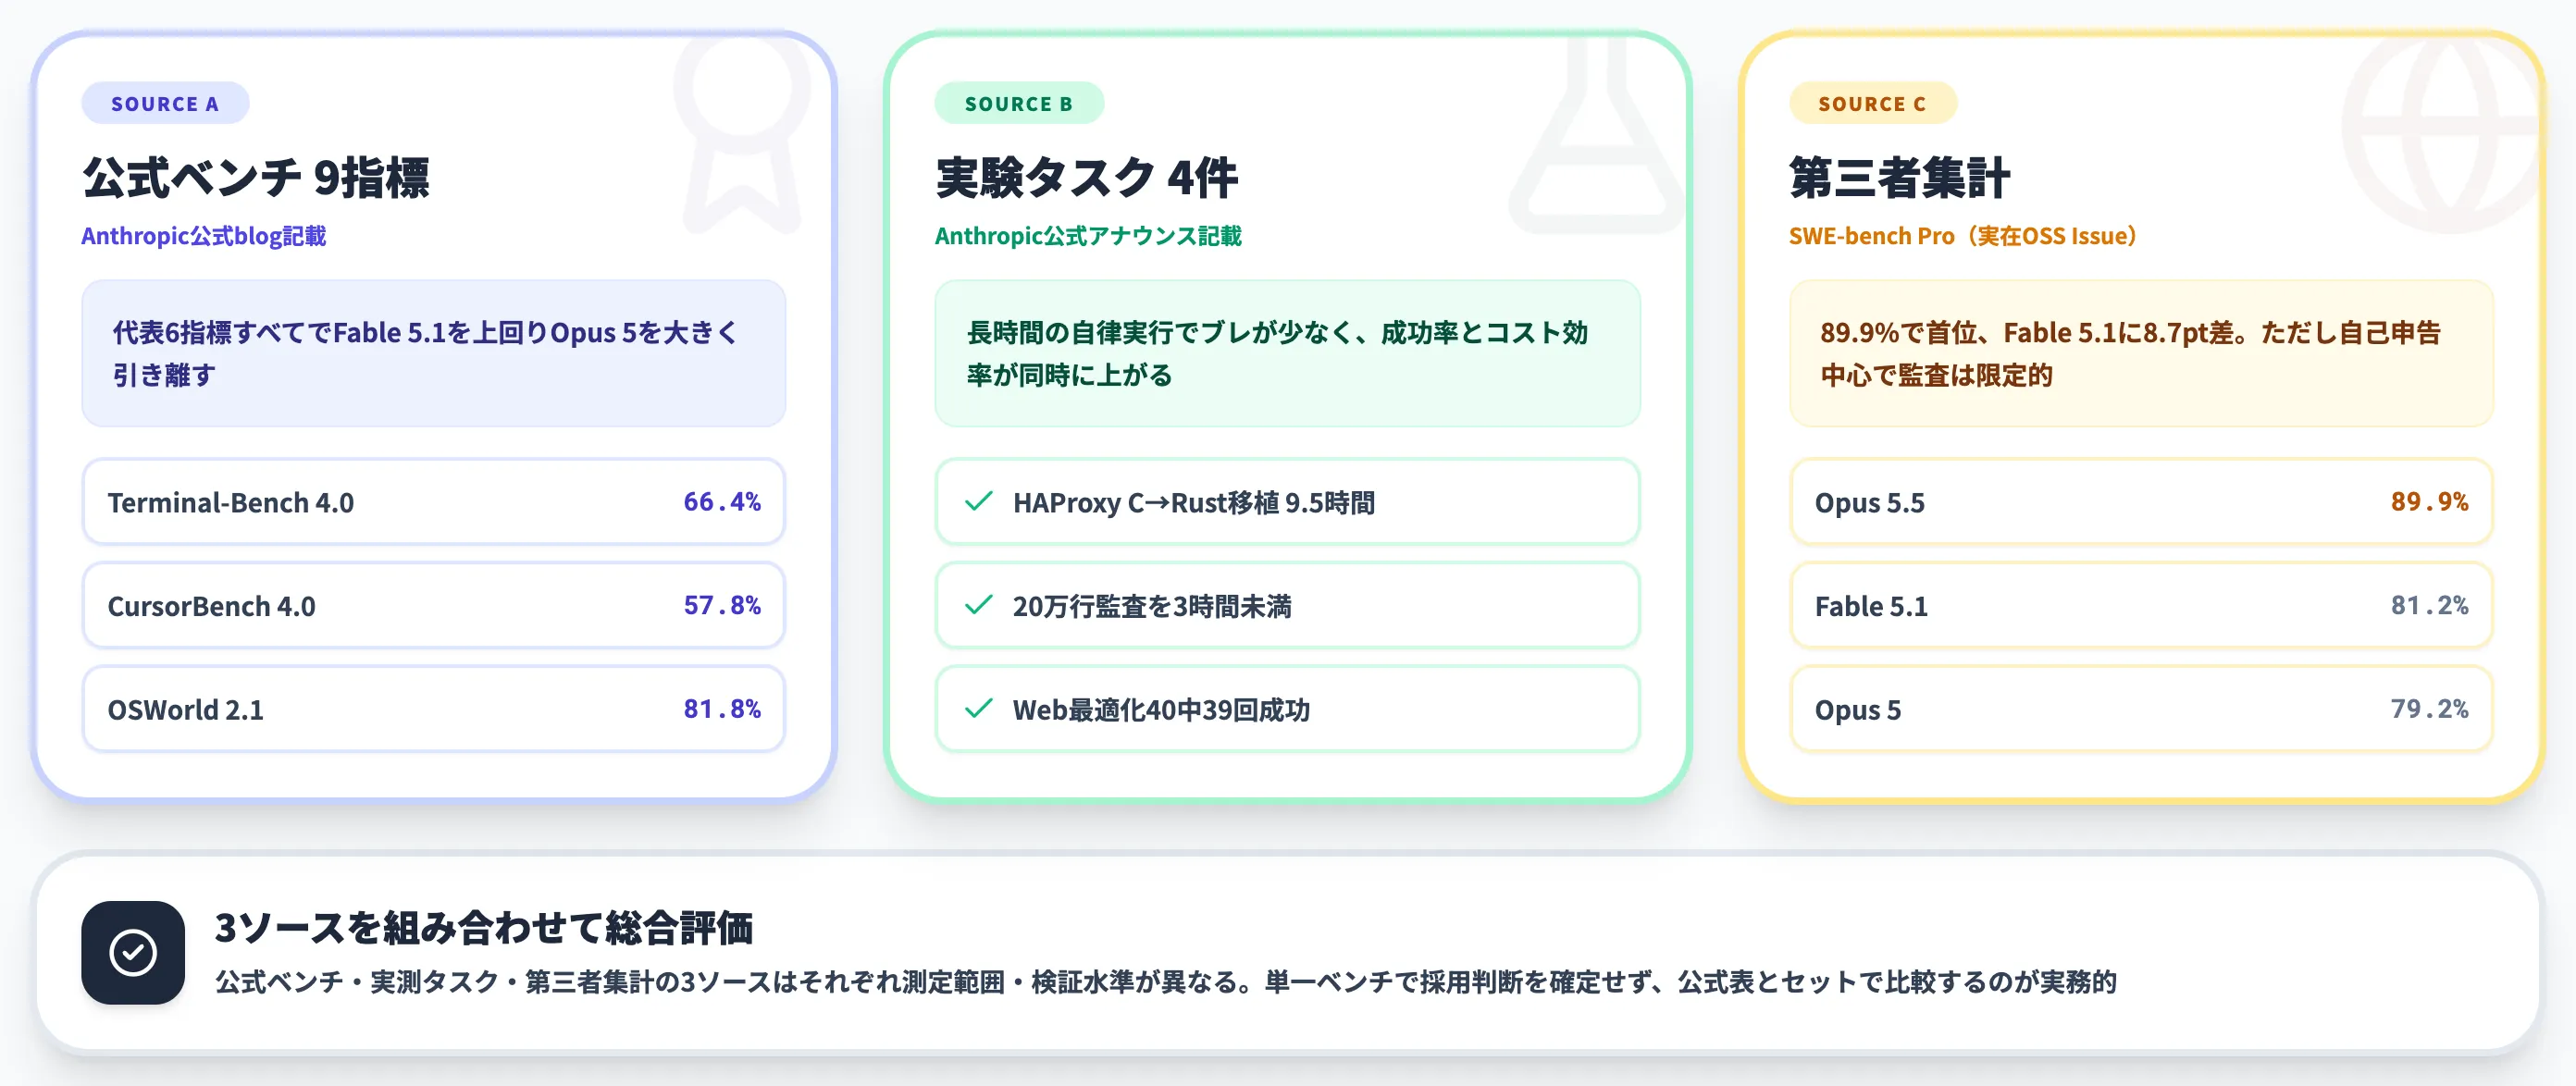
公式ベンチの代表6指標でFable 5.1に並ぶ
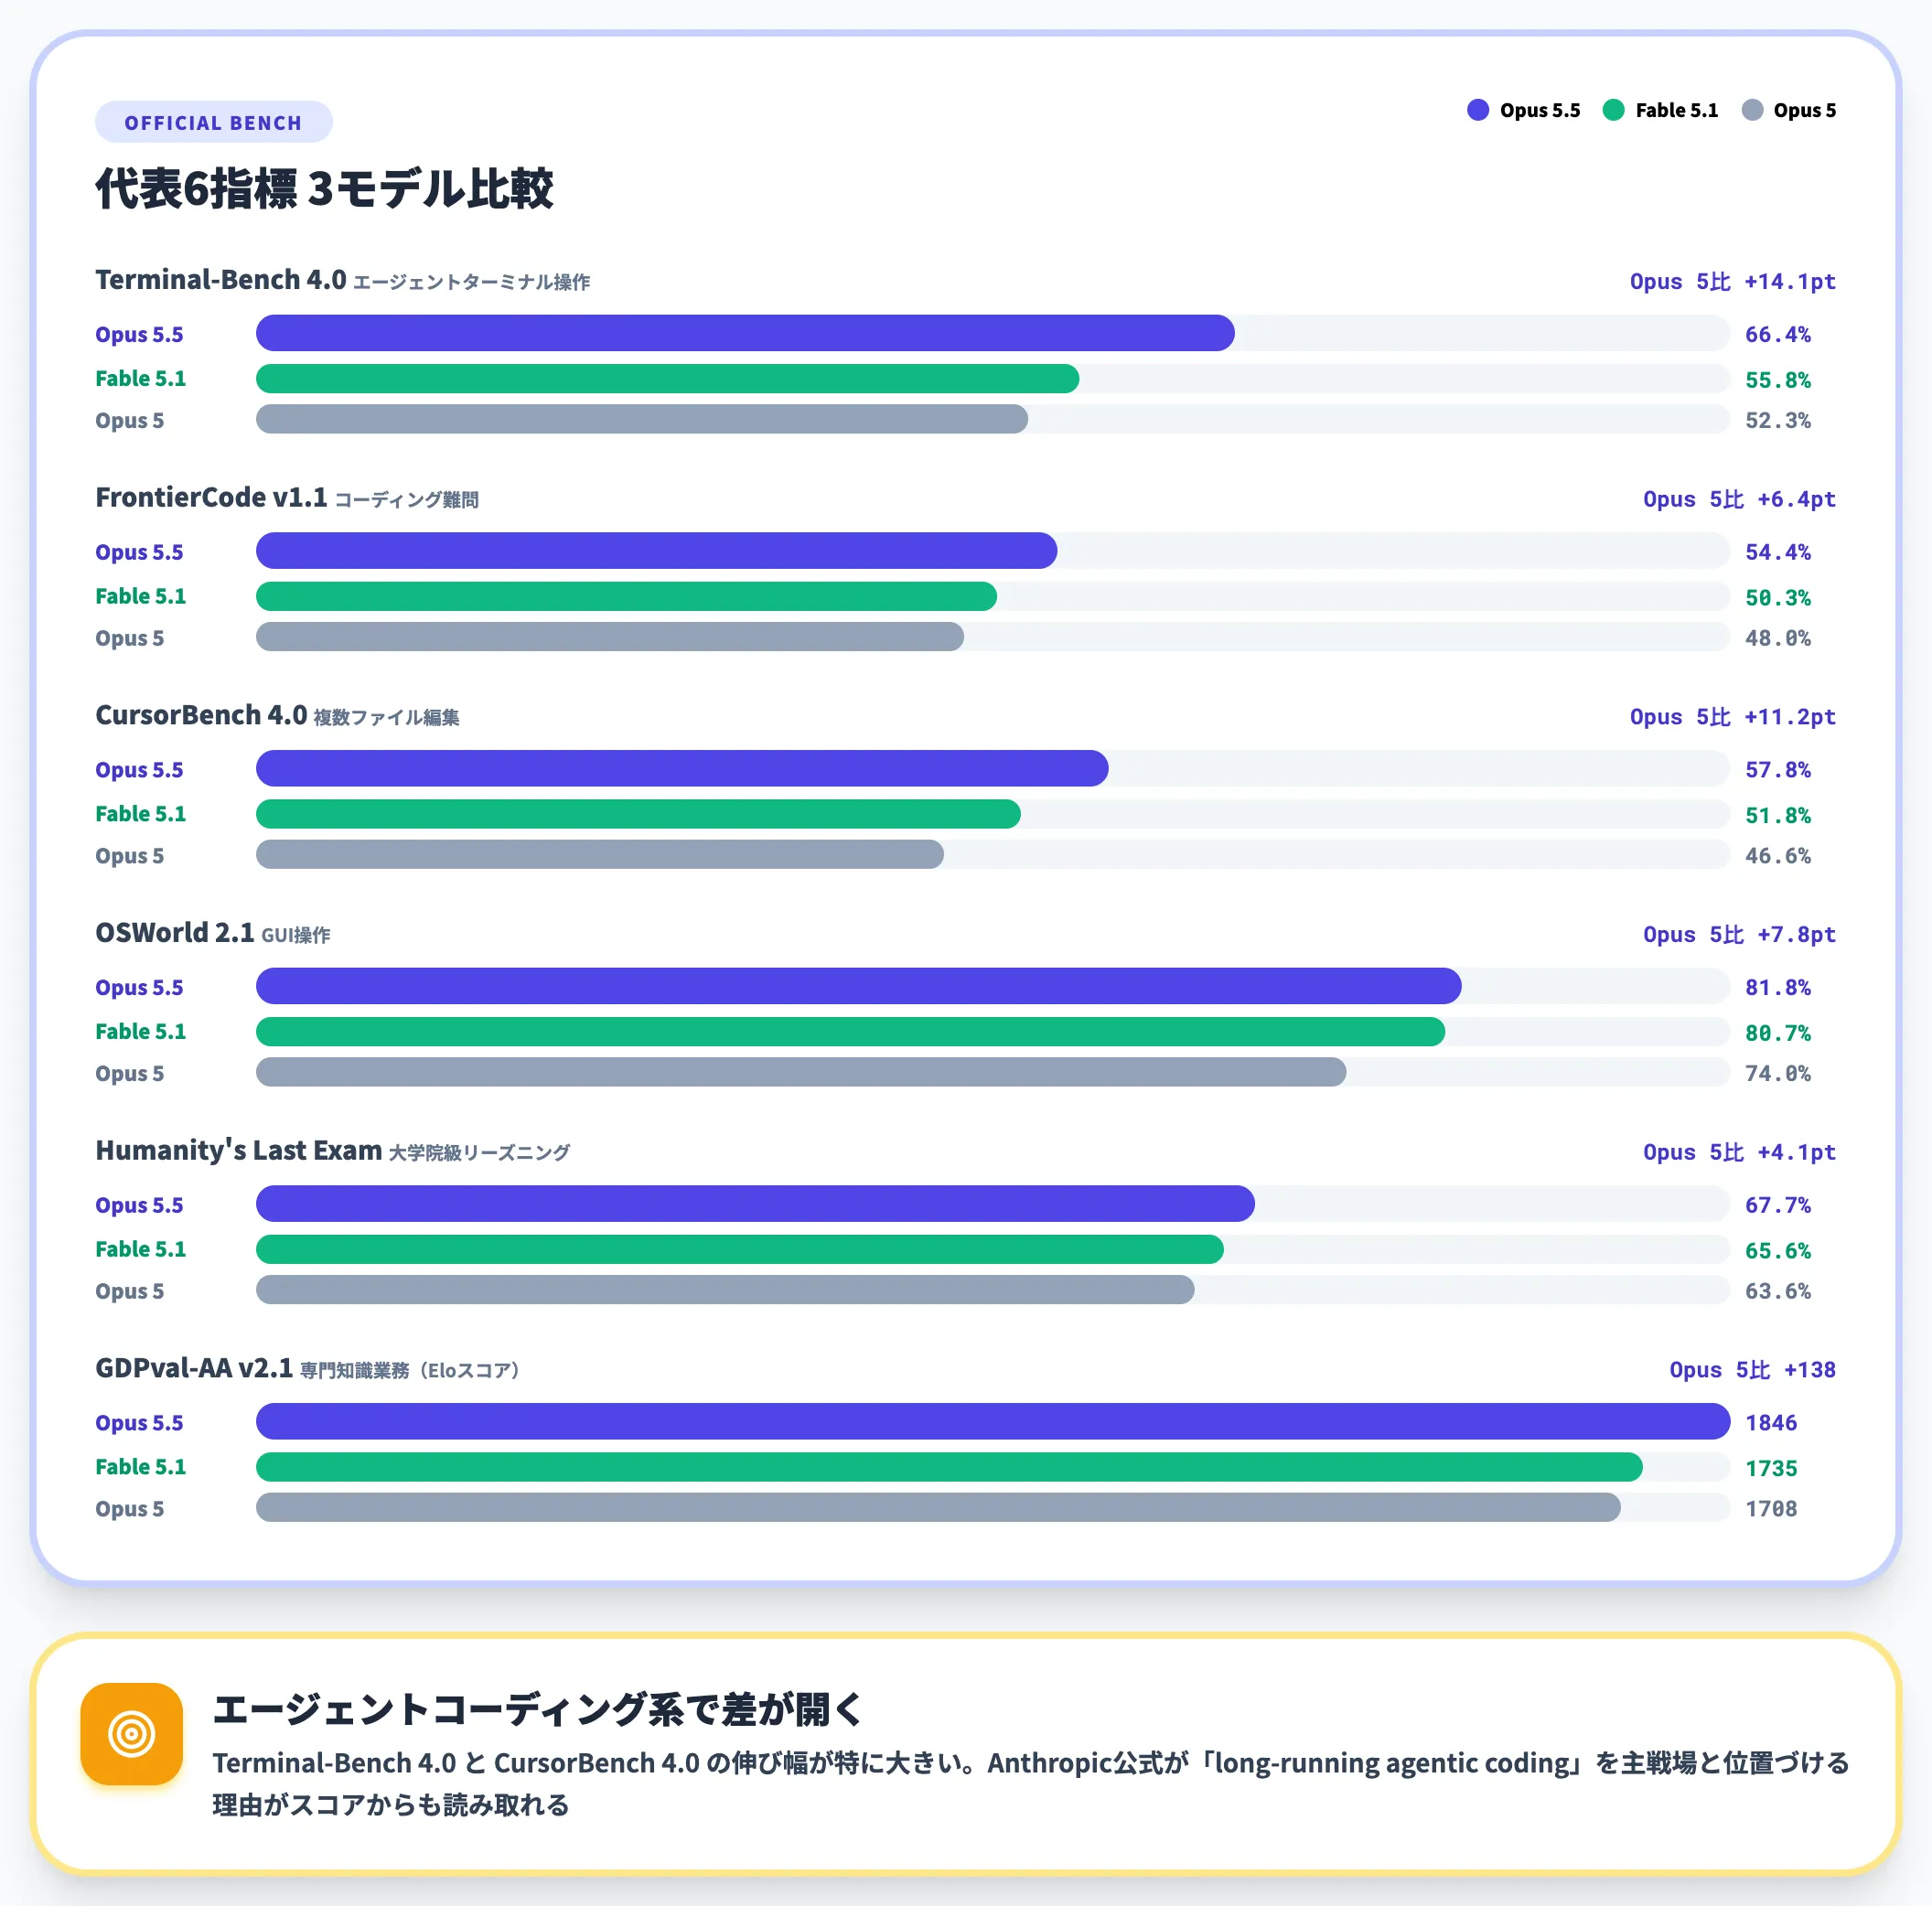
Anthropic公式が公開したベンチマーク結果を、Opus 5.5・Fable 5.1・Opus 5の3モデルで並べたのが以下の表です。
| ベンチマーク | 領域 | Opus 5.5 | Fable 5.1 | Opus 5 |
|---|---|---|---|---|
| Terminal-Bench 4.0 | エージェントターミナル操作 | 66.4% | 55.8% | 52.3% |
| FrontierCode v1.1 | コーディング難問 | 54.4% | 50.3% | 48.0% |
| CursorBench 4.0 | 複数ファイル編集 | 57.8% | 51.8% | 46.6% |
| GDPval-AA v2.1 | 専門知識業務(Eloスコア) | 1846 | 1735 | 1708 |
| OSWorld 2.1 | GUI操作 | 81.8% | 80.7% | 74.0% |
| Humanity's Last Exam | 大学院級リーズニング | 67.7% | 65.6% | 63.6% |
この表で見るべきは、Opus 5.5が代表6指標すべてでFable 5.1を上回りOpus 5を大きく引き離している点です。特にTerminal-Bench 4.0(Opus 5比 +14.1pt・Fable 5.1比 +10.6pt)とCursorBench 4.0(Opus 5比 +11.2pt・Fable 5.1比 +6.0pt)というエージェントコーディング系で差が開いており、Anthropic公式が「long-running agentic coding」を主戦場と位置づけている理由がスコアからも読み取れます。
なお公式が同時公開している残り3指標(AutomationBench 40.0% vs Fable 5.1: 31.4%/Terminal-Bench-Science 0.1 58.7% vs 52.6%/Chartography 89.0% vs 88.4%)でも順位関係は同じで、Opus 5.5がリードしています。公式表の測定は、Opus 5.5がadaptive thinking 「max」 effort、Terminal-Bench 4.0のみOpus 5.5が「xhigh」 effort・GPT-6 Astraが「high」 effortと、モデル別に最良スコアが出る effort で揃えられている点は前提として押さえておくと安全です。
実験タスクではHAProxyを51%安く移植
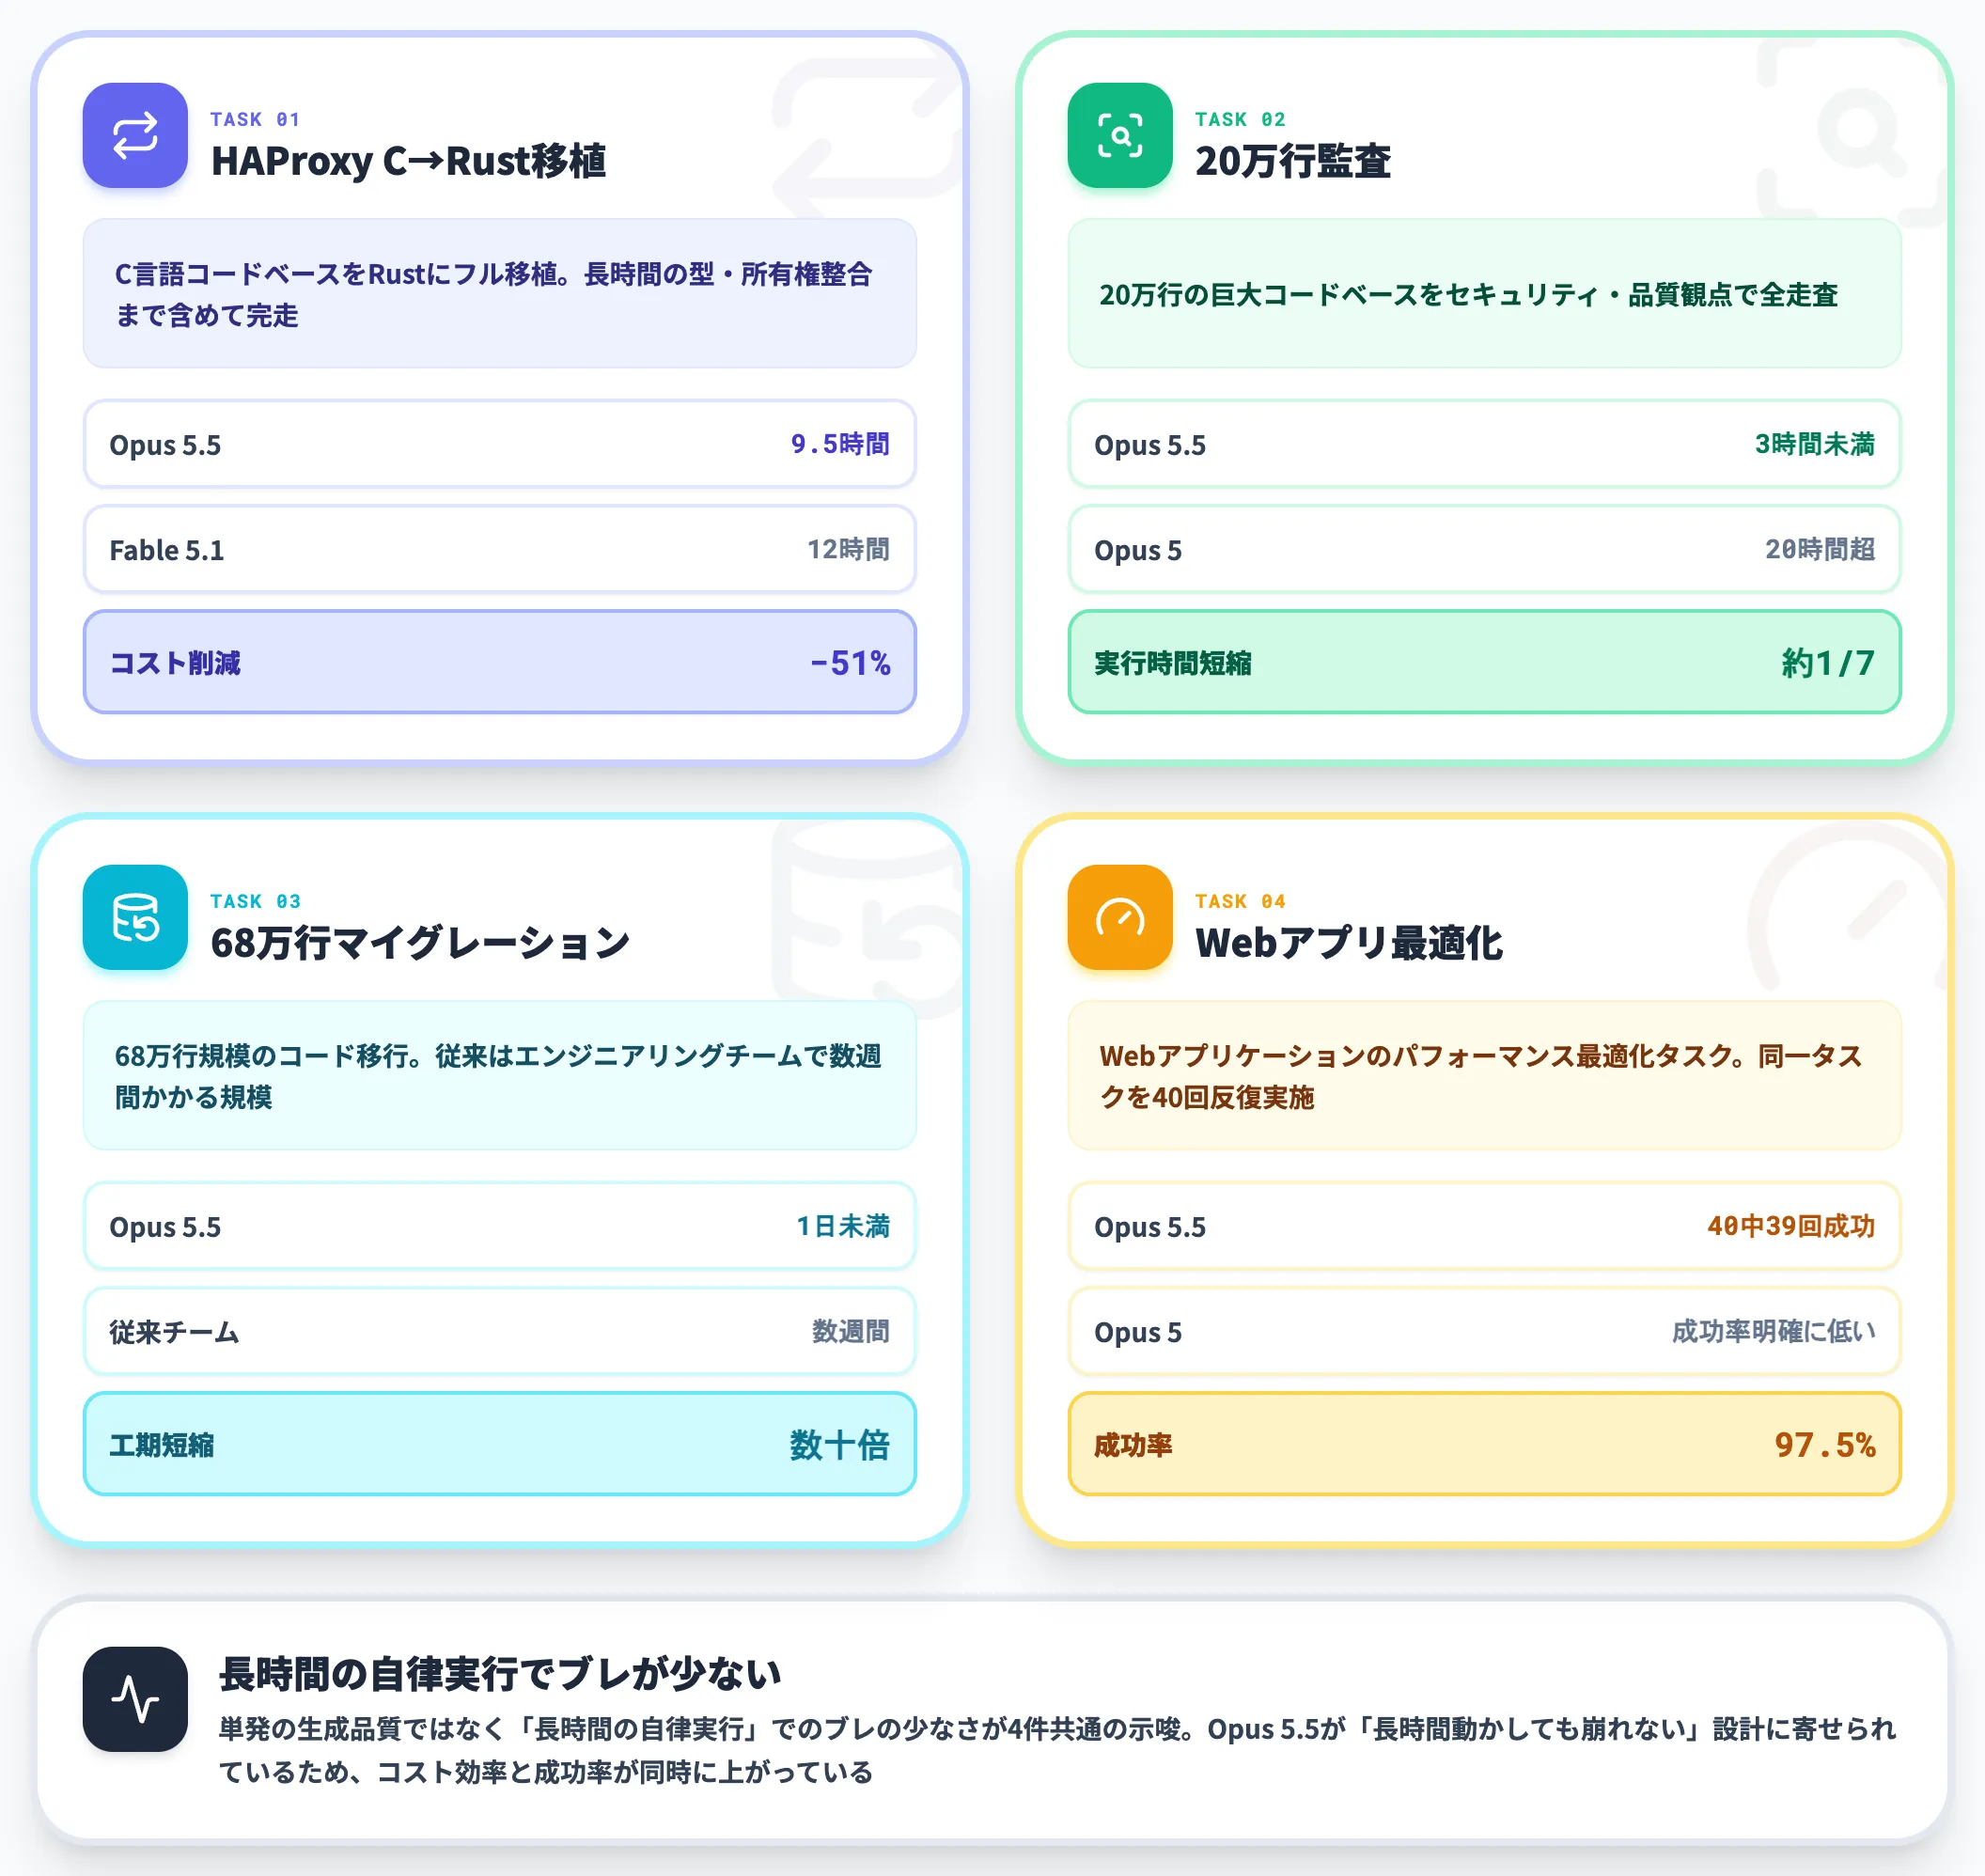
Anthropicは公式アナウンスで、Opus 5.5が実際のコーディングタスクで示した4つの結果を公開しています。
-
HAProxyのC→Rust移植
9.5時間で完了。同タスクでFable 5.1は12時間を要し、Opus 5.5は51%のコスト削減となった
-
20万行のコードベース監査
3時間未満で完了。同タスクをOpus 5で走らせると20時間超かかっていた
-
68万行のマイグレーション
1日未満で完了。従来はエンジニアリングチームで数週間かかる規模だった
-
Webアプリ最適化タスク
40回中39回成功。Opus 5では成功率が明確に低かった
この4件が示すのは、単発の生成品質ではなく「長時間の自律実行」でのブレの少なさです。Opus 5.5が「長時間動かしても崩れない」設計に寄せられているため、コスト効率と成功率が同時に上がっています。
SWE-bench Proでは89.9%で首位
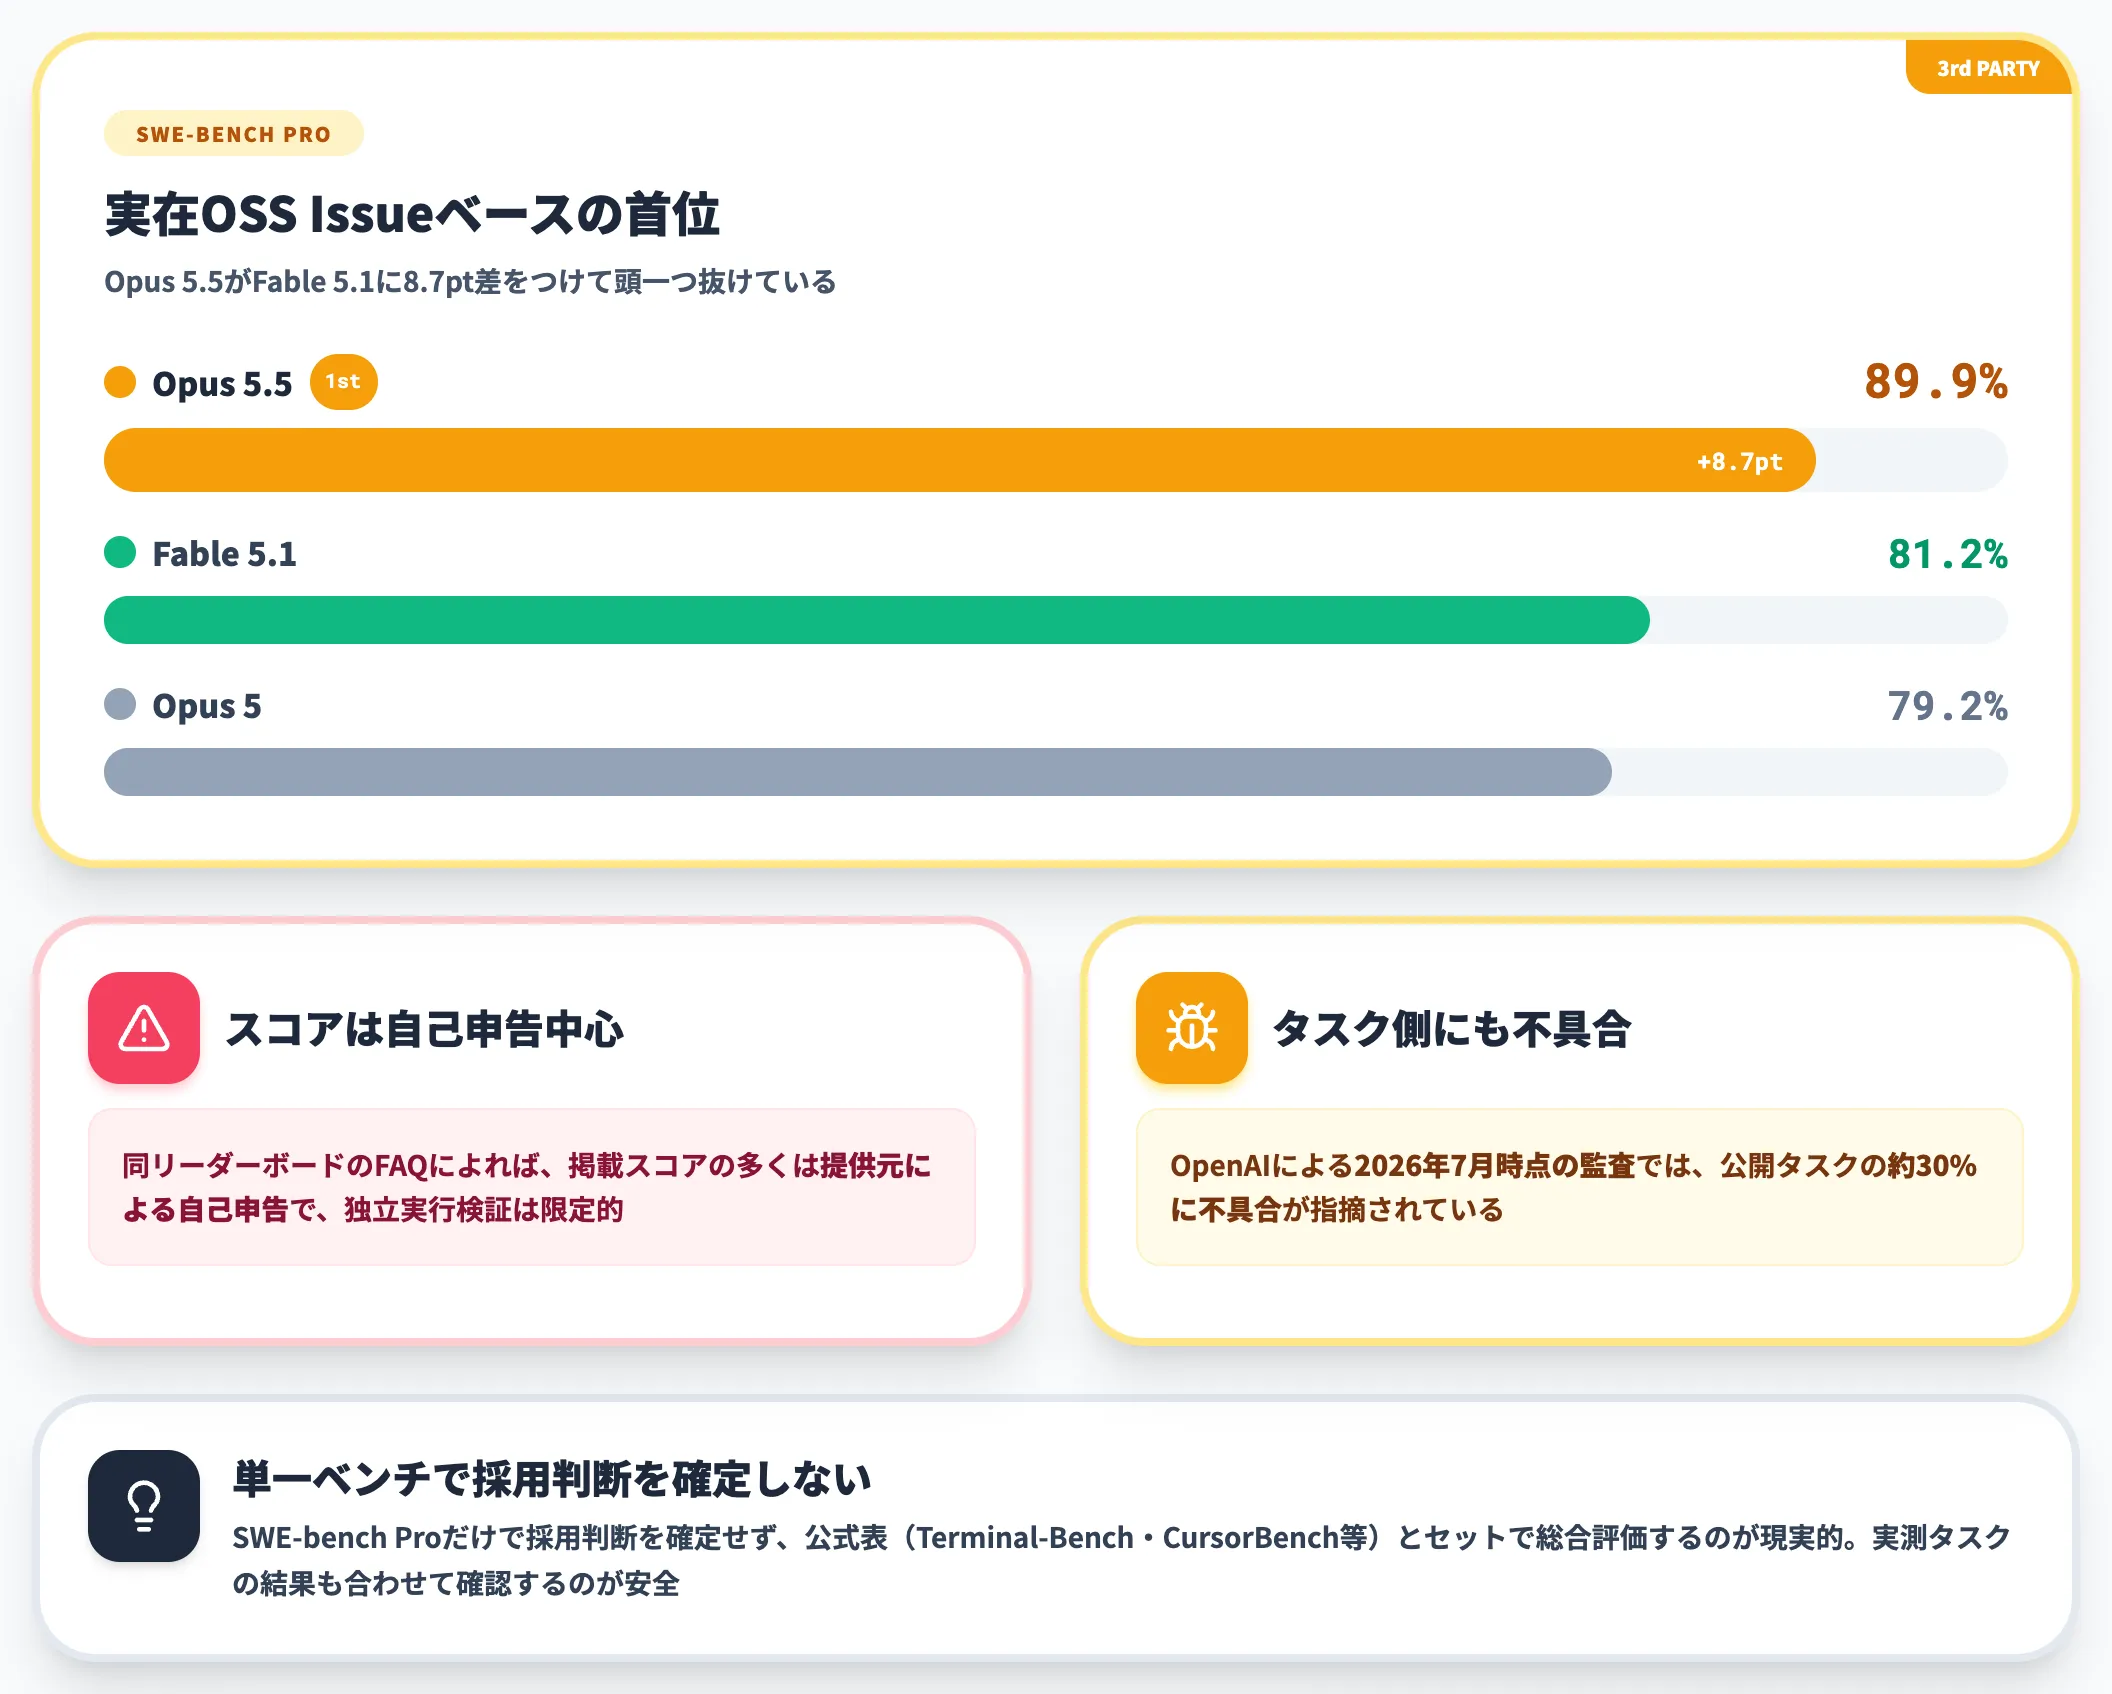
Anthropicが公式で採用したベンチマークとは別に、第三者集計のSWE-bench ProではOpus 5.5が89.9%で首位に立っています。
SWE-bench Proは実在OSSのIssueをそのままタスク化した実務寄りのベンチマークで、Fable 5.1は81.2%・Opus 5は79.2%と、Opus 5.5がFable 5.1に8.7ポイント差をつけて頭一つ抜けています。
ただし同リーダーボードのFAQによれば、掲載スコアの多くは提供元による自己申告で独立実行検証は限定的であり、OpenAIによる2026年7月時点の監査では公開タスクの約30%に不具合が指摘されています。単一ベンチマークだけで採用判断を確定せず、公式表とセットで総合評価するのが現実的です。
Claude Opus 5.5の拡張思考と安全設計
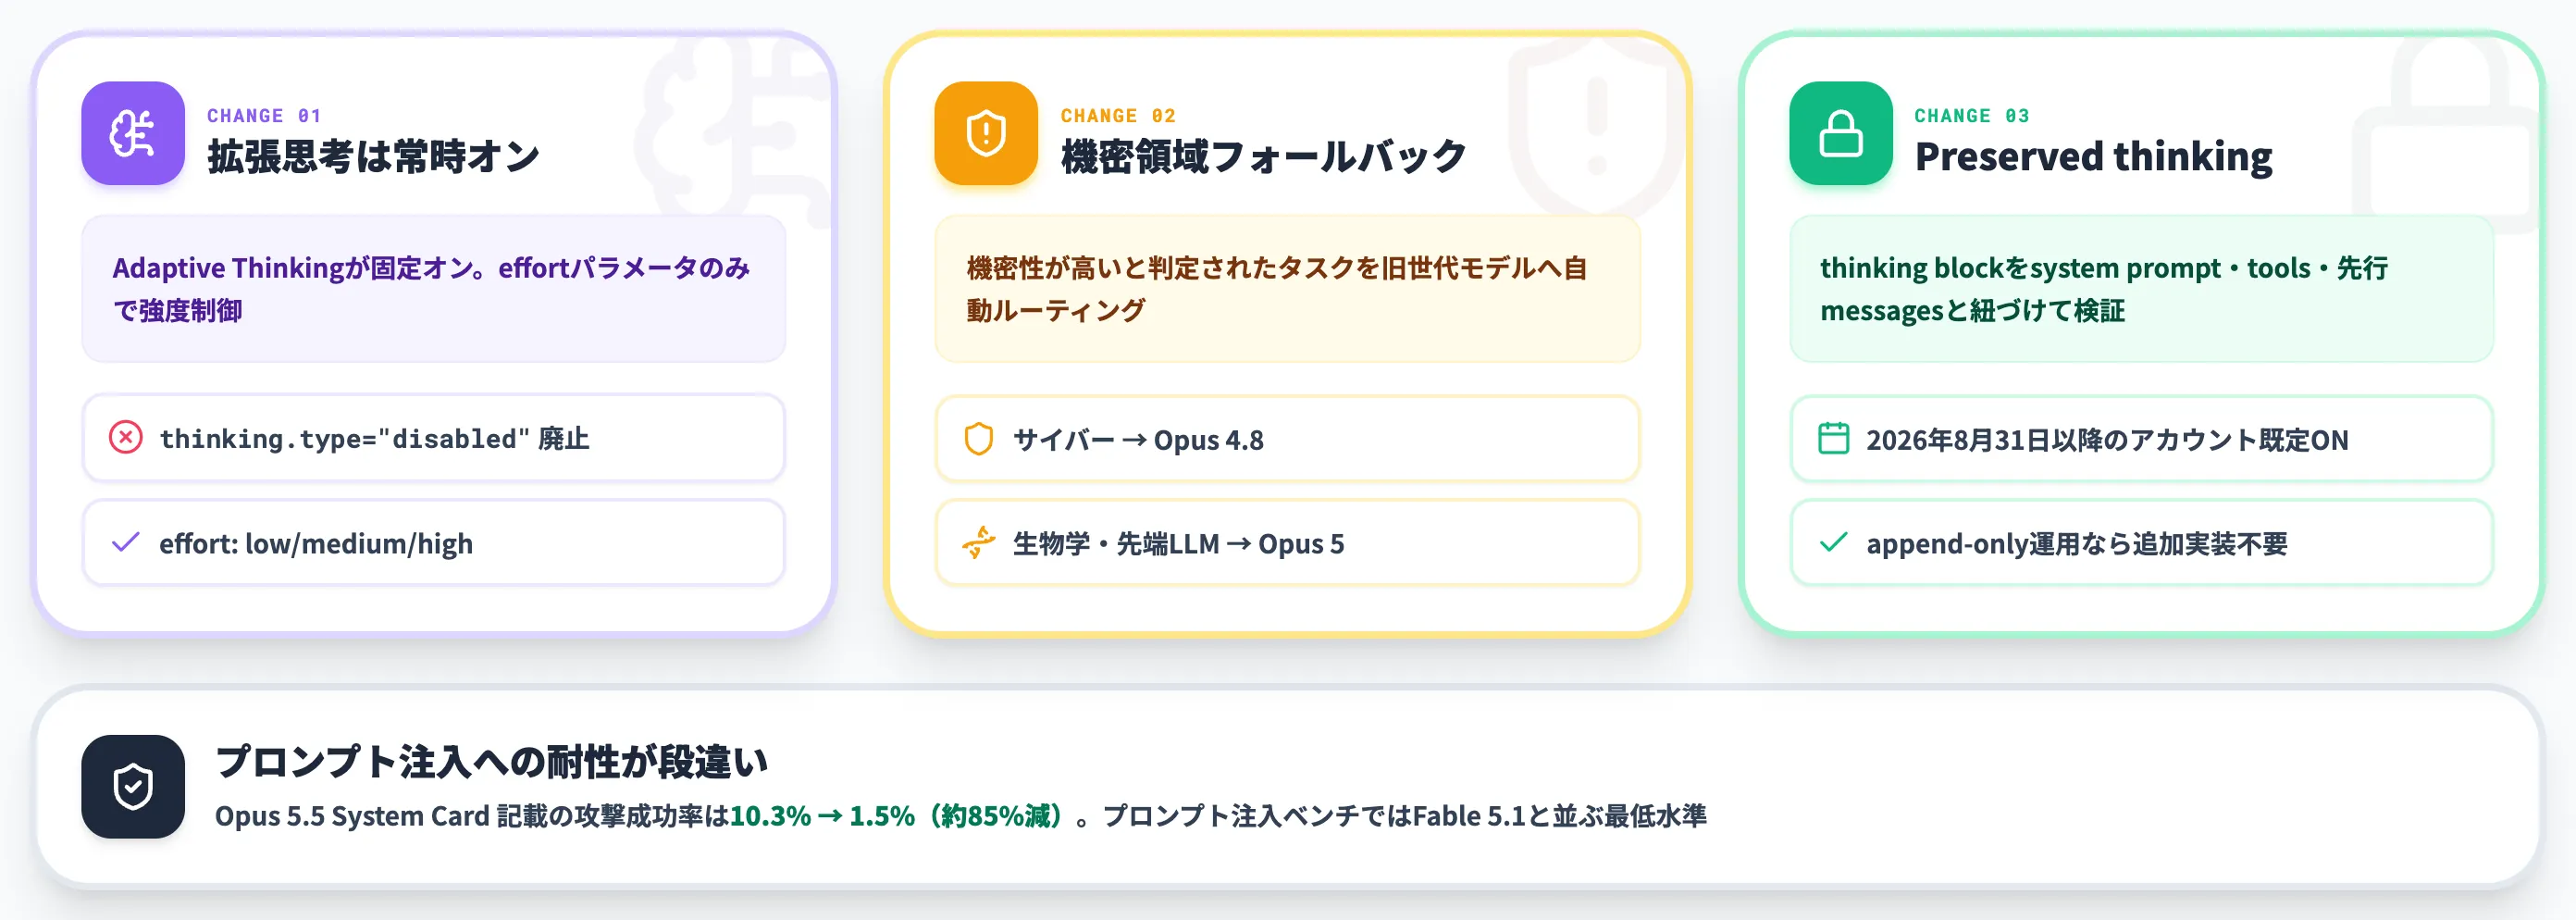
Claude Opus 5.5では、性能アップと同時に「思考の挙動」と「安全設計」の骨格が変わっています。単価だけ見て乗り換えると、実装側で挙動差に嵌まりやすい部分でもあります。
本セクションでは、拡張思考の常時オン化、機密タスクのフォールバック、Preserved thinkingの3点を整理します。
拡張思考は常時オンでeffortで強度制御
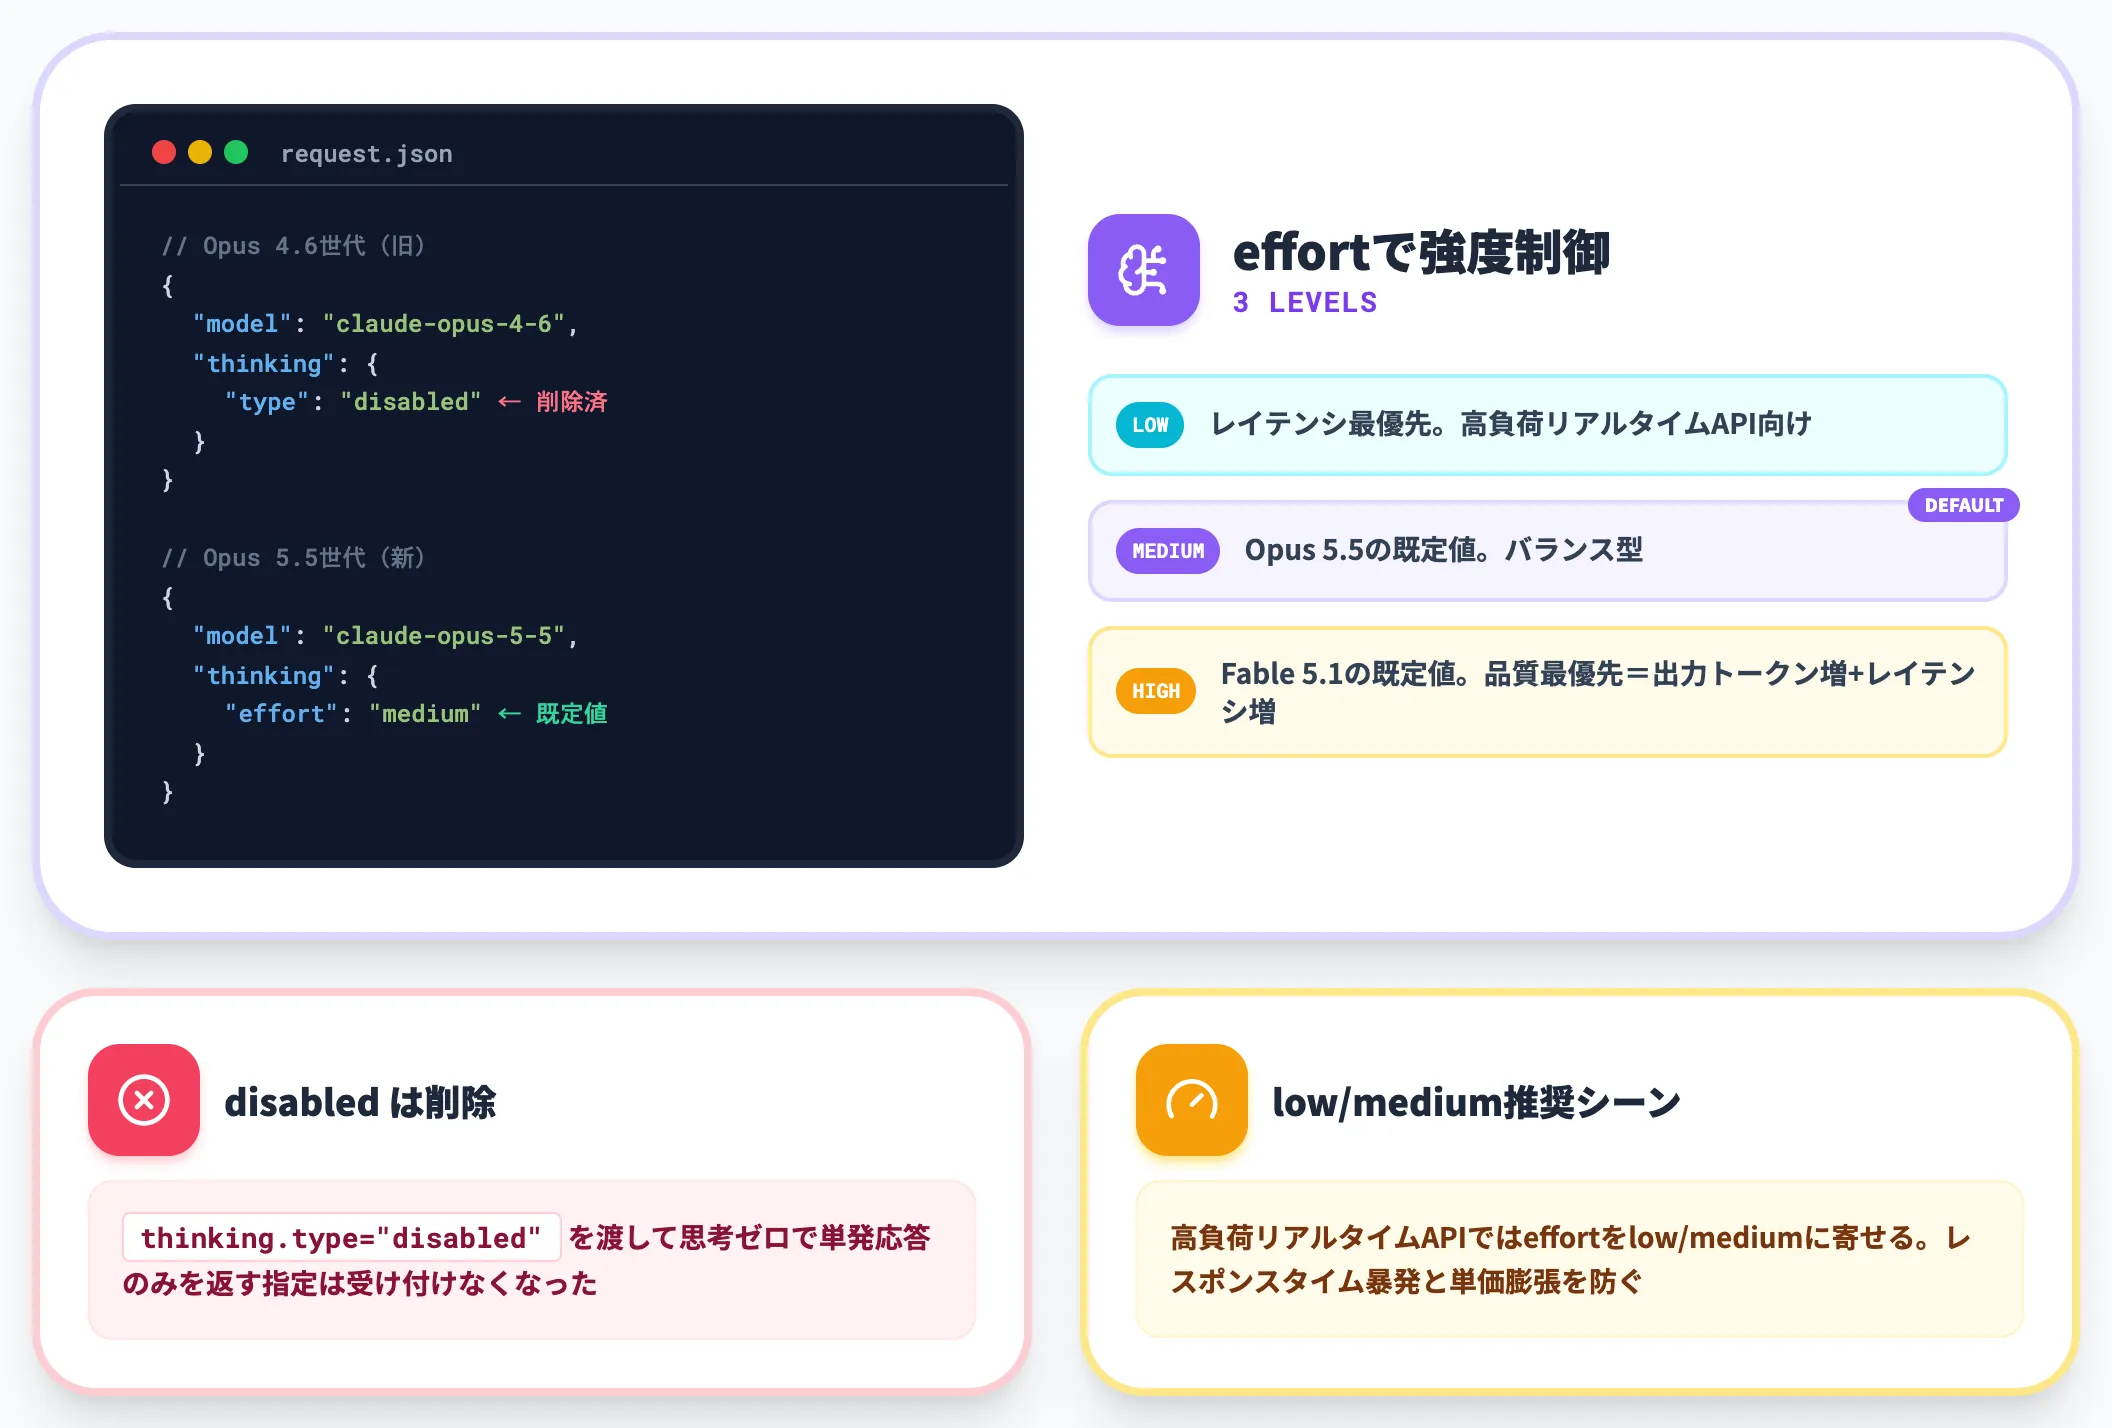
Opus 5.5とFable 5.1では、Adaptive Thinking(適応型拡張思考)が常時オンで固定されています。
Opus 4.6/Sonnet 4.6世代のように「thinking.type="disabled"」を渡して思考をゼロにする指定は受け付けなくなっており、思考ゼロで単発応答のみを返すユースケースには適しません。
その代わりに、effortパラメータで思考の強度を制御できます。既定値はOpus 5.5がmedium、Fable 5.1がhighで、highへ上げるほどベンチマークスコアが伸びる代わりに出力トークン量とレイテンシが増えます。
高負荷リアルタイムAPIで使う場合は、effortを明示的にlowかmediumに寄せて、レスポンスタイムと単価の暴発を防ぐのが安全側の判断です。
サイバーはOpus 4.8・生物学と先端LLMはOpus 5にフォールバック
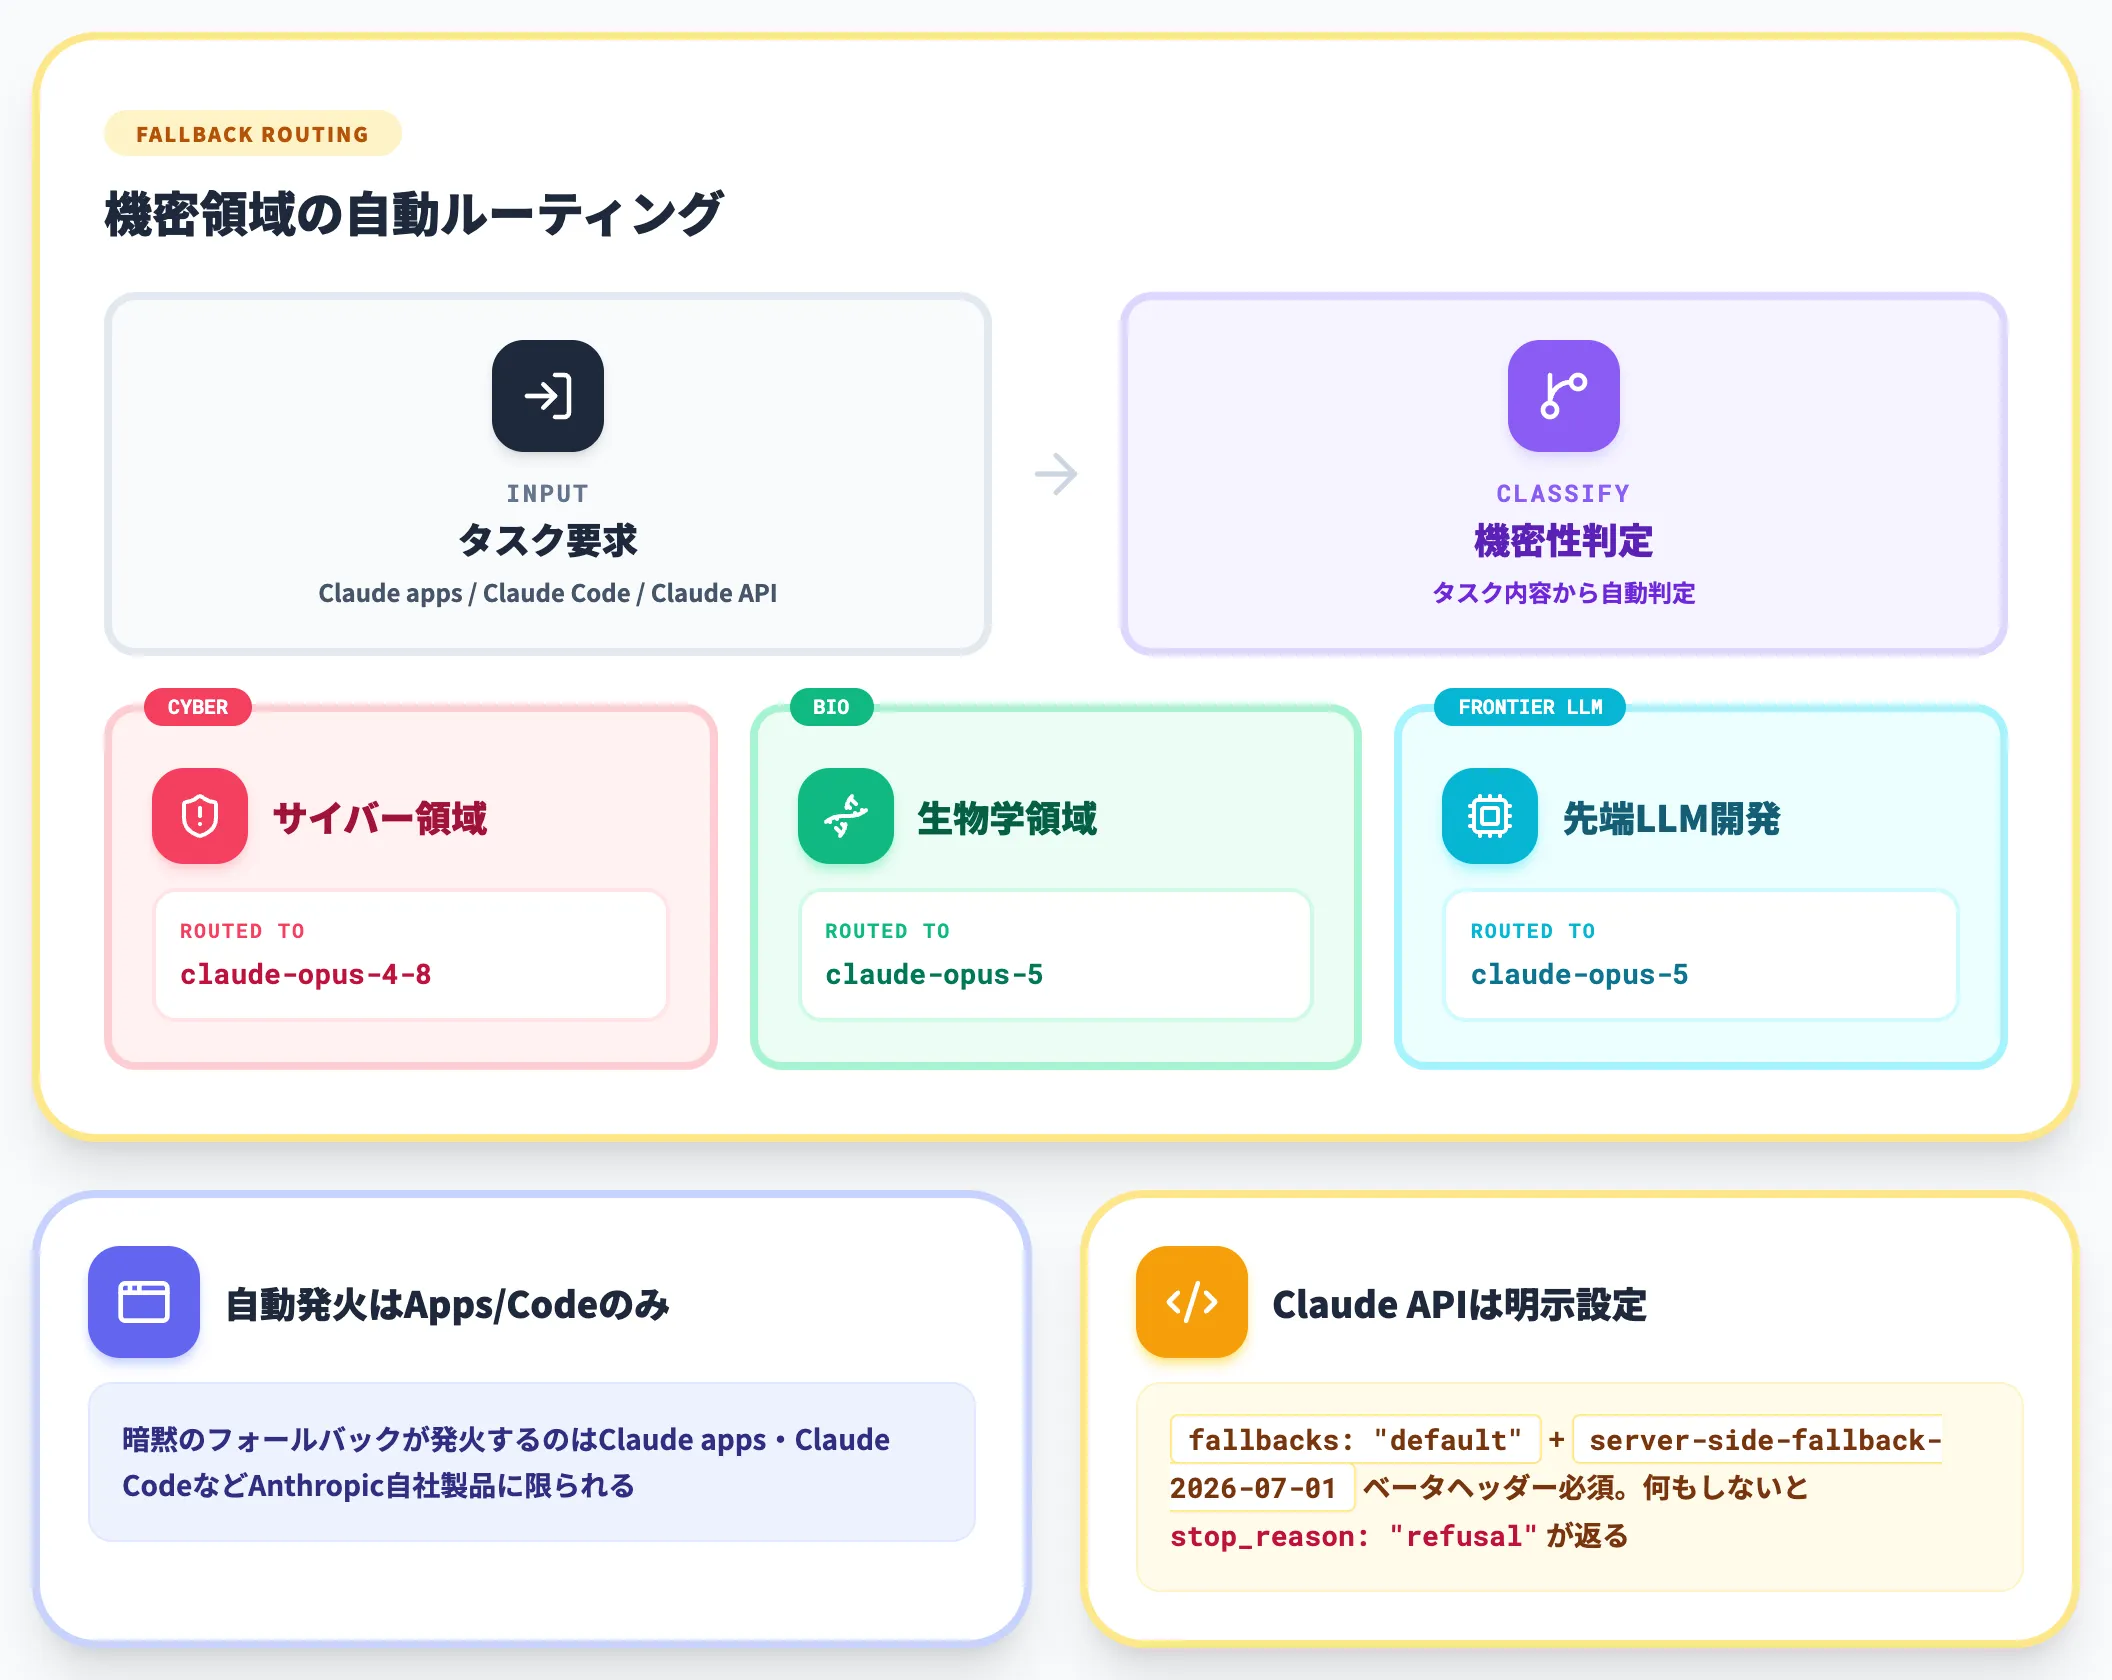
Opus 5.5には、機密性が高いと判定されたタスクを旧世代モデルへルーティングするフォールバック機構が組み込まれています。Anthropicの公式アナウンスで明示されている領域別の代替先は以下の通りです。
- サイバー領域 → claude-opus-4-8
- 生物学領域 → claude-opus-5(防御水準はClaude Fable 5.1と同じ設定)
- 先端LLM開発領域 → claude-opus-5
この自動ルーティングが暗黙で発火するのはClaude apps・Claude CodeなどAnthropic自社製品のみです。Claude APIで直接呼び出す場合は、以下のいずれかで対応します。
-
server-side fallback(Anthropic推奨)
リクエストに「fallbacks: "default"」を指定し、「server-side-fallback-2026-07-01」ベータヘッダーを付与する(ヘッダー未指定や別値では400エラー)。最大3モデルまでのカスタム指定も可能
-
SDK middleware / 独自リトライ
server-side以外の選択肢。各種制約があるためアプリ側で管理
-
何も設定しない
「stop_reason: "refusal"」が返るため、拒否パスの処理が必須
Amazon Bedrock・Google Cloud・Microsoft Foundryでは「fallbacks」パラメータ自体が使えないため、middlewareか独自リトライで代替します。詳細は公式のRefusals and fallbackドキュメントを参照してください。
fallback発動の確認方法は、採用した経路で変わります。
-
server-side fallback経由
応答の「model」フィールド・専用の「fallback」content block・「usage.iterations」の3点で追跡
-
SDK middleware経由
応答モデル・fallback block・「BetaFallbackState」で追跡
-
独自リトライ経由
API仕様としてのメタデータが揃わないため、アプリ側の呼び出しログで管理
生物学系タスクを扱う組織向けにはLife Sciences Verification Program(LSVP)が用意されており、Standard Useでは一般提供版より寛容な分類器が適用され、生物学ブロックを外すHigh-risk Useは特定プロジェクト単位での申請となる二段階運用です。いずれもサイバー等の他領域のセーフガードは残ったままである点は留意してください。
Preserved thinkingとアライメント指標
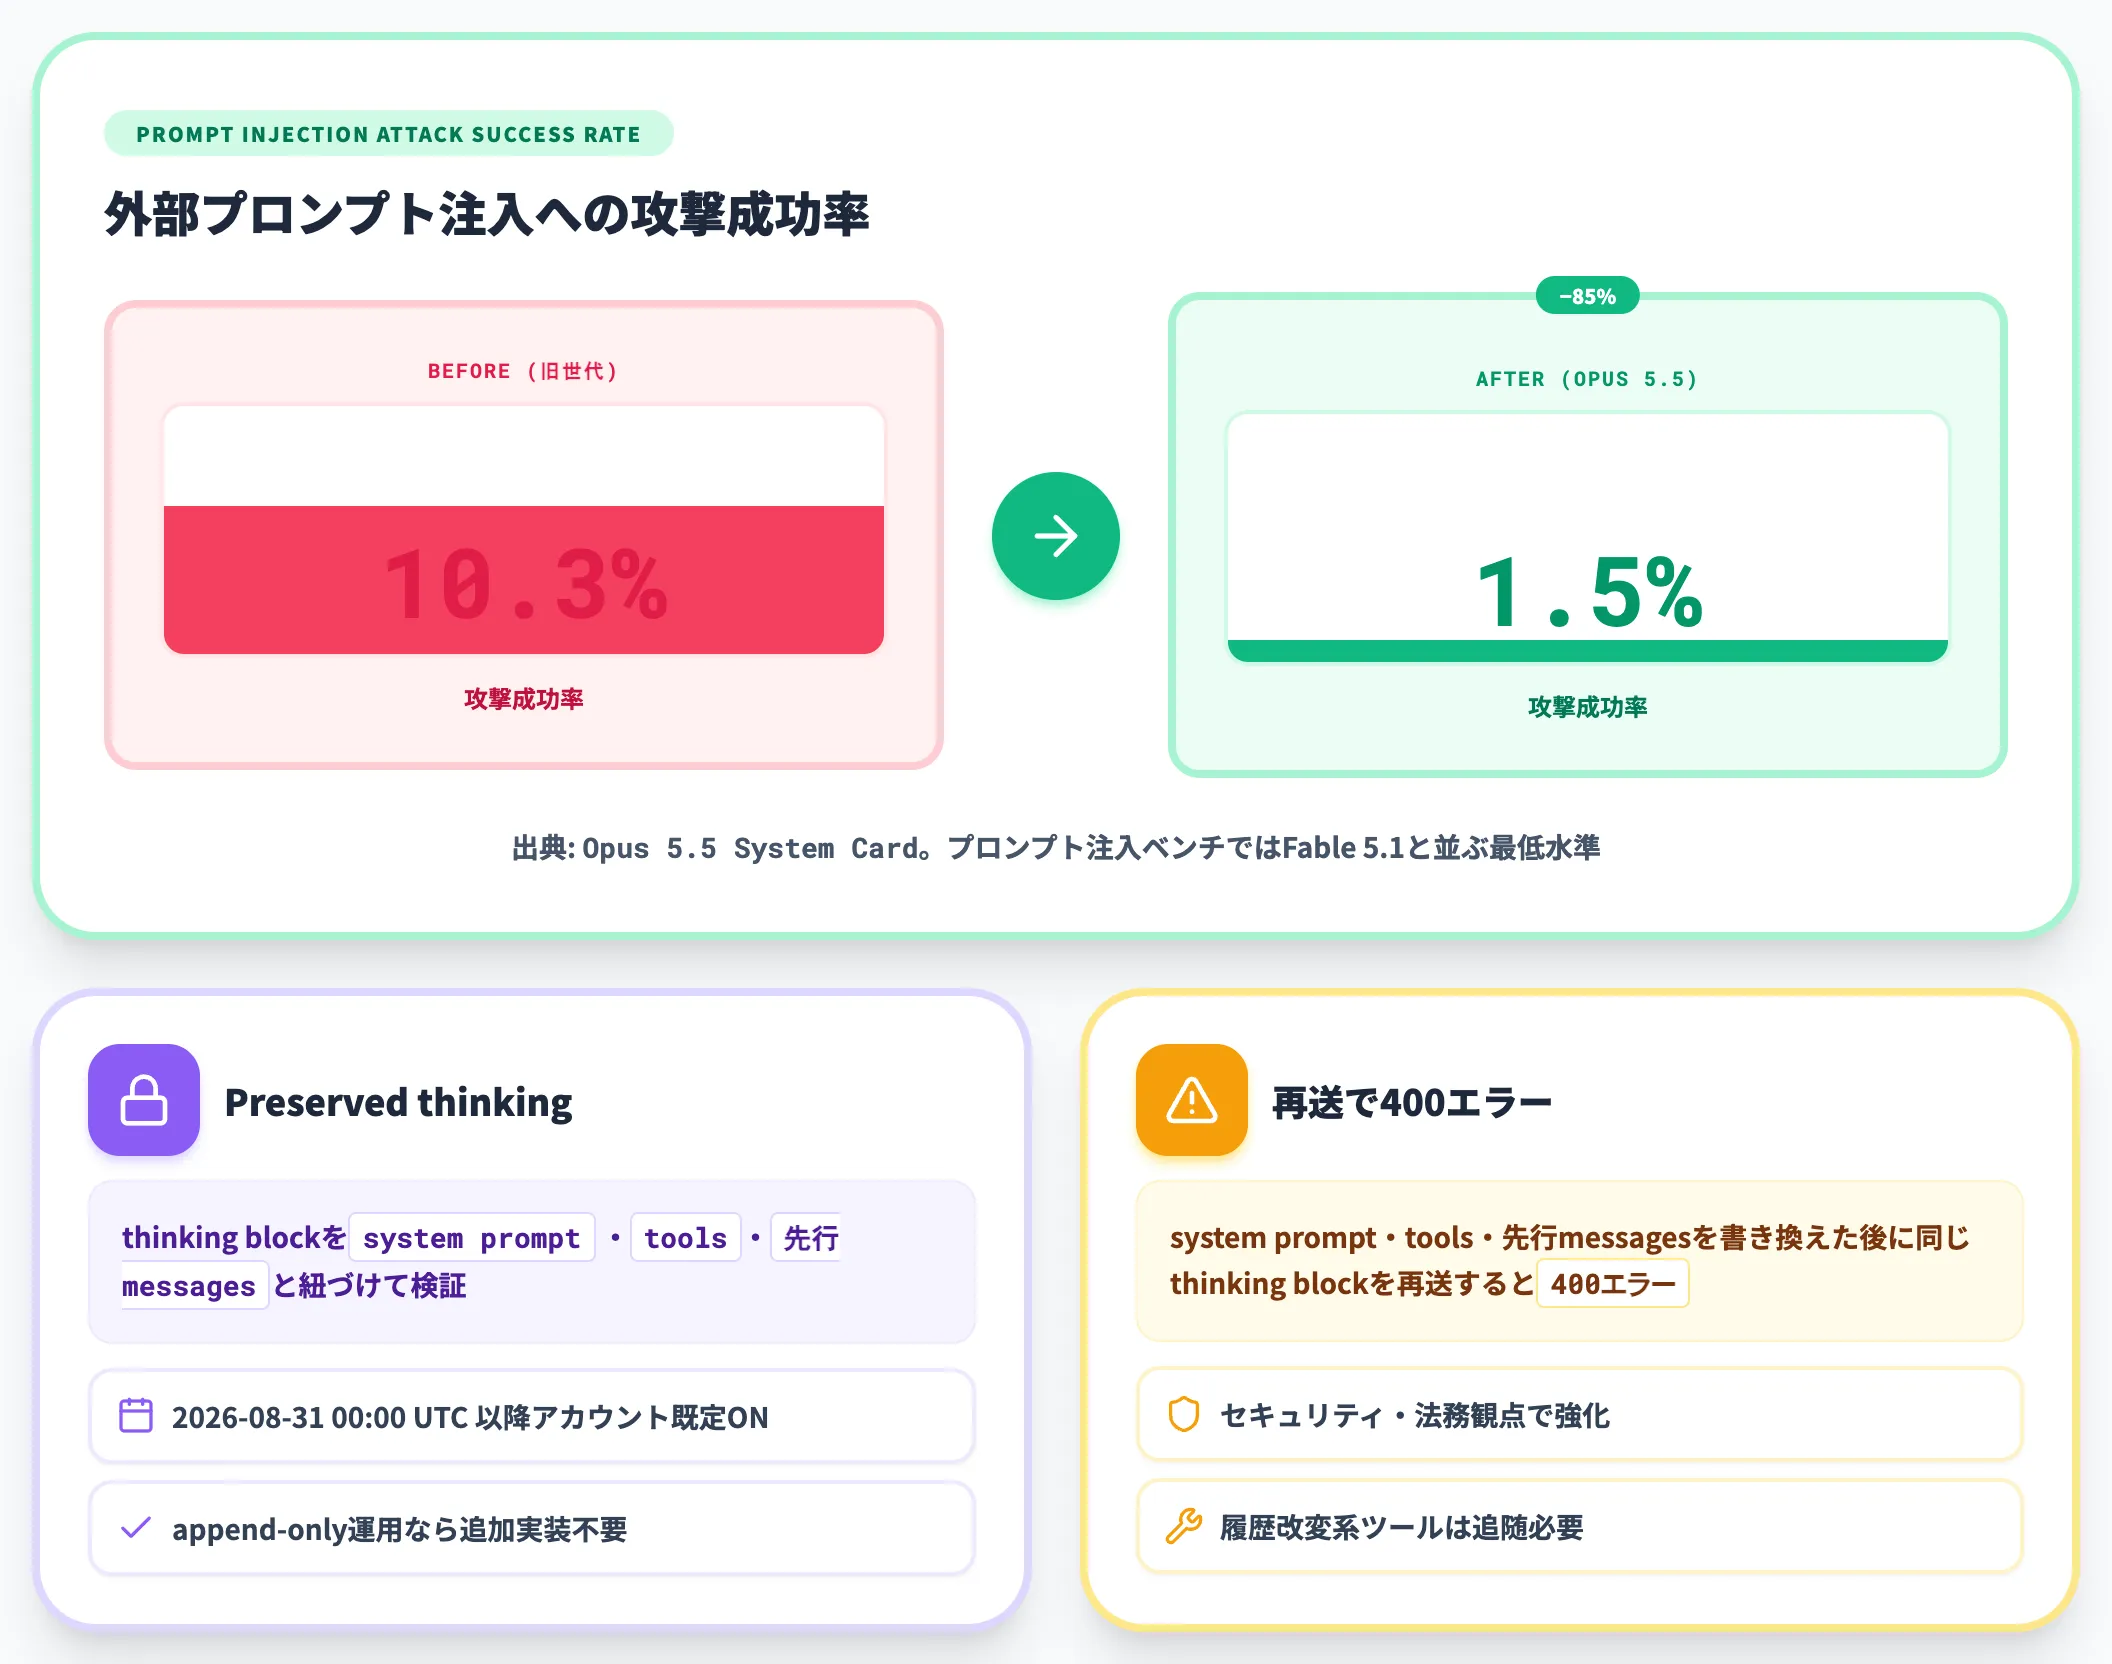
Opus 5.5では、Preserved thinking(保存された拡張思考)の不一致時の拒否が、2026年8月31日00:00 UTC以降に作成したAPIアカウントでデフォルト有効化されます。
これはthinking blockをsystem prompt・tools・先行messagesと紐づけて検証する仕組みで、会話をappend-only(システムプロンプト・tools・先行messagesを改変しない)で運用している限り追加実装は不要です。会話の途中でこれらを書き換えてから同じthinking blockを再送すると、デフォルトでは400エラーが返る挙動になります。
アライメント面でも改善が入っており、外部プロンプト注入ベンチマークでOpus 5.5はFable 5.1と並ぶ「最低の攻撃成功率」を記録しています。
モデル封じ込め境界を回避しようとする挙動は、Opus 5.5 System Cardが公表する数値(10.3%→1.5%)から計算すると約**85%**の減少にあたります。
セキュリティ・法務観点で「業務プロンプトの中身が漏れないか」「セーフガードを迂回する応答を返さないか」を気にする組織にとって、Opus 5.5世代は据え置きでは済まない改善が入ったバージョンです。
Fable 5.1・Opus 5との使い分け
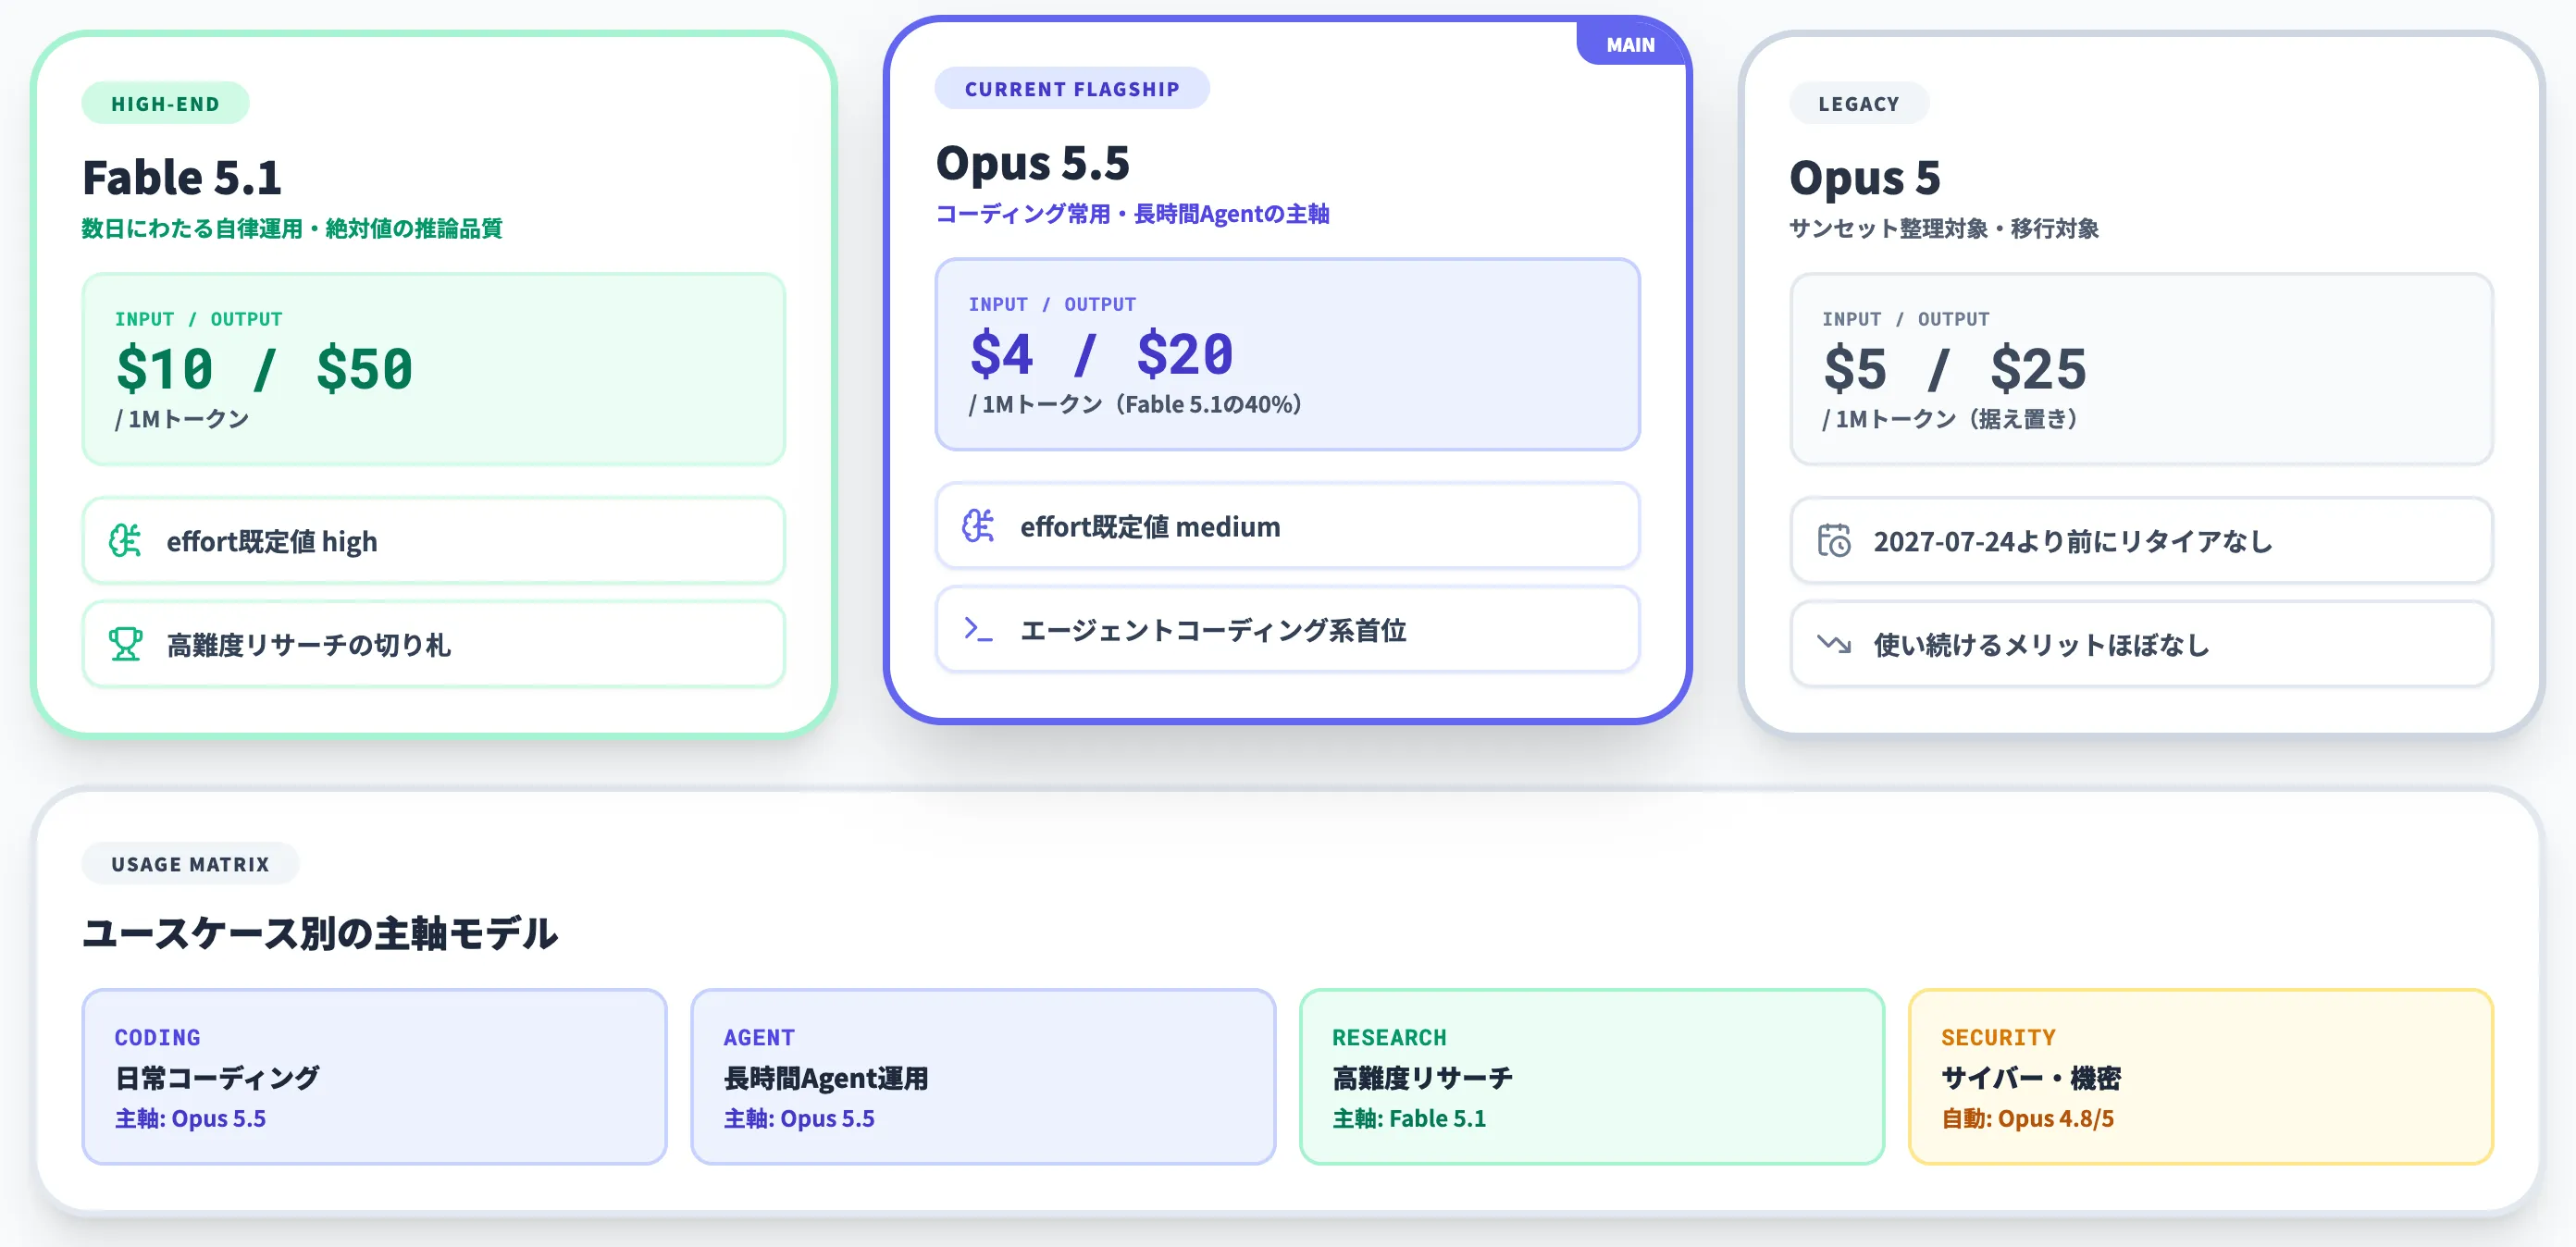
Opus 5.5のリリースで、Anthropicのフロンティア帯は「Fable 5.1・Opus 5.5・Opus 5」の3世代が同時に並ぶ構図になりました。
加えて2026年9月28日にリリースされた中位ラインClaude Sonnet 5.5($2/$10でSonnet 5から30%高速化)と、軽量ラインのClaude Haiku 4.5まで含めた現行4モデルラインアップは、Anthropic公式Docsで以下のように整理されています。
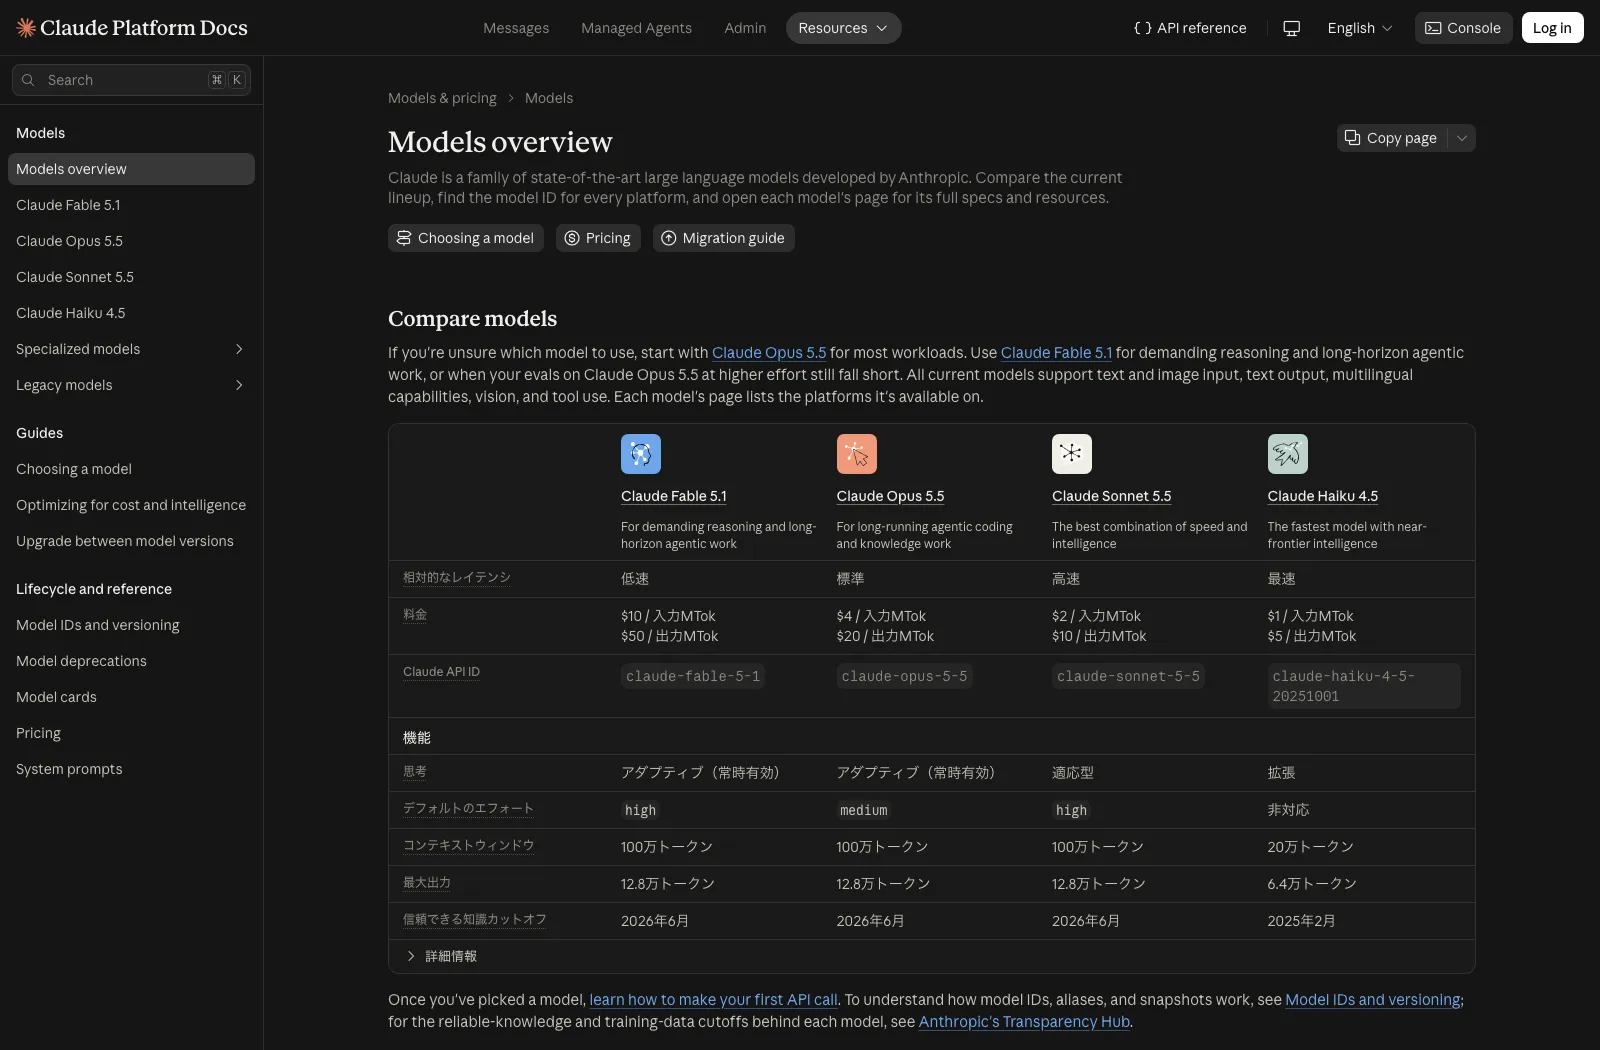
Anthropic公式Docsに掲載されている現行4モデルの比較(出典:Anthropic Models overview)
「Fable 5.1が高くて悩んでいた層」「Opus 5から移行するべきか迷う層」の両方で判断が分かれるのが、上位のFable 5.1・Opus 5.5・Opus 5の3世代です。以下ではケース別に主軸となるモデルを整理します。
コーディング常用の主軸はOpus 5.5
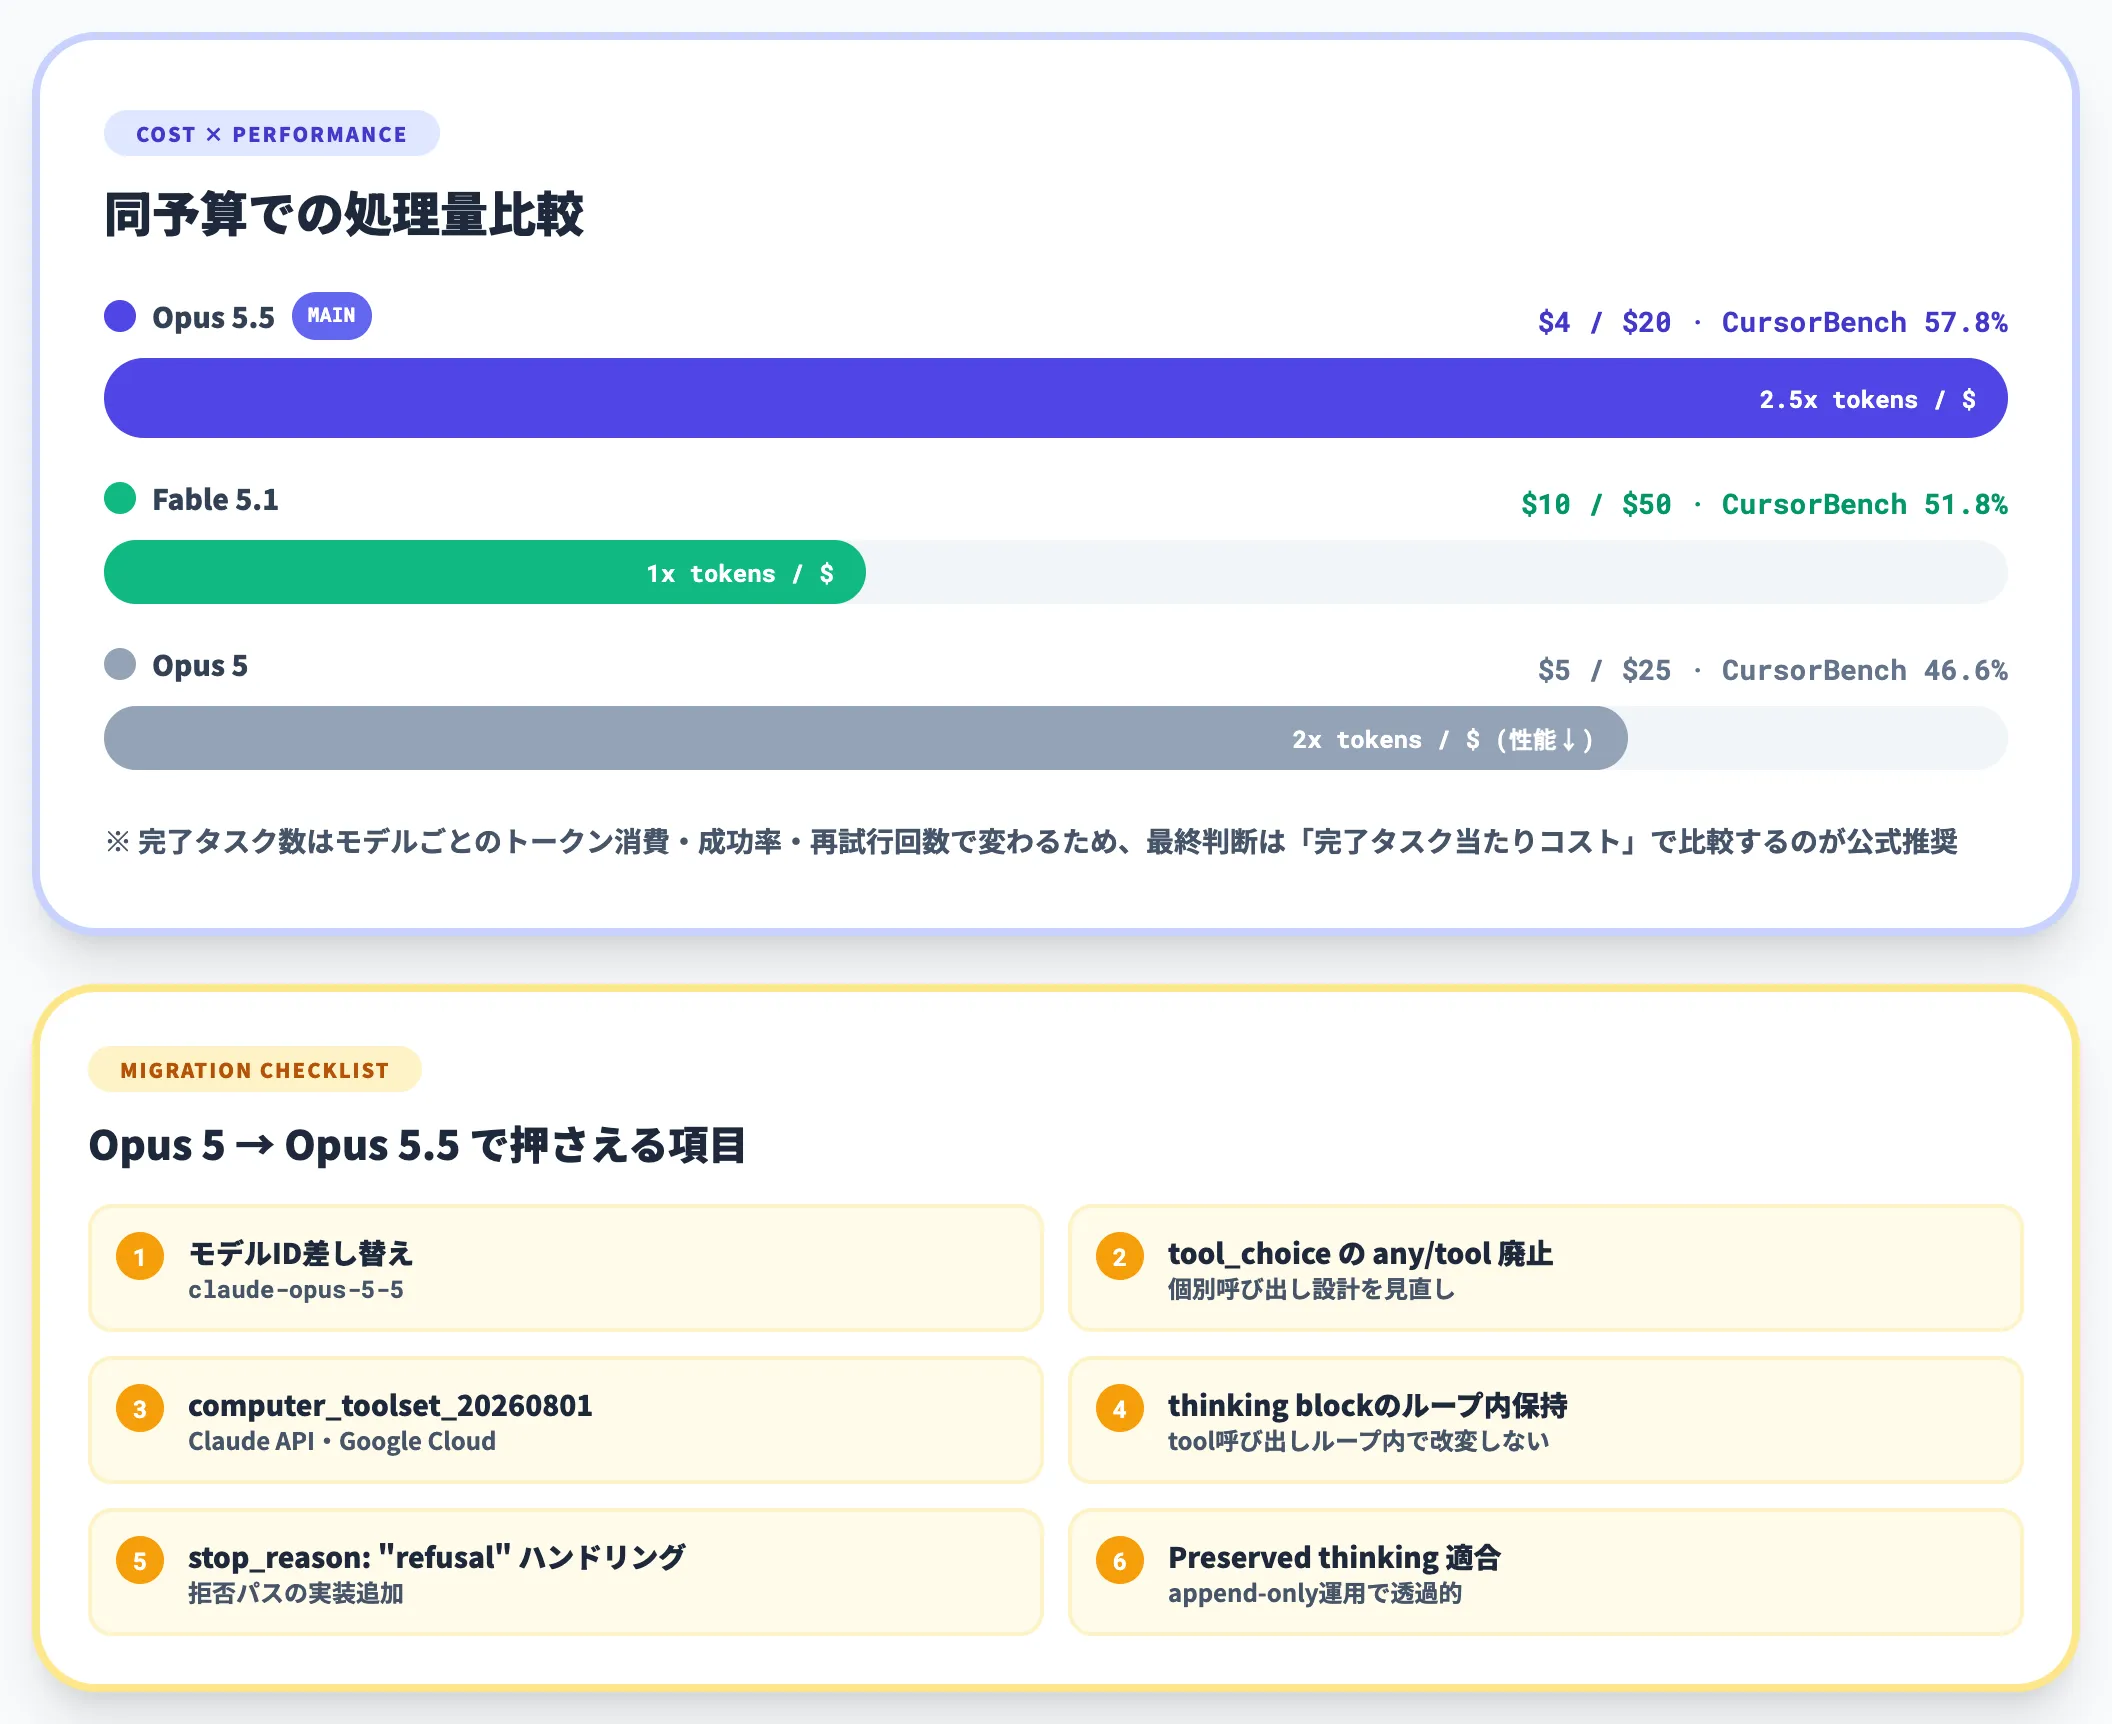
日常的にコーディングエージェントを走らせるチームであれば、Opus 5.5を主軸に据えるのが妥当です。
CursorBench 4.0・Terminal-Bench 4.0のようなエージェントコーディング系でOpus 5.5がFable 5.1を上回っており、単価はFable 5.1の40%($4/$20 vs $10/$50)で済みます。同一の入出力トークン構成なら、同じ予算で処理できるトークン量が単純計算で2倍以上になります。ただし完了タスク数はモデルごとのトークン消費・成功率・再試行回数で変わるため、最終判断は「完了タスク当たりコスト」で比較するのが公式推奨です。
Opus 5世代でエージェントコーディングを常用しているチームがOpus 5.5に移る場合は、モデルID差し替えに加えて「tool_choice」の「any」/「tool」廃止・「computer_toolset_20260801」への切替(Claude API・Google Cloud)・thinking blockのループ内保持・「stop_reason: "refusal"」ハンドリングなど、公式移行ガイドが列挙する必須項目を事前に洗い出す運用が想定されます。
思考の深さはeffortパラメータで吸収できますが、それ以外のAPI仕様差は個別の書き換えが必要で、切替に要する期間は対象ワークフロー数や呼び出しループの複雑さで大きく変わります。
超長時間の自律運用はFable 5.1
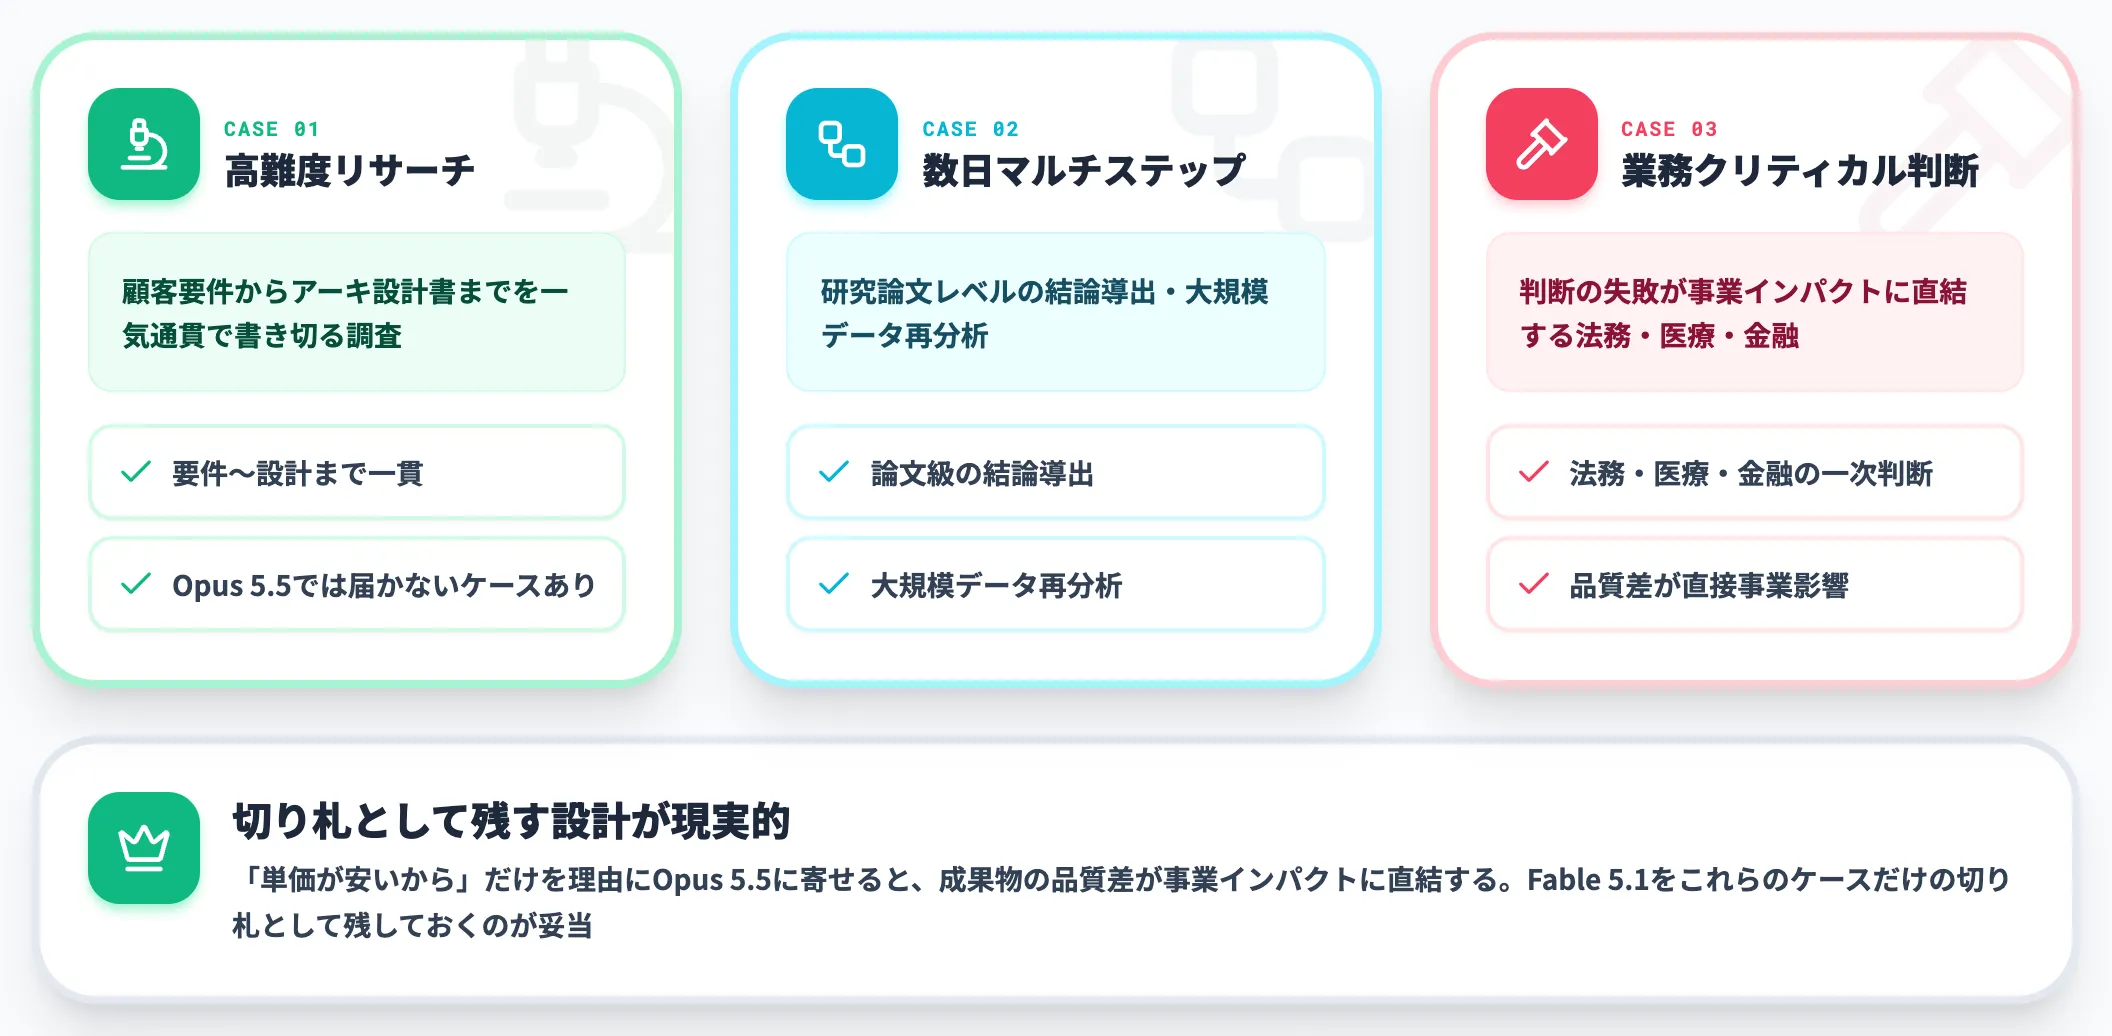
一方で、数日にわたる自律運用や、絶対値の推論品質を最優先する用途では、Fable 5.1が引き続き優位です。
Fable 5.1はデフォルトeffortがhighに設定され、想定される稼働時間帯・タスクの難易度もOpus 5.5より一段上を狙って設計されています。実装経験からは、以下のようなユースケースでOpus 5.5では届かないケースが実際に出ています。
- 顧客要件からアーキテクチャ設計書までを一気通貫で書き切るような高難度リサーチ
- 数日単位のマルチステップ検証(研究論文レベルの結論導出、大規模データ再分析)
- 判断の失敗が業務クリティカルな法務・医療・金融の一次判断支援
この領域で「単価が安いから」だけを理由にOpus 5.5に寄せると、成果物の品質差が事業インパクトに直結します。Fable 5.1を切り札として残しておく設計が現実的です。
Opus 5をいつまで使うか
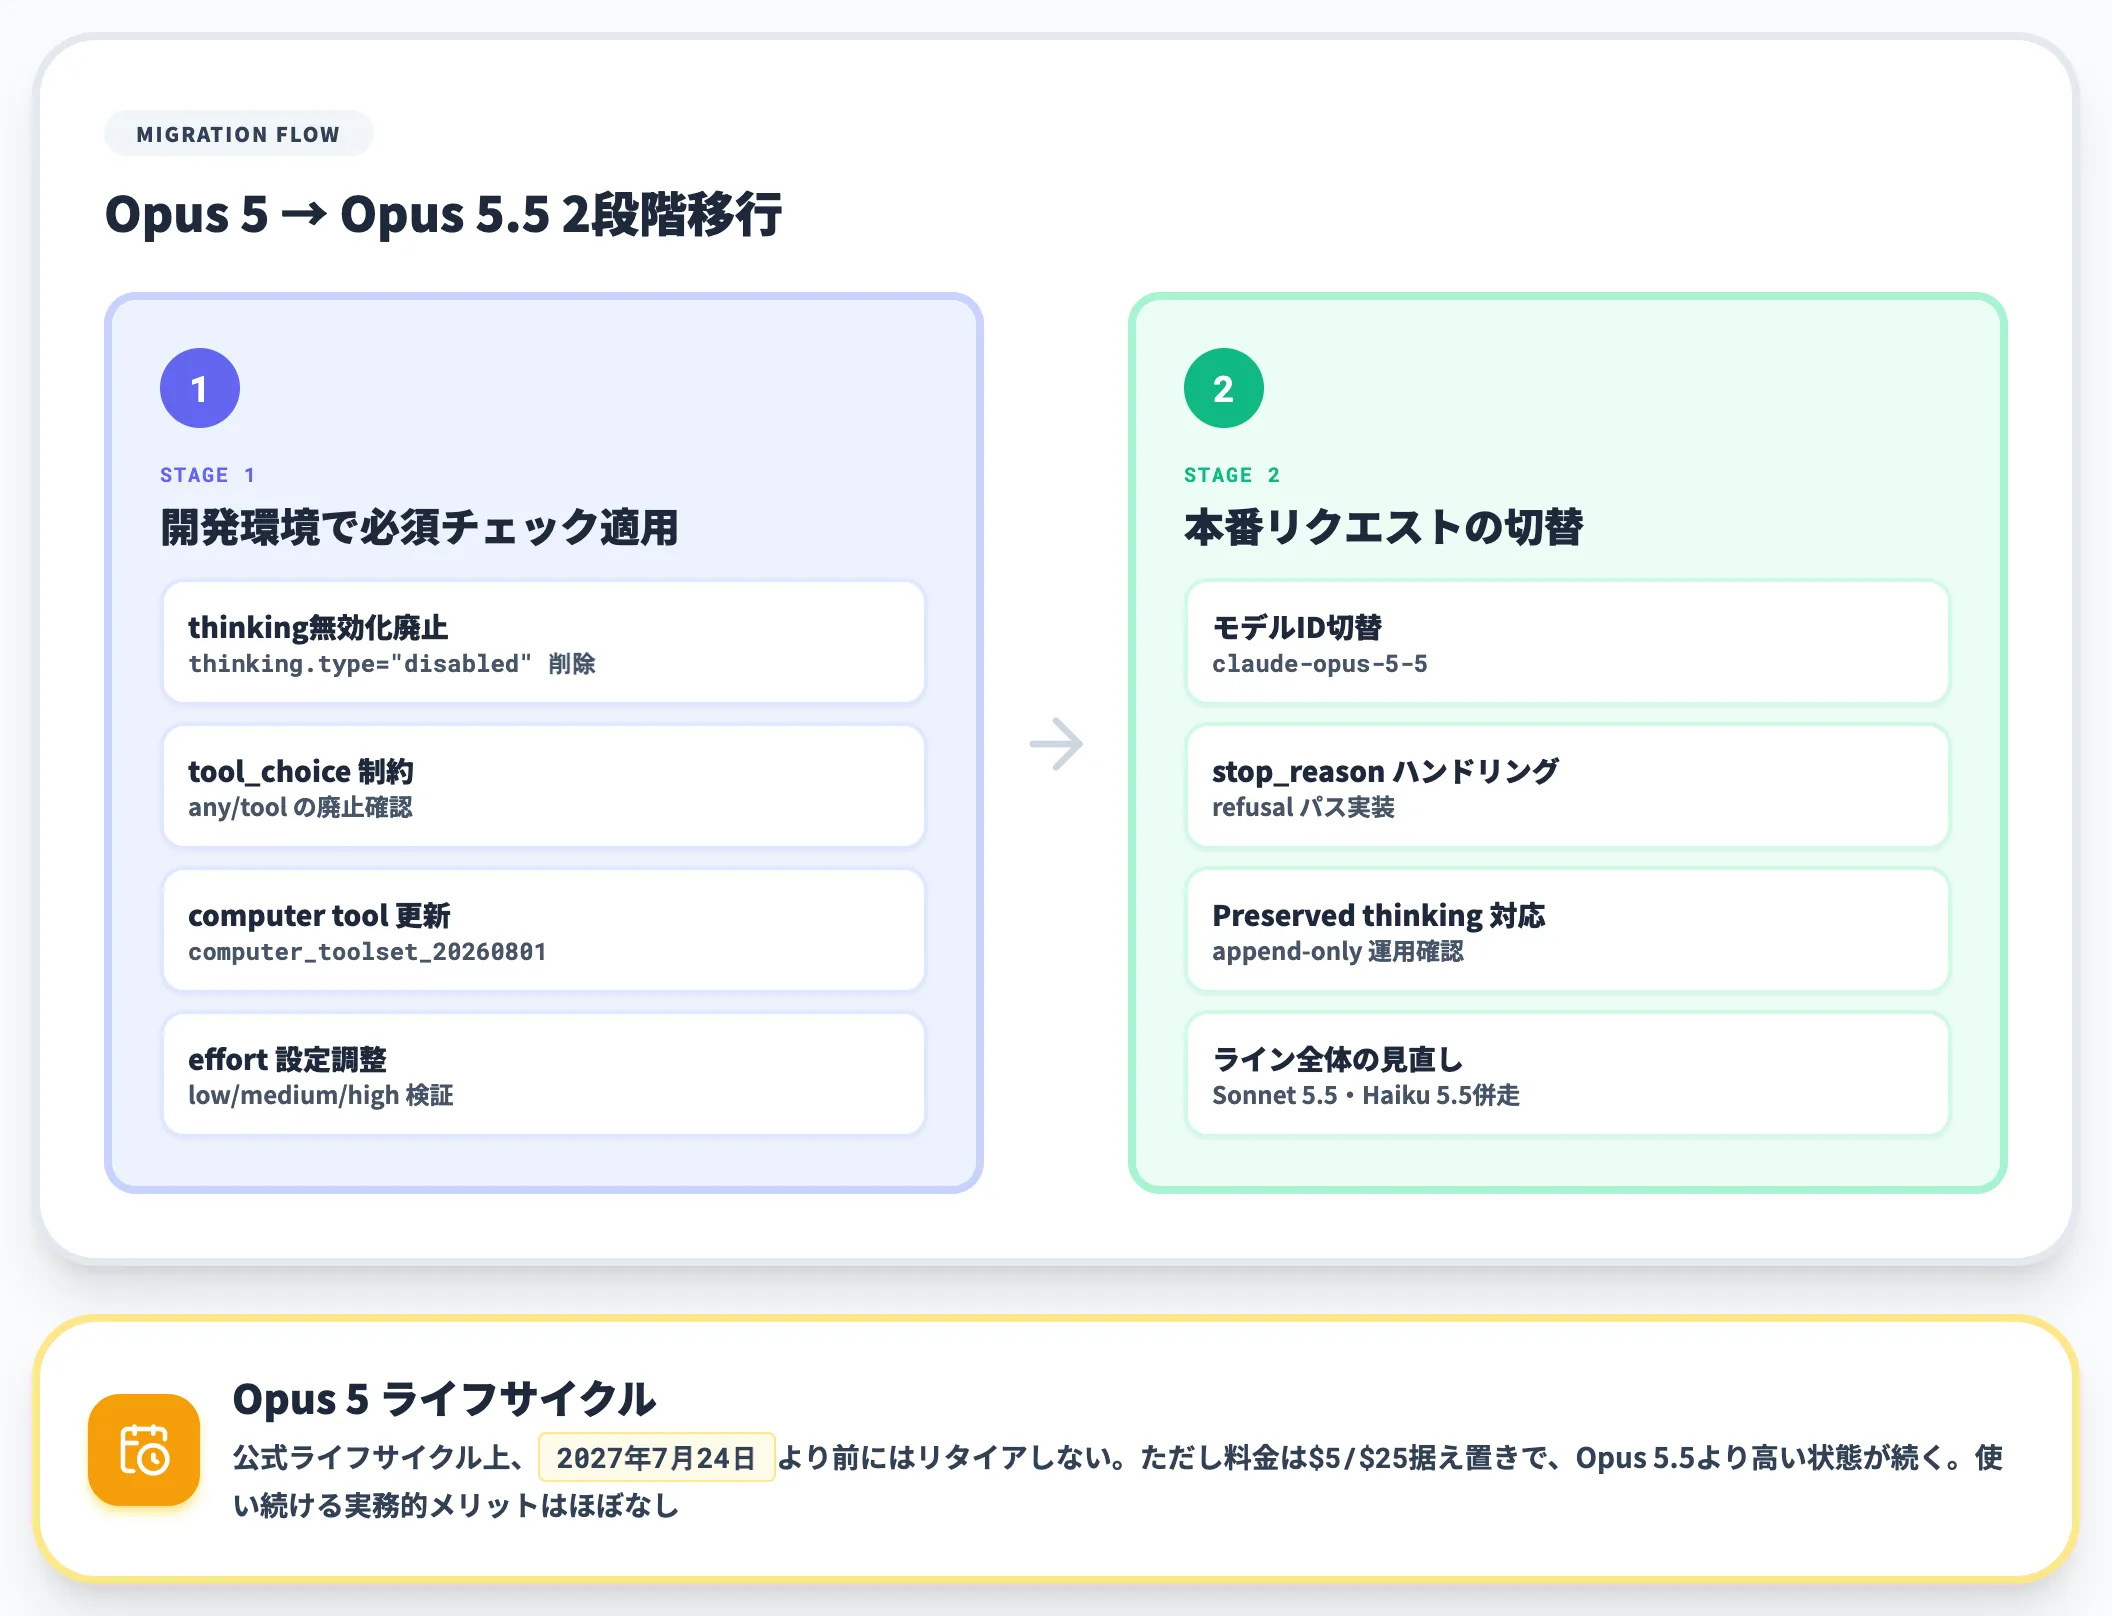
前世代のOpus 5は、Anthropicの公式ライフサイクル上で「2027年7月24日より前にはリタイアしない」と明記されています。ただし料金は据え置きで、Opus 5.5と単価が同じ$4/$20ではなく$5/$25のままです。
Opus 5を使い続ける実務的なメリットはほぼなく、コスト面・性能面ともにOpus 5.5に移行するのが合理的です。
移行の順序としては、公式移行ガイドの必須チェックリスト(thinking無効化廃止・「tool_choice」制約・computer tool更新・thinking blockのループ内保持・「stop_reason: "refusal"」ハンドリング・Preserved thinking)を開発環境で適用し、effort設定の調整もあわせて検証してから、本番リクエストのモデルIDを「claude-opus-5-5」に切り替える2段階が現実的な進め方になります。
Sonnet 5.5は2026年9月28日にすでにリリース済み(Sonnet 5と同単価$2/$10で30%高速化)、Haiku 5.5もAnthropicから「数週間以内」と予告されているため、モデルライン全体の再構成を予定している組織は、Opus 5.5移行と併せて低単価帯の見直しも同時に走らせるのがコスト最適です。
Claude Opus 5.5の使い方と提供チャネル
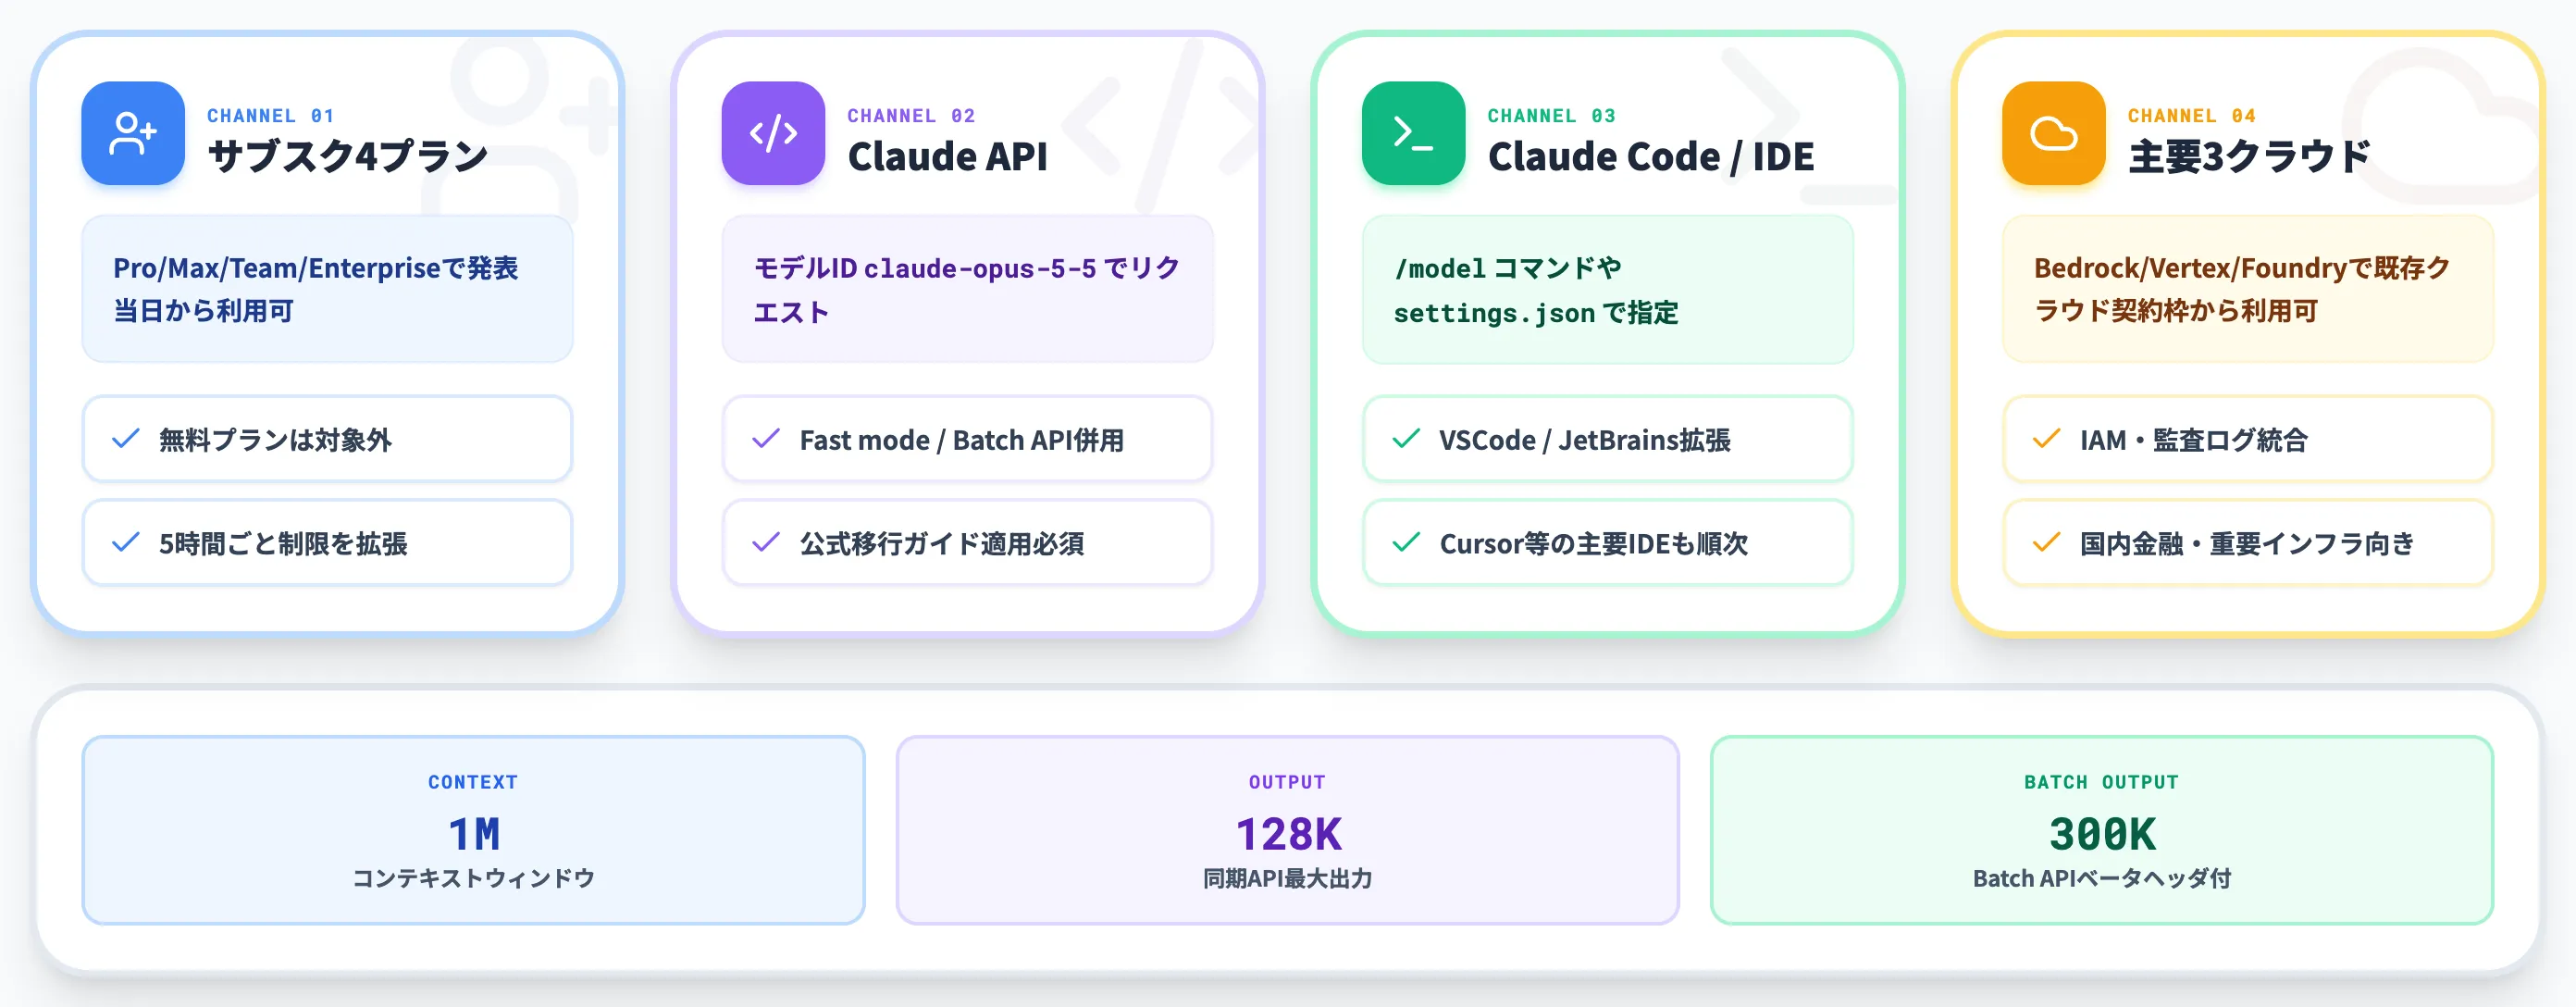
Claude Opus 5.5は、Claudeアプリのサブスクリプション・API・Claude Code・主要3クラウドまで、既存のOpusと同じ経路で提供されています。ここでは提供チャネルごとに何ができるかを整理します。
サブスク4プランで即日利用可
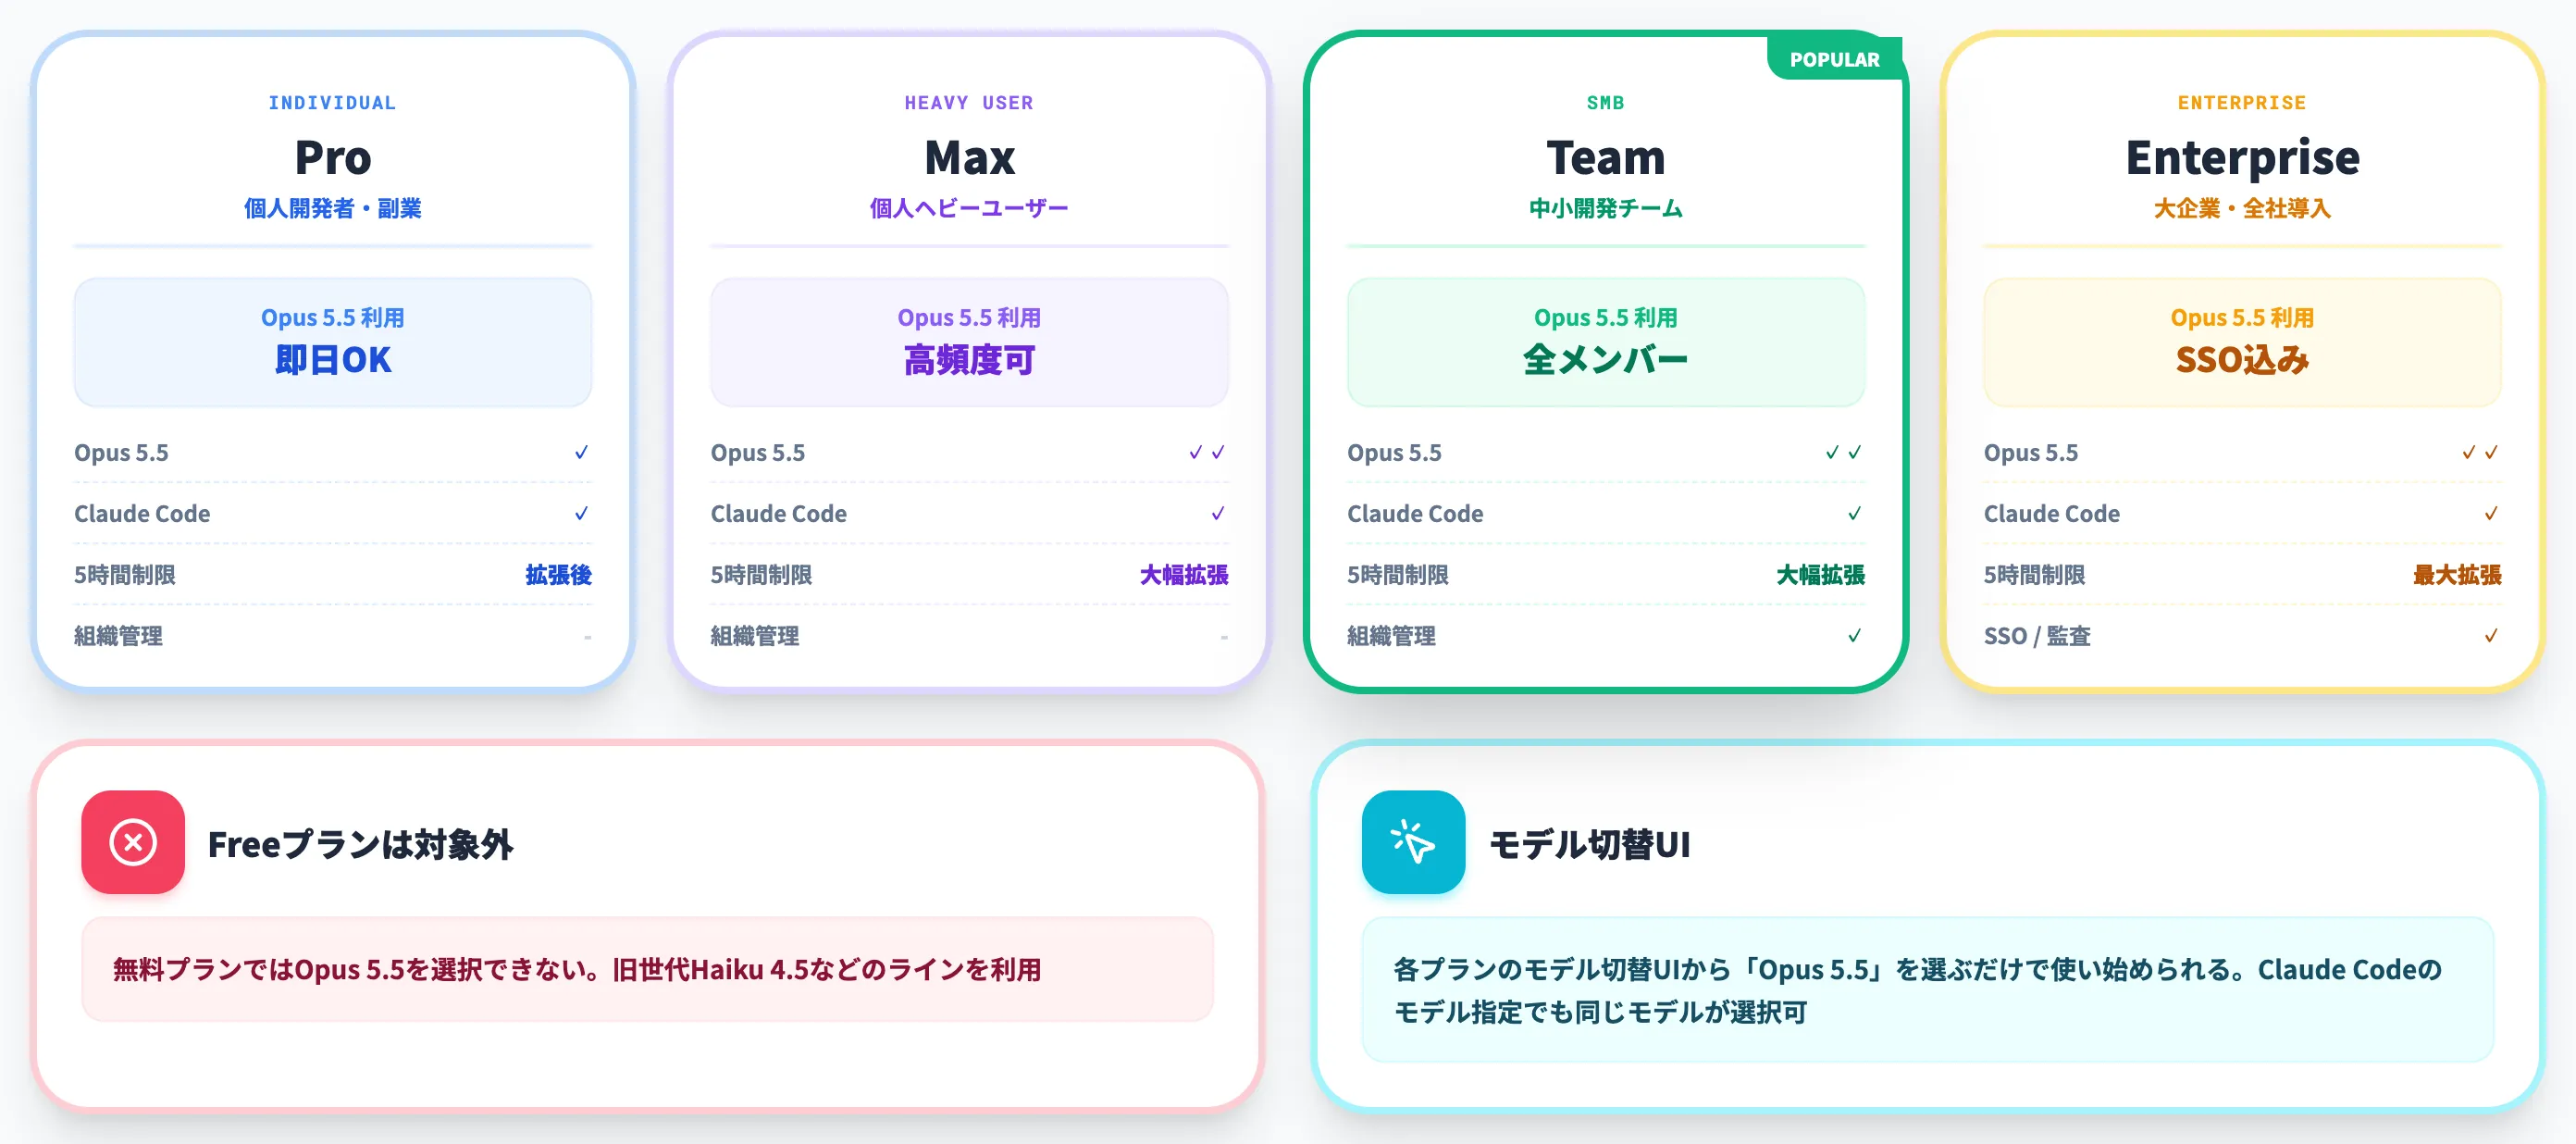
サブスクリプション側では、Pro・Max・Team・Enterpriseの各プランで発表当日から利用可能になりました。無料プランは対象外です。
各プランのモデル切替UIから「Opus 5.5」を選ぶだけで使い始められ、Claude Codeのモデル指定でも同じモデルが選択できます。5時間ごとの利用制限もOpus 5から拡張されており、Max・Team・Enterpriseは同一プランのままでOpus 5.5を長時間走らせやすくなっています。
各プランの利用制限とAPIキー発行の関係はClaude Codeの料金プランガイドで解説しています。
API・Claude Code・IDE統合での使い方
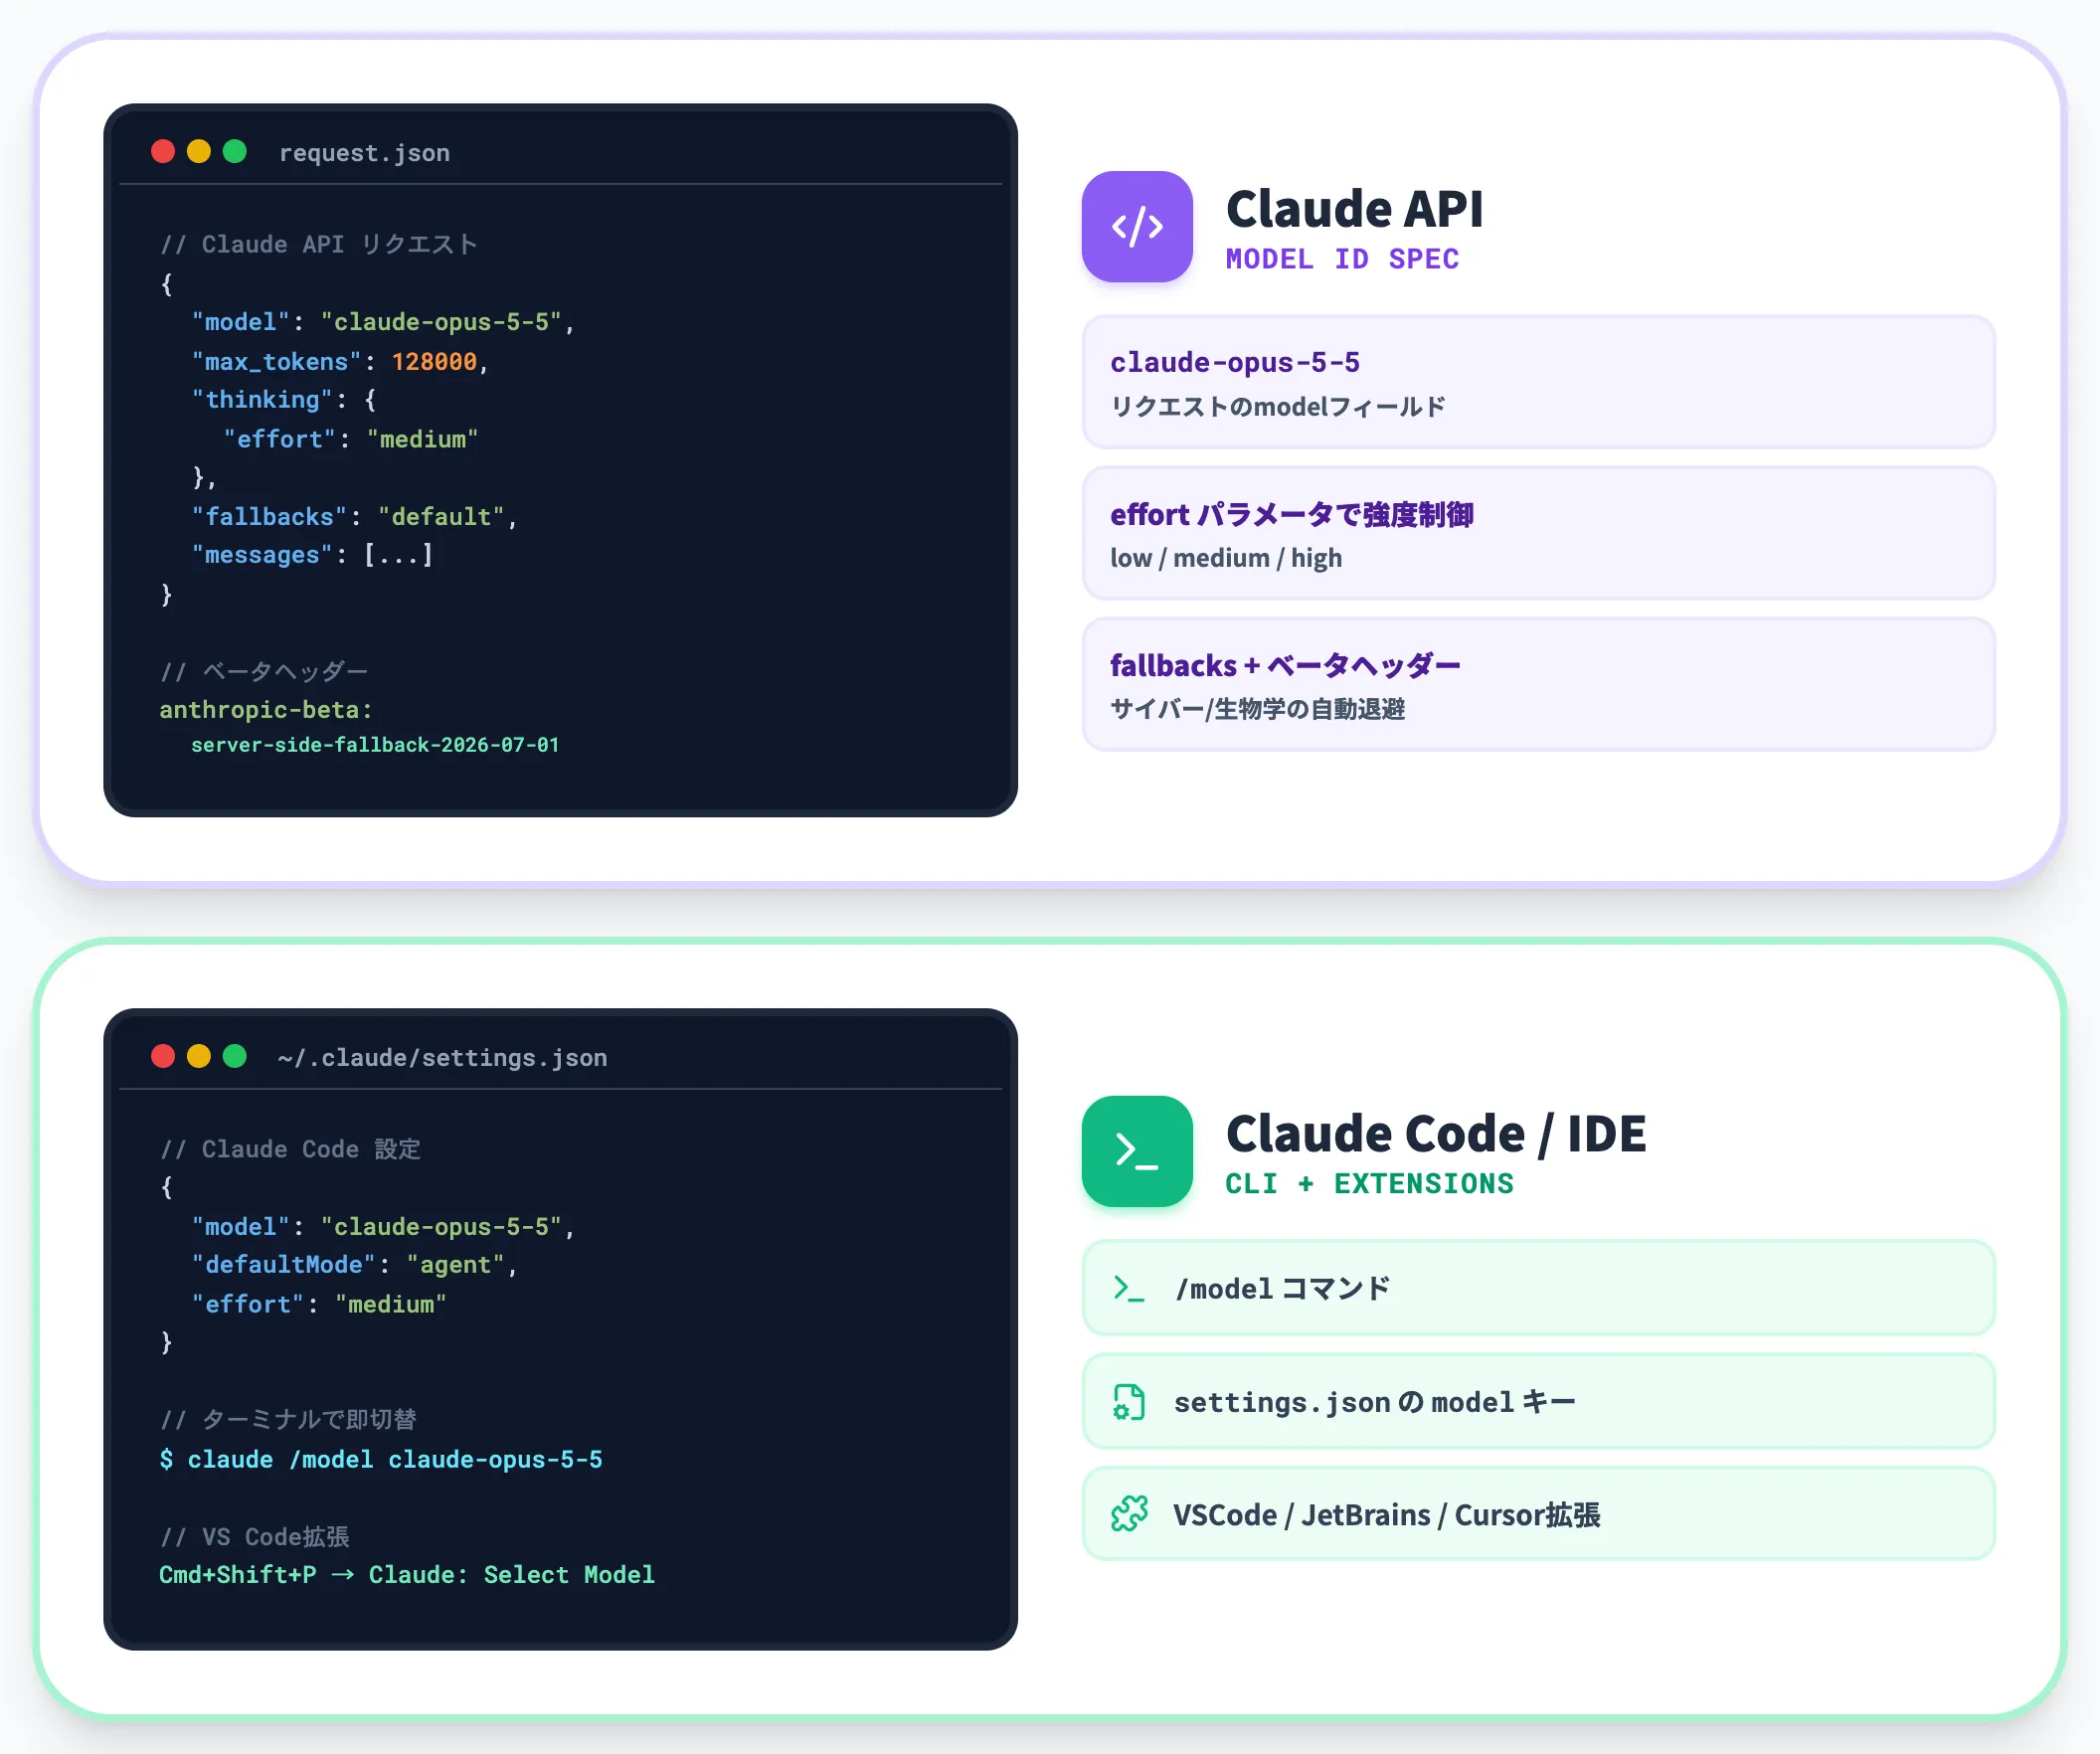
開発者向けの主要な入口は、Claude APIとClaude Code、各種IDE統合の3種類です。
-
Claude API
モデルID「claude-opus-5-5」をリクエストに渡して指定
-
Claude Code
「/model」コマンドまたは「settings.json」の「model」キーで指定。VSCode拡張・JetBrains拡張からも同じモデルIDが選択可能
-
主要IDE統合
Cursorなどでも順次対応が進んでおり、初日から普段のワークフローに載せられる
Opus 5からAPIで移行する場合は、モデルID差し替えに加えて以下が必須変更として公式移行ガイドに列挙されています。
- 「thinking.type="disabled"」の廃止
- 「tool_choice」の「any」/「tool」廃止
- 「computer_toolset_20260801」への切替(Claude API・Google Cloud)
- thinking blockのループ内保持
- 「stop_reason: "refusal"」ハンドリング
既存のプロンプト設計・ツール呼び出し設計のうち、これらに触れる部分は書き換えが必要です。
主要3クラウドでのモデルID
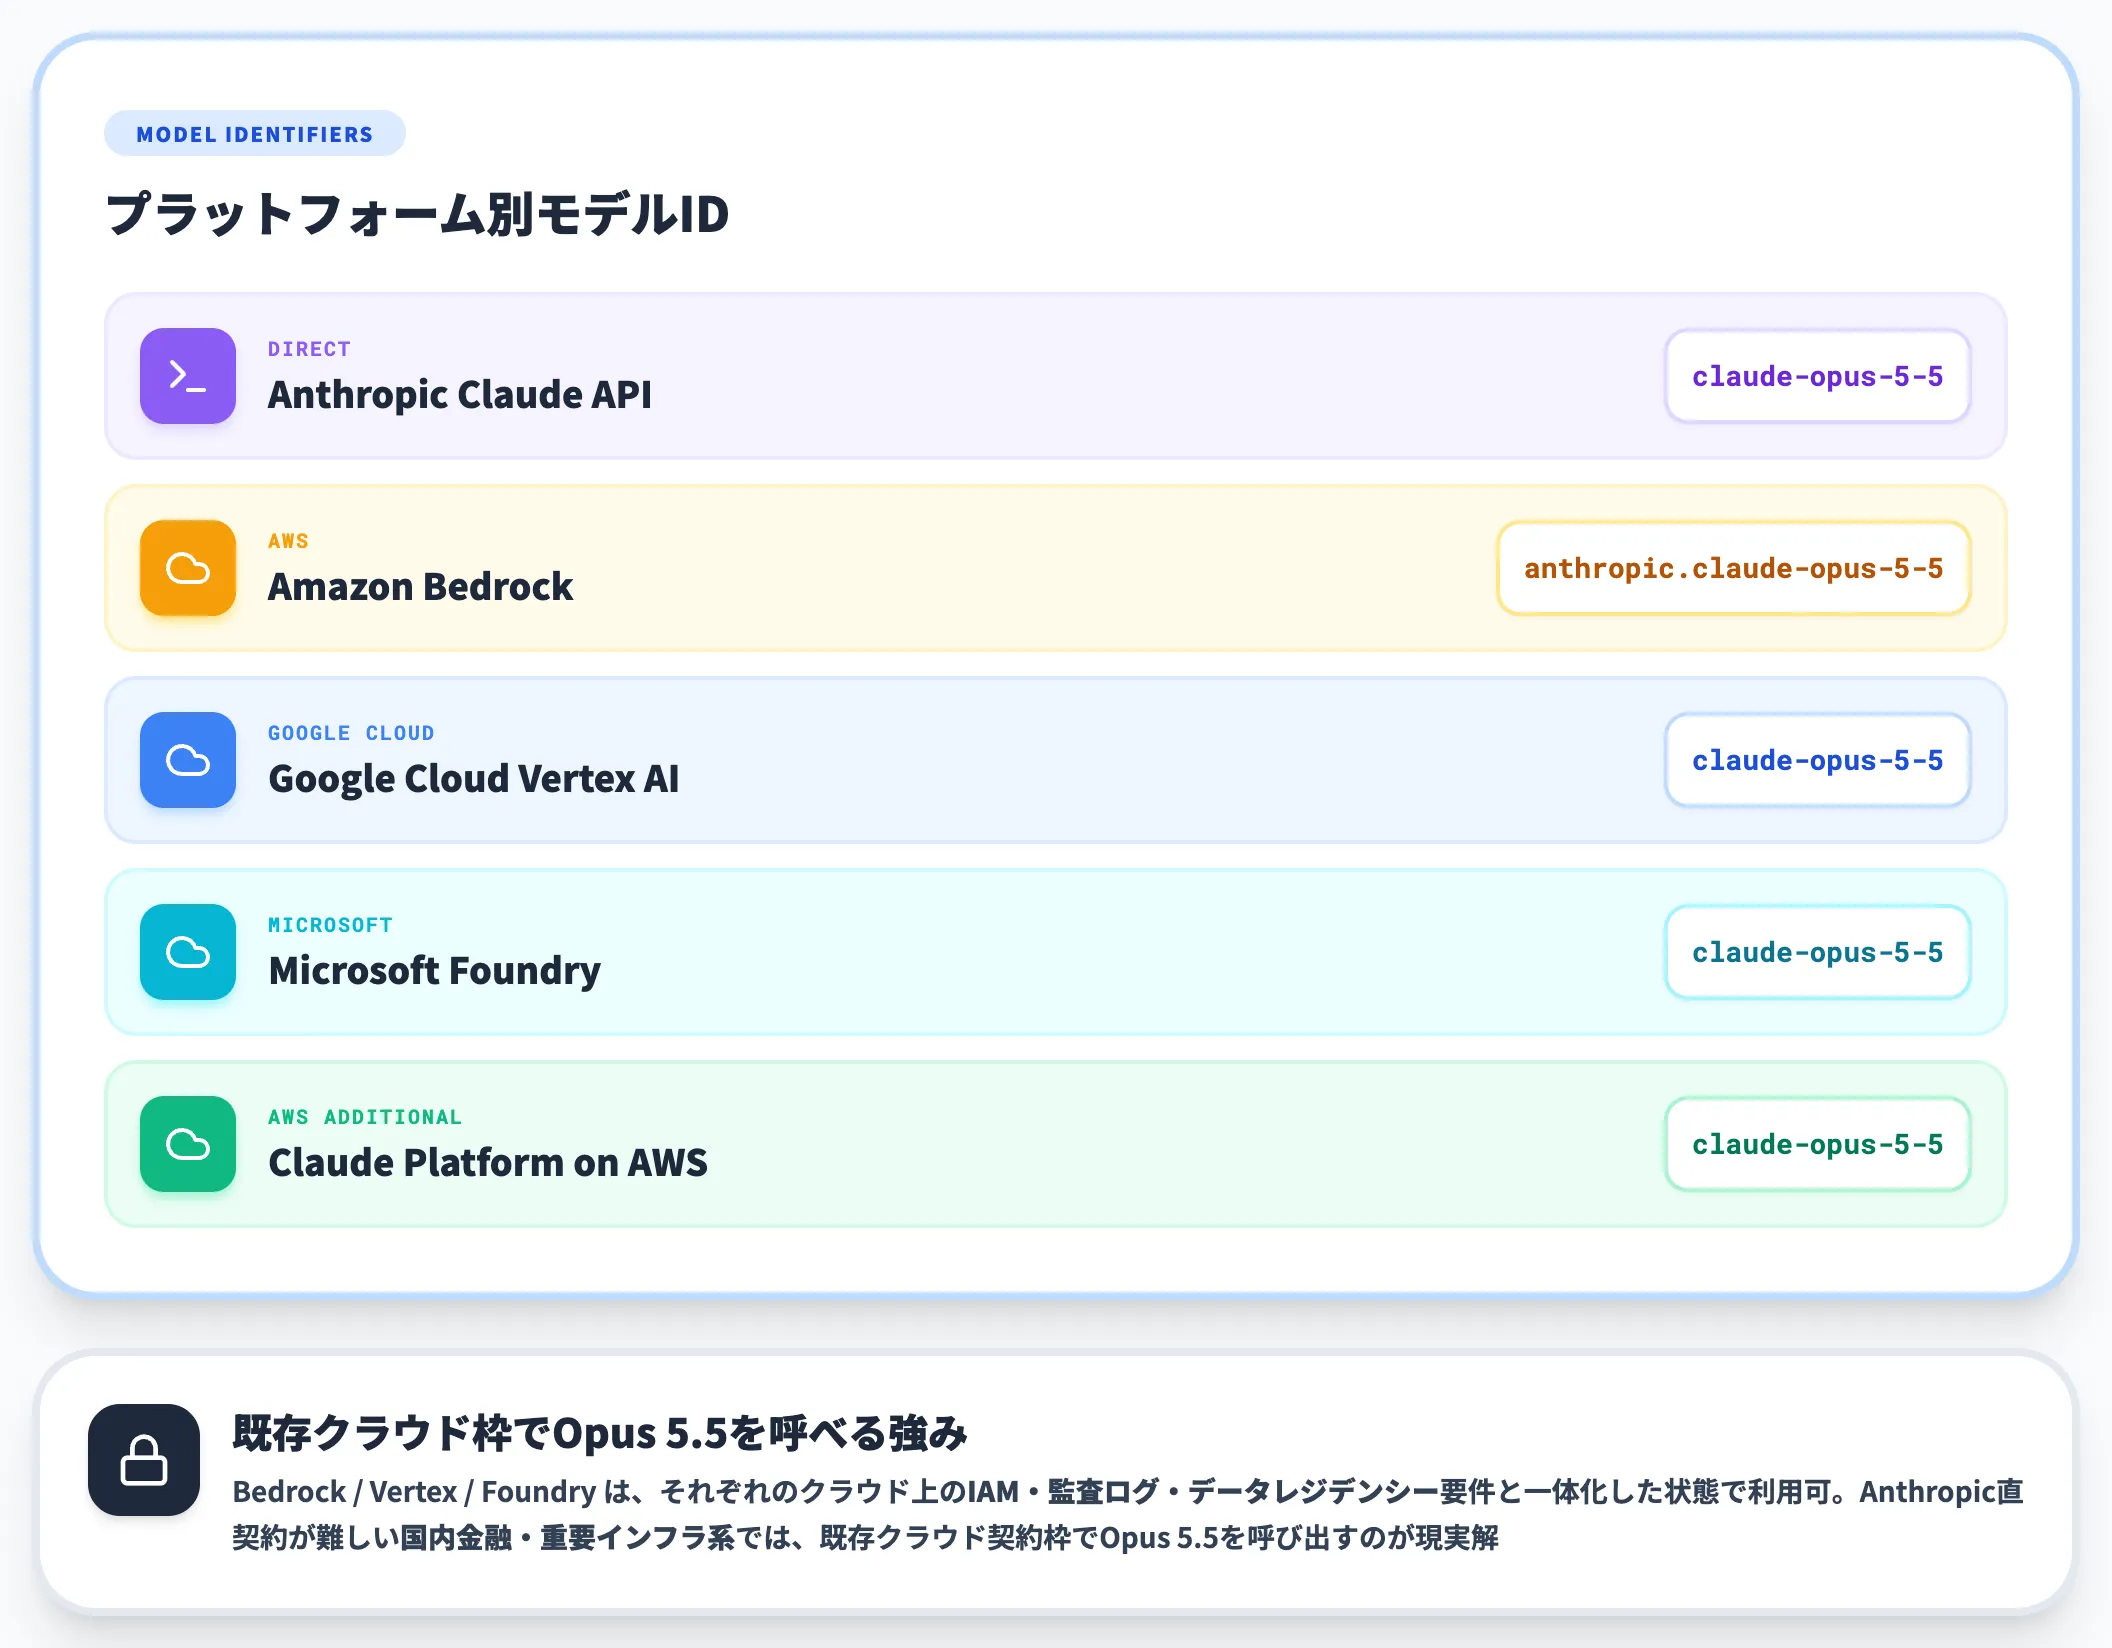
主要3クラウドでは、それぞれの命名規約でOpus 5.5が提供されています。以下がプラットフォームごとのモデル識別子です。
| プラットフォーム | モデル識別子 |
|---|---|
| Anthropic Claude API | 「claude-opus-5-5」 |
| Amazon Bedrock | 「anthropic.claude-opus-5-5」 |
| Google Cloud Vertex AI | 「claude-opus-5-5」 |
| Microsoft Foundry | 「claude-opus-5-5」 |
| Claude Platform on AWS | 「claude-opus-5-5」 |
Bedrock/Vertex/Foundryは、それぞれのクラウド上のIAM・監査ログ・データレジデンシー要件と一体化した状態でOpus 5.5を呼べるのが強みです。Anthropic直契約が難しい国内金融・重要インフラ系では、既存クラウド契約枠でOpus 5.5を呼び出す選択が現実解になります。
コンテキスト1M・出力128Kの上限
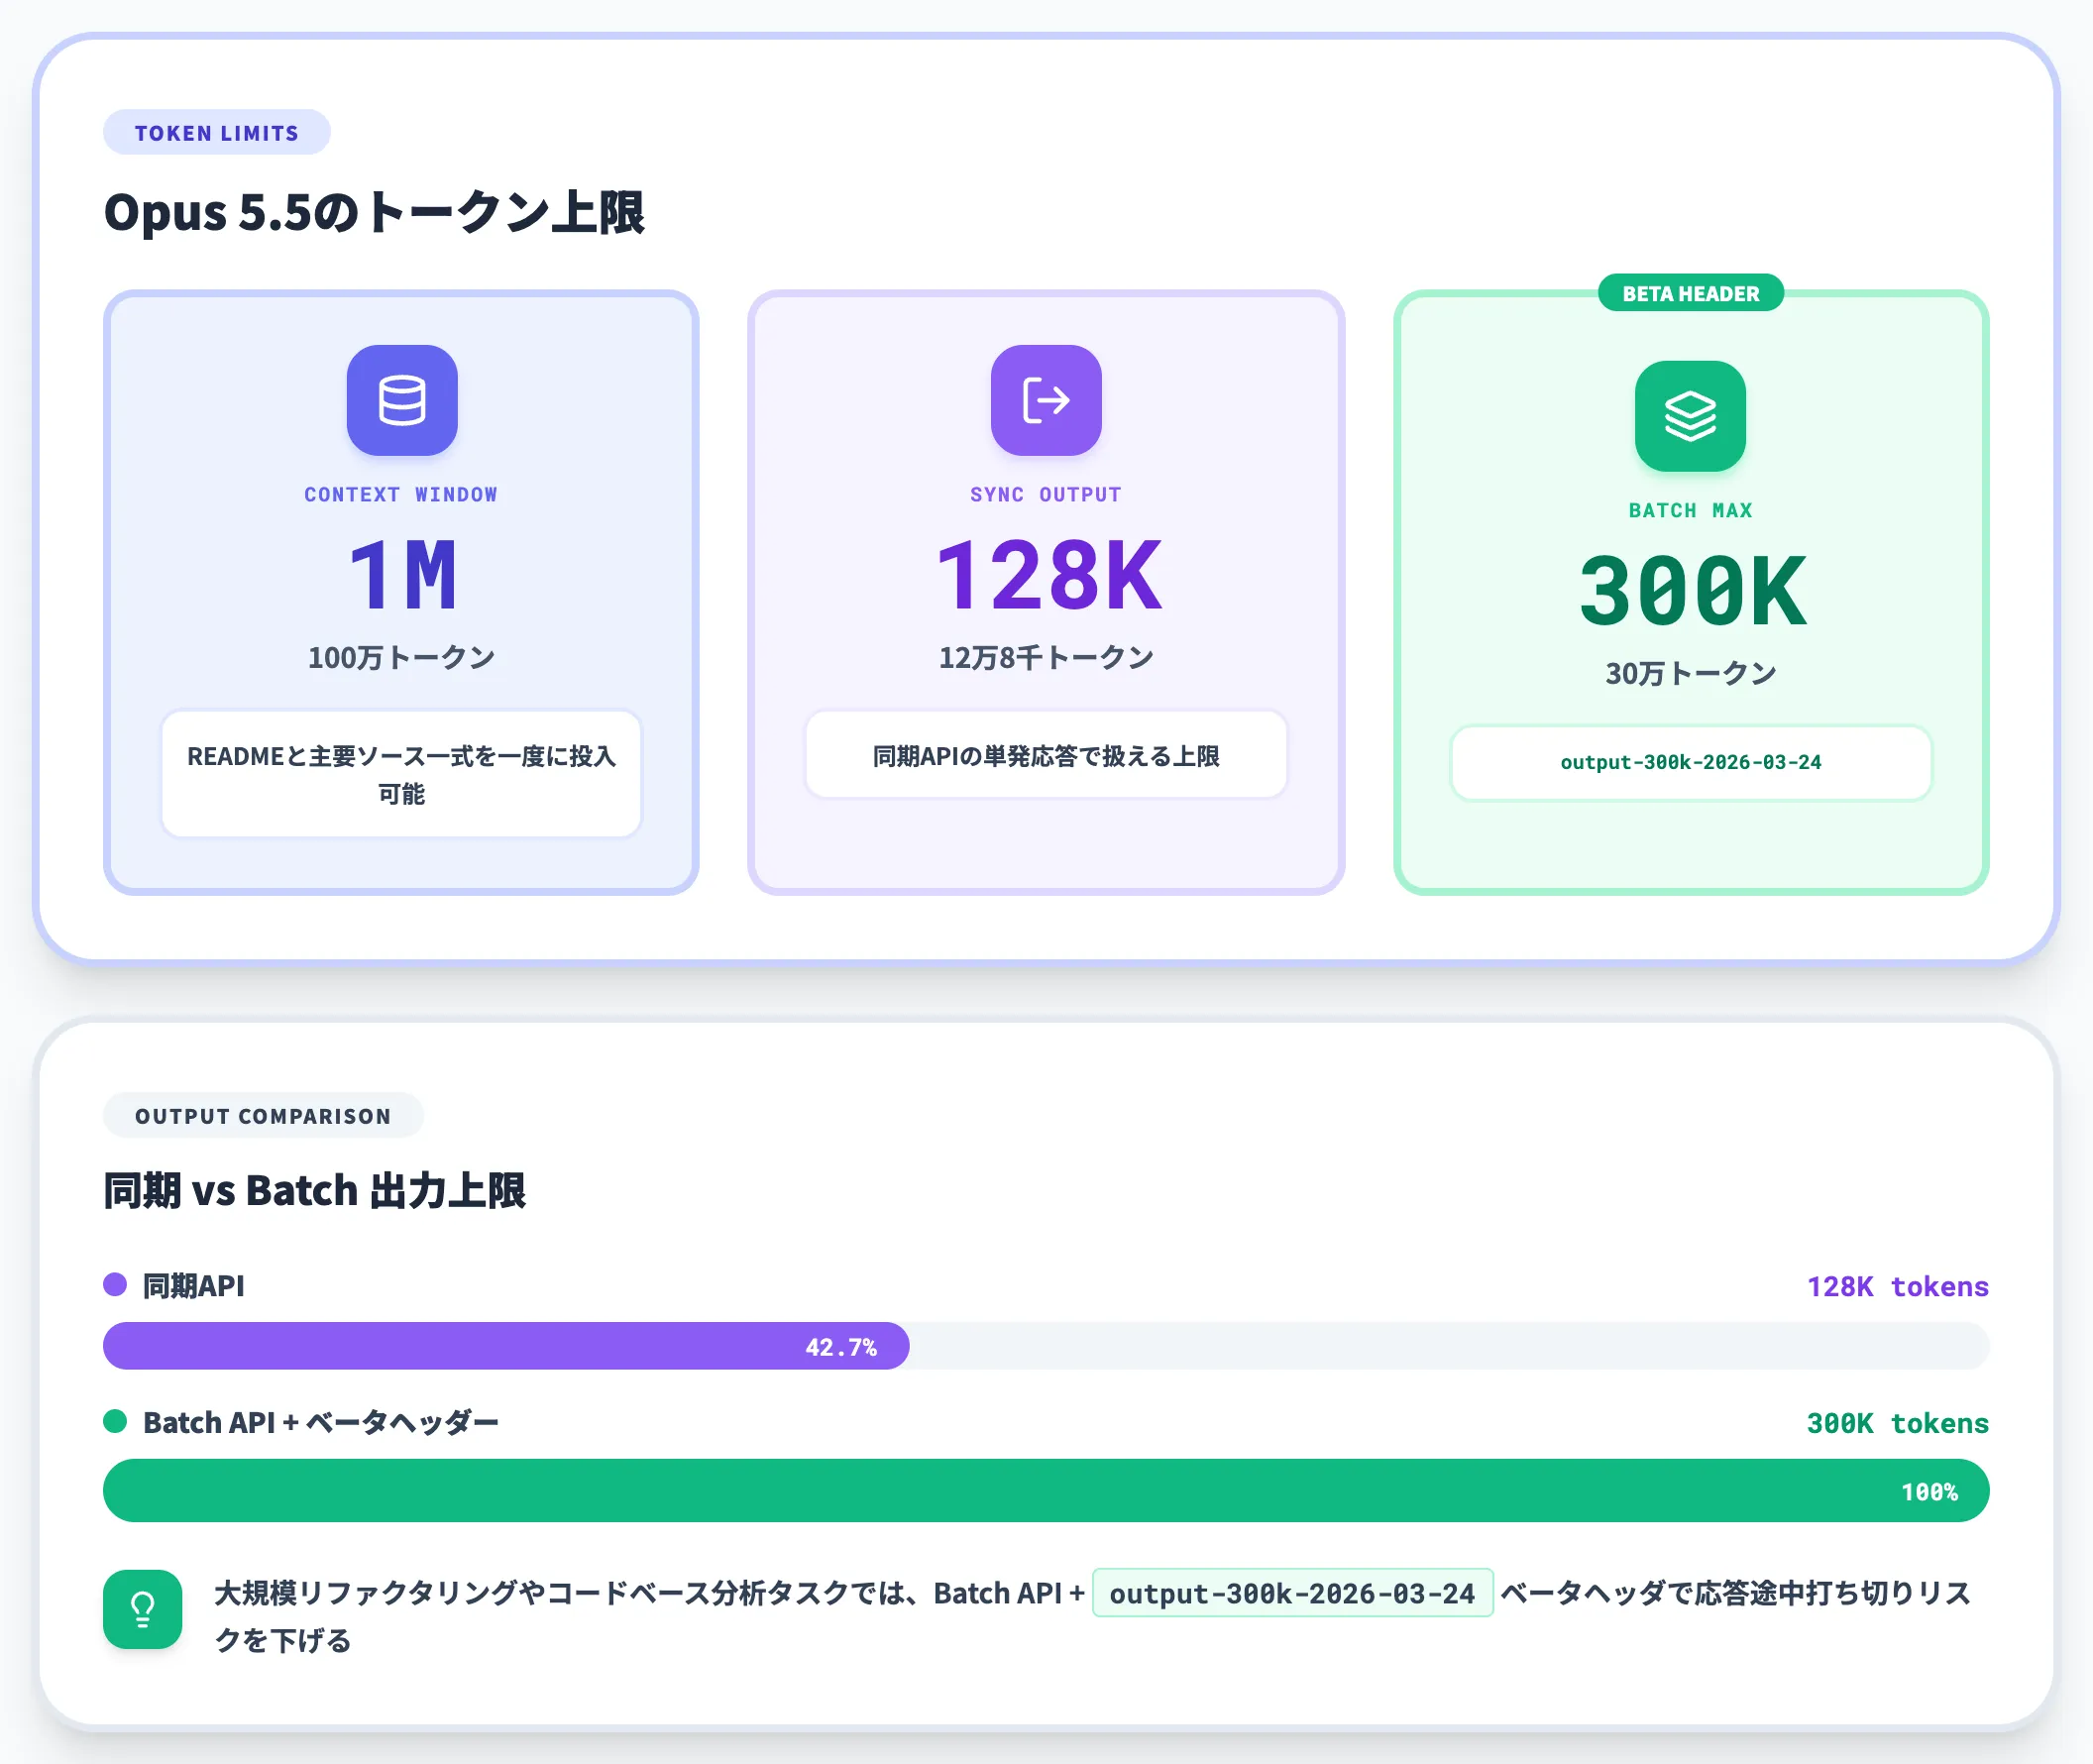
Opus 5.5のコンテキストウィンドウは1M(100万)トークン、同期APIの最大出力は128K(12万8千)トークンです。
Message Batches APIでは「output-300k-2026-03-24」ベータヘッダを付けることで、最大300Kトークンまで出力できます。大規模なリファクタリングやコードベース分析タスクで、応答が途中で打ち切られるリスクを下げる設計です。
1Mトークンで扱える日本語の文字数は文章・記号・コードの構成で変動するため、実装前にToken Counting APIで対象コーパスを実測するのがおすすめです。中規模〜大規模のコードベースであれば、READMEと主要ソース一式を一度に投入して分析させる運用が現実的な水準になっています。
Claude Opus 5.5への移行で詰まる論点
Claude Opus 5.5への移行は、モデルID差し替えに加えて公式移行ガイドが列挙する必須変更を一通り適用する必要があります。ここではOpus 5から挙動が変わって初回運用でハマりやすい代表的な論点を4つ整理します。
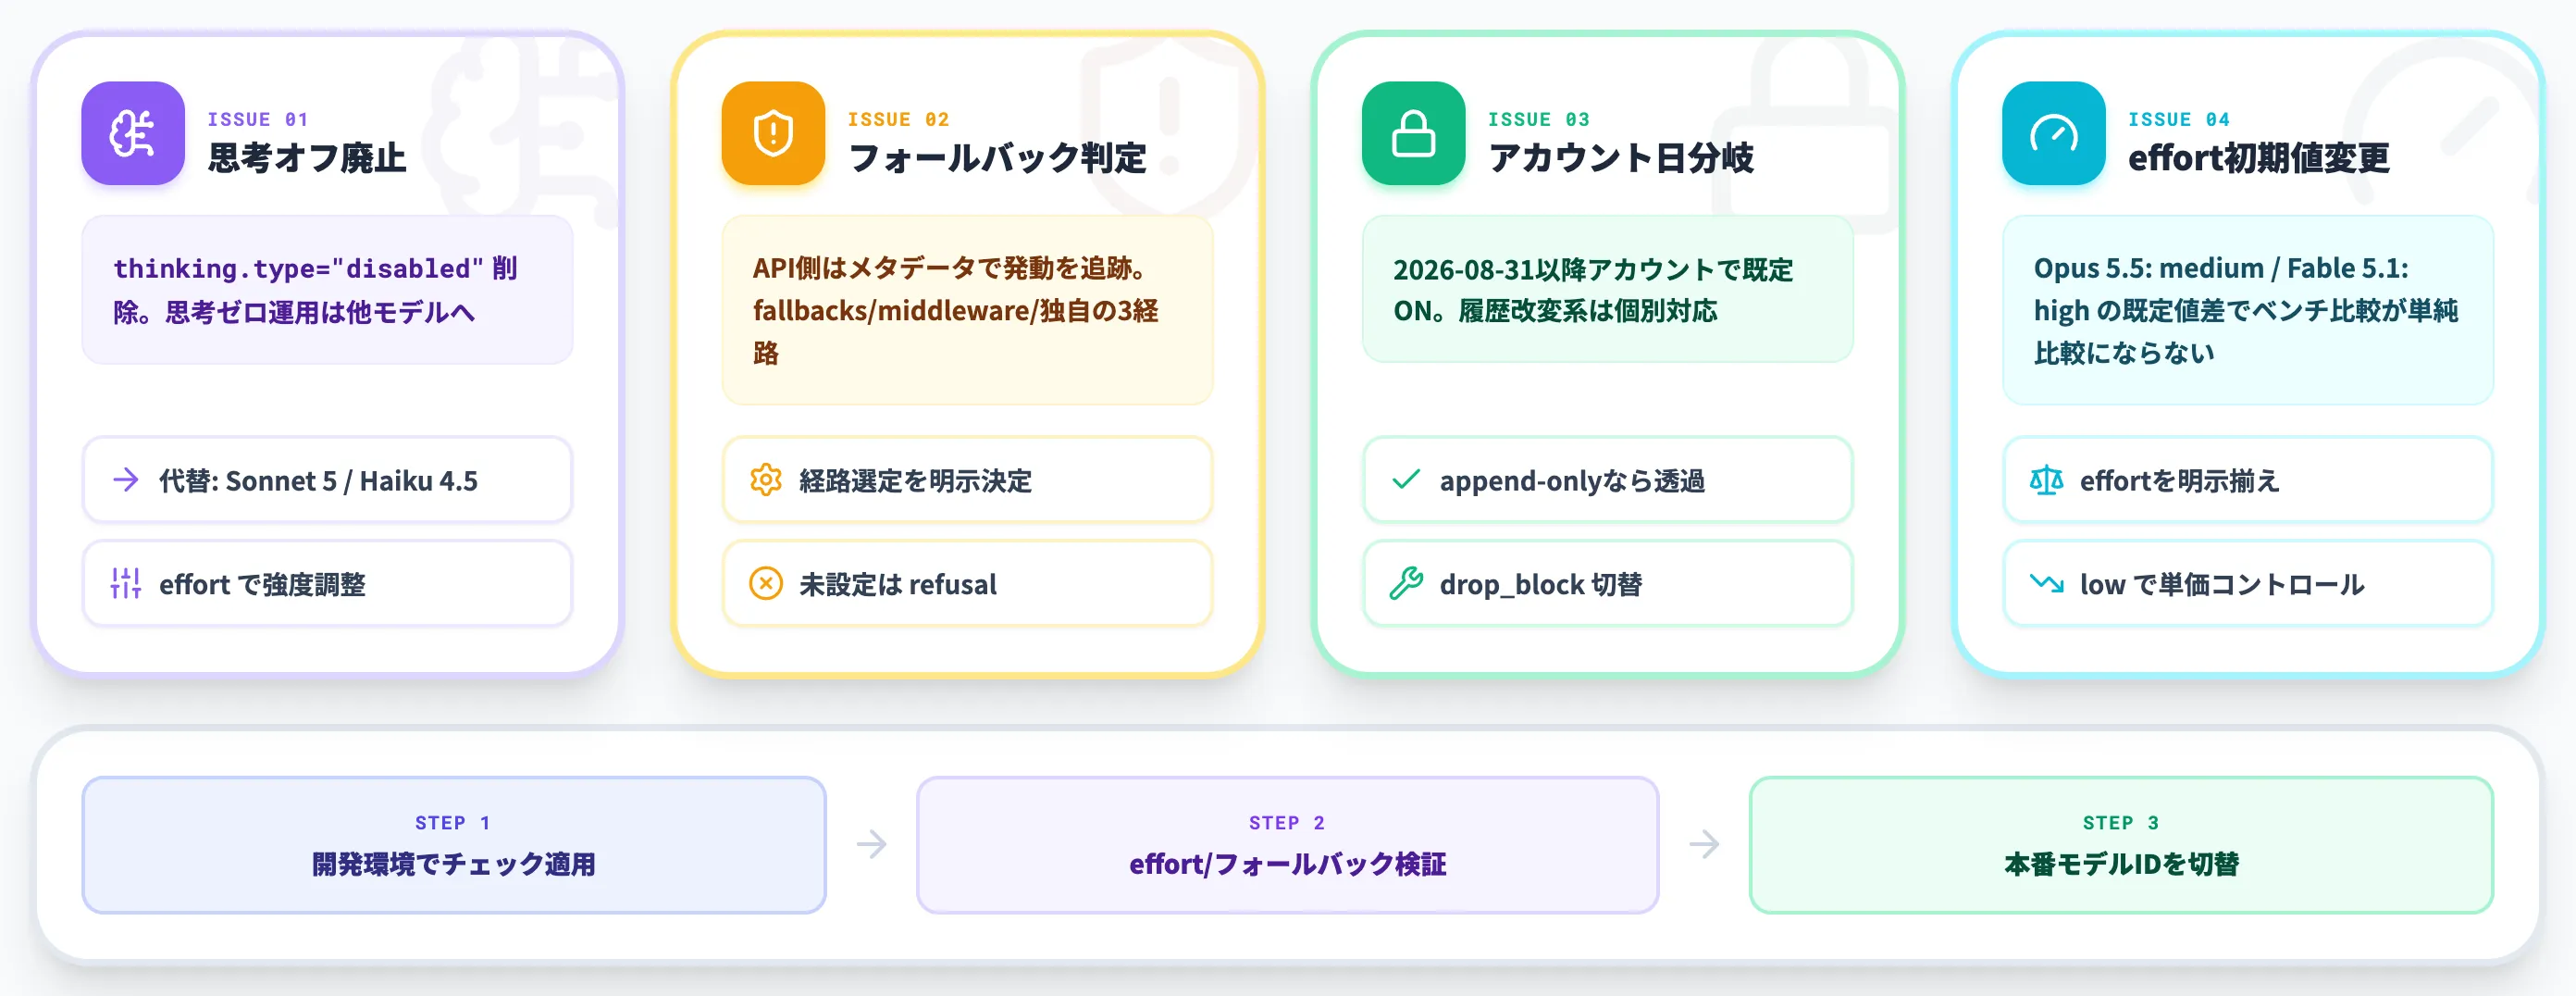
拡張思考は「オフ」の選択肢がない
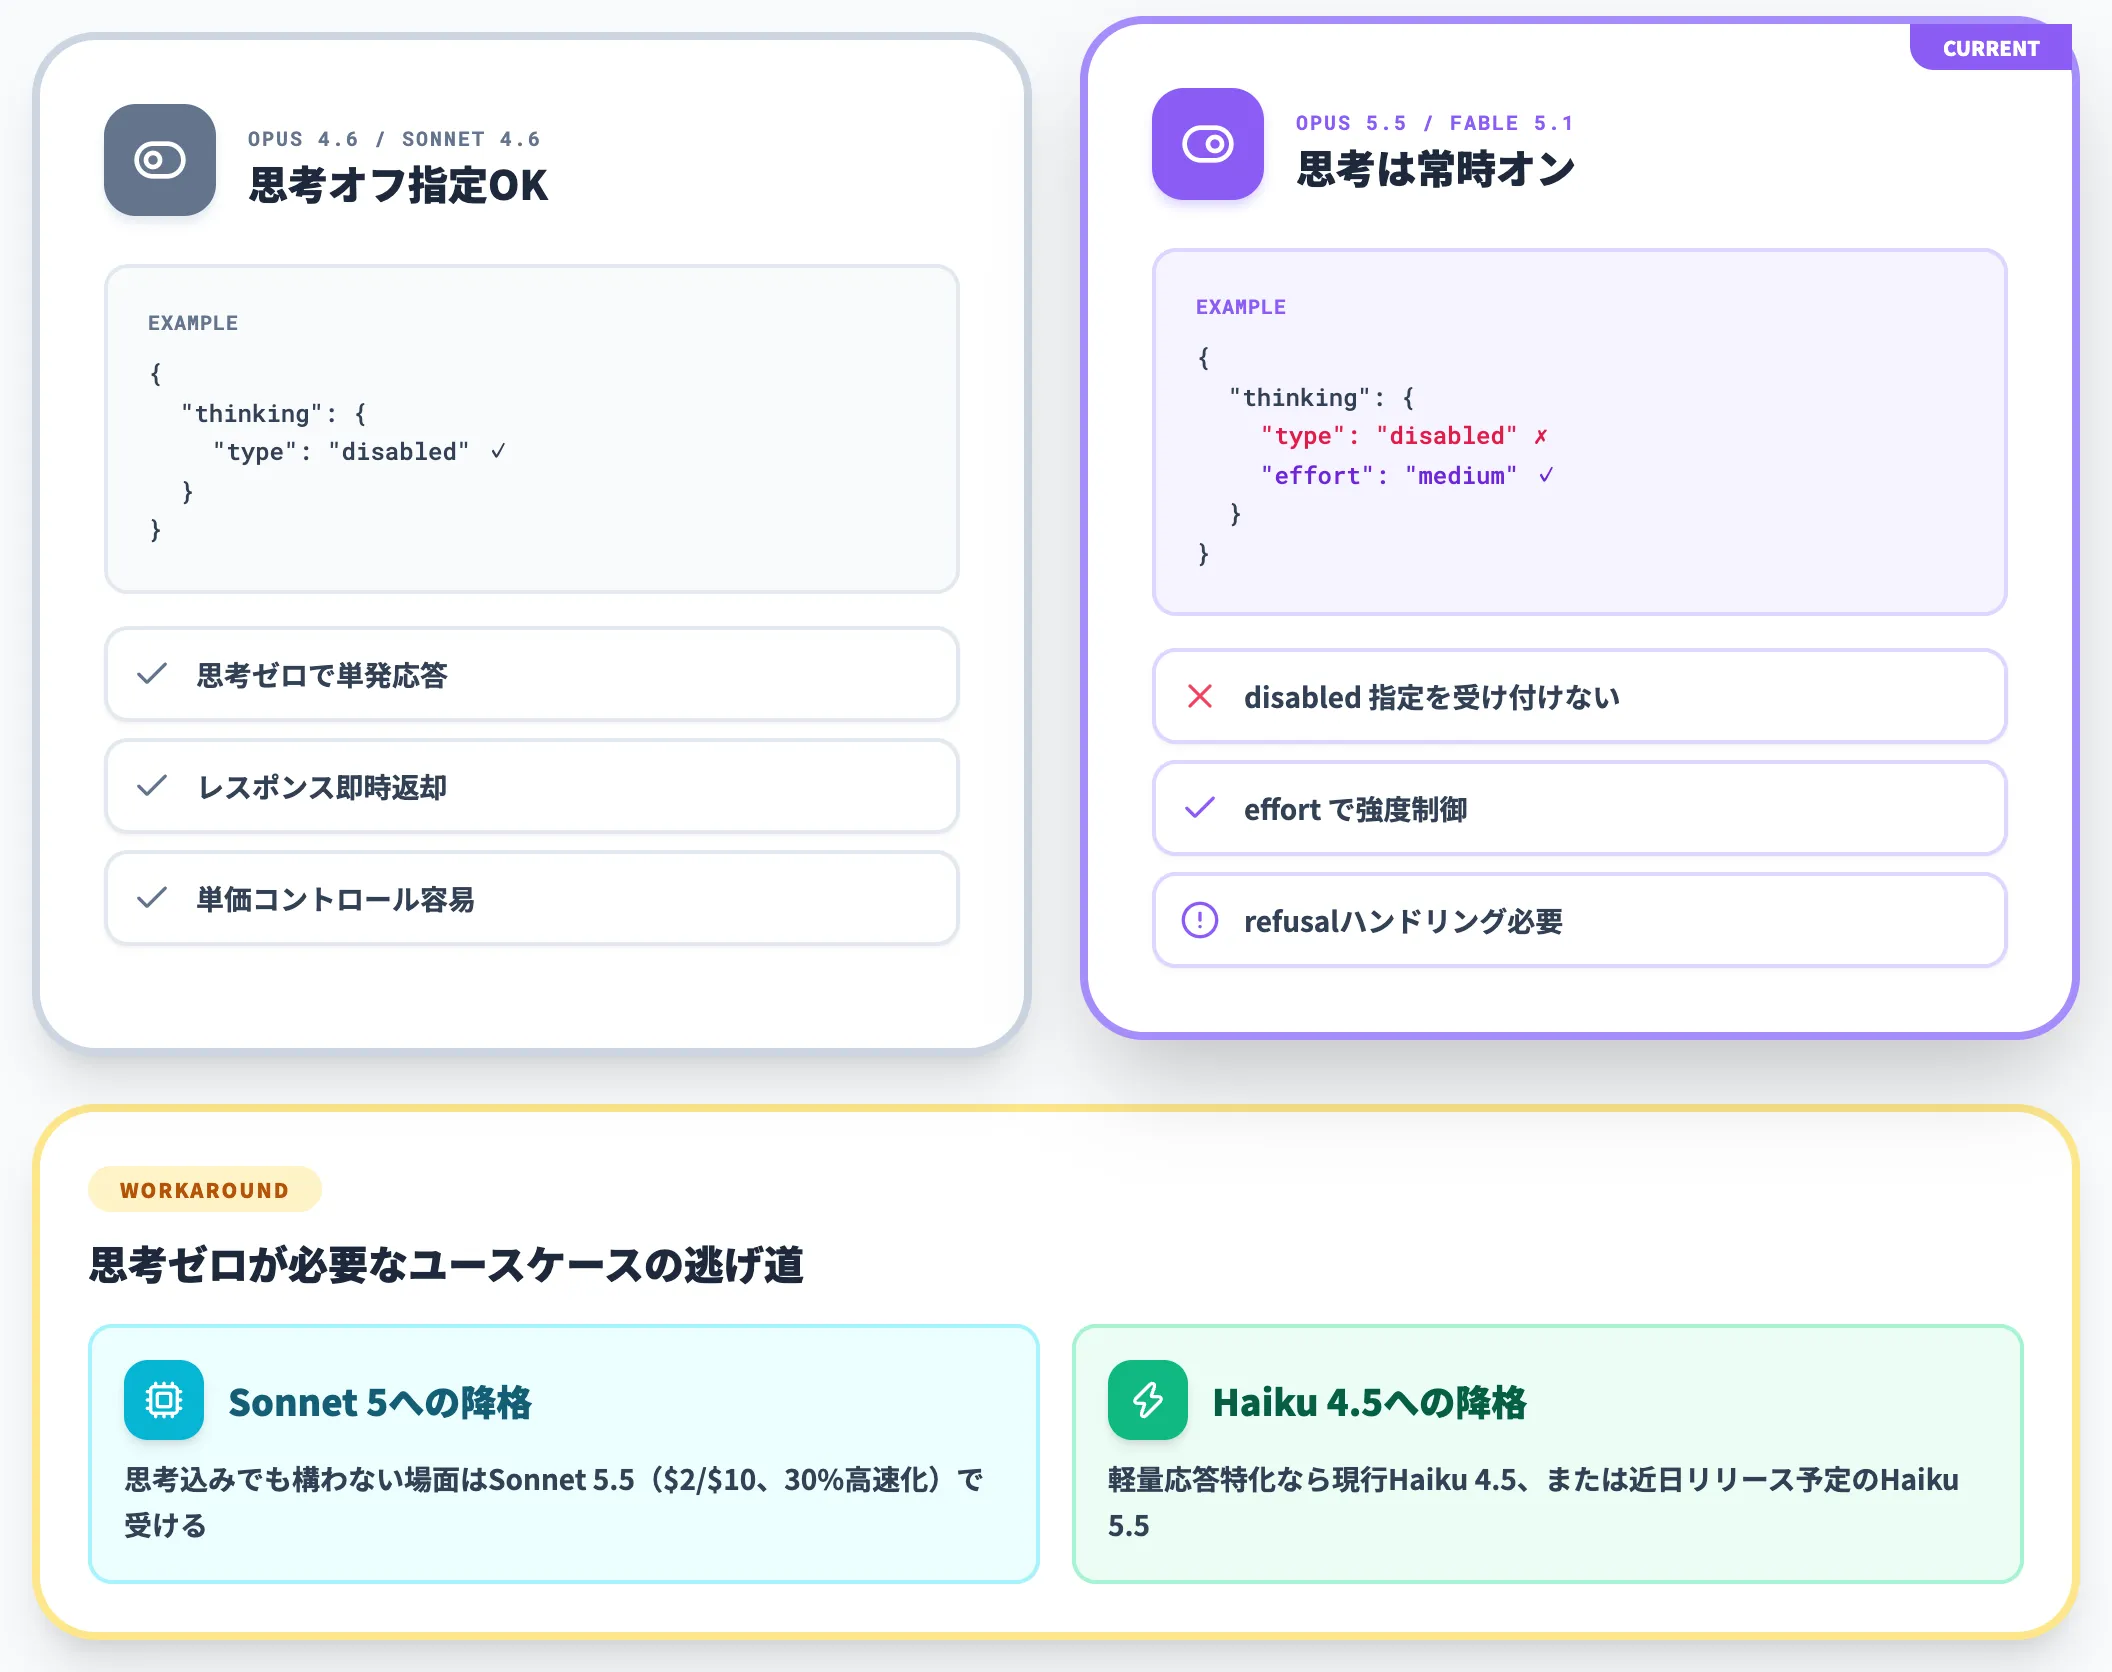
Opus 5からの最大の挙動変化は、拡張思考をオフにする指定を受け付けなくなった点です。
Opus 4.6/Sonnet 4.6世代で使えた「thinking.type="disabled"」は、Opus 5.5・Fable 5.1では削除されています。「思考させたくない・応答トークンだけ返してほしい」ユースケースをOpus系列で組んでいる場合、Claude Sonnet 5もしくはClaude Haiku 4.5への降格が対応策になります。
逆に、思考込みの応答を前提に業務ロジックを組んでいる場合でも、thinking blockをツール呼び出しループ内で改変せずそのまま返す実装や、「stop_reason: "refusal"」のハンドリング追加は必要です。effortでmedium/highを切り替えることで、思考の深さと単価のバランスも調整できます。
フォールバックの見分け方はメタデータで判定
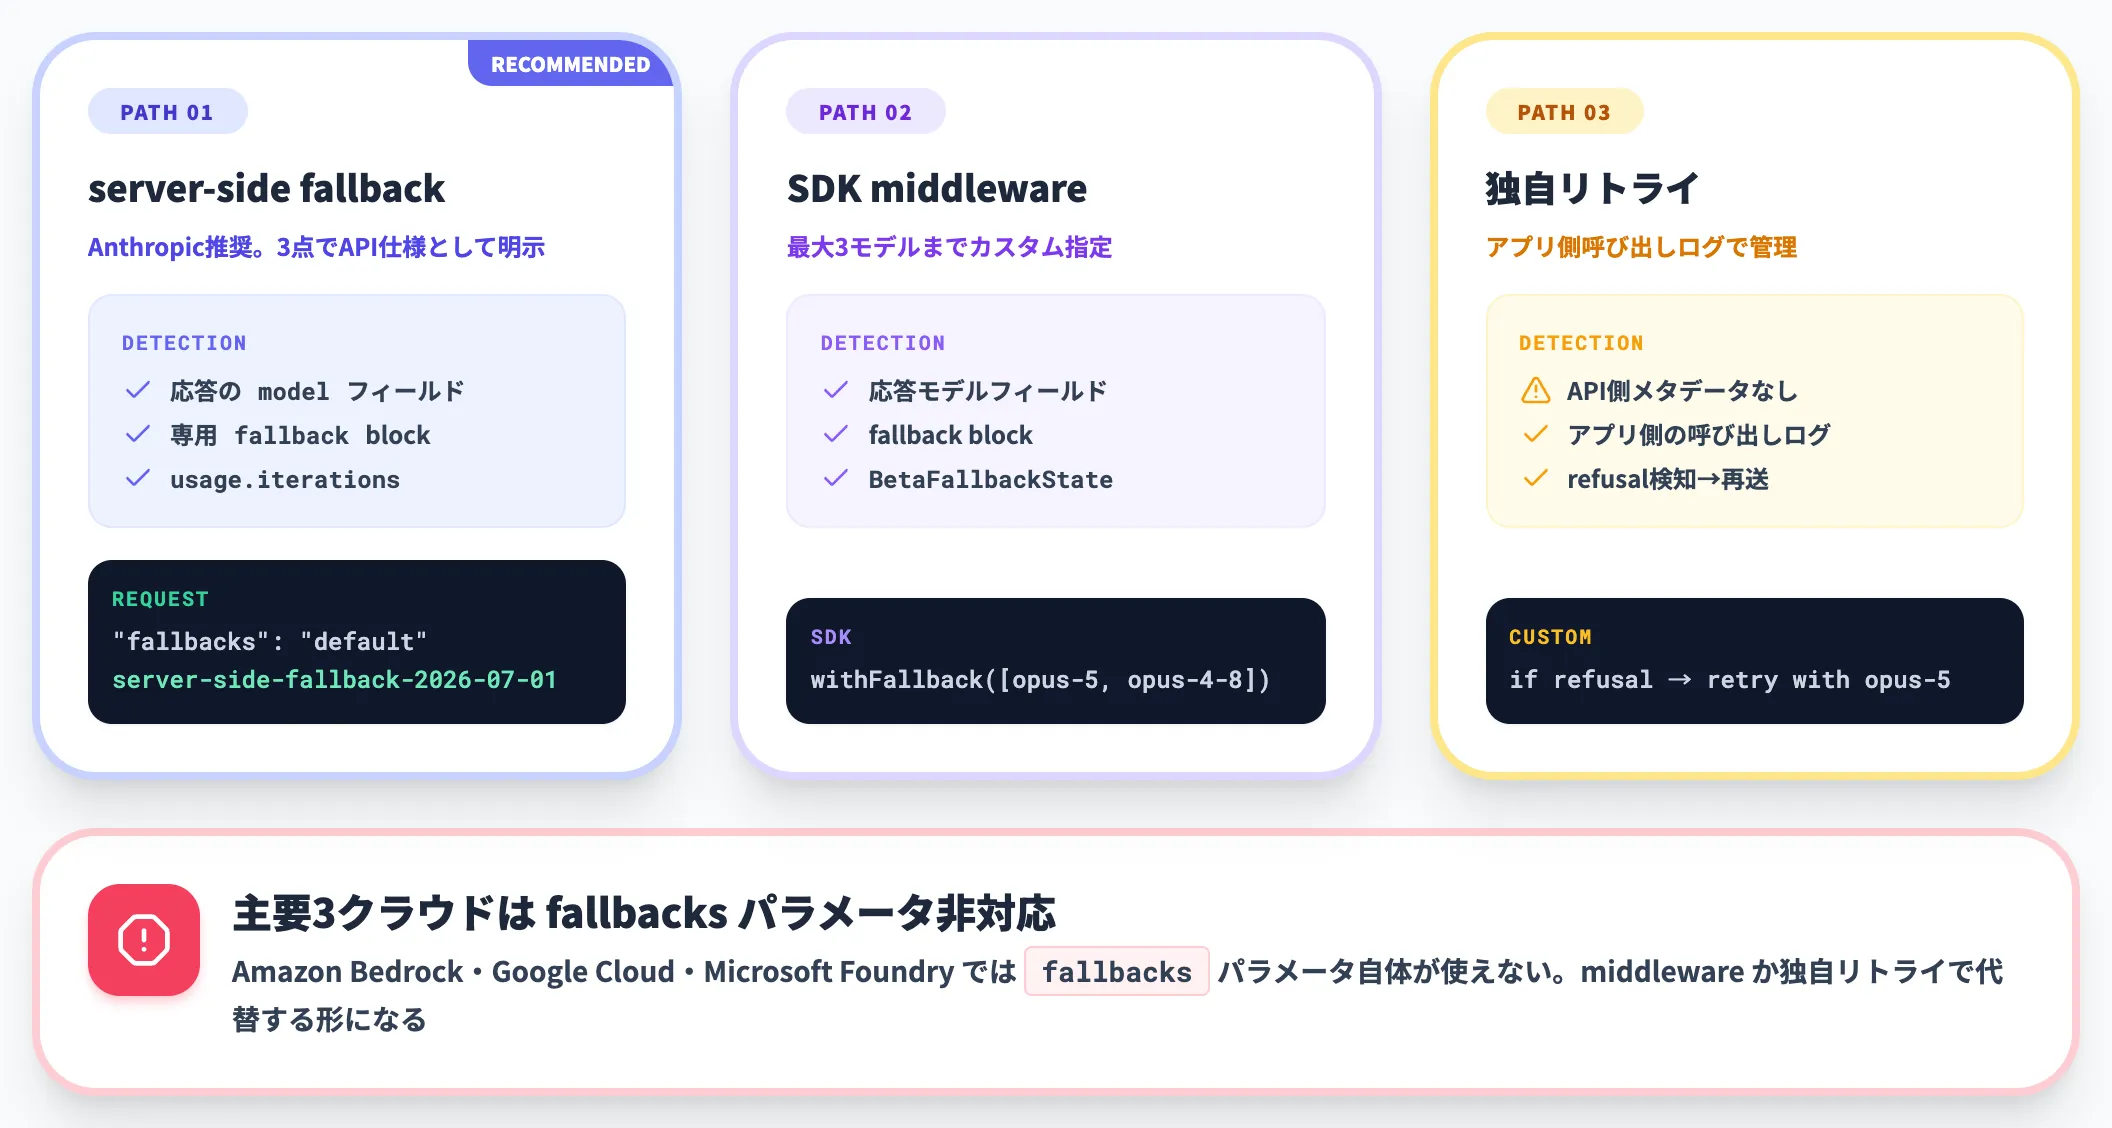
Claude APIでフォールバックを明示設定すると、サイバー領域はOpus 4.8・生物学と先端LLM領域はOpus 5へのルーティングが発火します。発動を見分ける方法は、採用した経路で変わります。
-
server-side fallback経由(「fallbacks: "default"」+「server-side-fallback-2026-07-01」ベータヘッダー)
応答の「model」フィールド・専用の「fallback」content block・「usage.iterations」の3点でAPI仕様として明示される
-
SDK middleware経由
応答モデル・fallback block・「BetaFallbackState」で追跡
-
独自リトライ経由
API仕様としてのメタデータが揃わないため、アプリ側の呼び出しログで追跡が必要
補足として、以下は設定・プラットフォーム側の前提です。
- server-side fallbackは「fallbacks: "default"」とベータヘッダーの両方が必須(ヘッダー未指定や別値では400エラー)
- 最大3モデルまでのカスタム指定やSDK middlewareでの代替も利用可
- 何も設定しなければ「stop_reason: "refusal"」が返るため、業務コードで拒否パスも同時に実装
- Amazon Bedrock・Google Cloud・Microsoft Foundryでは「fallbacks」パラメータ自体が使えず、middlewareや独自リトライで代替
脆弱性解析エージェント・レッドチーム自動化などをOpus 5.5で組む場合は、フォールバック設定(「fallbacks」パラメータ/middleware/独自リトライのどれで組むか)の方針を明示的に決めた上で、選んだ経路に応じたログ保持を組み込んでおくのが安全です。
Preserved thinkingはアカウント日で分岐
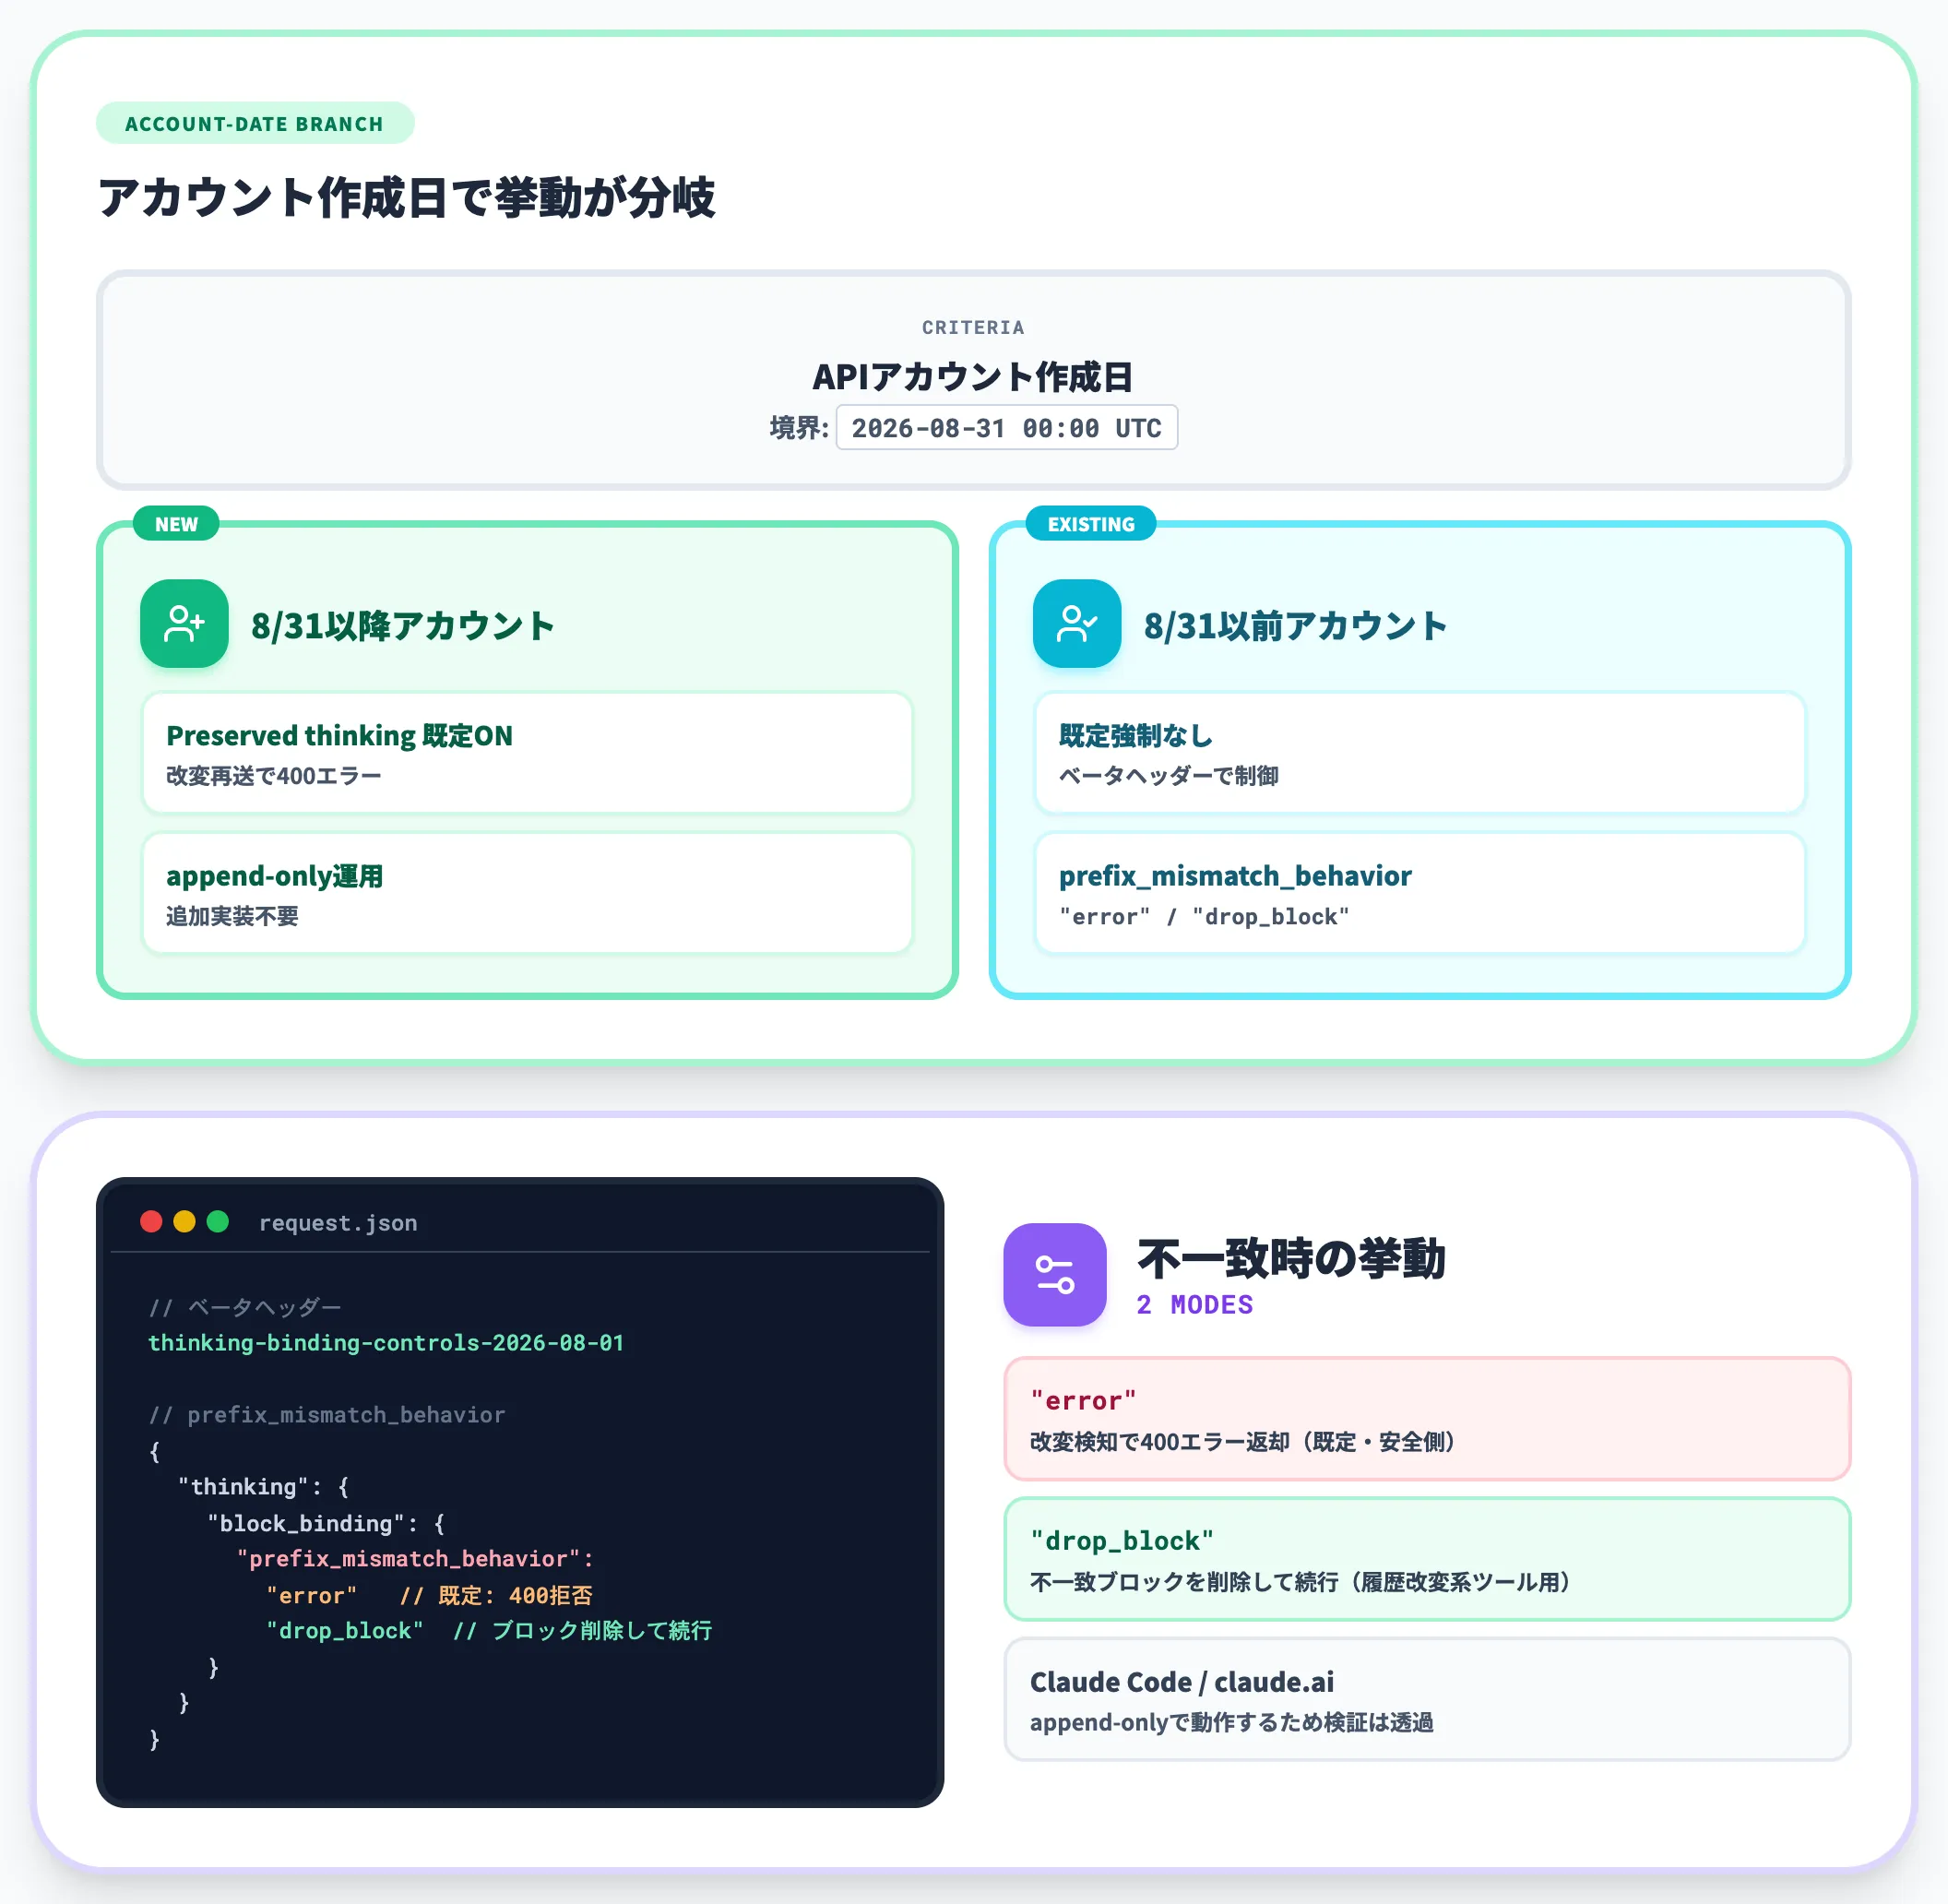
Preserved thinking(保存された拡張思考)の不一致時の拒否は、2026年8月31日00:00 UTC以降に作成したAPIアカウントでデフォルト有効化されます。同日以前に作成した既存アカウントではデフォルト強制されませんが、「thinking-binding-controls-2026-08-01」ベータヘッダー付きで「thinking.block_binding.prefix_mismatch_behavior」を指定すれば、不一致時の処理(「"error"」=拒否/「"drop_block"」=ブロック削除して続行 等)を制御できます。
検証内容は「system prompt・tools・先行messagesを改変した上でthinking blockを再送すると、既定の「"error"」動作では400エラーを返す」というもの。会話をappend-onlyで運用している限り応答内容は変わりません。Claude Code・claude.ai・Claude Managed Agents・Claude Agent SDKはappend-onlyで動作するため、この検証は透過的です。
過去コンテキストを改変してから思考blockを再送する実装(会話履歴の一部を書き換えてから続きを生成させるツール等)は、既定の「"error"」動作では400エラーになるため、「"drop_block"」への切替か実装側の追随が必要です。
effort初期値がmediumに変更された
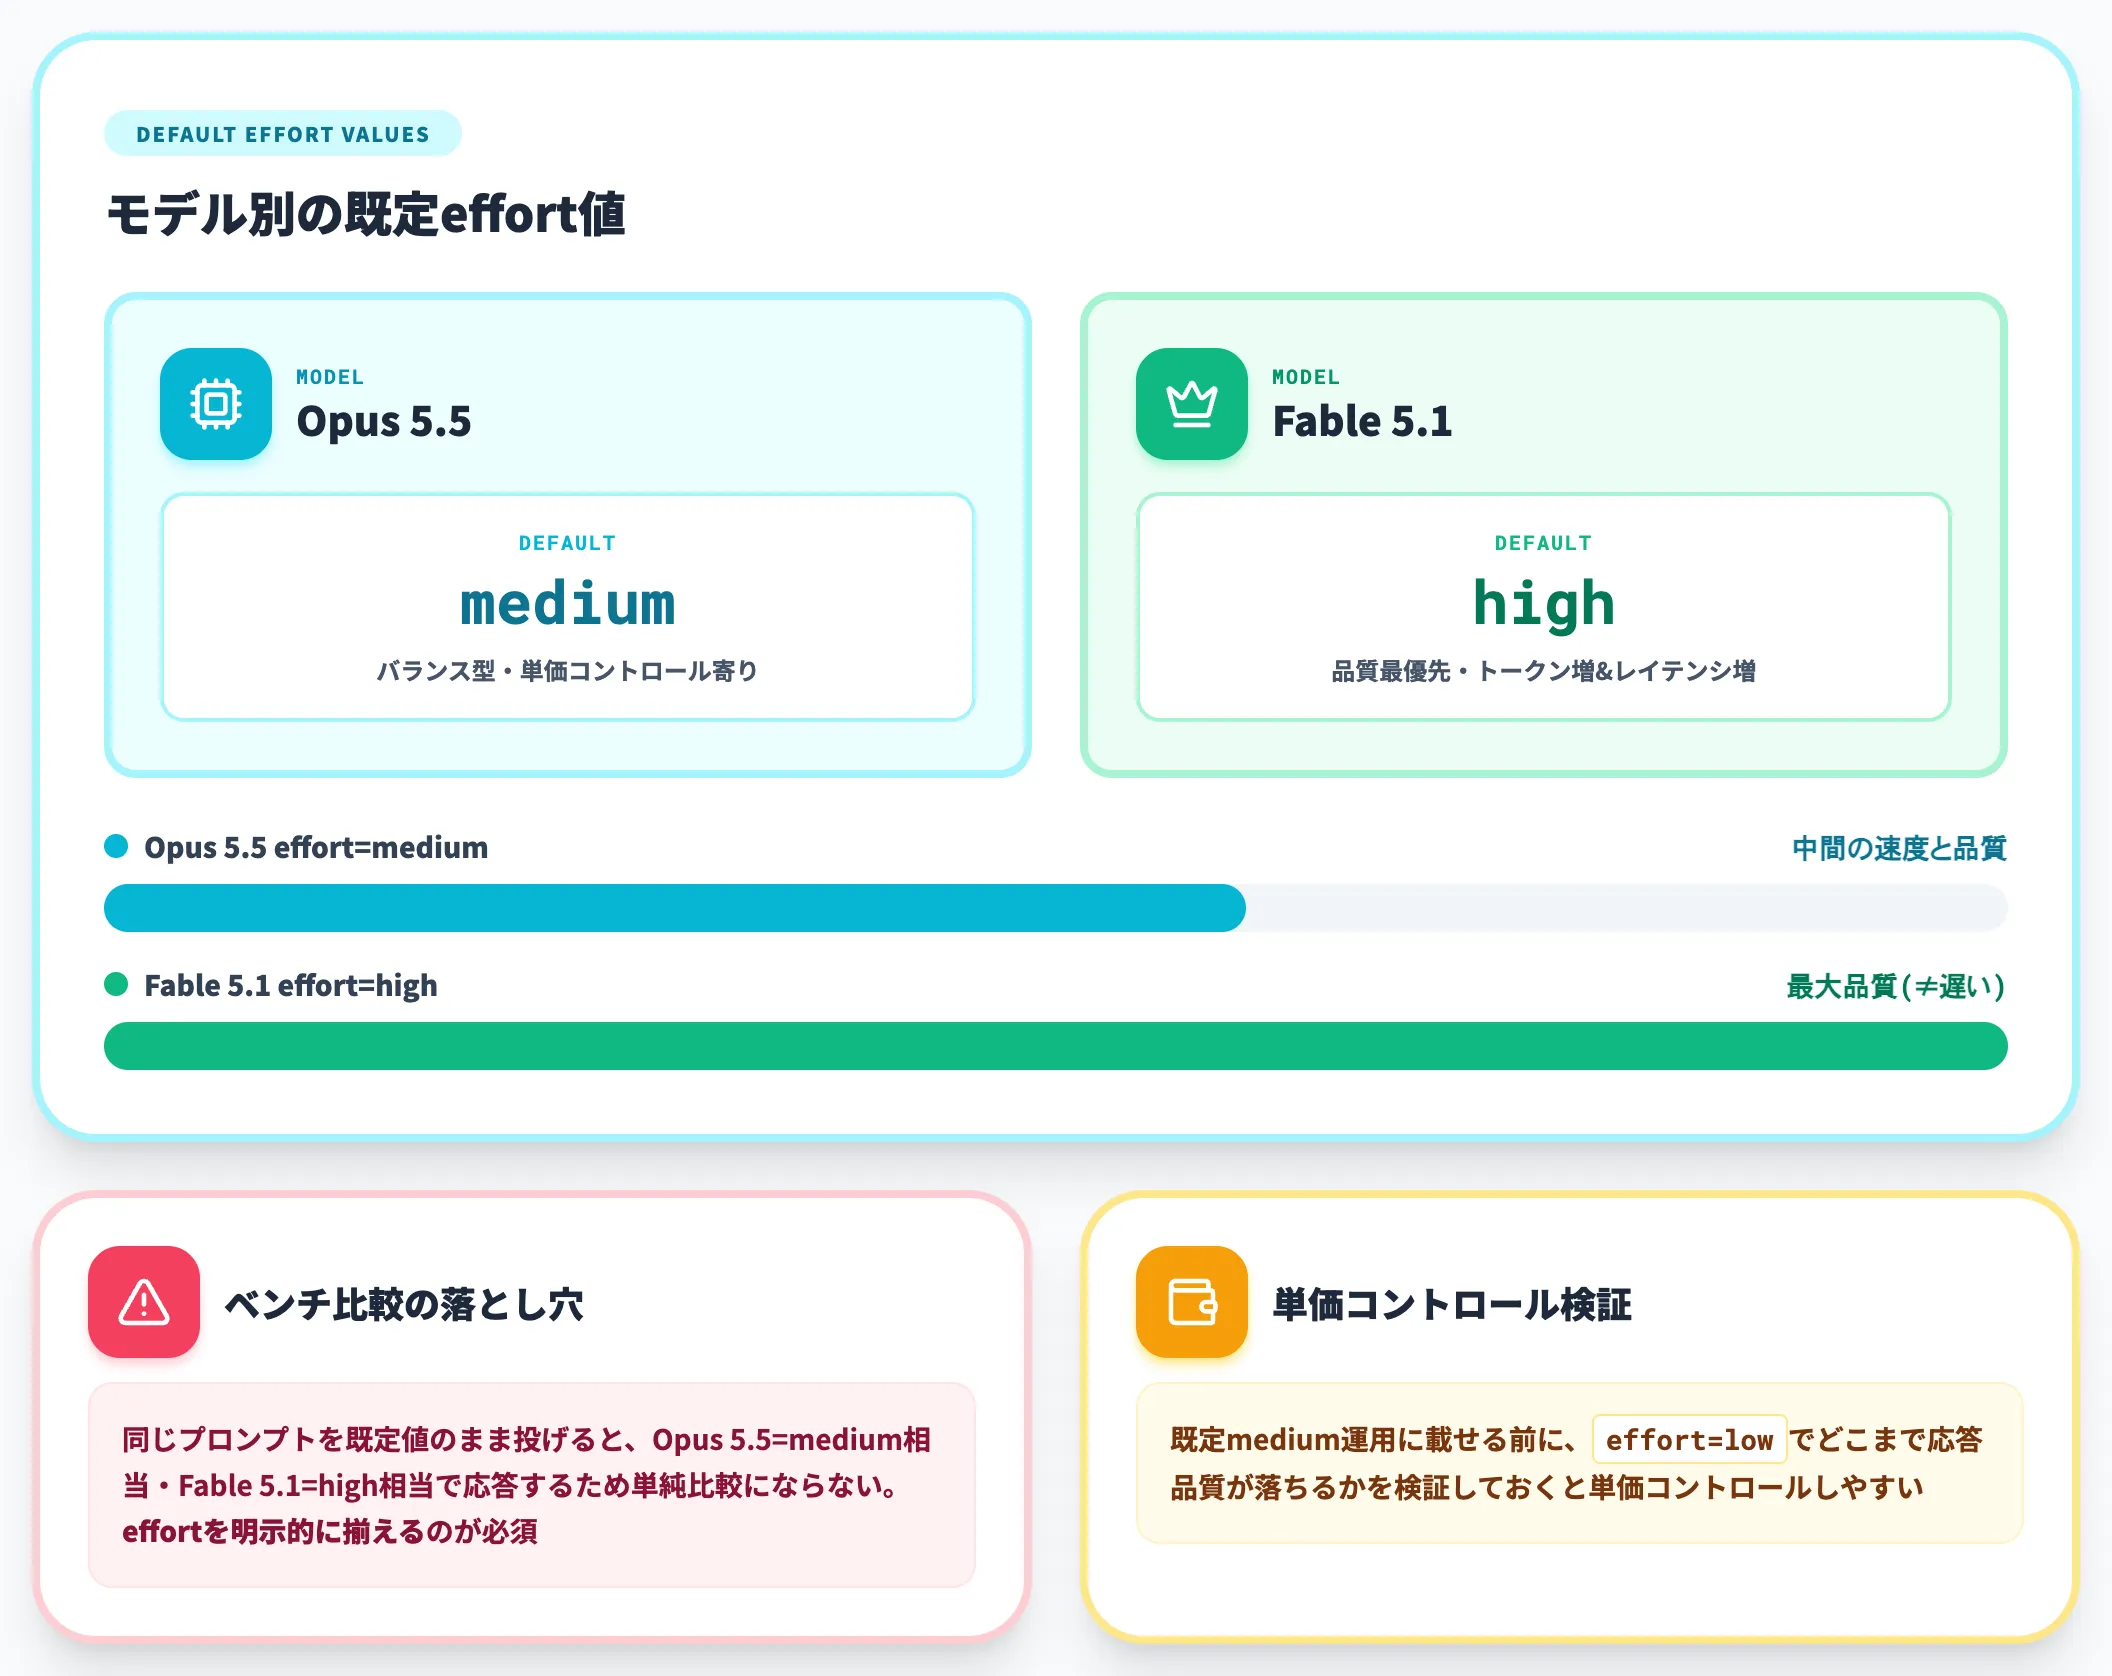
Opus 5世代までのモデルはeffortを指定しない場合の初期値が異なるモデルもありましたが、Opus 5.5では明確に「medium」が初期値です。Fable 5.1は「high」が初期値です。
同じプロンプトをOpus 5.5とFable 5.1に投げると、Opus 5.5側は「effort=medium相当の速度」で応答し、Fable 5.1側は「effort=high相当の速度と品質」で応答します。ベンチマークでOpus 5.5とFable 5.1を比較する場合、effortを明示的に揃えないと単純比較にならない点に注意が必要です。
Anthropic公式のコスト・性能最適化ガイドでもeffort別のコスト・精度・所要時間の測定例が公開されているため、既定値のままで運用に載せる前にeffort=lowでどこまで応答品質が落ちるかを検証しておくと単価コントロールがしやすくなります。
Opus 5.5世代の業務Agent移行と運用で詰まる論点を、実装事例から逆算して整理する
Claude Opus 5.5を業務Agentに載せる現場では、公式ドキュメントだけでは決めきれない論点が並びます。
- Opus 5.5・Fable 5.1・Opus 5の3世代をコーディング常用/超長時間自律/機密領域でどう使い分けるか
- 拡張思考の常時オン化とeffort(low/medium/high)を業務種別ごとにどう設計するか
- サイバー→Opus 4.8・生物学→Opus 5のフォールバック設定(fallbacks/middleware/独自リトライ)とrefusalハンドリングをどう組むか
- 公式移行ガイドの必須変更(thinking無効化廃止・tool_choice制約・computer tool更新・Preserved thinking)とBatch API+キャッシュのコスト最適化をどう並行で回すか
モデル使い分け・effort/フォールバック設計・移行対応・コスト最適化まで含めてOpus 5.5移行の実装可能性を棚卸ししたいなら、単体機能の解説記事ではなく、実装事例と組み合わせて話せる相手と一度整理するのが早道です。
AI Agent Hubは、Opus 5.5・Fable 5.1・Sonnet 5のモデル切替を吸収しながら業務Agent群を統合管理するエンタープライズAI基盤で、モデル使い分け設計・effort/フォールバック設計・移行対応・コスト最適化のいずれの入口からでも、実装から逆算した論点整理をご相談いただけます。
Opus 5.5移行と運用の論点を実装から逆算

モデル使い分け・effort/フォールバック・移行・コスト
Opus 5.5導入は、Fable 5.1/Opus 5との使い分け・拡張思考とeffort設計・機密領域フォールバック・公式移行ガイドの必須変更が絡み合います。AI Agent Hubのサービスページで、Opus 5.5を業務Agentに組み込む実装例をご確認ください。
まとめ
本記事では、Claude Opus 5.5の位置づけ・料金・ベンチマーク・拡張思考と安全設計・Fable 5.1やOpus 5との使い分け・提供チャネル・移行時の注意点を、2026年9月時点の公式一次情報で解説しました。
2026年9月時点で押さえておくべきポイントは次の3つです。
- Fable 5.1並みの性能を単価$4/$20(Opus 5比20%減、Fable 5.1比60%減)で提供する新フラグシップ
- 拡張思考は常時オンで固定、サイバー領域はOpus 4.8・生物学と先端LLM領域はOpus 5へフォールバック、API利用時は拒否処理・フォールバック設定込みで管理する必要がある
- コーディング常用の主軸はOpus 5.5、超長時間の自律運用はFable 5.1、Opus 5はサンセット整理という3世代の役割分担が明確
Opus 5でエージェントを常用している組織にとって、Opus 5.5への切り替えはモデルID差し替えを起点にした「単価と挙動の両方をアップデートする移行」です。公式移行ガイドが列挙する必須変更(thinking無効化廃止・「tool_choice」制約・computer tool更新・thinking blockのループ内保持・「stop_reason: "refusal"」ハンドリング・Preserved thinking)を順に潰していくのが標準ルートです。
Sonnet 5.5は2026年9月28日リリース済み・Haiku 5.5も数週間以内と予告されているため、モデルライン全体の見直しをOpus 5.5移行と併走させておくのが、世代交代をコスト効率よく吸収する動き方になります。