この記事のポイント
 MIT CSAIL発の新パラダイム。LLMが勾配降下なしで他ネットの重みをテキストとして読み書きし、GPT-6 AstraがQwen3.5-0.8Bを0.016%編集でMATH-500を7.9%→48.1%
- 読む・直す・ゼロから書くの3タスクを実証。Atari 4ゲームの重みから学習ゲームを識別し、Breakout用ポリシーをゼロから書いてスコア517.4を達成
- Claude Opus 5.5追試とSimon Willison検証では「重みの推論」ではなく「局所算術+データセット事前知識の照合」で説明可能という懐疑的な論点が同時進行
- ROME/MEMITなど既存モデル編集は特定事実のピンポイント更新が主目的、Weight-Space Programmingは任意推論ベース編集・ネット識別・ゼロ生成まで対応領域が広い
- EU AI Actが汎用AIモデル改変者の該当性を測る計算量目安では局所編集を捕捉しづらく、民間からはハッシュ検証・挙動評価が運用提案として提示されている
Microsoft MVP・AIパートナー。LinkX Japan株式会社 代表取締役。東京工業大学大学院にて自然言語処理・金融工学を研究。NHK放送技術研究所でAI・ブロックチェーンの研究開発に従事し、国際学会・ジャーナルでの発表多数。経営情報学会 優秀賞受賞。シンガポールでWeb3企業を創業後、現在は企業向けAI導入・DX推進を支援。
Weight-Space Programming(重み空間プログラミング)は、汎用大規模言語モデルが他のニューラルネットワークの重みを直接読み取り、解釈し、書き換える新しいパラダイムです。従来の勾配降下法や訓練ループを使わず、LLMが重みをテキストとして読み、推論に基づいて編集します。
2026年11月2日にMIT CSAILのRikiya Takehi氏らがブログ記事として提唱し、OpenAI GPT-6 Astraモデルを用いた実験では、Qwen3.5-0.8Bの重みのわずか0.016%を編集するだけでMATH-500のスコアが7.9%から48.1%まで跳ね上がったと報告されています。
本記事では、仕組み・MIT CSAILが示した3つの実証・批判的な追試結果・ROME/MEMITなど既存モデル編集技術との線引き・再帰的自己改善や解釈可能性への実務インパクト・EU AI Actの規制ギャップ・現時点のアクセス方法を、2026年11月時点の最新情報で体系的に解説します。
目次
Weight-Space Programmingとは?LLMが他のAIの重みを勾配降下なしで書き換える新パラダイム
Weight-Space Programmingの仕組み——重みをテキストで渡してLLMに読み書きさせる
MIT CSAILが示した3つの実証——「読む・直す・ゼロから書く」
「本当に重みを理解しているのか」——Claude Opus 5.5とQwenでの追試結果
後続研究——Qwen3.5-0.8B・9Bでの16軌跡・7ベンチマーク検証
従来のモデル編集技術との違い——ROME・MEMIT・ファインチューニングとの比較
実務インパクト——破滅的忘却回避・解釈可能性・再帰的自己改善
規制上の懸念——EU AI Actの計算量ベース測定では捕捉しづらい
Weight-Space Programmingを試せる環境と実装アクセス方法
Weight-Space Programmingとは?LLMが他のAIの重みを勾配降下なしで書き換える新パラダイム
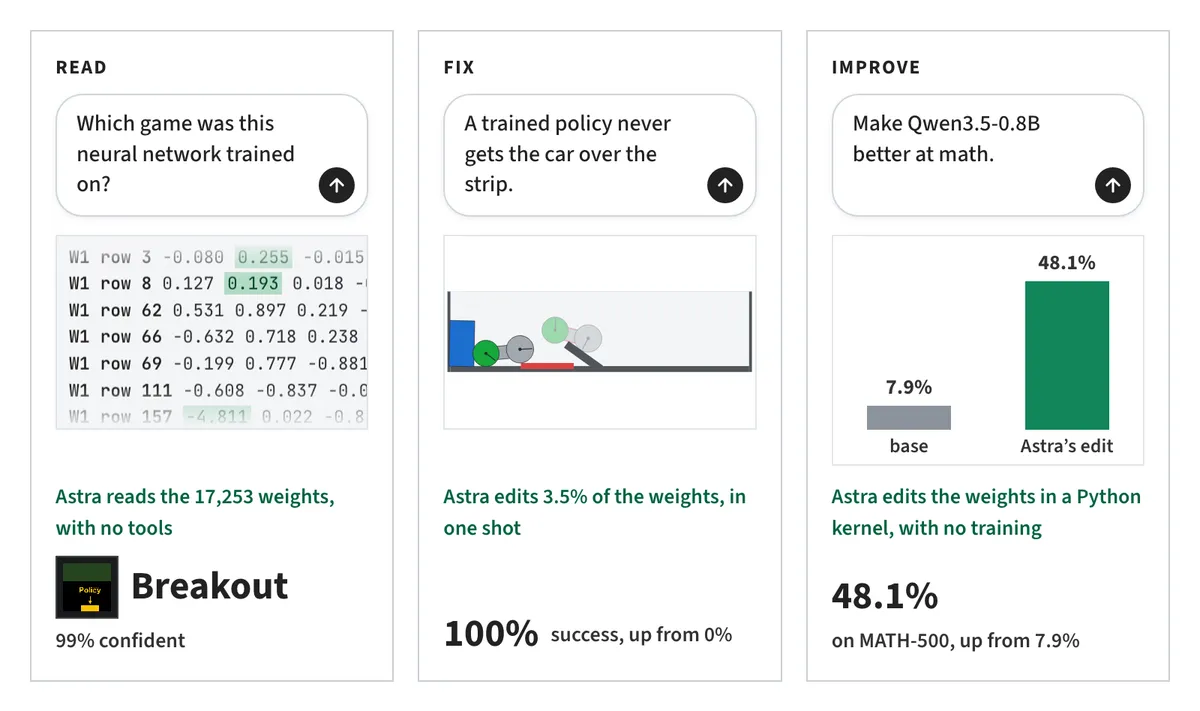
原著ブログ冒頭のキービジュアル。READ(重みから学習内容を読み取る)/FIX(3.5%編集で制御ポリシーを修復)/IMPROVE(Qwen3.5-0.8B のMATH-500 スコアを7.9%→48.1%に)の3タスクを1枚に凝縮しています(出典:Sparks of Weight-Space Programming(Takehi et al.))
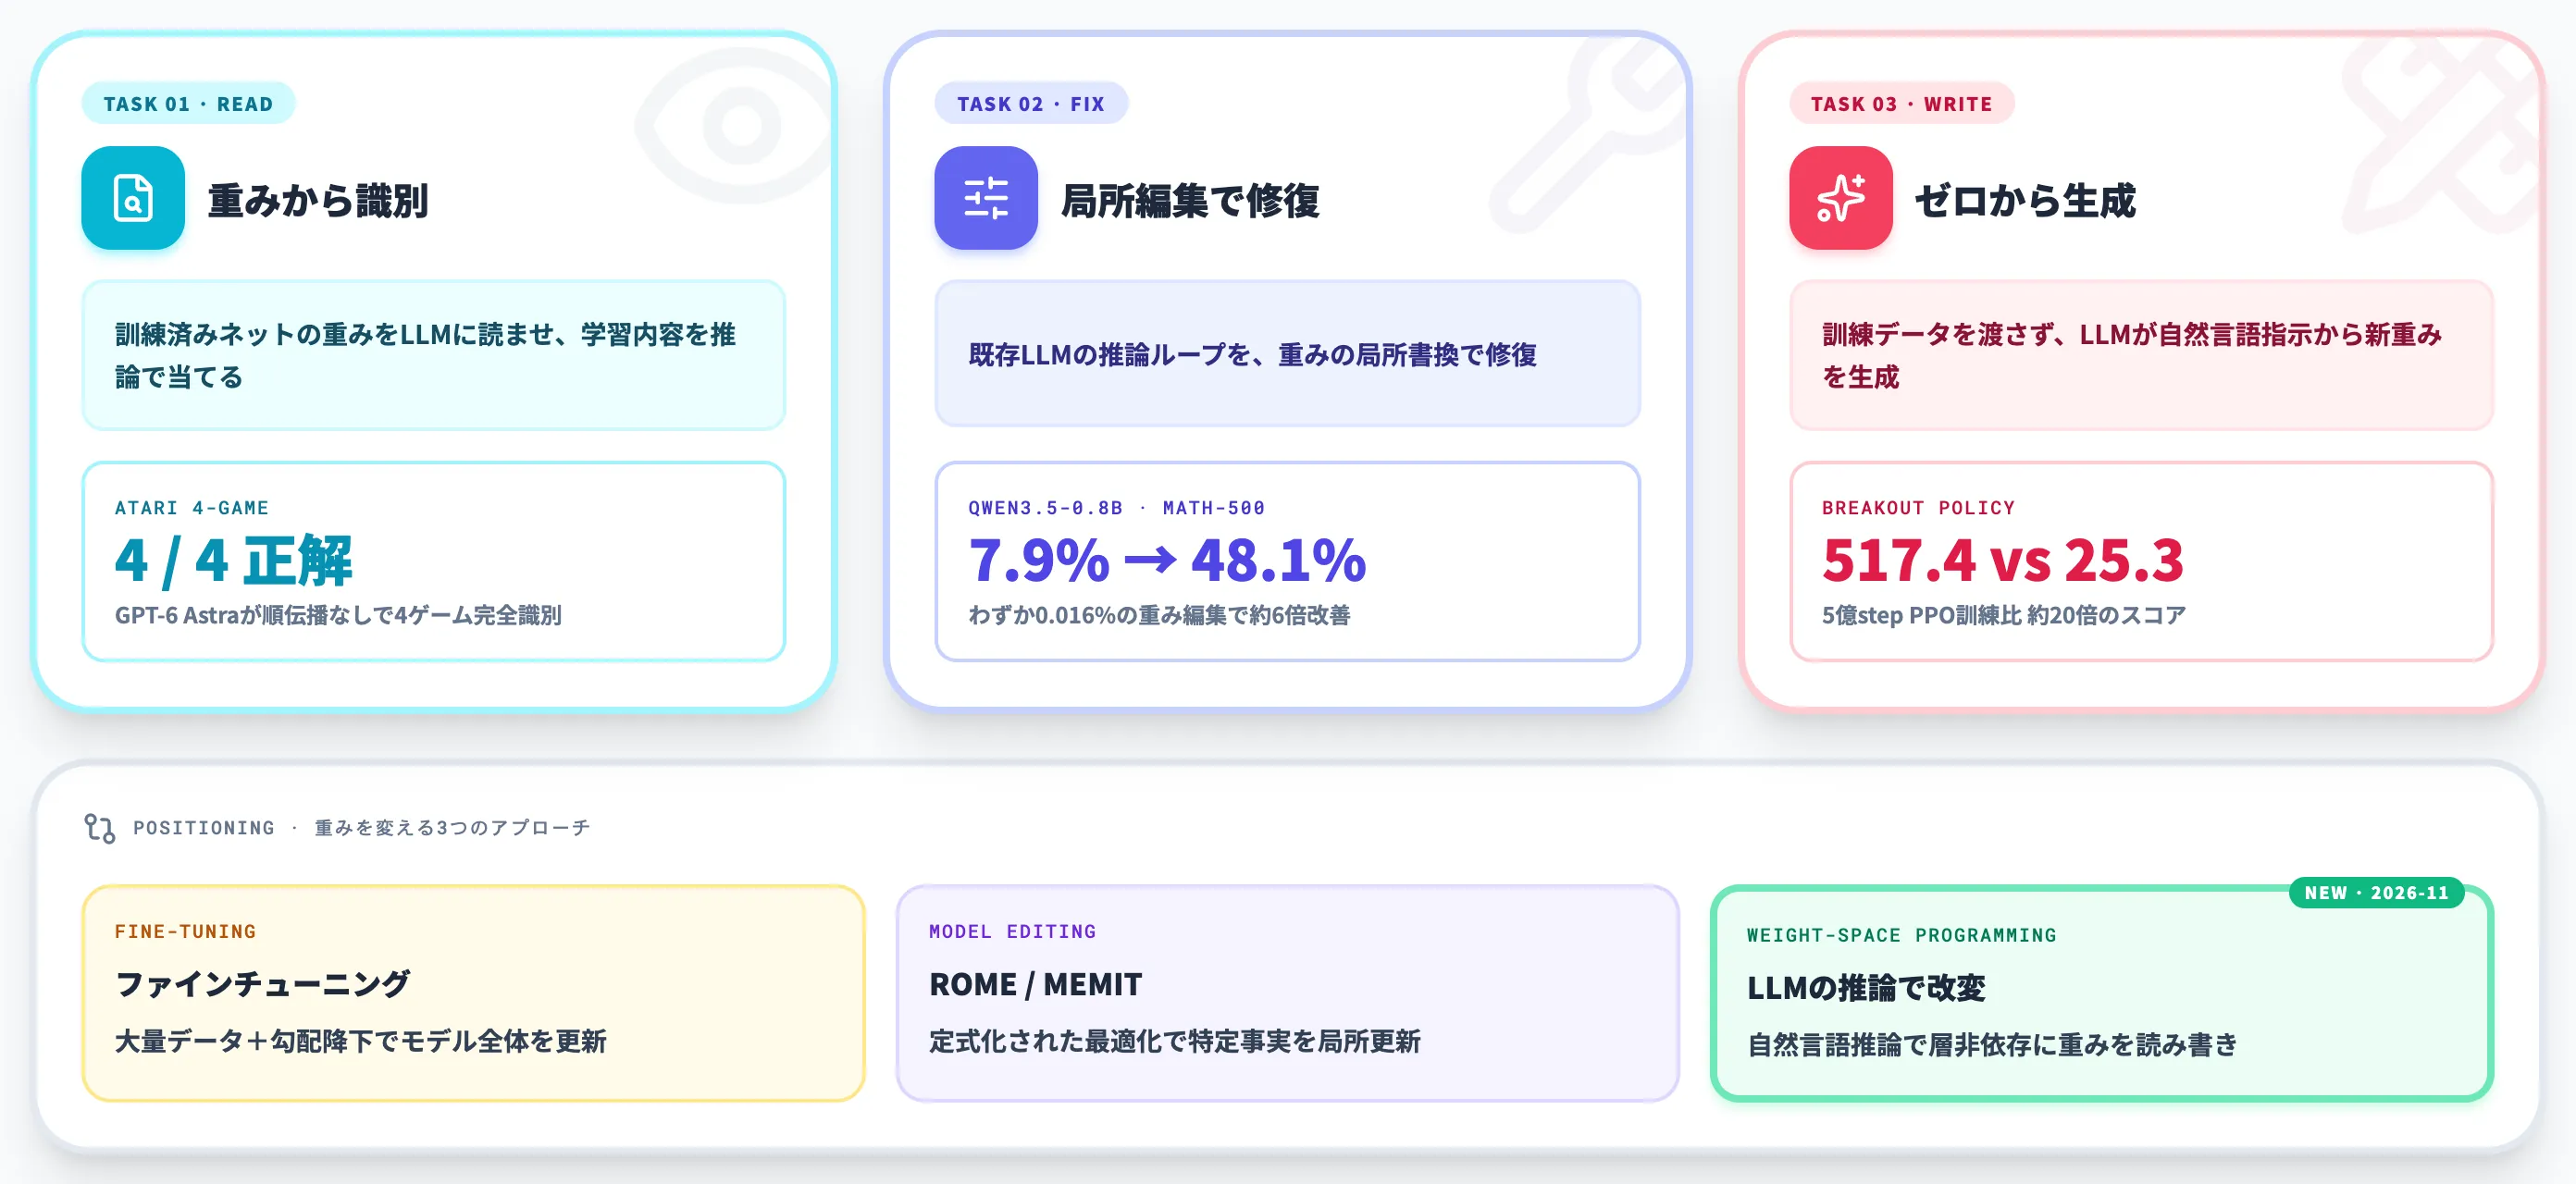
Weight-Space Programming(ウェイトスペース・プログラミング、重み空間プログラミング)は、汎用大規模言語モデル(LLM)が、他のニューラルネットワークの重みをテキストとして直接読み取り、解釈し、書き換えるアプローチの総称です。
MIT CSAILのRikiya Takehi氏ら4名が2026年11月2日にブログ記事「Sparks of Weight-Space Programming」として提唱した新しい用語で、Wikipedia項目も同月に新設されました。
従来、ニューラルネットワークの重みは主に勾配降下法と訓練ループで更新されてきました(TracrのようにプログラムからTransformerを直接構成する先行手法もあります)。
Weight-Space Programmingはこの主流手段とは別に、重みを「LLMが読み書きできるコード」として扱う経路を提案したものです。
Weight-Space Programmingの仕組み——重みをテキストで渡してLLMに読み書きさせる
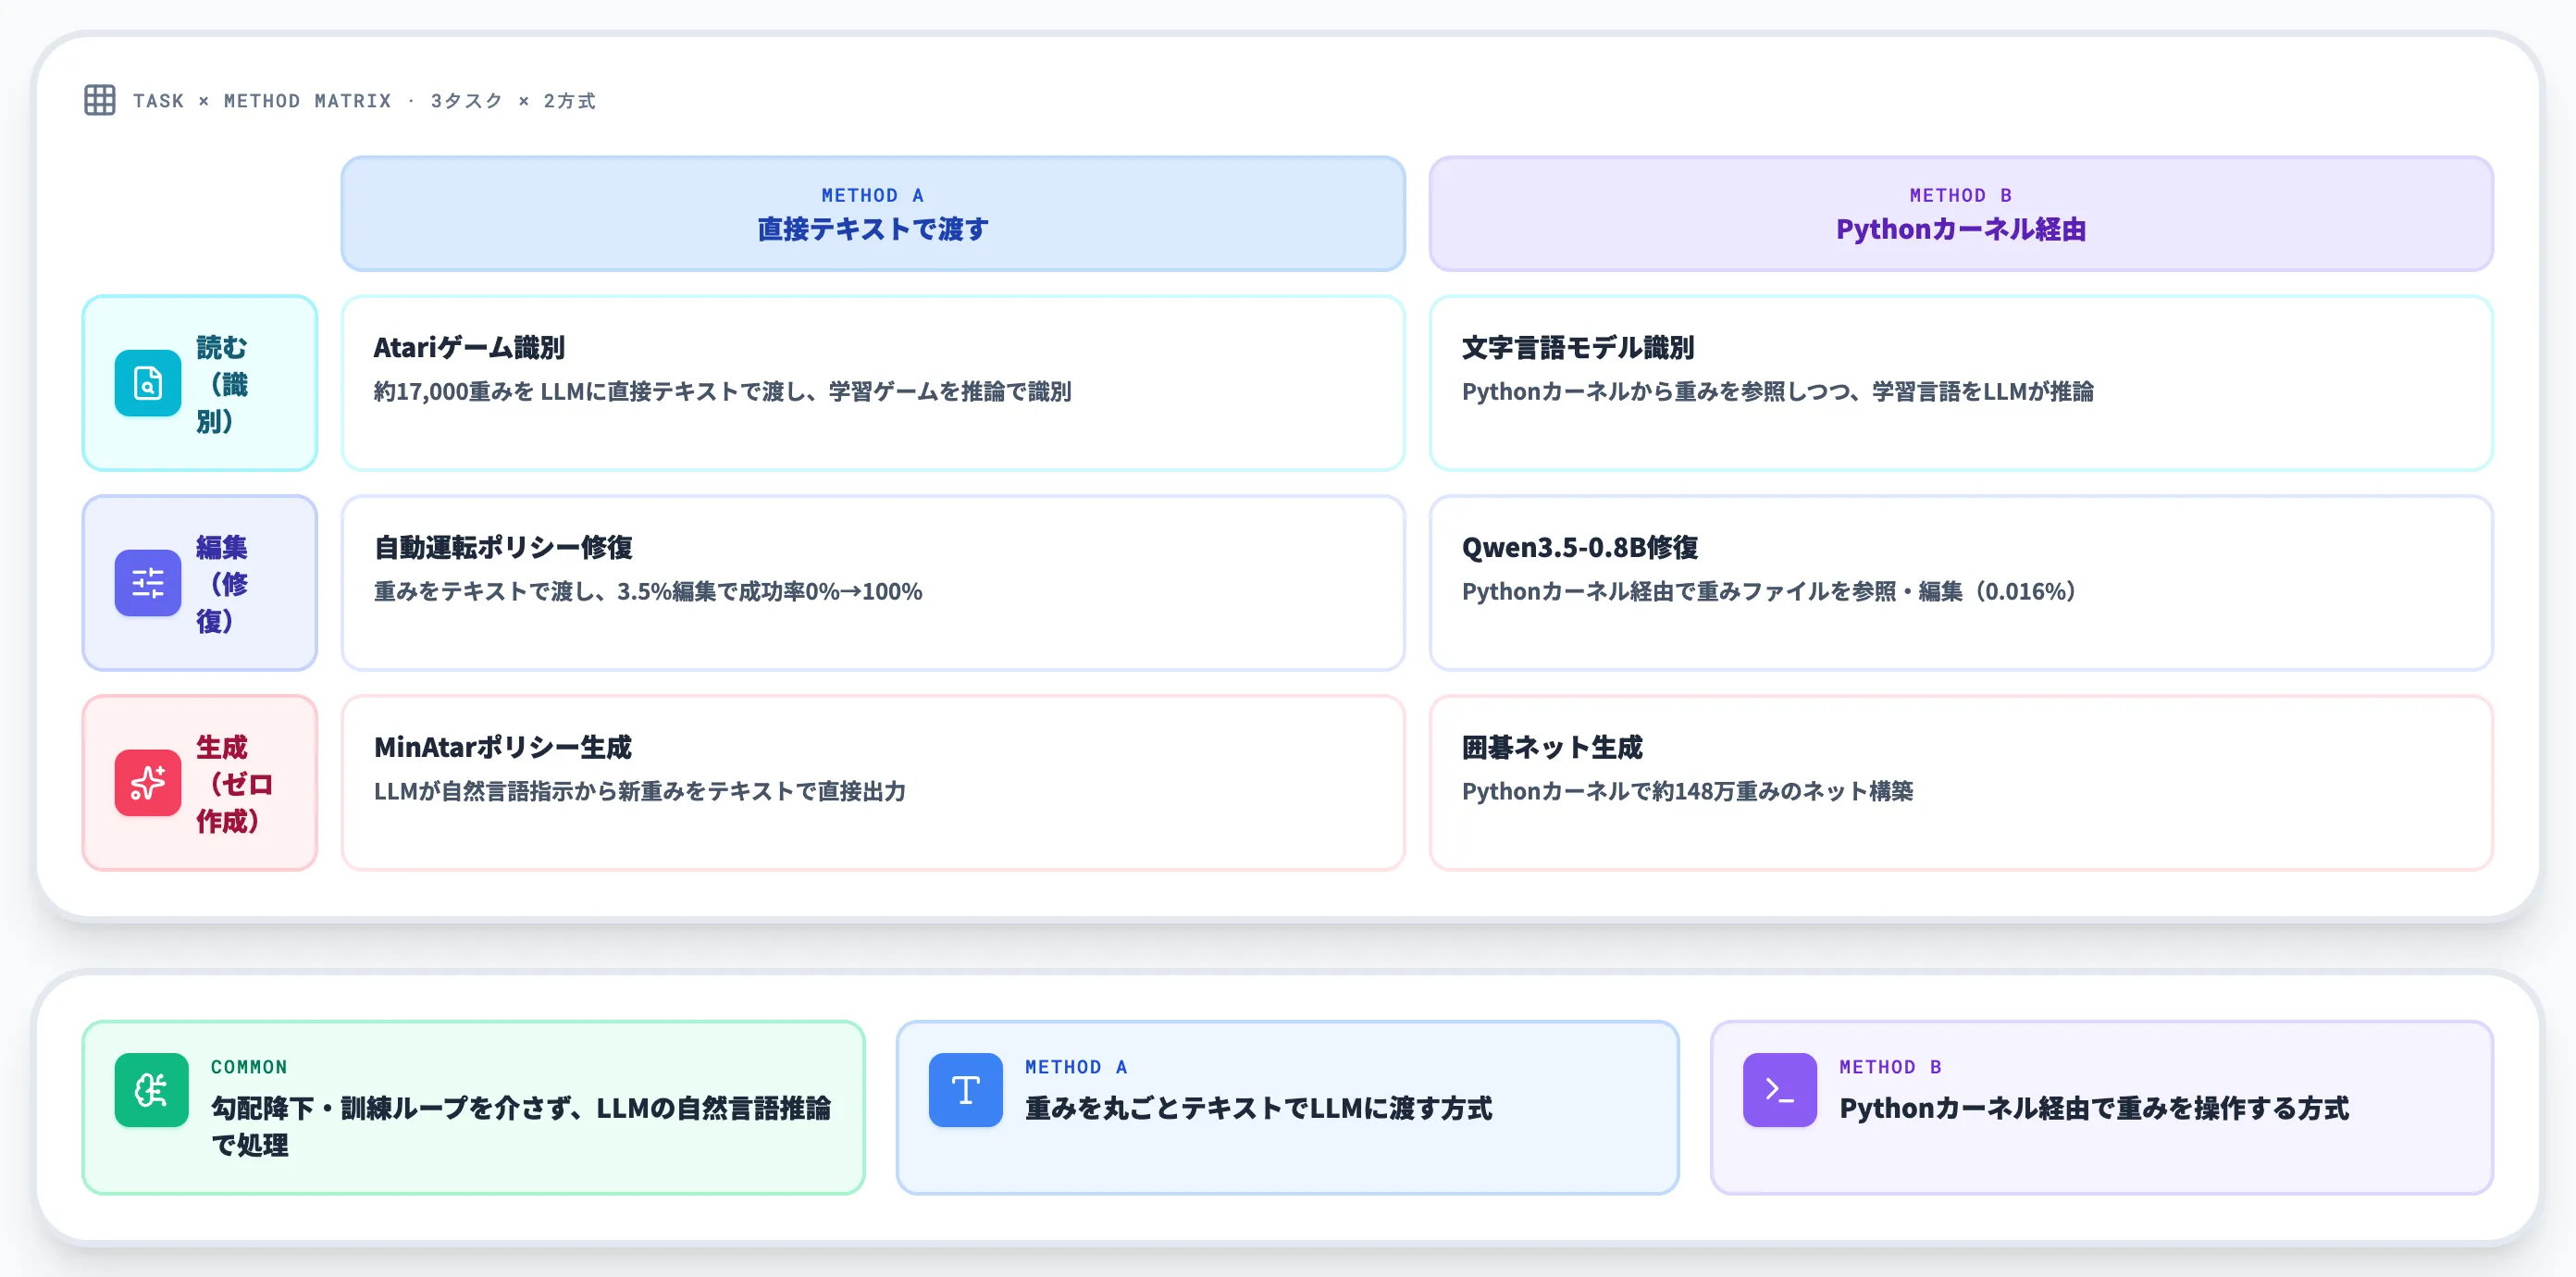
Weight-Space Programmingの技術的な構成は、処理の方向(タスク)が3通りに分かれます。
重みの受け渡し方式(LLMに直接テキストで渡すか、Pythonカーネル経由で扱うか)はタスクとは独立に選ばれ、原著の8実験では同じタスクでも実験例ごとに方式が異なります。
-
読む(識別)
既存ネットの重みから「どのゲームを学習したか」などの答えをLLMに言わせる処理。
Atariゲーム識別はPythonを使わず重みを直接テキストで渡す方式、文字言語モデルの言語識別はPythonカーネル経由で重みを扱う方式で実施されました。既存の重みは変更しません
-
生成(ゼロから書く)
「〇〇を解くネットワーク」の条件やルール・構造を自然言語で与え、新しい重みを出力させる処理。
MinAtarはPythonを使わず回答をテキストで返す方式、囲碁ネット生成はPythonカーネルを活用して重みを構築する方式で実施されました
-
編集(既存ネットの修復)
既存の重みを書き換えて挙動を変える処理。自動運転制御ポリシーの修復はPythonを使わない方式、Qwen3.5-0.8Bの推論ループ修復はPythonカーネル経由で既存重みファイルを参照・編集する方式で実施されました
いずれも損失関数の勾配を使った重み更新や訓練ループを介さず、LLMの自然言語推論を介する点が共通しています。
原著のQwen実験では、LLMが仮説検証のために順伝播を自ら呼び出すケースもあり、「順伝播ゼロ」ではなく「訓練ループを介さずLLM主導で処理する」というのが正確な位置づけです。
勾配降下を使わない「推論駆動最適化」
勾配降下法は「損失関数を測って、その勾配で重みを更新する」というアルゴリズム的な最適化です。
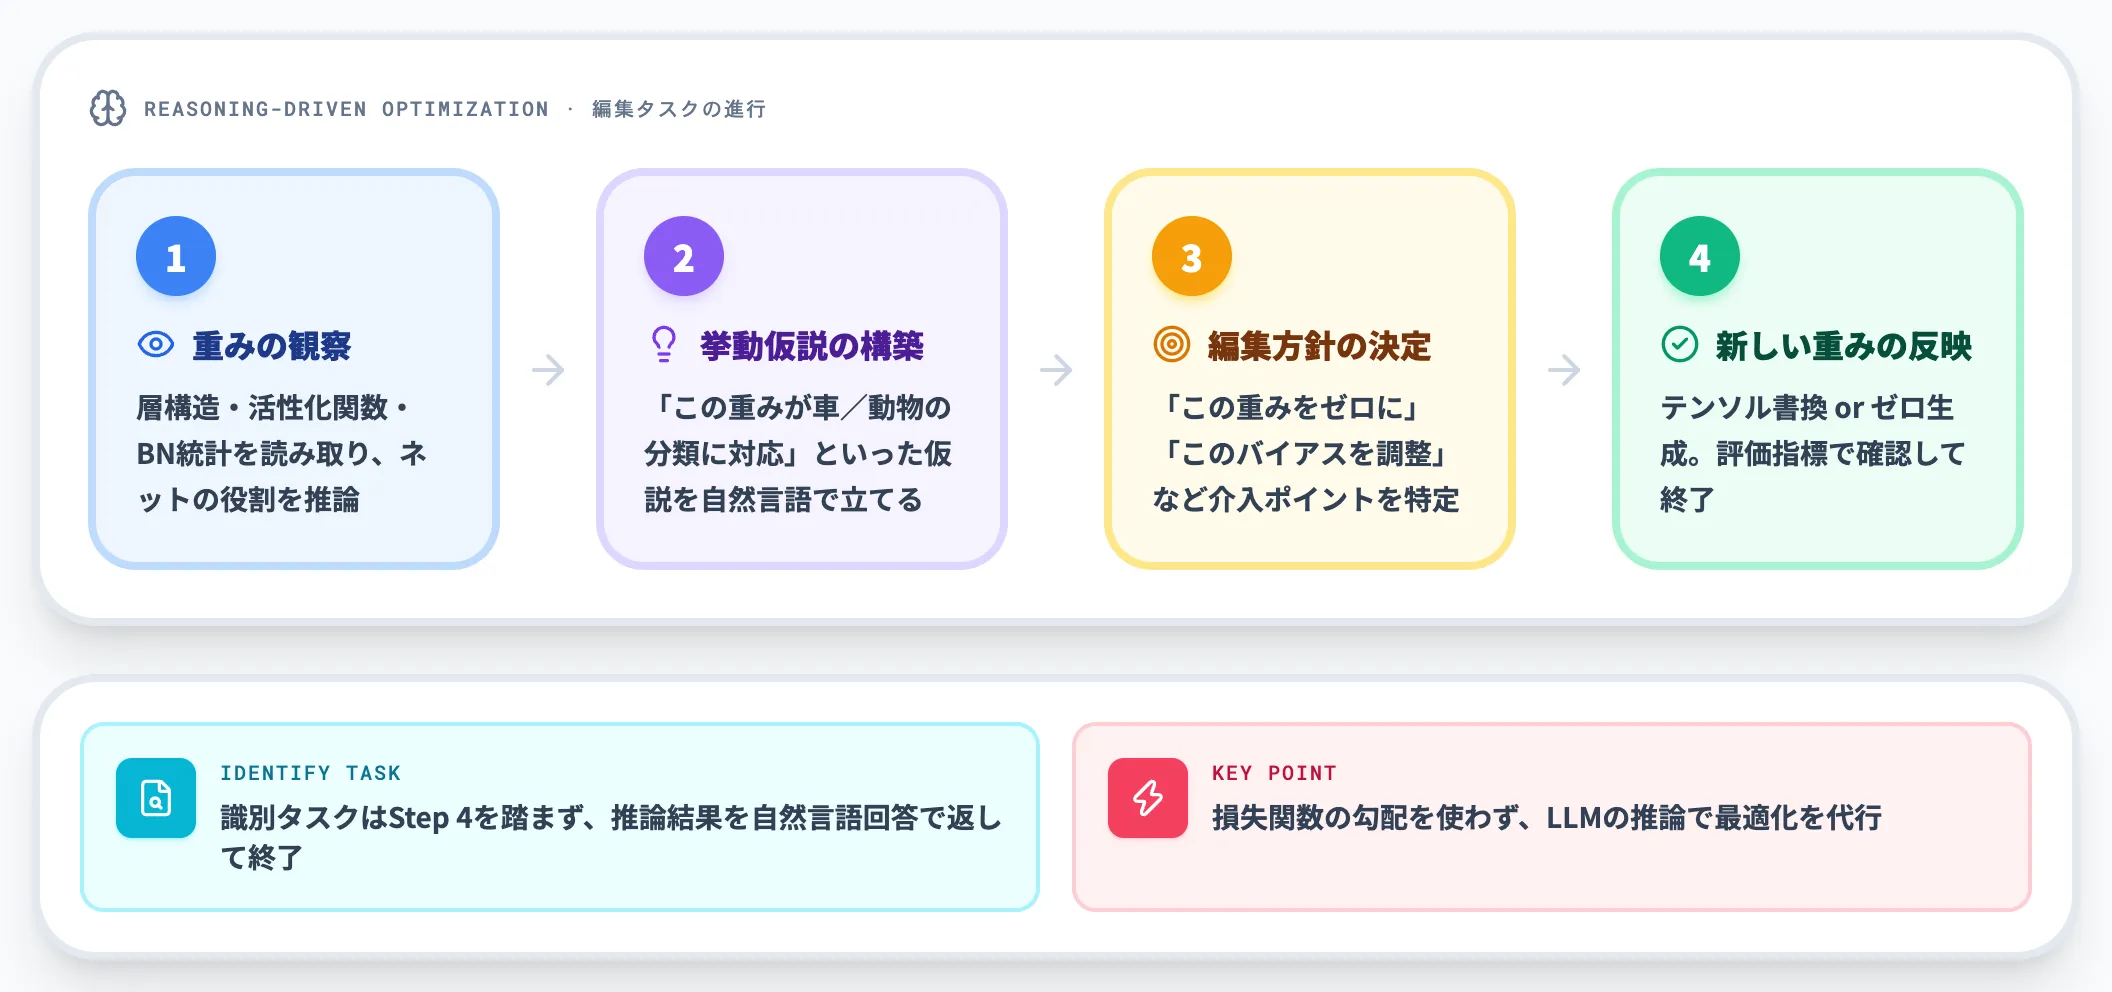
Weight-Space Programmingは、これをLLMの推論に置き換えます。「編集(既存ネットの修復)」タスクを例にとると、具体的には次の順序で進みます。
-
重みの観察
提示された重みのテキスト、またはPythonカーネル経由で参照した重みから、層構造・活性化関数・バッチ正規化統計などを読み取り、「このネットワークが何をしているか」を推論する
-
挙動仮説の構築
「出力層の重みが車/動物の分類に対応している」「中間層のこの部分が特定推論ステップを担当している」といった仮説をLLMが自然言語で立てる
-
編集方針の決定
「この重みをゼロにすれば誤推論ループを抑えられる」「このバイアスを調整すれば数学タスクが改善する」といった介入ポイントを特定する
-
新しい重みの反映
編集タスクでは該当テンソルを書き換え、ゼロ生成タスクでは新しい重みを出力する。どちらも実験例に応じて「直接テキストで出す/Pythonカーネル経由で操作する」のいずれかが採られる。必要なら評価指標で確認する
識別タスクはこの最終ステップを踏まず、推論の結果を自然言語の回答として返して終了します。
Takehi氏らはこの一連の自然言語推論による重み操作を「推論駆動最適化(reasoning-driven optimization)」と呼んでいます。
フロンティアLLMが前提
Weight-Space Programmingは、どのLLMでも実行できるわけではありません。
重みテンソルを読み込んで意味ある仮説を立てるには、フロンティアレベル(最先端帯)のLLM能力が前提になります。
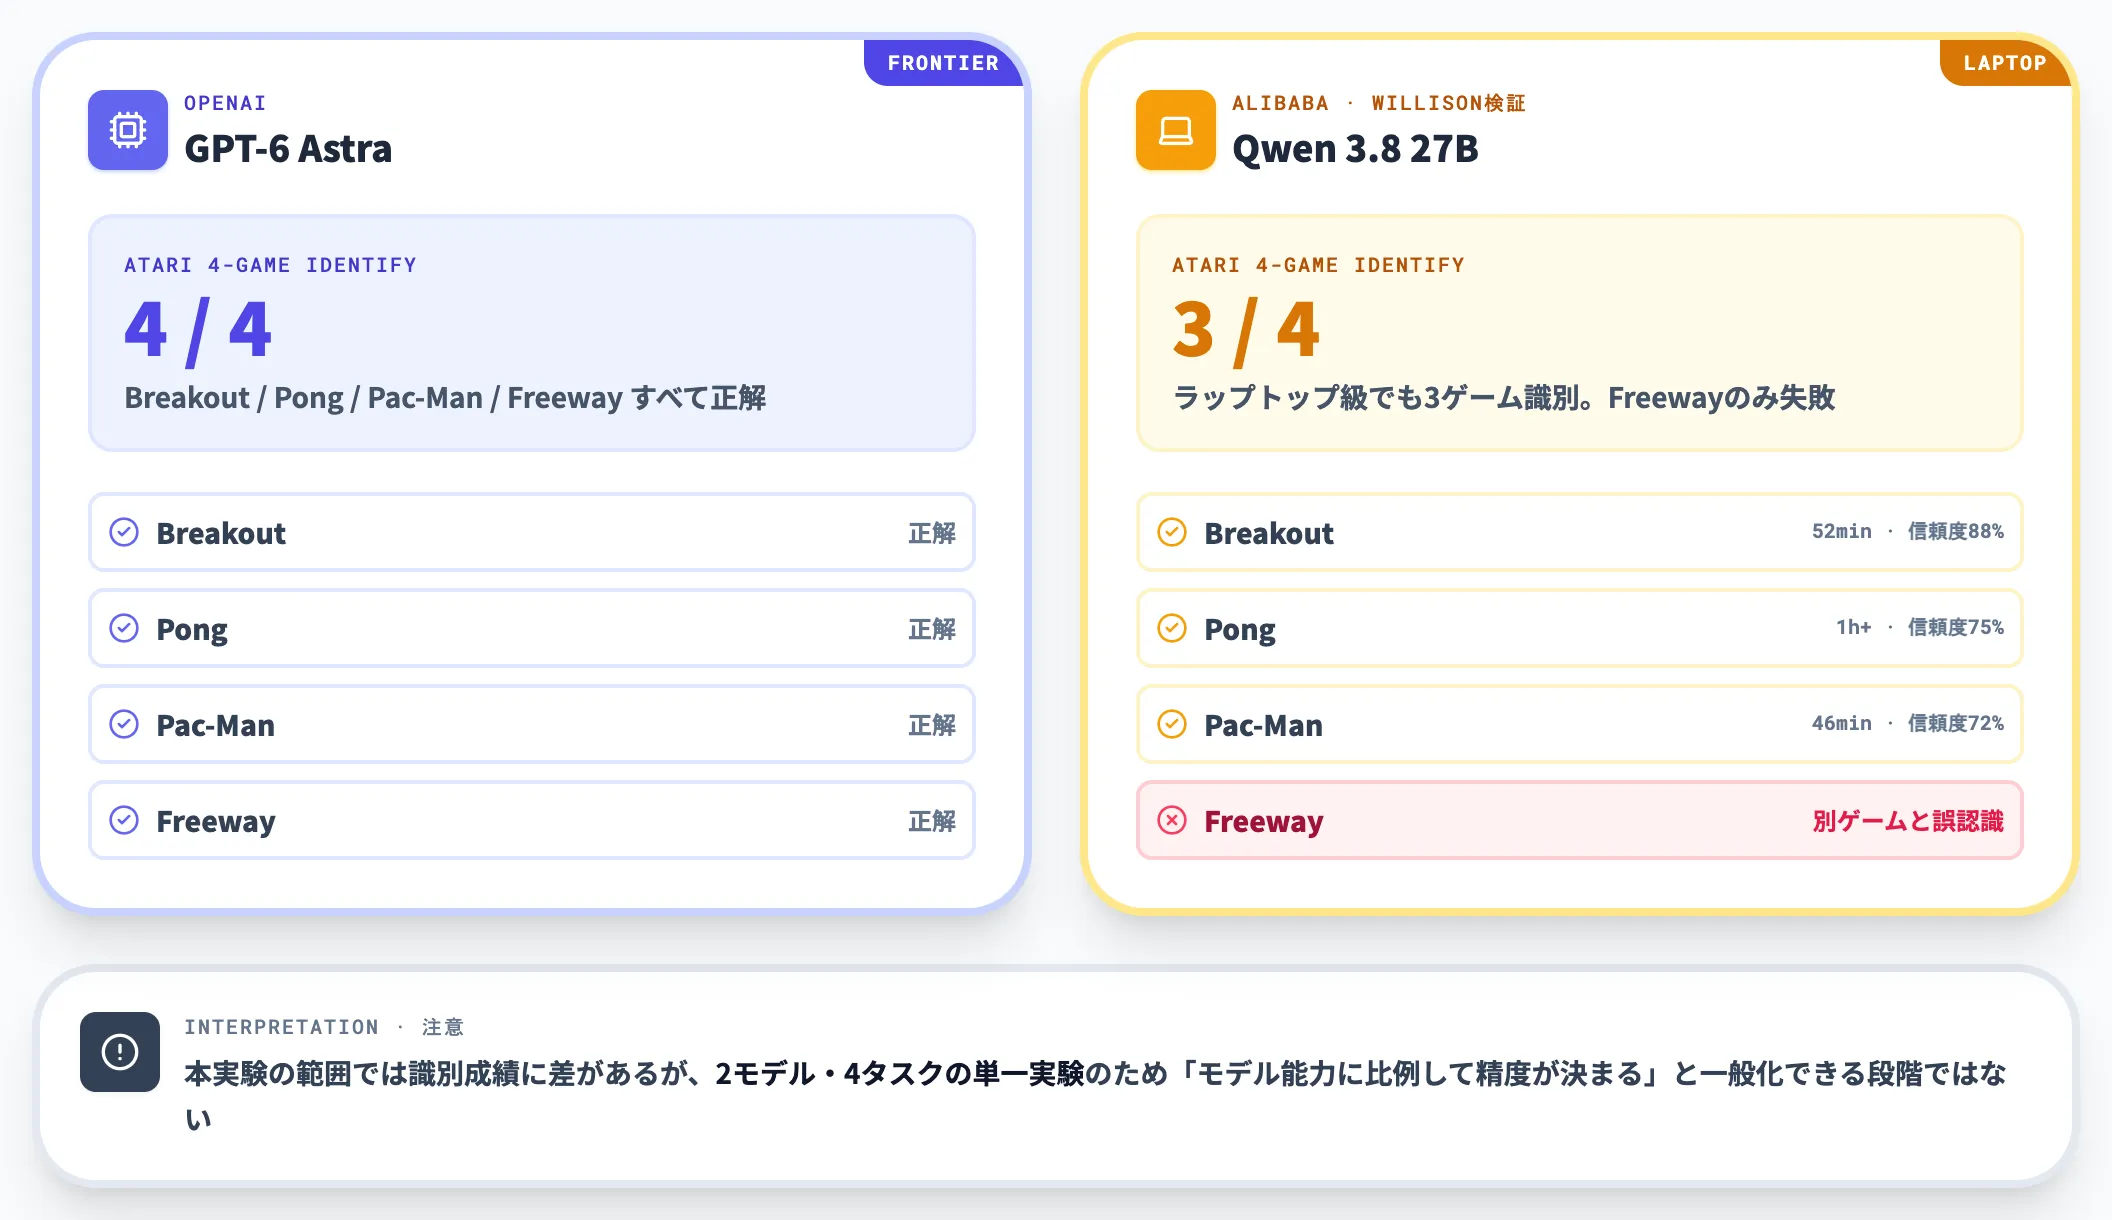
Takehi氏らの主要実験はOpenAI GPT-6 Astraで実施され、独立検証はAnthropicの Claude Opus 5.5 で行われました。
また、Simon Willison氏はQwen 3.8 27Bでも一部タスクが成立することを示しています。
ただし、Qwen 3.8 27Bでは4つのゲーム識別タスク中、Pac-Man・Pong・Breakoutは成功したものの、Freewayの識別には失敗しました。
本実験の範囲では、GPT-6 Astra(4/4正解)とQwen 3.8 27B(3/4正解)のあいだに識別成績の差が観察されています(モデルサイズと精度を直接結ぶ一般則までは、この2モデル・4タスクの検証からは確定しません)。
MIT CSAILが示した3つの実証——「読む・直す・ゼロから書く」
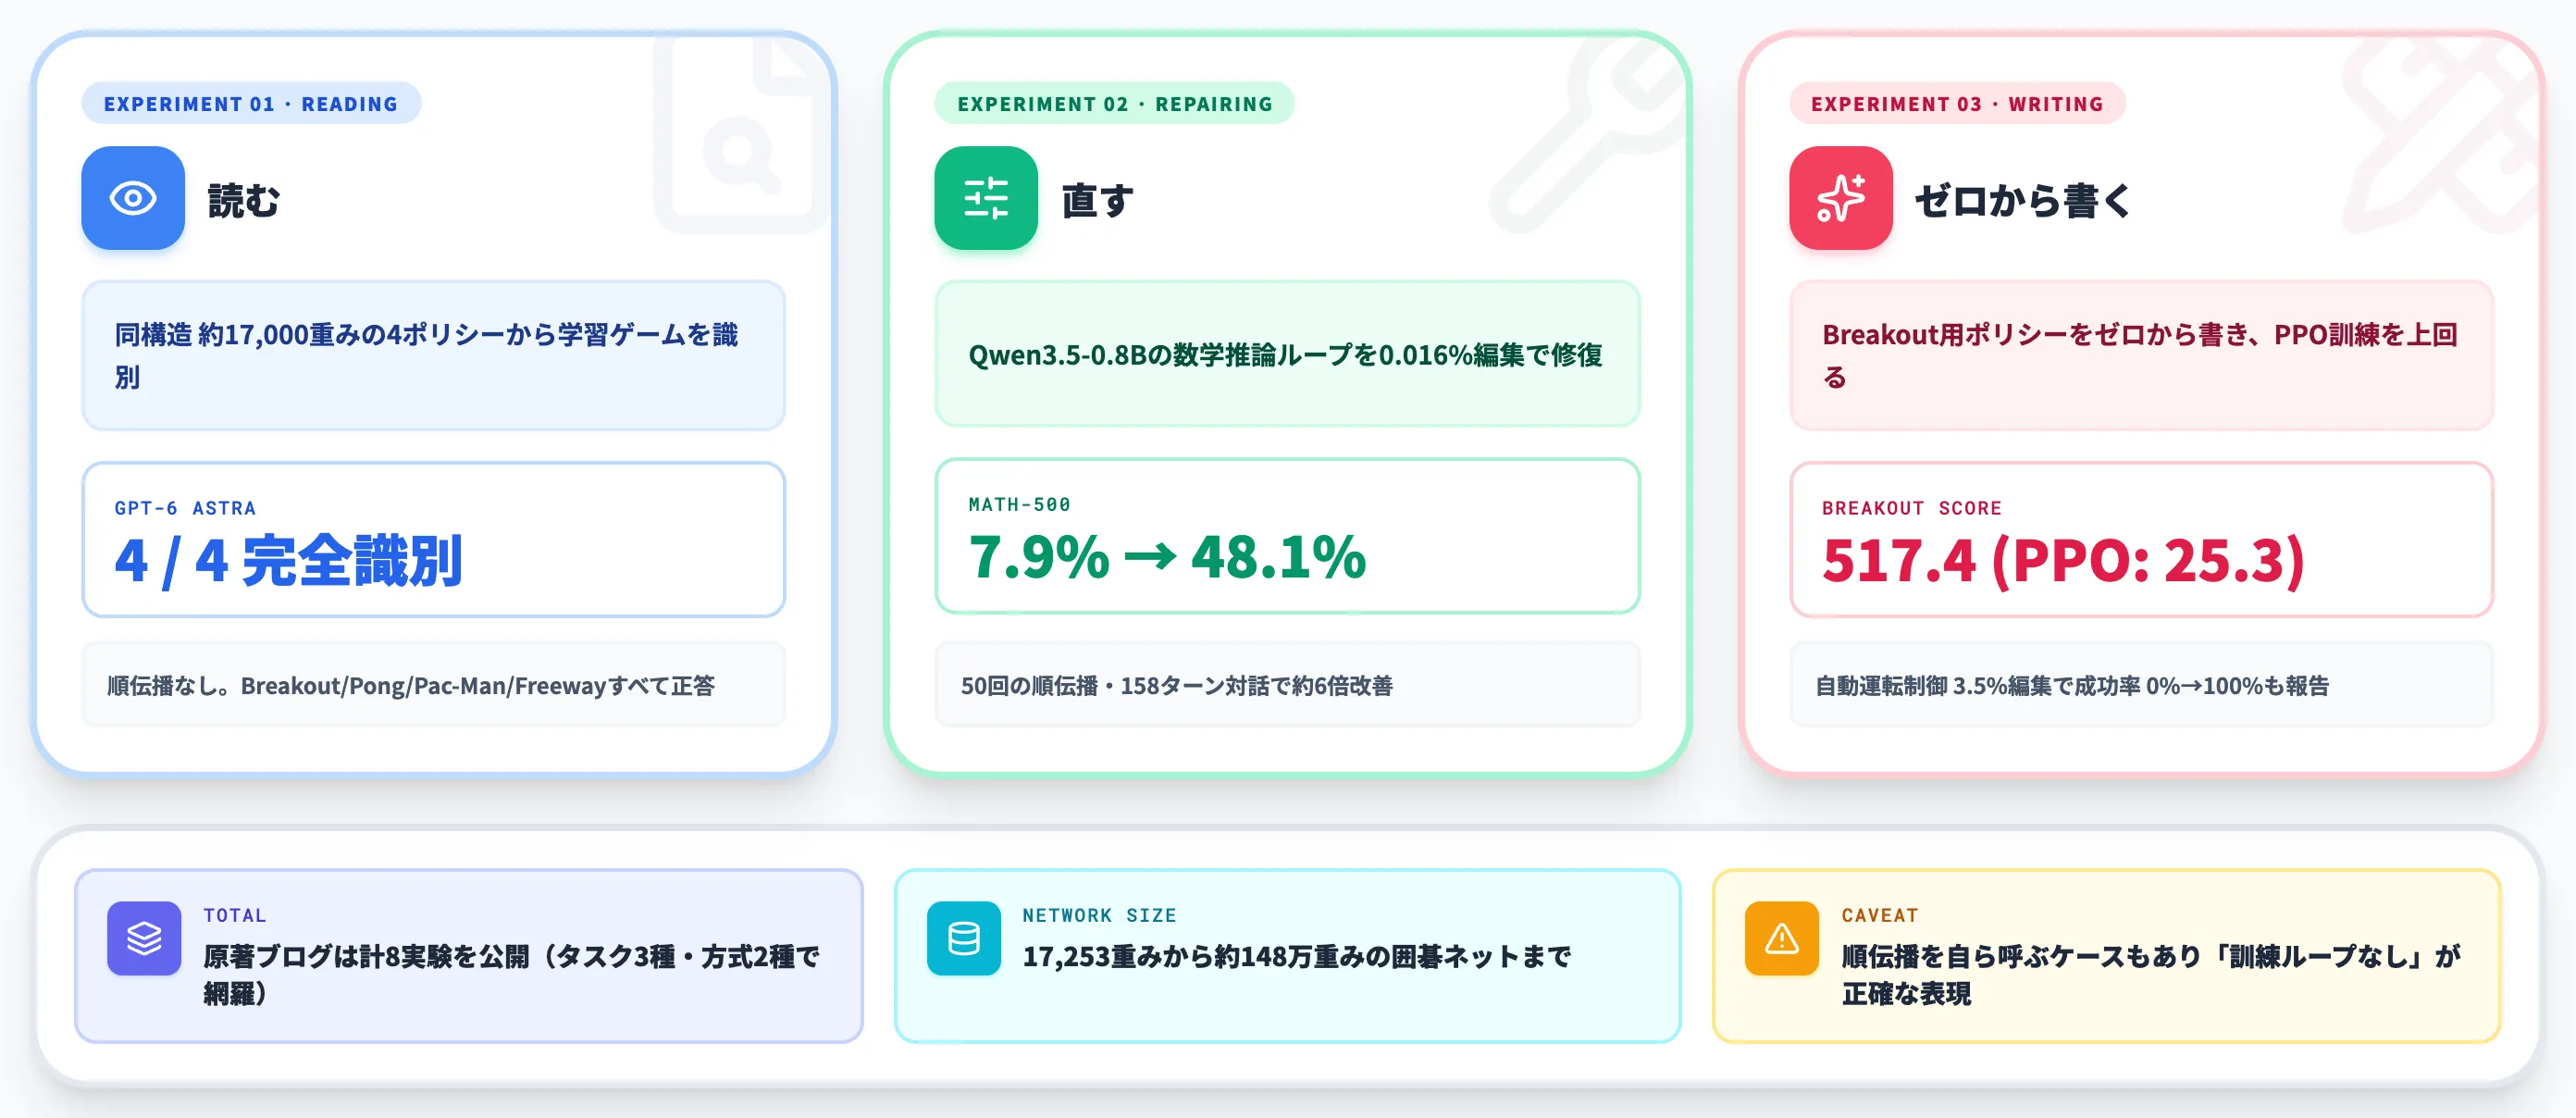
Takehi氏らのブログ記事では、Weight-Space Programmingの能力を「読む(Reading)」「直す(Repairing)」「ゼロから書く(Writing from scratch)」の3タスクに分けて8つの実験が公開されています。
本セクションでは、代表的な3実験の具体的な数値を整理します。
読む——Atariネットから学習ゲームを識別
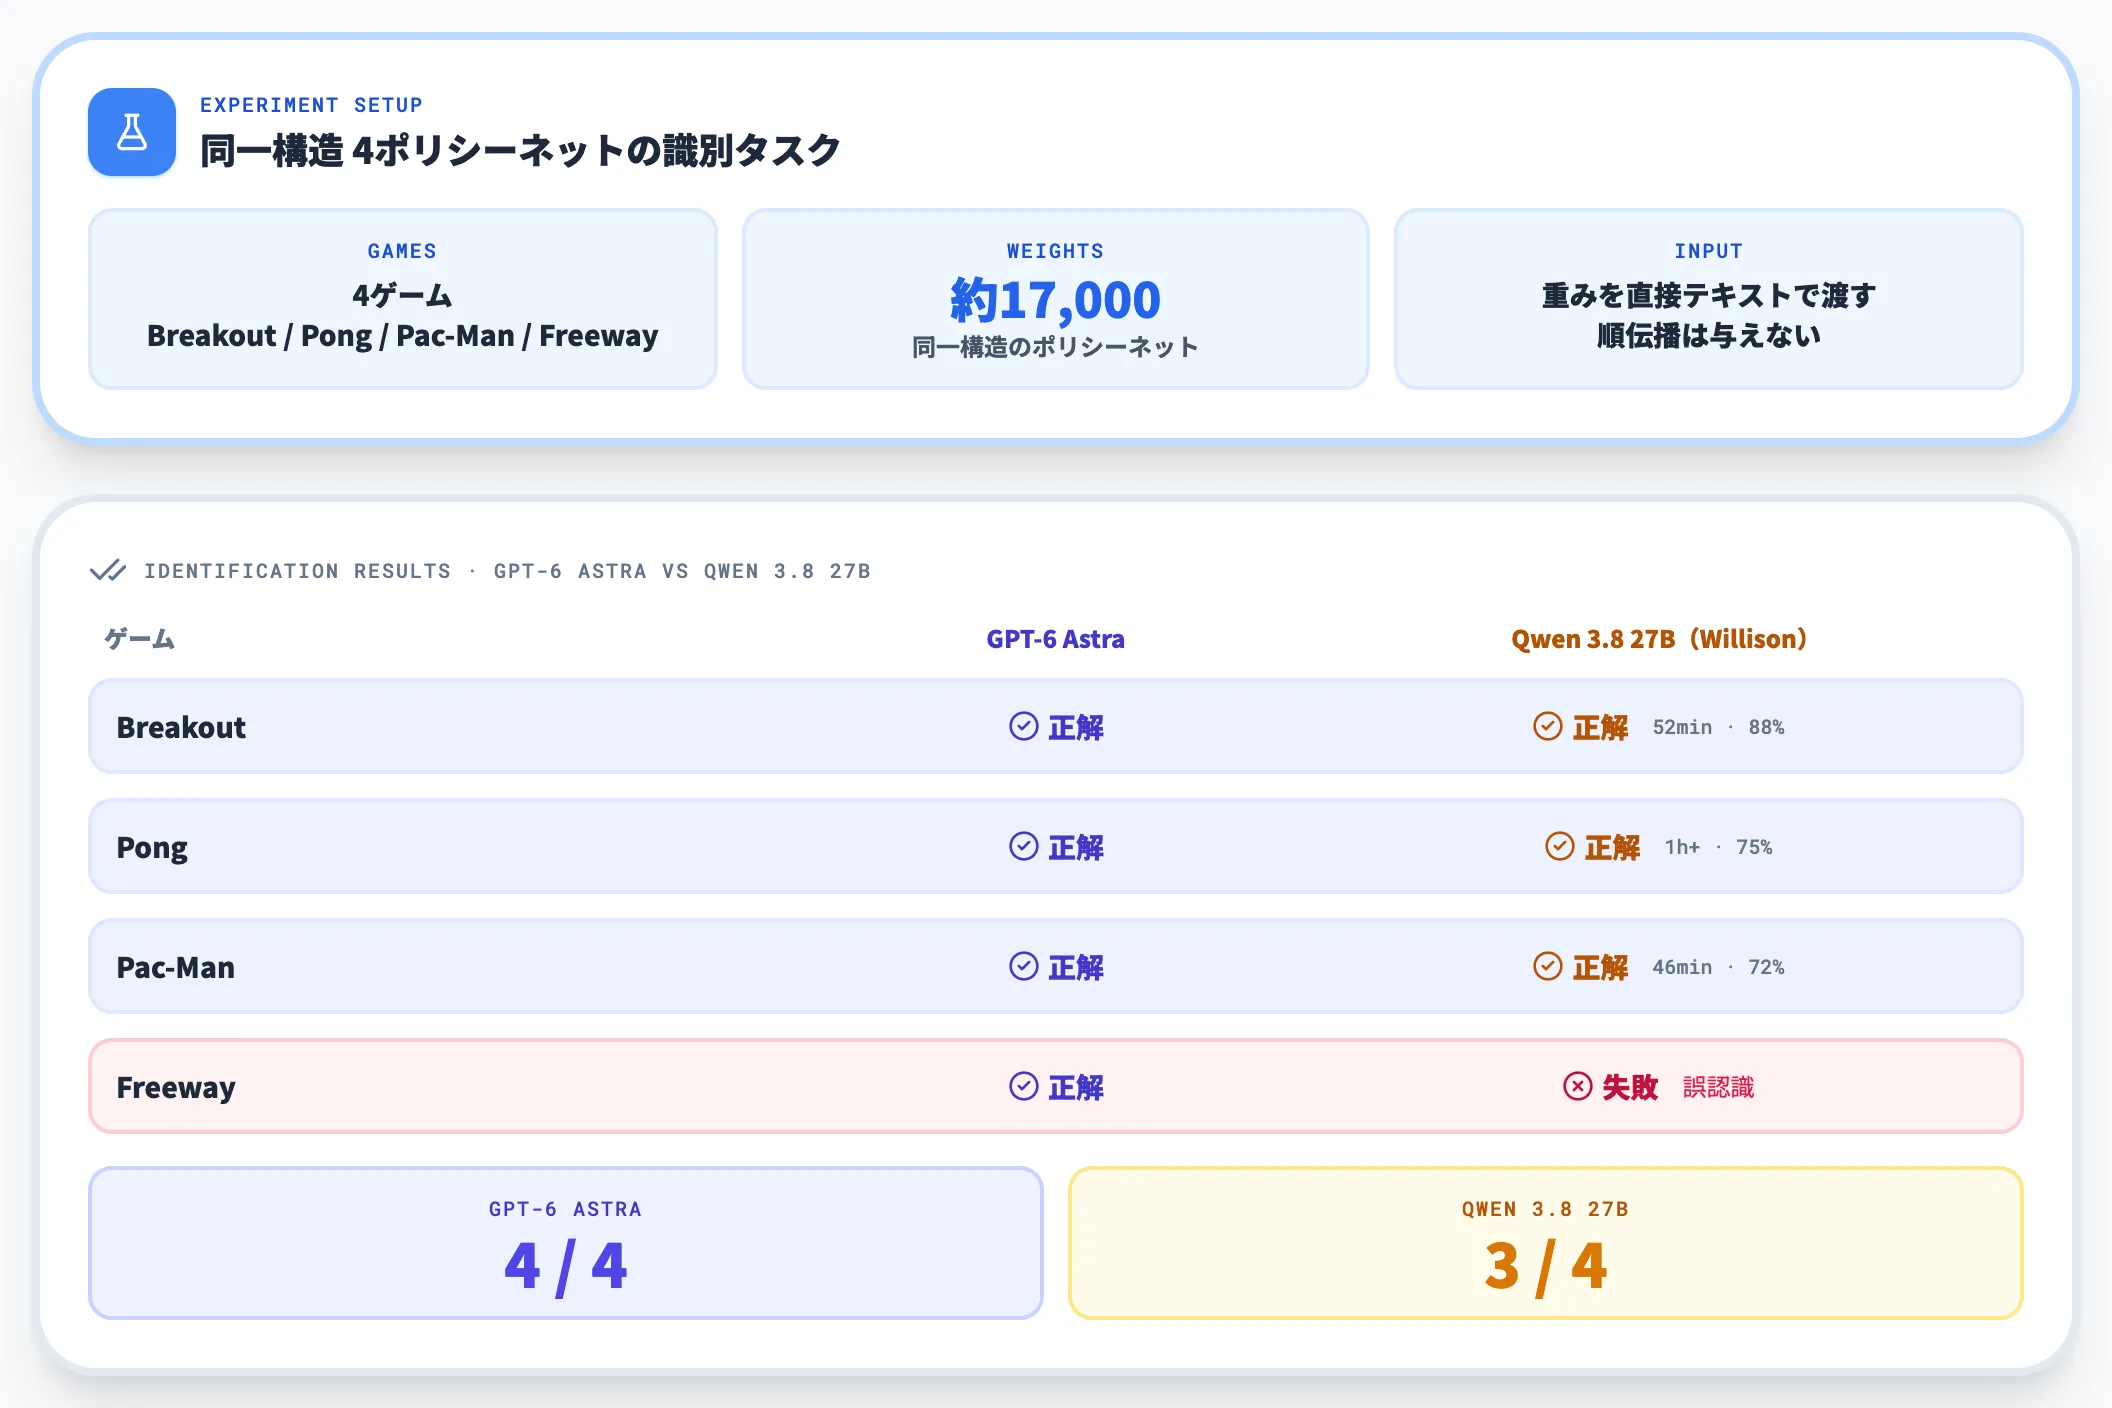
最初の実験は、訓練済みネットワークの重みだけから「何を学習したか」をLLMが当てるタスクです。
Takehi氏らはBreakout/Pong/Pac-Man/Freewayの4つのAtariゲームそれぞれで強化学習させた、同一構造の約17,000重みを持つ4つのポリシーネットワークを用意しました。
GPT-6 Astraに重みをテキストで渡し、順伝播(モデルを実行する手段)を与えずに「どのネットワークがどのゲームを学習したか」を尋ねたところ、4ネットすべてを正しく識別しました。
| タスク | GPT-6 Astra | Qwen 3.8 27B(Willison検証) |
|---|---|---|
| Breakout 識別 | 正解 | 正解(52分・信頼度88%) |
| Pong 識別 | 正解 | 正解(1時間以上・信頼度75%) |
| Pac-Man 識別 | 正解 | 正解(46分・信頼度72%) |
| Freeway 識別 | 正解 | 失敗(別ゲームと誤認識) |
本実験の範囲では、フロンティアLLMは4ゲーム全問正解、ラップトップ級のQwen 3.8 27Bは3/4で成功という結果です。識別成績に差があったことは確認できますが、2モデル・4タスクの単一実験なので、「モデル能力に比例して精度が決まる」と一般化できる段階ではありません。
直す——Qwenの数学推論を0.016%編集で改善
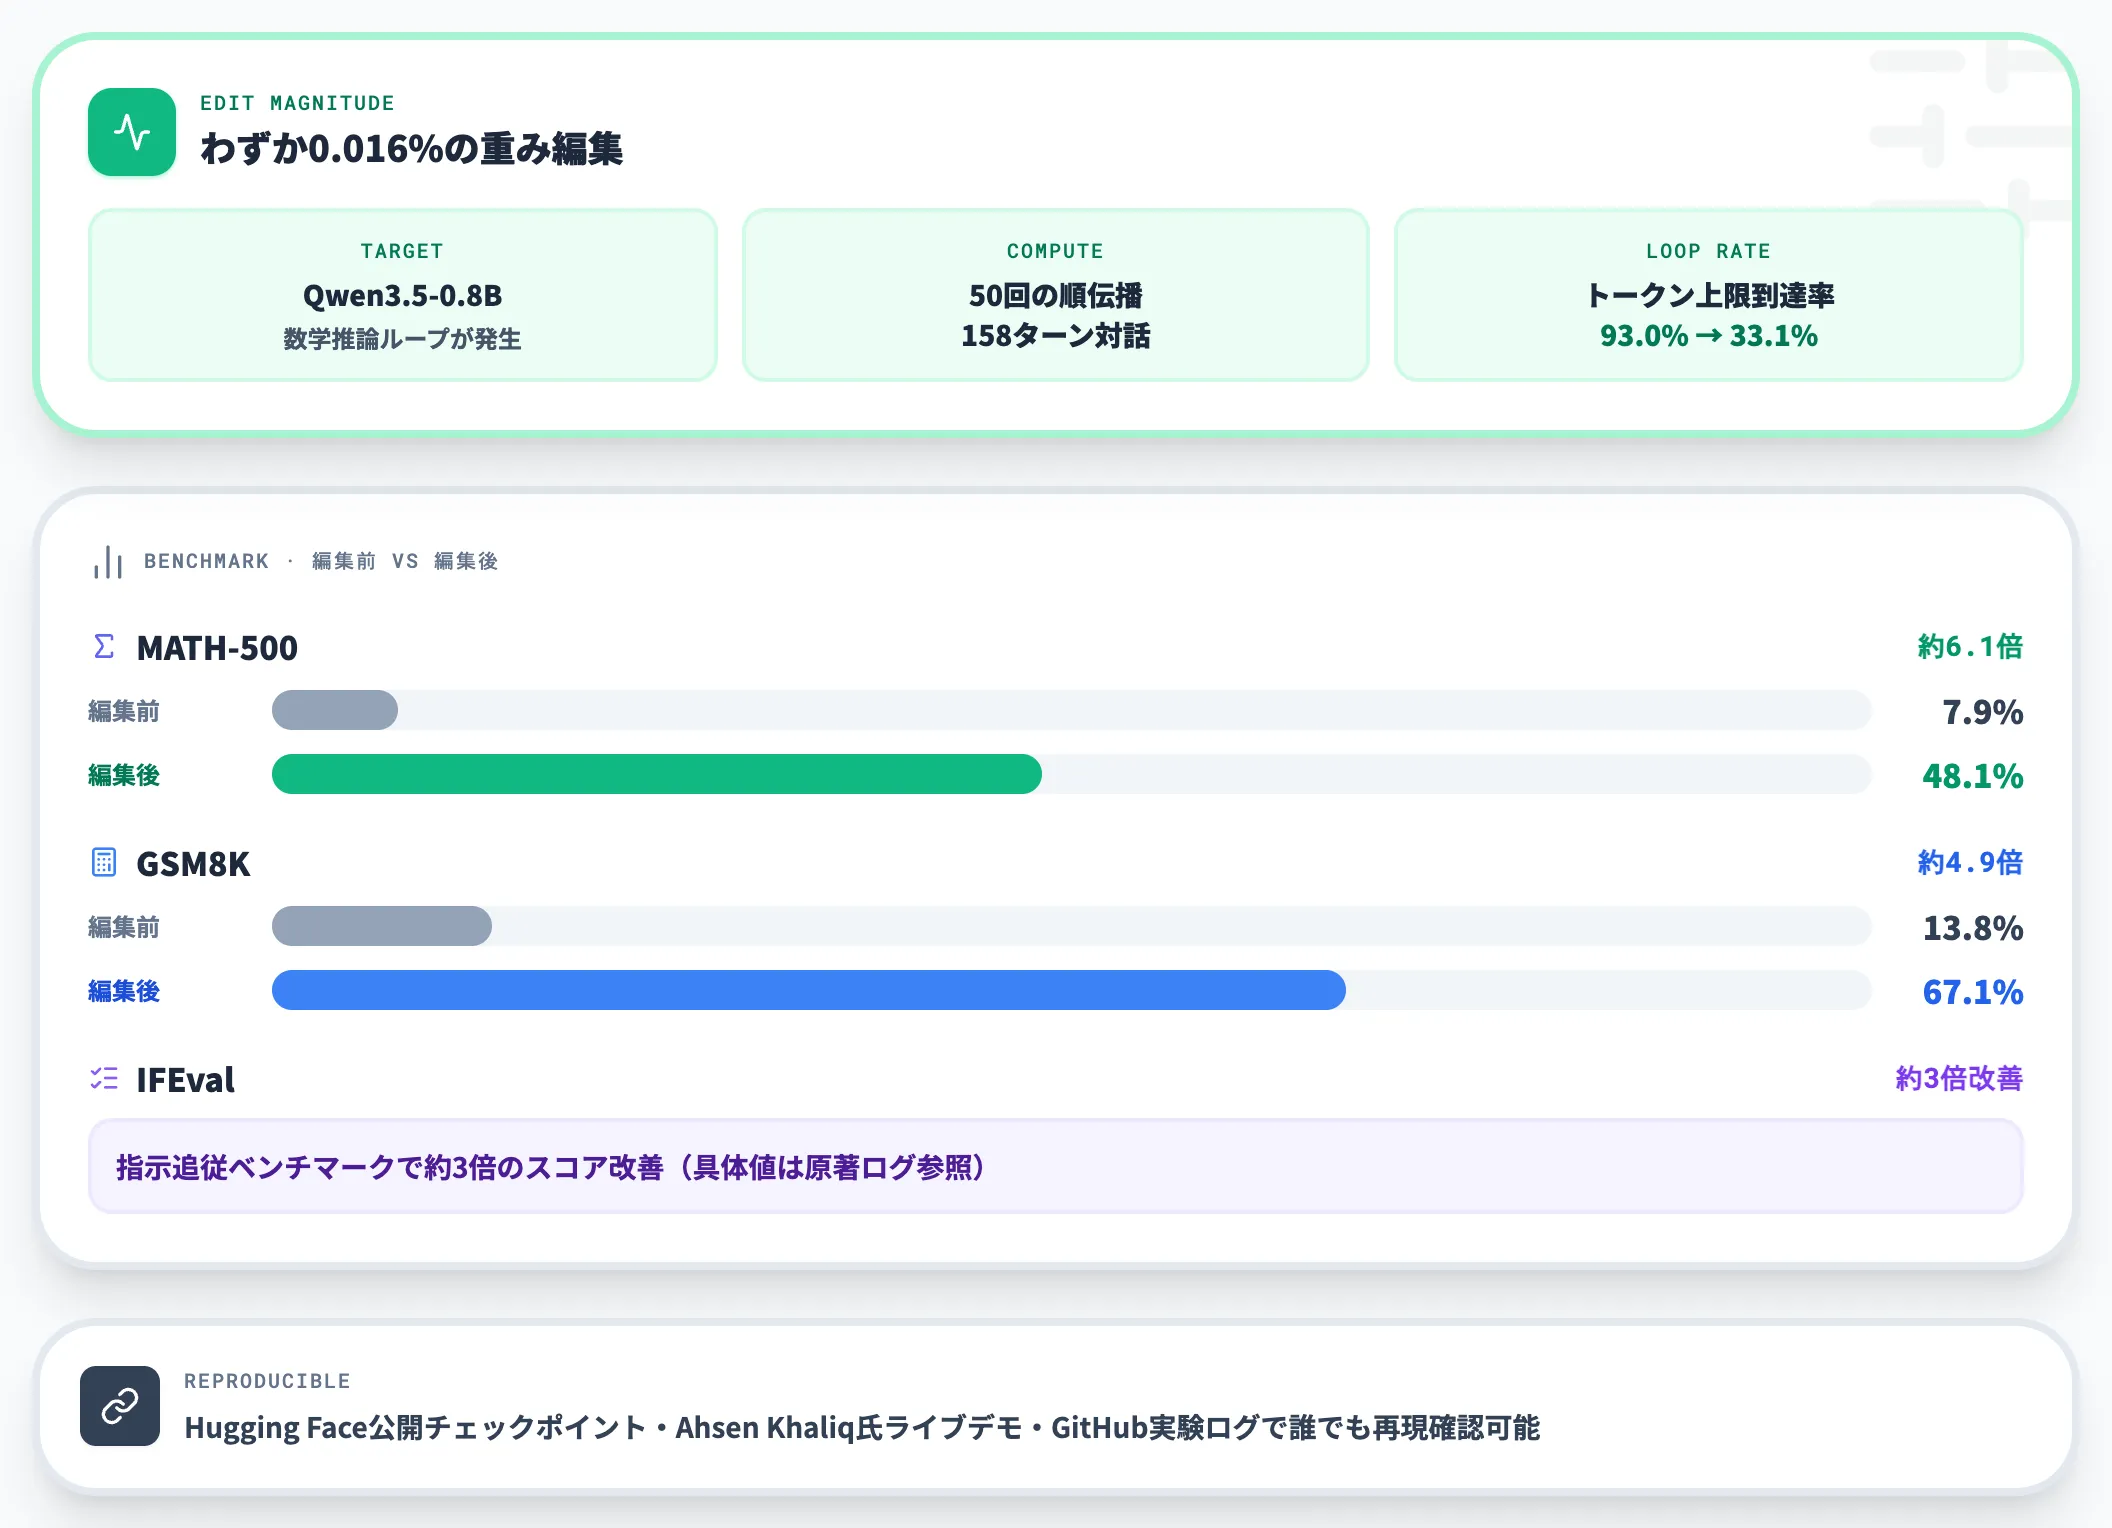
2つ目の実験は、既存LLMの推論ループを重み編集で修復するタスクです。
Qwen3.5-0.8Bは数学問題で「同じ計算を繰り返して結論に辿り着けない」推論ループが発生することが知られていました。
GPT-6 Astraに重みを渡して原因特定を指示したところ、重みのわずか0.016%を書き換えるだけで、MATH-500のトークン上限到達率が93.0%から33.1%まで下がり、ループが大きく軽減しました。
結果は以下のとおりです。
| ベンチマーク | 編集前 | 編集後 | 改善倍率 |
|---|---|---|---|
| MATH-500 | 7.9% | 48.1% | 約6.1倍 |
| GSM8K | 13.8% | 67.1% | 約4.9倍 |
| IFEval | — | 約3倍 | — |
Takehi氏ら原著の実験ログによれば、この改善には50回の順伝播・158ターンの対話・80回のPython実行・4つの会話が使われています。訓練データを用いた勾配降下とは別経路で、LLMの推論を介した重み編集で到達した結果という位置づけです。
同じ編集結果は、Takehi氏らがHugging Faceで公開している編集済みQwen3.5-0.8BチェックポイントとAhsen Khaliq氏によるライブデモで誰でも確認できます。
DEV Community の解説記事もこの事例を取り上げており、再現環境は一次公開されています。
ゼロから書く——PPO訓練を上回るネット生成
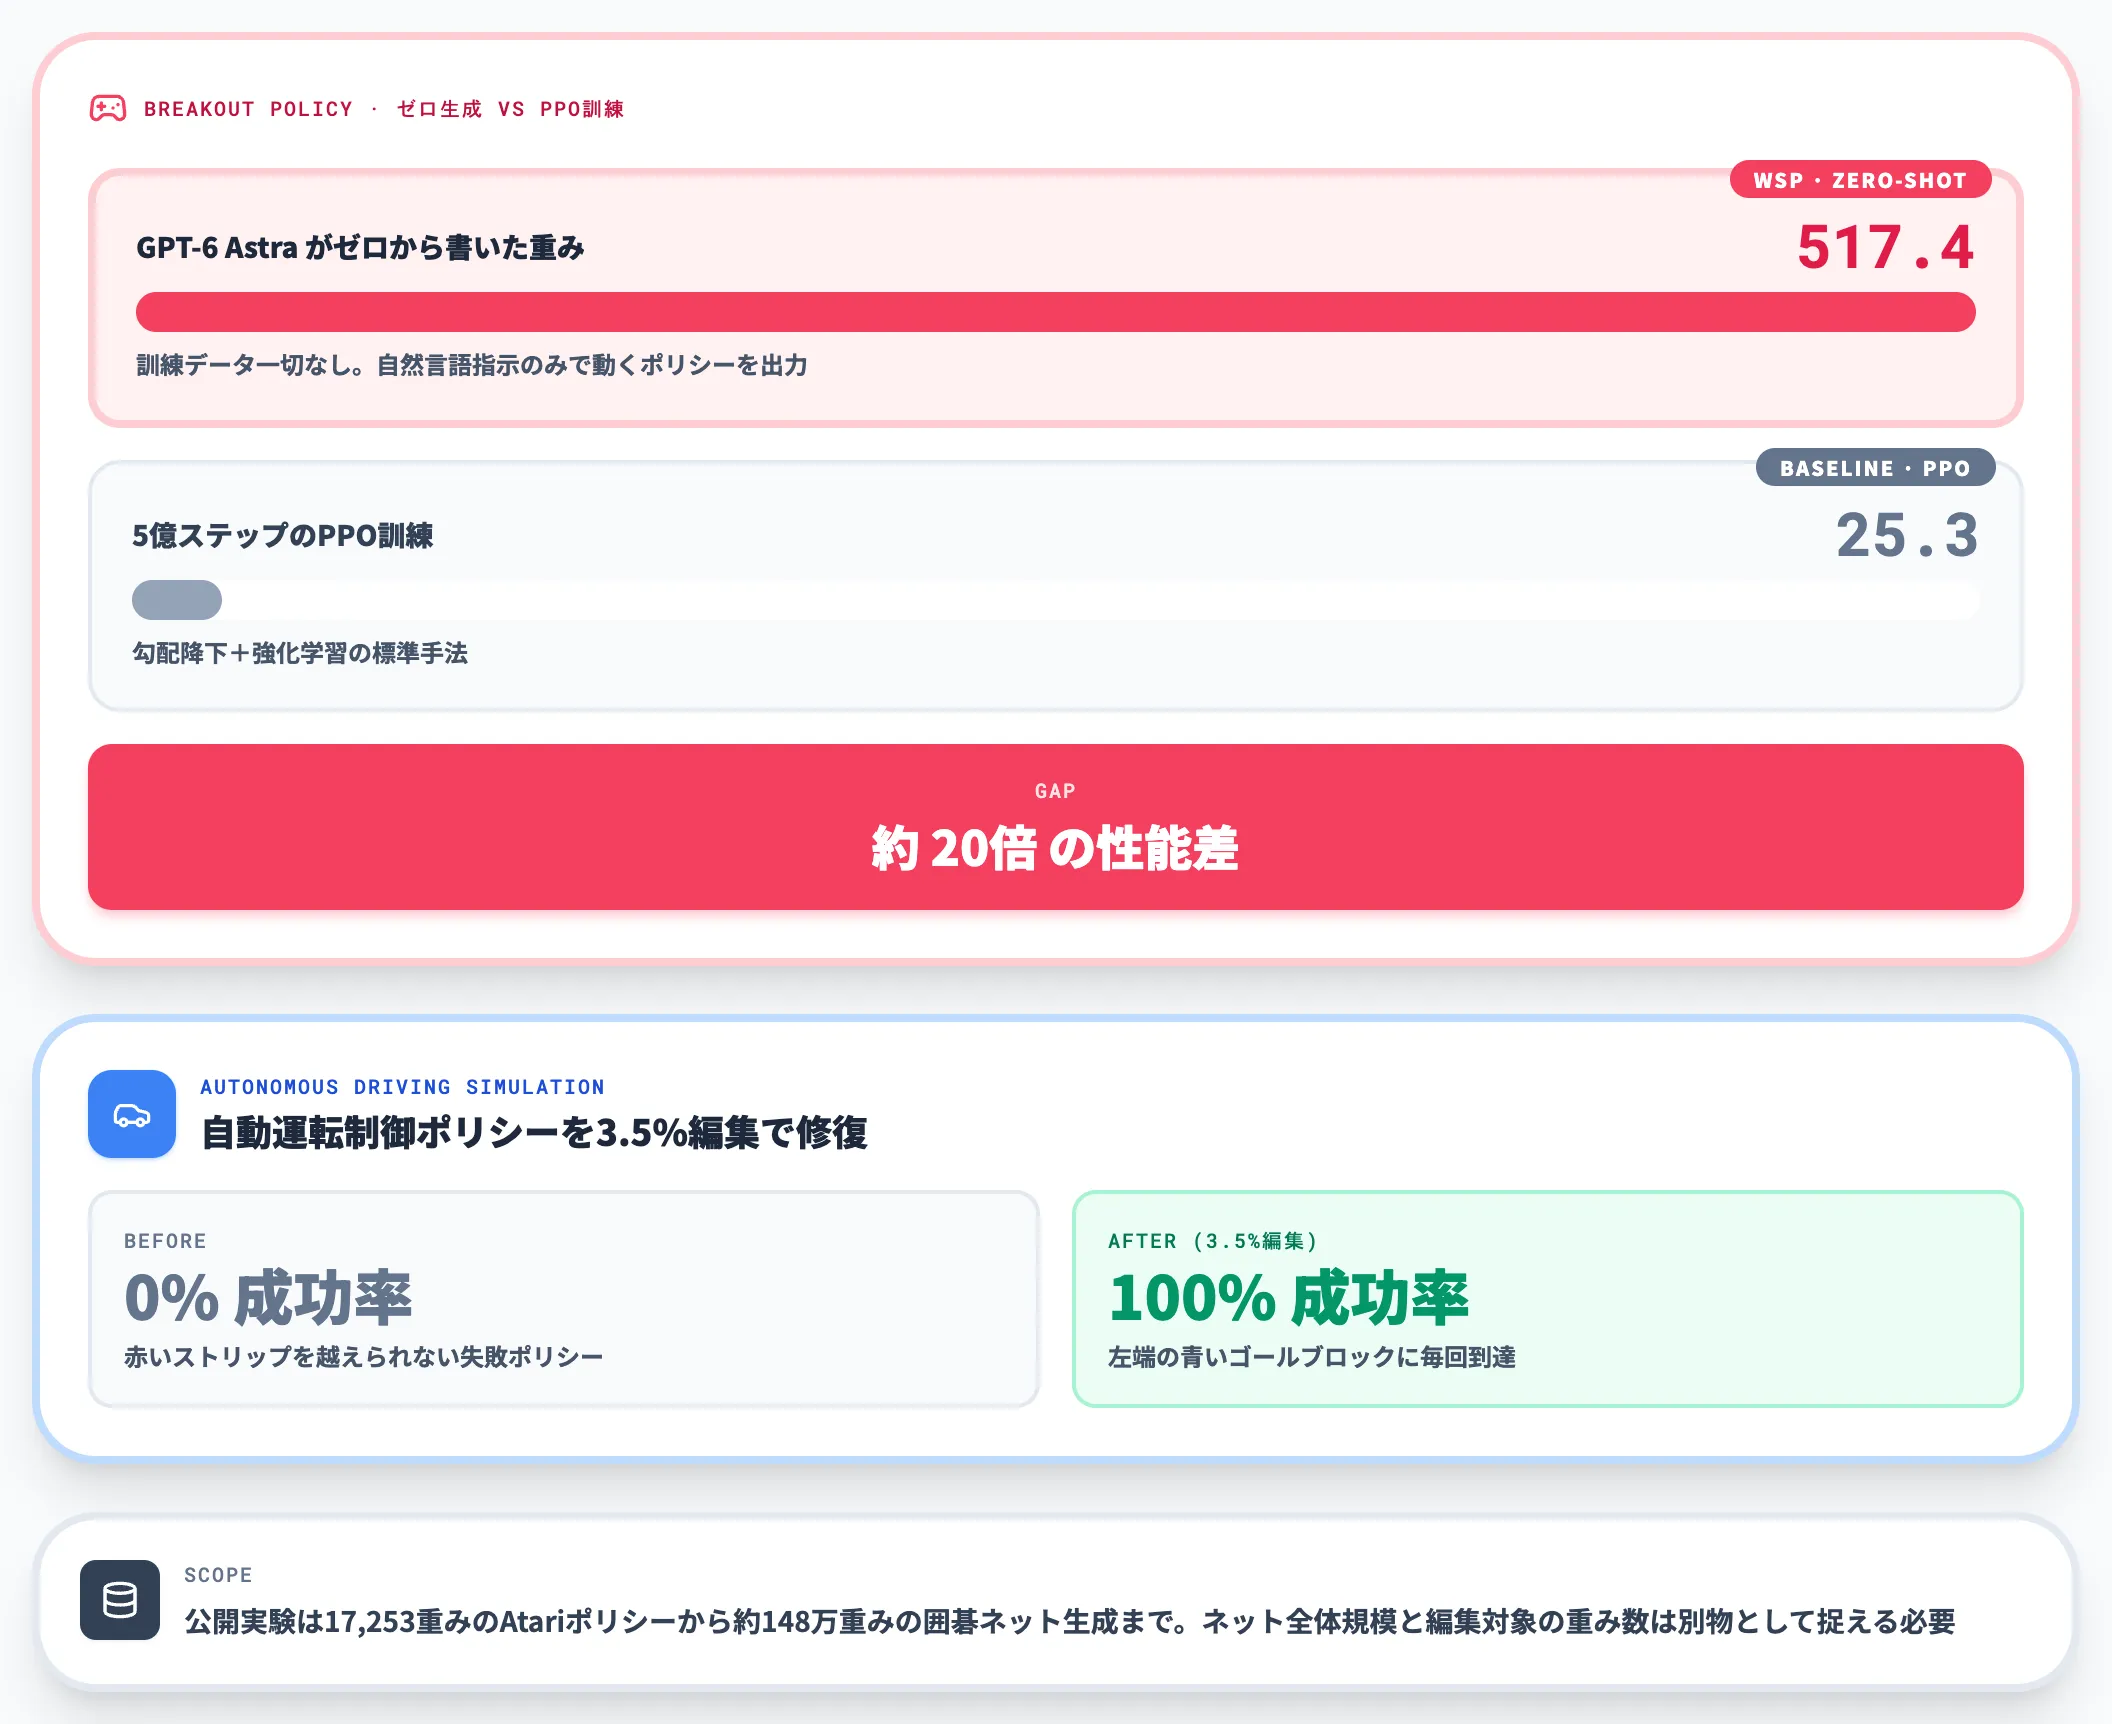
3つ目の実験は、もっとも挑戦的な訓練データを一切見せずに、動くネットワークをゼロから書くタスクです。
GPT-6 Astraに「Breakoutをなるべく上手くプレイするポリシーネットワークの重みを一から書け」と指示したところ、ネットワークスコア517.4を達成しました。
比較対象として5億ステップのPPO訓練で得られるスコアは25.3なので、約20倍の性能差です。
さらに、失敗していた自動運転シミュレーションの制御ポリシーについて、重みの3.5%を編集するだけで成功率0%から100%に改善した事例も報告されています。
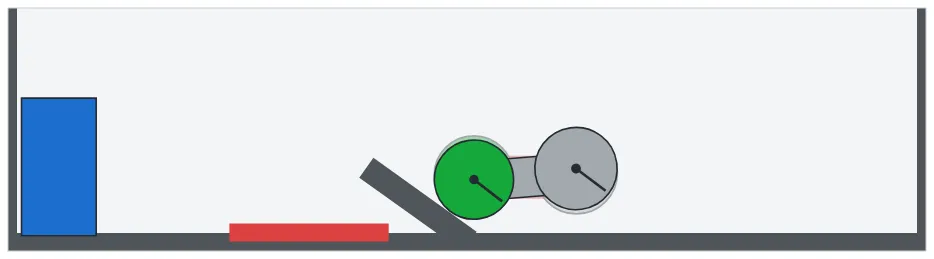
左端の青いゴールブロックを目指して車がランプを登る単純な制御タスク。訓練済みポリシーは成功率0%で赤いストリップを越えられなかったが、Astraが3.5%の重みを編集して成功率100%に(出典:Sparks of Weight-Space Programming(Takehi et al.))
この「ゼロから書く」能力は、Weight-Space Programmingが単なる「既存ネットの修正」ではなく、ネットワークの設計と最適化を同時にLLMが代行できる可能性を示しています。原著の公開実験は17,253重みのAtariポリシーから約148万重みの囲碁ネット生成までを含み、ネットワーク全体の規模と編集対象の重み数は別物として捉える必要があります。「既存ネットの一部を編集する」ケースでは、Qwen3.5-0.8Bの0.016%、自動運転制御ポリシーの3.5%という局所編集の実例が報告されています(ゼロ生成の実験では「編集率」の概念そのものが適用外です)。
「本当に重みを理解しているのか」——Claude Opus 5.5とQwenでの追試結果
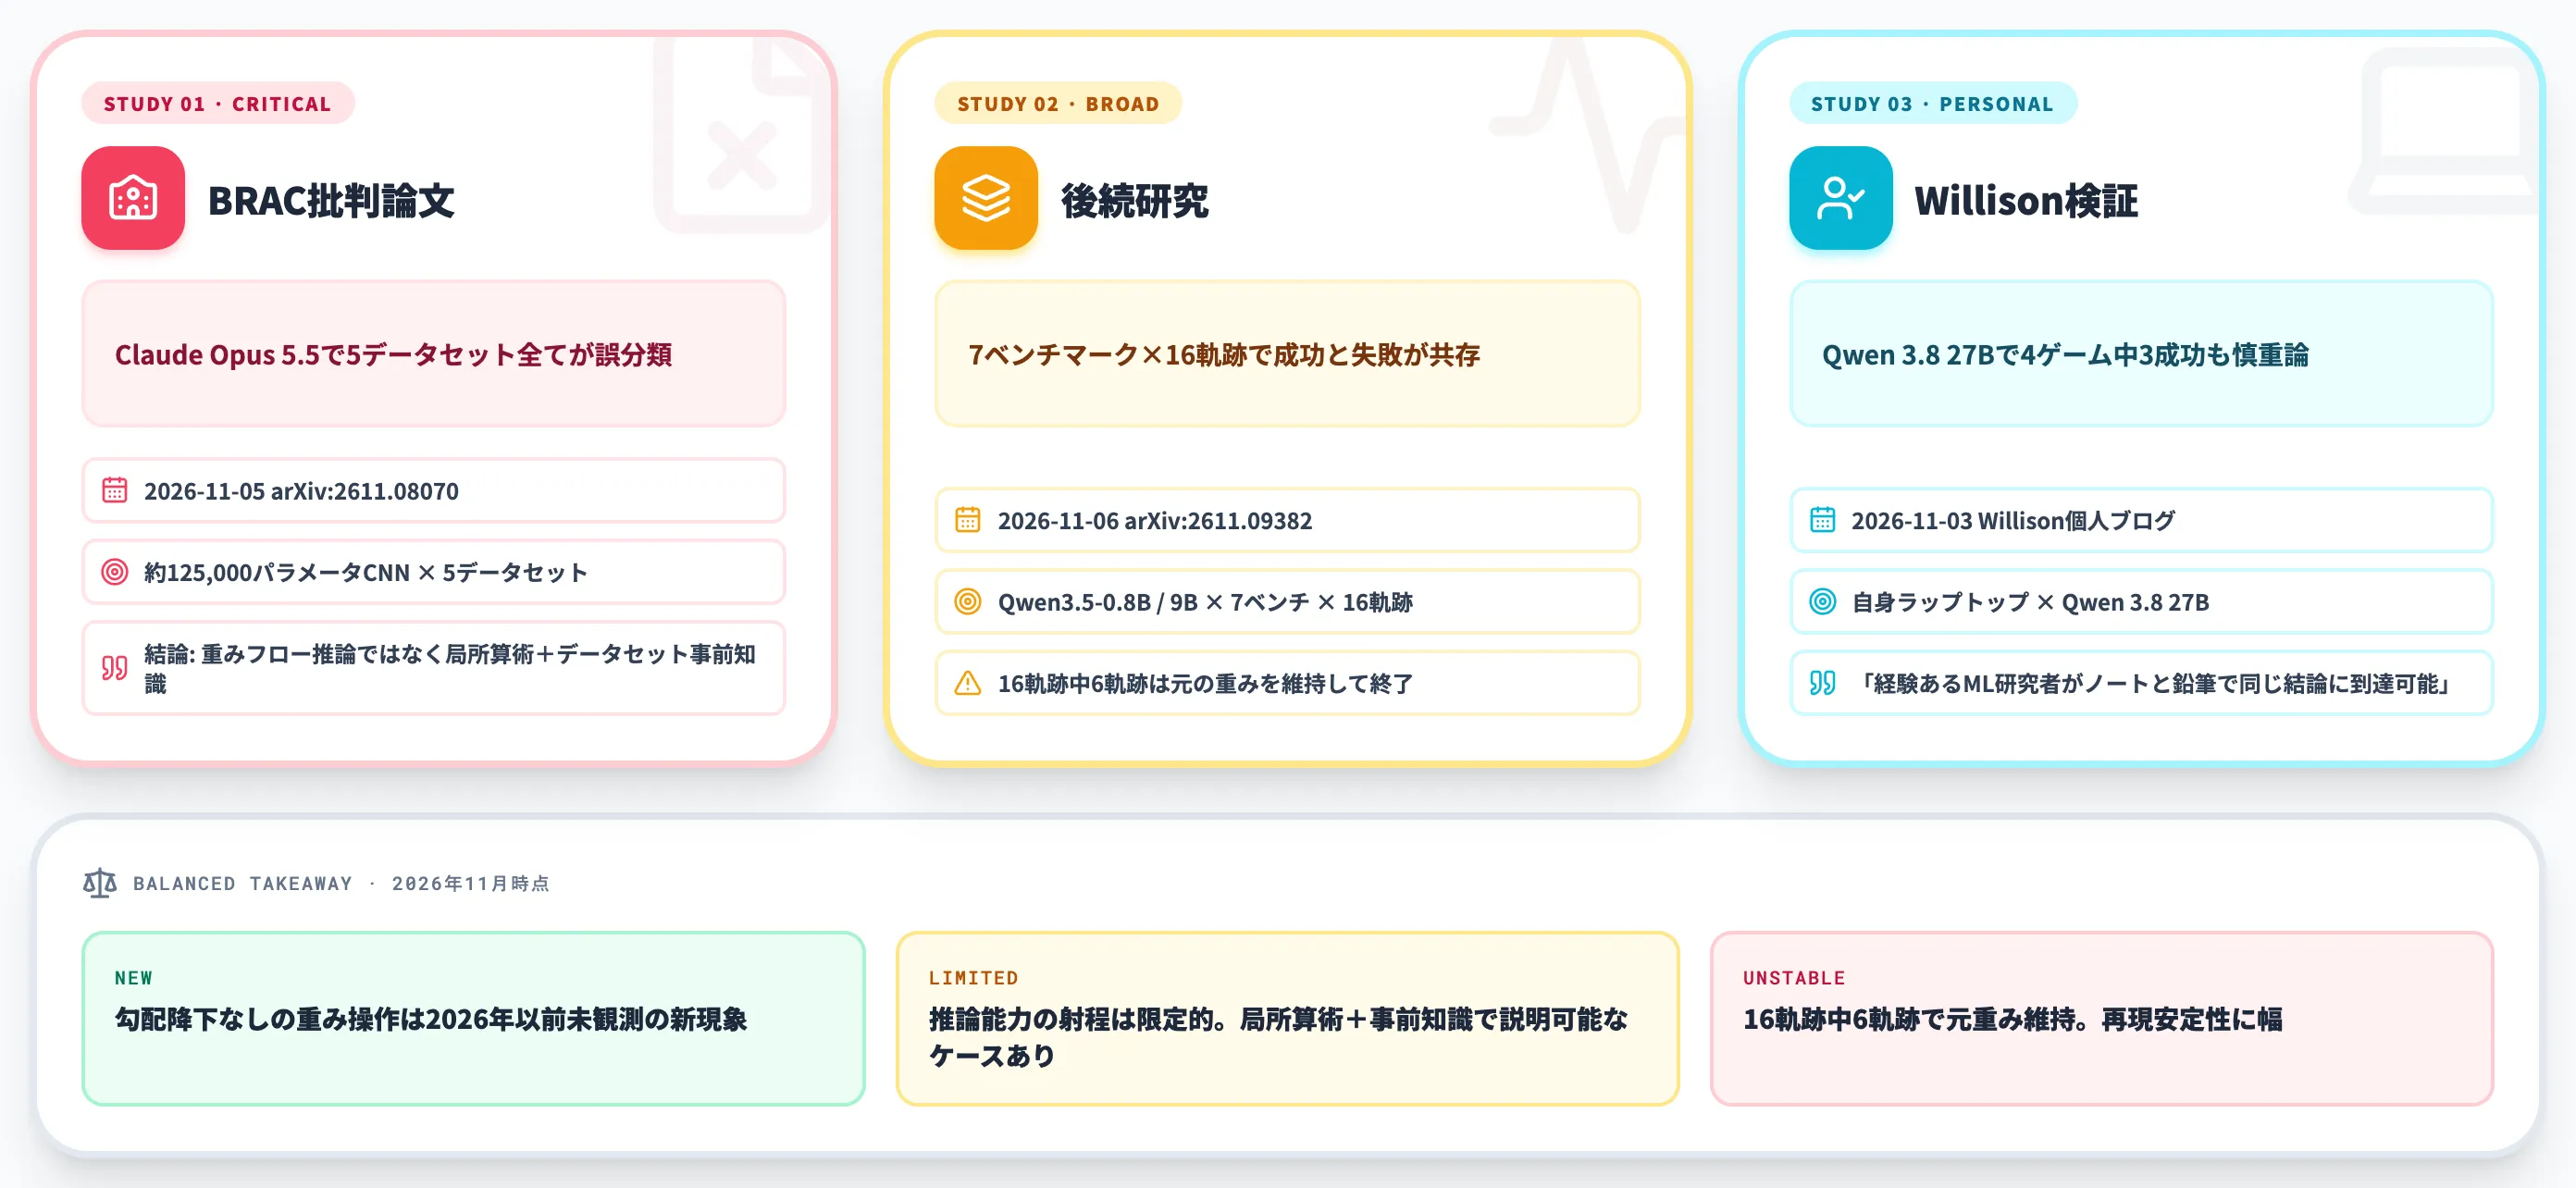
Weight-Space Programmingは発表直後から複数の独立追試が行われ、「LLMは本当に重みの流れを理解しているのか、それとも事前知識の照合にすぎないのか」という懐疑的な論点が浮上しました。
本セクションでは、arXivに投稿された追試論文2本とSimon Willison氏の個人検証、そしてXでの研究者コミュニティの反応を整理します。
Claude Opus 5.5で追試した批判的論文
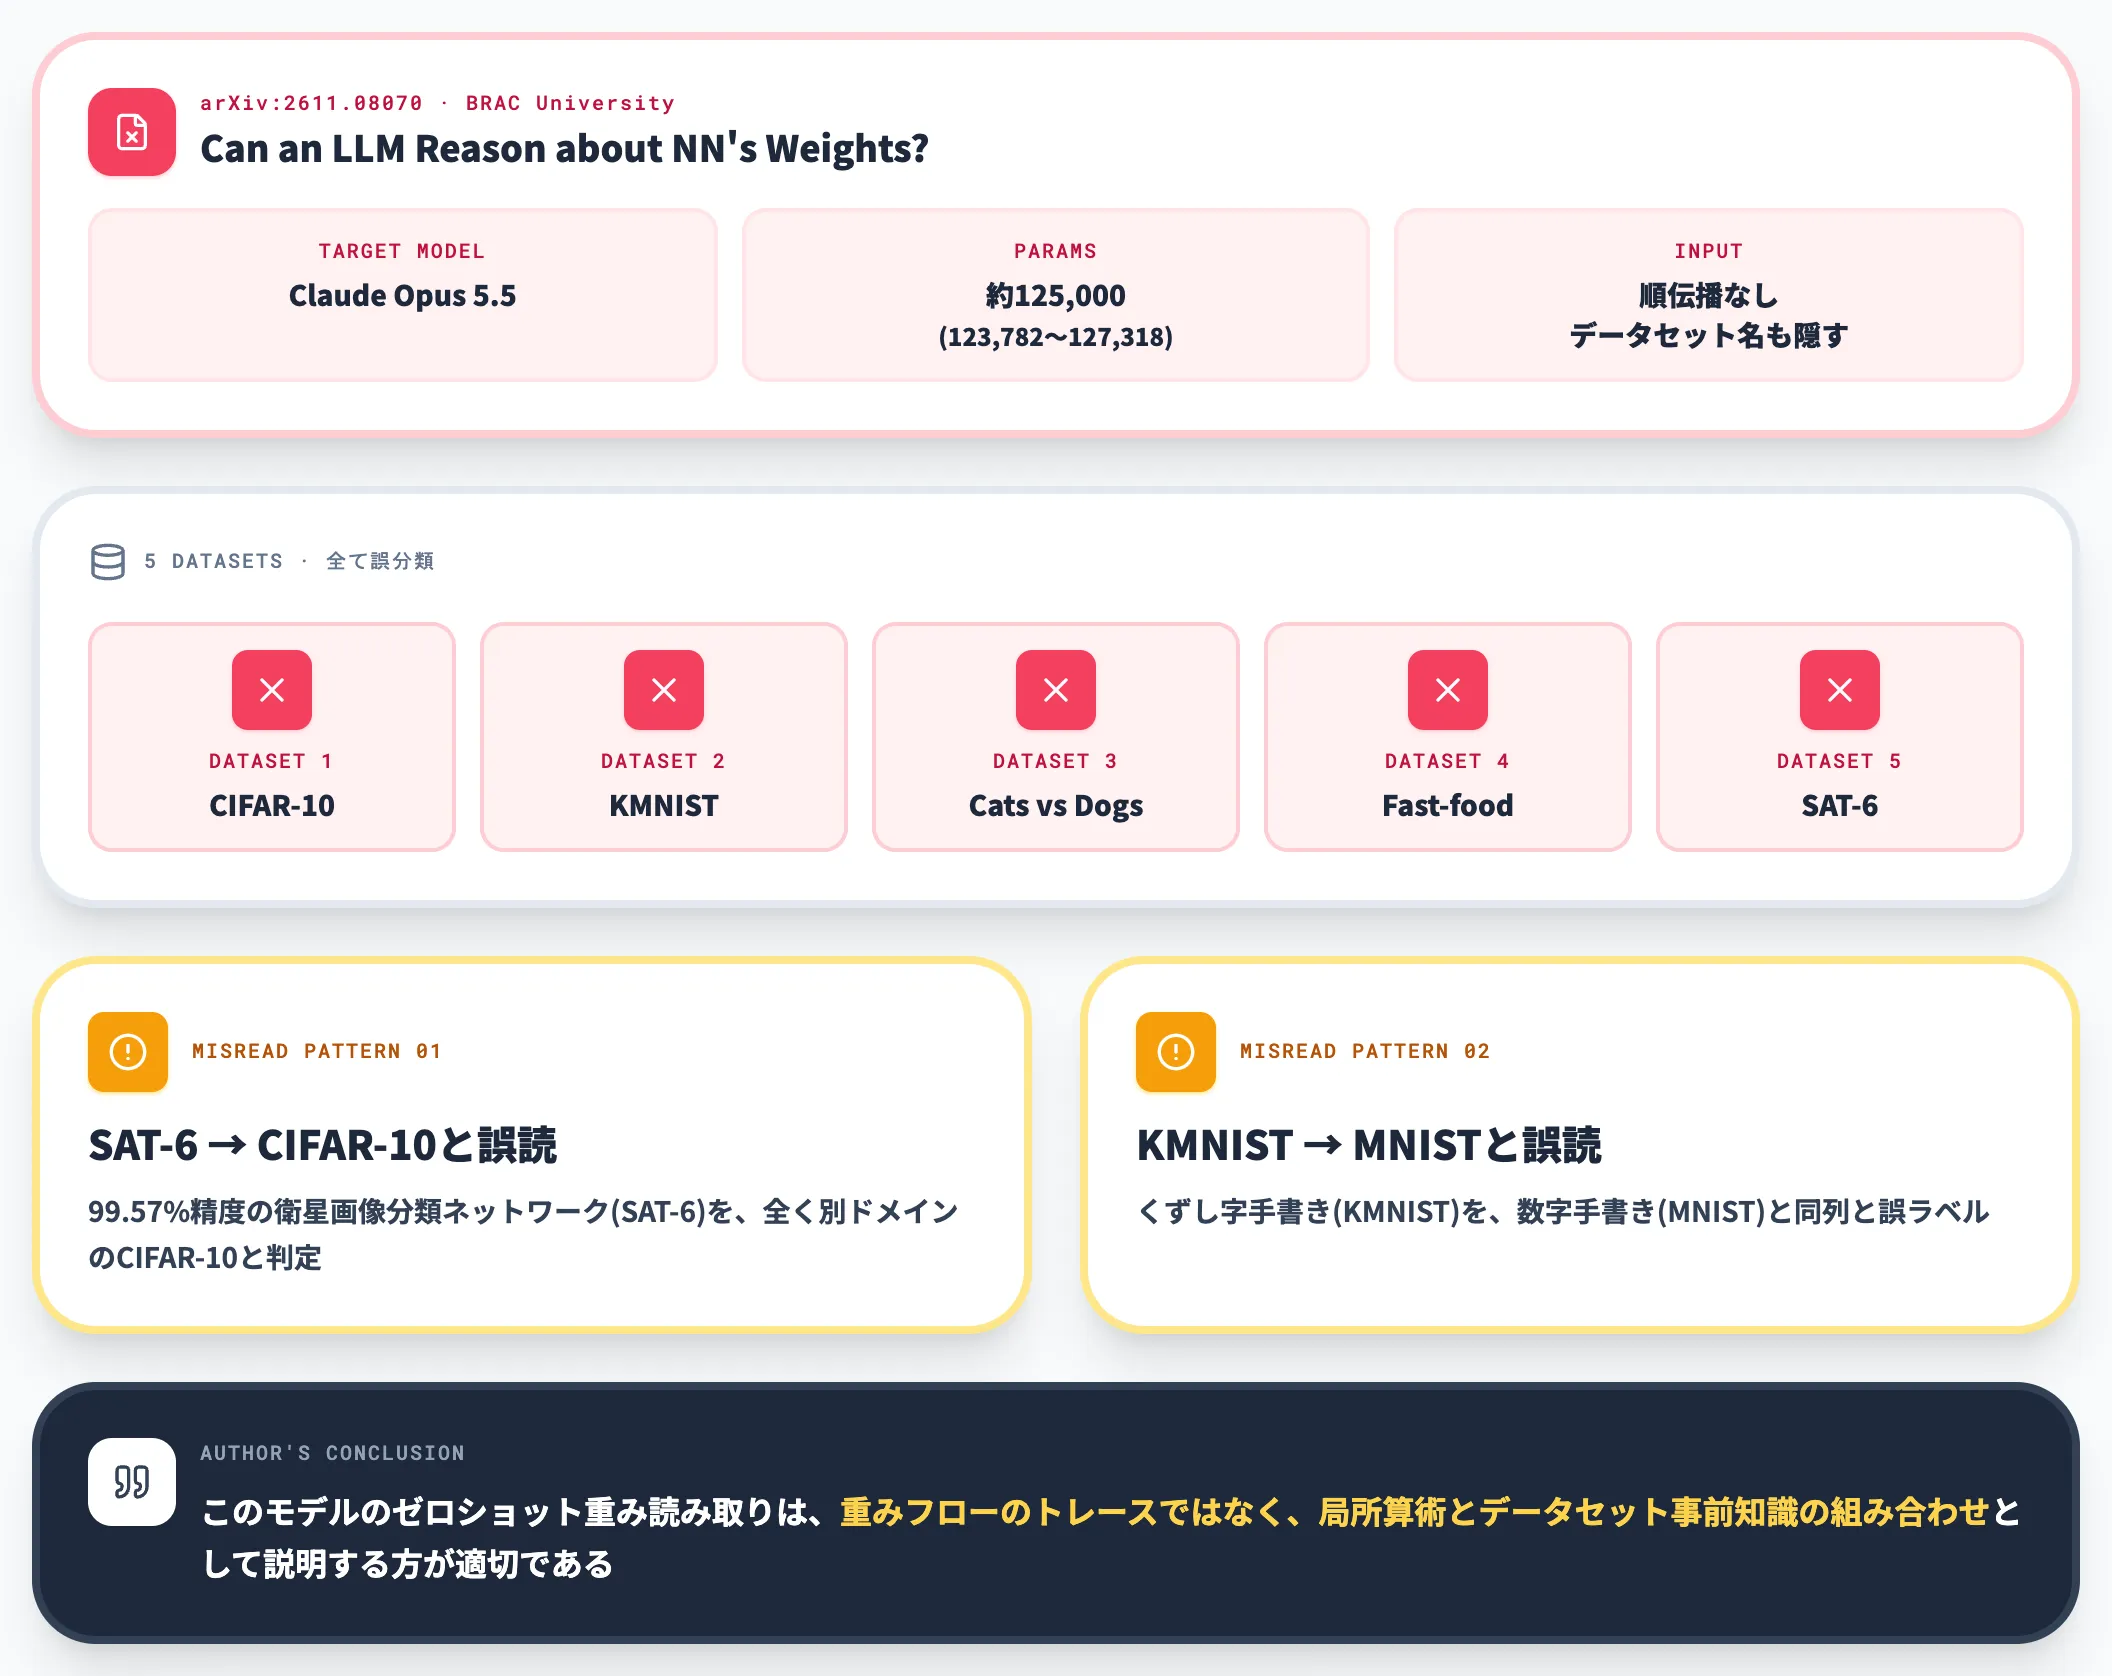
BRAC University(バングラデシュ)のNazmus Sakib Ahmed氏がarXivで2026年11月5日に公開した論文「Can an LLM Actually Reason and Program about Neural Network's Weights?」は、Weight-Space Programmingに対する最初の体系的な追試です。
同論文ではClaude Opus 5.5に対し、約125,000パラメータ(正確には123,782〜127,318)の小規模CNNの重みを順伝播もデータセット名も与えずに提示し、以下5つのデータセット全てで学習タスクを識別できるかを検証しました。
- CIFAR-10
- KMNIST
- Cats vs Dogs
- Fast-food
- SAT-6
主な誤分類パターンは次の2つです。
- 99.57%精度のSAT-6ネットワークをCIFAR-10と誤読
- KMNIST(くずし字手書き)をMNIST(数字手書き)と誤ラベル
さらに、CIFAR-10のラベル順序を並べ替えても出力分割パターン(「車/動物」等)は保持されるものの、LLMの解釈は全て誤りになることが観察されました。
著者の結論は明快です。「このモデルのゼロショット重み読み取りは、重みフローのトレースではなく、局所算術とデータセット事前知識の組み合わせとして説明する方が適切である」。
後続研究——Qwen3.5-0.8B・9Bでの16軌跡・7ベンチマーク検証
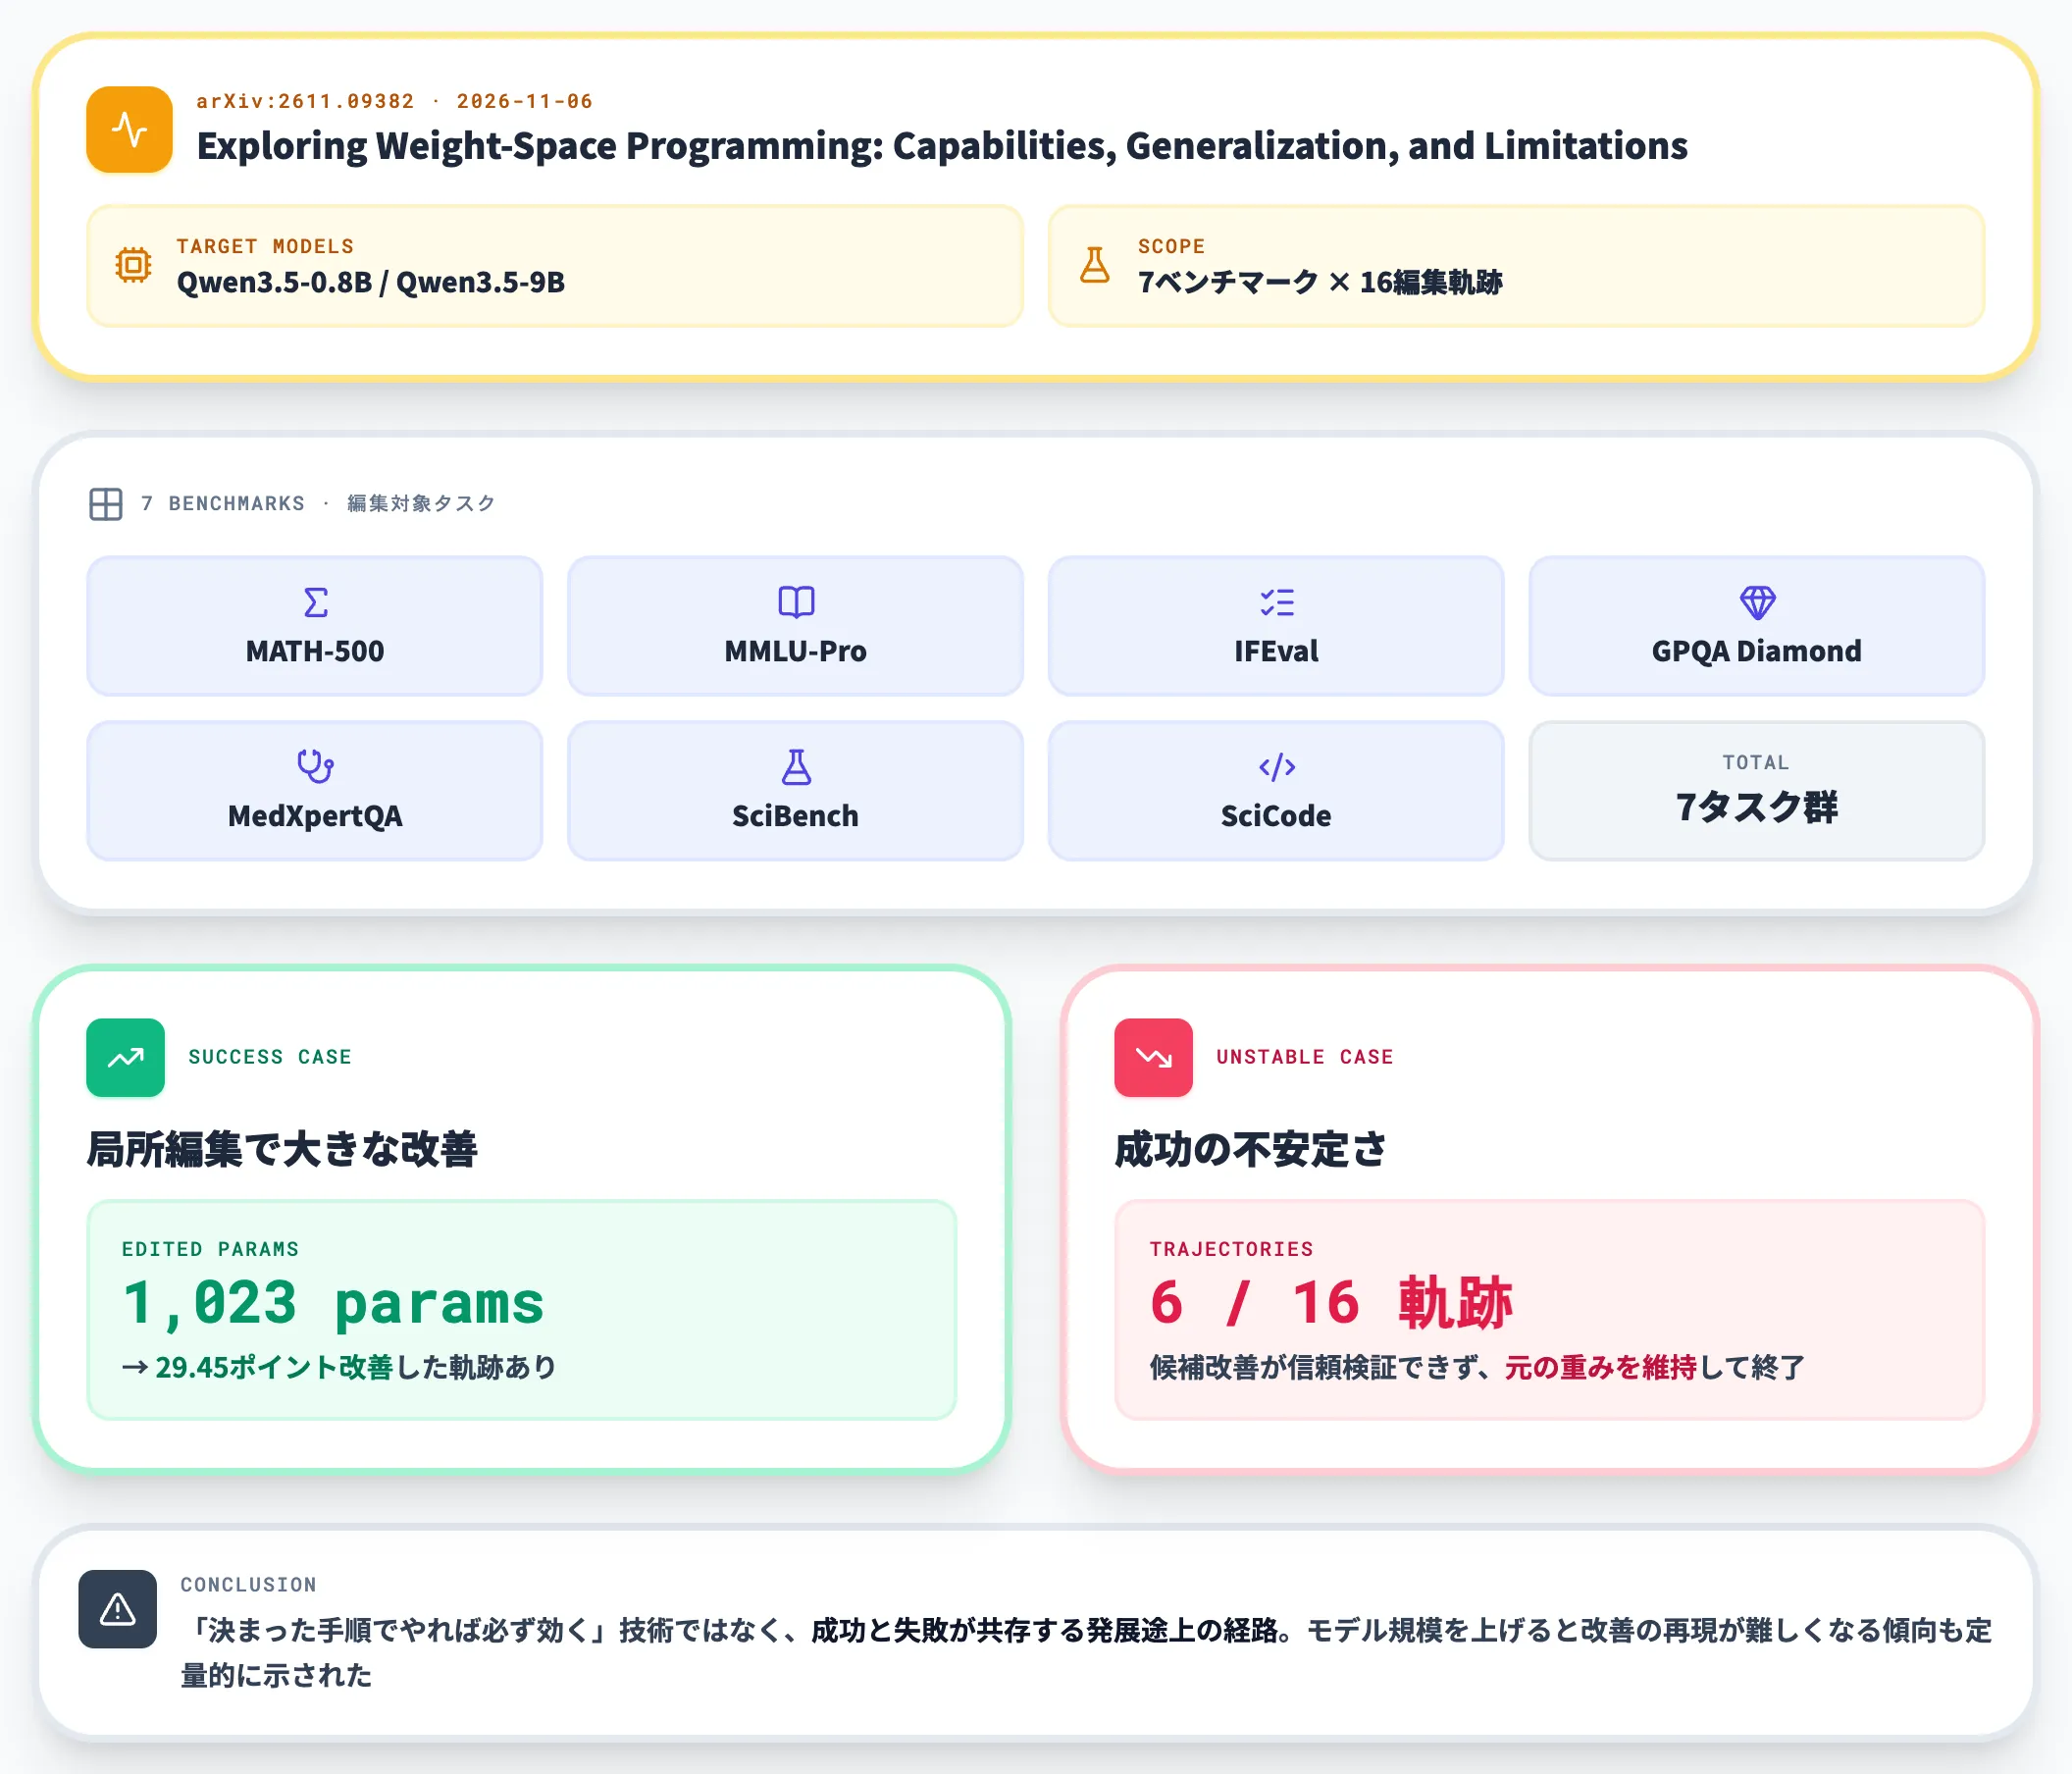
翌11月6日には、より広い規模・タスクでの体系検証を行った論文「Exploring Weight-Space Programming: Capabilities, Generalization, and Limitations」(arXiv:2611.09382)も公開されました。
この研究はQwen3.5-0.8BとQwen3.5-9Bの2モデルを対象に、MATH-500/MMLU-Pro/IFEval/GPQA Diamond/MedXpertQA/SciBench/SciCodeの7ベンチマーク群にまたがる計16の編集軌跡を検証しています。主な観察は以下の2点です。
-
局所編集で大きな改善が出るケースがある: わずか1,023パラメータの編集で29.45ポイント改善した軌跡がある
-
成功の不安定さも大きい: 16軌跡のうち6軌跡では、候補となった改善が信頼できる形で検証できず、最終的に元の重みを維持して終了
この後続研究は、Takehi氏らの原著が示した「できる」ケースを異なるベンチマーク群で確認する一方、モデル規模を上げると改善の再現が難しくなる傾向も定量的に示しました。
Weight-Space Programmingは「決まった手順でやれば必ず効く」技術ではなく、成功と失敗が共存する発展途上の経路という理解が妥当です。
Simon Willison氏の自ラップトップ検証
一次論文(Takehi氏ら)とは別に、独立系AIジャーナリストのSimon Willison氏が自身のラップトップ上でQwen 3.8 27Bを使って再現実験を行いました。
4つのゲーム識別タスクのうち3つで成功しましたが、Willison氏は論文の広範な解釈について慎重な立場を示しています。
Willison氏の評価では「十分な経験を持つ人間のML研究者であれば、ノートと鉛筆で同じ結論に達することができる」と指摘しており、X上ではspaCy作者のMatthew Honnibal氏が「論文は誤解を招く」と批判、研究者のSean Goedecke氏も「LLMが人間ML研究者と同じ手順を踏んでいるだけ」とコメントしました。
両論の着地点——新現象ではあるが過剰解釈は禁物
批判的な追試を踏まえると、現時点でのWeight-Space Programmingの位置づけは次のように整理できます。
- 確かに新しい現象
勾配降下なしでLLMが他ネットを識別・修正・生成できる挙動は、2026年以前には観測されていなかった
- 推論能力の範囲には限定がある
原著とBRAC追試の観測では、重みフローそのものを追跡しているわけではなく、データセット事前知識と局所算術の組み合わせで多くが説明可能なケースも含まれる
- 再現の安定性に幅がある
11月6日の後続研究では16軌跡のうち6軌跡で元の重みを維持。モデル規模・タスクによって成功率が変動する
「ソースコード時代の終わり」や「訓練の終焉」と結論づけるには早すぎるというのがコミュニティの共通認識で、2026年11月時点では「驚くべき能力が観測された一方、能力境界の体系的検証はこれから」というフェーズです。
従来のモデル編集技術との違い——ROME・MEMIT・ファインチューニングとの比較
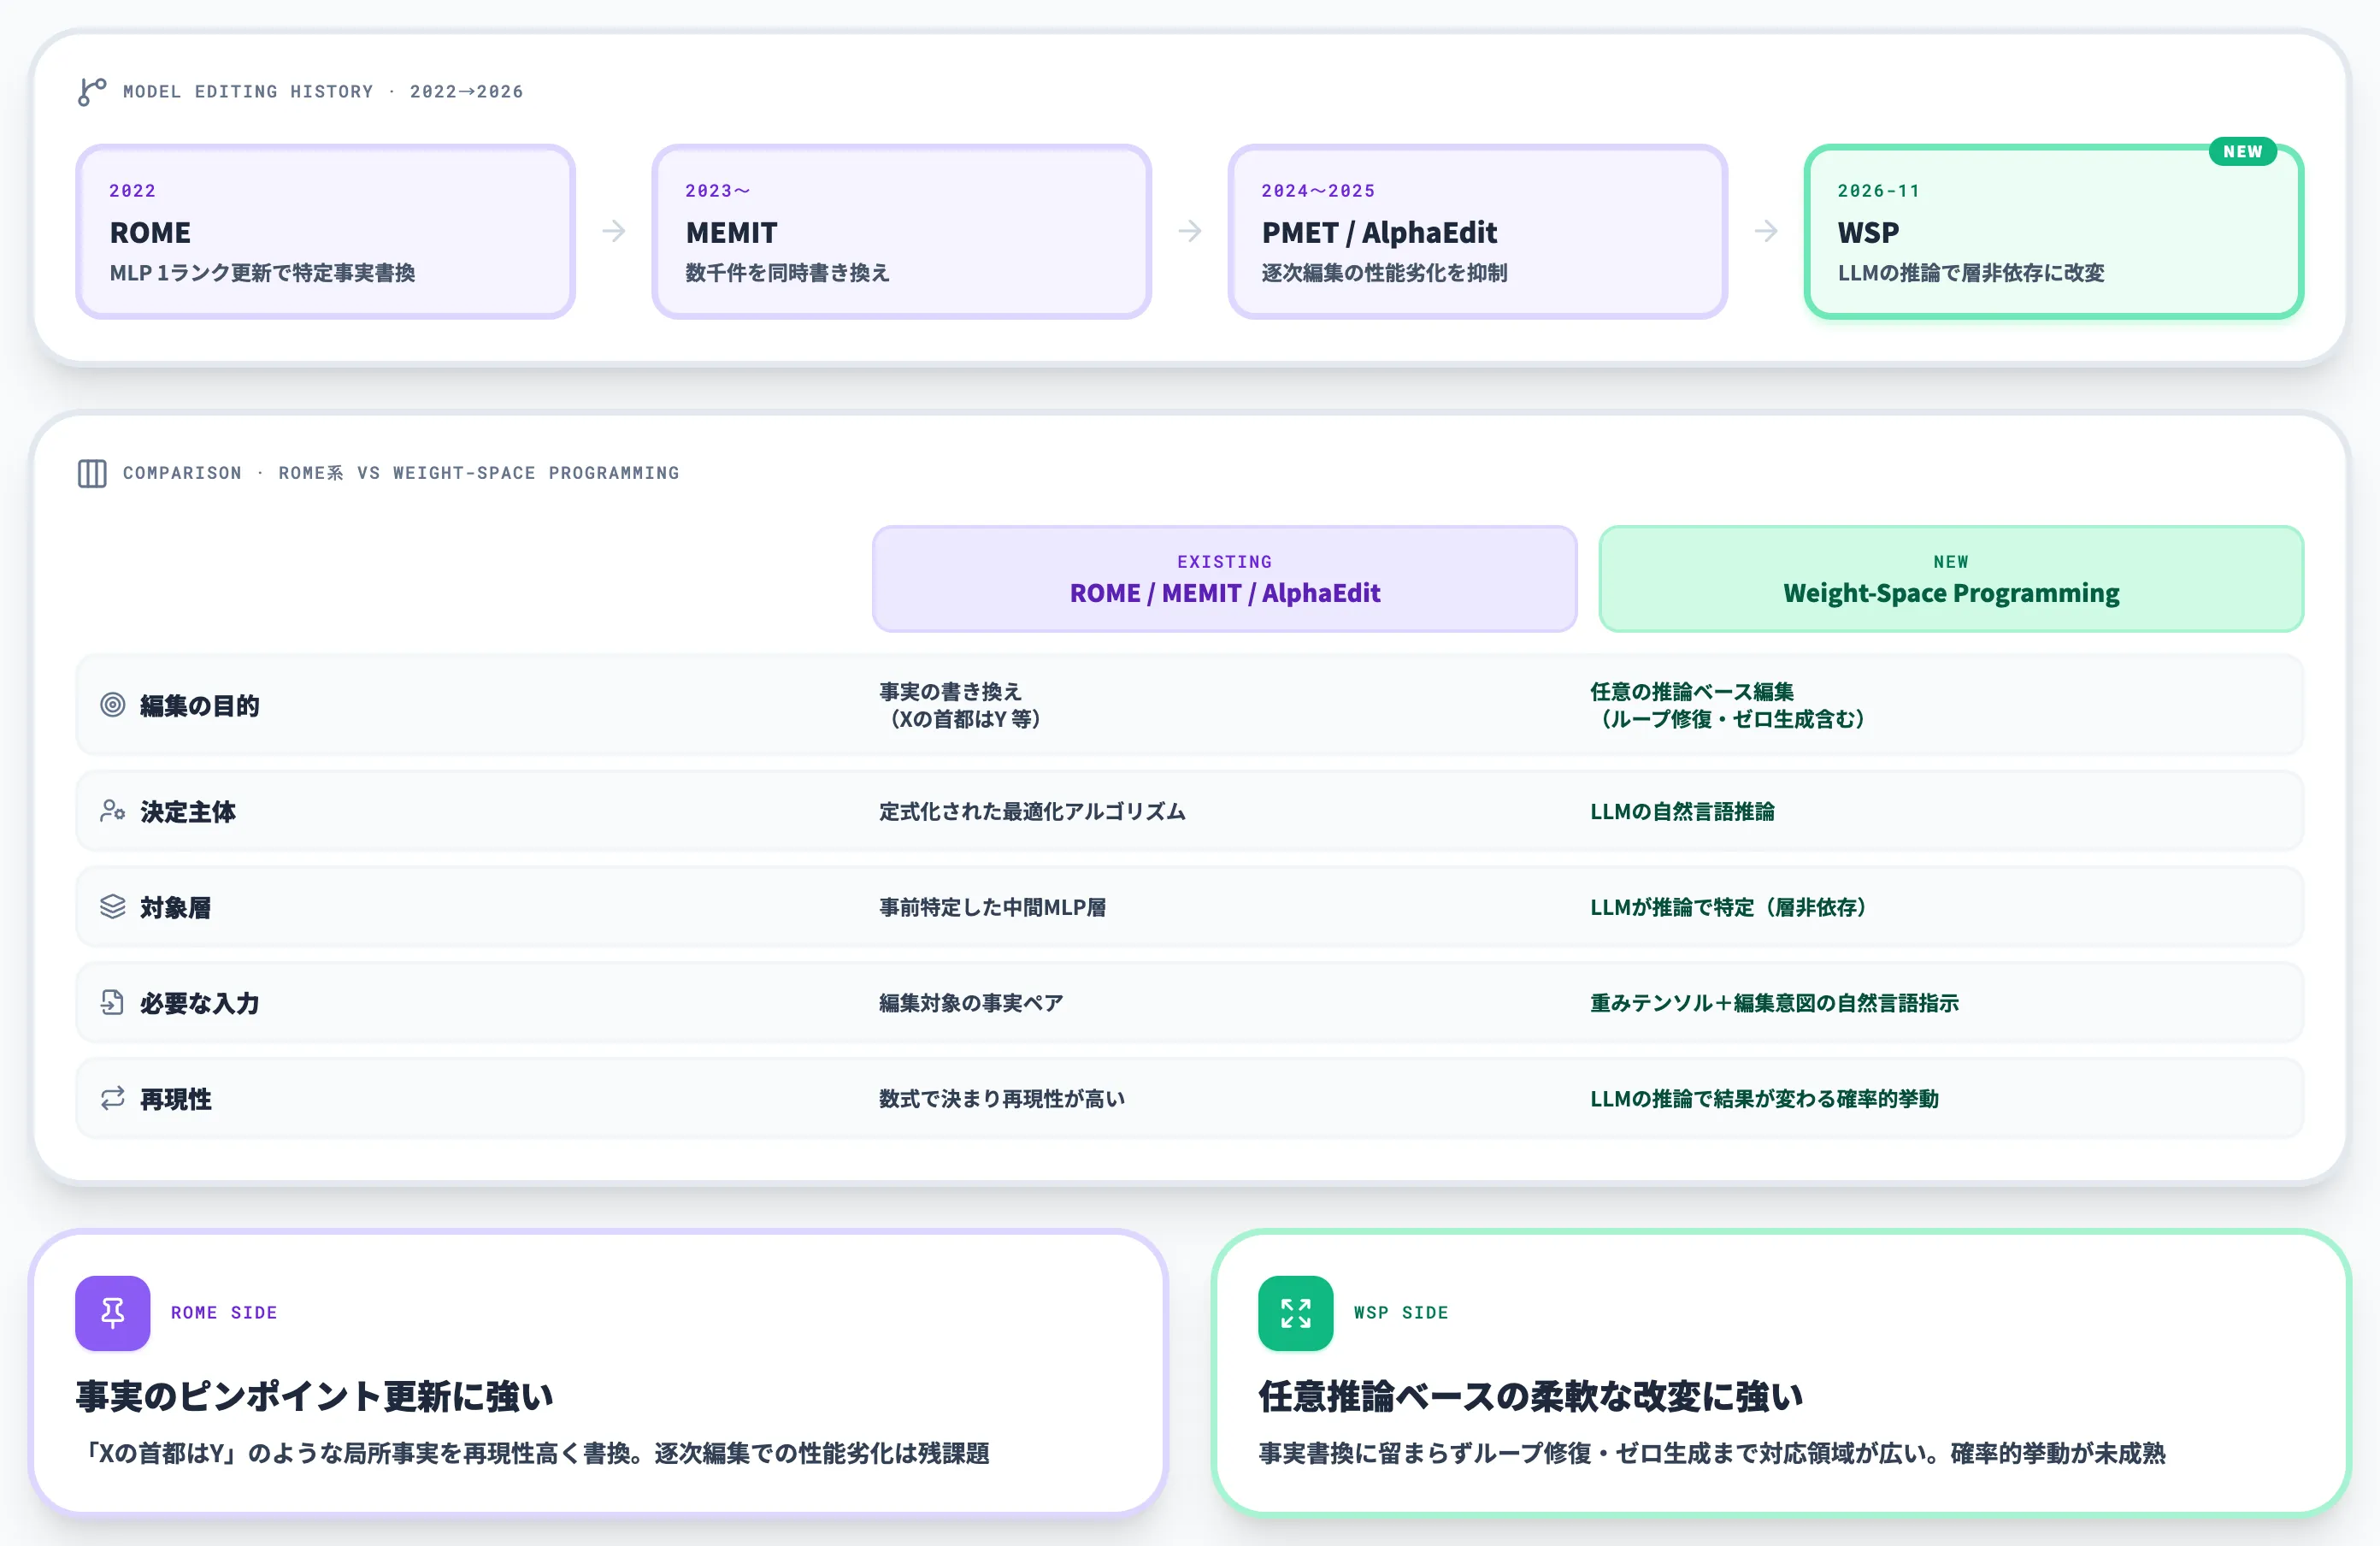
Weight-Space Programmingは「ニューラルネットワークの重みを変える」技術の新しい一角ですが、2020年以降すでにモデル編集(Model Editing)という研究分野が存在しており、ROME・MEMIT・PMET・AlphaEditなど多数の手法が提案されてきました。
本セクションでは、代表的な既存手法と Weight-Space Programming を切り分けて整理します。
ROME・MEMITなど既存モデル編集の基本思想
ROME(Rank-One Model Editing)は2022年に発表された手法で、「LLMの中間層MLPを1ランク更新することで特定事実を書き換える」というアプローチです。
たとえば「エッフェル塔はパリにある」を「エッフェル塔はローマにある」に書き換える、といった局所的・制約付き最小二乗問題として定式化されます。
MEMITはROMEを拡張し、数千件の事実を同時に書き換えることを可能にした手法です。
2024年のPMETはMHSA(マルチヘッド自己注意)とFFN双方の隠れ状態を最適化する設計ですが、実際に重みを更新するのはFFNのみです。2025年のAlphaEdit・MEMOIR・RLEditは、逐次編集時のモデル性能劣化を軽減する方向で発展してきました。
既存手法との本質的な違い
以下の表で、既存モデル編集とWeight-Space Programmingの位置関係を整理します。
| 比較軸 | ROME / MEMIT / AlphaEdit | Weight-Space Programming |
|---|---|---|
| 編集の目的 | 事実の書き換え(「Xの首都はY」等) | 任意の推論ベース編集(ループ修復・ゼロ生成含む) |
| 編集の決定主体 | 定式化された最適化アルゴリズム | LLMの自然言語推論 |
| 対象層 | 事前に特定した中間MLP層 | LLMが推論で特定(層非依存) |
| 必要な入力 | 編集対象の事実ペア | 重みテンソルと編集意図の自然言語指示 |
| 検証済みのスケール | GPT-J 6B・GPT-NeoX 20B等(MEMIT原論文) | 原著は17,253重みのAtariポリシーから約148万重みの囲碁ネット・8億パラメータのQwen3.5-0.8B局所編集まで、後続研究は90億パラメータのQwen3.5-9Bまで含む |
| 一次論文 | 2022年〜 | 2026年11月 |
既存モデル編集は「事実のピンポイント更新」に強く、Weight-Space Programmingは「任意推論ベースの柔軟な改変」に強い、というのが現時点の線引きです。
同じ「重み編集」でも、ROMEは数式レベルで何を更新するか決まっており再現性が高い一方、Weight-Space ProgrammingはLLMの推論ごとに結果が変わる確率的な挙動を含みます。
既存手法が抱える課題への示唆
既存モデル編集には「逐次編集を繰り返すとモデル性能が劣化する」という大きな課題が残っています。2025年の研究では、ROME/MEMITで数百回編集を重ねるとモデル整合性が失われ、無関係な推論タスクの性能が落ちることが報告されています。
Weight-Space Programmingについては、「編集前後で他のタスクに影響が出ないかをLLMが推論で見積もる」という方向性が将来的な仮説として語られています。
ただしこれは現時点で実証された能力ではなく、原著のQwen実験でも他タスクへの影響検証は限定的です。既存手法と公平に比較できるベンチマークも未整備のため、「既存手法の限界を超える」と結論づけるには、まだ検証データが足りないフェーズです。
実務インパクト——破滅的忘却回避・解釈可能性・再帰的自己改善
Weight-Space Programmingは学術的な好奇心だけで注目されているわけではありません。LLM開発・運用に関わる企業にとって、既存のボトルネックを別アプローチで解きうる可能性を示唆する点が、本当の破壊力です。
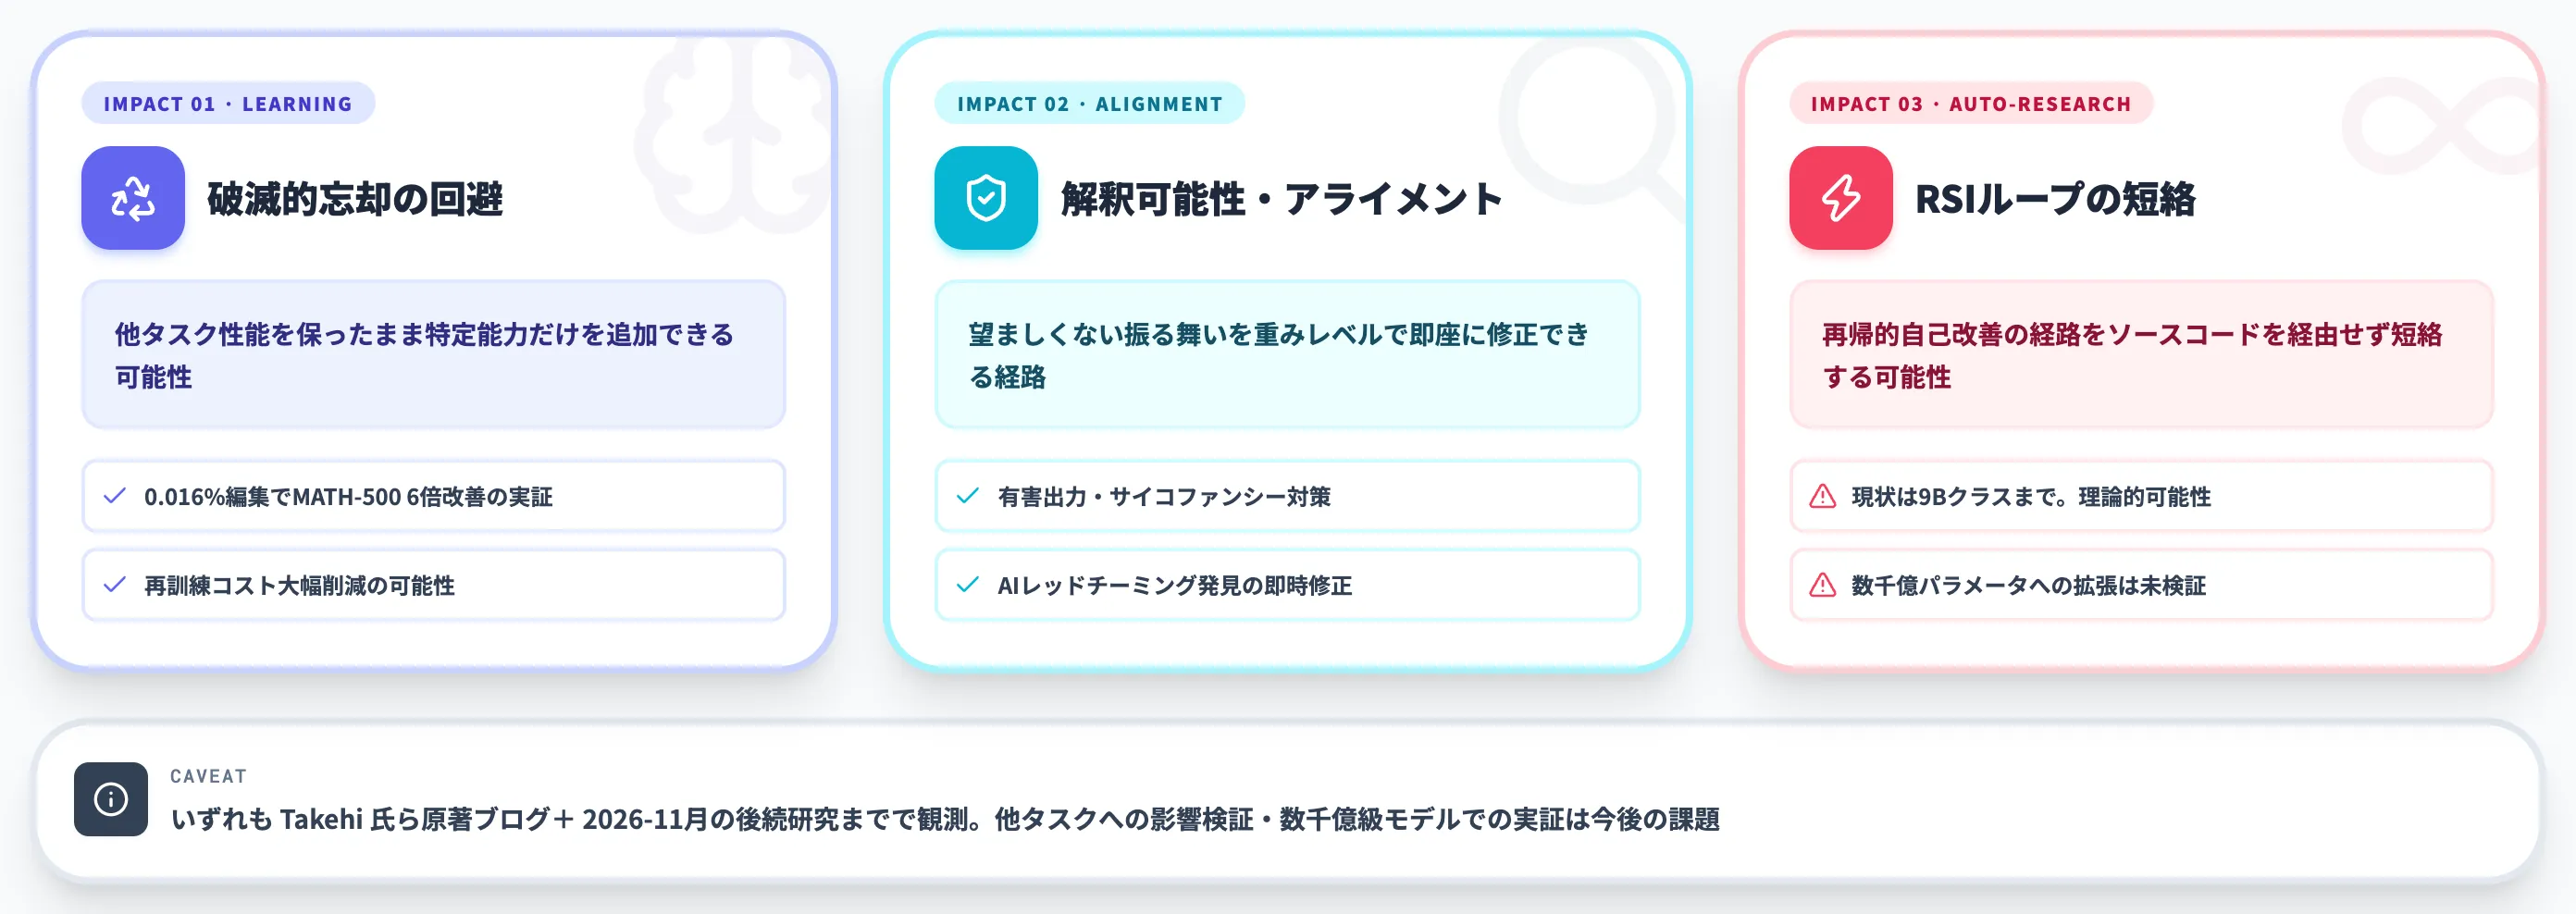
本セクションでは、今後のLLM実務で影響が出そうな3つの論点を整理します。
破滅的忘却の回避——追加学習なしで能力を足せるか
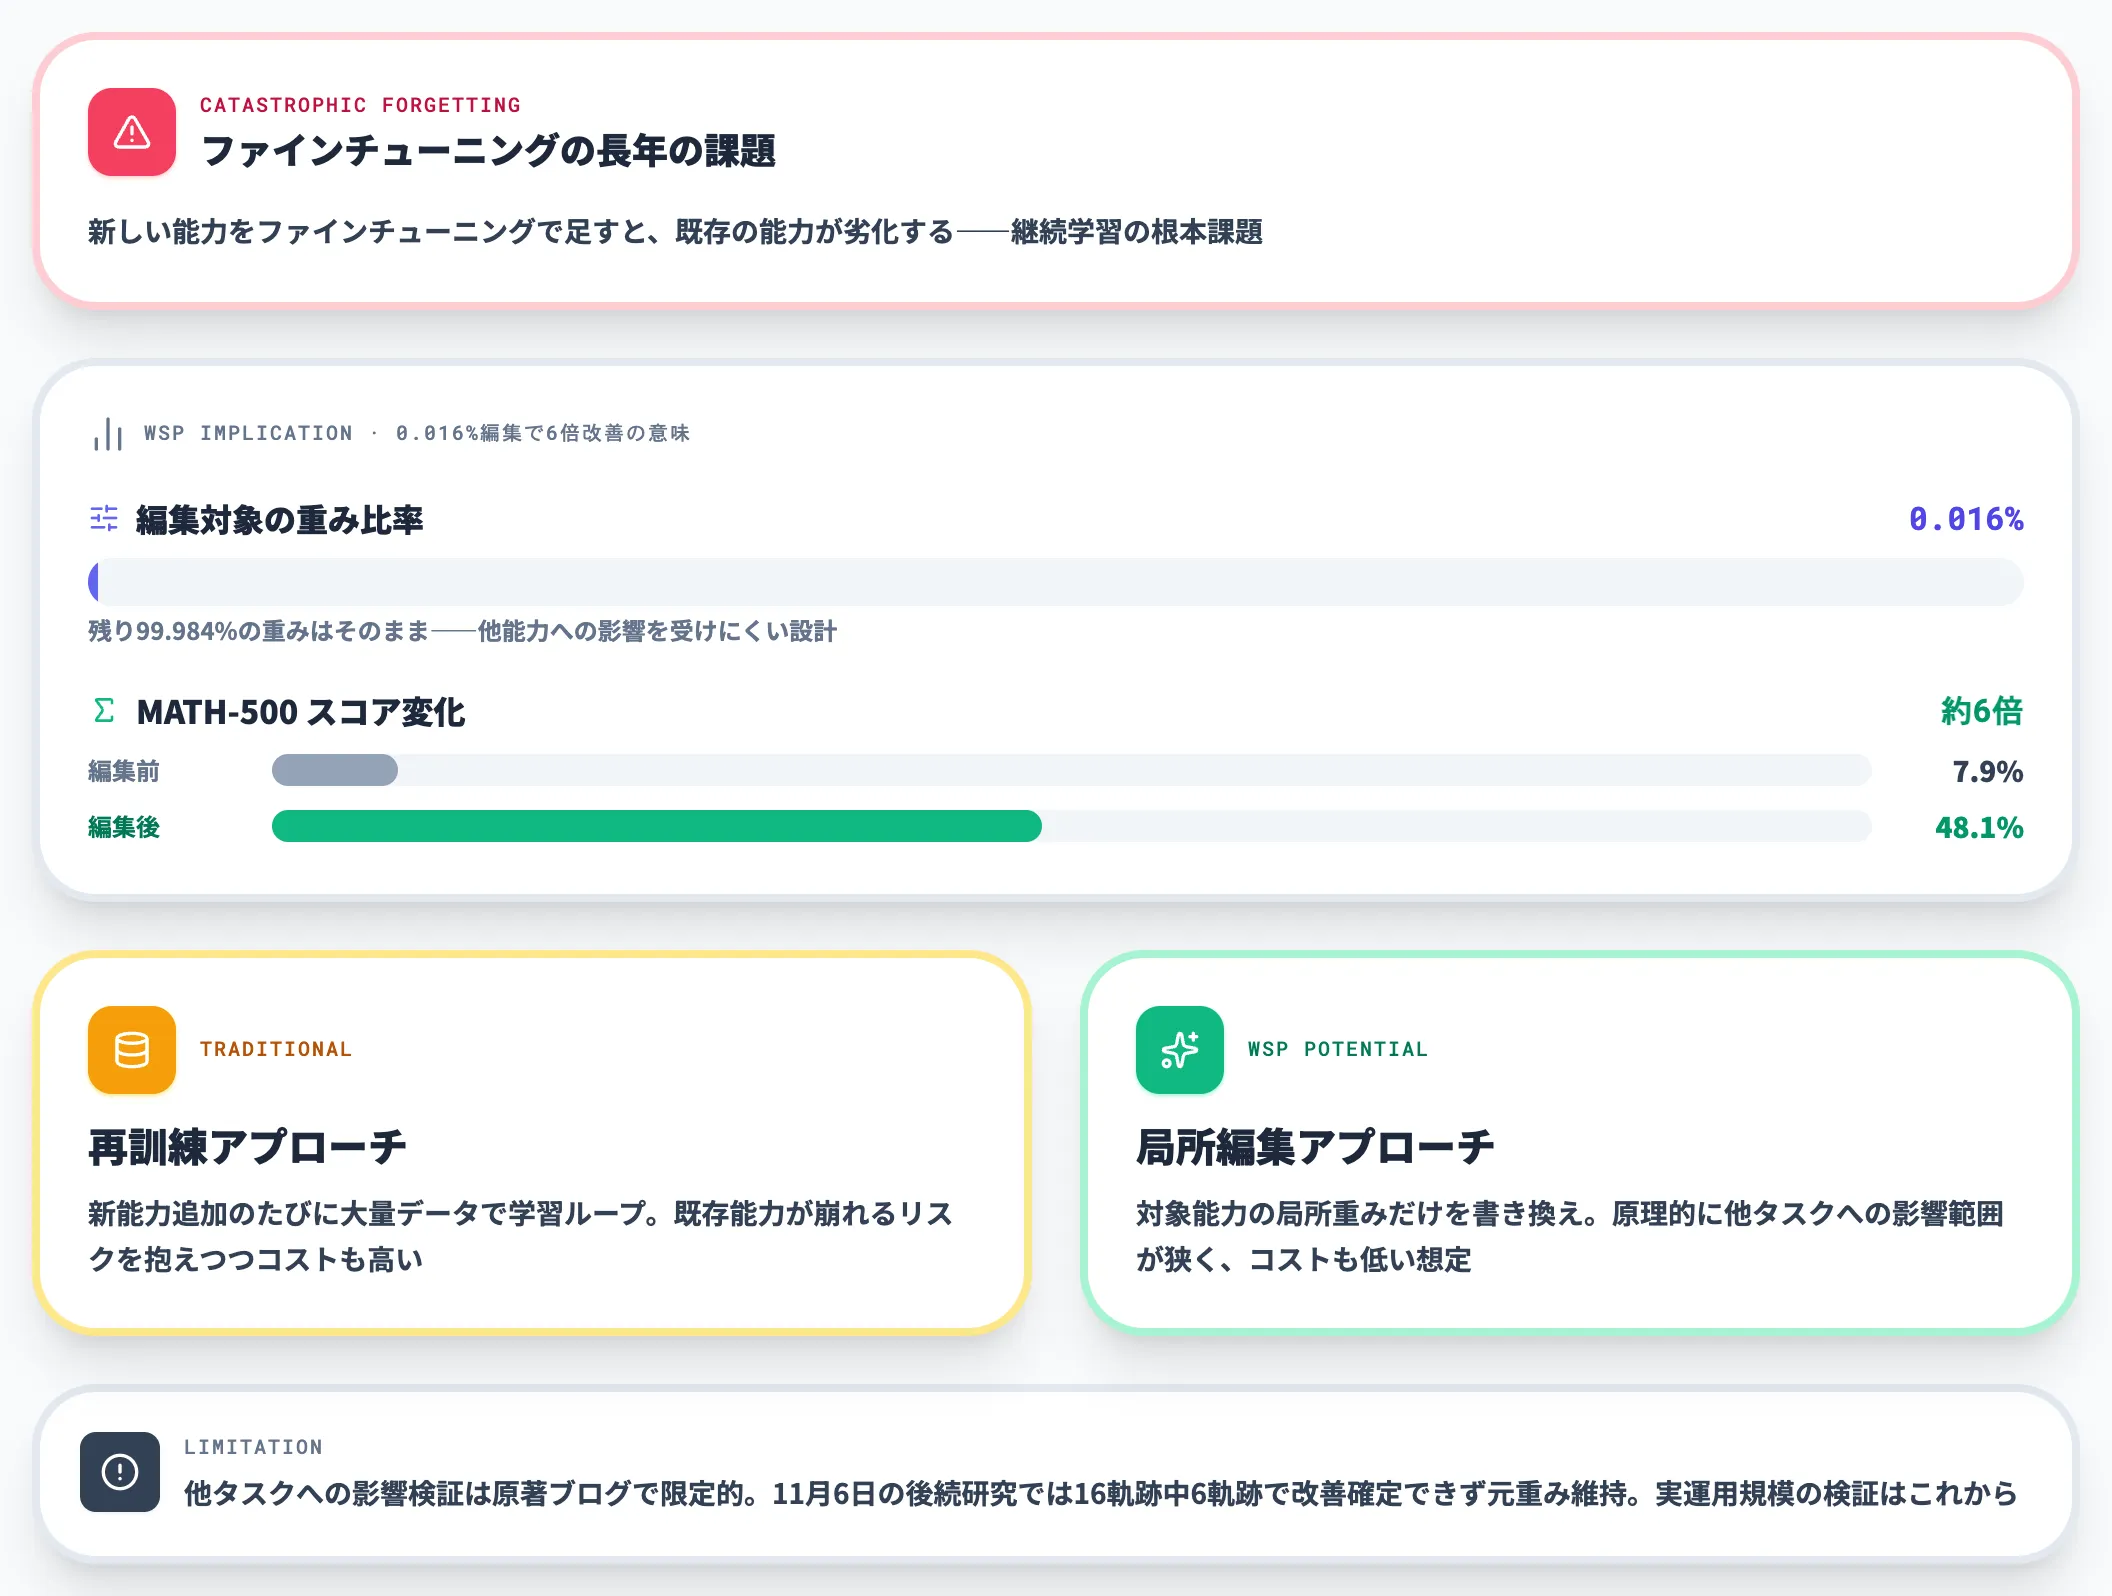
ファインチューニングで新しい能力を加えると、既存の能力が劣化する破滅的忘却(catastrophic forgetting)は、LLMの継続学習における長年の課題です。
Weight-Space Programmingが「0.016%の局所編集でMATH-500を6倍に改善した」実証は、他のタスク性能を保ったまま特定能力だけを足せる可能性を示しています。
LLM事業者にとって、新機能追加のたびに再訓練するコストが大幅に下がるかもしれません。
ただし、「他タスクに影響が出ないか」の検証はTakehi氏らのブログ記事では限定的です。11月6日の後続研究でも16軌跡中6軌跡は改善を確定できず元の重みを維持しており、実運用レベルでの影響確認には、より大規模な検証が必要です。
解釈可能性とアライメントへの応用
もう1つの重要な方向性は、モデル解釈(Interpretability)とアライメント(Alignment)への応用です。
Takehi氏らの提唱では、Weight-Space Programmingは次の用途でも効果が期待されるとしています。
- モデル挙動の原因特定: 問題のある出力がどの重みに起因するかをLLMが推論で特定する
- アライメント介入: 望ましくない振る舞い(有害出力・過剰迎合)を重みレベルで修正する
- サイコファンシー(過剰迎合)対策: ユーザーの意見に無批判に同意する挙動を、該当する重みの調整で抑制する
これらが実用化されれば、AIレッドチーミングで発見した脆弱性を即座に重みレベルで修正する、といった運用が現実味を帯びます。
再帰的自己改善(RSI)ループの短絡
もっとも議論を呼んでいるのが、再帰的自己改善(Recursive Self-Improvement, RSI)との接続です。
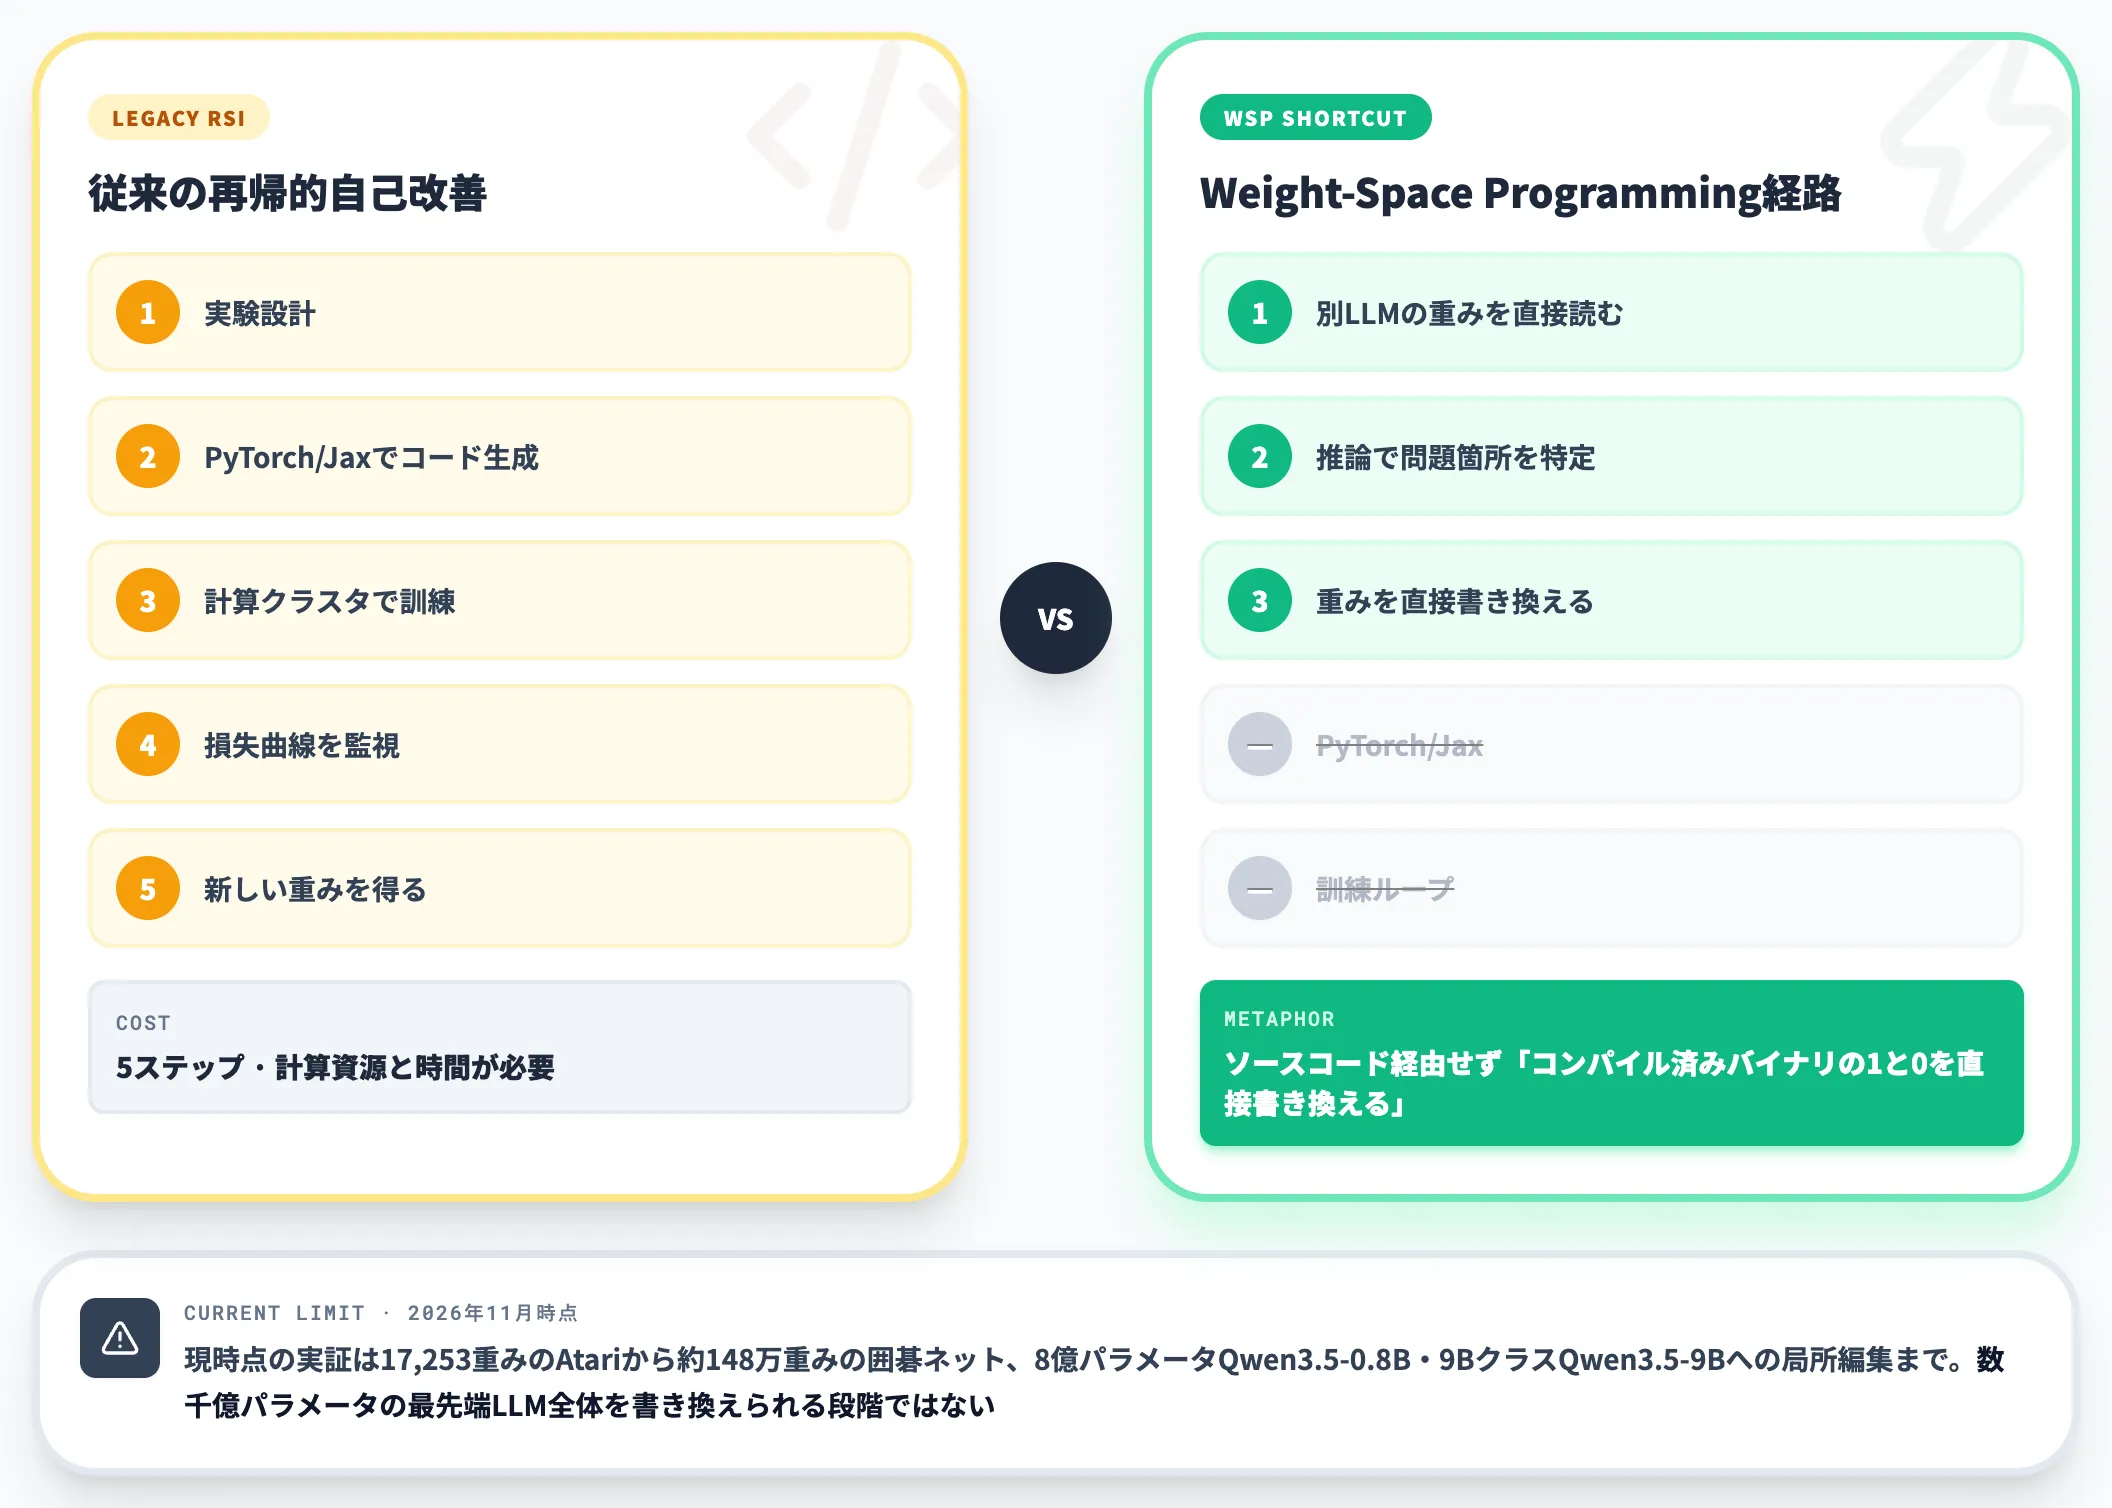
従来のRSI研究では、「賢いLLMが実験を設計し、PyTorch/Jaxでコードを書き、計算クラスタで訓練を走らせ、損失曲線を監視する」という自動化経路が想定されていました。
Latent Spaceの分析は、Weight-Space Programmingがこのループを「賢いLLMが別LLMの重みを直接読み書きする」経路で短絡させる可能性を指摘しています。
言い換えれば、ソースコードを経由せずにコンパイル済みバイナリの1と0を直接書き換えるようなイメージで、モデル改善サイクルが劇的に高速化する余地があります。
ただし、現時点の実証は17,253重みのAtariポリシーから約148万重みの囲碁ネット、原著の8億パラメータQwen3.5-0.8B・後続研究の9BクラスQwen3.5-9Bへの局所編集までで、数千億パラメータの最先端LLM全体を直接書き換えられる段階ではありません。RSI短絡はあくまで理論的可能性であって、2026年11月時点の実装可能な現実ではない点に注意が必要です。
規制上の懸念——EU AI Actの計算量ベース測定では捕捉しづらい
技術的な話題だけでなく、Weight-Space ProgrammingはAI規制の設計思想にも影響を与えつつあります。本セクションでは、EU AI Actを例に規制ギャップの具体像を整理します。
計算量目安の射程と限界
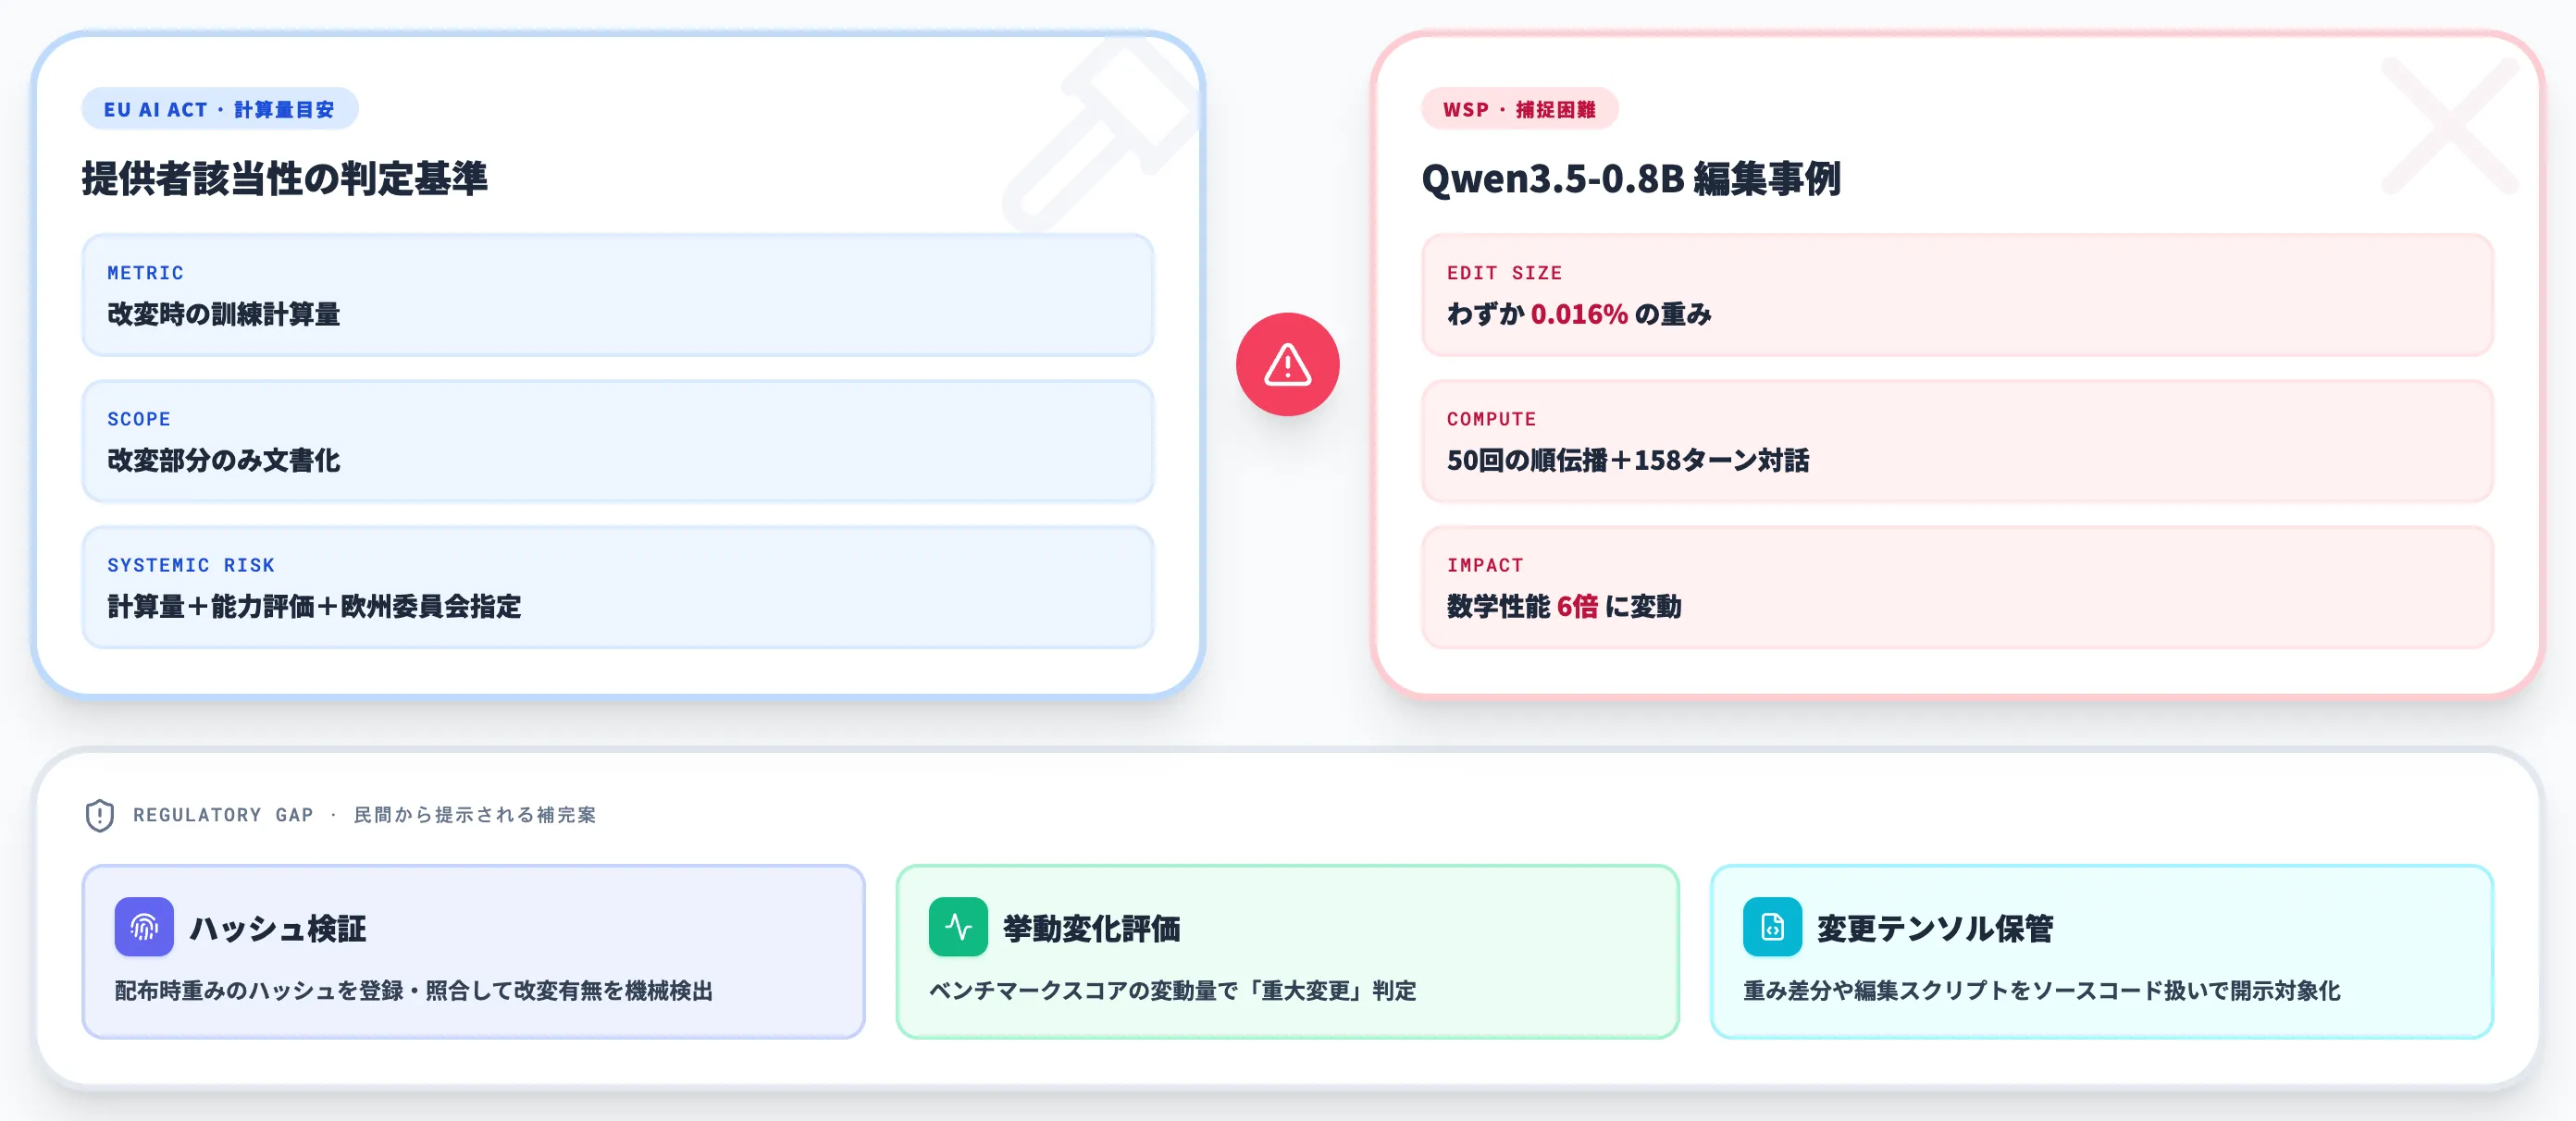
EU AI Actの下で欧州委員会が公開したガイドライン・公式FAQは、汎用AIモデルの第三者改変者が「提供者(provider)」に該当するかを判定する際の計算量目安を示しています。しきい値を超える訓練計算量を使った改変者は提供者として扱われますが、公式FAQでは文書化の範囲はモデル全体ではなく改変した部分に限定されます。
一方、システミックリスクの分類は訓練計算量だけでなく、能力評価や欧州委員会による指定も根拠にできる設計です(AI Act 第51条)。
しかしWeight-Space Programmingは、ほぼ訓練計算量を使わずにモデルの挙動を大きく変えます。Qwen3.5-0.8Bの数学性能を6倍にした原著の事例では、50回の順伝播と158ターンの対話で到達しており、従来の訓練プロセスとは異なる経路です。
i-scoopの解説は、民間の論評として「改変者の該当性を計算量だけで測るのは、重み空間プログラミング時代には不十分になる」と指摘しています。
民間から提案されている運用上の対策
規制側の正式な改訂議論が進む前から、民間の運用提案として以下のようなアイデアがi-scoop等の解説で提示されています。
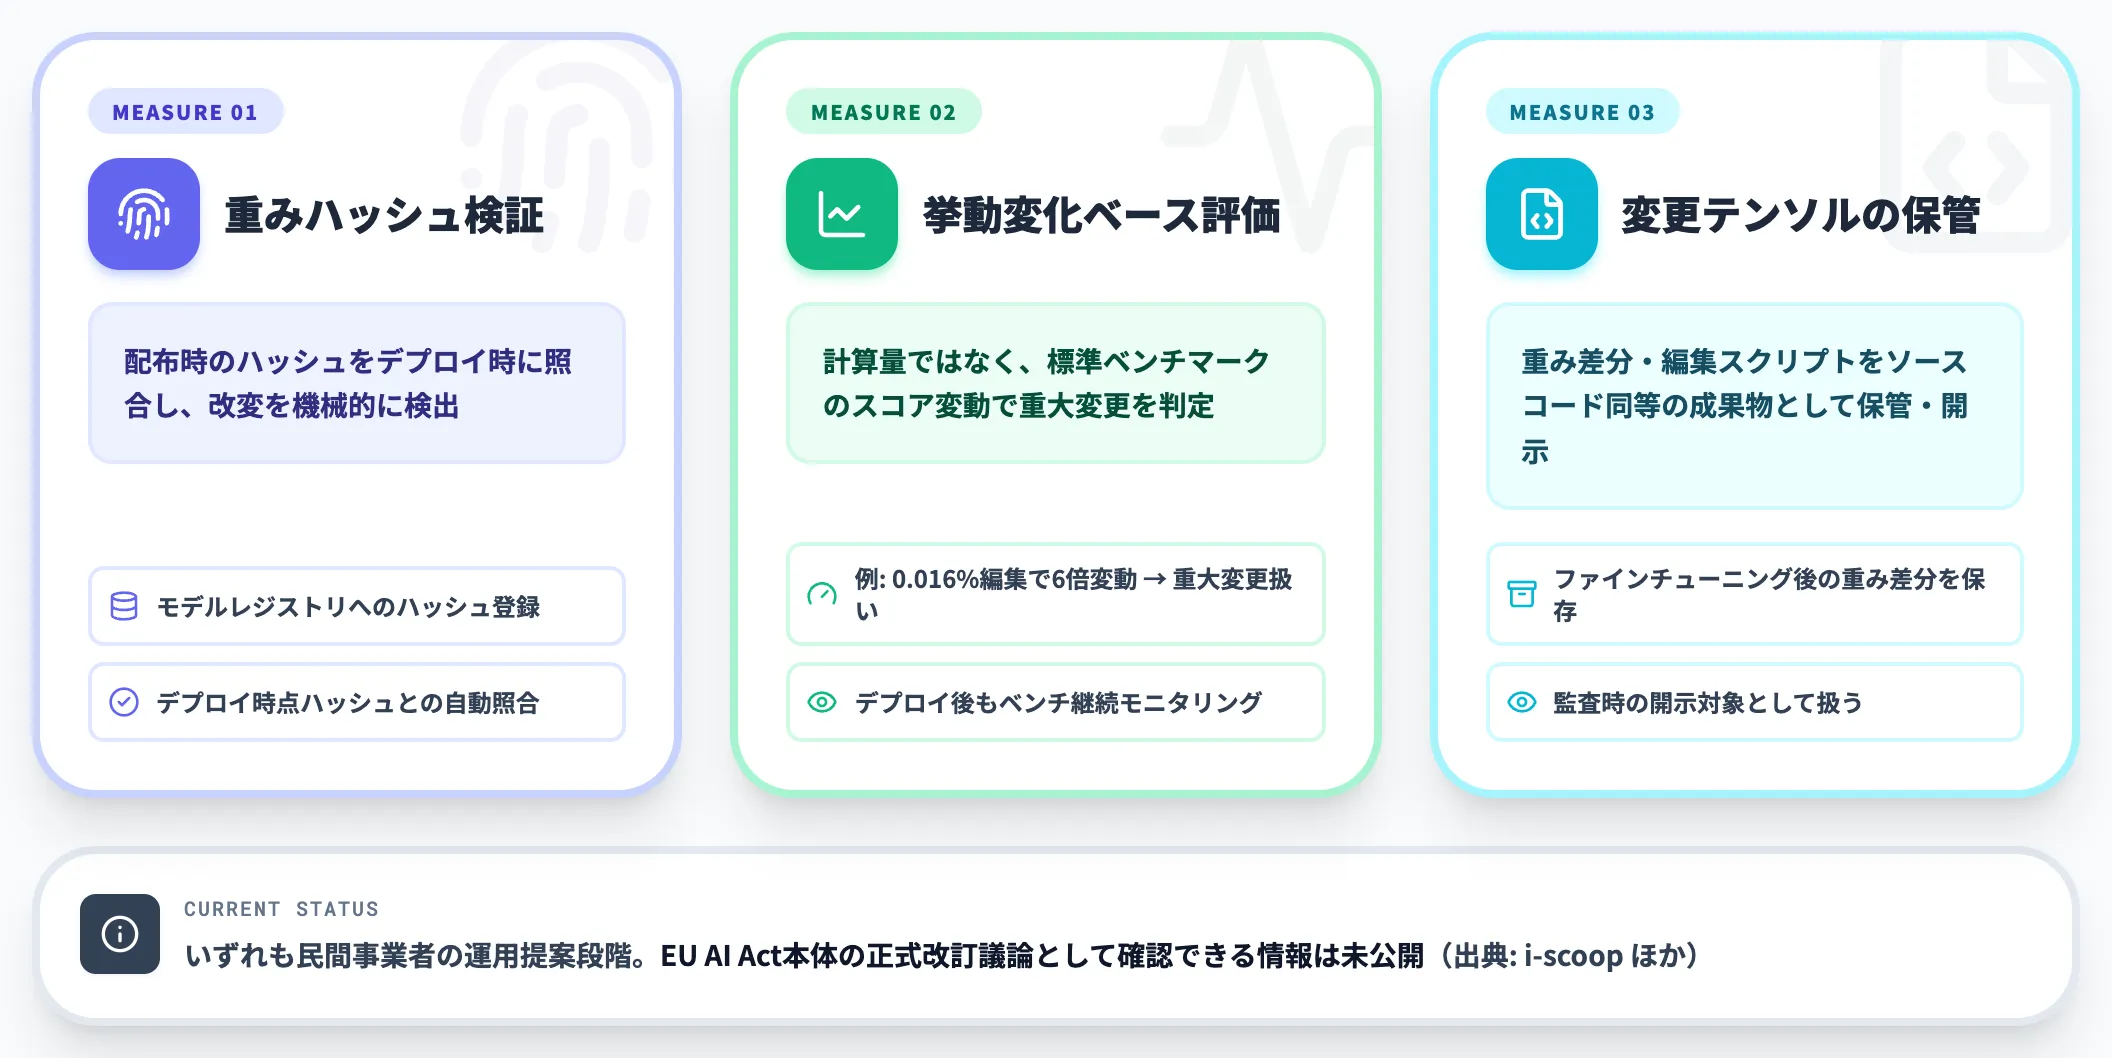
-
重みファイルのハッシュ検証
配布時のモデル重みのハッシュを登録し、デプロイ時点でのハッシュと照合して改変の有無を機械的に検出する
-
挙動変化ベースの評価
計算量ではなく、「標準ベンチマークのスコア変動」でモデル変更を測定する。0.016%の局所編集で性能が6倍変われば、それを「重大な変更」と扱う
-
変更テンソルのソースコード扱い
ファインチューニング後の重み差分や編集スクリプトを、ソースコードと同等の成果物として保管・開示対象にする
いずれも民間事業者の運用提案の段階で、EU AI Act本体の正式改訂議論として確認できる情報はまだ公開されていません。
日本企業が注視すべき実務ポイント
日本企業の立場からは、以下3点を抑えておく価値があります。
- オンプレ運用・ローカルLLMの意味合いが変わる: ローカルLLMやオープンソースLLMを自社で運用している場合、第三者による重み編集リスクが現実化する可能性がある
- モデルのサプライチェーン管理: 配布された重みファイルのハッシュ検証や署名検証を、調達時点・デプロイ時点で実施する運用設計を検討する
- Act対応だけでなくリスク管理として: EU AI Act対象外の日本国内運用でも、挙動変化ベースのモニタリングは「モデルの透明性確保」という観点で価値がある
Weight-Space Programmingは、規制と技術のどちらが先行するか——というより、規制が追いつく前に技術が広がる可能性が高い領域です。
企業としては、自社運用LLMに対する「予期しない改変」をどう検出・制御するかを、予防的に設計しておく価値があります。
Weight-Space Programmingを試せる環境と実装アクセス方法
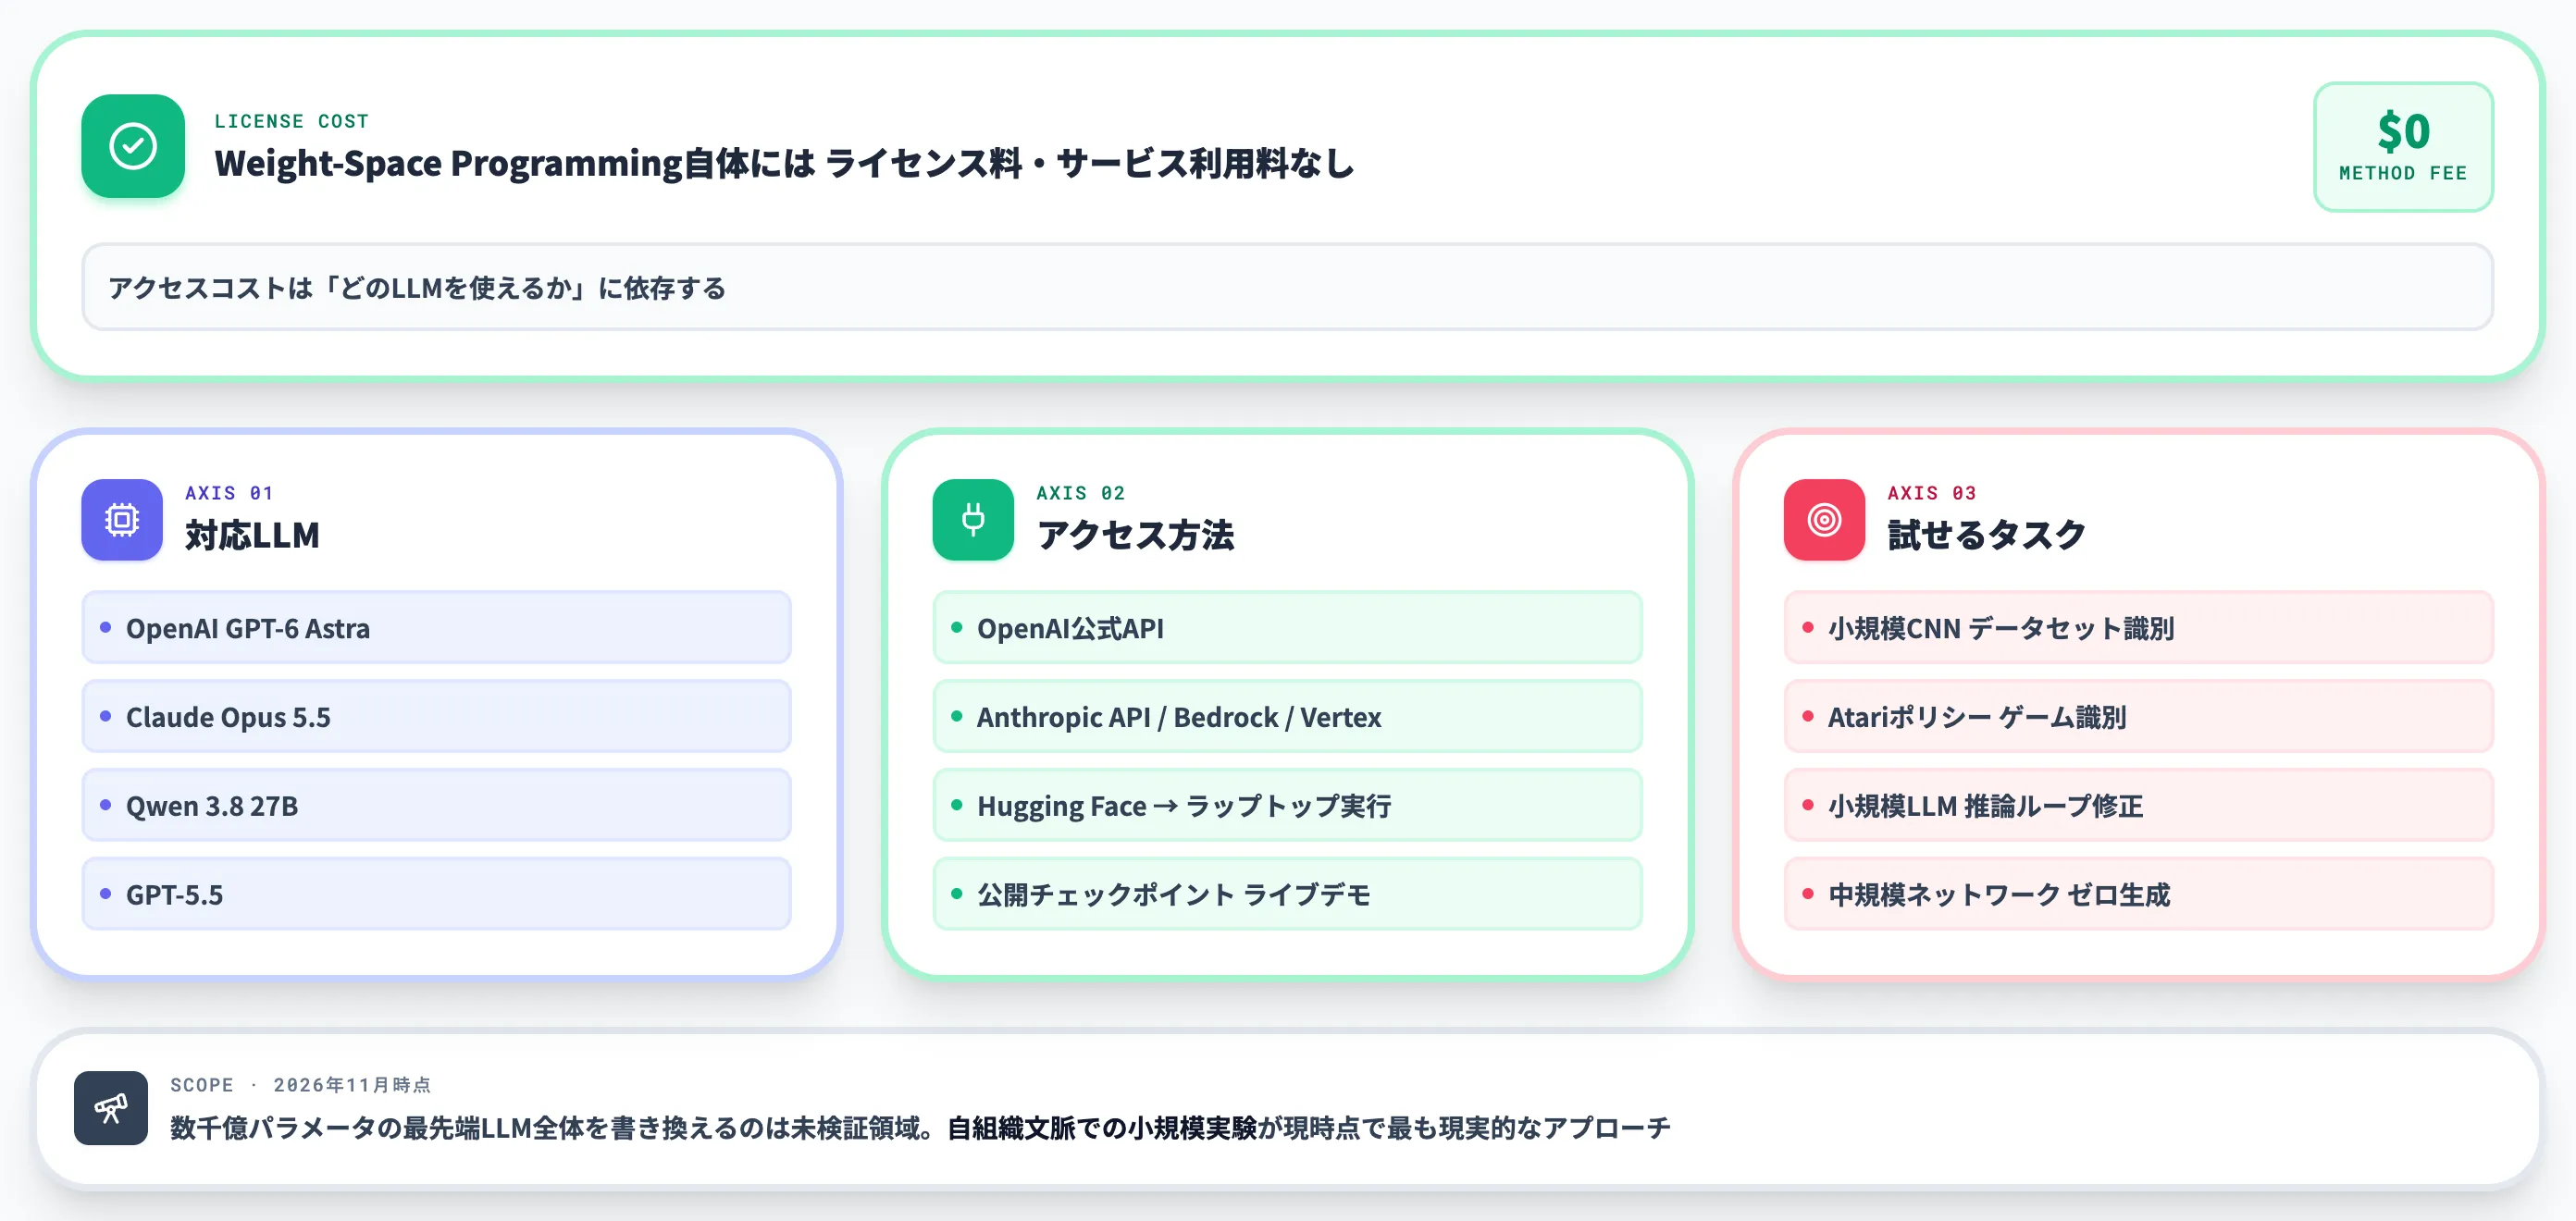
Weight-Space Programming自体にはライセンス料やサービス利用料はありません。手法として提案された概念なので、アクセスコストはむしろ「どのLLMを使えるか」に依存します。
主な実行経路
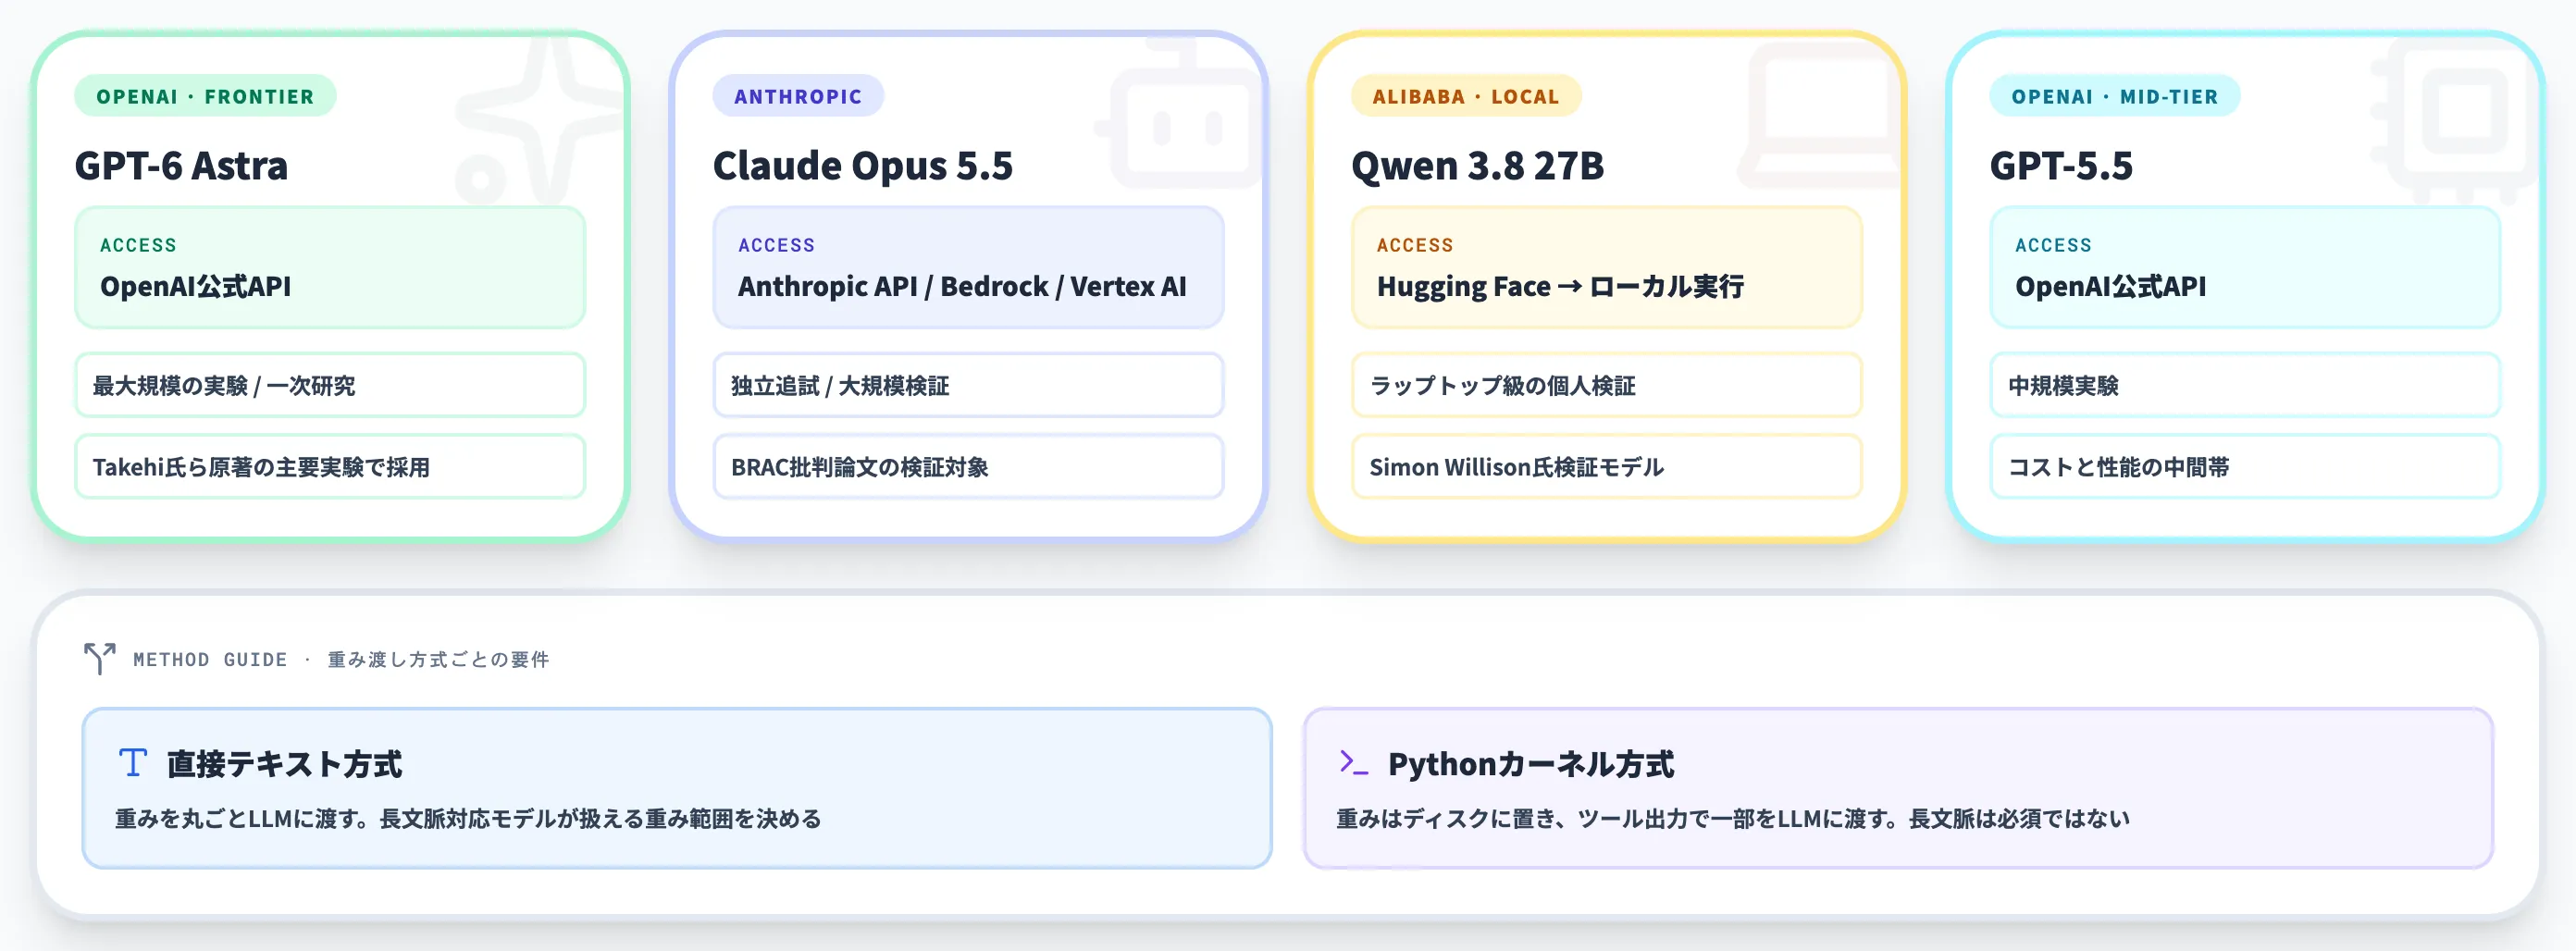
Takehi氏らの一次実験はGPT-6 Astraで実施されていますが、追試は複数のモデルで行われています。以下の表で、2026年11月時点の実行経路を整理しました。
| LLM | アクセス方法 | 典型用途 |
|---|---|---|
| OpenAI GPT-6 Astra | OpenAI公式API(API単価は公式ページ参照) | 最大規模の実験・一次研究 |
| Claude Opus 5.5 | Anthropic API / Amazon Bedrock / Vertex AI | 独立追試・大規模検証 |
| Qwen 3.8 27B | Hugging Faceからダウンロード、ローカル実行 | ラップトップ級の個人検証 |
| GPT-5.5 | OpenAI公式API | 中規模実験 |
重みを直接テキストでLLMに渡す方式(Atari識別・自動運転修復など)を採る場合、コンテキストウィンドウが長文脈に対応しているほど扱える重みの範囲が広がります。
一方、Pythonカーネル経由で重みを参照・編集する方式(文字言語モデル識別・囲碁ネット生成・Qwen3.5-0.8B修復など)では、重みファイルはディスク上に置いてLLMにはAPIコールやツール出力として一部だけ渡すため、長文脈は必須ではありません。
編集済みモデルで結果を確認する
自分で編集処理を再現する前に、Takehi氏らが公開している編集済みQwen3.5-0.8Bチェックポイントで結果を先に比較評価できます。
- RikiyaT/Qwen3.5-0.8B-weight-space-programming(Hugging Face) — 0.016%編集後の重み
- Ahsen Khaliq氏によるライブデモ — 編集前後のQwen3.5-0.8Bをブラウザで比較
- 完全な実験ログ — Astraに渡したプロンプト・コード・生成された重みの全記録
自組織での再現実験を計画する前に、まず公開チェックポイントが期待通りの挙動を示すかを自社ベンチマークで確認するのが堅実です。
個人で試す場合の構成例
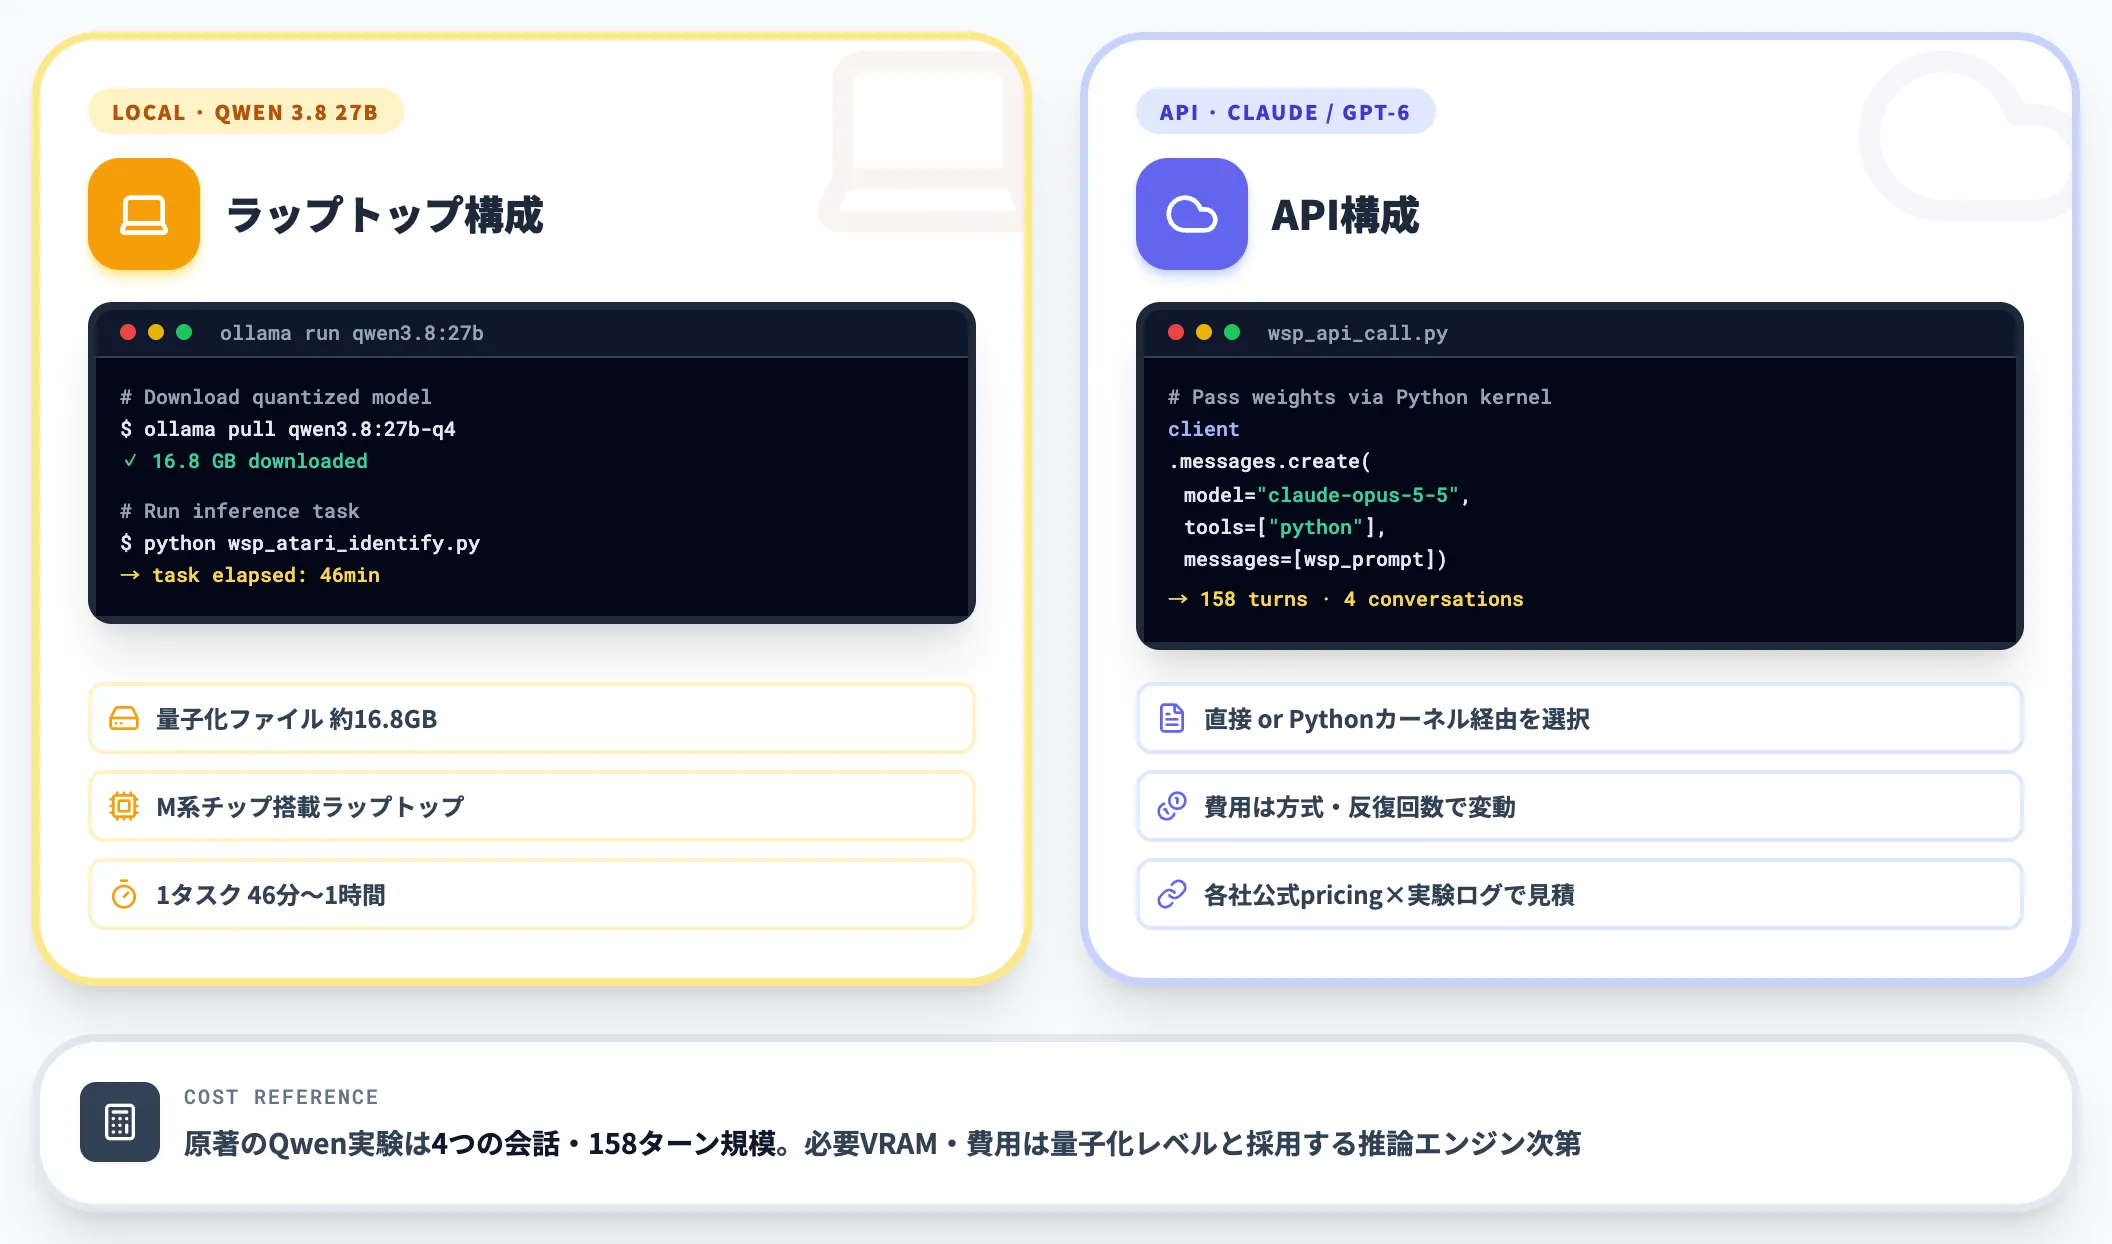
Qwen 3.8 27Bをローカル実行する場合、Simon Willison氏の検証では約16.8GBの量子化ファイルをM系チップ搭載のラップトップにダウンロードし、1タスクあたり46分〜1時間程度で推論が完結したと報告されています。
必要なVRAM・ディスク容量は量子化レベルと採用する推論エンジン次第で変動するため、詳細はQwen 3.8 27B公式モデルカードと採用するランタイムのドキュメントで確認してください。
API経由でClaude Opus 5.5やGPT-6 Astraを使う場合、重みテンソルを直接テキストで渡す方式か、Pythonカーネル経由で扱う方式かによって1回あたりのコンテキスト量が変わります。
実際の費用はタスク・方式・反復回数で変動するため、正確な見積もりは、各社の公式pricingページと実験ログのトークン数(原著の Qwen 実験は4つの会話・158ターン規模)を照合して算出してください。
試せるタスクの範囲
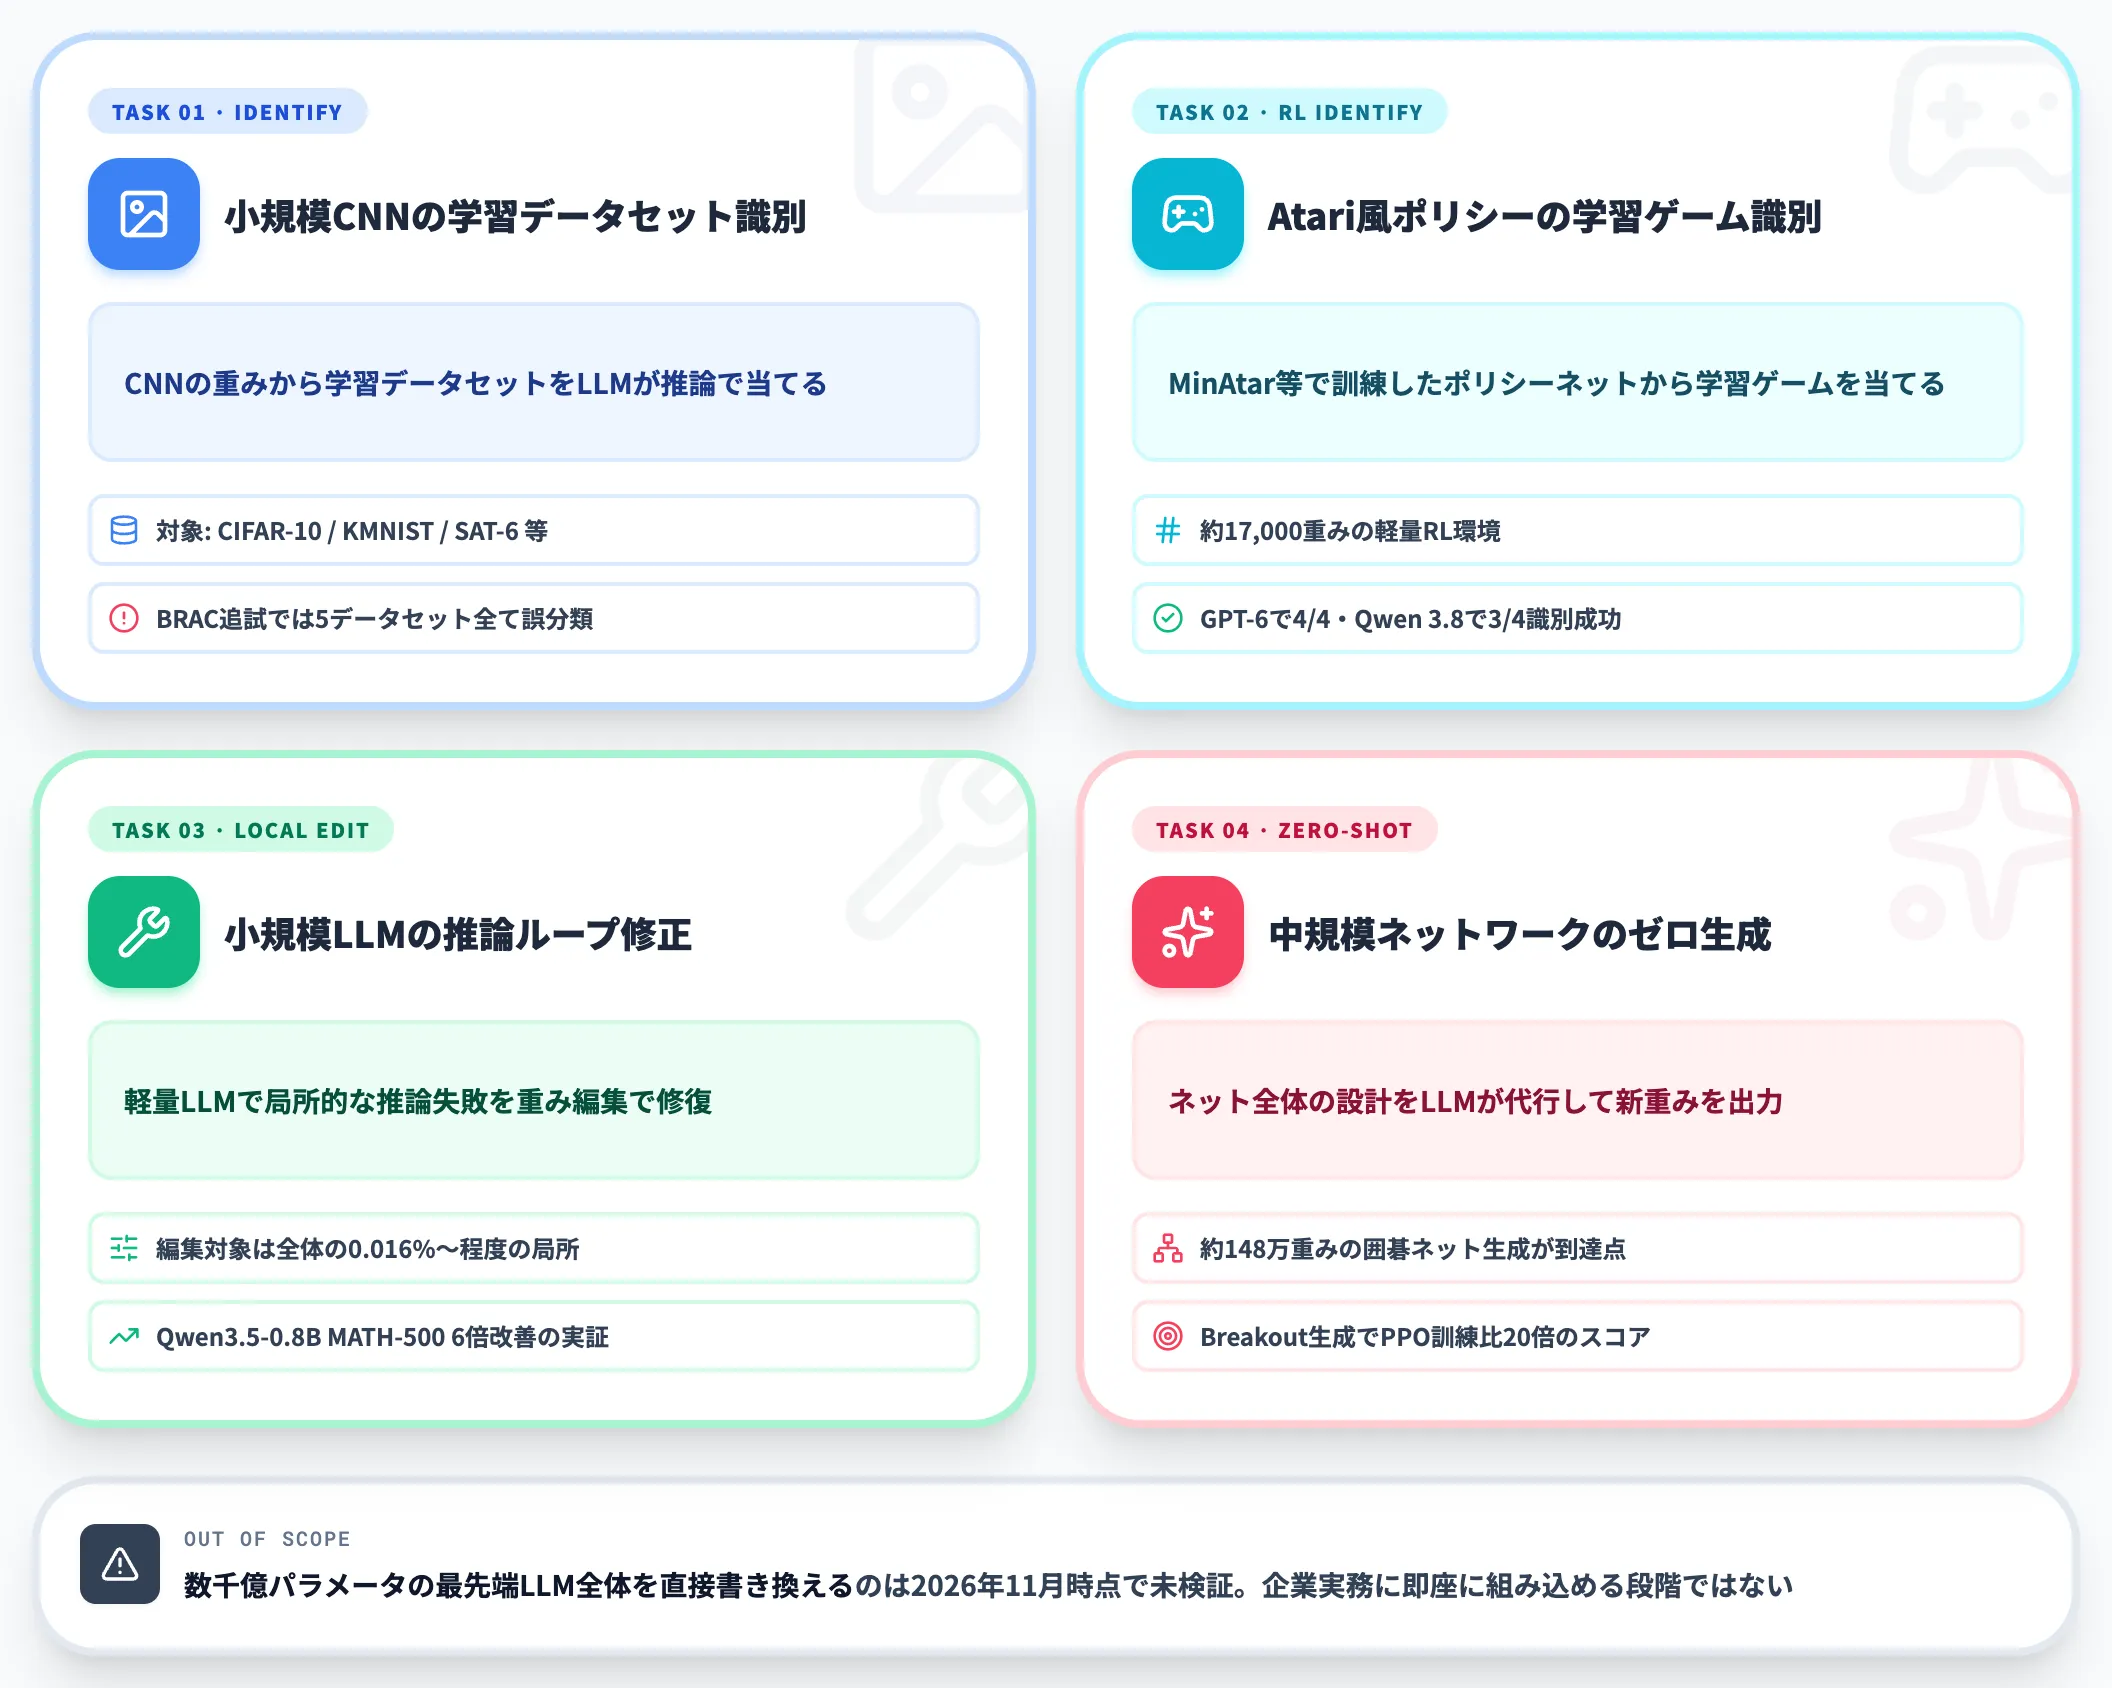
2026年11月時点で、公開されている実験レシピは以下のようにネットワーク全体規模と編集対象の重み数が別軸で広がっています。
- 小規模CNNの学習データセット識別: CIFAR-10 / KMNIST / SAT-6 等の小規模データセットで訓練したCNNの重みをLLMに読ませる
- Atari風ポリシーネットの学習ゲーム識別: MinAtar等の軽量RL環境で訓練したポリシーネットの重みから学習ゲームを当てる
- 小規模LLMの推論ループ修正: Qwen3.5-0.8Bのような軽量LLMで、局所的な推論失敗を重み編集で修復する(編集対象は全体の0.016%〜程度の局所)
- 中規模ネットワークのゼロ生成: 約148万重みの囲碁ネット生成のような、ネット全体の設計をLLMが代行するパターン
数千億パラメータの最先端LLM全体を直接書き換えるのは現時点で未検証領域なので、企業実務に即座に組み込める段階ではありません。
「どんなタスクでWeight-Space Programmingが成立するか」を自組織の文脈で小規模実験することが、2026年11月時点で取り得る最も現実的なアプローチです。
LLMが重みを書き換える時代に、業務の規定と判断の記録はモデルの外で持つ
ROMEが事実の書き換えを、Weight-Space Programmingが重みの0.016%の編集による数学の改善を示したように、重みに手を入れれば知識や能力を後から変えうる一方、ほかの処理への影響は確かめきれていません。社内の業務でAIエージェントを使うなら、規定や取引条件のように変わり続ける知識をモデルの外のデータとして持ち、モデルが変わったときのずれを自社の判断の記録で測る、という分け方が必要になります。
そこで選択肢になるのが、Agentが参照する業務データと、判定や承認の記録を、同じFabric/OneLakeに寄せるAI Agent Hubです。
- 規定やマスタは、重みに書き込まずに参照させる
社内規定や取引先のマスタはOneLake経由でAgentが参照するため、条件が変わったときに直すのはデータの側だけで、モデルに手を入れずに済みます。
- Agentの判定を、担当者の判断と並べて残す
Agentの実行データと承認・差し戻しの履歴がFabricに集まるため、モデルを替えたあとの判定が担当者の判断とずれていないかを、自社のデータで確かめる材料になります。
- 社内のデータを、外部のモデルの重みに渡さない
業務データは自社のテナント内で扱われ、AIの学習には使われないため、規定や取引条件が外部のモデルの重みに取り込まれることはありません。
AI総合研究所の専任チームが、規定やマスタのうちモデルの外で持つべき項目を洗い出し、OneLake経由で参照させるデータの範囲とAgentからの参照の経路を、業務ごとに設計します。
規定と判断の記録をモデルの外で持つ

重みに頼らず、データの側で直す
重みを書き換えて知識や能力を変える手法が広がるほど、業務で使うAIの規定や判断の記録は、モデルの外で持つほうが扱いやすくなります。規定やマスタはOneLake経由でAgentに参照させ、判定と担当者の承認の履歴はFabricにためるAI Agent Hubの構成なら、モデルを替えたあとのずれを確かめる材料が手元に残ります。
まとめ
本記事では、Weight-Space Programmingを「LLMが他のニューラルネットワークの重みをテキストとして読み取り、解釈し、書き換えるアプローチ」として整理し、仕組み・MIT CSAILの実証・批判的な追試・モデル編集との違い・実務への影響・規制上の懸念・試せる環境を解説しました。
2026年11月時点で押さえておくべきポイントは次の3つです。
- 勾配降下や訓練ループを使わず、LLMが推論で重みを読み書きし、Breakout用のポリシーをゼロから書いて、PPOで訓練したネットワークのスコアを上回った
- 読み取りの多くは局所の計算とデータセットの事前知識で説明できるとする追試が出て、編集の成否はモデルの規模やタスクによって揺れる
- 数式で更新を決めるROMEやMEMITと違い、LLMの推論で編集を決めるため、実行のたびに結果が変わる確率的な挙動を含む
AI総合研究所は、ローカルLLMやオープンソースのLLMを自社で運用する組織と、重みの変更を管理する手順を2段階で整えています。
まずは、配布された重みファイルのハッシュや署名の照合を、調達とデプロイの各時点の作業に組み込みます。
続いて、ファインチューニング後の重みの差分や編集スクリプトを、ソースコードと同じ成果物として保管する決まりを設けます。
訓練の計算量をほとんど使わずに挙動を大きく変えるため、改変者の該当性を計算量で測るEU AI Actの目安では捉えにくく、規制が後追いになりやすい領域です。
Weight-Space Programmingは査読前の段階ですが、重みを訓練の産物でなく、LLMが読み書きできるコードとして扱う経路を提案した研究です。