この記事のポイント
 self-improvementループ(タスク生成・スキャフォールド・ロールアウトの共同最適化)を製品化した最初期のオープンウェイトLLM
- 397Bは一部ベンチでOpus 4.8を上回るが、SWE-bench Pro・DeepSWE・Frontier-Benchでは劣後しKimi K3にも多くの指標で及ばない
- 9B Denseは単一80GB GPUで動き、量子化版は6.6GB程度でスマホ動作を想定できる
- MITライセンスでモデルは無料、実質コストはGPUと運用インフラに置き換わる
- クローズドAPIコストを削減したい・データを外に出せない企業なら第一候補、フロンティア精度が必要ならKimi K3やClaude Opus 5との併用が現実的
Microsoft MVP・AIパートナー。LinkX Japan株式会社 代表取締役。東京工業大学大学院にて自然言語処理・金融工学を研究。NHK放送技術研究所でAI・ブロックチェーンの研究開発に従事し、国際学会・ジャーナルでの発表多数。経営情報学会 優秀賞受賞。シンガポールでWeb3企業を創業後、現在は企業向けAI導入・DX推進を支援。
Ornith-1.5(オーニス1.5)は、AI研究組織DeepReinforceが2026年8月19日に公開した、9B Dense・35B MoE・397B MoEの3サイズで揃うオープンウェイトLLMのモデルファミリーです。
MITライセンスで配布され、モデル自身が学習タスクを提案し、その解答を強化学習に回す「self-improvementループ」を製品として実装した点が最大の特徴になります。
フラッグシップの397Bは、Terminal-Bench 2.1やSWE-bench VerifiedでClaude Opus 4.8と同水準のスコアを掲げていますが、Kimi K3・GLM-5.2との位置関係やベンチマーク間の勝ち負けを分解すると、単純な「Opus 4.8並み」では片づかない読み方が必要です。
本記事では、3サイズの使い分け・自己改善ループの仕組み・17指標で見たOpus 4.8との差分・他オープンウェイトモデルとの比較・DeepReinforce社の背景・必要GPUと導入方法・実質コスト・AI総研としてのケース別推奨まで、公式一次情報と初期試用レポートをもとに整理します。
目次
Ornith-1.5とは?自己改善型オープンウェイトLLMの新世代
自己改善ループの仕組み——タスク生成・スキャフォールド・ロールアウトを1つのループで最適化
「Claude Opus 4.8並み」の実像——17指標で分解する
GLM-5.2・DeepSeek V4・Kimi K3との比較——オープンウェイト内の立ち位置
開発元DeepReinforceの背景——CUDA最適化からLLMへ
Ornith-1.5の実質コスト——モデルは無料、負担はGPUへ
Ornith-1.5を採るべきケース・別モデルを推奨するケース
Ornith-1.5とは?自己改善型オープンウェイトLLMの新世代
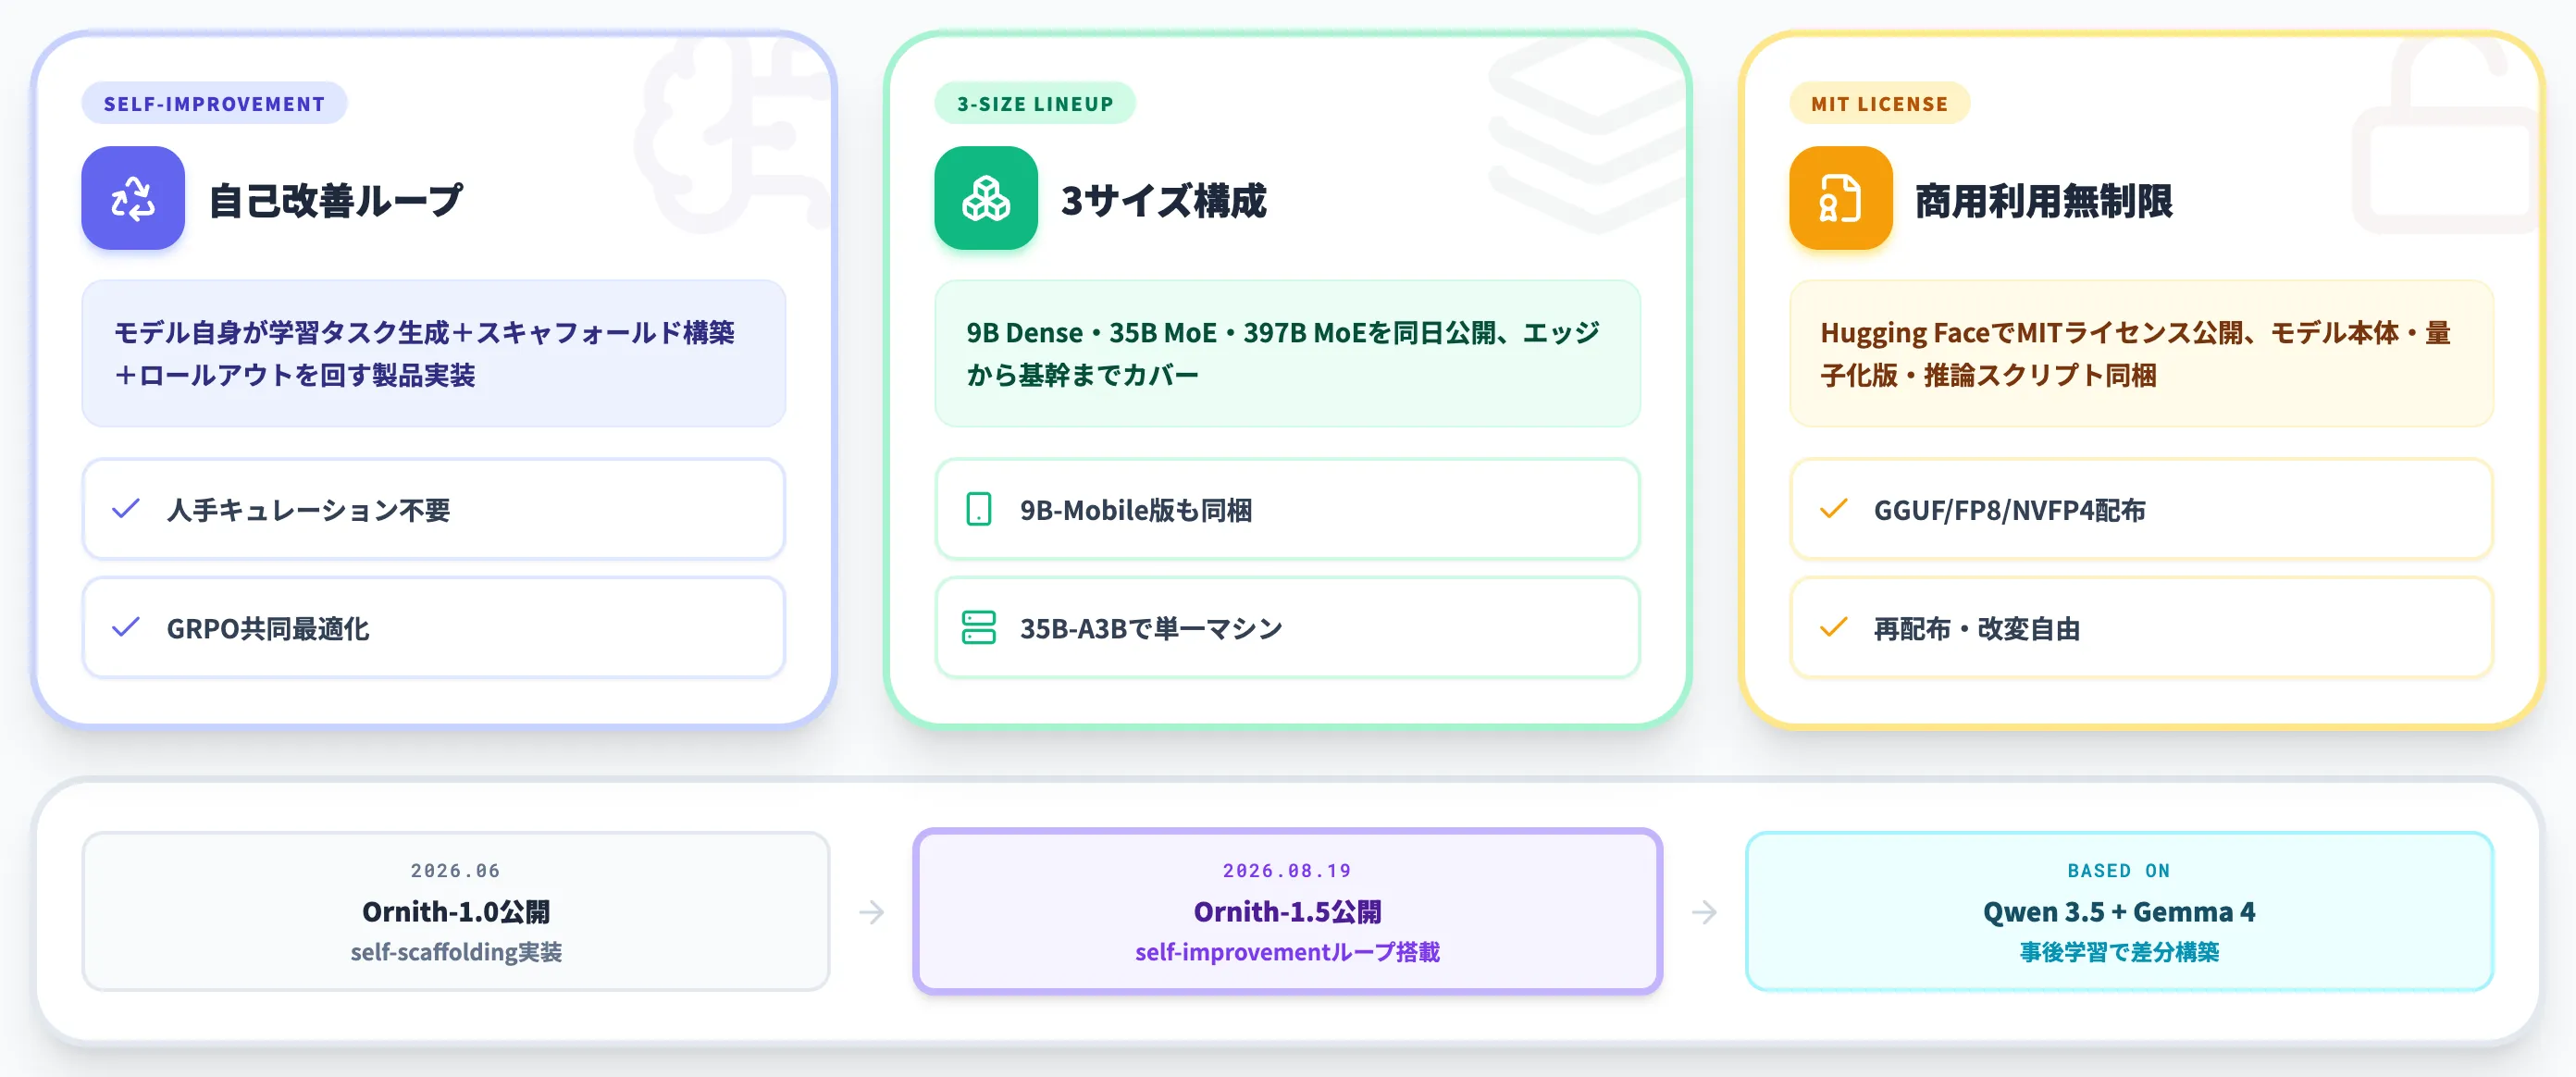
Ornith-1.5(オーニス1.5)とは、9B Dense・35B MoE・397B MoEの3サイズで構成される、自己改善型のオープンウェイト大規模言語モデル(LLM)ファミリーです。開発元のAI研究組織DeepReinforceは、2026年8月19日にHugging Face上でMITライセンス公開し、モデル本体・量子化版・推論スクリプトまで商用利用も無制限で使える形で揃えています。
中心にあるのは、「self-improvementループ」を製品として実装した設計思想です。モデル自身が解く価値のある学習タスクを提案し、その検証ハーネス(実行環境・ツール呼び出し)を組み立て、生成した解答を次の強化学習の材料として再投入する——この一連のサイクルがモデル内部で閉じている点で、人手の教師データ収集を前提とした従来の学習ループとは出発点から違っています。
系譜としては、2026年6月のOrnith-1.0が「人手が用意した固定タスクに対するスキャフォールド最適化」までだった段階から、1.5は「タスク生成そのものの自動化」まで踏み込んだ世代になります。
Qwen 3.5とGemma 4をベースに追加事後学習を重ねた397Bモデルは、Terminal-Bench 2.1やSWE-bench VerifiedでClaude Opus 4.8クラスのスコアを掲げており、オープンウェイトの上限がクローズド系フロンティアに手を伸ばし始めた象徴として読める水準に入ってきました。
Ornith-1.5の3サイズ構成と使い分け
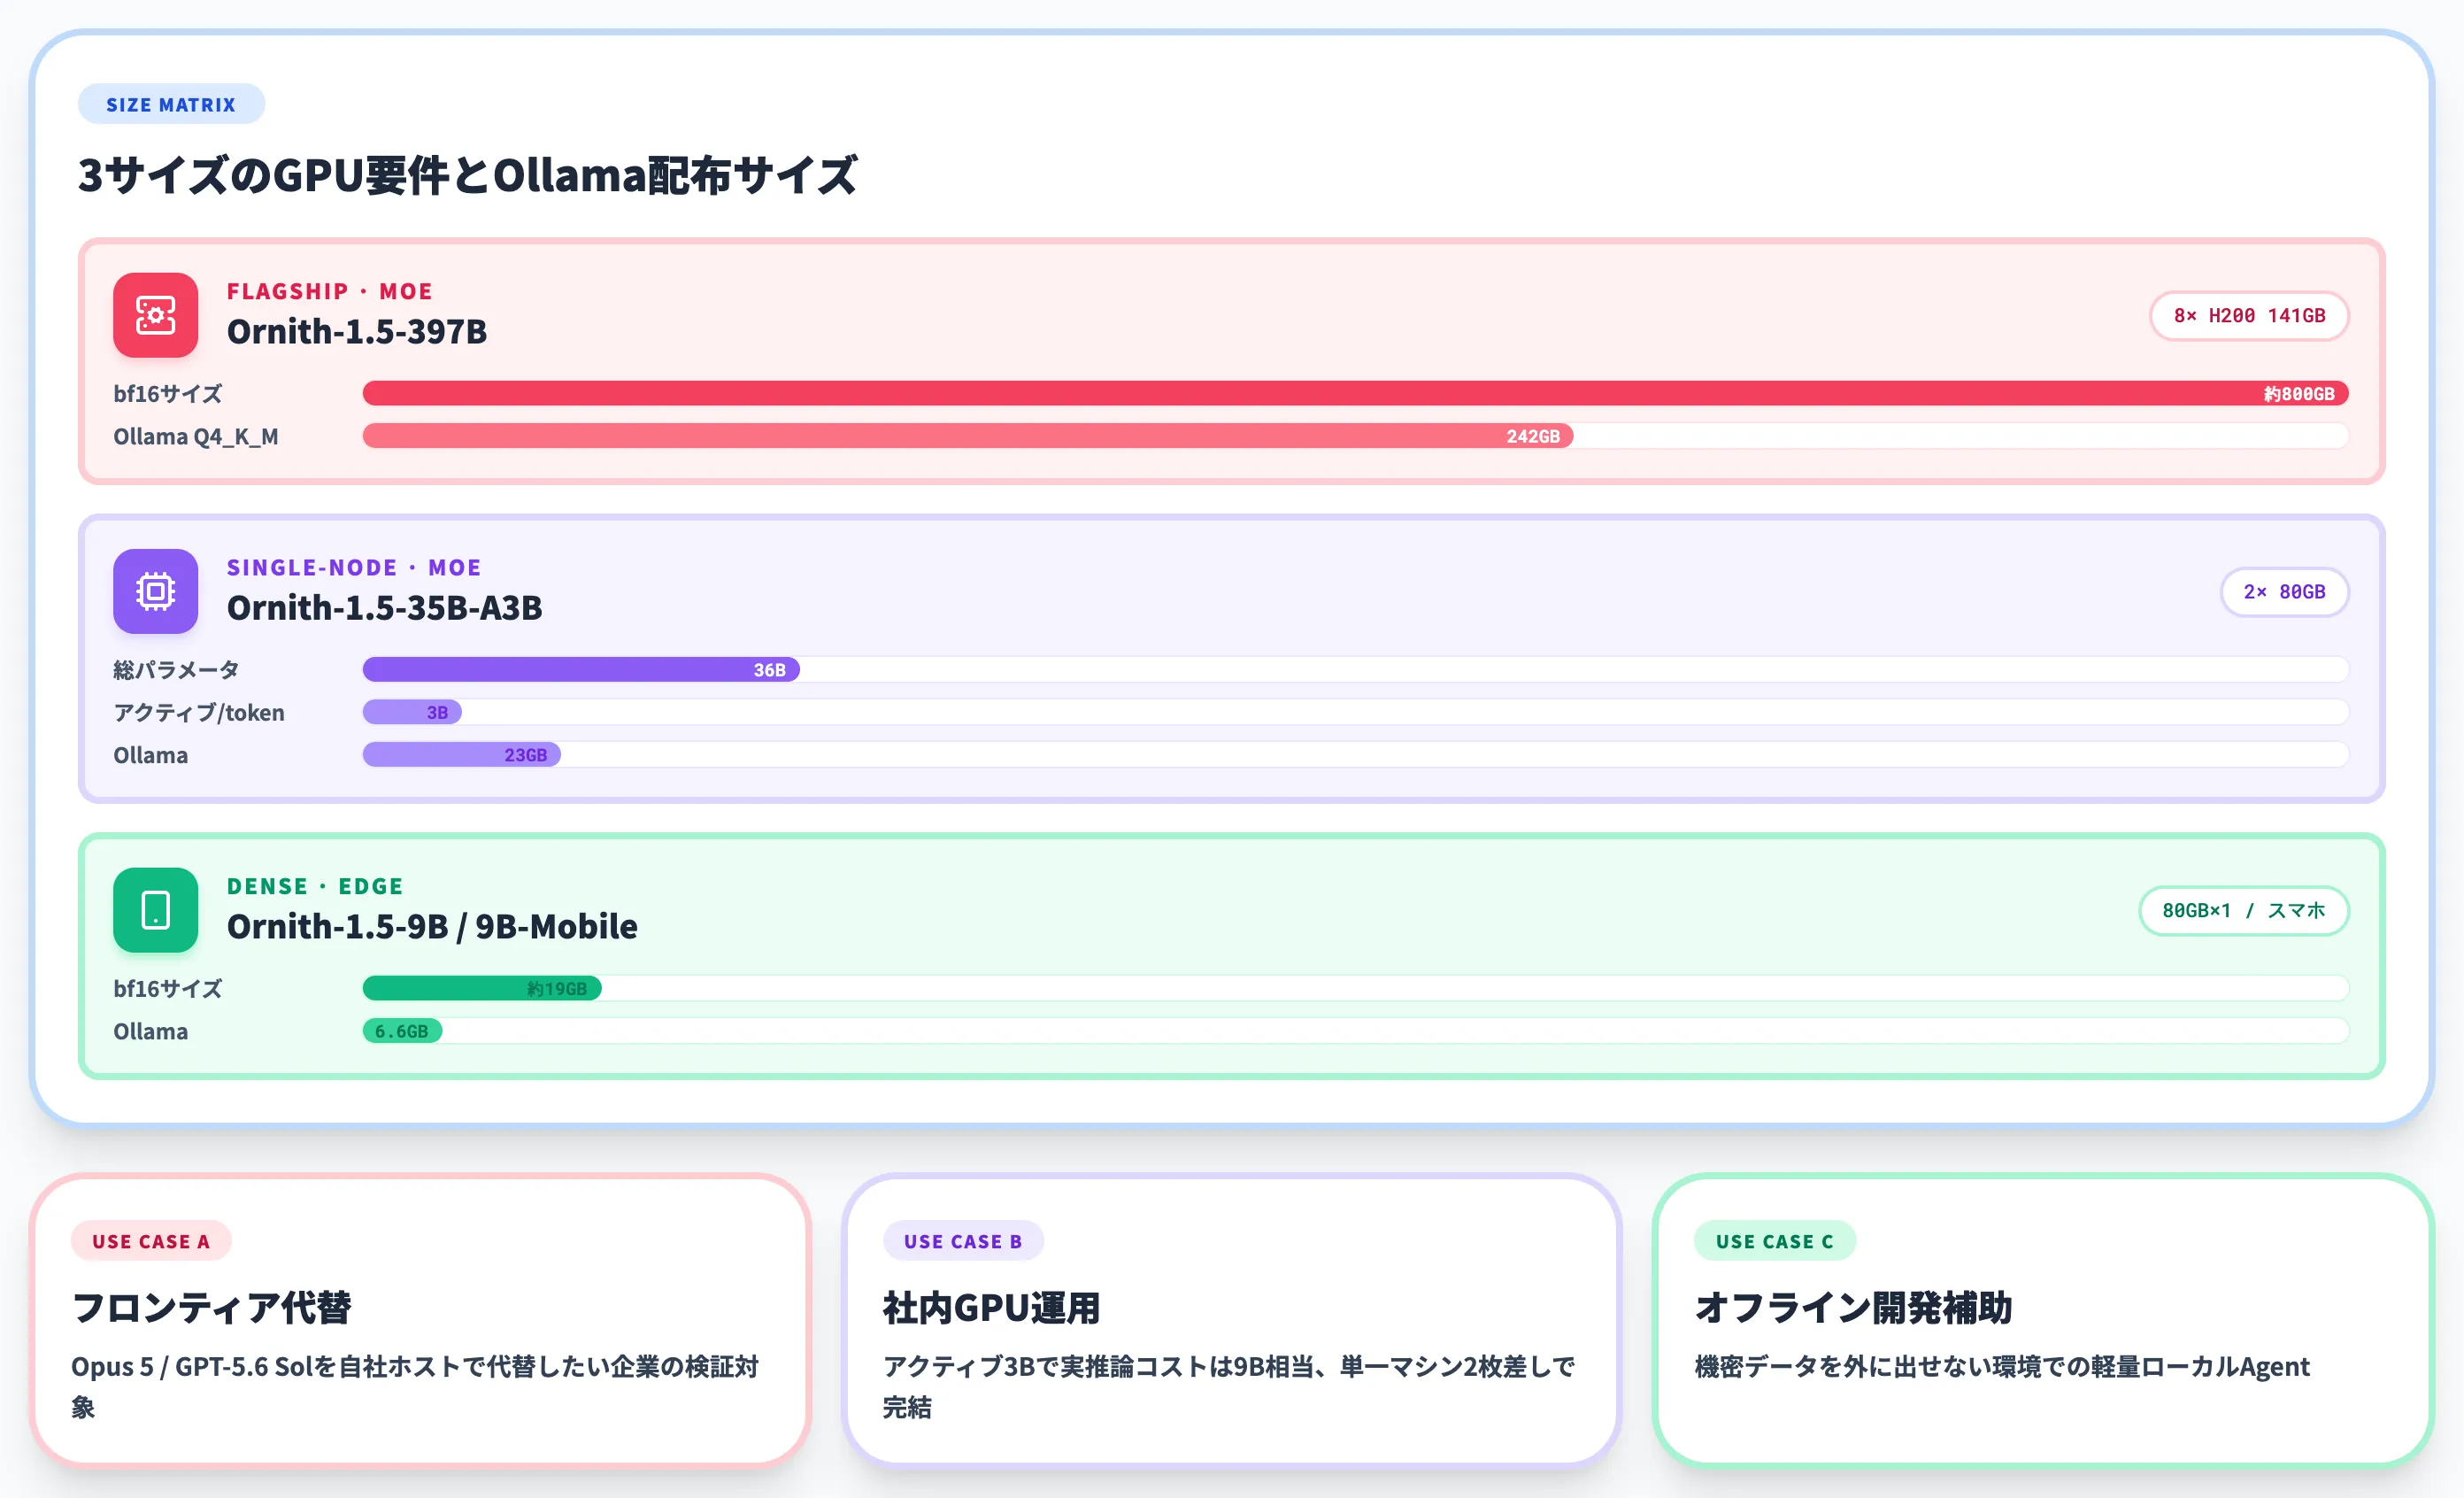
Ornith-1.5は3つのサイズが同時にリリースされており、想定用途と必要ハードが明確に分かれています。
以下の表で、各サイズのパラメータ・活性化パラメータ・想定ハード・主要ユースケースを整理しました。この表を軸に、次の各H3で個別サイズの実力を掘り下げていきます。
| モデル | 型 | 総パラメータ | アクティブ | 想定ハード | Ollama配布サイズ |
|---|---|---|---|---|---|
| Ornith-1.5-397B | MoE | 397B | 非公開 | 8× H200 141GB(bf16で約800GB) | 242GB |
| Ornith-1.5-35B-A3B | MoE | 36B | 3B/token | 2× 80GB GPU(bf16) | 23GB |
| Ornith-1.5-9B | Dense | 9B | 9B | 単一80GB GPU(bf16で約19GB) | 6.6GB |
| Ornith-1.5-9B-Mobile | Dense(量子化) | 9B相当 | 9B | iPhone / Android(GGUF/MLX) | — |
この表から分かるのは、フラッグシップの397Bは複数GPU構成前提、35B-A3Bで単一マシン2枚差し、9Bなら単体80GBで動くという段階的な設計になっているという点です。
特に35B-A3BのMoEはアクティブパラメータが3Bと軽いため、実推論コストは9Bに近い挙動になります。
397B——フラッグシップMoE
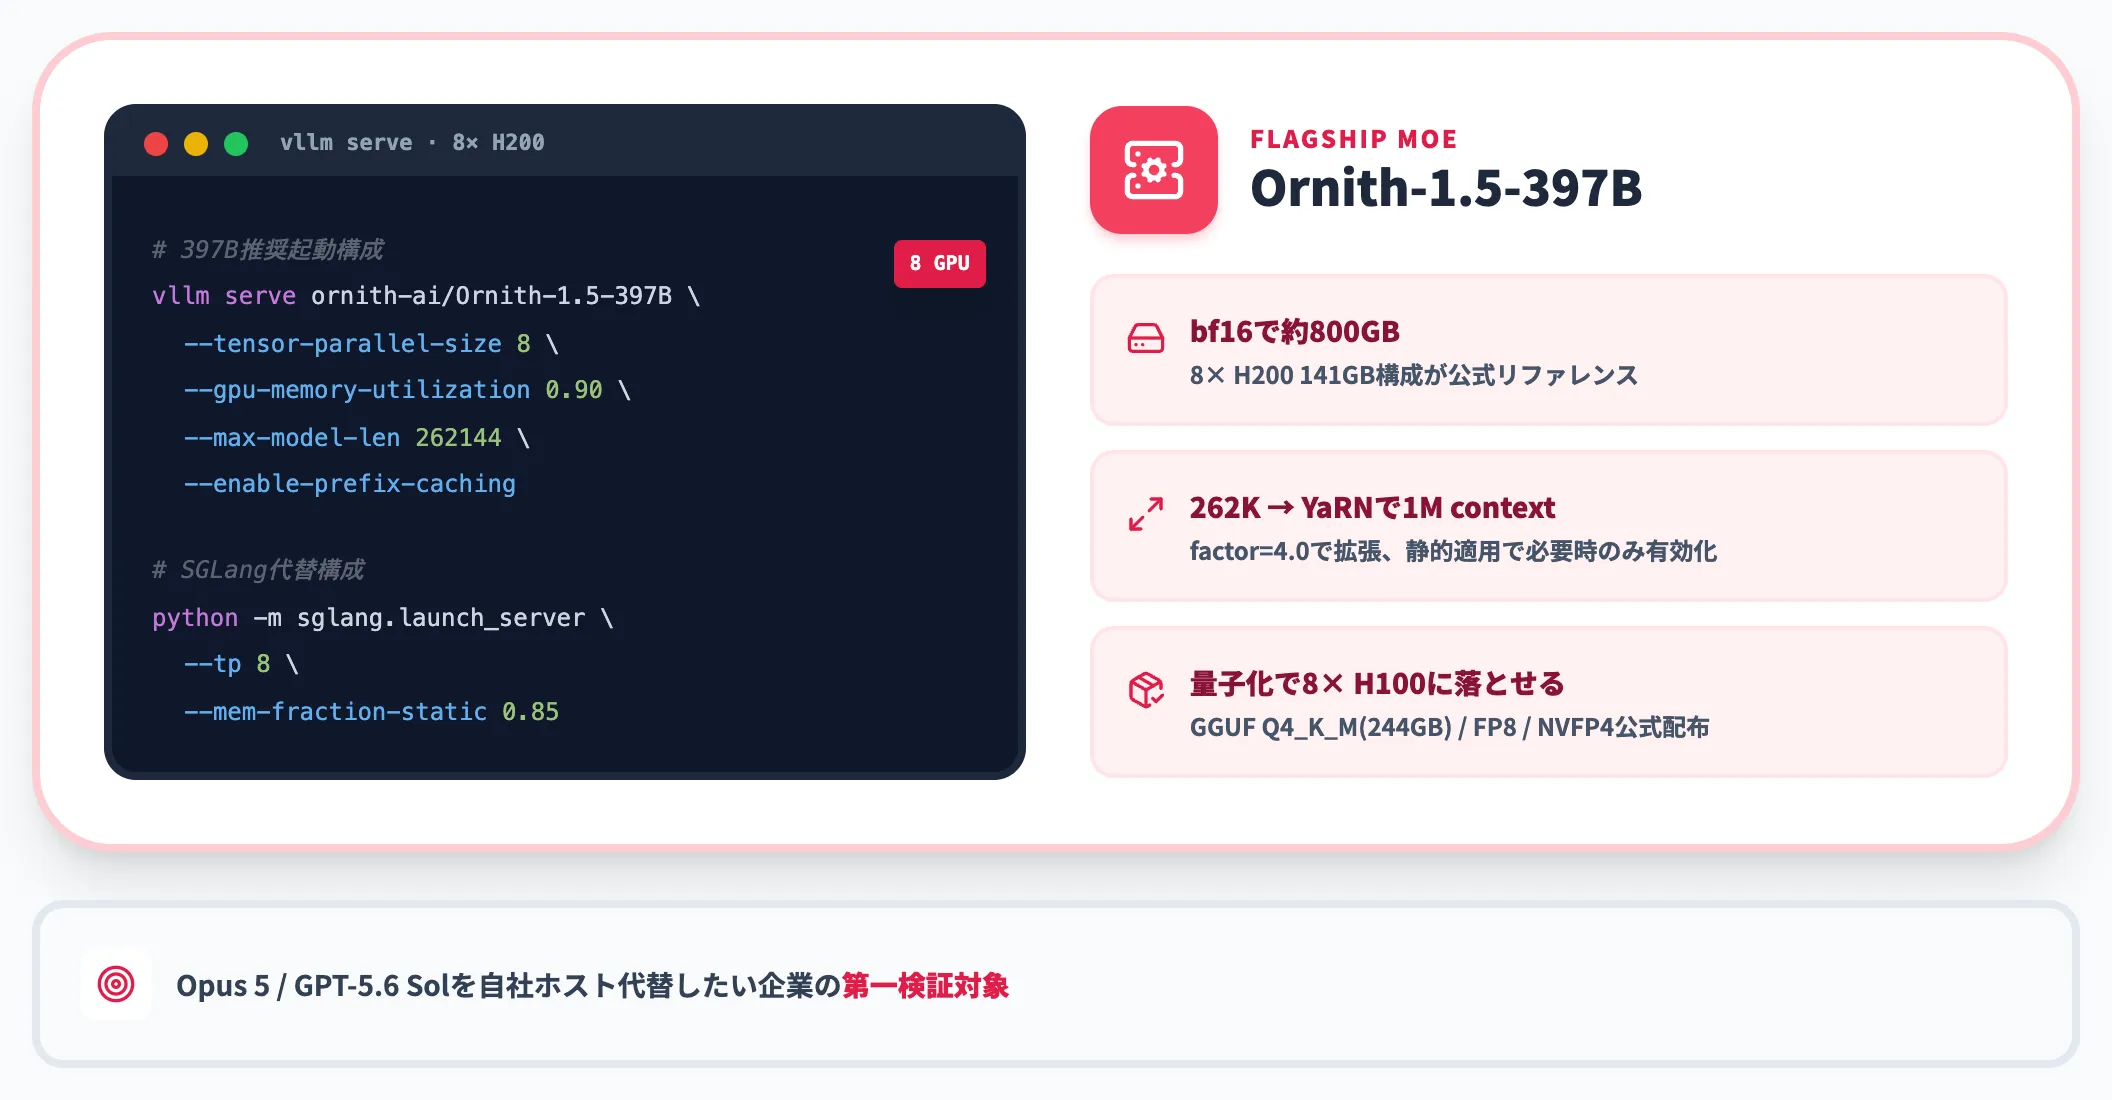
397Bは、Ornith-1.5の主張の中核となるフラッグシップMoEモデルで、bf16推論で約800GBのモデルサイズを持ちます。
DeepReinforceのHugging Faceモデルカードでは、8×H200 141GBを構成例として挙げ、vLLMでは「--tensor-parallel-size 8 --gpu-memory-utilization 0.90」、SGLangでは「--tp 8 --mem-fraction-static 0.85」を指定した起動例が提示されています。
コンテキスト長は標準262,144トークン、YaRN scaling(factor=4.0)で最大約1Mトークンまで拡張可能です。量子化版はGGUF(Q4_K_M時244GB)、FP8、NVFP4が公式配布されており、Q4_K_Mであれば8×H100/H200構成で稼働できます。
クローズド系のフラッグシップ(Opus 5 / GPT-5.6 Sol)を自社ホストで代替したい企業が、まず検証対象に据える構成になります。
35B-A3B——単一マシンで動くMoE
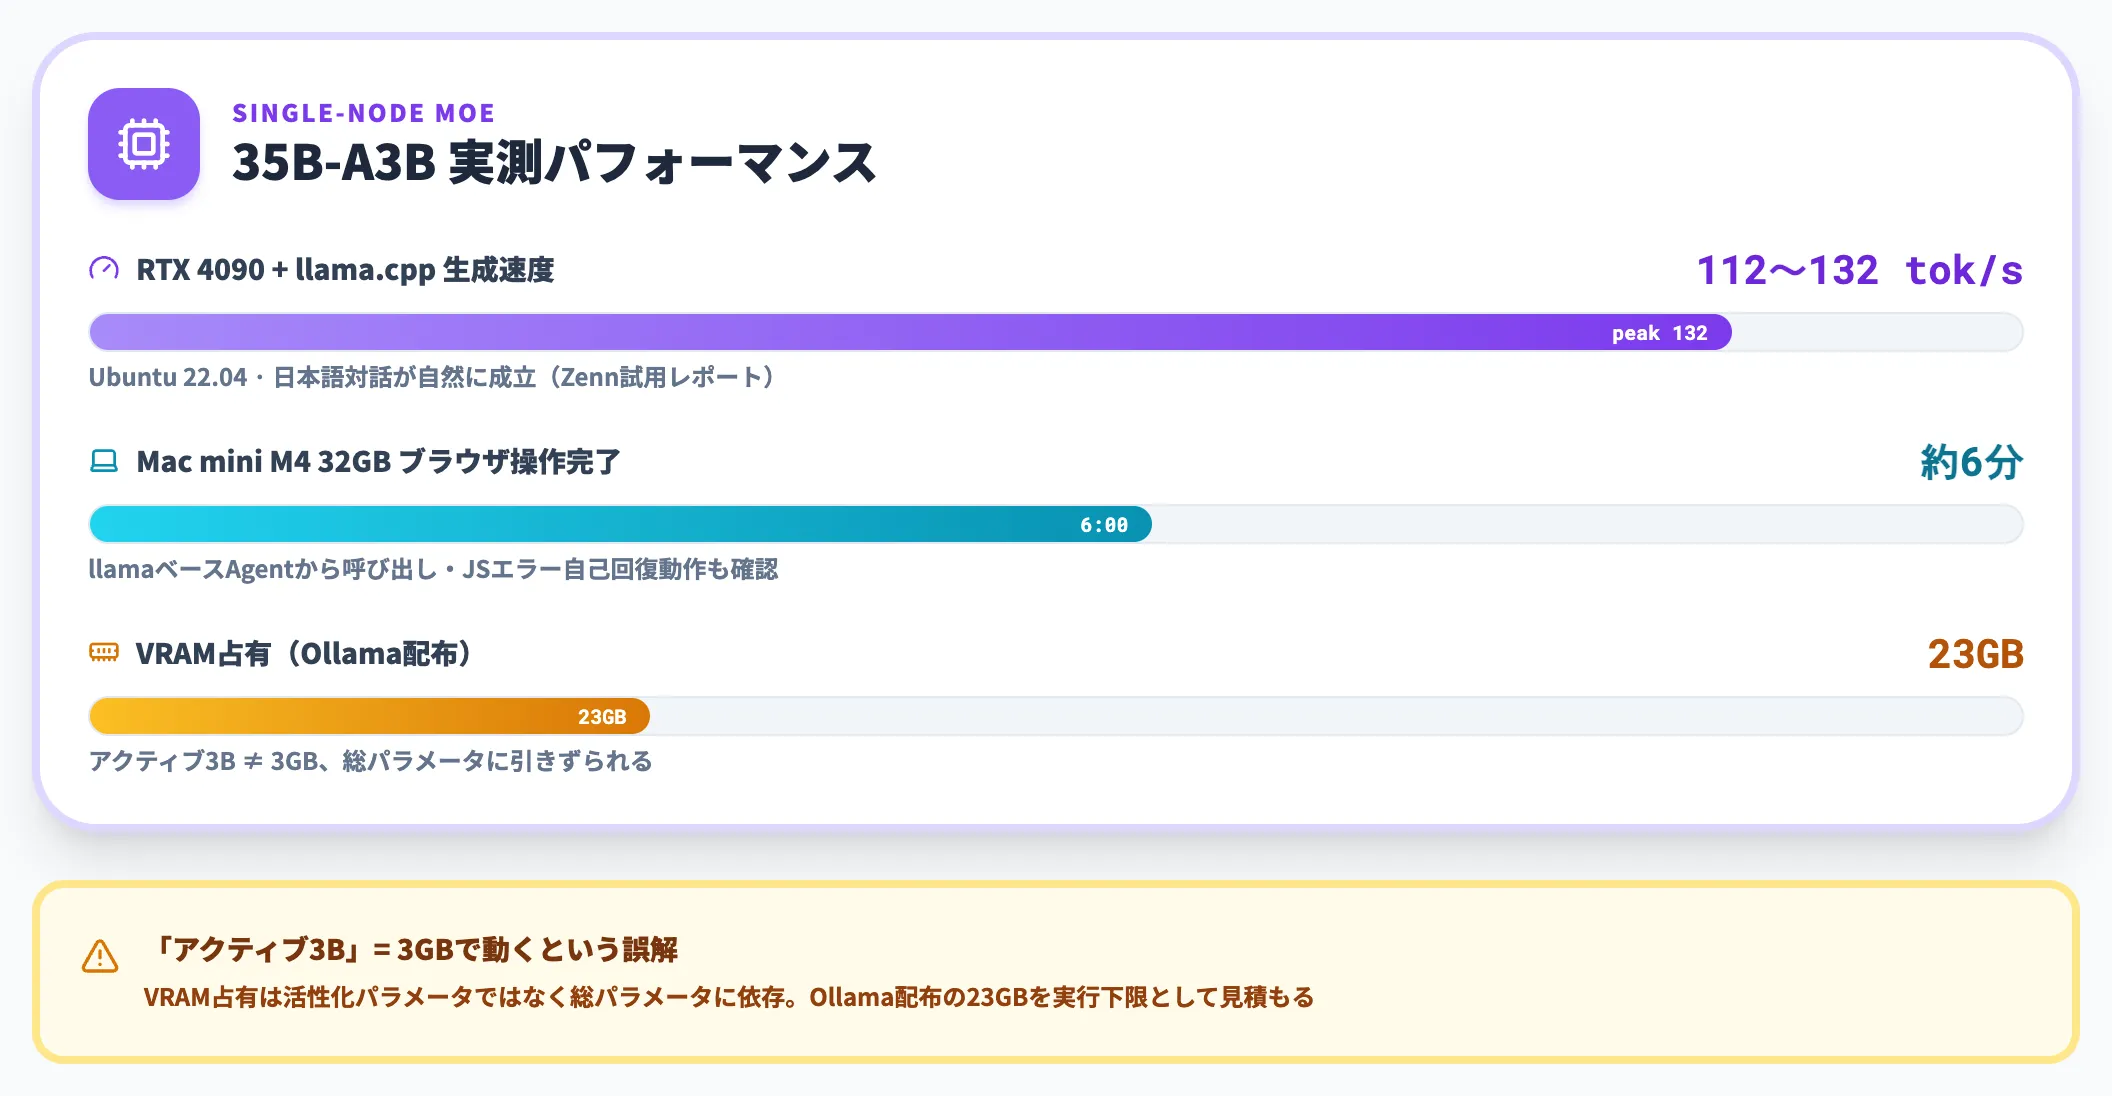
35B-A3B(Active 3B)は、アクティブパラメータを3B/tokenに抑えたMoE設計で、単一マシン2枚差しGPU(80GB×2)で運用できます。
Zennの試用レポートでは、Ubuntu 22.04 + RTX 4090 でllama.cppを介して動作させ、日本語対話も自然に成立したと報告されています。生成速度は小型モデルで112〜132トークン/秒に達しています。
Mac mini M4 32GBでの実行例では、35B-A3BをllamaベースのローカルAgentから呼び出し、ブラウザ操作タスクを約6分で完了できたという実測がnoteの検証記事で共有されています。JavaScriptエラー時に「同期処理で書き直します」と自己回復する動作も観察されており、単純な単発推論だけでなくエージェント文脈でも実用的に振る舞う印象です。
「アクティブ3B」=「3GBで動く」ではない点には注意が必要です。VRAM占有は活性化パラメータではなく総パラメータに引きずられるため、Ollama配布の23GBを実行に必要な下限として見ておくのが現実的です。
9B Dense・9B-Mobileのサイズ感
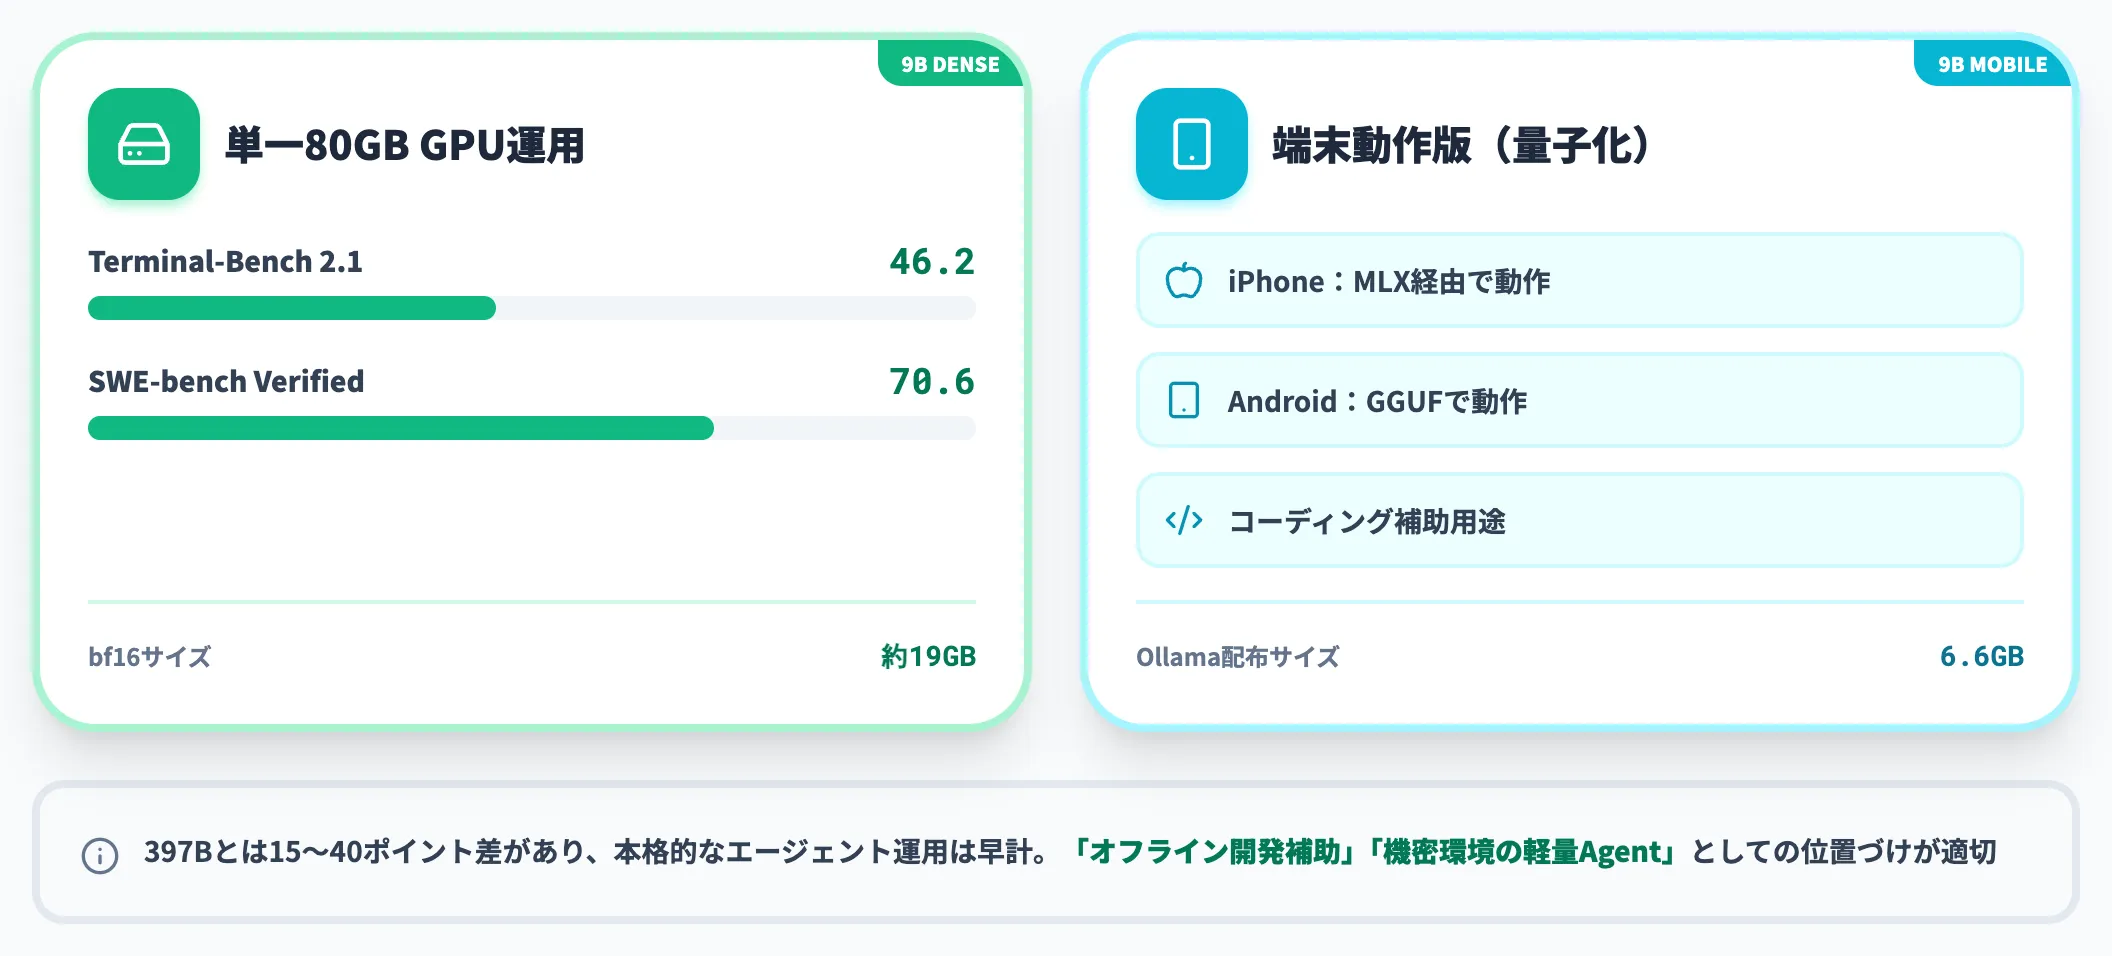
9B Denseモデルは、bf16で約19GB、単一80GB GPUで動作するサイズです。
DeepReinforceは同時にOrnith-1.5-9B-Mobileという量子化版をリリースしており、iPhone/Android上でGGUFまたはMLX経由で動かせることを公表しています。Ollama配布サイズは6.6GBで、日常的なコーディング補助用途ならエッジ推論に載る規模感です。
ベンチマーク単独で見ると9BはTerminal-Bench 2.1 (Terminus-2)で46.2、SWE-bench Verifiedで70.6のスコアで、同サイズ帯のオープンモデルと比較しても上位に位置します。
ただしフラッグシップの397Bとは、同指標で15〜40ポイント幅の差があり、本格的なエージェント運用に9B単体を据えるのは早計です。「オフライン開発補助用のローカルLLM」「機密データを外に出せない環境での軽量Agent」として位置づけると効きます。
自己改善ループの仕組み——タスク生成・スキャフォールド・ロールアウトを1つのループで最適化
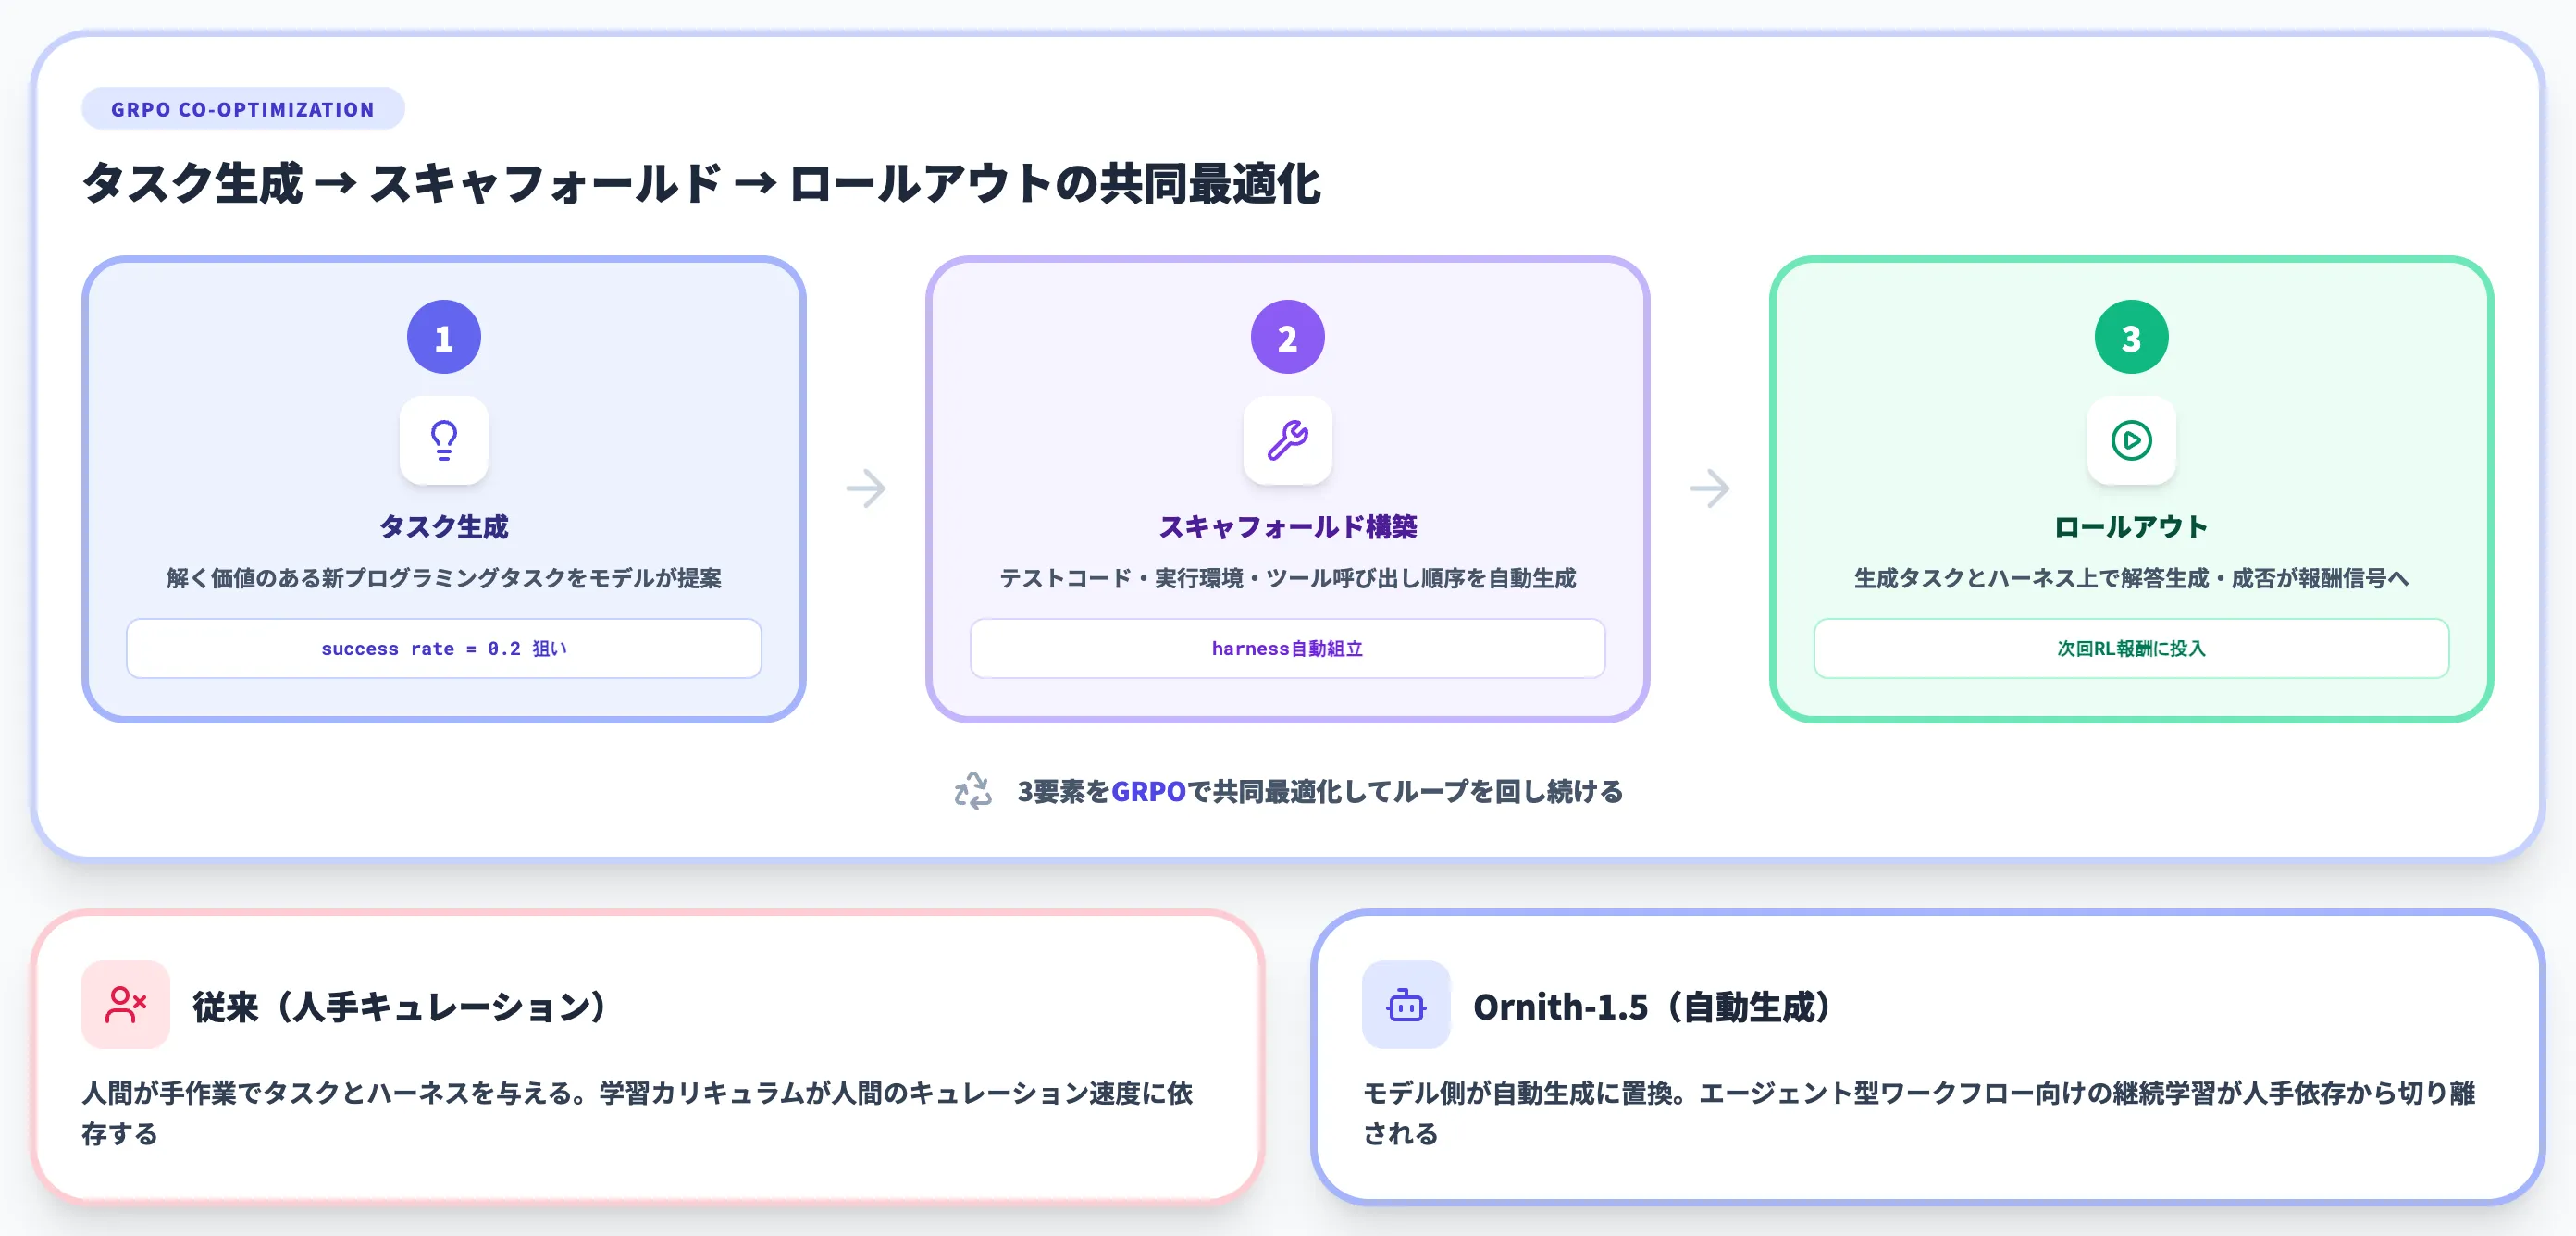
Ornith-1.5の最大の技術的アピールは、モデル自身が学習カリキュラムを書く「self-improvementループ」を製品として実装した点にあります。
このセクションでは、1.0との違い・報酬設計・自己生成タスクへの過学習リスクの3点を、公式ブログの内容に沿って整理します。
Ornith-1.0からのループ拡張
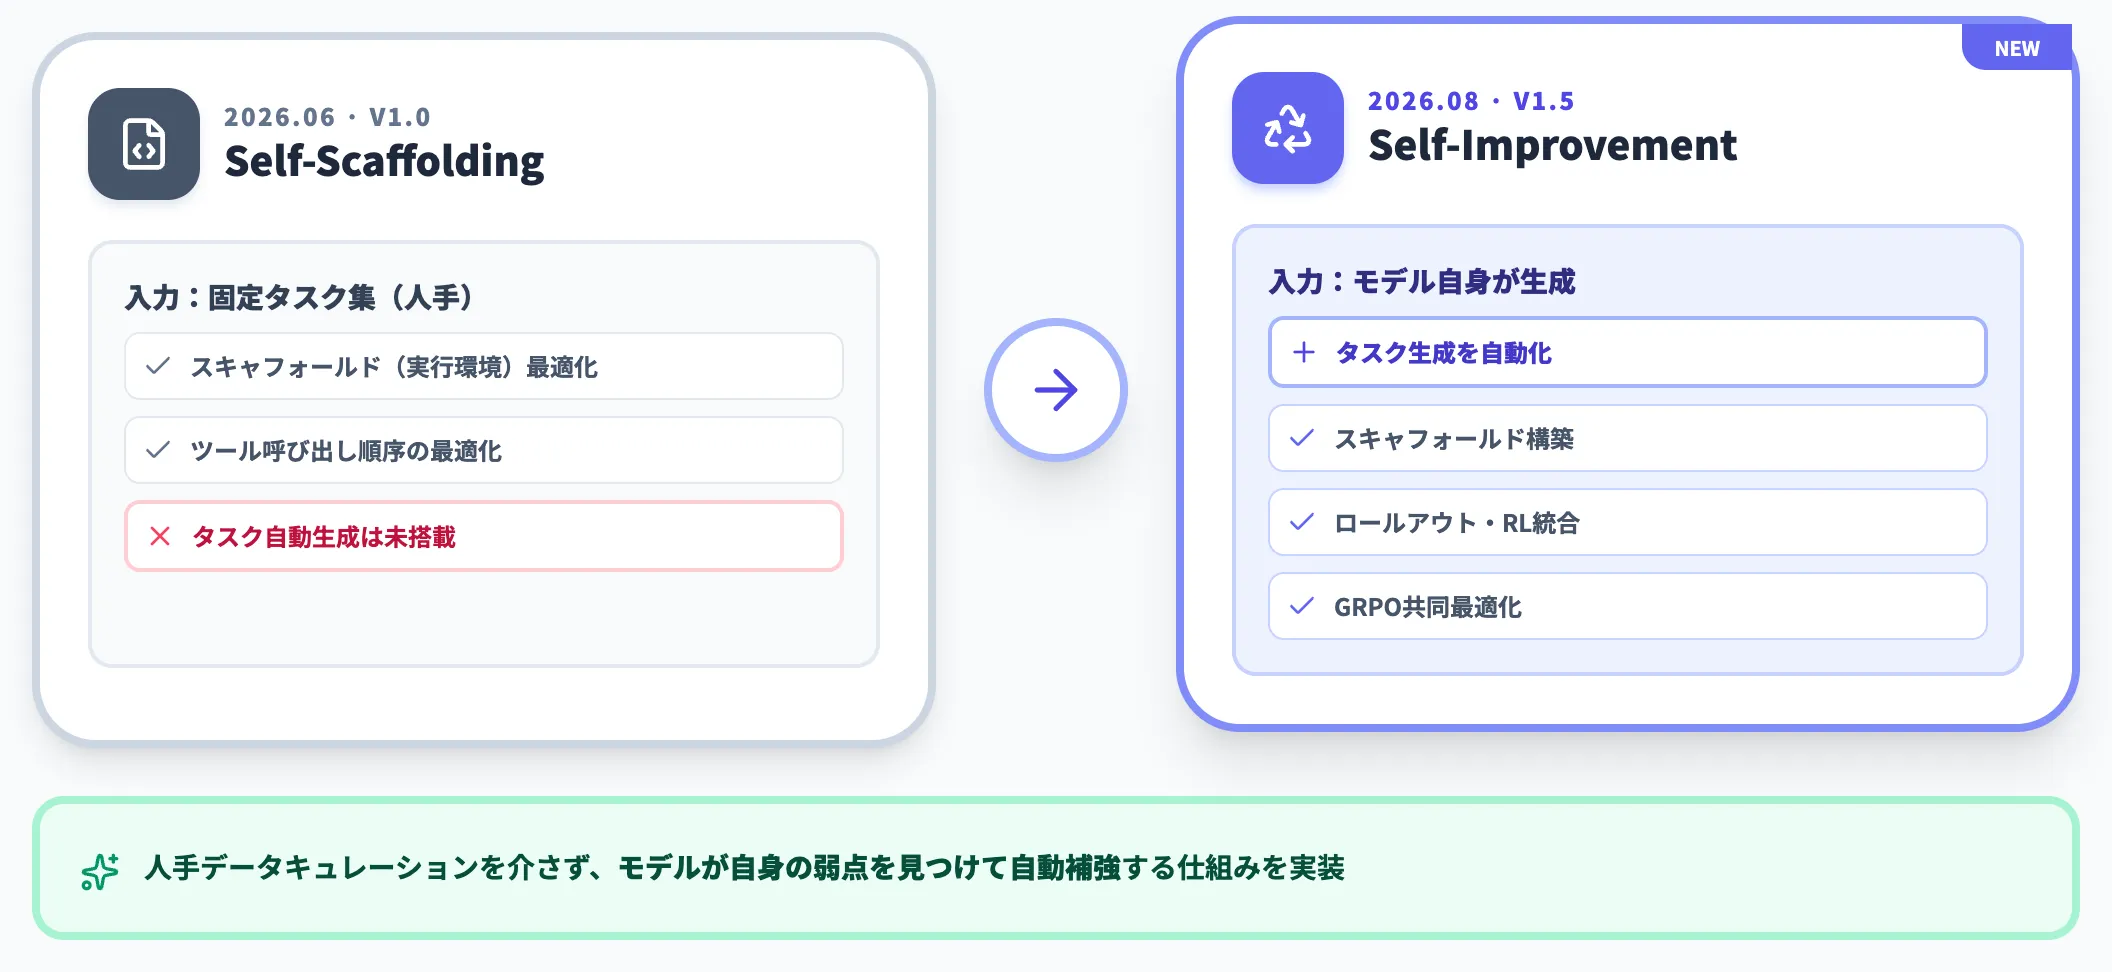
前世代のOrnith-1.0は、「人間が用意した固定タスク集」を前提に、モデルがそのタスクを解くためのスキャフォールド(実行環境・ツール呼び出し)を最適化するアプローチでした。
Ornith-1.5では、この枠を外し、モデル自身が新しい学習タスクを提案する段階から自動化しています。DeepReinforceの公式ブログによれば、self-improvementループは以下の3要素をGRPO(Group Relative Policy Optimization)で共同最適化する形で構成されます。
-
タスク生成
モデルが「解く価値のある新しいプログラミングタスク」を自ら提案する。難易度は経験的成功率0.2(=frontier difficulty)を狙って調整される
-
スキャフォールド構築
提案されたタスクを検証するためのハーネス(テストコード・実行環境・ツール呼び出し順序)をモデルが自動生成する
-
ソリューションロールアウト
生成されたタスクとハーネス上で、モデルが実際に解答を生成し、その成否が次の強化学習ラウンドの報酬信号になる
このループが回り続けることで、人手のデータキュレーションを介さずに、モデルが自身の弱点に該当するタスクを見つけて自動的に補強していく仕組みが成立します。
報酬設計——妥当性 × 難易度 × 新規性の掛け算
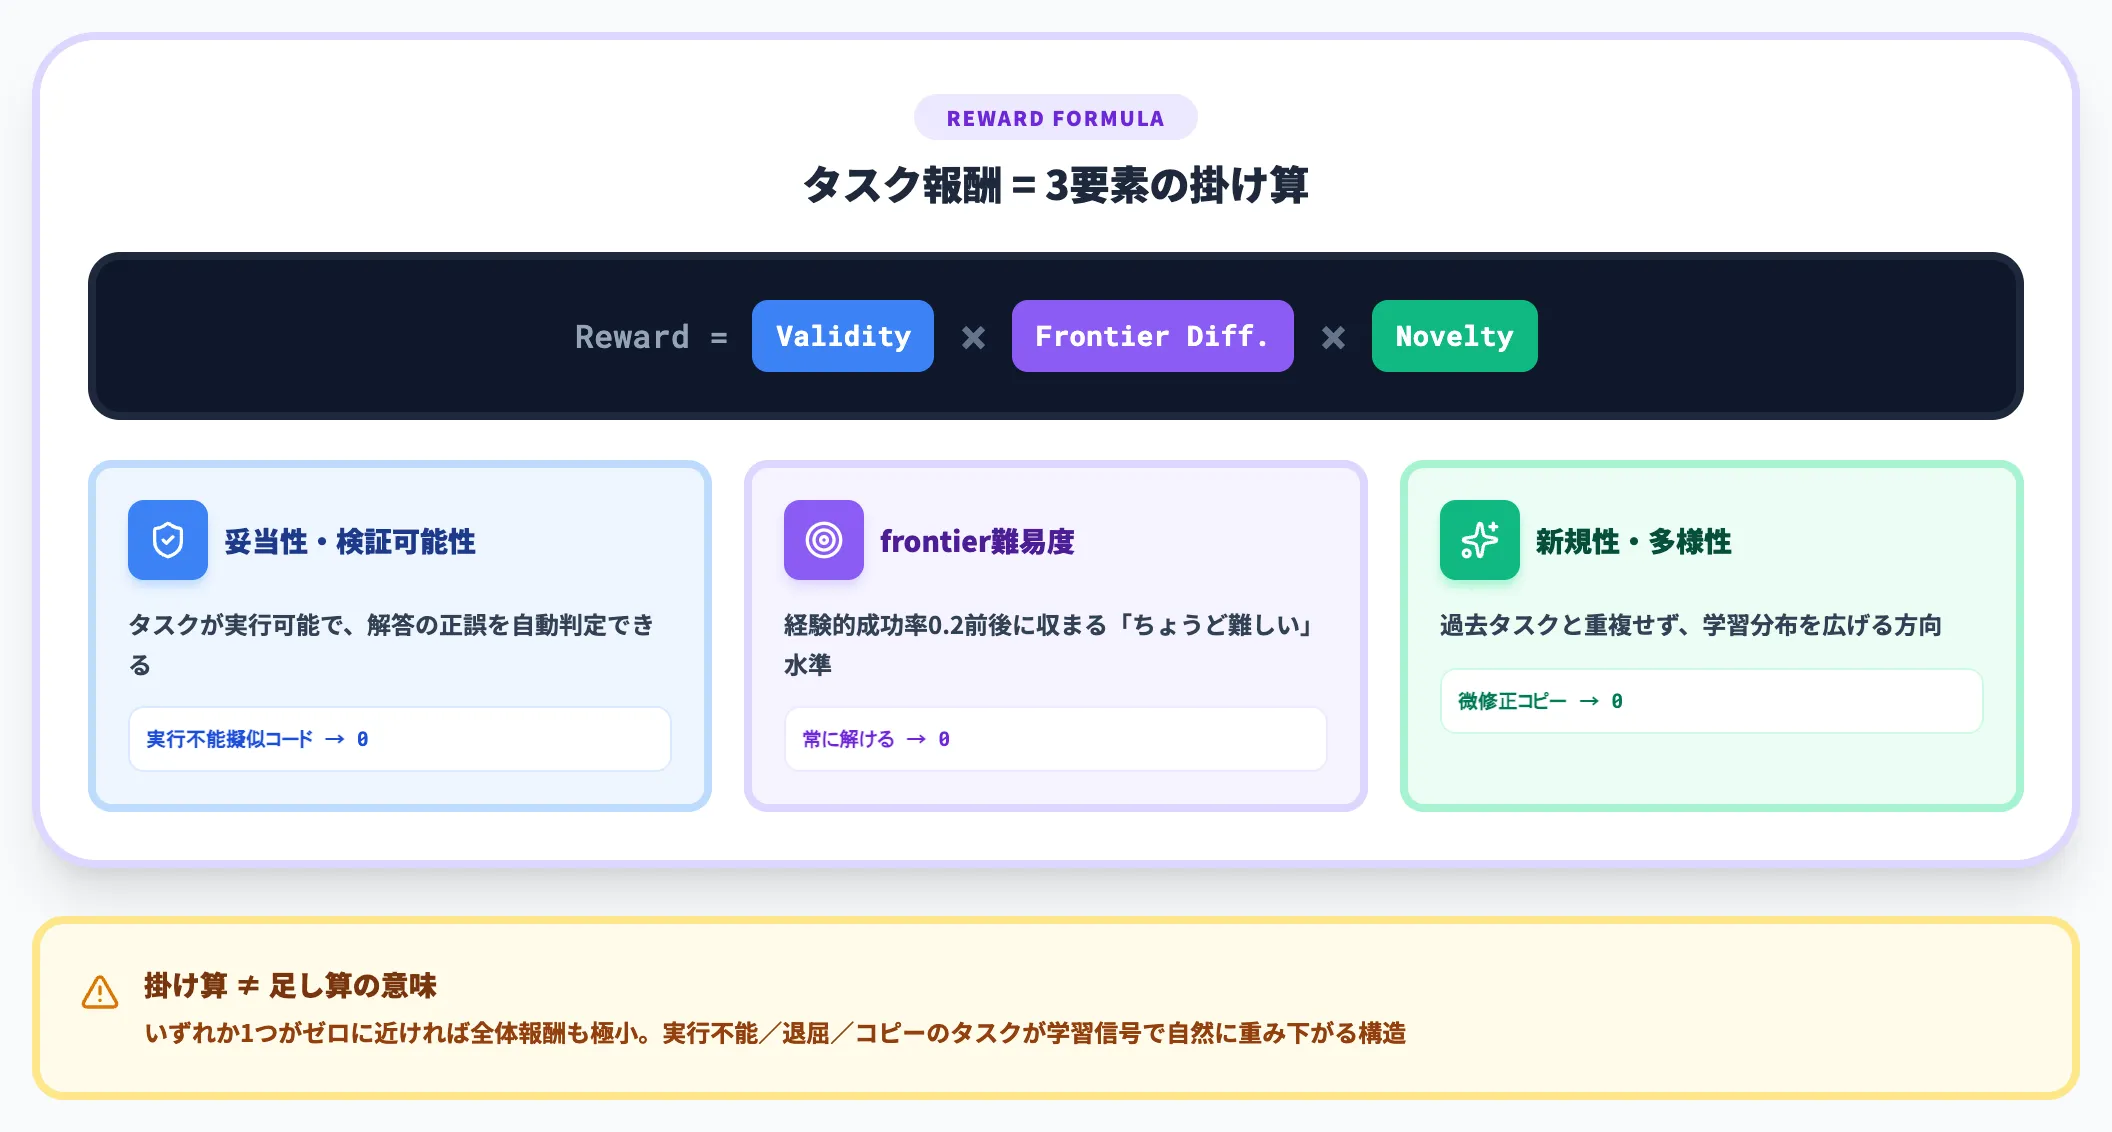
自己改善ループが健全に働くための鍵は、タスク報酬の設計にあります。Ornith-1.5は、生成されたタスクを以下3要素の掛け算で評価する構造を採用しています。
-
妥当性・検証可能性(Validity and Verifiability)
生成されたタスクが実行可能で、解答の正誤を自動判定できること
-
frontier難易度(Frontier Difficulty)
経験的成功率が0.2前後に収まる、モデルにとって「ちょうど難しい」水準であること
-
新規性・多様性(Novelty and Diversity)
過去に生成したタスクと重複せず、学習分布を広げる方向のものであること
3要素が足し算ではなく掛け算になっている点が重要で、いずれか1つがゼロに近ければ全体の報酬も極端に小さくなります。この設計により、「実行不能な擬似コード」「モデルが常に解ける退屈なタスク」「過去タスクの微修正コピー」は学習信号として弱く評価され、学習カリキュラムで相対的に重みが下がる構造になります。
自己生成タスクへの過学習リスク
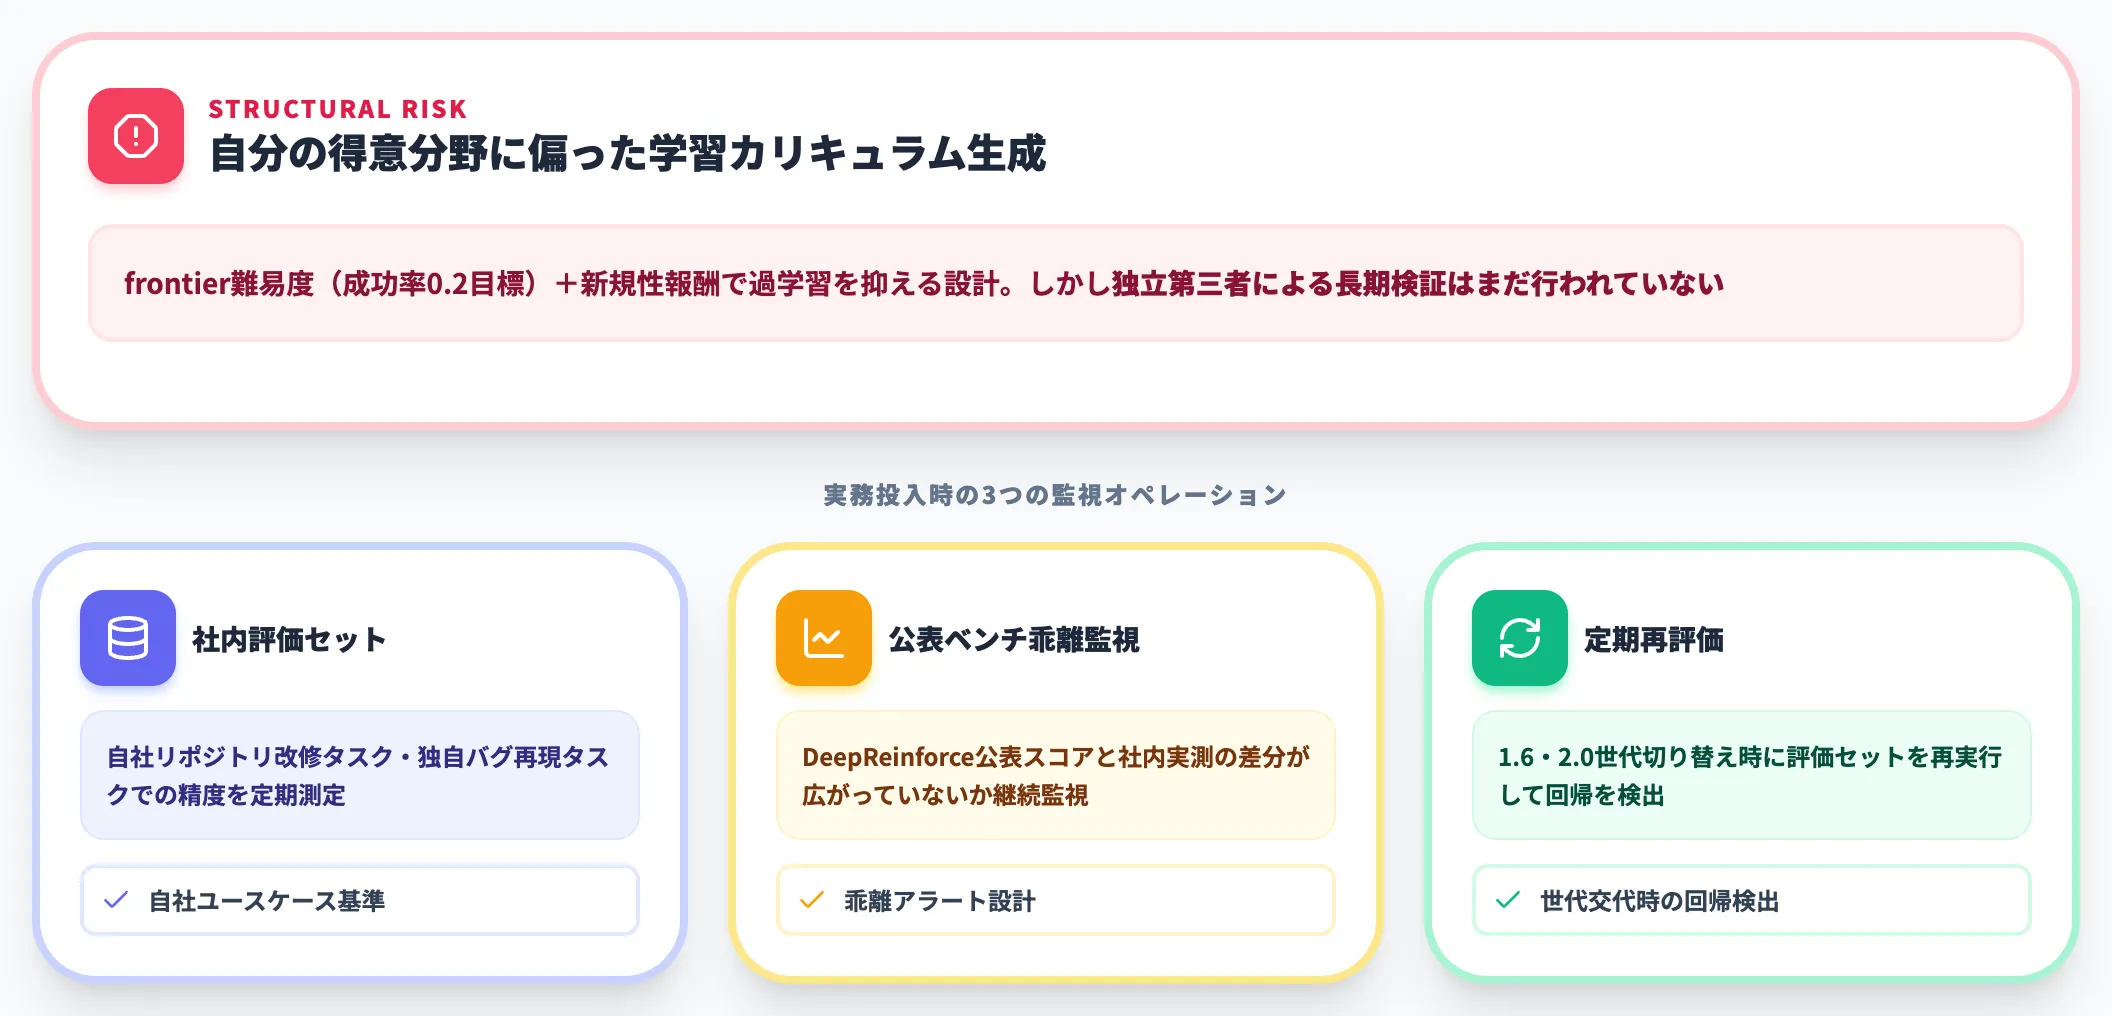
自己改善ループを継続的に回すと、モデルが自分の得意分野に偏った学習カリキュラムを生成し続けるリスクが構造上ついて回ります。
DeepReinforceは、frontier難易度(成功率0.2目標)と新規性報酬の組み合わせで過学習を抑える設計にしていると説明していますが、独立第三者による長期的な検証はまだ行われていません。
実務投入時は、社内評価セット(自社リポジトリの改修タスク・独自のバグ再現タスク)に対する精度を定期的に測り、公表ベンチとの乖離が広がっていないかを監視するオペレーションが必要になります。
「Claude Opus 4.8並み」の実像——17指標で分解する
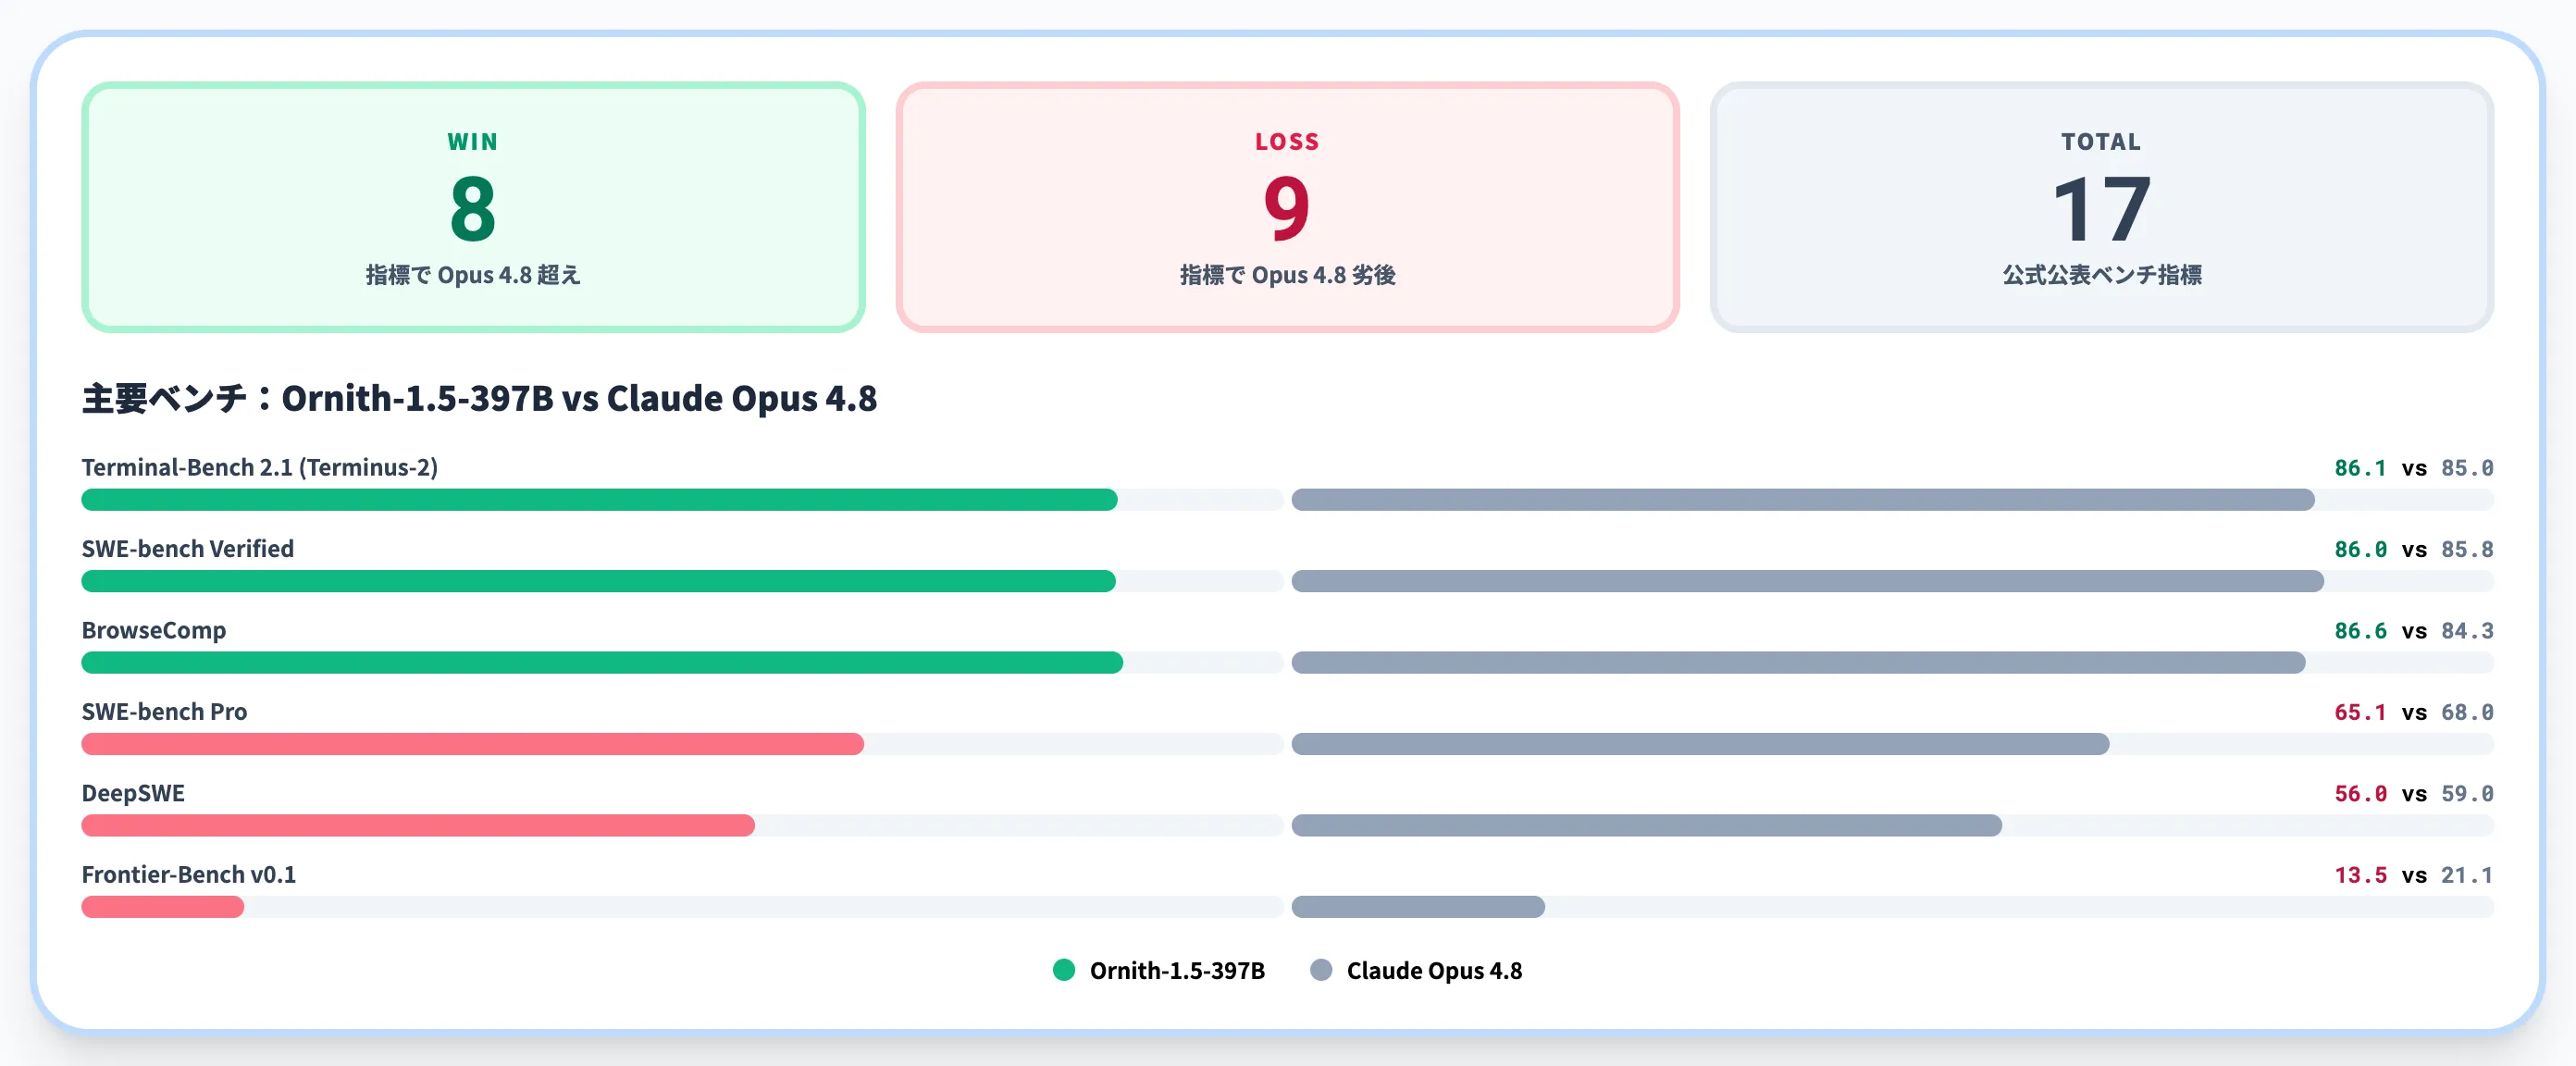
Ornith-1.5-397Bは「Claude Opus 4.8並み」を掲げていますが、実際にはベンチマークごとに勝ち負けが分かれており、単純な同水準ではありません。
このセクションでは、公式が公表している17指標を横並びで整理し、勝敗の構造を分解します。
397B vs Opus 4.8の勝ち・負け指標
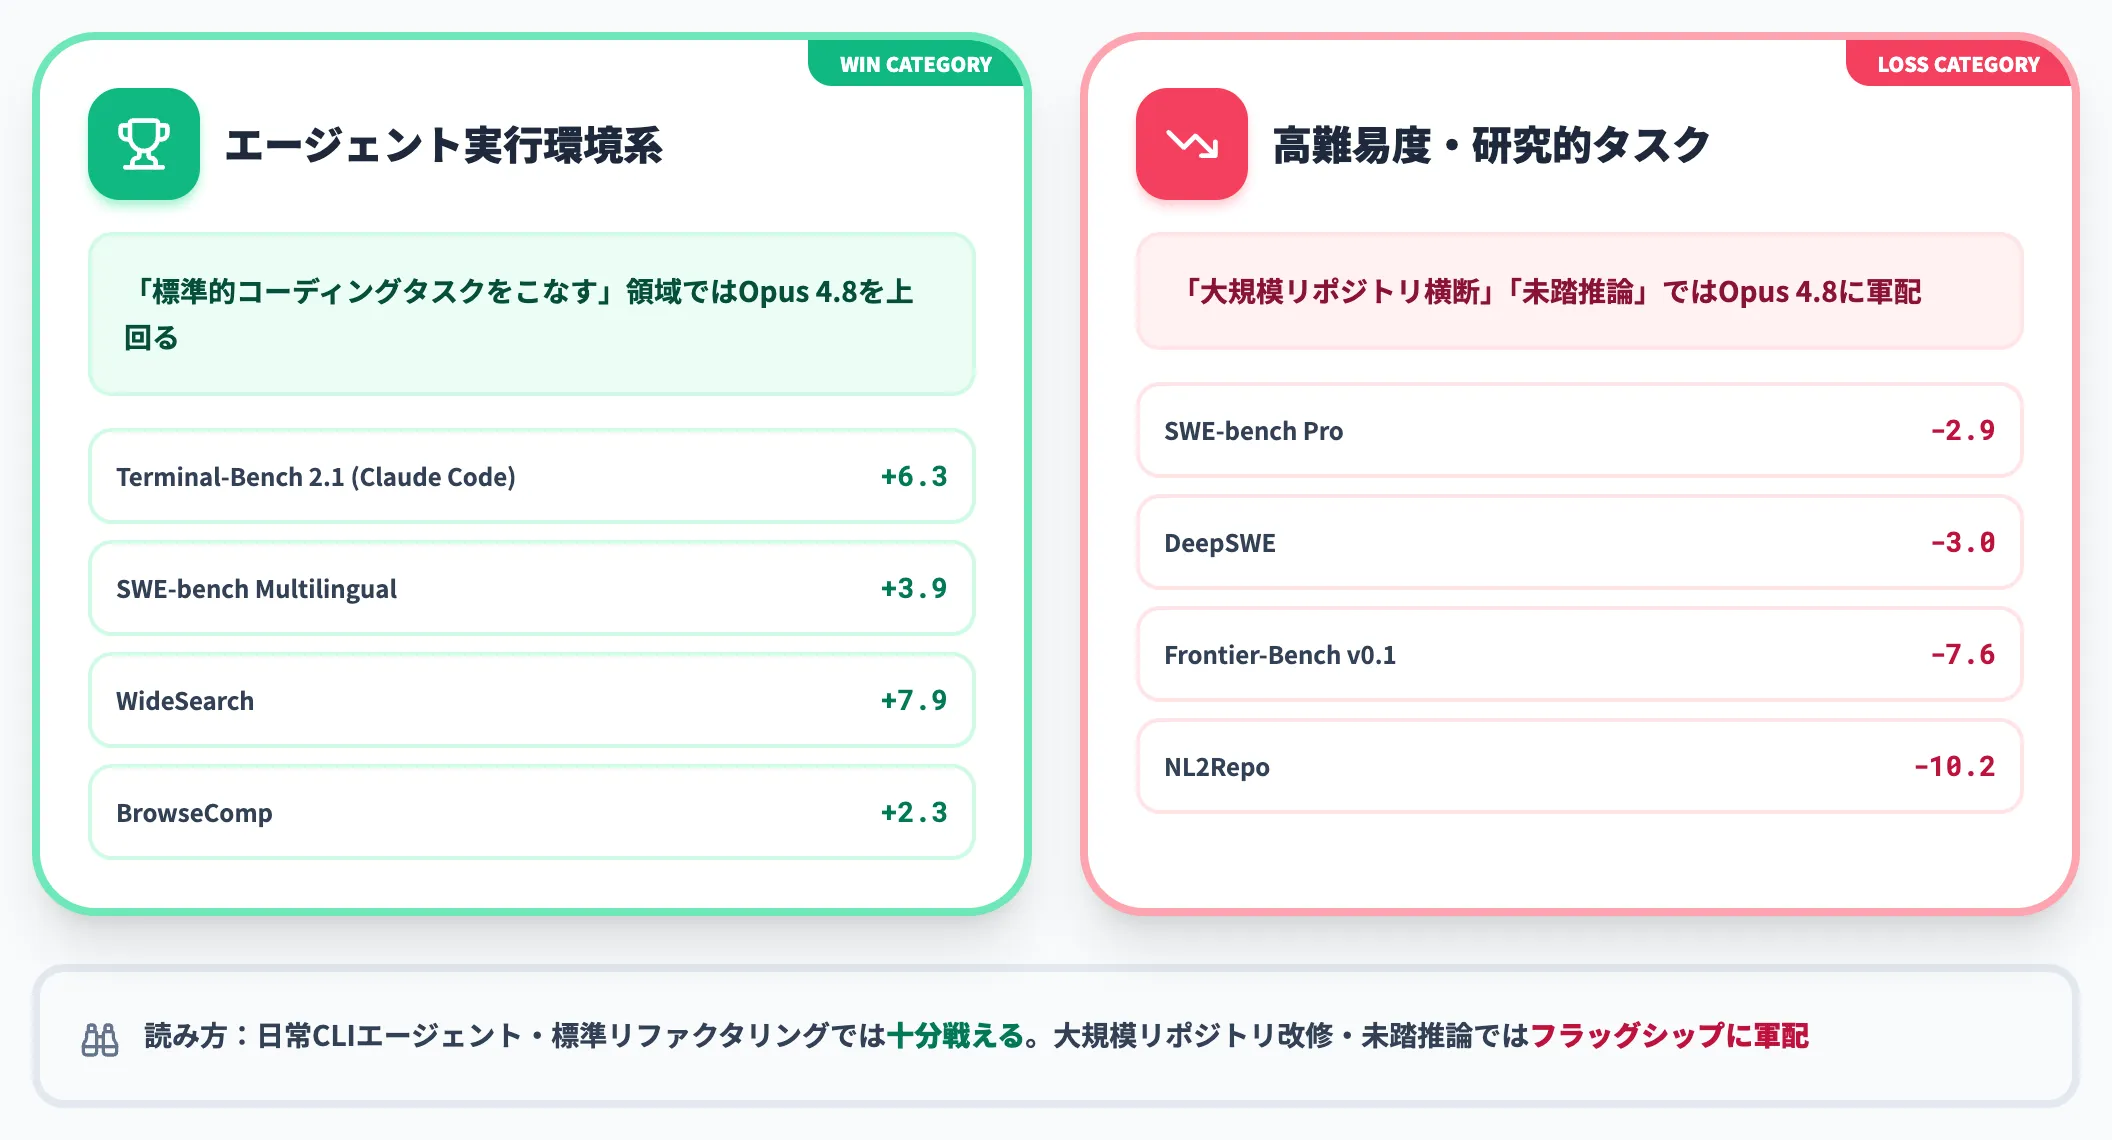
以下の表で、Ornith-1.5-397BとClaude Opus 4.8の主要ベンチマーク比較を整理しました。数値はすべてDeepReinforceの397Bモデルカードで公開されている自社評価値です。
| ベンチマーク | Ornith-1.5-397B | Claude Opus 4.8 | 勝敗 |
|---|---|---|---|
| Terminal-Bench 2.1 (Terminus-2) | 86.1 | 85.0 | 勝ち |
| Terminal-Bench 2.1 (Claude Code) | 85.2 | 78.9 | 勝ち |
| SWE-bench Verified | 86.0 | 85.8 | 勝ち |
| SWE-bench Pro | 65.1 | 68.0 | 負け |
| SWE-bench Multilingual | 79.6 | 75.7 | 勝ち |
| DeepSWE | 56.0 | 59.0 | 負け |
| Frontier-Bench v0.1 | 13.5 | 21.1 | 負け |
| NL2Repo | 59.5 | 69.7 | 負け |
| SWE Atlas - QnA | 55.6 | 59.7 | 負け |
| HLE (no tools) | 44.6 | 49.8 | 負け |
| HLE (with tools) | 56.1 | 57.9 | 負け |
| GPQA Diamond | 92.8 | 93.6 | 負け |
| MCP-Atlas | 80.0 | 82.2 | 負け |
| Toolathlon-Verified | 71.2 | 76.2 | 負け |
| WideSearch | 80.8 | 72.9 | 勝ち |
| BrowseComp | 86.6 | 84.3 | 勝ち |
| ClawEval | 81.4 | 80.2 | 勝ち |
この比較から分かるのは、Terminal-Bench系・SWE-bench Verified・ClawEvalなど「エージェント実行環境上で標準的なコーディングタスクをこなす」指標では優位、SWE-bench Pro・DeepSWE・Frontier-Bench・NL2Repoなど「難易度が高い実務コード改修や研究的タスク」ではOpus 4.8に劣後するという構造です。
Web情報探索を測るBrowseCompでも397Bが86.6と優位で、Web探索を含むエージェント用途での相対的な強みが見えます。実務観察としては、日常的なCLIエージェントや標準的なリファクタリングでは十分戦えるが、大規模リポジトリ横断のリファクタリングや未踏の推論タスクではフラッグシップに軍配、というのが正直な読み方です。
Kimi K3との位置関係
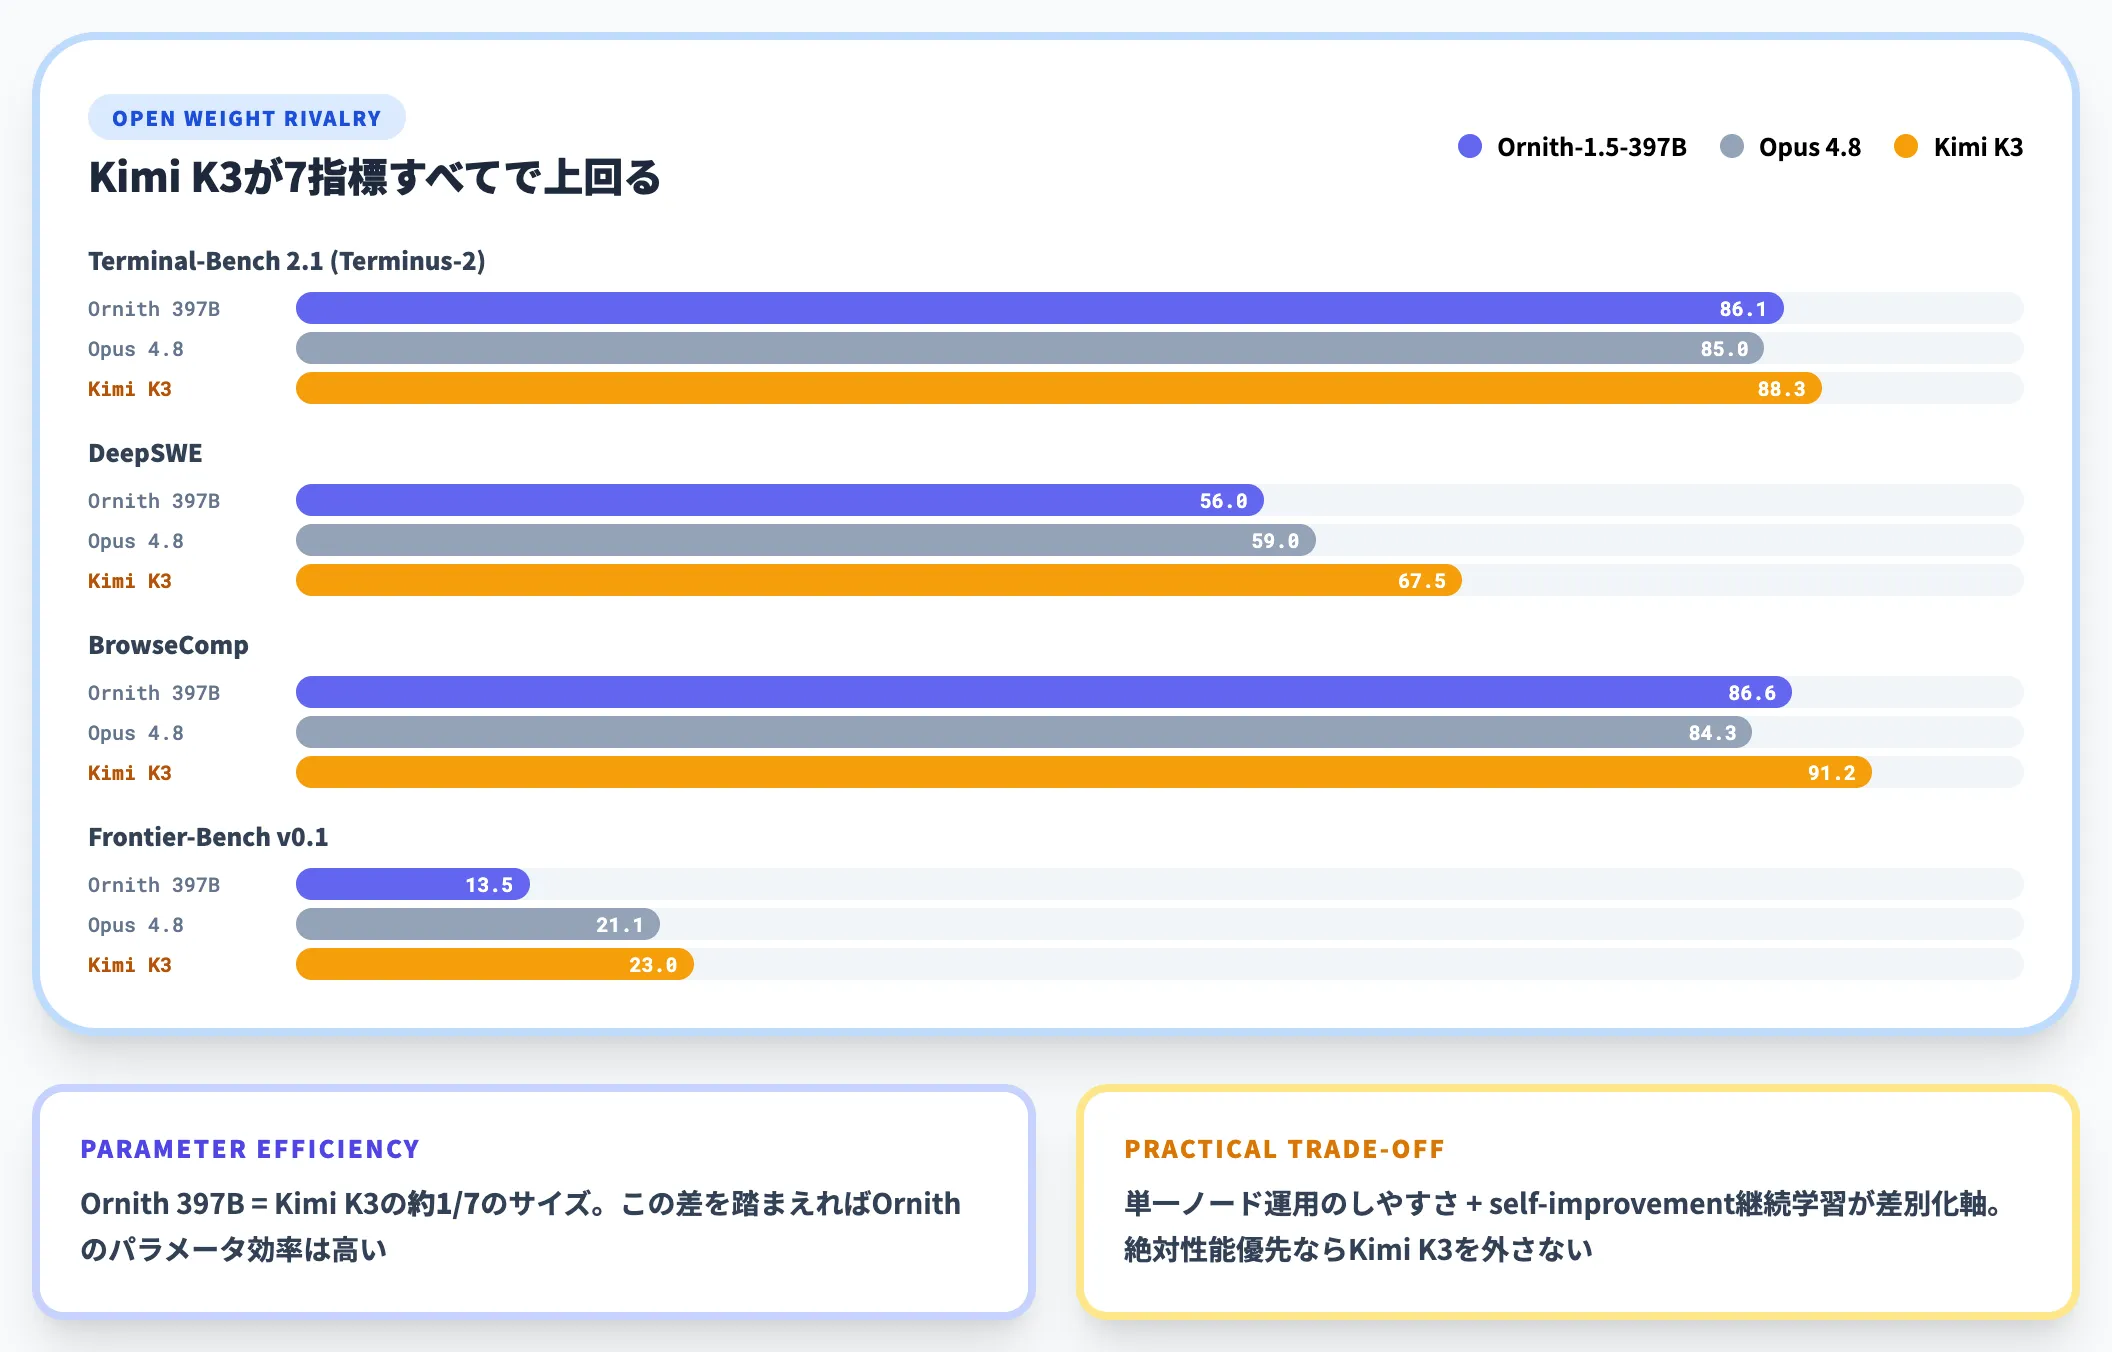
Ornith-1.5-397Bの評価をさらに難しくしているのが、同じくオープンウェイトのKimi K3(2.8T MoE、Moonshot AI)が多くの指標でOrnith-1.5を上回っているという事実です。
以下の表で、Ornith-1.5-397B・Claude Opus 4.8・Kimi K3の3者を並べます。
| ベンチマーク | Ornith-1.5-397B | Claude Opus 4.8 | Kimi K3 |
|---|---|---|---|
| Terminal-Bench 2.1 (Terminus-2) | 86.1 | 85.0 | 88.3 |
| SWE-bench Verified | 86.0 | 85.8 | 86.2 |
| DeepSWE | 56.0 | 59.0 | 67.5 |
| Frontier-Bench v0.1 | 13.5 | 21.1 | 23.0 |
| GPQA Diamond | 92.8 | 93.6 | 93.5 |
| MCP-Atlas | 80.0 | 82.2 | 82.3 |
| BrowseComp | 86.6 | 84.3 | 91.2 |
Kimi K3はOrnith-1.5-397Bを、掲載した7指標すべてで上回っています。特にTerminal-Bench 2.1・DeepSWE・Frontier-Bench・BrowseCompでは2.2〜11.5ポイント差がつき、公式スコアだけを横並びで見ればKimi K3の方が総合点で前に出る構造です。
Ornith-1.5-397Bの397Bというサイズは、Kimi K3の2.8Tと比較すればおよそ1/7の規模で、この差を考慮すればOrnith側のパラメータ効率は高いと言えます。Kimi K3との差別化はself-improvementループの学習継続性と、単一ノード運用に収めやすいサイズ感の2点で、絶対性能を優先するなら競合を評価対象から外すのは早計です。
自社評価の再現性——第三者検証はまだ揃っていない
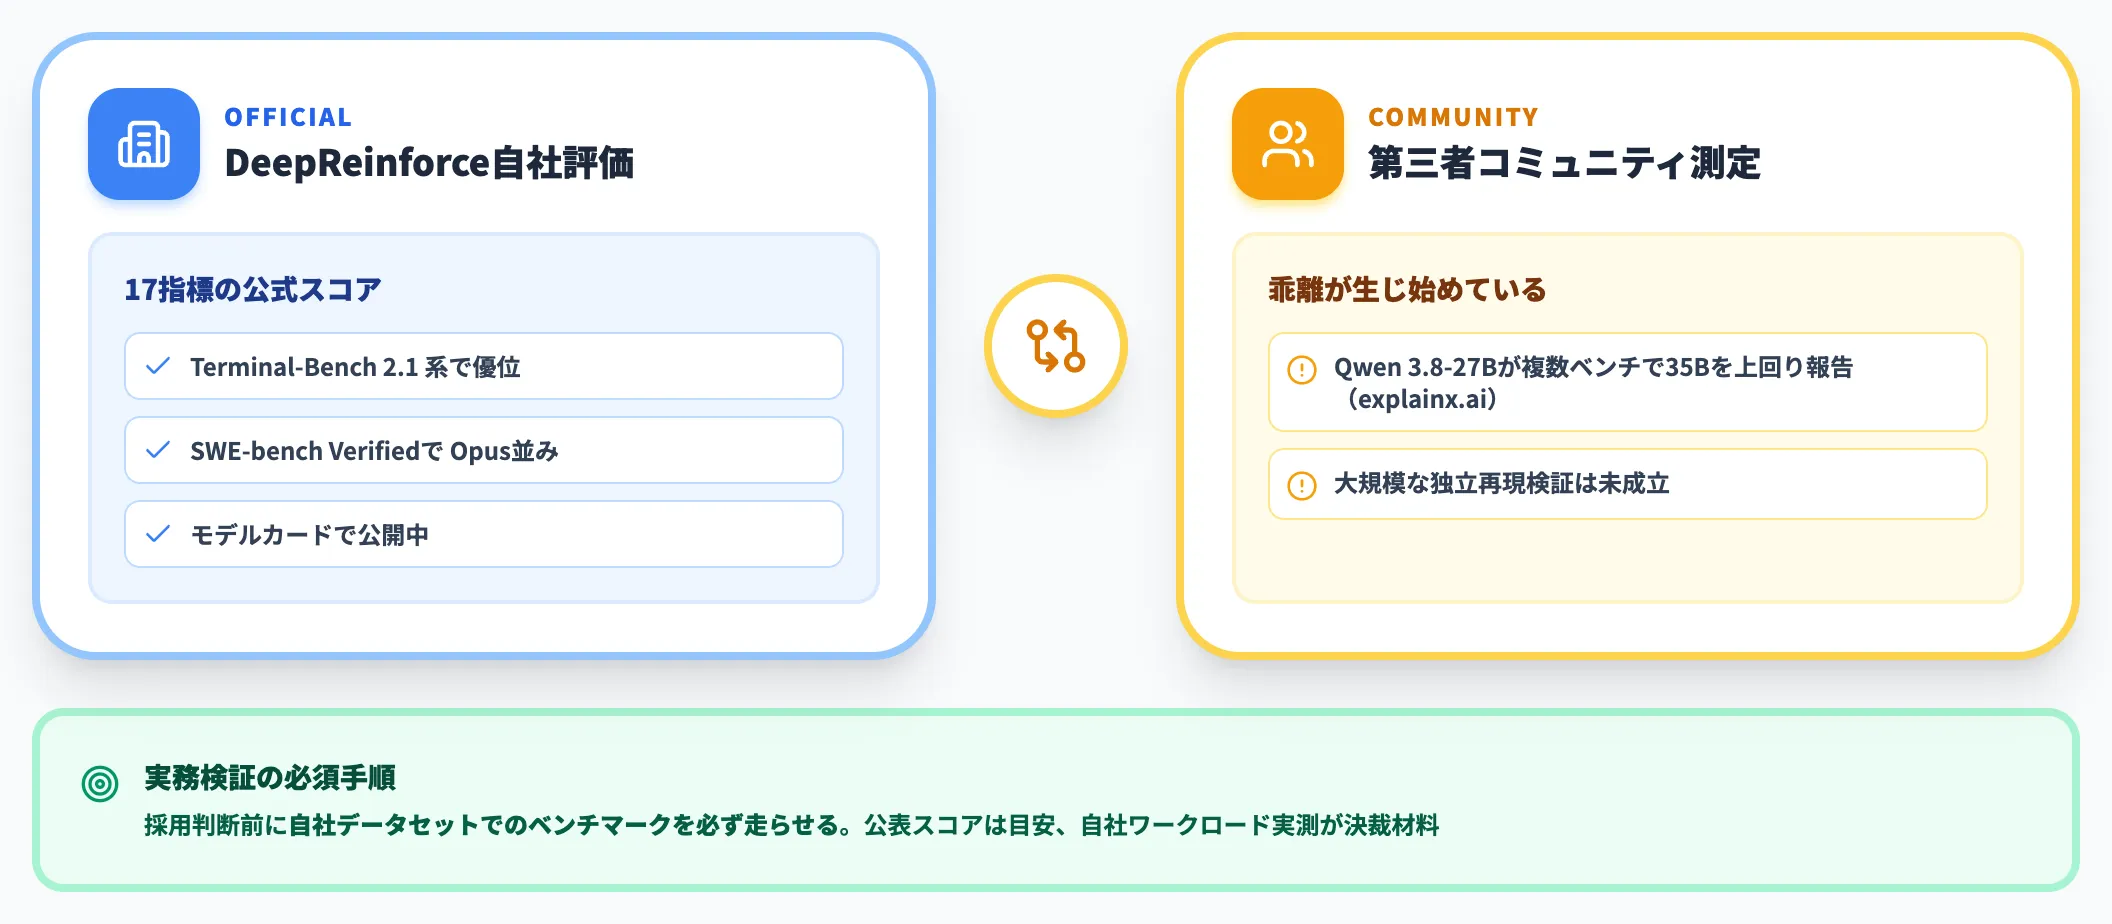
上記のスコアはすべてDeepReinforce自身が公表している自社評価値であり、独立した第三者による大規模な再現検証はまだ揃っていません。
explainx.aiの検証記事では「Qwen 3.8-27Bが複数ベンチマークでOrnith-1.5-35Bを上回った」というコミュニティ報告に触れており、公表ベンチと独立測定の間に乖離が生じ始めていることを示唆しています。実務検証にあたっては、自社データセットでのベンチマークを必ず走らせてから採用判断に入るべきです。
GLM-5.2・DeepSeek V4・Kimi K3との比較——オープンウェイト内の立ち位置
Ornith-1.5がクローズド系フロンティアと比較してどうか、という論点と別に、オープンウェイト同士でどのポジションにあるかを整理しておくことも実務判断で欠かせません。
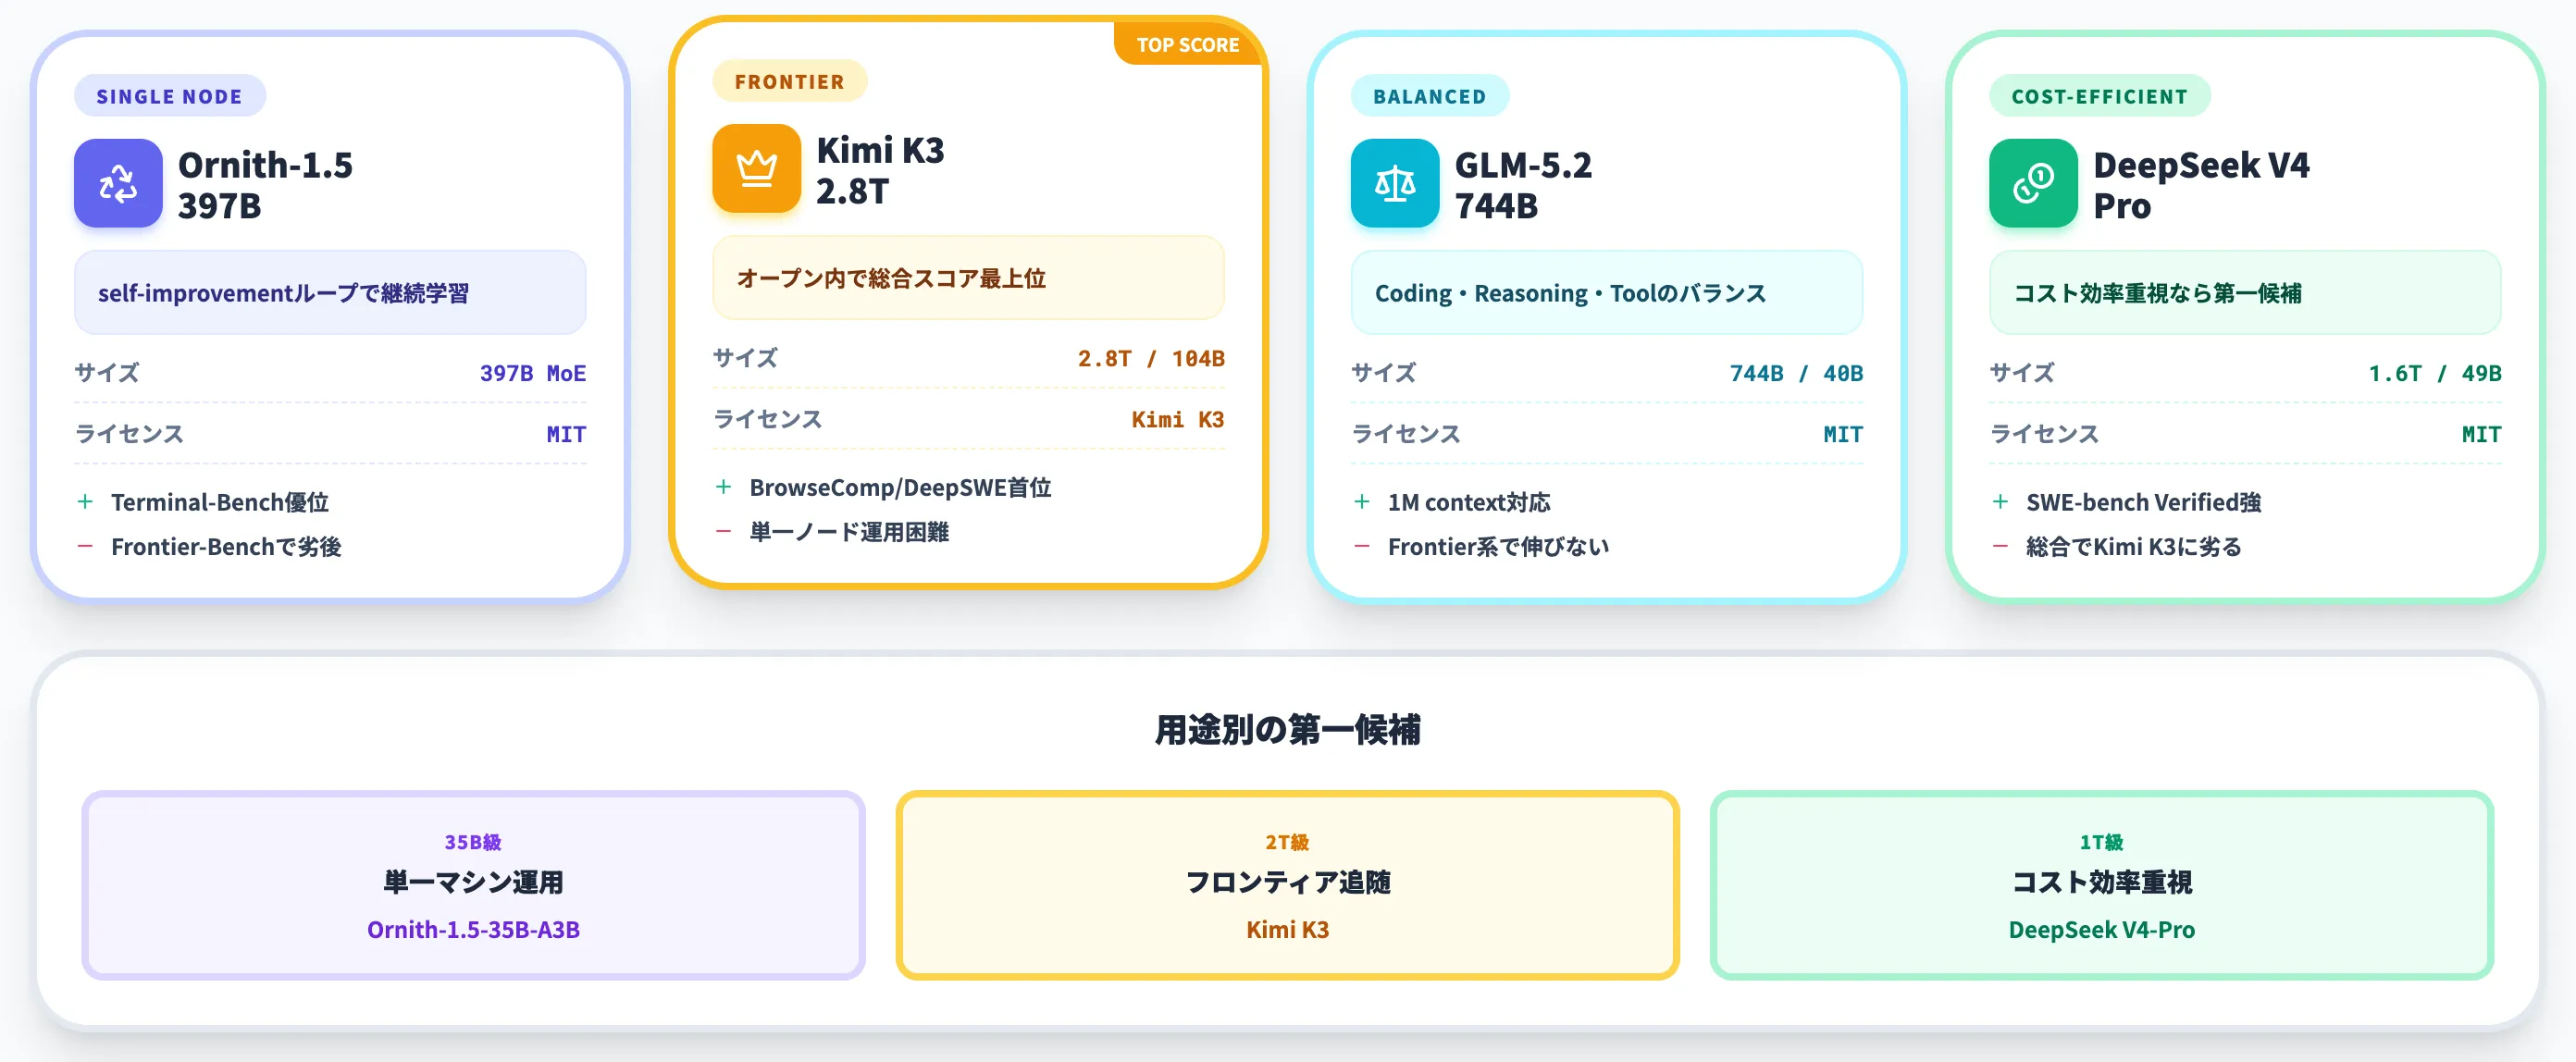
以下の表で、2026年8月時点で主要な選択肢となるオープンウェイトLLMを、規模・ライセンス・強みの軸で比較します。
| モデル | 総パラメータ | アクティブ | ライセンス | 強み | 弱み |
|---|---|---|---|---|---|
| Ornith-1.5-397B | 397B (MoE) | 非公開 | MIT | Terminal-Bench 2.1・self-improvementループ | Frontier-Bench・DeepSWEで負け、Kimi K3に多くで劣後 |
| Kimi K3 | 2.8T (MoE) | 104B | Kimi K3 License | 総合性能・BrowseComp・DeepSWE | サイズが大きく単一ノード運用しづらい |
| GLM-5.2 | 744B (MoE) | 40B | MIT | Coding/Reasoning/Agentic Tool-useのバランス、1M context | Frontier-Bench等でスコアが伸びない |
| DeepSeek V4-Pro | 1.6T (MoE) | 49B | MIT | コスト効率、SWE-bench Verified | 総合スコアはKimi K3・Ornithに一歩譲る |
| Ornith-1.0 | 9B〜397B | 対応 | MIT | 前世代・実装リファレンス | 1.5でself-improvementループが完成、旧版扱い |
実務で選ぶ際のポイントは、用途を「単一マシンで動く35B級」「複数GPU構成での397B〜1T級」「フロンティア追随の2T級」の3層に分けて考えることです。
単一マシン運用ならOrnith-1.5-35B-A3B、フロンティア追随ならKimi K3、コスト効率重視ならDeepSeek V4-Proが第一候補となります。
Ornith-1.5の独自の強みは、self-improvementループの継続学習を前提にしている点にあります。
今後の1.6・2.0世代でこのループがどこまで自動的に性能を押し上げるかによって、他のオープンウェイトとの差が広がる可能性はあります。逆に、現時点の絶対性能だけを比較するなら、必ずしも第一候補にはなりません。
開発元DeepReinforceの背景——CUDA最適化からLLMへ
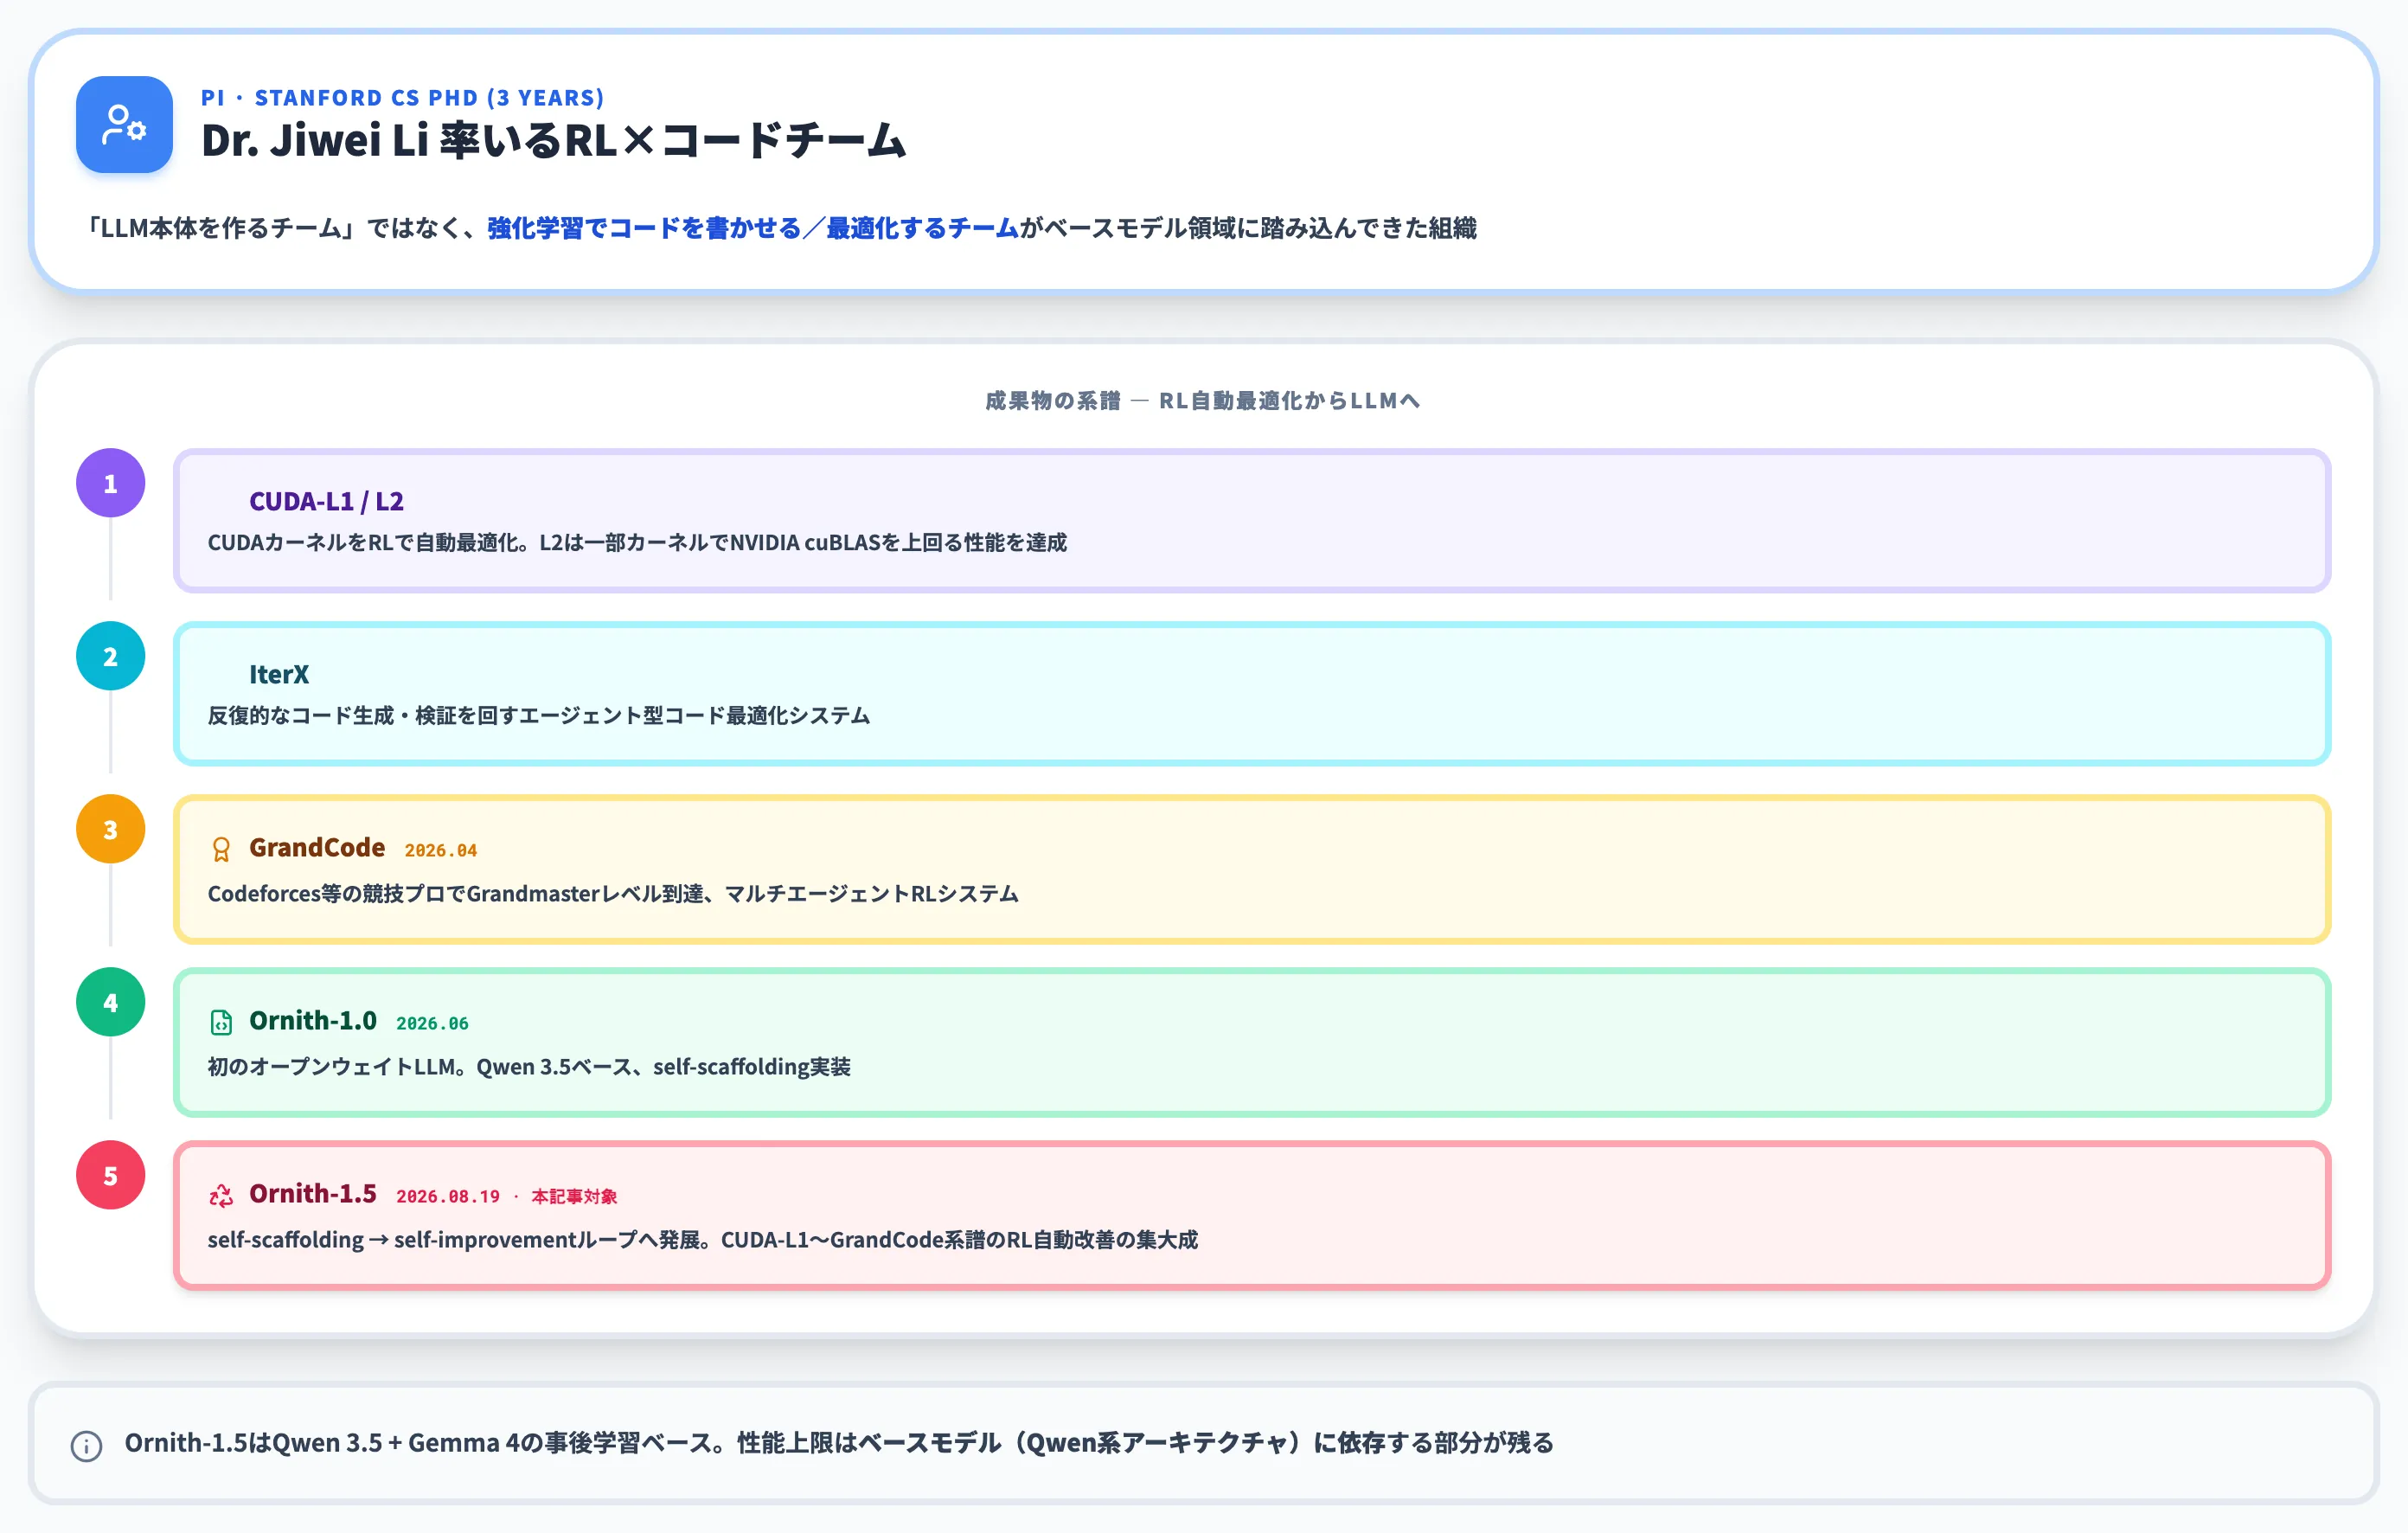
Ornith-1.5を評価するうえで、開発元のDeepReinforceがどのような組織かを押さえておくと、モデルの技術的方向性が読み解きやすくなります。
DeepReinforceは、Stanford Computer ScienceのPhDを3年で取得したDr. Jiwei Liが率いるAI研究組織で、Ornithシリーズ以前から強化学習を軸としたコード最適化領域で複数の成果を出してきました。
-
CUDA-L1・CUDA-L2
CUDAカーネルを強化学習で自動最適化するフレームワーク。手作業のCUDAチューニングをRLで置き換えるアプローチで、CUDA-L2は一部カーネルでNVIDIAのcuBLASを上回る性能を達成したと公表されている
-
IterX
反復的なコード生成・検証を回すエージェント型のコード最適化システム
-
GrandCode
2026年4月に発表された、Codeforces等の競技プログラミングでGrandmasterレベルに到達したマルチエージェント強化学習システム
-
Ornith-1.0
2026年6月にリリースされたDeepReinforce初のオープンウェイトLLM。Qwen 3.5をベースにself-scaffoldingを実装
-
Ornith-1.5
2026年8月19日リリース。1.0のself-scaffoldingからself-improvementループへ発展
つまりDeepReinforceは、「LLM本体を作るチーム」というよりも「強化学習でコードを書かせる/最適化するチーム」がベースモデル領域に踏み込んできた組織として位置づけられます。
この背景を踏まえると、Ornith-1.5のself-improvementループが単発の実験ではなく、CUDA-L1やIterXから続く「コード生成タスクをRLで自動改善する」路線の集大成であることが理解できます。
同時に、Ornith-1.5はQwen 3.5 + Gemma 4という既存オープンウェイトを土台に、事後学習と自己改善ループで差分を作る戦略を採っています。この構造がある限り、Ornith-1.5の性能上限はベースモデル(Qwen系のアーキテクチャ)に依存する部分が残ります。
Ornith-1.5の導入方法と実行環境
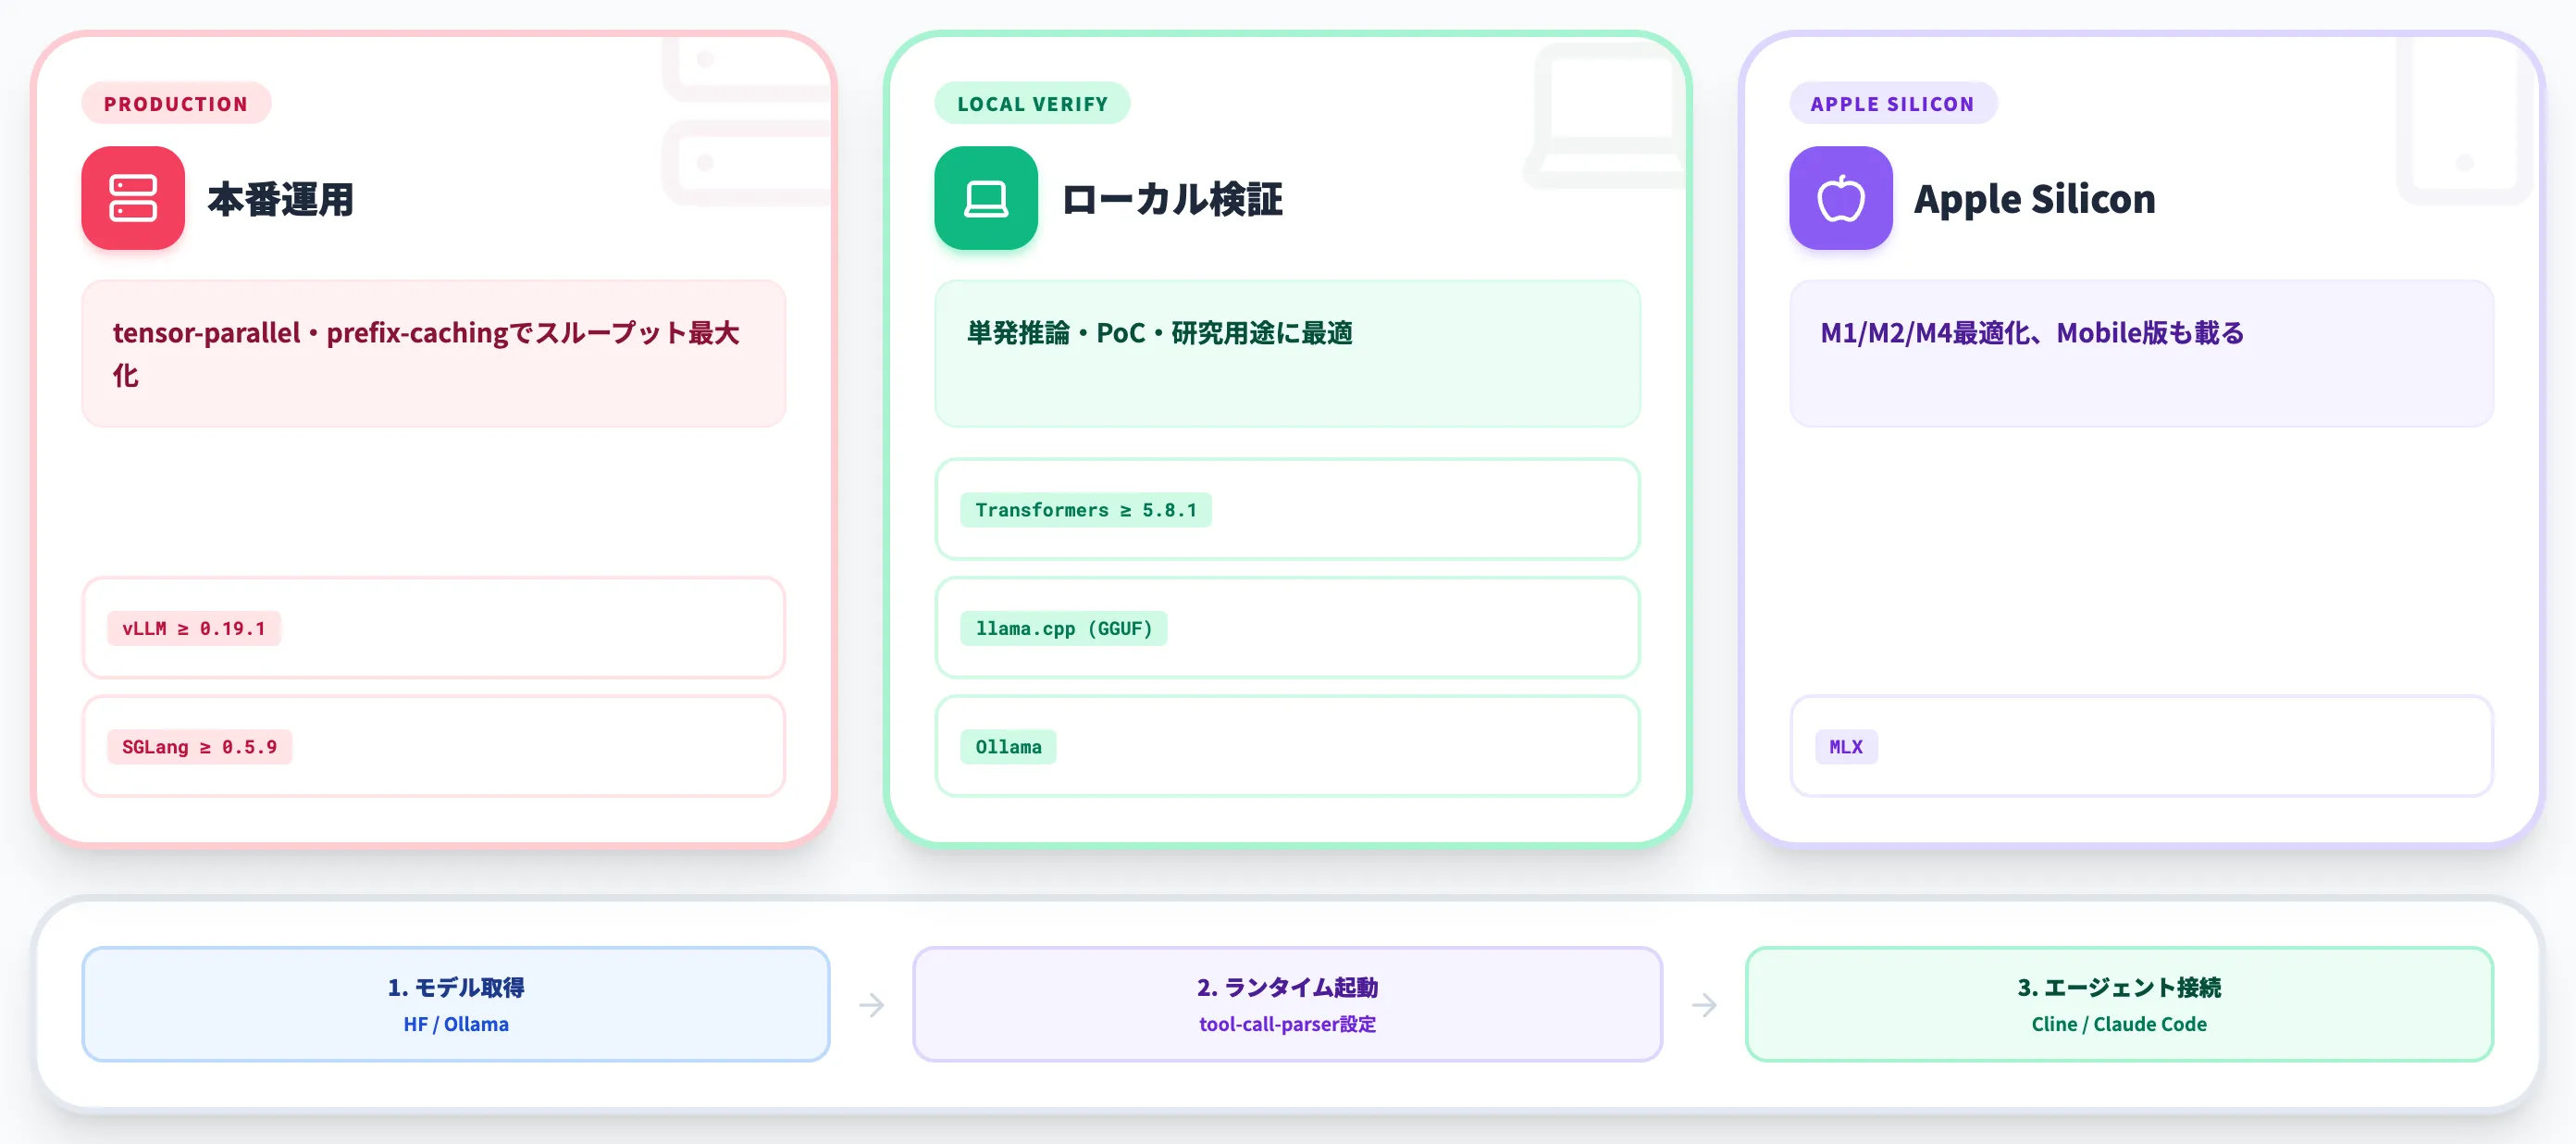
Ornith-1.5は複数の推論ランタイムに公式対応しており、規模と用途に応じて選択肢が用意されています。
このセクションでは、代表的な起動手順と、既存のエージェントツールへの組み込み方を整理します。
対応ランタイムとバージョン要件
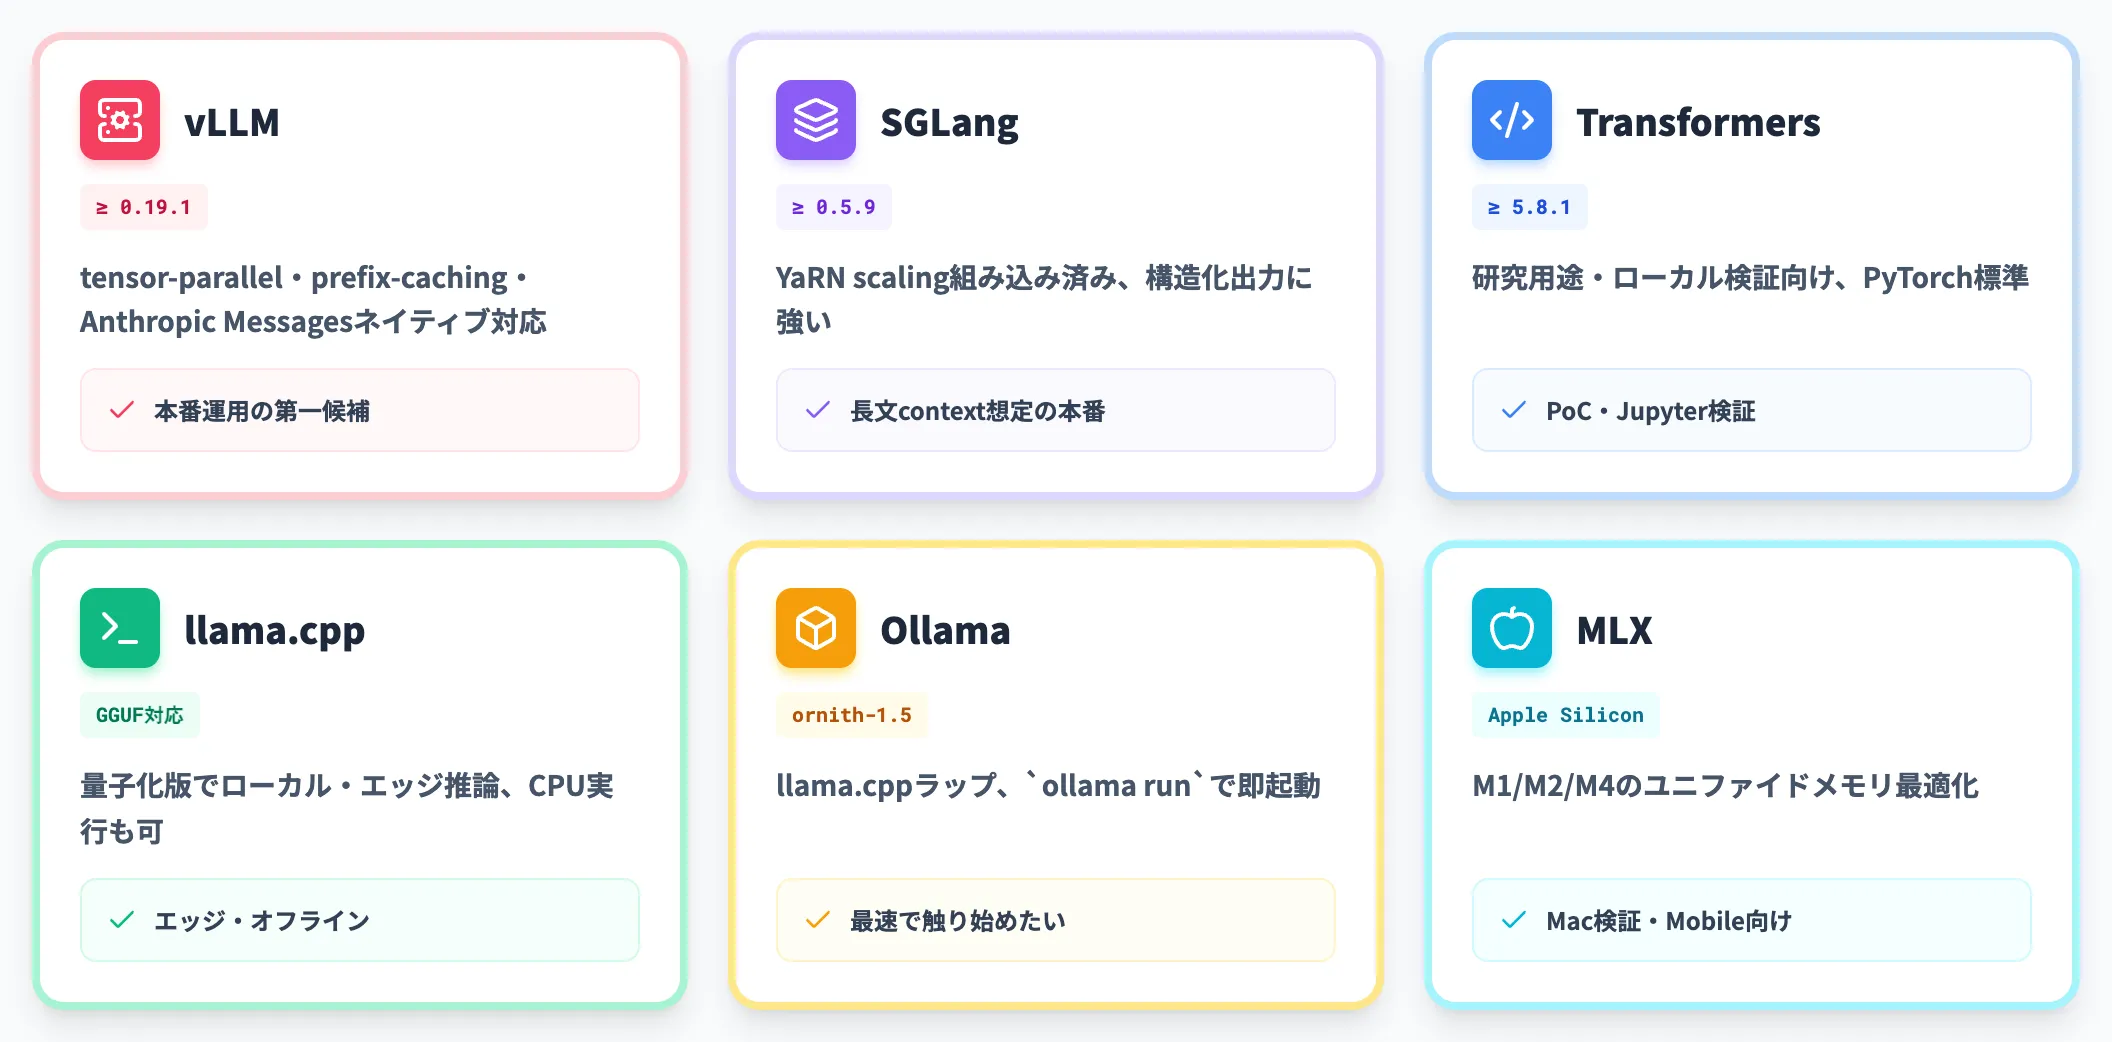
Ornith-1.5は以下のランタイムで動作確認されています。バージョン要件は公式モデルカードに従うのが安全です。
- vLLM ≥ 0.19.1(tensor-parallel・prefix-caching対応)
- SGLang ≥ 0.5.9(YaRN組み込み済み)
- Transformers ≥ 5.8.1(研究・ローカル検証用途)
- llama.cpp(GGUF量子化版・ローカル/エッジ推論)
- Ollama(llama.cppラップ・簡易起動)
- MLX(Apple Silicon最適化)
これらのうち、本番運用ならvLLMまたはSGLang、ローカル検証ならHugging Face TransformersかOllama、Apple Silicon利用ならMLXという使い分けが典型です。
vLLMでの起動例(35B-A3B)
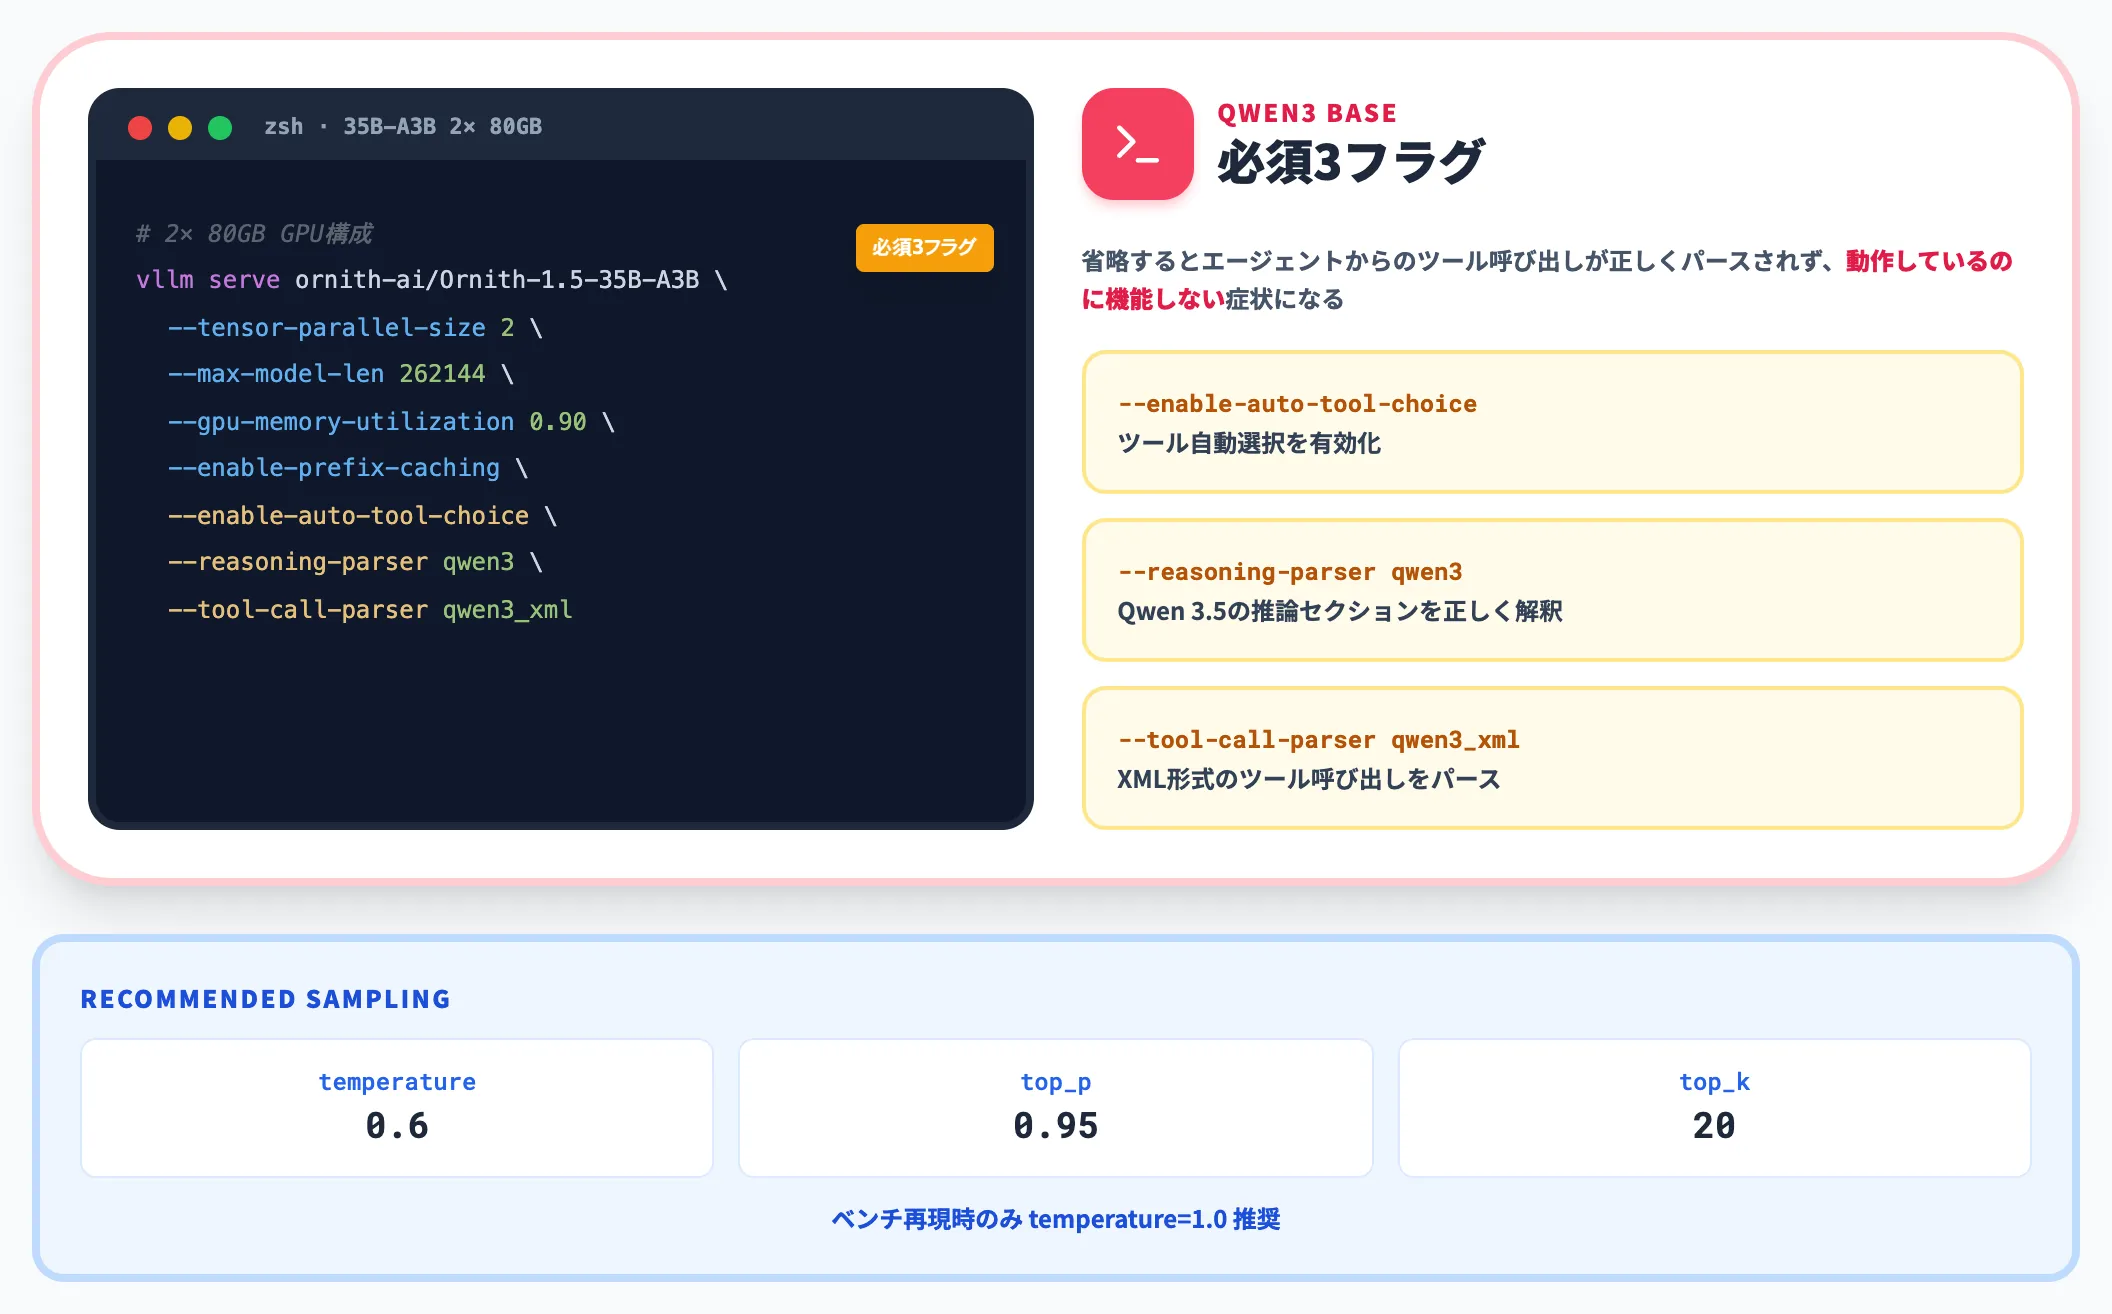
35B-A3Bを2×80GB GPU構成で起動する場合、公式モデルカードでは以下のコマンドが提示されています。
vllm serve ornith-ai/Ornith-1.5-35B-A3B \
    --tensor-parallel-size 2 \
    --max-model-len 262144 \
    --gpu-memory-utilization 0.90 \
    --enable-prefix-caching \
    --enable-auto-tool-choice \
    --reasoning-parser qwen3 \
    --tool-call-parser qwen3_xml
--enable-auto-tool-choice・--reasoning-parser qwen3・--tool-call-parser qwen3_xml の3つが、Qwen 3.5ベースの推論とツール自動選択・呼び出しパースを正しく機能させるために必要です。
これらを省略するとエージェントからのツール呼び出しがうまく処理できず、動作しているのに機能しないような症状が出ることがあります。
推奨サンプリングパラメータは、一般タスクで temperature=0.6, top_p=0.95, top_k=20、ベンチマーク再現時のみ temperature=1.0 が推奨されています。
YaRN scalingは静的適用のため、262K以上のcontextが必要な場合のみ有効化するのが実用的です。
Ollamaでの簡易起動
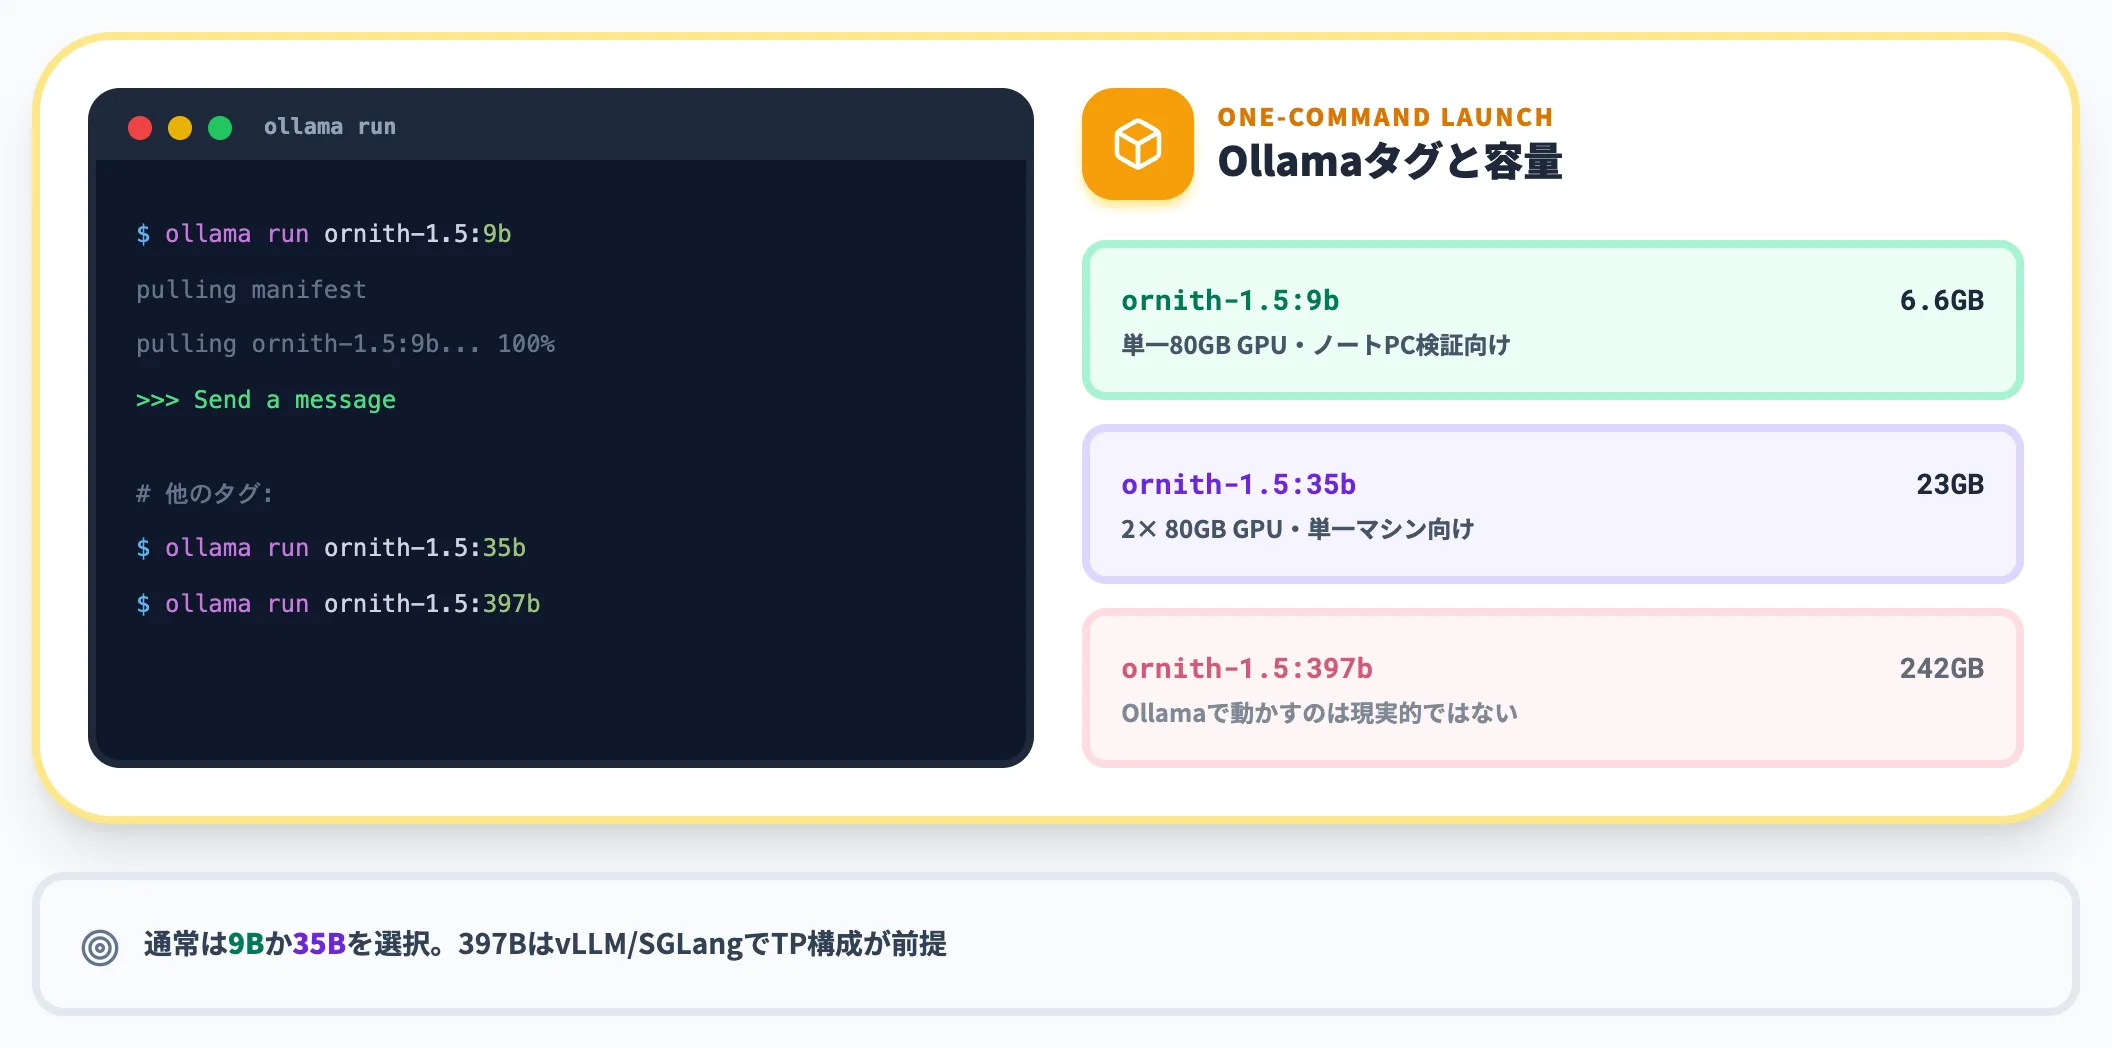
Ollamaを使えば、ローカル環境で数コマンドで実行可能です。
ollama run ornith-1.5:9b
タグは ornith-1.5:9b(6.6GB)・ornith-1.5:35b(23GB)・ornith-1.5:397b(242GB)の3種類が用意されており、GPU容量と用途に応じて選びます。397BをOllamaで動かすのは現実的ではないため、通常は9Bまたは35Bを選ぶことになります。
エージェントツールへの組み込み
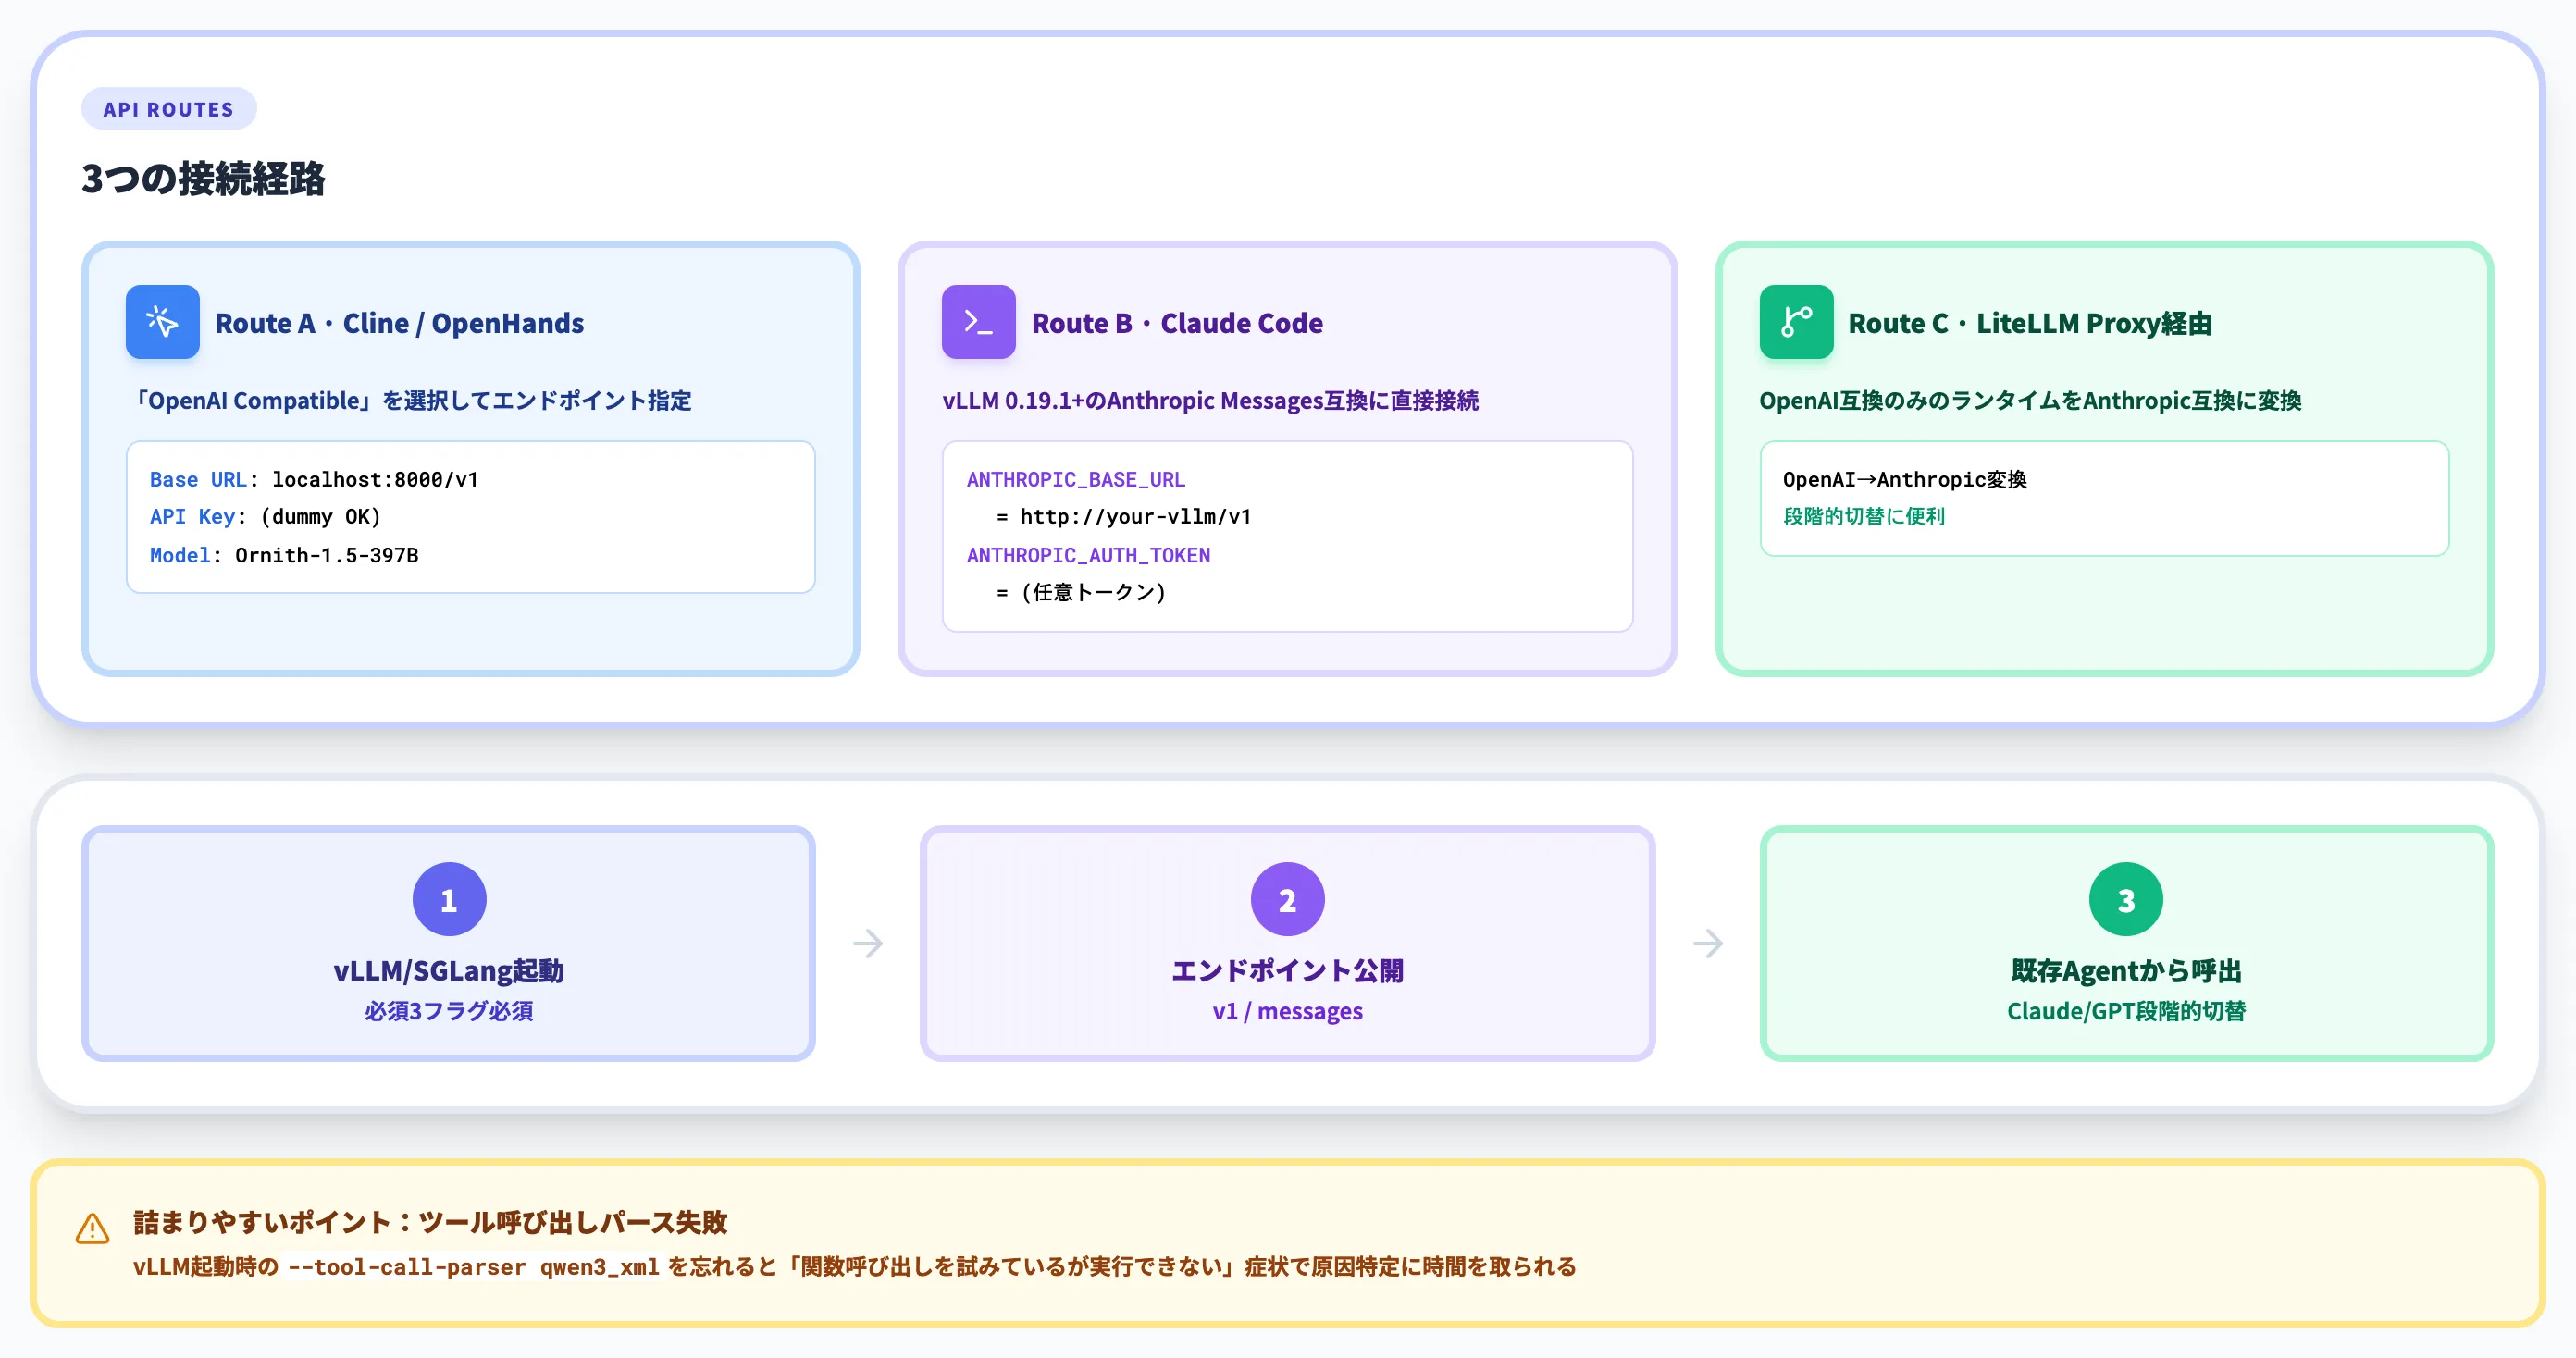
Ornith-1.5は、OpenAI互換APIを提供するランタイム(vLLM・SGLang・llama.cppのllama-server等)に載せることで、Cline・OpenHands・Hermes Agentといった既存のコーディングエージェントから呼び出せます。
Claude CodeはAnthropic Messages互換の接続先を要求する仕様ですが、vLLM 0.19.1以降はAnthropic Messages APIにネイティブ対応しているため、vLLMのエンドポイントを直接指定できます。OpenAI互換のみを提供するランタイムを経由する場合は、LiteLLM Proxy等でAnthropic互換に変換する前段を挟む構成が選択肢になります。
-
Cline
GUIの設定画面で「OpenAI Compatible」を選び、Base URLに自ホストのvLLM/SGLangエンドポイント(例:http://localhost:8000/v1)、API Key(ダミー可)、Model IDに ornith-ai/Ornith-1.5-397B(またはOllamaのタグ)を指定します。
-
Claude Code
vLLM 0.19.1以降のAnthropic Messagesエンドポイント、またはLiteLLM経由のAnthropic互換エンドポイントに対して、ANTHROPIC_BASE_URL と ANTHROPIC_AUTH_TOKEN を切り替えて使う形になります。既存のエージェント運用の中で、ClaudeやGPTから段階的にOrnith-1.5に切り替えるフェーズ移行も可能です。
詰まりやすいポイントとして、ツール呼び出しのパース失敗が挙げられます。
vLLM起動時のtool-call-parser指定を忘れると、エージェントが「関数呼び出しを試みているように見えるが実行できない」状態になり、原因特定に時間を取られやすいので注意してください。
Ornith-1.5の実質コスト——モデルは無料、負担はGPUへ
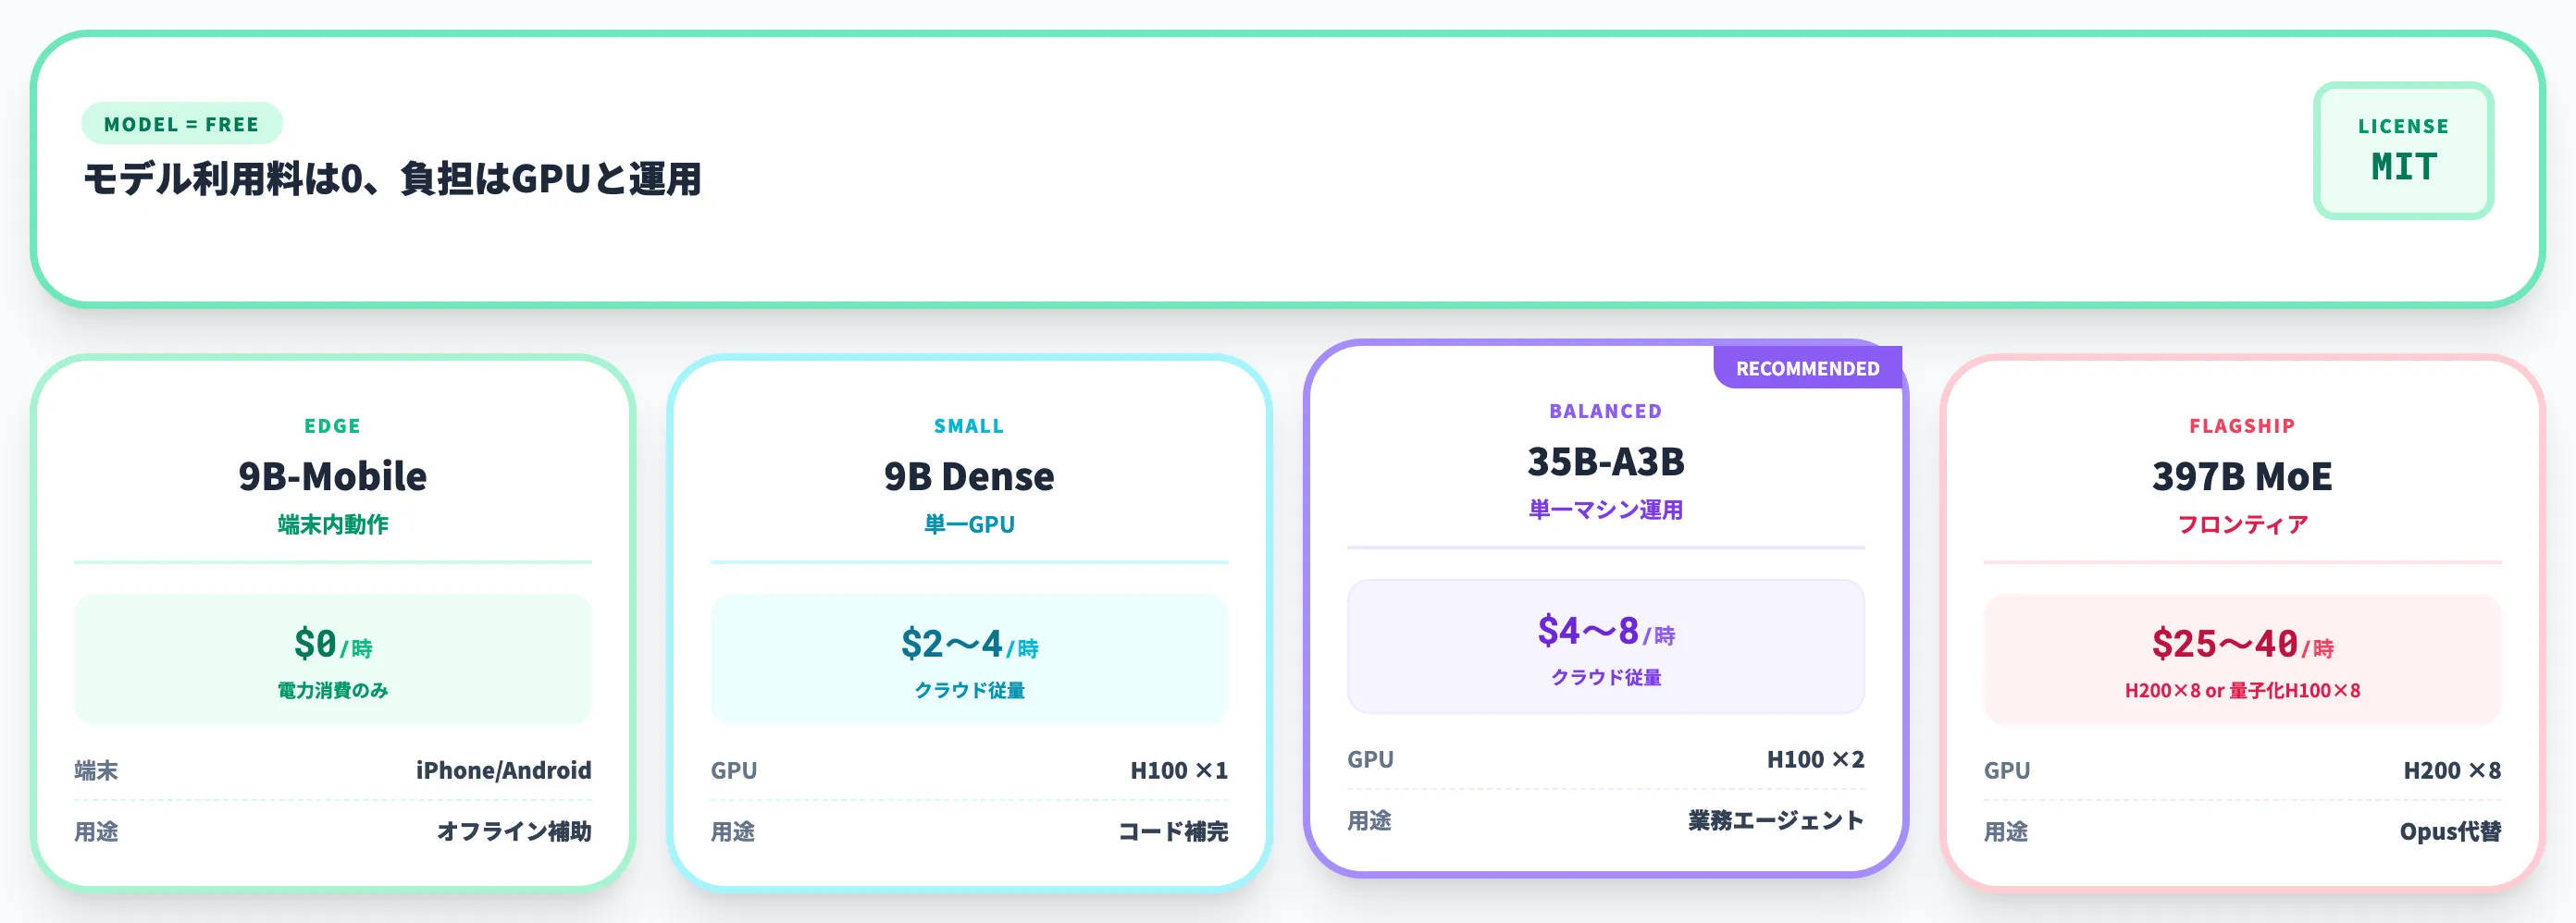
Ornith-1.5はMITライセンスのオープンウェイトモデルとして無料配布されているため、モデルの利用料は発生しません。ただし実質コストはGPUと運用インフラに置き換わります。
自己ホストのGPU/インフラ見積もり
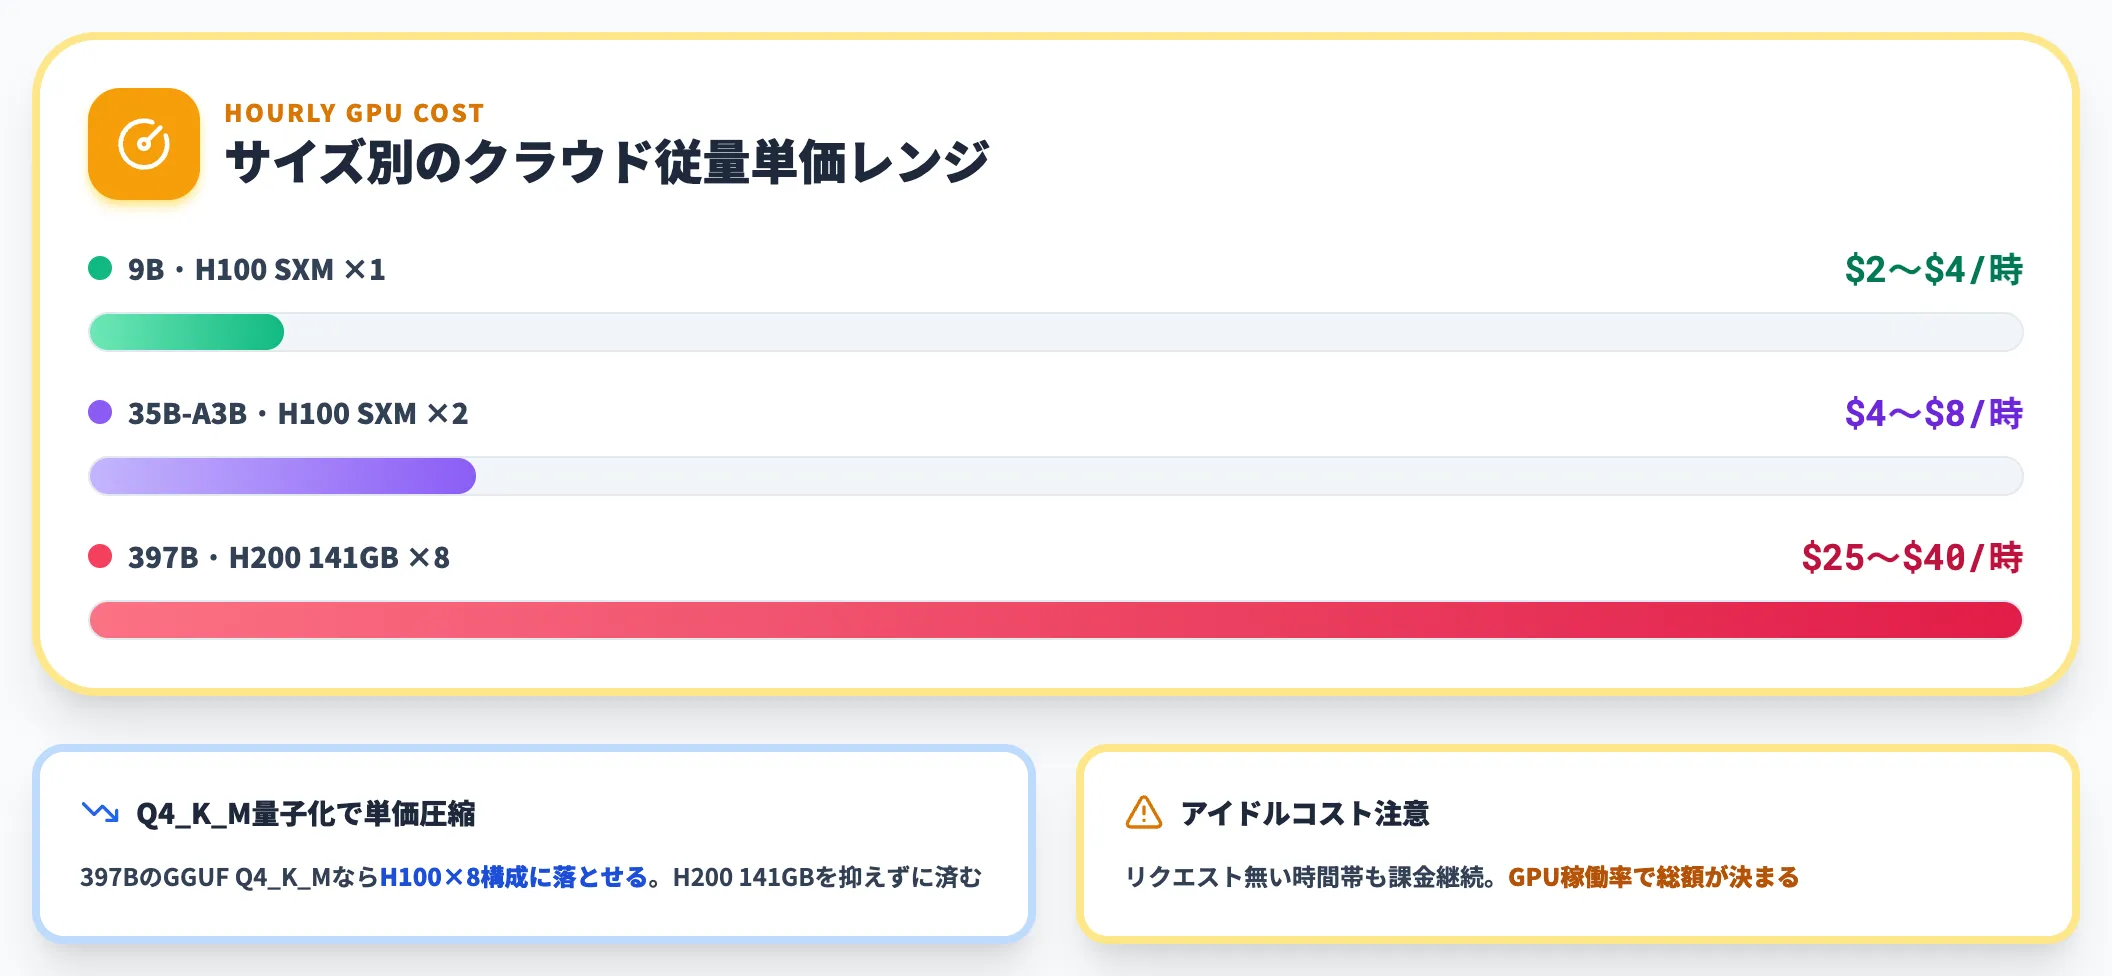
サイズごとの推論に必要な構成例の目安は以下の通りです。
-
9B
単一80GB GPU(H100 SXM相当)1枚。クラウド従量なら$2〜$4/時
-
35B-A3B
80GB GPU 2枚(H100 SXM×2)。クラウド従量なら$4〜$8/時
-
397B
H200 141GB×8が公式の構成例。単価は$25〜$40/時(インスタンス次第)、GGUF Q4_K_M量子化でH100×8構成に落とすことも可能
-
9B-Mobile
iPhone/Androidの端末リソース内で動作するため追加コストゼロ(電力消費のみ)
API課金型と比べるべきか
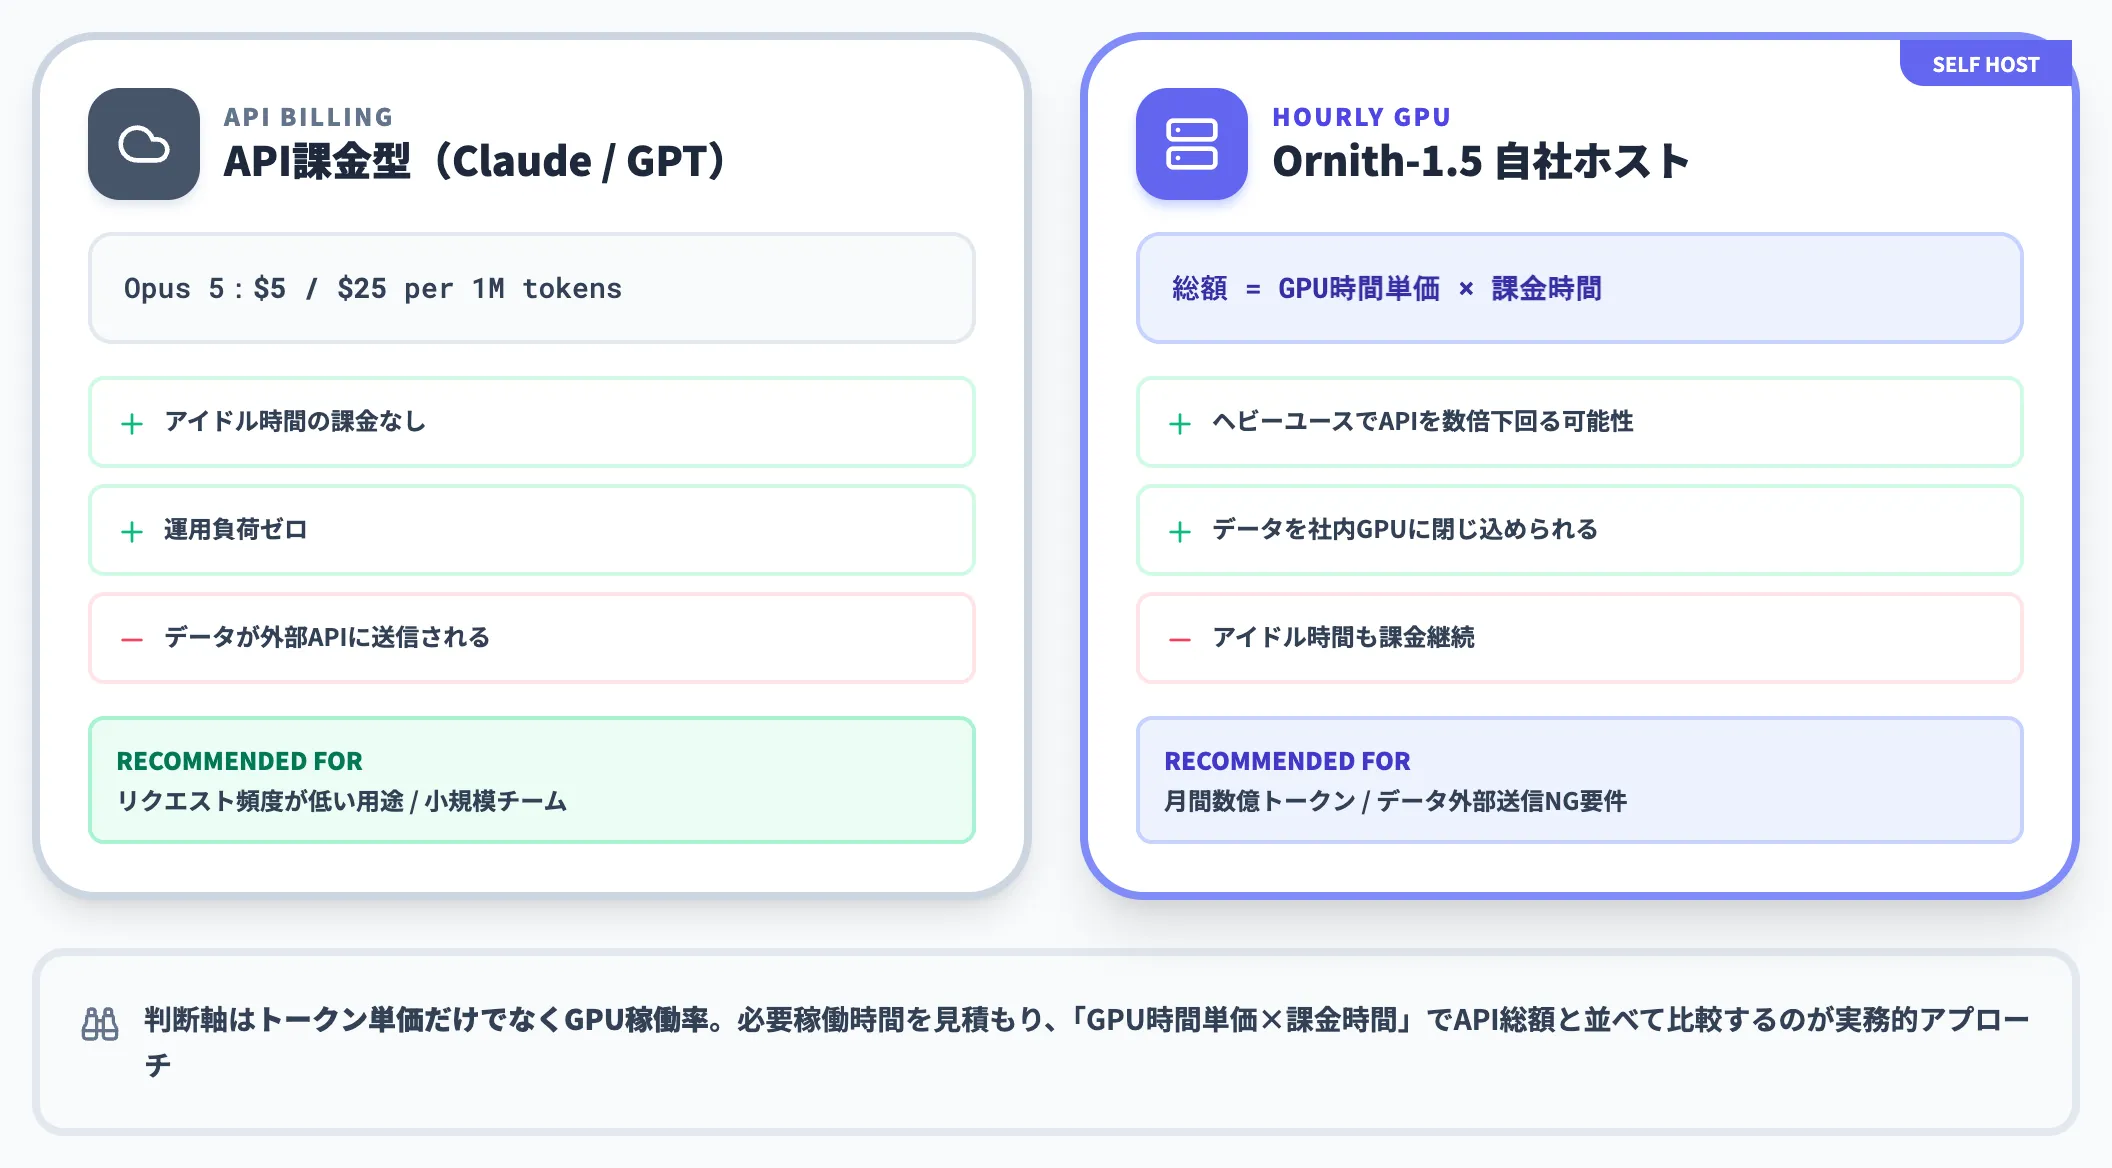
Claude API(Opus 5:$5/$25 per 1M tokens)やGPT-5.5 APIとの直接比較は、単純なトークン単価だけでは判断できない構造になっています。
自社ホストの場合、GPU占有時間中にリクエストがない時間帯は「アイドルコスト」として発生し続けるため、リクエスト頻度が低い用途では API 課金の方が総額で安くなるケースが多く見られます。
逆に、月間数億トークンを回すヘビーユースや、データを外部APIに出せない要件がある場合は、Ornith-1.5の自社ホストがAPI課金型を数倍下回るコストに収まる可能性があります。
実際の見積もりは、GPU時間単価 × 課金時間 で自社ホスト側の総額を算出し、トークン数は「必要稼働時間」を見積もる入力変数として扱うのが基本です。これをAPI課金型と並べて比較するのが実務的なアプローチになります。
API課金ならClaude Opus 5やGPT-5.5、自社ホストならOrnith-1.5とKimi K3・GLM-5.2の3択で見積もると全体像が掴めます。
Ornith-1.5を採るべきケース・別モデルを推奨するケース
ここまで整理してきたベンチマーク・コスト・技術背景をもとに、AI総研としての実務推奨をケース別に示します。
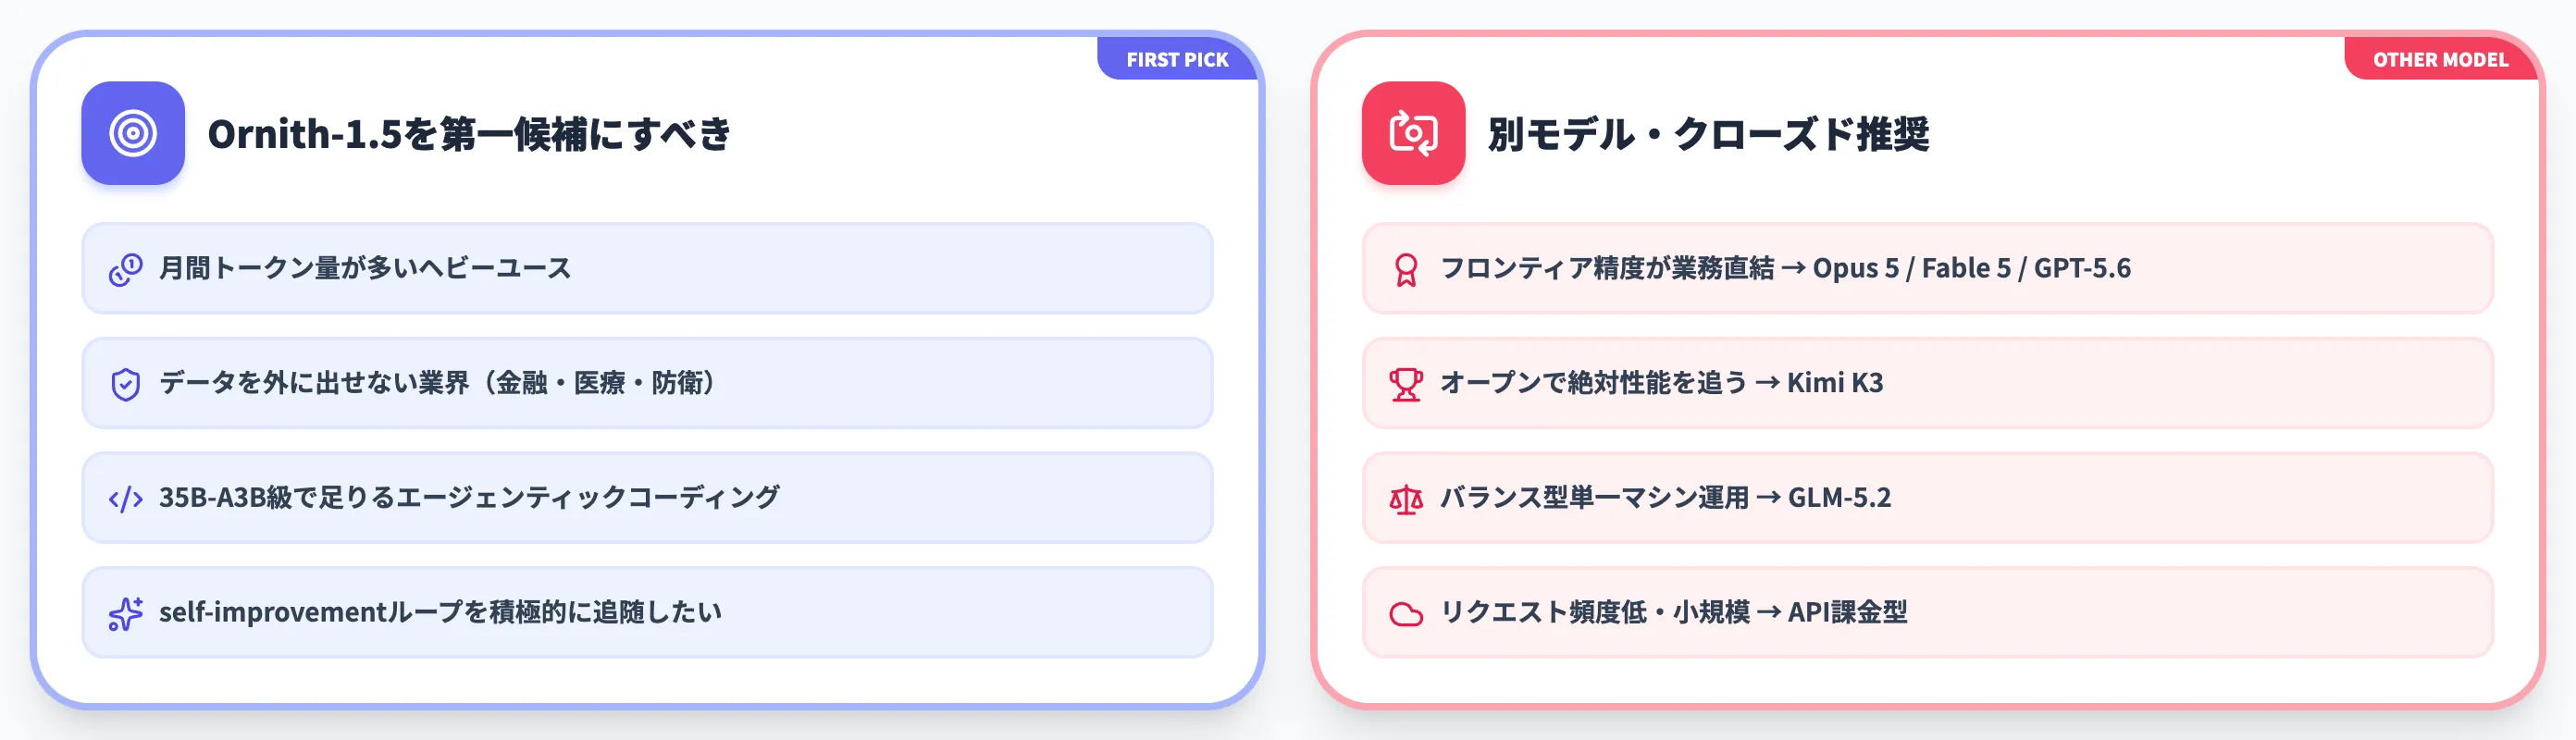
Ornith-1.5を第一候補にすべきケース
-
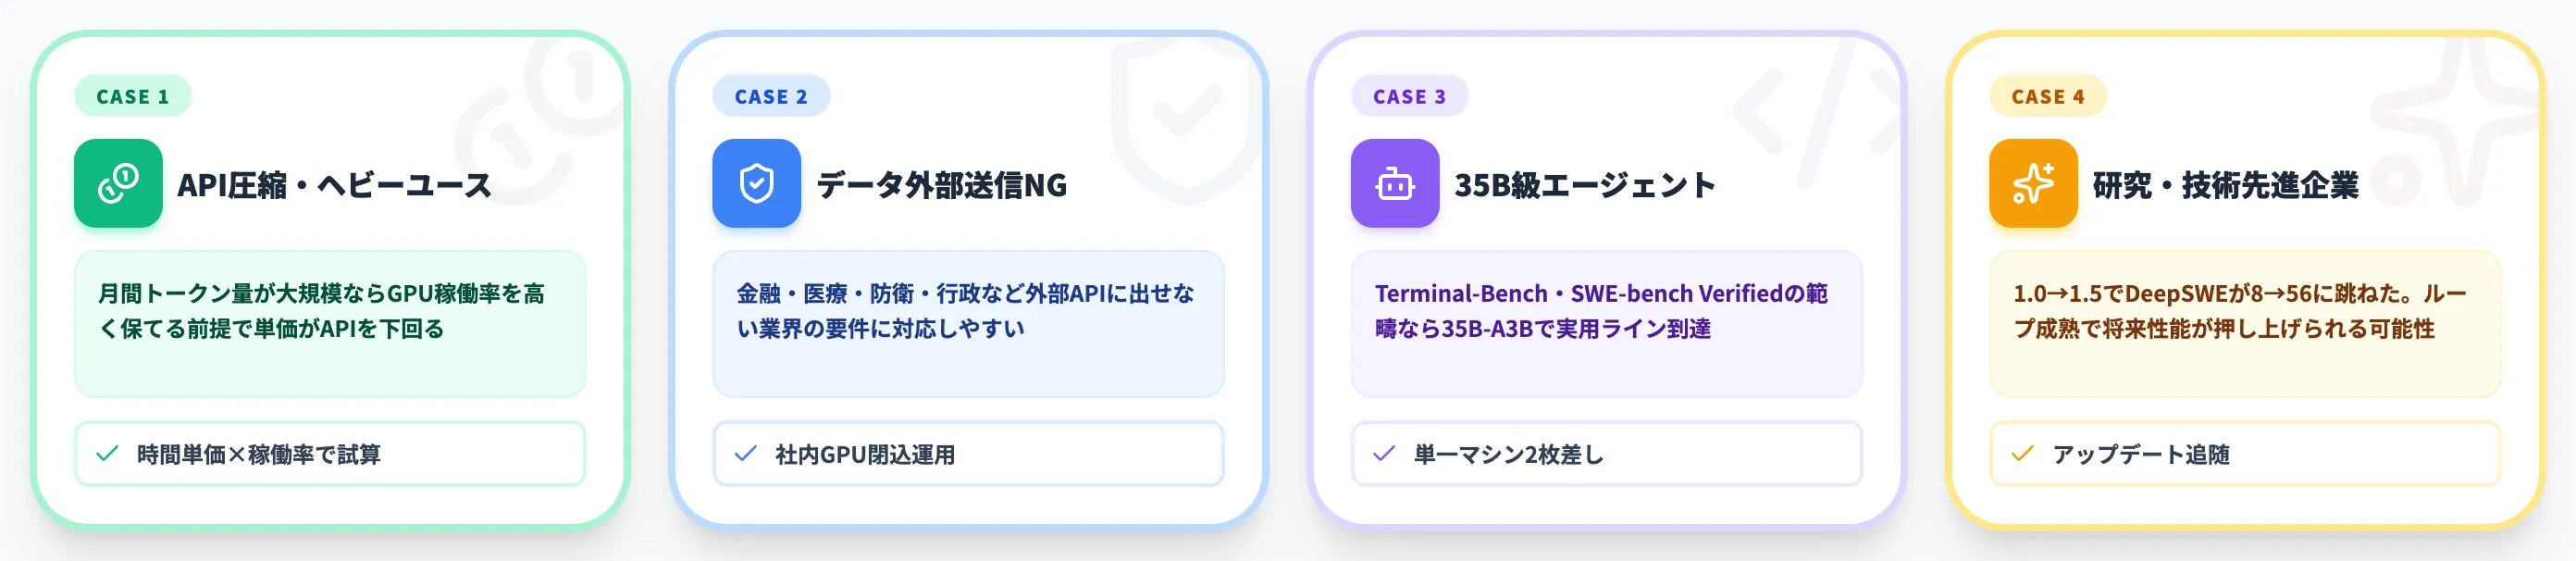
クローズドAPIコストを大幅圧縮したい、かつ月間トークン量が多い企業
大規模なトークン消費を安定的に回すヘビーユースなら、GPU稼働率を高く保てる前提で自社ホストGPUの単価がAPI課金を下回る可能性がある。採用判断前にGPU時間単価と推定稼働率で試算する
-
データを外部APIに出せない業界(金融・医療・防衛・行政)
モデル本体を社内GPUに閉じ込められるため、データの外部送信を避ける要件に対応しやすい(運用・鍵管理・監査など自社側の保護責任は別途発生する)
-
エージェンティックコーディングを社内基盤に組み込みたい、かつ35B-A3B級で足りる規模
Terminal-Bench・SWE-bench Verifiedの範疇なら、Ornith-1.5-35B-A3Bで実用ラインに達する
-
self-improvementループのアップデート追随を積極的に取り込みたい研究/技術先進企業
1.0→1.5でDeepSWEが8.0→56.0に跳ねたように、ループの成熟が将来性能を押し上げる可能性がある
別モデル・クローズドを推奨するケース
-
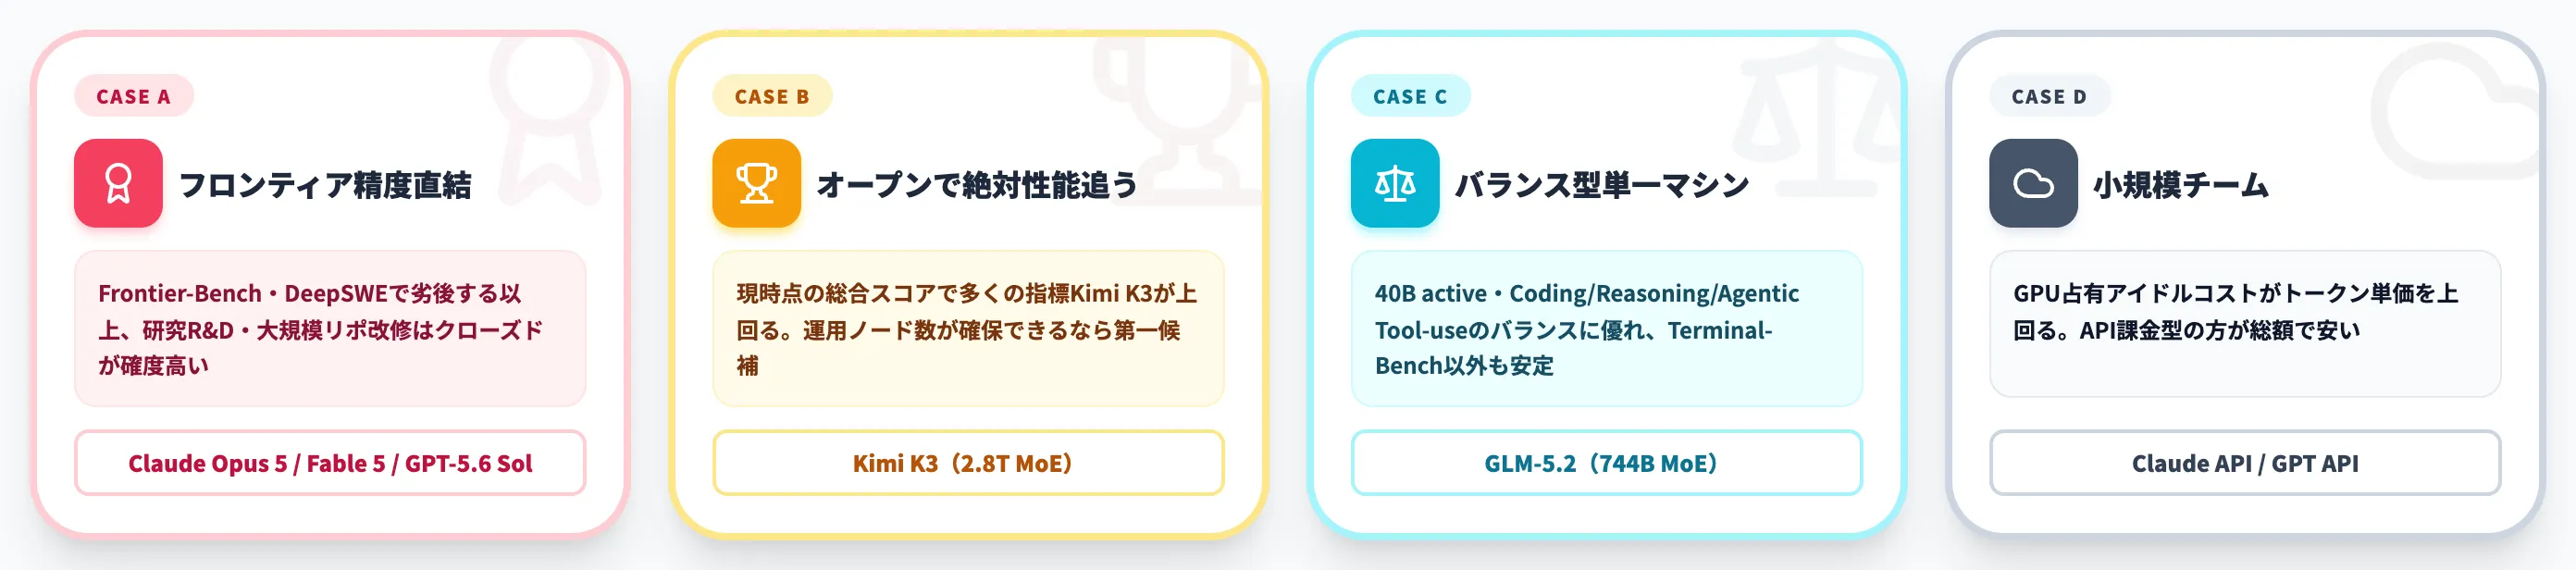
フロンティア精度が業務直結する用途(研究R&D、複雑な大規模リポジトリ改修)
Frontier-Bench・DeepSWEで劣後する事実がある以上、Claude Opus 5やClaude Fable 5、GPT-5.6 Solの方が確度が高い
-
オープンウェイトで絶対性能を追う場合
現時点の総合スコアではKimi K3が多くの指標でOrnith-1.5を上回る。運用ノード数が確保できるならKimi K3が第一候補
-
バランス型で扱いやすい単一マシン運用を狙う場合
GLM-5.2(40B active)は総合バランスに優れ、Terminal-Bench以外の指標も安定している
-
リクエスト頻度が低く、GPU稼働率を高く保てない小規模チーム
GPU占有のアイドルコストがトークン単価を上回る構造になりやすく、API課金型(Claude/GPT)の方が総額で安くなるケースが多い
導入で見落としやすい3つの前提
Ornith-1.5を導入する前に確認しておきたい実務論点を整理します。
-
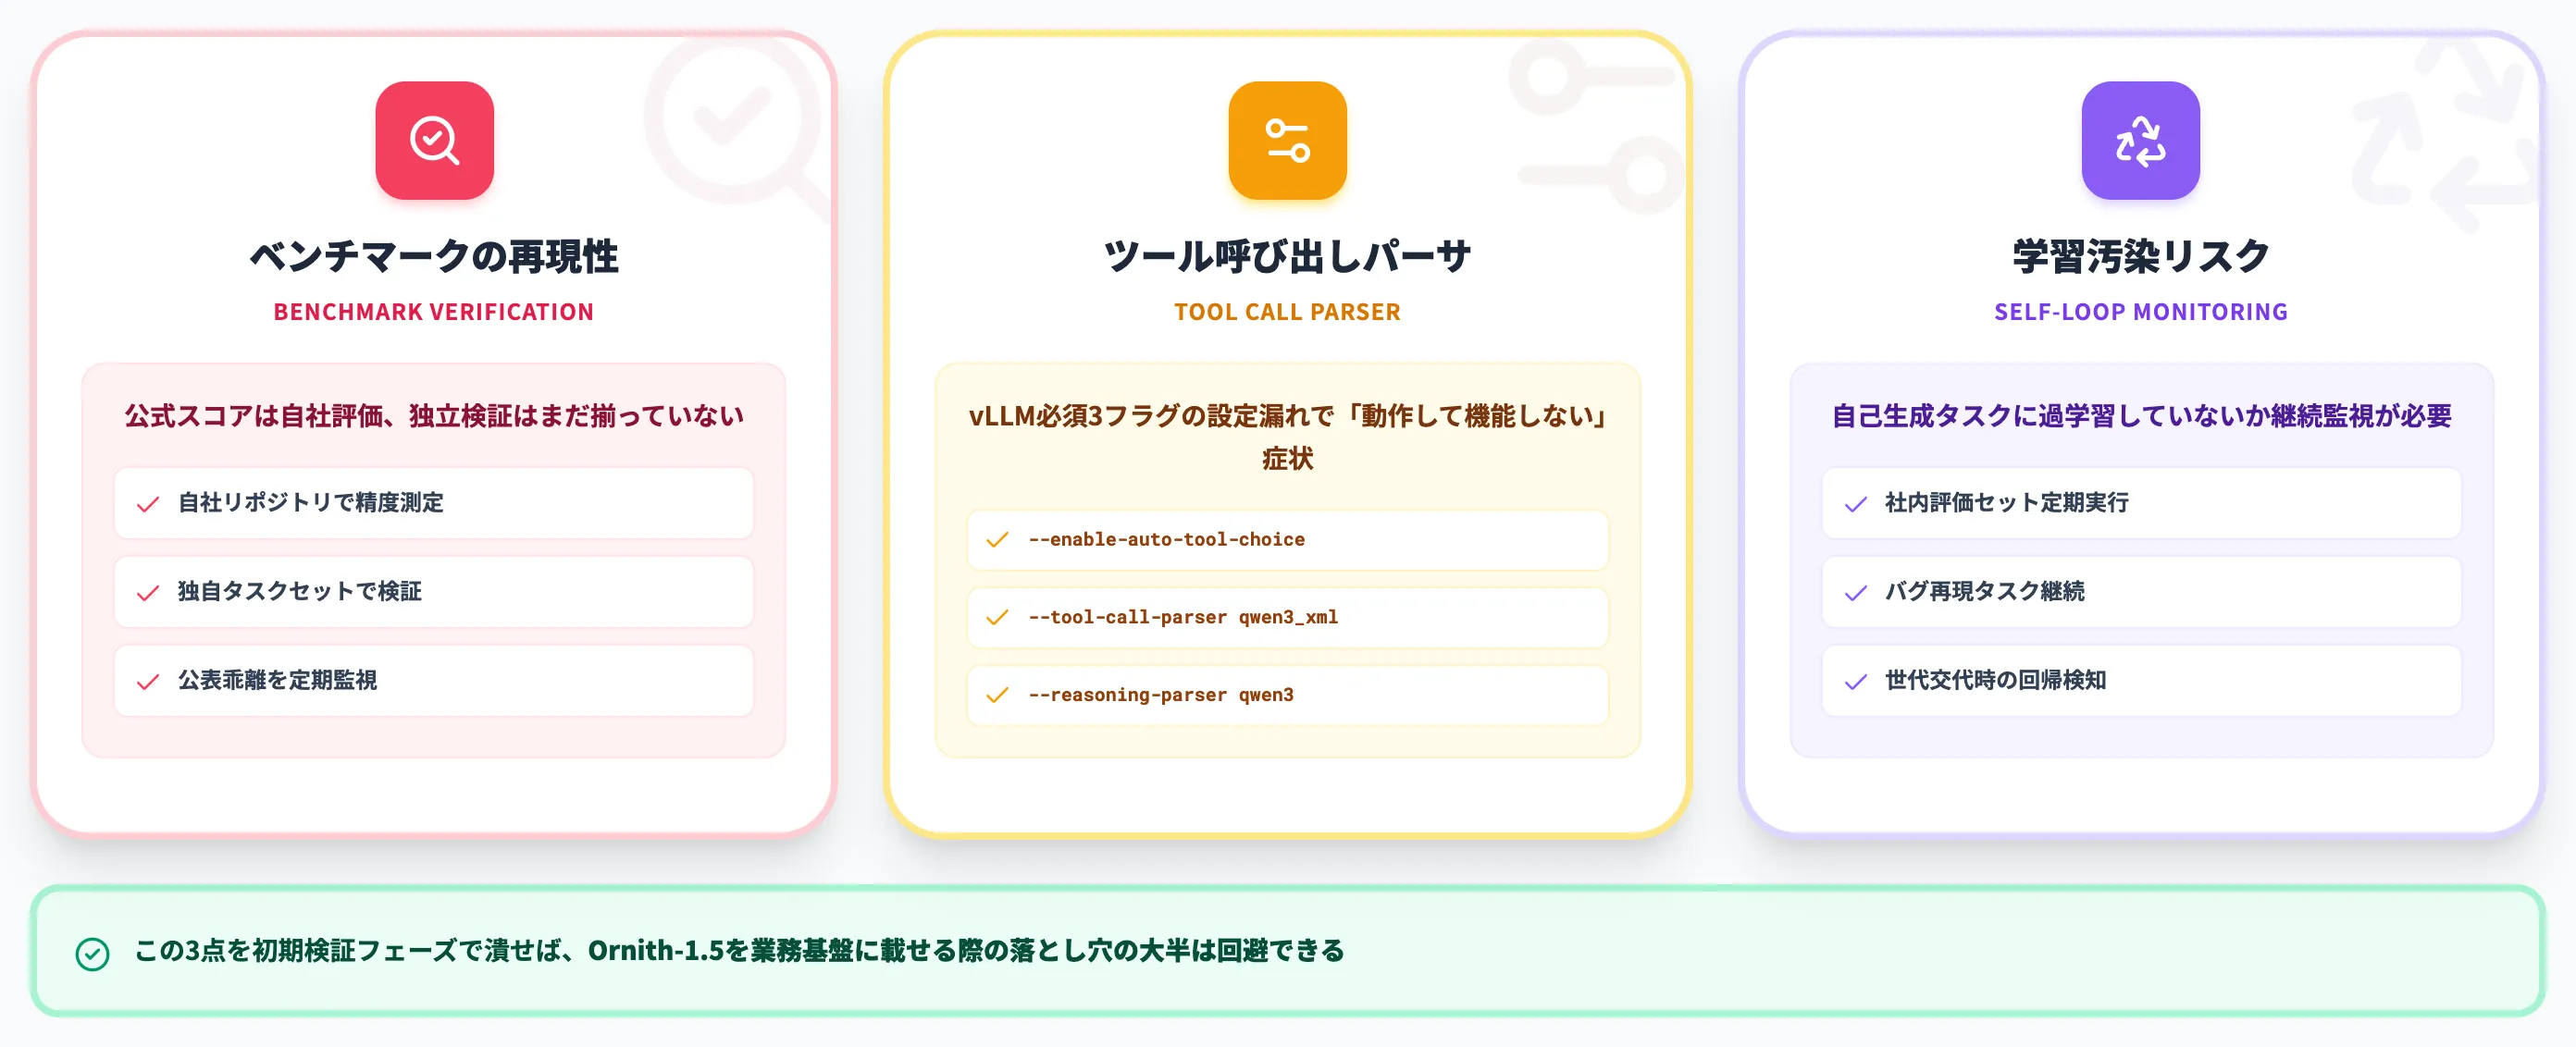
ベンチマークの再現性
公式スコアは自社評価であり、独立検証はまだ揃っていない。自社リポジトリ・独自タスクセットでの精度検証を必ず走らせる
-
ツール呼び出しパーサの設定
vLLM起動時の --enable-auto-tool-choice・--tool-call-parser qwen3_xml・--reasoning-parser qwen3 を忘れると、エージェント統合が「動いているように見えて動いていない」状態になる
-
self-improvementループの学習汚染リスク
モデルが自己生成タスクに過学習していないかを、社内評価セットで継続的に監視するオペレーションが必要
これら3点を初期検証フェーズで潰しておけば、Ornith-1.5を業務基盤に載せる際の落とし穴の大半は回避できます。
版が上がり続けるOrnith-1.5を、自社の業務で試してから切り替える
Ornith-1.5の公表スコアはDeepReinforce自身の評価で、自己改善ループには、自分で作ったタスクに偏って学習するリスクが残ります。DeepSWEのスコアが1.0の8.0から1.5で56.0に跳ねたように、版が上がるたびに得意な処理が変わる前提で、手元のデータで確かめてから切り替える手順が欠かせません。自社でホストするなら、リクエストのない時間帯にかかるGPUの費用をどう抑えるかが、あわせて問われます。
この2つを支えるのが、経費精算から稟議・申請まで、バックオフィスの業務ごとにAgentを組み、本番前のテストとバージョン管理を1つの基盤で扱うAI Agent Hubです。
- 本番の前に、ツール呼び出しまで動くかを試す
サンドボックス環境で過去の申請を使ってAgentを動かし、判定の精度と、基幹システムへの入力まで処理が進むかを、稼働中のシステムに触れずに確かめます。
- 載せ替える前の状態を残しておく
ワークフローはJSON形式でエクスポートしてバージョン管理できるため、1.6や2.0が出たときは、今の構成を保ったまま、新しいモデルでの判定と見比べます。
- 複数の業務のAgentから同じモデルを呼ぶ
80GBのGPU2枚で動く35B-A3Bへの接続を要件に応じて設計・構築し、経費精算や請求書処理のAgentから共通で呼び出す形にすれば、1つの用途に絞るよりGPUの稼働率を上げやすくなります。
AI総合研究所の専任チームが、Ornith-1.5を共通で使う業務の組み合わせと、新しい版を見極める手順を、自社のGPU構成に合わせて設計します。
オープンLLMの新しい版を本番前に試す

GPUの空き時間を複数の業務で埋める
Ornith-1.5のように自己改善で版が上がるモデルは、公表スコアではなく自社の業務で精度を確かめてから切り替え、自社でホストするGPUは複数の業務で共有するのが、無理のない進め方です。AI Agent Hubでは、ワークフローのバージョンを管理し、今の構成を残したまま新しいモデルを試します。
まとめ
本記事では、Ornith-1.5を「DeepReinforceが公開した自己改善型のオープンウェイトLLMファミリー」として整理し、サイズ構成・学習ループの仕組み・ベンチマークの読み方・他モデルとの比較・導入方法・実質コスト・ケース別の推奨を解説しました。
2026年8月時点で押さえておくべきポイントは次の3つです。
- 397BがOpus 4.8と並ぶのは標準的なコーディングやWeb探索の指標で、難度の高いコード改修や研究的なタスクでは及ばない
- オープンウェイトで絶対性能を求めるならKimi K3が先を行き、Ornith-1.5の強みは単一ノードに収めやすいサイズにある
- データを社外に出せない金融や医療の業界なら第一候補になるが、鍵管理や監査といった保護の責任は自社側に残る
AI総合研究所が自社ホストでの導入を支援する場合は、サイズを選んでから既存ツールにつなぐまでを二段で進めます。
まずは、VRAMが総パラメータで決まる点を踏まえて9Bか35B-A3Bを選び、本番はvLLMかSGLang、ローカルの試用はOllamaで立ち上げます。
続いて、Claude CodeとClineの接続先を、それぞれvLLMのAnthropic Messages互換とOpenAI互換のエンドポイントに向けます。
既存のオープンウェイトに事後学習を重ねる作り方では、ベースにしたQwen系のアーキテクチャが性能の上限を左右します。
そのためOrnith-1.5の実力は、同じQwen系の最新モデルと比べて、自己改善ループでどれだけ上乗せできているかで見るのが妥当です。