この記事のポイント
 Praxis-1は動画生成基盤を流用した27.2BのオープンウェイトWAMで、Apache 2.0ライセンスで商用利用まで一括カバー
- RoboLab-120で46.2%・Franka FR3実機で88%とWAM系首位の数字だがRunway自己報告で独立再現は限定的
- Hugging Faceにbase・DROID・YAM・SO-101・LeRobot・NVFP4対応版の10リポジトリが揃い、NeMo AutoModel・vLLM-Omni・SGLangから呼び出し可能
- bf16運用はH100の80GB VRAM前提、NVFP4版は配布チェックポイントこそbf16形式で約54.4GB、ランタイム量子化後はポリシー約17.5GB・テキストエンコーダとVAE込みで約23.5GB、Blackwell世代(RTX 5090 32GB・RTX PRO 6000 Blackwell 96GB・B200/B300・Jetson Thor)で動作(RTX 4090・H100は非対応)
- π0.7・NVIDIA GR00T 2・Gemini Robotics 2との比較はライセンス・embodiment適応・推論スタックで判断軸が分かれる
Microsoft MVP・AIパートナー。LinkX Japan株式会社 代表取締役。東京工業大学大学院にて自然言語処理・金融工学を研究。NHK放送技術研究所でAI・ブロックチェーンの研究開発に従事し、国際学会・ジャーナルでの発表多数。経営情報学会 優秀賞受賞。シンガポールでWeb3企業を創業後、現在は企業向けAI導入・DX推進を支援。
Praxis-1(プラクシス・ワン)は、動画生成AIで知られるRunwayが動画生成基盤モデルから派生させたオープンウェイトのWorld Action Model(WAM)で、2026年11月11日にApache 2.0ライセンスで一般公開されました。
26.9BパラメータのMoE Diffusion Transformer動画バックボーンに約314MのAction Expertを組み合わせた合計27.2B構成で、動画と動作を同時にデノイズしながらH100上で1.6秒分のロボット動作を約0.55秒で生成します。
本記事では、2026年11月時点の公式情報をもとに、Praxis-1の技術アーキテクチャ・ベンチマーク性能・公開チェックポイントとライセンス・対応ハードウェアと実装フロー・π0.7やNVIDIA GR00T 2との比較・導入判断で押さえたい観点までを体系的に解説します。
目次
Praxis-1とは?Runwayがオープンウェイトで公開したWorld Action Model
Praxis-1の技術アーキテクチャ——動画生成基盤をロボット制御に転用する仕組み
フロンティアLLMエージェント(GPT-6 Astra)との速度・コスト比較
Praxis-1とは?Runwayがオープンウェイトで公開したWorld Action Model
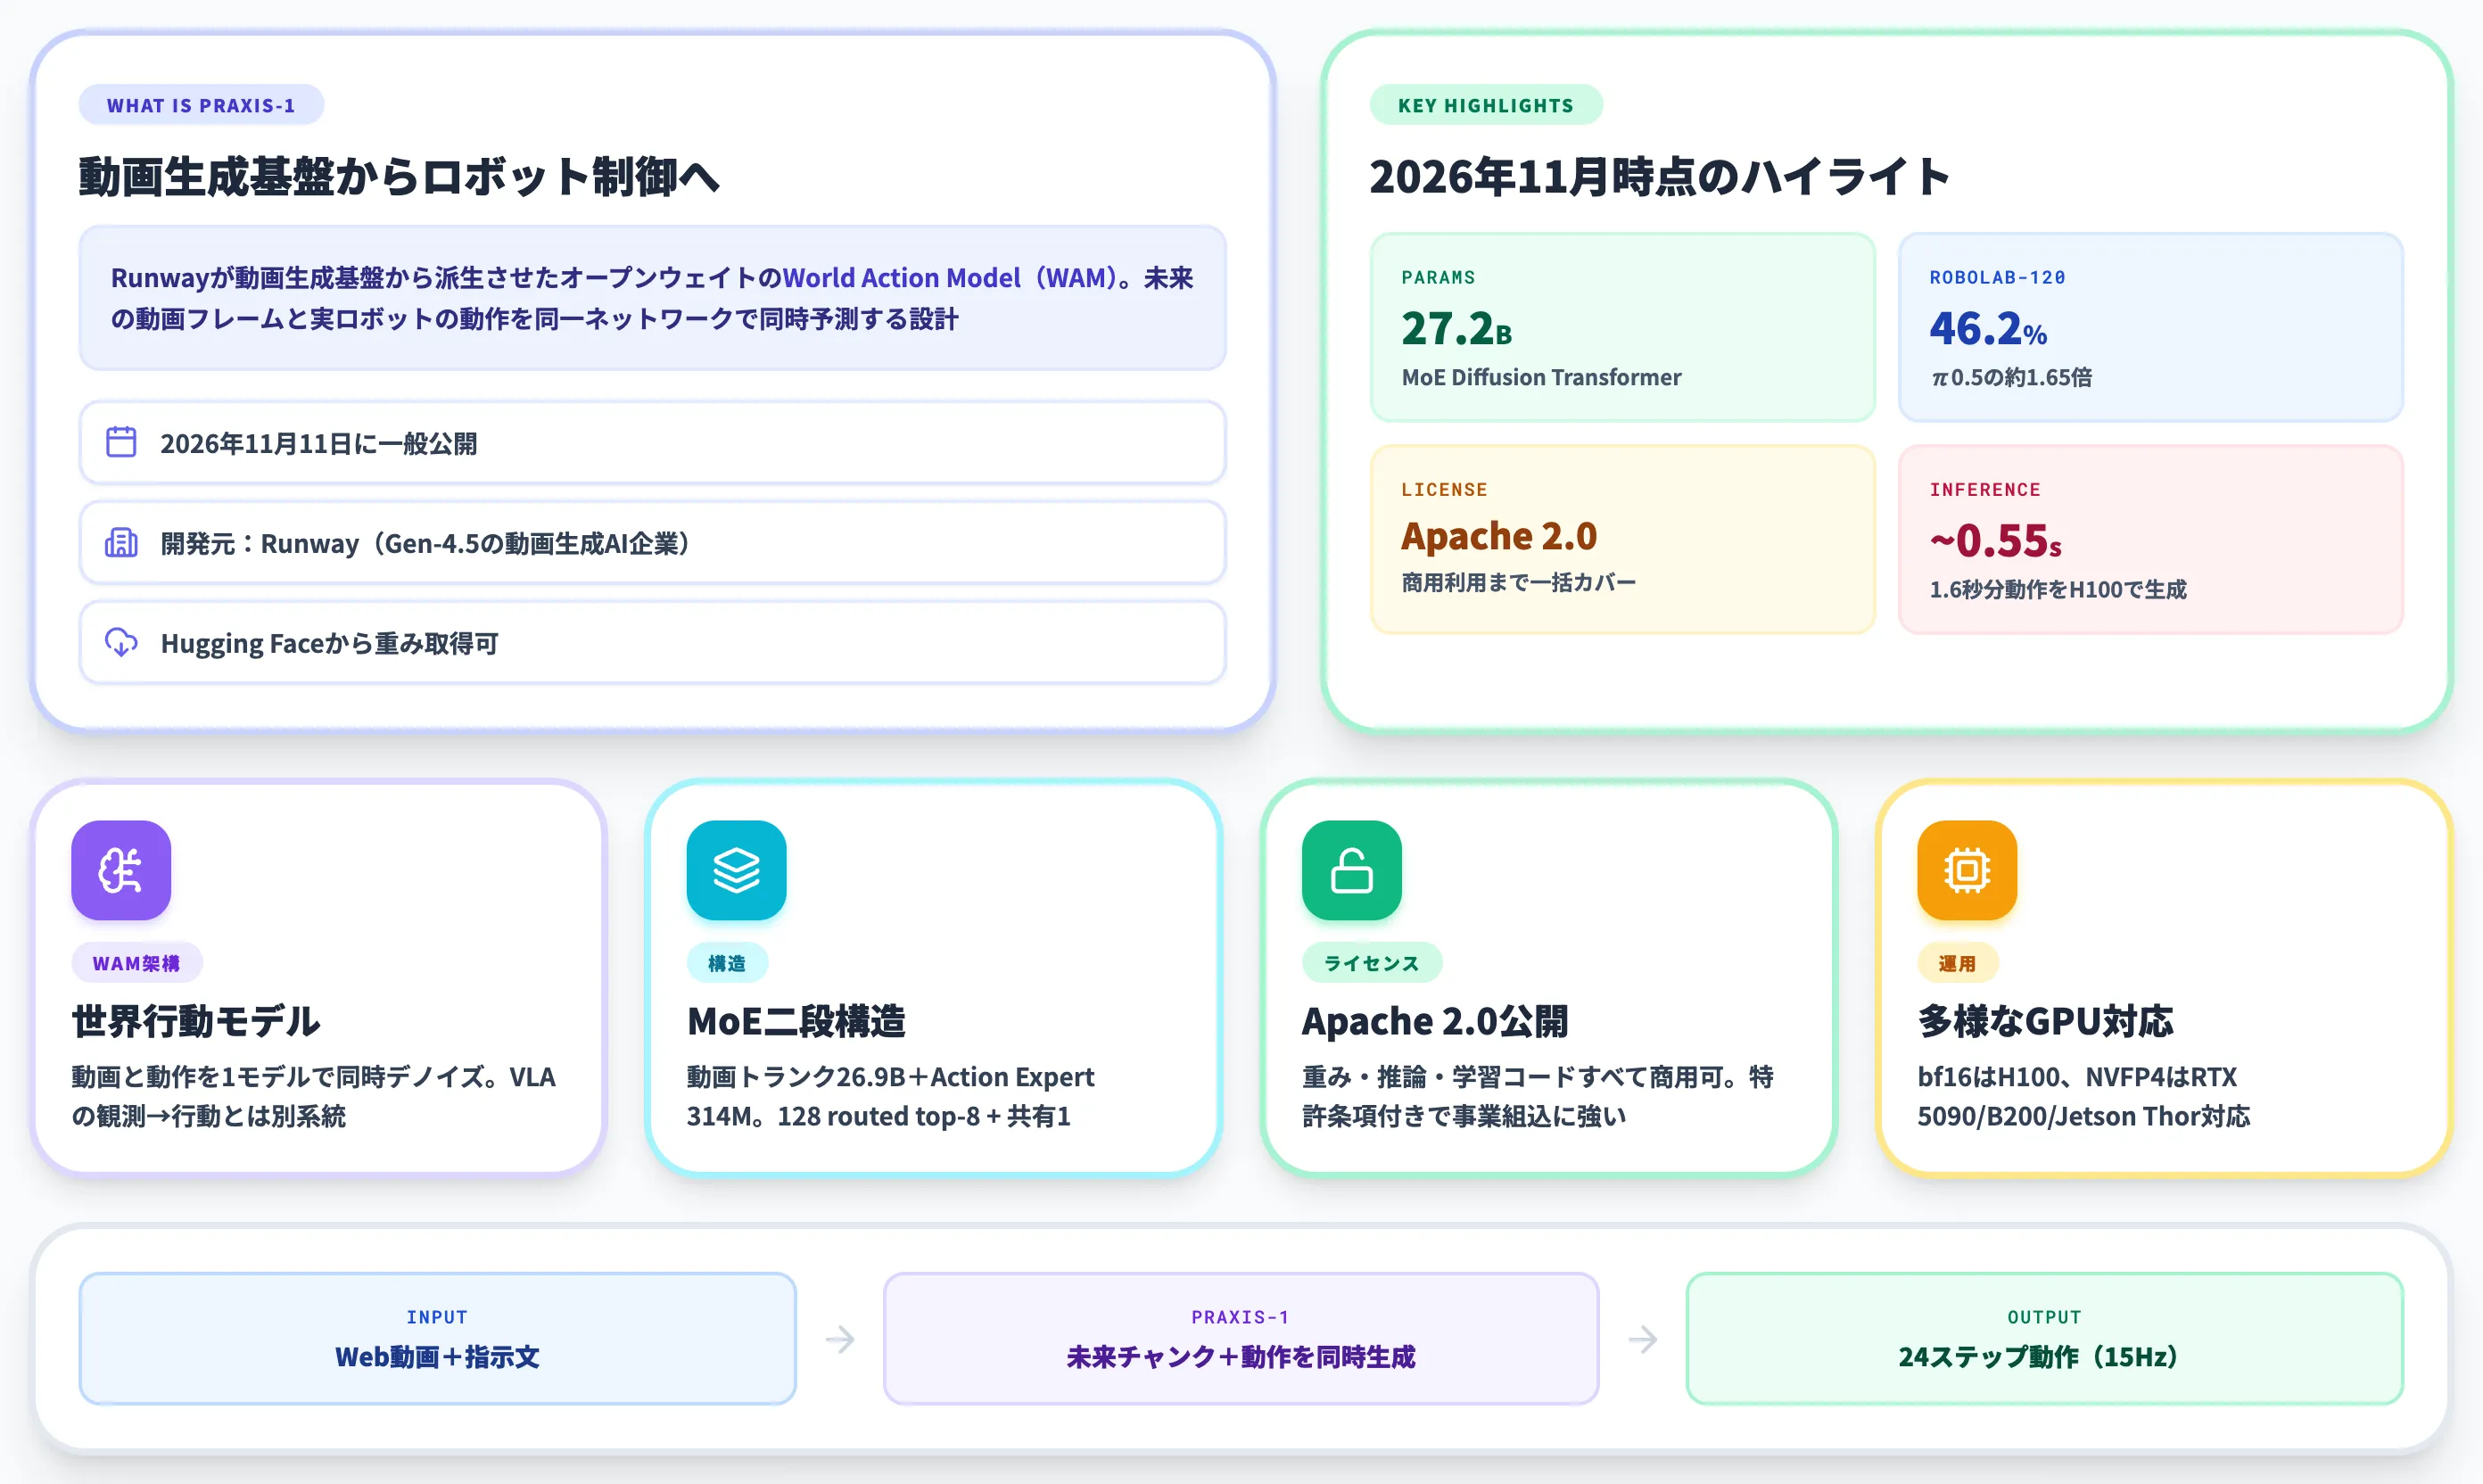
Praxis-1(プラクシス・ワン)は、動画生成AIで知られるRunwayが、自社の動画生成基盤モデルから派生させたオープンウェイトのWorld Action Model(WAM、ワールド・アクション・モデル)です。
「未来の動画と実ロボットの動作を同時に予測する生成モデル」として位置づけられており、観測から動作へ直接マッピングする従来の方策とは異なる設計を取ります。
2026年11月11日にモデルウェイト・推論コード・学習コードがApache 2.0ライセンスで一般公開され、Hugging Faceから27.2Bパラメータの重みをダウンロードして商用利用まで自由に扱えます。
Runway公式Tech Report「Praxis-1: From Video Pretraining to Robot Control」のキービジュアル(出典:Runway Research)
Runway Gen系からのPraxis-1の位置づけ
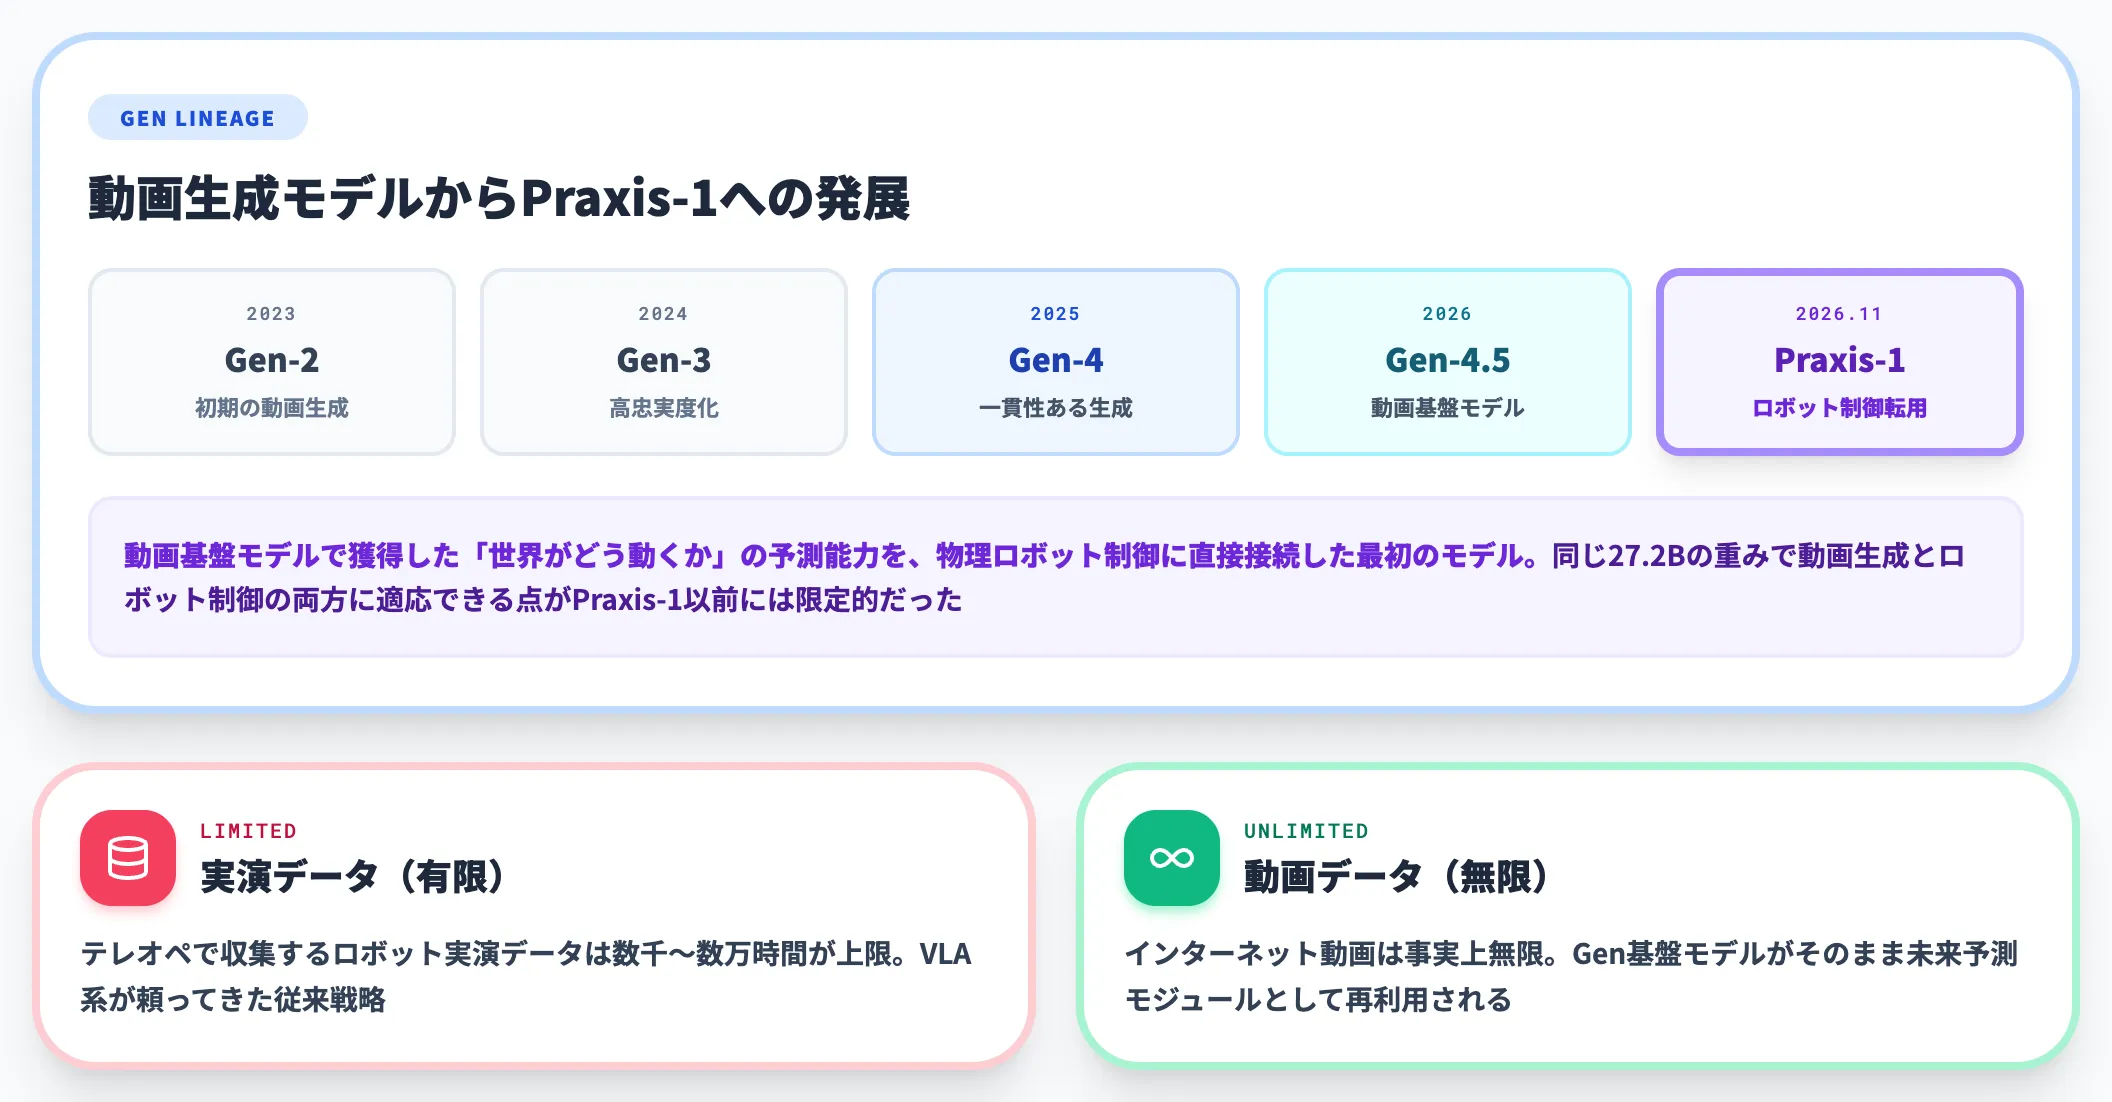
RunwayはこれまでGen-2・Gen-3・Gen-4・Gen-4.5と動画生成モデルを連番で公開してきたクリエイティブAI企業です。
Praxis-1は、その動画生成基盤モデルで積み上げた「世界がどう動くか」の予測能力を、物理ロボット制御にそのまま接続した最初のモデルという位置づけになります。
Runwayは9月30日の初回発表ポストで「ロボットの実演データは有限だが動画データは無限にある」という前提を示しており、Gen系の動画基盤モデルがそのまま未来予測モジュールとして再利用されています。
同じ27.2Bの重みが、動画生成タスクと並行してロボット制御タスクにも適応できることが示されたのは、Praxis-1以前には限定的でした。
Praxis-1の技術アーキテクチャ——動画生成基盤をロボット制御に転用する仕組み
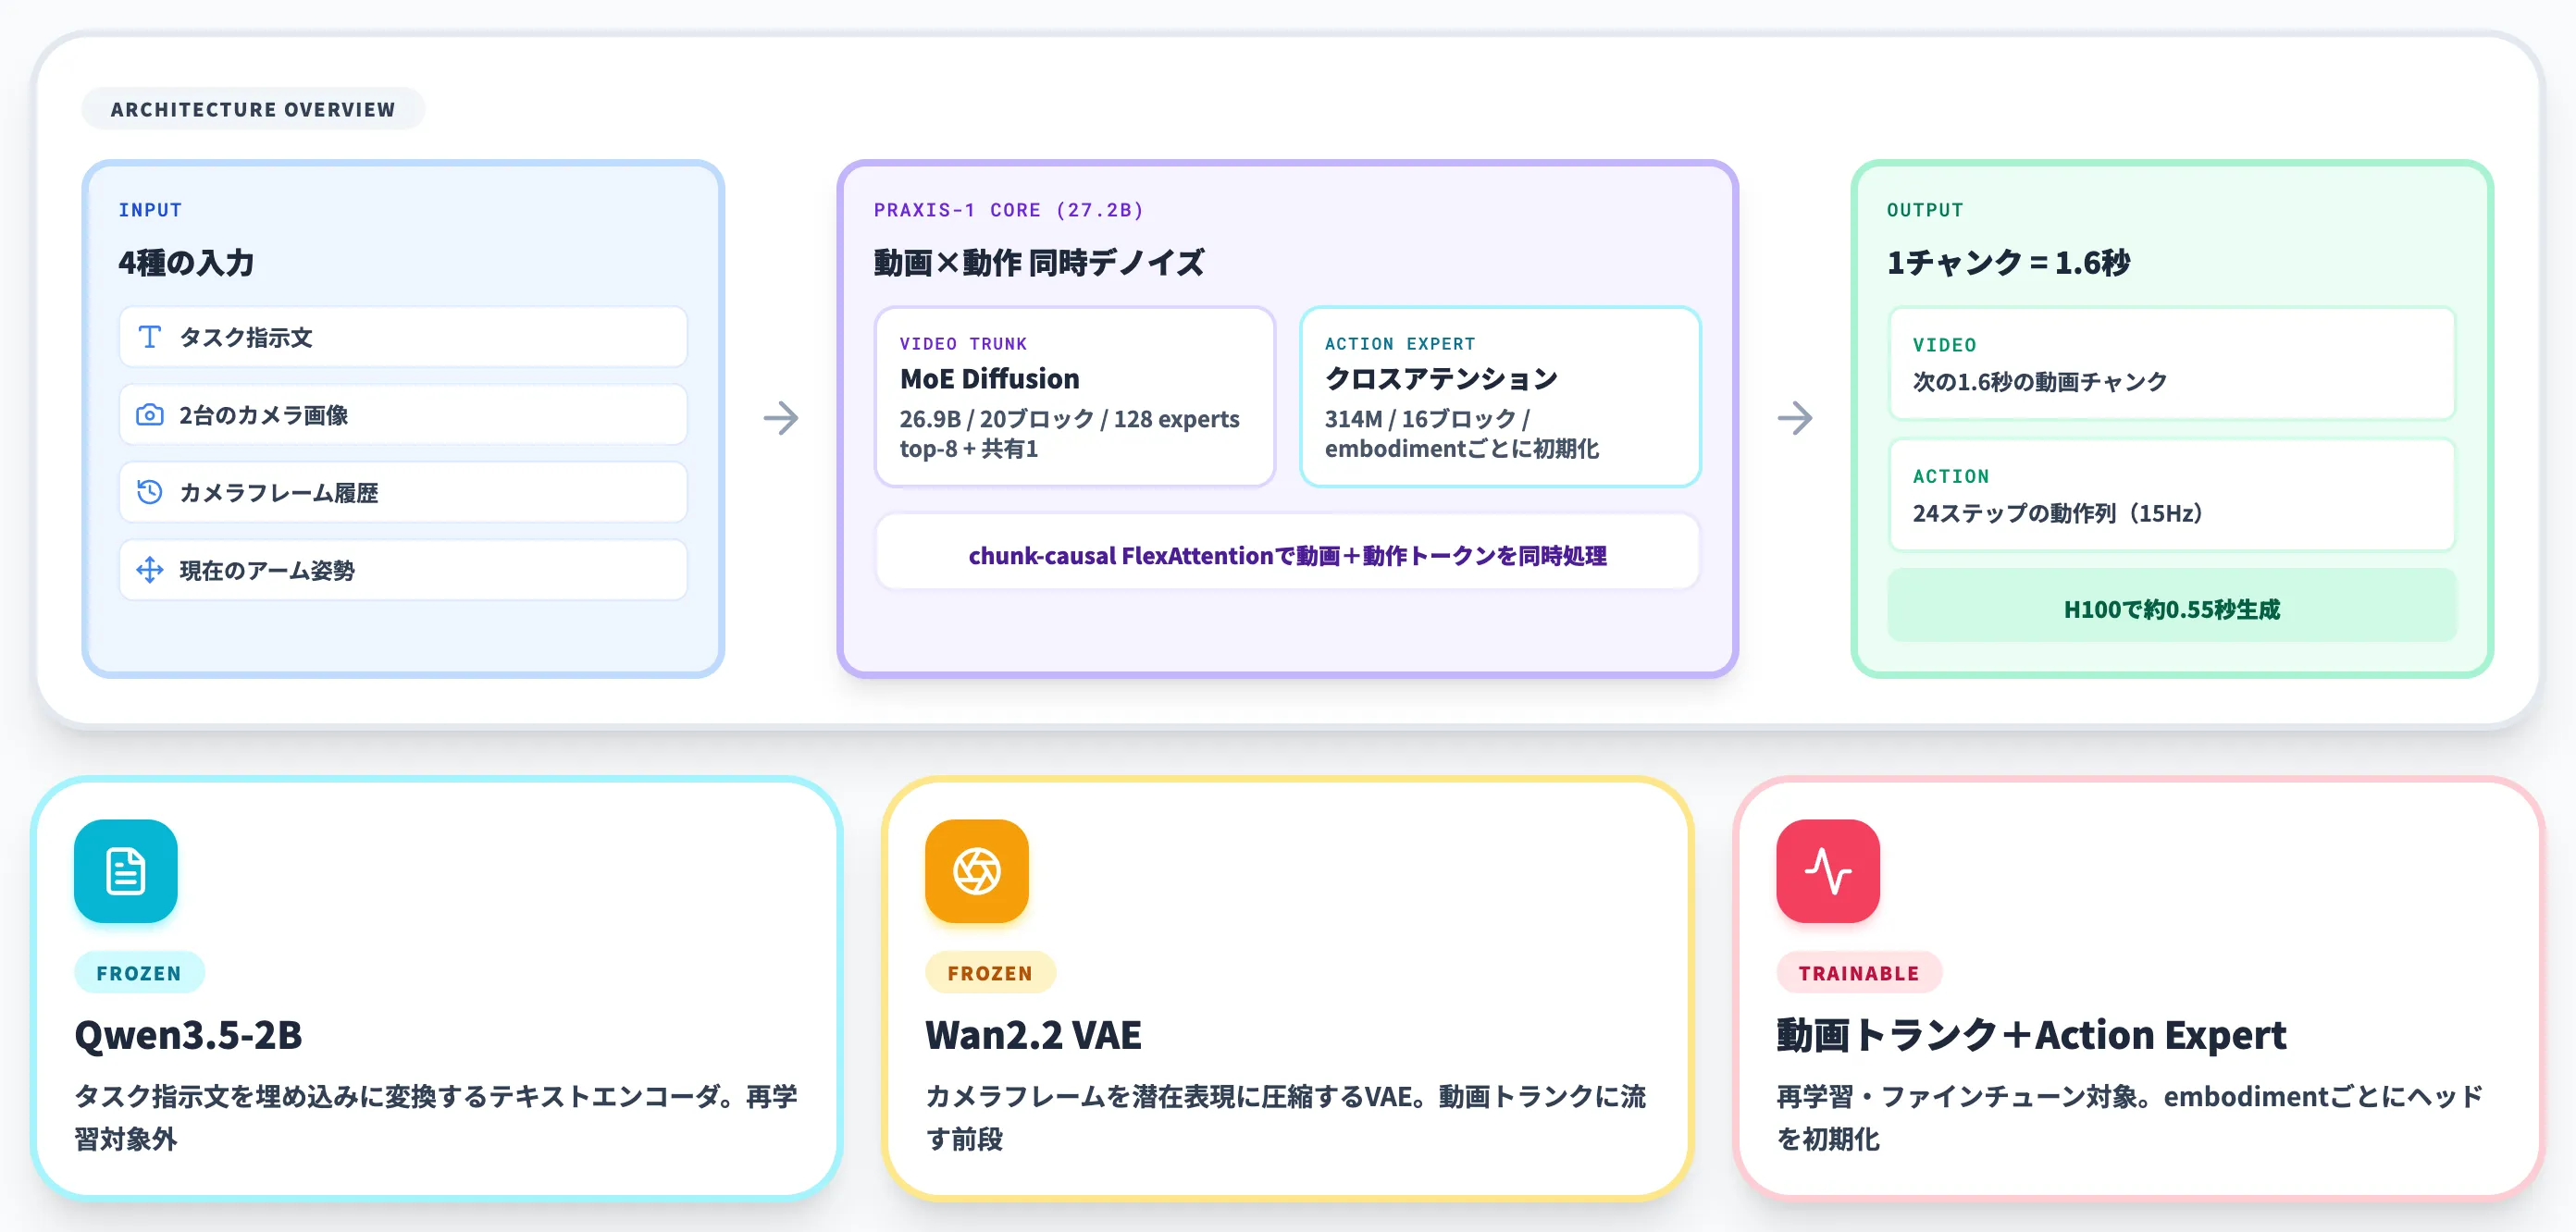
Praxis-1の核心は、「次の動画チャンクと次の動作列を1つのネットワークで同時にデノイズする」二段構造にあります。従来のVLAモデルが観測→行動の直接マッピングを学ぶのに対し、Praxis-1は動画生成で獲得した物理理解を介在させた上で動作を導きます。
ここからは、アーキテクチャの層構造・モデル規模・利用している外部コンポーネント・事前学習データの性質を順に整理します。
未来予測と行動生成を同時に扱う二段構造
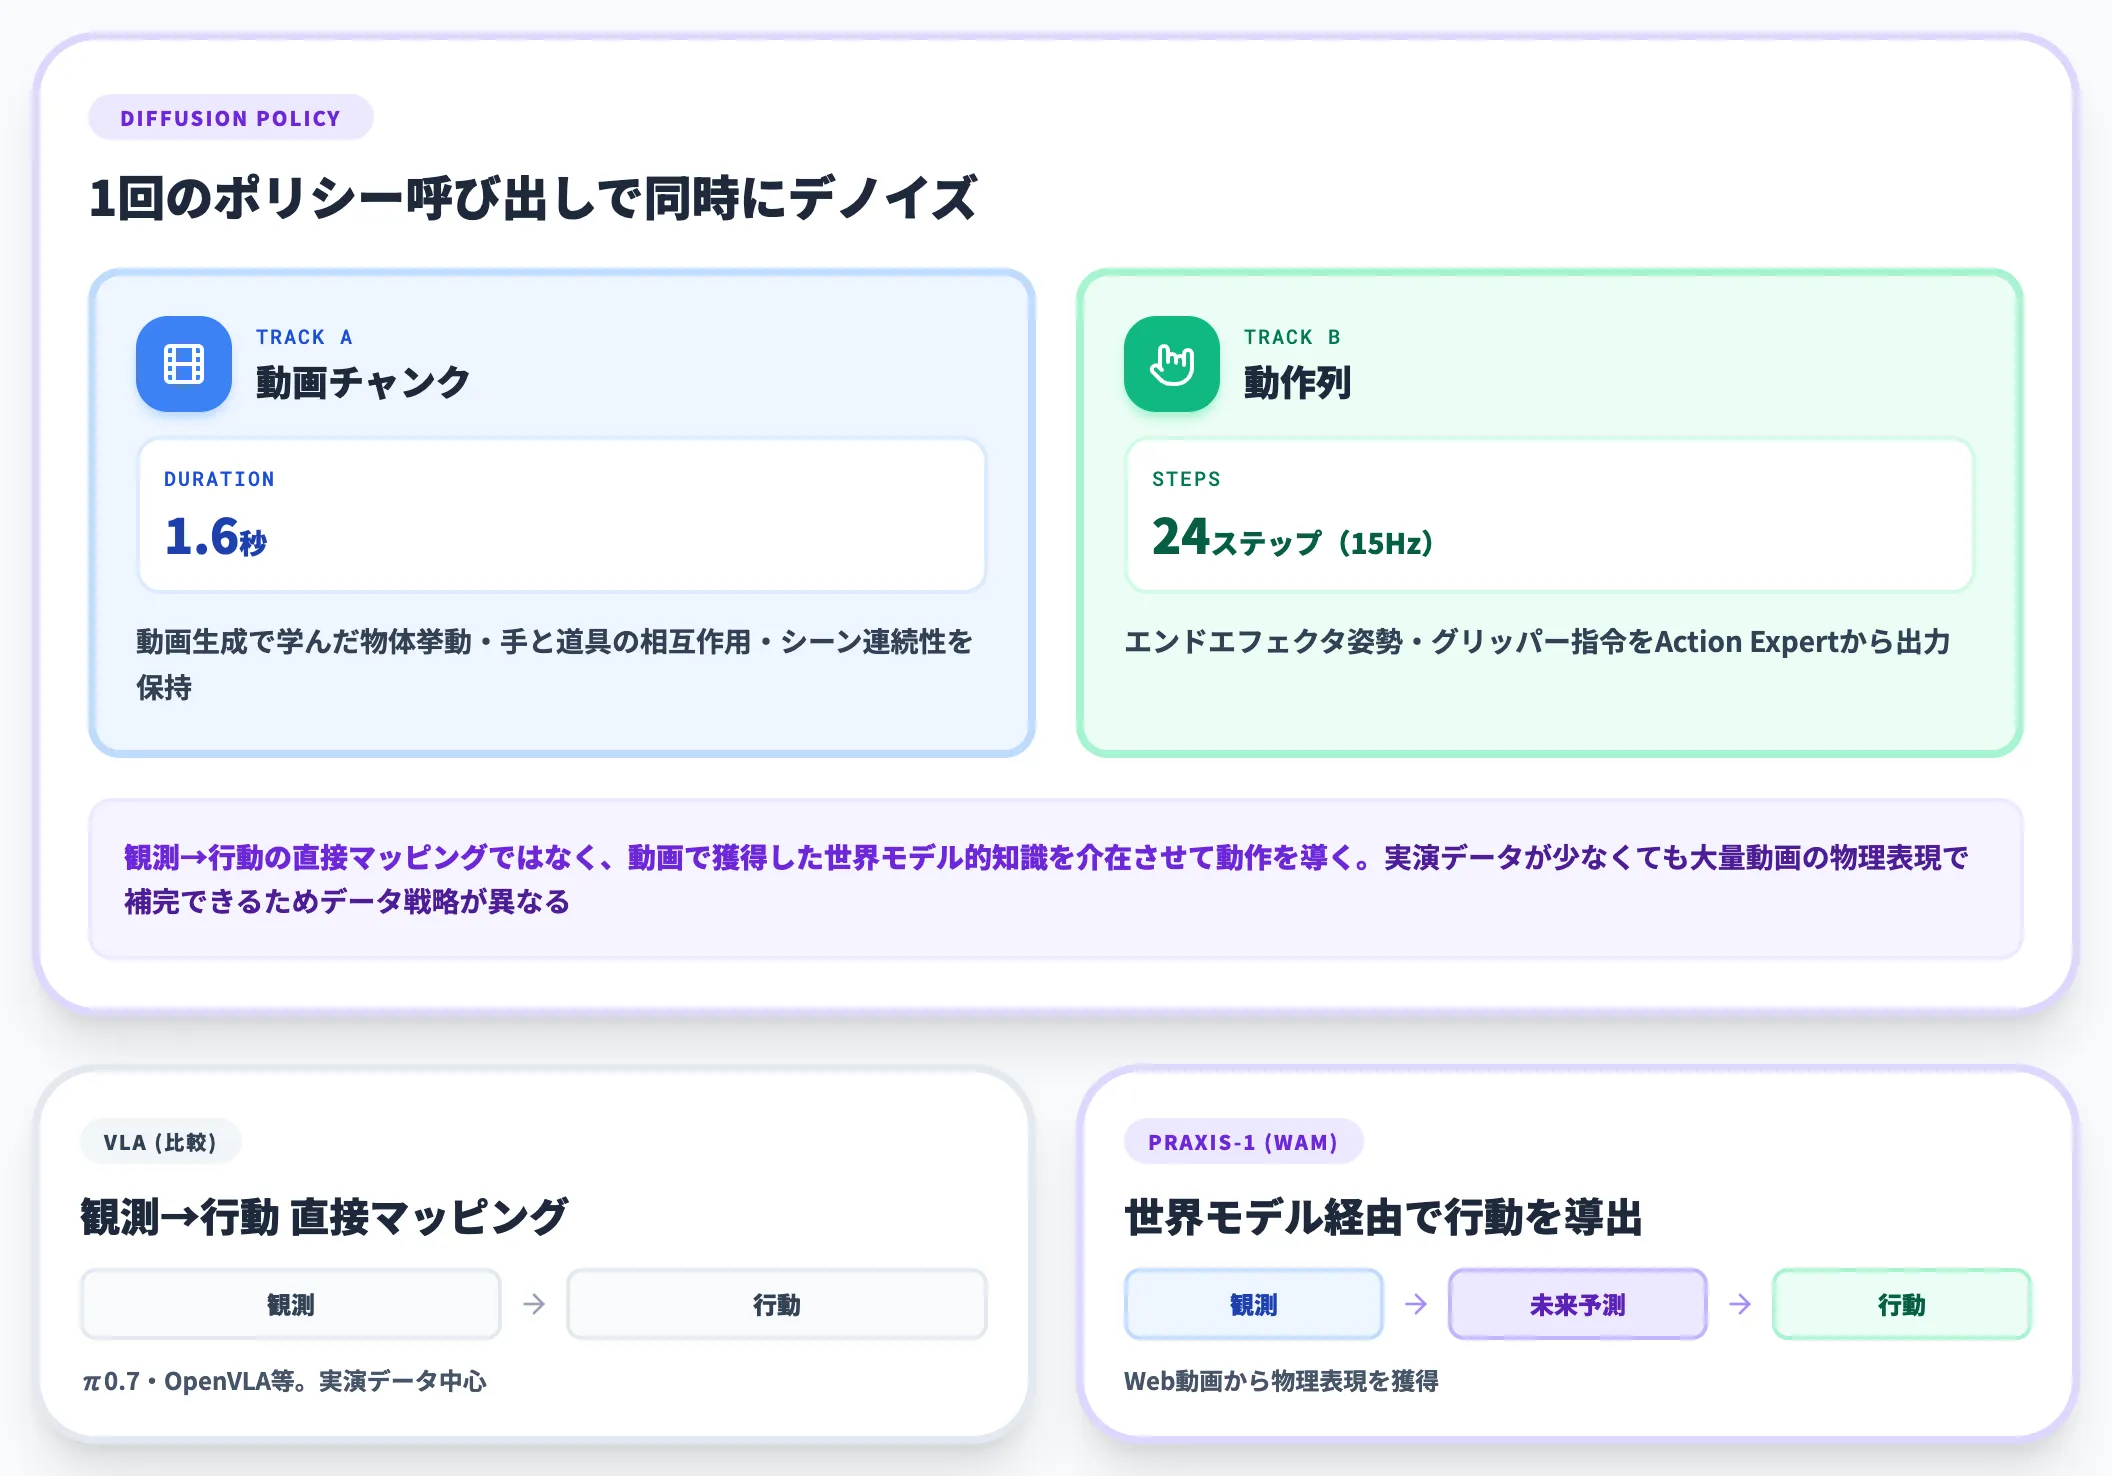
Praxis-1は、1回のポリシー呼び出しで「次の1.6秒の動画チャンク」と「24ステップ分の動作列(15Hz動作)」を同時にデノイズするDiffusion Policyとして動きます。
モデルの入力は、タスク指示文・2台のカメラ画像・実行済みチャンクのカメラフレーム履歴・現在のアーム姿勢の4点です。
この構造の利点は、動画生成で学んだ「物体の挙動」「手と道具の相互作用」「シーンの連続性」といった世界モデル的な知識を、行動推論の文脈にそのまま載せられる点にあります。
実データでしか得られない行動ラベルが少なくても、大量のインターネット動画で獲得した物理表現が補完として効くため、Physical Intelligence(π)やOpenVLAのような実演ベースのVLAモデルとはデータ戦略が異なります。
MoE Diffusion Transformerの構造
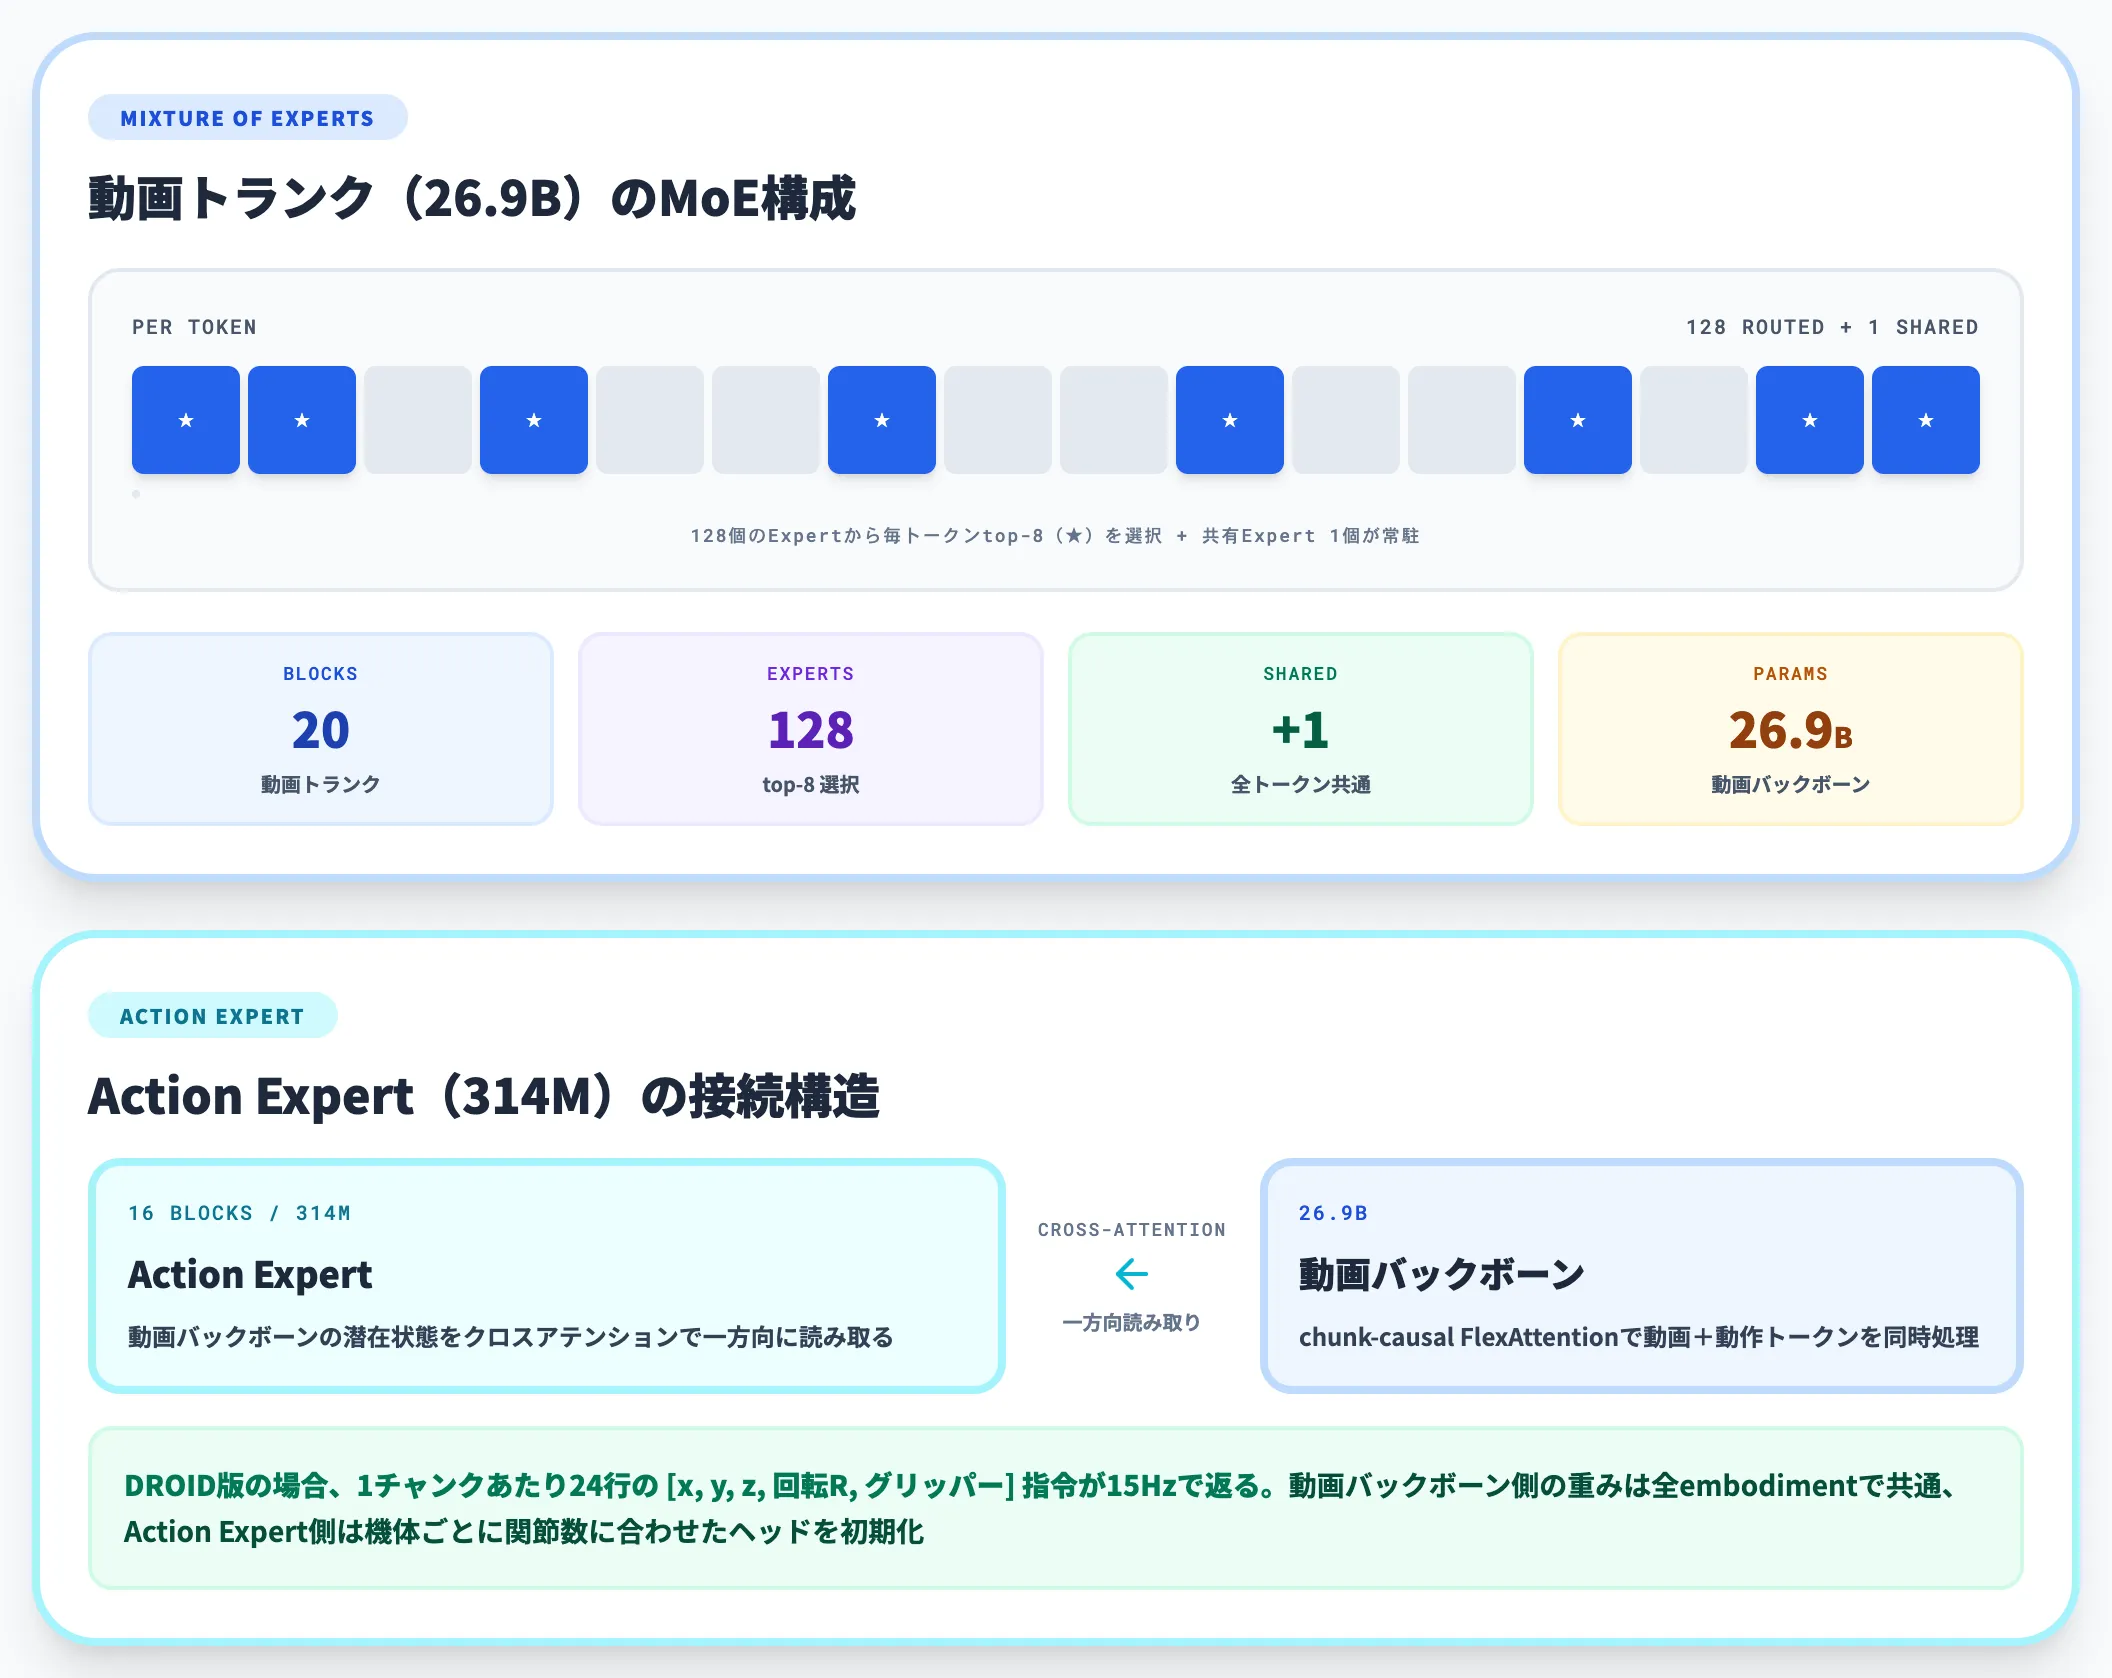
公式のモデルカードによれば、Praxis-1のバックボーンはchunk-causal構造を持つ26.9BパラメータのMoE Diffusion Transformerで、Action Expert(約314M)と合わせた合計規模は27.2Bです。
GitHubリポジトリrunwayml/praxis-1-ossのドキュメントでは、動画トランクが20ブロック構成で、Mixture of Experts側は128個の経路選択Expertから毎トークンtop-8を選び、それに加えて全トークンが共通で使う共有Expertが1個常駐する設計になっています。
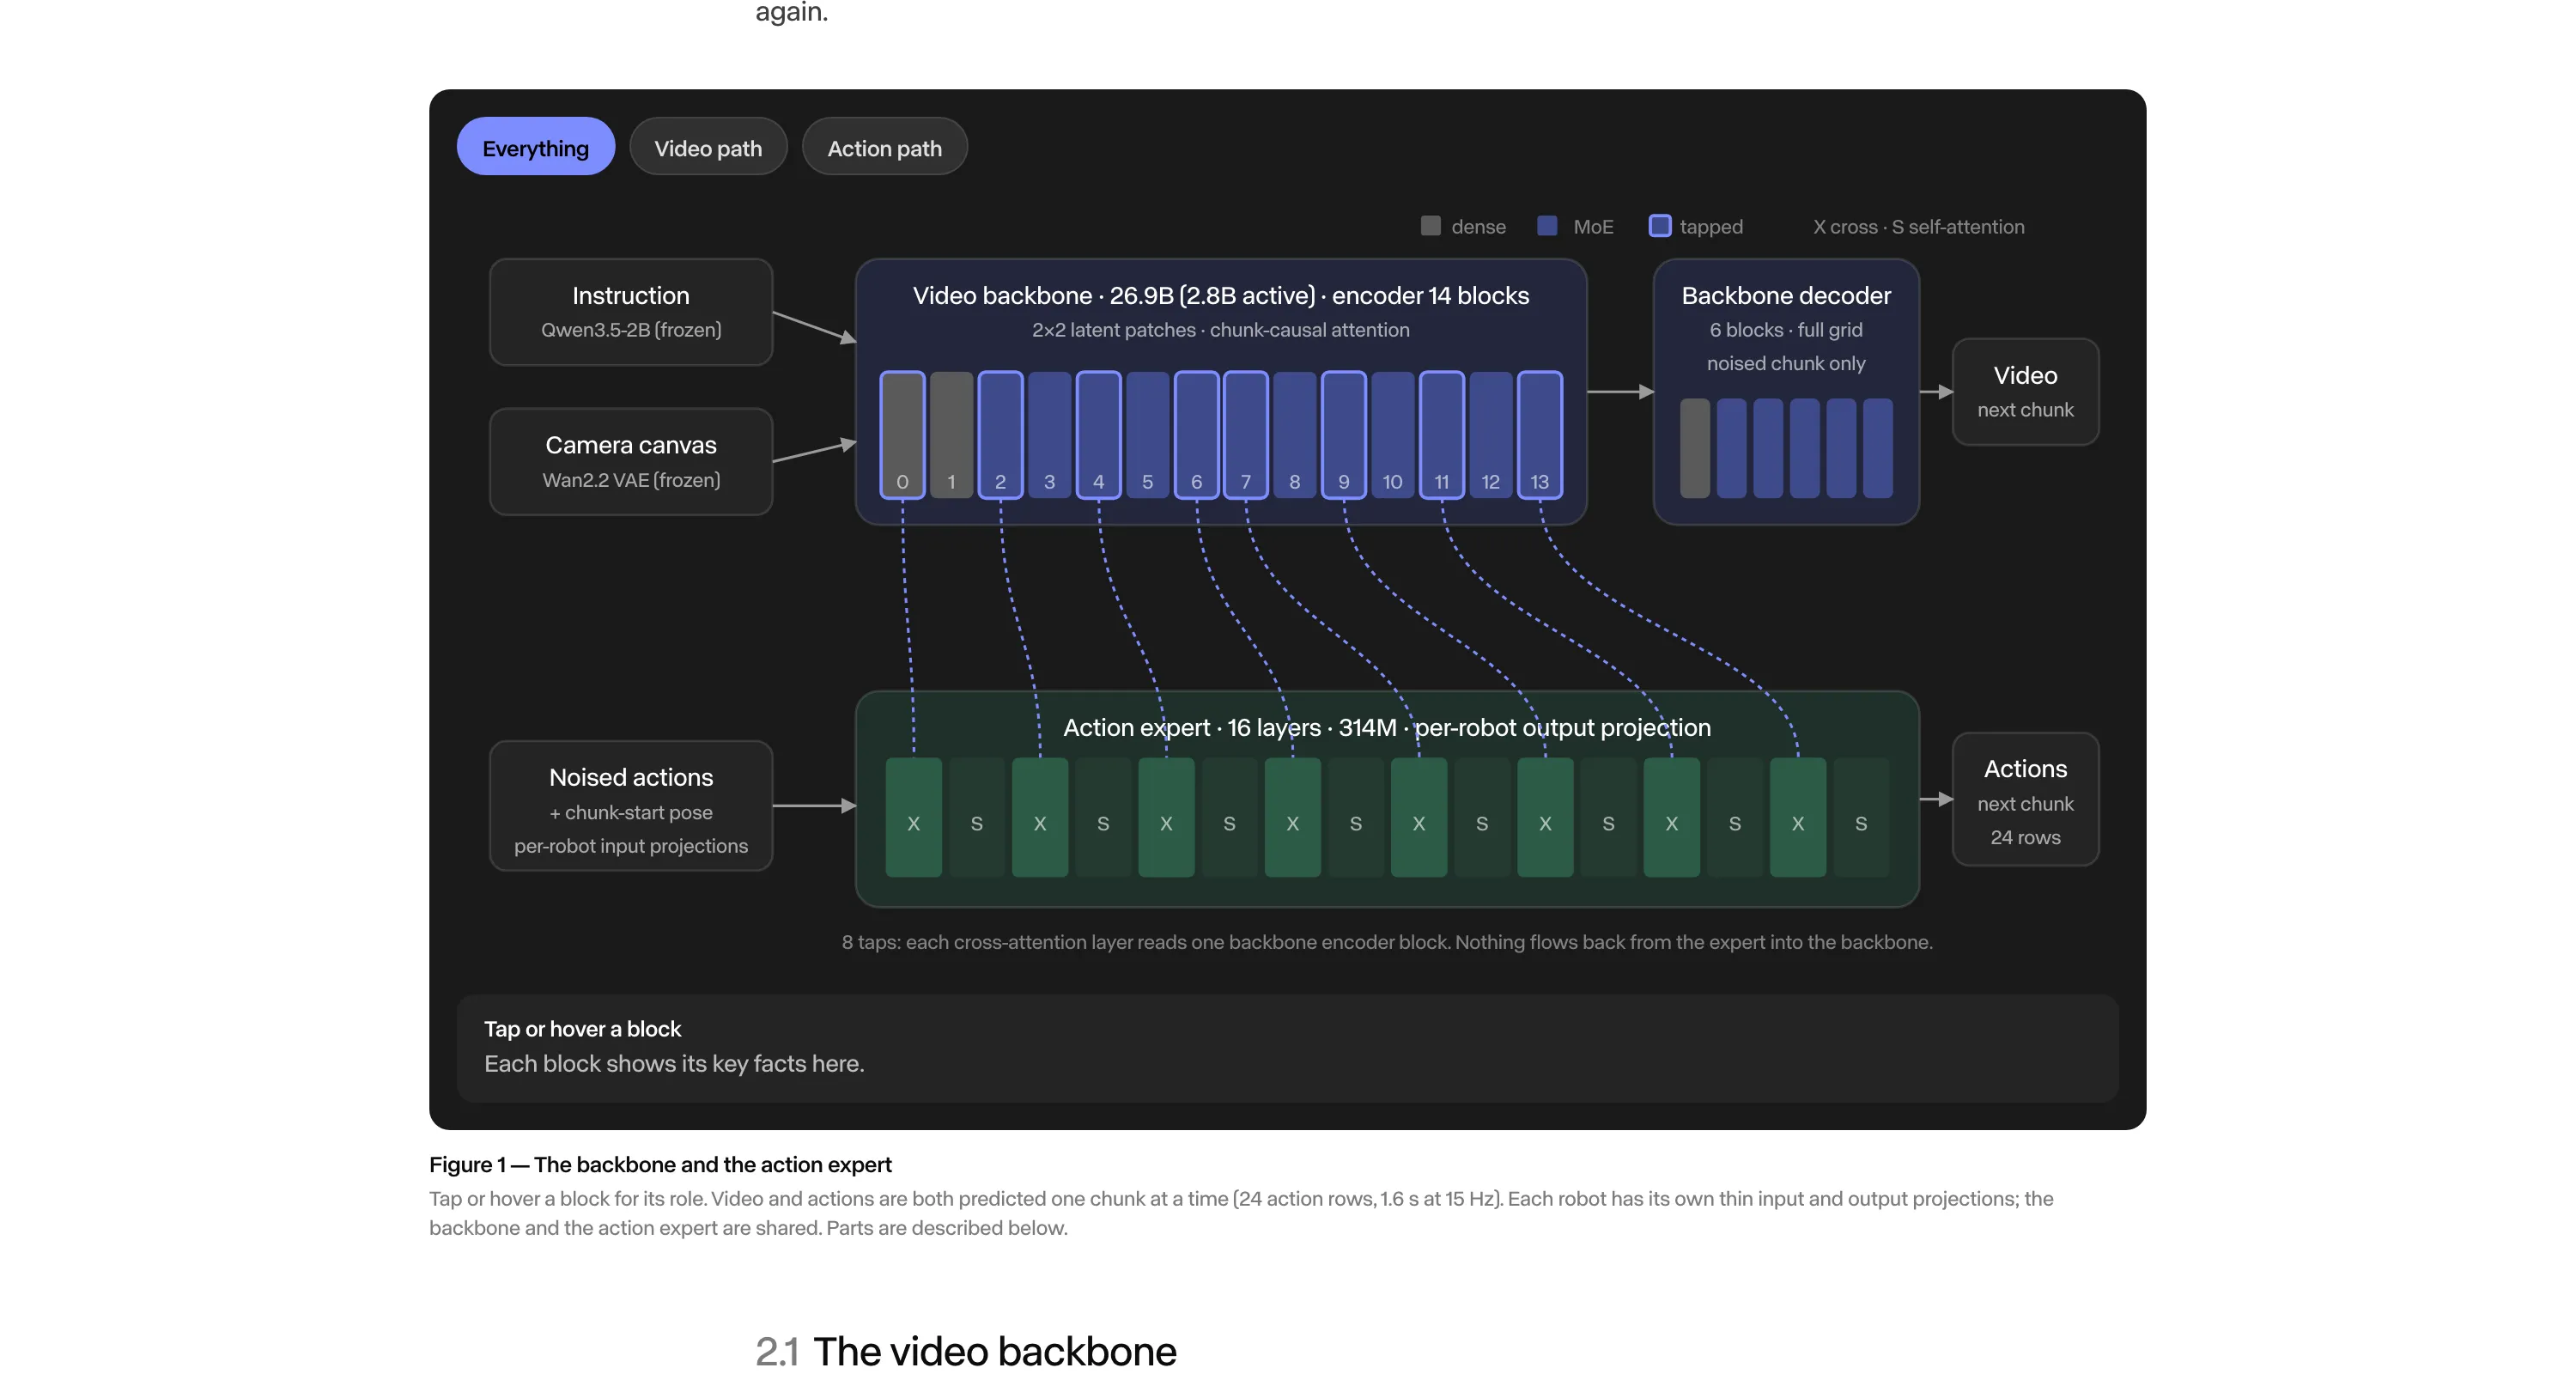
Praxis-1のアーキテクチャ:Action Expertが動画バックボーンの特徴をクロスアテンションで一方向に読み取るモジュール構成(出典:Runway Research)
公式図が示すとおり、入力側には指示文を受けるQwen3.5-2BテキストエンコーダとカメラフレームをWan2.2 VAEで圧縮する経路が並び、中央の動画バックボーンが未来チャンクのデノイズを担当します。
Attentionはchunk-causal FlexAttentionマスクを採用し、動画と動作のトークン列を1つのモデルで同時に扱えるようになっています。
ここに16ブロックで約314M(約3.1億)パラメータのAction Expertが接続され、動画バックボーンの潜在状態をクロスアテンションで読み取ってエンドエフェクタ姿勢とグリッパー指令を出力します。
DROID版の場合、1チャンクあたり24行の [x, y, z, 回転R, グリッパー] 指令が15Hzで返る形になります。
この二段構成により、動画バックボーン側の重みは全embodimentで共通しつつ、Action Expert側は機体ごとに関節数・固有受容情報の次元に合わせたヘッドを初期化し、新しい機体なら base チェックポイントからのフル微調整、既存DROID機体の新タスクならLoRA、というルートで適応させる設計になっています。
各モジュールの役割分担
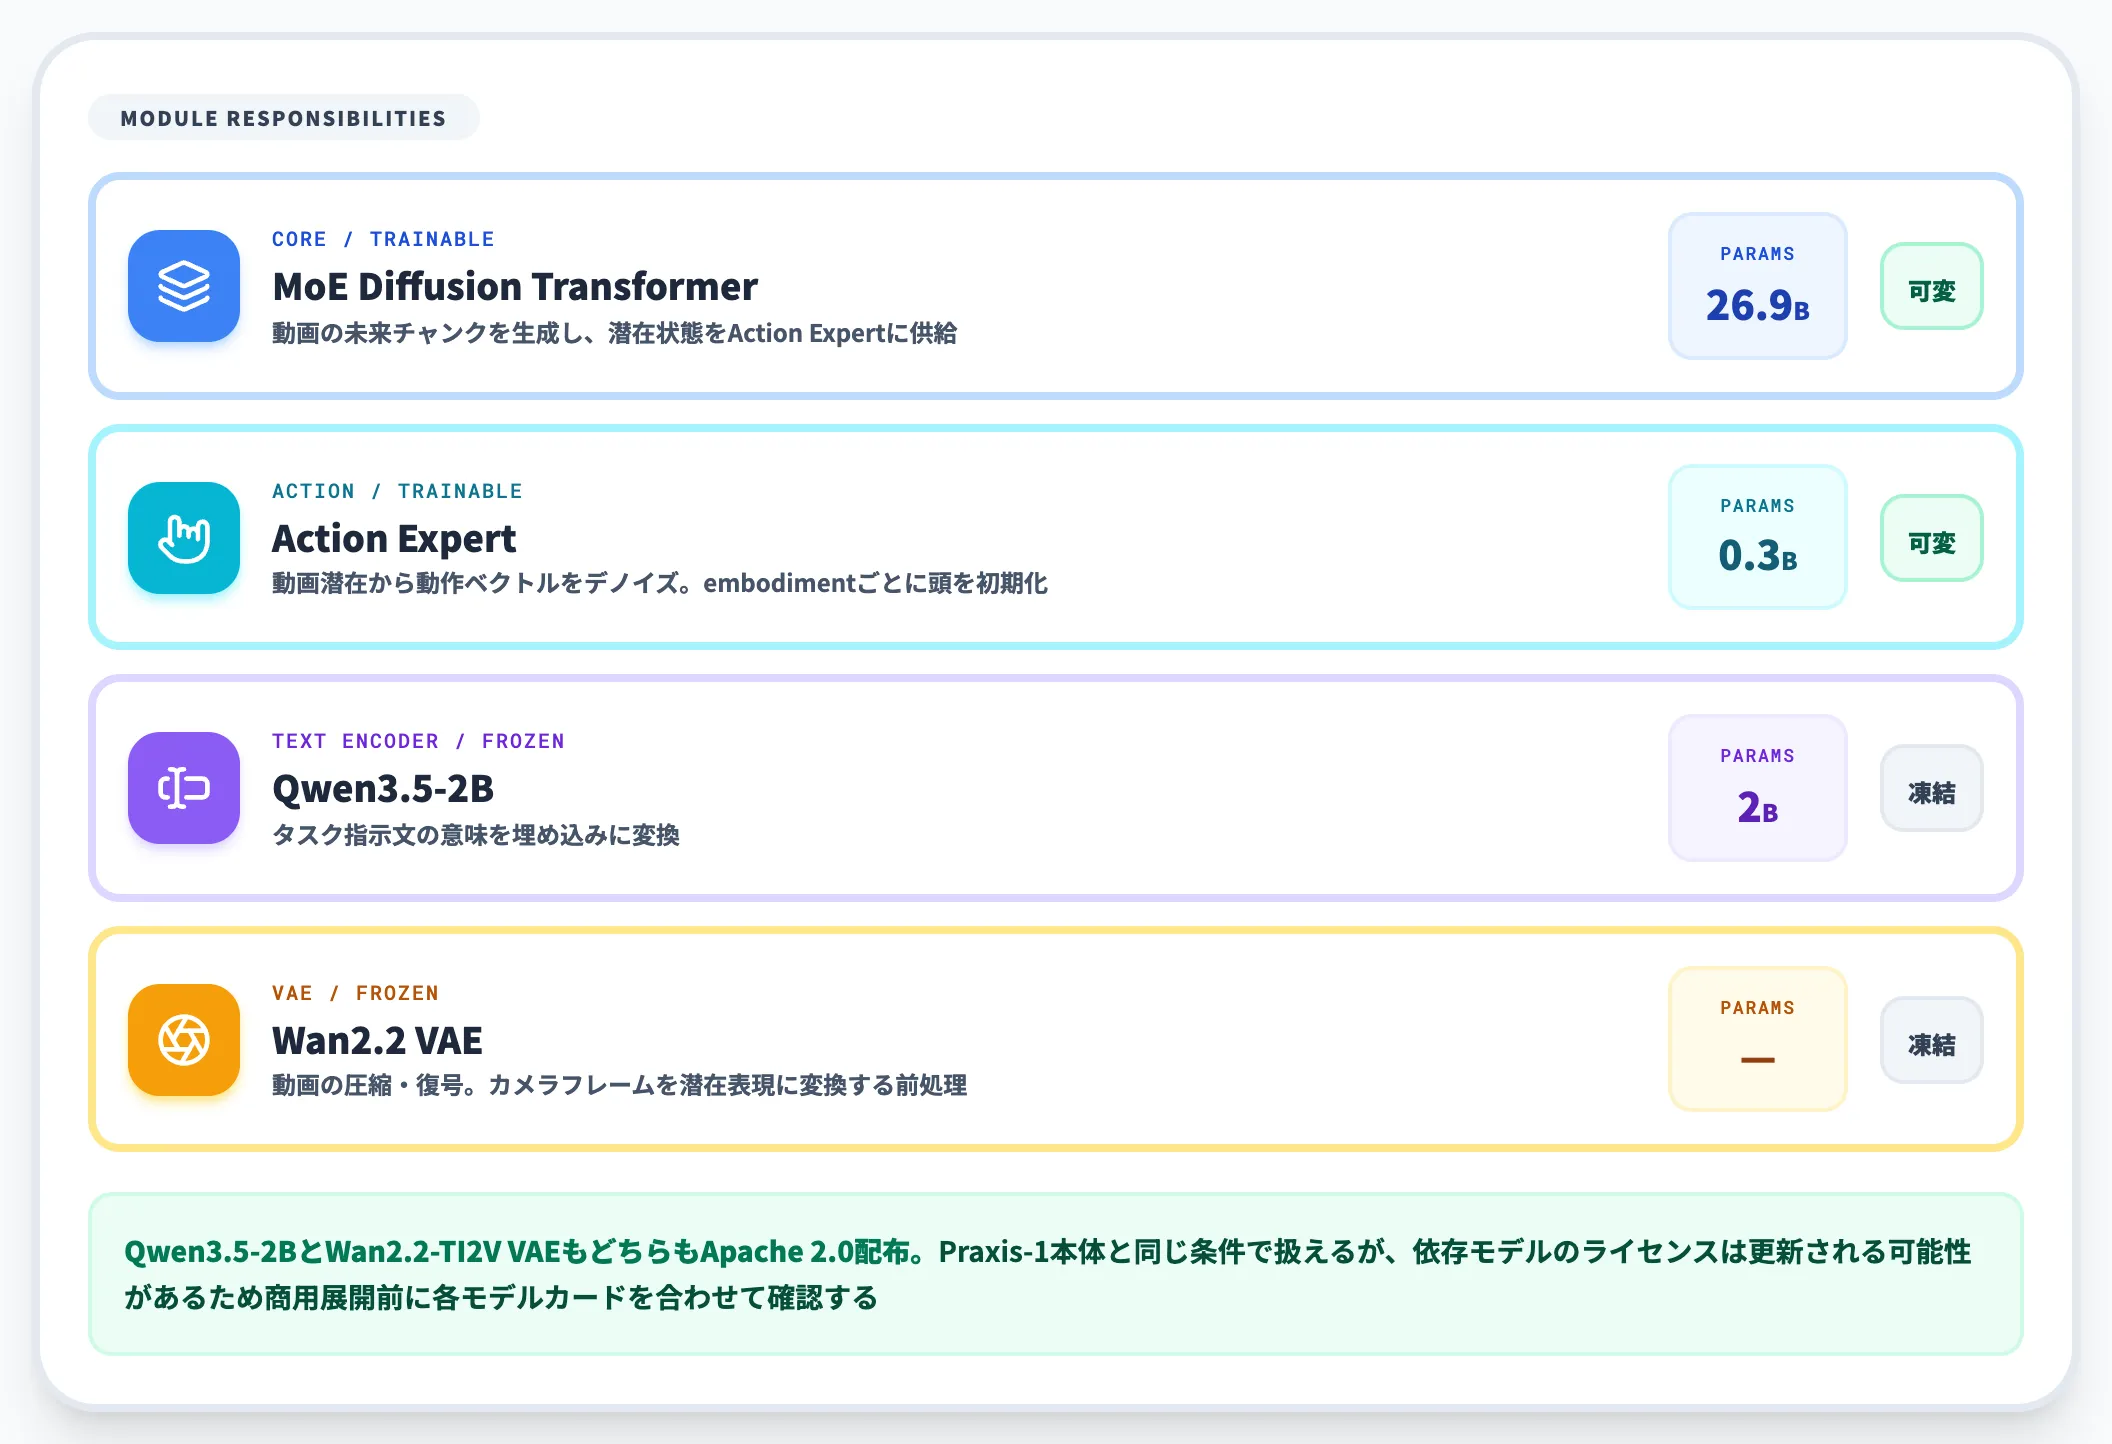
Praxis-1は外部コンポーネントとして、Qwen3.5-2Bをテキストエンコーダ、Wan2.2を動画のVAE(Variational Autoencoder)として組み込んでいます。両者は学習・推論時に凍結(frozen)扱いで、再学習の対象になるのは本体のMoEトランクとAction Expertのみです。
以下の表で、Praxis-1を構成する主要モジュールと、それぞれの役割を整理しました。
| モジュール | パラメータ規模 | 学習扱い | 役割 |
|---|---|---|---|
| MoE Diffusion Transformer(動画トランク) | 26.9B(128 routed experts top-8 + 共有Expert 1) | 可変(事前学習・ファインチューン対象) | 動画の未来チャンクを生成し、潜在状態を提供 |
| Action Expert | 0.3B(16ブロック) | 可変(embodimentごとに微調整) | 動画潜在から動作ベクトルをデノイズ |
| Qwen3.5-2B テキストエンコーダ | 2B | 凍結 | タスク指示文の意味を埋め込みに変換 |
| Wan2.2 VAE | — | 凍結 | 動画の圧縮・復号 |
この構成が示すのは、同梱されるQwen3.5-2BテキストエンコーダとWan2.2-TI2V VAEもどちらもApache 2.0で配布されており、Praxis-1本体と同じ条件で扱える点です。それでも依存モデルのライセンスは更新される可能性があるため、商用展開の前に各モデルカードを合わせて確認するのが実装者の仕事になります。
また、Praxis-1 baseはembodiment非依存の中間学習チェックポイントで、特定のロボットで動かすには、Action Expertに関節数・固有受容情報の次元に合わせた「頭」を初期化してからファインチューンする必要があります。公
式リポジトリに同梱の初期化スクリプトがそのための処理を提供しています。
Web動画事前学習と遠隔操作映像の同等性
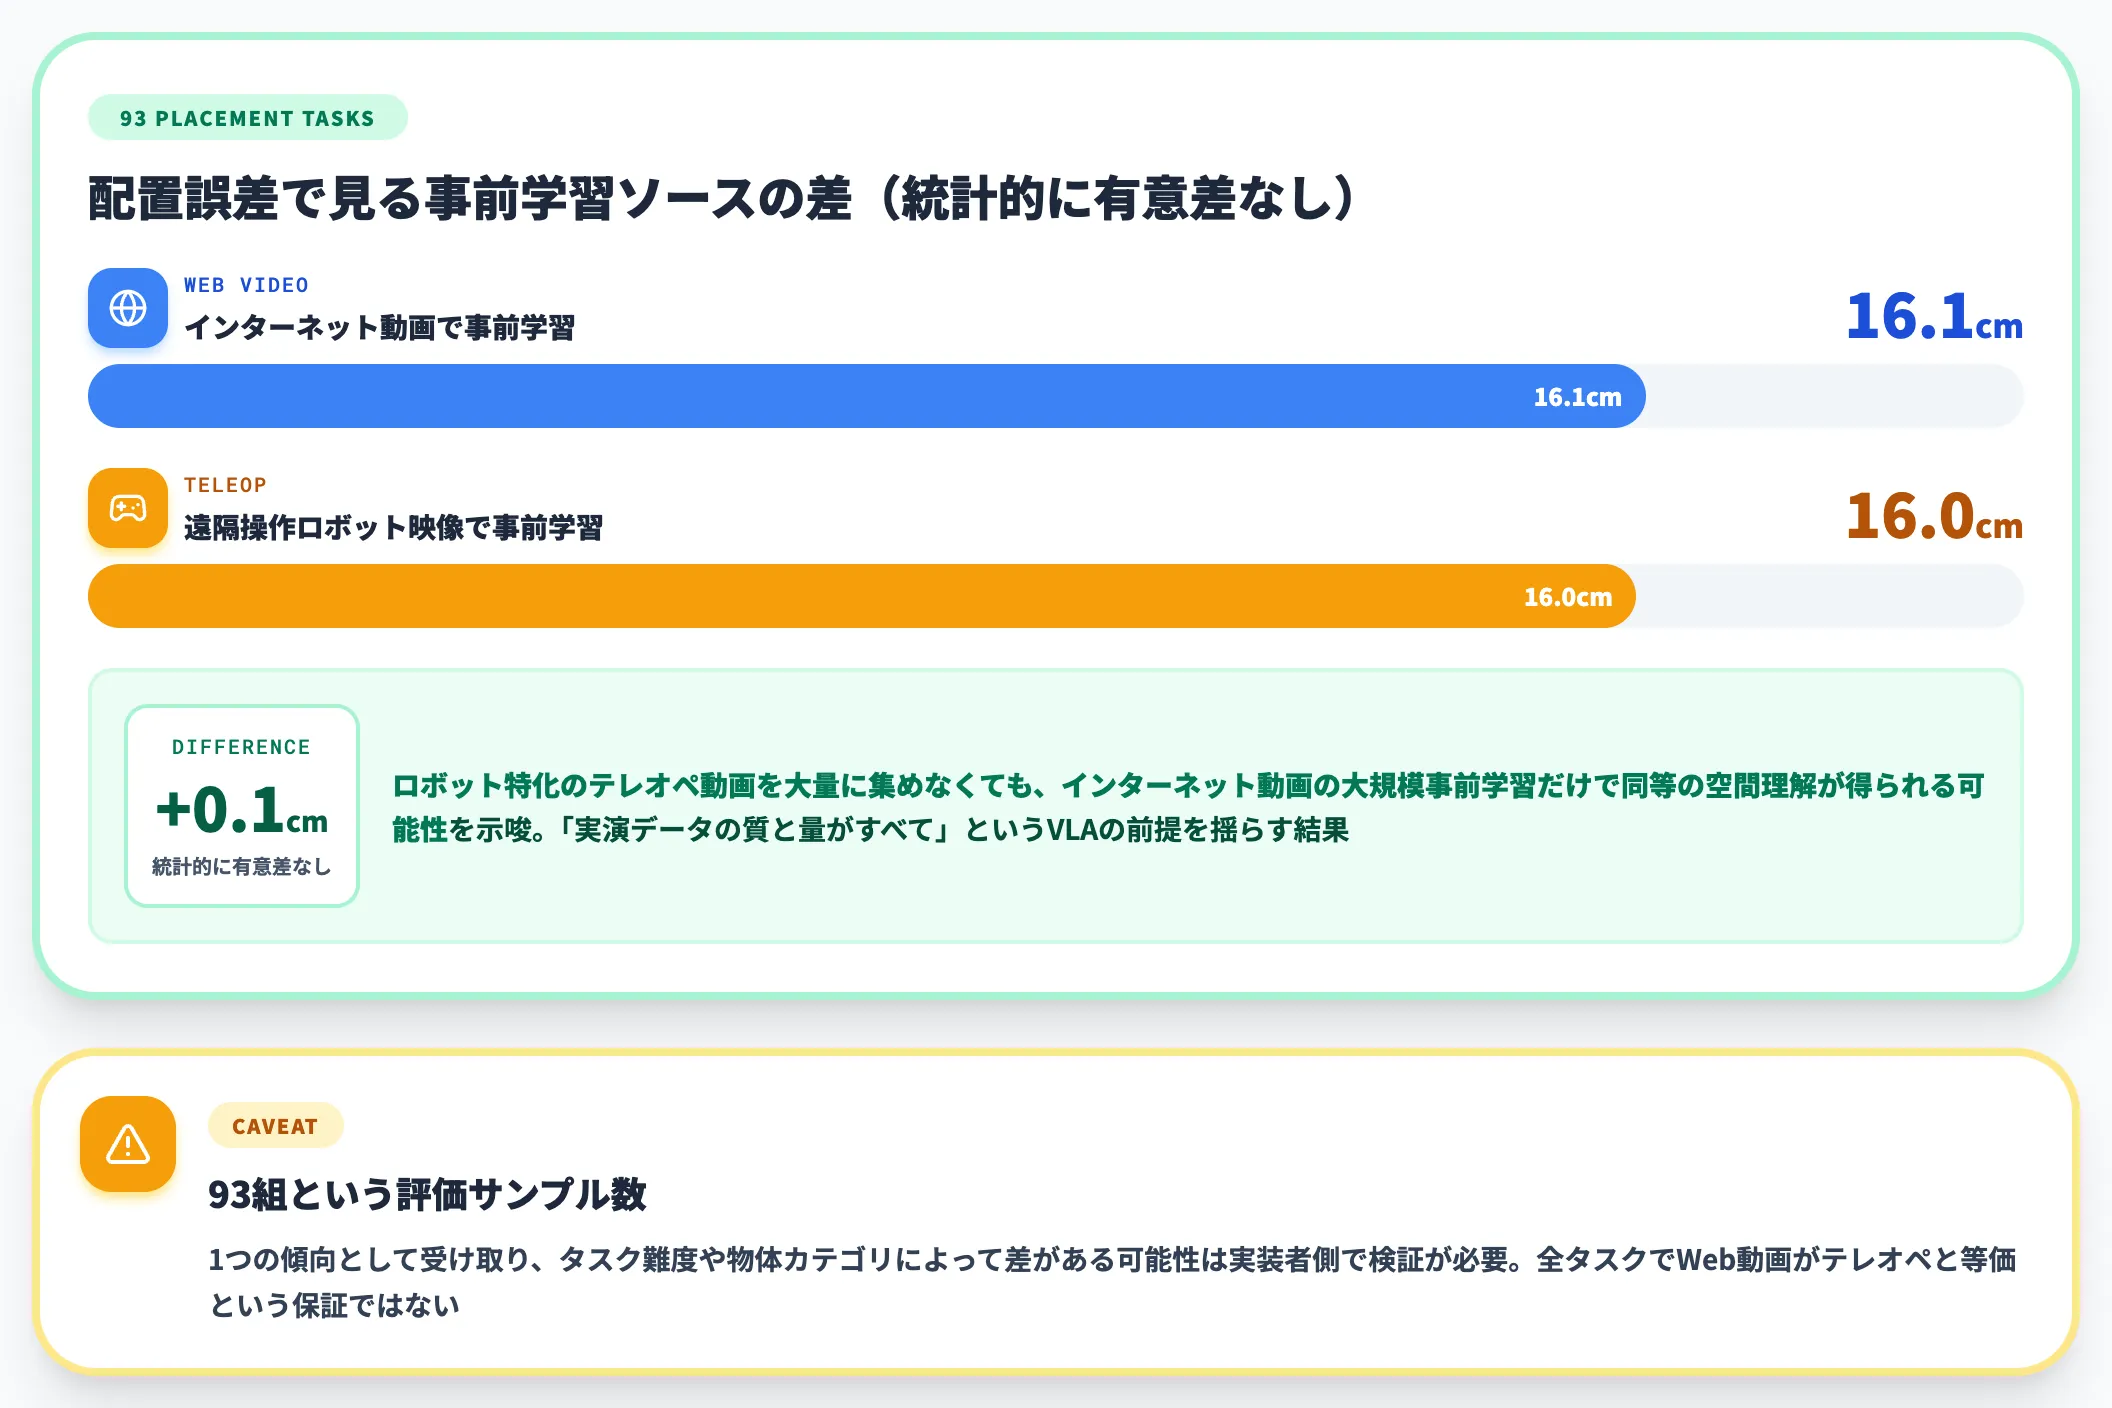
Runwayの技術報告の中で最も象徴的な数字は、93組の配置タスクで計測された平均誤差です。Webから集めた動画のみで事前学習したモデルが配置精度16.1cm、遠隔操作ロボットの映像で事前学習した対照モデルが16.0cmと、両者に統計的に意味のある差が出ませんでした。
この結果は、ロボット特化のテレオペ動画を大量に集めなくても、インターネット動画の大規模事前学習だけで同等の空間理解が得られる可能性を示しています。
これはVLA系のモデル開発でこれまで前提にされてきた「実演データの質と量がすべて」という設計思想を揺らす主張で、WAMの戦略的優位性としてRunwayが強調しているポイントです。
ただし、93組という評価サンプル数は決して多くないため、1つの傾向として受け取り、タスク難度や物体カテゴリによって差がある可能性は実装者側で検証する必要があります。
Praxis-1のベンチマーク性能と実機デモ
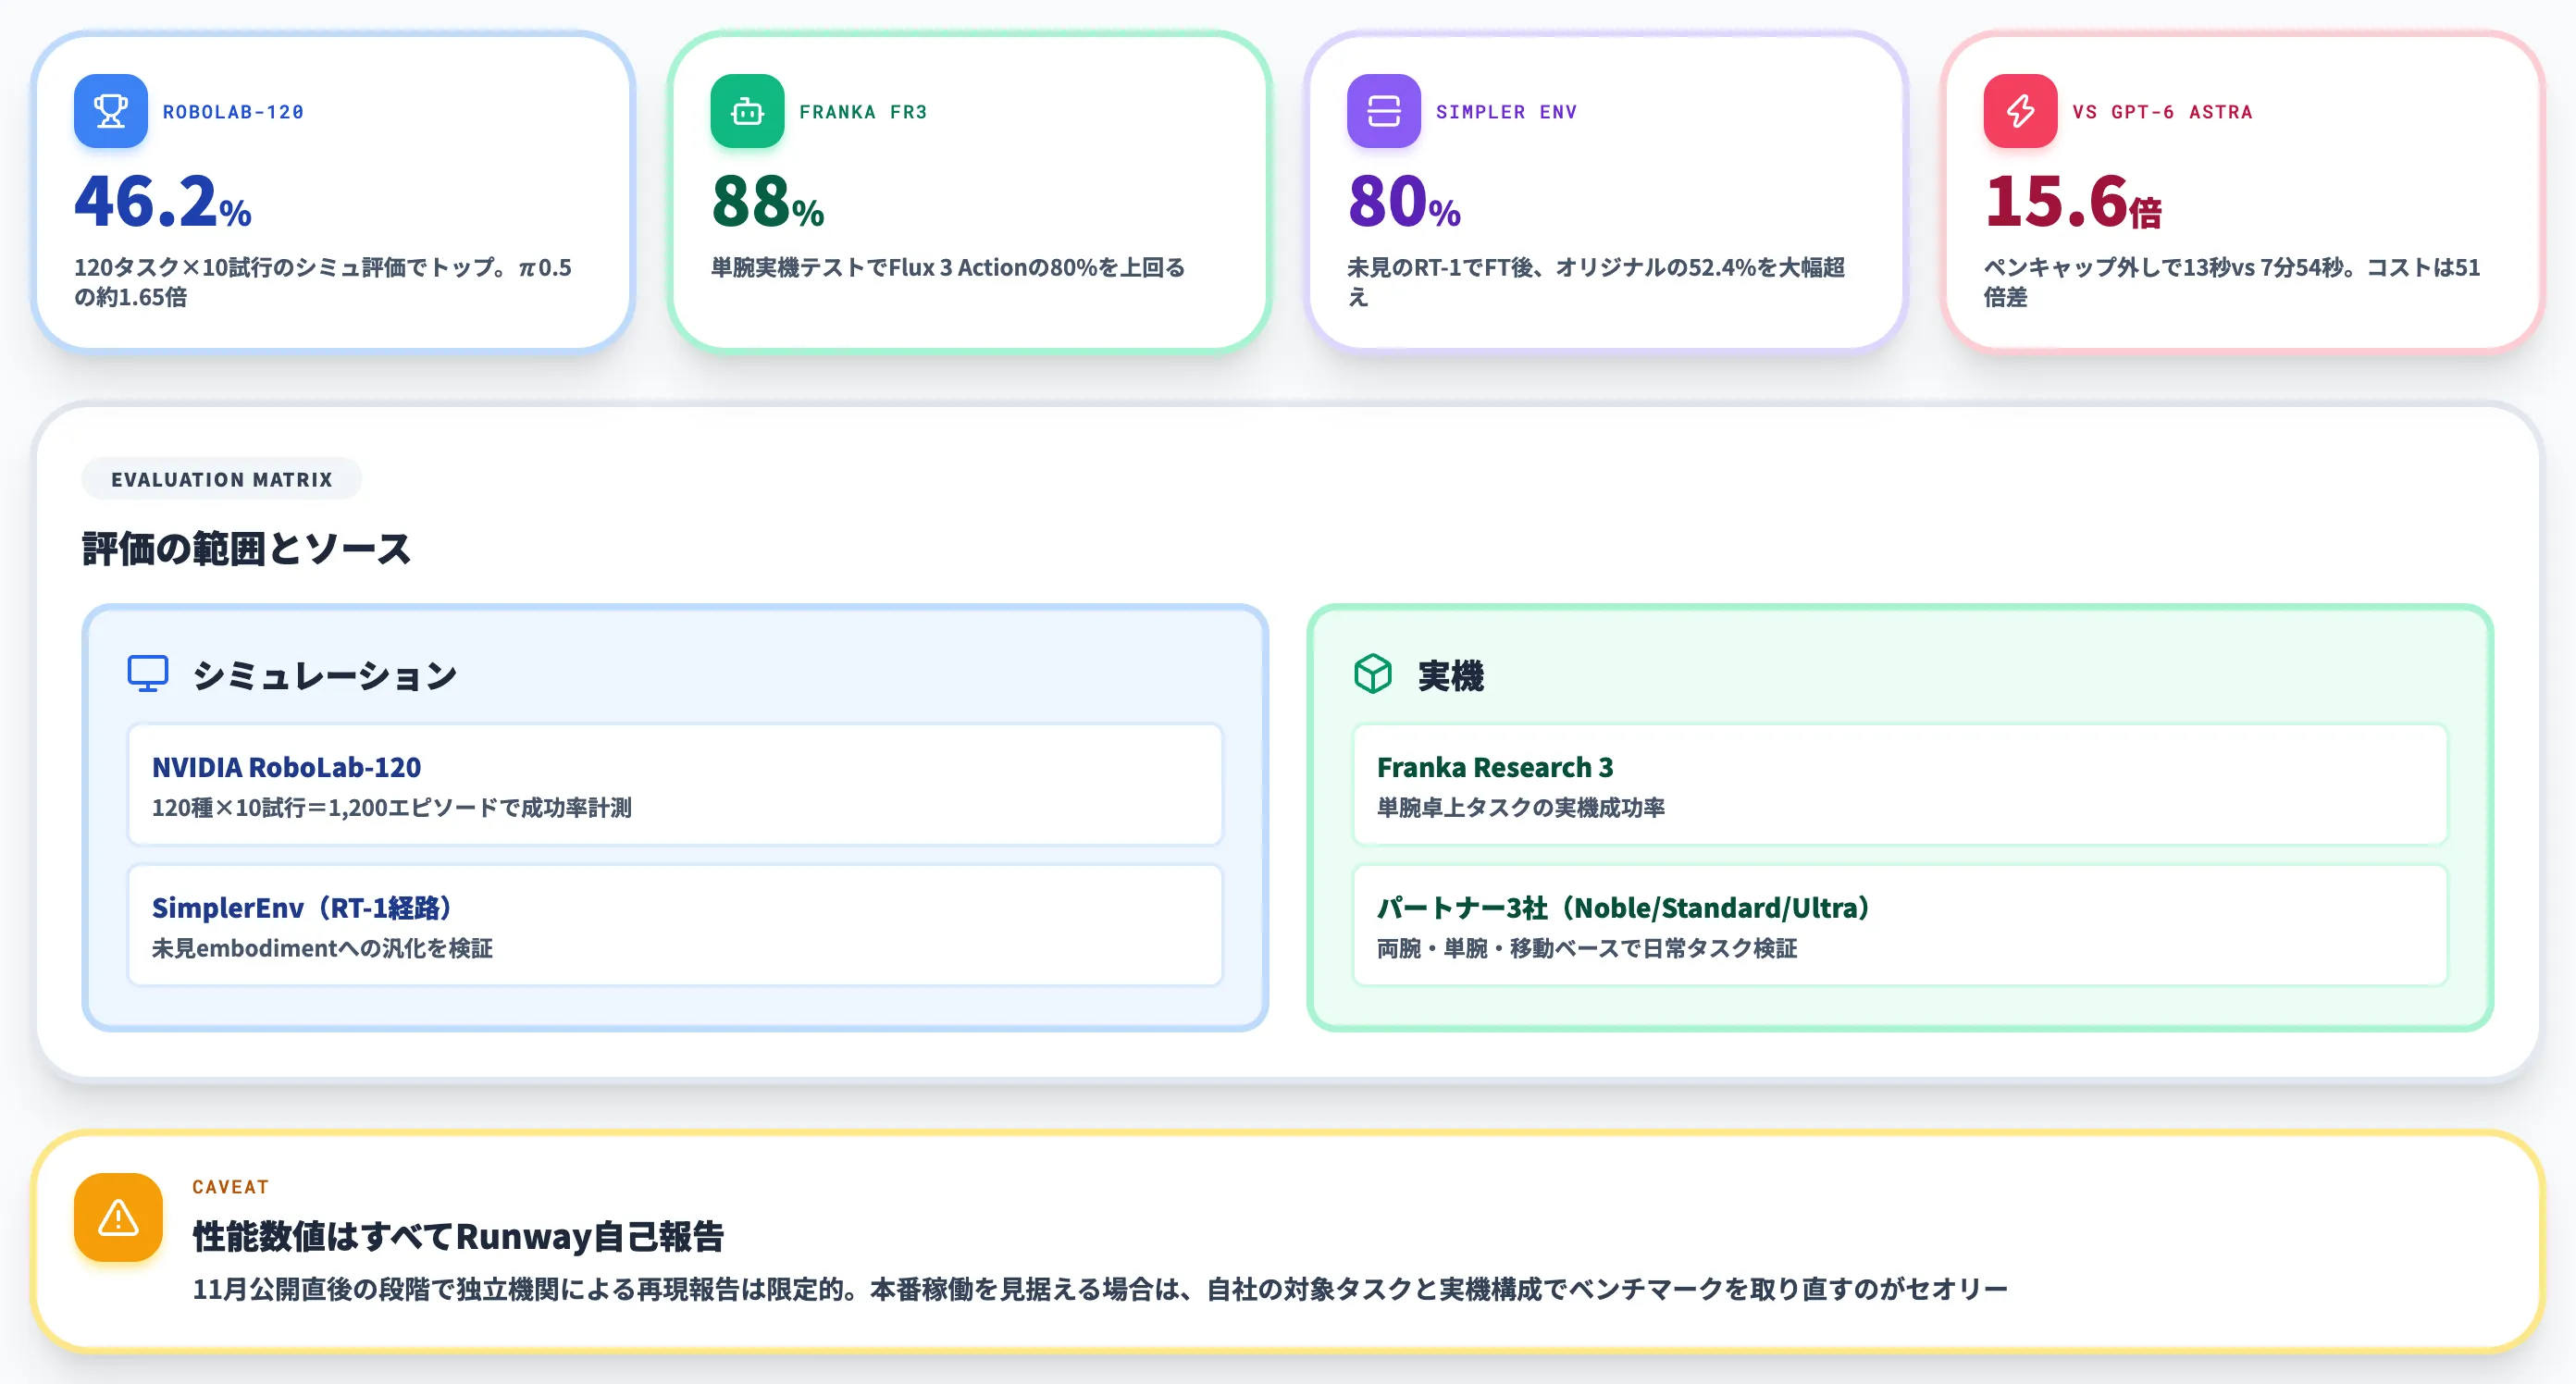
Praxis-1の評価は、シミュレーションのロボティクスベンチマークと実機2種類の両方で行われています。Runwayはこれらすべての数値を自社レポートとして公開していますが、2026年11月時点で独立機関による再現報告は限定的な状態です。
ここでは、NVIDIAのRoboLab-120、Google RT-1のSimplerEnv、Franka FR3実機、そしてパートナー3社のデモ内容を順に整理します。
RoboLab-120で46.2%・π0.5の1.65倍
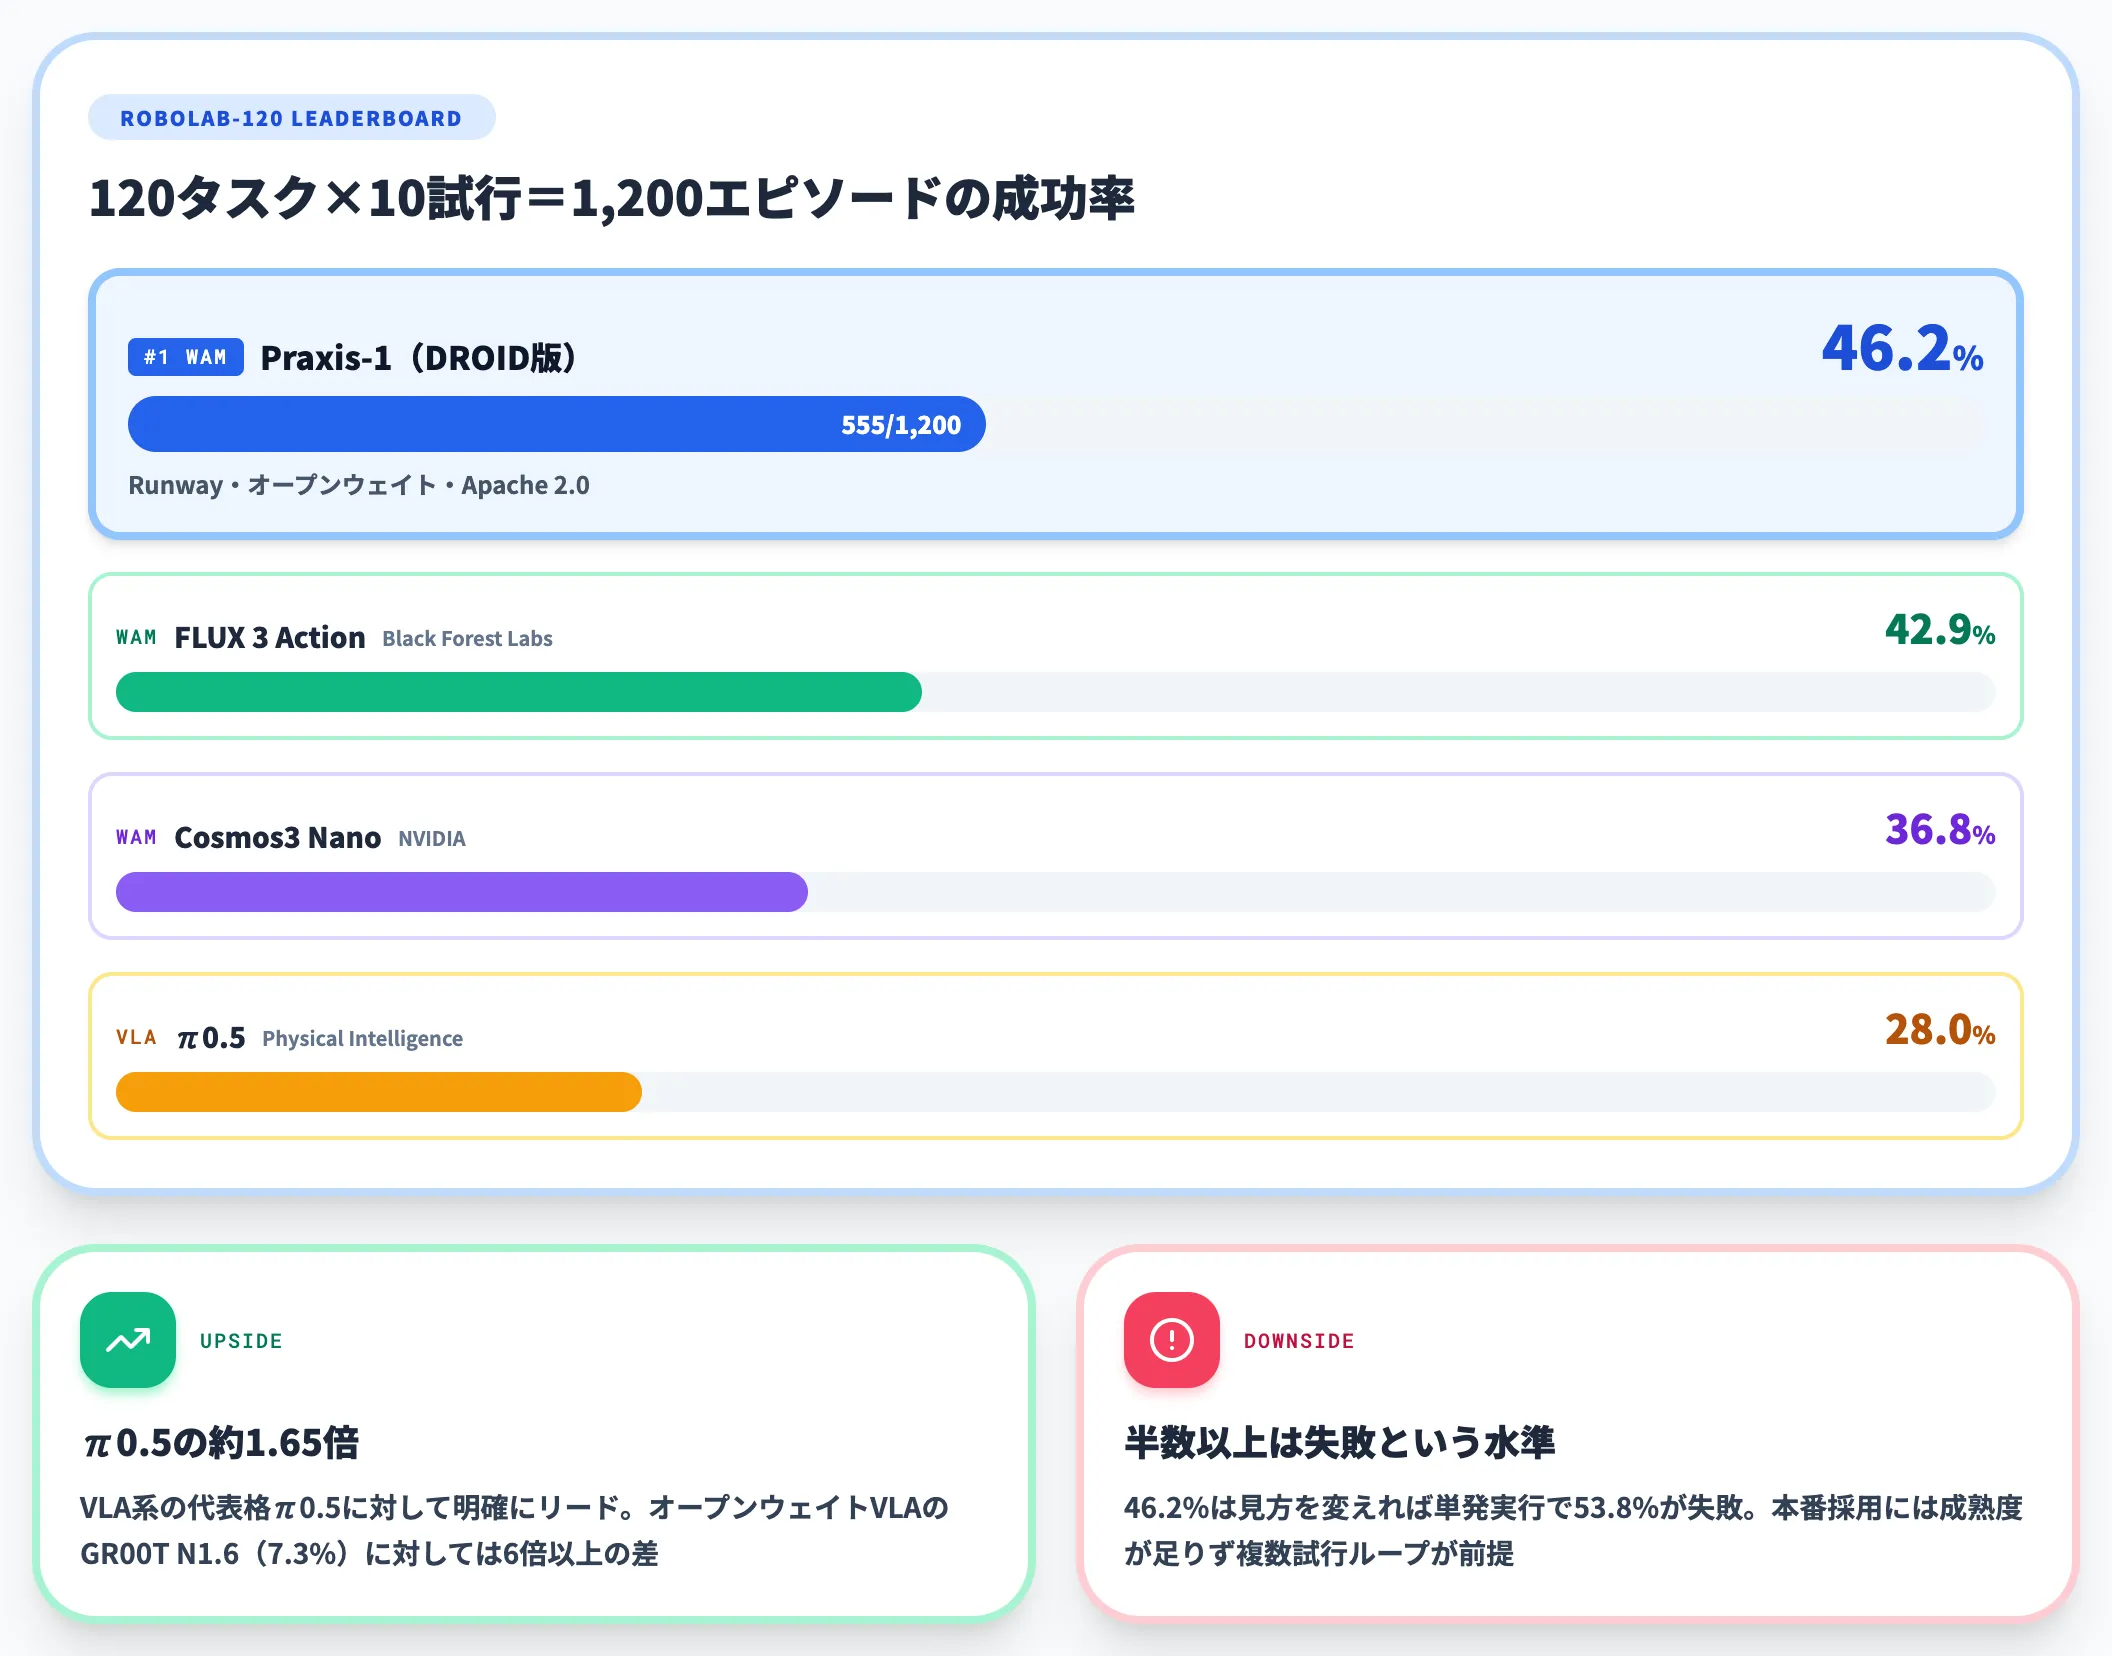
NVIDIAがホストするロボティクスベンチマーク「RoboLab-120」は、120種類のテーブルトップ操作タスクをそれぞれ10回試行して成功率を測るシミュレーション評価です(Runway公式Tech Reportの §6.1 RoboLab-120で詳細が公開されています)。
Praxis-1(DROIDファインチューン版)はこの1,200エピソードのうち555を成功させ、46.2%の成功率で既存のオープンロボット基盤モデルを抜いてトップに立ちました。
以下の表で、RoboLab-120リーダーボード上の主要4モデルを比較します(Praxis-1と π0.5 の間に Atomic-WAM 39.6%・OASIS WAM 39.0% などの他WAM系が並びます)。
| モデル | 開発元 | RoboLab-120成功率 | 補足 |
|---|---|---|---|
| Praxis-1(DROID版) | Runway | 46.2%(555/1,200) | WAM・オープンウェイト・Apache 2.0 |
| FLUX 3 Action | Black Forest Labs | 42.9% | Flux系からの拡張 |
| Cosmos3 Nano | NVIDIA | 36.8% | Cosmos系の小型モデル |
| π0.5 | Physical Intelligence | 28.0% | VLA系の代表格 |
この比較が示すのは、Praxis-1がVLA系の代表モデルであるπ0.5に対して約1.65倍のスコアを出している点、そして同じWAM系に分類されるCosmos3 NanoやFLUX 3 Actionに対しても明確に上回っている点の2つです。FourWeekMBAの解説記事がπ0.5比1.65倍という数字を広めた経緯があります。
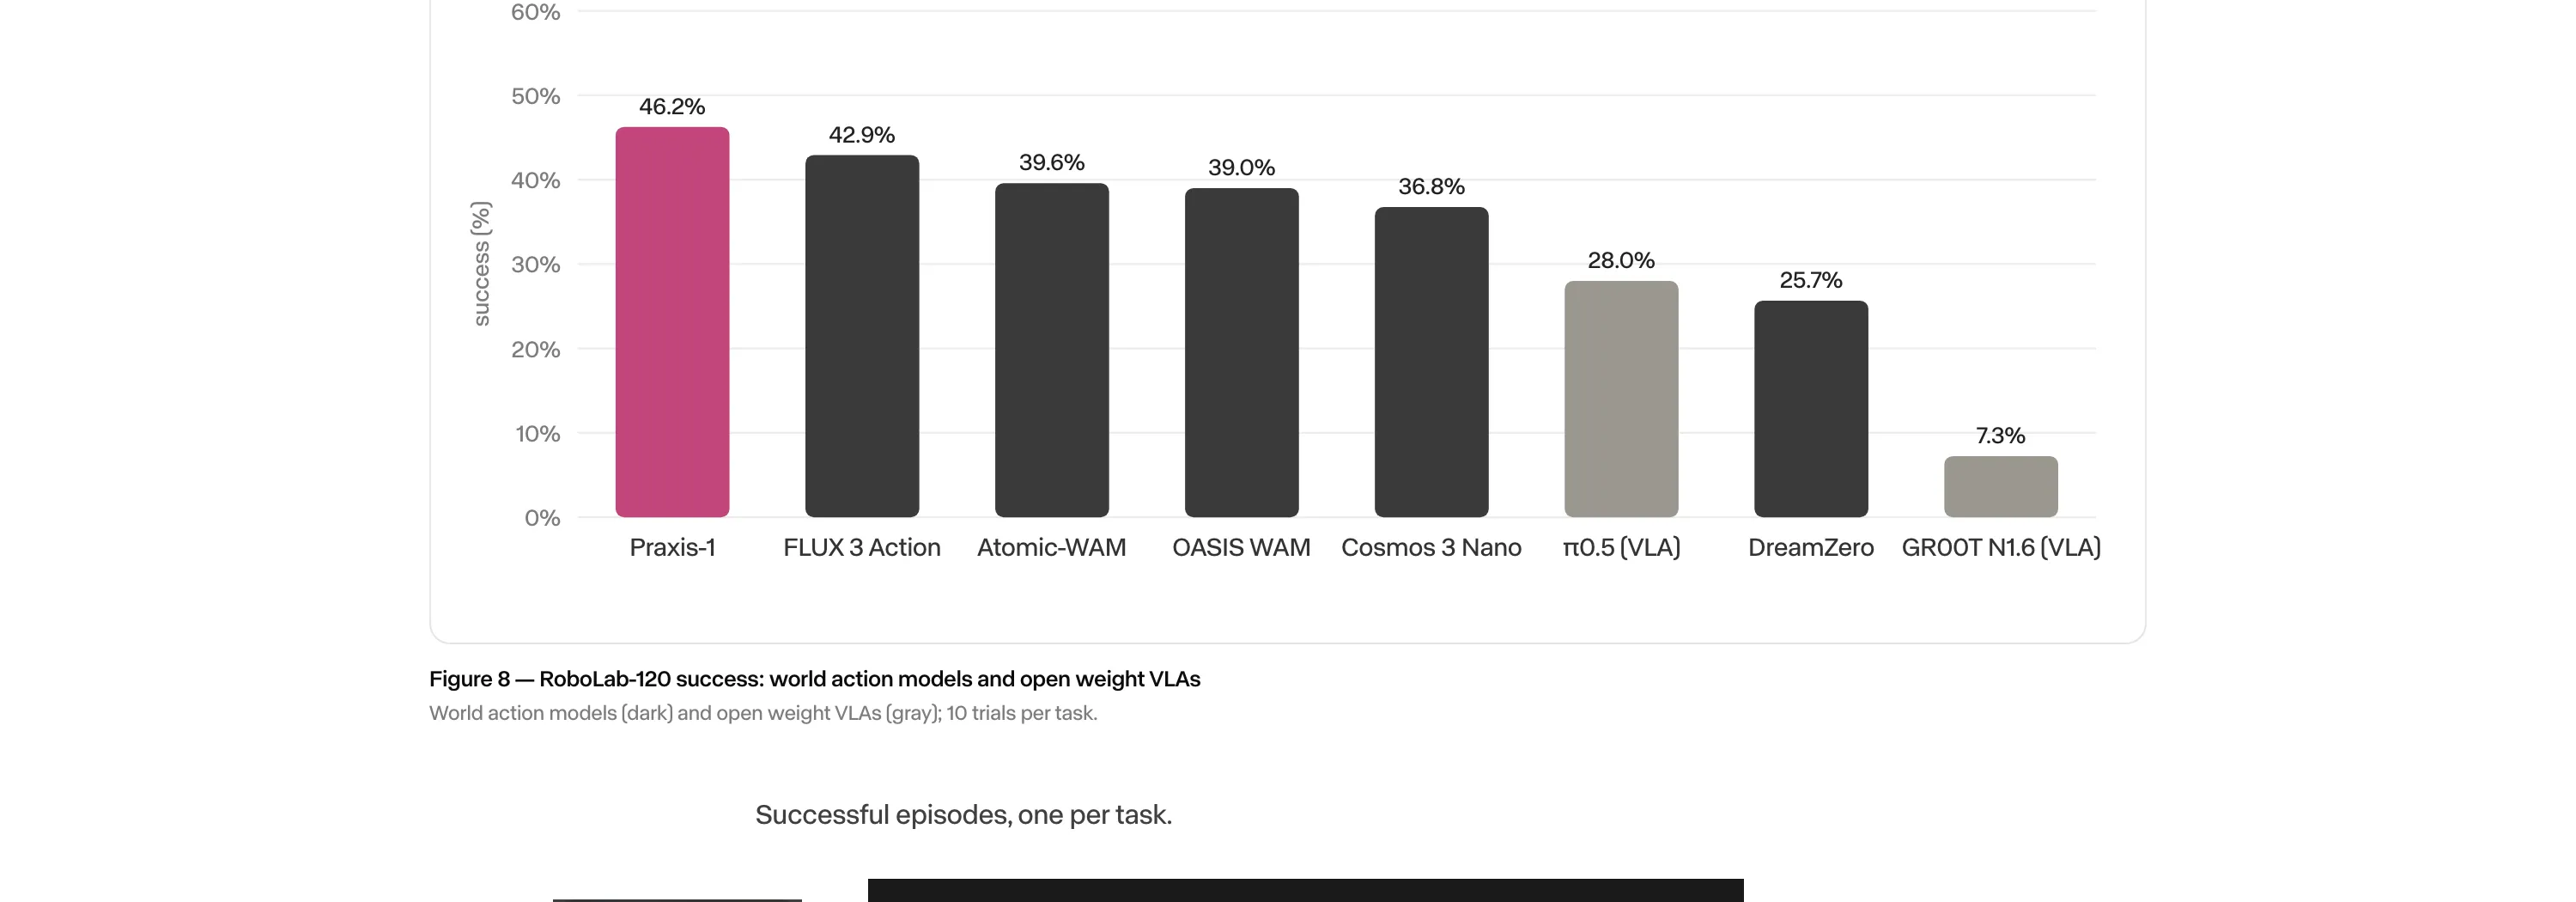
RoboLab-120リーダーボード:世界行動モデル(濃色)とオープンウェイトVLA(薄色)の成功率比較(出典:Runway Research)
公式リーダーボード図では、WAM系が濃いピンク〜チャコールで、VLA系が薄いグレーで色分けされており、Praxis-1がオープンウェイトVLAの代表格であるGR00T N1.6(7.3%)に対しても6倍以上のスコア差で先行している構図が読み取れます。
ただし「46.2%」という水準は見方を変えれば「半数以上は失敗している」ということでもあり、単発実行での本番採用には適さない成熟度である点も同時に示されています。
Franka FR3の実機とSimplerEnvのシム評価
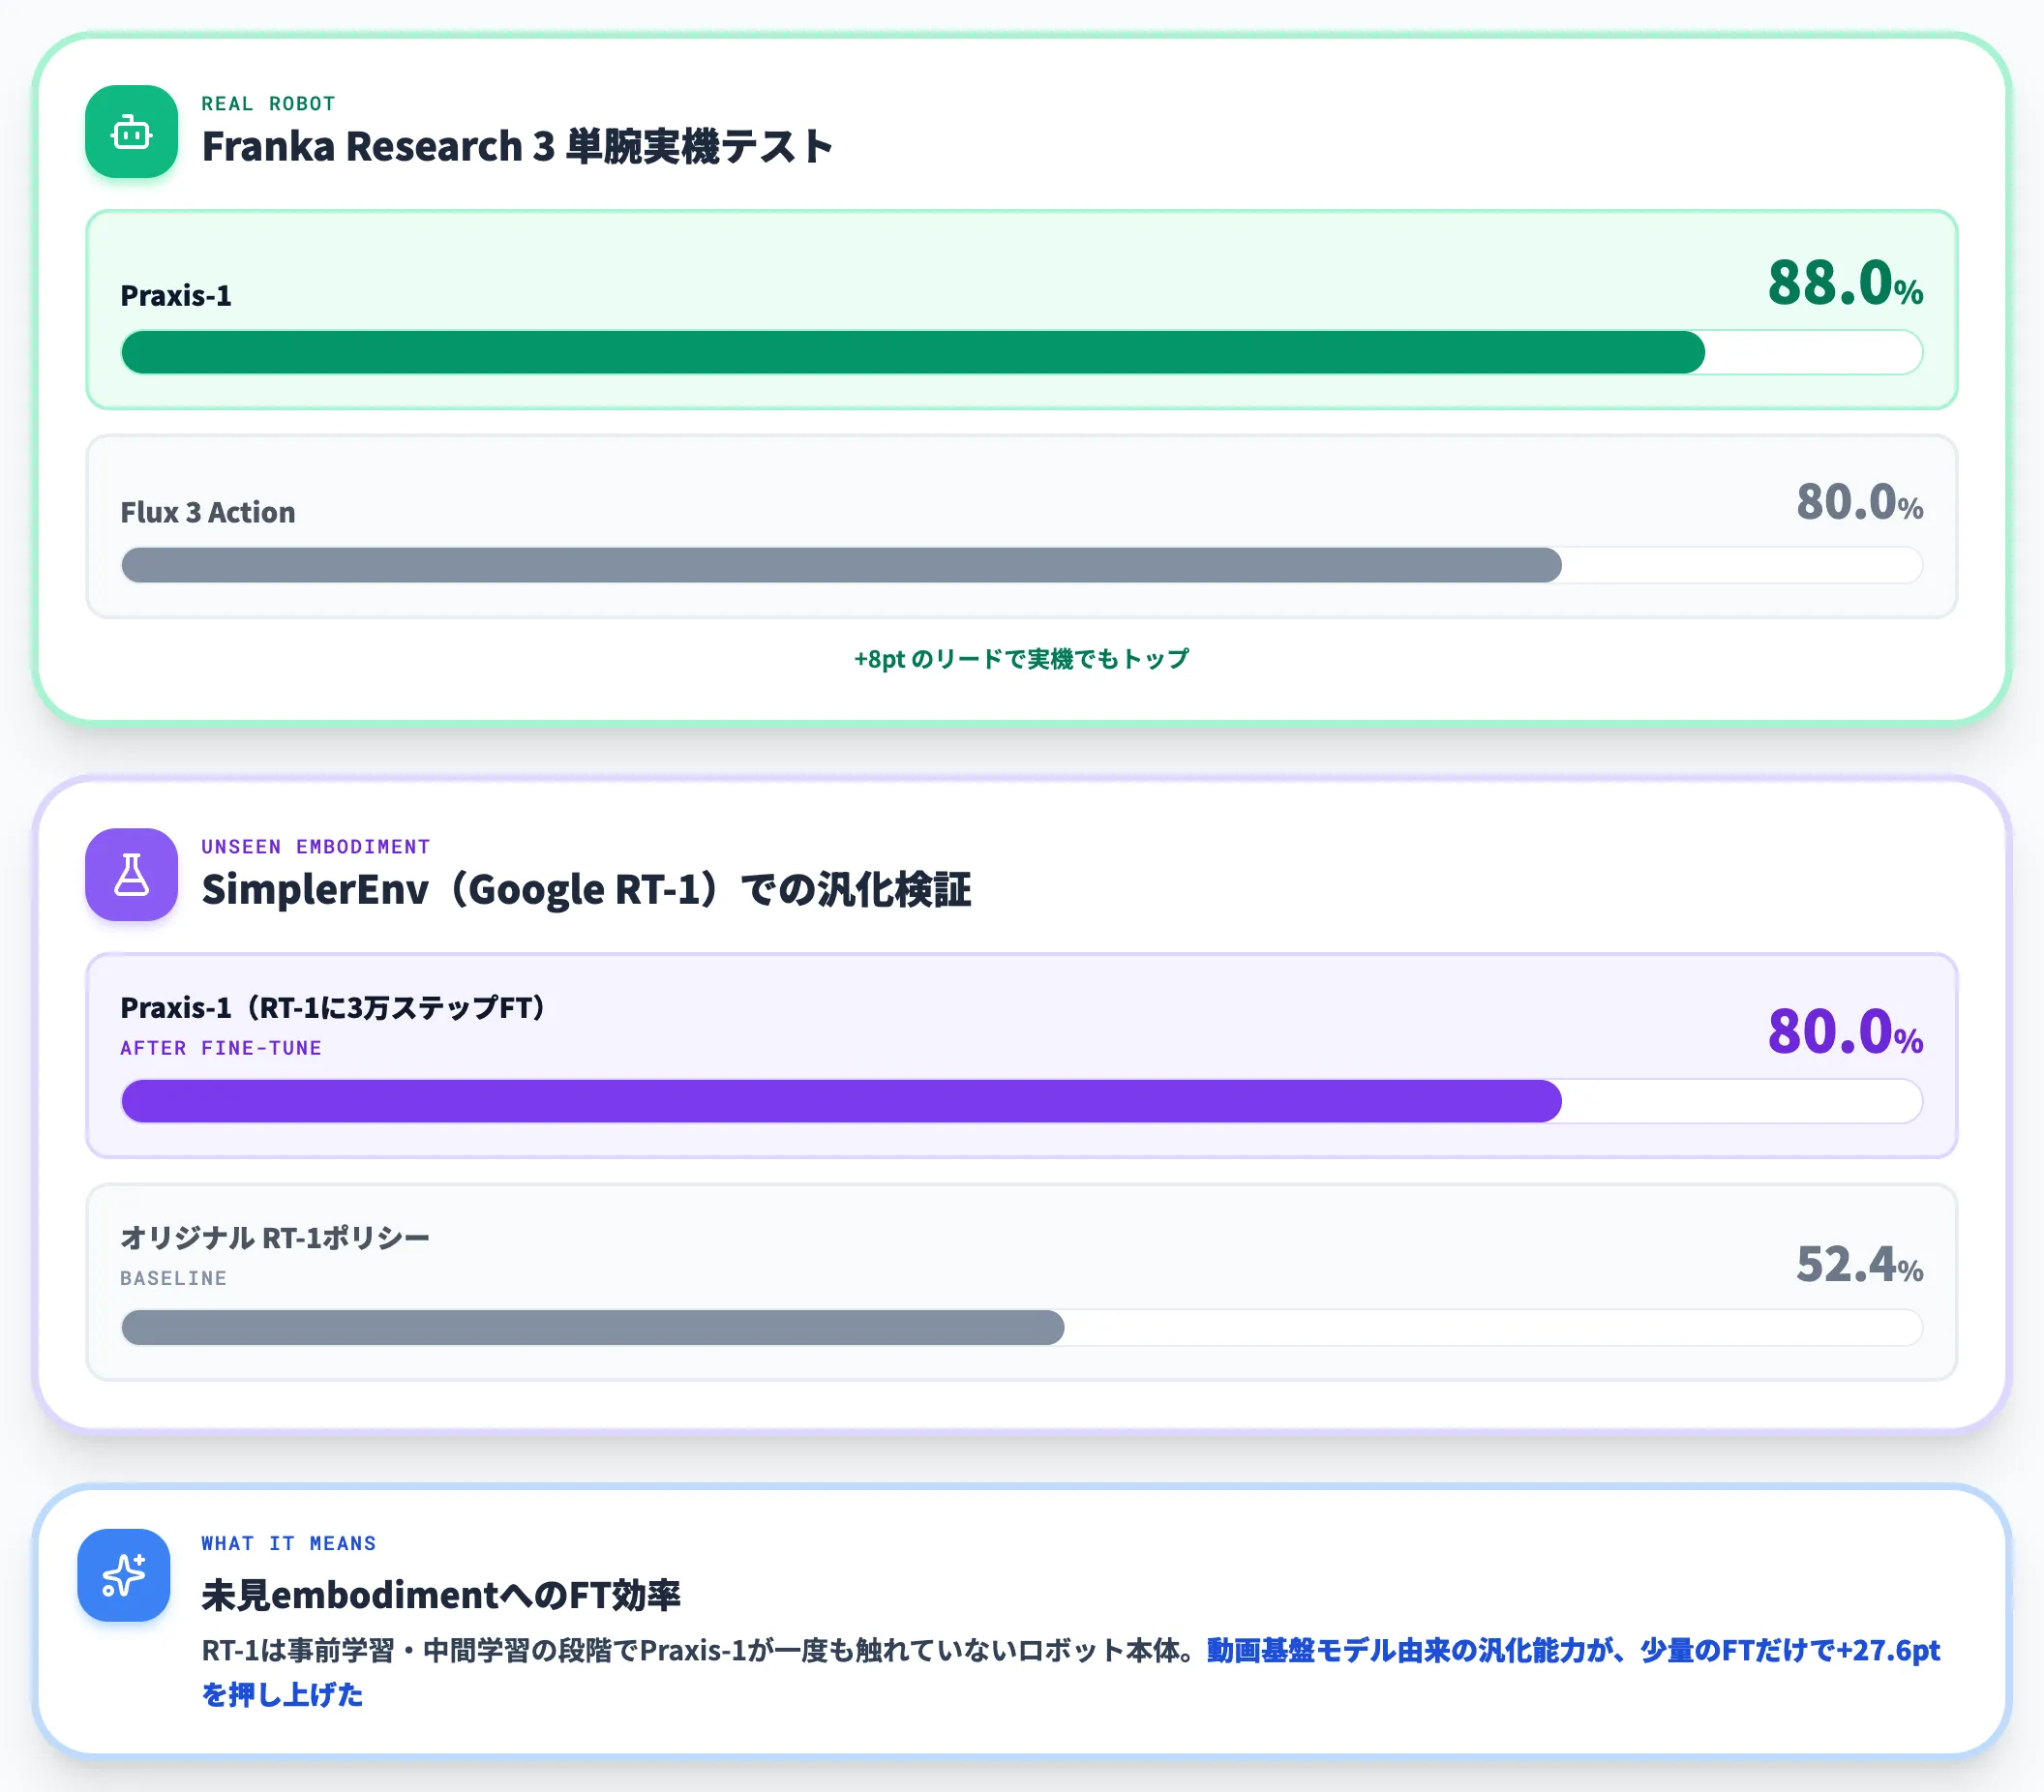
シミュレーションだけでなく実機でも評価が行われています。Praxis-1をFranka Research 3(FR3)単腕ロボットに載せた実機テストでは、Flux 3 Actionの80.0%に対してPraxis-1は88.0%の成功率を記録しました。
また、GoogleのRT-1ロボットにファインチューンした構成でSimplerEnvベンチマークを走らせると、Praxis-1は80.0%のスコアを出し、オリジナルのRT-1ポリシーの52.4%を大きく上回りました。
特にSimplerEnvの結果が重要なのは、RT-1が事前学習・中間学習の段階でPraxis-1が一度も触れていないロボット本体だった点です。
そこにRT-1データで3万ステップのファインチューンを加え、SimplerEnvのシミュレーション評価を回した構図で、動画基盤モデル由来の汎化能力が未見embodimentへのファインチューン効率に効くことを示す結果になっています。
中間学習(mid-training)で押し上げた汎化能力が少量の機体特化ファインチューンで活きる性質こそ、WAM系モデルがVLA系に対して差別化を図れる主戦場で、RunwayはPraxis-1の中間学習をキーテクノロジーとして位置付けています。
早期アクセスパートナー3社のデモ内容
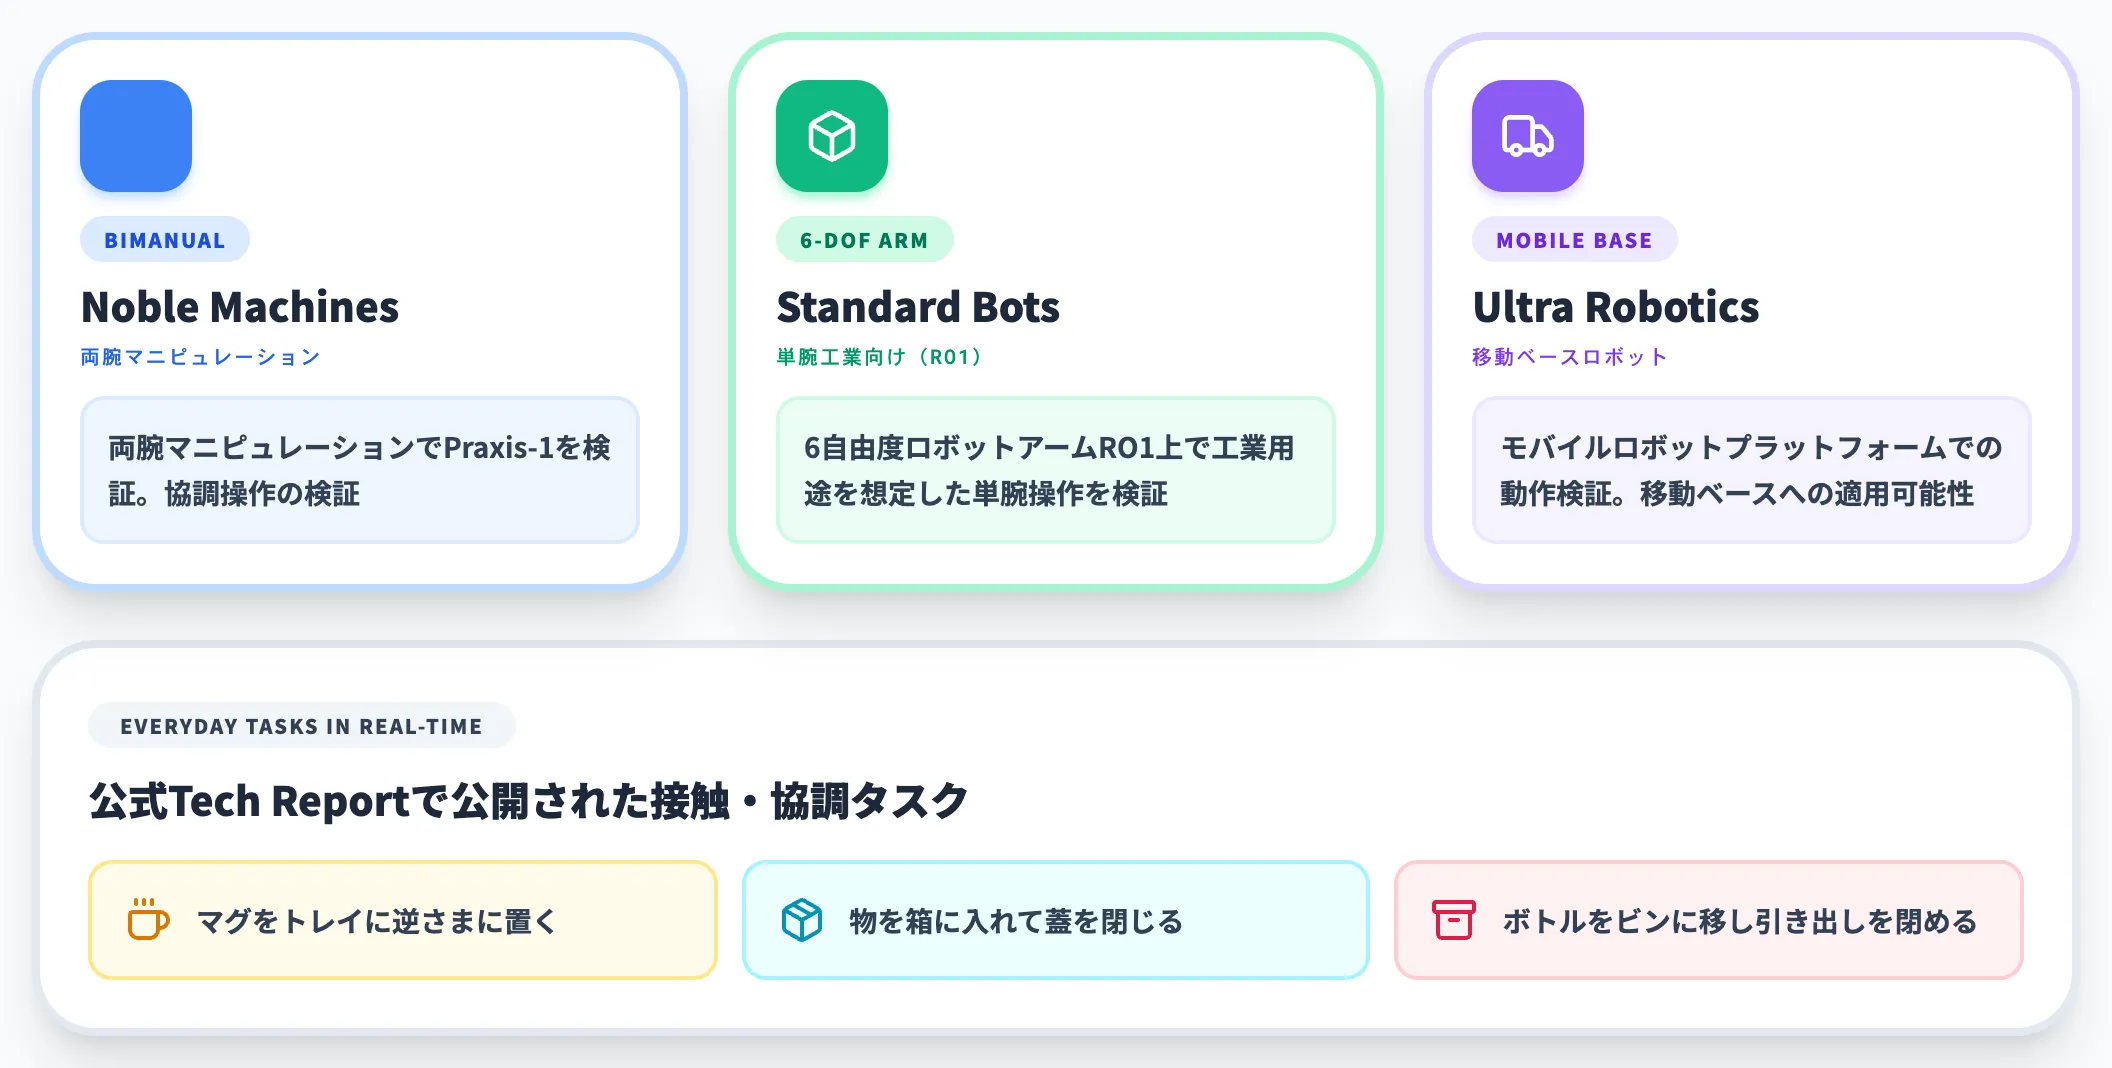
一般公開に先行して検証を担っていた早期アクセスパートナーは3社です。それぞれが異なるロボットフォームファクターでPraxis-1を走らせ、公式研究ページでその結果が共有されました。
-
Noble Machines
両腕マニピュレーションを担当
-
Standard Bots
6自由度ロボットアーム「RO1」上でPraxis-1を運用。工業用途を想定した単腕操作の検証を実施
-
Ultra Robotics
モバイルロボットプラットフォームでの動作検証。移動ベースを持つロボットへの適用可能性を示した
これらの検証を通じて、Runwayは異なる機体・環境でのPraxis-1の実機動作例を公式Tech Report §7 Everyday Tasks in Real-timeで公開しています。
マグをトレイに逆さまに置く、物を箱に入れて蓋を閉じる、ボトルをビンに移して引き出しを閉める、といった接触と協調を要する日常タスクが具体例として挙げられています。
フロンティアLLMエージェント(GPT-6 Astra)との速度・コスト比較
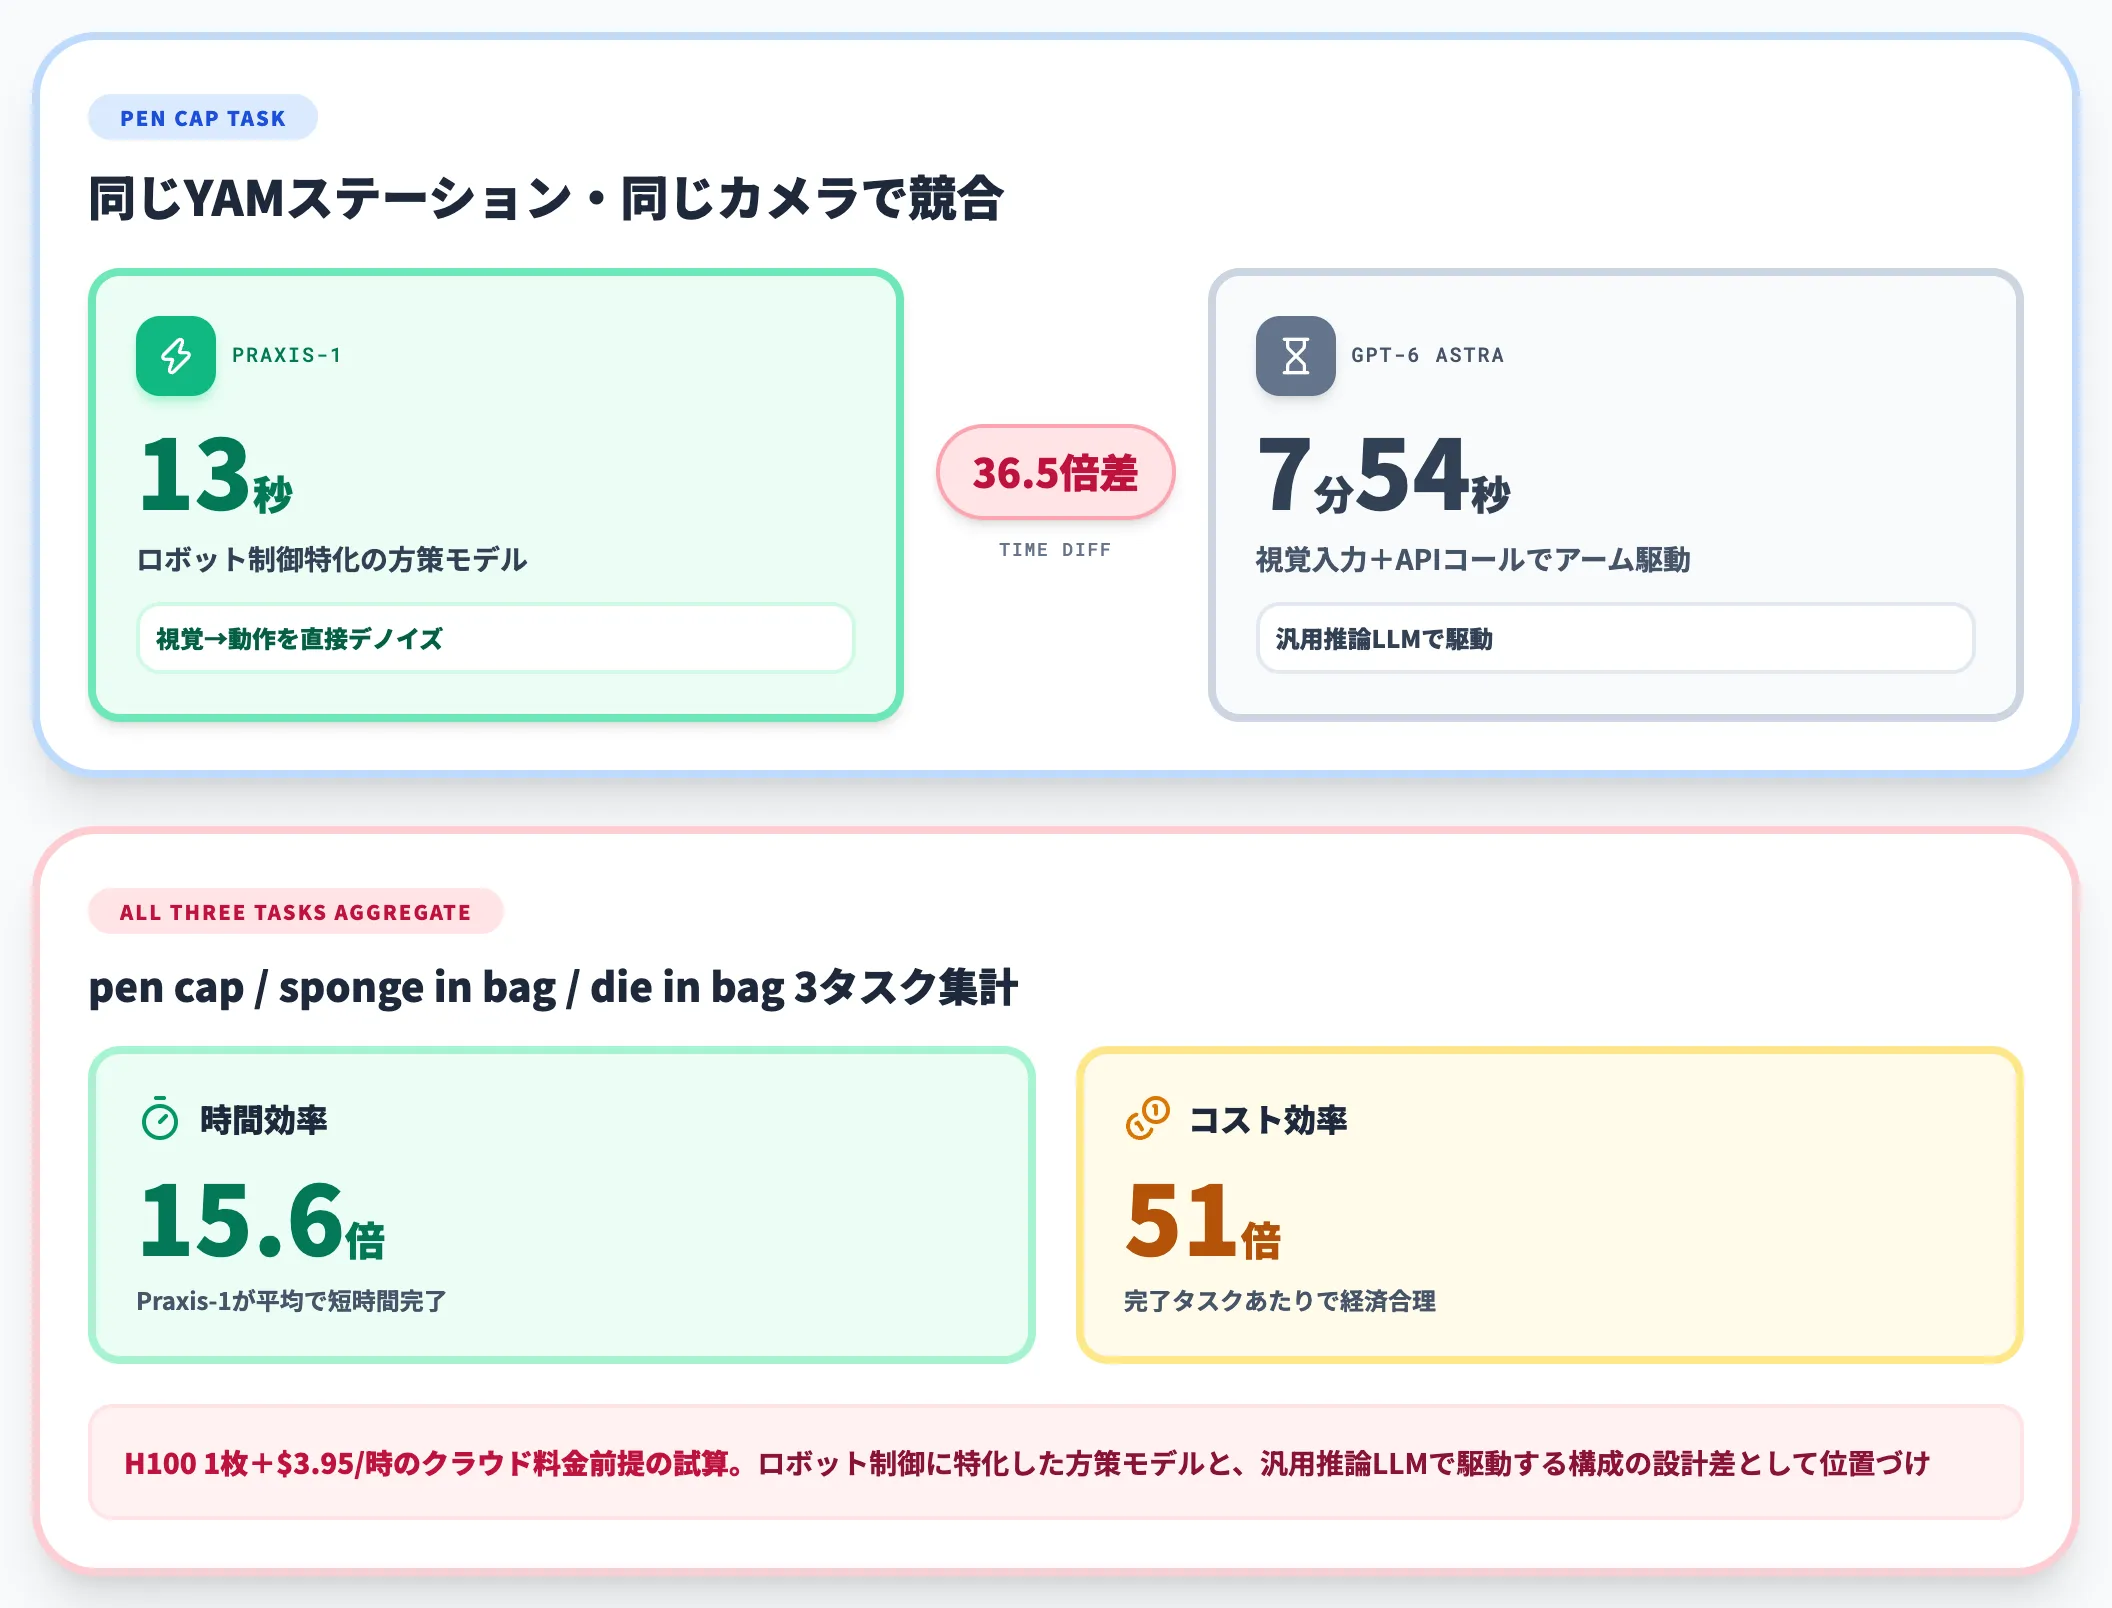
Runwayは専用ロボットポリシーの優位性を示すために、フロンティアLLMであるGPT-6 Astraを同じYAM両腕ステーションに接続してエージェントとして動かすゼロショット条件での比較を公開しています。
Astra側は視覚入力+APIコール経由でアームを駆動する構成で、ロボット特化で学習されたポリシーとの差分を測る狙いです。
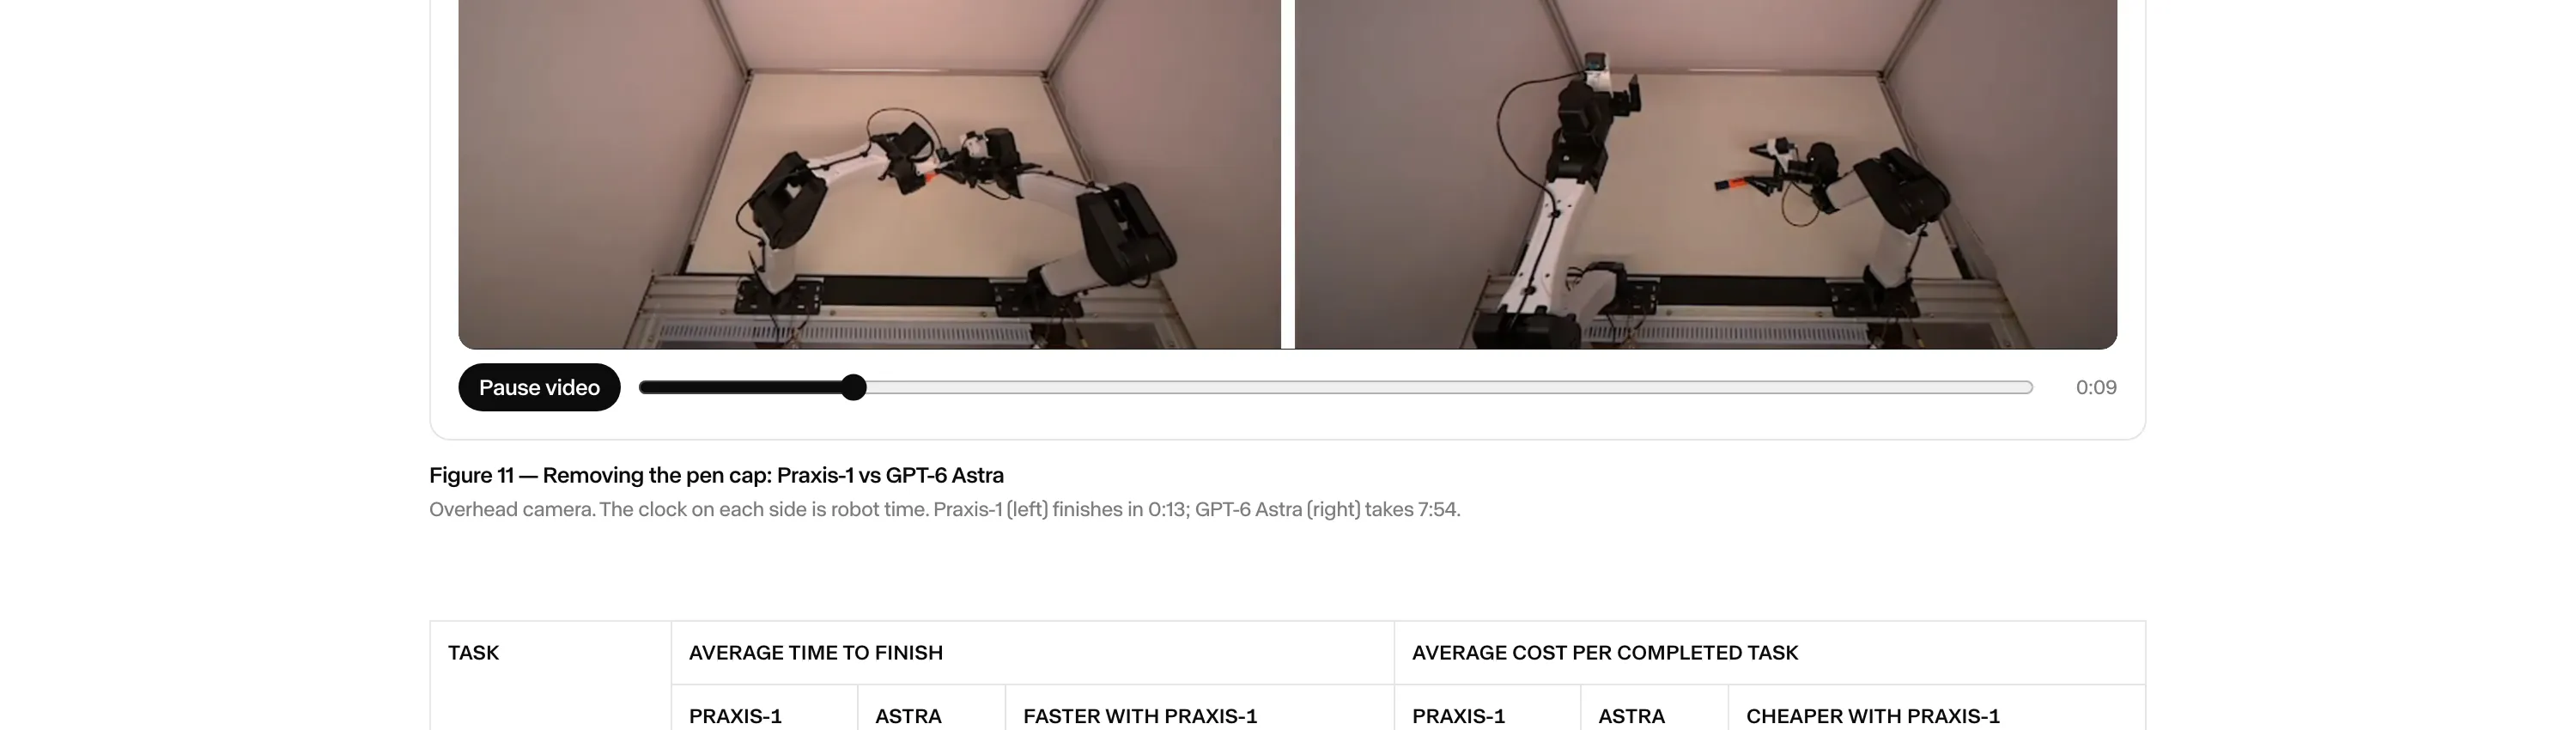
「ペンのキャップを外す」タスクの左右同時再生:Praxis-1が13秒で完了、GPT-6 Astraは7分54秒を要した(出典:Runway Research)
同じハードウェア・同じカメラ構成で、Praxis-1は実機作業が始まってから13秒で成功し、同条件のGPT-6 Astraは7分54秒かけて同じタスクに到達しました。Runwayはこの差を「ロボット制御に特化した方策モデルと、汎用推論LLMで駆動する構成の設計差」として位置付けています。
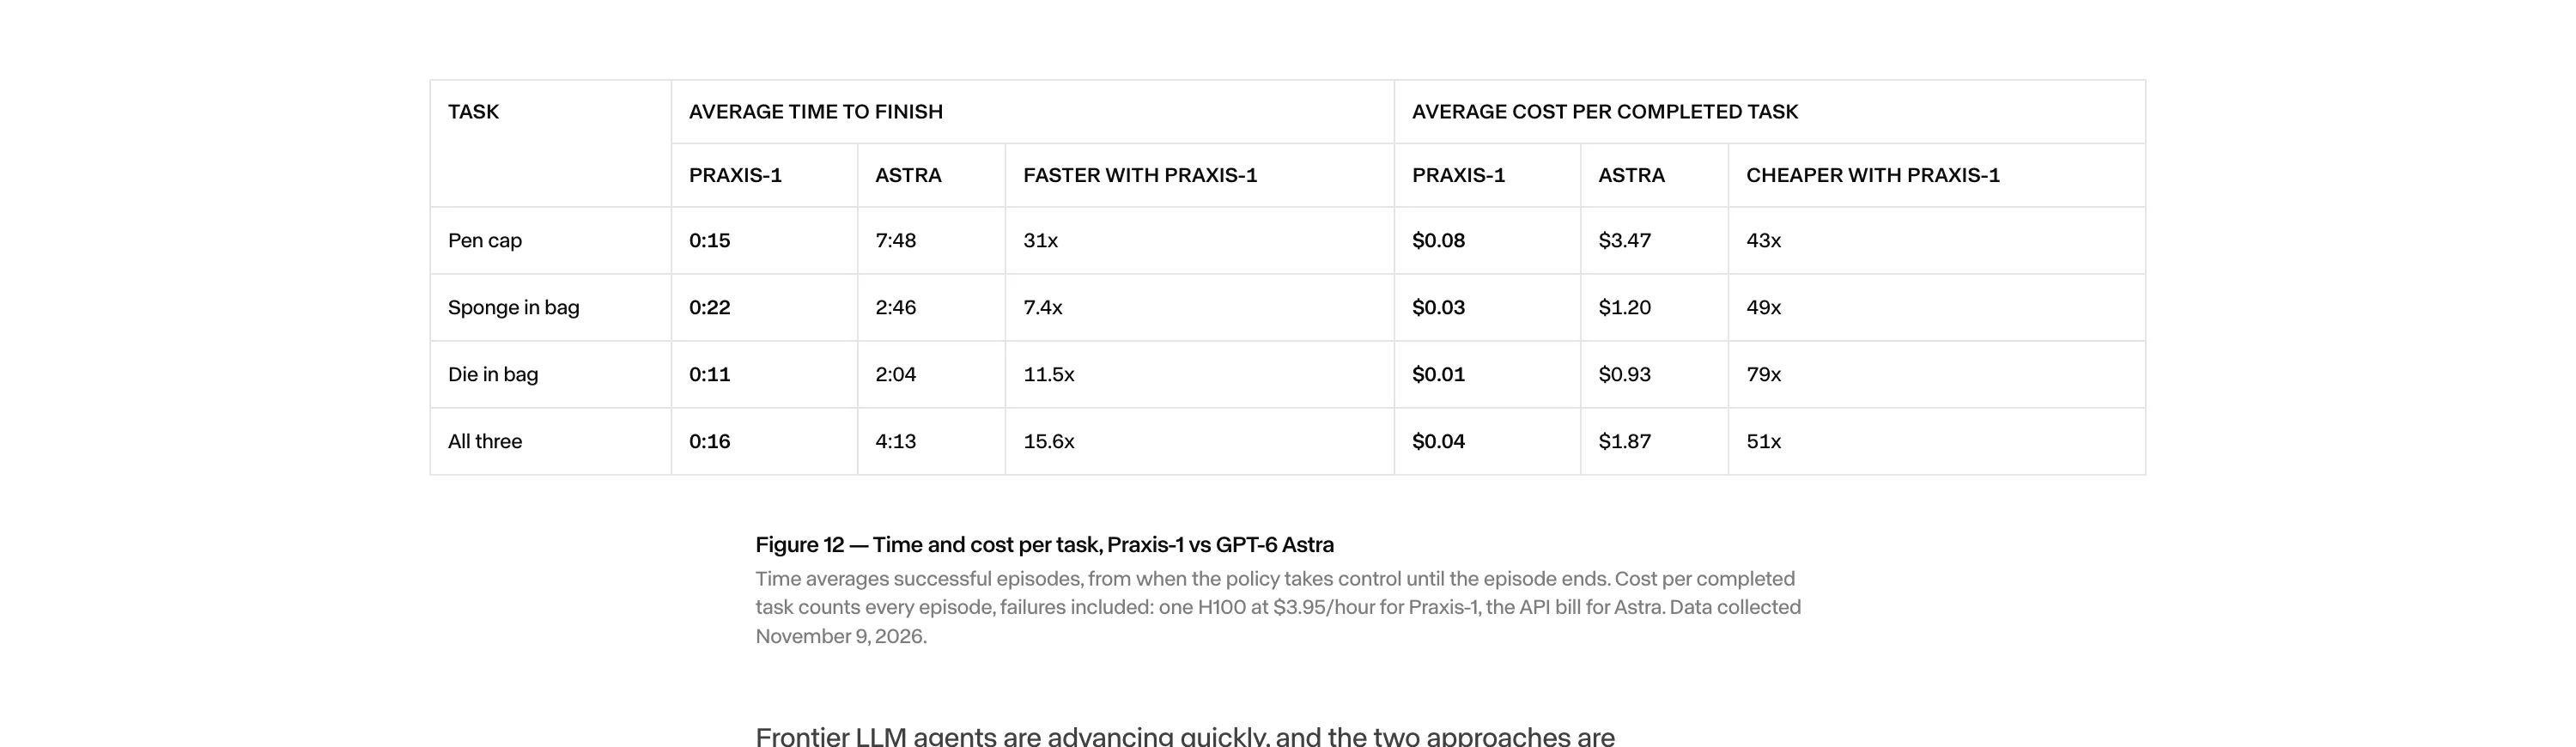
3タスク(pen cap・sponge in bag・die in bag)と全体集計all threeでの平均成功所要時間と完了タスクあたりの平均コストでのPraxis-1とGPT-6 Astraの比較(出典:Runway Research)
Runwayは、同じYAMステーションでの3タスク(pen cap・sponge in bag・die in bag)全体の集計で、Praxis-1が平均15.6倍の時間効率と完了タスクあたり51倍のコスト効率を記録したと報告しています。
H100 1枚+$3.95/時のクラウド料金前提の試算で、ロボット特化ポリシーの経済合理性を示す数字として提示されています。
独立再現がない点に注意
Praxis-1の性能数値は現時点ですべてRunway側の自己報告です。ベンチマークの再現やサードパーティ評価は11月公開直後の段階で限定的で、各数字は「開発元の内部計測結果」として受け止めるのが安全です。
FourWeekMBAなどの技術解説でも、RoboLab-120の数字はRunway自己報告であり独立再現が確認されていない点に留保が付されています。
本番稼働を見据える場合は、公表数値を鵜呑みにせず、自社の対象タスクと実機構成で改めてベンチマークを取るのがセオリーです。
Praxis-1のライセンスと公開チェックポイント
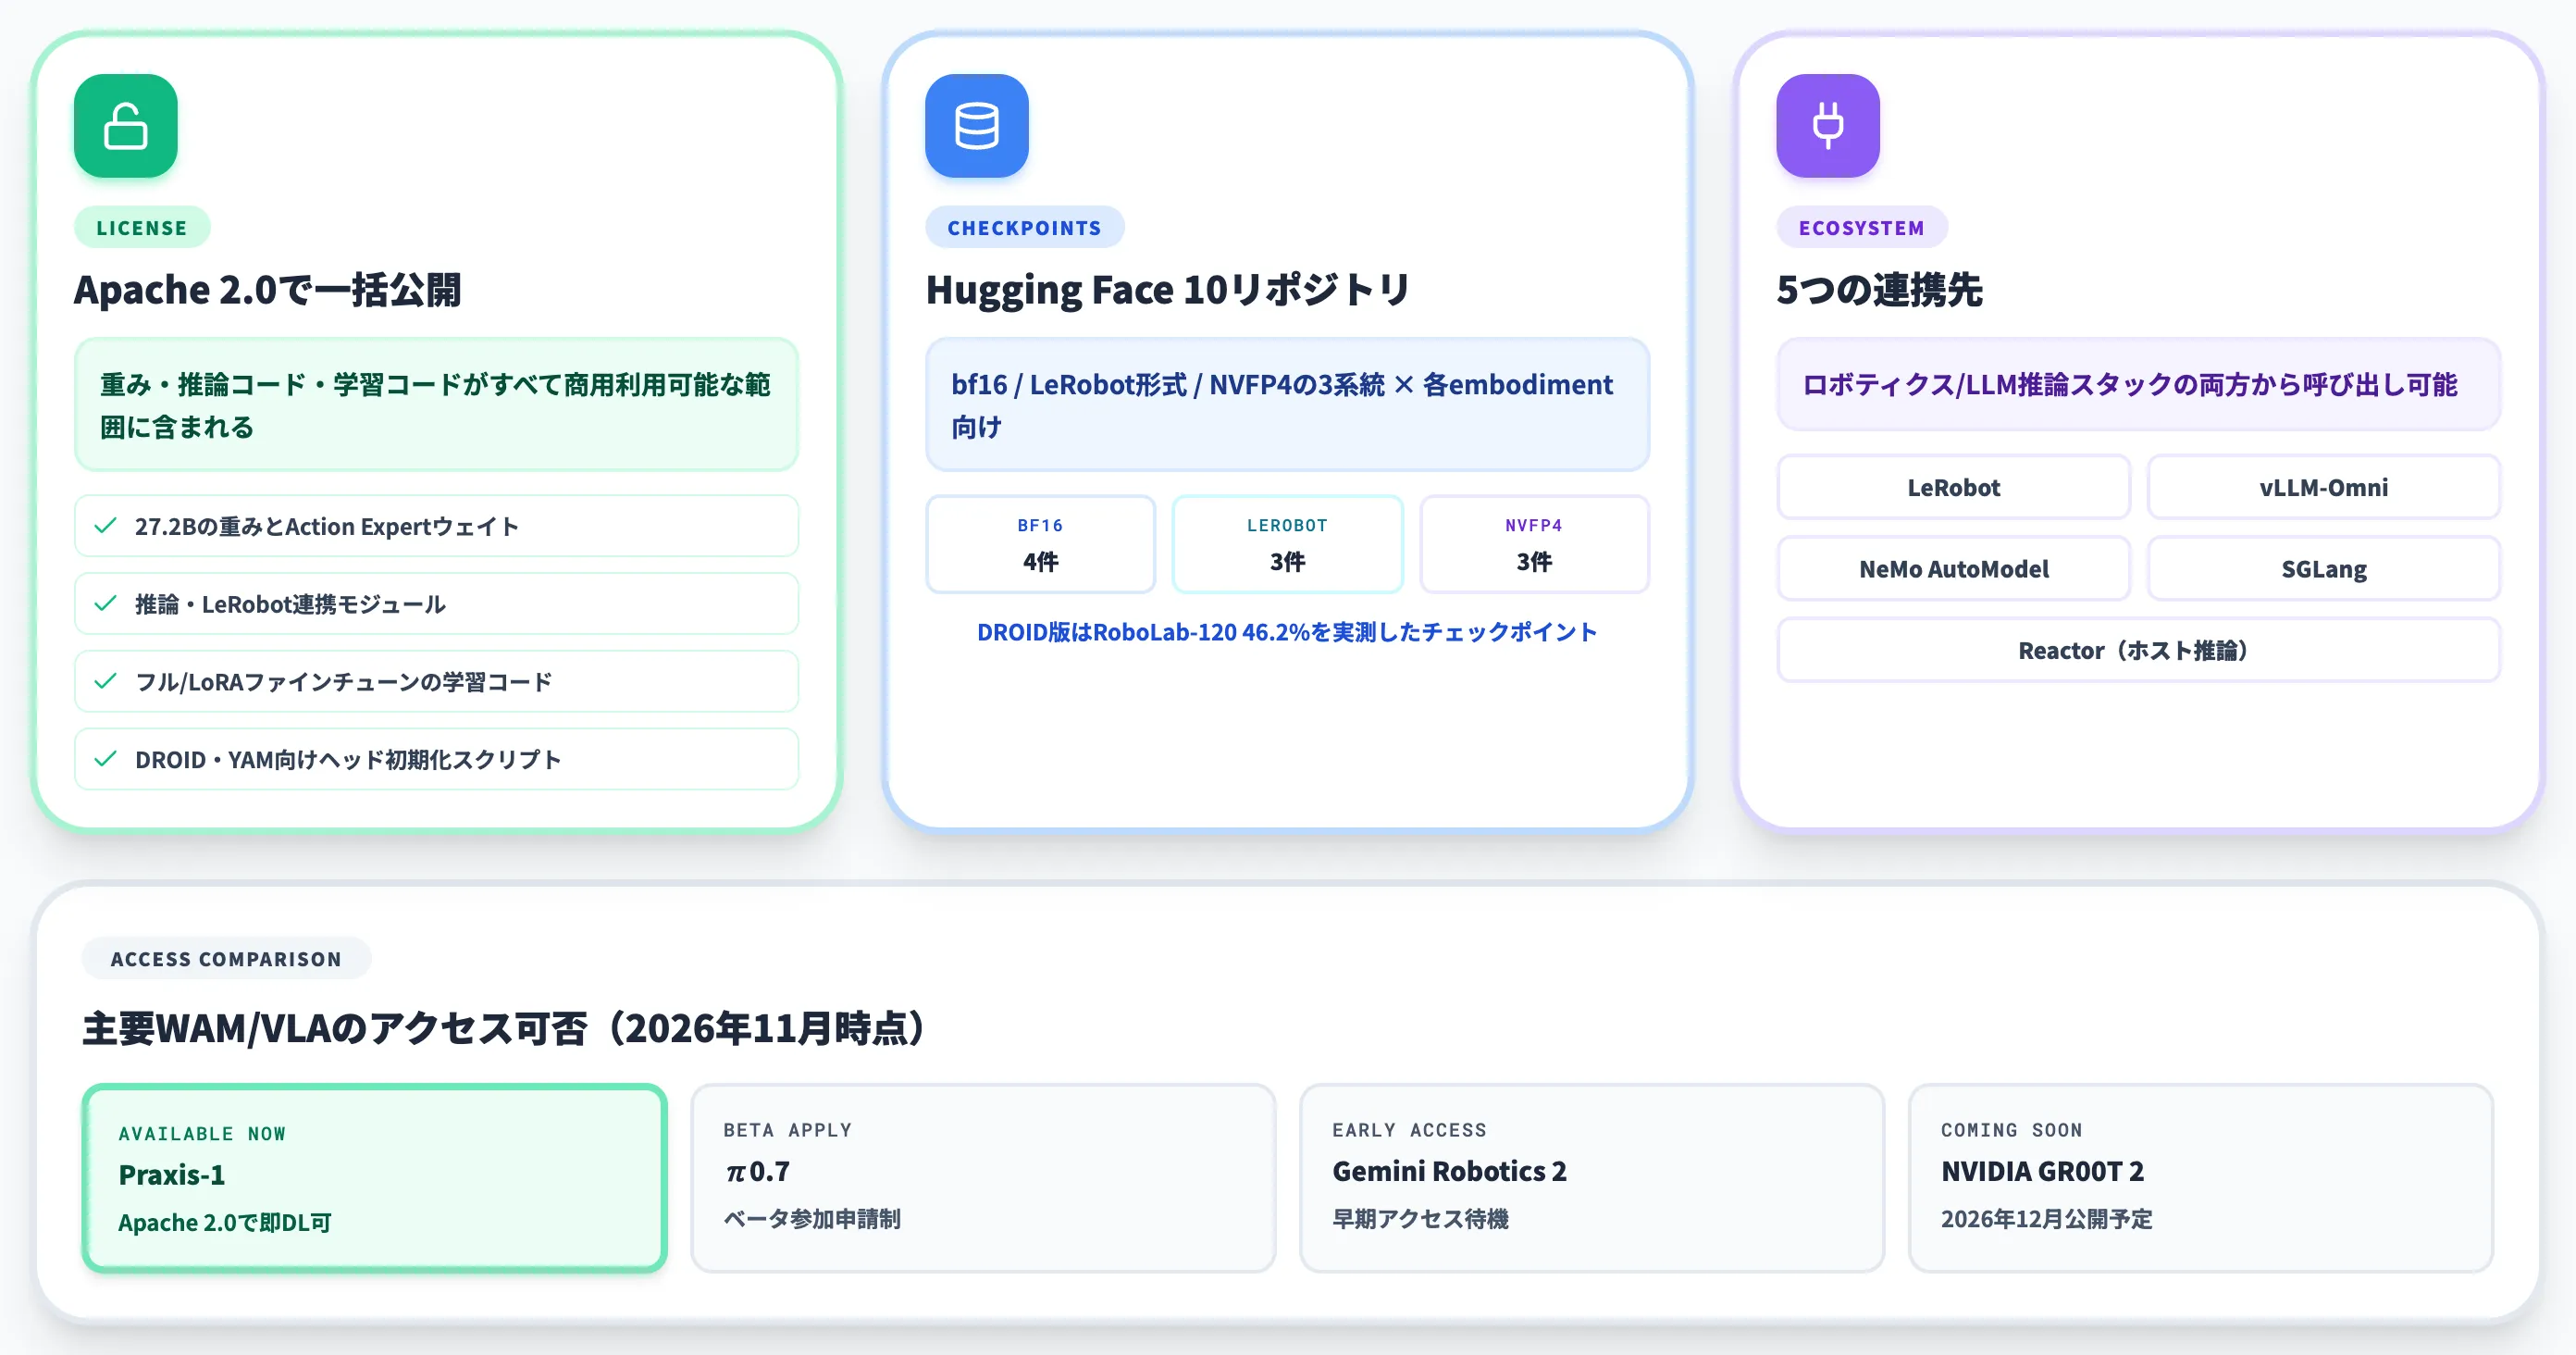
Praxis-1はモデルの重み・推論コード・学習コードがすべてApache 2.0ライセンスで公開されており、商用利用・改変・再配布まで広くカバーされている点が最大の特徴です。ここではライセンス構造と、Hugging Faceで利用可能な10件のリポジトリ、そして外部ツールチェーンとの連携状況を整理します。
Apache 2.0による重みとコードの一括公開
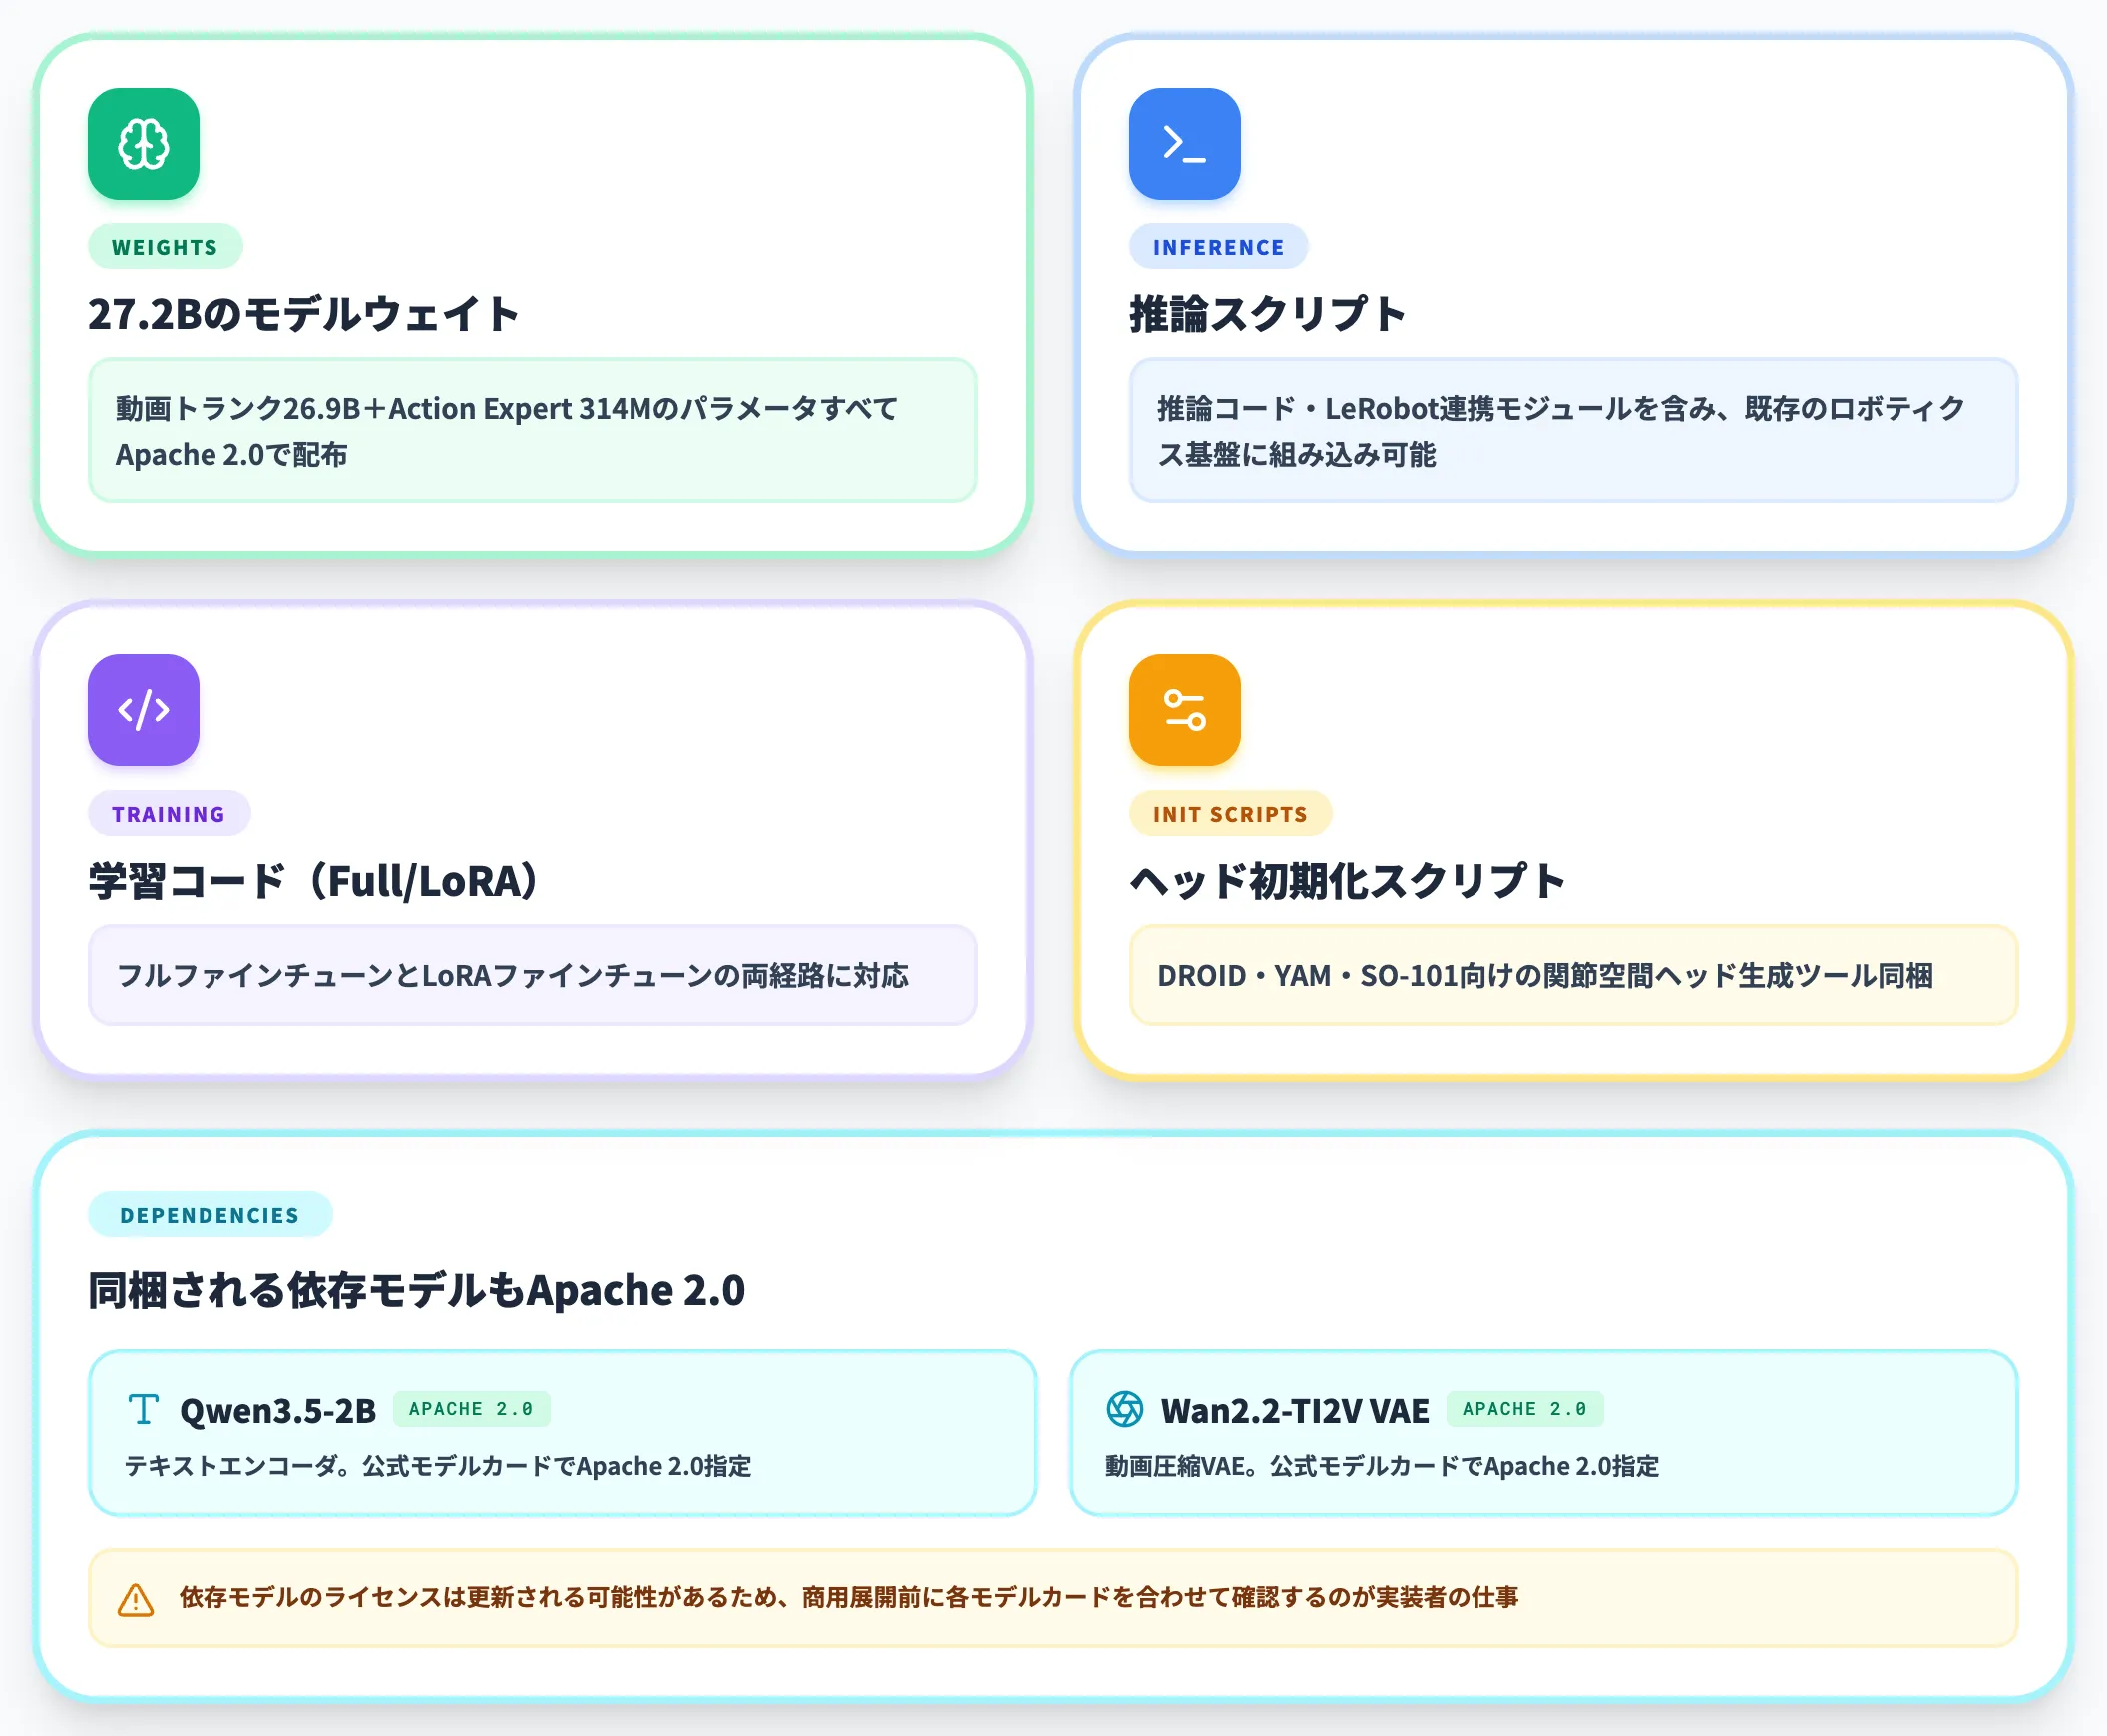
公式GitHubリポジトリはApache License 2.0で配布されており、以下すべてが商用利用可能な範囲に含まれます。
- 27.2BのモデルウェイトとAction Expertウェイト
- 推論スクリプト・LeRobot連携モジュール
- フルファインチューン・LoRAファインチューンの学習コード
- DROID・YAM向けのヘッド初期化スクリプト
Apache 2.0は特許条項を含むOSSライセンスのため、自社製品に組み込んで販売するタイプのユースケースでも契約的な障害が少ないのが利点です。
Physical Intelligence πのAPIはベータ参加申請制、Gemini Robotics 2のVLAは早期アクセス待機、NVIDIA GR00T 2はコード公開が2026年12月予定と、現時点で誰でも即ダウンロードして自社GPUに載せられるWAMとしてはPraxis-1が先行している状況です。
同梱されるQwen3.5-2BテキストエンコーダとWan2.2-TI2V VAEもどちらもQwen3.5-2B公式モデルカード・Wan2.2-TI2V-5B公式モデルカードでApache 2.0が指定されており、商用展開の障害は小さく抑えられます。
それでも依存モデルのライセンスは更新される余地があるため、公開時点の各モデルカードは合わせて確認するのが実装者の仕事になります。
Hugging Faceの10件のチェックポイント構成
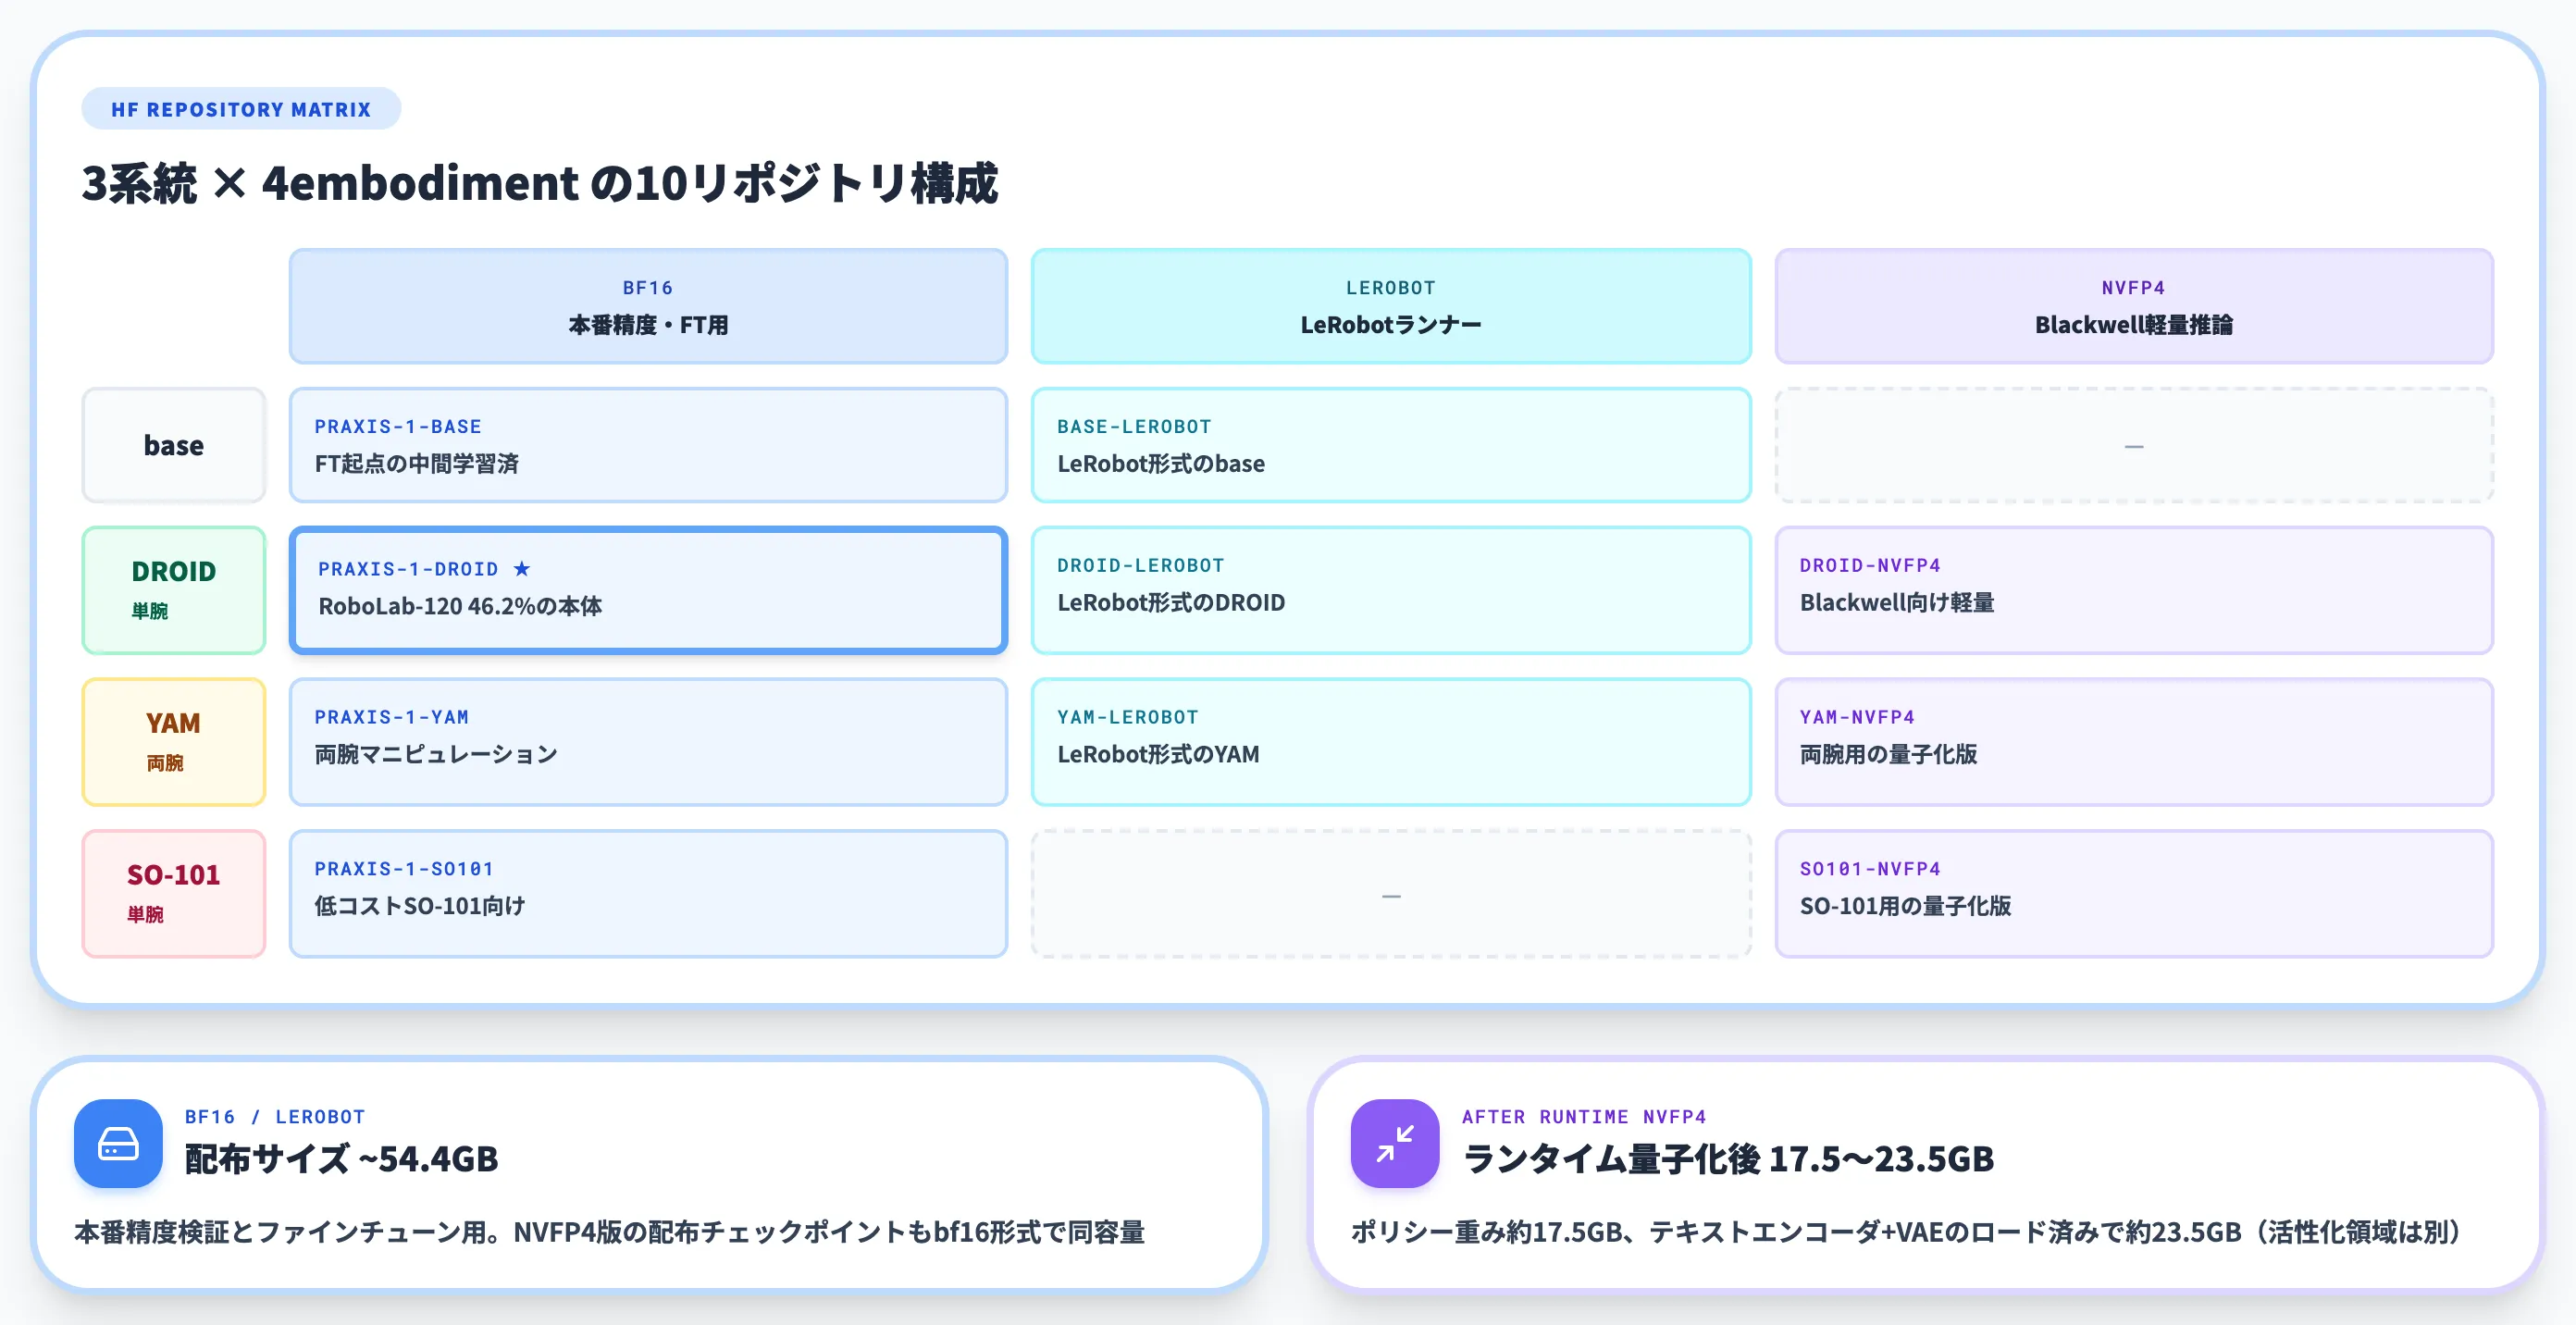
Runway のHugging Face organizationには、Praxis-1関連で10件のリポジトリが用意されています。bf16/LeRobot形式/NVFP4量子化の3系統に、DROID・YAM・SO-101の各embodiment向けが揃った構成です。
以下の表で、各リポジトリの位置づけと想定用途を整理しました。
| リポジトリ | ロボット | 量子化 | 想定用途 |
|---|---|---|---|
| runwayml/praxis-1-base | — | bf16 | ファインチューン起点の中間学習済みチェックポイント |
| runwayml/praxis-1-droid | DROID単腕 | bf16 | 単腕卓上タスクのすぐ使えるポリシー |
| runwayml/praxis-1-yam | YAM両腕 | bf16 | 両腕マニピュレーション用ポリシー |
| runwayml/praxis-1-so101 | SO-101単腕 | bf16 | 低コストSO-101アーム向けポリシー |
| runwayml/praxis-1-base-lerobot | — | bf16 | LeRobotフレームワーク向けbase |
| runwayml/praxis-1-droid-lerobot | DROID | bf16 | LeRobotランナーで動くDROID版 |
| runwayml/praxis-1-yam-lerobot | YAM | bf16 | LeRobotランナーで動くYAM版 |
| runwayml/praxis-1-droid-nvfp4 | DROID | NVFP4対応版 | Blackwell世代GPUでの軽量運用 |
| runwayml/praxis-1-yam-nvfp4 | YAM | NVFP4対応版 | 両腕用の量子化版 |
| runwayml/praxis-1-so101-nvfp4 | SO-101 | NVFP4対応版 | SO-101用の量子化版 |
配布チェックポイントはbf16版もNVFP4版もbf16形式で約54.4GBあり、ランタイム側でNVFP4量子化がかかるとポリシー重みが約17.5GB、テキストエンコーダとVAEを合わせたロード済み状態で約23.5GBまで圧縮される構造です(活性化領域は別)。
実装者視点では、bf16版は本番精度の検証とファインチューン用、NVFP4版は対応GPU上での軽量推論用というすみ分けがわかりやすい運用になります。
特にDROID版は、RoboLab-120で46.2%の数字を実際に叩き出したチェックポイントで、まず試すならここから入るのが近道です。
LeRobot・vLLM-Omni・NeMoとの連携
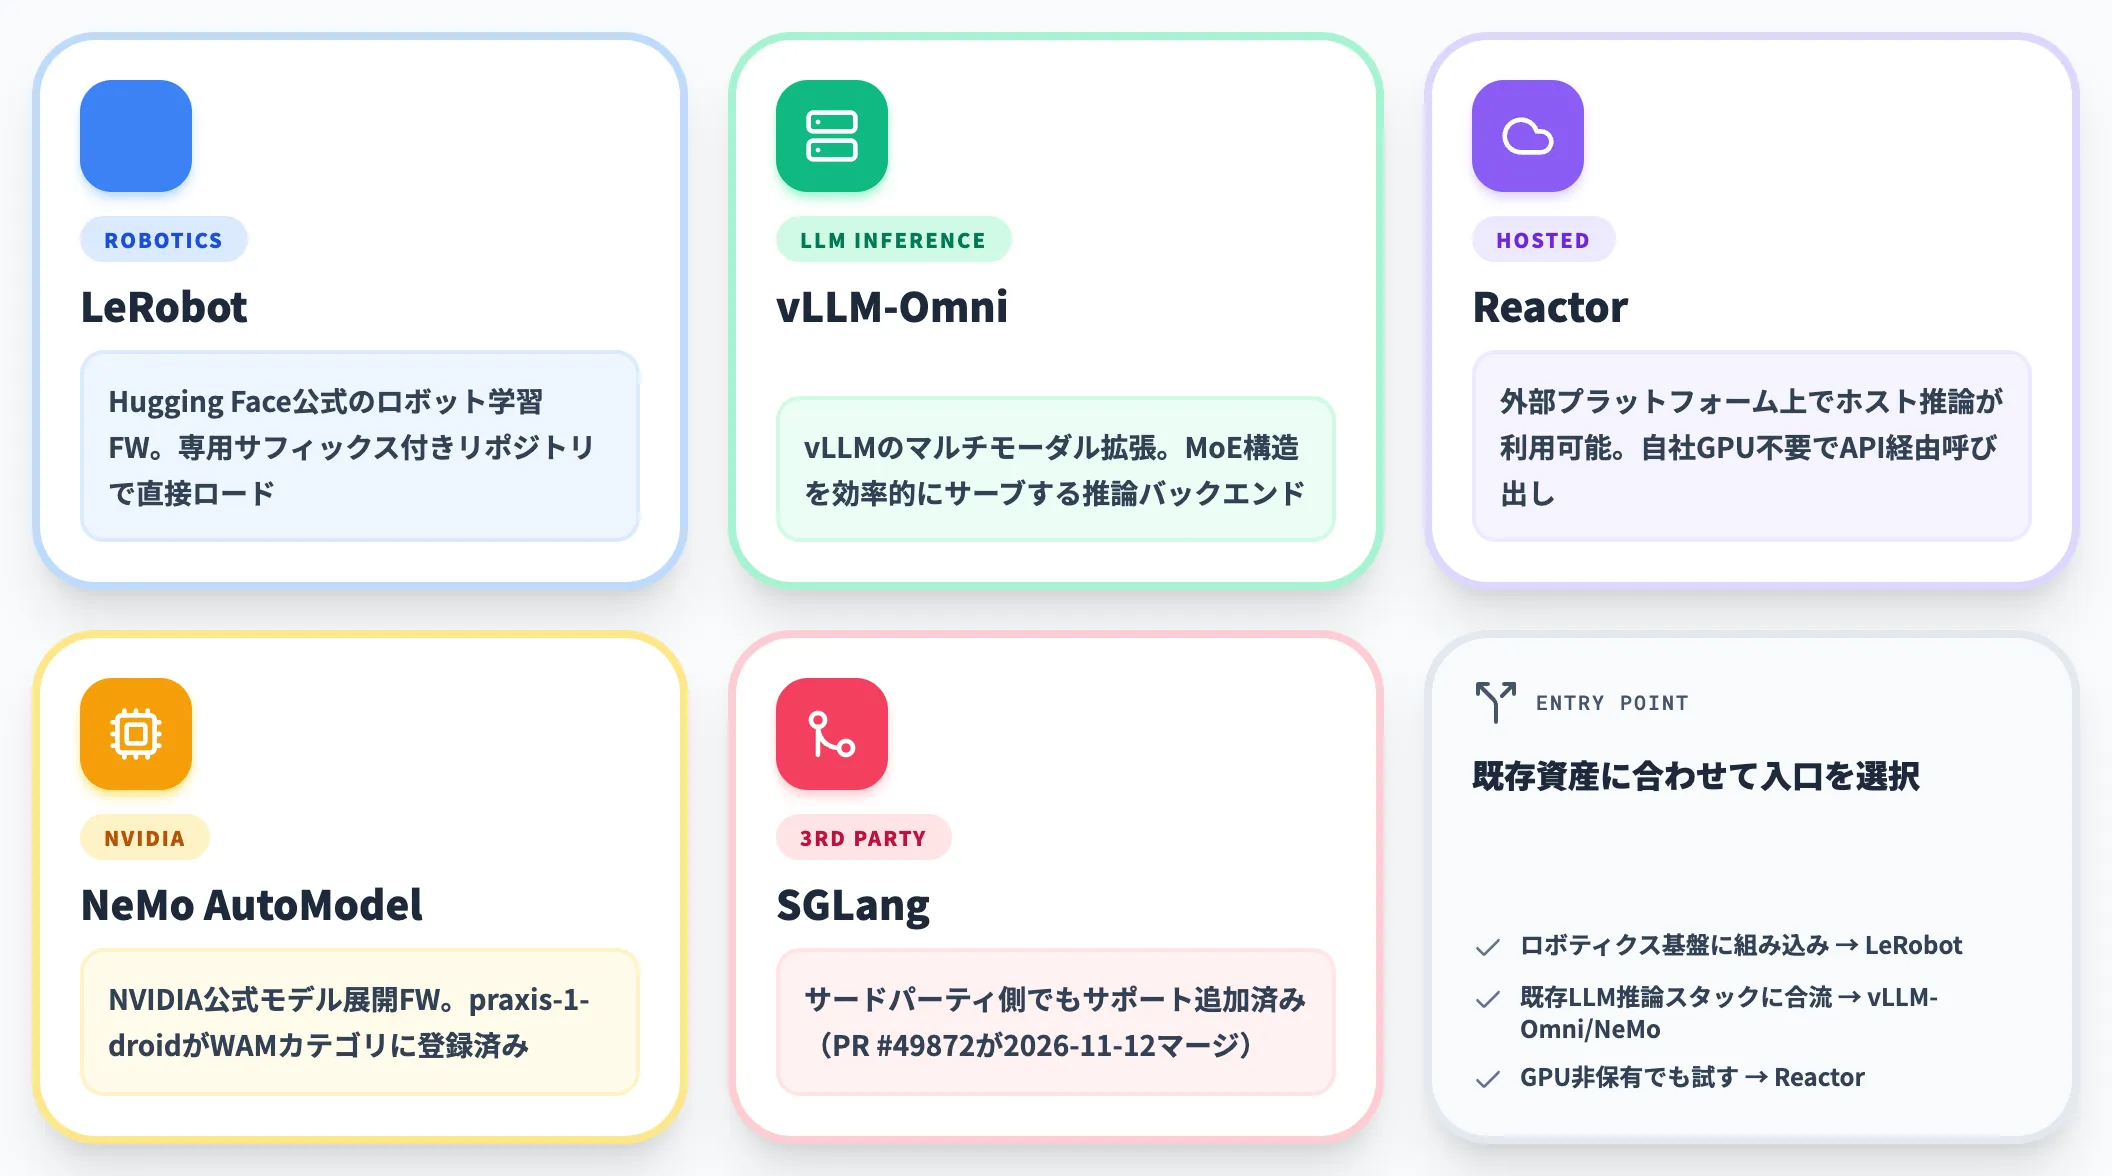
Praxis-1は単体で動かすだけでなく、既存のロボティクス・LLM推論基盤と統合されている点も特徴です。
-
LeRobot
Hugging Face公式のロボット学習フレームワーク。Praxis-1はLeRobotのポリシー形式に準拠した専用サフィックス付きのリポジトリで直接ロード可能
-
vLLM-Omni
vLLMのマルチモーダル拡張。Praxis-1のMoE構造を効率的にサーブする推論バックエンドとして利用できる
-
Reactor
外部プラットフォームReactor上でPraxis-1のホスト推論が利用可能。自社GPUを持たない場合でもAPI経由で呼び出せる経路
-
NVIDIA NeMo AutoModel
NVIDIAの公式モデル展開フレームワーク。praxis-1-droidがWAMカテゴリに登録済みで、NeMo経由でも推論・学習が走る
-
SGLang
サードパーティ側でもサポート追加済み(PR #49872が2026年11月12日にマージ)。代替サーブ経路として利用可能
既存のロボティクス基盤に組み込みたい場合はLeRobot経路、既存のLLM推論スタックに合流させたい場合はvLLM-OmniやNeMo経由と、組織の既存資産に合わせて入口を選べる柔軟性があります。
Praxis-1を動かすための要件と実装フロー
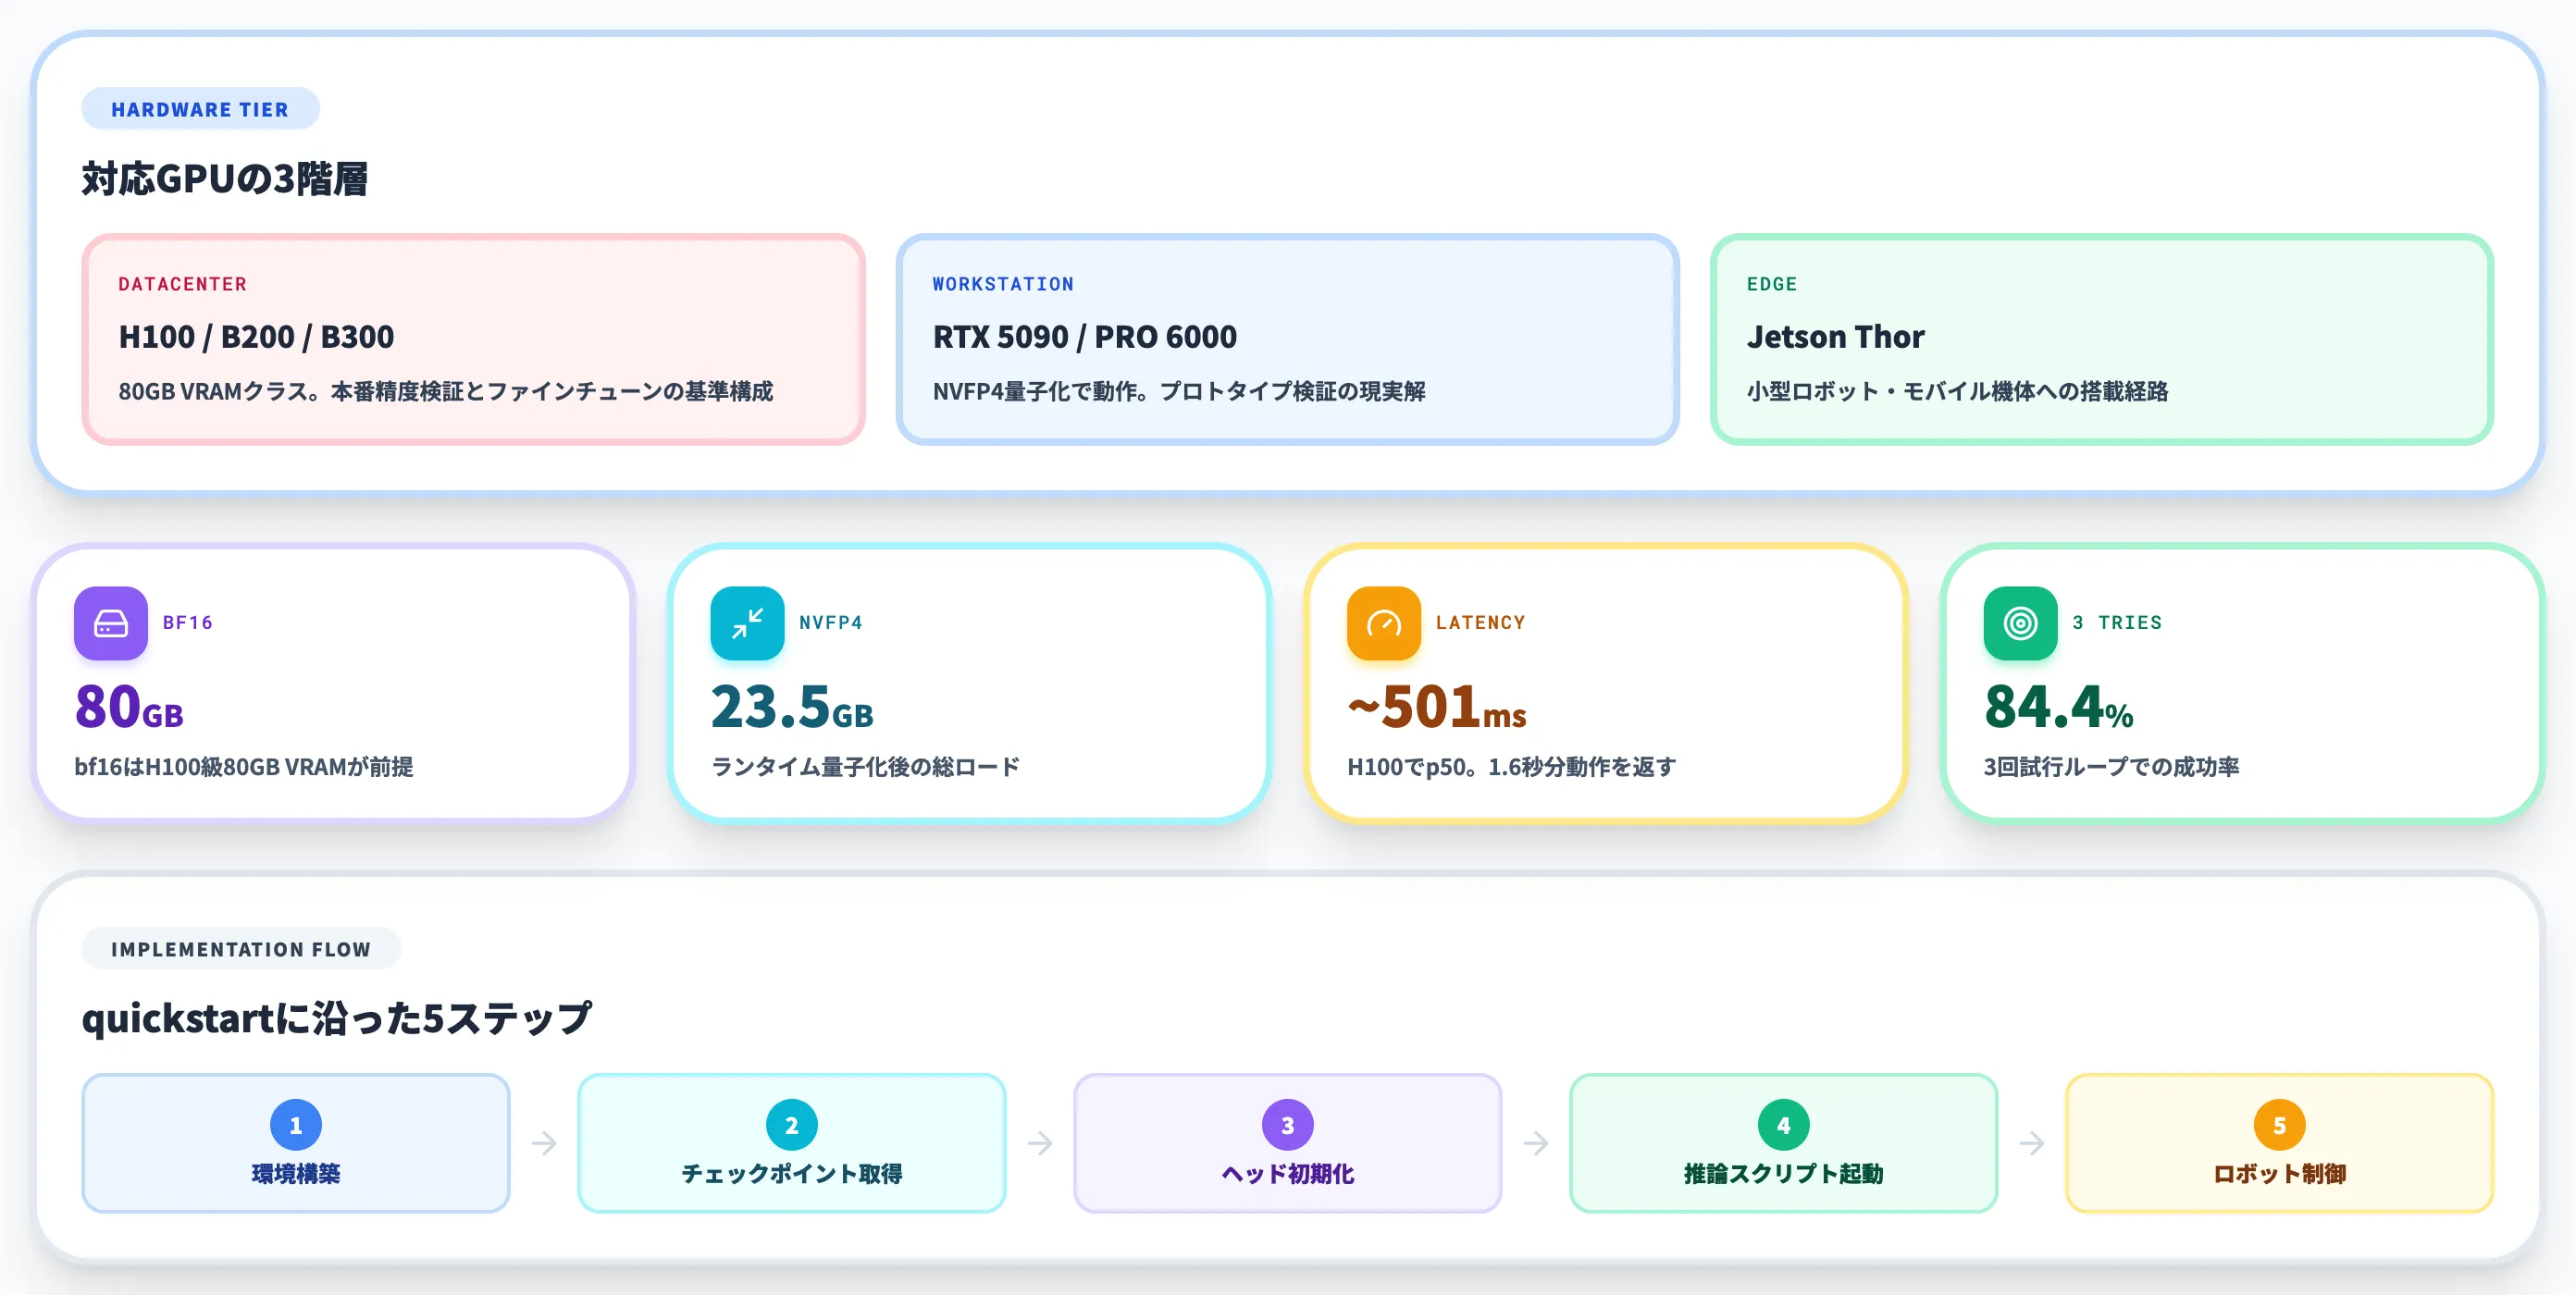
Praxis-1の重みを入手できても、そのまま動かすには相応のGPUとセットアップが必要です。
ここでは、公式GitHubリポジトリのドキュメントとDEV Communityの開発者ガイドの情報から、GPU要件・推論性能・セットアップ手順・コスト感を整理します。
対応GPUとエッジデバイスのラインナップ
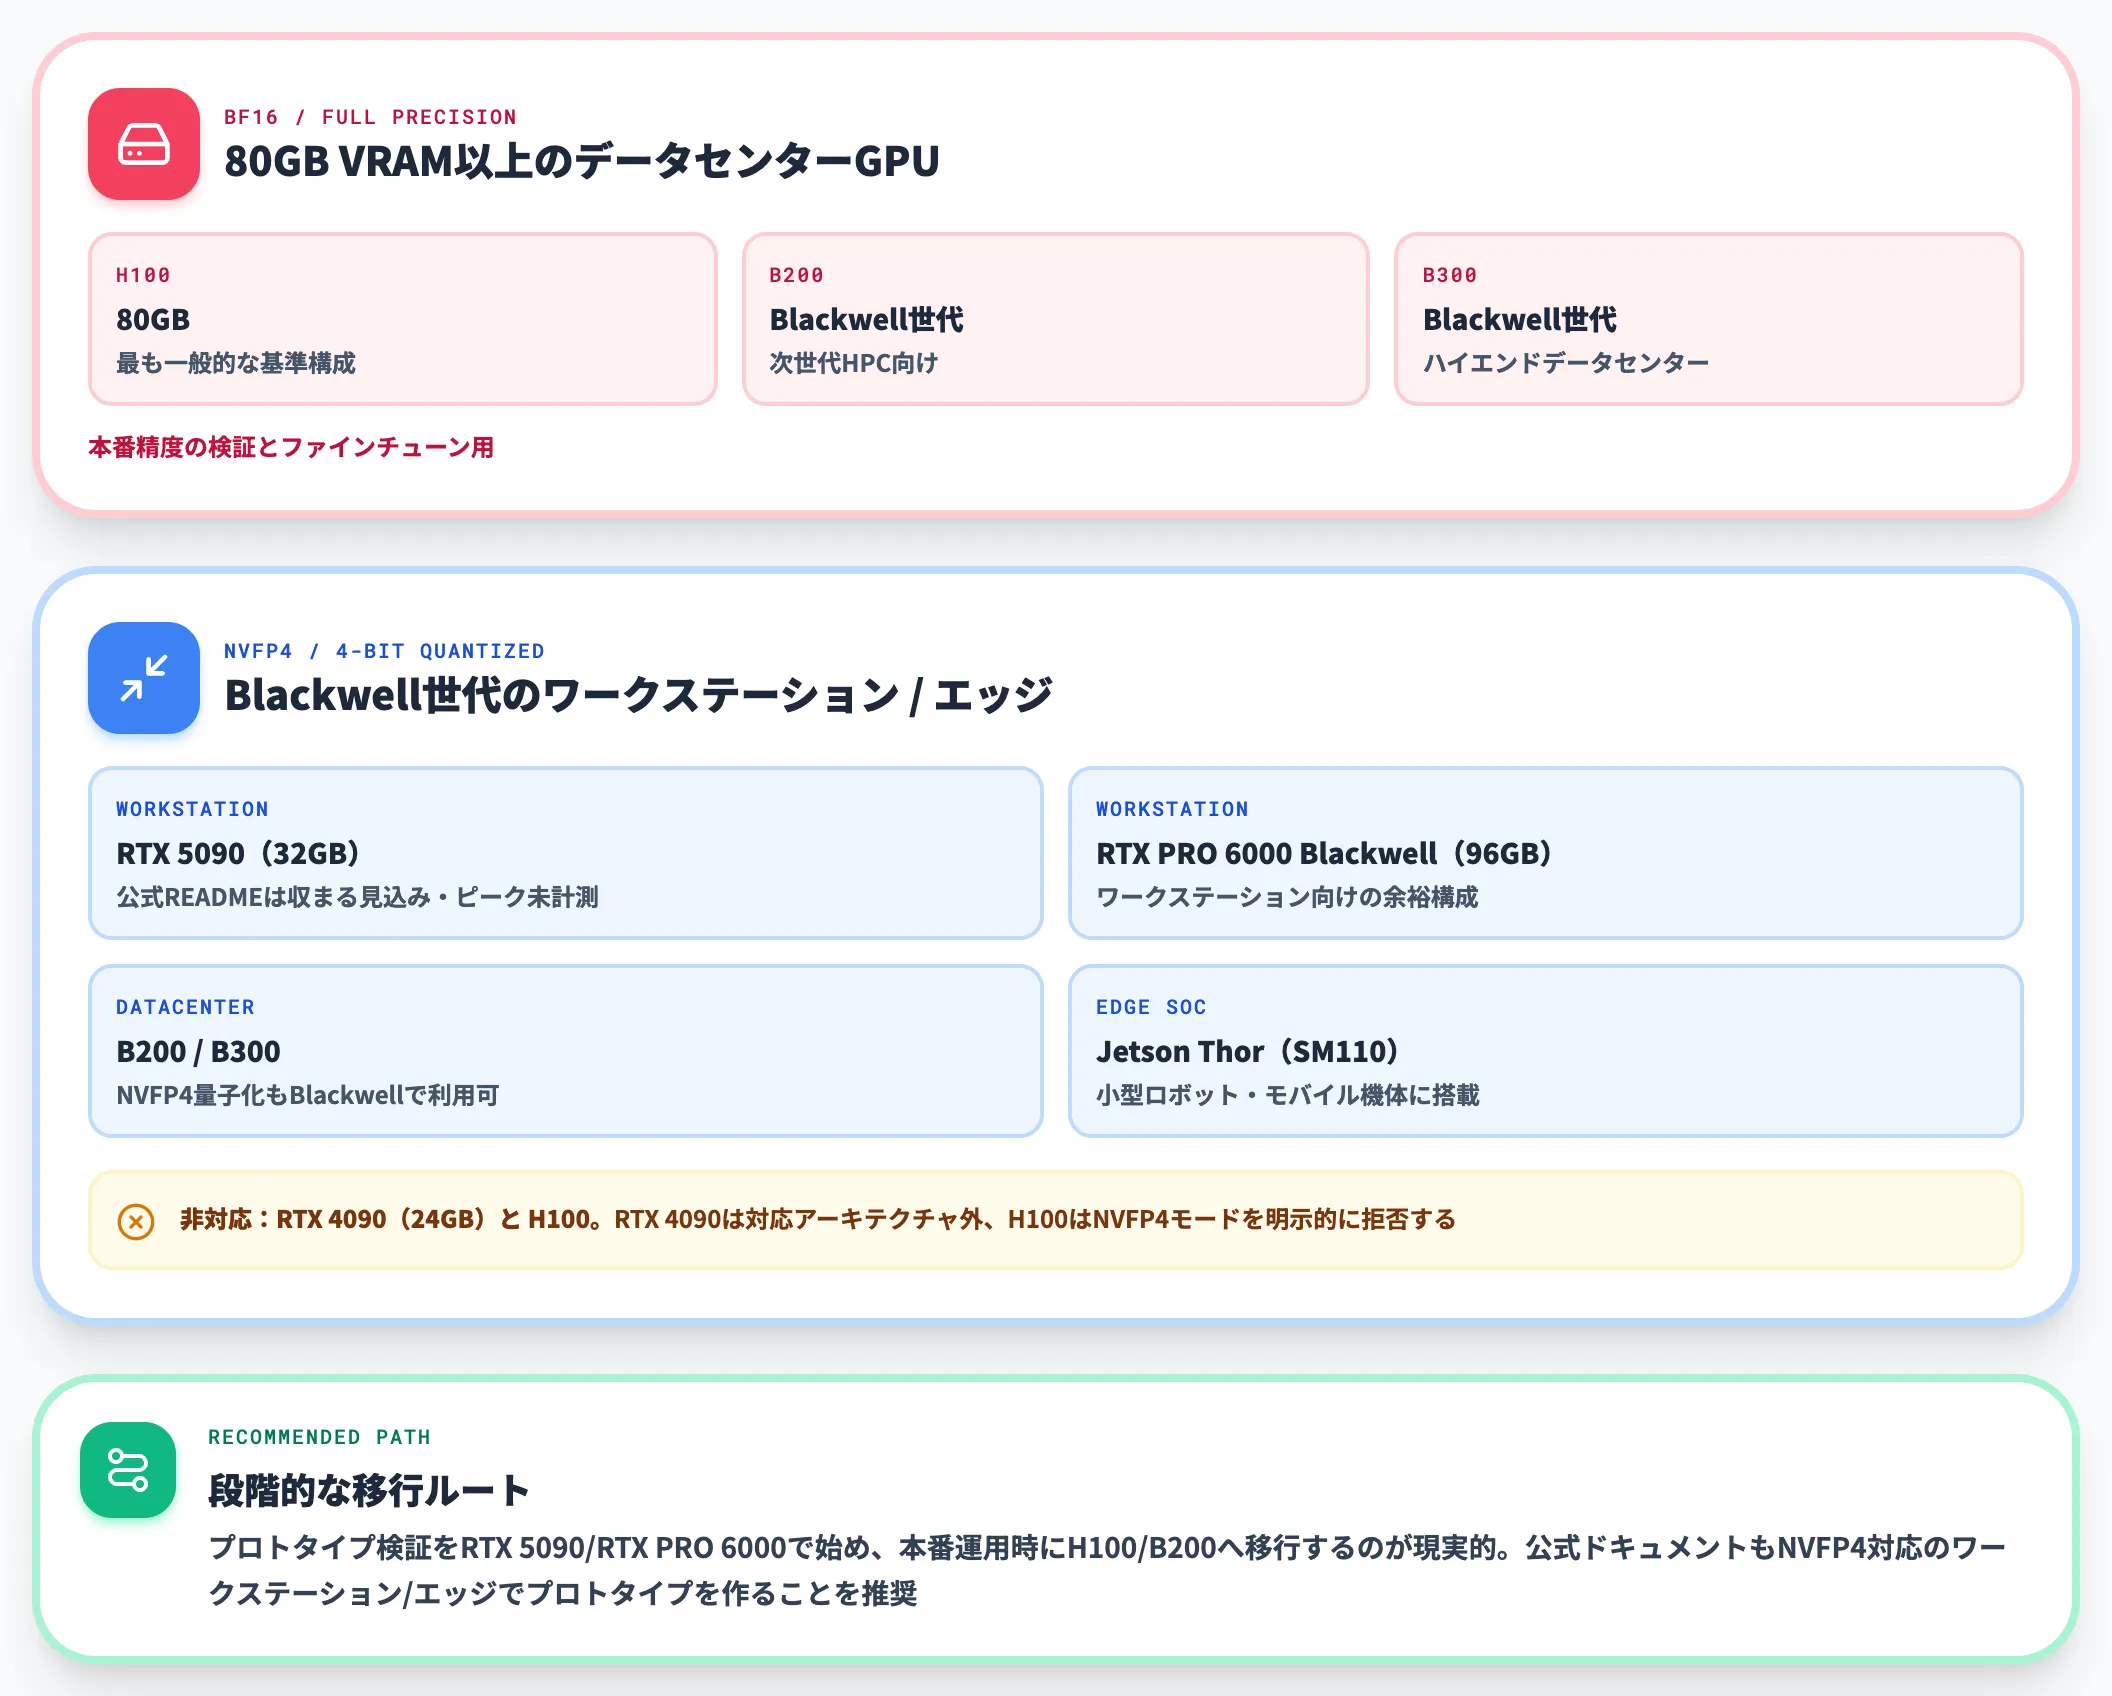
Runwayは対応GPUとして、データセンター向けのH100・B200・B300、ワークステーション向けのRTX 5090(32GB)・RTX PRO 6000 Blackwell(96GB)、そしてエッジ向けのJetson Thorまでを挙げています。
以下のリストで、精度設定と要求VRAMの対応を整理します。
-
フル精度(bf16)
80GB以上のVRAMを持つGPUが必要。H100 80GB・B200・B300が対象で、本番精度の検証とファインチューン用の基準構成
-
NVFP4量子化(4-bit)
配布チェックポイントはbf16形式で約54.4GB・ランタイム量子化後のポリシー重みは約17.5GB(テキストエンコーダとVAE込みで約23.5GB、活性化領域は別)。
ランタイム側のNVFP4量子化はBlackwell世代(SM100/SM103/SM110/SM120)でのみ動作し、RTX 5090(32GB)・RTX PRO 6000 Blackwell(96GB)・B200/B300・Jetson Thorが対象。RTX 5090 32GBでも公式READMEは収まる見込みとするがピーク使用量は未計測。H100はNVFP4モードを明示的に拒否するため使えない
-
Jetson Thor(エッジ)
NVFP4対応のエッジSoC(SM110)で、小型ロボット・モバイル機体に搭載できる経路。推論帯域はデータセンターGPUより下がるが、エッジ側でのリアルタイム推論を可能にする
GPU要件と精度の組み合わせで、プロトタイプから本番、エッジまで段階的に設計できる構造です。
公式ドキュメントでは「NVFP4対応のワークステーション/エッジGPUでプロトタイプを作る」ことを推奨しており、まずRTX 5090やRTX PRO 6000 Blackwellで検証、本番運用時にH100・B200へ移行するルートが現実的です。
bf16とNVFP4量子化のVRAM要件
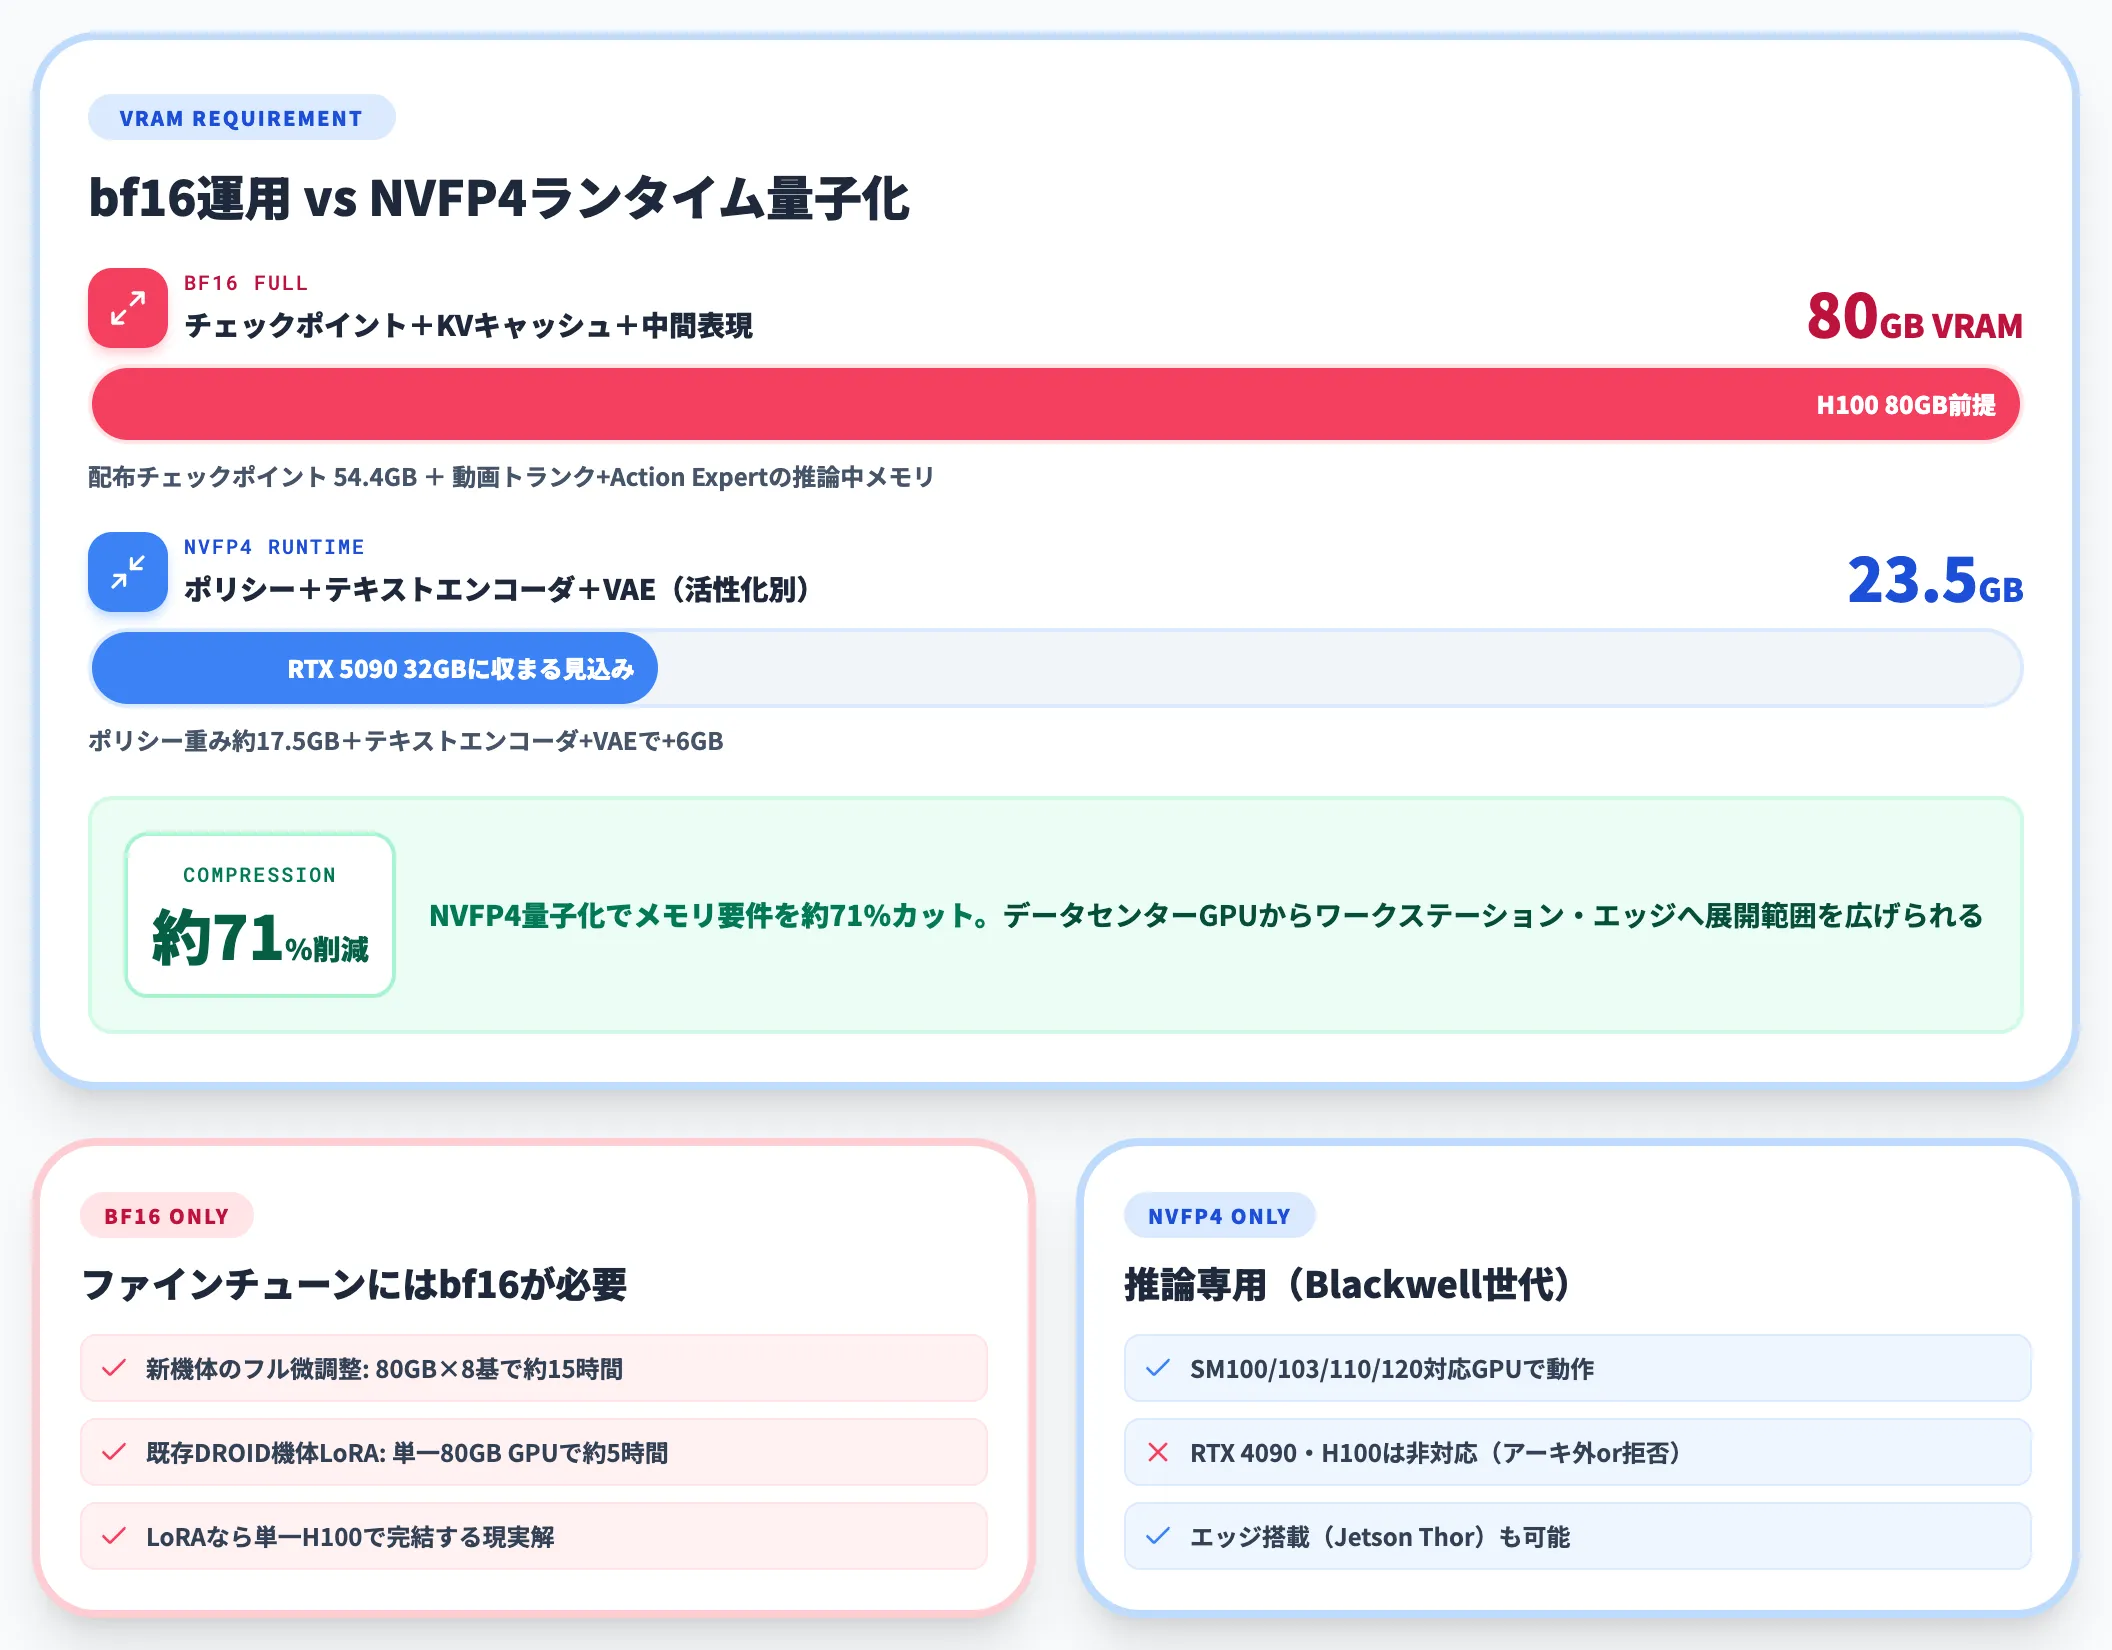
実運用時のVRAM消費は、動画トランクとAction Expertの両方をロードする必要があるため、bf16運用ではチェックポイント54.4GBに加えて推論中のKVキャッシュと中間表現で、実質的に80GB VRAMが前提になります。
NVFP4版の配布チェックポイントもbf16形式で約54.4GBあり、ランタイム側のNVFP4変換後にポリシー重みが約17.5GBまで圧縮され、テキストエンコーダとVAEを含めたロード済み状態で約23.5GBになります(活性化領域は別)。
NVFP4対応のBlackwell世代GPU(RTX 5090 32GB・RTX PRO 6000 Blackwell 96GB・B200/B300・Jetson Thor)で動作し、RTX 5090 32GB上でも収まる見込みですがピーク使用量は公式未計測です。24GBのRTX 4090は対応アーキテクチャ外、H100もNVFP4モードを拒否するため対象外です。
ただし、量子化は推論用で、ファインチューンにはbf16形式のチェックポイントが必要です。新しい機体への適応では praxis-1-base を、既存DROID機体の新タスクへのLoRA適応では praxis-1-droid の bf16 チェックポイントを起点に使います。公開モデルの最終ステージ(中間学習後のDROID向け機体特化ファインチューン)は277時間の実演データ+H100 128基という規模で、配布モデル作成側の学習実績に相当します。
公式が案内する通常のファインチューン目安は、新しい機体への適応が80GB GPU×8基で約15時間、既存DROID機体の新タスクへのLoRA適応は単一80GB GPUで約5時間です。
LoRAアダプタで既存DROID機体の新タスクに局所適応する経路なら単一H100で完結し、新しい機体用のフル微調整でも8基構成で数日以内という現実的な範囲に収まります。
セットアップ手順と推論レイテンシ
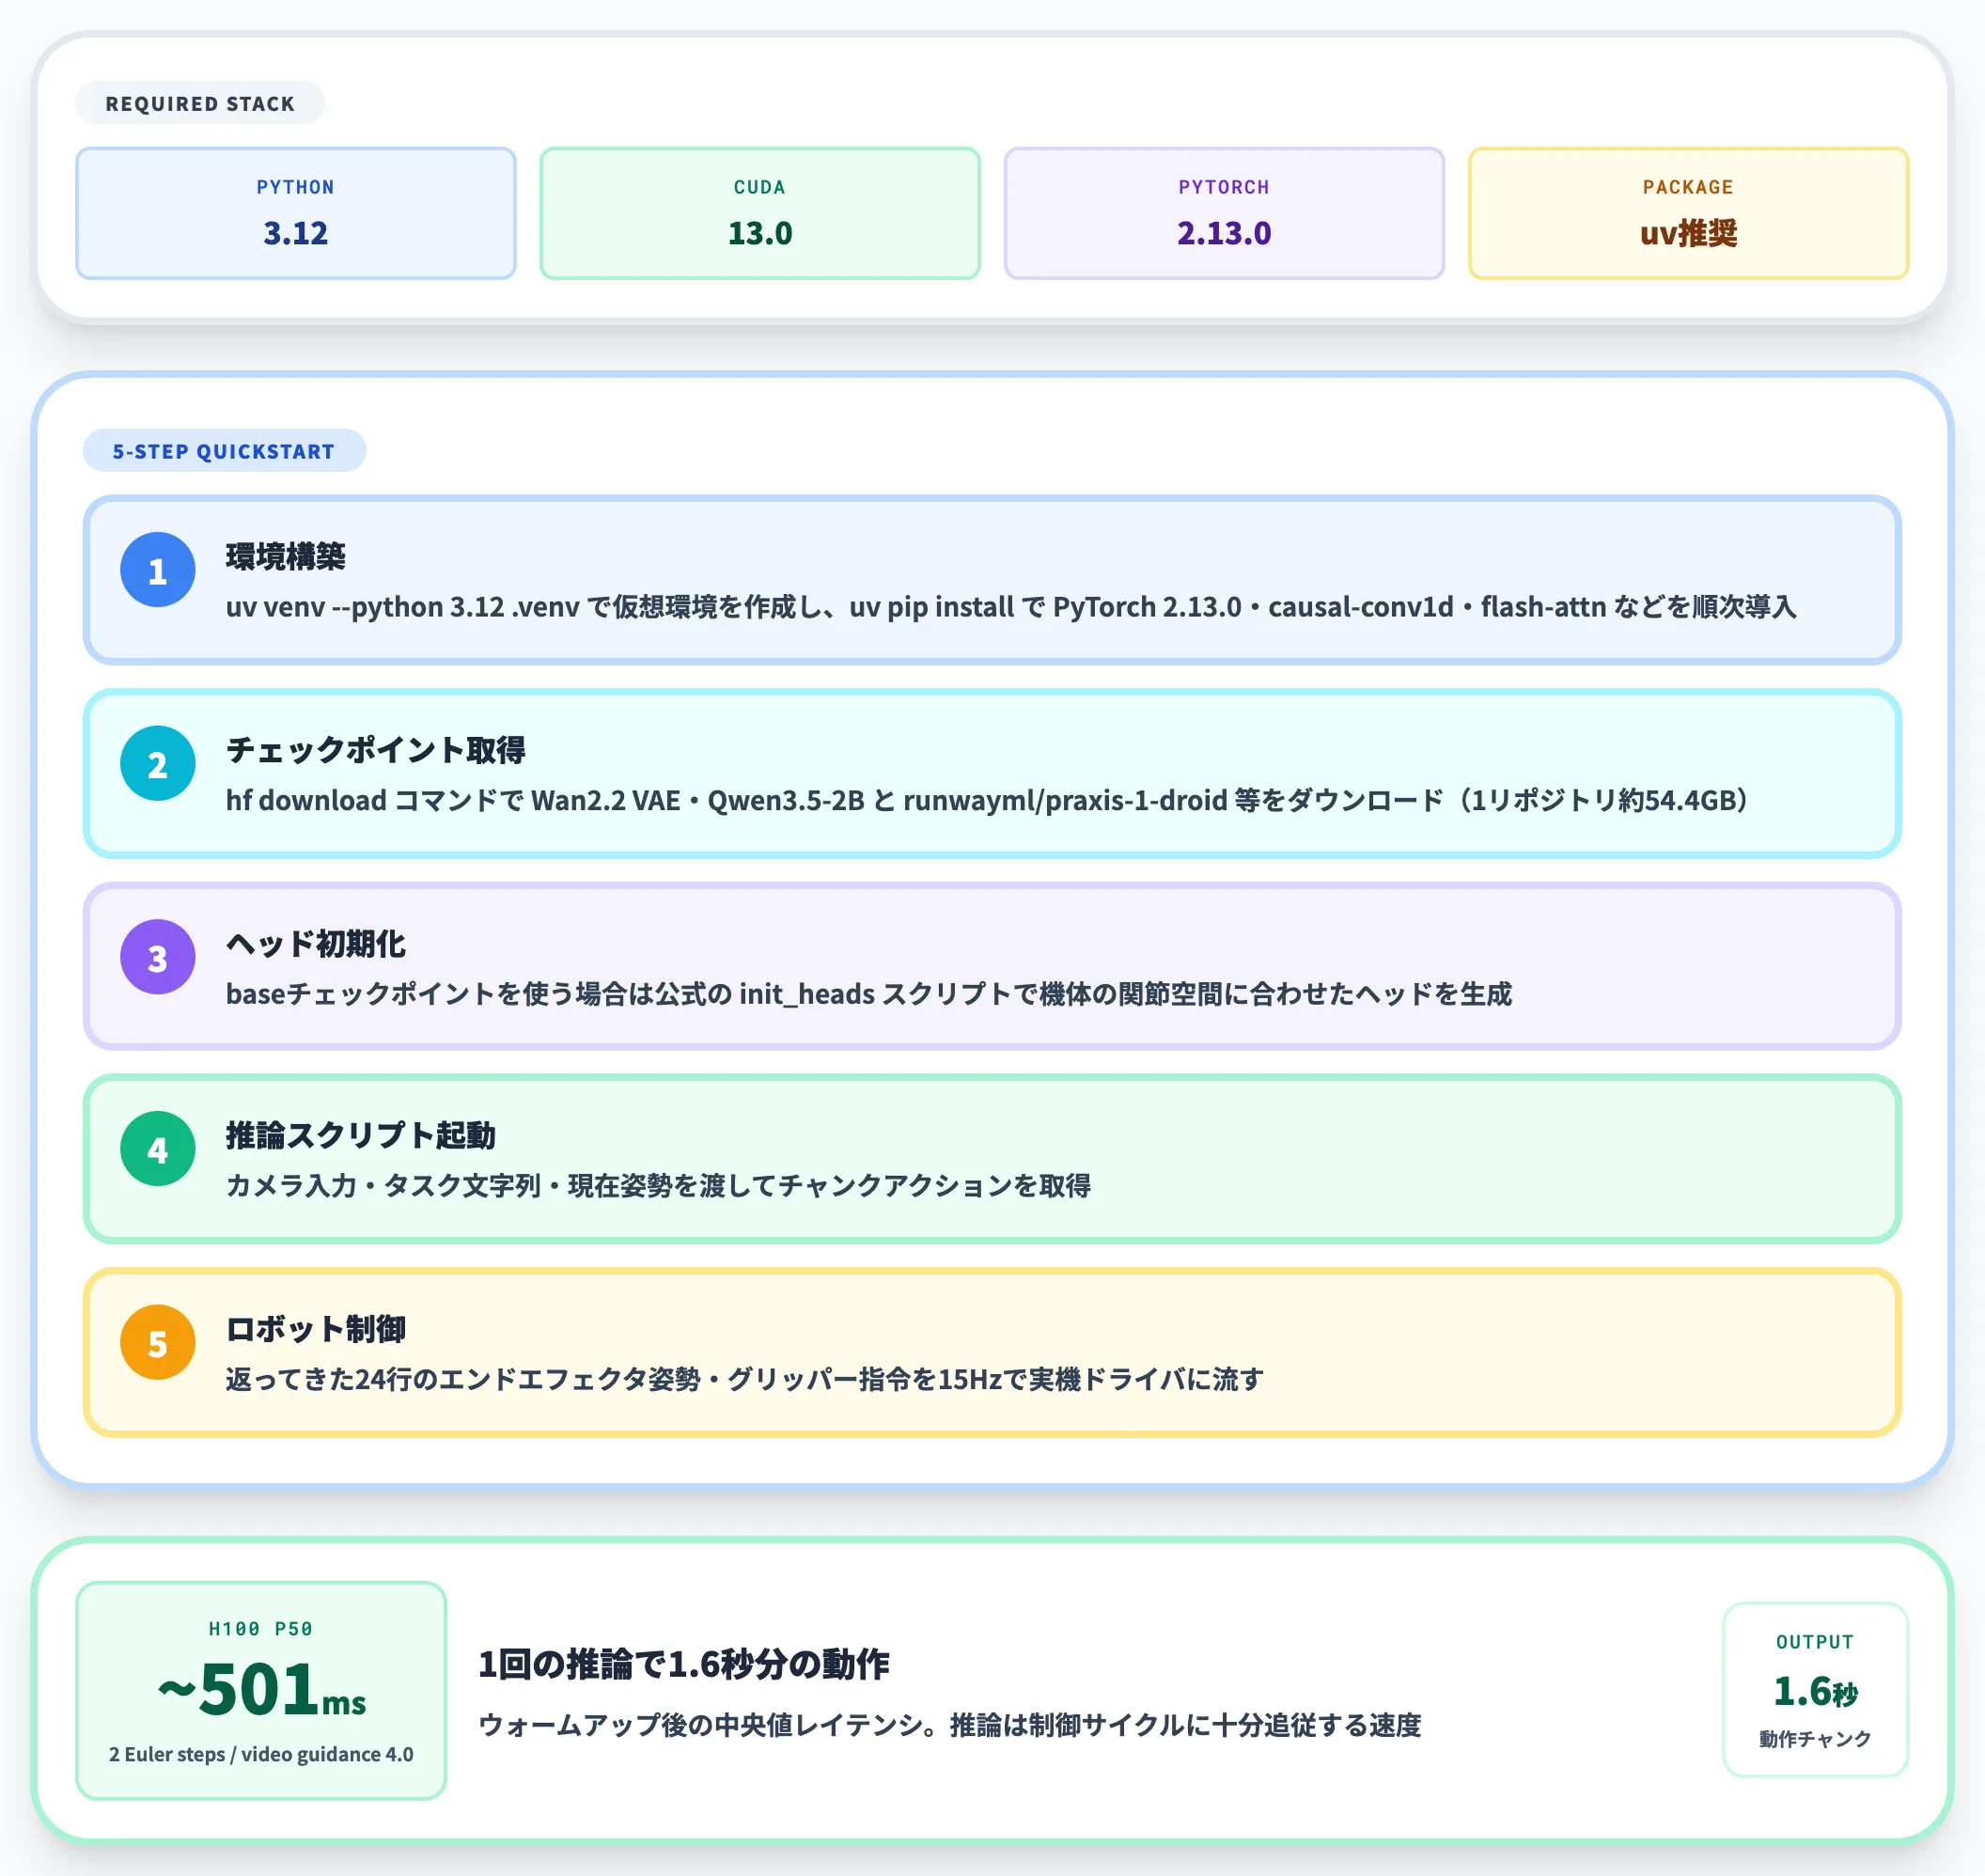
実装手順は公式リポジトリのquickstart手順に沿って進めます。Python 3.12、CUDA 13.0、PyTorch 2.13.0が要求環境で、uvパッケージマネージャによる依存解決が推奨されています。
典型的なセットアップ手順は以下のように整理できます。
- 環境構築
uv venv --python 3.12 .venv で仮想環境を作成し、uv pip install で PyTorch 2.13.0・causal-conv1d・flash-attn などを順次導入(公式quickstartの手順に従う)
- チェックポイント取得
hf download コマンドで Wan2.2 VAE・Qwen3.5-2B と runwayml/praxis-1-droid 等をダウンロード(1リポジトリあたり約54.4GB)
- ヘッド初期化
baseチェックポイントを使う場合は公式の init_heads スクリプトで機体の関節空間に合わせたヘッドを生成
- 推論スクリプト起動
カメラ入力・タスク文字列・現在姿勢を渡してチャンクアクションを取得
- ロボット制御
返ってきた24行のエンドエフェクタ姿勢・グリッパー指令を15Hzで実機ドライバに流す
H100上でのレイテンシは、2 Euler steps・video guidance 4.0のデフォルト設定で、ウォームアップ後のp50が約501msと報告されています。
1回の推論で1.6秒分の動作が返ってくるため、推論は制御サイクルに十分追従する速度です。
複数試行ループで成功率を引き上げる設計
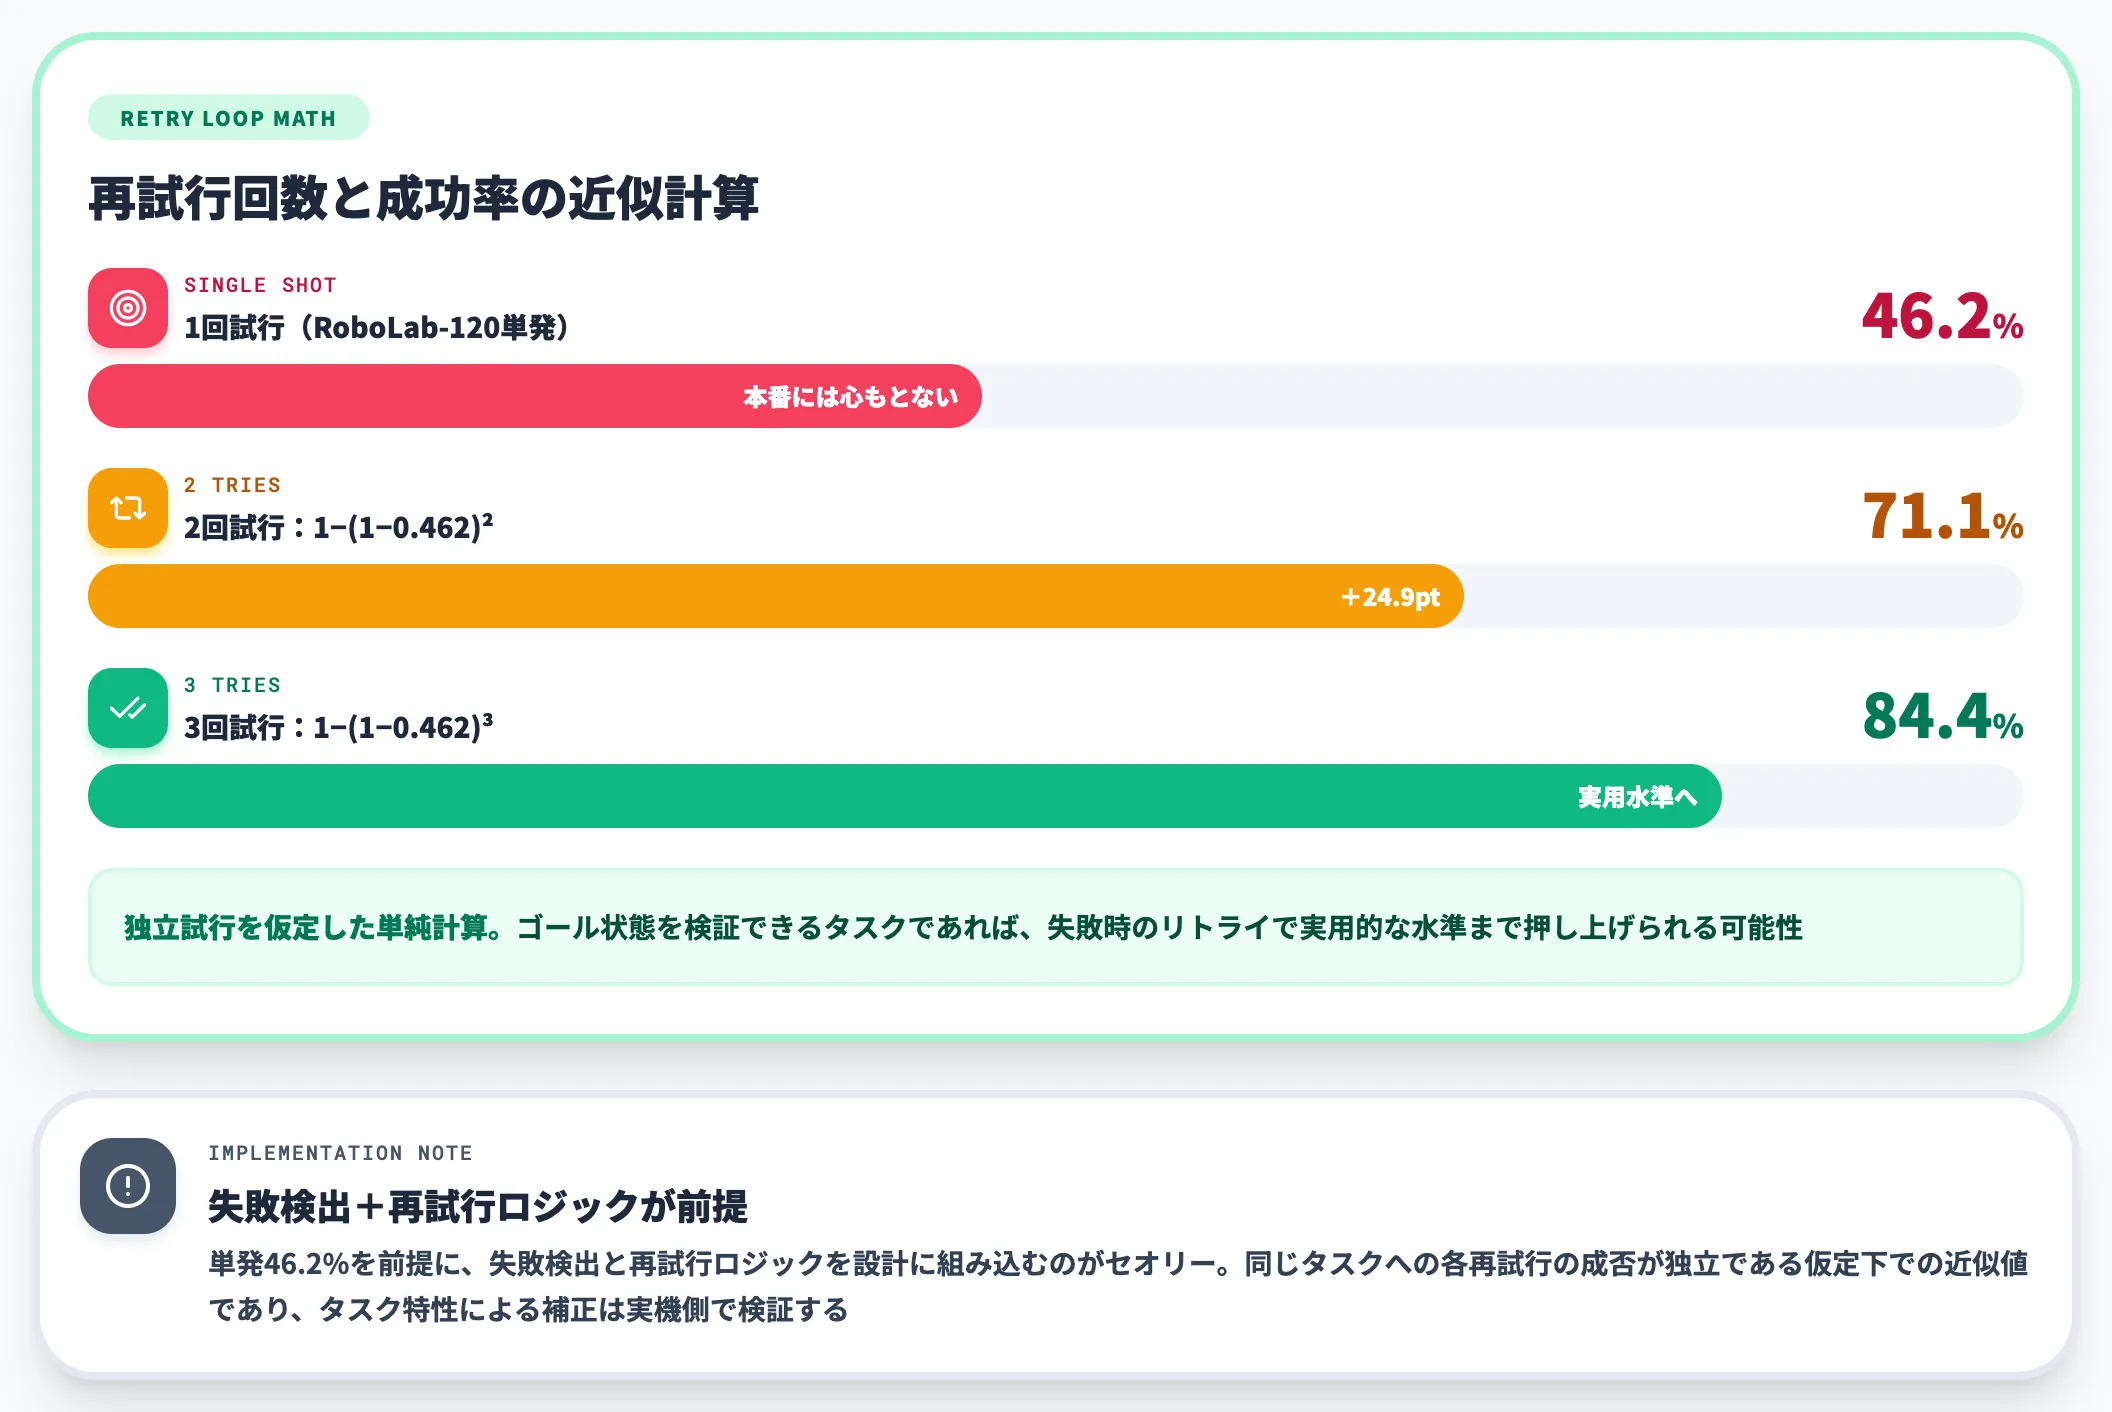
RoboLab-120の46.2%という単発成功率は、本番ワークフローではそのまま使うには心もとない水準です。
DEV Communityの開発者ガイドは、この数字を複数試行ループでかさ上げする設計を推奨しています。
想定される成功率の上がり方は、独立試行を仮定した単純計算で以下のようになります。
- 2回試行: 1 − (1 − 0.462)² ≒ 71.1%
- 3回試行: 1 − (1 − 0.462)³ ≒ 84.4%
この計算は同じタスクへの各再試行の成否が独立である前提での近似ですが、ゴール状態を検証できるタスクであれば失敗時にリトライするだけで実用的な水準まで押し上げられる可能性があります。
実装する側は「単発46.2%」を前提に、失敗検出と再試行ロジックを設計に組み込むのがセオリーです。
H100運用時の推論コストの目安
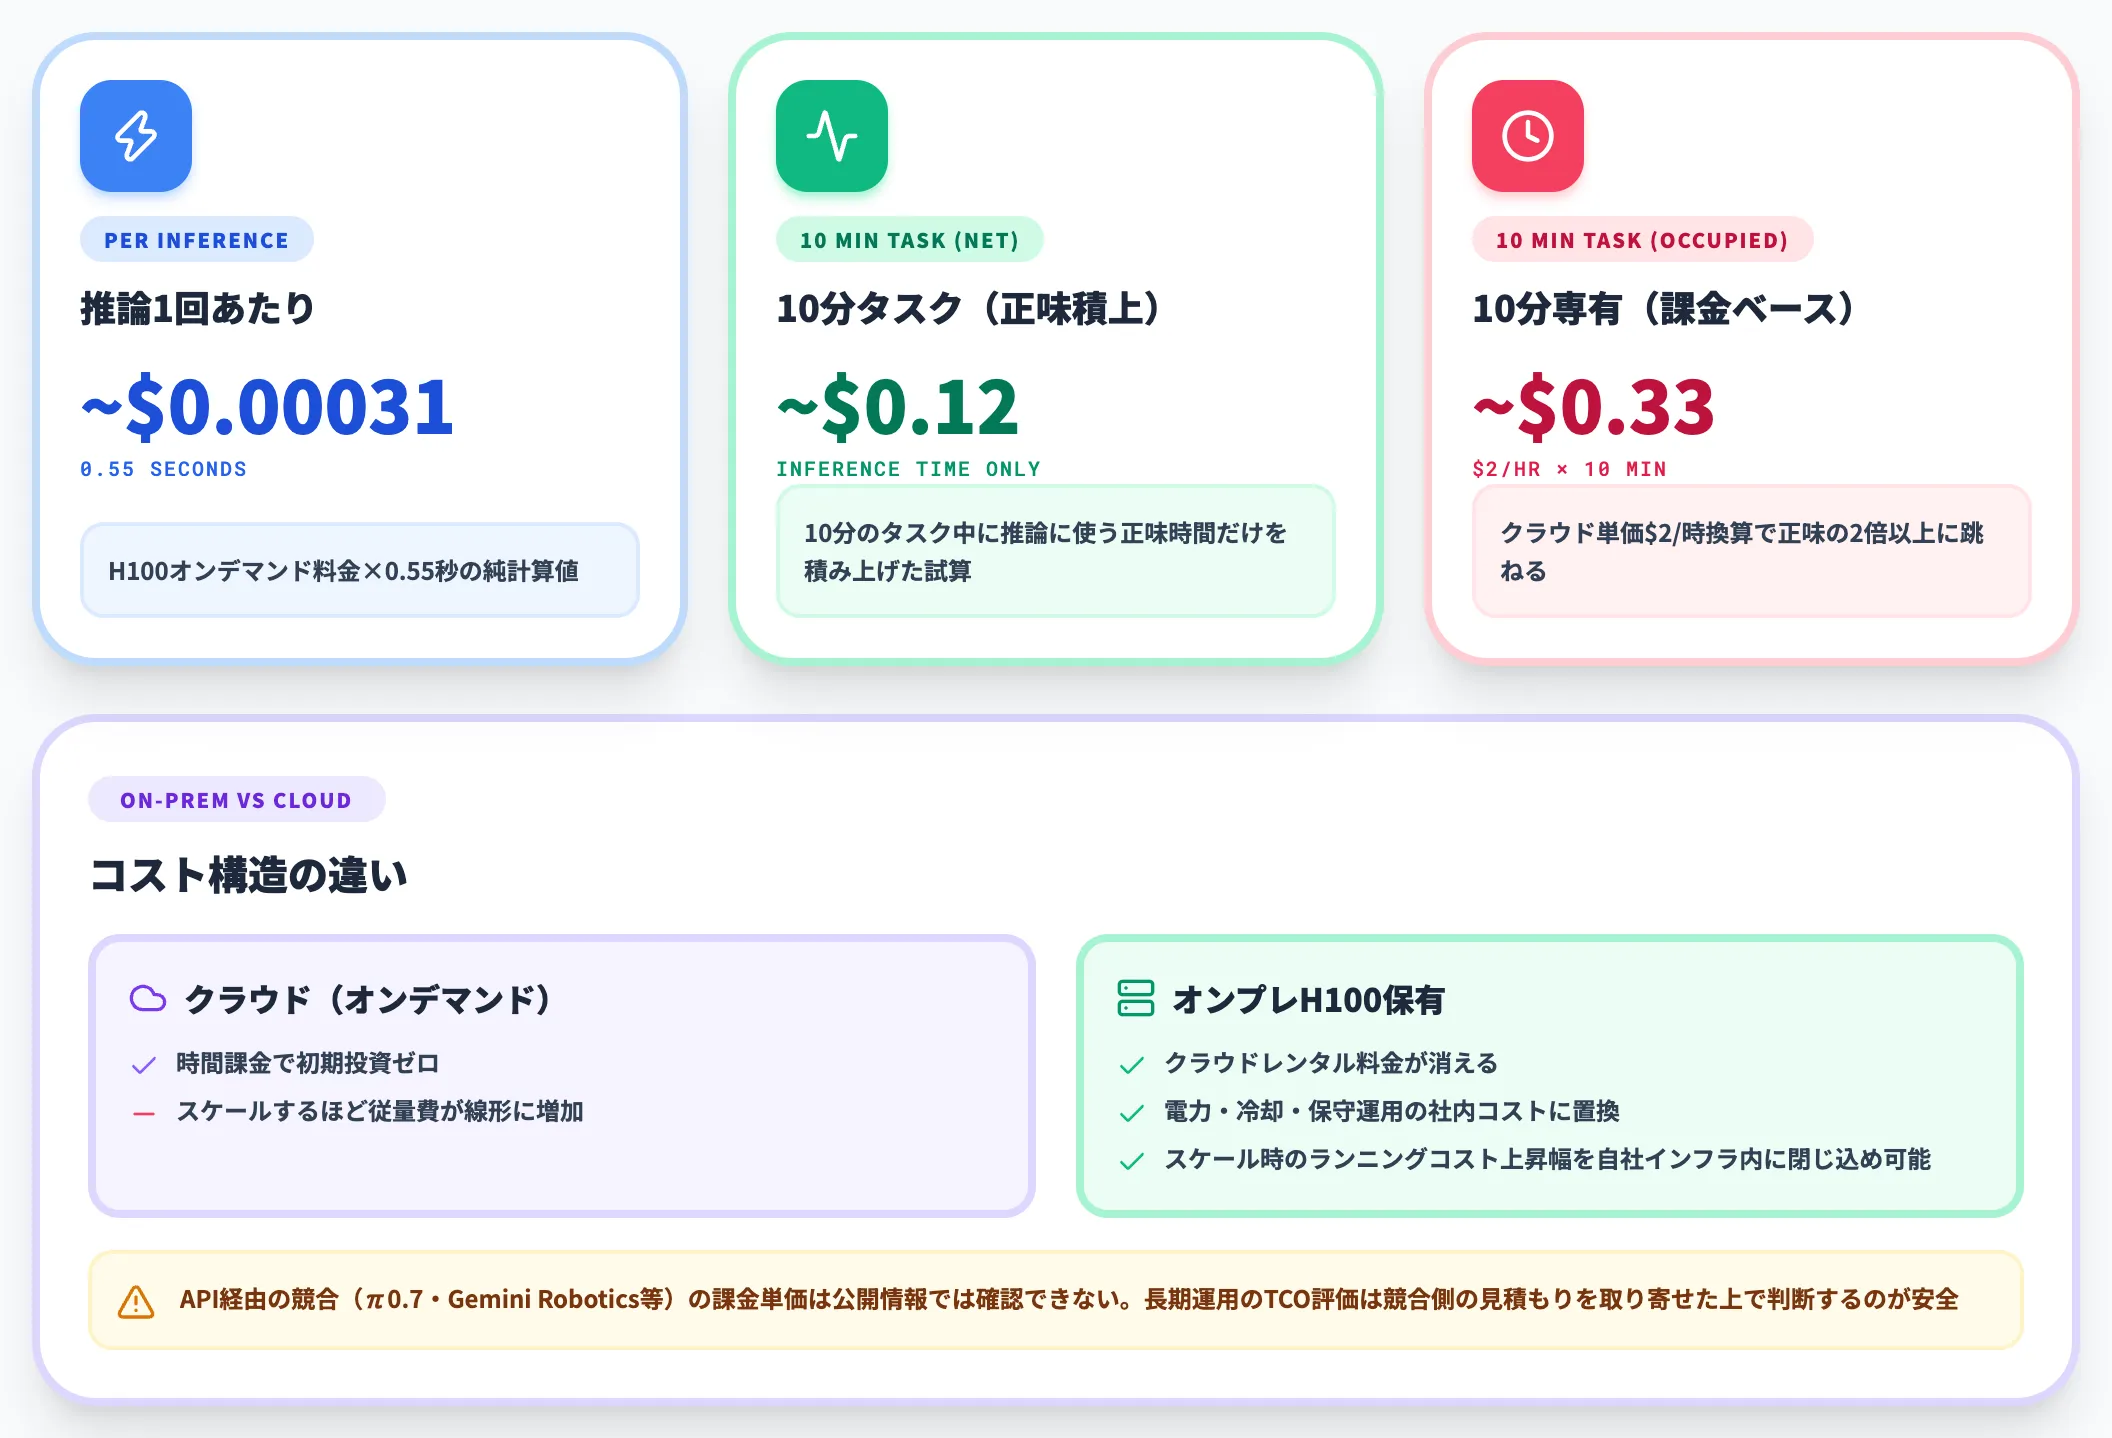
H100 80GBをオンデマンドで借りる想定で、GPU計算時間だけを積み上げると0.55秒の推論1回あたり約$0.00031、10分間のタスク実行で推論に使う正味時間だけを積み上げた試算が約$0.12(DEV Communityのチェックリスト見積もり)になります。
ただしGPUを10分間専有し続けるならクラウド単価$2/時換算で約$0.33と、課金時間基準で2倍以上に跳ねます。
オンプレのH100を保有する組織なら、クラウドレンタル料金が消え、電力・冷却・保守運用の社内コストに置き換わる構造になります。
API経由の競合モデル(π0.7・Gemini Robotics等)の課金単価は公開情報では確認できないため直接比較はできませんが、オンプレのH100を保有する組織なら、スケールするほどランニングコストの上昇幅を自社インフラ側に閉じ込められる構造にはなります。
長期運用のTCO評価は、競合側の見積もりを取り寄せた上で判断するのが安全です。
Praxis-1と競合モデルの比較
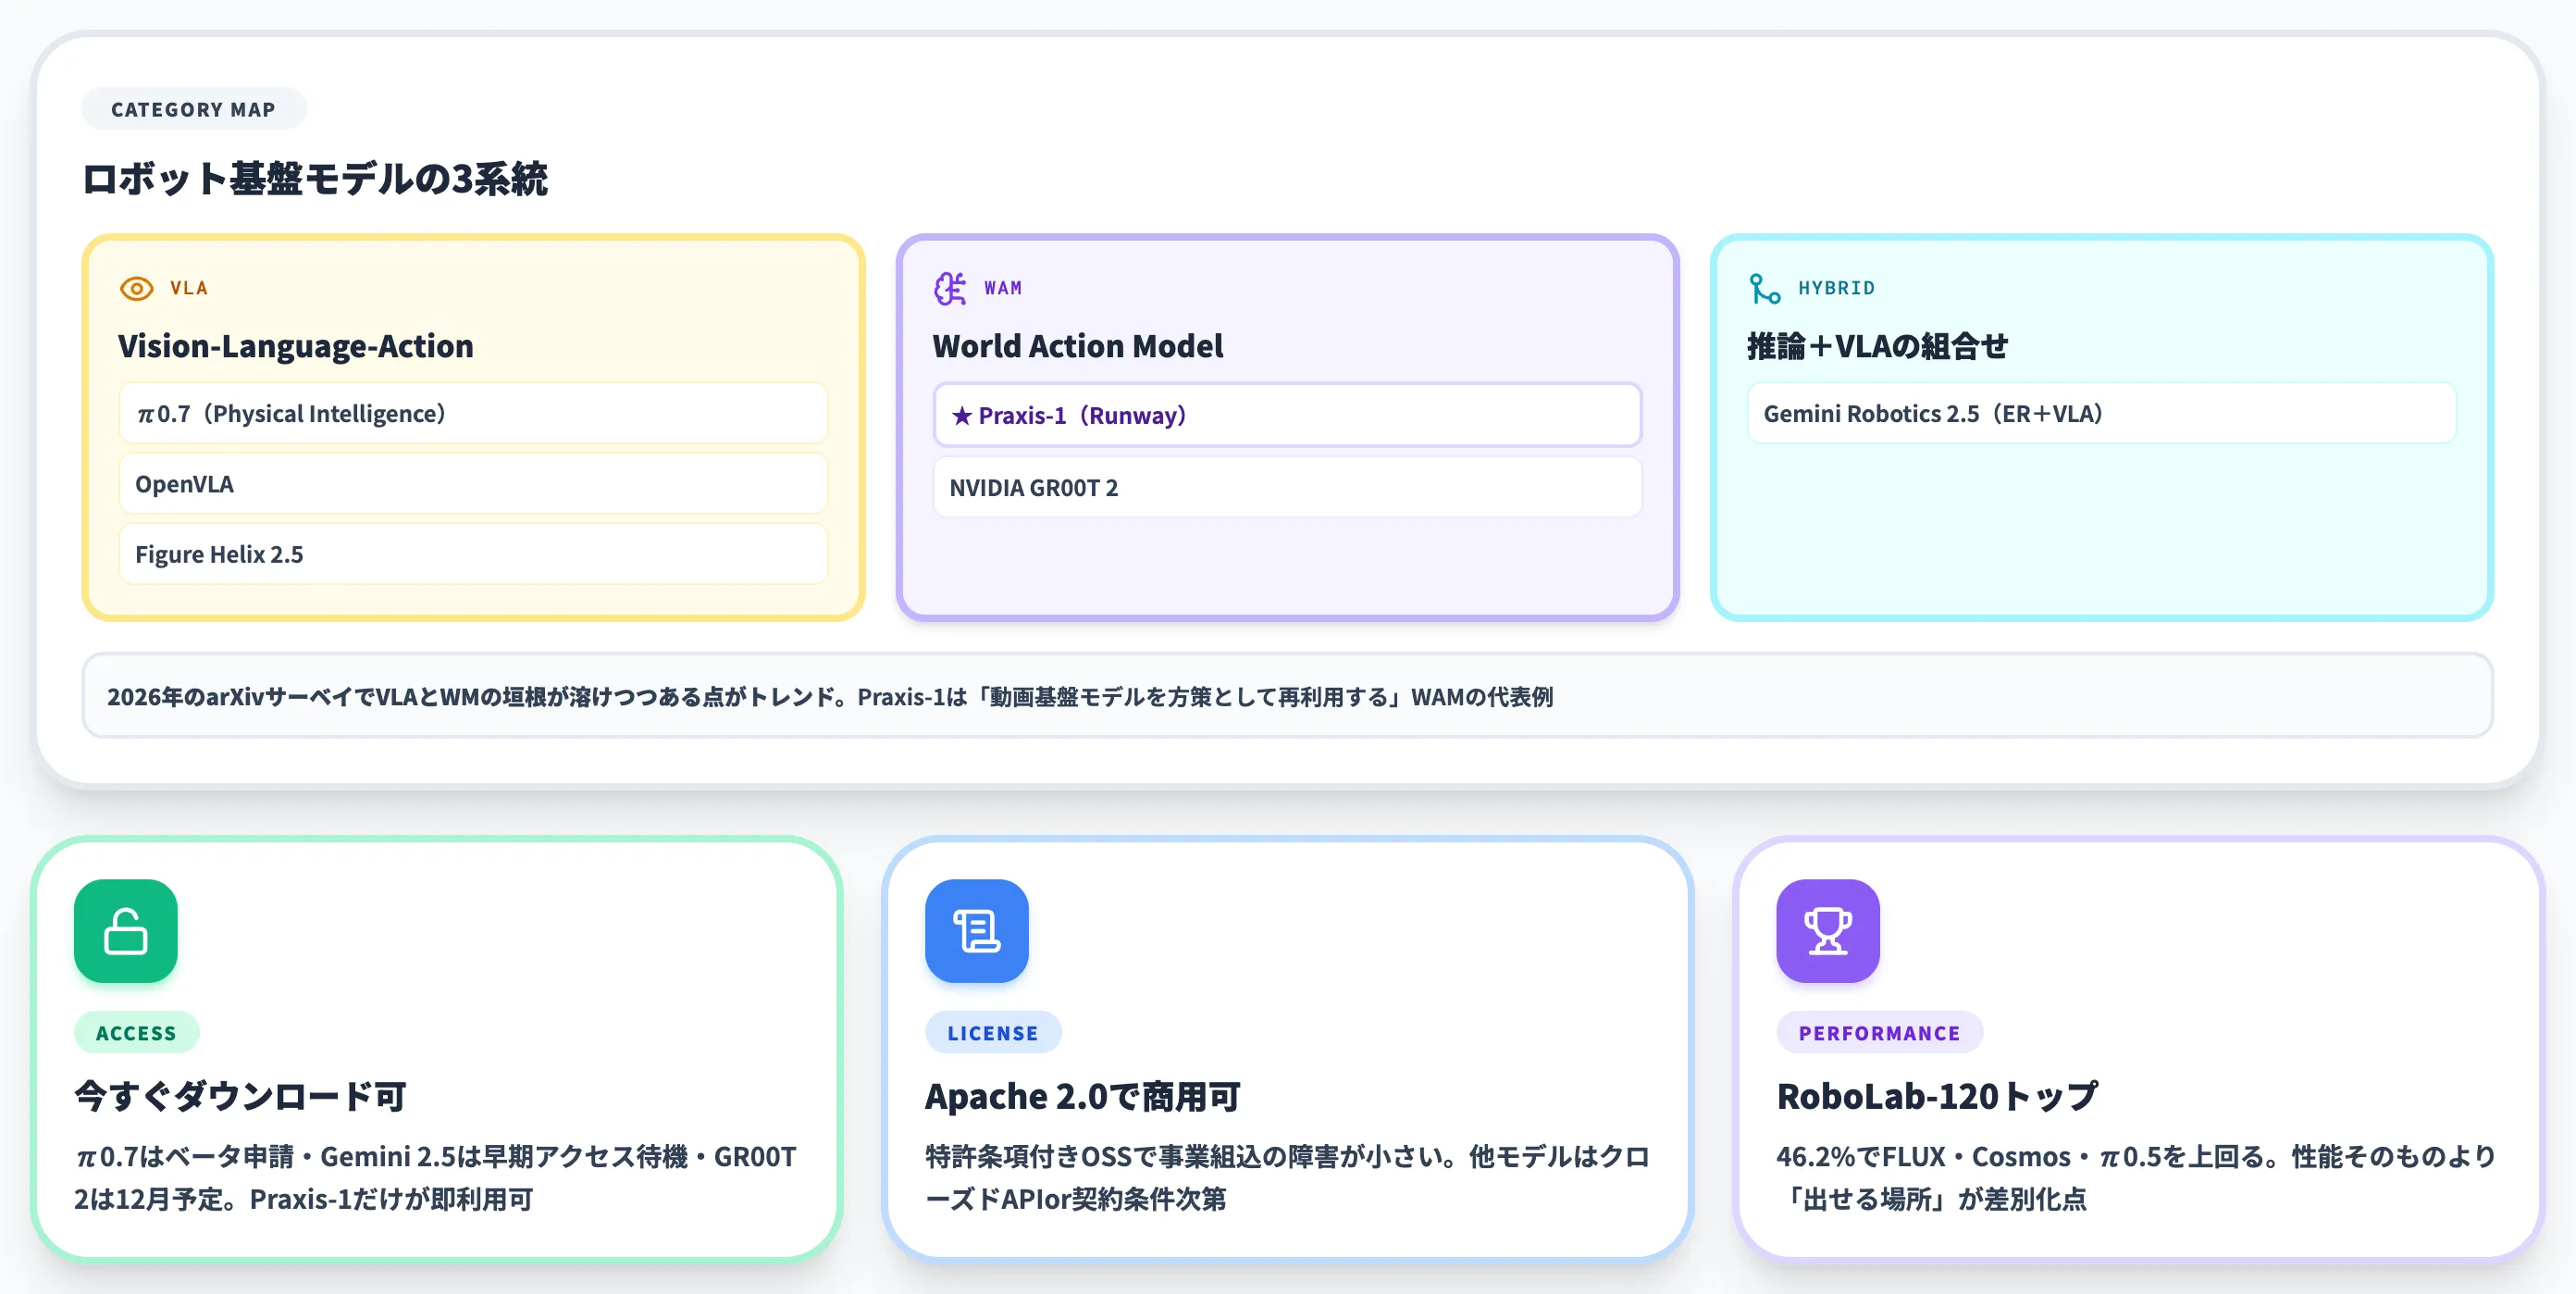
Praxis-1はロボット基盤モデルのなかで、どの位置に立つのでしょうか。
VLA系・WAM系・ヒューマノイド特化系の主要モデルと、ライセンス・アーキテクチャ・ユースケースの3軸で並べて見ていきます。
VLA系とWAM系のアーキテクチャ差
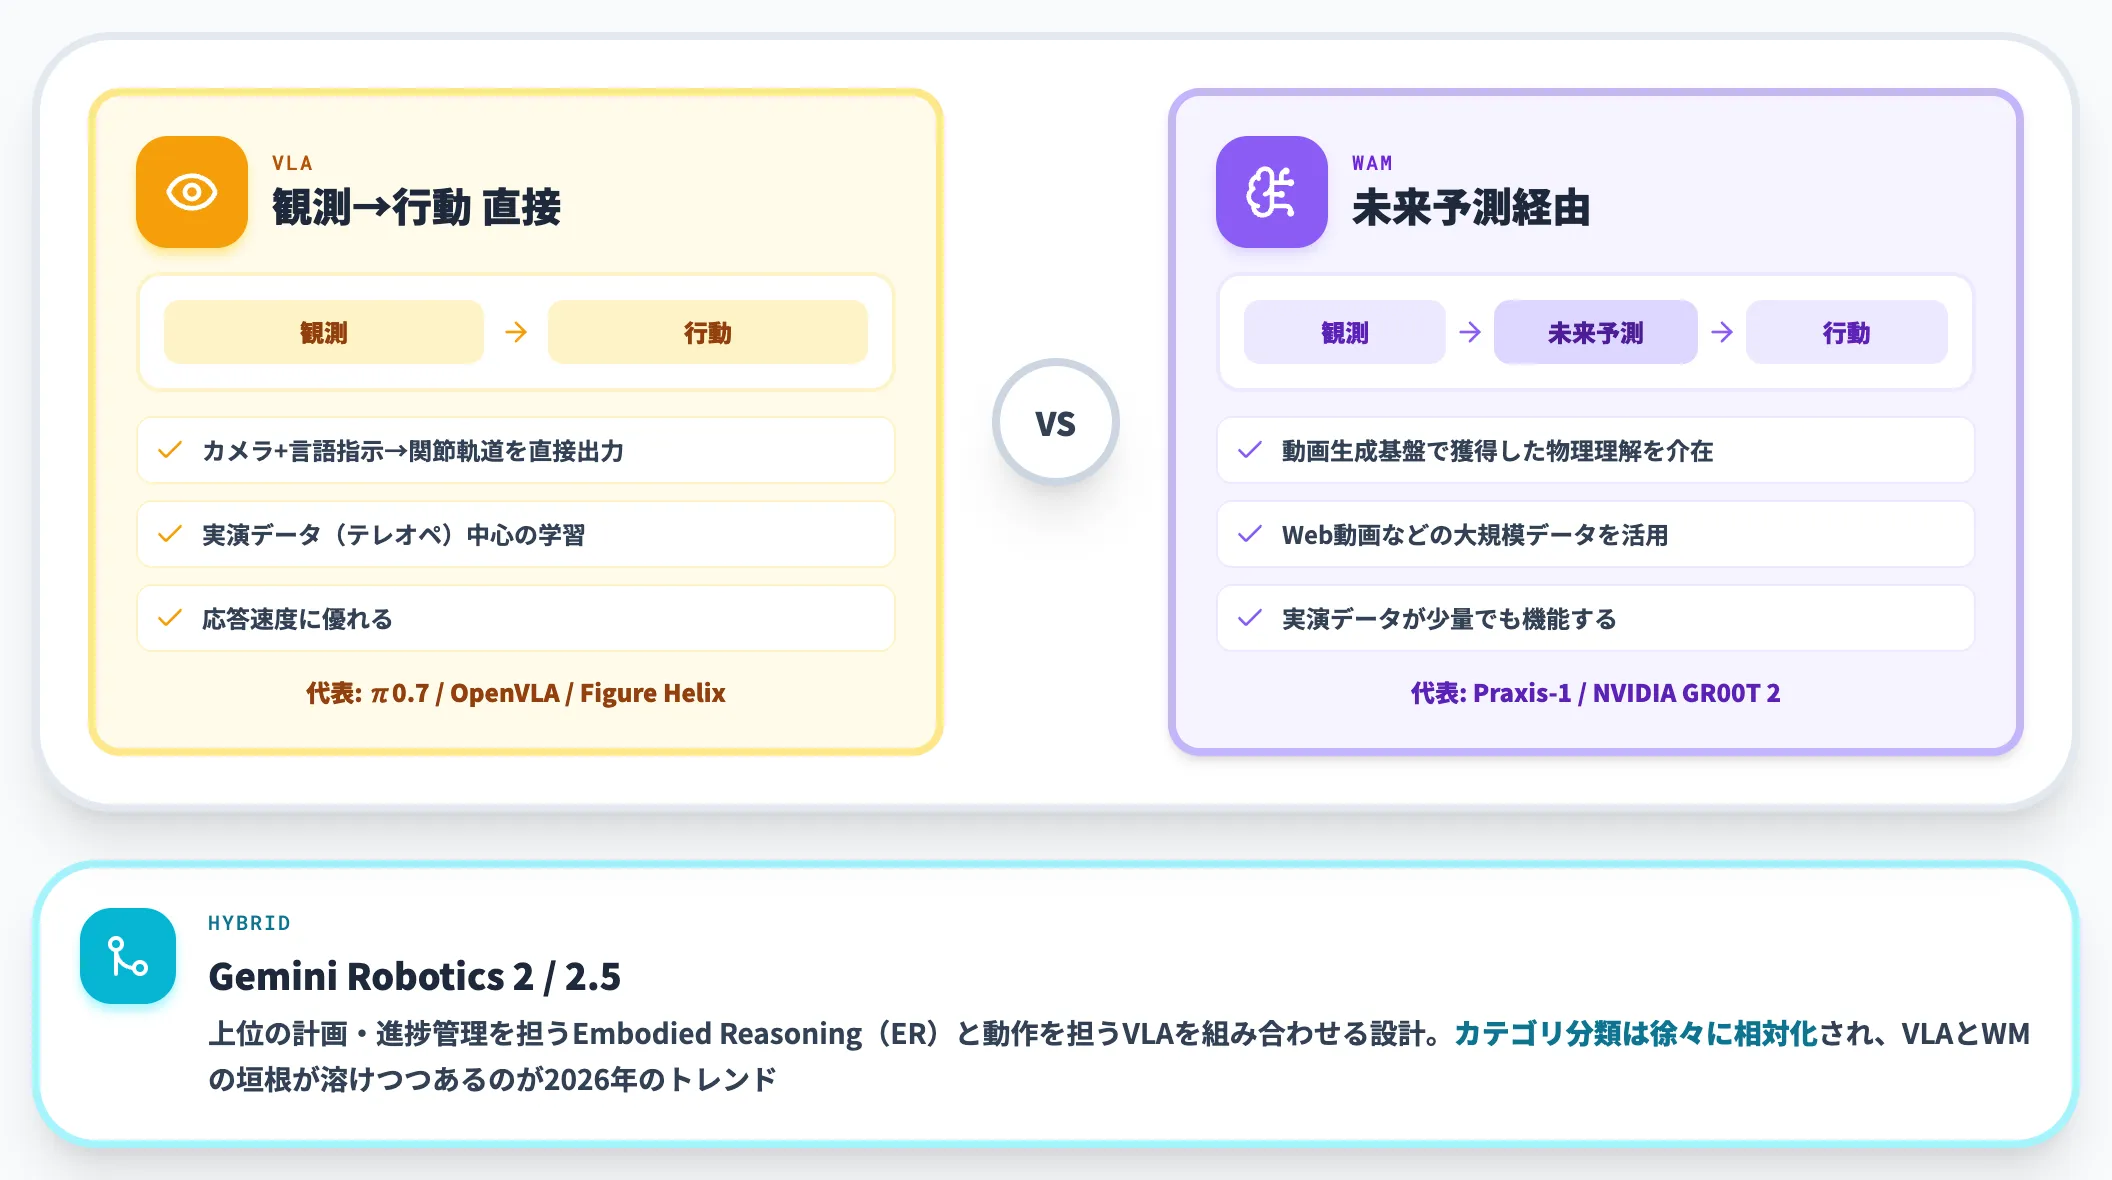
ロボット基盤モデルは、観測から行動を直接マップするVLA系と、未来の世界状態を予測してから行動を導くWAM系に大別できます。
-
VLA系
π0.7・OpenVLA・Figure Helixなどが代表例。カメラと言語指示から直接関節軌道を出力する。実演データ(テレオペ)中心の学習で、応答速度に優れる
-
WAM系(World Action Model)
Praxis-1・NVIDIA GR00T 2などが該当。動画生成基盤モデルで獲得した物理理解を介して行動を出力する。Web動画などの大規模データを活用しやすい
-
ハイブリッド系
Gemini Robotics 2および2026年11月10日発表の Gemini Robotics 2.5 は、上位の計画・進捗管理を担う Embodied Reasoning(ER)と動作を担うVLAを組み合わせる設計で、カテゴリ分類は徐々に相対化されつつある
2026年のarXivサーベイ論文では、VLAとWMの垣根が溶けつつある点がトレンドとして指摘されており、Praxis-1は「動画基盤モデルを方策として再利用する」WAMの代表例として位置付けられます。
ベンチマーク性能とライセンスの比較
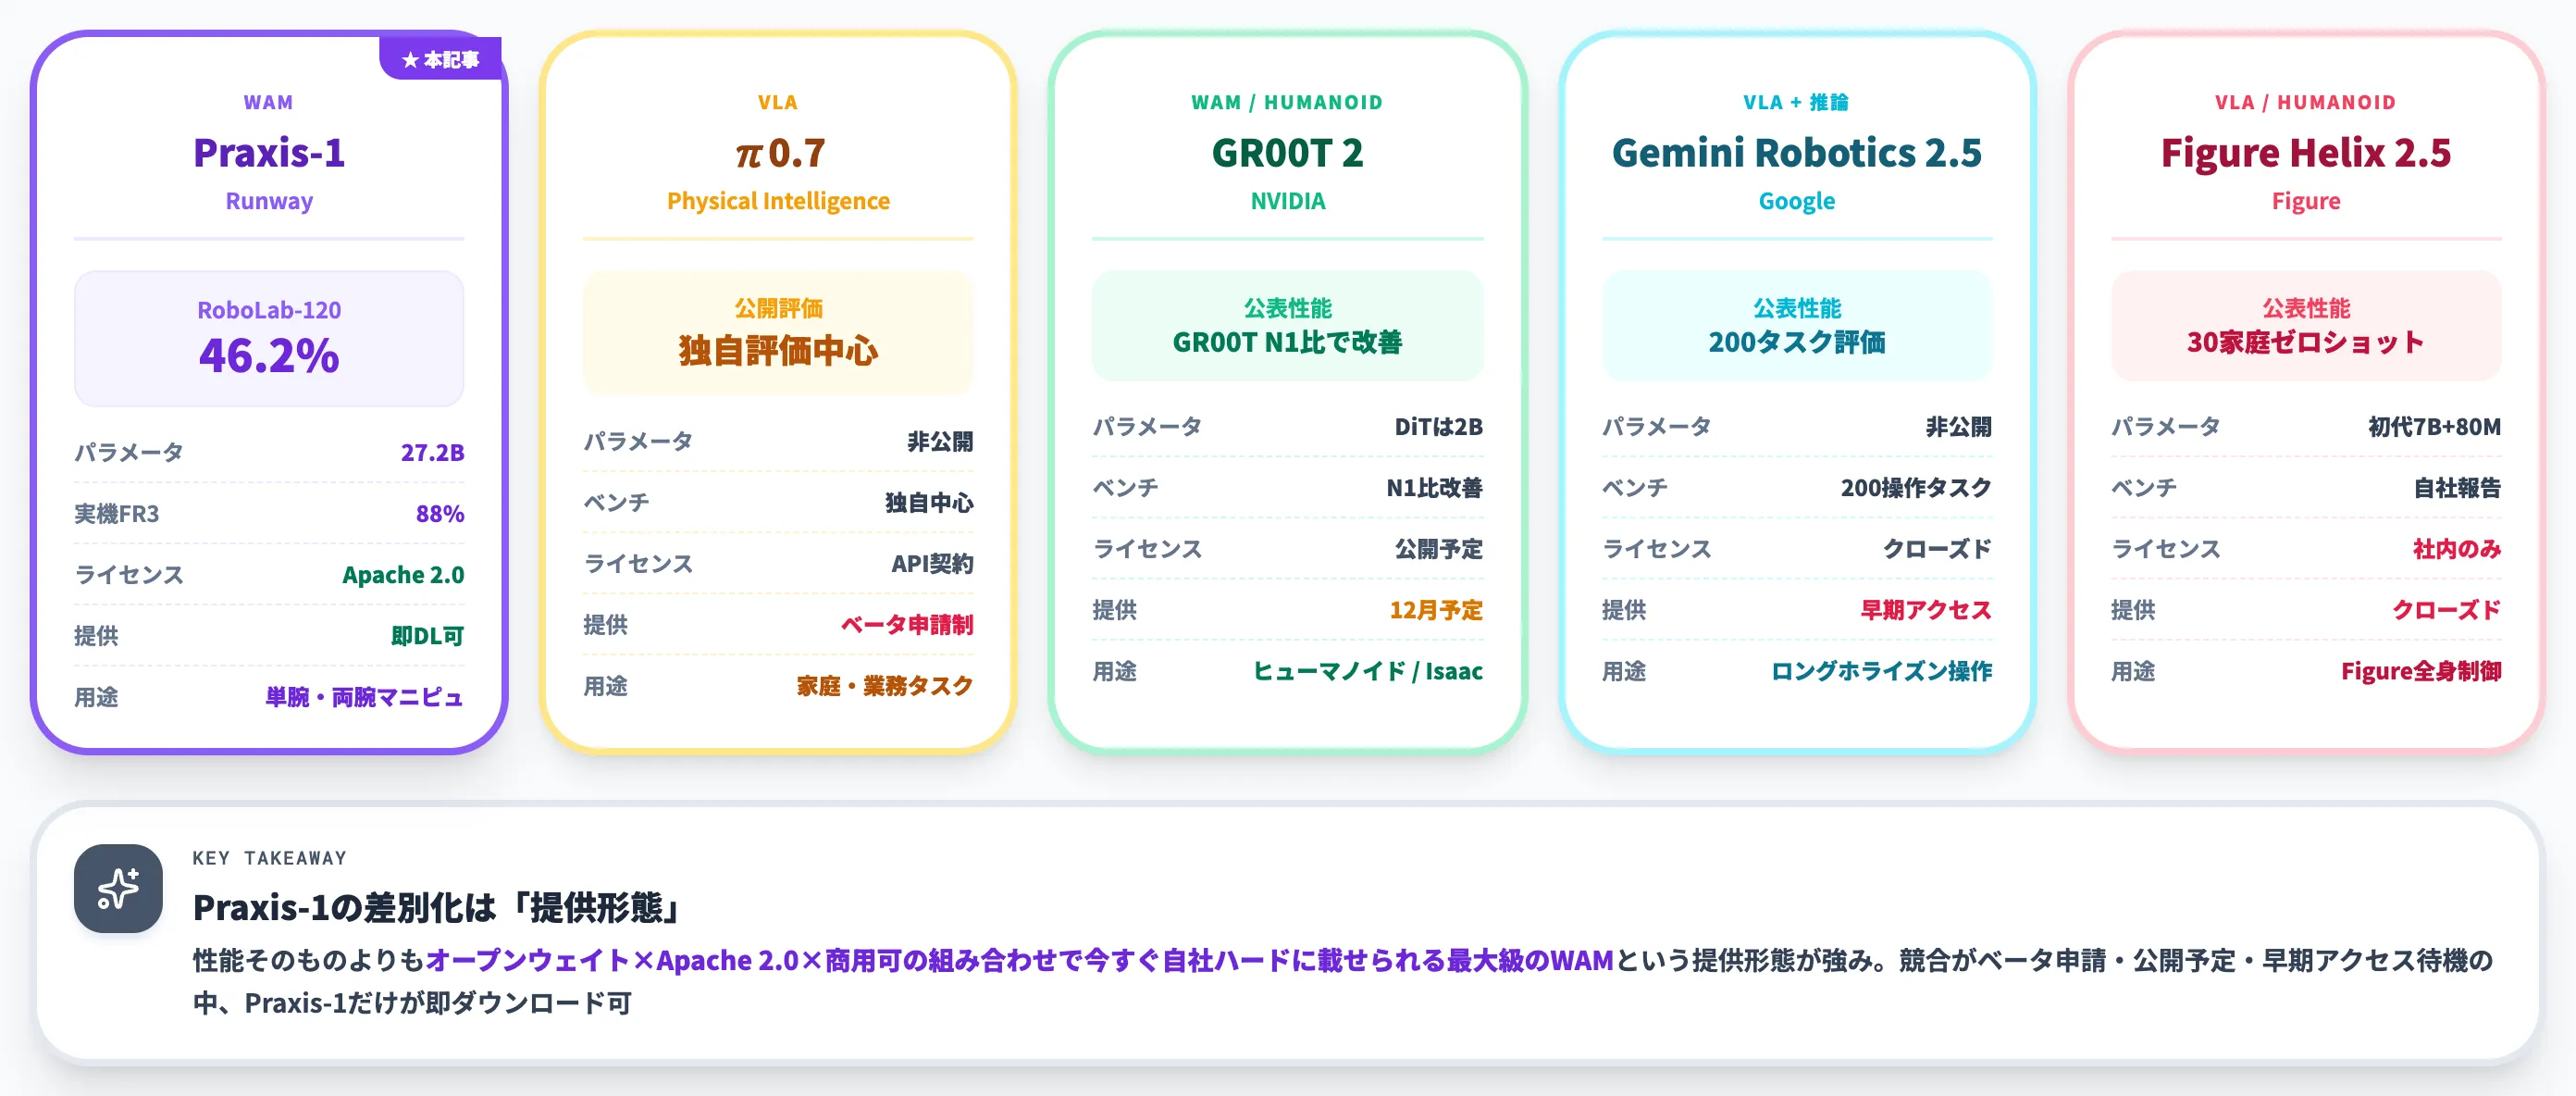
以下の表で、Praxis-1と主要競合4モデルの基本スペックを整理しました。公表スコア・ライセンス・推論経路で違いが出ます。
| モデル | 系統 | パラメータ | ベンチマーク性能 | 提供形態 | 想定ユースケース |
|---|---|---|---|---|---|
| Praxis-1 | WAM | 27.2B(動画バックボーン26.9B+Action Expert 314M) | RoboLab-120 46.2% / Franka FR3 88% | Apache 2.0(オープンウェイト・商用可、即ダウンロード可) | 単腕・両腕マニピュレーション、機体特化ファインチューン |
| π0.7 | VLA | 非公開 | 独自評価中心 | API(ベータ参加申請制) | 汎用家庭・業務タスク、家庭ロボ |
| NVIDIA GR00T 2 | WAM/ヒューマノイド | 全体規模非公表(DiTは2B) | GR00T N1比で改善 | コード公開予定(2026年12月) | ヒューマノイド、Isaac Sim連携 |
| Gemini Robotics 2.5 | VLA+推論 | 非公開 | 200種類の操作タスクで成功率・速度・器用さを評価(公式発表) | 早期アクセス申請・パートナー向け展開 | 推論を伴うロングホライズン操作 |
| Figure Helix 2.5 | VLA(humanoid) | 詳細非公開(初代は7B+80Mの2system) | 30家庭ゼロショット転移を自社報告 | クローズド(Figure社内のみ) | Figureヒューマノイド全身制御 |
この比較から見えるのは、Praxis-1の差別化は性能そのものよりも、オープンウェイト×Apache 2.0×商用可の組み合わせで今すぐ自社ハードに載せられる最大級のWAMという提供形態にある点です。
性能面はGR00T 2やGemini Robotics 2.5との競合関係にありますが、2026年11月時点でのアクセス可否と商用展開の自由度では、競合がベータ申請・公開予定・早期アクセス待機であるのに対し、Praxis-1はすでにダウンロードして動かせる状態にあります。
想定ユースケースの棲み分け
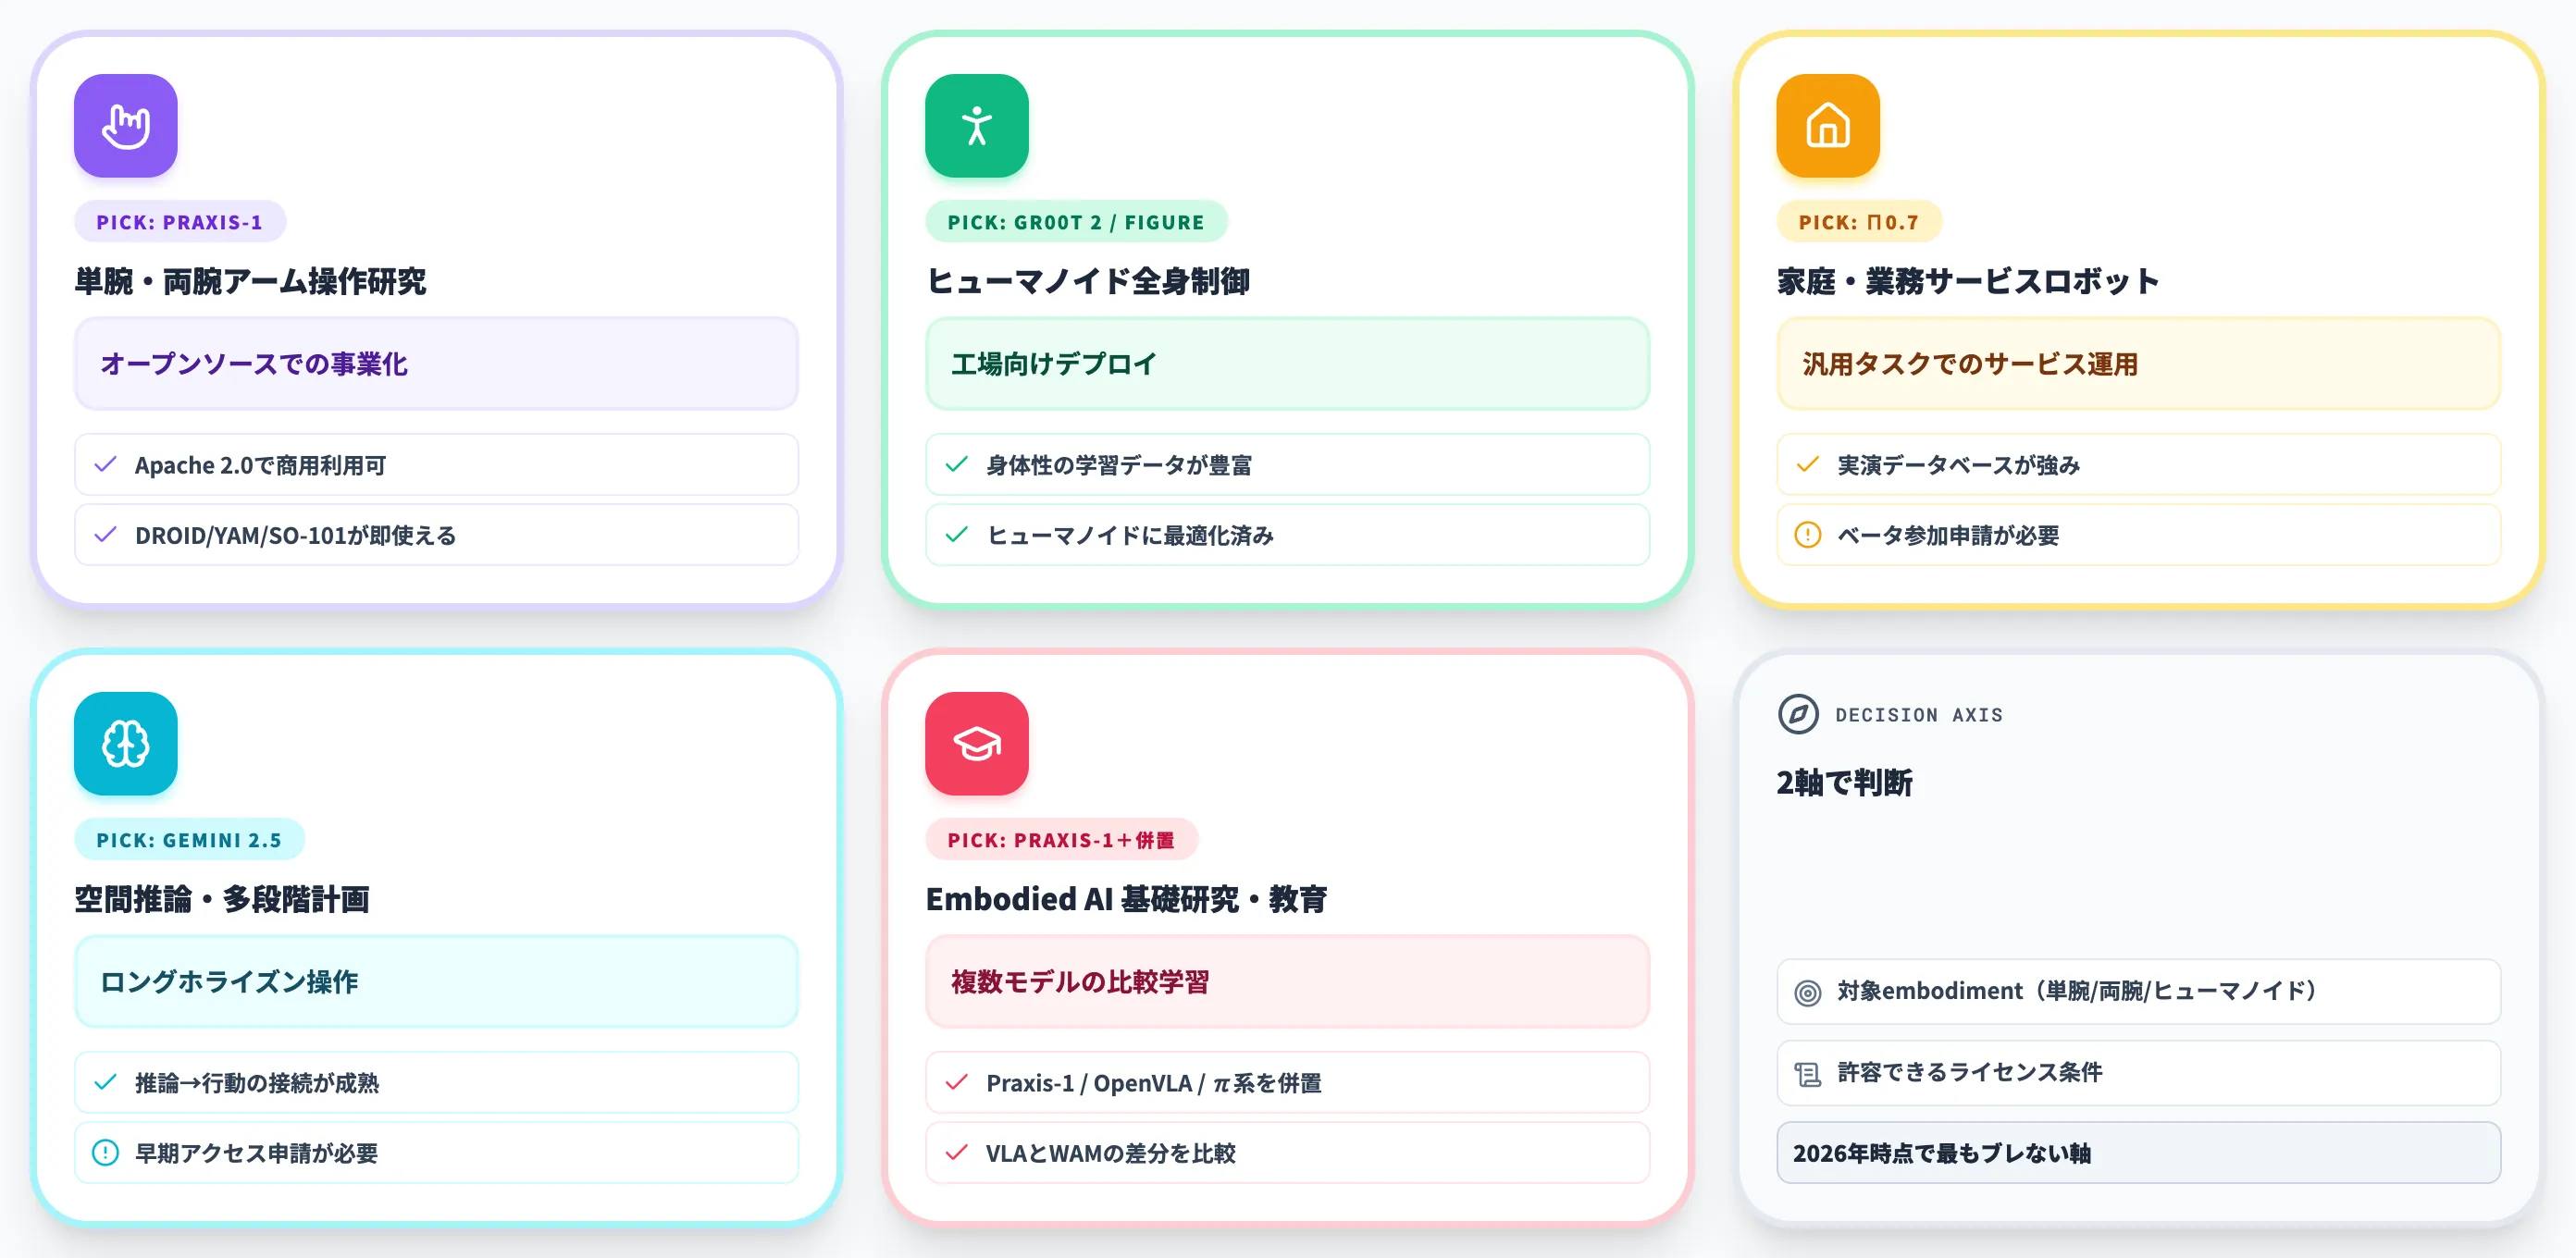
各モデルがどんな用途で第一候補になるかを、2026年11月時点の公開情報をもとに整理します。
-
単腕・両腕アームでの操作研究/オープンソースでの事業化
Praxis-1が第一候補。商用利用可のApache 2.0が決め手で、DROID・YAM向けのチェックポイントが即使える
-
ヒューマノイド全身制御・工場向けデプロイ
NVIDIA GR00T 2やFigure Helixが優位。身体性の学習データと最適化がヒューマノイドに寄っている
-
家庭・業務サービスロボットでの汎用タスク
π0.7の実演データベースが強み。ただし利用にはPhysical Intelligence公式サイトでのベータ参加申請が必要
-
空間推論・多段階計画を伴うロングホライズン操作
Gemini Robotics 2.5が有利。推論能力をロボット行動に接続する設計が成熟しているが、利用は早期アクセス申請・パートナー向け展開に限られる
-
Embodied AIの基礎研究・教育用途
VLAモデルの比較やEmbodied AIの基礎を押さえた上で、Praxis-1・OpenVLA・π系を併置して比較するのが定石
Praxis-1を選ぶ場面と、他モデルの方が合う場面は明確に分かれます。対象embodimentと許容できるライセンス条件で判断するのが、2026年時点では最もぶれない基準です。
Praxis-1の導入判断で押さえたい3つの観点
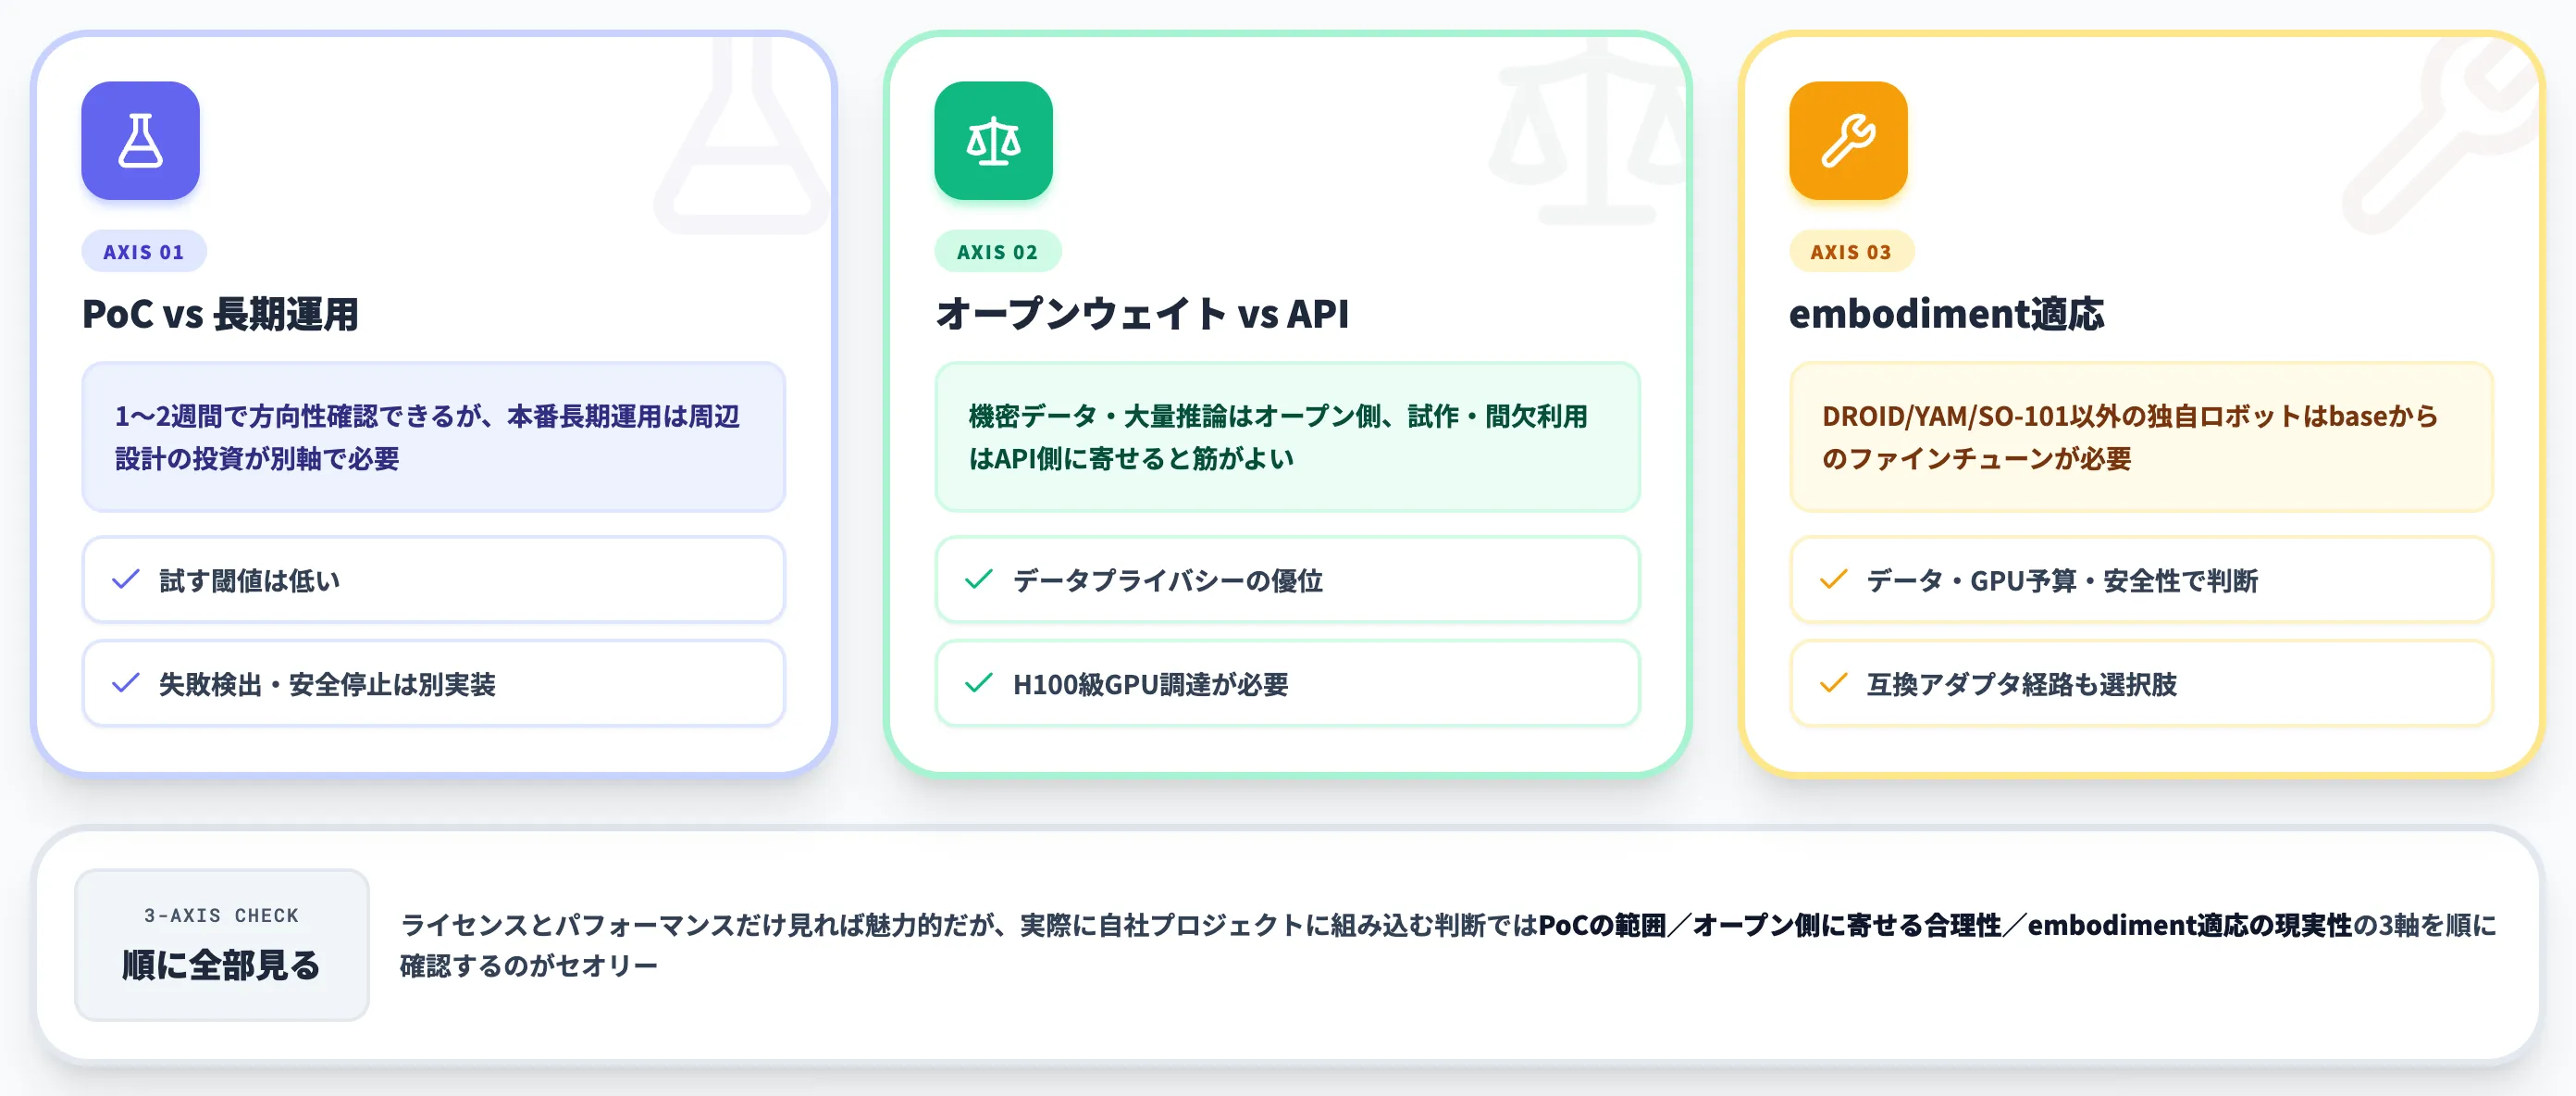
Praxis-1のライセンスとパフォーマンスだけ見れば魅力的ですが、実際に自社プロジェクトに組み込むかを判断する場面では、別軸の論点が効いてきます。
ここでは、単発PoCと長期運用の分岐・オープンウェイトとクローズドAPIの選び方・自社embodimentでのファインチューン判断の3点を整理します。
単発PoCと長期運用の分岐
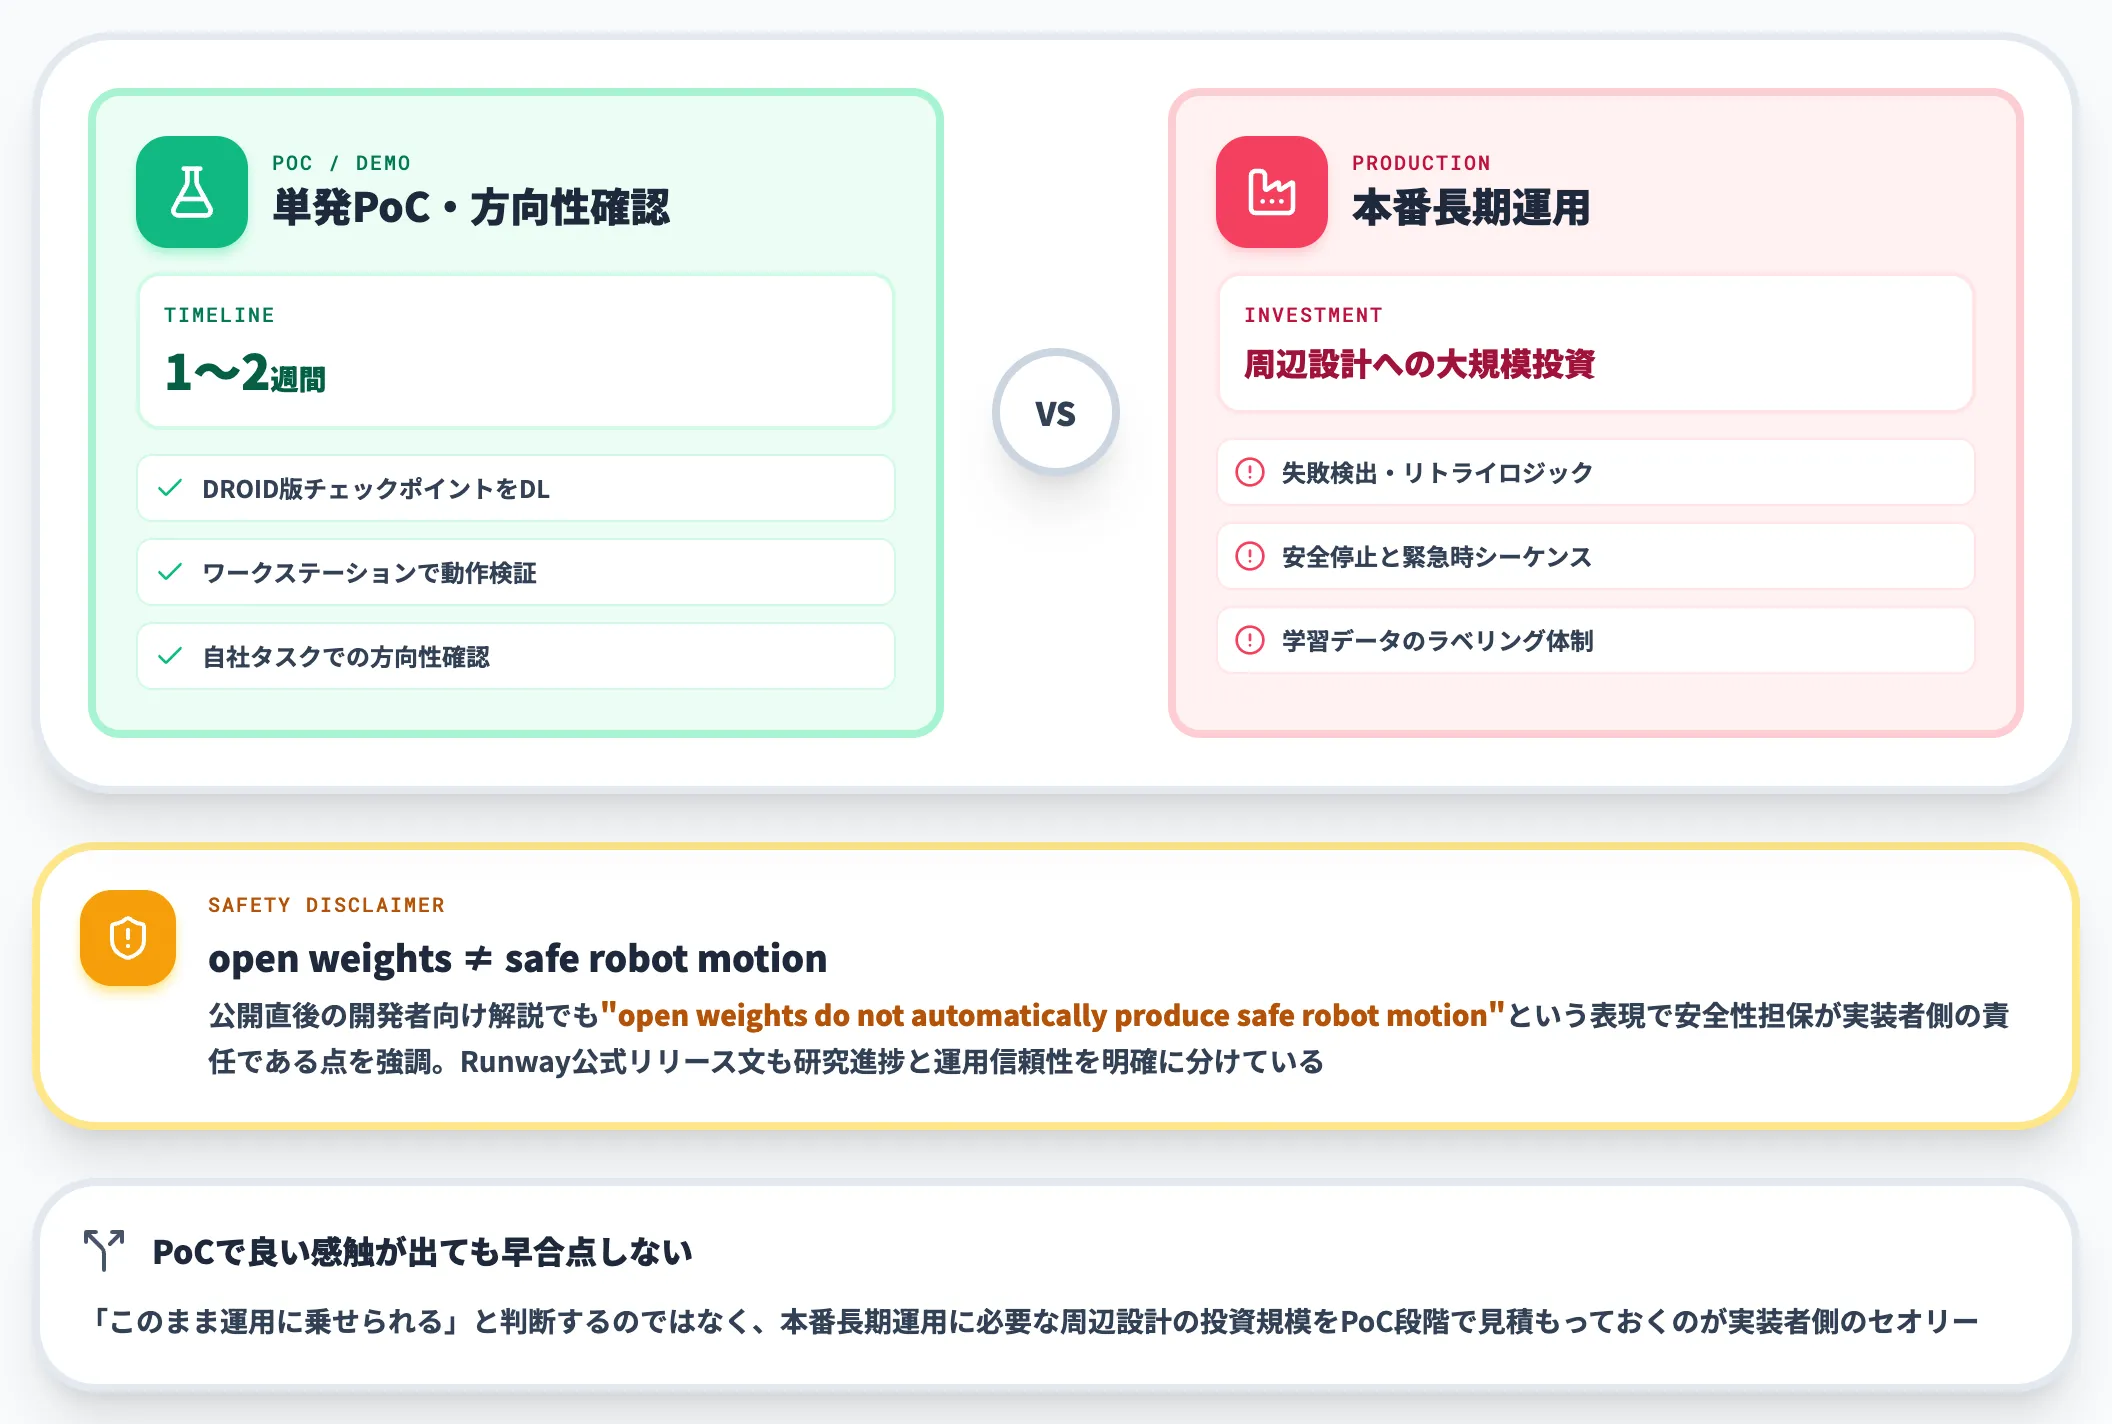
Praxis-1は「とりあえず試す」コストが他のWAMと比べて低い一方、本番運用に持ち込むなら周辺設計が必要です。
-
単発PoC・デモ用途
DROID版チェックポイントをダウンロードし、ワークステーションで動作検証して方向性を確認するまでは、1〜2週間の作業で到達できる領域
-
本番長期運用
失敗検出・リトライロジック・安全停止・学習データのラベリング体制など、Praxis-1外側の仕組みに大きな投資が必要。公開直後の開発者向け解説でも「open weights do not automatically produce safe robot motion」という表現で安全性担保が実装者側の責任である点が強調されている
PoCで良い感触が出た段階で、「このまま運用に乗せられる」と早合点しないのが実装者側のセオリーです。Runway公式のリリース文自体が、研究進捗と運用信頼性を明確に分けて記述しています。
オープンウェイトとクローズドAPIの選び方
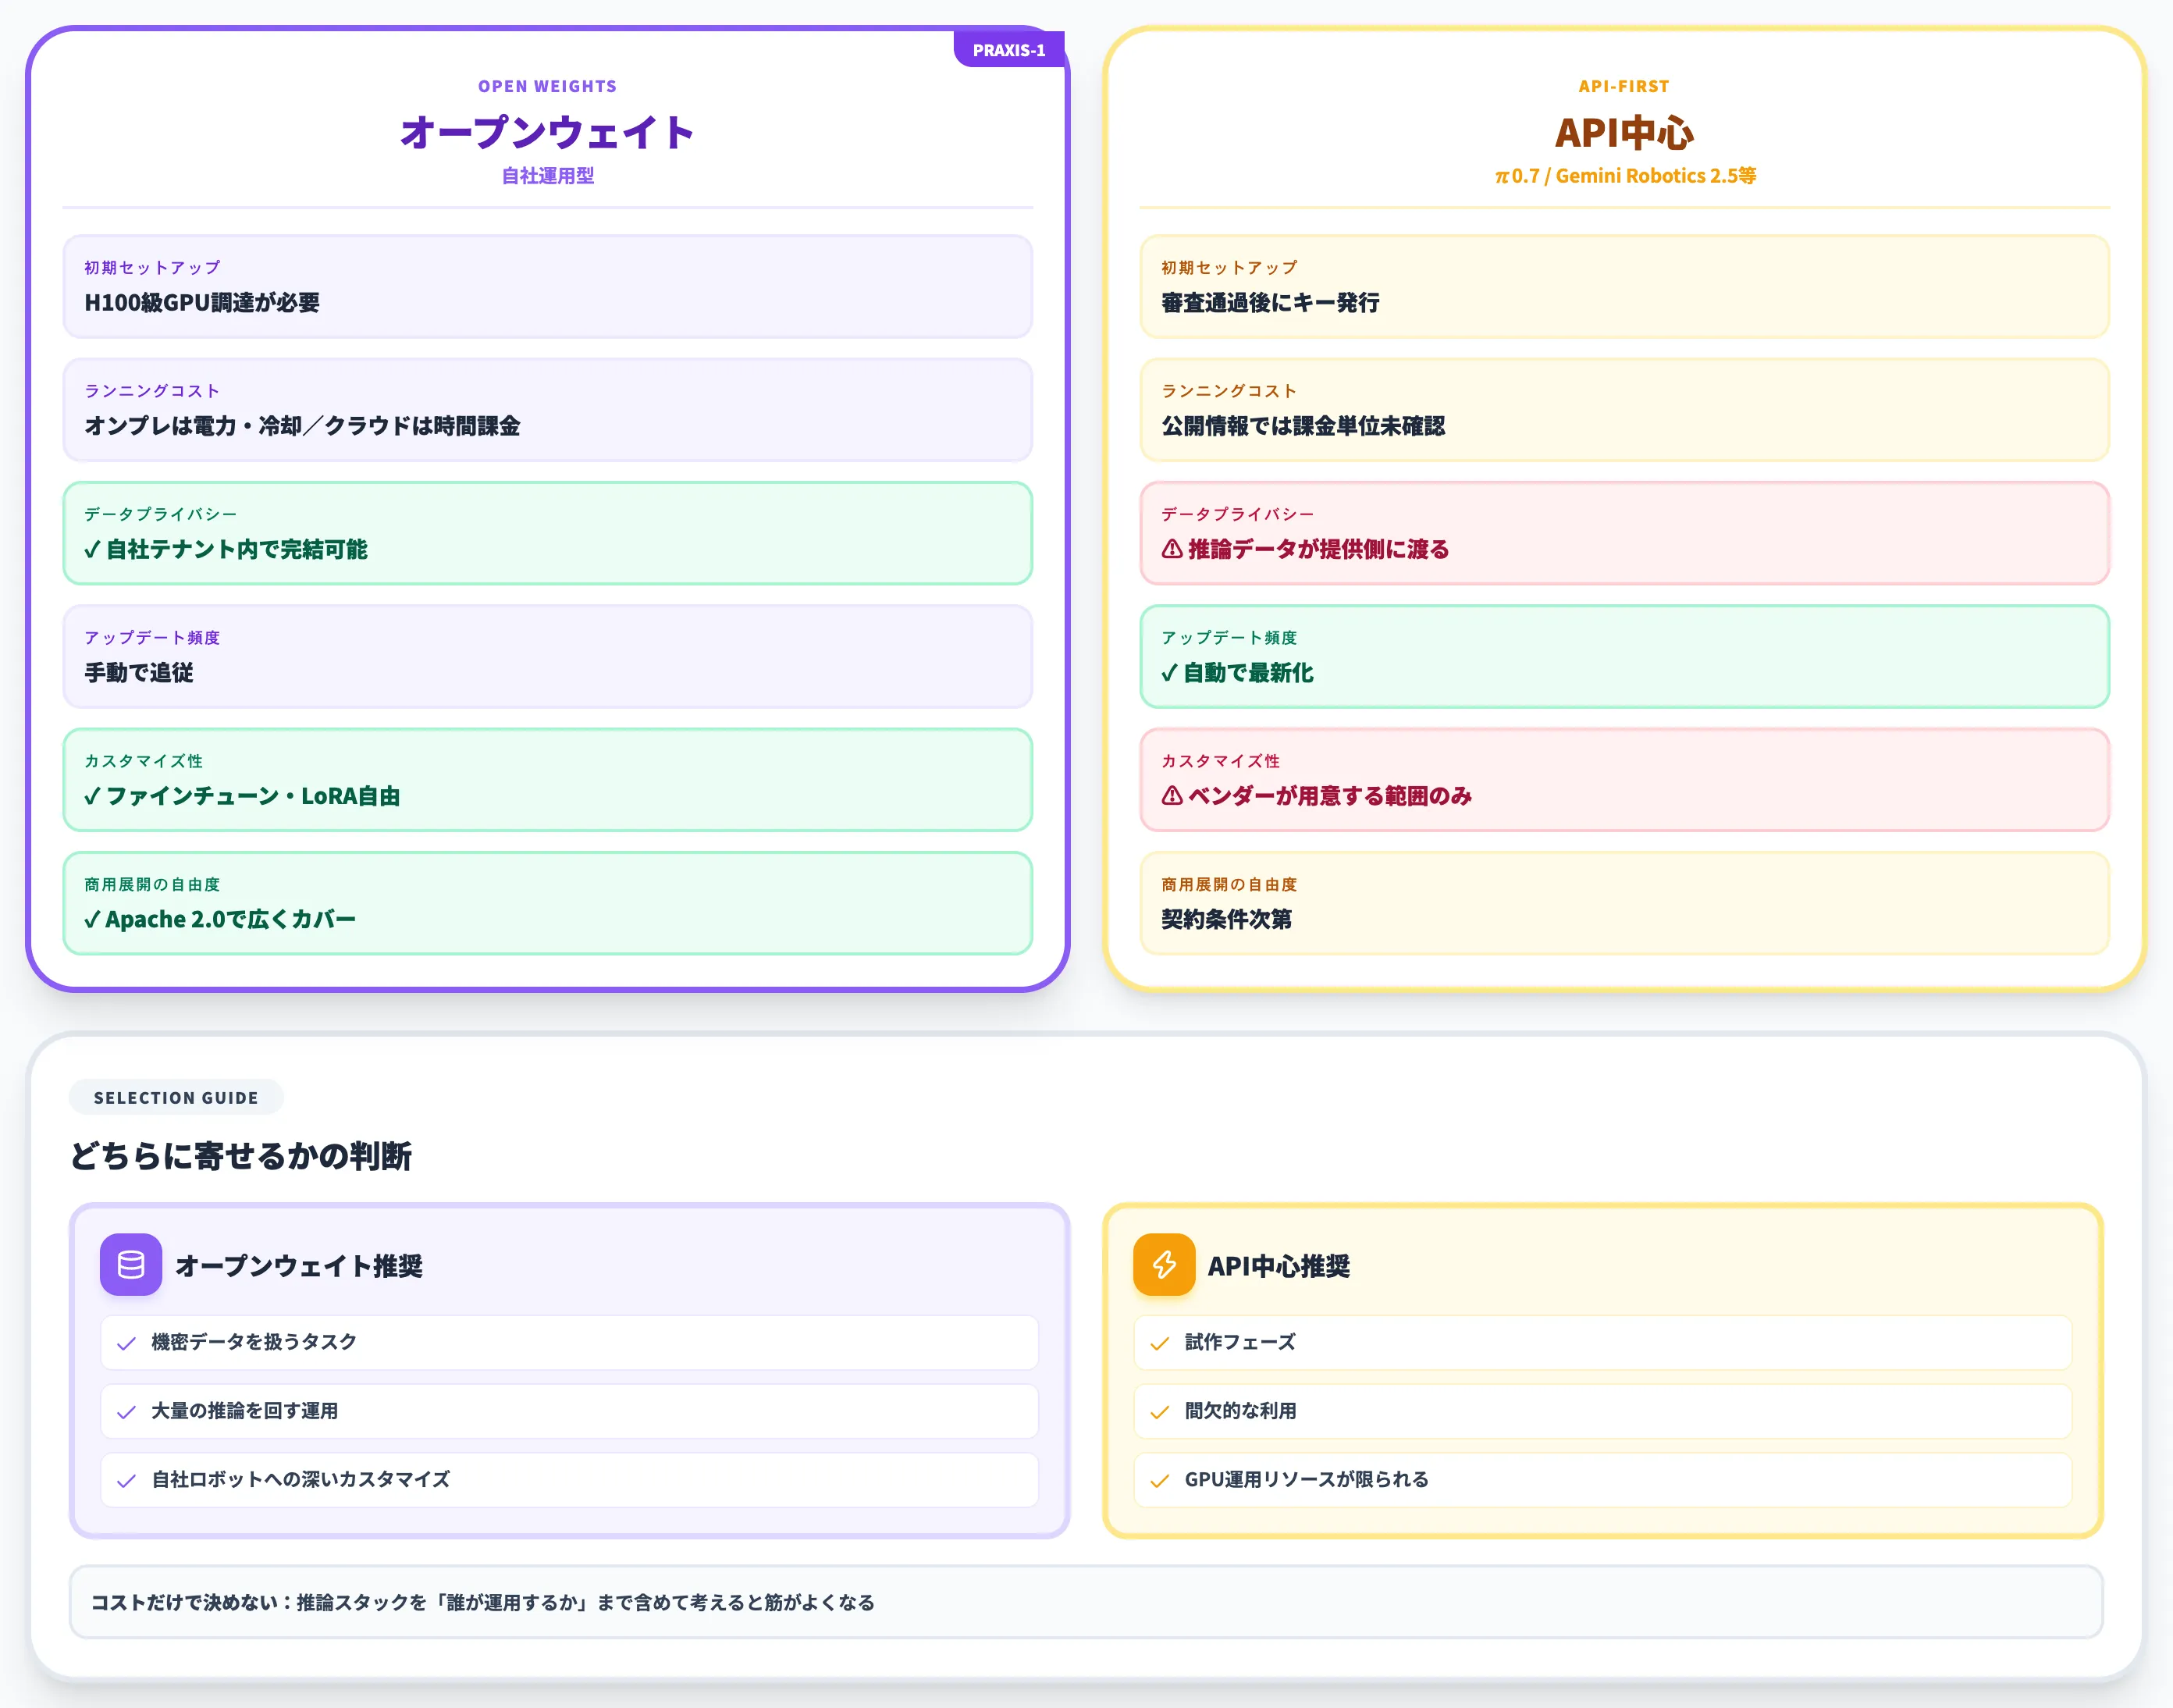
Praxis-1をAPI経由のモデル(π0.7・Gemini Robotics 2.5)と比較するときの判断軸は、以下のように整理できます。
| 判断軸 | オープンウェイト(Praxis-1) | API中心(π0.7・Gemini Robotics 2.5等) |
|---|---|---|
| 初期セットアップ | H100級GPU調達が必要 | π APIはベータ参加申請・Gemini Robotics 2.5は早期アクセス申請など、審査通過後にキーが発行される |
| ランニングコスト | オンプレは電力・冷却・保守/クラウドは時間課金 | 公開情報では課金単位未確認(申請後に提示される想定) |
| データプライバシー | 自社テナント内で完結可能 | 推論データが提供側に渡る |
| アップデート頻度 | 手動で追従 | 自動で最新化 |
| カスタマイズ性 | ファインチューン・LoRA自由 | ベンダーが用意する範囲のみ |
| 商用展開の自由度 | Apache 2.0で広くカバー | 契約条件次第 |
このマトリクスから見えるのは、機密データを扱うタスクや大量の推論を回す運用はオープンウェイト側に寄せた方がトータルで合理的、試作や間欠的利用はAPI側が速いという棲み分けです。選定はコストだけでなく「推論スタックを誰が運用するか」までを含めて考えると筋がよくなります。
自社embodimentでのファインチューン判断
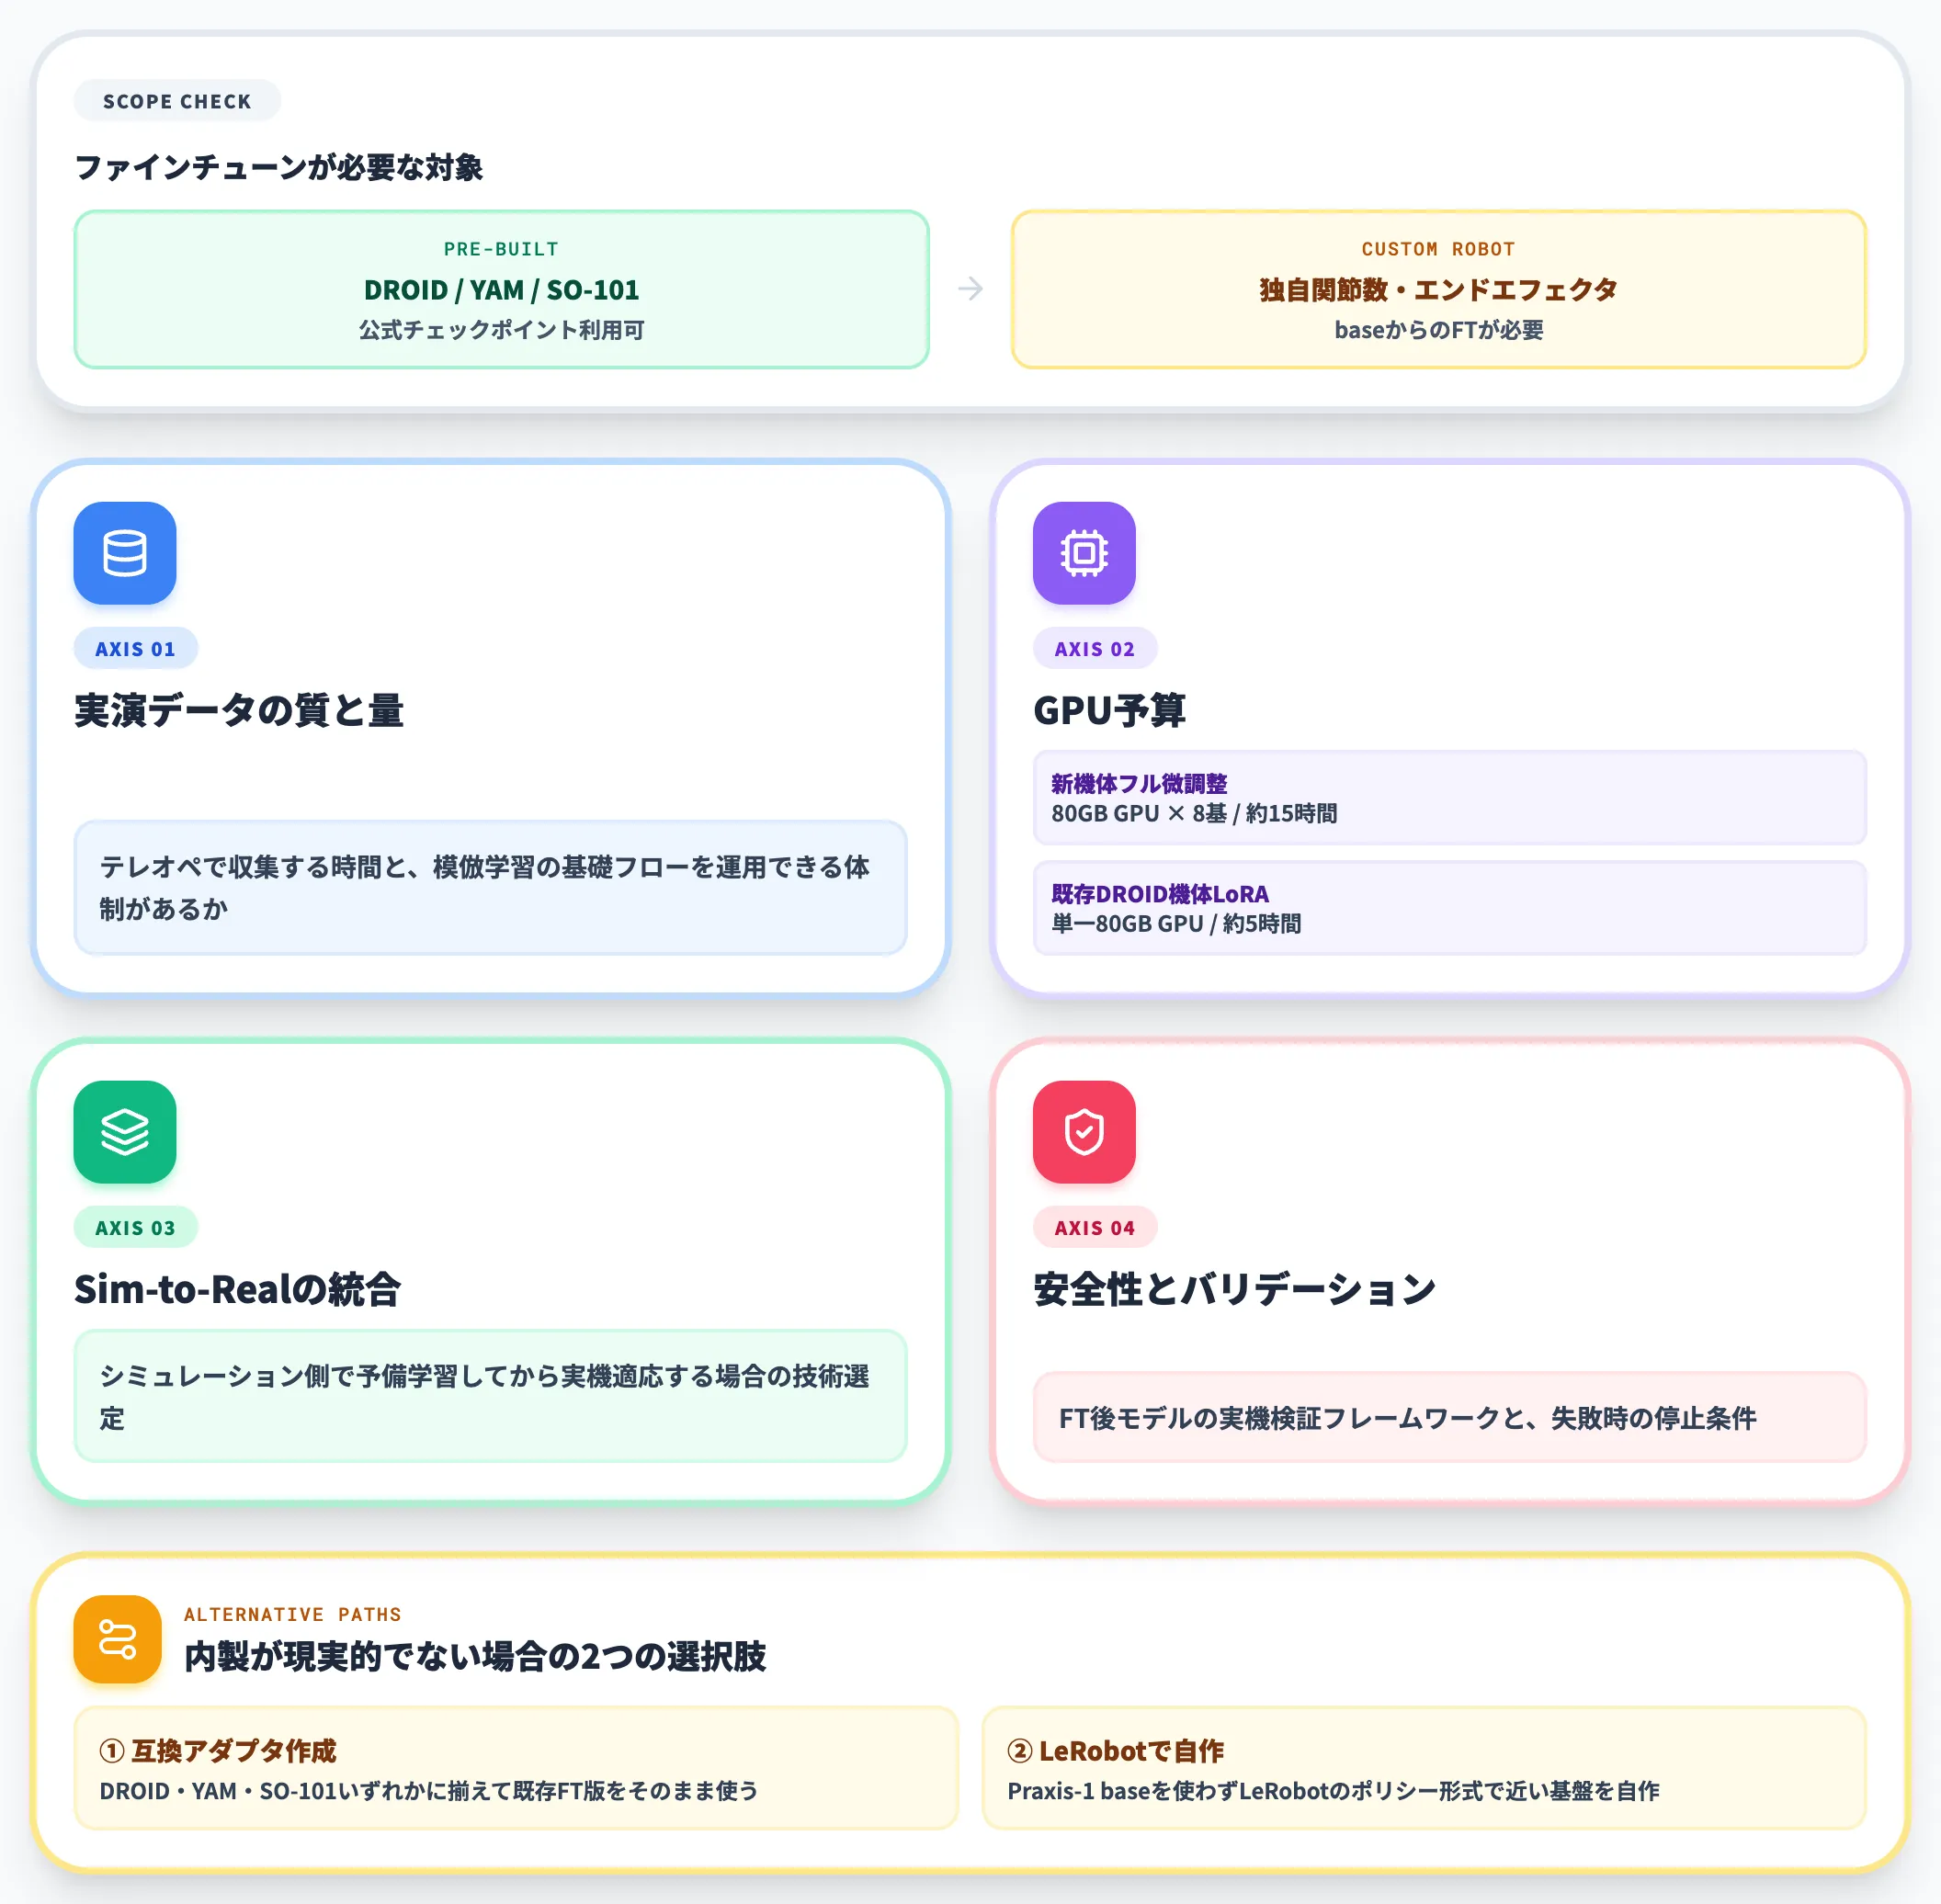
Praxis-1はDROID単腕・YAM両腕・SO-101単腕向けのチェックポイントが公式に用意されていますが、これら以外の独自ロボット(異なる関節数、固有のエンドエフェクタ等)で使うにはbaseチェックポイントからのファインチューンが必要です。
ファインチューンに取り組む前に、以下の観点で現実性を評価するのが先決です。
- 実演データの質と量
テレオペで収集する時間と、模倣学習の基礎フローを運用できる体制があるか
- GPU予算
新embodimentへのフル微調整なら80GB GPU×8基で約15時間、既存DROID機体の新タスクへのLoRA適応なら単一80GB GPUで約5時間が公式案内の目安
- Sim-to-Realの統合
シミュレーション側で予備学習してから実機適応する場合、Sim-to-RealやReal-to-Simの技術選定も必要
- 安全性とバリデーション
ファインチューン後のモデルを実機で検証するフレームワークと、失敗時の停止条件
全部を内製するのが現実的でないケースでは、DROID・YAM・SO-101いずれかの互換アダプタを作って既存のファインチューン版をそのまま使う、あるいはPraxis-1 baseを使わずLeRobotのポリシー形式で近い基盤を自作する選択肢もあります。
Praxis-1の単発46.2%を、自社のタスクでやり直しを含めて測り直す
Praxis-1がRoboLab-120で出した46.2%は単発の試行での成功率で、失敗を検出してやり直す前提なら、独立した試行と仮定して2回で約71%、3回で約84%まで上がる計算です。ただ、数字はRunwayの自己報告で、やり直しがどこまで効くかはタスクによって変わります。DROID版でPoCを回す段階から、試行ごとの成否とやり直しの回数を記録しておくことが、本番に進めるかを判断する鍵になります。
その記録を集めて読み解くところを受け持つのが、センサーログや作業動画を現場データとしてOneLakeにまとめ、部門別のテンプレートAgentで扱う、製造業のためのAI Agent Hubです。
- 試行の記録は、タスクと機体ごとにそろえて残す
ロボット側のログと作業動画に、タスク名や機体、使ったチェックポイントのタグを付けてOneLakeに統合し、DROID版とLoRA適応後のような条件の違いを後から比べやすくします。
- やり直しを含めた成功率を、タスクごとに並べる
リアルタイム分析Agentが、1回目で成功した割合と、2回目・3回目までに成功した割合を集計し、計算どおりに上がらない組み合わせを見つけます。
- 検証の経過は、報告書にまとめて関係者に配る
週ごとの成功率や止めた試行の理由は、製図・レポートAgentが自動で文書にするため、本番に進めるかの議論を同じ数字から始めます。
AI総合研究所の専任チームが、PoCで残す記録の項目とタグの付け方を決め、集計した数字で本番に進める範囲を絞り込むところまで伴走します。
やり直し込みの成功率を自社で測る

試行の記録を作業ごとに集計する
Praxis-1がRoboLab-120で出した46.2%は単発の成功率で、やり直しを含めてどこまで上がるかは自社のタスクで測るほかありません。試行のログや作業動画を条件ごとにそろえ、成功率を集計して報告にまとめるまでの流れを、AI Agent Hubの製造業向けページで確認できます。
まとめ:Praxis-1が示す「動画基盤→ロボット制御」のインパクト
本記事では、Praxis-1を「Runwayが動画生成の基盤モデルから派生させたオープンウェイトのWorld Action Model」として整理し、技術の仕組み・性能・公開形態と利用条件・動かすための要件・競合モデルとの棲み分け・採用を決める観点を解説しました。
2026年11月時点で押さえておくべきポイントは次の3つです。
- 次の動画と次の動作を一つのネットワークで同時に生成するWAMで、観測から動作を直接出すVLA系とは設計が異なる
- Apache 2.0の重みを今すぐ自社のGPUで動かせる点で先行し、競合の多くは申請制や公開待ちの段階にある
- フル精度の推論とファインチューンにはH100級のGPUが要り、軽量なNVFP4版はBlackwell世代でしか動かない
AI総合研究所は、Praxis-1を試す前に、手持ちの機体とGPUで動く構成を確定させます。
まずは、自社のロボットがDROID・YAM・SO-101のどれに近いかを調べ、当てはまらない場合はbaseからのファインチューンに要る実演データの量を把握します。
続いて、手元のGPUの世代を見て、bf16版とNVFP4版のどちらのチェックポイントで動かすかを選びます。
公開された重みはロボットの動きの安全性までは保証しないため、停止の条件と仕組みは実装する側で用意する前提で設計を進めます。
実演データの量で競ってきたロボット基盤モデルの開発に、Praxis-1はWeb動画という別の資源を持ち込みました。