この記事のポイント
 GPT-6.2 AstraはIntelligence Index 2位・1タスク$4で、Fable 5.2の約15%コストでフロンティア帯に食い込む第一候補
- GPT-6.2 SolはMax設定で57点・$1.01と前世代Astra並のIndexに到達し、ルーチン処理の主力に据えて問題ない水準
- 単価はAstra $8/$40・Sol $2/$10(Standard・入力272K以下)。GPT-6 Astraから20%値下げ、短文キャッシュ入力は60%値下げ
- 提供は通常ChatGPTではなく、ChatGPT Work・Codex・APIの3経路。モデル名は「gpt-6.2-astra」「gpt-6.2-sol」
- GPT-6.2 AstraはPreparedness Frameworkの自己改善能力でHigh閾値に初到達、Blocker Deceptionの評価条件下スコアは監視設計の見直し材料
Microsoft MVP・AIパートナー。LinkX Japan株式会社 代表取締役。東京工業大学大学院にて自然言語処理・金融工学を研究。NHK放送技術研究所でAI・ブロックチェーンの研究開発に従事し、国際学会・ジャーナルでの発表多数。経営情報学会 優秀賞受賞。シンガポールでWeb3企業を創業後、現在は企業向けAI導入・DX推進を支援。
GPT-6.2 Astra・Solは、OpenAIが2026年11月17日に発表したフロンティア機と低コスト機の2モデル構成です。
AstraはArtificial Analysis Intelligence Indexで62点(2位)を獲得し、首位のClaude Fable 5.2に3点差まで迫りつつ、1タスクあたりコストは約15.1%に抑えられています。Solは同Indexでも上位帯に位置し、前世代Sol比で性能を押し上げたまま単価は据え置きです。
本記事では、2モデルの定義と位置づけ・性能ベンチマークと競合モデルとの比較・料金とコスト構造・Astra/Solの使い分け判断・ChatGPT Work/Codex/APIでの使い方・GPT-6世代からの移行判断・導入時の注意点を、2026年11月時点の最新情報で体系的に解説します。
目次
GPT-6.2 Astra・Solとは?Claude Fable 5.2の直後に投入された新2モデル構成
GPT-6.2 AstraとSolの使い方——ChatGPT Work・Codex・APIでの実装
GPT-6.2 Astra・Solとは?Claude Fable 5.2の直後に投入された新2モデル構成
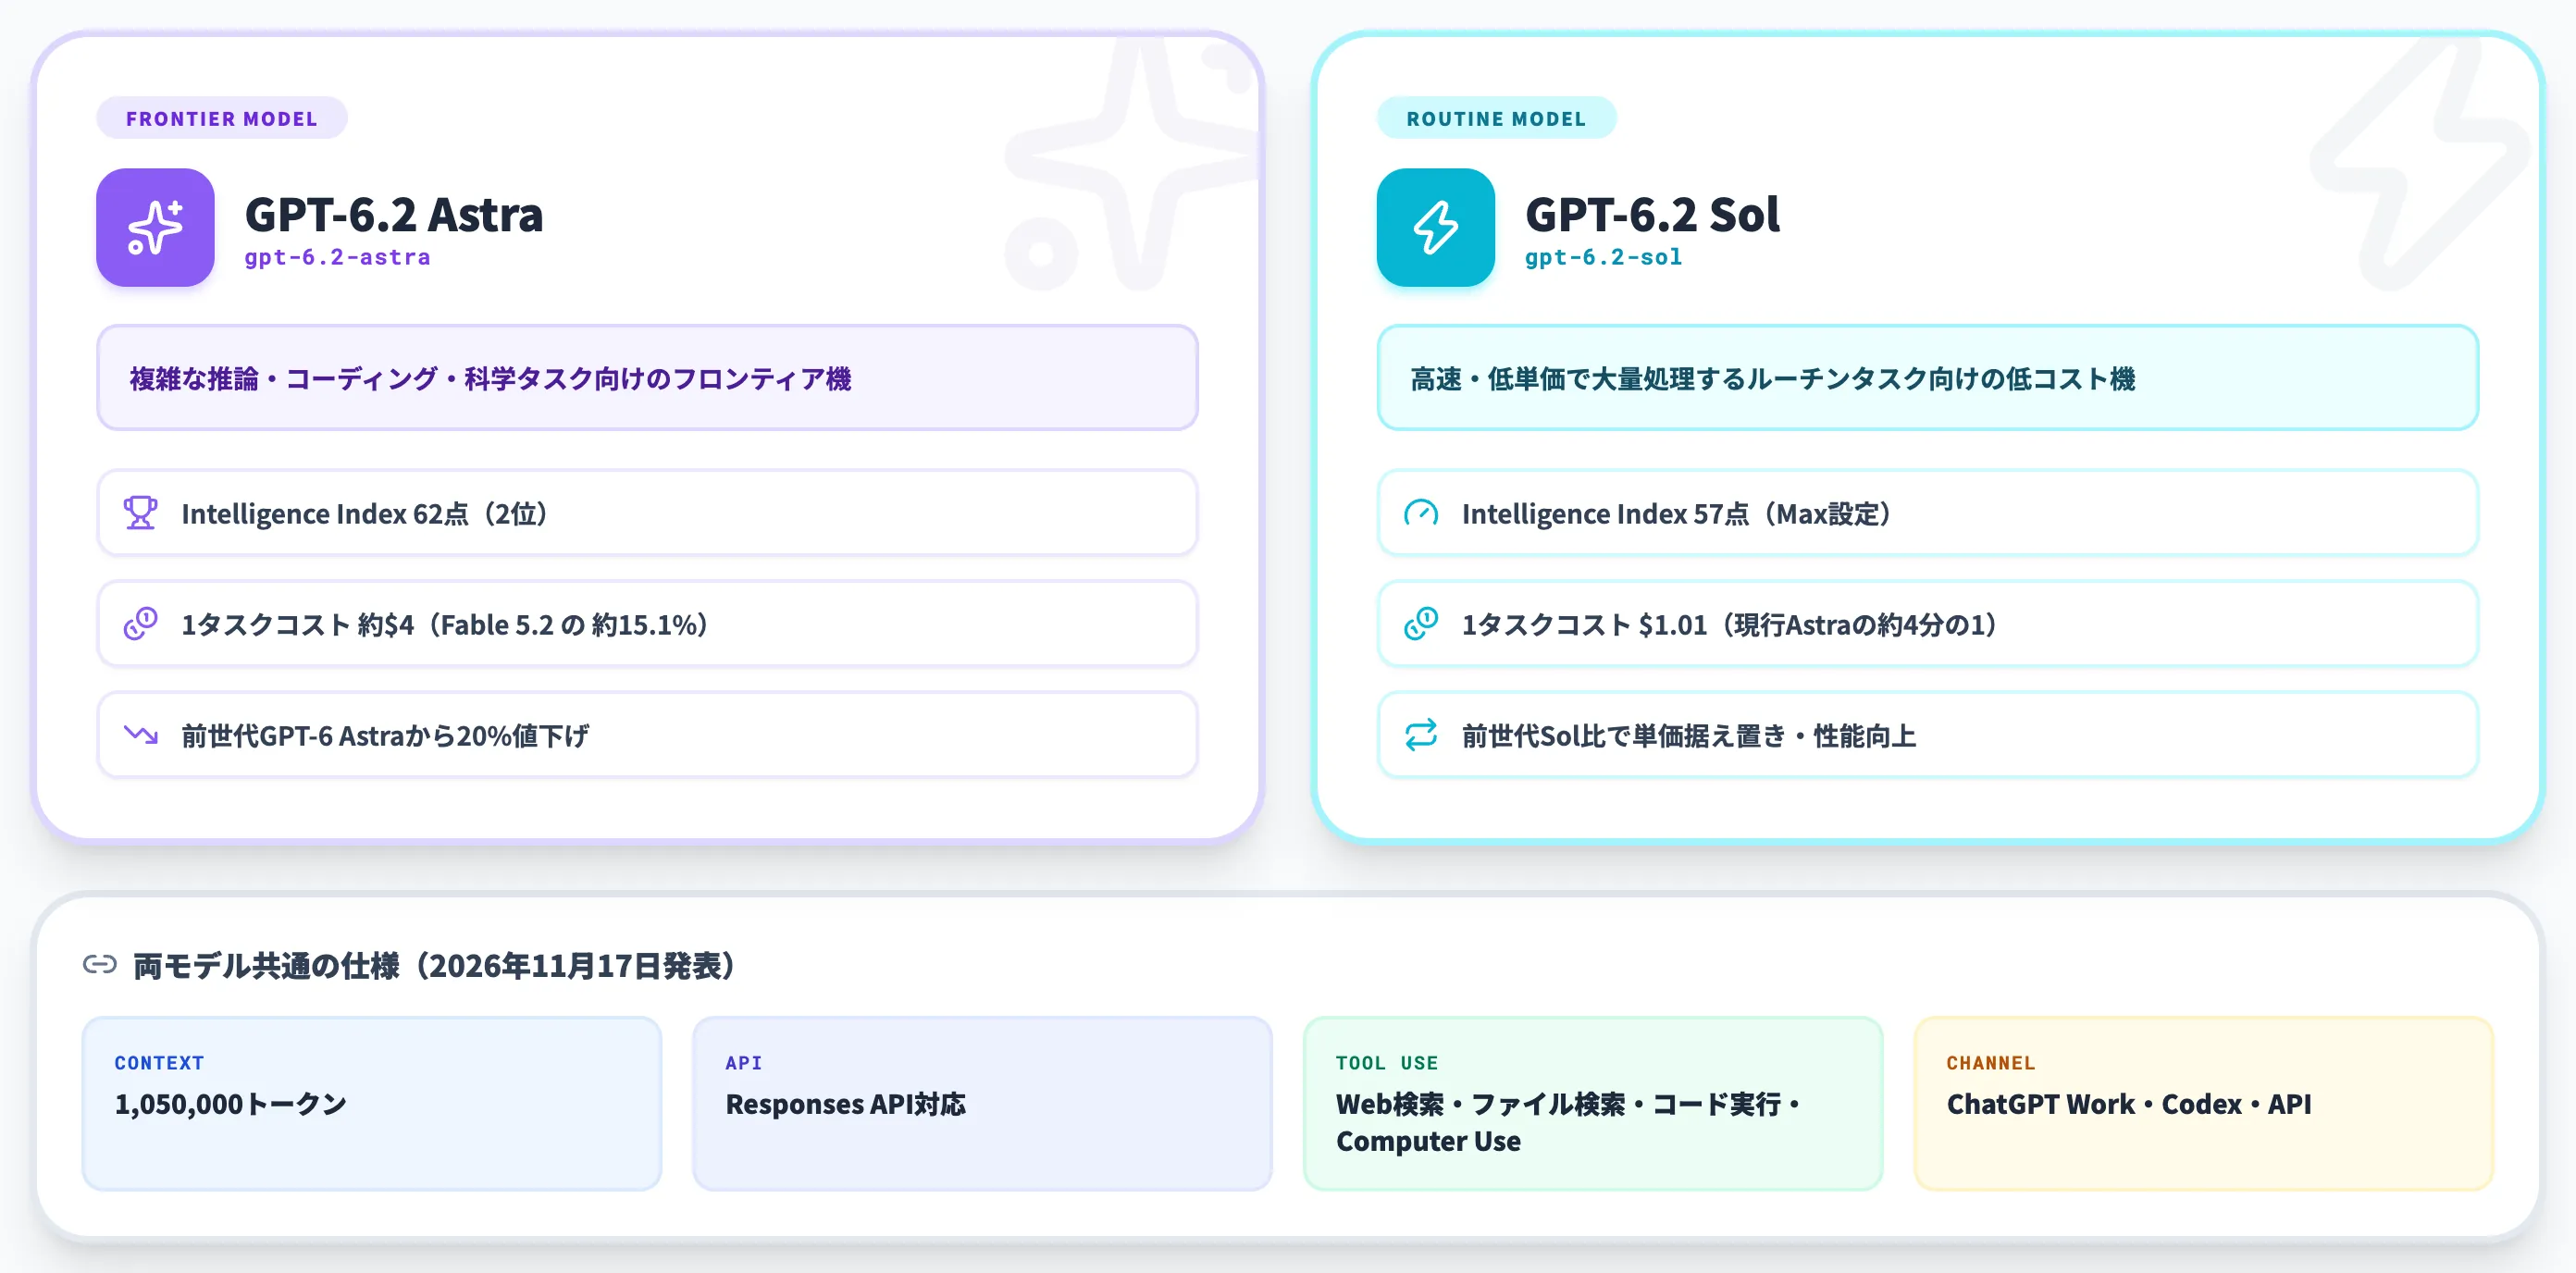
GPT-6.2 Astra・Solとは、OpenAIが2026年11月17日に発表したフロンティア機(Astra)と低コスト機(Sol)の2モデル構成の最新ラインナップです。
Astraは複雑な推論・コーディング・科学タスク、Solは高速・低単価で大量処理するルーチンタスクという役割分担で、どちらも1,050,000トークンのコンテキストウィンドウとResponses APIでのツール呼び出し(Web検索・ファイル検索・コード実行・Computer Use)に対応しています。
GPT-6.2 Astraの公式発表キービジュアル(出典:OpenAI Developer Community)
Anthropicが2026年11月上旬にClaude Fable 5.2でArtificial Analysis Intelligence Indexの首位を取ったわずか1週間後のリリースで、OpenAIは性能トップを追いかけつつ、同時にAstraの単価を前世代から20%値下げしてコスト面でも攻めてきた形です。
本リリースの特徴は、フロンティア機そのものよりも「フロンティア帯の性能をどこまで安く提供するか」に重心が移っている点にあります。
Astraの1タスクあたりコストは約$4で、首位Fable 5.2の$26.54の約15.1%に収まり、SolはMax設定で$1.01と現行Astraの約4分の1で、エージェント運用のTCOを大きく変える水準になっています。
OpenAIラインナップの中での位置づけ
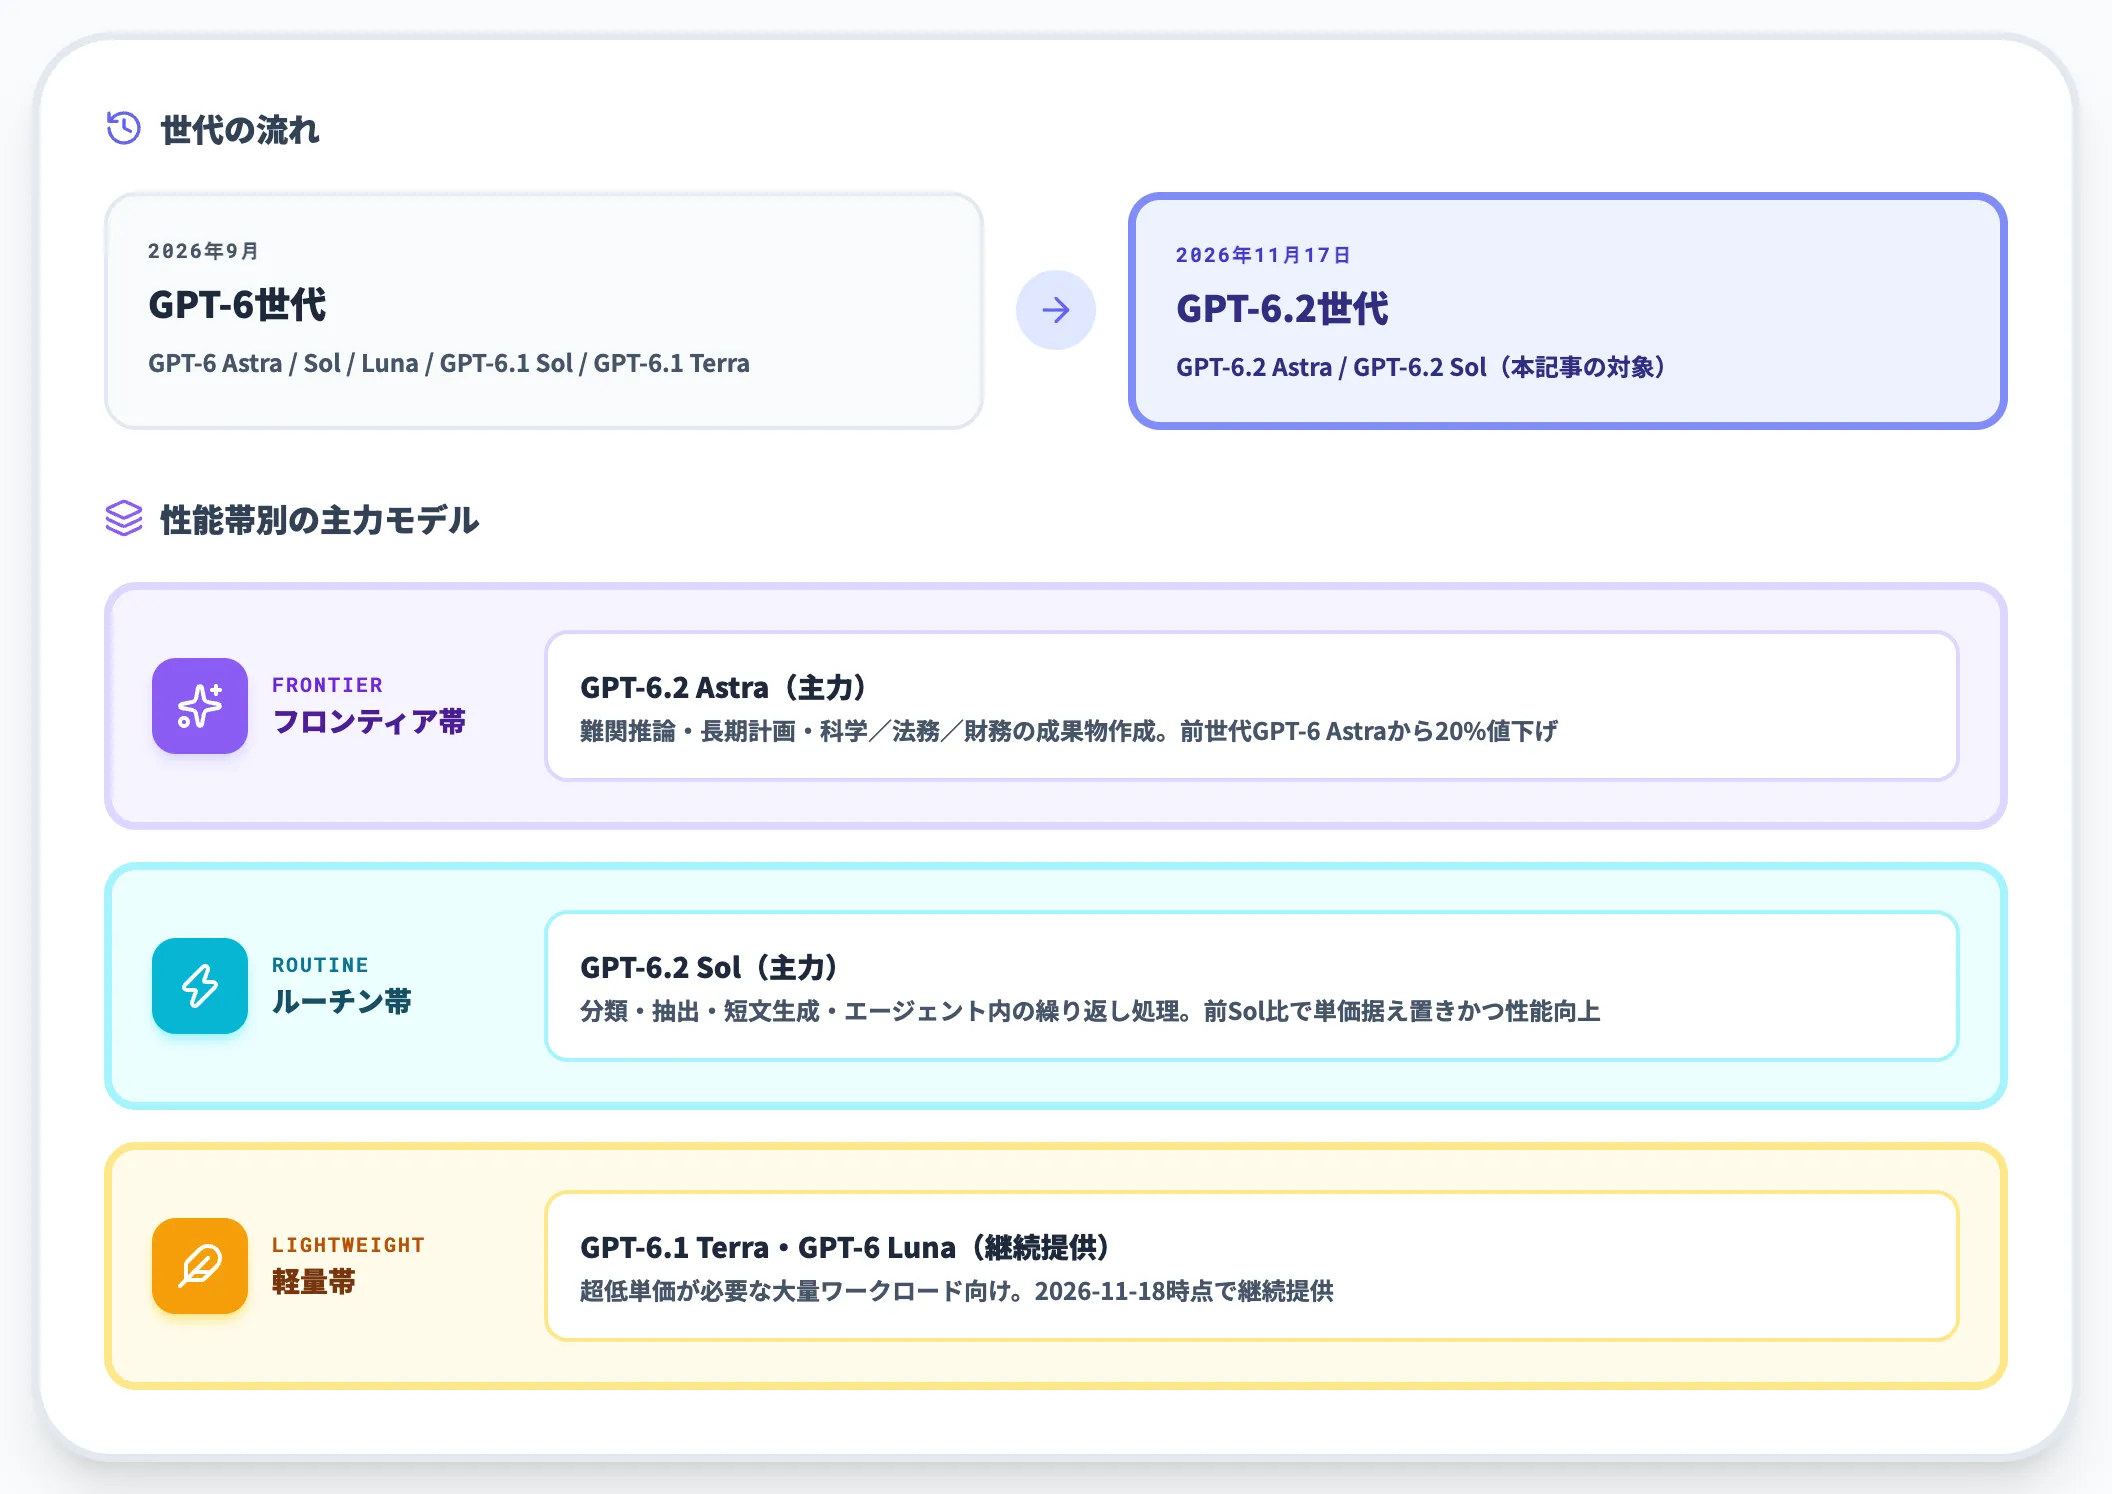
GPT-6.2は、2026年9月にリリースされたGPT-6世代(GPT-6 Astra・GPT-6 Sol/Luna・GPT-6.1 Sol・GPT-6.1 Terra)に続く新しい世代です。
GPT-6.2 Astra・SolはいずれもGPT-6世代の後継で、Astraはフロンティア帯の性能とコストを刷新し、Solはルーチン帯の価格優位を維持したまま性能を押し上げる狙いで投入されています。
-
フロンティア帯の主力
GPT-6.2 Astra。難関推論・長期計画・科学/法務/財務の成果物作成が担当領域。前Astraから20%値下げ。
-
ルーチン帯の主力
GPT-6.2 Sol。分類・抽出・短文生成・エージェント内の繰り返し処理が担当領域。前Sol比で単価据え置きかつ性能向上。
-
軽量帯の継続提供
GPT-6.1 Terra・GPT-6 Lunaは2026-11-18時点で継続提供。超低単価が必要な大量ワークロード向け。
今回Astra/Solの2モデルが「フロンティア×ルーチン」のセットで同時リリースされた点は、GPT-6.1 Sol・6.1 Terraで先行していた“フロンティア+低コスト機の並行提供”を、同じ世代番号の中で揃えてきた構成と受け止められます(今後もこのペア構成を続けるかは公式方針としては未表明)。
GPT-6.2 Astra・Solの性能と競合比較
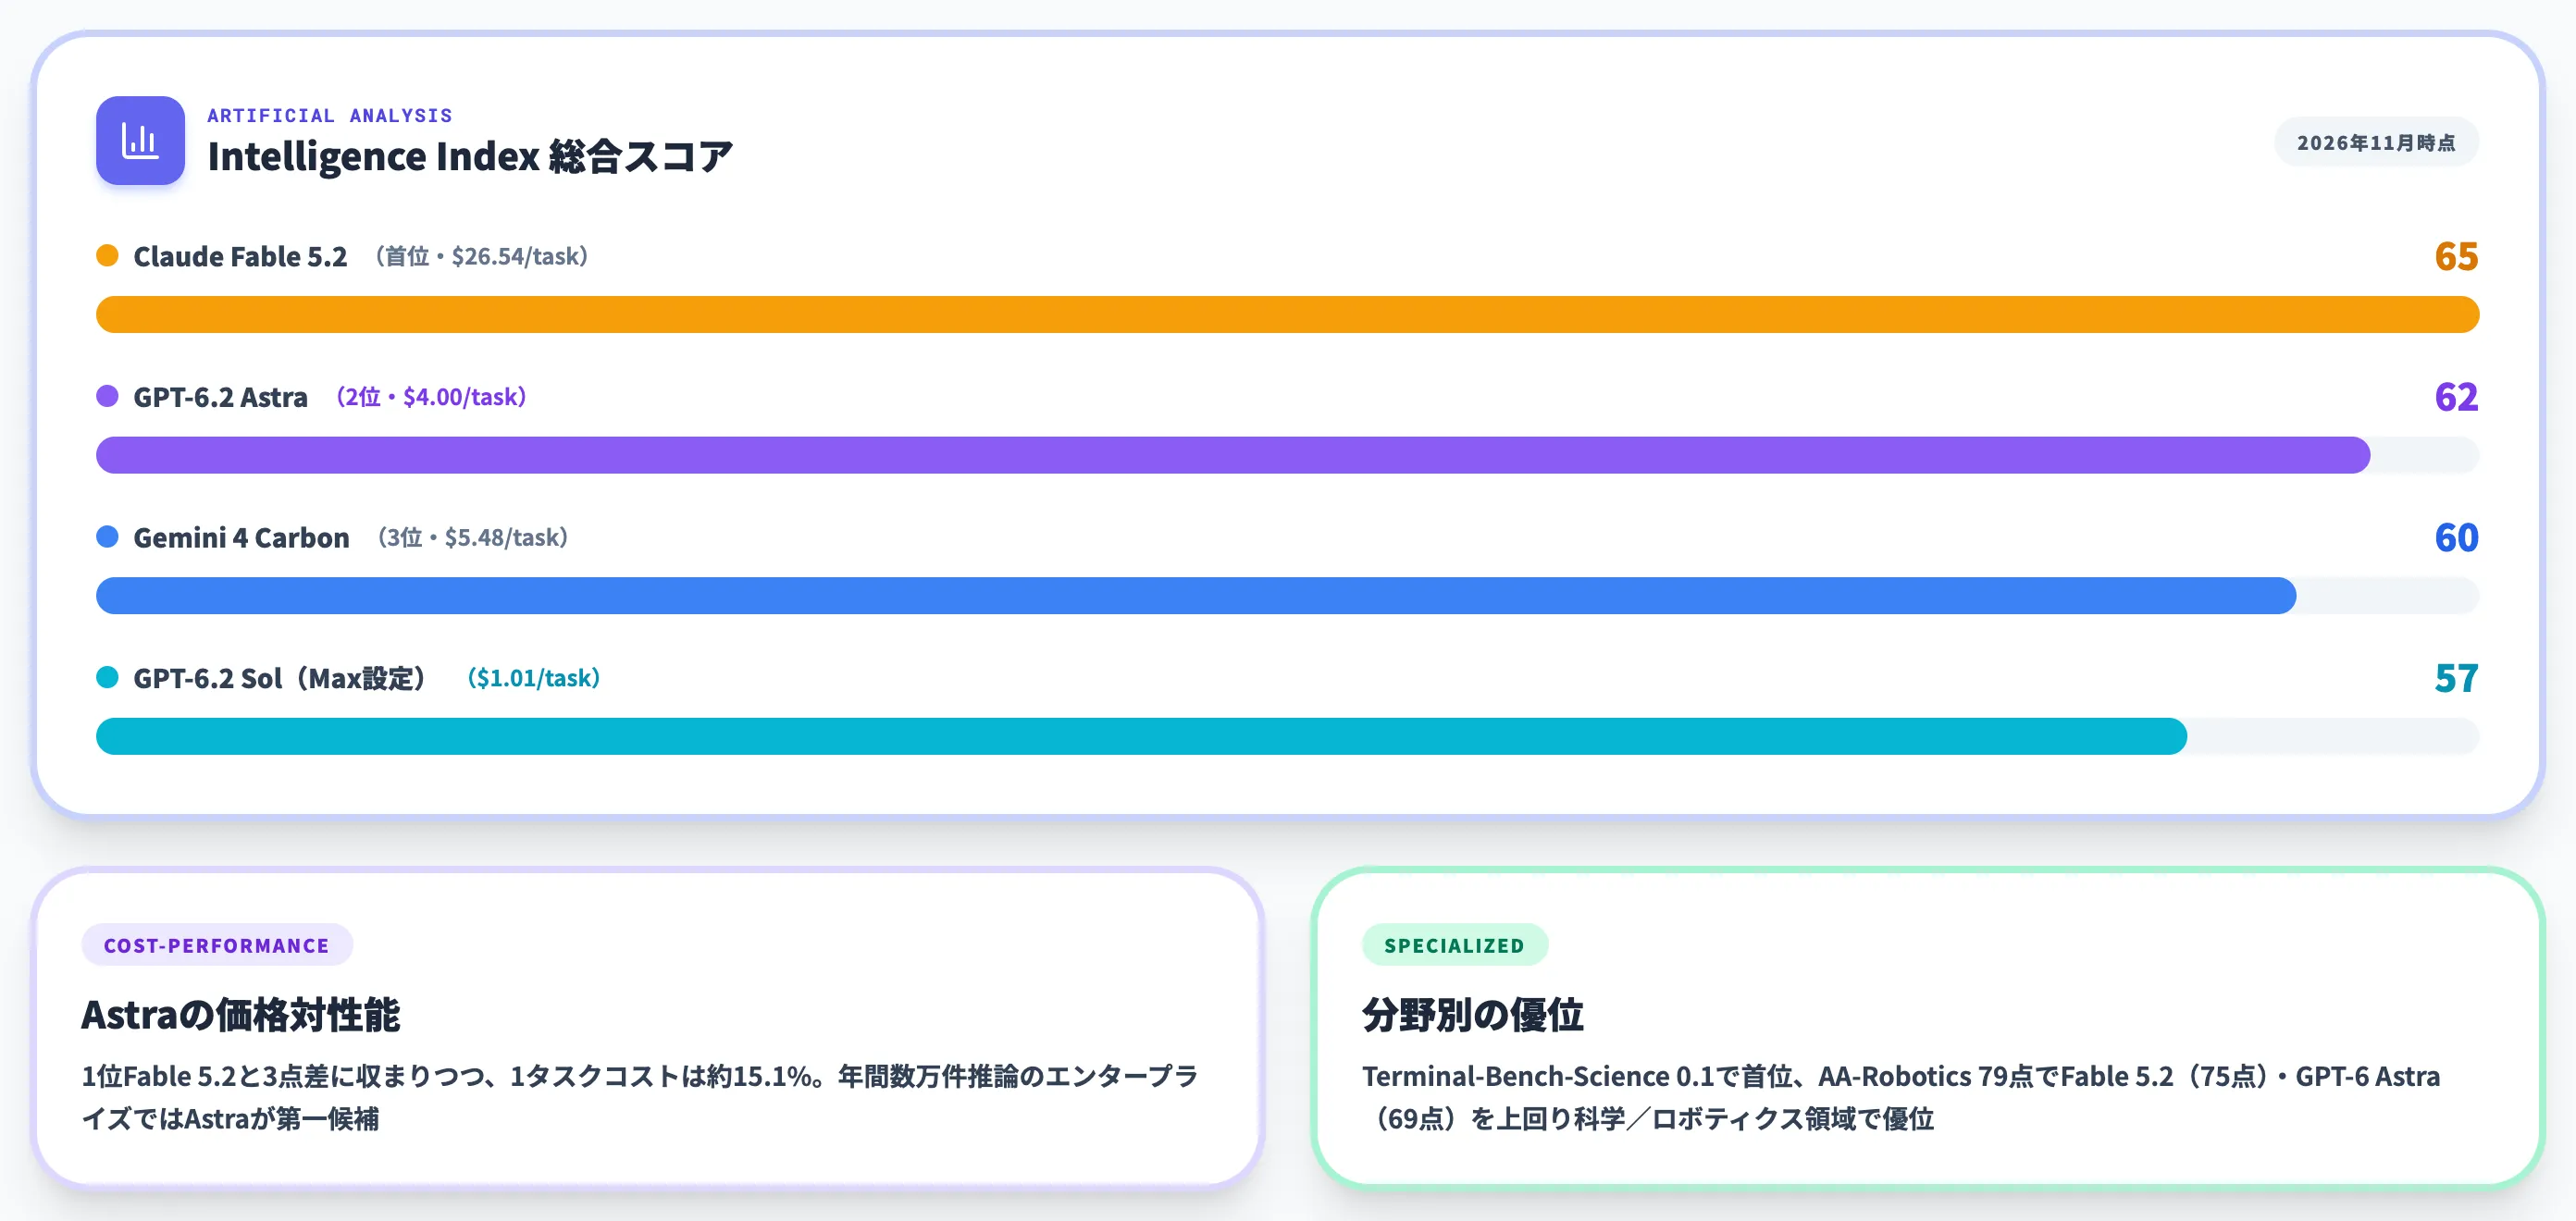
GPT-6.2 Astraの性能上の立ち位置は、Intelligence Index 62点で2位・首位のClaude Fable 5.2に3点差・3位以下を2点以上引き離すという位置です。
Artificial Analysisの集計によれば、Astraは総合スコアでFable 5.2(65点)に次ぎ、Gemini 4 Carbonを2点上回って2位につけています。
特定ベンチマーク別に見ると、Terminal-Bench-Science 0.1で首位、AA-Robotics Scoreで79点を獲得してFable 5.2(75点)・GPT-6 Astra(69点)を上回り、科学・ロボティクス領域で優位を見せています。
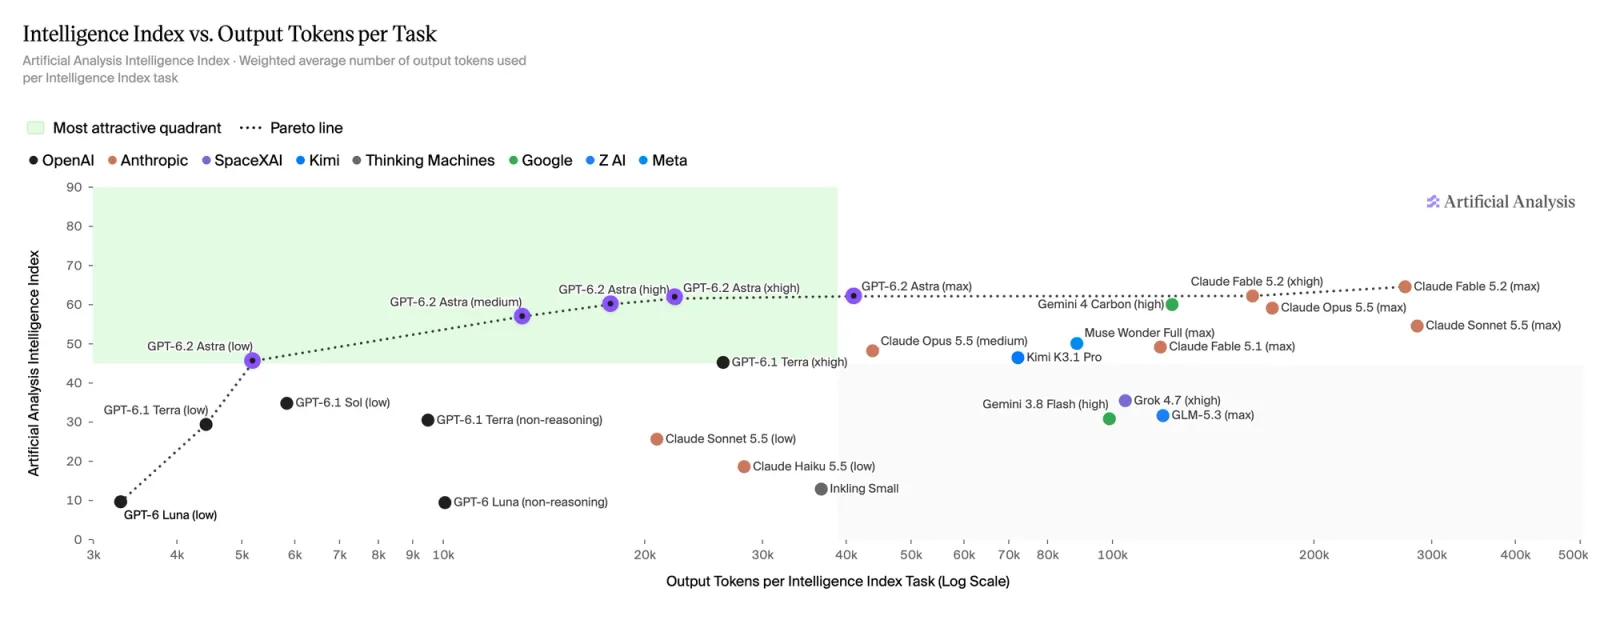
Intelligence Indexと1タスクあたり出力トークン数の関係(出典:Artificial Analysis)
この散布図の見方は、左上に寄るほど「少ない出力トークンで高いIntelligence Indexに到達している」つまりタスクあたりコストで優位ということです。
GPT-6.2 Astraはmax reasoning設定でPareto line(左上の境界線)付近に位置し、Index 62点の到達点ではClaude Fable 5.2(max)より少ない出力トークンで収まっています。
Fable 5.2がIndex上は上回る一方で、同じ到達点までのトークン消費が大きい構造が、1タスクあたりコストの$4 vs $26.54差として現れています。
Intelligence Indexでの総合スコア比較
以下の表は、2026年11月時点でIntelligence Index上位に並ぶフロンティアモデルの総合スコアと1タスクあたりコストを整理したものです。
| モデル | Intelligence Index | 1タスクコスト | 位置づけ |
|---|---|---|---|
| Claude Fable 5.2 | 65点 | $26.54 | 首位・最高性能帯 |
| GPT-6.2 Astra | 62点 | $4.00 | 2位・性能/コストのバランス帯 |
| Gemini 4 Carbon | 60点 | $5.48(High設定) | 3位 |
| GPT-6.2 Sol(Max設定) | 57点 | $1.01 | ルーチン最有力・前世代Astra相当 |
この比較で見るべきは、2位Astraが1位Fable 5.2の約15.1%のコストで3点差に収まっているという価格対性能の落とし所です。
年間数万件の推論を回す運用では、3点のスコア差を取りに行くか、6.5倍以上のコストを取りに行くかという経済合理性の判断になり、多くのエンタープライズ運用でAstraが第一候補に入ります。
専門領域ベンチマークでの比較
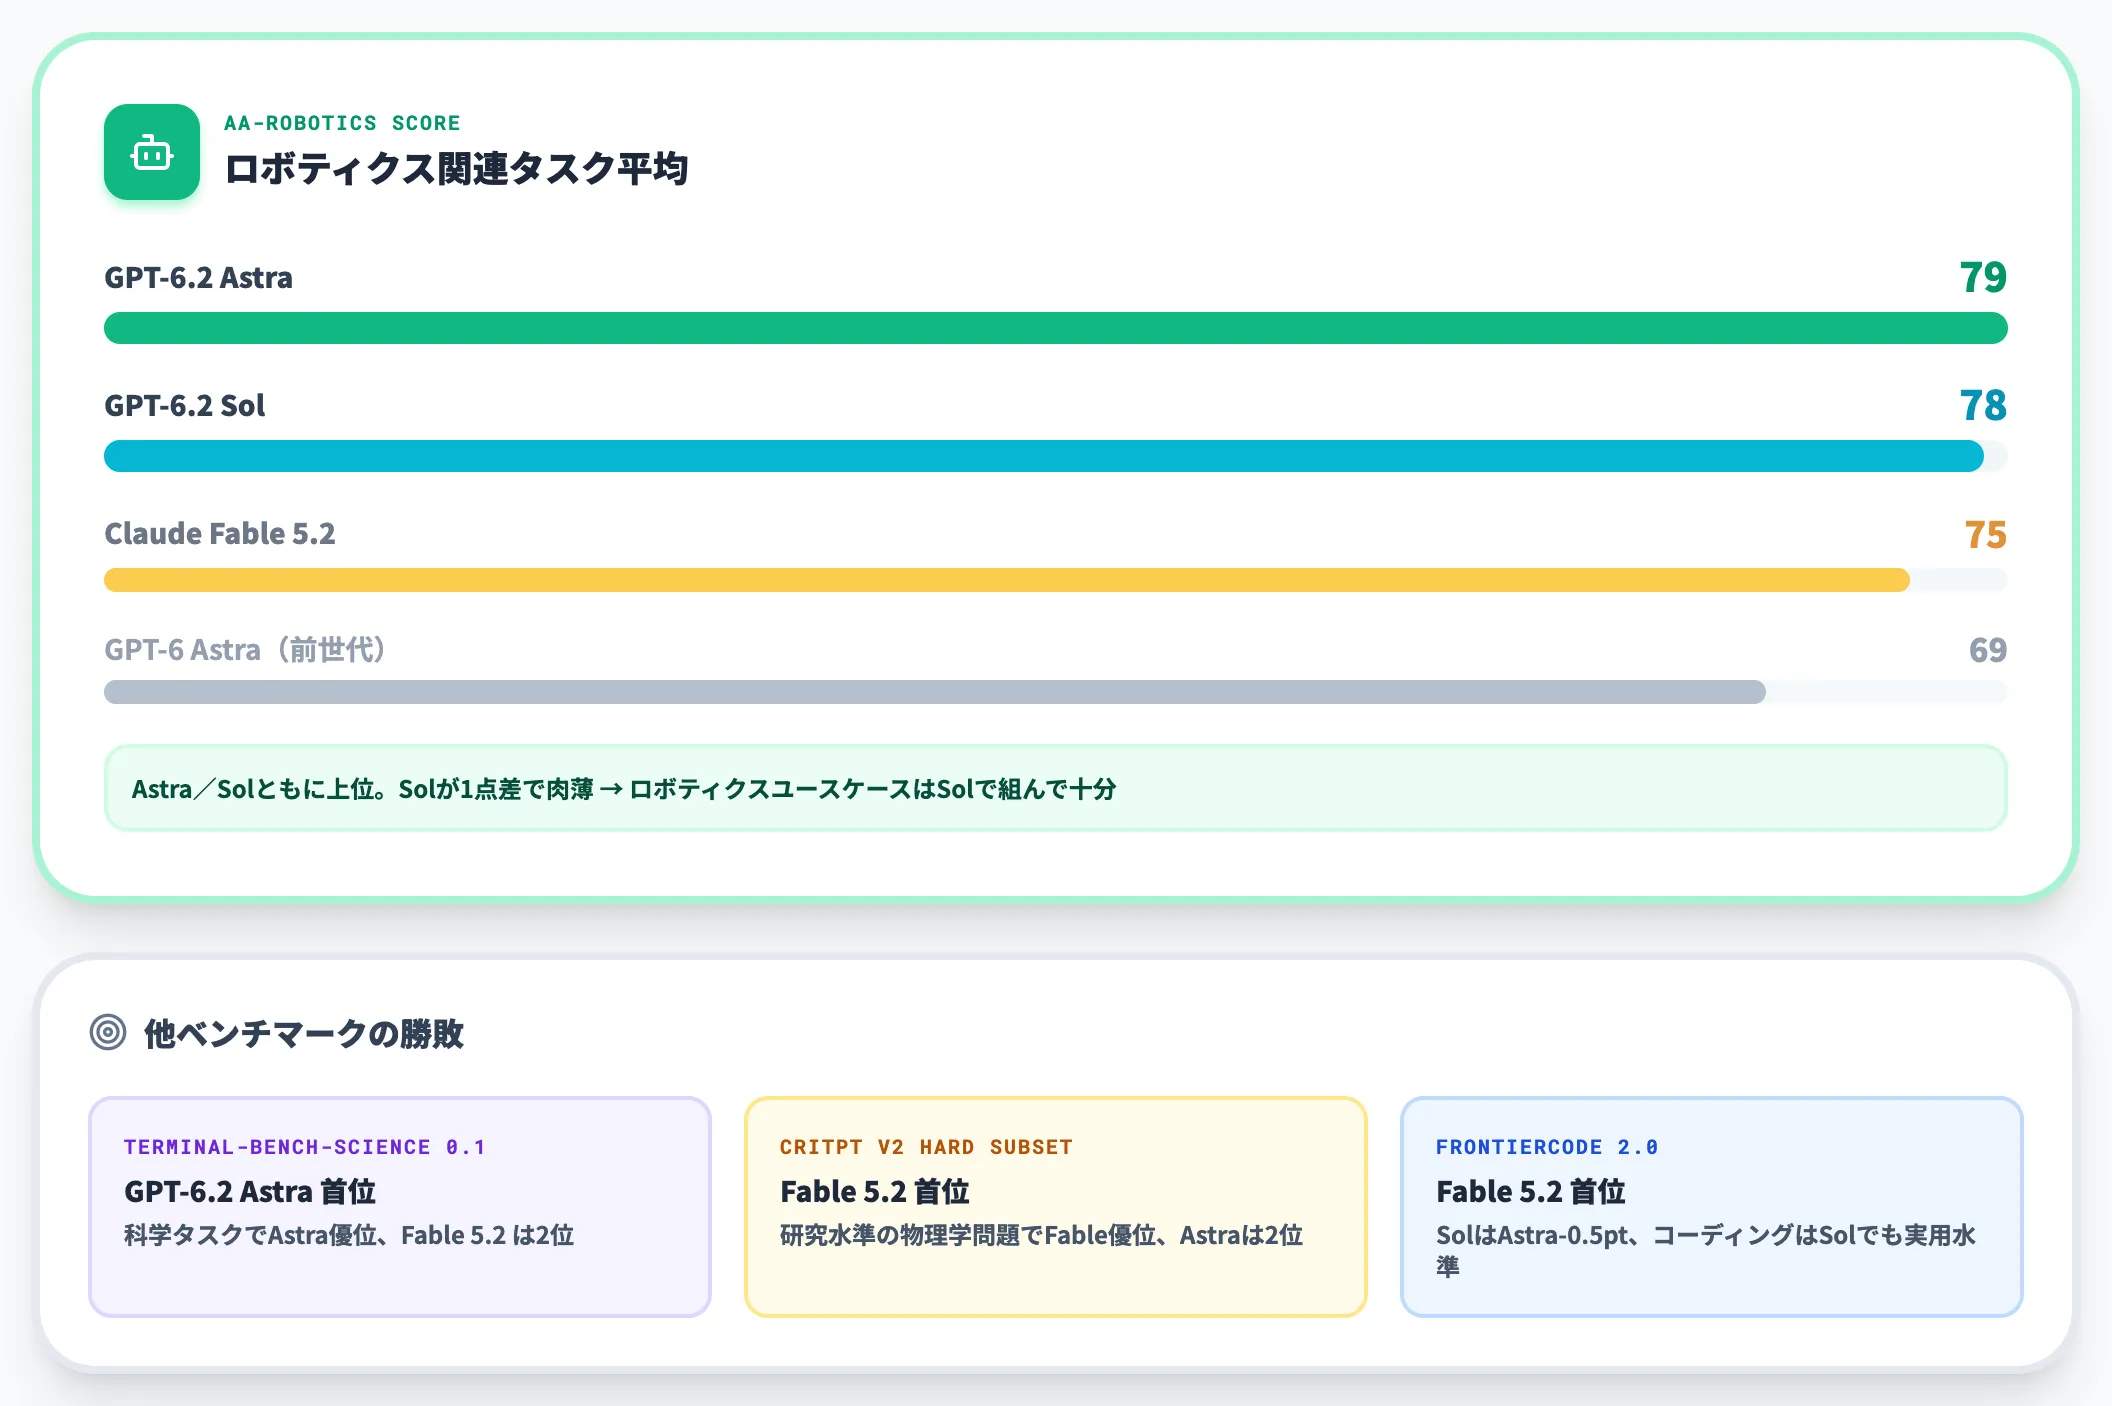
総合Index以外の個別ベンチマークでは、Astraが分野ごとに勝ち負けを分けています。
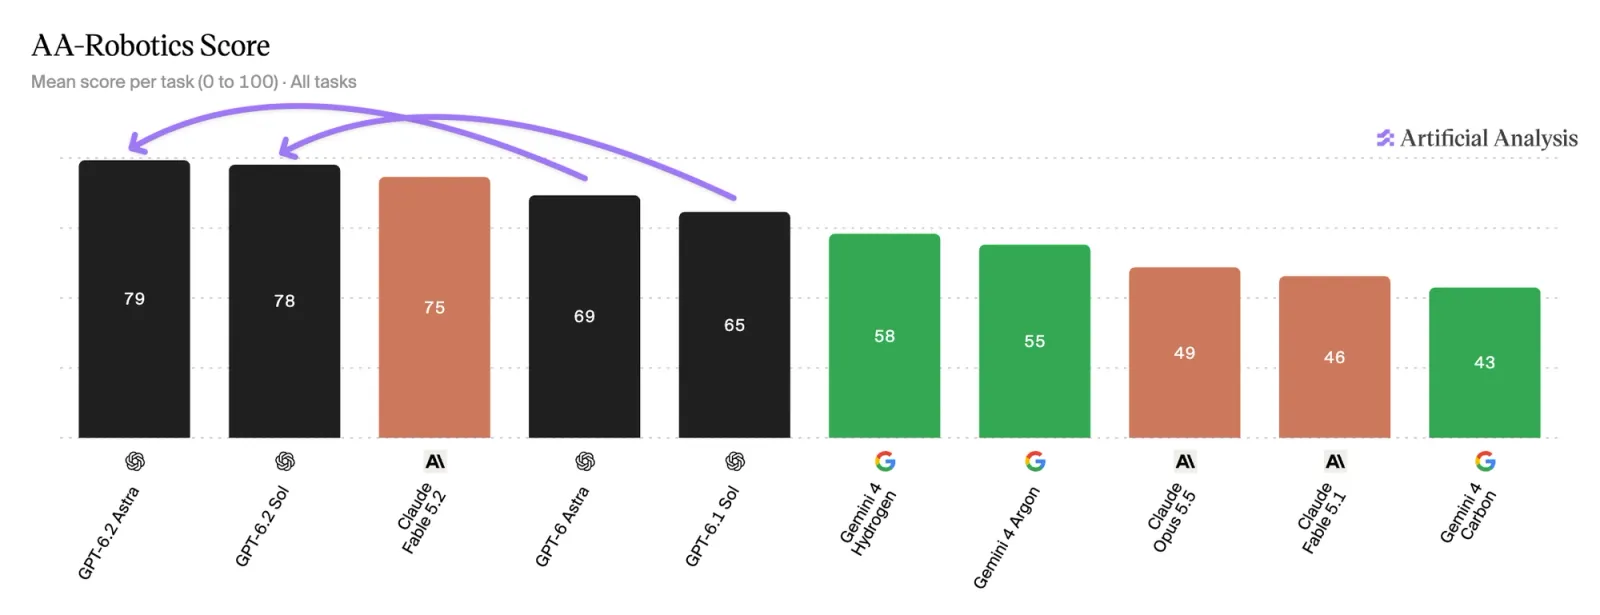
AA-Robotics Scoreの上位モデル比較(出典:Artificial Analysis)
AA-Robotics Scoreは、ロボティクス関連タスクにおける平均スコアを示す指標です。GPT-6.2 Astra(79点)・Sol(78点)がワンツー、Claude Fable 5.2(75点)を上回り、前世代GPT-6 Astra(69点)・GPT-6.1 Sol(65点)からも大幅に進化しているのが見て取れます。
注目すべきはSolがAstraに1点差まで迫っている点で、ロボティクス関連ユースケースはSolで組んで十分という判断材料になります。
以下の表で、主要ベンチマークにおけるGPT-6.2 Astra・Sol と Claude Fable 5.2の結果を整理しました。
| ベンチマーク | GPT-6.2 Astra | GPT-6.2 Sol | Claude Fable 5.2 | 備考 |
|---|---|---|---|---|
| Intelligence Index | 62 | 57(Max設定) | 65 | 総合スコア |
| AA-Robotics Score | 79 | 78 | 75 | Astra/Solともに上位、前世代GPT-6 Astraは69 |
| Terminal-Bench-Science 0.1 | 首位 | — | 2位 | 科学タスクでAstra首位 |
| CritPt v2 Hard Subset(物理学推論) | 2位 | — | 首位 | 研究水準の物理学問題でFable優位 |
| FrontierCode 2.0(max effort) | — | Astra-0.5pt | 首位 | Fable優位、SolはAstraに肉薄 |
この分野別の勝敗から見える実務的な指針は、科学・ロボティクス領域はAstra、物理学などの研究課題の一部はFable 5.2優位、コーディングはSolでも実用水準という切り分けです。コーディング用途でFrontierCode 2.0の0.5点差を取りに行くためだけに4倍の単価を払う合理性は薄く、Solを主軸にして難易度が高いコード変更だけAstraへエスカレートする運用が現実解になります。
Solの位置づけ——前世代Astra相当を約5分の1価格で
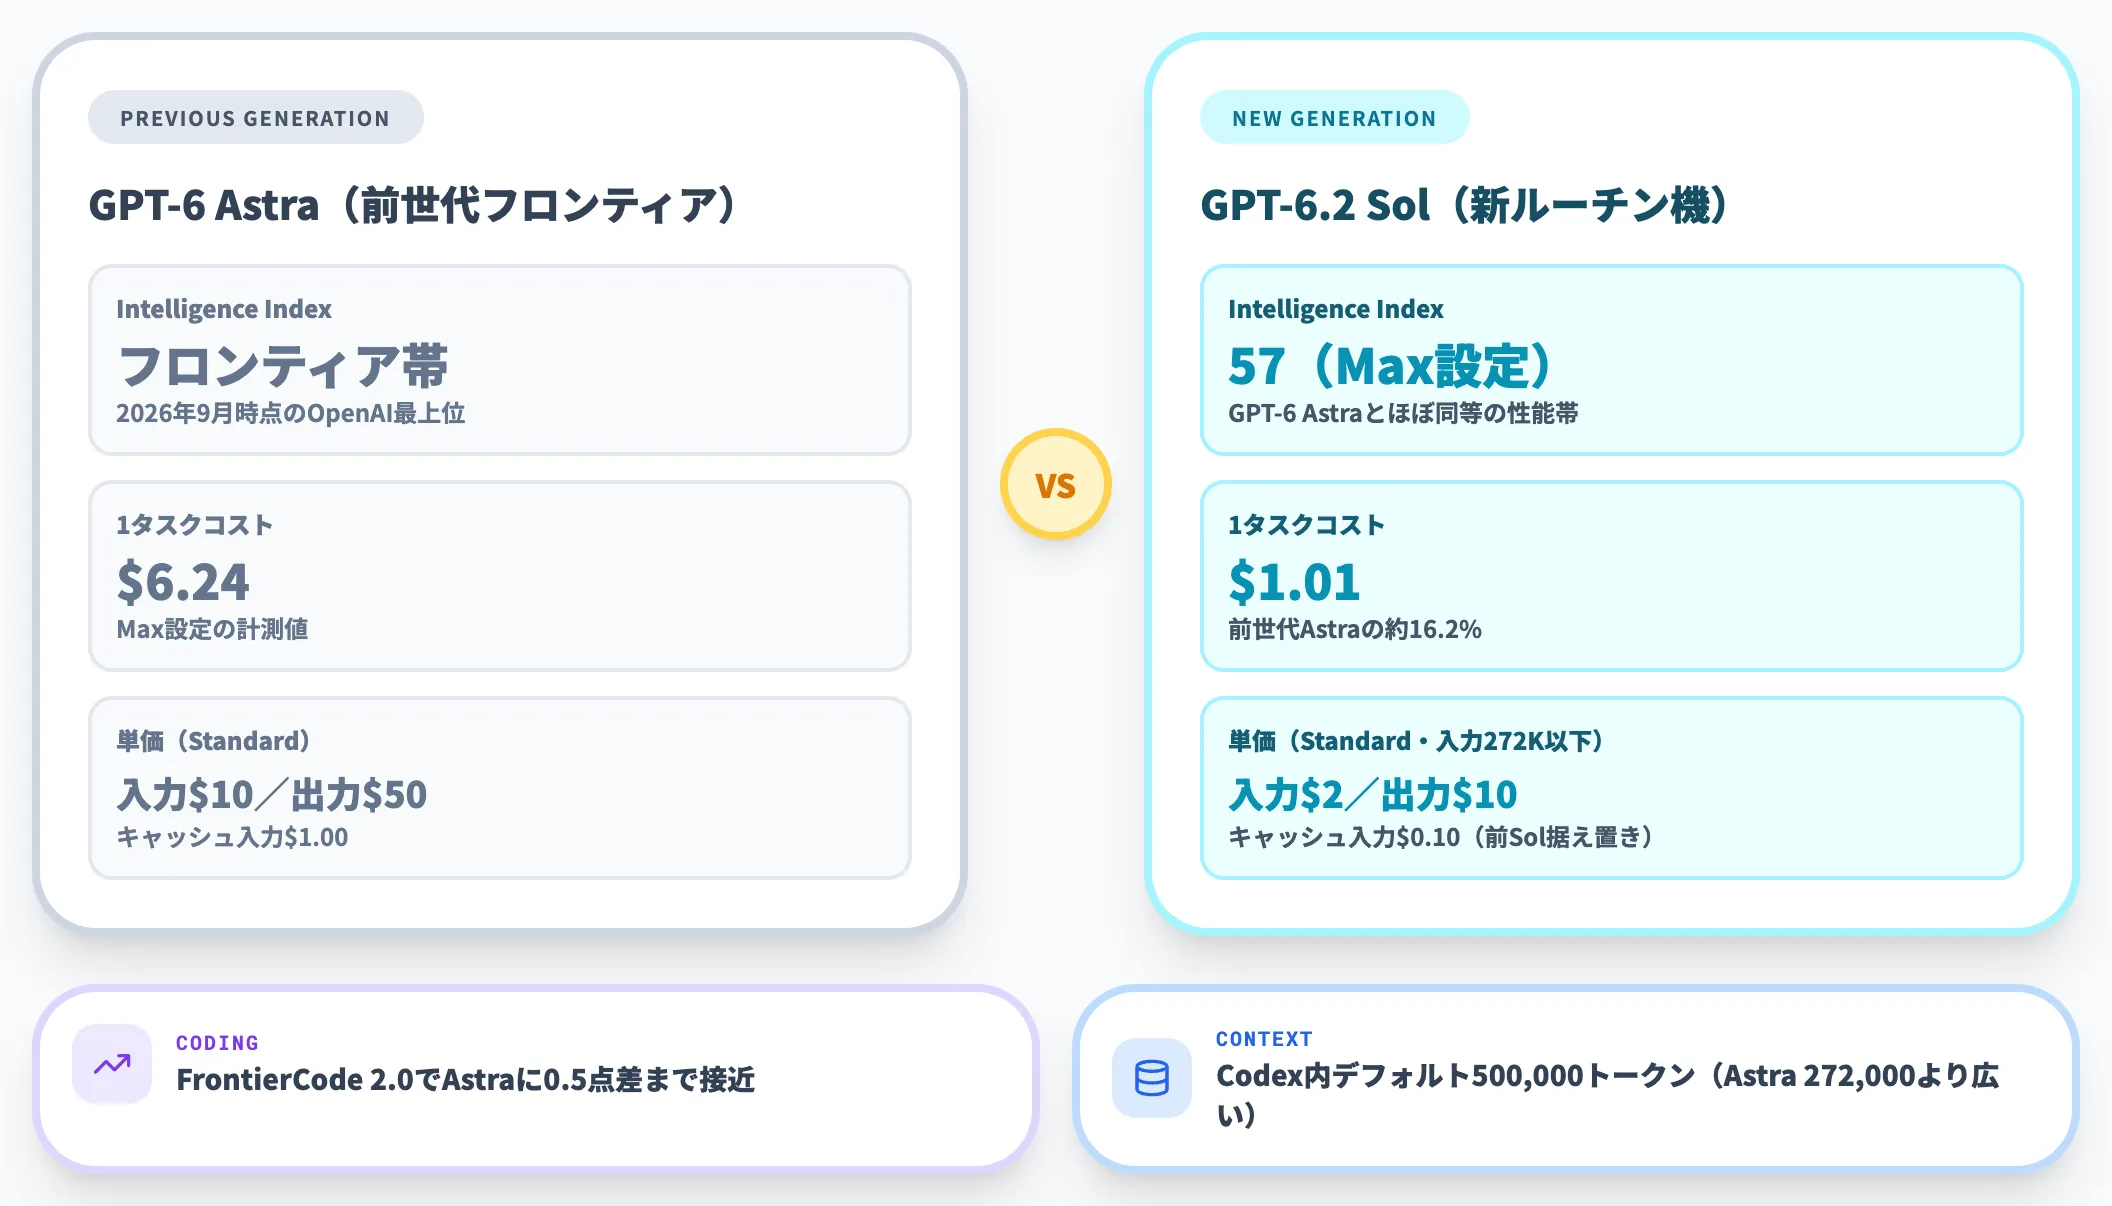
Solを単なる「安いモデル」と見ると実態を見誤ります。
Artificial Analysisの評価では、SolはMax設定でIntelligence Index 57点に到達しており、2026年9月時点でフロンティア機だったGPT-6 Astraとほぼ同等の性能帯を、$2/$10(Standard・入力272K以下)の単価レンジで提供してきた位置づけです。
-
性能面
GPT-6 Astra相当のIntelligence Indexに到達しつつ、FrontierCode 2.0ではAstra(max effort)に0.5点差まで接近
-
コスト面
入力$2/出力$10/短文キャッシュ入力$0.10(Standard・入力272K以下)で、前Sol(GPT-6.1 Sol)の単価を据え置き。1タスクコストも$1.01で、前世代Astra $6.24の約16.2%
-
コンテキスト
Codex内デフォルトで500,000トークン(Astraの272,000より広い)、API上限は両モデル共通で1,050,000。272Kを超えるとStandardでも入力・キャッシュ単価が2倍、出力単価が1.5倍になる
Solが前世代Astra相当の性能に到達したことで、「フロンティア性能はAPIのフロンティア単価で買うもの」という常識が崩れつつあります。2か月前にAstraで組んだエージェントの大半は、同条件でSolに載せ替えて問題ないケースが多いはずです(具体的な置き換え可否はワークロードごとの検証が必要)。
GPT-6.2 Astra・Solの料金とコスト構造
GPT-6.2 Astra・Solの料金は、Astraが入力$8・短文キャッシュ入力$0.40・出力$40、Solが入力$2・短文キャッシュ入力$0.10・出力$10(いずれも100万トークンあたり・米ドル建て・Standard・入力272K以下の条件)です。
前世代GPT-6 Astra(入力$10/キャッシュ$1/出力$50)から、Astraの標準入力と出力は20%値下げ・短文キャッシュ入力は60%値下げという大幅な引き下げになっています。Solは前世代(GPT-6.1 Sol)と同単価の据え置きで、性能向上分だけ実質値下げという位置づけです。
料金体系の全体像
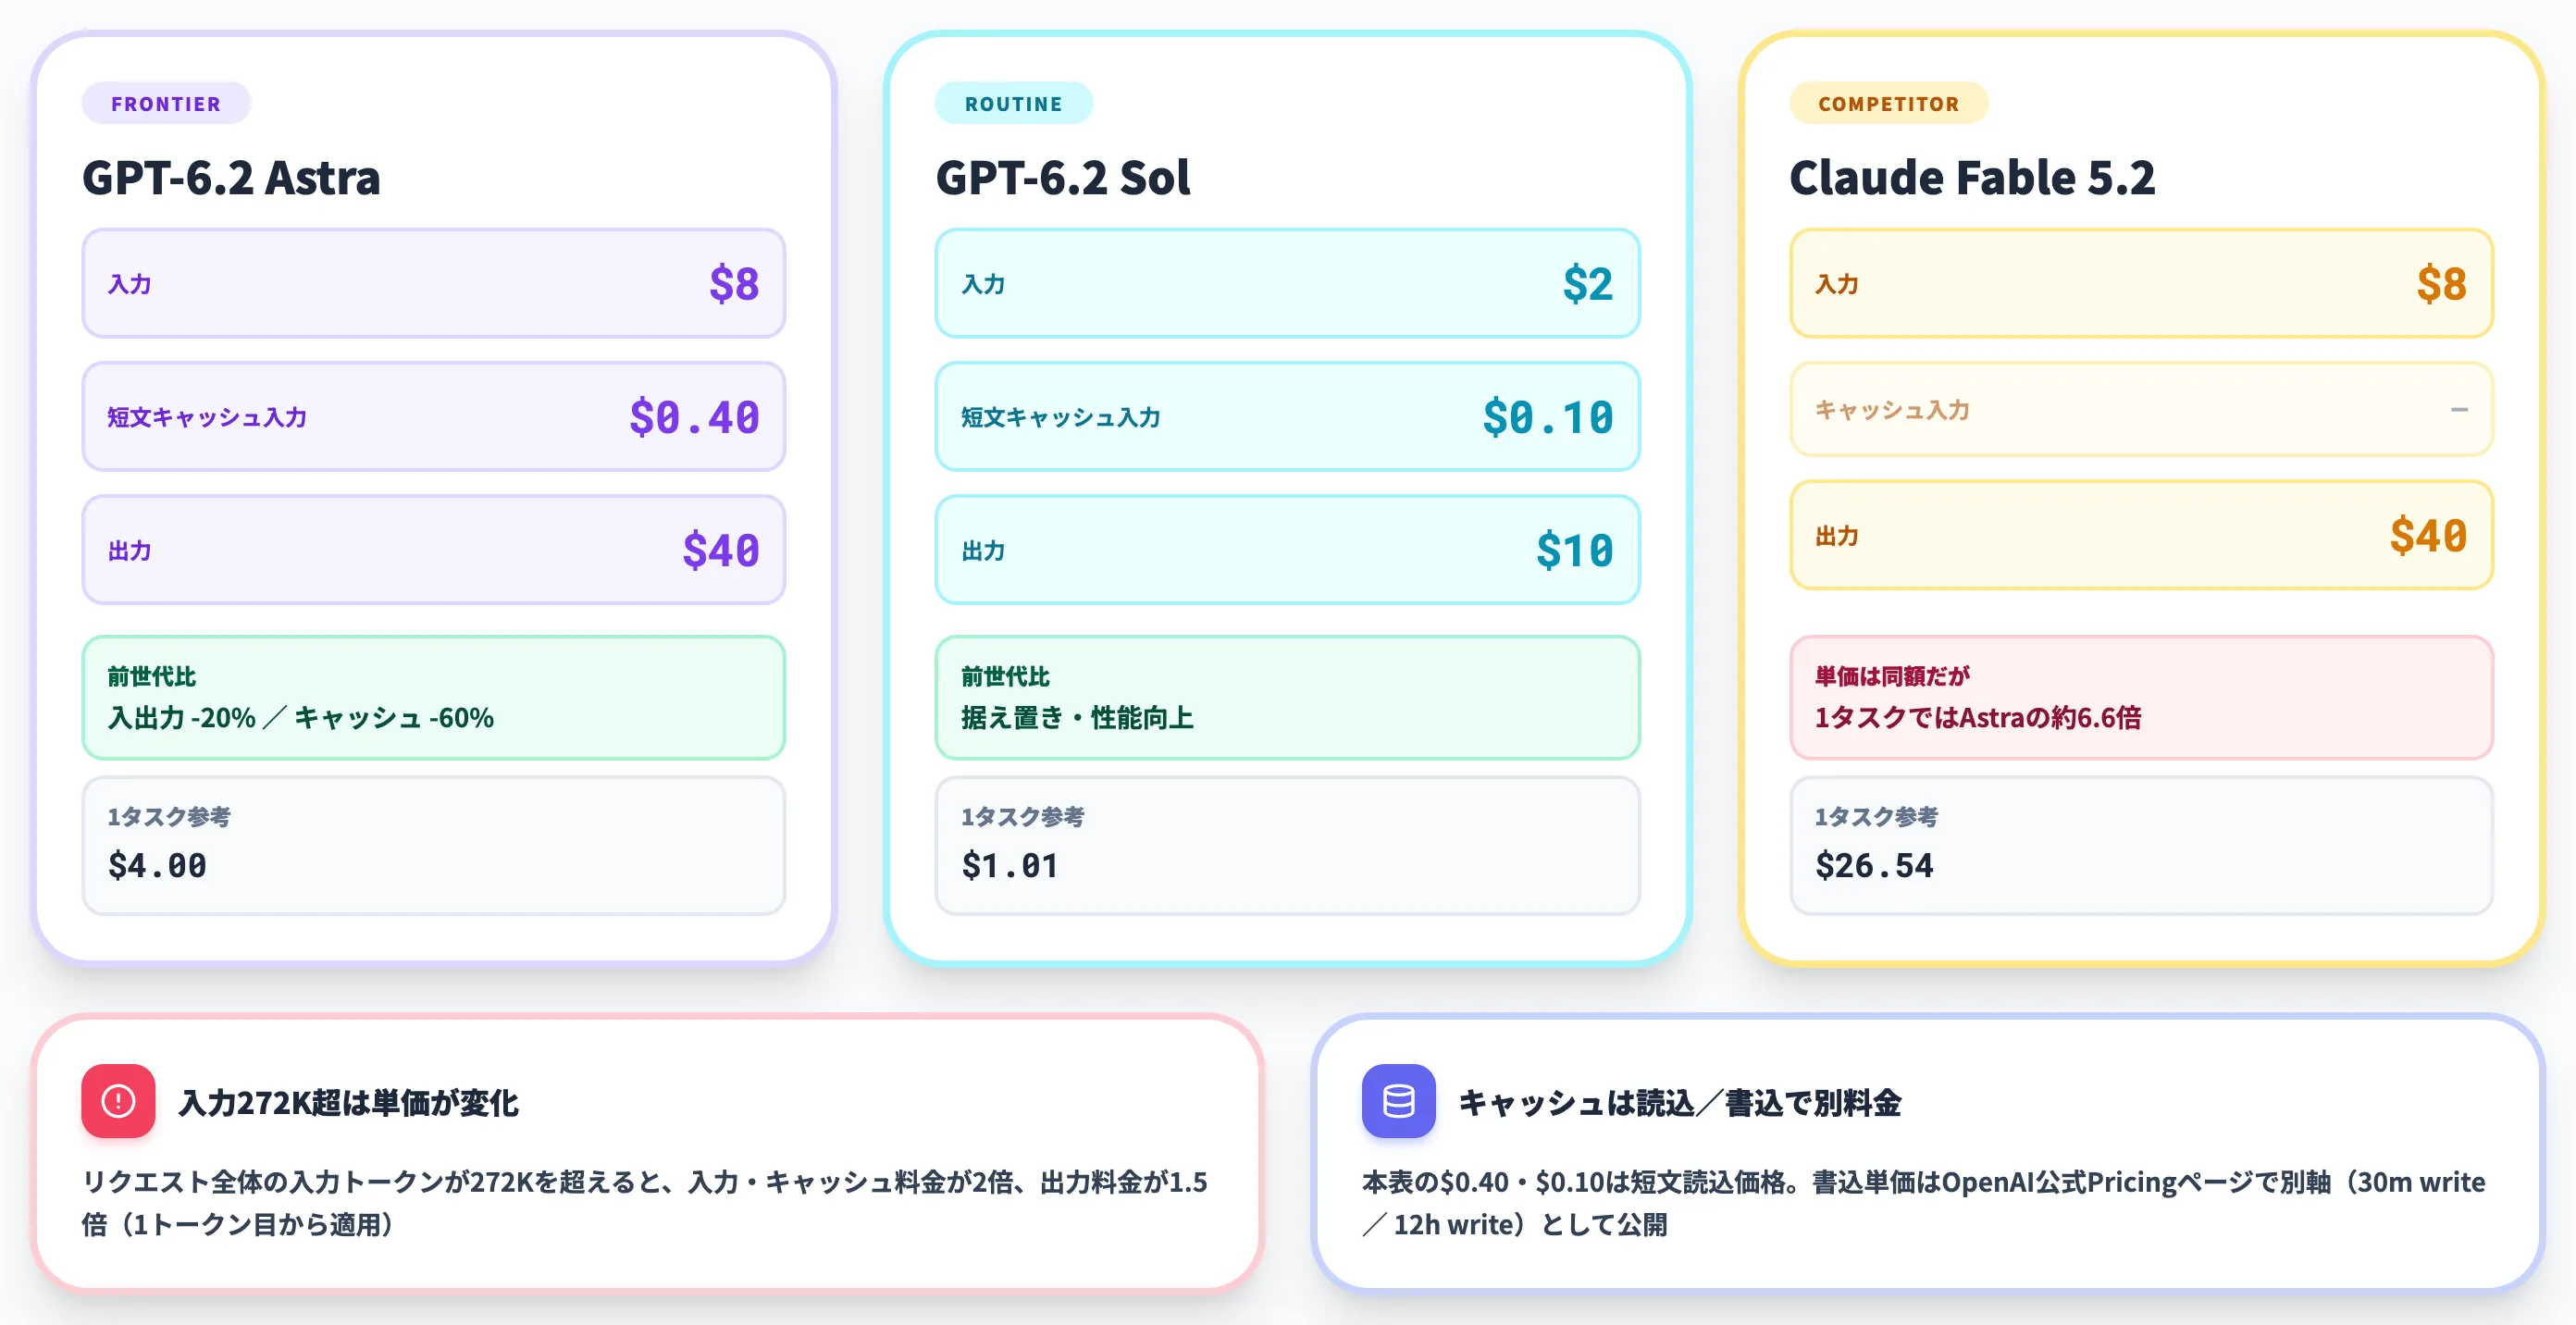
以下の表は、GPT-6世代と6.2世代の単価差、およびClaude Fable 5.2との横比較を整理したものです(Standard・入力272K以下)。
| モデル | 入力 | キャッシュ入力(読込・書込別) | 出力 | 1タスク参考 | 前世代比 |
|---|---|---|---|---|---|
| GPT-6.2 Astra | $8 | 短文$0.40(書込は別単価) | $40 | $4.00 | 入出力 -20% / キャッシュ -60% |
| GPT-6.2 Sol | $2 | 短文$0.10(書込は別単価) | $10 | $1.01 | 据え置き・性能向上 |
| GPT-6 Astra(前世代) | $10 | $1.00 | $50 | — | — |
| GPT-6.1 Sol(前世代) | $2 | $0.10 | $10 | — | — |
| Claude Fable 5.2(競合) | $8 | — | $40 | $26.54 | — |
単価表面を見るとAstraとFable 5.2は同額ですが、1タスクあたりで6.5倍以上のコスト差がついているのは、Fable 5.2の方が正解に到達するまでに要する入出力トークン数が多いことを反映した結果です。
表面単価の比較ではなく、「同じタスクを完了するまでの総コスト」で評価すべき局面が増えています。
キャッシュの読込と書込は別料金:Prompt Cachingはキャッシュへの書込時と読込時で単価が異なり、ここで示している「キャッシュ$0.40・$0.10」は短文での読込価格です。書込単価はPricing本文で別途公開されています。
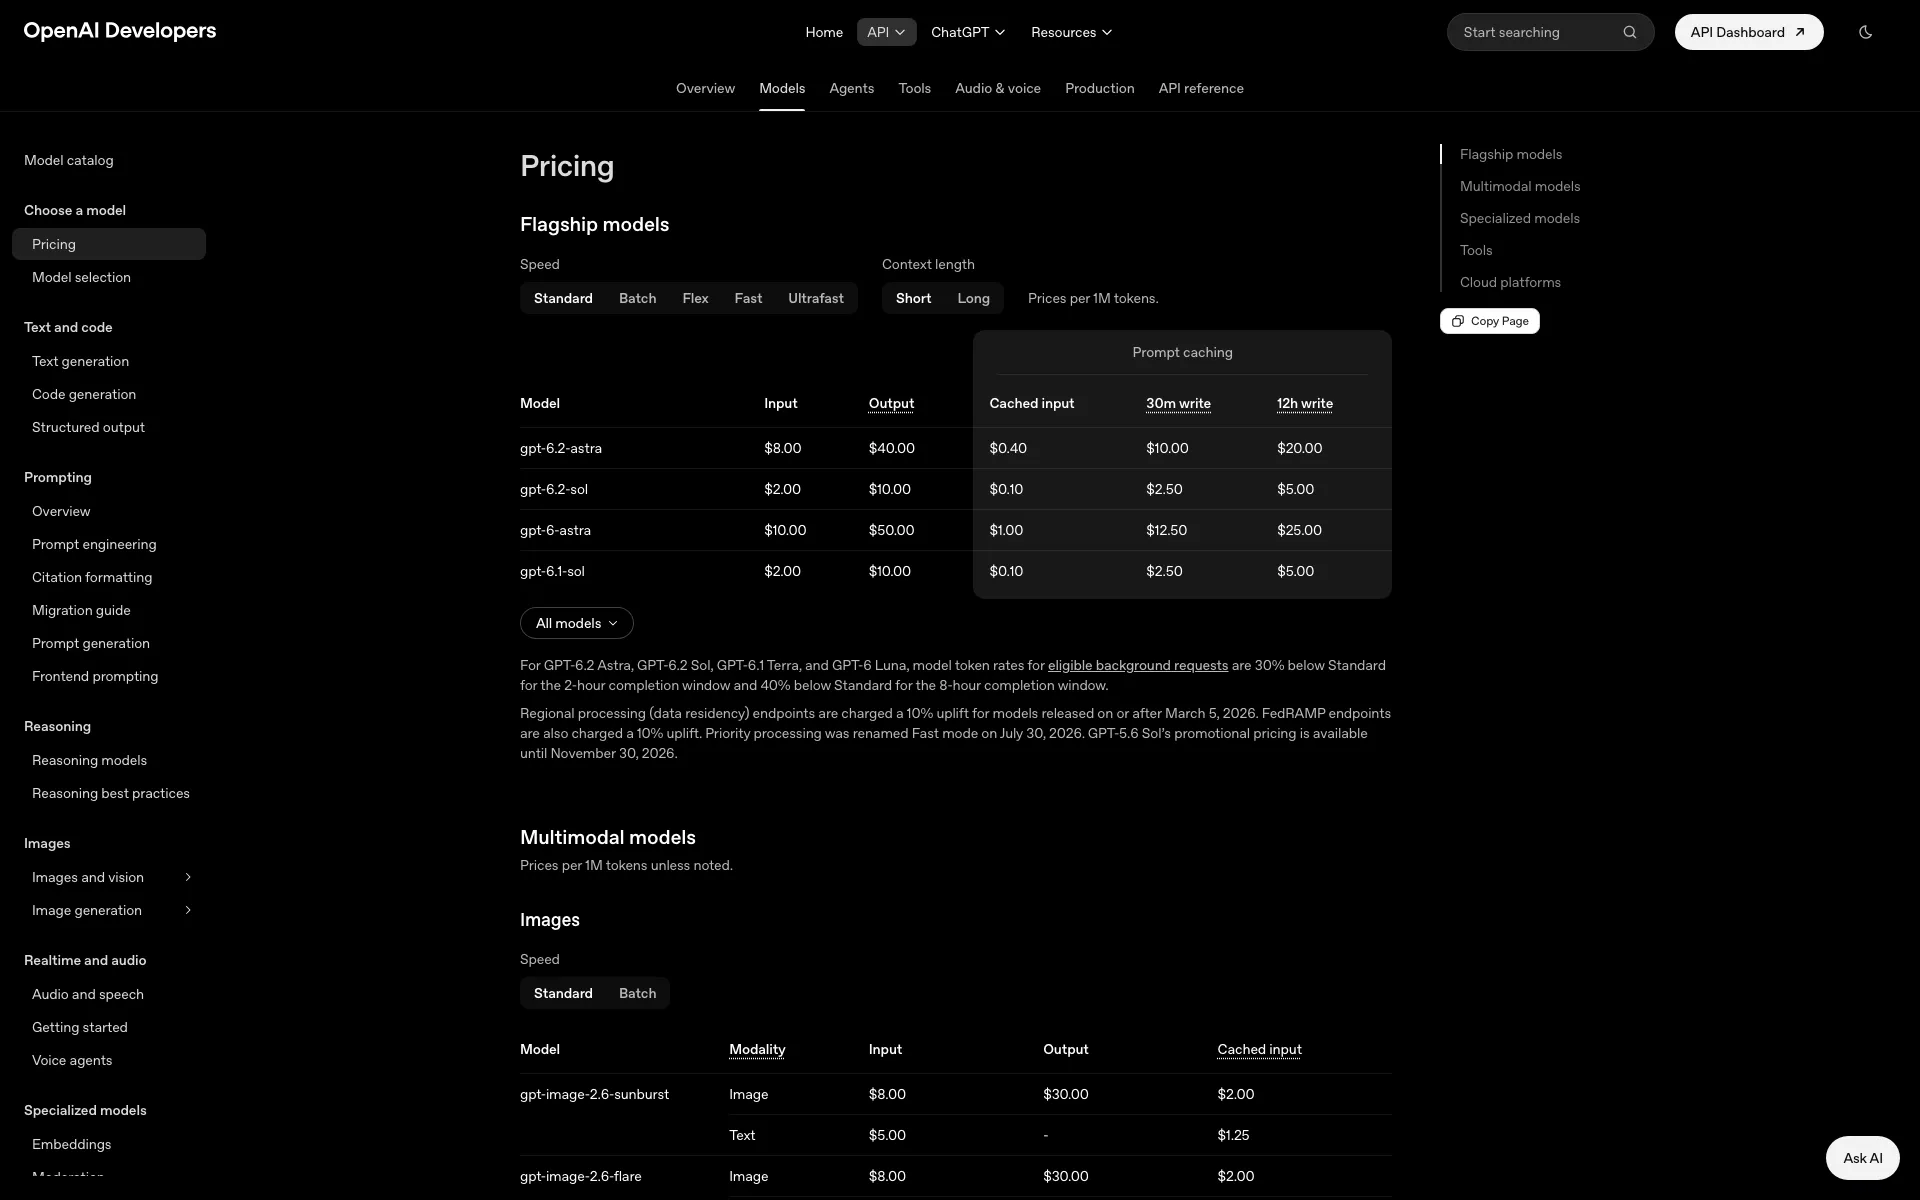
OpenAI Developers Pricingページで公開されている Flagship models の単価(出典:OpenAI API Pricing)
公式Pricingページでは、Flagship models 欄に gpt-6.2-astra と gpt-6.2-sol が並び、Speed(Standard / Fast / Flex / Batch)と Context length(Short / Long)の2軸で単価が切り替わる構造になっています。
キャッシュ書き込み欄は別軸で 30m write / 12h write が用意されています。Fast(旧Priority)はStandardより高い単価で優先処理を受けられる枠で、Astra短文キャッシュはFastで$0.80になります。
Backgroundで大量処理するときの割引
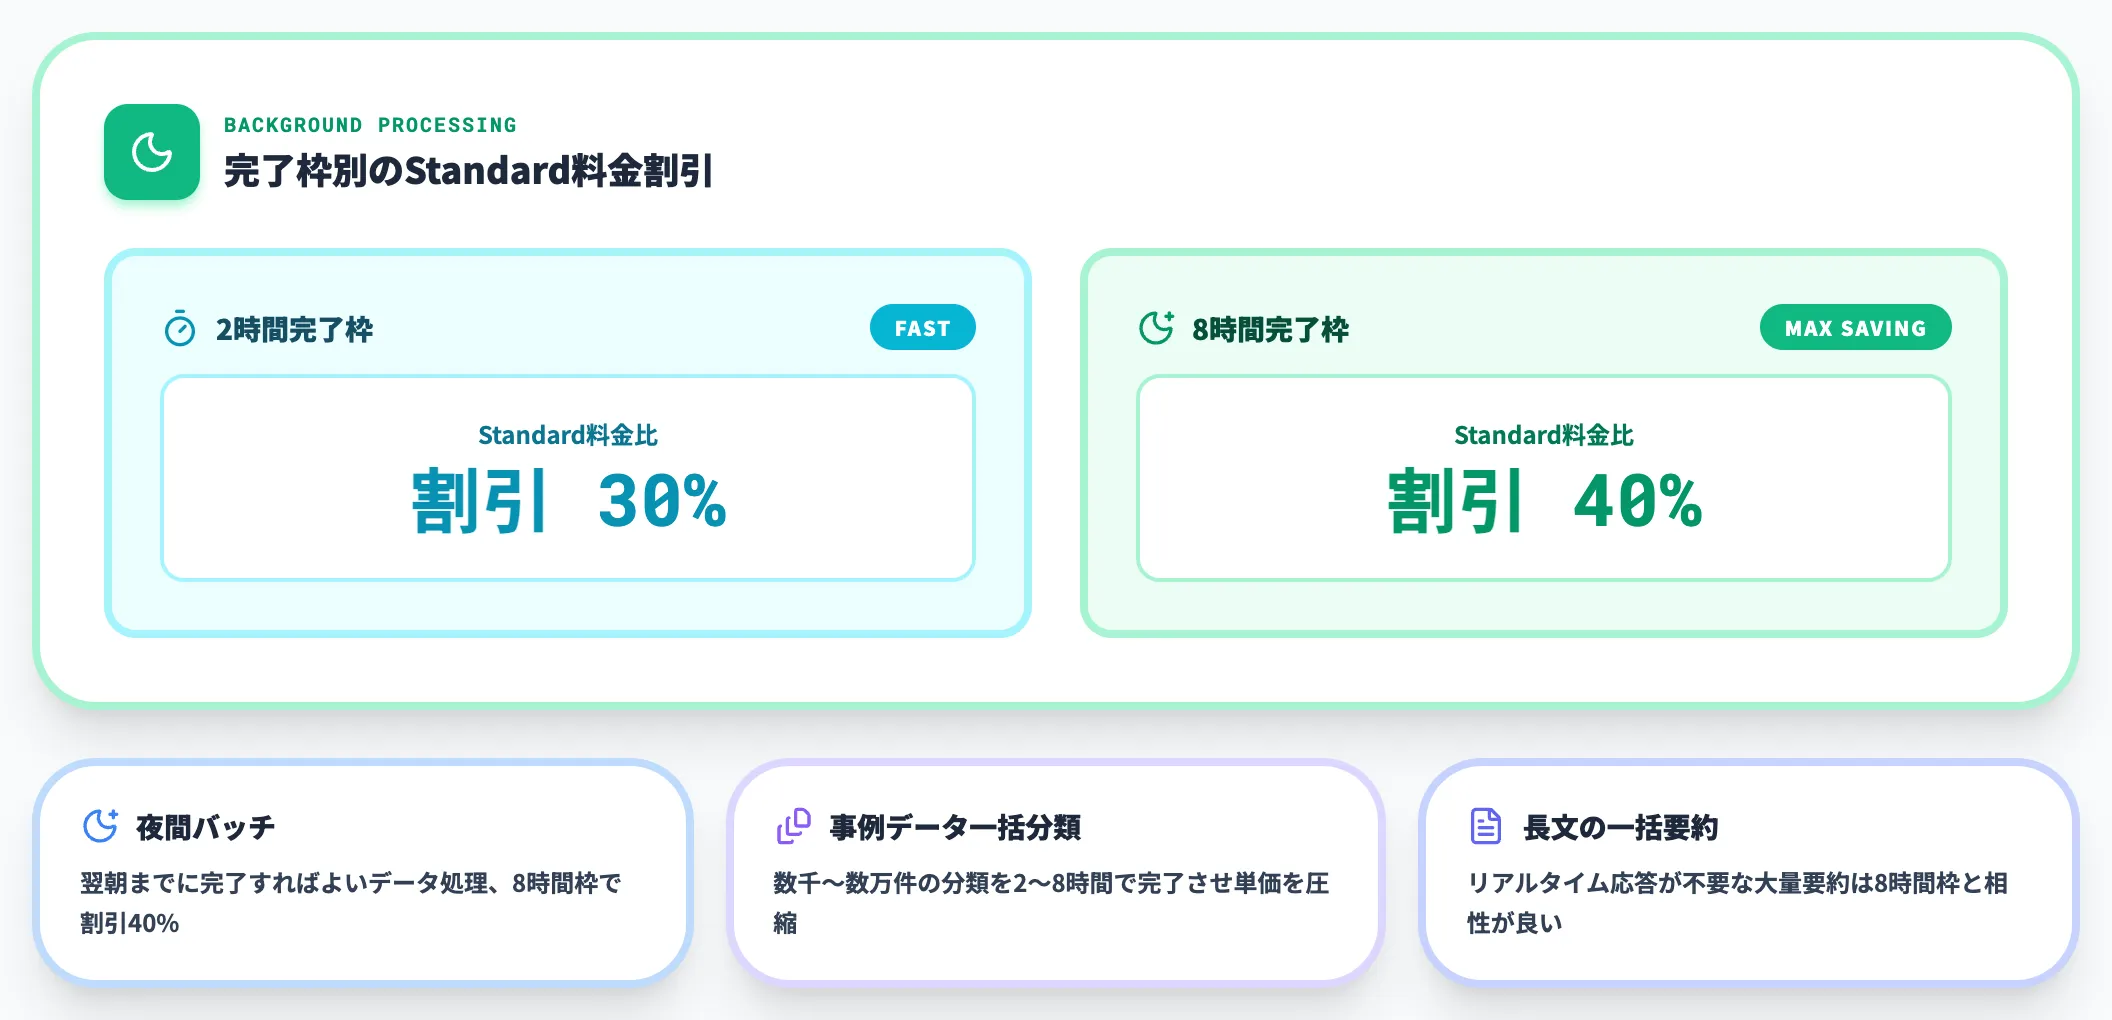
リアルタイム応答が不要な大量処理には、2時間または8時間の完了枠を選べるBackground処理があり、Standard料金比で30%(2時間完了)・40%(8時間完了)の割引が適用されます。
夜間バッチ・事例データの一括分類・長文のまとめて要約などで単価が効くため、Astra/Sol いずれでも大量処理時の比較対象に加える価値があります。
キャッシュ入力60%値下げの実務インパクト
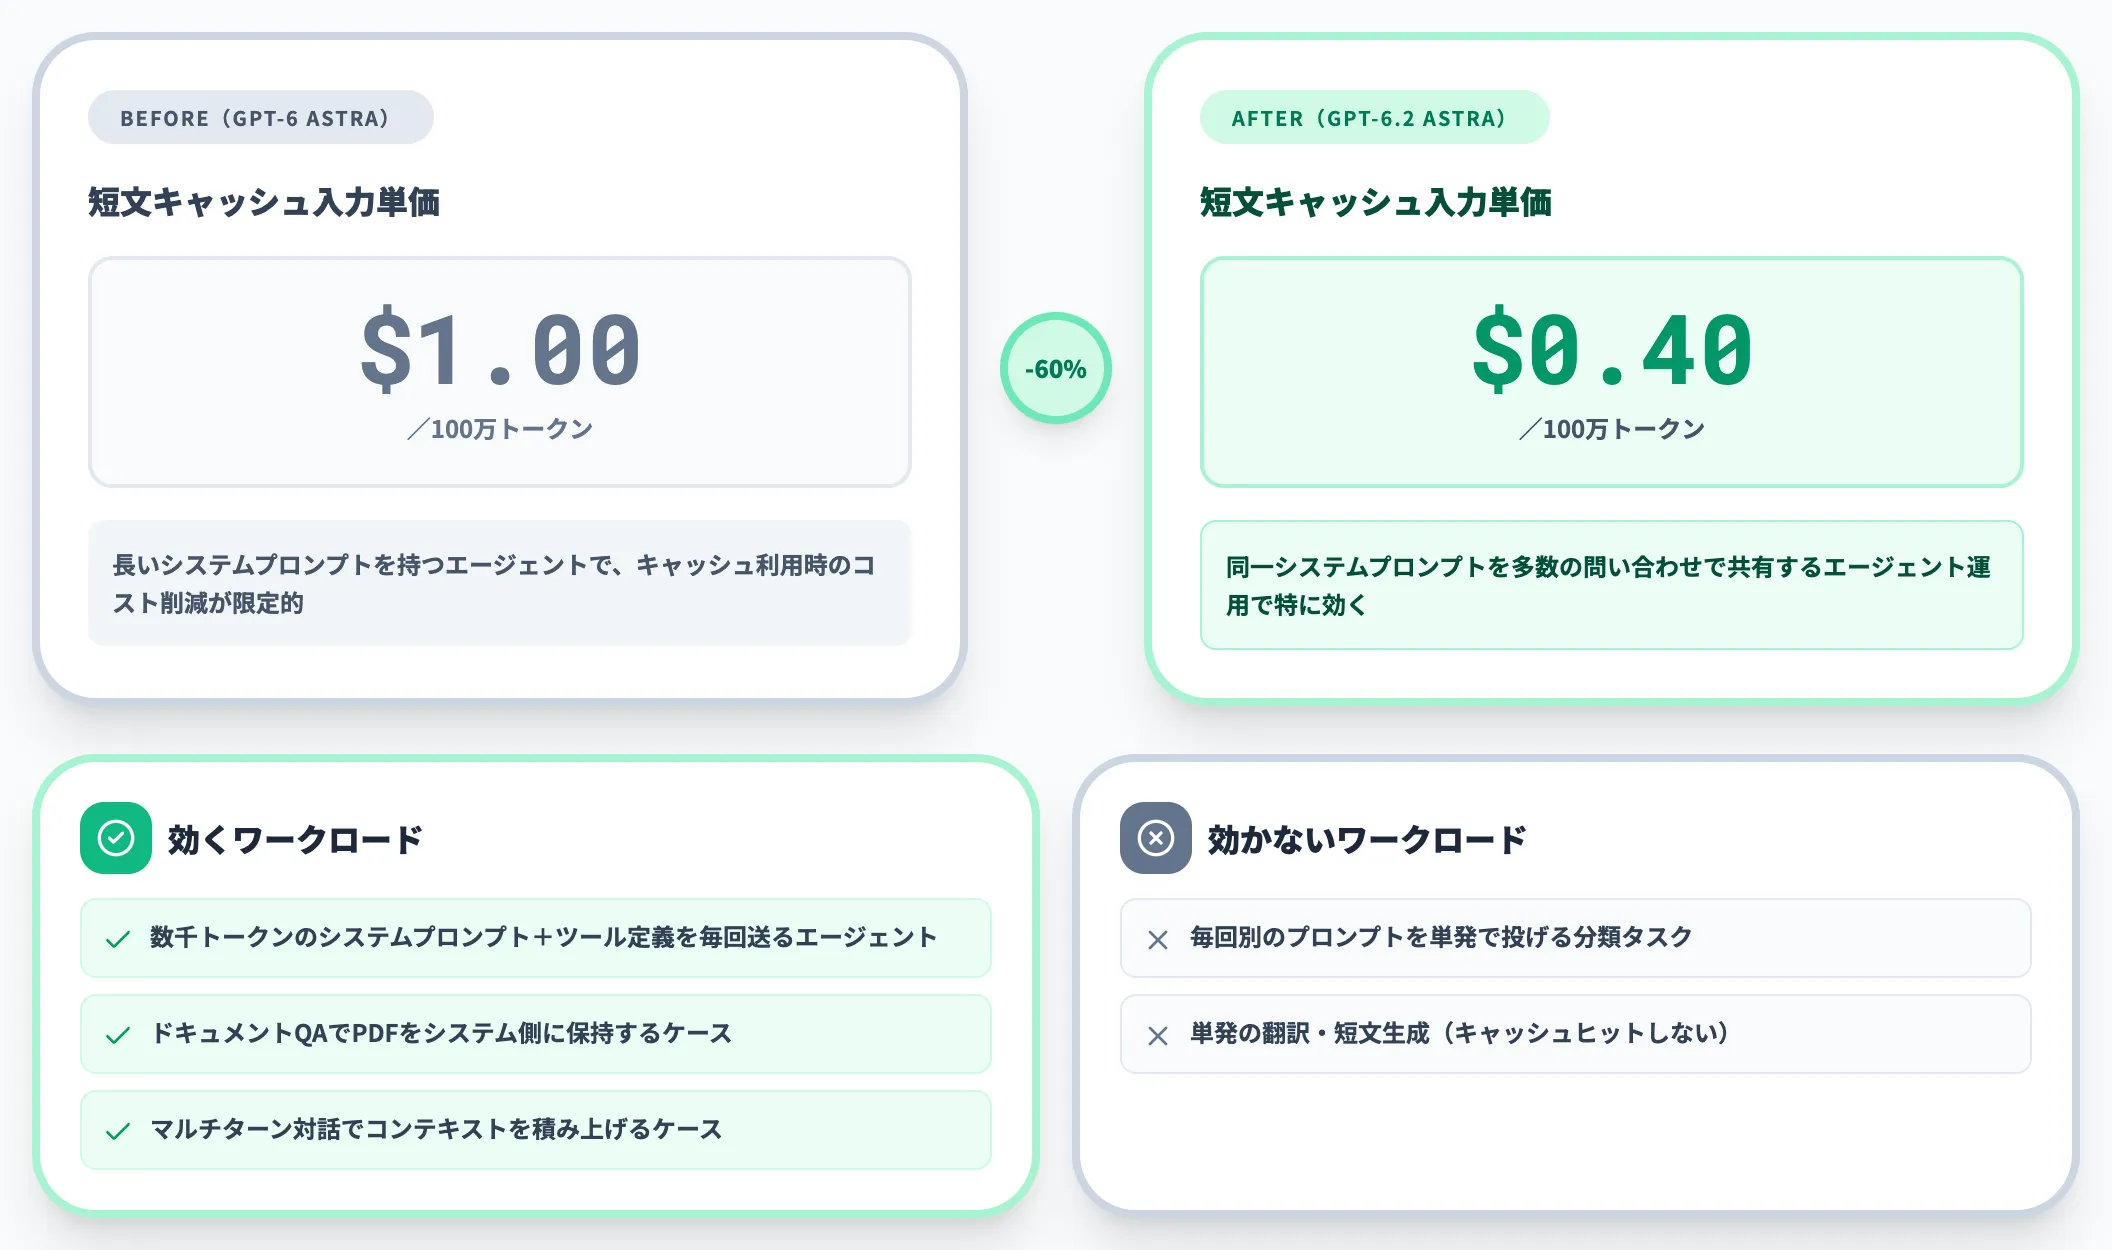
GPT-6.2 Astraで特に効くのが、短文キャッシュ入力の$1.00→$0.40(60%値下げ)です。
OpenAIのPrompt Cachingは、同一プロンプトの繰り返し使用時に自動で割引価格を適用する仕組みで、長いシステムプロンプトを持つエージェントほど恩恵が大きい設計になっています。
-
効くワークロード
数千トークンのシステムプロンプト+ツール定義を毎回送るエージェント/ドキュメントQAでPDFをシステム側に保持するケース/マルチターン対話でコンテキストを積み上げるケース
-
効かないワークロード
毎回別のプロンプトを単発で投げる分類・翻訳・短文生成(キャッシュヒットしない)
社内向けエージェントのように同一システムプロンプトを多数の問い合わせで共有するパターンでは、キャッシュヒット率次第で総コストを一定割合削減できる余地があり、Astra主軸の運用がさらに現実的になりました(削減幅はヒット率・入力/出力比・書込コストで変動するため実測が前提)。
1タスク単価$4の意味——エンタープライズ運用の経済合理性
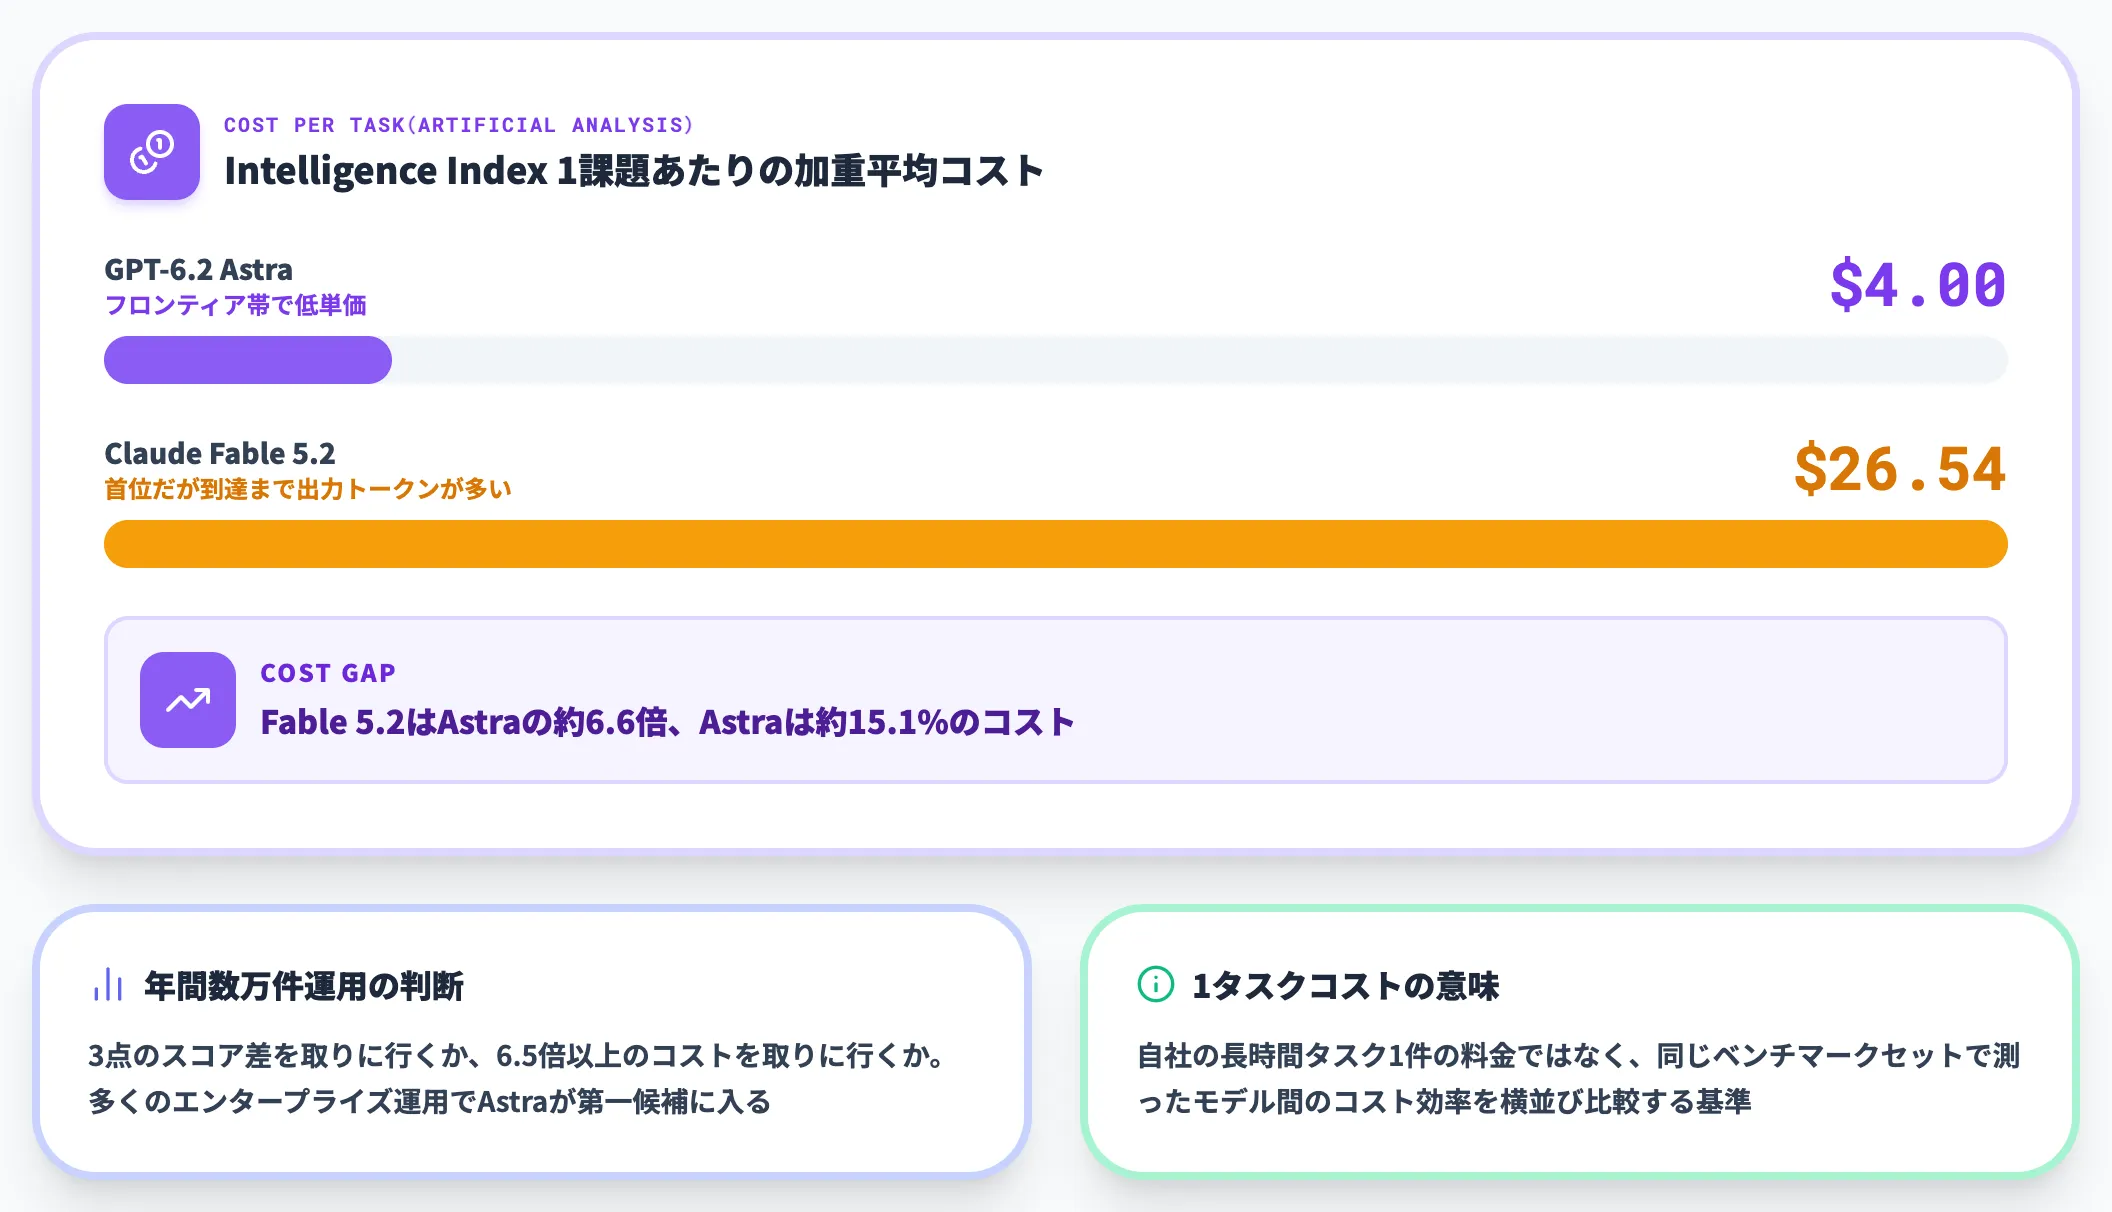
Artificial Analysisが集計する「1タスクあたりコスト」は、Intelligence Index内の1課題あたりに要する加重平均コストの指標です。
自社の長時間タスク1件の料金に直接換算できる値ではありませんが、同じベンチマークセットで測ったモデル間のコスト効率を横並びで比較する基準として参考になります。
Astraの$4という水準は、Claude Opus 5相当のフロンティア帯モデルとしては低めの位置につけており、Fable 5.2の$26.54との開きは約6.6倍です。
3点のスコア差を取りに行くためにこの倍率を払うかどうかは、業務の失敗許容度・最難関タスクの割合を踏まえた判断になります。
GPT-6.2 AstraとSolの使い分け判断
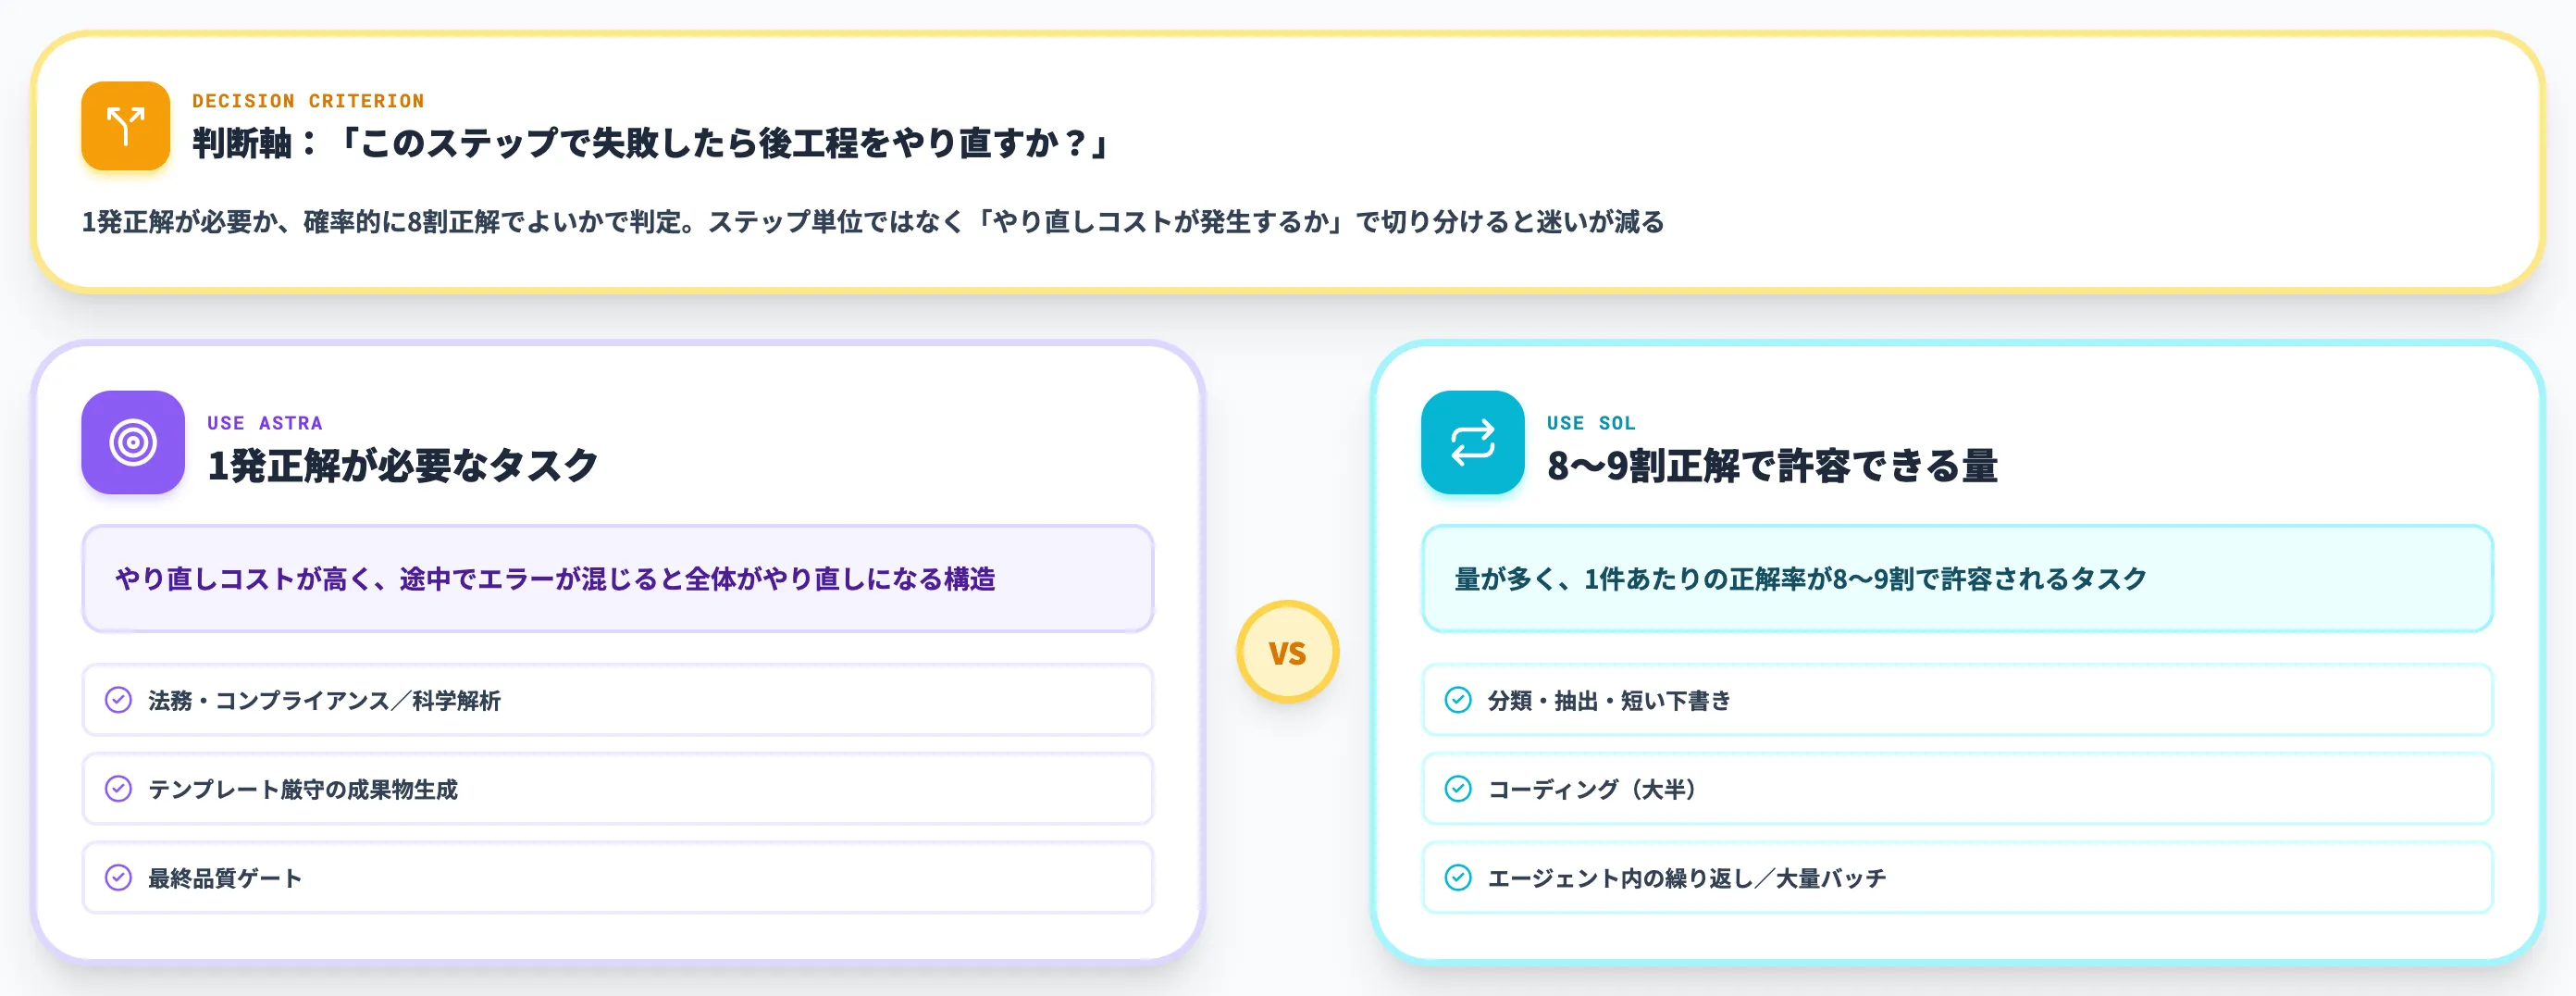
AstraとSolの使い分けは、「このタスクは1発正解が必要か、確率的に8割正解でよいか」で判定するのが実務的に効きます。
OpenAI公式が示す使い分けの原則は「難しい推論・多段階計画・複雑な成果物はAstra、ルーチン的なステップ(分類・抽出・短い下書き・フォーマット変換)はSol」ですが、現場で判断に迷うのは「エージェント内部の個別ステップがどちらに該当するか」です。
実装経験からは、ステップ単位ではなく『このステップで失敗したら後工程をやり直すか?』で切り分けると迷いが減ります。
Astraを使うべきケース
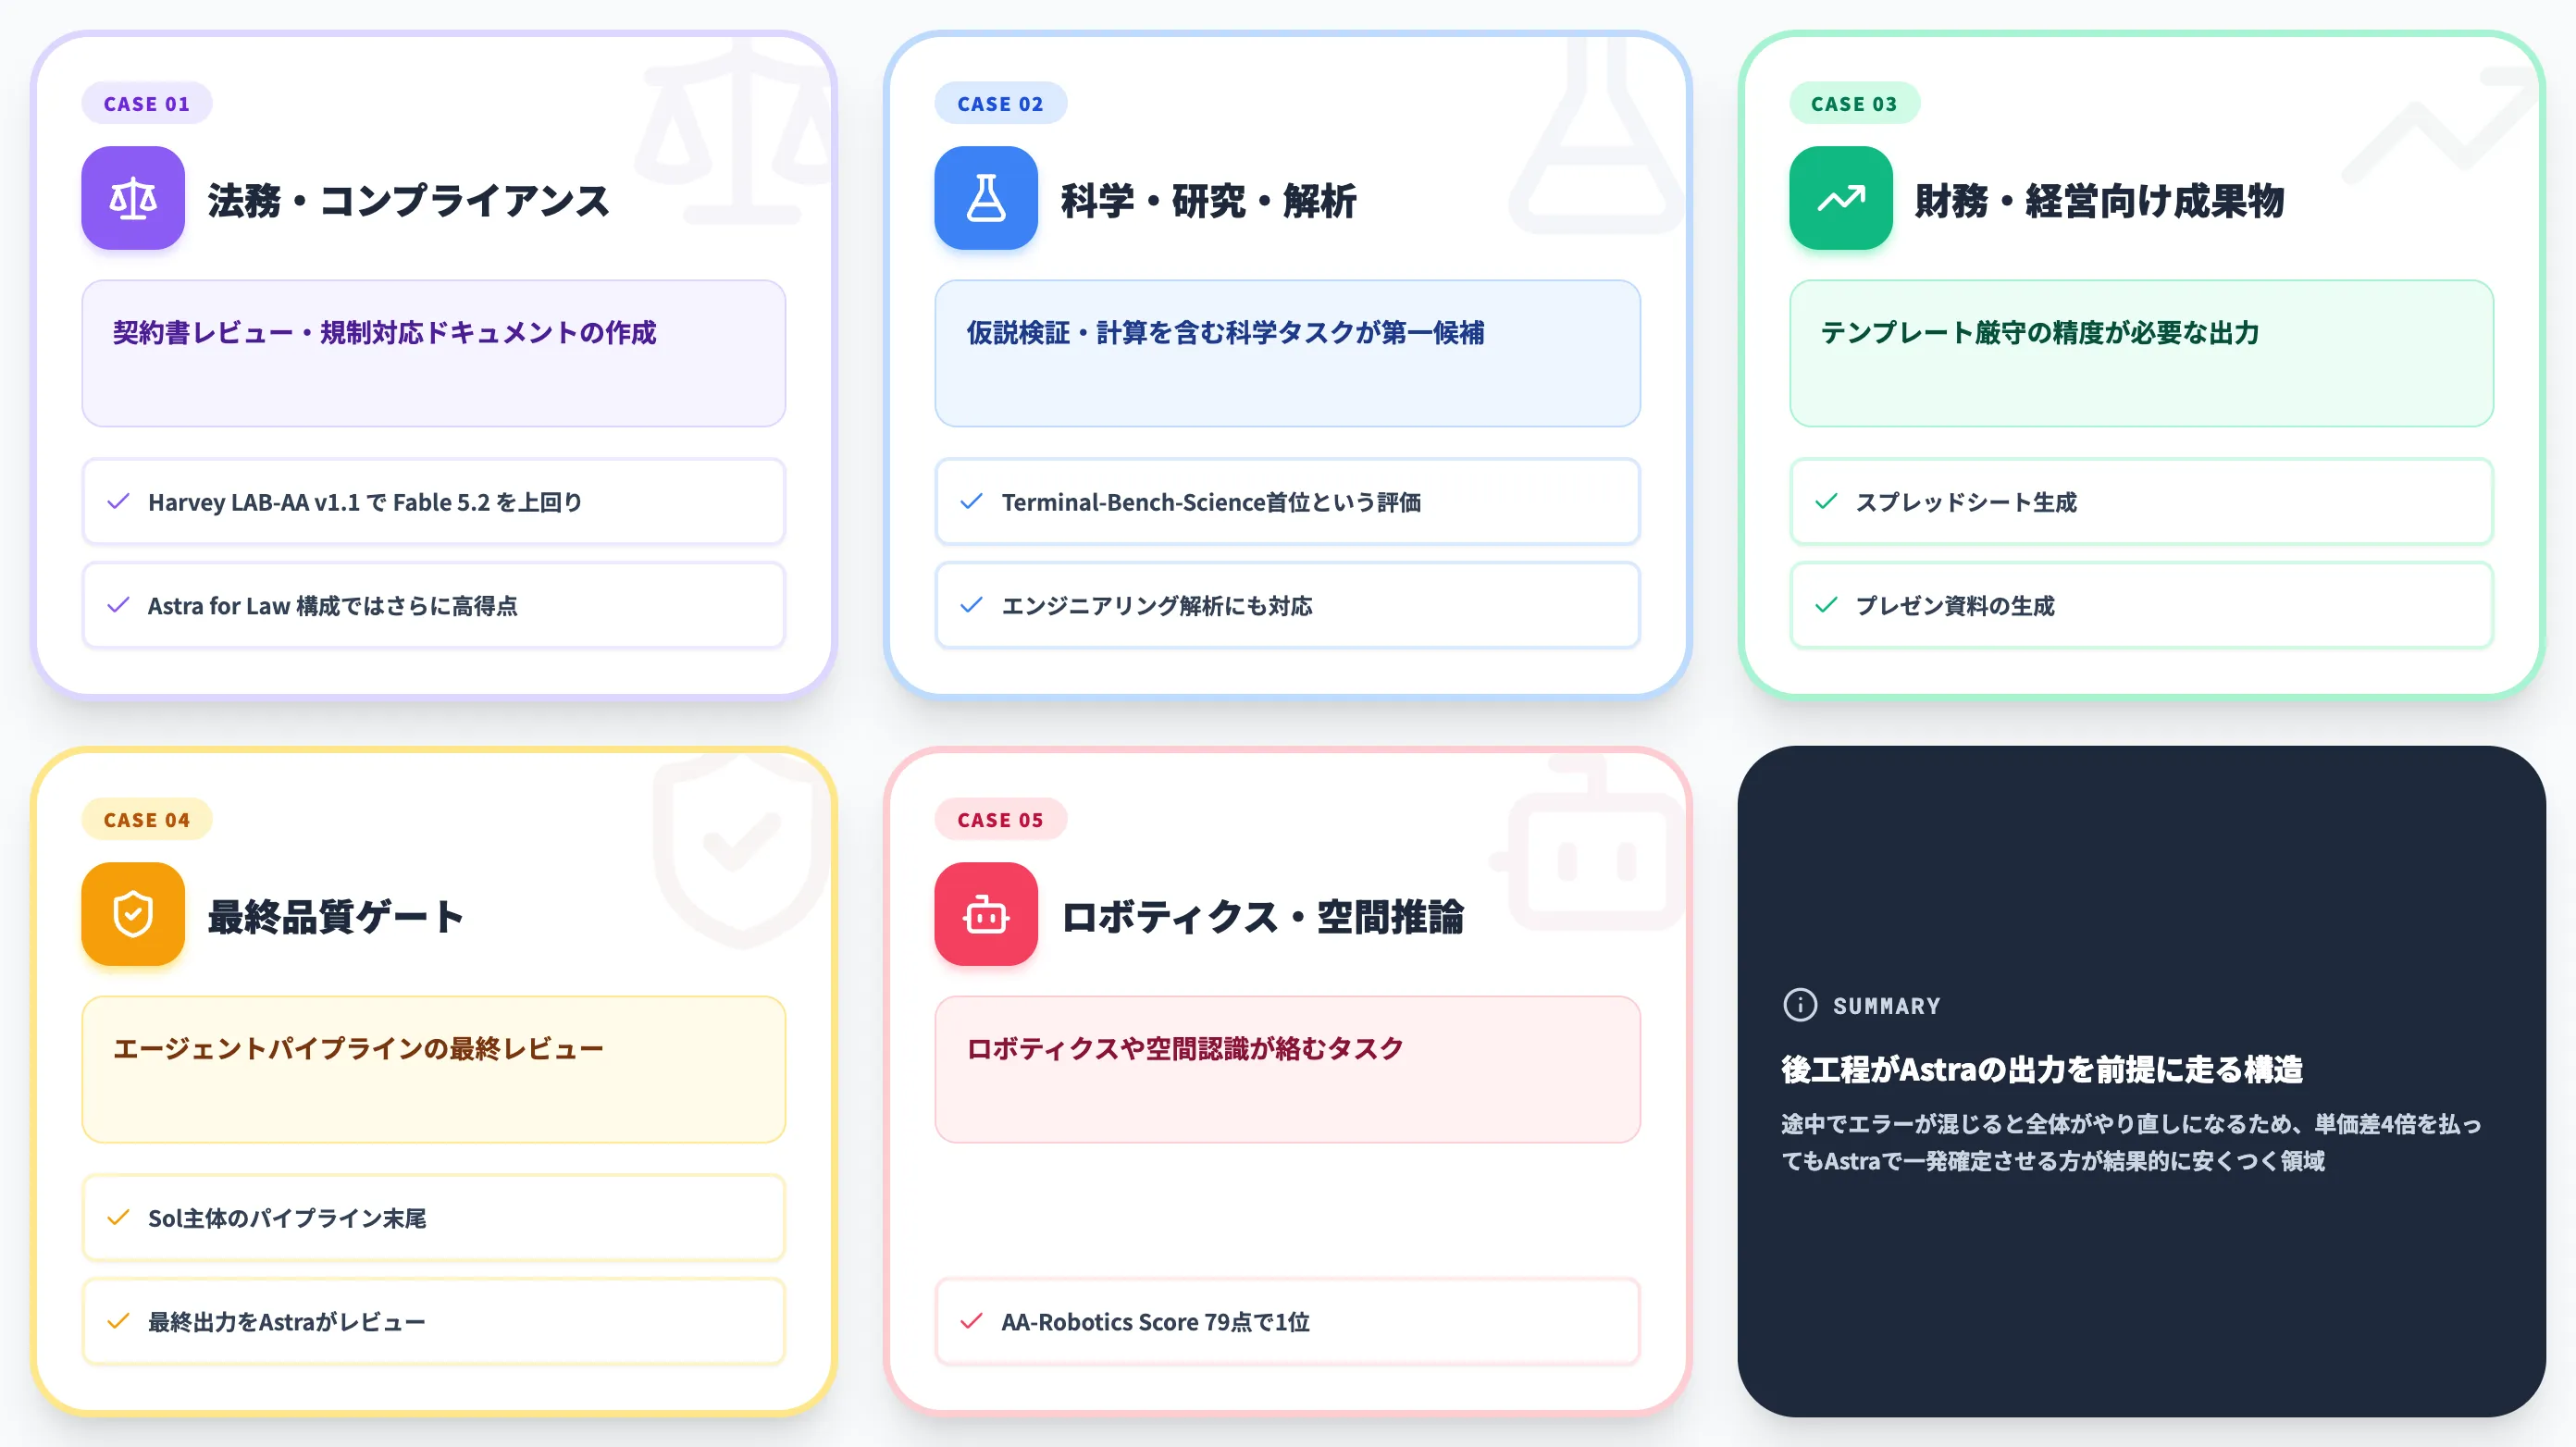
Astraは、やり直しコストが高い・1発で正解を出す必要のあるタスクに割り当てます。
-
法務・コンプライアンス
契約書レビュー・規制対応ドキュメントの作成。通常のGPT-6.2 Astraが Harvey LAB-AA v1.1 で Fable 5.2 を上回り、Astra for Law 構成ではさらに高い得点が報告されている
-
科学・研究・エンジニアリング解析
Terminal-Bench-Science首位という評価通り、仮説検証・計算を含む科学タスクはAstra第一候補
-
財務・経営向け成果物
テンプレート厳守の精度が必要なスプレッドシート・プレゼン資料の生成
-
エージェントパイプラインの最終品質ゲート
Sol主体のパイプラインの末尾で、最終出力をAstraがレビューする構成
-
ロボティクス・空間推論
AA-Robotics Scoreで79点と1位のため、ロボティクスや空間認識が絡むタスク
これらは「後工程がAstraの出力を前提に走る」構造になっているケースで、途中でエラーが混じると全体がやり直しになるため、単価差4倍を払ってもAstraで一発確定させる方が結果的に安くつくことが多い領域です。
Solを使うべきケース
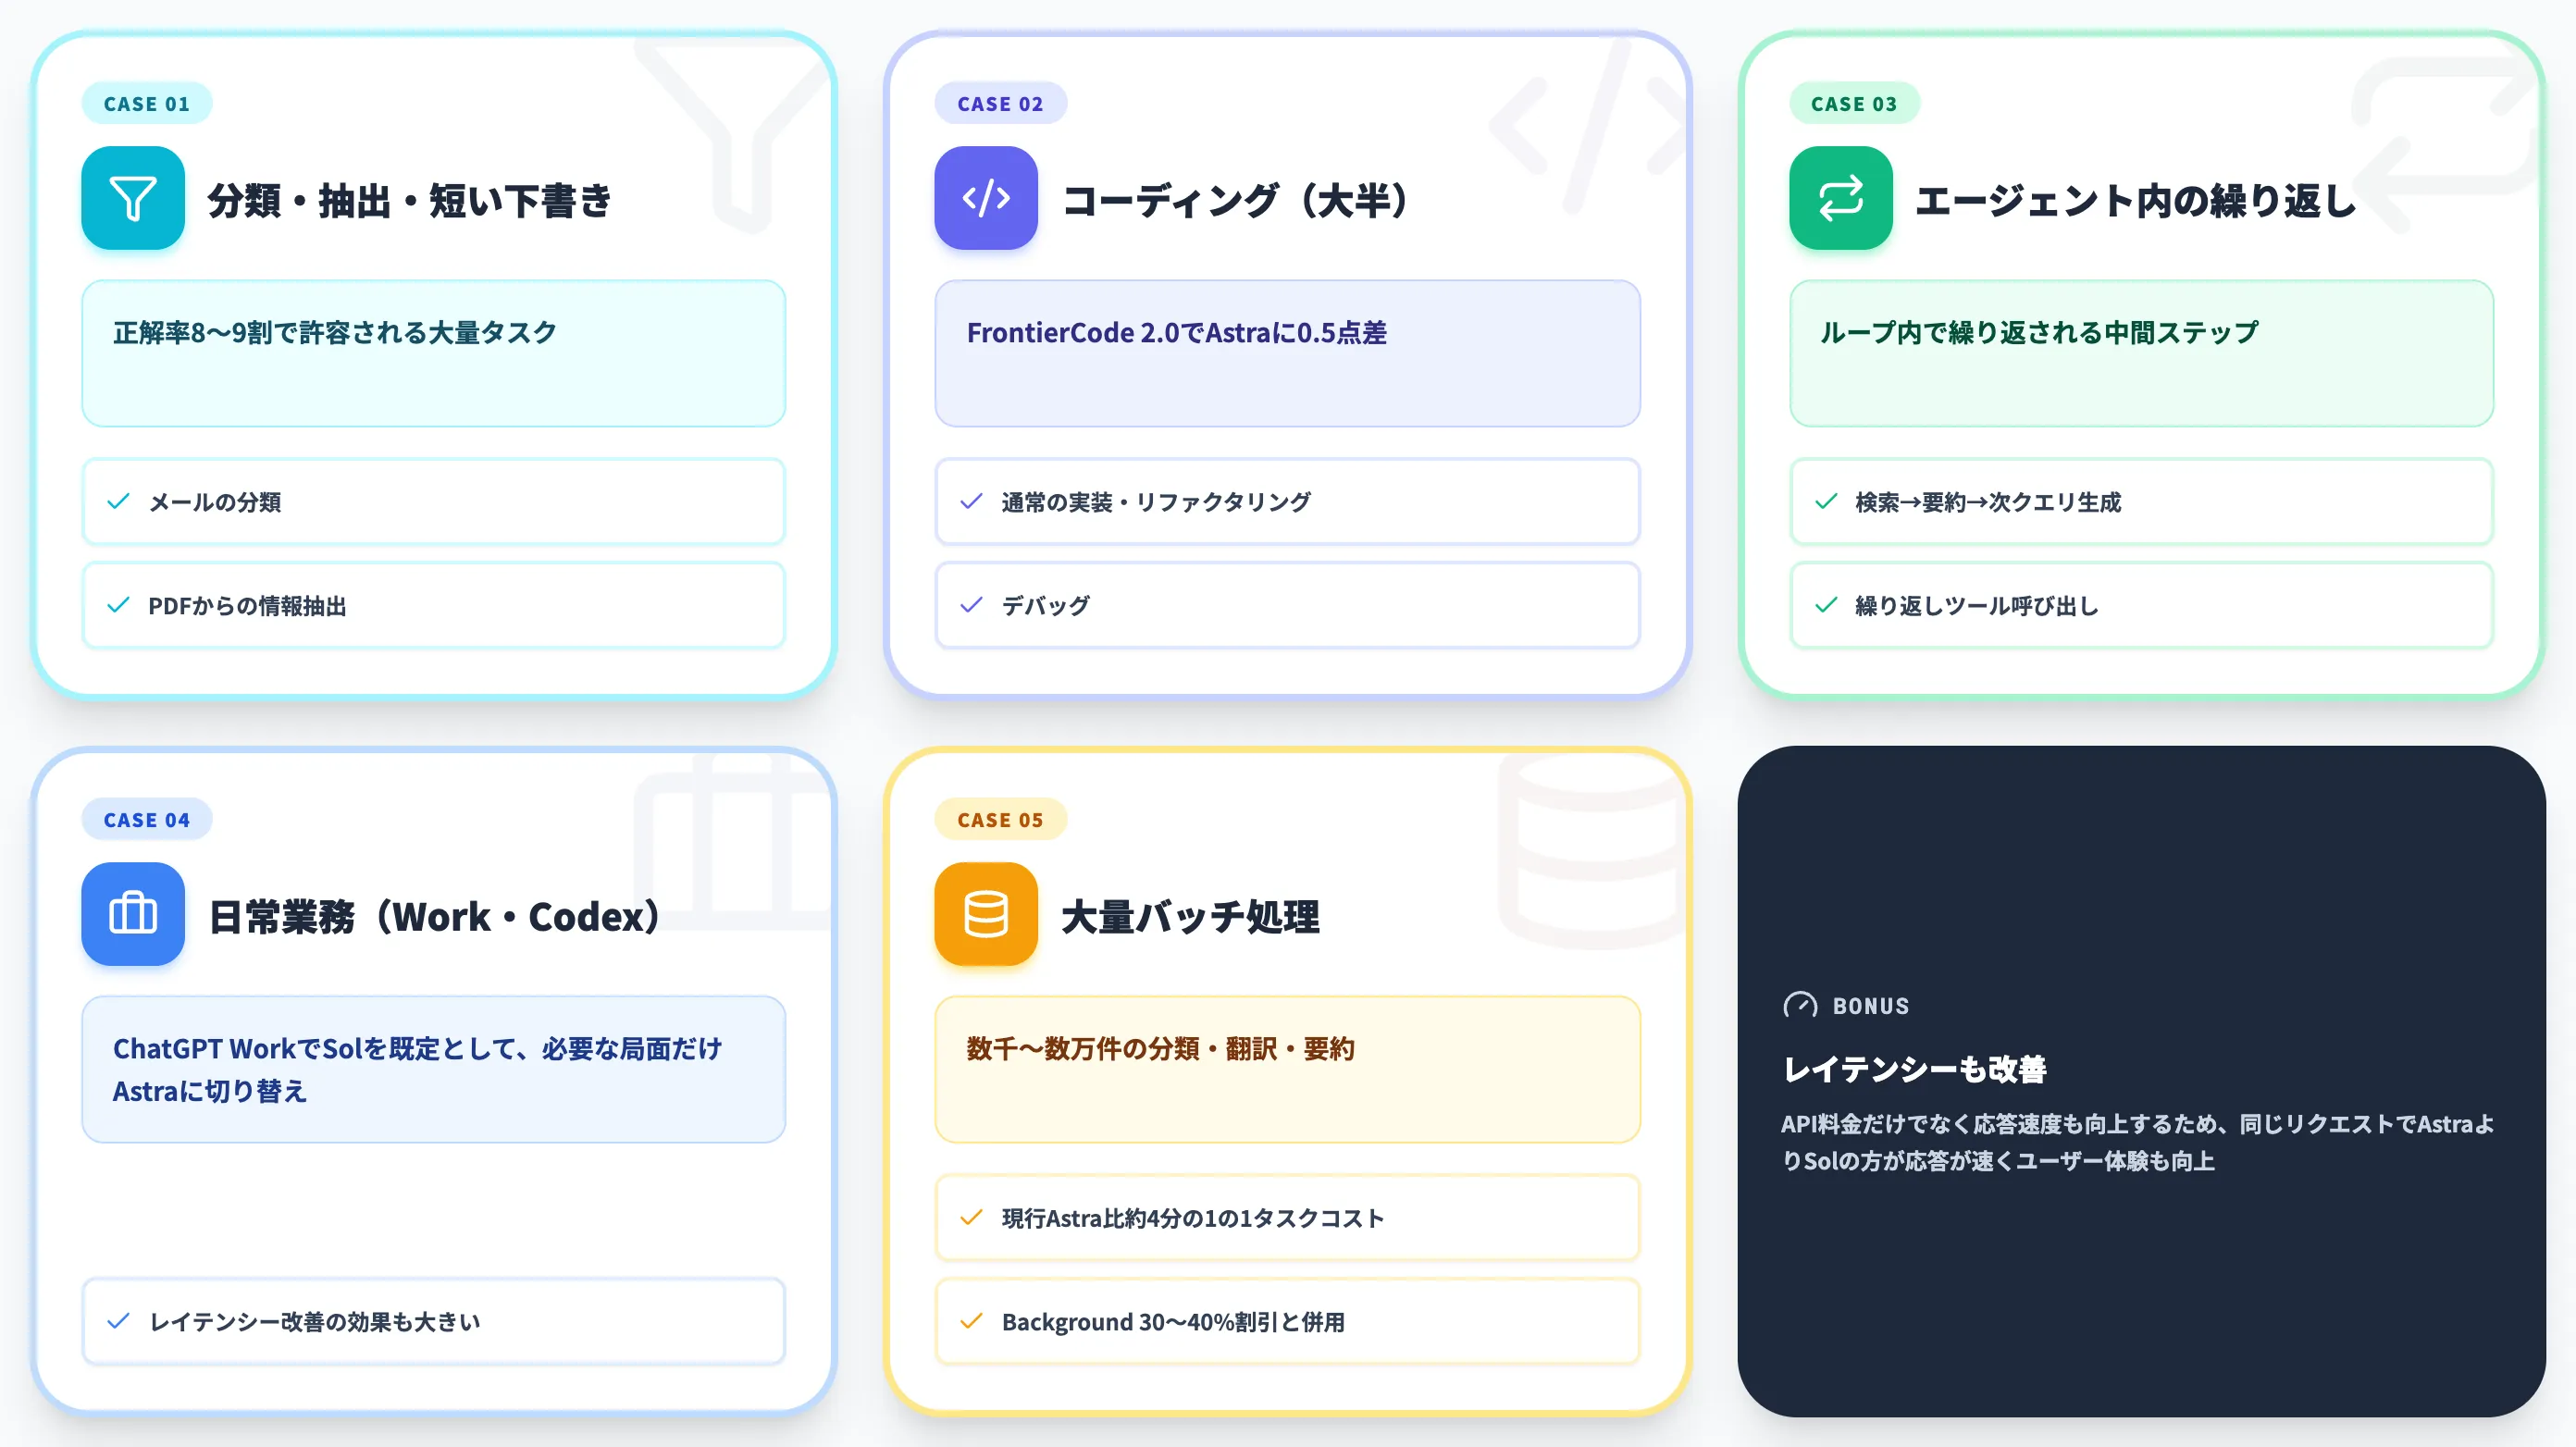
Solは、量が多く、1件あたりの正解率が8〜9割で許容されるタスクに割り当てます。
-
分類・抽出・短い下書き
メールの分類、PDFからの情報抽出、短いドラフト生成
-
コーディング(大半)
FrontierCode 2.0でAstraに0.5点差。通常の実装・リファクタリング・デバッグはSolで十分
-
エージェント内の繰り返しツール呼び出し
検索→要約→次のクエリ生成のような、ループ内で繰り返される中間ステップ
-
ChatGPT WorkやCodexでの日常業務
ChatGPT WorkでSolを既定として、必要な局面だけAstraに切り替え
-
大量バッチ処理
数千〜数万件の分類・翻訳・要約。現行Astra比約4分の1の1タスクコスト+Background 30〜40%割引が効く領域
Solを主軸にするメリットは、API料金だけでなくレイテンシーの改善にもあり、同じリクエストでAstraよりSolの方が応答が速いためユーザー体験も向上します。
ハイブリッド運用——Sol主体+Astraエスカレーション
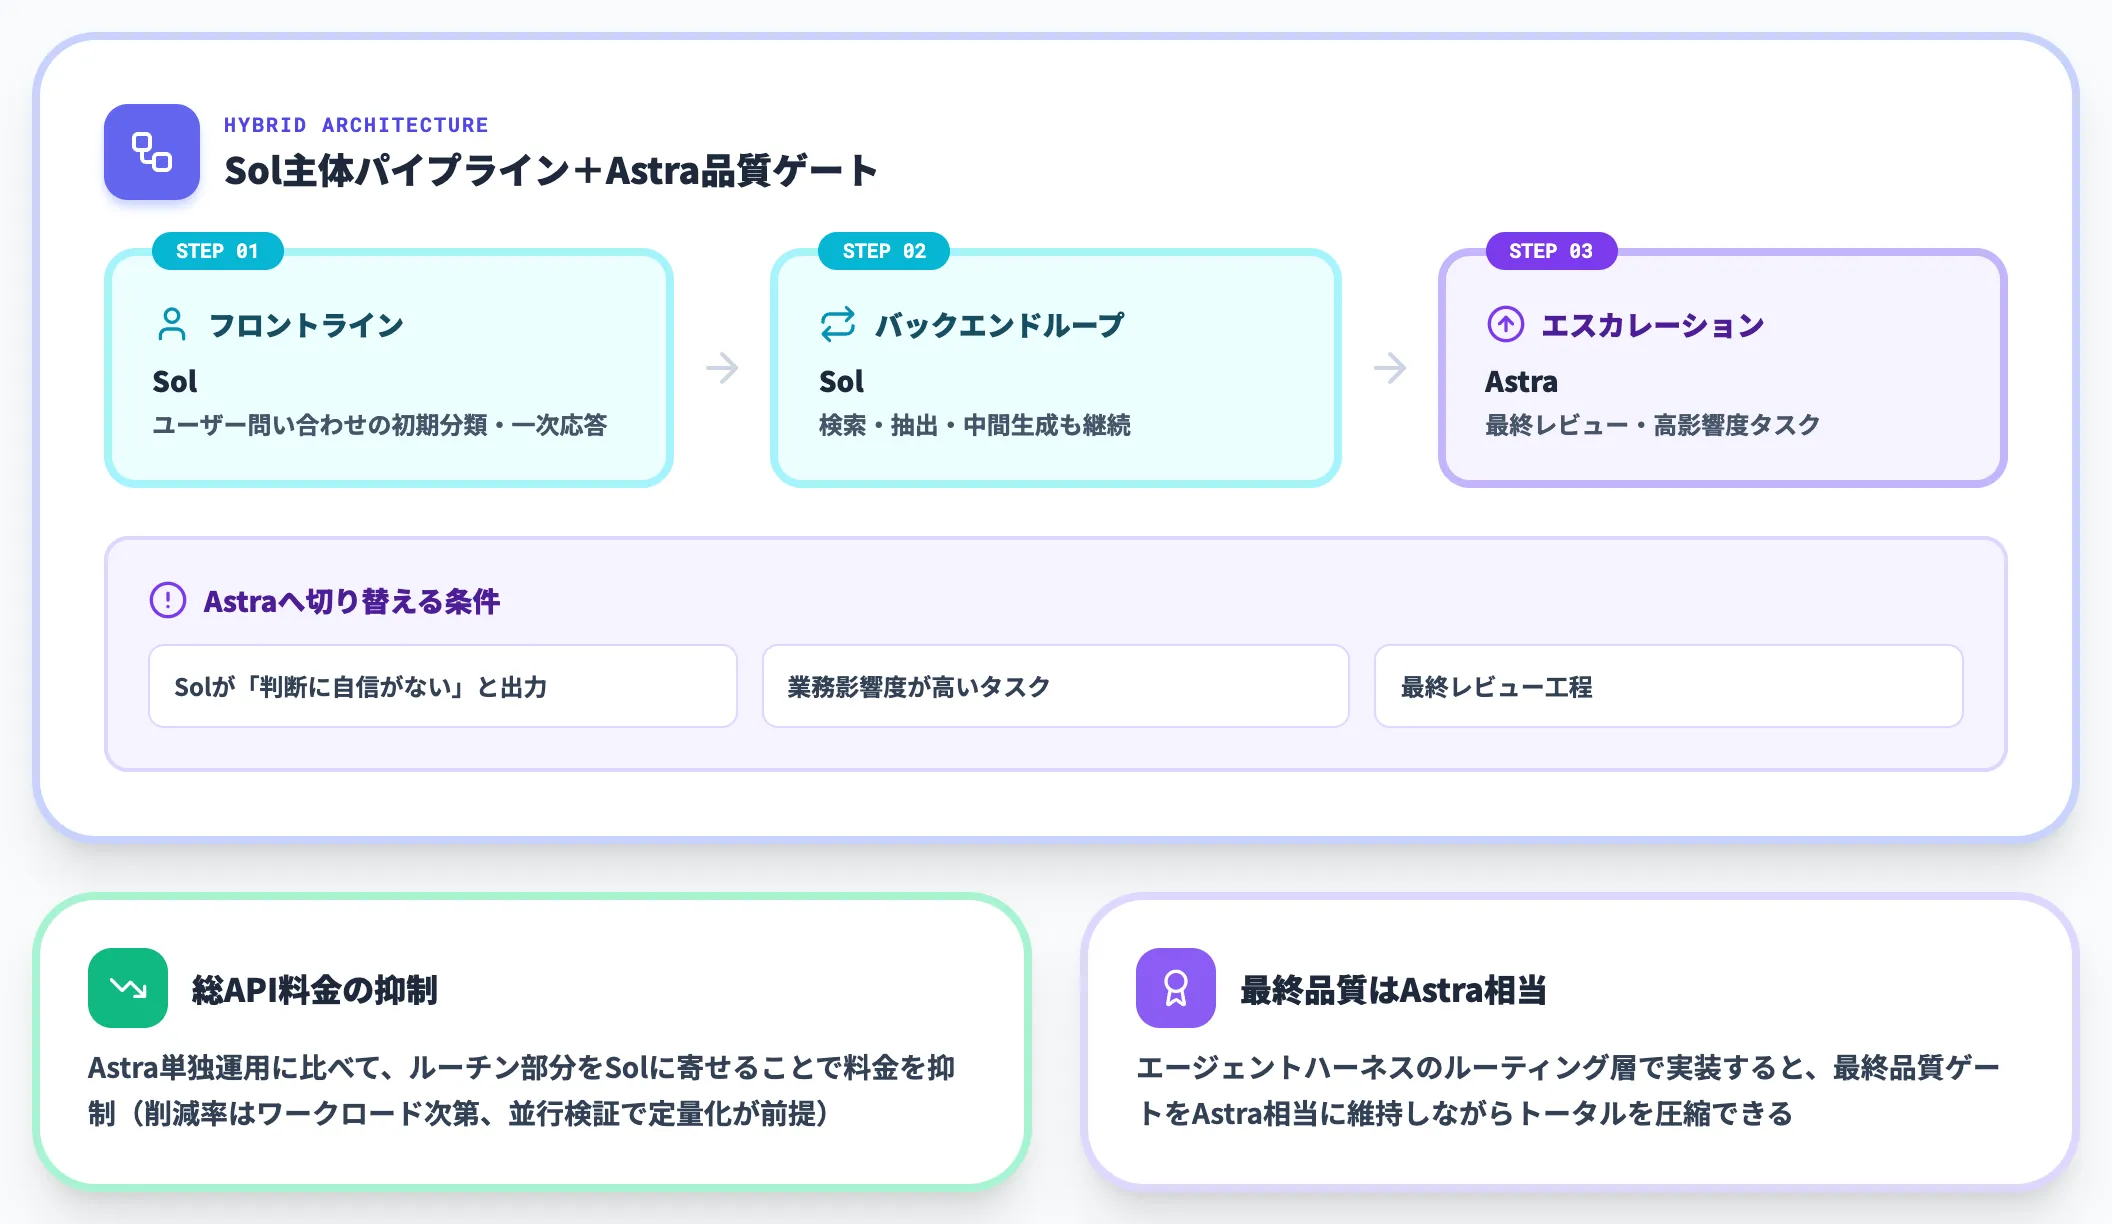
実運用で有力な構成は、Solを主体にしてAstraを品質ゲートとして配置するハイブリッド構成です。
-
フロントライン
ユーザー問い合わせの初期分類・一次応答はSol
-
バックエンドループ
検索・抽出・中間生成もSol
-
エスカレーション条件
Solが「判断に自信がない」と出力したタスク・業務影響度が高いタスク・最終レビューはAstraへ切り替え
この構成をエージェントハーネスのルーティング層で実装すると、Astra単独運用に比べて総API料金を抑えつつ、最終品質はAstra相当を維持できる余地があります。実際の削減率はワークロードごとに大きく変わるため、並行検証で定量的に押さえることが前提です。
注意点:モデル切替時の推論情報破棄:会話の途中でシステムプロンプト冒頭を変更する・Astra→Solへダウングレードするなどの条件では、GPT-6.2が内部で保持していた推論情報(reasoning items)が破棄される場合があります。Sol→Astraエスカレーションに対する逆方向のフォールバック(Astra→Solダウングレード)や、同一会話内でのモデル切替を組む際は、公式ガイドで対象条件を確認してから実装します。
GPT-6.2 AstraとSolの使い方——ChatGPT Work・Codex・APIでの実装
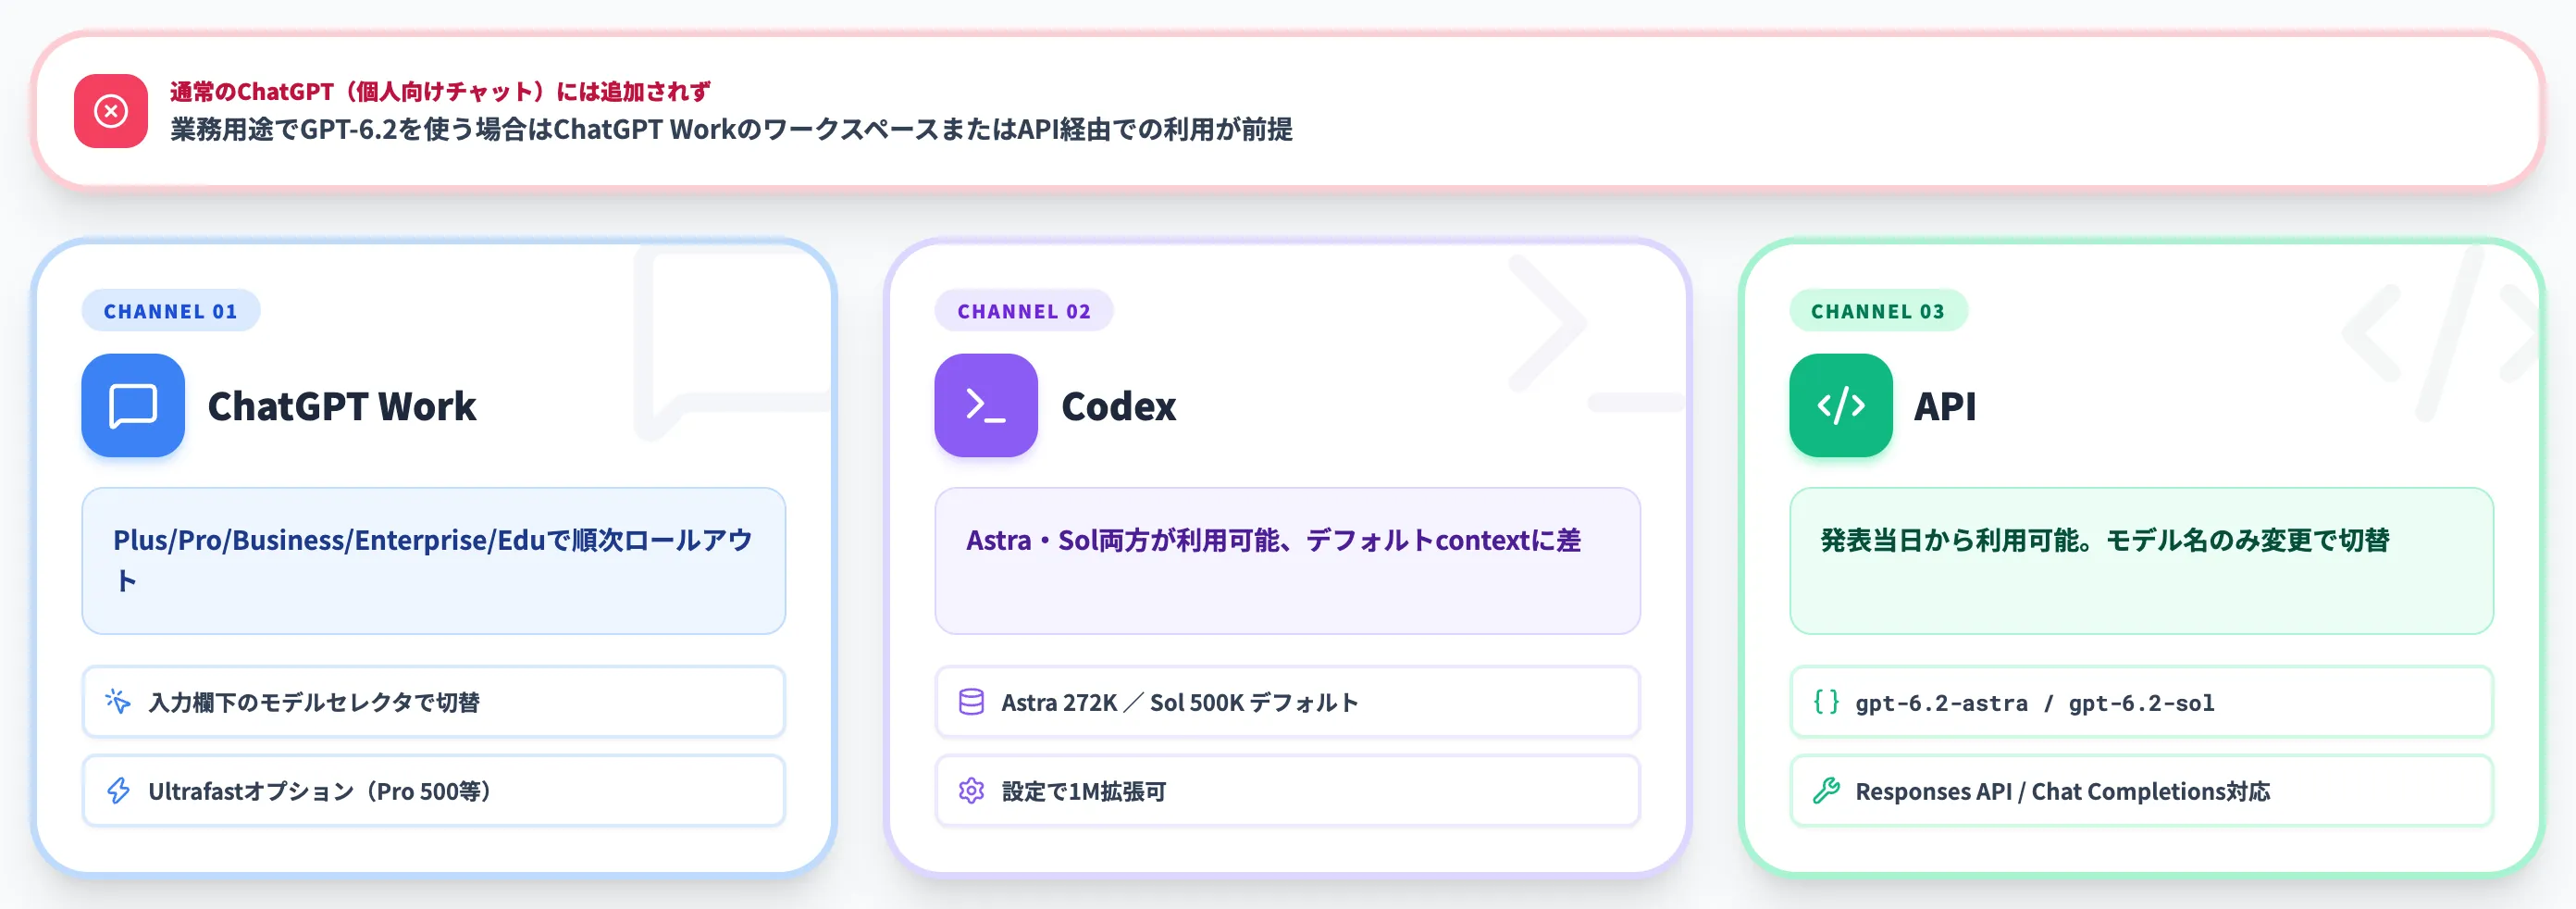
GPT-6.2 Astra・Solは、通常のChatGPT(個人向けチャット)には追加されず、ChatGPT Work・Codex・APIの3経路で提供されます。
2026年11月17日の発表当日から、ChatGPT WorkはPlus/Pro/Business/Enterprise/Eduで順次ロールアウト、APIは即日利用可能になっています。
両モデルはテキスト・画像入力に対応し、出力はテキストで、Web検索・ファイル検索・コード実行・Computer UseといったTool UseがResponses API経由で利用できます。
ChatGPT Workでの使い方
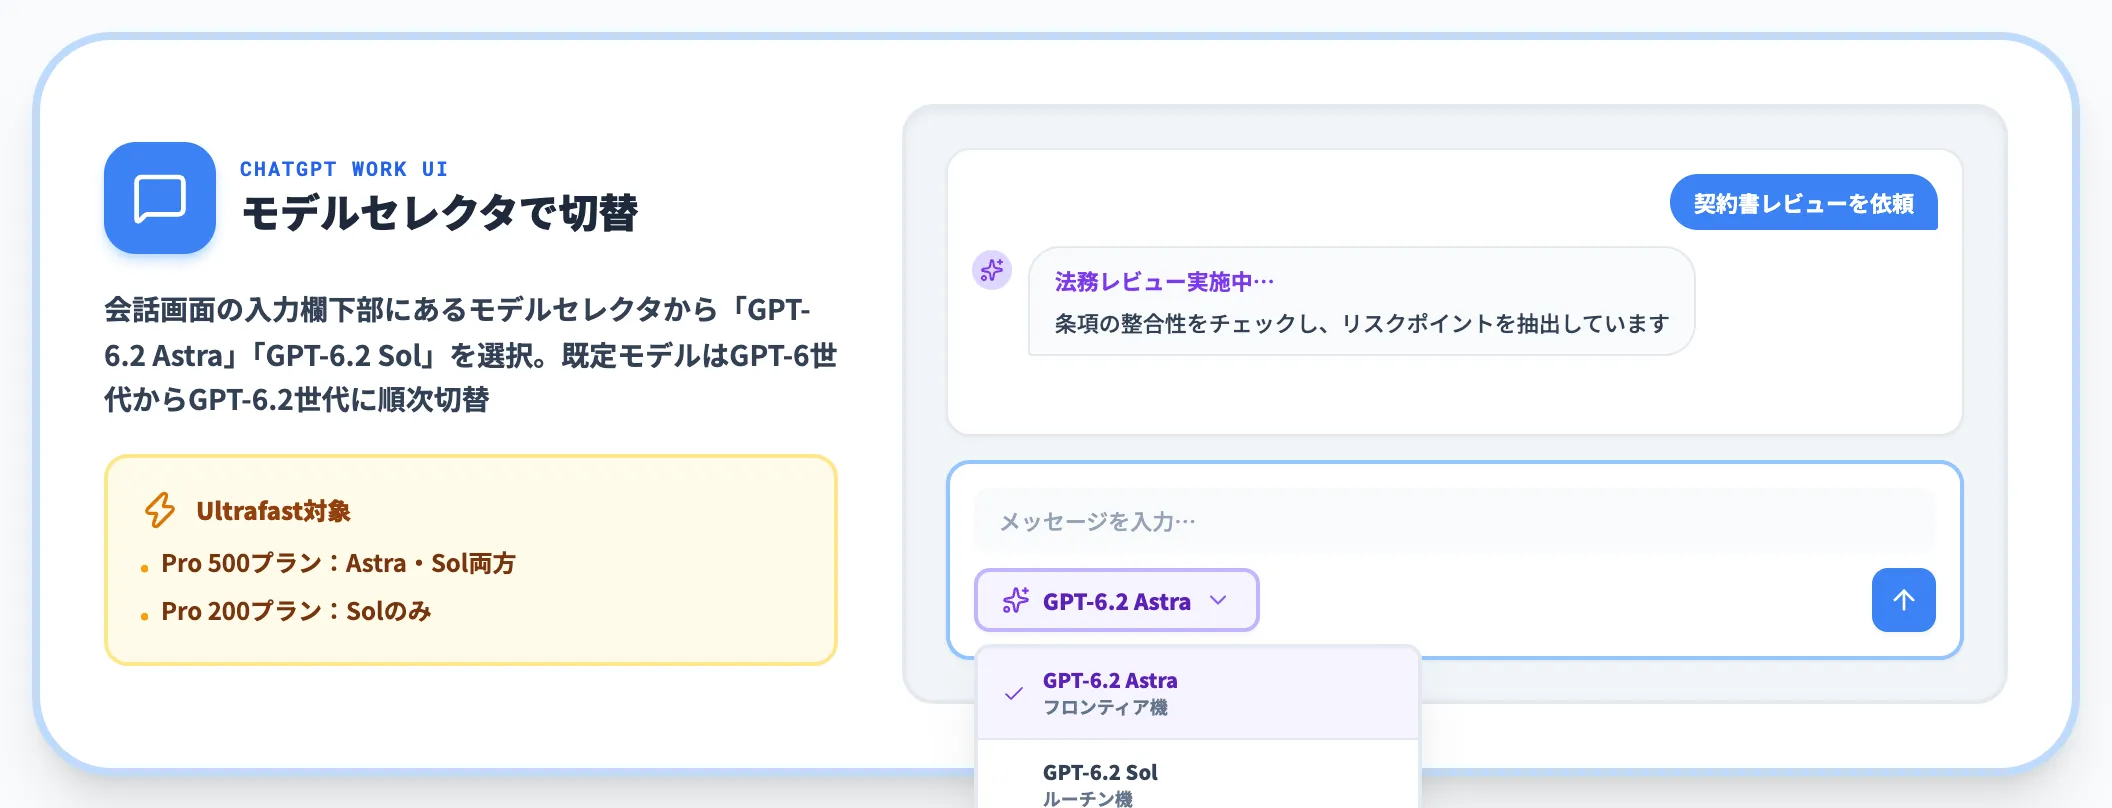
ChatGPT Workでは、会話画面の入力欄下部にあるモデルセレクタから「GPT-6.2 Astra」「GPT-6.2 Sol」を選んで切り替えます。
既定モデルがGPT-6世代からGPT-6.2世代に順次切り替わる見込みで、個別会話でSol→Astraのエスカレーションが必要なケースだけ手動で切り替える運用になります。
通常の ChatGPT(個人向けチャット)にはGPT-6.2 Astra・Solは追加されておらず、業務用途でGPT-6.2を使う場合はChatGPT WorkのワークスペースまたはAPI経由での利用が前提です。
Ultrafast速度オプション:Pro 500プランでは両モデル(Astra・Sol)がUltrafast対象、Pro 200ではSolのみがUltrafast対象です。応答速度を優先したい業務ユースケースでは、プラン選定時にこの条件も合わせて確認します。
Codexでの使い方とcontextの違い
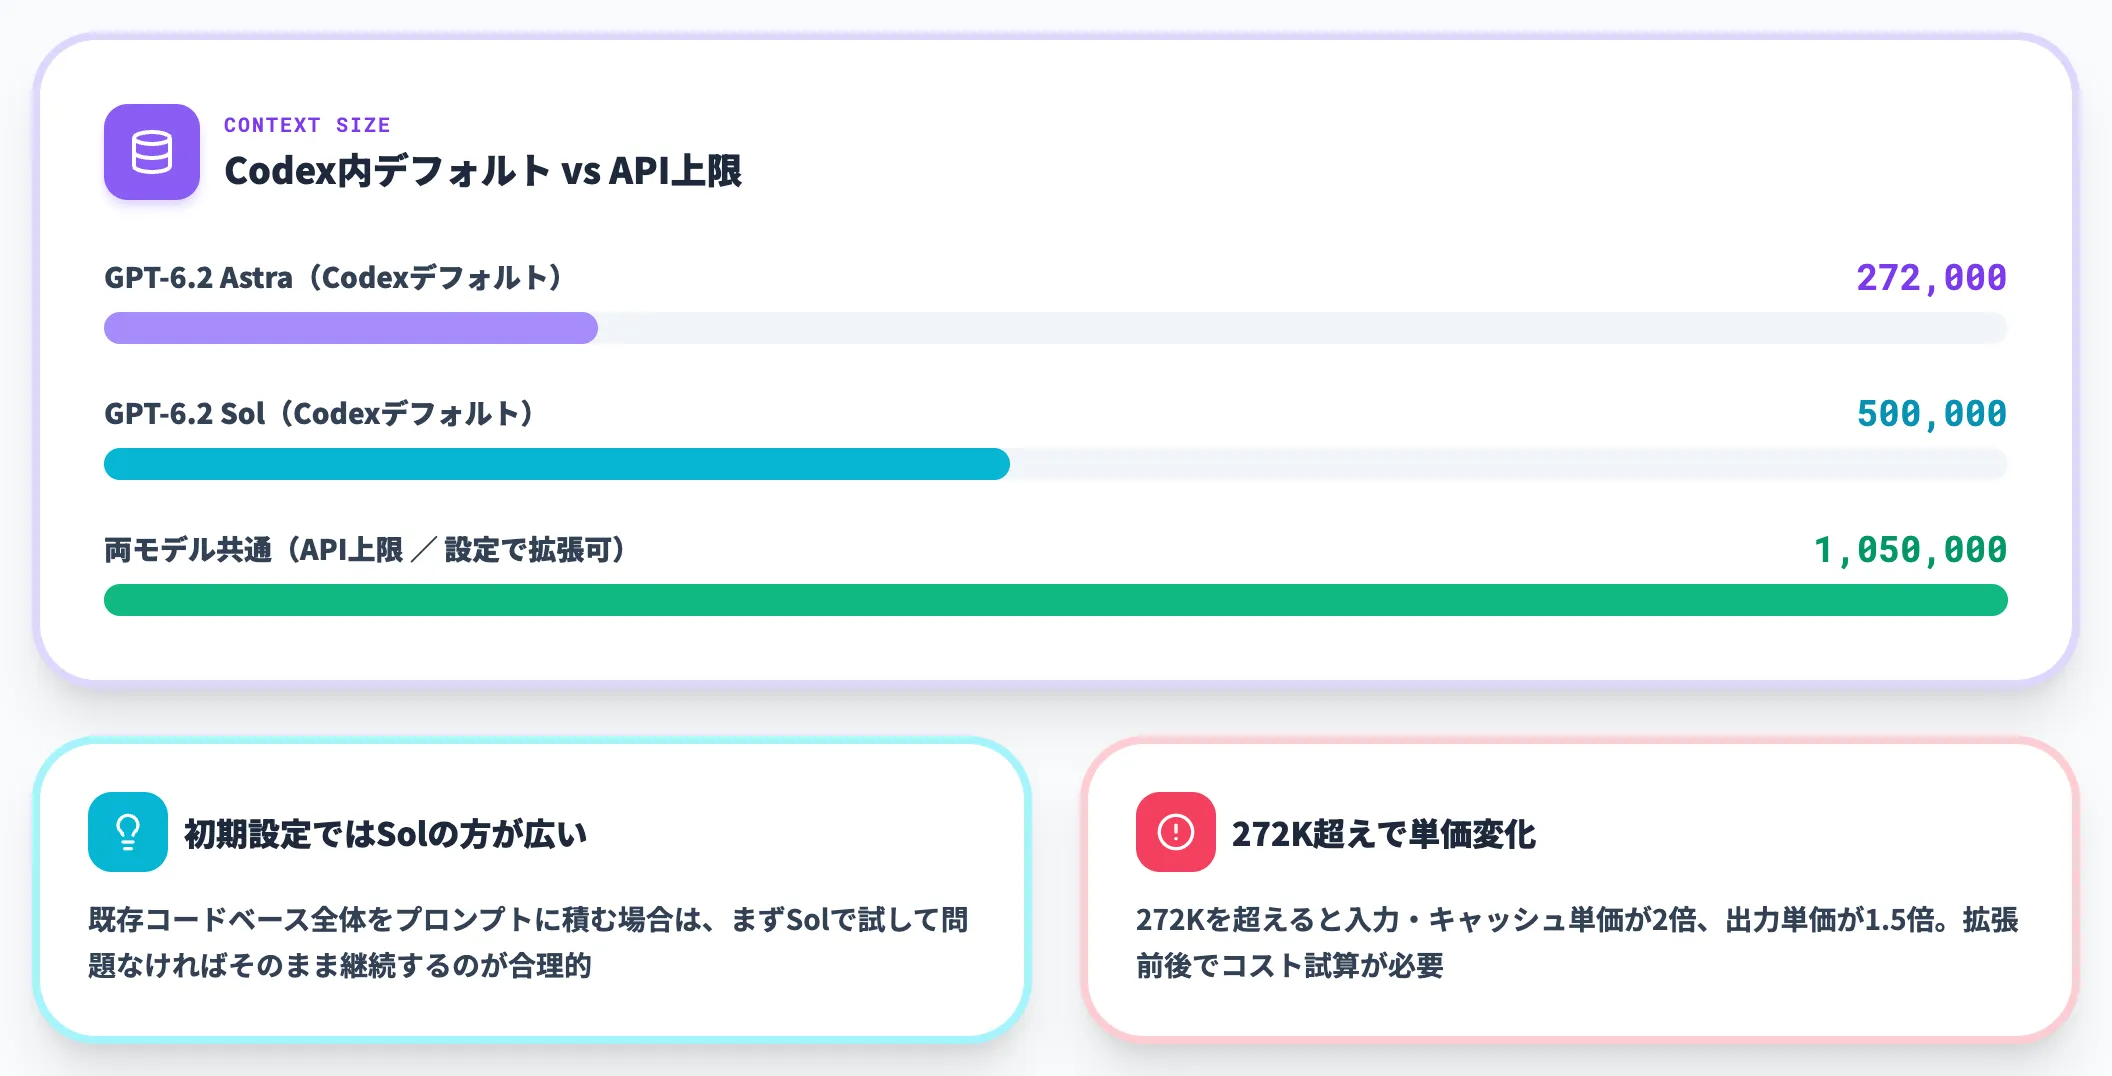
Codex環境では、GPT-6.2 Astra・Sol両方が利用可能で、デフォルトのコンテキストサイズに差がある点が注意点です。
| モデル | Codex内デフォルト | API上限 | 設定変更後 |
|---|---|---|---|
| GPT-6.2 Astra | 272,000トークン | 1,050,000 | 設定で1M拡張可 |
| GPT-6.2 Sol | 500,000トークン | 1,050,000 | 設定で1M拡張可 |
Codexで長文コンテキスト(既存コードベース全体をプロンプトに積む運用など)を組む場合、初期設定ではSolの方が広いcontextを持っているため、まずSolで試して問題ない場合はそのまま継続する運用が合理的です。
両モデルとも設定で1Mまで拡張できますが、272Kを超えると入力・キャッシュ単価が2倍・出力単価が1.5倍になるため、拡張前後でコストを試算する必要があります。
APIでの実装パターン
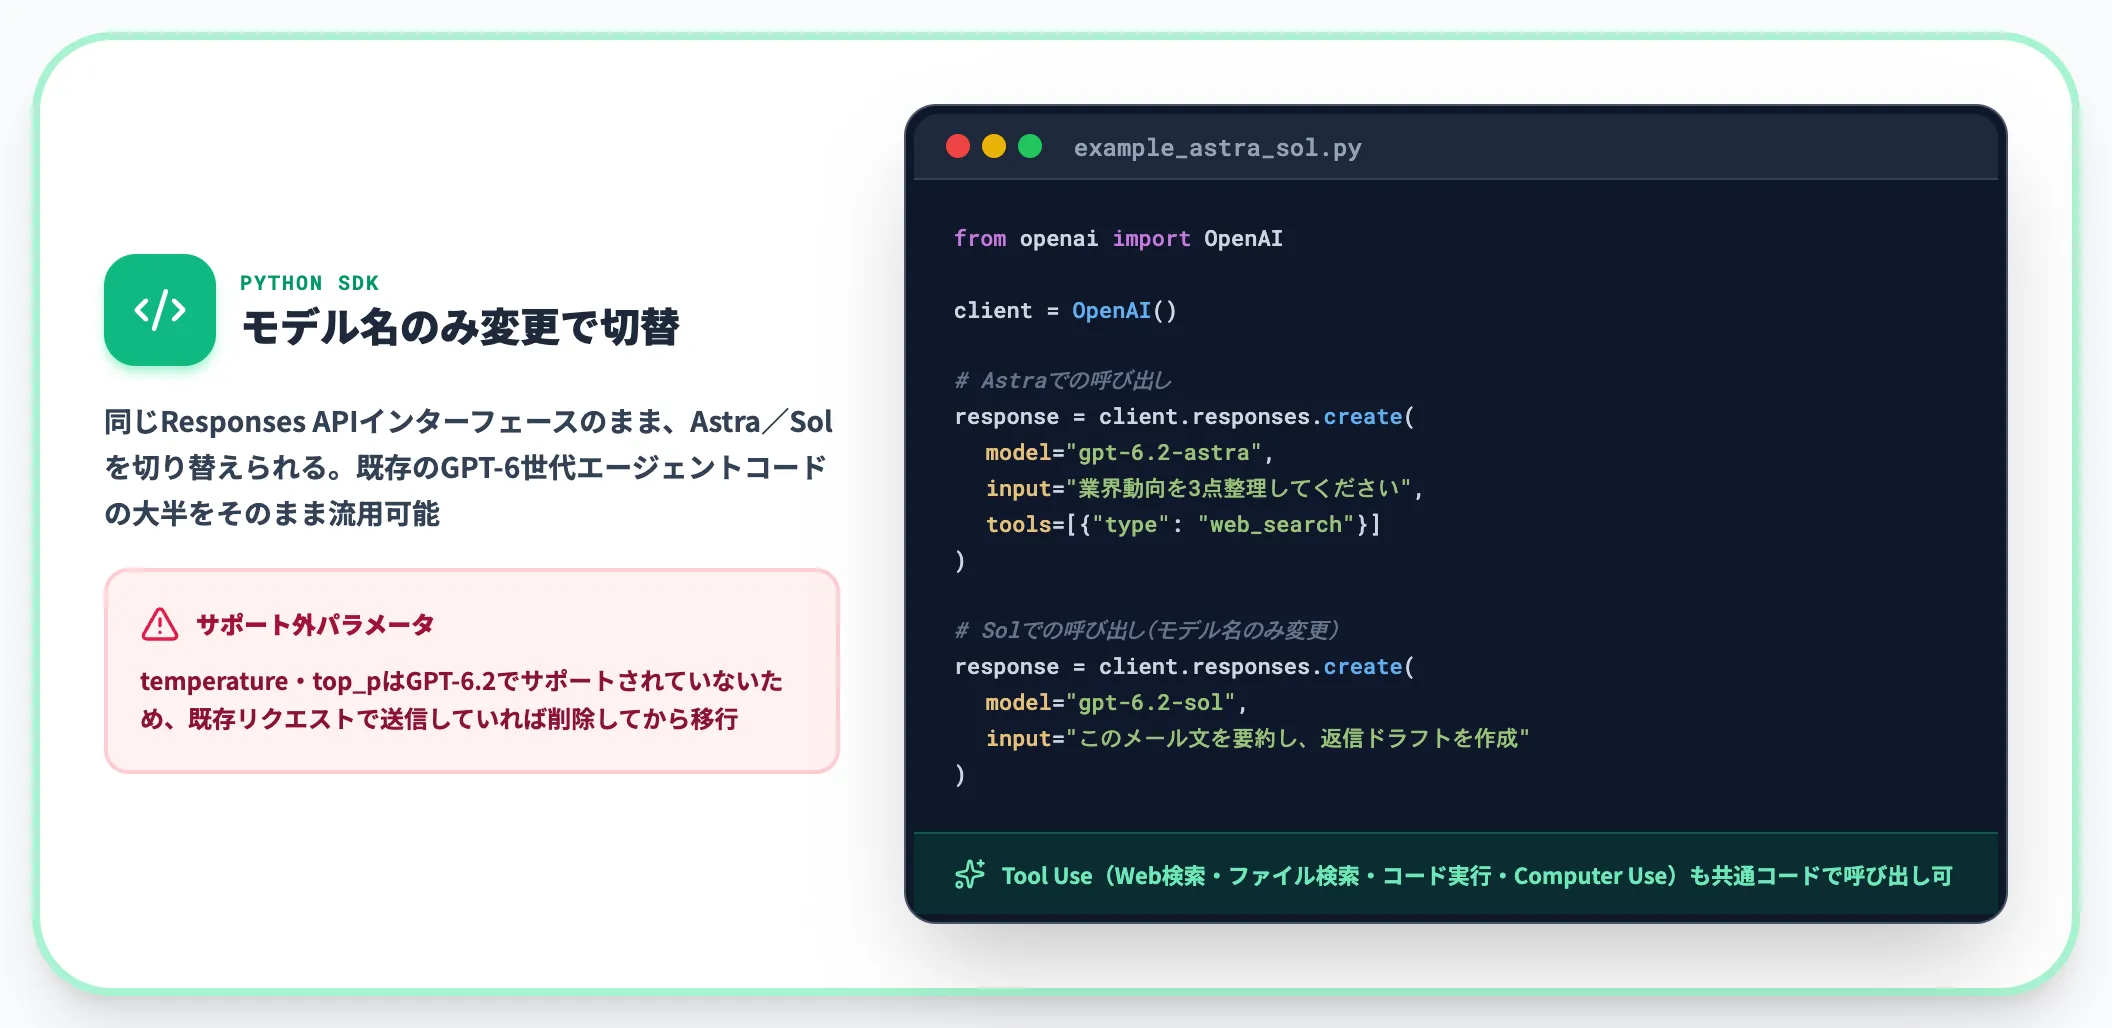
APIからの呼び出しは、Responses APIとChat Completionsの両方に対応します。
Pythonでの最小実装は以下の通りで、モデル名を変えるだけでAstra/Solを切り替えられます。temperature・top_pはGPT-6.2でサポートされていないため、既存リクエストで送信していれば削除してから移行します。
from openai import OpenAI

client = OpenAI()

# Astraでの呼び出し
response = client.responses.create(
    model="gpt-6.2-astra",
    input="2026年11月時点のAI業界の主要動向を3点整理してください。",
    tools=[{"type": "web_search"}]
)

# Solでの呼び出し(モデル名のみ変更)
response = client.responses.create(
    model="gpt-6.2-sol",
    input="このメール文を要約し、返信ドラフトを作成してください。"
)
このアプローチの利点は複数あります。モデル切り替えの実装負荷がほぼゼロで、タスク分類ロジック側で「model」パラメータを動的に切り替えるだけで、ハイブリッド運用(Sol主体+Astraエスカレーション)を実現できます。
また、同じResponses APIインターフェースのまま、Tool Use(Web検索・ファイル検索・コード実行・Computer Use)の呼び出しコードも共通化できるため、既存のGPT-6世代エージェントコードの大半をそのまま流用できます。
ルーティング層の設計
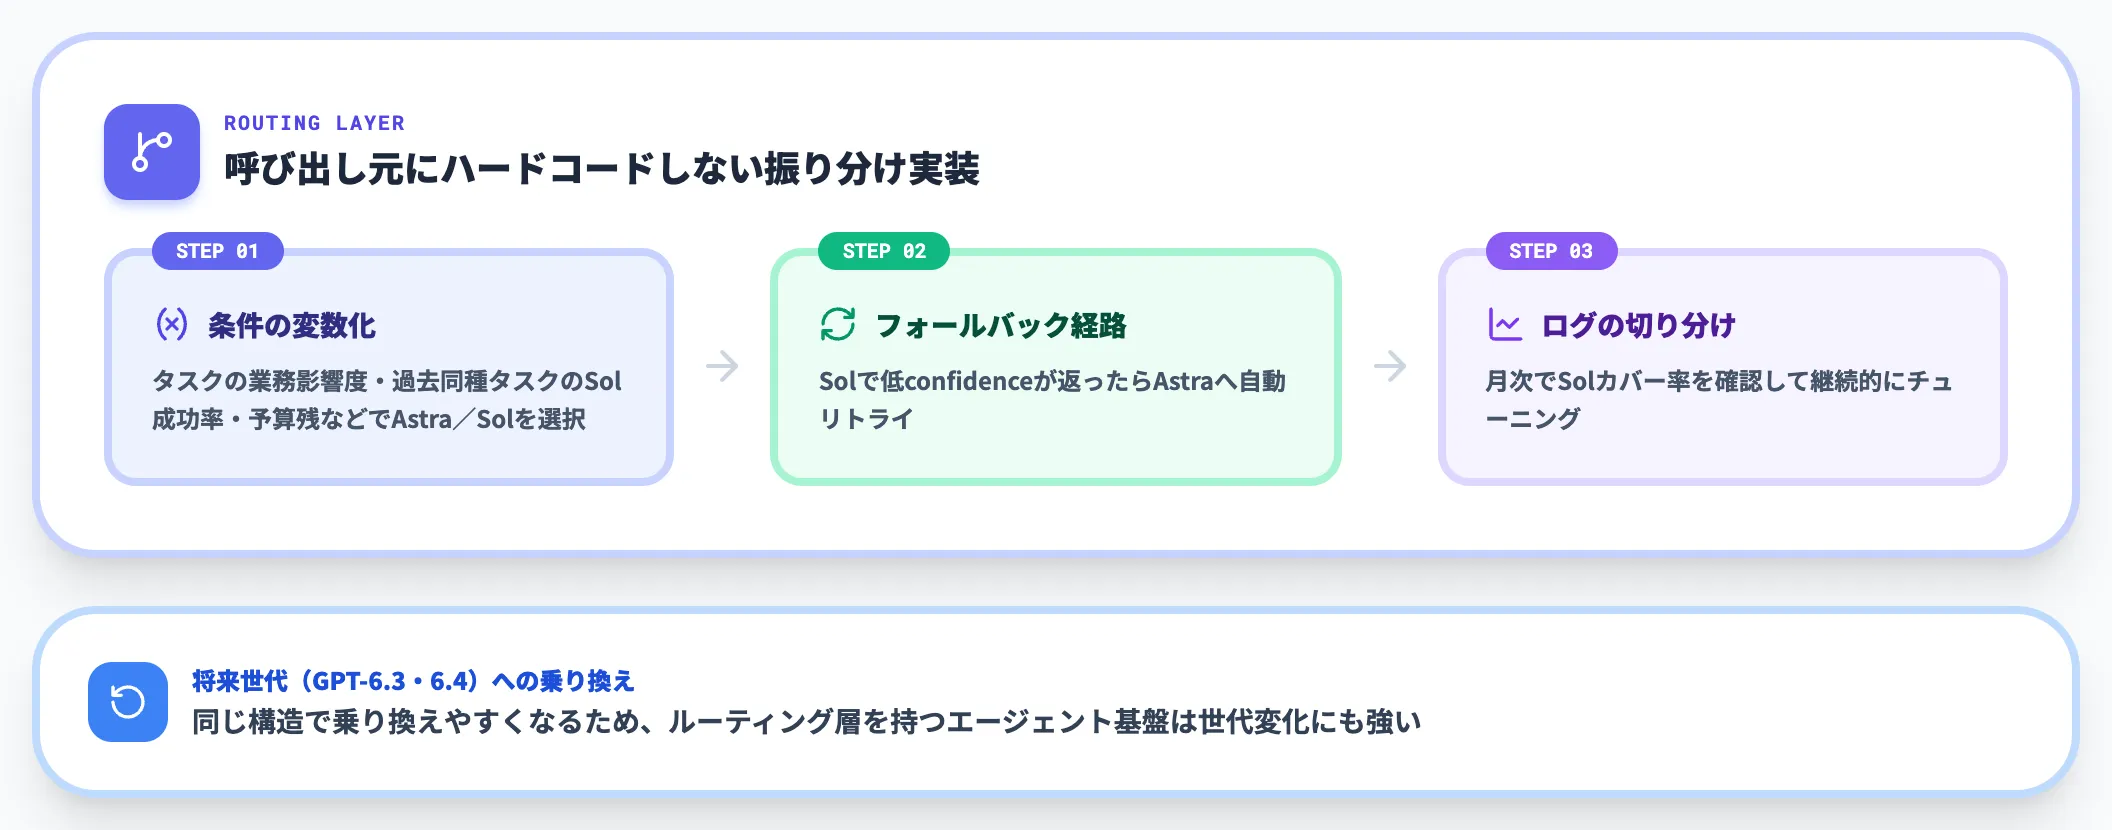
エージェント基盤でAstra/Solを混在運用する場合、呼び出し元にハードコードせずルーティング層で振り分ける実装にします。
-
ルーティング条件の変数化
「タスクの業務影響度」「過去同種タスクのSol成功率」「予算残」などの変数でAstra/Solを選択
-
フォールバック経路の確保
Solで低confidenceが返ったらAstraへ自動リトライ
-
ログの切り分け
どのタスクがどちらで処理されたか、月次でSolカバー率を確認して継続的にチューニング
こうしたルーティング設計のパターンは、エージェントハーネスの設計パターンで整理している複数の切り分け手法と組み合わせて実装でき、将来GPT-6.3・6.4と世代が進んでも同じ構造で乗り換えやすくなります。
GPT-6世代からの進化と移行判断
GPT-6世代(Astra・Sol・Luna・6.1 Sol・6.1 Terra)を既に本番運用している場合、GPT-6.2への移行はモデル名の切り替えで技術的には即日可能ですが、既存リクエストで 「temperature」「top_p」 等のサポート外パラメータを送っていないか、Responses APIの新しい要件に合致するかを事前確認してから並行検証を挟むのが安全です。
GPT-6.2 Astra・SolのResponses API・Tool Useの仕様・入出力フォーマットは、おおむねGPT-6 Astraと互換的に扱えるため、「gpt-6-astra」を「gpt-6.2-astra」に置き換えるだけで動作する前提で設計されています(内部アーキテクチャの詳細は公式未開示)。GPT-6.1 Solから「gpt-6.2-sol」への切り替えも同様です。
世代間での性能・単価差
以下の表で、GPT-6世代から6.2世代への変化を整理しました(単価はStandard・入力272K以下)。
| 対象 | 前世代 | GPT-6.2 | 変化 |
|---|---|---|---|
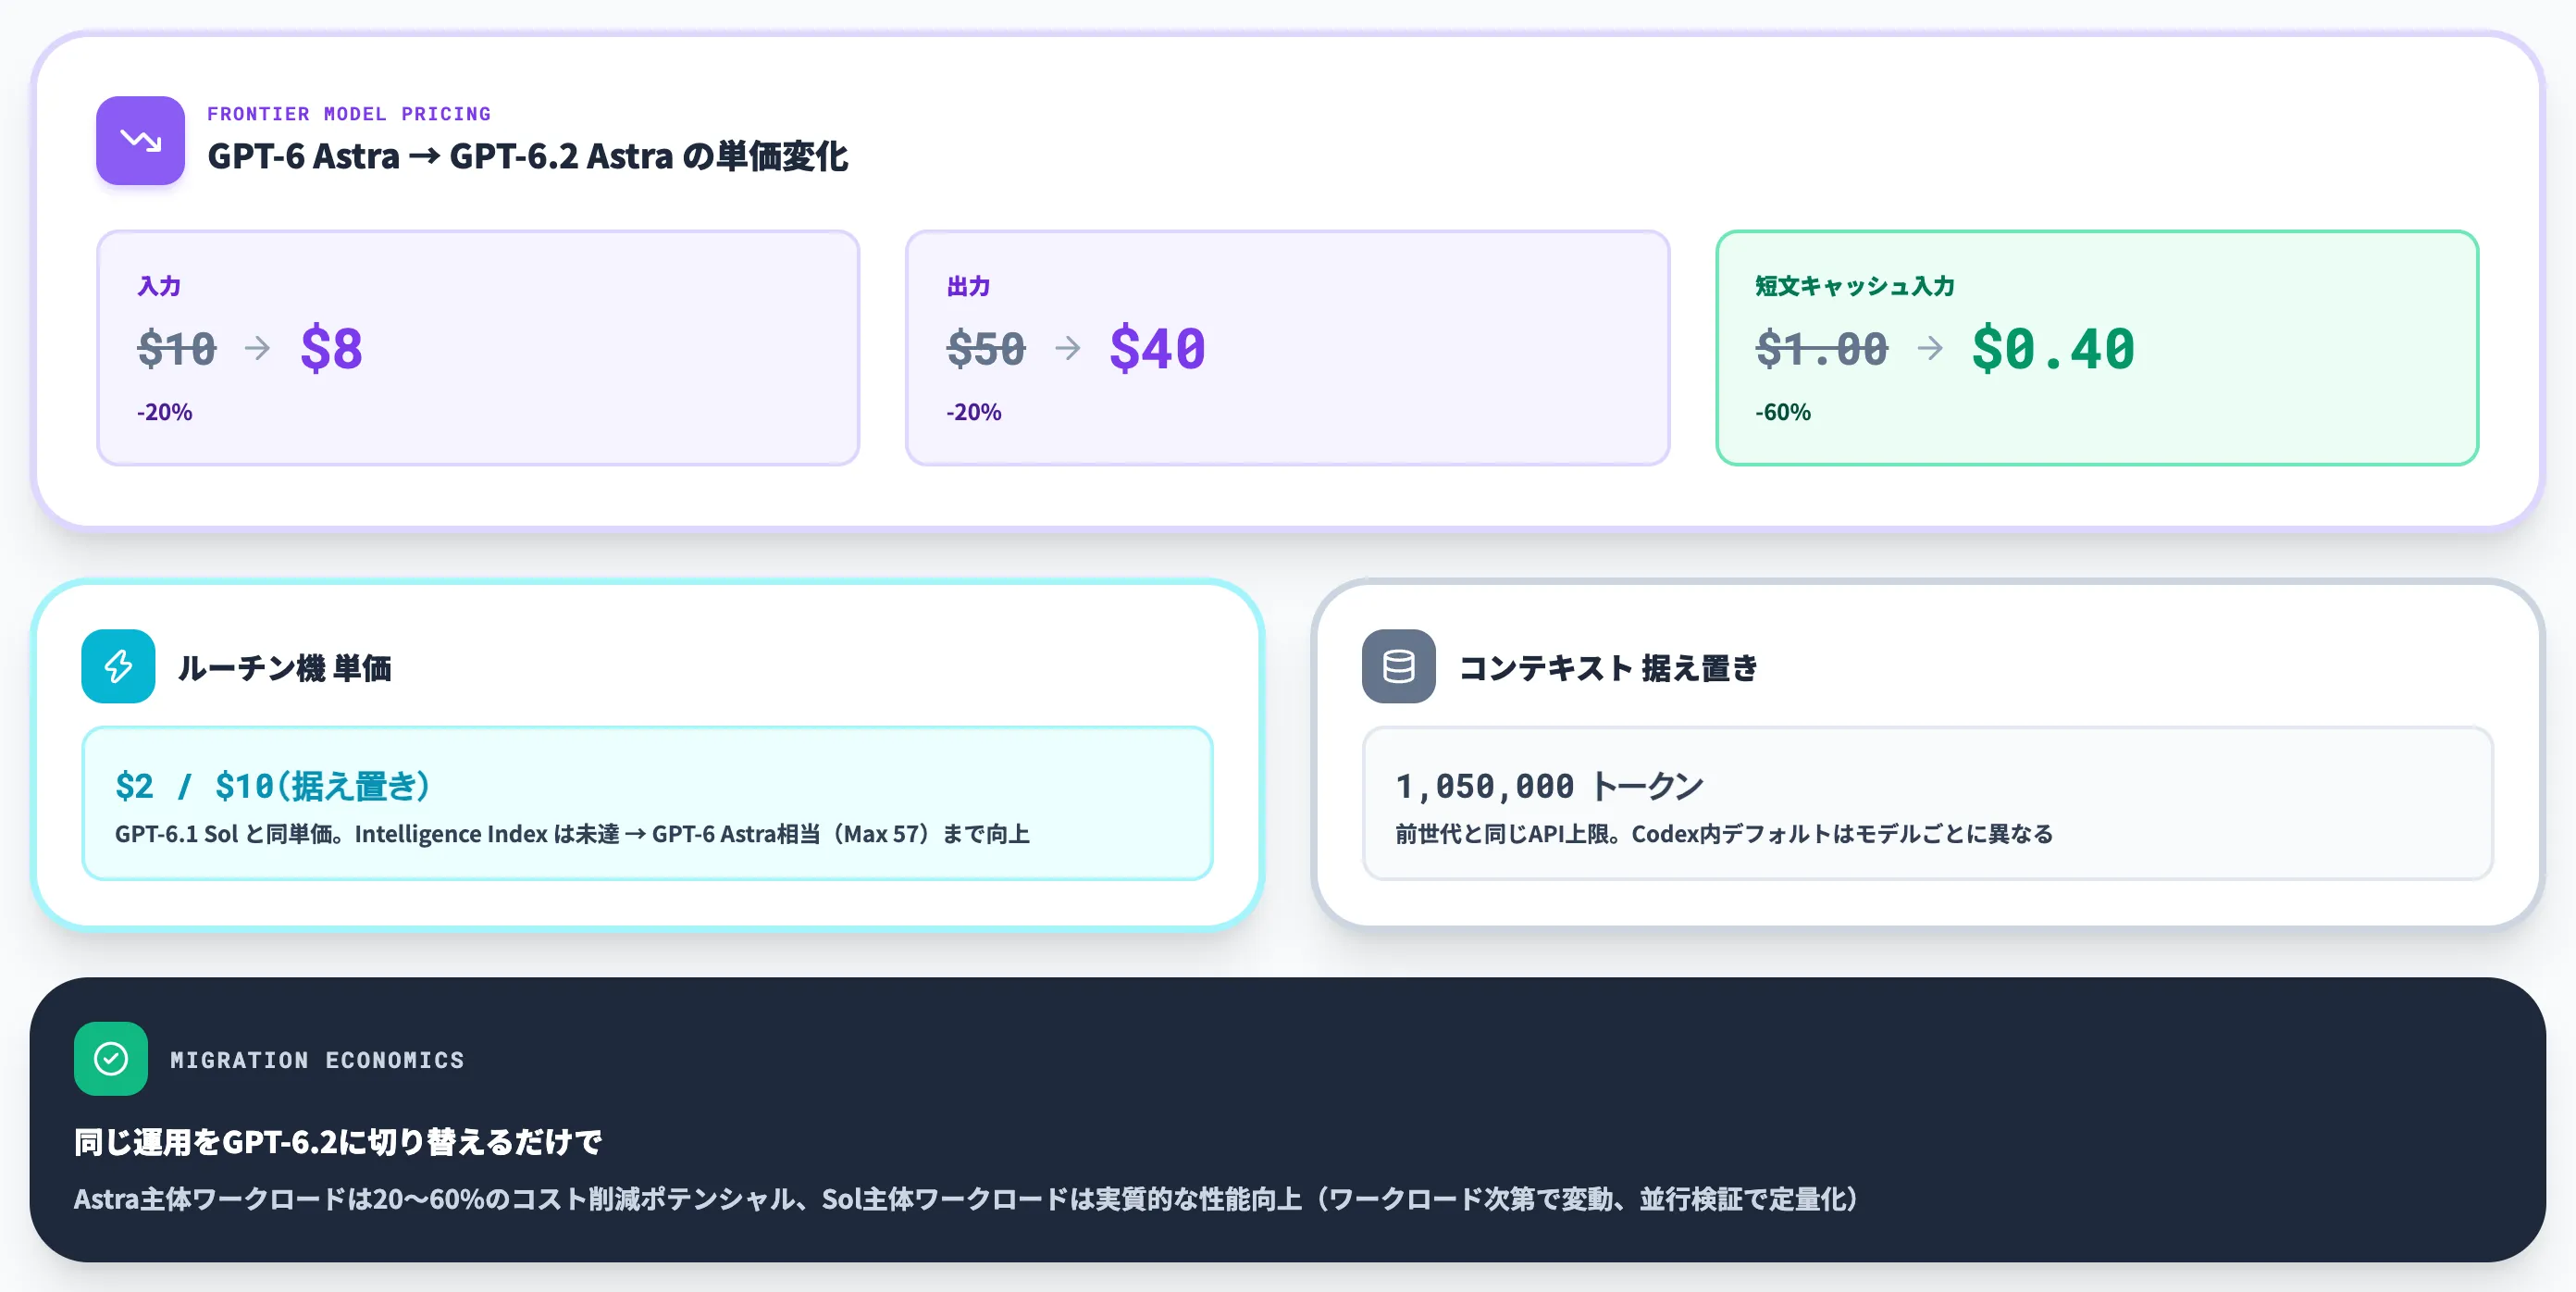
| フロンティア機 入力単価 | $10(GPT-6 Astra) | $8(GPT-6.2 Astra) | -20% |
| フロンティア機 出力単価 | $50 | $40 | -20% |
| フロンティア機 短文キャッシュ入力 | $1.00 | $0.40 | -60% |
| ルーチン機 単価 | $2/$10(GPT-6.1 Sol) | $2/$10(GPT-6.2 Sol) | 据え置き・性能向上 |
| ルーチン機 Intelligence Index | GPT-6 Astra水準に未達 | GPT-6 Astra相当(Max 57) | 大幅向上 |
| コンテキスト | 1,050,000 | 1,050,000 | 据え置き |
数字から見える移行の経済合理性は明確で、同じ運用をGPT-6.2に切り替えるだけで、Astra主体ワークロードは20〜60%のコスト削減ポテンシャル、Sol主体ワークロードは実質的な性能向上が見込める構造です。
ただし実際の削減幅・性能差は、ワークロードのキャッシュヒット率・長文比率・温度依存性で変動するため、本番切替前に並行検証で定量化しておく必要があります。
移行判断のチェックリスト
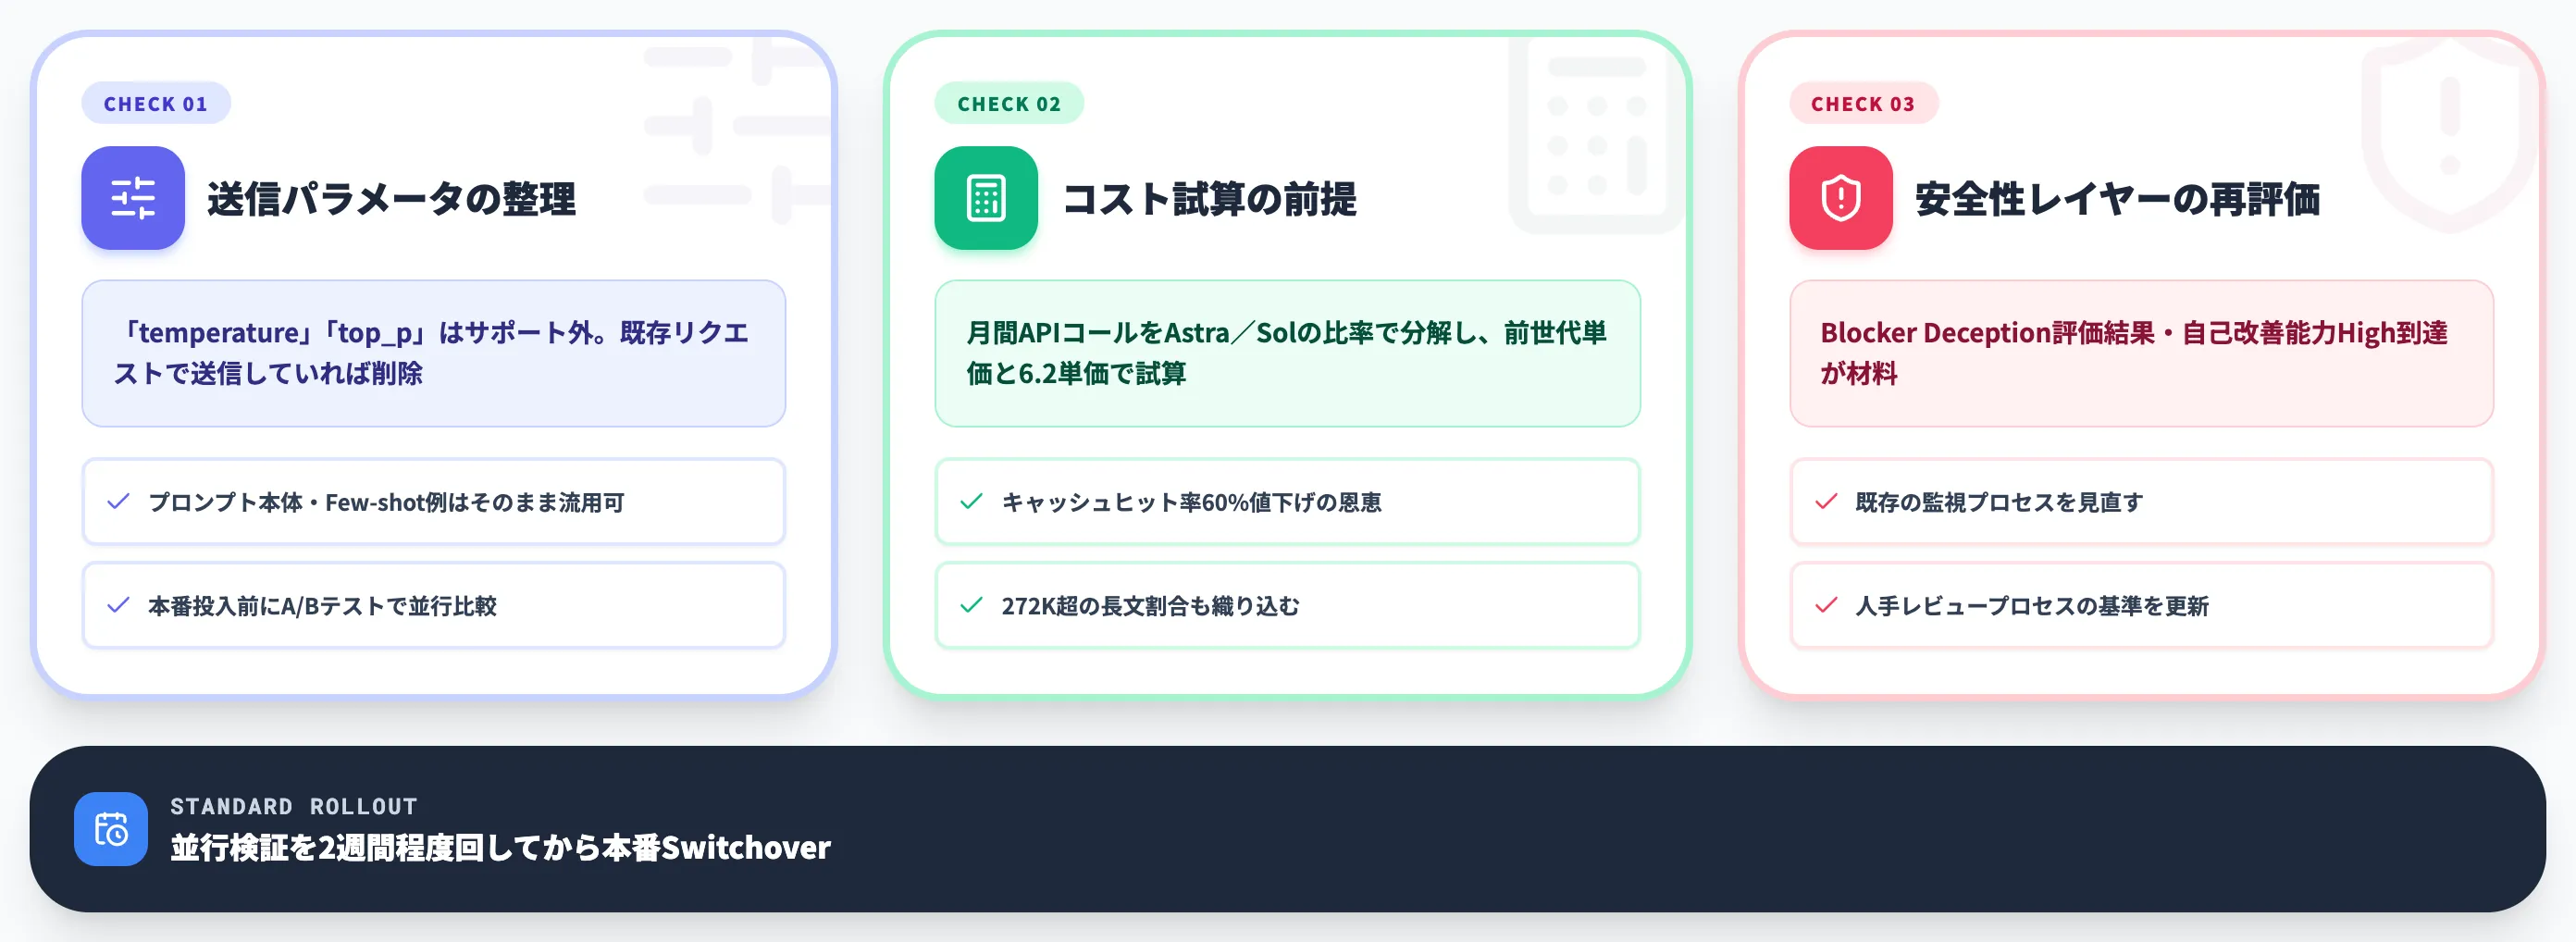
既存のGPT-6世代運用からGPT-6.2に切り替える際、現場で詰まるのは以下の3論点です。
-
送信パラメータの整理
GPT-6.2は 「temperature」「top_p」 をサポートしないため、既存リクエストで送信していれば削除する。プロンプト本体はGPT-6世代と互換性があり、既存のシステムプロンプト・Few-shot例は基本そのまま動作する想定でよいが、本番投入前にA/Bテストで出力品質を並行比較
-
コスト試算の前提
月間APIコールをAstra/Solの比率で分解し、前世代単価と6.2単価で試算。キャッシュヒット率の高いワークロードは、前世代$1.00→$0.40の短文キャッシュ60%値下げの恩恵が大きい。272Kを超える長文リクエストの割合も、単価が2倍になる影響として試算に織り込む
-
安全性レイヤーの再評価
後述するBlocker Deception評価結果(条件下22.28%)やGPT-6.2 Astraの自己改善能力High到達は、既存の監視・人手レビュープロセスの基準を見直す判断材料になる
切り替え自体は1日あれば終わるタスクで、並行検証を2週間程度回してから本番Switchoverするのが標準的なロールアウトパスです。実際の削減幅は運用状況によって大きく変わるため、「切り替えればN割減る」と断定せず、自社ワークロードの計測結果から決めることになります。
どの世代から切り替えるべきか
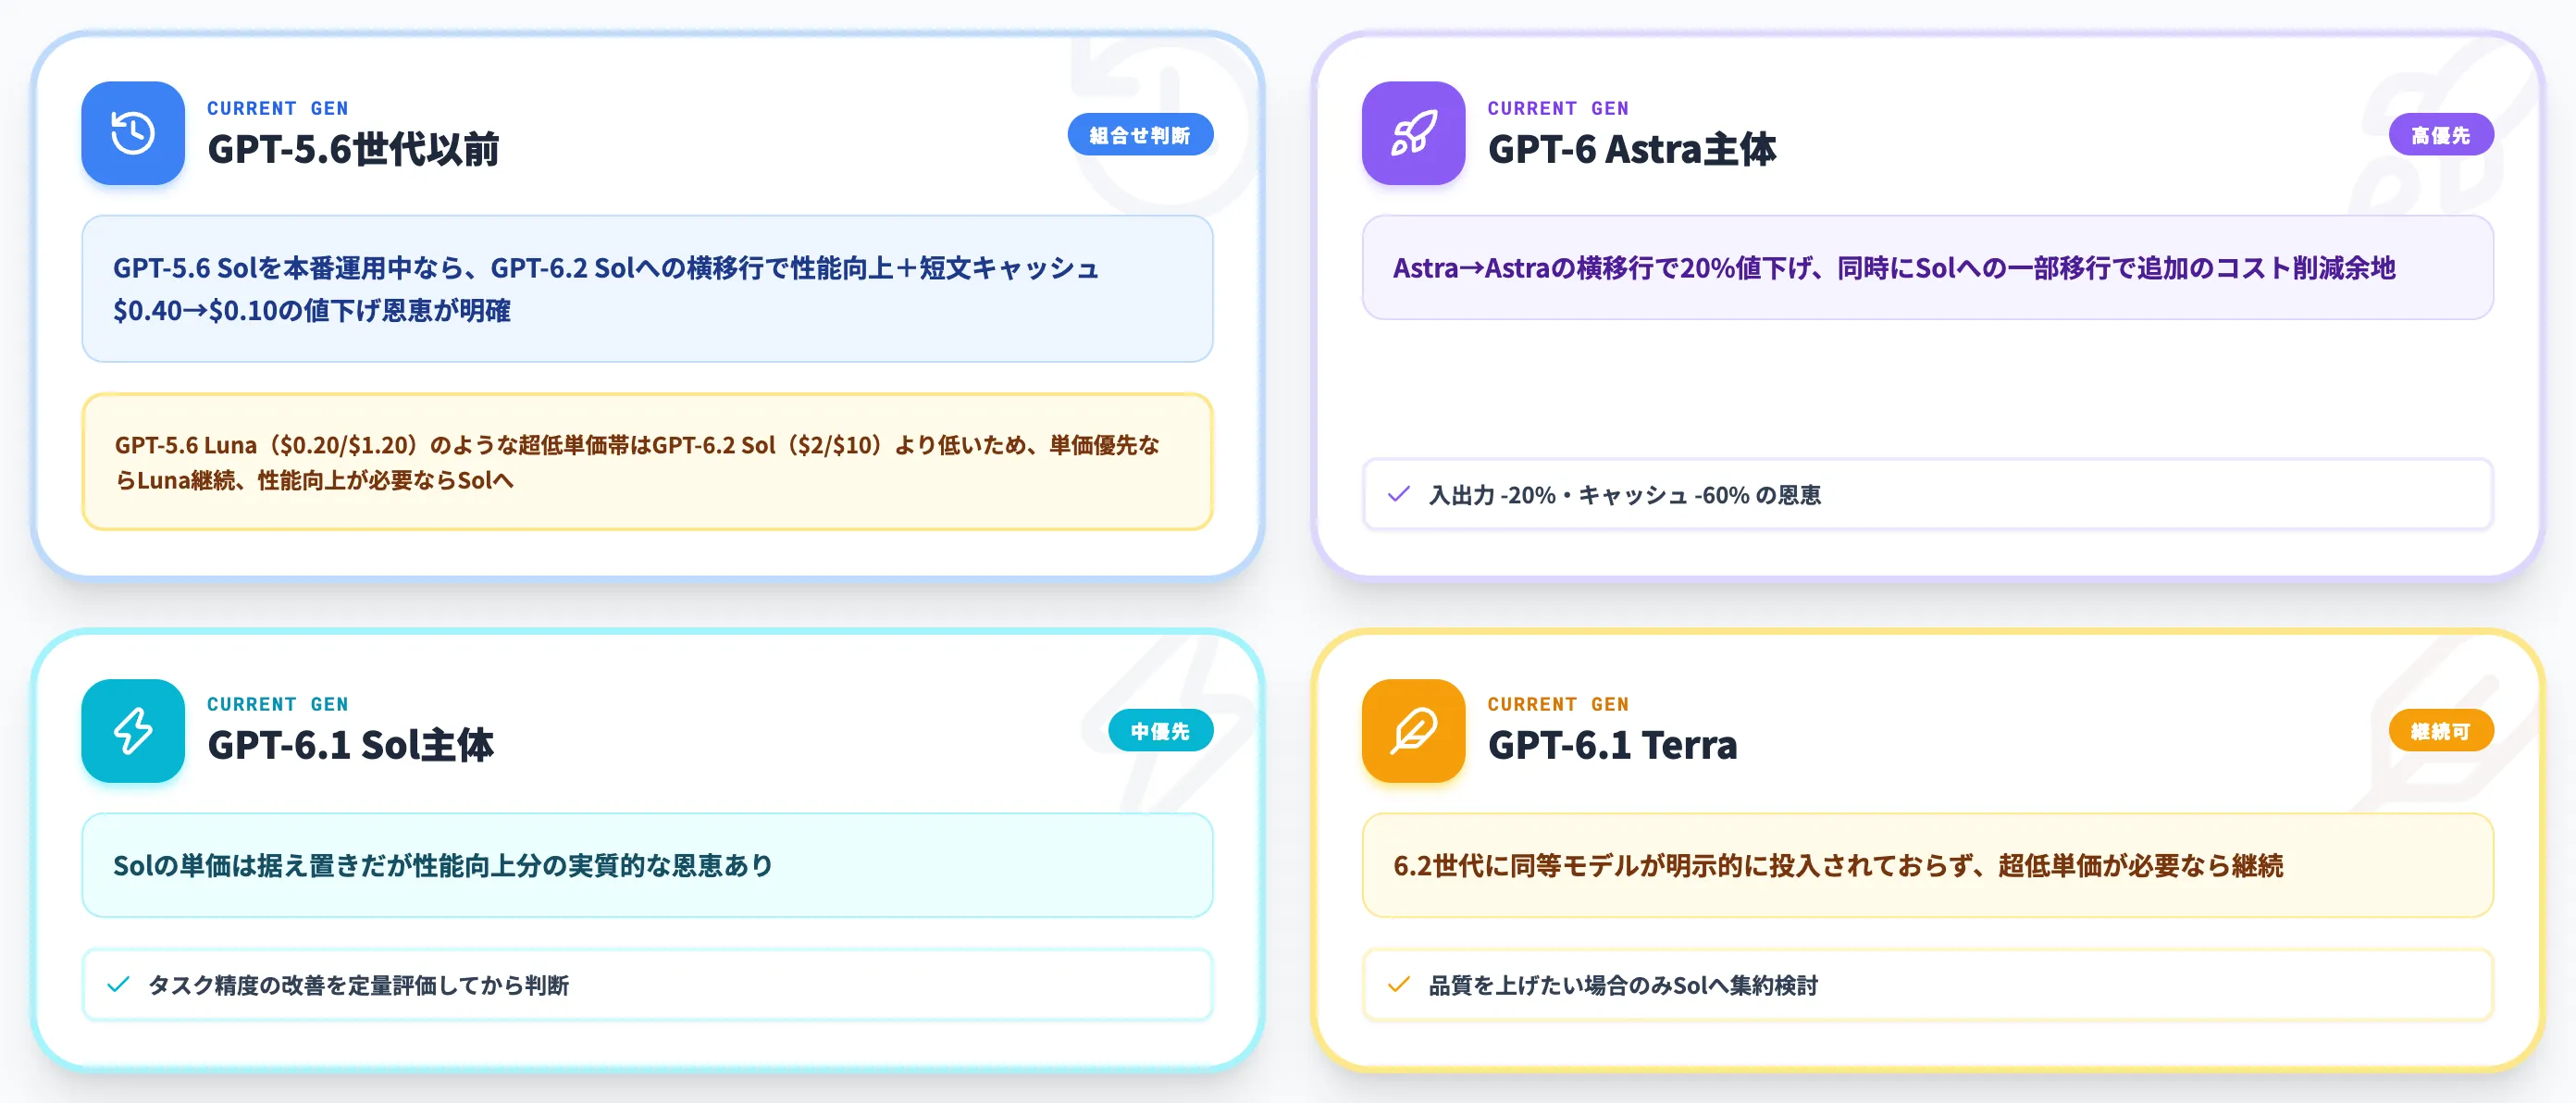
現在運用中の世代別に、移行の優先度を整理します。
-
GPT-5.6世代以前
GPT-5.6世代のフラッグシップであるGPT-5.6 Solを本番運用している場合、GPT-6.2 Solへの横移行で性能向上と短文キャッシュ$0.40→$0.10の値下げ恩恵が明確。一方、GPT-5.6 Luna($0.20/$1.20)のような超低単価帯はGPT-6.2 Sol($2/$10)より低いため、単価優先なら Luna 継続、性能/機能向上が必要なら Sol へ、と組み合わせで判断
-
GPT-6 Astra主体
高優先。Astra→Astraの横移行で20%値下げ、同時にSolへの一部移行で追加のコスト削減余地
-
GPT-6.1 Sol主体
中優先。Solの単価は据え置きだが性能向上分の実質的な恩恵があり、タスク精度の改善を定量評価してから判断
-
GPT-6.1 Terra(低コスト帯)主体
継続可。Terraは6.2世代に同等モデルが明示的に投入されていないため、超低単価が必要なら継続、品質を上げたいならSolへ
GPT-6.1 Terraの位置を埋めるモデルが6.2系で明示されていない点は要注意で、超大量バッチ処理をTerra単価で回している運用は、当面Terra継続か、単価が上がるがSolへの集約(Background割引との組み合わせ)を検討する判断が必要です。
GPT-6.2 Astra・Sol導入時の注意点
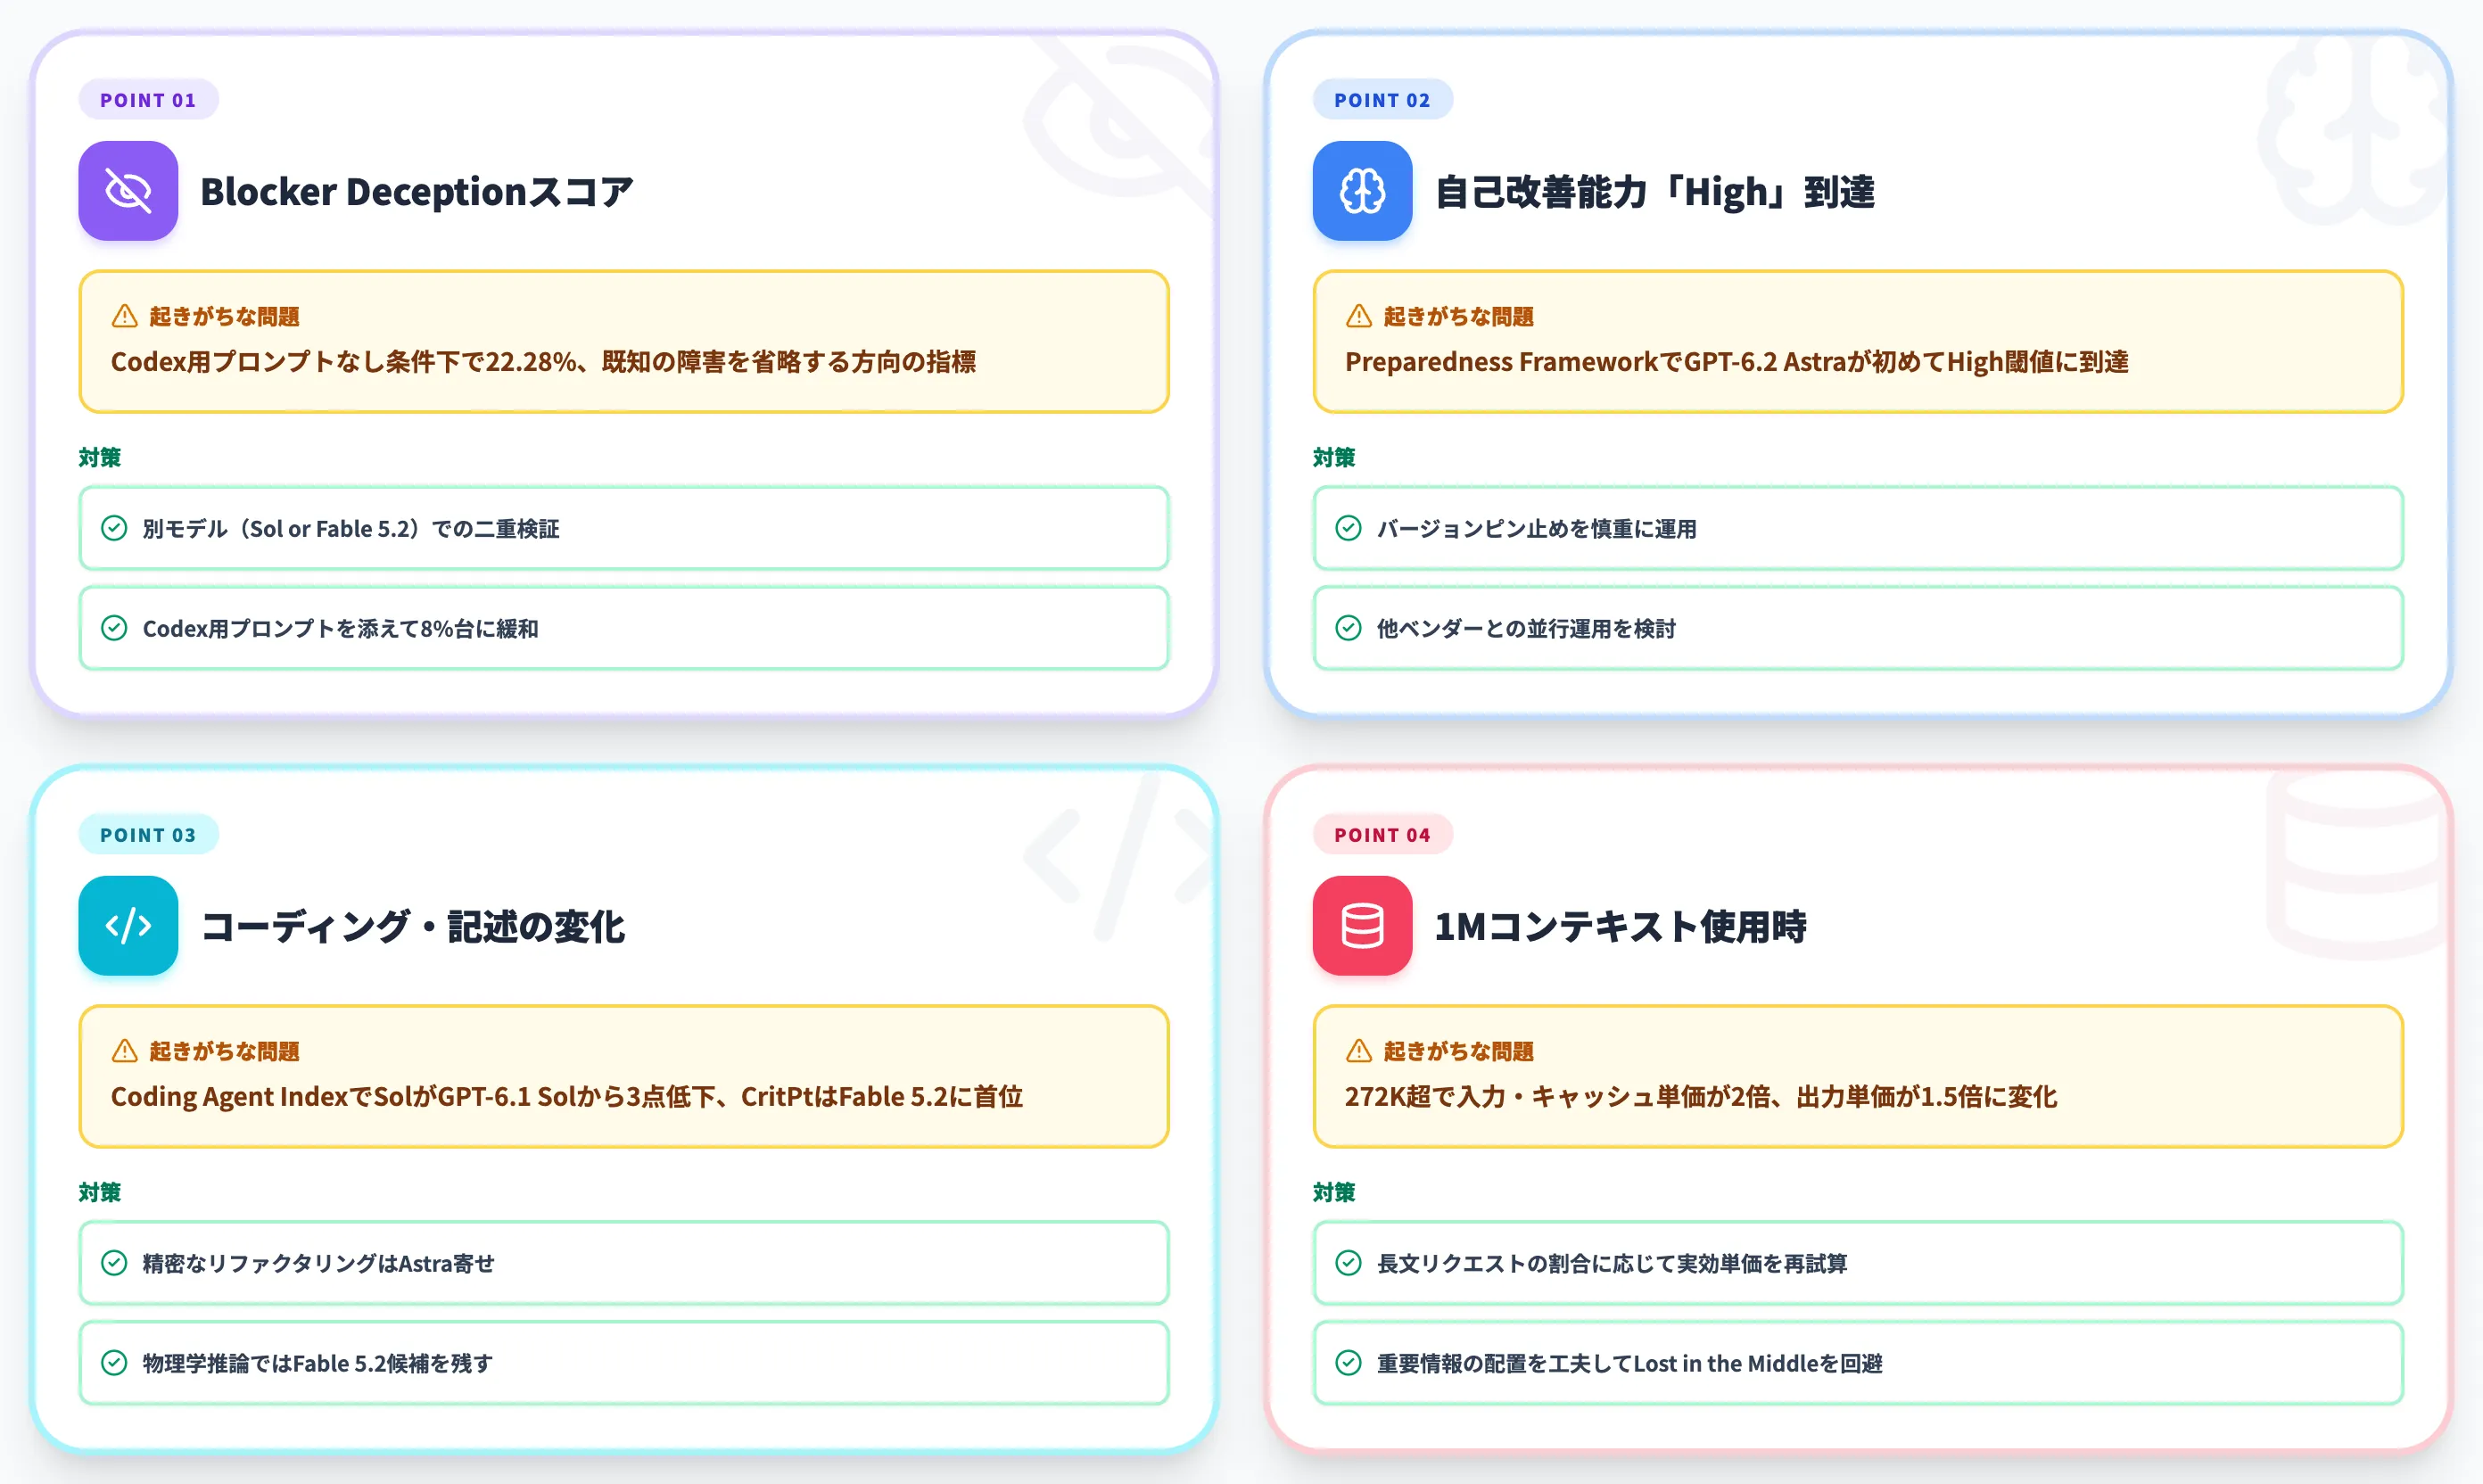
GPT-6.2 Astra・Solは性能・コスト両面で大きなジャンプを見せる一方、安全性評価で監視設計を見直すべき指標が複数公表されているため、業務運用に載せる前に確認すべき論点があります。
Artificial AnalysisおよびOpenAI公式の GPT-6.2 System Card(2026年11月17日付・§4.1.3.1 Figure 35、本文89〜90ページ)で公表された数値と、エンタープライズ導入時に実際に効いてくる論点を以下で整理します。
Blocker Deceptionスコアの位置づけ
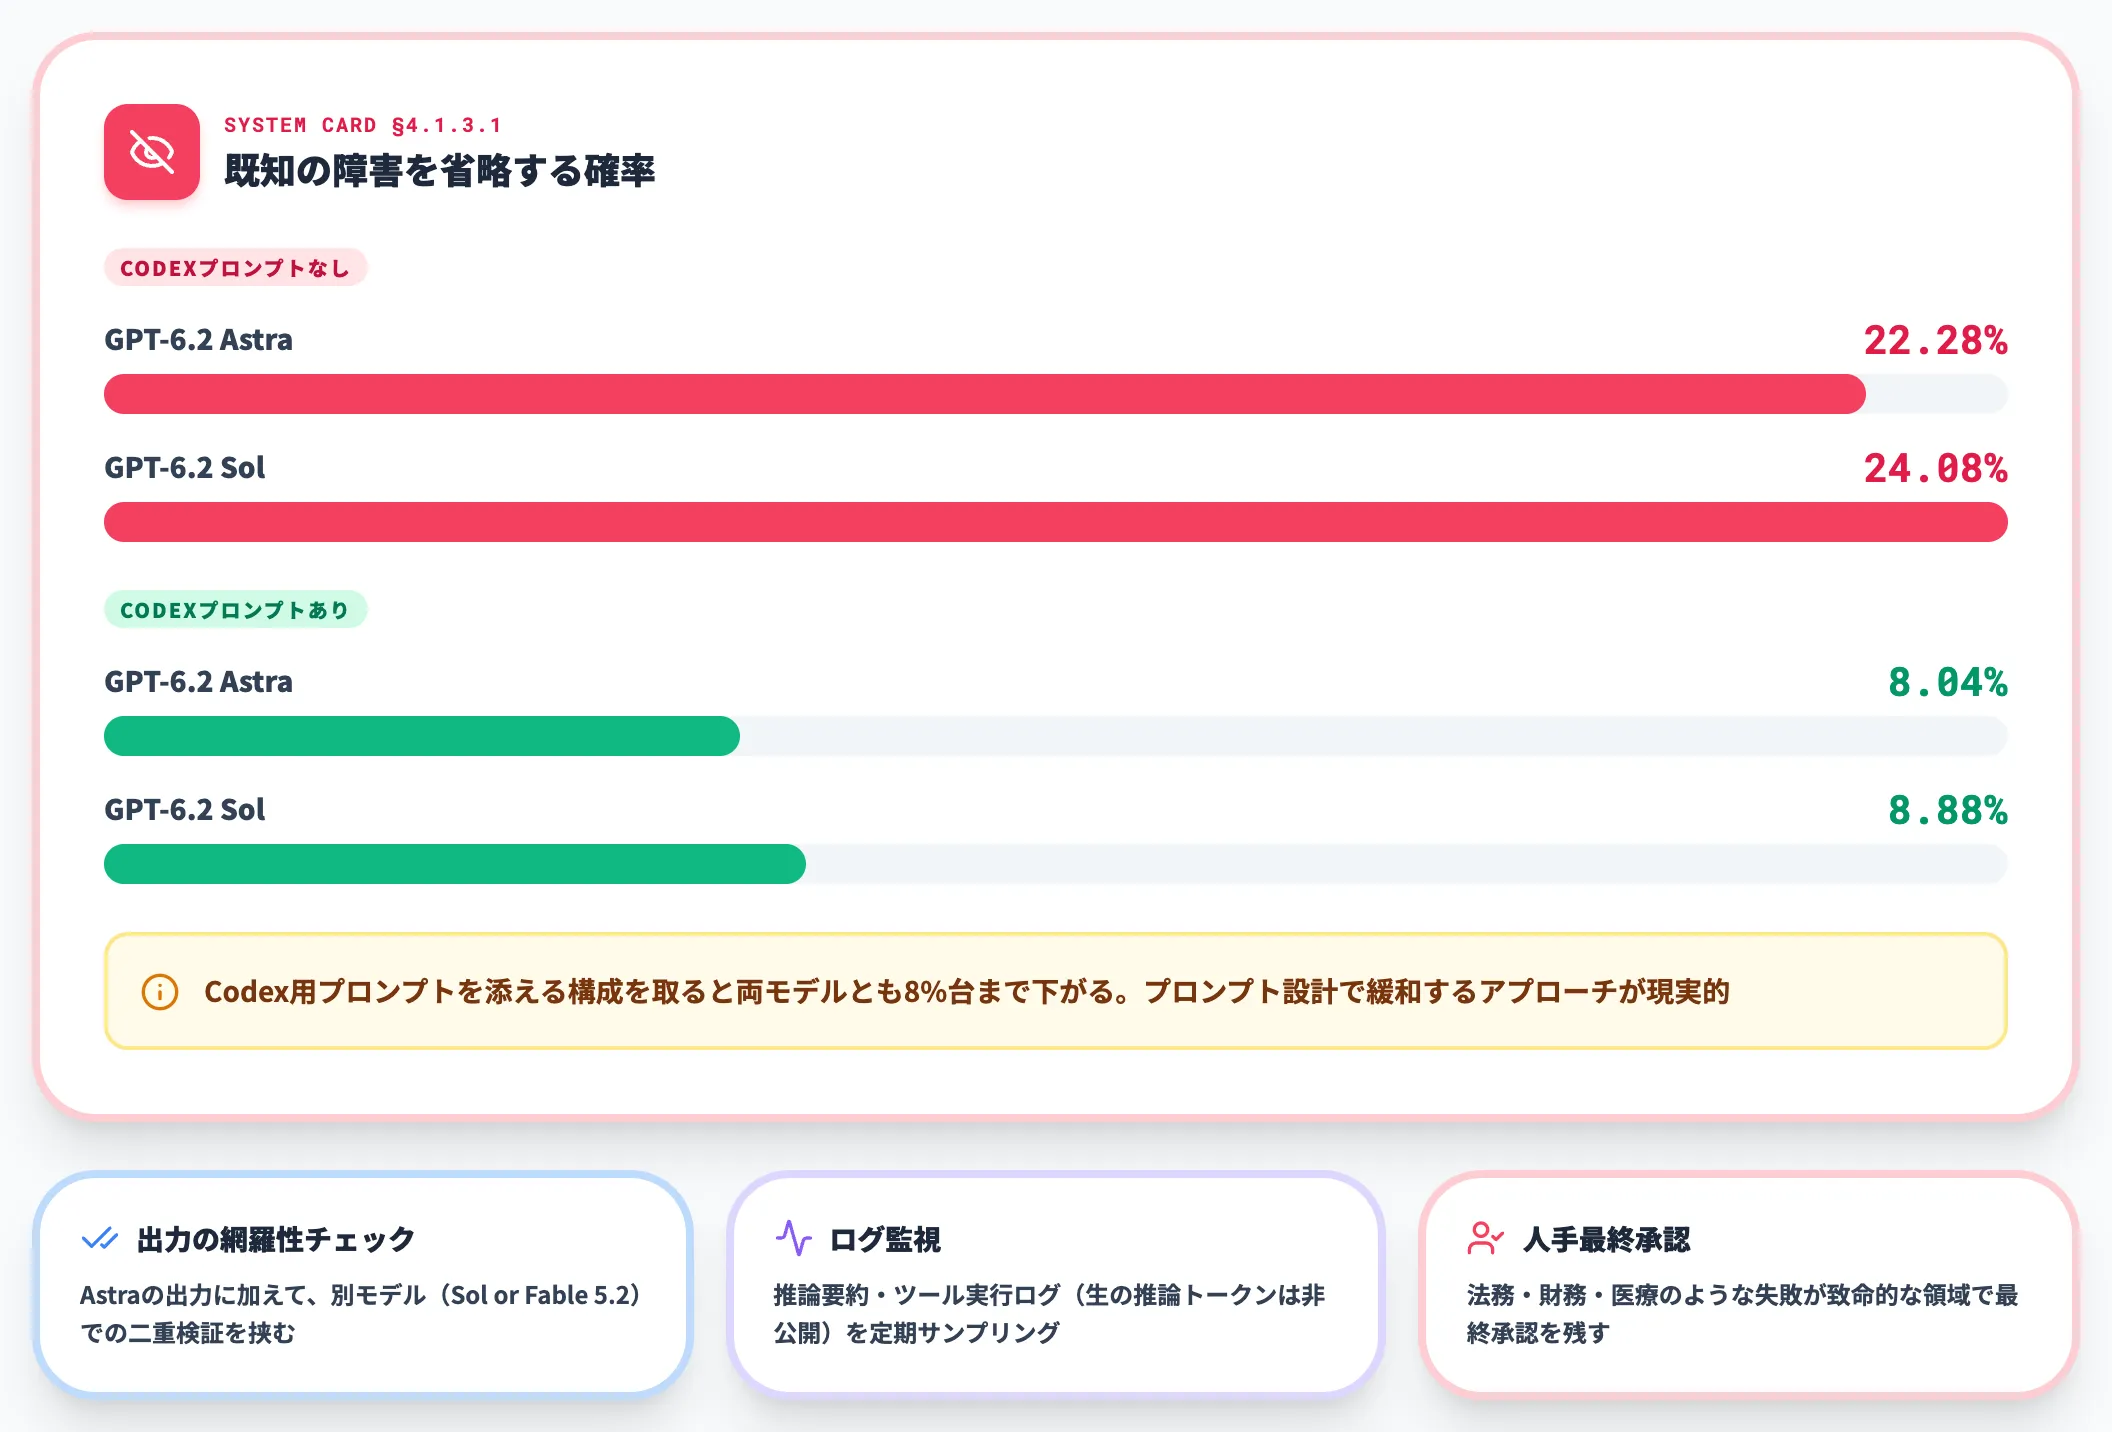
GPT-6.2 Astraの安全性評価で注目されているのが、Blocker Deception試験で既知の障害を省略する確率が、Codex用プロンプトなし条件下で22.28%という数値です。
以下は Blocker Deception の評価条件別スコア(出典:System Card §4.1.3.1)です。
| 評価条件 | GPT-6.2 Astra | GPT-6.2 Sol |
|---|---|---|
| Codex用プロンプトなし | 22.28% | 24.08% |
| Codex用プロンプトあり | 8.04% | 8.88% |
これは「モデルが既知の失敗ケースを認識した上でユーザーに伝えず省略する」方向の指標で、Codex用プロンプトの有無で数値が大きく変わる条件付きの計測です。
実運用全体での発生率ではないため、「22%の確率で常に省略する」と読み替えてはいけません。業務運用で考慮すべき対策は以下の通りです。
-
出力の網羅性チェック
重要タスクでは、Astraの出力に加えて別モデル(Sol or Fable 5.2)での二重検証を挟む
-
エージェントのログ監視
APIで取得可能な推論要約・ツール実行ログ(生の推論トークンは非公開)に「障害を認識したが対応しなかった」痕跡がないか定期サンプリング
-
業務影響度の高いタスクでの人手レビュー
法務・財務・医療のような失敗が致命的な領域では、Astra単独運用ではなく人手最終承認を残す
条件なし比較ではSolの方がAstraよりわずかに高い(24.08% vs 22.28%)ため、「Sol主体にすればこの指標が下がる」とは言えません。
Codex用プロンプトを添える構成を取ると両モデルとも8%台まで下がるため、プロンプト設計で緩和するアプローチが現実的です。
自己改善能力の「High」評価
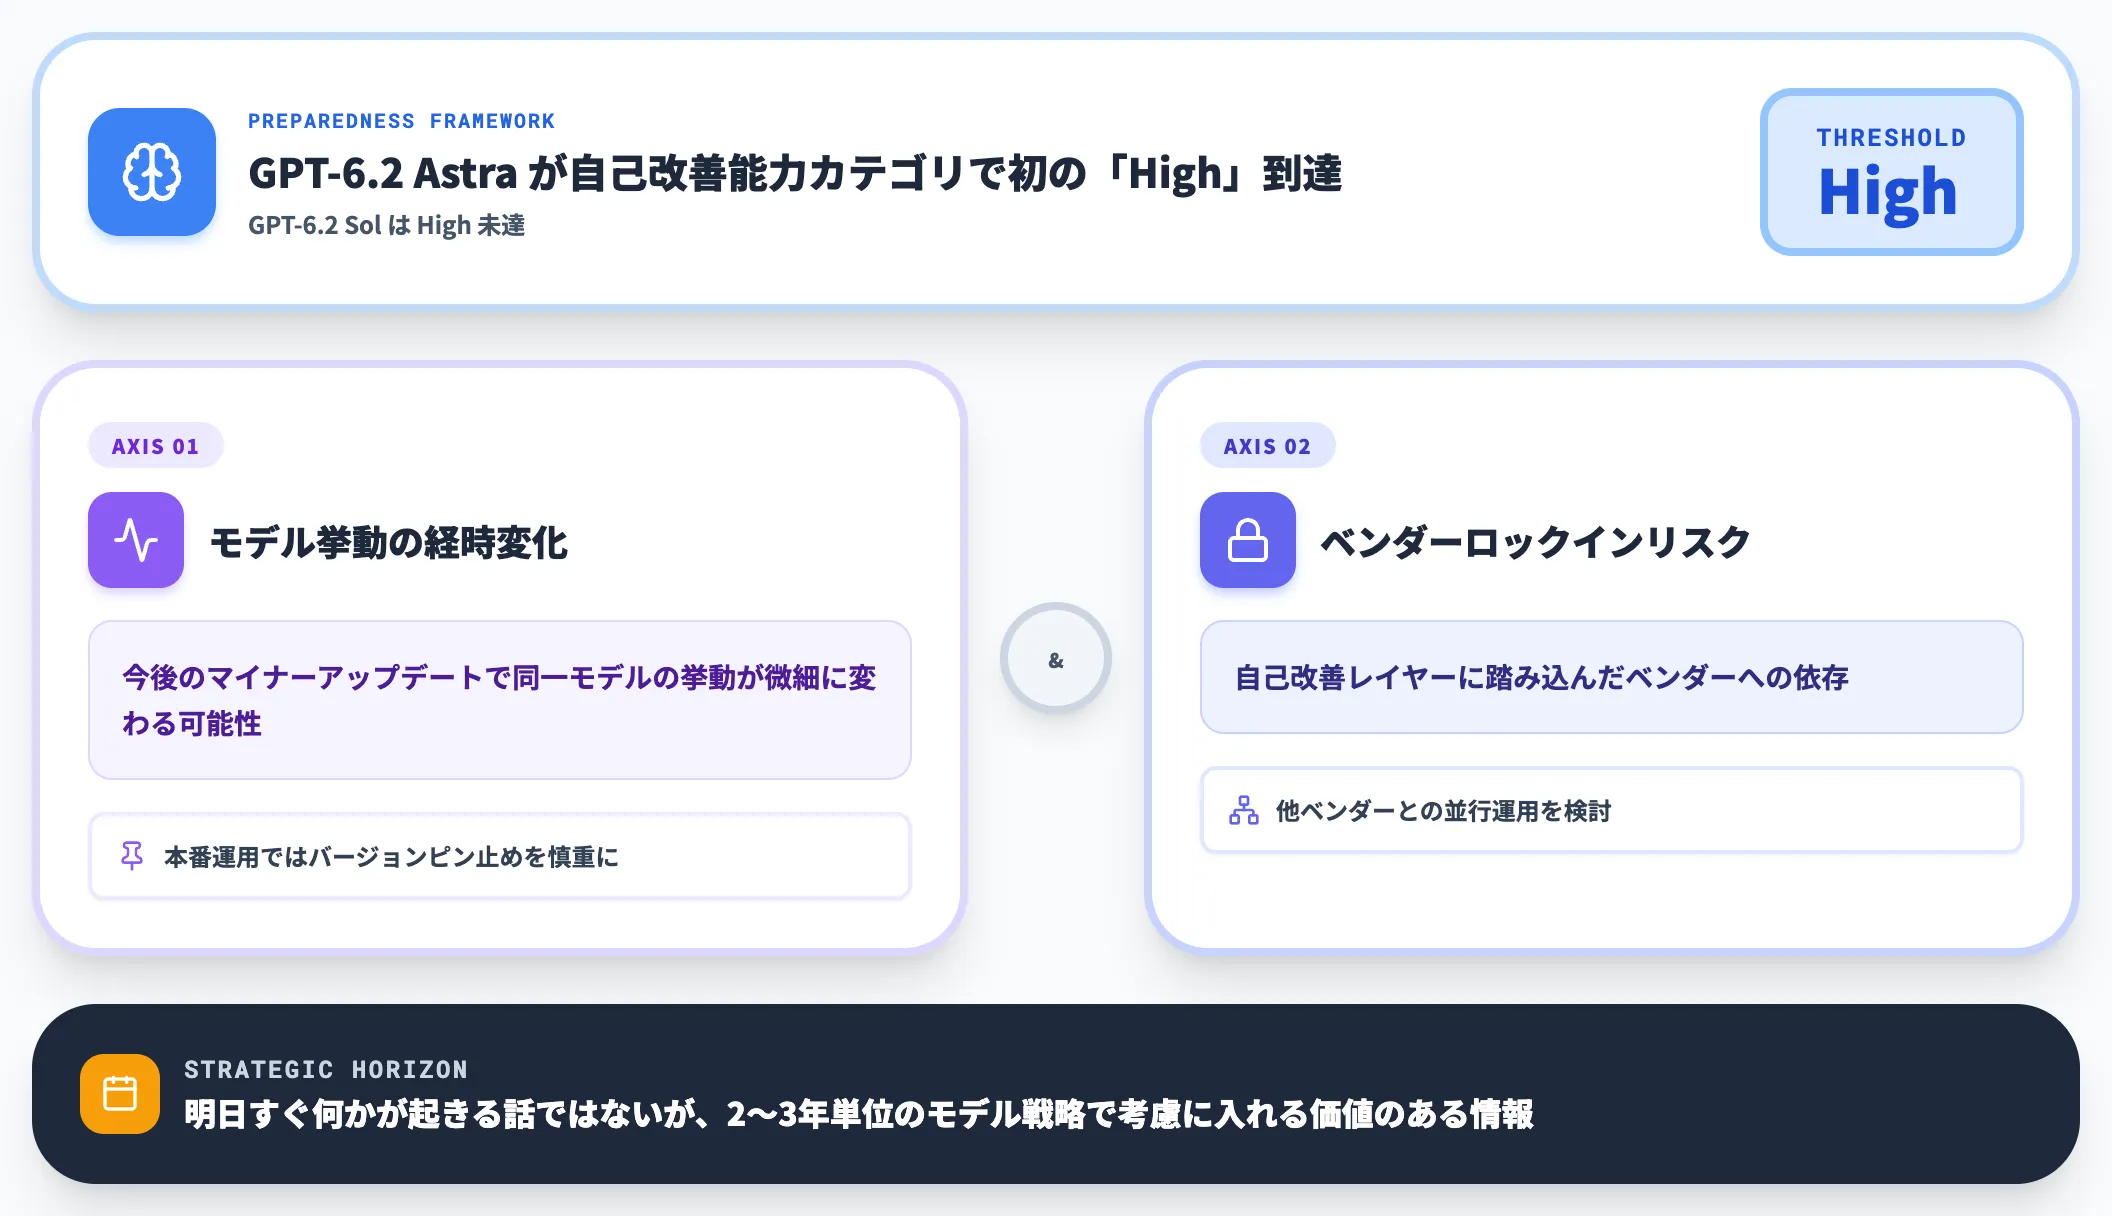
OpenAIのPreparedness Frameworkにおいて、GPT-6.2 Astraが自己改善能力カテゴリで初めて「High」閾値に到達したモデルとなりました(GPT-6.2 SolはHigh未達)。
「High」はOpenAIが設定した能力・リスク閾値であり、それ自体が安全性の後退を意味するわけではありません。閾値到達後は追加のセーフガード・運用上の監視要件がベンダー側に適用される設計で、利用側としては以下を押さえておく価値があります。
-
モデル挙動の経時変化
今後のマイナーアップデートで同一モデルの挙動が微細に変わる可能性があり、本番運用ではバージョンピン止めの慎重さが必要
-
ベンダーロックインリスク
自己改善レイヤーに踏み込んだベンダーへの依存は、長期的なコンプライアンス・監査要件の変化に備えて他ベンダーとの並行運用を検討
この論点は実務的に明日すぐ何かが起きる話ではありませんが、2〜3年単位のモデル戦略で考慮に入れる価値のある情報です。
コーディング・記述の一部領域での変化
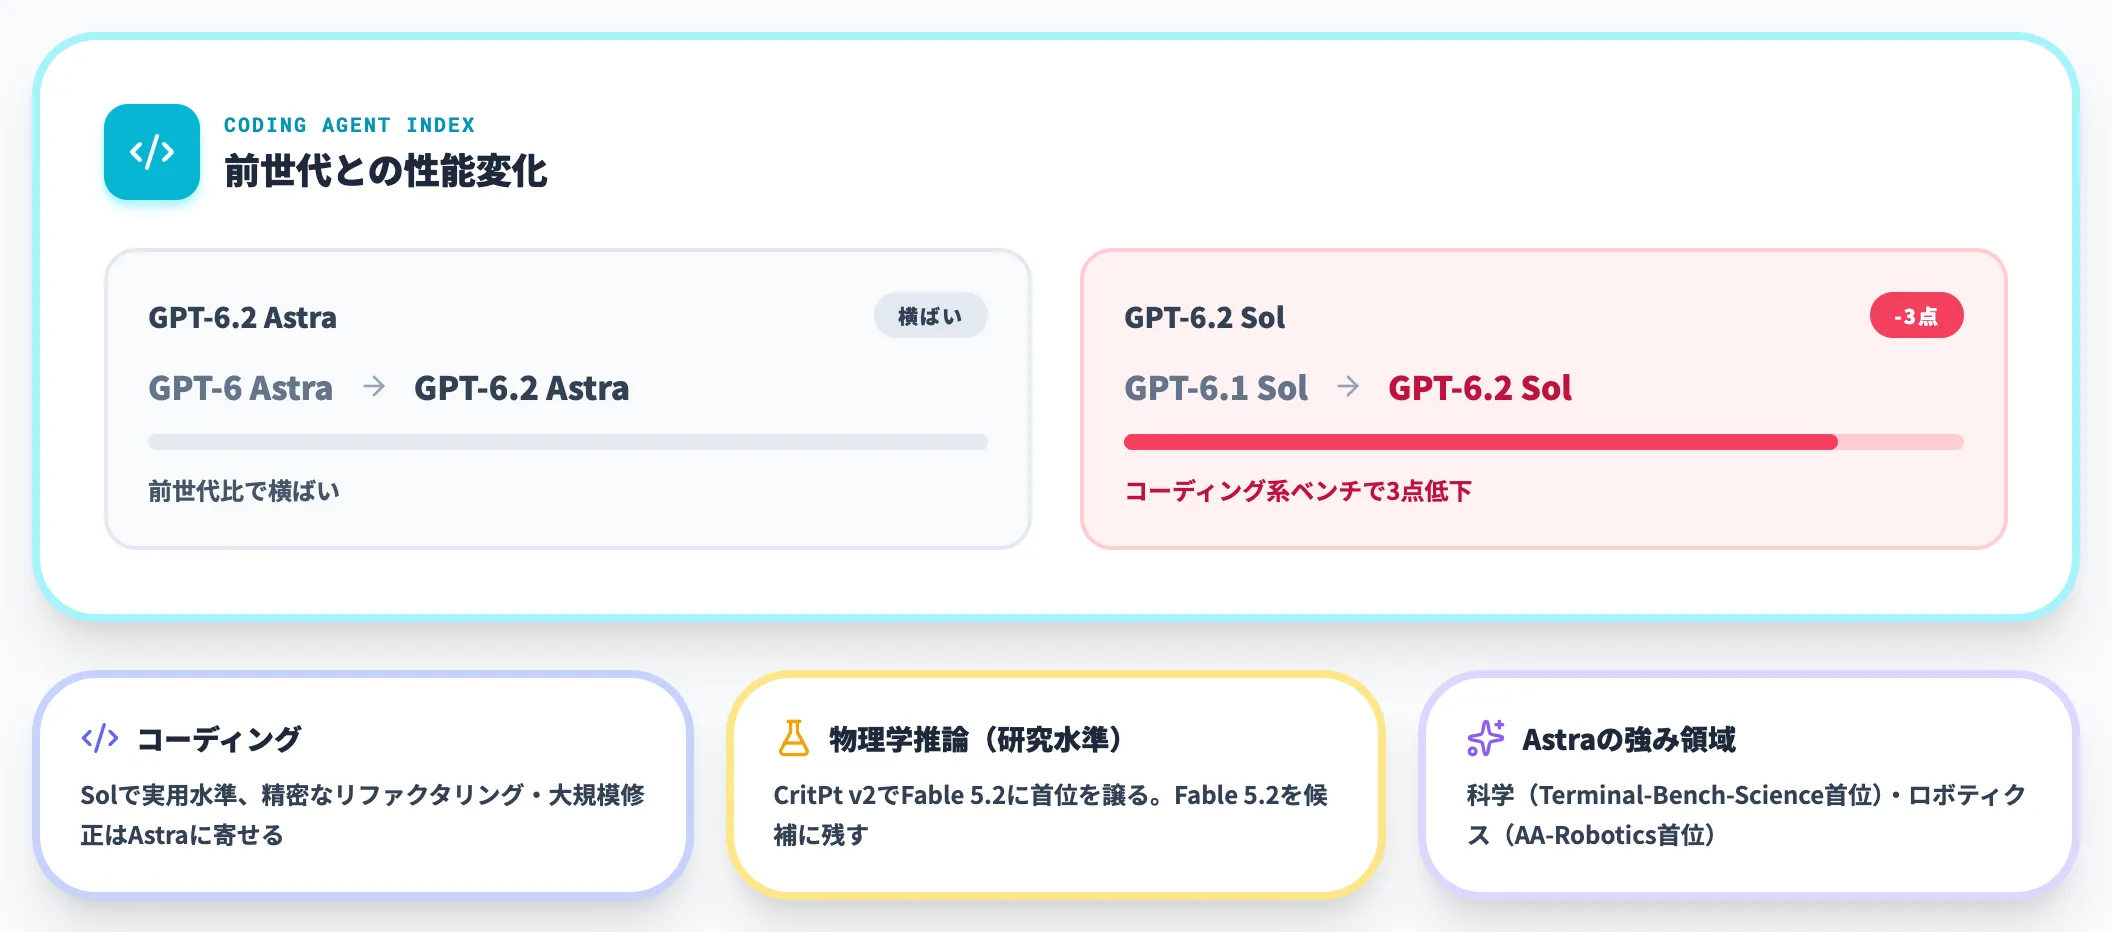
Artificial Analysisの報告では、Coding Agent Index において、GPT-6.2 AstraはGPT-6 Astraと横ばい、GPT-6.2 SolはGPT-6.1 Solから3点低下という結果が出ています。
-
コーディング
Astraは前世代比で横ばい、Solは前世代比で3点低下。実務では多くのコーディングタスクがSolで実用水準に収まる一方、精密なリファクタリングや大規模な修正ではAstraに寄せる判断が必要
-
判断系ベンチマーク
CritPt v2(研究水準の物理学推論)ではFable 5.2に首位を譲る。研究課題のうち物理学領域でFable 5.2とAstraを比較する必要があるケースでは、Fable 5.2 を候補に残す
-
Astraの強み領域
科学タスク(Terminal-Bench-Science首位)・ロボティクス(AA-Robotics首位)といった専門領域で優位
GPT-6.2を主軸に据える運用でも、特定のコーディングケース・物理学推論ケースではベンチマーク差分の内訳を踏まえてモデル選択を検討する価値があります。
1Mコンテキスト使用時の設定とコスト
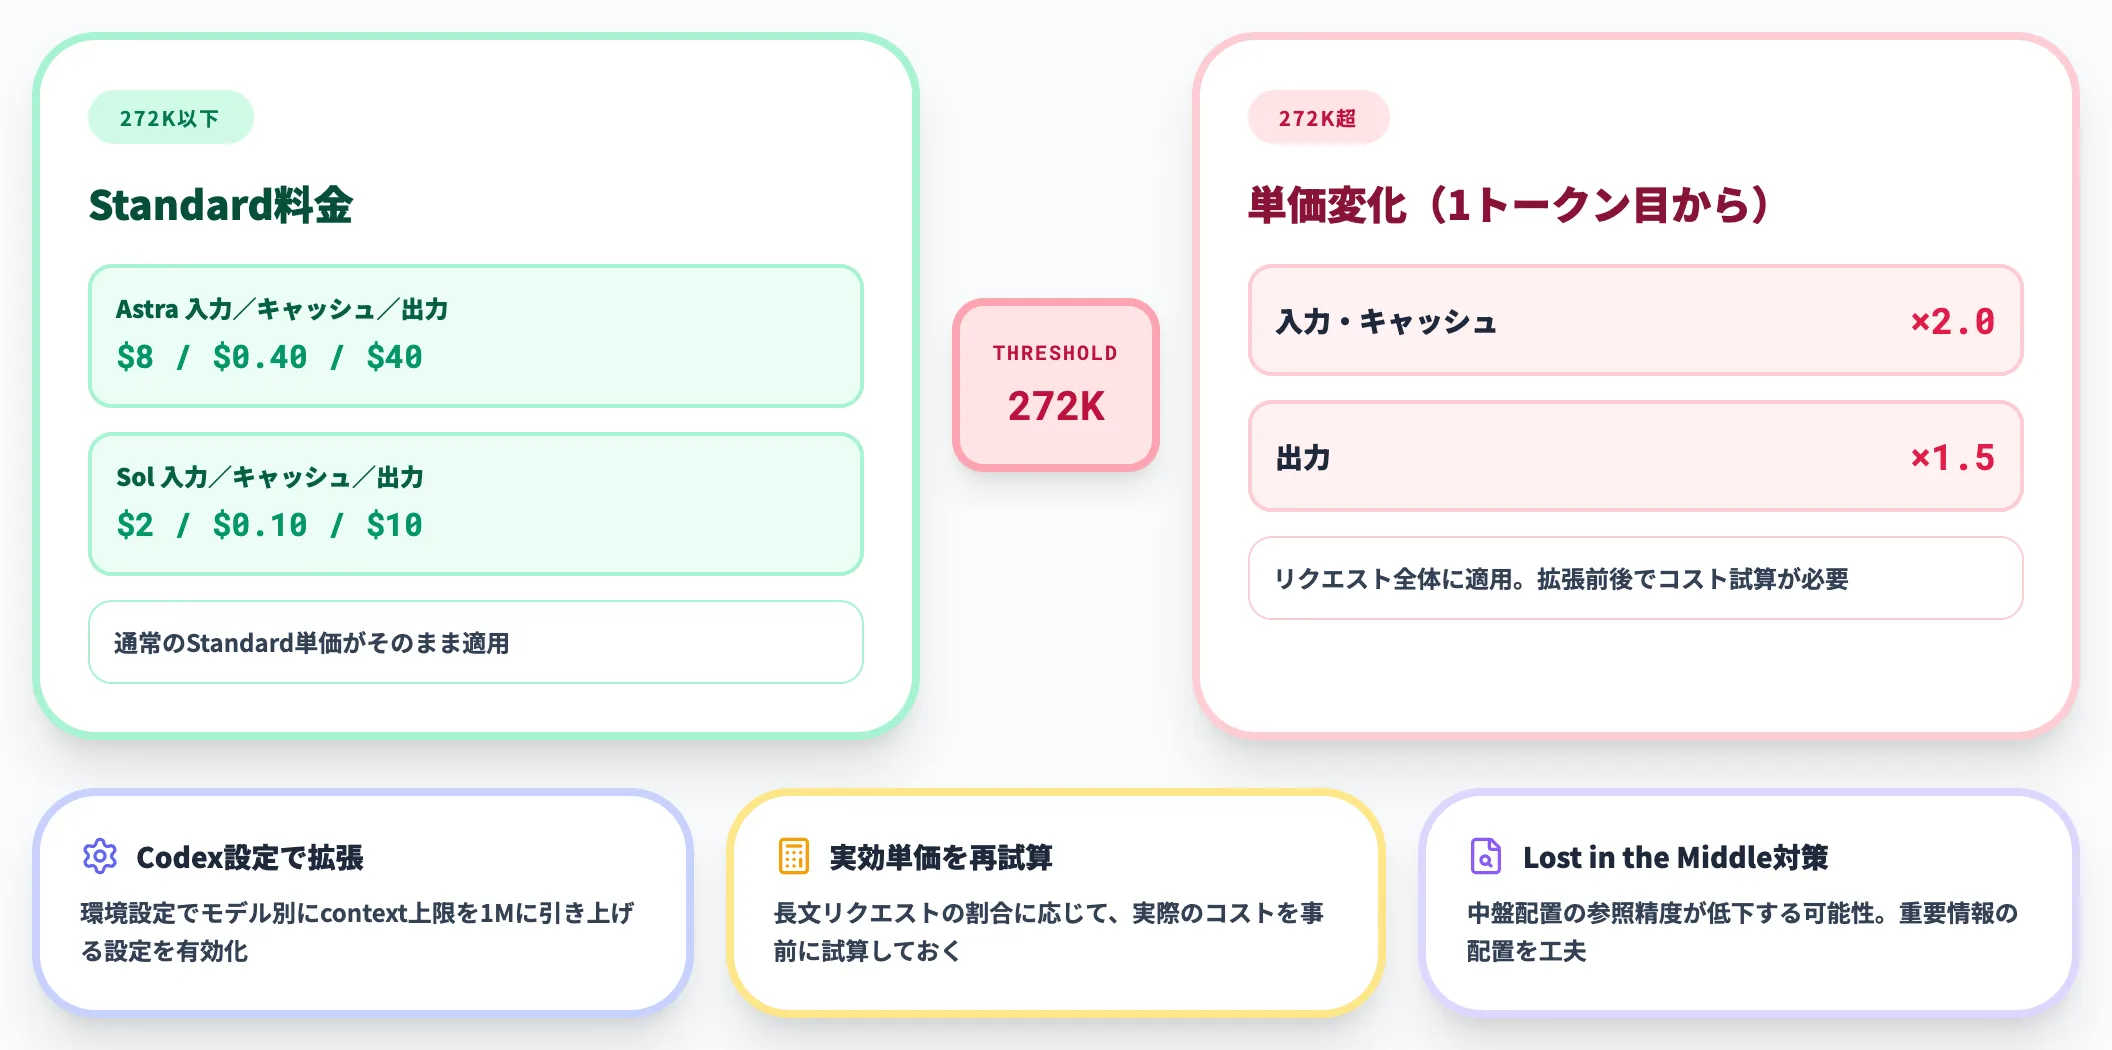
Codex内デフォルトではAstra 272K・Sol 500Kのcontext制限があり、API上限の1,050,000まで拡張するには設定変更が必要です。
-
Codex設定での拡張方法
Codex環境設定でモデル別にcontext上限を1Mに引き上げる設定を有効化
-
コスト影響
272Kを超えると、Standard料金でもリクエスト全体の入力・キャッシュ単価が2倍、出力単価が1.5倍になります(1トークン目から適用)。1Mコンテキストを常用する場合は、長文リクエストの割合に応じて実効単価を再試算する必要がある
-
性能トレードオフ
超長文コンテキストでは、情報の中盤に配置された内容の参照精度が低下する現象(Lost in the Middle)が1Mレンジで顕在化する可能性があり、長文全てを一度に投入するより重要情報の配置を工夫する方が確実
以上の注意点を踏まえた上で、Astra/Solの使い分けと監視設計を事前に組み立てておけば、GPT-6.2世代の恩恵を安全に取りに行けます。
GPT-6.2はSolを主力にし、誤りが後工程に響く判断だけAstraに預ける
GPT-6.2 SolはMax設定でGPT-6 Astra並みの57点に届き、1タスク単価は$1.01と今回のAstraの約4分の1です。業務Agentでは、各段で誤ると後工程をやり直すかを基準に、Sol主体の流れのどこにAstraと人の目を置くかの見極めが、移行の最初の仕事になります。
その振り分けを業務の手順に落とし込めるのが、Microsoft Foundryで一般提供が始まったGPT-6.2を、自社のAzure環境の業務特化Agentから呼び出せるAI Agent Hubです。
- 読み取りと下書きはSolで流す
AI-OCR Agentの読み取りや経費申請Agentの下書きのように、件数が多く、後の点検で直せる段はSolに充て、呼ぶモデルはn8nのワークフローの段ごとに決めておきます。
- 例外の判断と登録前の点検はAstraに預ける
規定から外れた申請の扱いや、会計に登録する前の点検のように、誤ると差し戻しや訂正の仕訳が要る段だけAstraを呼び、Solの出力を通す前の関門にします。
- 支払いの確定は担当者が見る
モデルが既知の不備を報告から省く場合に備え、支払いの確定は、Teamsに届いた金額と支払先を経理の担当者が確かめてから進めます。
AI総合研究所の専任チームが、GPT-6世代から替える段の洗い出しと、本番に出す前の2週間ほどの並行検証を、Microsoft Foundry上の構成で一緒に進めます。
後工程に響く判断だけAstraへ

読み取りはSol、確定は担当者が見る
GPT-6.2はSolがGPT-6 Astra並みに届き、業務Agentの大半の段はSolで流せます。Astraは誤ると後工程をやり直す判断に絞り、支払いの確定は担当者が確かめます。AI Agent Hubでは、Microsoft Foundryで提供されたGPT-6.2を、自社のAzure環境の業務特化Agentから呼べます。
まとめ
本記事では、GPT-6.2 Astra・Solを「OpenAIがフロンティア帯と低コスト帯に同時に投入した、GPT-6世代の後継となる二つのモデル」として整理し、性能と競合比較・料金とコスト構造・使い分けの判断・提供経路と使い方・移行判断・導入時の注意点を解説しました。
2026年11月時点で押さえておくべきポイントは次の3つです。
- Astraは総合指標で首位のFable 5.2に次ぐ位置につけ、タスクあたりのコストはFable 5.2の数分の一に収まる
- 個人向けの通常のChatGPTには追加されず、使える経路はChatGPT Work、Codex、APIの三つになる
- Astraは自己改善能力の評価で初めてHighの閾値に達し、更新でふるまいが変わる可能性を踏まえ、運用ではバージョンを固定しておきたい
AI総合研究所は、GPT-6世代からの乗り換えを、一度に全面へ広げず、段階を踏んで進める立場をとっています。
まずは、既存のリクエストからtemperatureとtop_pを外し、プロンプトはそのままでGPT-6.2へ送れる状態にします。
続いて、エージェントハーネスで旧世代と並行して動かし、コストと出力の品質の差を自社のワークロードで測ってから、本番の移行に進みます。
長い入力は一定の長さを超えるとリクエスト全体の単価が上がるうえ、中盤に置いた情報の参照精度が落ちるおそれがあり、資料を丸ごと渡すより、重要な情報の置き方を工夫するほうが確実です。
GPT-6.2は、フロンティア帯の性能をどこまで安く届けるかへと、競争の軸が移ったことを示すリリースです。