この記事のポイント
 NVIDIA GB200/GB300比で電力効率1.5〜1.9倍・レイテンシ最大3.6倍改善という実測値がSemiAnalysis InferenceXで公開
- OpenAI・Broadcom・Celesticaの3社分担で、チップ設計・シリコン実装・システム統合を垂直統合した初のカスタムASIC
- 9か月でtape-outを達成した高性能ASICは業界最速級、OpenAI自身のモデルが設計・最適化・カーネル生成を加速
- Google TPU・Microsoft Maia・AWS Trainium・Meta MTIAに続くハイパースケーラー独自ASICの新顔
- 外販計画は公表されておらずOpenAI社内利用が前提だが、ChatGPT・API・Codexのトークン単価・応答速度・可用性に間接的な影響が波及しうる
Microsoft MVP・AIパートナー。LinkX Japan株式会社 代表取締役。東京工業大学大学院にて自然言語処理・金融工学を研究。NHK放送技術研究所でAI・ブロックチェーンの研究開発に従事し、国際学会・ジャーナルでの発表多数。経営情報学会 優秀賞受賞。シンガポールでWeb3企業を創業後、現在は企業向けAI導入・DX推進を支援。
Jalapeño(ハラペーニョ)は、OpenAIがBroadcomと共同開発した、大規模言語モデル(LLM)推論のために白紙から設計された初のカスタムAI推論チップです。
2026年6月24日の発表に続き、8月25日には初期ベンチマーク結果が公開され、NVIDIA GB200/GB300を電力効率とレイテンシの両面で上回る実測値が示されました。
外販計画は公表されておらずOpenAI社内利用が前提ですが、ChatGPT・API・Codexの応答速度・可用性・トークン単価に間接的な影響を及ぼしうる動きとして、法人ITと投資家の双方から注目が集まっています。
本記事では、性能ベンチマーク、アーキテクチャ設計思想、9か月tape-outが示す新パラダイム、ハイパースケーラー独自シリコン戦略での位置づけ、ChatGPT・API・Codex利用企業へのコストインパクトを、2026年8月時点の公式一次情報を中心とした公開情報で解説します。
目次
Jalapeño(ハラペーニョ)とは?OpenAIとBroadcomが白紙設計した初の推論専用ASIC
Jalapeñoの性能ベンチマーク——NVIDIA GB200/GB300を電力効率で最大1.9倍上回る
SemiAnalysis InferenceXで3モデル計測
GB200・GB300との比較——電力効率と遅延の両面で優位
Jalapeñoのアーキテクチャ設計思想——prefill・decodeを1チップで両立
9か月でtape-out——AIがAIチップを設計する新パラダイム
ハイパースケーラー独自シリコン戦略でのJalapeñoの位置づけ
Broadcom + Marvellがco-design市場の95%を独占
NVIDIAとの共存戦略——訓練は継続、推論に独自ASICを充てる二層構造
ChatGPT・API・Codex利用企業への影響とコストインパクト
OpenAIのTCO削減効果——電力効率1.9倍が意味するもの
SIerポジション——「NVIDIA×独自ASIC並行運用時代」への備え
Jalapeño(ハラペーニョ)とは?OpenAIとBroadcomが白紙設計した初の推論専用ASIC
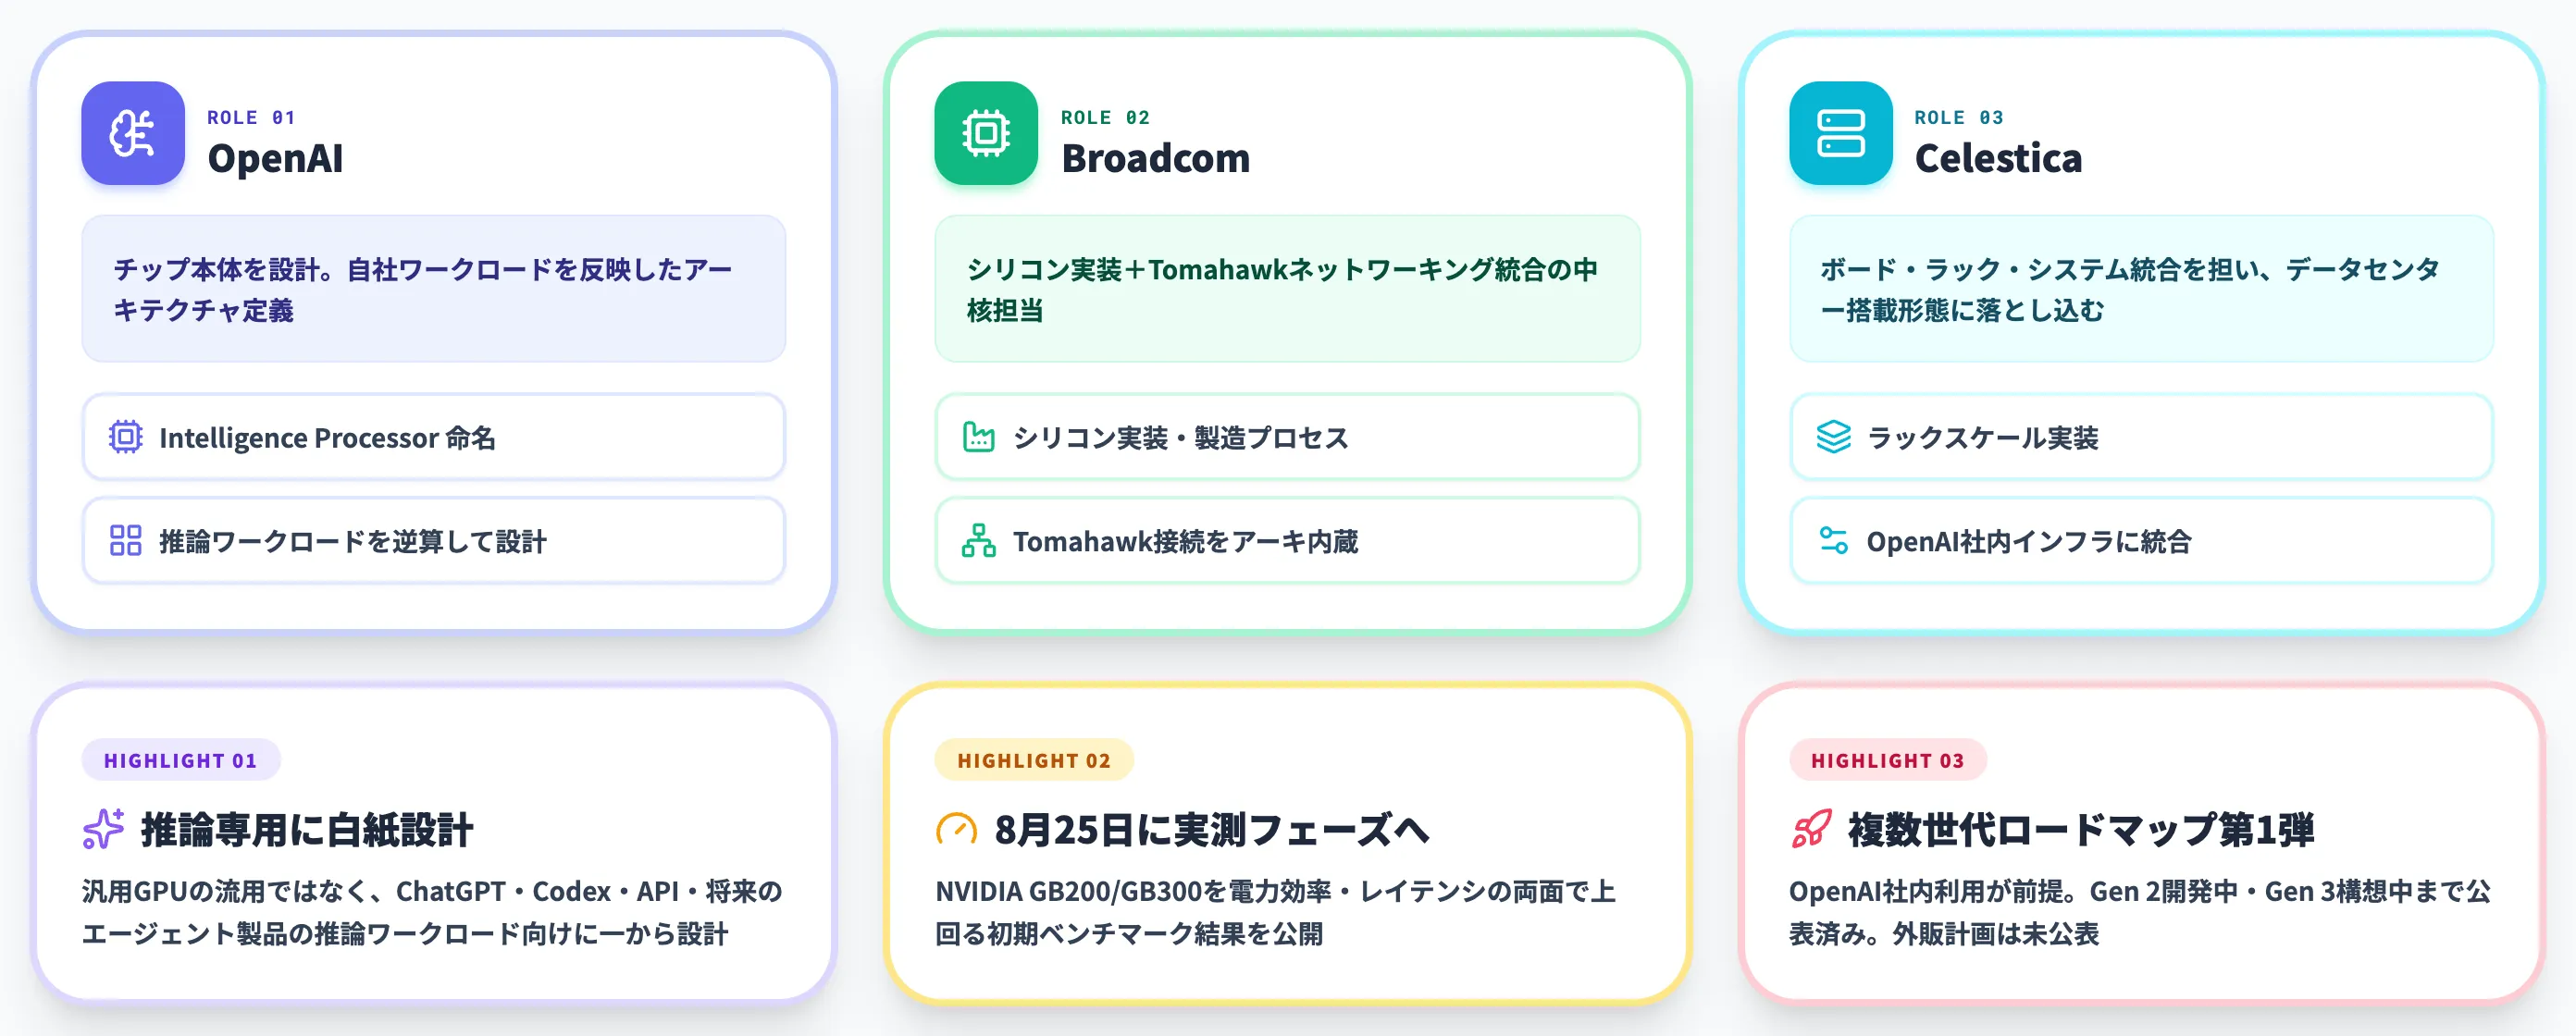
Jalapeño(ハラペーニョ)は、OpenAIがBroadcom(NASDAQ: AVGO)と共同で設計した、大規模言語モデル(LLM)推論のために白紙から作られた初のカスタムAI推論チップです。
OpenAIはこのチップを「Intelligence Processor(知能プロセッサ)」と呼び、既存の汎用GPUを流用したものではなく、ChatGPT・Codex・API・将来のエージェント製品といった自社サービスで動く推論ワークロードを効率化するために一から設計したと公式発表で説明しています。
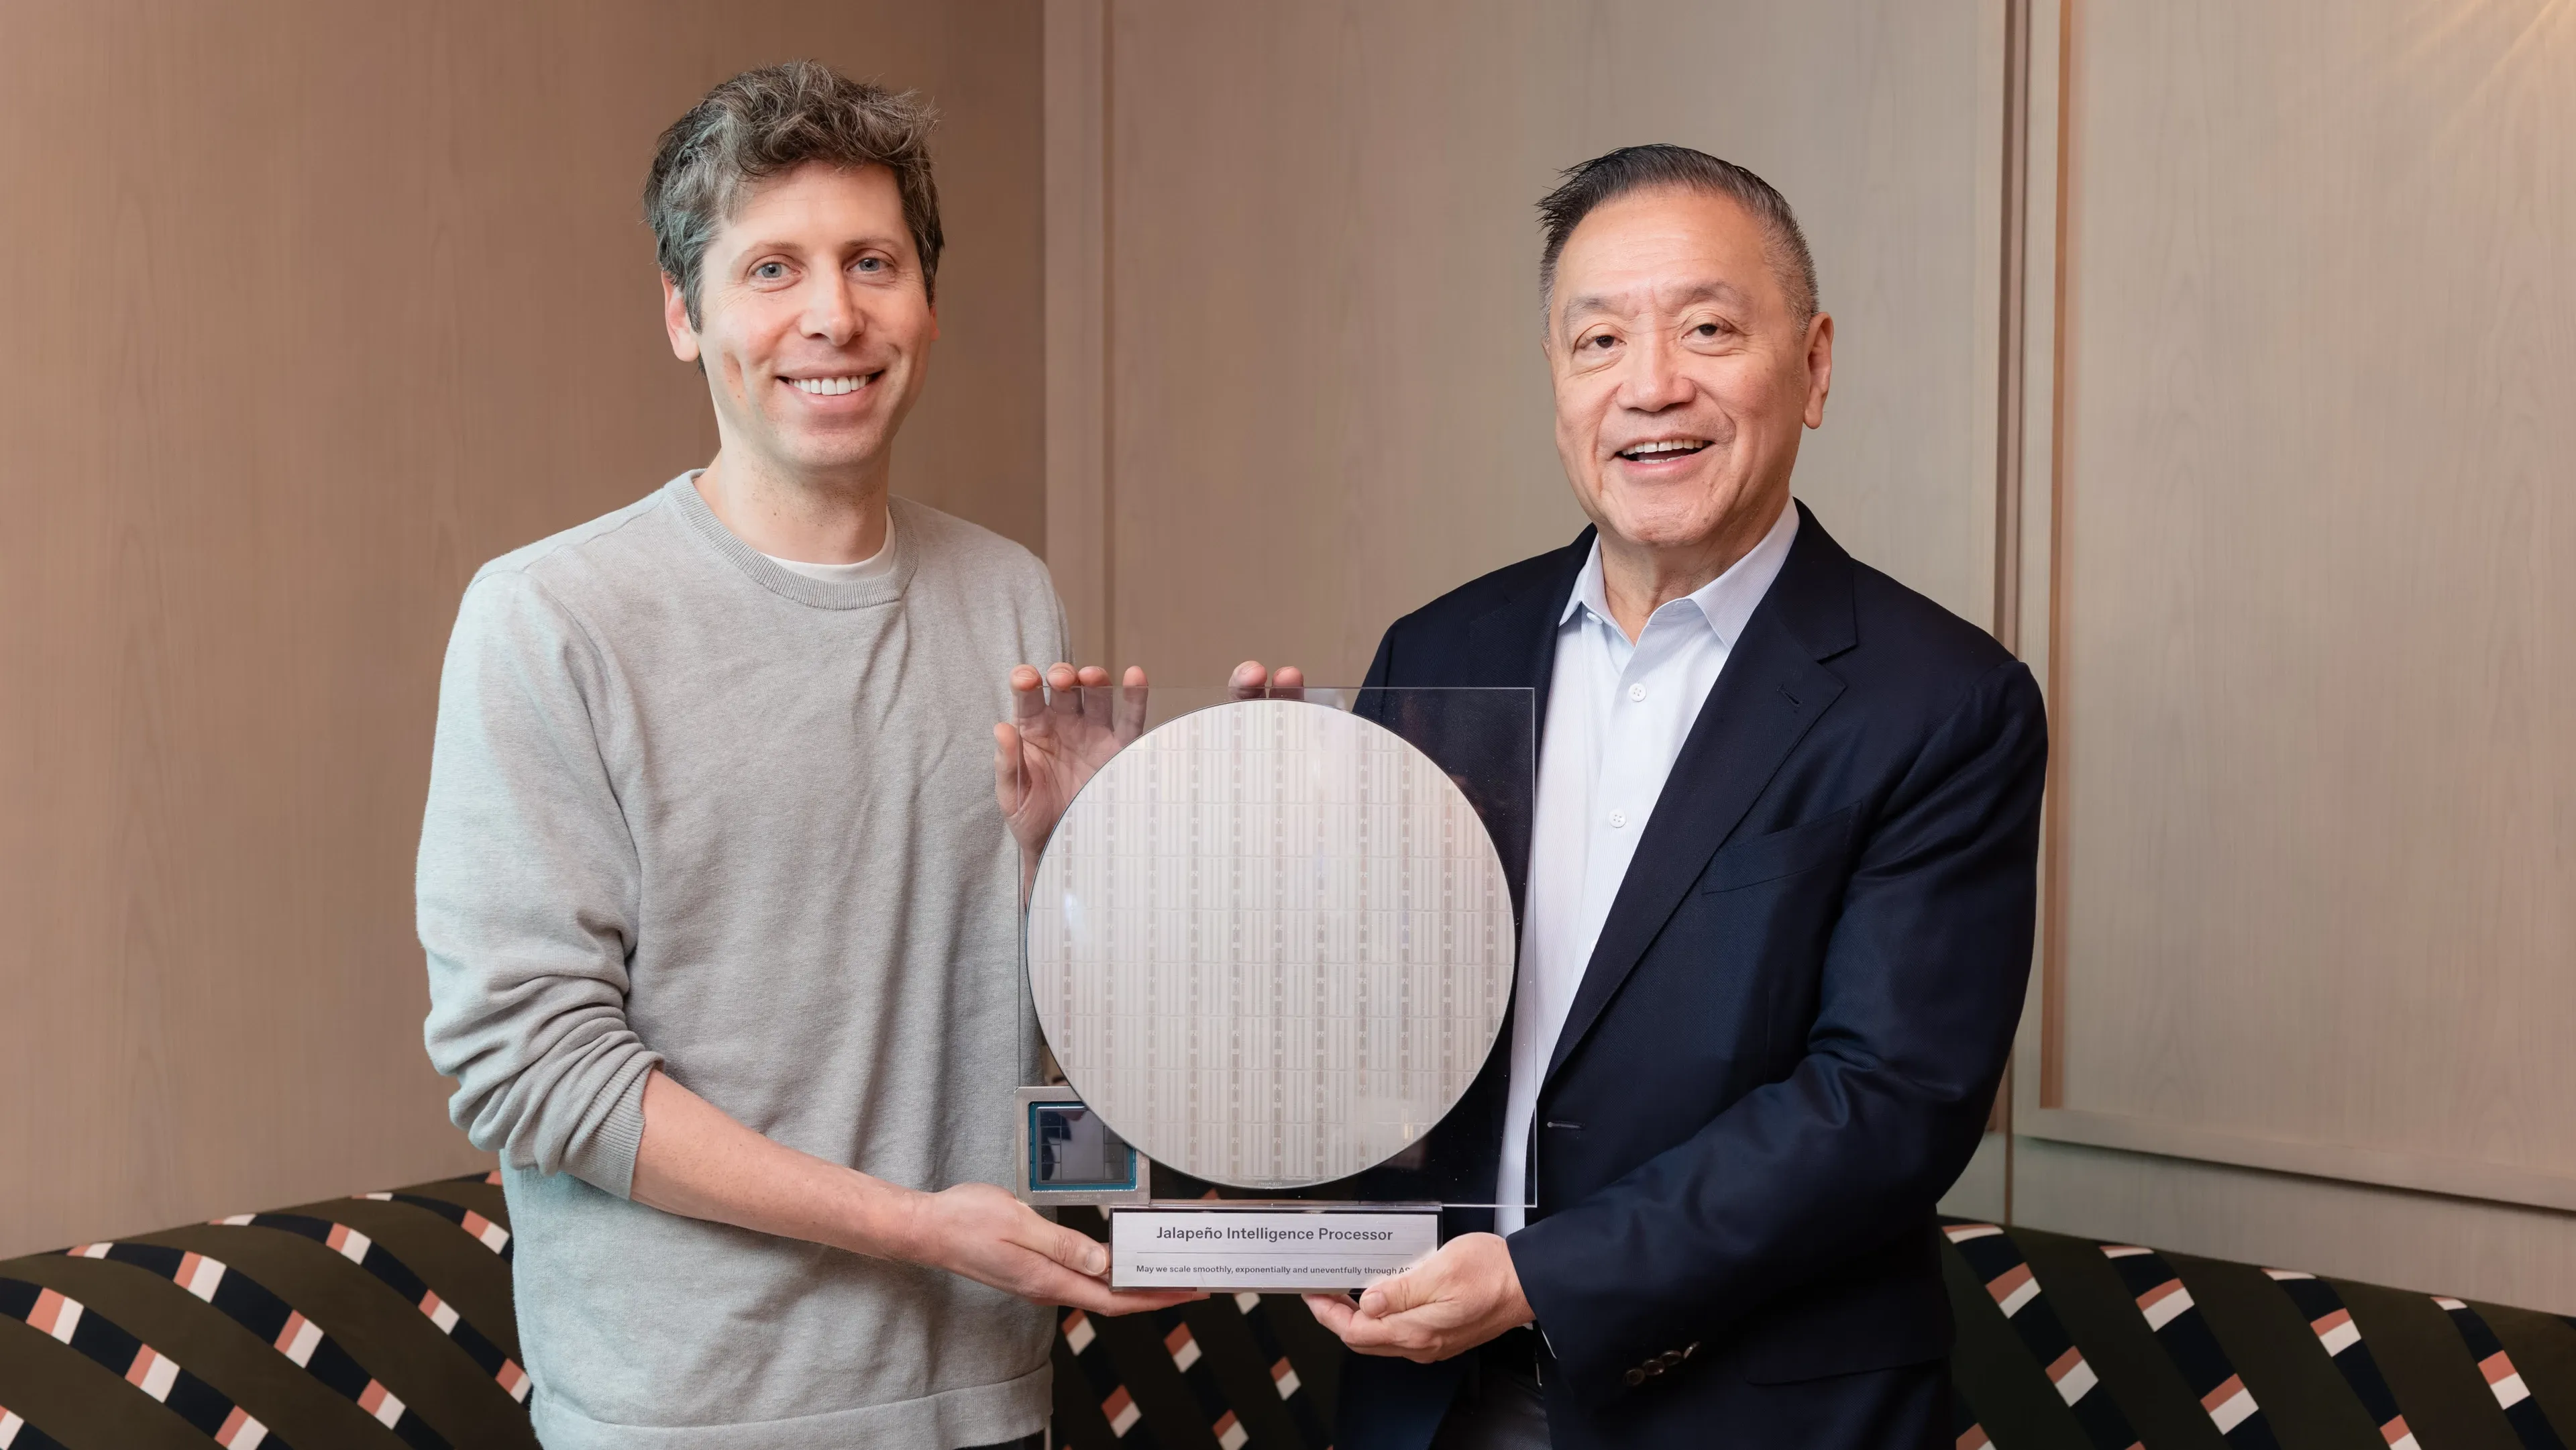
OpenAIのSam Altmanとブロードコムの陳福陽(Hock Tan)両CEOが、Jalapeñoの初号チップを披露する発表当日のワンショット(出典:OpenAI)
発表から実測フェーズへの進展と3社分担体制
2026年6月24日の発表時は概要のみが公開されていましたが、2026年8月25日には初期ベンチマーク結果も公開され、発表イベントの延長ではなく実測フェーズへと一歩踏み込んだ位置づけへ進んでいます。
チップ本体はOpenAIが設計、Broadcomがシリコン実装(Tomahawkネットワーキング含む)、Celesticaがボード・ラック・システム統合を担う3社分担構造で、複数世代にわたる共同開発プラットフォームの第1弾として設計されています。現時点で外販計画は公表されておらず、OpenAIの自社インフラでの利用が前提です。
Jalapeñoの性能ベンチマーク——NVIDIA GB200/GB300を電力効率で最大1.9倍上回る
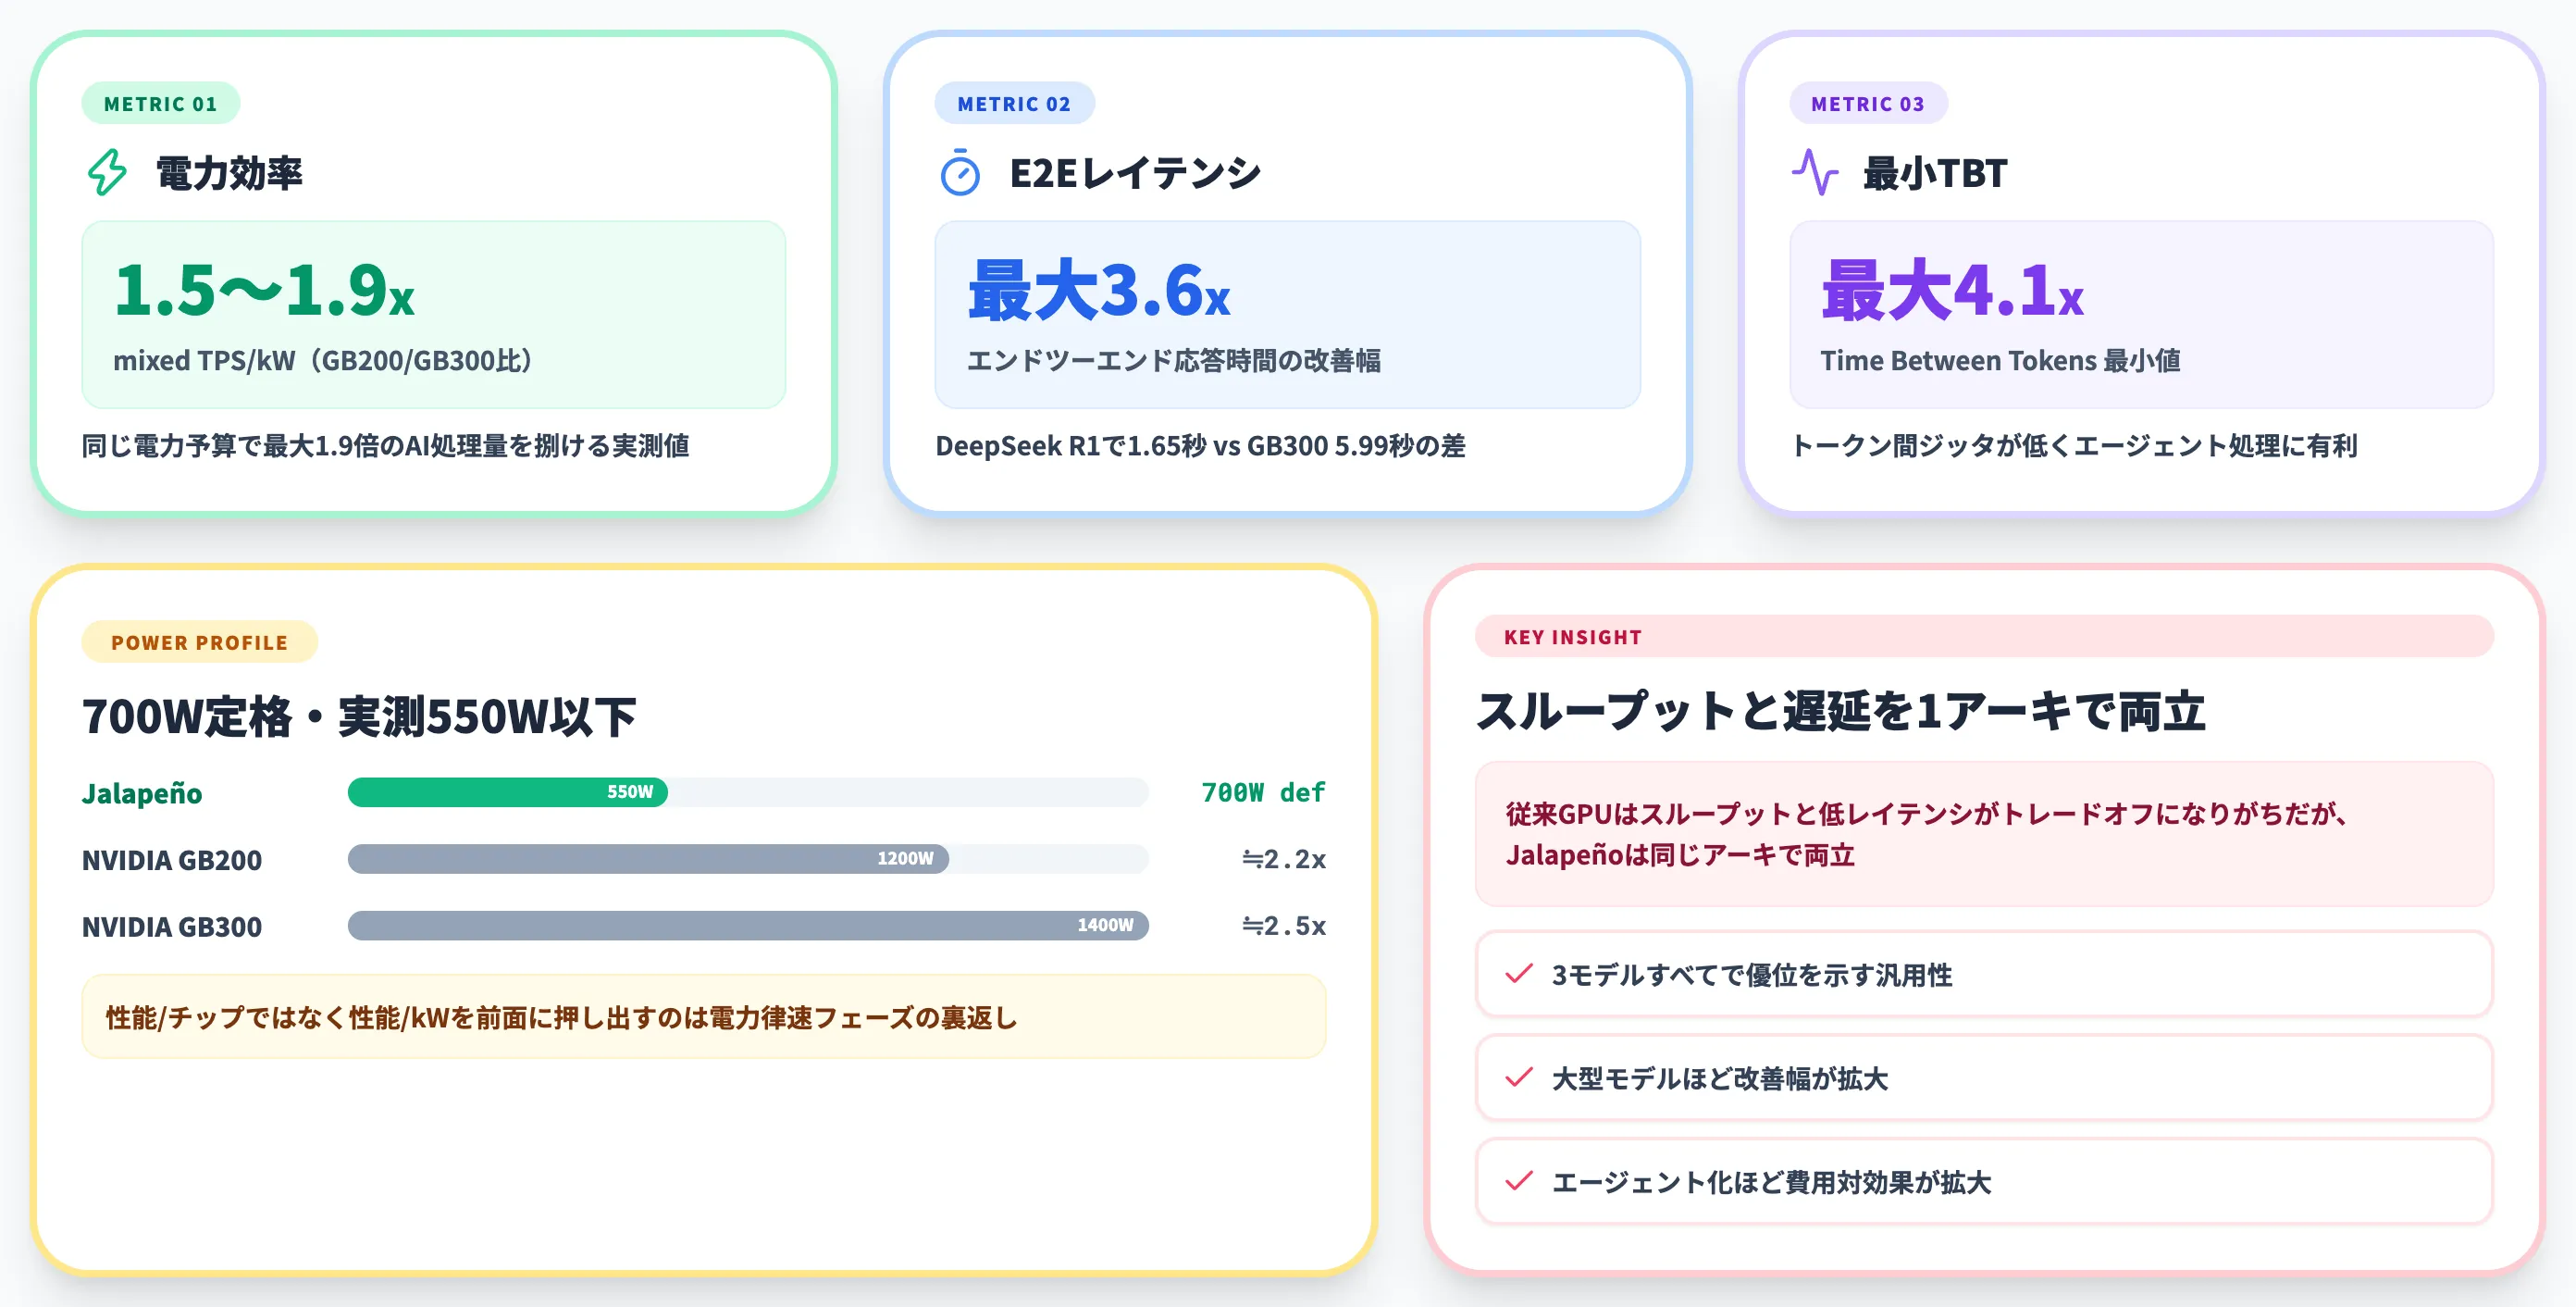
OpenAIが8月25日に公開した実測値の要点は、同じ電力で1.5〜1.9倍のAI処理量を出しつつ、応答時間も最大3.6倍速いという一言に集約できます。
従来のGPUは高スループットと低レイテンシがトレードオフになりがちでしたが、Jalapeñoは同じアーキテクチャで両立させた点が特徴です。
本セクションでは、測定に使われたベンチマーク・比較対象・電力設計を順に整理します。
SemiAnalysis InferenceXで3モデル計測
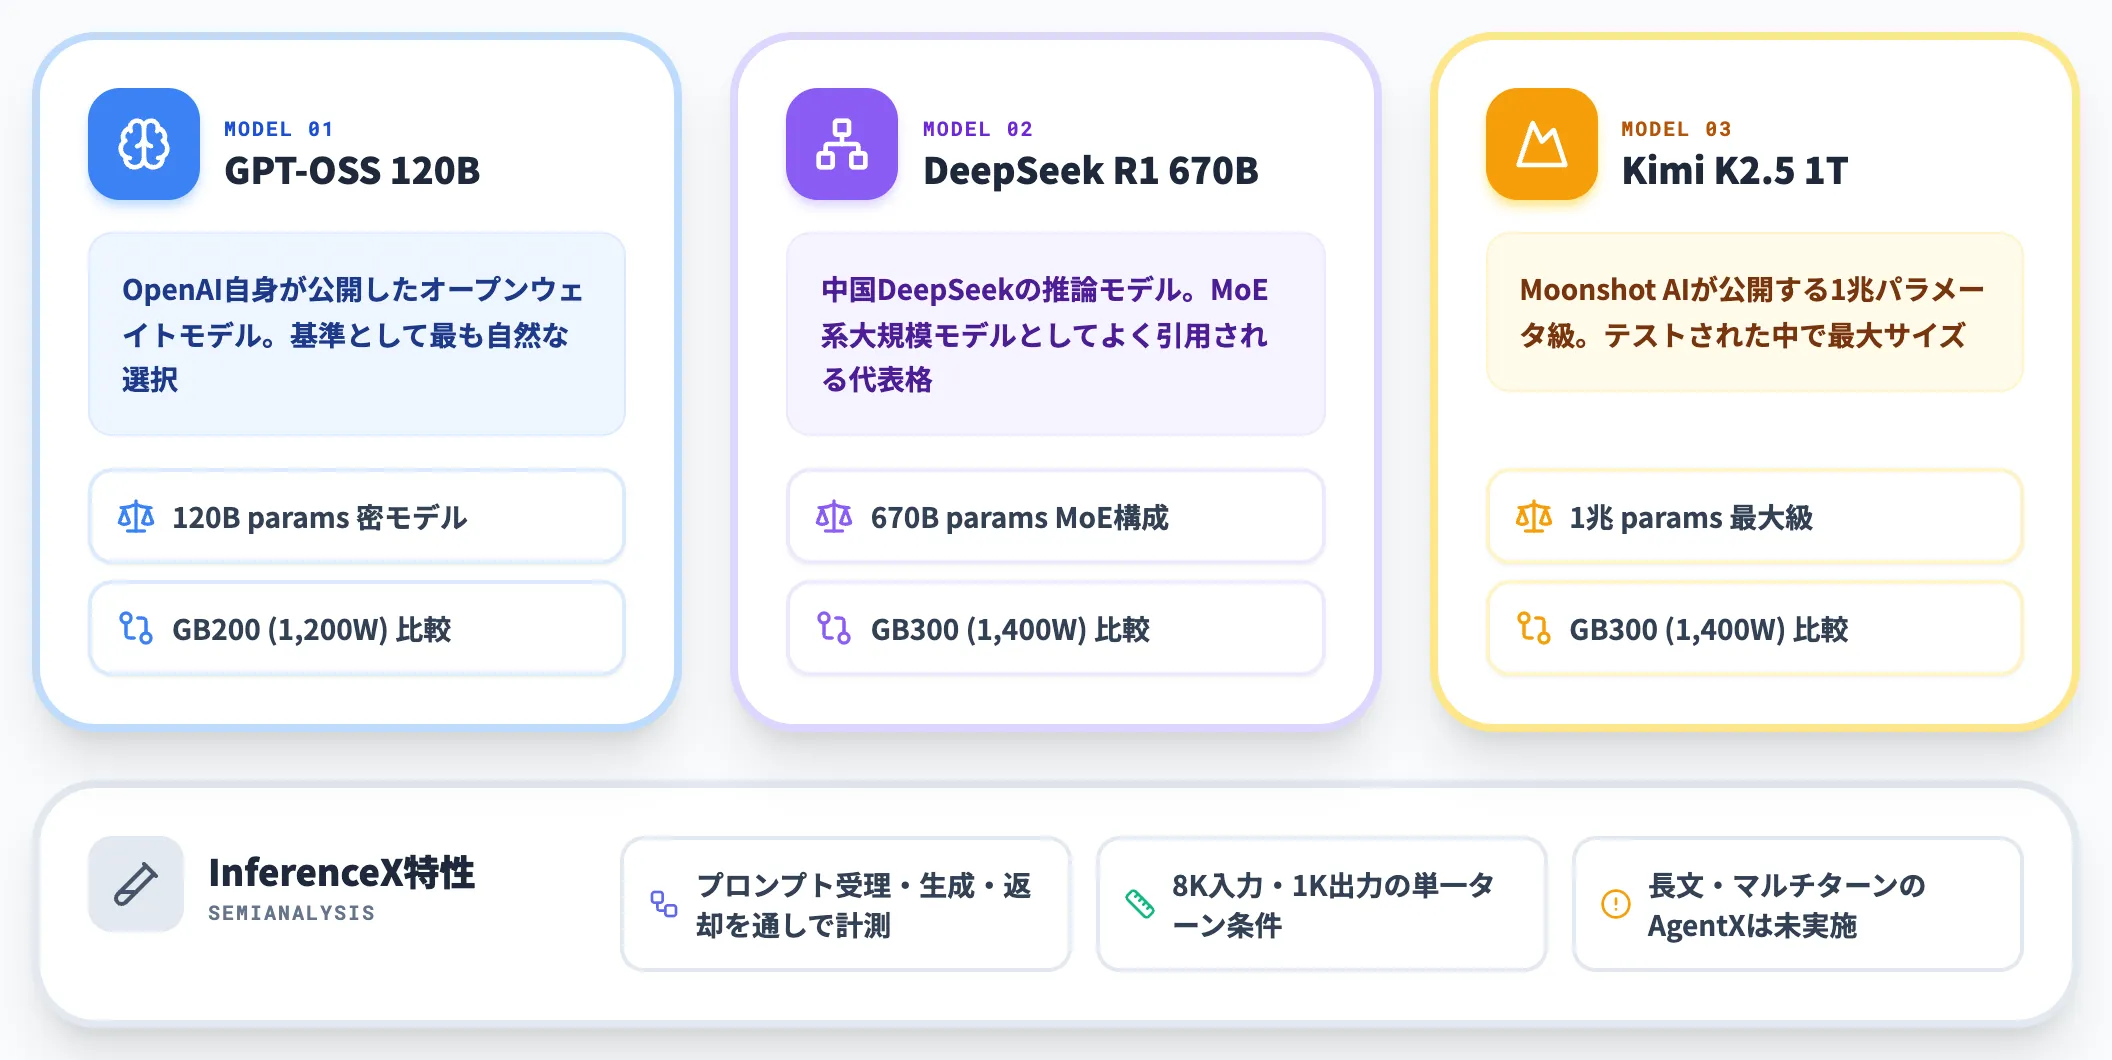
計測に使われたのは、SemiAnalysisが公開している推論ベンチマーク「InferenceX」です。これは単純なピーク性能ではなく、AIリクエストを処理する一連の流れ(プロンプト受理・トークン生成・レスポンス返却)を通しで計測するベンチマークです。
ただし、今回の結果は8K入力・1K出力の単一ターン条件で、長文・マルチターンの実運用負荷を想定したAgentXは未実施です。
比較対象として選ばれたのは、以下の3つの公開モデルです。
-
GPT-OSS 120B
OpenAI自身が公開したオープンウェイトモデル。基準として最も自然な選択。
-
DeepSeek R1 670B
中国DeepSeekの推論モデル。MoE系の大規模モデルとしてよく引用される。
-
Kimi K2.5 1T
Moonshot AIが公開する1兆パラメータ級モデル。テストされた中で最大のモデル。
3モデルすべてでJalapeñoが優位、というのは「自社モデルだから速い」で片づかない結果です。アーキテクチャそのものの汎用性を示す設計になっています。
GB200・GB300との比較——電力効率と遅延の両面で優位
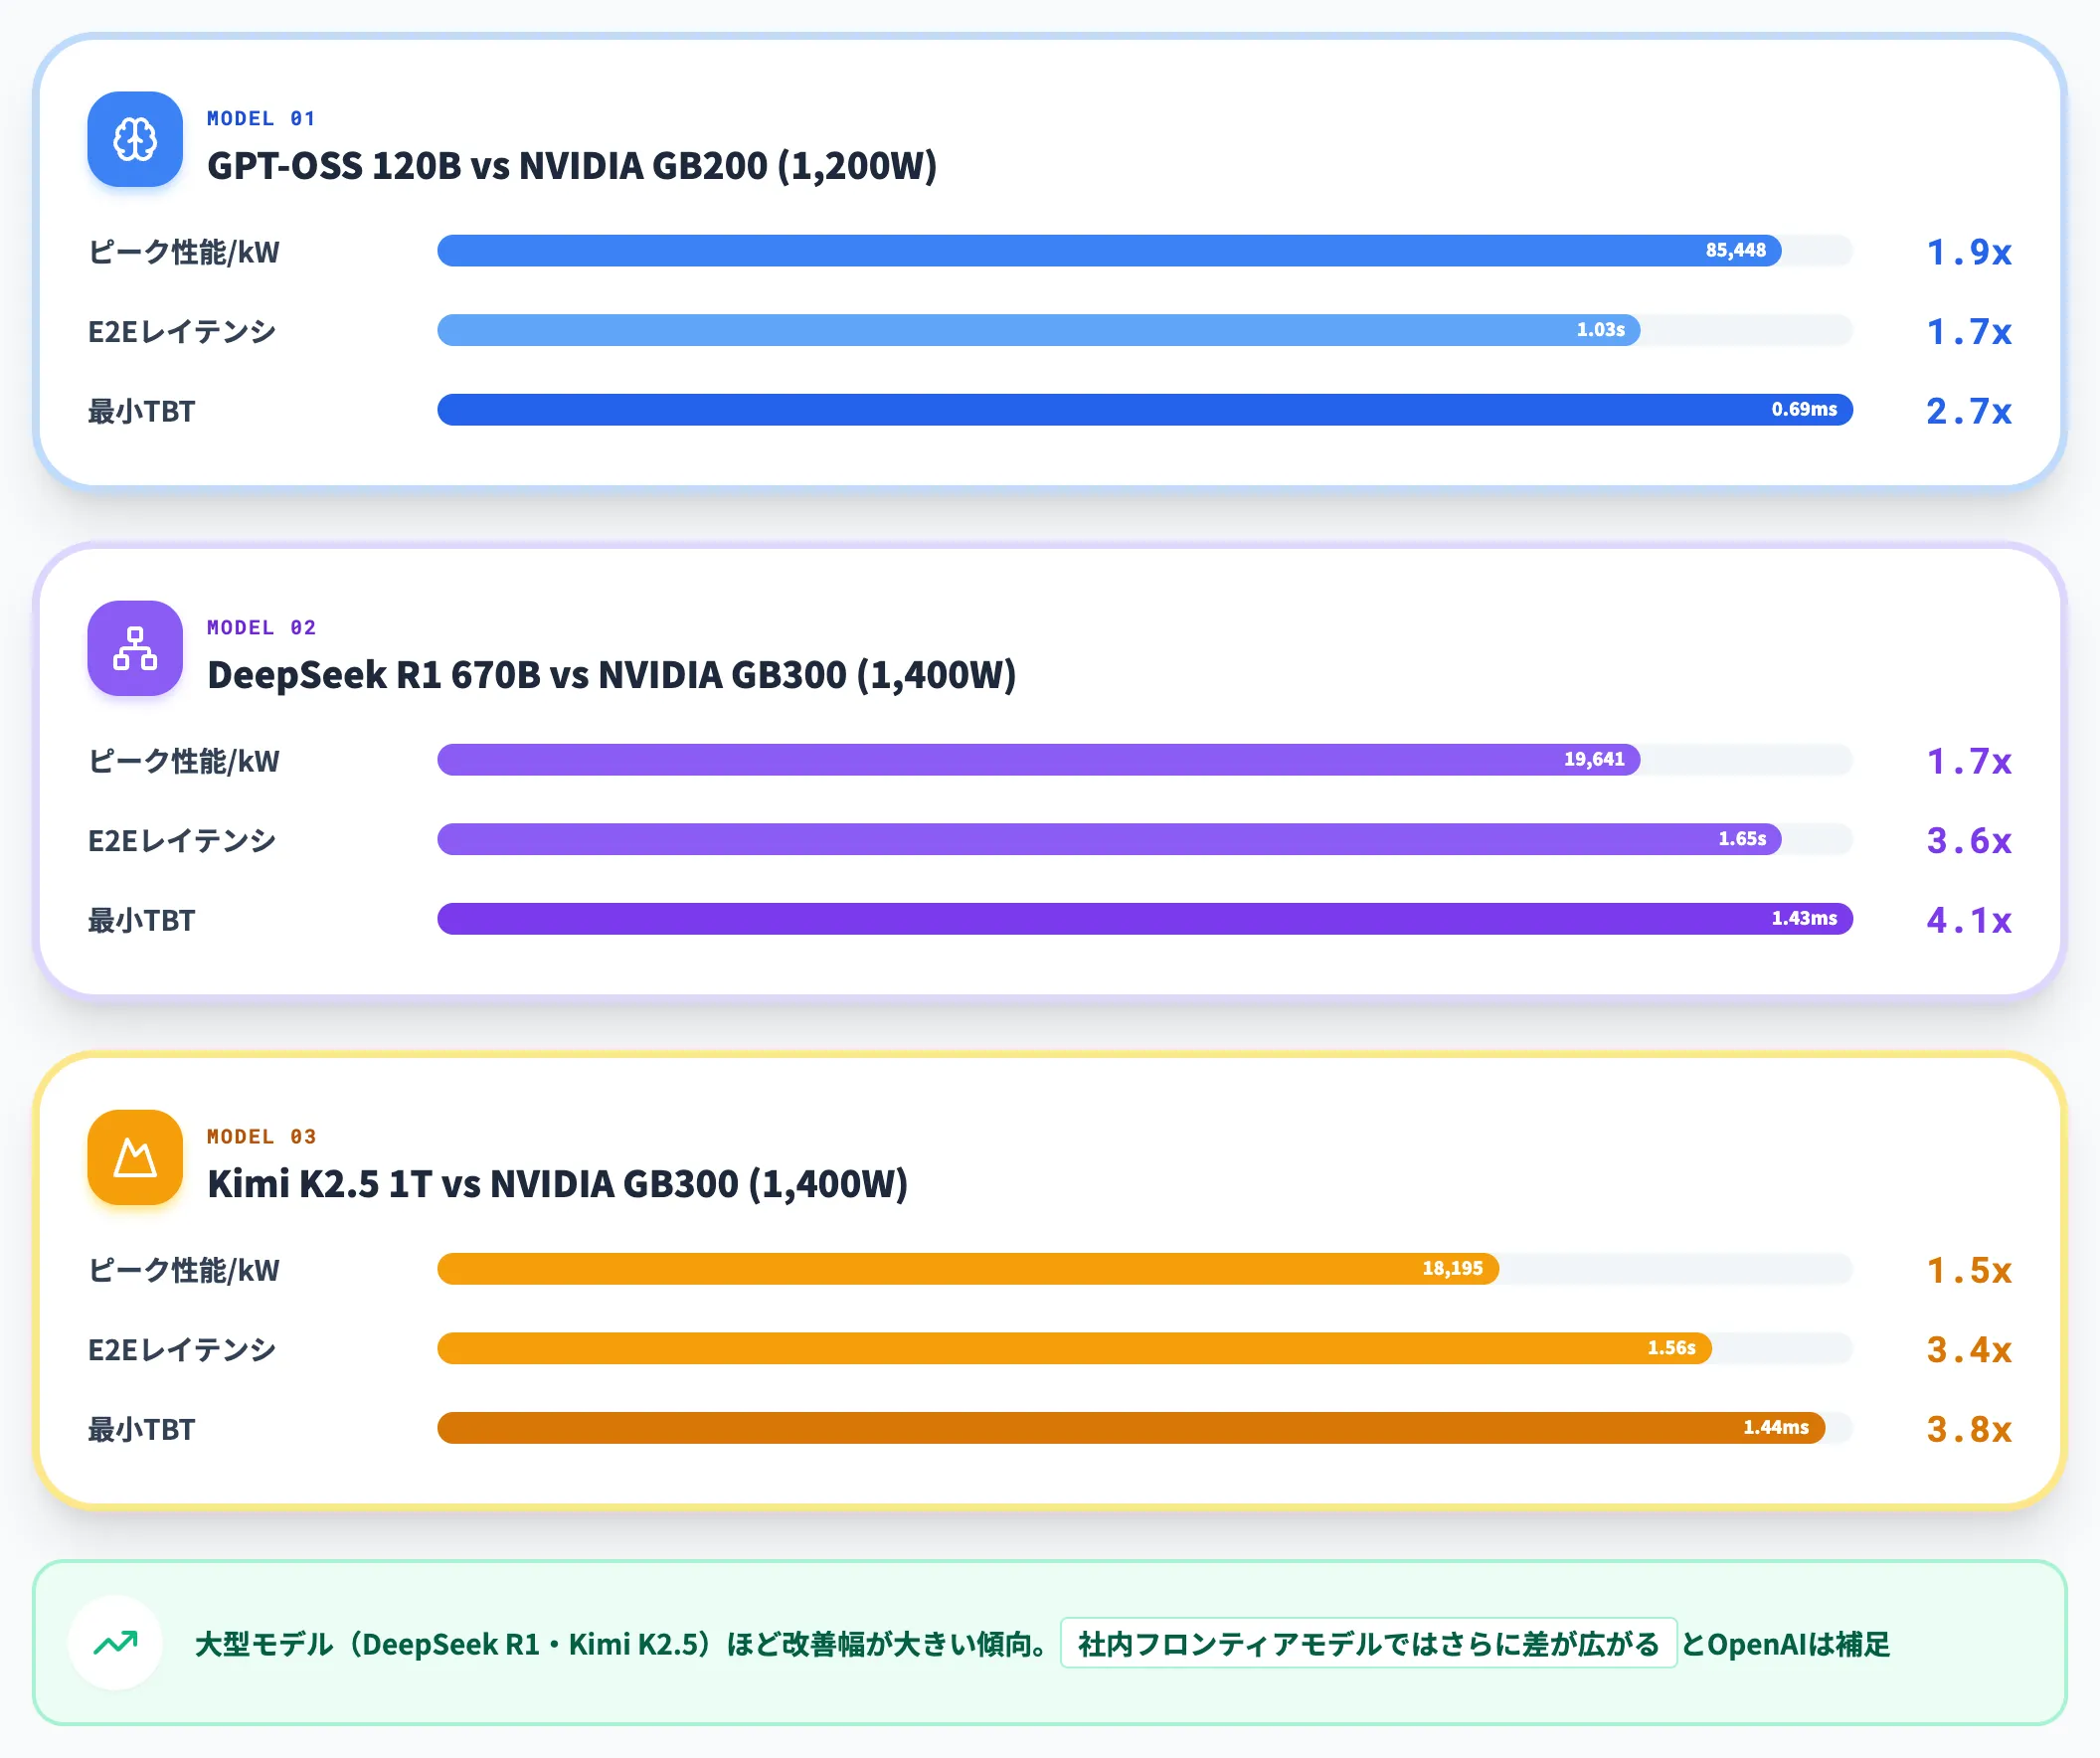
以下の表で、公式に公開された3モデル別の主要な比較指標を整理しました。「mixed TPS/kW」は1キロワットあたりの混合スループット(プロンプト処理と生成の合算値)、「エンドツーエンドレイテンシ」はリクエストからレスポンス完了までの時間です。
| 対象モデル | 比較対象 | ピーク性能/kW比 | エンドツーエンドレイテンシ比 | 最小TBT比 |
|---|---|---|---|---|
| GPT-OSS 120B | NVIDIA GB200(1,200W) | 約1.9倍(85,448 vs 44,960) | 約1.7倍(1.03秒 vs 1.80秒) | 約2.7倍(0.69ms vs 1.87ms) |
| DeepSeek R1 670B | NVIDIA GB300(1,400W) | 約1.7倍(19,641 vs 11,781) | 約3.6倍(1.65秒 vs 5.99秒) | 約4.1倍(1.43ms vs 5.90ms) |
| Kimi K2.5 1T | NVIDIA GB300(1,400W) | 約1.5倍(18,195 vs 11,862) | 約3.4倍(1.56秒 vs 5.31秒) | 約3.8倍(1.44ms vs 5.48ms) |
特に差が広がるのはDeepSeek R1・Kimi K2.5のような大型モデル側で、GB300比のレイテンシ差が3倍超まで開いています。GPT-OSS 120BのGB200比1.7倍と比べると、大型モデルほど大きな改善幅が出る傾向が読み取れます(GB300を比較対象とする2モデル内では、DeepSeek R1が3.6倍・Kimi K2.5が3.4倍と単調に増えているわけではありません)。
OpenAIはこの点について「社内のフロンティアモデルではさらに差が広がる」と補足しており、大規模化・エージェント化が進むほど独自ASICの費用対効果が高まる構造です。
700W定格・実測550W以下という電力設計
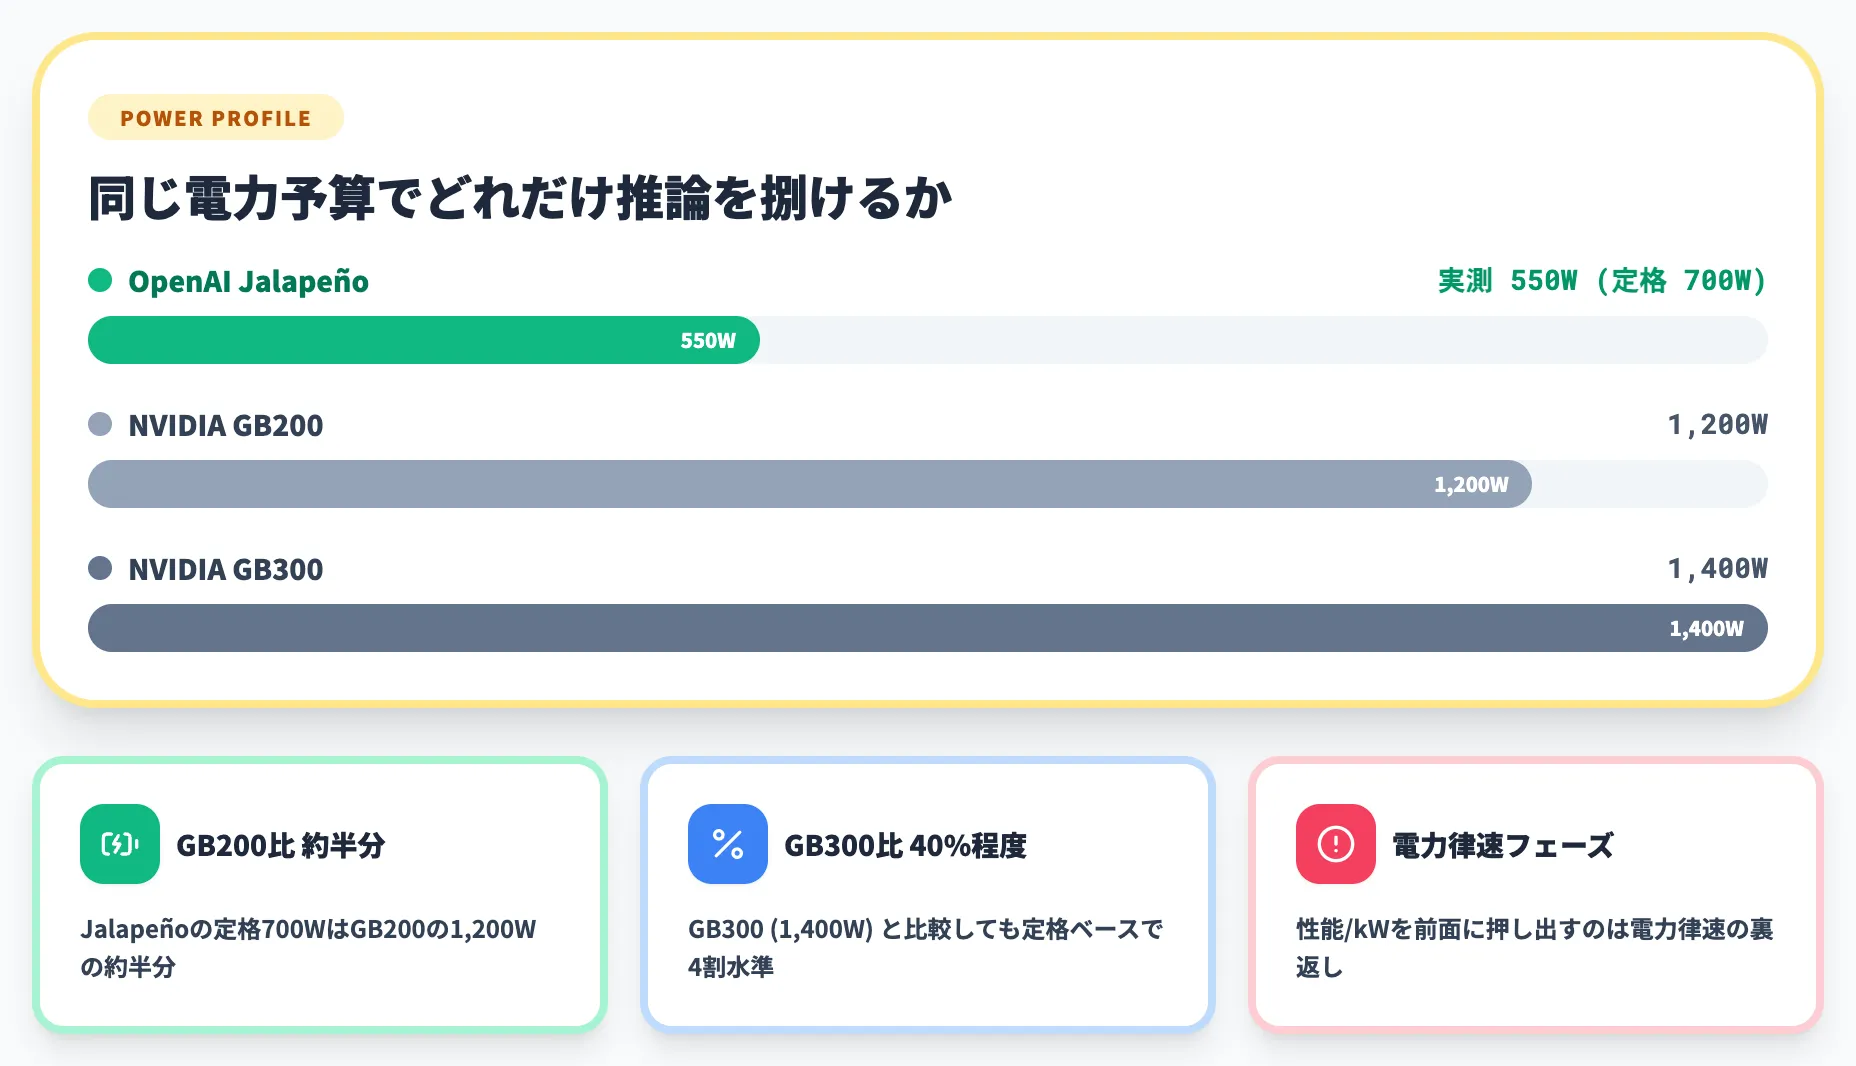
Jalapeñoの定格電力は700W、実測ではテストされたワークロードで550W以下に収まっています。これはNVIDIA GB200(1,200W)の約半分、GB300(1,400W)の40%程度に相当します。
データセンター全体で見ると、電力枠は物理的な制約です。同じ電力予算でどれだけ多くの推論を捌けるかが、事業者のコスト構造と処理容量を左右します。
比較指標として「性能/チップ」ではなく「性能/kW」を前面に押し出しているのも、OpenAI自身が電力律速のフェーズに入っていることの裏返しです。
Jalapeñoのアーキテクチャ設計思想——prefill・decodeを1チップで両立
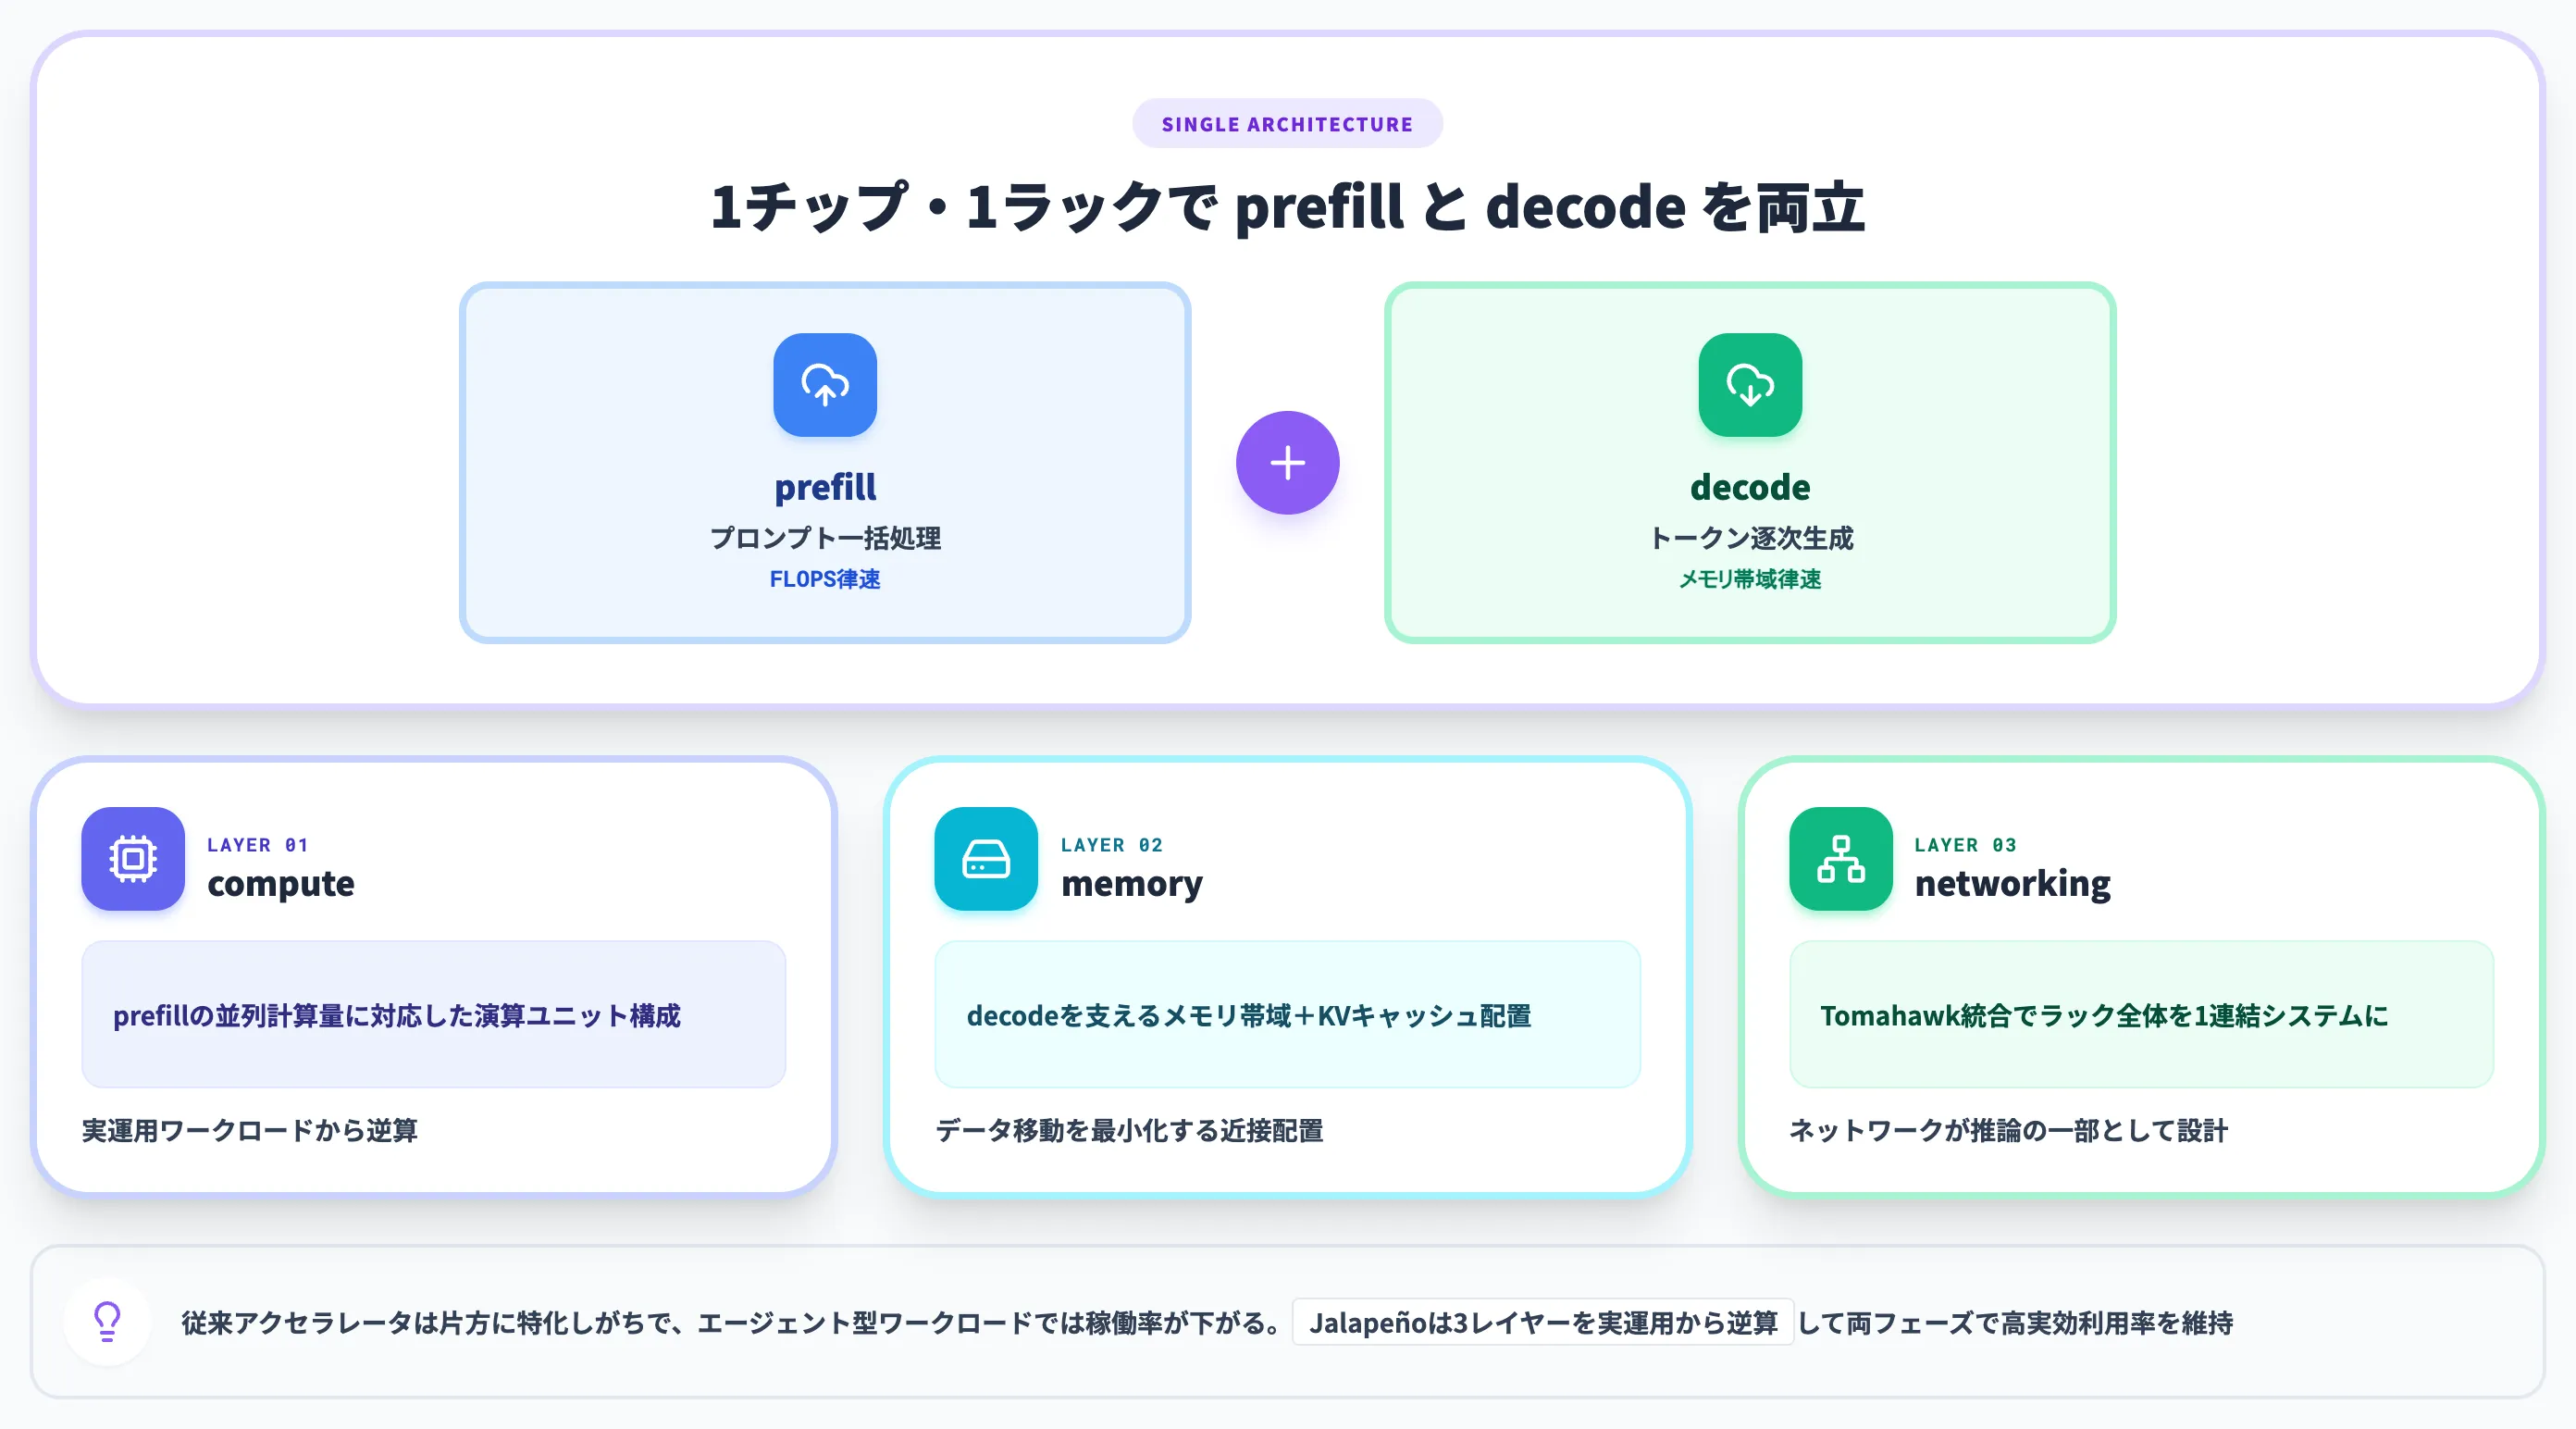
OpenAIが「single architecture」と繰り返し強調するのは、通常なら別々のシステム設計に分かれるプレフィル(prompt処理)とデコード(token生成)の両フェーズを、1つのチップと1つのラックスケール設計で最適化した点です。ここに従来型GPUとの根本的な違いがあります。
本セクションでは、AI推論の内部構造からJalapeñoの設計判断を読み解きます。
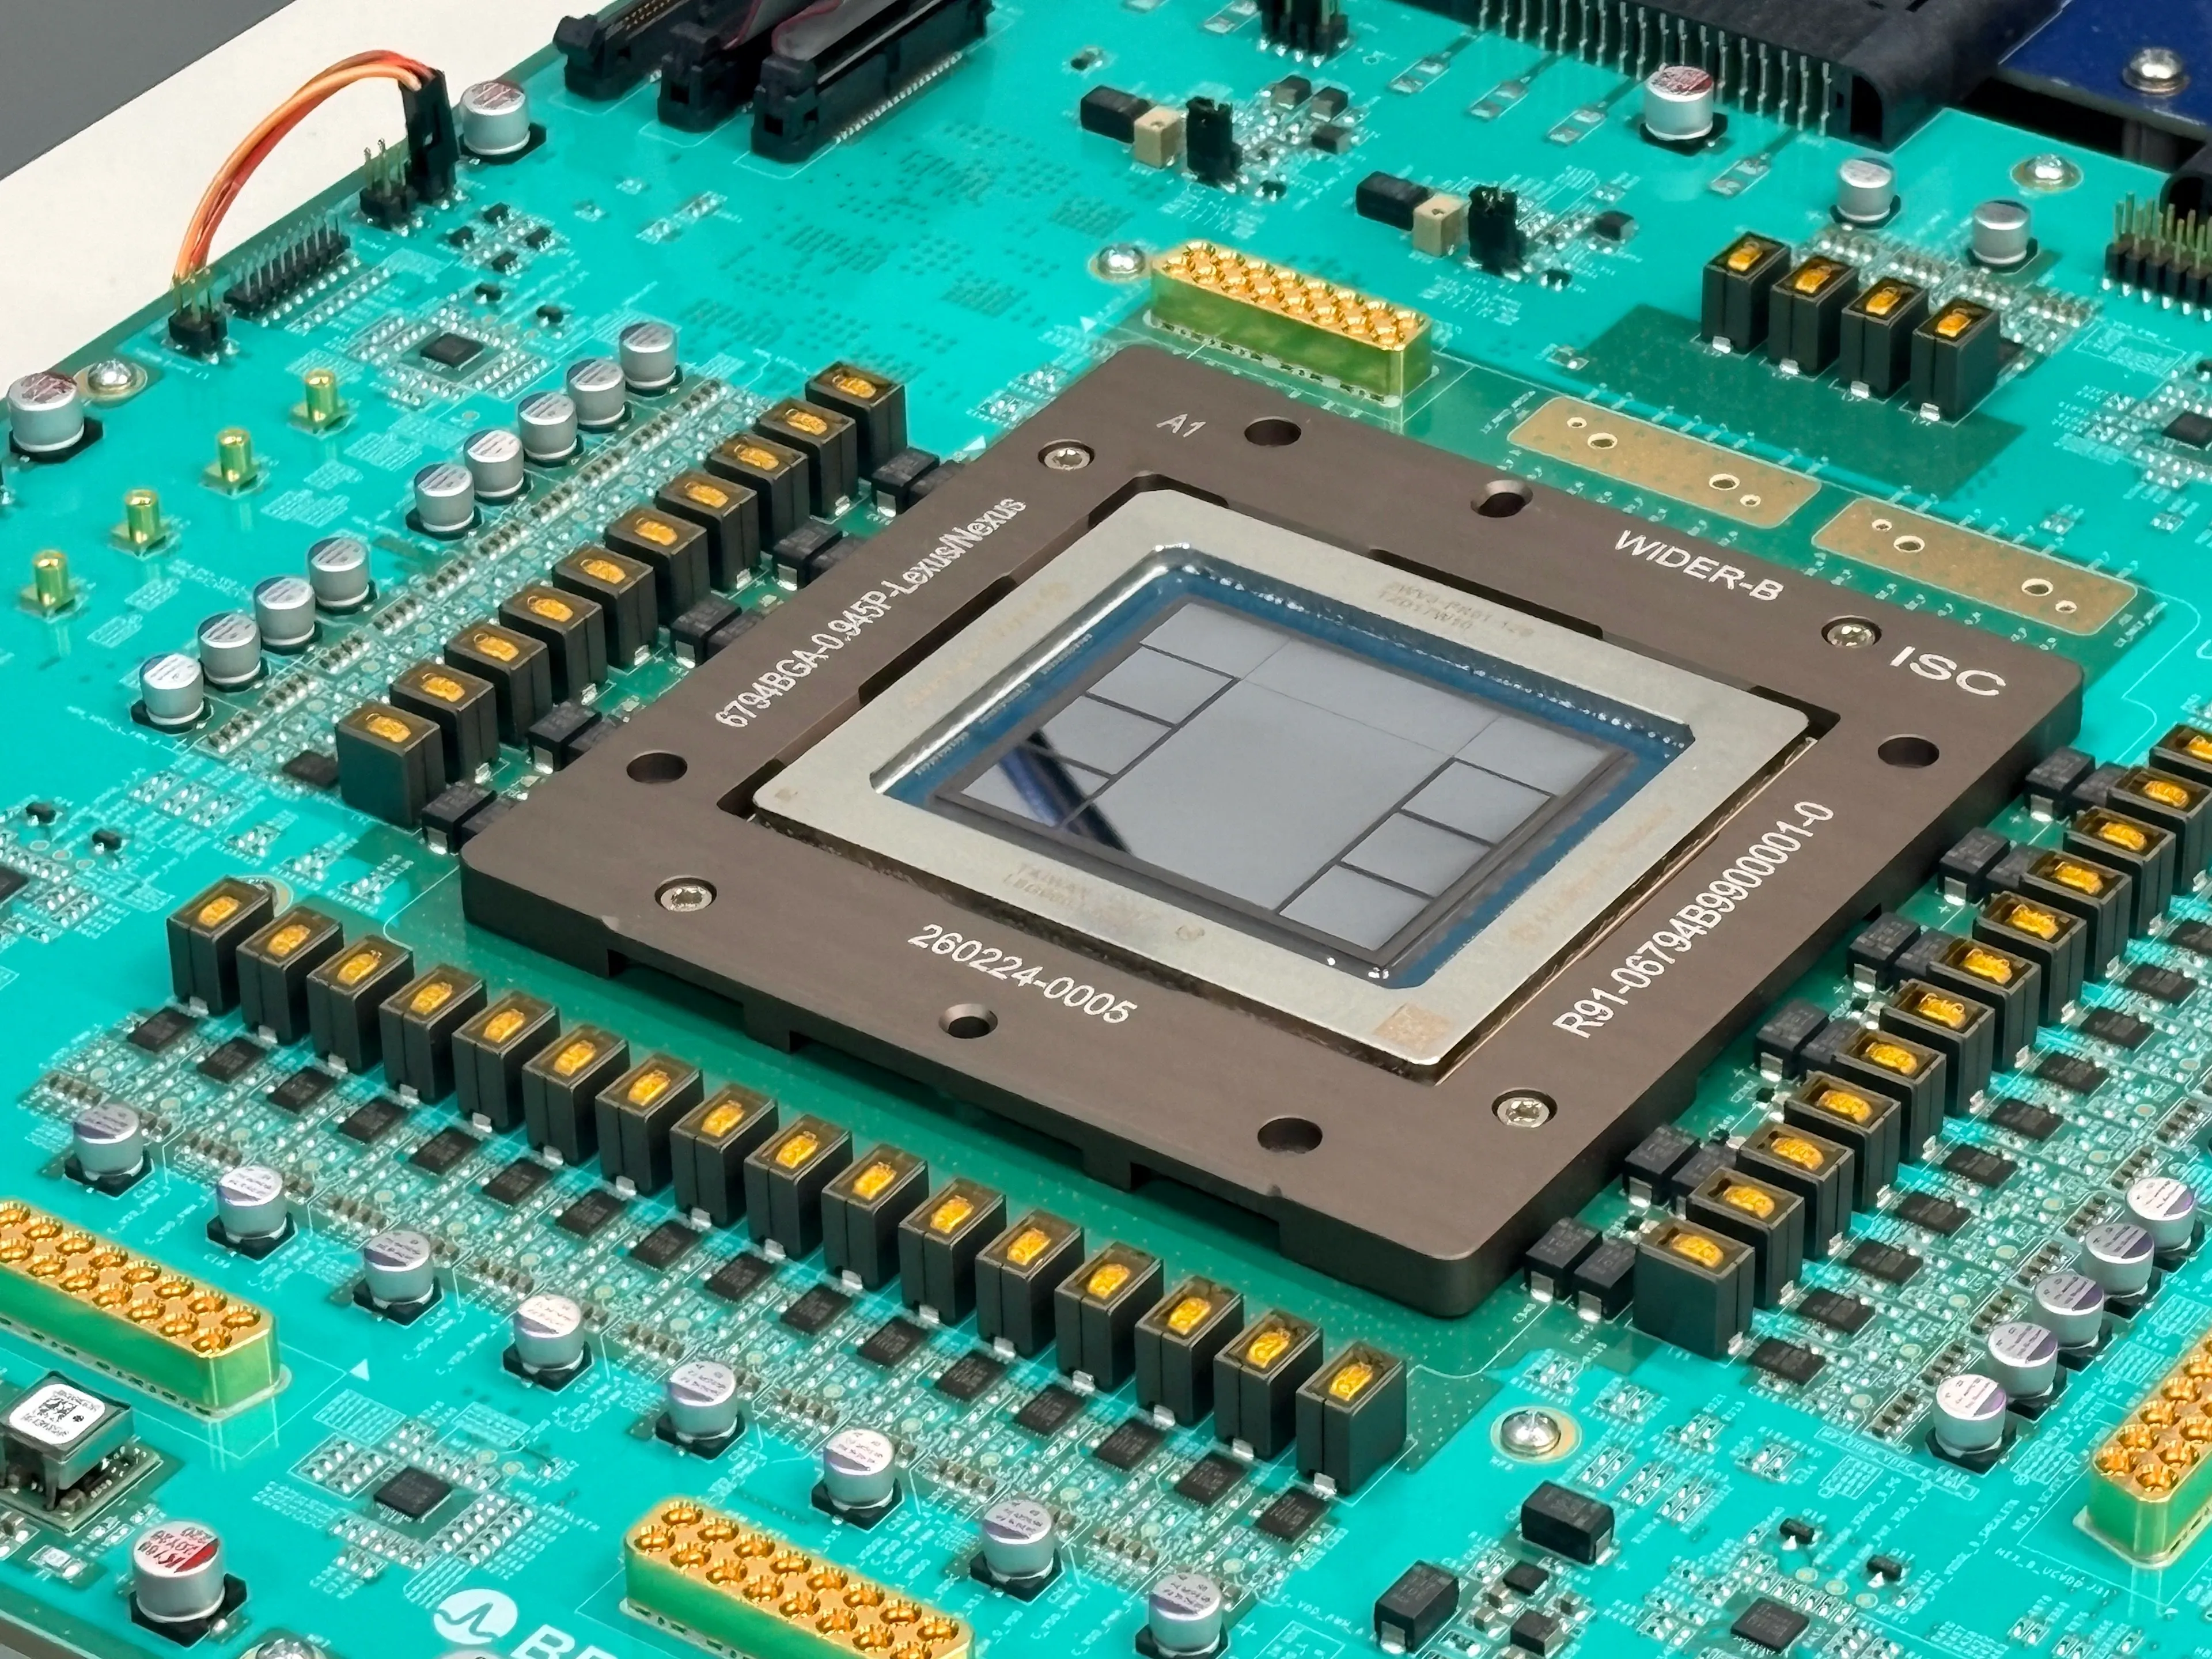
ティール色の評価ボードに実装されたJalapeñoの初号機(出典:OpenAI)
prefillとdecodeで異なる律速要因を1つに統合
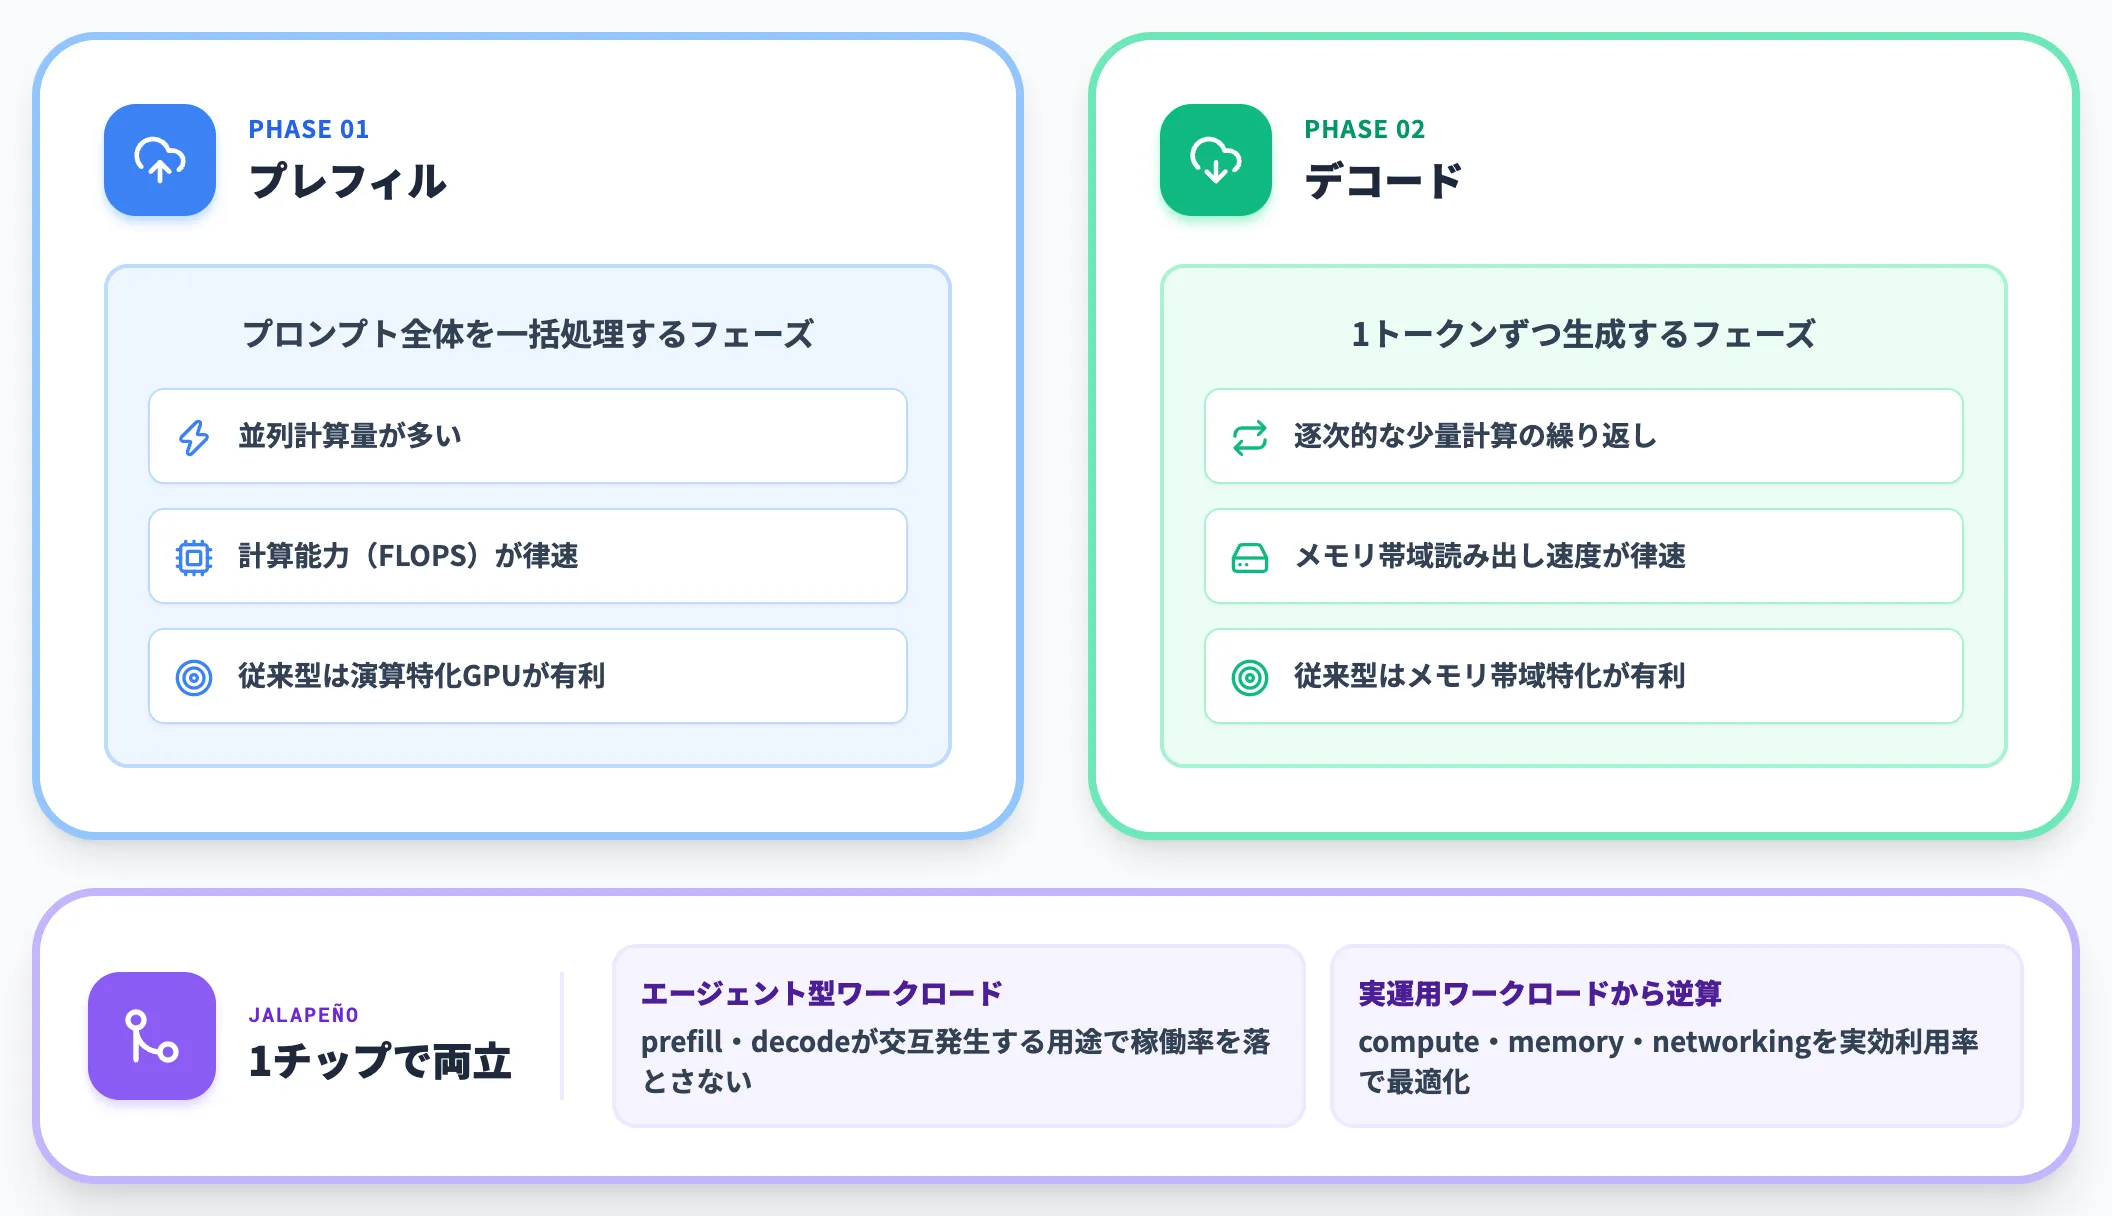
LLM推論は、以下の2フェーズに分かれます。
-
プレフィル(prefill)
プロンプト全体を一括で処理するフェーズ。並列計算量が多く、計算能力(FLOPS)が律速要因になる。
-
デコード(decode)
1トークンずつレスポンスを生成するフェーズ。メモリ帯域から読み出す速度が律速要因になる。
従来のアクセラレータは、どちらか一方に強く、他方では処理待ちが発生しやすい設計でした。特にエージェント型ワークロード(複数ステップを連続実行する用途)では、プレフィルとデコードが交互に発生するため、片方に特化した設計だとチップ全体の稼働率が下がります。
Jalapeñoは、compute・memory・networkingのバランスを実運用ワークロードから逆算して設計したことで、両フェーズで高い実効利用率を維持できる構造です。
KVキャッシュのローカル配置とネットワーク統合設計
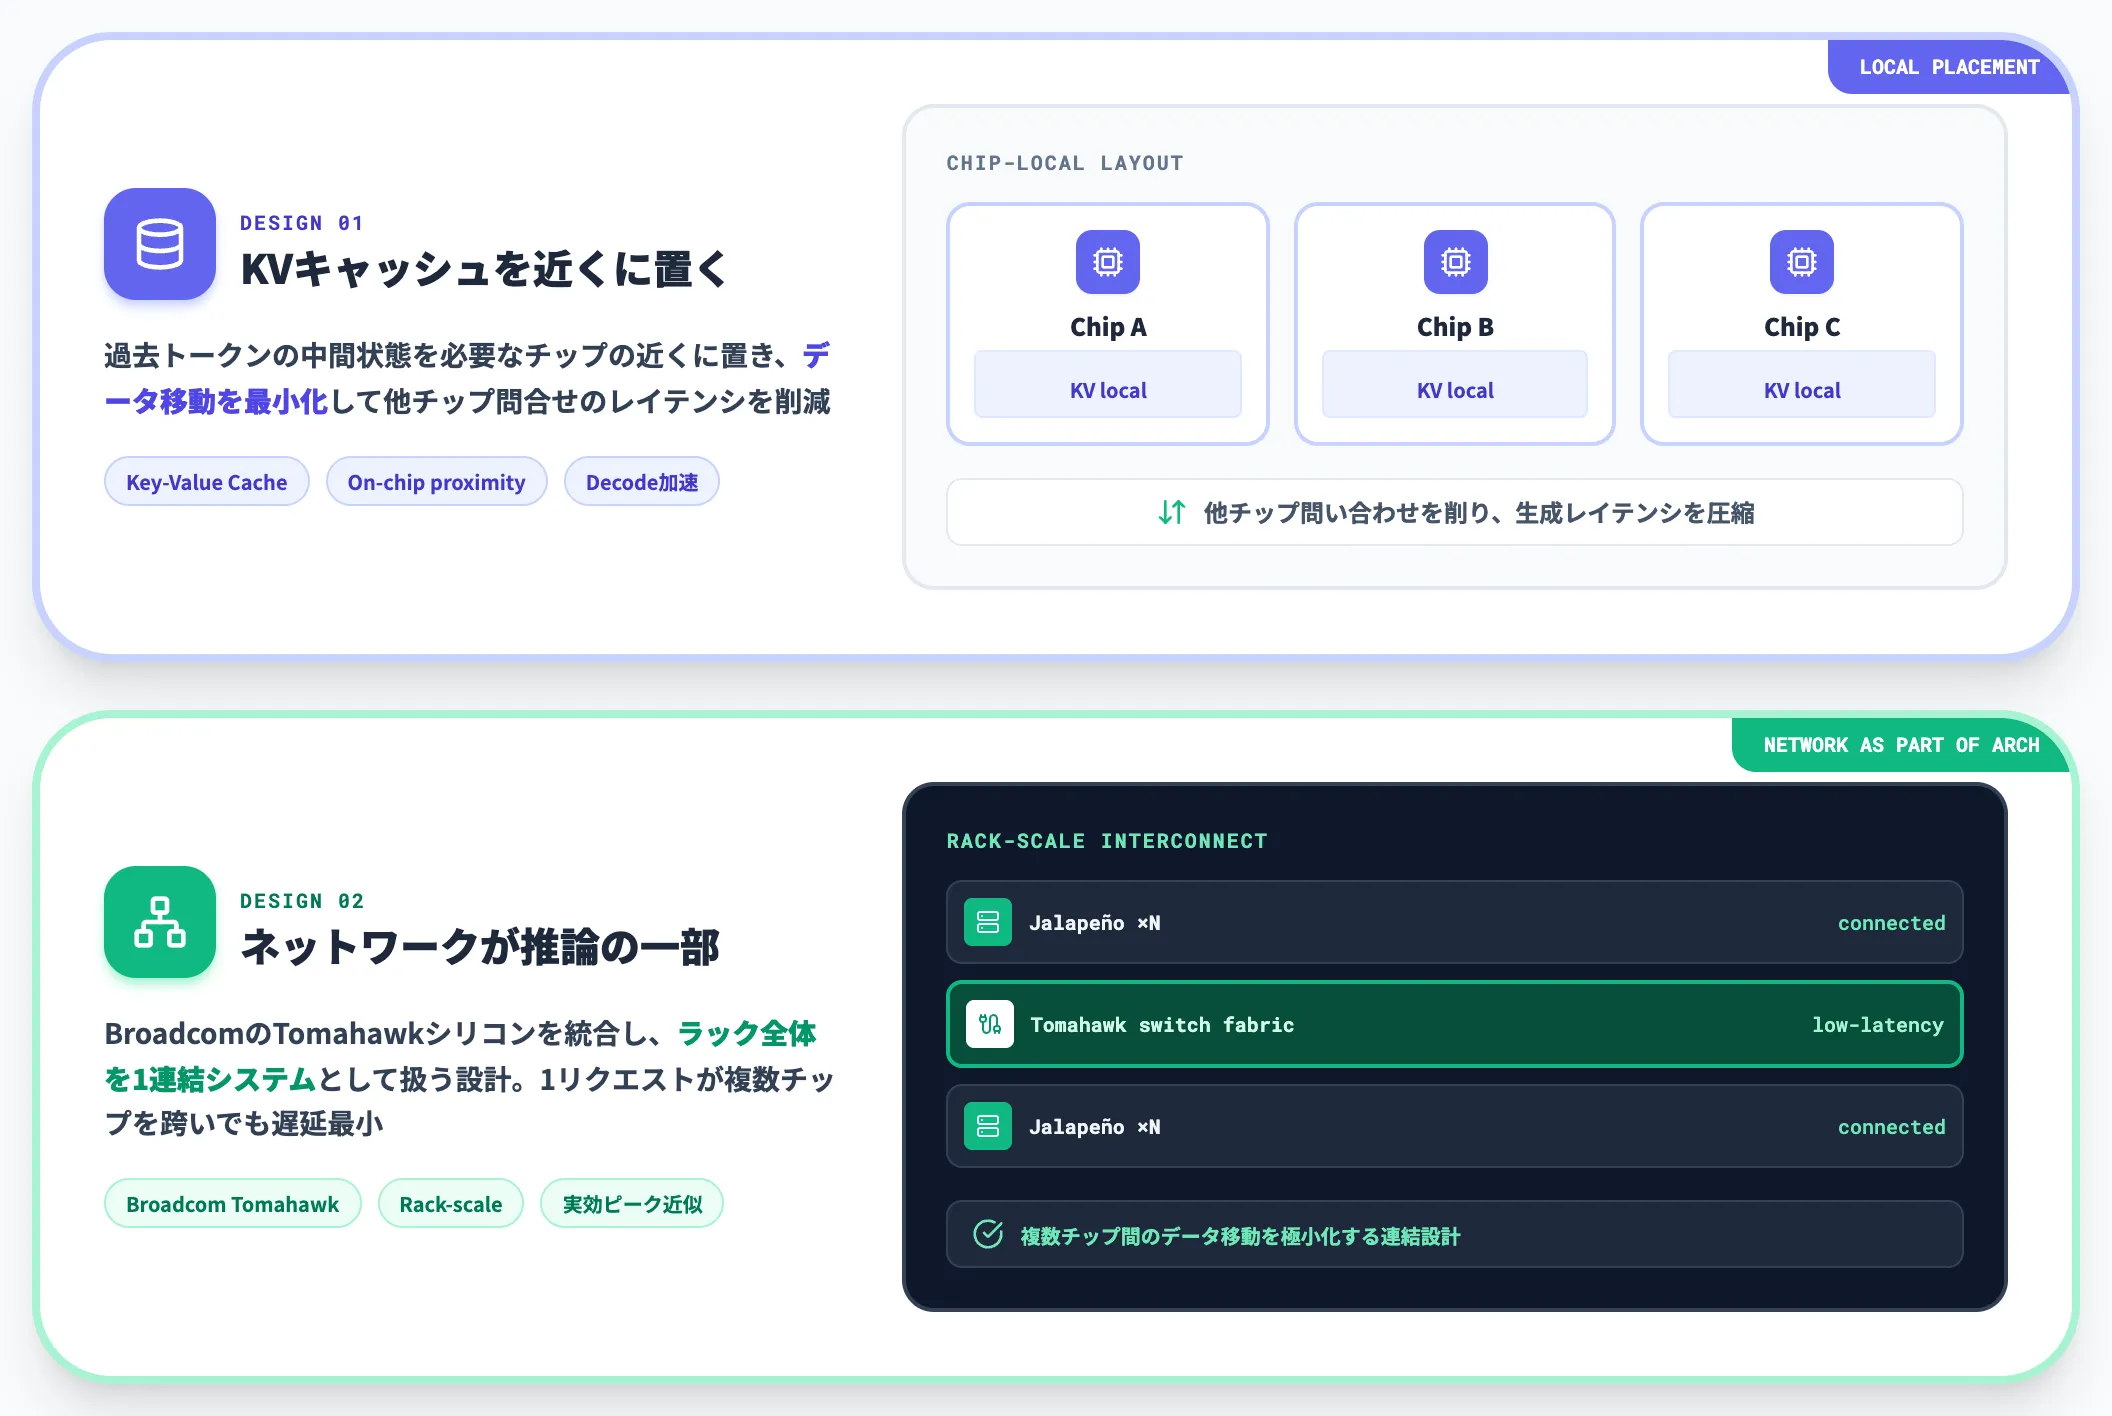
Jalapeñoが具体的にどう「両立」を実現しているかの核が、KVキャッシュのローカル配置とネットワークをアーキテクチャに組み込んだ設計です。
-
KVキャッシュのローカル配置
LLM推論で使われるKey-Valueキャッシュ(過去トークンの中間状態を保持する仕組み)を、必要なチップの近くに置く。データ移動を最小化するため、生成中に他チップへ問い合わせるレイテンシを削れる。
-
ネットワークが推論の一部
BroadcomのTomahawkネットワーキングシリコンを統合し、ラック全体を1つの連結システムとして扱う設計。1リクエストが複数チップ間を跨いでも遅延が最小化される。
推論の実効性能を左右するのは「1チップの理論性能」ではなく「複数チップ間でデータをどれだけ動かさずに済むか」です。Jalapeñoはこの原則を設計の中心に据えており、結果として理論ピークに近い実効利用率が得られる構造になっています。
フルスタックco-designという設計プロセス
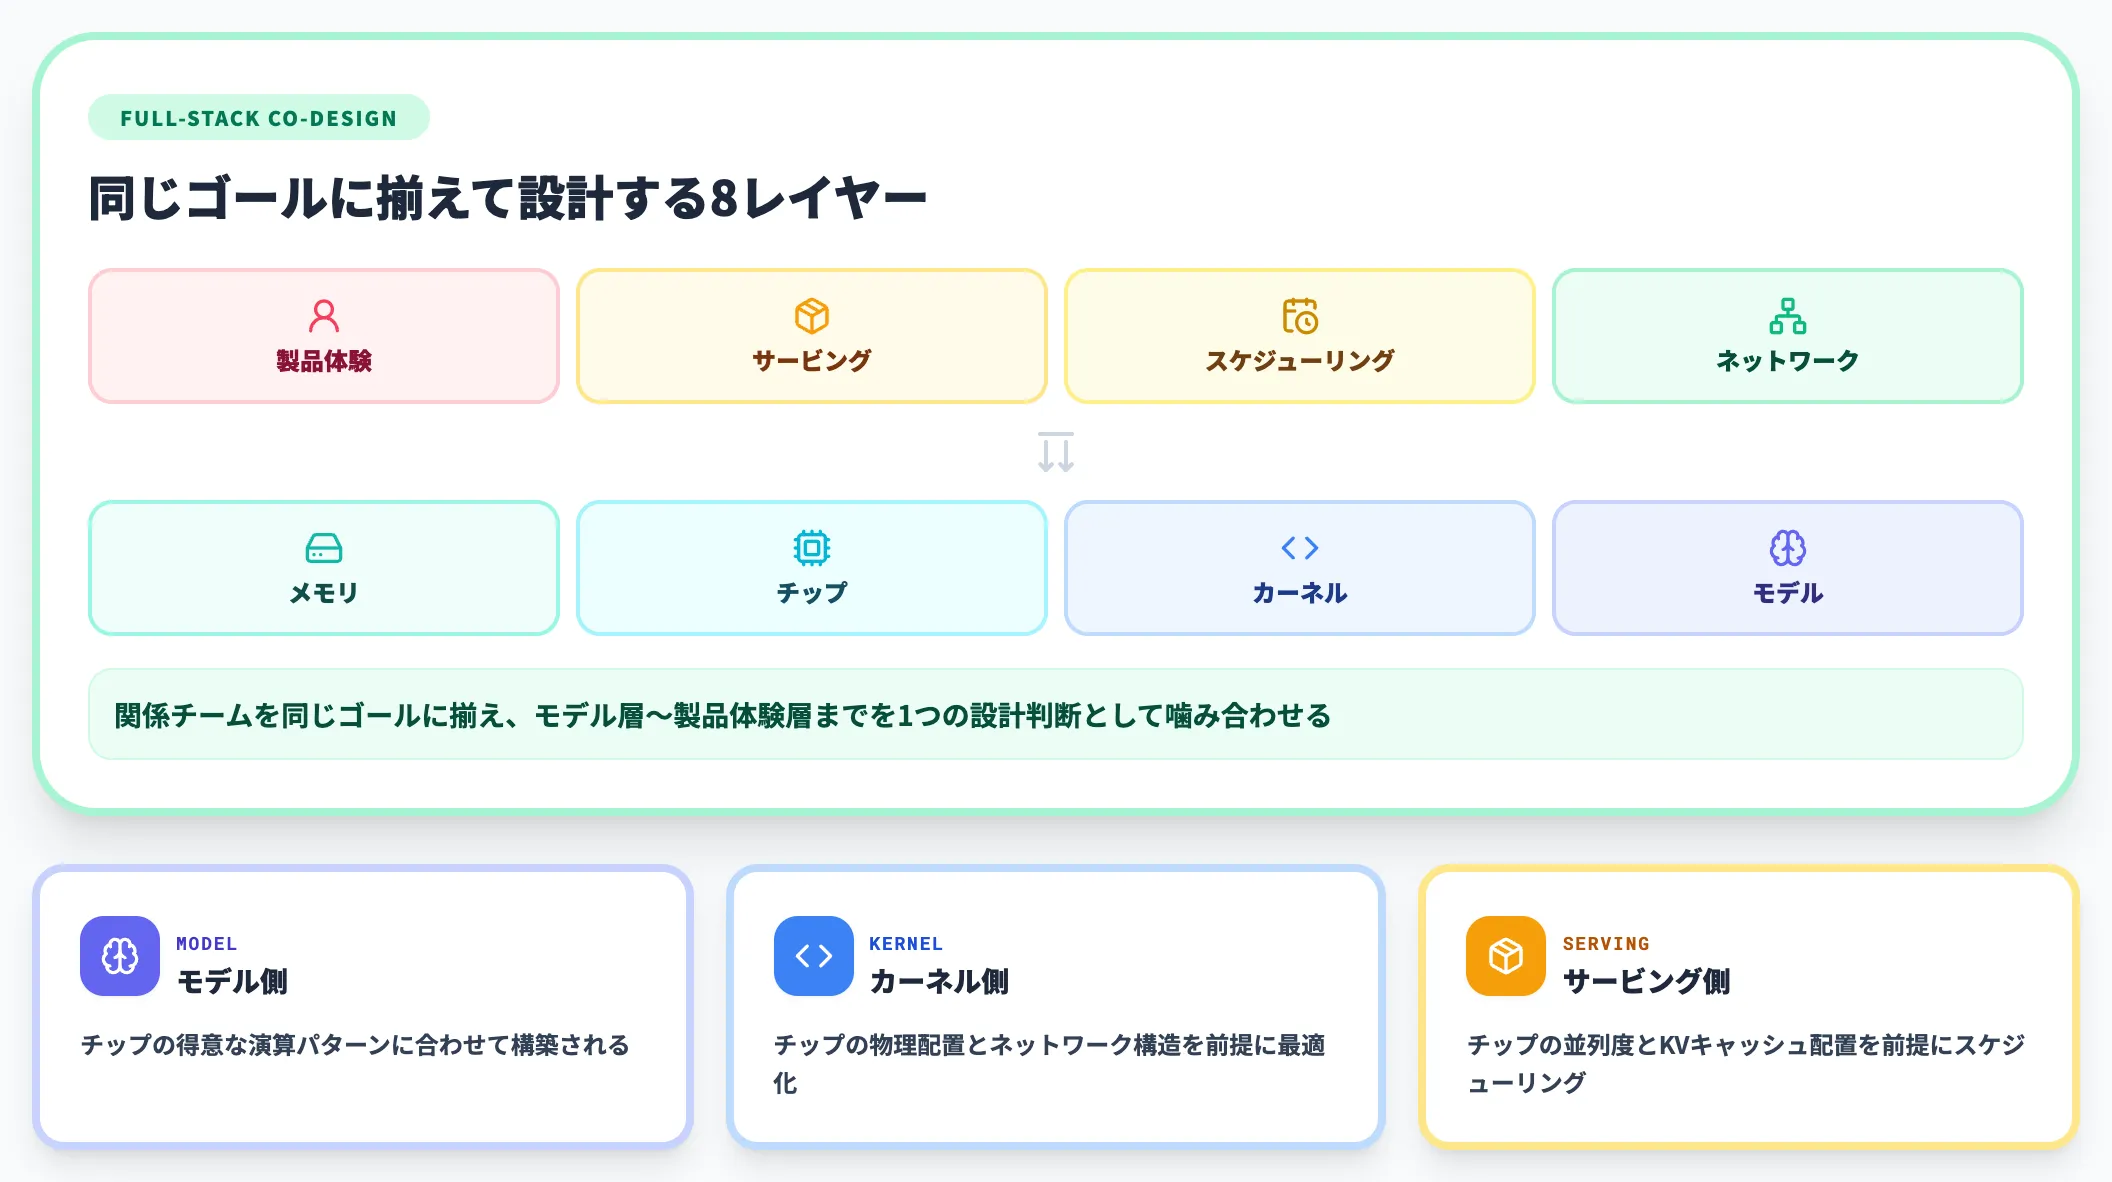
Jalapeñoは、モデル・カーネル・チップ・メモリ・ネットワーク・スケジューリング・サービング・製品体験までを関係チームで同じゴールに揃えて設計する「フルスタックco-design」の産物です。
- モデル側は、チップの得意な演算パターンに合わせて構築される
- カーネル側は、チップの物理配置とネットワーク構造を前提に最適化される
- サービング側は、チップの並列度とKVキャッシュ配置を前提にスケジューリングする
この統合設計は、モデル層・チップ層・システム層を別々の会社が担う従来のスタックでは実現しにくい構造でした。OpenAIが全レイヤーの設計に関与する体制だからこそ噛み合う設計思想です。
9か月でtape-out——AIがAIチップを設計する新パラダイム
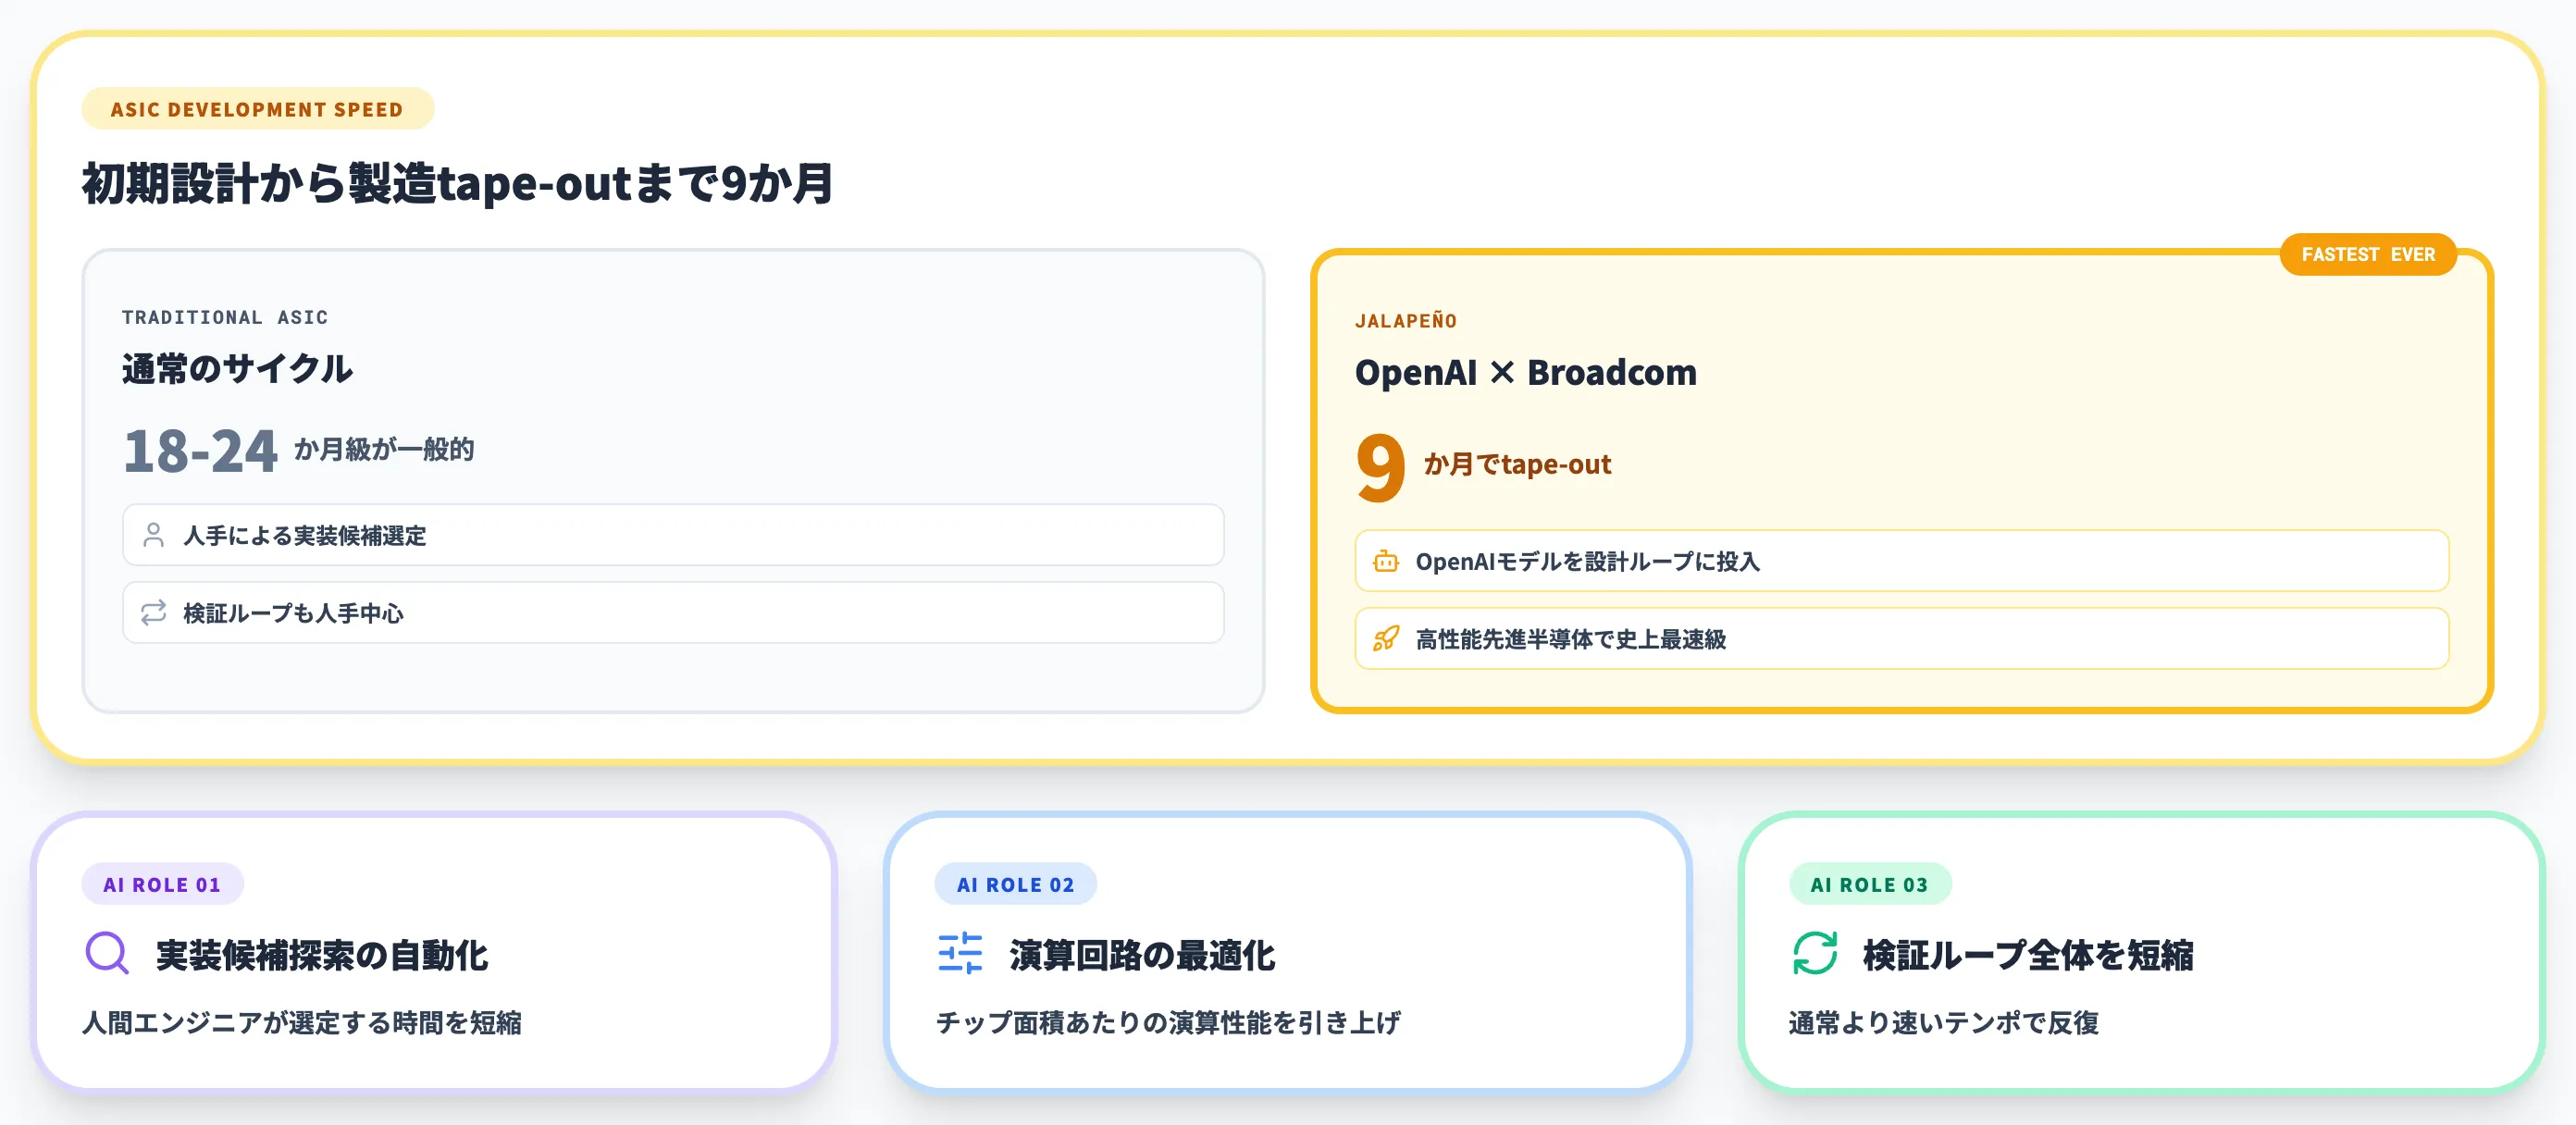
Jalapeño開発で業界が最も驚いたのは、初期設計から製造tape-outまで9か月というスピードです。OpenAI/Broadcomはこれを「高性能先進半導体で史上最速のASIC開発サイクル」と自負しています。
このスピードを可能にしたのが、OpenAI自身のAIモデルを設計プロセスに投入したことです。本セクションでは、AIがチップ設計に果たした具体的な役割を整理します。
AI活用による設計・検証ループの短縮
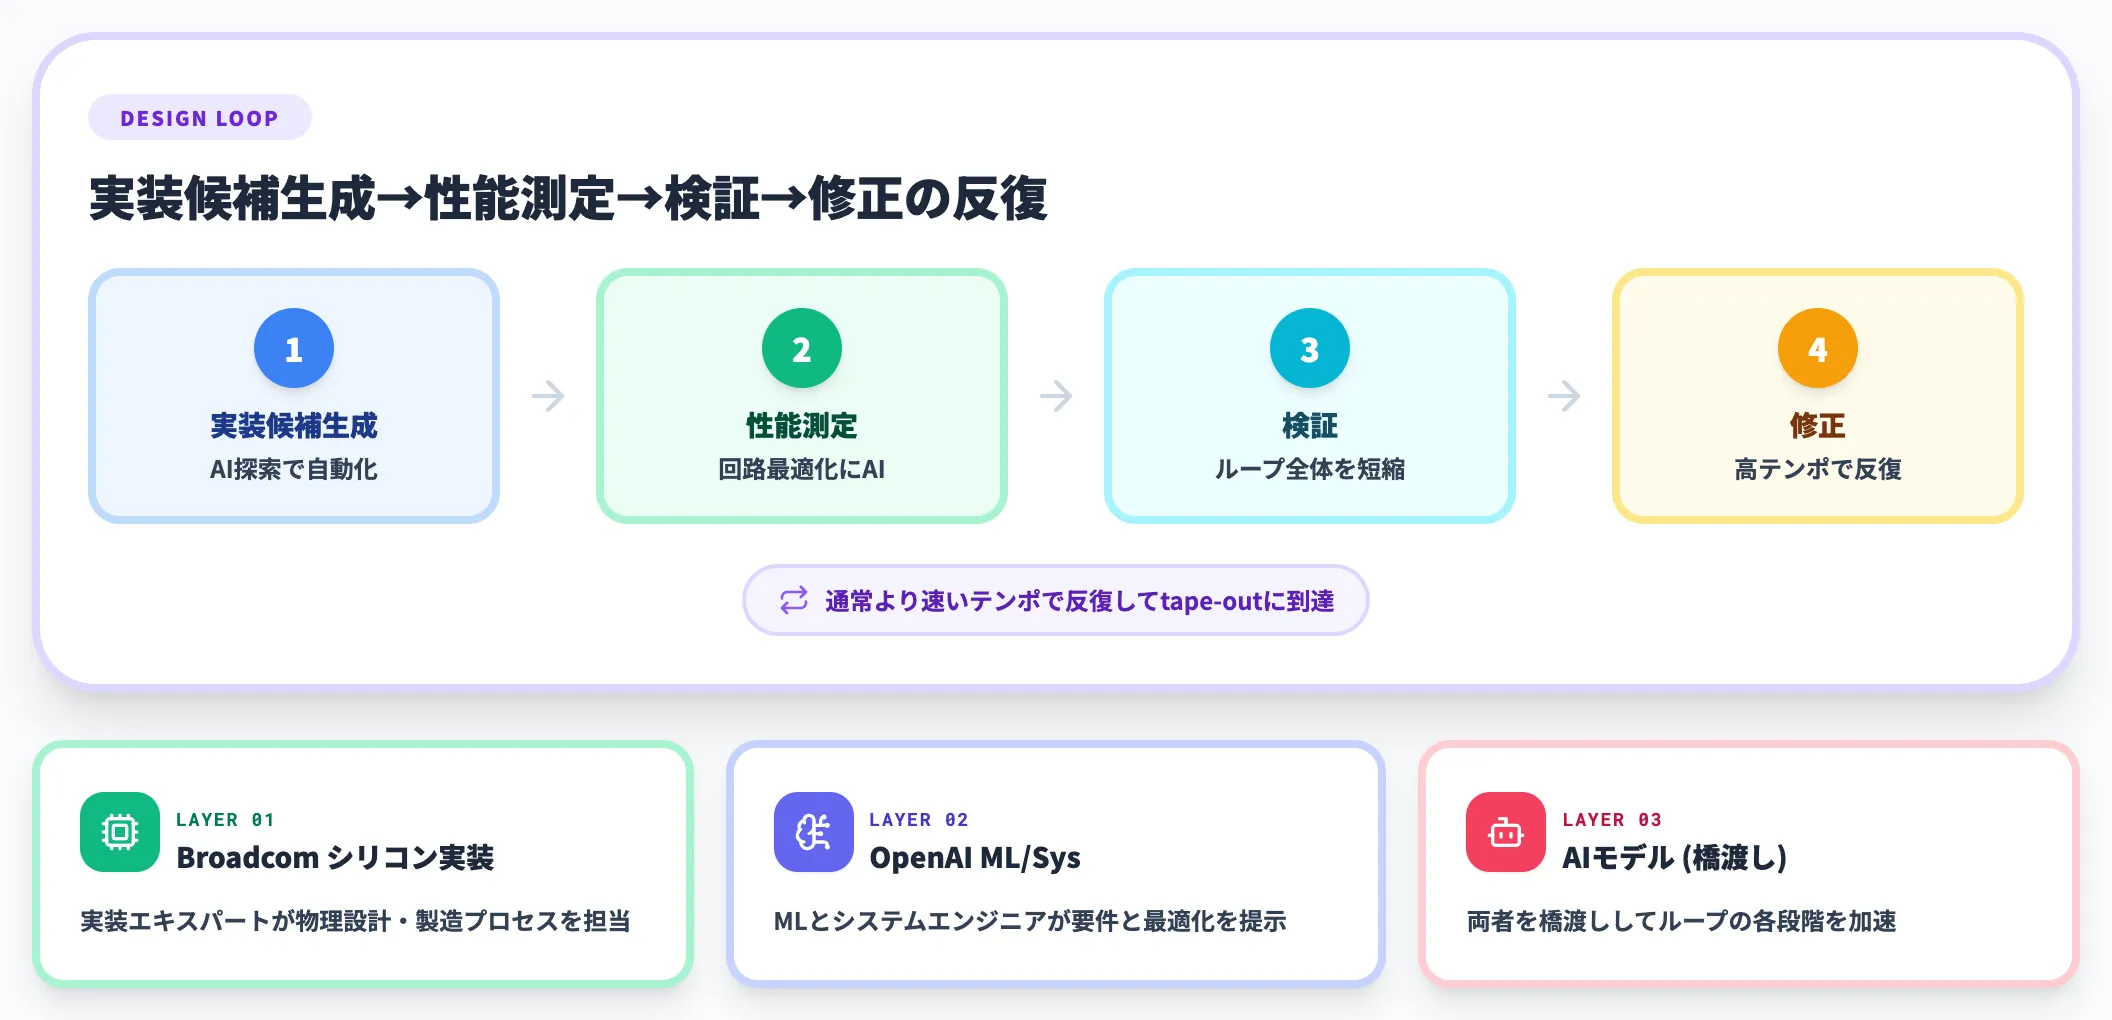
チップ設計は、実装候補の生成 → 性能測定 → 検証 → 修正 の反復です。Jalapeño開発では、OpenAIの既存モデル(Codex系を含む)をこのループの各段階に組み込みました。
- 実装候補の探索を自動化し、人間エンジニアが選定する時間を短縮
- 演算回路の最適化にAIを使い、チップ面積あたりの演算性能を引き上げ
- 設計・測定・検証ループそのものを短縮し、通常より速いテンポで反復
Broadcom側のシリコン実装エキスパートと、OpenAI側のML/システムエンジニア、そして両者を橋渡しするAIモデルの3層構成で開発サイクルを回した結果、極めて短い期間でtape-outに到達した形です。
Codex + GPT-Astraで3モデル対応期間の短縮
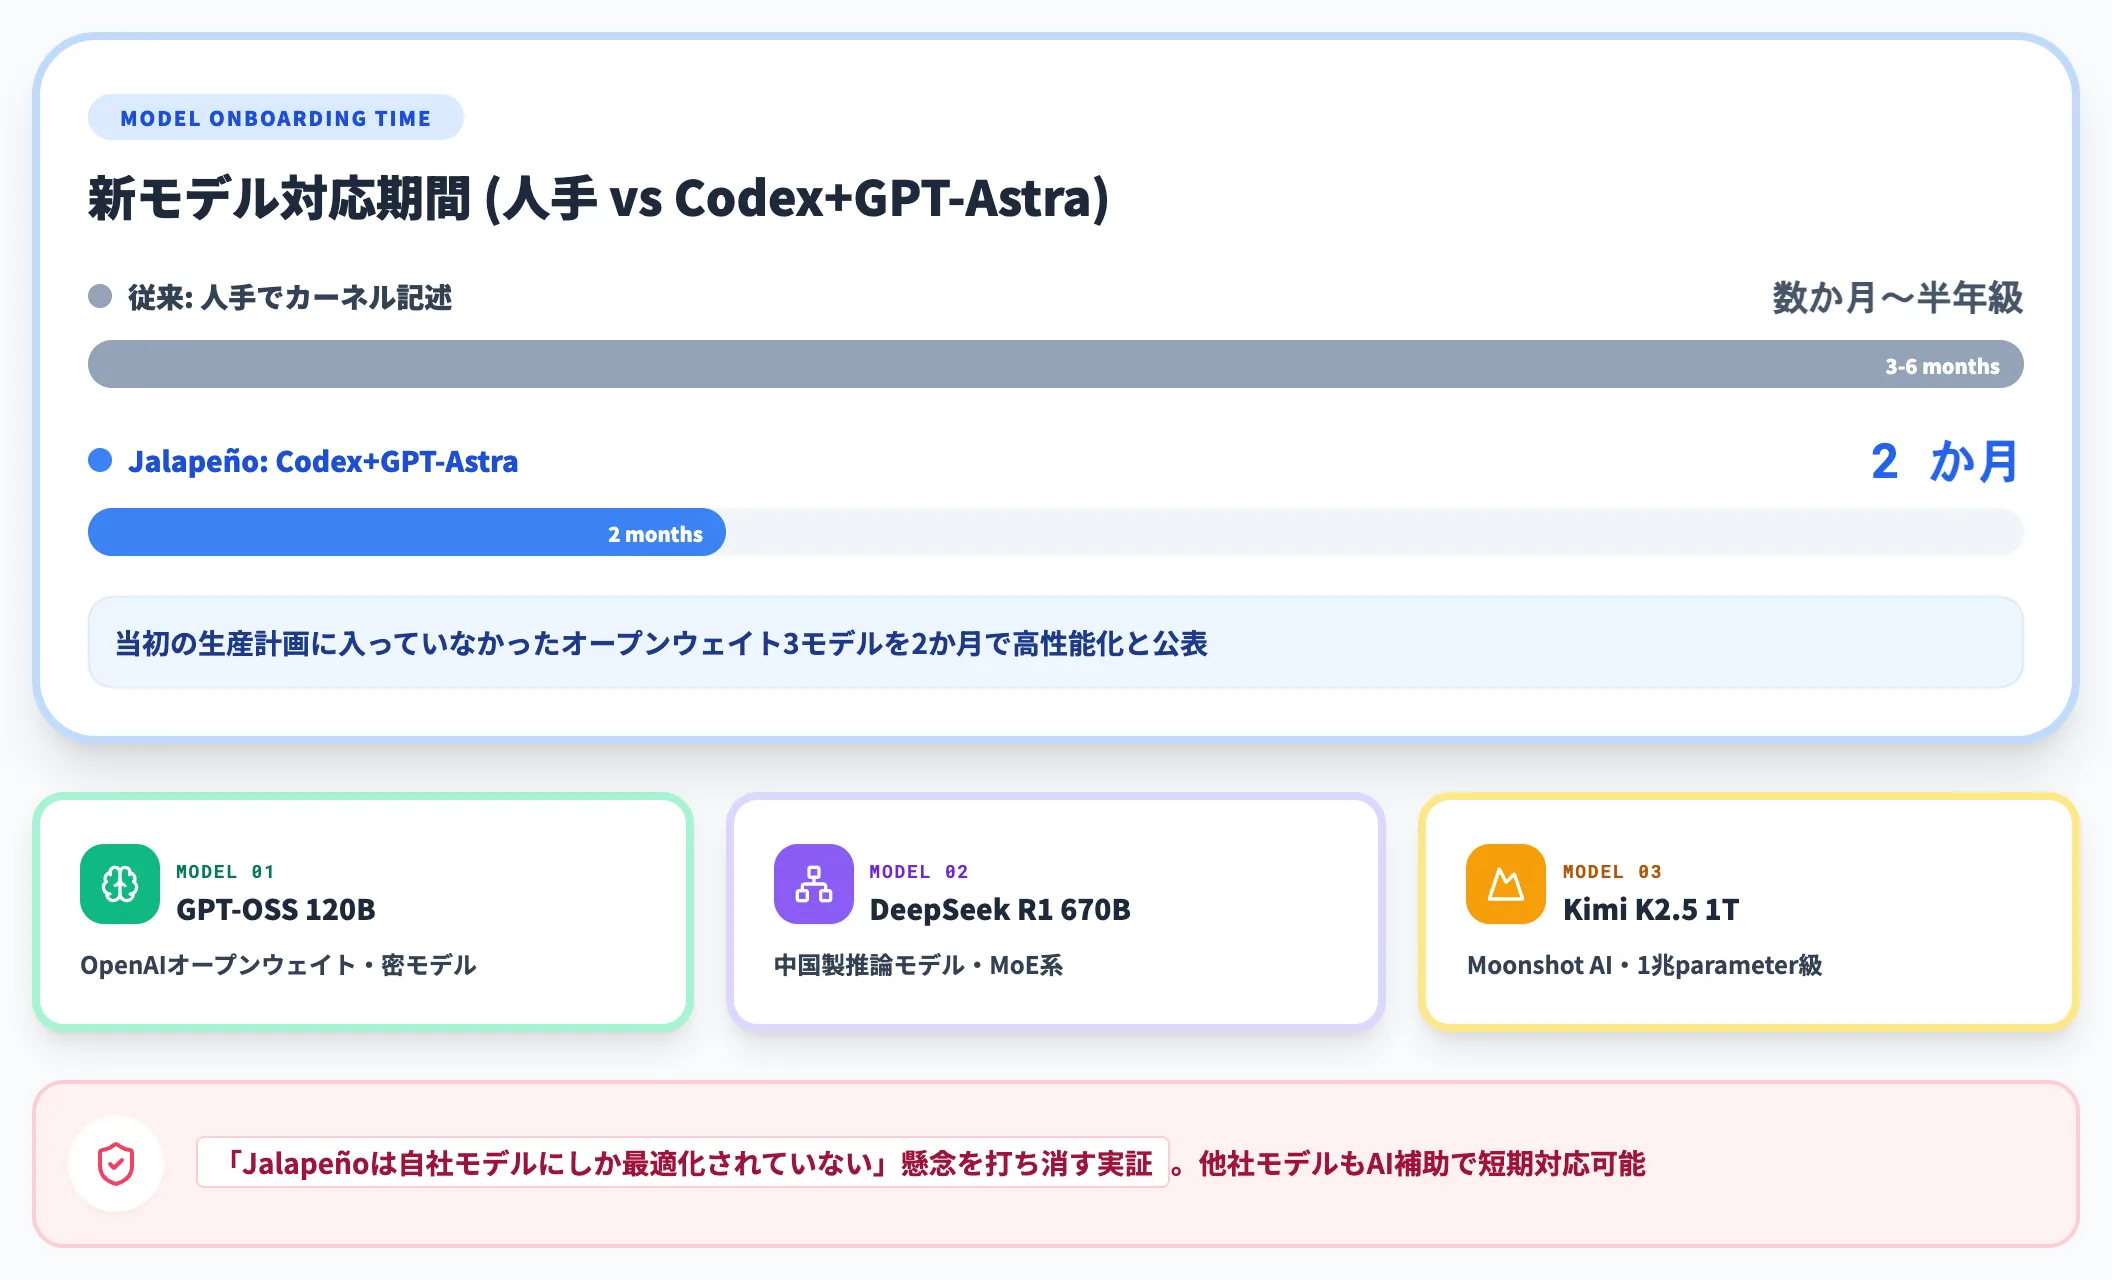
Jalapeñoが公開されたベンチマークで3モデル(GPT-OSS 120B・DeepSeek R1・Kimi K2.5)を測れたのも、AI活用の副産物です。
新しいモデルファミリーへの対応には、通常はモデル固有のカーネル・最適化を人手で書く必要があります。OpenAIは、CodexとGPT-Astraを使い、当初の生産計画には入っていなかった3つのオープンウェイトモデルを2か月で高性能化したと公表しています。
これは「Jalapeñoは自社モデルにしか最適化されていない」という懸念を明確に打ち消す結果です。OpenAI以外のモデルでもAI補助で短期間に対応できることを実証した形になります。
AI生成カーネルが人手を1.5〜1.8倍上回った実例
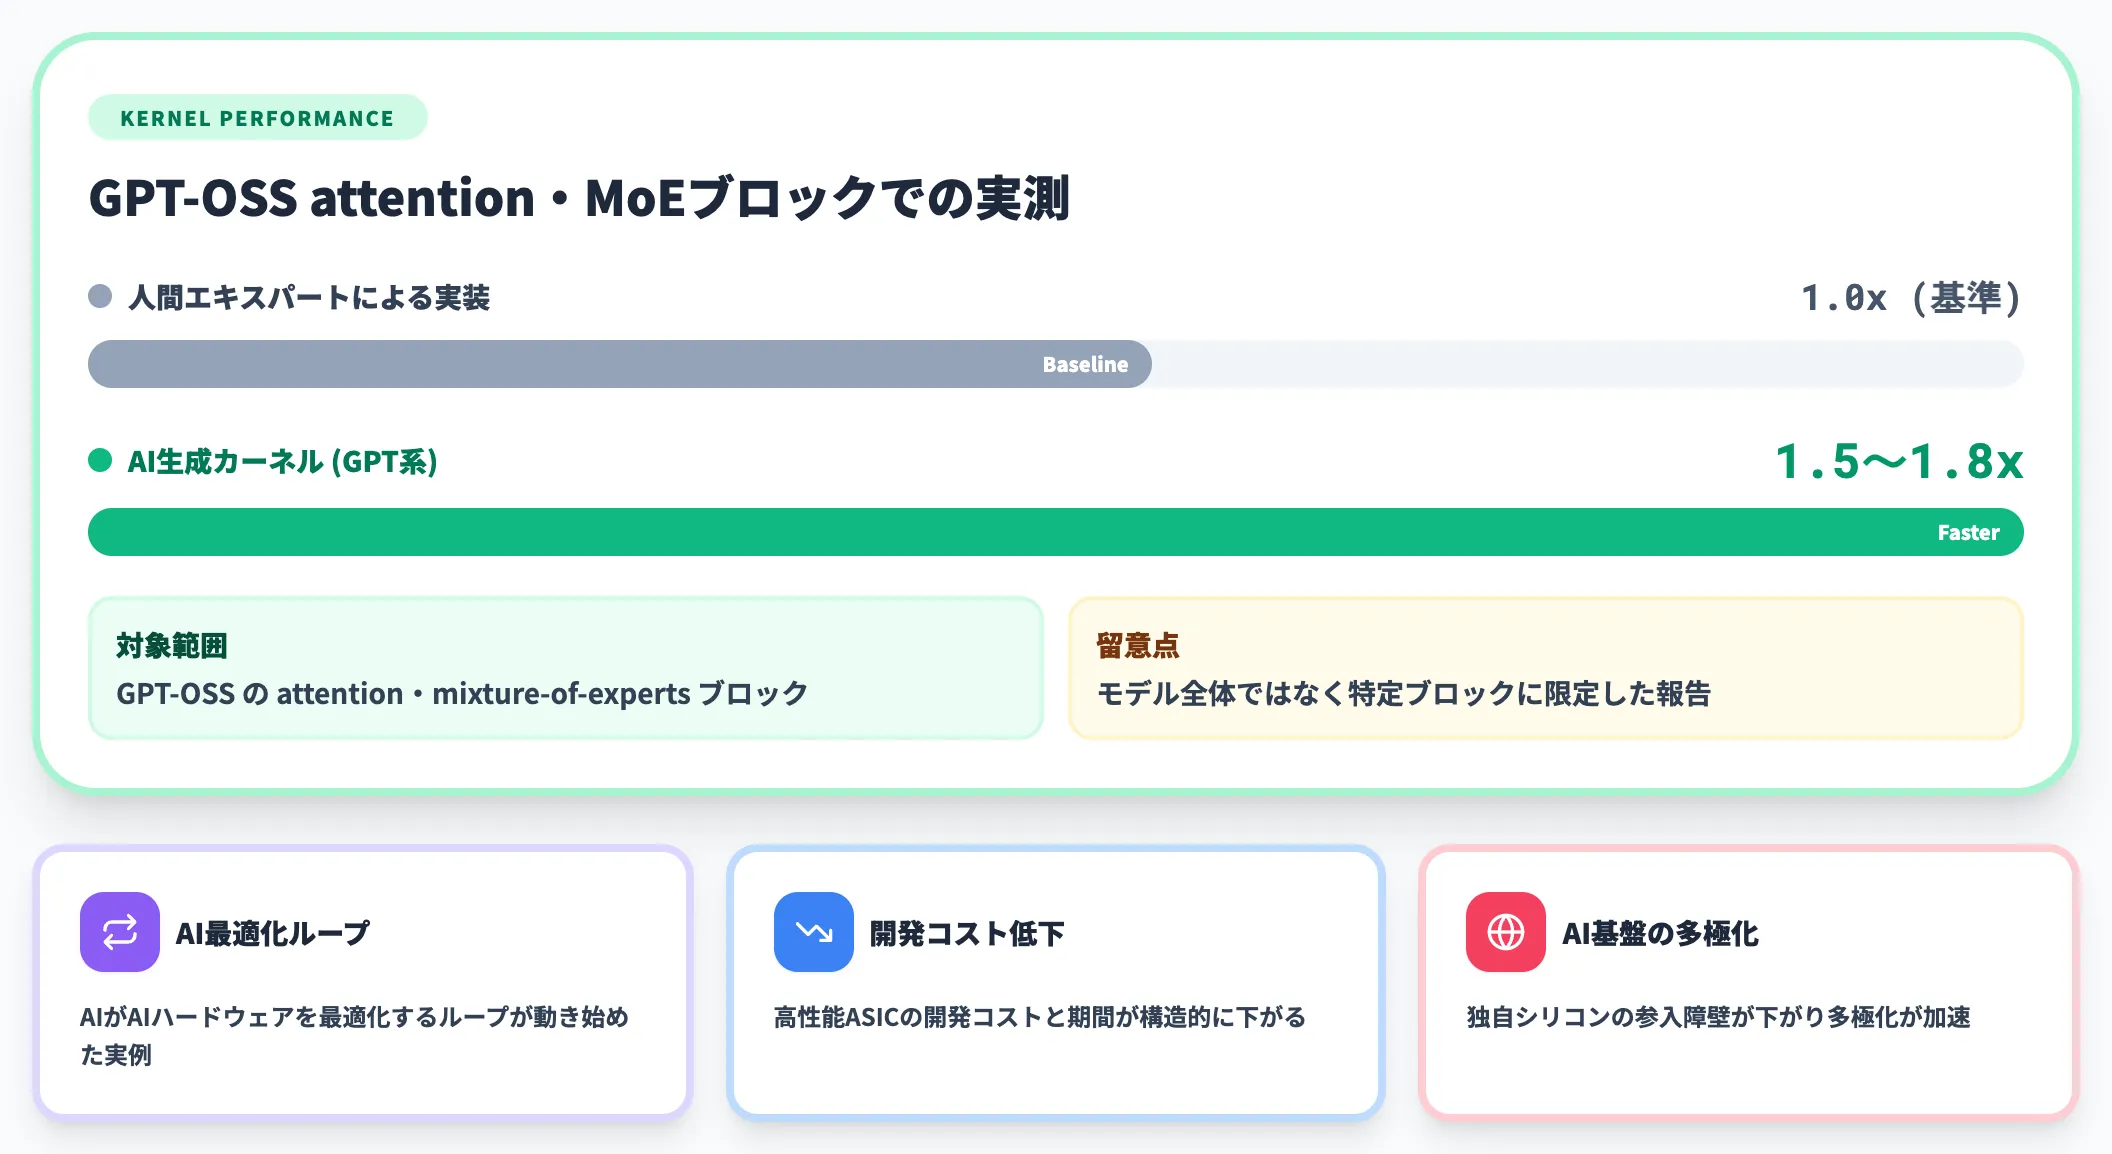
さらに興味深いのが、GPT-OSSの一部(attention・mixture-of-expertsブロック)でAIが生成したカーネル実装が、人間エキスパートが書いた既存実装を1.5〜1.8倍上回ったという報告です。
対象はモデル全体ではなく特定のブロックに限られますが、「AIがAIハードウェアを最適化する」ループが実際に動き始めていることの実例といえます。
これは長期的にも重要なポイントです。もしAIがチップ設計とカーネル最適化のかなりの部分を担えるなら、高性能ASICの開発コストと期間は構造的に下がります。結果として、いま数社に集中している独自シリコンの参入障壁が下がり、AI基盤の多極化が加速する可能性があります。
ハイパースケーラー独自シリコン戦略でのJalapeñoの位置づけ
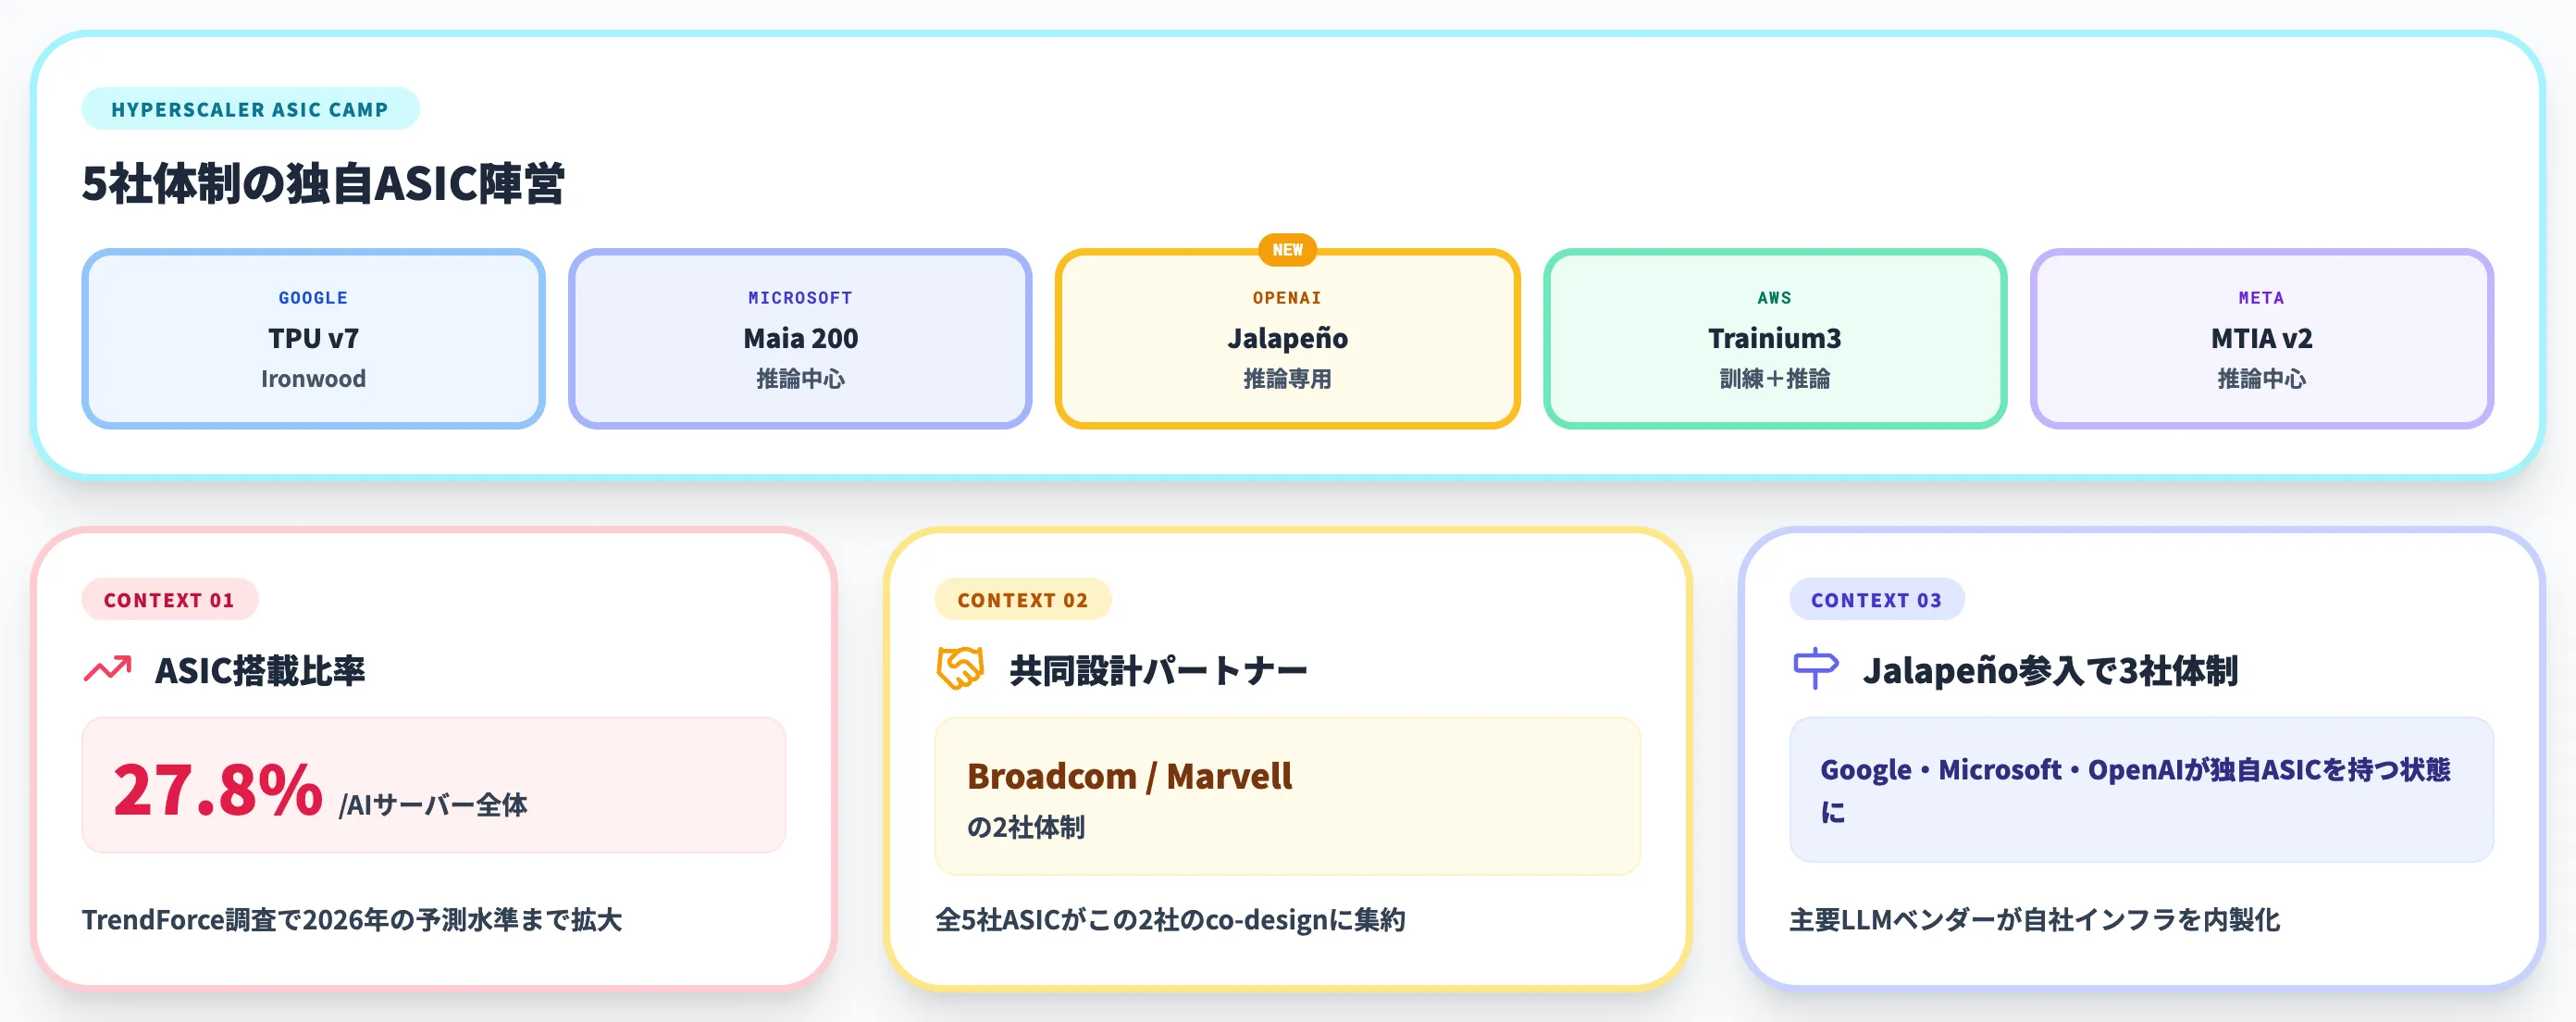
Jalapeñoは、Google・Microsoft・AWS・Metaに続く主要ハイパースケーラー独自ASICの新顔という位置づけになります。
カスタムAI ASIC市場では、TrendForceの調査によれば2026年のAIサーバー全体に占めるASIC搭載比率が27.8%まで拡大する見込みで、ハイパースケーラー各社の内製シフトが本格化しています。
本セクションでは、他社ASICとの並列関係と、Jalapeño登場が業界構造に持つ意味を整理します。
主要独自ASICとJalapeñoの並列比較
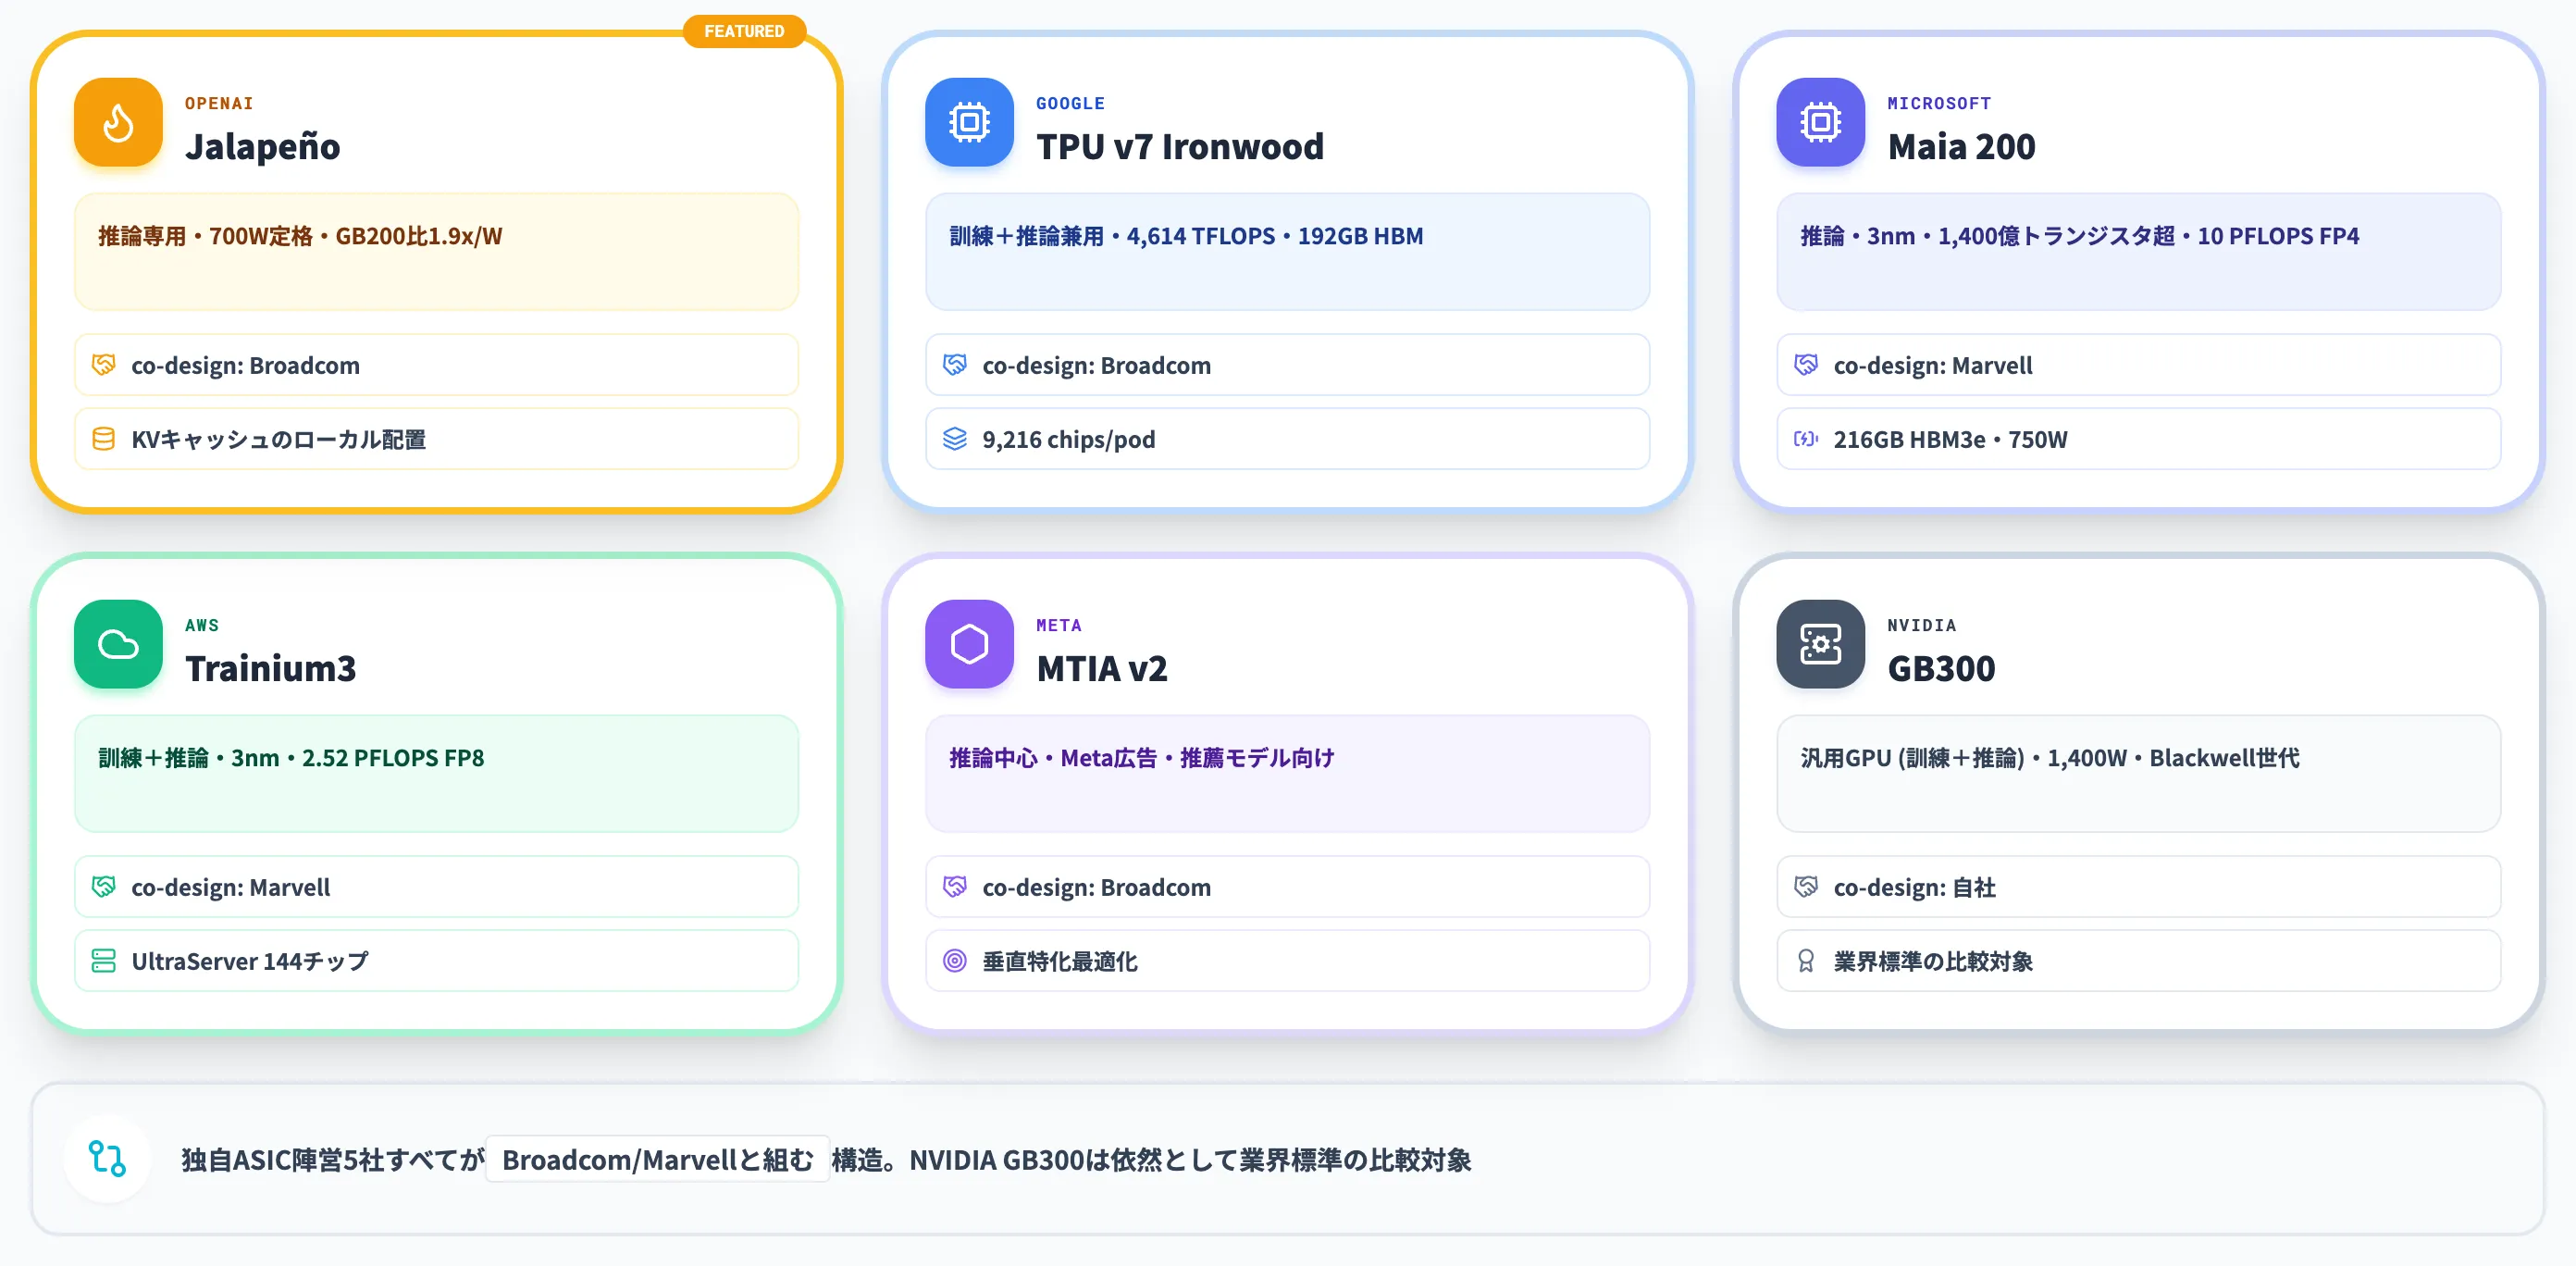
以下の表で、2026年時点で公表されている主要ハイパースケーラーASICを整理しました。設計者はOpenAI/Google/Microsoft/AWS/Metaの各社、共同設計パートナーの多くをBroadcomかMarvellが担っています。
| チップ | 設計元 | co-designパートナー | 主用途 | 主な特徴 |
|---|---|---|---|---|
| Jalapeño | OpenAI | Broadcom | 推論専用 | 定格700W、KVキャッシュのローカル配置、GB200比1.9x/W |
| Google TPU v7 Ironwood | Broadcom | 訓練+推論 | 4,614 TFLOPS、192GB HBM、9,216 chips/pod | |
| Microsoft Maia 200 | Microsoft | Marvell | 推論 | TSMC 3nm製造、1,400億トランジスタ超、10 PFLOPS FP4、216GB HBM3e、750W |
| AWS Trainium3 | AWS | Marvell | 訓練+推論 | 3nm、2.52 PFLOPS FP8、UltraServer 144チップで362 PFLOPS |
| Meta MTIA v2 | Meta | Broadcom | 推論中心 | Meta広告・推薦モデル向け、垂直最適化 |
| NVIDIA GB300 | NVIDIA | 自社 | 汎用GPU(訓練+推論) | 1,400W、Blackwell世代、業界標準の比較対象 |
この比較から見えるのは、独自ASIC陣営がすでに5社体制、そのすべてがBroadcom/Marvellと組んでいるという構造です。OpenAIがJalapeñoで参入したことで、Google・Microsoft・OpenAIの3社が独自ASICを持つ状態になりました。
Broadcom + Marvellがco-design市場の95%を独占
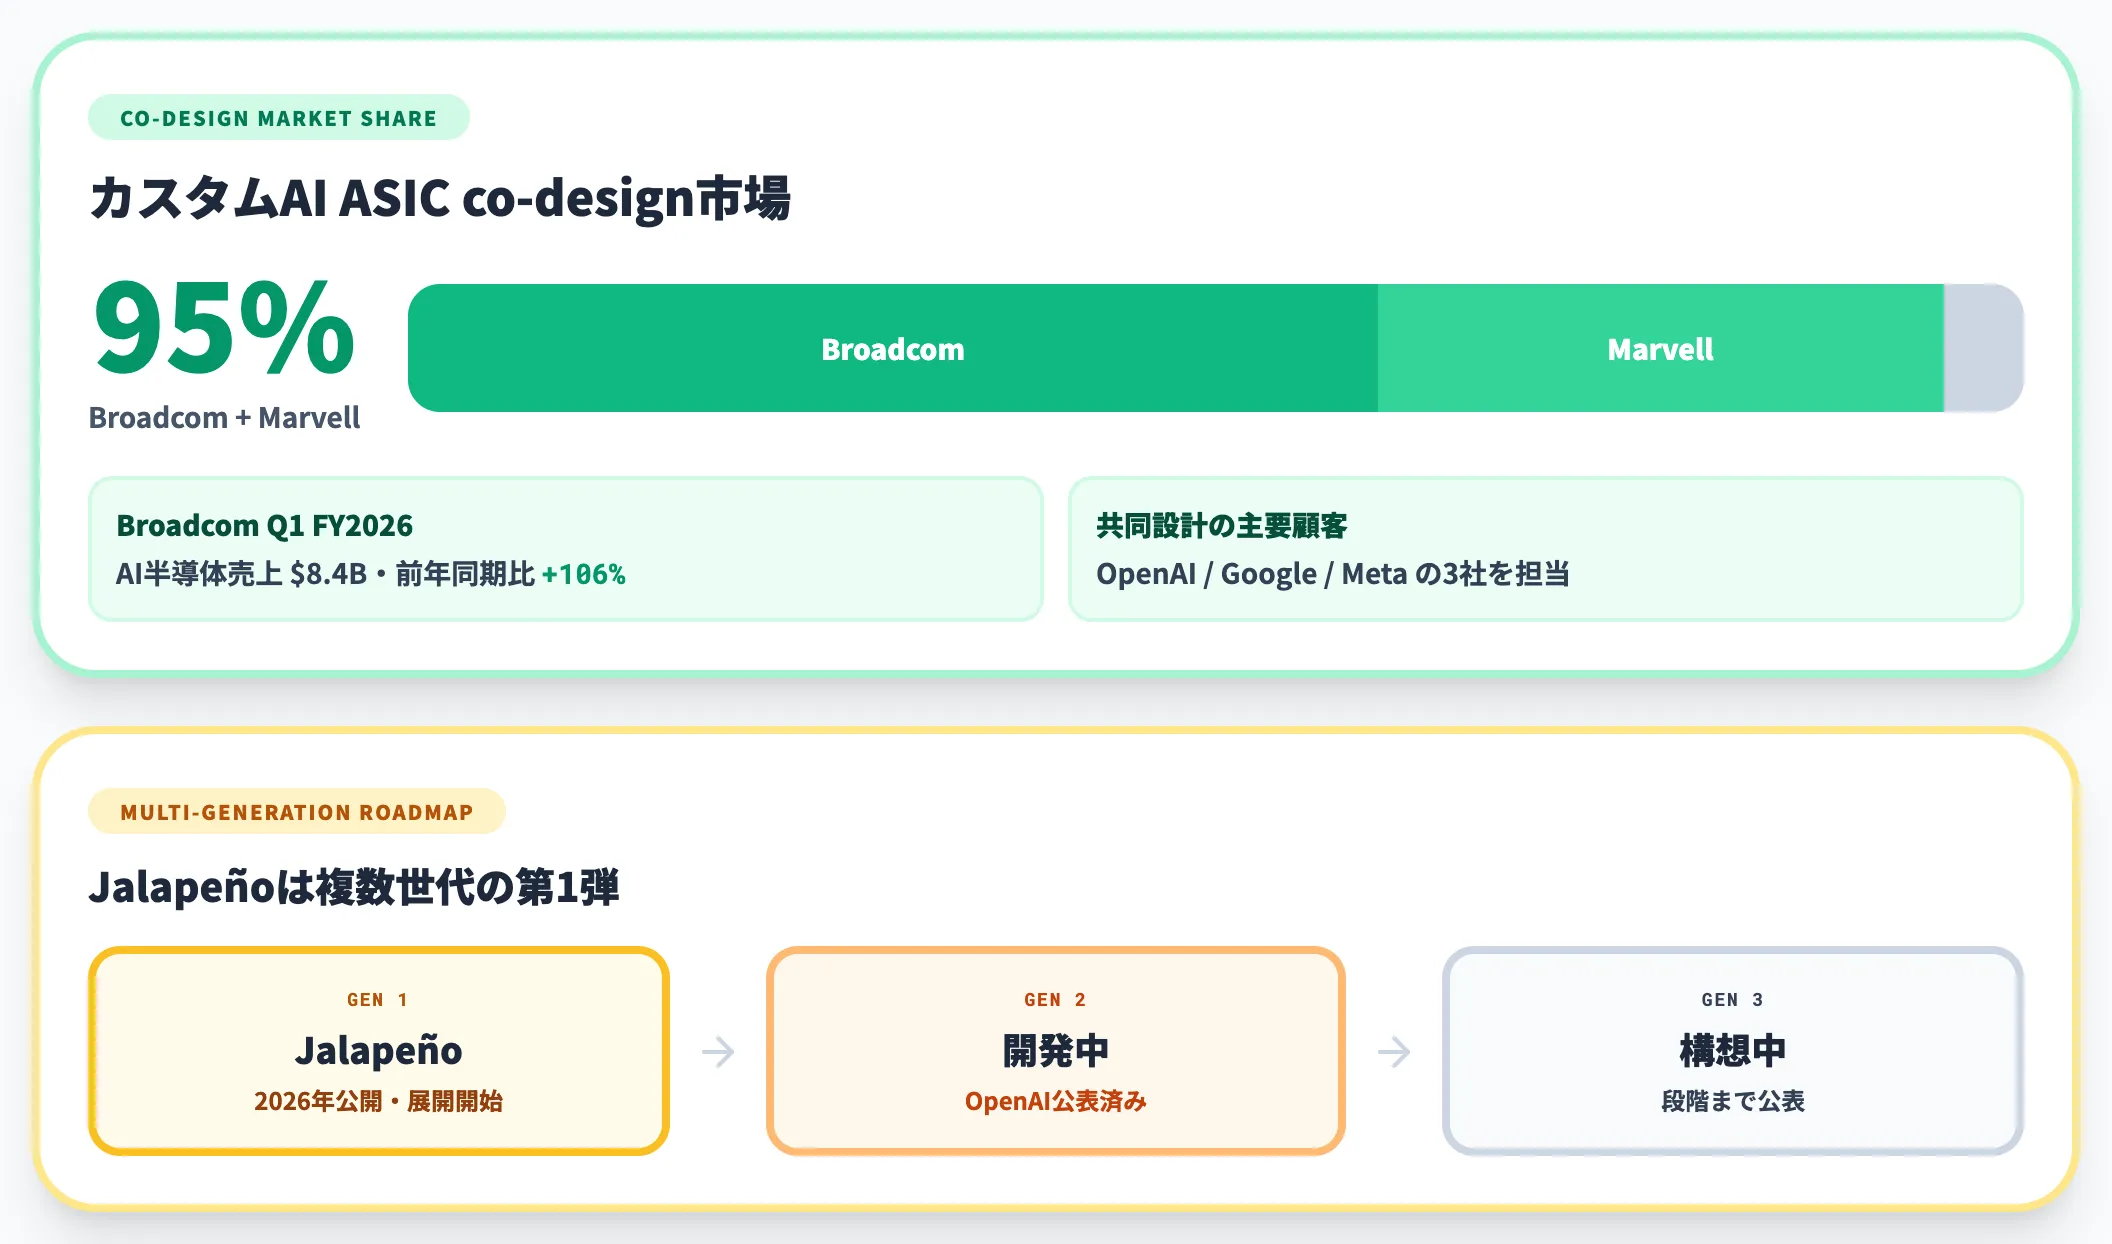
このASIC乱立の裏で恩恵を受けているのが、共同設計パートナーの2社です。
Tom's Hardwareの分析ではBroadcom + Marvellがカスタム AI ASIC co-design市場の推定95%を握るとされ、Broadcomの2026会計年度Q1決算ではAI半導体売上$8.4B・前年同期比+106%と急伸しています。
BroadcomのHock Tan CEOは、Jalapeñoが「複数世代ロードマップの第1弾」と表明しており、OpenAI側の公表では第2世代(Gen 2)が開発中、第3世代(Gen 3)が構想中の段階までが明かされている状況です。
NVIDIAとの共存戦略——訓練は継続、推論に独自ASICを充てる二層構造
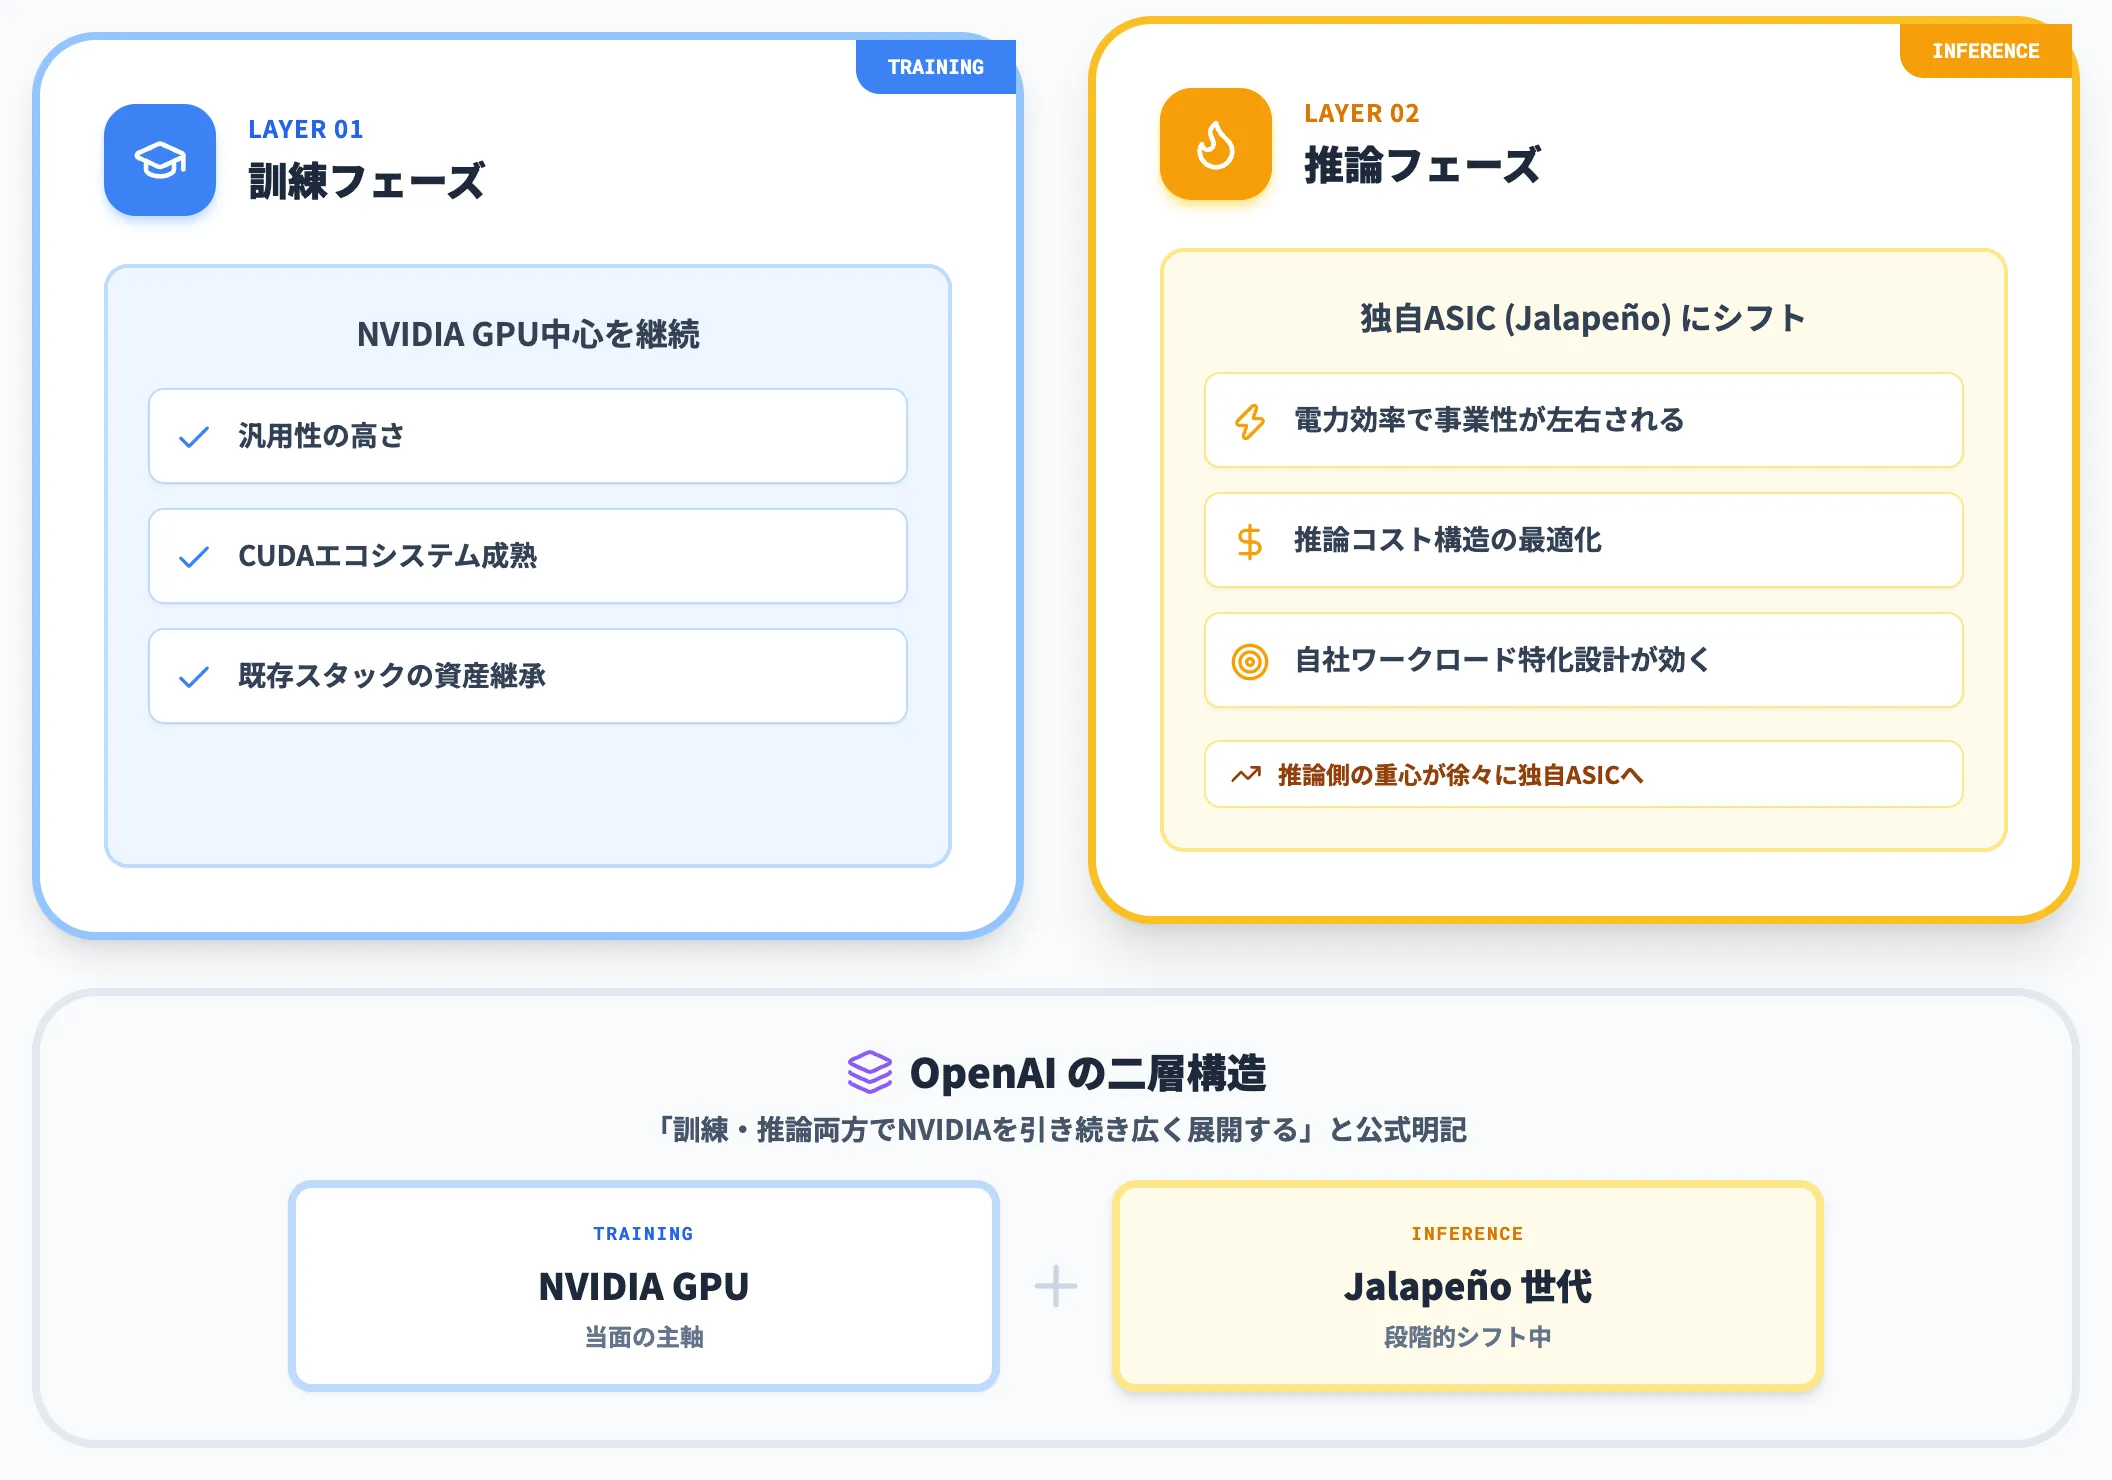
Jalapeñoが発表されても、OpenAIはNVIDIA GPUの利用を止めるわけではありません。公式ブログでも「訓練・推論ワークロードの両方でNVIDIAをはじめとするパートナーからのアクセラレータを引き続き広く展開する」と明記されています。
読み解きとしては、以下の二層構造で進むと見るのが自然です。
- 訓練フェーズ: 汎用性・エコシステム成熟度から引き続きNVIDIA GPU中心
- 推論フェーズ: コスト・電力効率が事業性を左右するため、独自ASIC(Jalapeño)へのシフトを進める
ChatGPTを支えるNVIDIAとの関係は当面続きますが、推論側の重心は徐々に独自ASICに移る流れが業界横断で見えつつある局面です。
ChatGPT・API・Codex利用企業への影響とコストインパクト
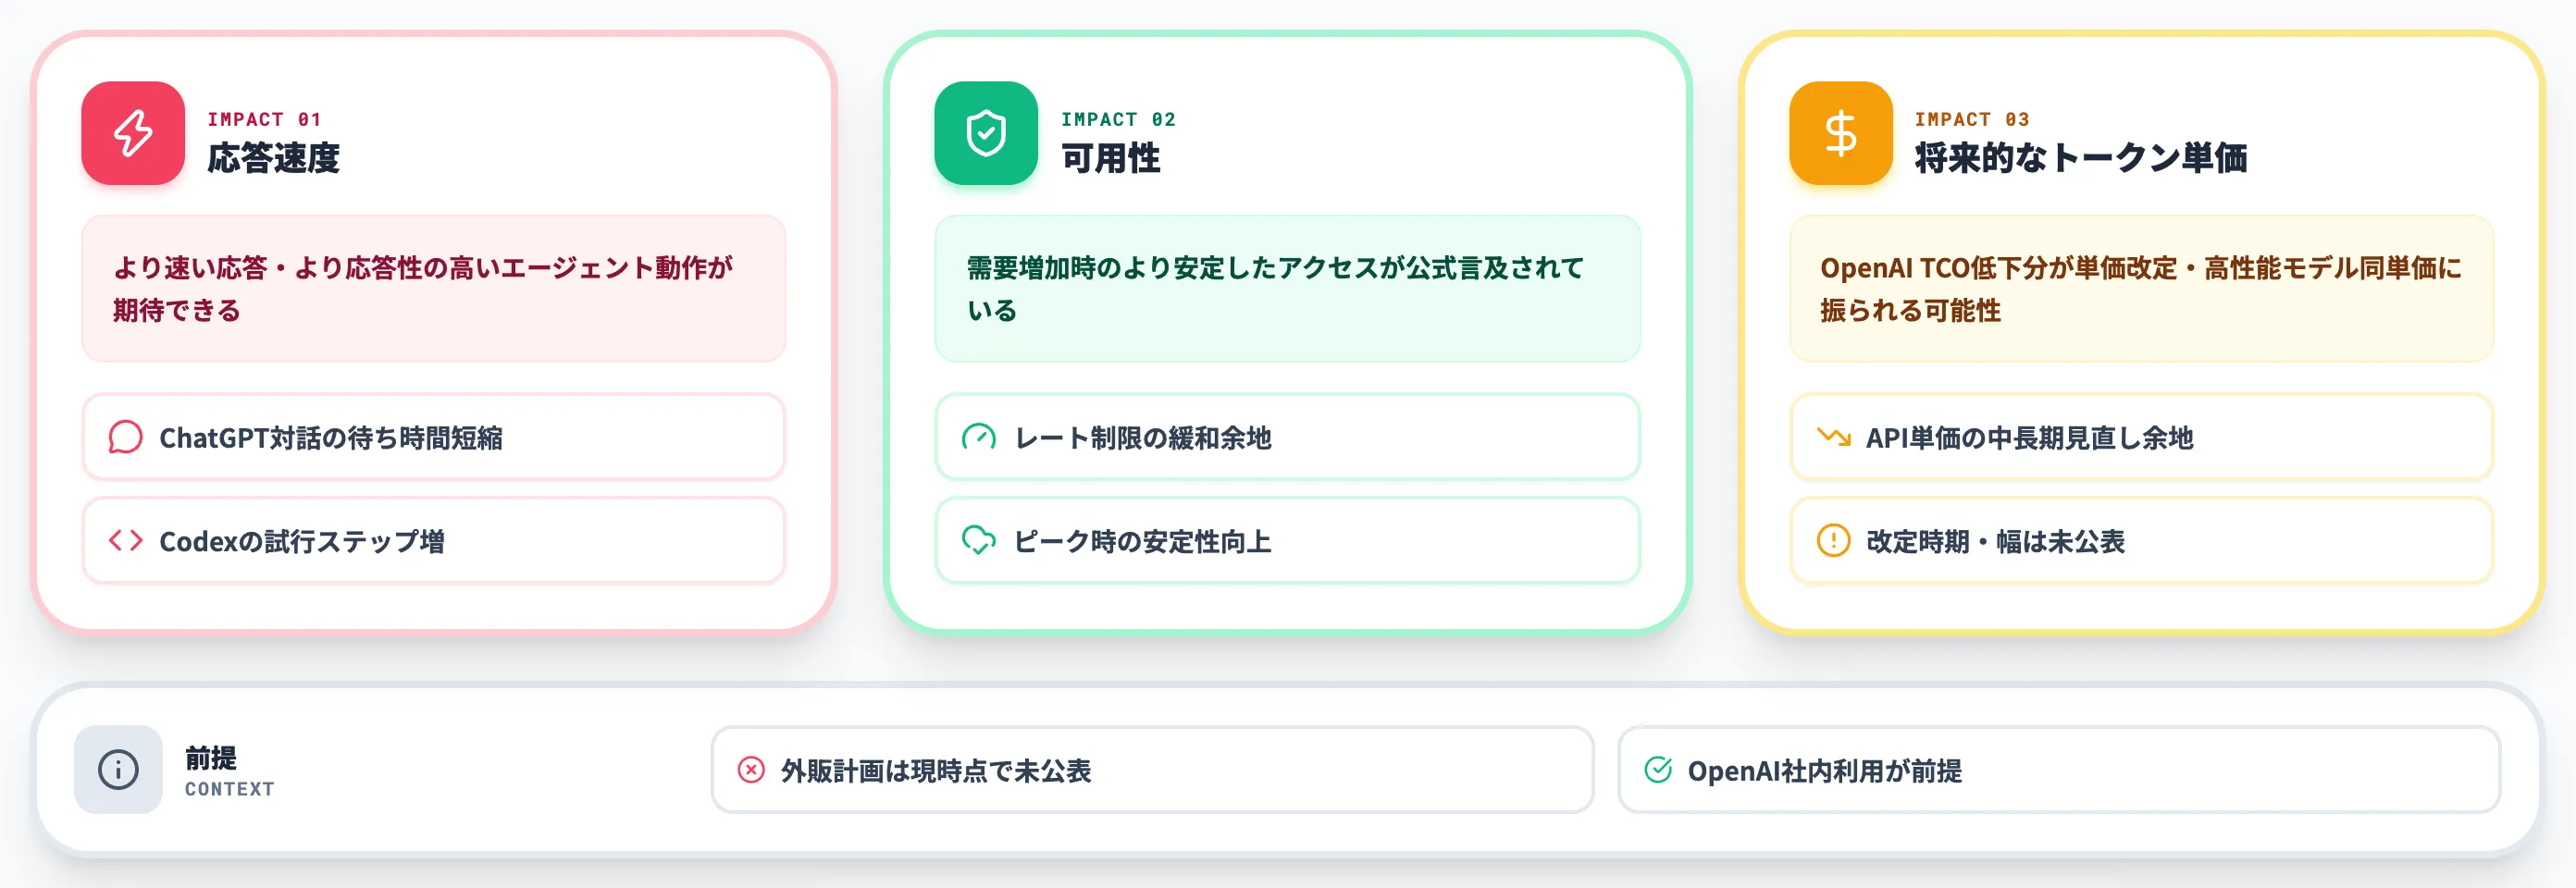
Jalapeñoの外販は公表されていないため、法人ユーザーが直接購入して自社基盤に載せる選択肢は現時点で示されていません。ただし、OpenAIの推論コスト構造が下がる方向に働くため、ChatGPT・API・Codexを業務で使う企業には応答速度・可用性・将来的なトークン単価の3面で波及する可能性があります。
OpenAI公式も「より速い応答・より応答性の高いエージェント・需要増時の安定アクセス」につながり得るとしていますが、価格改定・製品別ルーティングまでは明言していません。
本セクションでは、法人ユーザーが取れる備えをAI総合研究所の支援経験を踏まえて整理します。
OpenAIのTCO削減効果——電力効率1.9倍が意味するもの
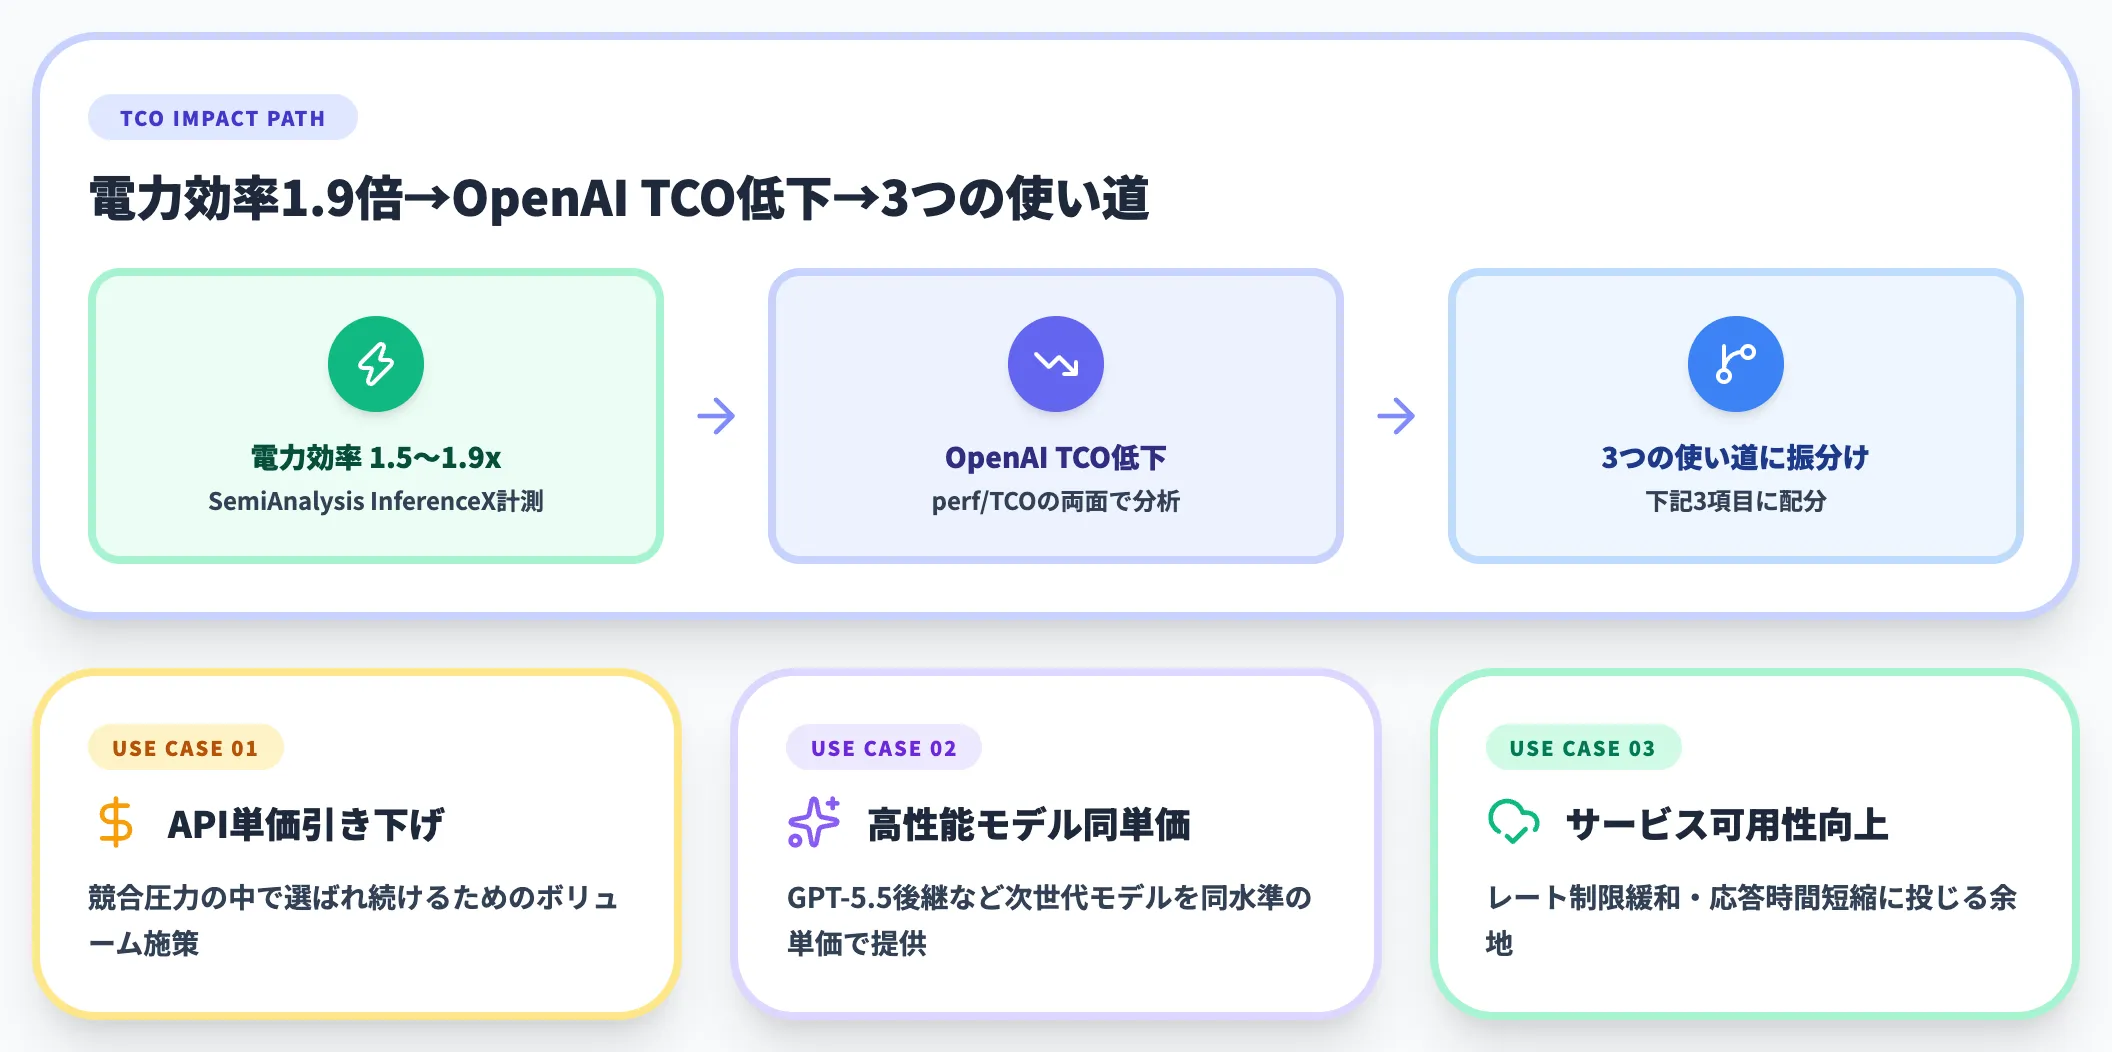
同じ推論量を、同じ電力予算で、より速く捌けるようになるということは、OpenAI側の運用コスト(TCO)低下に寄与し得ることを意味します。SemiAnalysisもJalapeñoをperf/W(電力あたり性能)とperf/TCO(総所有コストあたり性能)の両面で分析しています。
OpenAIが自社でこのTCOを圧縮できた場合、その差分は次の用途に使われる可能性があります。
Jalapeñoの本格運用が始まる時期以降、単価水準が動く可能性は織り込んでおく価値があります(改定時期・改定幅・対象プランはOpenAIから公表されていません)。
Ultra-fast mode拡張と対話体験の変化
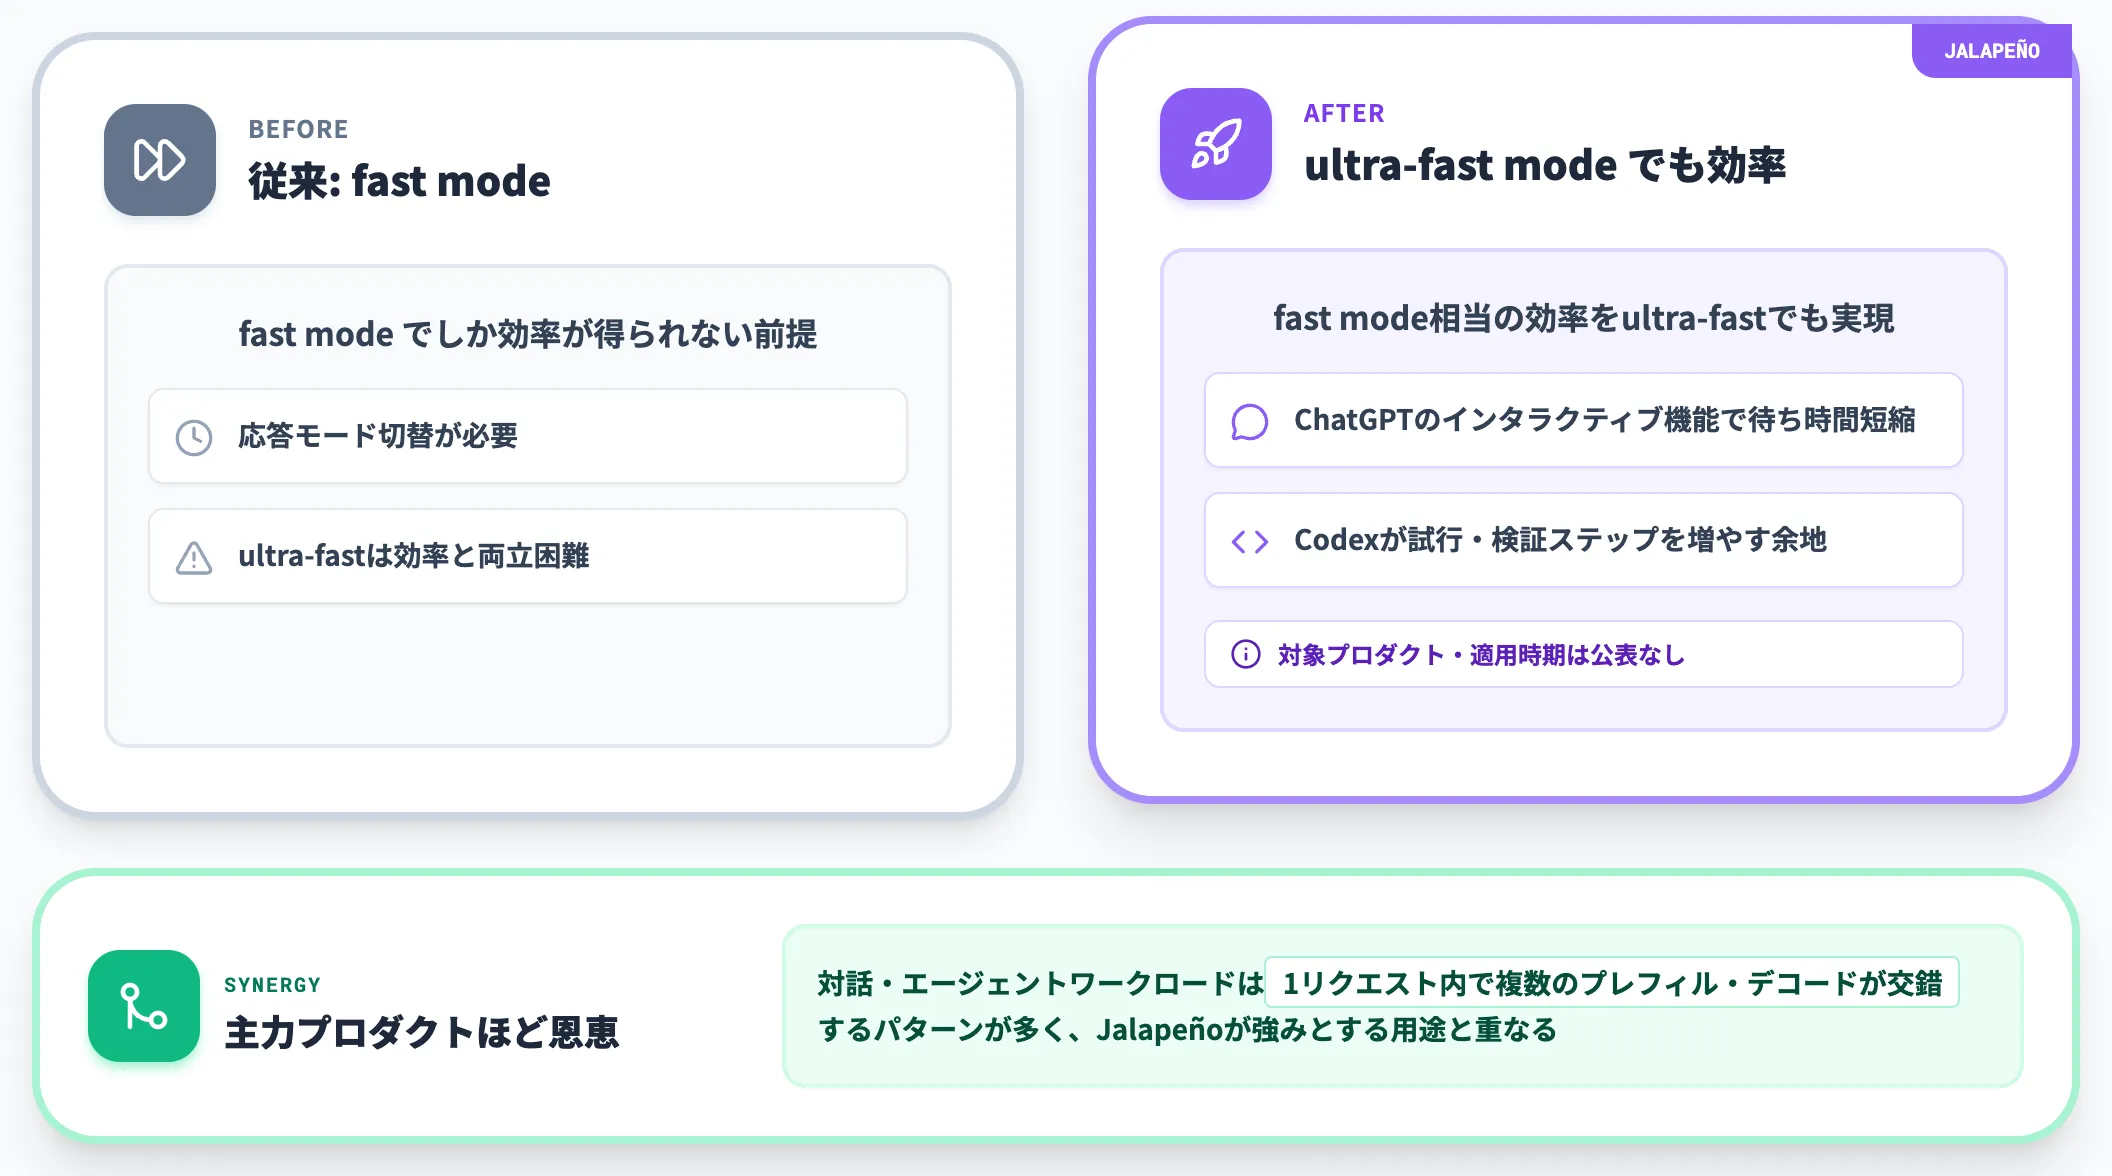
OpenAI公式は、Jalapeñoが「これまでfast modeだけで得られていた効率をultra-fast modeでも実現できる」と表現しています。ユーザー体験としては、次のような変化が想定される範囲です(対象プロダクトや適用時期は公表されていません)。
- ChatGPTのインタラクティブ機能で、待ち時間が短縮される可能性
- Codexのようなコーディングエージェントが、より多くの試行・検証ステップを許容できる余地
対話・エージェントワークロードは「1リクエスト内で複数のプレフィル・デコードが交錯する」パターンが多く、Jalapeñoが強みとする用途と重なります。OpenAIの主力プロダクトほど恩恵が乗りやすい設計です。
2029年10GW目標と法人契約戦略への示唆
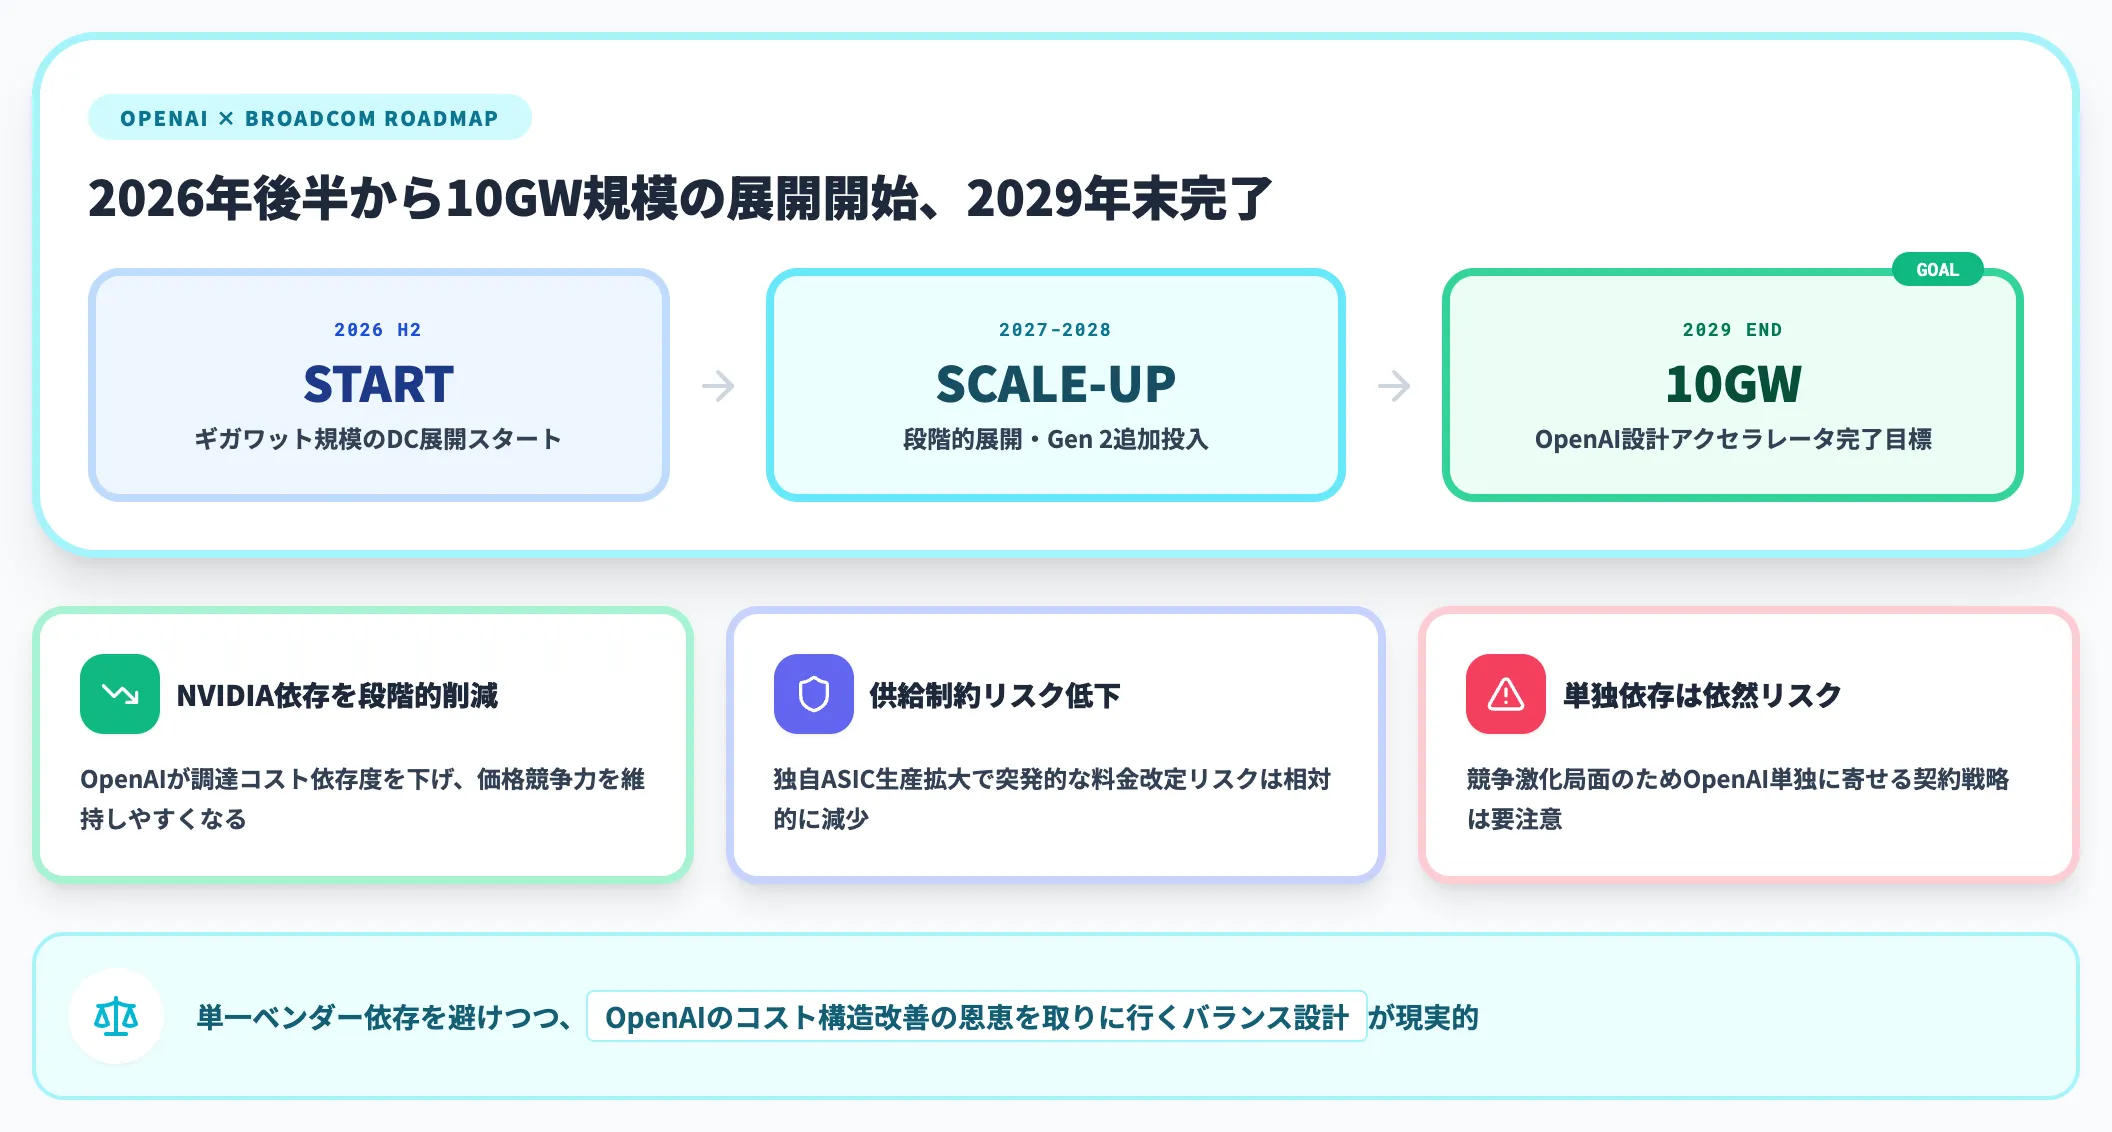
OpenAIはOpenAI・Broadcom戦略提携発表で、2026年後半から10GW規模のOpenAI設計アクセラレータの展開を開始し、2029年末までの完了を目指す計画を公表しています。
Broadcom CEOのHock Tanが「2026年からギガワット規模のデータセンターでの展開を開始する」と発表したのは、この10GW計画の入口です。
この規模感を法人契約の目線で読み解くと、以下の示唆が得られます。
- 中長期でOpenAIはNVIDIA調達コスト依存を段階的に下げ、価格競争力を維持しやすくなる
- 独自ASICの生産量が拡大するほど、供給制約による突発的な料金改定リスクは相対的に減る
- ただし、生成AIサービス市場は競争が激化する局面が続くため、OpenAI単独に寄せる契約戦略は引き続き注意が必要
単一ベンダー依存を避けつつ、OpenAIのコスト構造改善の恩恵を取りに行くバランス設計が現実的な打ち手です。
SIerポジション——「NVIDIA×独自ASIC並行運用時代」への備え
AI総合研究所の支援現場でも、2026年に入って「クラウドとオンプレ、フロンティアLLMと軽量LLMをどう並行運用するか」という論点が急速に増えています。Jalapeñoの登場は、この並行運用の必要性を一段強めます。
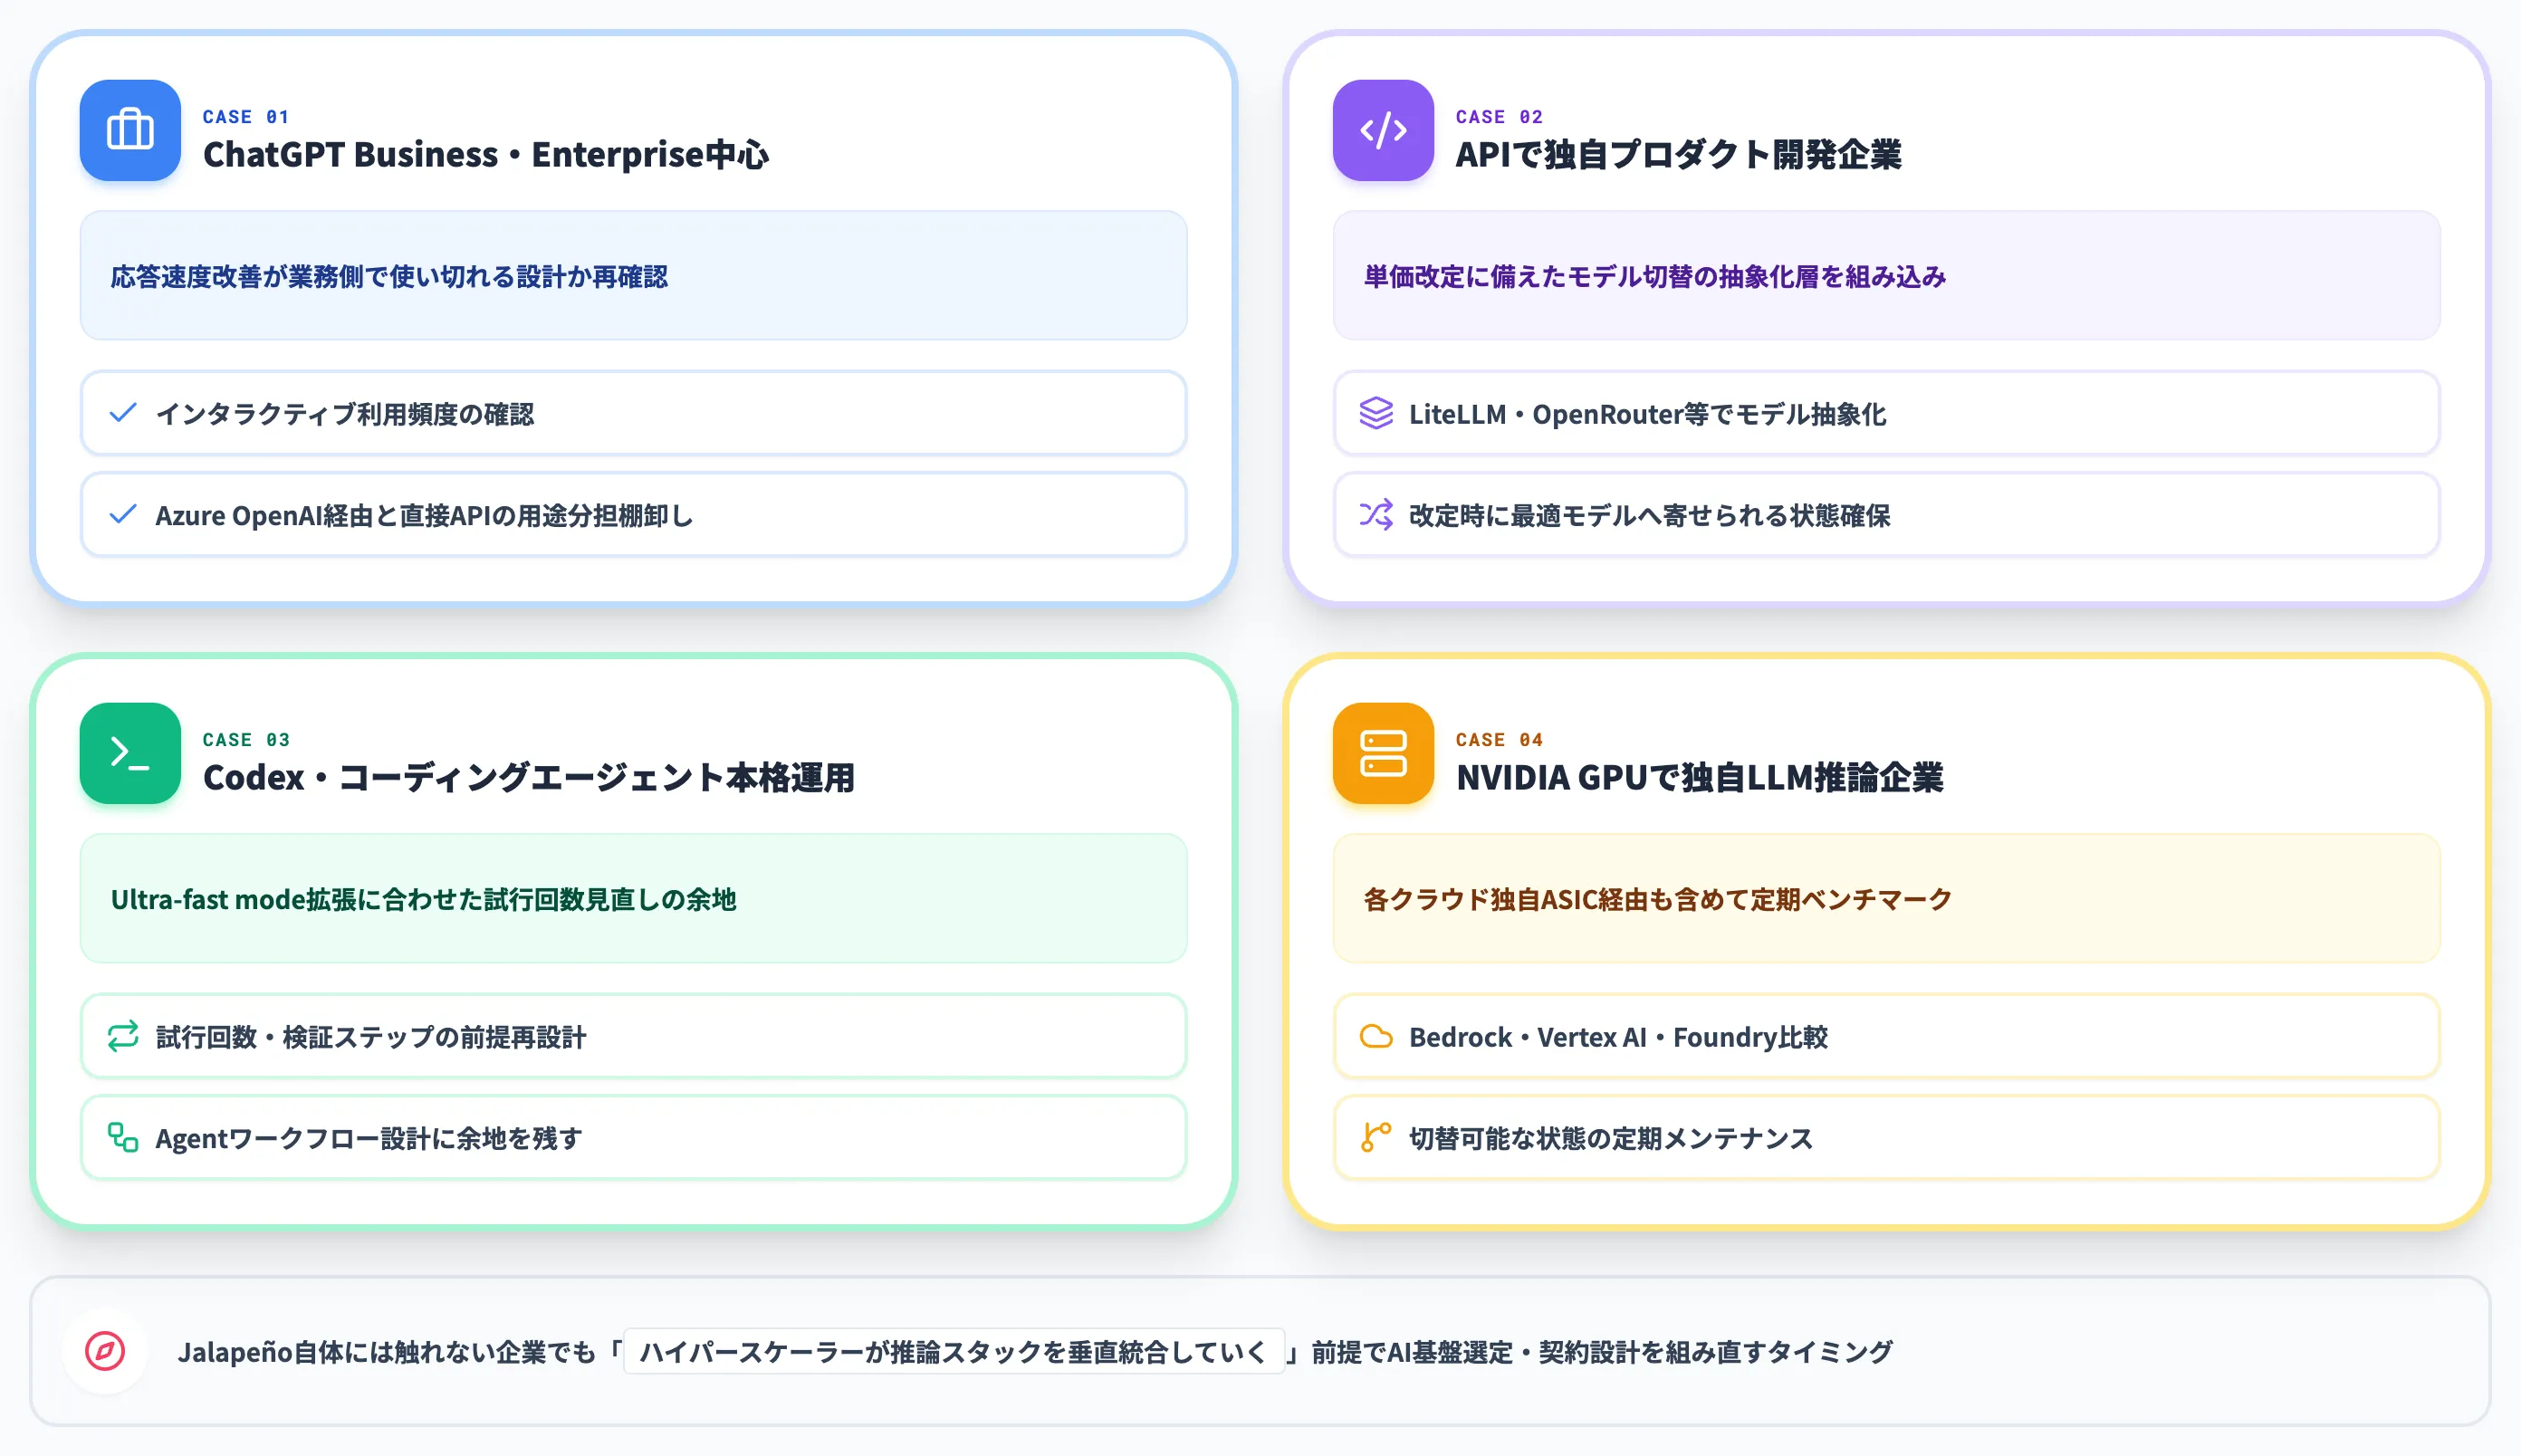
ケース別に整理すると、以下のような備えが実務的です。
-
ChatGPT Business・Enterprise中心の企業
応答速度改善が波及した場合に業務側で使い切れる設計か(インタラクティブ利用の頻度・許容レイテンシ)を再確認する。Azure OpenAI Service経由と直接API経由の両ルートを併用している場合は、契約状態と用途分担を棚卸ししておく。
-
APIで独自プロダクトを開発している企業
将来的に単価改定が起きた場合に備えて、モデル選定を柔軟に切替できる抽象化層(LiteLLM・OpenRouter等)をアーキテクチャに組み込んでおく。改定時に最適モデルへ寄せられる状態を作る。
-
Codex・コーディングエージェントを本格運用している企業
Ultra-fast mode拡張が波及した場合に、試行回数・検証ステップを増やす前提のワークフロー設計に見直せる余地を残しておく。
-
NVIDIA GPU上で独自LLMを推論している企業
NVIDIA以外の選択肢(Amazon Bedrock・Vertex AI・Microsoft Foundryなど、各クラウドの独自ASIC経由も含む)でのコスト・応答速度を定期的にベンチマークし、切替可能な状態を維持する。
Jalapeño自体には触れない企業でも、「ハイパースケーラーが自社推論スタックを垂直統合していく」という業界の方向性を前提に、AI基盤選定・契約設計を組み直すタイミングに入っています。
独自ASIC時代のAI基盤選定で詰まる論点を、実装事例から逆算して整理する
Jalapeñoのような独自ASIC世代を睨んでAI基盤を組み直す現場では、公式ドキュメントだけでは決めきれない論点が並びます。
- OpenAIのTCO改善が単価・応答速度に波及した場合、業務側で使い切れる設計にどう見直すか
- LiteLLM/OpenRouter等のモデル抽象化層をどこまで組み込み、単価改定時にモデル切替を効かせるか
- Codex・エージェント運用でUltra-fast mode拡張を試行回数増前提のワークフローにどう落とすか
- NVIDIA GPU上の独自LLMと各クラウド独自ASIC(Bedrock・Vertex・Foundry)経由をどう並行ベンチ・切替可能に維持するか
モデル・チップ世代交代の吸収・契約戦略・並行運用ベンチ・業務Agent統合まで含めてAI基盤の実装可能性を棚卸ししたいなら、単体機能の解説記事ではなく、実装事例と組み合わせて話せる相手と一度整理するのが早道です。
AI Agent Hubは、モデル・チップ世代交代を吸収しながら業務Agent群を統合管理するエンタープライズAI基盤で、モデル選定・Router設計・並行運用ベンチ・業務Agent実装のいずれの入口からでも、実装から逆算した論点整理をご相談いただけます。
独自ASIC時代のAI基盤選定を実装から逆算

モデル選定・Router・並行運用ベンチ・Agent実装
Jalapeño世代のAI基盤見直しは、モデル抽象化層の設計・単価改定備え・Codexワークフロー拡張・NVIDIA×独自ASICの並行運用ベンチが絡み合います。AI Agent Hubのサービスページで、モデル・チップ世代交代を吸収する業務Agent実装例をご確認ください。
まとめ
本記事では、Jalapeñoについて、性能ベンチマーク・アーキテクチャ設計思想・9か月tape-outが示す新パラダイム・ハイパースケーラー独自シリコン戦略での位置づけ・ChatGPT/API/Codex利用企業への影響を、2026年8月時点の公式一次情報を中心とした公開情報で解説しました。
2026年時点で押さえておくべきポイントは次の3つです。
- OpenAI・Broadcom・Celestica分担で白紙設計された初のLLM推論専用ASIC、SemiAnalysis InferenceX計測でNVIDIA GB200/GB300比の電力効率1.5〜1.9倍・レイテンシ最大3.6倍改善が実測公開
- 9か月tape-outはOpenAIモデル自身が設計・カーネル最適化を加速した成果、AIがAIハードウェアを設計する新パラダイムの実例でAI生成カーネルが人手を1.5〜1.8倍上回るケースも報告
- 外販計画なしでOpenAI社内利用前提だが電力効率改善はTCO低下方向に働く、ChatGPT・API・Codex利用企業の応答速度・可用性・トークン単価に波及し、2029年末に10GW独自シリコン展開完了計画
Jalapeñoは「自社が使えるかどうか」よりも「ハイパースケーラーが推論スタックを垂直統合していく前提で、AI基盤の選定と契約戦略を組み直せるか」を問う節目の動きです。モデル・チップの世代交代を吸収できる業務Agent基盤を先に整え、単価・応答速度に変化が生じた場合にその効果を業務に取り込める状態を作っておくことが、独自ASIC時代の最も実用的な備えになります。