この記事のポイント
 同一モデルでもハーネス(スキャフォールド)の違いでSWE-bench Proのスコアは大きく動き、フロンティアモデル間のスコア差を上回る実務インパクトが生じうる
- 設計パターン18種は「メモリ/ワークフロー/ツール/安全」4領域で整理できる実装カタログ
- ハーネスの実装差は「隔離・承認・文脈維持」の3領域に集中、ループとツールディスパッチは各社で収束している
- 長時間自律タスクはExplore-Plan-Act・Context-Isolated Subagents・Fork-Join Parallelismの組合わせが第一候補
- Microsoft Agent Framework 1.0 GA(2026-04)は企業内製向け、Claude Codeの動的ワークフローは探索型タスクで優位
Microsoft MVP・AIパートナー。LinkX Japan株式会社 代表取締役。東京工業大学大学院にて自然言語処理・金融工学を研究。NHK放送技術研究所でAI・ブロックチェーンの研究開発に従事し、国際学会・ジャーナルでの発表多数。経営情報学会 優秀賞受賞。シンガポールでWeb3企業を創業後、現在は企業向けAI導入・DX推進を支援。
エージェントハーネスの設計パターンとは、AIエージェントをLLMの外側で安定動作させる実行基盤の型です。
Particula社が整理した業界レポートでは、同一モデルでもハーネス(スキャフォールド)の違いでSWE-bench Pro(Scale AI公式)のスコアが大きく動く一方、フロンティアモデルを横並びにしたときのスコア差は小さくなる、という傾向が報告されています。
本記事では、Memory & Context、Workflow & Orchestration、Tools & Permissions、安全・検証系の4領域から18の設計パターンを整理し、Claude Code・OpenAI Codex・Devin・mini-swe-agent・Microsoft Agent Framework 1.0の実装差とユースケース別の選び方を、2026年11月時点の最新情報で体系的に解説します。
目次
エージェントハーネスの設計パターンとは?スキャフォールド選びがベンチマーク結果を動かす時代の型
「設計パターン」として扱うべき理由——スキャフォールド差とモデル差のインパクト逆転
3つの一次ソースの定義——Böckeler・OpenAI Codex・Anthropicの読み方
Memory & Context の設計パターン5選——文脈管理がハーネスの個性を決める
1. Persistent Instruction File Pattern——CLAUDE.md/AGENTS.mdで常駐ルールを渡す
2. Scoped Context Assembly Pattern——階層的にルールを束ねる
3. Tiered Memory Pattern——コンパクト索引・トピックファイル・全履歴の3層構成
4. Dream Consolidation Pattern——アイドル時にメモリを整理する
5. Progressive Context Compaction Pattern——段階圧縮で古い履歴を折りたたむ
Workflow & Orchestration の設計パターン6選——エージェントループの組み合わせ
6. Explore-Plan-Act Loop Pattern——権限段階を3フェーズに分ける
7. Context-Isolated Subagents Pattern——オーケストレーターとワーカーで文脈を分離
8. Fork-Join Parallelism Pattern——並列ワークツリーで複数タスクを同時実行
9. Sequential/Loop/Parallel Pattern——Google ADKの3基本フロー
10. Supervisor(Coordinator/Dispatcher)Pattern——1つの司令塔が専門エージェントを振り分ける
11. Generator-Critic(Reflection)Pattern——生成と評価を別エージェントに分離する
Tools & Permissions の設計パターン4選——ツール設計と承認モードの組合わせ
12. Progressive Tool Expansion Pattern——最小ツールセットから動的に増やす
13. Command Risk Classification Pattern——リスク分類で承認フローを自動化
14. Single-Purpose Tool Design Pattern——汎用shellではなく専用ツールを並べる
15. OpenAI Codex approval_policy の現行モードと Auto モード
安全・検証系の設計パターン3選——Hooks・Guardrails・Verification Loop
16. Deterministic Lifecycle Hooks Pattern——ライフサイクル点で確定動作を挟む
17. Guardrails Pattern——入出力で違反を検知して止める
18. Verification Loop Pattern——テスト・lint・型チェックを検証ステップに組み込む
主要ハーネスの実装差──Claude Code・OpenAI Codex・Devin・mini-swe-agent・Microsoft Agent Framework 1.0
Microsoft Agent Framework 1.0 GAの立ち位置
長時間自律タスク——Explore-Plan-Act+サブエージェント構成が第一候補
マルチエージェント業務ワークフロー——Supervisor+Sequential/Loop/Parallelの組合わせ
セキュリティ重視・社内本番運用——Hooks+Guardrails+承認モードの三重防御
エージェントハーネスの設計パターンとは?スキャフォールド選びがベンチマーク結果を動かす時代の型
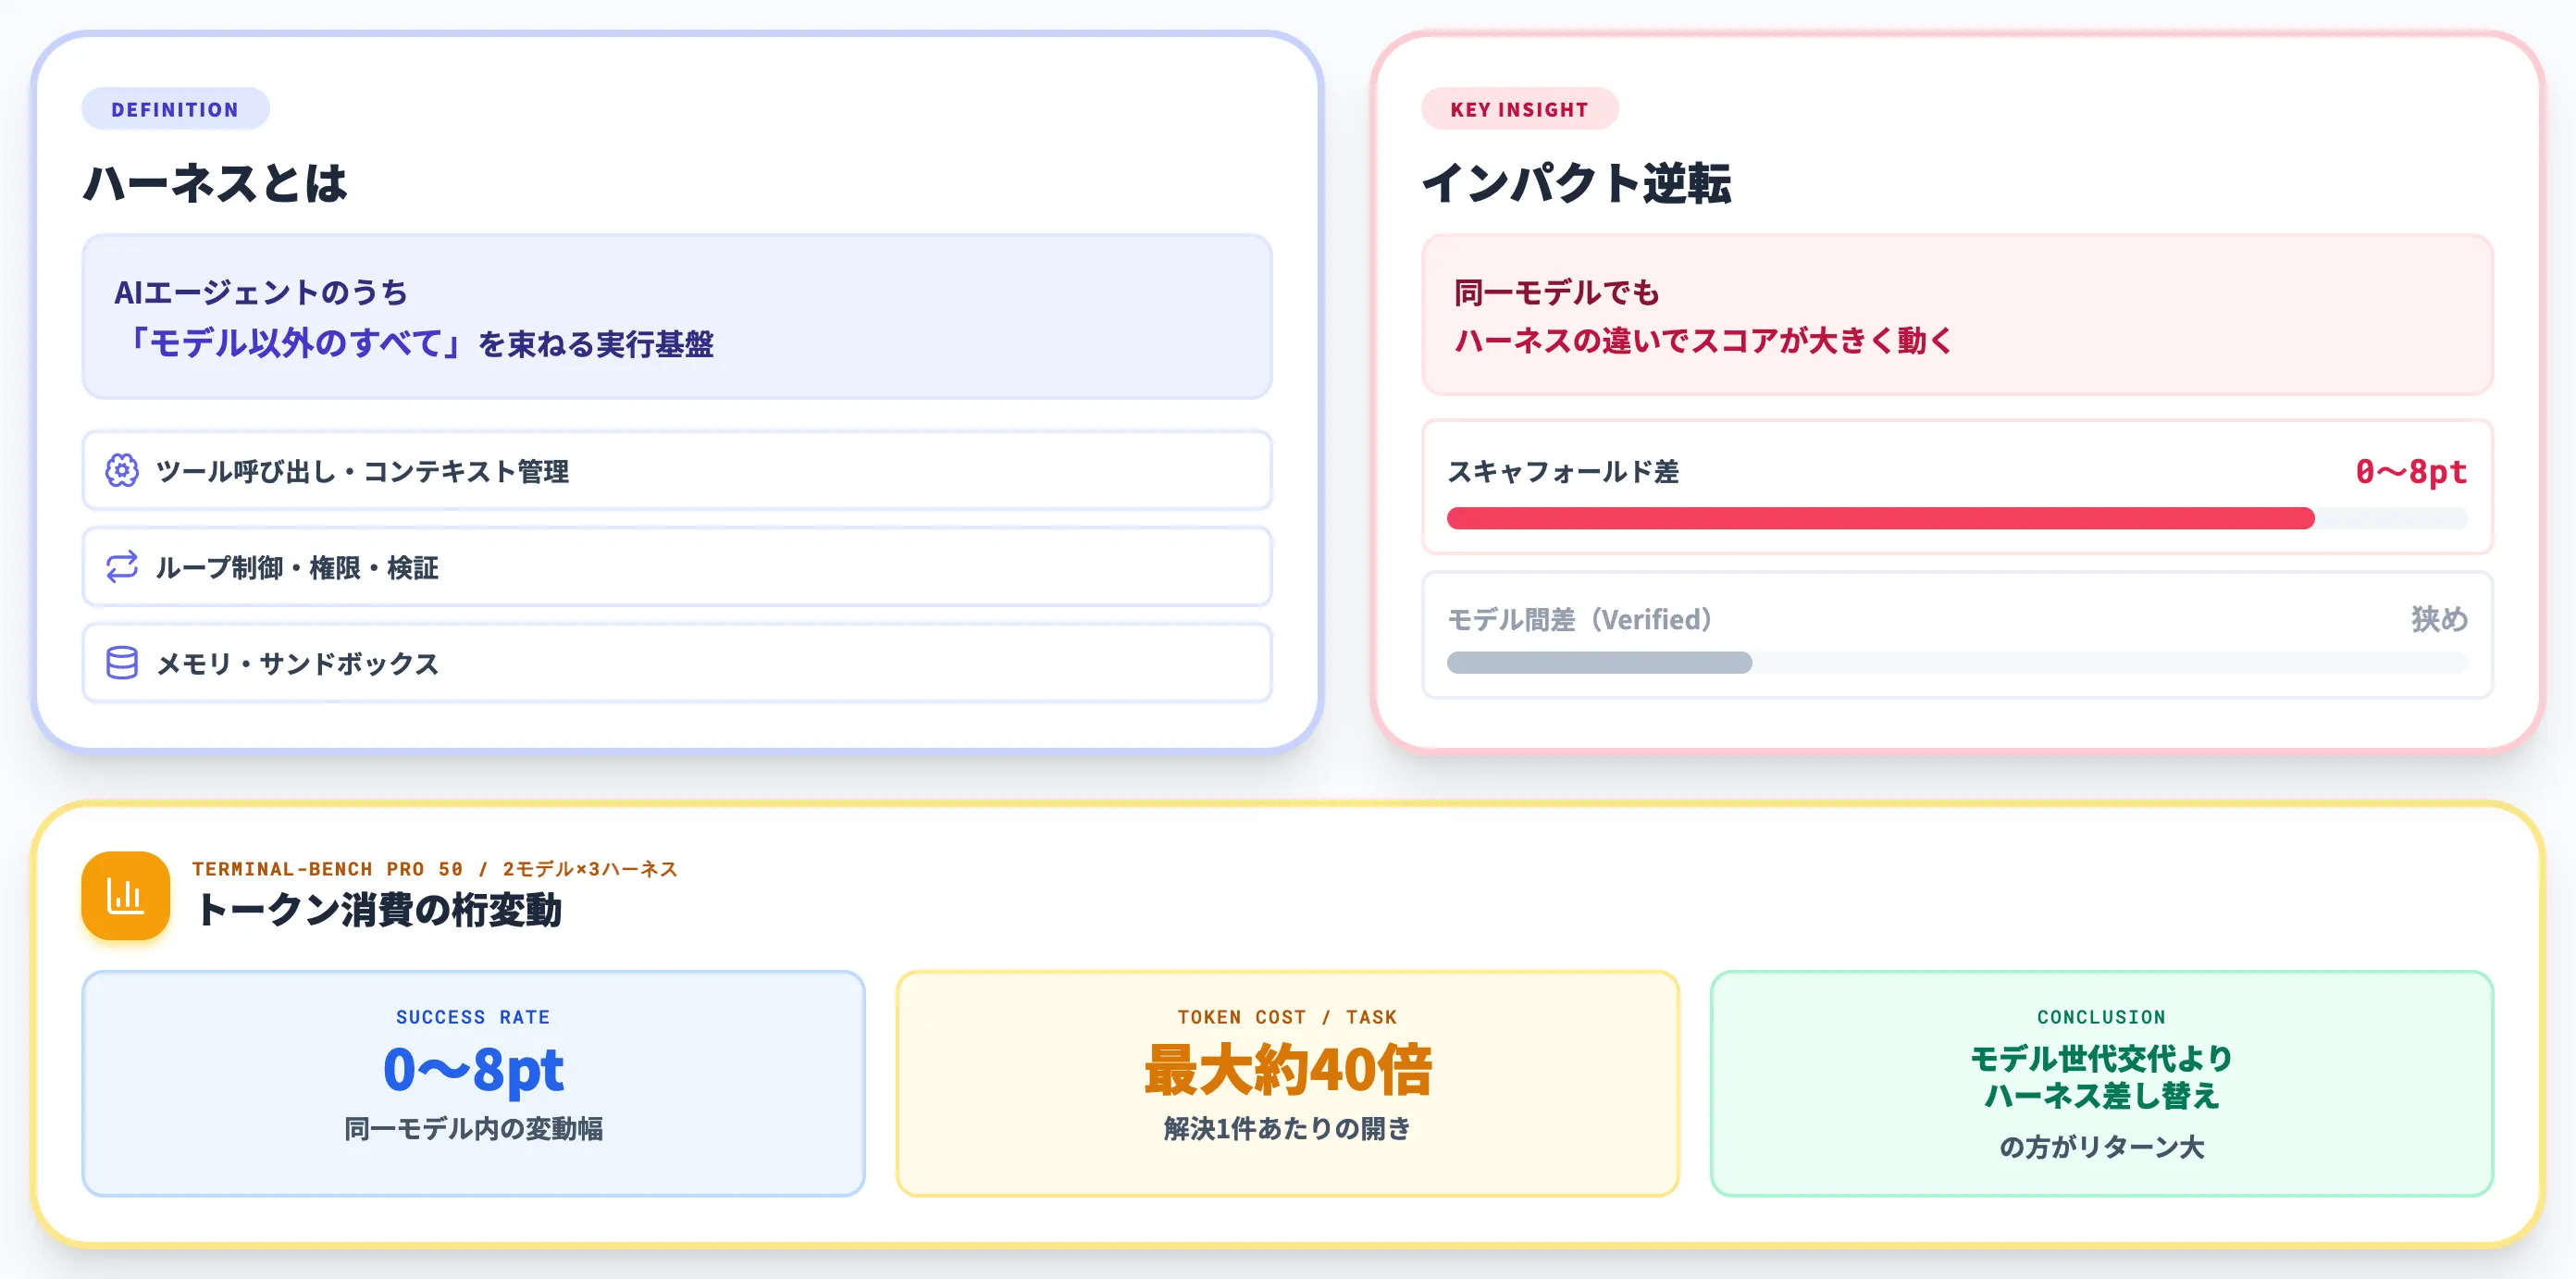
エージェントハーネスの設計パターンは、LLMを「使えるAIエージェント」へと変える実行基盤(ハーネス)のw繰り返し使える型のことを指します
ツール呼び出し、コンテキスト管理、メモリ、権限、検証、ループ制御といった要素を束ねる層で、2025年末から2026年にかけてモデル選びより先にハーネス設計で勝負が決まるという認識が業界で急速に広がりました。
「設計パターン」として扱うべき理由——スキャフォールド差とモデル差のインパクト逆転
ハーネスを「設計パターン」として扱うべきだと主張する直接的な根拠は、Particula社がまとめたSWE-bench Pro関連の分析です。
同記事は、SWE-bench Pro環境でスキャフォールド(ハーネス)の違いだけでスコアが大きく動くケースを紹介しています。
一方、フロンティアモデルを横並びにしたときの差(SWE-bench Verifiedで観測されるモデル間差)は、スキャフォールド差と比べて小さく収まる傾向が報告されています。
この傾向が意味するのは、モデルを1世代新しくするより、ハーネスを1つ賢い型に差し替えるほうが大きなリターンを生みうるという事実です。
arXivのスキャフォールド効果論文「The Scaffold Effect in Coding Agents」は、Terminal-Bench Pro 50タスクで2モデル(Qwen 3.6 Plus/MiniMax M2.5)× 3ハーネス(Goose/OpenCode/OpenHands-SDK)を比較し、同一モデルでも成功率が0〜8ポイント動き、解決1件あたりのトークン数は最大約40倍開くという結果を示しました。
精度差はそこまで巨大ではなくても、同じ結果を出すのに必要な推論コストが桁で変動することを裏付けるデータです。
ハーネスを構成する7レイヤーと設計パターンのマッピング
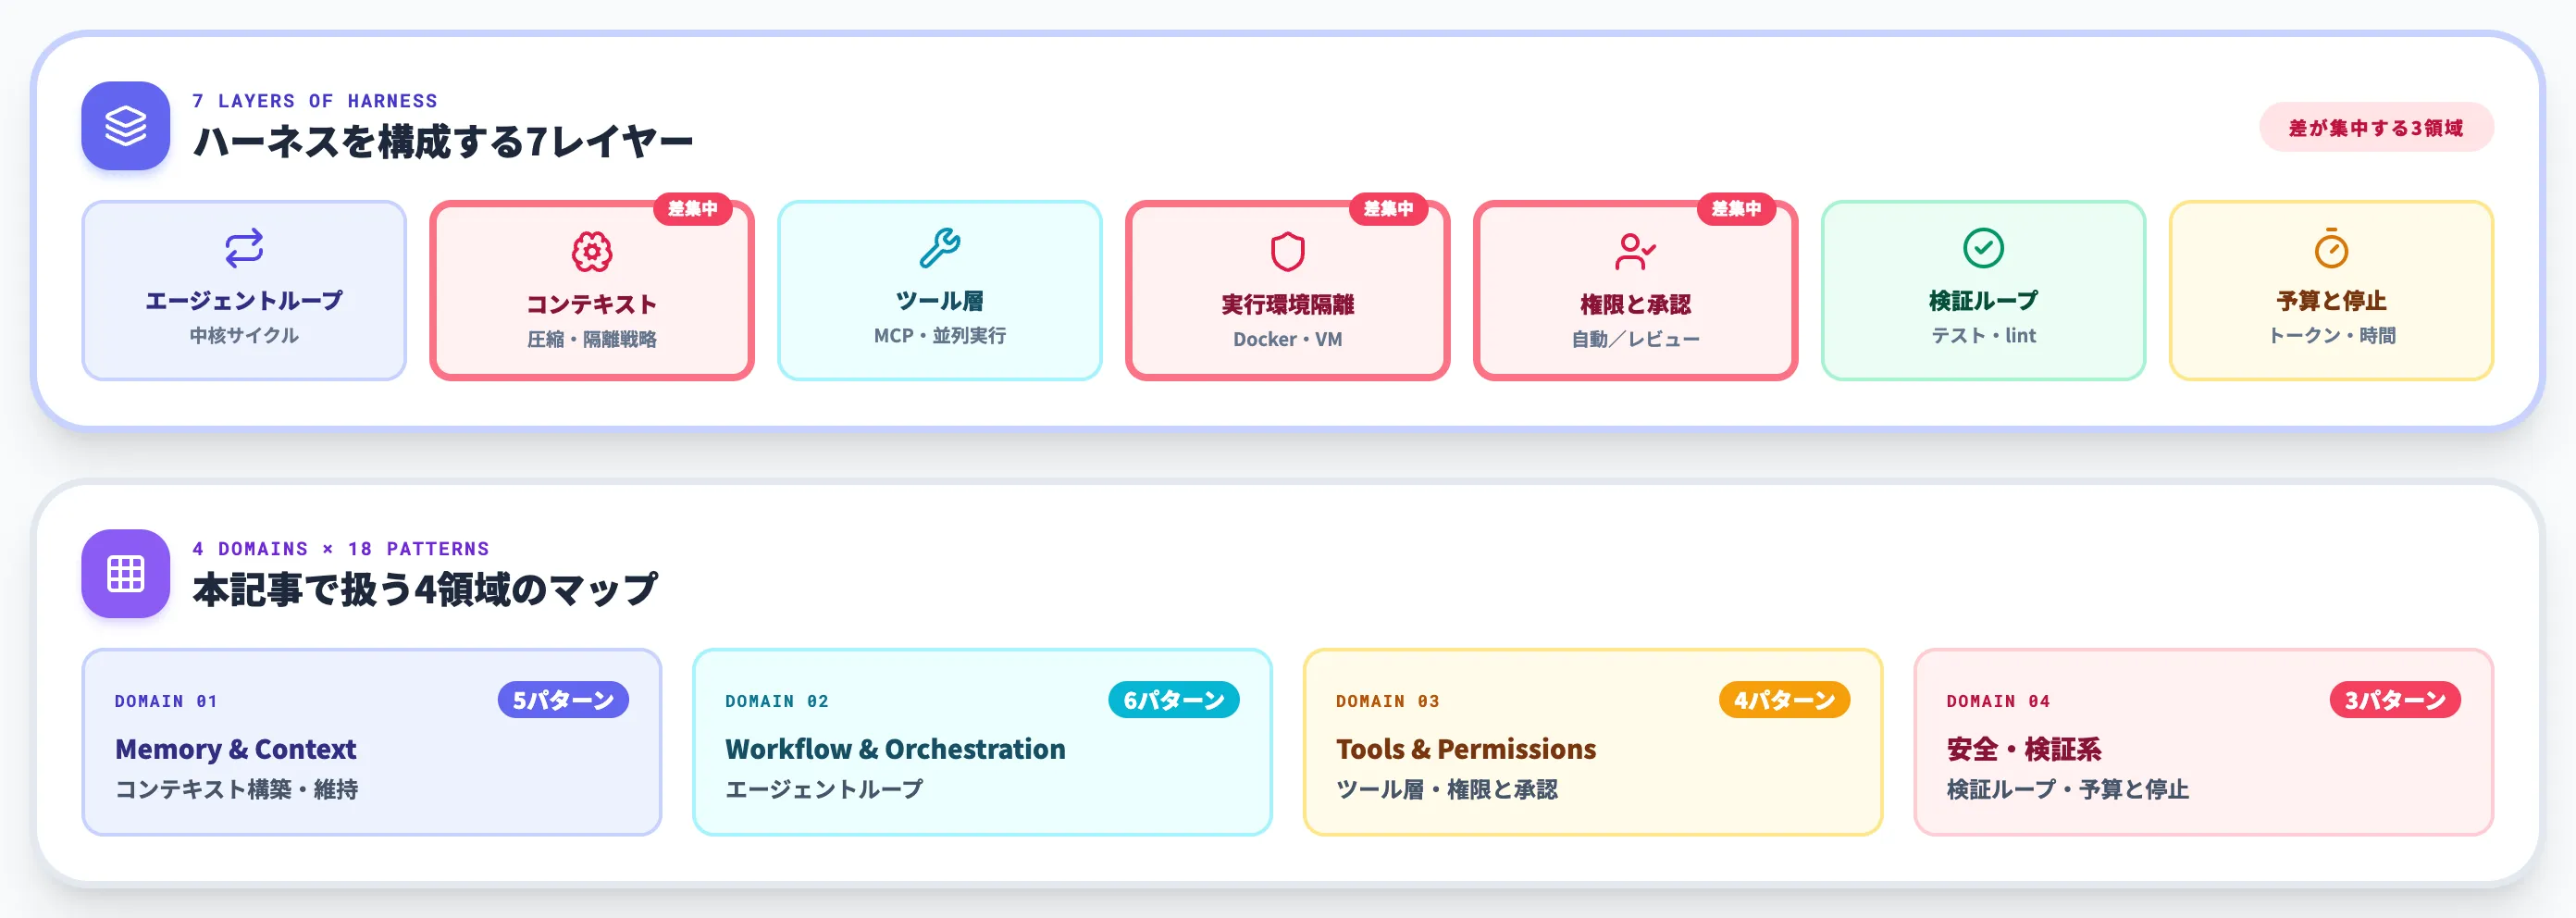
ハーネスの設計パターンは、ハーネスを構成する7つのレイヤーのどこを対象とするかで役割が分かれます。
ここでは、まず公式定義を3つ並べて共通構造を確認した後、7レイヤーと本記事で扱う18パターンのマッピングを示します。
3つの一次ソースの定義——Böckeler・OpenAI Codex・Anthropicの読み方
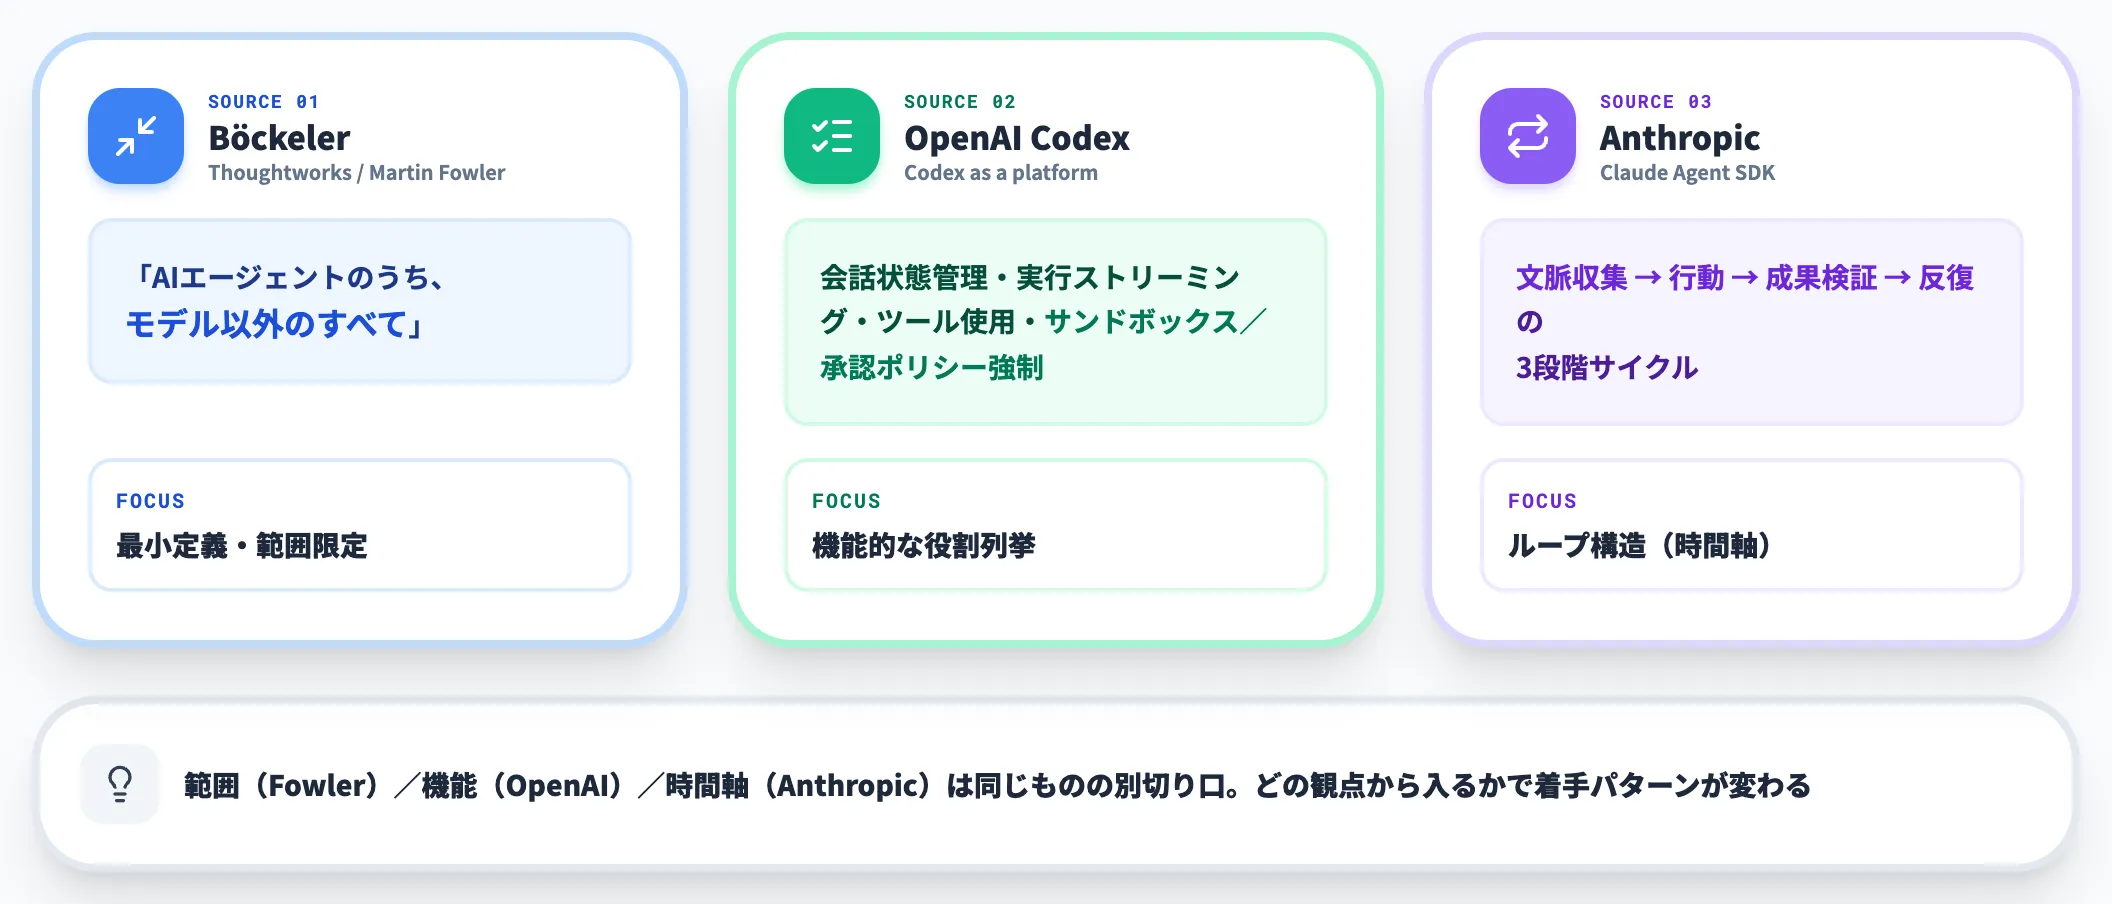
ハーネスの定義は、ベンダー・研究者の3つの一次ソースを並べると共通構造が浮かび上がります。
| 出典 | 定義の骨子 | 重点 |
|---|---|---|
| Birgitta Böckeler「Harness engineering for coding agent users」(Martin Fowler のサイト) | 「AIエージェントのうち、モデル以外のすべて」 | 最小定義、範囲限定 |
| OpenAI「Codex as a platform」 | 「会話状態の管理、実行のストリーミング、ツール使用、設定されたサンドボックスと承認ポリシーの強制」 | 機能的な役割列挙 |
| Anthropic「Building agents with the Claude Agent SDK」 | 「文脈収集 → 行動 → 成果検証 → 反復」の3段階サイクル | ループ構造 |
この比較から見えるのは、各社が同じものを別の切り口で言語化しているという点です。範囲(Fowler)、機能(OpenAI)、時間軸(Anthropic)が重なり合い、どの観点から入るかで最初に手を付けるパターンが変わります。
ハーネスの7レイヤー——どのレイヤーに差が集中するか
本記事では複数の整理を踏まえて、設計パターンの対応関係が見やすい形にハーネスを以下の7レイヤーへ再整理します。
-
エージェントループ
モデル呼び出し・行動抽出・ツール実行・観測記録を繰り返す中核サイクル
-
コンテキスト構築・維持
何を見せるか、溢れたときの圧縮や隔離の戦略
-
ツール層
登録・ルーティング・並列実行・MCP連携などの仕組み
-
実行環境隔離
ローカル/サンドボックス/Docker/リモート実行の線引き
-
権限と承認
自動許可する操作と人間のレビューを挟む操作の区別
-
検証ループ
テスト・lint・型チェックなど出力の正しさを機械的に確かめる仕組み
-
予算と停止条件
ステップ数・トークン・コスト・時間による自動停止
6実装を並べると、エージェントループとツールディスパッチの形式は各社で収束している一方、実行環境隔離・権限と承認・コンテキスト維持の3つに実装差が集中していることが分かっています。
つまり、ハーネス設計で読者が差をつけに行くべき領域はこの3つに絞られます。
18パターンと4領域のマッピング
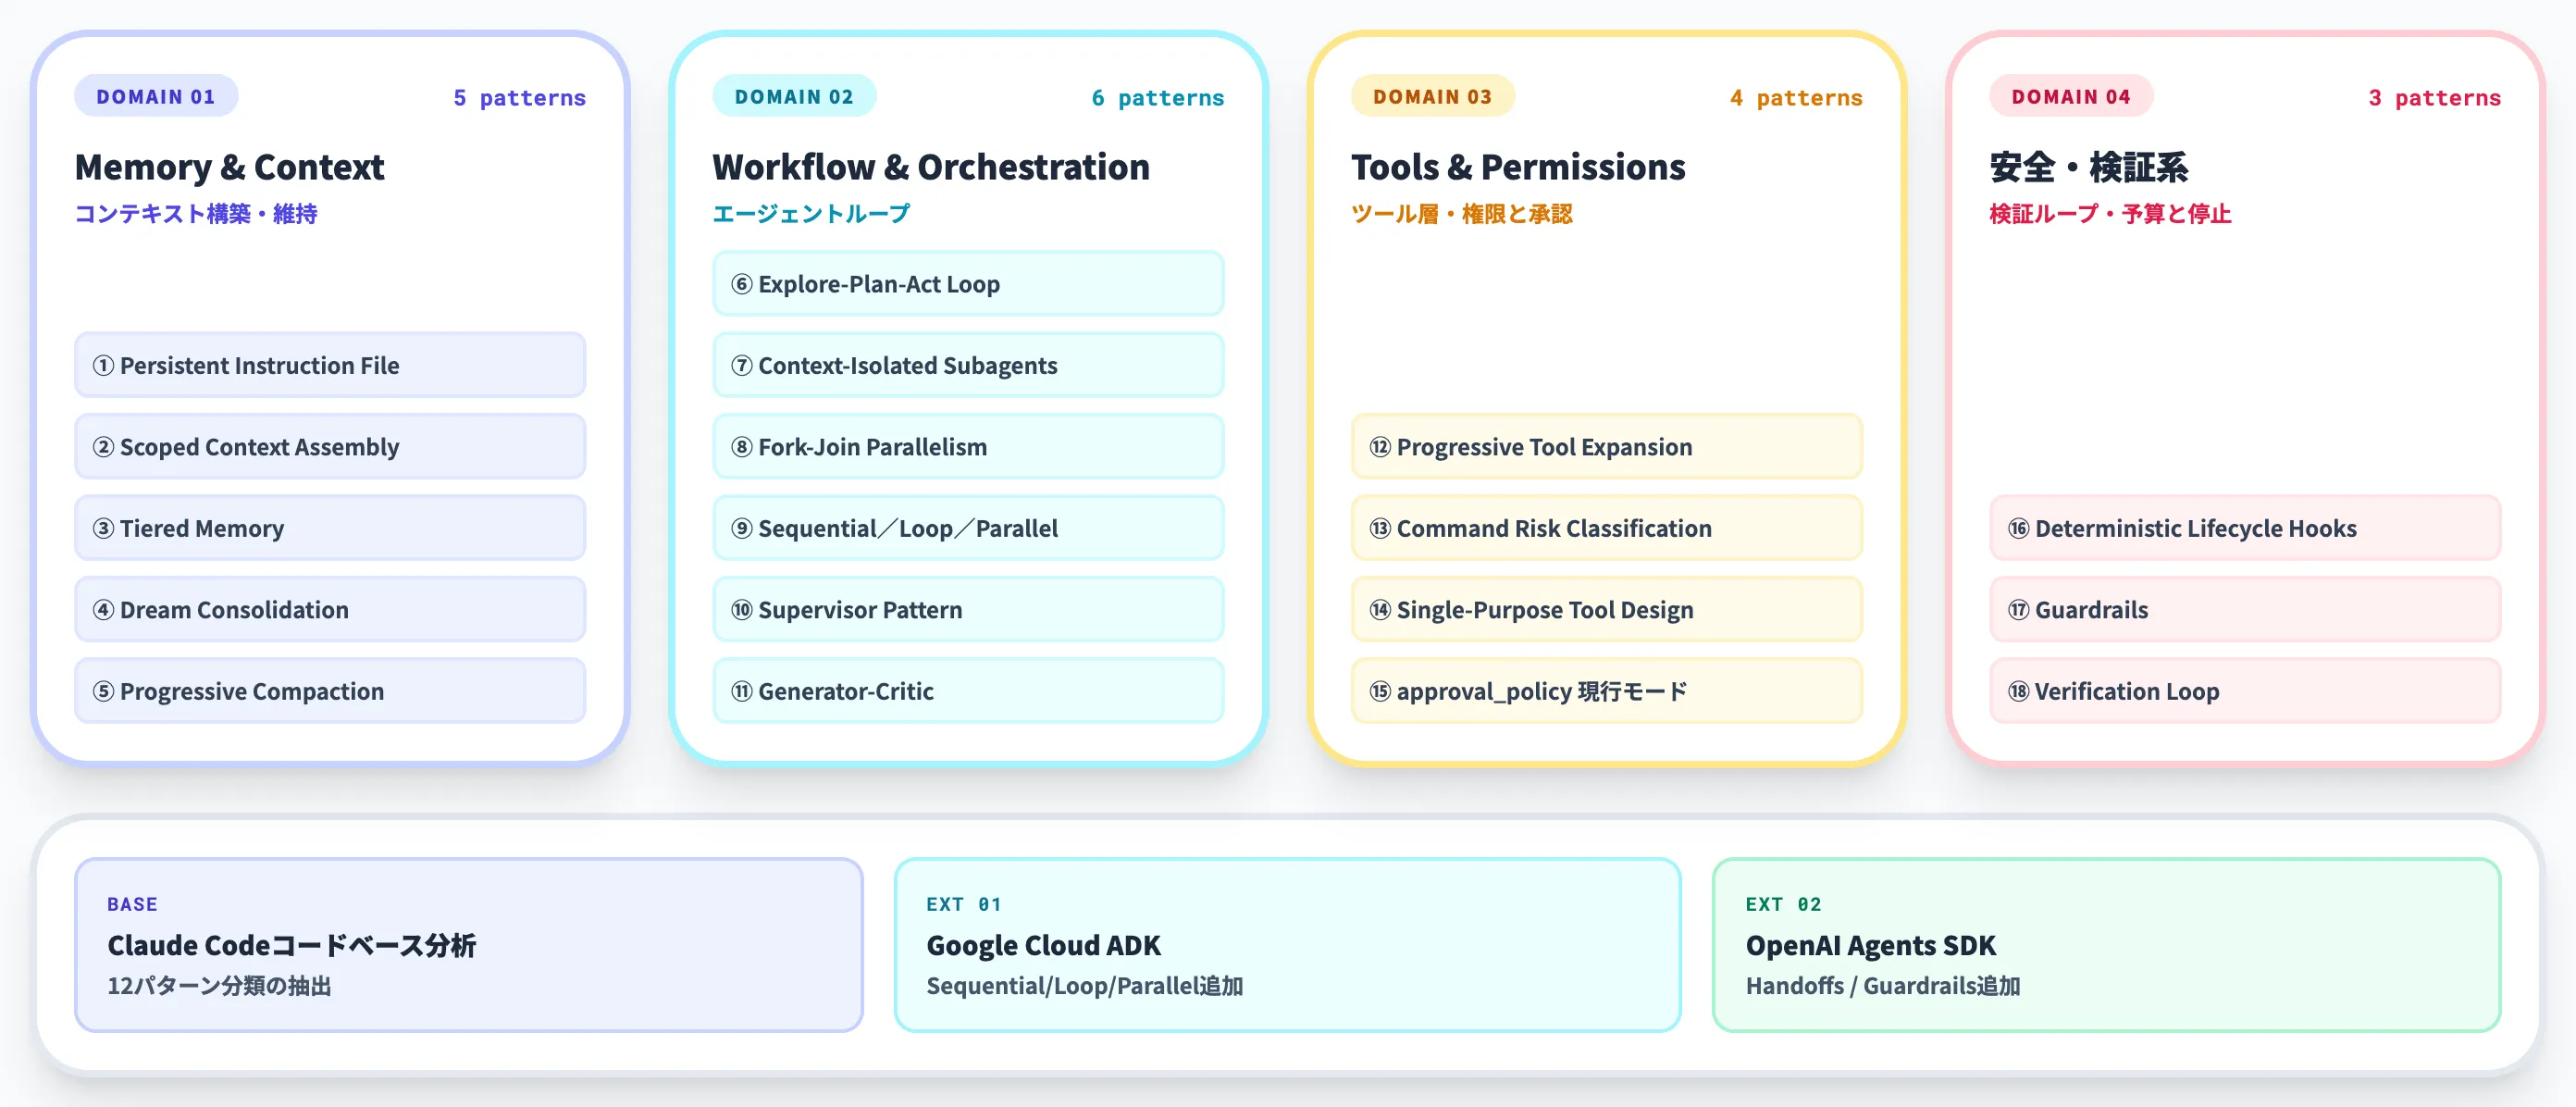
本記事で扱う18パターンは、7レイヤーを4つのテーマ領域にグループ化して整理します。
以下の表は、4領域と各領域のパターン数・対象レイヤーをまとめたものです。
| 領域 | 対象レイヤー | パターン数 | 主なパターン名 |
|---|---|---|---|
| Memory & Context | コンテキスト構築・維持 | 5 | Persistent Instruction File、Tiered Memory、Progressive Context Compaction など |
| Workflow & Orchestration | エージェントループ | 6 | Explore-Plan-Act、Context-Isolated Subagents、Fork-Join、Sequential/Loop/Parallel など |
| Tools & Permissions | ツール層、権限と承認 | 4 | Progressive Tool Expansion、Command Risk Classification、approval_policy の現行モード など |
| 安全・検証系 | 検証ループ、予算と停止条件 | 3 | Deterministic Lifecycle Hooks、Guardrails、Verification Loop |
この4領域の並びは、Claude Codeのコードベース分析で抽出された12パターン分類をベースに、Google Cloud ADK・OpenAI Agents SDKで扱われる主要パターンを追加して拡張したものです。
自社でハーネスを組むときのチェックリストとしてそのまま使える粒度を意識して設計しています。
Memory & Context の設計パターン5選——文脈管理がハーネスの個性を決める
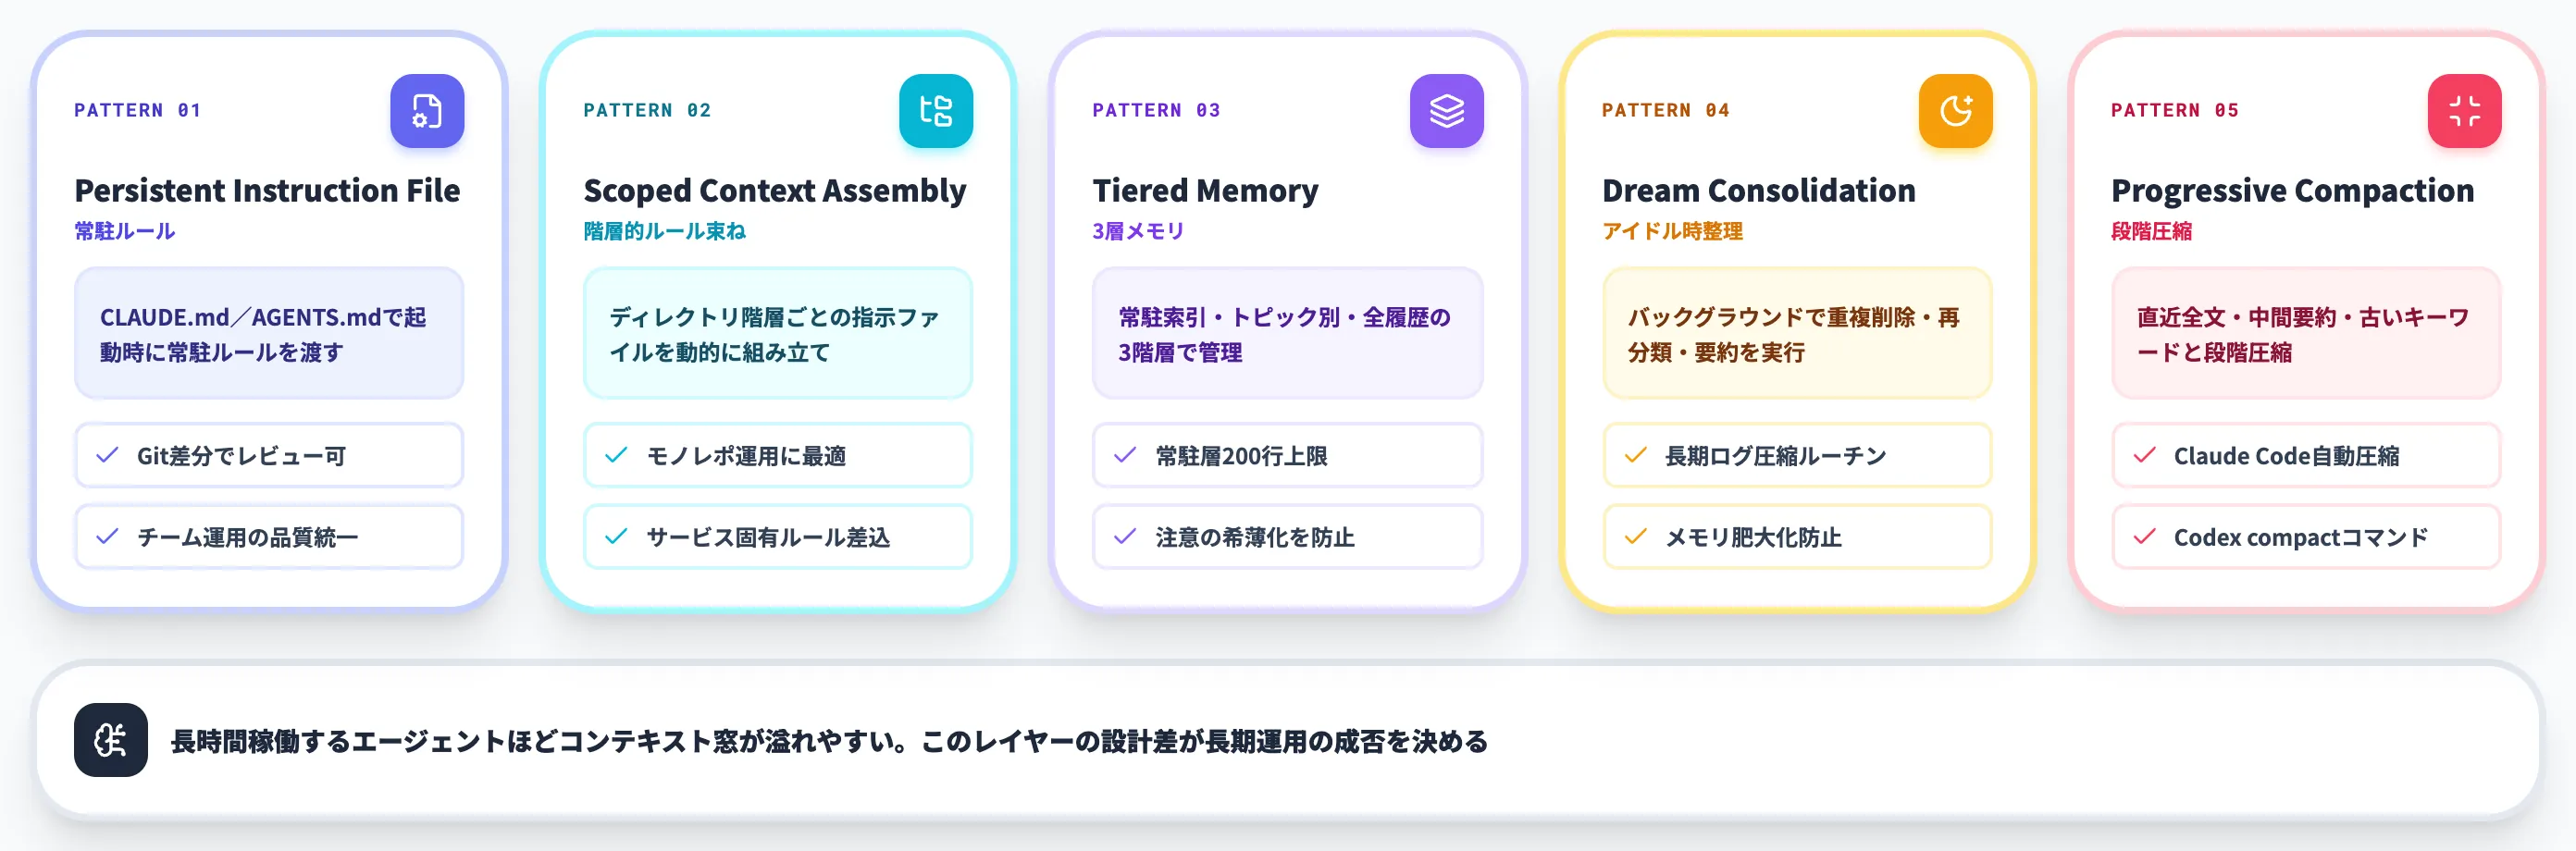
Memory & Context領域の5パターンは、モデルに何をどの順で見せるかを制御します。
長時間稼働するエージェントほどコンテキスト窓が溢れ、品質が崩壊しやすいため、このレイヤーの設計が長期運用の成否を分けます。
1. Persistent Instruction File Pattern——CLAUDE.md/AGENTS.mdで常駐ルールを渡す
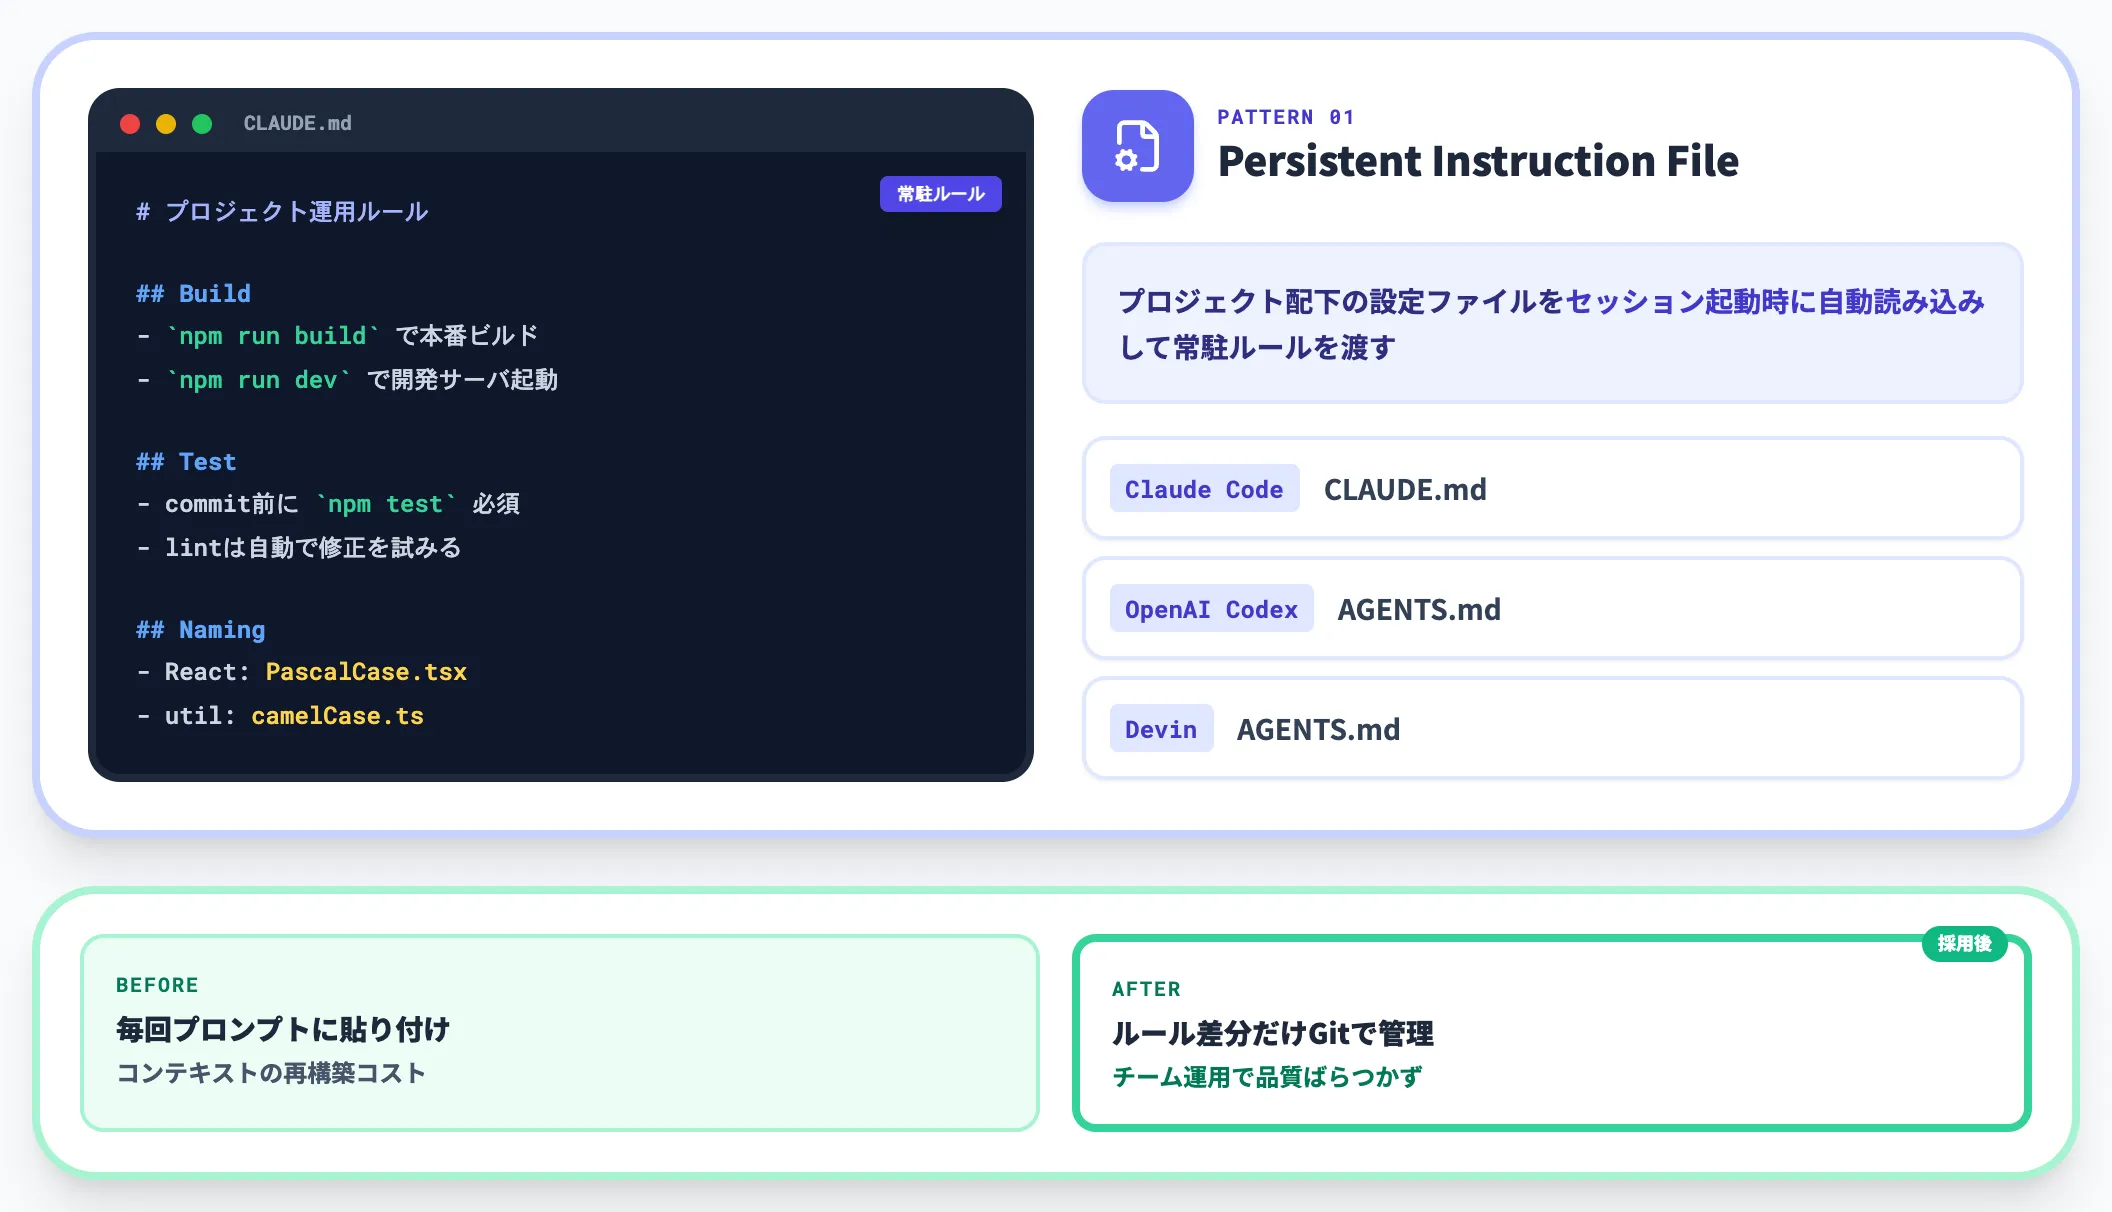
Persistent Instruction Fileは、プロジェクト配下に置いた設定ファイルをセッション起動時に自動読み込みし、ビルド・テスト・命名規則などの常駐ルールをモデルに渡す型です。
Claude Codeの「CLAUDE.md」、OpenAI CodexとDevinの「AGENTS.md」など、各ハーネスで微妙に表記は違うものの同じ思想を採用しています。
このパターンが効くのは、「毎回プロンプトに貼り付ける」運用から脱して、ルール差分だけ管理できるようになる点です。
Gitで差分をレビューできるため、チーム規模のエージェント運用で品質がばらつかなくなります。
2. Scoped Context Assembly Pattern——階層的にルールを束ねる
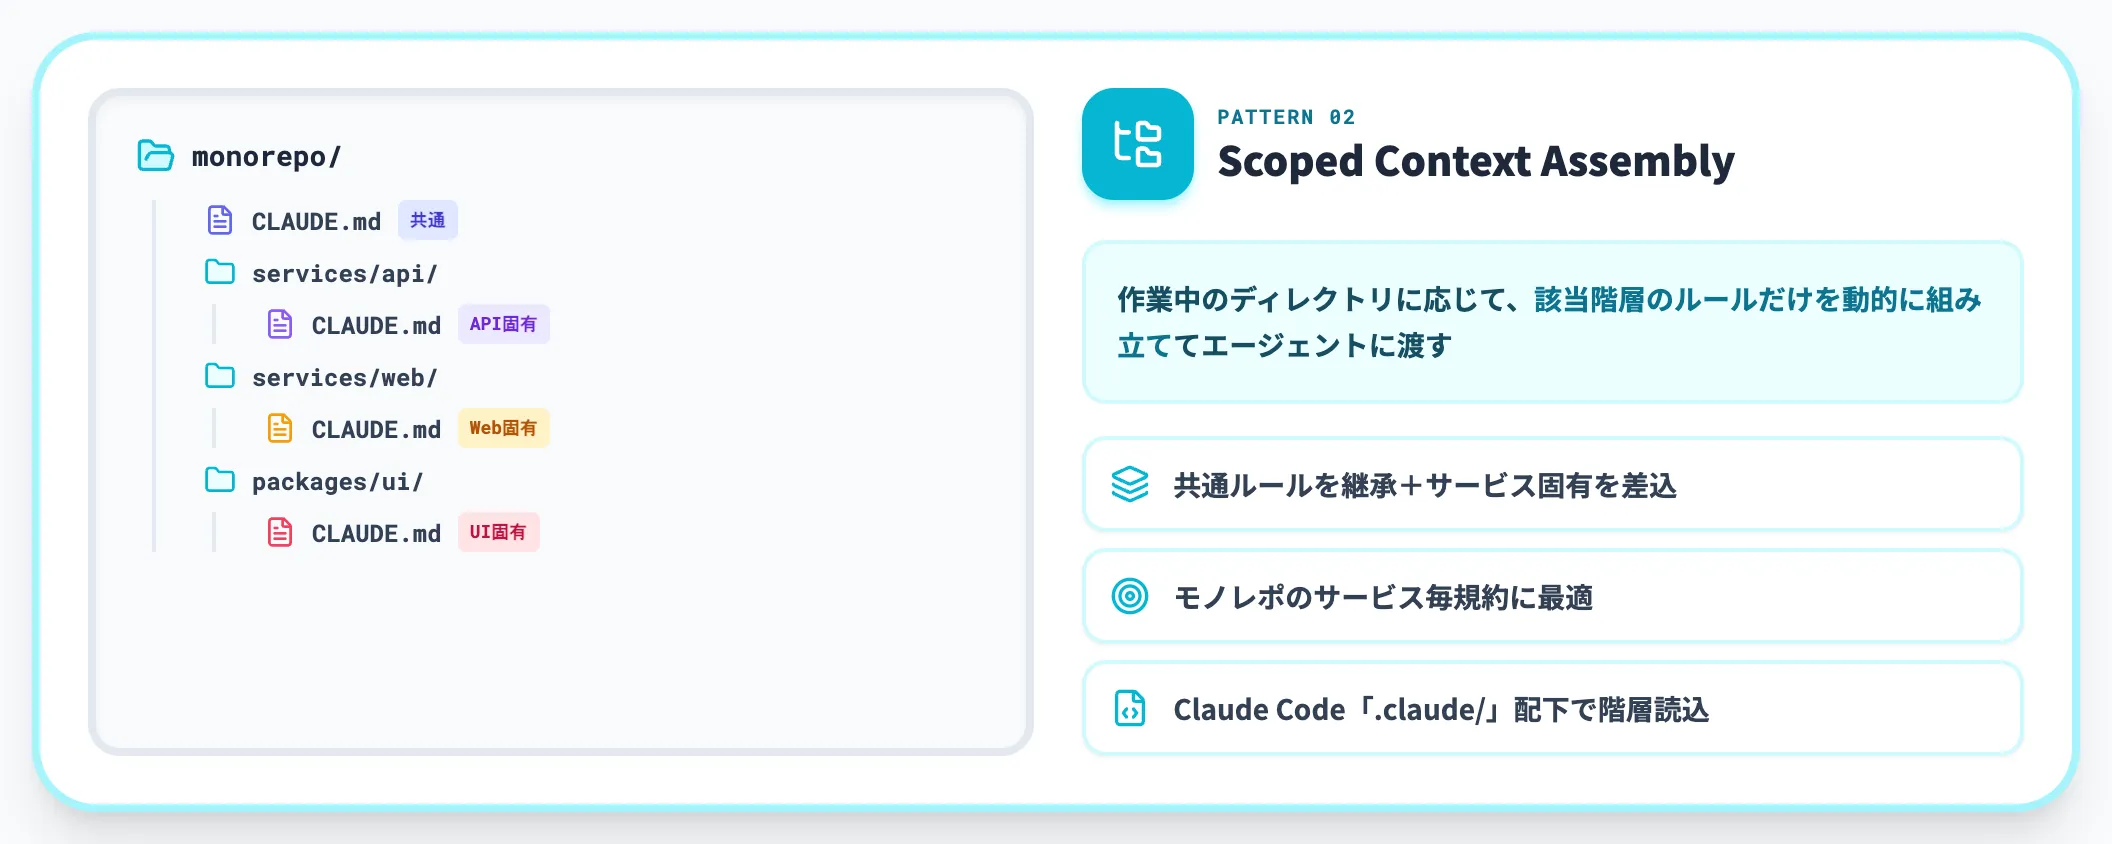
Scoped Context Assemblyは、ディレクトリ階層ごとに異なる指示ファイルを配置し、エージェントが作業中の場所に応じて該当階層のルールだけを動的に組み立てる型です。
モノレポのようにサービスごとに規約が違う構成で、ルートの共通ルールを継承しつつサービス固有のルールを差し込む運用が可能になります。Claude Codeは「.claude/」配下のサブディレクトリでこの階層読み込みをサポートしています。
3. Tiered Memory Pattern——コンパクト索引・トピックファイル・全履歴の3層構成
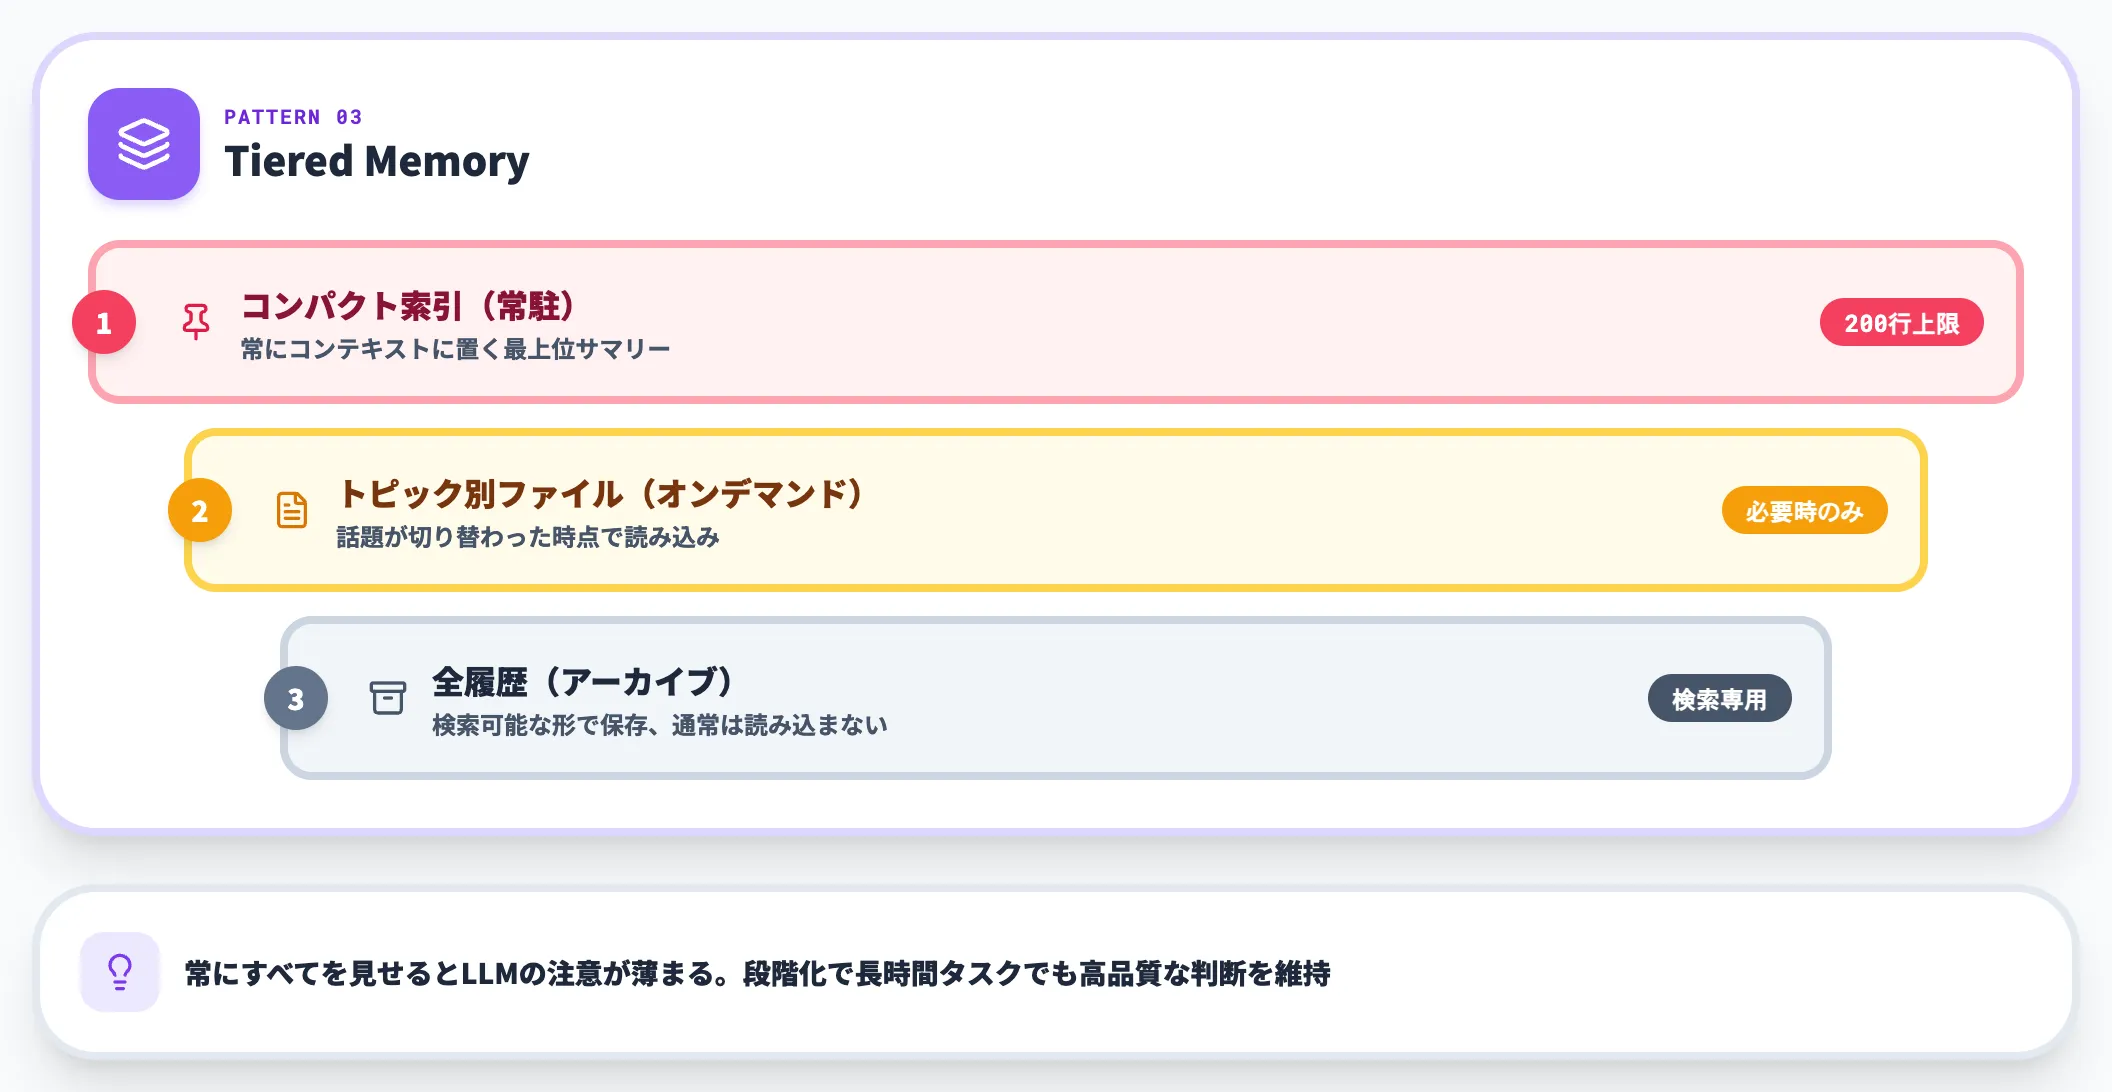
Tiered Memoryは、エージェントのメモリを常駐層・トピック別層・全履歴層の3階層に分けて管理する型です。
-
コンパクト索引(常駐)
200行上限に抑え、常にコンテキストに置く
-
トピック別ファイル(オンデマンド)
話題が切り替わった時点で必要なファイルだけ読み込む
-
全履歴(アーカイブ)
検索可能な形で保存、通常は読み込まない
常にすべてを見せるとLLMの注意が薄まり、精度が落ちます。見せる情報を段階化することで長時間タスクでも高品質な判断が維持されます。
4. Dream Consolidation Pattern——アイドル時にメモリを整理する
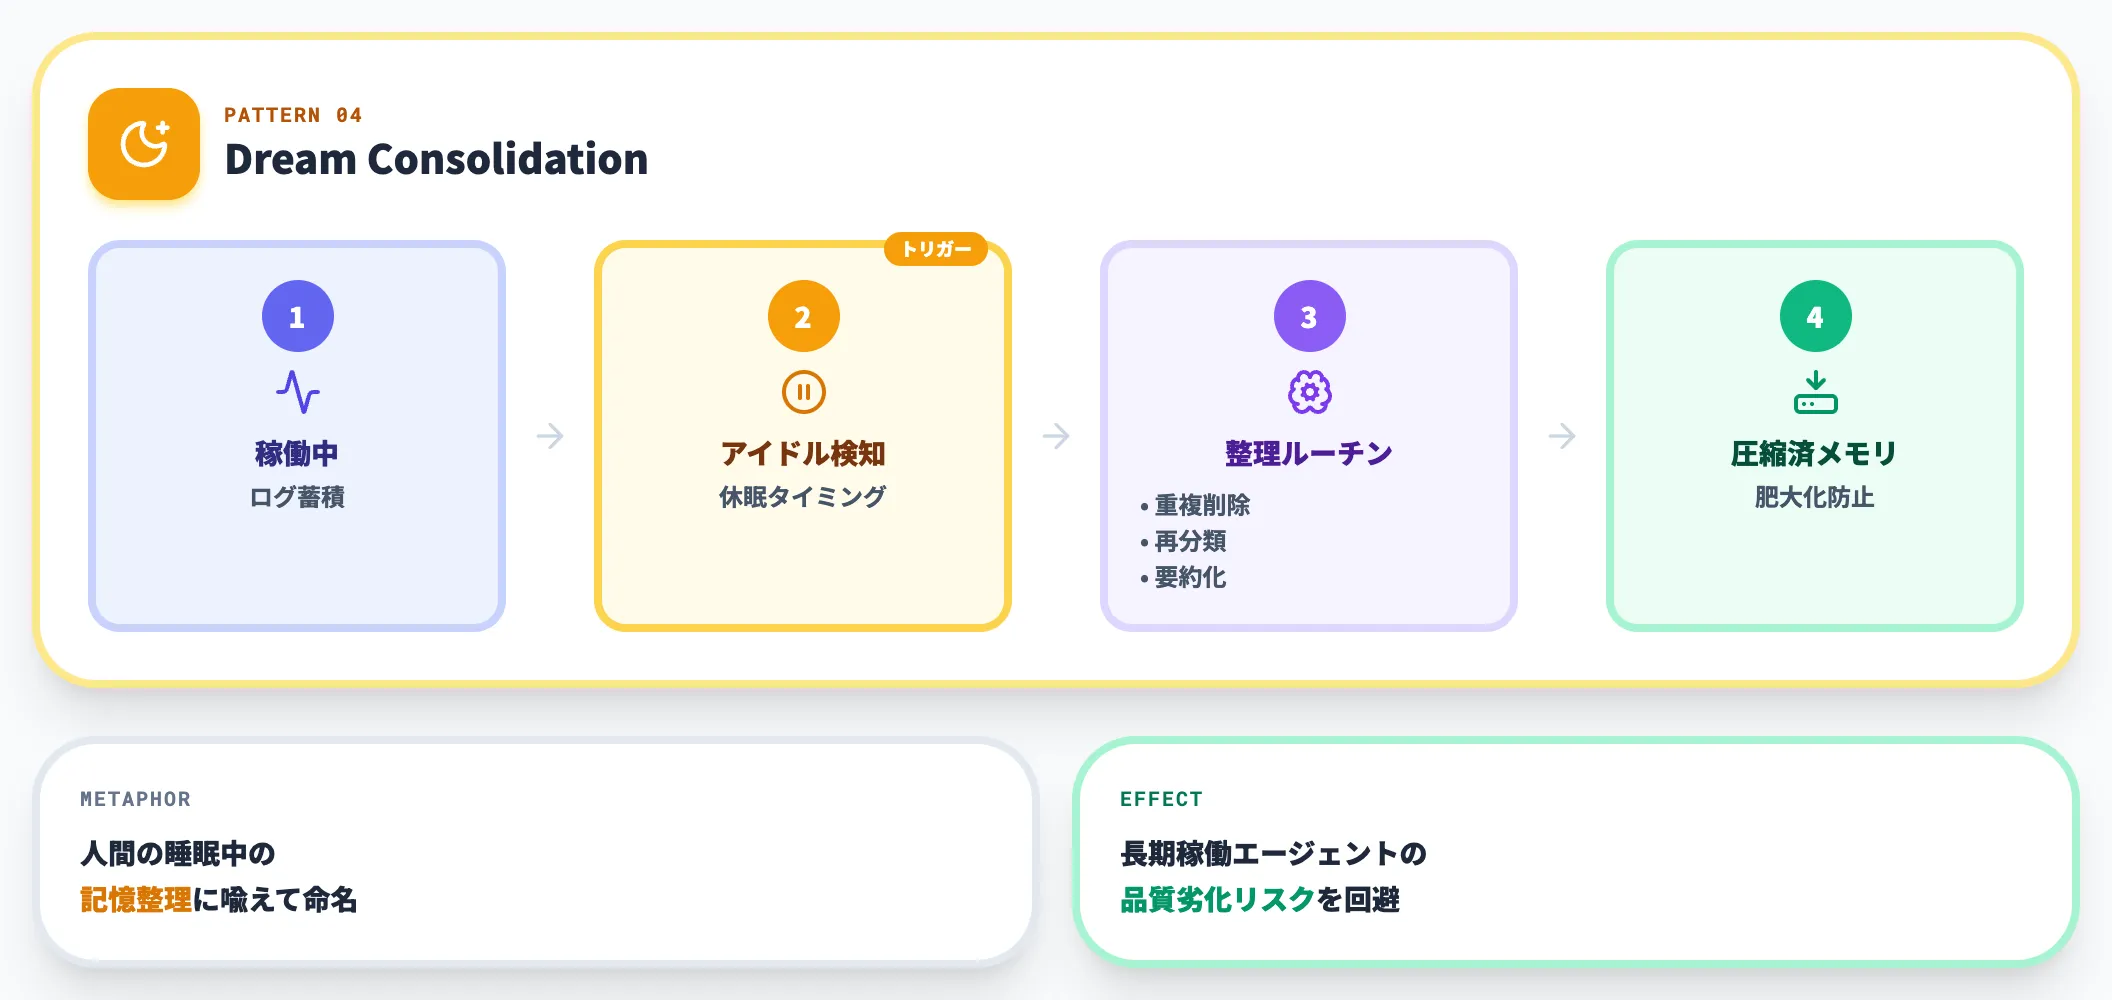
Dream Consolidationは、アイドル時間に走らせるバックグラウンド処理でメモリの重複削除・再分類・要約を行う型です。
人間の睡眠中の記憶整理に喩えて命名されていますが、技術的には「蓄積ログをルーチンで圧縮する運用タスク」です。長期稼働エージェントではこの処理の有無がメモリの肥大化と品質劣化のリスクを左右します。
5. Progressive Context Compaction Pattern——段階圧縮で古い履歴を折りたたむ
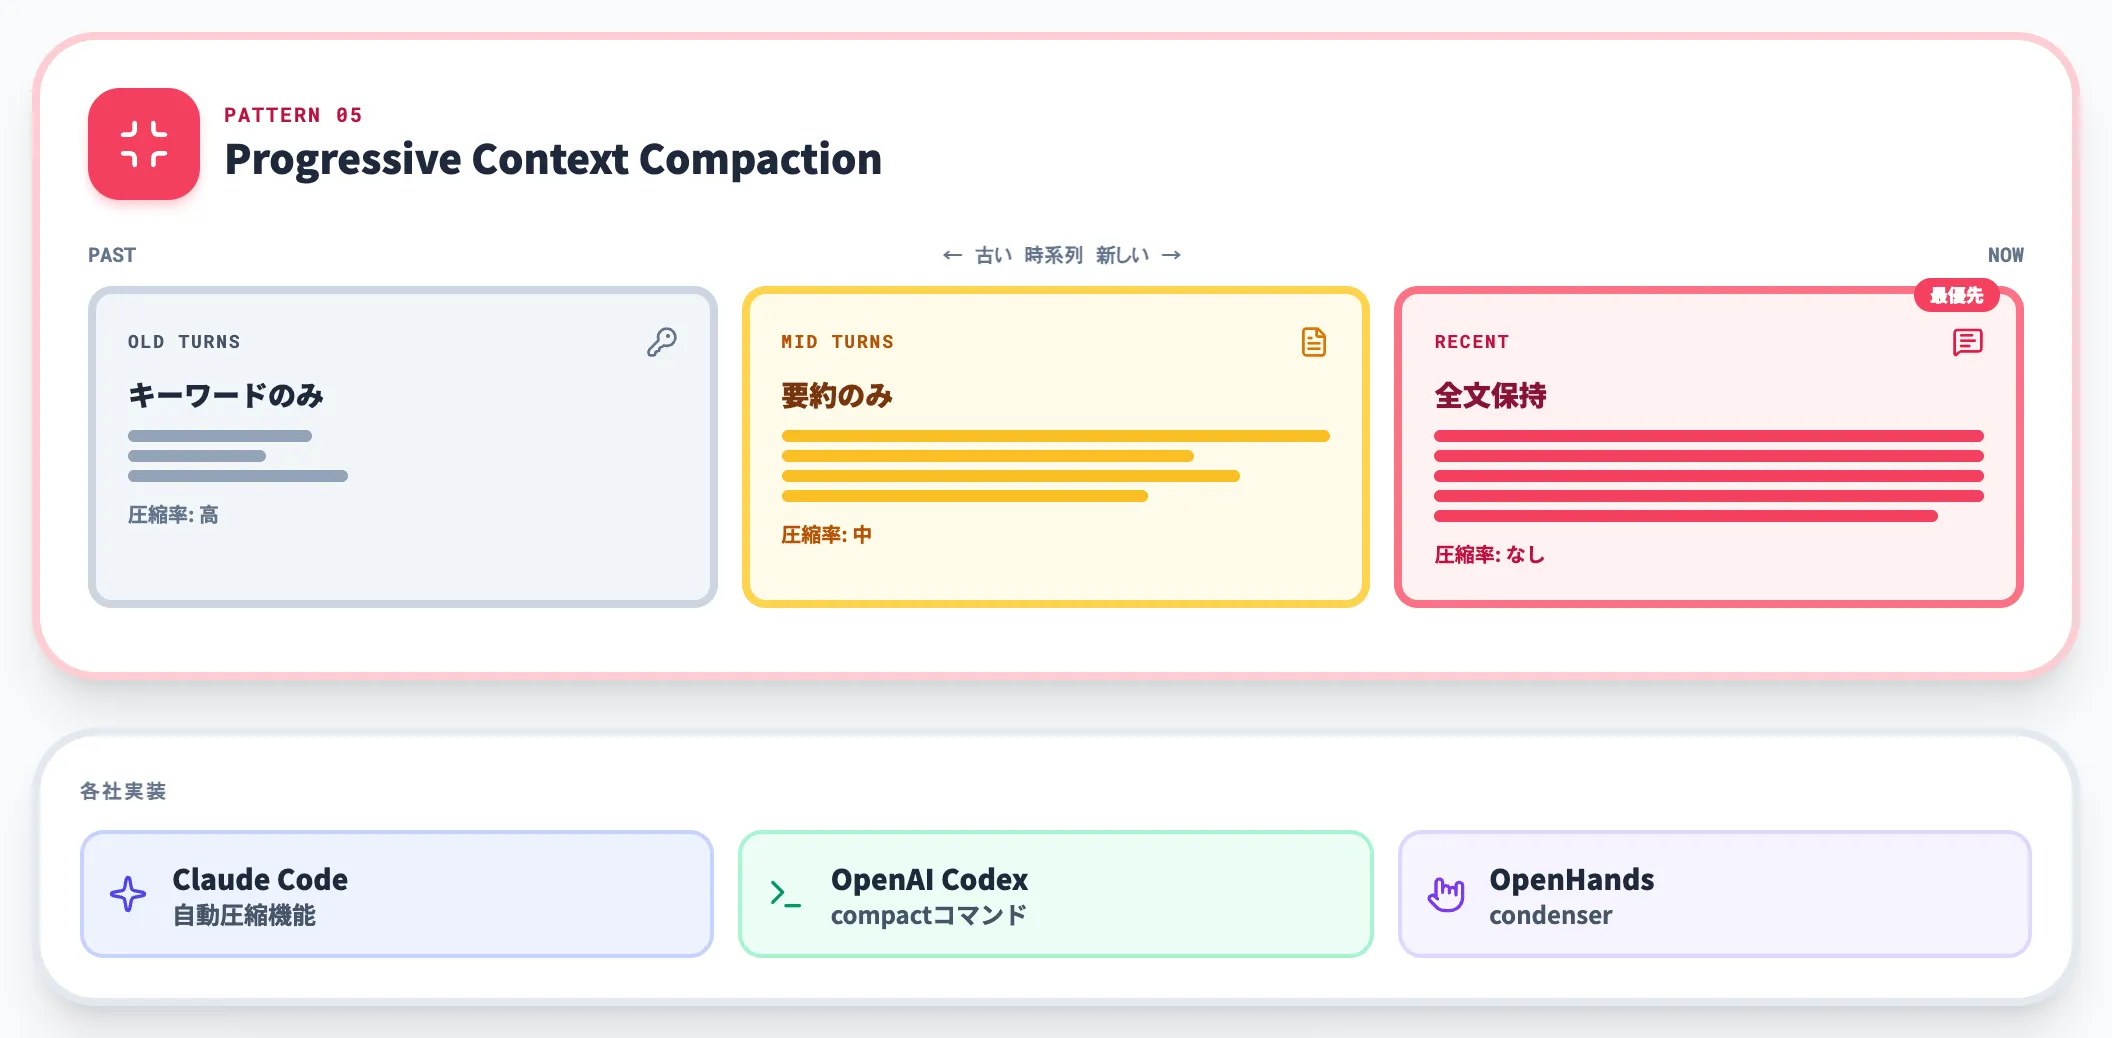
Progressive Context Compactionは、会話履歴を直近ターンは全文・中間ターンは要約・古いターンはキーワードのみと段階的に圧縮する型です。
Claude Codeの自動圧縮機能、OpenAI Codexの「compact」コマンド、OpenHandsの「condenser」など、主要ハーネスはすべてこの思想を実装しています。実装の差は「どのタイミングで」「どこまで圧縮するか」の閾値設計に現れます。
Workflow & Orchestration の設計パターン6選——エージェントループの組み合わせ
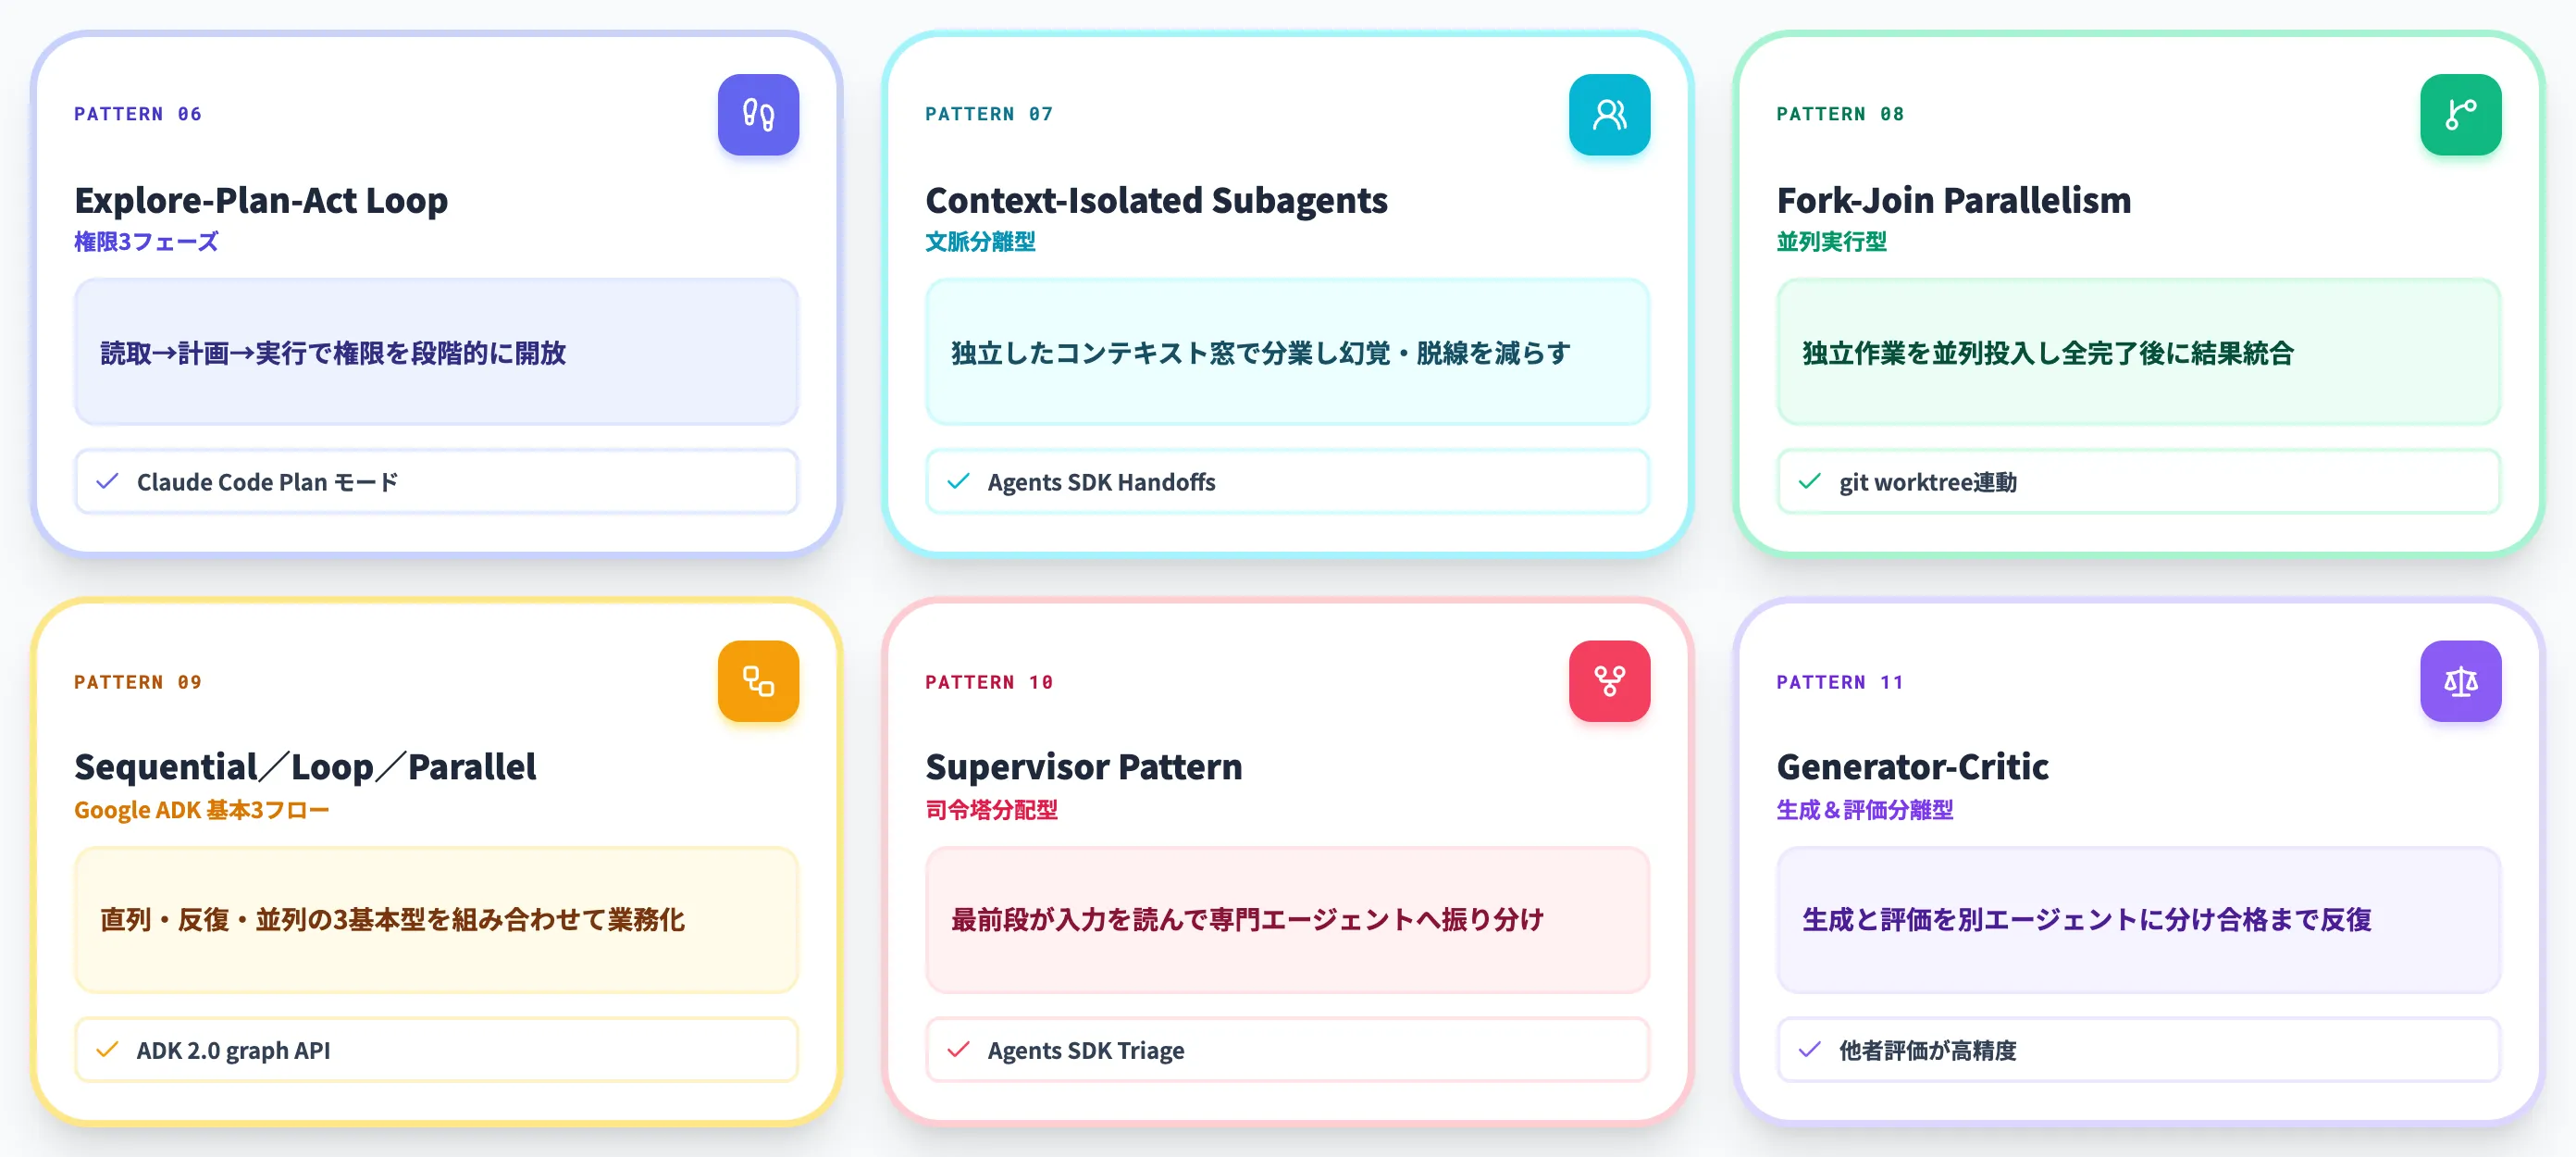
Workflow & Orchestration領域の6パターンは、単一ループを超えた複雑なワークフローをどう組み立てるかを規定します。
Google Cloudのマルチエージェント設計とAnthropicの動的ワークフローを主な参照として整理しています。
6. Explore-Plan-Act Loop Pattern——権限段階を3フェーズに分ける
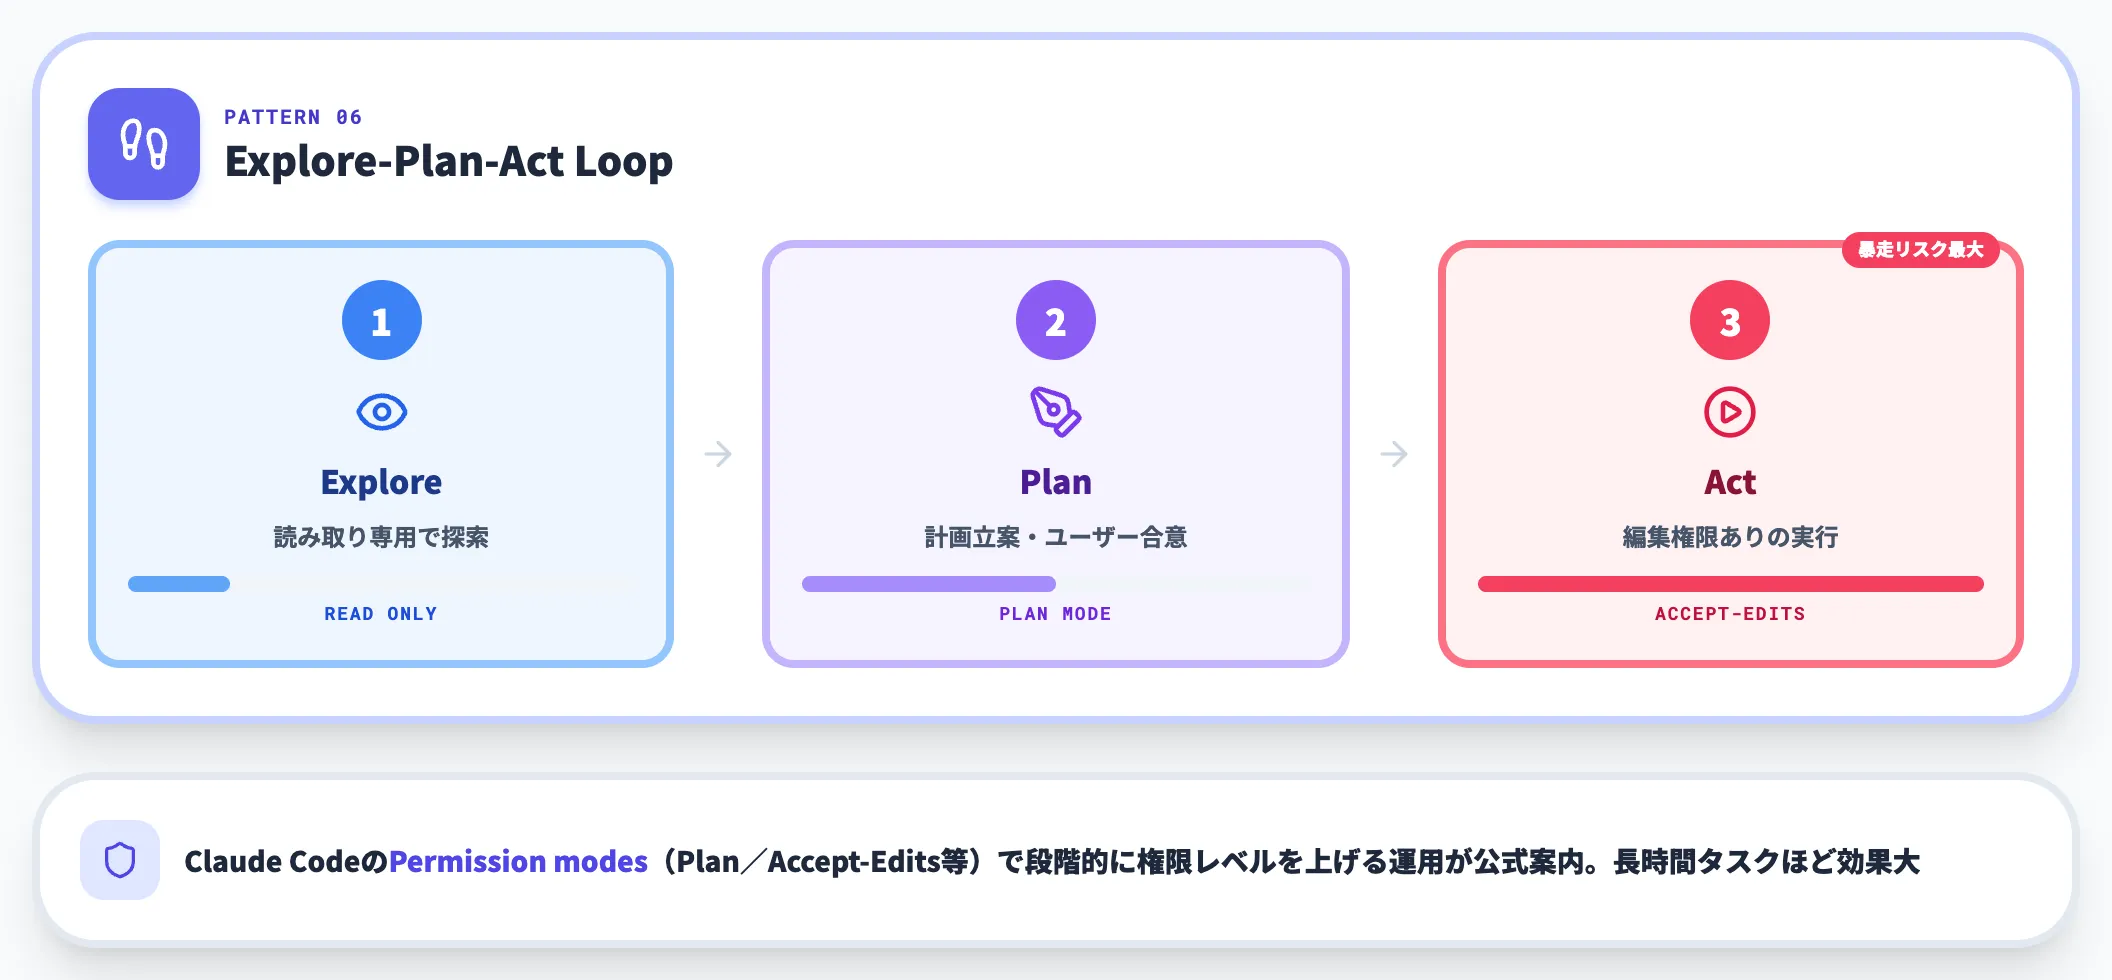
Explore-Plan-Act Loopは、ワークフローを読み取り専用の探索フェーズ → 計画立案フェーズ → 編集権限ありの実行フェーズの3段階に分け、権限を段階的に開放する型です。
AnthropicのClaude Code Permission modesでは、Planモードや Accept-Edits モード等を切り替えて権限レベルを段階的に上げていく運用が公式に案内されています。
デフォルトモード自体は読み取り専用ではなく、Plan モードを明示的に挟むことで「まず読み取り→合意→実行」の流れを設計できます。暴走リスクが大きい長時間タスクほど、この3フェーズ分割の効果が効いてきます。
7. Context-Isolated Subagents Pattern——オーケストレーターとワーカーで文脈を分離
Context-Isolated Subagentsは、オーケストレーターが独立したコンテキスト窓を持つサブエージェントを生成し、必要最小限の情報だけ渡して分業する型です。
Claude Codeのサブエージェント機能、OpenAI Agents SDKのHandoffs、Devinのサブタスク分割などで実装されています。OpenAI Agents SDK の Handoffs は既定では引き継ぎ先に会話履歴を渡すため、履歴を絞って渡したい場合は 「input_filter」 を設定して渡す範囲を明示的に制限する必要があります。
文脈を適切に切り分けることで、それぞれのエージェントが本来のタスクに集中でき、幻覚や脱線が減るのが利点です。
Anthropic公式ブログ「A harness for every task: dynamic workflows in Claude Code」では、Claude Codeがタスクごとに最適なハーネスを動的に生成し、サブエージェントを呼び分ける設計思想が示されています。
Anthropic公式ブログがClaude Codeの動的ワークフローを解説したポスト(出典:A harness for every task: dynamic workflows in Claude Code)
このブログでは 「agent()」「parallel()」「pipeline()」 の3プリミティブを組み合わせて、1タスクごとに専用の多段ワークフローを組み立てる例が紹介されており、Context-Isolated Subagents パターンの最新実装の典型例になっています。
8. Fork-Join Parallelism Pattern——並列ワークツリーで複数タスクを同時実行
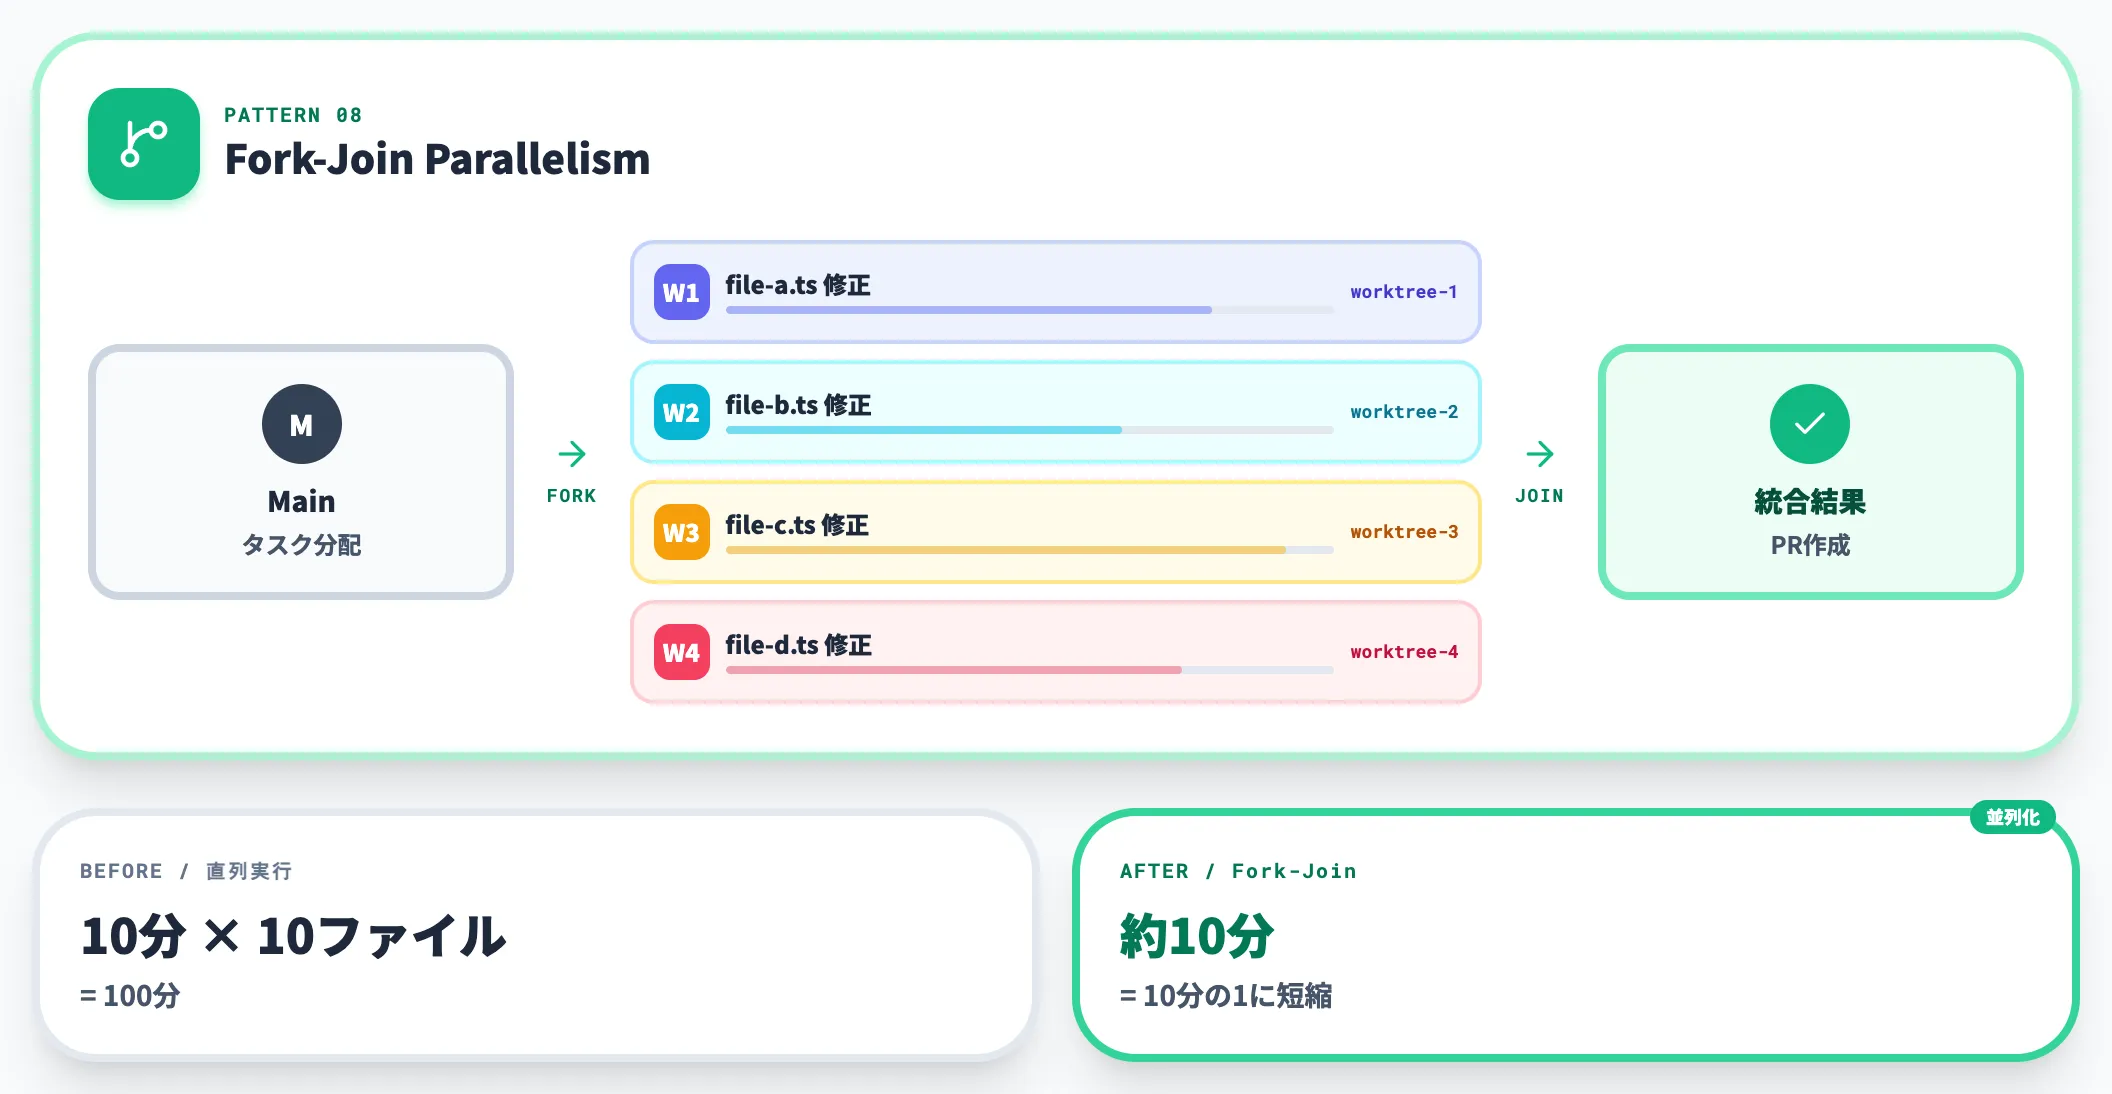
Fork-Join Parallelismは、独立性の高い作業を複数のサブエージェントに並列で投げ、全完了後に結果を統合する型です。
Claude Codeはgit worktreeと連動して、ファイル衝突を起こさずに並列実行ができます。10ファイルを個別に修正する類のバッチタスクでは、直列実行から10分の1の時間に短縮できる場合もあります。
9. Sequential/Loop/Parallel Pattern——Google ADKの3基本フロー
Google Agent Development Kitは、マルチエージェントの基本実行フローをSequential・Loop・Parallelの3つに整理しています。
| フロー | 定義 | 使いどころ |
|---|---|---|
| Sequential | 前段の出力を後段へ直列に流す決定論的パイプライン | データ取得→分析→推奨の工程分離 |
| Loop | タスク実行→評価→改善を満足水準まで反復 | 出力品質を上げる反復改善 |
| Parallel | 独立タスクを並列実行 | レイテンシ削減・スループット向上 |
どれも単独で使うことは少なく、複雑な業務では組み合わせて使う前提です。
Google Cloud公式のリファレンスアーキテクチャでは、Coordinator が入力を受けて Sequential パイプラインと Iterative Refinement(反復改善)を選び分ける構成が代表例として示されています。
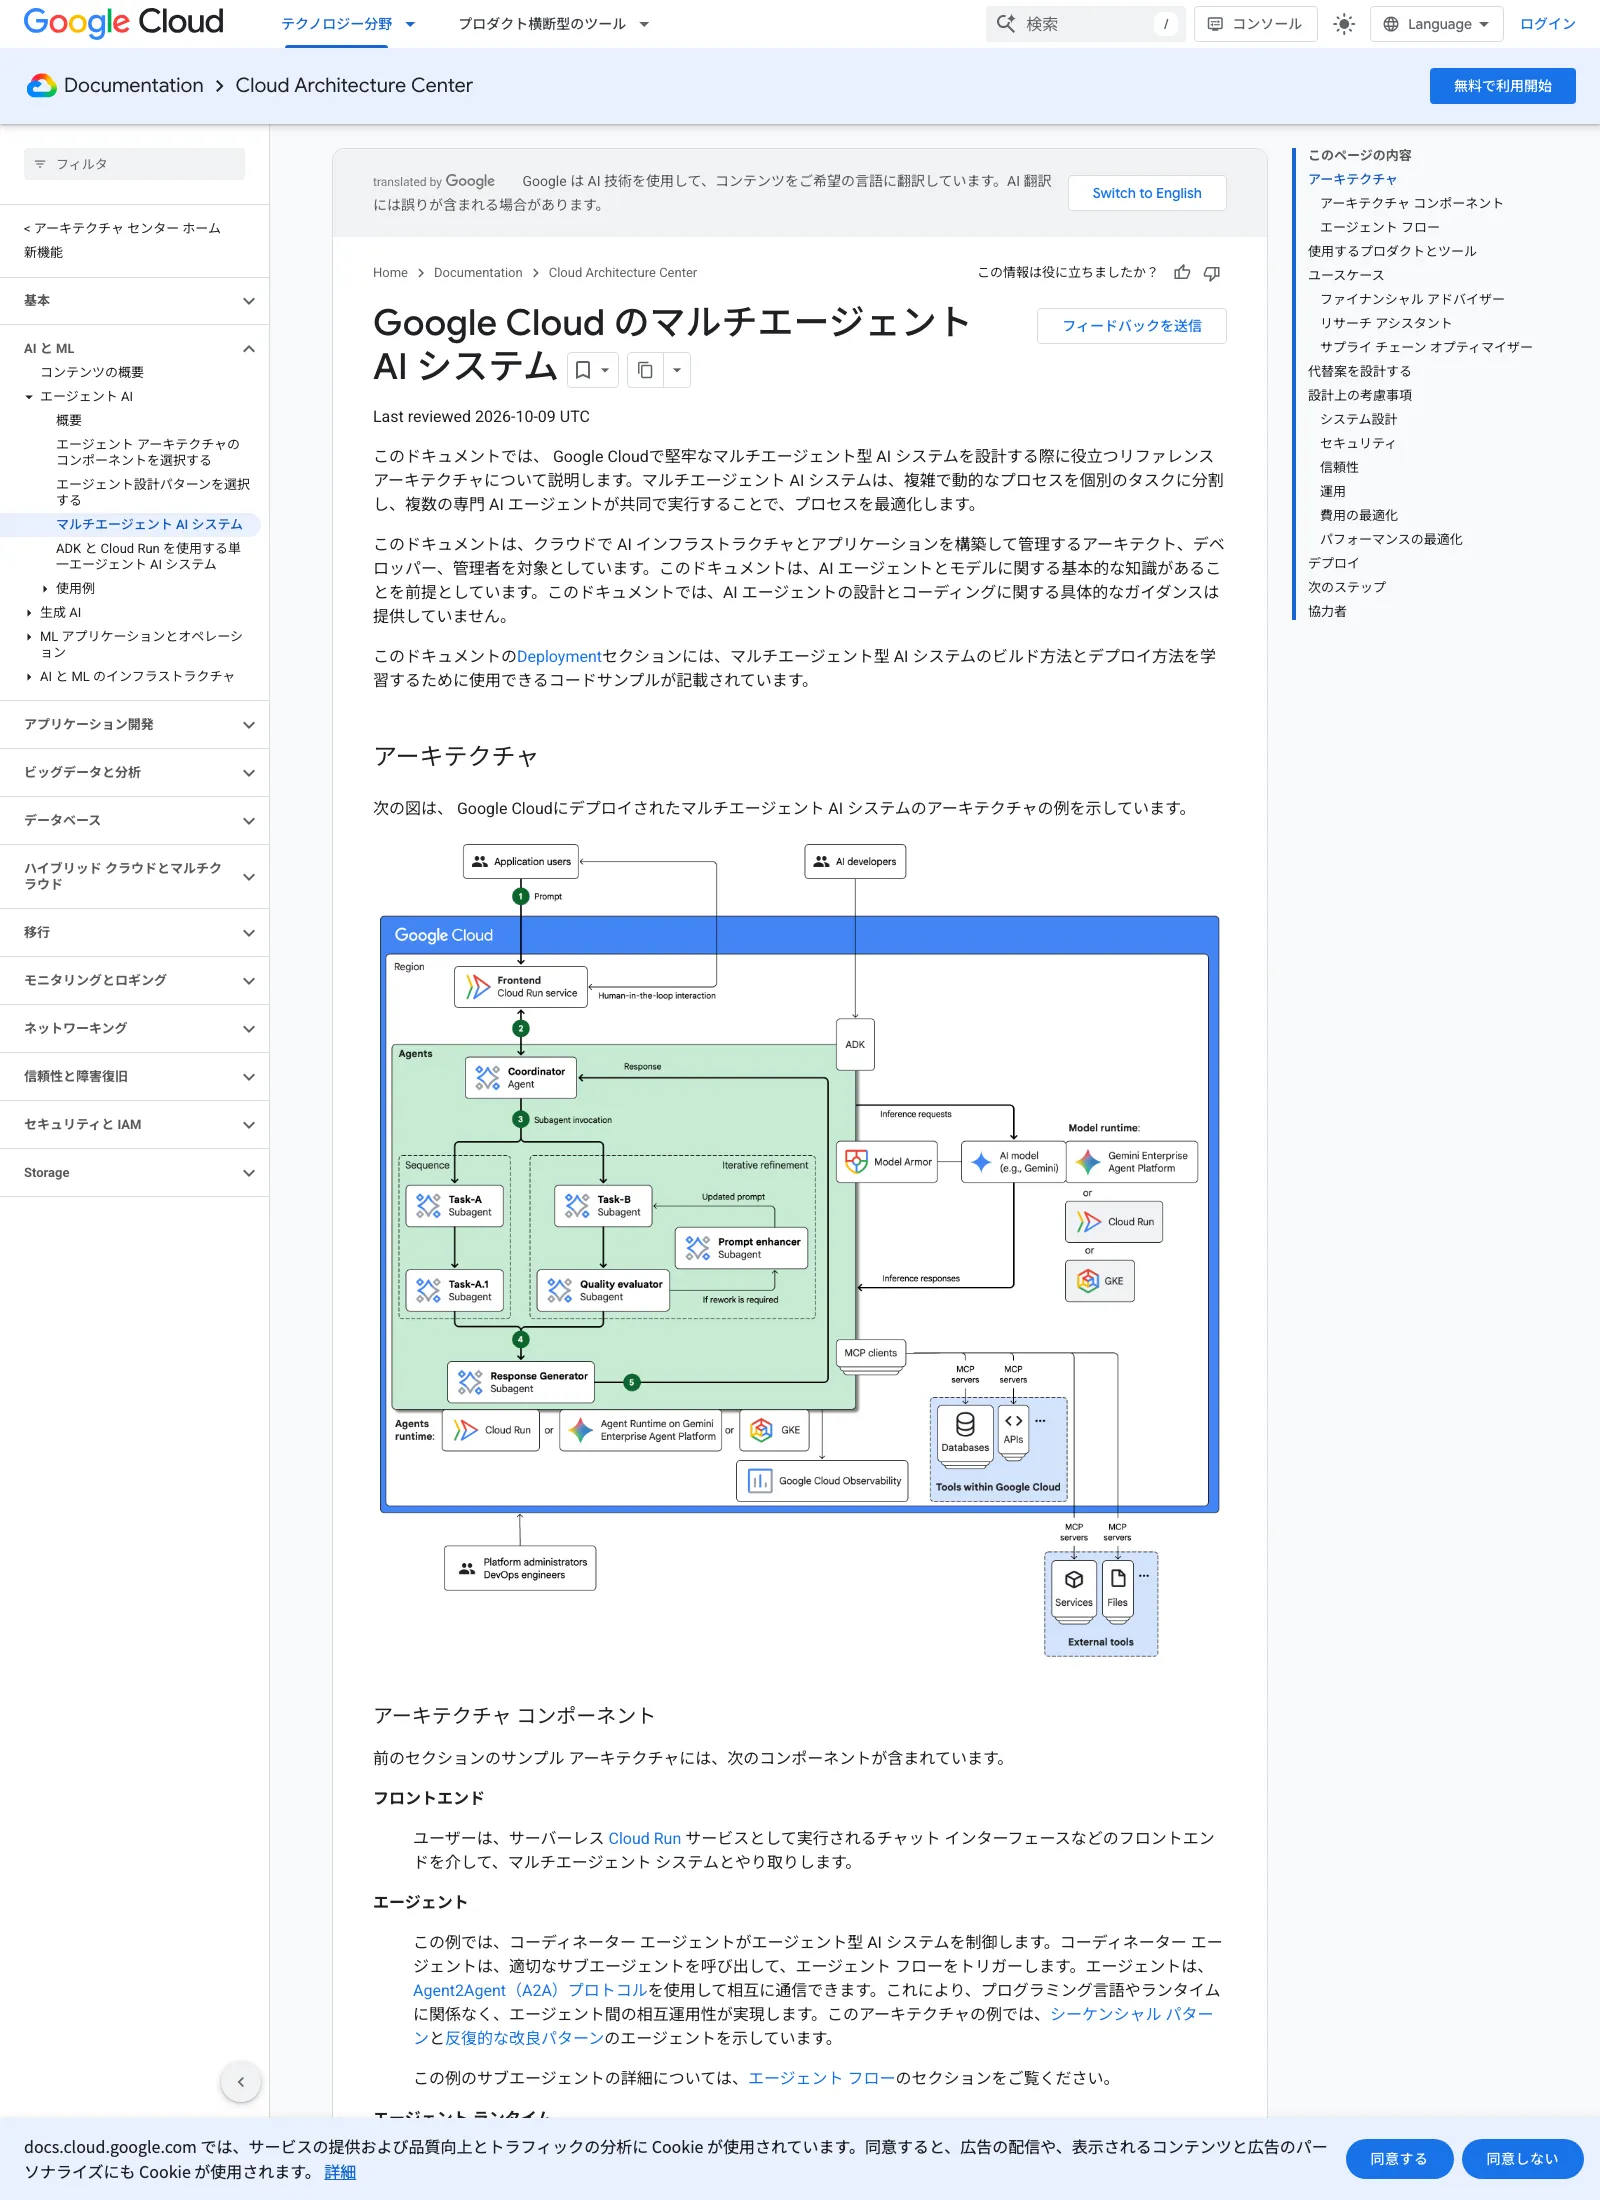
Google Cloud Architecture Centerが整理したマルチエージェント AIシステムの参考アーキテクチャ(出典:Google Cloud のマルチエージェント AI システム)
掲載図では、入力を受ける Coordinator と、下流に Sequential Pipeline/Iterative Refinement を配置する構成が描かれています。
Python/Go 版 ADK 2.0 では、こうした構成を記述するための graph/dynamic workflows が後継APIとして案内されており、新規に実装する読者は3基本フローを土台にしつつ graph API の採用も検討対象になります。
10. Supervisor(Coordinator/Dispatcher)Pattern——1つの司令塔が専門エージェントを振り分ける
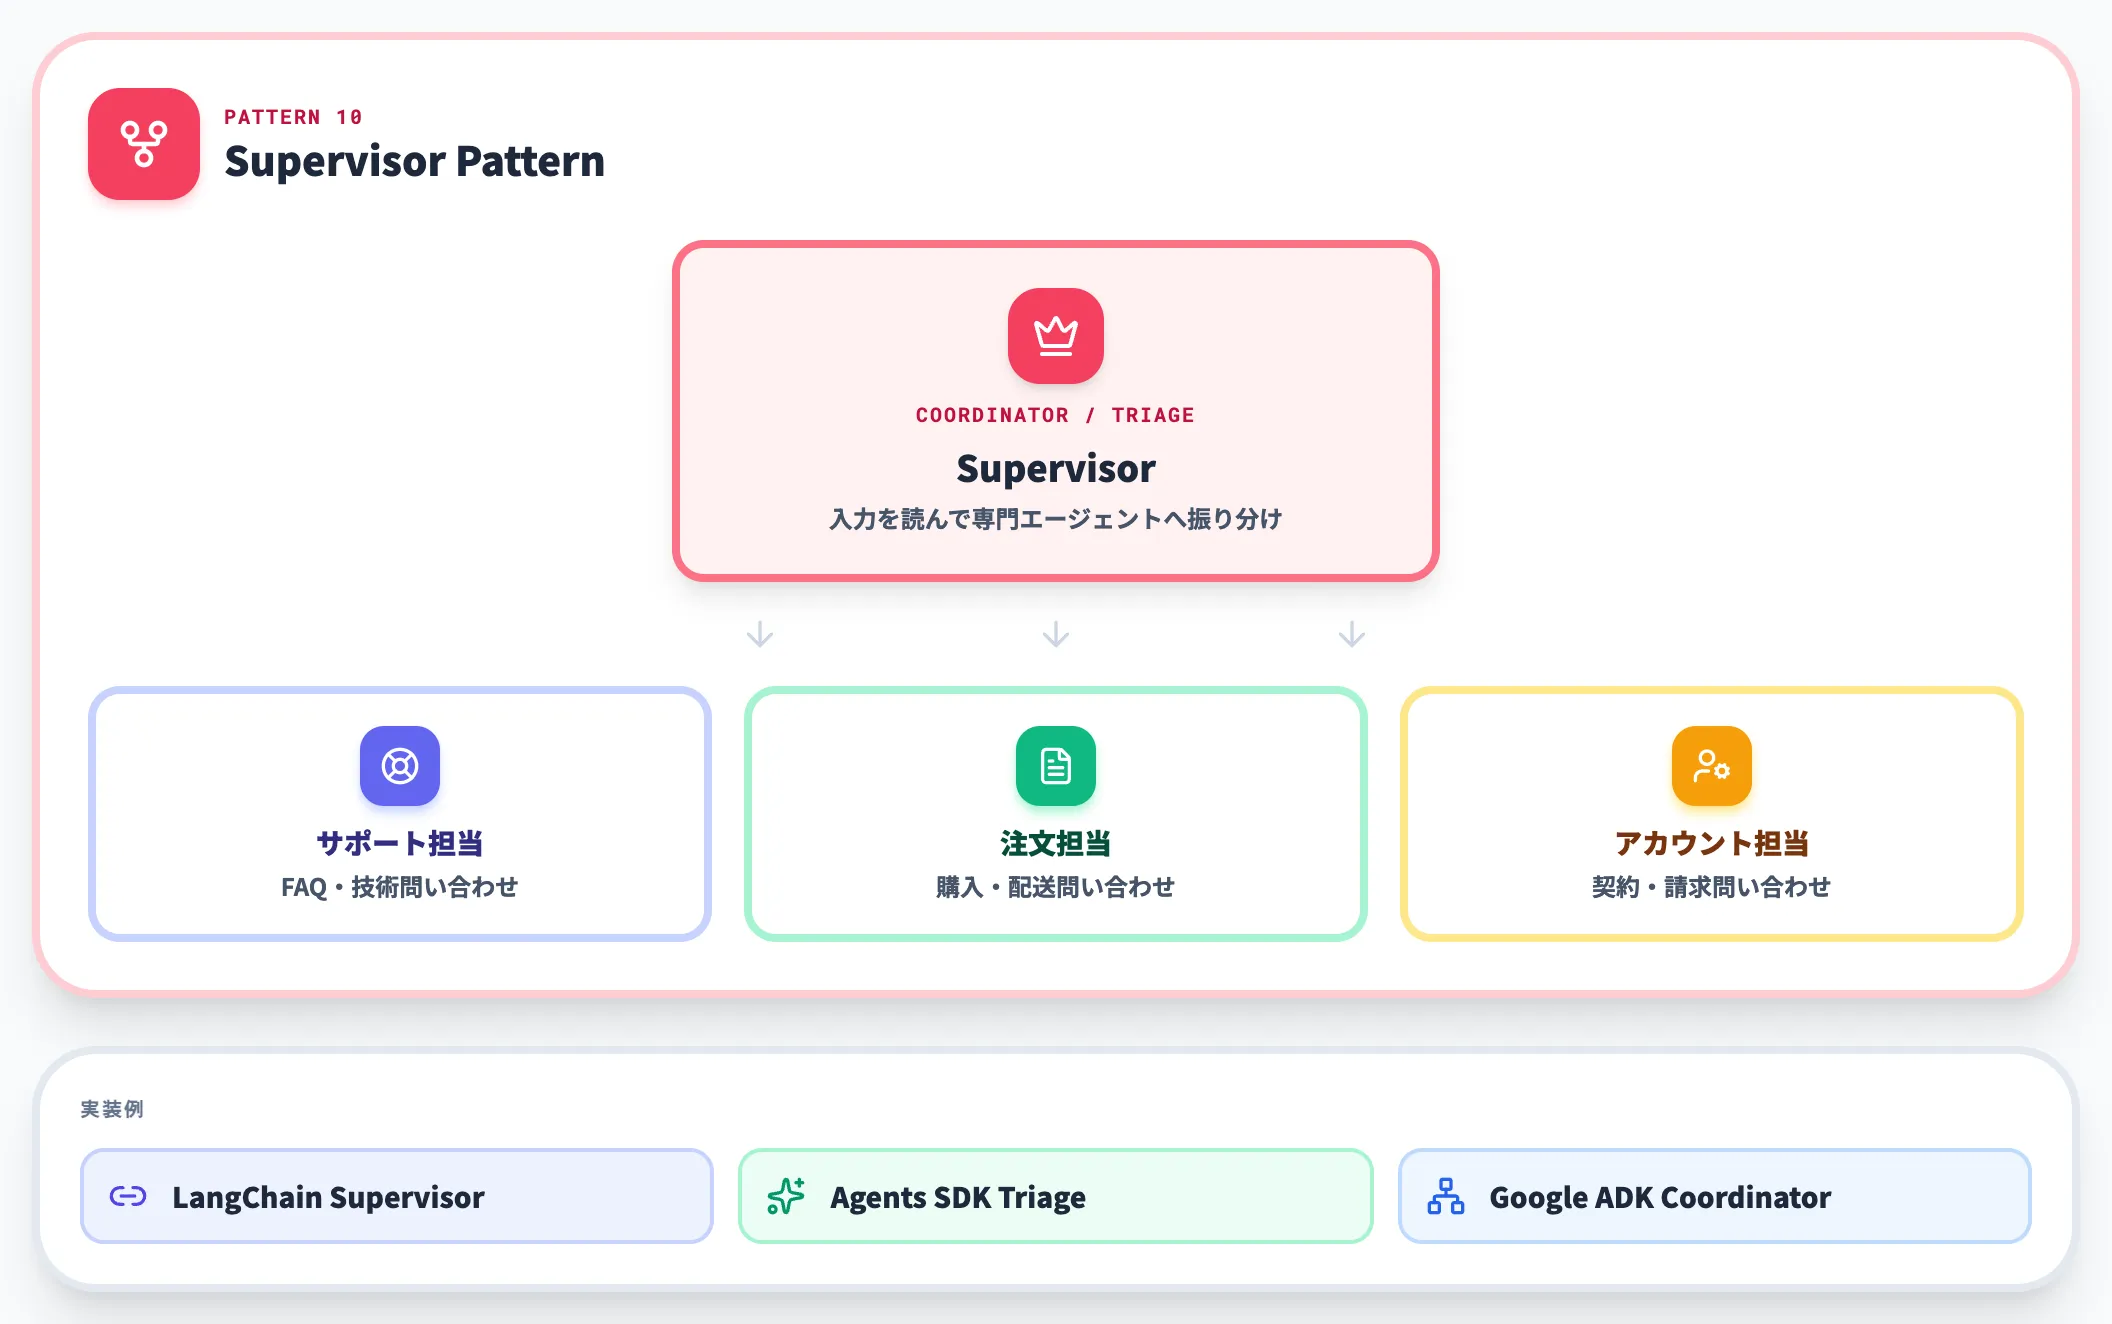
Supervisor Patternは、最前段のエージェントが入力内容を読んで適切な専門エージェントへ振り分ける型です。
LangChainのSupervisor、OpenAI Agents SDKのTriage Agent、Google ADKのCoordinatorなどが該当します。
質問の性質で担当エージェントを分ける顧客対応AIが典型的な利用シーンで、1つのエージェントで全てを担うより精度とスループットの両方が上がる構造です。
11. Generator-Critic(Reflection)Pattern——生成と評価を別エージェントに分離する
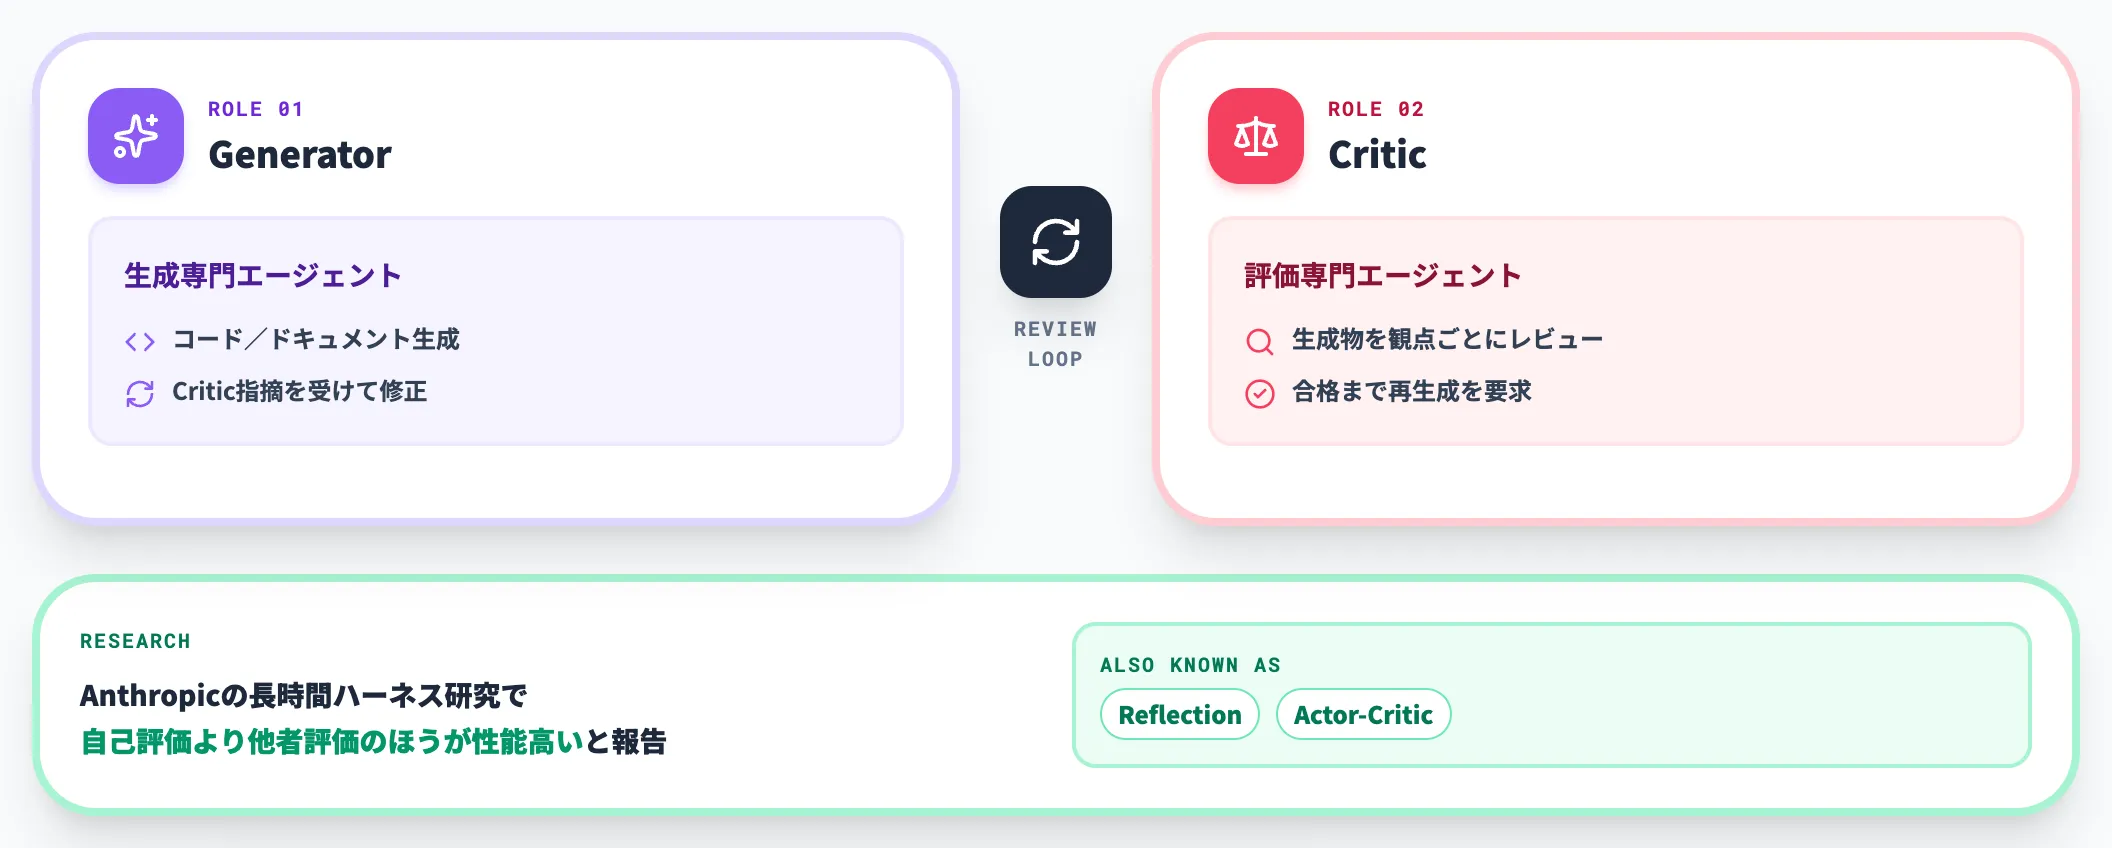
Generator-Criticは、生成エージェントと評価エージェントを明確に分離し、評価側が合格を出すまで生成を繰り返す型です。
Anthropicの長時間ハーネスに関する研究でも、自己評価より別エージェントによる他者評価のほうが性能が高いことが報告されています。
コードレビューをLLMにさせるケースで広く使われるパターンで、Reflection Pattern・Actor-Critic Patternとも呼ばれます。
Tools & Permissions の設計パターン4選——ツール設計と承認モードの組合わせ
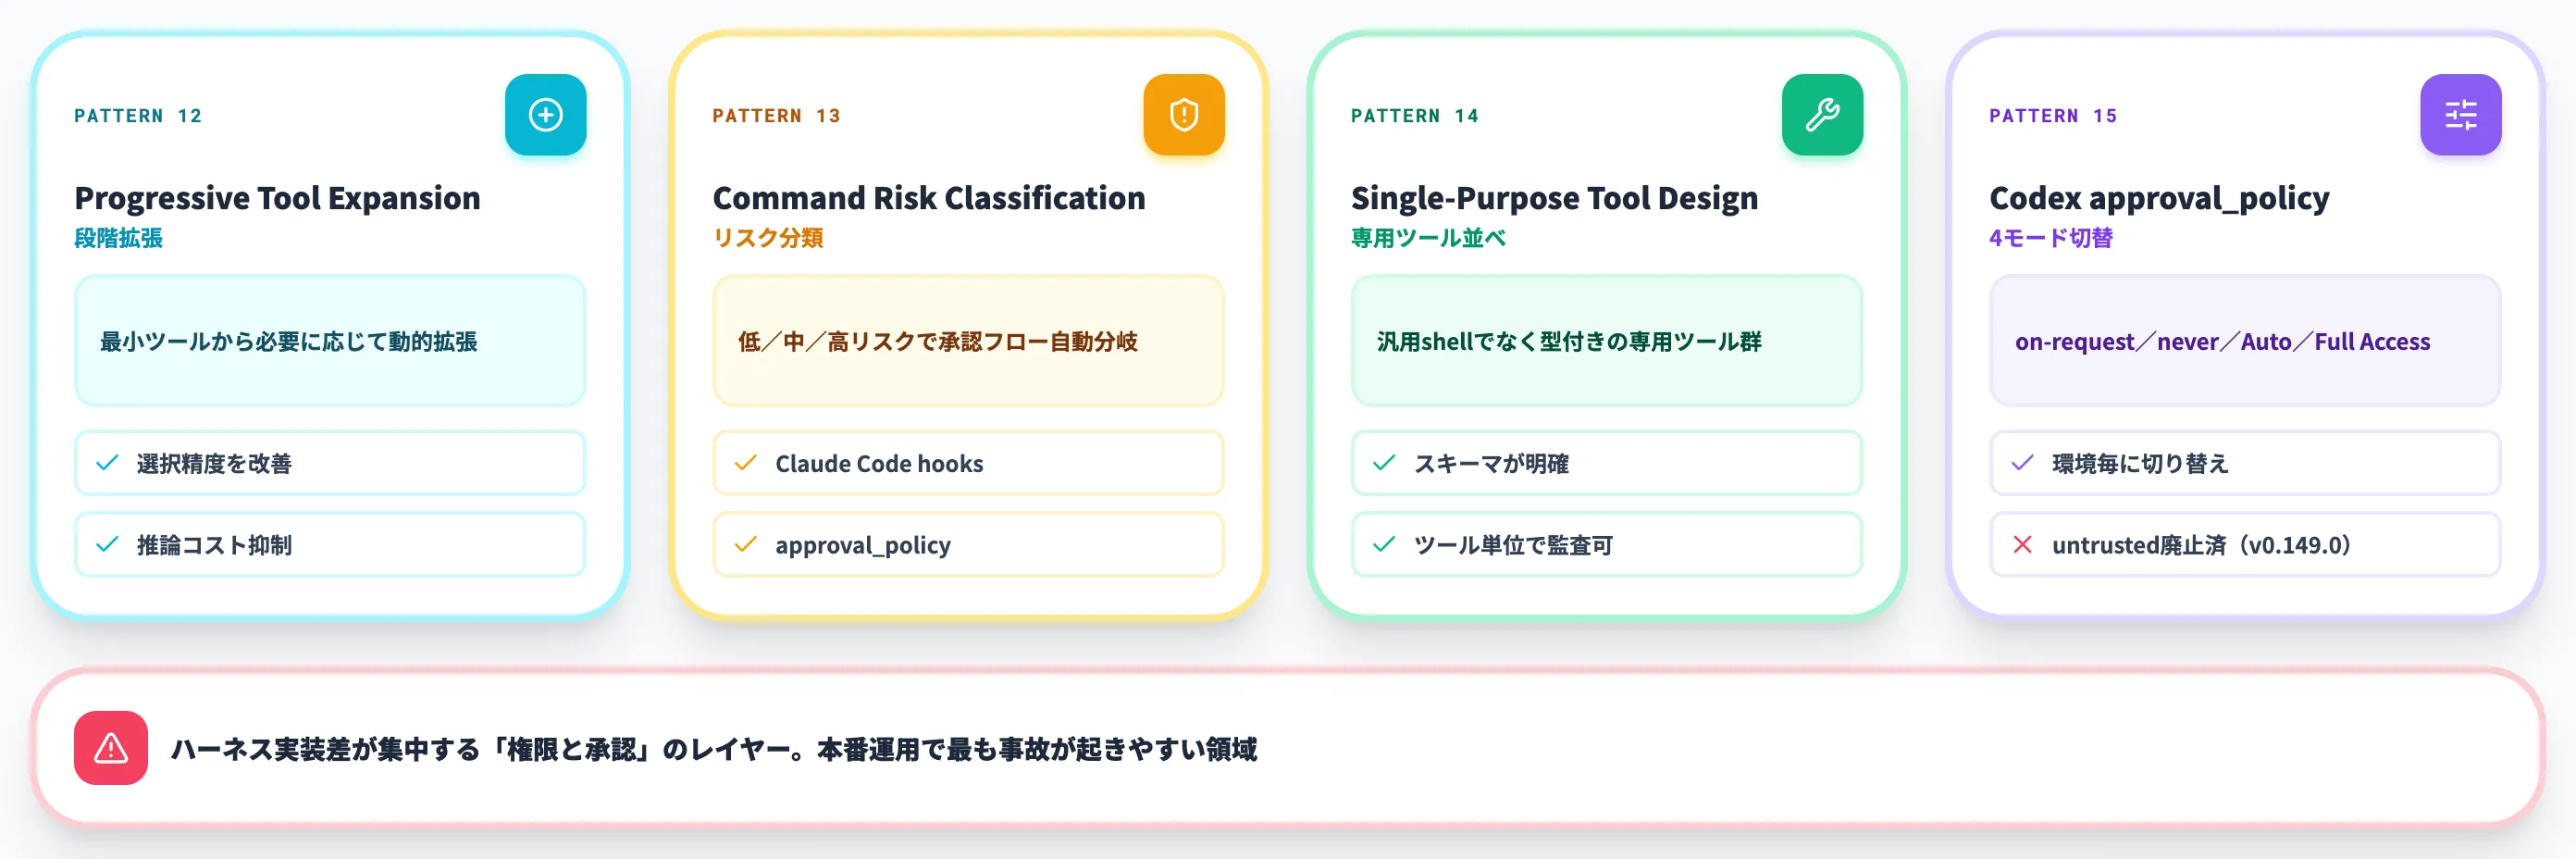
Tools & Permissions領域の4パターンは、エージェントが外部世界と相互作用する接点を規定します。
ハーネス実装差が集中する「権限と承認」のレイヤーがこの領域にあり、本番運用で最も事故が起きやすい箇所でもあります。
12. Progressive Tool Expansion Pattern——最小ツールセットから動的に増やす
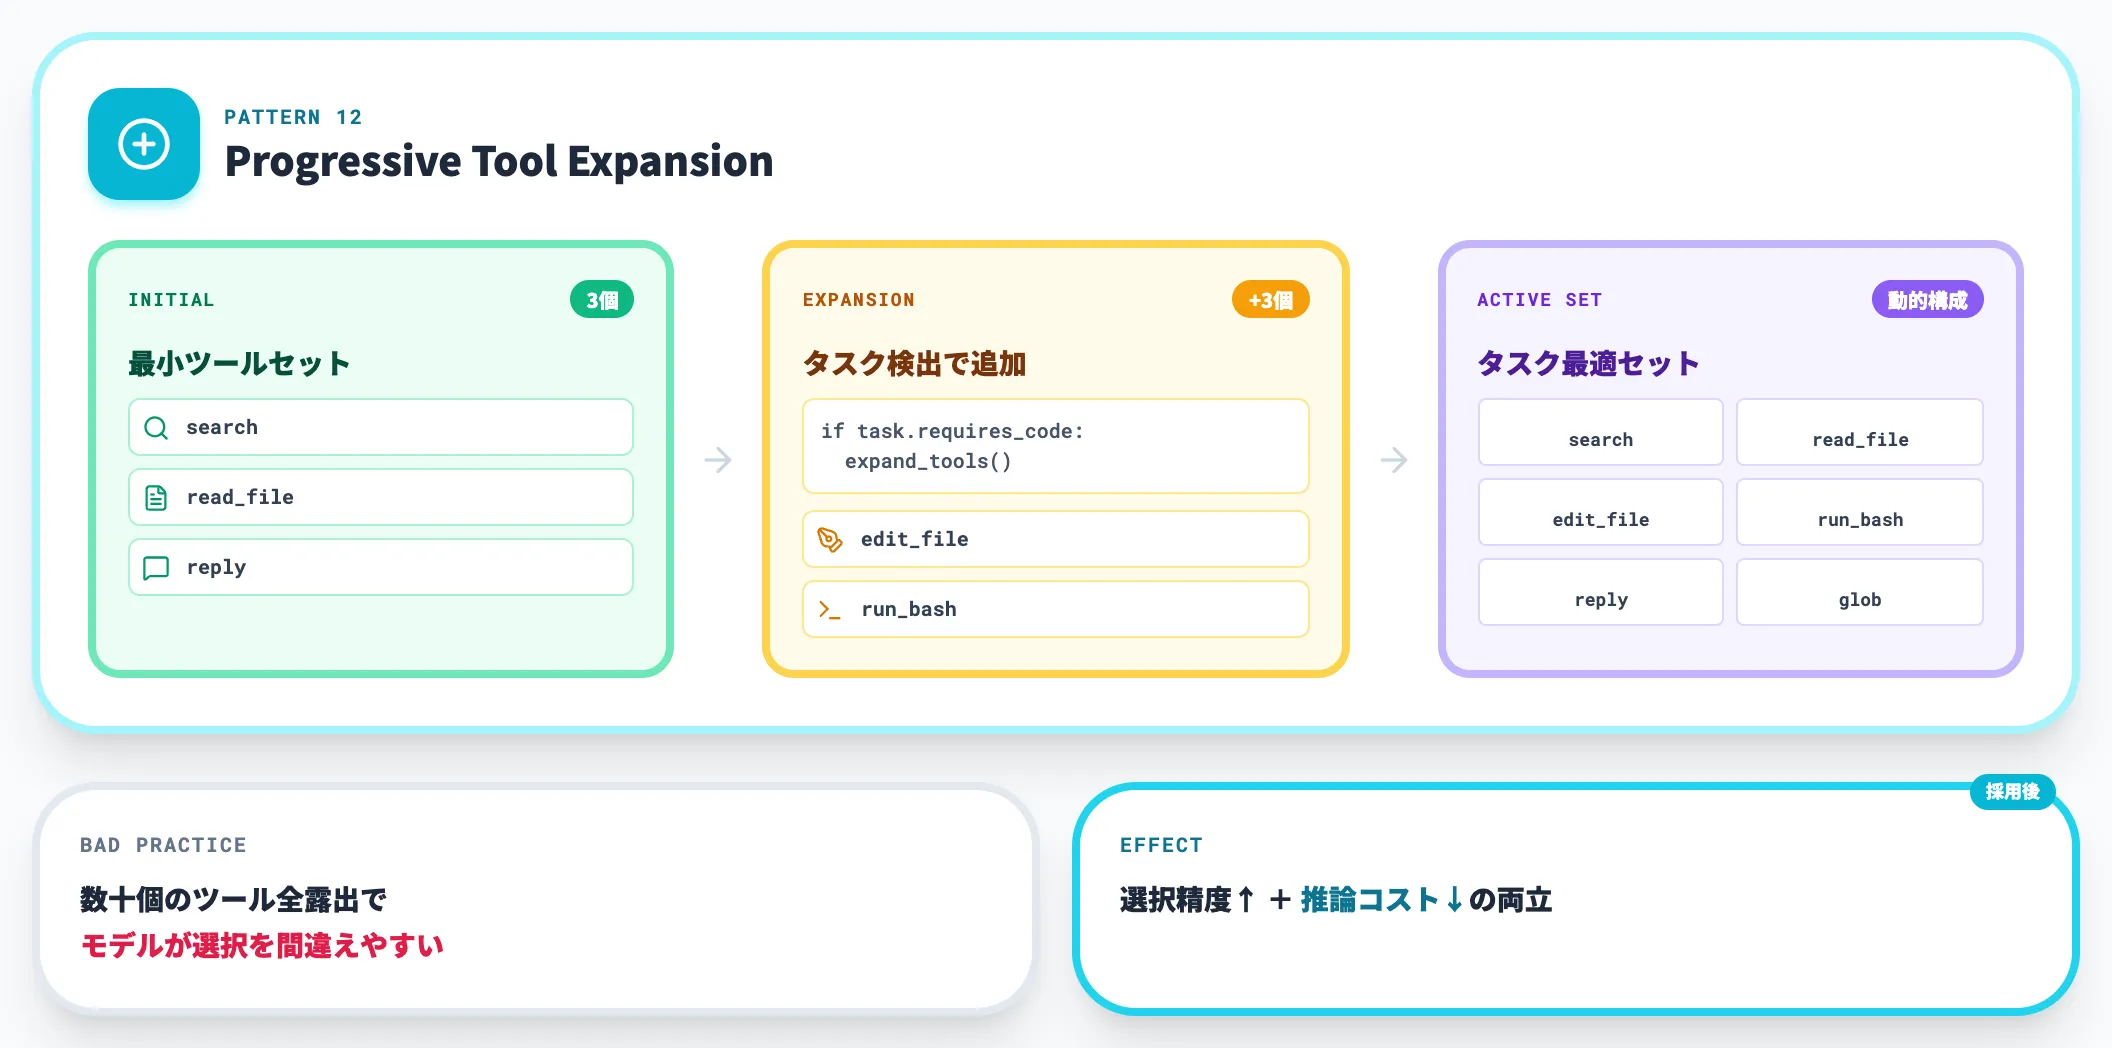
Progressive Tool Expansionは、セッション開始時は最小ツールセットのみを露出し、必要に応じて追加ツールを活性化する型です。
数十個のツールを最初から全部渡すとモデルが選択を間違えやすくなります。タスクに応じて段階的に広げることで、モデルの選択精度と推論コストの両方が改善します。
13. Command Risk Classification Pattern——リスク分類で承認フローを自動化
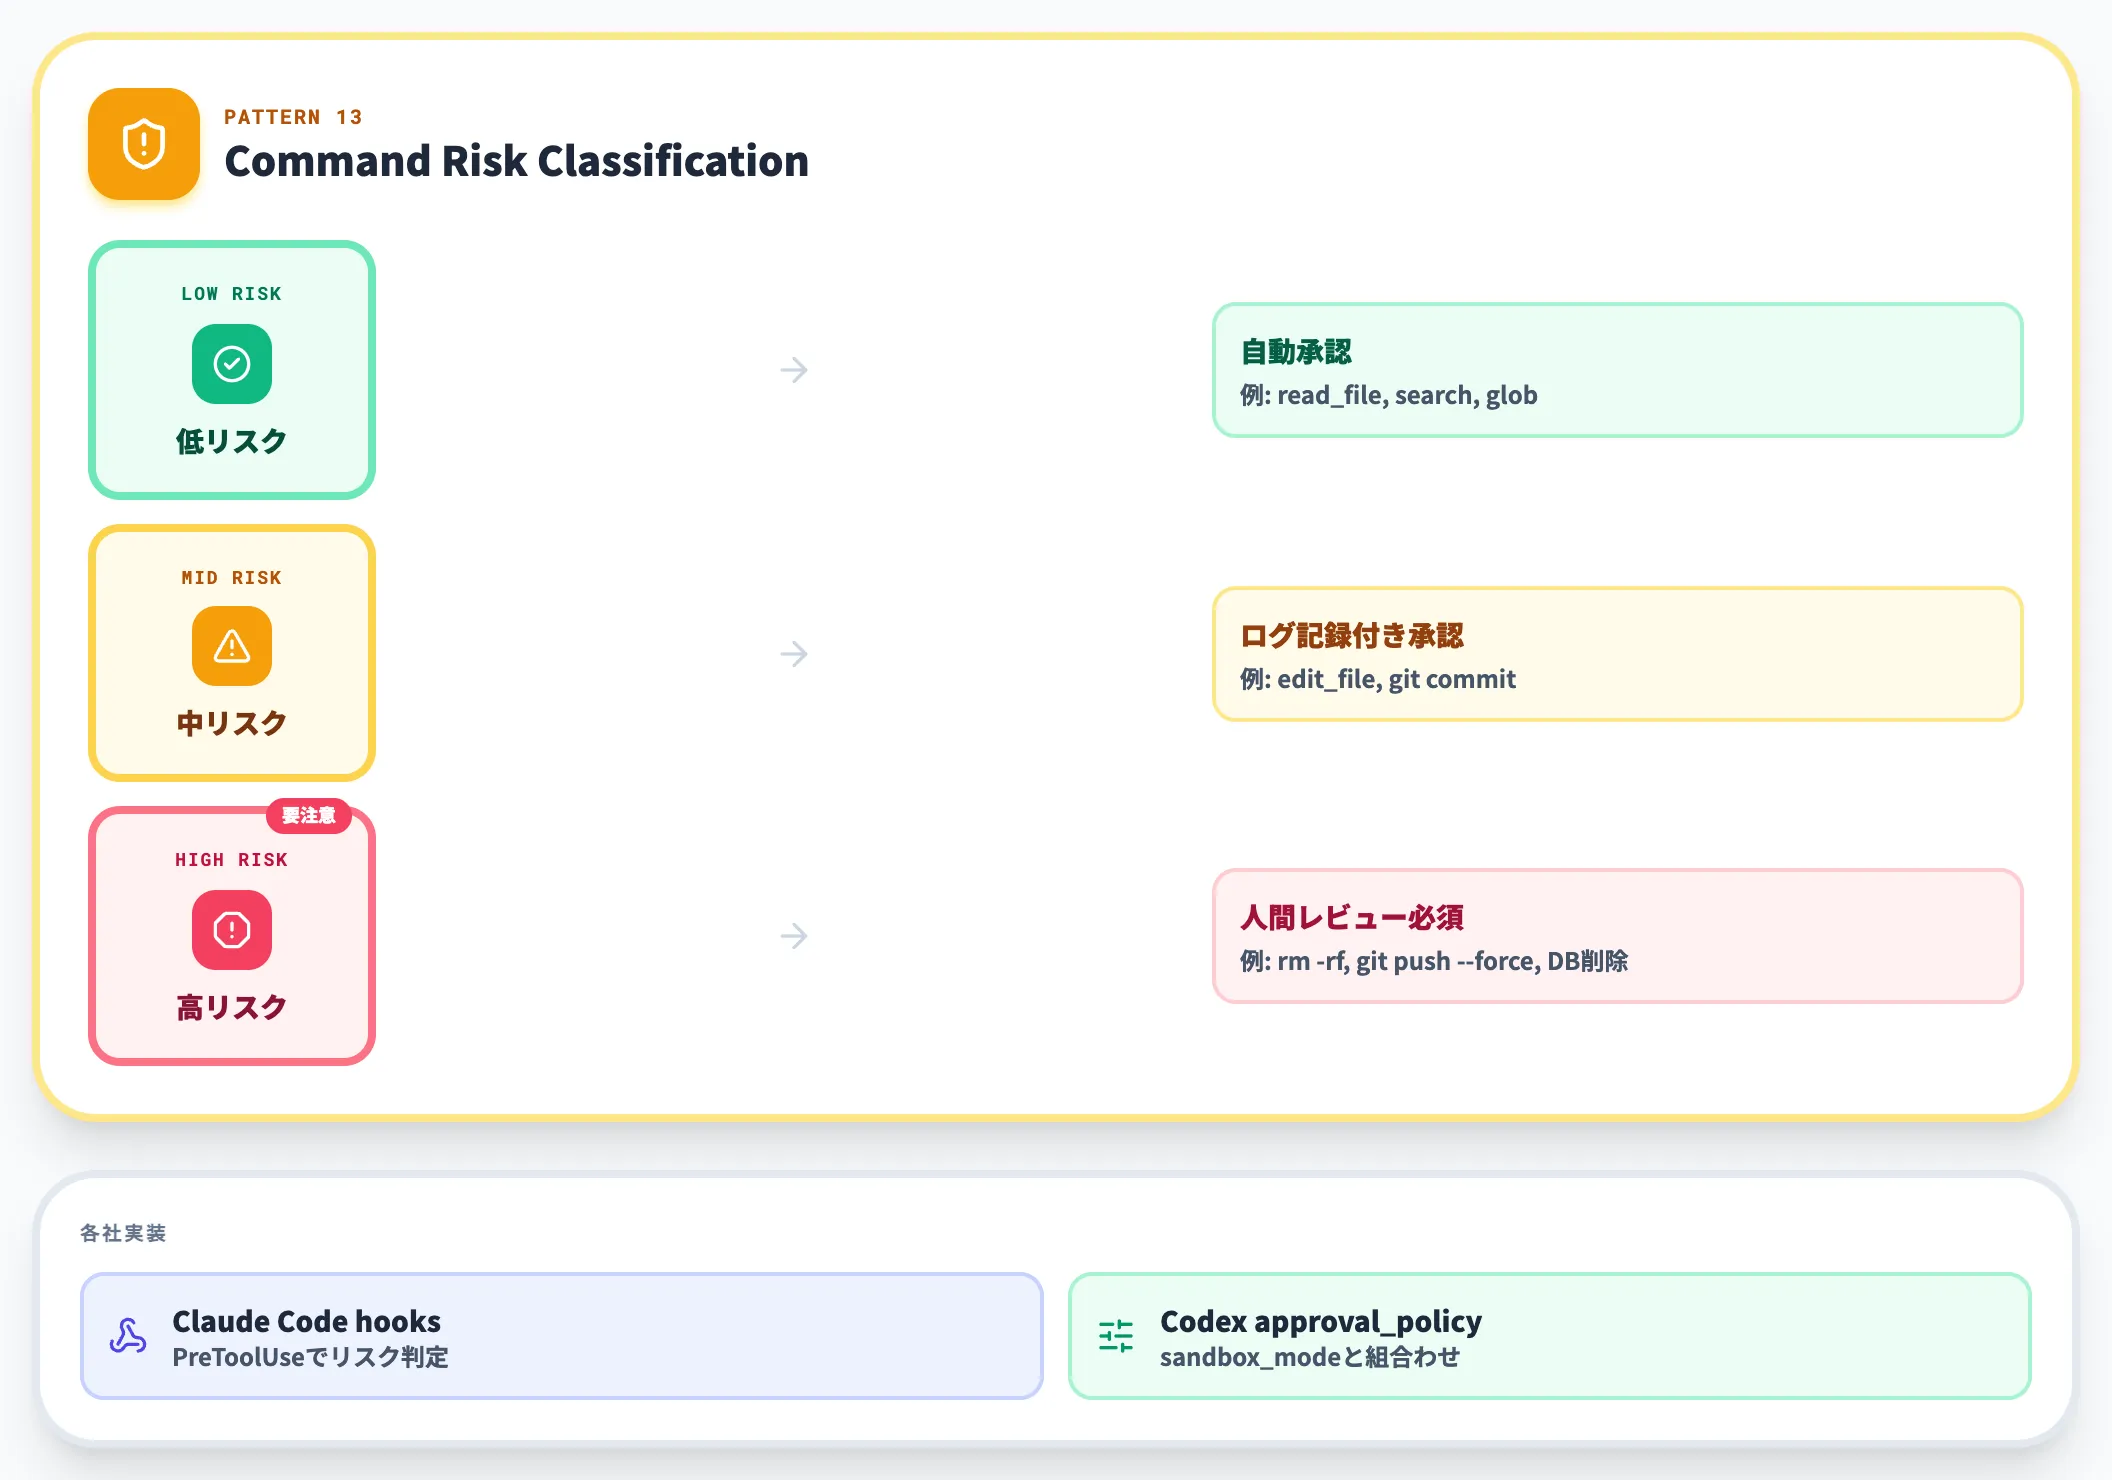
Command Risk Classificationは、ツール呼び出しをあらかじめ低リスク/中リスク/高リスクに分類し、低リスクは自動承認・中リスクはログ記録付き承認・高リスクは人間レビュー必須、という具合に承認フローを自動で分岐させる型です。
Claude Codeのhooks機能、OpenAI Codex の 「approval_policy」 設定(on-request/never 等)と 「sandbox_mode」 の組み合わせがこの思想を実装しています。
全操作に人間が関与すると運用が回らず、全自動では事故が起きるという中間を埋めるパターンです。
14. Single-Purpose Tool Design Pattern——汎用shellではなく専用ツールを並べる
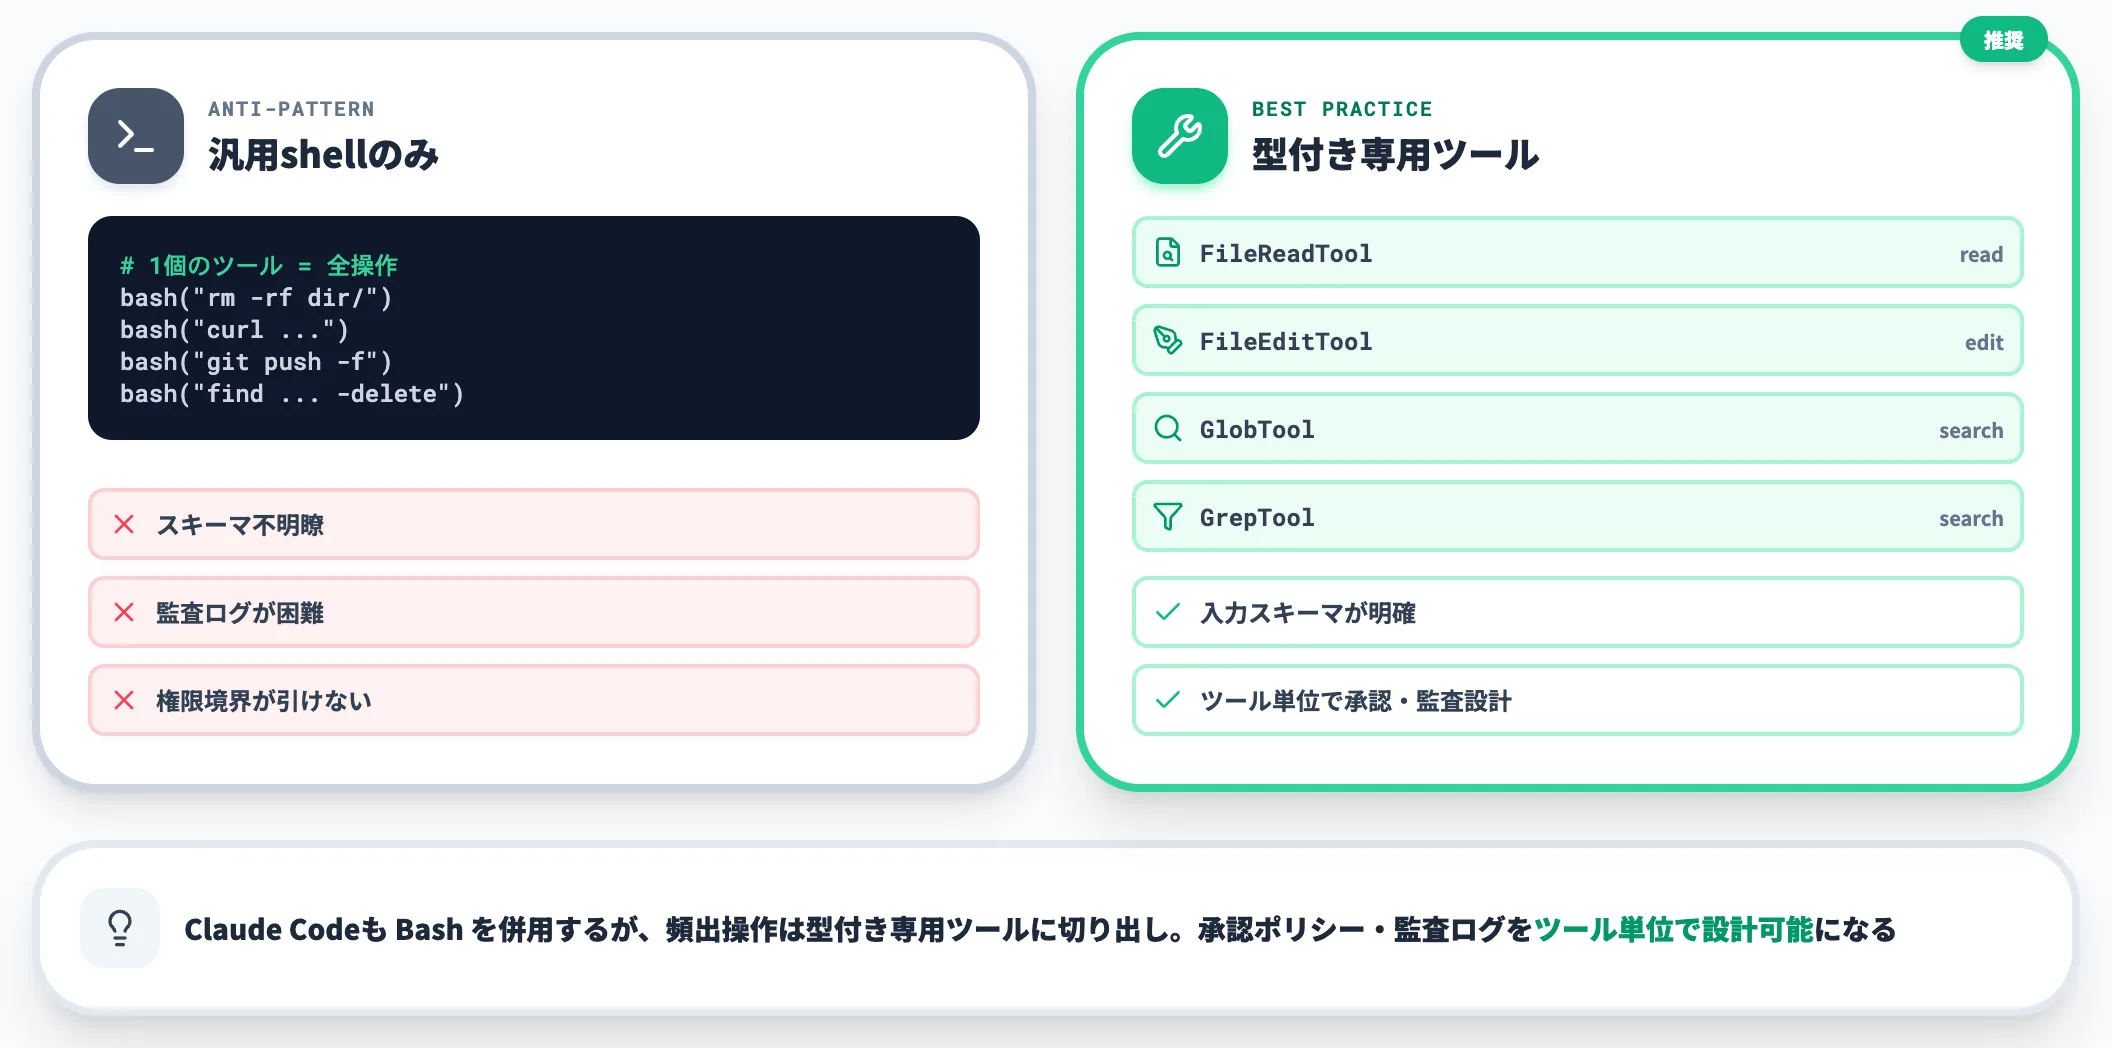
Single-Purpose Tool Designは、汎用シェルを渡すだけで済ませる代わりに、FileReadTool・FileEditTool・GlobTool・GrepToolのような型付きの専用ツールを並べて渡す型です。
専用ツールは入力スキーマが明確で、権限境界も個別に設定できる点が利点です。Claude Code自身も Bash ツールを併用しますが、頻出操作は型付きの専用ツールに切り出しておくことで、承認ポリシーや監査ログをツール単位で設計できるようになります。
15. OpenAI Codex approval_policy の現行モードと Auto モード
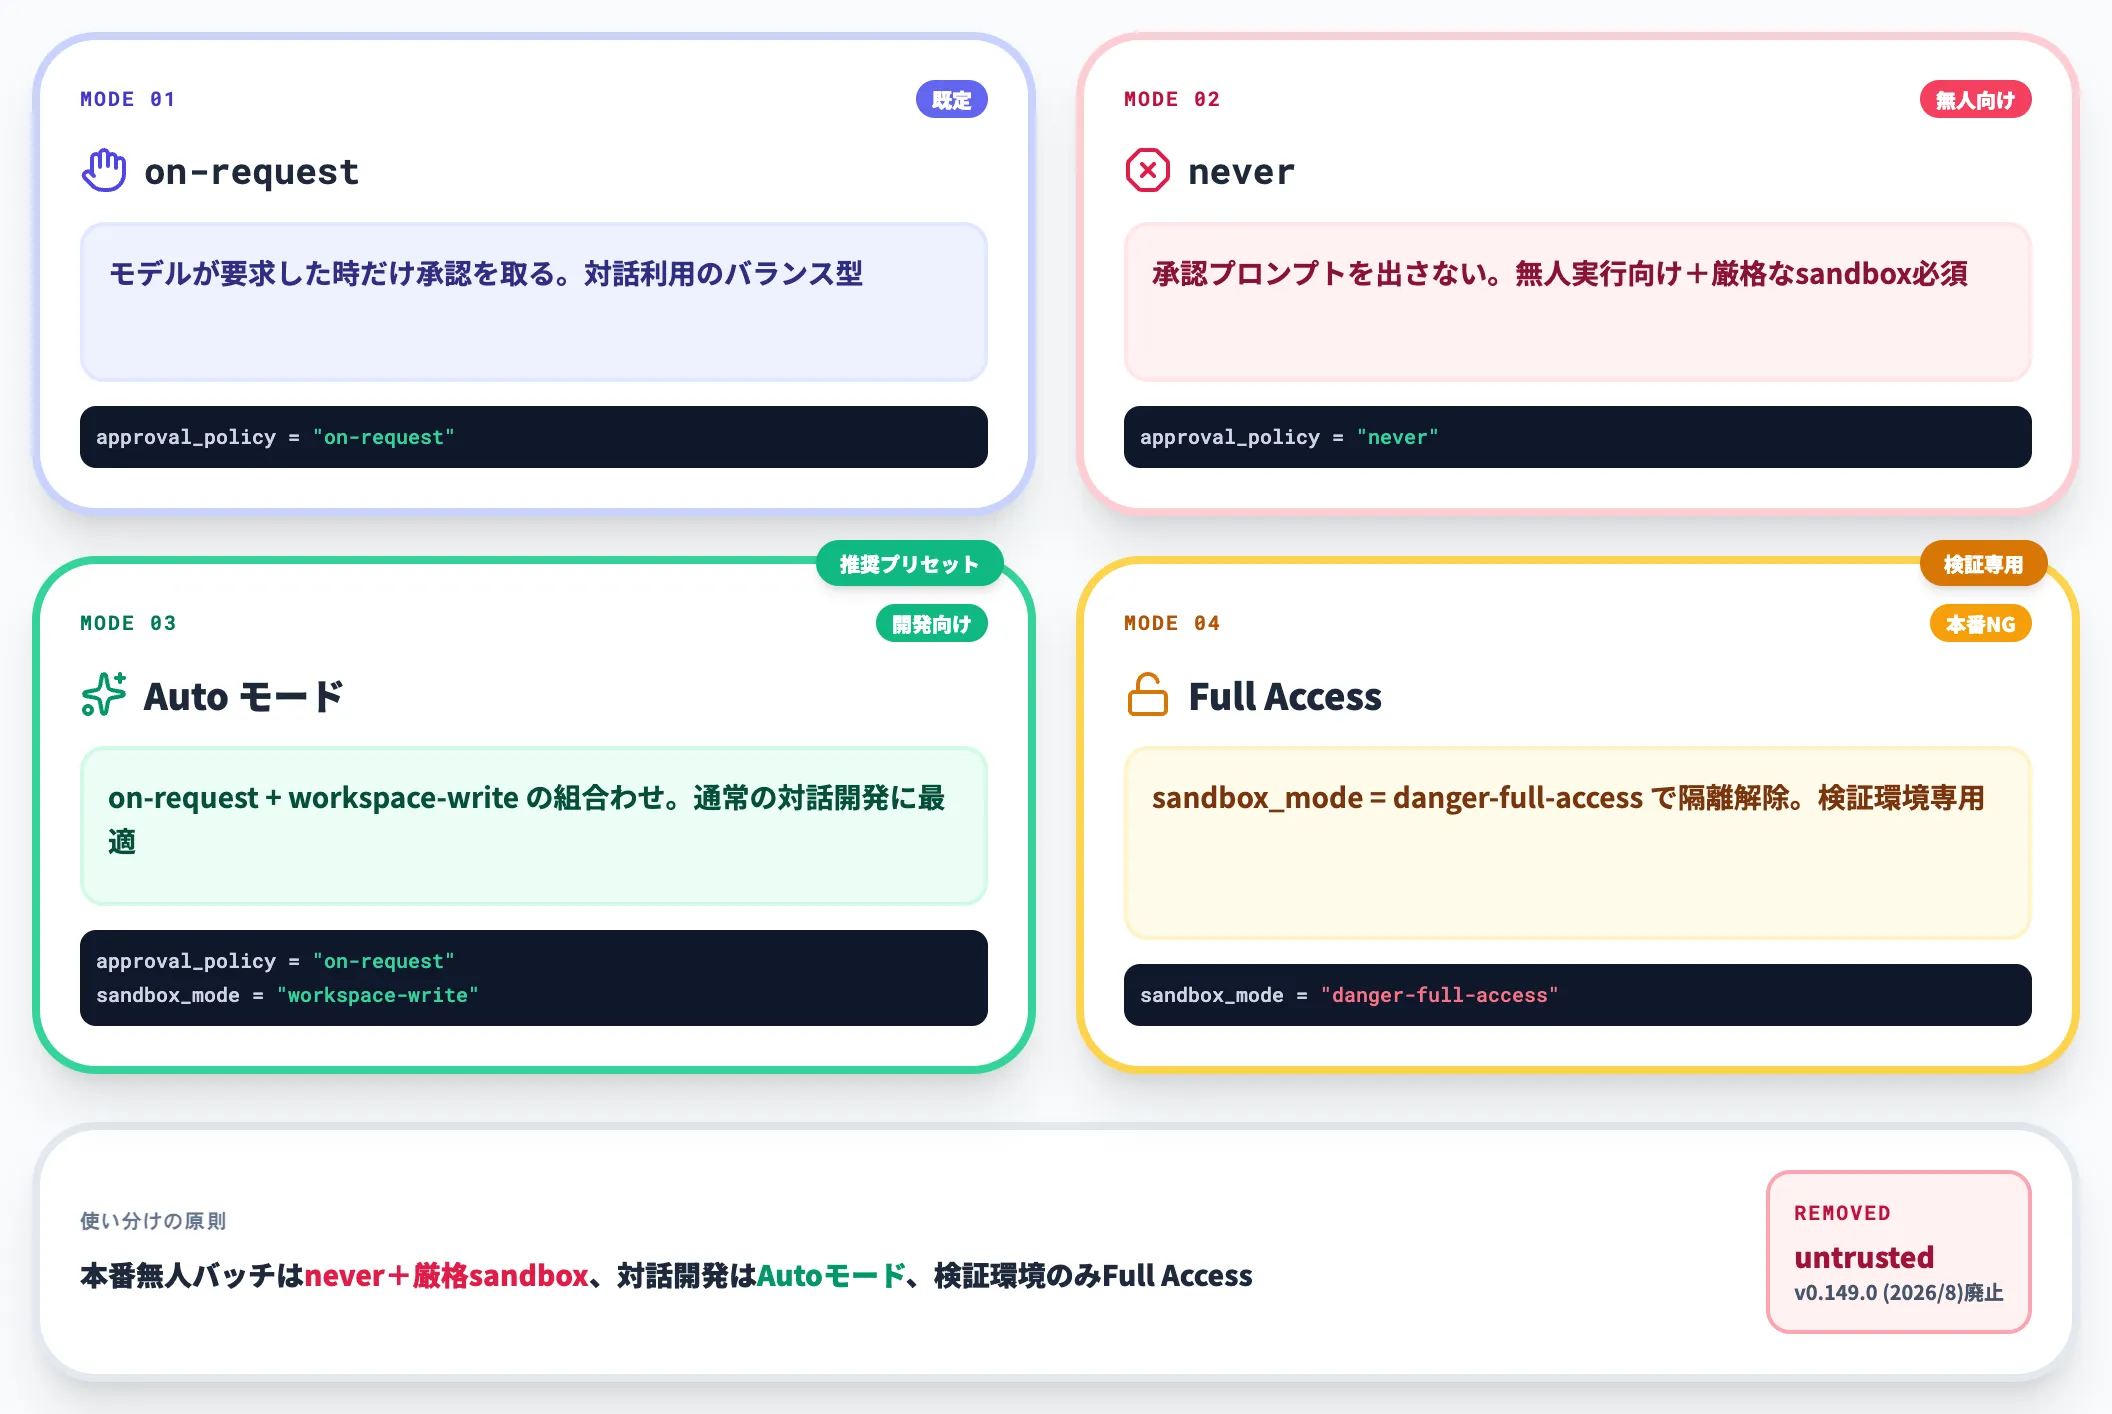
OpenAI Codex は、ツール実行に対する承認ポリシーを 「approval_policy」 設定で切り替える設計です。2026年8月のアップデート(v0.149.0)で 「untrusted」 モードは廃止され、現行の主要な選択肢は以下に整理されています。
-
on-request
モデルが要求した時だけ承認を取る(対話利用の既定・バランス型)
-
never
承認プロンプトを出さない(無人実行向け・sandbox_modeとの組合わせで安全性を担保)
-
Auto モード
「approval_policy = on-request」と「sandbox_mode = workspace-write」を組み合わせた推奨プリセット(通常の対話開発向け)
-
Full Access モード
「sandbox_mode = danger-full-access」で隔離を解除する構成(本番運用では非推奨・検証環境専用)
このモード設計は環境ごとに切り替える前提です。たとえば本番の無人バッチは「never+厳格なsandbox」、対話的な開発は「Autoモード(on-request+workspace-write)」、検証環境でのみ限定的に「Full Access」を使い分けます。
なお、以前存在した「untrusted」は2026年8月(v0.149.0)以降廃止されたため、過去の設定を踏襲する場合も読み替えが必要です。
安全・検証系の設計パターン3選——Hooks・Guardrails・Verification Loop
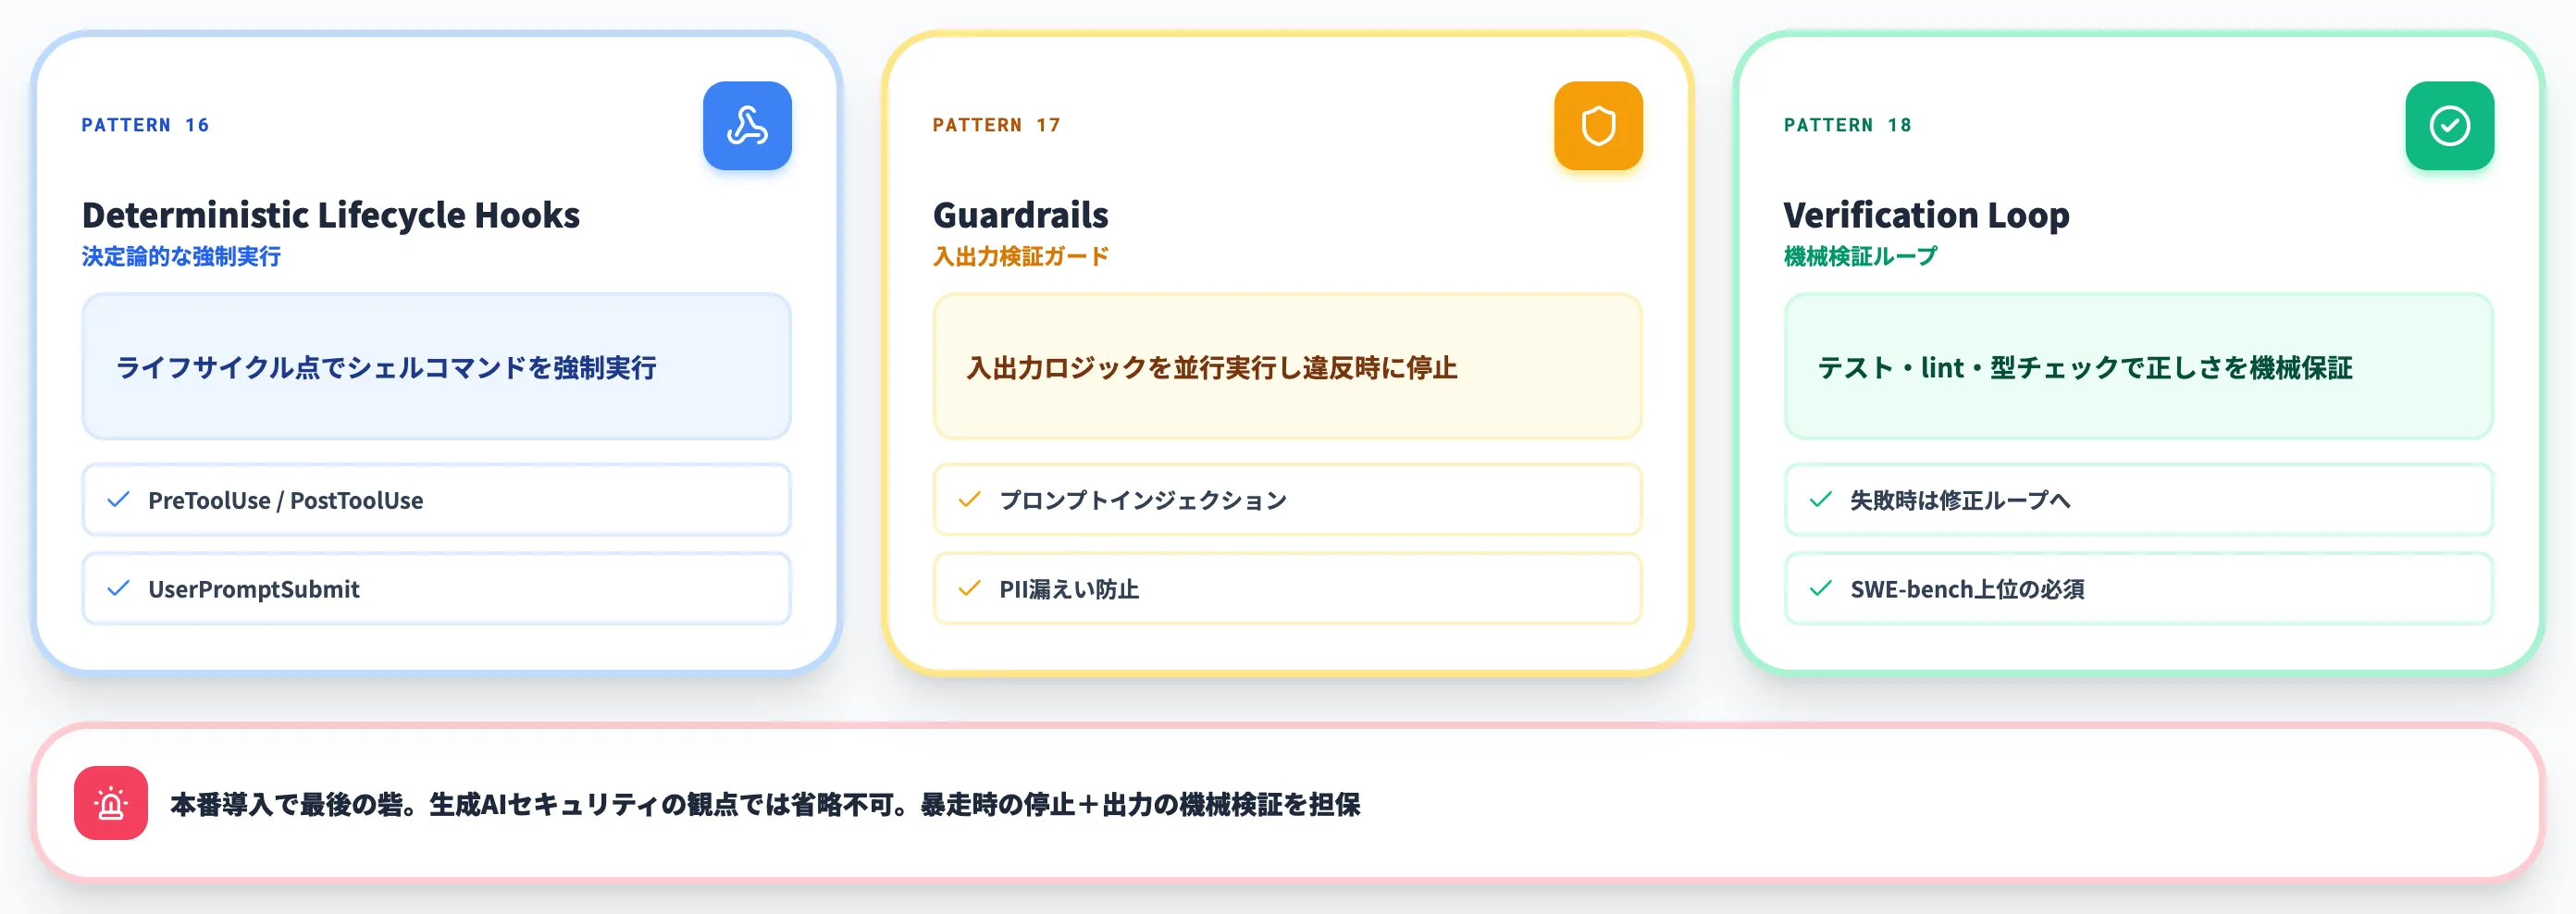
安全・検証系の3パターンは、エージェントが暴走したときに止める仕組みと、出力の正しさを機械的に確認する仕組みを提供します。
本番導入で最後の砦になる領域で、特に生成AIセキュリティの観点では省略できません。
16. Deterministic Lifecycle Hooks Pattern——ライフサイクル点で確定動作を挟む
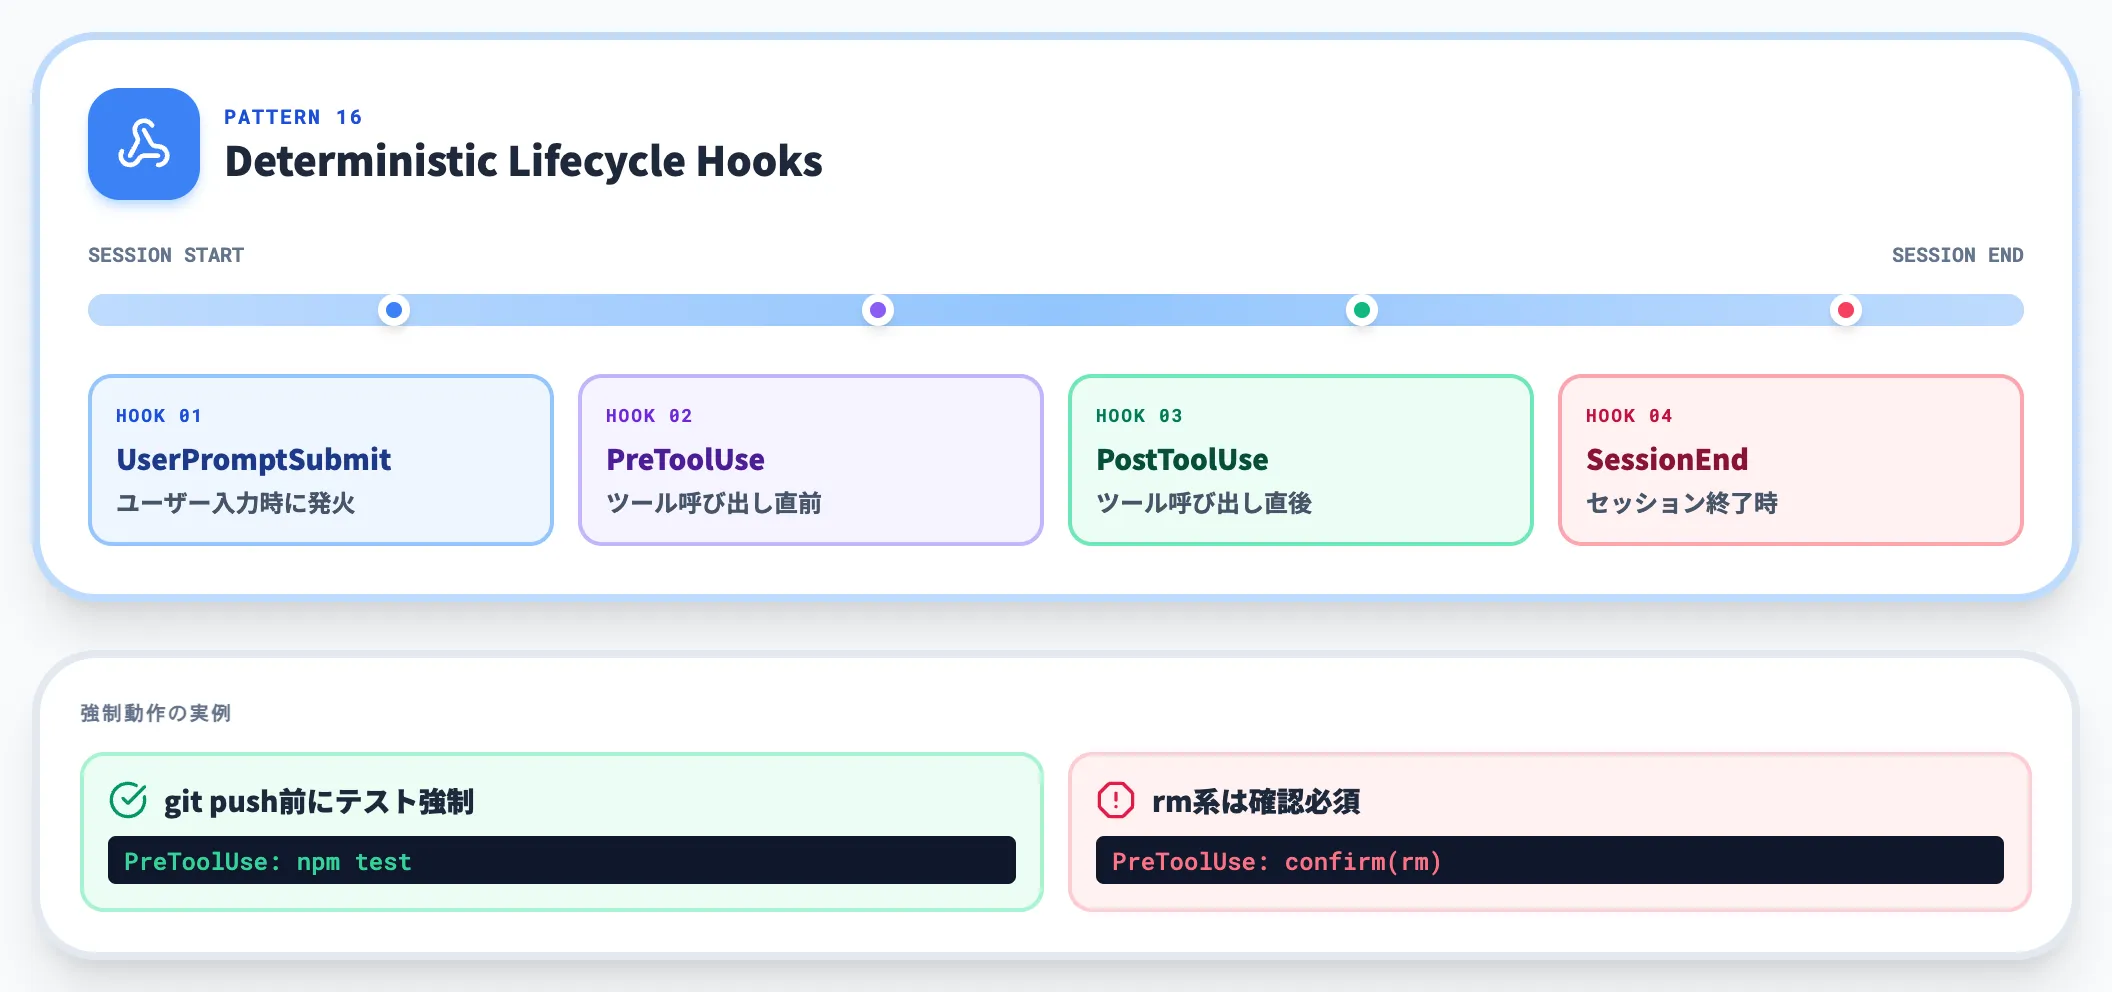
Deterministic Lifecycle Hooksは、エージェントのライフサイクル上の特定ポイント(ツール呼び出し前後、セッション終了時など)で決定論的なシェルコマンドを強制実行する型です。
Claude CodeのPreToolUse・PostToolUse・UserPromptSubmitなどのhooksが代表例で、たとえば「git pushの前に必ずテストを走らせる」「rm系コマンドは必ずダイアログで確認を取る」といった不変動作をハーネス側で担保できます。
17. Guardrails Pattern——入出力で違反を検知して止める
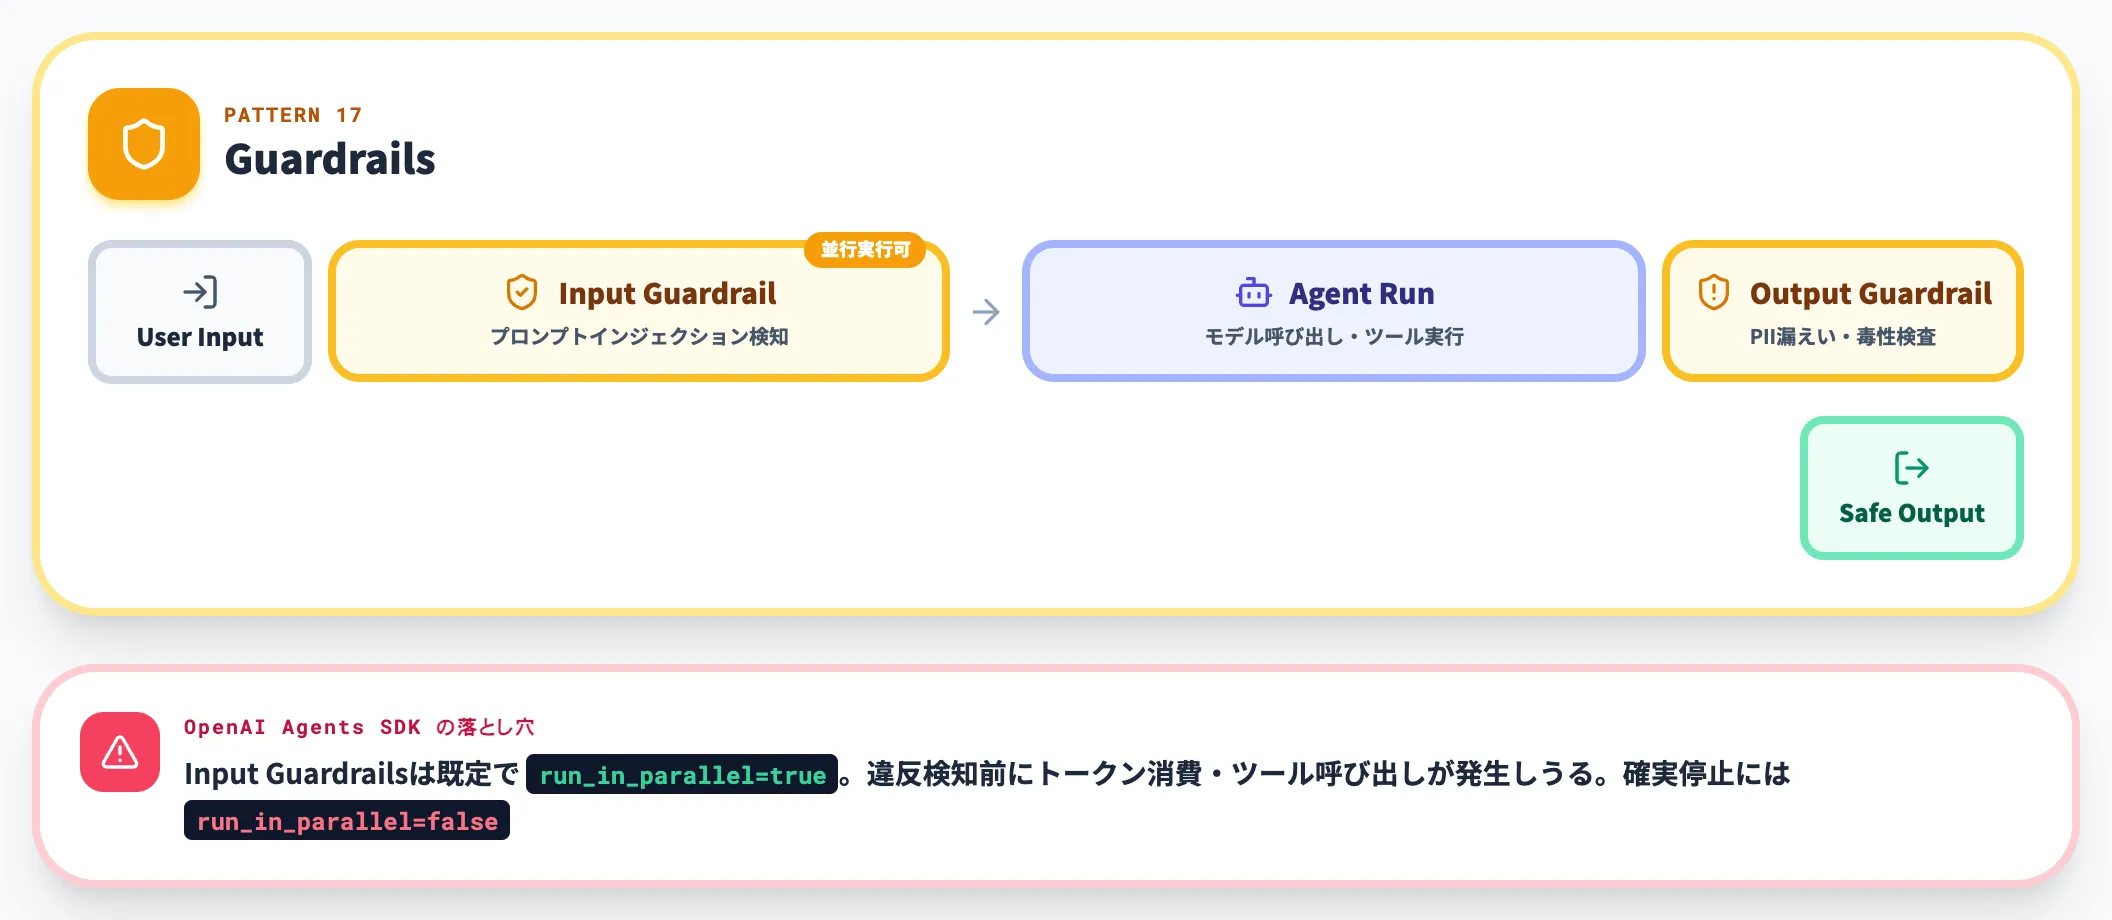
Guardrailsは、エージェント本体の実行と連動して入出力検証ロジックを走らせ、違反検出時は実行を止める型です。
OpenAI Agents SDK のGuardrailsでは、Input Guardrails は既定で 「run_in_parallel=true」 となりエージェント実行と並列で走るため、違反検出前にトークン消費やツール呼び出しが発生しうる点に注意が必要です。コスト発生前に確実に停止したい場合は 「run_in_parallel=false」 を指定し、モデル呼び出し前に実行する構成に切り替えます。Output Guardrails はエージェント完了後に走り、最終出力の内容を検証します。プロンプトインジェクション対策やPII漏えい防止で広く使われています。
18. Verification Loop Pattern——テスト・lint・型チェックを検証ステップに組み込む
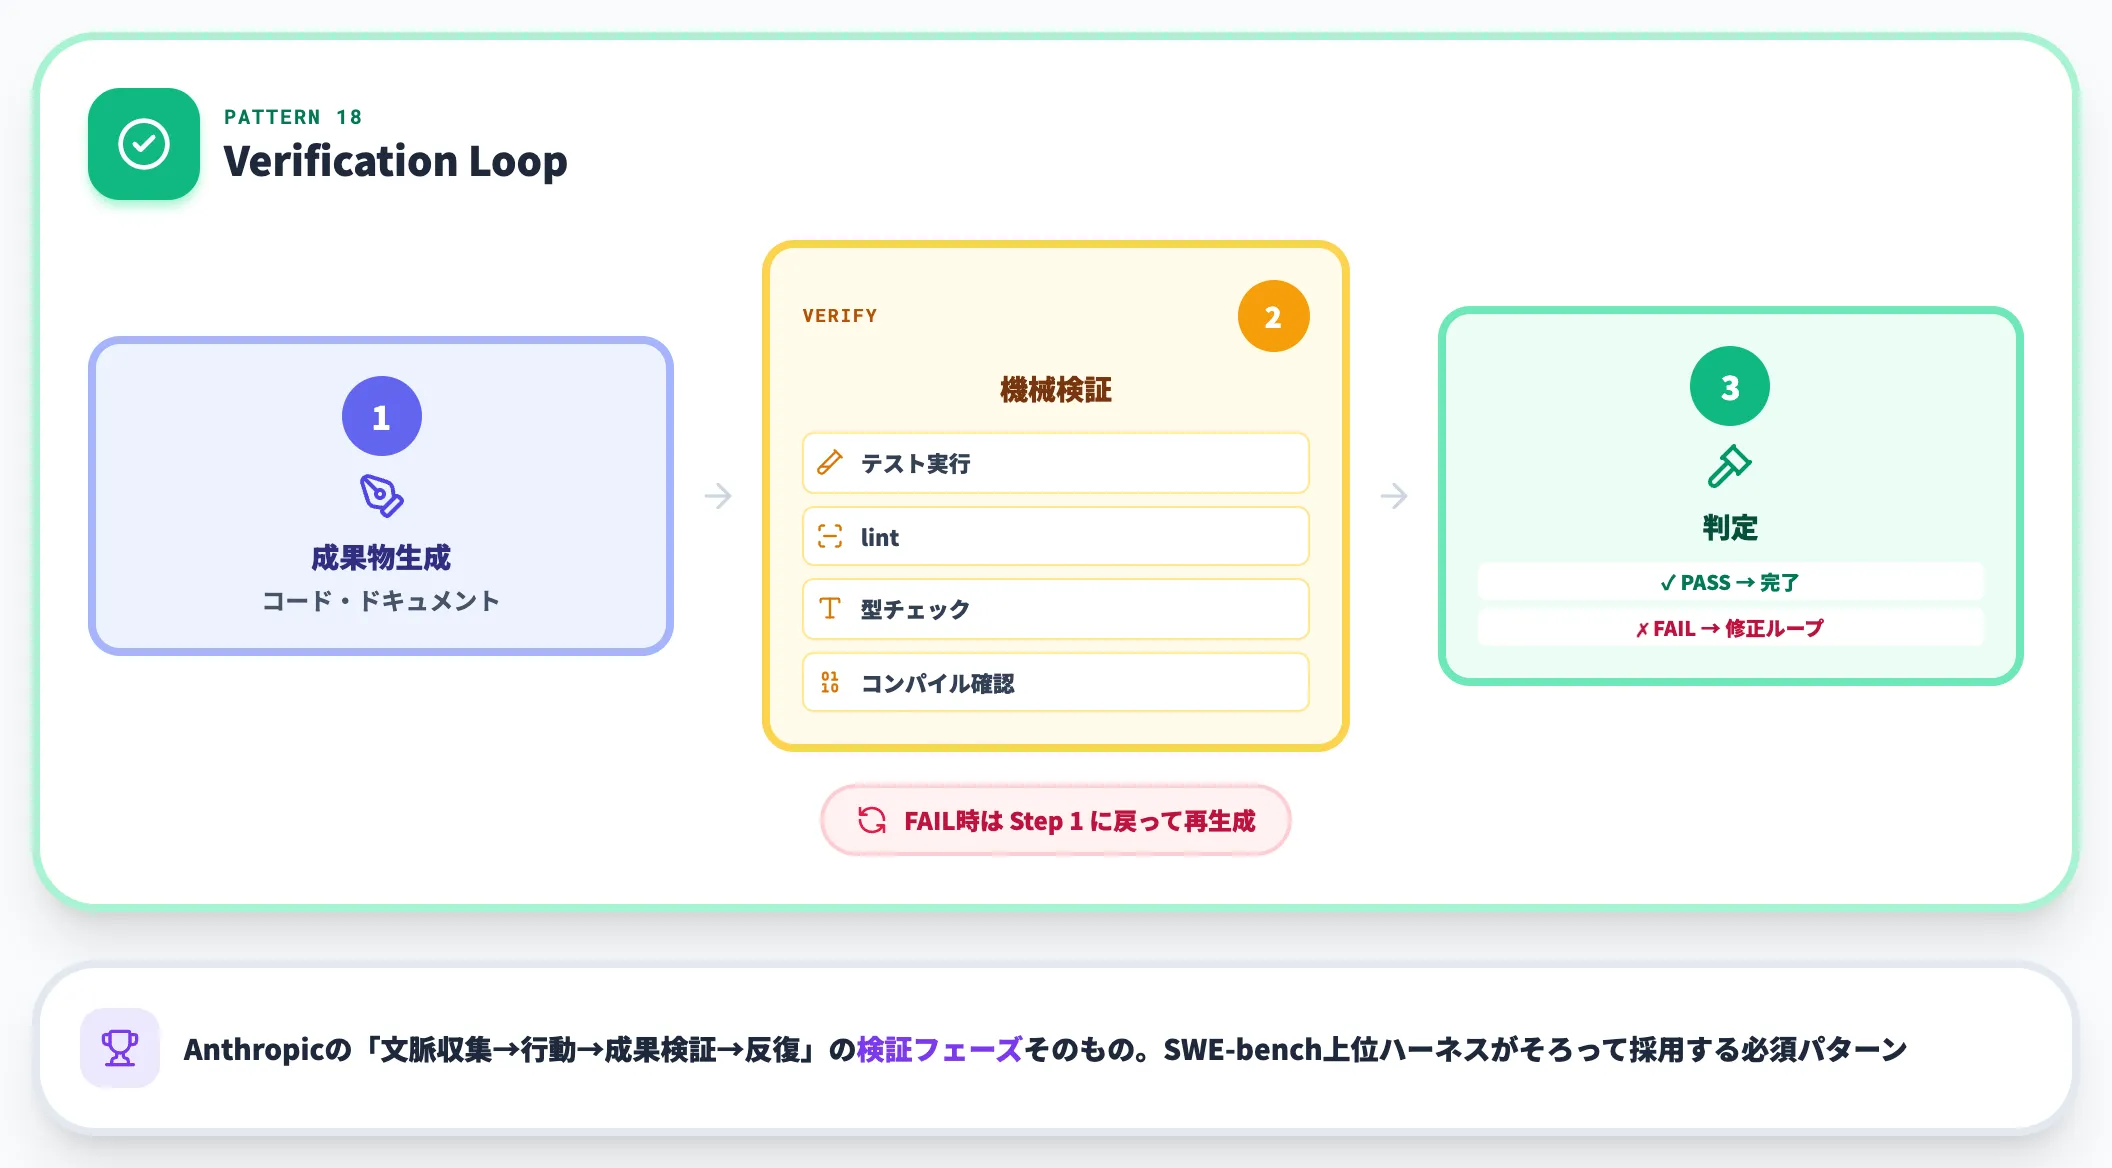
Verification Loopは、エージェントが生成した成果物に対してテスト実行・lint・型チェック・コンパイル確認などの機械検証を自動で走らせ、失敗時は修正ループへ戻す型です。
Anthropicの「文脈収集 → 行動 → 成果検証 → 反復」ループの検証フェーズそのもので、モデル任せでは担保できない正しさを機械的に保証します。SWE-benchで上位ハーネスがそろって採用している必須パターンです。
主要ハーネスの実装差──Claude Code・OpenAI Codex・Devin・mini-swe-agent・Microsoft Agent Framework 1.0
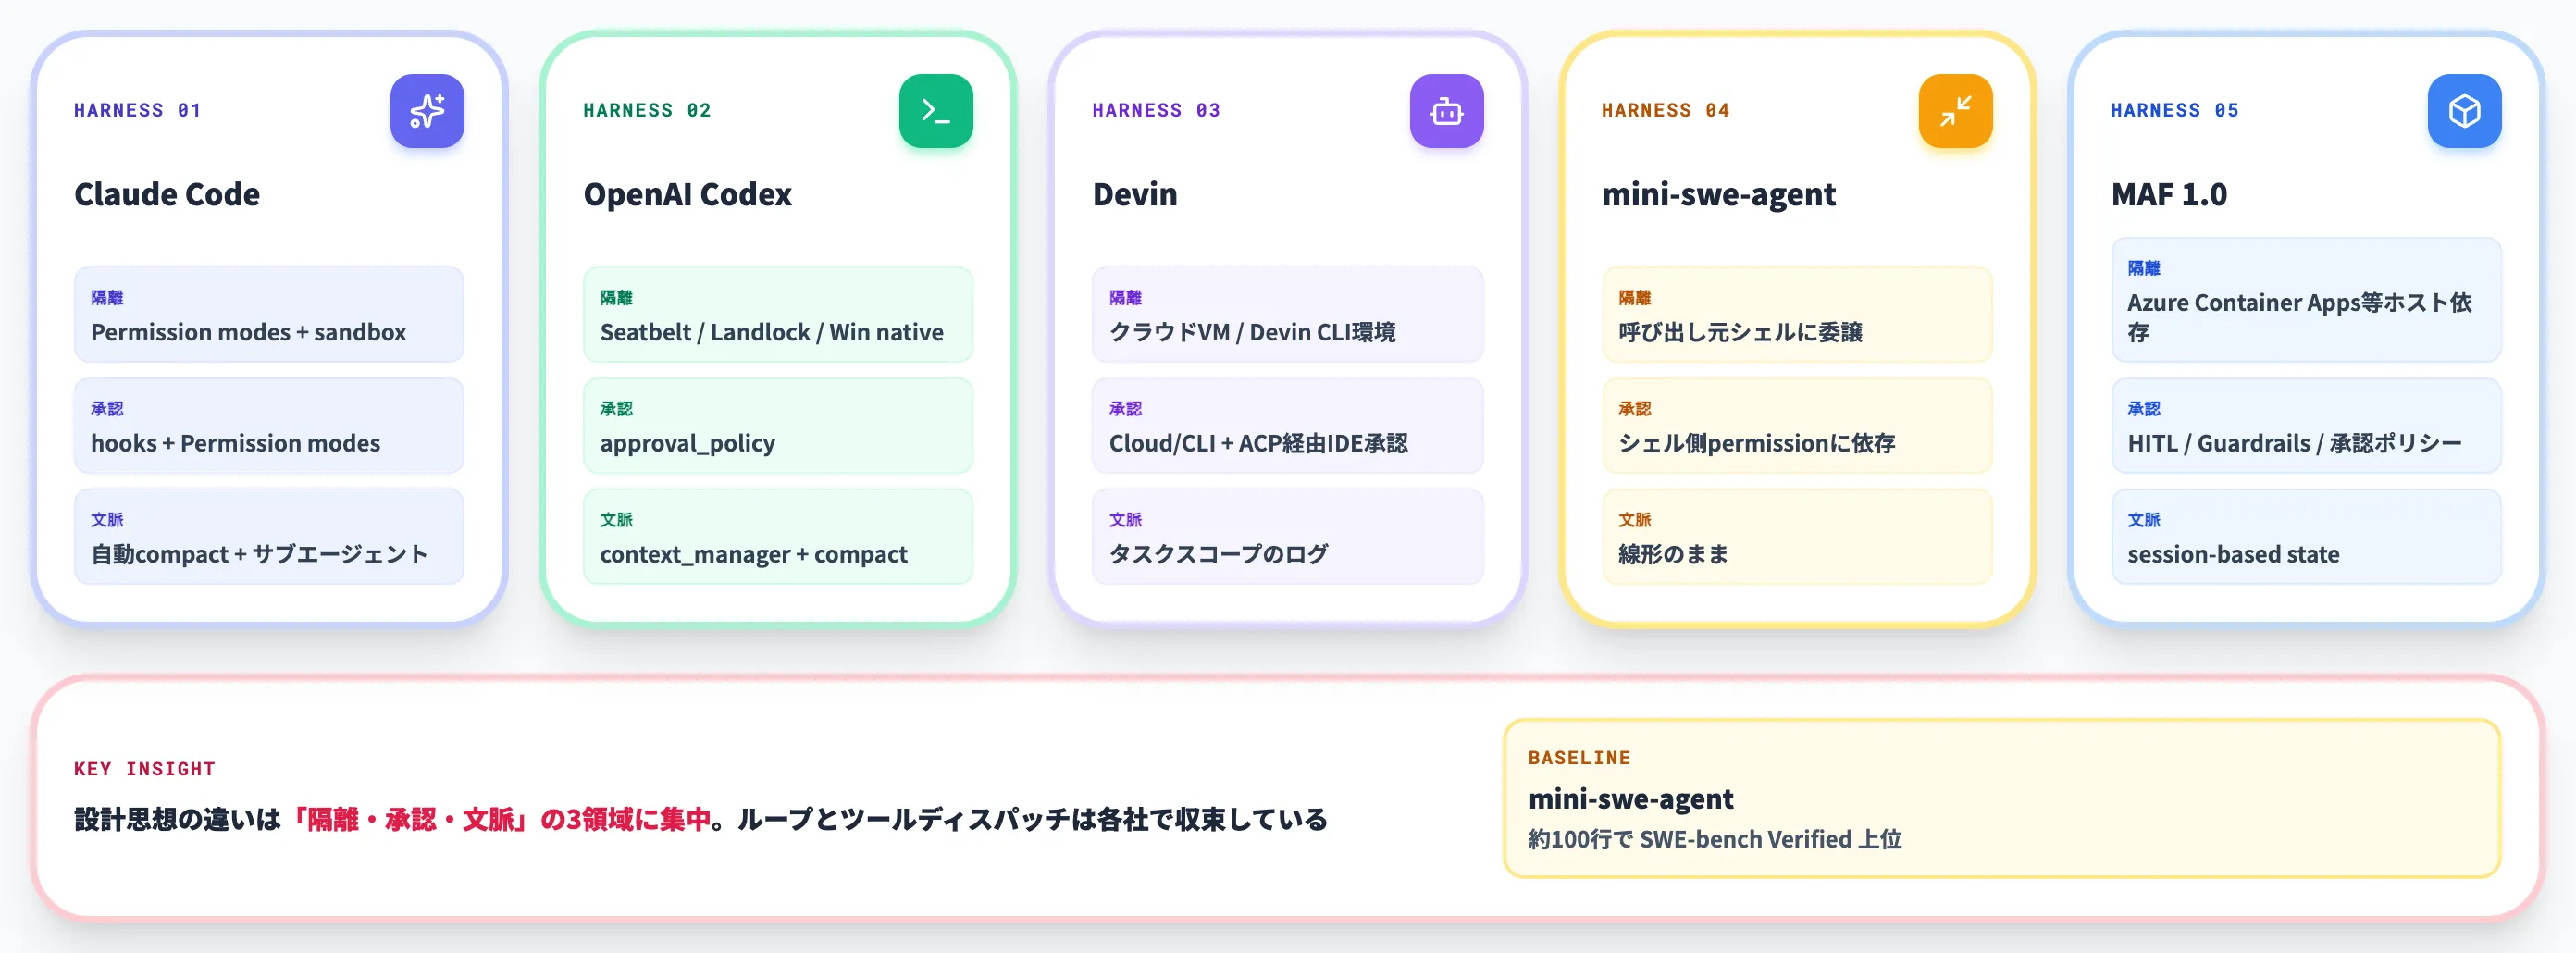
ここまでの18パターンが、実際の主要ハーネス5つでどう実装されているかを横断比較します。
5実装の横断比較表
以下の表は、主要5ハーネスを6つの観点で整理したものです。
| 観点 | Claude Code | OpenAI Codex | Devin | mini-swe-agent | Microsoft Agent Framework 1.0 |
|---|---|---|---|---|---|
| 隔離戦略 | Permission modes+サンドボックス | Seatbelt/Landlock/Windows native | クラウドVM/Devin CLI実行環境 | 呼び出し元シェルに委譲 | 実行ホスト(Azure Container Apps/自前ホスティング)依存 |
| 承認方式 | hooks(PreToolUse等)+Permission modes | approval_policy(on-request/never等) | Devin Cloud/CLIでの人間レビュー+ACP経由のIDE承認 | シェル側のpermissionに依存 | HITL/Guardrails/承認ポリシーで実装 |
| 文脈維持 | 自動compact+サブエージェント | context_manager+compact | タスクスコープのログ | 線形のまま | session-based state |
| ツール設計 | 専用Edit/Bash/Glob/Grep | registry+MCP双方向 | 専用API群+ACP通信 | shellコマンド中心 | 型安全な.NET/Python関数 |
| 停止条件 | ターン上限+予算 | ターン/トークン予算 | イテレーション+予算 | ステップ/コスト/時間/フォーマットエラー | グラフ完了判定 |
| 推論コスト特性 | サブエージェント並列でコスト嵩む傾向 | ターン・トークン予算と compact で抑制 | 長時間タスク向けでトークン多め | 最小実装でオーバーヘッドが少ない | middleware最適化で調整可 |
この比較から見えるのは、設計思想の違いが「隔離・承認・文脈」の3領域に集中しているという事実です。
たとえば mini-swe-agent(公式リポジトリ)は約100行のエージェント本体で SWE-bench Verified の上位スコアを報告しており、これが「ハーネスに複雑さを足すならどれくらいの投資対効果が見込めるか」を測る実質的なベースラインになっています。
mini-swe-agentの最小実装が突きつける事実
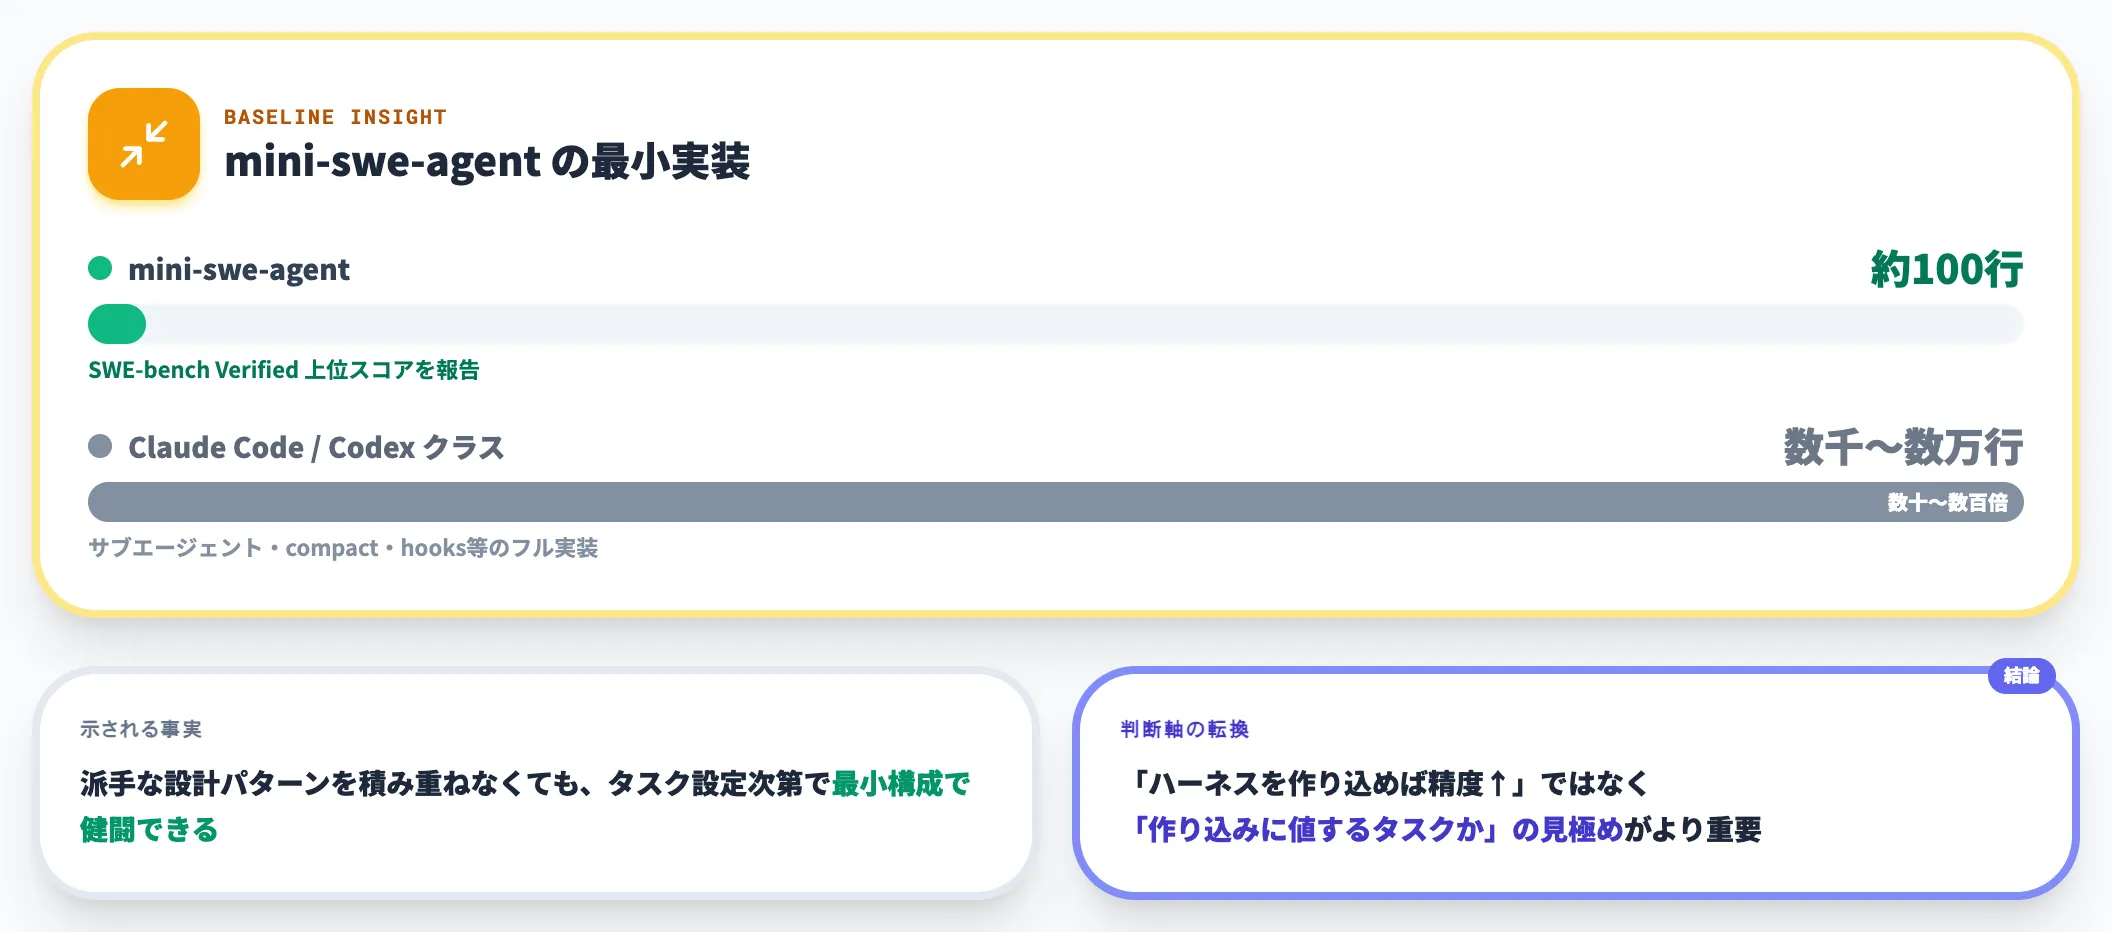
mini-swe-agentの示す結果は、派手な設計パターンを積み重ねなくても、タスク設定によっては最小構成で健闘できることを示しています。
つまり、「ハーネスを作り込めば精度が上がる」というより、「作り込みに値するタスク」と「作り込まなくても十分なタスク」を見極めることのほうが重要という結論に近づきます。この視点はパターン選定の判断軸に直結します。
Microsoft Agent Framework 1.0 GAの立ち位置
Microsoft Agent Frameworkは、2026年4月3日に.NETとPythonで 1.0 GA を達成しました。AutoGenとSemantic Kernelの統合後継で、Goは現在パブリックプレビューの段階です。
AutoGenは2025年10月にmaintenance modeに入り、その後 GitHubリポジトリもアーカイブされています。
今後のエージェントフレームワーク選定では、LangGraph vs Microsoft Agent Frameworkという構図が中心になります。特に.NETエコシステムの企業では、MAF 1.0が既存のSemantic Kernel/AutoGenプロジェクトからの移行支援を公式で提供している点が実務的な選定理由になります。
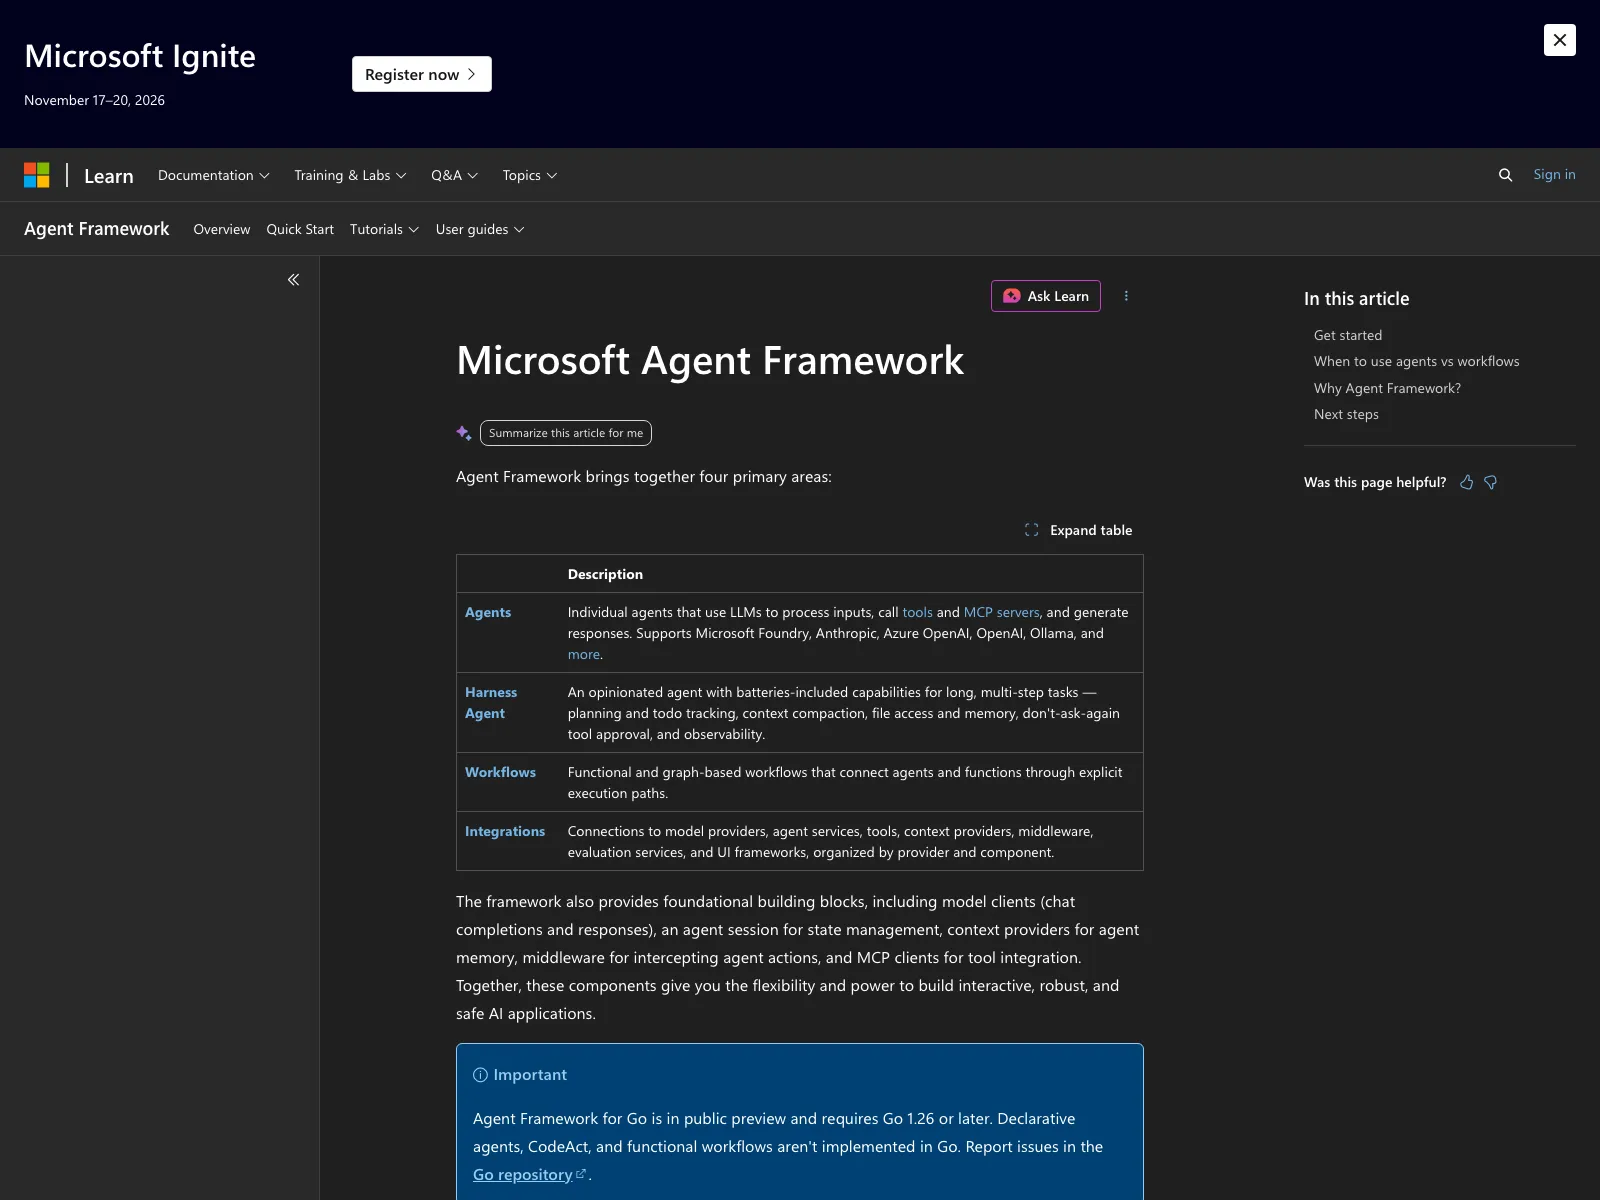
Microsoft Learn が整理する Agent Framework の4つの主要領域(Agents/Harness Agent/Workflows/Integrations・出典:Microsoft Agent Framework Overview)
公式Overviewでは、Agents(LLM+ツール+MCP+指示の最小単位)、Harness Agent(計画・todo管理・コンテキスト圧縮・承認・テレメトリを備えた長時間稼働向けのランタイム)、Workflows(複数エージェントの長時間オーケストレーション)、Integrations(接続先サービス)の4領域で構成が示されています。
特に 「create_harness_agent」 など公式が提供する Harness Agent 実装は、本記事で扱った Memory & Context/Workflow & Orchestration/Tools & Permissions のパターンがそのままMAF上の組み立て部品として並ぶ設計になっており、企業内製のテンプレートとして参照しやすい形です。
設計パターンを選ぶ判断軸──ユースケース別の推奨
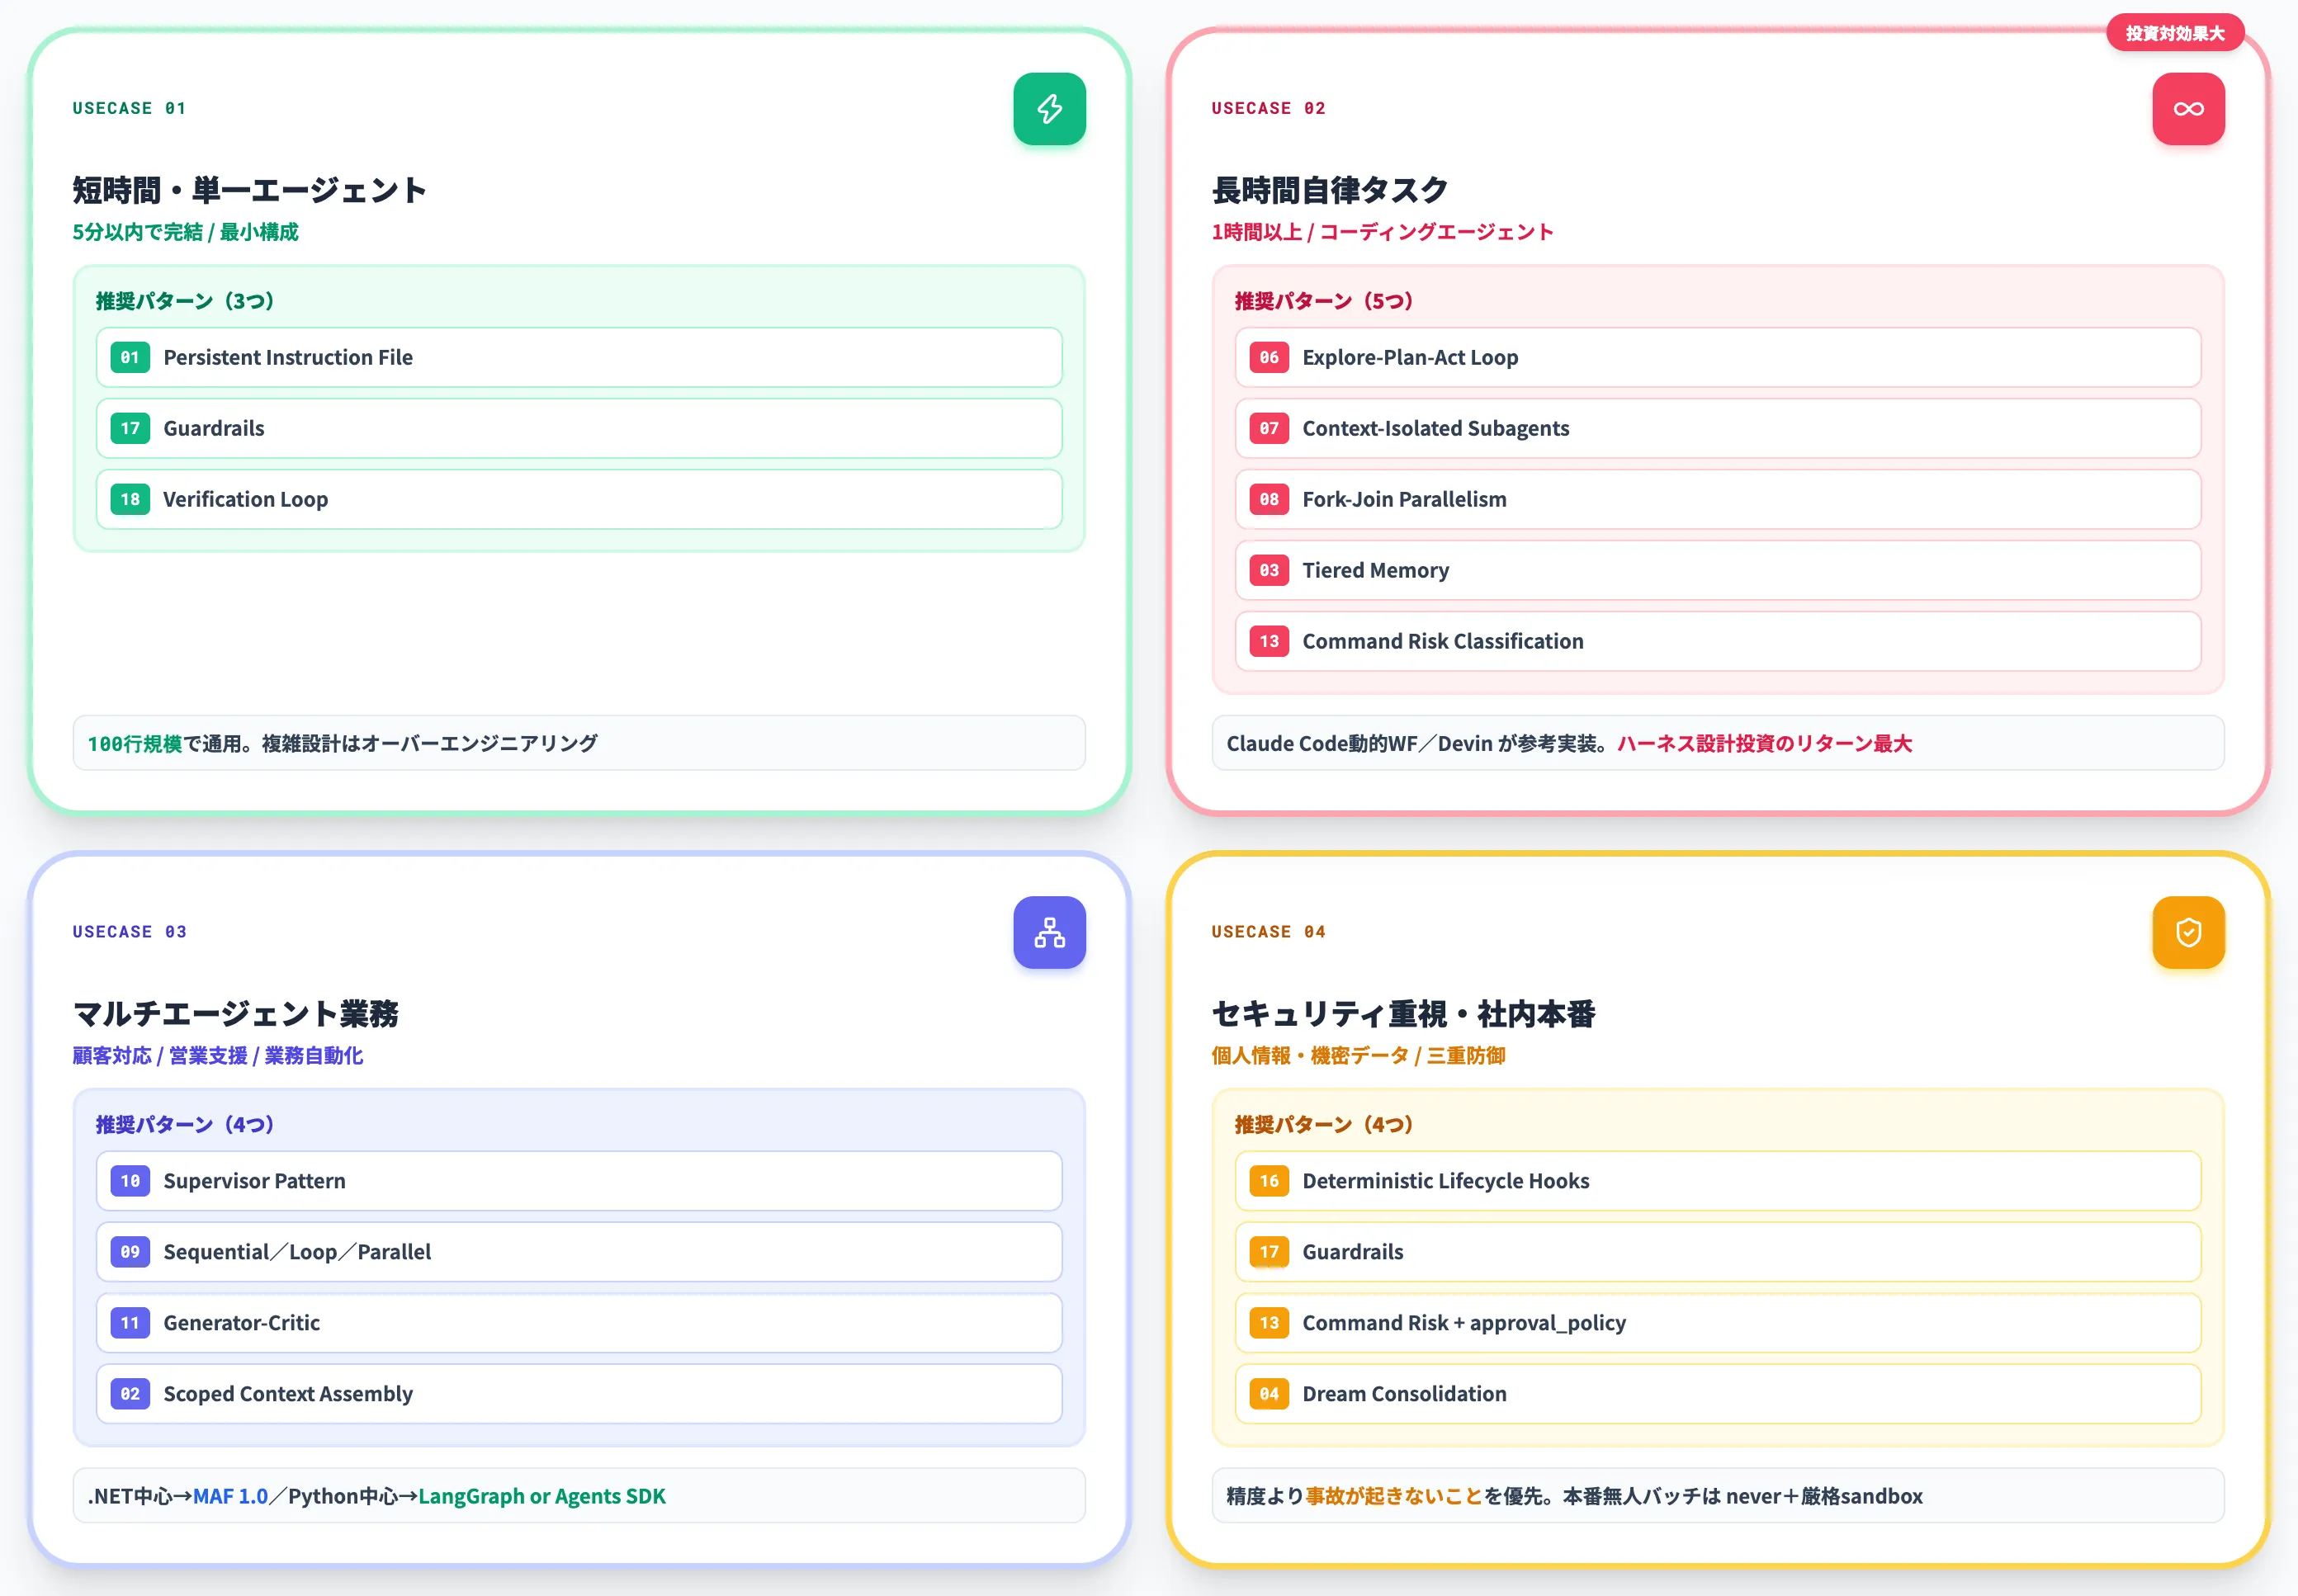
18パターンすべてを採用する必要はありません。ユースケースに応じて組み合わせを選ぶのが本記事の結論です。
ここではAI総研の実装支援経験から、4象限でユースケース別の推奨パターンを示します。
短時間・単一エージェントタスク——最小構成で十分
5分以内で完結するQA応答やデータ抽出のような短時間タスクでは、以下の3パターンで十分です。
- Persistent Instruction File(ルール常駐)
- Verification Loop(出力検証)
- Guardrails(入出力検証)
mini-swe-agentの思想に近く、100行規模のハーネスで通用する領域です。ここで複雑な設計を入れるとオーバーエンジニアリングになります。
長時間自律タスク——Explore-Plan-Act+サブエージェント構成が第一候補
1時間以上の長時間タスクや、コーディングエージェント的な自律実行では、以下のパターンの組合わせが第一候補になります。
- Explore-Plan-Act Loop(権限段階化)
- Context-Isolated Subagents(文脈分離)
- Fork-Join Parallelism(独立作業の並列化)
- Tiered Memory(メモリ階層化)
- Command Risk Classification(高リスク操作の人間レビュー)
Claude Codeの動的ワークフローや、Devinのタスクスコープ運用が参考実装です。この領域ではハーネス差がベンチマークスコアを大きく動かしうることが報告されており、ハーネス設計への投資が最もリターンを生みます。
マルチエージェント業務ワークフロー——Supervisor+Sequential/Loop/Parallelの組合わせ
顧客対応AI、営業支援エージェント、業務プロセス自動化などのマルチエージェント構成では、以下のパターンが鍵になります。
- Supervisor(Coordinator)Pattern(司令塔)
- Sequential/Loop/Parallel(基本フロー)
- Generator-Critic(品質保証)
- Scoped Context Assembly(階層的ルール管理)
実装基盤としては、.NETエコシステム中心ならMicrosoft Agent Framework 1.0、Python中心ならLangGraphまたはOpenAI Agents SDKが第一候補です。
AIエージェントフレームワークの徹底比較に主要8選の詳細比較があります。
セキュリティ重視・社内本番運用——Hooks+Guardrails+承認モードの三重防御
個人情報・機密データを扱う社内本番運用では、以下の三重防御が最低ラインです。
- Deterministic Lifecycle Hooks(不変動作の強制)
- Guardrails(入出力検証)
- Command Risk Classification+ Codex の 「approval_policy」 等による権限管理
- Dream Consolidation(長期ログ整理)
この領域では精度より事故が起きないことが優先されます。Codex系では対話的な開発を「on-request」、本番の無人バッチを「never+厳格なsandbox」で切り分け、Claude Code系では Plan モードや hooks で高リスク操作に人間レビューを挟むのが実務的な線引きです。
ハーネスの差が出る隔離・承認・文脈維持を、業務エージェントでは基盤に任せる
主要ハーネスを並べると、エージェントループやツールの呼び出し方は各社で収束し、差は隔離・承認・文脈維持の3つに集まっていました。経理や総務の業務エージェントを部署ごとに別のハーネスで組むと、実行環境の線引き、承認モードの選び方、コンテキストに入れる業務データの範囲が部署の数だけ分かれるため、この3つを共通にしておく層が必要になります。
その層をまとめて担えるのが、業務Agentの実行環境と人の確認の流れ、データの参照先を部署横断で用意するAI Agent Hubです。
- 実行環境の線引きを、Agentごとに変えない
Agentは、Azure Managed Applicationsで自社のサブスクリプションに組んだ環境の中で動くため、実行先を選び直す手間がなく、業務データを外部のサービスに出さずに済みます。
- 人の確認を挟む操作は、申請の中身で振り分ける
承認ルートは金額や申請の種類に応じてフロー判定Agentが選び、担当者はTeamsで届いた依頼に承認か差し戻しで答えるため、確認の段をAgentの数だけ用意する必要がありません。
- コンテキストに入れる業務データを、OneLakeで絞る
ERPや社内文書のデータは複製せずにOneLakeから参照できるため、Agentごとに見せる範囲を決め、必要な分だけをコンテキストに渡せます。
AI総合研究所の専任チームが、最小構成で足りる処理と作り込みに値する業務を切り分け、どこからAgentを組むかを一緒に決めます。
隔離・承認・文脈を基盤でそろえる

作り込みに値する業務を見極める
主要ハーネスの差は隔離・承認・文脈維持に集まるため、業務エージェントを増やすたびに別々に組むと、この3つの設計が積み上がっていきます。AI Agent Hubでは、Azure上の自社環境での実行、申請に応じた承認ルートの判定、OneLakeを通じたデータ参照を、共通の仕組みとして用意しています。
まとめ
本記事では、エージェントハーネスの設計パターンを「AIエージェントをLLMの外側で安定して動かす実行基盤の、繰り返し使える型」として整理し、型として扱う理由・ハーネスの構成レイヤー・領域ごとの設計パターン・代表的なハーネスの実装差・ユースケース別の選び方を解説しました。
2026年11月時点で押さえておくべきポイントは次の3つです。
- モデルを据え置いたままハーネスを替えるだけで、ベンチマークの成績が大きく動き、同じ課題を解くための推論コストは桁が変わるほど開く
- 長時間の自律実行では、探索・計画・実行の順に権限を開く流れを軸に、文脈を分けたサブエージェントと並列の作業分担を重ねる
- 正しさはモデル任せにせず、lintや型チェックを回す検証ループで確かめ、評価は生成と別のエージェントに分けるほうが性能が高い
AI総合研究所では、Claude CodeやCodexを社内に入れたばかりのチームと、2つの整備から取りかかります。
まずは、ビルドやテストの手順、命名の決まりをCLAUDE.mdやAGENTS.mdに書き出し、ルールの変更はGitの差分でレビューします。
続いて、プッシュ前のテストのように毎回必ず通したい手順は、フックに移してハーネスの側で強制します。
エージェントに渡すツールは、数を増やすより、型を付けて絞り込むほうが、選択の精度と推論コストの両方に効きます。
エージェントハーネスの設計パターンは、製品ごとの呼び名の違いを越えて、自社のハーネスに何が足りないかを点検するための共通の物差しです。