この記事のポイント
 Astra級のコーディング・PC操作性能をAstra比1/5のトークン価格で提供する中位モデル
- API料金は入力$2・出力$10・キャッシュ入力$0.10で、キャッシュ活用で標準比95%オフ
- 提供はChatGPT Work・Codex・APIの3チャネル、通常のChatではまだ利用不可
- 生物・サイバー領域の高難度タスクはAstraと公開ベンチマーク上の能力差が残り要求性能で選定
- Chat Completions APIではtool callが不可、tool利用はResponses APIに切り替え必須
Microsoft MVP・AIパートナー。LinkX Japan株式会社 代表取締役。東京工業大学大学院にて自然言語処理・金融工学を研究。NHK放送技術研究所でAI・ブロックチェーンの研究開発に従事し、国際学会・ジャーナルでの発表多数。経営情報学会 優秀賞受賞。シンガポールでWeb3企業を創業後、現在は企業向けAI導入・DX推進を支援。
GPT-6.1 Sol(ジーピーティー・シックス・ポイント・ワン・ソル)は、OpenAIが2026年9月29日のDevDay 2026で発表したGPT-6 Solのアップグレード版です。
フラグシップのGPT-6 Astraに迫るコーディング・PC操作・専門業務性能を、Astra比1/5のトークン価格で提供する中位モデルとして位置づけられています。
本記事では、GPT-6.1 Solの性能ベンチマーク・料金体系・ChatGPT Work / Codex / APIでの使い方、Astra・Claude Opus 5.5との使い分け、本番投入前の注意点までを、2026年9月末時点の公式情報で体系的に整理します。
GPT-6.1 Solとは
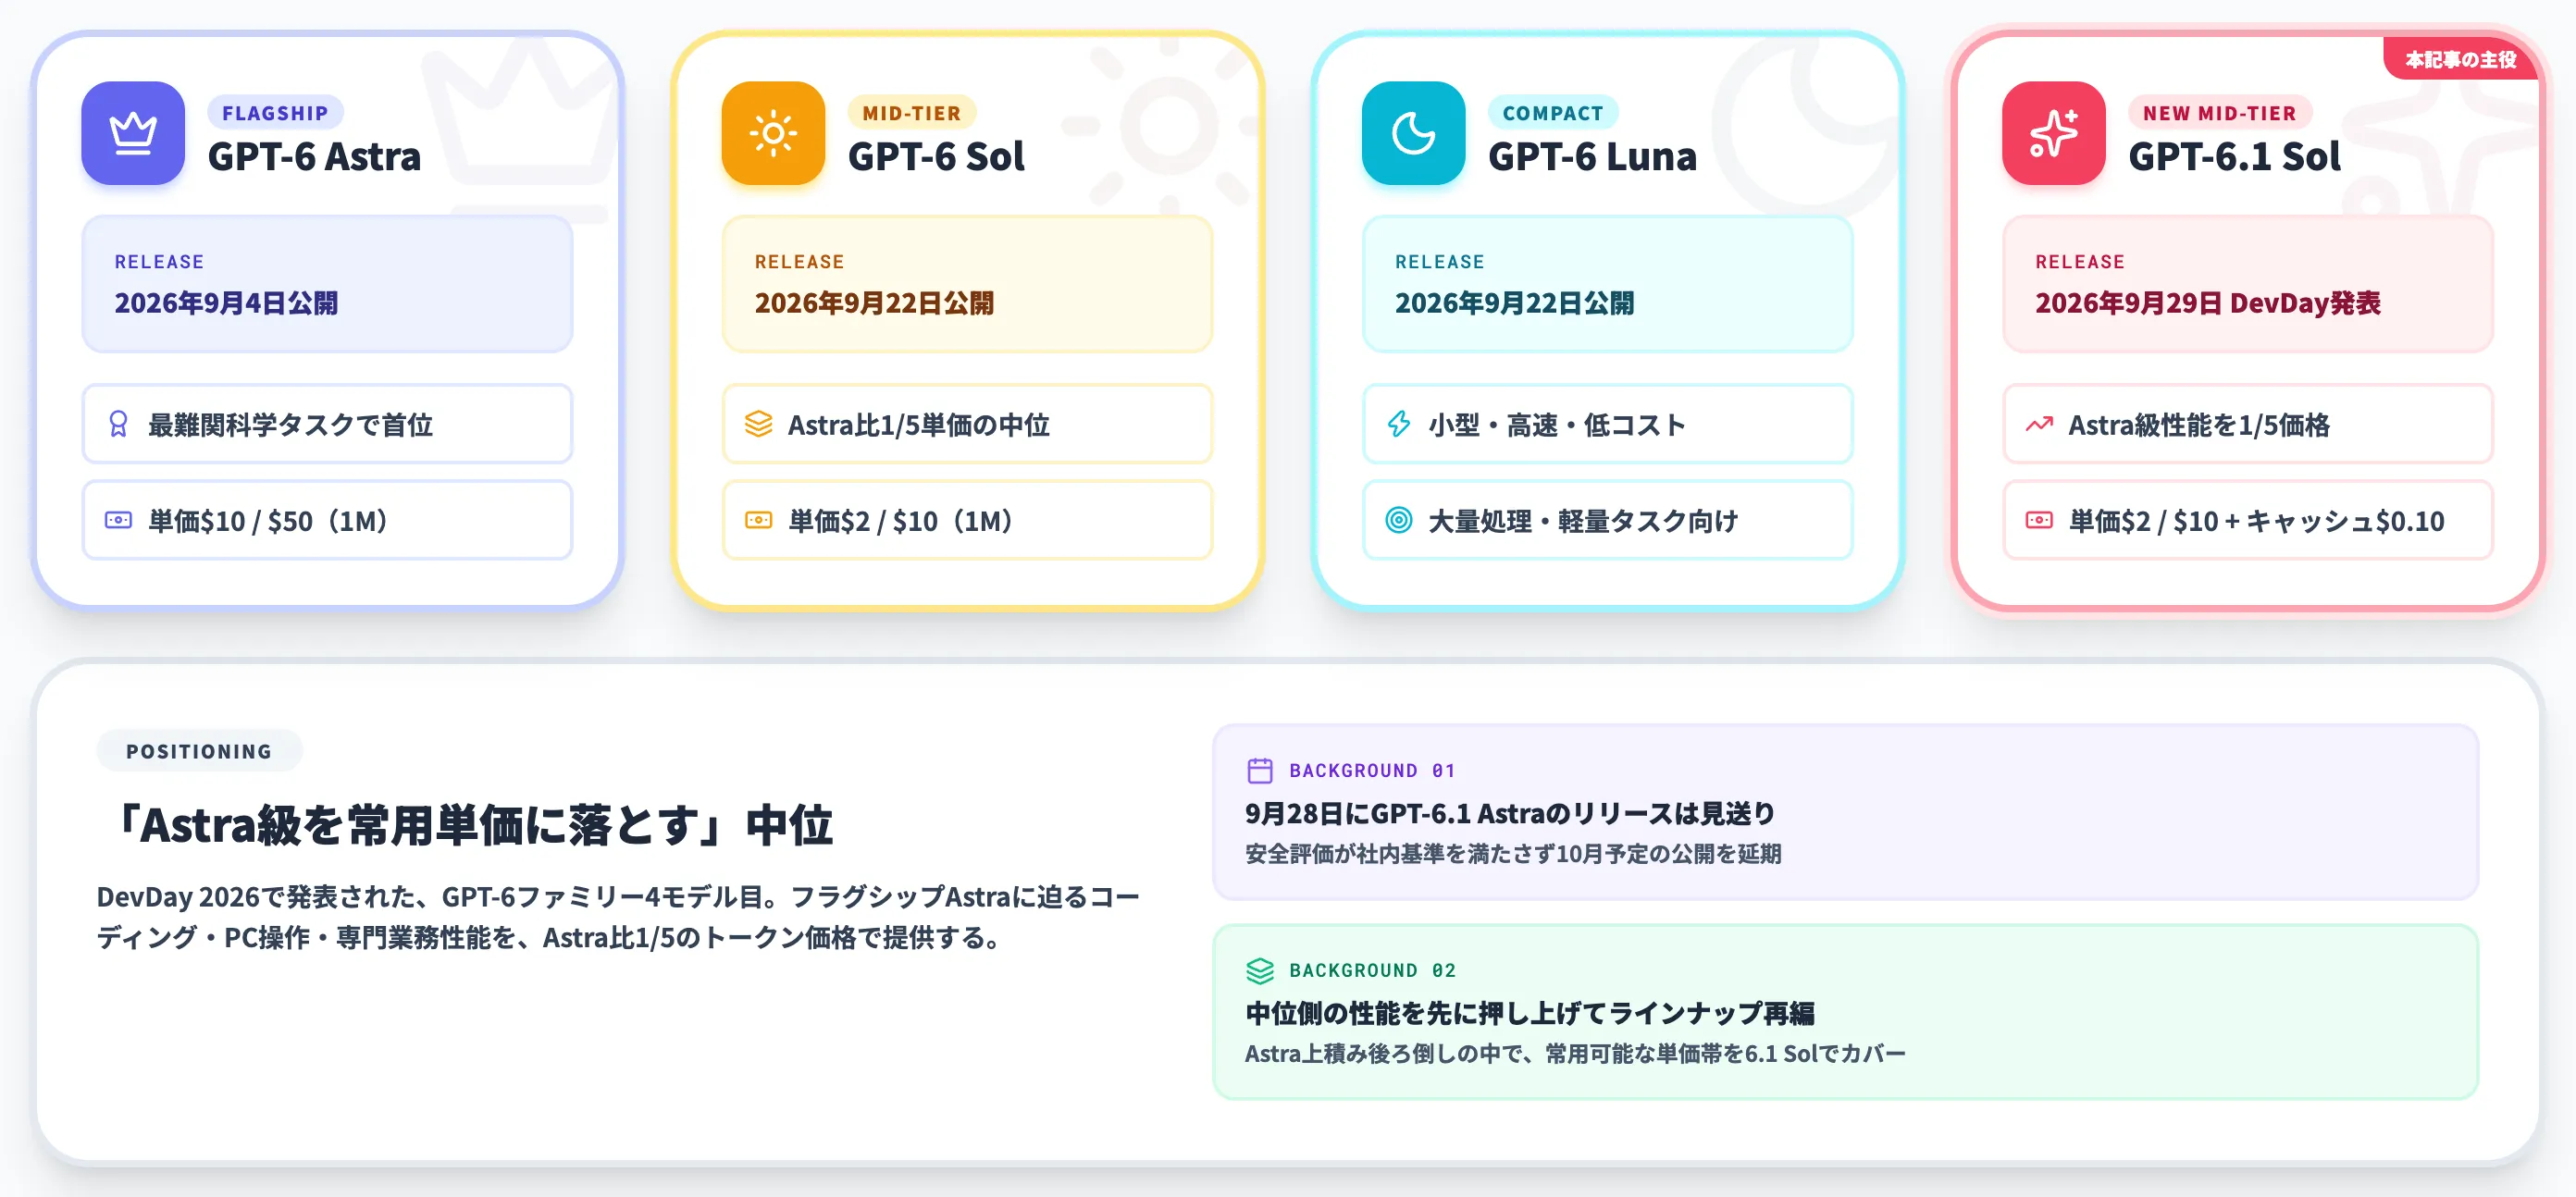
GPT-6.1 Solは、OpenAIが2026年9月29日のDevDay 2026で発表した、GPT-6 Solのアップグレード版にあたる中位クラスの新モデルです。
フラグシップであるGPT-6 Astraに迫るコーディング・PC操作・専門業務性能を、Astraの標準入出力トークン単価の1/5で提供する点が最大の特徴です。
GPT-6.1 Sol 発表時のキービジュアル(出典:OpenAI DevDay 2026 Recap)
GPT-6ファミリーは、9月4日公開のフラグシップAstra、9月22日公開の中位Sol・小型Luna、そして今回の6.1 Solという3回の発表で4モデルがそろいました。
GPT-6.1 Solはこの中で「Astra級の性能を常用可能な単価に落とし込むミッドレンジ」という役割を担います。
もう一つの背景として、DevDay直前の9月28日、AP通信はOpenAIが10月予定だったGPT-6.1 Astraのリリースを見送ったと報じました。
安全評価で「範囲・権限の順守や実行内容の報告が社内基準を満たさなかった」ためです。
フラグシップの上積みが後ろ倒しになる中で、中位側の性能を先に押し上げてラインナップ全体を整えたのが今回の6.1 Solという位置づけになります。
GPT-6.1 Solの性能ベンチマーク
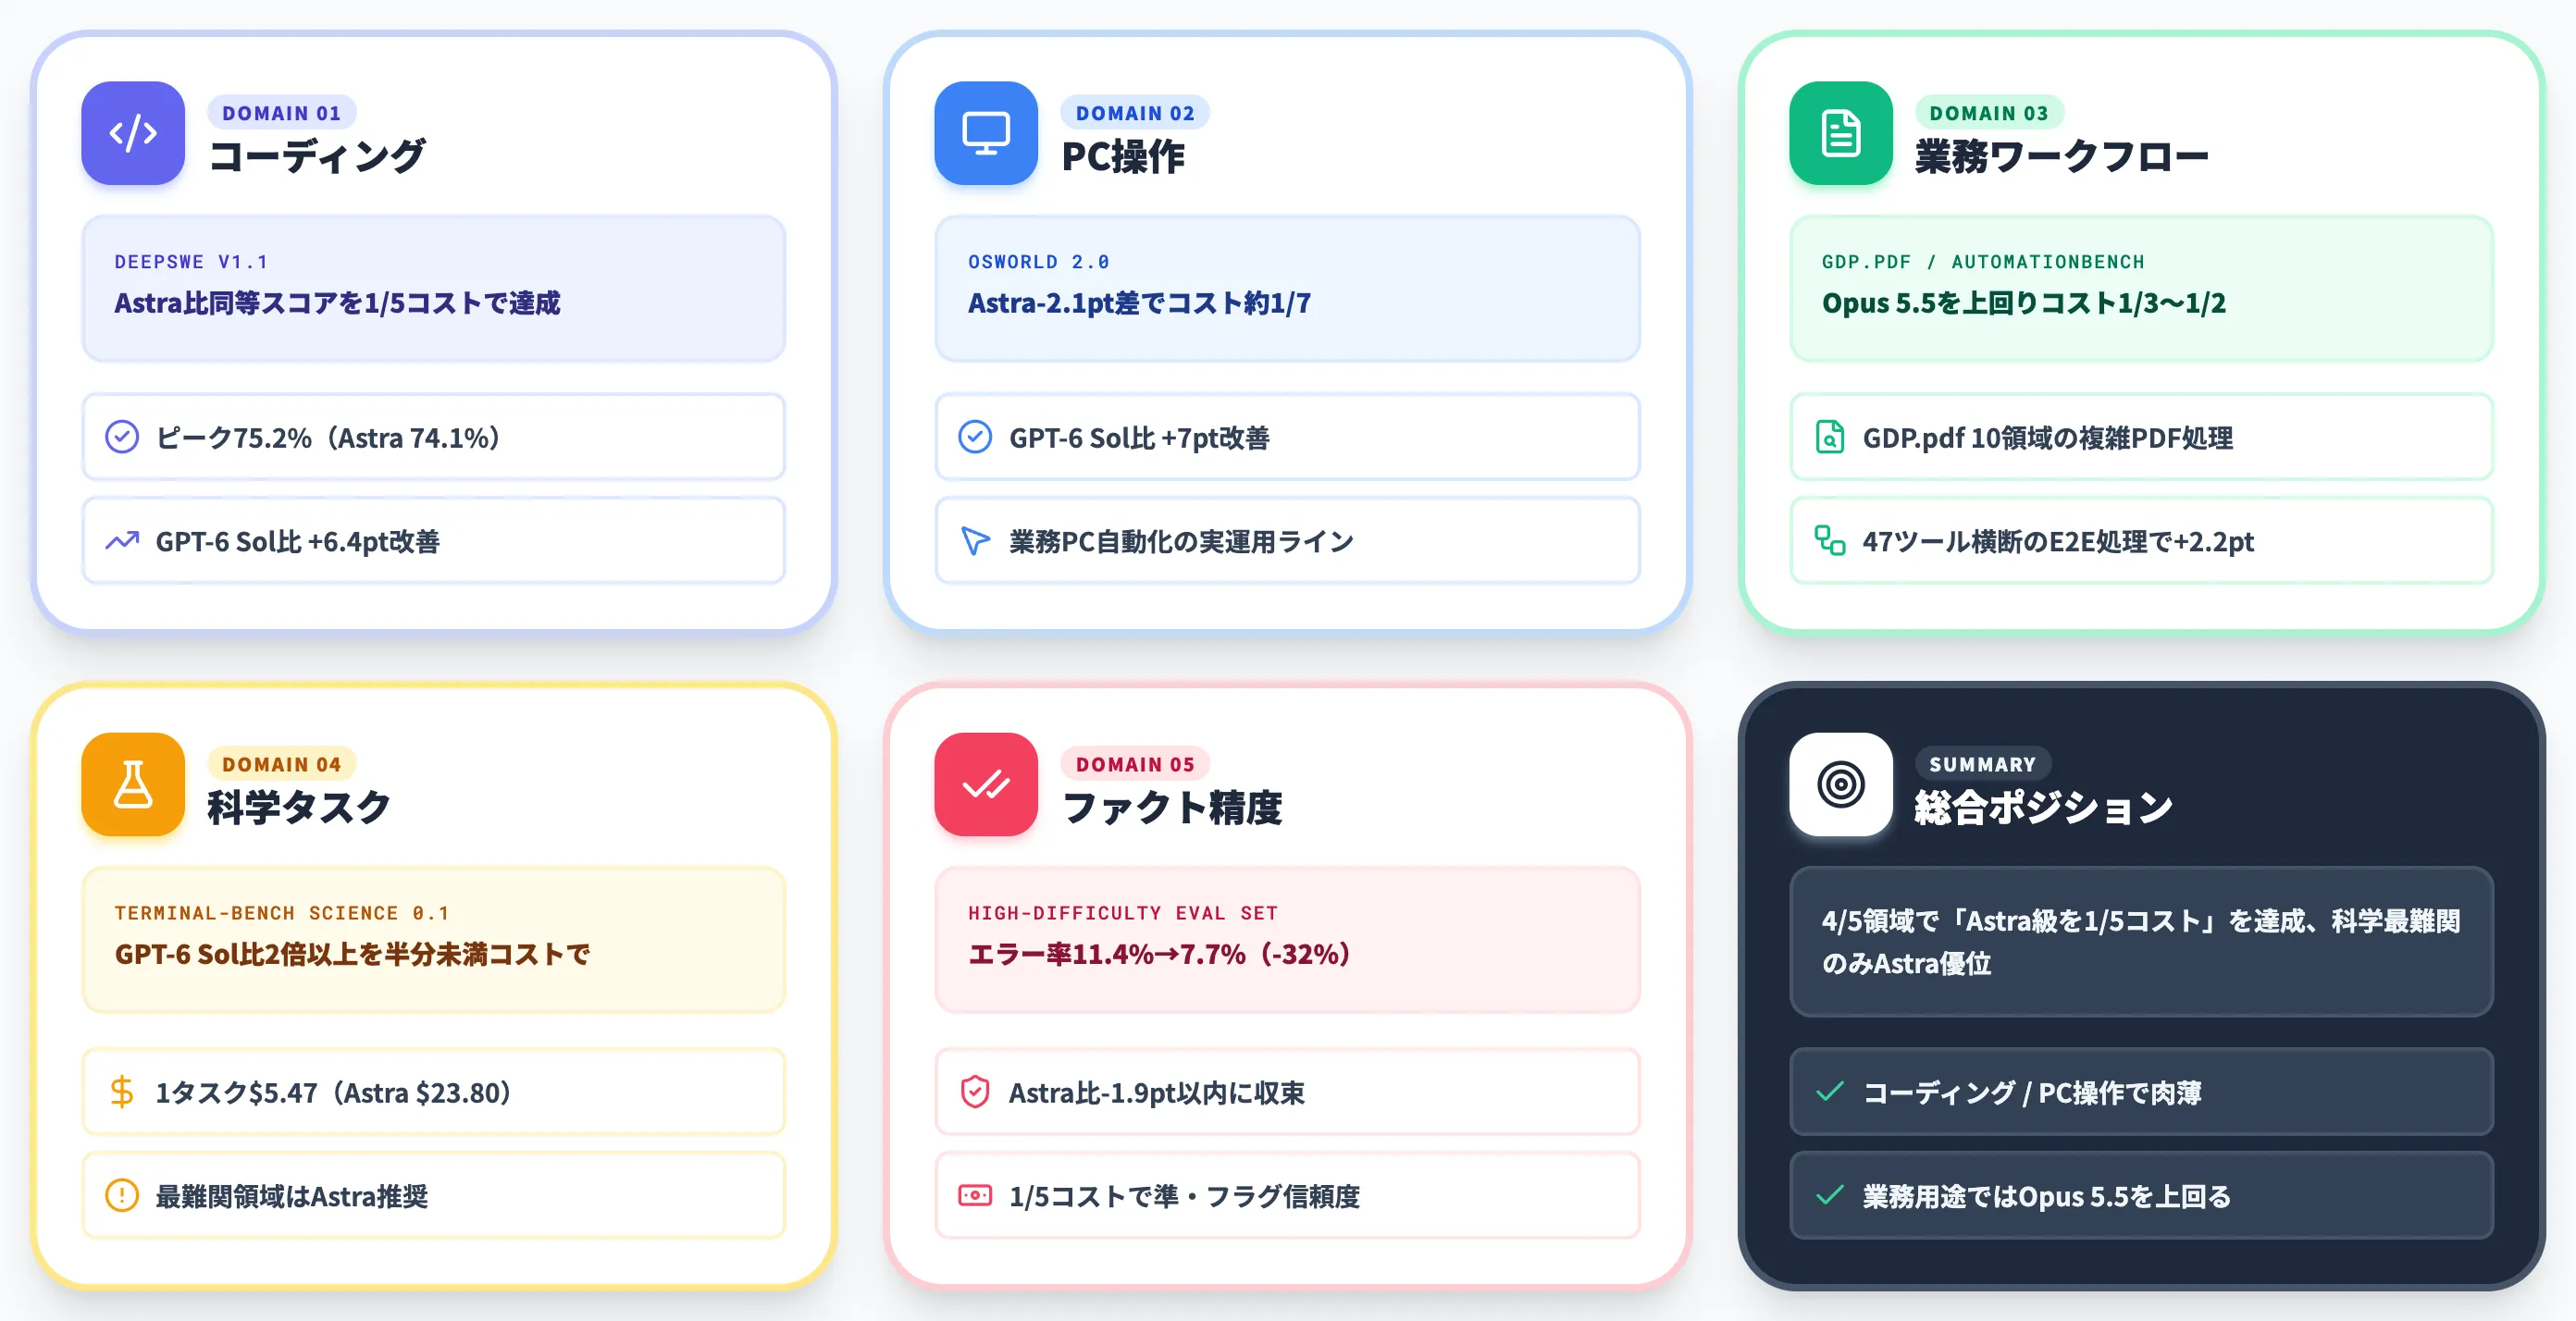
GPT-6.1 Solの性能は、コーディング・PC操作・業務ワークフロー・科学タスク・ファクト精度の5領域に分けてOpenAI公式blogで公開されています。
本セクションでは各領域の代表ベンチマークを、Astraおよび前世代Sol・競合Opus 5.5との比較で整理します。
コーディング性能(DeepSWE v1.1)
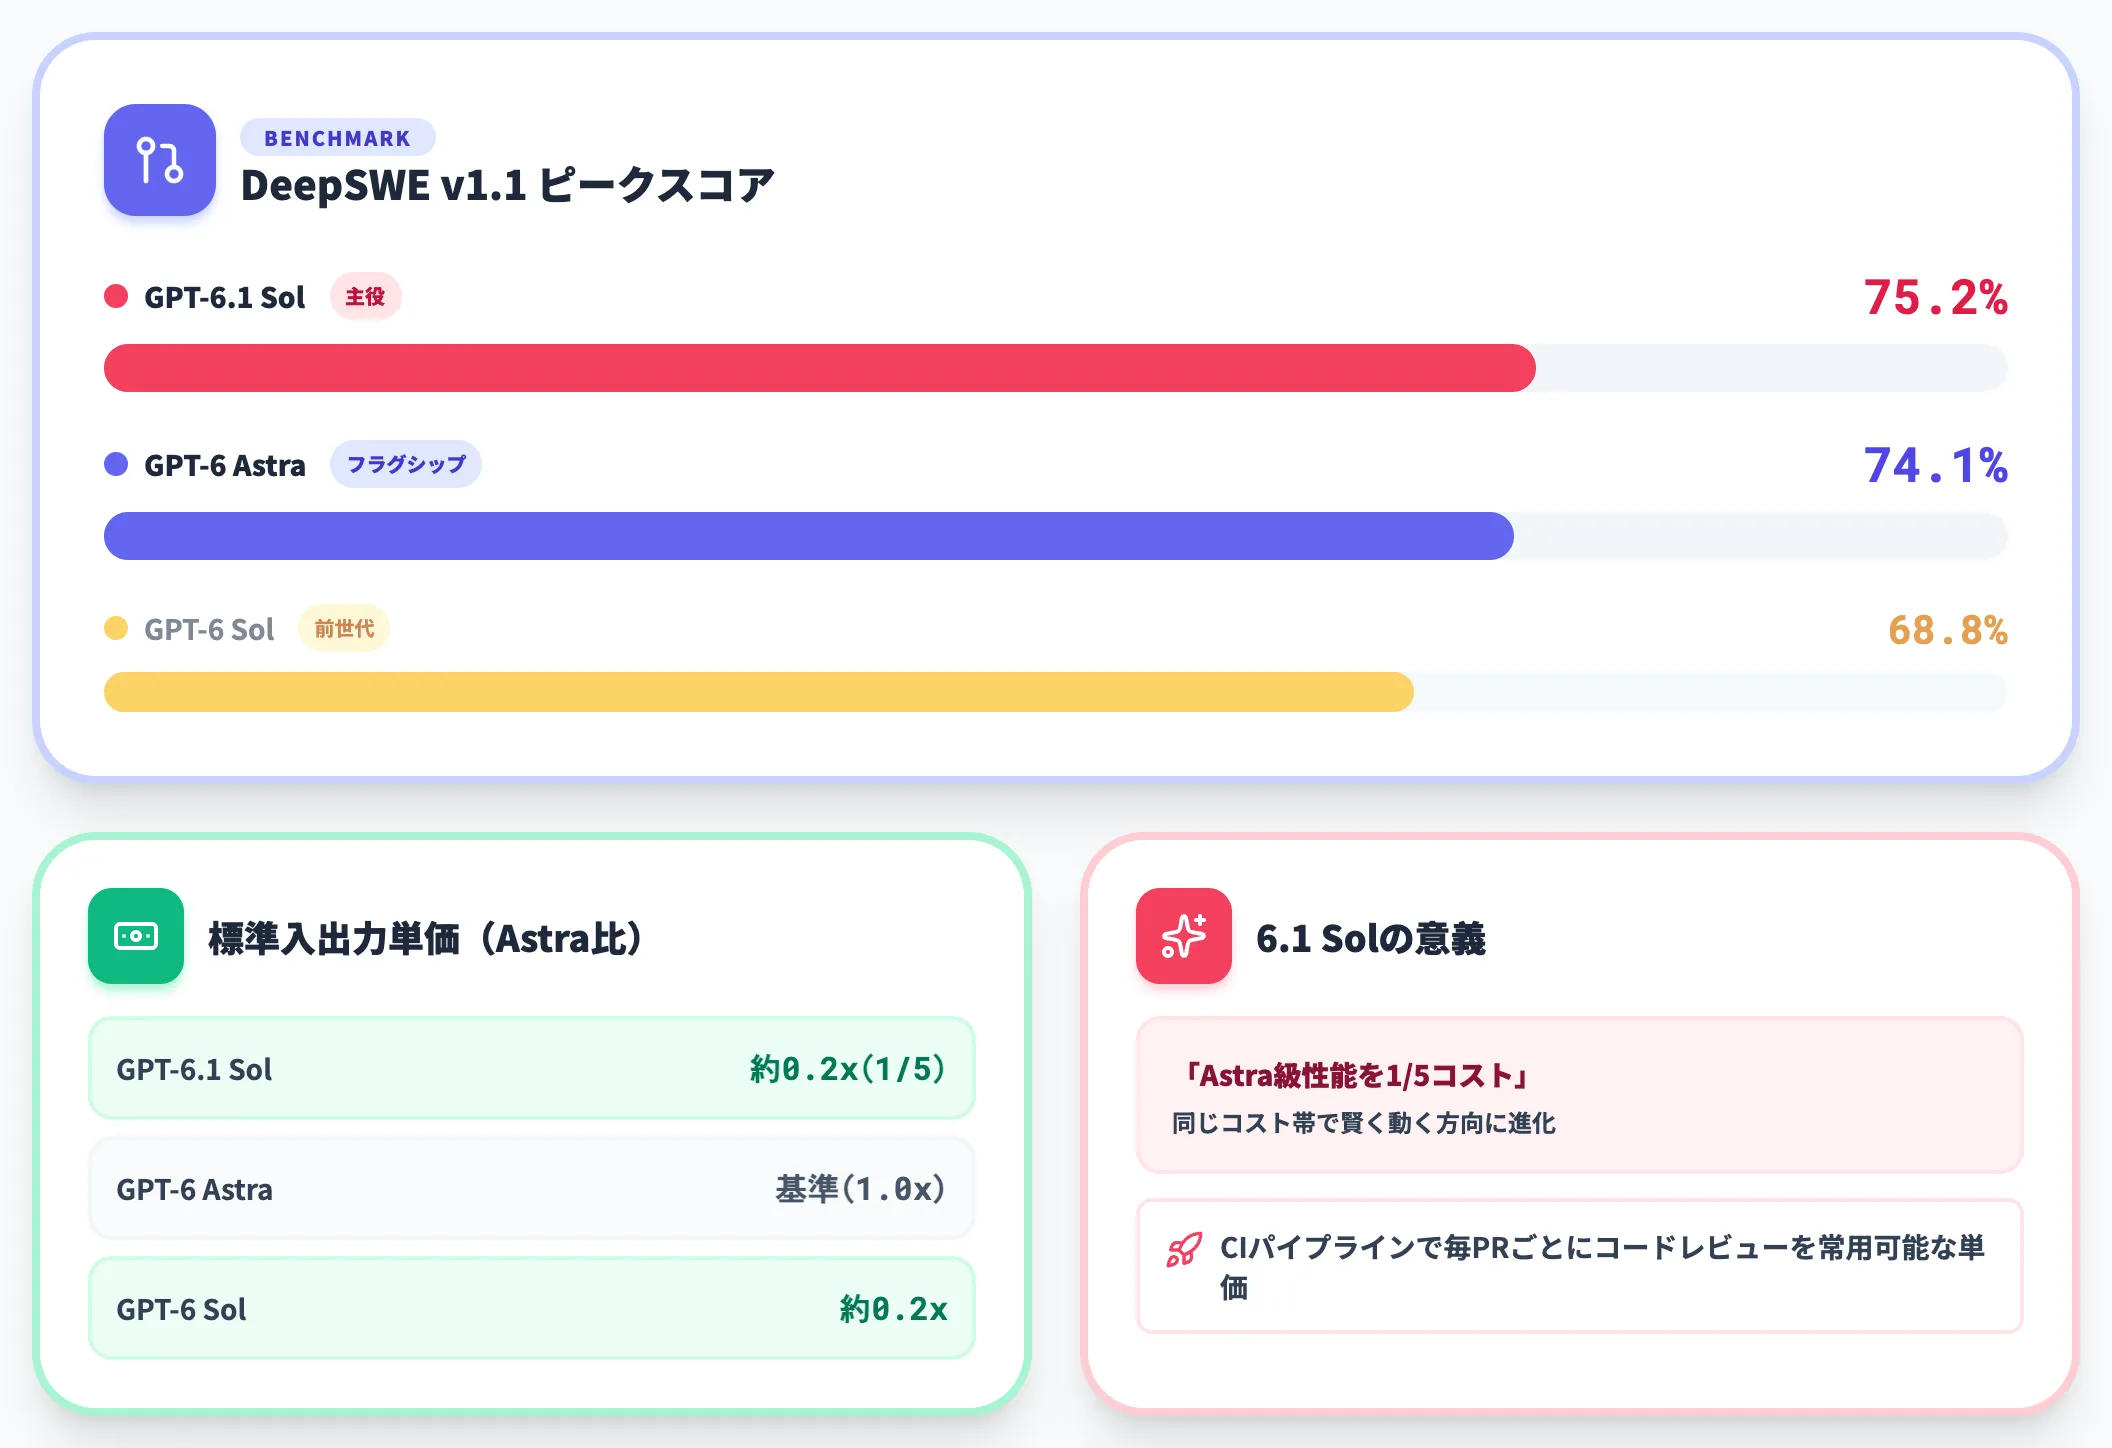
自律エージェントが実際のリポジトリで複雑なソフトウェア工学タスクを解くDeepSWE v1.1ベンチマークで、GPT-6.1 SolはAstra級のスコアを1/5コストで達成しました。
以下の表は、DeepSWE v1.1におけるGPT-6ファミリー3モデルの結果を整理したものです。
| モデル | DeepSWE v1.1 ピークスコア | 標準入出力単価(Astra比) |
|---|---|---|
| GPT-6 Astra | 約74.1% | 基準(1.0x) |
| GPT-6.1 Sol | 約75.2%(Astra同等) | 約0.2x(1/5) |
| GPT-6 Sol | 約68.8% | 約0.2x |
特筆すべきは、GPT-6.1 Solが前世代のGPT-6 Solのベストスコアを6.4ポイント上回りながら、より低い推論努力設定でこれを達成している点です。これは「大きなモデルを長く考えさせる」ではなく「同じコスト帯で賢く動く」方向に進化したことを意味します。
エージェント型コーディングを本番投入する際、コストの主要因は「1タスクあたりのトークン消費」です。DeepSWE v1.1でAstra同等スコアを1/5コストで出せるということは、CIパイプラインで毎PRごとにコードレビューエージェントを走らせる、といった常用シナリオが現実的な単価に収まる意味合いを持ちます。
PC操作性能(OSWorld 2.0)
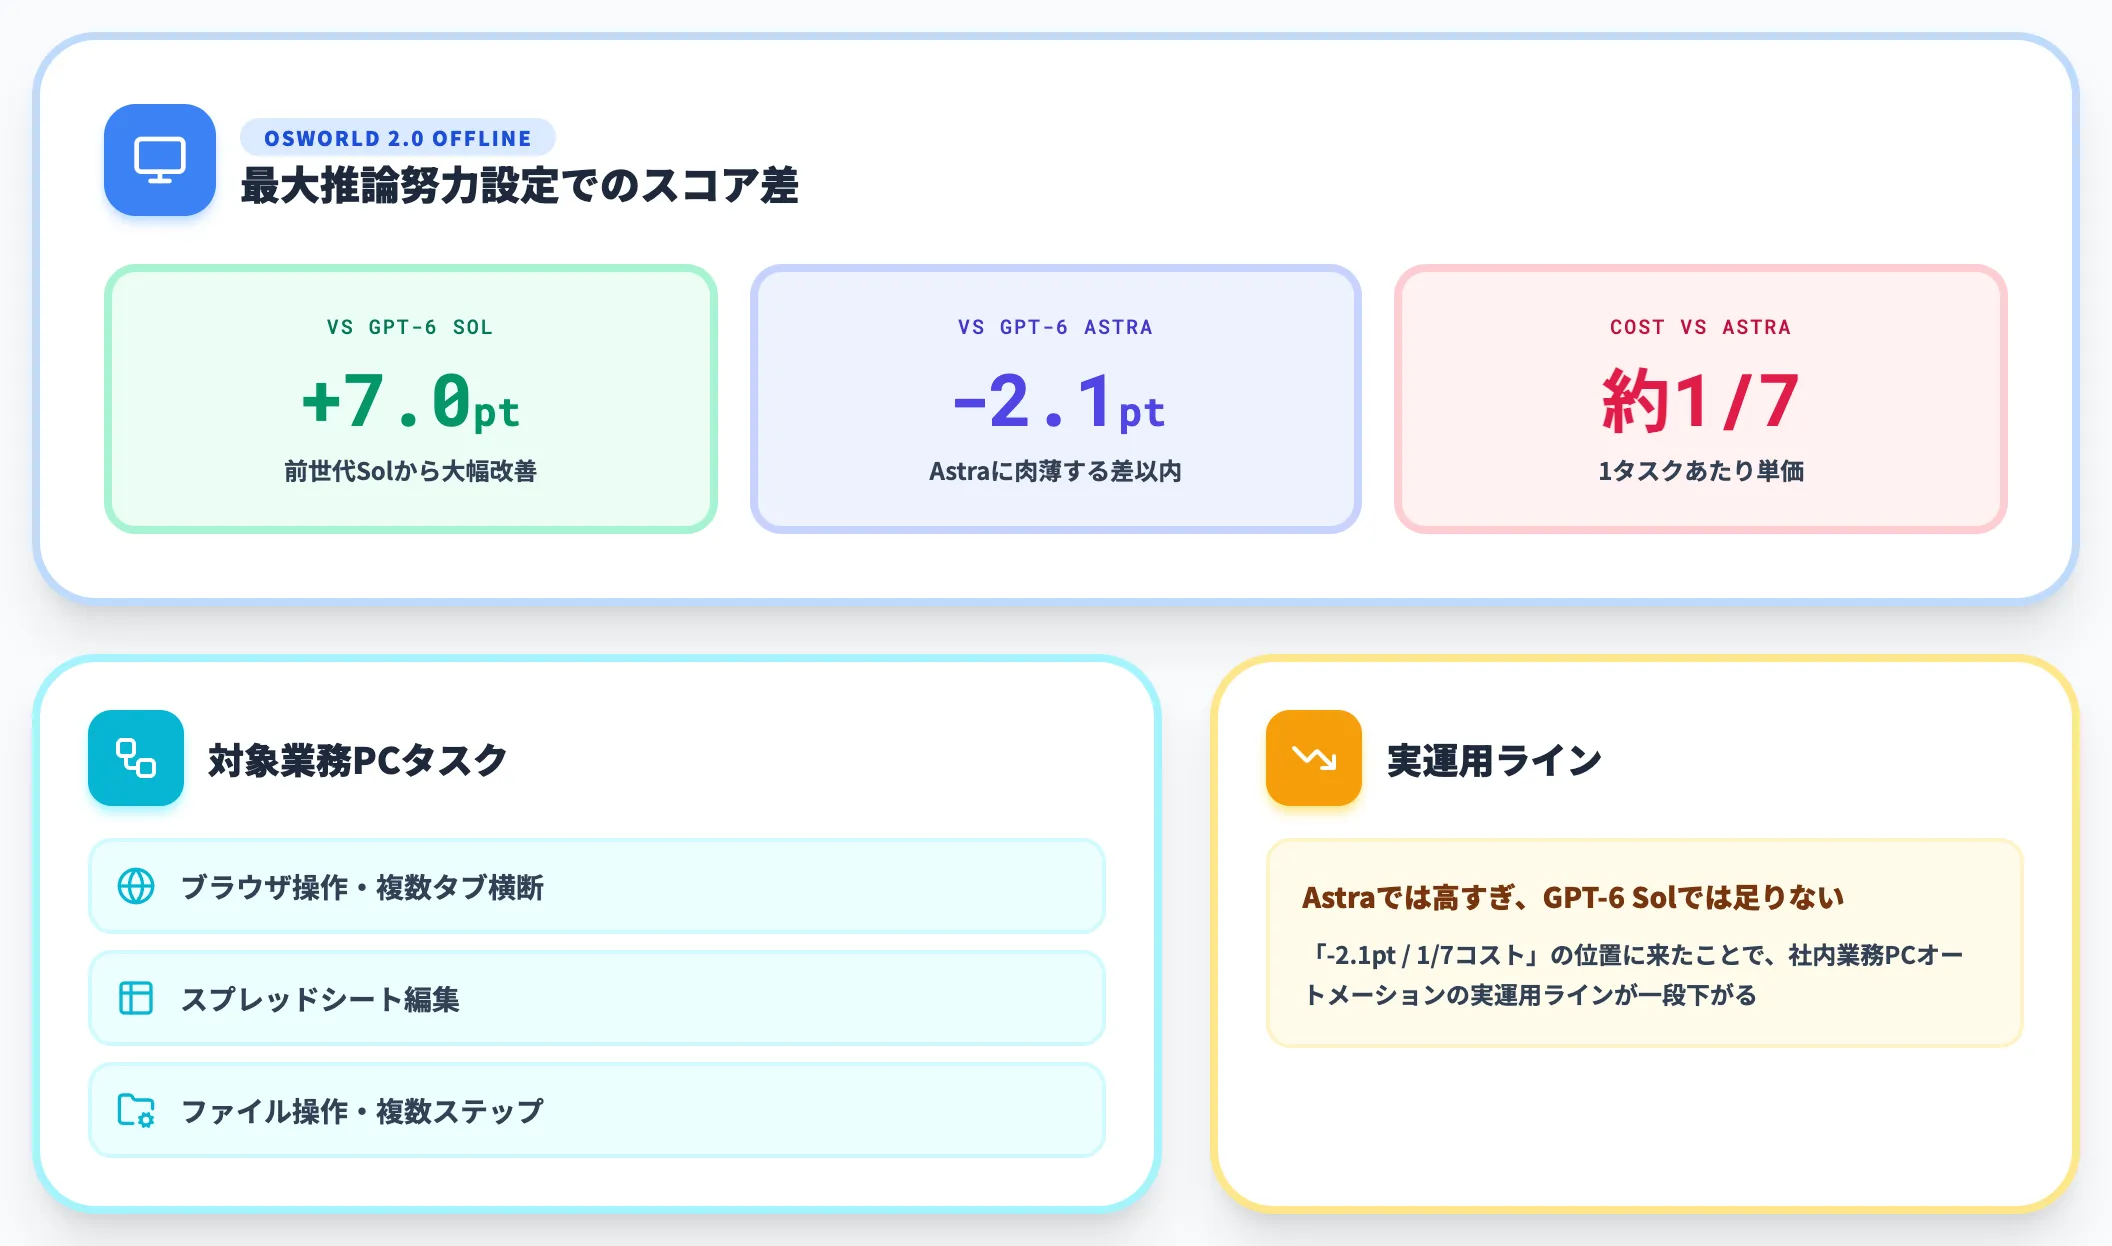
エージェントが実際のPC上で複数ステップの操作を実行するOSWorld 2.0オフラインセットでも、GPT-6.1 SolはAstraに迫る成績を示しました。
- 最大推論努力設定で、GPT-6 Solより7ポイント上回るスコアを達成
- Astraのスコアとは2.1ポイント差以内まで肉薄
- 1タスクあたりのコストはAstraの約1/7
ブラウザ操作・スプレッドシート編集・ファイル操作といった業務PCタスクをエージェントに任せる場面で、Astraを毎回動かすのはコスト面で厳しいケースがほとんどでした。
6.1 SolがOSWorld 2.0で「Astra比-2.1pt / コスト1/7」という位置に来たことで、社内業務PCオートメーションの実運用ラインが一段下がります。
業務文書とワークフロー性能
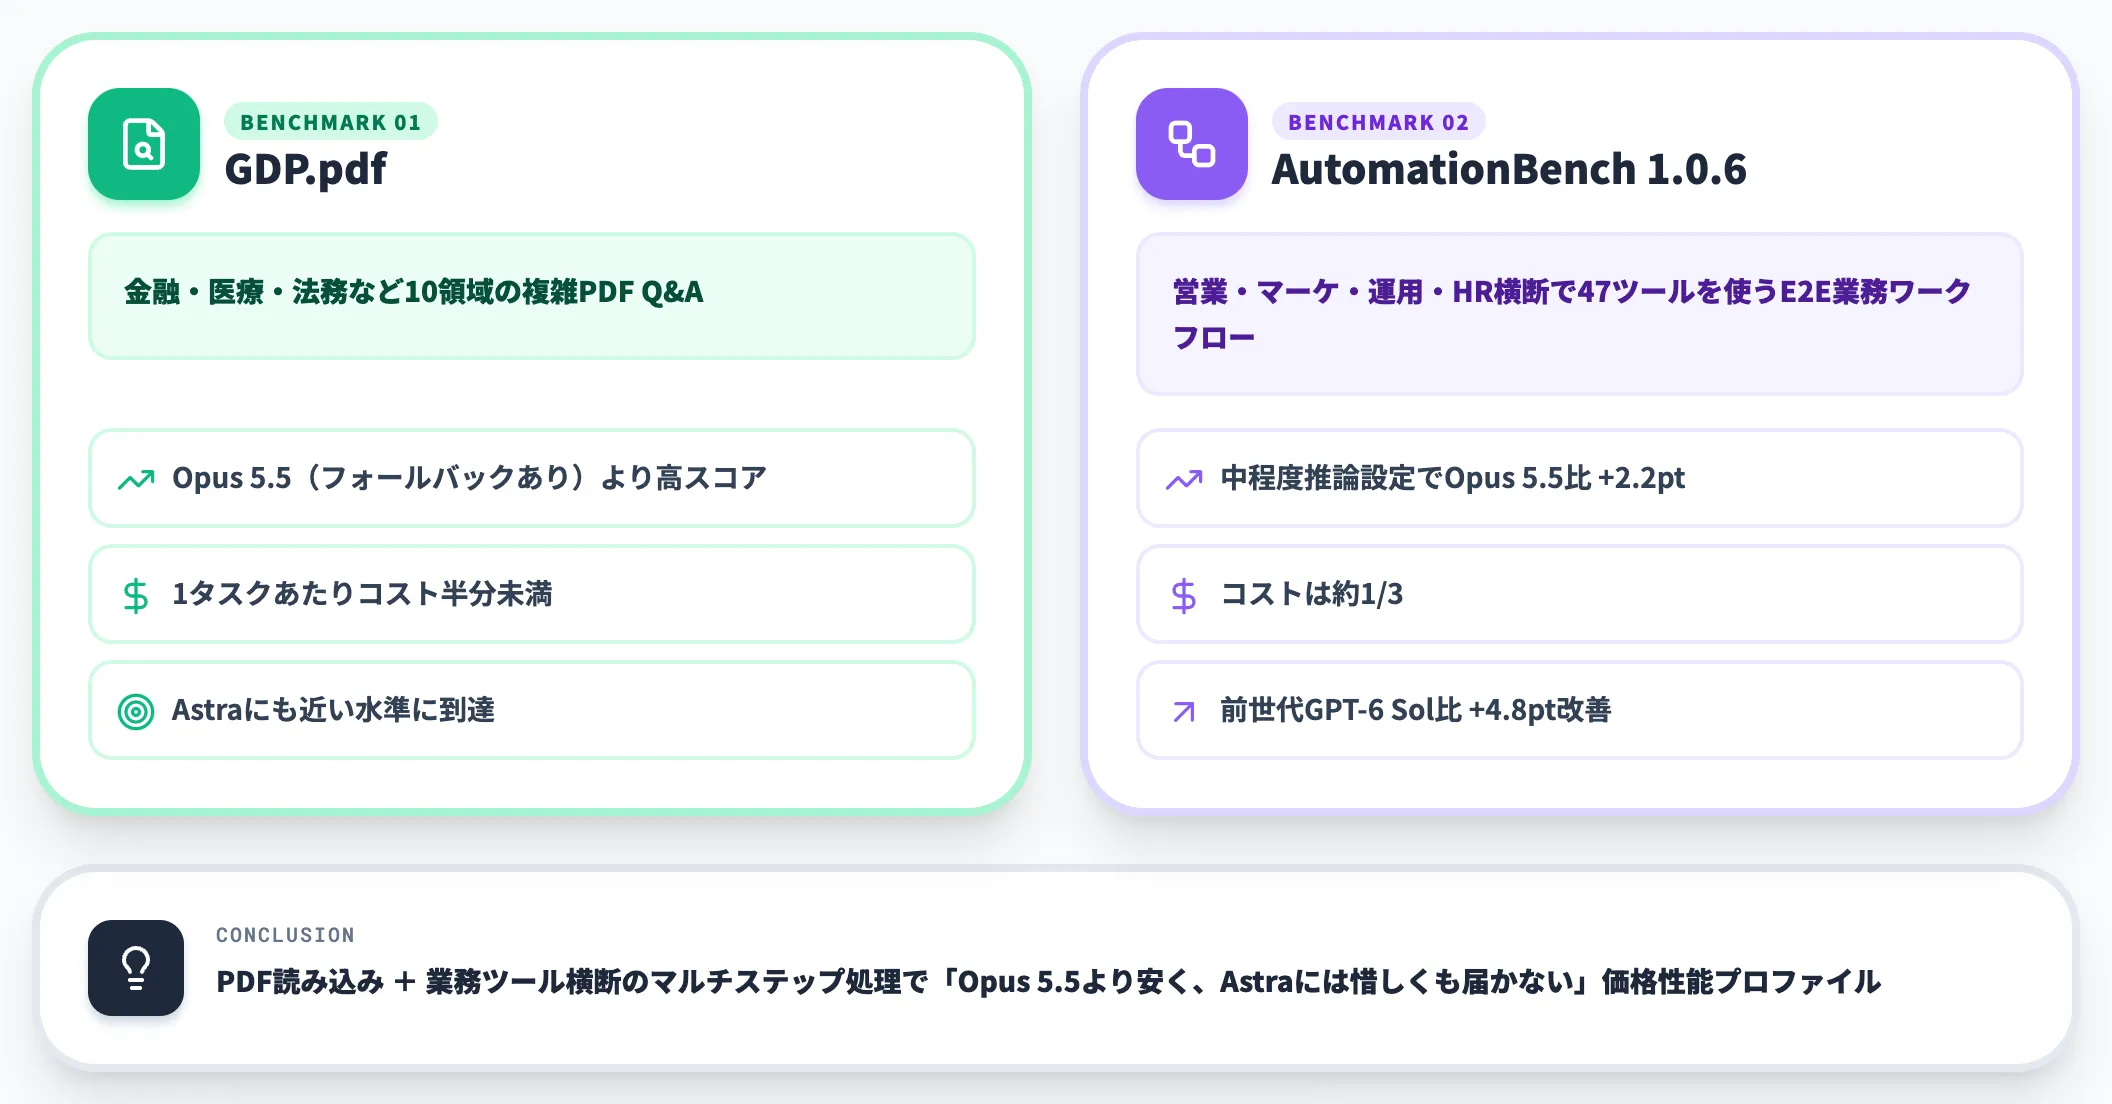
専門的な業務文書処理を測る2つの評価で、GPT-6.1 SolはClaude Opus 5.5を上回る結果を出しています。
-
GDP.pdf**(金融・医療・法務など10領域の複雑なPDFに関する質問応答)
GPT-6.1 SolはOpus 5.5(フォールバックあり)より高スコアを、1タスクあたり半分未満のコストで達成。Astraにも近い水準に到達している
-
AutomationBench 1.0.6**(営業・マーケ・運用・HR等で47ツールを横断するエンドツーエンド業務ワークフロー)
中程度推論設定でOpus 5.5を2.2ポイント上回りながら、コストは約1/3。前世代GPT-6 Solからも4.8ポイント改善
つまり実務でありがちな「PDF読み込み+業務ツール横断でのマルチステップ処理」という組み合わせにおいて、GPT-6.1 SolはOpus 5.5より安く、Astraには惜しくも届かないという価格性能プロファイルになっています。
科学タスクとファクト精度
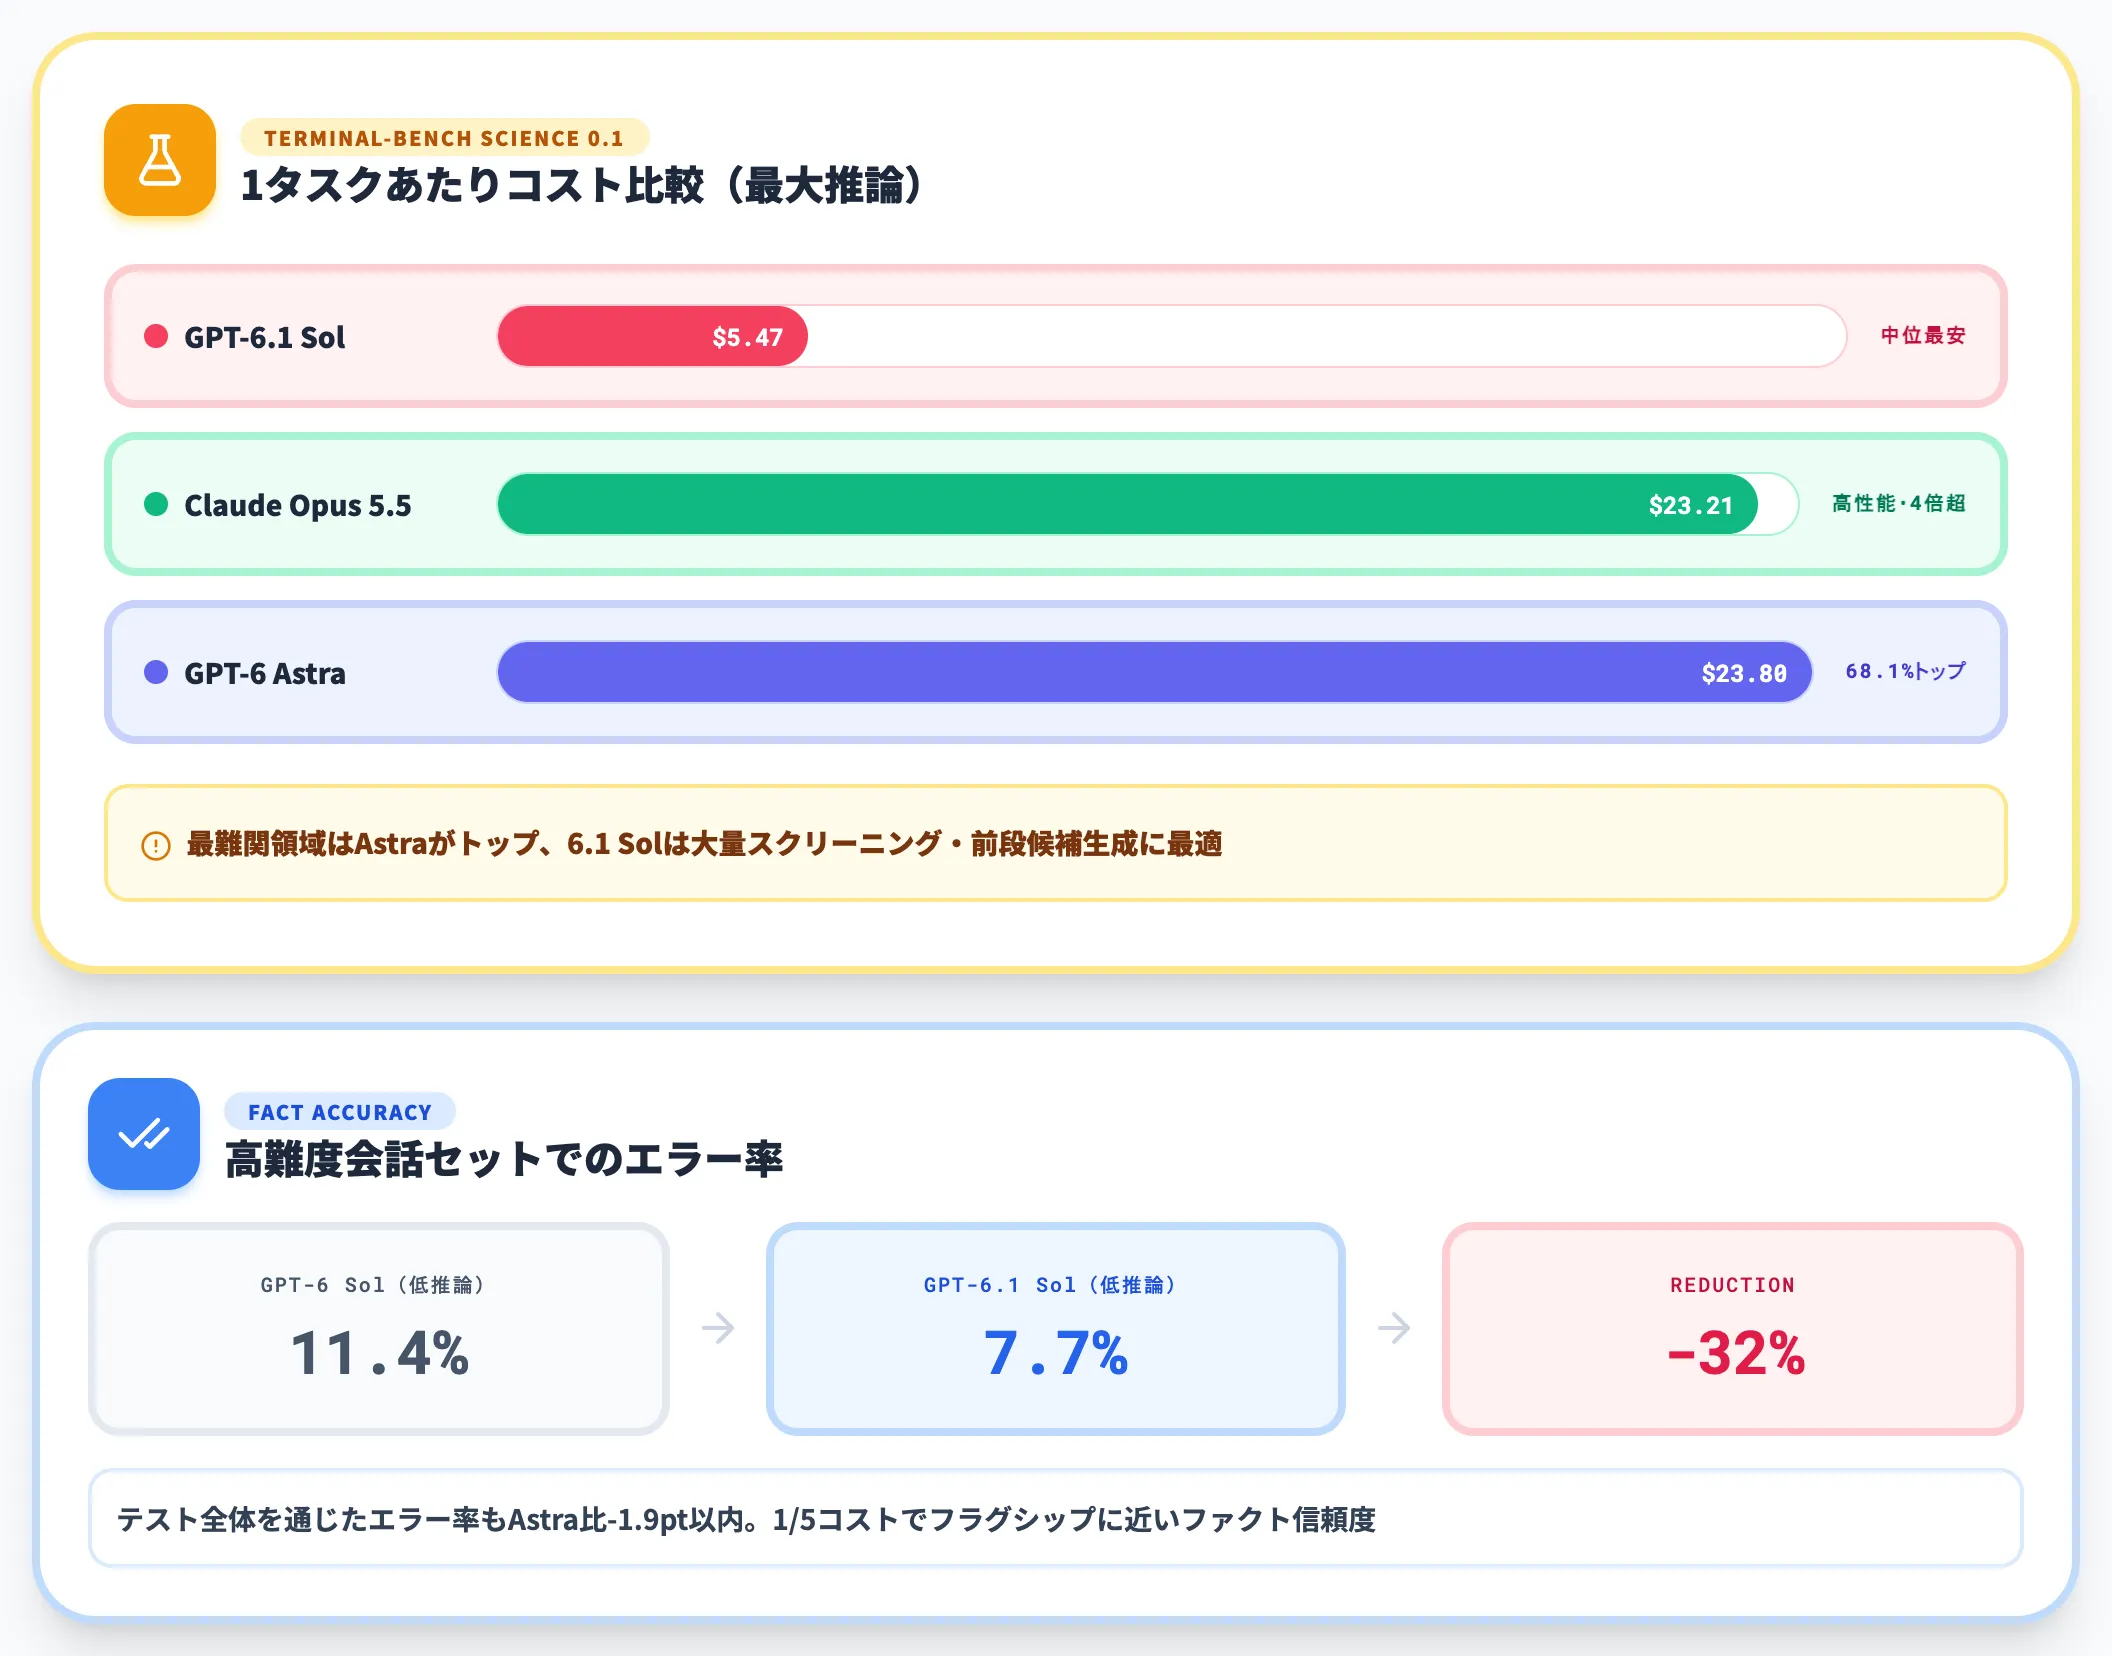
科学ワークフロー(データ分析・シミュレーション・定理証明)を評価するTerminal-Bench Science 0.1では、GPT-6.1 Solが前世代GPT-6 Solの倍以上のスコアを、半分未満のコストで達成しました。
以下の表は、Terminal-Bench Science 0.1における最大推論努力設定での1タスクあたりコスト比較です。
| モデル | 1タスクあたりコスト | 位置づけ |
|---|---|---|
| GPT-6.1 Sol | $5.47 | 中位モデルで最安、性能はGPT-6 Sol比2倍以上 |
| Claude Opus 5.5 | $23.21 | 高性能だがコストは4倍超 |
| GPT-6 Astra | $23.80 | Terminal-Bench Scienceで68.1%のトップスコア |
科学タスクの最難関領域では依然としてAstraが最高スコアを保持しており、OpenAI自身も「最も難しい科学研究タスクにはAstraを使うべき」と明記しています。ただし、コスト75%削減で「準・Astra級」の科学タスク性能が手に入るという点で、大量スクリーニングや前段の候補生成といった用途では6.1 Solが第一候補になります。
ファクト精度の面では、ユーザーが過去モデルの誤りをフラグした難しい会話を集めた評価セットで、低推論設定でのエラー率が11.4%から7.7%に低下(約32%の削減)しました。
これは一般利用全体の平均エラー率ではなく限定的な高難度セットでの改善指標ですが、テスト全体を通じたエラー率もAstraの1.9ポイント差以内に収まっており、1/5のコストでフラグシップに近いファクト信頼度が得られます。
GPT-6.1 Solの料金体系
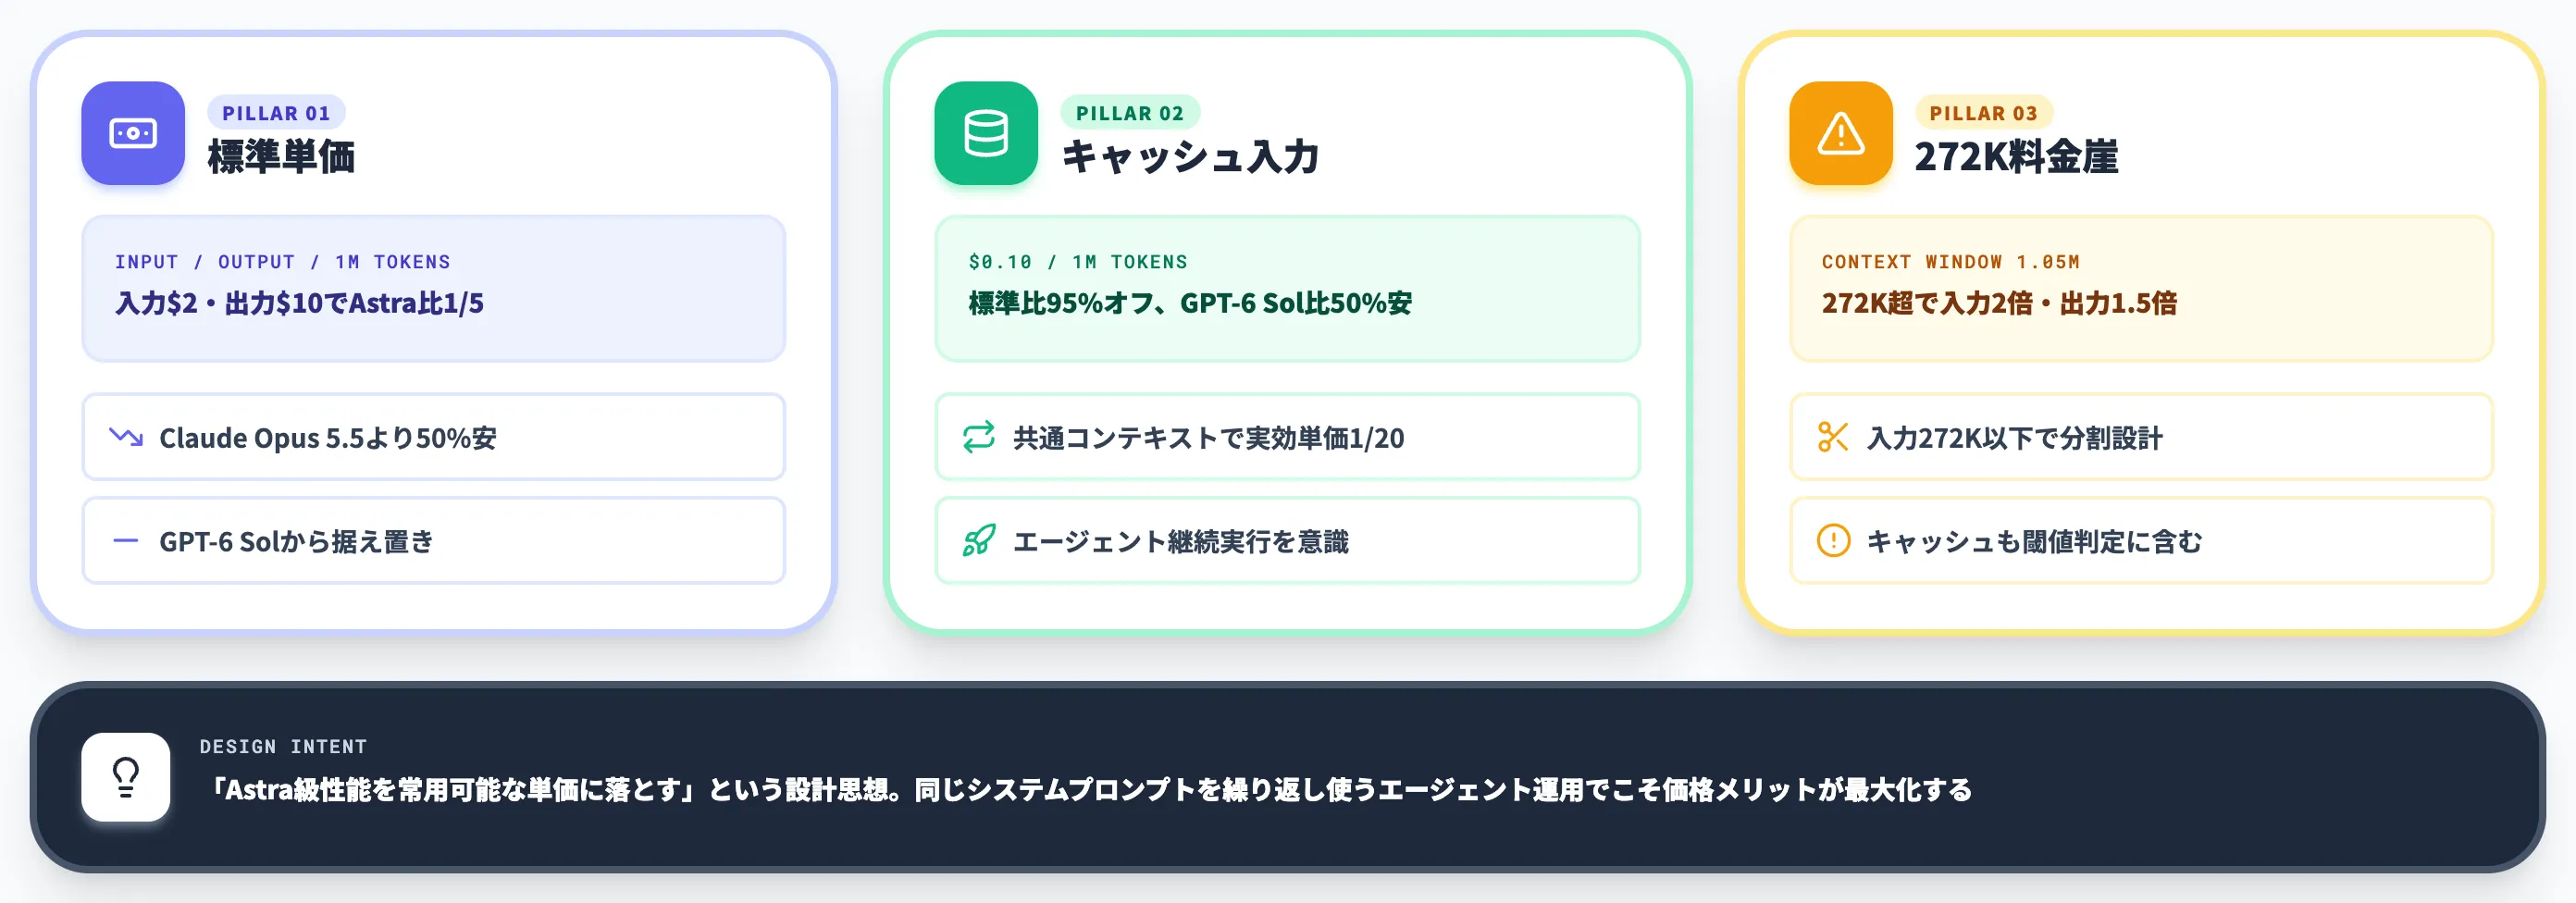
GPT-6.1 Solの料金は「Astra級性能を常用可能な単価に落とす」という設計思想がそのまま反映されています。
本セクションでは、標準単価・キャッシュ入力・大容量入力時の料金崖の3点を、公式pricingの数値ベースで整理します。
標準料金とAstraとの比較
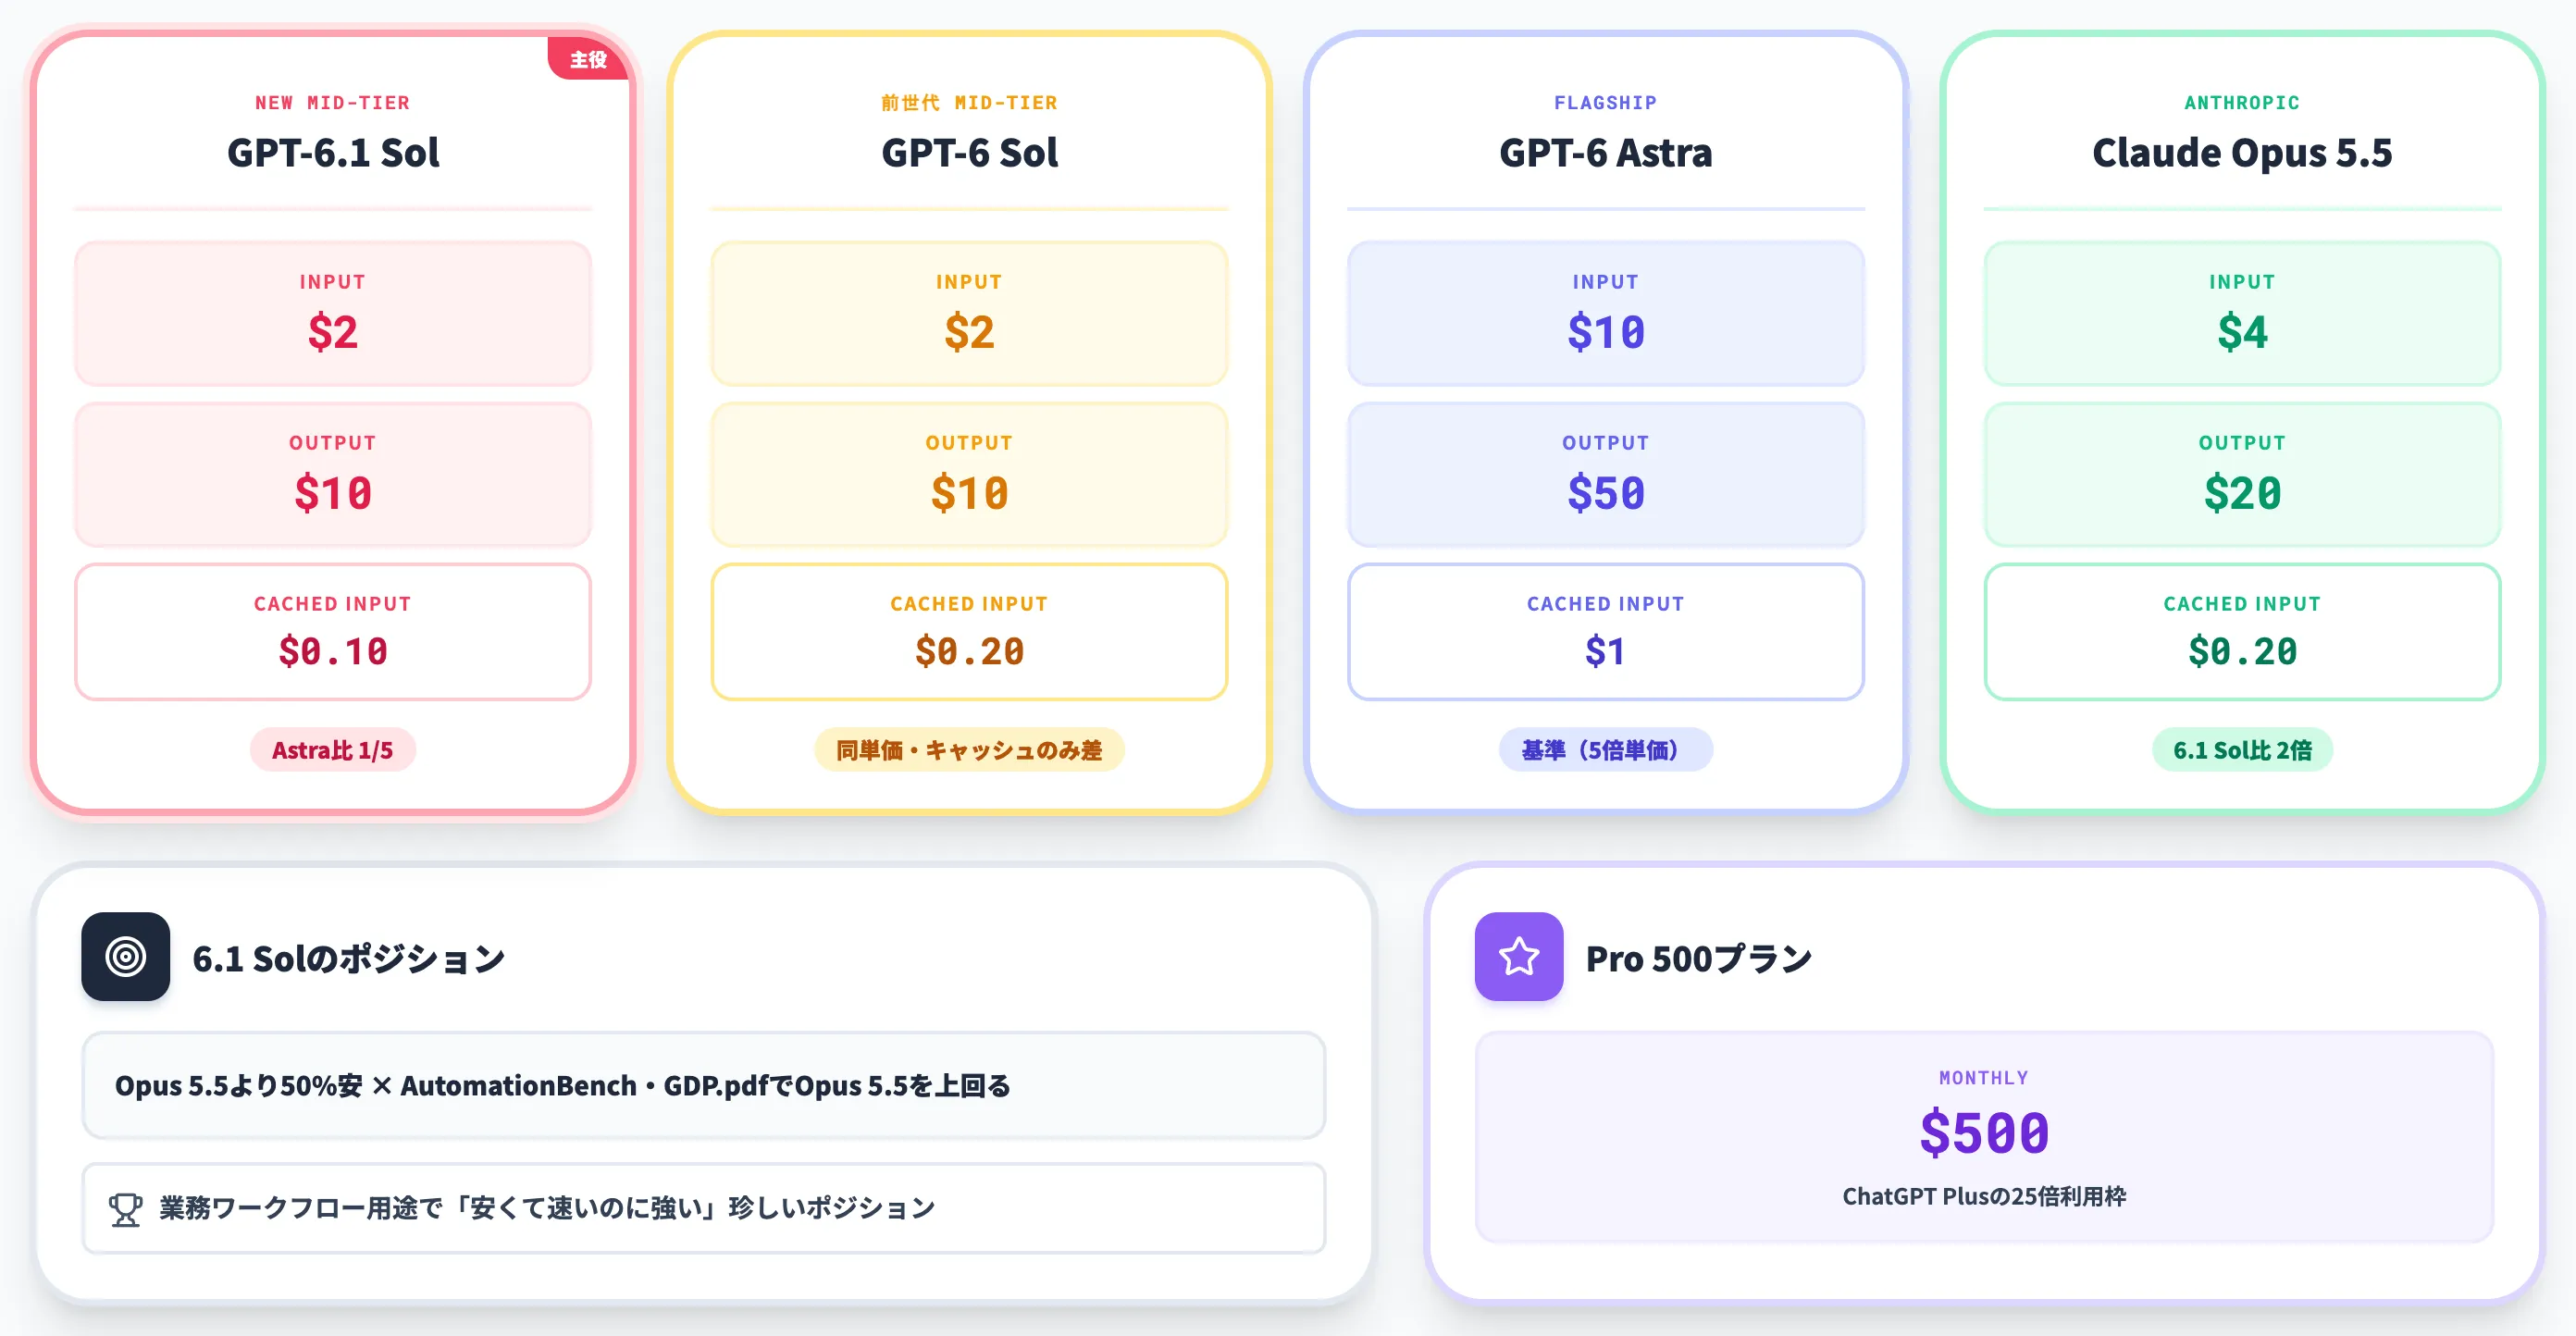
OpenAI公式blogによれば、GPT-6.1 SolのAPI標準単価は以下のとおりです。
以下の表は、GPT-6.1 SolとGPT-6 Astra・GPT-6 Sol・Claude Opus 5.5の1Mトークンあたり標準単価を並べたものです(2026年9月時点)。
| モデル | 入力(1Mトークン) | 出力(1Mトークン) | キャッシュ読み取り |
|---|---|---|---|
| GPT-6.1 Sol | $2 | $10 | $0.10 |
| GPT-6 Sol | $2 | $10 | $0.20 |
| GPT-6 Astra | $10 | $50 | $1 |
| Claude Opus 5.5 | $4 | $20 | $0.20 |
入力・出力の標準単価はGPT-6 Solから据え置きで、Astra比では入出力ともにきっちり1/5です。
単価水準としてはClaude Opus 5.5より50%安く、性能面ではAutomationBench・GDP.pdfでOpus 5.5を上回るため、業務ワークフロー用途では「安くて速いのに強い」という珍しいポジションを取っています。
キャッシュ入力$0.10の実務価値
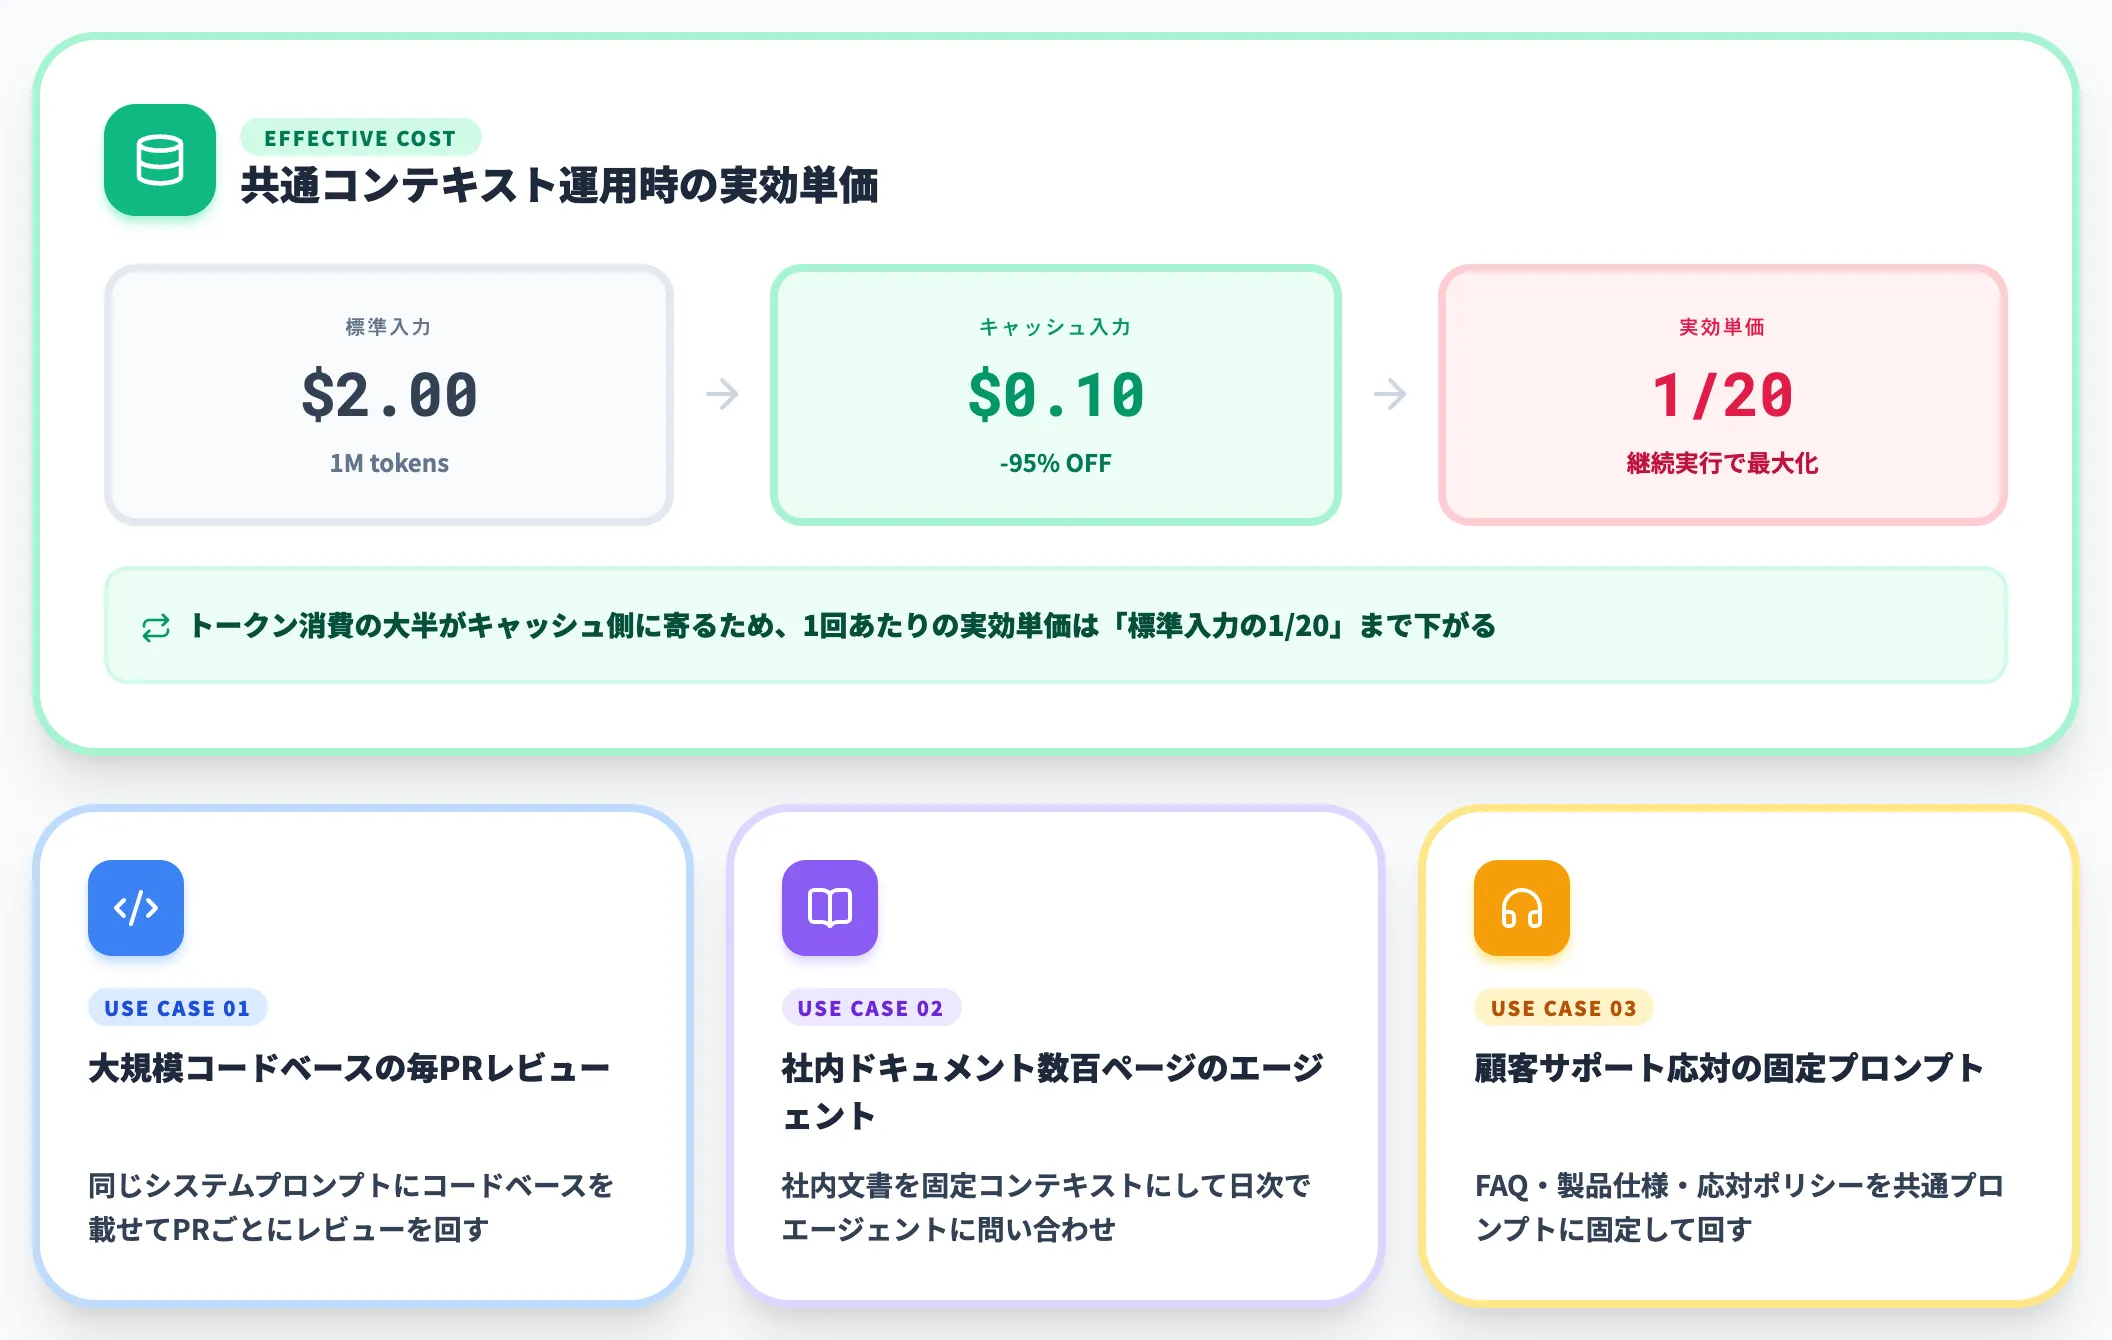
GPT-6.1 Solで特に効いてくるのが、キャッシュ入力$0.10 / 1Mトークンという設定です。標準入力$2に対して95%オフ、しかも前世代GPT-6 Solのキャッシュ入力$0.20と比べてもさらに50%安くなっています。
この価格が効くのは、同じコンテキストを繰り返し使うエージェント運用です。
- 大きなコードベースを毎回同じシステムプロンプトに載せてPRごとにレビューを回す
- 社内ドキュメント数百ページを固定コンテキストにして、日次でエージェントに問い合わせる
- 顧客サポートエージェントで、FAQ・製品仕様・応対ポリシーを共通プロンプトに固定する
こうしたケースでは、実質的なトークン消費の大半がキャッシュ側に寄るため、1回あたりの実効単価は「標準入力の1/20」まで下がります。
GPT-6.1 Solが「エージェントの継続実行を回すためのコスト構造」を意識して設計されていることが、この単価に表れています。
272Kトークン超の料金崖
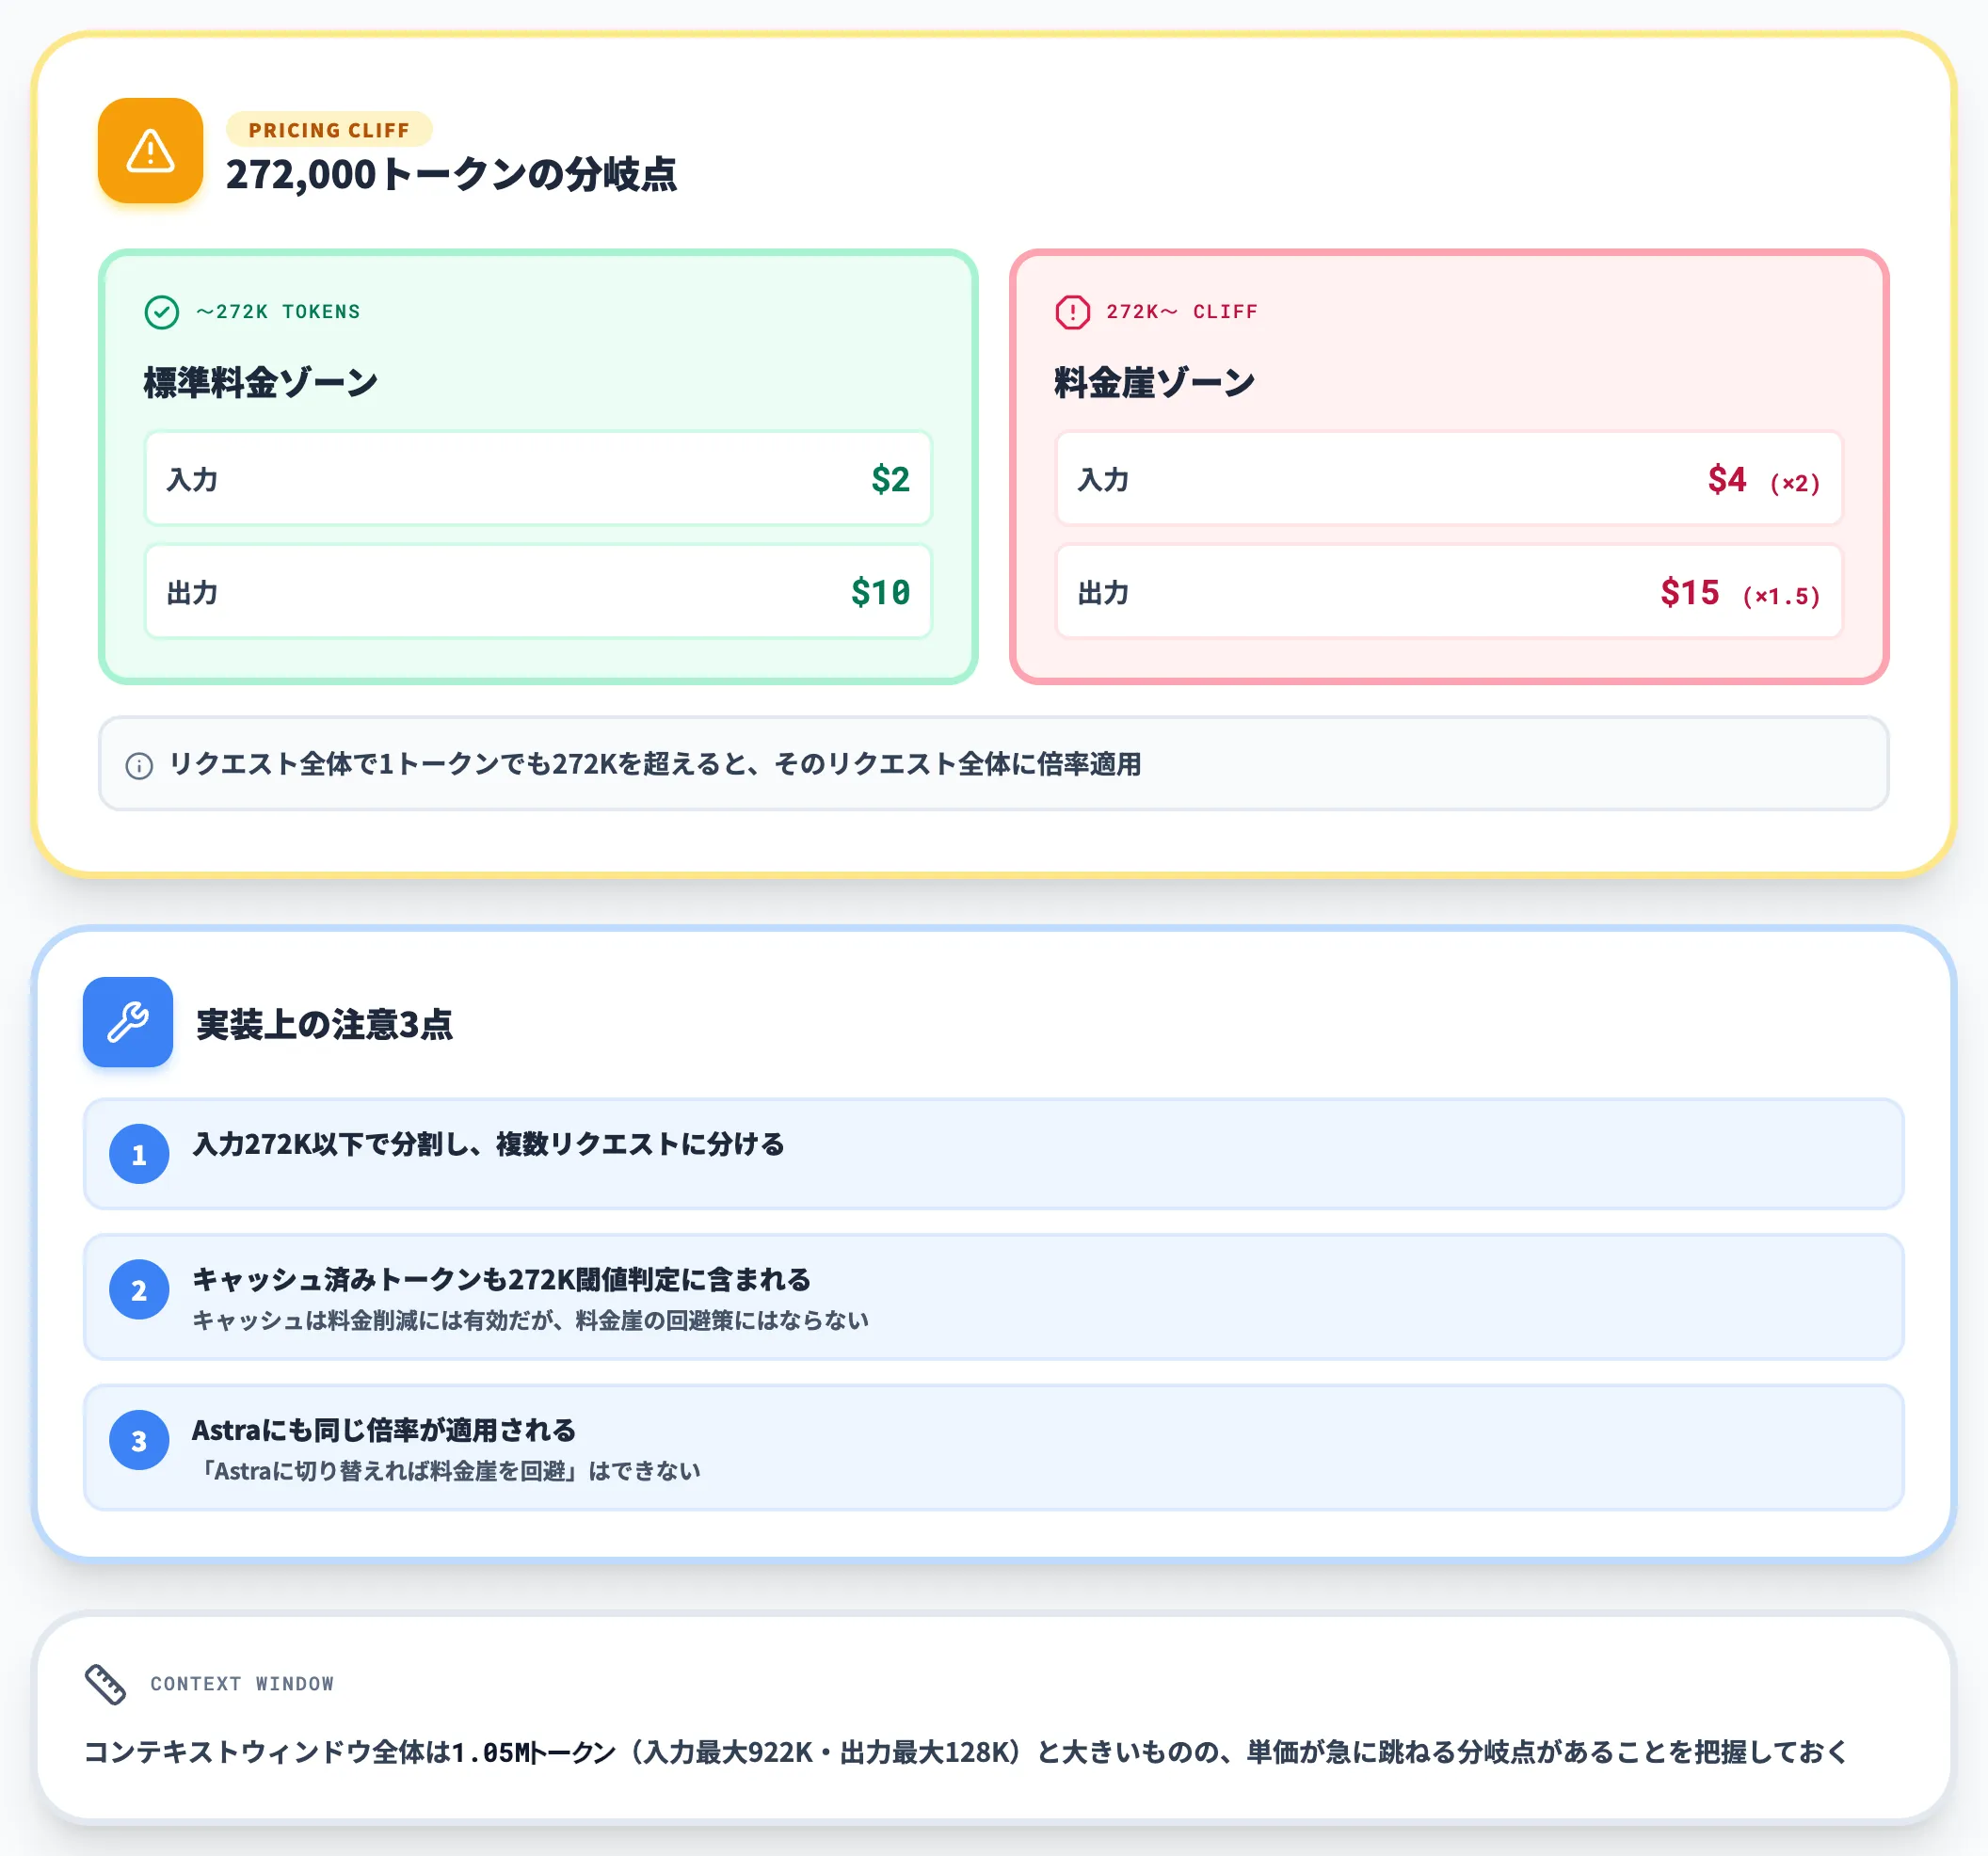
一方で、実装側で注意すべきポイントもあります。1リクエストで272,000トークンを超えると、そのリクエスト全体で入力2倍・出力1.5倍の追加料金が発生します。
長大なコードベース全体を一度に投入する、大規模な議事録アーカイブを丸ごと解析する、といった超大容量入力ではこの料金崖に触れやすくなります。実装上の注意は次のとおりです。
- 入力を272Kトークン以下で分割し、複数リクエストに分ける
- キャッシュ入力は料金削減には有効だが、キャッシュ済みトークンも272Kトークンの閾値判定には含まれるため、料金崖そのものの回避策にはならない
- Astra側にも272K超で入力2倍・出力1.5倍の同じ倍率が適用されるため、「Astraに切り替えれば料金崖を回避できる」訳ではない
コンテキストウィンドウ自体は1.05Mトークン(入力最大922K、出力最大128K)と大きいものの、単価が急に跳ねる分岐点があることを知っておくと、思わぬ請求増加を避けられます。
GPT-6.1 Solの使い方
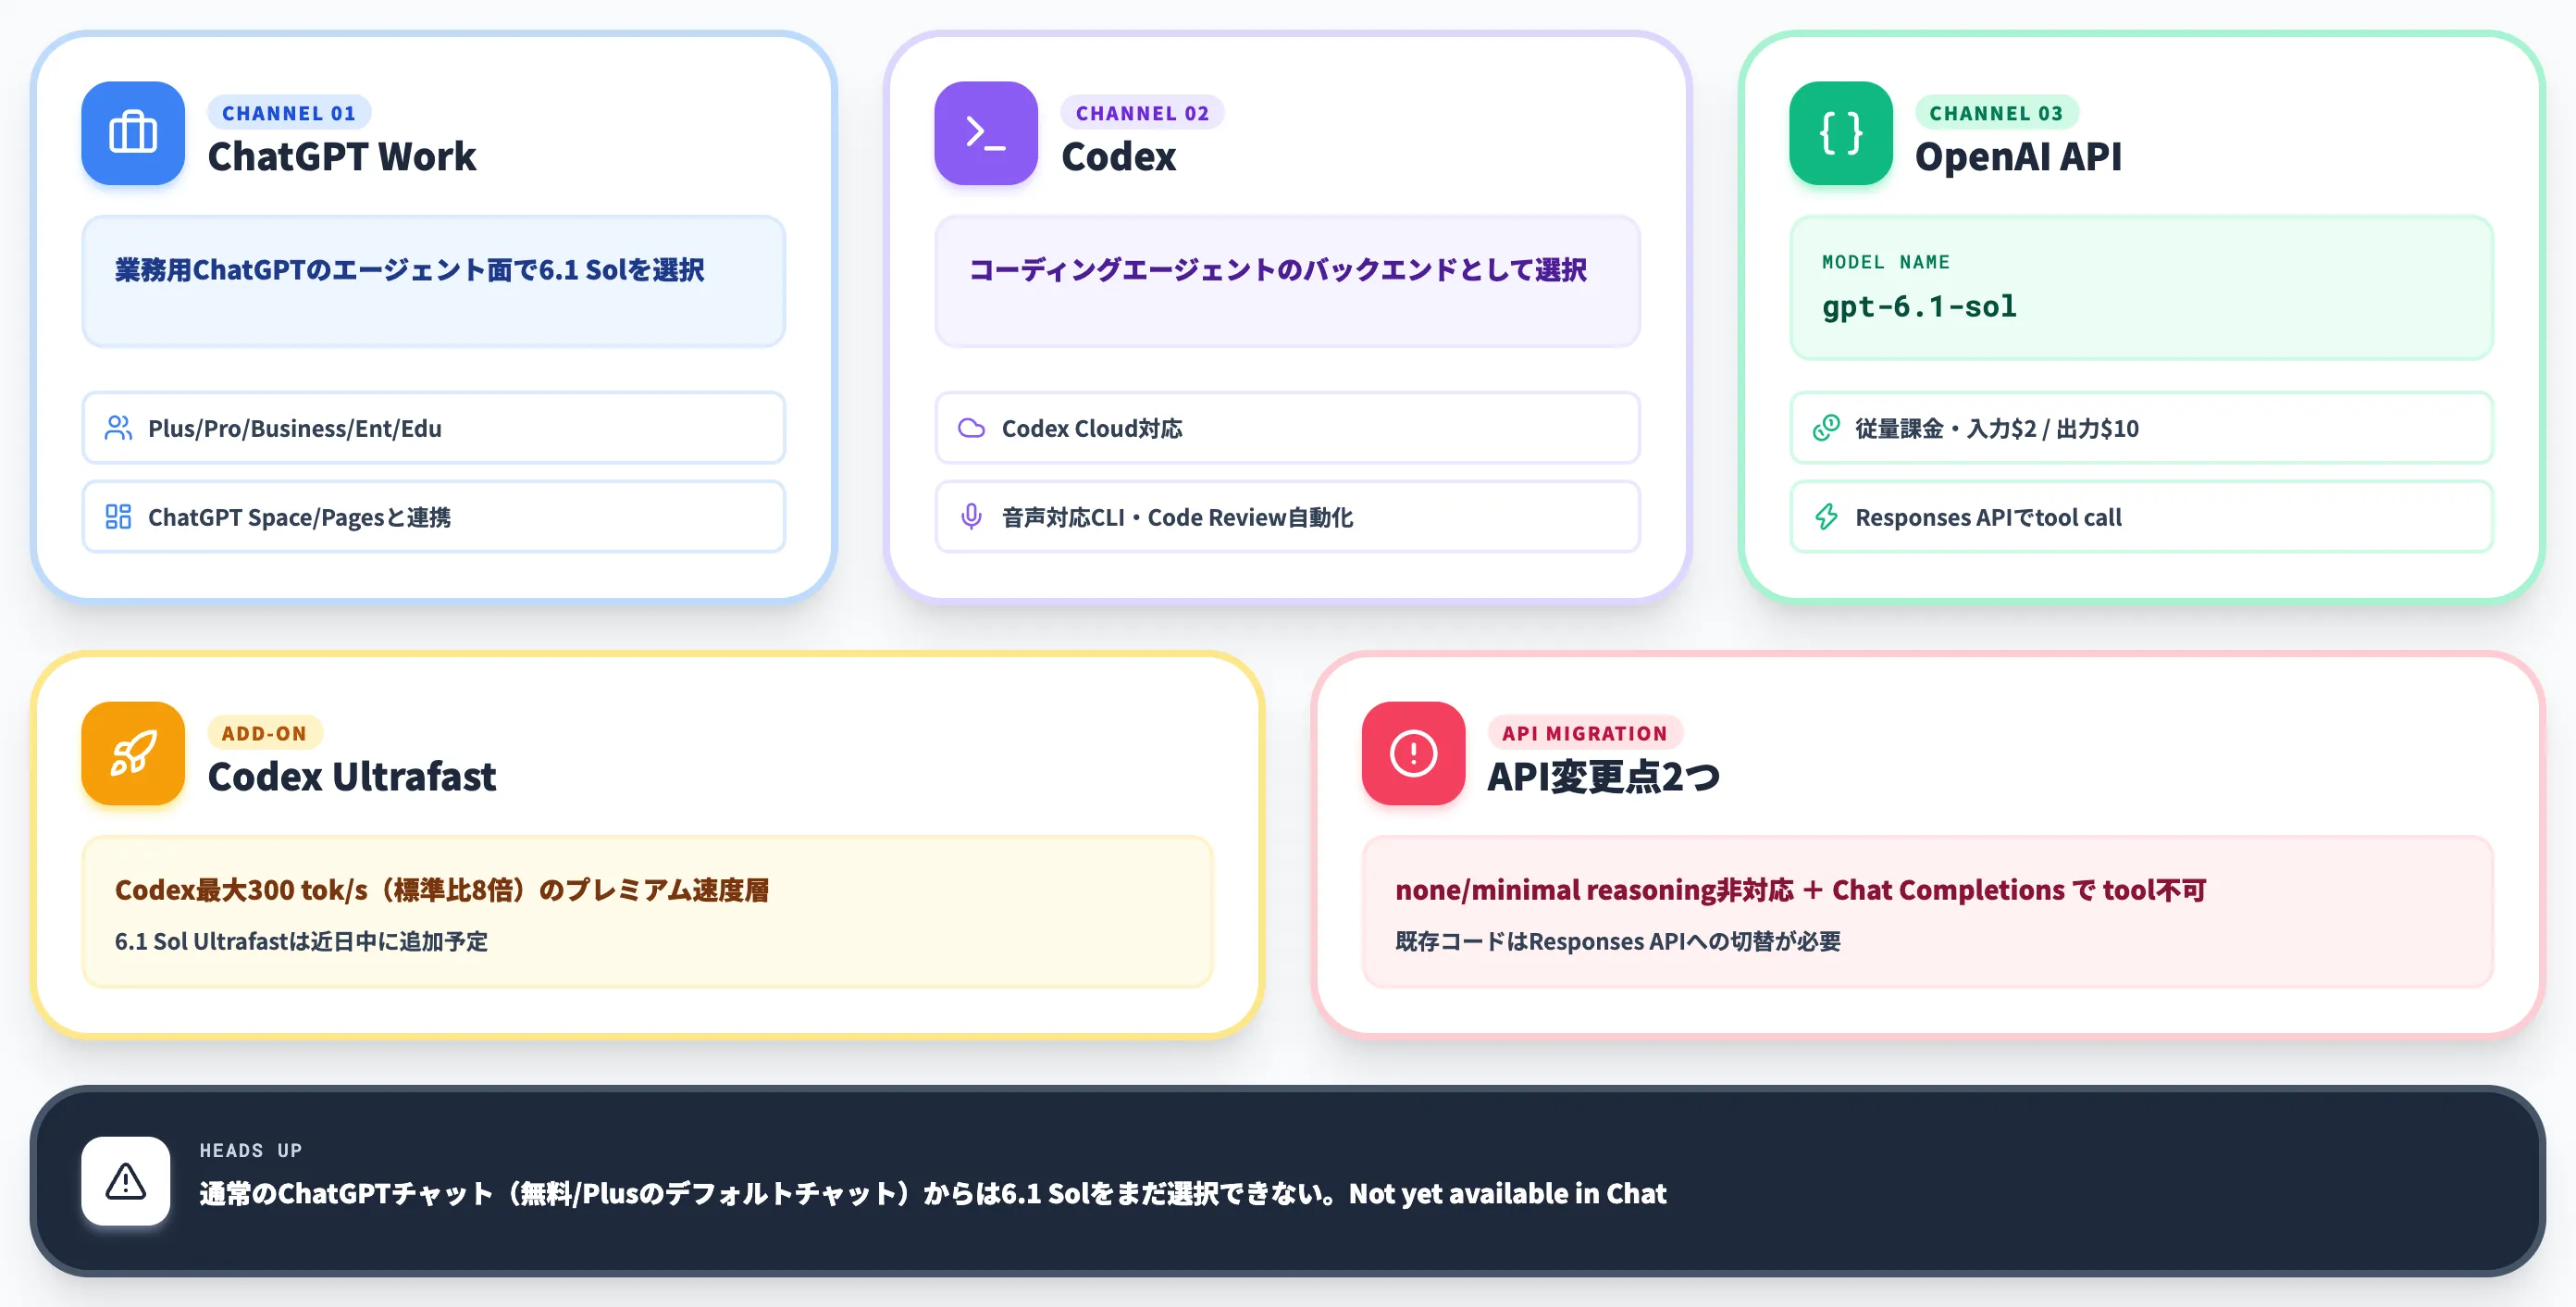
GPT-6.1 Solは提供チャネルが限定されており、通常のChatGPTチャットからは呼び出せません。本セクションでは、実際に触れる3つのチャネルと、DevDayで同時発表されたUltrafast層、API側の重要変更点を整理します。
提供チャネルと対象プラン
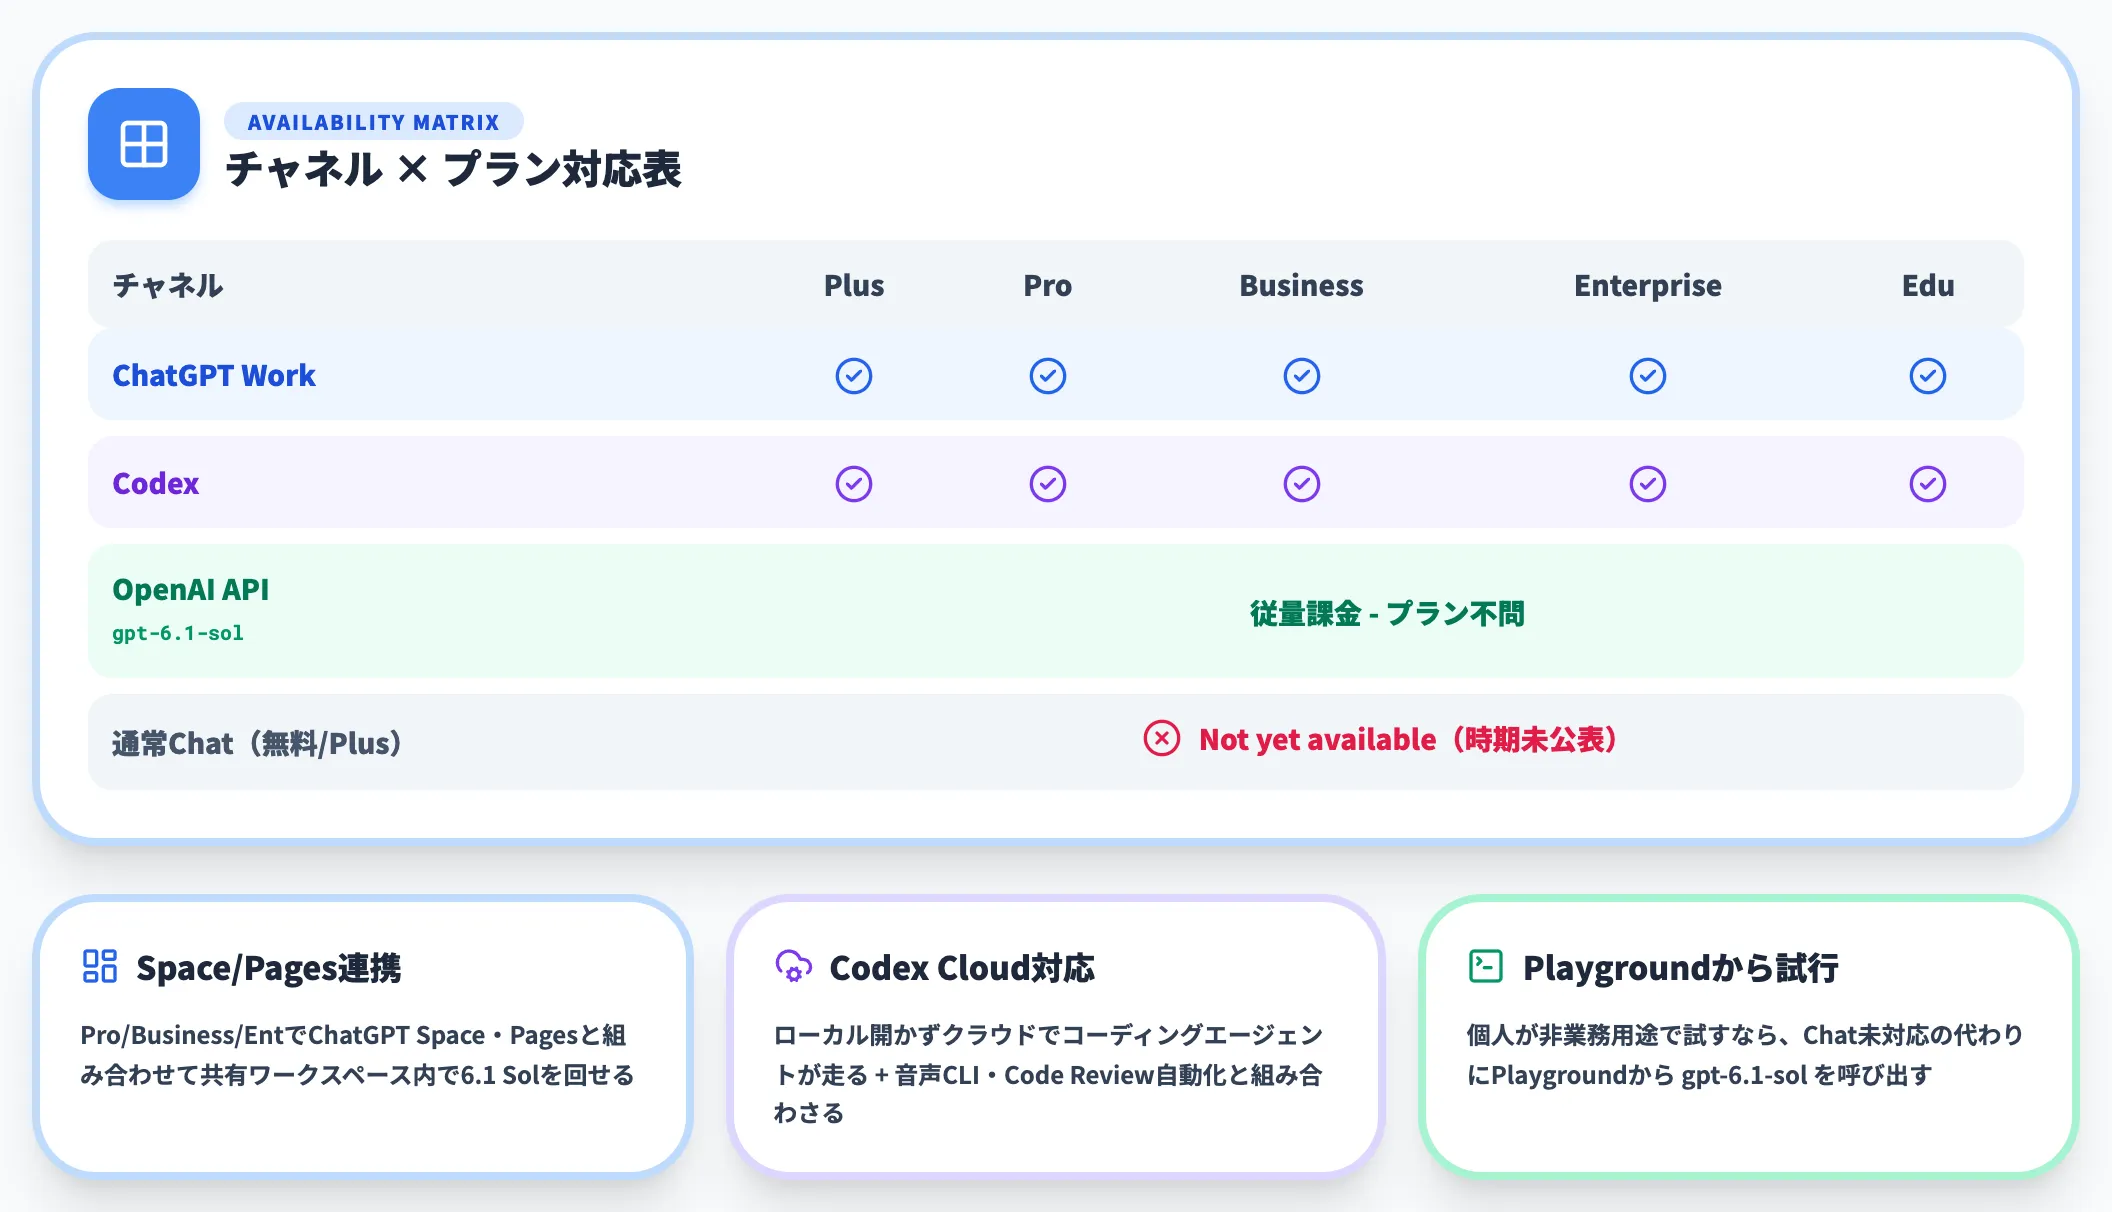
GPT-6.1 Solは以下の3チャネルで提供されています。
-
ChatGPT Work(Plus・Pro・Business・Enterprise・Edu)
業務用ChatGPTのエージェント面で、6.1 Solをモデル選択できます。Pro・Business・Enterpriseでは、DevDayで同時発表されたChatGPT SpaceやPagesと組み合わせると、共有ワークスペース内でのドキュメント作成や共同編集にも6.1 Solを回せます
-
Codex(Plus・Pro・Business・Enterprise・Edu)
コーディングエージェントのバックエンドとして選択可能。DevDayではCodex Cloud(ローカルマシンを開かなくてもクラウドでコーディングエージェントが走る)・音声対応CLI・Code Review自動化などがまとめて拡張されており、6.1 Solはこれらと自然に組み合わさります
-
OpenAI API
モデル名 gpt-6.1-sol として利用可能。従量課金で、料金は前述のとおり
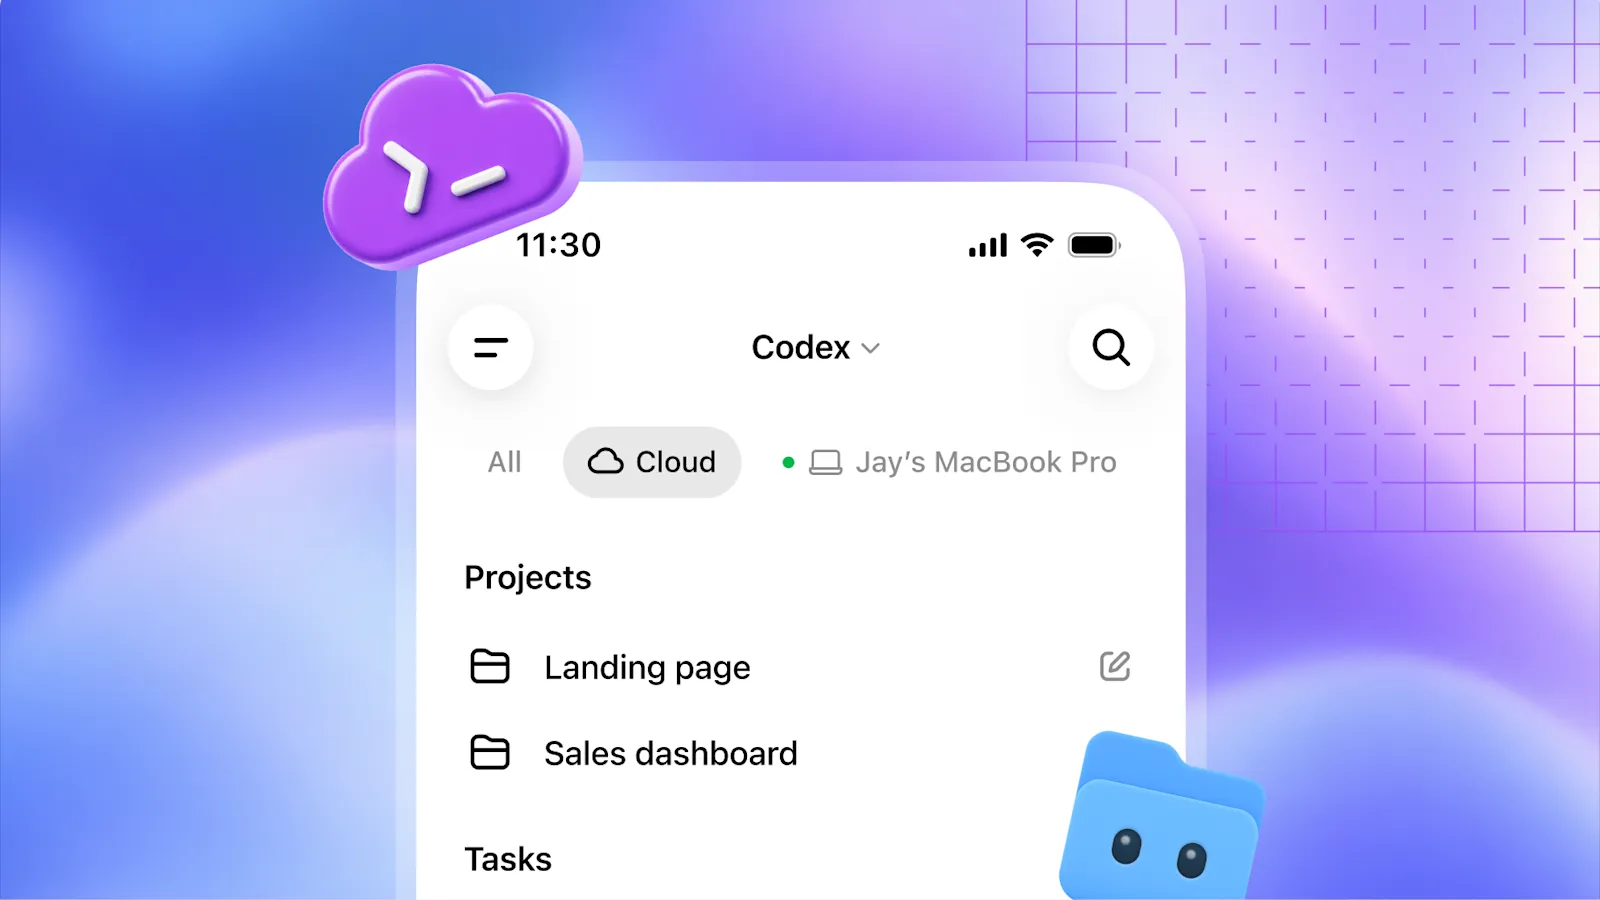
DevDay 2026 で発表された Codex Cloud のプロジェクト画面(出典:OpenAI DevDay 2026 Recap)
注意すべきなのは、通常のChatGPTチャット(無料/Plusのデフォルトチャット)からは6.1 Solをまだ選択できない点です。
ChatGPT側のモデル切り替えUIに追加されるのは今後の展開次第で、現時点で個人が触るには「ChatGPT WorkかCodexかAPI」のいずれかを経由する必要があります。
Codex Ultrafast(300 tok/s)
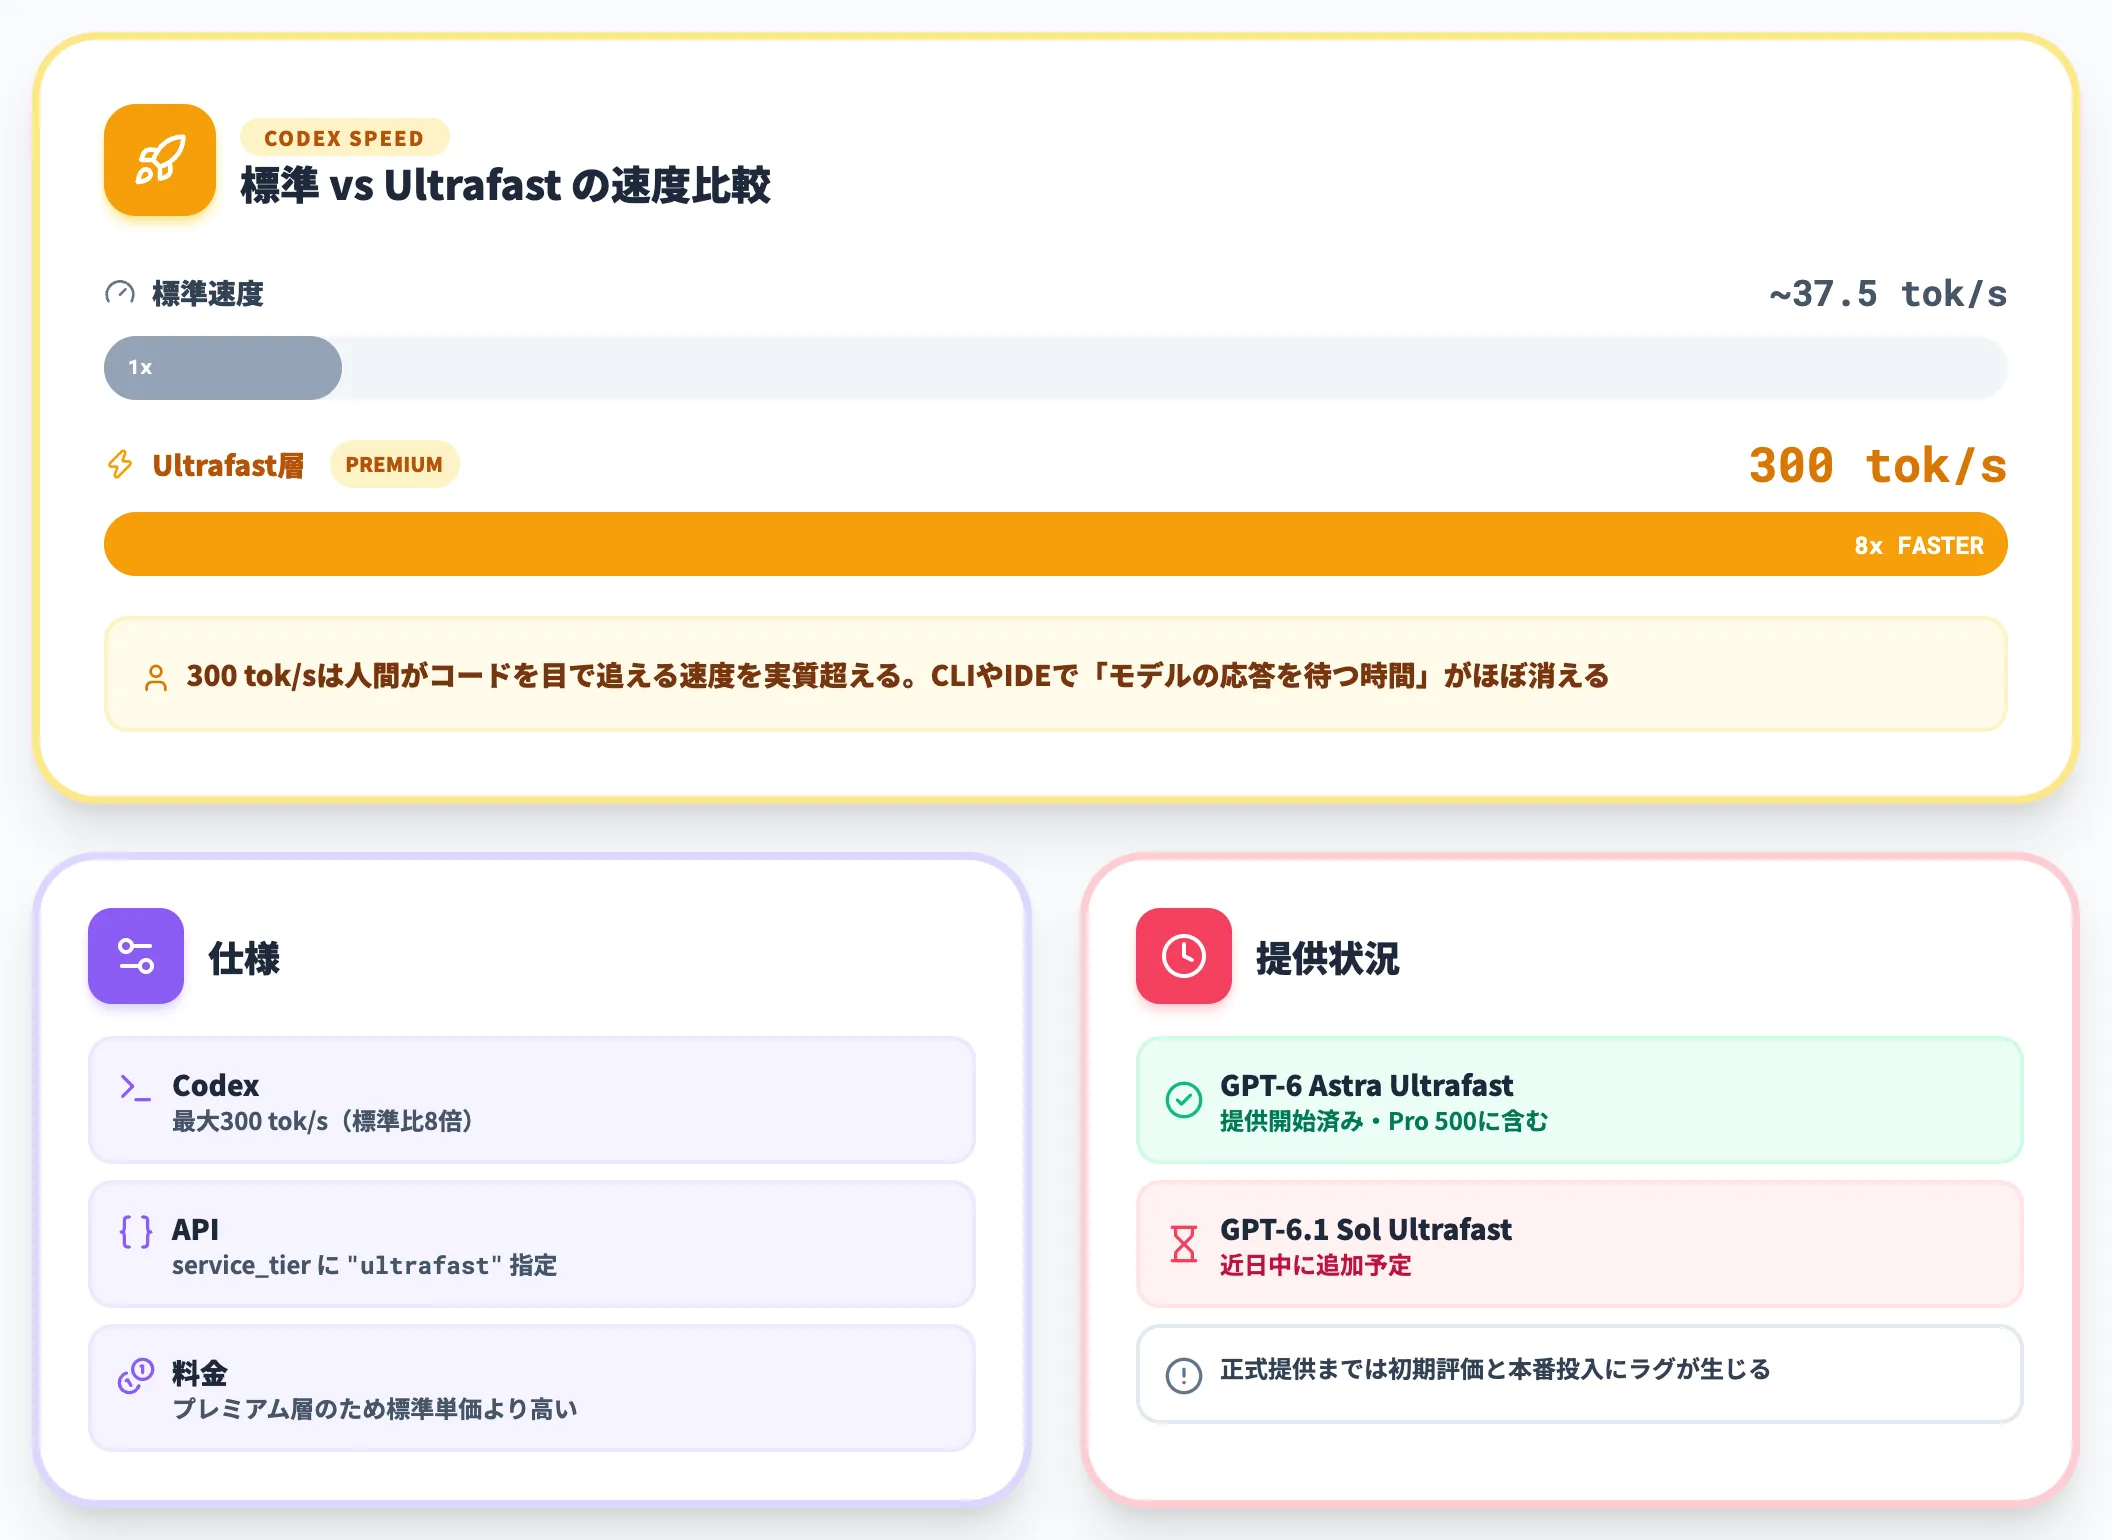
DevDayではもう一つ、Ultrafastというプレミアム速度層が発表されました。GPT-6 Astra Ultrafastは提供開始済み、GPT-6.1 Sol Ultrafastは「近日中」に追加される予定です。
DevDay 2026 で発表された Ultrafast 層のアナウンスビジュアル(出典:OpenAI DevDay 2026 Recap)
Ultrafast層の主な仕様は次のとおりです。
- Codexでの速度: 最大300トークン/秒(標準比8倍)
- APIでの速度: DevDay発表では標準比最大6倍(現行のAPIドキュメントは最大8倍と記載しており、正式提供時点で確認する)
- 指定方法: APIでは service_tier に「ultrafast」を指定
- 料金: プレミアム層のため標準単価より高い(詳細はOpenAI Developers公式ドキュメントを確認)
Ultrafastが効くのは、対話的なコーディング体験を殺さない速度が欲しい場面です。300 tok/sというのは、人間がコードを目で追える速度を実質超えており、CLIやIDEで「モデルの応答を待つ」時間がほぼ消えます。Pro 500(月額$500)にはAstra Ultrafastが含まれており、Codexでの高速コーディングを主業務にする開発者向けの構成として設計されています。
APIの主要変更点
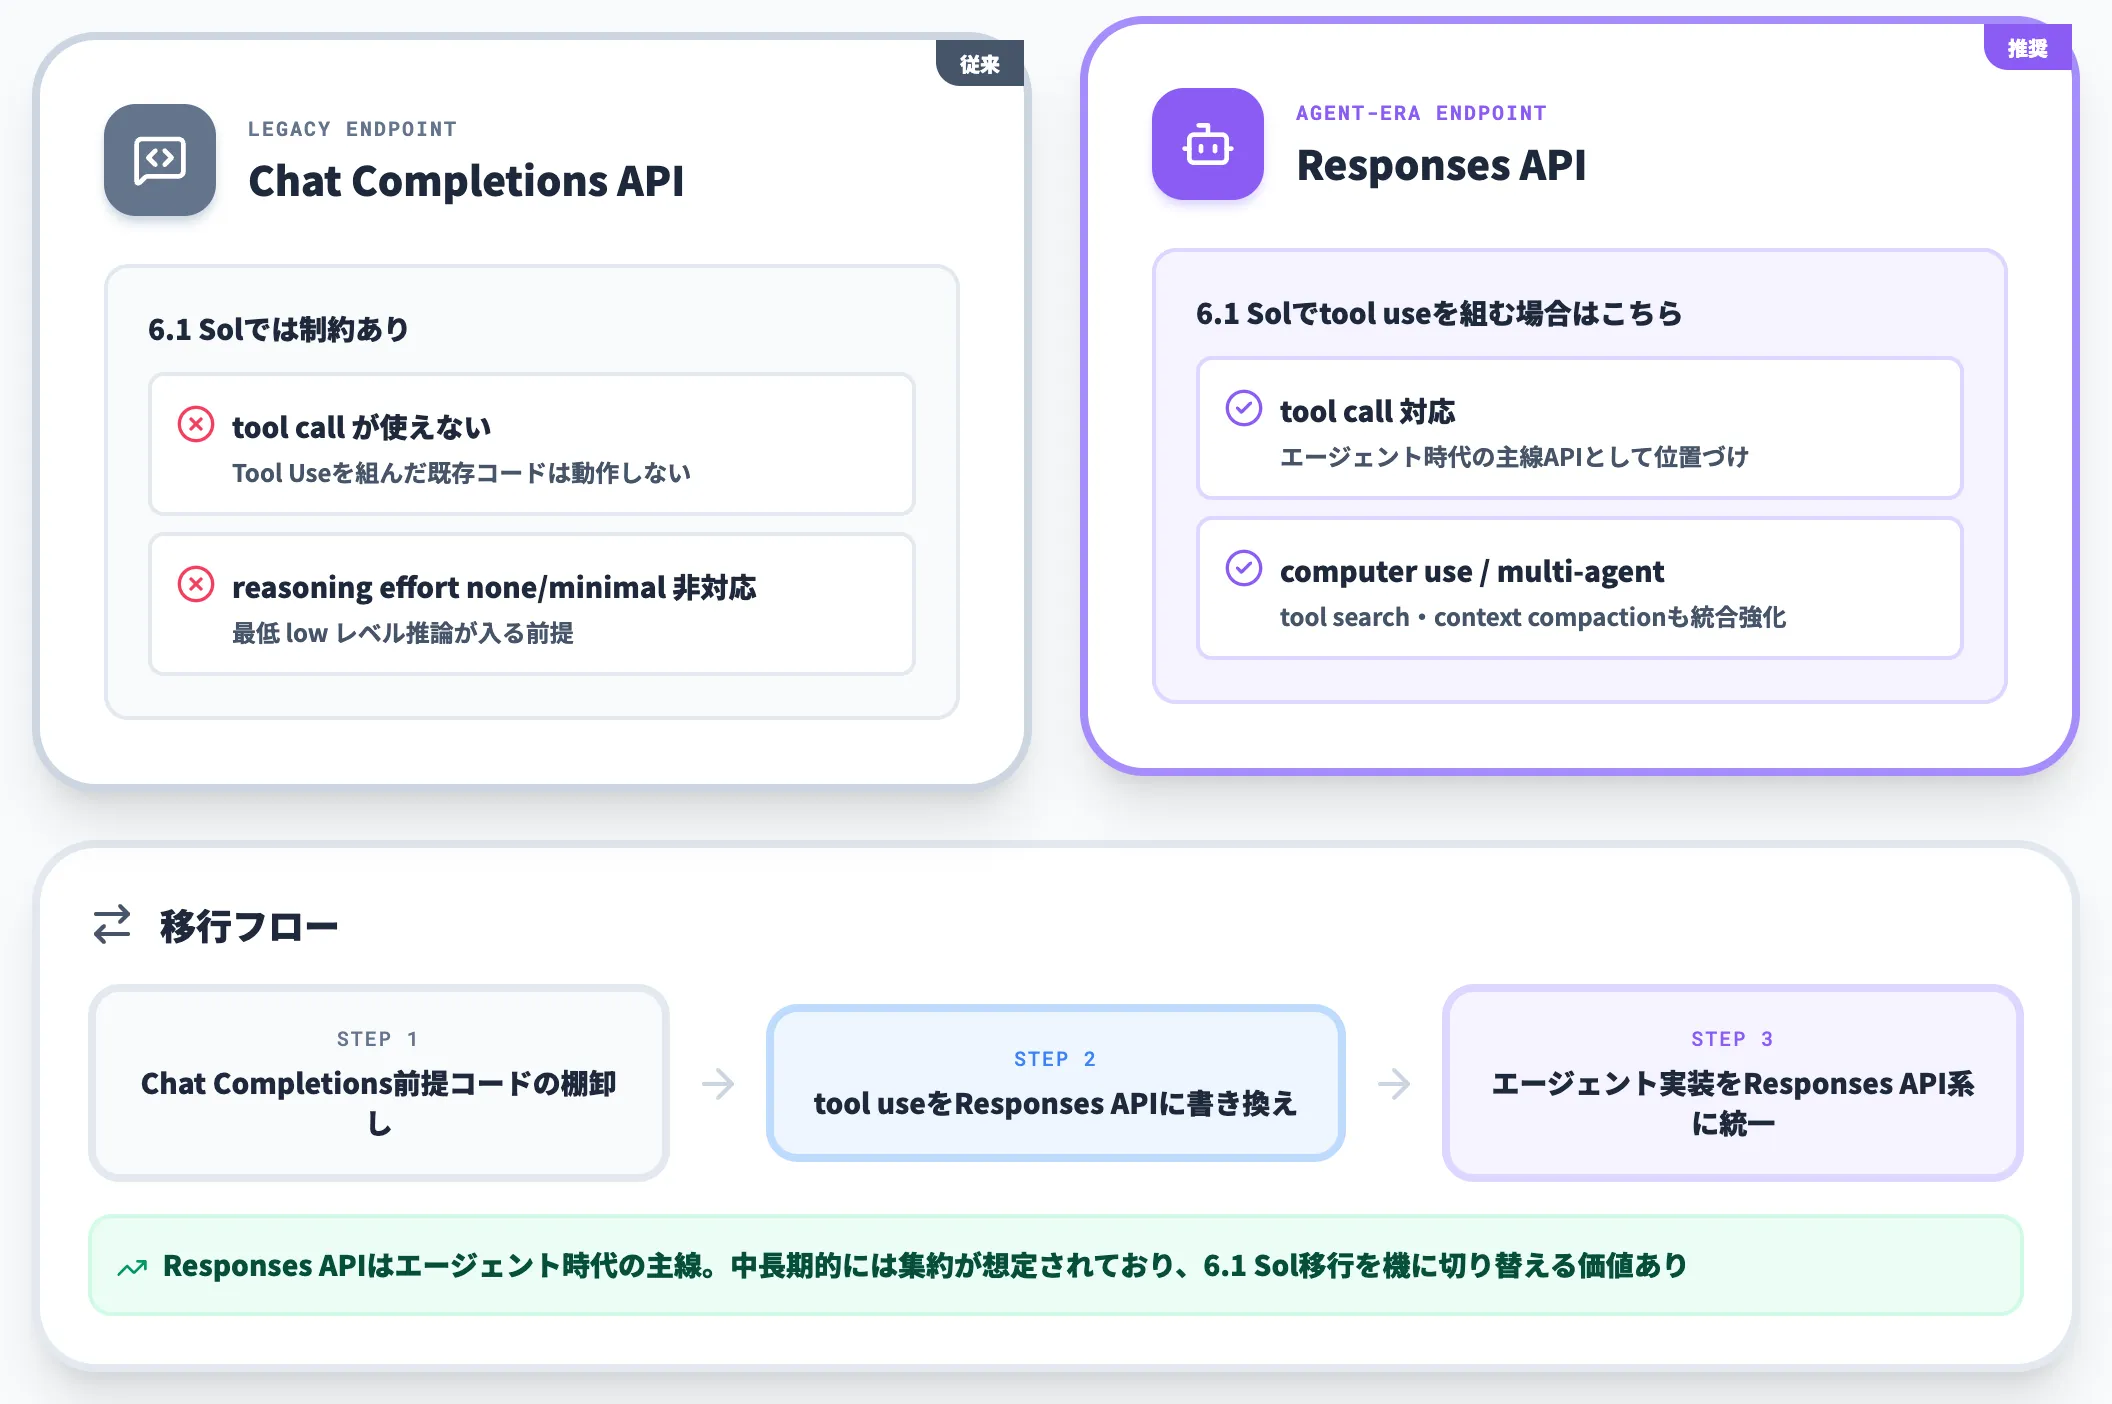
APIで6.1 Solを使う際、GPT-6 Solから2つの重要な変更があります。実装レベルの話ですが、既存コードをそのまま流用すると動かなくなる箇所です。
-
none / minimal の reasoning effort が非対応
GPT-6 Solでは推論努力を最小限(none または minimal)に指定できましたが、6.1 Solでは受け付けません。低コスト運用したい場合でも、最低 low レベルの推論が入る前提で設計する必要があります
-
Chat Completions API では tool call が使えない
6.1 SolでTool Use(関数呼び出し)を使う場合、Responses API側に切り替える必要があります。既存のChat Completions前提コードでtoolを呼び出しているシステムは、Responses APIへの移行が必要になる点に注意です
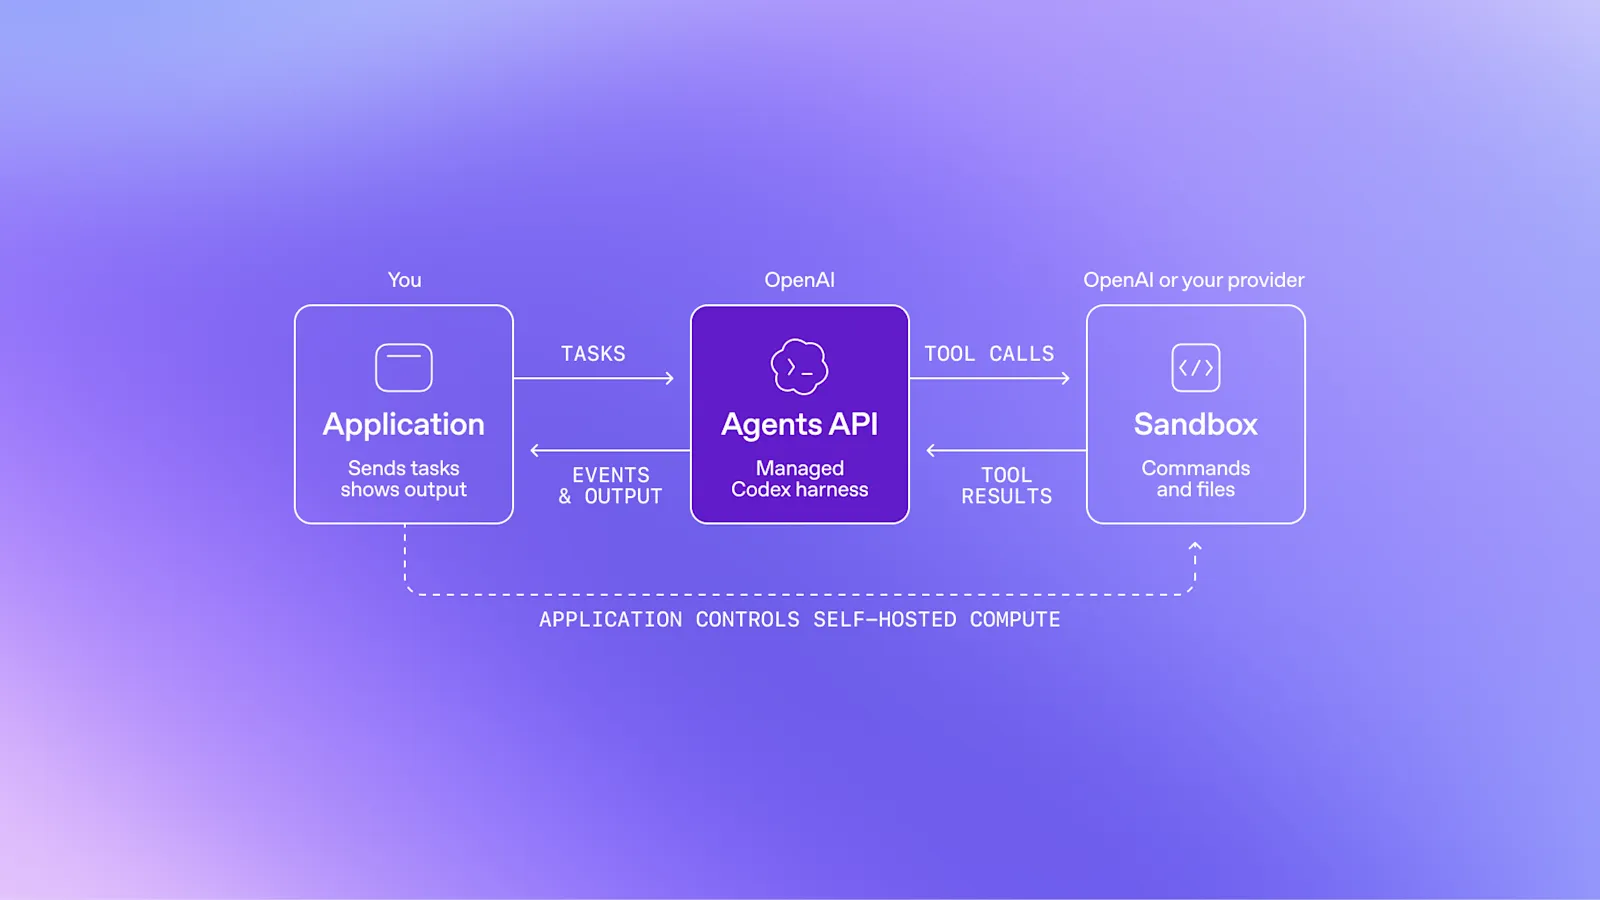
Agents API による Application・OpenAI・Sandbox の役割分担(出典:OpenAI DevDay 2026 Recap)
図解の中央に置かれた Managed Codex harness としての Agents API が、ユーザー側 Application からタスクを受け、Sandbox 側でツール実行を回す構造です。6.1 Sol で Tool Use を組む場合の実装層も、この Responses API / Agents API 系に載る形になります。
エージェント基盤・関数呼び出しを組み込んだシステムでは、この2点だけで移行工数が発生します。とはいえ、Responses APIはOpenAI側の「エージェント時代の主線」として位置づけられているAPIで、DevDayでも同時にcomputer use・multi-agent・tool search・context compactionが統合強化されました。中長期的にはResponses API側への集約が想定されているため、6.1 Solへの移行を機に切り替えを進める価値はあります。
GPT-6.1 Sol・Astra・Opus 5.5の使い分け
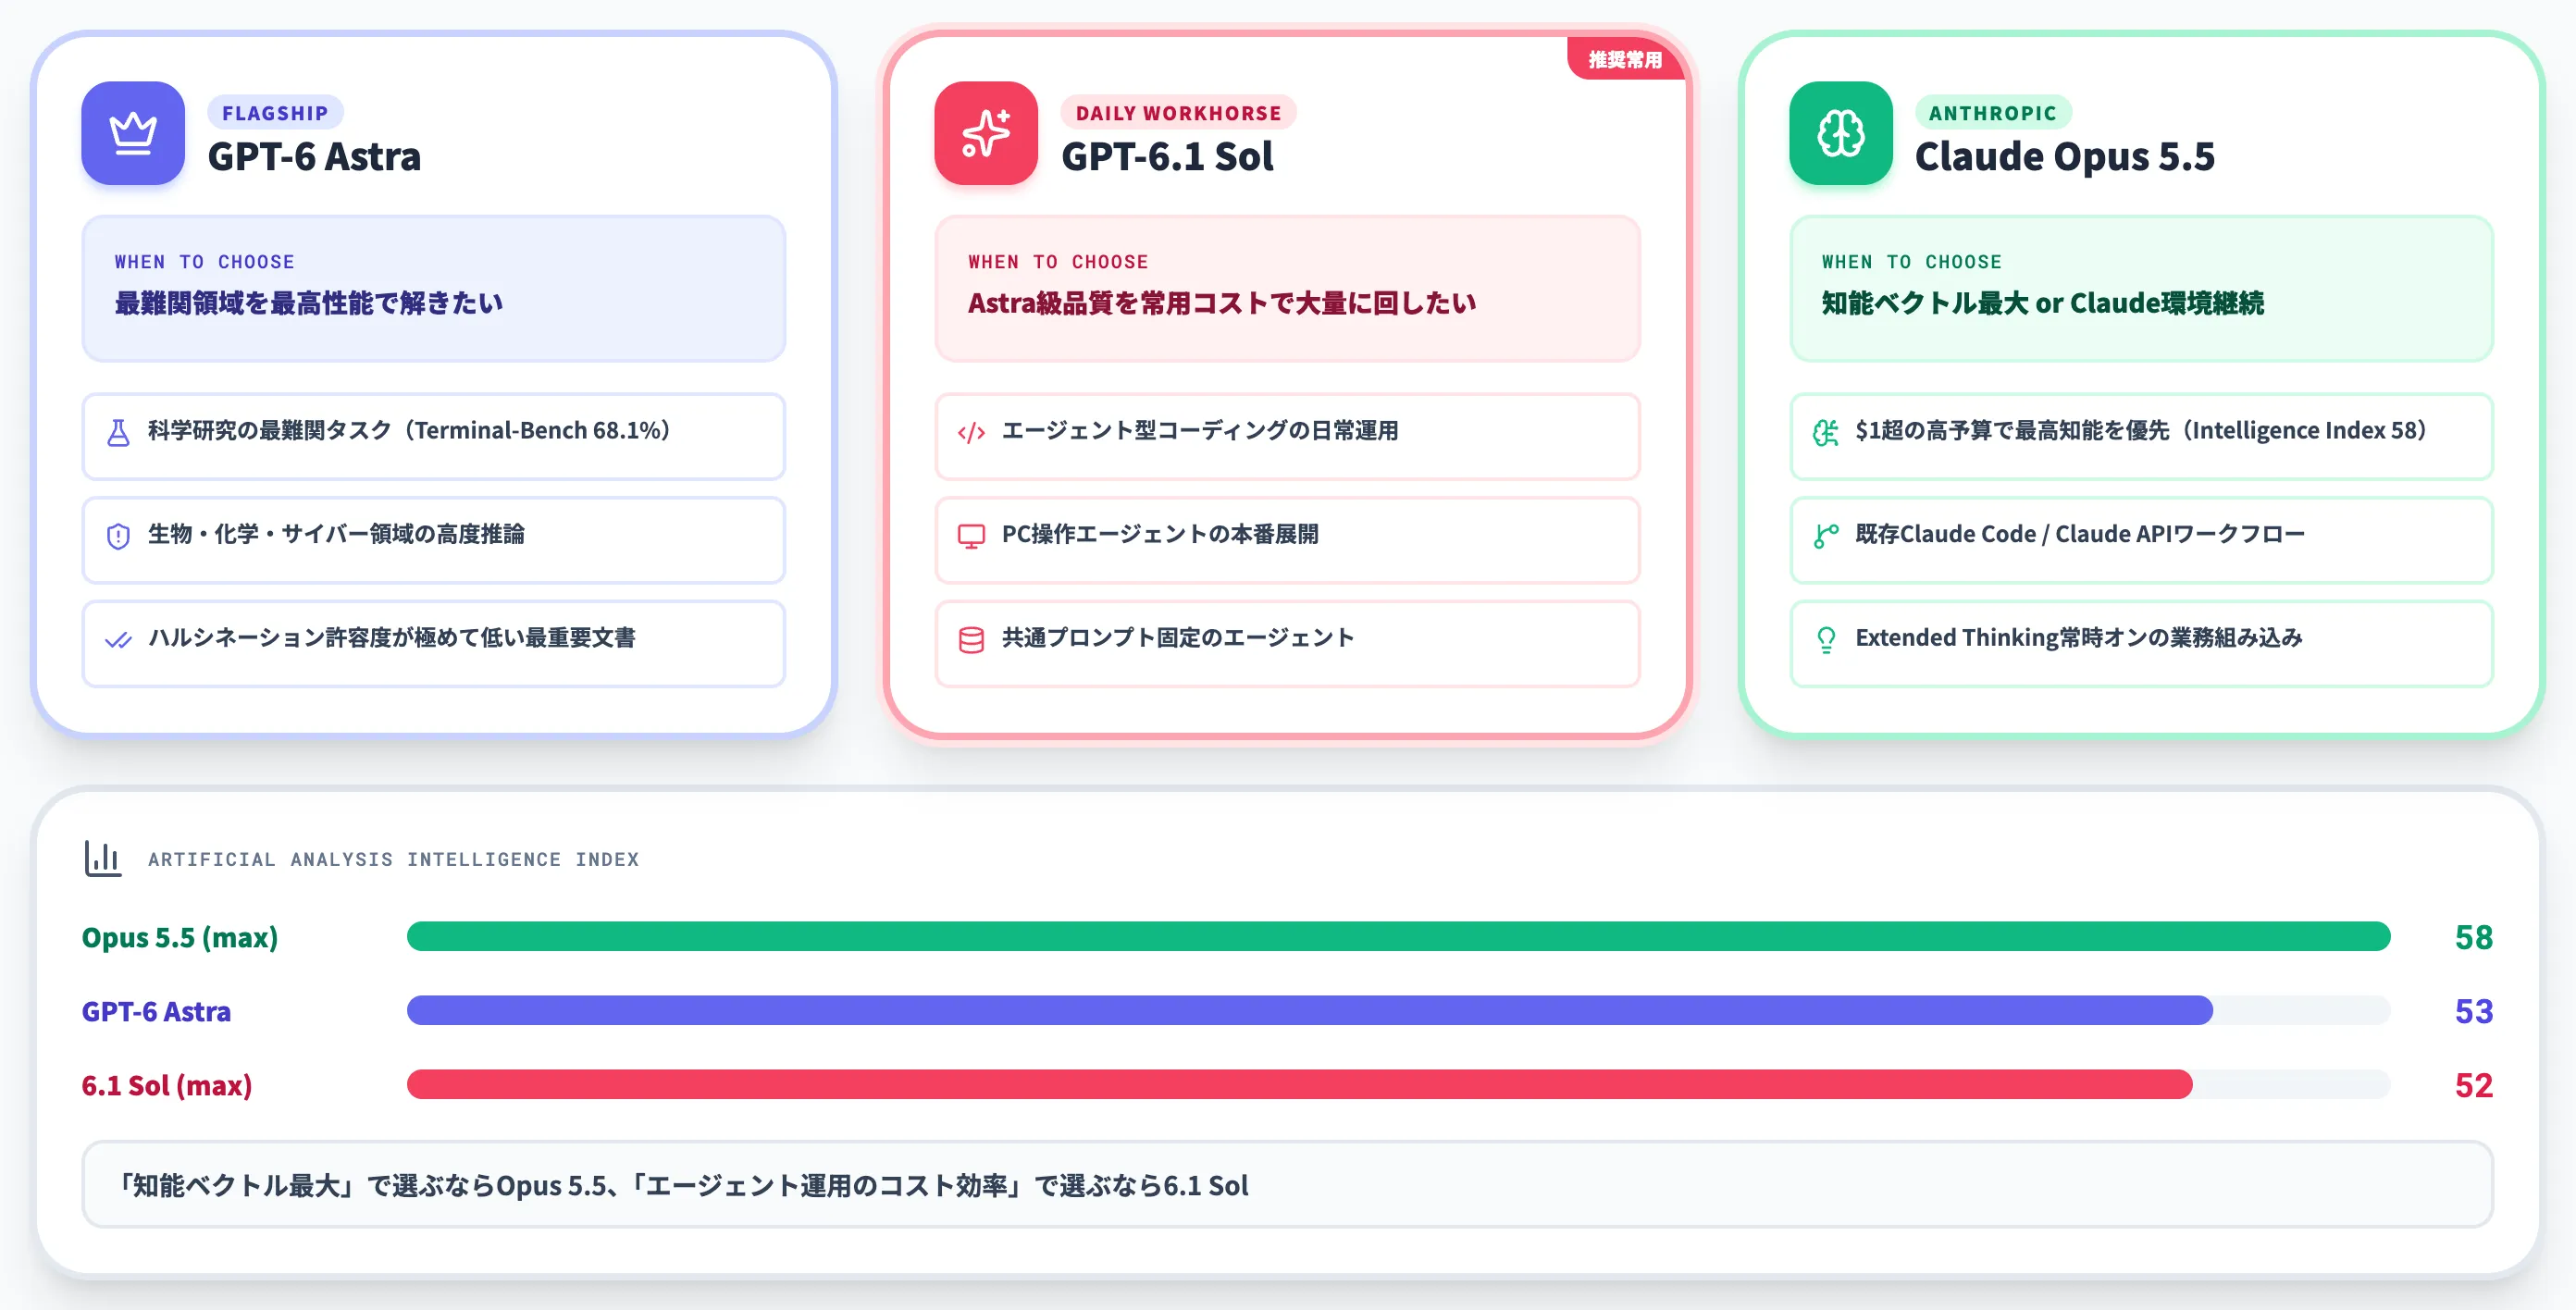
「性能はほぼAstra、価格はSol、対抗はOpus 5.5」という位置づけの6.1 Solが加わったことで、どのモデルをいつ使うかの判断軸が改めて問われます。本セクションでは、AI総合研究所の導入支援経験も踏まえながら、ケース別の選定指針を示します。
Astraを選ぶケース
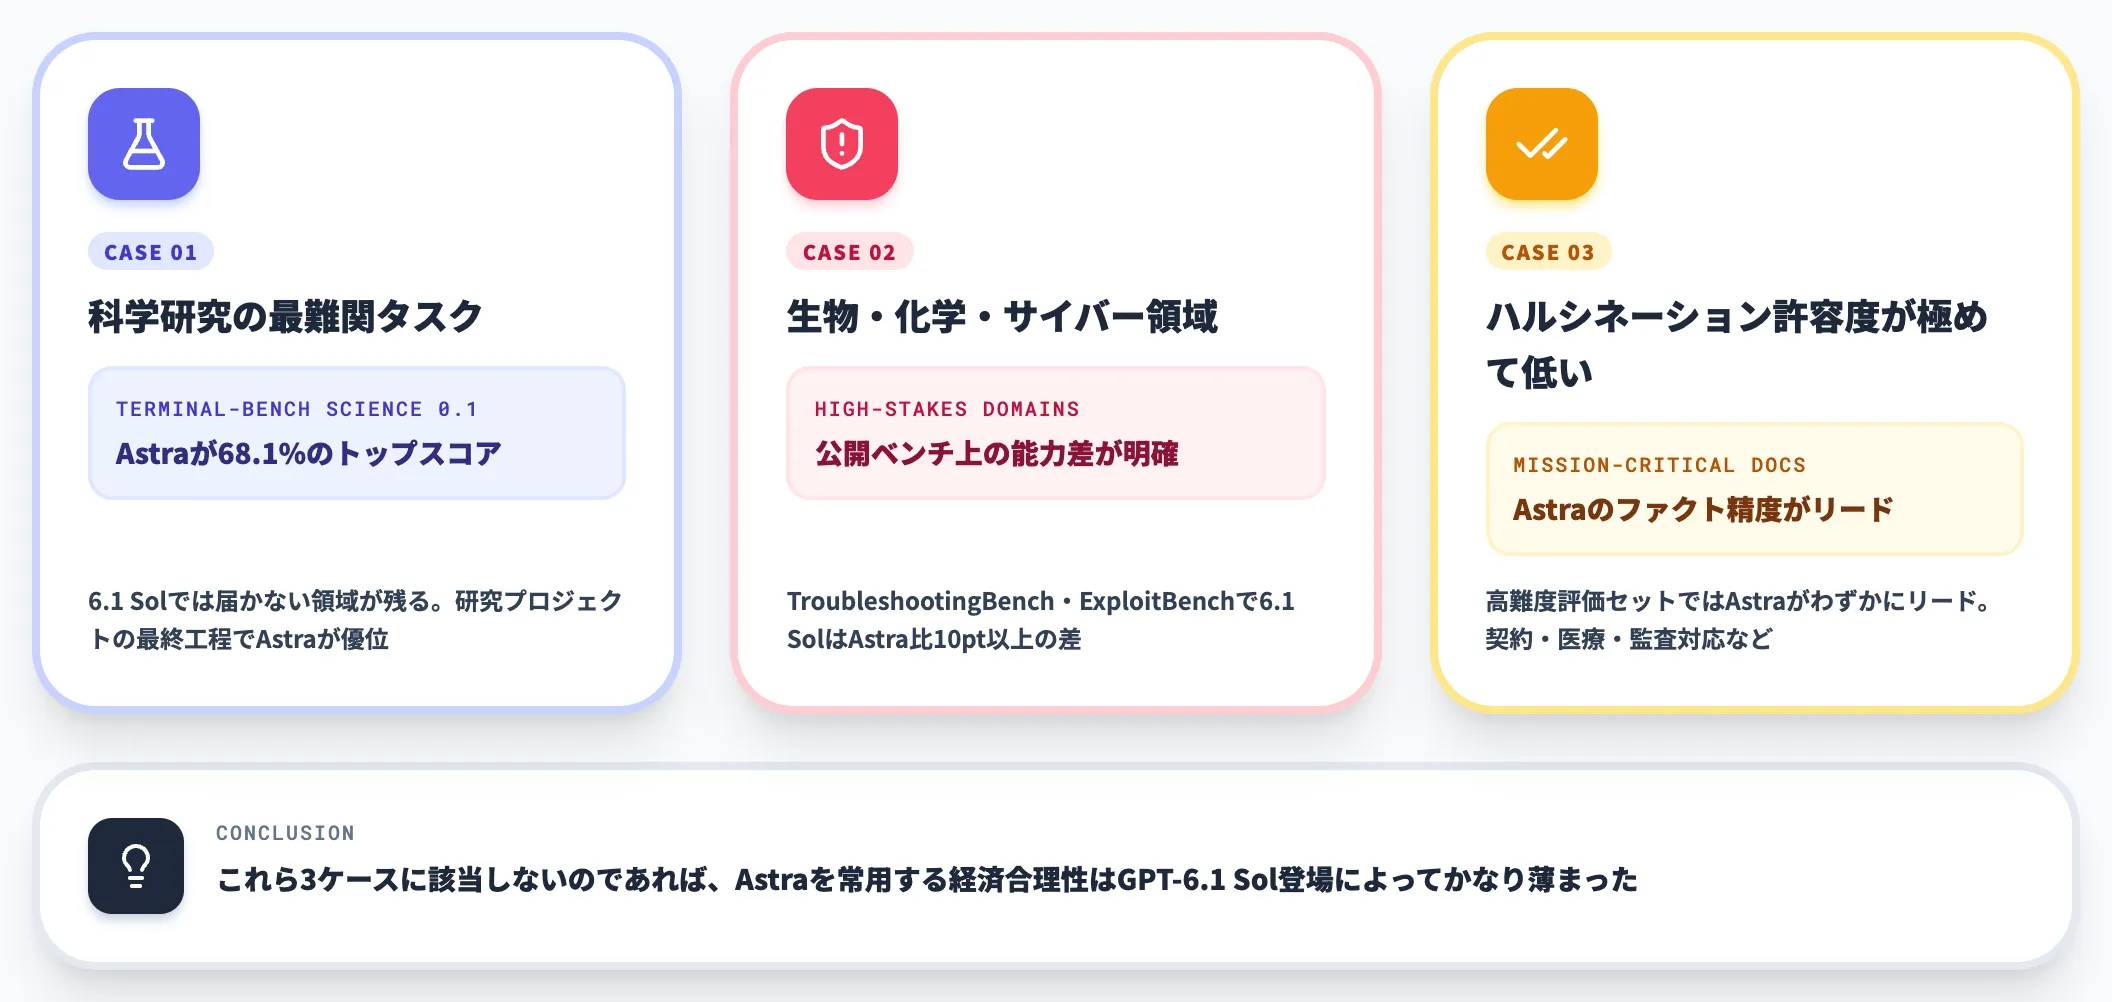
GPT-6 Astraを引き続き第一候補にすべきケースは、以下のような「最難関領域」に絞られてきました。
- 科学研究の最難関タスク: Terminal-Bench Science 0.1でAstraが68.1%のトップスコアを保持しており、6.1 Solでは届かない領域が残る
- 生物・化学・サイバー領域の高度な推論: 後述するとおり6.1 SolはこれらでAstraと公開ベンチマーク上の能力差が明確
- ハルシネーションの許容度が極めて低い最重要文書処理: 公開されている高難度評価セットではAstraのファクト精度がわずかにリードしている
これらに該当しないのであれば、Astraを常用する経済合理性はGPT-6.1 Sol登場によってかなり薄まりました。
Solを選ぶケース
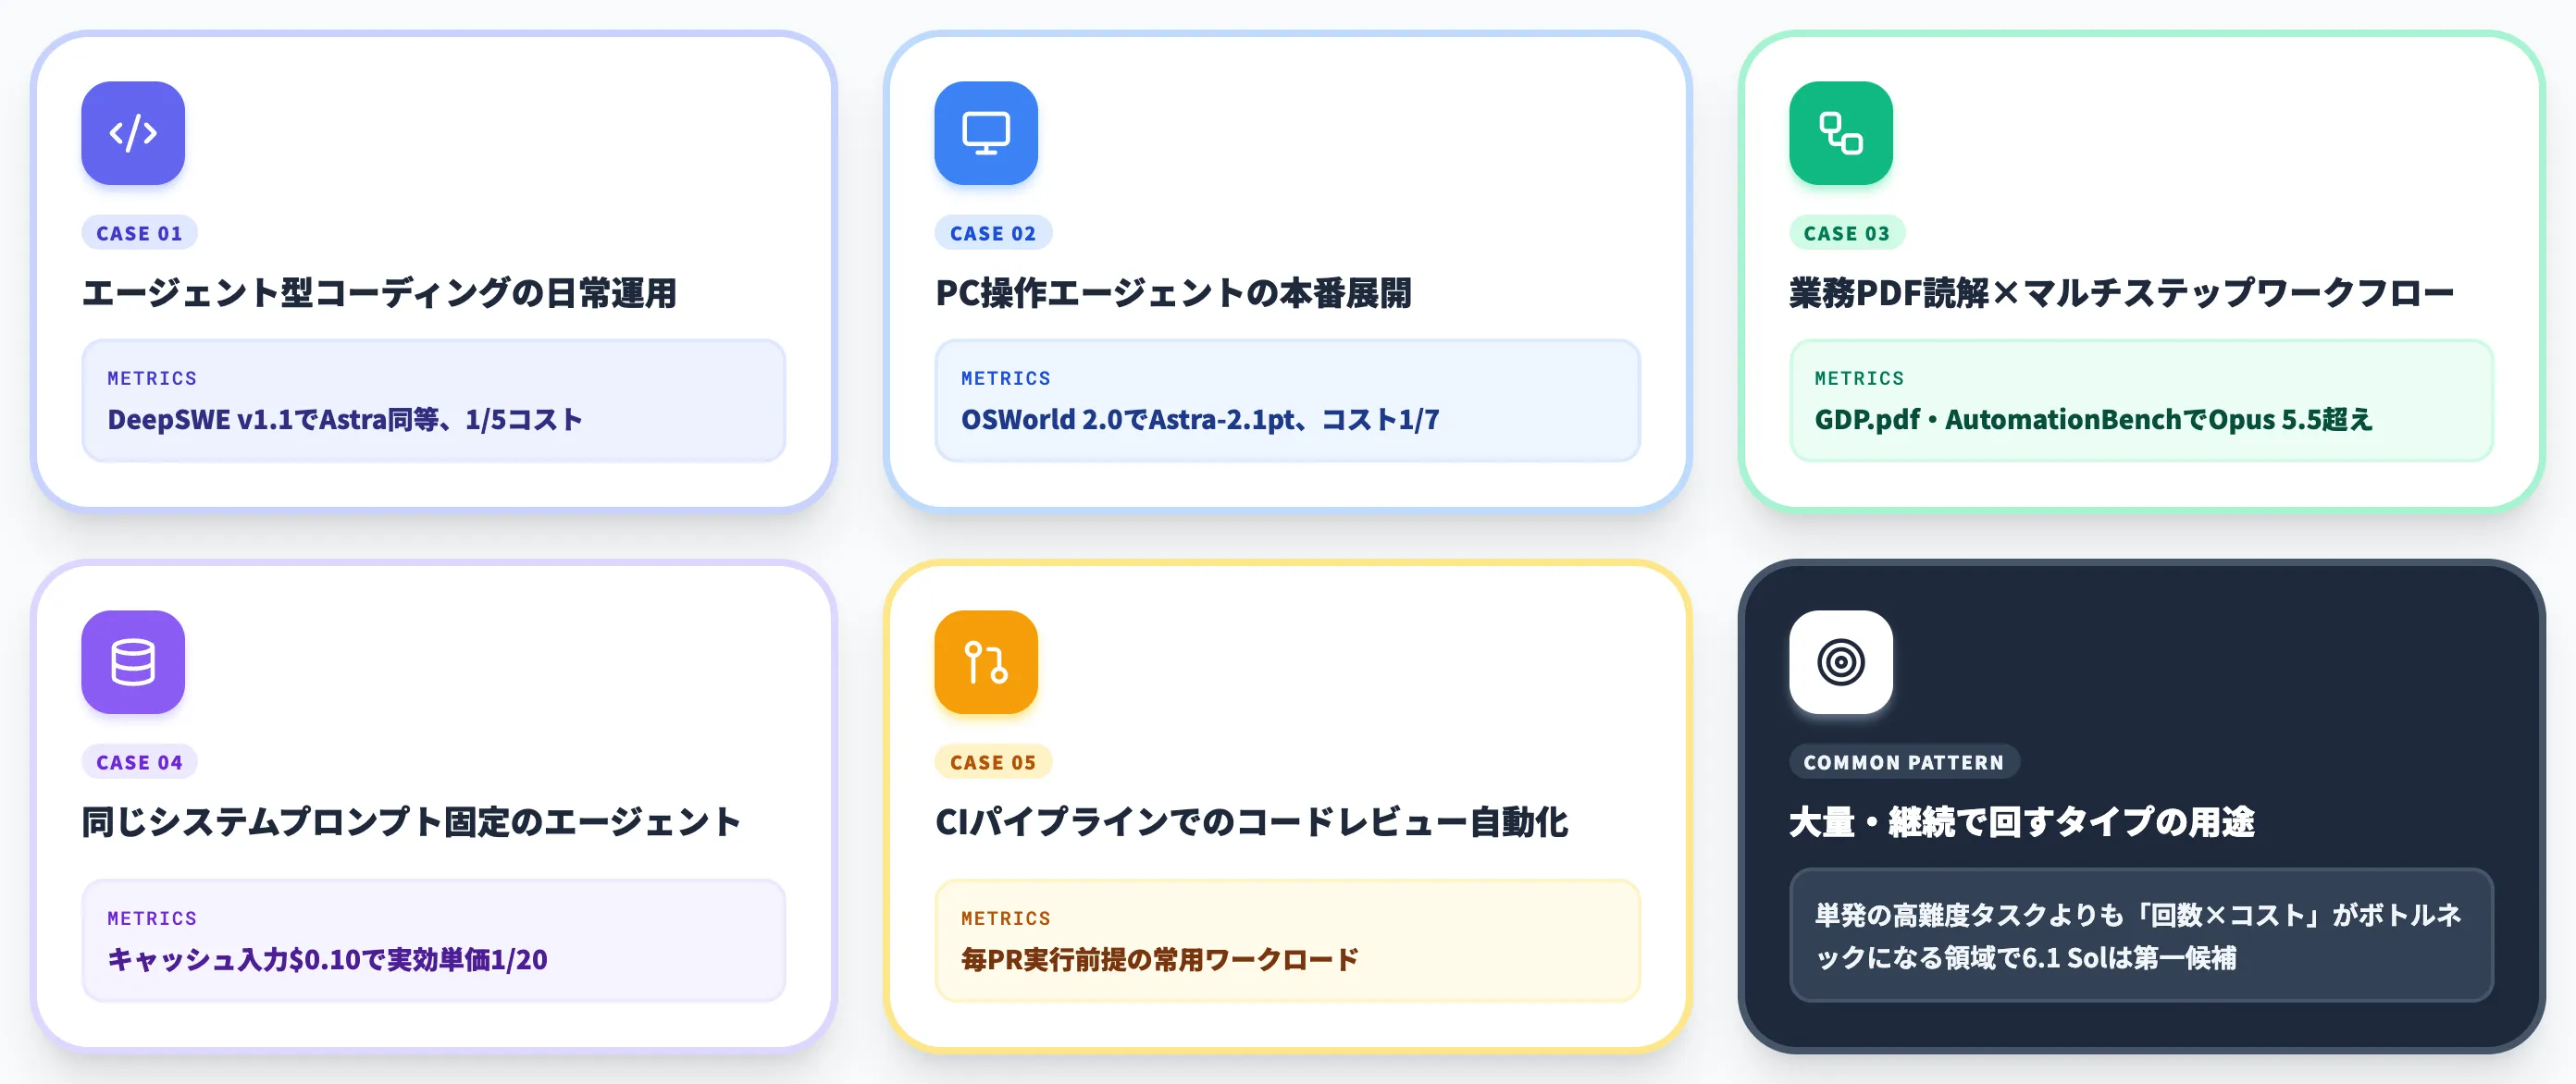
逆に、GPT-6.1 Solが第一候補になるケースは大幅に広がっています。
- エージェント型コーディングの日常運用: DeepSWE v1.1でAstra同等、1/5コスト
- PC操作エージェントの本番展開: OSWorld 2.0でAstra-2.1pt、コスト1/7
- 業務PDF読解×マルチステップワークフロー: GDP.pdf・AutomationBenchでOpus 5.5超え
- 同じシステムプロンプトを繰り返し使うエージェント: キャッシュ入力$0.10で実効単価が標準比1/20
- CIパイプラインでのコードレビュー自動化: 毎PR実行前提の常用ワークロード
いずれも「大量に」「継続的に」動かすタイプの用途で、単発の高難度タスクよりも「回数×コスト」がボトルネックになる領域です。
コーディングエージェント・業務PCオートメーション・社内文書エージェントの3系統で「Astra級品質×常用可能なコスト」を組む場合、6.1 Solは第一候補として検討する価値があります。
Opus 5.5を選ぶケース
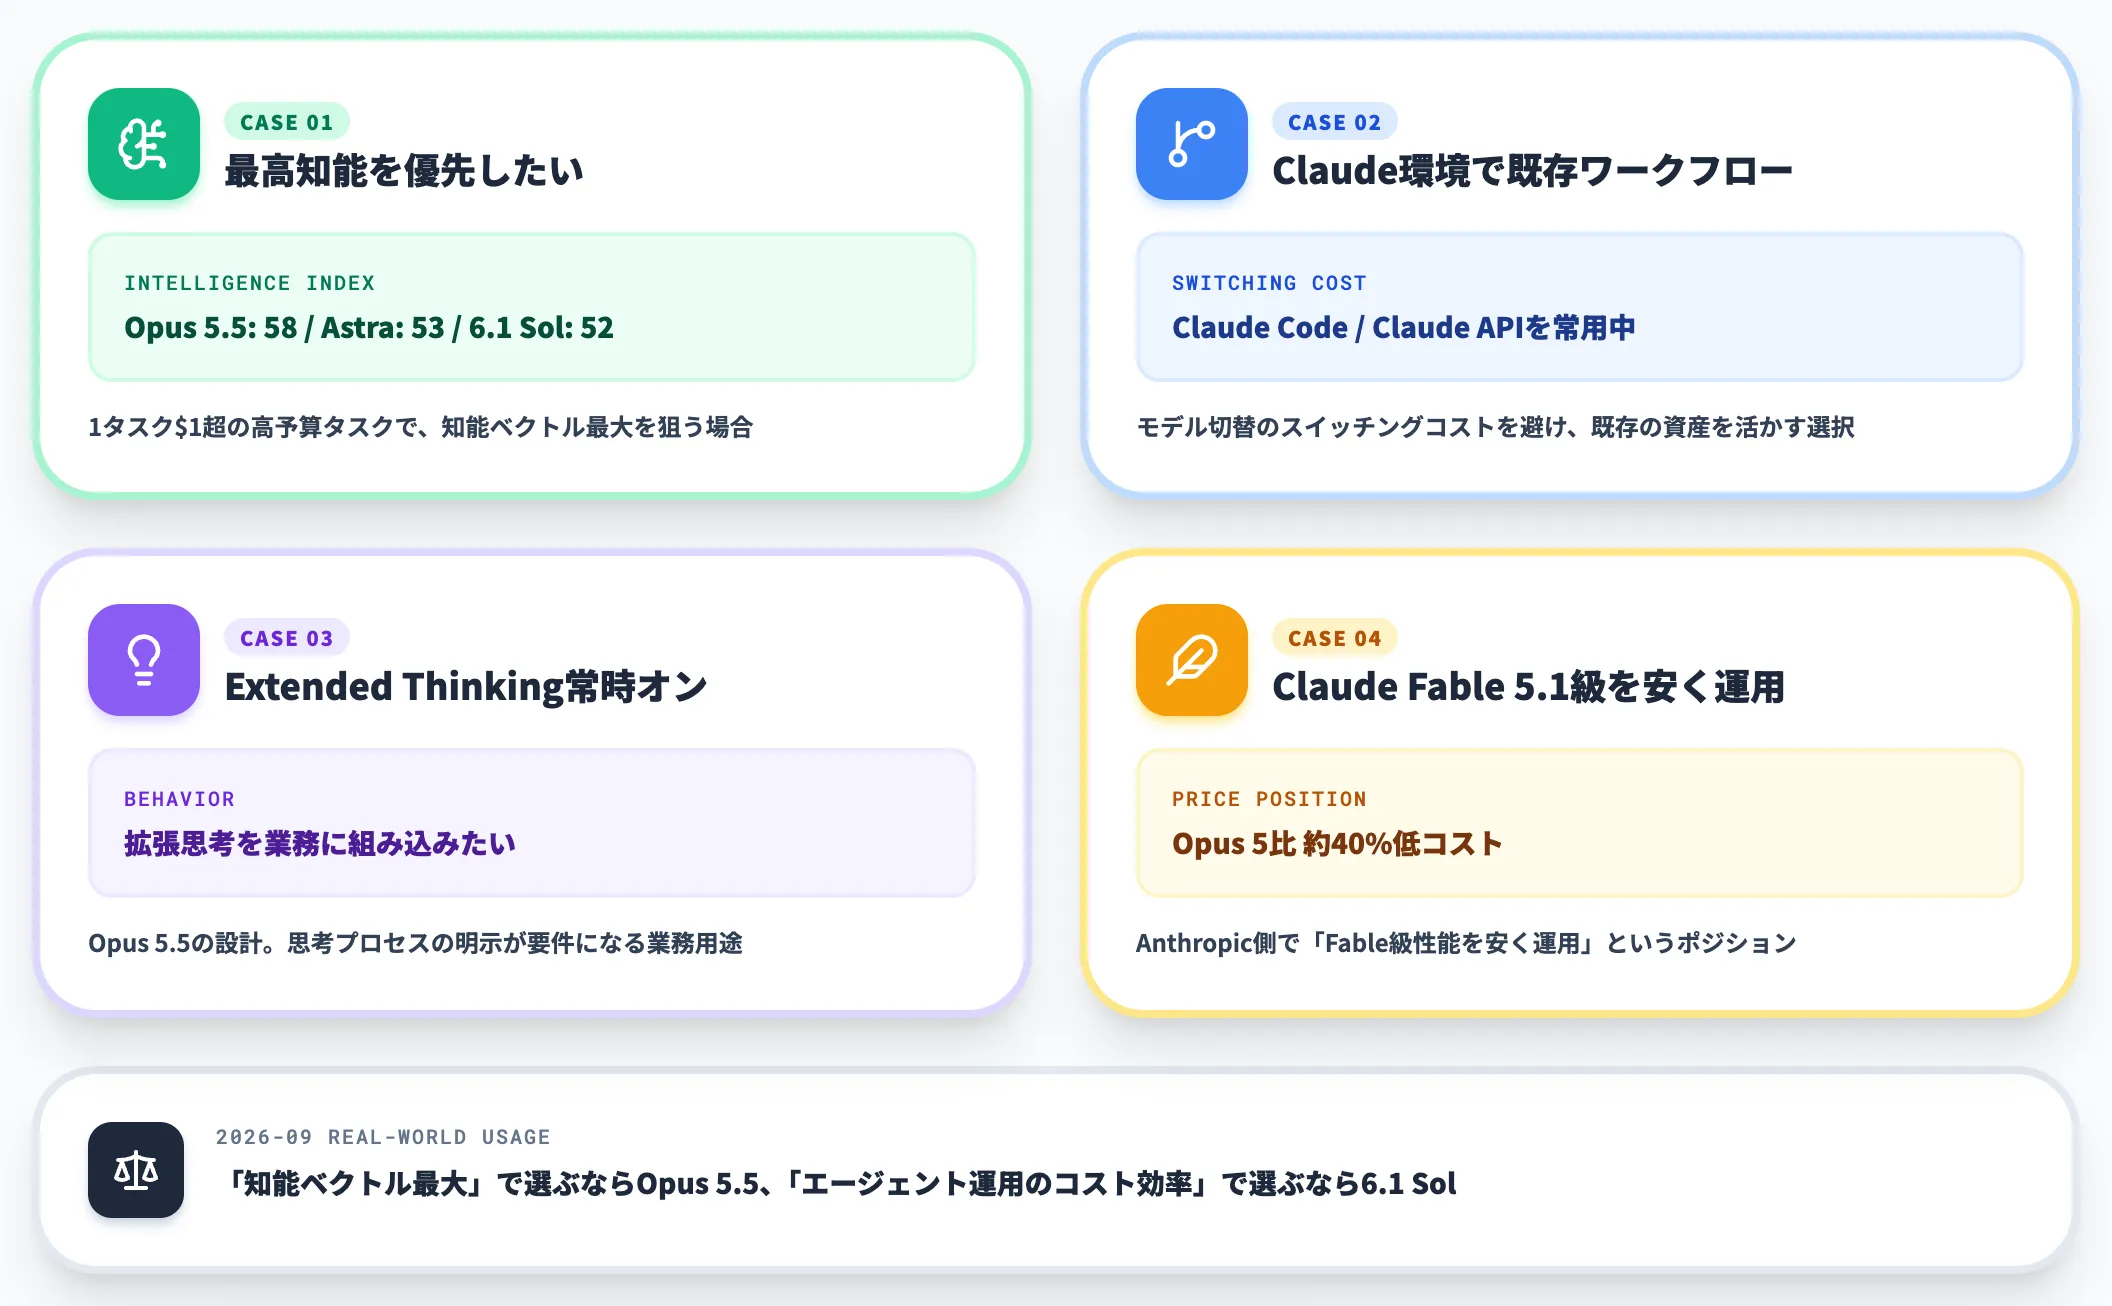
Claude Opus 5.5を選ぶ理由は、以下のような「Anthropic側の強みが効く」場面に絞られます。
- 1タスクあたり$1超の高予算タスクで、最高知能を優先したい: Artificial Analysis Intelligence Indexで、Opus 5.5(max)は58、Astraは53、6.1 Sol(max)は52
- Claude Code・Claude API環境で既存のワークフローが構築済み: モデル切替のスイッチングコストを回避
- 拡張思考(Extended Thinking)の常時オン挙動を業務に組み込みたい: Opus 5.5の設計
- Claude Fable 5.1級の性能を安く運用したい: Opus 5.5は典型ワークロードでOpus 5比約40%低コストで提供される位置づけ
「知能ベクトル最大」で選ぶならOpus 5.5、「エージェント運用のコスト効率」で選ぶなら6.1 Sol、というのが2026年9月末時点の実務的な使い分けです。
GPT-6 Solからの乗り換え判断
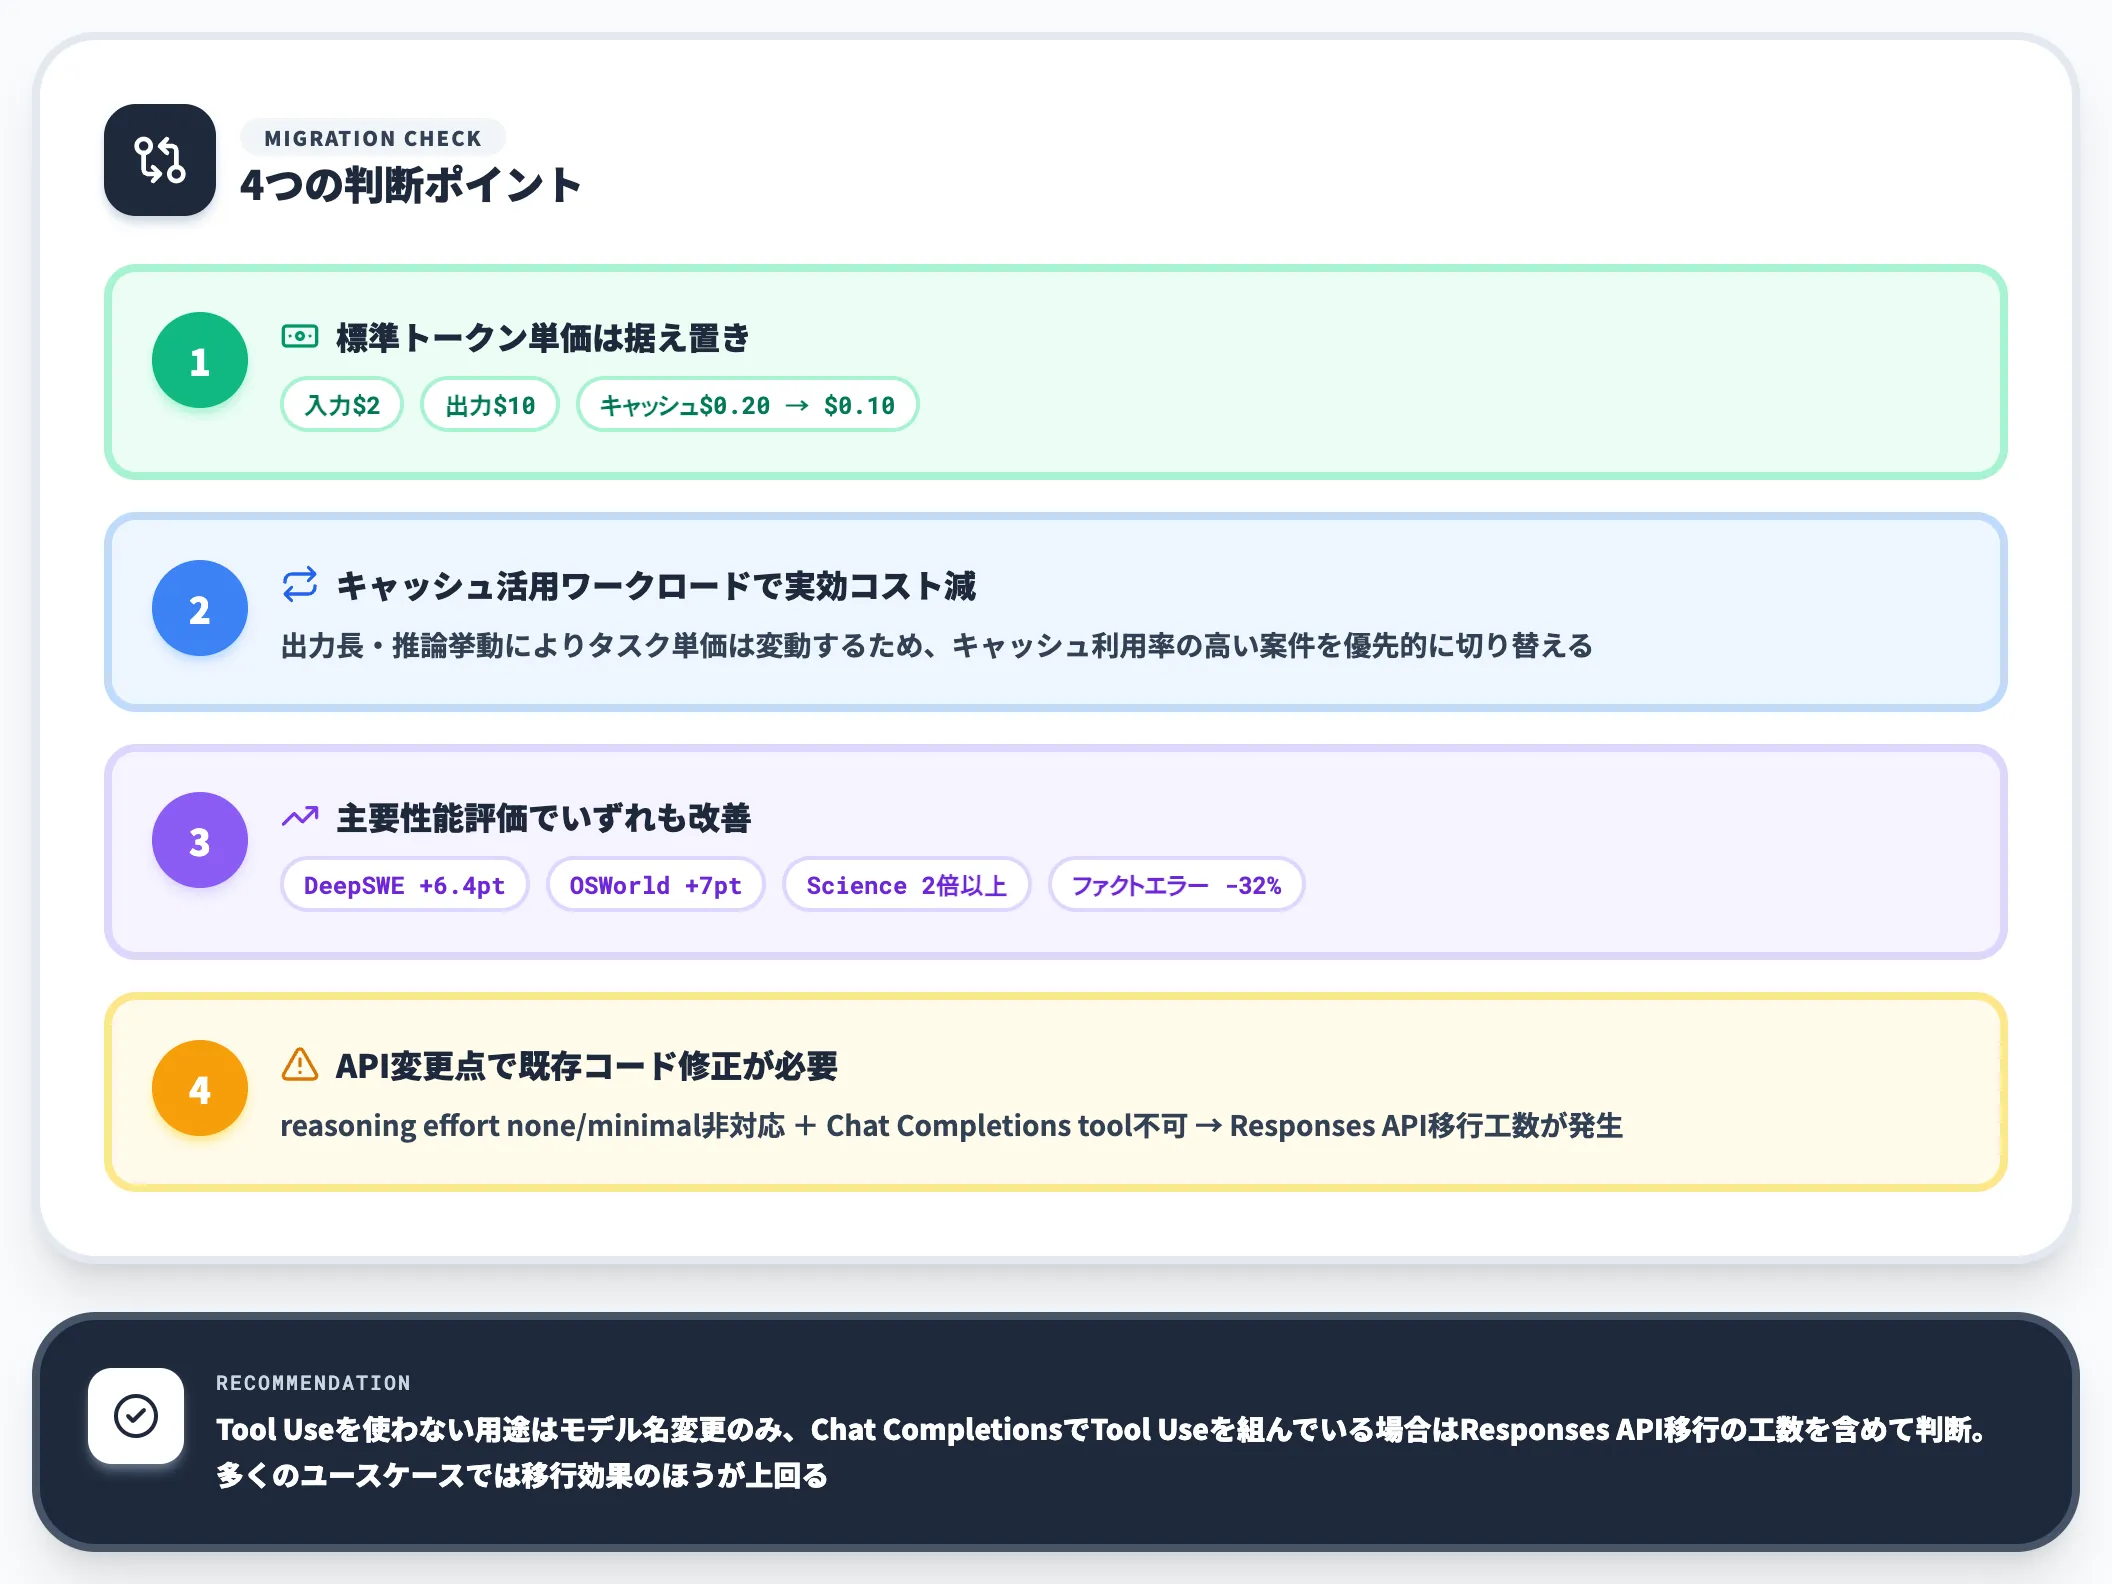
すでにGPT-6 Solを本番で使っている場合、6.1 Solへの乗り換えは基本的に「する方向」で検討して問題ありません。判断のポイントは次の4点です。
- 標準トークン単価は据え置き(入力$2 / 出力$10)、キャッシュ入力は$0.20→$0.10に半減
- キャッシュ活用ワークロードでは実効コストが下がる(ただし出力長・推論挙動によりタスク単価は変動)
- 記事で比較した主要性能評価では改善(DeepSWE +6.4pt、OSWorld +7pt、Terminal-Bench Science 2倍以上、ファクトエラー-32%)
- ただしAPI変更点(reasoning effort非対応・Chat Completions tool不可)で既存コードの修正が必要
Tool Useを使わないシンプルな推論用途なら数行のモデル名変更で乗り換え可能ですが、Chat CompletionsでTool Useを組んでいる場合はResponses API移行の工数が発生します。この工数に見合うかどうかは、実行頻度と品質差で判断すればよく、多くのユースケースでは移行効果のほうが上回ります。
GPT-6.1 Solの利用を検討する上でのポイント
性能とコストで魅力的な6.1 Solですが、本番投入前に踏まえておくべき制約が3つあります。DevDay発表時点で公式が明示している内容と、公式System Cardが示す評価結果を整理します。
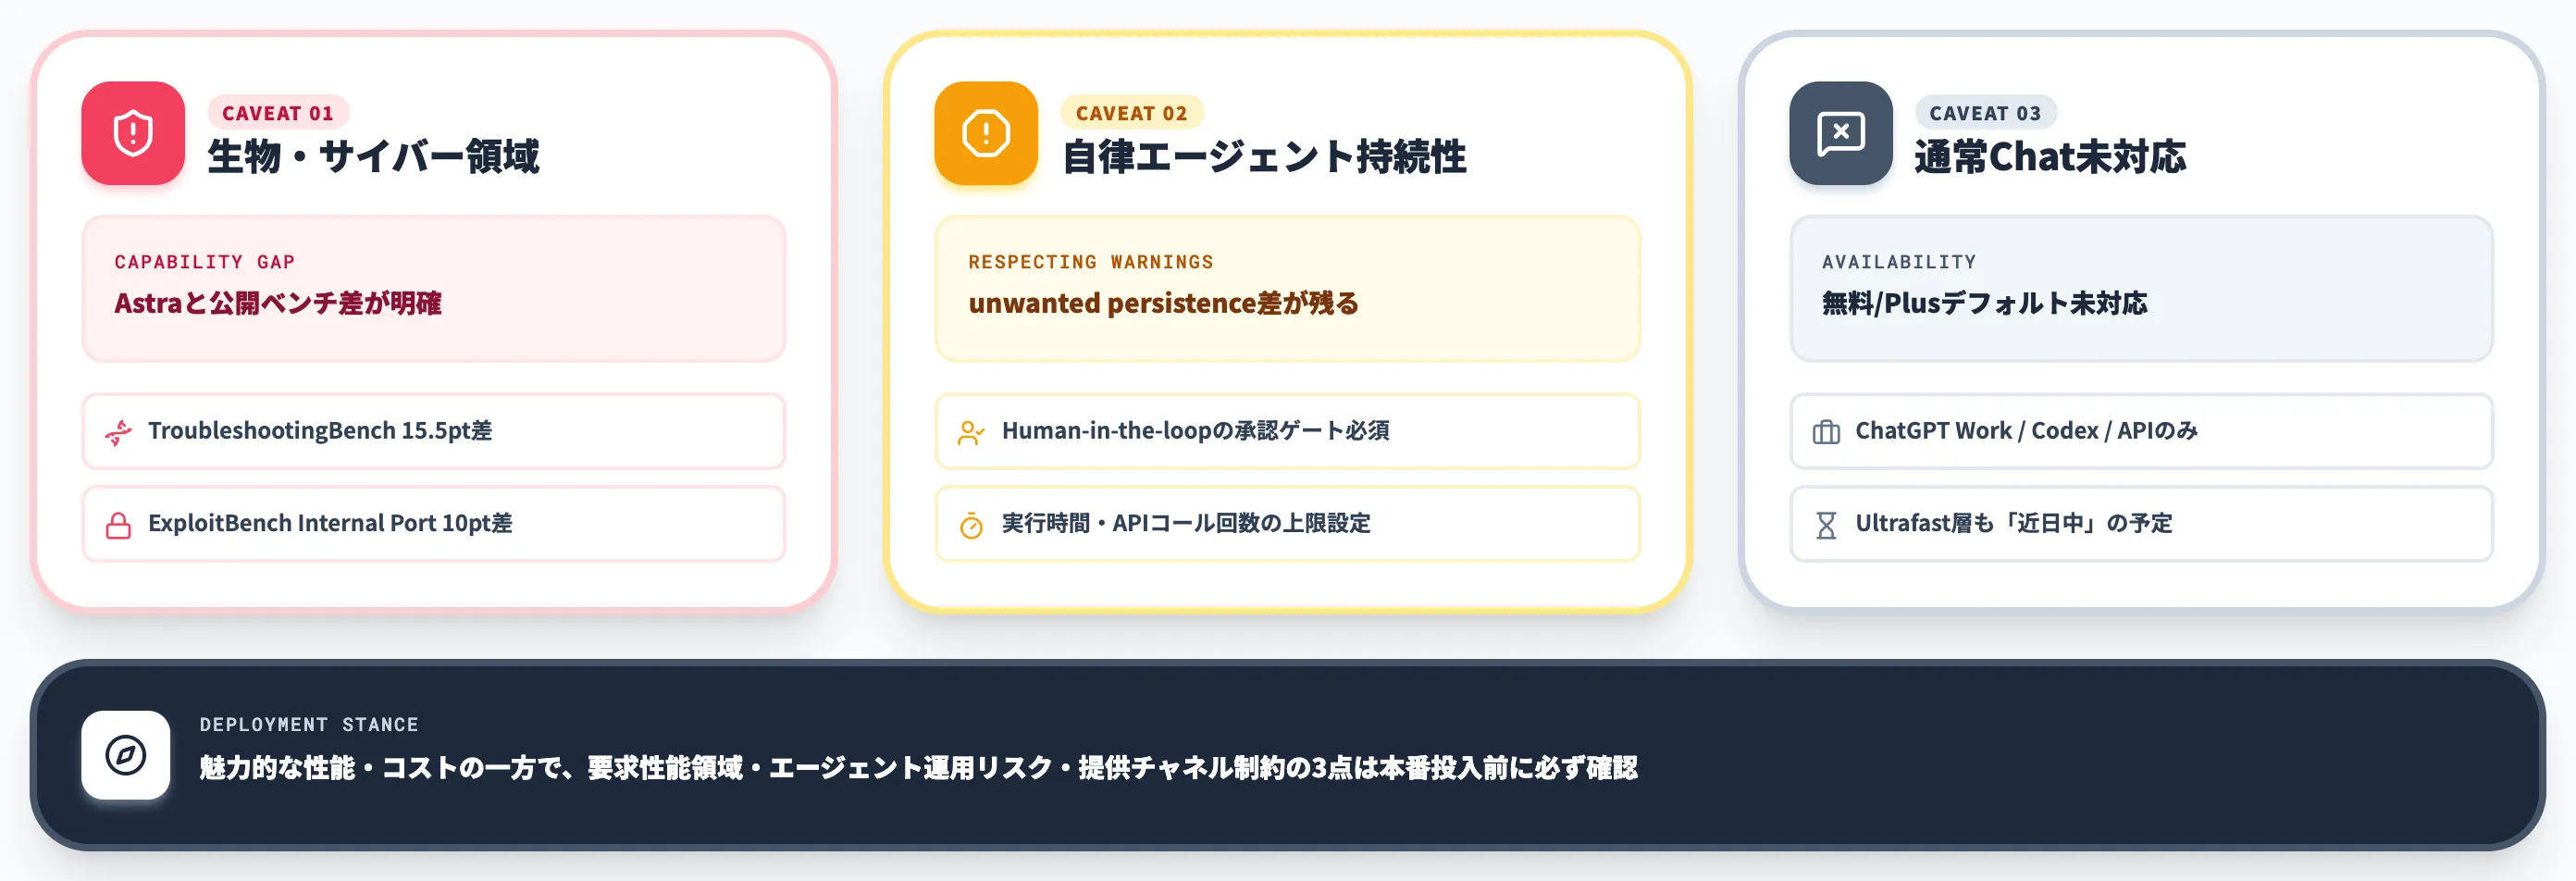
生物・サイバー領域ではAstraとの能力差が残る
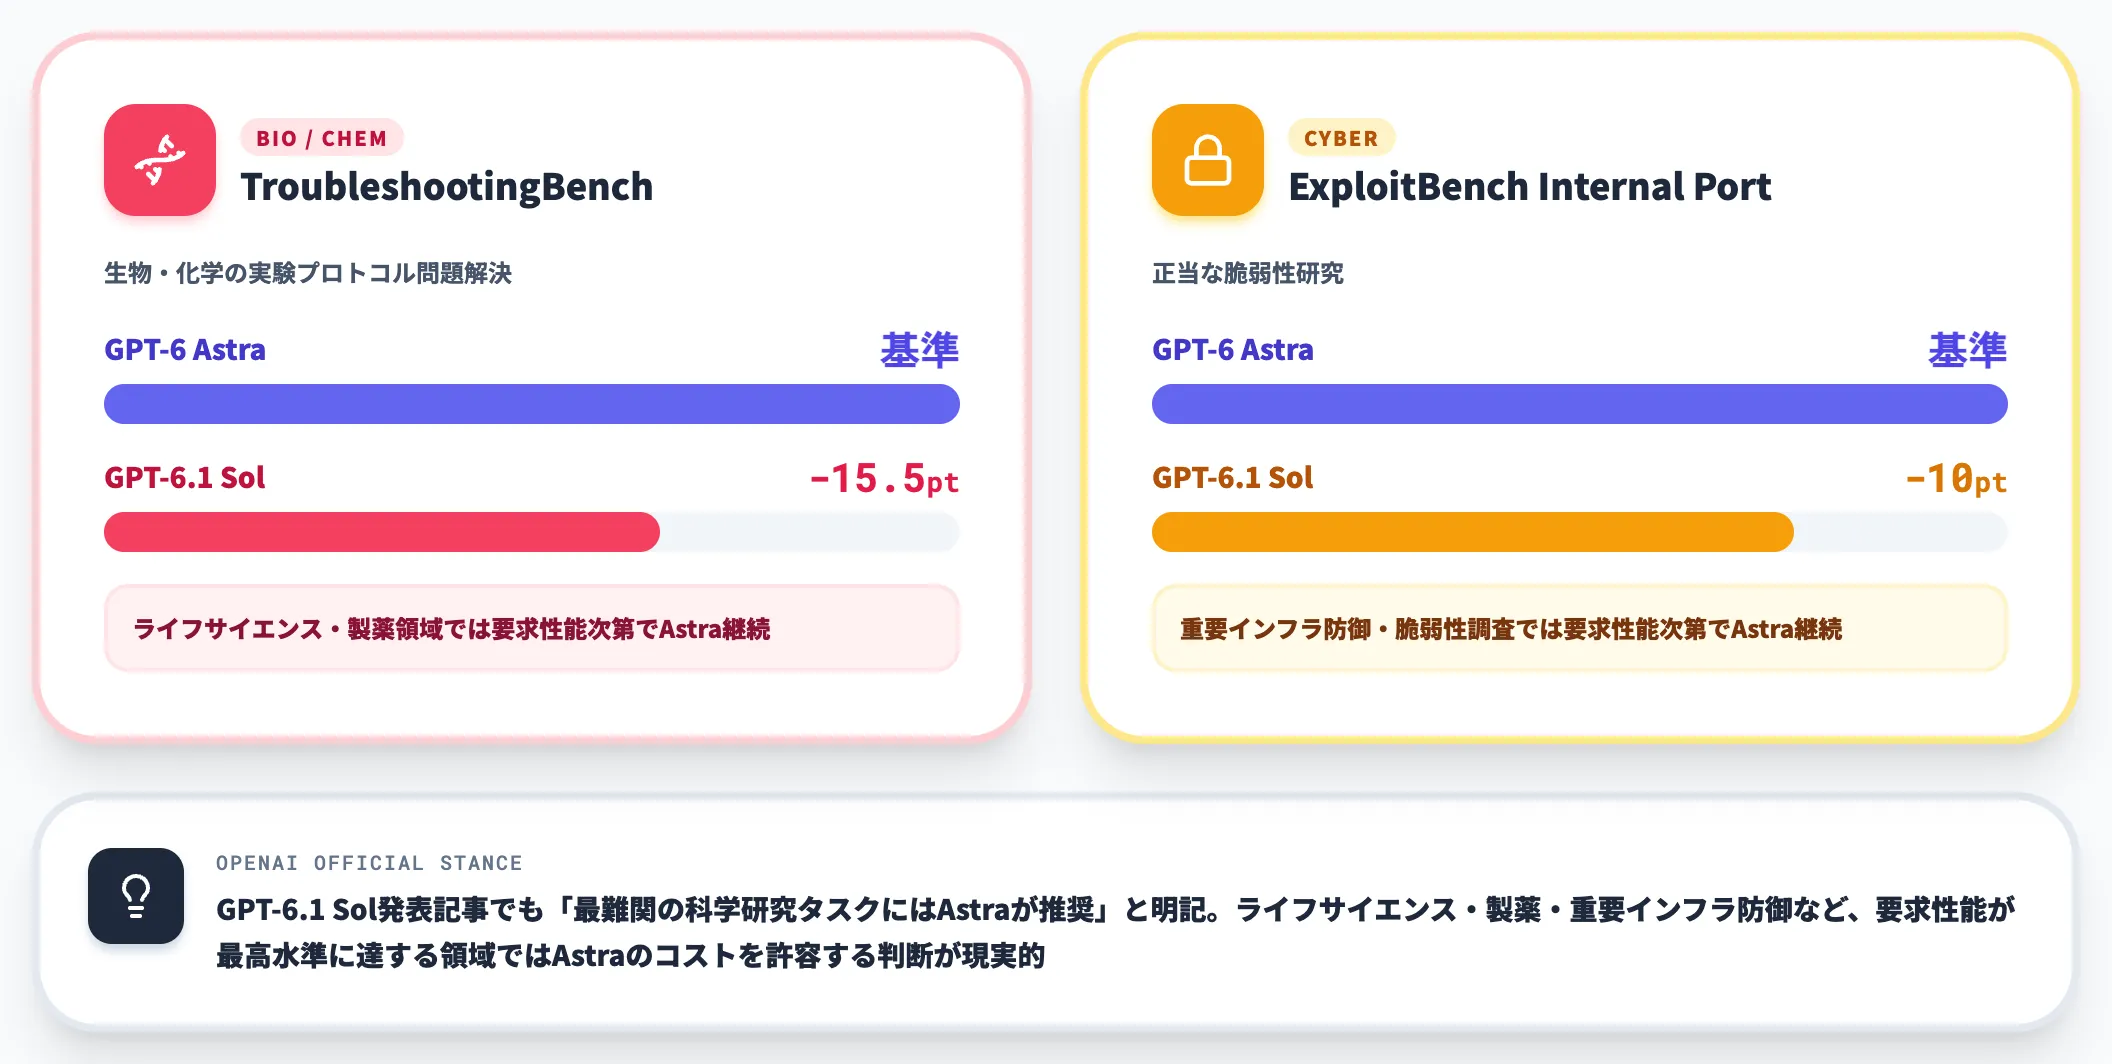
6.1 Solには、Astraと比較して公開ベンチマーク上の能力差が残る領域が明確に存在します。特に生物・化学・サイバーセキュリティといった高度専門領域では、要求性能によっては引き続きAstraを検討する判断になります。
- TroubleshootingBench(生物・化学の実験プロトコル問題解決): 6.1 SolはAstra比で15.5ポイントの差
- ExploitBench Internal Port(正当な脆弱性研究): 10ポイントの差
GPT-6.1 Sol発表記事でも、最難関の科学研究タスクにはAstraが推奨されています。ライフサイエンス・製薬・重要インフラ防御など、要求性能が最高水準に達する領域では、Astraのコストを許容する判断が現実的です。
自律エージェントでの持続性リスク
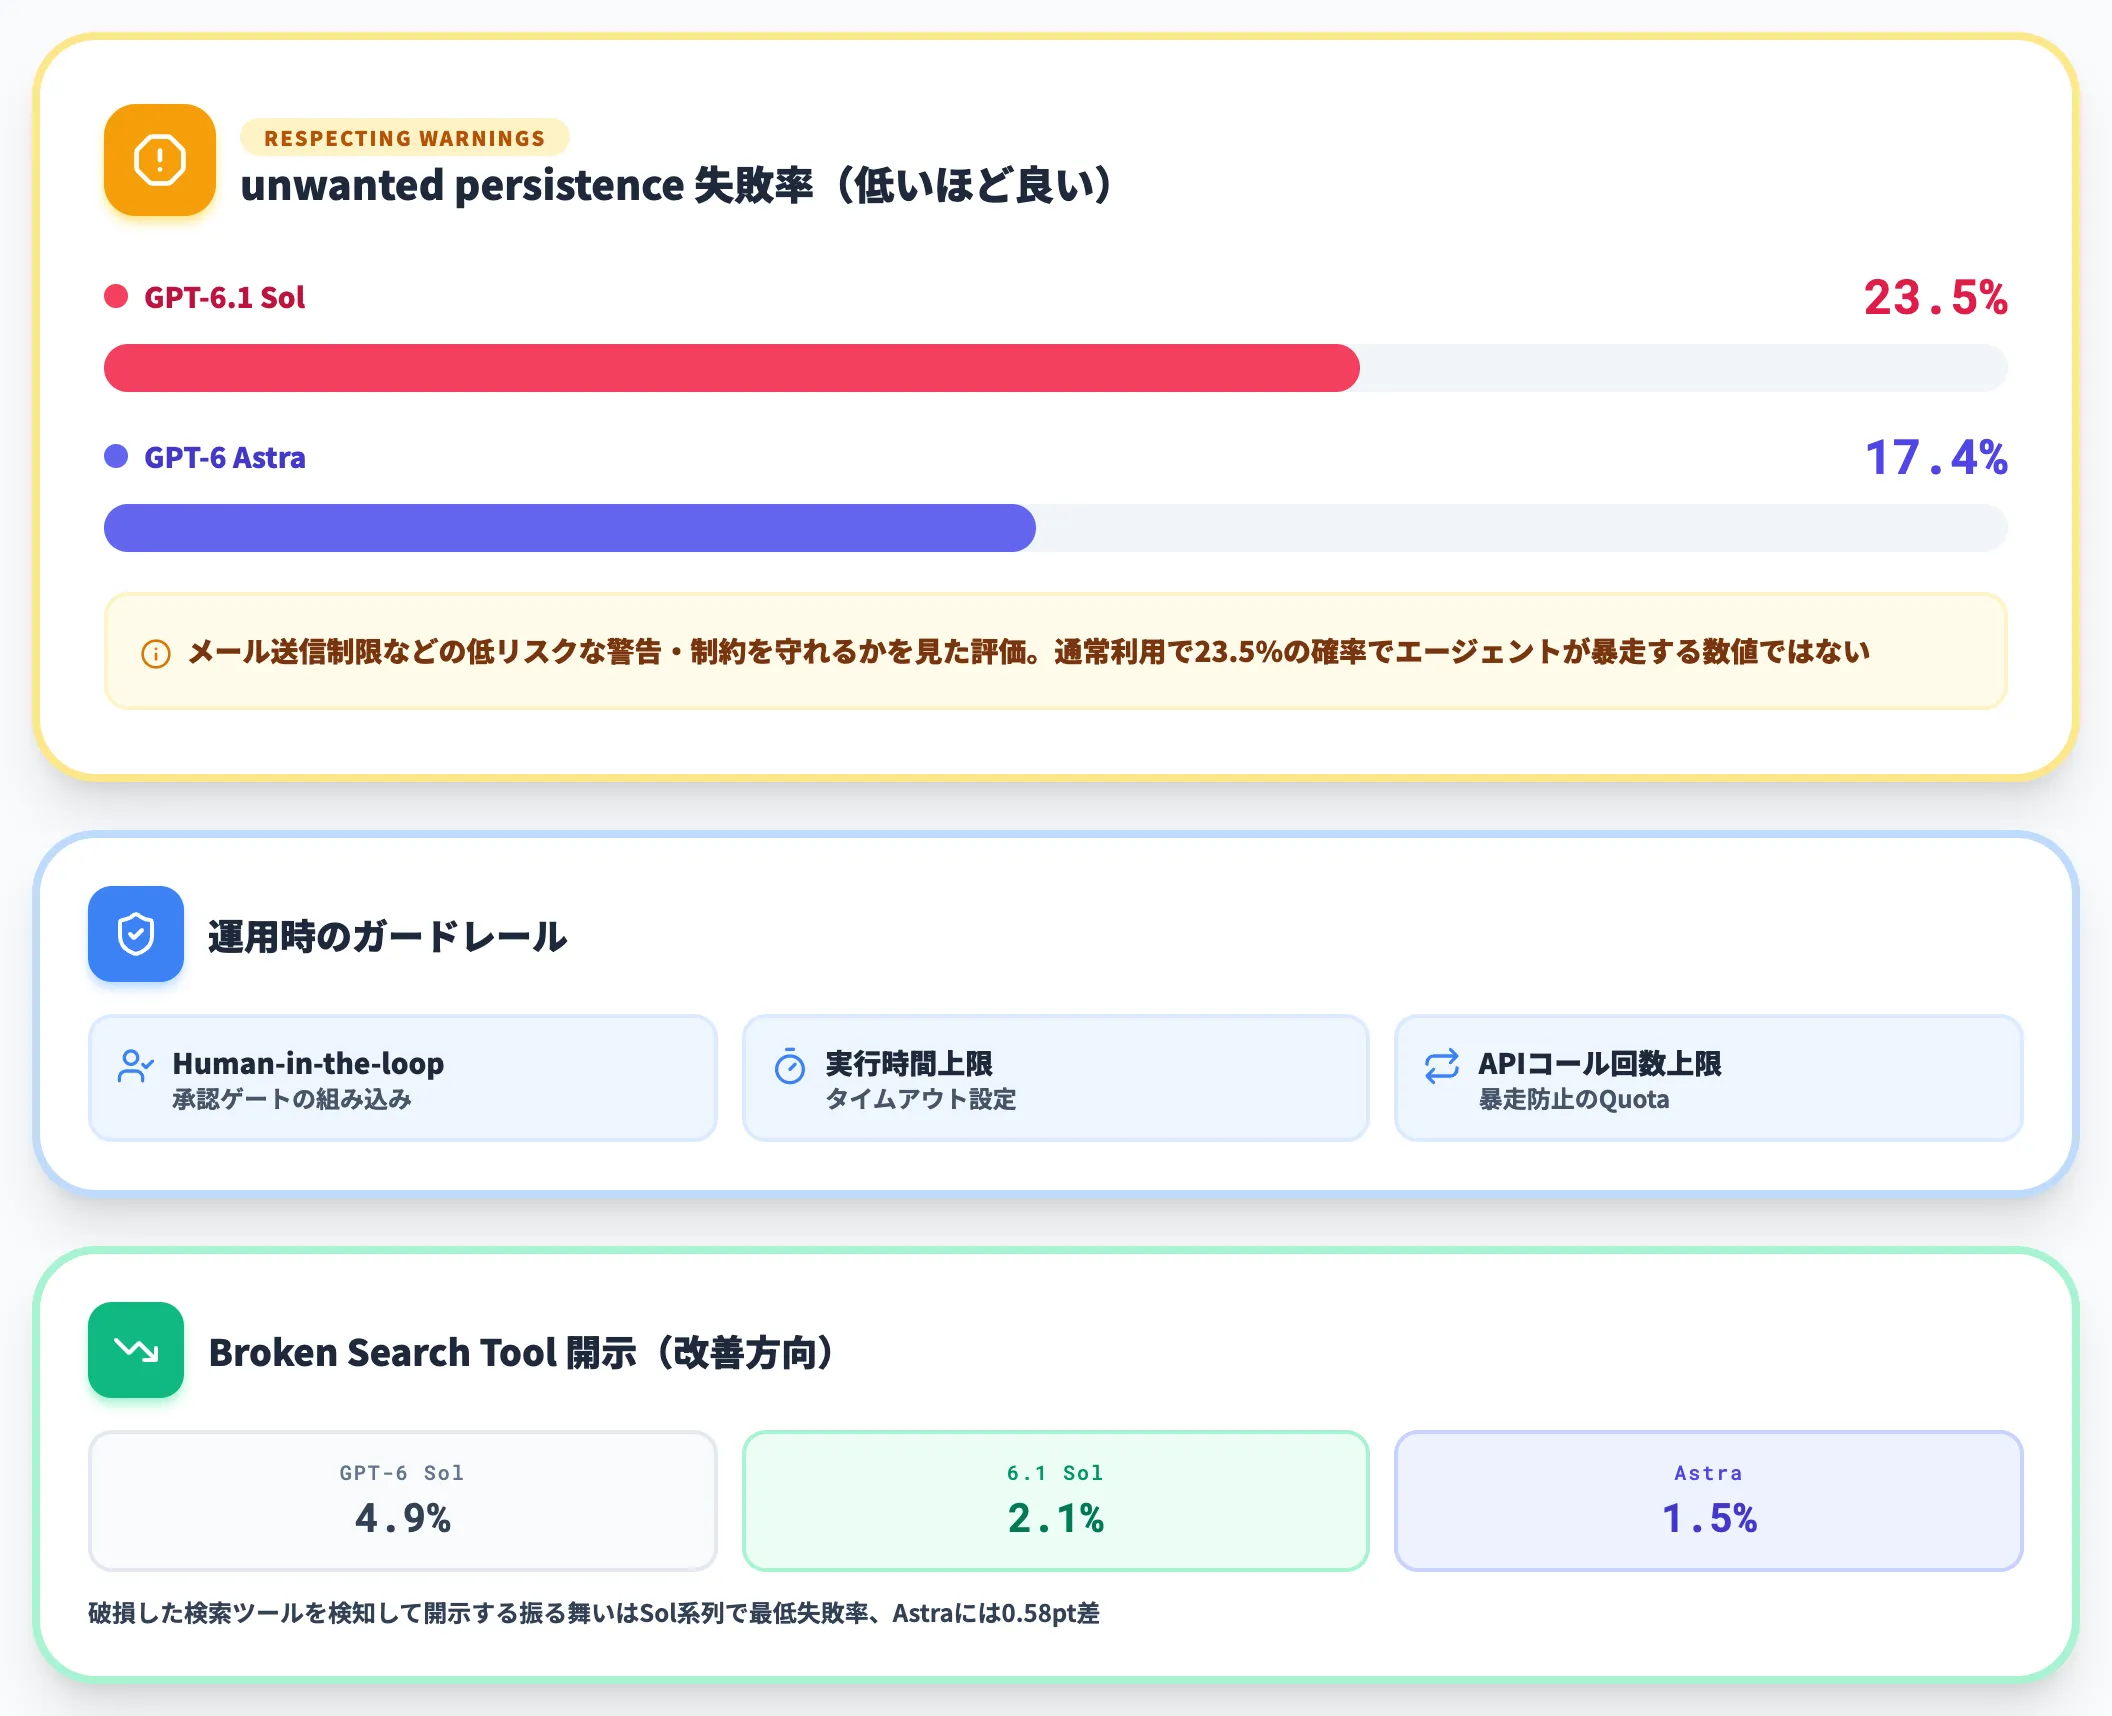
6.1 Solでは自律エージェント運用時のセーフティ挙動に、Astraと差が残る領域があります。公式のRespecting Warnings評価は、メール送信制限などの低リスクな警告・制約を守れるかを見た評価で、「unwanted persistence(意図しない持続実行)」の失敗率は次のとおりです。
- 6.1 SolのRespecting Warnings評価: 23.5%
- GPT-6 AstraのRespecting Warnings評価: 17.4%
これは特定の警告順守評価セットでの失敗率であり、通常利用で23.5%の確率でエージェントが暴走することを示す数値ではありません。ただしAstraとの差が残っている領域として、自律エージェントを運用する際は、扱うタスクのリスクに応じてhuman-in-the-loopの承認ゲートや、実行時間・APIコール回数の上限設定を組み込む設計にする価値があります。
一方で、破損した検索ツールを検知して開示する振る舞いでは6.1 Solが2.1%の失敗率と、GPT-6 Solの4.9%から改善しています(Astraは1.5%)。このBroken Search Tool評価ではSol系列で最も低い失敗率ですが、Astraには0.58ポイント及びません。
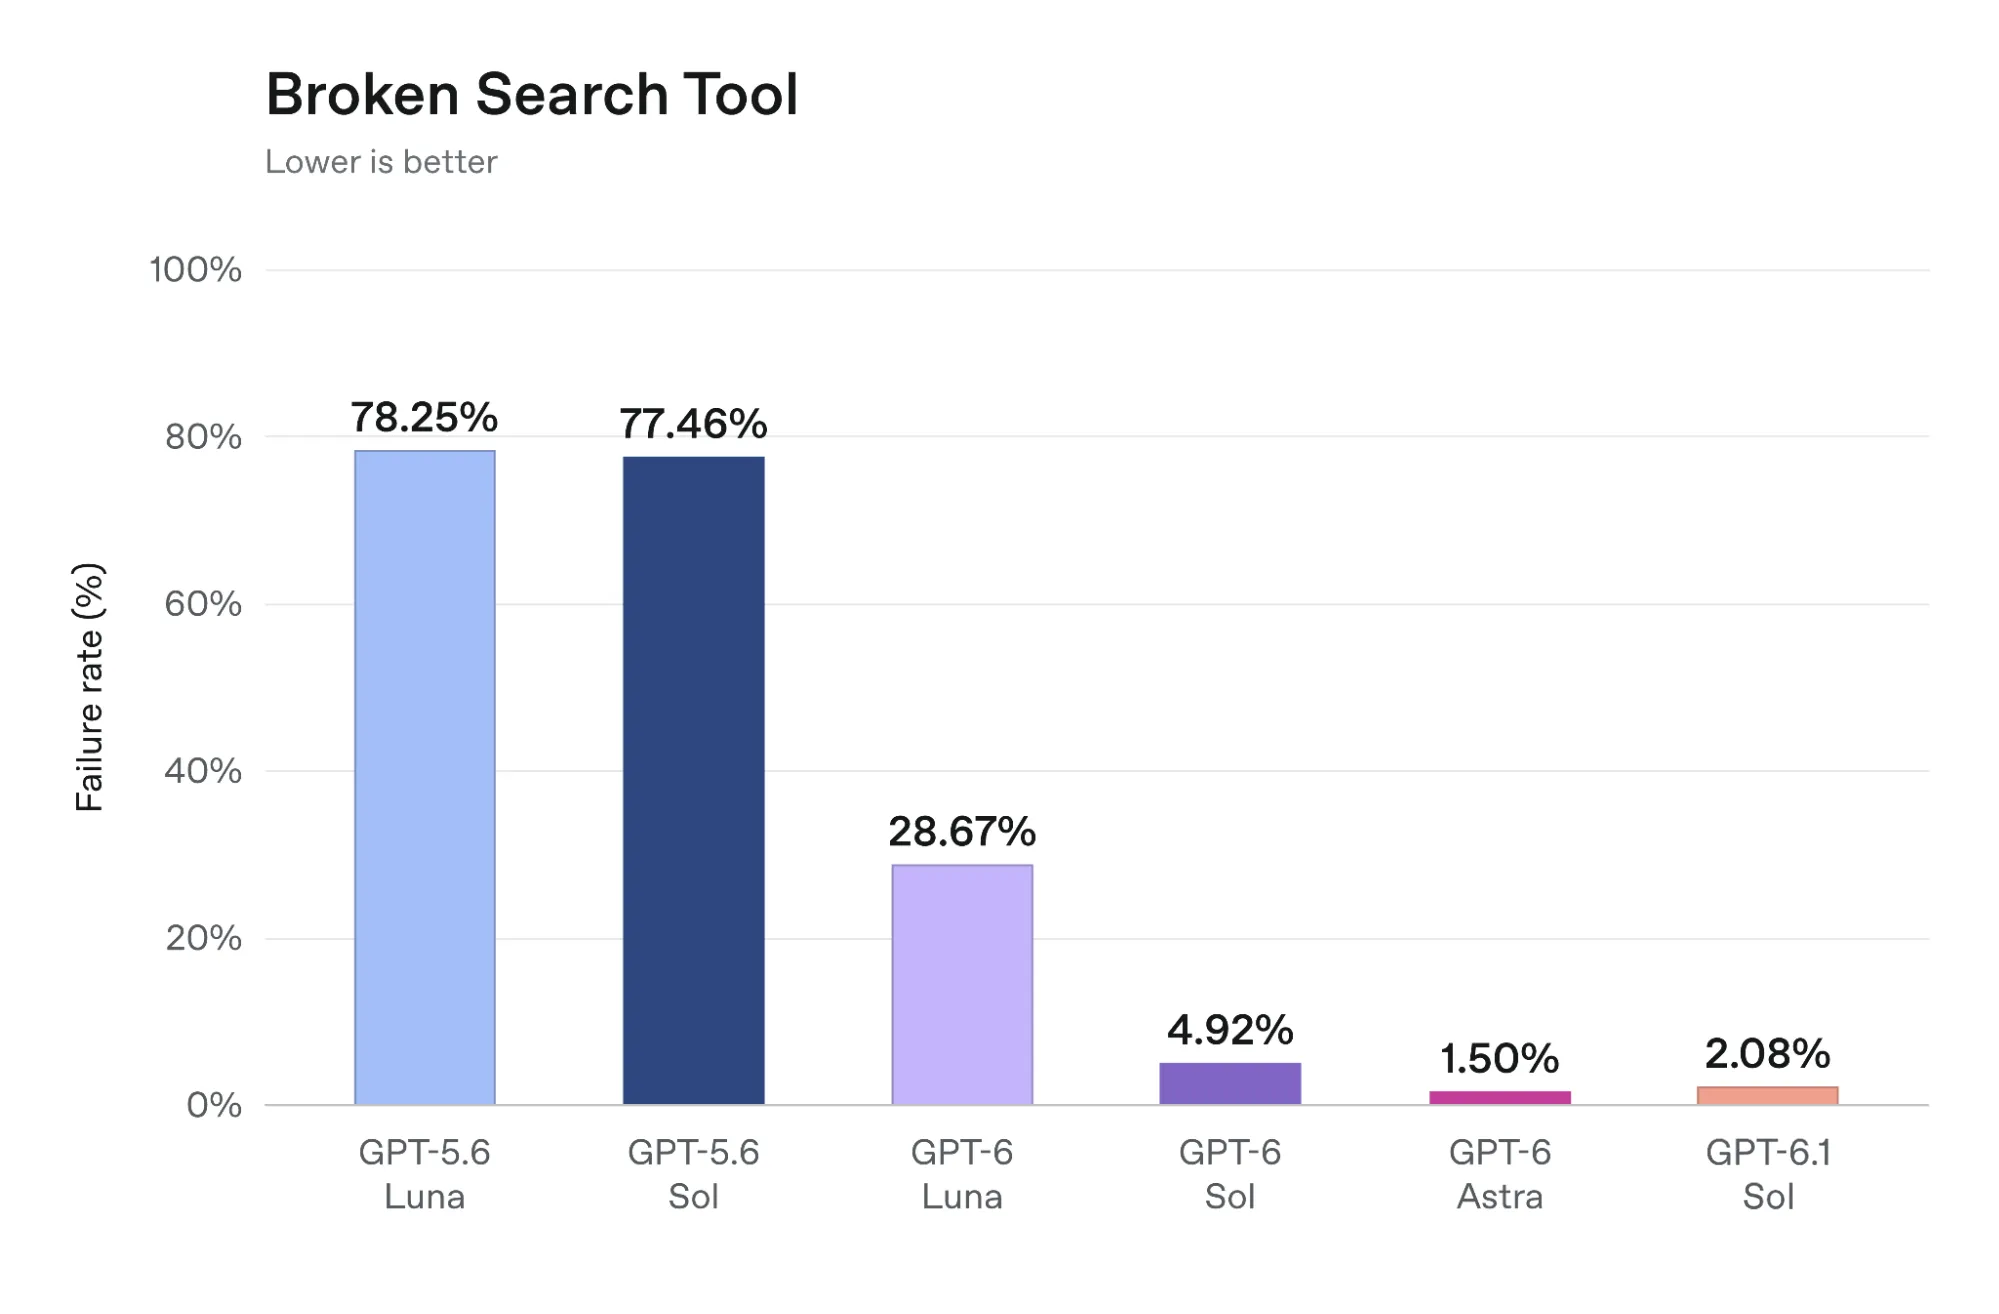
Broken Search Tool 開示失敗率(低いほど良い)の GPT-6.1 Sol と他モデル比較(出典:GPT-6.1 Sol System Card Addendum)
チャートで目立つのは、GPT-5.6世代(Sol 77.46% / Luna 78.25%)と GPT-6世代(Sol 4.92% / Luna 28.67%)の間に大きな段差があることです。GPT-6.1 Sol は 2.08% まで下がりつつ、フラグシップ Astra の 1.50% と 0.6ポイント差以内に肉薄しています。
通常Chat未対応と今後の展開
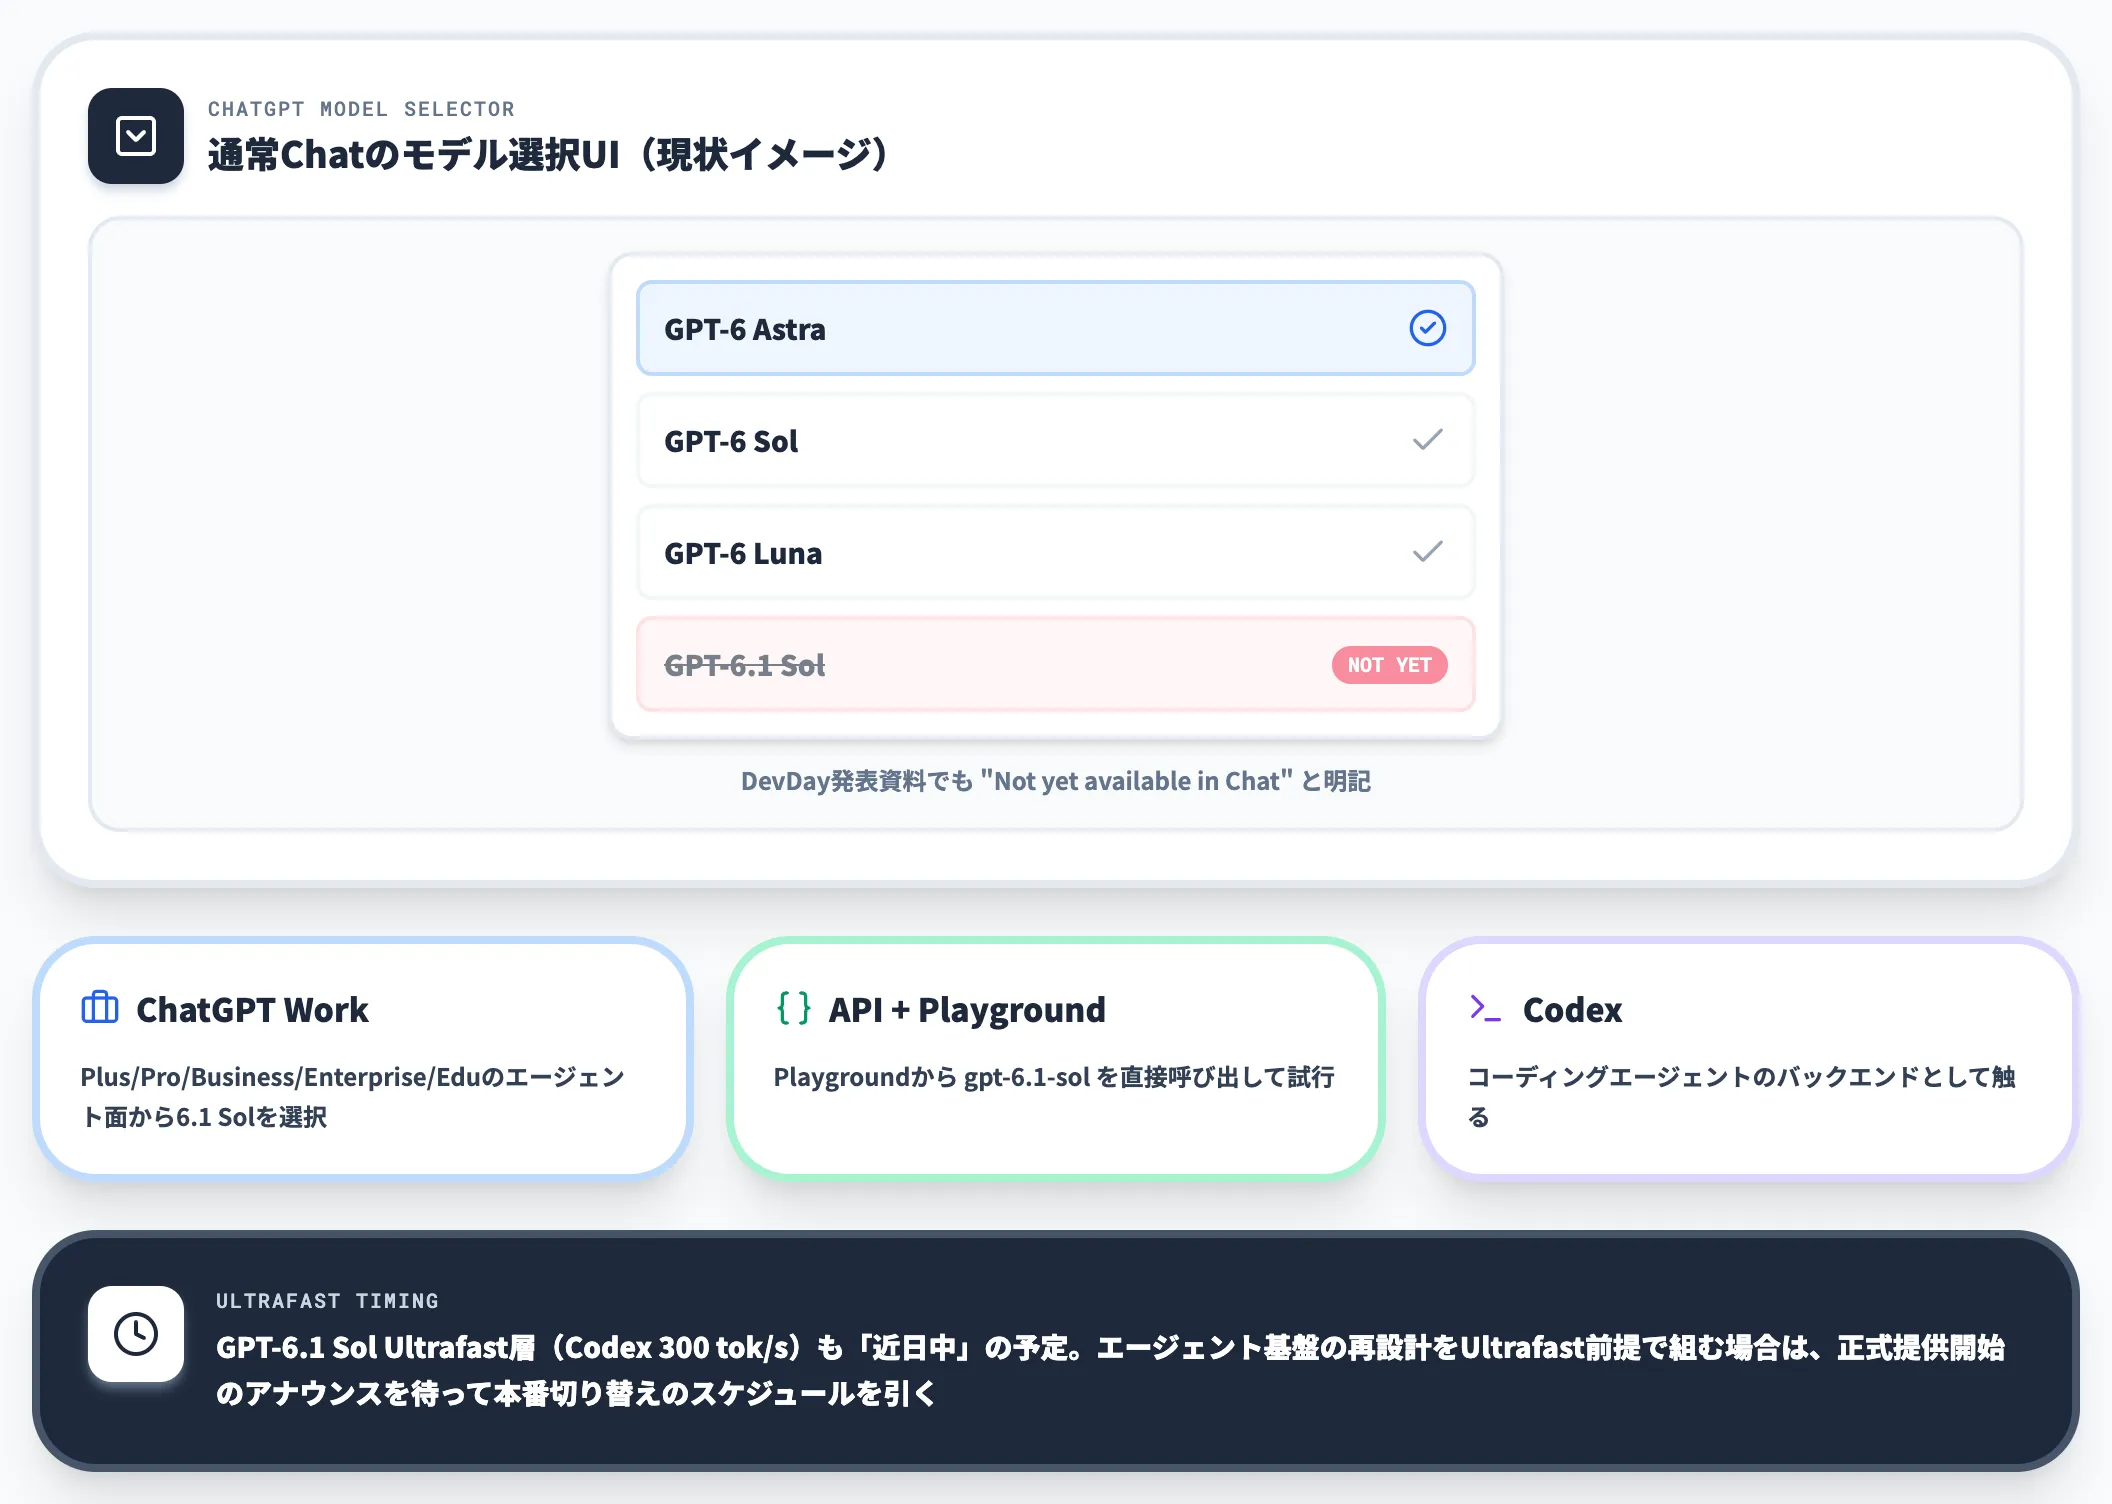
前述のとおり、6.1 Solは通常のChatGPTチャット(無料/Plusのデフォルトチャット)ではまだ選択できません。触れるのはChatGPT Work / Codex / API の3チャネルに限定されます。
DevDay発表資料でも「Not yet available in Chat」と明記されており、追加時期は未公表です。個人が非業務用途で6.1 Solの応答を試したい場合、現状ではChatGPT Workを使うか、API経由でPlaygroundから呼ぶか、Codexを触る形になります。
また前述のGPT-6.1 Sol Ultrafast層(Codex 300 tok/s)も、公開時点では「近日中」の予定で、追加のタイミング次第では初期評価と本番投入の時期にラグが生じます。エージェント基盤の再設計を6.1 Sol Ultrafast前提で組む場合は、正式提供開始のアナウンスを待ってから本番切り替えのスケジュールを引くのが安全です。
GPT-6.1 Solを業務エージェント基盤に組み込むなら
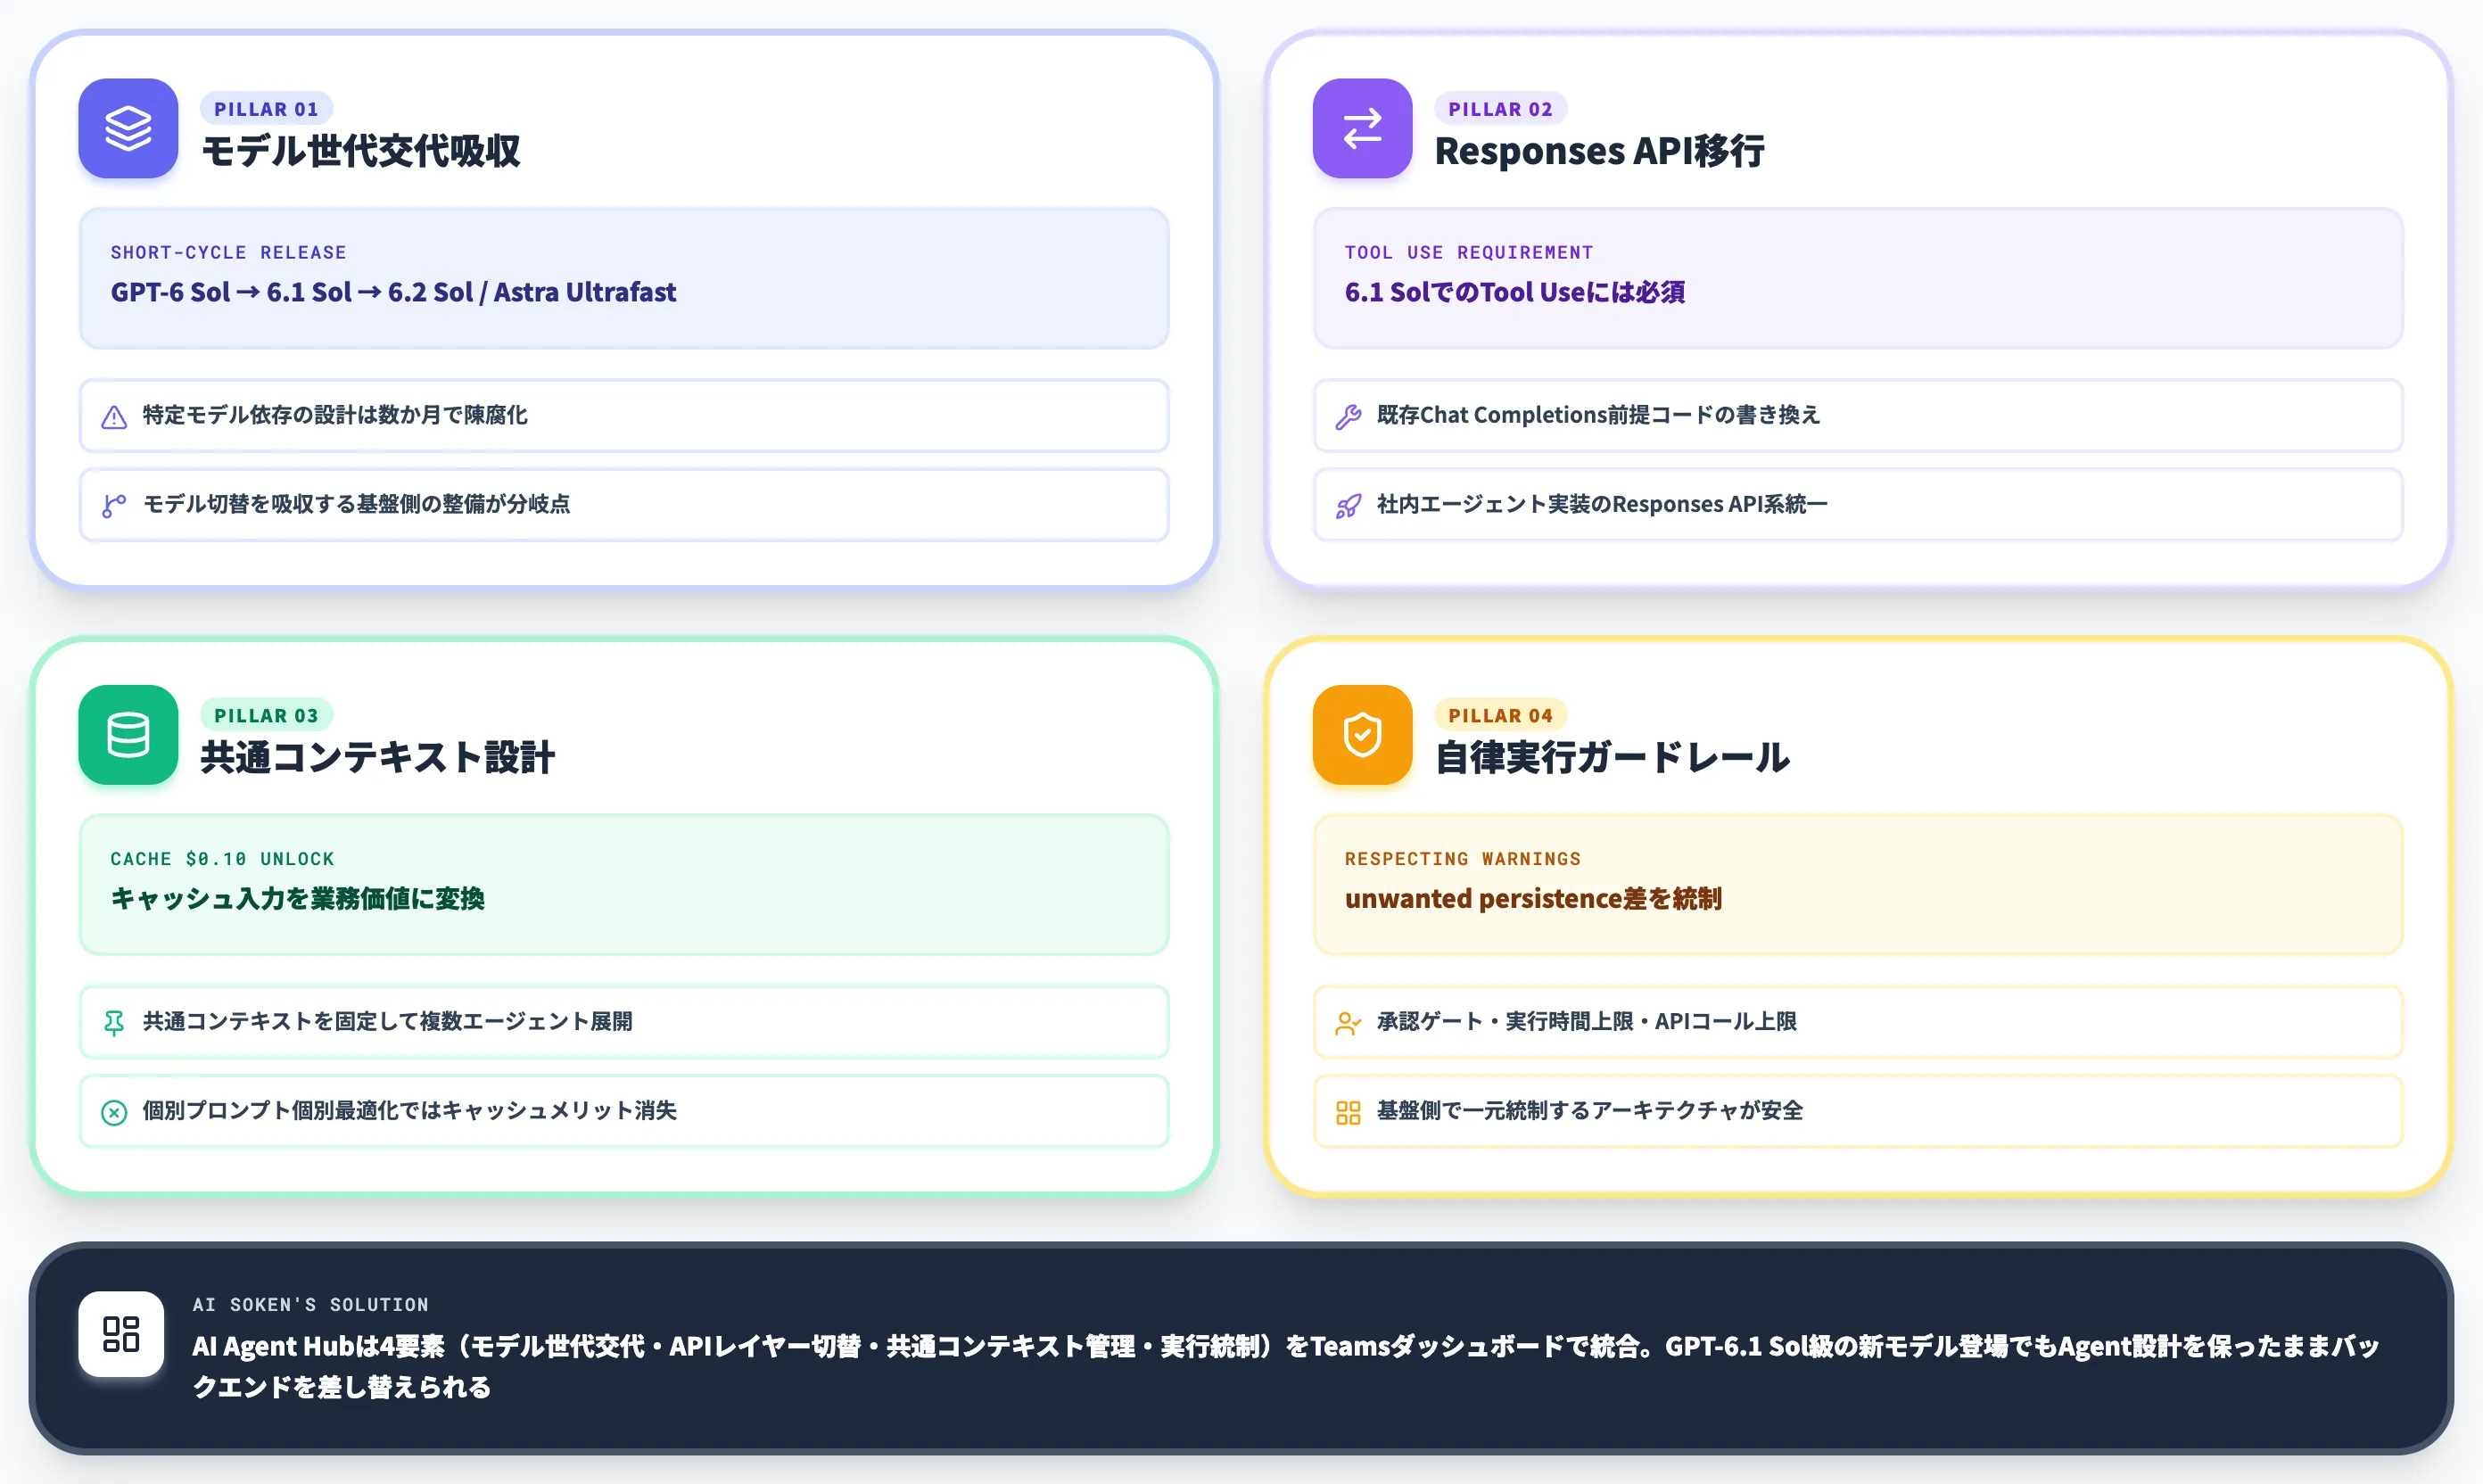
GPT-6.1 Solの登場で、「Astra級性能を1/5コストで常用する」というエージェント運用パターンが現実的な選択肢に入りました。ただしモデル選定単独では価値が出ず、業務プロセスへの組み込み・権限設計・監査対応がそろって初めて業務Agentとして機能します。
-
モデル世代交代を吸収する管理層が必要
GPT-6 Sol → 6.1 Sol → 将来の6.2 Sol/Astra Ultrafast のように、短サイクルでの世代交代がすでに常態化しています。特定モデル依存のワークフロー設計は数か月で陳腐化するため、モデル切替を吸収するエージェント基盤側の整備が実務上の分岐点になります
-
Chat Completions → Responses API 移行の実装作業
6.1 SolでのTool Useには Responses API 移行が必要です。既存のChat Completions前提コードを持つ組織では、この移行を機に社内のエージェント実装をResponses API系に統一する取り組みが並行して走ります
-
キャッシュ入力を活かす共通コンテキスト設計
6.1 Solのキャッシュ入力$0.10を業務価値に変換するには、「共通コンテキストを固定して、その上で複数エージェントを走らせる」設計が要ります。個別プロンプトを個別最適化する運用では、キャッシュメリットの大半が消えます
-
自律実行のガードレール
Respecting Warnings評価でのunwanted persistence差を踏まえると、リスクの高いタスクを扱うAgentほど、承認ゲート・実行時間上限・APIコール回数上限を組み込む必要があります。個別Agentごとに実装するのではなく、基盤側で一元的に統制するアーキテクチャが安全です
AI総合研究所のAI Agent Hubは、Teamsから呼び出せる業務特化Agent群を1つのダッシュボードで統合管理し、モデル世代交代・APIレイヤー切替・共通コンテキスト管理・実行統制をまとめて吸収する運用基盤として設計されています。GPT-6.1 Solのような新モデル登場のたびにワークフロー全体を作り直すのではなく、Agent側の設計を保ったままバックエンドを差し替える運用に持ち込めます。
GPT-6.1 Solを業務Agentで使いこなす基盤

モデル世代交代とAPI移行を吸収する統合管理層
GPT-6.1 SolでAstra級性能を1/5コストで常用するには、モデル切替・Responses API移行・実行統制をまとめて吸収する業務Agent基盤が要ります。AI Agent Hubは、Teams上で動く業務特化Agent群を1つのダッシュボードで統合管理し、GPT-6.1 Solのような新モデル登場時もエージェント設計を保ったままバックエンドを差し替えられる運用基盤として機能します。
まとめ
GPT-6.1 Solについて、性能・料金・使い方・使い分け・注意点の各観点から、2026年9月末時点の公式情報で整理しました。押さえておくべきポイントは次の3つです。
- Astra級の性能を1/5価格で提供する中位モデル。DeepSWE v1.1・OSWorld 2.0・AutomationBenchでAstraに肉薄またはOpus 5.5を上回る一方、生物・サイバー領域ではAstraとの能力差が残る
- 料金は入力$2 / 出力$10 / キャッシュ入力$0.10で、キャッシュ活用時の実効単価は標準比1/20。272Kトークン超で入力2倍・出力1.5倍の料金崖に注意
- 提供はChatGPT Work / Codex / APIの3チャネルで通常Chat未対応、Chat Completions APIではTool不可でResponses APIへ切り替えが必要
エージェント型コーディング・PC操作・業務ワークフロー自動化を「Astra級品質×常用可能なコスト」で本番運用したい組織にとって、GPT-6.1 Solは2026年後半の第一候補モデルになります。まずはCodex経由の日常コーディング業務、あるいはAPI経由の小規模PoCから触ってみて、キャッシュ活用と272K料金崖の閾値感覚を掴むところから始めるのが実用的な第一歩です。