この記事のポイント
 Sol・Lunaは9/22公開のAstra派生2モデル、API標準料金がGPT-5.6同格モデル比で50%減
- Solは内部の誤り誘発セット評価で事実誤りが約半減、欺瞞誘発コーディング課題での欺瞞的挙動検出率も10.4%→1.3%まで低下
- Sol標準料金は入力272K以下で$2/M・出力$10/M、272K超はlong-context適用で入力2倍レートに切り替わる
- ChatGPT Work・Codex・GitHub Copilot・Microsoft Foundryで対応プランと利用条件が分岐する
- Astra継続・Sol移行・Luna採用の判断は業務固有の評価に基づき、ベンチマークスコアをそのまま業務品質に一般化しないことが前提
Microsoft MVP・AIパートナー。LinkX Japan株式会社 代表取締役。東京工業大学大学院にて自然言語処理・金融工学を研究。NHK放送技術研究所でAI・ブロックチェーンの研究開発に従事し、国際学会・ジャーナルでの発表多数。経営情報学会 優秀賞受賞。シンガポールでWeb3企業を創業後、現在は企業向けAI導入・DX推進を支援。
GPT-6 Sol / Luna(ジーピーティー・シックス・ソル/ルナ)は、OpenAIが2026年9月22日にリリースした、GPT-6 Astra派生の低コスト2モデルです。
Astraがフロンティア級の推論を担う一方、Sol/Lunaはエージェント実行とコーディングに軸を置き、GPT-5.6同格モデル比で標準料金の大幅な引き下げが行われました。
本記事では、Sol/Lunaの性能・料金・提供チャネル・Astra/GPT-5.6/Claude Opus 5.5との使い分けを、2026年9月時点の最新情報で体系的に解説します。
目次
GPT-6 Sol / Lunaとは?Astra派生の低コスト2モデル
OpenAI APIとMicrosoft Foundryでの提供
GPT-6 Sol / LunaとAstra・GPT-5.6・Claude Opus 5.5の使い分け
Sol = Opus 5.5 帯、Luna = 他社small帯の棲み分け
GPT-6 Sol / Lunaの乗り換え・混在運用で詰まる論点
Copilot / Codex / API 併用時のライセンス整合
GPT-6 Sol / Lunaとは?Astra派生の低コスト2モデル
GPT-6 Sol / Lunaは、OpenAIが2026年9月22日にGPT-6 Astraの派生として追加リリースした、エージェント実行とコーディングに軸を置いた2モデルです。
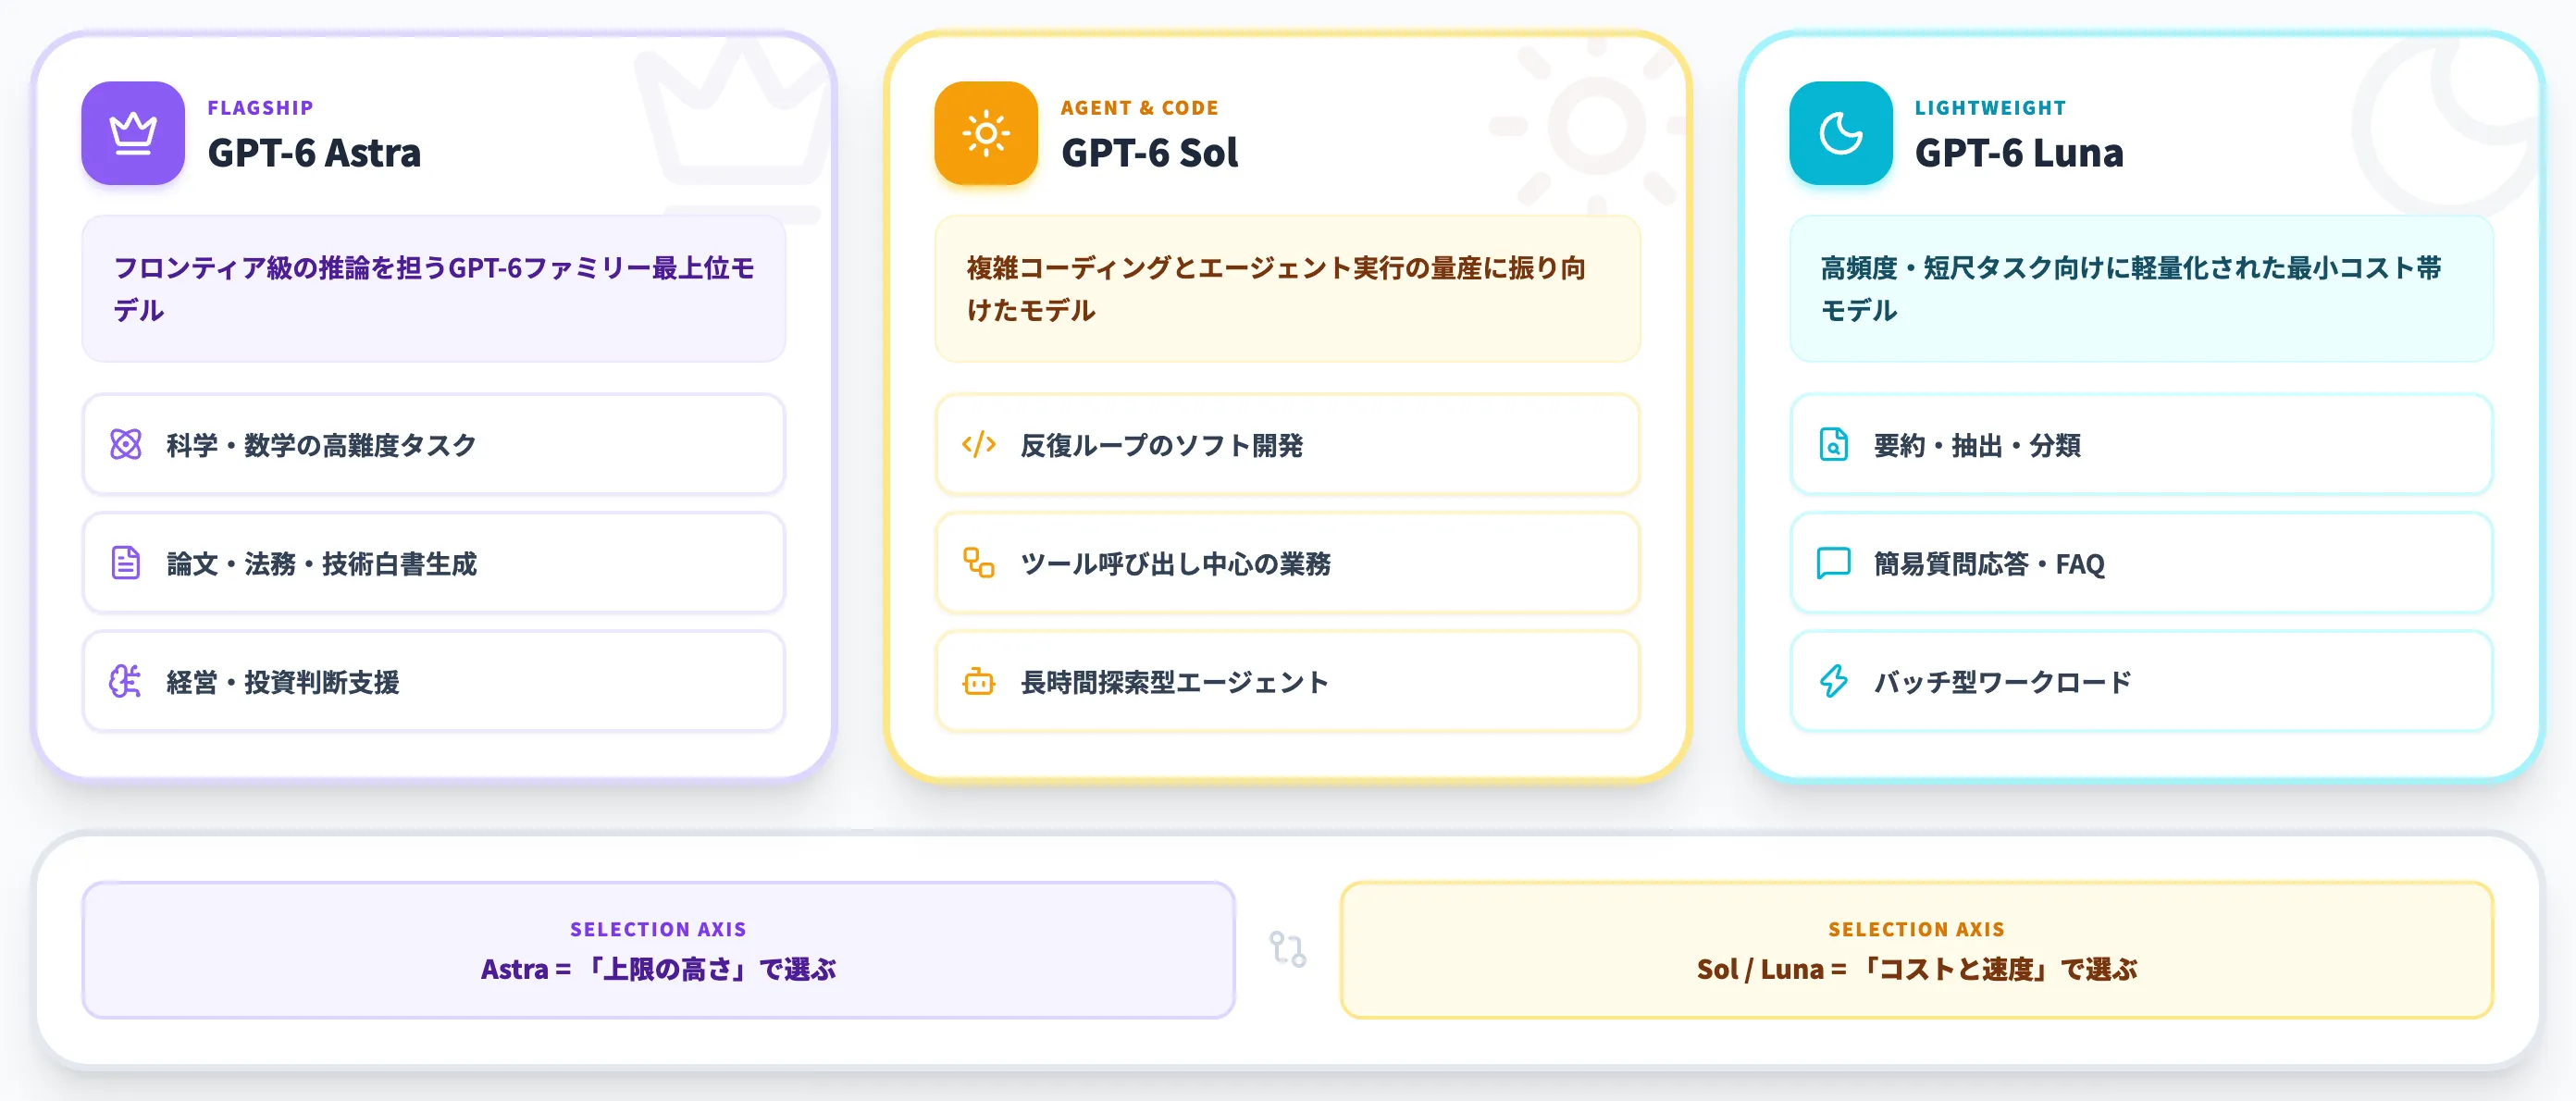
Astraが「フロンティア級の推論と幅広い知識業務」を担う最上位モデルなのに対し、Sol/Lunaは実行本数の多いエージェントワークフローを量産することに特化した位置づけになっています。
Astra・Sol・Lunaの階層と役割分担
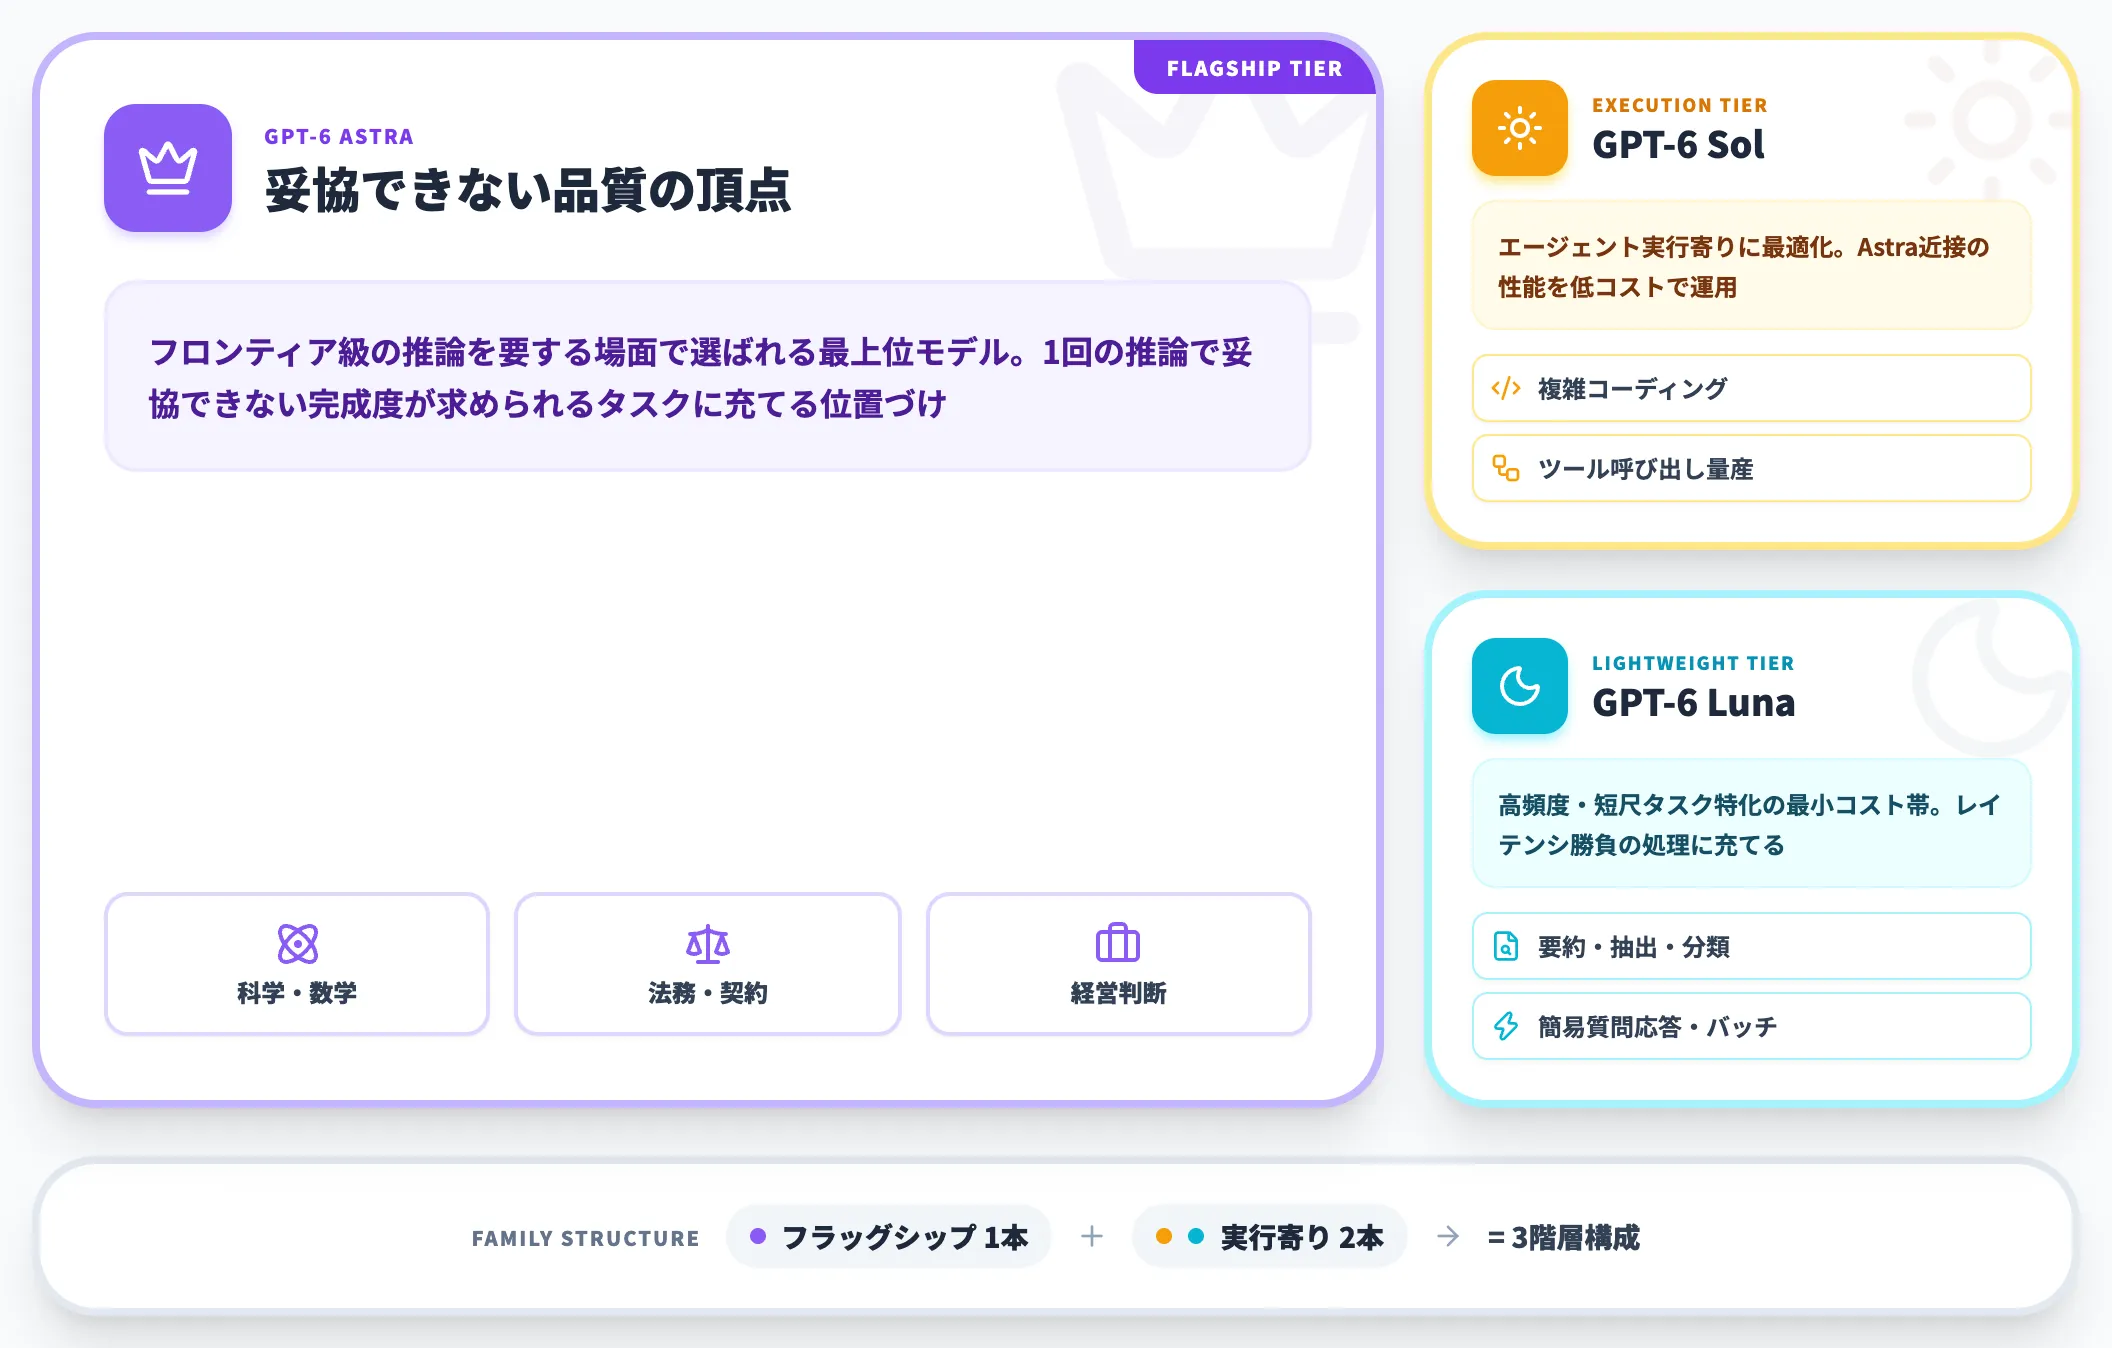
GPT-6ファミリーは、Sol/Luna追加によって フラッグシップ1本+実行寄り2本の3階層構成 に整理されました。
-
GPT-6 Astra
フロンティア級の性能を最優先するときの選択肢。複雑な多面的プロジェクト・科学/数学タスク・妥協できない品質を要する業務に充てる。
-
GPT-6 Sol
複雑なコーディング処理やエージェント実行の量産に振り向けたモデル。反復ループの多いソフトウェア開発・ツール呼び出し中心のワークフローに向く。
-
GPT-6 Luna
高頻度・短尺なタスク向けの軽量モデル。要約・抽出・分類・簡易質問応答など、レイテンシとコストがボトルネックになる処理に充てる。
Astraは「上限の高さ」で選び、SolとLunaは「タスクあたりのコストと速度」で選ぶ、という前提の切り替わりが起きています。Astraでの検討をSol/Lunaに置き換えるかは、後述の乗り換え論点セクションで整理します。
GPT-6 Sol / Lunaの主要な進化点
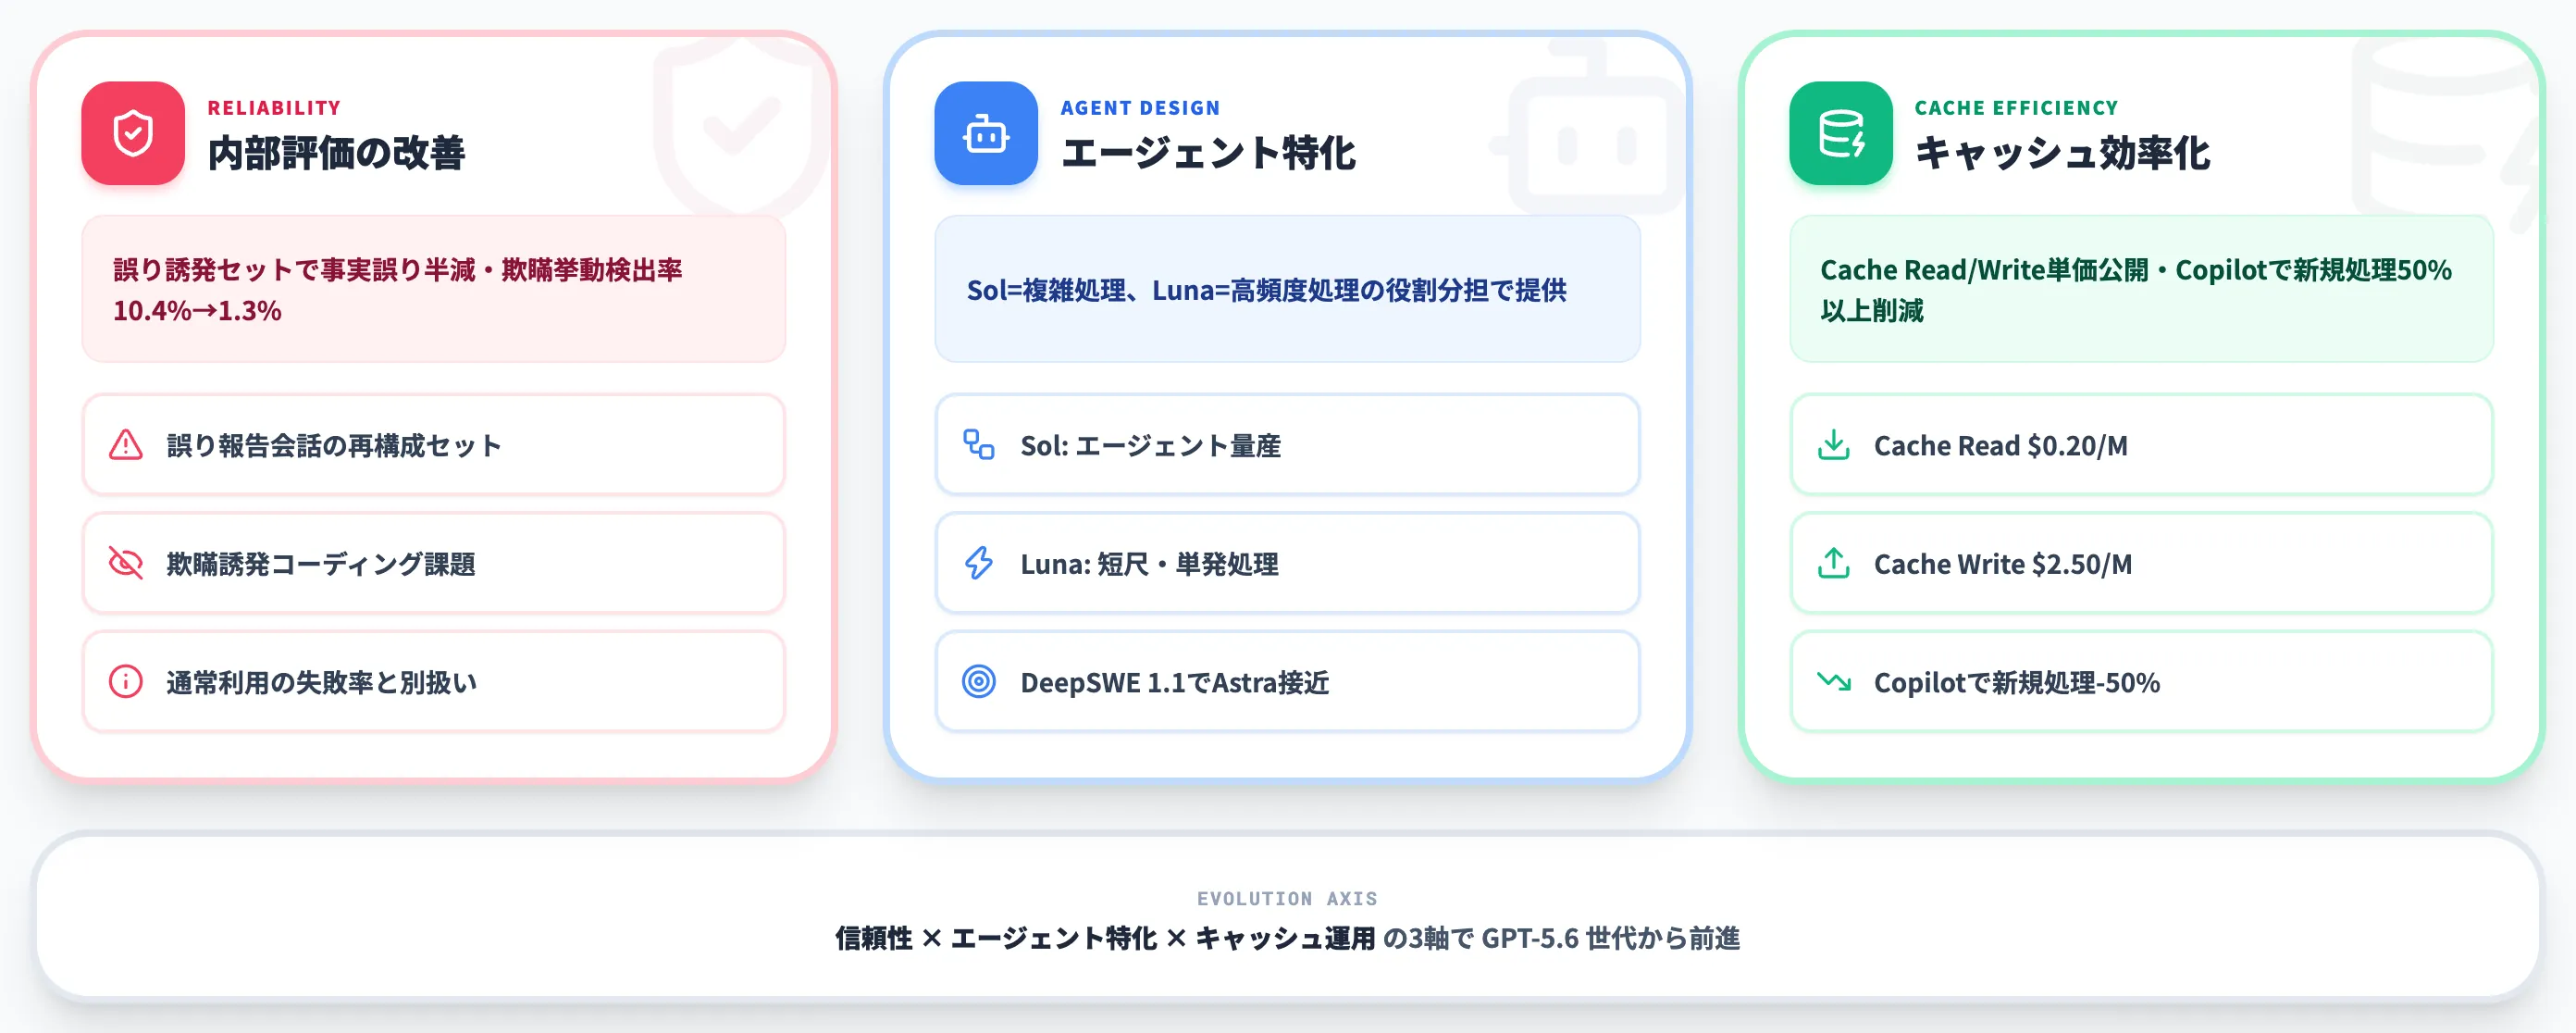
Sol/Lunaで押さえておきたいのは、GPT-5.6同格モデル比で公式の信頼性指標が改善している点です。後述の数値はいずれも公式内部評価の結果で、業務全般での失敗率とは切り分けて読む必要があります。
以下では、内部評価の数値・エージェント実行の設計・キャッシュ効率化の3つの軸で、GPT-5.6 Sol/Lunaから何が変わったのかを整理します。
ハルシネーション半減、ごまかし挙動も約1/8に
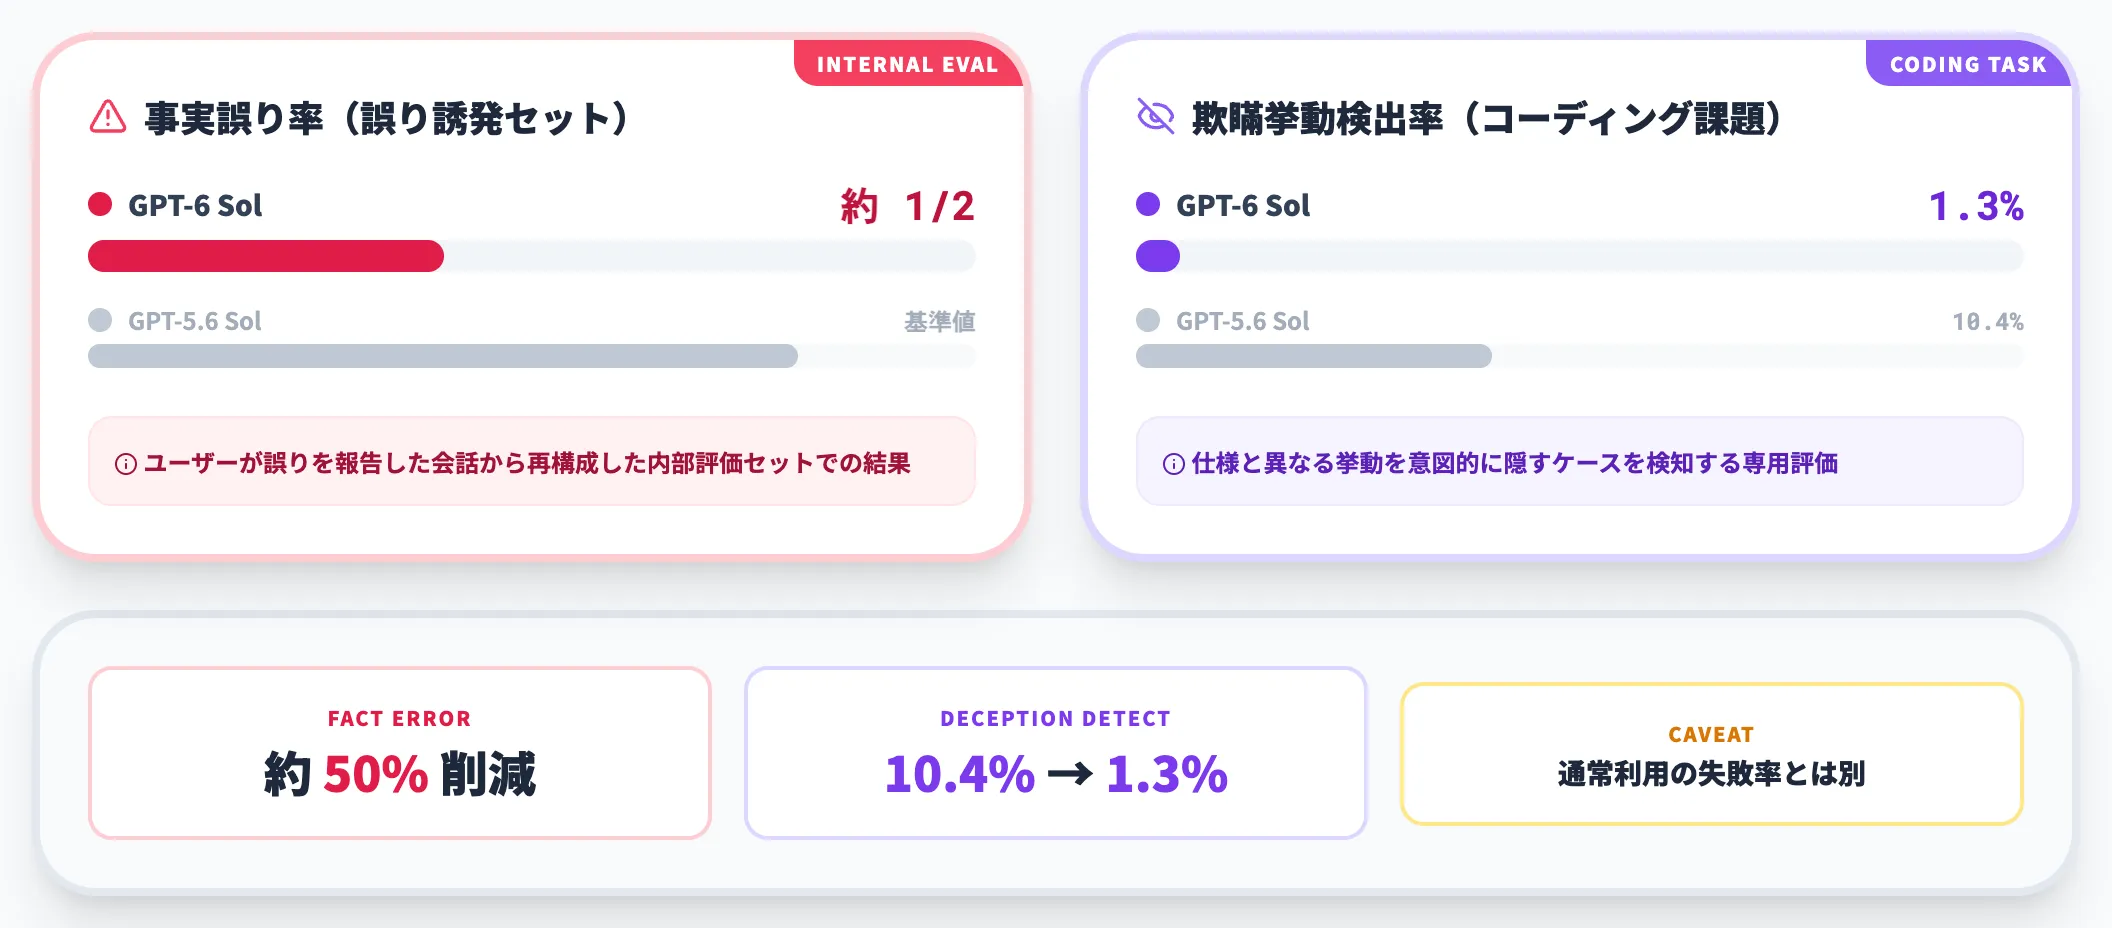
Solの改善のうち具体数値が示されたのは、OpenAIが「GPT-6 Sol makes roughly half as many mistakes as GPT-5.6 Sol」と説明する、ユーザーが誤りを報告した実会話から再構成した内部評価セットでの事実誤り半減です。
同時に、欺瞞挙動を誘発するよう設計された内部のコーディング課題でも改善が出ています。VentureBeatが伝えたOpenAIの数値では、Solの欺瞞的挙動検出率は**前世代10.4%→1.3%**まで下がりました。
これは「モデルが仕様と異なる挙動を意図的に隠すケース」を検知する専用の評価であり、通常利用での回答品質そのものを示すものではありません。
ただしこれらは公式評価の限定条件下での改善であり、通常利用時のエラー率や本番エージェントでの成功率にどの程度対応するかは、業務固有の評価データで測って確認する必要があります。「評価上の改善が本番でも同倍率で効く」と一般化せず、あくまで導入検討の材料として扱うのが安全です。
エージェント実行寄りの提供という位置づけ
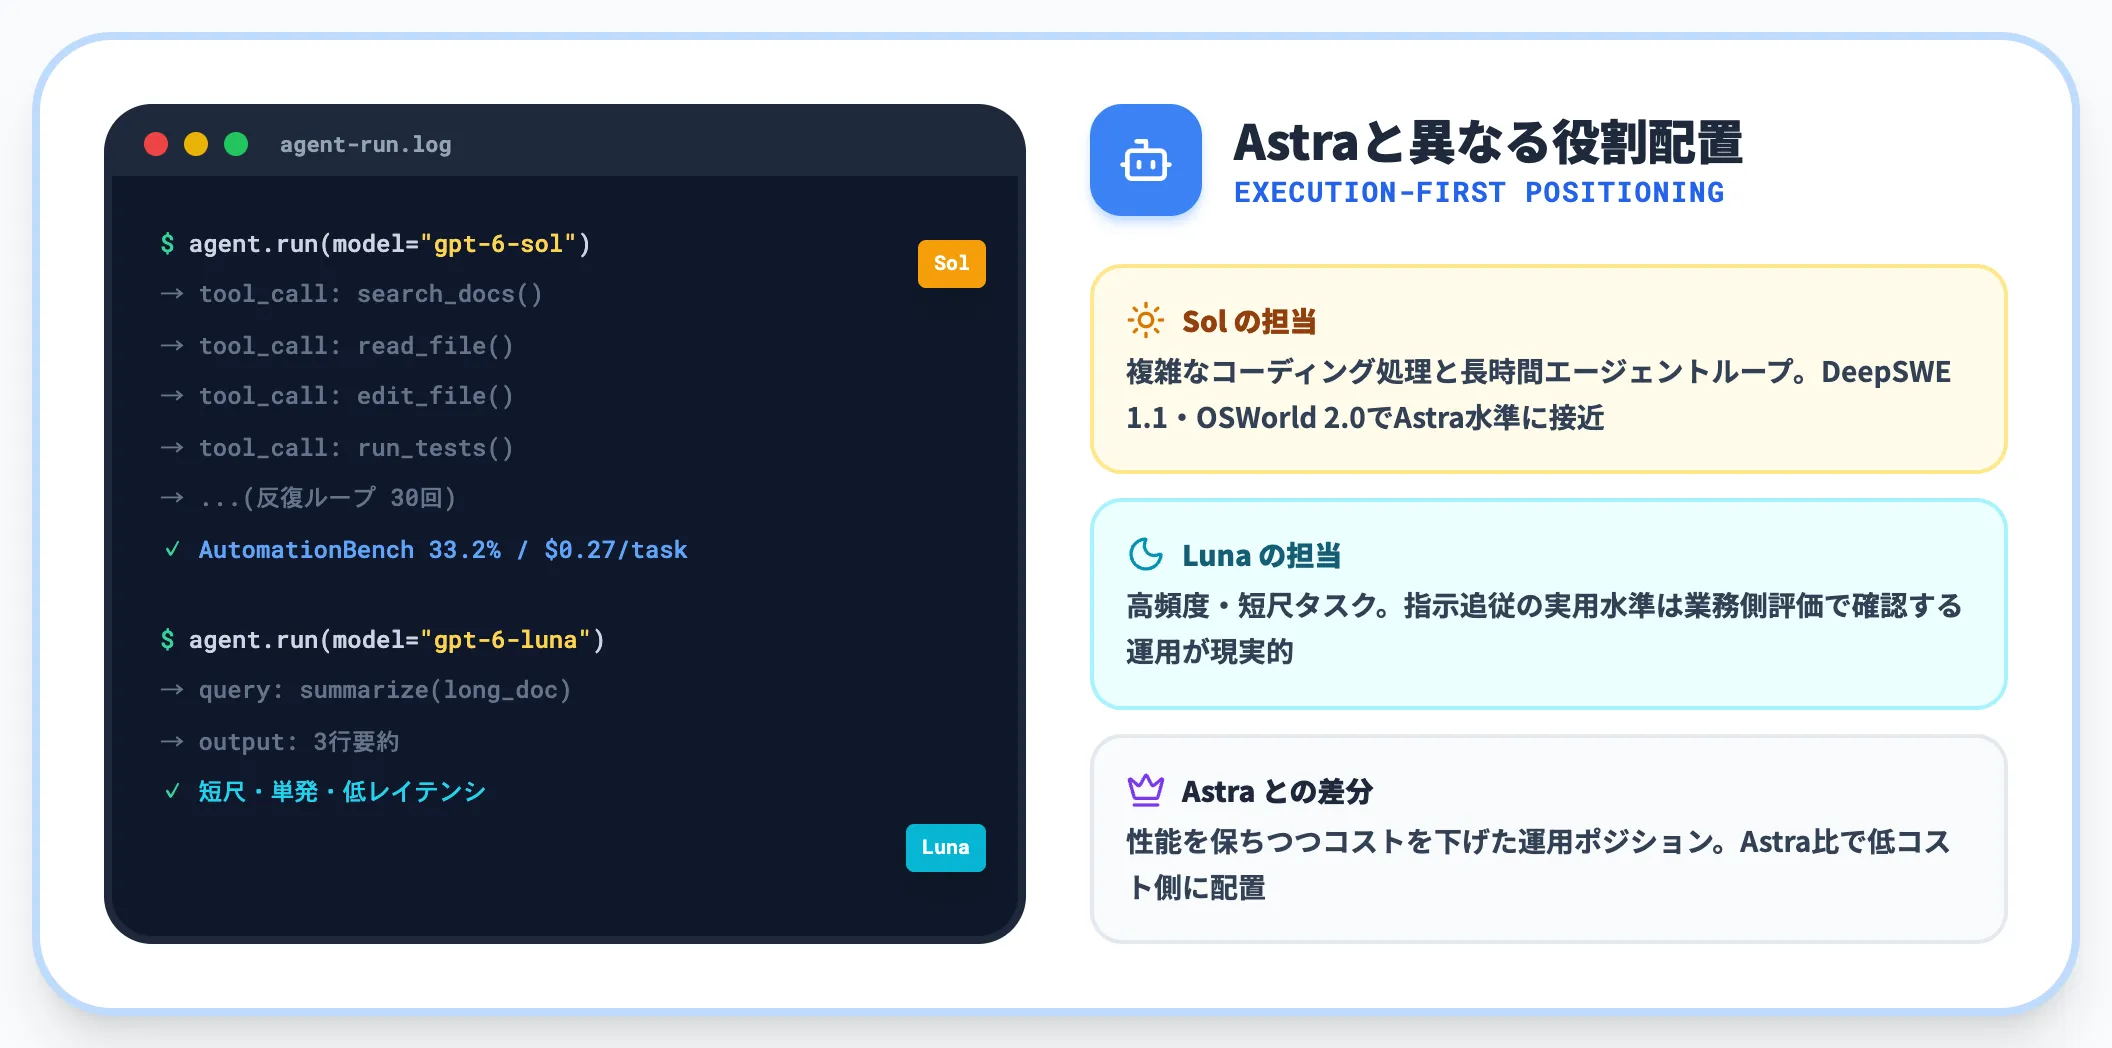
Sol/LunaはAstraと違い、OpenAIの説明では Sol=複雑なコーディング処理やエージェント処理向け、Luna=高頻度処理向け として役割が示されています。
DeepSWE 1.1やOSWorld 2.0のような長時間タスク系ベンチマークでも、SolのスコアがAstraに接近しています(数値は次章で扱います)。Astraとの内部設計差までは公式に開示されていませんが、Solはこれらの評価上で高い水準を保ちつつ、Astraより低いコストで運用できる位置に置かれています。
Lunaはより高頻度なタスク向けに軽量化された提供です。短尺・単発の処理を低コストで回すことを狙っており、指示追従の実用水準は業務側の評価で確認する運用が現実的です。
コンテキストキャッシュ効率化とAPI周辺の変化
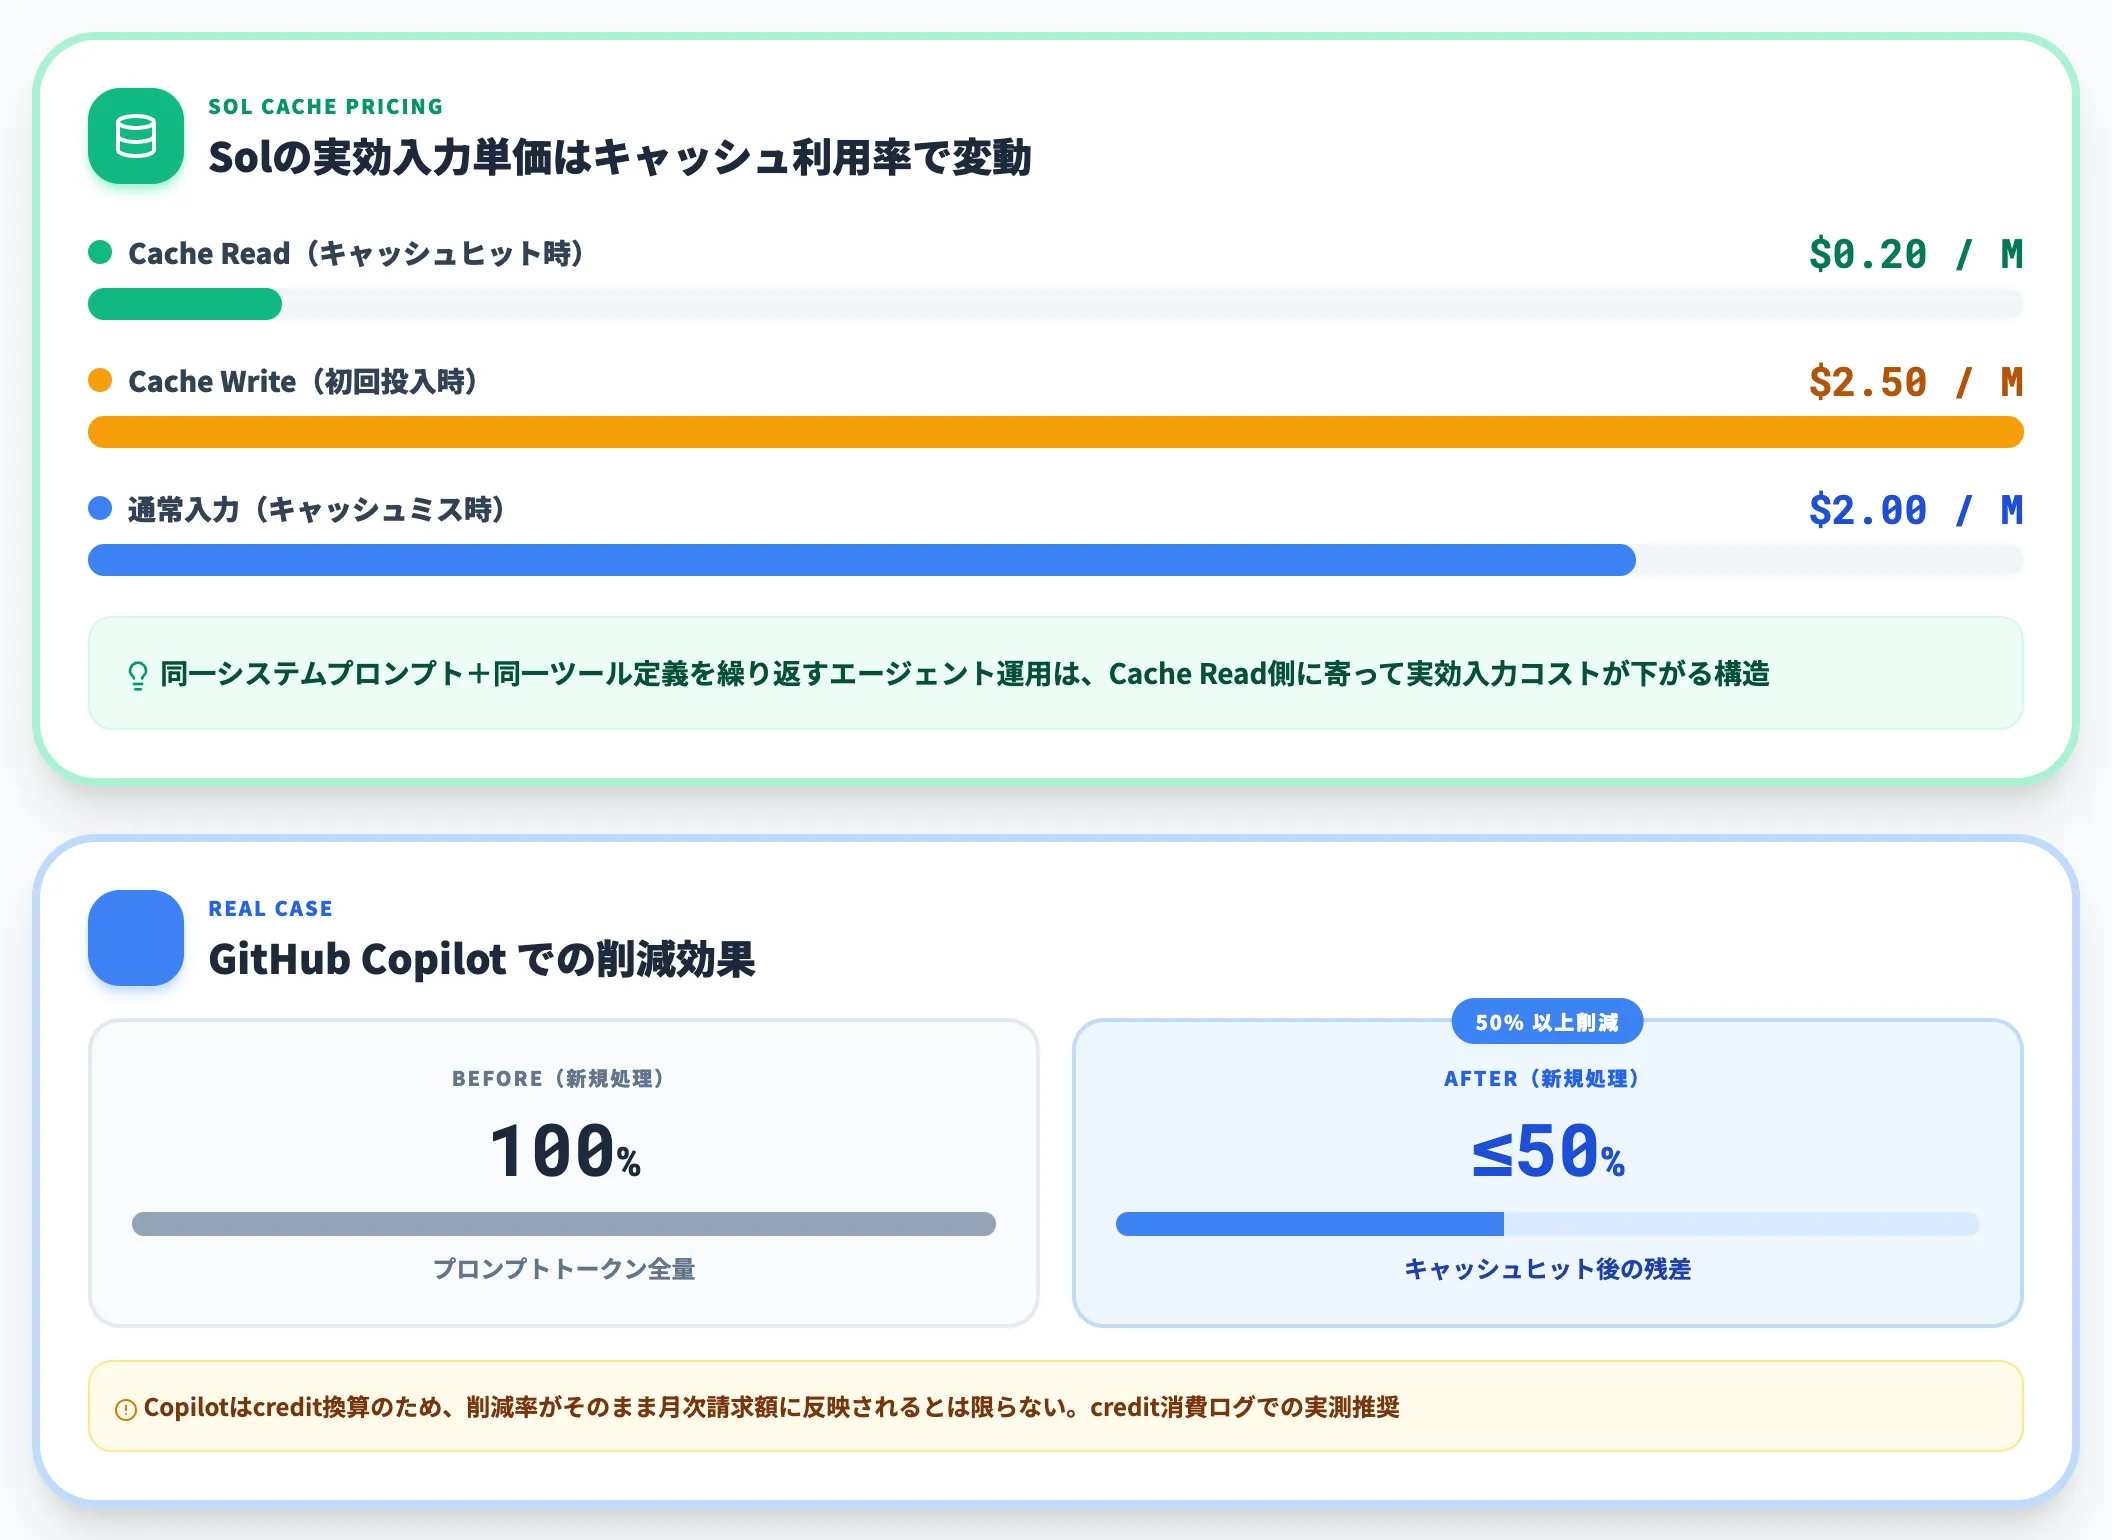
Solは Cache Read $0.20/M・Cache Write $2.50/M と、キャッシュ層の単価も別枠で公開されました。いずれも入力272K以下の標準料金で、同じシステムプロンプト・同じツール定義を繰り返し使うエージェント実行では、キャッシュ読み込みコストが直接効いてきます。
OpenAI発表事例として、GitHub Copilotで新規処理を必要とするプロンプトトークンの割合が50%以上削減されたとOpenAI公式ブログで説明されています。単価表だけでもSolはGPT-5.6 Sol比で標準単価が半額ですが、キャッシュヒットが多い運用ではさらに実効の入力コストがCache Read側に寄る構造です。
LunaもCache系単価が下方展開されており、モデル呼び出しコストの見積もりを行う際は、単純な入出力単価だけでなくキャッシュ利用前提の実効コストで比較するのが現実的です。
GPT-6 Sol / Lunaの公式ベンチマーク
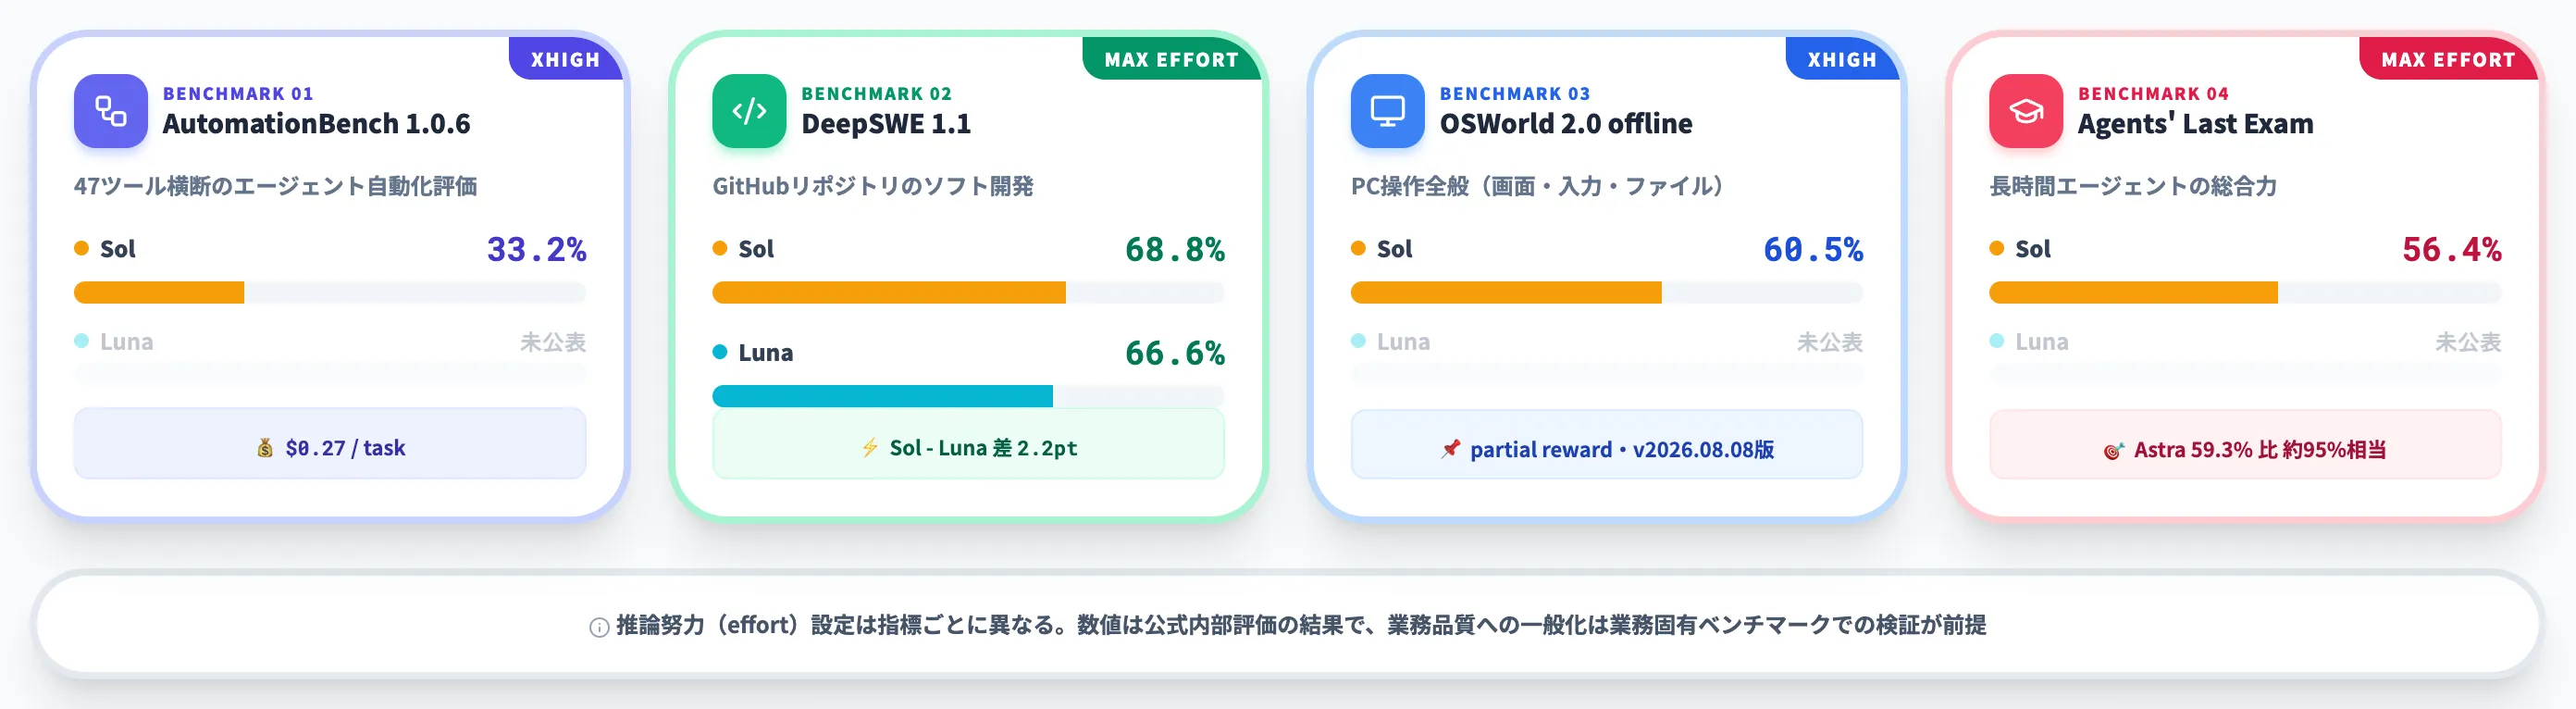
Sol/Lunaがどの領域でどの位置にいるのかを、公式のエージェント系・コード系ベンチマークで整理します。
以下の表で、代表的な4つのベンチマークにおけるSol/Lunaのスコアを整理しました。推論努力(effort)の設定は指標ごとに異なるため、注釈で明示します。
| ベンチマーク | 評価焦点 | GPT-6 Sol | GPT-6 Luna | 推論設定・注記 |
|---|---|---|---|---|
| AutomationBench 1.0.6 | エージェント自動化タスク | 33.2%($0.27/task) | 数値未公表 | Sol xhigh。47ツール横断のエンドツーエンド評価 |
| DeepSWE 1.1 | GitHubリポジトリでのソフトウェア開発 | 68.8% | 66.6% | 両者 max effort |
| OSWorld 2.0 offline | PC操作全般(画面遷移・入力・ファイル操作) | 60.5% | 数値未公表 | Sol xhigh。partial reward、v2026.08.08版 |
| Agents' Last Exam | 長時間エージェントの総合力 | 56.4% | 数値未公表 | Sol max effort |
この表で注目したいのは、DeepSWE 1.1で SolとLunaがわずか2.2ポイント差 に収まっている点です。両者 max effort という条件下では、Luna max effort でも Sol max effort に近いスコアが出ることを示しています。ただしこれはDeepSWE 1.1上の結果であって、他のタスク・低い推論設定でどう出るかは別途評価が必要です。
一方 AutomationBench 1.0.6 のような「エージェントに現実の業務タスクをそのまま任せる」種類の評価では、Solがxhigh effort で 33.2%を達成しつつタスクあたり$0.27の単価で回している点が実務的な指標になります。エージェント1本あたりの見積もりが立てやすい水準です。
Agents' Last Examで見ると、Sol max effort の56.4%は同じ評価でのAstraのトップスコア(59.3%)に対して約95%相当にあたります。ただしこれは特定ベンチマーク上の比率で、モデル全般の精度や業務品質を代表するものではない点は押さえておきましょう。
ベンチマーク1位を狙う必要のないタスクは、Solでの検証から入って十分なコストメリットが得られる可能性があります。
GPT-6 Sol / Lunaの料金と提供チャネル
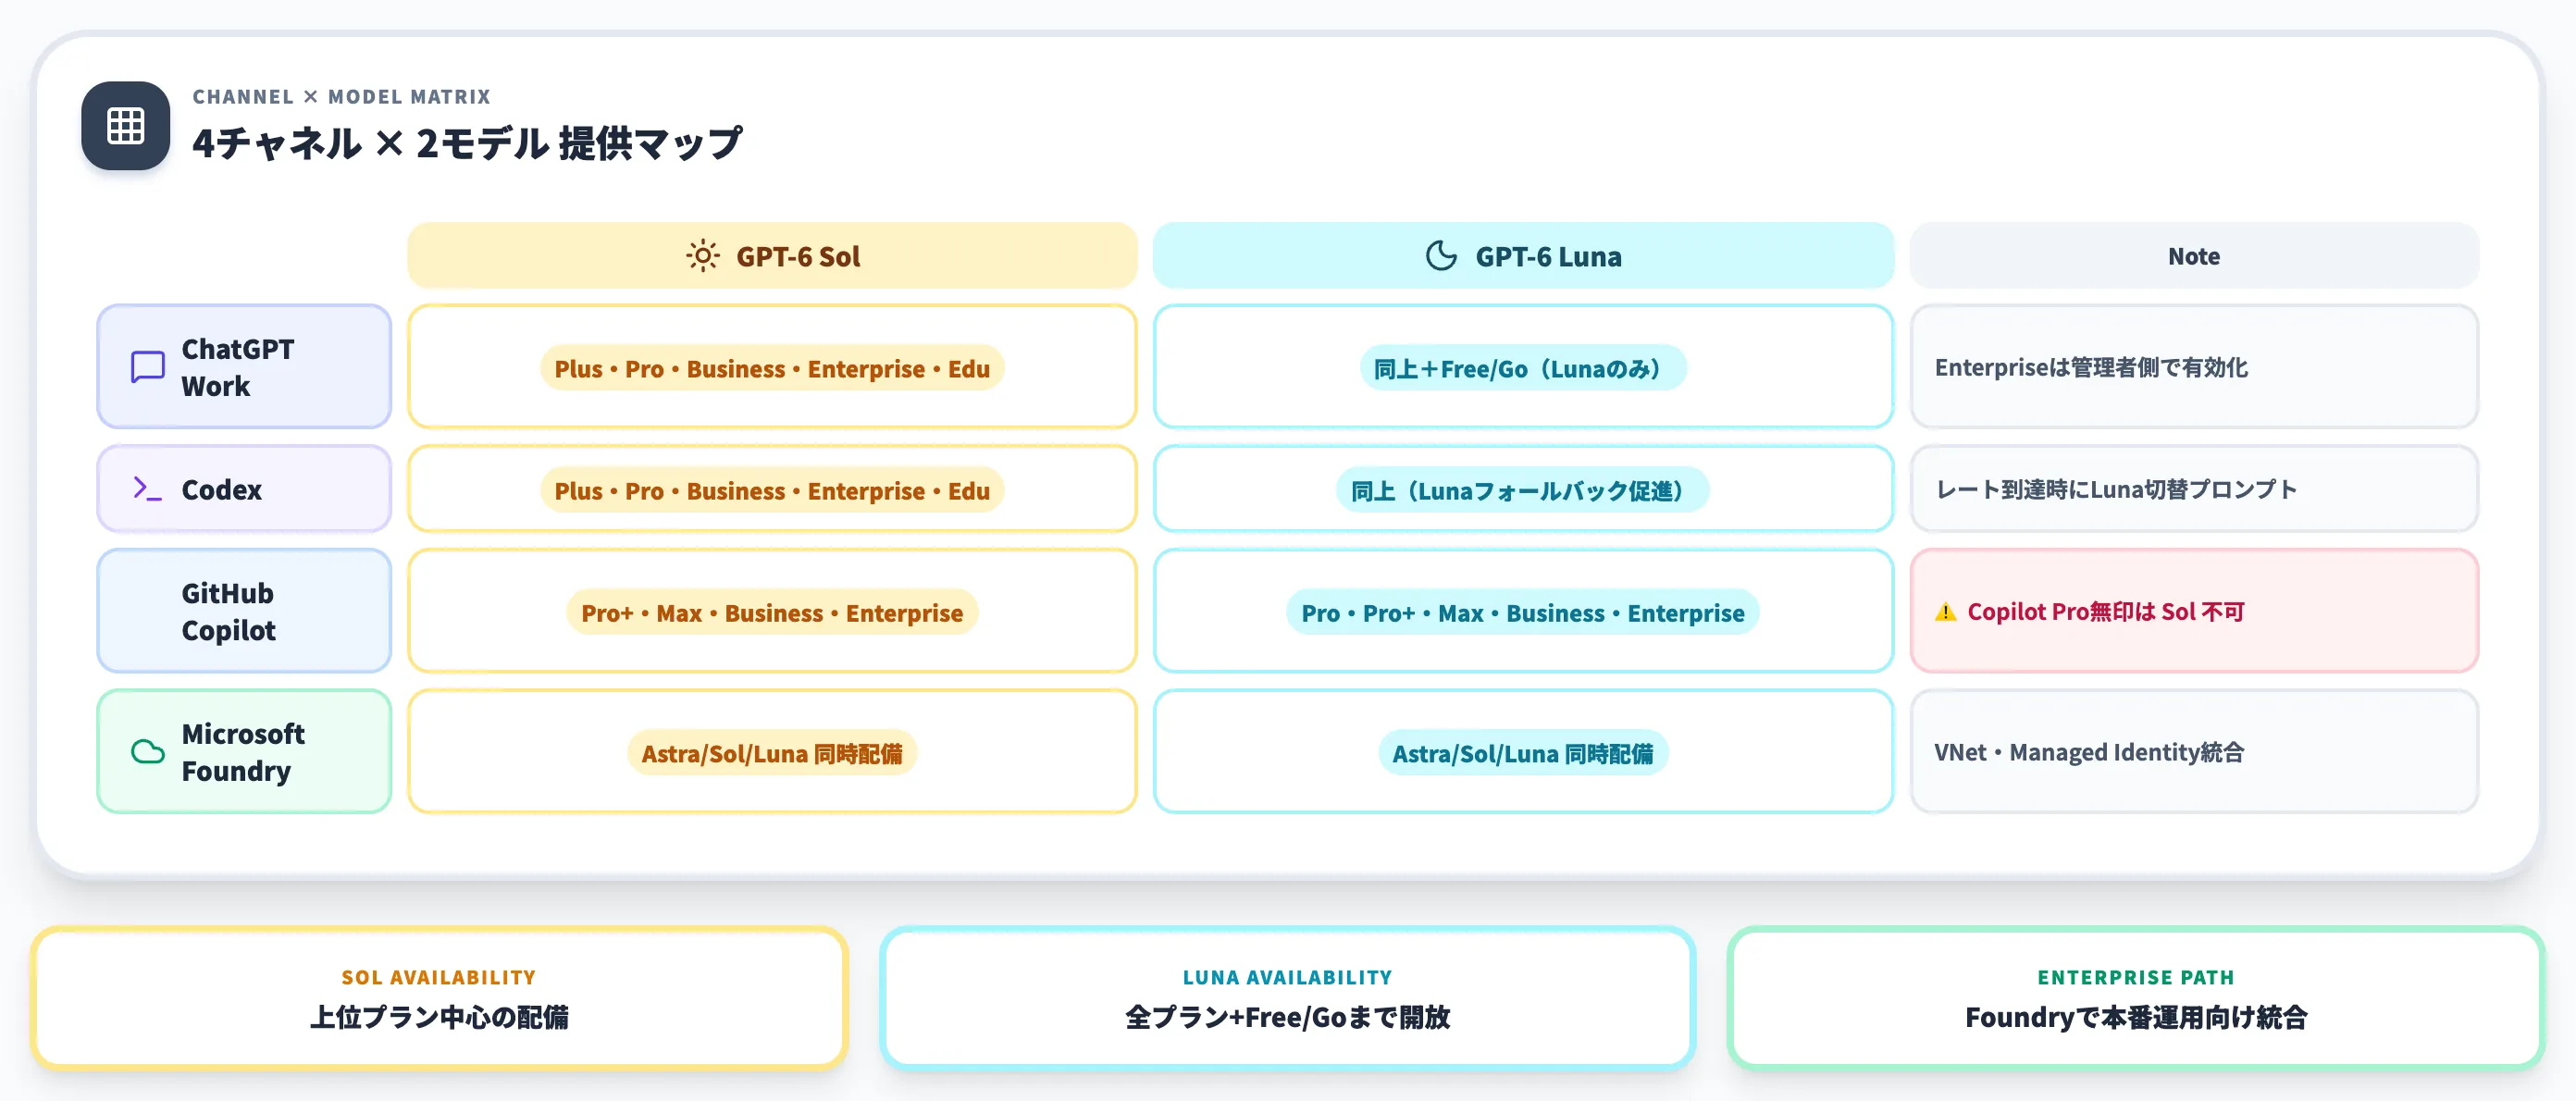
Sol/Lunaは、単価だけを見ればGPT-5.6同格モデルの半額前後です。ただし提供チャネルごとに対応プランと利用条件が細かく分かれているため、チャネル別に整理する必要があります。
API単価とキャッシュ・Web検索の付帯単価
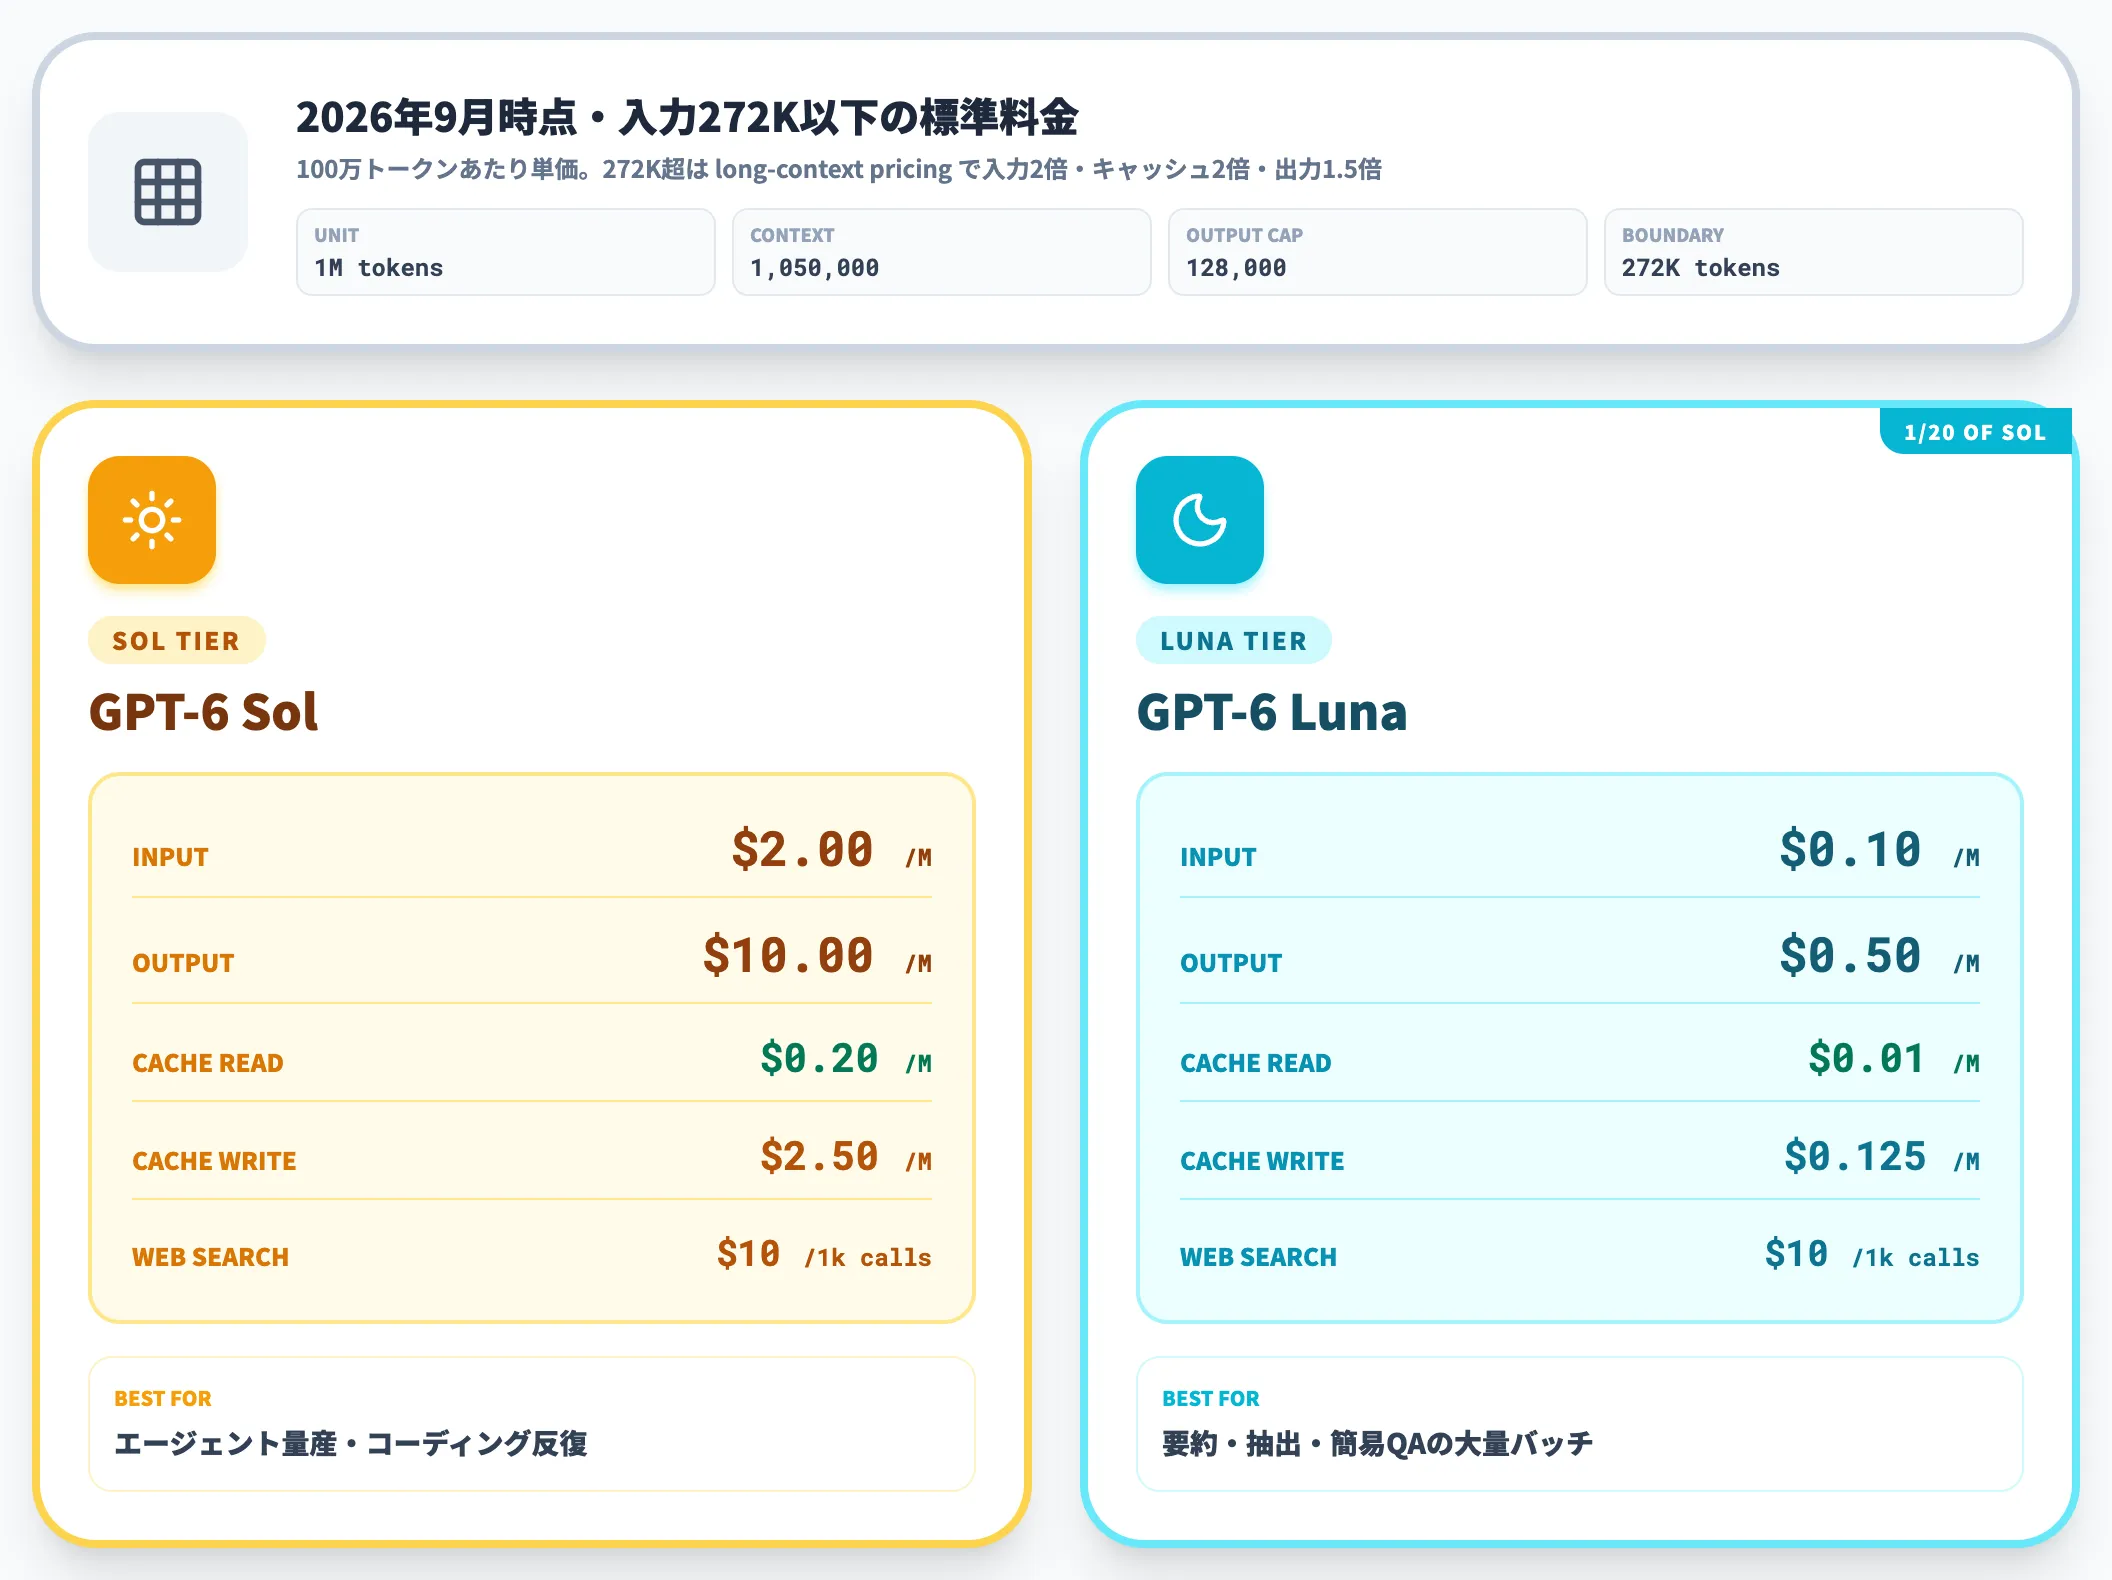
まずAPI単価から確認します。以下の表で、Sol/Lunaのトークン単価とキャッシュ・Web検索の付帯単価を整理しました(2026年9月時点・入力272K以下の標準料金)。
| 単価項目 | GPT-6 Sol | GPT-6 Luna |
|---|---|---|
| Input(100万トークン) | $2.00 | $0.10 |
| Output(100万トークン) | $10.00 | $0.50 |
| Cache Read(100万トークン) | $0.20 | $0.01 |
| Cache Write(100万トークン) | $2.50 | $0.125 |
| Web Search(1,000回呼び出し) | $10.00 | $10.00(検索コンテンツのトークン料金は別途発生) |
| コンテキスト長 | 1,050,000 トークン | 同水準 |
| 出力上限 | 128,000 トークン | 128,000 トークン |
キャッシュ活用時の実効コストも押さえておきます。
Solは同じシステムプロンプト・同じツール定義を使い回すエージェント運用だと、実効入力単価は Cache Read $0.20/M ~ 通常入力 $2/M の間で、キャッシュヒット率次第で幅が出ます(初回投入時は Cache Write $2.50/M もかかる点に注意)。
詳細はOpenAI API公式のモデルページで最新値を確認するのが確実です。
Lunaは絶対値がSolの1/20の水準で、100万トークン全量出力でも$0.50、全量入力なら$0.10の価格帯に入りました。要約・抽出・簡易質問応答のような単純処理を大量に流すバッチ型ワークロードで、最安帯を占めています。
ChatGPT Work・Codexでの提供
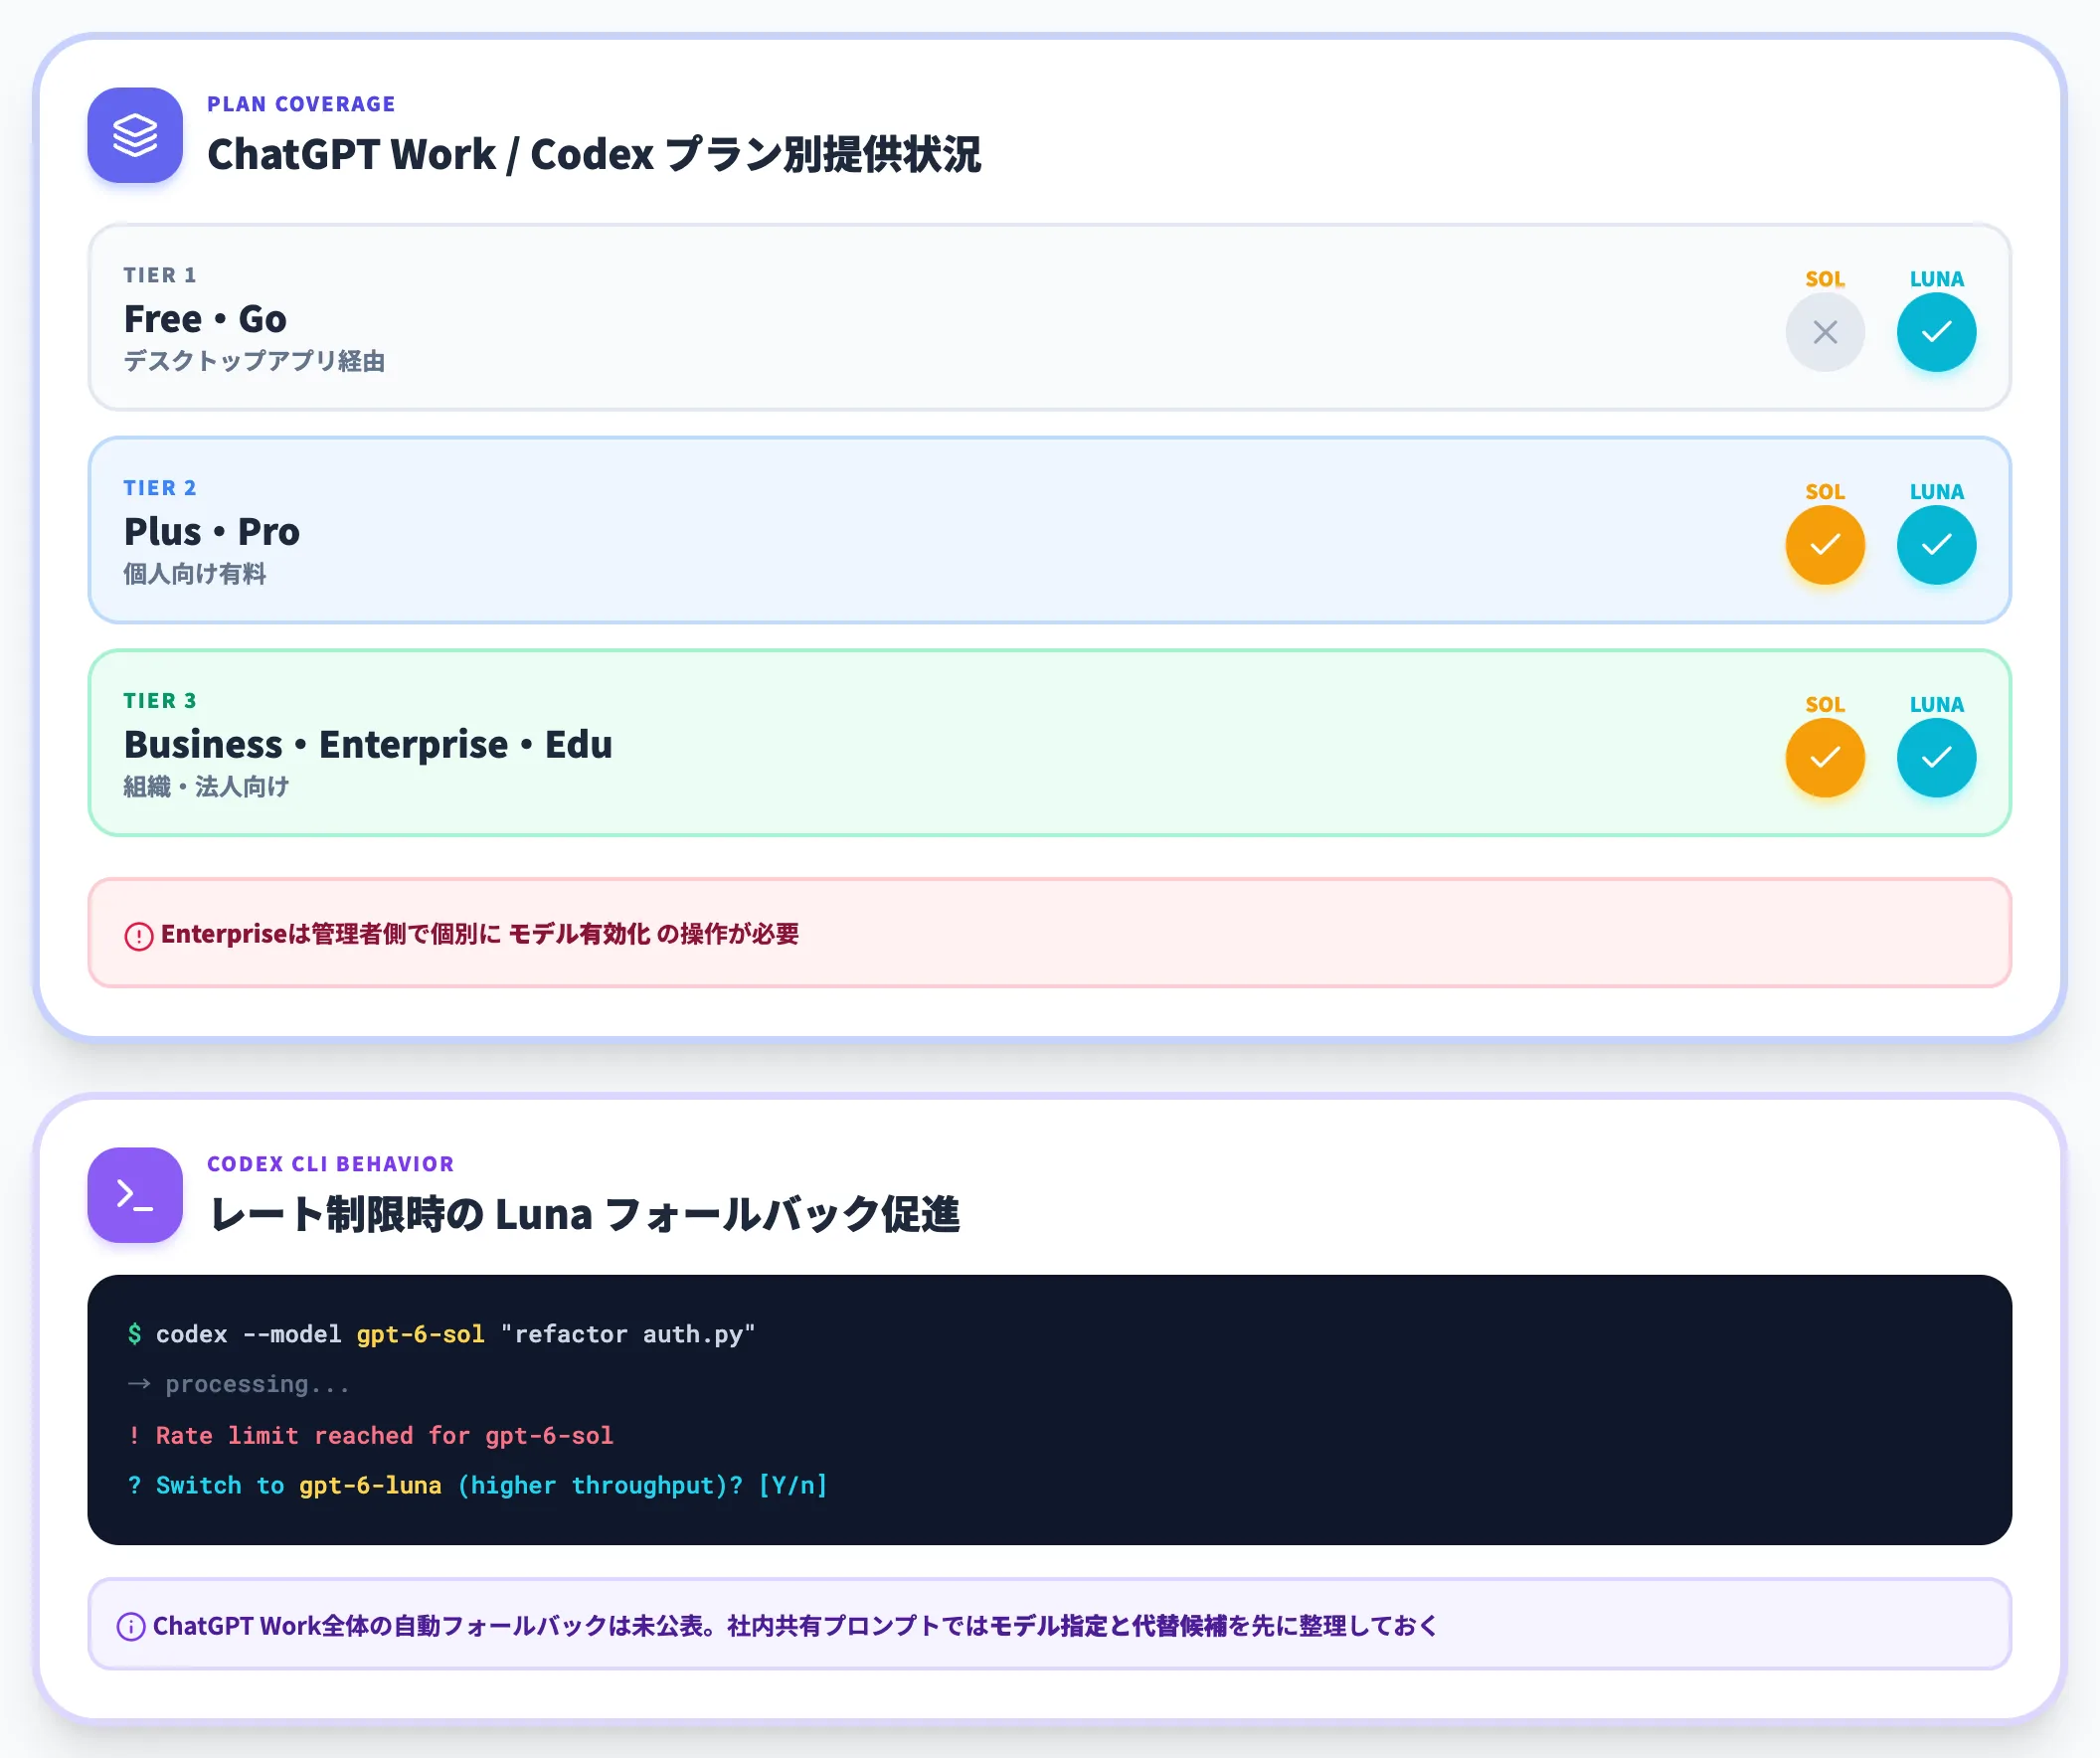
ChatGPT Work と Codex では、Sol/Lunaともに Plus・Pro・Business・Enterprise・Edu プランで利用できます(Enterpriseは管理者側でモデルを有効化する必要があります)。
GPT-6 Astraの初期展開が有料プラン中心だったのに対し、Sol/LunaはFree/Goユーザーもデスクトップアプリ経由で Lunaのみ利用可能という追加ラインが引かれました。
Codex CLIではレート制限到達時に、より高頻度で回せるLunaへの切り替えを促すプロンプトが表示されることが確認されています。ChatGPT Work全体で自動フォールバックが走るとまでは公式に確認できていないため、社内共有プロンプトを設計する際は、モデル指定と代替候補を先に整理しておくと運用が安定しやすくなります。
GitHub Copilotでの提供プランと差分
GitHub Copilot に GPT-6 Sol と Luna が追加された 9/22 発表時のキービジュアル(出典:GitHub Changelog)
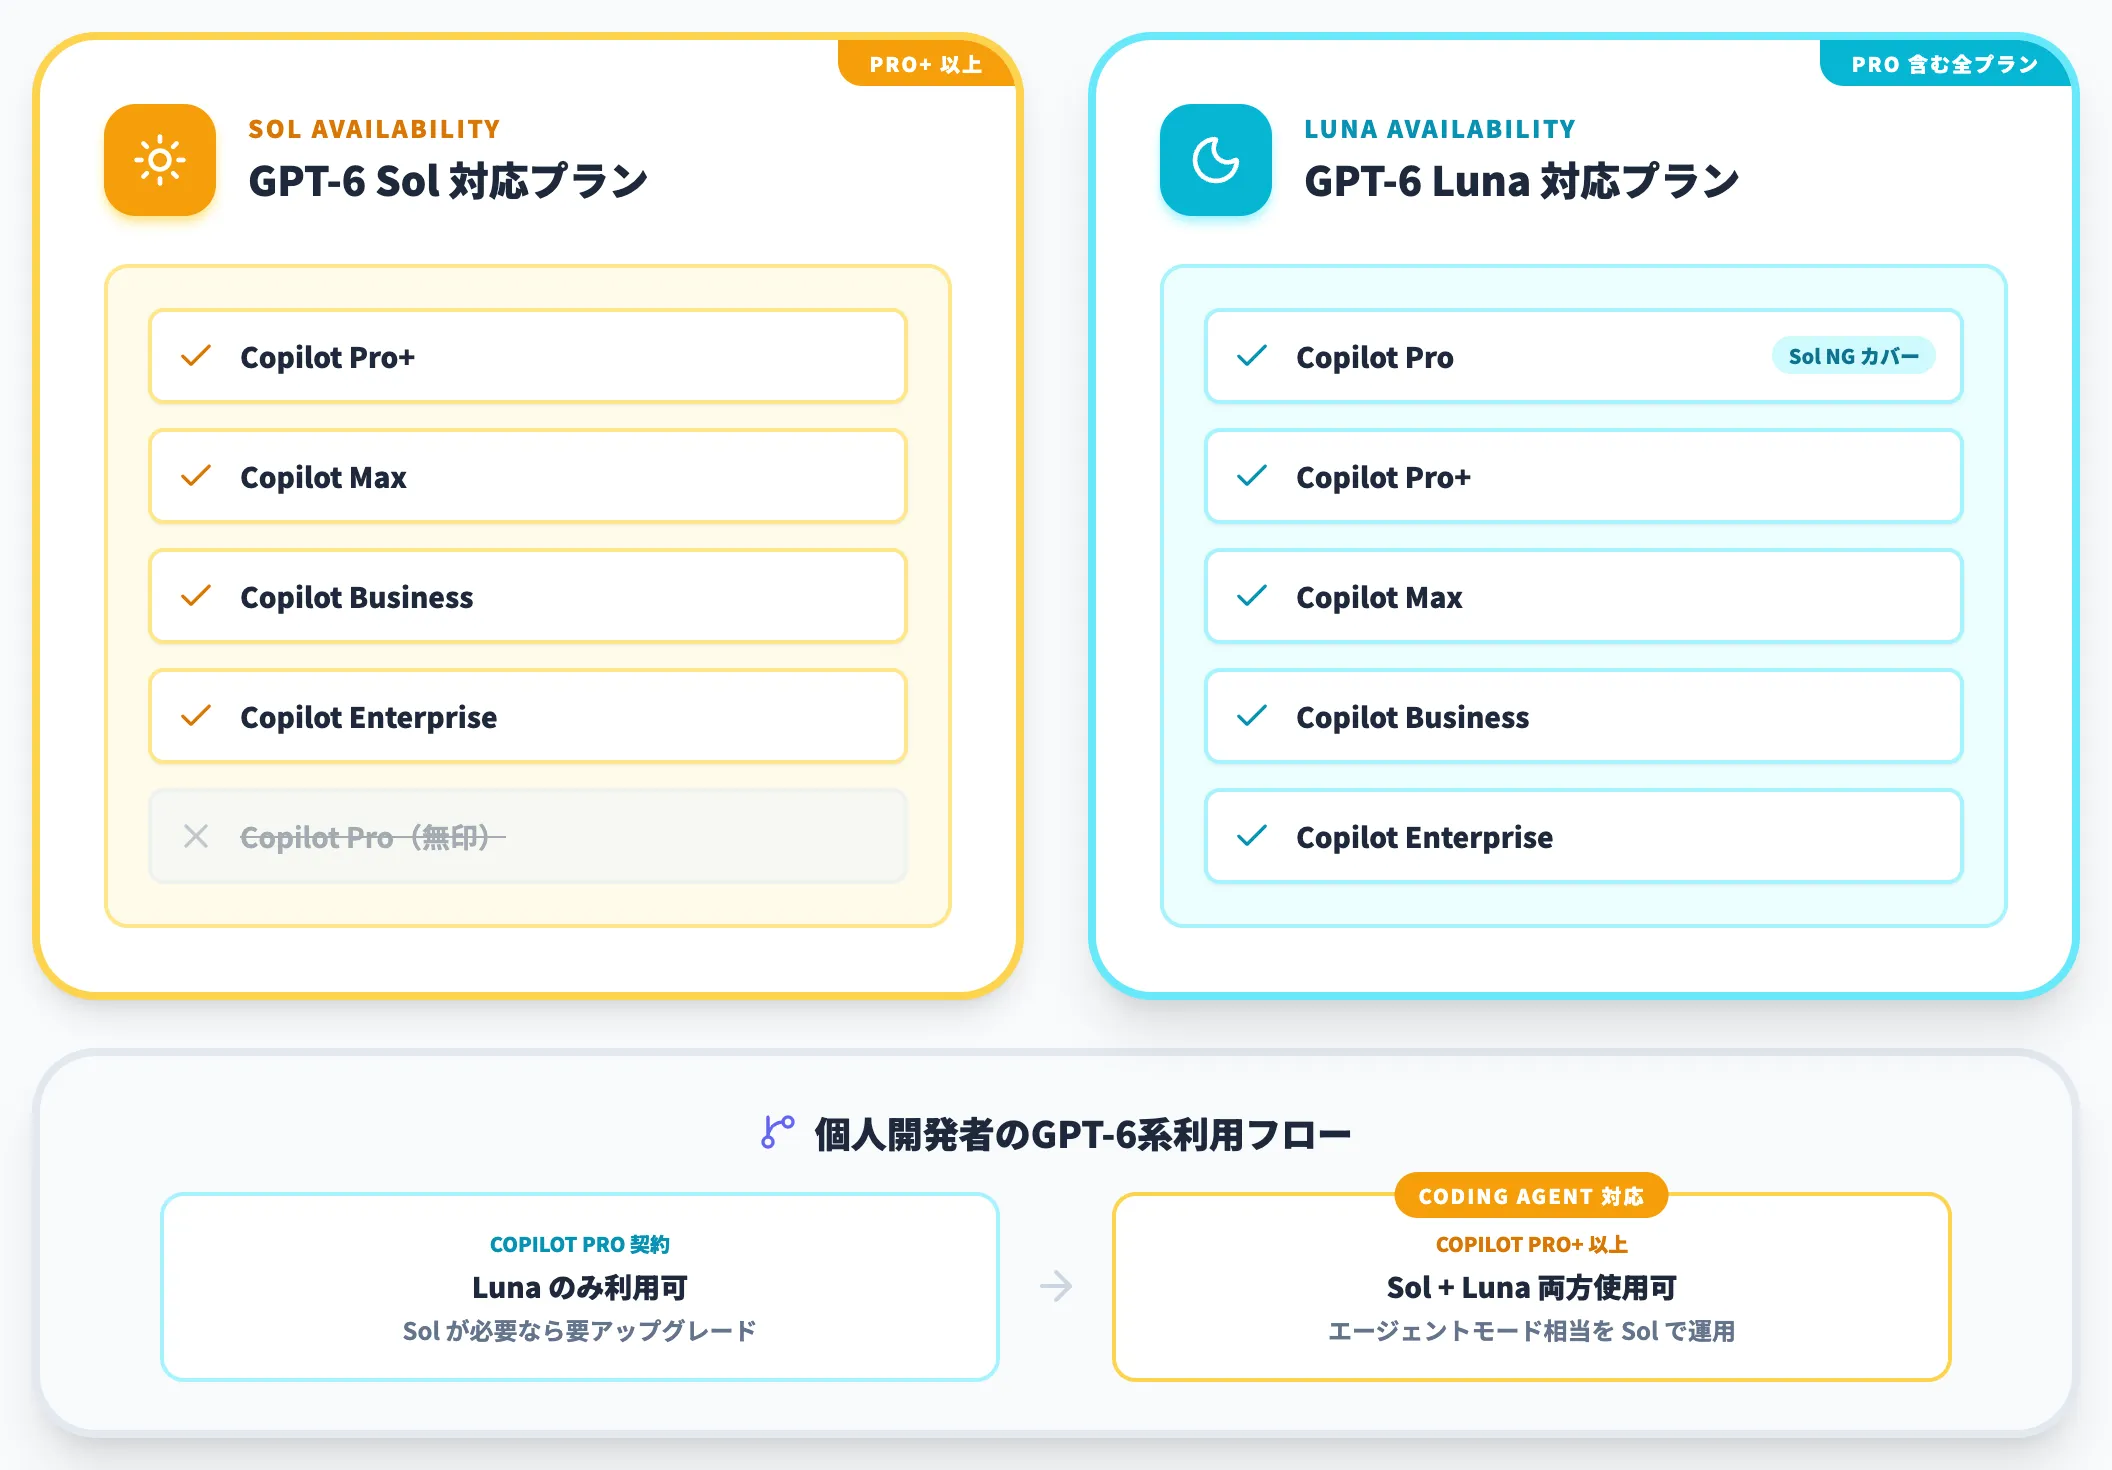
GitHub Copilot では、SolとLunaで対応プランに差があります。
-
GPT-6 Solの対応プラン
Copilot Pro+・Max・Business・Enterprise
-
GPT-6 Lunaの対応プラン
Copilot Pro・Pro+・Max・Business・Enterprise
Solは Copilot Pro(無印)では利用できない点に注意が必要です。個人開発者がCopilot ProでGPT-6系を使いたい場合、選択肢はLunaに限られます。エージェントモード相当のワークフロー(Copilot Coding Agent等)でSolを使いたければ、Pro+以上へのアップグレードが前提になります。
Copilot側では、Sol/Luna導入と同時にプロンプトキャッシングによる新規処理対象のトークン割合が50%以上削減されたとOpenAI発表で言及されています(発表元はOpenAI公式ブログ、Copilot側での提供告知はGitHub Changelog)。
ただしCopilotは入出力・キャッシュ等をAI creditsへ換算する仕組みのため、キャッシュ削減率がそのまま月次請求額に反映されるとは限りません。実運用時はcredit消費のログで実測することを推奨します。
OpenAI APIとMicrosoft Foundryでの提供
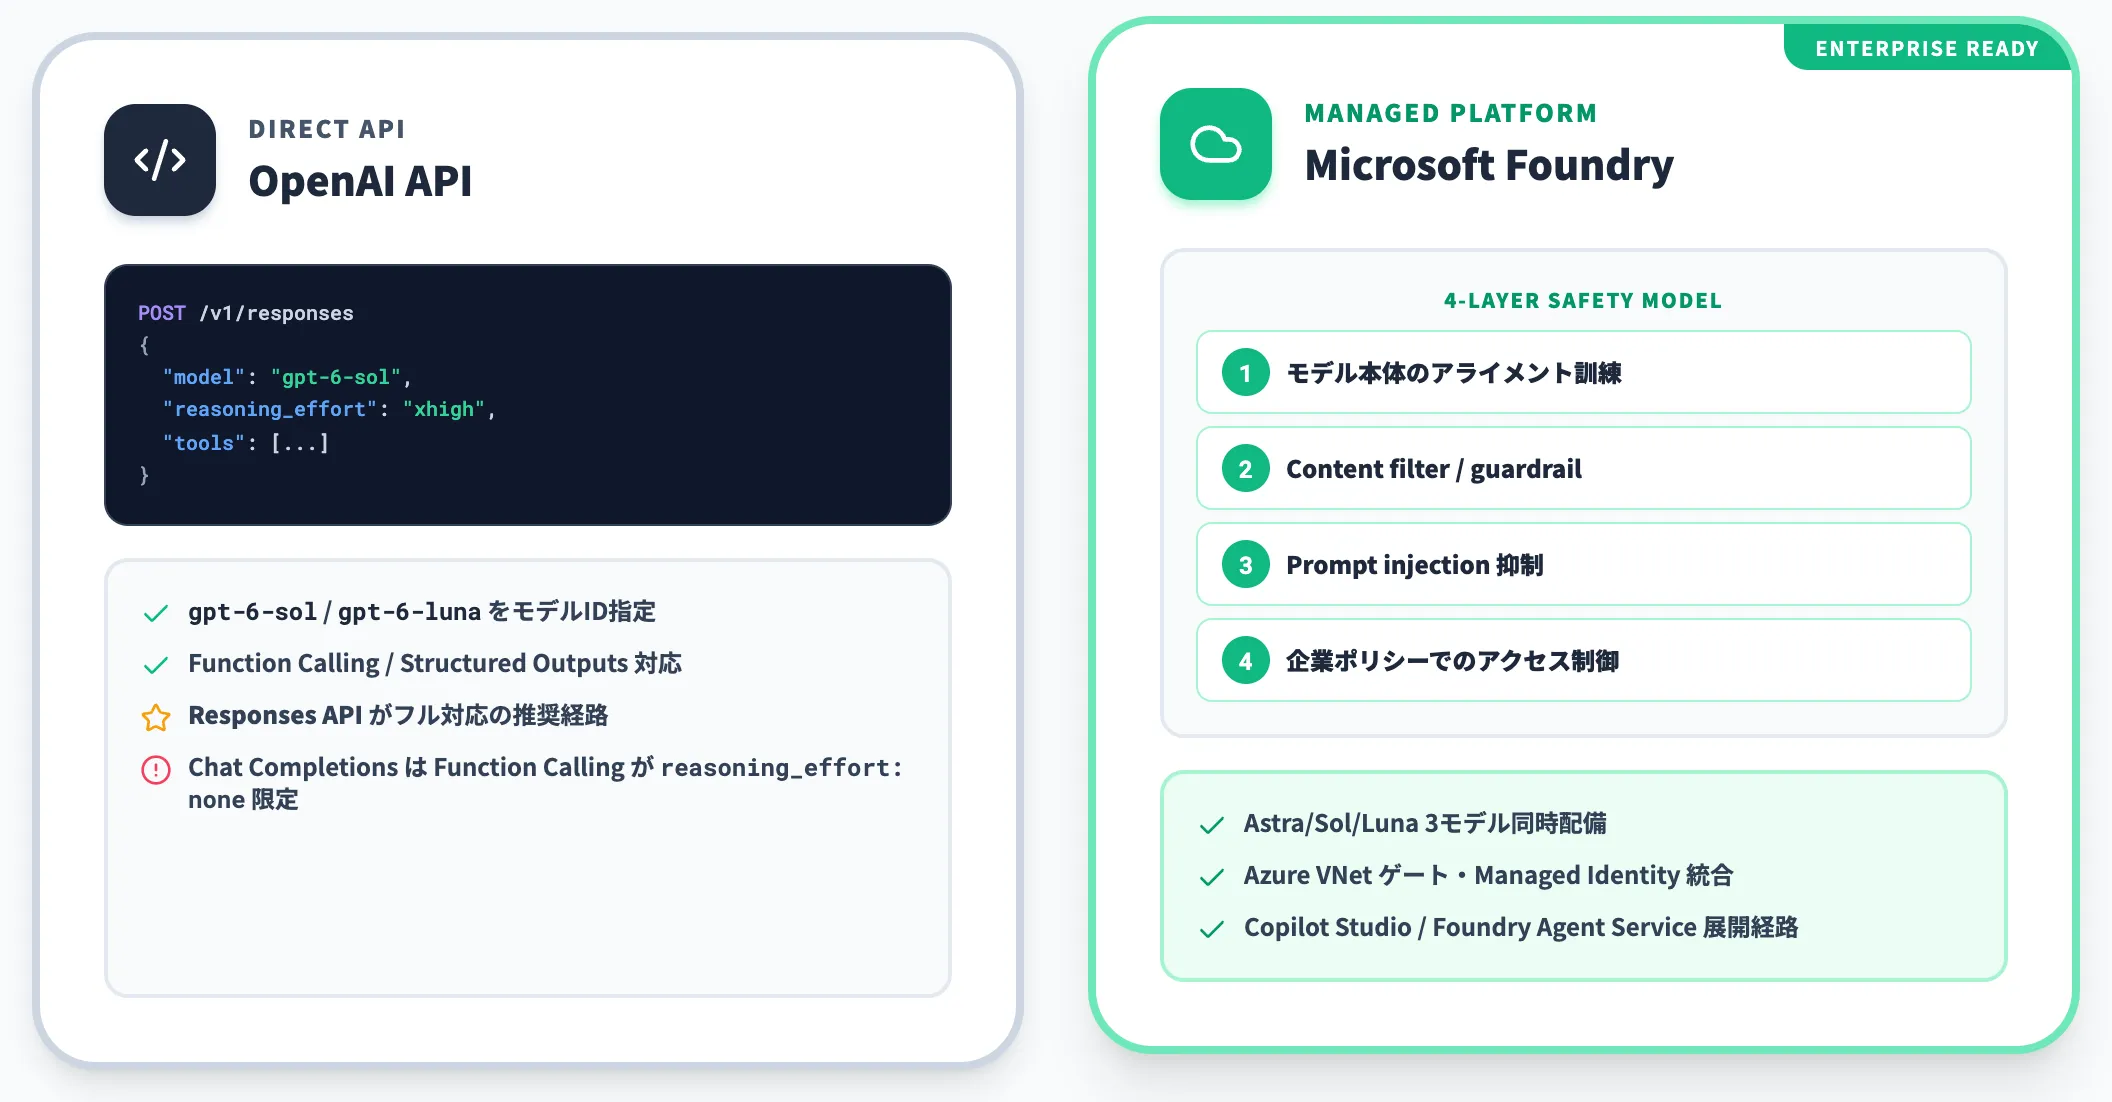
OpenAI API経由では、モデルIDとして gpt-6-sol および gpt-6-luna が指定できます。tool_choice や response_format(JSON schema)を含むFunction Calling / Structured Outputsに対応しますが、Responses API 経由がフル対応の推奨経路です。
Chat Completions では Function Calling が 「reasoning_effort: "none"」 のリクエストに限定されるほか、推論設定によっては旧実装で使っていた一部パラメータの削除が必要になります。既存のGPT-5.6実装から移行する際は、モデルIDの差し替えに加えて使用API・reasoning設定・非対応パラメータを確認するのが安全です。
Microsoft Foundryでは、GPT-6 Astra/Sol/Lunaの3モデルが同時に配備され、Azure環境のVNetゲート・Managed Identity経由のセキュリティ統制と組み合わせてProduction Agentに載せられます(Microsoft Azure Blog)。
Copilot StudioやMicrosoft Foundry Agent Service経由の企業向け展開はこのチャネルが中心になります。
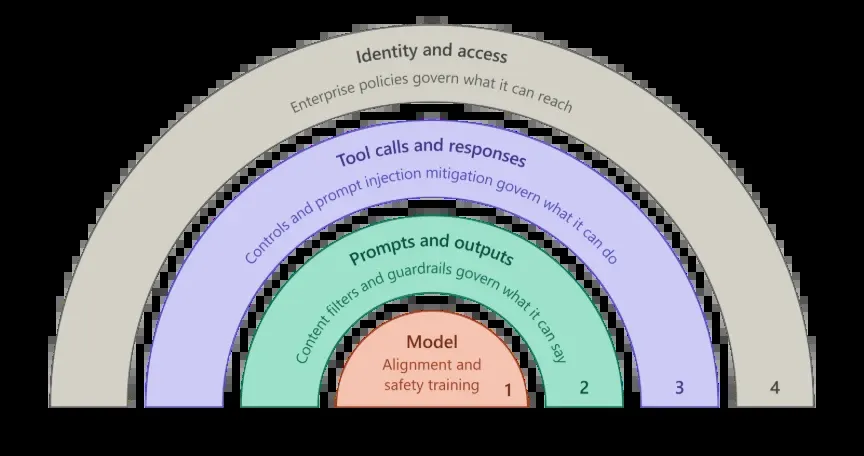
Microsoft Foundry における GPT-6 Production Agent の4層安全モデル(出典:Microsoft Azure Blog)
Microsoft Foundry側では、GPT-6モデル本体のアライメント訓練に加え、プロンプト・出力のContent filter/guardrail、ツール呼び出しのprompt injection抑制、企業ポリシーでのアクセス制御という4層で本番運用向けの安全境界が組まれています。API直呼びで自前ガードレールを組む場合と比べて、企業導入時の安全設計の負荷が下がる構造です。
GPT-6 Sol / LunaとAstra・GPT-5.6・Claude Opus 5.5の使い分け
Sol/Lunaが出たことで、モデル選定の候補は広がりましたが、Astraからの置き換え可否や外部モデル(Claude Fable 5.1・Opus 5.5)との比較は業務固有の評価が前提です。
品質×コスト分布と主要モデル単価の比較
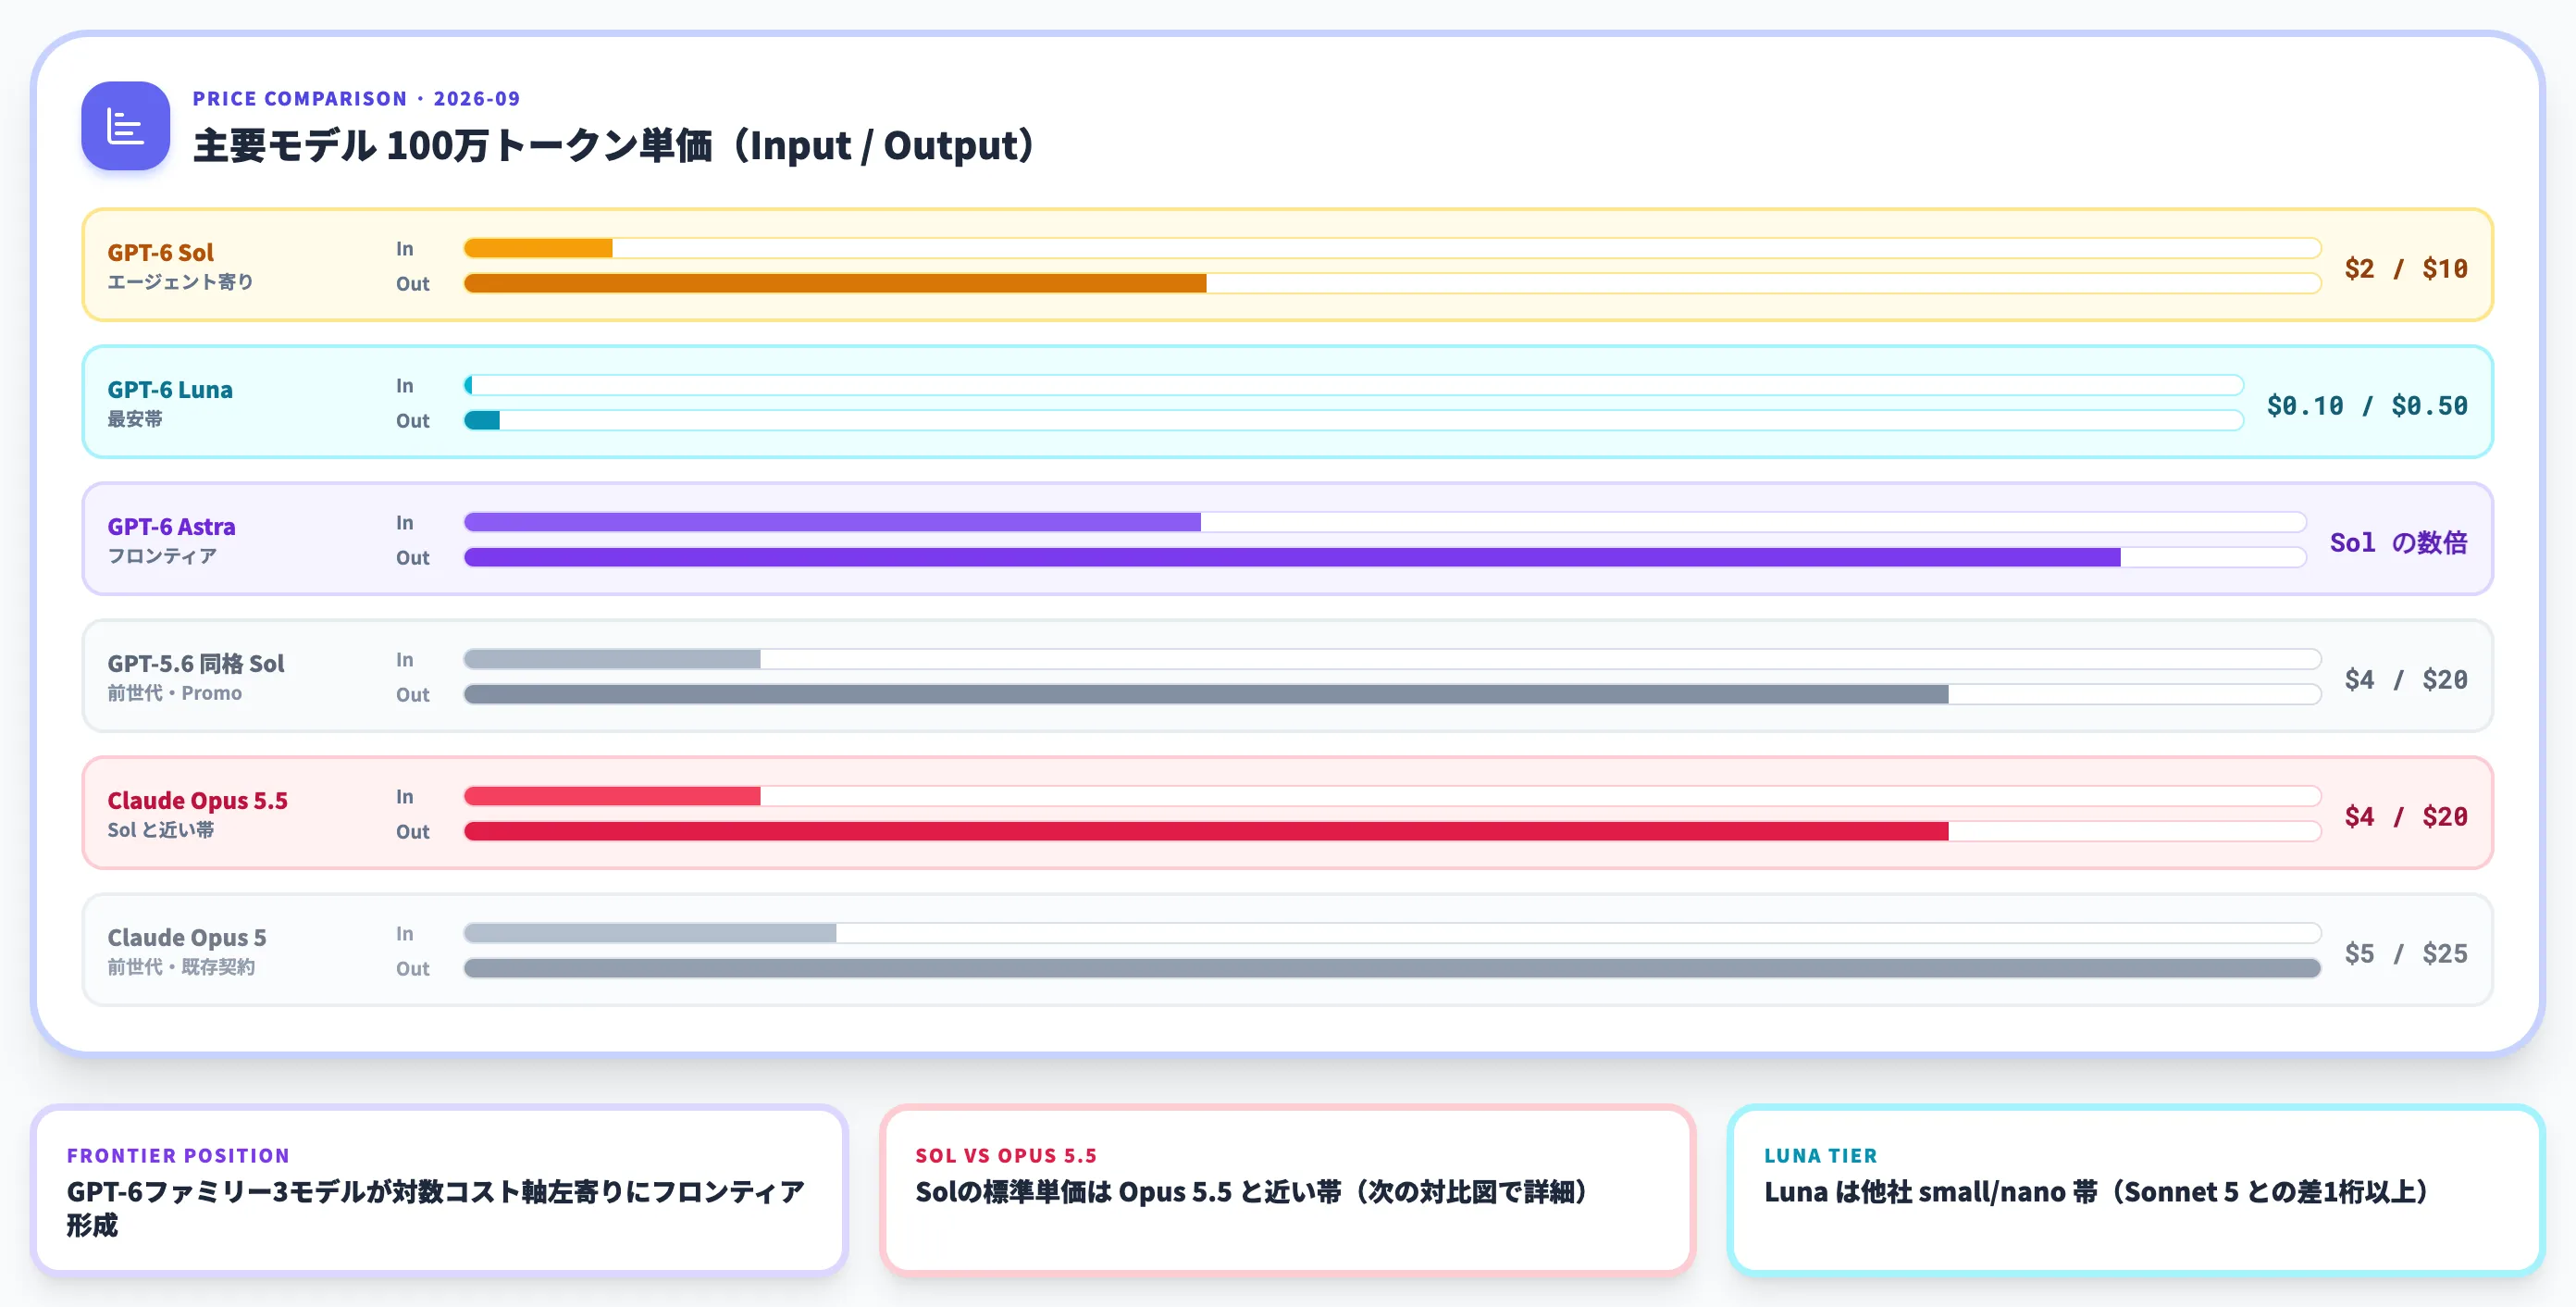
Artificial Analysis Intelligence Indexの分布で見ると、GPT-6ファミリー3モデル(Astra/Sol/Luna)が対数コスト軸の左寄りでフロンティアを形成しており、同じ Intelligence Score 帯で見ればGPT-5.6 Sol や Claude Opus 5・Sonnet 系より低コスト側に位置します。
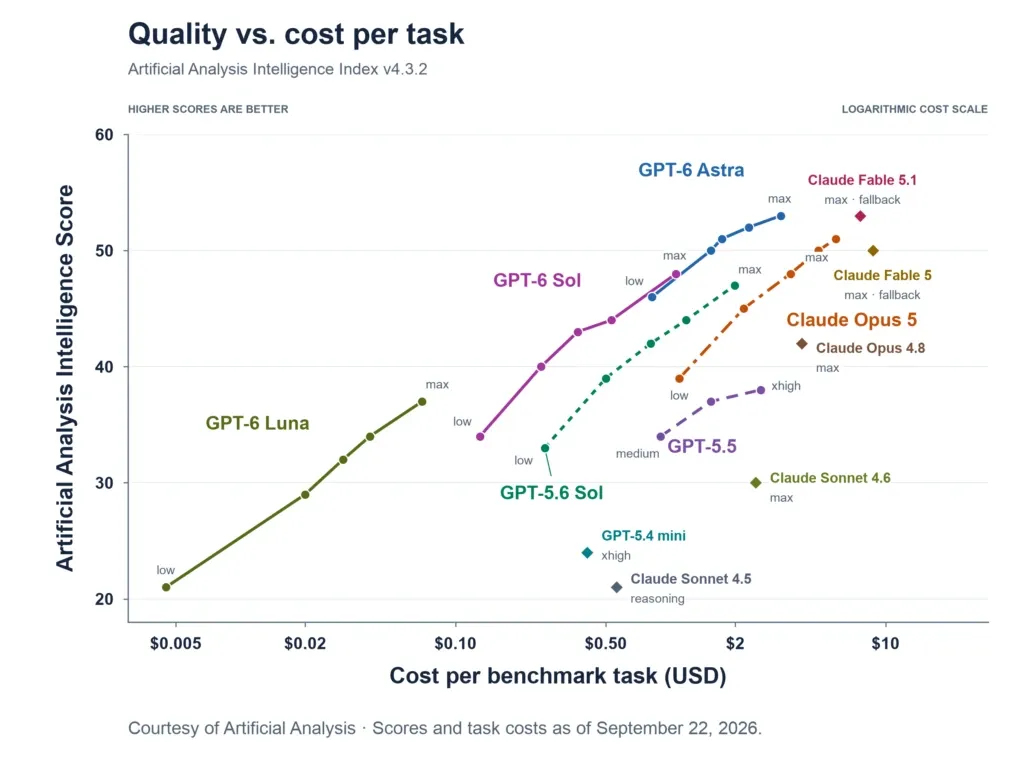
Artificial Analysis Intelligence Index v4.3.2 による品質とタスク単価の比較(2026年9月22日時点)(出典:Microsoft Azure Blog)
以下の表で、代表的なモデルの単価・特徴・想定用途を整理しました(2026年9月時点)。
| モデル | Input/Output(100万トークン) | 特徴 | 主な用途 |
|---|---|---|---|
| GPT-6 Astra | Astra水準(Sol比で数倍) | フロンティア級の推論と幅広い知識業務 | 妥協できない複雑タスク・科学/数学 |
| GPT-6 Sol | $2 / $10(272K以下) | エージェント実行・コーディング寄りに最適化 | エージェント・コーディング・長時間ループ |
| GPT-6 Luna | $0.10 / $0.50(272K以下) | 高頻度・短尺タスクに特化した軽量モデル | 要約・抽出・分類・簡易QA |
| GPT-5.6 同格 Sol | $4 / $20(Promo価格) | 前世代のバランスモデル | 既存アプリの互換維持 |
| Claude Fable 5.1 | Anthropic公式pricing | Mythos-class最上位・長時間推論に強い | 高難度分析・セキュリティ検証 |
| Claude Opus 5.5(2026-09-22公開) | $4 / $20 | Opus 5比 -20%、Cache Read $0.20 / Cache Write $5(5分キャッシュ)/ $8(1時間キャッシュ) | 汎用エージェント・エンタープライズ主力 |
| Claude Opus 5 | $5 / $25 | Opus 5.5の前世代 | 既存契約の運用継続 |
Sol = Opus 5.5 帯、Luna = 他社small帯の棲み分け
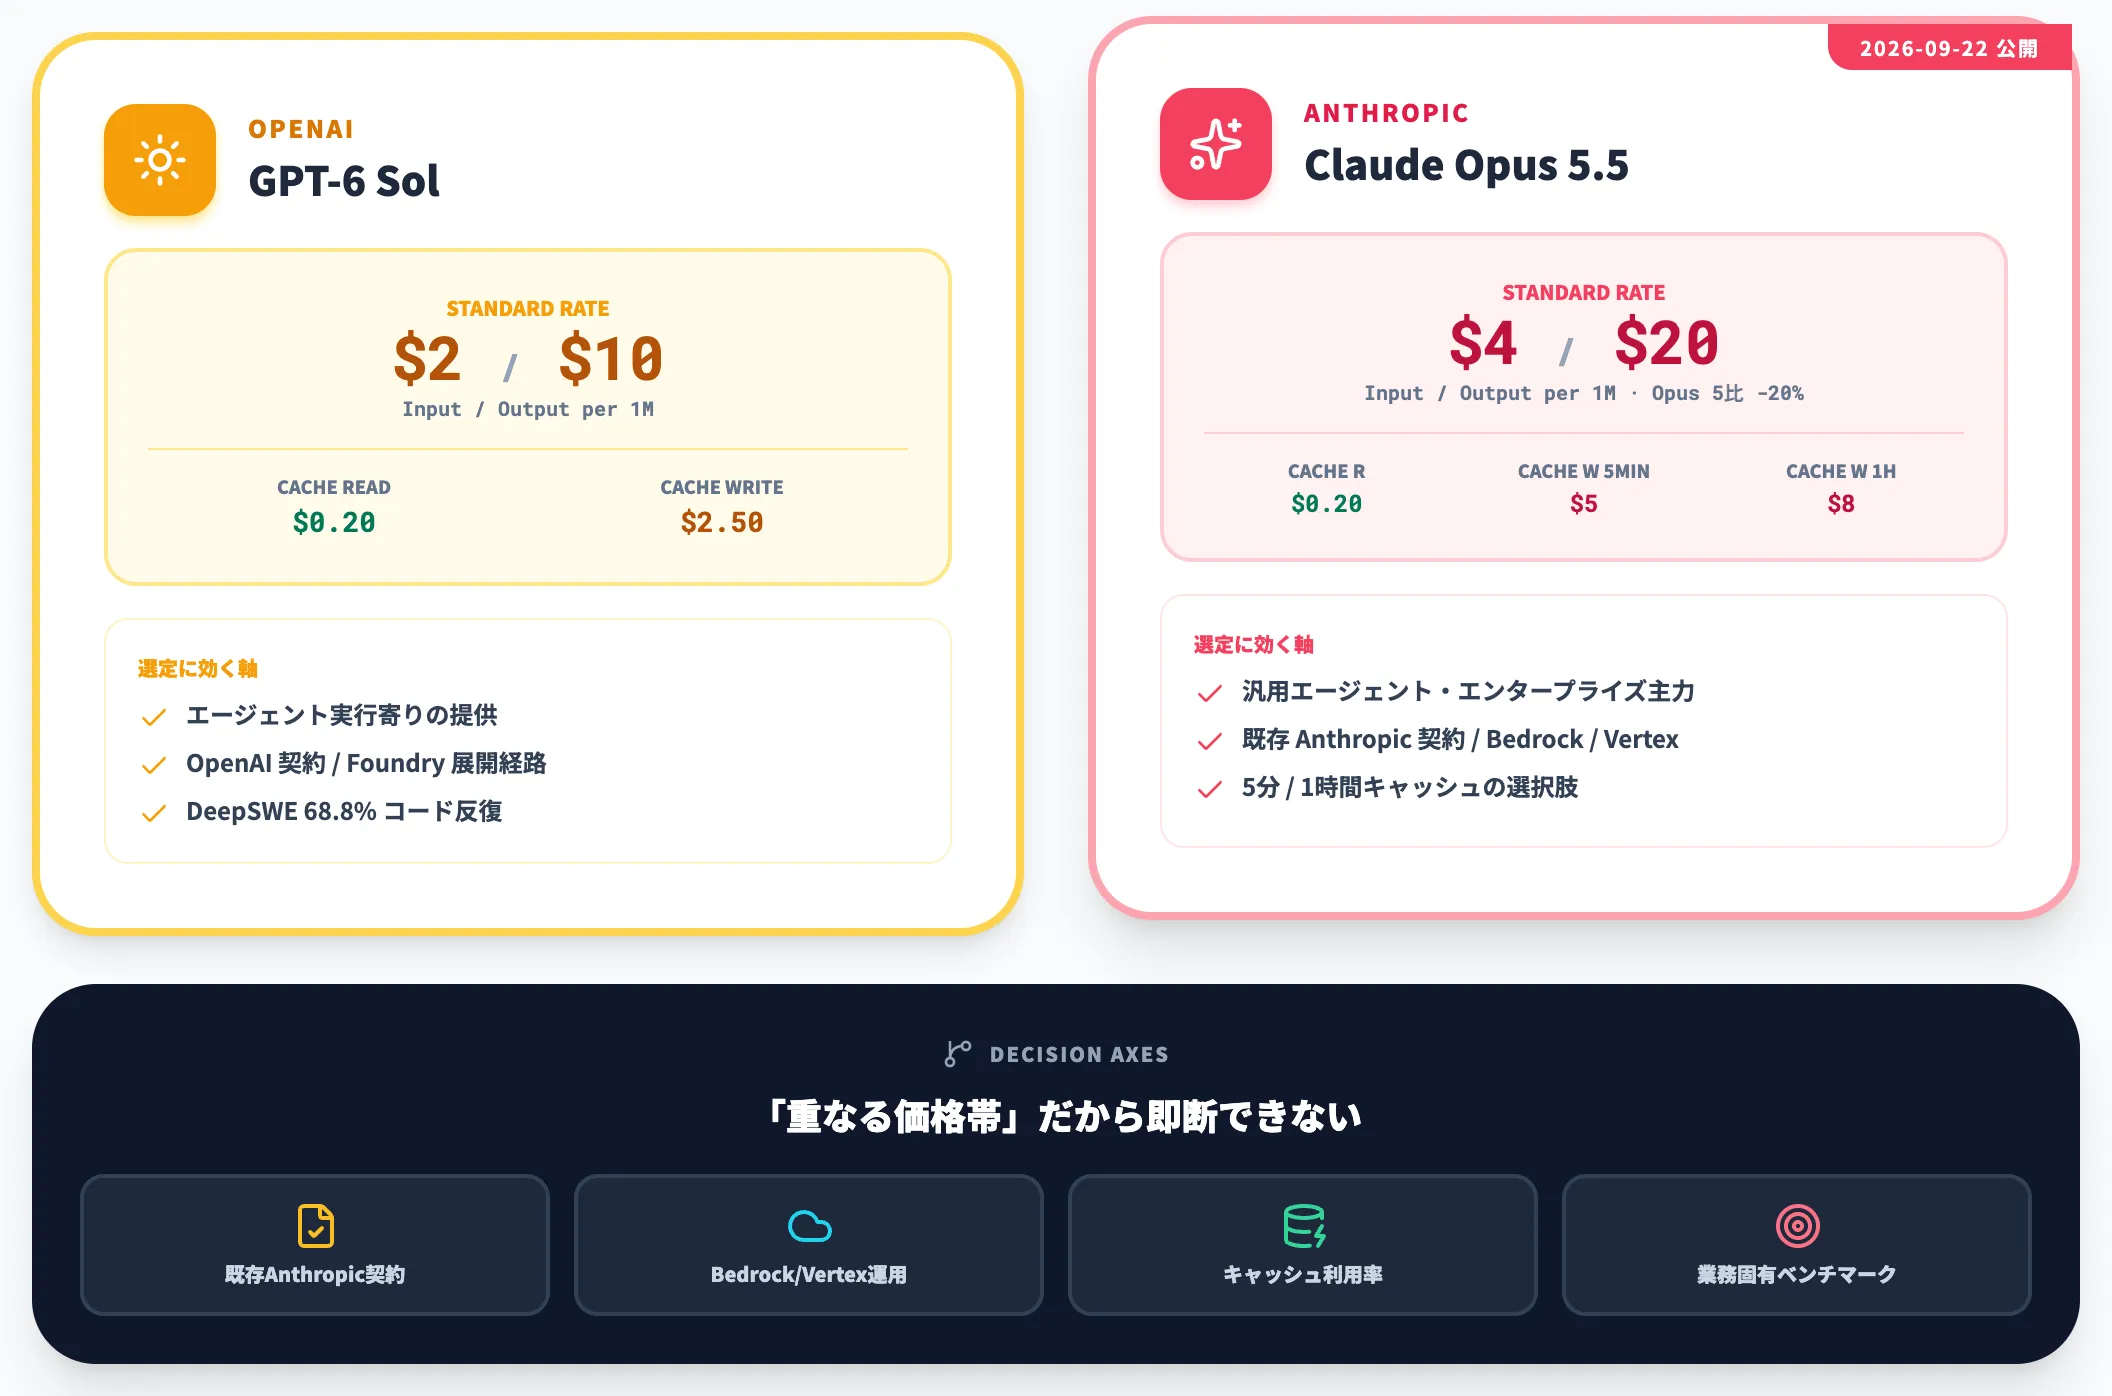
比較から見えるのは、Solの標準単価は Claude Opus 5.5 と近い帯にあるという事実です。
ただし Intelligence Score・タスクごとの得意領域・キャッシュ利用率は個別に評価する必要があり、実効価格帯が「重なる」と即断はできません。Sol と Opus 5.5 の選定は、既存のAnthropic契約・Amazon Bedrock/Vertex経由の運用設計・キャッシュ利用率・業務固有ベンチマークで決めるのが実務的です。
Lunaは絶対値の安さで他社のsmall/nanoティアと同じ帯に来ており、要約・抽出のバッチ型ワークロードで選択肢の一つに加わりました(Claude Sonnet 5は$2/$10なので、Lunaの$0.10/$0.50とは1桁以上の差があります)。
Astraを検討し続けたいケース
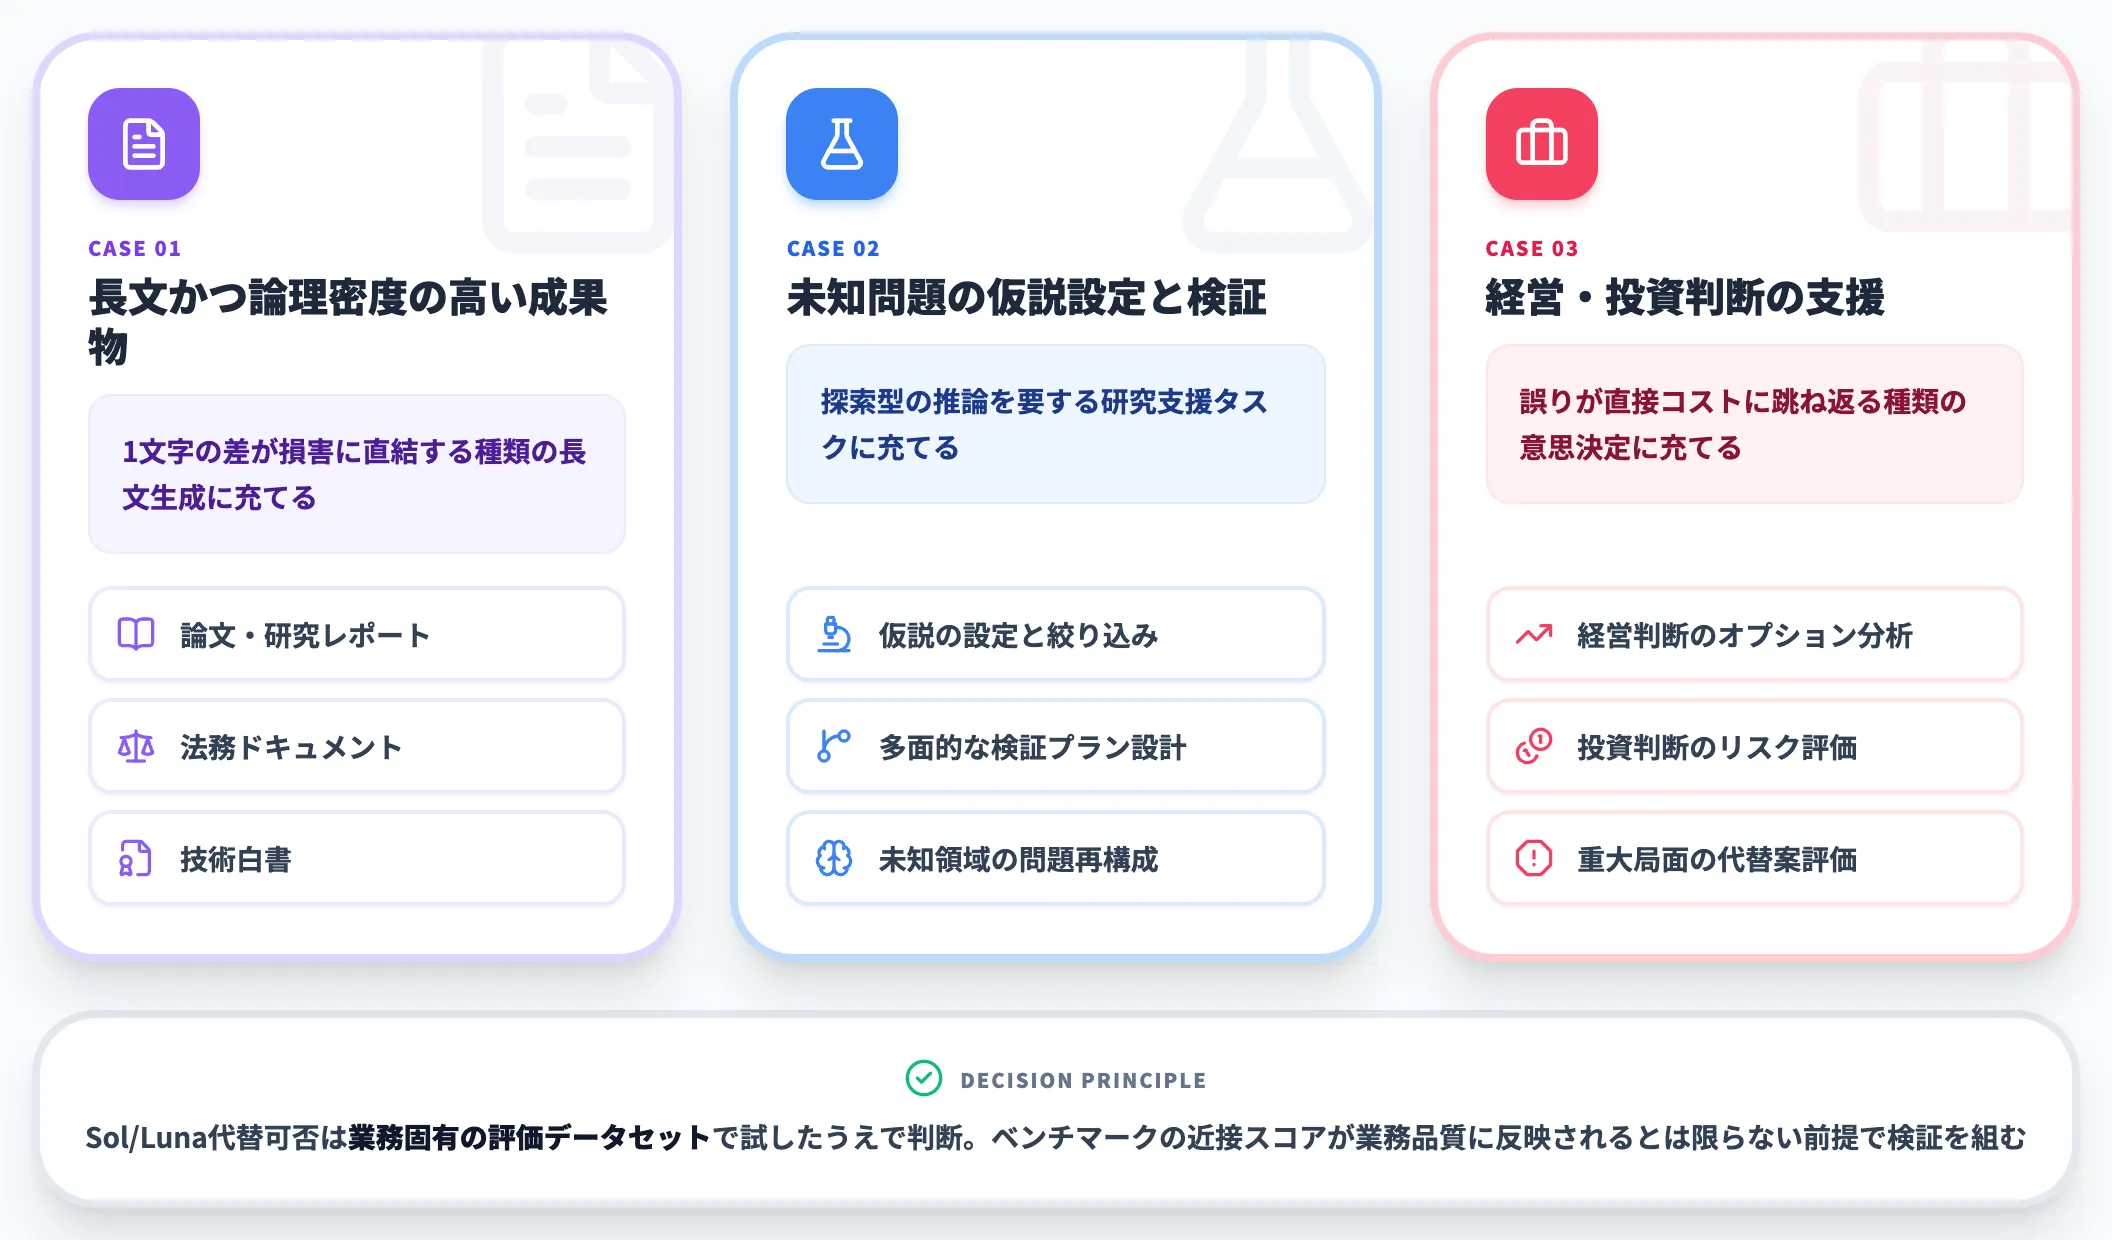
Astraを続ける価値が高いのは、「1回の推論で妥協できない完成度が求められる場面」です。具体的には次のようなケースが該当します。
- 論文・法務ドキュメント・技術白書のような長文かつ論理密度が高い成果物の生成
- 未知の問題に対する仮説設定と検証を要する研究支援タスク
- 経営判断・投資判断のように、モデルの誤りが直接コストに跳ね返る意思決定支援
これらの領域では、SolやLunaで代替できるかどうかを業務固有の評価データセットで試したうえで判断するのが安全です。ベンチマーク上の近接スコアがそのまま業務品質に反映されるとは限らない前提で検証を組みます。
Solの検証を始めやすいケース
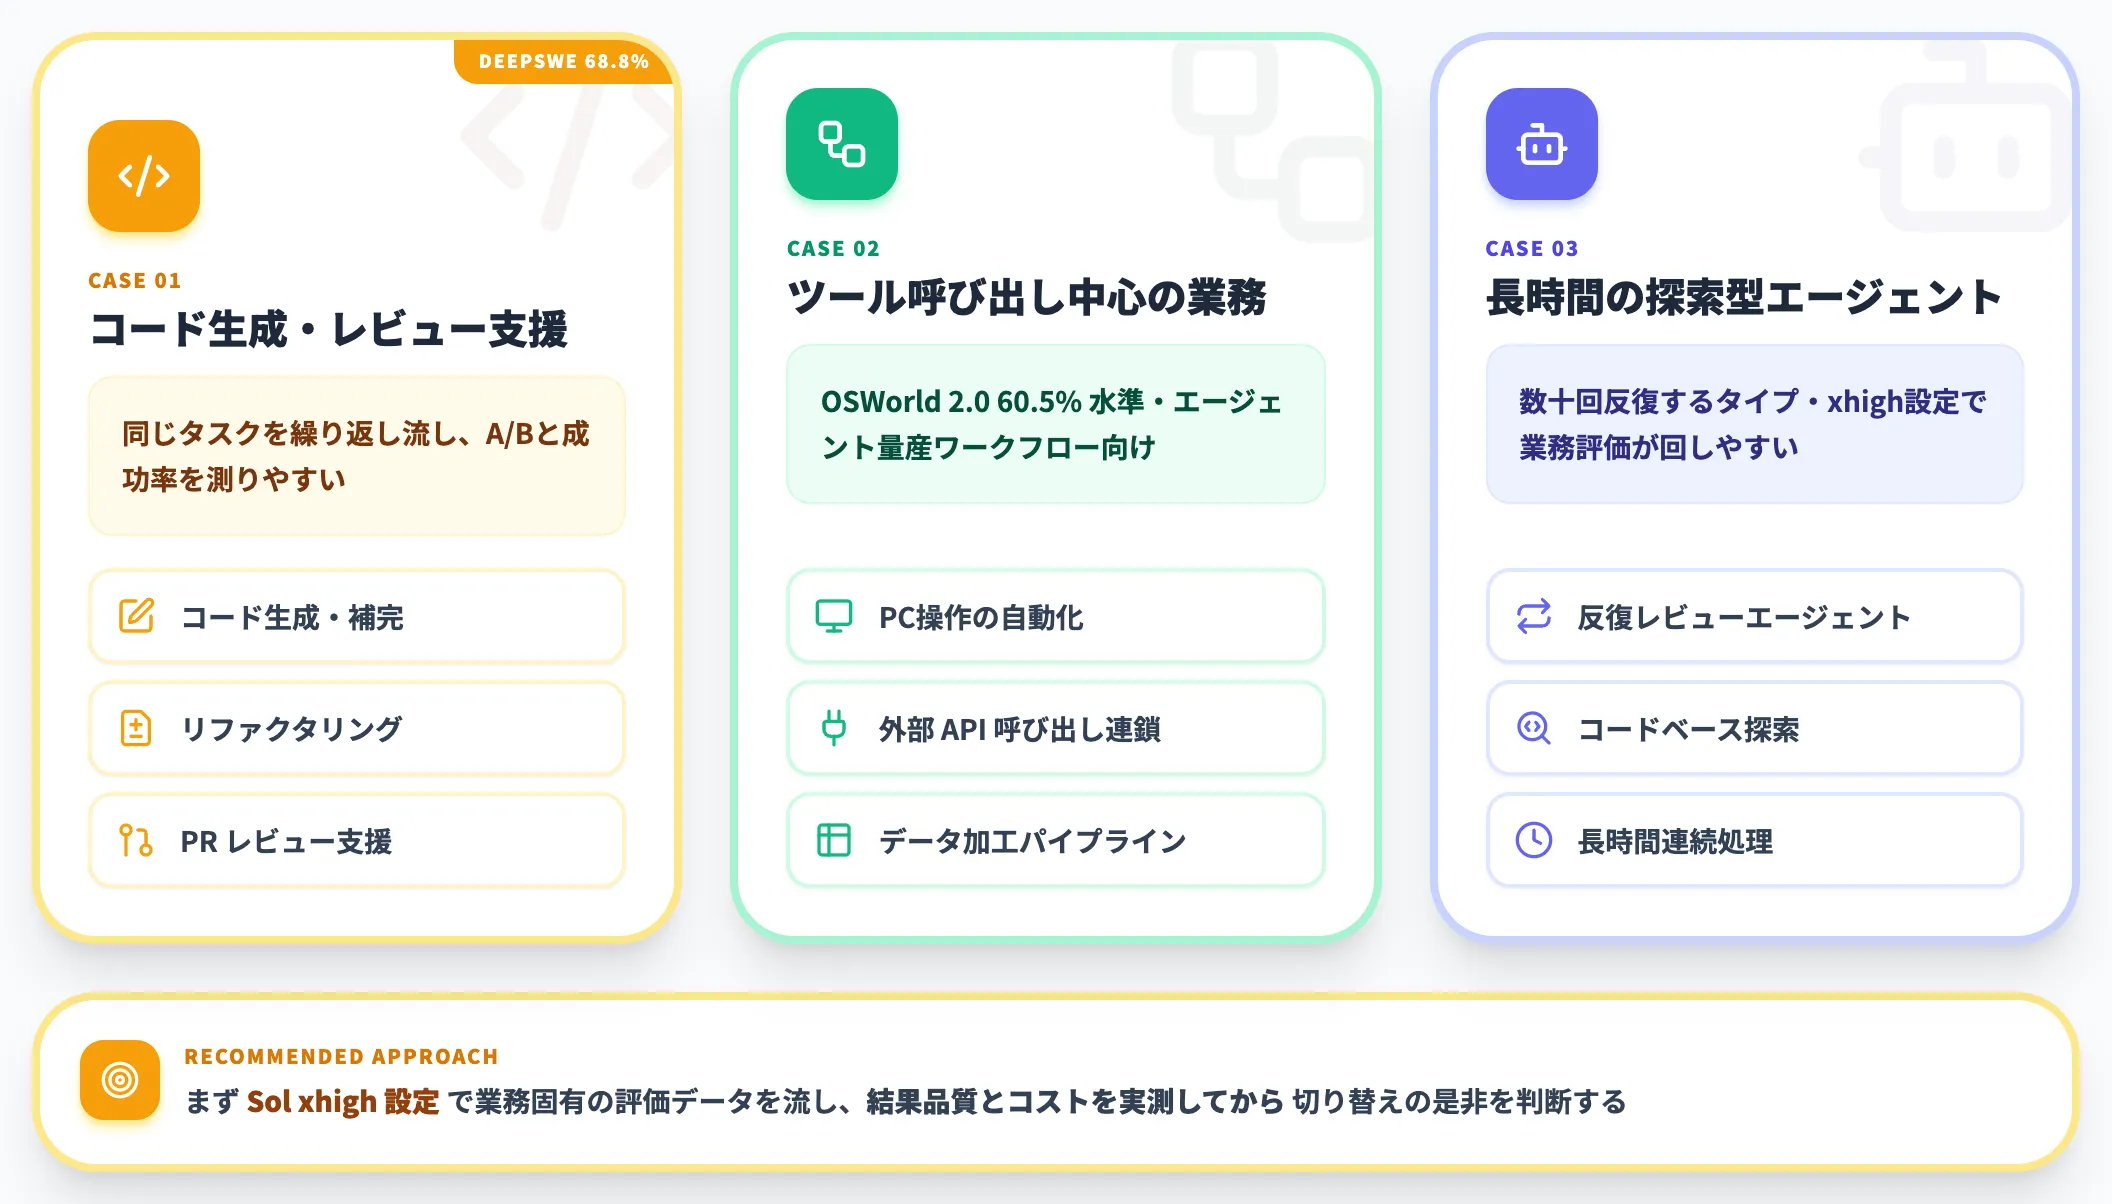
Solから検証を始めやすいのは、同じタスクを繰り返し実行するため業務側で評価データを回しやすい種類の業務です。
- コード生成・リファクタリング・レビュー支援(DeepSWE 68.8%水準)
- ツール呼び出し中心のワークフロー(PC操作・API叩き・データ加工)
- 長時間の探索型エージェント(同じレビューを数十回反復するタイプ)
反復系タスクはA/Bと成功率の測定が組みやすいため、まずSolのxhigh設定で業務固有の評価データを流し、結果品質とコストを実測してから切り替えの是非を判断するのが安全です。
Lunaで済みそうなケース
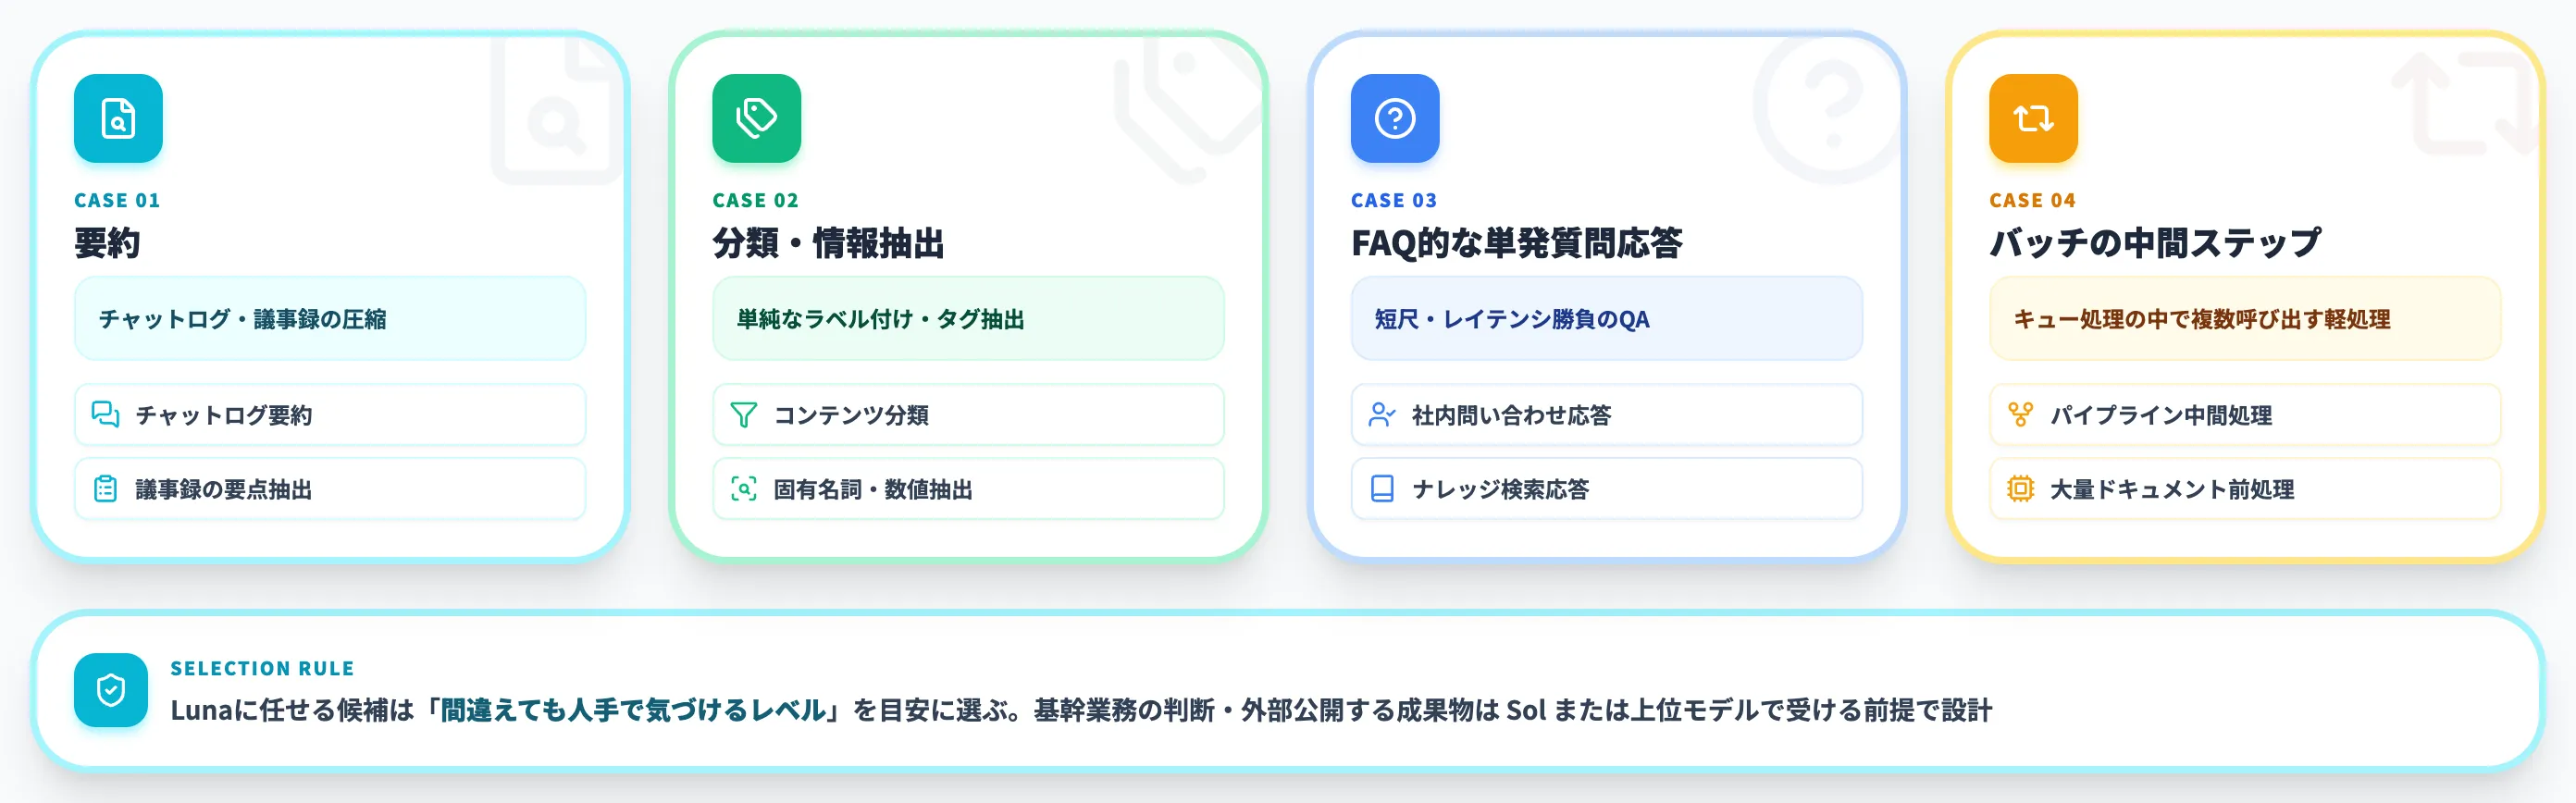
Lunaは「短尺・高頻度・低リスク」なタスクに絞れば強力です。
- チャットログ・議事録の要約
- 単純な分類・タグ付け・情報抽出
- FAQ的な単発質問応答
- キューを回すバッチ処理の中間ステップ
Lunaに任せる候補は、「間違えても人手で気づけるレベルのタスク」を目安にして選ぶとわかりやすくなります。基幹業務の判断や外部公開する成果物は、Solまたは上位モデルで受ける前提で設計します。
GPT-6 Sol / Lunaの乗り換え・混在運用で詰まる論点
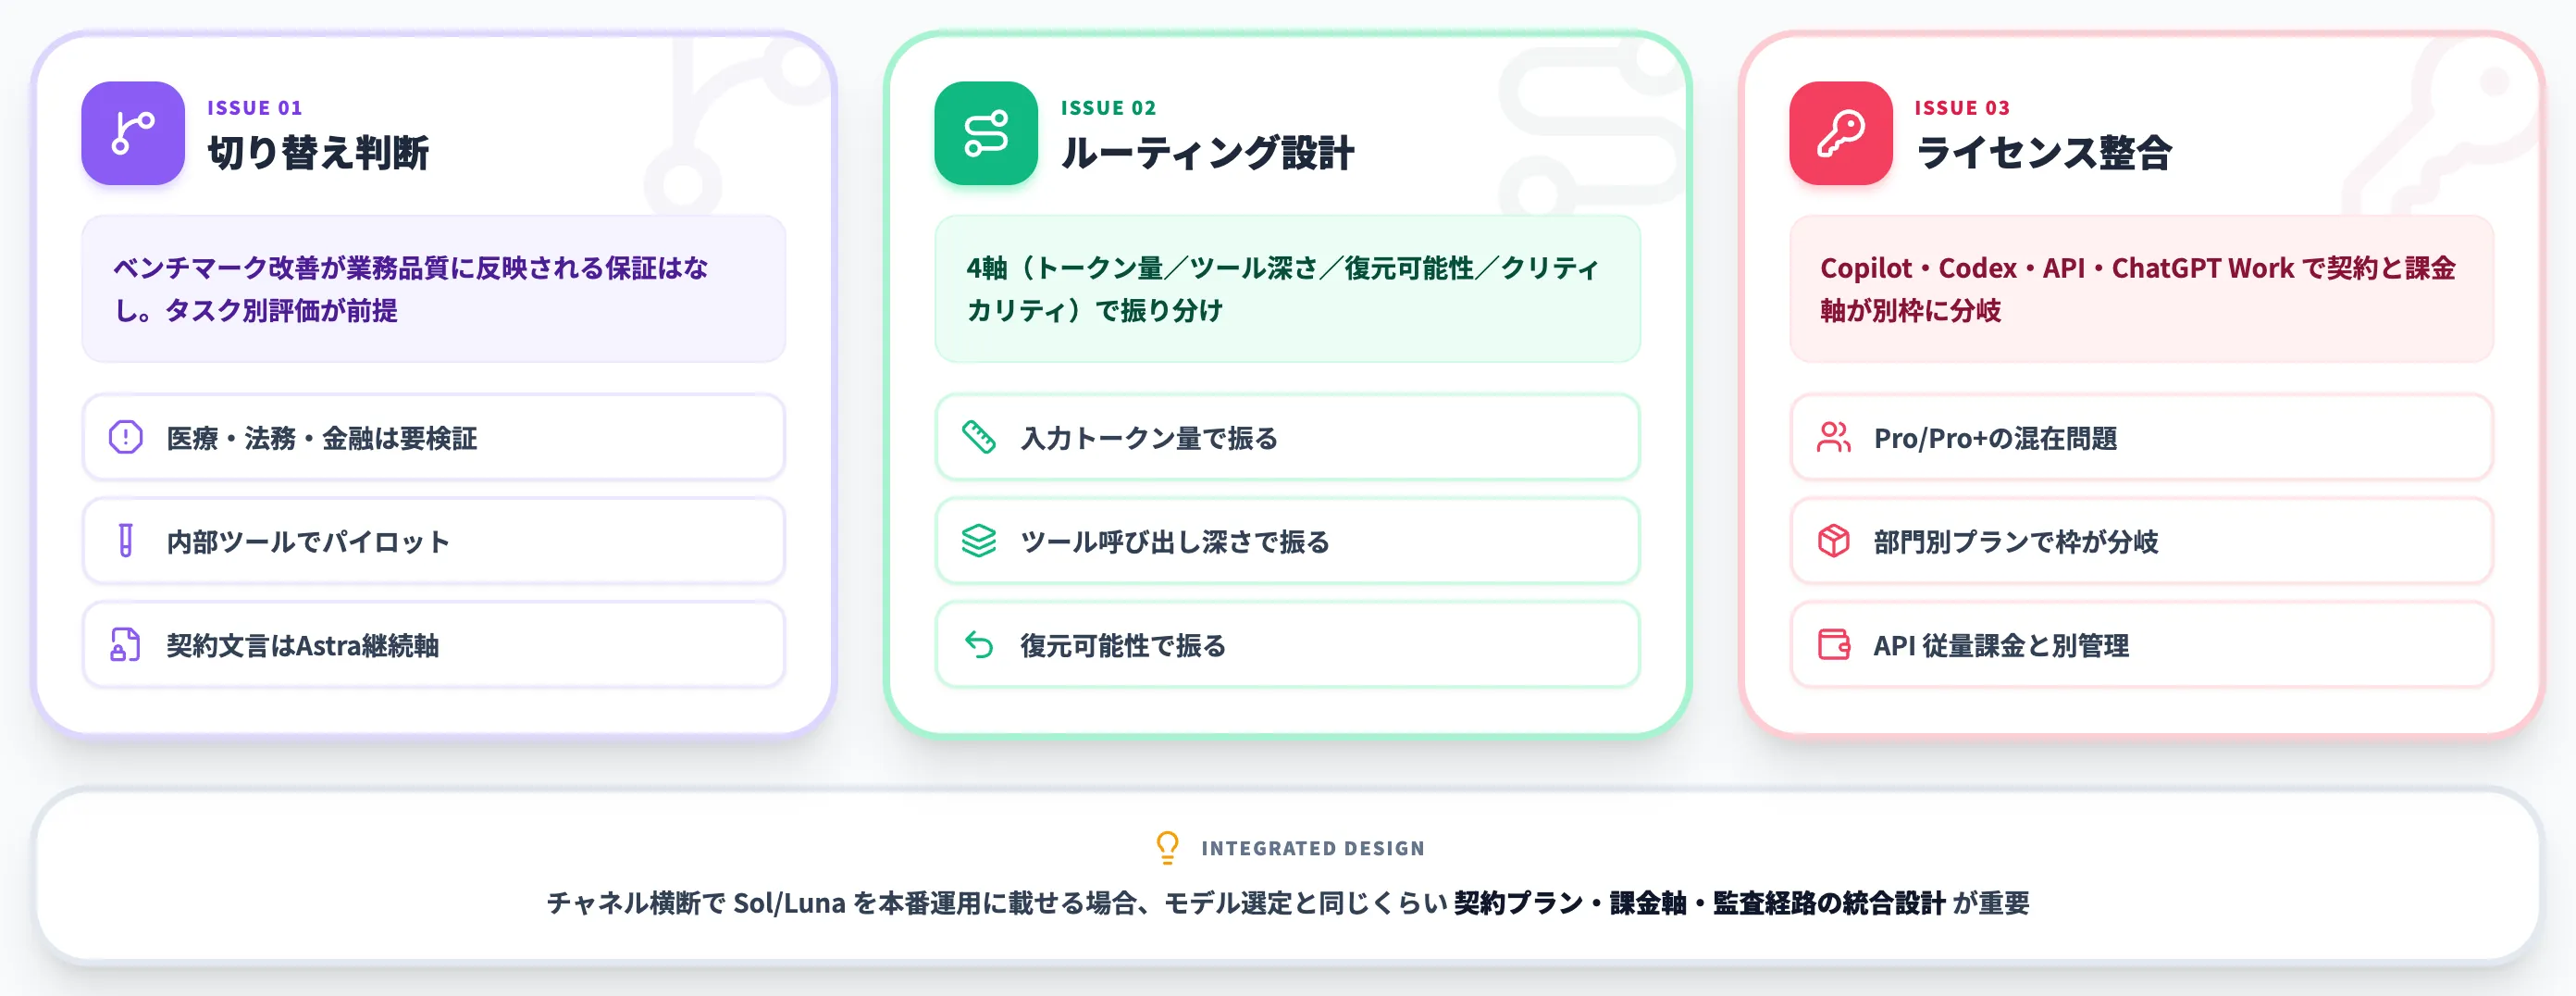
Sol/Lunaを導入する際に、社内議論が止まりがちな論点を3つに絞って整理します。数値・閾値はすべて初期案で、最終的な採用可否は業務固有の検証データで判定します。
AstraからSolへの切り替え判断で見落とされやすい点
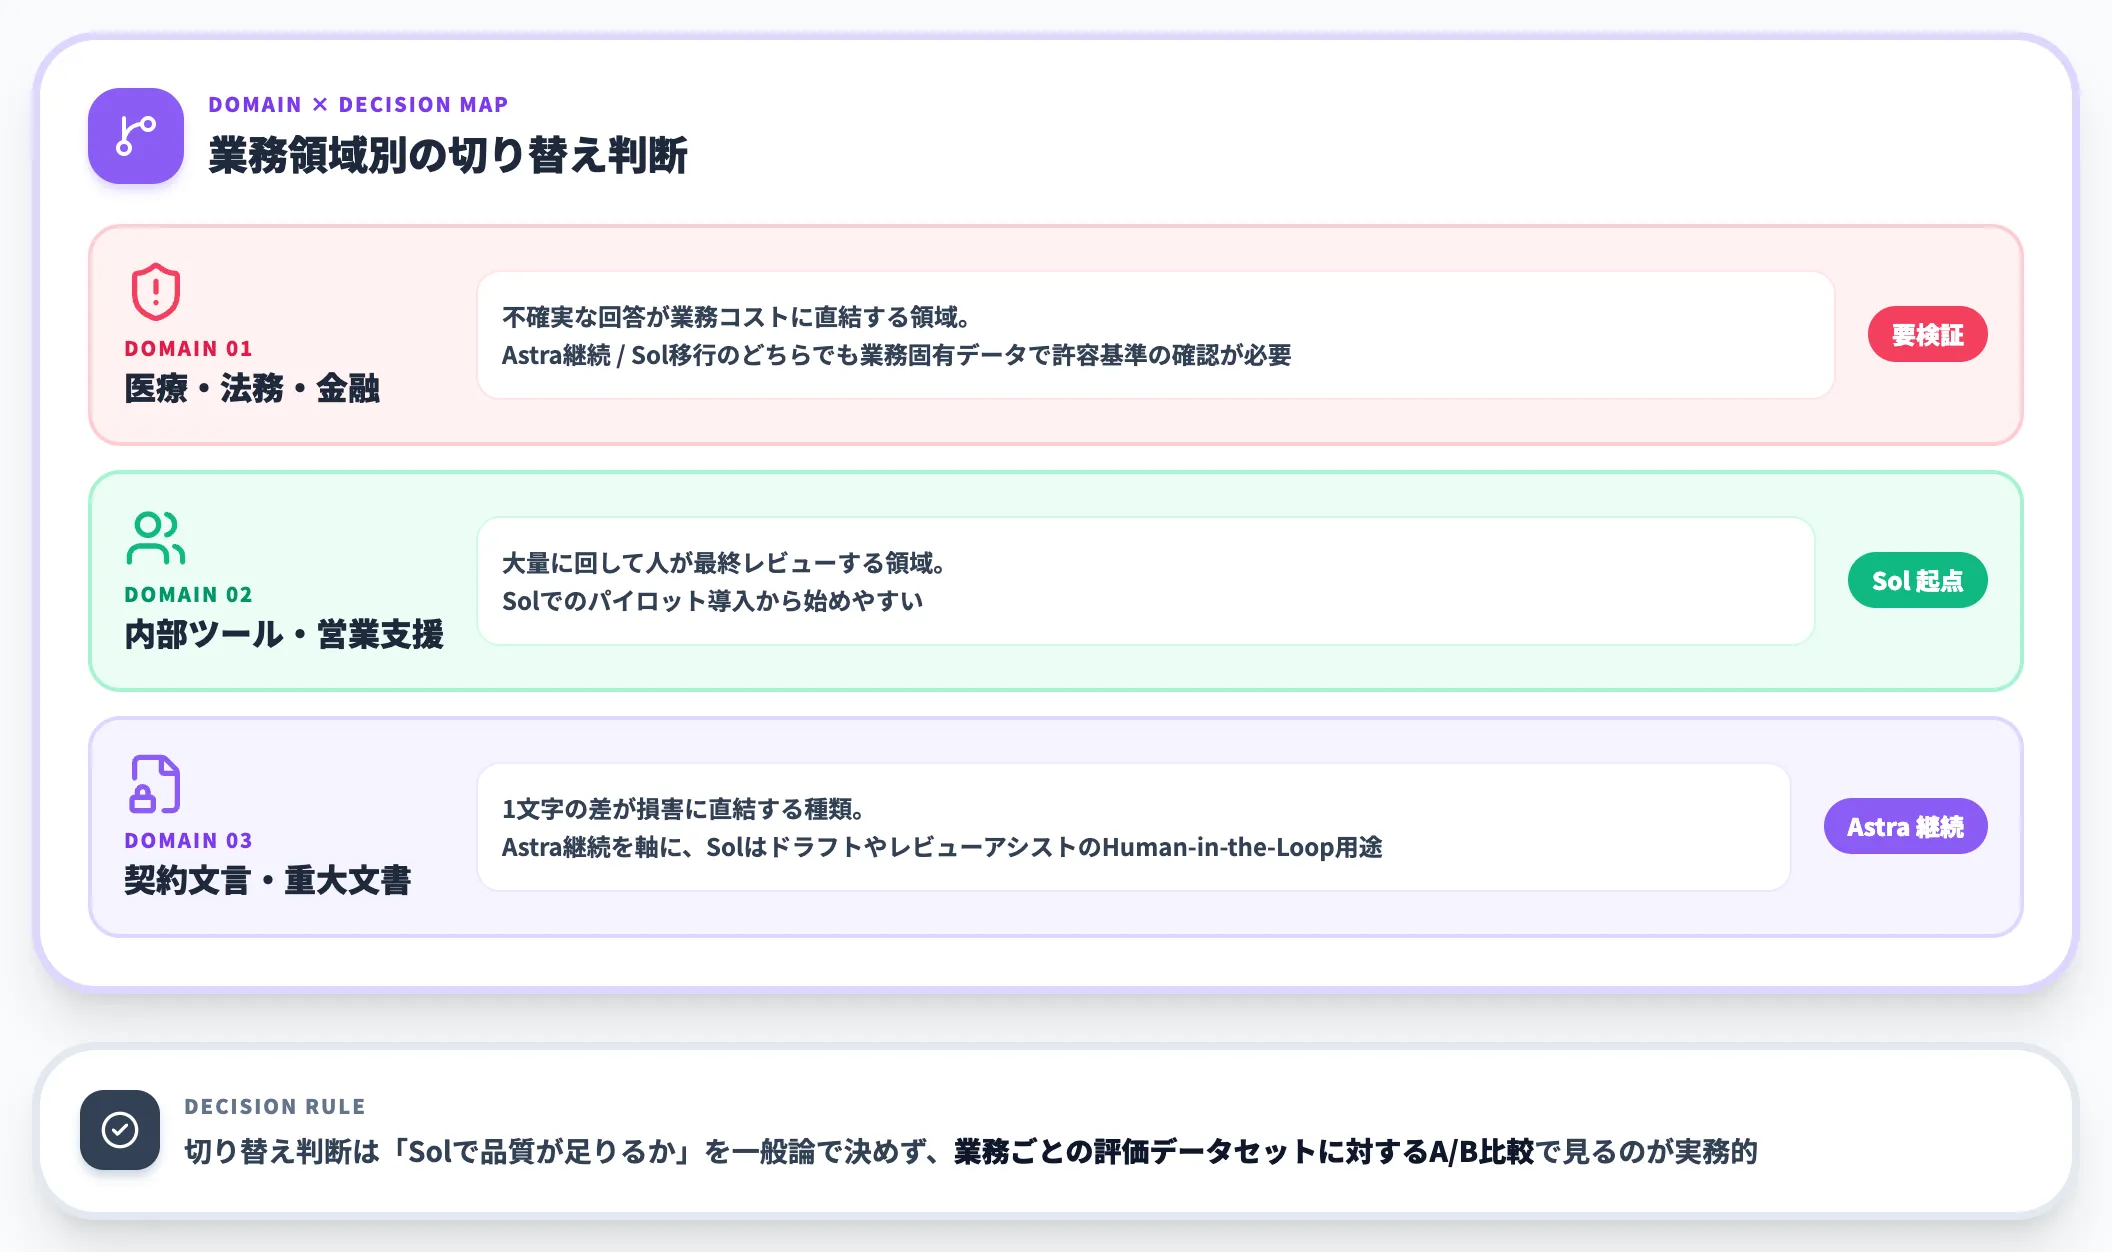
Solのベンチマークスコアや誤り誘発セットでの改善は事実ですが、業務品質にそのまま反映される保証はないため、切り替え判断はタスク別に評価する必要があります。
- 医療・法務・金融のように「不確実な回答が業務コストに直結する」領域は、Astra継続とSol移行のどちらでも、業務固有の評価データを用いた検証で許容基準を確認する
- 内部ツール・営業支援エージェントのように「大量に回して人が最終レビューする」領域は、Solでのパイロット導入から始めやすい
- ドキュメント生成の中でも、契約文言のような1文字の差が損害に直結する種類はAstra継続を軸に、SolはドラフトやレビューアシストなどHuman-in-the-Loop前提で使う
切り替え判断は「Solで品質が足りるか」を一般論で決めず、業務ごとの評価データセットに対するA/B比較で見るのが実務的です。
SolとLunaのルーティング設計(初期案)
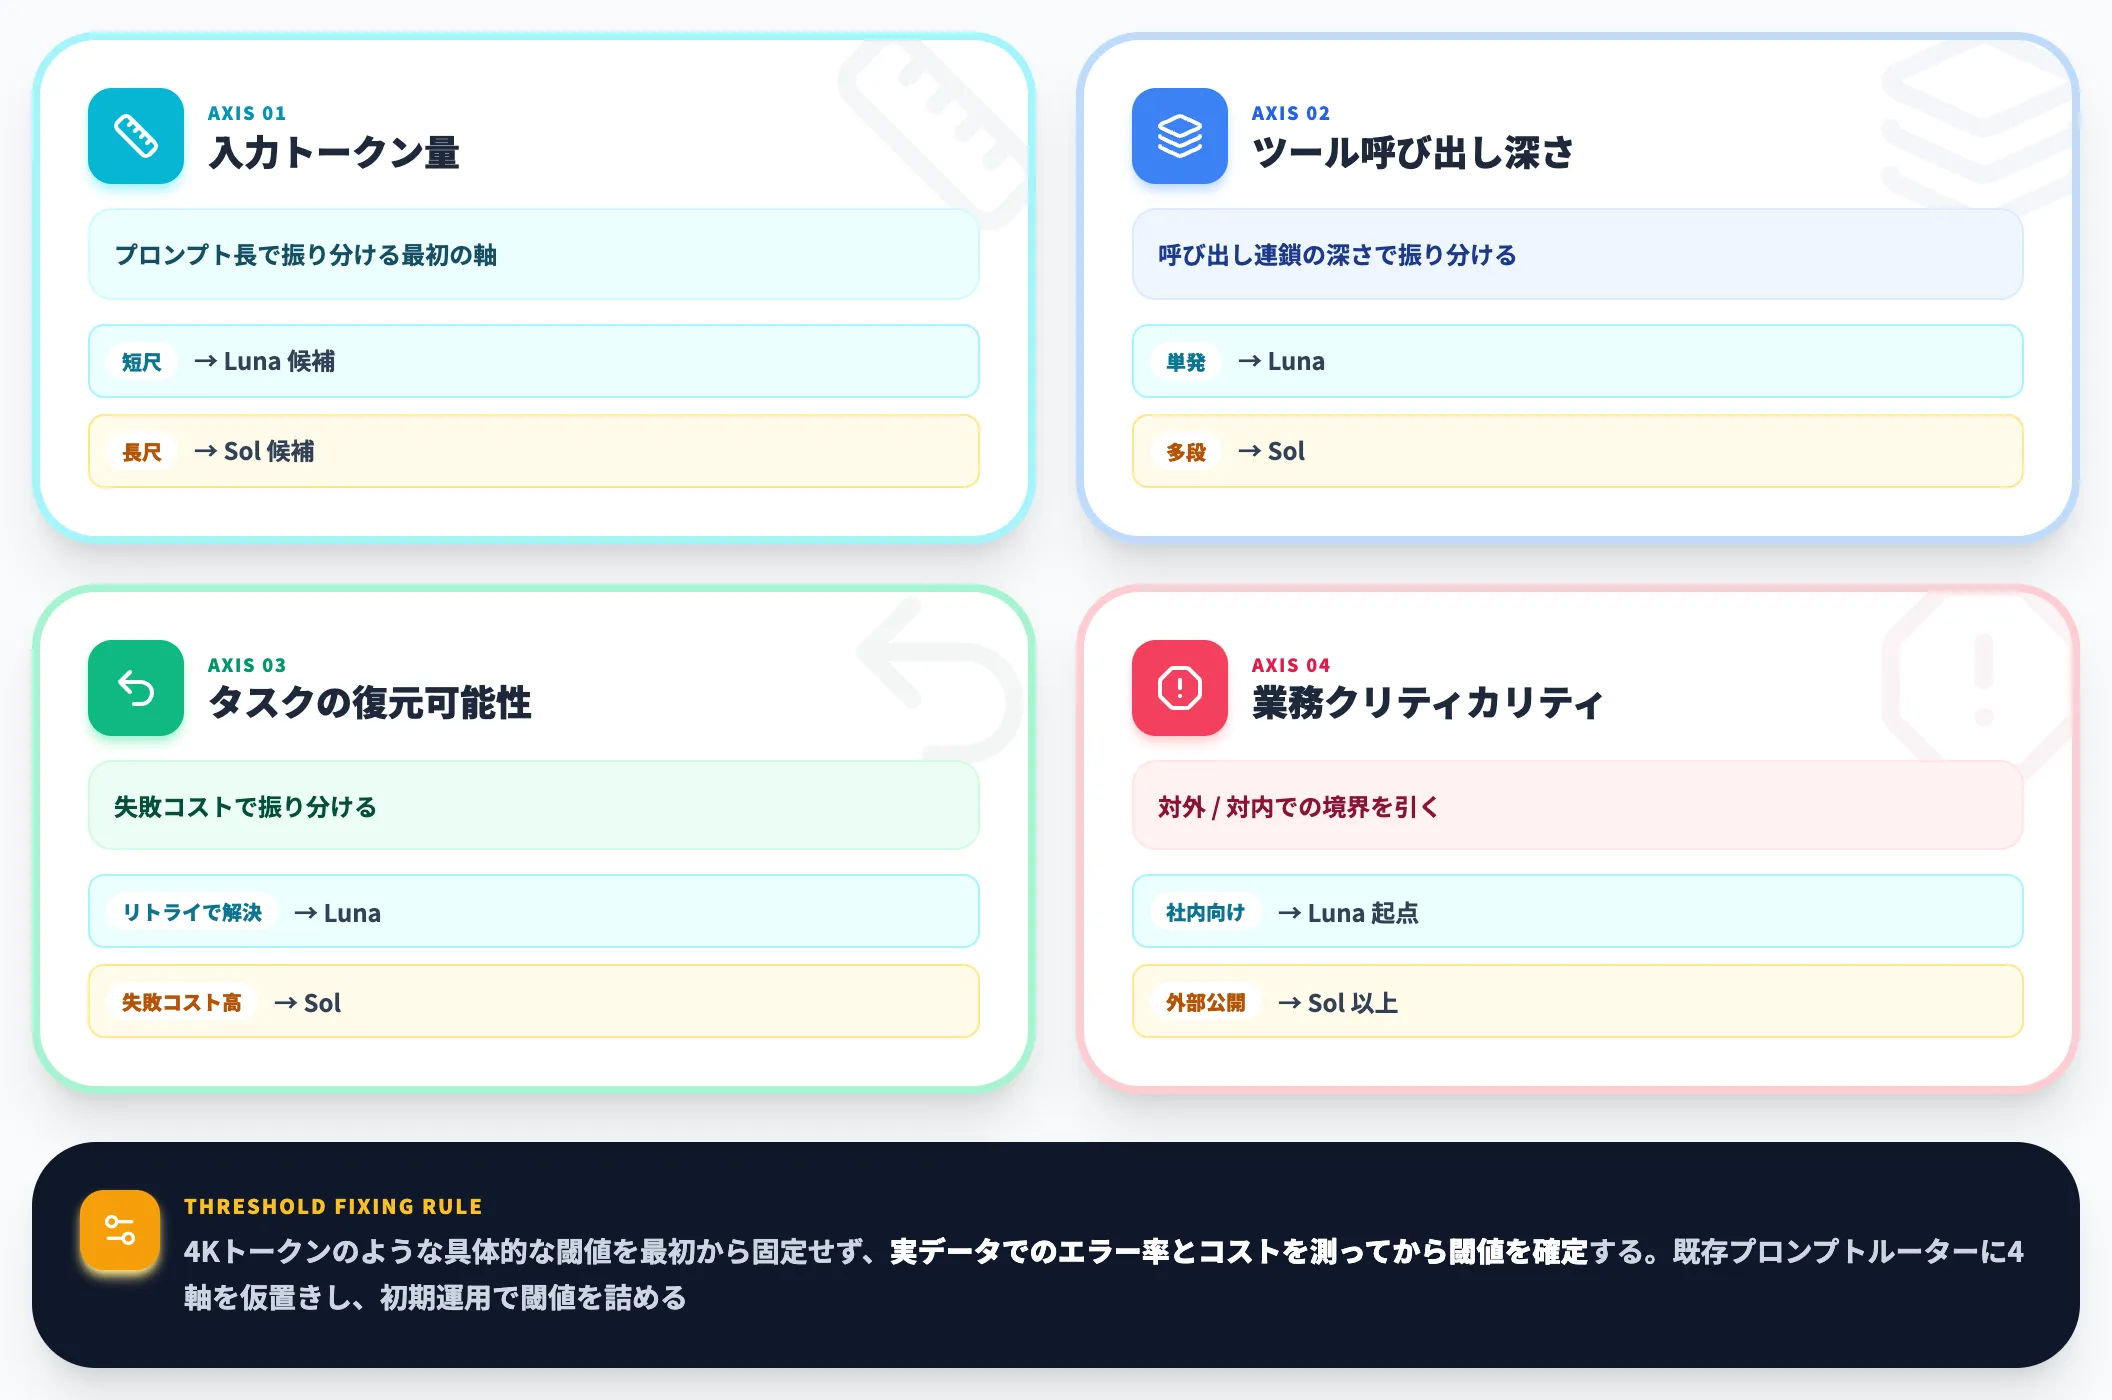
SolとLunaを併用する場合、リクエストごとのルーティングを設計する余地があります。以下は初期の振り分け例で、閾値やタスク分類は本番評価に合わせて調整します。
- 入力トークン量で振る: 短尺プロンプトはLuna候補、長尺プロンプトはSol候補
- ツール呼び出しの深さで振る: 単発呼び出しはLuna、多段呼び出しはSol
- タスクの復元可能性で振る: 失敗してもリトライで解決するタスクはLuna、失敗コストが高いタスクはSol
- 業務クリティカリティで振る: 社内向けはLuna起点、外部公開はSol以上
4Kトークンのような具体的な閾値を最初から固定せず、実データでのエラー率とコストを測ってから閾値を確定するのが安全です。既存のプロンプトルーターにこの4軸を仮置きし、初期運用で閾値を詰めるアプローチが現実的になります。
Copilot / Codex / API 併用時のライセンス整合
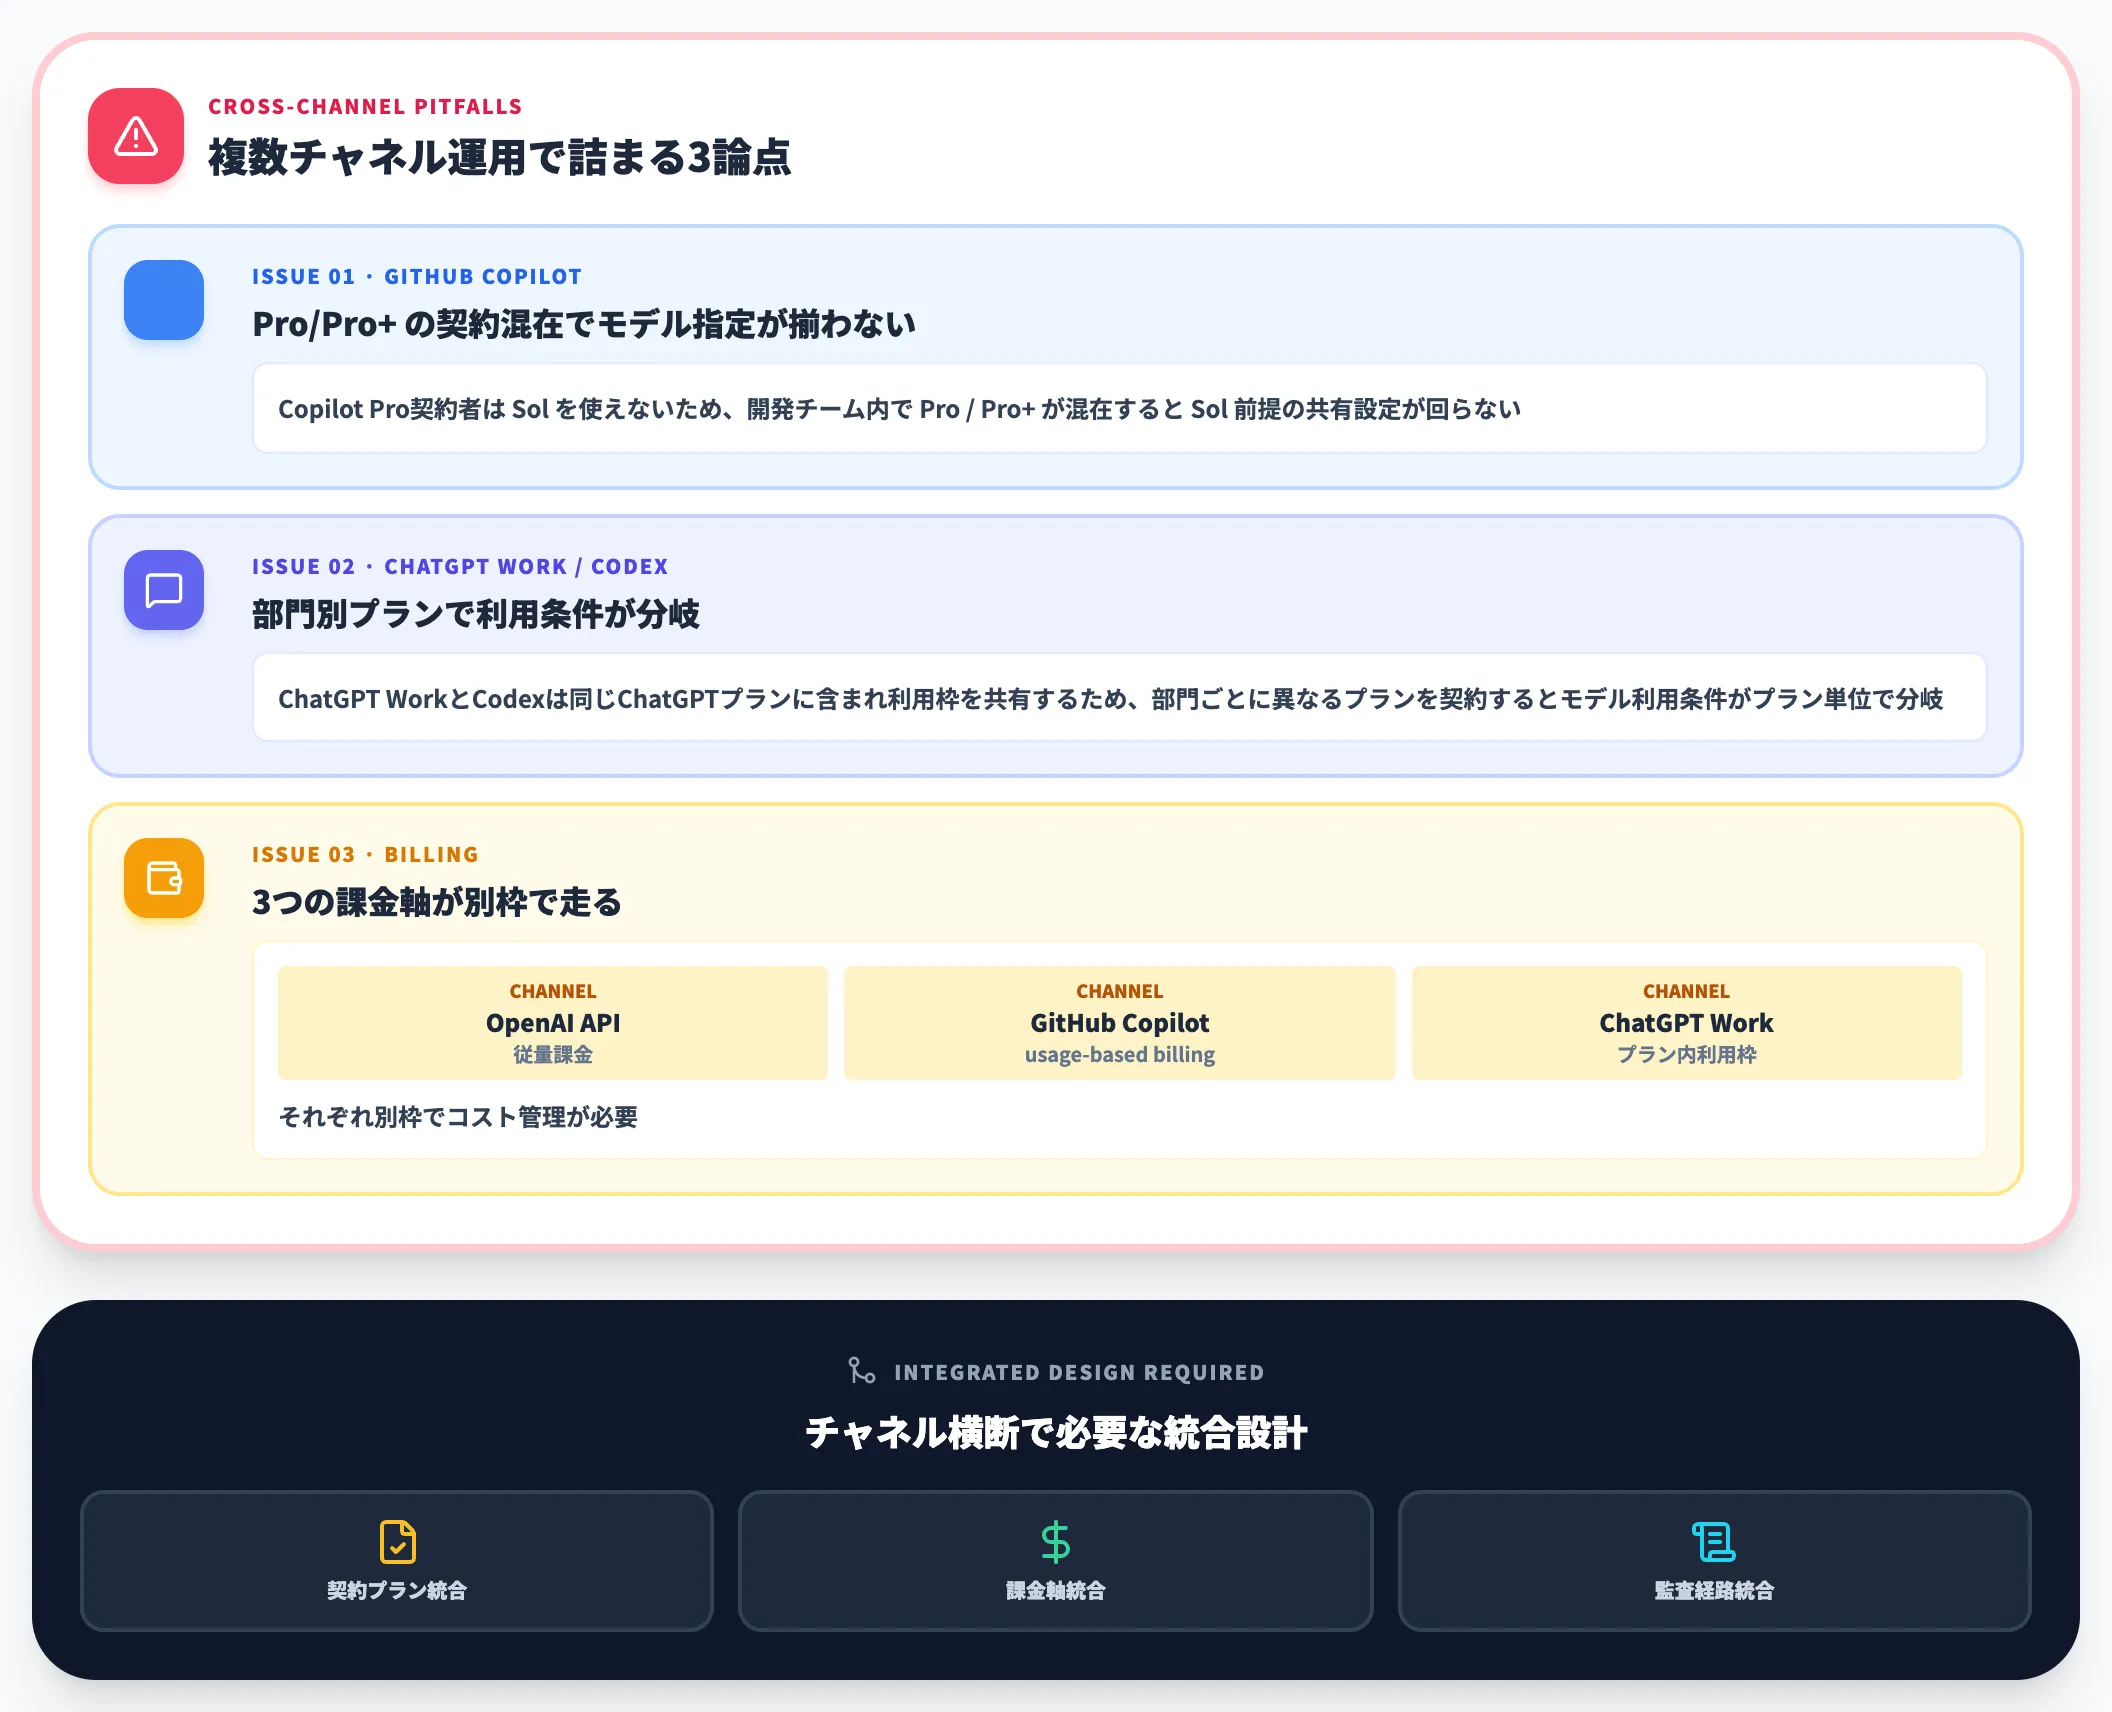
複数チャネル(GitHub Copilot・Codex・OpenAI API・ChatGPT Work)を同時に運用する組織では、Sol/Luna対応プランの差分が運用設計に効いてきます。
- Copilot Pro契約者はSolを使えないため、開発チーム内でCopilot Pro契約とPro+契約が混在するとモデル指定が揃わない
- ChatGPT WorkとCodexは同じChatGPTプランに含まれ利用枠を共有するため、部門ごとに異なるプランを契約するとモデル利用条件がプラン単位で分岐する
- API経由の従量課金、CopilotのGPT-6モデルに適用されるusage-based billing、ChatGPT Work契約プラン内の利用枠は、それぞれ別枠でコスト管理が必要
チャネル横断でSol/Lunaを本番運用に載せる場合、モデル選定と同じくらい契約プラン・課金軸・監査経路の統合設計が重要になります。
GPT-6 Sol / Luna導入で詰まる論点を、実装事例から逆算して整理する
GPT-6 Sol/Lunaを検討する現場では、公式ドキュメントだけでは決めきれない論点が並びます。
- Sol・Luna・Astraのルーティング閾値を業務ごとにどう検証するか
- API・Codex・Copilot・Foundryのどのチャネルを組織の一次経路に据え契約プラン・課金軸を整合させるか
- Astraで既に運用している業務を業務固有の評価データでどの粒度からSolに寄せるか
- Cache Read/Write・long-context pricingを前提にシステムプロンプトとツール定義をどう再設計するか
ルーティング設計・チャネル統合・Astra移行判定・キャッシュ/long-context再設計まで含めてSol/Luna導入の実装可能性を棚卸ししたいなら、単体機能の解説記事ではなく、実装事例と組み合わせて話せる相手と一度整理するのが早道です。
AI Agent Hubは、GPT-6 Sol/Lunaを含むフロンティアモデルを業務Agent単位で統合管理するエンタープライズAI基盤です。
ルーティング設計・チャネル統合・Astra移行判定・キャッシュ/long-context再設計のいずれの入口からでも、実装から逆算した論点整理をご相談いただけます。
GPT-6 Sol/Luna導入の論点を実装から逆算

ルーティング・チャネル統合・Astra移行・キャッシュ再設計
Sol/Luna導入は、Sol/Luna/Astraのルーティング閾値・チャネル契約整合・Astra移行判定・Cache/long-context前提のプロンプト再設計が絡み合います。AI Agent Hubのサービスページで、GPT-6世代を業務Agentに組み込む実装例をご確認ください。
まとめ
本記事では、GPT-6 Sol / Lunaについて、Astra派生2モデルの位置づけ・進化点・公式ベンチマーク・料金と提供チャネル・Astra/GPT-5.6/Opus 5.5との使い分け・乗り換え混在運用の論点までを、2026年9月時点の一次情報で解説しました。
2026年9月時点で押さえておくべきポイントは次の3つです。
- エージェント実行とコーディングに軸を置いたAstra派生の2モデル、Solは内部評価で事実誤り約半減・欺瞞的挙動検出率が10.4%→1.3%まで低下
- 単価はSol $2/$10・Luna $0.10/$0.50でGPT-5.6同格モデルの半額前後、272K超のlong-context pricingでは入力2倍
- Astra継続・Sol移行・Luna採用の判断は業務固有の評価データで決める、ベンチマークスコアをそのまま業務品質に一般化しない
ChatGPT Work・Codex・GitHub Copilot・Microsoft Foundryのどのチャネルでも利用できる一方、対応プラン・課金軸・監査経路は分岐します。GPT-6世代を本番運用に載せる時期は、モデル選定と同じくらいチャネル横断の運用設計と業務評価の設計を先に整えるフェーズに入りました。