この記事のポイント
 Ryzen AI Embedded X100はStrix Haloダイの組み込み転用、コンシューマ版Ryzen AI Max+ 395で先行PoCが可能
- 全6モデル(X168/X188/X199+i付き産業温度版)で8〜16コア・50 TOPS NPU・LPDDR5x-8533統一、産業温度版は-40〜105℃対応
- 128GB統合メモリで200B+パラメータモデルもエッジローカル推論可能、NVIDIA Jetson Orin/Thor比の比較結果として大容量メモリを訴求
- Xen Hypervisor+Linux RT Kernel+RT BIOSで、リアルタイムOSと汎用Linuxを1チップ上で同居できる仮想化設計
- 2026年6月サンプル・Q4 2026量産・24/7稼働で最長10年ライフサイクル、産業機器の長期BOM設計に耐える設計思想
Microsoft MVP・AIパートナー。LinkX Japan株式会社 代表取締役。東京工業大学大学院にて自然言語処理・金融工学を研究。NHK放送技術研究所でAI・ブロックチェーンの研究開発に従事し、国際学会・ジャーナルでの発表多数。経営情報学会 優秀賞受賞。シンガポールでWeb3企業を創業後、現在は企業向けAI導入・DX推進を支援。
Ryzen AI Embedded X100は、AMDが2026年1月に予告し7月23日のAdvancing AI 2026で製品詳細を発表した、フィジカルAI向けの組み込みSoCシリーズです。
Zen 5 x86 CPU(最大16コア)、RDNA 3.5 iGPU(最大40 Compute Unit)、XDNA 2 NPU(50 TOPS)を1チップに統合し、ロボティクス・産業オートメーション・医療・航空宇宙防衛といった自律システム向けに設計されています。
本記事では、Ryzen AI Embedded X100の全6モデルのラインナップ・ゼロコピー統合SoCの設計思想・NVIDIA JetsonやIntel Core Ultra Series 3に対するAMD公式のベンチマーク条件・ソフトウェアスタック(ROCm・ROS 2・Xen Hypervisor)・Kria AI SoMとRobotics Developer Platform・想定ユースケース・採用検討で押さえる論点までを、2026年9月時点の一次情報で体系的に解説します。
目次
Ryzen AI Embedded X100とは?Strix Halo組み込み版が担うフィジカルAIの単一SoC
CPU・GPU・NPUを1チップに束ねるゼロコピー統合SoCという設計選択
Ryzen AI Embedded X100の性能ベンチマークと比較条件
Ryzen AI Embedded X100のソフトウェアスタックとCUDA→HIP移行
Kria AI SoMとRobotics Developer Platformの位置づけ
Ryzen AI Embedded X100が想定するフィジカルAIのユースケース
Ryzen AI Embedded X100の採用検討で押さえる論点
Ryzen AI Embedded X100とは?Strix Halo組み込み版が担うフィジカルAIの単一SoC
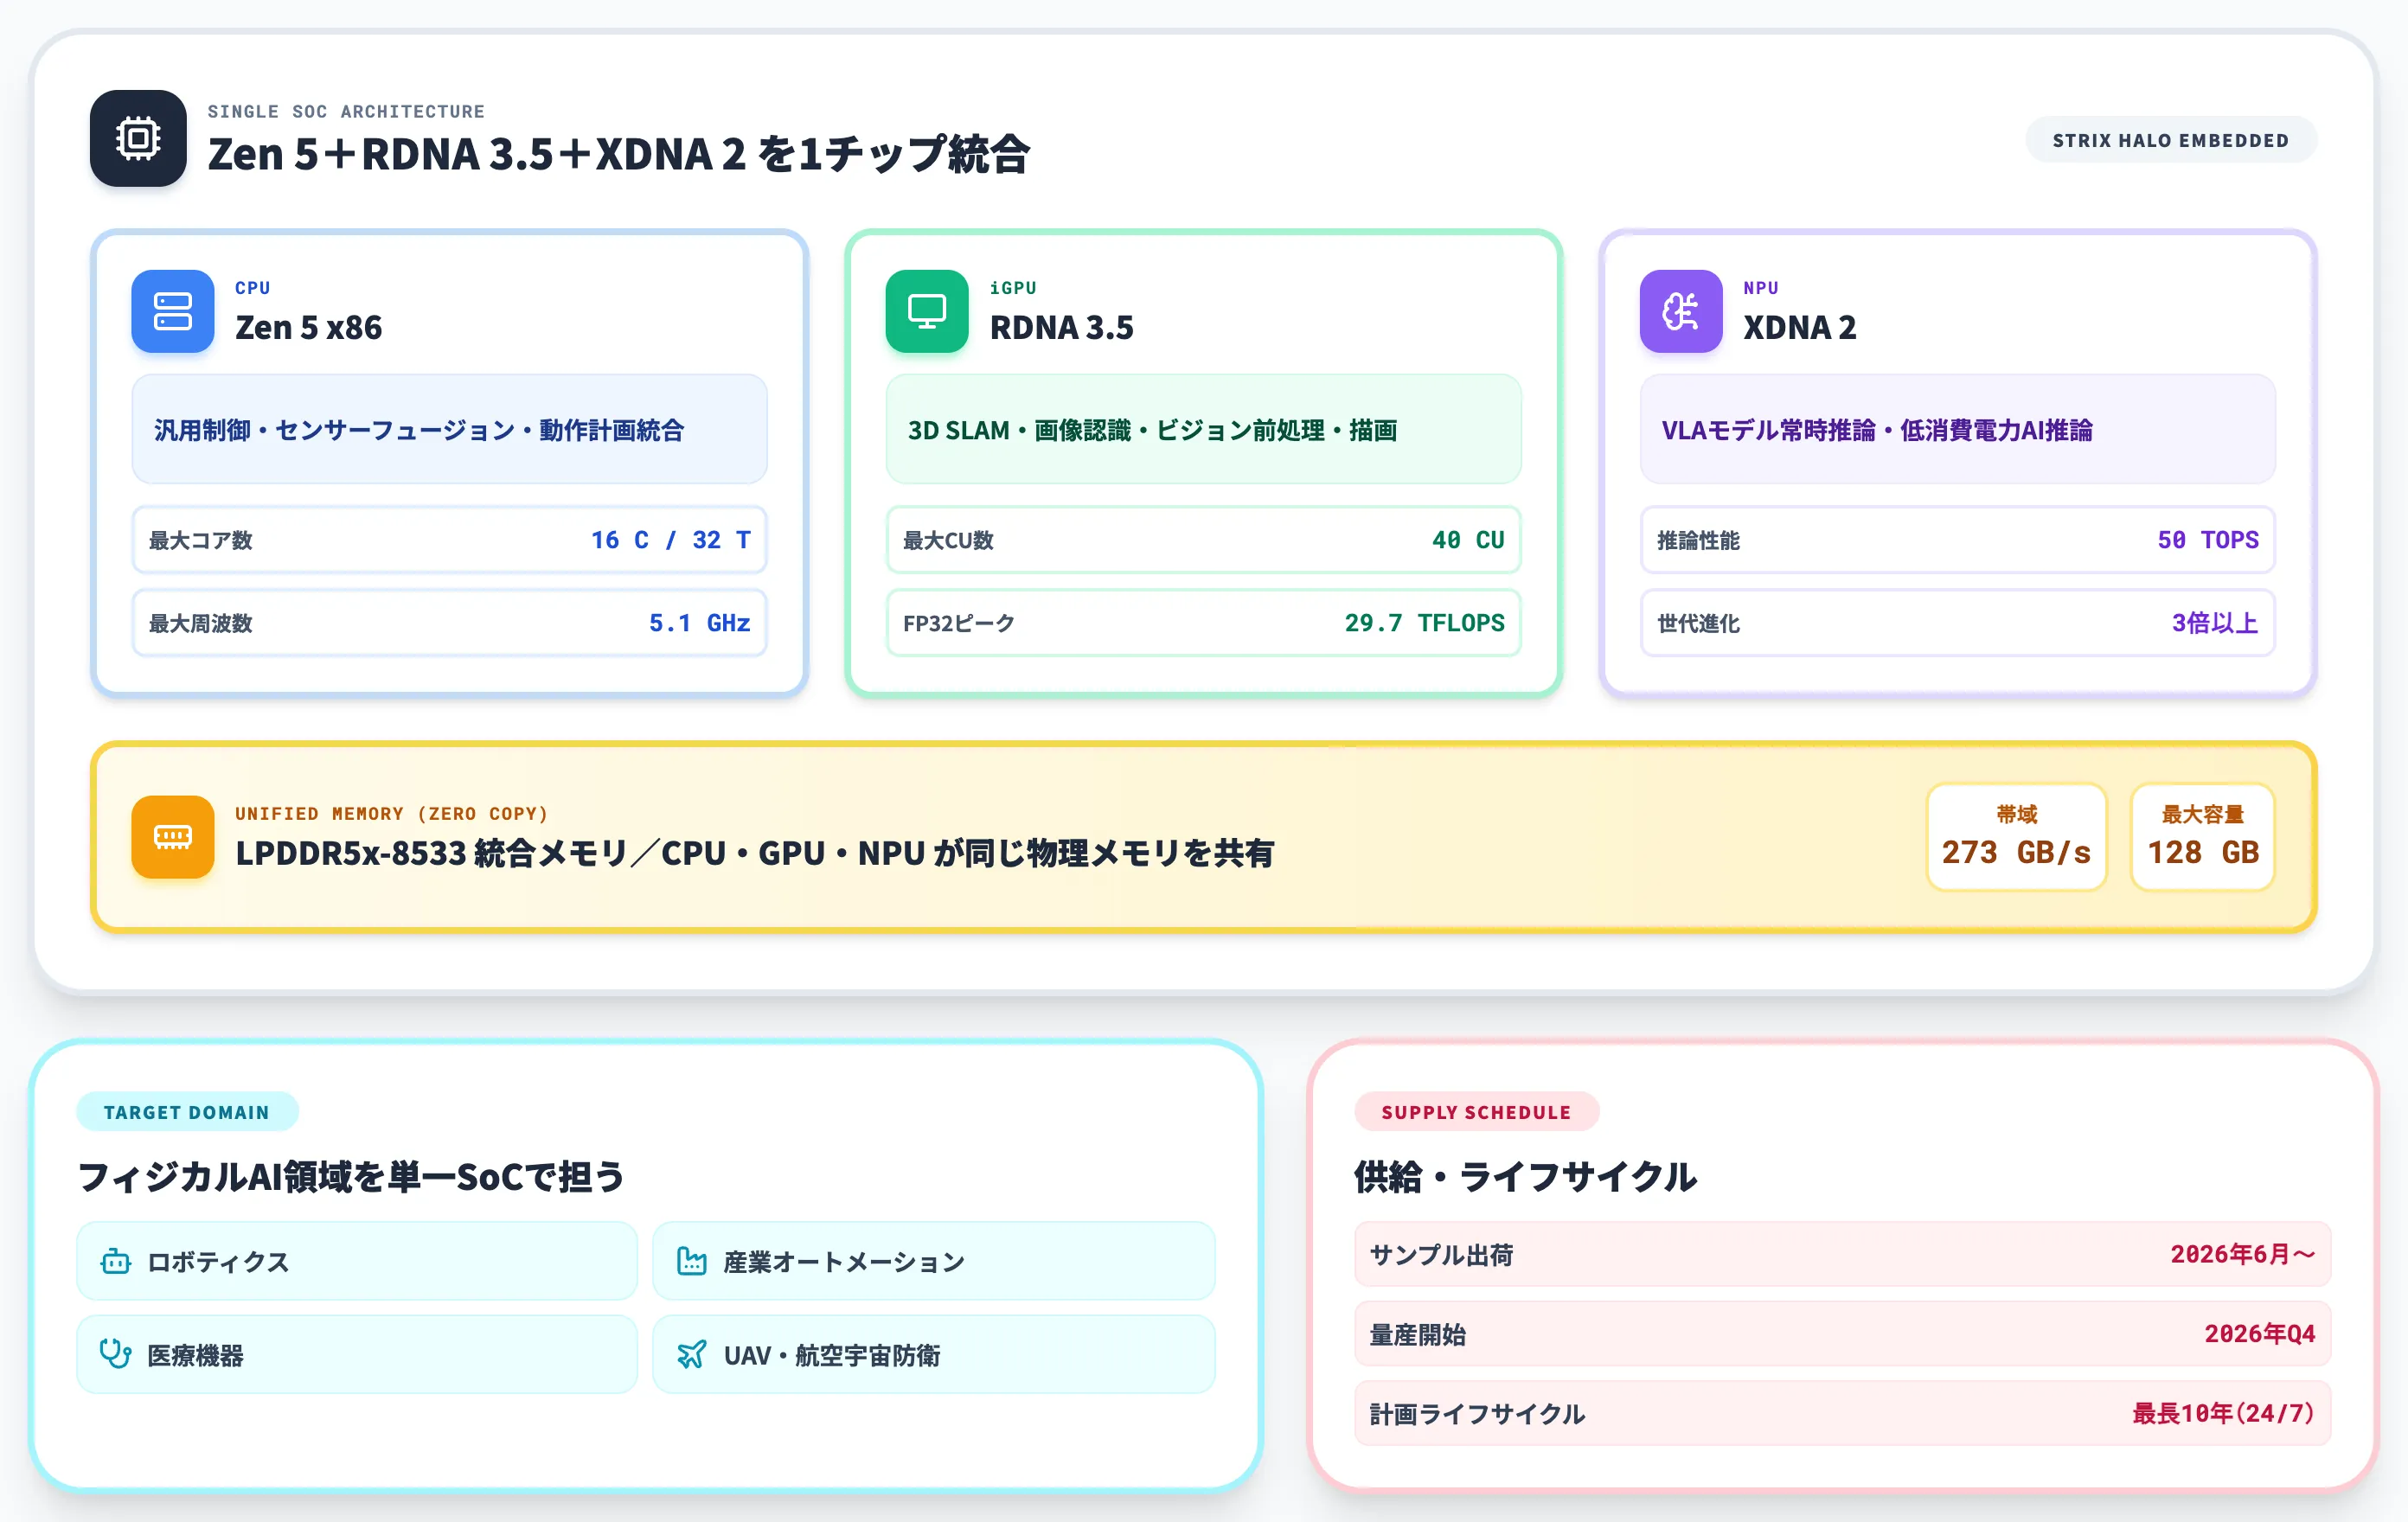
Ryzen AI Embedded X100シリーズは、AMDが2026年1月に予告し7月23日のAdvancing AI 2026で製品詳細を発表した、フィジカルAI向けの組み込みSoCシリーズです。
コンシューマ向けのRyzen AI Max+ 395(コードネームStrix Halo)と同じダイを組み込み用途に振り分けた製品で、Zen 5 x86 CPU最大16コア、RDNA 3.5 iGPU最大40 Compute Unit、XDNA 2 NPU 50 TOPSを1つのSoCに統合しています。
フラグメント化した従来の組み込みAI実装——CPUボード+外付けGPUカード+NPUアクセラレータの多チップ構成——を1チップに集約し、ゼロコピーの統合メモリで決定論的な低遅延処理を可能にした構成が中核の特徴です。
用途はロボティクス・産業オートメーション・医療・UAV(無人航空機)・航空宇宙防衛など、リアルタイム性が求められる自律システムを想定しており、2026年6月からサンプル出荷、量産開始はQ4 2026、24/7稼働で最長10年の産業向けライフサイクルが付きます。
Ryzen AI Embeddedシリーズのチップキービジュアル。Zen 5・RDNA 3.5・XDNA 2を単一SoCに統合する(出典:AMD Ryzen AI Embedded X100 Series)
Ryzen AI Embeddedブランドの中での位置づけ
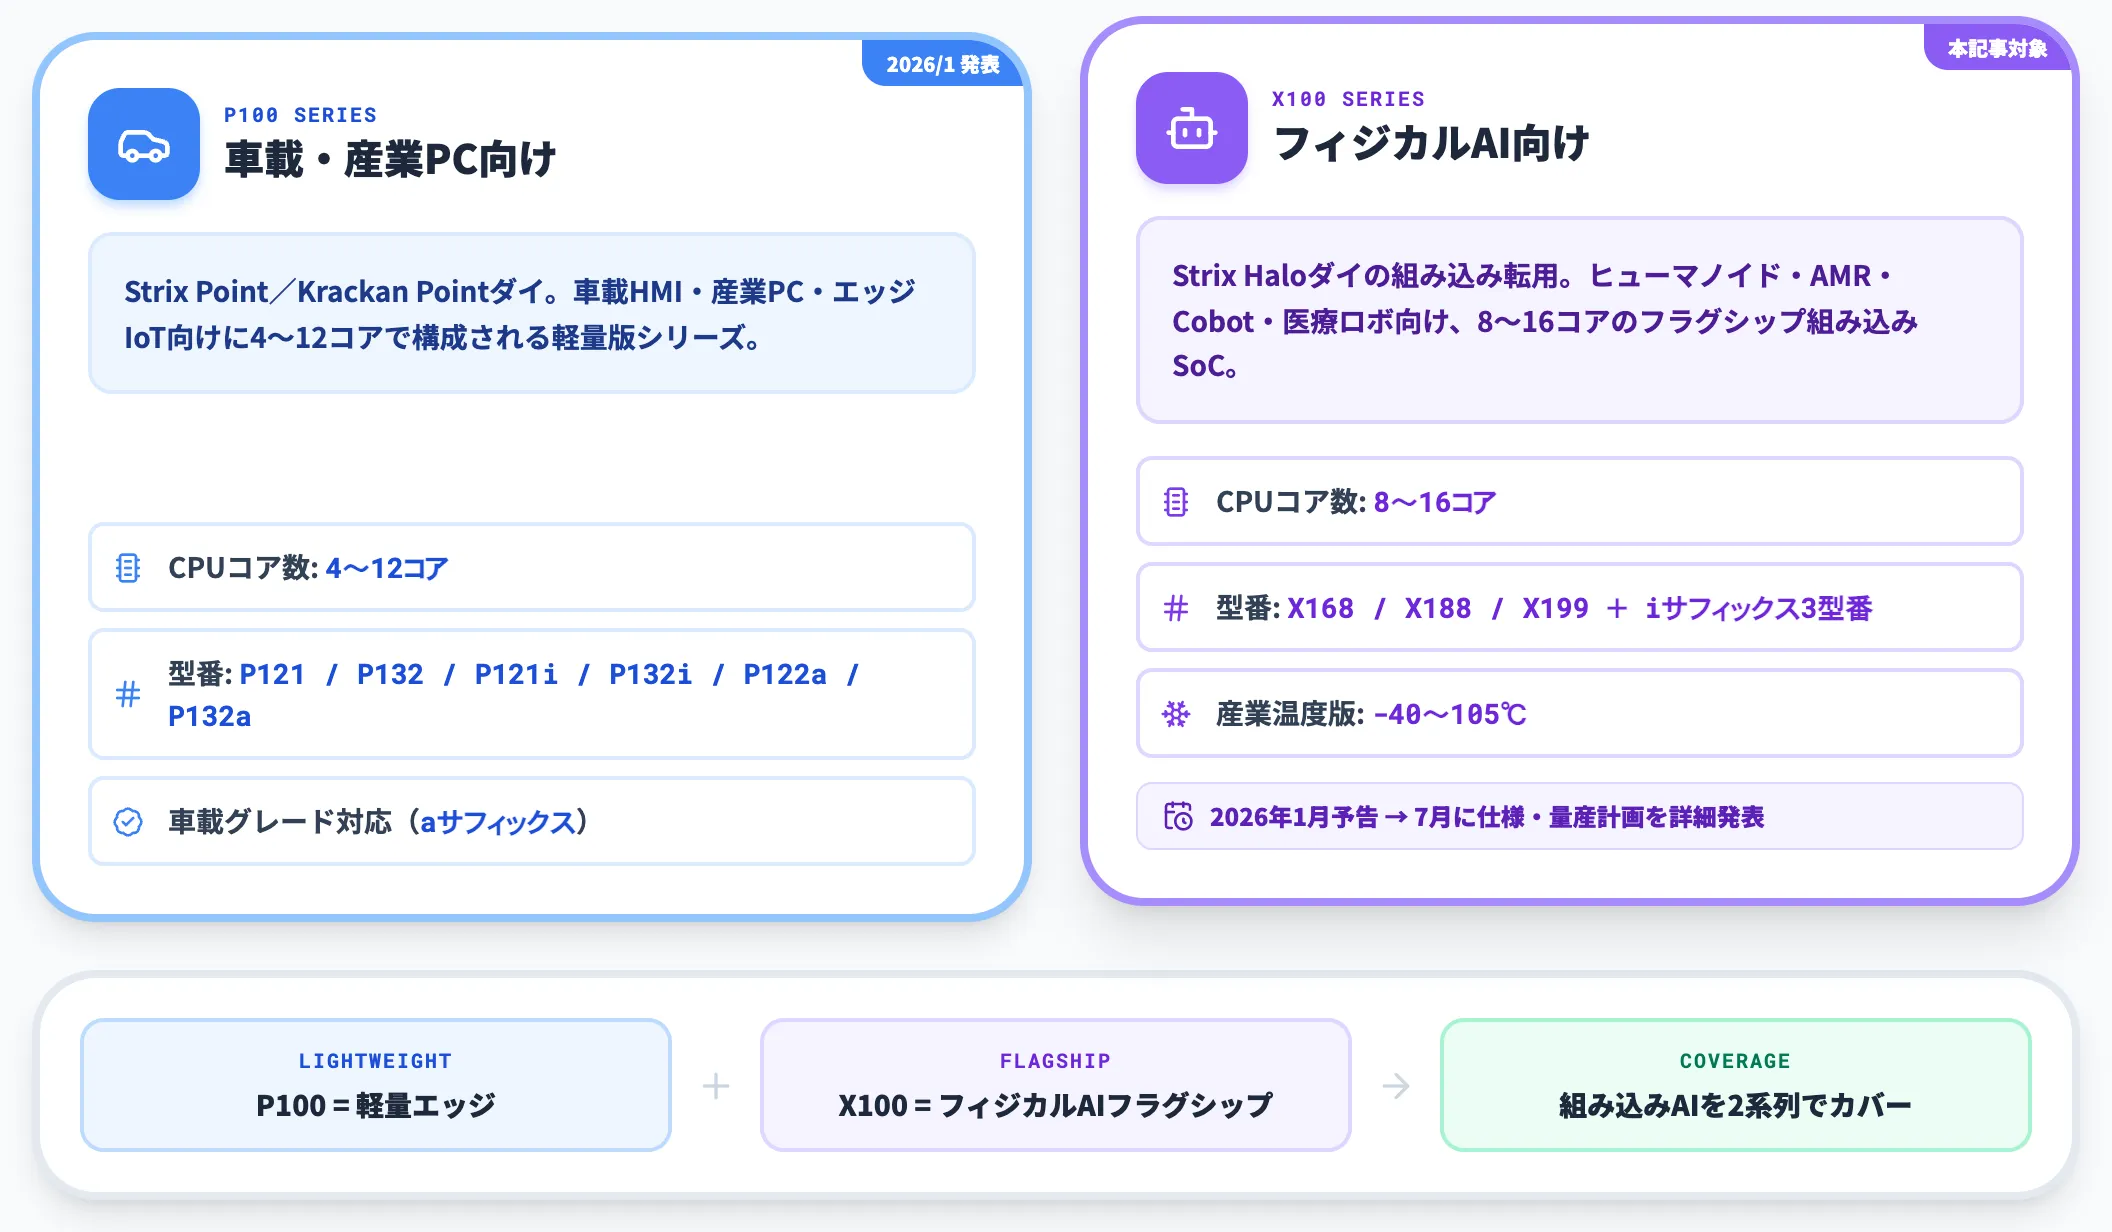
Ryzen AI Embeddedブランドは、2026年1月にAMDが同時予告したP100とX100の2系列で構成されます。
P100はStrix Point/Krackan Pointベースの車載・産業オートメーション向け(4〜12コア)、X100はStrix Haloベースのフィジカルロボティクス・自律システム向けで、X100は2026年7月に具体的な型番仕様・サンプリング・量産計画が明かされました。
-
P100シリーズ(2026年1月発表)
車載HMI・産業PC・エッジIoT向け。4〜12コア構成、P121・P132・P121i・P132i・P122a・P132a等の型番があり、車載グレード(「a」サフィックス)も用意
-
X100シリーズ(本記事の対象・2026年1月予告/7月に詳細発表)
ヒューマノイド・AMR・Cobot・産業ロボ・医療ロボットなどフィジカルAI向け。8〜16コア構成、標準品3型番+産業温度版(-40〜105℃)3型番の計6型番
ここでのポイントは、X100はAMDが「エッジ推論はデータセンターGPUの縮小版ではなく、決定論と統合メモリを両立した専用シリコンで担う」という設計思想を打ち出したフラグシップ組み込みSoC、という点です。
CPU・GPU・NPUを1チップに束ねるゼロコピー統合SoCという設計選択
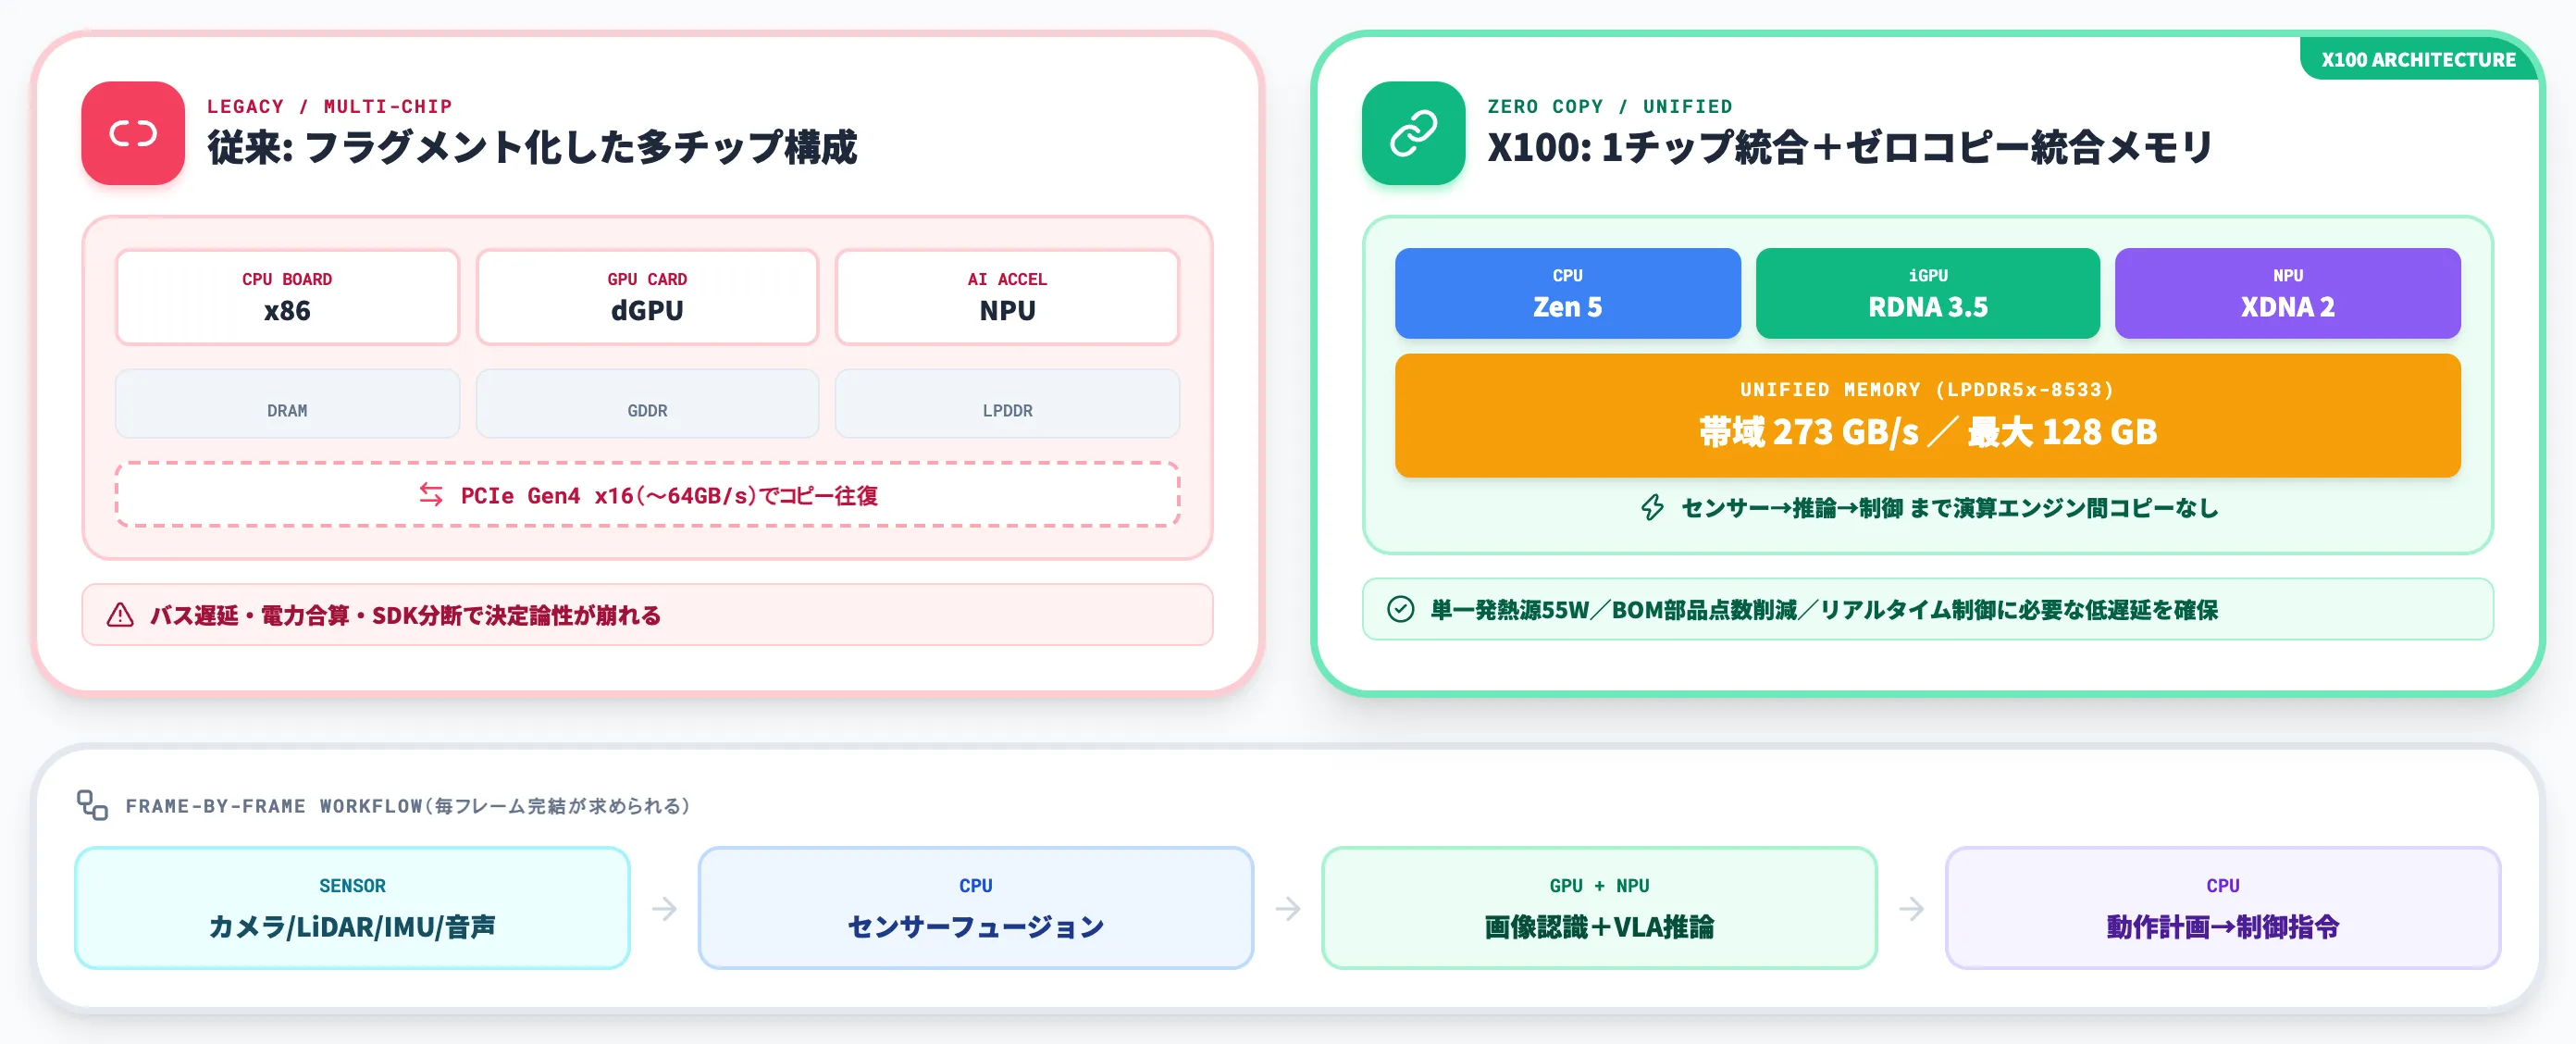
Ryzen AI Embedded X100の技術的な核は、演算エンジンを3種類(CPU・GPU・NPU)搭載しながら、これらが同じ物理メモリを共有する「ゼロコピー統合メモリアーキテクチャ」にあります。
従来のロボット向け組み込み構成では、x86 CPUボードにディスクリートGPU/AIアクセラレータを別基板で追加する多チップ構成も一般的でした。X100はこれらを1パッケージに畳み込んで演算エンジン間のデータコピーを排し、リアルタイム制御に必要な低遅延を確保する狙いを持ちます。
なぜフィジカルAI推論に統合メモリが効くのか
ロボットのフィジカルAI推論は、カメラ・LiDAR・IMU・音声などのマルチセンサーデータをCPUで前処理し、GPUで画像認識モデルを走らせ、NPUで軽量VLAモデルを常時推論し、CPUで動作計画に統合する——という「センサー到達から制御出力までを毎フレーム完結させる」ワークフローで動きます。
多チップ構成ではCPU↔GPU↔AIアクセラレータ間のPCIeバス転送とメモリコピーが処理サイクルで無視できないコストになり、決定論的なレイテンシ確保が難しくなります。
-
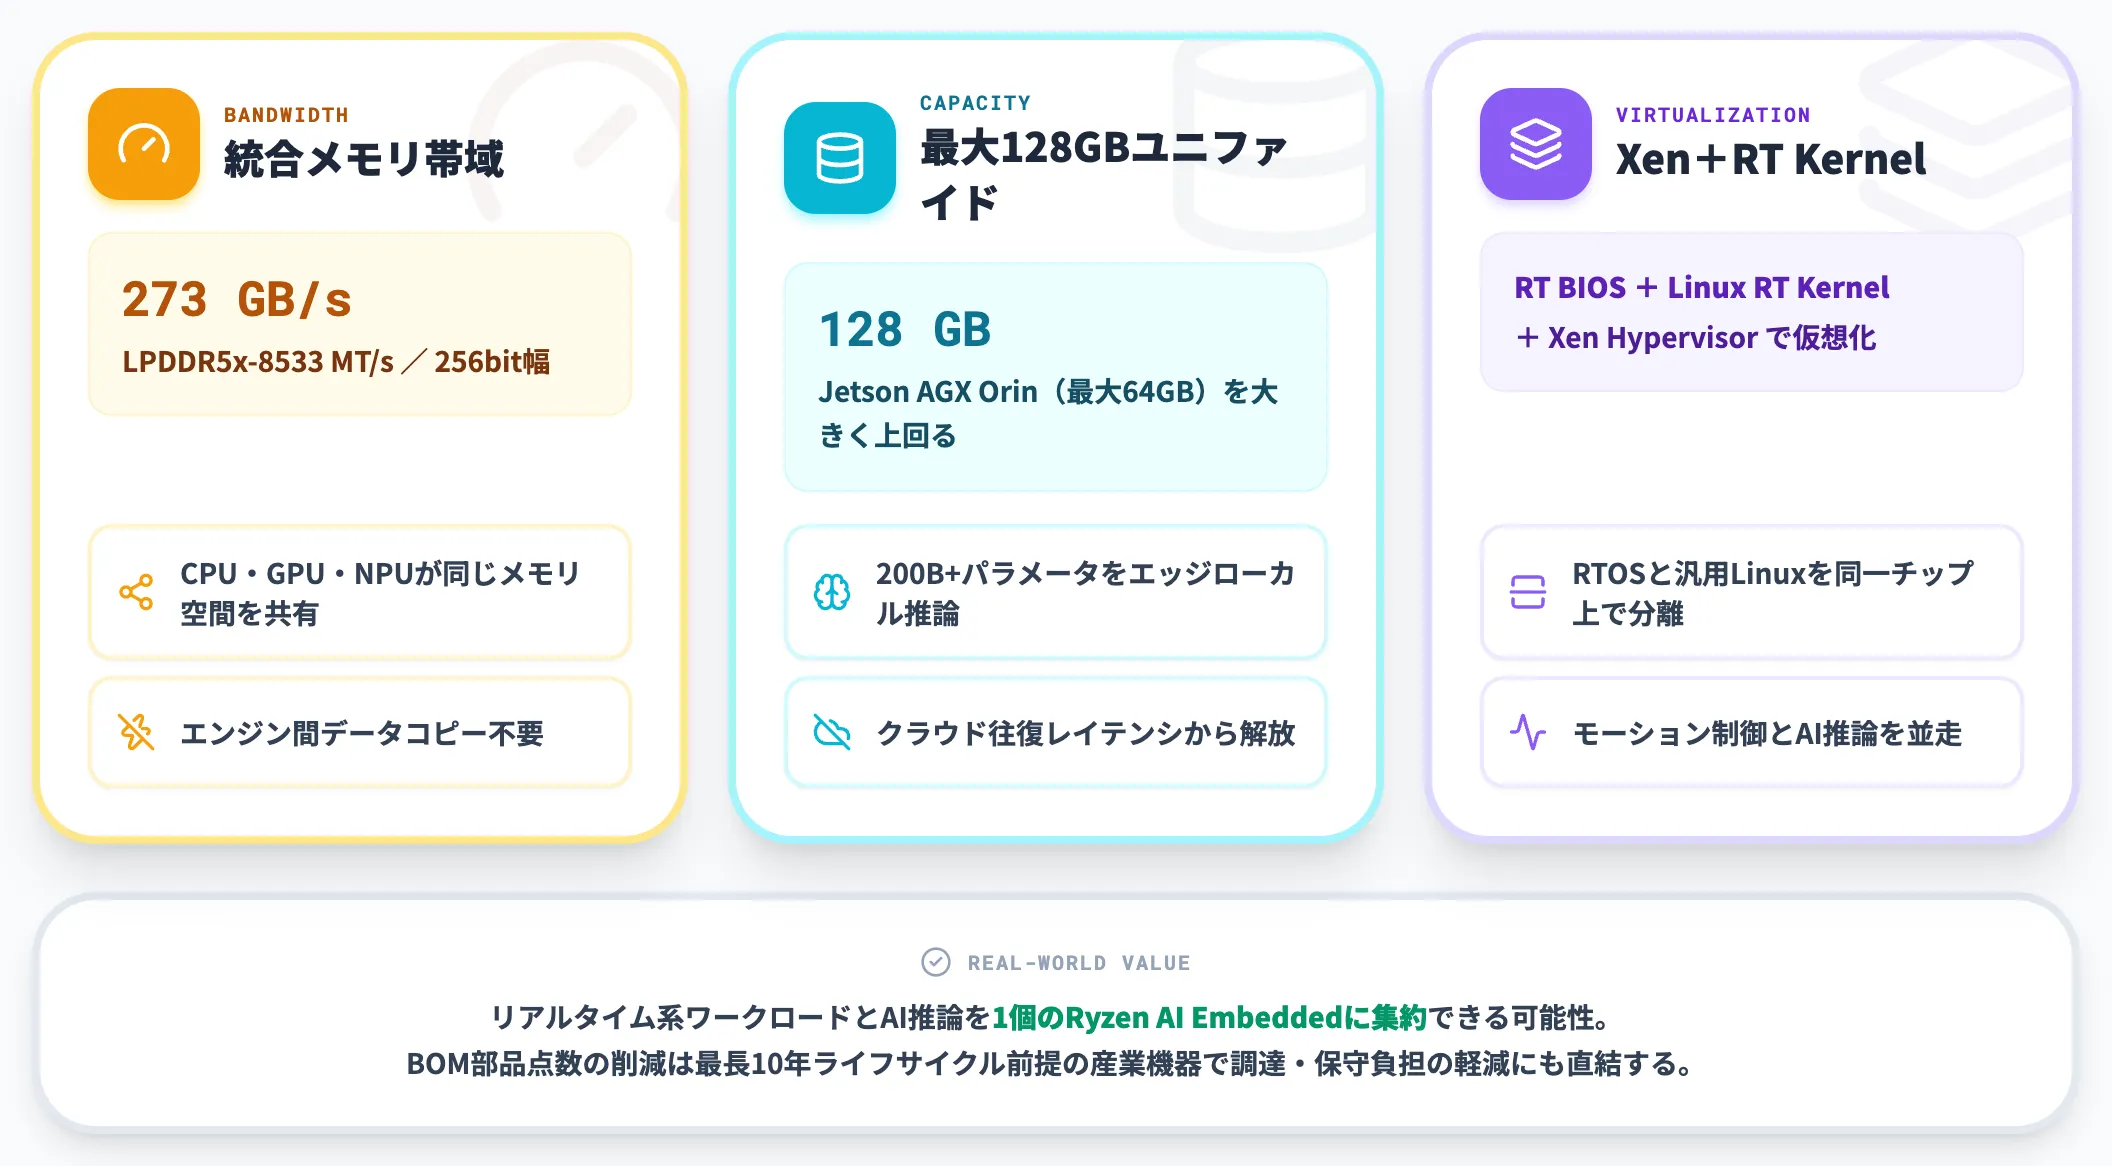
統合メモリ帯域273 GB/s
LPDDR5x-8533 MT/s 256bit幅で、GPU・NPU・CPUがすべて同じメモリ空間を共有。センサー入力→推論→制御指令までを、演算エンジン間のデータコピーなしで完結できる
-
最大128GBのユニファイドメモリ
外付けメモリ128GBまで対応するため、200B+パラメータの大規模モデルもエッジローカルで推論可能。NVIDIA Jetson AGX Orin(最大64GB)を大きく上回るメモリ容量
-
RT BIOS+Linux RT Kernel+Xen Hypervisor
リアルタイム対応BIOSとカーネルに加え、Xen Hypervisorによる仮想化で、RTOS(モーション制御・センサー処理)と汎用Linux(AI推論・上位アプリ)のワークロードを同一チップ上で分離しながら並走させられる
この構成の実務価値は、リアルタイム系ワークロードとAI推論を別チップに分けていた構成を1個のRyzen AI Embeddedに集約できる可能性がある点にあります。
BOM部品点数を減らせれば、最長10年の計画ライフサイクル前提の産業機器では調達・保守負担の軽減にも効いてきます(機能安全認証相当の設計が必要な用途では別途認証プロセスが要ります)。
既存の多チップ構成が抱える3つの課題
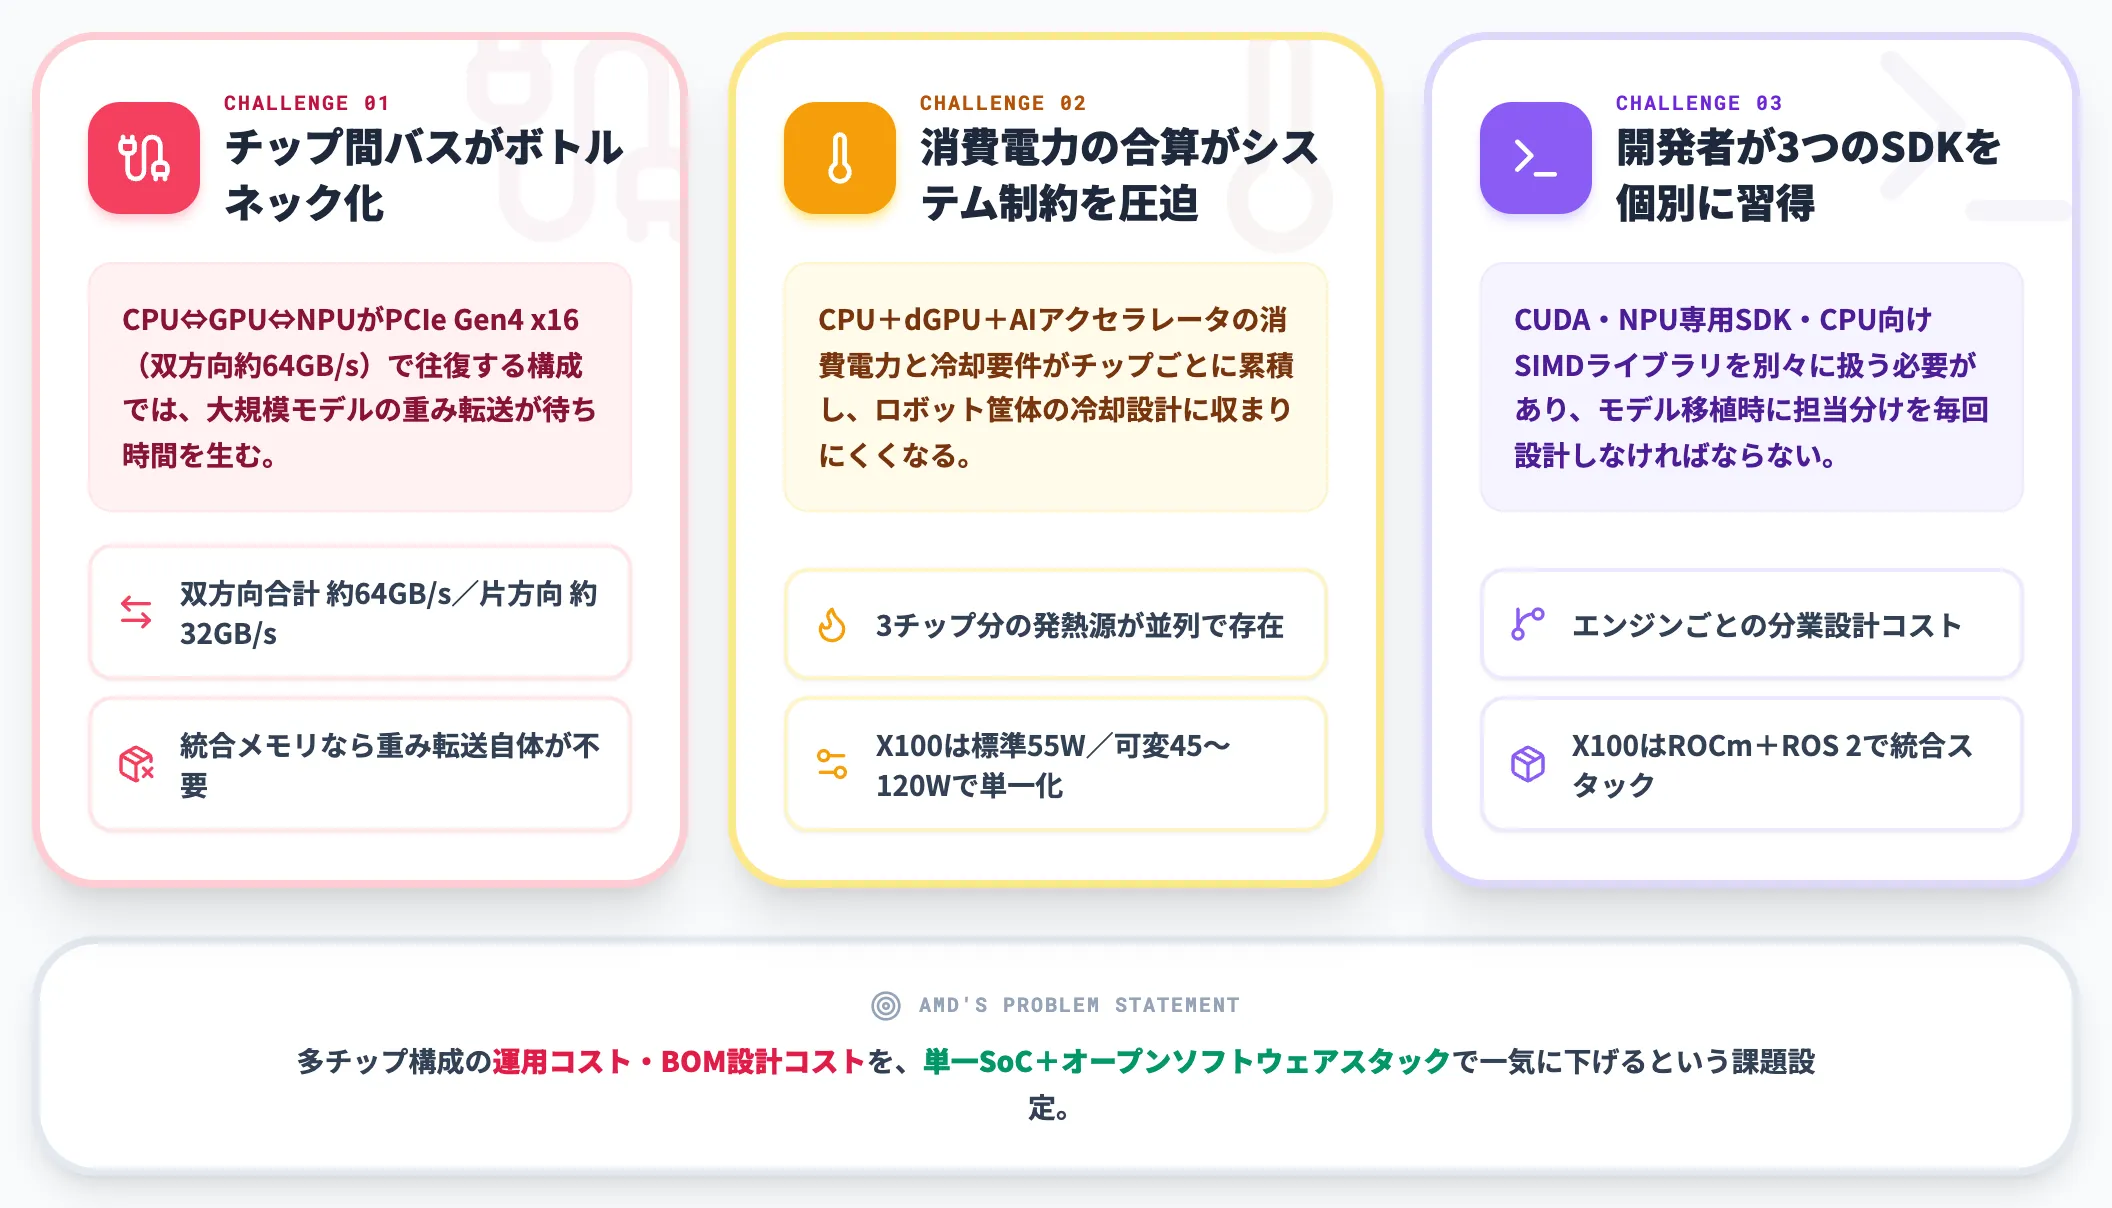
X100のような統合SoCが求められる背景として、既存のフラグメント構成が抱える課題を整理します。
-
チップ間バスがボトルネック化
CPU・GPU・NPUを別チップにするとPCIe Gen4 x16の帯域(双方向合計約64GB/s/片方向約32GB/s)で行き来する必要があり、大規模モデルの重み転送では実効帯域と容量に応じて無視できない待ち時間になる。統合メモリなら重み転送そのものが不要
-
消費電力の合算がシステム制約を圧迫
CPU・ディスクリートGPU・AIアクセラレータの消費電力と冷却要件がチップごとに累積し、ロボット搭載可能な冷却設計に収まらないことが多い。X100は標準55W・可変45〜120Wで単一発熱源として設計できる
-
開発者が3つのSDKを個別に習得
CUDAとNPU専用SDKとCPU向けSIMDライブラリを別々に扱う必要があり、モデル移植時に演算エンジンごとの担当分けを毎回設計する必要がある
AMDがX100で解こうとしているのは、こうした多チップ構成の運用コストとBOM設計コストを、単一SoCとオープンソフトウェアスタックで一気に下げるという課題設定です。
X100全6モデルのラインナップと産業温度版の使い分け
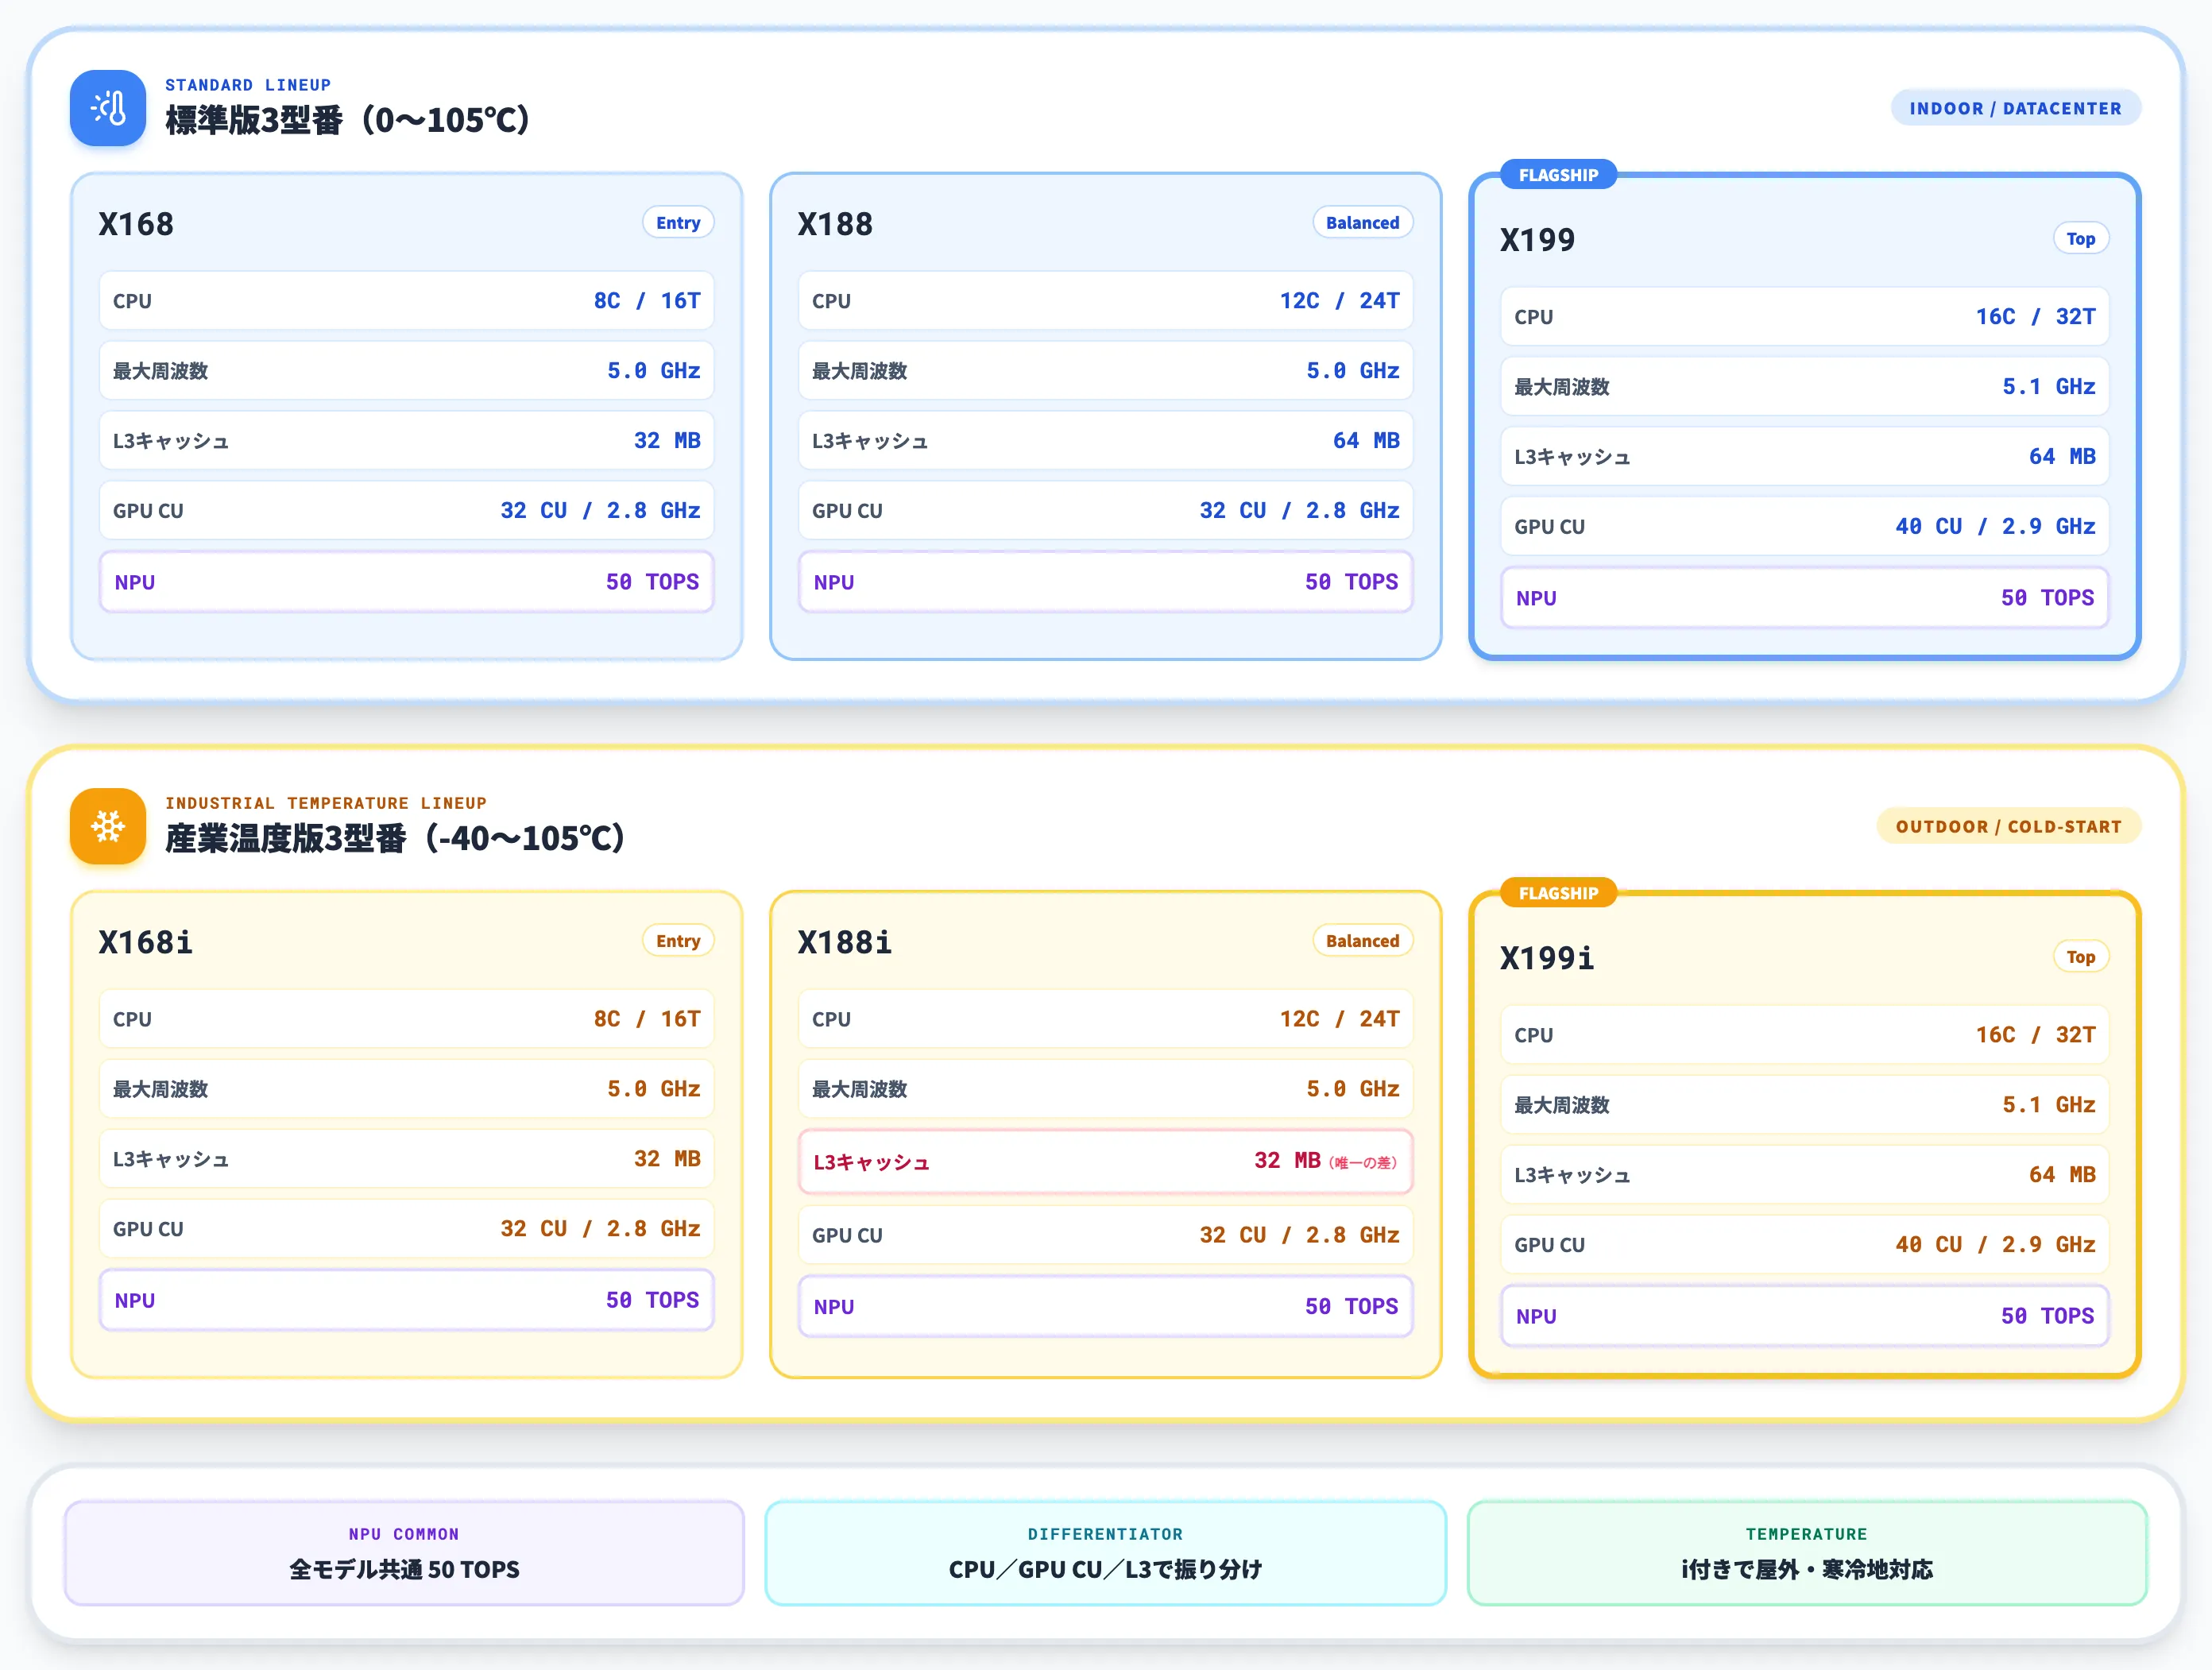
Ryzen AI Embedded X100は、コア数・グラフィックスCU数の異なる3種類(X168・X188・X199)に、産業温度範囲対応の「i」サフィックス版を加えた計6モデル構成です。
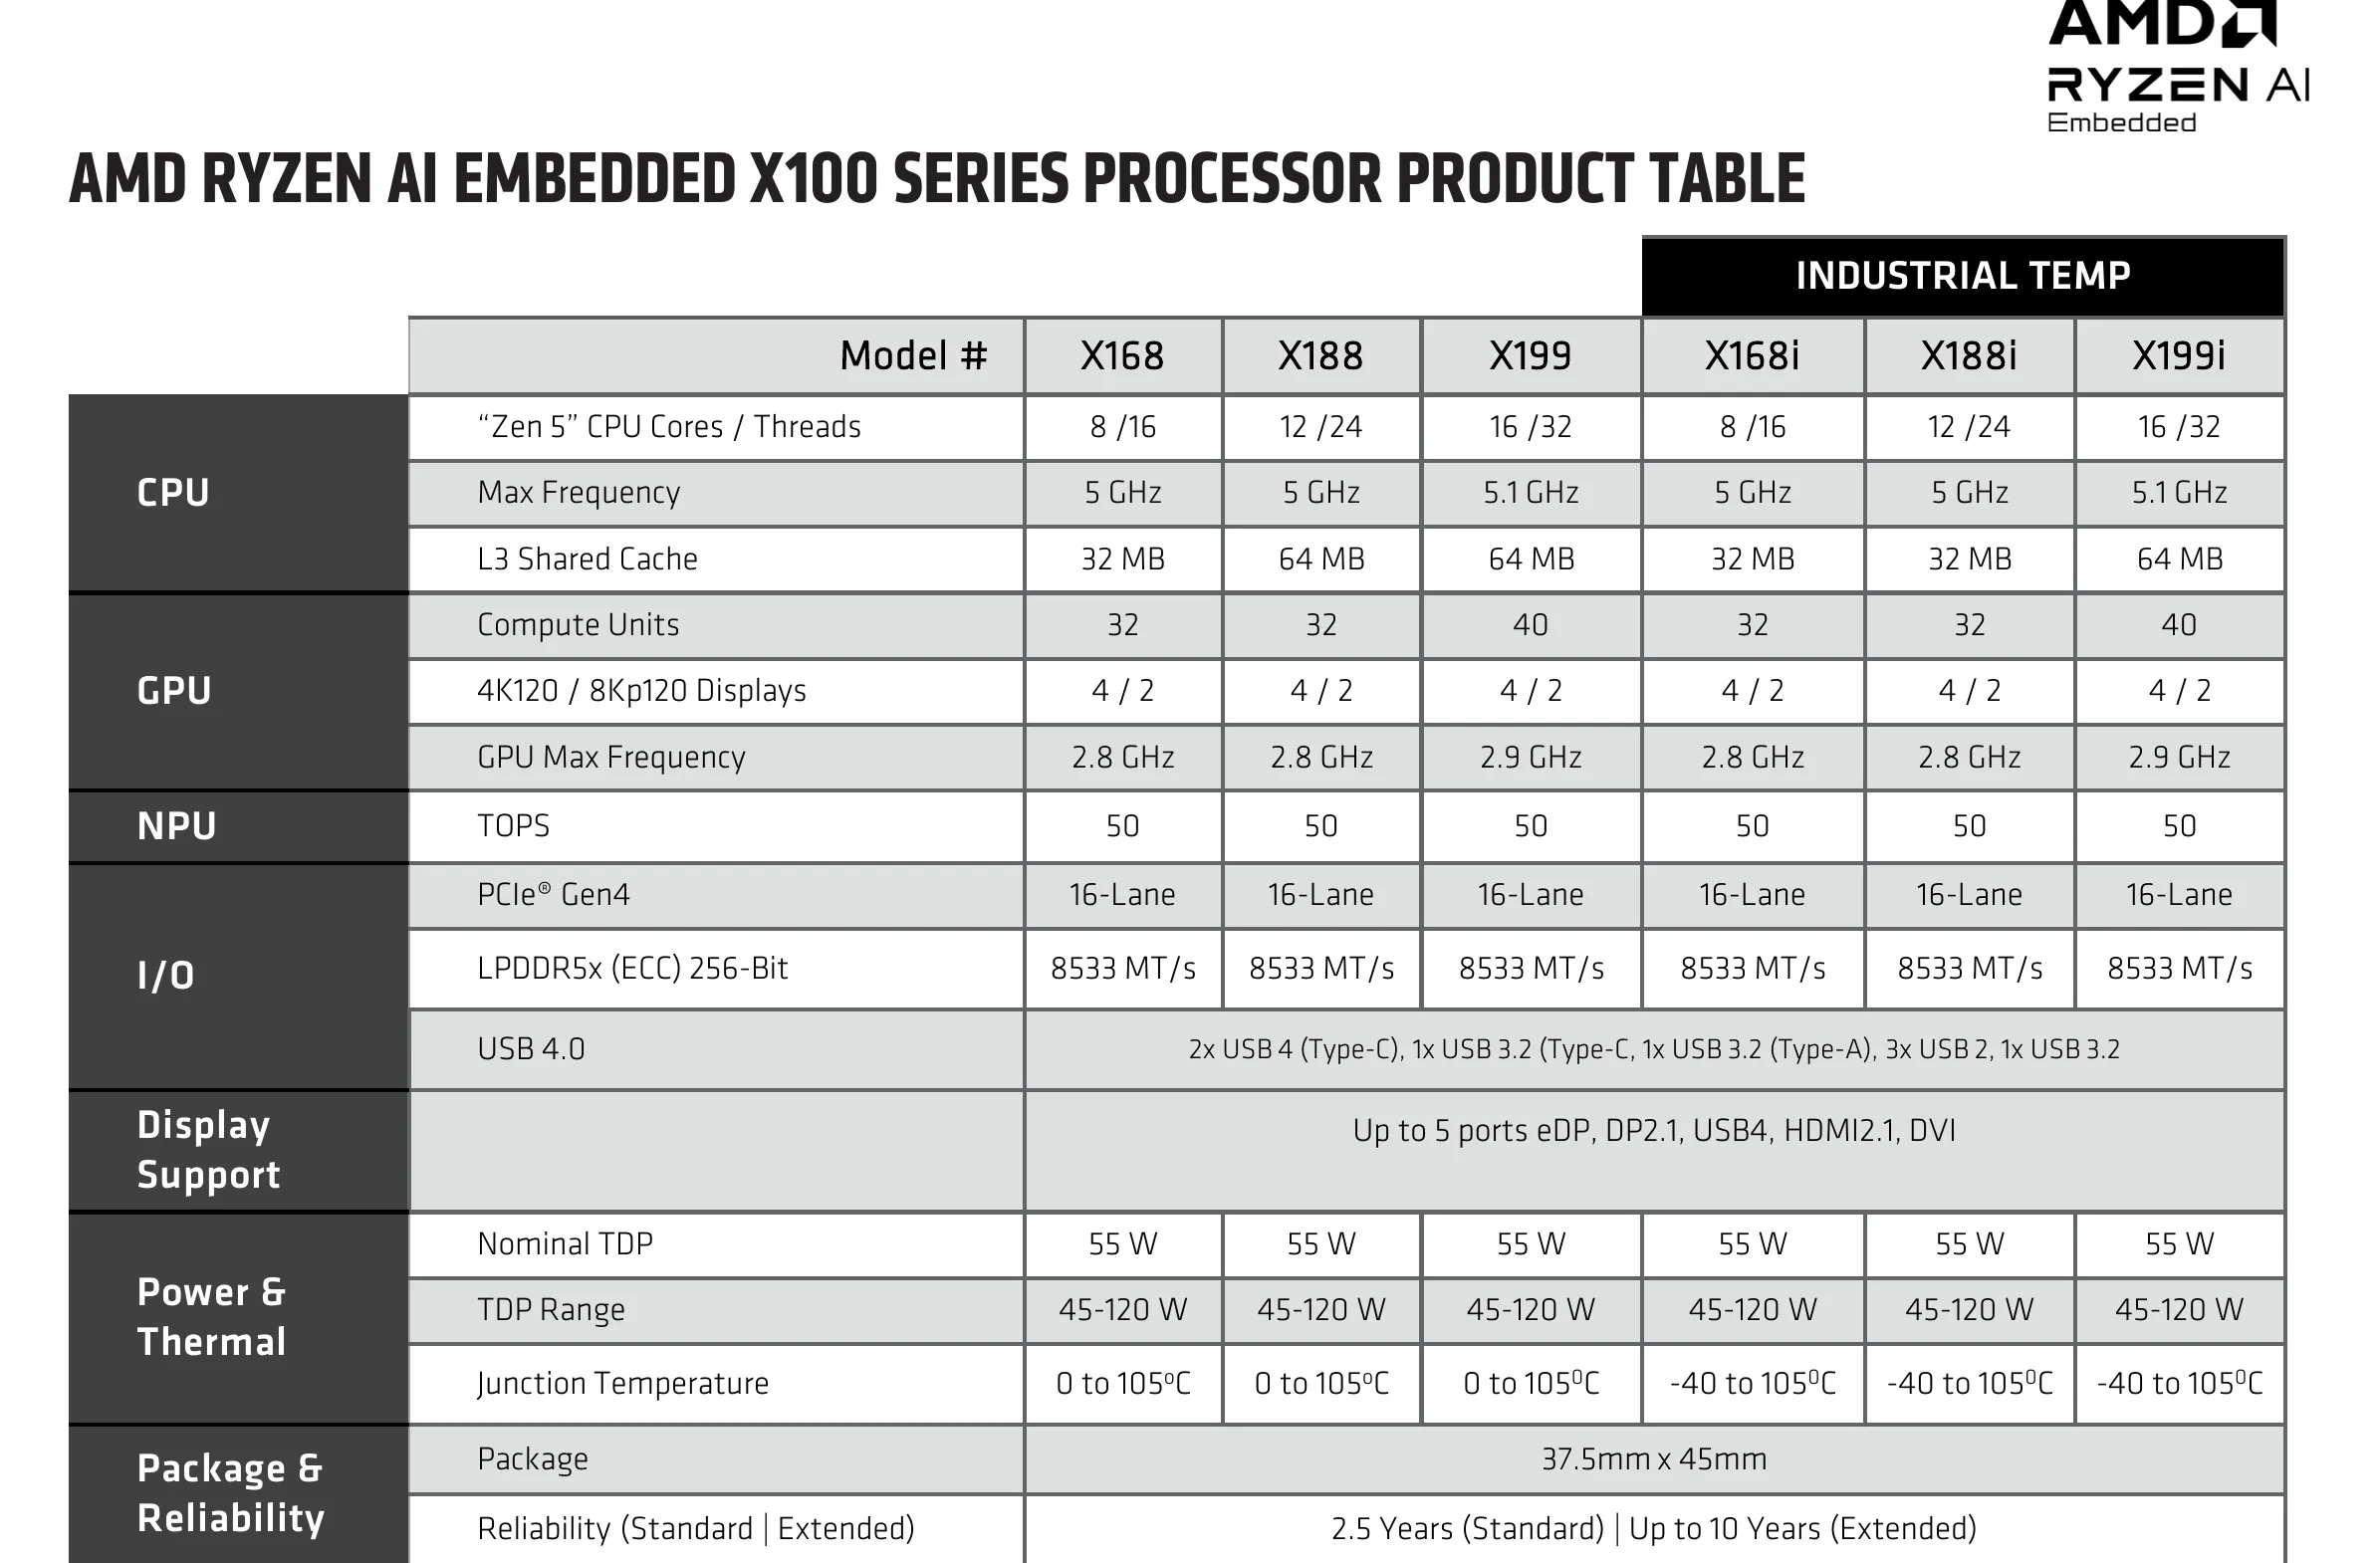
AMD公式Product Briefに掲載された全6モデルスペック表。CPU/GPU/NPU/I/O/電力/温度の全項目を1枚に集約している(出典:AMD Ryzen AI Embedded X100 Series Product Brief)
公式表を読み解くと、標準版と「i」付き産業温度版はJunction Temperature(0〜105℃ vs -40〜105℃)以外のスペックがほぼ同一で、CPU・GPU・NPU・メモリ・I/Oのラインナップは横に共通しています。
ただしX188のL3キャッシュだけは標準版が64MB/i版(X188i)が32MBと差があり、X199/X199iはGPU Compute Units 40と最大周波数5.1GHzで一段上に振られる構造です。
以下の表は、AMD公式Product Briefに基づいて、全6モデルの主要スペックを整理したものです。
標準版とi付き版は動作温度範囲以外の仕様がほぼ揃っており(X188のL3のみ例外)、産業温度版は-40℃の低温始動が必要な屋外設置・寒冷地稼働向けに用意されています。
| 型番 | CPUコア/スレッド | 最大周波数 | L3キャッシュ | GPU CU数 | GPU最大周波数 | NPU TOPS | 動作温度 |
|---|---|---|---|---|---|---|---|
| X168 | 8/16 | 5.0 GHz | 32 MB | 32 | 2.8 GHz | 50 | 0〜105℃ |
| X188 | 12/24 | 5.0 GHz | 64 MB | 32 | 2.8 GHz | 50 | 0〜105℃ |
| X199 | 16/32 | 5.1 GHz | 64 MB | 40 | 2.9 GHz | 50 | 0〜105℃ |
| X168i | 8/16 | 5.0 GHz | 32 MB | 32 | 2.8 GHz | 50 | -40〜105℃ |
| X188i | 12/24 | 5.0 GHz | 32 MB | 32 | 2.8 GHz | 50 | -40〜105℃ |
| X199i | 16/32 | 5.1 GHz | 64 MB | 40 | 2.9 GHz | 50 | -40〜105℃ |
NPUのTOPS値は全モデル共通で50 TOPSに揃っています。差別化は「CPUコア数」「GPU CU数」「L3キャッシュ」に集約されており、AI推論性能そのものではなく「汎用計算とグラフィックスをどこまで積むか」で型番選びが決まる構造です。
型番選定の判断軸
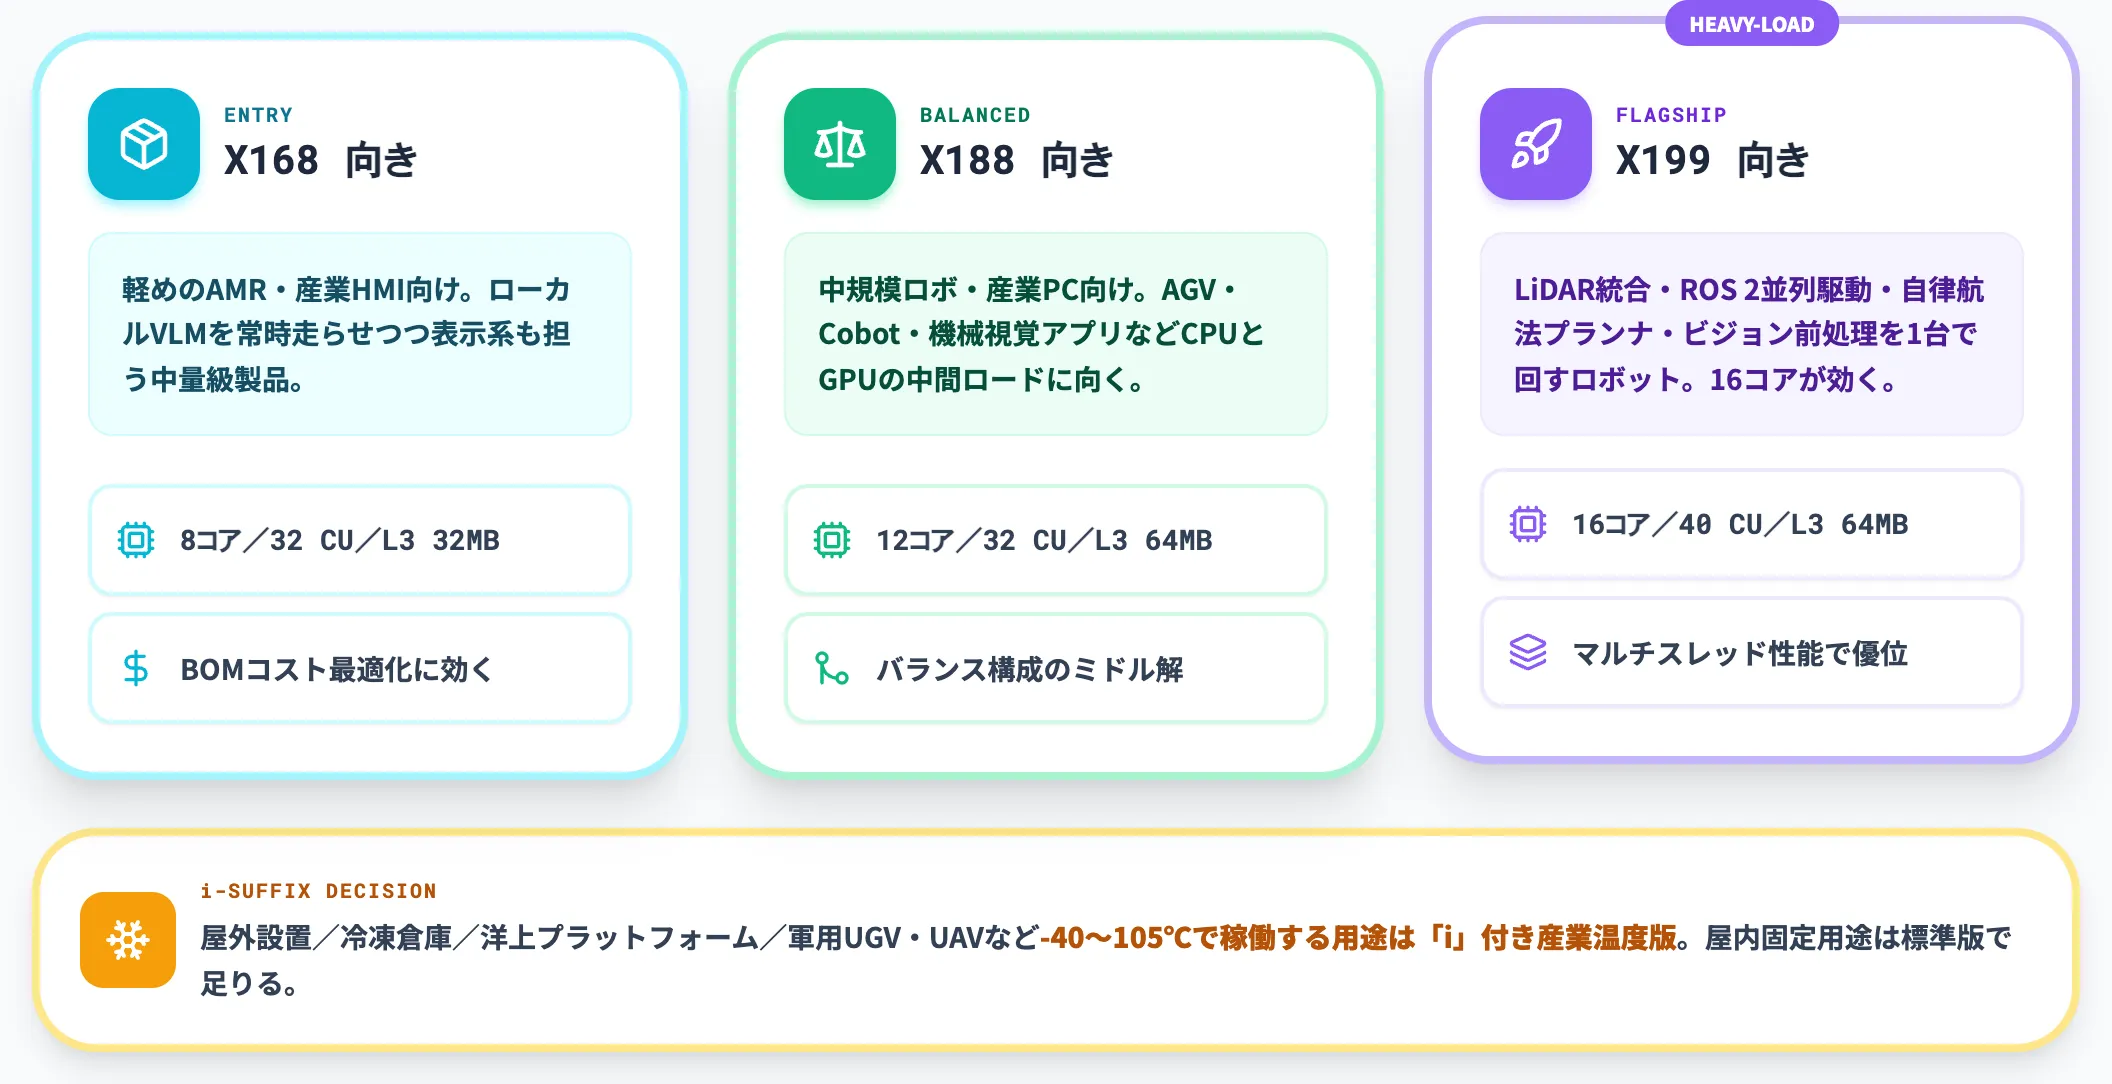
型番選びで迷いやすいのは「X199で常にオーバースペックか、X168で足りるのか」という論点です。以下の観点で切り分けると設計が組みやすくなります。
-
CPUヘビーな並列制御・シグナル処理を回すならX199
LiDARマルチセンサー統合・ROS 2ノードの並列駆動・自律航法プランナ・ビジョン前処理を1台で回すロボットは16コアが効く。X199のL3キャッシュ64MBもマルチスレッド性能に寄与
-
中規模ロボ・産業PCならX188
12コア/32 CU/L3 64MBのバランス構成。AGV・Cobot・機械視覚アプリケーションなど、CPUとGPUの中間ロードに向く
-
軽めのAMR・産業HMIならX168
8コア/32 CU/L3 32MBの構成で、ローカルVLMを常時走らせつつ表示系も担う中量級製品向け。BOMコスト最適化に効く
i付き産業温度版は屋外設置・冷凍倉庫・洋上プラットフォーム・軍用UGV/UAVなど、機器を-40〜105℃で稼働させる必要があるユースケースが対象です。標準版と価格差が生じる可能性があるため、屋内固定用途では標準版で足ります。
共通仕様と可変TDP設計
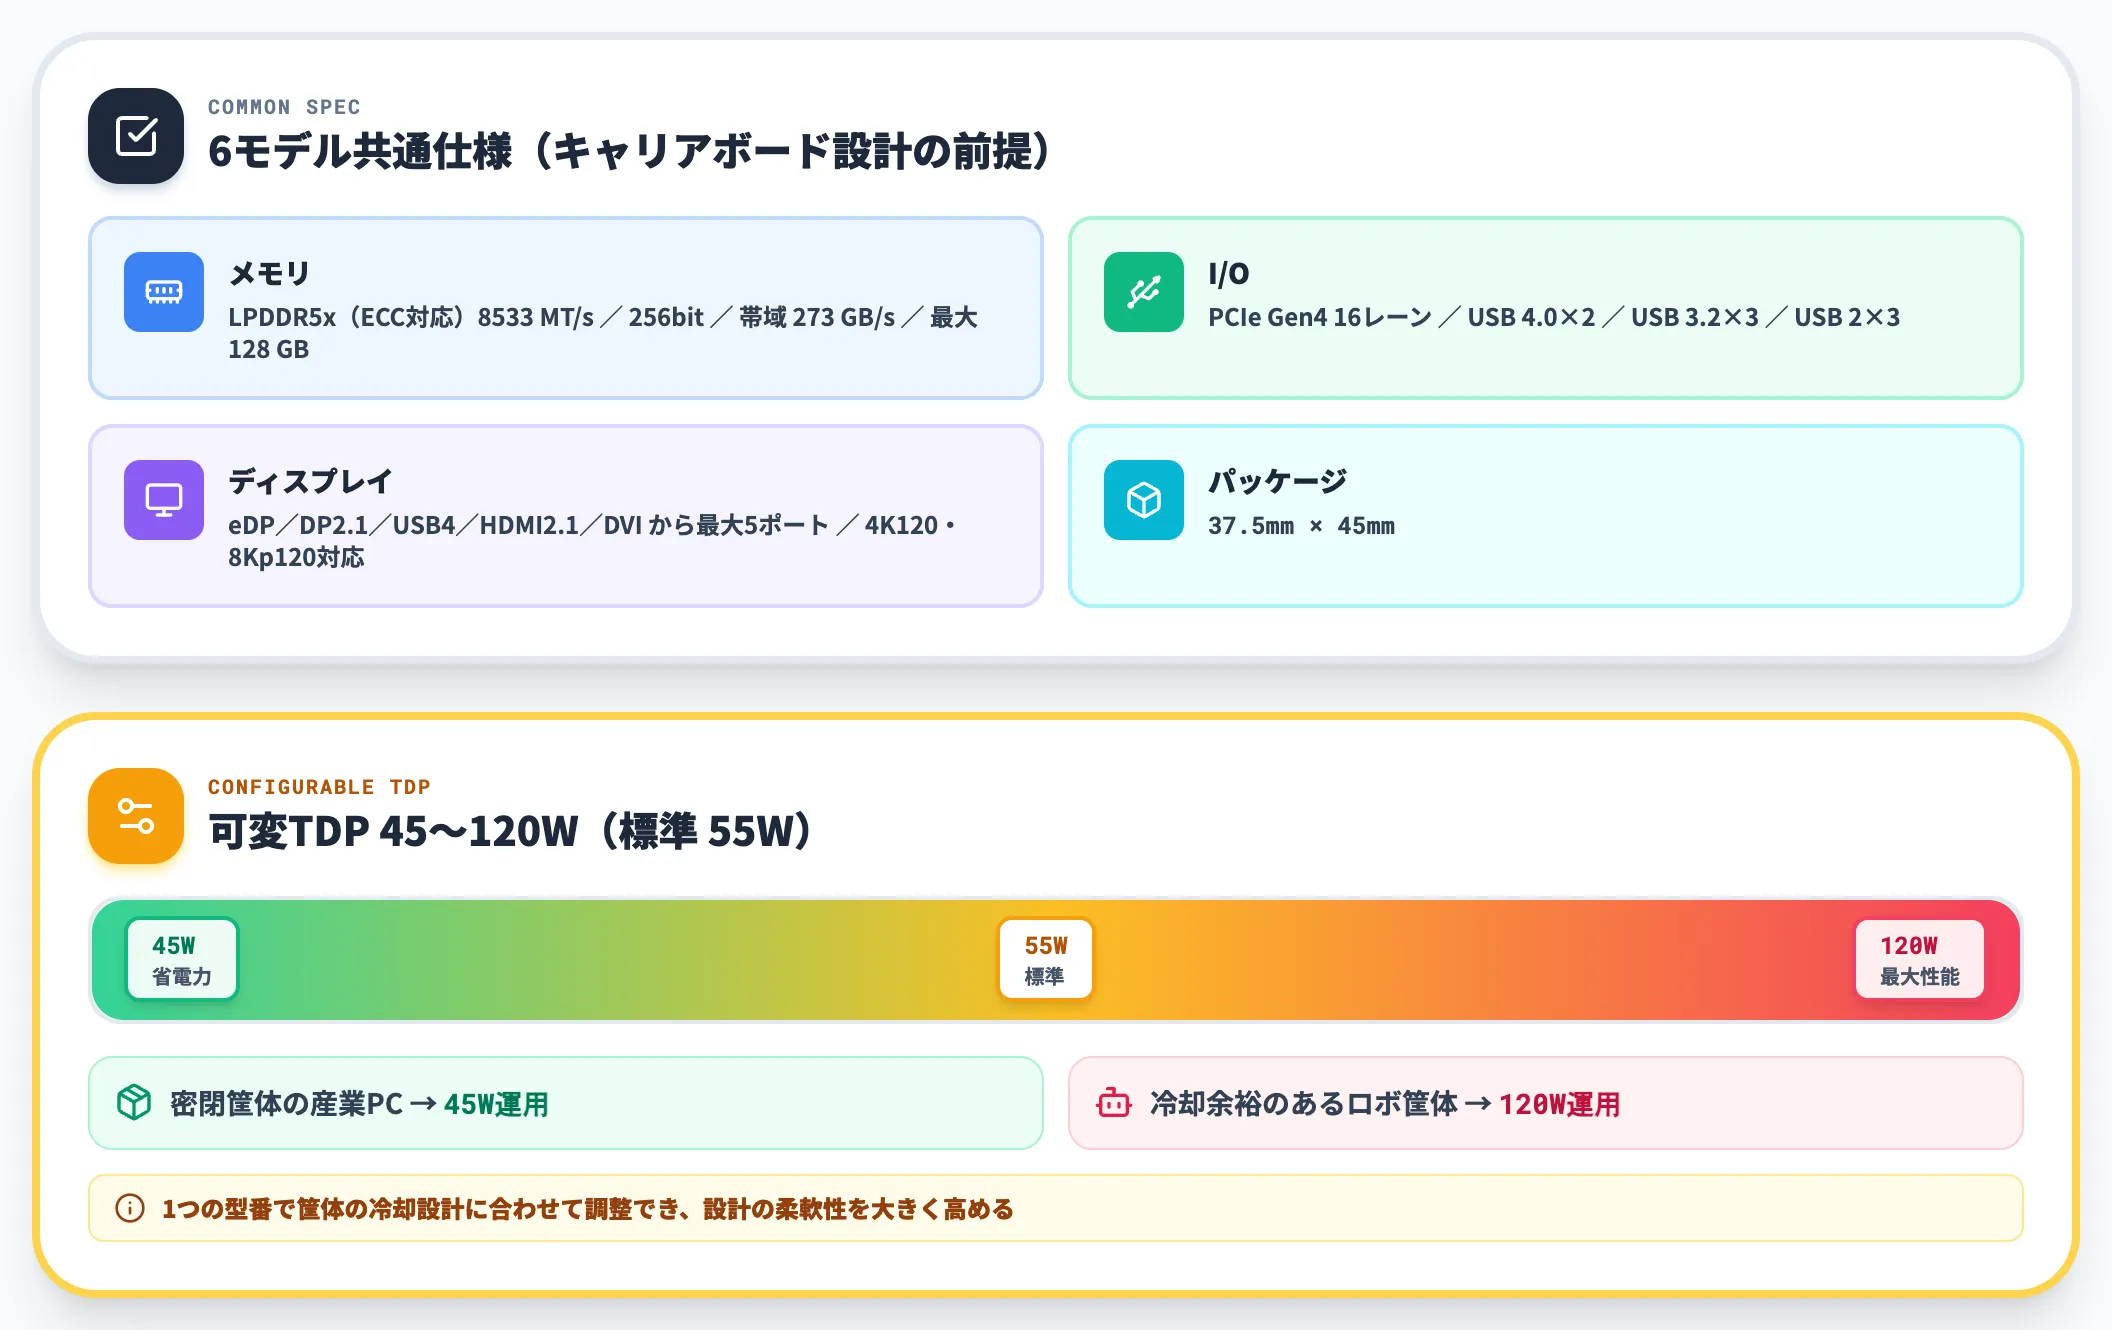
6モデル共通で、以下の仕様を持ちます。設計時にはこの共通仕様を前提にキャリアボード側を組む構造です。
- メモリ: LPDDR5x(ECC対応)8533 MT/s、256bit、統合メモリ帯域273 GB/s、最大128GBまで
- I/O: PCIe Gen4 16レーン、USB 4.0×2、USB 3.2×3、USB 2×3
- ディスプレイ: eDP/DP2.1/USB4/HDMI2.1/DVIから最大5ポート、4K120/8Kp120対応
- TDP: 標準55W、可変45〜120Wで筐体の冷却設計に合わせて調整可能
- パッケージ: 37.5mm×45mm
可変TDP設計は組み込み設計の柔軟性を大きく高めるポイントで、密閉筐体の産業PCなら45Wで運用、冷却余裕のあるロボット筐体なら120Wで性能を引き出すといった使い分けが1つの型番で完結します。
Ryzen AI Embedded X100の性能ベンチマークと比較条件
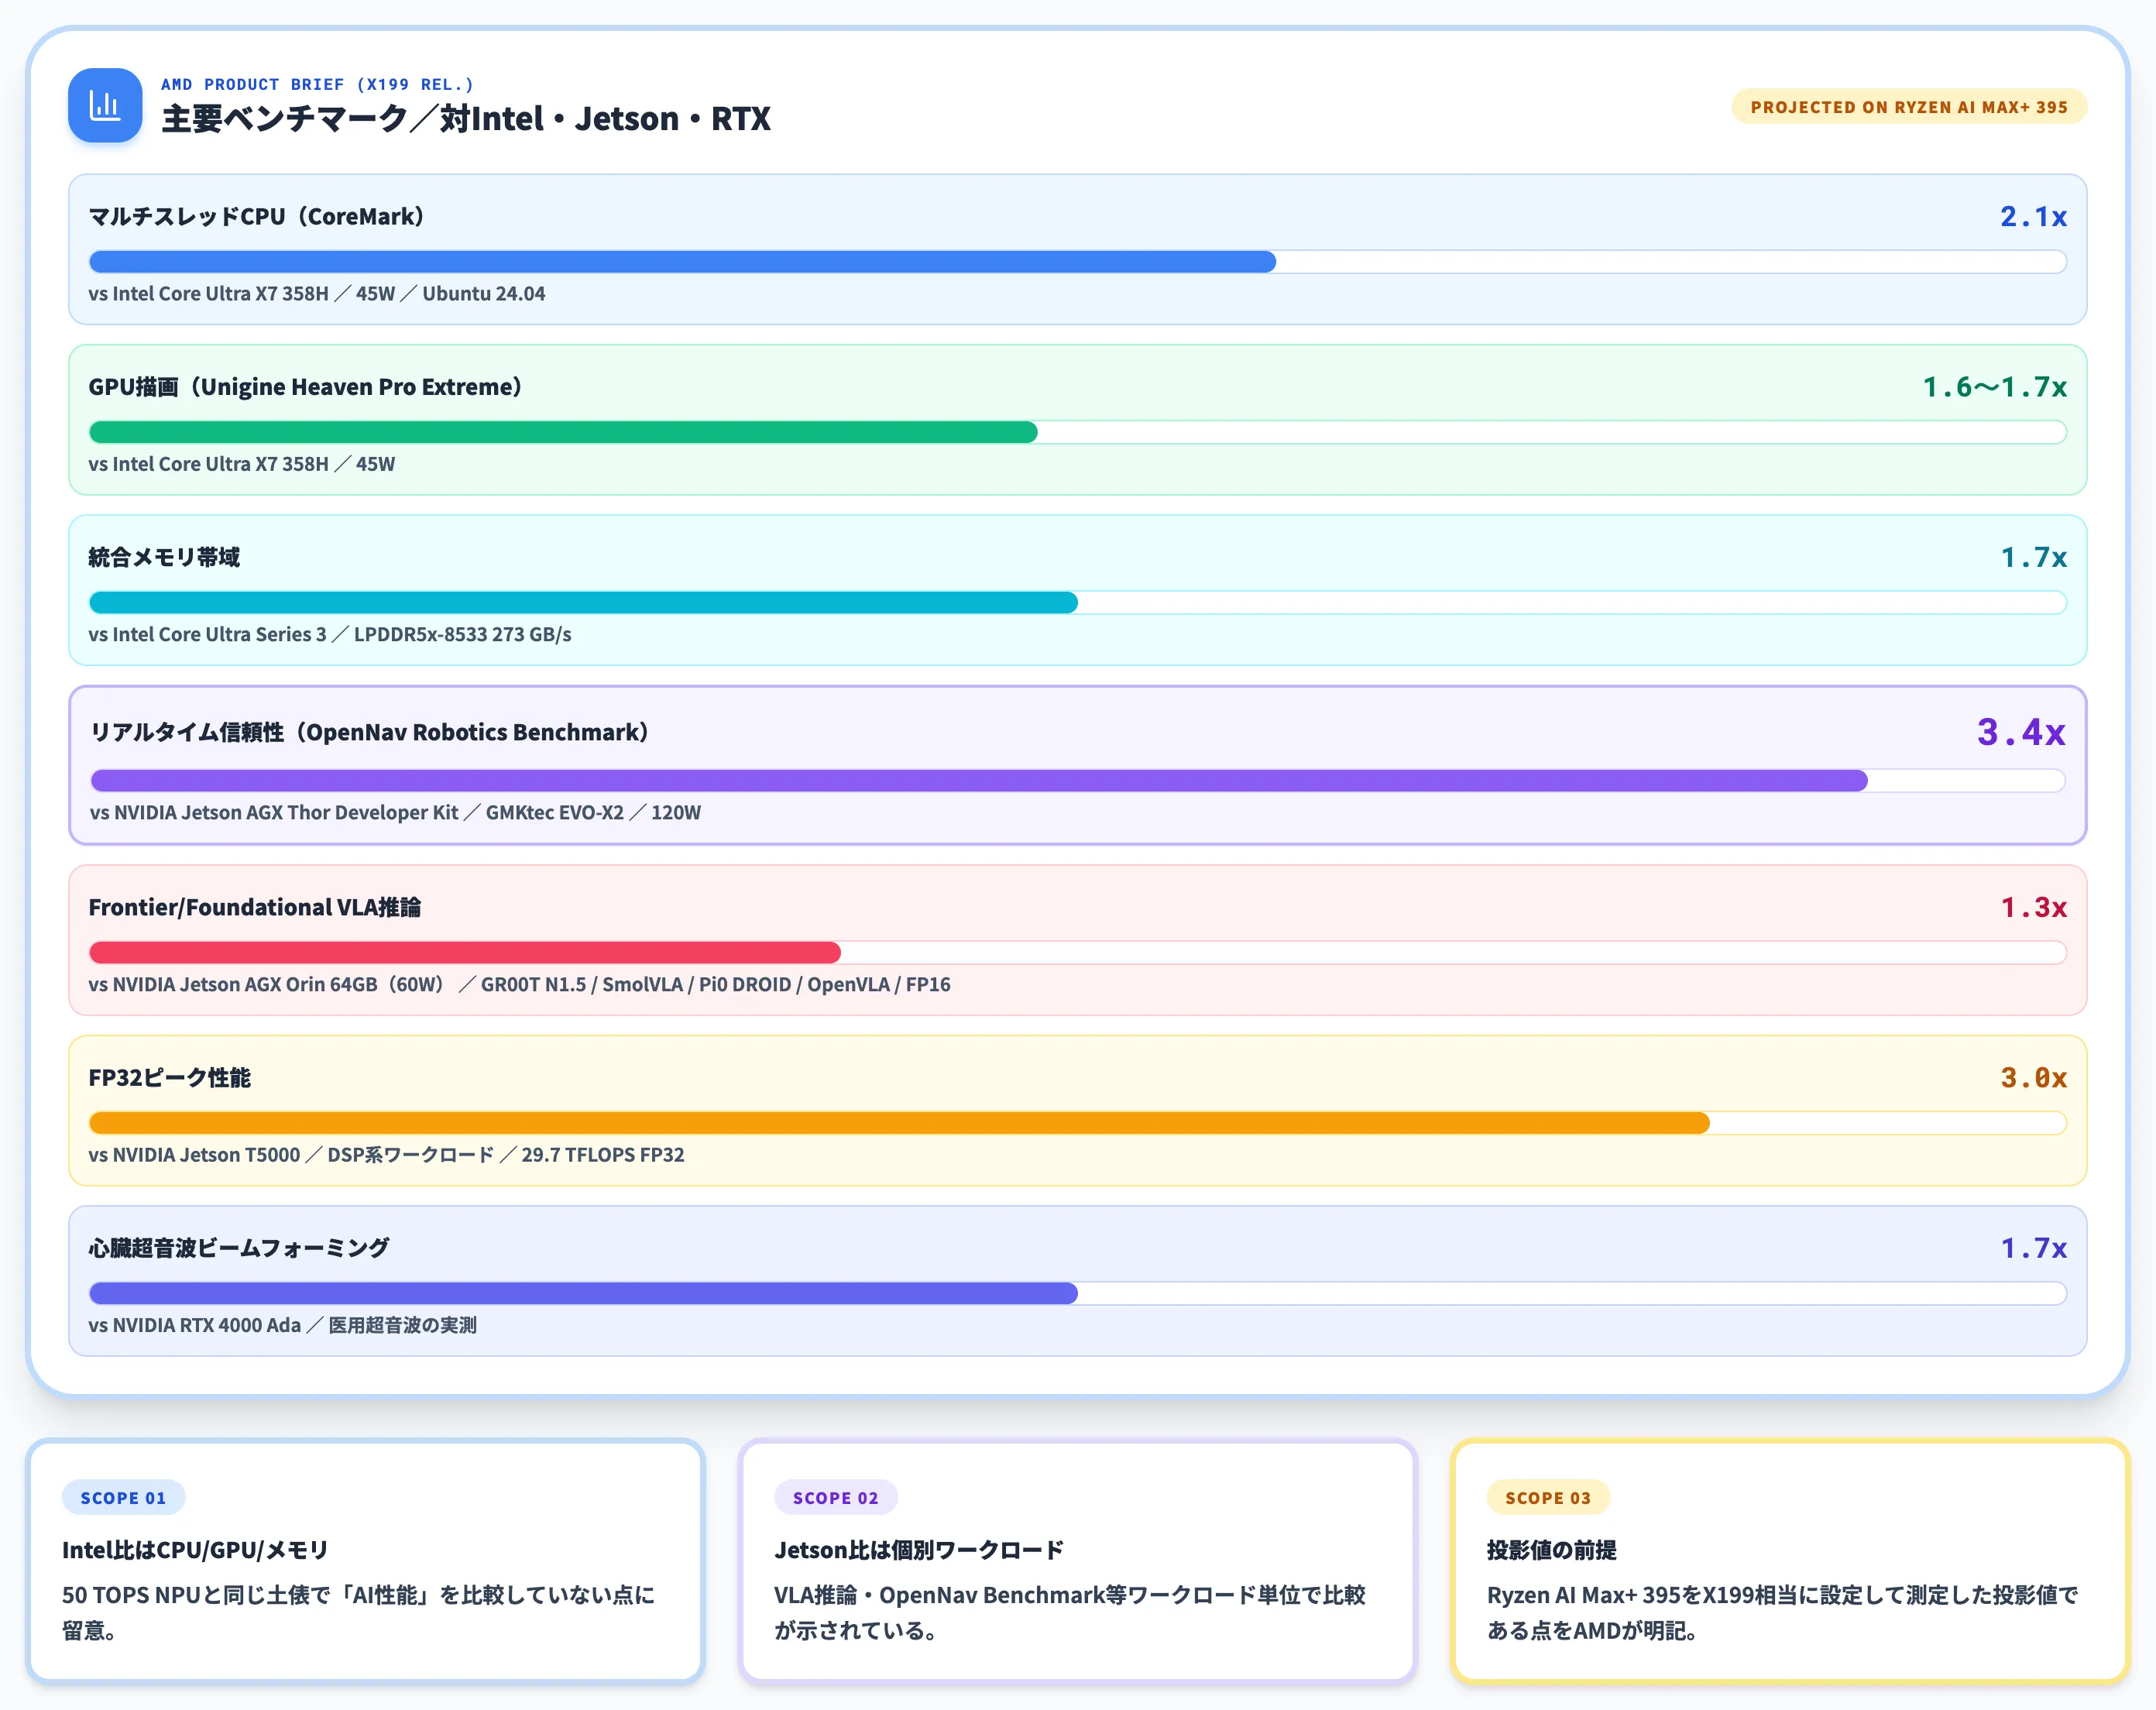
Ryzen AI Embedded X100の性能訴求で頻繁に引用される「Intel比2.1倍」「NVIDIA Jetson Thor比3.4倍」といった数値は、AMD公式Product Briefに掲載されているベンチマーク投影値です。
ただし、AMD自身がendnoteで「Ryzen AI Max+ 395をX199相当に設定して測定した投影値」と明記しているため、比較条件を正しく読み取ることが重要です。
以下の表は、AMD公式が示した主要ベンチマークとその比較条件を整理したものです。
| 比較項目 | AMD公式主張 | 比較条件 |
|---|---|---|
| マルチスレッドCPU(CoreMark) | Intel Core Ultra X7 358Hの2.1倍 | X199相当構成・45W/CoreMark v1.01・Ubuntu 24.04 |
| GPU描画(OpenGL/Unigine) | Intel Core Ultra X7 358Hの1.6〜1.7倍 | X199相当構成・45W/Unigine Heaven Pro Extreme |
| 統合メモリ帯域 | Intel Core Ultra Series 3の1.7倍 | LPDDR5x-8533、273 GB/s |
| リアルタイム信頼性 | NVIDIA Jetson AGX Thor Developer Kitの3.4倍 | GMKtec EVO-X2でX199相当構成・120W/OpenNav Robotics Benchmark |
| Frontier/Foundational VLA推論 | NVIDIA Jetson AGX Orin 64GB(60W)の1.3倍 | GR00T N1.5・SmolVLA・Pi0 DROID・Pi0.5 DROID・OpenVLAの幾何平均・FP16 |
| FP32ピーク性能 | NVIDIA Jetson T5000の3倍 | DSP系ワークロード(29.7 TFLOPS FP32) |
| 心臓超音波ビームフォーミング | NVIDIA RTX 4000 Adaの1.7倍 | 医用超音波の実測 |
この一覧で押さえておきたいのは、Intel Core Ultra X7 358Hとの比較はCPU・GPU・メモリ帯域が対象で、X100の50 TOPS NPUと同じ土俵で「AI性能」を比較しているわけではない点です。
マルチスレッドCPUとGPUのベンチマークが中心で、NVIDIA Jetsonシリーズに対しては後述するVLA推論・OpenNav Benchmarkなど個別ワークロード単位での比較が示されています。
VLA推論と実信頼性ベンチの読み方
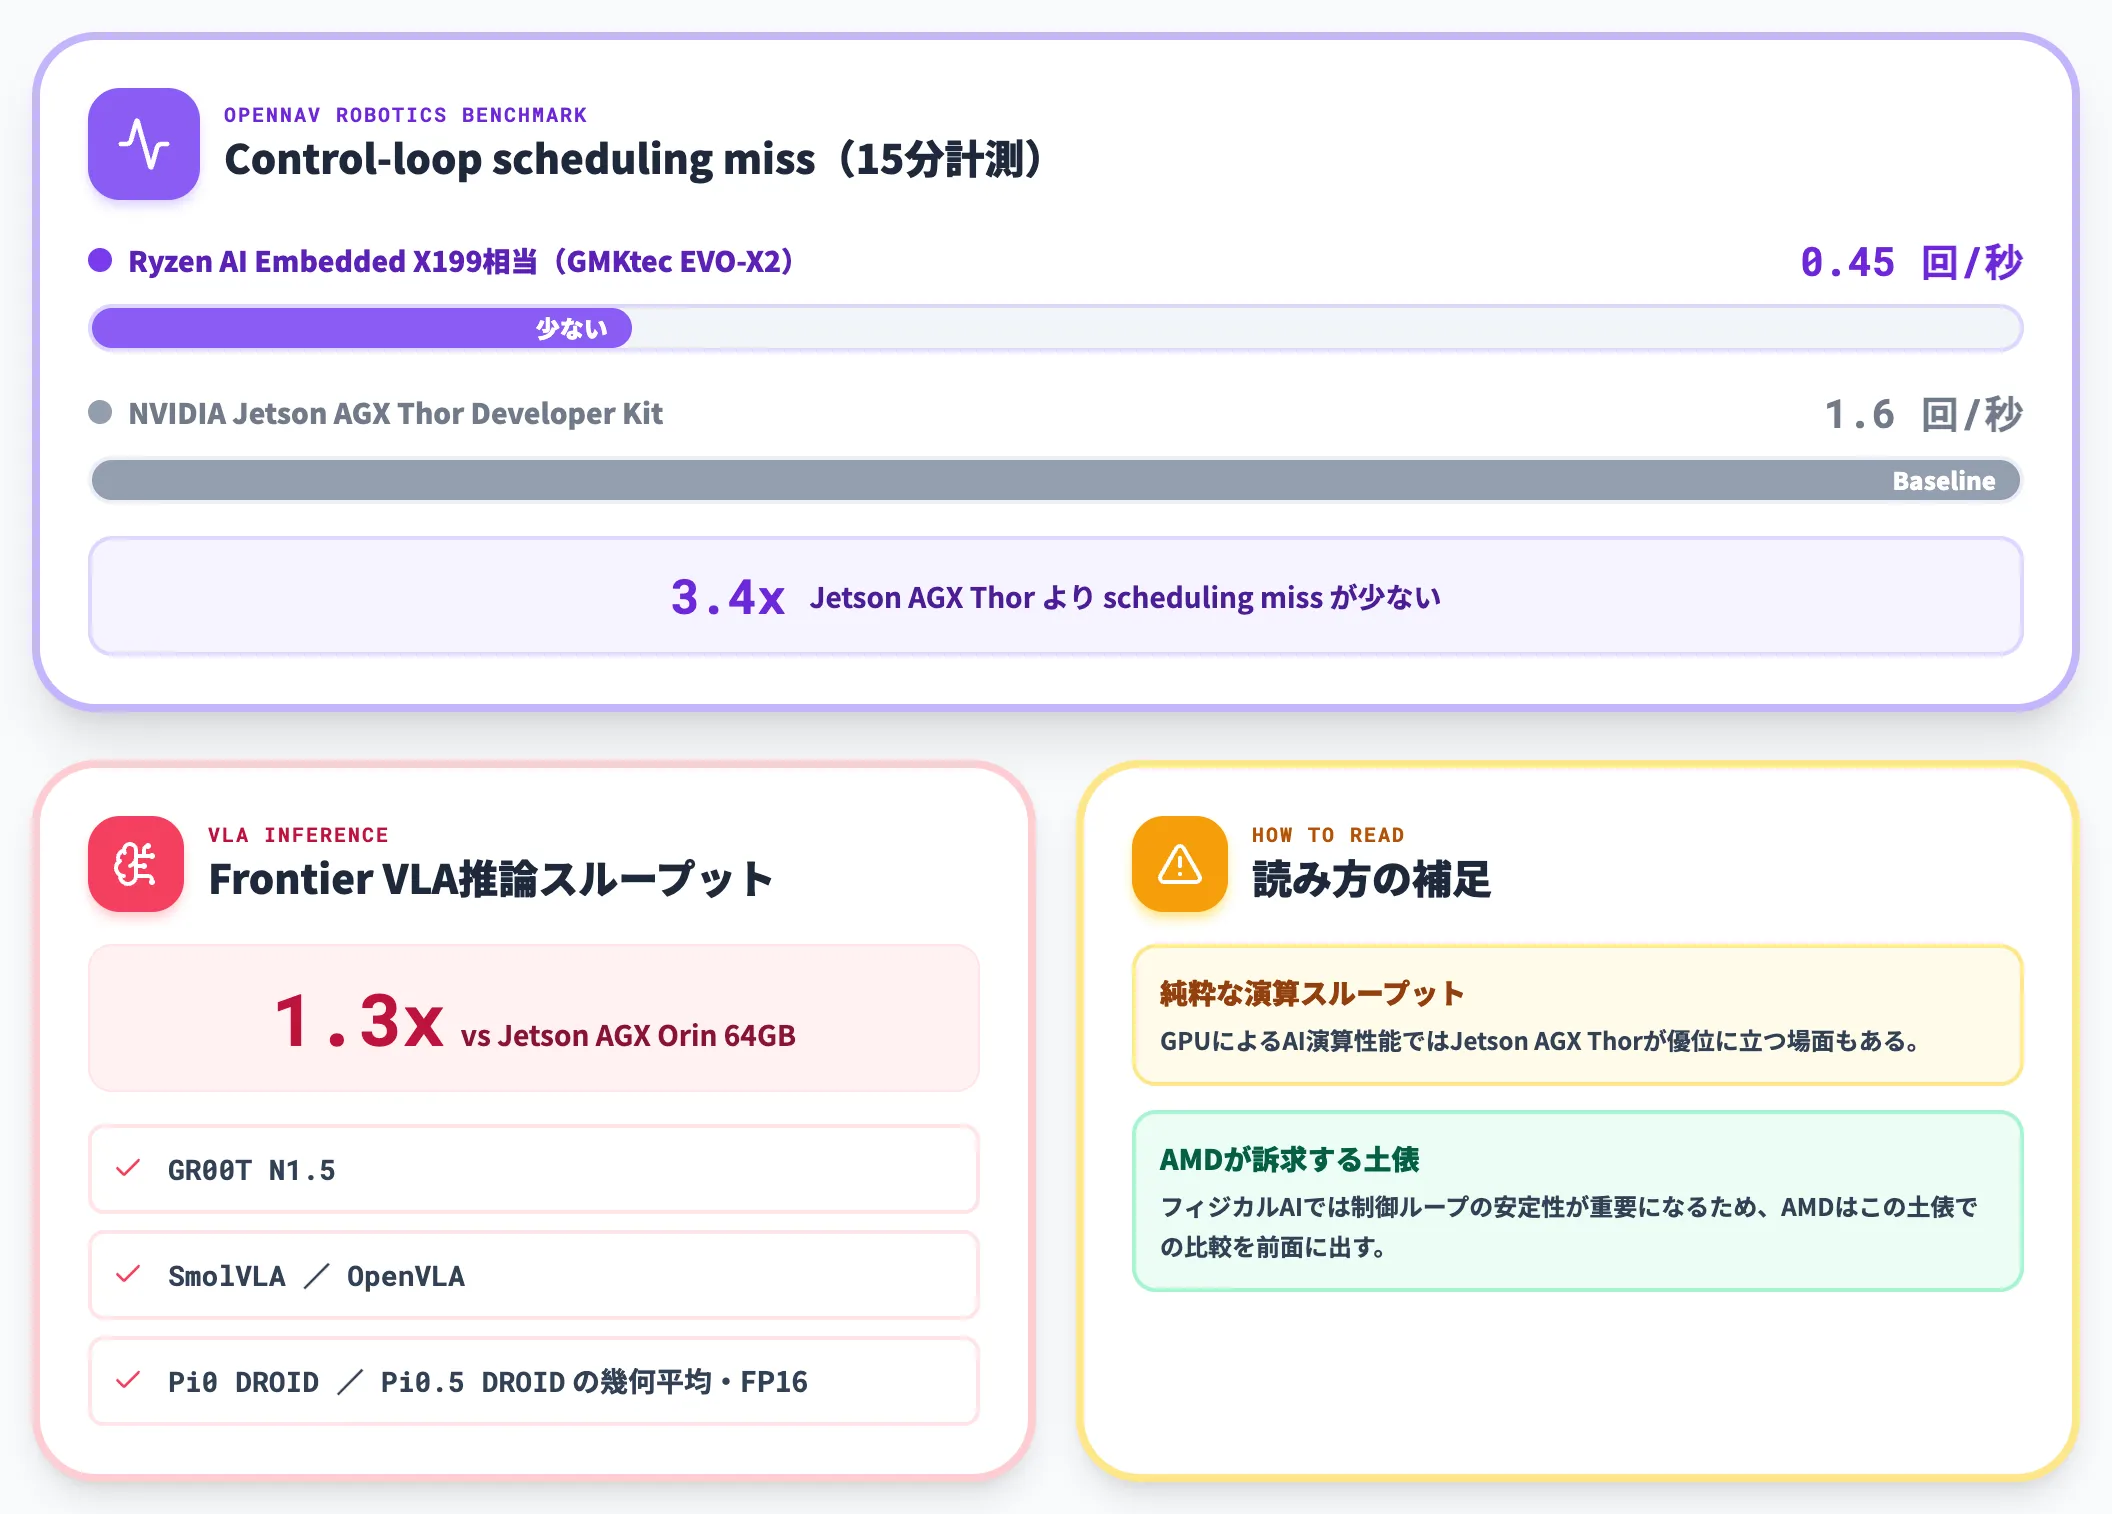
比較項目の中でも実務的にインパクトが大きいのは「Frontier/Foundational VLA推論」と「OpenNav Robotics Benchmark」の2つです。
VLA(Vision-Language-Action)モデルは、視覚入力と自然言語指示から次の動作を出力するロボット向け基盤モデル群で、NVIDIA GR00T N1.5・SmolVLA・Pi0 DROID・OpenVLAなどが代表格です。
X100のFP16推論スループットがJetson AGX Orin 64GBの1.3倍という数値は、これら基盤モデルの推論性能を測る一つの指標になります。
-
OpenNav Robotics Workload Benchmark
Open Navigation LLCが2026年7月に公開した、ROS 2ベースの制御ループを15分間走らせて control-loop scheduling missの頻度を測るベンチマーク。単一の推論TOPS競争ではなく、実運用に近い条件でのスケジューリング安定性を評価する設計
-
リアルタイム信頼性3.4倍の意味
X100(X199相当構成)は0.45回/秒、Jetson AGX Thor Developer Kitは1.6回/秒のscheduling missが観測され、AMDはこの差分から「3.4倍少ない」としてこの倍率を示している
純粋な演算スループットで比較すると、GPUによるAI演算性能ではJetson AGX Thorが優位に立つ場面もあります。ただしフィジカルAI用途ではこうした制御ループの安定性が重要になるため、AMDはこの土俵での比較を前面に出しています。
コンシューマ版で先行PoCができる強み
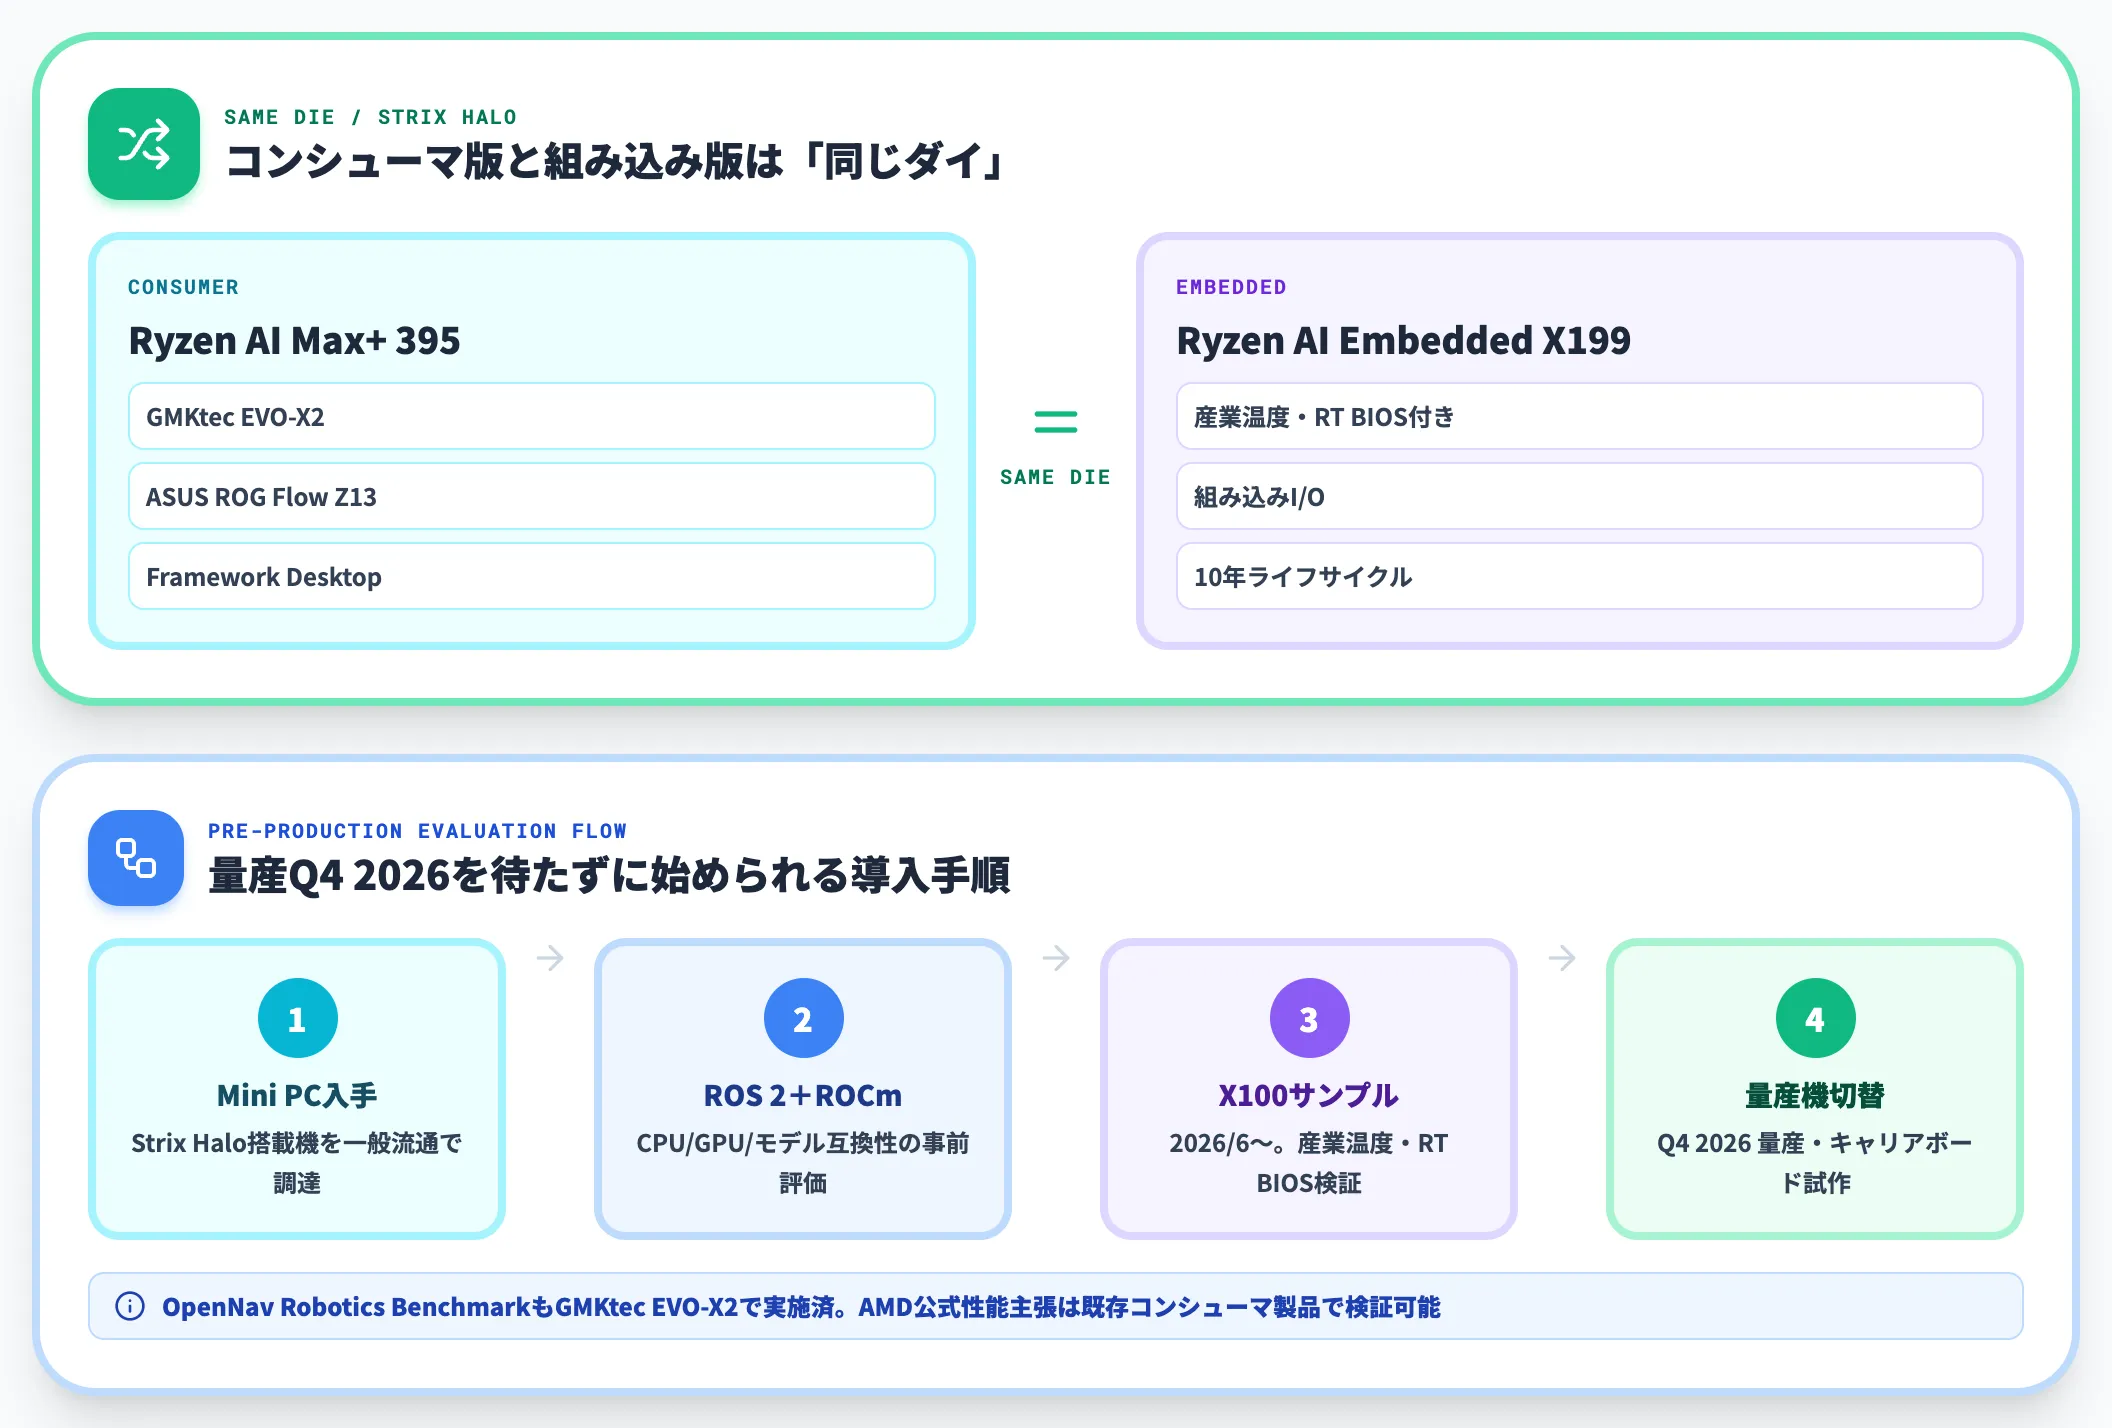
AMD公式のベンチマーク条件で見逃せないのは、Product Briefのendnoteに「Ryzen AI Max+ 395をX199相当に設定して測定した」と明記されている点です。
これは、コンシューマ向けのRyzen AI Max+ 395を搭載するGMKtec EVO-X2・ASUS ROG Flow Z13・Framework DesktopなどのMini PC/ラップトップが、量産Q4 2026を待たずに基本的なCPU/GPU処理・ROCm・モデル互換性の事前評価の受け皿になることを意味します(産業温度・RT BIOS・組み込みI/O・長期信頼性の検証はX100サンプル・量産機での確認が必要)。
実際、OpenNav Robotics BenchmarkもGMKtec EVO-X2で実施されており、AMDの性能主張は「既に世に出ているコンシューマ製品で検証可能」という透明性を伴います。
ロボットベンチャーや産業機器メーカーが「Q4 2026量産まで待たずに実装評価を始めたい」と考える場合、コンシューマ版Strix Halo搭載機を先に手に入れて、ROS 2+ROCmでの動作を確認する順序で導入判断ができる構造です。
Ryzen AI Embedded X100のソフトウェアスタックとCUDA→HIP移行
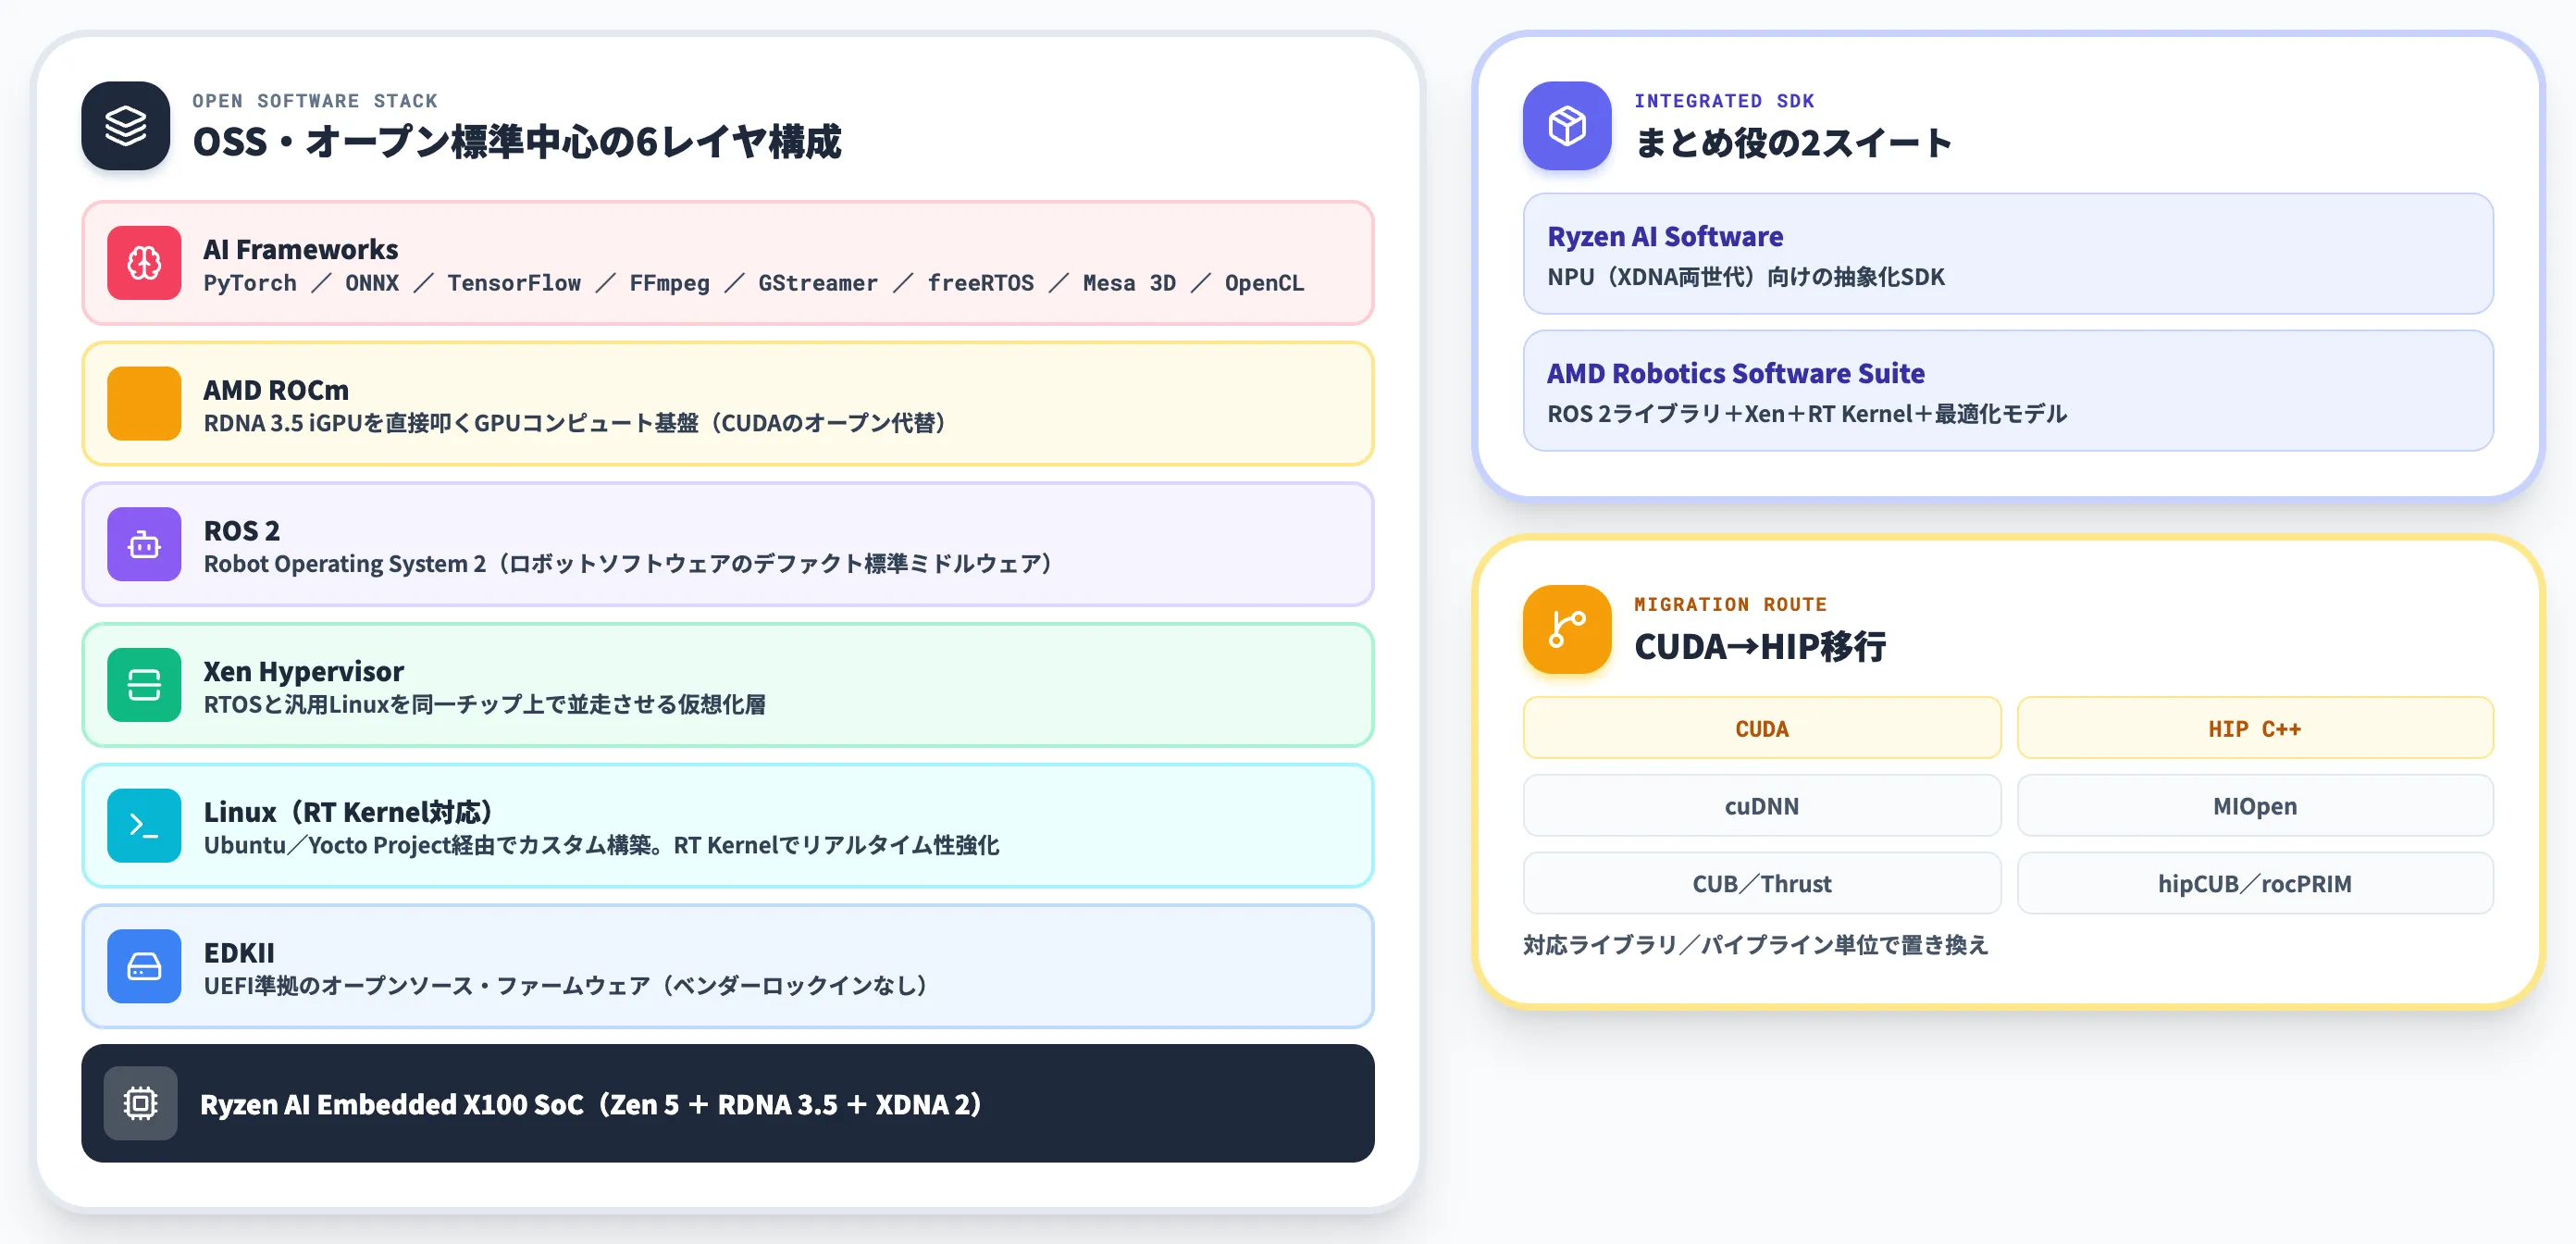
Ryzen AI Embedded X100は、Linuxとオープンソースエコシステムを前提としたソフトウェアスタックで動きます。
ハードだけを高性能化しても、既存資産の移植コストが重ければ採用は進みません。ここではAMDが用意した各レイヤーのスタックと、既存NVIDIA/CUDA資産からの移行ルートを整理します。
スタック全体像
X100のソフトウェアスタックは、以下の6レイヤーで構成されます。ハードに直接触れるファームウェアから、AI開発者が触る高レベルフレームワークまで、OSS・オープン標準を中心に構成されている点が特徴です。
-
EDKII
UEFI準拠のオープンソース・ファームウェア。ブートローダー層をベンダーロックインなしで実装できる
-
Linux(RT Kernel対応)
標準UbuntuやYocto Project経由でカスタムディストリビューションを構築可能。RT Kernelでリアルタイム性を強化
-
Xen Hypervisor
リアルタイムOSと汎用Linuxを同一チップで並走させるための仮想化層。産業用途のワークロード分離に活用できる
-
ROS 2
Robot Operating System 2。ロボットソフトウェアのデファクト標準ミドルウェア
-
AMD ROCm
RDNA 3.5 iGPUを直接叩くGPUコンピュート基盤。CUDAのオープン代替
-
AI Frameworks
PyTorch・ONNX・TensorFlow・FFmpeg・GStreamer・freeRTOS・Mesa 3D・OpenCLに対応
Ryzen AI SoftwareとAMD Robotics Software Suiteがこれらのレイヤーをまとめ、開発者は個別ライブラリを直接組み合わせなくても、リファレンス実装から入れるようになっています。
Robotics Software Suiteの構成
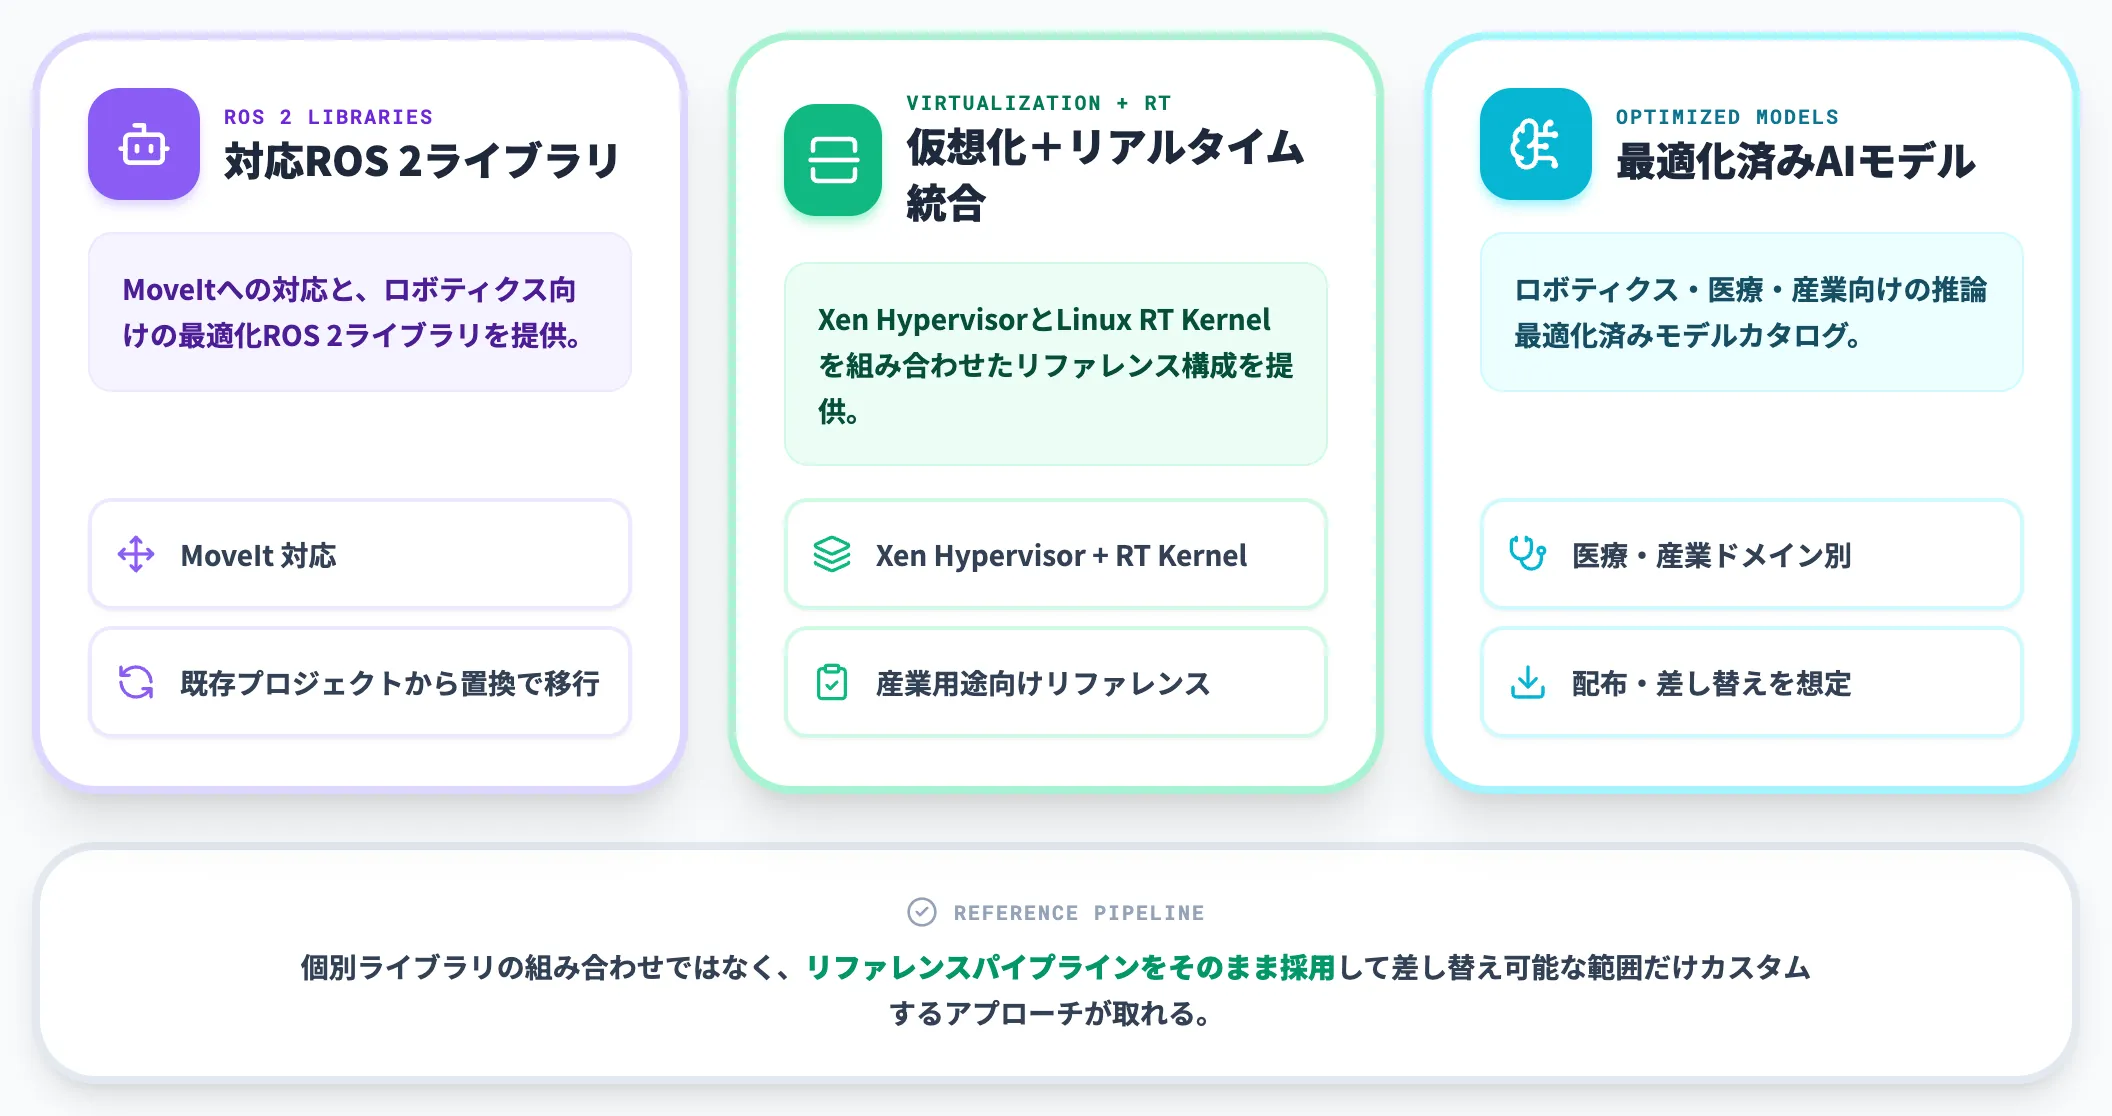
AMD Robotics Software Suiteは、ロボティクス向けにチューニングされたROS 2ライブラリ・仮想化ランタイム・リアルタイムサポート・最適化AIモデルをまとめた統合スタックです。
-
ROS 2向け対応ライブラリ
MoveItへの対応と、ロボティクス向けの最適化ROS 2ライブラリが提供される。既存ROS 2プロジェクトからは対応ライブラリへの置換で移行しやすくなる
-
仮想化+リアルタイム統合
Xen HypervisorとLinux RT Kernelを組み合わせたリファレンス構成が提供される
-
最適化済みAIモデル
ロボティクス・医療・産業向けの推論最適化済みモデルカタログ
個別ライブラリを組み合わせるのではなく、リファレンスパイプラインをそのまま採用して差し替え可能な範囲だけカスタムする、というアプローチが取れます。
CUDA→HIP移行の現実的な進め方
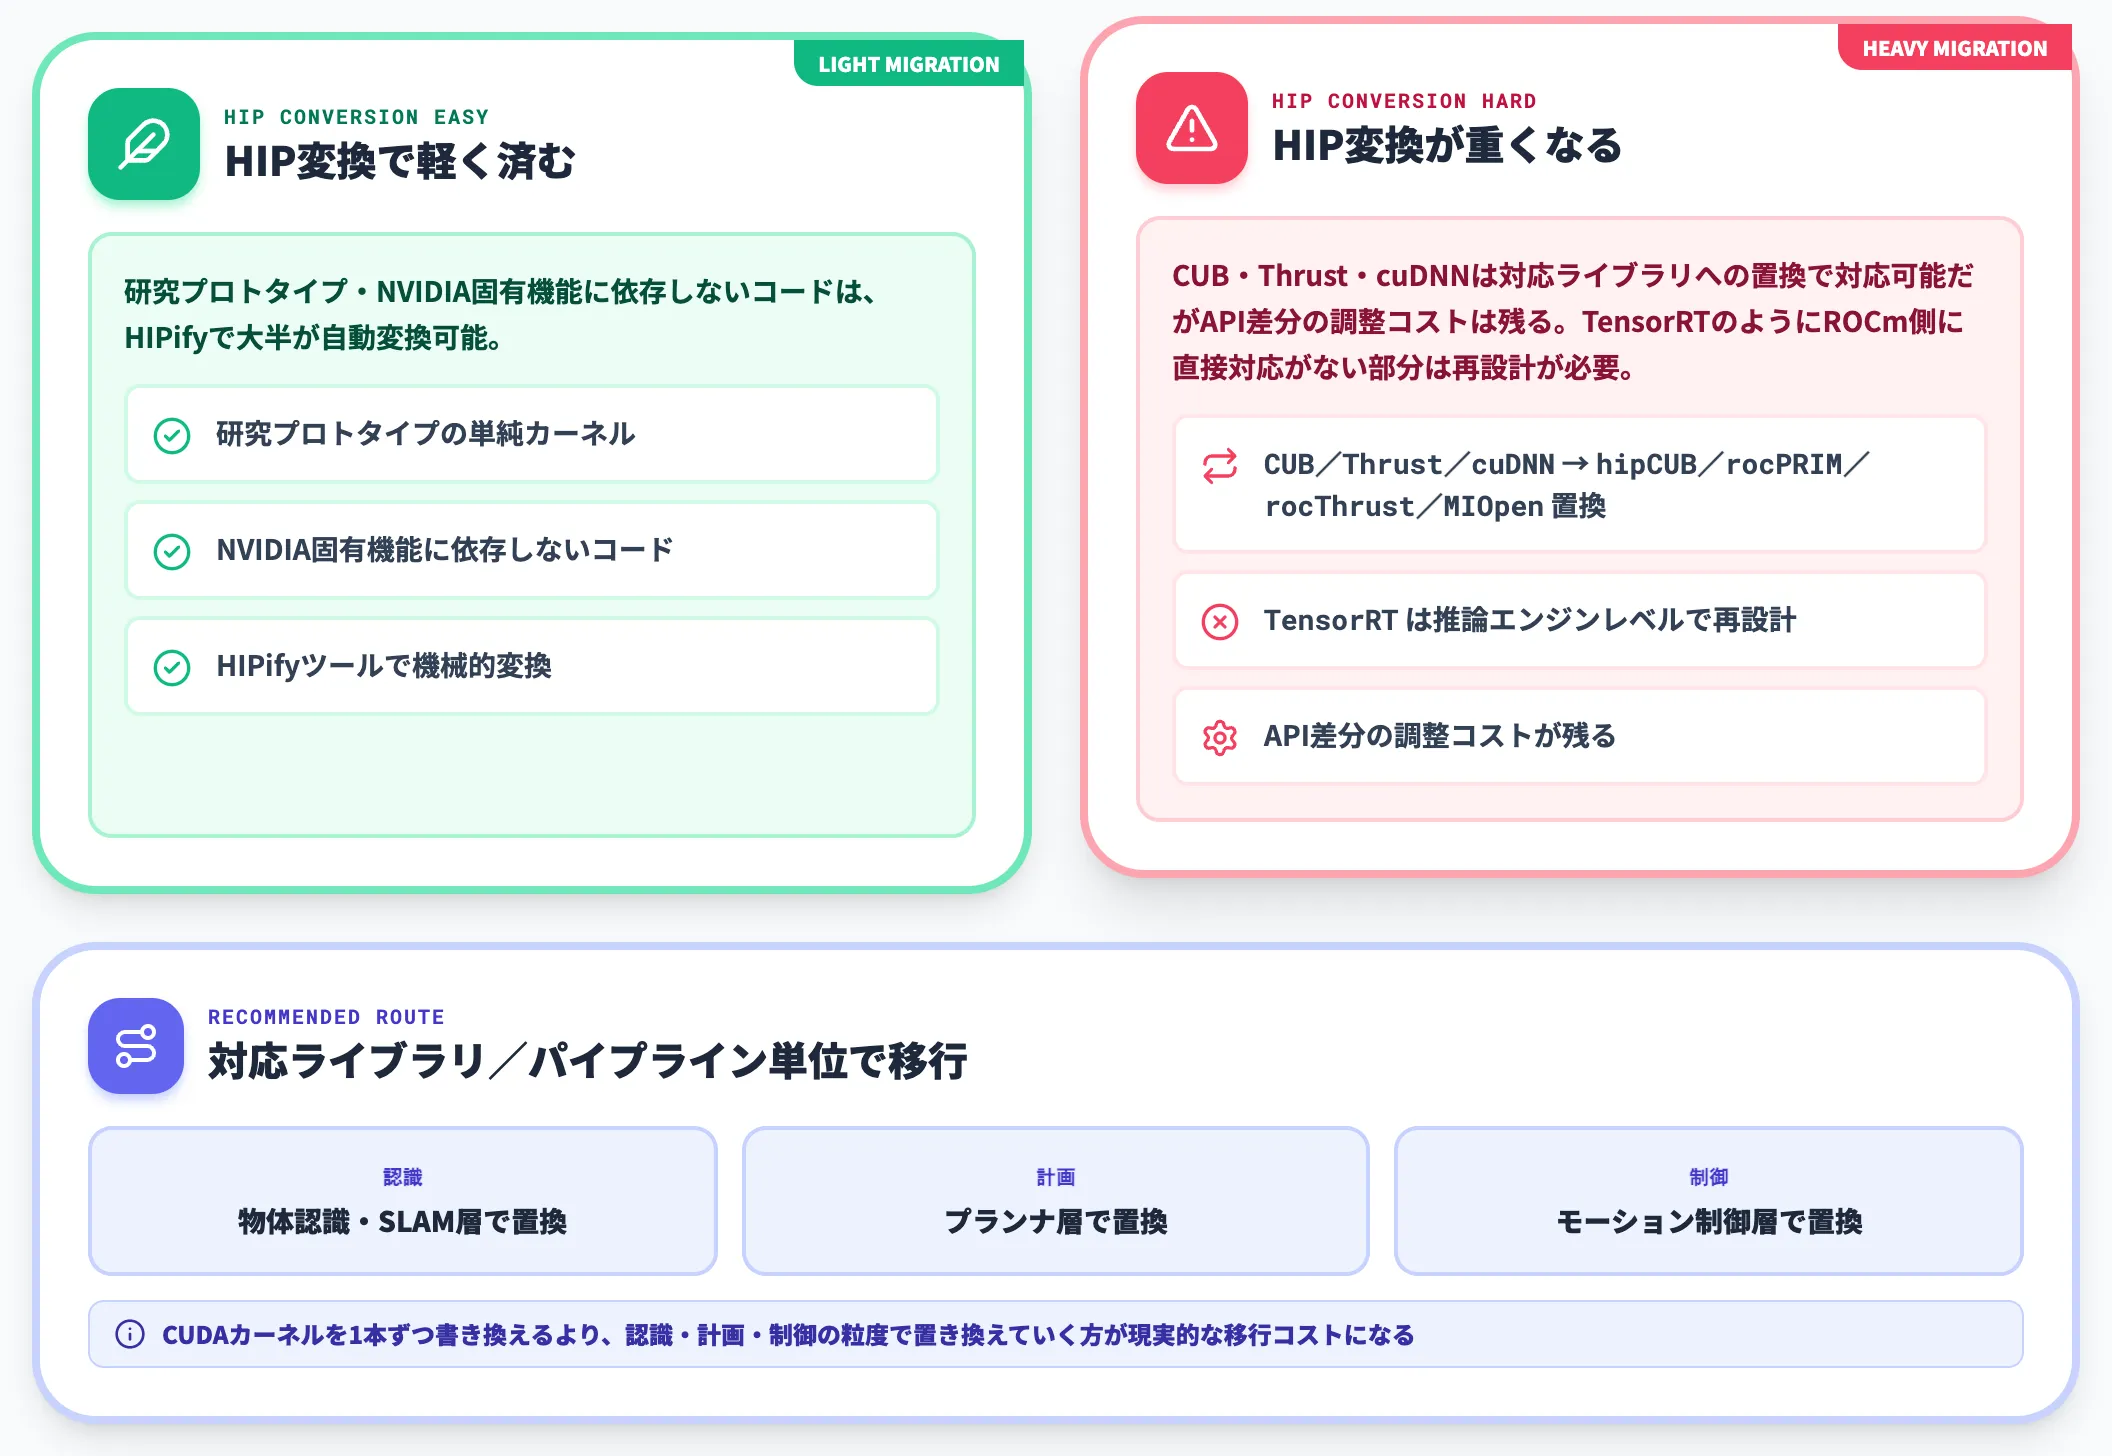
AMDは「AMD HIP C++でCUDAから容易に移行できる」と強調しています。
HIPはCUDA互換のC++ APIで、HIPifyツールでCUDAコードを機械的に変換できる設計です。ただし、既存の大規模CUDAコードベースを持つロボメーカーが直接HIP変換で移植する現実コストは軽くありません。
-
HIP変換で軽く済むケース
研究プロトタイプの単純カーネル・NVIDIA固有機能に依存しないコード。HIPifyで大半が自動変換可能
-
HIP変換が重くなるケース
CUB・Thrust・cuDNNはhipCUB/rocPRIM/rocThrust/MIOpen等の対応ライブラリへの置換で概ね対応できるが、API差分の調整コストは残る。TensorRTのようにROCm側に直接対応がない部分は、推論エンジンレベルでの再設計が必要になり得る
実務で採用しやすいのは、「対応ライブラリ/パイプライン単位での移行」を経由するルートです。AMD Robotics Software Suiteが提供するROS 2向けライブラリを置き換えの単位に据えれば、開発者はライブラリ差し替えという抽象度で移行を進められます。
CUDAカーネルを1本ずつ書き換えるより、認識・計画・制御の粒度で置き換えていく方が現実的な移行コストになります。
XDNA 2 NPUがXDNAから性能3倍以上
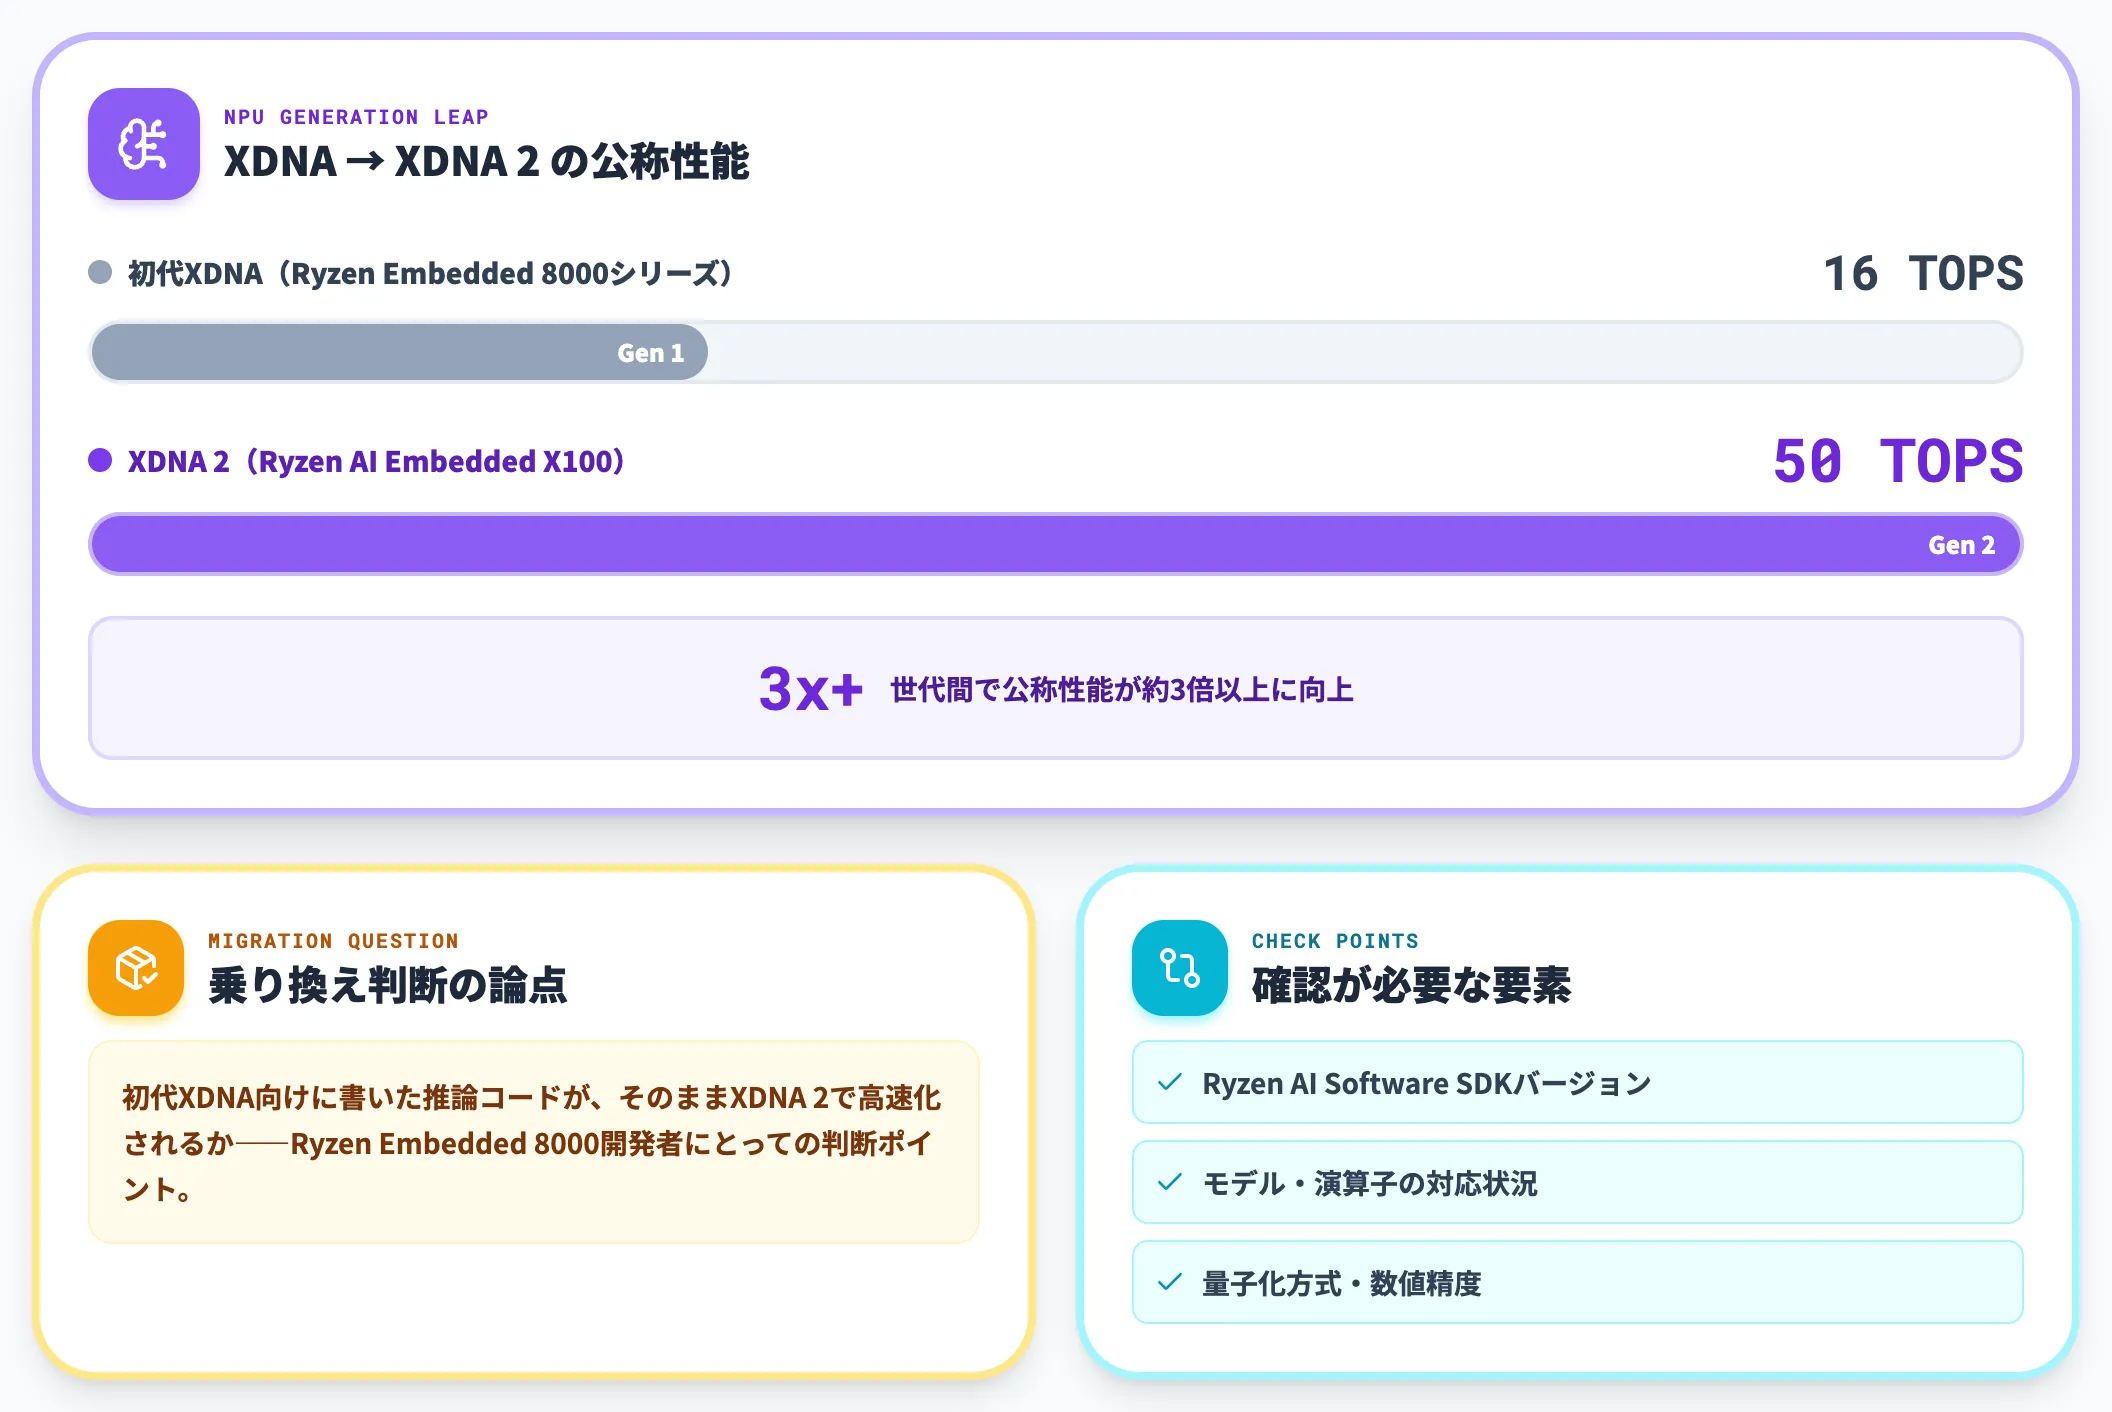
Ryzen AI Embedded X100が搭載するXDNA 2 NPUは、組み込み向け先行世代のRyzen Embedded 8000シリーズが搭載する初代XDNA(16 TOPS)から50 TOPSへと約3倍以上に公称性能が向上した第2世代NPUです。
Ryzen Embedded 8000など、初代XDNA搭載製品の開発者にとっては、「初代XDNA向けに書いた推論コードがそのままXDNA 2で高速化されるのか」が乗り換え判断の論点になります。
Ryzen AI Software SDKはXDNA両世代を対象とした抽象化レイヤーを提供していますが、SDKバージョン・モデル・演算子・量子化方式ごとに互換性を個別に確認する必要があります。TOPSの公称値どおりの実性能が出せるかは、モデル構成・ソフトウェアスタック・量子化条件など複数の要因に依存します。
Kria AI SoMとRobotics Developer Platformの位置づけ
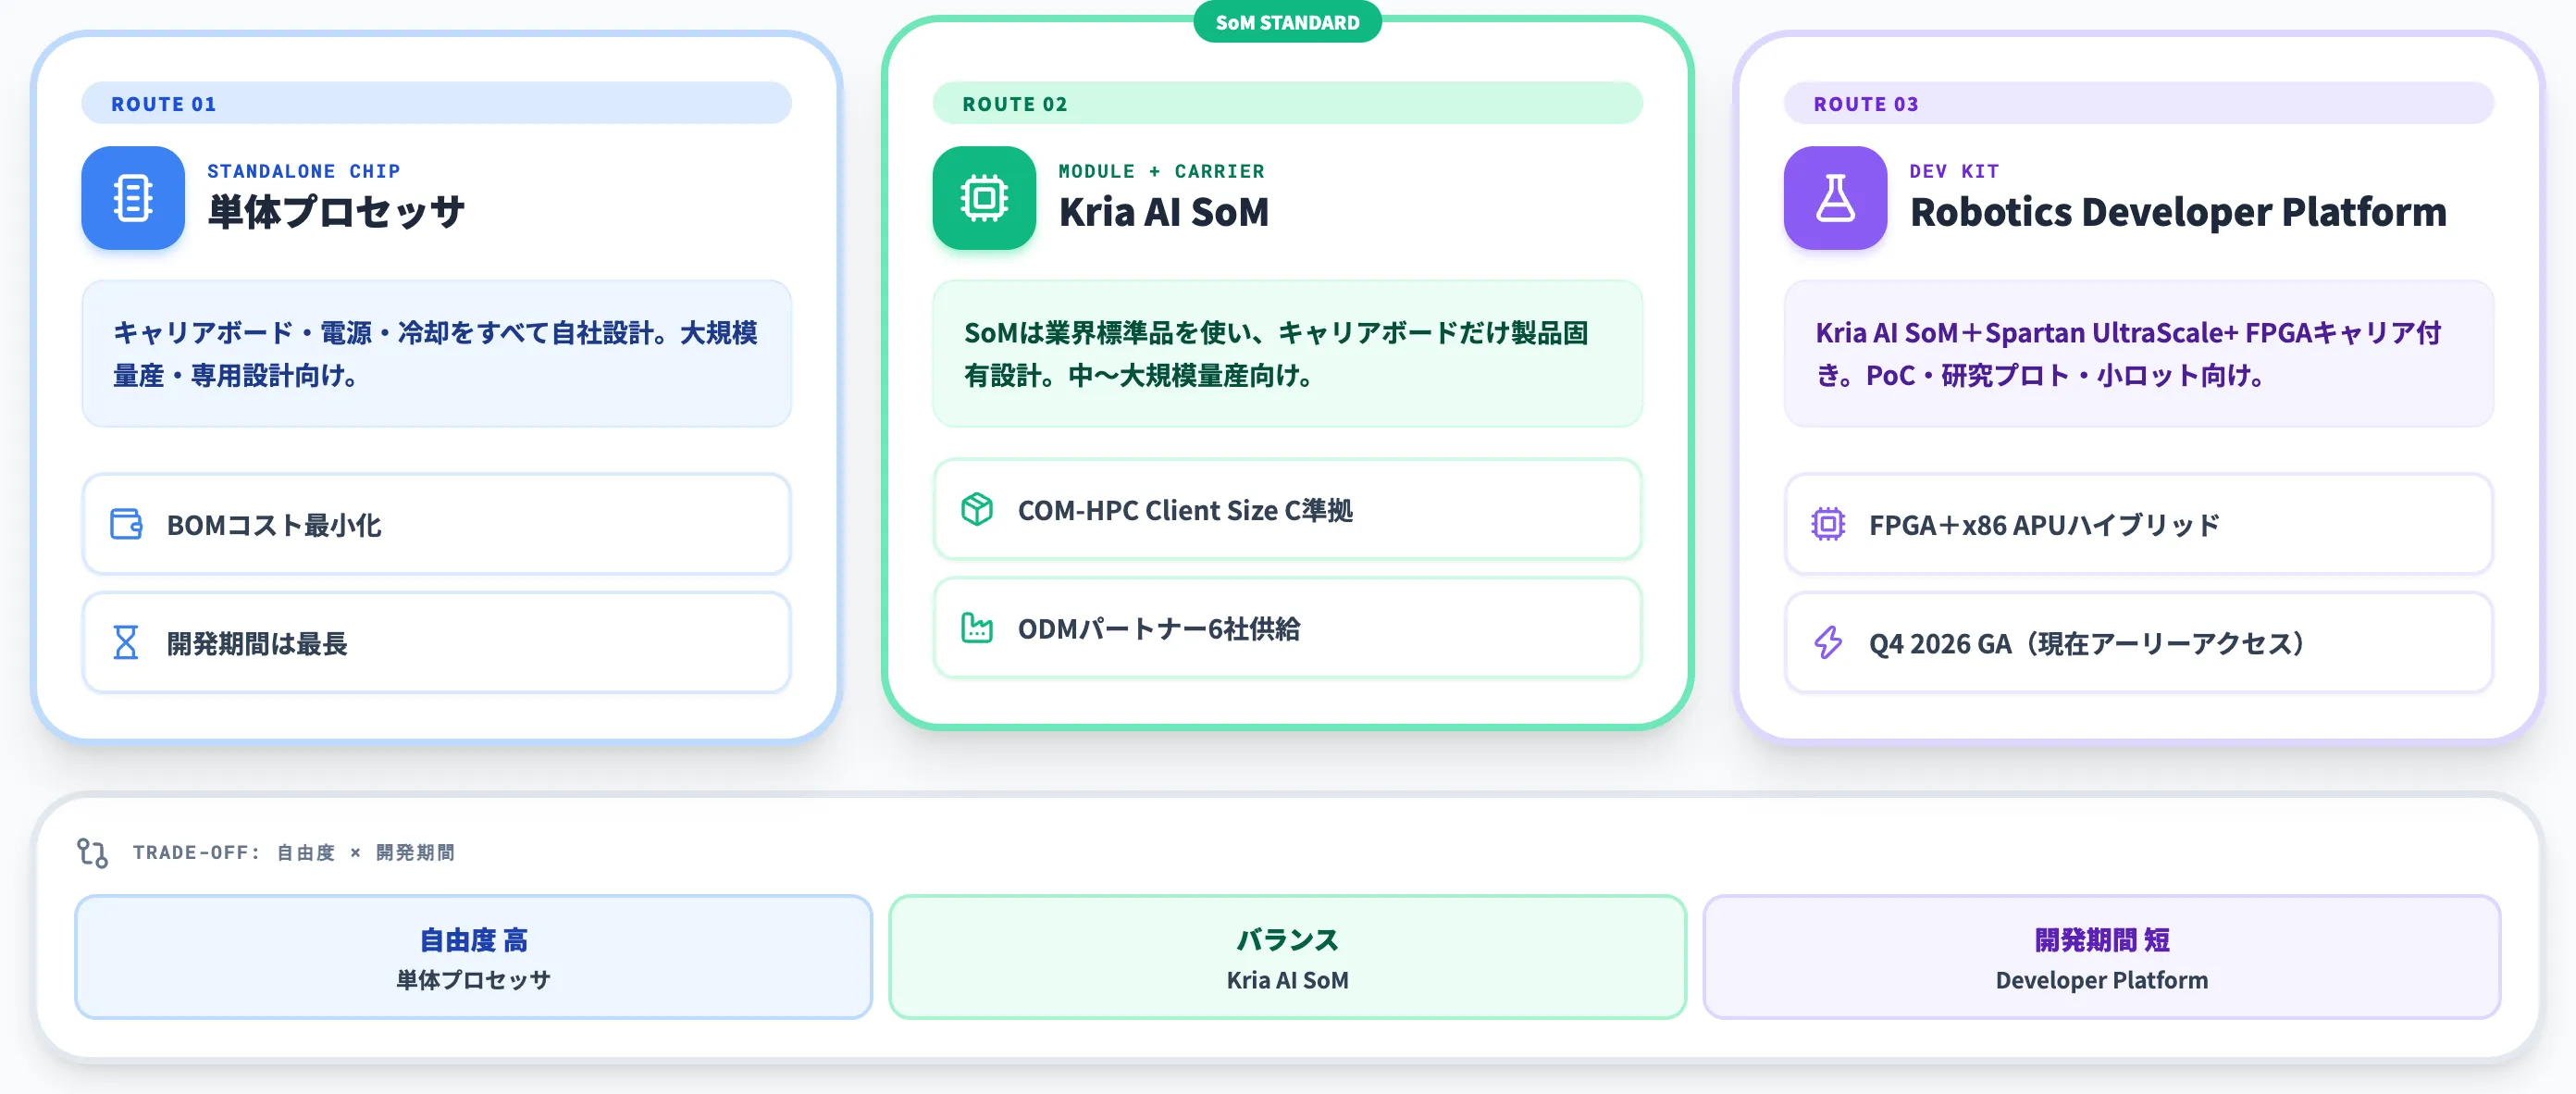
Ryzen AI Embedded X100は、単体プロセッサとして購入するルートに加え、AMDが提供する「Kria AI SoM」というシステムオンモジュール製品としても入手できます。
ODMパートナー経由でCOM-HPC規格のボードに載った形で提供されるため、キャリアボードだけ自社設計すればロボット・産業機器に組み込みやすい構造です。
FPGA時代からAPUへ広がるKria
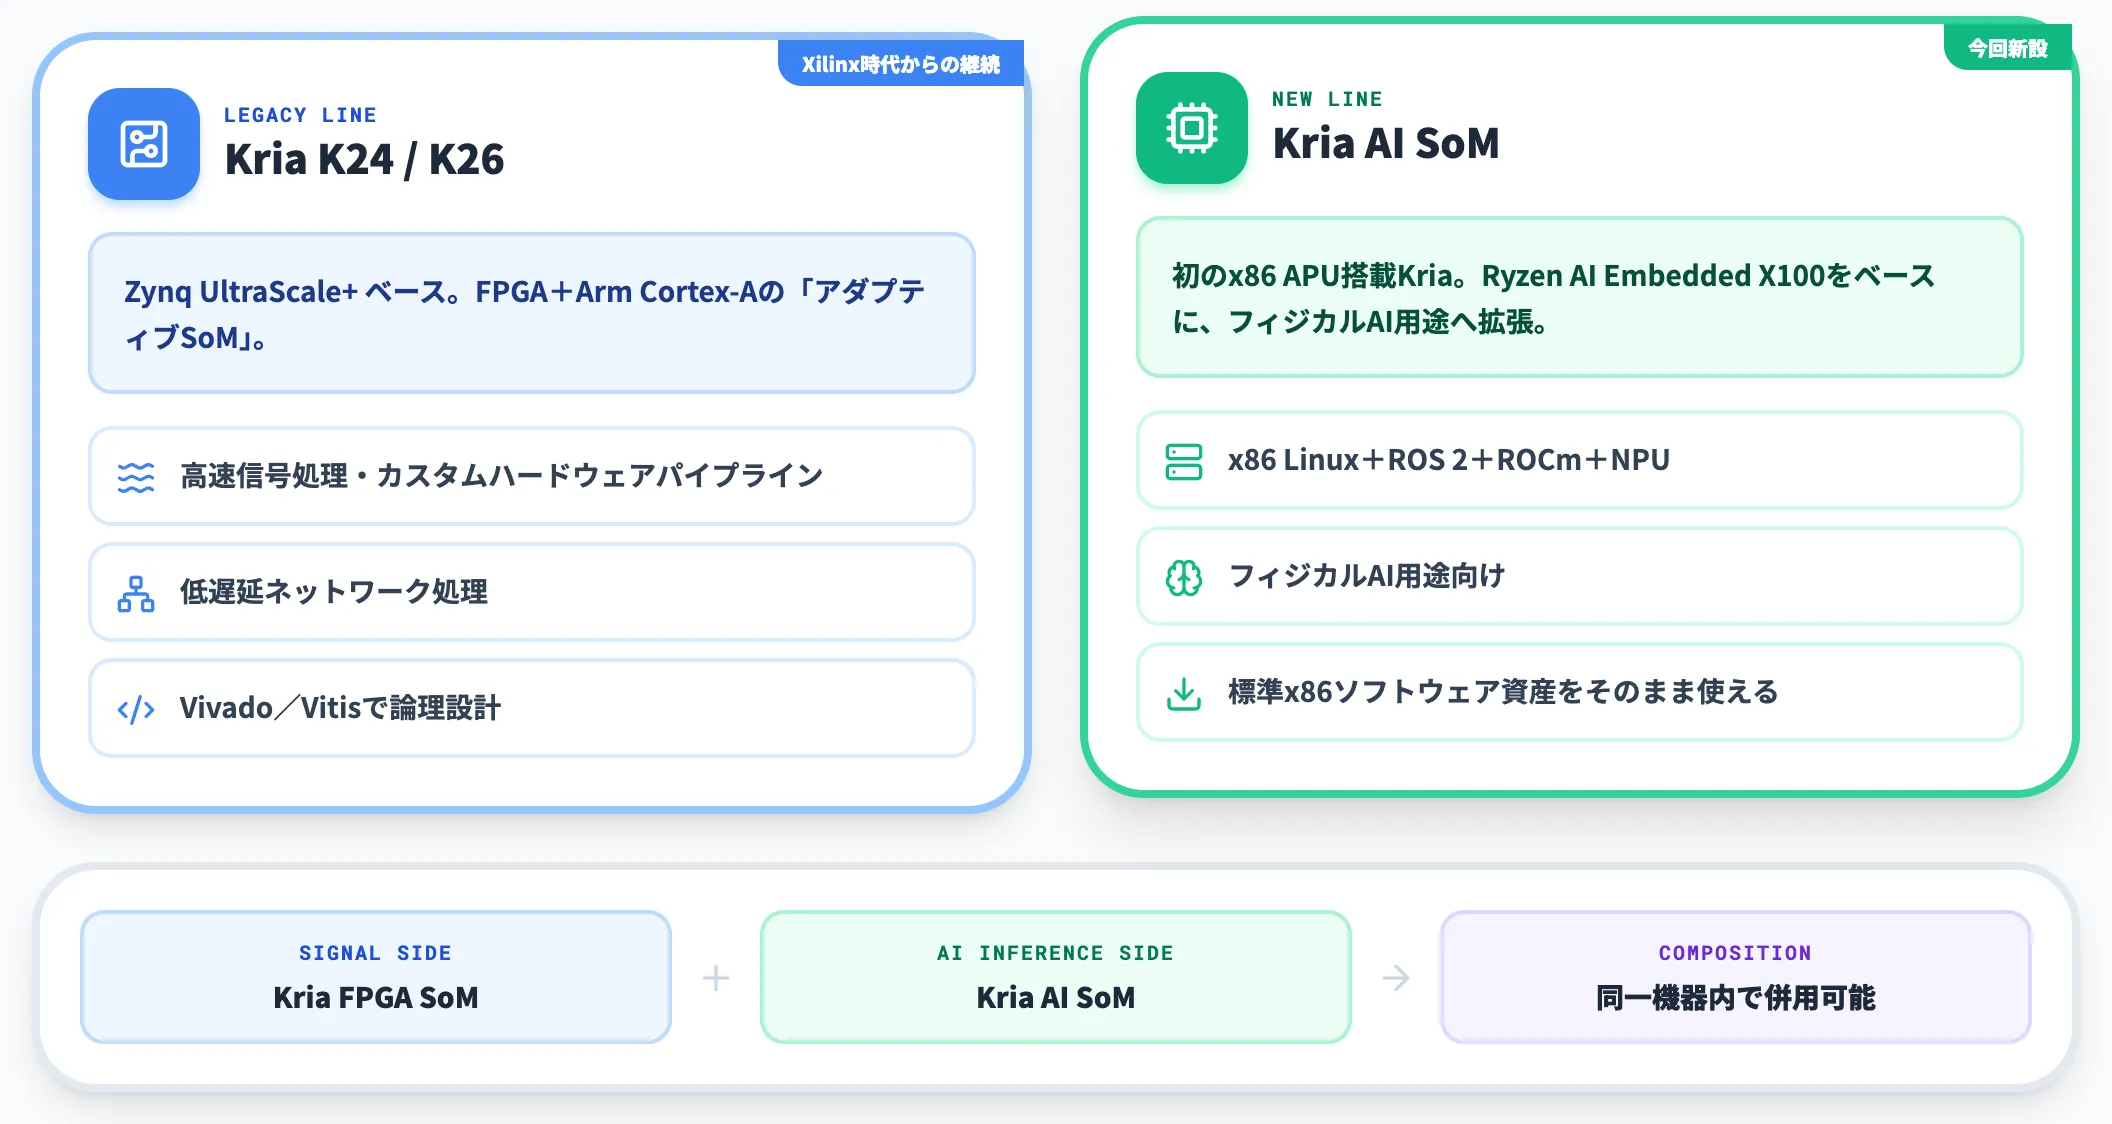
Kriaブランドは、もともとXilinx時代のZynq UltraScale+搭載SoM(K24/K26)として提供されていました。FPGA+Arm Cortex-Aを組み合わせた「アダプティブSoM」の位置づけです。
今回のKria AI SoMは初めてx86 APU(Ryzen AI Embedded X100)搭載Kriaで、Xilinx→AMD統合後のKriaブランド拡張として設計されています。従来のFPGA志向のKriaと、今回のx86 APU志向のKriaは、以下の役割分担で並存します。
-
Kria K24/K26(従来型・FPGAベース)
高速信号処理・カスタムハードウェアパイプライン・低遅延ネットワーク処理などFPGA固有領域。Vivado/Vitisで論理設計
-
Kria AI SoM(新型・Ryzen AI Embedded X100搭載)
x86 Linux+ROS 2+ROCm+NPUを前提としたフィジカルAI用途。標準的なx86ソフトウェア資産をそのまま使える
両者は競合ではなく補完関係にあり、産業機器の中に「Kria FPGA SoM(信号処理側)+Kria AI SoM(AI推論側)」を組み合わせて搭載するといった構成も想定されます。
Kria AI SoMの基本仕様
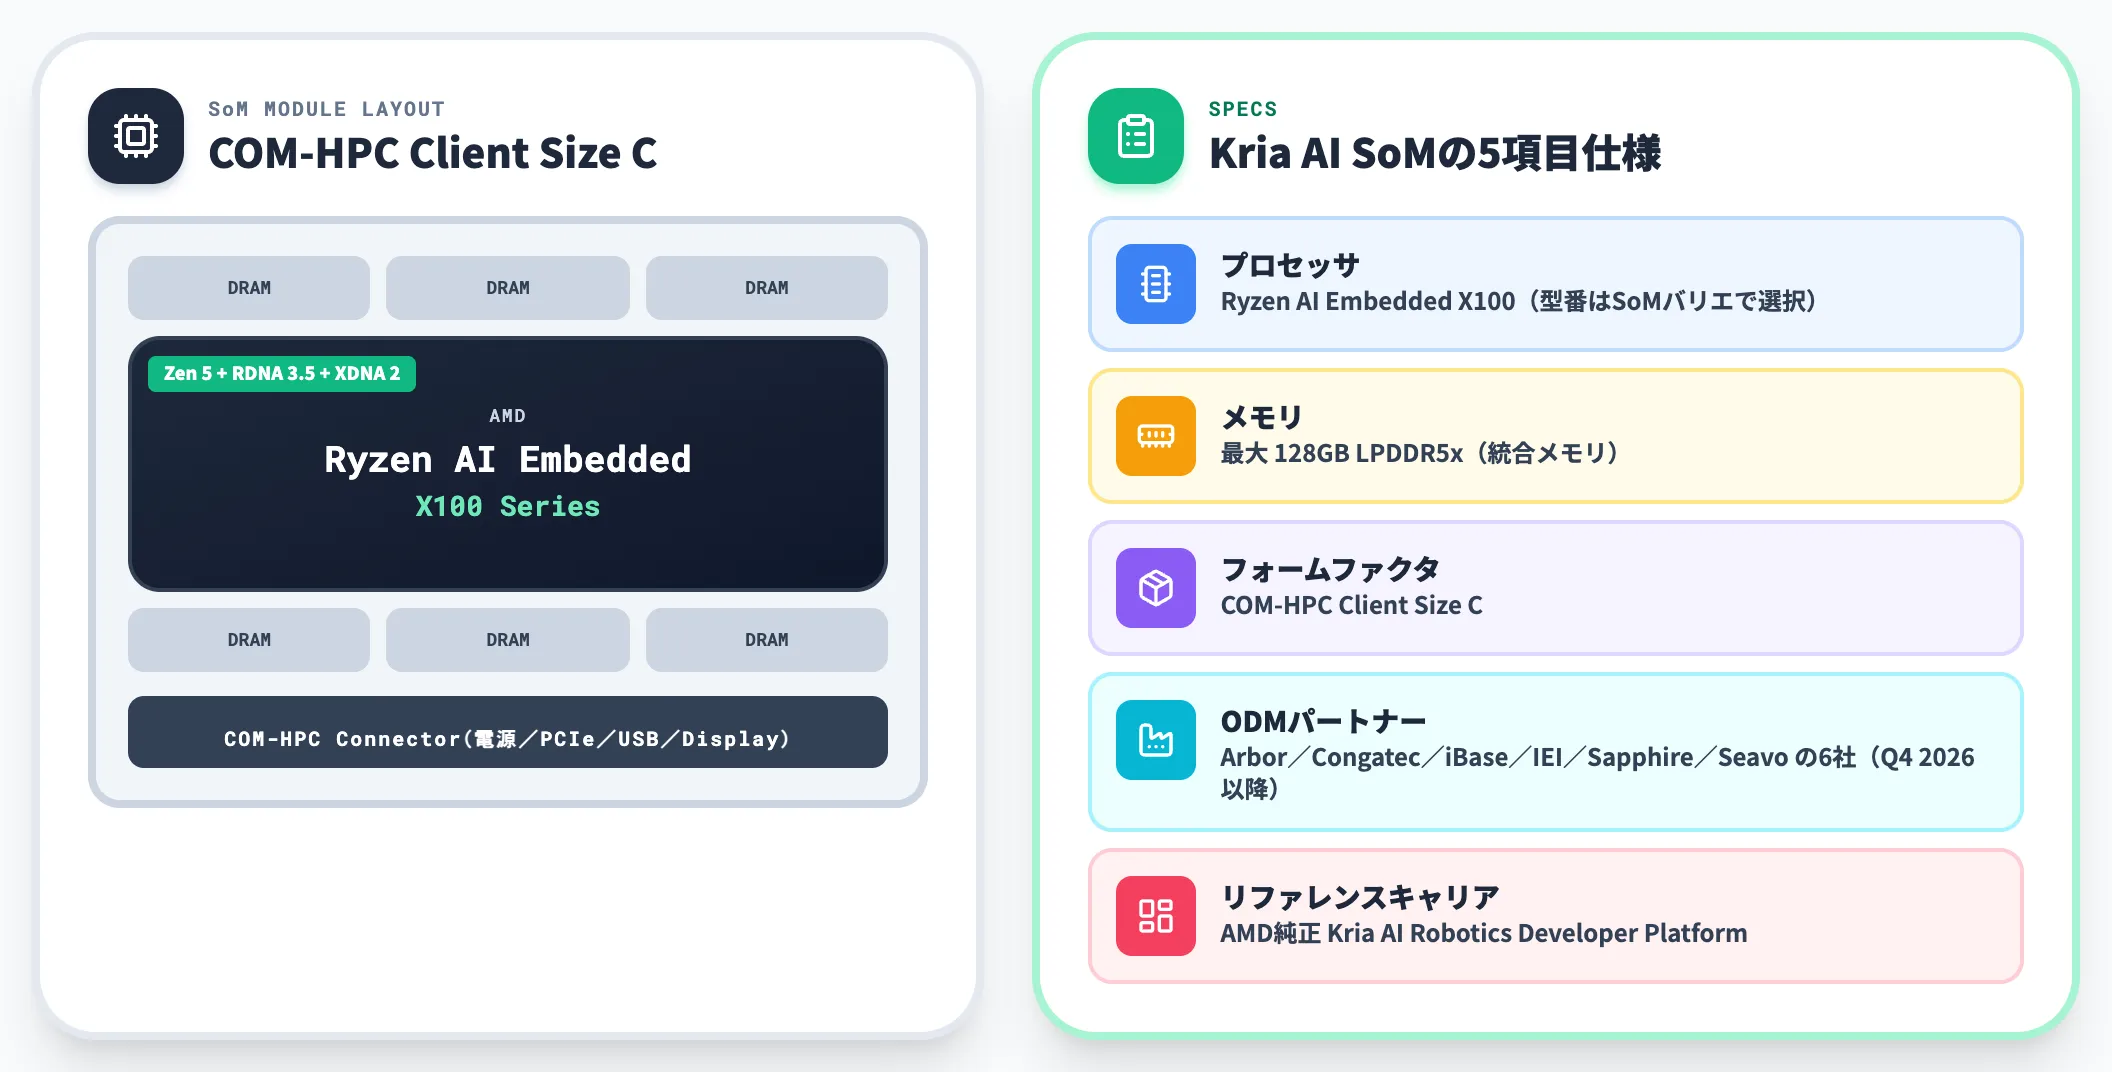
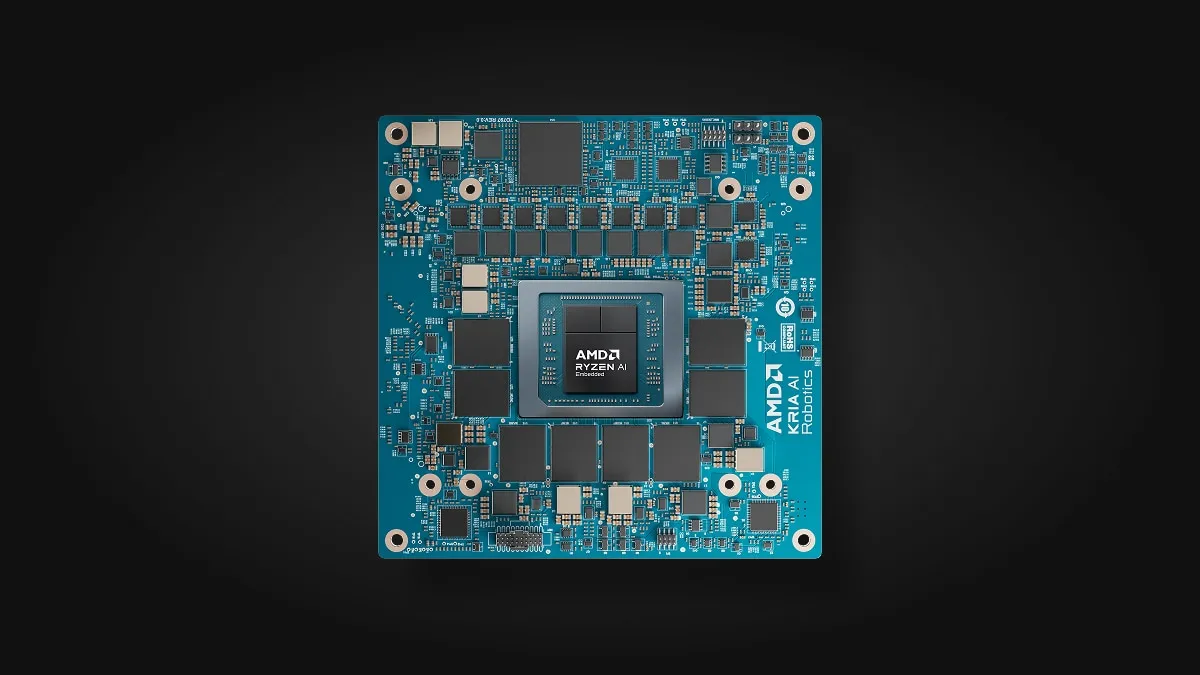
COM-HPC Client Size C形状のKria AI SOM。中央にRyzen AI Embeddedチップを配置し、周囲を独立DRAMパッケージが囲む(出典:AMD Kria AI Solutions)
Kria AI SoMはCOM-HPC Client Size C規格のシステムオンモジュールとして提供されます。基本仕様は以下のとおりです。
- 搭載プロセッサ: Ryzen AI Embedded X100シリーズ(型番はSoMバリエーションで選択)
- メモリ: 最大128GB LPDDR5x(統合メモリ)
- フォームファクタ: COM-HPC Client Size C
- ODMパートナー: Arbor Technology・Congatec・iBase・IEI・Sapphire・Seavoの計6社から2026年Q4以降に順次提供
- 主なリファレンスキャリア: AMD純正のKria AI Robotics Developer Platform
ODMパートナーからのSoM製品は、標準的なCOM-HPCコネクタ経由で電源・PCIe・USB・ディスプレイ出力を親基板に引き出す形で、キャリアボードを自社設計するときにピン配置を業界標準に合わせられる利点があります。
AMDが用意する開発キットの構成
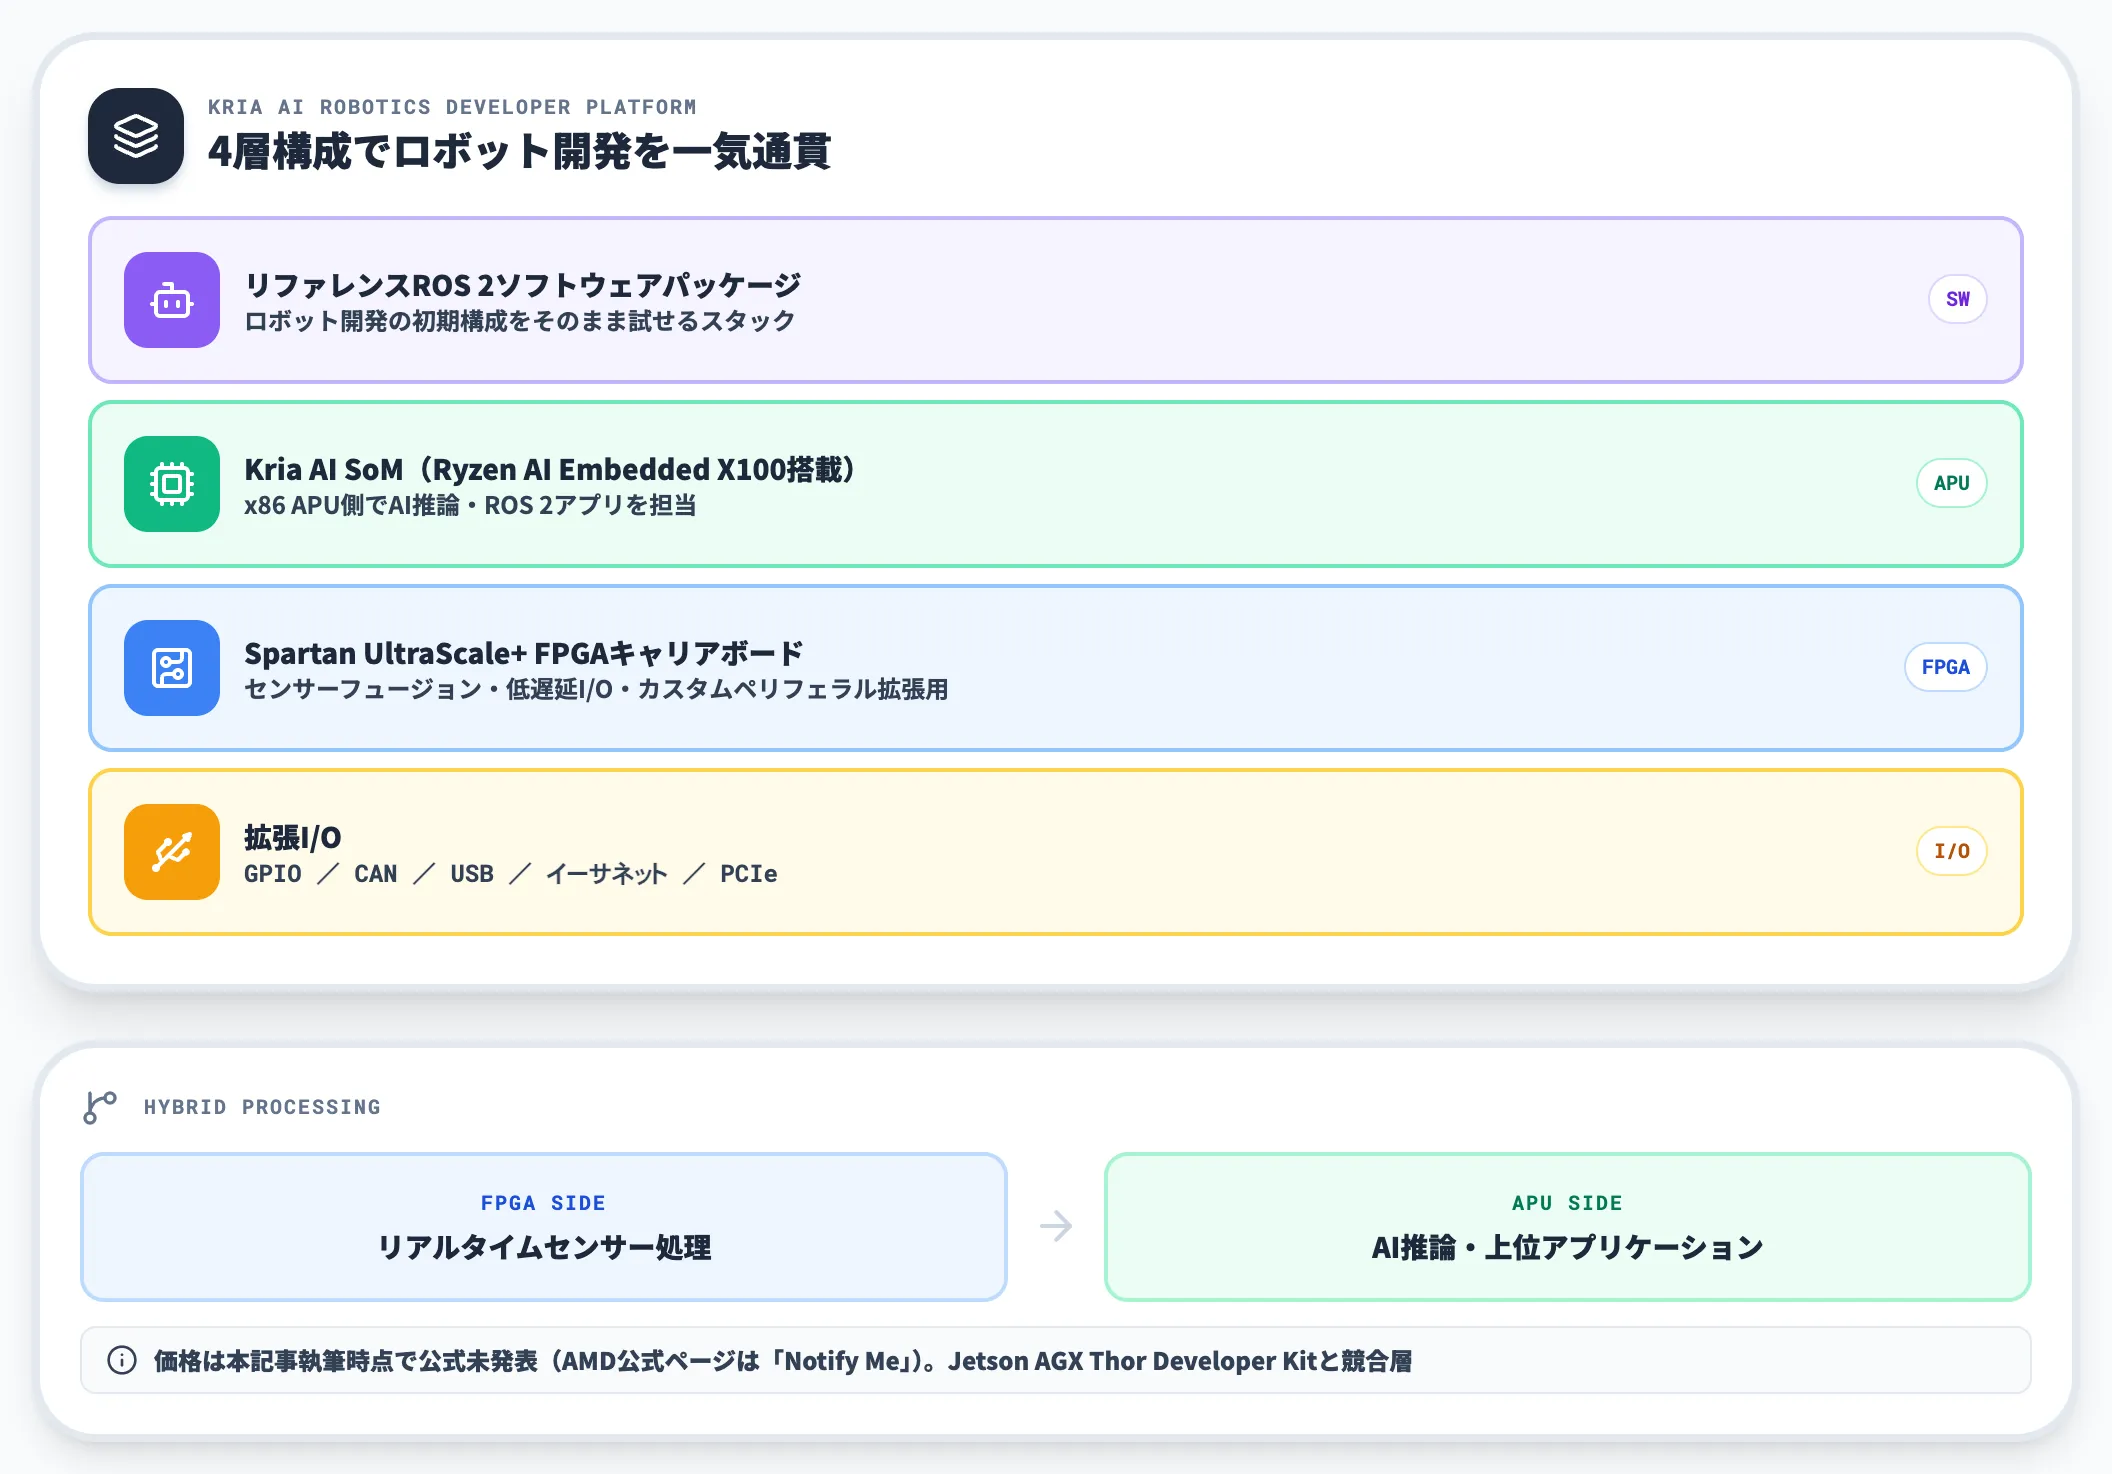
AMDは開発キットとして「Kria AI Robotics Developer Platform」も同時発表しました。Kria AI SoMをキャリアボードに載せた開発者向けボードで、以下の構成を持ちます。
- Kria AI SoM(Ryzen AI Embedded X100搭載)
- Spartan UltraScale+ FPGAキャリアボード(センサーフュージョン・低遅延I/O・カスタムペリフェラル拡張用)
- 拡張I/O(GPIO・CAN・USB・イーサネット・PCIe)
- リファレンスROS 2ソフトウェアパッケージ
Robotics Developer PlatformはFPGA+x86 APUのハイブリッド構成で、リアルタイムセンサー処理をFPGA側、AI推論をAPU側で担う設計が可能です。
価格は本記事執筆時点で公式未発表(AMD公式ページは「Notify Me」表示)ですが、NVIDIA Jetson AGX Thor Developer Kitと競合する開発キット層に位置づけられます。
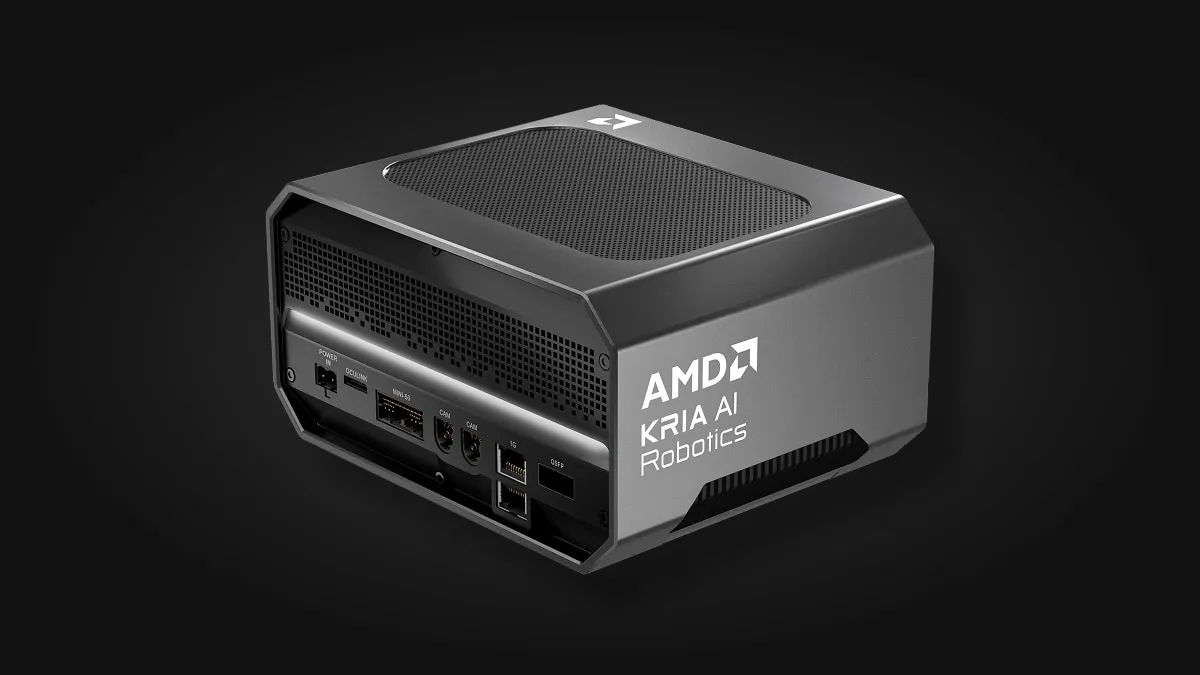
Kria AI Robotics Developer Platformの筐体外観。電源・OCuLink・CAN 2ポート・1GbE・QSFPを1台に集約する(出典:AMD Kria AI Robotics Developer Platform)
単体プロセッサとSoMの選び分け
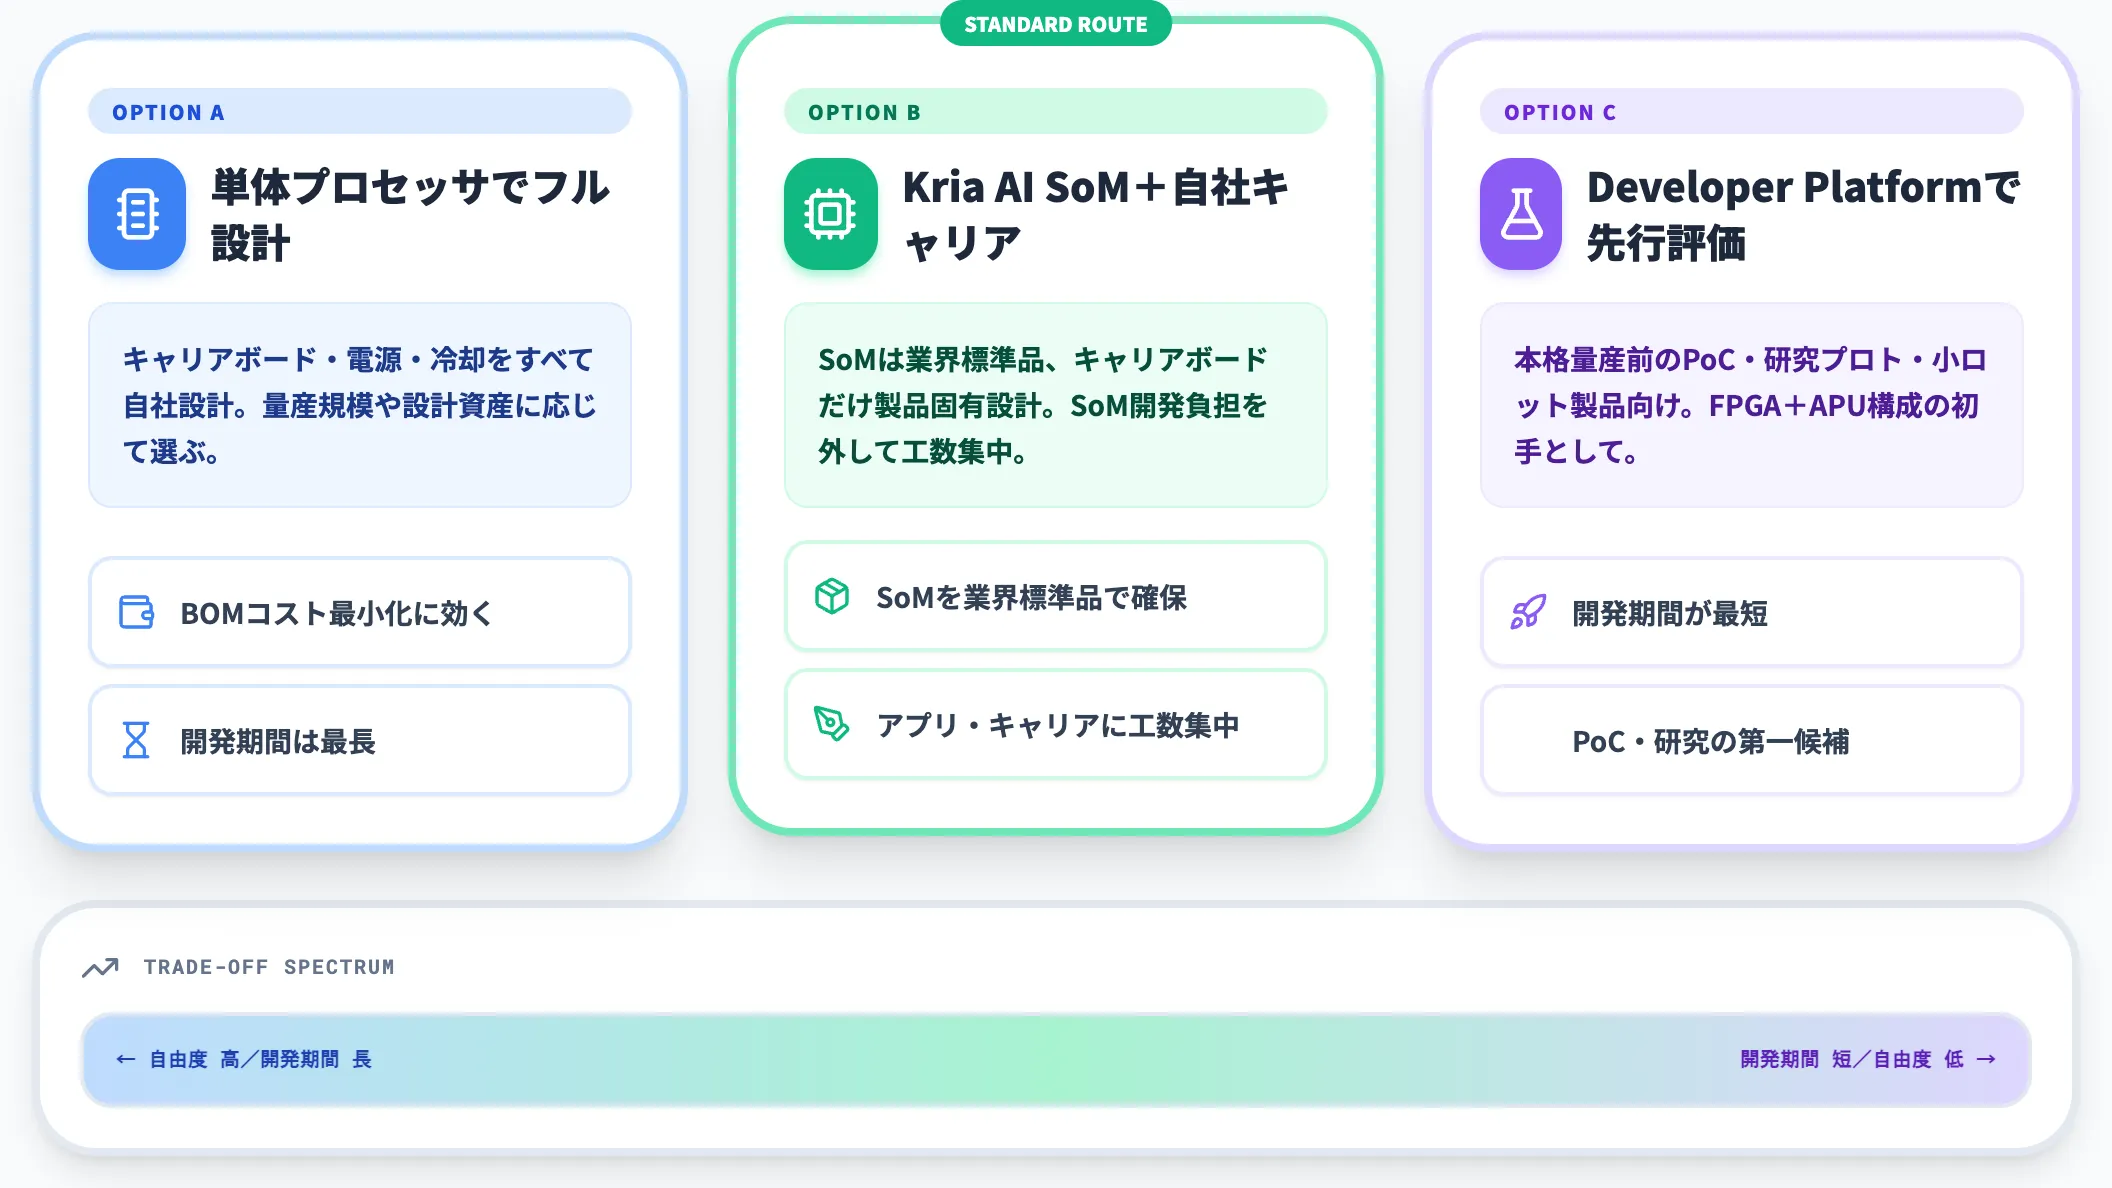
Ryzen AI Embedded X100の入手ルートは3種類(単体プロセッサ/Kria AI SoM/Robotics Developer Platform)あります。以下の観点で選び分けが決まります。
-
単体プロセッサでフル設計
量産規模や設計資産に応じて、キャリアボード・電源・冷却をすべて自社設計するルート。BOMコスト最小化に効くが、開発期間は最長
-
Kria AI SoM+自社キャリアボード
SoMは業界標準品を使い、キャリアボードだけ製品固有設計するルート。SoM開発の負担を外し、キャリア設計とアプリケーションに工数を集中できる
-
Robotics Developer Platformで先行評価
本格量産前のPoC・研究プロトタイプ・小ロット製品向け。FPGA+APU構成を触りたい場合の第一候補
ロボット・産業機器の量産規模に応じて、単体プロセッサ→Kria AI SoM→Developer Platformの順に自由度が下がる代わりに開発期間が短くなる、というトレードオフで選び分ける構造です。
Ryzen AI Embedded X100が想定するフィジカルAIのユースケース
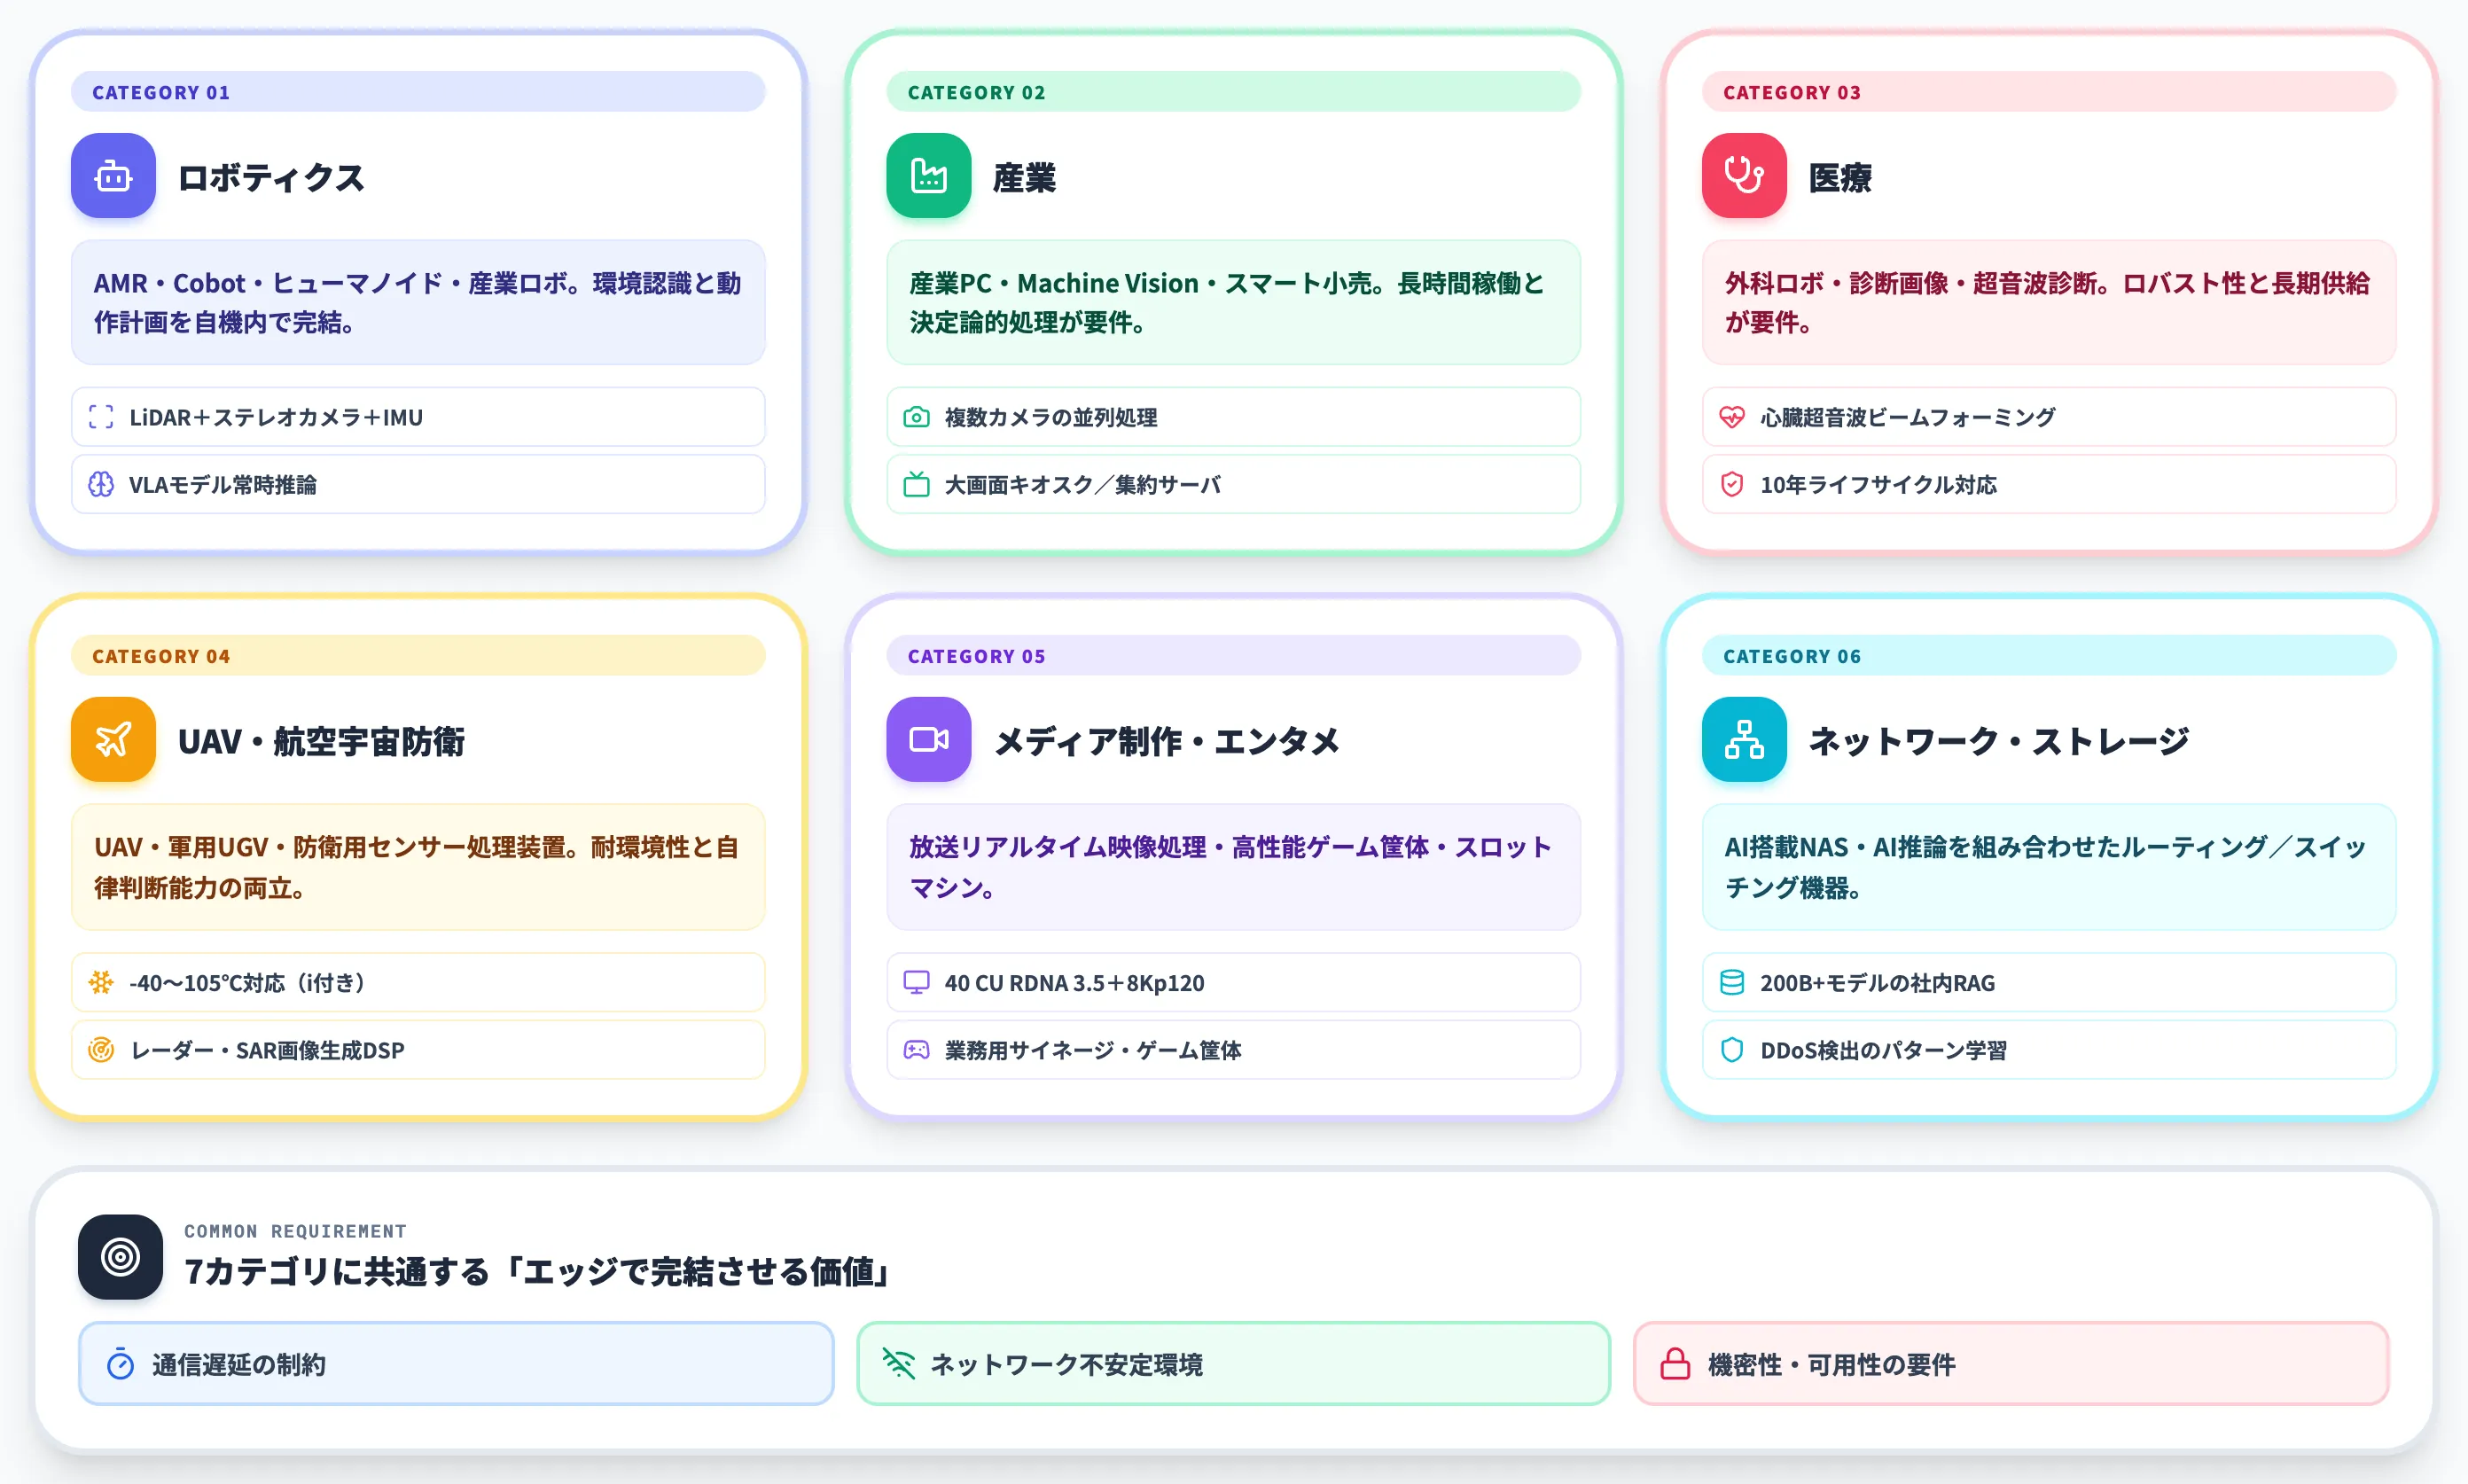
Ryzen AI Embedded X100が想定するユースケースは、AMD公式が挙げる6カテゴリに加え、Product Briefで言及されるネットワーキング・ストレージ用途を含めた計7カテゴリに整理できます。共通するのは「エッジ側で低遅延に処理し、複数ワークロードを1台に統合したい」という要件です。
ロボティクス(AMR・Cobot・ヒューマノイド)
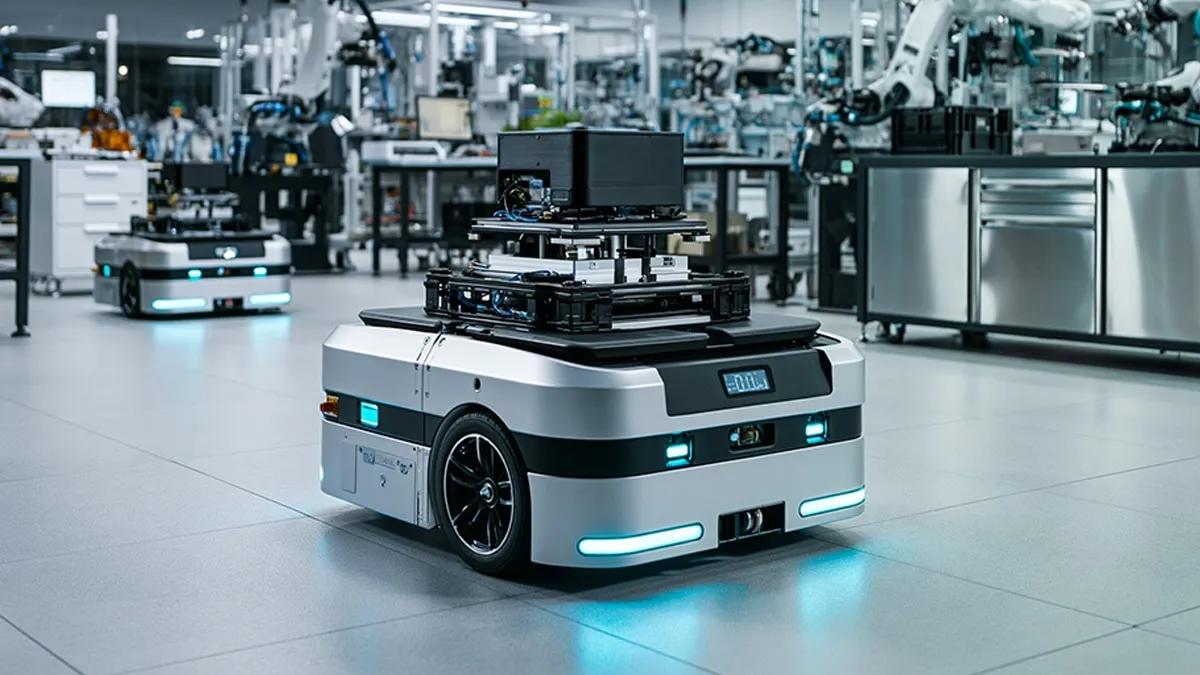
AMR・Cobot・産業ロボットが並ぶスマート工場イメージ。AMDがX100のロボティクス代表シーンとして公式に示す構成(出典:AMD Ryzen AI Embedded X100 Series)
産業ロボット・協働ロボット(Cobot)・自律走行搬送車(AMR)・ヒューマノイドといった、環境認識と動作計画を自機内で完結させる必要があるロボット群が主要なターゲットです。
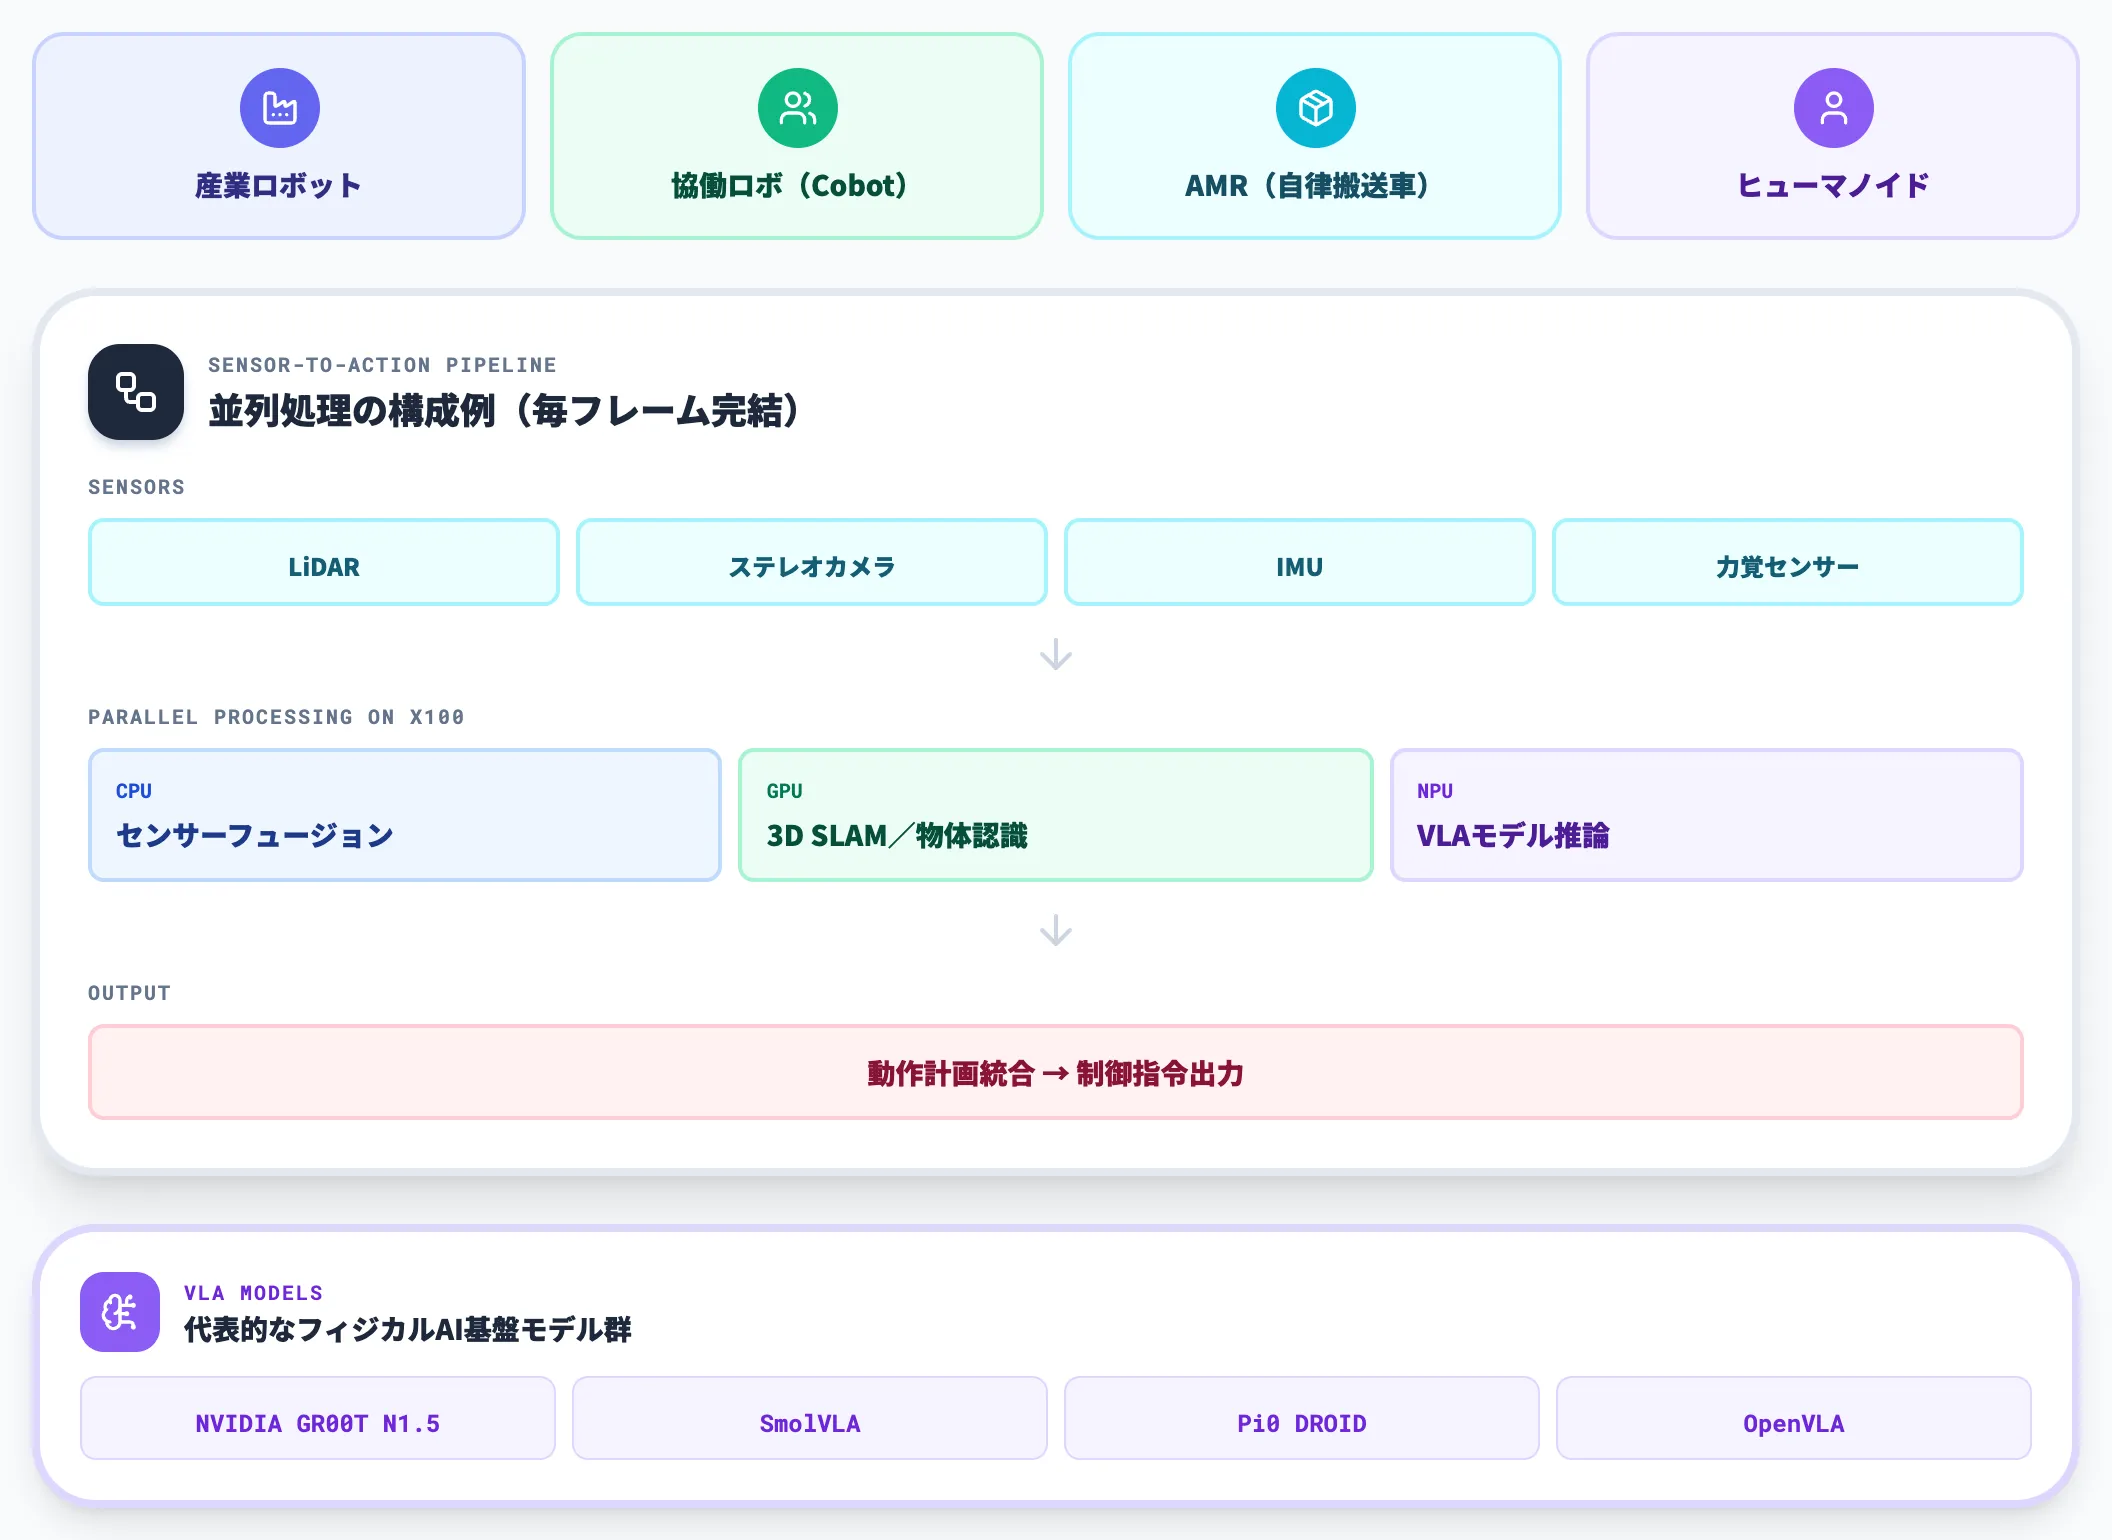
センサーの多くはLiDAR・ステレオカメラ・IMU・力覚センサーの組み合わせで、CPUでセンサーフュージョン、GPUで3D SLAM・物体認識、NPUでVLA(Vision-Language-Action)モデル推論、CPUで動作計画統合、という並列処理の構成例が挙げられます。X100の統合メモリ設計は、この並列処理間のデータコピーを排除する点で効きます。
VLAモデルの代表例はNVIDIA GR00T N1.5・SmolVLA・Pi0 DROID・OpenVLAなどで、NVIDIA Isaac Simなどのシミュレータで学習させたモデルをX100搭載ロボットにデプロイする構成は、2026年時点の選択肢の一つとして挙げられます。
産業(産業PC・マシンビジョン・スマート小売)
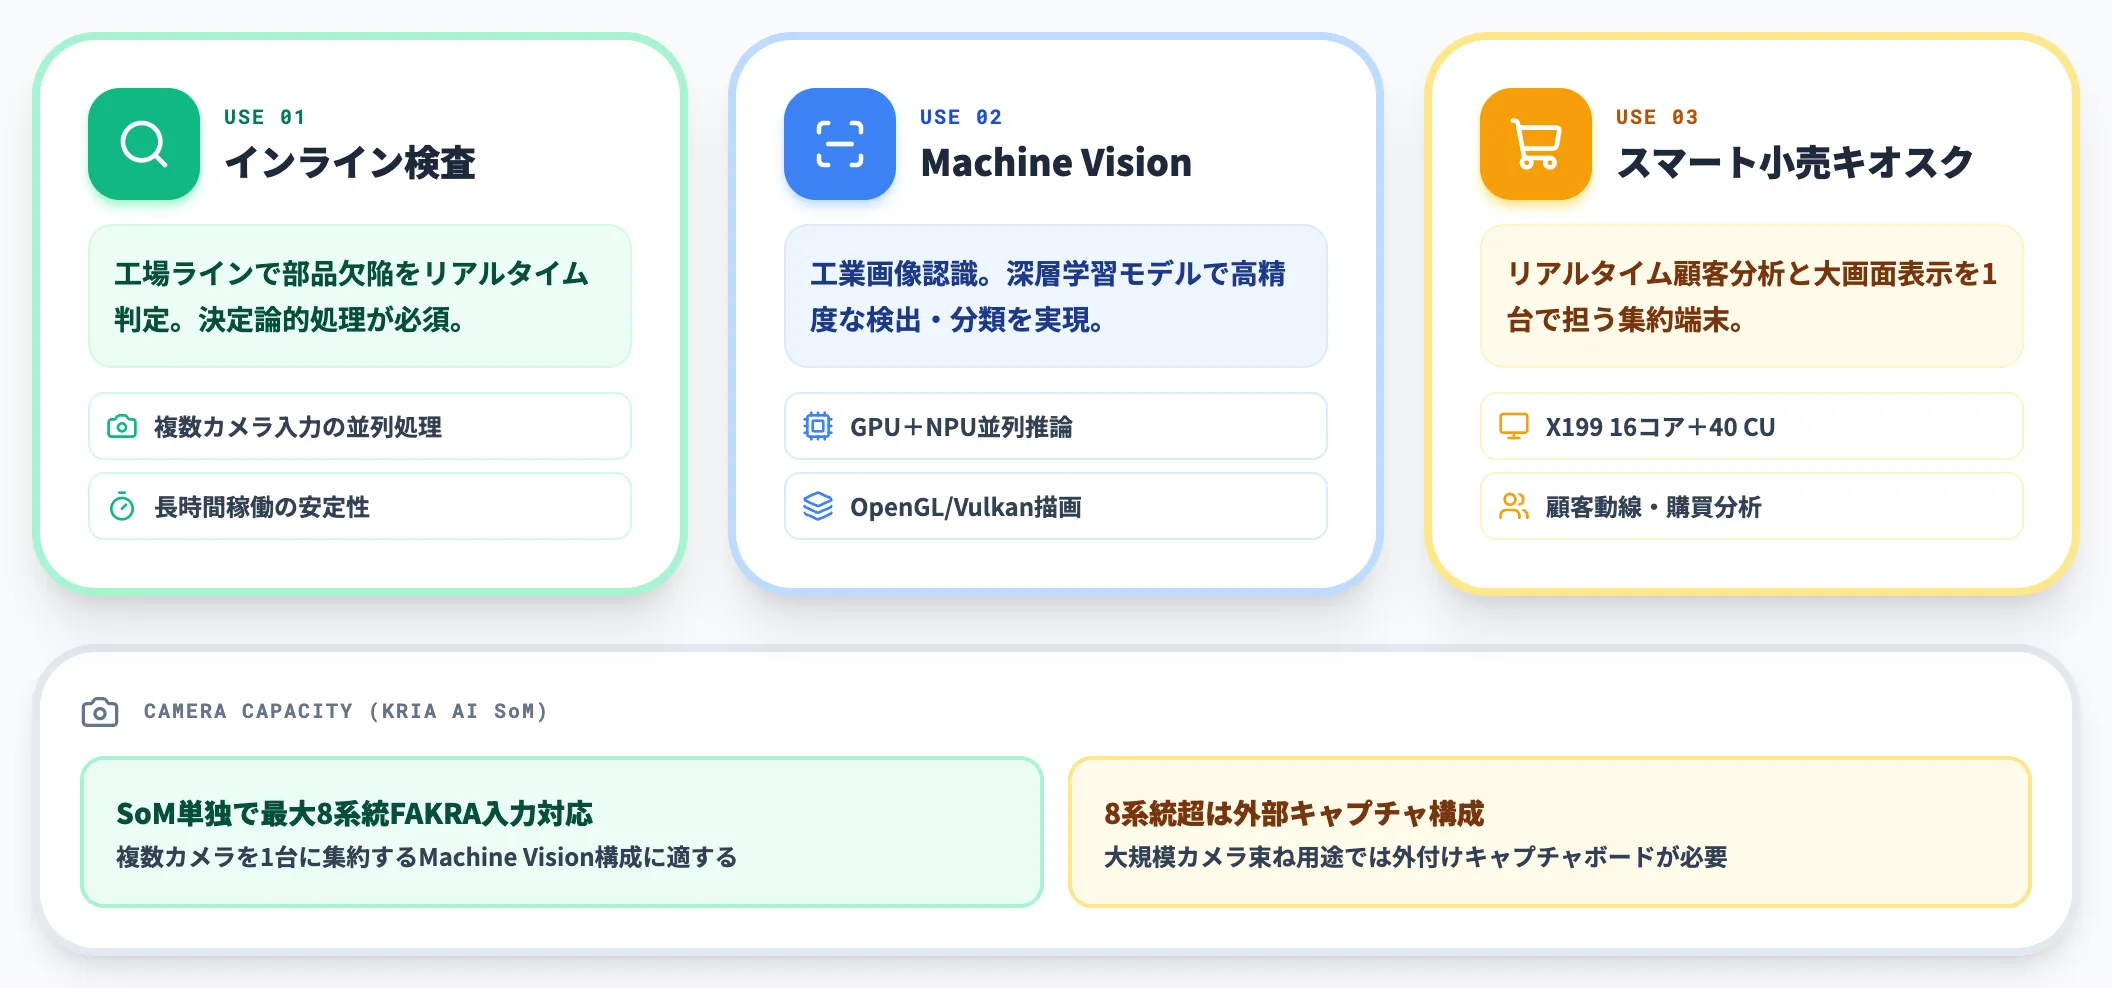
工場のインライン検査、Machine Vision(工業画像認識)、スマート小売のリアルタイム顧客分析といった、長時間稼働と決定論的処理が必要な産業向けPCが対象です。
複数カメラ入力の並列処理・OpenGL/Vulkan描画・AI推論を1台で担う構成で、X199の16コア+40 CU+50 TOPSは大画面表示のスマート小売キオスク端末や、複数カメラを束ねる集約サーバー用途に向きます(AMD Kria AI Solutions公式仕様ではSoM側で最大8系統FAKRA入力に対応。これを超えるカメラを束ねる場合は外部キャプチャ構成が必要)。
産業用ロボットアーム群と3Dモデル解析モニターが並ぶ組立ラインのイメージ。産業PC・Machine Vision向け(出典:AMD Ryzen AI Embedded X100 Series)
医療(外科ロボット・診断画像)
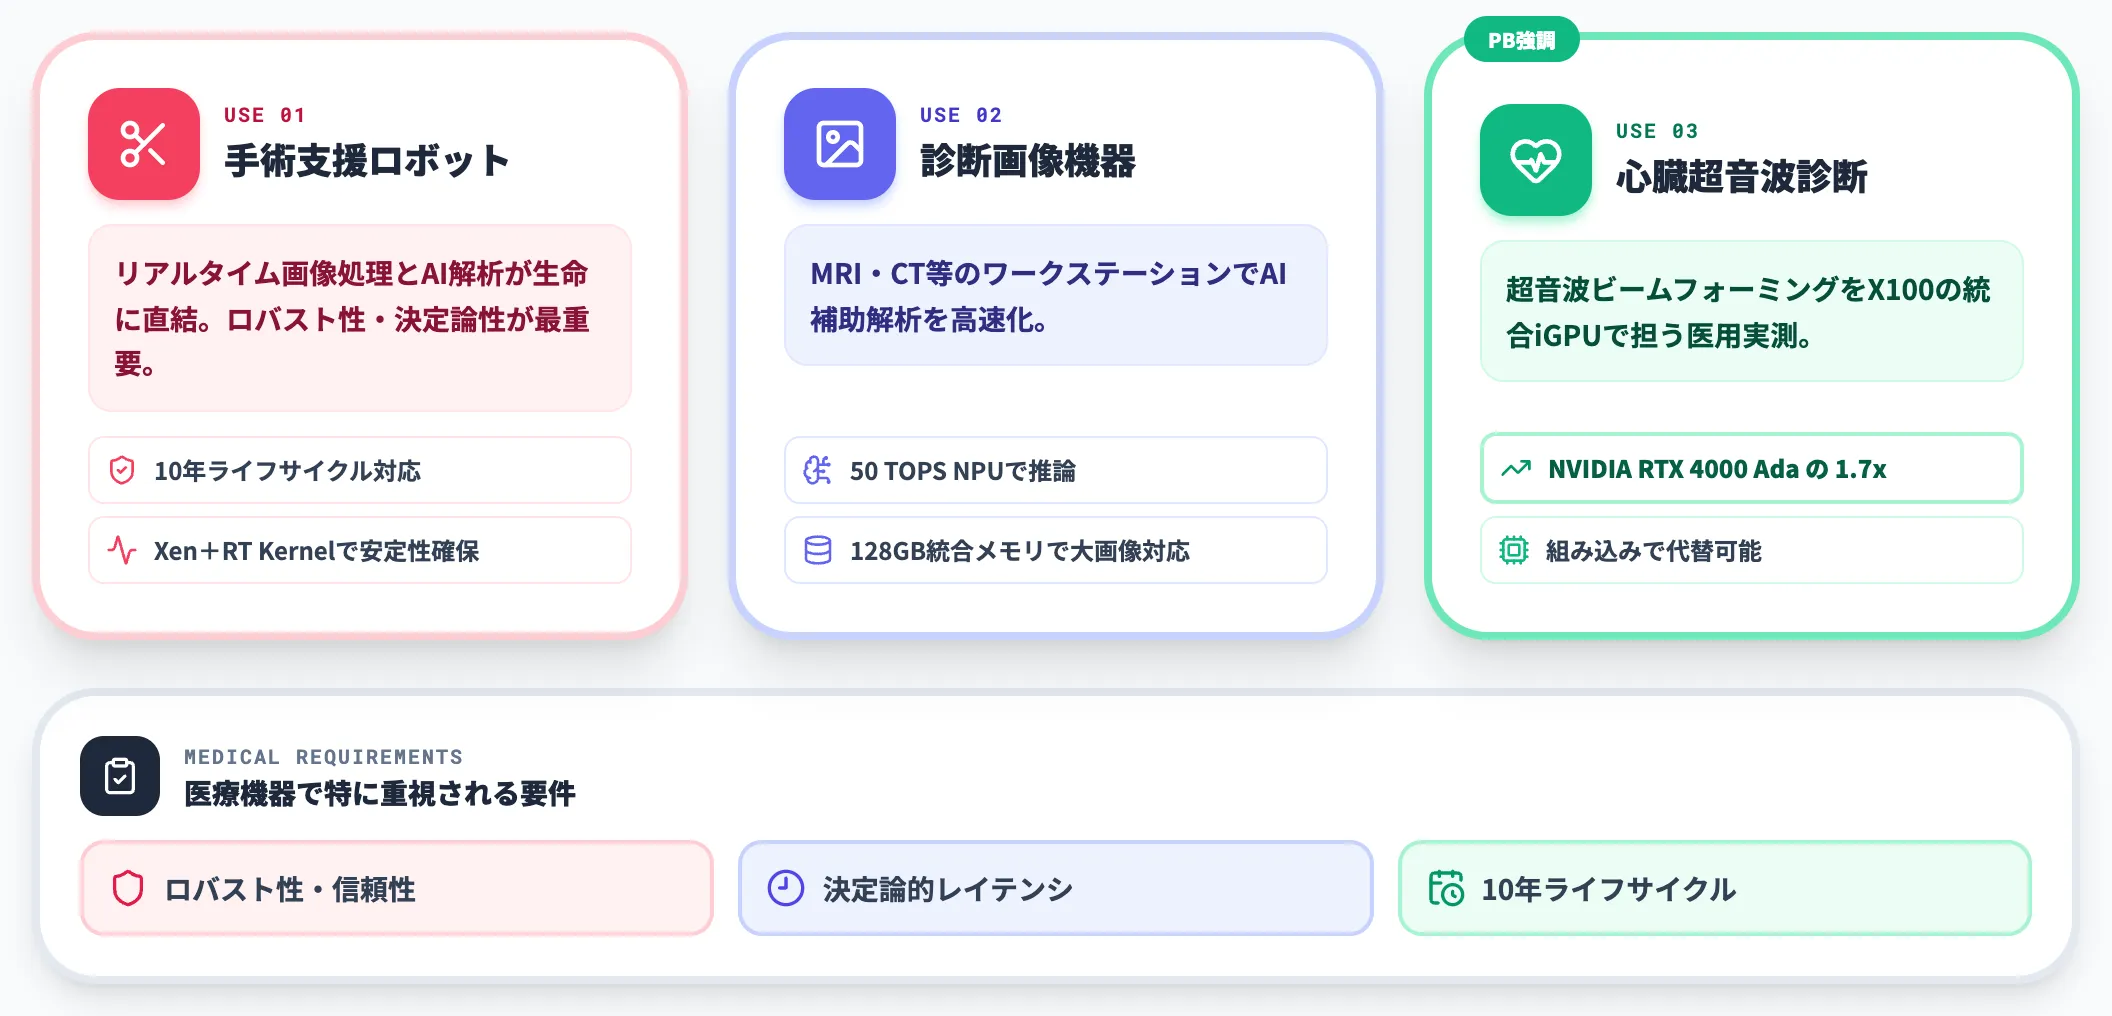
手術支援ロボット・診断画像機器・超音波診断装置など、リアルタイム画像処理とAI解析が生命に直結する医療機器が対象です。
Product Briefで挙げられる「心臓超音波ビームフォーミングでNVIDIA RTX 4000 Adaの1.7倍」の性能主張は、この分野を強く意識した比較です。
手術ロボットではロバスト性・決定論性・長期供給が特に重視され、Ryzen AI Embedded X100の10年ライフサイクル設計が採用判断の材料になります。
MRIスキャナーと診断ワークステーションを備えた放射線室のイメージ。医療画像処理・手術ロボット向け(出典:AMD Ryzen AI Embedded X100 Series)
UAV・航空宇宙防衛(無人機・信号処理)
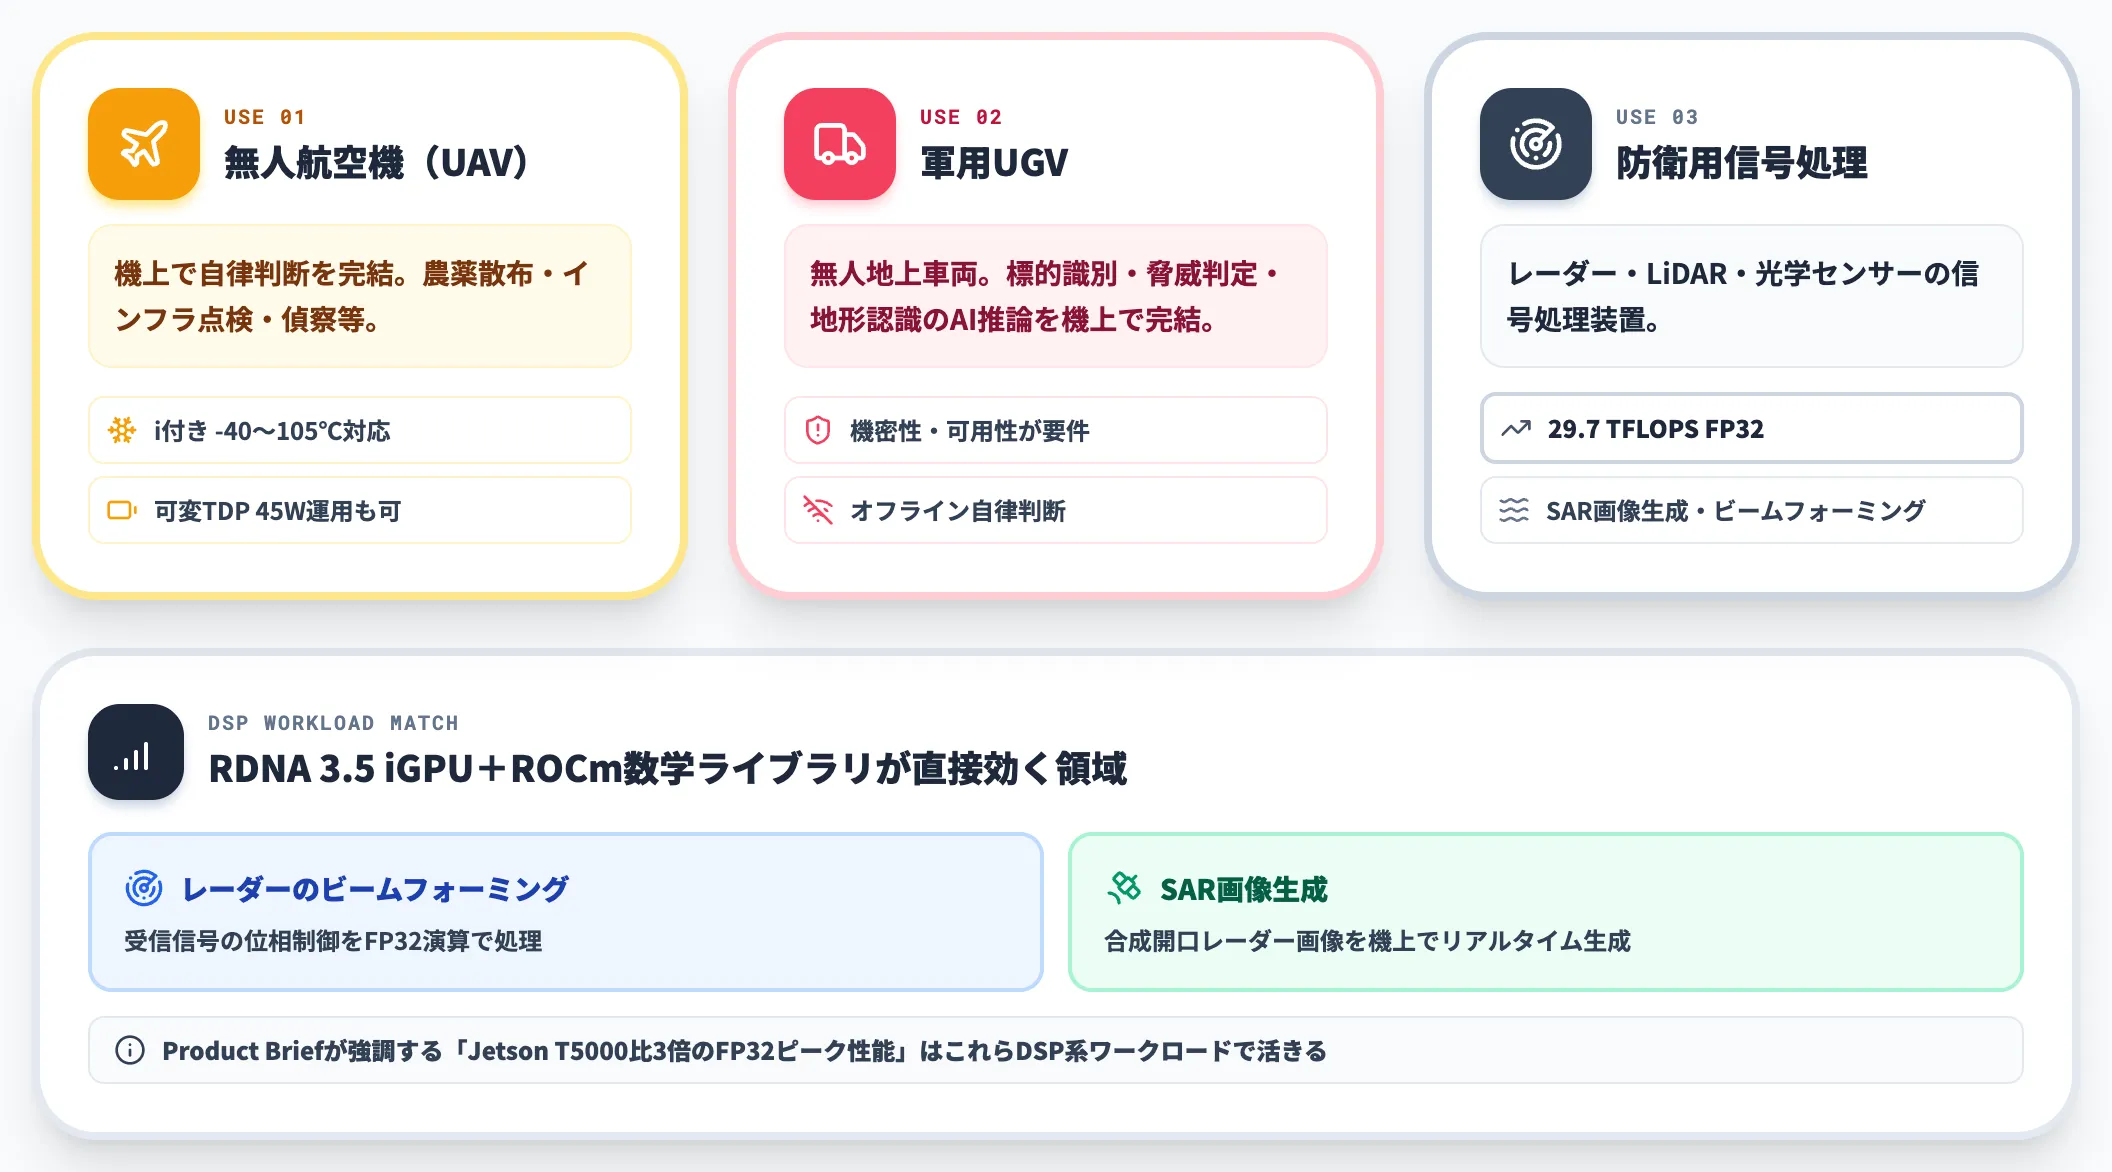
無人航空機(UAV)・軍用UGV・防衛用センサー処理装置など、耐環境性と自律判断能力の両立が求められる用途です。
産業温度版(i付き)モデルの-40〜105℃対応が効くのはこの領域で、レーダー・LiDAR・光学センサーの信号処理と、標的識別・脅威判定のAI推論を機上で完結させる構成が可能です。Product Briefが強調する「29.7 TFLOPS FP32(RDNA 3.5 iGPU/ROCm数学ライブラリ)」はレーダーのビームフォーミング・SAR画像生成といったDSPワークロードで直接活きます。
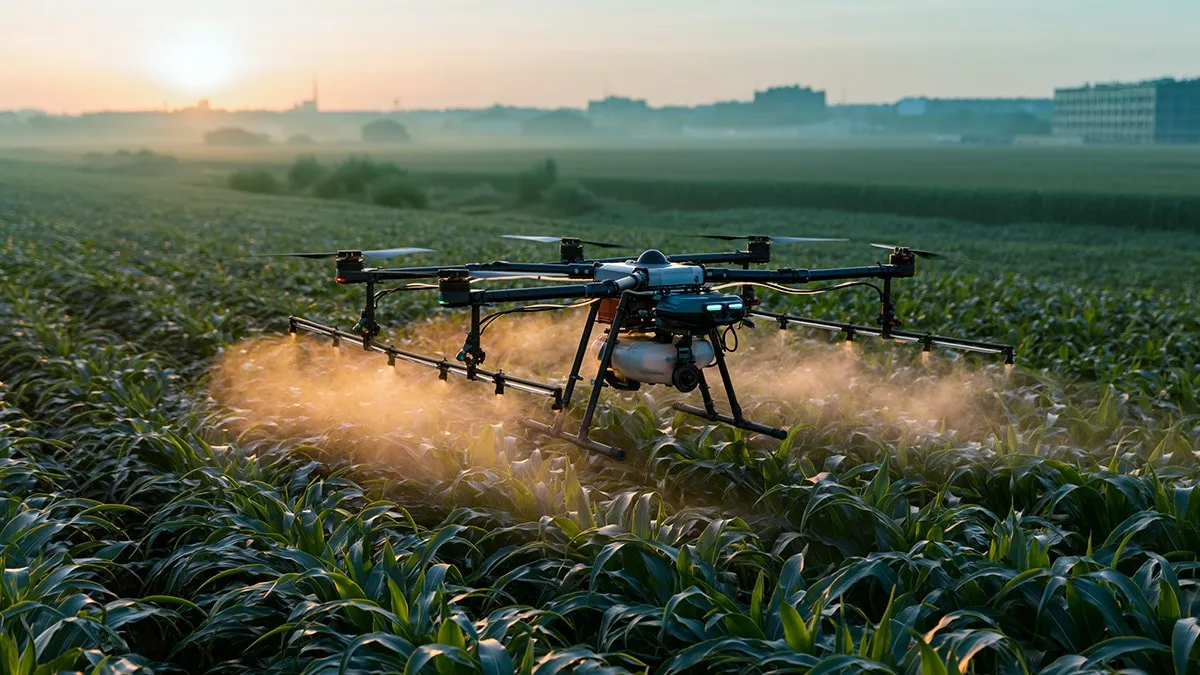
農薬散布中の大型自律農業ドローンイメージ。UAV・スマート農業・インフラ点検向けの想定シーン(出典:AMD Ryzen AI Embedded X100 Series)
メディア制作・インタラクティブエンタメ
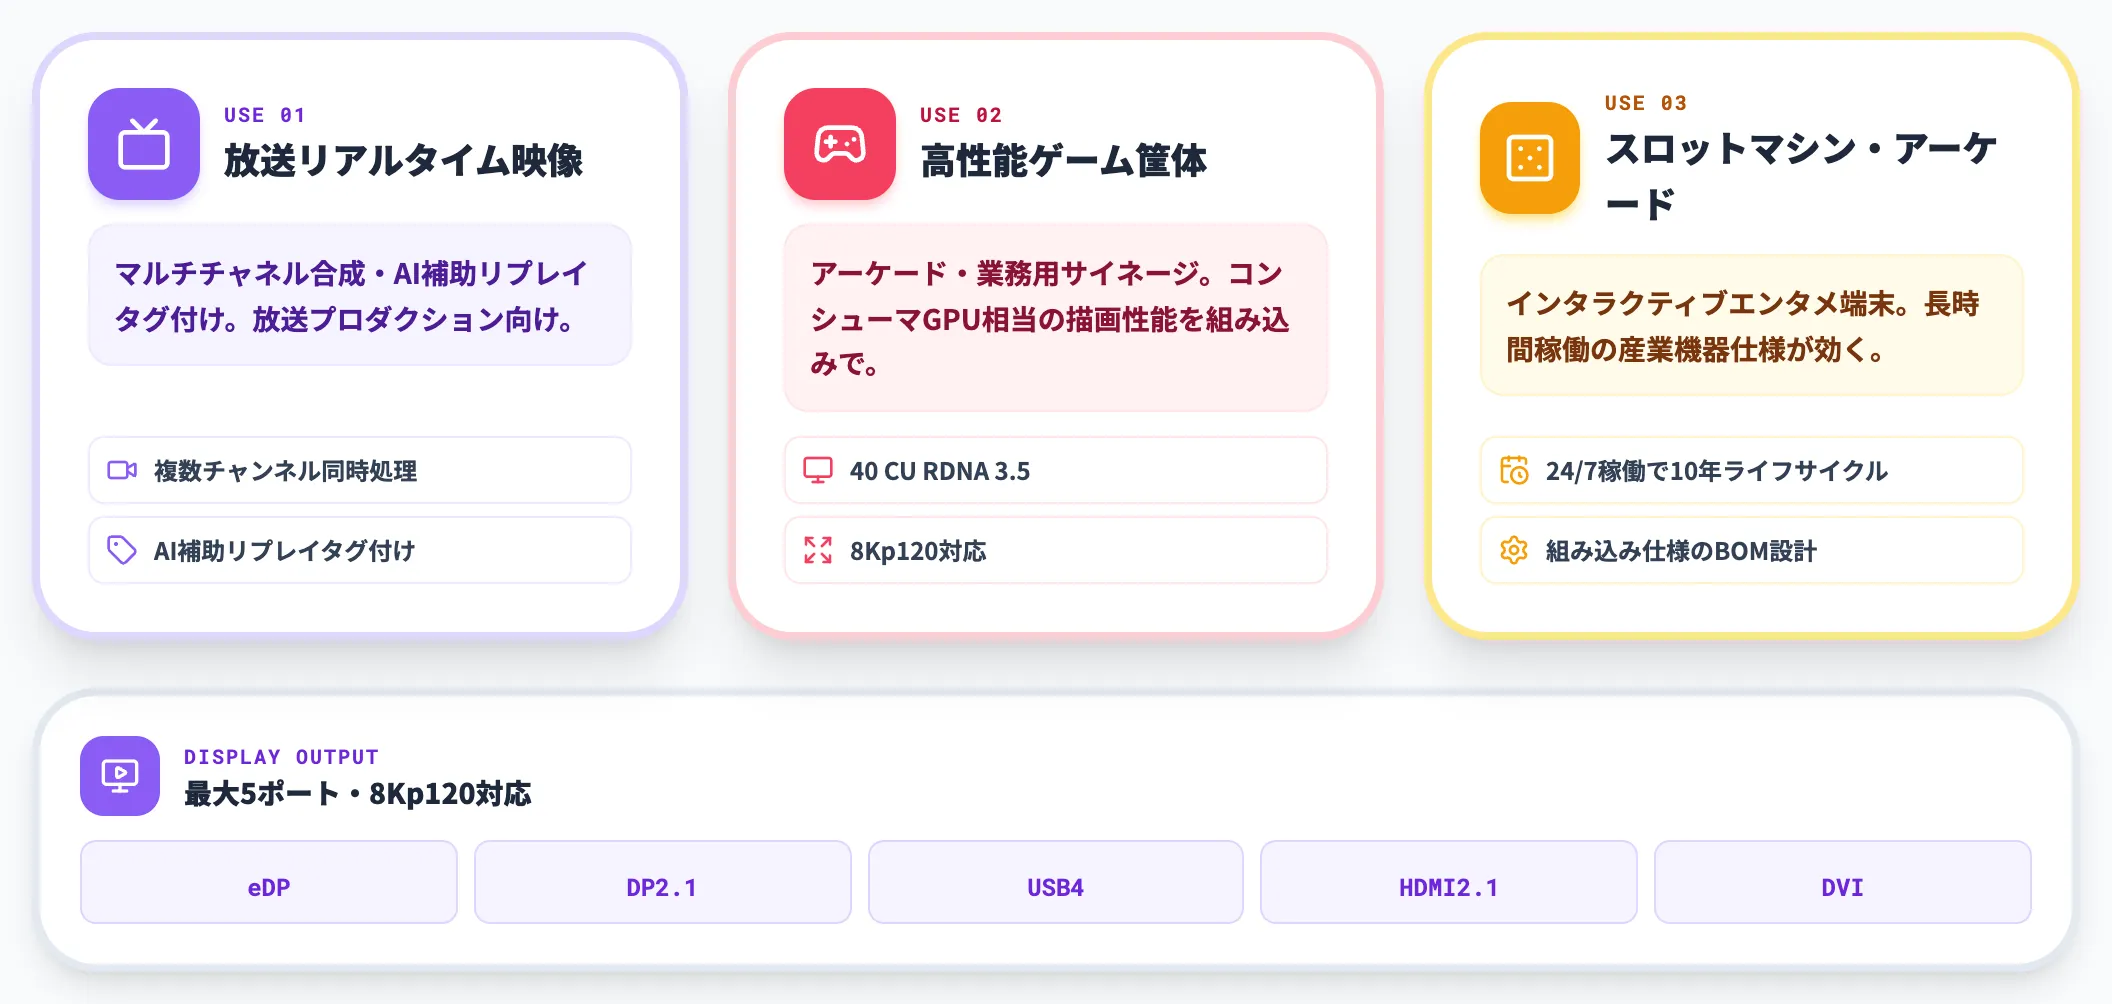
放送向けリアルタイム映像処理(マルチチャネル合成・AI補助リプレイタグ付け)、高性能ゲーム筐体、スロットマシン・アーケード機器などのインタラクティブエンタメが対象です。
40 Compute UnitのRDNA 3.5 iGPUと8Kp120対応の映像出力を活かした業務用サイネージ・高解像度ゲーミング筐体・スポーツ分析システムに向けた用途で、コンシューマ向けGPUに近い描画性能を組み込み仕様で使える点が強みです。
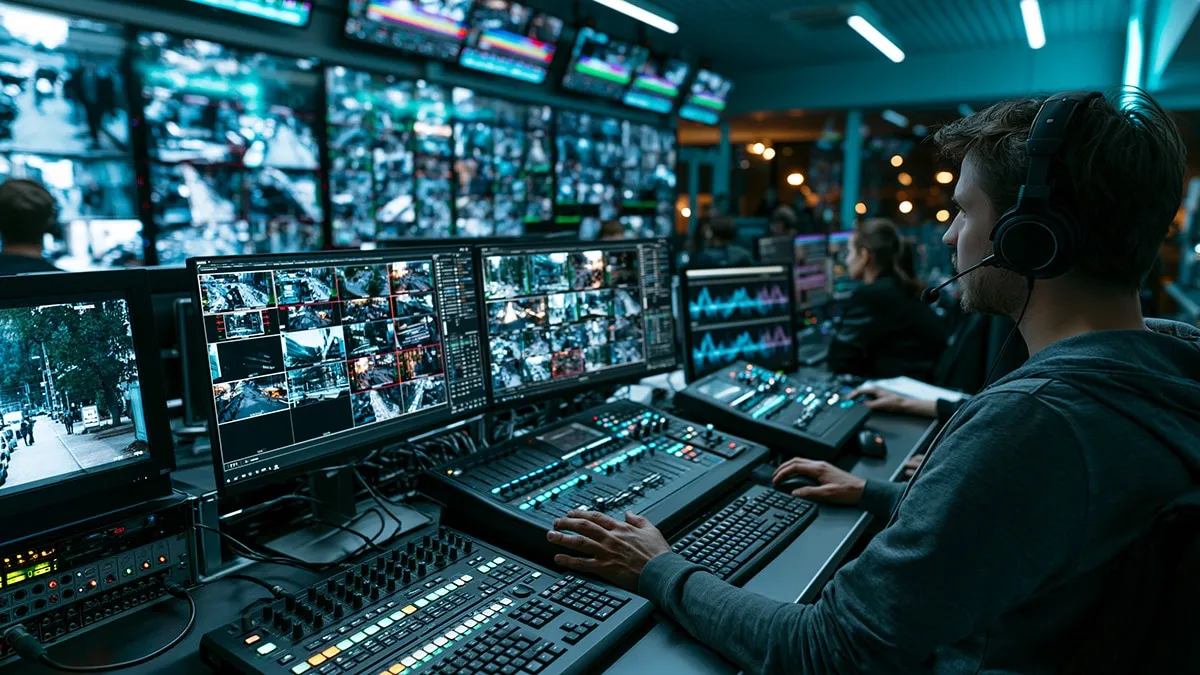
放送用管制室のマルチチャネル映像処理イメージ。AI補助リプレイ・タグ付けや放送プロダクションを想定したシーン(出典:AMD Ryzen AI Embedded X100 Series)
ネットワーク・ストレージ(AI NAS・スイッチング)
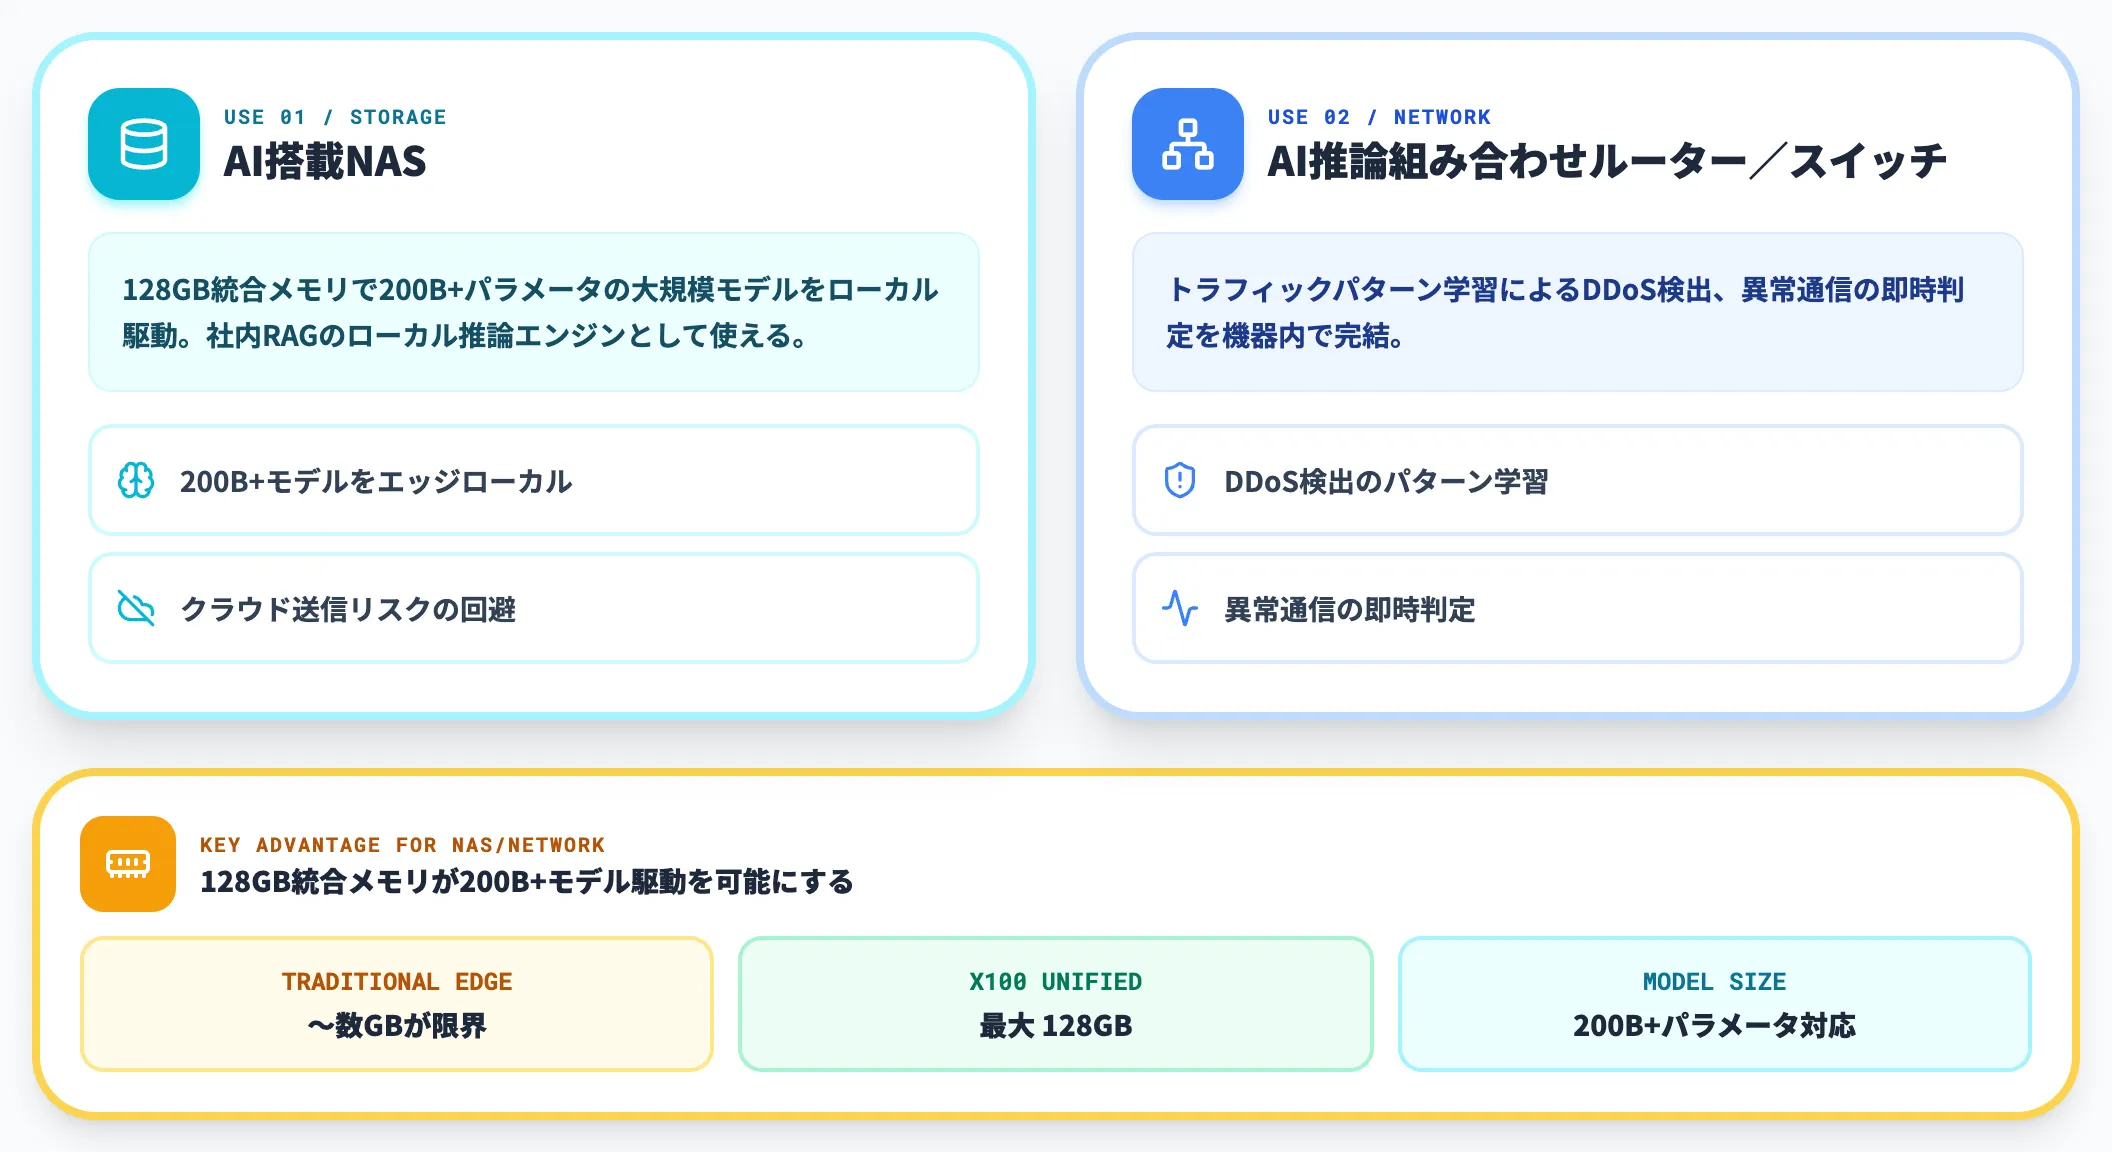
Product Briefで新たに追加されたカテゴリで、AI搭載NAS・AI推論を組み合わせたルーティング・スイッチング機器が対象です。
128GB統合メモリで200B+パラメータの大規模モデルをローカル駆動できる特性を活かし、AI NASでは「社内RAGのローカル推論エンジン」として、ルーター・スイッチでは「トラフィックパターン学習によるDDoS検出」として使う構成が想定されます。
フィジカルAIの共通要件——エッジ推論の主戦場
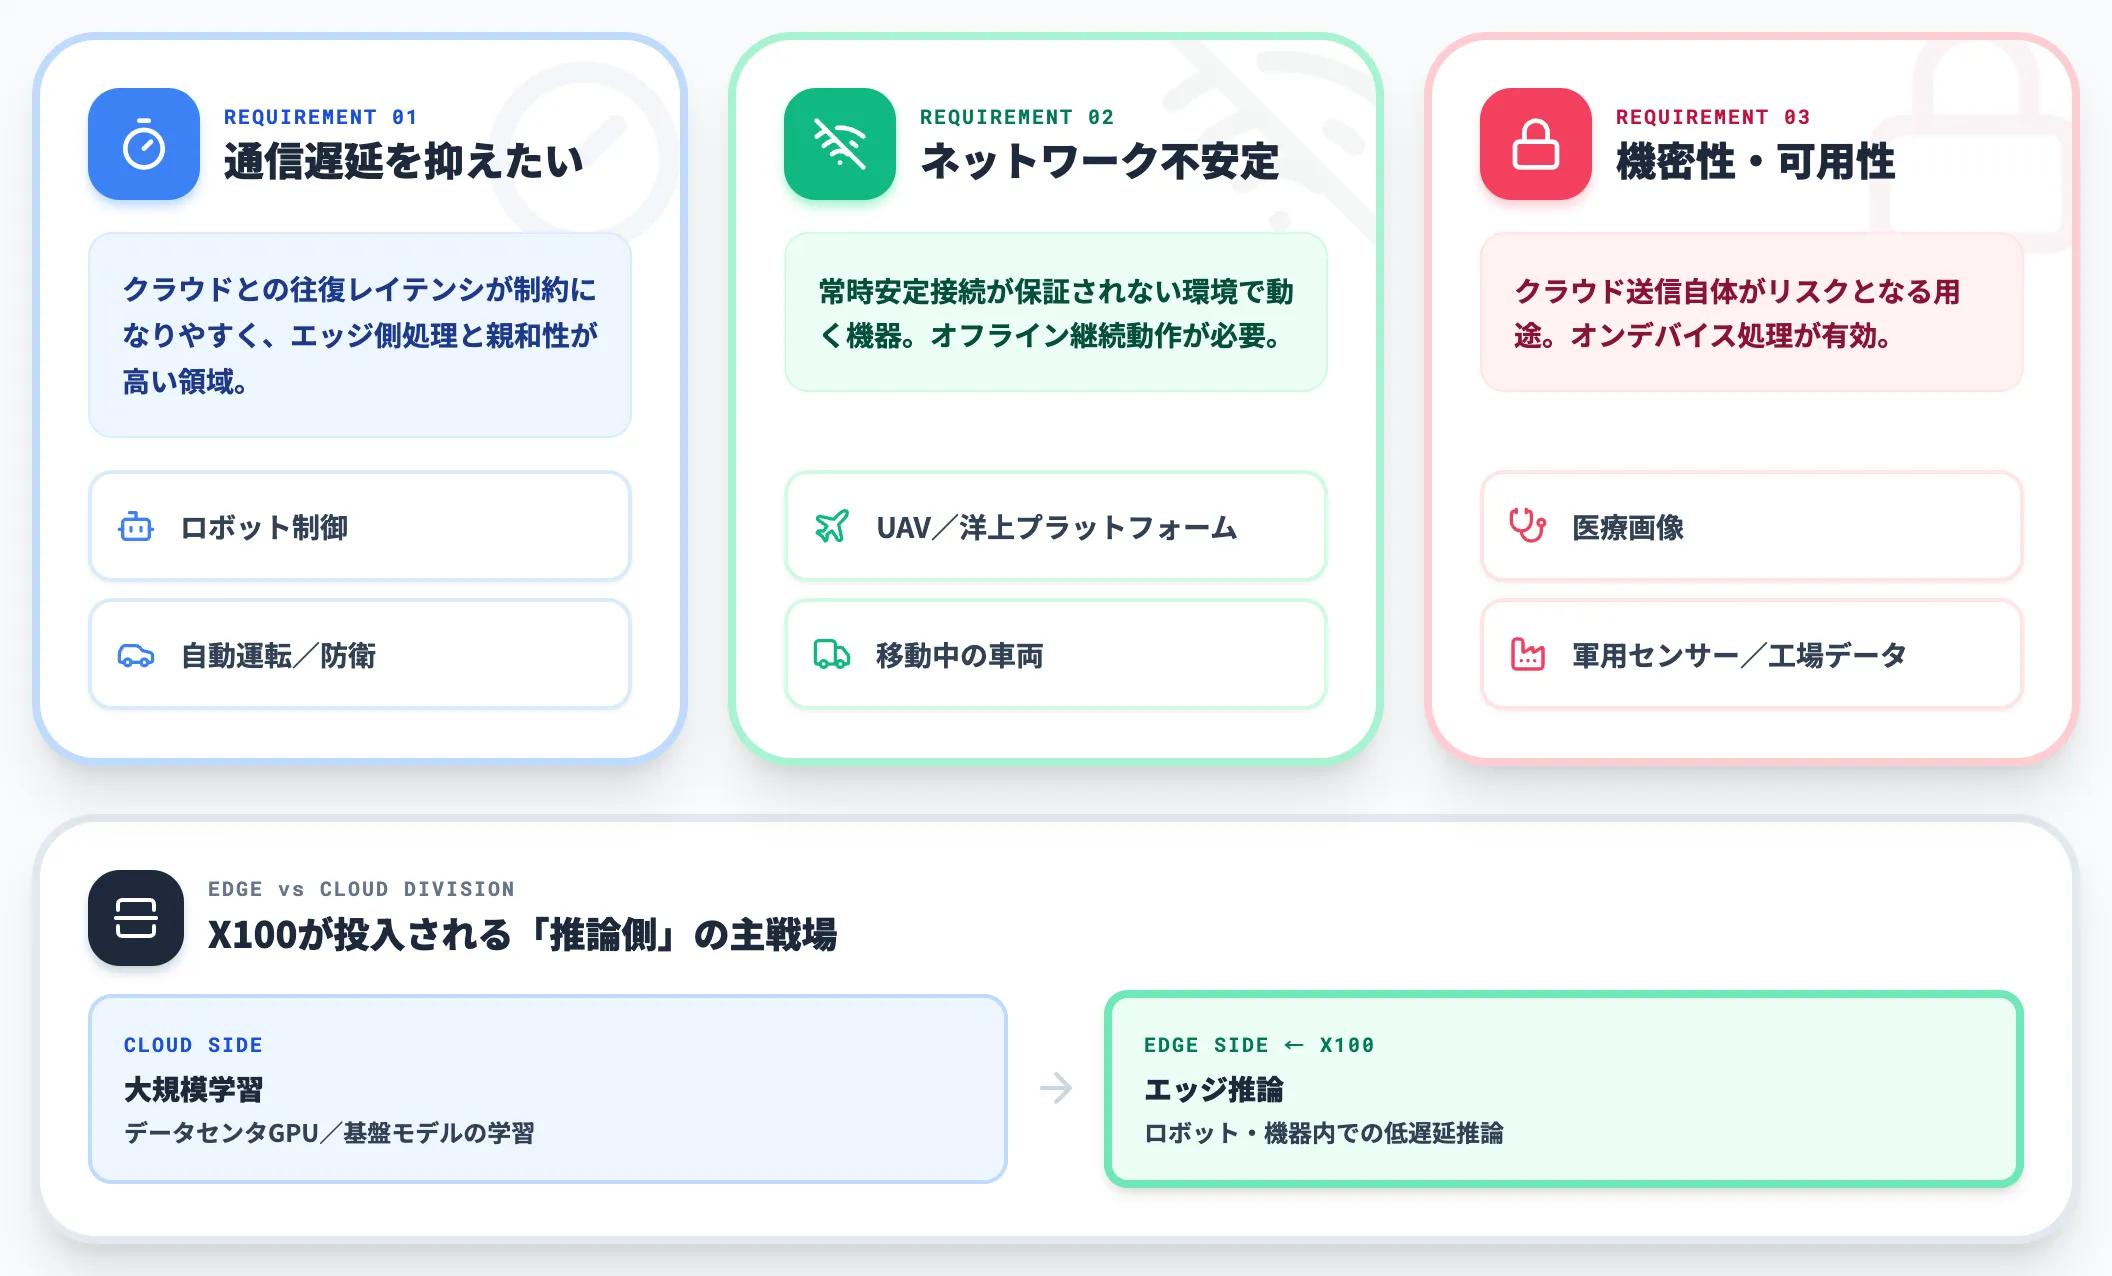
上記6〜7カテゴリに共通するのは、「AI推論をクラウドではなくデバイス側で完結させる価値が高い」という要件です。
この設計思想は、フィジカルAI(物理AI)と呼ばれる分野の広がりを背景にしています。
-
通信遅延を抑えたい
ロボット制御・医療機器・自動運転・防衛は、クラウドとの往復レイテンシが制約になりやすく、エッジ側での処理と親和性が高い
-
稼働時にネットワークが安定しない
UAV・洋上プラットフォーム・移動中の車両など、常時安定接続が保証されない環境で動く
-
機密性・可用性の観点でオンデバイス処理が有効
医療画像・軍用センサーデータ・工場の生産データなど、クラウド送信自体がリスクとなる用途
エッジAIとクラウドAIの役割分担で言えば、Ryzen AI Embedded X100は「大規模な学習はクラウドで、推論はエッジで」というワークフローの後半——推論側の主戦場に投入されるシリコンという位置づけです。
Ryzen AI Embedded X100の採用検討で押さえる論点
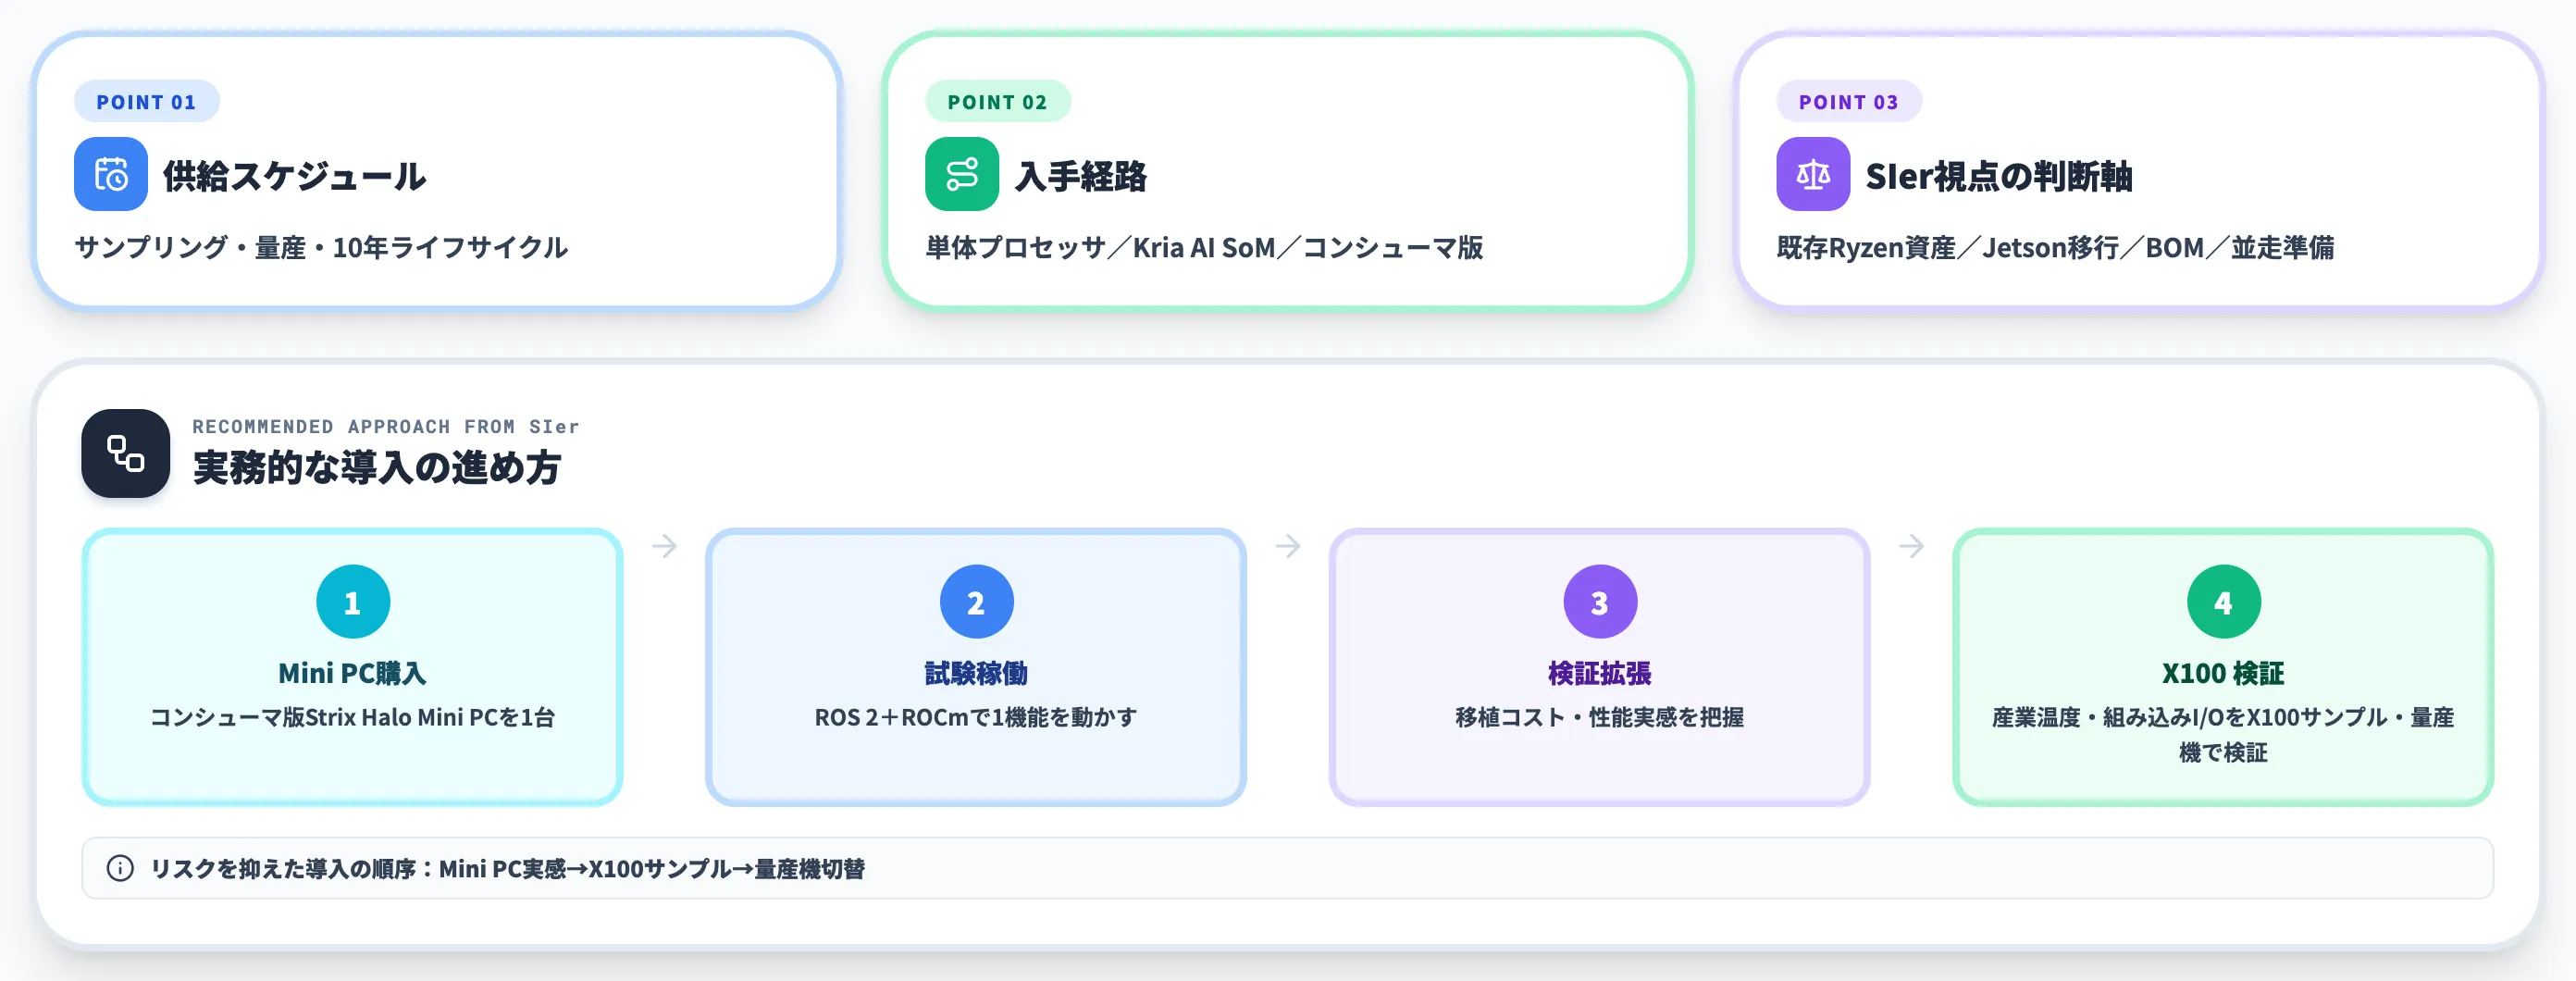
量産Q4 2026を控えた現時点でRyzen AI Embedded X100の採用を検討する企業が押さえておきたい論点を、供給スケジュール・入手経路・SIer視点の判断軸の3つで整理します。
サンプリング・量産スケジュールと10年ライフサイクル
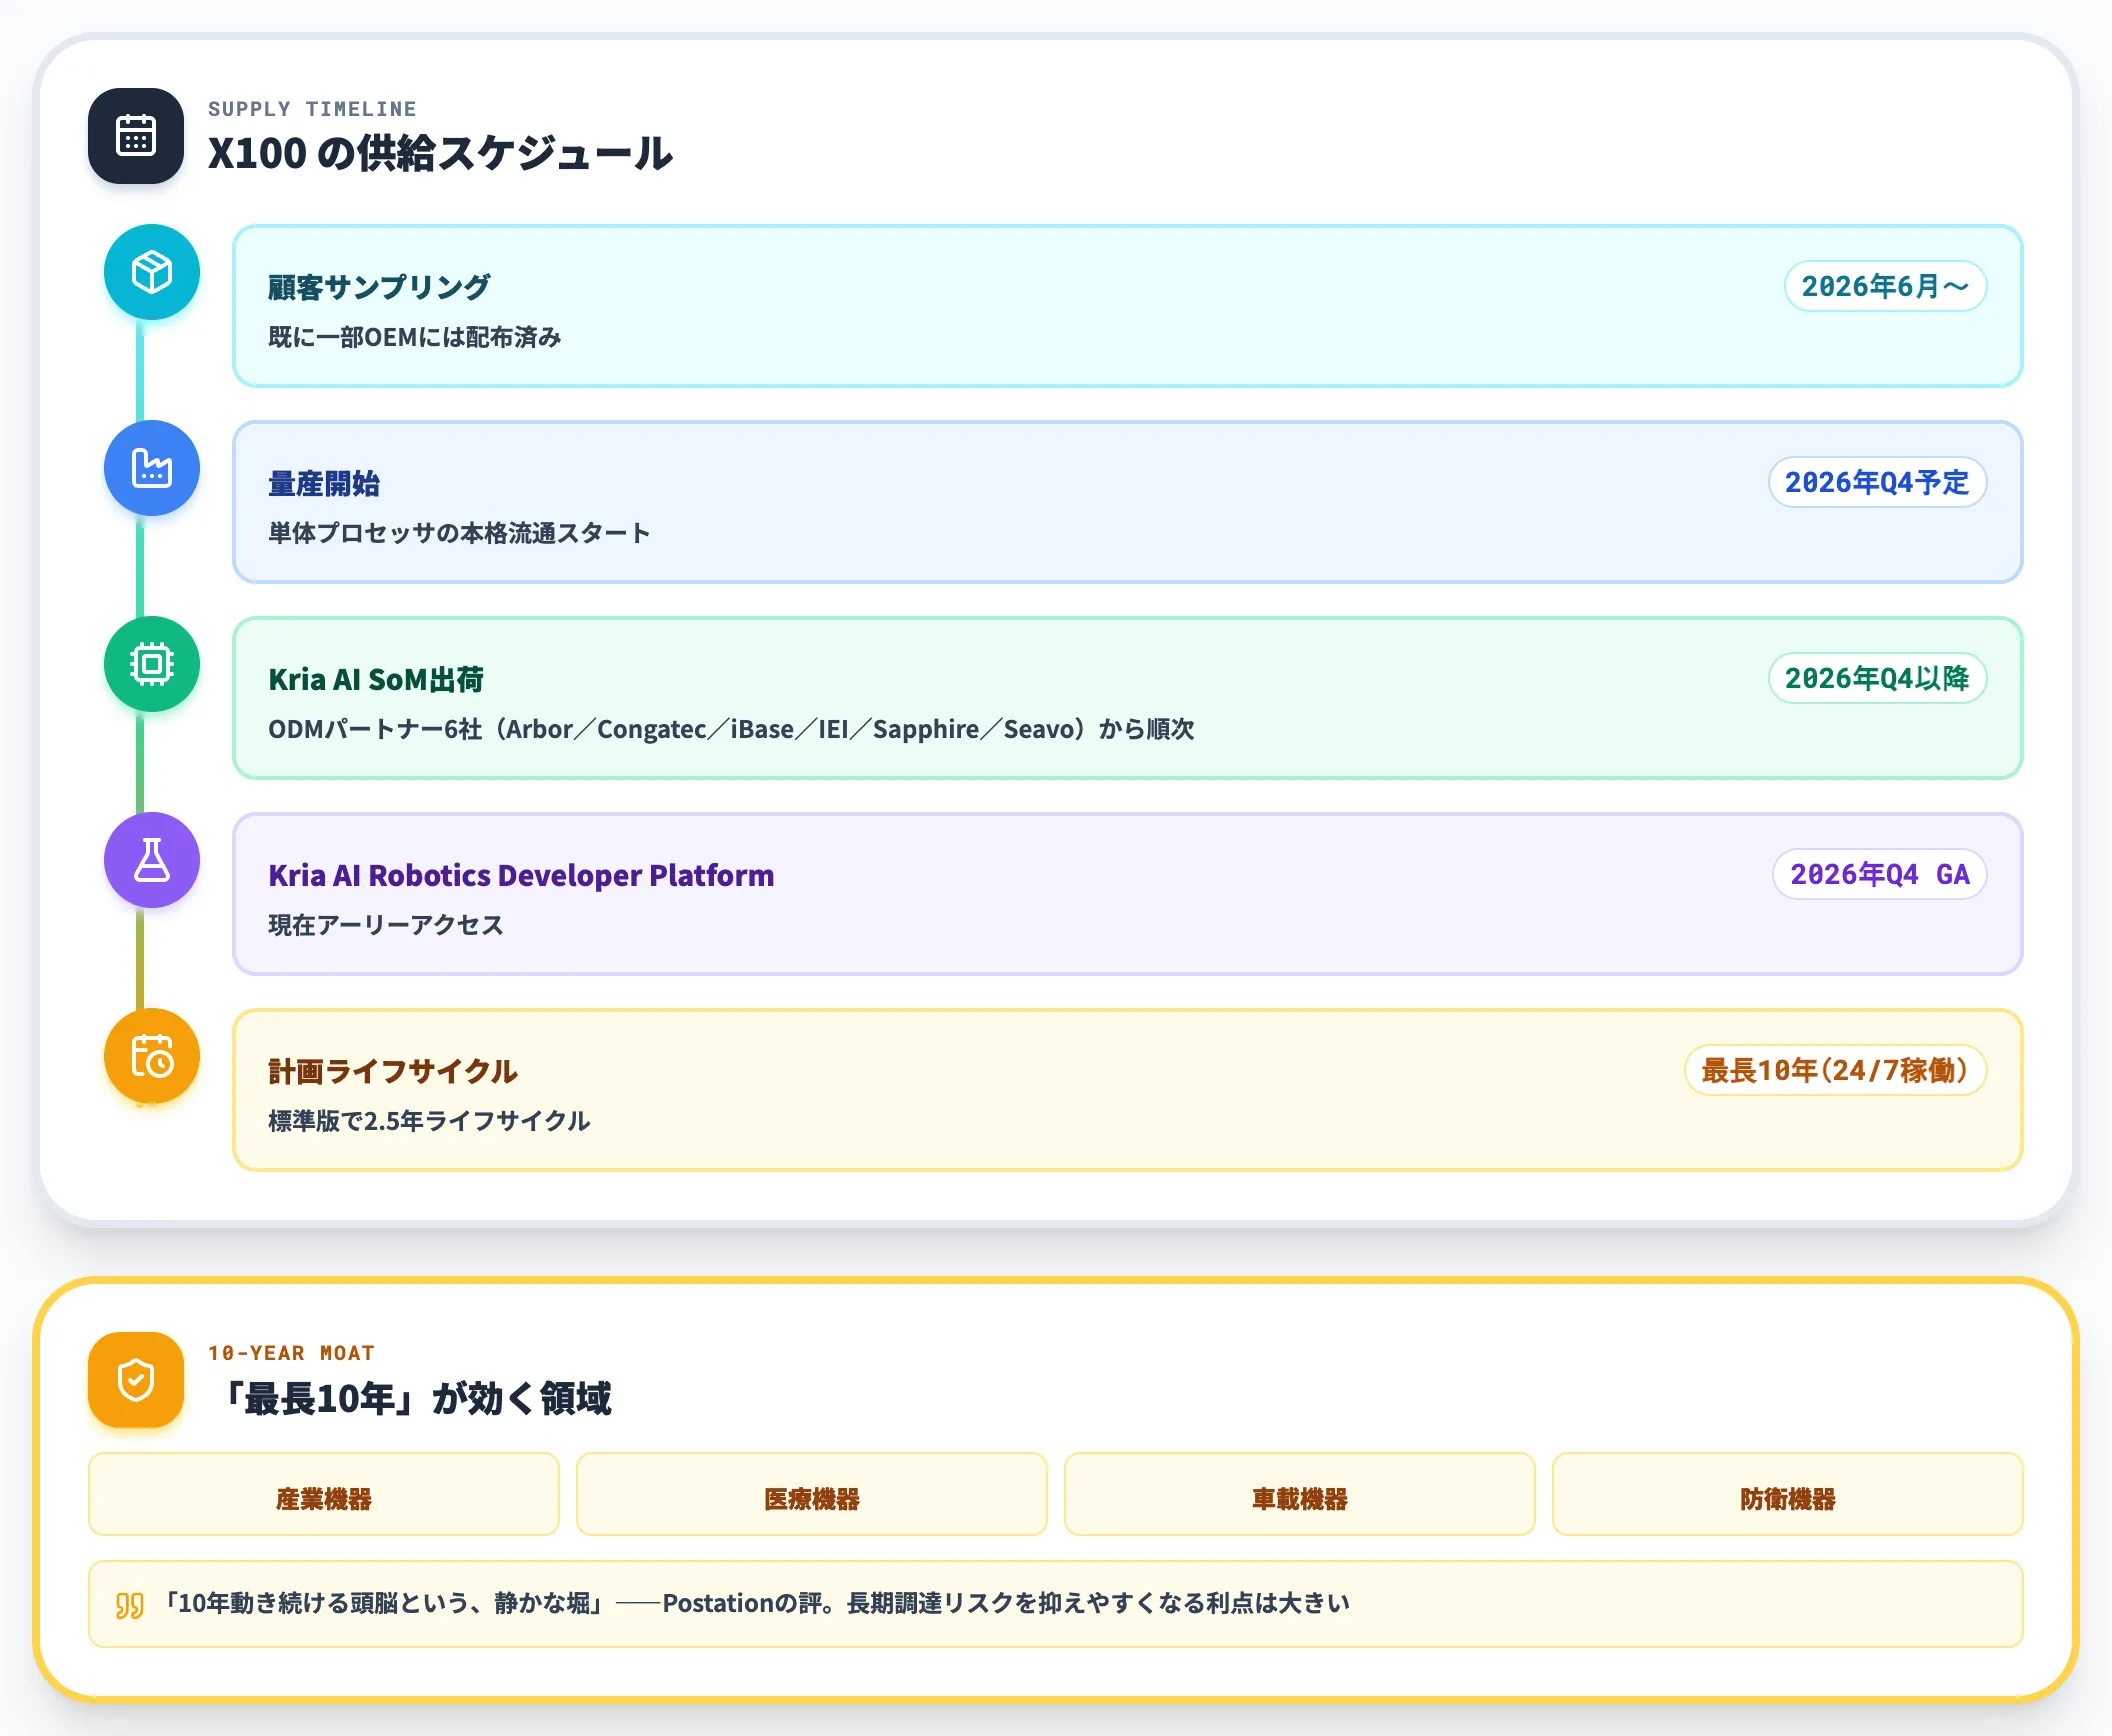
X100の供給スケジュールは、AMD公式Newsroomによれば以下のとおりです。
- 顧客サンプリング: 2026年6月から開始(既に一部OEMには配布済み)
- 量産開始: 2026年Q4予定
- Kria AI SoM出荷: 2026年Q4以降、ODMパートナー6社から順次
- Kria AI Robotics Developer Platform: 2026年Q4 GA、現在はアーリーアクセス
- ライフサイクル: 24/7稼働で最長10年、標準版で2.5年ライフサイクル
「最長10年」は、産業機器・医療機器・車載機器・防衛機器といった長期運用が前提の設計に特に効きます。設計固定後に長期の計画ライフサイクルが提示される点は、コンシューマ向けCPUでは得られない産業向け半導体固有の価値で、Postationの解説が「10年動き続ける頭脳という、静かな堀」と評した所以です。
長期調達リスクを抑えやすくなる利点は大きい一方、実際の供給は最長10年の計画ライフサイクル内での運用となります。
入手経路とコンシューマ版で先行PoC
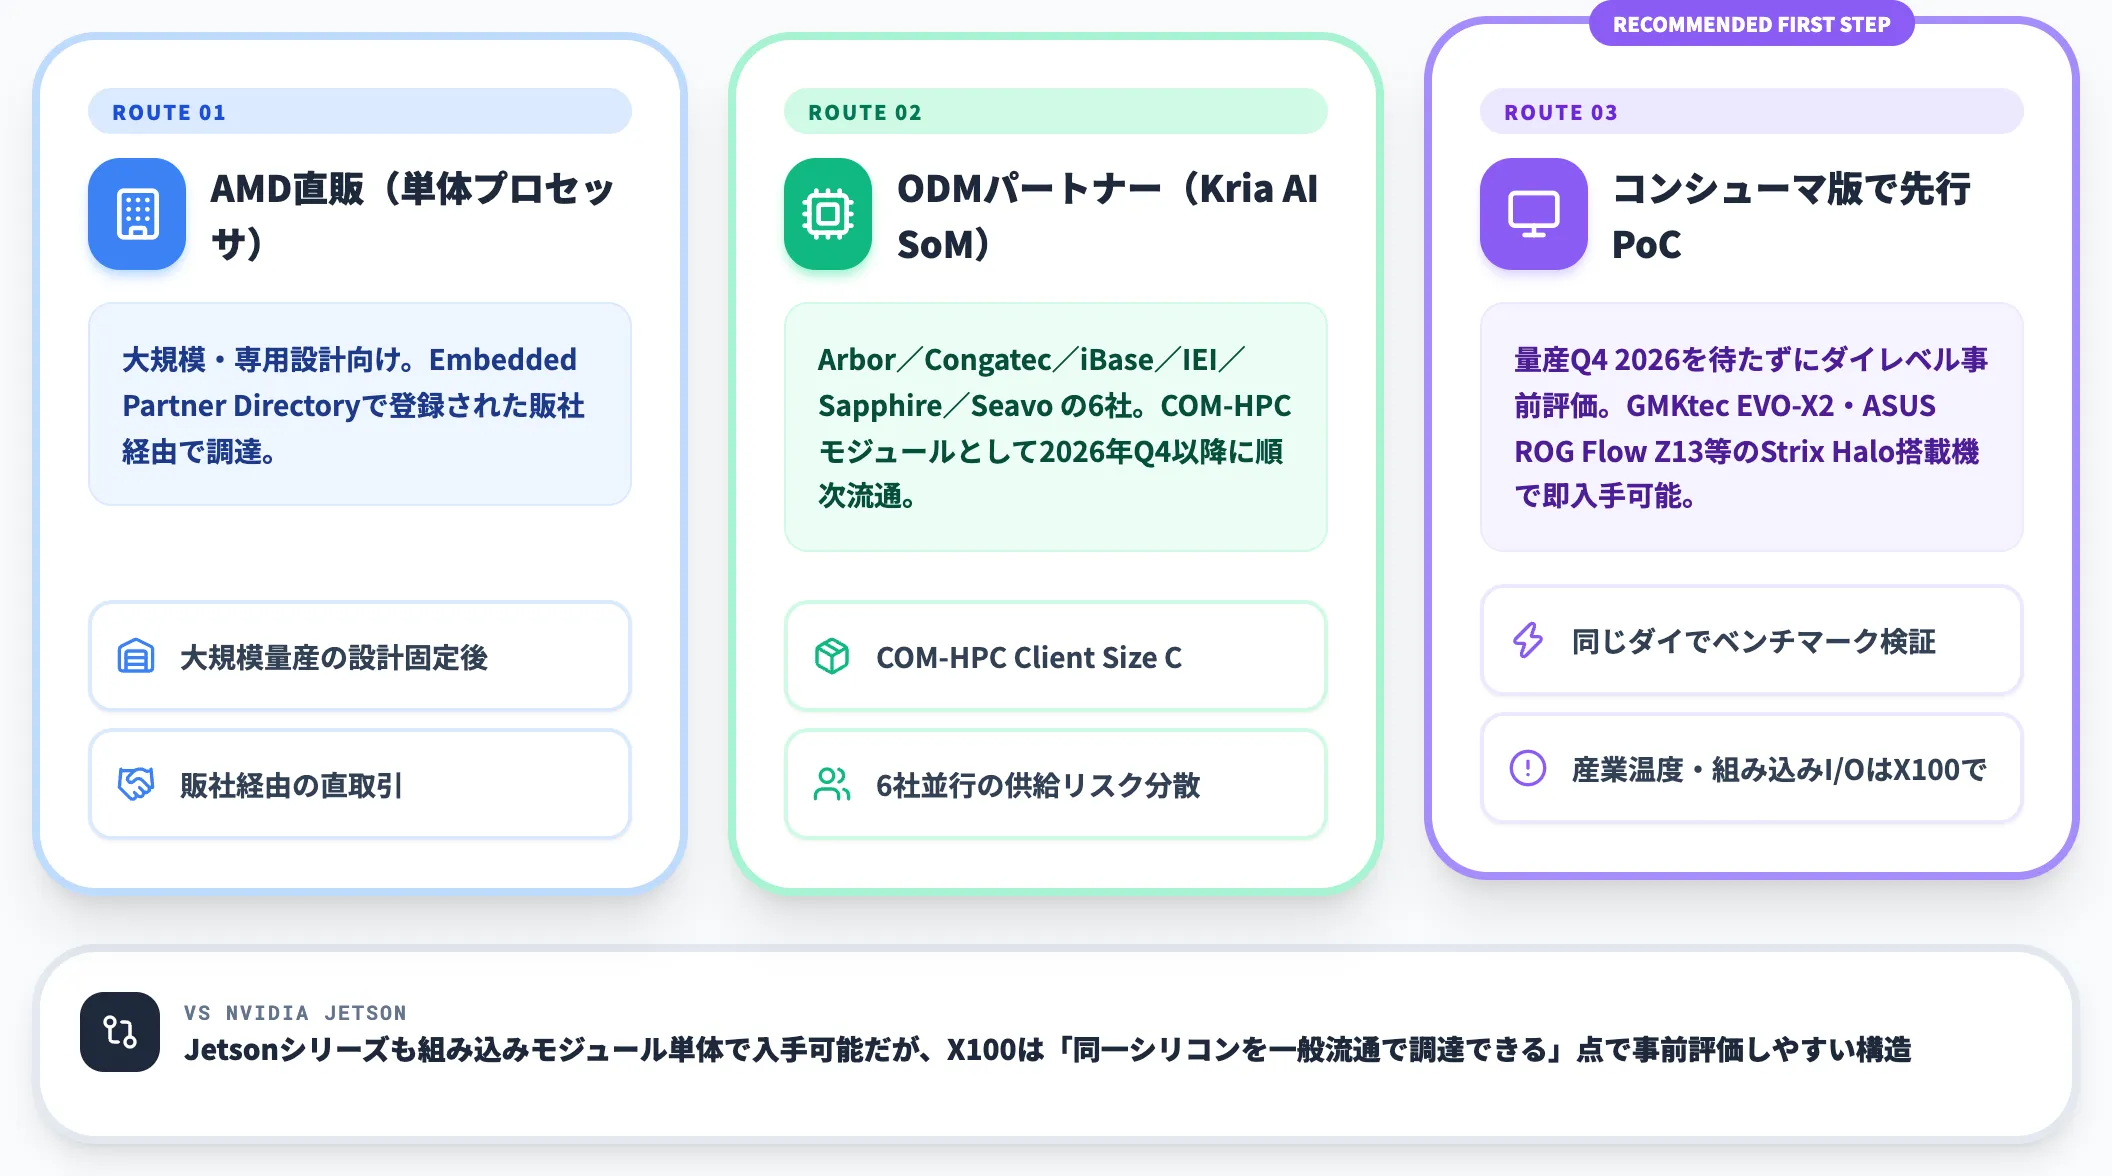
Ryzen AI Embedded X100の入手ルートは、量産規模と開発フェーズに応じて3つあります。
-
AMD直販ルート(単体プロセッサ)
単体プロセッサを使う大規模・専用設計向け。AMD Embedded Partner Directoryで登録された販社経由で調達
-
ODMパートナー経由(Kria AI SoM)
Arbor・Congatec・iBase・IEI・Sapphire・Seavoの6社。各社のCOM-HPCモジュールとして2026年Q4以降に順次流通
-
コンシューマ版Ryzen AI Max+ 395で先行PoC
量産Q4 2026を待たずにダイレベルの事前評価がしたい場合、GMKtec EVO-X2やASUS ROG Flow Z13などのStrix Halo搭載Mini PC/ラップトップが即入手可能。同じダイなのでベンチマーク・ROS 2動作確認・ROCmでのAIモデル推論確認まではカバーできる(産業温度・RT BIOS・組み込みI/Oの検証はX100サンプル入手後)
特に3番目のコンシューマ版先行PoCは、Ryzen AI Embedded X100の特徴の一つです。
NVIDIA Jetsonシリーズも組み込み向けモジュール単体で入手可能ですが、コンシューマ向けMini PCと同一シリコンを一般流通で調達できるという点で、X100は事前評価しやすい構造にあります。
X100搭載機の検査結果を、装置条件やロットと結んでERPの品質記録まで届ける
Ryzen AI Embedded X100を産業PCや検査機に載せれば、インライン検査の推論をクラウドに送らず、工場の装置側で完結できます。ただ、良否の判定が検査機の中にとどまり、加工や洗浄の条件、MESの工程実績と結び付かないままだと、不良が増えたときに原因と影響ロットを絞り込めません。エッジで出した判定を歩留まりの改善に使うには、装置の外で検査結果をロットと結ぶ仕組みが必要になります。
その仕組みを担うのが、工場内のエッジで集めた装置と検査のデータを、既存のMESやERPの業務までつなぐAI Agent HubのEdge to ERPです。
- 装置と検査のデータをロットで結ぶ
加工機・検査機・PLCの通信やログからデータを取り、今のMESは入れ替えずに工程実績と対応付けて、どの装置のどの条件を通ったロットかをたどれるようにします。
- 不良の原因候補と影響ロットをAIが示す
不良率が上がると、AIが装置条件と検査履歴を照合し、原因の候補と同じ条件を通ったロットを、根拠となるデータと合わせて提示します。
- 処置は人が決め、ERPの品質記録に残す
追加検査や保留は品質担当者が判断して承認し、品質記録・保留在庫・不良原価を、SAPなど既存のERPに業務APIで登録します。
AI総合研究所の専任チームが、改善したい品質課題と対象の工程を決め、1つの工程で検査結果からERPの記録までを通すところから伴走します。
検査結果をERPの品質記録まで届ける

装置条件とロットを結んで原因を絞る
X100を載せた検査機や産業PCで判定をエッジに置いても、結果が装置の中にとどまると、不良が増えたときに原因と影響ロットを絞り込めません。装置条件と検査結果をロットで結び、ERPの品質記録まで届ける流れは、AI Agent HubのEdge to ERPのページでご覧いただけます。
まとめ
本記事では、Ryzen AI Embedded X100を「Strix Haloのダイを組み込み向けに転用したフィジカルAI用のSoC」として整理し、統合メモリの設計・型番の選び方・ベンチマークの読み方・CUDAからの移行・Kria AI SoM・想定ユースケース・採用時の論点を解説しました。
2026年9月時点で押さえておくべきポイントは次の3つです。
- CPU・GPU・NPUが同じメモリを共有する設計で、別々のチップに分けていたリアルタイム制御とAI推論を1チップにまとめる構成が取れる
- AMD公式の性能倍率はRyzen AI Max+ 395で測った投影値で、GPUのAI演算だけで比べればJetson AGX Thorが上回る場面がある
- CUDA資産の移植はカーネルを1本ずつHIPに書き換えるより、ROS 2の対応ライブラリを単位に、認識・計画・制御の粒度で置き換えるほうが負担が軽い
AI総合研究所では、X100の採用検討を、市販機で済む検証と、サンプルの入手後に行う検証の2段に分けて進めています。
まずは、X100と同じダイのStrix Halo搭載機を用意し、ROS 2とROCmの上で自社のモデルとパイプラインが動くかを確かめます。
続いて、産業温度・RT BIOS・組み込み向けのI/OはX100のサンプルで確認し、量産規模に合わせて、SoMを使うか単体プロセッサで基板から設計するかを決めます。
ロボットに載せるAI半導体の比較では、演算性能の高さに加えて、推論を走らせながら制御ループを乱さないことが問われるようになっています。
X100はその要件に統合メモリとリアルタイム向けの仮想化で応えようとするSoCで、長期の供給計画と合わせて、ロボットや産業機器の次の世代の頭脳を選ぶ際の有力な候補になります。