この記事のポイント
 CUDA 13でMaxwell/Pascal/Volta世代のサポートは削除。Turing・Ampere・Ada・Hopper・BlackwellがCUDA 13.x系の対象世代
- CUDA ToolkitとCUDA-Xライブラリ群(cuBLAS/cuDNN/cuFFT/CUTLASS)は無償、NVIDIA AI EnterpriseとGPU本体調達は別コスト
- 2026年の新展開はTile Programming+cuTile Python DSL、およびRust→PTXコンパイラcuda-oxide(実験段階)の登場
- 実務ではPyTorch/JAX/TensorRT経由が主流。直接CUDAカーネルを書くのは超低レイテンシ推論・特殊メモリ最適化・ハードウェア密着型の限定シナリオ
- ドライバ×Toolkit×cuDNN×フレームワーク(PyTorch/TensorFlow)の4層バージョン整合が導入で最も詰まる論点
Microsoft MVP・AIパートナー。LinkX Japan株式会社 代表取締役。東京工業大学大学院にて自然言語処理・金融工学を研究。NHK放送技術研究所でAI・ブロックチェーンの研究開発に従事し、国際学会・ジャーナルでの発表多数。経営情報学会 優秀賞受賞。シンガポールでWeb3企業を創業後、現在は企業向けAI導入・DX推進を支援。
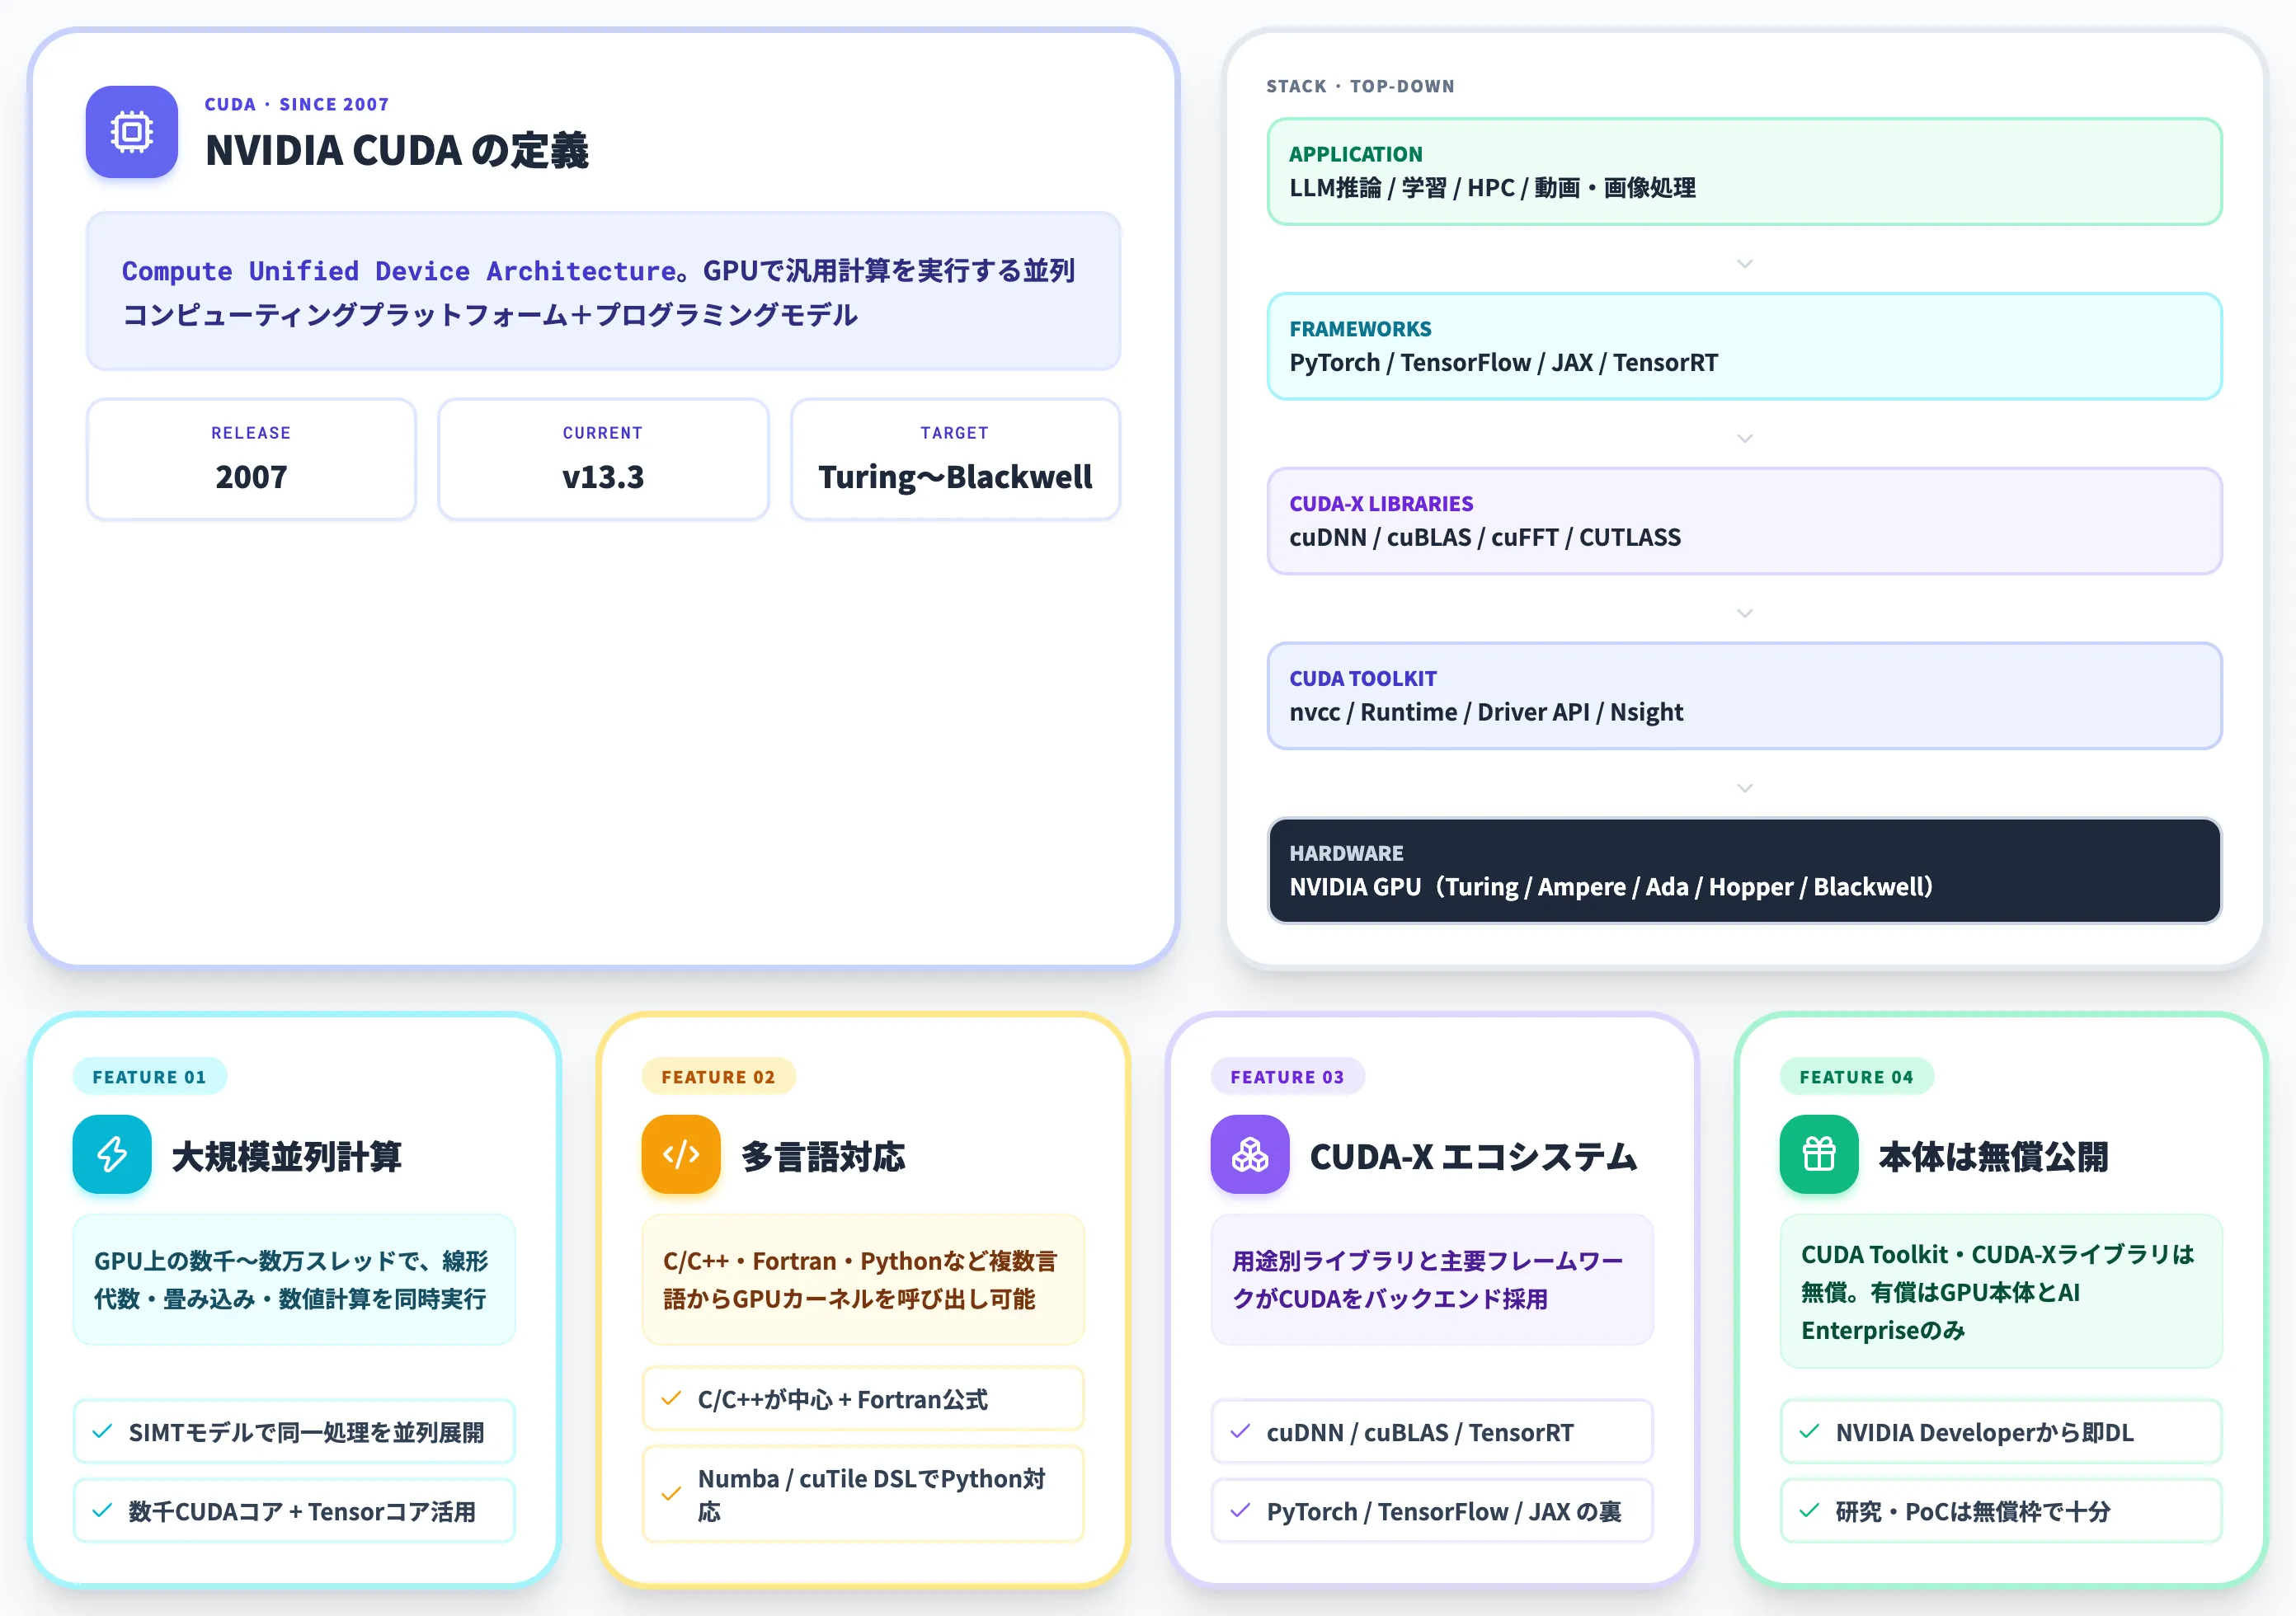
NVIDIA CUDAとは、NVIDIAが2007年に公開した、GPUで汎用計算を実行するための並列コンピューティングプラットフォームです。
大規模言語モデルの推論・学習、科学技術計算、動画・画像処理まで、NVIDIA GPUを利用するAI・HPCワークロードの多くはCUDAスタック上で動いています。
2026年時点ではCUDA 13でMaxwell/Pascal/Volta世代のサポートが打ち切られ、Turing〜Blackwellが対象。Tile Programmingが正式追加され、周辺ではNVIDIA Labsが実験的なRust→PTXコンパイラcuda-oxideも公開しています。AI推論から科学技術計算までを支える中核基盤に位置づけられています。
本記事では、プログラミングモデル・CUDA Toolkitの中身・CUDA 13の変化・Windows/Linuxのインストール手順・料金体系とGPU調達・活用領域・フレームワーク経由と直接カーネル記述の使い分け・導入で詰まる論点を、2026年7月時点の最新情報で解説します。
目次
NVIDIA CUDAとは?GPUで汎用計算を実行するための並列コンピューティング基盤
スレッド階層——Thread / Warp / Block / Grid
Compute Capability——世代ごとに使える命令が異なる
CUDA-Xライブラリ群——用途別に最適化された高性能ライブラリ
Tile Programming——CUDA 13で追加された新しい記述層
Maxwell / Pascal / Volta世代のサポートを削除
Blackwell / Grace Blackwell 対応の継続・強化
cuTile Python DSL——PythonからGPU並列カーネルを書ける新経路
cuda-oxide——Rustで書いてPTXに直接コンパイル
CUDAのインストール手順——Windows / Linux / WSL2
Linuxでのインストール手順(Ubuntu 22.04/24.04)
環境変数とパス設定——PATH / LD_LIBRARY_PATH / CUDA_HOME
動作確認——nvidia-smi と nvcc、それぞれ役割が違う
直接カーネルを書くケース——超低レイテンシ・特殊メモリ最適化・ハードウェア密着
CUDA Toolkitと主要ライブラリのライセンス——本体は無償
NVIDIA AI Enterprise——エンタープライズ向けの有償サポート契約
GPU本体の調達——コンシューマー / ワークステーション / データセンター
クラウドGPUの従量課金——AWS / Azure / GCPの相場感
1. ドライバ × Toolkit × cuDNN × フレームワークの4層バージョン整合
2. Windows Native vs WSL2 vs Native Linuxの選択
NVIDIA CUDAとは?GPUで汎用計算を実行するための並列コンピューティング基盤
NVIDIA CUDAは2007年公開以降、GPU汎用計算の中核プラットフォームとして位置づけられている(出典:NVIDIA CUDA Zone)
NVIDIA CUDA(Compute Unified Device Architecture)とは、NVIDIAが2007年に一般公開した、GPUで汎用計算を実行するための並列コンピューティングプラットフォームおよびプログラミングモデルです。もともとグラフィックス描画に特化していたGPUを、線形代数・畳み込み・数値シミュレーションといった非グラフィックス用途に転用するための共通APIとして設計されており、C/C++・Fortran・Pythonなど複数言語から利用できます。
2026年時点では、PyTorch・TensorFlow・JAXといった主要な機械学習フレームワークがCUDAをバックエンドに採用しており、AI推論・学習・科学技術計算の多くがCUDA層の上で動いています。GPUベンダーが提示する演算性能を実際のワークロードで引き出せるかどうかは、この層の理解に左右されます。
CUDAが2026年時点でカバーするアーキテクチャ帯
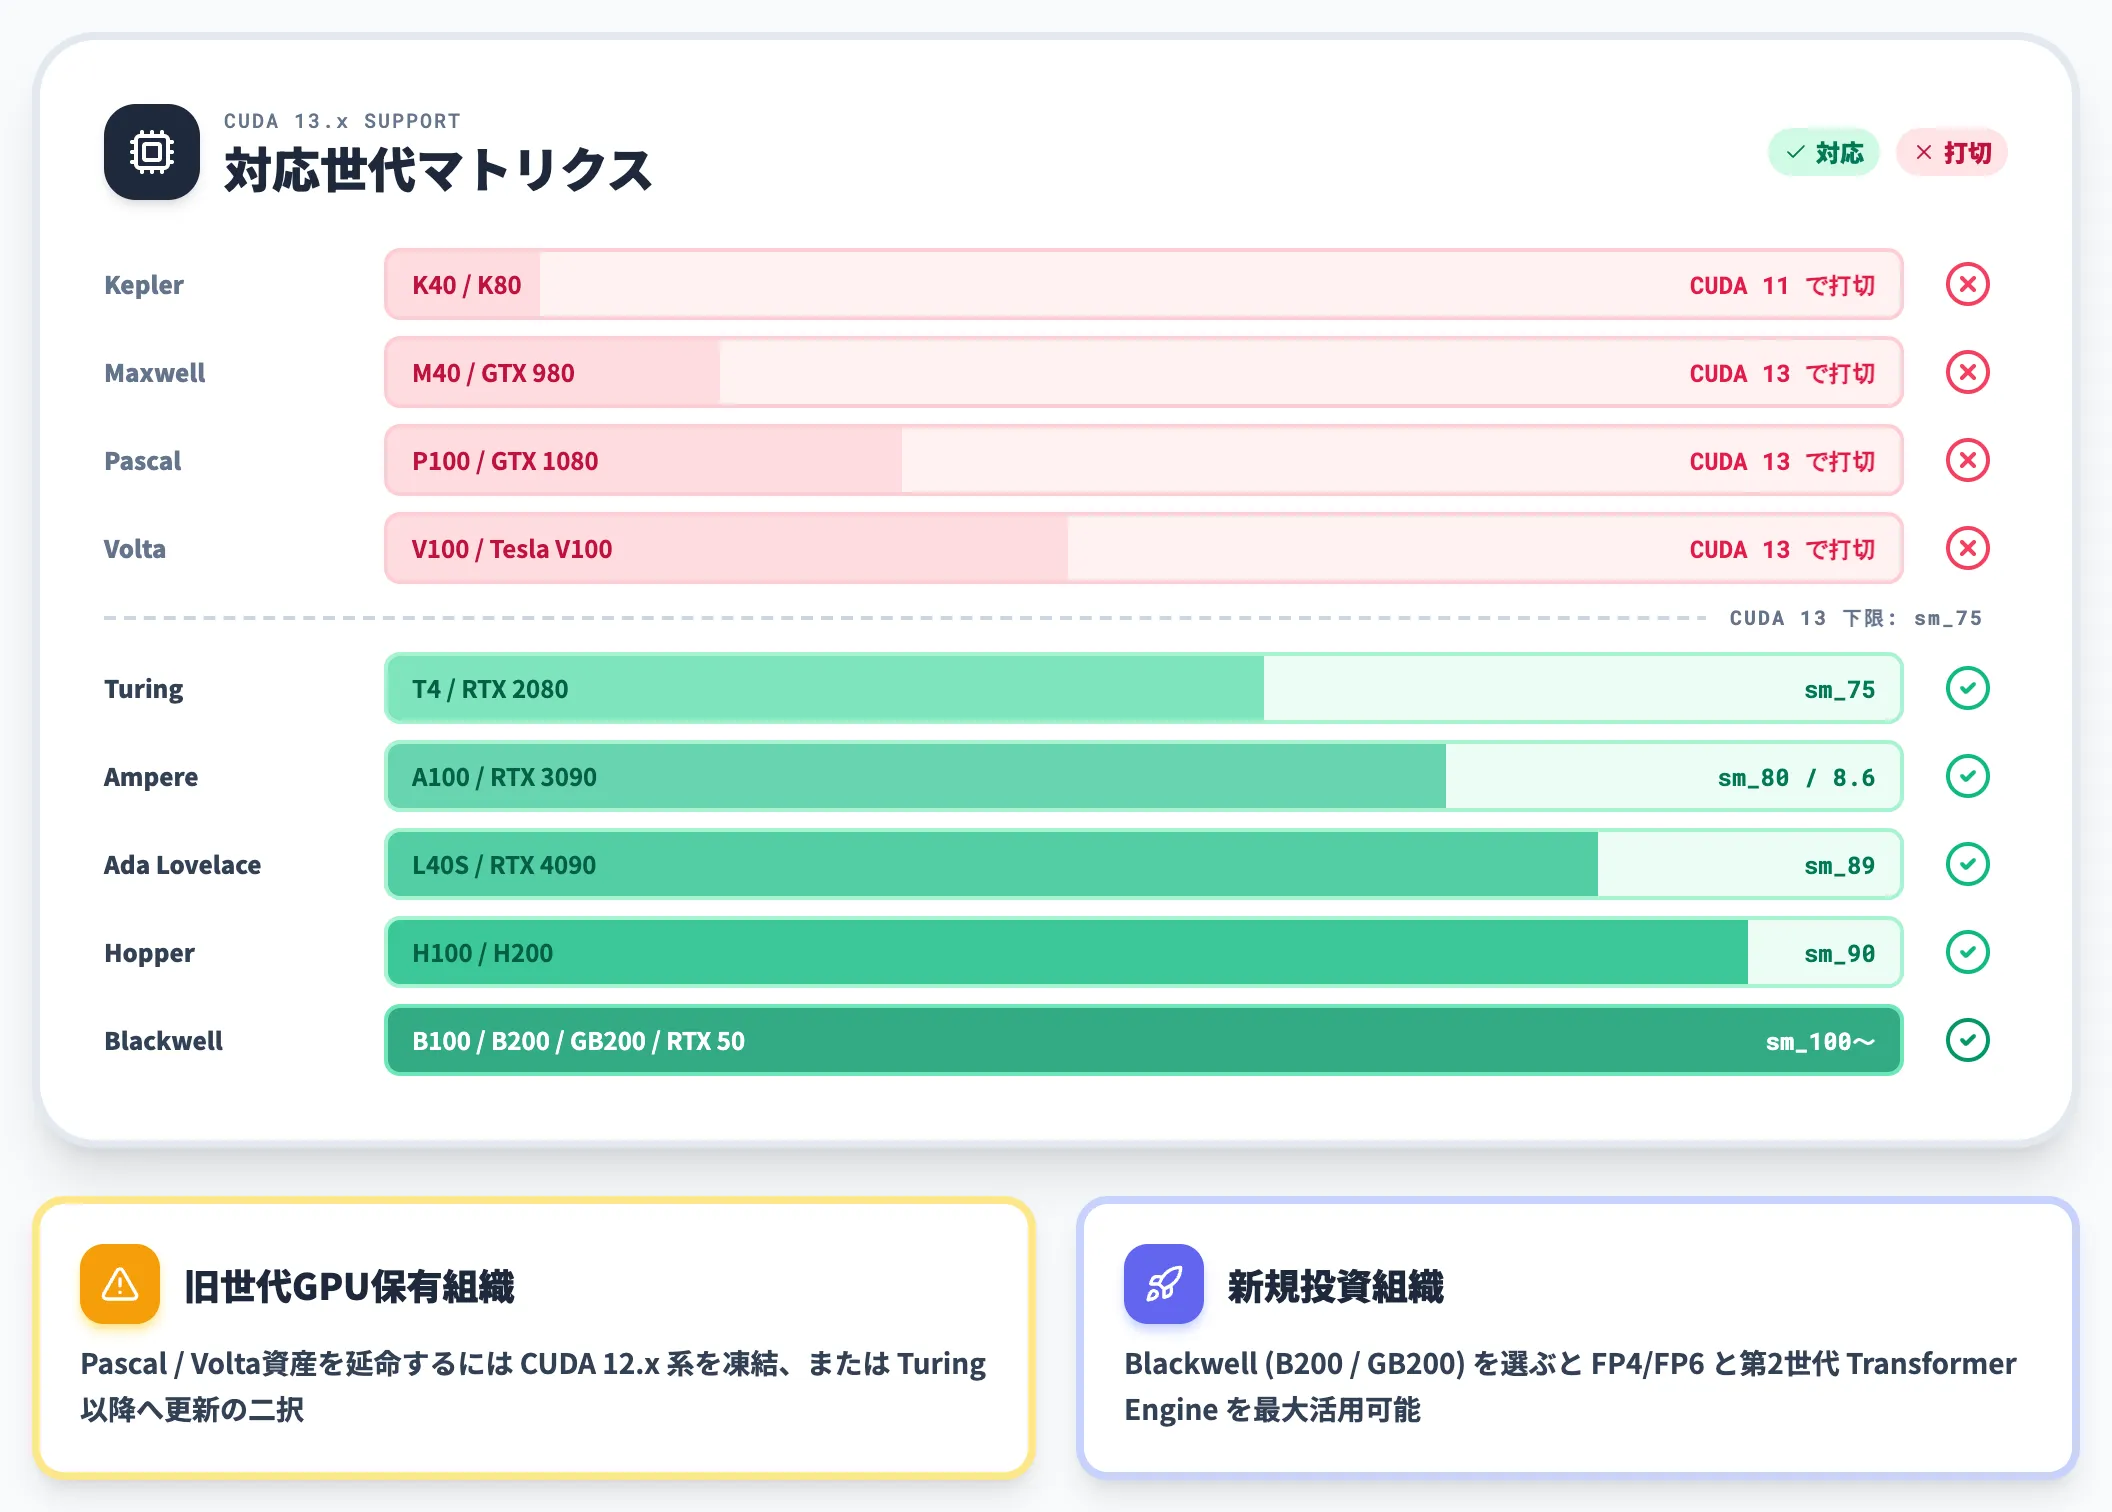
CUDA 13系(2026年時点の主流)は、Maxwell・Pascal・Volta世代の対応を打ち切り、Turing以降のアーキテクチャに絞ってサポートされています。旧世代GPUのライフサイクルが実質的にCUDA側で区切られている点は、2026年時点で最初に押さえるべき事実です。
対応アーキテクチャの具体列挙(Turing・Ampere・Ada・Hopper・Blackwell)と、Pascal/Volta保有組織向けのアクション(CUDA 12.x系継続 or GPU更新)は、後段の「CUDA 13で変わったサポートアーキテクチャ」セクションで扱います。
CUDAのアーキテクチャとプログラミングモデル
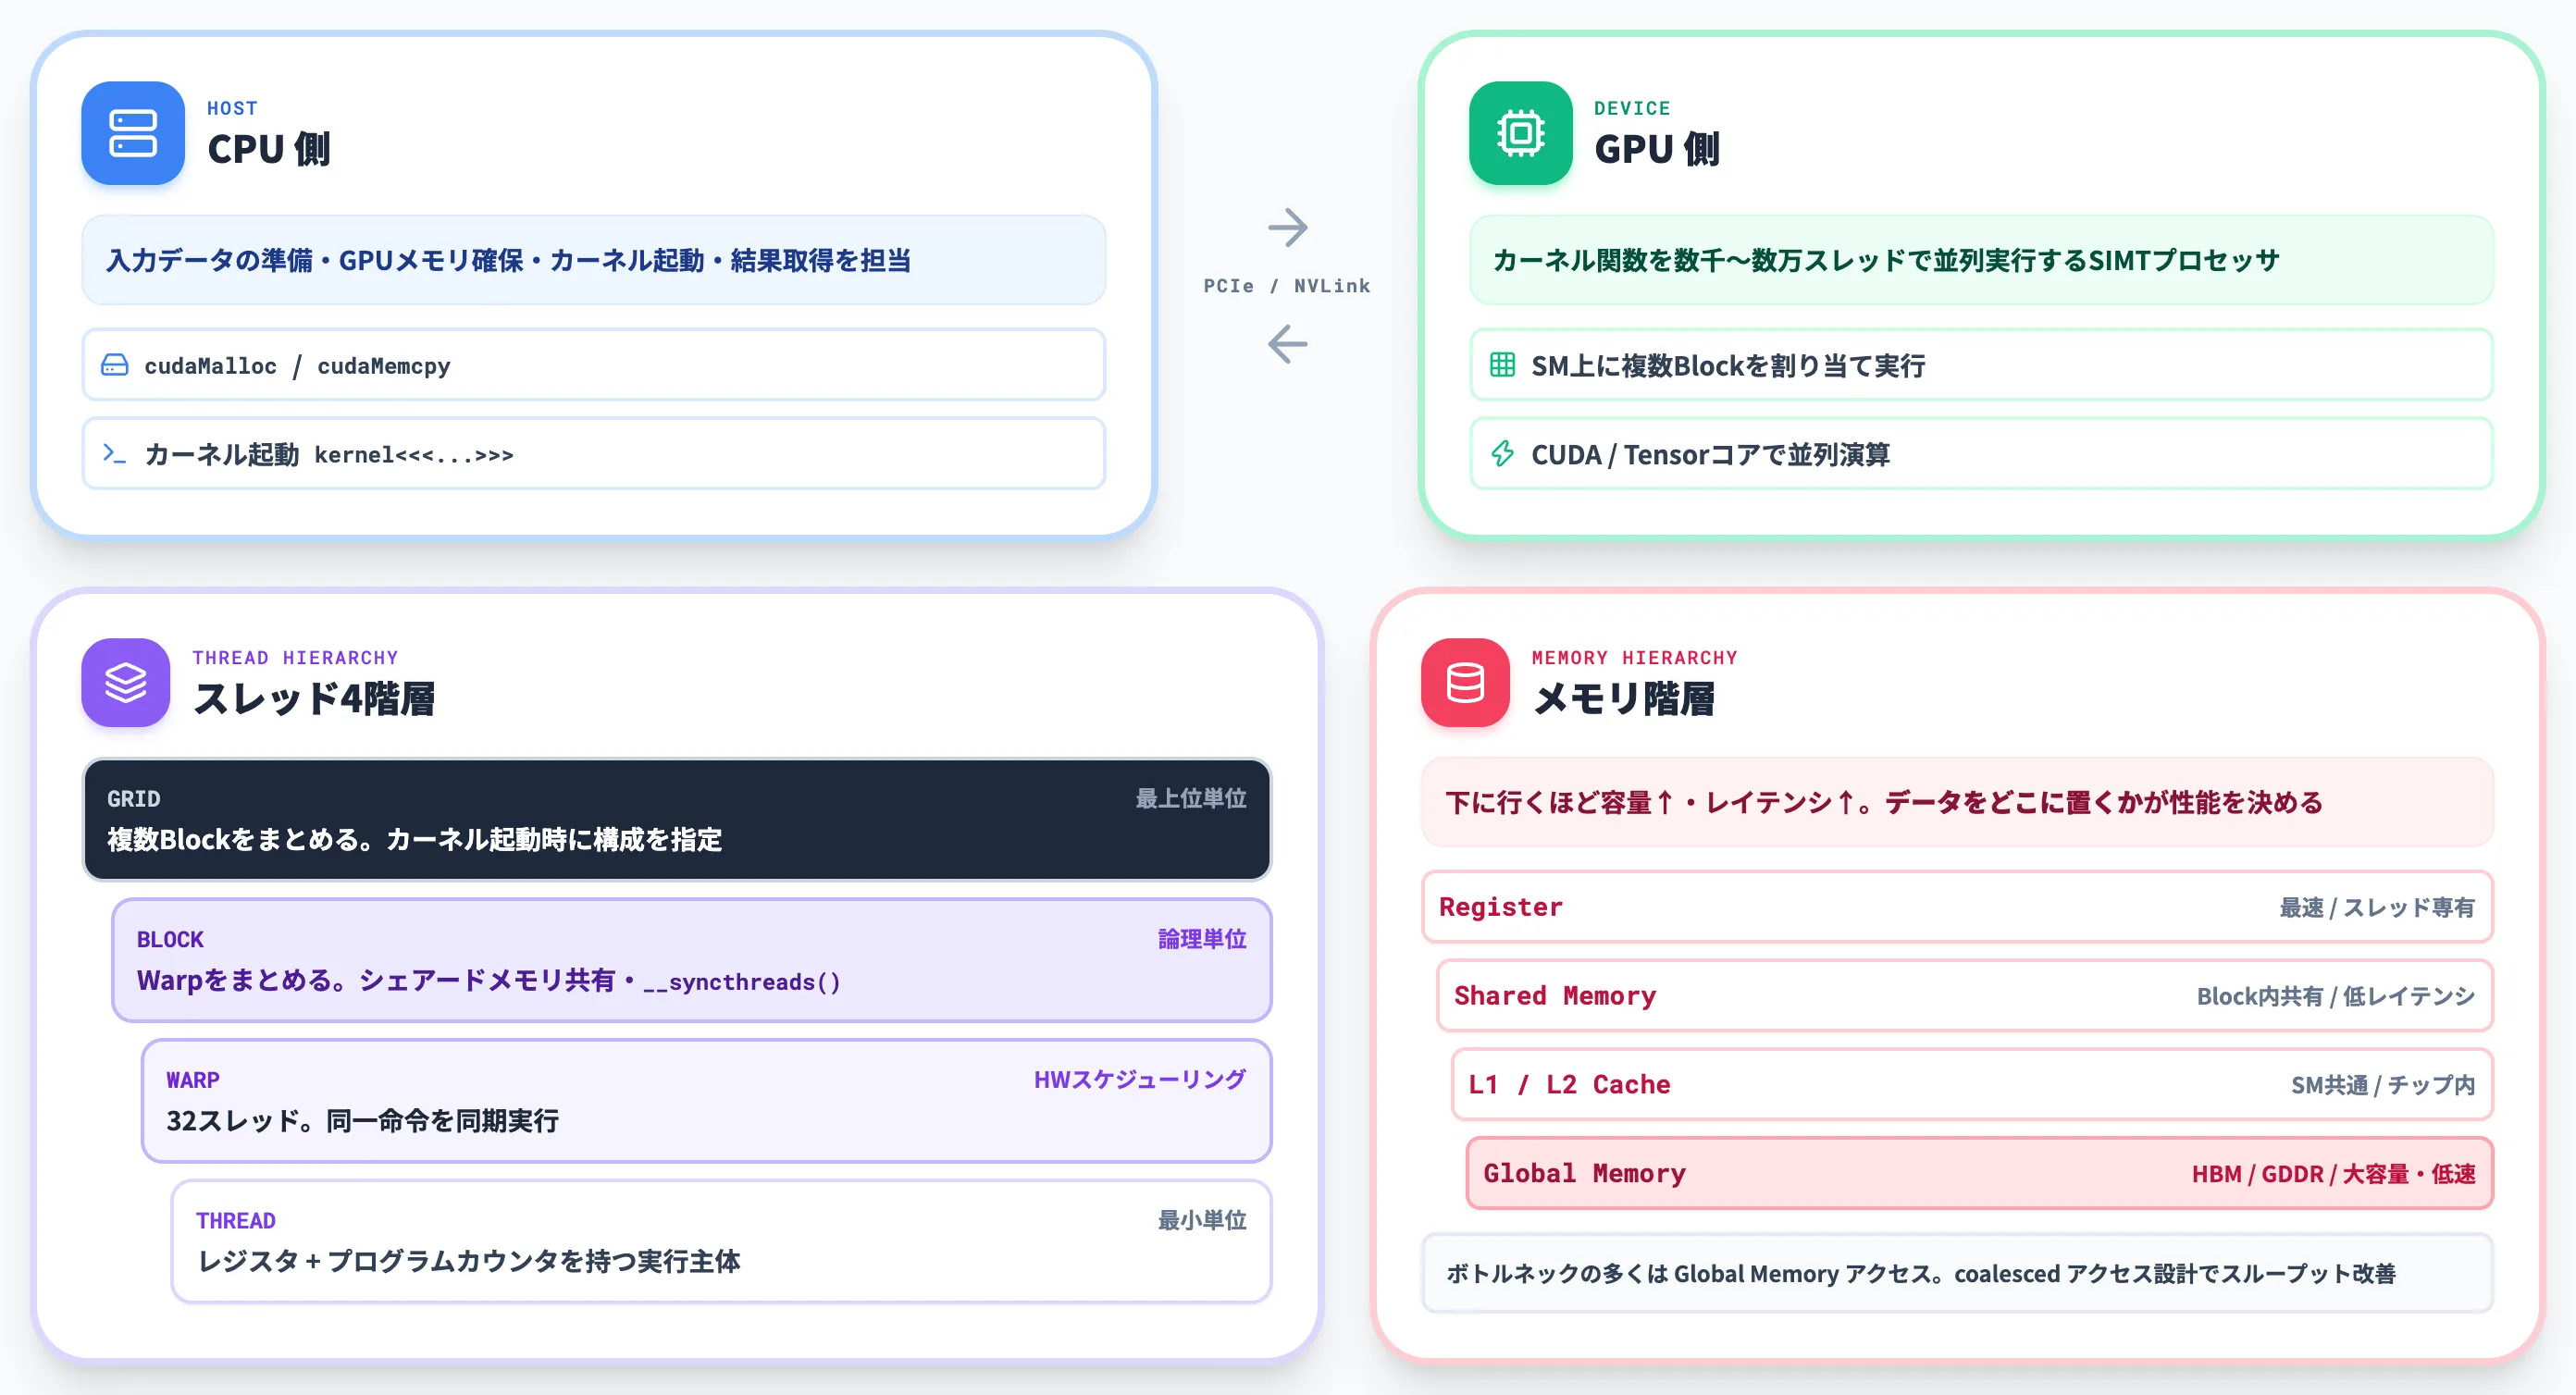
CUDAが「GPUで汎用計算を動かすための共通レイヤー」として機能する仕組みは、ホストとデバイスの分業・カーネル関数・スレッド階層の3点で説明できます。ここではGPUで初めて計算を回すエンジニアが押さえるべき最小限のモデルを整理します。
ホスト(CPU)とデバイス(GPU)の役割分担
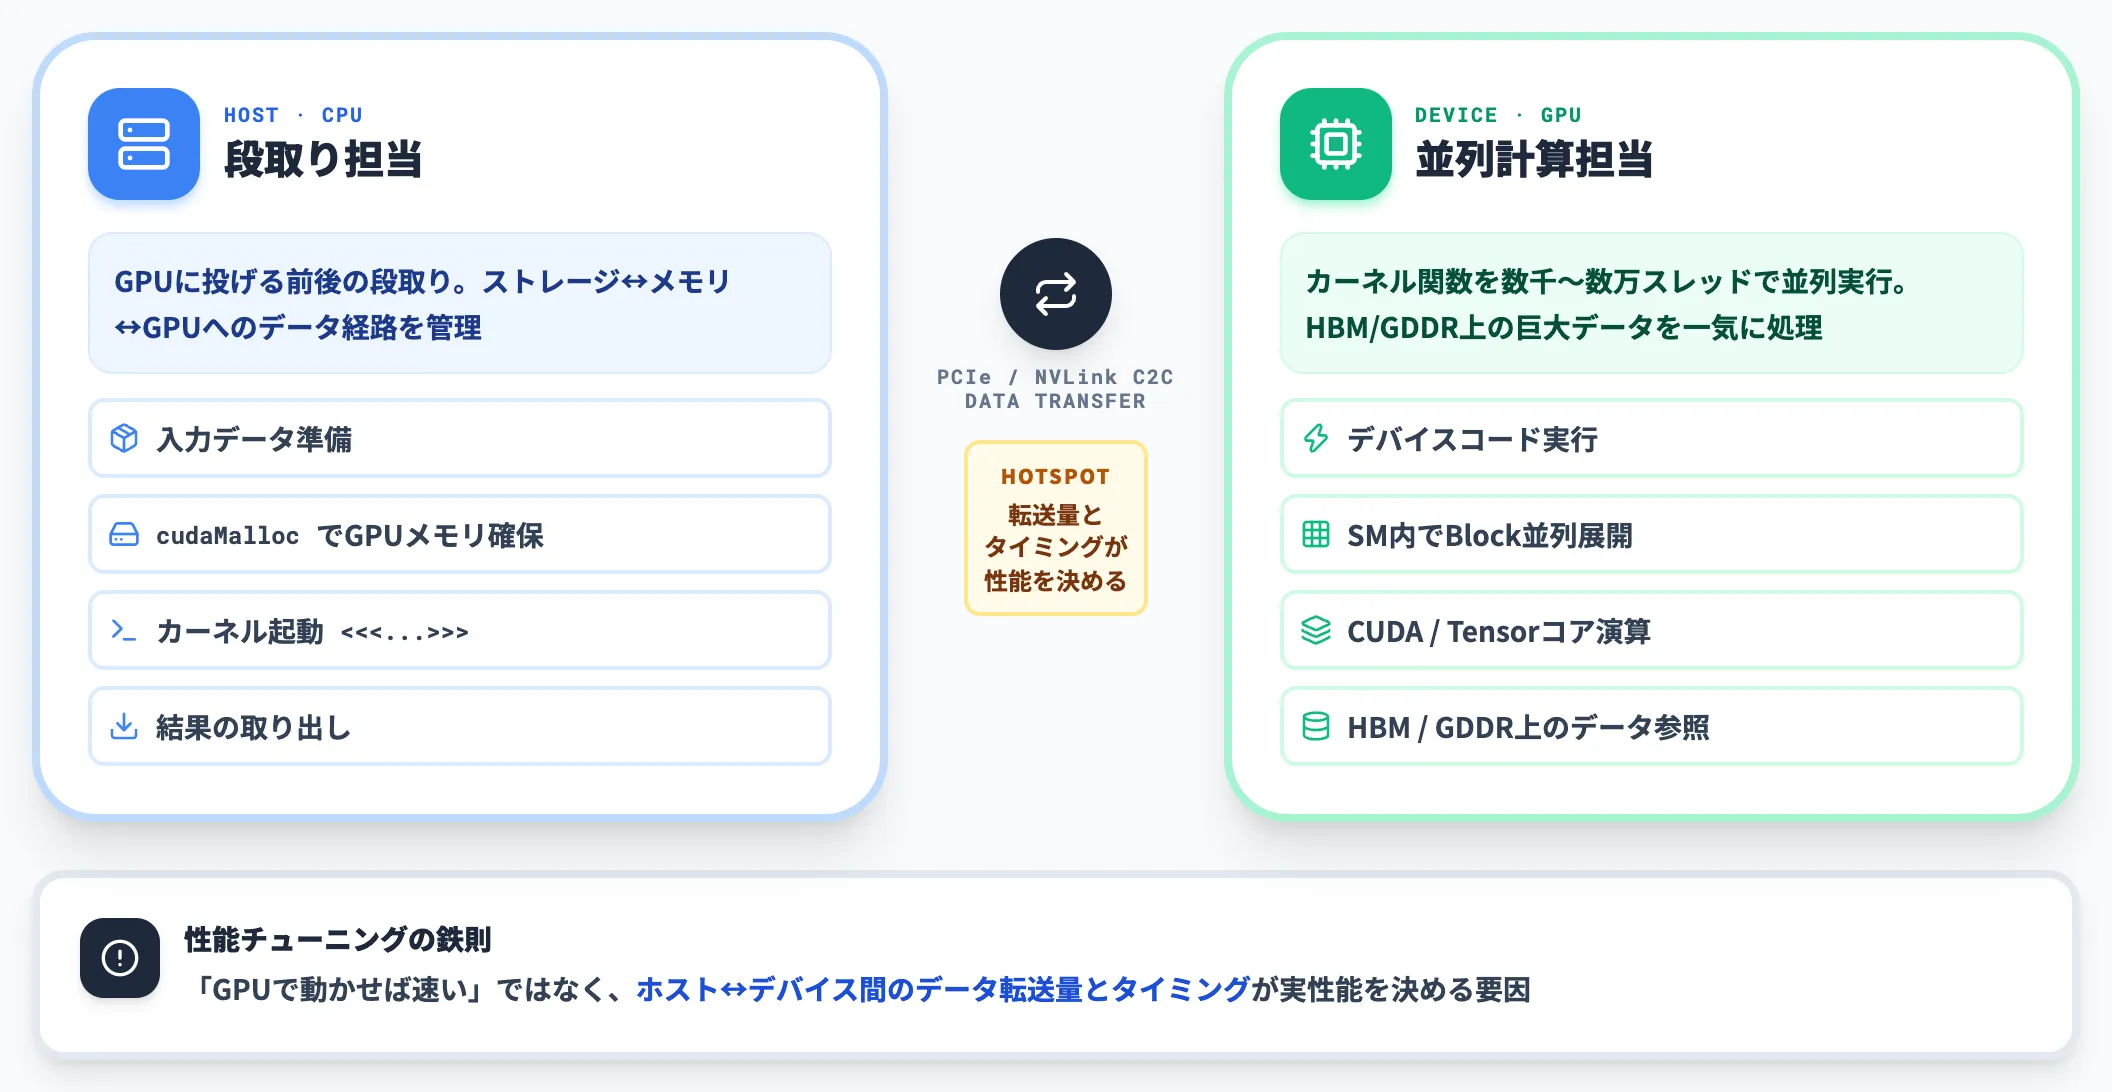
CUDAプログラムは、CPU側で動く「ホストコード」とGPU側で動く「デバイスコード」に分かれています。
ホスト側では入力データの準備・GPUメモリの確保・カーネルの起動・結果の取り出しを行い、実際の並列計算はデバイス側のカーネル関数が担当します。ホストとデバイスは物理的に別のメモリ空間を持ち、cudaMalloc / cudaMemcpy などのAPIを介してデータを転送する必要があります。
この分業モデルを理解しておかないと、「GPUで動かせば速い」という漠然としたイメージが実装レベルで崩れます。実務では、ホスト↔デバイス間のデータ転送量とタイミングが性能を決める主要な要因になることが少なくありません。
カーネル関数——GPUで並列実行される最小単位
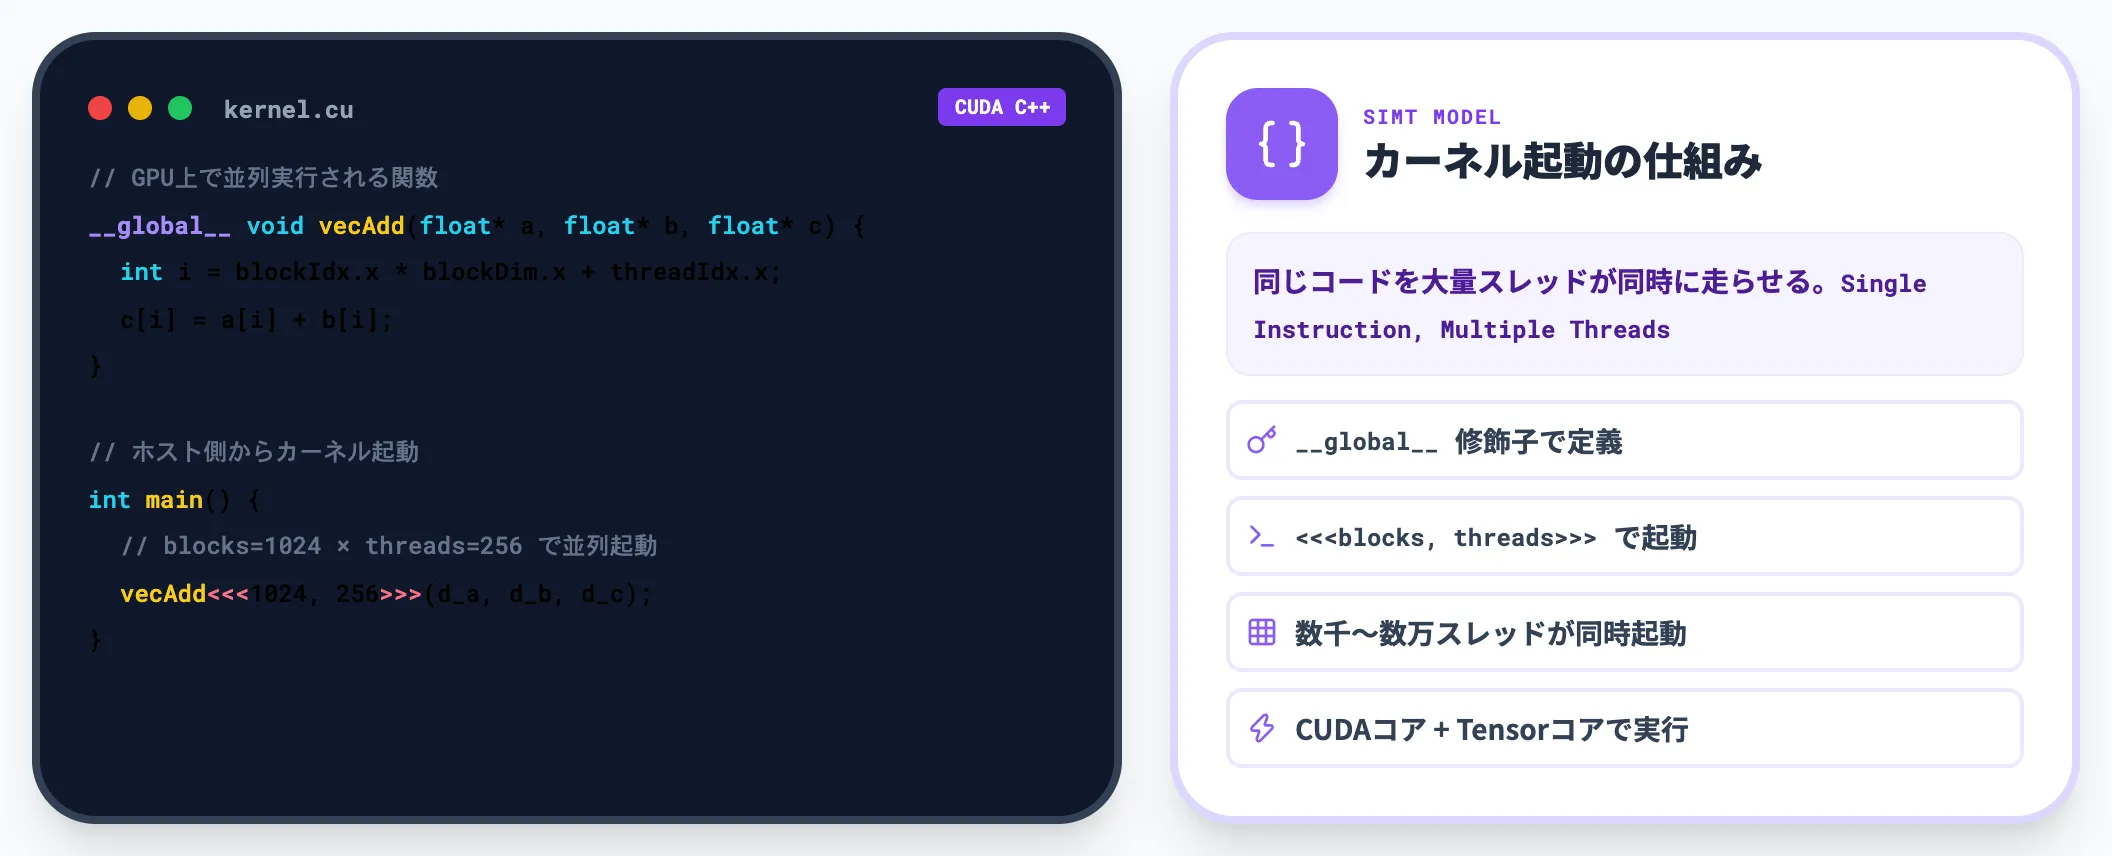
カーネル関数は、GPU上で並列に実行される処理を書き下したC/C++の関数で、global 修飾子を付けて定義します。
呼び出すときは kernel<<<blocks, threads>>>(args) の形で「いくつのブロック × いくつのスレッドで動かすか」を指定し、GPU側でスレッドが同時に立ち上がって同一のカーネル関数を実行します。
この「同じコードを大量のスレッドが同時に走らせる」設計をSIMT(Single Instruction, Multiple Threads)と呼び、CUDAコアが持つ数千〜数万の並列度を活かす前提になっています。CUDAコアとTensorコアの役割分担も、このSIMTモデルの上で成り立っています。
スレッド階層——Thread / Warp / Block / Grid
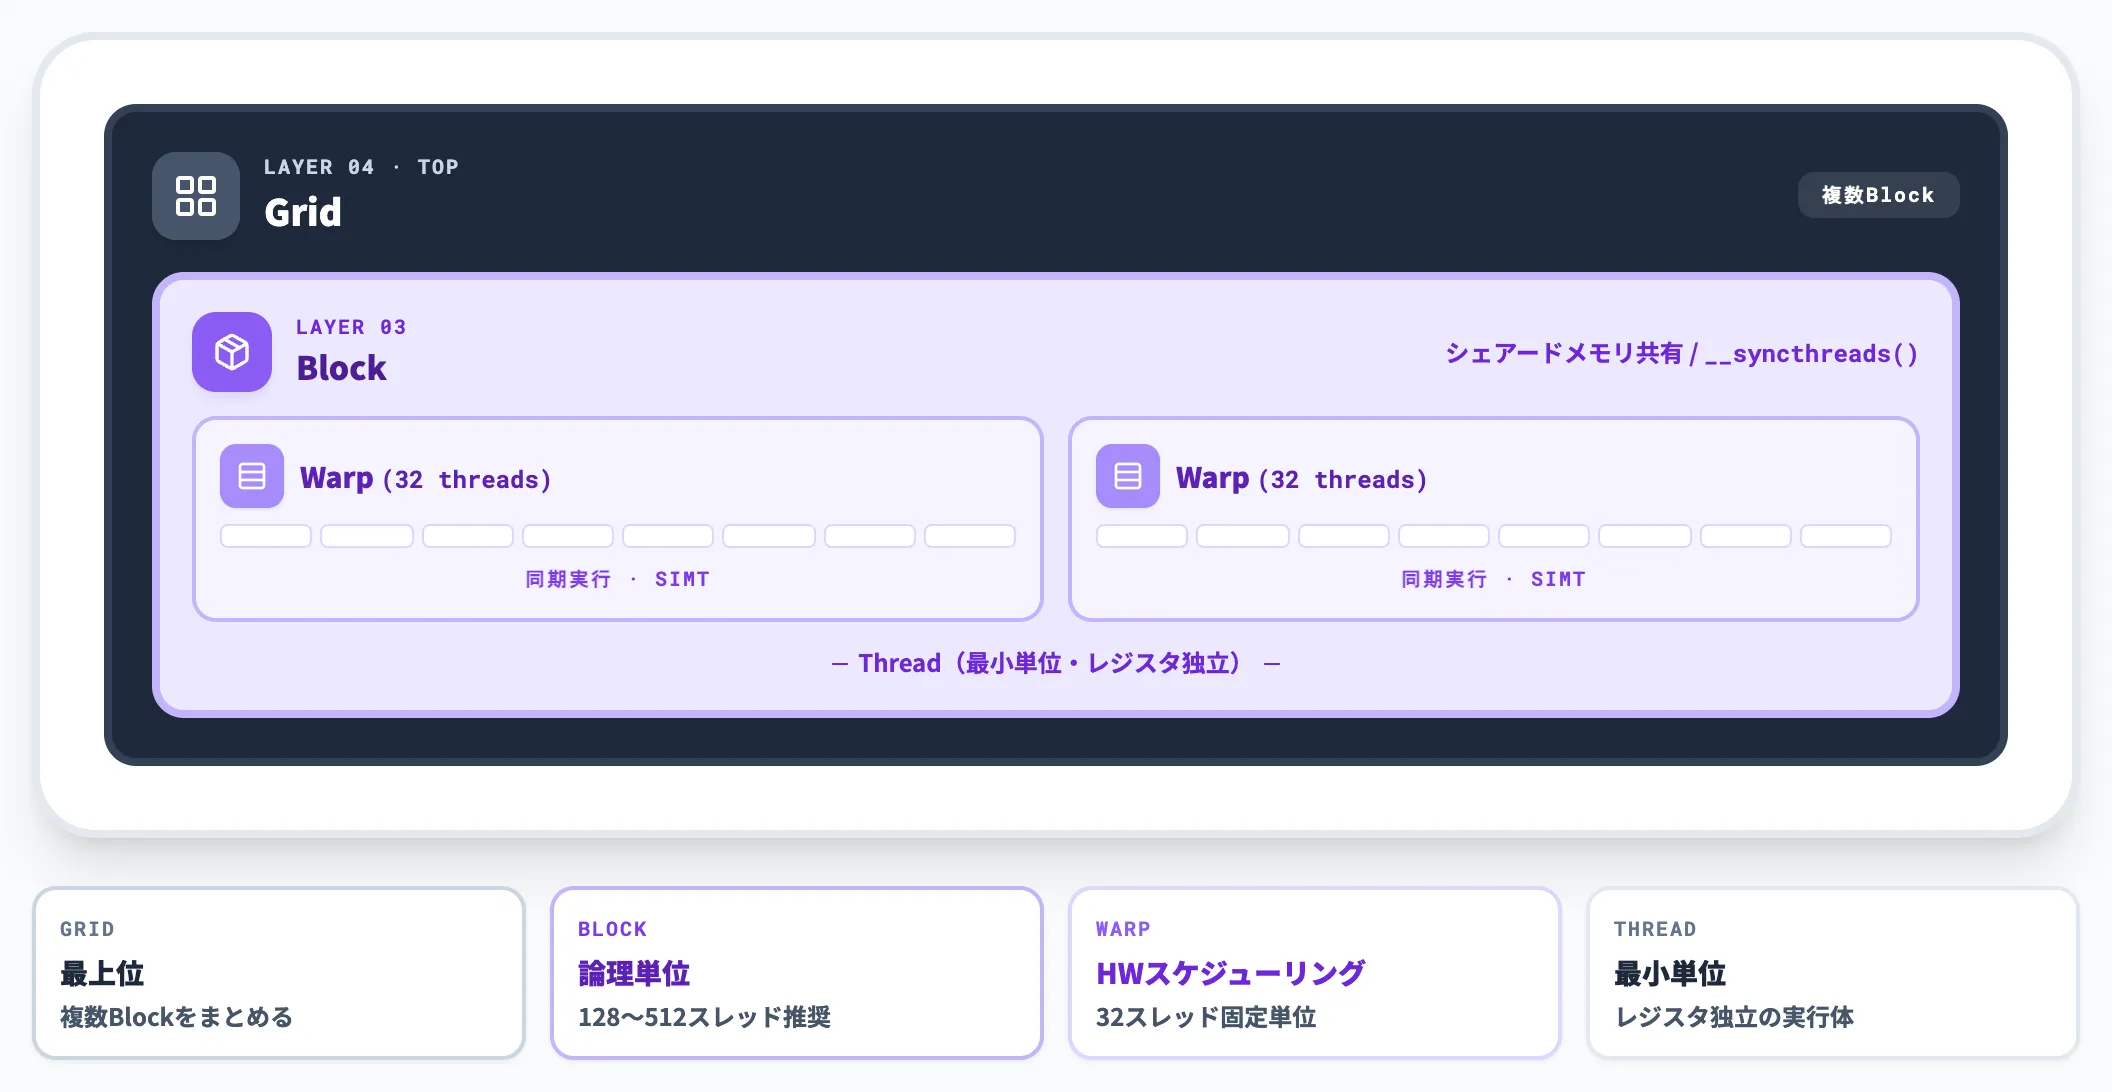
CUDAのスレッドは、下から順に Thread → Warp(32スレッドの集まり) → Block → Grid の4階層で組織化されます。
-
Thread
最小単位。1スレッドが1組のレジスタ・プログラムカウンタを持ち、独立に命令を実行する
-
Warp
32スレッドのまとまり。ハードウェアが実際にスケジューリングする最小単位で、Warp内のスレッドは基本的に同じ命令を同期実行する
-
Block
Warpをまとめた論理単位。同じBlock内のスレッドはシェアードメモリを共有し、__syncthreads() で同期できる
-
Grid
Blockをまとめた最上位単位。カーネル起動時のGrid × Block構成が「合計でいくつのスレッドを立ち上げるか」を決める(実際の同時実行数はSMへのBlock割り当てに依存)
Blockサイズをどう選ぶか(一般的には128〜512スレッド)、Blockごとのシェアードメモリをどう使うかが、カーネルチューニングの中心テーマになります。
Compute Capability——世代ごとに使える命令が異なる
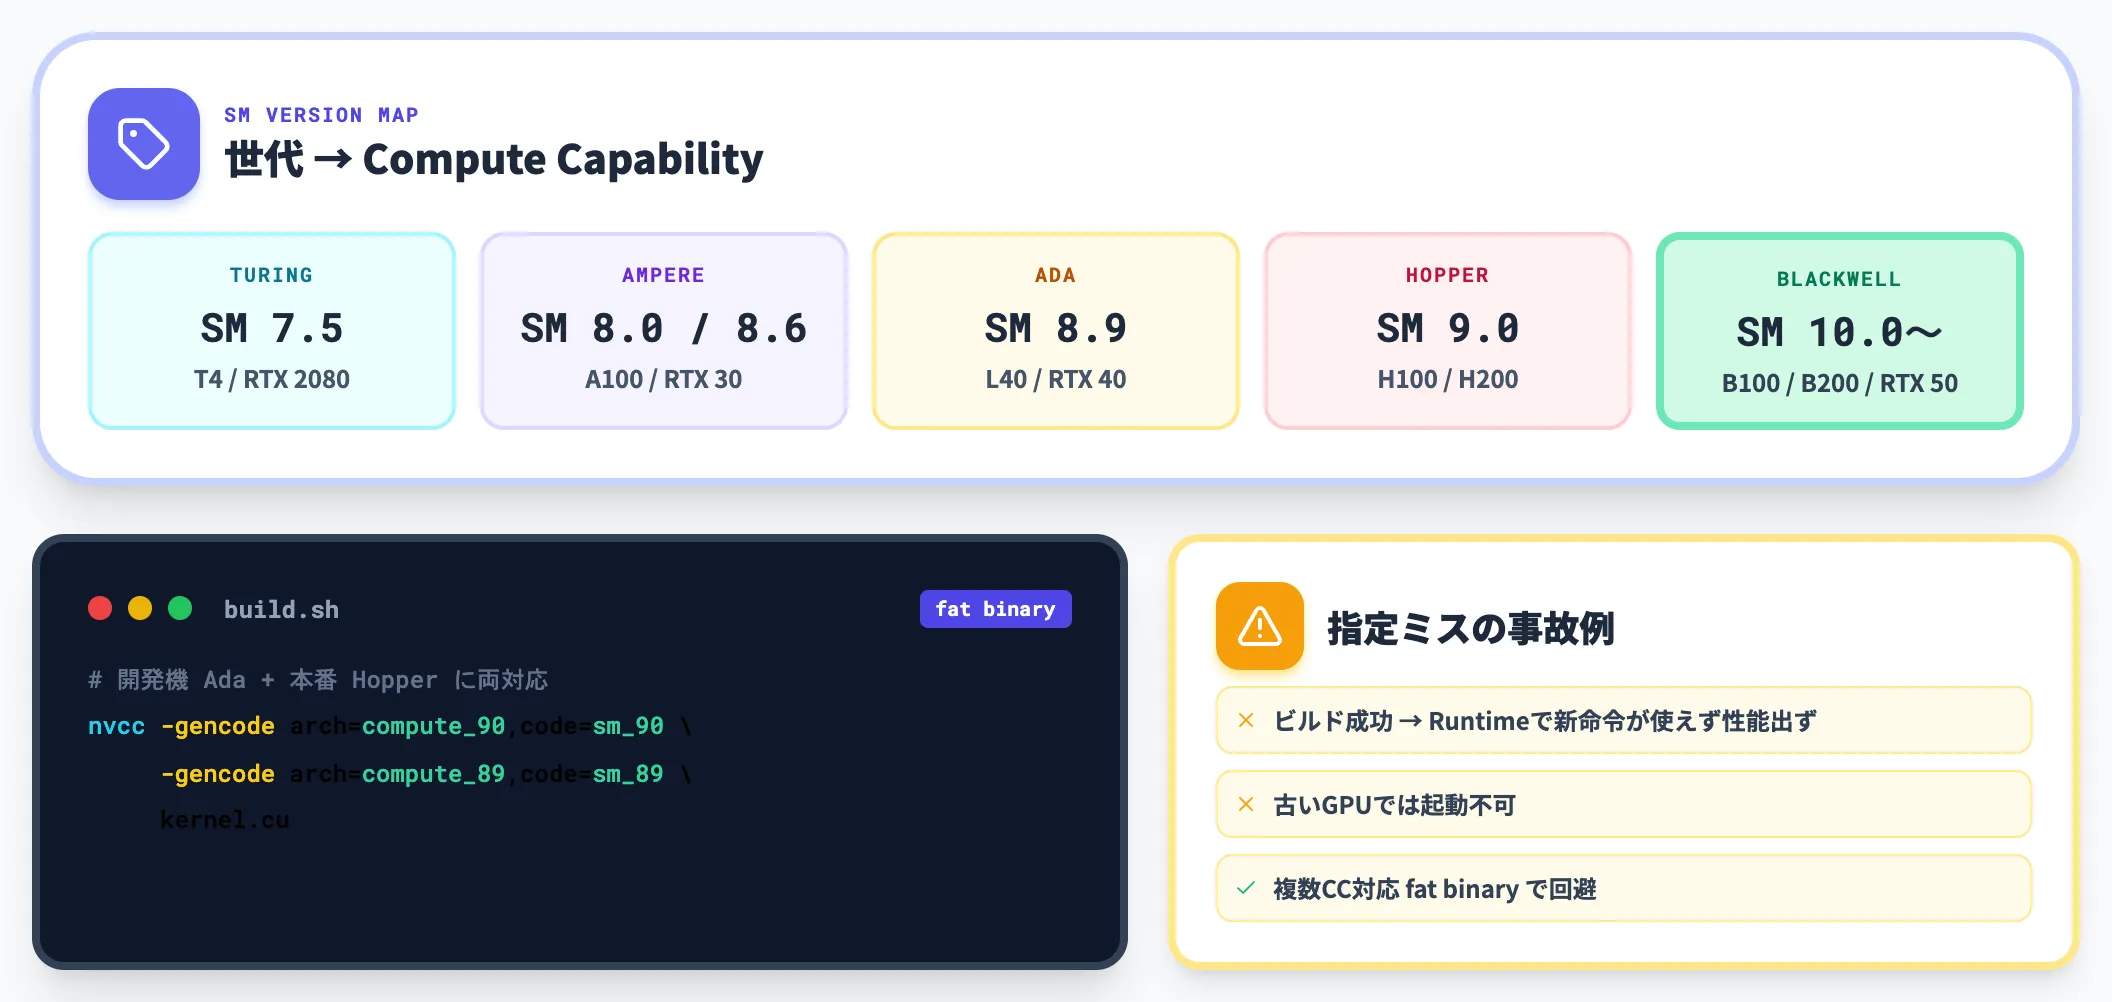
Compute Capability(CC)は、GPUがサポートする命令セットと機能レベルを示すバージョン番号です。TuringはSM 7.5、AmpereはSM 8.0/8.6、AdaはSM 8.9、HopperはSM 9.0、BlackwellはSM 10.0以降と、世代ごとに番号が上がっていきます。
nvccでコンパイルする際は -arch=sm_XX オプションでターゲットCCを指定します。指定を間違えると、ビルドは通ってもRuntimeで新命令が使えず性能が出ない、あるいは古いGPUでは起動できない、といった事故が起きます。
実務でよくあるのは「開発機はAda(sm_89)だが本番はHopper(sm_90)」といったケースで、この場合は複数CCに対応するfat binaryを吐かせる指定を追加します。
nvcc -gencode arch=compute_90,code=sm_90 \
     -gencode arch=compute_89,code=sm_89 \
     kernel.cu
メモリ階層の要点——性能を大きく左右する
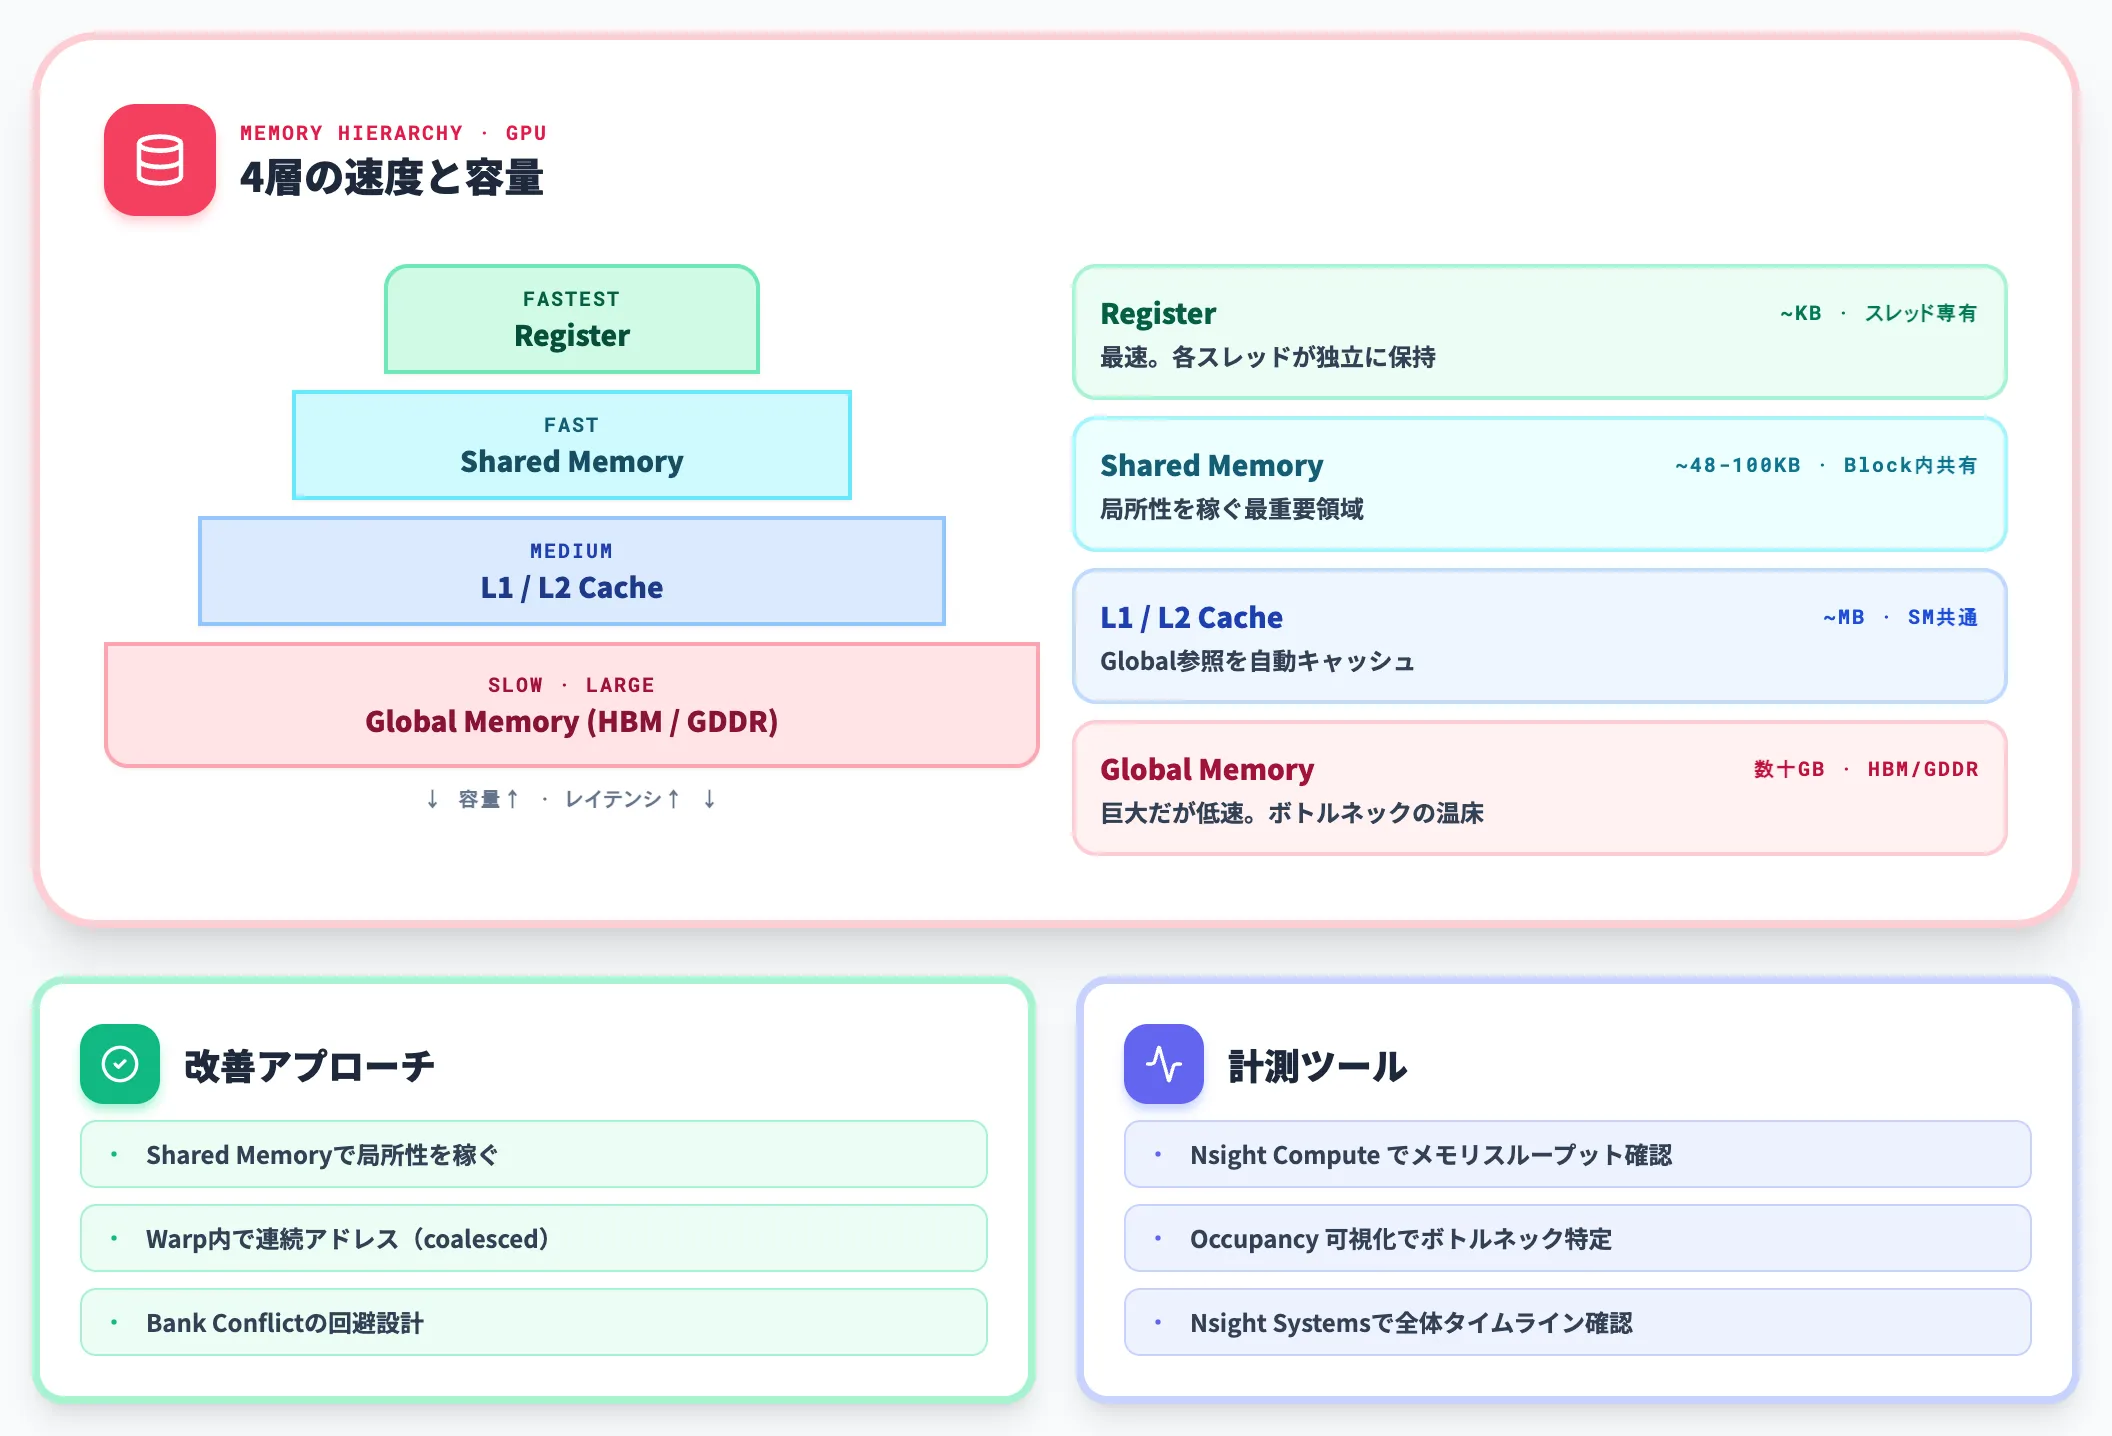
GPUには レジスタ → シェアードメモリ → L1/L2キャッシュ → グローバルメモリ(HBM/GDDR)の階層があり、下に行くほど容量は大きく、アクセスレイテンシは長くなります。
性能チューニングの多くは、このメモリ階層でどこにデータを置くかの最適化に集約されます。グローバルメモリへのアクセスが多いカーネルは、シェアードメモリで局所性を稼いだり、Warp内のスレッドが連続アドレスにアクセスするcoalescedアクセスを設計するだけで、スループットが改善するケースが多くあります(詳細はCUDA C++ Best Practices Guide参照)。
逆に、初心者が最初に書いたカーネルが期待した速度を出さないよくある原因の一つがメモリアクセスパターンです。
Nsight Computeなどのプロファイラで「メモリスループット」と「Occupancy」を確認し、ボトルネックを可視化してから最適化に入るのが近道です。
CUDA ToolkitとCUDA-Xライブラリ群の全体像
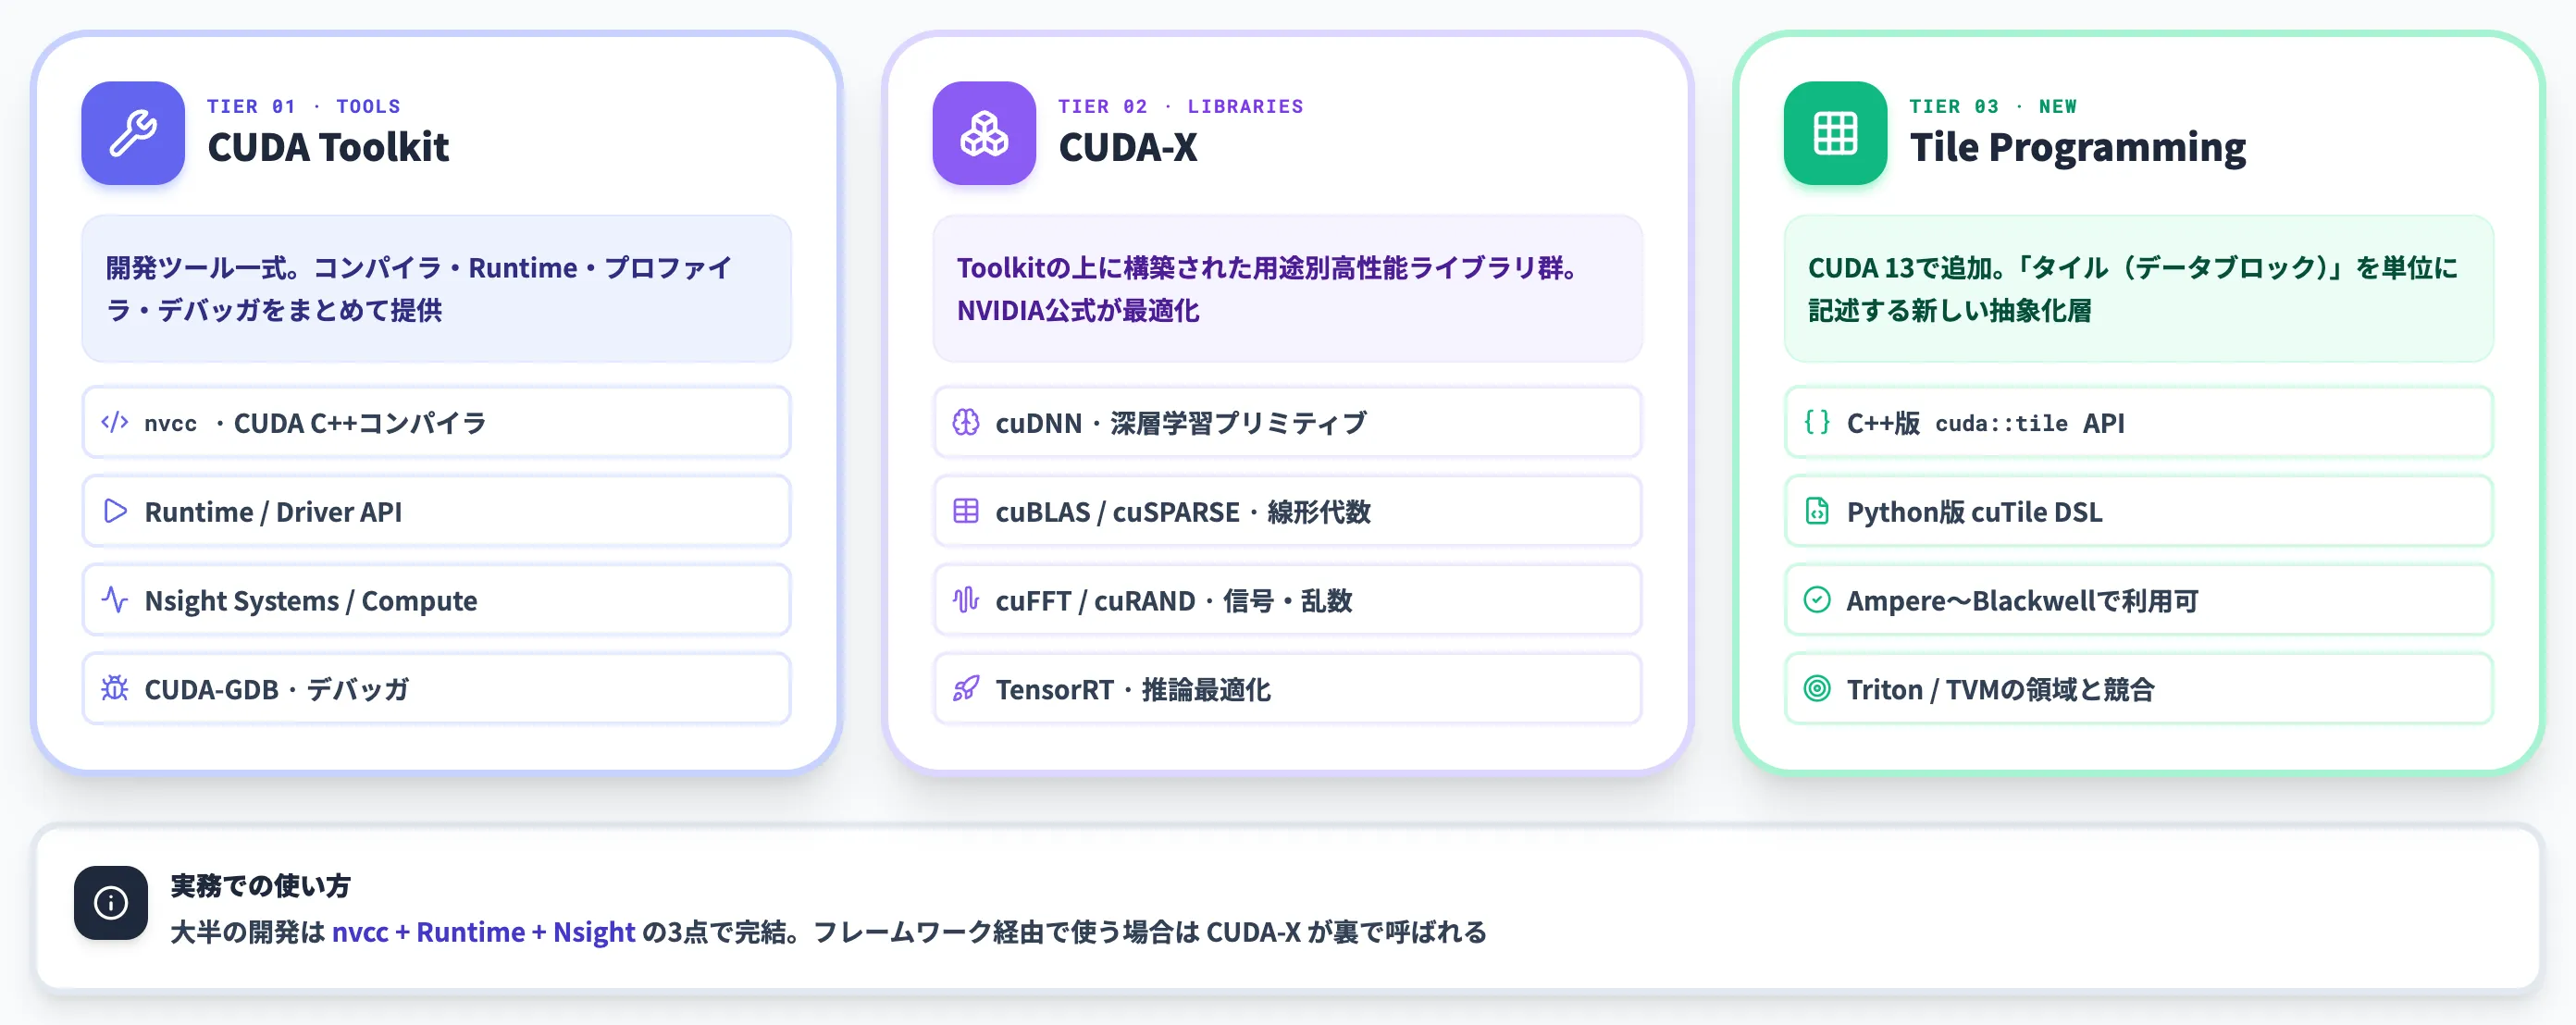
CUDAを使って開発するときに触る具体的なソフトウェア群が、CUDA ToolkitとCUDA-Xライブラリ群です。
前者はコンパイラやデバッガなどの「開発ツール一式」、後者は「用途別の高性能ライブラリ集」という位置づけで、実務ではこの両方を組み合わせて使います。
CUDA Toolkitに含まれる主要コンポーネント
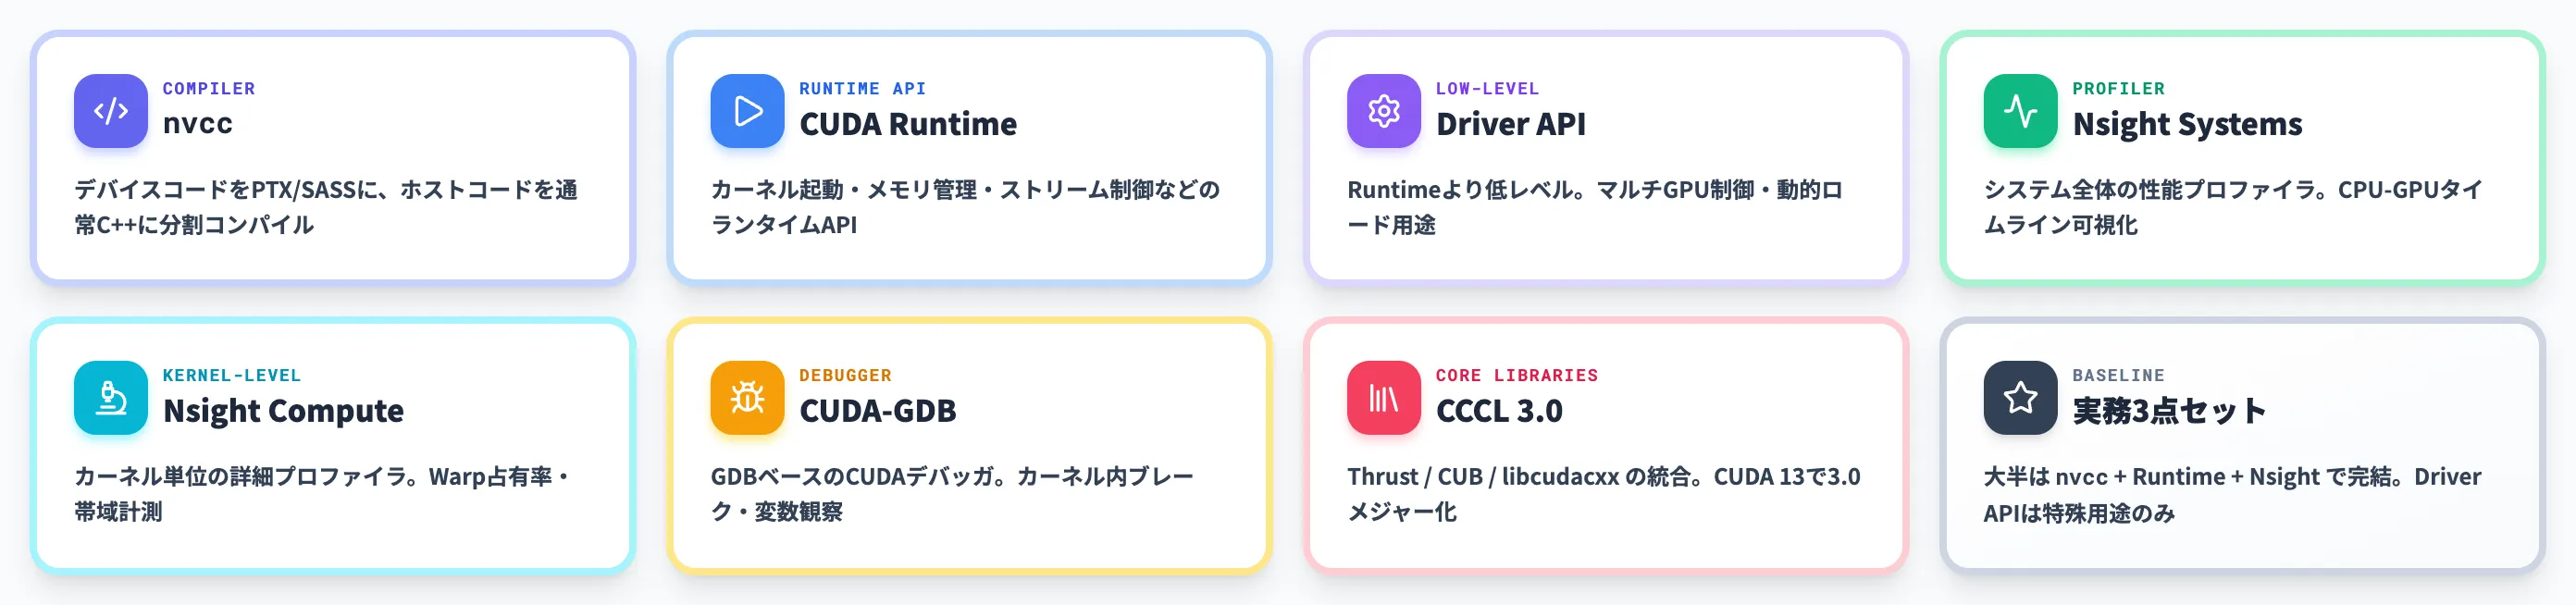
CUDA Toolkitは、CUDAアプリケーションを開発・実行するための一式で、NVIDIA Developerから無償でダウンロードできます。
以下の表で、Toolkitに含まれる主要コンポーネントと役割を整理しました。「なぜToolkit全部を入れる必要があるのか」を理解しておくと、後述のインストール手順で悩む場面が減ります。
| コンポーネント | 役割 |
|---|---|
| nvcc | CUDA C/C++コンパイラ。デバイスコードをPTX/SASSに、ホストコードを通常のC++に分割してコンパイルする |
| CUDA Runtime | カーネル起動・メモリ管理・ストリーム制御などのランタイムAPI |
| CUDA Driver API | Runtimeより低レベルなAPI。マルチGPU制御や動的ロード用途で使う |
| Nsight Systems | システム全体のパフォーマンスプロファイラ。CPU-GPU間のタイムラインを可視化 |
| Nsight Compute | カーネル単位の詳細プロファイラ。Warp占有率・メモリ帯域を計測 |
| CUDA-GDB | GDBベースのCUDAデバッガ。カーネル内のブレーク・変数観察が可能 |
| CCCL 3.0 | CUDA C++ Core Libraries(Thrust / CUB / libcudacxx の統合パッケージ)。CUDA 13.0で3.0メジャーに |
ほとんどのCUDA開発は nvcc + Runtime + Nsight の3点セットで完結します。Driver APIは、フレームワーク開発者や特殊なマルチGPU実装を書く場合に踏み込む領域です。
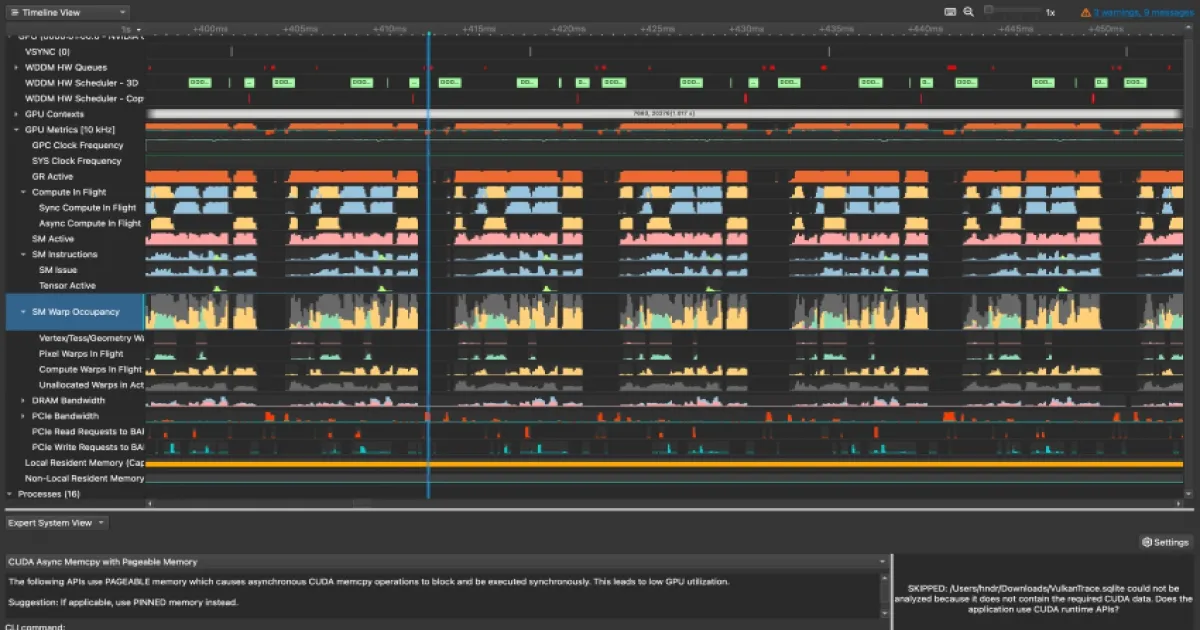
Nsight SystemsはCPU-GPU間のタイムライン・SM Warp Occupancy・DRAM帯域を可視化するCUDA公式プロファイラ(出典:NVIDIA Nsight Systems)
Nsight Systemsの画面では、GPUカーネル実行・PCIe転送・CUDA API呼び出しがミリ秒単位のタイムラインで並び、ボトルネックが「メモリ転送」「カーネル起動レイテンシ」「Warp占有率不足」のどこにあるかを一目で判別できます。
「GPUが速いのに全体は遅い」という現象を切り分けるための基本ツールです。
CUDA-Xライブラリ群——用途別に最適化された高性能ライブラリ
CUDA-Xは深層学習・線形代数・信号処理などGPU向けの用途別ライブラリ群として構築されている(出典:NVIDIA Developer)
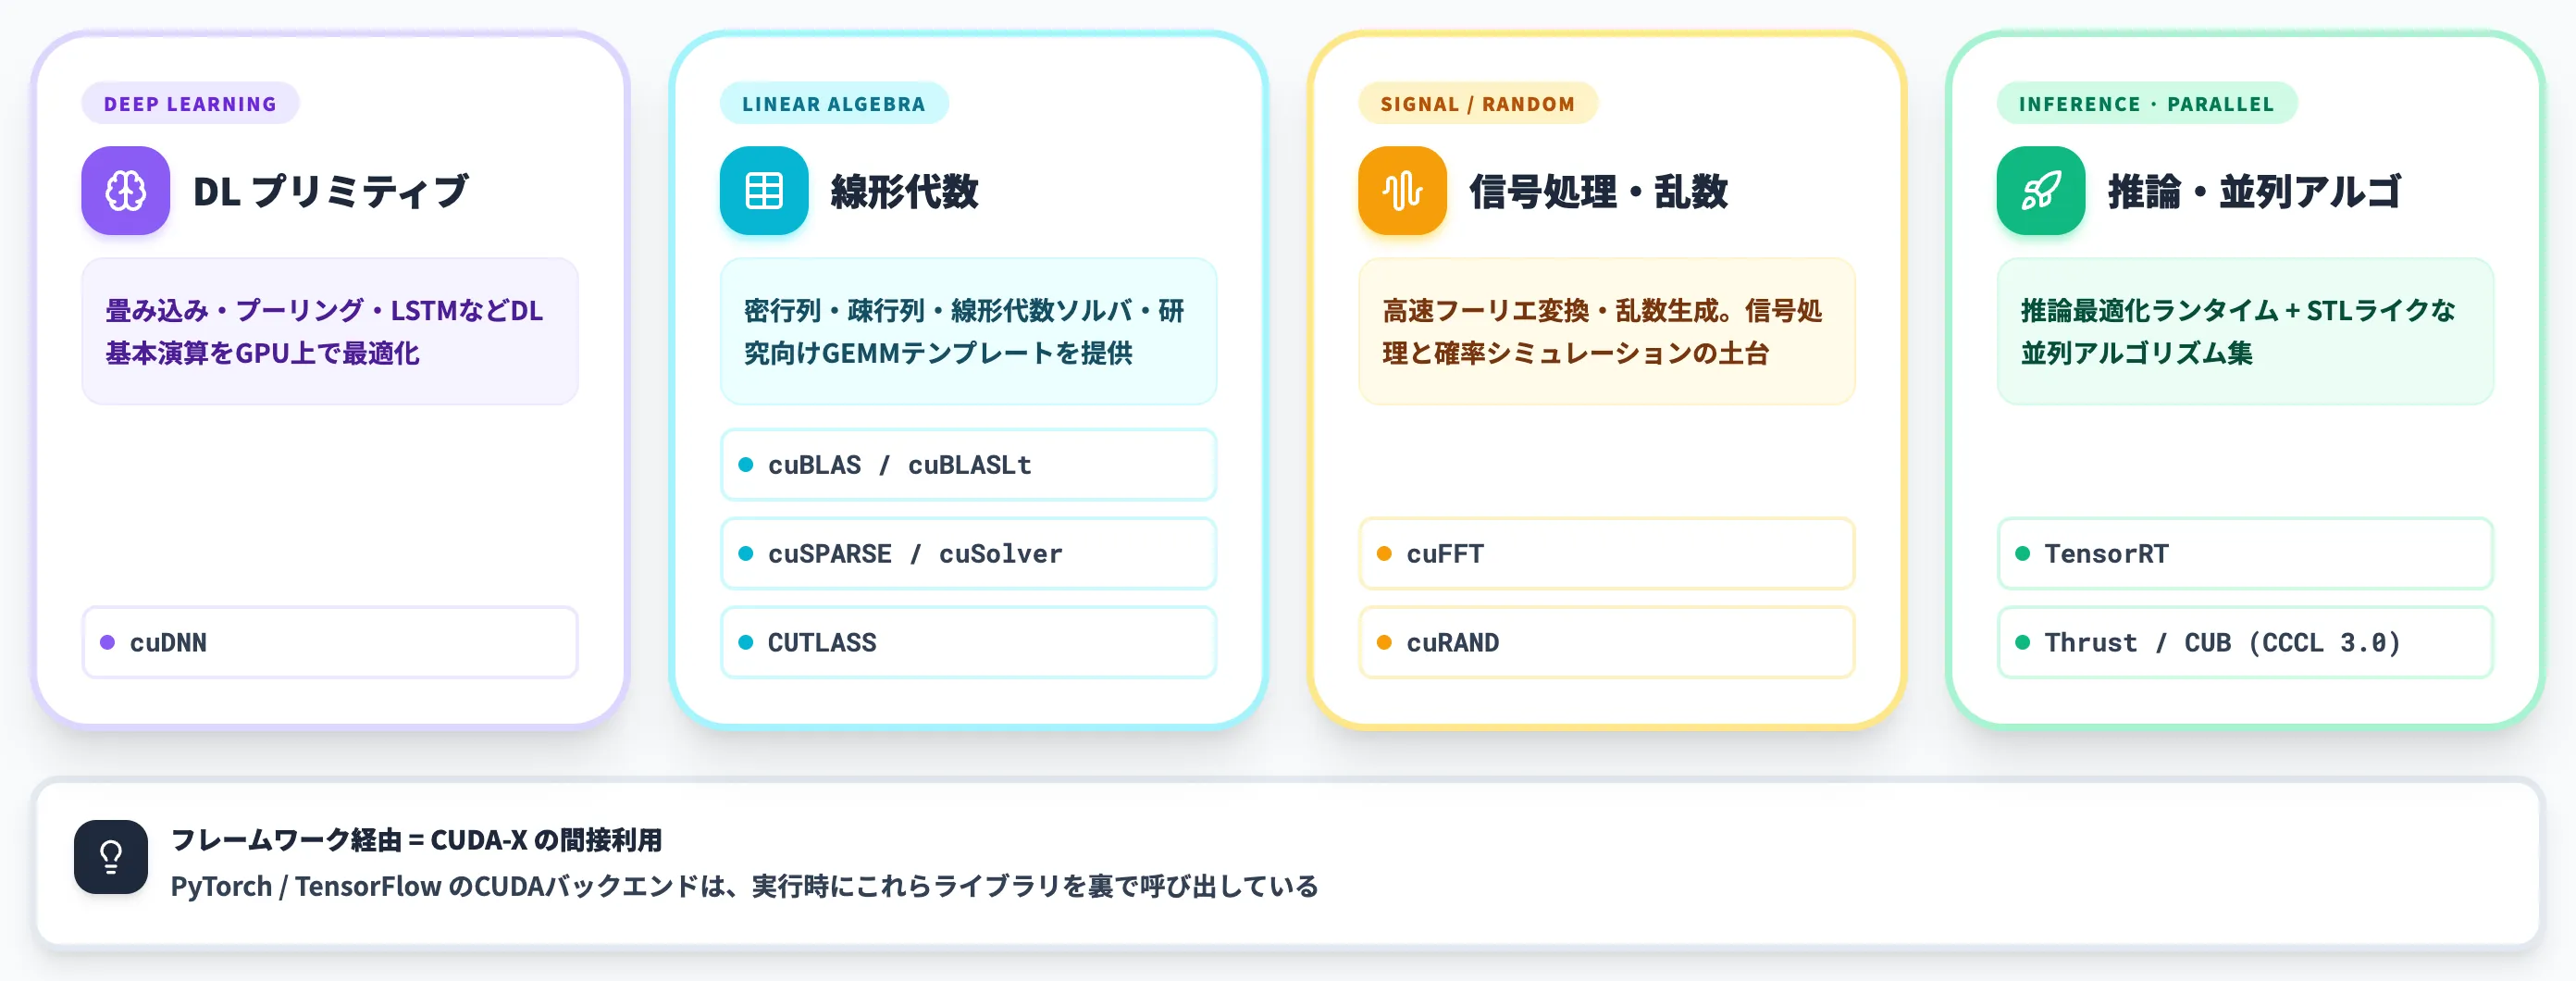
CUDA-Xは、CUDA Toolkitの上に構築された用途別の高性能ライブラリ群の総称です。「NVIDIA公式が最適化してくれたGPUカーネル」の集合と考えると理解しやすくなります。
以下の表で、代表的なCUDA-Xライブラリと用途を整理しました。深層学習・線形代数・信号処理など、AI/HPCで頻出する演算はほぼこのライブラリ群でカバーされています。
| ライブラリ | 用途 |
|---|---|
| cuDNN | ディープラーニング用の畳み込み・プーリング・LSTM等のプリミティブ集 |
| cuBLAS | 密行列に対する線形代数(BLAS準拠) |
| cuBLASLt | 混合精度・Grouped GEMM対応の拡張BLAS |
| cuSPARSE | 疎行列演算 |
| cuFFT | 高速フーリエ変換 |
| cuRAND | 乱数生成 |
| cuSolver | 線形代数ソルバ(LU分解・固有値等) |
| CUTLASS | GEMMカーネルのテンプレートライブラリ。研究者・上級エンジニア向け |
| Thrust / CUB | STLライクな並列アルゴリズム集(CCCL 3.0の中核) |
| TensorRT | 推論最適化ランタイム。量子化・レイヤー融合を自動適用 |
| Nsight Deep Learning Designer | DLモデルの分析・最適化GUI |
PyTorch・TensorFlowでNVIDIA GPUのCUDAバックエンドを選択して使う場合、実行時にはこれらのライブラリが裏で呼ばれています(CPU版wheelを選んだ場合はCUDA-Xは呼ばれません)。フレームワーク経由でGPUを使うことは、実質的にCUDA-Xを間接的に呼び出していることと同じです。
Tile Programming——CUDA 13で追加された新しい記述層
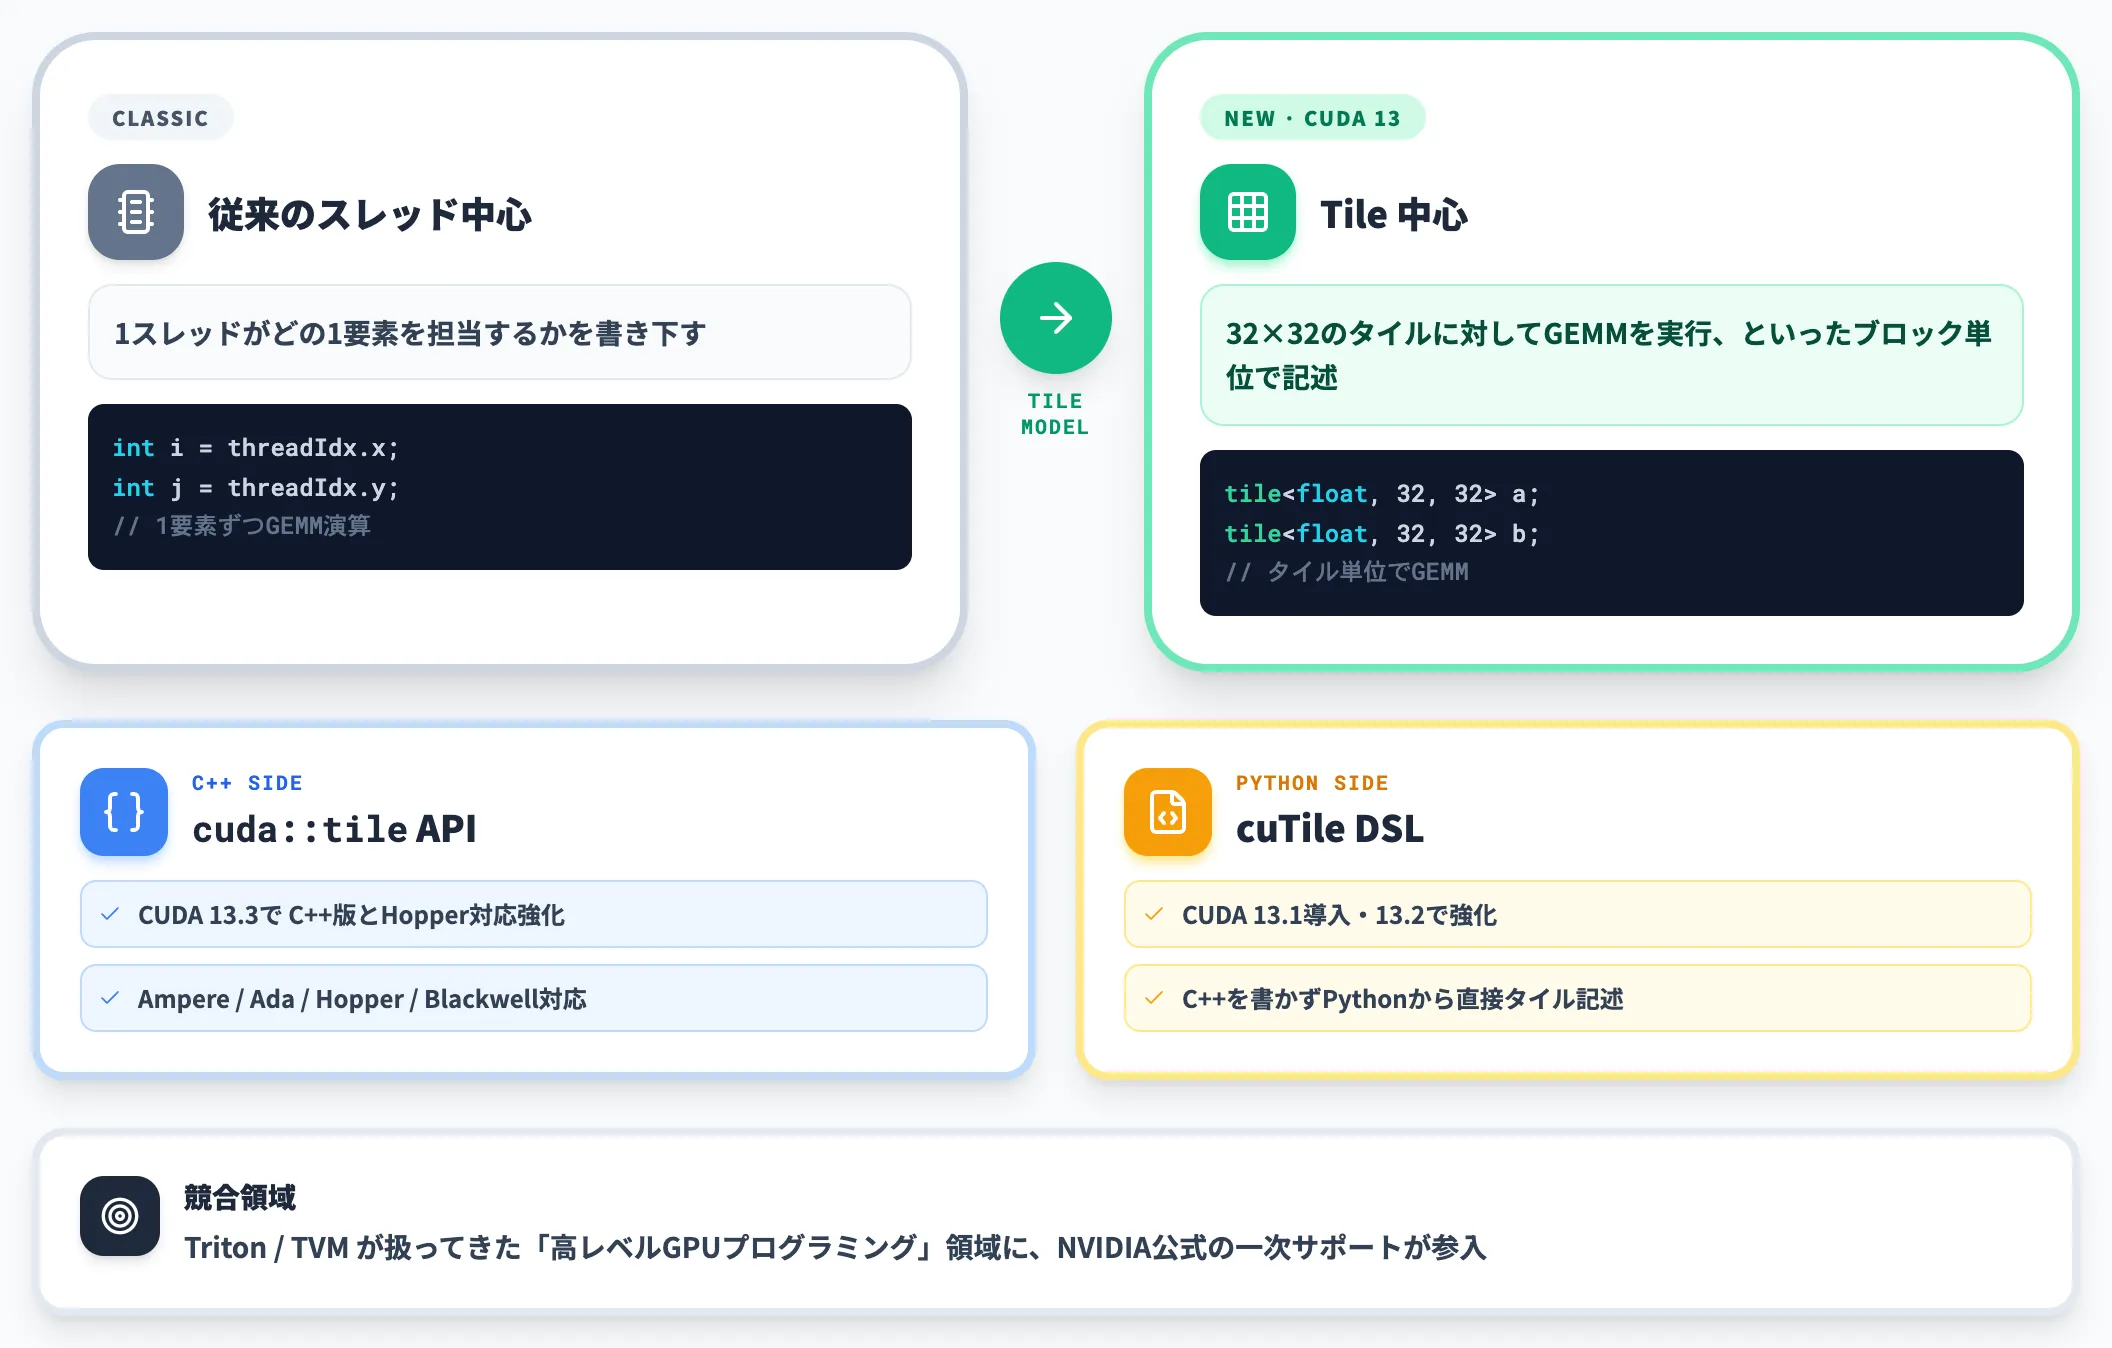
Tile Programmingは、従来のスレッド中心のカーネル記述に加え、「タイル(データブロック)を単位として計算を記述する」新しい抽象化層で、CUDA 13.1でcuTile Python DSLが導入され、13.2で強化、13.3でC++版APIとHopper対応が追加されました。
C++版の cuda::tile APIと、Pythonから直接タイル計算を書ける cuTile DSLの2系統で提供され、Ampere・Ada・Hopper・Blackwell世代で利用できます。
従来のCUDAカーネルは「スレッドがどの1要素を担当するか」を書き下す必要がありましたが、Tile Programmingでは「32×32のタイルに対してGEMMを実行する」といったブロック単位のロジックをそのまま書けます。TritonやTVMなど他の高レベルGPUプログラミング環境と競合する領域で、NVIDIAが公式に一次サポートを提供し始めた点が重要です。
CUDA 13で何が変わったか——2026年時点の最新動向
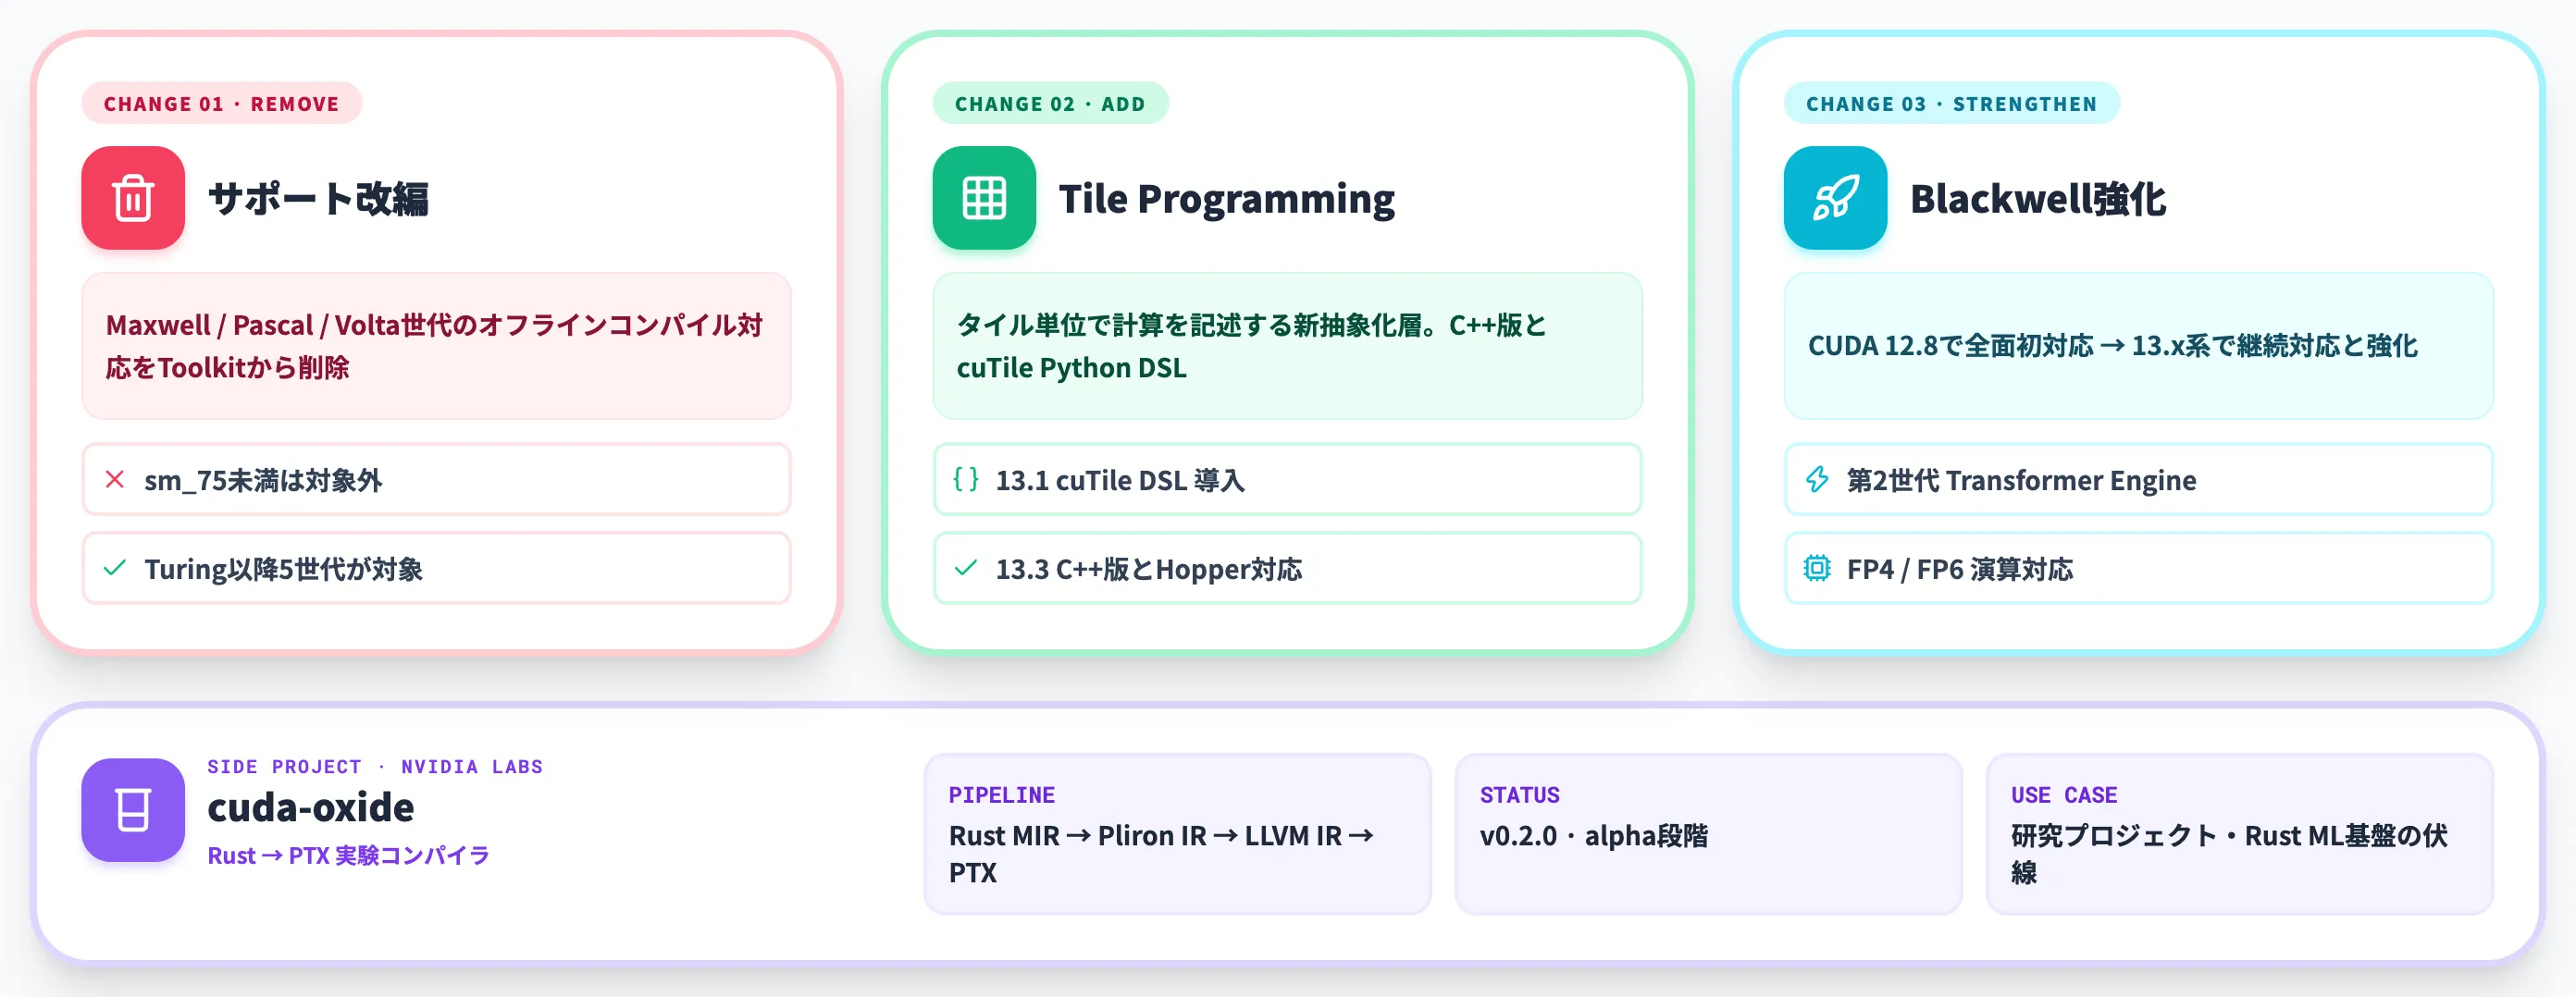
CUDA 13系は2026年時点の主流バージョンで、サポートアーキテクチャの改編・Tile Programming追加・Blackwell/Grace Blackwell対応の継続と強化という3方向の変化がCUDA本体で起きています(Blackwell全面初対応はCUDA 12.8)。
加えて周辺プロジェクトとして、NVIDIA Labsが実験的なRust→PTXコンパイラcuda-oxideをGitHubで公開しました。
Maxwell / Pascal / Volta世代のサポートを削除
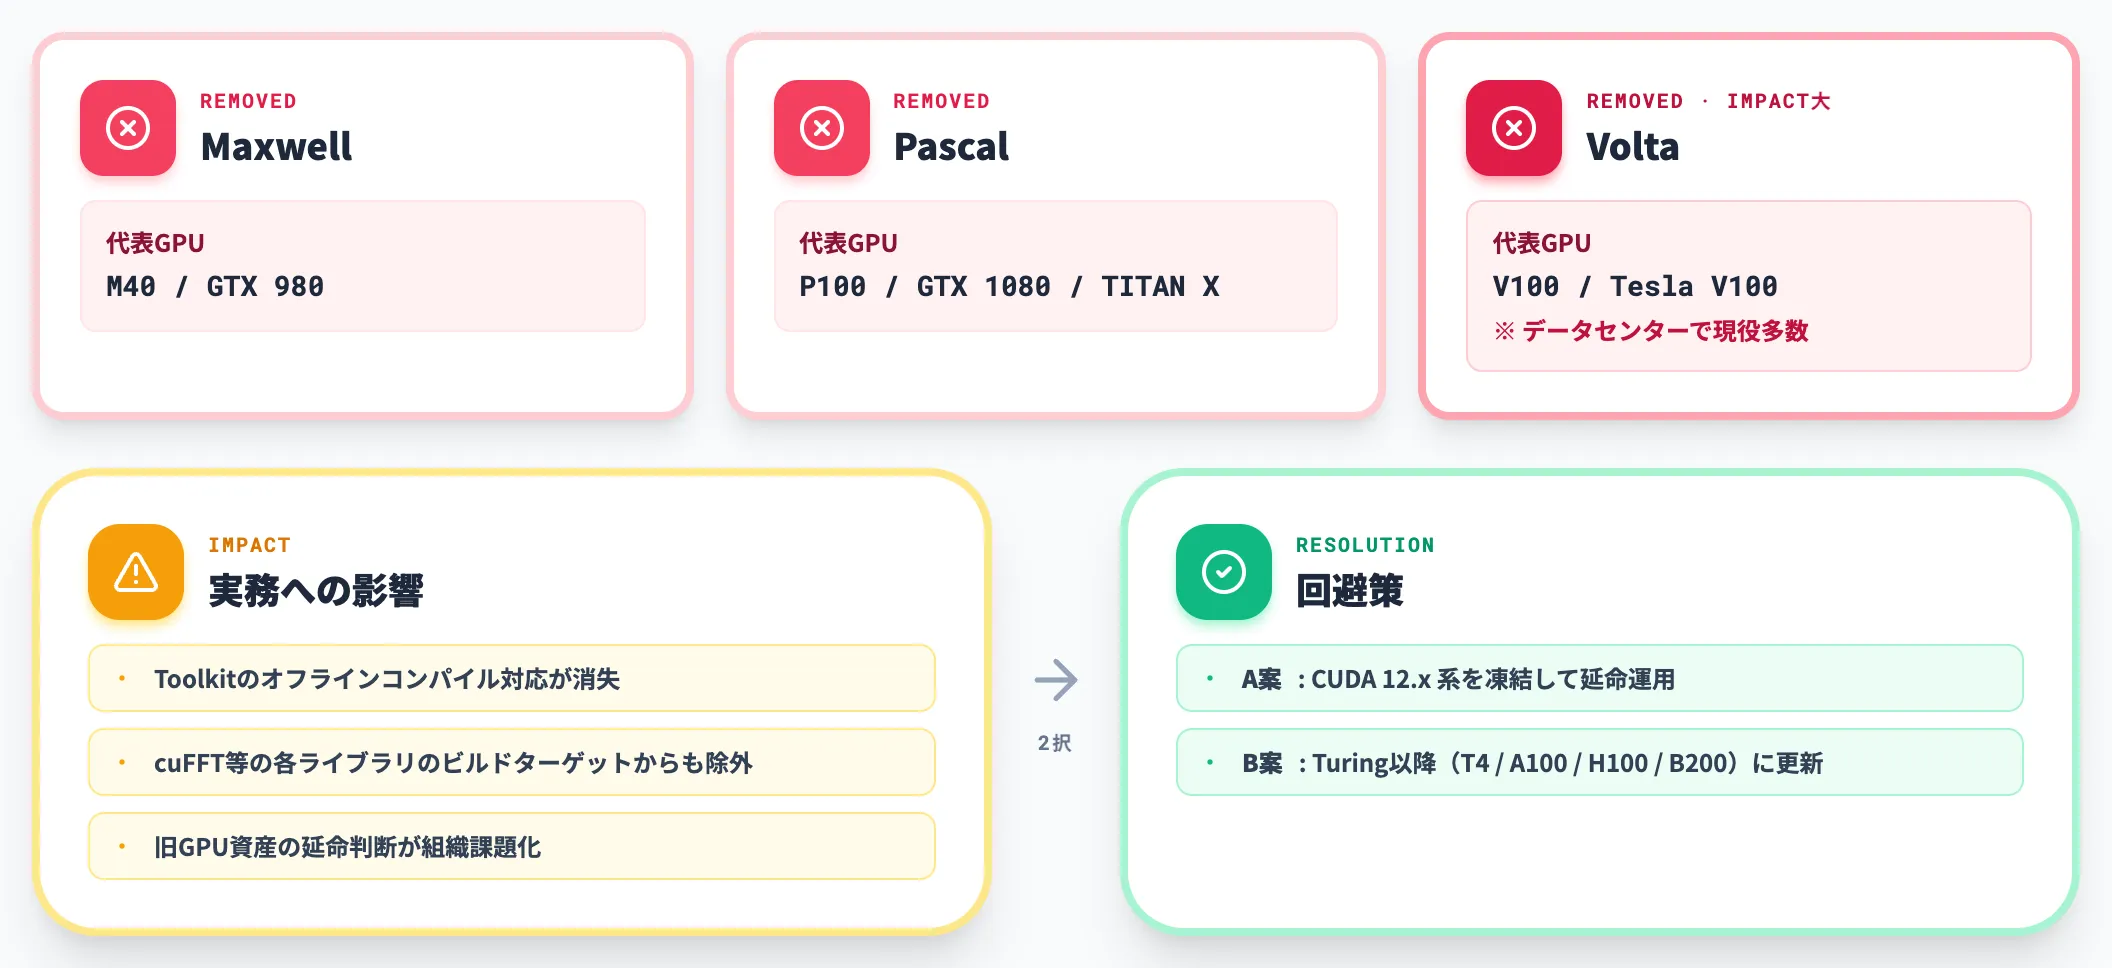
CUDA 13.0(2025年8月リリース)で、Compute Capability 7.5未満(Maxwell / Pascal / Volta)のオフラインコンパイル対応がToolkitから削除されました。
cuFFT等の各ライブラリでも同時にこれらの世代へのビルドターゲットが除外されています(詳細はNVIDIA公式のCUDA Toolkit 13.0発表ブログ参照)。
以下の表で、CUDA 13で対象内・対象外となったアーキテクチャを整理しました。旧GPU資産の延命を検討している組織は、CUDA 12.x系との併用が必要になる場合があります。
| 世代 | 代表GPU | CUDA 13.x対応 |
|---|---|---|
| Kepler | K40 / K80 | ×(CUDA 11で打ち切り) |
| Maxwell | M40 / GTX 980 | ×(CUDA 13で打ち切り) |
| Pascal | P100 / GTX 1080 / TITAN X | ×(CUDA 13で打ち切り) |
| Volta | V100 / Tesla V100 | ×(CUDA 13で打ち切り) |
| Turing | T4 / RTX 2080 | ○ |
| Ampere | A100 / RTX 3090 | ○ |
| Ada Lovelace | L40S / RTX 4090 | ○ |
| Hopper | H100 / H200 | ○ |
| Blackwell | B100 / B200 / GB200 / RTX 50シリーズ | ○ |
V100はデータセンターで根強く現役なため、既存のV100基盤を維持したい組織は「CUDA 12.x系を凍結して延命する」か「Turing以降のGPUに更新する」の二択になります。
Hopper世代のH100/H200はCUDA 13で継続対応。CUDA 13対応の下限はTuring(sm_75)以降(出典:CUDA Toolkit・Driver・Architecture Matrix)
CUDA 13の下限ラインはTuring(sm_75)以降で、Turing・Ampere・Ada Lovelace・Hopper・Blackwellの5世代がToolkitのオフラインコンパイル対象になります。
旧世代(Maxwell / Pascal / Volta)を運用している組織はCUDA 12.x系を凍結するか、Turing以上のGPUへの更新が必要です。
Blackwell / Grace Blackwell 対応の継続・強化
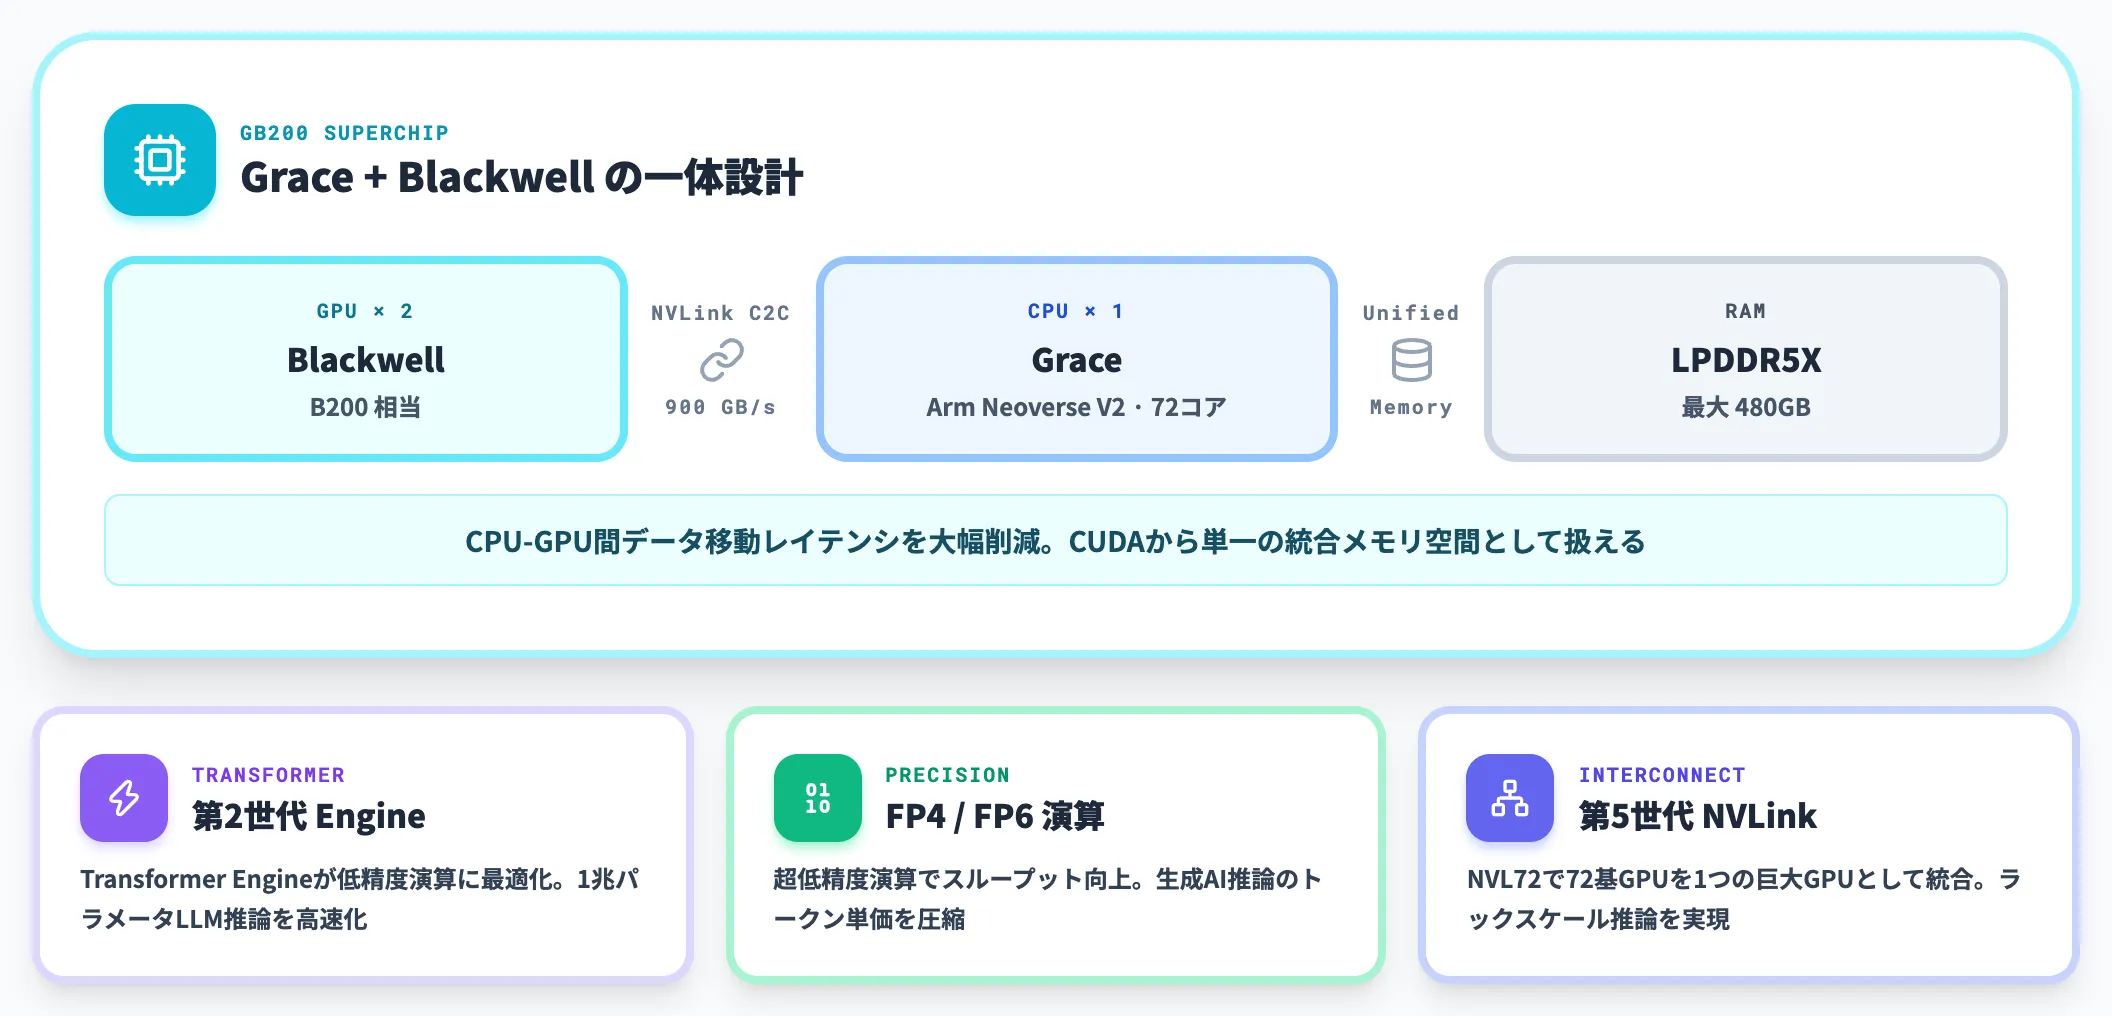
NVIDIA Blackwellアーキテクチャの全面的な初対応はCUDA 12.8で入っており、CUDA 13.x系ではその継続対応と強化が進んでいます。
Blackwell世代の主要な特徴は、第2世代Transformer Engine・FP4/FP6演算・第5世代NVLinkなどです。
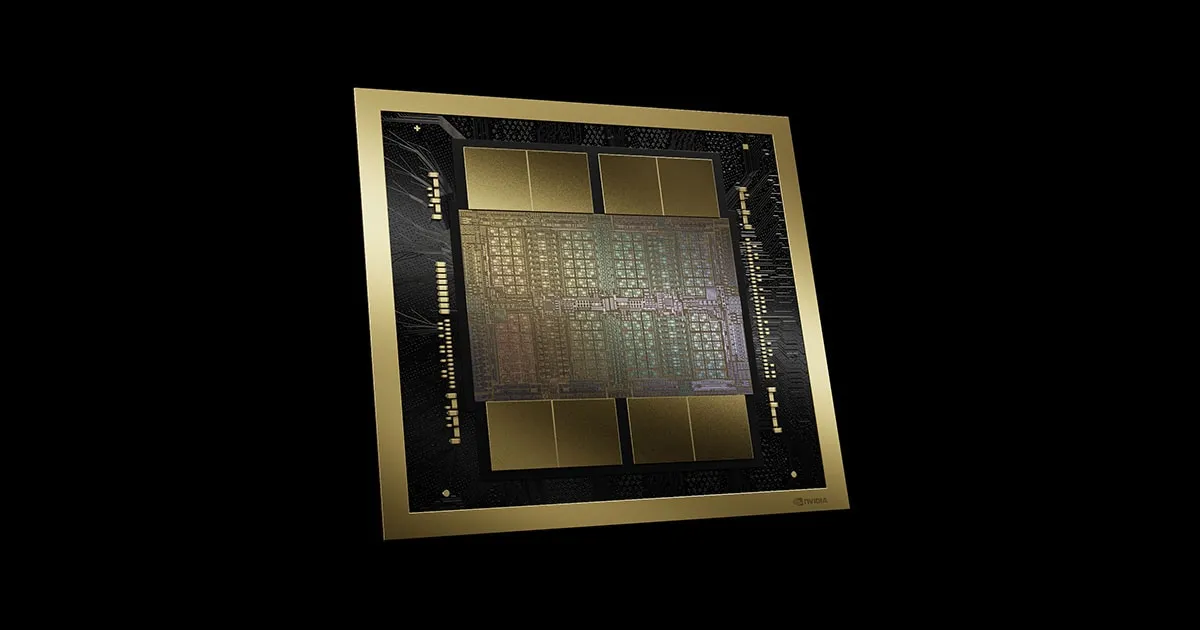
BlackwellアーキテクチャのGPUは第2世代Transformer Engine・FP4/FP6演算・第5世代NVLinkを統合(出典:NVIDIA Blackwell Architecture)
2基のBlackwell GPUと1基のGrace CPU(72 Neoverse V2コア)を NVLink C2Cで接続したGrace Blackwell Superchip(GB200)は、NVIDIA AI Factory構想の中核ハードウェアで、CUDA 12.8以降で本領を発揮する設計になっています。
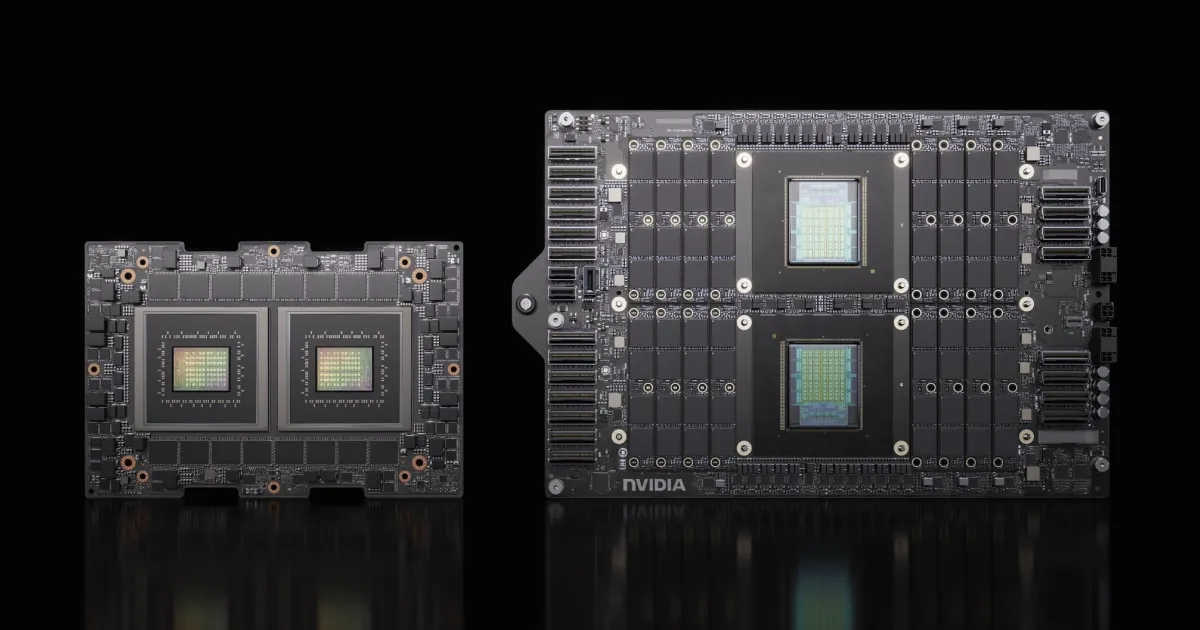
NVIDIA Grace CPU Superchip(左)とGH200 Grace Hopper Superchip(右)。Arm Neoverse V2ベースの72コアCPUを軸に、NVLink C2Cで他プロセッサと直結する構成が同シリーズの特徴(出典:NVIDIA Grace CPU)
Grace CPUはArm Neoverse V2ベースで、LPDDR5Xメモリを最大480GB統合しています。
CPUとGPUを別基板で扱う従来設計と比べ、Grace CPUとBlackwell GPUを900GB/sのNVLink C2Cで直結する構成は、CPU-GPU間のデータ移動レイテンシを大きく削減します。GB200 SuperchipはこのCPU-GPU一体設計(Grace 1基+Blackwell 2基)を1ユニット化したもので、CUDA経由で単一の統合メモリ空間として扱えます。
1兆パラメータ級LLMの推論・学習で、Hopper世代に対して大幅なスループット改善が公式に打ち出されており、NemotronなどNVIDIA自身のフラッグシップLLMもBlackwell最適化を前提に設計されています。
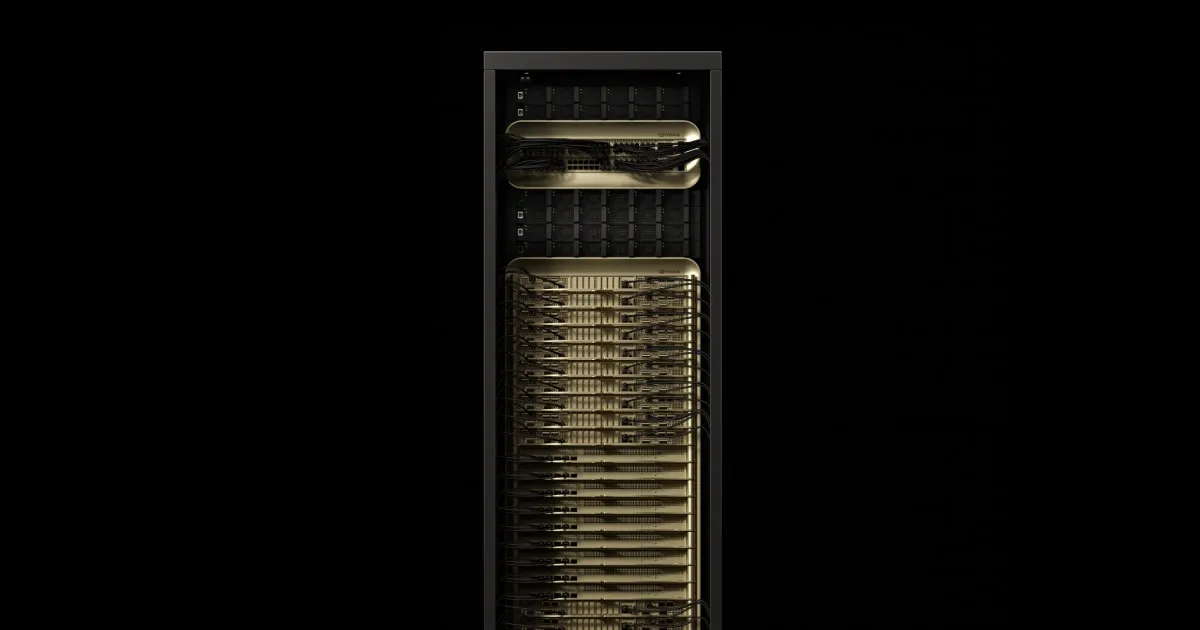
GB200 NVL72は72基のBlackwell GPUと36基のGrace CPUを1ラックに統合したフルスケール構成(出典:NVIDIA GB200 NVL72)
GB200 NVL72は「1ラック=1つの巨大なGPU」として動作するように設計されており、内部の第5世代NVLinkドメインで72基のGPUを1つの計算資源として束ねます。兆パラメータクラスLLMのリアルタイム推論を1ラックで完結させるのが公式の想定シナリオで、AI Factoryを構成するラックスケール基盤の一つとして位置づけられています。
cuTile Python DSL——PythonからGPU並列カーネルを書ける新経路
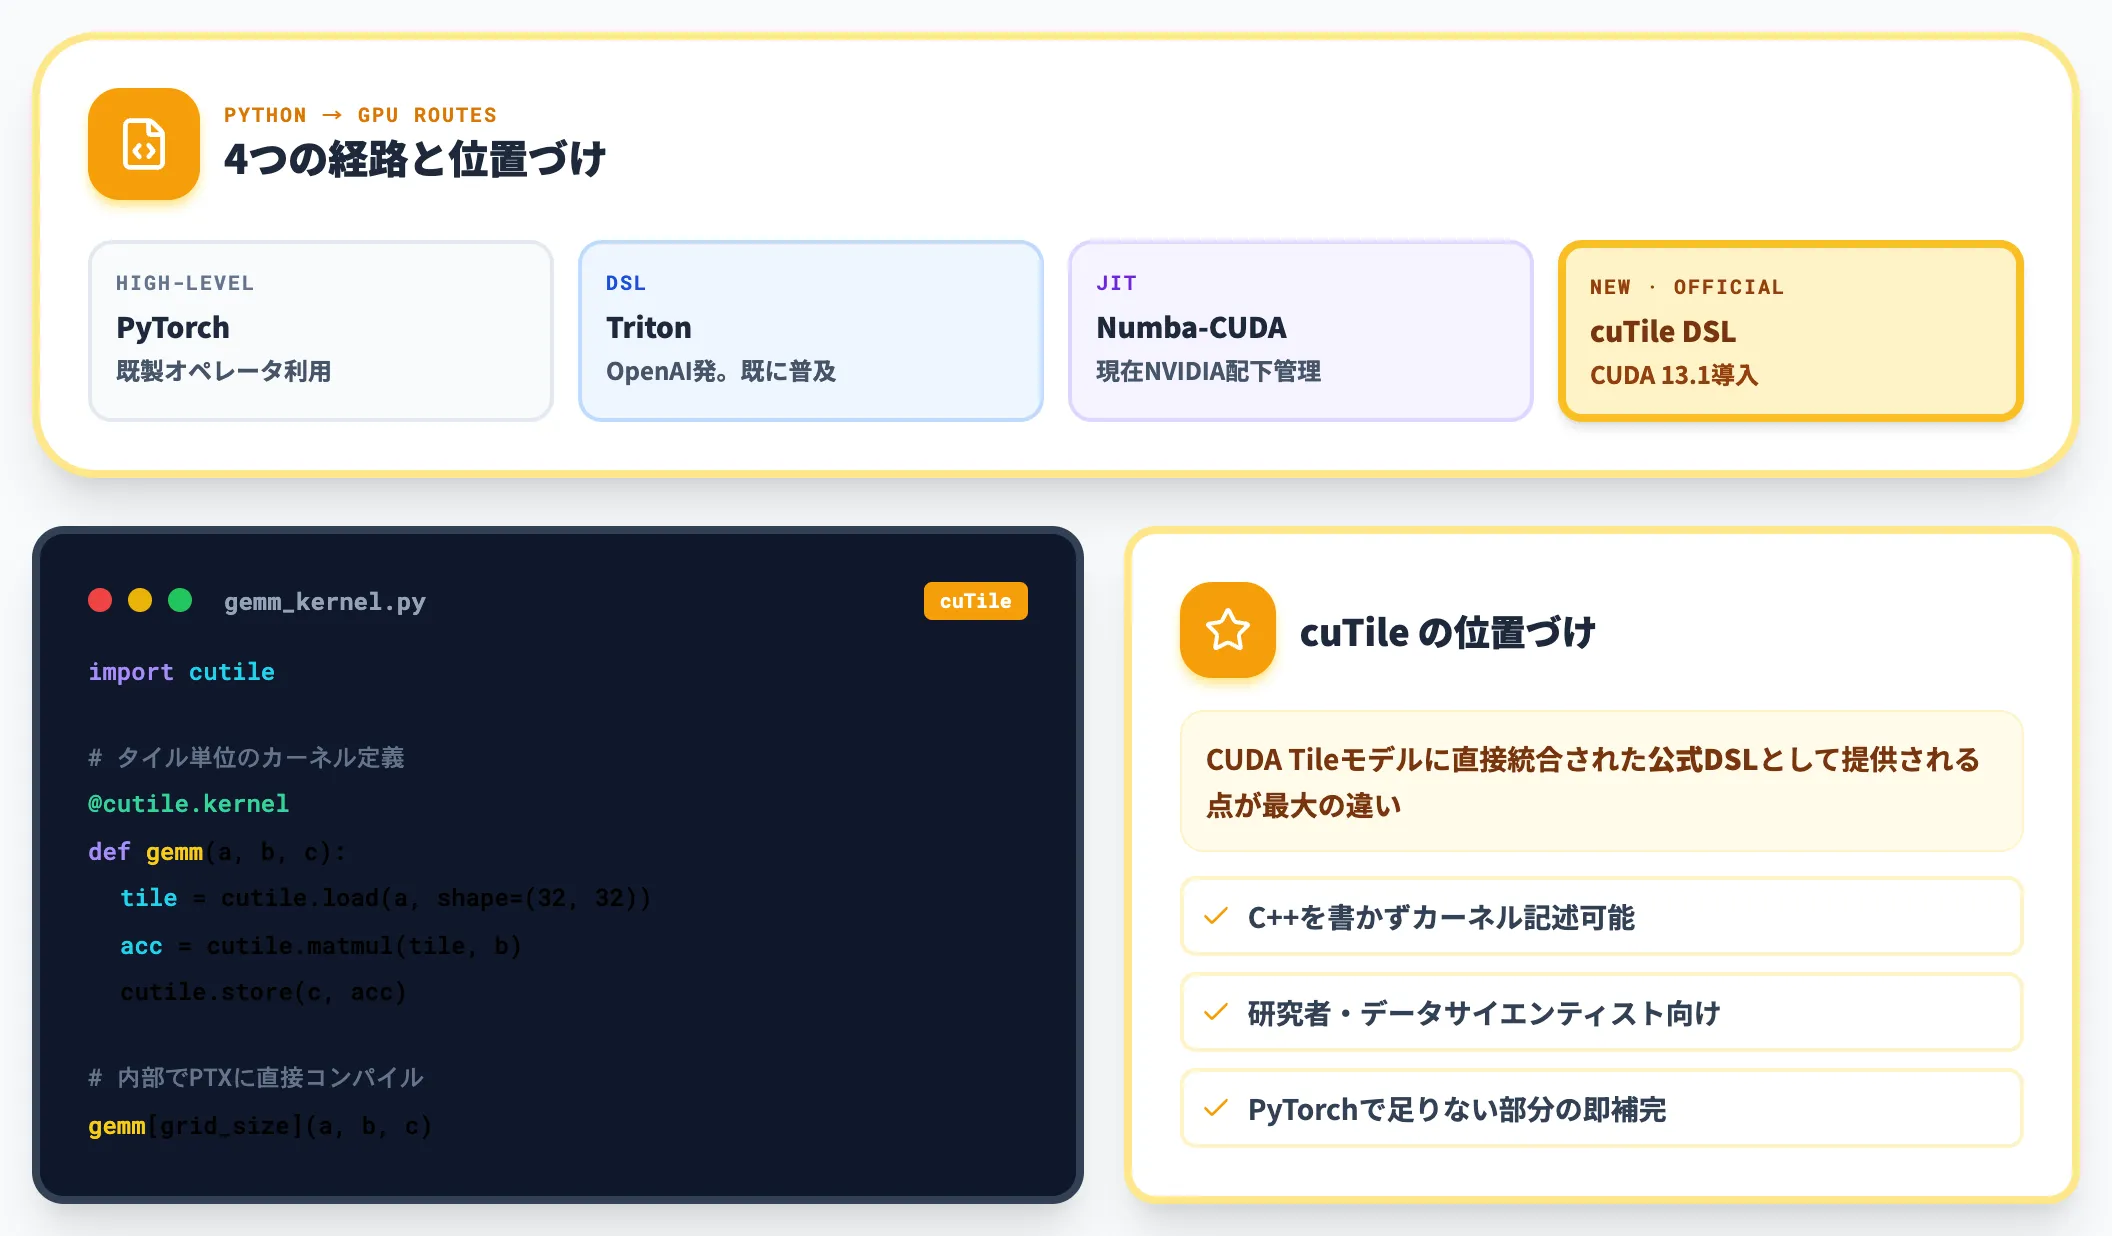
Tile Programming(前述)のPython向けフロントエンドとして、cuTile Python DSLがCUDA 13.1で導入され、13.2で機能強化されました。
従来、低レベルなCUDAカーネル実装ではC++が中心で、Python側からはTritonやNumba-CUDA(現在NVIDIA配下で管理)などを使うのが一般的でした。cuTileを使うとPythonのままカーネルを記述し、内部でPTXにコンパイルされて実行されます。TritonやNumbaと目的は近いですが、CUDA Tileモデルに直接統合された公式DSLとして提供されている点が最大の違いです。
研究者やデータサイエンティストが「PyTorchで足りない部分を短時間で書き足す」用途に強く、C++を書かずにNVIDIA公式DSLでカーネル層に触れられる経路が広がった形になります。
cuda-oxide——Rustで書いてPTXに直接コンパイル
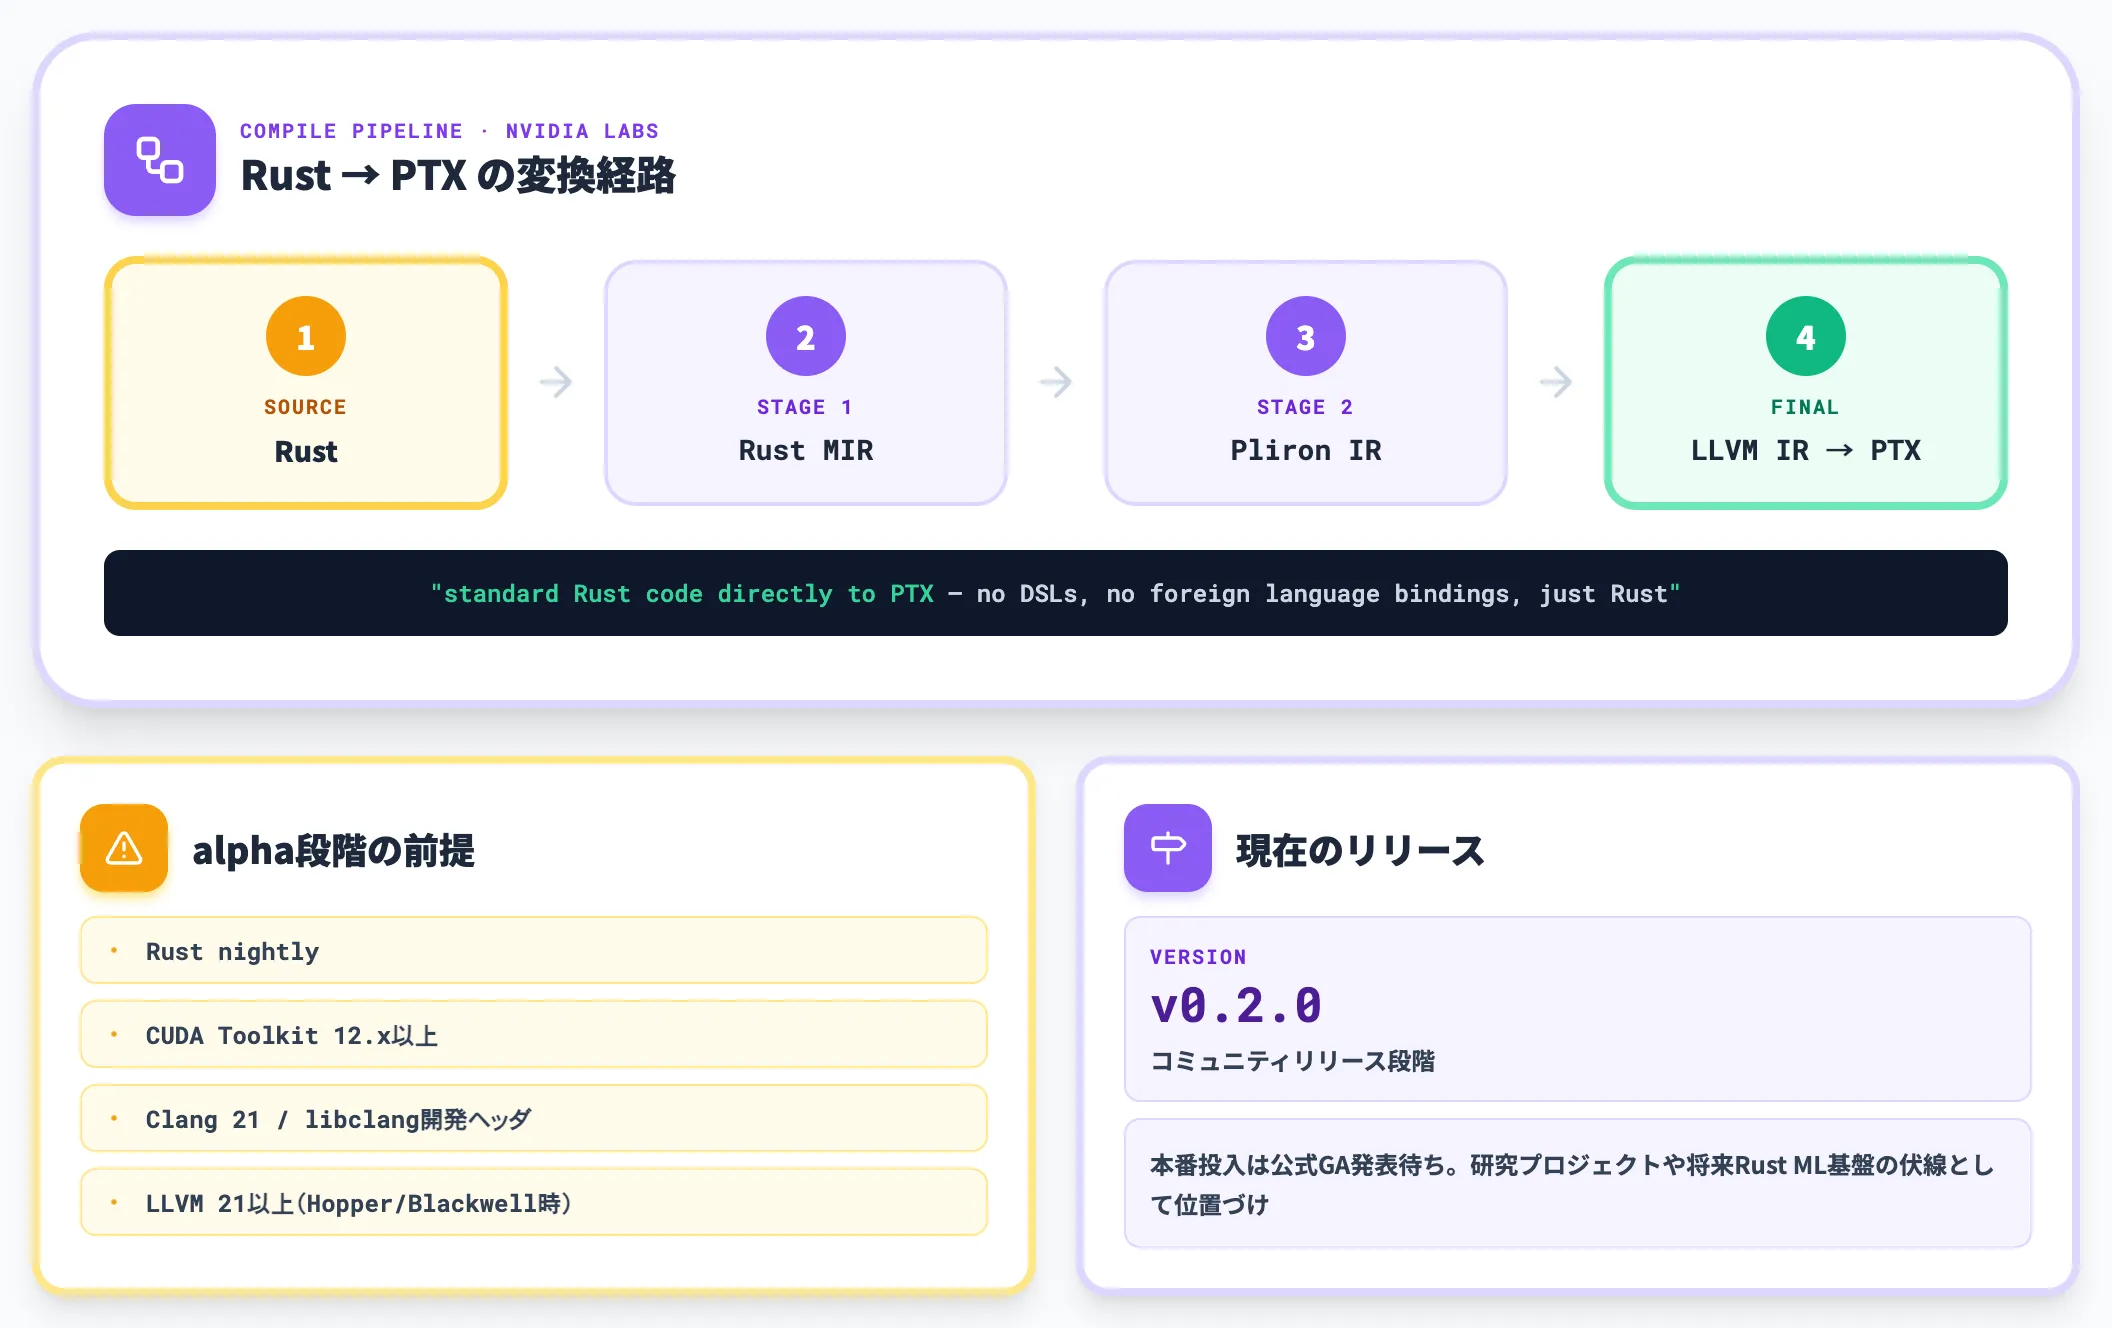
もう一つの2026年の新展開が、NVIDIA Labsが公開した実験的コンパイラcuda-oxideです。Rustソースコードから直接PTXへコンパイルする、Rust MIR → Pliron IR → LLVM IR → PTXのパイプラインを持っています。
C++やCMake、外部のFFIバインディングを介さず、Rustのままカーネルを書ける点が特徴です。GitHubのREADMEにも「standard Rust code directly to PTX — no DSLs, no foreign language bindings, just Rust」と明記されており、v0.2.0がコミュニティリリースとして公開されています。
ただし現時点ではalpha段階で、Rust nightly・CUDA Toolkit 12.x以上・Clang 21/libclang開発ヘッダが必要という強い前提があります(LLVM 21以上はHopper/Blackwell向け機能を扱う場合に必要)。
研究プロジェクトや将来のRustベースML基盤の伏線として位置づけ、本番投入は公式のGA発表を待つ判断が現実的です。
次世代アーキテクチャ「Rubin」への準備
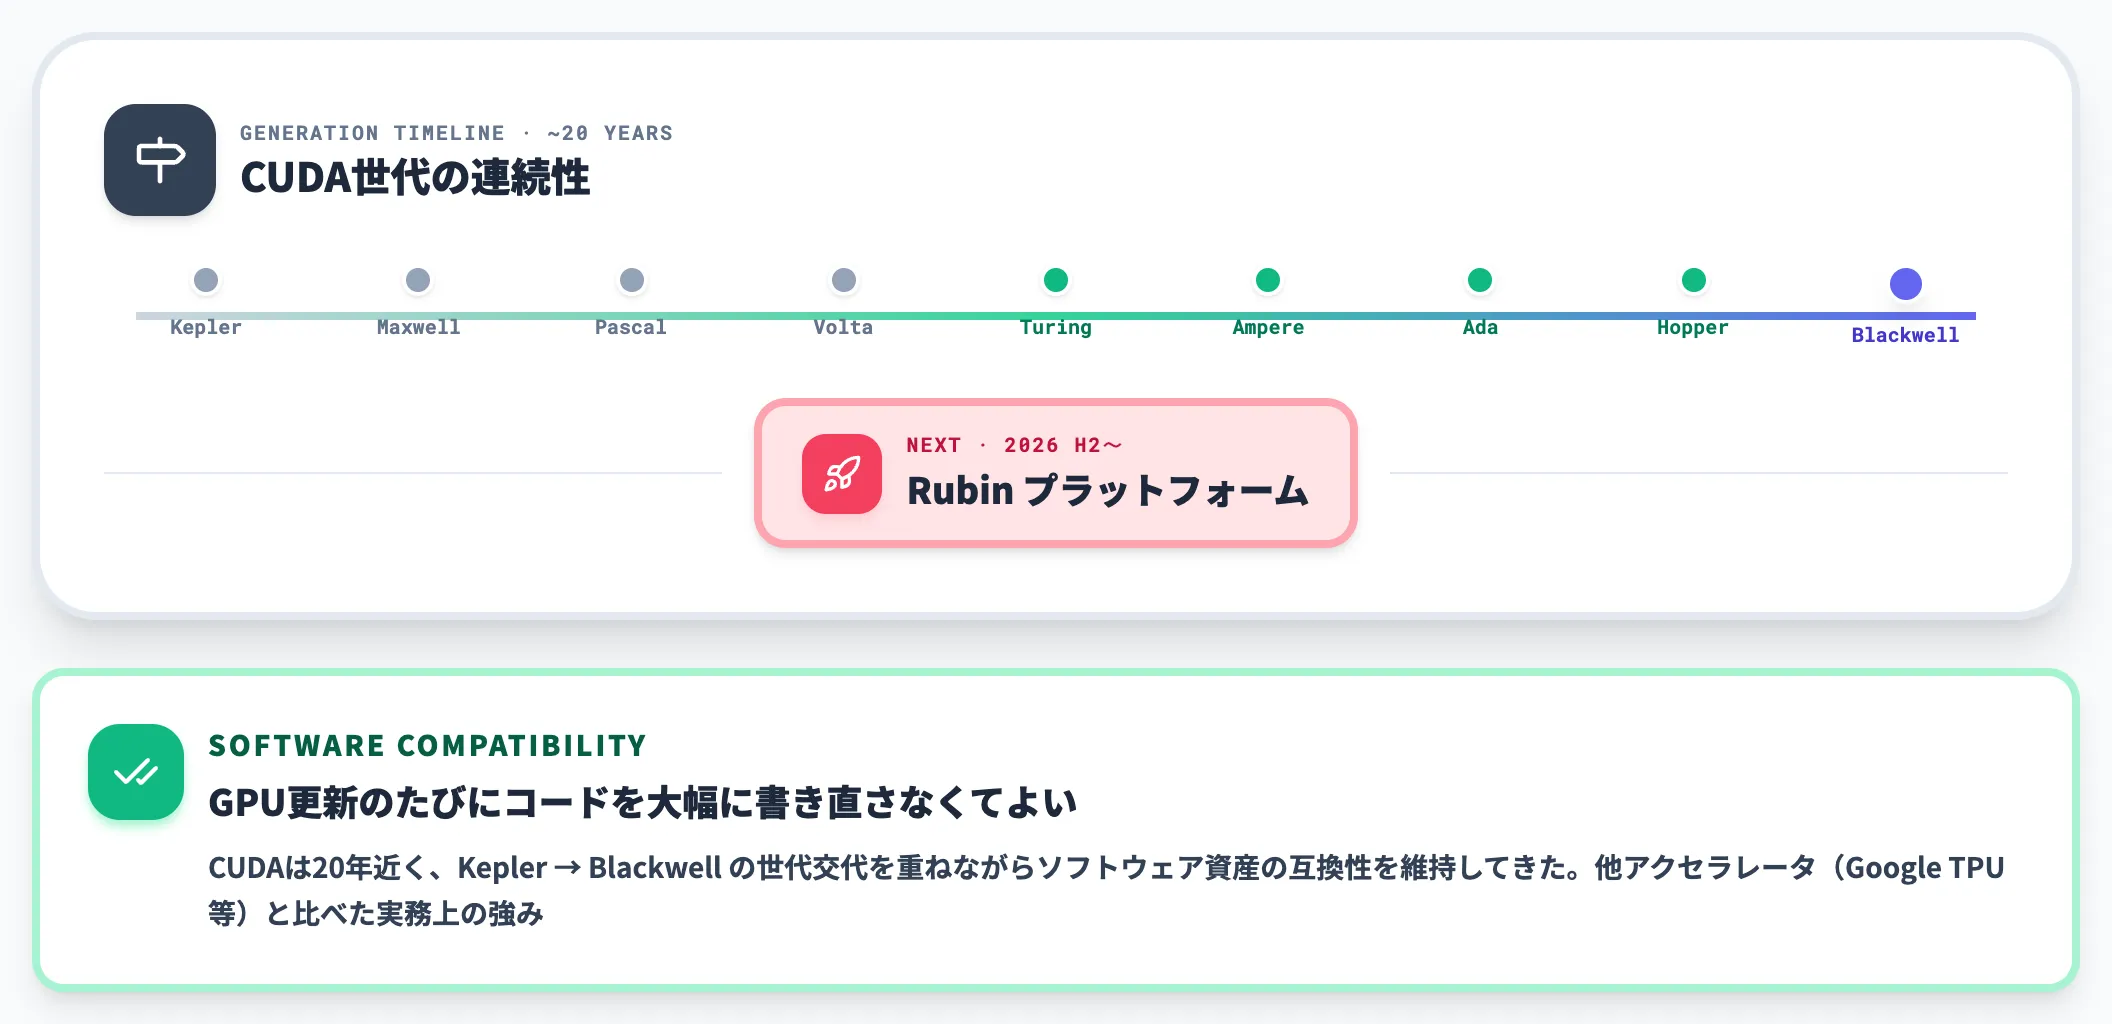
Blackwellの次世代となるRubinプラットフォームはNVIDIA公式発表時点でフル生産段階に入っており、OEMパートナー製品の出荷は2026年後半以降が予定されています。
CUDAはこれまで20年近く、Kepler→Maxwell→Pascal→Volta→Turing→Ampere→Ada→Hopper→Blackwellと世代交代を重ねながらソフトウェア資産の互換性を維持してきました。GPU更新のたびにコードを大幅に書き直さなくてよいという点は、他のアクセラレータ(Google TPU等)と比べたCUDAの実務上の強みでもあります。
CUDAのインストール手順——Windows / Linux / WSL2
ここからは、CUDAを実際に手元の環境にインストールする手順を整理します。
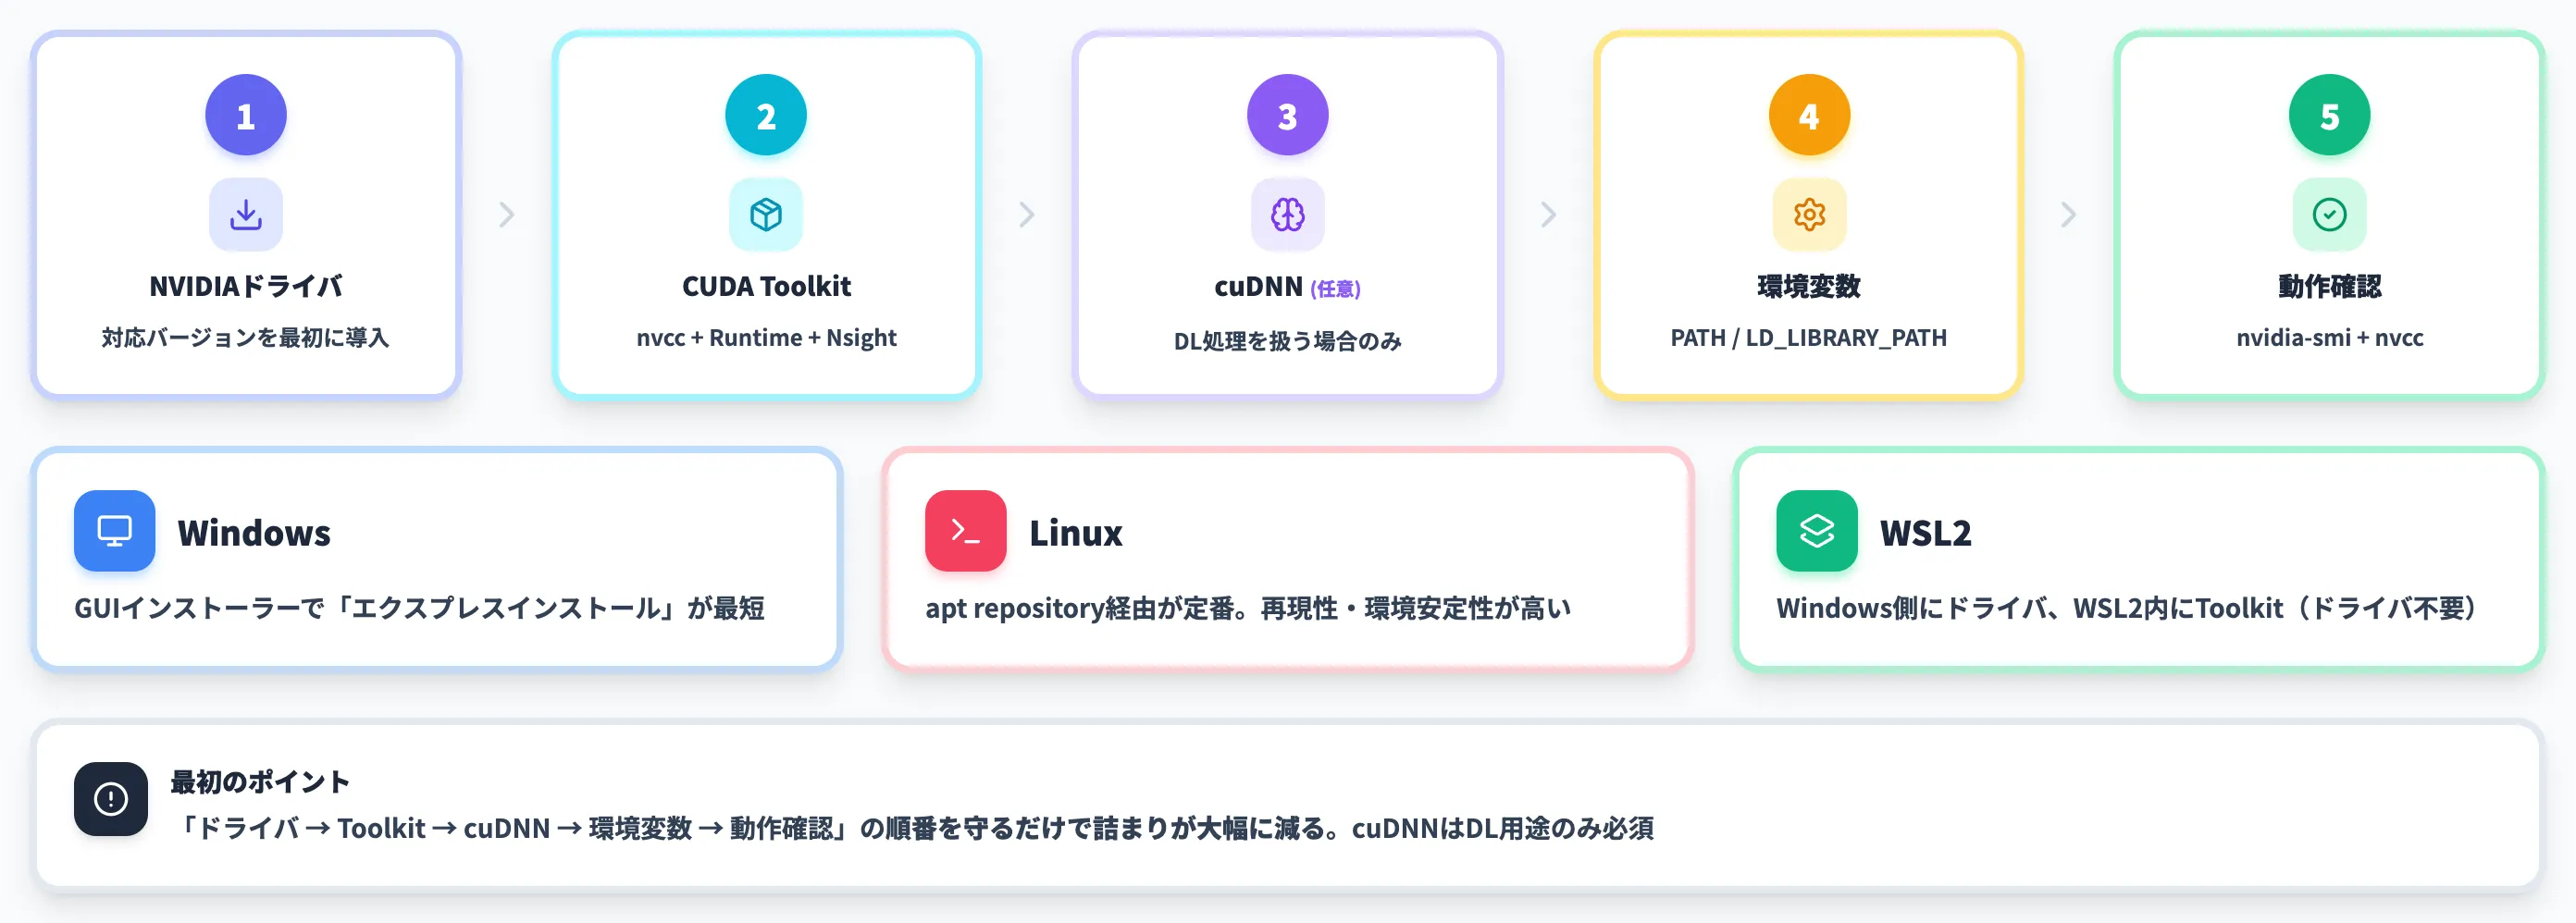
ドライバ → Toolkit →(必要に応じてcuDNN)→ 環境変数 → 動作確認の順で進めるのが基本で、順番を守るだけで詰まりが大幅に減ります(cuDNNは深層学習向けのライブラリで、一般的なCUDA C++アプリすべてに必要というわけではありません)。
事前確認——GPU・ドライバ・OSの整合
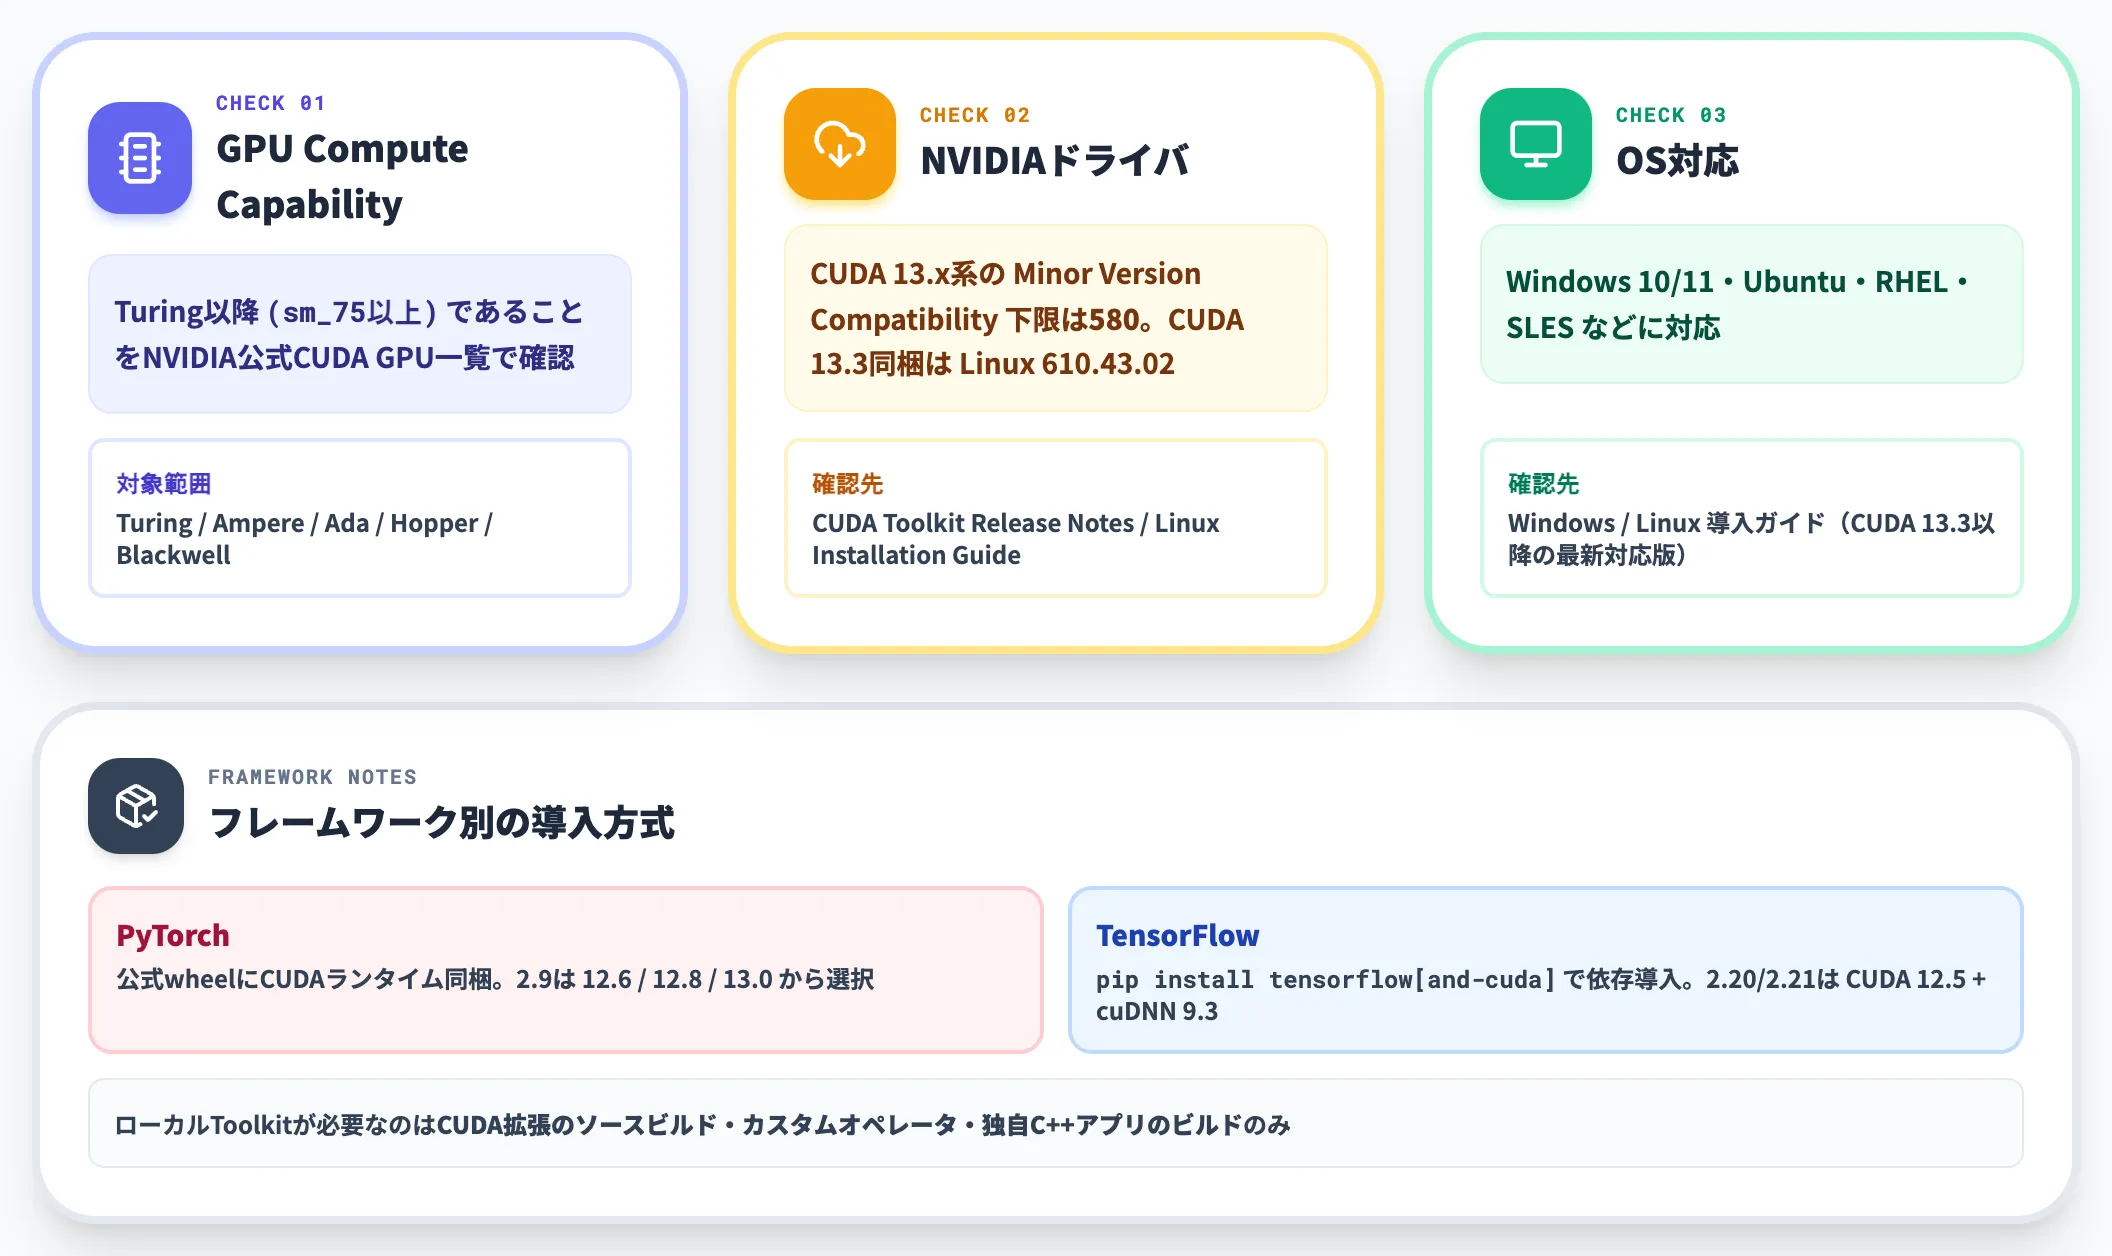
インストール前に、以下の3点を確認します。
-
GPUのCompute Capability
Turing以降(sm_75以上)であることをNVIDIA公式のCUDA GPU一覧で確認する
-
NVIDIAドライバのバージョン
CUDA 13.x系のMinor Version Compatibility下限は580で、CUDA 13.3に同梱・対応するToolkit Driver Versionは610.43.02(Linux)です。両者は役割が異なるため区別して確認する(詳細はCUDA Toolkit Release NotesとLinux Installation Guideで確認)
-
OS
Windows 10/11・Ubuntu・RHEL・SLESなどが対応(代表例。CUDA 13.3以降の最新対応版はWindows導入ガイド/Linux導入ガイドで確認)
フレームワークごとに導入方式が異なります。PyTorchの公式wheelはCUDAランタイムを同梱しており、PyTorch 2.9はCUDA 12.6・12.8・13.0の3種類から選択できます。TensorFlowは pip install tensorflow[and-cuda] で依存ライブラリを導入する方式で、TensorFlow 2.20/2.21の公式GPUビルド表ではCUDA 12.5+cuDNN 9.3が対応版として示されています。ローカルToolkitが必要になるのは、CUDA拡張のソースビルド・カスタムオペレータ実装・独自C++アプリのビルドで、cuDNNはそのうち処理が依存する場合にのみ追加します。
Windowsでのインストール手順
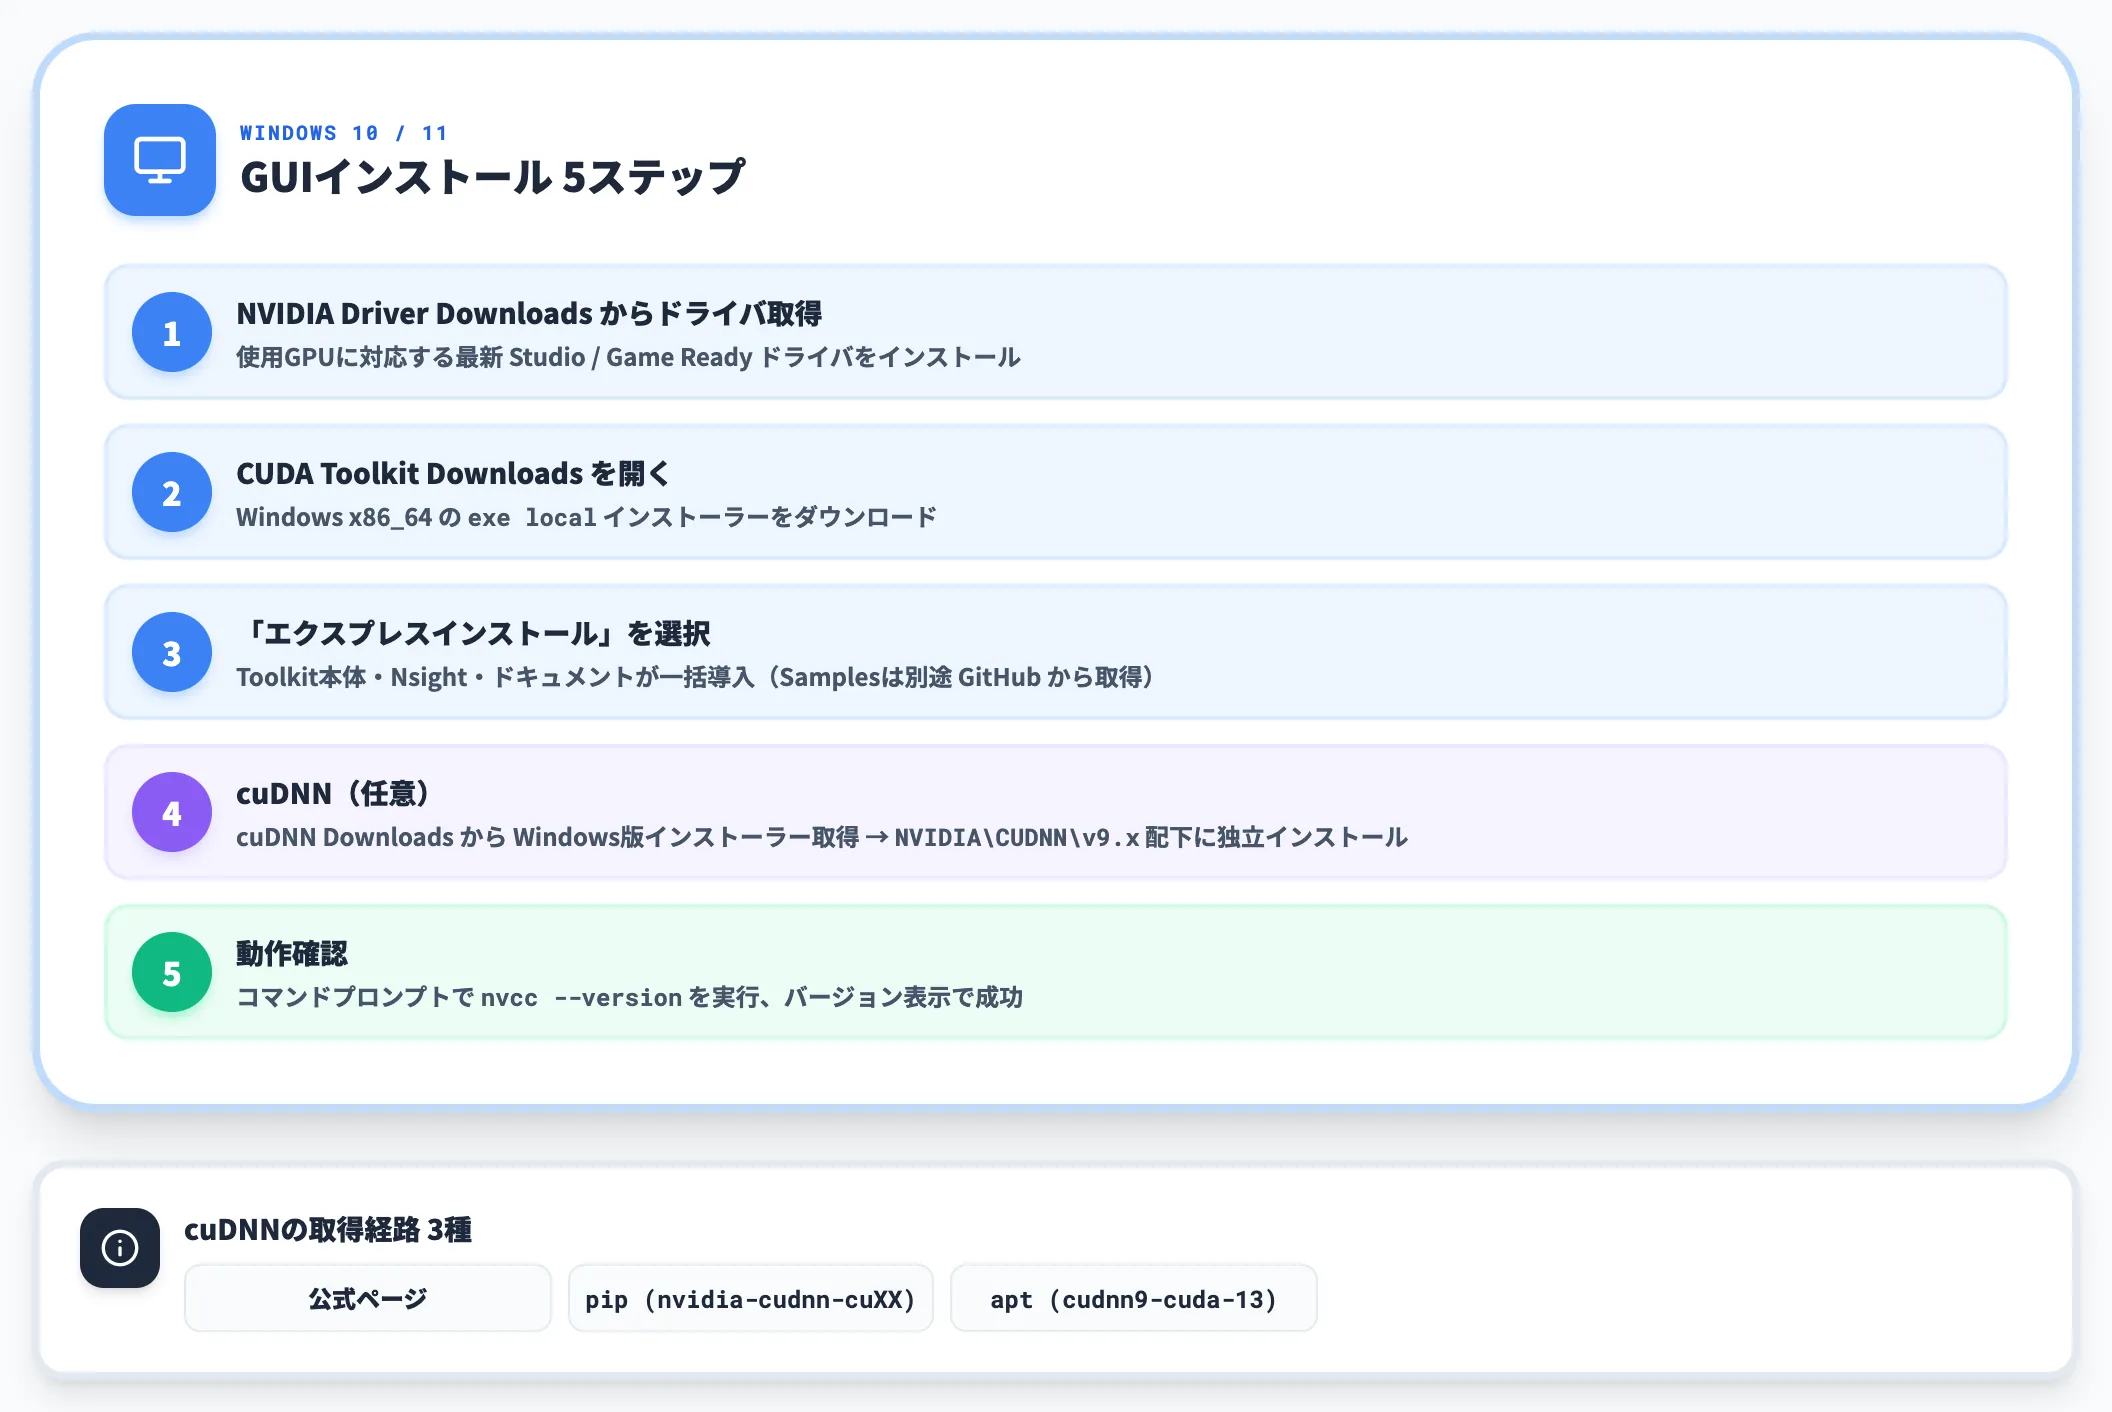
Windows環境では、GUIインストーラーを使う経路がもっとも短時間で完了します。
- NVIDIA Driver Downloadsから使用GPUに対応する最新Studio/Game Readyドライバをインストール
- CUDA Toolkit DownloadsからWindows x86_64のインストーラー(exe local)をダウンロード
- インストーラーを起動し「エクスプレスインストール」を選択(Toolkit本体・Nsight・ドキュメントが一括導入される。CUDA SamplesはGitHubリポジトリから別途取得)
- cuDNNを使う場合はcuDNN DownloadsからWindows版cuDNNインストーラーを取得し、独立した NVIDIA\CUDNN\v9.x 配下にインストールする([cuDNN Windows公式手順]
(https://docs.nvidia.com/deeplearning/cudnn/installation/latest/windows.html)参照。CUDA Toolkitフォルダへ手動コピーする旧手順は現行版では推奨されません)
- コマンドプロンプトで nvcc --version を実行し、バージョンが表示されればインストール成功
cuDNNは公式ページ・pip(nvidia-cudnn-cuXX パッケージ)・パッケージマネージャー(Linuxの cudnn9-cuda-13 メタパッケージ等)から取得できます。PyTorchの公式wheelを使う場合はwheel側にCUDAランタイム相当が同梱されているため、cuDNNのローカルインストールが必要になるのは主にCUDA拡張のソースビルドやカスタムオペレータ実装時のうち、深層学習プリミティブに依存する処理を書くケースに限られます。
Linuxでのインストール手順(Ubuntu 22.04/24.04)
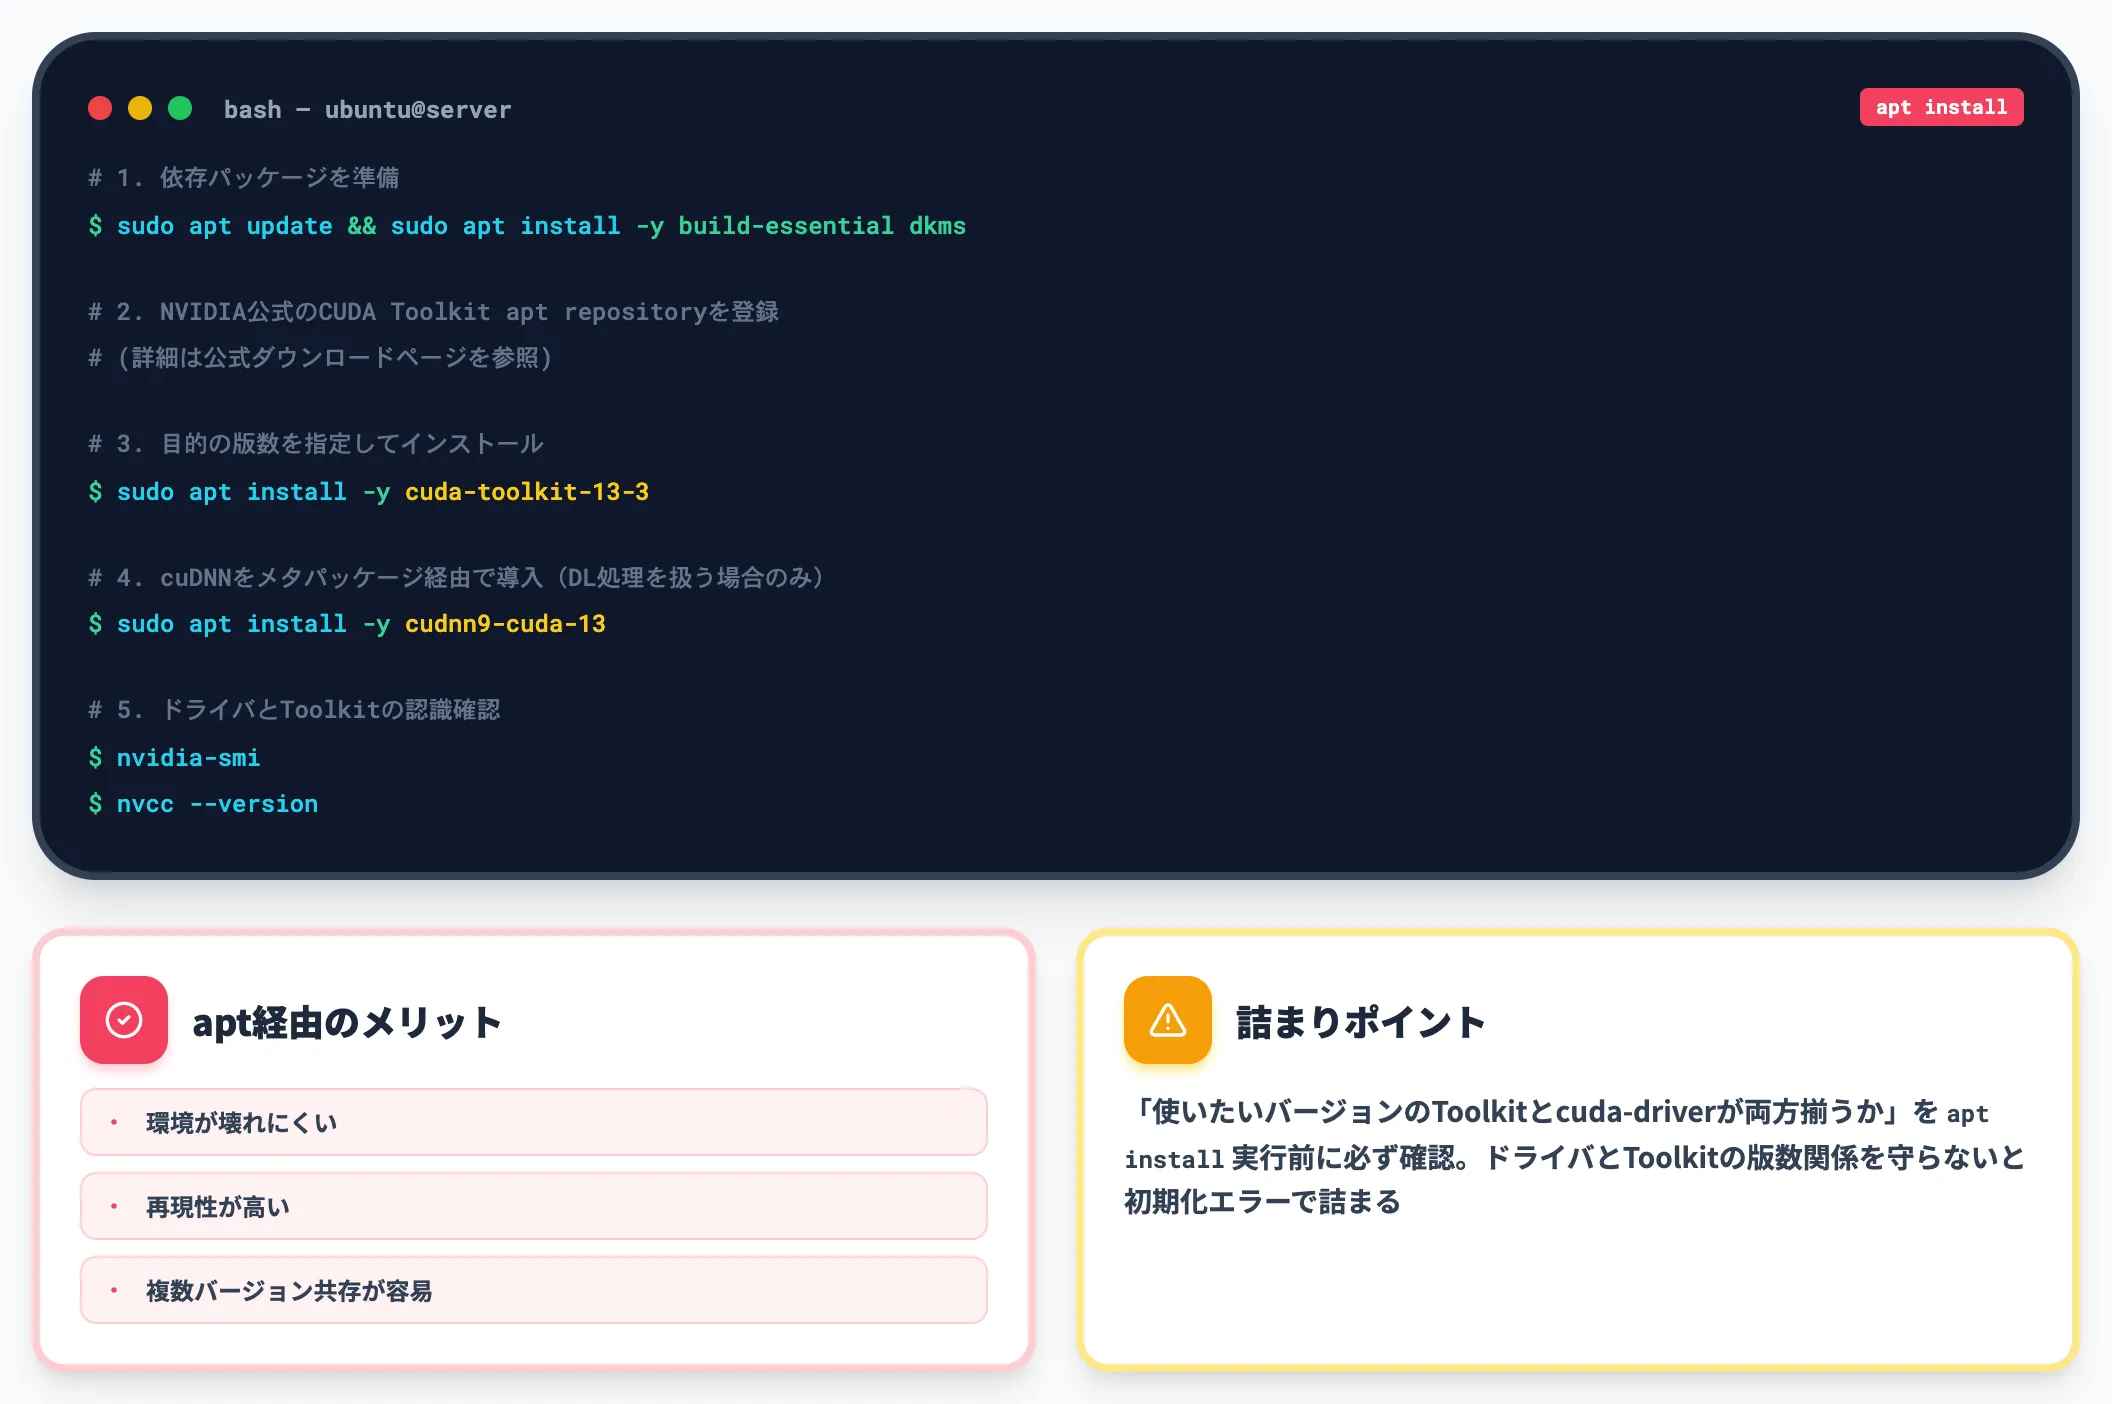
Linuxではパッケージマネージャ経由でセットアップするのが定番で、環境が壊れにくく再現性も高い方法です。
# 1. 依存パッケージを準備
sudo apt update && sudo apt install -y build-essential dkms

# 2. NVIDIA公式のCUDA Toolkit apt repositoryを登録(詳細は公式ダウンロードページ)

# 3. 目的の版数を指定してインストール
sudo apt install -y cuda-toolkit-13-3

# 4. cuDNNをメタパッケージ経由で導入(cuDNNを使う場合のみ・開発ヘッダ・ランタイム一式)
sudo apt install -y cudnn9-cuda-13

# 5. ドライバとToolkitの認識確認
nvidia-smi
nvcc --version
apt repositoryのセットアップ手順はNVIDIA公式のCUDA Toolkitダウンロードページを参照します。
「使いたいバージョンのCUDA Toolkitとcuda-driverが両方揃うか」の互換性確認は、apt install実行前に必ず行います。特にドライバとToolkitの版数関係を守らないと、CUDA初期化時のドライバ互換性エラーで詰まります。
WSL2でのインストール手順
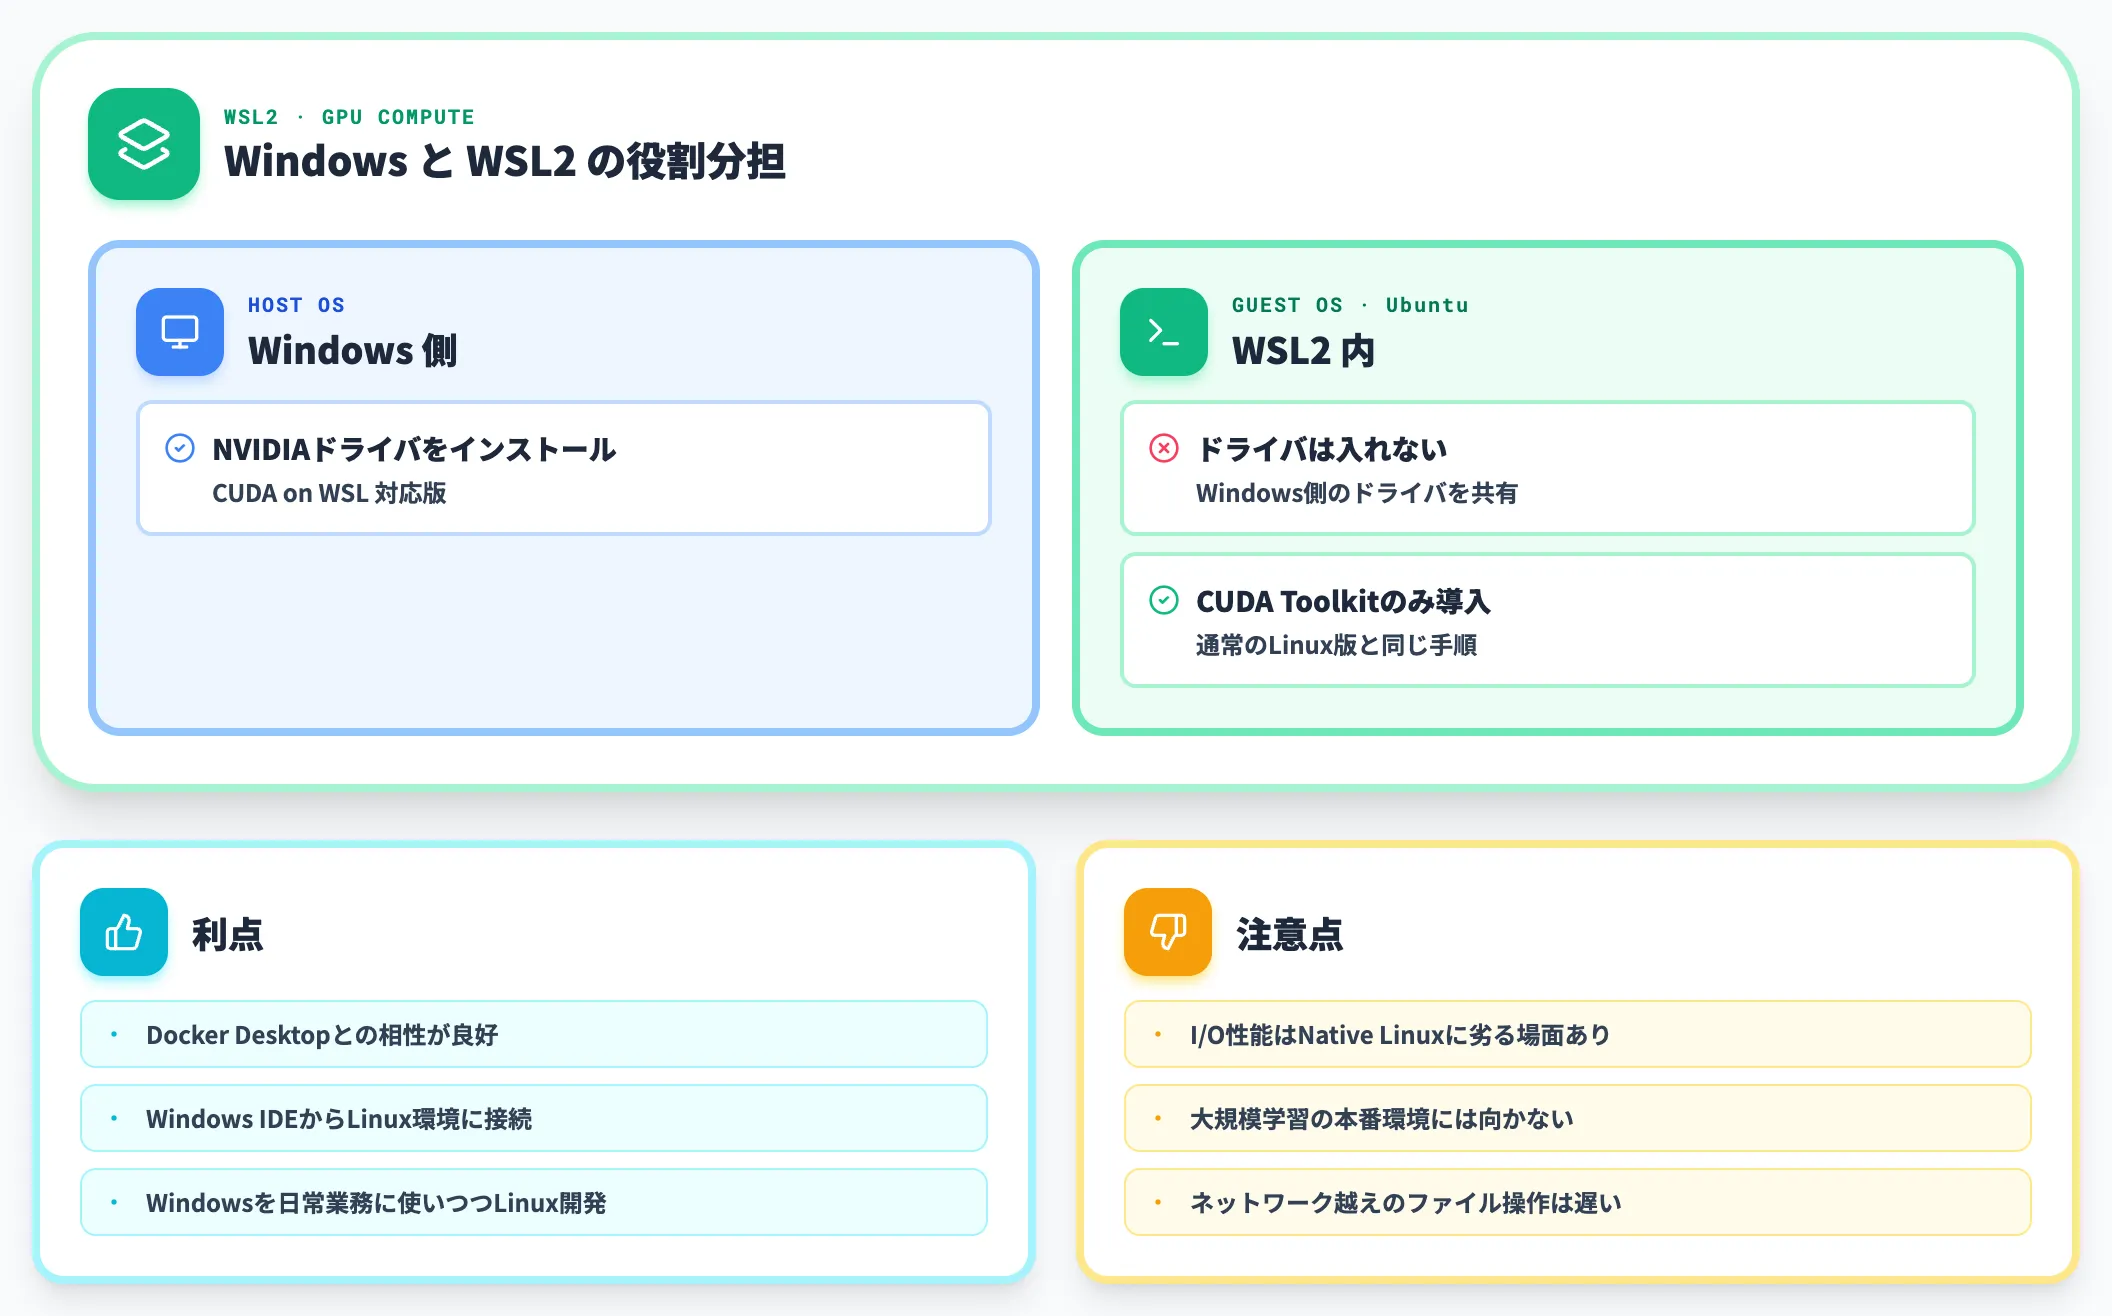
Windows上でLinuxの開発体験を得たい場合は、WSL2上のCUDAを使う経路も現実的です。
Windows側にNVIDIAドライバ(CUDA on WSL対応版)を入れた上で、WSL2のUbuntu内ではドライバをインストールせず、CUDA Toolkitのみを入れる、というのが公式の推奨手順です。
WSL2は「Docker Desktopとの相性が良い」「Windows上のIDEからそのままLinux環境に接続できる」という利点があり、開発機がWindowsの組織にとって現実的な選択肢になります。ただしI/O性能はネイティブLinuxより下がる場面があるため、大規模学習の本番環境には向きません。
環境変数とパス設定——PATH / LD_LIBRARY_PATH / CUDA_HOME
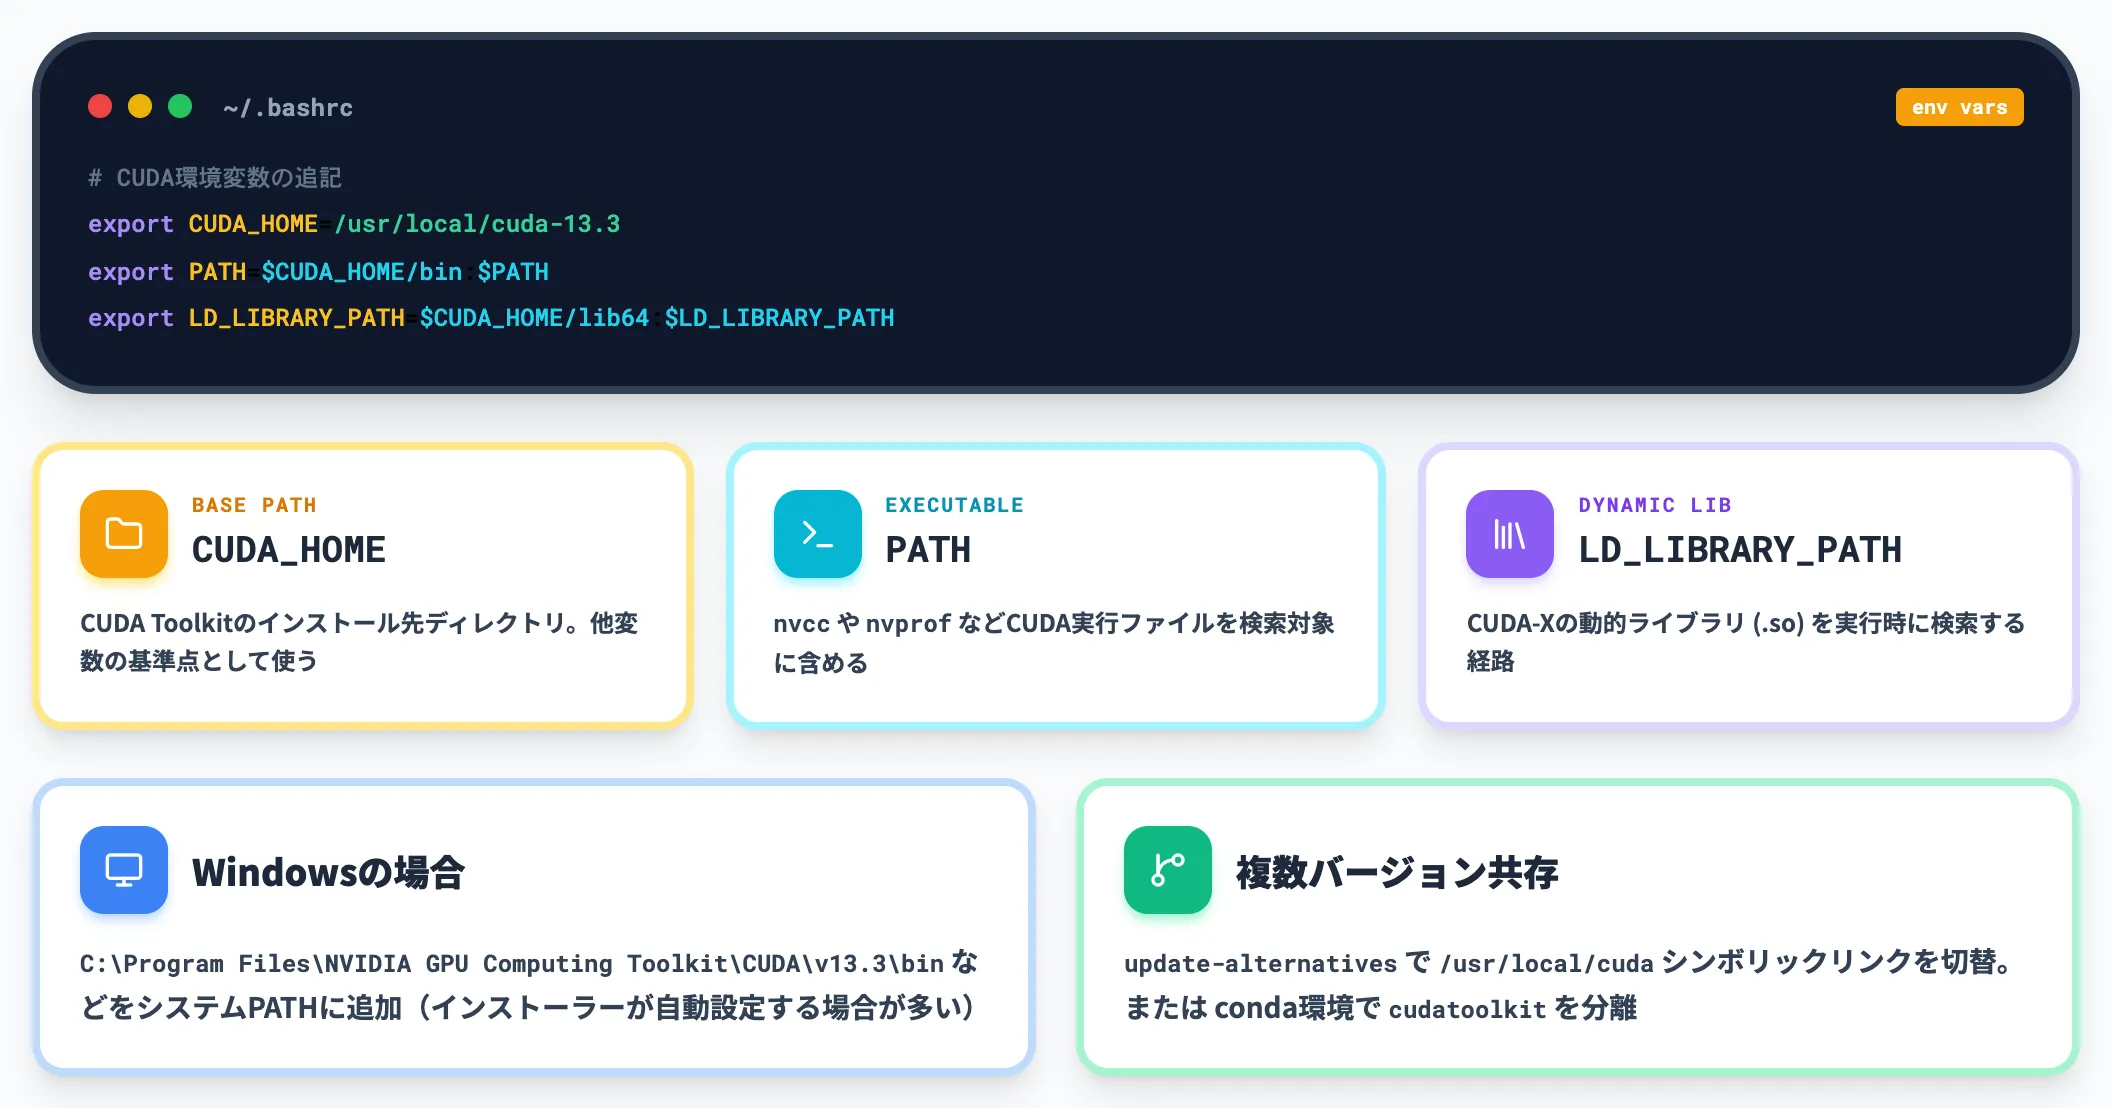
インストール後は、環境変数の設定を確認します。
-
Windows
C:\Program Files\NVIDIA GPU Computing Toolkit\CUDA\v13.3\bin などをシステムPATHに追加(インストーラーが自動設定する場合が多い)
-
Linux
~/.bashrc に以下を追記
export CUDA_HOME=/usr/local/cuda-13.3
export PATH=$CUDA_HOME/bin:$PATH
export LD_LIBRARY_PATH=$CUDA_HOME/lib64:$LD_LIBRARY_PATH
複数バージョンのCUDAを共存させる組織では、update-alternatives で /usr/local/cuda シンボリックリンクを切り替える運用が一般的です。プロジェクトごとにconda環境で cudatoolkit を分けてしまう手もあります。
動作確認——nvidia-smi と nvcc、それぞれ役割が違う
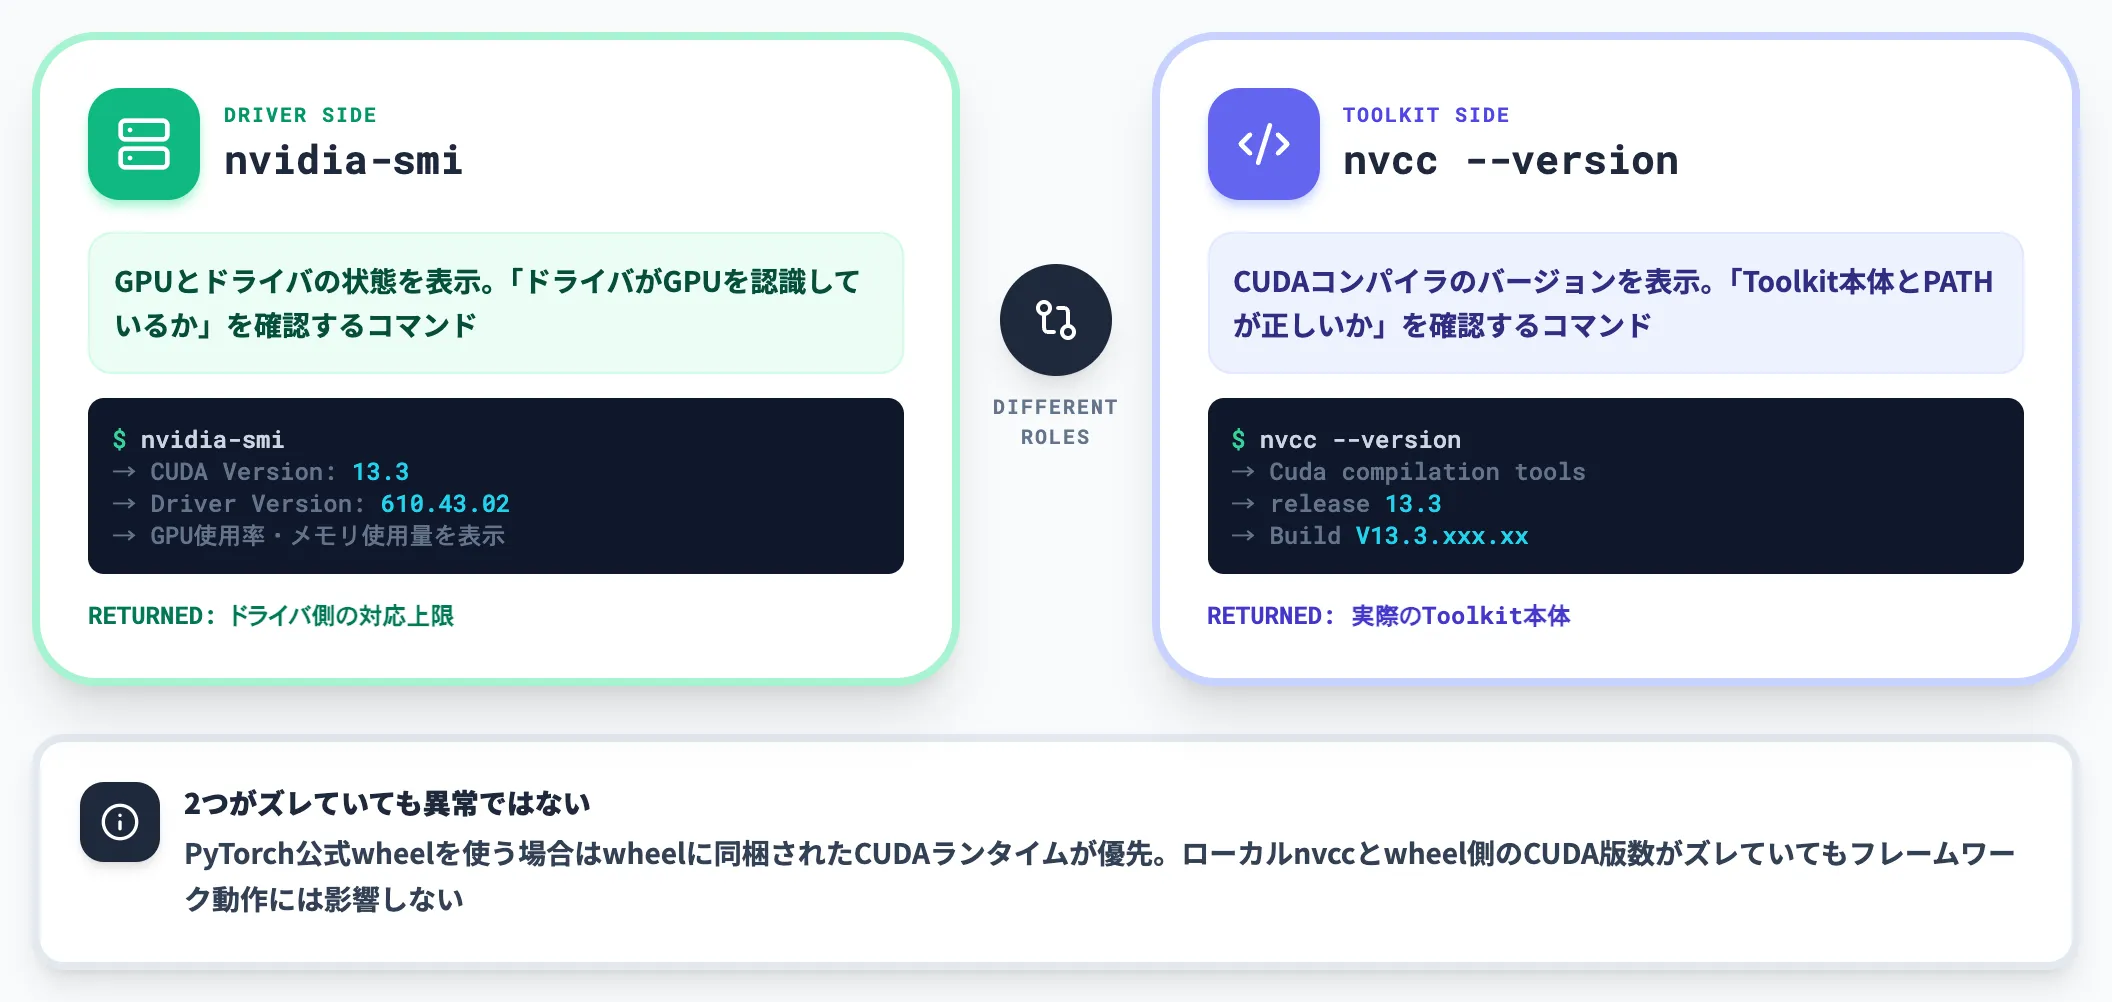
インストール完了後の動作確認は、以下2つのコマンドで行います。
-
nvidia-smi
GPUとドライバの状態を表示。「ドライバがGPUを認識しているか」を確認するコマンド
-
nvcc --version
CUDAコンパイラのバージョンを表示。「Toolkitが正しくインストールされ、PATHが通っているか」を確認するコマンド
2つはよく混同されますが、nvidia-smi が返すCUDA Versionはドライバ側の対応上限で、nvcc --version が返すのが実際にインストールされたToolkit本体のバージョンです。両者がズレていても異常ではなく、CUDAバックエンドを選択しているPyTorchの公式wheelを使う場合はwheelに同梱されたCUDAランタイムが優先されるため、ローカルnvccとwheel側のCUDA版数がズレていてもフレームワーク動作には影響しません(TensorFlowは tensorflow[and-cuda] 経由で依存ライブラリを導入する方式なので、こちらも同様にwheel/依存側が要求するCUDA版数が基準になります)。
CUDAを直接書くケースと、フレームワーク経由で使うケース
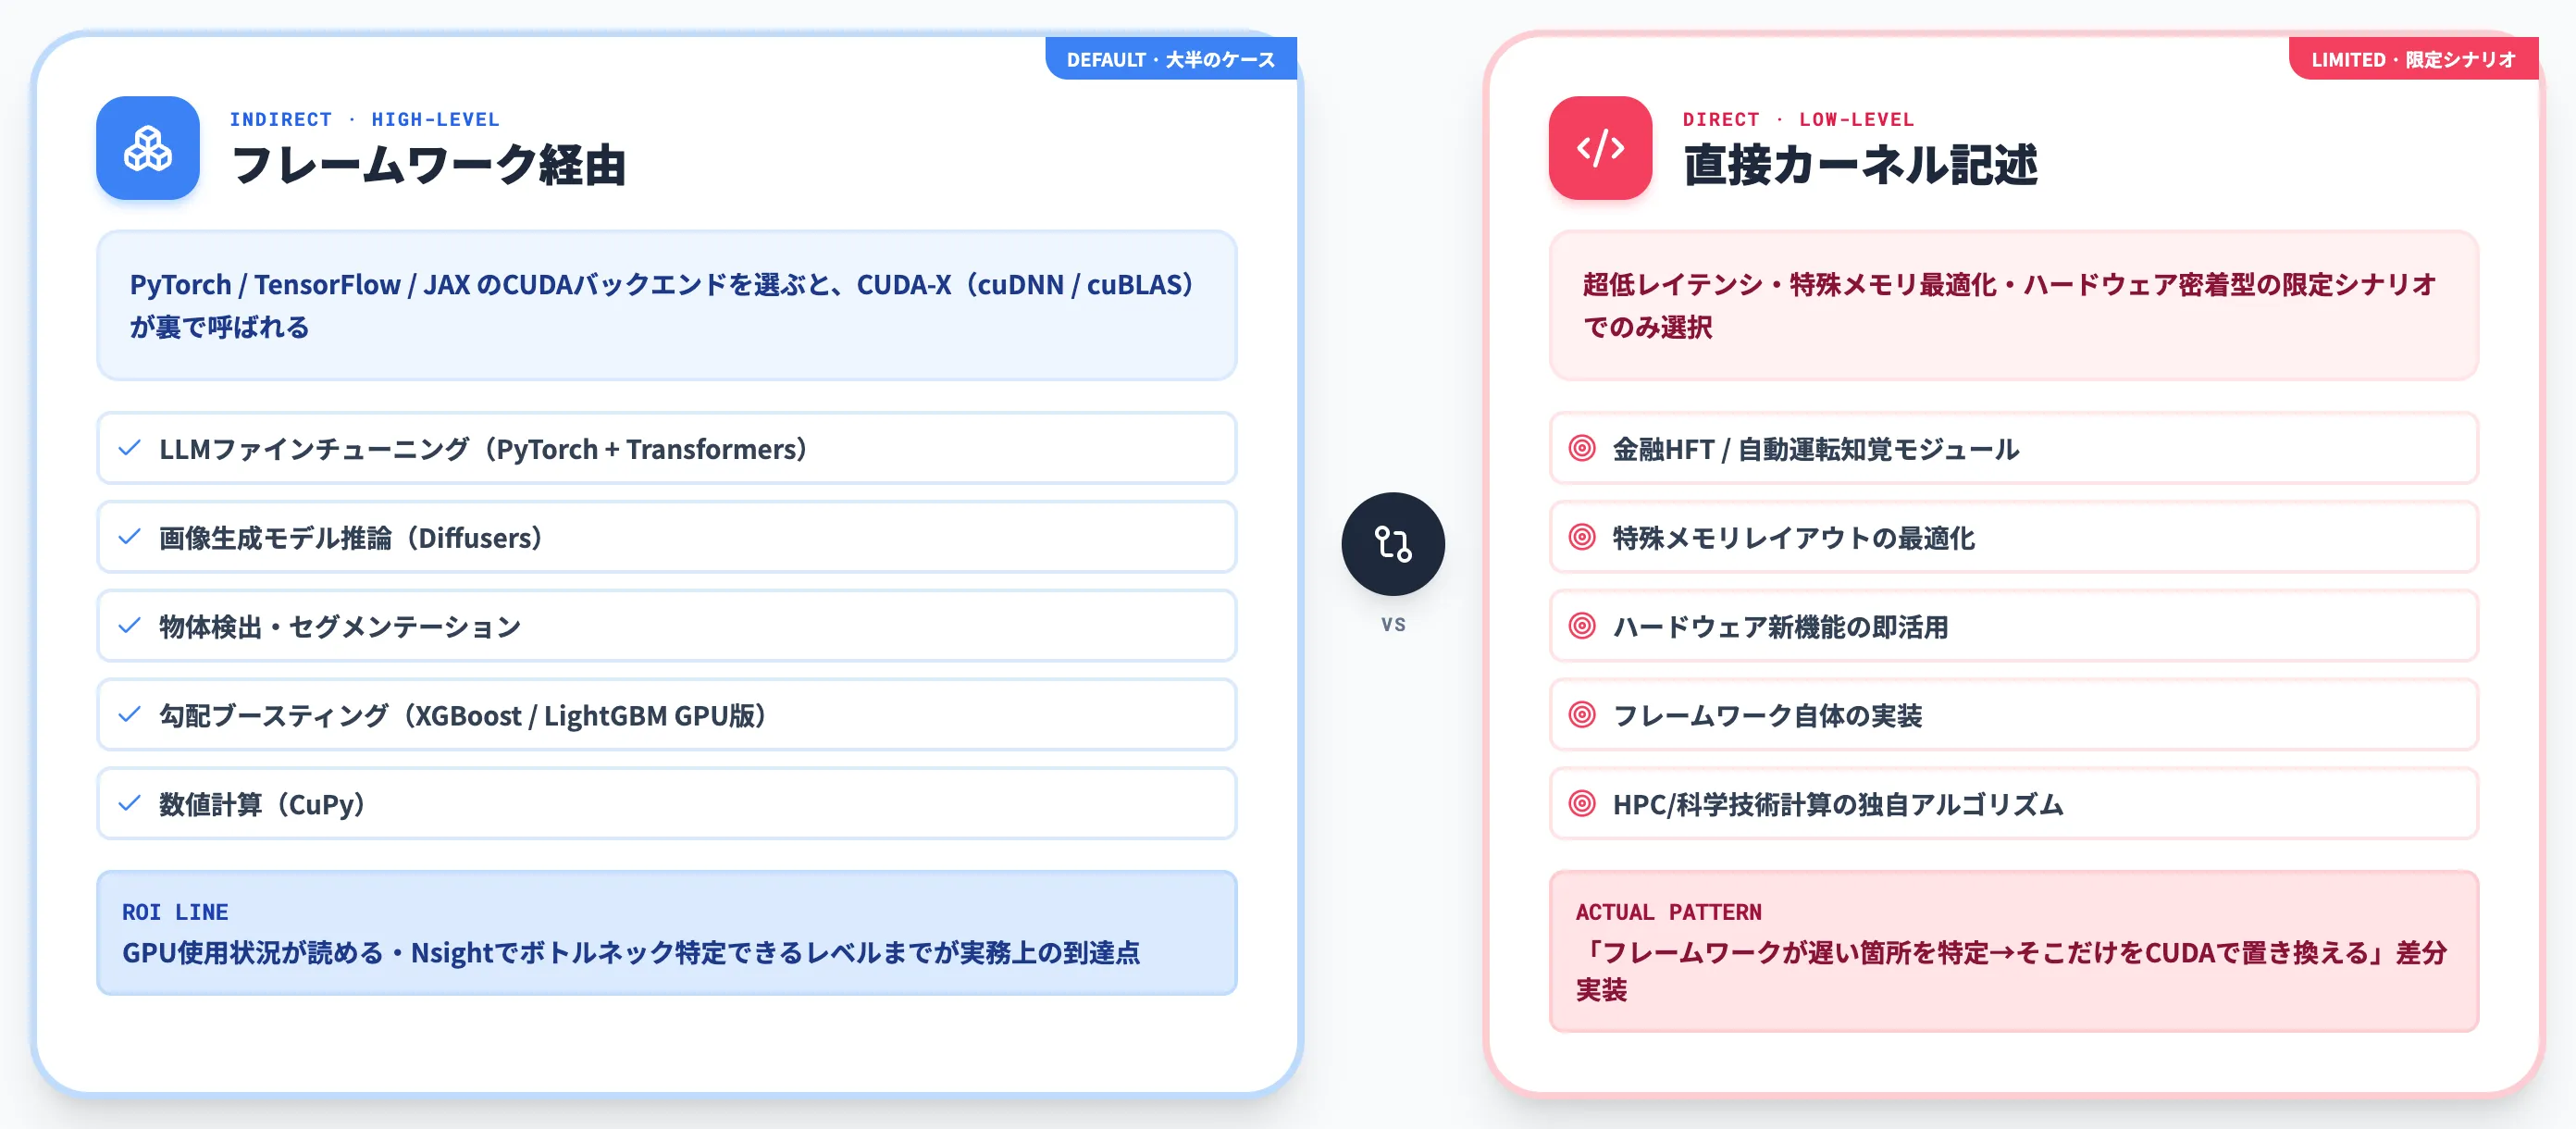
2026年時点でCUDAに触る現実的なシナリオを整理すると、大半はPyTorch/JAX/TensorRT経由での間接利用で完結します。逆に「直接CUDAカーネルを書く」ケースはかなり限定的で、この線引きを最初に理解しておくと、学習コストの投資判断がしやすくなります。
フレームワーク経由がデフォルト
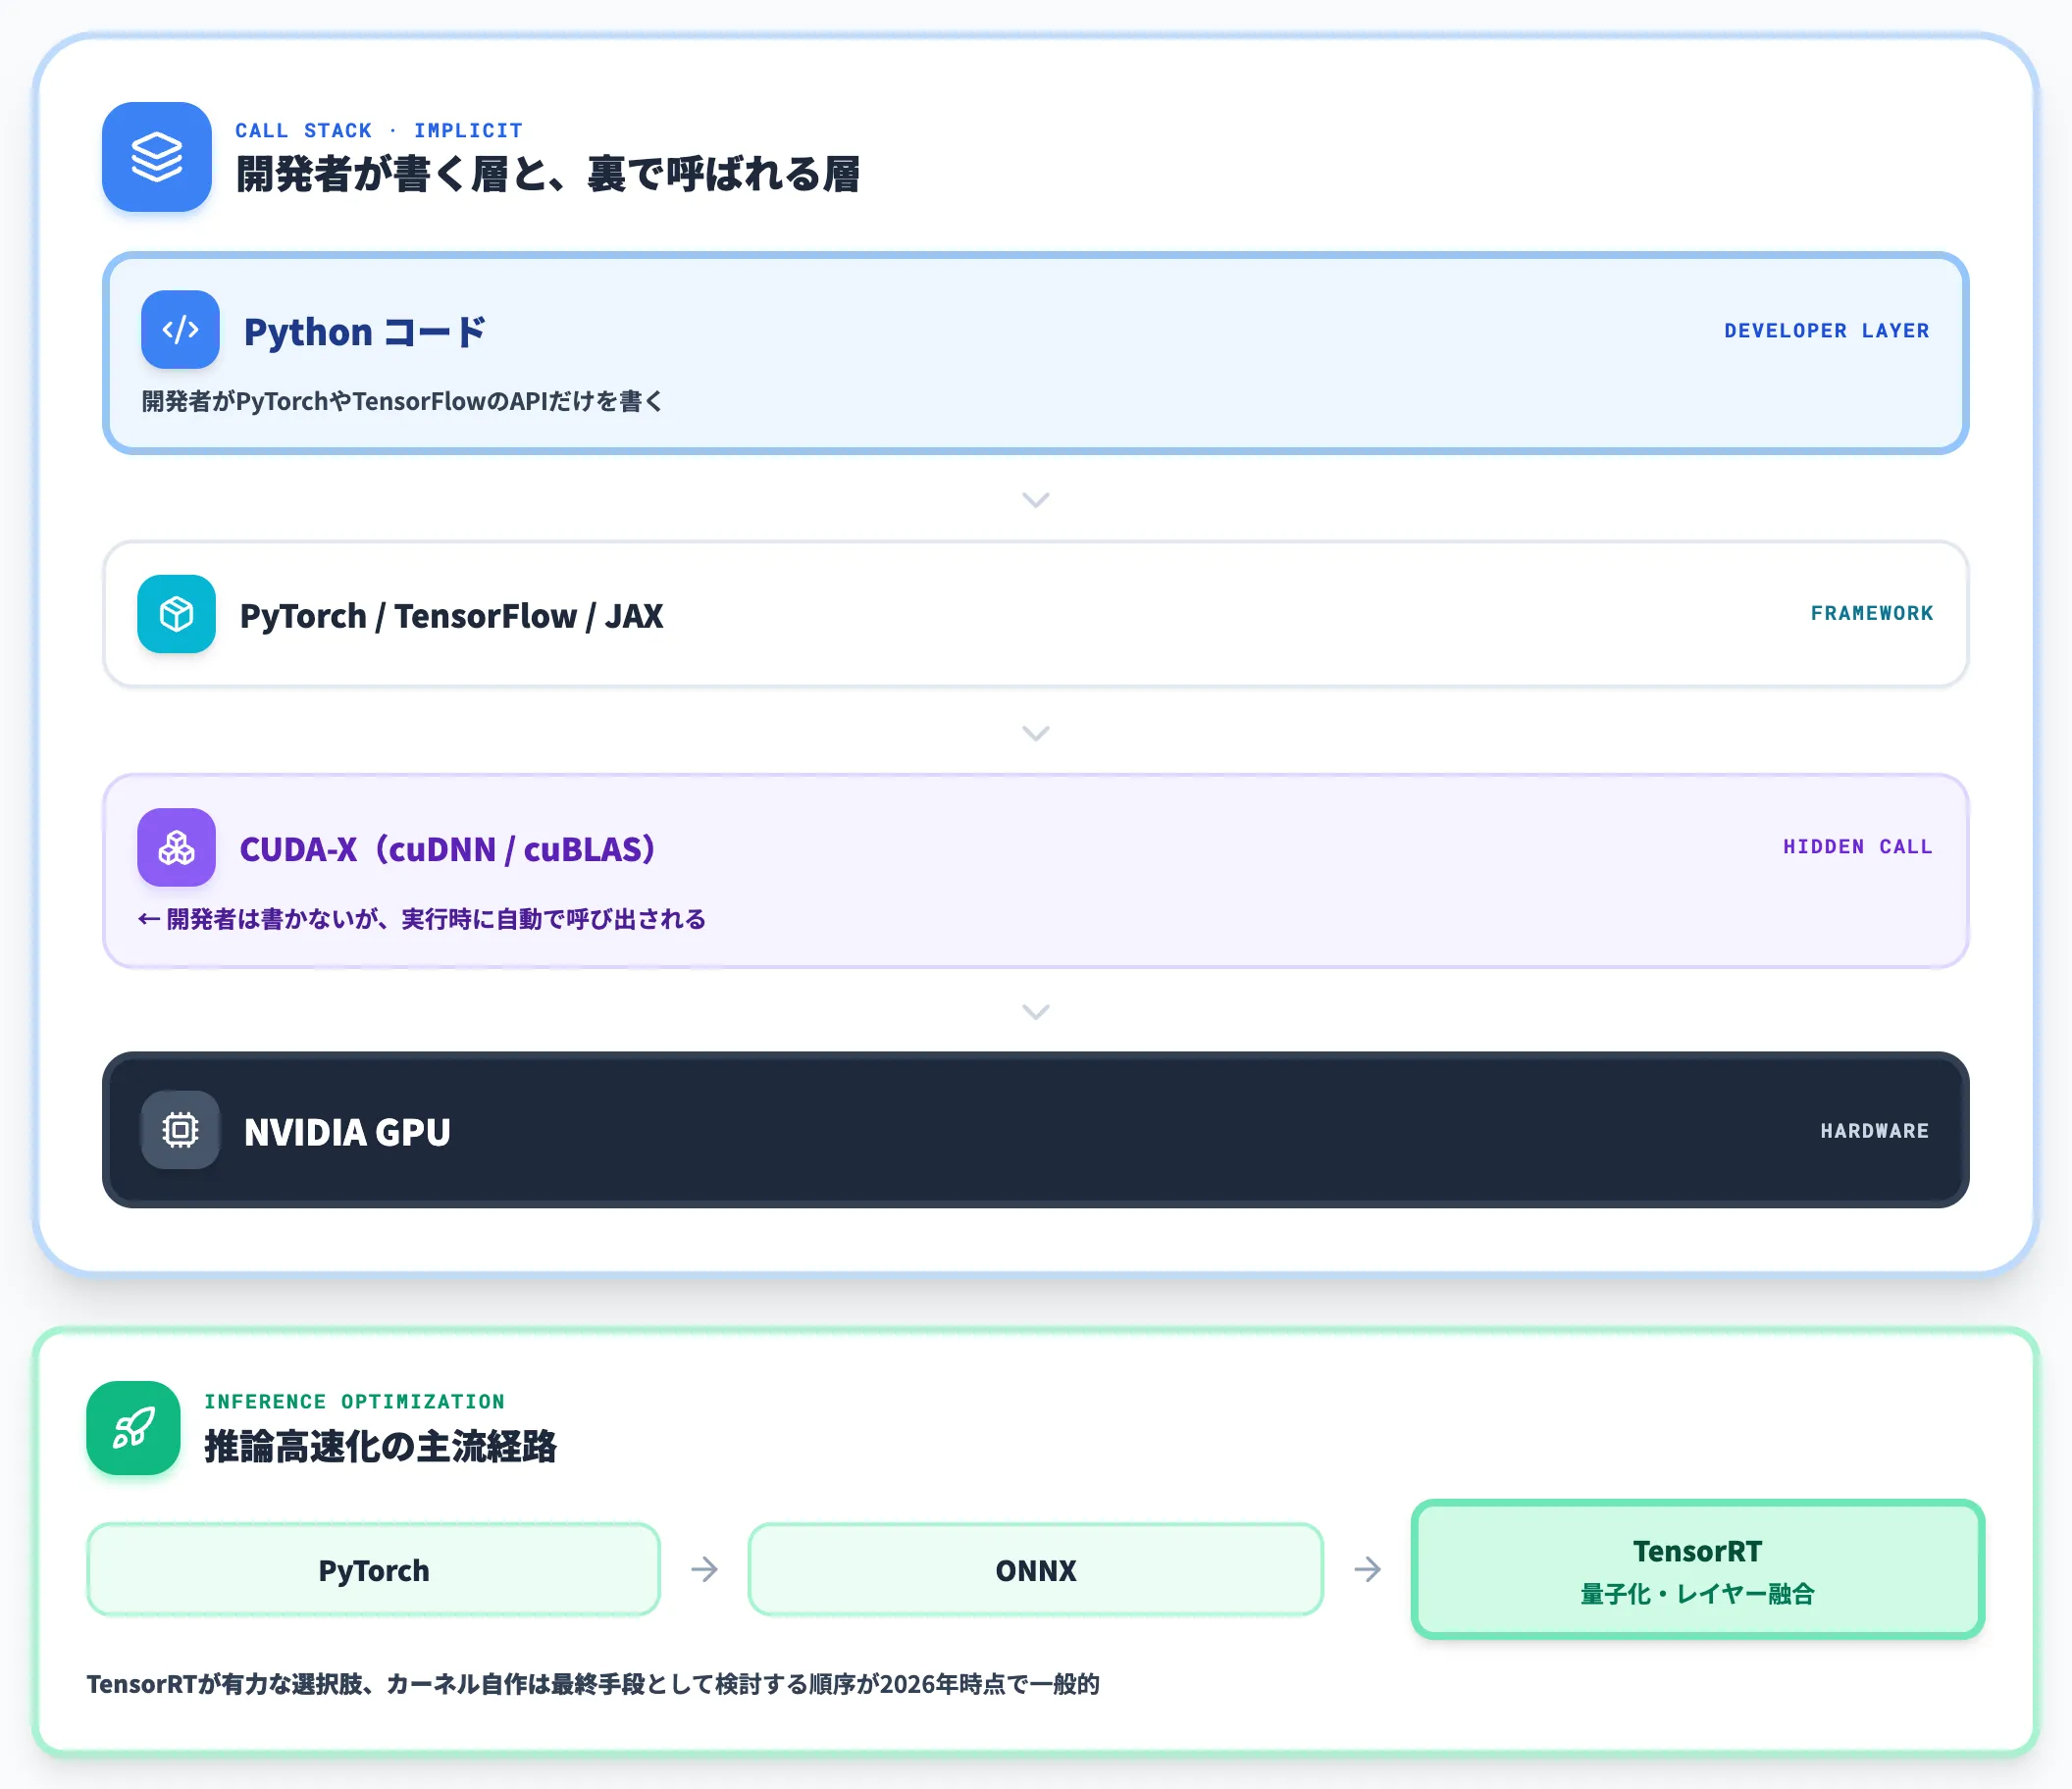
現代のAI開発では、PyTorch・TensorFlow・JAXでNVIDIA GPUのCUDAバックエンドを選択した場合、CUDA-X(cuDNN・cuBLAS)が裏で呼び出され、開発者はPythonの高水準APIだけを書くのが標準的な進め方です。
以下のようなワークロードは、CUDAカーネルを直接書かずに済むケースがほとんどです。
- LLMのファインチューニング(PyTorch + Transformers + PEFT)
- 画像生成モデルの推論(Diffusers)
- 物体検出・セグメンテーション(Ultralytics YOLO / mmdetection)
- 表形式データの勾配ブースティング(XGBoost / LightGBM GPU版)
- BLAS/LAPACK系の数値計算(CuPy)
この層で「CUDAを勉強する」意味は、フレームワークが吐くGPU使用状況を読める・Nsightでボトルネックを特定できるレベルまでが実務上のROIラインになります。カーネルを1から書くスキルは、この層ではオーバースペックです。
TensorRTは量子化・レイヤー融合を自動適用するCUDA上の推論最適化ランタイム(出典:NVIDIA TensorRT)
推論を最適化したいケースでも、多くの場合はCUDAカーネルを直接書かず、TensorRT経由でモデルを変換するだけでスループット改善が得られる場合があります(実際の効果はTensorRT Benchmarkingのとおりワークロード条件に依存)。
PyTorch→ONNX→TensorRTの一連のパイプラインが確立しており、本番推論の高速化ではTensorRTが有力な選択肢、カーネル自作は最終手段として検討する順序が2026年時点で一般的です。
直接カーネルを書くケース——超低レイテンシ・特殊メモリ最適化・ハードウェア密着
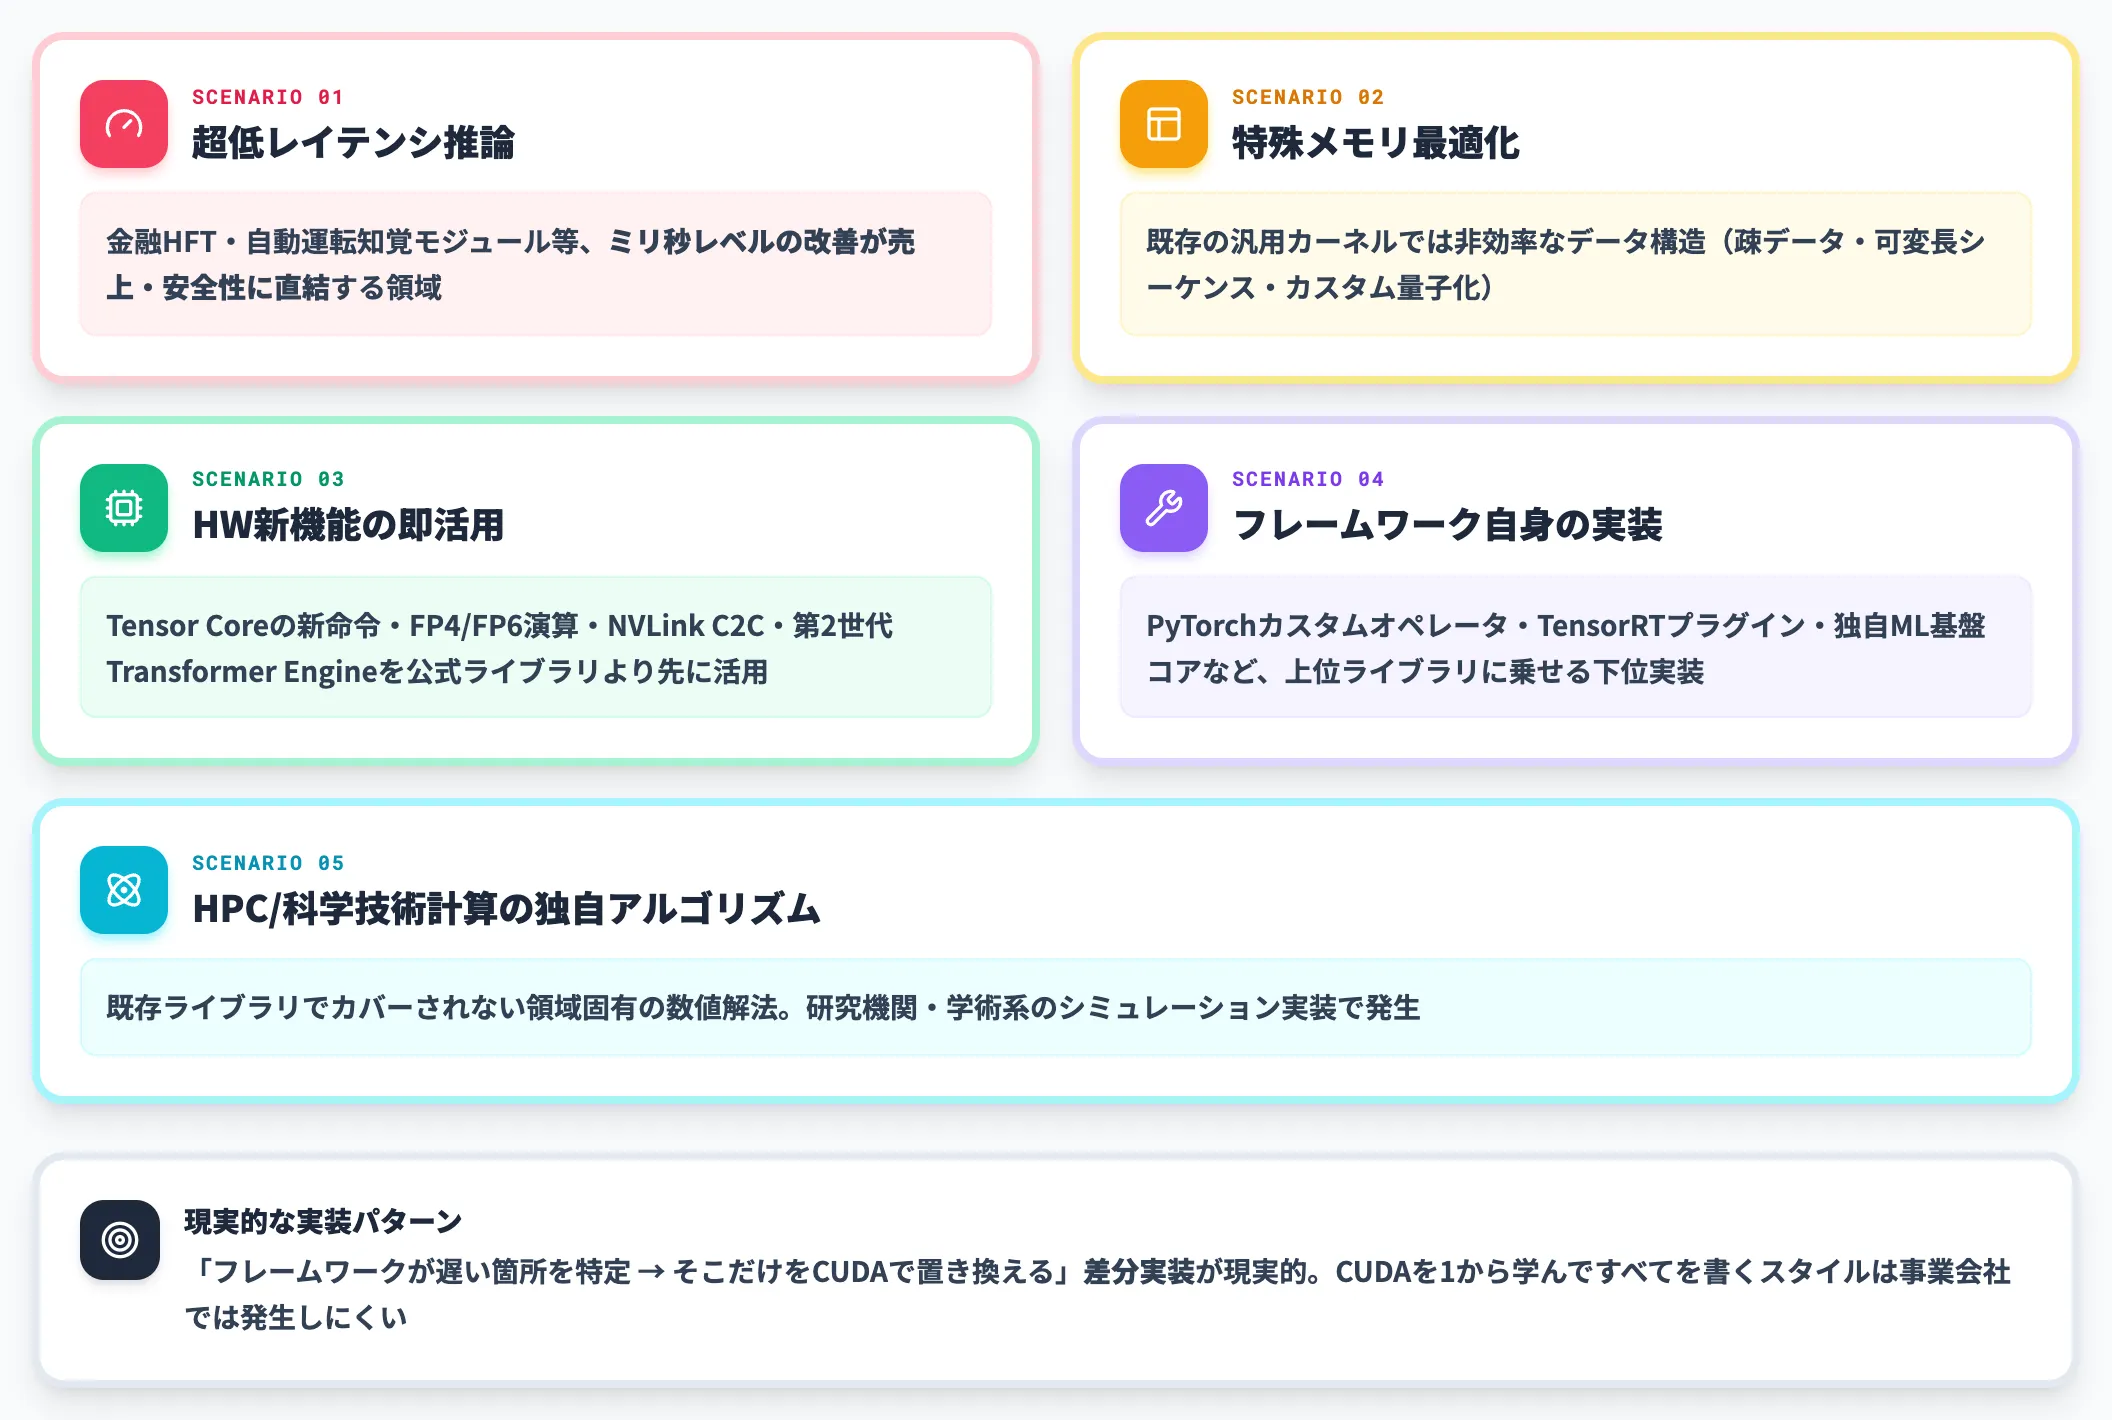
一方で、以下のようなシナリオではCUDAカーネルを直接書く価値があります。
-
超低レイテンシ推論
金融のHFT・自動運転の知覚モジュール等、ミリ秒レベルの改善が売上・安全性に直結する領域
-
特殊なメモリレイアウト最適化
既存の汎用カーネルでは非効率なデータ構造(疎データ・可変長シーケンス・カスタム量子化)
-
ハードウェア新機能の即活用
Tensor Coreの新命令・FP4/FP6演算・NVLink C2C・第2世代Transformer Engineなど、公式ライブラリが対応する前に自分で書き込む
-
フレームワーク自体の実装
PyTorchのカスタムオペレータ・TensorRTプラグイン・独自のML基盤コアなど、上位ライブラリに乗せる下位実装
-
HPC/科学技術計算の独自アルゴリズム
既存ライブラリでカバーされない領域固有の数値解法
これらは基本的に「フレームワークが遅い箇所を特定→そこだけをCUDAで置き換える」という差分実装が現実的で、記事の書きぶりのように「CUDAを1から学んですべてを書く」というスタイルは、事業会社では発生することが少ないパターンです。
実務での使い分け判断——3ステップ
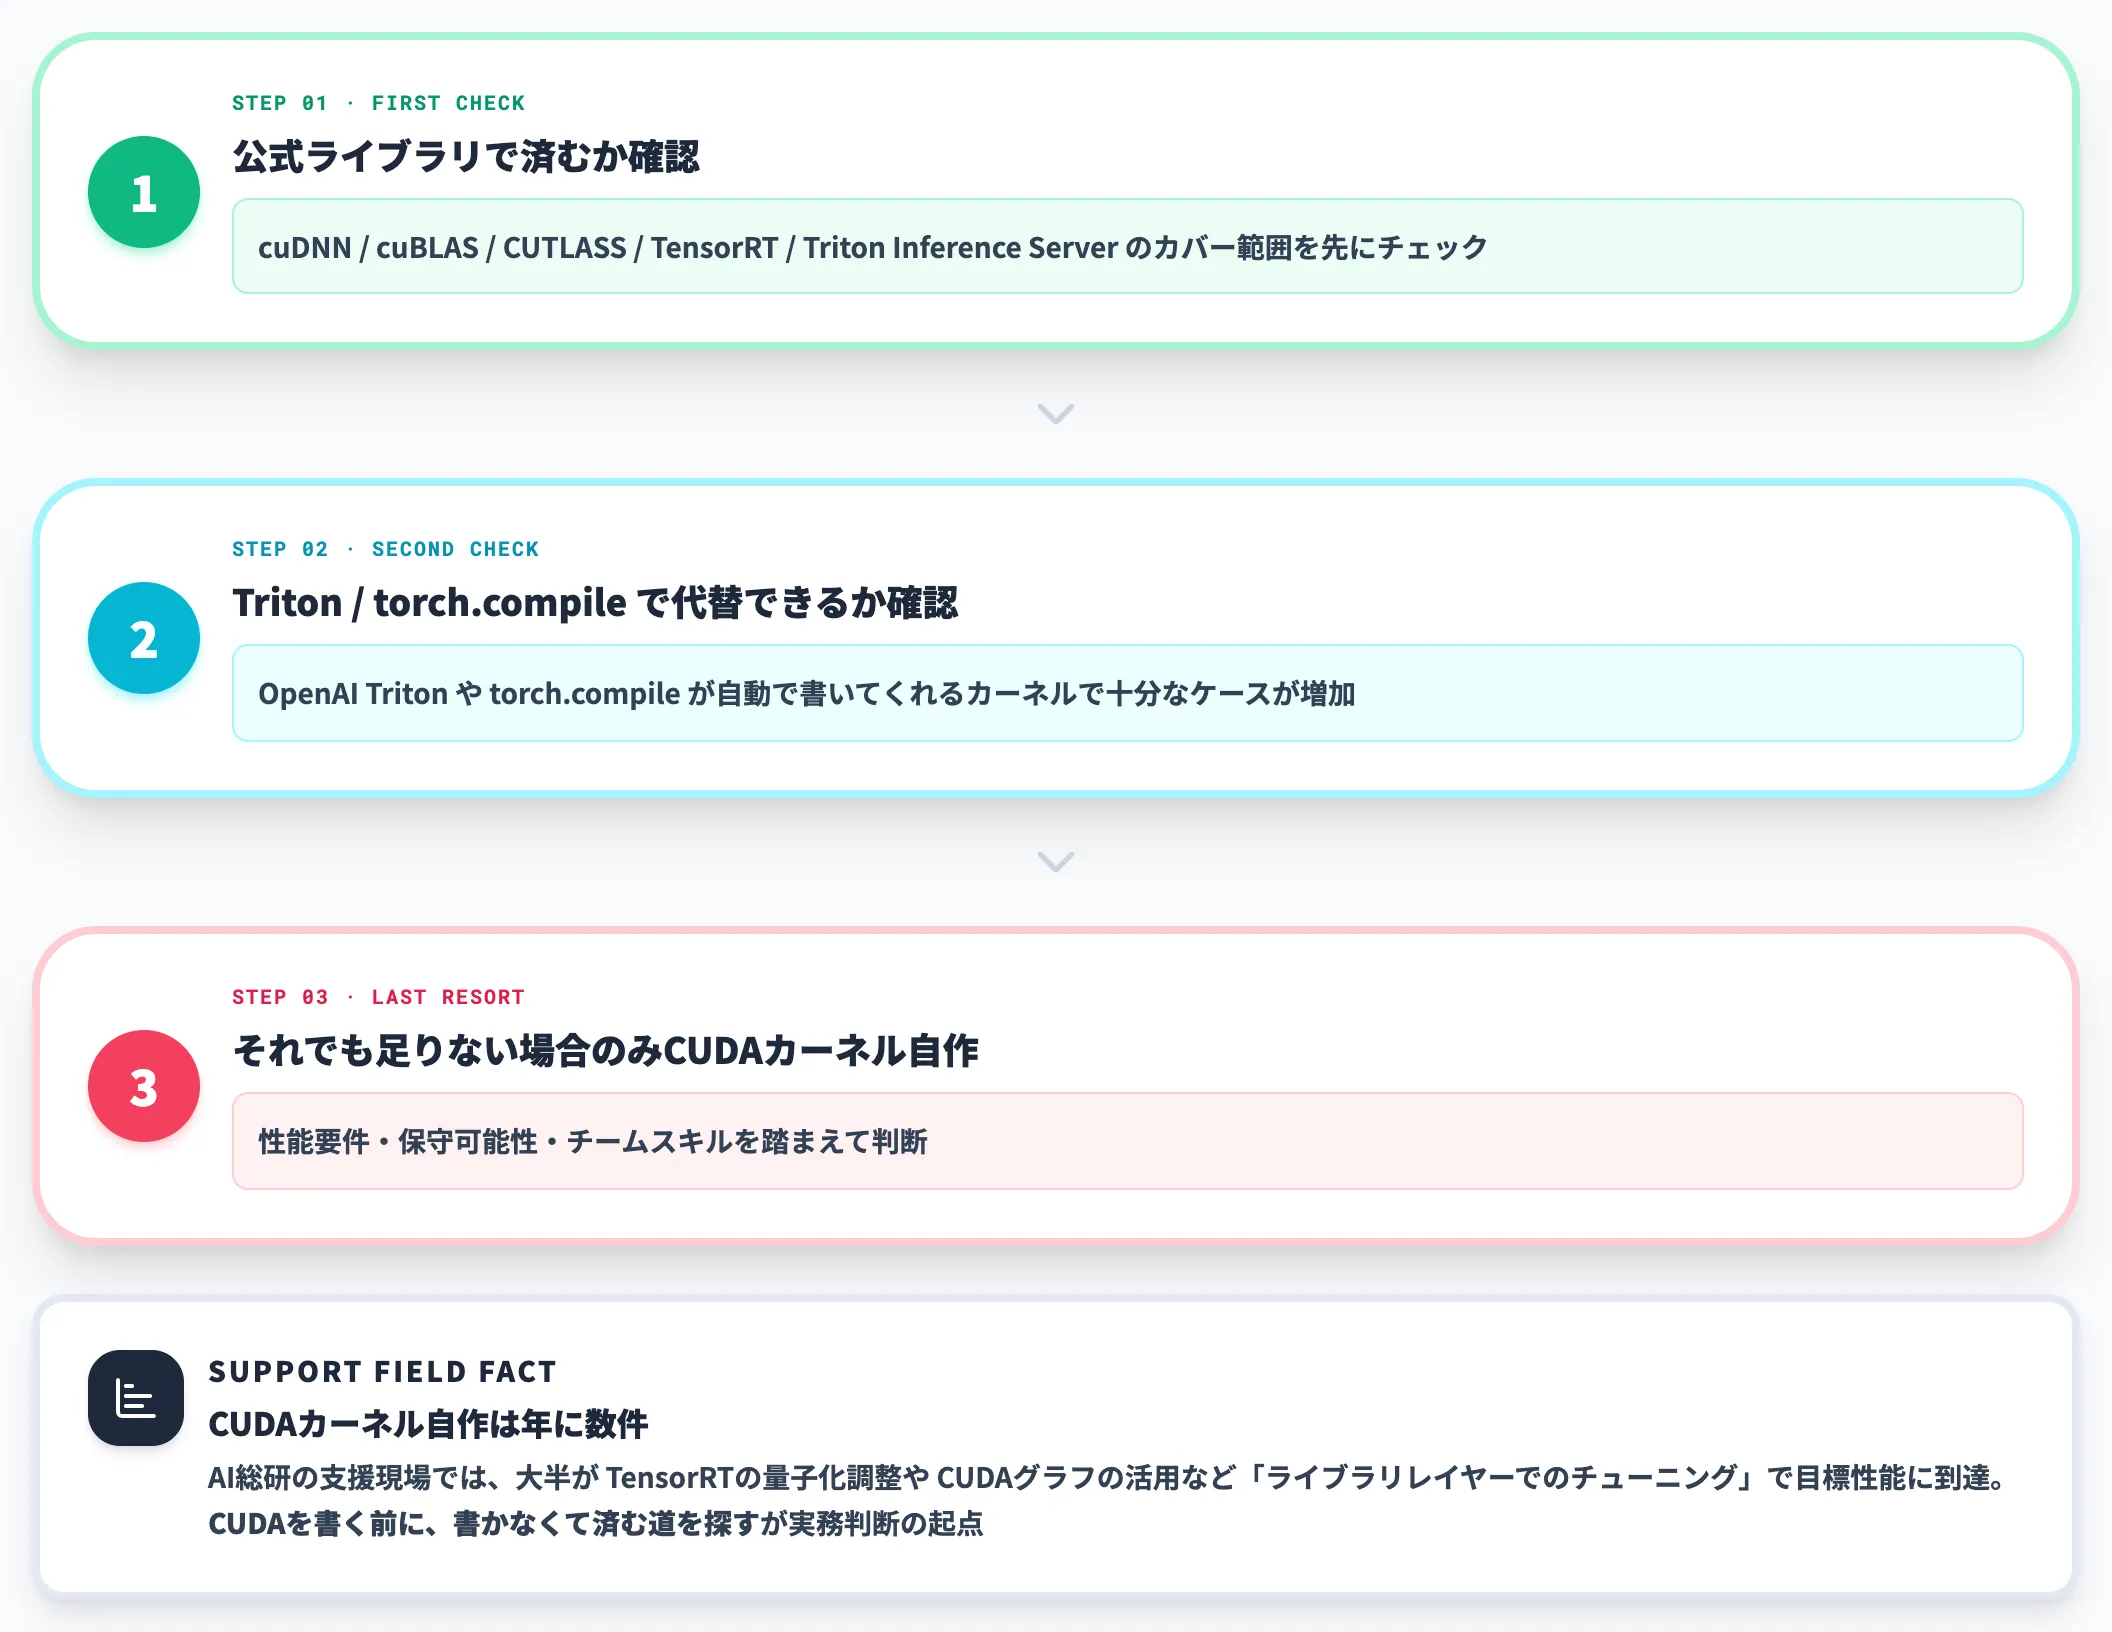
CUDAを直接書くべきか判断するときは、以下の3ステップで検討するのが実務的です。
-
ステップ①: 公式ライブラリで済むか確認
cuDNN / cuBLAS / CUTLASS / TensorRT / Triton Inference Server のカバー範囲を先にチェック
-
ステップ②: Tritonやtorch.compileで代替できるか確認
OpenAI Tritonやtorch.compileが自動で書いてくれるカーネルで十分なケースが増加
-
ステップ③: それでも足りない場合のみCUDAカーネル自作
性能要件・保守可能性・チームスキルを踏まえて判断
AI総研の支援現場でも、CUDAカーネル自作に踏み切る案件は年に数件で、大半はTensorRTの量子化調整やCUDAグラフの活用など「ライブラリレイヤーでのチューニング」で目標性能に到達します。CUDAを書く前に、書かなくて済む道を探すが実務判断の起点です。
CUDAの料金と必要なGPU調達コスト
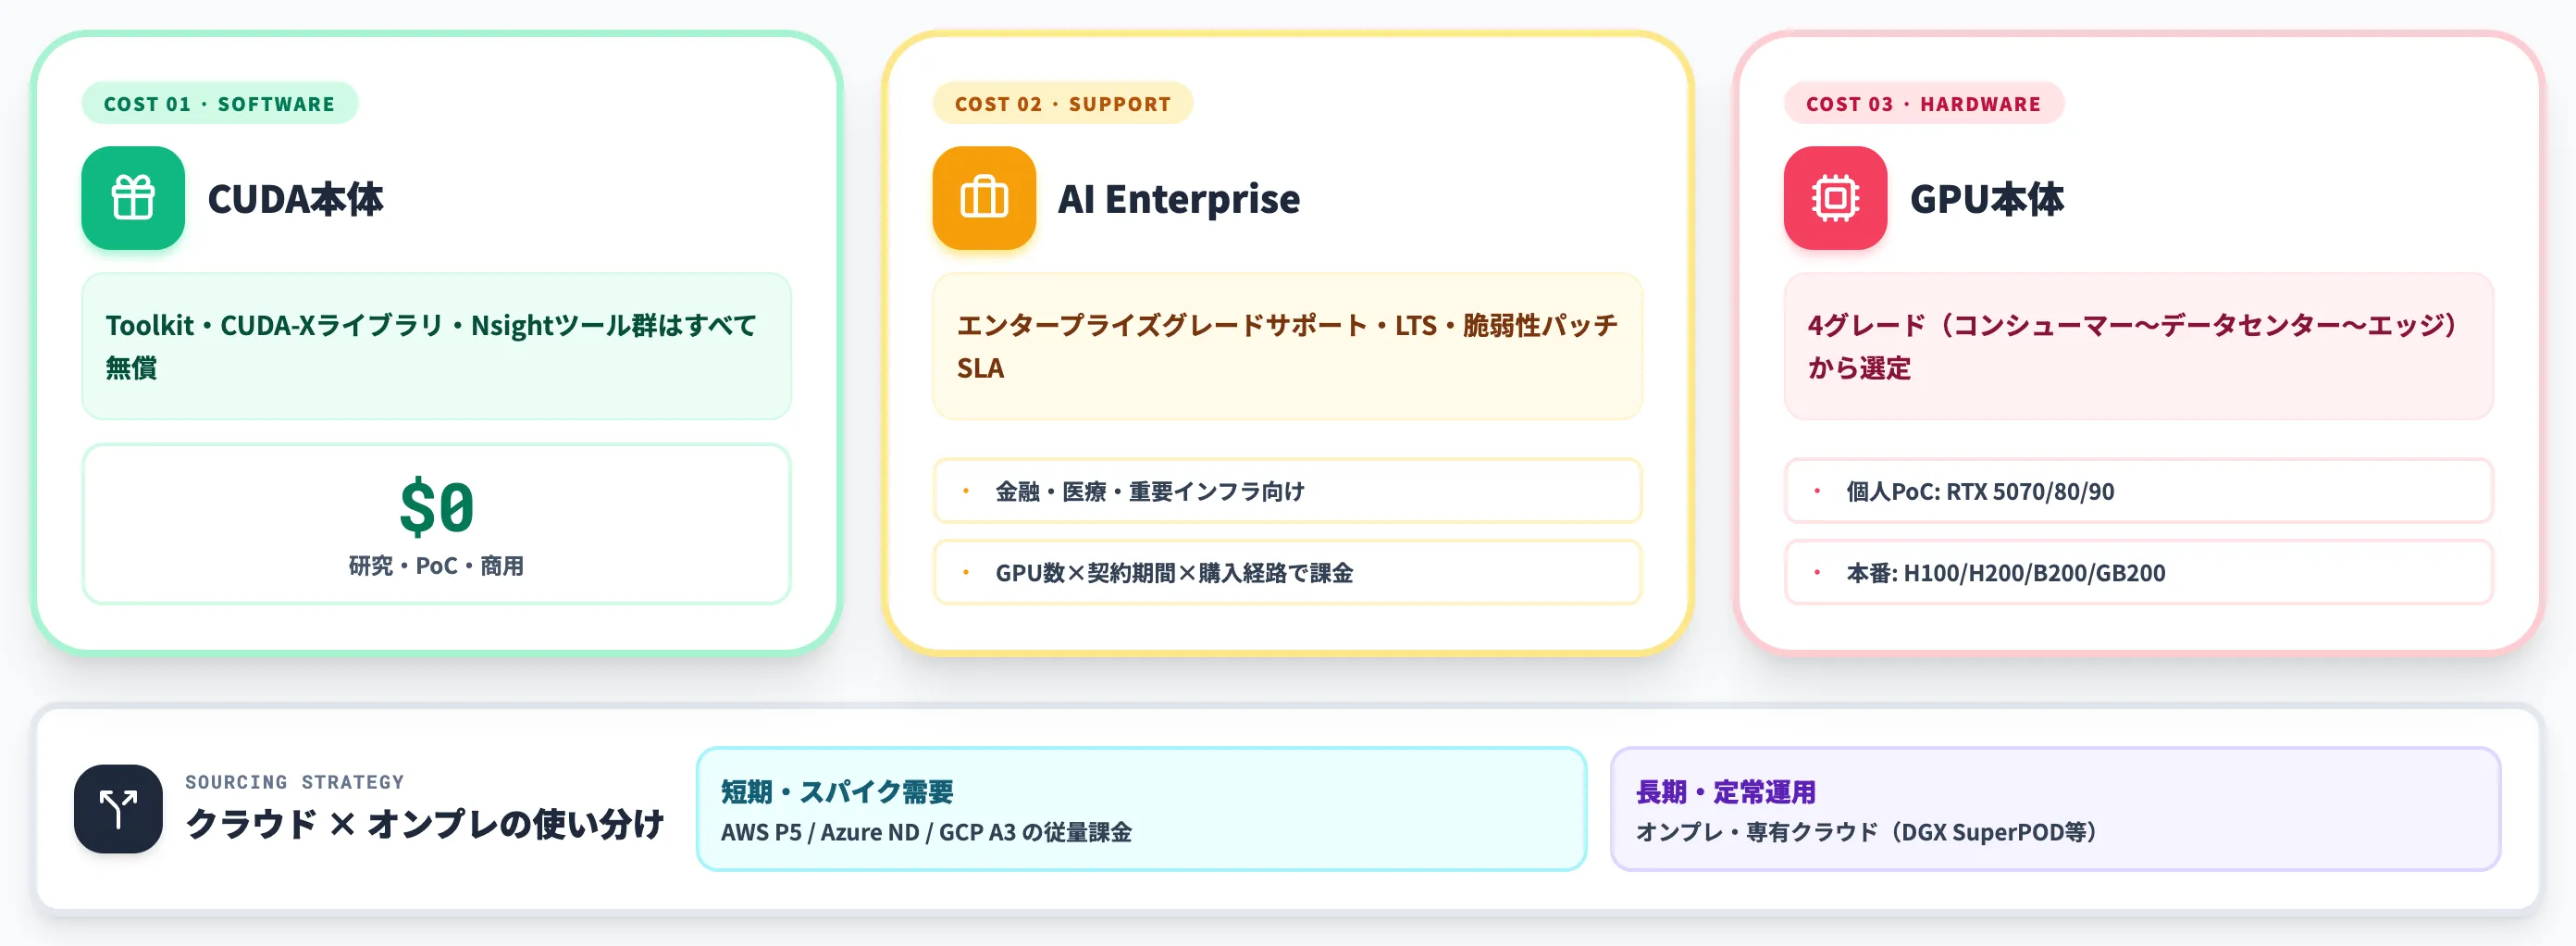
CUDA自体は無償で使えますが、GPU本体・エンタープライズサポート・クラウド利用料の3つを合わせた総コストが実際の投資規模になります。ここは概論記事の中でも判断が分かれやすい論点なので、それぞれを分けて整理します。
CUDA Toolkitと主要ライブラリのライセンス——本体は無償
CUDA Toolkit本体・cuDNN・cuBLAS・cuFFT・cuSPARSE・CUTLASS・Nsightツール群など、開発に必要なライブラリはすべてNVIDIA Developerから無償で入手できます。cuDNNやTensorRTは公式ページ・pip・パッケージマネージャーなど複数の経路で取得でき、いずれも費用は発生しません。
「GPUだけ買えばCUDAで開発できる」という基本構造は2007年から変わっておらず、CUDA自体のライセンス費用が導入判断に影響することは実質ありません。
NVIDIA AI Enterprise——エンタープライズ向けの有償サポート契約
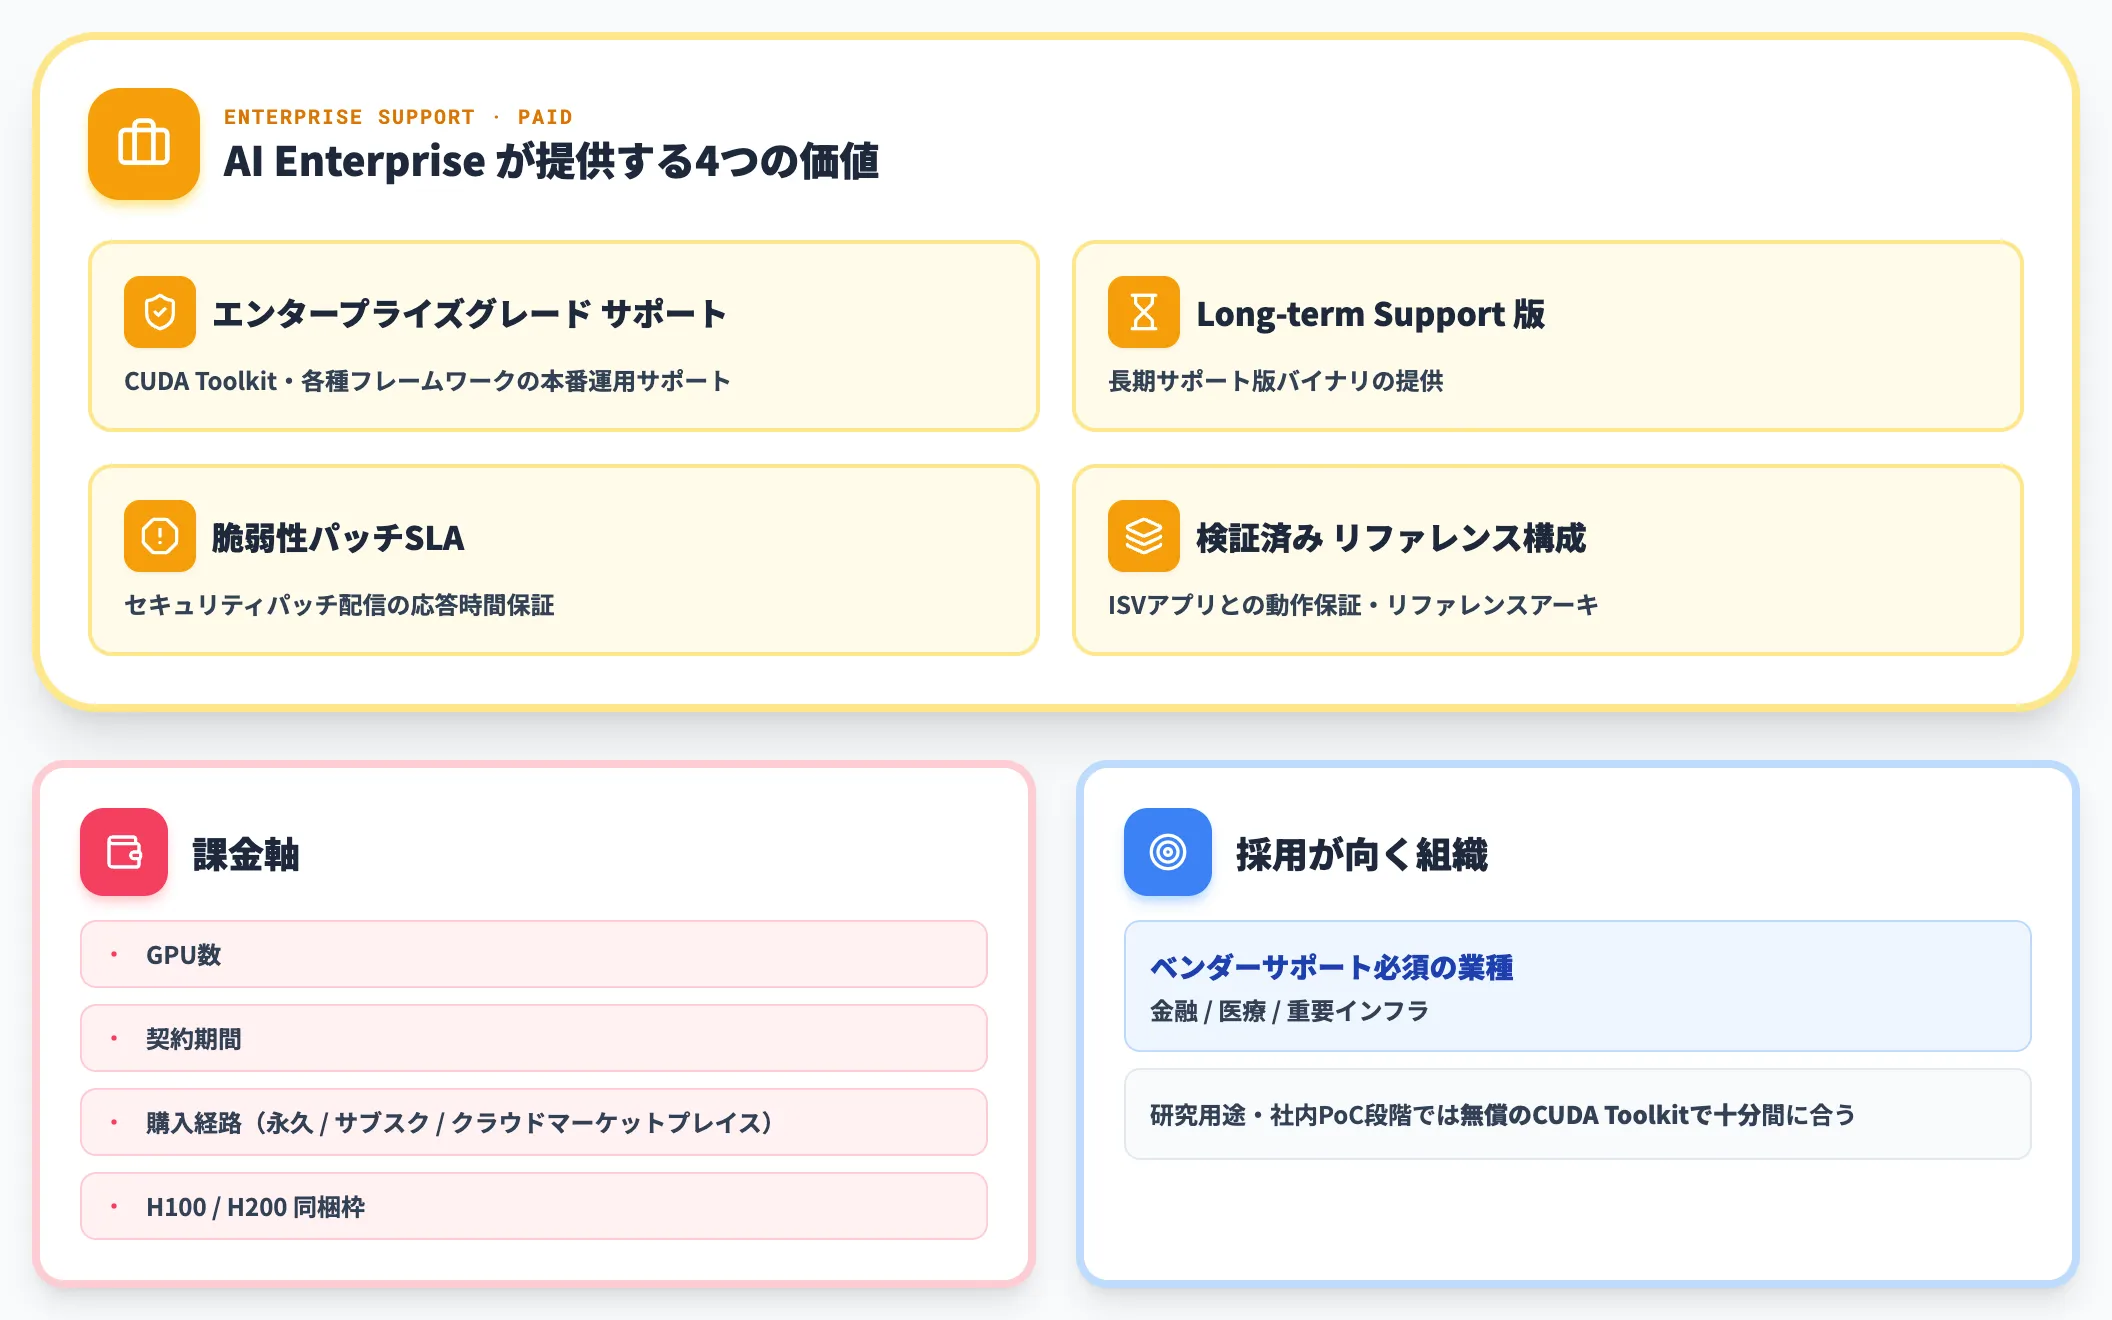
エンタープライズ運用で選択肢となるのがNVIDIA AI Enterpriseです。CUDA Toolkitや各種フレームワークのエンタープライズグレードのサポート、Long-term Support版、脆弱性パッチのSLA、ISVアプリケーションとの検証済みリファレンスアーキテクチャがバンドルされます。
ベンダーサポートを必要とする組織(金融・医療・重要インフラ等)で採用されるライセンスです。
課金体系はGPU数・契約期間・購入経路(永久ライセンス/サブスク/クラウドマーケットプレイス/H100・H200同梱枠 等)で複数の軸があるため、実際の見積りはNVIDIA AI Enterprise Licensing Guideと各代理店の一次見積りで確認する前提になります。研究用途や社内PoCの段階では、無償のCUDA Toolkitで十分間に合います。
GPU本体の調達——コンシューマー / ワークステーション / データセンター
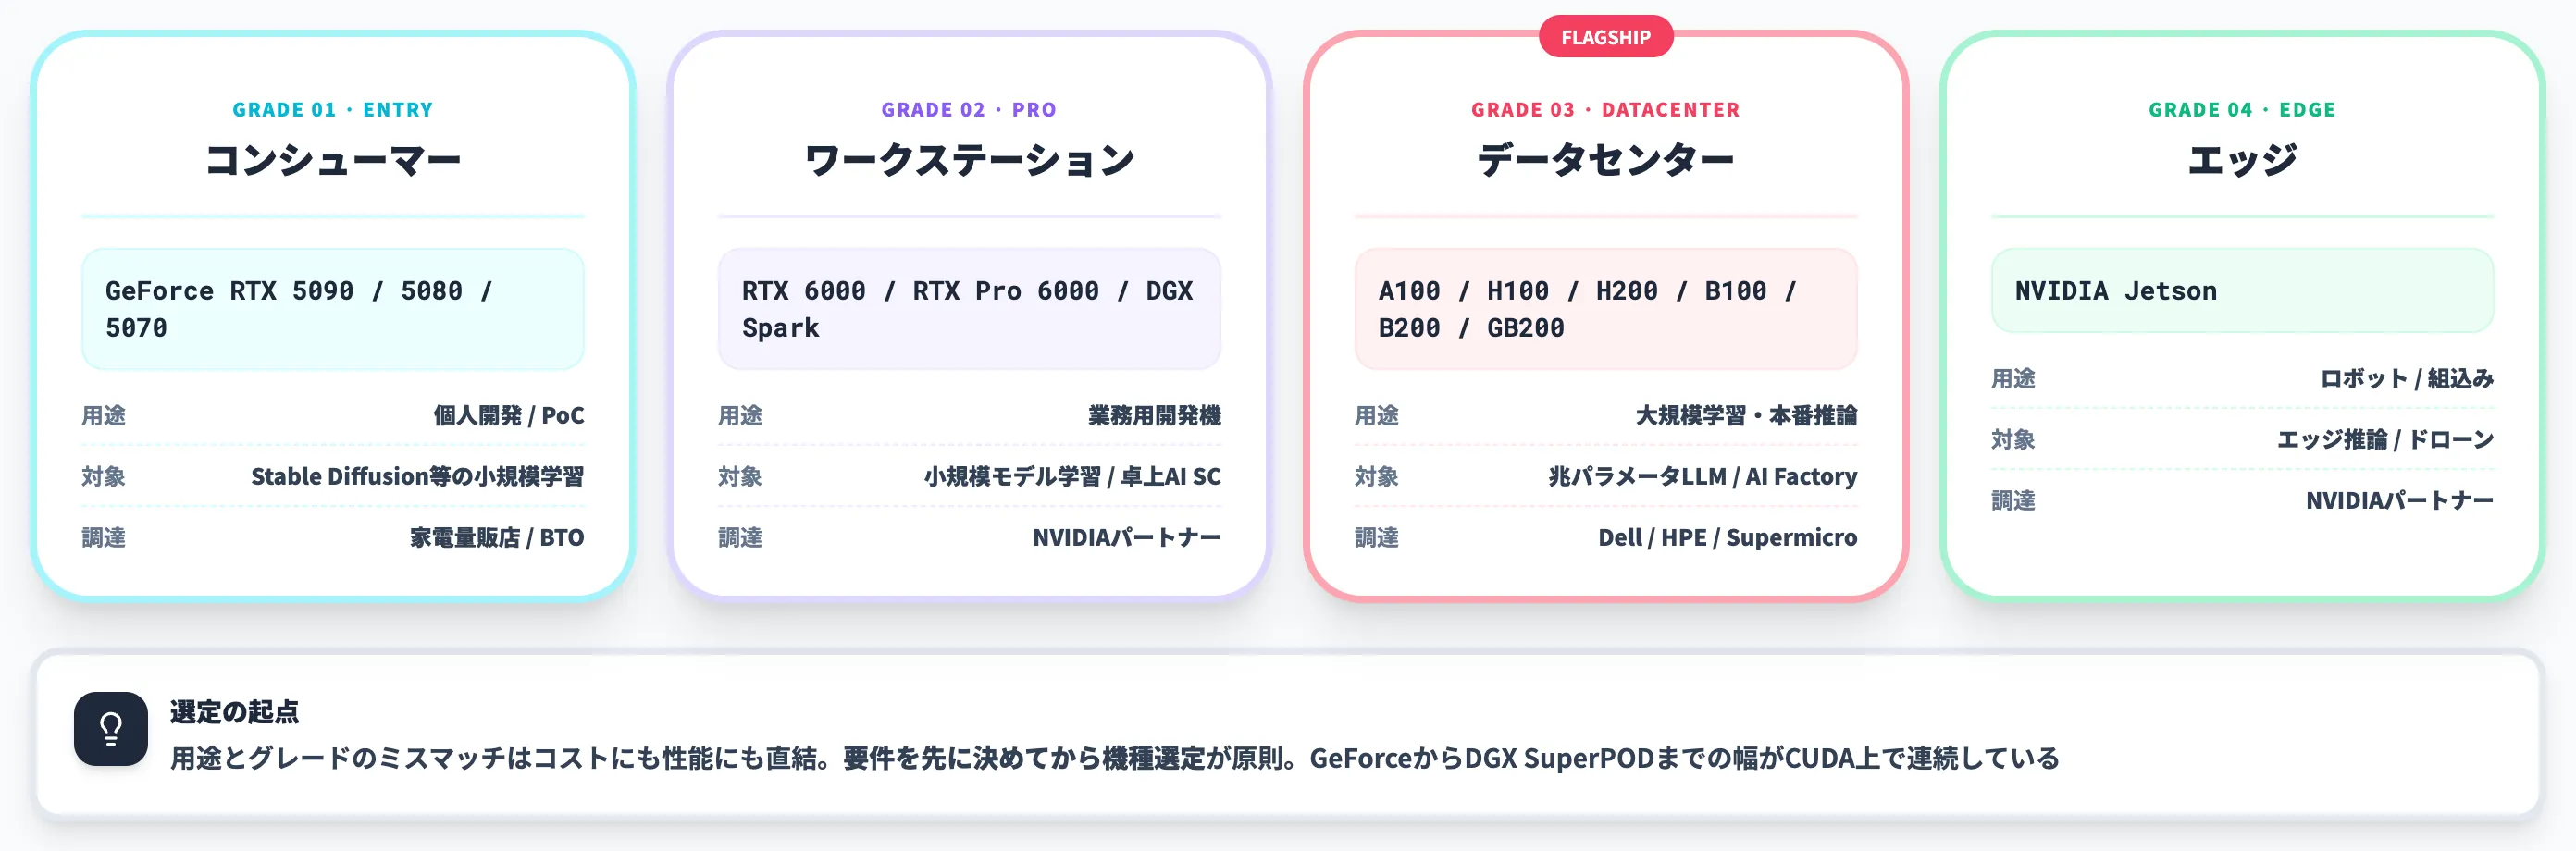
CUDAが動くGPUは、大きく4つのグレードに分かれます。
以下の表で、代表的なGPUと想定用途・調達ルートを整理しました。用途とグレードのミスマッチはコストにも性能にも直結するので、要件を先に決めてから機種選定するのが原則です。
| グレード | 代表GPU | 用途 | 調達ルート |
|---|---|---|---|
| コンシューマー | GeForce RTX 5090 / 5080 / 5070 | 個人開発・PoC・Stable Diffusionなどの小規模学習 | 家電量販店・BTOショップ |
| ワークステーション/デスクトップAI | RTX 6000 Ada / RTX 5000 Ada / RTX Pro 6000 Blackwell / DGX Spark | 業務用開発機・小規模モデル学習・卓上AIスーパーコンピュータ | NVIDIAパートナー経由・エンジニアリングPC専門店 |
| データセンター | A100 / H100 / H200 / B100 / B200 / GB200 | 大規模学習・推論本番運用 | NVIDIA公式・OEMサーバーベンダー(Dell/HPE/Supermicro等) |
| エッジ | NVIDIA Jetson | ロボット・組込み・エッジ推論 | NVIDIAパートナー |
データセンター用GPUの調達期間は、SKU・数量・OEMベンダー・地域に依存して大きくブレます。この現実を踏まえると、後述のクラウドGPU利用と、オンプレミス生成AI基盤の使い分けが実務判断の中心になります。
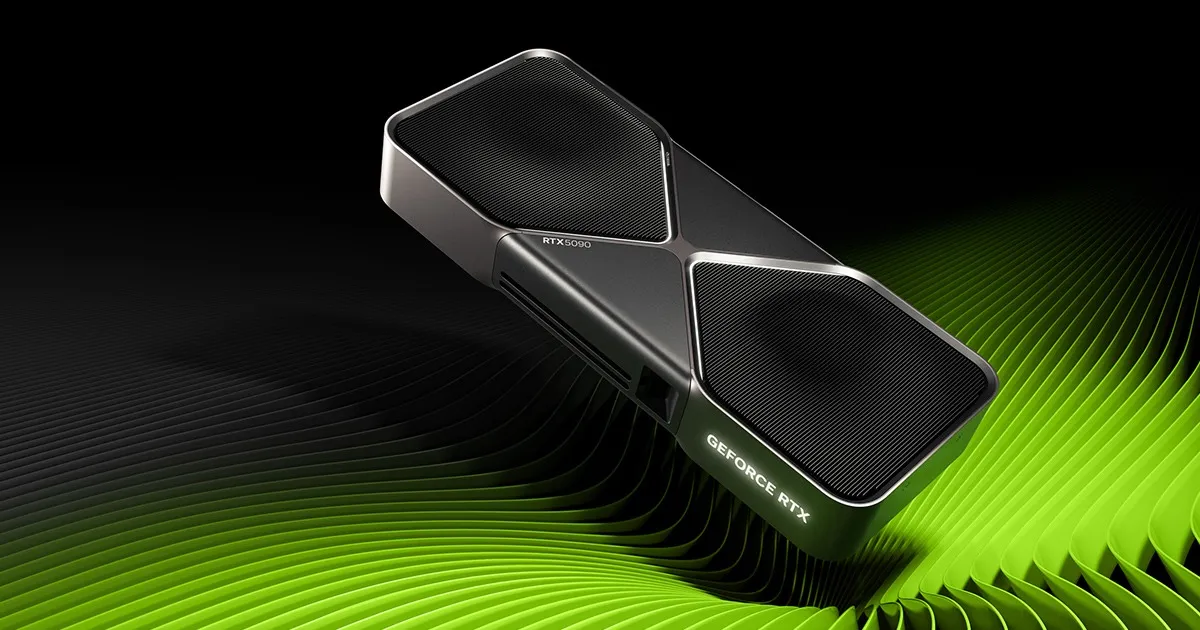
GeForce RTX 50シリーズはBlackwell世代のコンシューマグレードGPU(出典:GeForce RTX 50シリーズ)
コンシューマグレードのGeForce RTX 50シリーズは、個人開発・小規模PoC・画像生成用途などでVRAM容量とワークロードに合わせてRTX 5070/5080/5090から選ぶ候補となります。
実際の選定はモデルサイズ・バッチサイズ・想定並列度で変わるため、GeForce RTX 50シリーズ公式仕様で各SKUのVRAM・帯域・CUDAコア数を確認してから決めるのが実務的です。
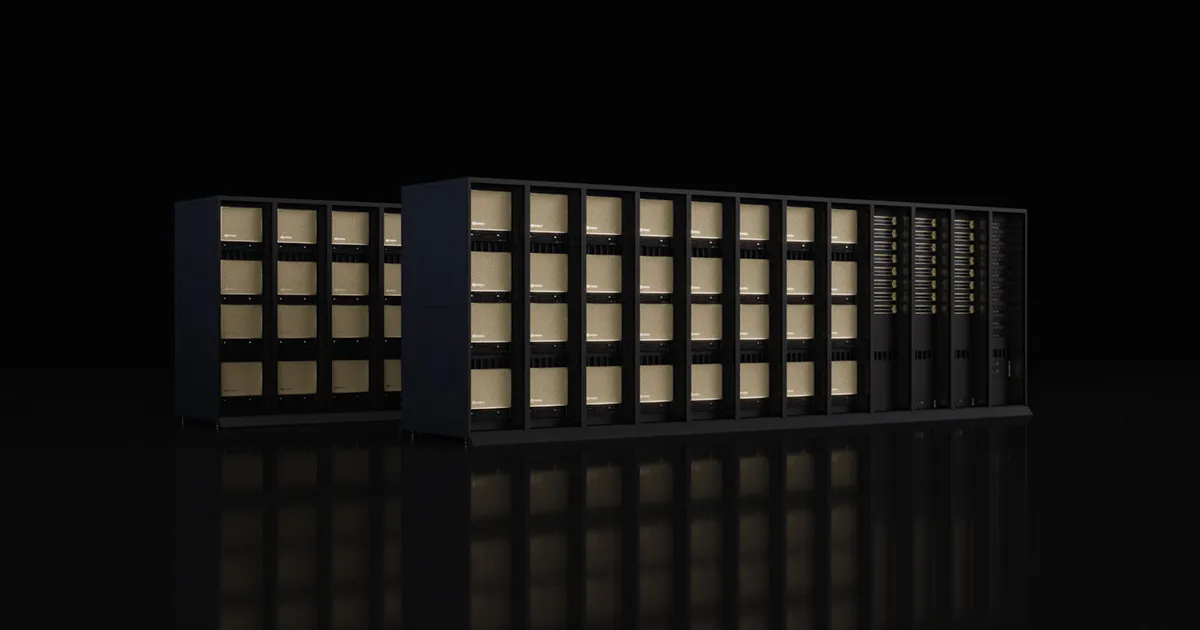
DGX SuperPODはH200/GB200を統合した大規模学習・推論向けのフルラックスケール構成(出典:NVIDIA DGX SuperPOD)
対照的に、DGX SuperPODは複数ラックのGPU群をInfiniBandで接続し、単一の計算資源として運用する大規模学習向けの構成です。
最先端モデルの事前学習や兆パラメータ級の大規模推論など、最も要求の厳しいワークロードで選択される構成として位置づけられています。
個人開発のGeForceからエンタープライズのDGX SuperPODまでの幅がCUDAという同一プラットフォーム上で連続している点が、CUDAスタックの実務的な強みです。
クラウドGPUの従量課金——AWS / Azure / GCPの相場感
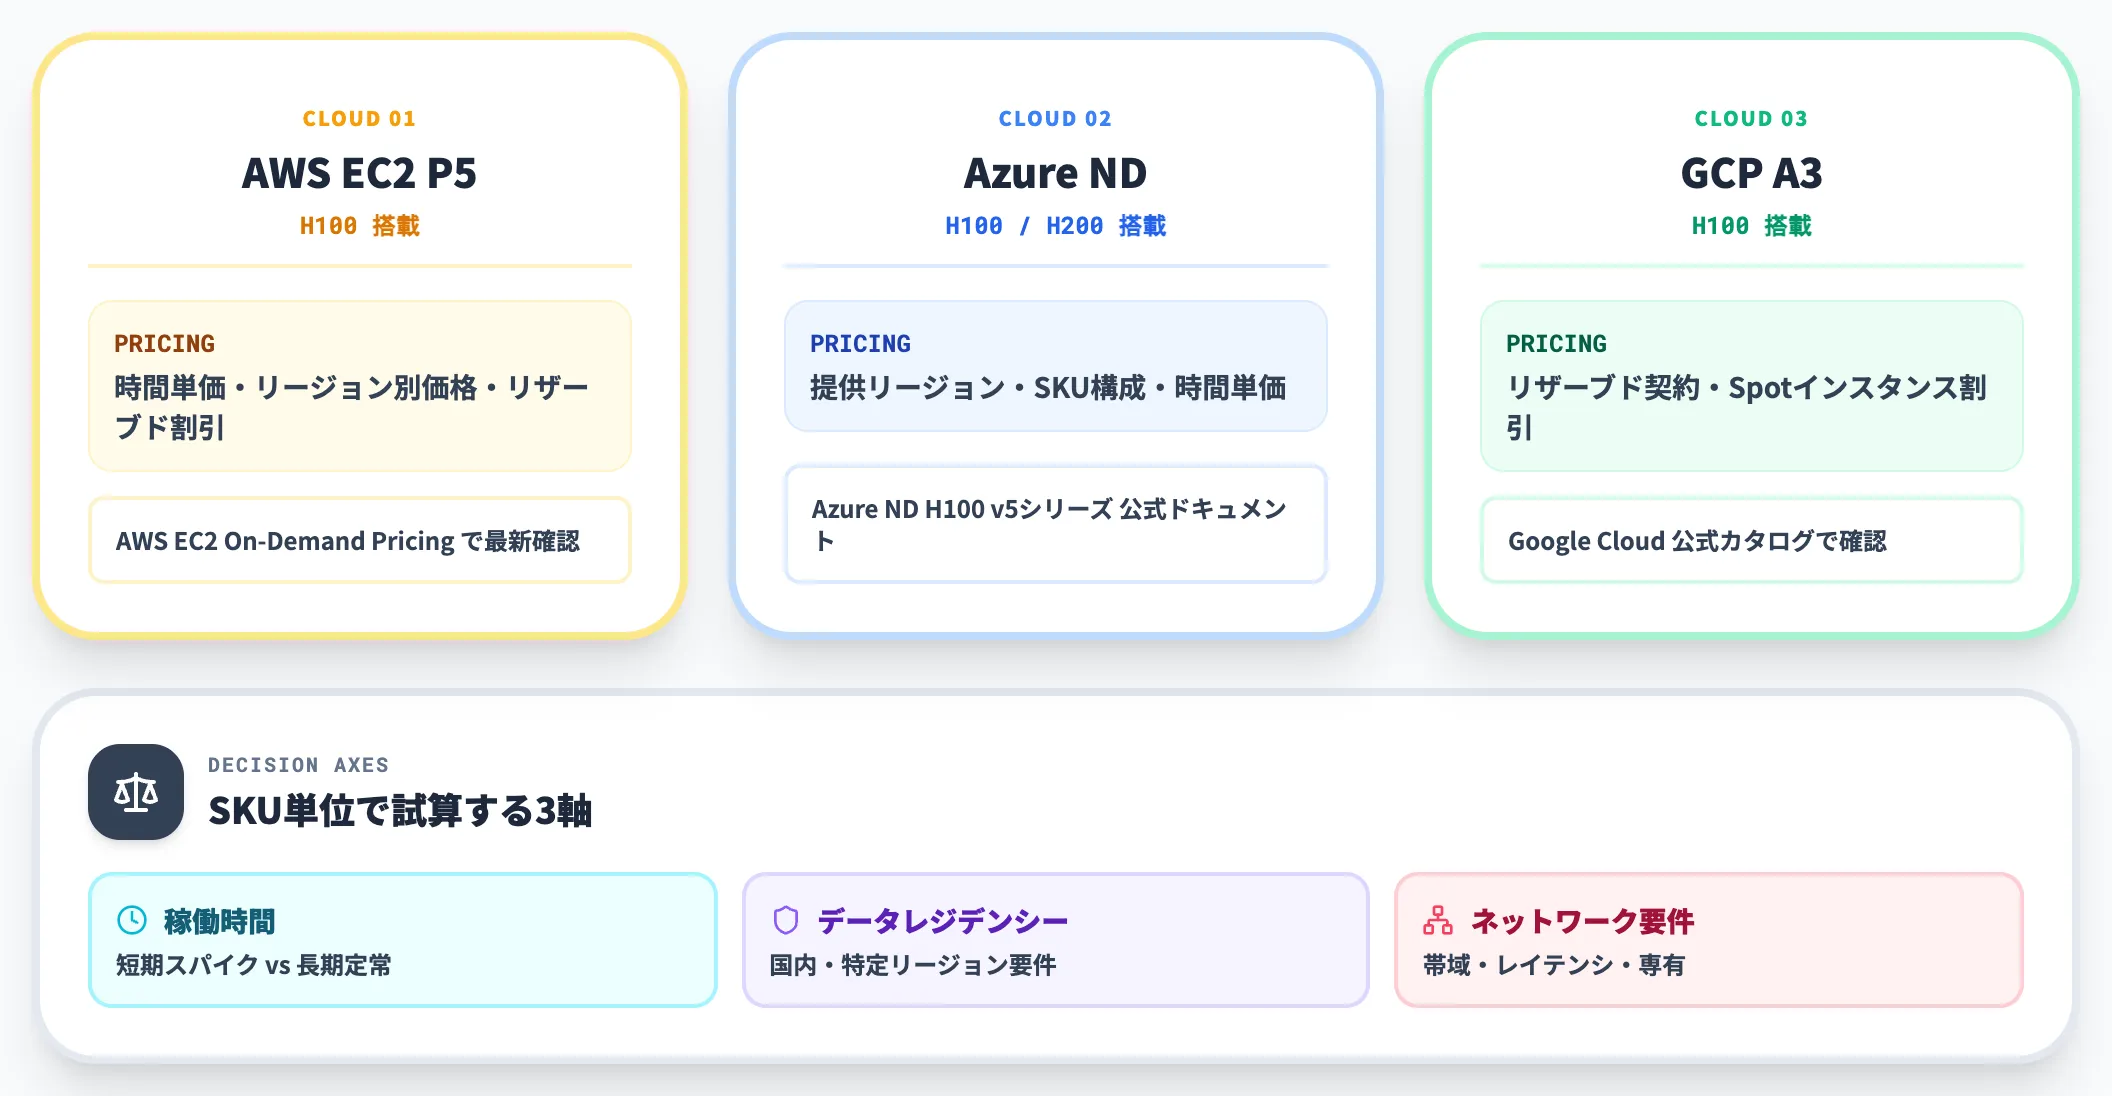
クラウド経由でCUDA環境を借りる場合、主要3社に代表的なインスタンス系列が用意されています。
-
AWS EC2 P5系(H100搭載)
時間単価・リージョン別価格・リザーブド割引の最新情報はAWS EC2 On-Demand Pricingで確認する
-
Azure NDシリーズ(H100 / H200搭載)
提供リージョン・SKU構成・時間単価はAzure ND H100 v5シリーズなどの公式ドキュメントで確認する
-
Google Cloud A3系(H100搭載)
リザーブド契約・Spotインスタンスの割引体系が公開されている
実務では、短期の検証・スパイク需要はクラウド、長期の定常運用はオンプレ・専有クラウドを検討する、という切り分けが判断軸になります。稼働時間・データレジデンシー・ネットワーク要件の3軸をSKU単位で試算してから決めるのが、後戻りを避けるための基本形です。
CUDAの主要な活用領域
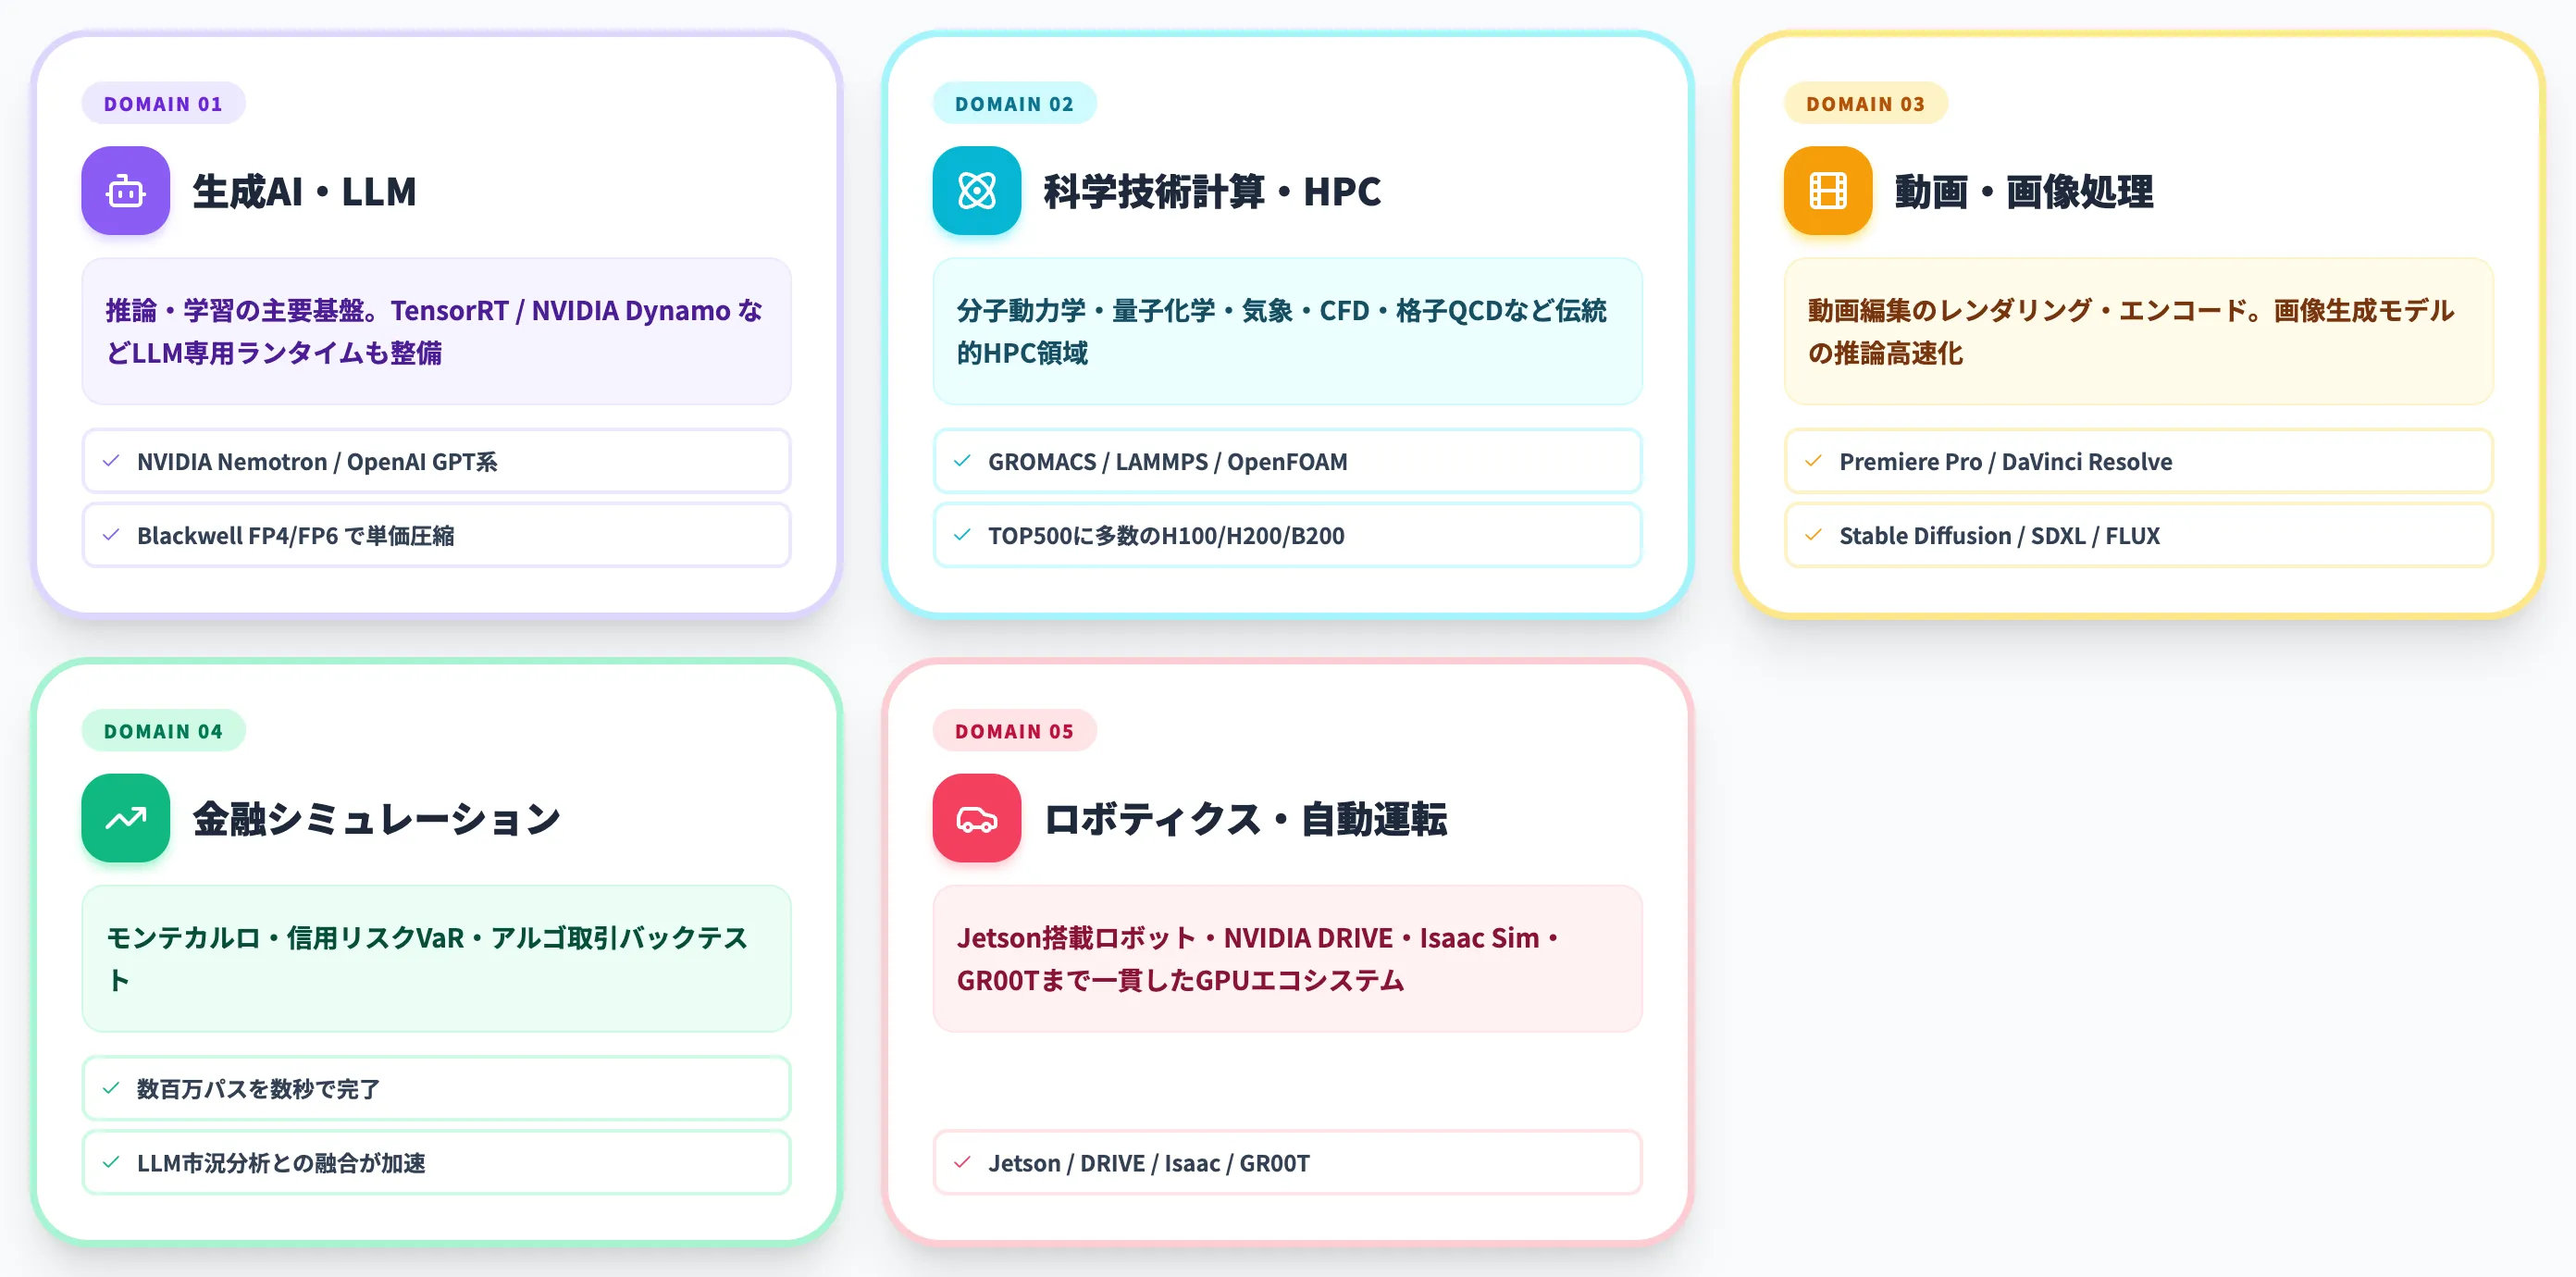
CUDAがどこで実際に使われているかを整理すると、AI/HPC以外にも動画処理・金融シミュレーション・ロボティクスまで裾野が広いことがわかります。ここでは代表的な活用領域を、事例URLと合わせて紹介します。
生成AI・LLMの推論と学習
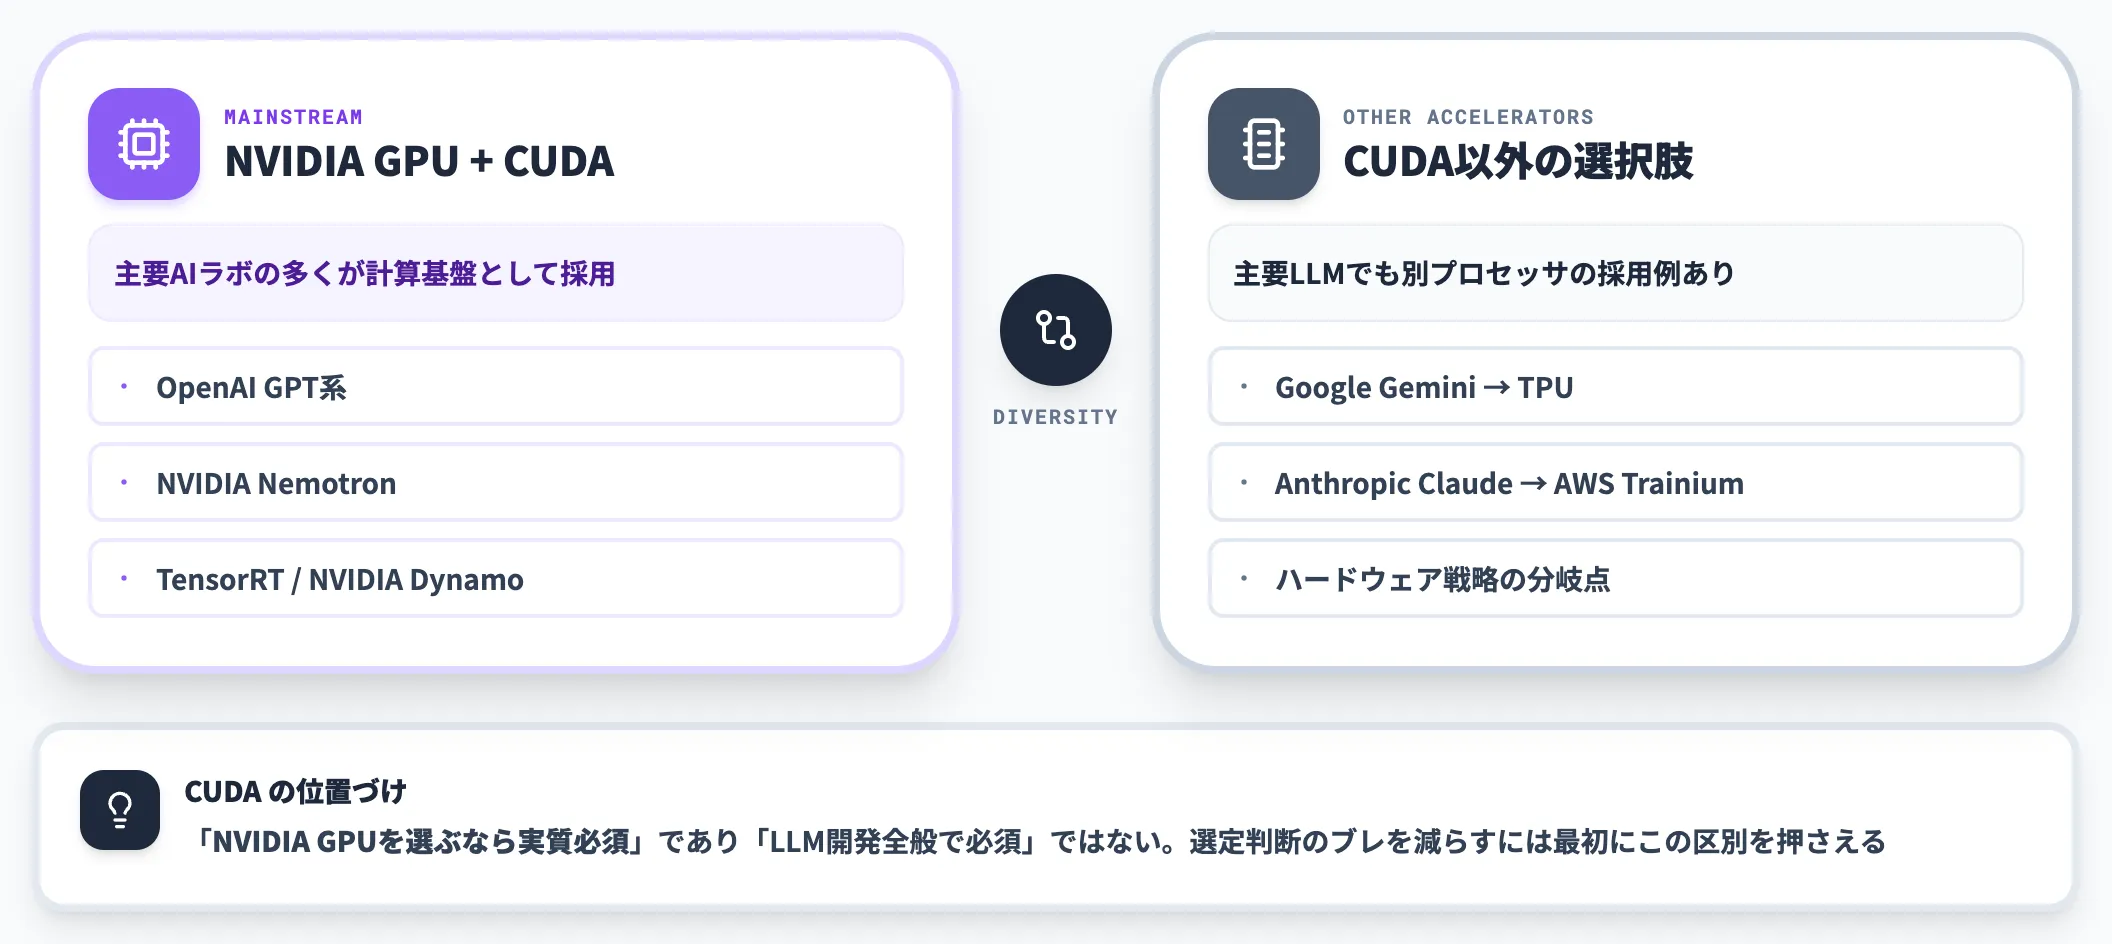
主要な活用領域の一つが、生成AI・LLMの推論と学習です。NVIDIA GPU上で学習・推論を回すLLMでは、CUDAに加えNCCLやcuDNNなどが用途に応じて利用され、推論フェーズではTensorRT / NVIDIA DynamoといったLLM向け推論基盤も選択肢に入ります(NemotronなどNVIDIA自身のLLMがその代表例)。
一方で、GoogleのGeminiはTPUを主要な学習・提供基盤として採用しており、AnthropicのClaudeもAWS Trainiumを学習基盤に組み込んでいるため、LLM全体がNVIDIA GPU + CUDAのみで動いているわけではありません。
CUDAは「NVIDIA GPUを選ぶなら実質必須」であり、「LLM開発全般で必須」ではない点を最初に押さえておくと選定判断のブレが減ります。
Blackwell世代のFP4/FP6演算とTransformer Engineは、生成AI推論のトークン単価を大幅に下げるために設計されており、NVIDIA AI Factory構想でも中核ハードウェアとして位置づけられています。
企業レベルでは、ChatGPTとNVIDIAの関係に見られるように、OpenAIなど主要AIラボの多くがNVIDIA GPU + CUDAを主要な計算基盤として採用しており、モデル選定と同じレベルでハードウェア調達が経営課題になっています。
科学技術計算・HPC
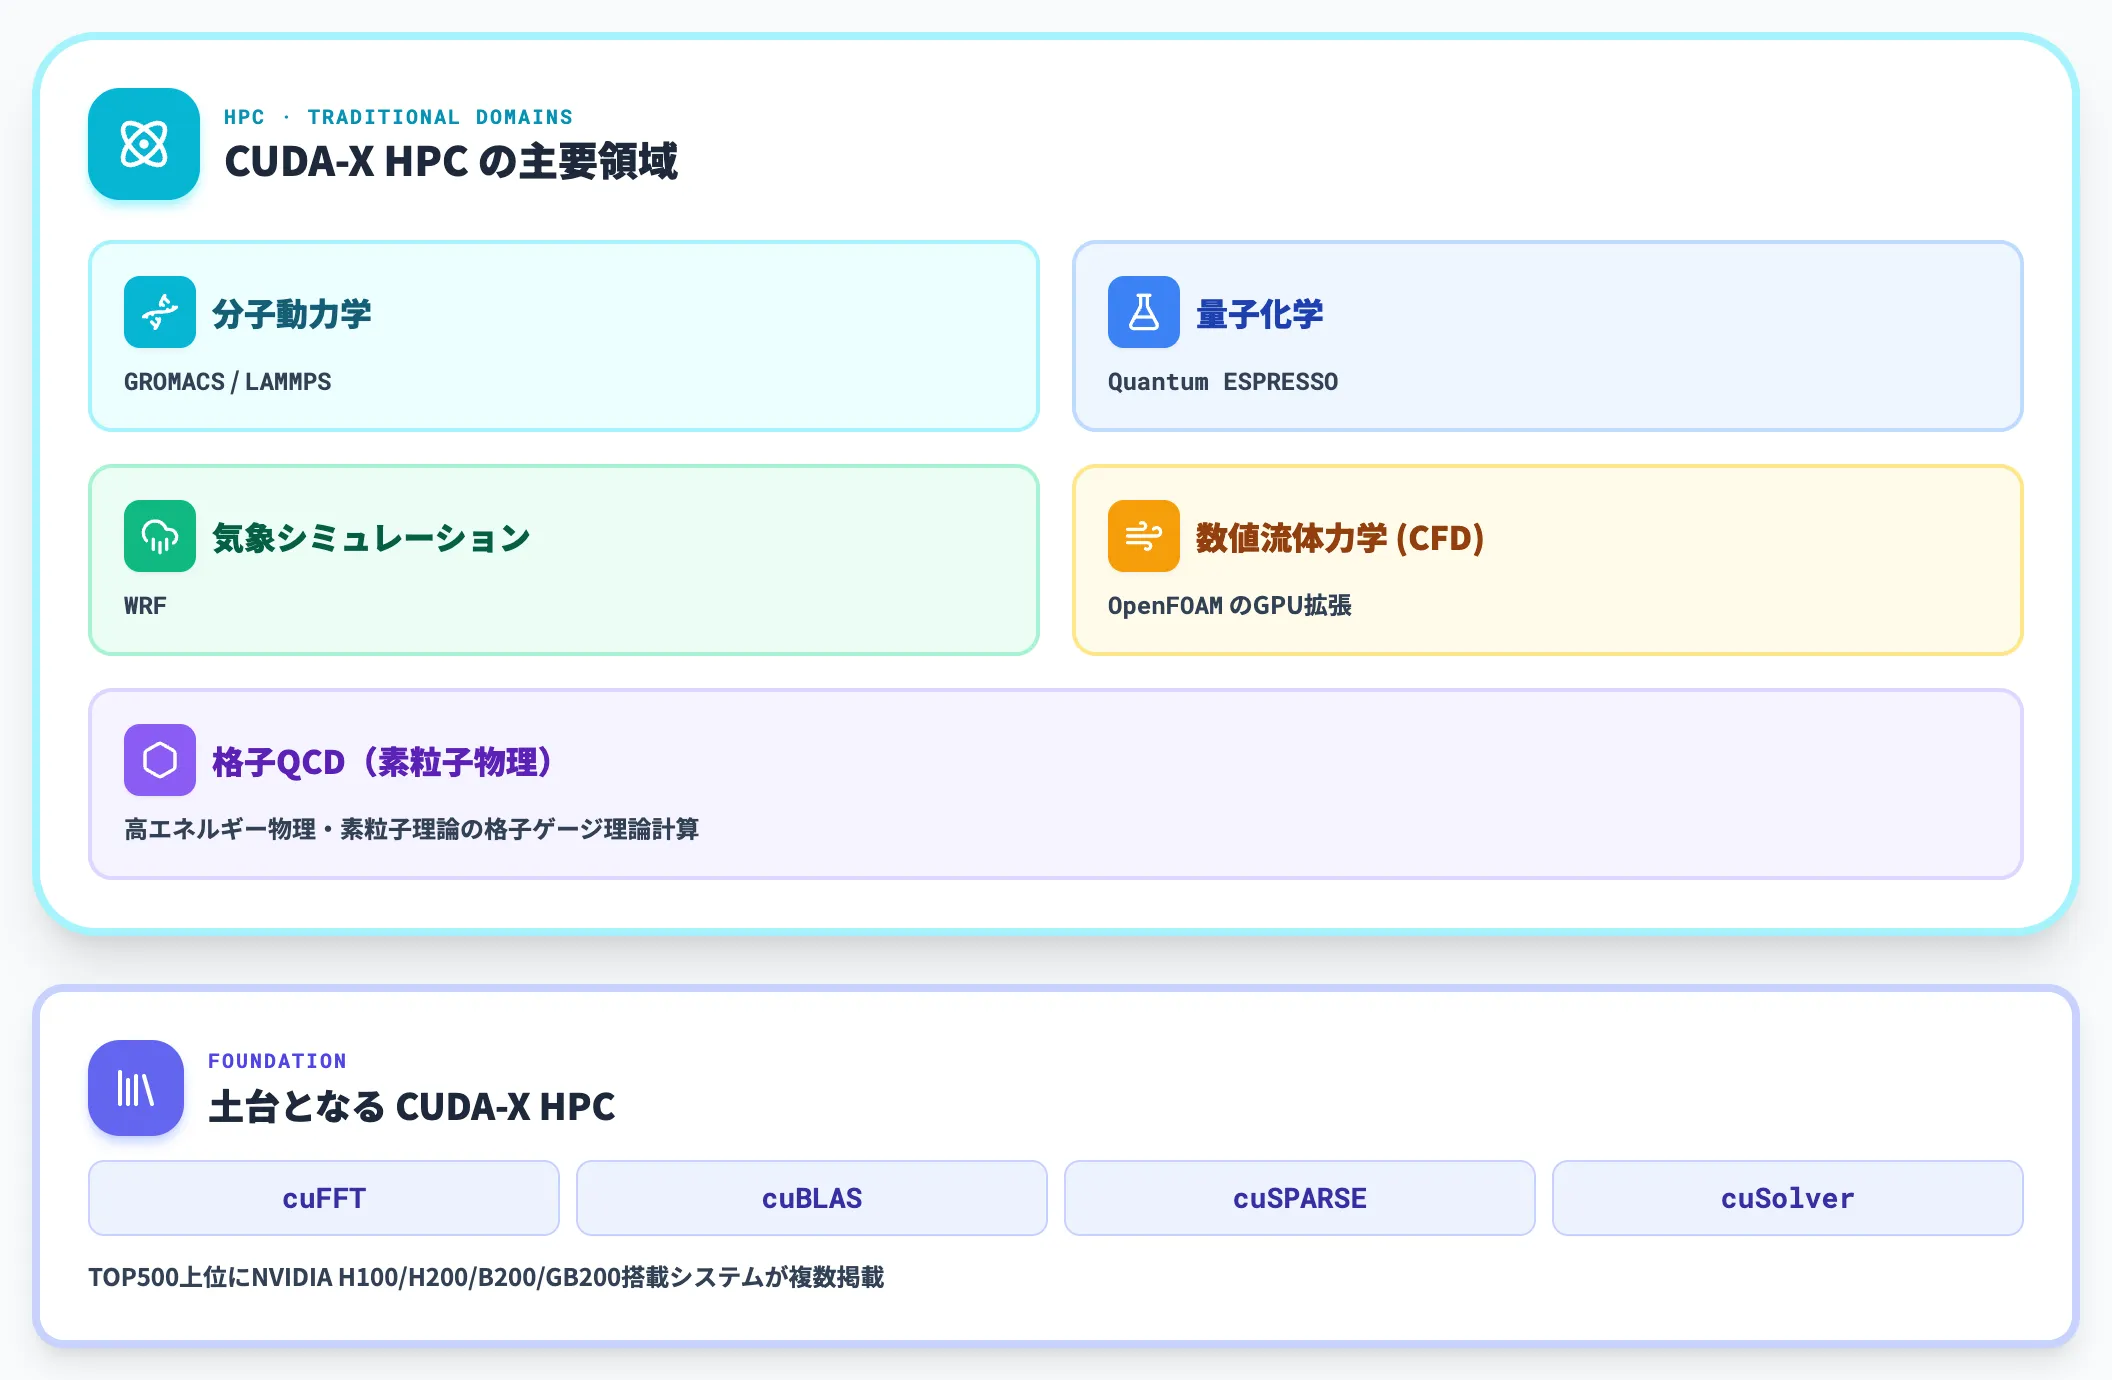
分子動力学(GROMACS / LAMMPS)・量子化学(Quantum ESPRESSO)・気象シミュレーション(WRF)・数値流体力学(OpenFOAM のGPU拡張)・格子QCDなど、伝統的なHPC領域はCUDA-X HPCライブラリ群(cuFFT / cuBLAS / cuSPARSE / cuSolver)を土台に構築されています。
スーパーコンピュータランキング(TOP500)でも、NVIDIA H100/H200/B200/GB200などを搭載したシステムが複数掲載されており、学術・産業両方の計算基盤としての存在感が2026年時点でさらに強まっています。
動画処理・画像処理
Adobe Premiere Pro・DaVinci Resolve・After Effectsなどの動画編集ソフトは、エフェクトのレンダリング・エンコード・AIノイズ除去にCUDAを活用しています。GeForceグレードのGPUでも顕著に書き出し時間が短縮されるため、映像制作領域では「CUDAを意識していなくてもCUDAの恩恵を受けている」ユーザーが多い状況です。
Stable Diffusion / SDXL / FLUXなどの画像生成モデルも、Stable Diffusion向けGPUとしてCUDAを前提に最適化されており、消費者向けAI画像生成の裏側も基本的にはこの層で動いています。
金融シミュレーション・リスク計算
モンテカルロ法によるオプション価格評価・信用リスクVaR計算・アルゴリズム取引のバックテストなど、金融の大規模シミュレーションはCUDA導入の初期から代表的な活用領域でした。数百万パスのシミュレーションを数秒で終わらせられるかは、実務のシステム設計に直結する差になります。
2026年時点では、これらの計算にLLMベースの市況要因分析やAIエージェントによる裁量判断の補助を組み合わせる動きが加速しており、伝統的HPC + 生成AIの融合例が金融領域でも広がっています。
ロボティクス・自動運転
NVIDIA Jetsonを搭載したロボットやドローン、自動運転車の知覚・計画モジュールもCUDAで動作します。
NVIDIA DRIVEプラットフォームは自動運転用の統合SDKで、Isaac Simは物理シミュレーション、GR00Tはヒューマノイド基盤モデルと、ロボット領域全体でCUDA/GPUエコシステムが広がっています。
CUDA導入で詰まる論点——バージョン整合と運用の実務
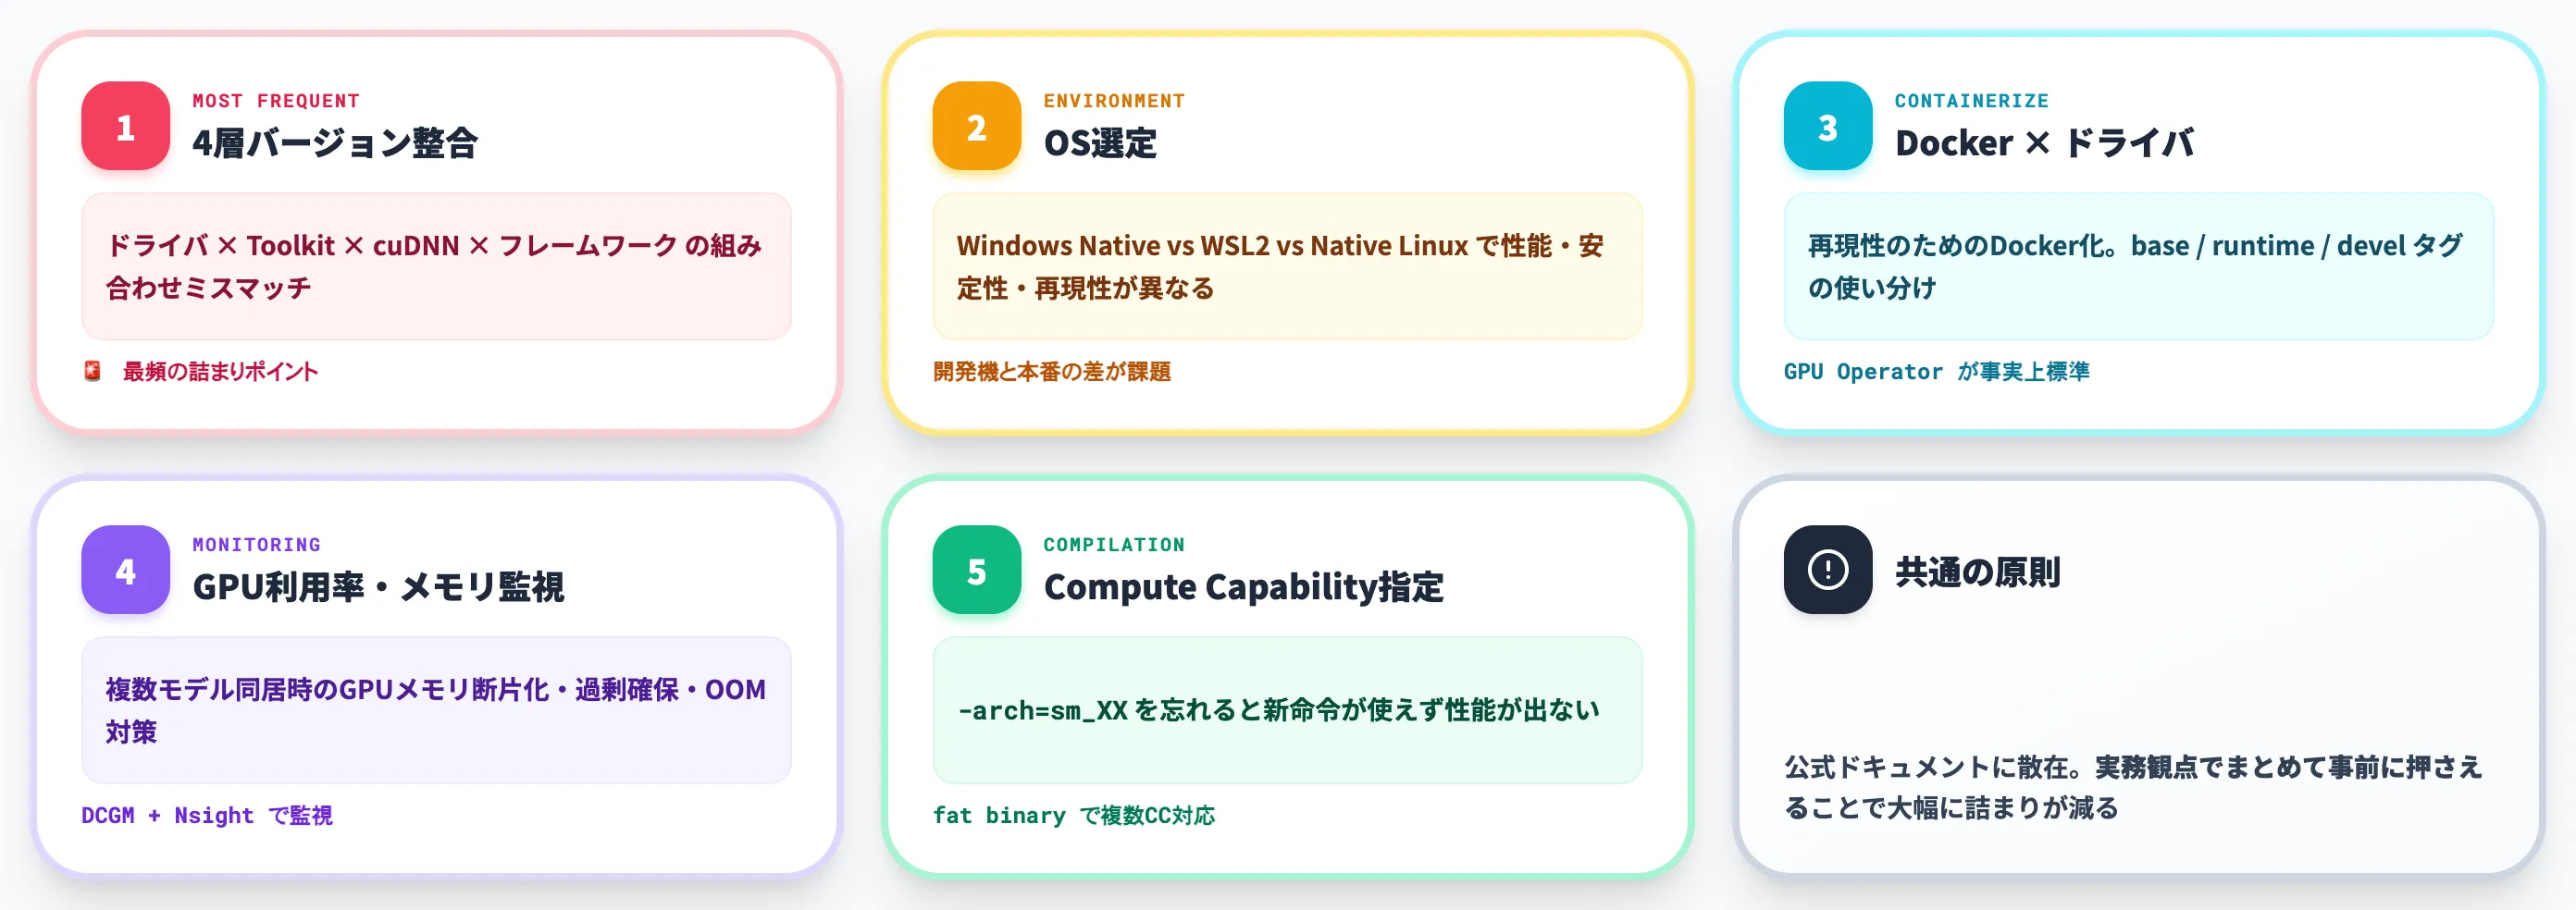
CUDAで初めての本番運用を回すときに詰まりやすいのは、バージョン整合・環境の再現性・監視の3点です。ここは公式ドキュメントには断片的に散在しているため、実務観点でまとめておきます。
1. ドライバ × Toolkit × cuDNN × フレームワークの4層バージョン整合
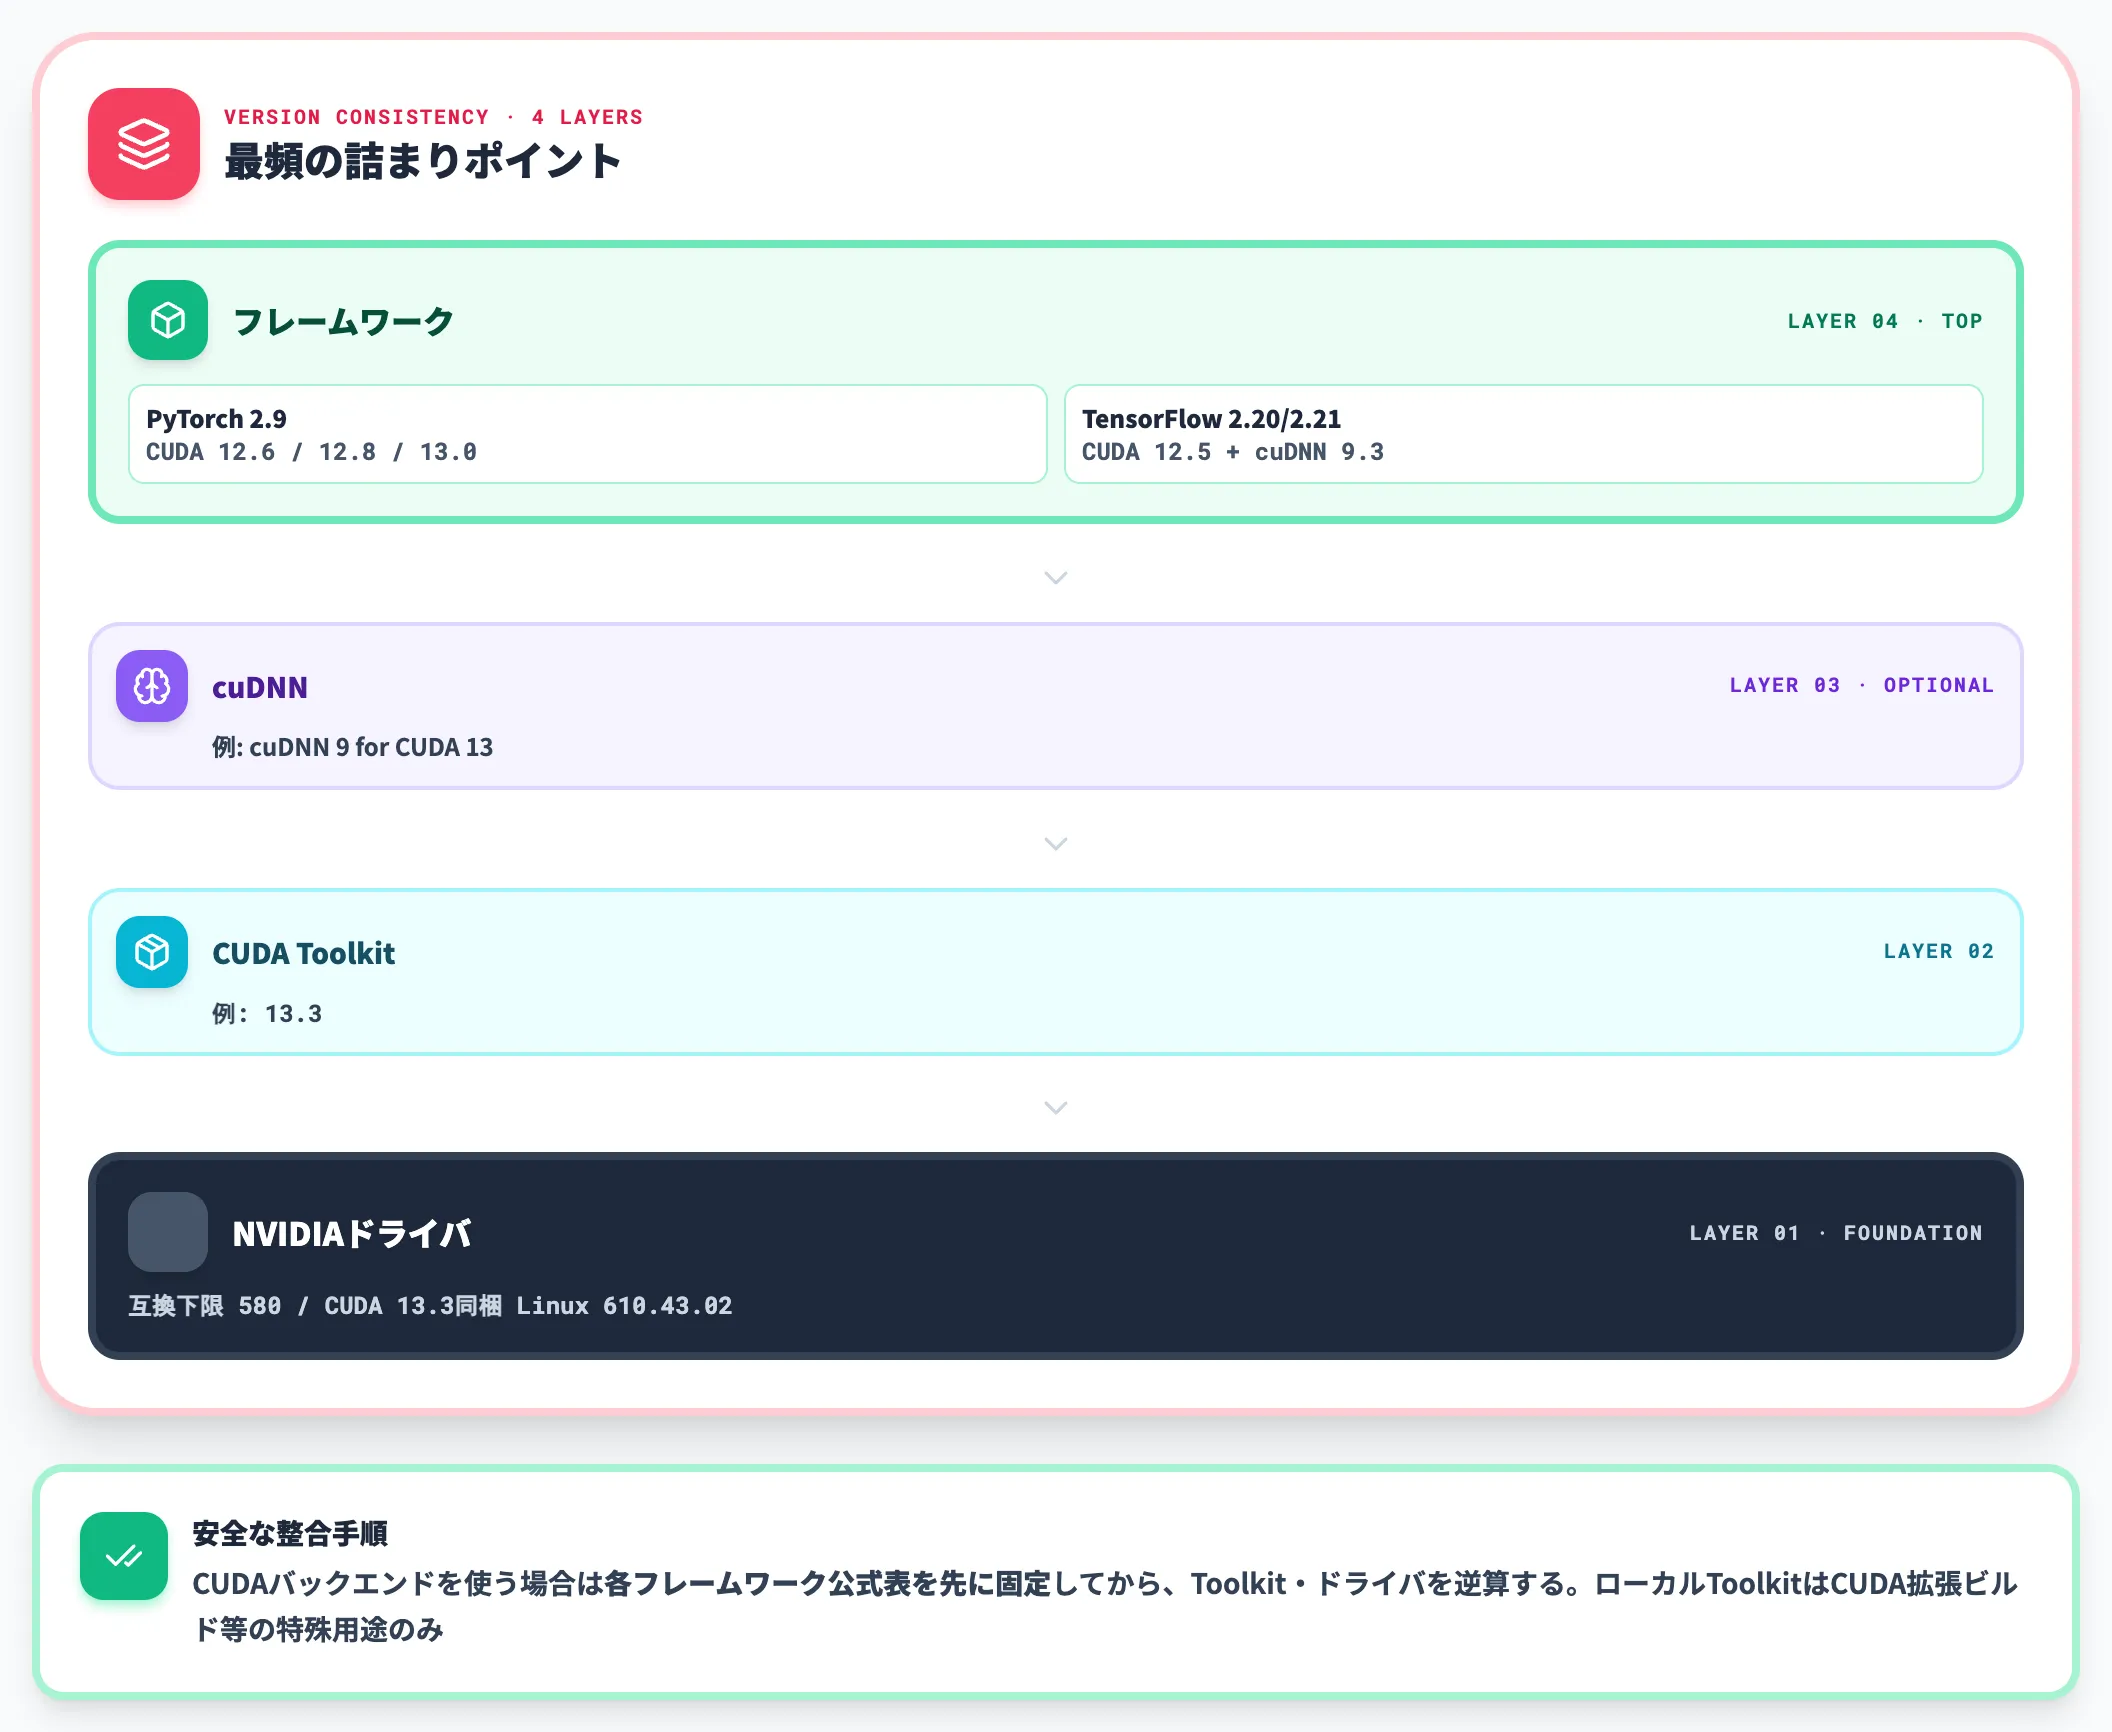
もっとも頻発するのが、以下4層のバージョン組み合わせのミスマッチです。
- NVIDIAドライバ(例: 互換下限580以降、CUDA 13.3同梱ドライバはLinux 610.43.02)
- CUDA Toolkit(例: 13.3)
- cuDNN(例: cuDNN 9 for CUDA 13)
- フレームワーク(例: PyTorch 2.9はCUDA 12.6/12.8/13.0から選択/TensorFlow 2.20/2.21はCUDA 12.5+cuDNN 9.3)
フレームワークによって配布方式・対応CUDA版数が異なるため、CUDAバックエンドを使う場合は各フレームワークの公式表を先に固定してから、Toolkit・ドライバを逆算するのが安全です(cuDNNは処理が依存する場合のみ追加)。ロ
ーカルToolkitを別途入れるのは、独自C++アプリのビルドやCUDA拡張のソースビルドなど、wheel/依存パッケージ範囲外の作業をする場合に限られます。
2. Windows Native vs WSL2 vs Native Linuxの選択
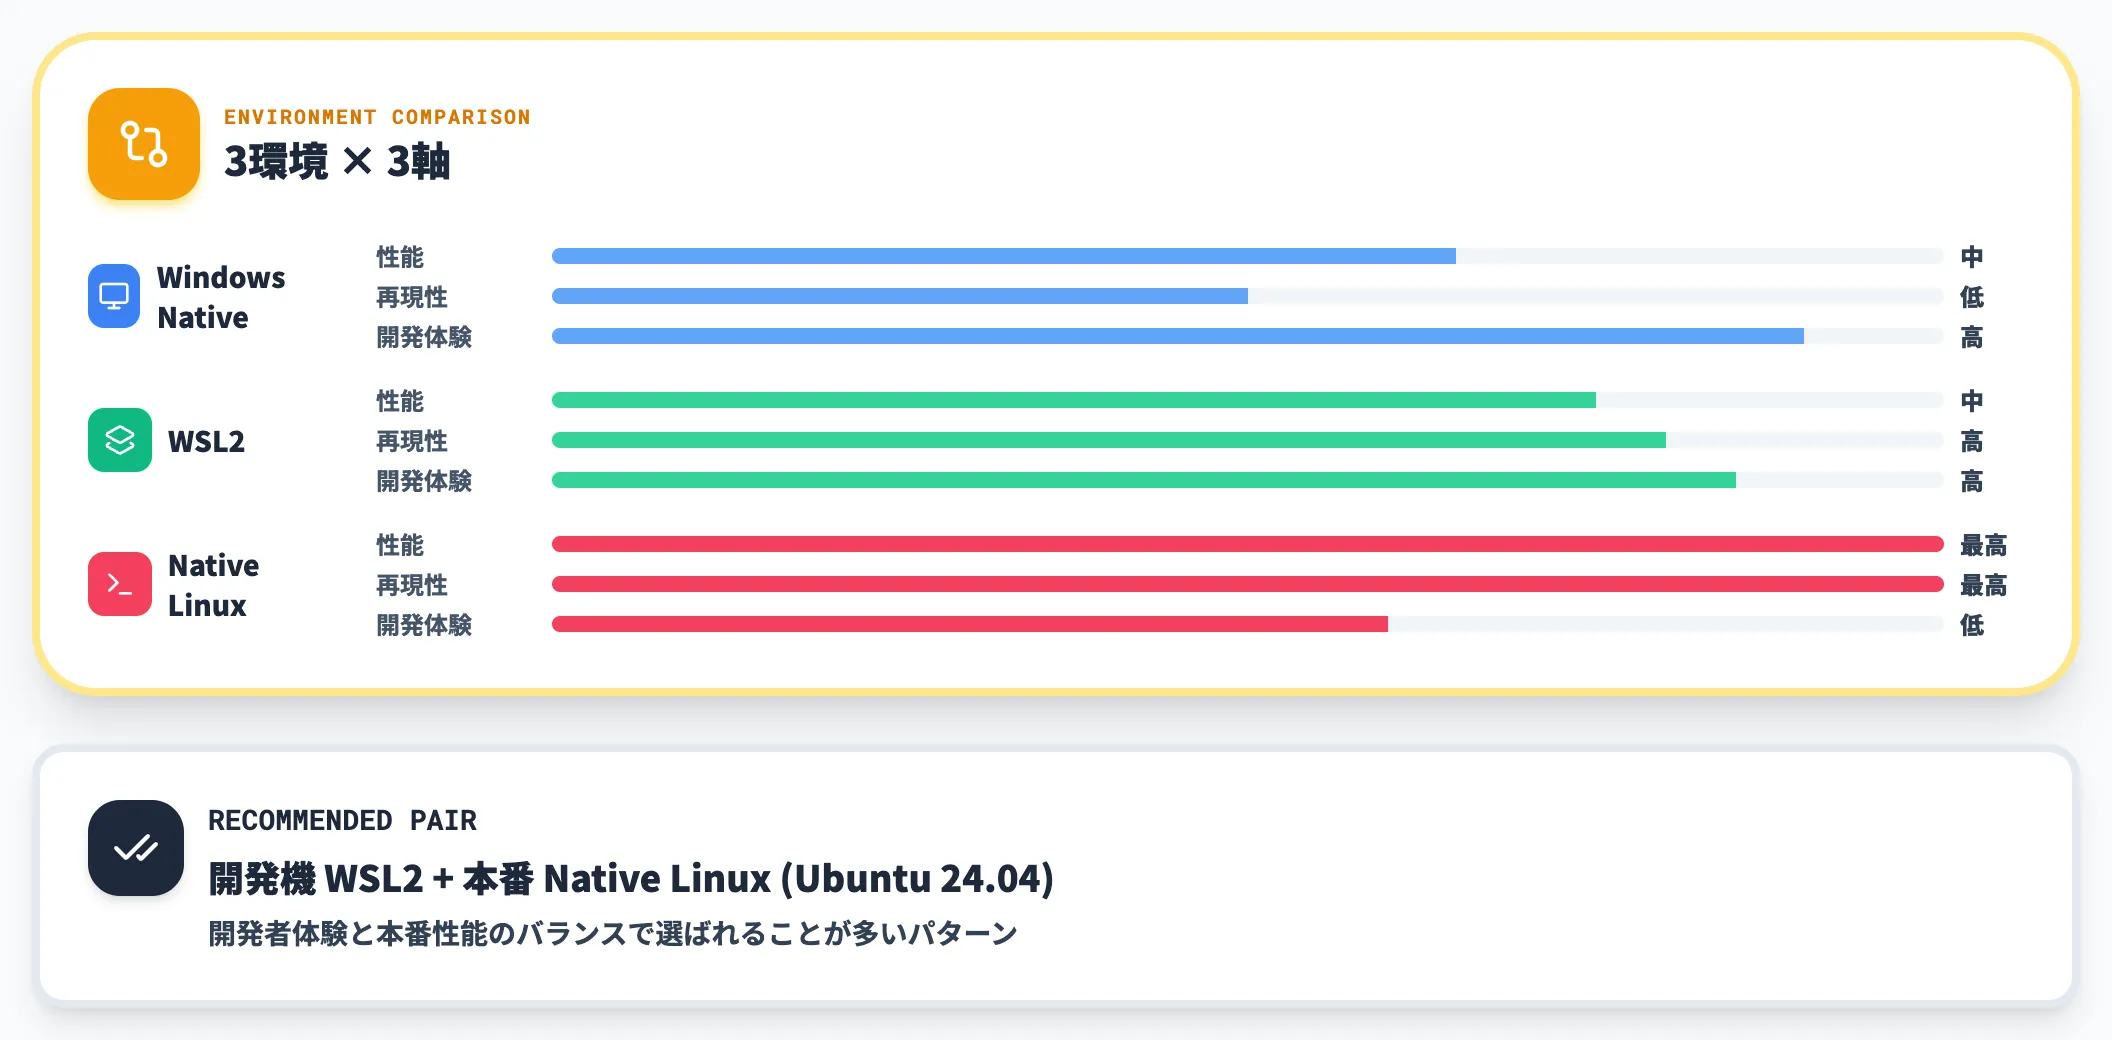
同じCUDAでも、動かす環境によって性能・安定性・再現性が異なります。
-
Windows Native
GUI IDEとの相性が良く、開発機として使いやすい。ただし本番Linuxとの環境差が大きい
-
WSL2
Windows上でLinuxの開発体験を得られる。Docker Desktopとも相性◎。ただしI/O・ネットワーク性能はNative Linuxに劣る
-
Native Linux(Ubuntu / RHEL)
本番と同じ環境で開発でき、性能も最良。ただしWindowsユーザーには学習コストがかかる
「開発機はWSL2、本番はNative Linux(Ubuntu 24.04)」という組み合わせが、開発者体験と本番性能のバランスで選ばれることが多いパターンです。
3. DockerとGPUドライバの分離運用
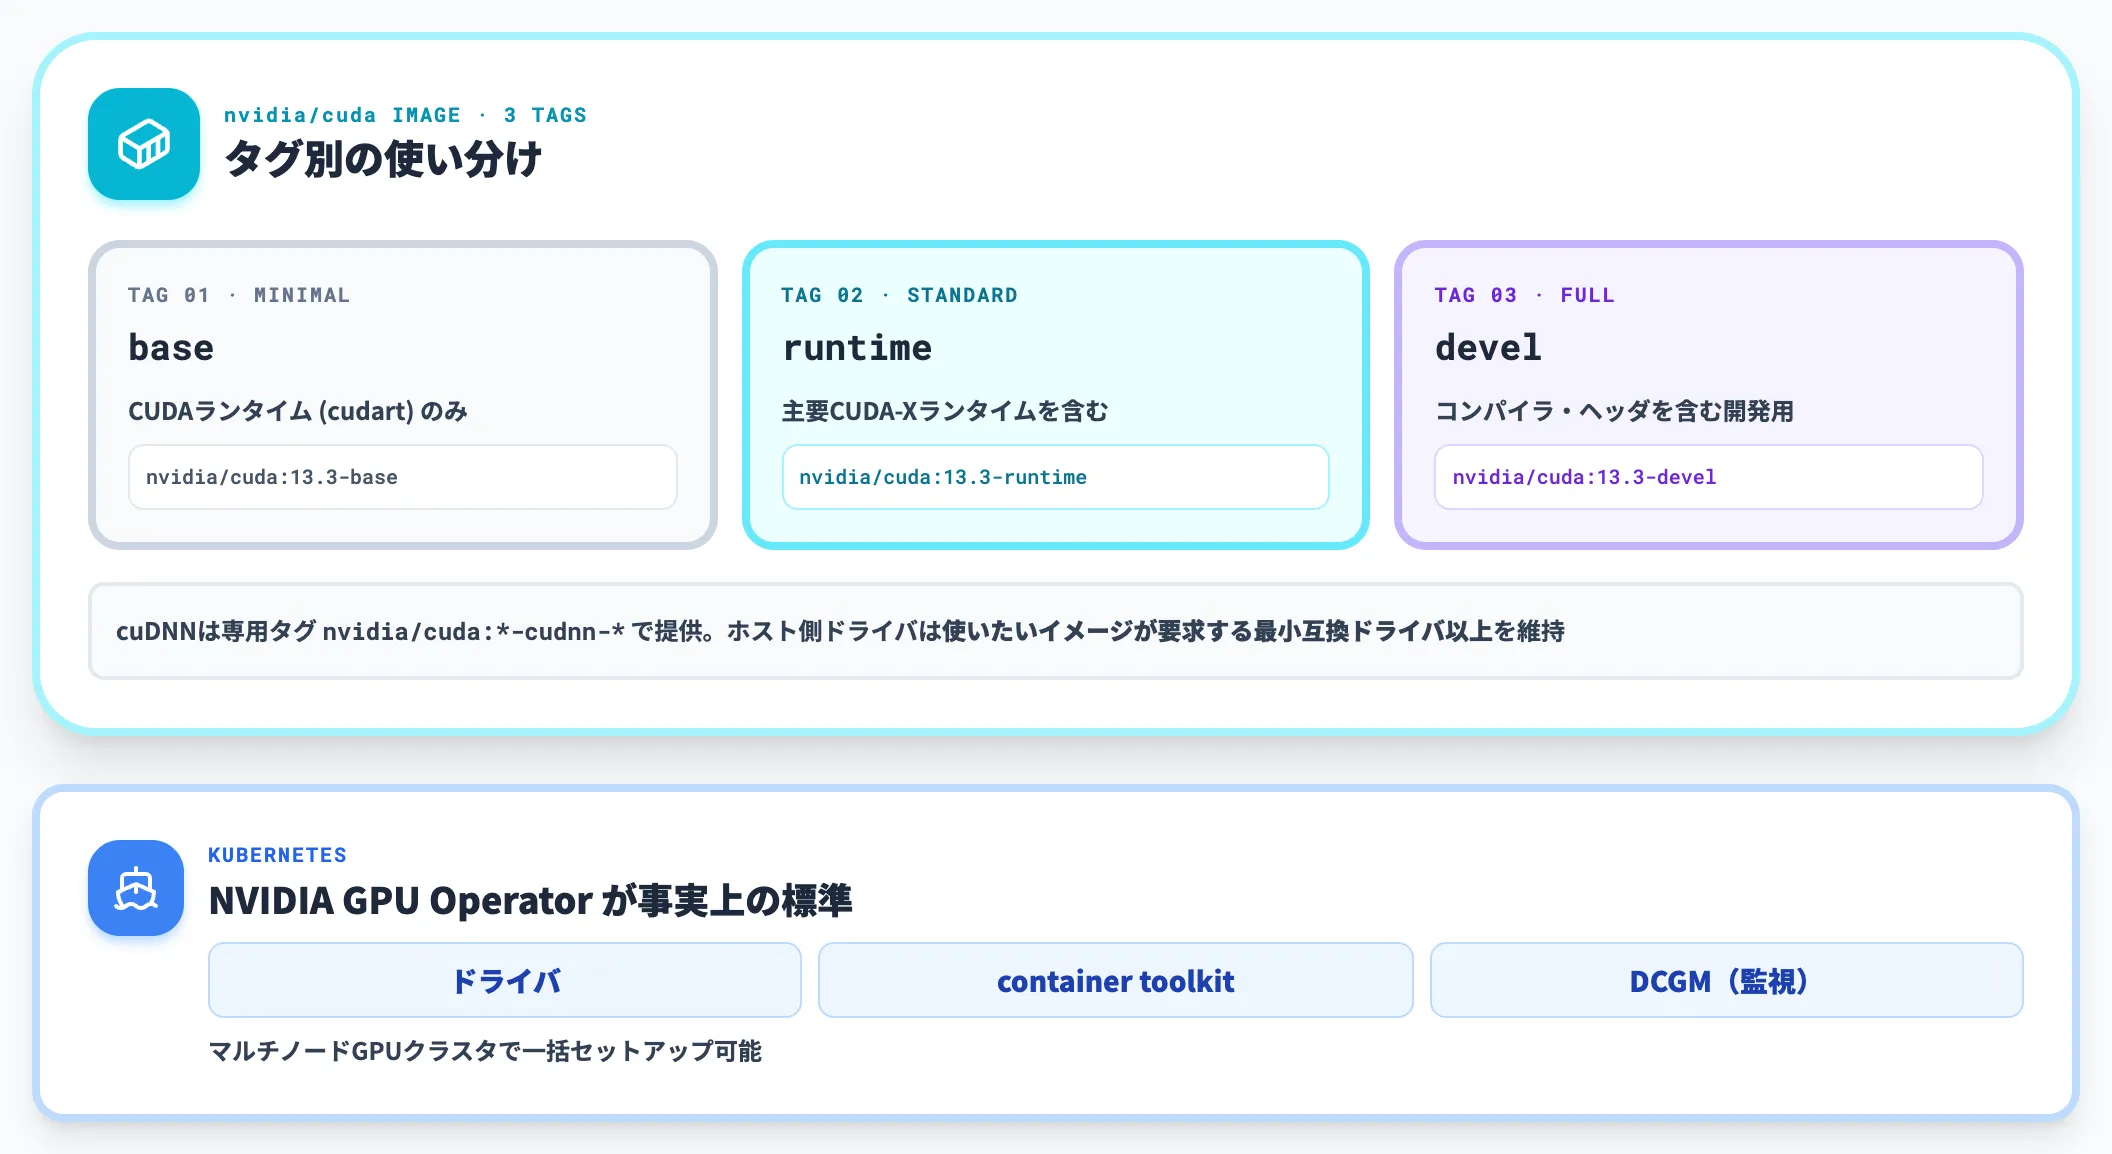
再現性を担保するために、CUDAアプリケーションをDocker化する運用が定番になっていますが、ここでも組み合わせが重要です。
NVIDIAが公式提供するnvidia/cudaイメージには3種類のタグがあり、baseはCUDAランタイム(cudart)のみ、runtimeは主要CUDA-Xランタイムを含み、develはコンパイラ・ヘッダを含む開発用です。cuDNNは専用タグ(nvidia/cuda:-cudnn-)で提供されます。ホスト側ドライバは常に「使いたいイメージが要求する最小互換ドライバ」以上を維持する必要があります。
Kubernetesで運用する場合は、NVIDIA GPU Operatorを使うと、ドライバ・container toolkit・DCGM(監視)まで一括セットアップできます。
マルチノードGPUクラスタを組む場合は、この経路が事実上の標準です。
4. GPU利用率とメモリ使用量の監視
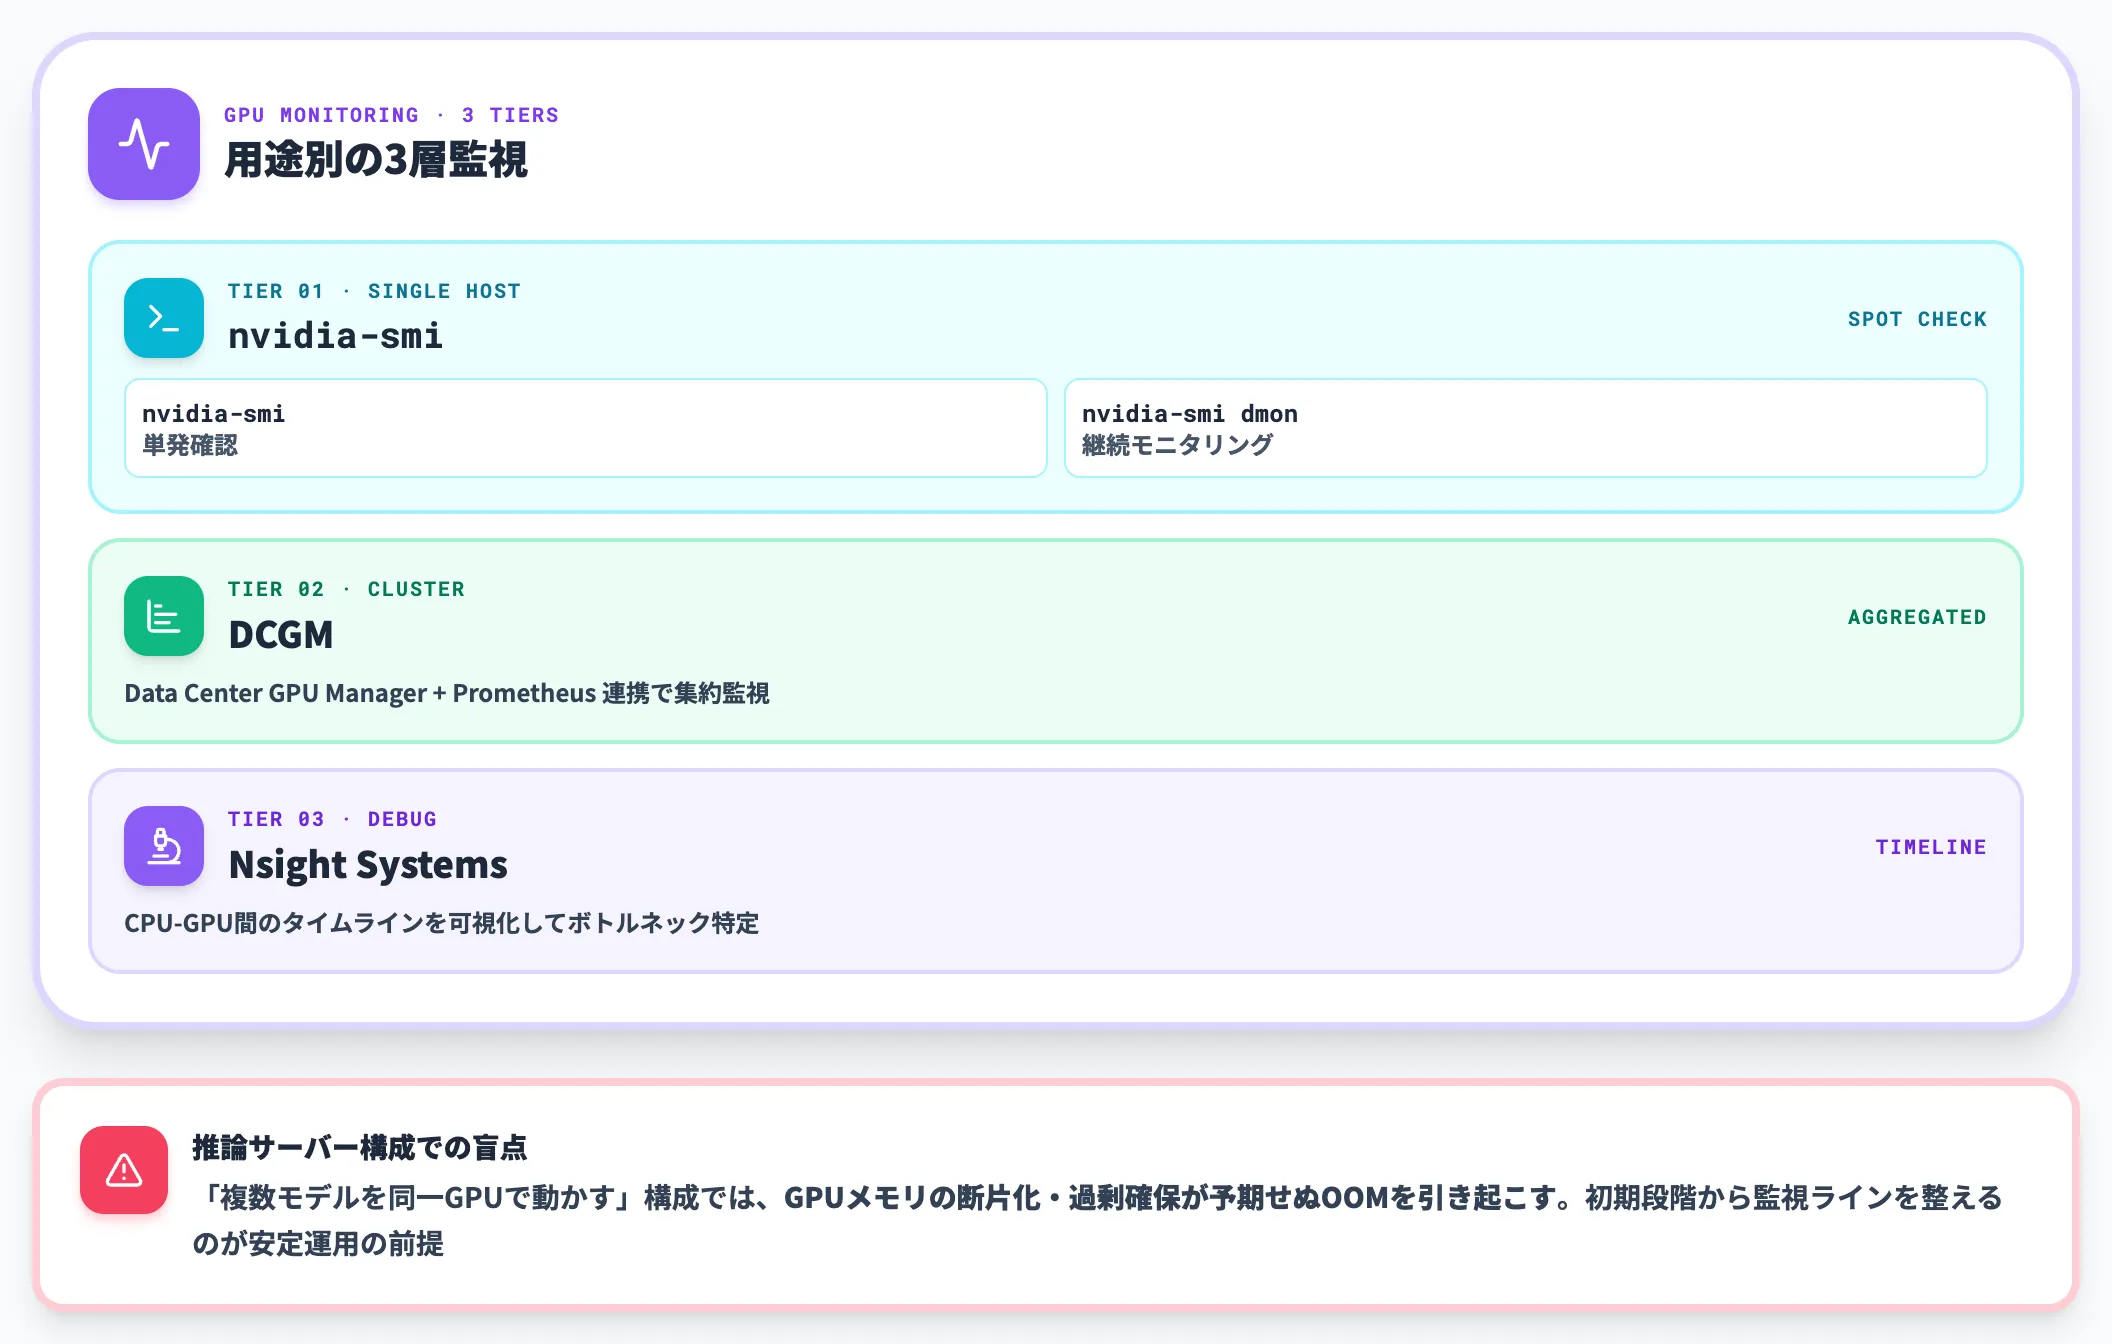
本番運用で見えなくなりがちなのが、GPU利用率とメモリ使用量です。
- nvidia-smi で単発の確認、nvidia-smi dmon で継続的なモニタリング
- DCGM(Data Center GPU Manager)でPrometheusと連携した集約監視
- Nsight SystemsでCPU-GPU間のタイムラインを確認し、ボトルネックを特定
特に「複数モデルを同一GPUで動かす」推論サーバー構成では、GPUメモリの断片化・過剰確保が予期せぬOOMを引き起こすため、初期段階から監視ラインを整えておくことが安定運用の前提になります。
5. Compute Capabilityの指定ミスによる性能低下
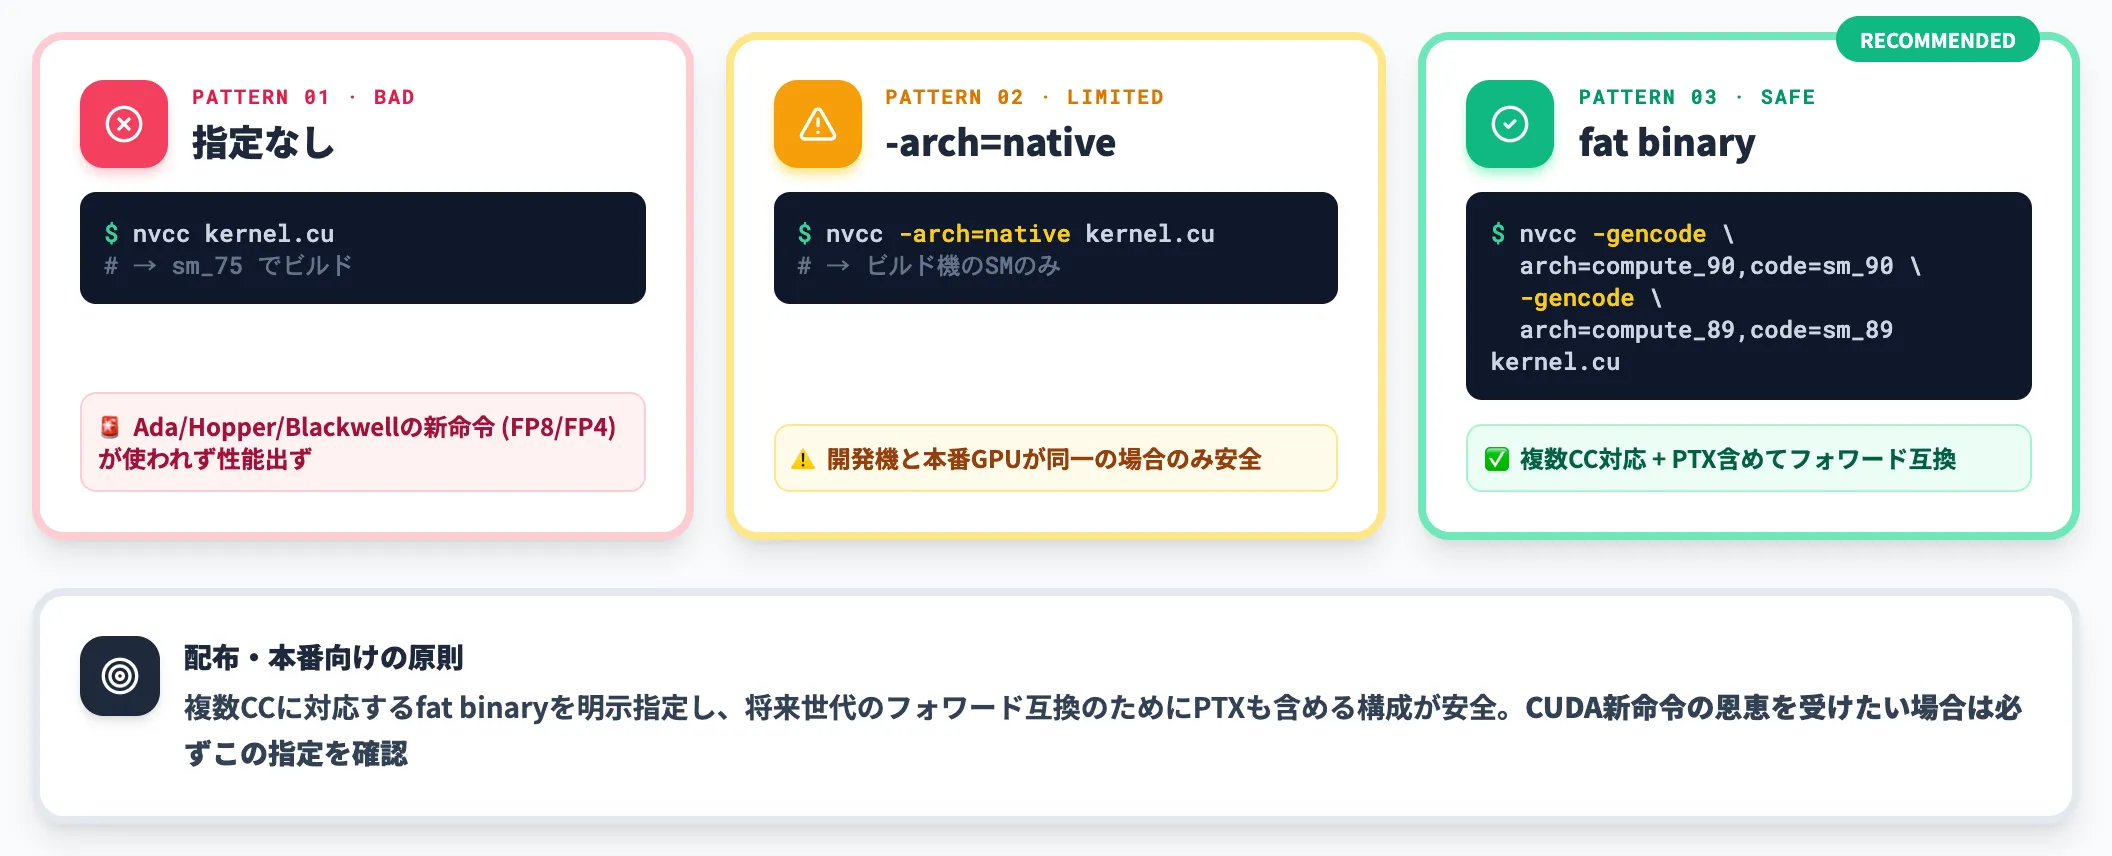
nvccの -arch=sm_XX の指定を忘れると、コンパイラはCUDA 13.3のデフォルトターゲット(sm_75)向けにビルドしてしまい、Ada/Hopper/Blackwellが持つ新命令(Tensor Core FP8/FP4等)が使われず性能が出ないケースがあります。
-arch=native はビルドを実行するGPUのSMだけをターゲットにしPTXを含めないため、開発機と本番GPUが同一の完結ビルドに限って便利です。配布・本番向けには実行GPUで動く保証がないので、複数CCに対応するfat binaryを明示指定し、将来世代のフォワード互換のためにPTXも含める構成が安全です。CUDA新命令の恩恵を受けたい場合は、この指定を必ず確認します。
GPUで動くAIを業務プロセスに載せるなら
CUDA上でモデルの推論・学習を回せる状態になっても、その先に「業務プロセスに組み込む」という別レイヤーの実装が控えています。
CUDAはあくまで計算基盤の層で、実際に業務価値を生むのは、モデルの結果を承認フローや基幹システム連携に接続し、権限管理・実行ログ・セキュリティ統制を整える「業務エージェント実行層」です。
このレイヤーを担うのが、自社Azureテナント内で動くエンタープライズAIエージェント基盤です。AI総合研究所のAI Agent Hubは、Teamsから呼び出せる業務特化Agent群を1つのダッシュボードで統合管理し、GPUで動くモデルを業務プロセスに載せる運用基盤として機能します。
-
モデル層と業務層を分離した設計
GPUクラスタで動くAIモデル(社内学習・クラウド学習・API呼び出しのいずれも)を、業務エージェント側から差し替え可能な形で呼び出せます。モデルの世代交代でワークフロー全体を作り直す必要がありません。
-
Teamsから呼び出す業務特化Agent群
経費精算Agent・請求書受領Agent・設計製図Agentなど業務特化Agentを、社員が普段使うTeamsから直接呼び出せます。GPUで動くモデルの結果を「承認→ERP登録→通知」まで一気通貫で実行します。
-
データは100%自社Azureテナント内に保持
社内のコード・図面・請求書・顧客情報はAIの学習対象から完全除外。Azure Managed Applicationsとして自社テナント内で動作が完了する設計です。
AI総合研究所の専任チームが、Microsoft MVP / Solution Partner認定の実績をもとに、GPU基盤の選定から業務エージェント実装までを一貫して支援します。AI Agent Hubのサービスページで、GPUで動くAIを業務プロセスに載せる全体像をご確認ください。
GPUで動くAIを業務プロセスに載せるなら
モデル実装から業務エージェント運用まで
CUDA上でモデルが動いても、実際の業務プロセスに組み込むには基幹システム連携・権限管理・実行ログを扱う実装層が別途必要です。AI Agent Hubのサービスページで、AIをTeamsから呼び出せる業務エージェント基盤として運用する全体像をご確認ください。
まとめ
本記事では、NVIDIA CUDAについて、プログラミングモデル・CUDA Toolkit・CUDA 13の変化・インストール手順・料金・活用領域・詰まる論点までを、2026年7月時点の最新情報で解説しました。
2026年時点で押さえておくべきポイントは次の3つです。
- CUDA 13でMaxwell/Pascal/Volta世代のサポートが打ち切られ、Turing〜Blackwellが対象。旧世代GPUを延命したい場合はCUDA 12.x系との併用が必要
- Tile Programming+cuTile Python DSL・cuda-oxide(Rust対応)が新展開。ただし本番運用の中心は引き続き公式ライブラリ(cuDNN/cuBLAS/CUTLASS/TensorRT)+PyTorch/JAX/TensorFlow経由
- 直接CUDAカーネルを書くのは超低レイテンシ推論・特殊メモリ最適化・ハードウェア新機能の即活用など限定シナリオ。実務判断は「書かなくて済む道を探す」を起点にする
CUDAは20年近くソフトウェア資産の互換性を維持しながら、Blackwell・次のRubinへとハードウェアと歩調を合わせて進化を続けています。「使うかどうか」ではなく「どのレイヤーで触るか」を最初に決めることが、CUDAへの実務投資でもっとも効くポイントになります。