この記事のポイント
 文章生成を捨てて選択肢ごとの確信度だけを返す設計で、ルーティング・分類・優先度付けをGPT-6.1 Sol比79分の1コストで回せる専用モデル
- Microsoft社内のCopilotとCoworkで稼働中、Epic・Equinor・Atos・Raiffeisen Bankを含む4,000を超える顧客が利用
- 2026年10月のMicrosoft-Decision-1(Qwen3.5-9Bベース)から1か月でGemma 4 26B A4Bに基盤を乗せ替えマルチモーダル化・2倍速化した1.1がGA
- 入力$0.042/100万トークン・出力無料でJev 1.14と同額、Gemini Decision 1やGPT-6 Lunaの半額以下という価格設計
- Decision Index v2.1では68点で主要競合を上回るが、首位のLiquid d1.2-ultra(74.8)には劣るため絶対最強ではなく価格性能比で選ぶモデル
Microsoft MVP・AIパートナー。LinkX Japan株式会社 代表取締役。東京工業大学大学院にて自然言語処理・金融工学を研究。NHK放送技術研究所でAI・ブロックチェーンの研究開発に従事し、国際学会・ジャーナルでの発表多数。経営情報学会 優秀賞受賞。シンガポールでWeb3企業を創業後、現在は企業向けAI導入・DX推進を支援。
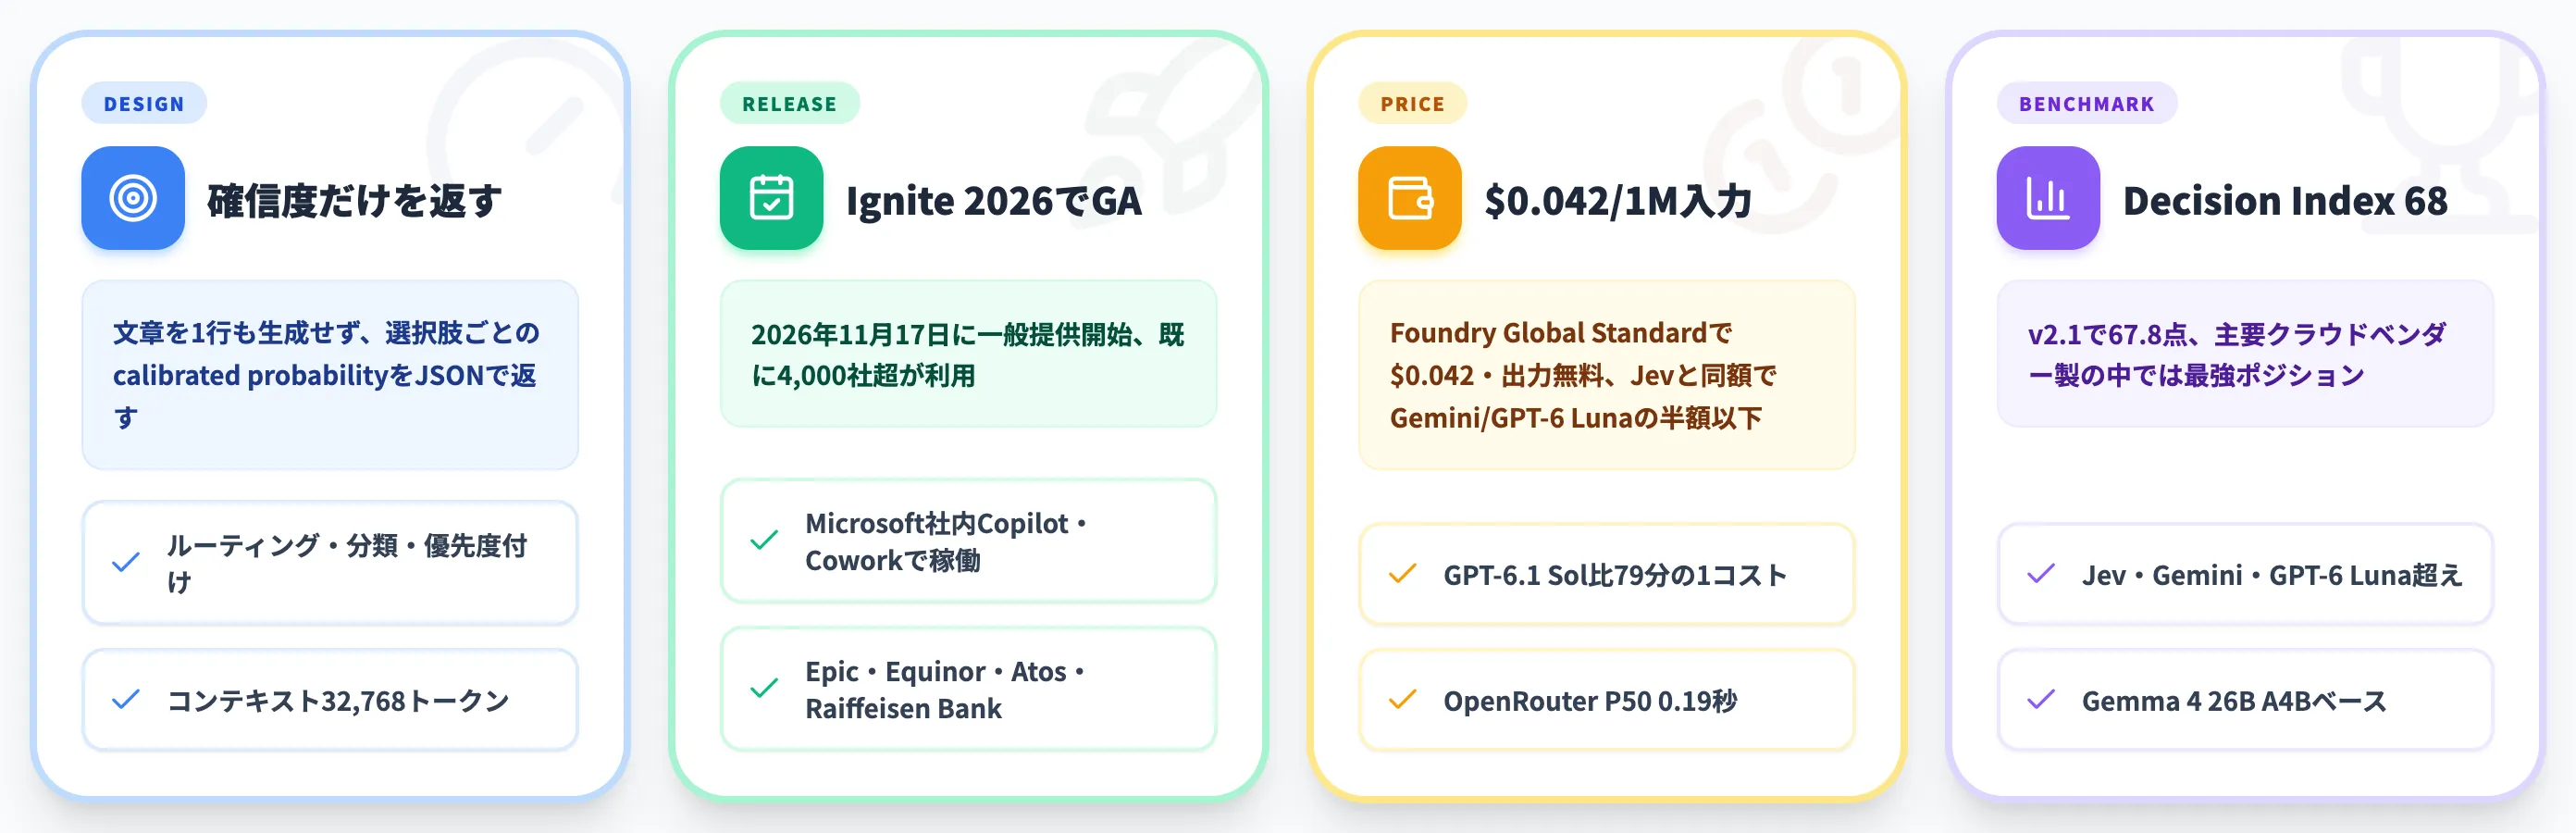
MAI Decision 1とは、Microsoftが2026年11月17日のIgnite 2026基調講演で一般提供(GA)を開始した、文章を生成せず選択肢ごとの確信度だけを返す意思決定専用モデルです。
最新版のMicrosoft-Decision-1.1はGemma 4 26B A4Bをベースに再構築され、画像入力を含むマルチモーダル対応・OpenRouter実測でP50 0.19秒の低レイテンシ・Foundry Global Standardで$0.042/1Mトークンからの入力料金で、Artificial Analysis Decision Index v2.1でJev 1.14・Gemini Decision 1・GPT-6 Lunaを上回る67.8点(Microsoft公表値「68」)を記録しています。
本記事では、2026年11月時点の最新情報として、MAI Decision 1の仕組みと性能・料金・活用シーン・Jevをはじめとする他Decision modelとの違い・Foundry/OpenRouter/Vercelでの使い方・導入で詰まる論点までを体系的に解説します。
目次
MAI Decision 1とは?文章を生成せず選択肢の確信度だけを返す意思決定専用モデル
MAI Decision 1の仕組みと性能——calibrated probabilityで判定する設計
MAI Decision 1の料金——Global Standardで$0.042/1Mから始まるデータゾーン別料金
MAI Decision 1の活用シーンとMicrosoft社内事例
MAI Decision 1と他社のDecision modelの違い——4モデル比較
MAI Decision 1とは?文章を生成せず選択肢の確信度だけを返す意思決定専用モデル
MAI Decision 1とは、Microsoftが2026年11月17日のIgnite 2026で公開した、文章を1行も生成せず、与えられた選択肢ごとの確信度(calibrated probability)だけを返す意思決定専用モデルです。
より広いMicrosoft MAIファミリーや同時発表の新7モデルの中では、意思決定特化の系列に位置づけられます。
汎用の大規模言語モデル(LLM)が「質問に文章で答える」ことを前提に設計されているのに対し、MAI Decision 1は「ルーティング・分類・優先度付け・検証・ワークフロー制御」といった、アプリケーションが直接消費できる判定だけを高速・低コストで返すことに全振りした設計になっています。
Microsoft-Decision-1.1公式発表ページのキービジュアル(出典:Microsoft Command Line)
1.0から1.1への進化点
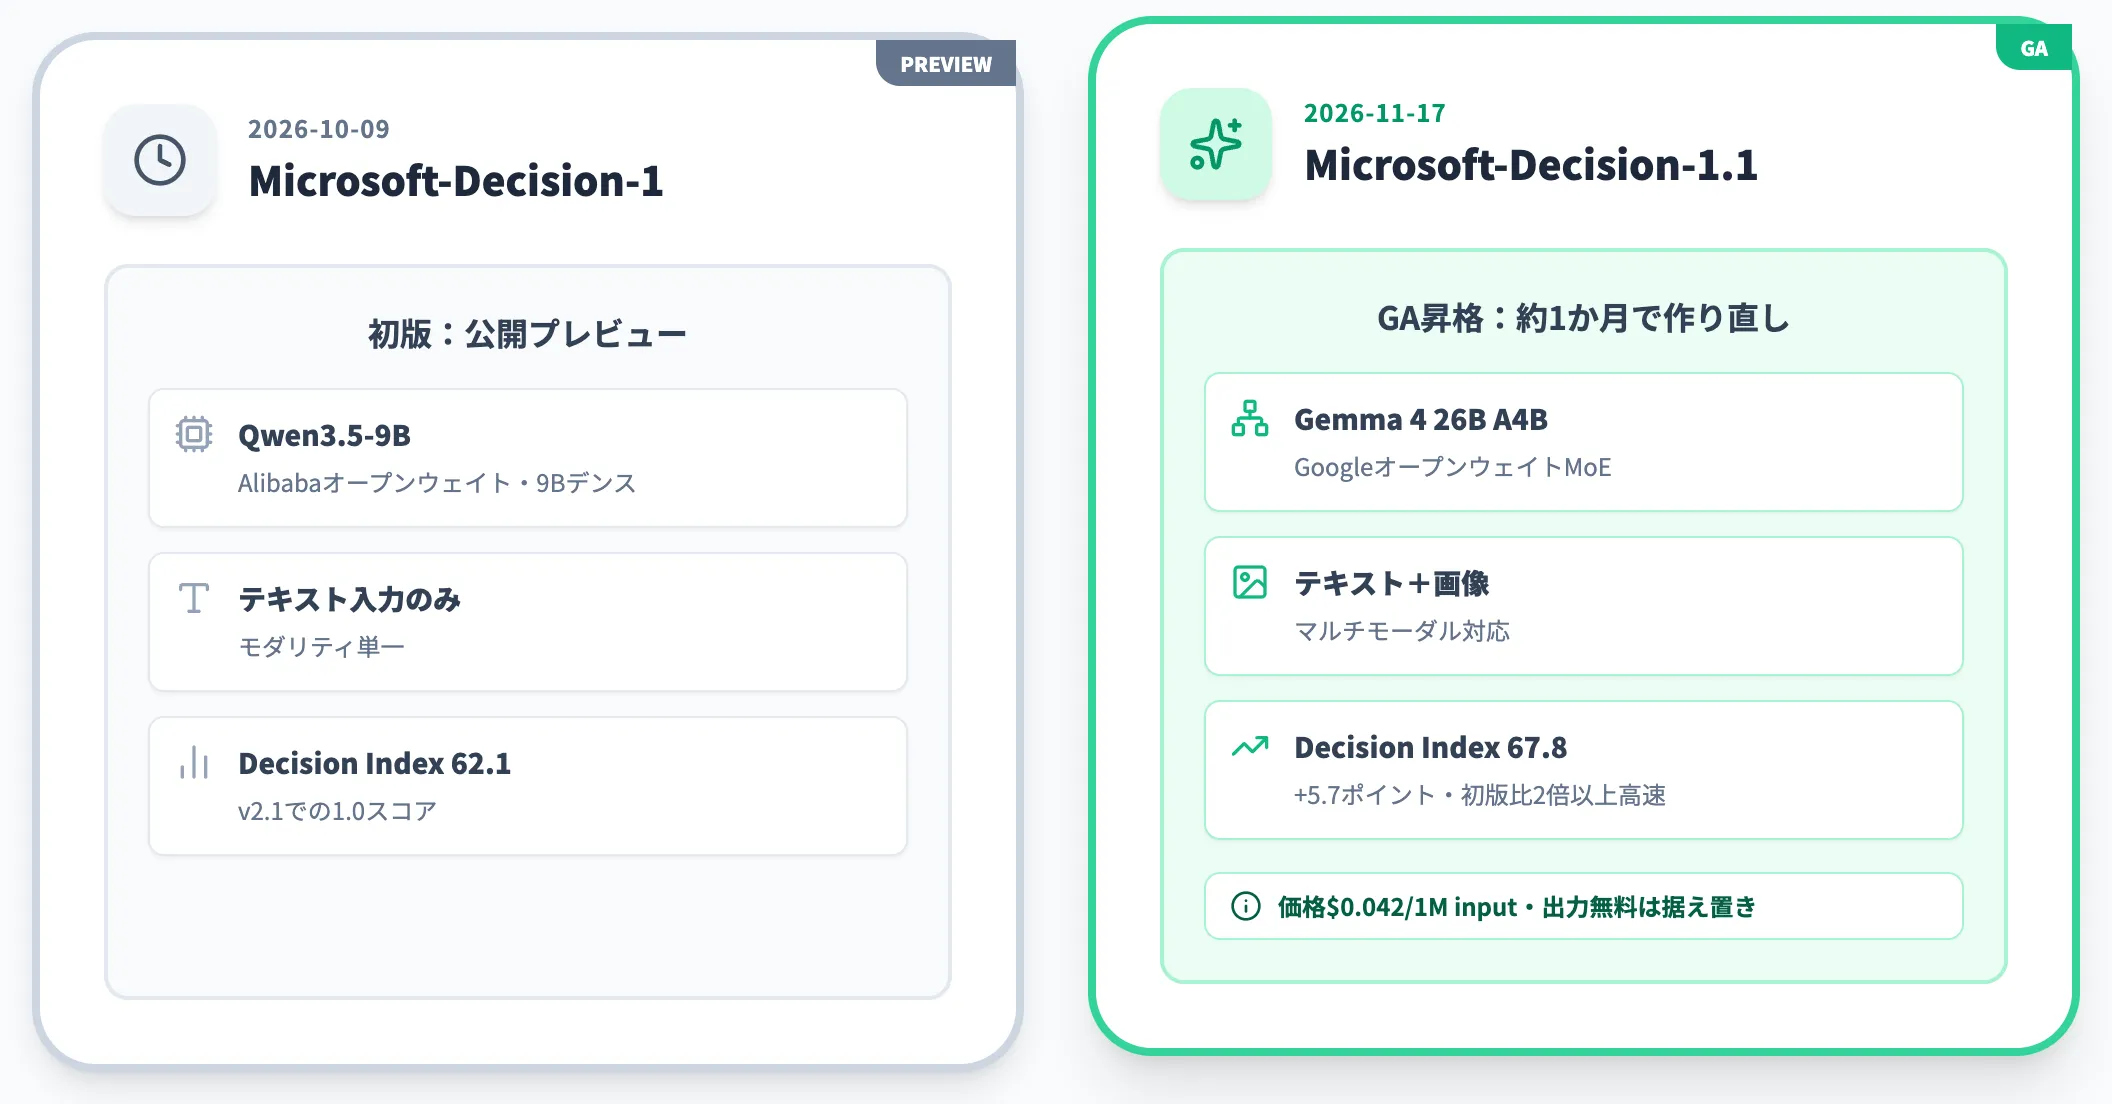
初版のMicrosoft-Decision-1はAlibabaのオープンウェイトQwen3.5-9Bを判断専用にポストトレーニングした9Bモデルでしたが、Ignite 2026で発表された1.1はベースモデル自体をGoogleのオープンウェイトGemma 4(26B A4B・Mixture-of-Experts)に差し替えた実質的な作り直し版です。
以下の表で、1.0と1.1の変化点を整理しました。
| 項目 | Microsoft-Decision-1(2026-10-09) | Microsoft-Decision-1.1(2026-11-17) |
|---|---|---|
| 提供ステータス | 公開プレビュー | 一般提供(GA) |
| ベースモデル | Qwen3.5-9B(9Bデンス) | Gemma 4 26B A4B(Mixture-of-Experts) |
| モダリティ | テキスト入力のみ | テキスト+画像入力 |
| 速度の公式訴求 | 中央値85ミリ秒(初版公表値) | 初版比2倍以上高速(Microsoft公式) |
| Decision Index v2.1 | 62.1点 | 67.8点(+5.7ポイント) |
| 提供先 | Foundry / OpenRouter | Foundry / OpenRouter / Vercel |
| Foundry Global Standard価格 | $0.042/1M input・出力無料 | $0.042/1M input・出力無料(据え置き) |
価格は据え置いたまま性能と提供チャネルだけ引き上げたのが1.1の設計思想で、既に1.0を利用していた4,000を超える顧客はコード変更ほぼなしで性能向上を受け取れる構造になっています。
MAI Decision 1の仕組みと性能——calibrated probabilityで判定する設計
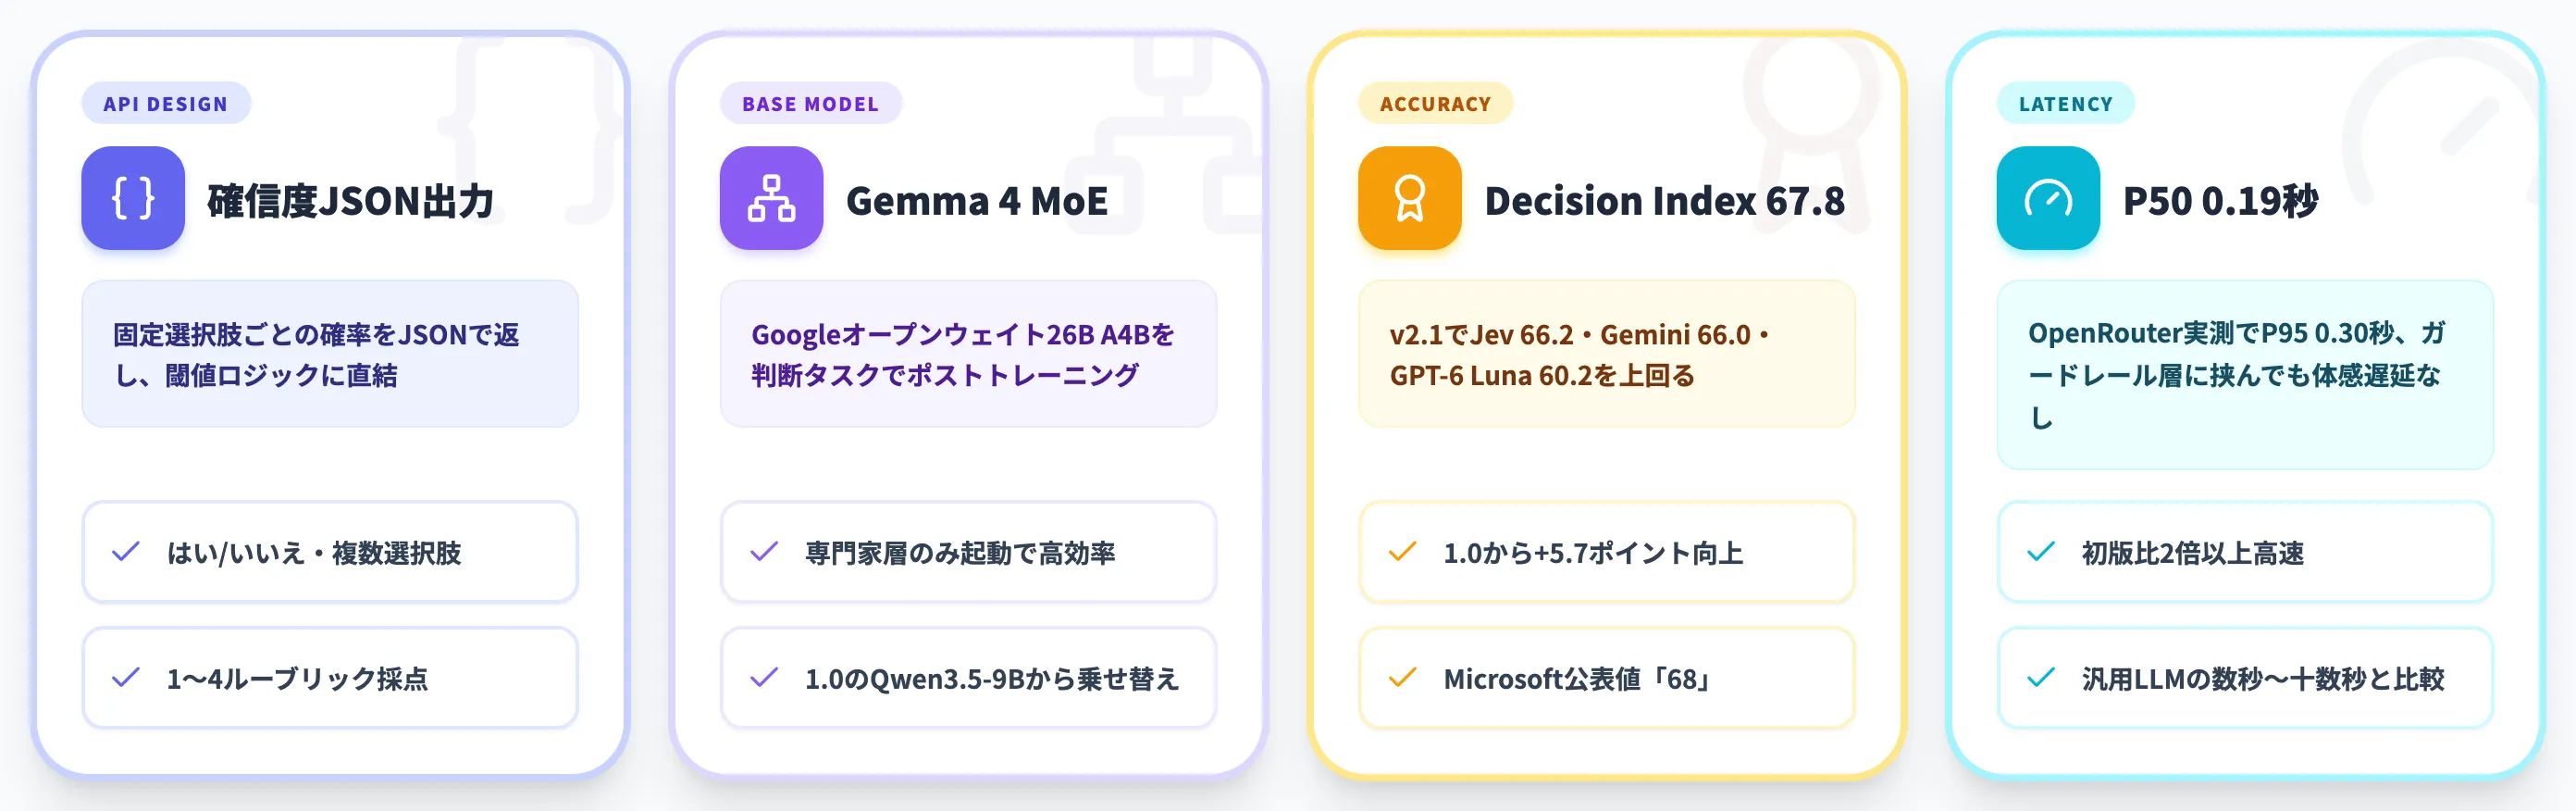
MAI Decision 1の最大の特徴は、同じ入力に対して「生成されたテキスト」ではなく「各選択肢に対する確信度の数値」を返すという出力形式そのものにあります。
この設計がルーティング・分類といった判定業務の信頼性と速度を同時に引き上げている核になっています。
確信度を返すAPI設計
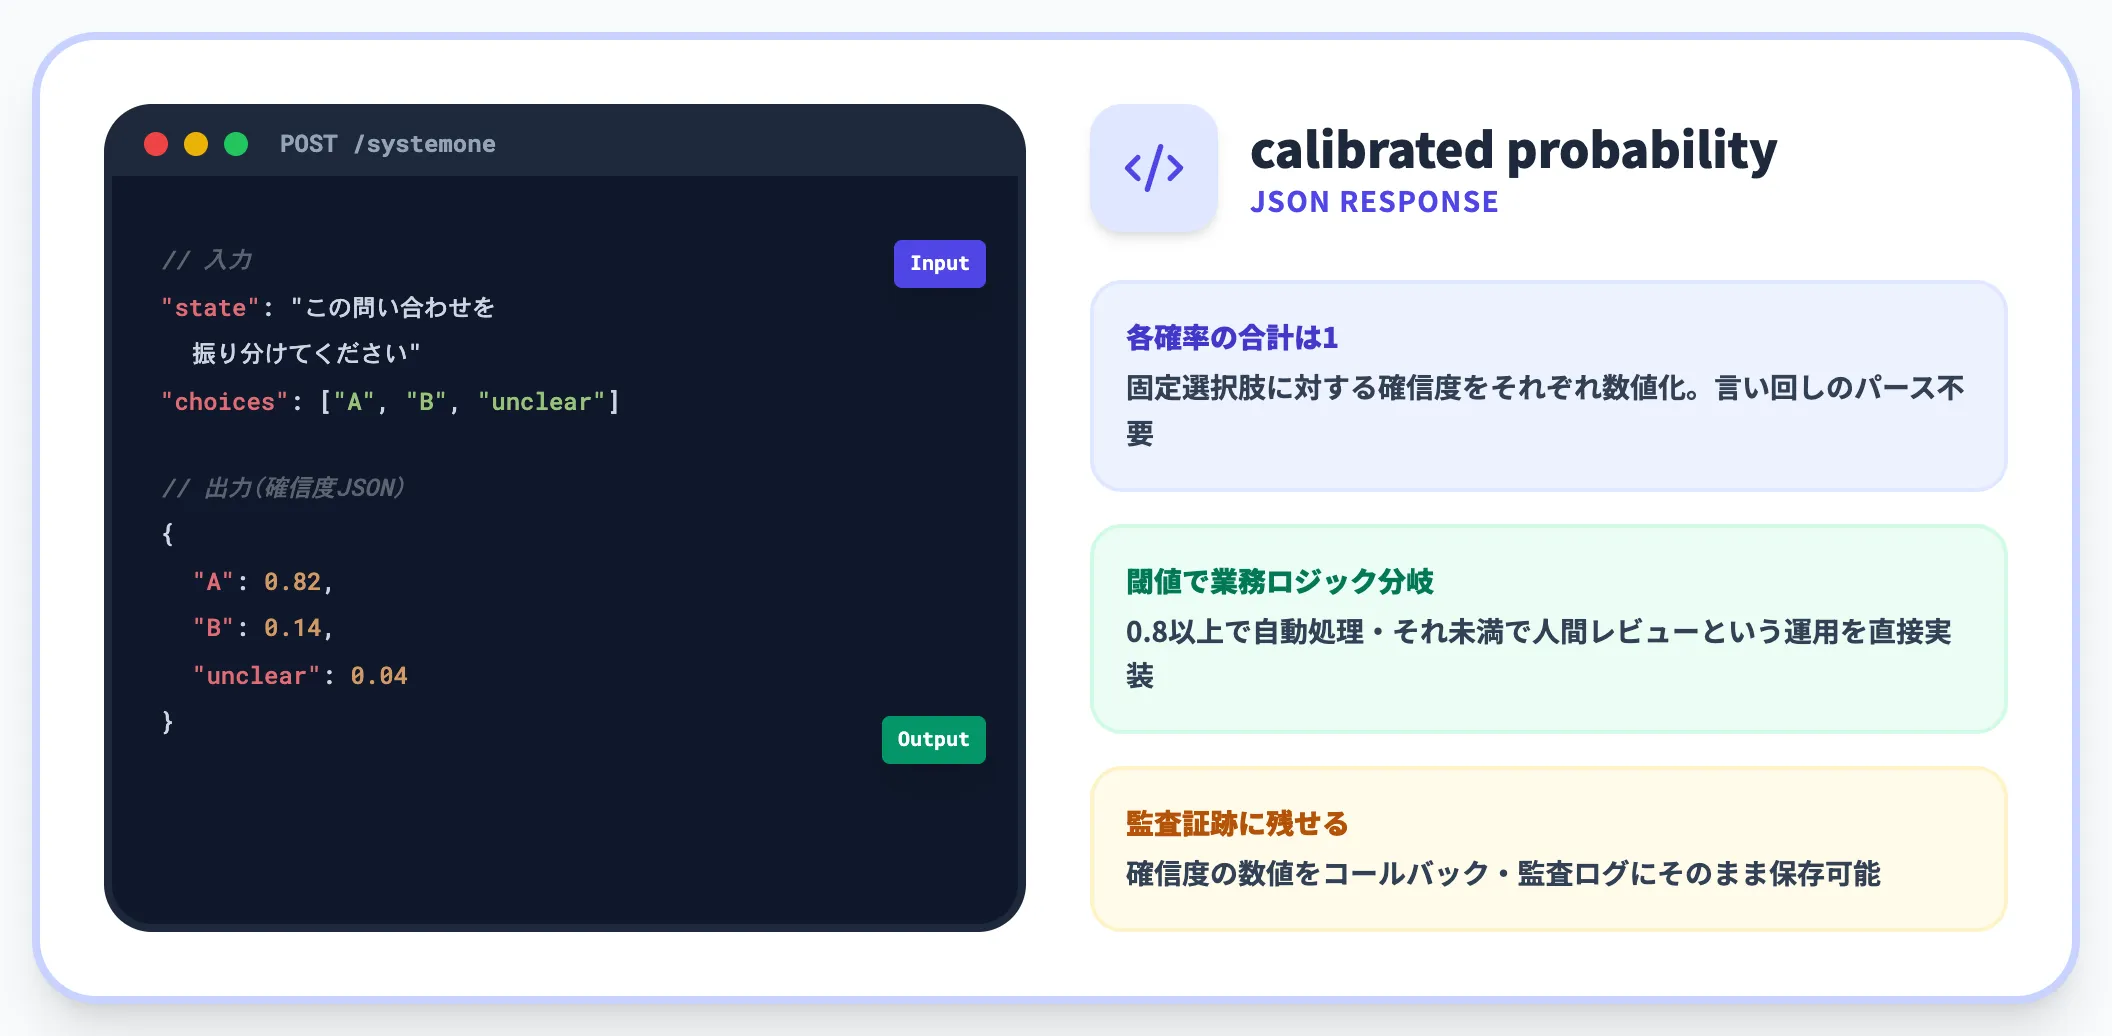
MAI Decision 1はテキスト最大32,768トークンと「はい/いいえ」「複数選択肢」「1〜4のルーブリック採点」といった固定された回答選択肢をセットで受け取り、各選択肢に対する確信度をJSON形式で返します。
たとえば「この問い合わせはサポートAとサポートBのどちらに振り分けるべきか」という質問に対して、通常のLLMが「サポートAに振り分けるべきです。理由は〜」と文章で返すのに対し、MAI Decision 1は次のような構造化された確率だけを返します。
この確率がそのまま運用ロジックの入力になるという設計が重要です。LLMの生成文を正規表現でパースして分岐させる従来のアプローチと違い、言い回しの揺れや並べ替えで判定結果が壊れる心配がなく、コールバックや監査証跡にそのまま確信度の数値を残せます。
ベースモデルはGemma 4 26B A4B
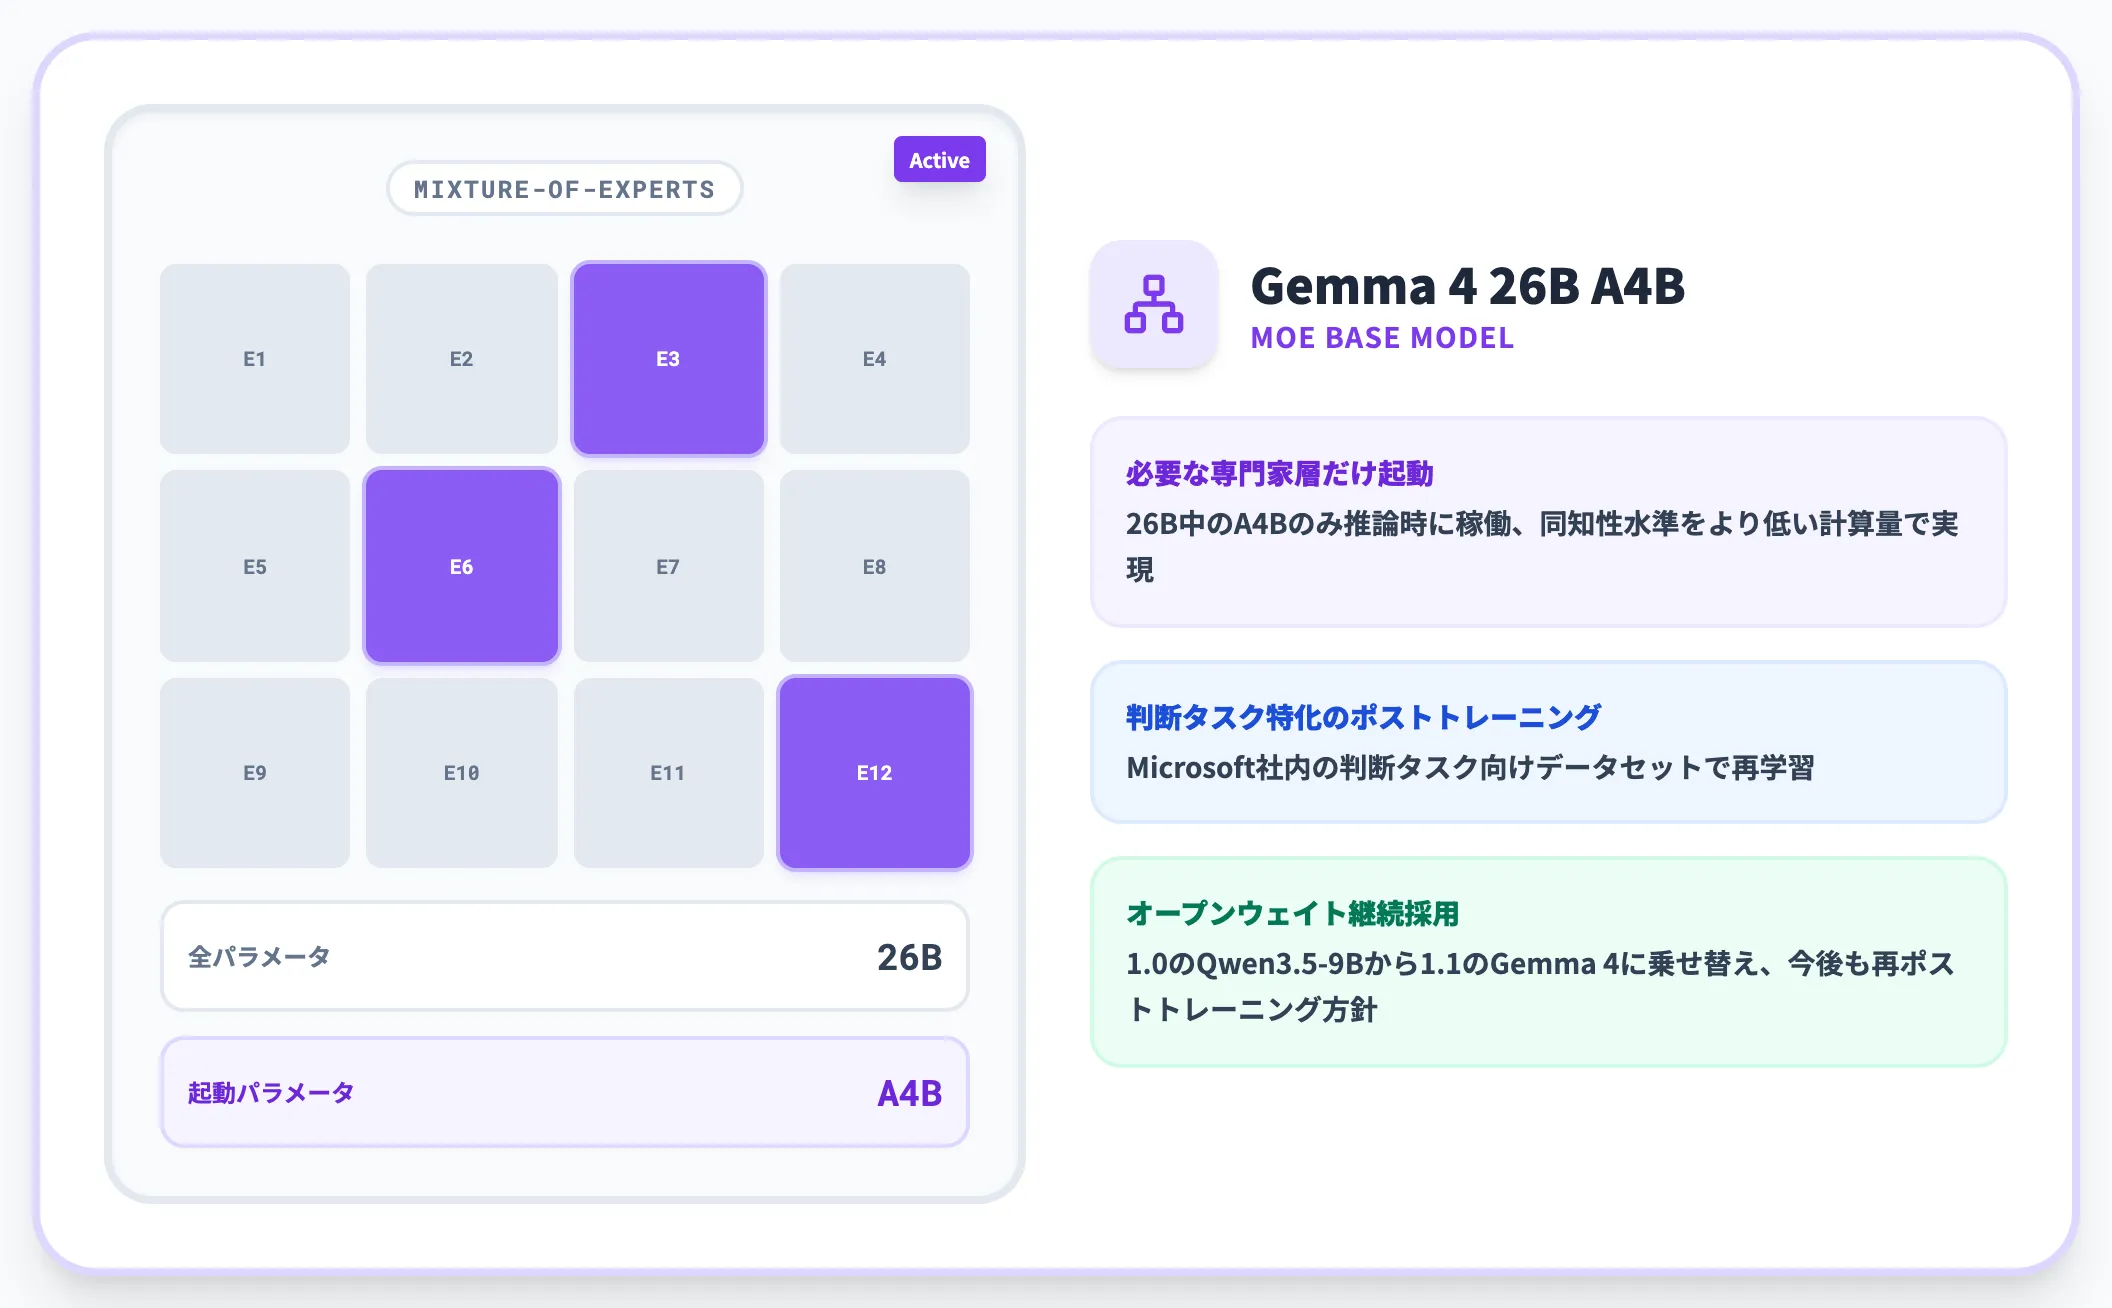
1.1はGemma 4ファミリーのMixture-of-Experts(MoE)版である26B A4Bをベースに、Microsoft社内の判断タスク向けデータセットでポストトレーニングされています。
Microsoft AI公式ブログは「決定に必要な知性を持ちつつ、ハードウェア効率を保つのに十分小さなMoE」としてGemma 4 26B A4Bを選定したと説明しています。
-
MoE構造の利点
一度の推論で全パラメータを使うデンスモデル(1.0のQwen3.5-9B)と違い、入力ごとに必要な専門家層だけを起動することで、同じ知性水準をより低い実計算量で得られる
-
オープンウェイトベースの継続性
Qwenから Gemmaへの乗せ替えで分かるとおり、Microsoftは今後もMAI独自モデルや他のオープンウェイトへの再ポストトレーニングを継続する方針。アプリケーション側は特定ベースモデルに依存しない前提で運用設計する必要がある
Decision Index v2.1で68点
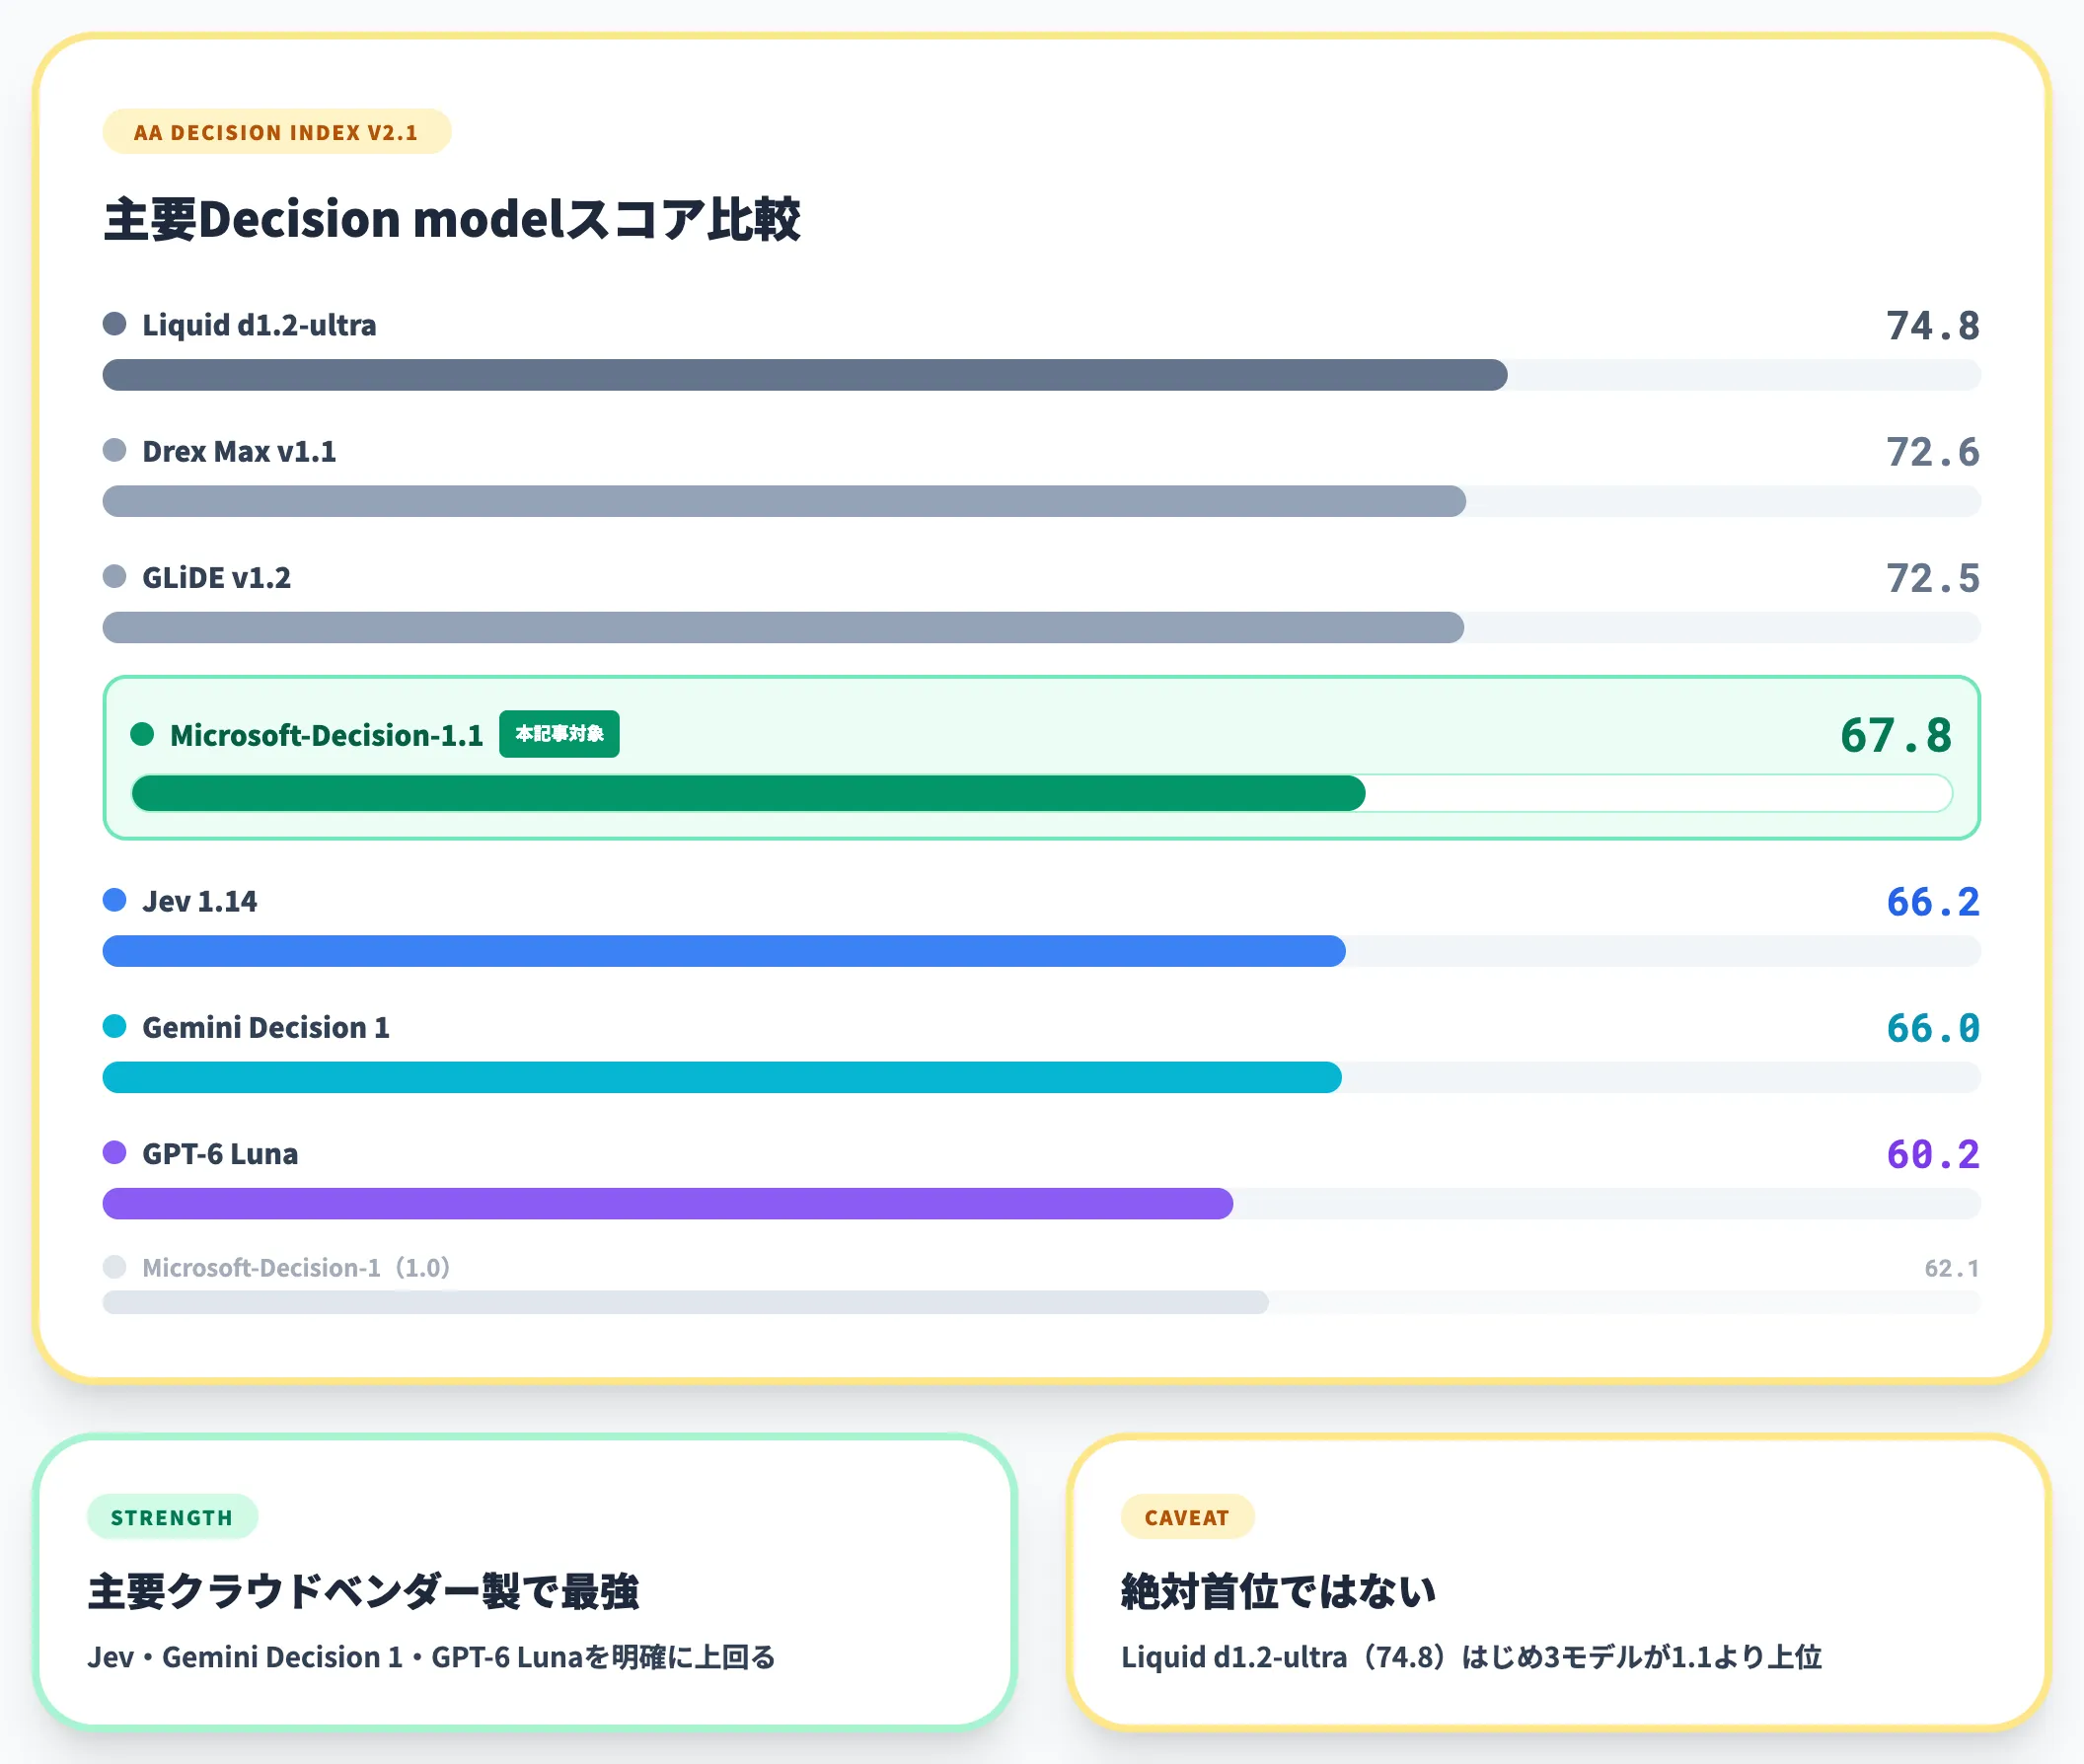
第三者ベンチマークArtificial Analysis Decision Index v2.1における1.1のスコアは67.8点(Microsoft公表値「68」はこの丸め)で、競合他社の代表的なDecision modelを上回っています。
以下の表で、2026年11月時点の主要Decision modelのDecision Index v2.1スコアを整理しました。
| モデル | Decision Index v2.1 | ベースモデル・提供元 |
|---|---|---|
| Liquid d1.2-ultra | 74.8 | Liquid AI独自 |
| Drex Max v1.1 | 72.6 | Nace AI独自 |
| GLiDE v1.2 | 72.5 | Fastino Labs独自 |
| Microsoft-Decision-1.1 | 67.8(公表値「68」) | Gemma 4 26B A4B派生 |
| Jev 1.14 | 66.2 | TypeSafe AI独自 |
| Gemini Decision 1 | 66.0 | Google Gemini系 |
| GPT-6 Luna(Decisions) | 60.2 | OpenAI独自 |
| Microsoft-Decision-1 | 62.1 | Qwen3.5-9B派生 |
Microsoft公式の訴求は「Jev・Google・OpenAIを上回る」というもので、これは事実として裏付けられています。
一方で、Liquid AIのd1.2-ultraをはじめとする3モデル(d1.2-ultra 74.8・Drex Max 72.6・GLiDE 72.5)が1.1より明確に上に位置している点は見落とさない方がよい情報です。
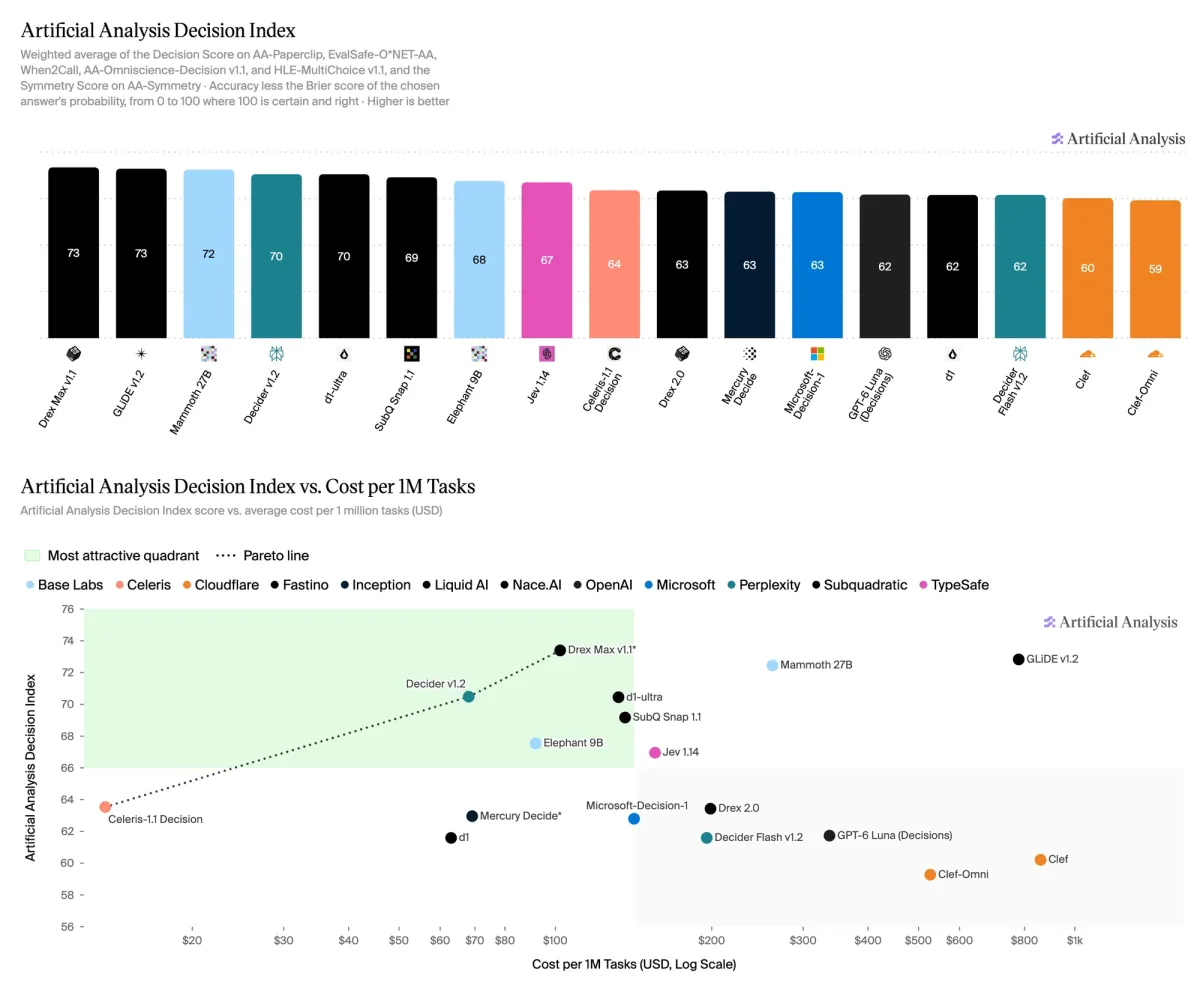
Artificial Analysis Decision Index v2資料(2026年11月8日公開)の主要Decision modelスコア順位と価格ポジション(図中のMicrosoft-Decision-1.0は63点でv2時点の値・v2.1では62.1点に更新/出典:Artificial Analysis)
上段の棒グラフでは Drex Max v1.1(73)・GLiDE v1.2(73)・Mammoth 27B(72)・Decider v1.2(70)・d1-ultra(70)・SubQ Snap 1.1(69)・Elephant 9B(68)・Jev 1.14(67)が上位を占め、Microsoft-Decision-1(1.0)は図中 63 点の位置にあります。下段の散布図は Index v.s. 100万タスク当たりコストで、左上(高スコア・低コスト)が「最も魅力的な象限」として緑色で示されています。
1.1リリース後の最新v2.1版ではMicrosoft-Decision-1.1が67.8点でJev・Gemini・GPT-6 Lunaを上回る位置に移った格好です。
P50 0.19秒という推論レイテンシ
Microsoft公式ブログは1.1について「初版比2倍以上高速」と表明しています。一方、OpenRouter上の実測値はP50 0.19秒・P95 0.30秒です。
測定条件(計測レイヤー・入力トークン長・判定数)が初版の公表値「中央値85ミリ秒」とは一致しないため両者は直接比較できませんが、OpenRouterの実測レベルで100〜300ミリ秒の帯に収まっているという事実は、プロダクション投入の判断材料になります。
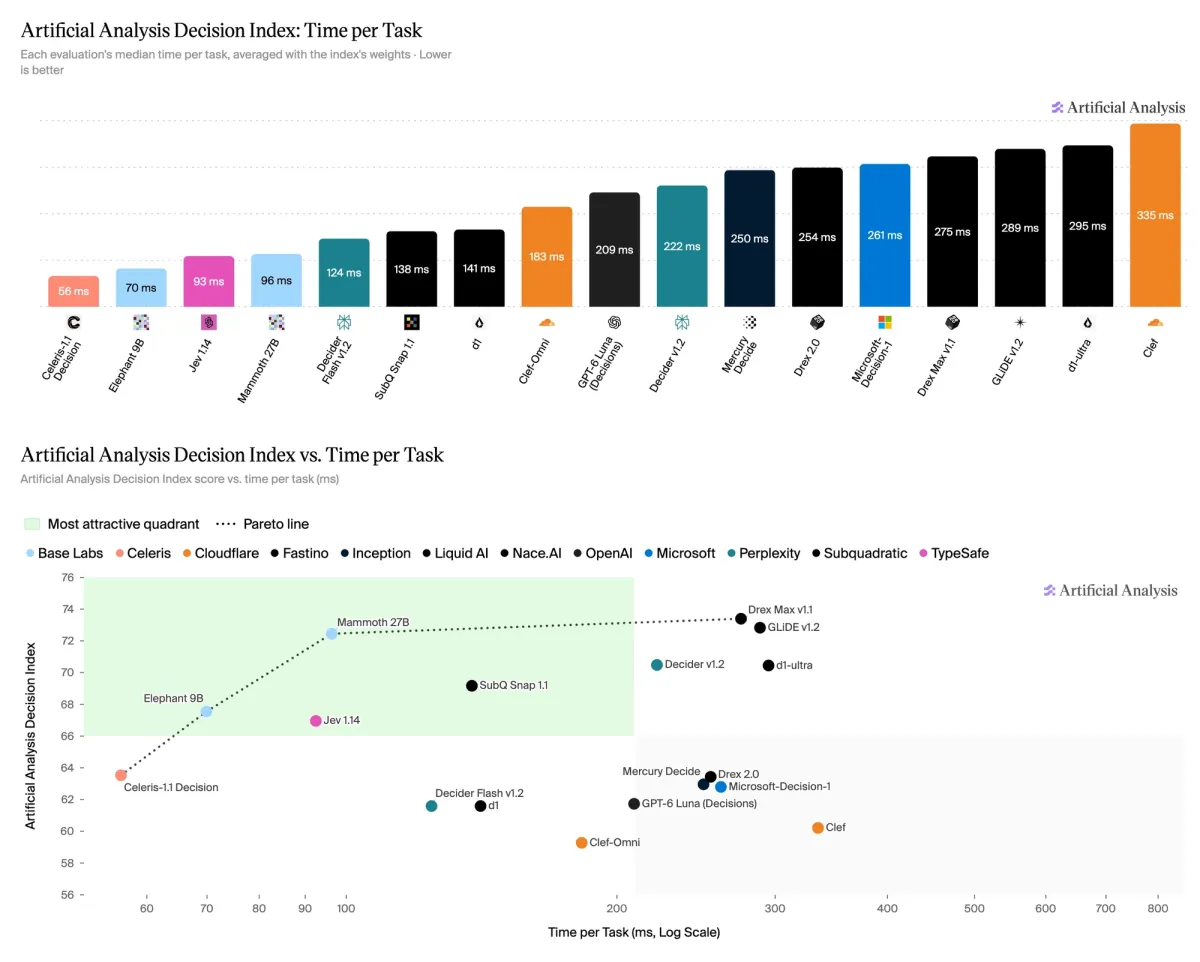
主要Decision modelのタスク当たり処理時間比較(Decision Index v2資料・2026年11月8日公開時点/出典:Artificial Analysis)
棒グラフを見ると、最速は Celeris-1.1 Decision の56ms、続いて Elephant 9B(70ms)・Jev 1.14(93ms)・Mammoth 27B(96ms)が100ms以下の帯に並びます。
Microsoft-Decision-1(1.0)は261msで中位に位置しており、1.1はMicrosoft公式の「初版比2倍以上高速」訴求に従えばこのチャートからさらに左(高速側)に移る位置づけです。
汎用LLMの推論レイテンシが数秒〜十数秒かかることと比較すると、1件あたり数百ミリ秒で判定が返ってくるため、ユーザーリクエストのルーティング層やストリーミング対話のガードレール層に挟んでも体感上の遅延を生まない設計になっています。
MAI Decision 1の料金——Global Standardで$0.042/1Mから始まるデータゾーン別料金
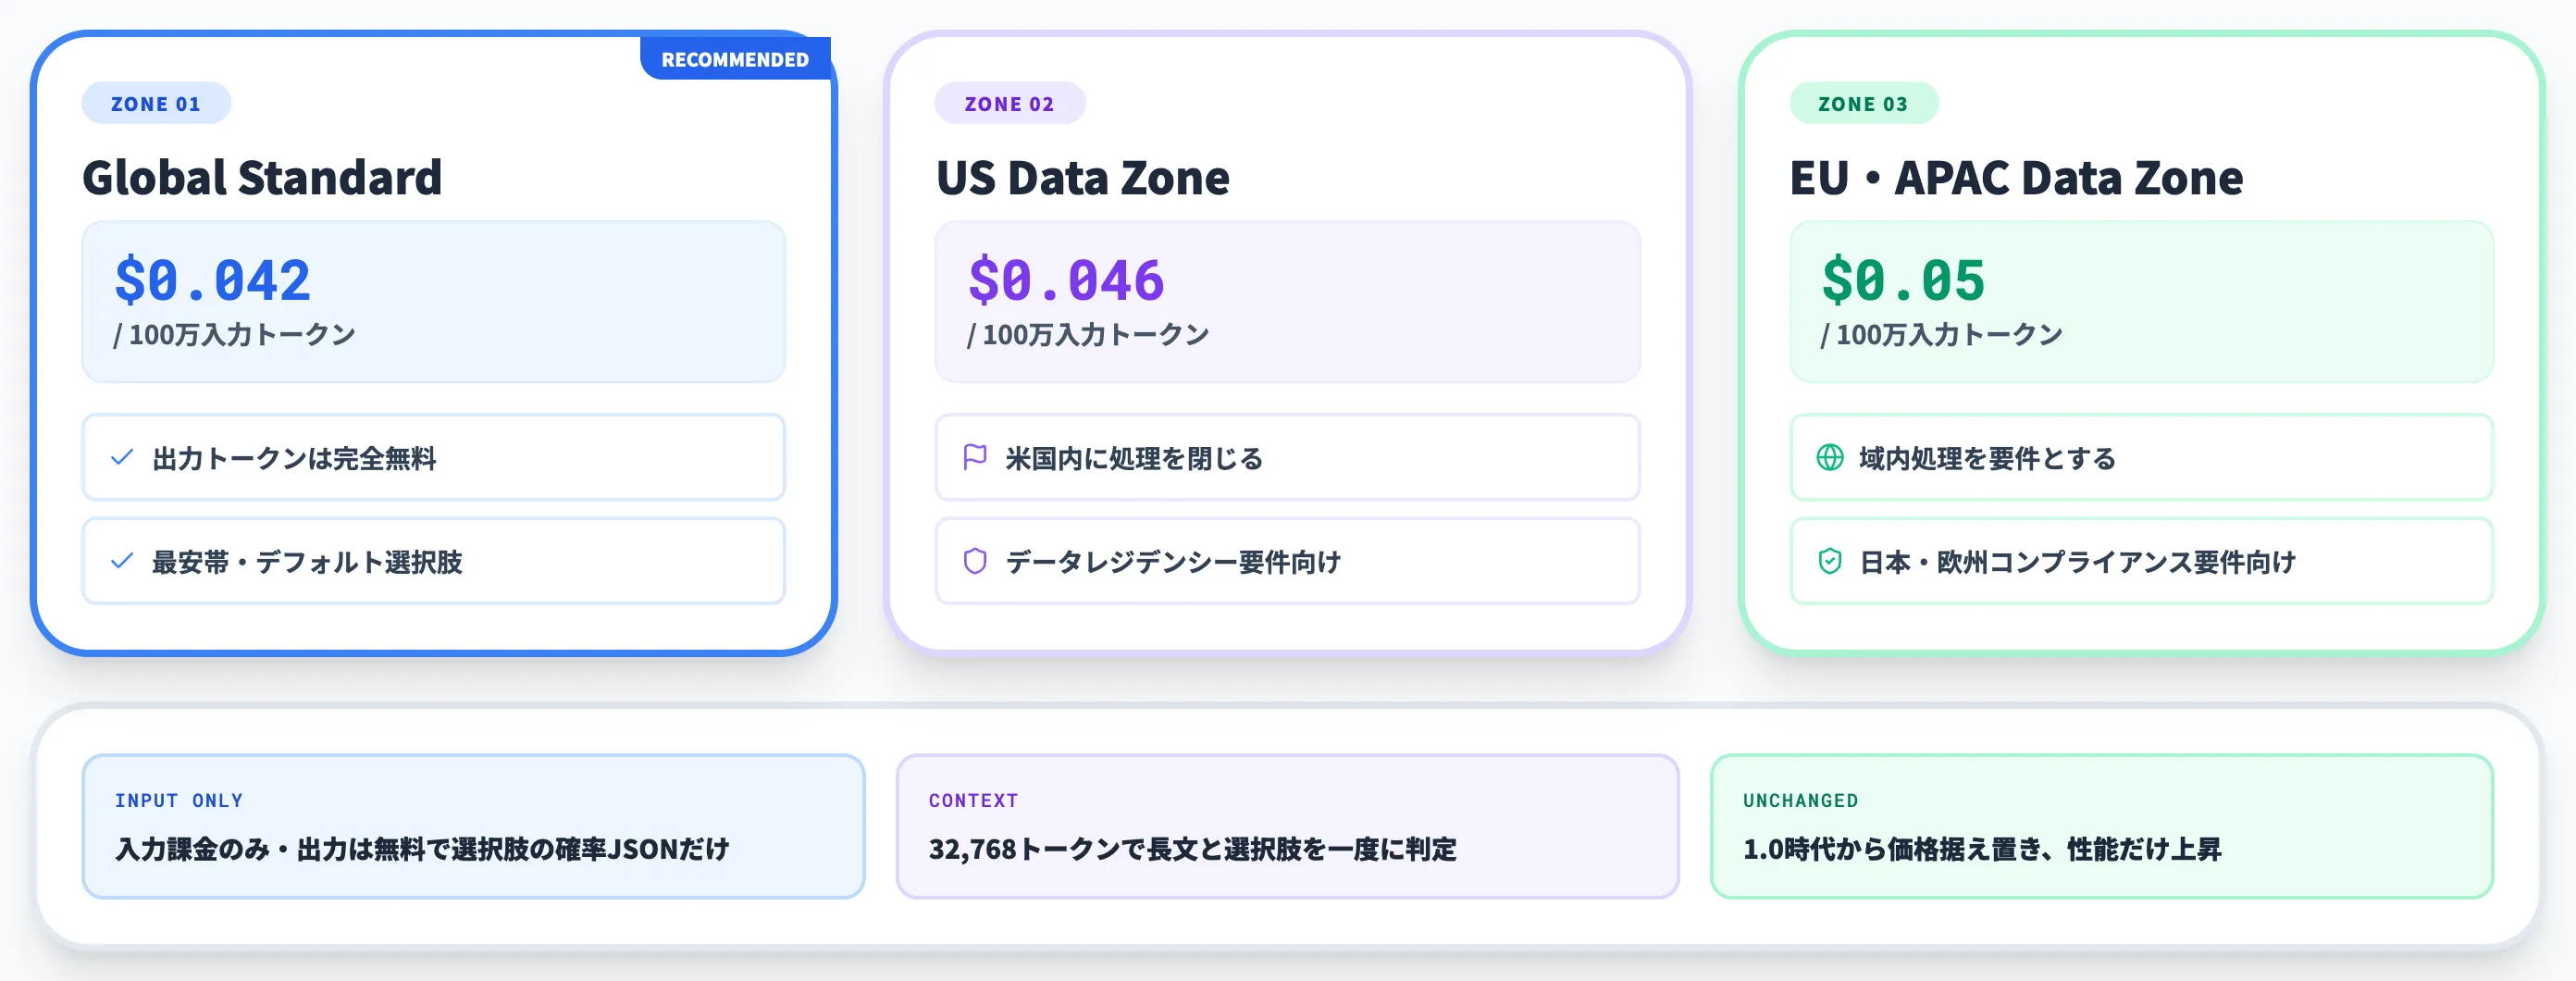
MAI Decision 1の料金は入力課金のみ・出力無料で、GAリリースにあたっても1.0時代の価格から変更されていません。
ただしMicrosoft Foundryでの単価はデータゾーンで異なり、Global Standardは$0.042/1M input、US Data Zoneは$0.046/1M input、EU・APAC Data Zoneは$0.05/1M inputに設定されています。
入力課金のみ・出力は無料
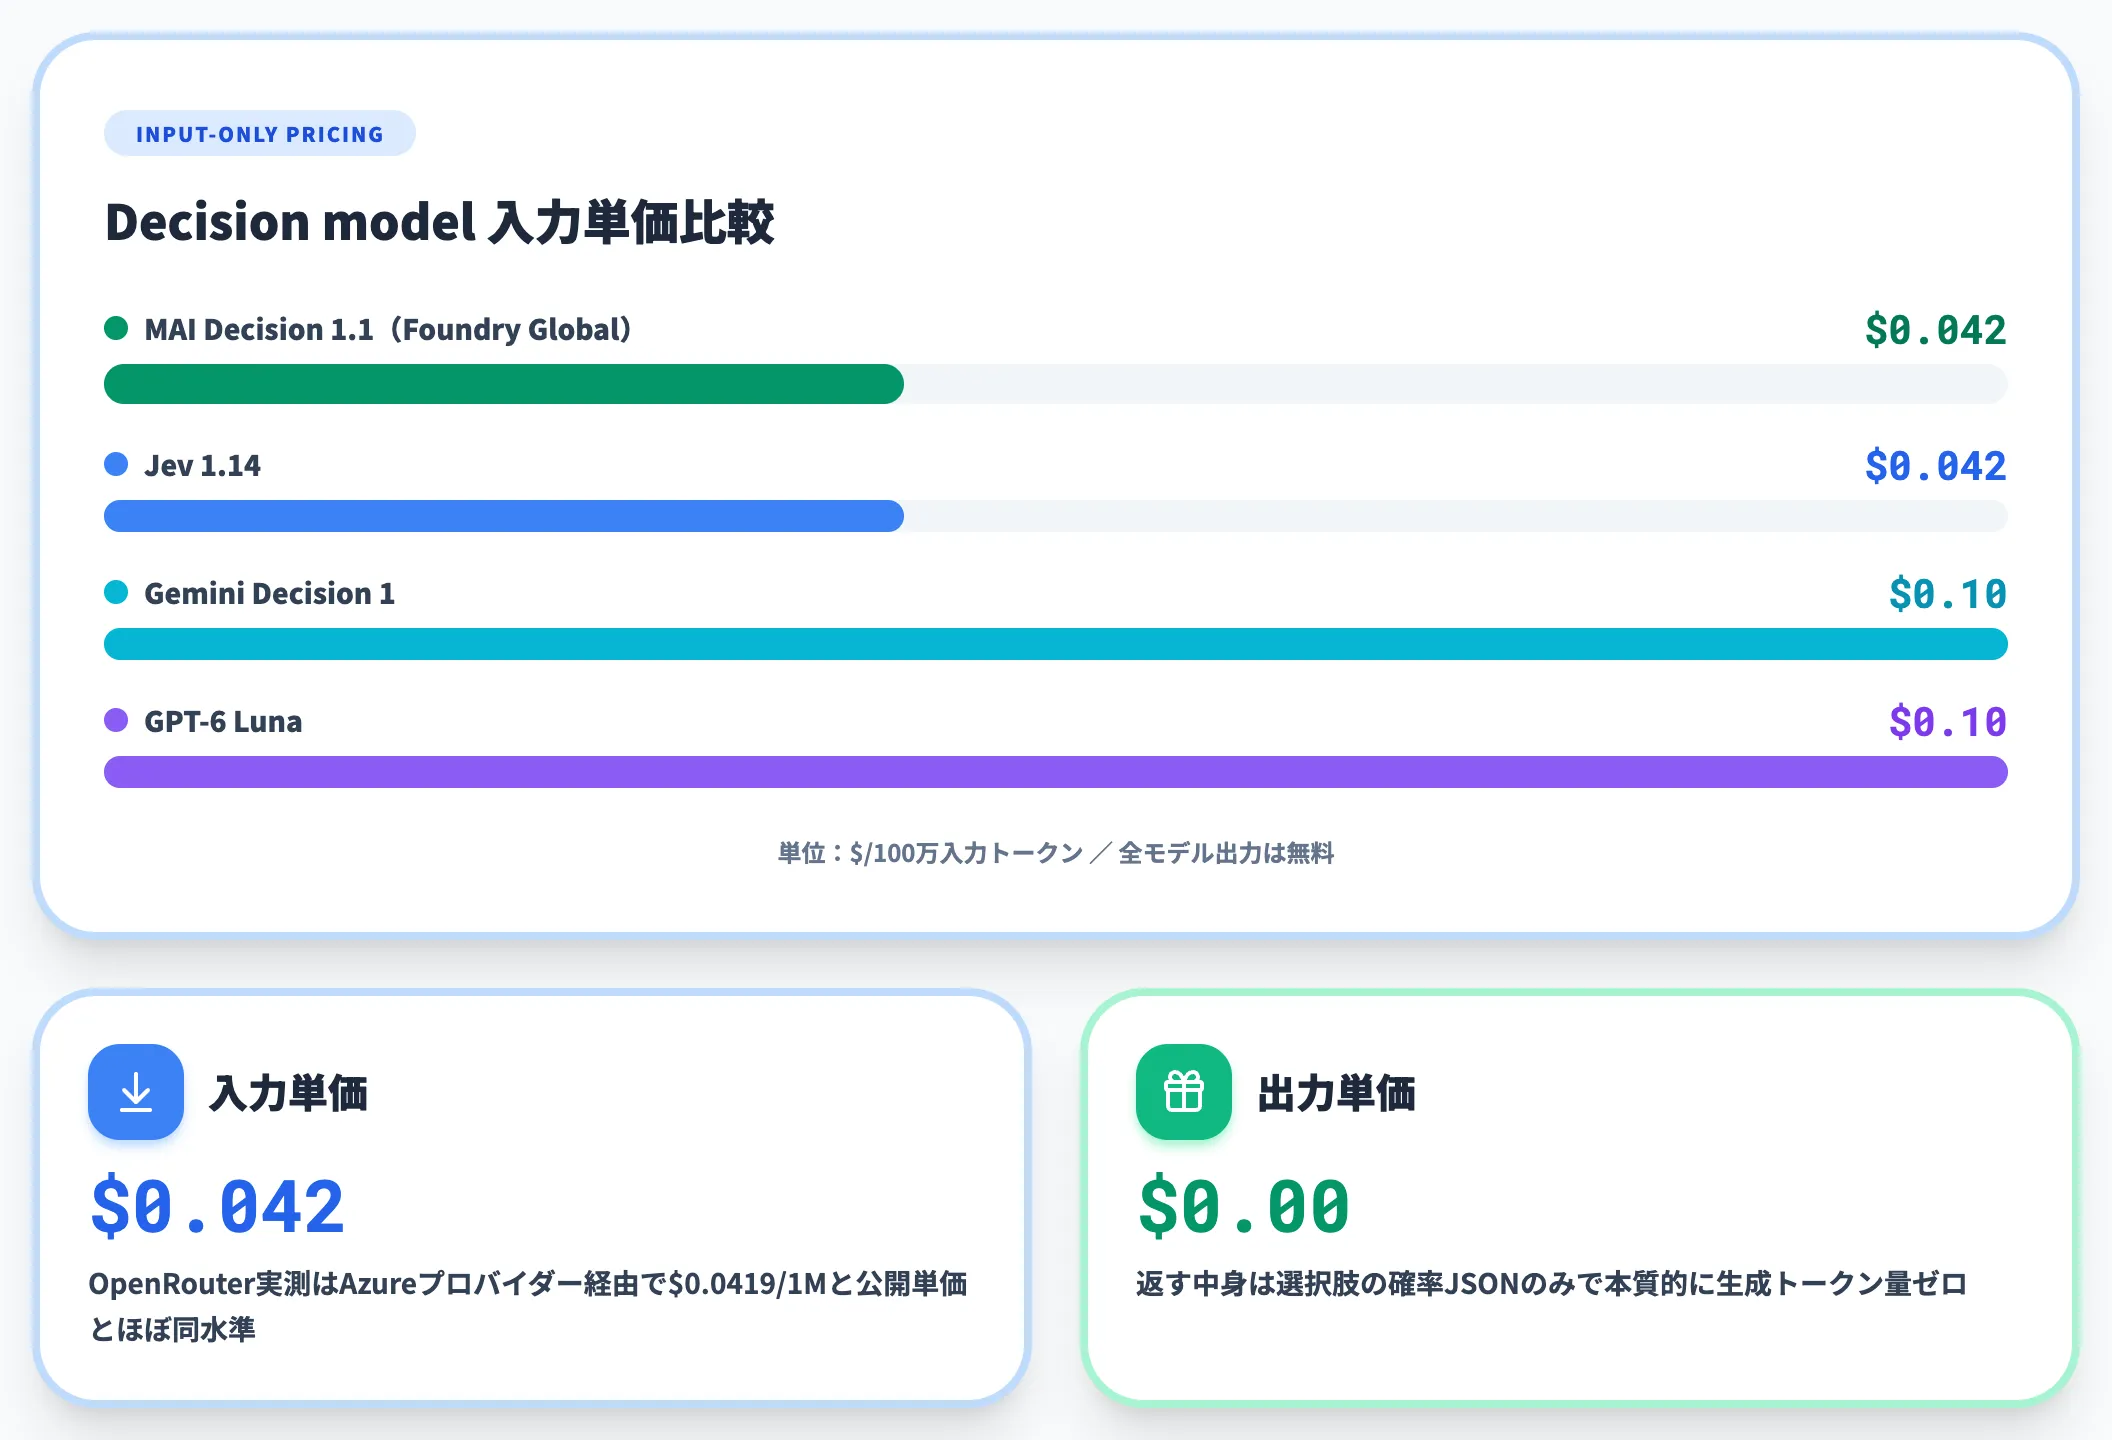
OpenRouterの実測価格履歴でも、Azureプロバイダー経由の実効入力単価は$0.0419/1Mトークンで、公開単価とほぼ同じ水準で推移しています。
出力トークンは返しても0トークンとして扱われるため完全無料です。
-
入力単価(Foundry Global Standard)
$0.042 / 100万トークン
-
入力単価(Foundry US Data Zone)
$0.046 / 100万トークン(米国内に処理を閉じるディプロイメント)
-
入力単価(Foundry EU・APAC Data Zone)
$0.05 / 100万トークン(域内処理を要件とするディプロイメント)
-
出力単価
$0.00 / 100万トークン(出力は選択肢の確率JSONのみで本質的に生成トークン量ゼロ)
-
コンテキスト長
32,768トークン(長文コンテンツを選択肢と共に一度に判定可能)
50倍速・79倍安訴求の読み解き
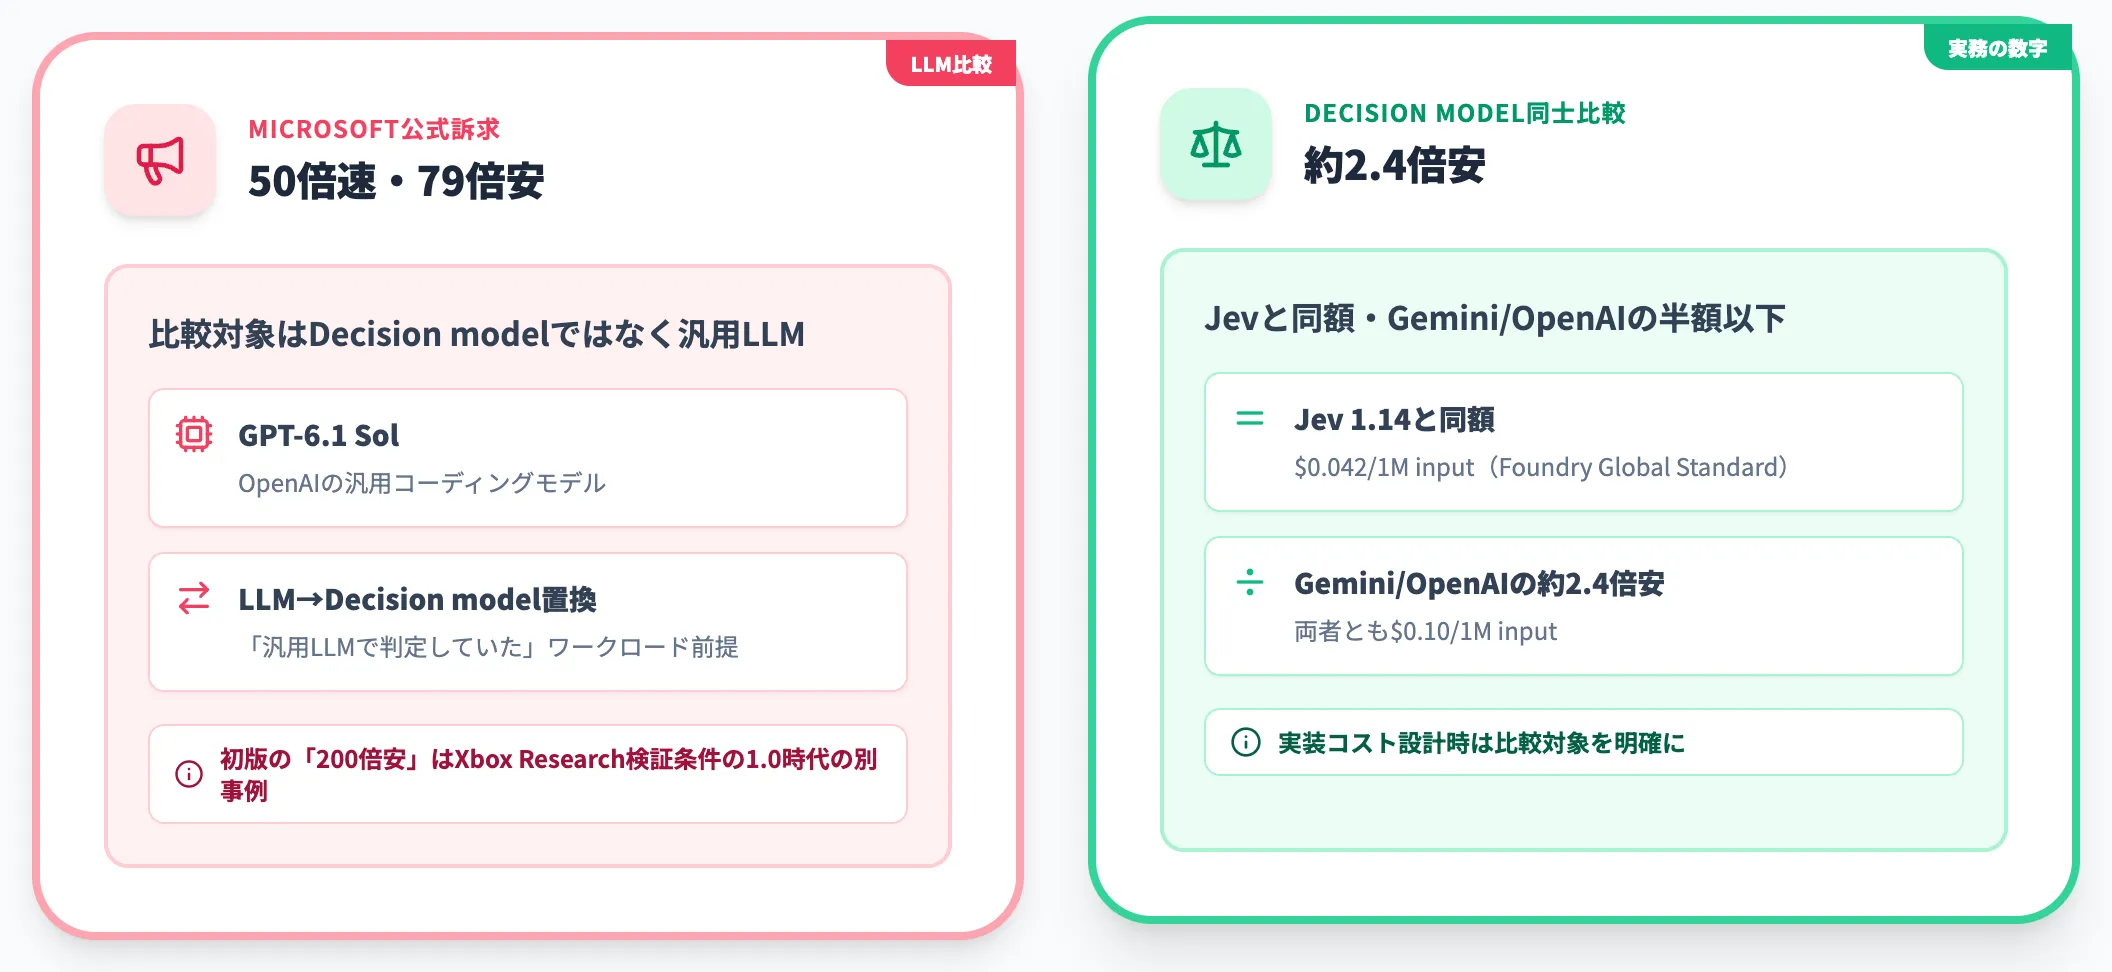
Microsoftは1.1の発表にあたって、GPT-6.1 Sol比で「50倍高速・79倍低コスト」と訴求しています(別途、初版のMicrosoft-Decision-1の事例ではXbox Researchでの検証条件で「200倍安」という数値も公表されていますが、これは1.0時代の別条件の結果です)。
この「50倍・79倍」はOpenAIの汎用コーディングモデルGPT-6.1 Solを対象に据えた比較で、他のDecision model同士の比較ではありません。
Decision modelカテゴリ全体で見ると、価格性能比の近い競合はJev 1.14(Foundry Global Standard同額の$0.042/1M input・Decision Index 66.2)で、入力単価はまったく同額です。
OpenAI Decisions API(GPT-6 Luna)とGoogle Gemini Decisions APIは共に$0.10/1M inputで、MAI Decision 1の約2.4倍の単価になります。
つまり「79倍安」はLLMをDecision modelに置き換える判断を迫る訴求で、Decision model同士のコスト競争では「Jev同額の中で性能と提供チャネルで勝つ」という構図です。
実装時のコスト設計では、どの比較対象と話しているかを明確にしておく必要があります。
月間1,000万件判定のコスト試算
月間1,000万件の判定処理を回す場合、1件あたり平均入力500トークン・選択肢200トークンの合計700トークンで試算すると、月間入力トークンは70億トークンとなります。
| モデル | 入力単価 | 月間コスト(70億トークン) |
|---|---|---|
| MAI Decision 1.1 | $0.042/1M | $294 |
| Jev 1.14 | $0.042/1M | $294 |
| Gemini Decision 1 | $0.10/1M | $700 |
| GPT-6 Luna | $0.10/1M | $700 |
| GPT-6.1 Sol(参考・汎用) | 入力$2/1M・出力$10/1M | 入力分$14,000+出力分(概算) |
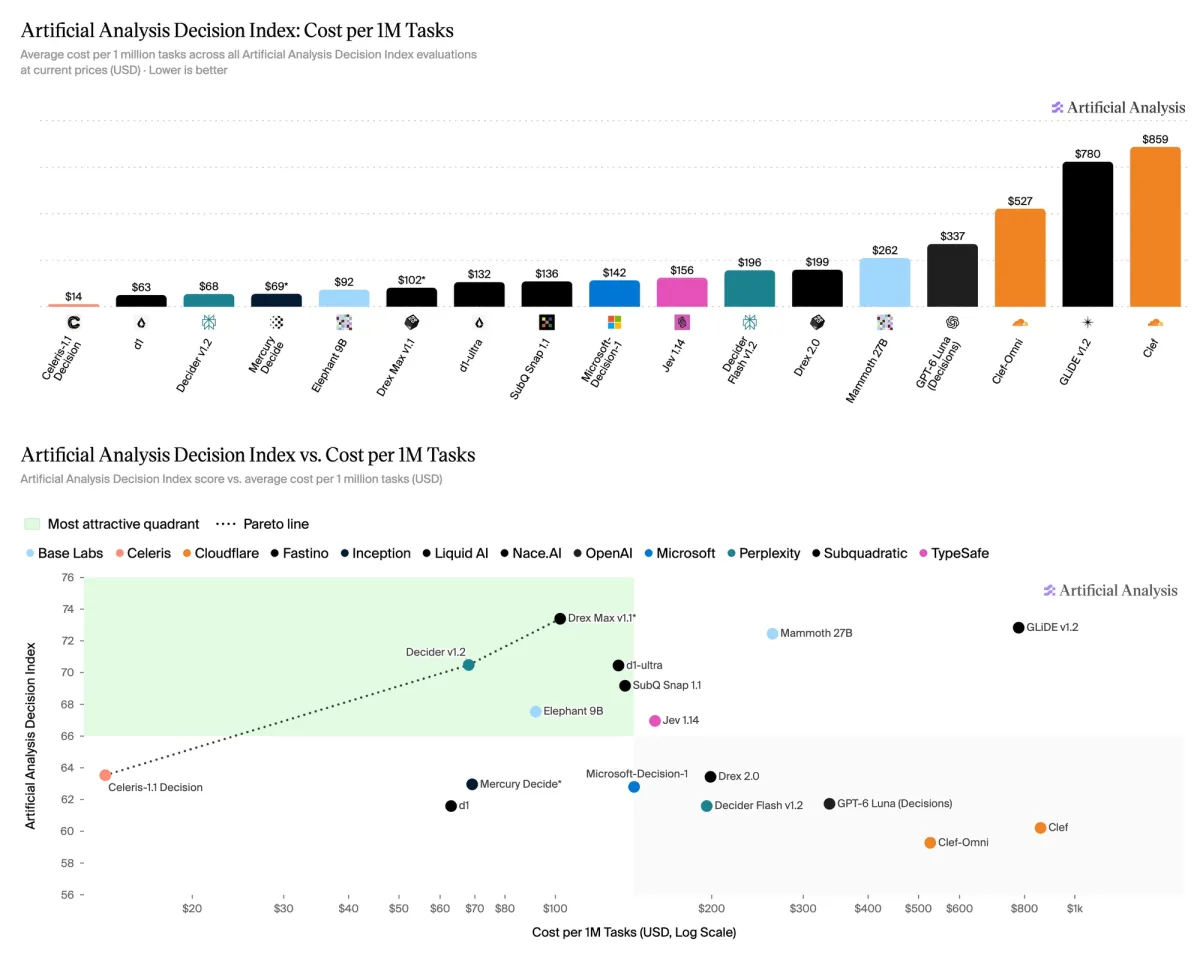
主要Decision modelの100万タスク当たりコスト比較(Decision Index v2資料・2026年11月8日公開時点/出典:Artificial Analysis)
棒グラフの左端が最安帯で、Celeris-1.1 Decision が$14、d1が$63、Decider v1.2が$68、Mercury Decideが$69と続き、Microsoft-Decision-1(1.0)は$142で中位の9番目に位置しています。
入力単価が安くてもAA-Paperclipベンチマークのタスク構成で見ると、1タスクあたりに消費する入力トークン数が多いモデルは実コストで中位以上に押し上がる構造です。1.1は入力単価$0.042/1M(Foundry Global Standard)を据え置いているため、このチャート上の相対位置もおおむね変わらない前提と見ておけます。
汎用LLMで同じ判定を回していたワークロードを置き換えると、入力料金だけでも月間1万ドル超から数百ドル規模まで圧縮される計算になります(出力料金は別途かかるため実際の削減額はこれより大きい)。
AIエージェントのツール呼び出し判断や、カスタマーサポートの初段分類など、トラフィック量が多い判定層ほど効果が大きくなる価格設計です。詳細なChatGPT APIの料金体系との比較も参考にすると、置き換え対象のコスト構造が明確になります。
MAI Decision 1の活用シーンとMicrosoft社内事例
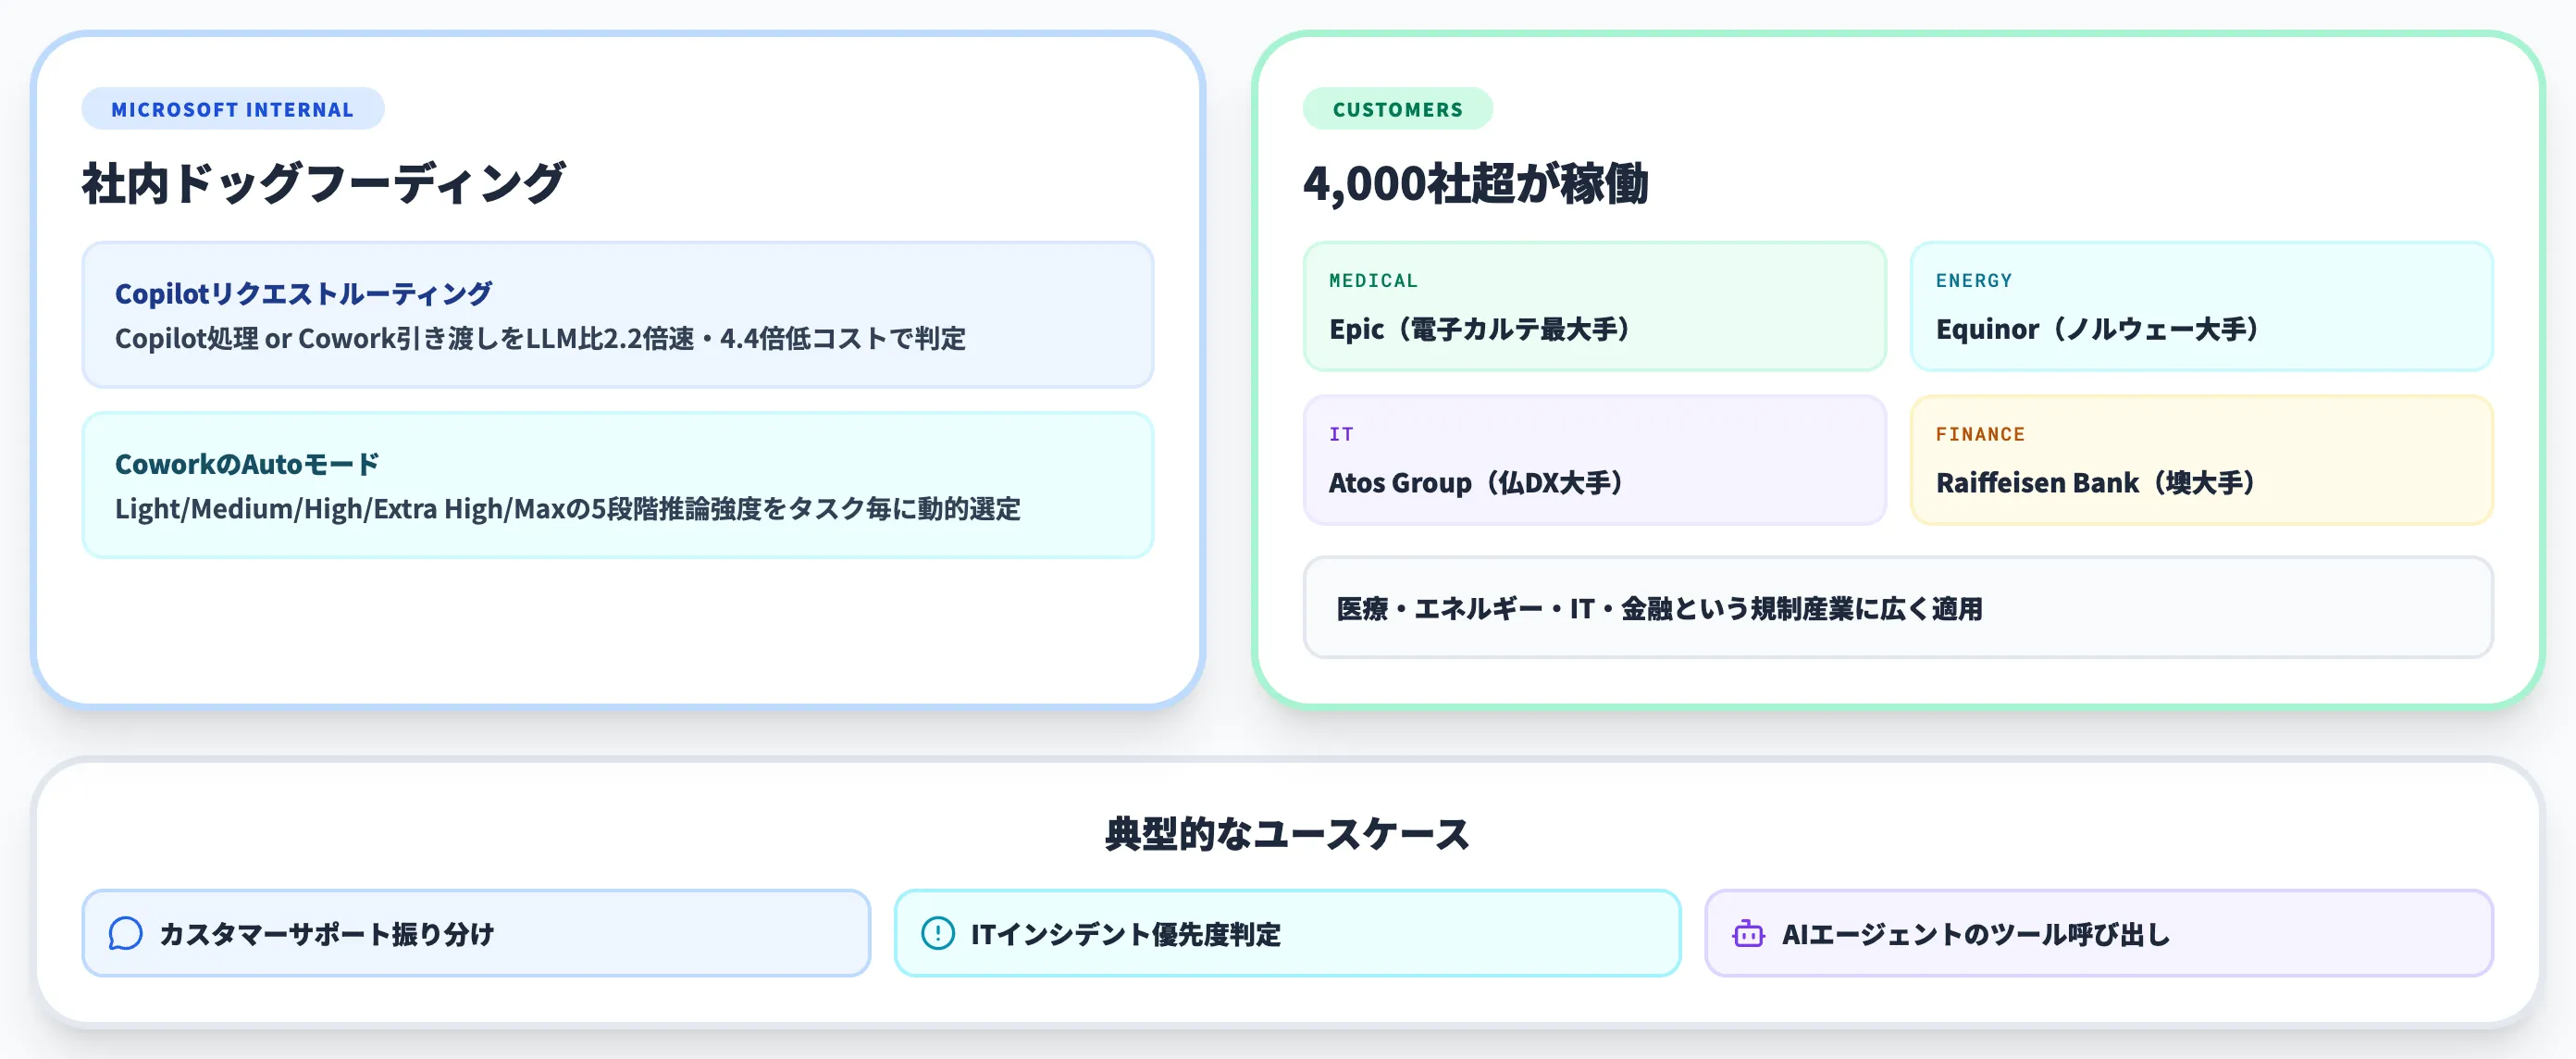
MAI Decision 1は、Microsoft社内で既にCopilotやCoworkの判定層として本番稼働しており、外部顧客でも4,000社超が採用しています。
Microsoft自身がドッグフーディングしている点が、他のDecision modelと比べたときの信頼度の基盤になっています。
Copilot内部でのリクエストルーティング
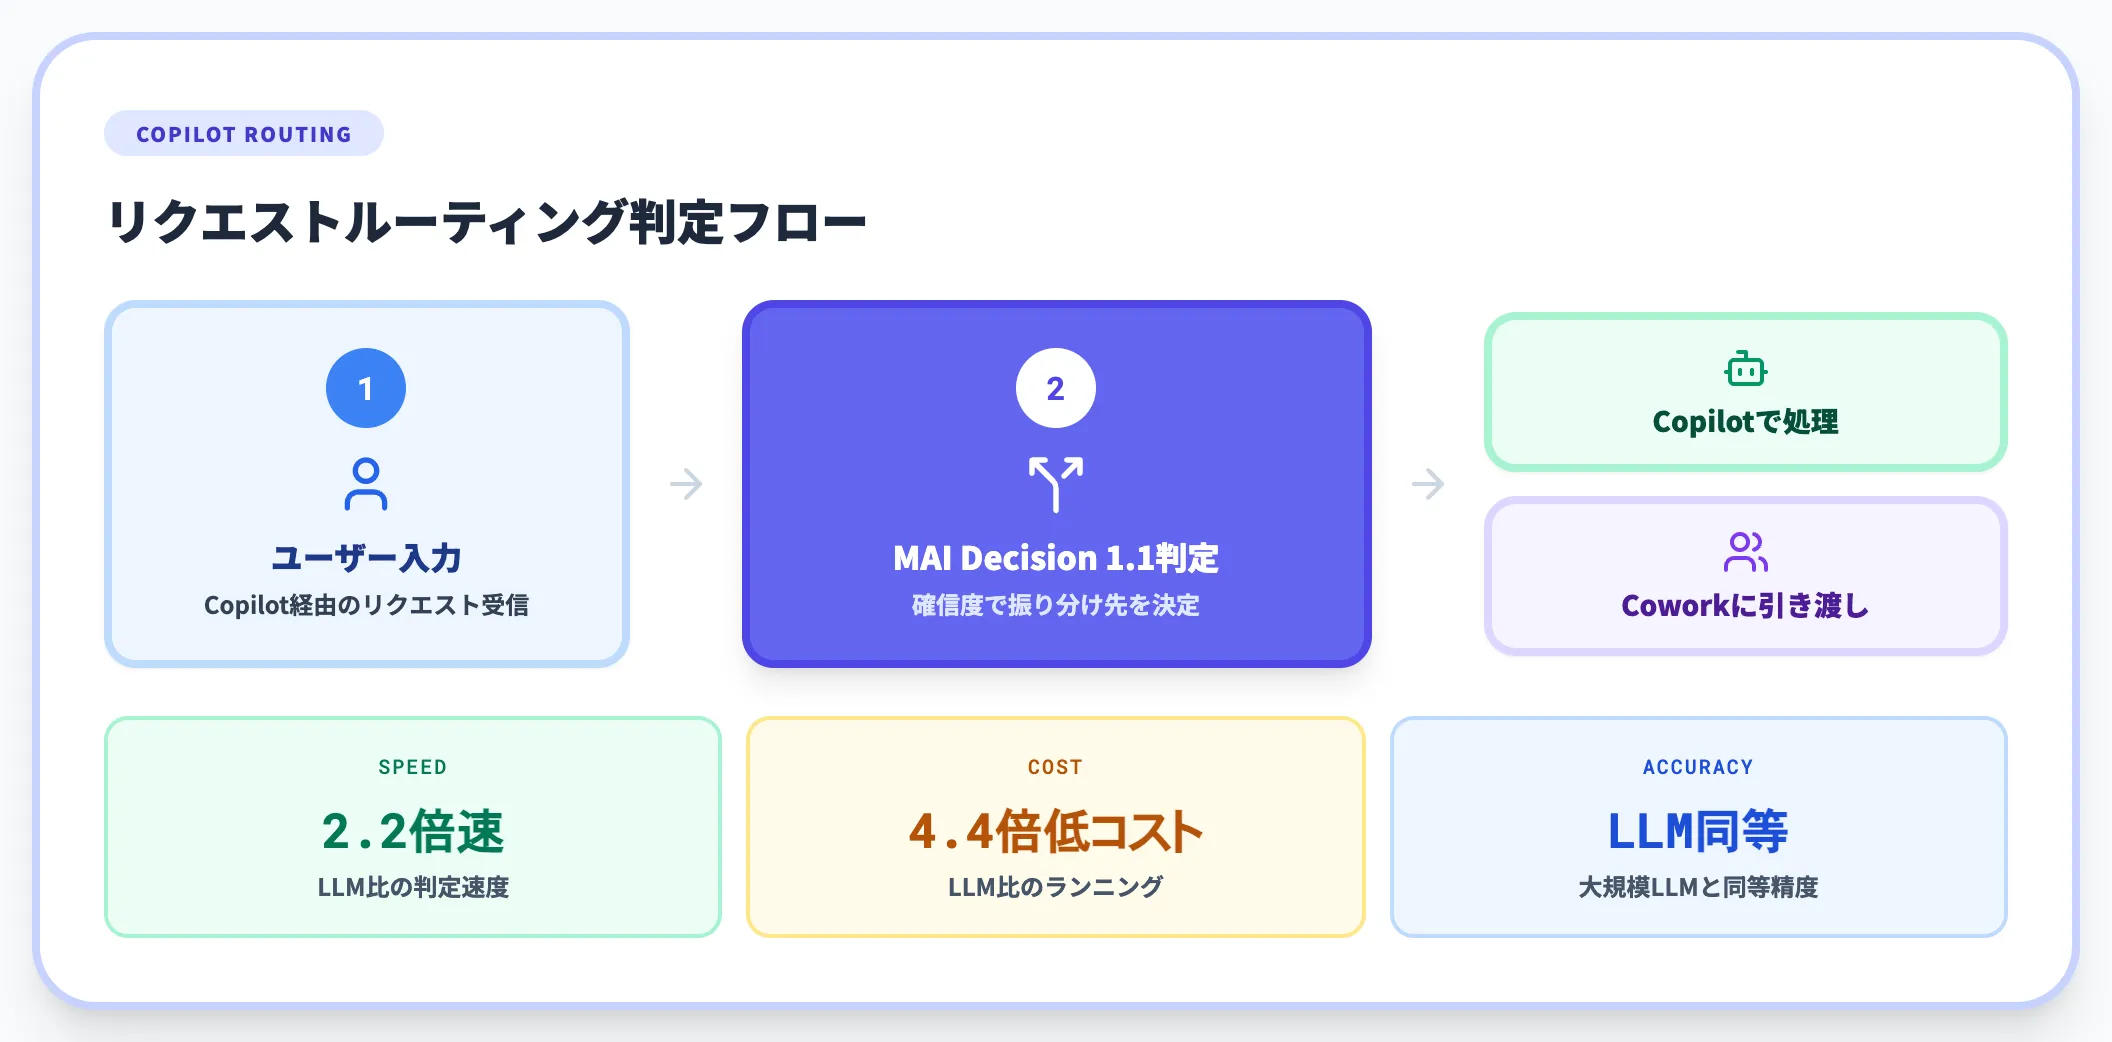
Microsoft AI公式ブログは、Microsoft Copilotが受け取ったユーザーリクエストを「Copilotで処理するか、Coworkに引き渡すか」の判断にMAI Decision 1.1を使っていると公表しています。
同ブログによると、この振り分け判定は大規模LLMと同等の精度を2.2倍速・4.4倍低コストで実現しており、Copilot全体のレスポンス速度とランニングコストの両方に直接効いています。
CoworkのAutoモードでの推論強度切替
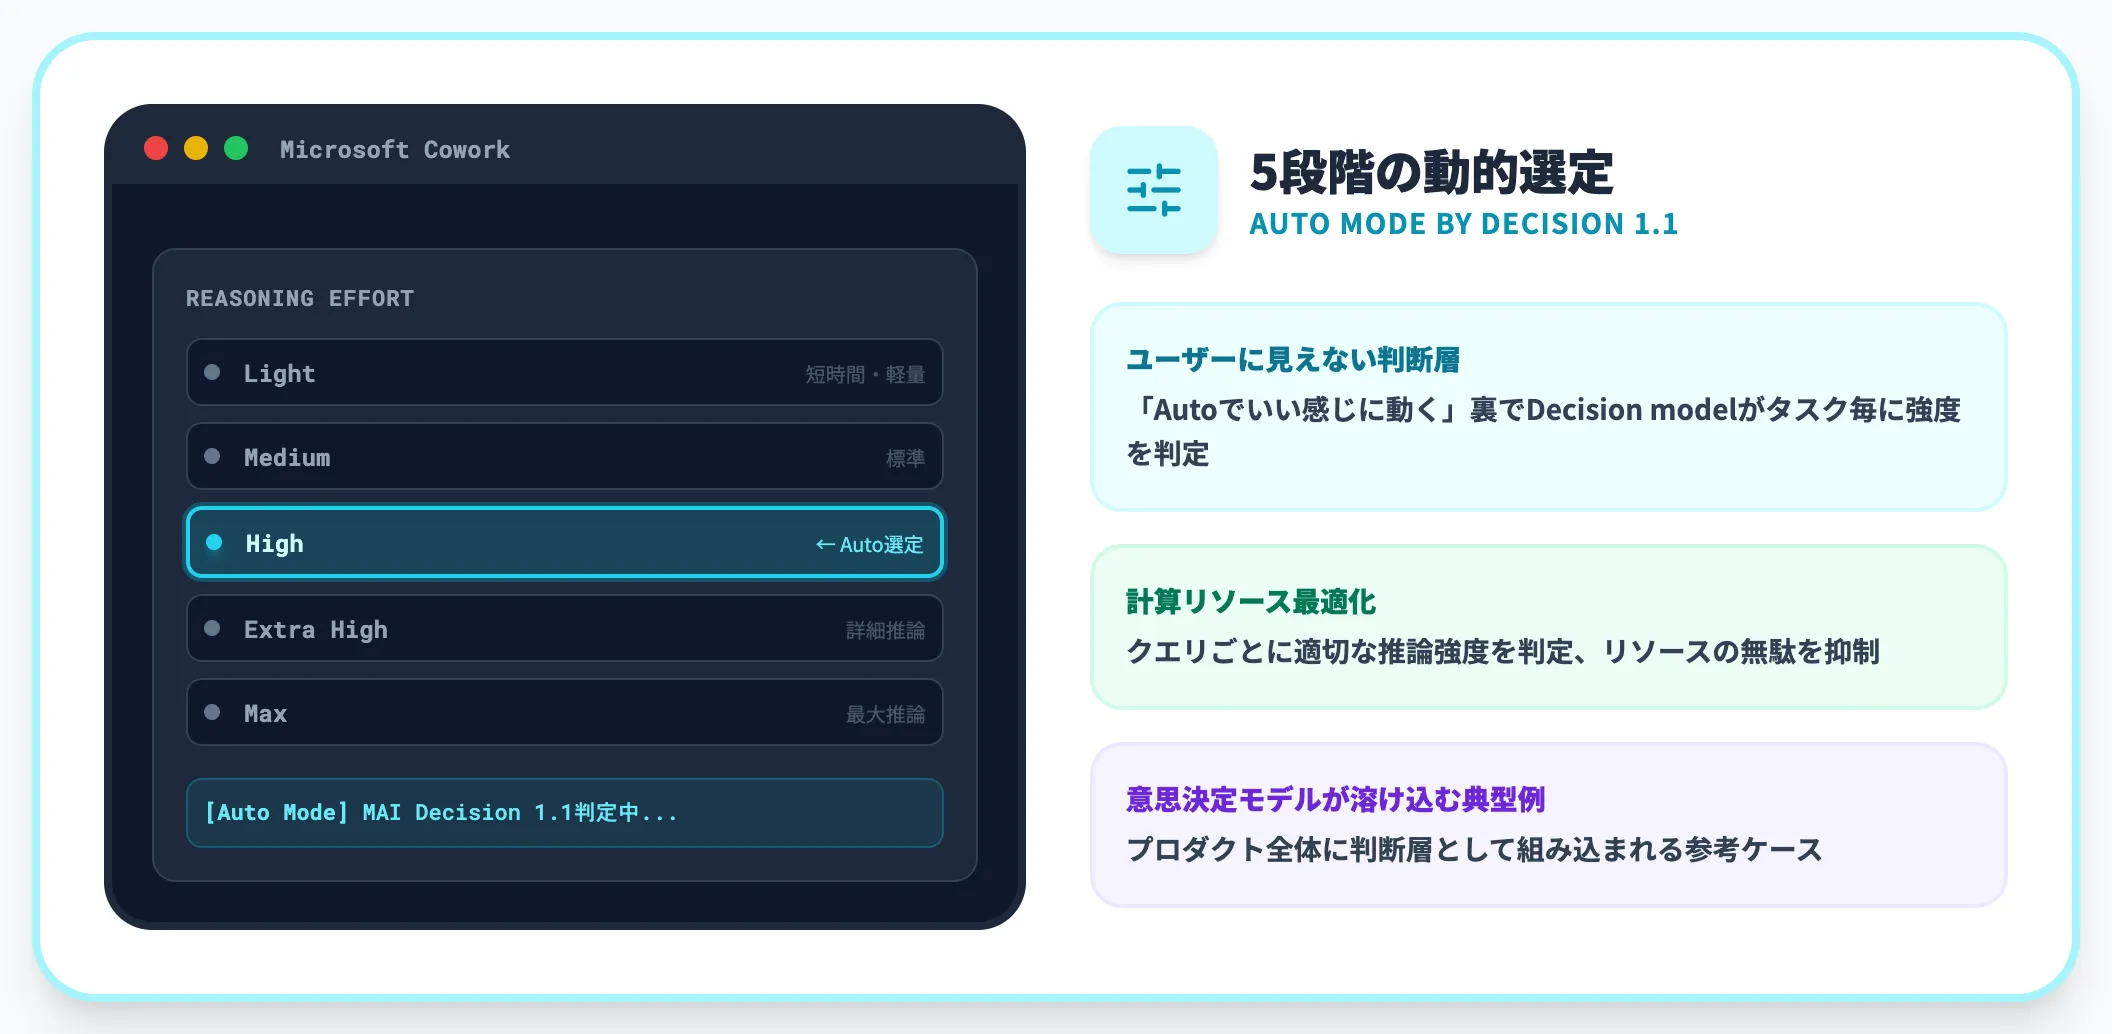
Microsoft CoworkにはLight/Medium/High/Extra High/Maxの5段階のReasoning Effort(推論強度)設定があり、ユーザーが「Auto」を選んだ場合はMAI Decision 1.1がタスクごとに適切な強度を動的に選定しています。
この構造は、意思決定モデルが「ユーザーに見えない判断層」としてプロダクト全体に溶け込む典型例です。ユーザーは「Autoでいい感じに動く」としか感じないが、裏では低コストのDecision modelが、タスクごとに「このクエリにどれだけ計算リソースを使うか」を毎回判定している構造になっています。
業種別の主要採用企業
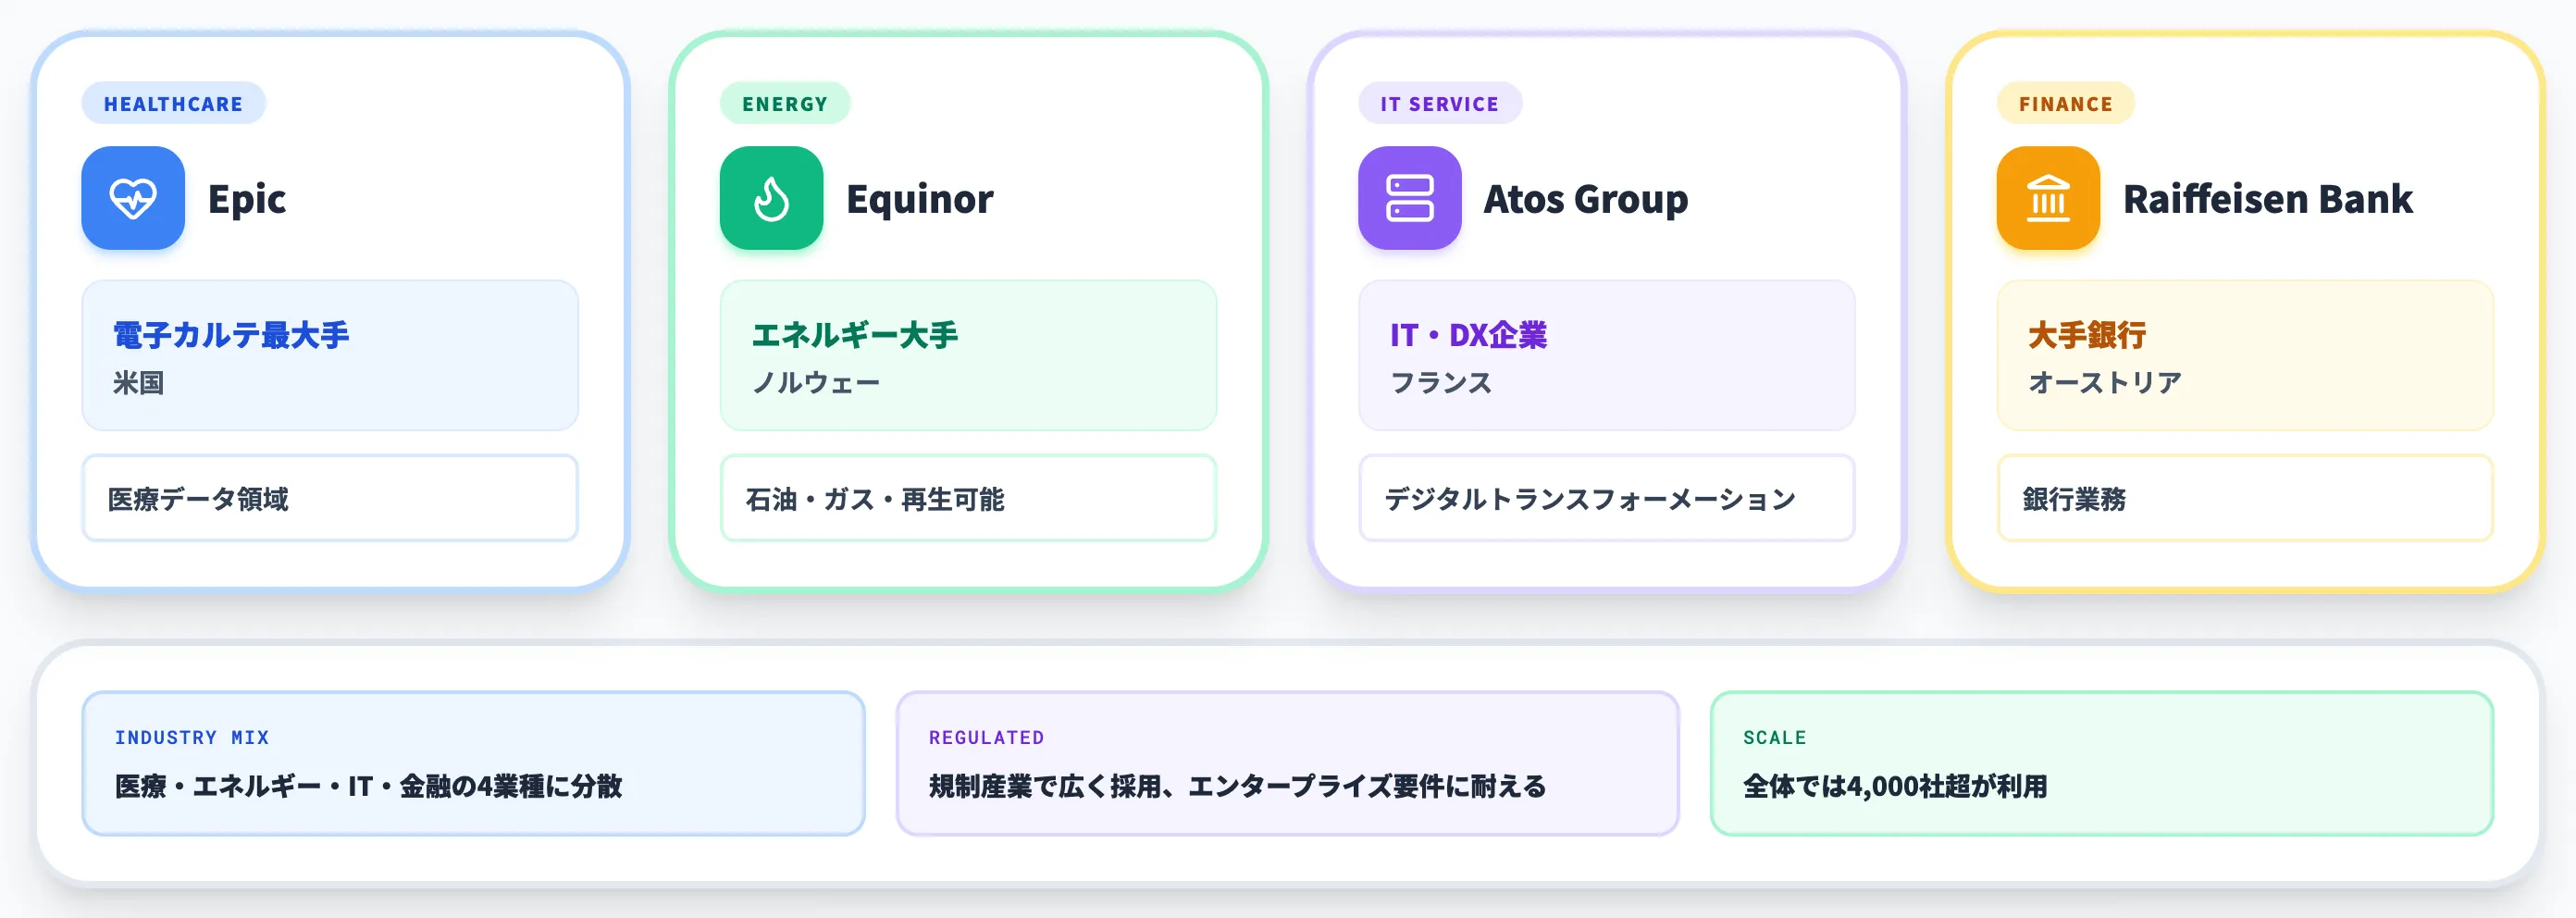
公式リリースで名前が挙がっている主要採用企業は以下の4社です。
-
Epic
米国の電子カルテ最大手
-
Equinor
ノルウェーのエネルギー大手
-
Atos Group
フランスのIT・デジタルトランスフォーメーション企業
-
Raiffeisen Bank
オーストリアの大手銀行
4社とも業種が分散しており、医療・エネルギー・IT・金融という規制産業に広く適用されている点が特徴です(各社とも具体的な利用用途はMicrosoft公式では公開されていません)。
主な想定ユースおース
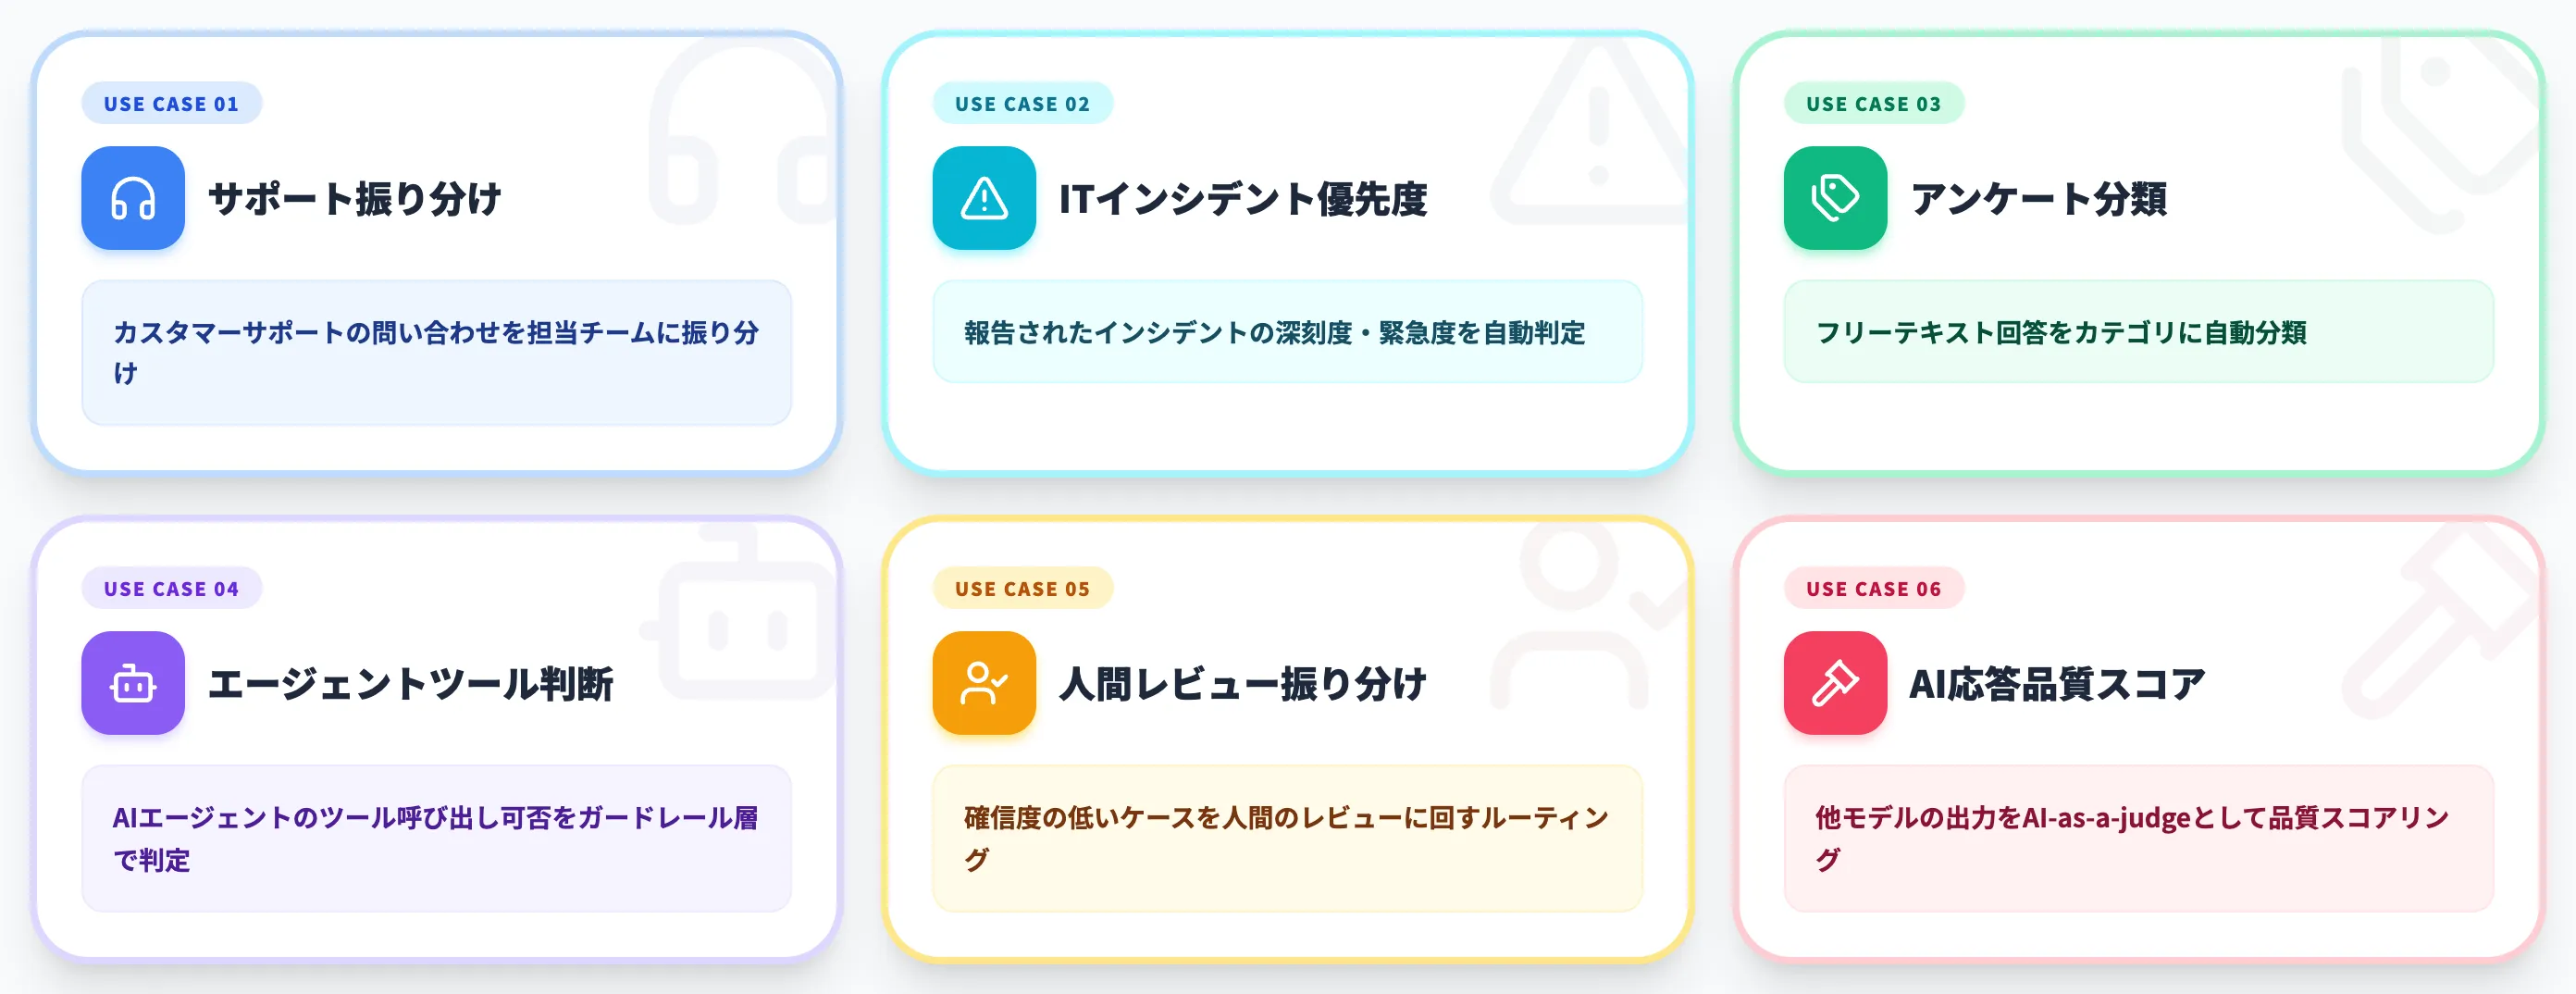
Microsoft公式が挙げている典型的な用途は、以下のとおりです。
- カスタマーサポートの問い合わせ振り分け
- ITインシデントの優先度判定
- フリーテキストアンケートの分類
- AIエージェントのツール呼び出し判断(ガードレール)
- 確信度の低いケースを人間のレビューに回すルーティング
- モデル応答の品質スコアリング(AI-as-a-judge)
意思決定モデルが最も効くのは、「毎日大量に発生する、構造化された判断」です。Mustafa Suleyman氏が基調講演で指摘したように、GPT-6.1 Solなどフロンティア価格帯のLLMを判定層で叩き続けるとトークン請求が大きくなりやすく、Decision modelに切り分けて置く設計が検討されるようになっています。
MAI Decision 1と他社のDecision modelの違い——4モデル比較
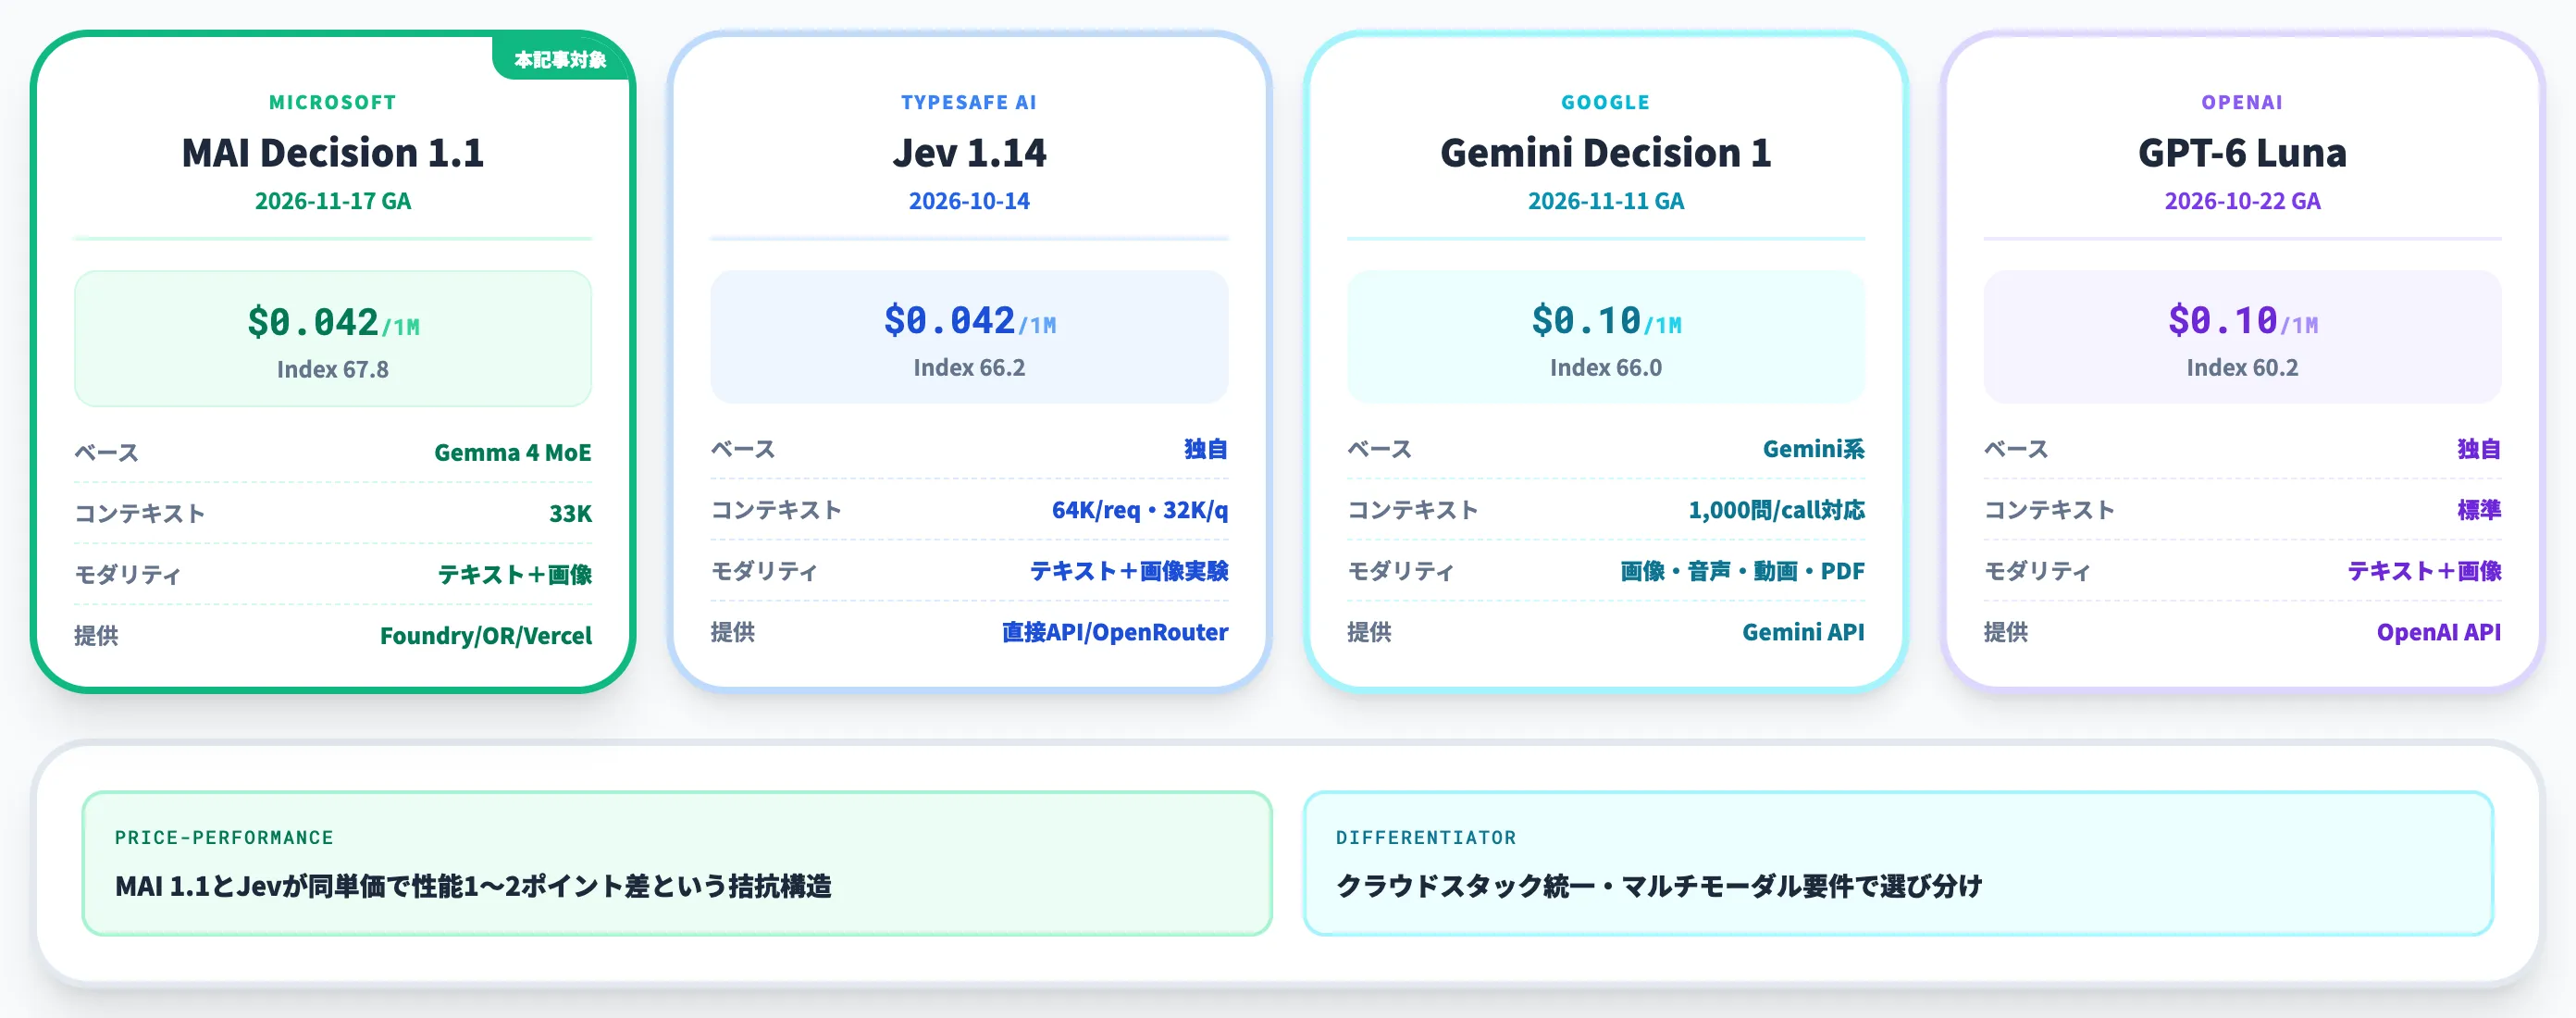
Decision modelというカテゴリは2026年9月にTypeSafe AIのJevが切り拓いた非常に新しい領域で、わずか3か月で主要クラウドベンダー4社が参入する激戦区になっています。MAI Decision 1を評価するには、このカテゴリ全体の時系列と現在のプレイヤー配置を理解しておく必要があります。
Decision modelカテゴリの時系列
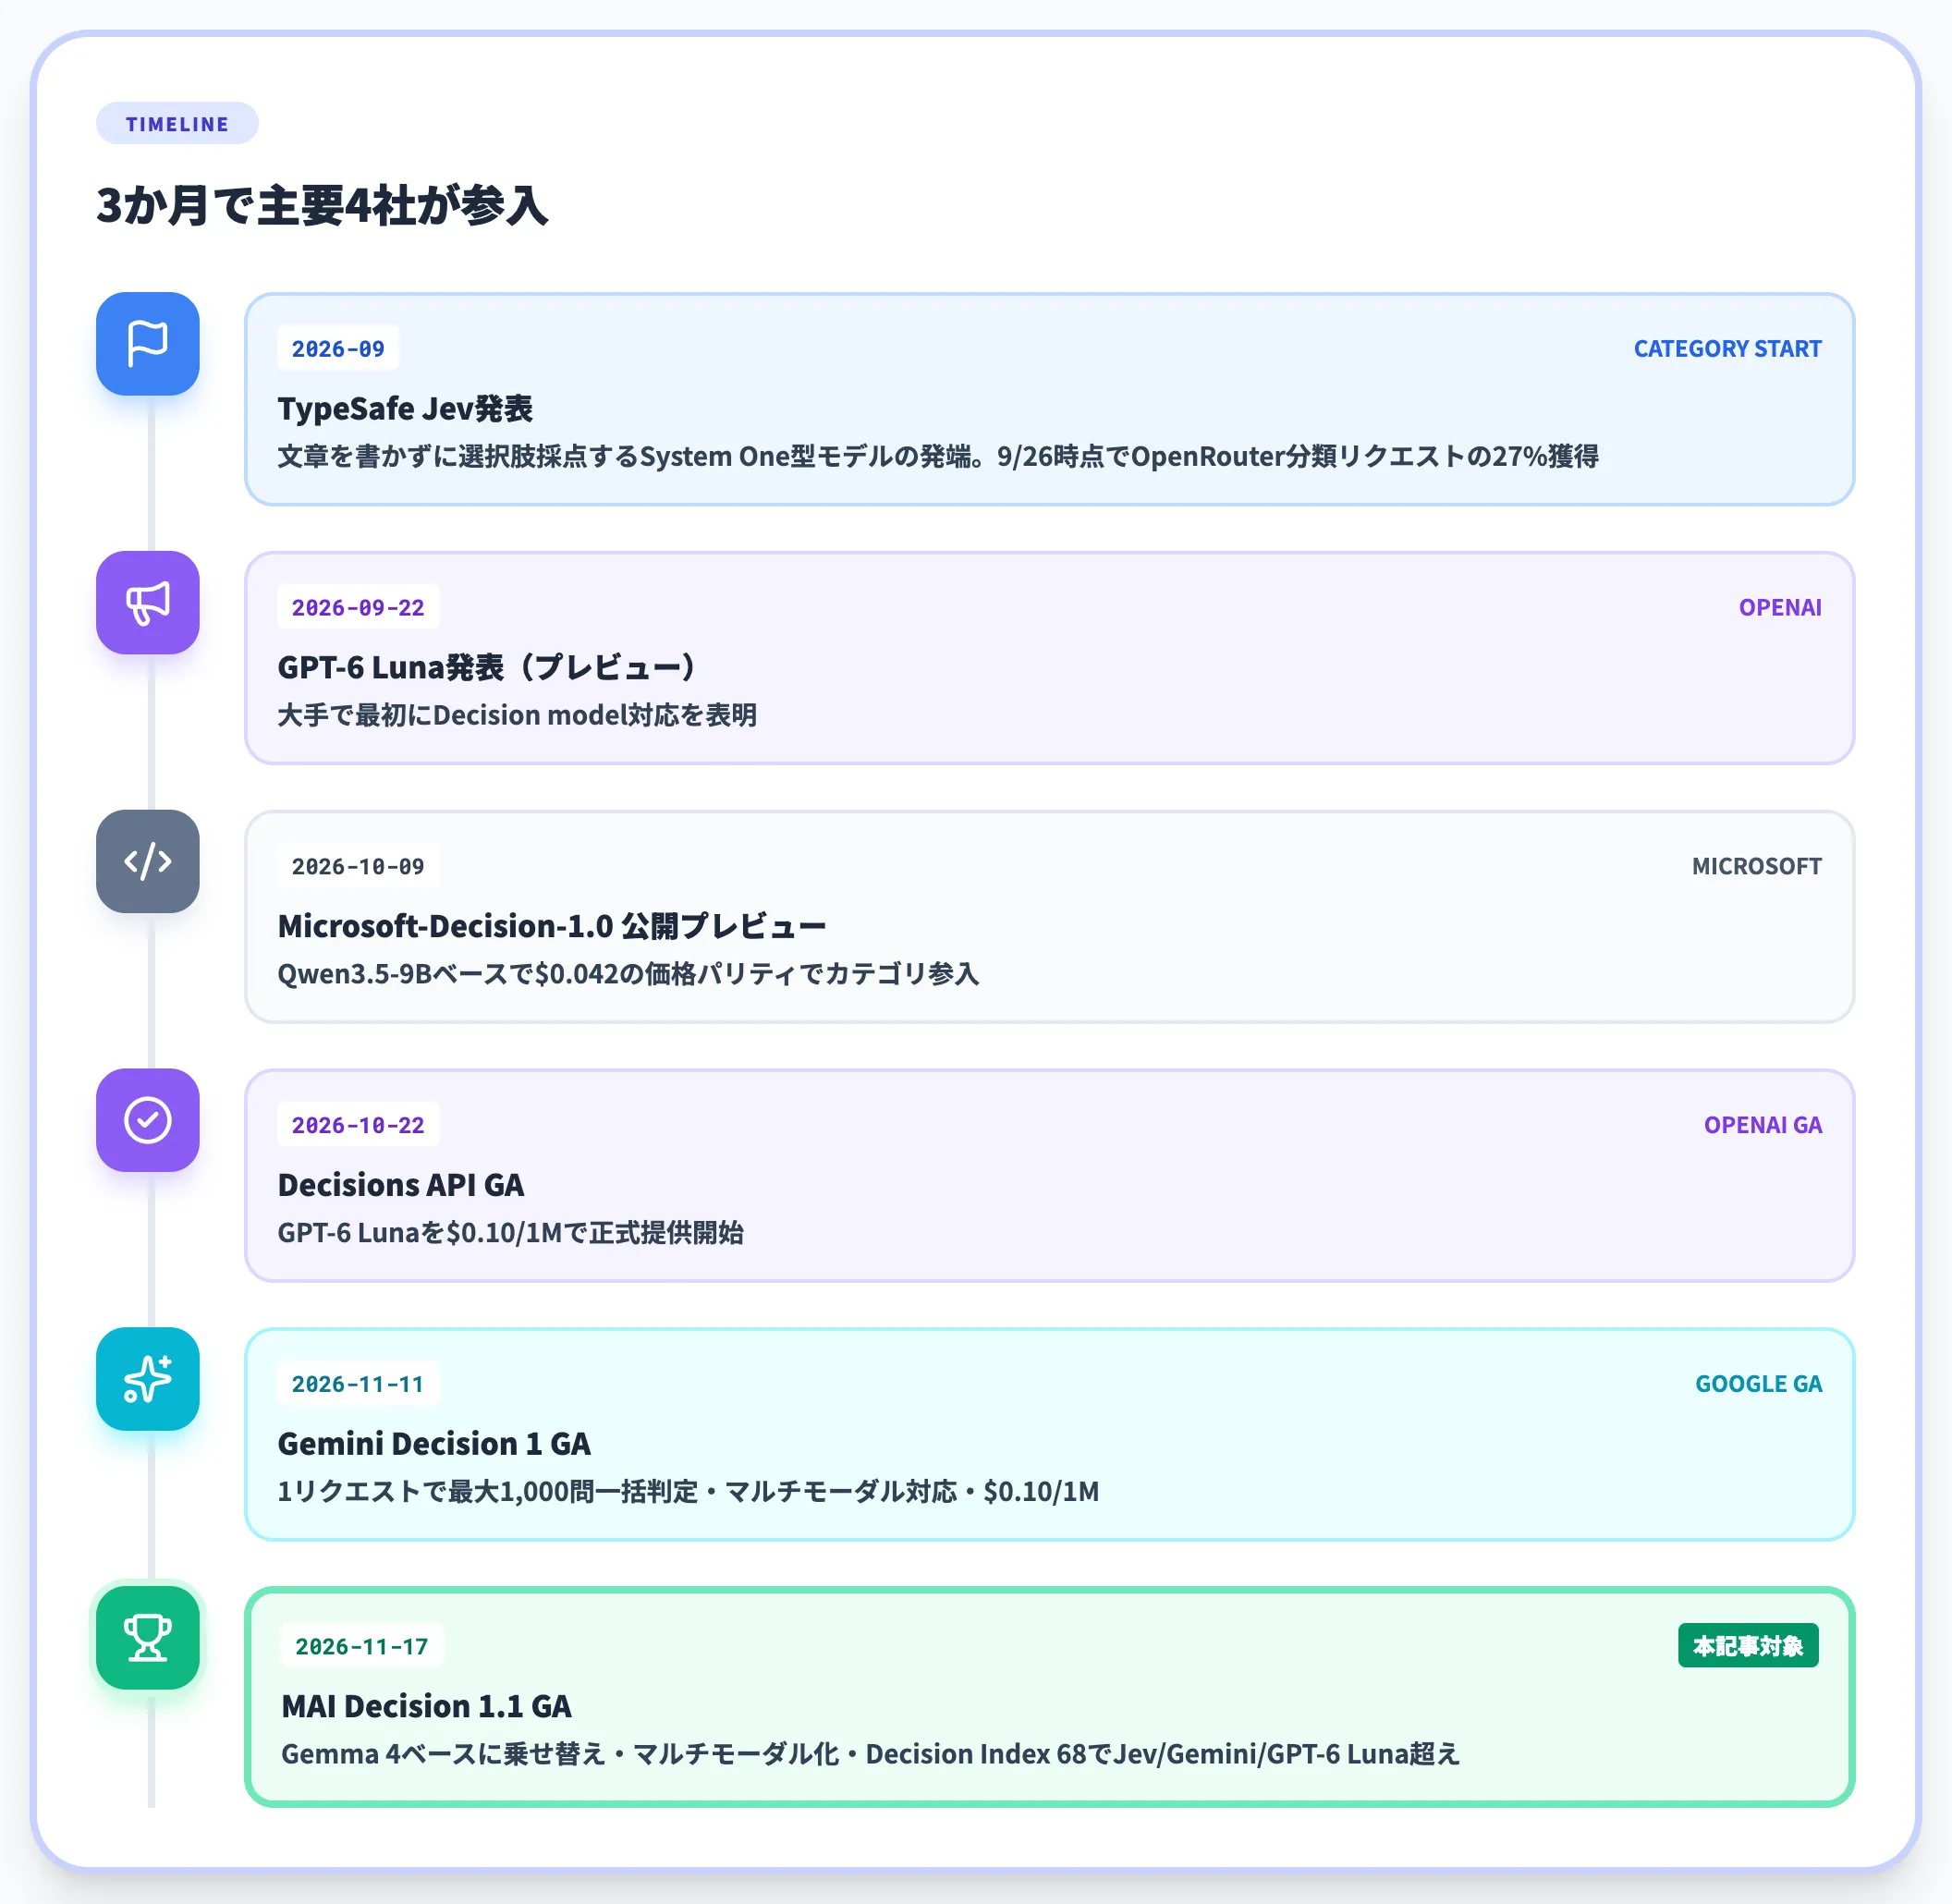
-
2026-09 TypeSafe Jev発表
文章を書かずに選択肢を採点するSystem One型モデルというカテゴリの発端。70〜500msレイテンシ・低単価で、OpenRouterでは9月26日時点でclassification分野の週リクエストの27%を獲得。本稿で参照するJev 1.14自体は10月14日公開版
-
2026-09-22 OpenAI GPT-6 Luna発表(Decisions APIプレビュー)
大手の中では最初にDecision model対応を表明
-
2026-10-09 Microsoft-Decision-1.0公開プレビュー
Qwen3.5-9Bベースで$0.042の価格パリティでカテゴリ参入
-
2026-10-22 OpenAI Decisions API GA
GPT-6 Lunaを$0.10/1Mで正式提供開始
-
2026-11-11 Google Gemini Decision 1 GA
1リクエストで最大1,000問を一括判定・マルチモーダル対応・$0.10/1M
-
2026-11-17 MAI Decision 1.1 GA(本稿対象)
Gemma 4ベースに乗せ替えてマルチモーダル化・2倍速化・Decision Index 68でJev/Gemini/GPT-6 Luna超え
4モデル比較表
以下の表で、2026年11月時点の主要Decision model 4本の仕様を整理しました。
| 項目 | MAI Decision 1.1 | Jev 1.14 | Gemini Decision 1 | GPT-6 Luna |
|---|---|---|---|---|
| 提供元 | Microsoft | TypeSafe AI | OpenAI | |
| リリース | 2026-11-17(GA) | 2026-10-14 | 2026-11-11(GA) | 2026-10-22(GA) |
| 入力単価 | $0.042/1M(Foundry Global Standard) | $0.042/1M | $0.10/1M | $0.10/1M |
| 出力単価 | 無料 | 無料 | 無料 | 無料 |
| Decision Index v2.1 | 67.8 | 66.2 | 66.0 | 60.2 |
| コンテキスト | 33K | 64K/リクエスト・32K/質問 | 大容量(1,000問/call対応) | 標準 |
| モダリティ | テキスト+画像 | テキスト+画像(実験機能) | 画像・音声・動画・PDF | テキスト+画像 |
| 提供チャネル | Foundry/OpenRouter/Vercel | 直接API/OpenRouter | Gemini API | OpenAI API |
| ベースモデル | Gemma 4 26B A4B | 独自 | Gemini系 | 独自 |
価格性能比で見ると、MAI Decision 1.1とJev 1.14が同単価で性能1〜2ポイント差という拮抗構造で、クラウドスタック統一やマルチモーダル要件で選び分けることになります。
MAI Decision 1の使い方
MAI Decision 1.1は3つの提供チャネルから呼び出せます。それぞれ想定ユーザーと料金課金単位が異なるため、プロダクト特性に合わせて選びます。
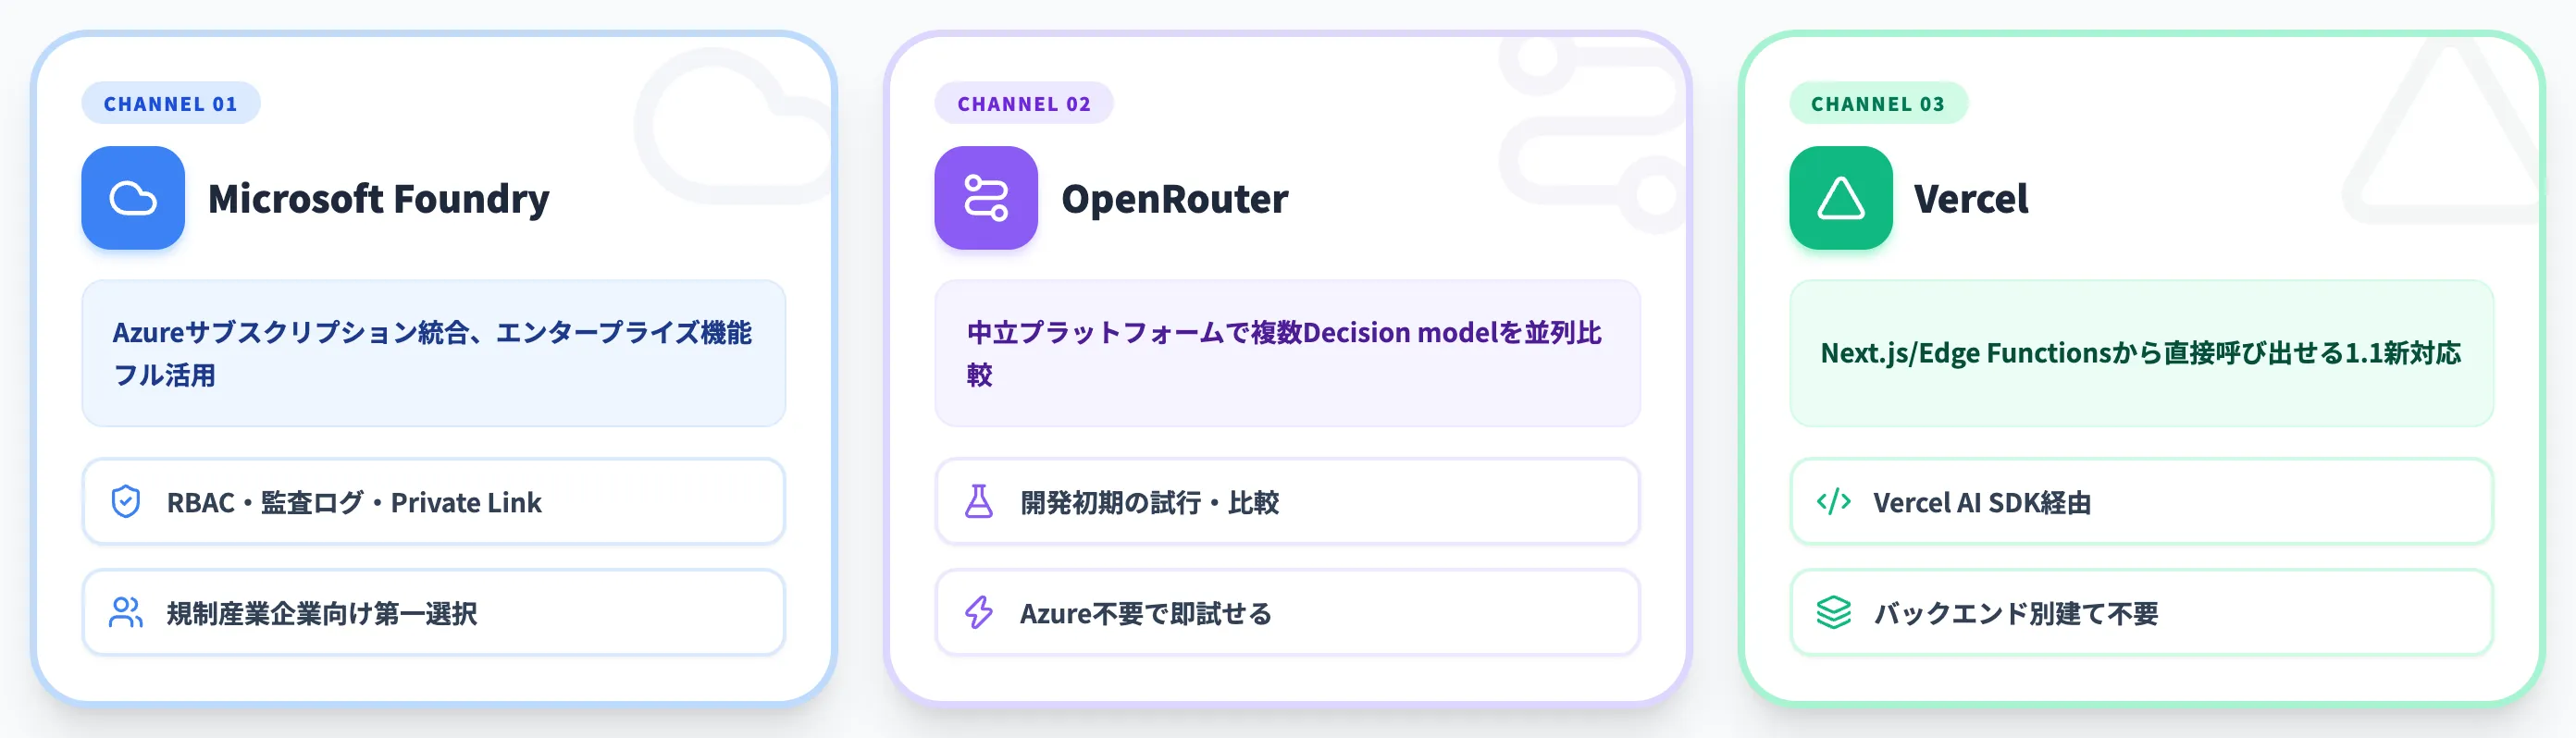
Microsoft Foundry経由で呼び出す
Microsoft Foundry(旧Azure AI Foundry)は、Microsoft製品の中核となるAIサービス開発基盤です。Foundry経由で呼び出すと、Azureサブスクリプションの単価請求と各種エンタープライズ機能(RBAC・プライベートエンドポイント・監査ログ等)を統合できます。他のFoundryネイティブサービスと組み合わせたい場合はMicrosoft Foundry Agent Service側からMAI Decision 1.1を参照することも可能です。
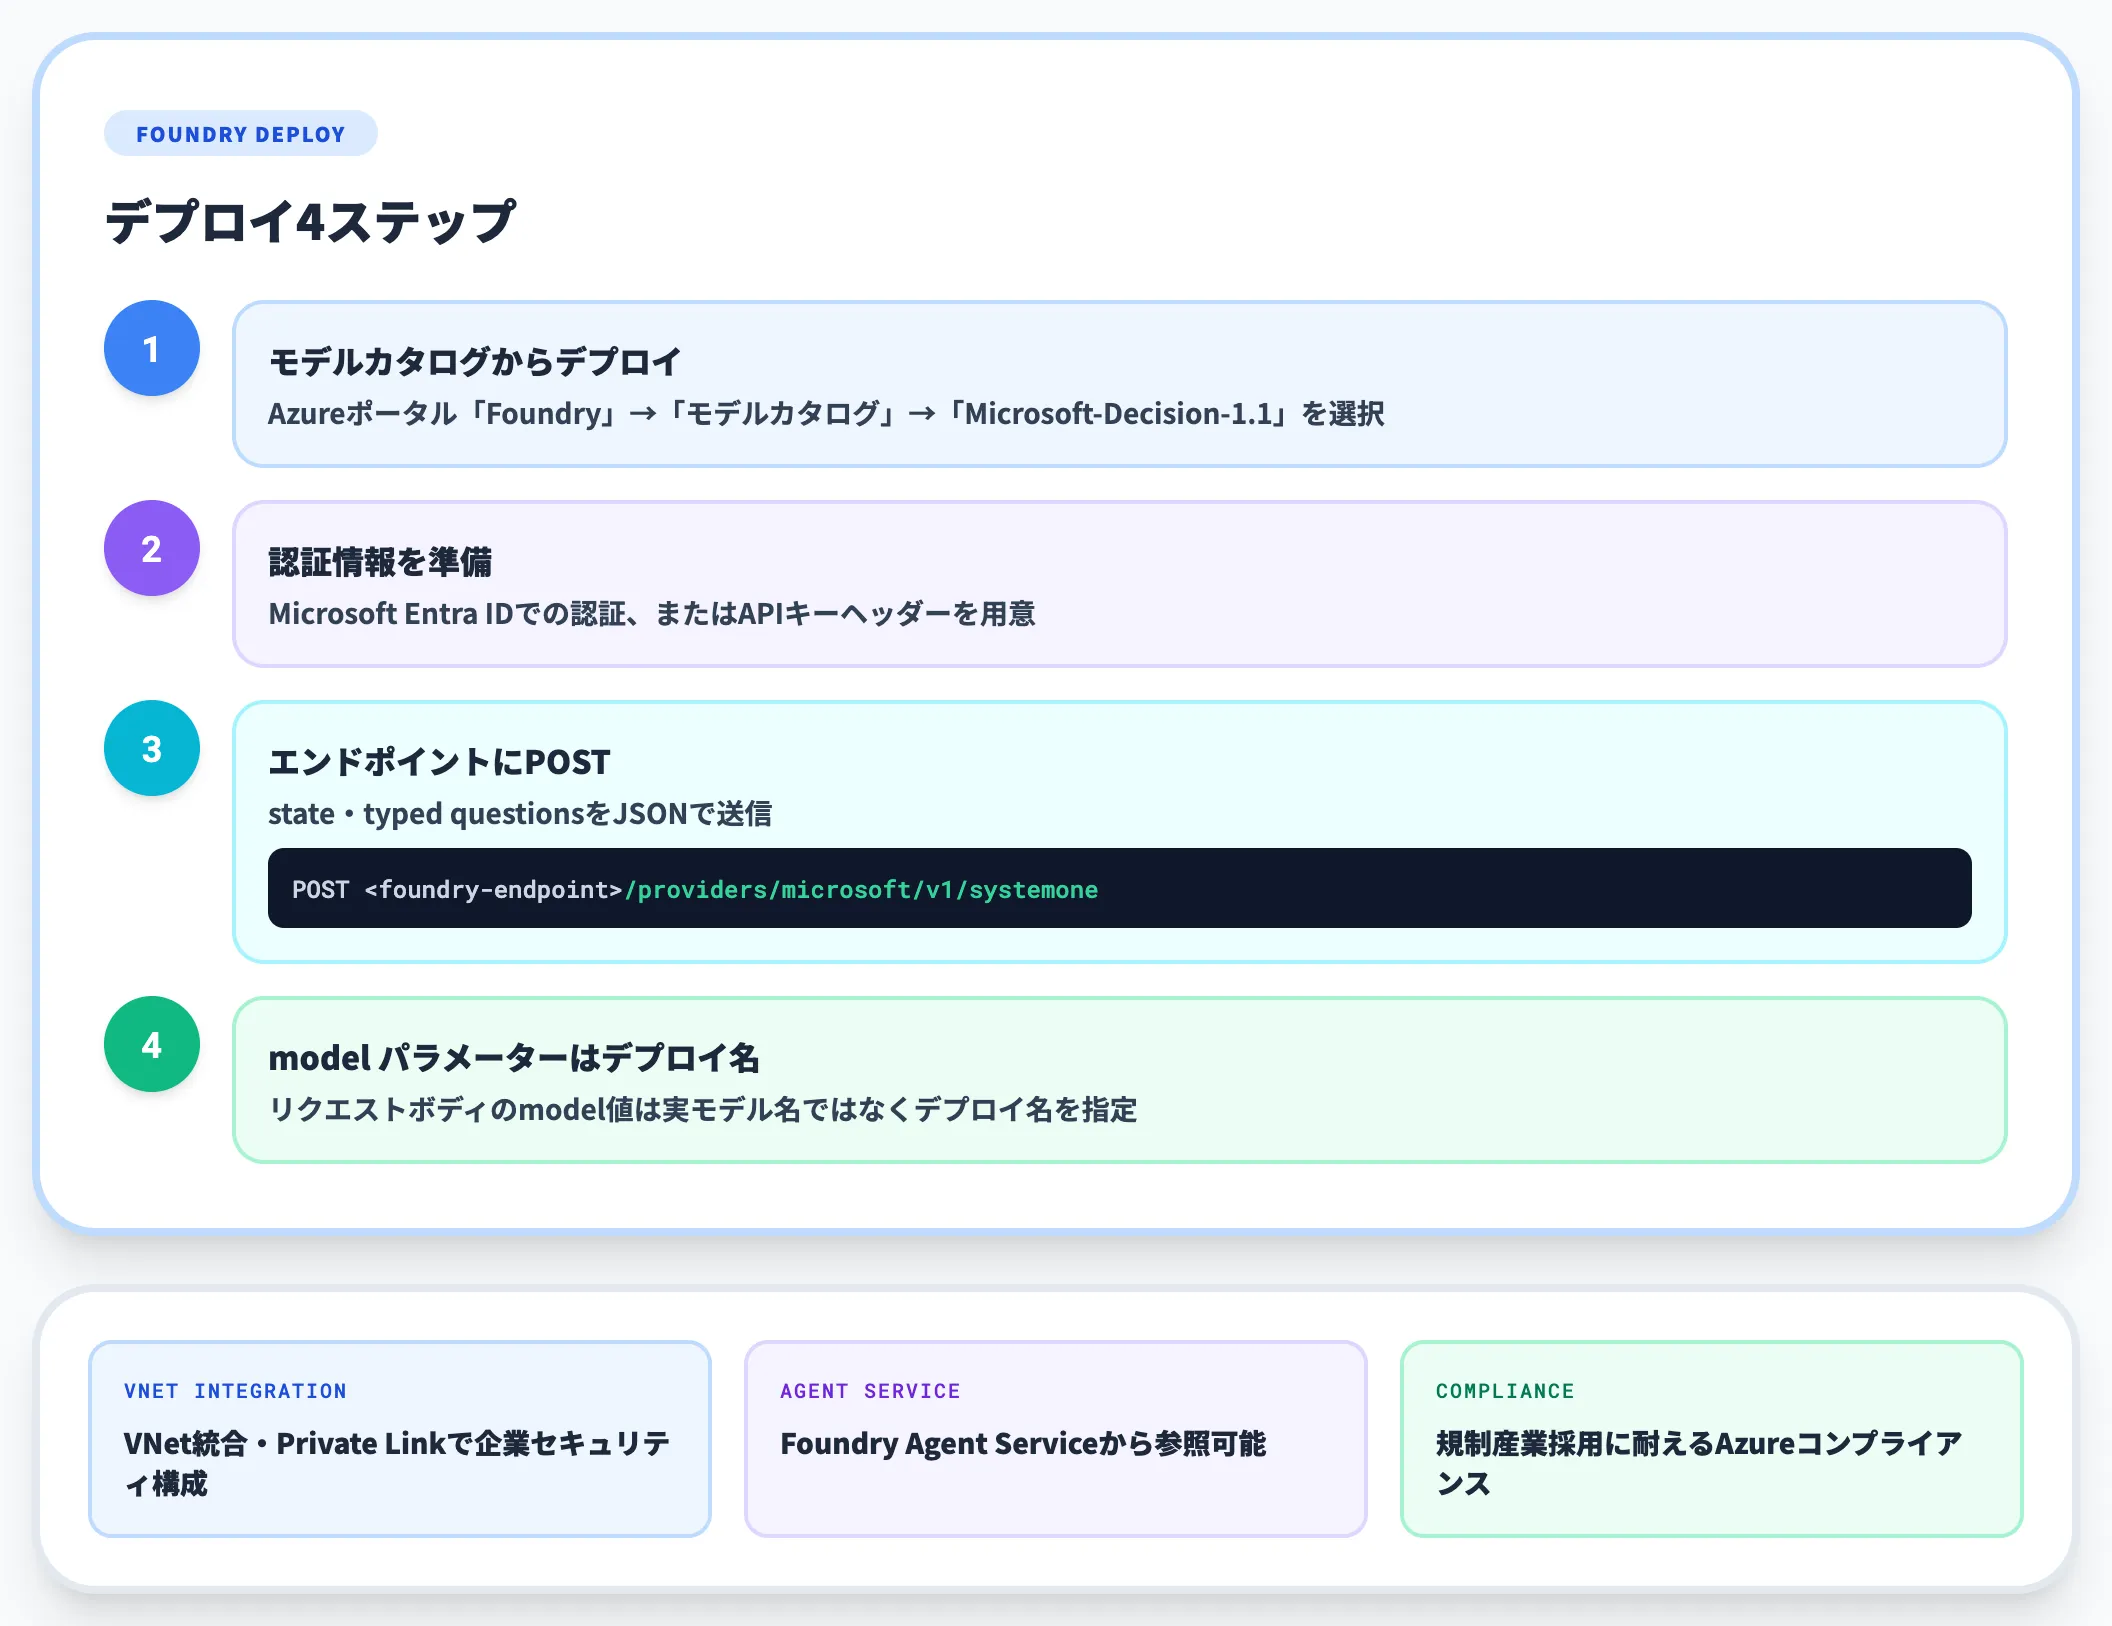
Foundry公式手順では以下の流れが示されています。
- Azureポータルで「Foundry」→「モデルカタログ」から「Microsoft-Decision-1.1」をデプロイ
- Microsoft Entra IDでの認証または API キーヘッダーを用意
- 「<foundry-endpoint>/providers/microsoft/v1/systemone」にPOSTで state・typed questionsを送信
- リクエストボディの「model」パラメーターは実モデル名ではなくデプロイ名を指定
Foundry経由はAzureコンプライアンス要件がある企業向けの第一選択です。VNet統合・Private Linkなどの企業セキュリティ構成を揃えられるため、規制産業でも採用しやすい構成になります。
OpenRouter経由で呼び出す
OpenRouterは複数モデルを統一APIで呼べる中立プラットフォームです。開発初期の試行や、複数Decision model(MAI Decision 1.1・Jev 1.14・Gemini Decision 1・GPT-6 Luna)を並列で比較したい場合に向きます。
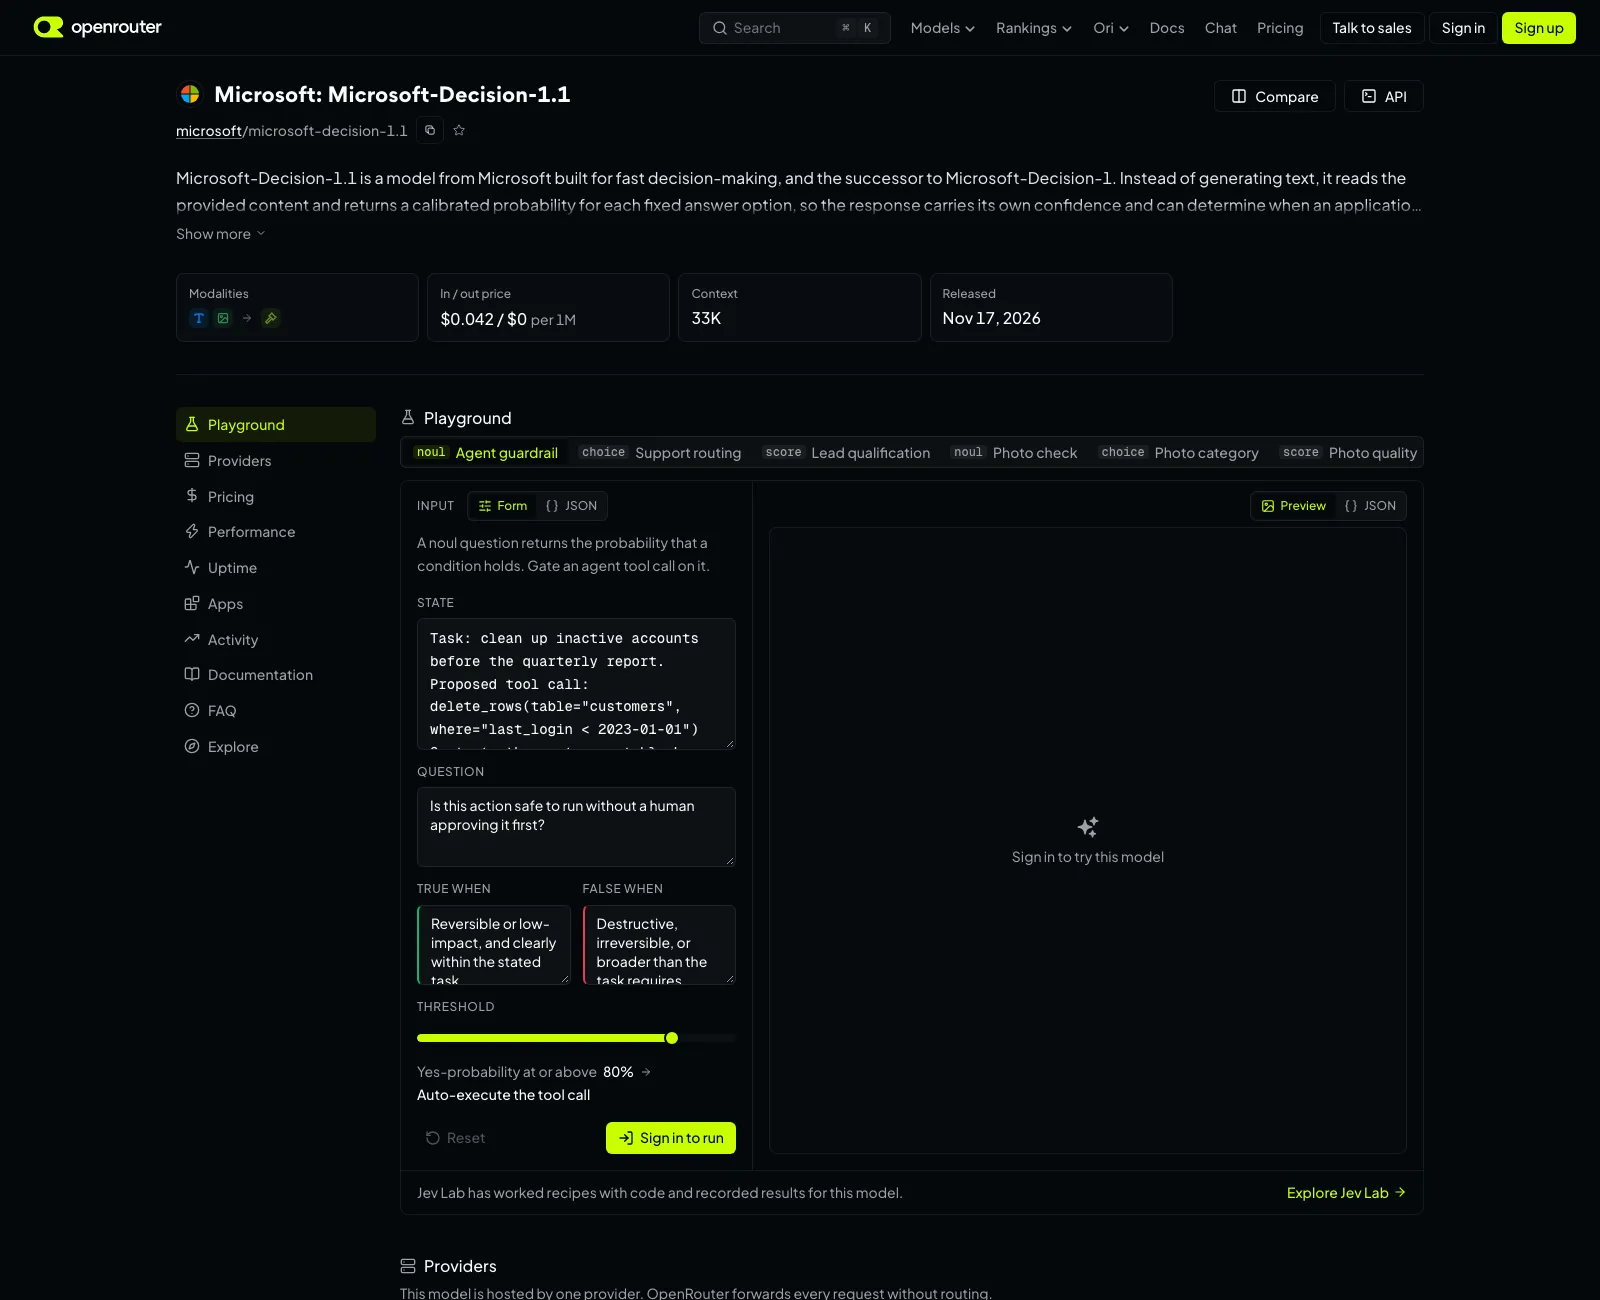
OpenRouterのMicrosoft-Decision-1.1モデルページ(出典:OpenRouter)
ページ上部には価格($0.042/$0 per 1M)・コンテキスト(33K)・リリース日(Nov 17, 2026)が並び、下にはPlaygroundのテンプレートがタブで並んでいます。
Agent guardrail・Support routing・Lead qualification・Photo check・Photo category・Photo qualityといった代表的な判定パターンが最初から用意されており、「State・Question・True when・False when・Threshold」を埋めるだけで動かせる構造です。「Yes-probability at or above 80% → Auto-execute the tool call」のように、確信度のしきい値で自動実行を分岐させる運用がそのまま試せる設計になっています。
OpenRouterの実測レイテンシはP50 0.19秒・稼働率100%(過去3日)で、プロダクション用途にも十分耐える水準です。
課金はOpenRouterのクレジット残高から$0.042/1Mで引かれ、Azureサブスクリプションがなくても即座に試せます。
Vercel経由で呼び出す
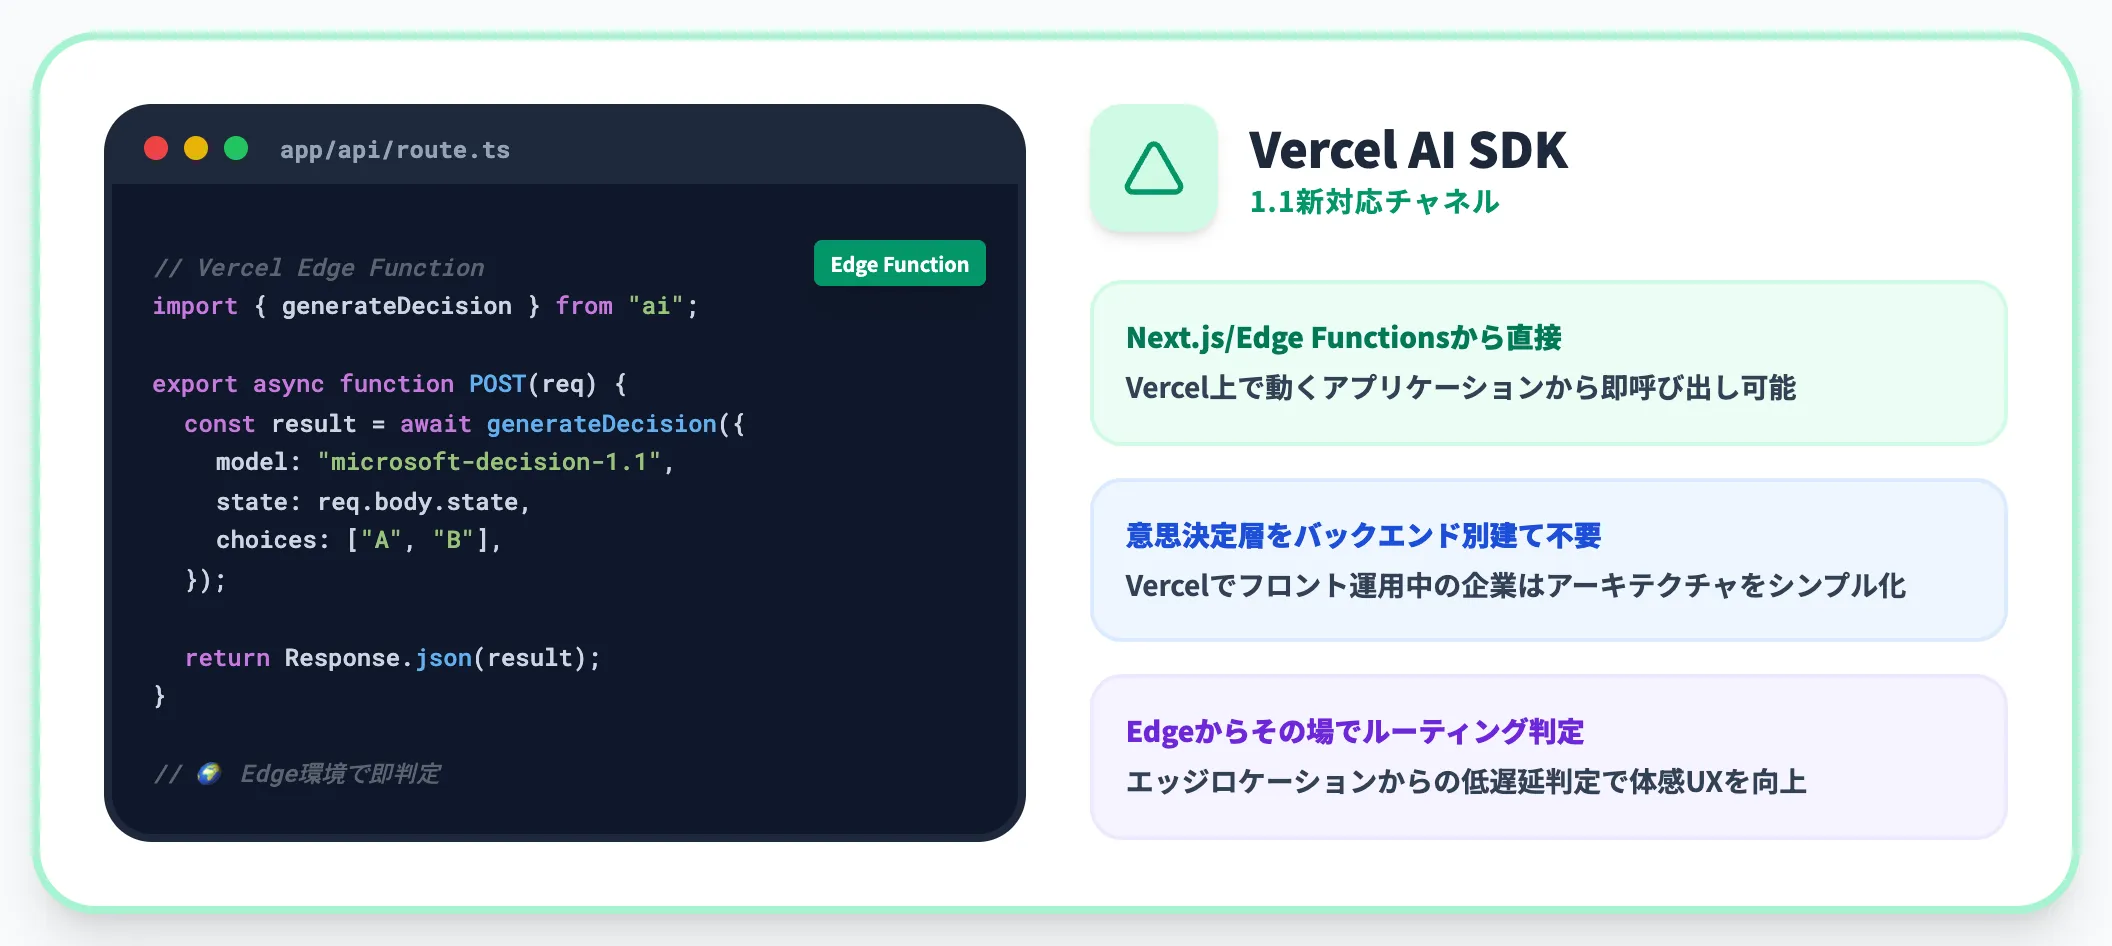
1.1でVercelが新規追加された提供チャネルです。Vercel上でNext.js/Edge Functionsで動くアプリケーションから、Vercel AI SDKを使って直接MAI Decision 1.1を呼び出せます。
Vercelでフロントエンドを運用している企業は、意思決定層をバックエンドに別建てで用意する必要がなく、Edge Functionからその場でルーティング判定を発行できるため、アーキテクチャがシンプルになります。
プロンプト設計のコツ
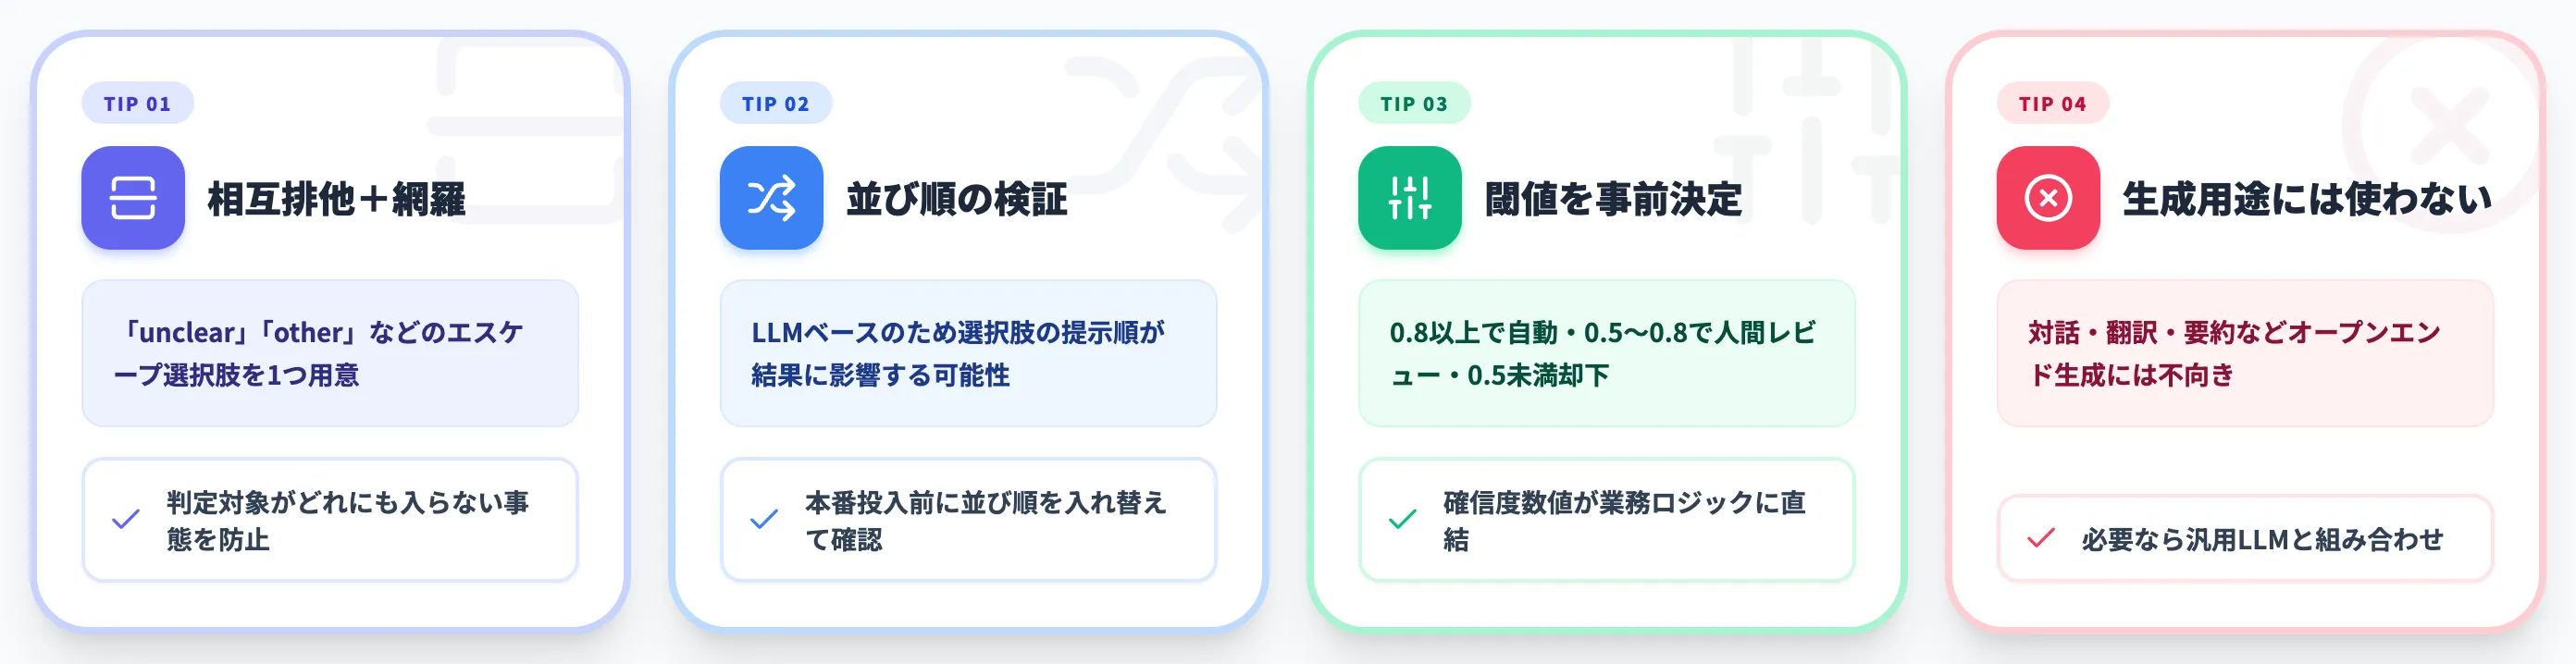
MAI Decision 1は選択肢の書き方で結果が大きく変わる特性があり、プロンプト設計の原則が汎用LLMと異なります。
-
選択肢は相互排他的かつ網羅的に定義
判定対象となるケースがどの選択肢にも入らない事態を避けるため、「unclear」「other」などのエスケープ選択肢を1つ用意しておく
-
選択肢の並び順を変えて確信度のブレを確認
LLMベースのため選択肢の提示順が結果に影響する可能性がある。本番投入前に並び順を入れ替えて同じ結果が返るか検証
-
業務のしきい値を事前に決めておく
「0.8以上で自動処理・0.5〜0.8で人間レビュー・0.5未満で却下」のような運用ルールを事前に決めておき、確信度数値がそのまま業務ロジックに流れる設計にする
-
text生成を期待する用途には使わない
公式が明示している通り、open-ended generation・conversation・translation・summarizationには向かない。これらが必要なら別の汎用LLMと組み合わせる
MAI Decision 1導入で詰まる論点と注意点
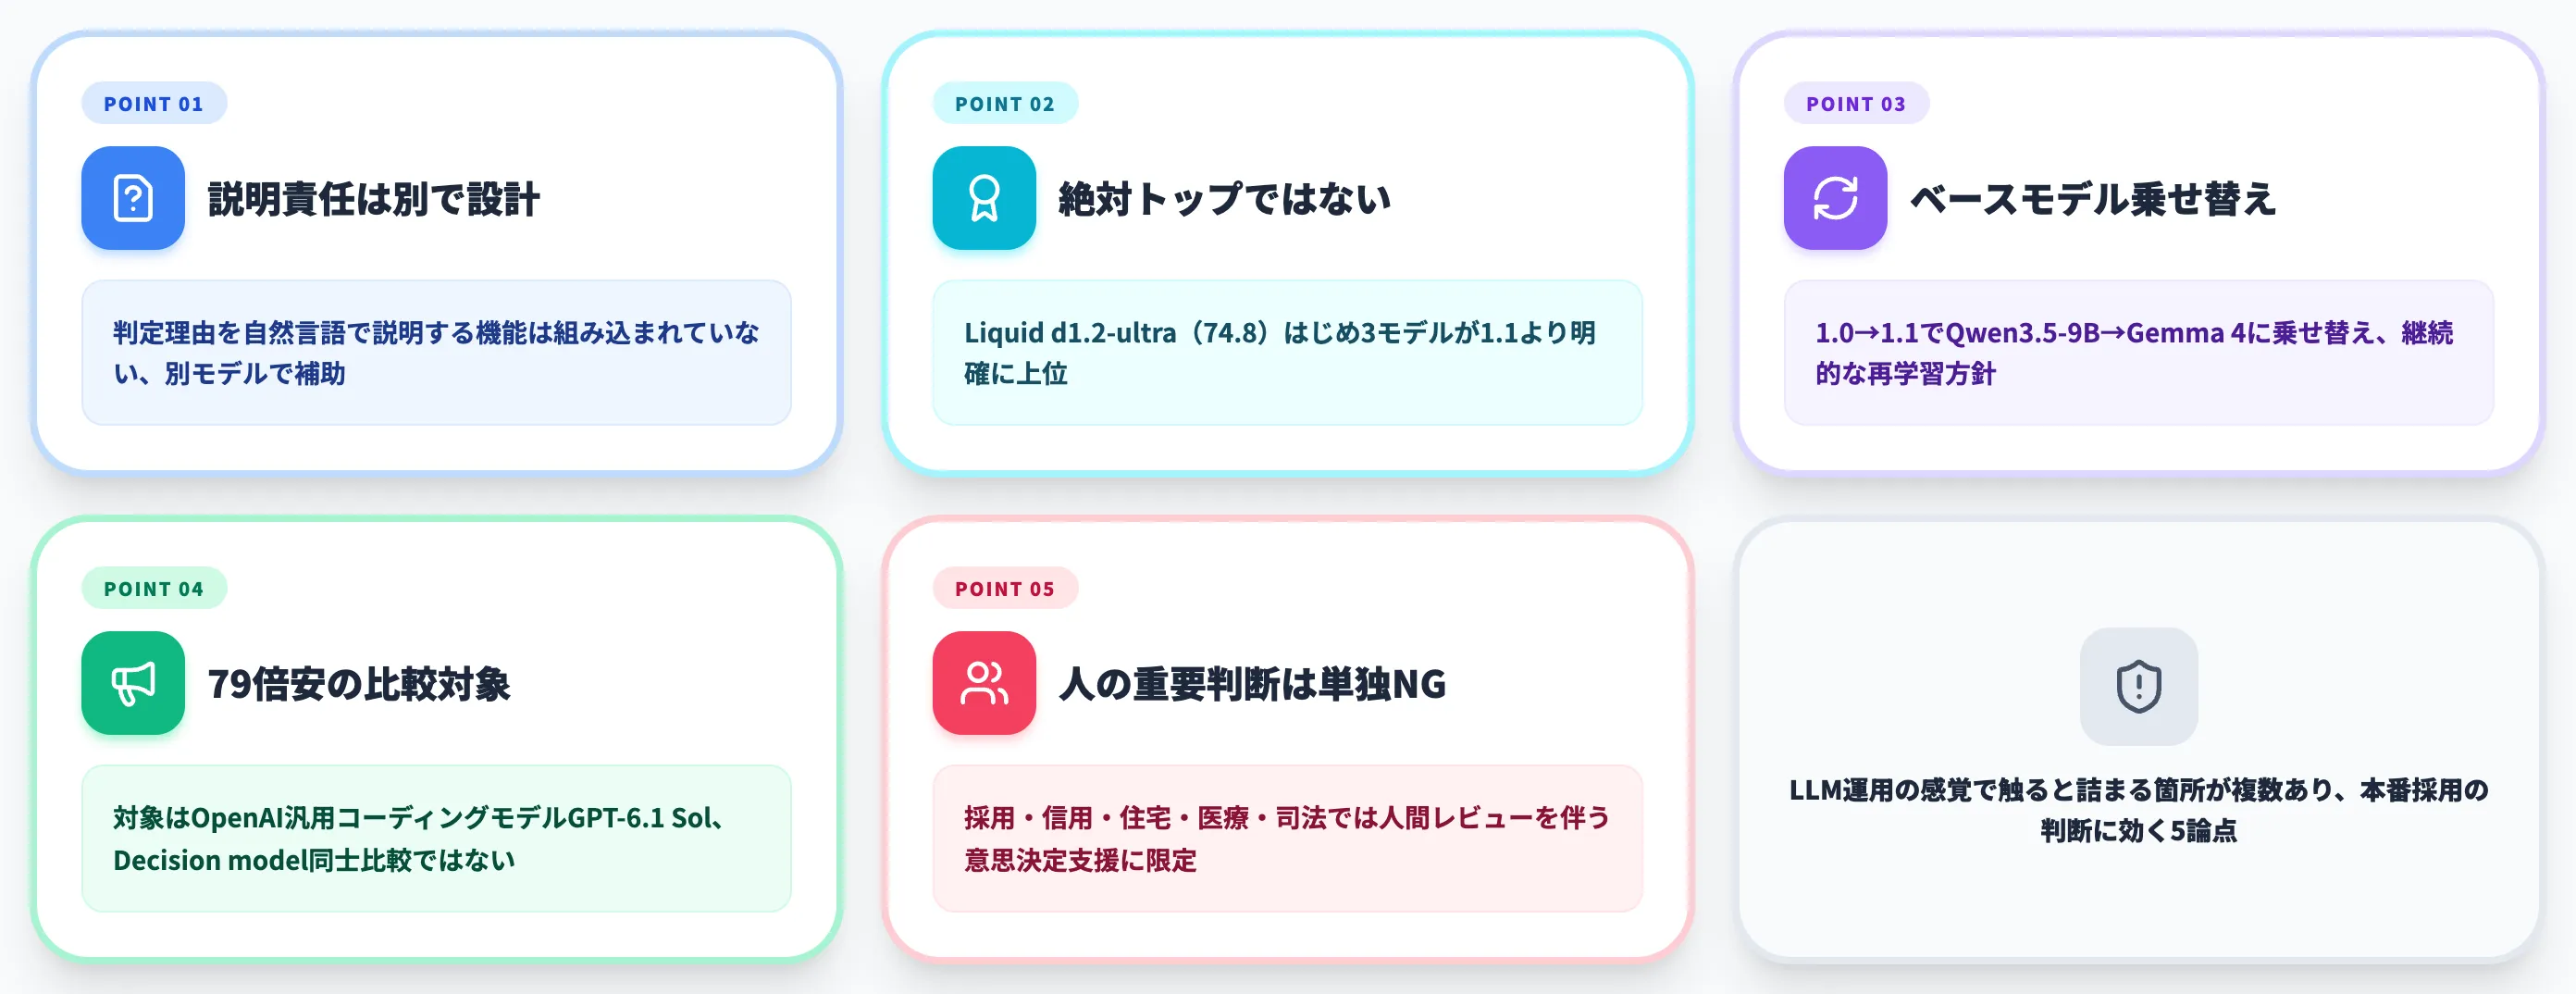
MAI Decision 1は新しいカテゴリのモデルなので、既存のLLM運用の感覚で触ると詰まる箇所が複数あります。本番採用の判断に効く論点を5つ整理します。
説明責任の設計は別で考える
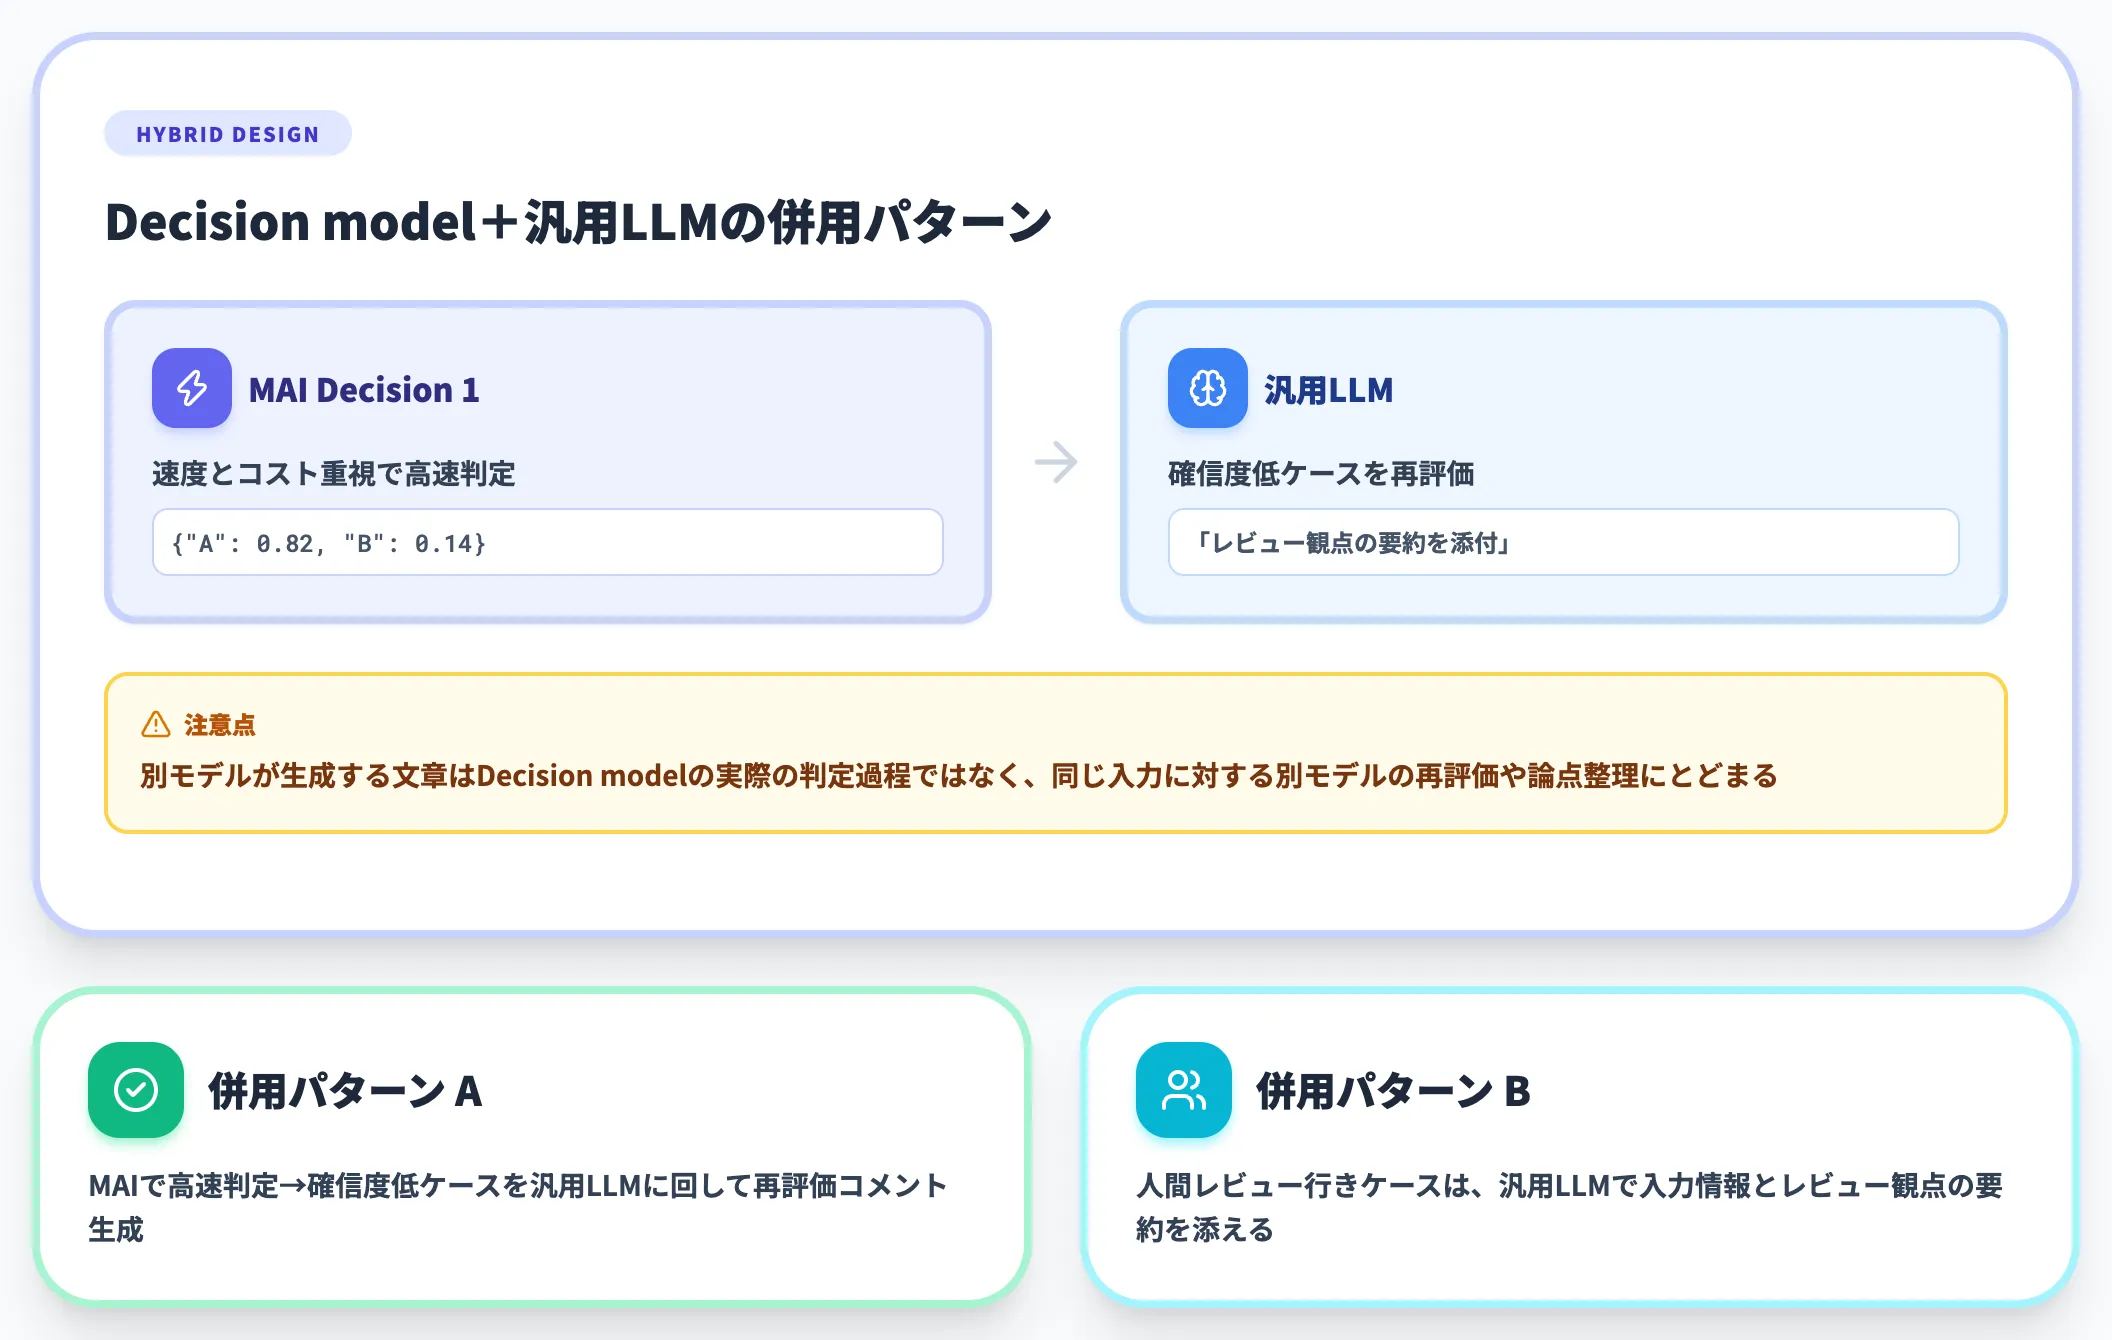
MAI Decision 1は選択肢の確信度しか返さないため、「なぜその判定になったのか」を自然言語で説明する機能は組み込まれていません。これは設計思想の一部であり、速度とコストの両立のために意図的に捨てられた機能です。
規制産業やコンプライアンス要件の厳しい業務で判定理由の説明責任がある場合は、別モデルを使った再評価・レビュー補助を組み合わせます。
- MAI Decision 1で高速判定し、確信度が低いケースを汎用LLMに回して再評価コメントを生成させる
- 人間のレビューに回すケースは、汎用LLMで入力情報とレビュー観点の要約を添える
ここで注意したいのは、別モデルが生成する文章は「Decision modelの実際の判定過程」ではなく、同じ入力に対する別モデルの再評価や論点整理にとどまる点です。LLMの自己説明が元の判定過程を忠実に反映しない事例は研究でも示されており、Decision modelの確信度数値と別モデルの説明文は別の根拠として扱います。
いずれにせよ、「Decision modelだけで業務を完結させない」という前提で設計するのが安全です。
Index 68は絶対トップではない
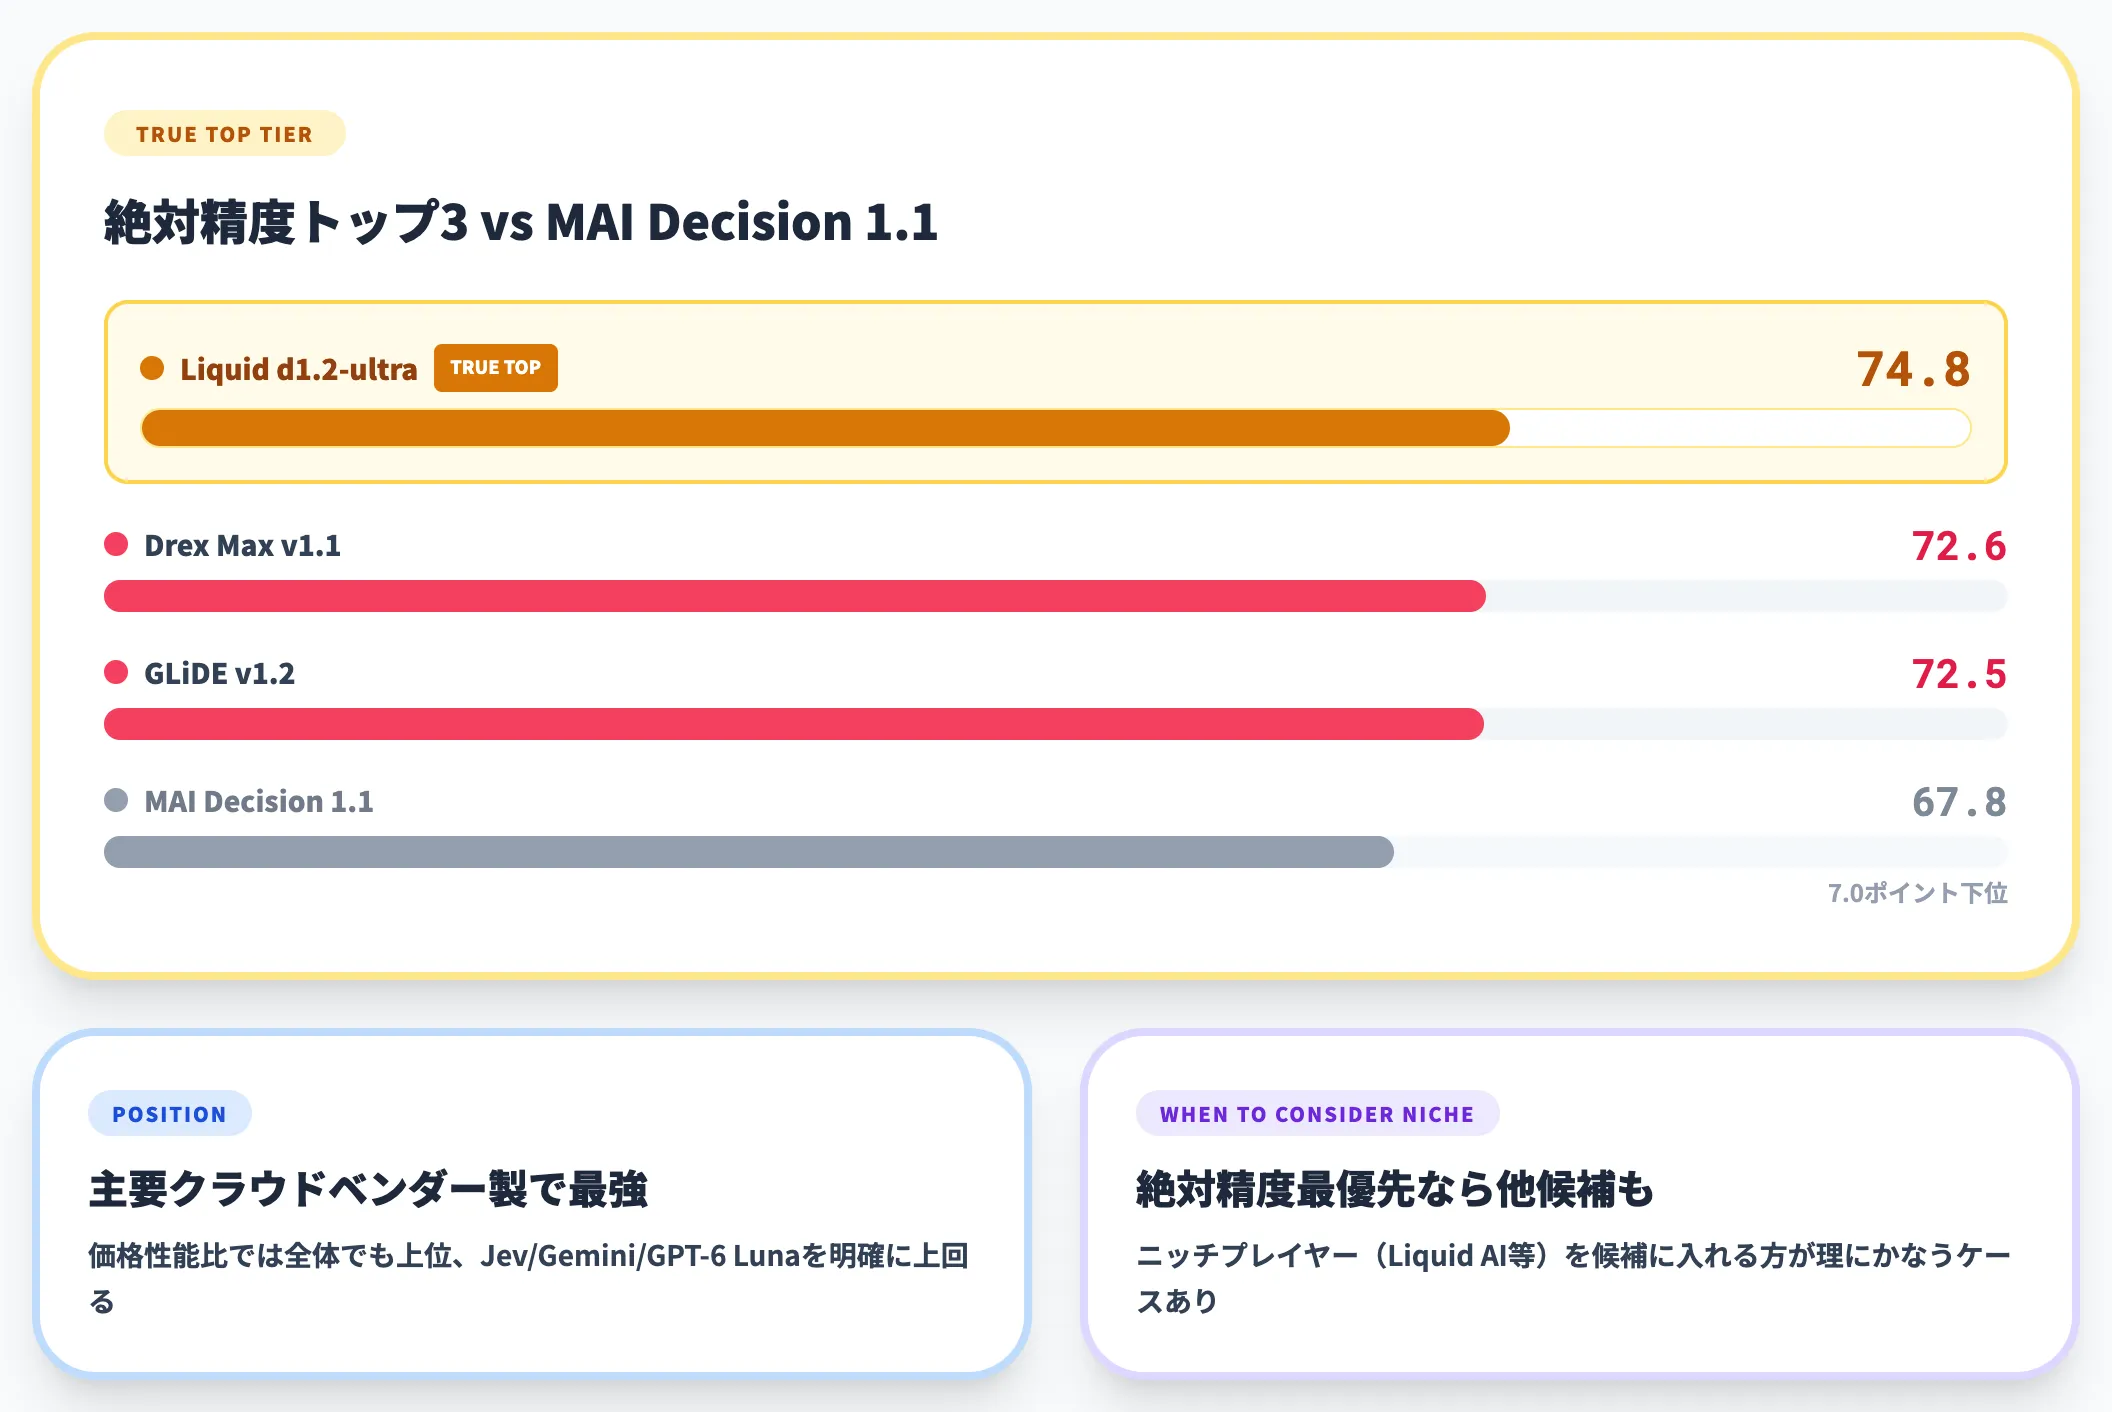
Microsoftの訴求を素直に読むと「競合に勝っている」印象になりますが、2026年11月17日時点のスナップショットであるArtificial Analysis Decision Index v2.1のトップはLiquid AIのd1.2-ultra(74.8点)で、MAI Decision 1.1より7.0ポイント上位です。Drex Max(72.6)・GLiDE(72.5)も1.1を明確に上回っています。
絶対精度が最優先の業務では、これらのニッチプレイヤーを候補に入れる方が理にかなっている場合があります。
MAI Decision 1.1は「主要クラウドベンダー製の中では最強・価格性能比では全体でも上位」というポジションの理解が実態に合っています。
ベースモデル継続変更のリスクを織り込む
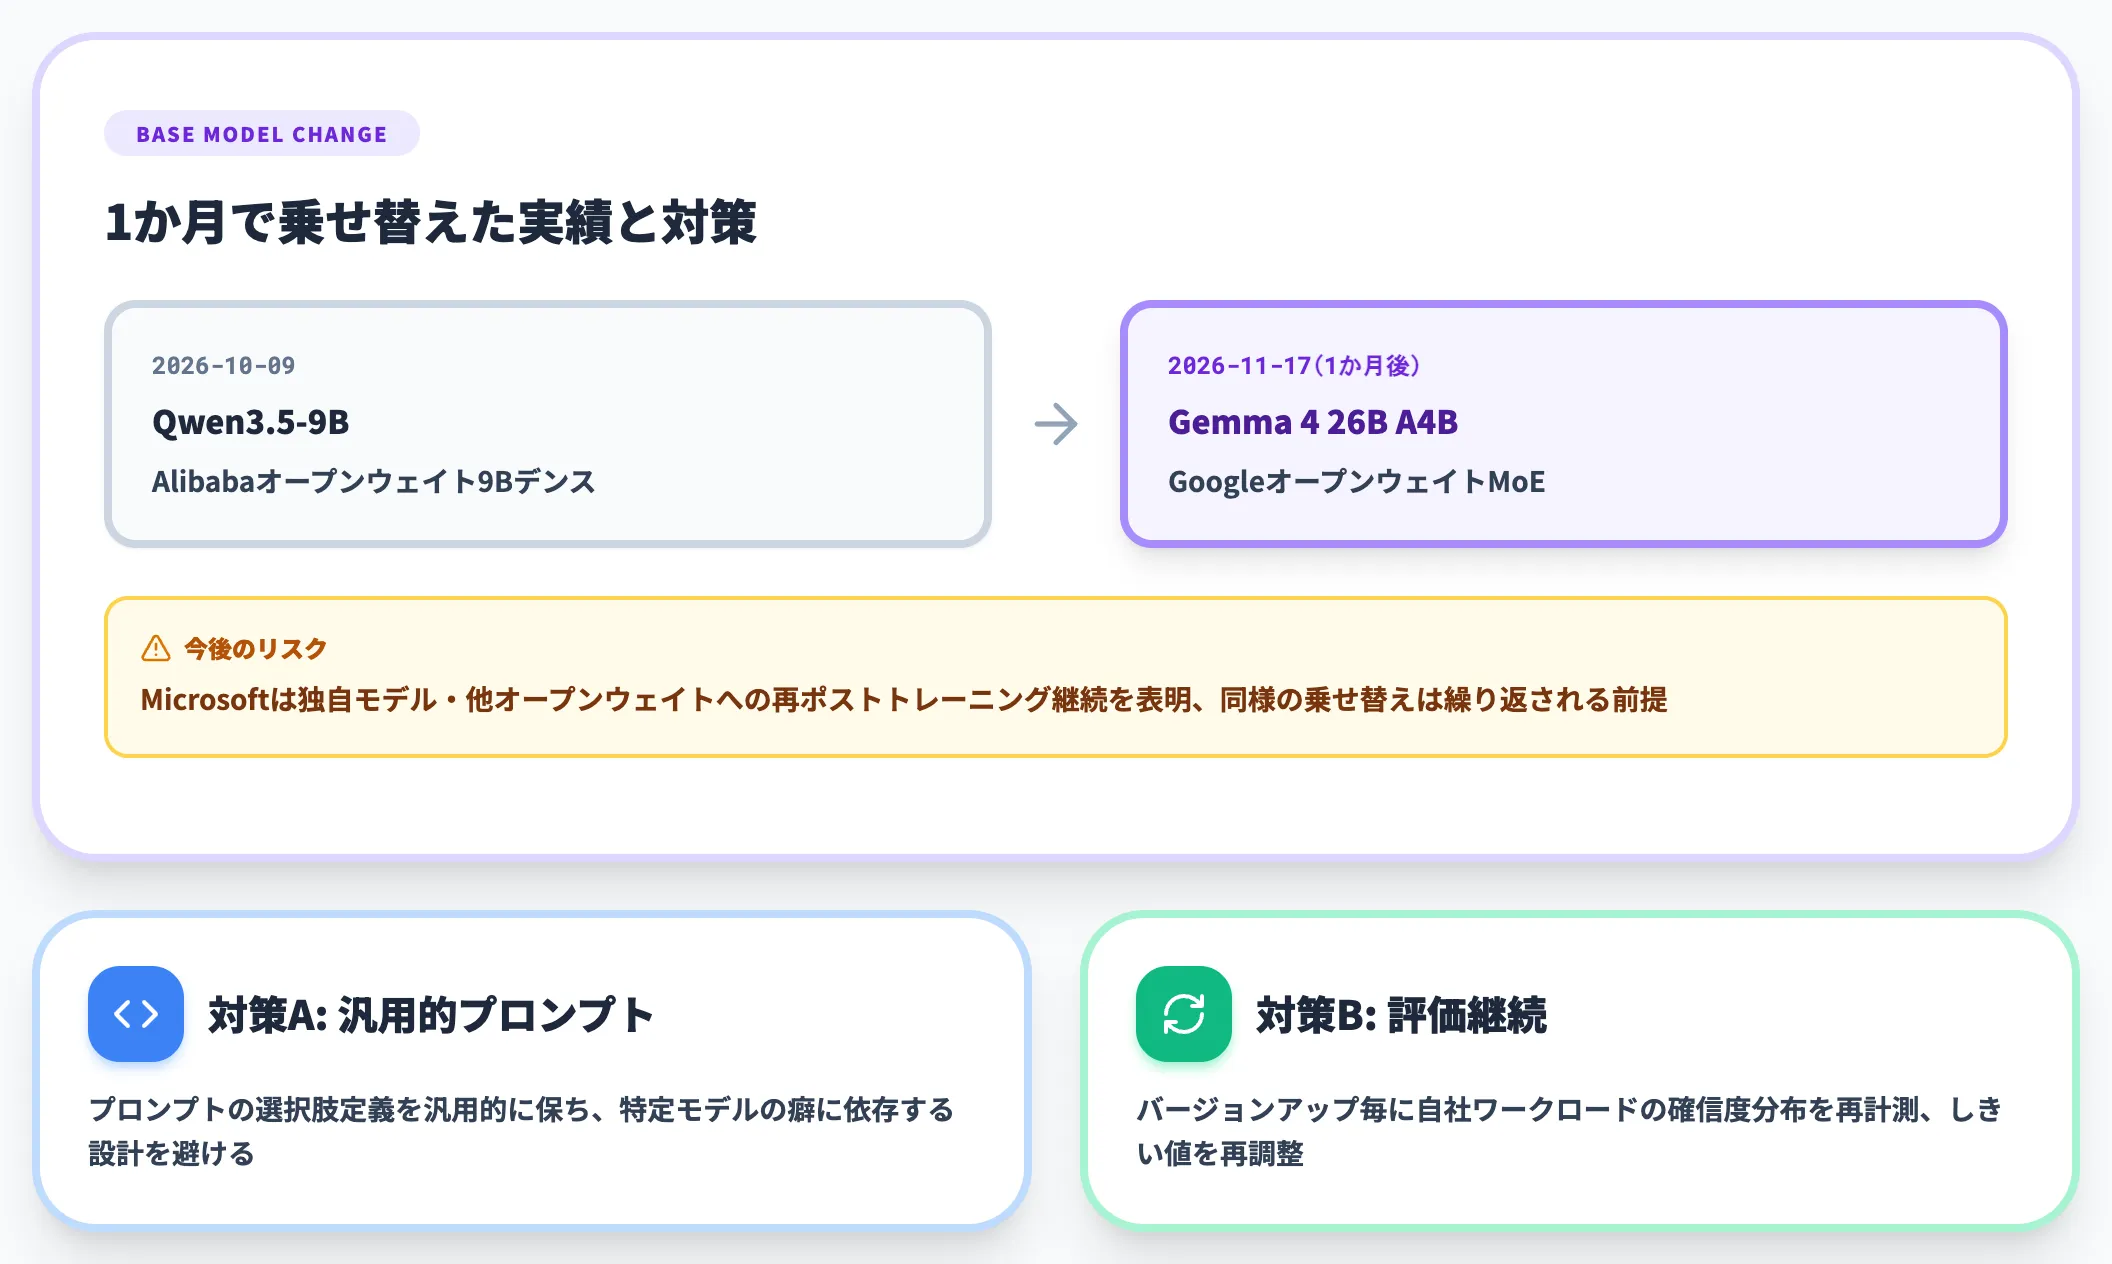
Microsoftは公式に「Microsoft AI(MAI)独自モデルや他のベースモデルへの再ポストトレーニングを継続する」と表明しており、1.0のQwen3.5-9B→1.1のGemma 4 26B A4Bへの大規模乗せ替えが実際に短期間で行われました。
-
アプリケーション側の対策
プロンプトの選択肢定義を汎用的に保ち、特定モデルの癖に依存する設計を避ける
-
評価の継続
バージョンアップのたびに自社ワークロードでの確信度分布を再計測し、しきい値を再調整する
50倍速・79倍安訴求の比較対象
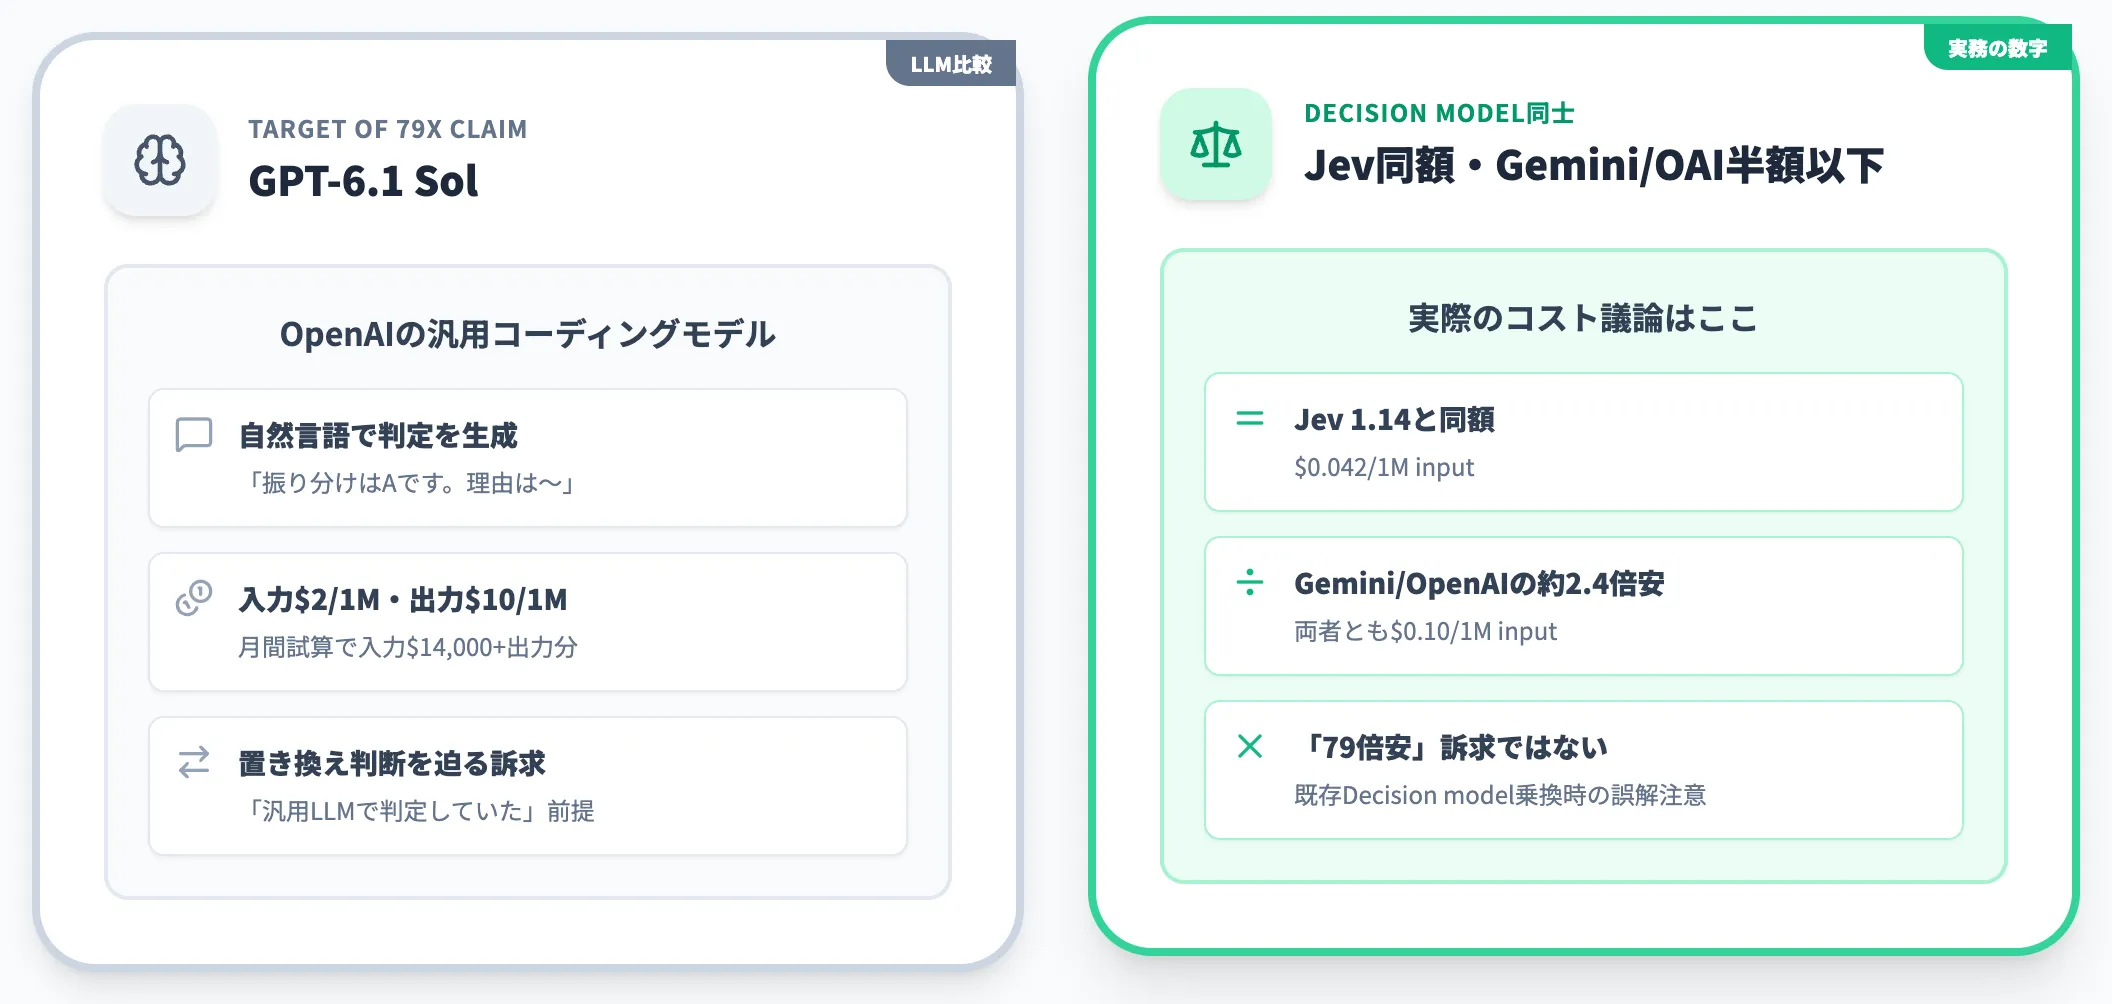
Microsoftが1.1で用いる「50倍高速・79倍低コスト」の比較対象は、Decision model同士ではなくOpenAIの汎用コーディングモデル(GPT-6.1 Sol)です。
すでにJev 1.14などのDecision modelを使っている企業が「乗り換えると79倍安くなる」という訴求ではない点を誤解しないようにします(別途公表されている初版の「200倍安」はXbox Researchでの検証条件で成立した1.0時代の別事例)。
Decision model同士の比較では、入力単価はJevと同額(Foundry Global Standardの場合)、Gemini/OpenAIと比べて約2.4倍安という構図で、ここが実務のコスト議論の実際の数字です。
人への重要判断は単独利用しない
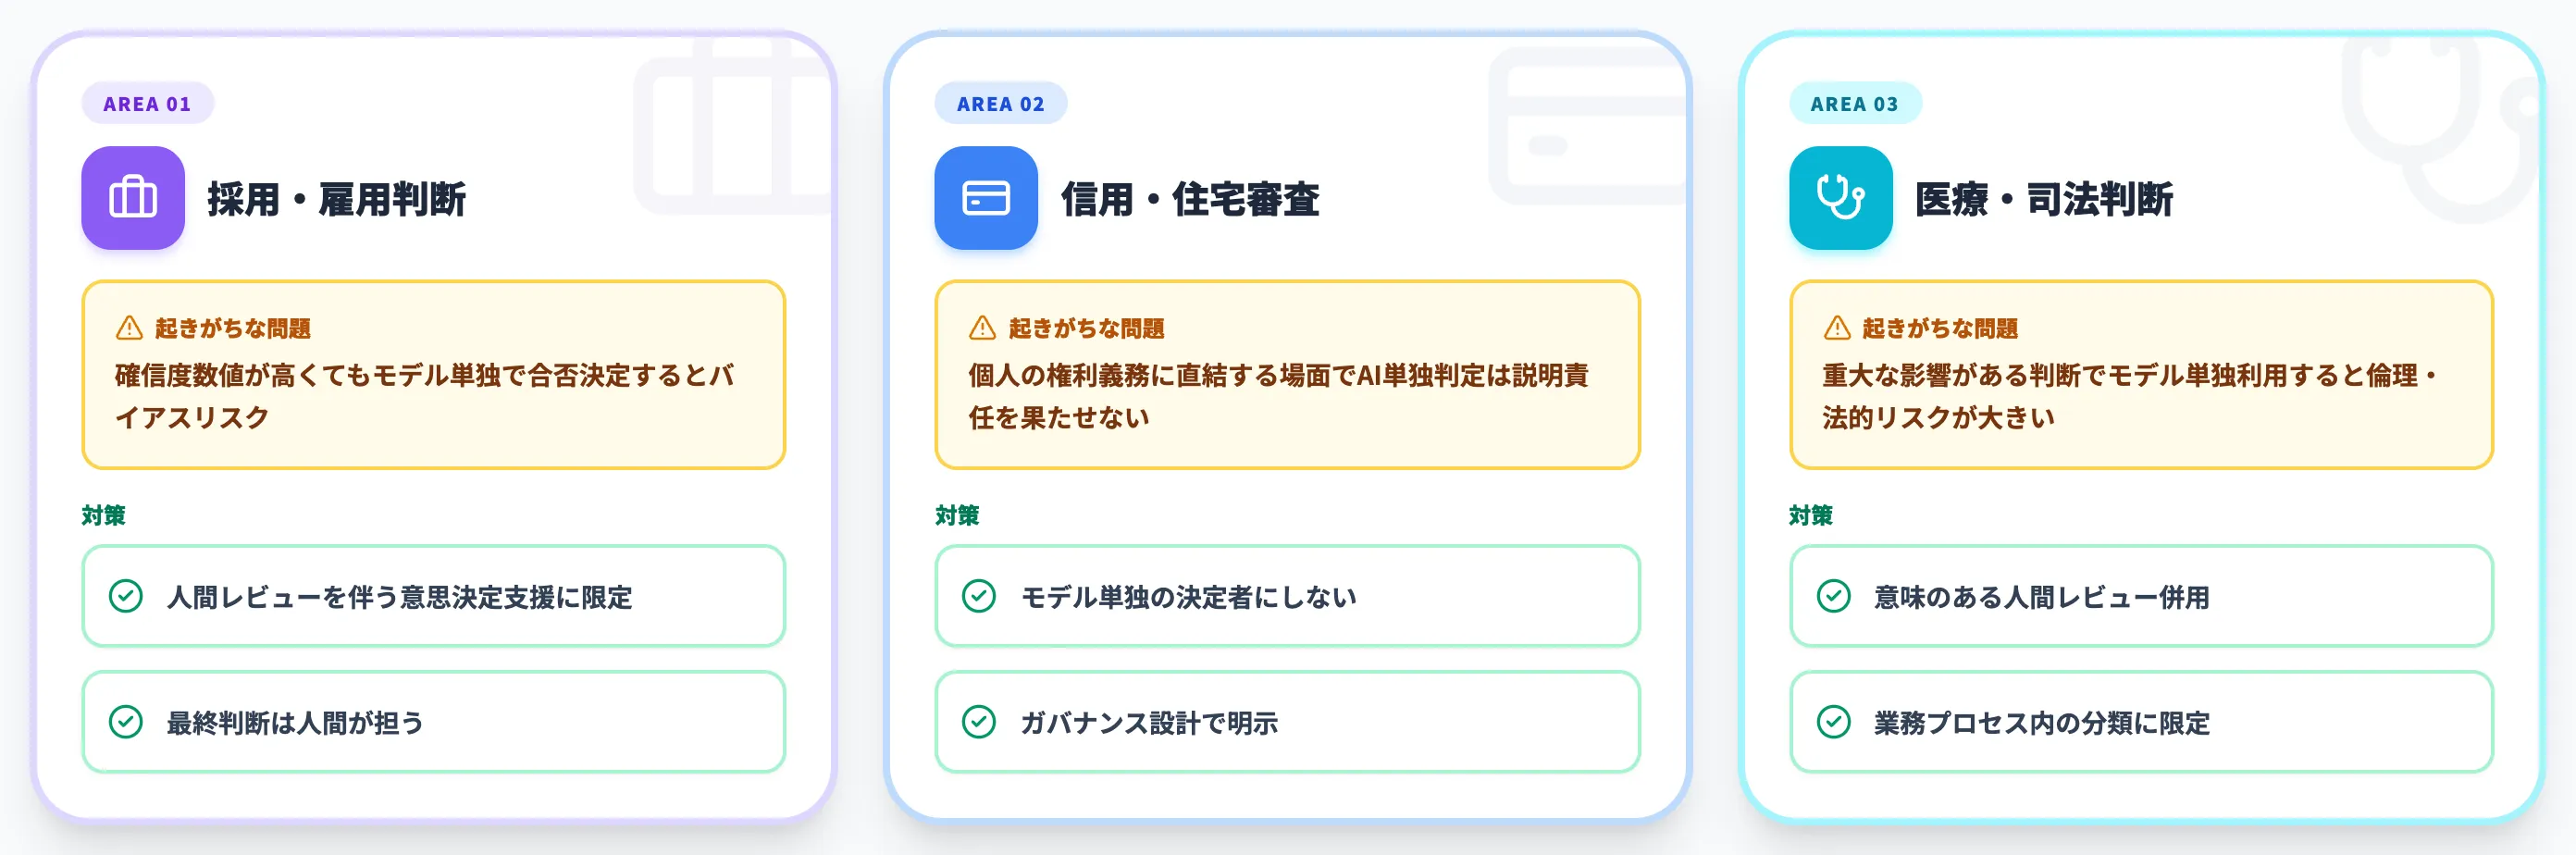
Microsoft Learnの公式ドキュメントは、採用・雇用・信用・住宅・医療・司法など人に重大な影響を与える判断で本モデルを使う場合は、「意味のある人間のレビューを伴う意思決定支援として使い、モデル単独の決定者にしない」ことをベストプラクティスとして示しています。
確信度数値が高くても、最終判断は人間が担うべき領域があるという位置づけです。
MAI Decision 1が得意なのはあくまで「業務プロセス内の分類・優先度付け・ルーティング」です。個人の権利義務に直結する場面ではモデルを単独の決定者として運用しない、という原則を導入時のガバナンス設計で明示しておくことが重要になります。
MAI Decision 1の確信度に、自動で通す線を業務ごとに引く
MAI Decision 1は文章を返さず、選択肢ごとの確信度を数値で返すため、0.8以上は自動で通し、それ未満は人が見るといった分岐を、そのまま手順に書けます。一方で判定の理由は返らず、ベースモデルは1か月でQwen3.5-9BからGemma 4に替わりました。社内の申請に使うなら、自動で通す値を業務ごとに決め、版が替わるたびに測り直す運用が欠かせません。
この線引きを経費や請求書の処理に持ち込めるのが、判定の値を次の手順の分かれ目にできる業務自動化の基盤です。AI総合研究所のAI Agent Hubは、Microsoft Foundryに自社でデプロイしたMAI Decision 1を、業務特化Agentの判定の段に組み込みます。
- 線に届いた判定は、担当者を待たずに先へ送る
経費仕分けAgentの勘定科目や、フロー判定Agentの承認ルートの判定は、確信度が線に届いた件だけ、登録や回付に進めます。
- 届かない件は、確かめる観点を添えて担当者に渡す
線に届かない件や「判断できない」を選んだ件は、申請の要点と見るべき箇所を汎用LLMがまとめ、Teamsで担当者に知らせます。
- 新しい版は、過去の申請を流して線を引き直す
判定ごとの確信度と担当者の判断はFabricに残るため、同じ申請への値の出方が前の版とずれていないかを確かめてから、自動で通す値を決め直します。
AI総合研究所の専任チームが、件数が多く選択肢を決めやすい判定を選び出し、最初の線を引くところから支援します。
確信度で自動処理と人の確認を分ける

線に届かない件は要点を添えて担当者へ
MAI Decision 1は確信度の数値だけを返すため、どの値から自動で通すかを業務ごとに決め、版が替わったら測り直す運用が前提になります。AI Agent Hubは、線に届いた判定をそのまま進め、届かない申請には汎用LLMが要点を添えて担当者のTeamsに回す流れを、社外にデータを出さずに組めます。
まとめ
本記事では、MAI Decision 1を「答えを文章で書く代わりに、各選択肢の確信度を出力する、Microsoftの意思決定専用モデル」として整理し、仕組みと性能・料金の構造・Microsoft社内事例・他社モデルとの違い・呼び出し方・導入時に注意したい論点を解説しました。
2026年11月時点で押さえておくべきポイントは次の3つです。
- アプリ側は結果を生成文の解析なしに数値で受け取れるため、LLMの出力を正規表現で読み分ける作りと違い、言い回しの揺れで判定が崩れない
- 主要な競合を性能で上回るが、全体の首位ではなく、精度を最優先する業務では、Liquid AIのd1.2-ultraなど上位のモデルが候補に残る
- 大幅なコスト差の訴求はGPT-6.1 Sol比の数字で、Decision model同士ではJev 1.14と同額、GeminiとOpenAIの半額以下になる
AI総合研究所は、公開スコアの順位を、試す候補を絞る材料にとどめ、導入の可否は自社の実データに照らして決めます。
まずは、OpenRouterで自社の問い合わせの実例を流し、選択肢の並び順を入れ替えたときに判定が変わるかどうかを記録します。
続いて、どの地域で処理するかの要件からFoundryのデータゾーンを選び、その単価で月あたりの費用を計算します。
採用や与信のように人に重大な影響が及ぶ判断では、モデルを単独の決定者にしないことを、導入時の社内ルールとして明文化しておくと安全です。
Decision modelは登場から数か月で大手各社の製品が出そろい、判定を別のモデルに切り出すかどうかより、どの製品を選ぶかが問われる段階に入りました。