この記事のポイント
 2026年の全社CapExはAlphabet $195〜205B・Microsoft約$170B・Amazon約$220B・Meta $135〜145Bで合計約$730B規模、AI向け割合は各社が別途説明
- カスタムAIシリコン(AWS Trainium 3・Google TPU Ironwood・Microsoft Maia 200)はNVIDIA依存を下げる一方、captive silicon化で自社クラウド囲い込みに直結
- 市場シェアはSynergy Research Q3 2026でAWS 26%・Azure 19%・GCP 16%(合計61%・市場規模$167.7B・+55% YoY)、GoogleはQ4 2024の12%から7四半期で+4ptと伸長
- OpenAIは2026年4月27日のMicrosoft契約改定でAzure排他が解消され3クラウドで提供可、Anthropicは2023年のGoogle Cloud提携を起点に3社+NVIDIAの多重体制に拡大
- 日本の実務解はワークロード単位の分散配置で、Neocloudの単価優位・さくらONE H200/B200等の国産GPU基盤・2026年3月のガバメントクラウド正式認定が追い風になっている
Microsoft MVP・AIパートナー。LinkX Japan株式会社 代表取締役。東京工業大学大学院にて自然言語処理・金融工学を研究。NHK放送技術研究所でAI・ブロックチェーンの研究開発に従事し、国際学会・ジャーナルでの発表多数。経営情報学会 優秀賞受賞。シンガポールでWeb3企業を創業後、現在は企業向けAI導入・DX推進を支援。
ハイパースケーラーとは、世界規模でデータセンターを運営し、膨大な計算資源とストレージを従量課金で提供する超大型クラウド事業者を指します。代表格はAWS、Microsoft Azure、Google Cloudの3社で、ここにOracle・Meta・Alibaba等が続きます。
2026年は4社合計で全社CapExが$730B規模に達し、独自AIチップの量産とAIラボ提携の再編が同時に進む、クラウド産業の構造が大きく動いている年です。
本記事では、ハイパースケーラーの定義から3社の市場シェア、2026年の設備投資規模、カスタムAIシリコンの展開状況、OpenAI・Anthropicとの提携関係、Neocloud・ソブリンクラウドとの使い分け、そして日本企業がハイパースケーラーを採用する際の判断軸までを、2026年10月時点の最新情報で解説します。
目次
ハイパースケーラーとは?世界規模のクラウド基盤を運営する超大型事業者
「ハイパー」が指す規模感——世界で数百万台のサーバーを束ねる水準
ハイパースケーラー3社の市場シェアと2026年の設備投資規模
Q3 2026の市場シェア——AWS 26%・Azure 19%・GCP 16%
AWS Trainium 3——TSMC 3nm・144GB HBM3e、2025年12月GA
Google TPU Ironwood(v7)——4,614 FP8 TFLOPS、2025年11月GA
Microsoft Maia 200——TSMC 3nm・216GB HBM3e、2026年1月発表
OpenAI——AWS/Oracle拡大と2026年4月のMicrosoft排他解消
Anthropic——2023年のGoogle提携から3社+NVIDIA体制へ
ハイパースケーラーとNeocloud・ソブリンクラウドの使い分け
ハイブリッド運用——訓練はNeocloud、本番はハイパースケーラーという構成例
日本企業の選定ステップ——Japan Eastリージョンとガバナンス優先
ハイパースケーラーとは?世界規模のクラウド基盤を運営する超大型事業者
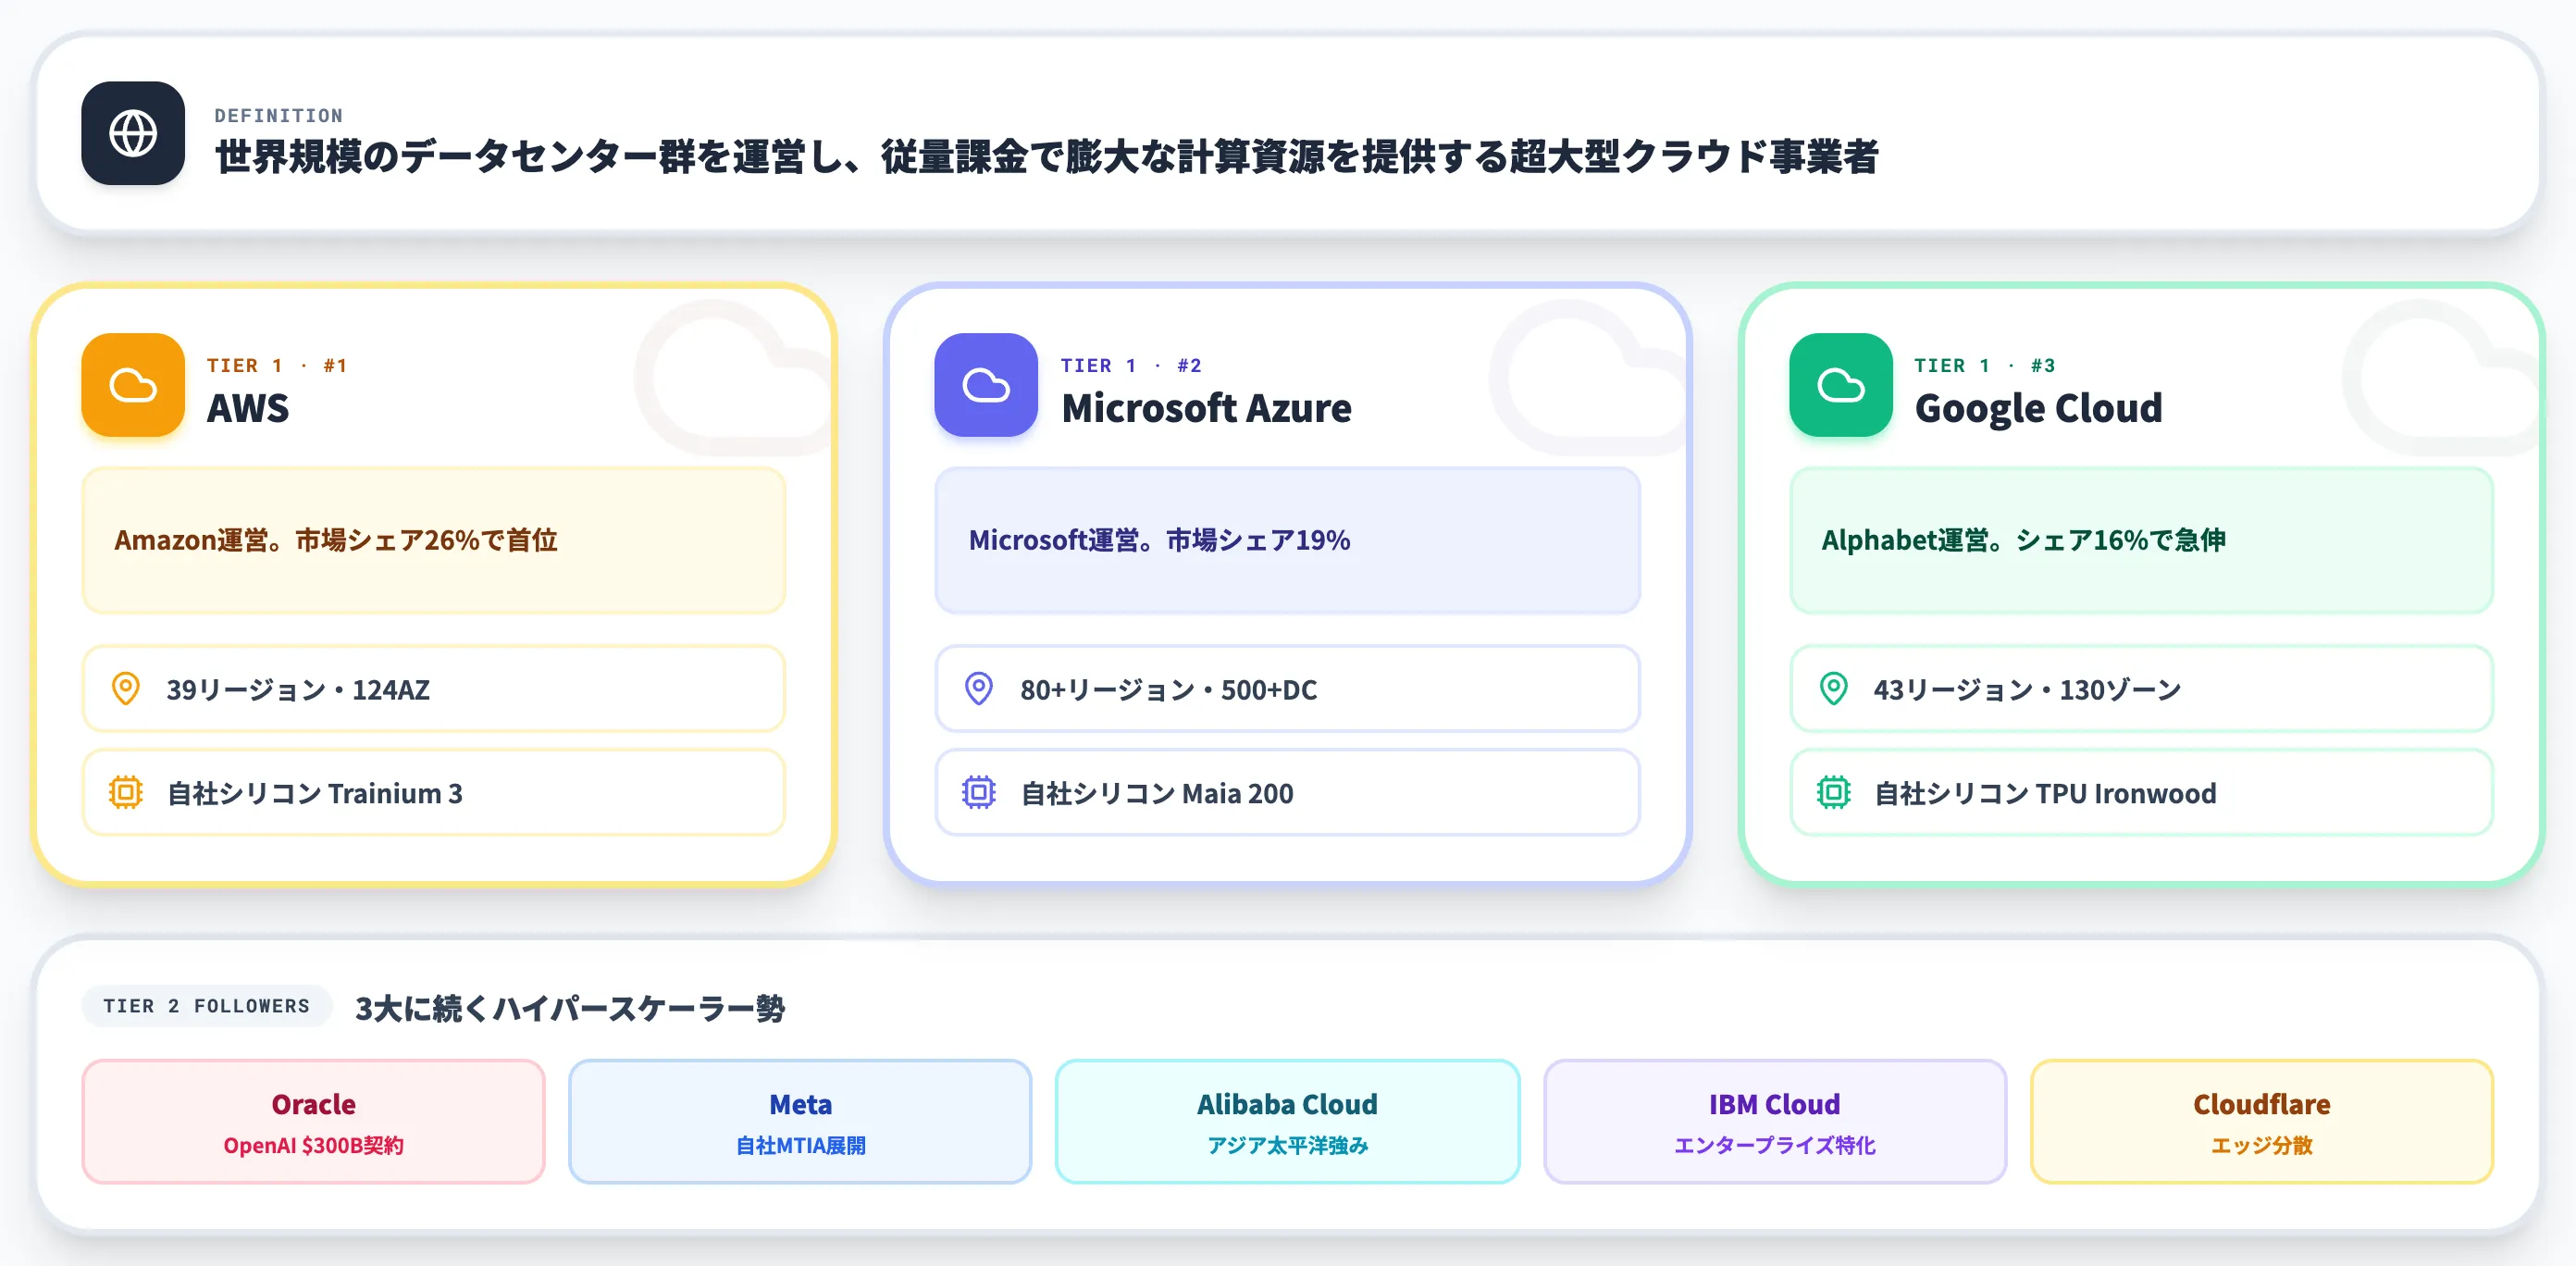
ハイパースケーラーとは、世界規模でデータセンター群を運営し、膨大な計算資源とストレージ、ネットワークを従量課金で提供する超大型クラウド事業者を指します。
「ハイパー(超)」と「スケール(規模)」を組み合わせた造語で、1施設あたり数万台、全世界で数百万台規模のサーバーを束ねて動かすクラウド事業者がこの名前で呼ばれています。クラウドAIの基盤を支えるインフラ層としても、ハイパースケーラーが中心的な役割を果たしています。
代表格はAWS(Amazon)、Microsoft Azure、Google Cloudの3社で、これにOracle Cloud・Meta Platforms・Alibaba Cloud等が続きます。
「ハイパー」が指す規模感——世界で数百万台のサーバーを束ねる水準
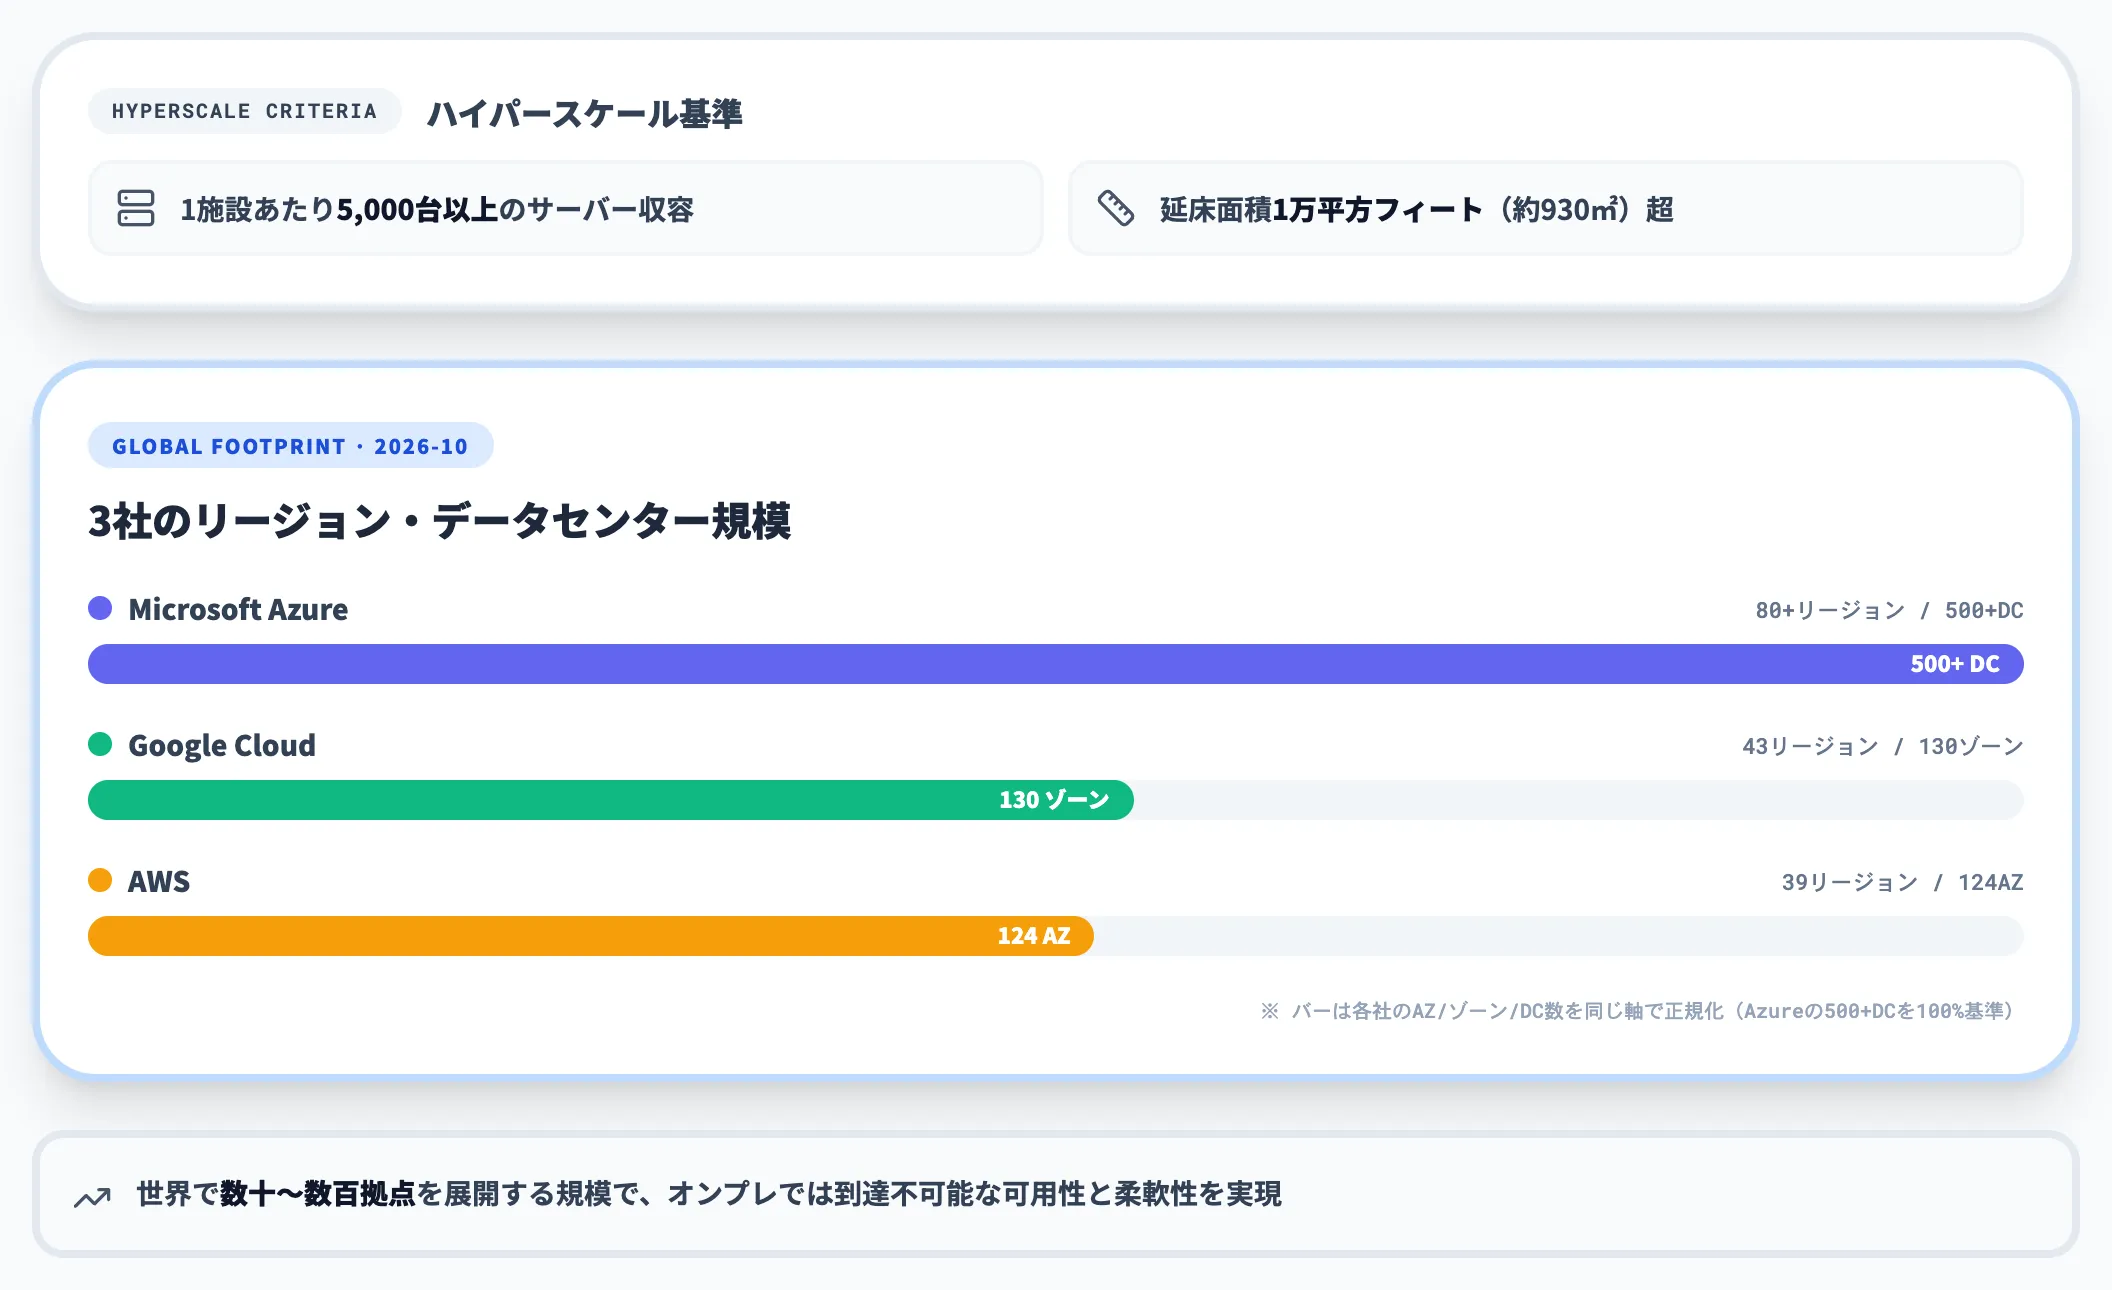
ハイパースケーラーの「ハイパー」が指すのは、単に大きいクラウドではなく、業界で「ハイパースケール」と呼ばれる基準を満たす規模感です。
具体的には、1つのデータセンター施設に5,000台以上のサーバーが収容され、延床面積が1万平方フィート(約930㎡)を超える施設を「ハイパースケールデータセンター」と呼び、こうした施設を世界中に数十〜数百拠点展開する事業者がハイパースケーラーに該当します。
-
AWS
全世界39のリージョン、124のアベイラビリティーゾーンを展開(2026年10月時点)
-
Microsoft Azure
80以上のリージョン、500以上のデータセンターを運営
-
Google Cloud
43のリージョン、130のゾーンを展開(2026年1月のBangkok開設で43リージョンに到達)
この拠点網があるからこそ、ユーザーは必要なときに必要なリージョンで、ほぼ無制限にスケールするコンピュートとストレージを調達できます。企業が自前のオンプレミス施設では到達できない可用性と柔軟性が、ハイパースケーラーの本質的な強みです。
ハイパースケーラー3社の市場シェアと2026年の設備投資規模
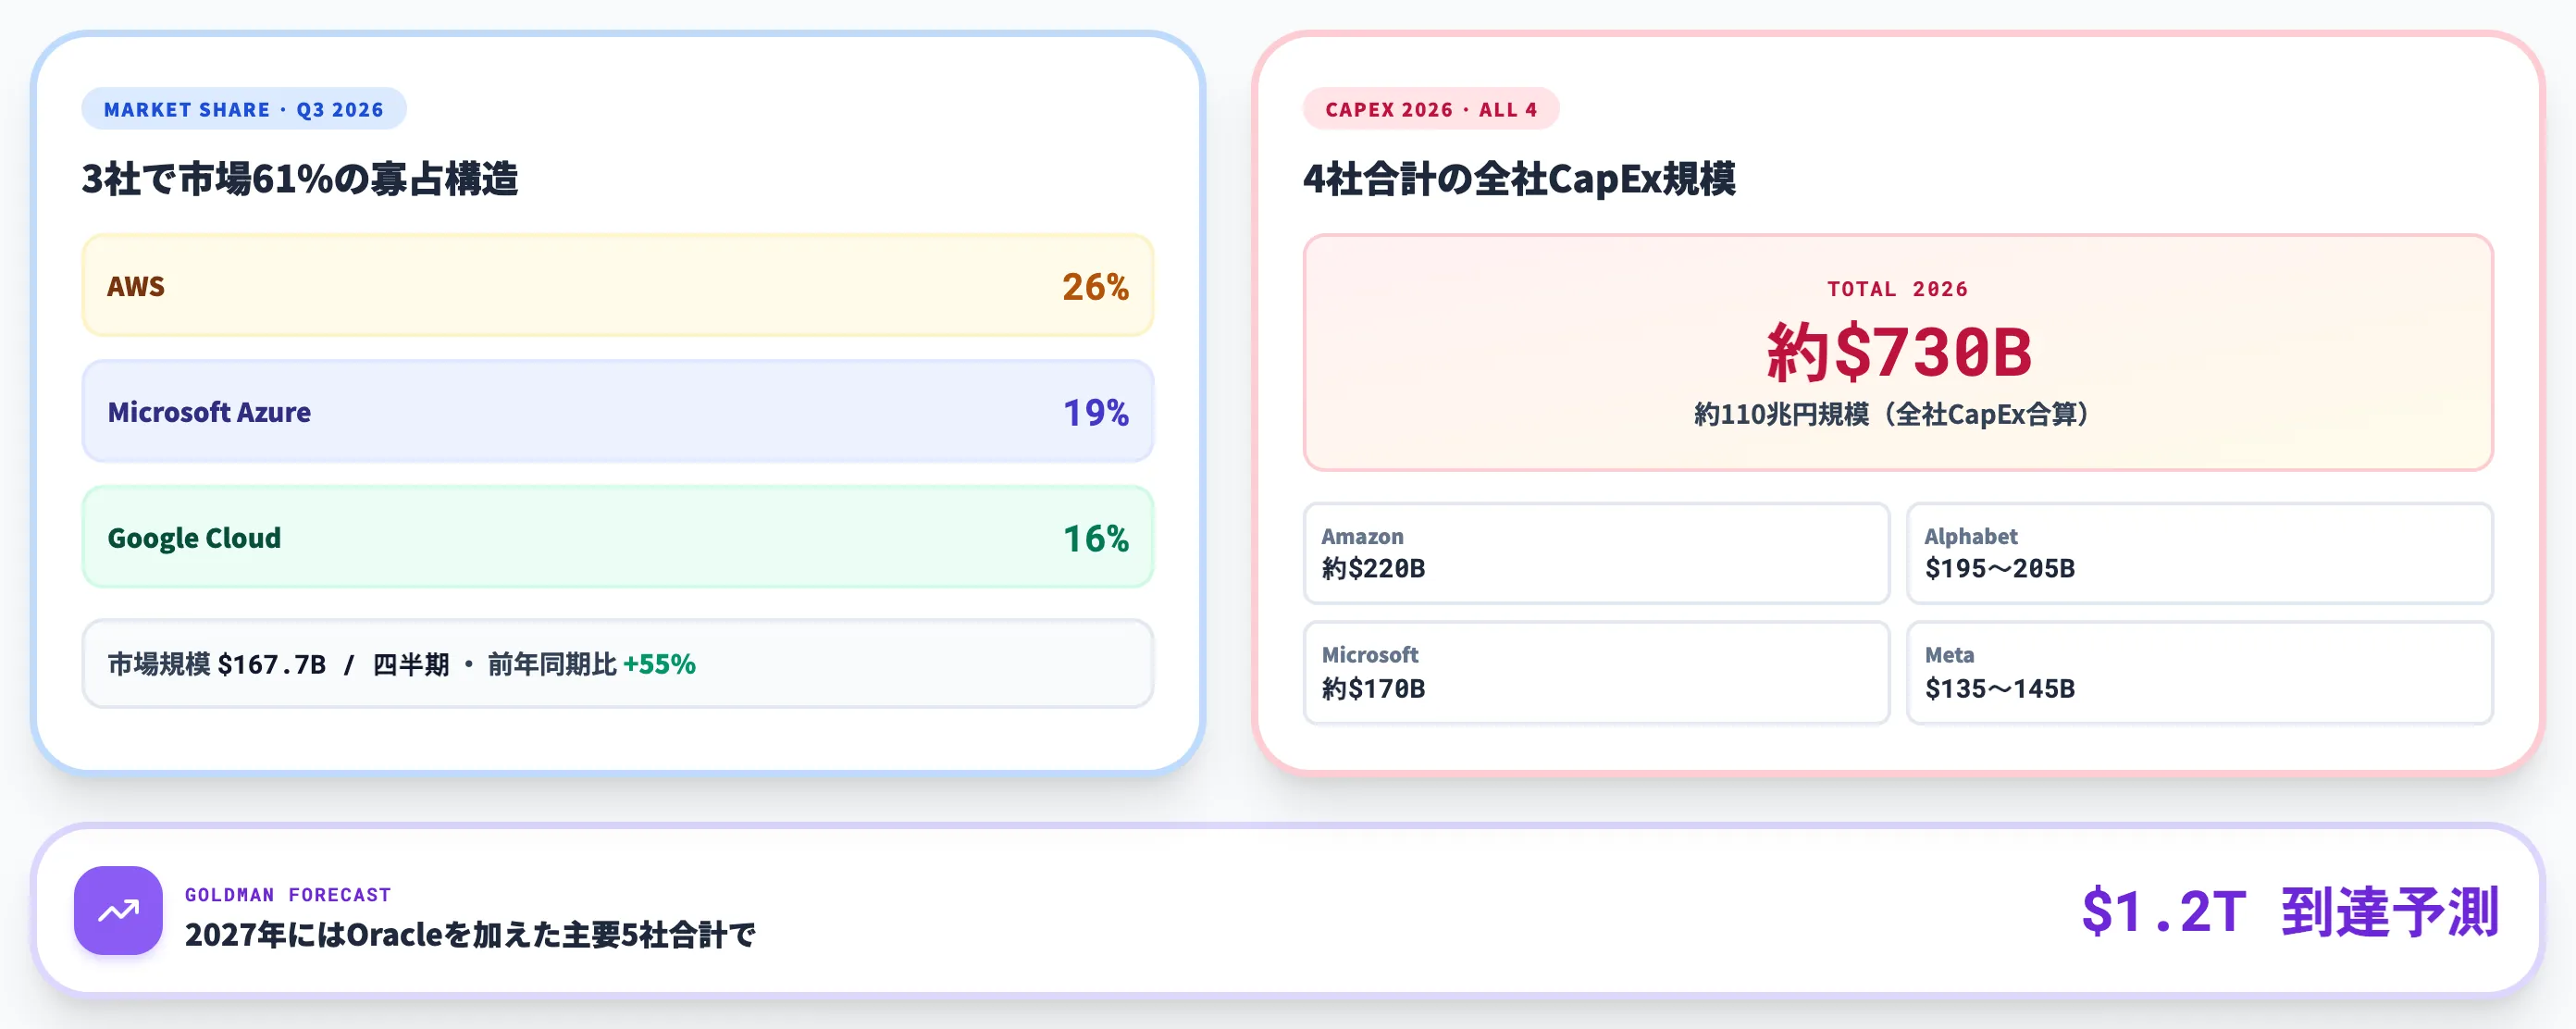
ハイパースケーラーの中核を占めるAWS・Azure・Google Cloudの3社は、クラウドインフラ市場全体の63%を占める寡占構造を形成しています。
2026年に入り、各社ともAI投資の急拡大で設備投資が過去最高水準を更新しています。
本セクションでは、Synergy Researchの最新調査と各社の2026年設備投資ガイダンスをもとに、3社の勢力図と投資規模を整理します。
Q3 2026の市場シェア——AWS 26%・Azure 19%・GCP 16%
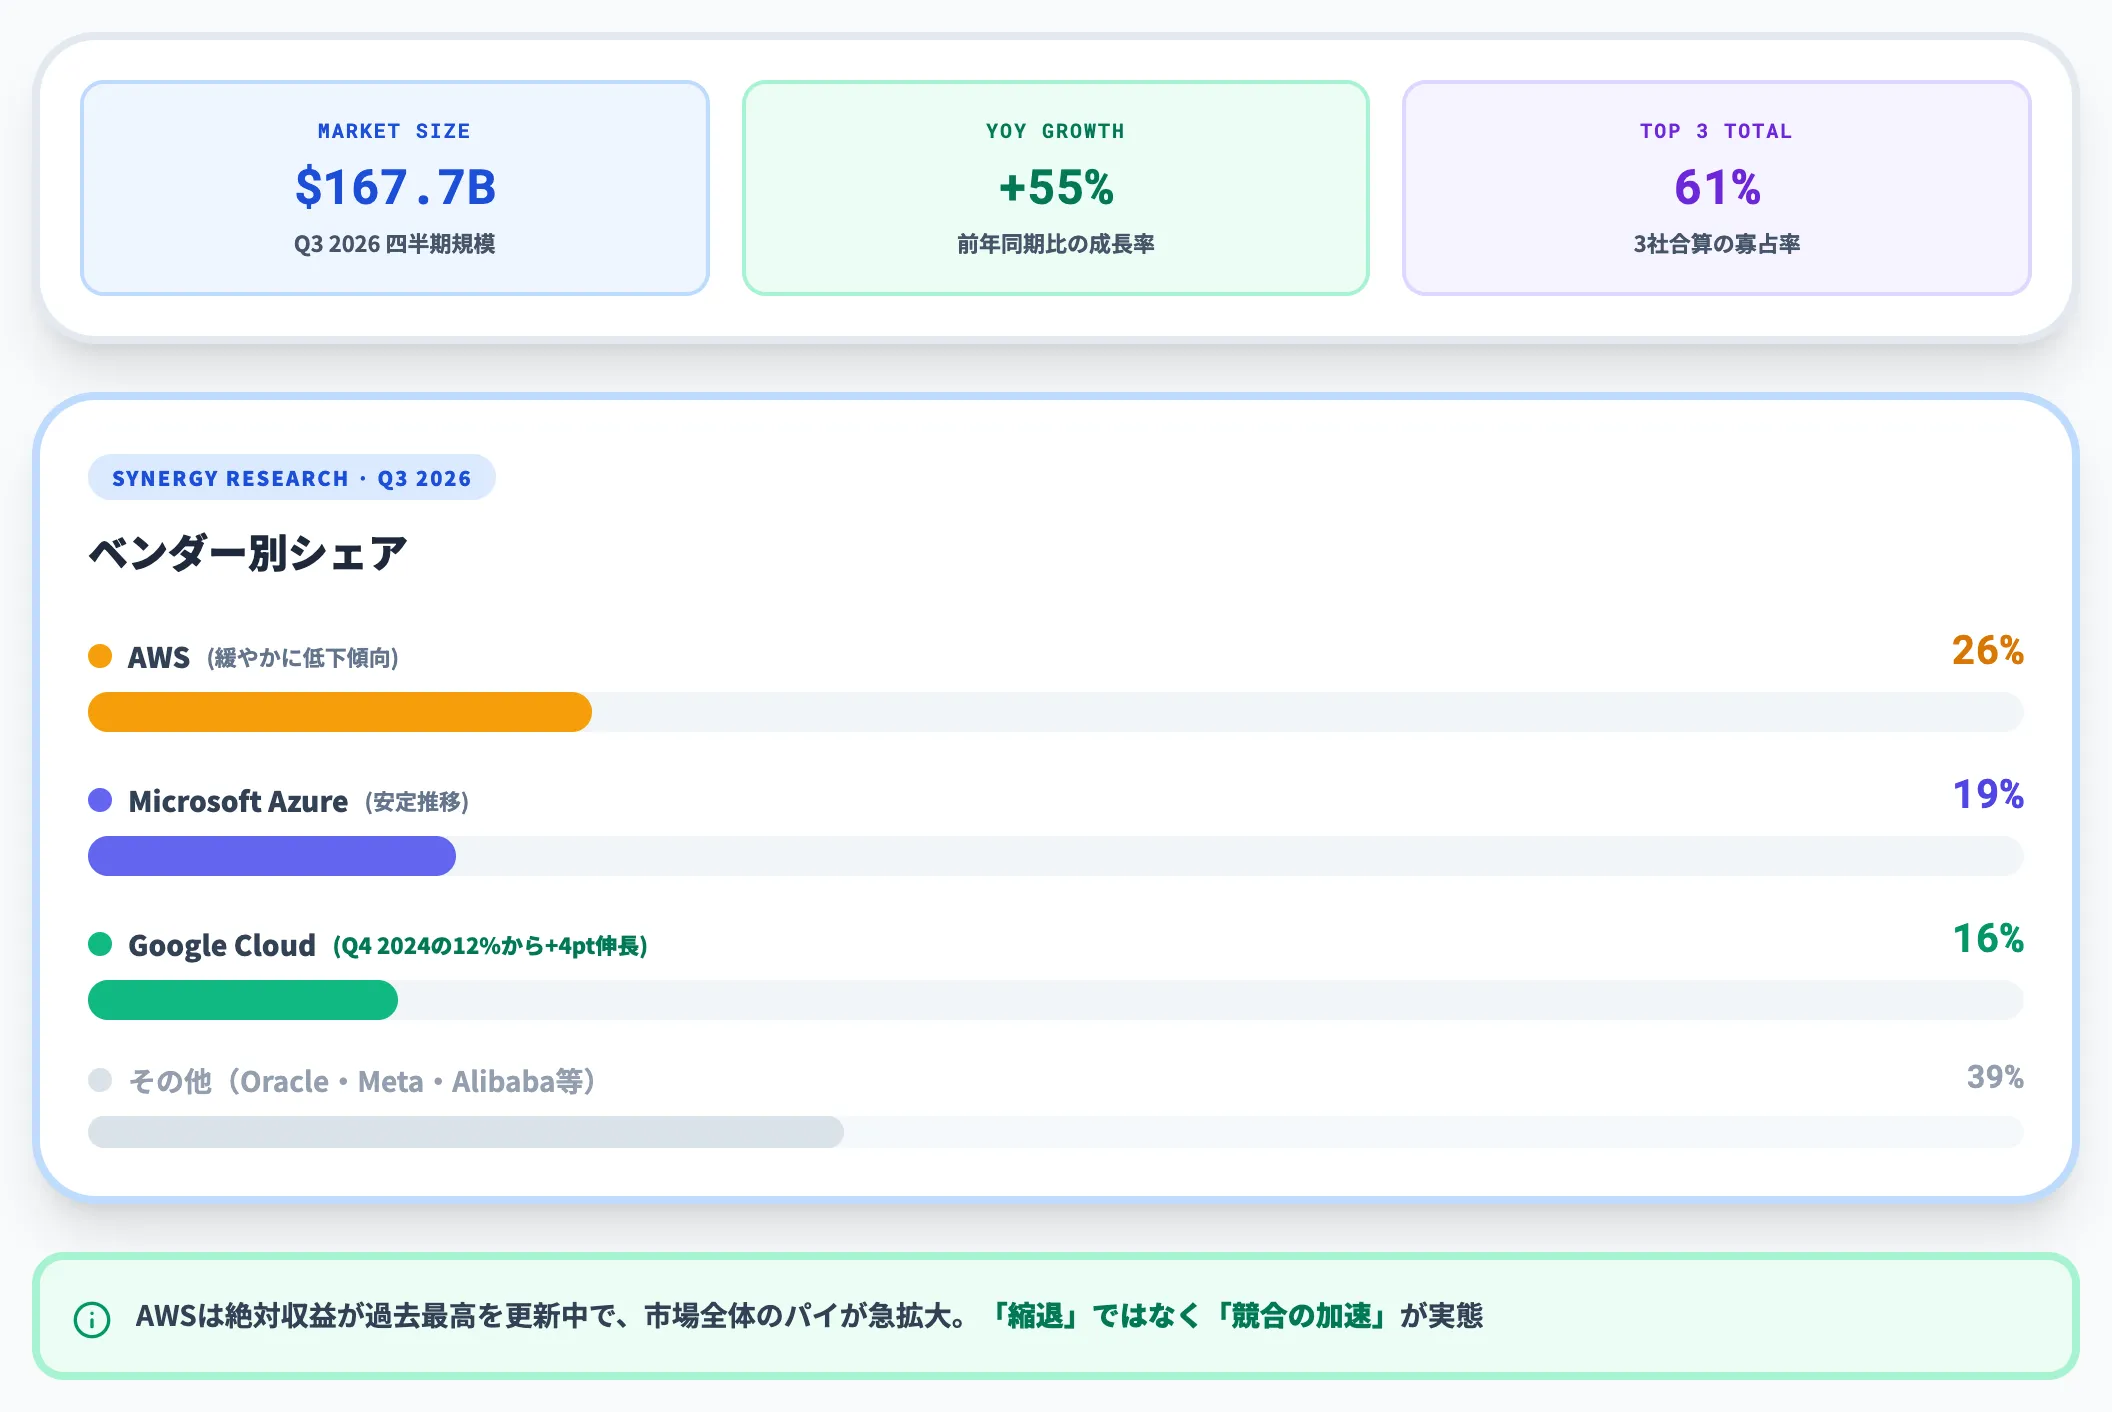
Synergy Research Groupの2026年Q3調査(2026年10月29日公開)によれば、クラウドインフラ市場は四半期で1,677億ドル規模(前年同期比+55%)に達し、ハイパースケーラー3社が市場の61%(AWS 26%・Azure 19%・GCP 16%の合算)を占めています。
| ベンダー | Q3 2026シェア | 前年同期比 |
|---|---|---|
| AWS | 26% | シェア緩やかに低下傾向 |
| Microsoft Azure | 19% | 安定推移 |
| Google Cloud | 16% | Q4 2024の12%から7四半期で+4pt伸長 |
この表から読み取れるのは、AWSが依然トップではあるものの、Googleが2024年Q4の12%から2026年Q3の16%まで4ポイント上昇し、3社の差が縮まりつつあるという点です。
AWSはシェアこそ緩やかに下がっているものの、絶対収益は過去最高を更新しており、市場全体のパイが急拡大しているため「縮退」ではなく「競合の加速」と読み解くのが実態に近い状況です。
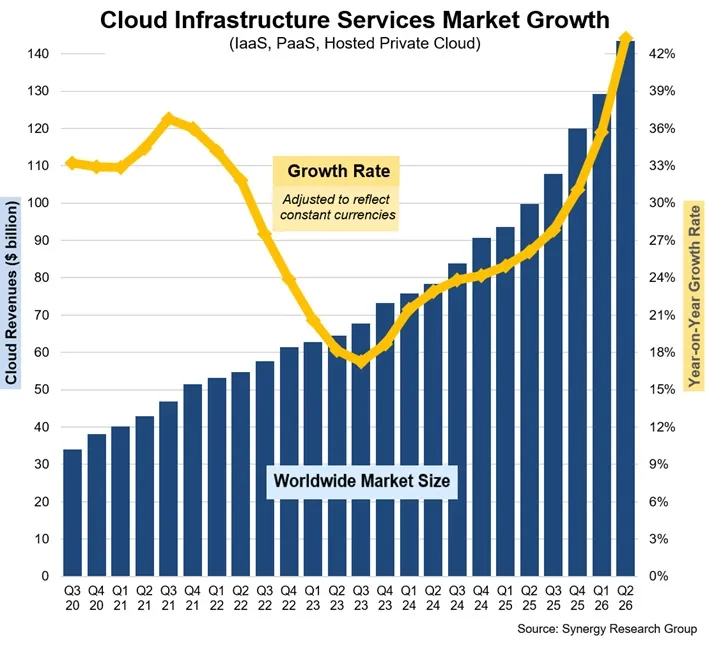
クラウドインフラ市場の規模推移(Q3 2020〜Q2 2026)とYoY成長率。最新のQ3 2026では市場規模が$167.7B、YoY成長率が55%に拡大している(出典:Synergy Research Group)
グラフの右端で跳ね上がっているのが2026年Q2の$143.4Bで、2021年末の局所ピークを大きく越えています。
YoY成長率(黄色折れ線)も2023年Q3の約17%から直近は42%台まで戻しており、AIワークロードがクラウド市場全体の成長率を一段上に押し上げている構造が見て取れます。
2026年の全社設備投資は4社合計で約$730B規模
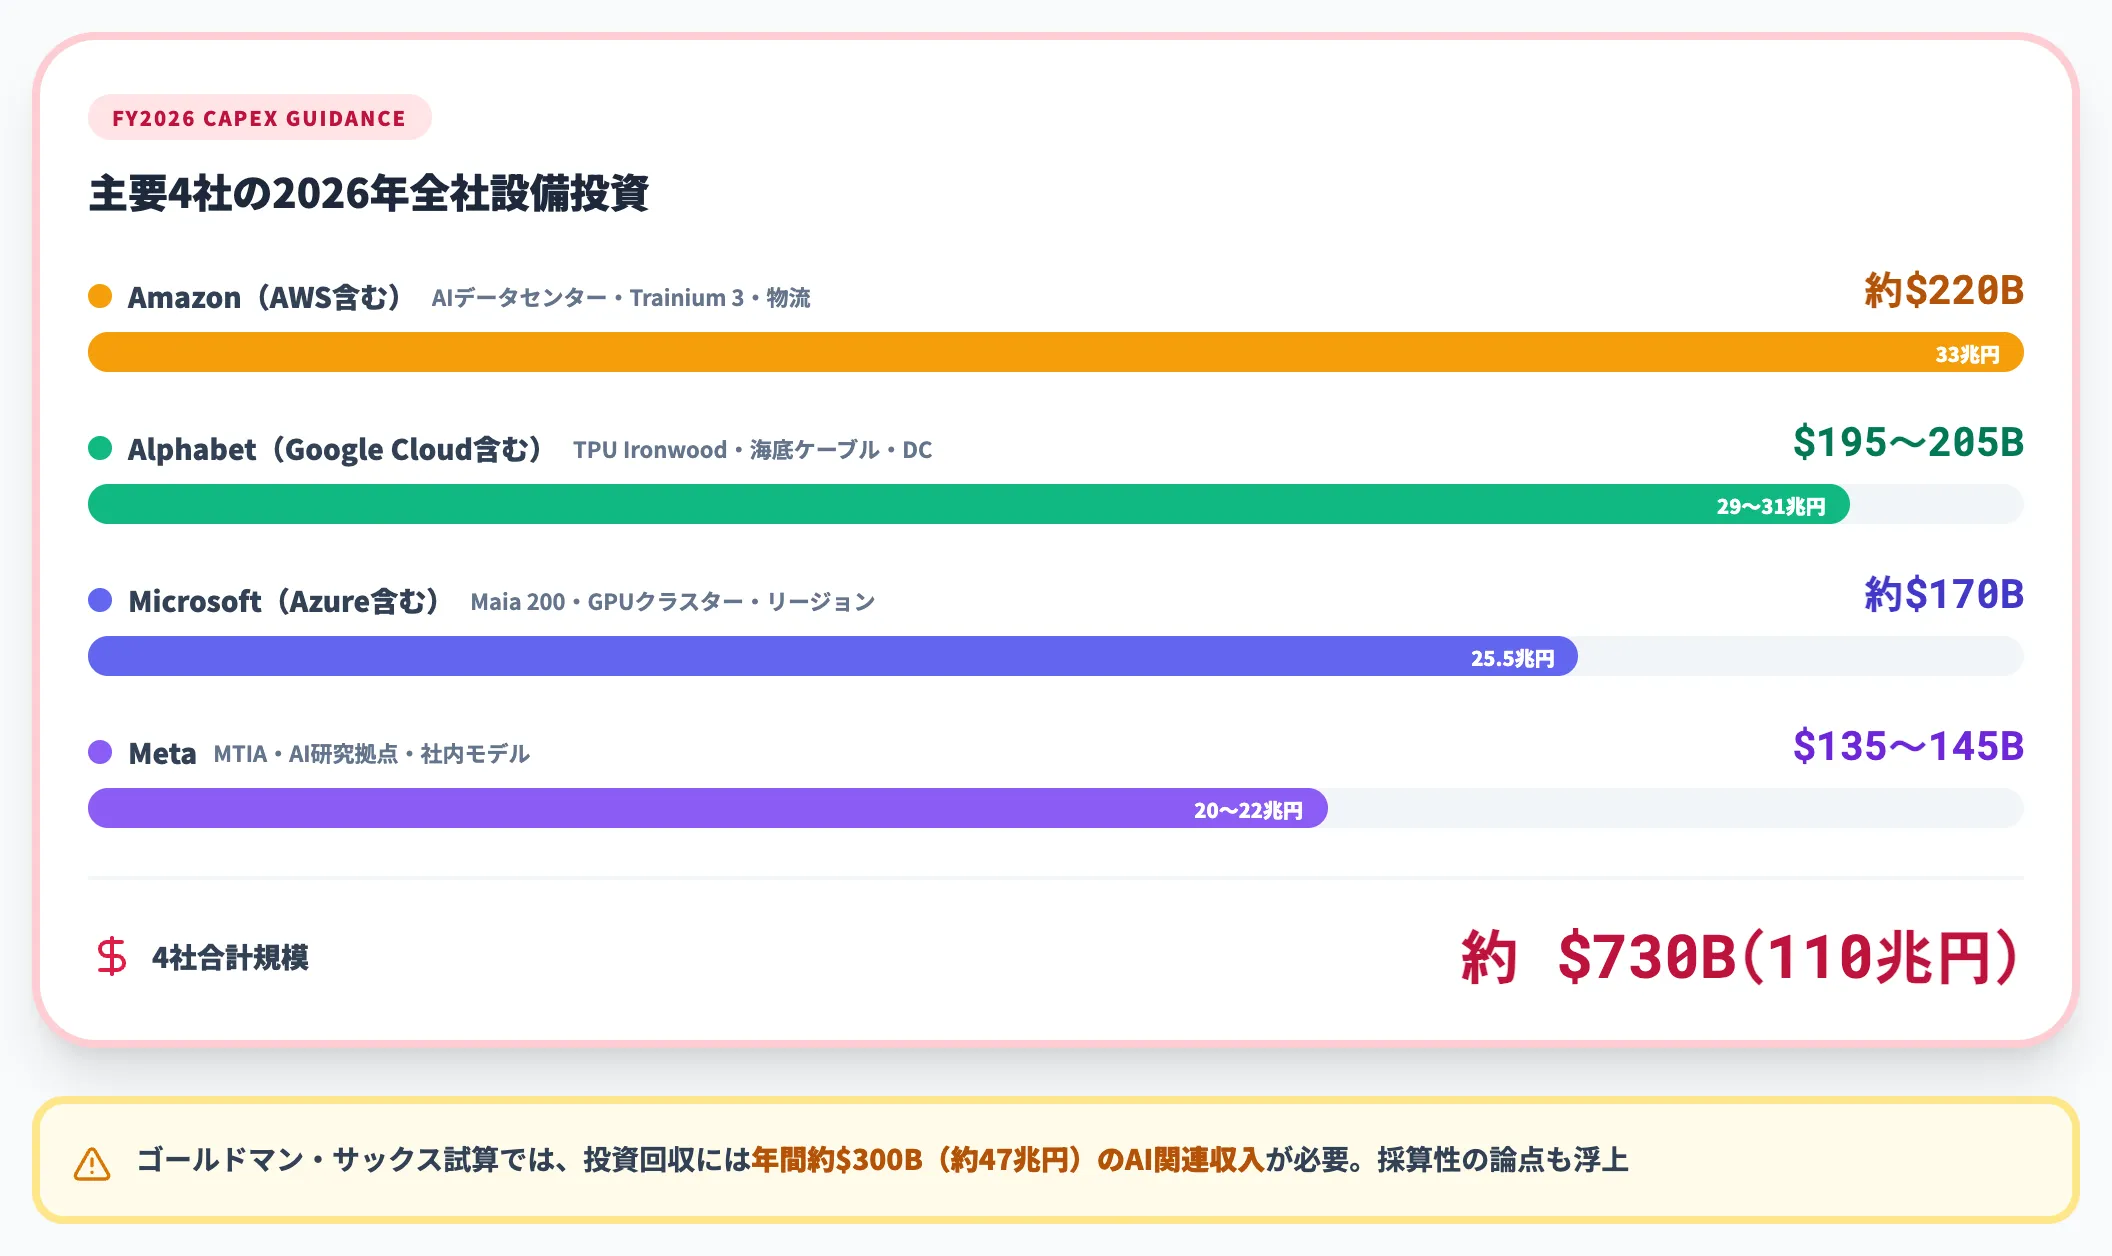
AI向け計算需要の急拡大を受け、ハイパースケーラー各社は2026年の全社設備投資(CapEx)ガイダンスを過去最大水準に引き上げました。各社の決算開示をもとに、主要4社の2026年全社CapExをまとめると以下のとおりです。
| 企業 | 2026年全社CapExガイダンス | 主な投資先 |
|---|---|---|
| Amazon(AWS含む) | 約$220B(約33兆円・Q3 2026決算で据え置き) | AIデータセンター、Trainium 3、物流・ネットワーク |
| Microsoft(Azure含む) | 約$170B(約25.5兆円・FY27 Q1決算、3Pキャパシティ遅延で下方修正) | Maia 200展開、GPUクラスター、Azureリージョン |
| Alphabet(Google Cloud含む) | $195〜205B(約29〜31兆円・2026 Q3決算で据え置き) | TPU Ironwood・TPU 8t/8i、海底ケーブル、データセンター |
| Meta | $135〜145B(約20〜22兆円・2026 Q3決算でレンジを上方修正) | MTIA、AI研究拠点、社内モデル訓練 |
4社合計で約$730B規模(約110兆円)に達します。ただしこれは各社の全社設備投資であり、全額がAIインフラ向けではない点に注意が必要です(AI向け割合は各社が決算で別途説明しており、AmazonやMicrosoftはAIが主体、Metaは「データセンター関連CapEx」として開示)。ゴールドマン・サックスは上記4社にOracleを加えた主要5社の合計で、2027年に1兆2,000億ドル規模に拡大する見通しと試算しています(Bloomberg報道経由)。
同時に、ゴールドマンは投資回収には年間約$300B(約47兆円)のAI関連収入が必要と試算しており、採算性の論点も浮上しています。
企業がハイパースケーラー経由でAIを利用する際の料金動向は、この採算ラインが維持できるかに大きく影響します。
投資を律速する4つの制約——電力・半導体・人材・許認可
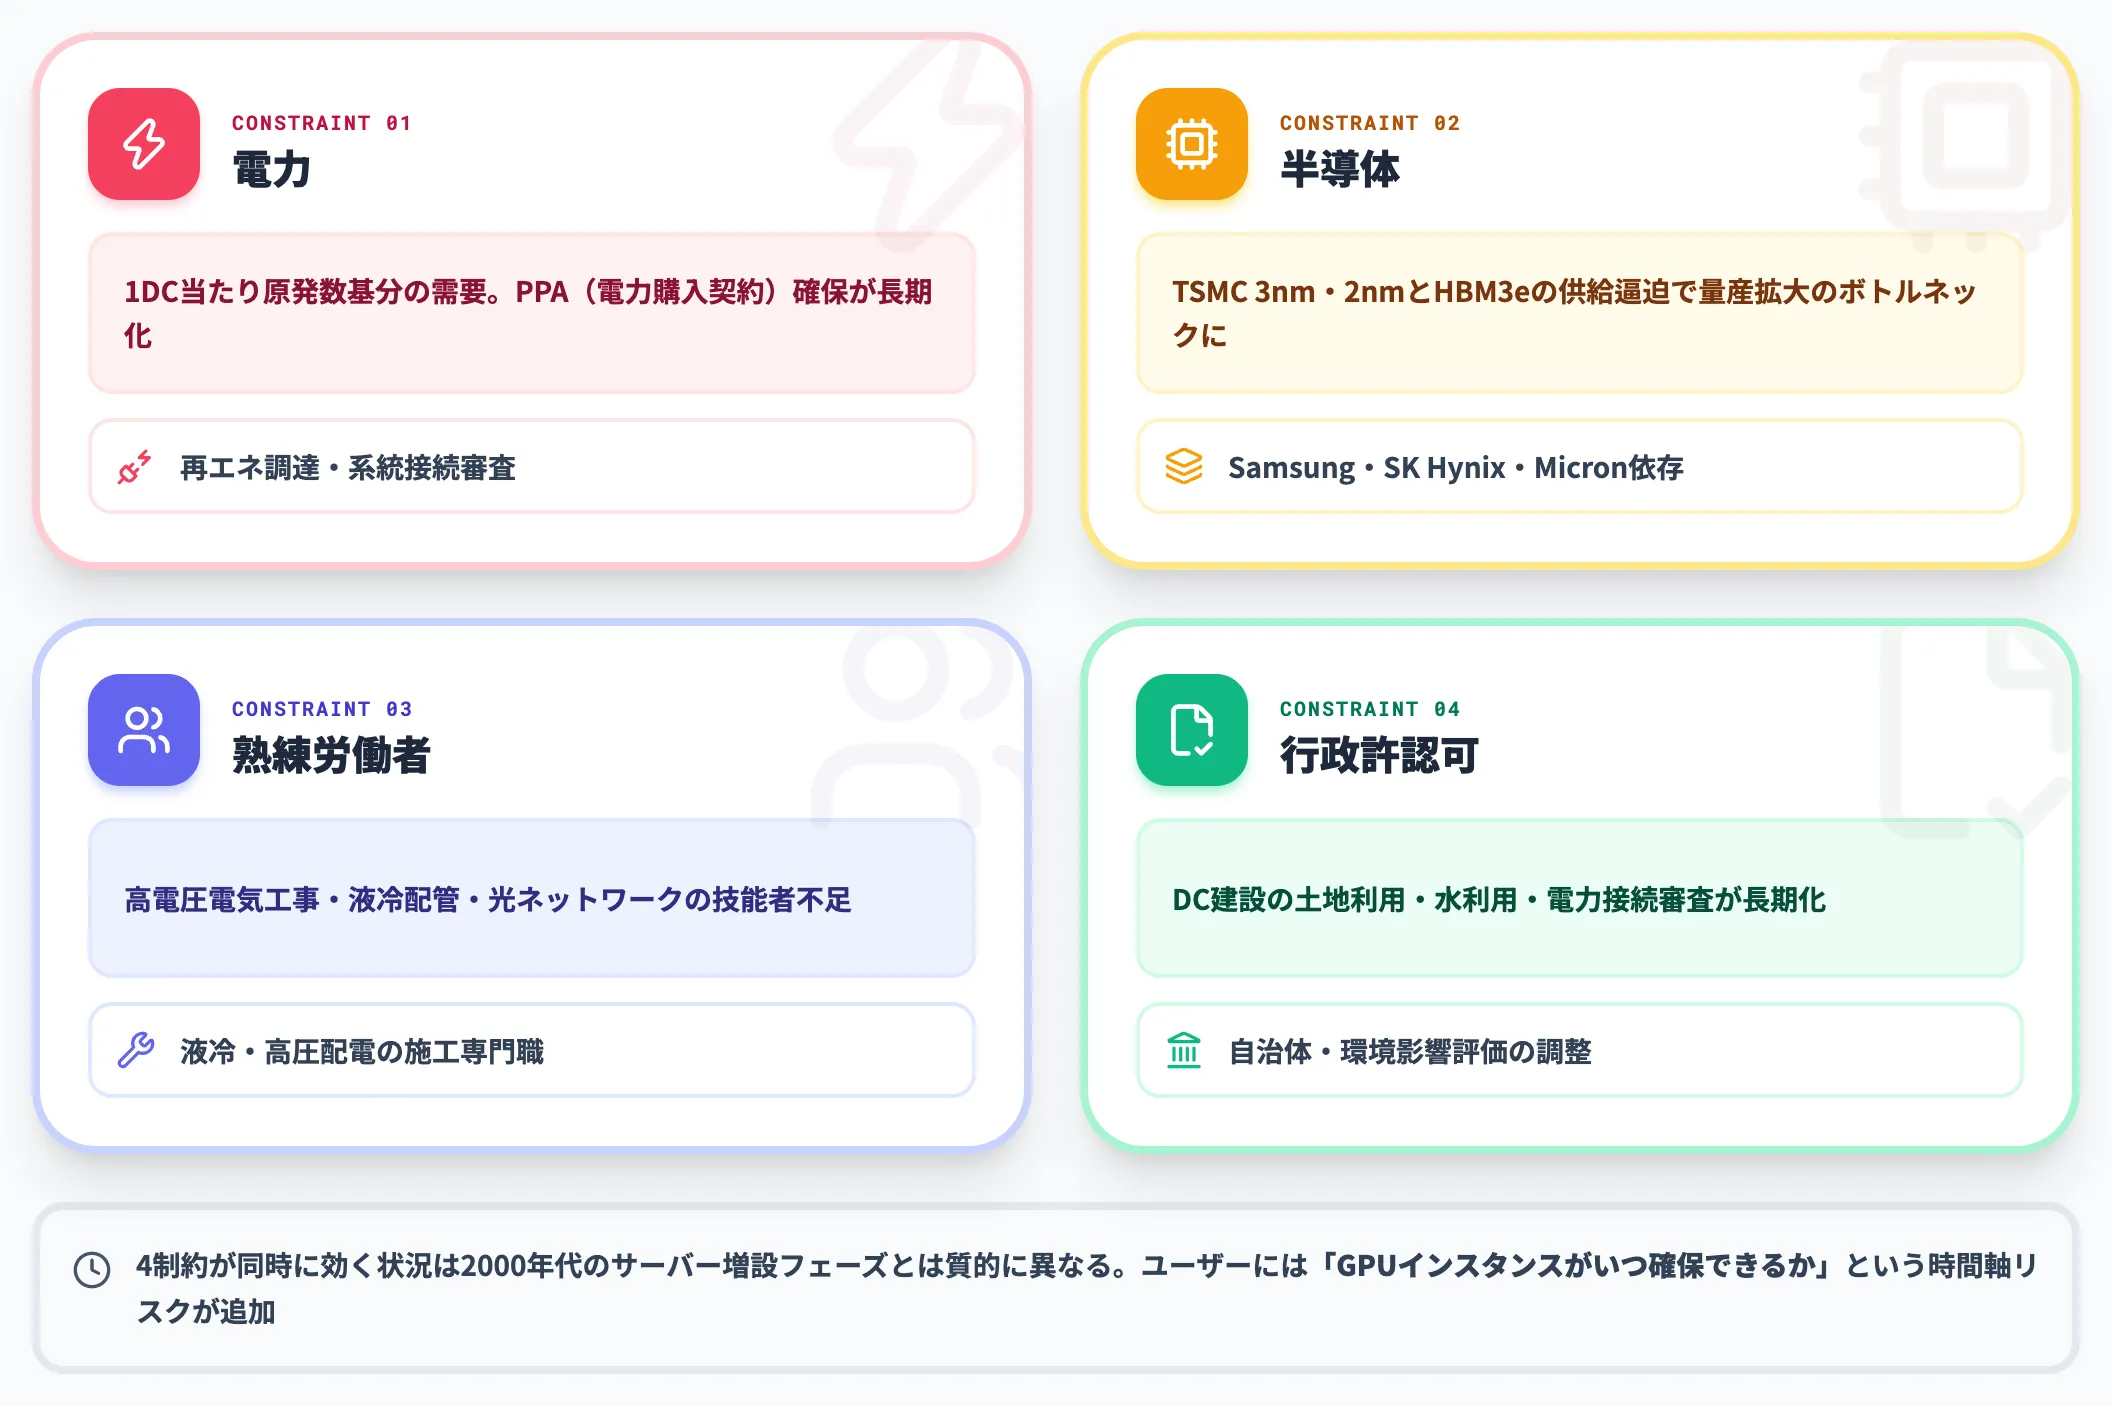
CapExを張っても、物理的な制約がボトルネックになりつつあります。野村総合研究所の分析でも電力や人材などの供給制約が物価高を通じて影響する点が整理されています。実務で意識されているのは以下4つの制約です。
-
電力
データセンターの電力需要は原子力発電所数基分に相当し、PPA(電力購入契約)確保が長期化
-
半導体
最先端ロジック(TSMC 3nm・2nm)とHBM3e(Samsung・SK Hynix・Micron)の供給が逼迫
-
熟練労働者
高電圧電気工事・液冷配管・光ネットワークの技能者不足
-
行政許認可
データセンター建設の土地利用・水利用・電力接続審査が長期化
この4制約が同時に効いている状況は、2000年代前半のサーバー増設フェーズとは質的に異なります。
企業側から見ると、ハイパースケーラー採用判断に「このリージョンでGPUインスタンスがいつ確保できるか」という時間軸のリスクが追加されたという意味を持ちます。
ハイパースケーラーが進めるカスタムAIシリコン競争
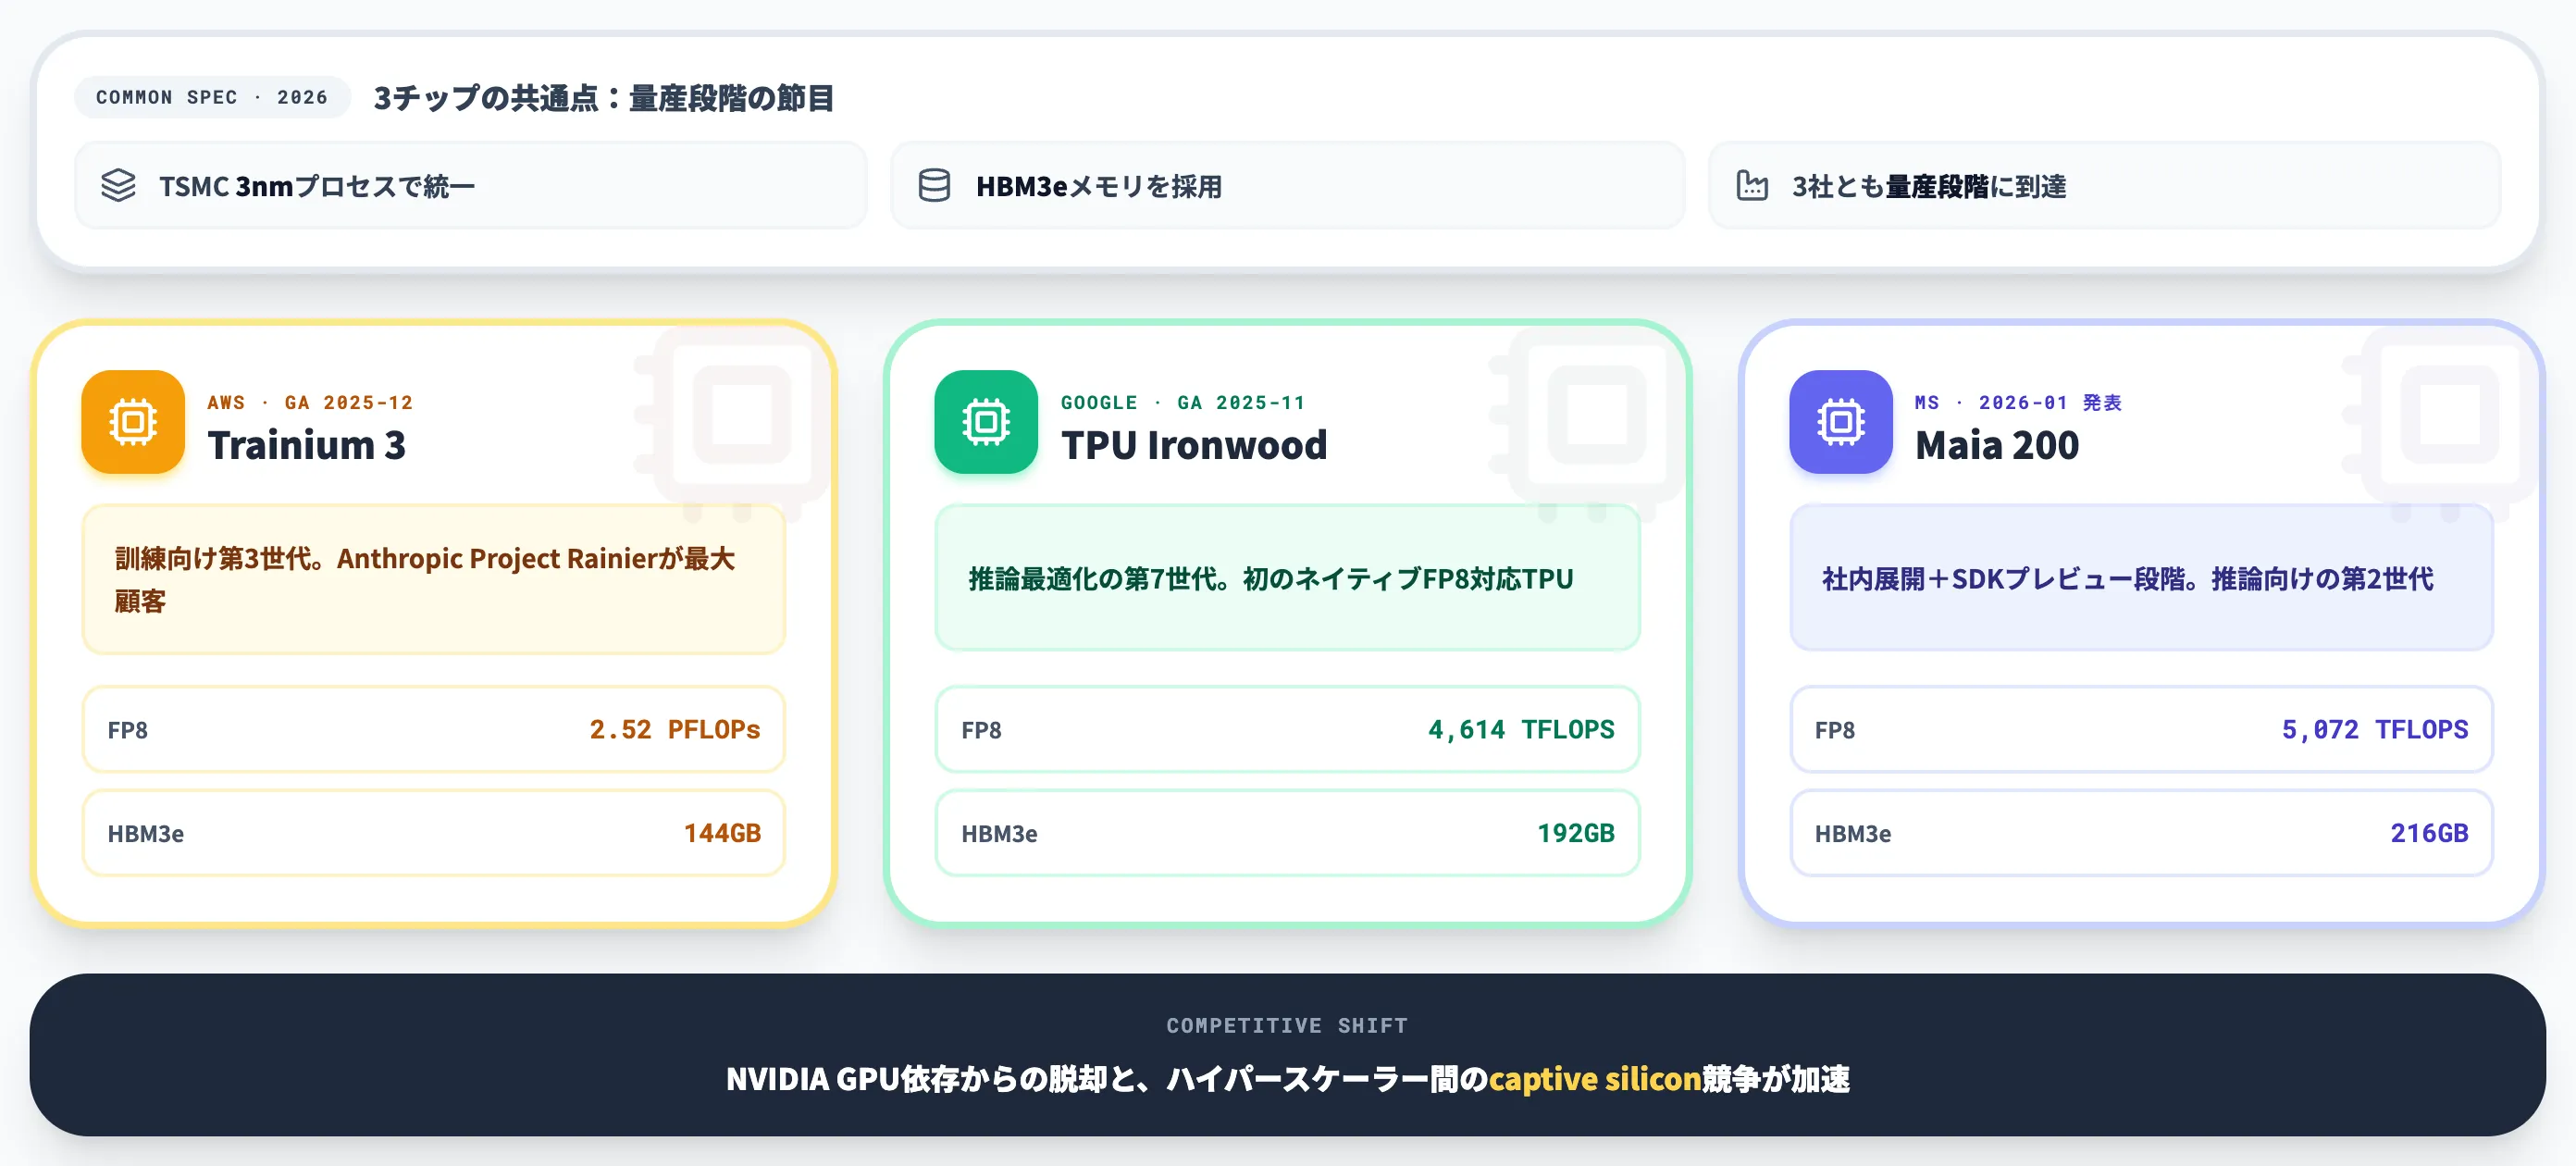
2026年のハイパースケーラー競争を象徴するのが、各社が独自に設計するAIアクセラレータ(カスタムシリコン)の本格展開です。NVIDIA GPUに依存する構造を抜け出すため、AWSはTrainium、GoogleはTPU、MicrosoftはMaia、MetaはMTIAと、各社が自社設計チップを量産段階に乗せています。
本セクションでは、2025年末〜2026年にかけて量産段階に乗った主要3チップの状況と、ユーザー視点での意味合いを整理します(AWS Trainium 3とGoogle TPU Ironwoodは一般顧客向けGA到達、Microsoft Maia 200は社内展開・SDKプレビュー段階)。
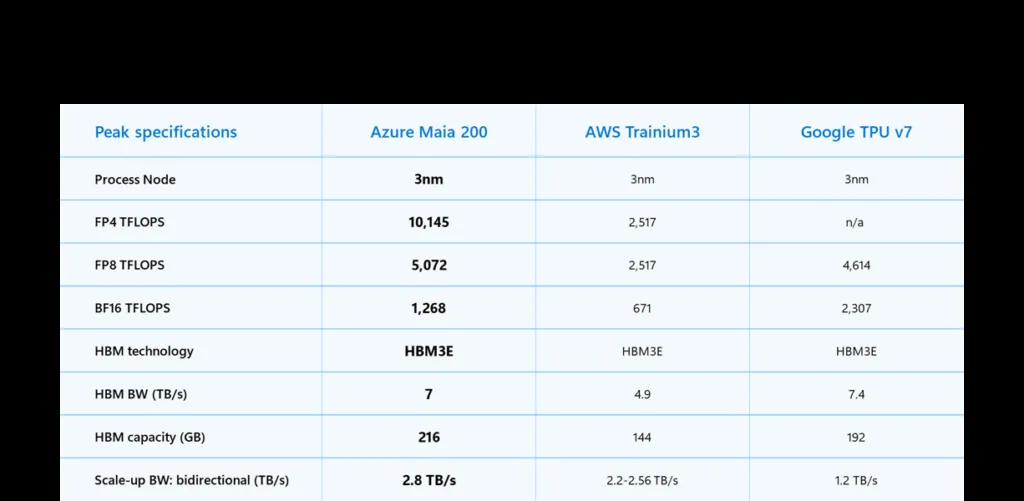
Microsoftが公開したAzure Maia 200・AWS Trainium 3・Google TPU v7のピークスペック比較表(出典:Microsoft Blog)
3社のチップはいずれもTSMC 3nmプロセスで、HBM3eメモリを採用している点が共通しています。FP8演算性能はMaia 200が5,072 TFLOPS、TPU v7が4,614 TFLOPS、Trainium 3が2,517 TFLOPS、HBM容量はMaia 200が216GBと最大で、TPU v7が192GB、Trainium 3が144GBと続きます。
「3社ともに本気の自社設計を同じプロセスノードで量産段階に乗せた」という事実そのものが、2026年のハイパースケーラー競争の節目を象徴しています。
AWS Trainium 3——TSMC 3nm・144GB HBM3e、2025年12月GA
AWSは2025年12月のre:Invent 2025で第3世代の自社AI学習チップTrainium 3を発表し、EC2 UltraServerとして一般提供を開始しました。
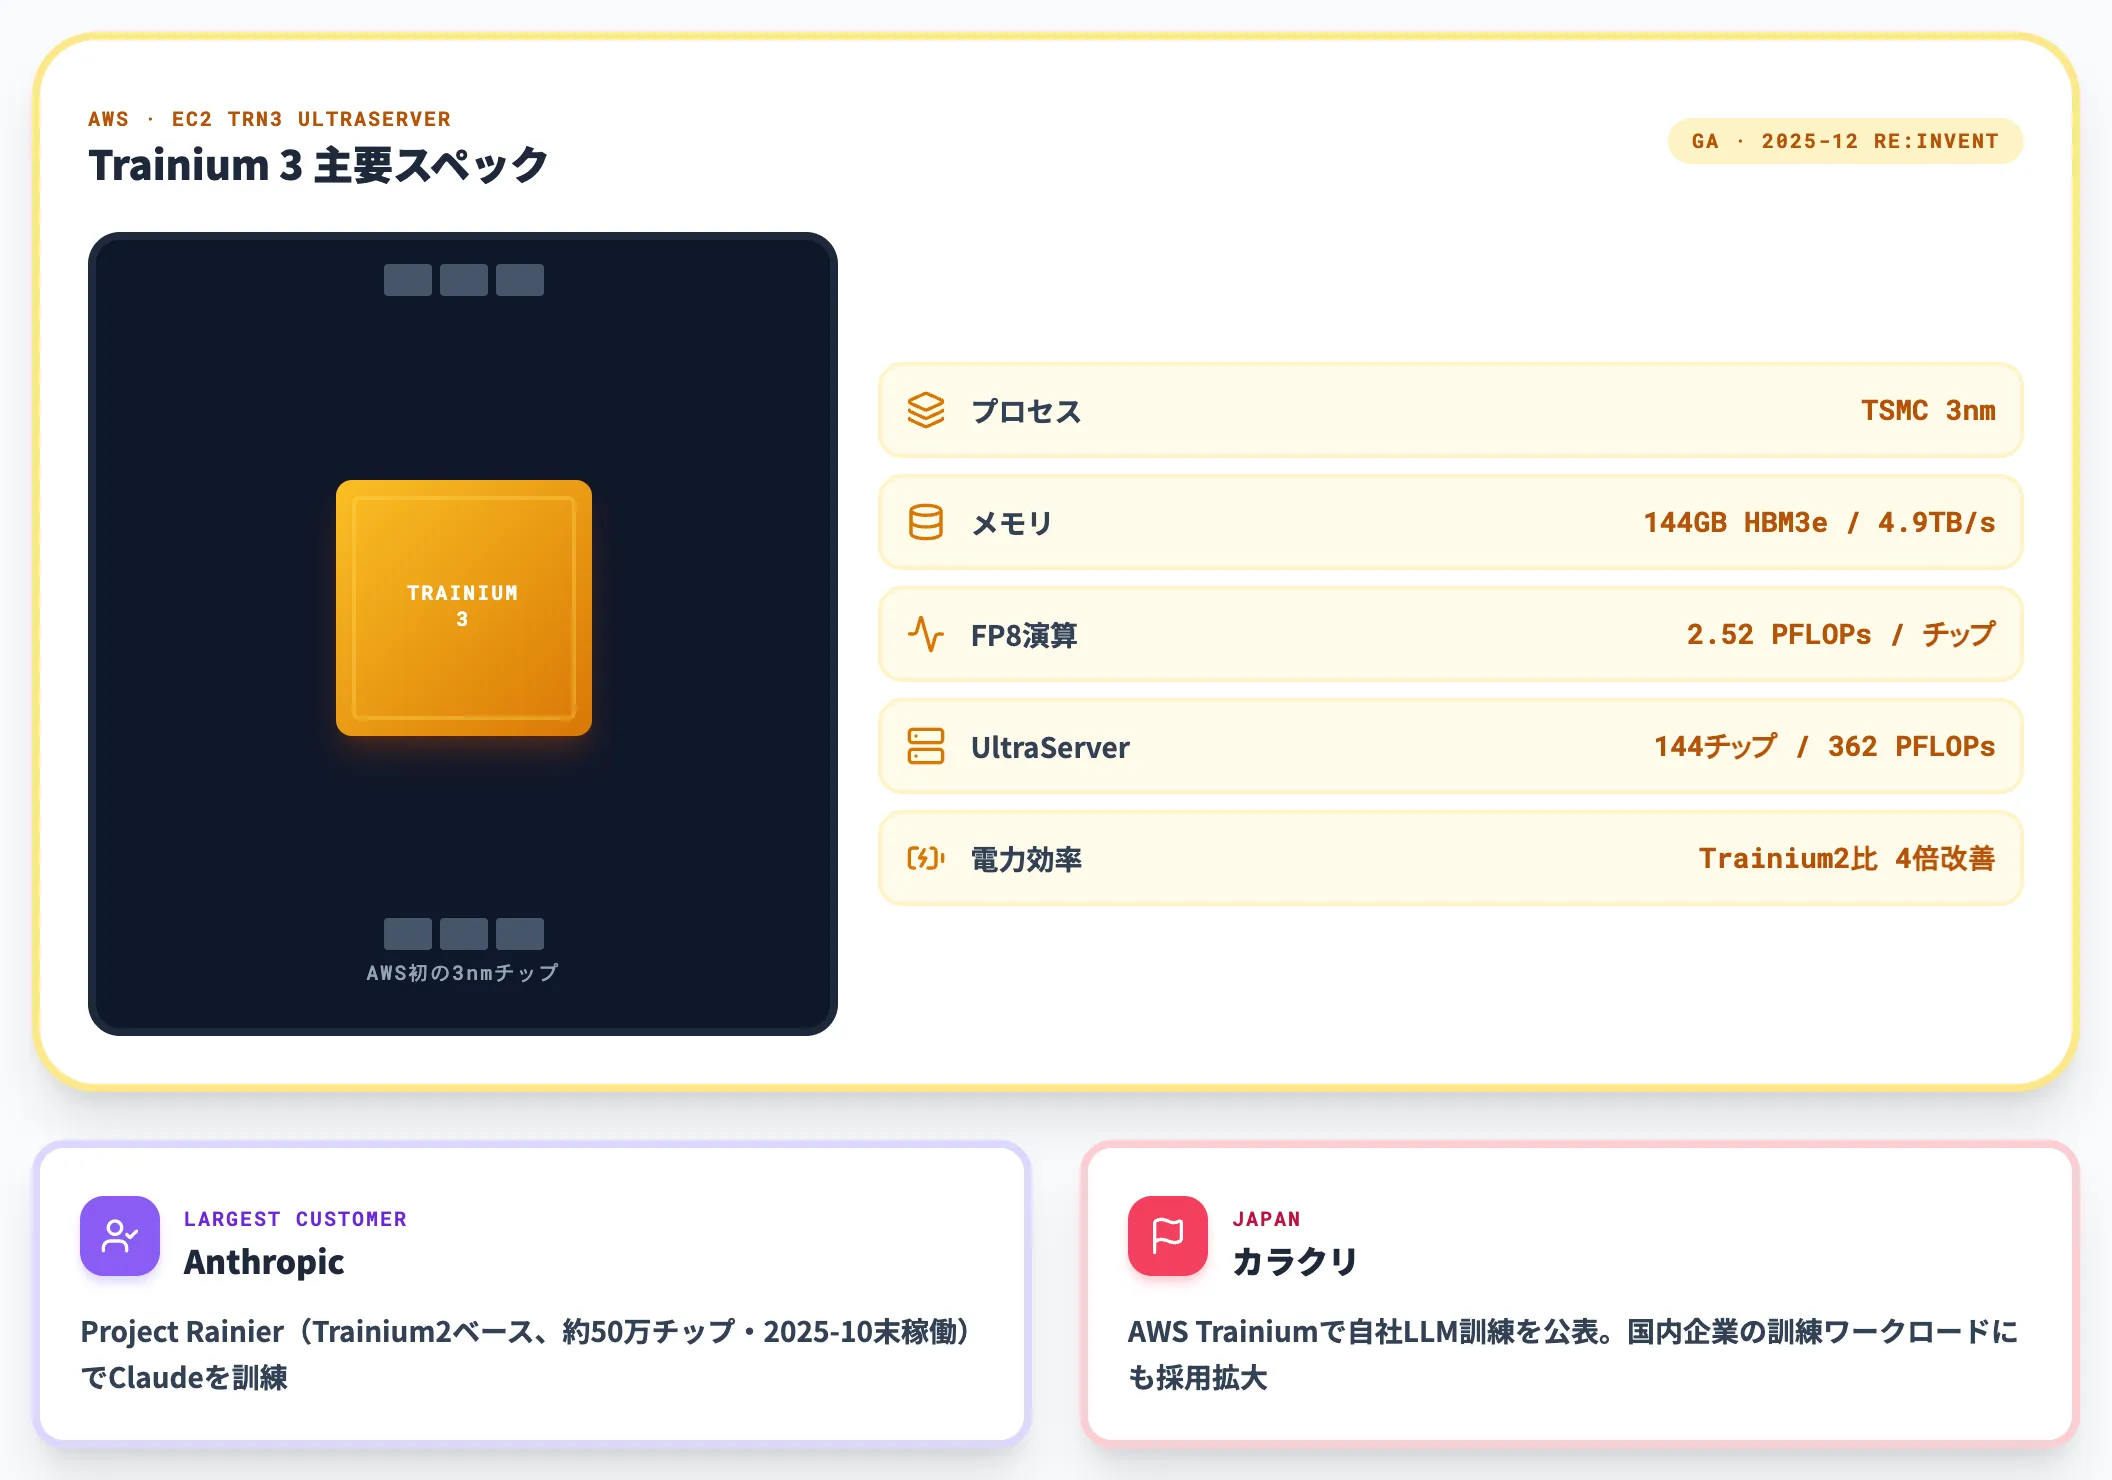
主要スペックは以下のとおりです。
- プロセス: TSMC 3nm(AWS初の3nmチップ)
- メモリ: 144GB HBM3e、帯域4.9TB/s(Trainium2比+70%)
- FP8演算性能: 2.52 PFLOPs/チップ
- UltraServer構成: 144チップで362 FP8 PFLOPs、最大100万チップまでクラスター接続可能
- 電力効率: Trainium2比で4倍改善
Anthropicは最大顧客で、Project Rainierと呼ばれるクラスターを構えています。ただしProject RainierはTrainium2ベースで、2025年10月末の稼働発表時点で約50万チップ規模です。
「100万チップ超」はAnthropicがClaude全体で2025年末までにTrainium2で動かす目標であり、Rainier単独の拡張計画とは区別して読む必要があります。
Trainium 3の採用先とは別軸の話として扱うのが安全です。日本からはカラクリがAWS Trainiumで訓練を公表しており、国内企業の訓練ワークロードにAWS自社設計チップが載る流れはTrainium世代から継続しています。
Google TPU Ironwood(v7)——4,614 FP8 TFLOPS、2025年11月GA
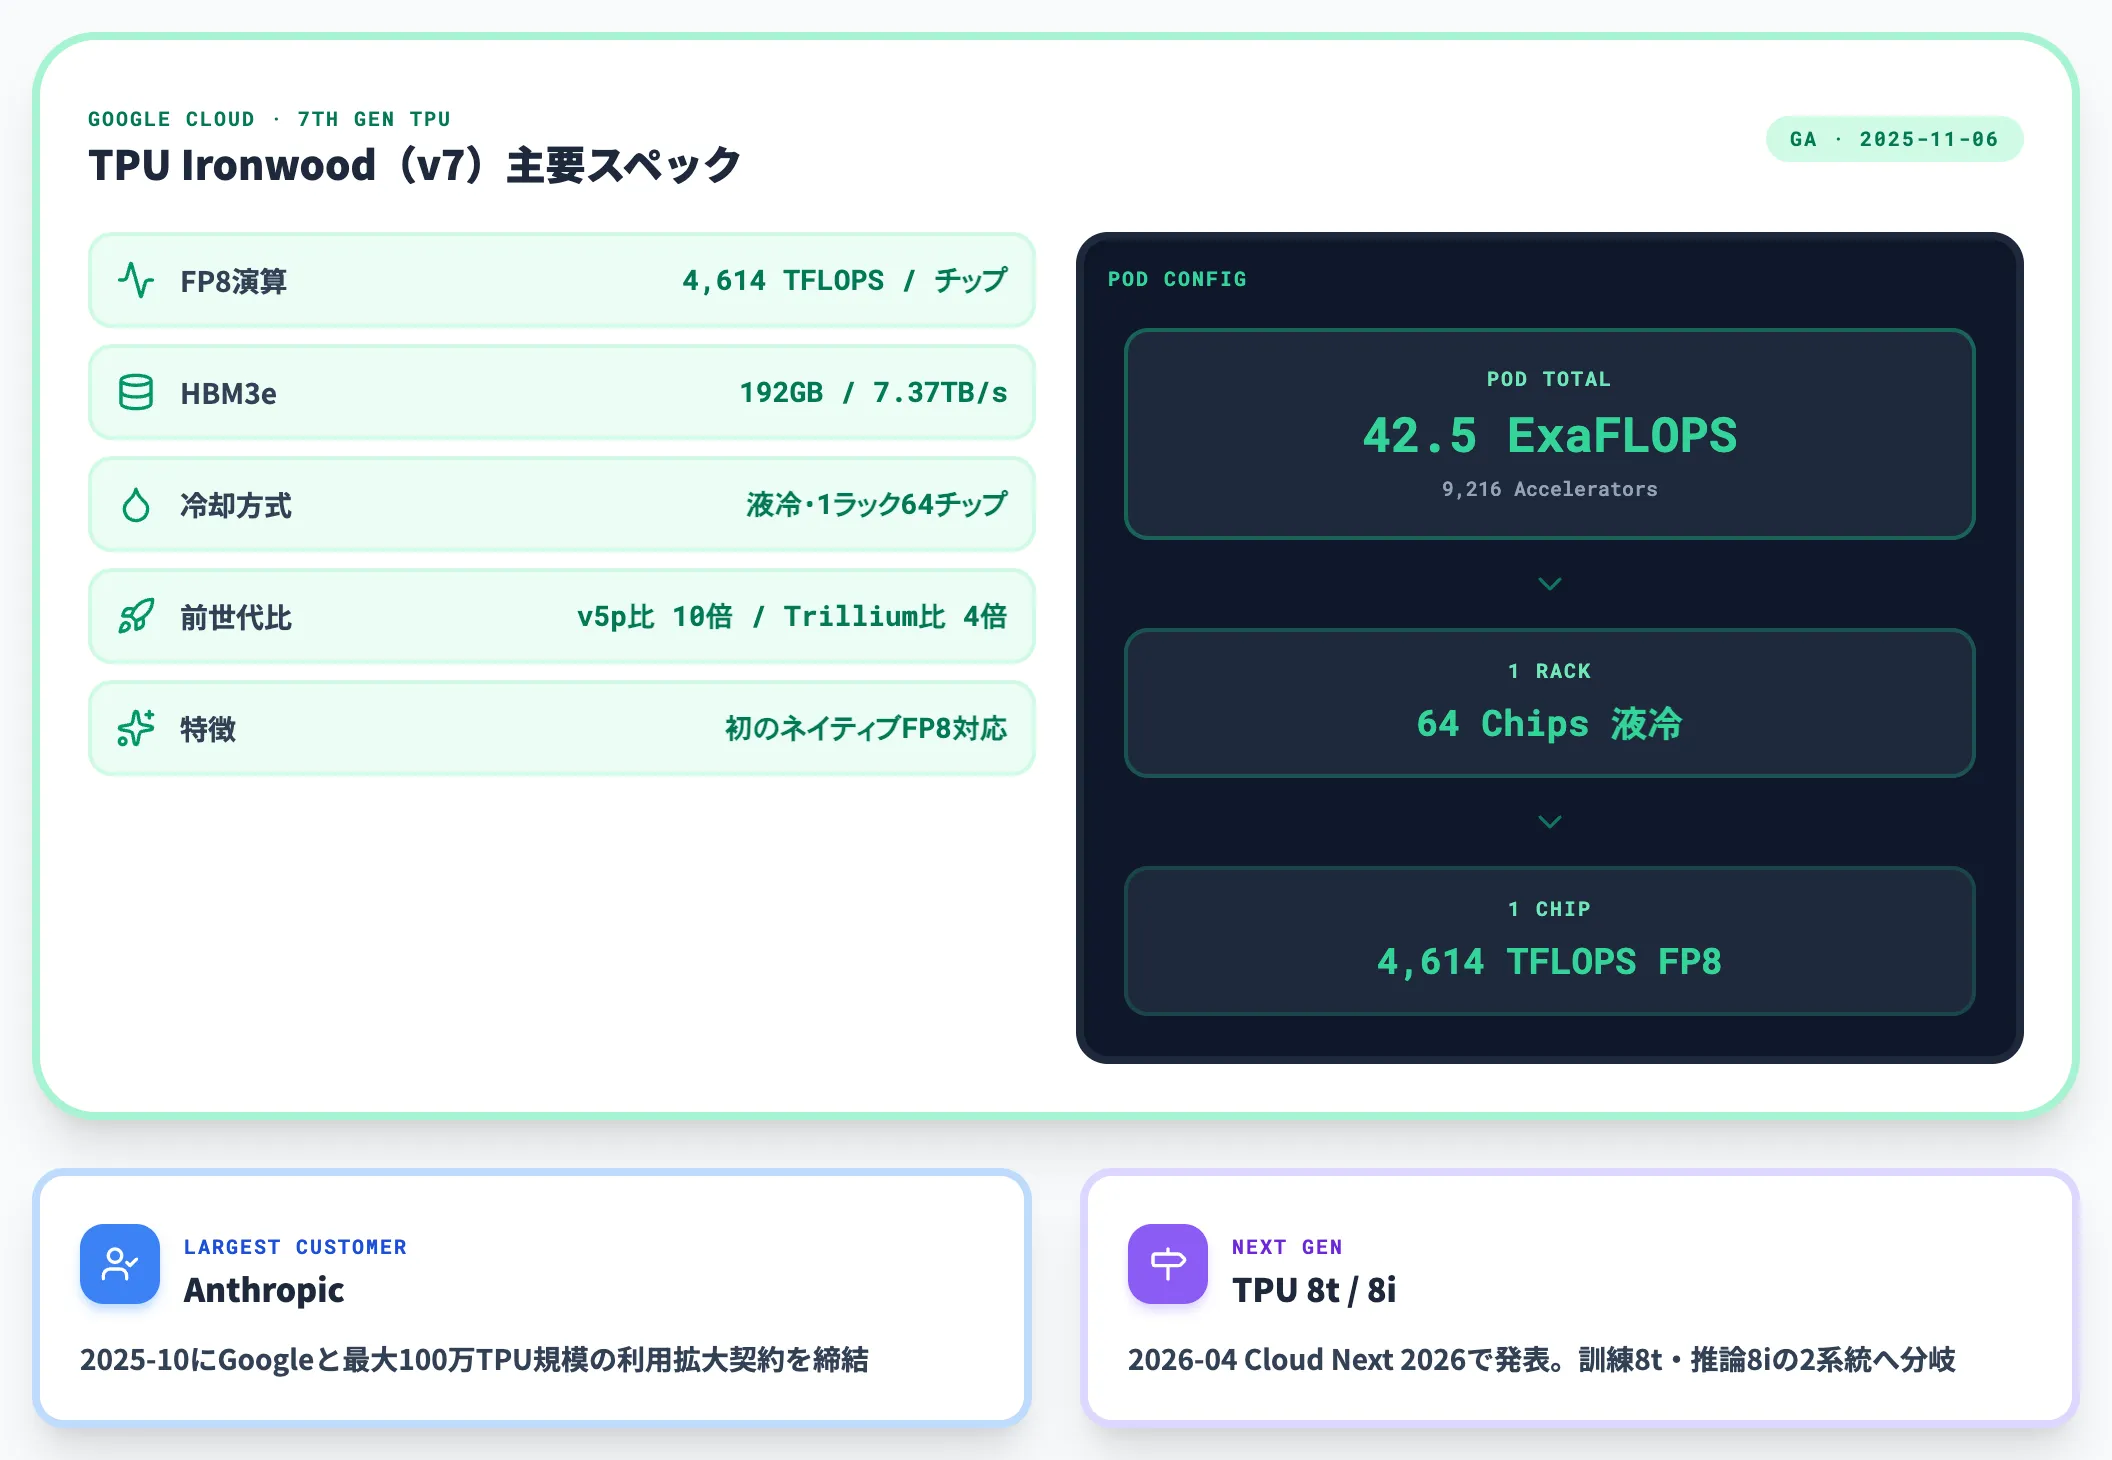
Googleは2025年11月6日のCloud公式ブログで第7世代TPU「Ironwood」の一般提供を発表し、2026年4月のCloud Next 2026で主力モデルを展示しました。
| 項目 | TPU Ironwood(v7) |
|---|---|
| FP8演算性能 | 4,614 TFLOPS/チップ |
| メモリ | 192GB HBM3e、帯域7.37TB/s |
| 冷却方式 | 液冷(1ラックあたり64チップで高密度収容) |
| Pod構成 | 9,216アクセラレータで42.5 FP8 ExaFLOPS |
| 前世代比性能 | TPU v5p比10倍、Trillium比4倍 |
Ironwoodは初のネイティブFP8対応TPUで、推論用途に最適化されています。
Anthropicは最大100万チップ規模のTPU利用契約を2025年10月にGoogleと締結しており、AWS Trainium・NVIDIA GPUと並行して複数系統のアクセラレータを使い分ける構造を取っています。
Google自身は、Gemini系モデルの提供でGPU・TPUを併用しており、Alphabet決算説明でもその方針が明示されています。
また、2026年4月22日のGoogle Cloud Next 2026では次世代TPU 8t(訓練向け)と8i(推論向け)が発表されており、Ironwoodは「汎用TPU最終世代」として位置付けられ、2026年後半以降は用途別の2系統へ分岐していく展開です。
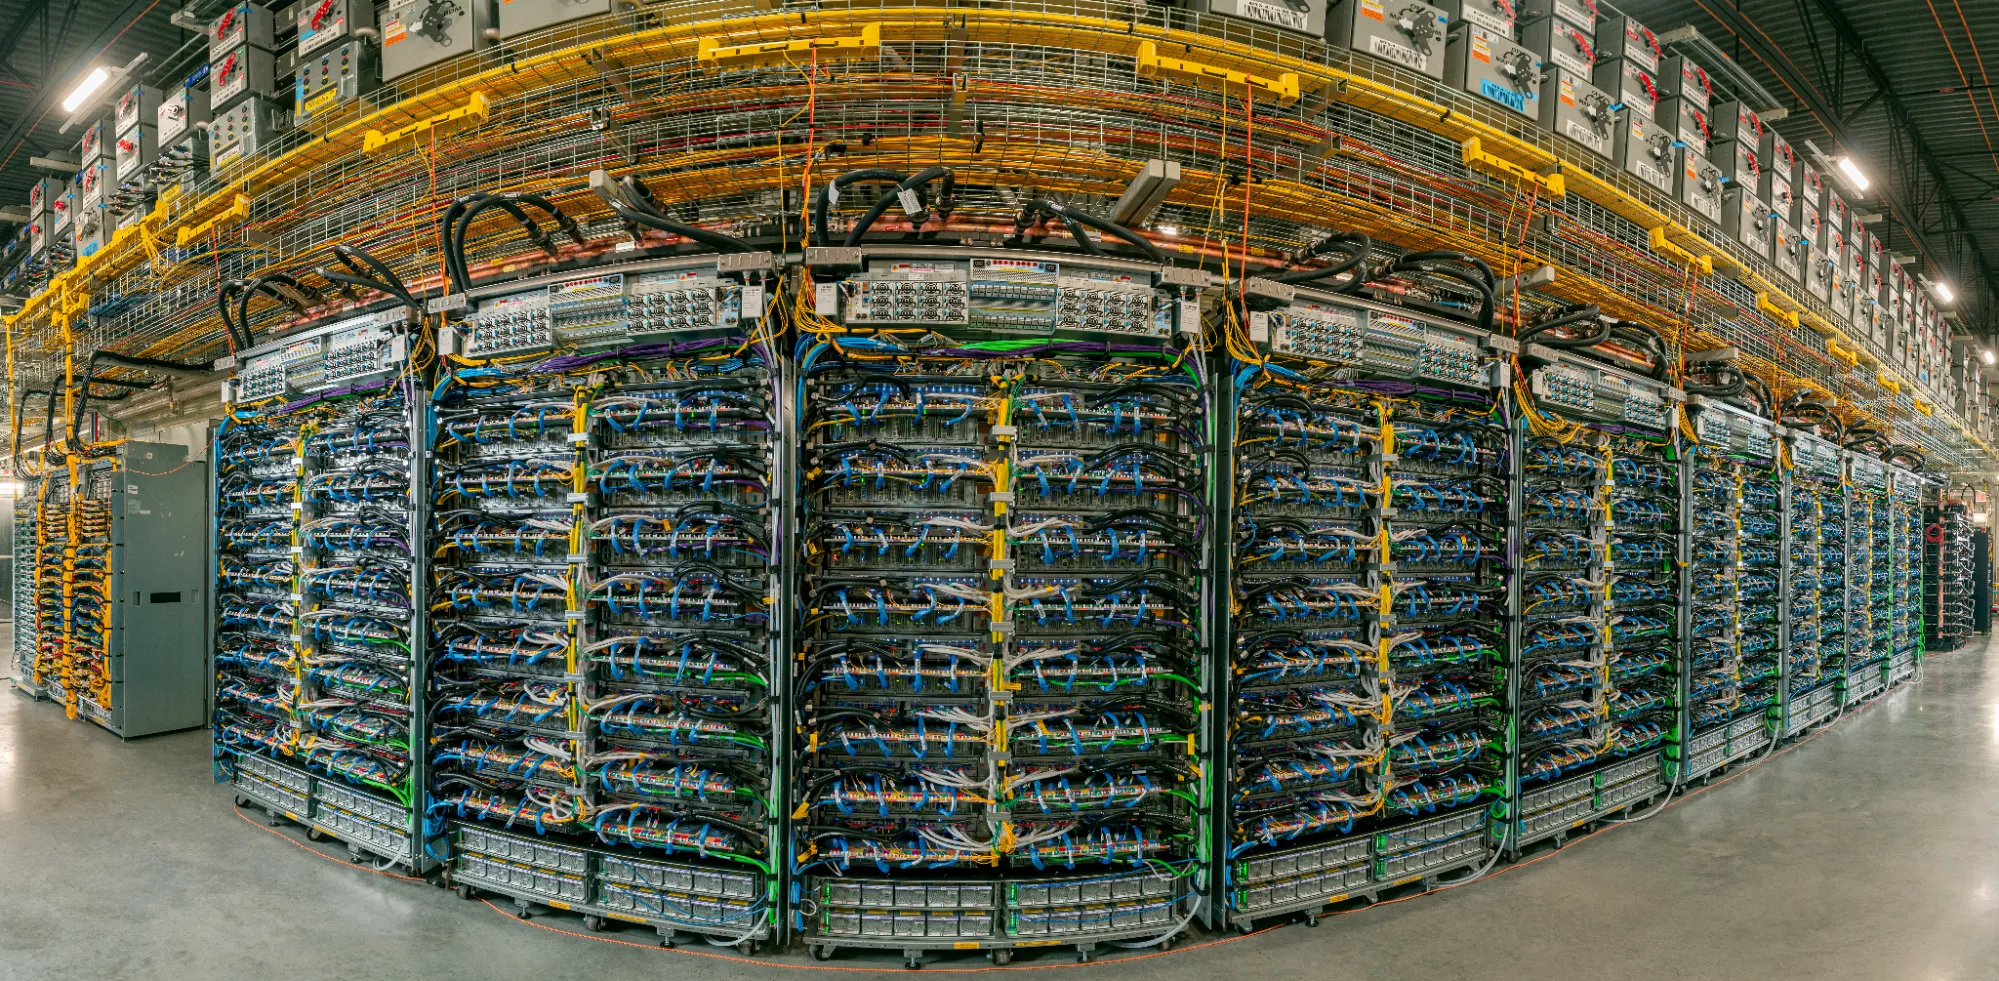
Google Cloudに設置されたIronwood TPUのラック群(出典:Google Cloud Blog)
Ironwoodは1ラックあたり64チップが液冷で高密度に収容され、Podあたり9,216チップで42.5 ExaFLOPSに到達します。1施設でこれほどのTPU密度を立ち上げられるのは、Googleが2015年の初代TPU開発以来、10年近く自社設計シリコンのサプライチェーンと液冷データセンター設計を内製し続けてきた蓄積の結果です。
なお、Alphabetの決算説明では、TPUシステムを顧客データセンターへ販売するビジネスにも触れられており、TPUが完全にcaptive(Google Cloud内のみ)とは限らない運用が始まっています(対象SKU・条件の詳細は各四半期の決算質疑を要確認)。
Microsoft Maia 200——TSMC 3nm・216GB HBM3e、2026年1月発表
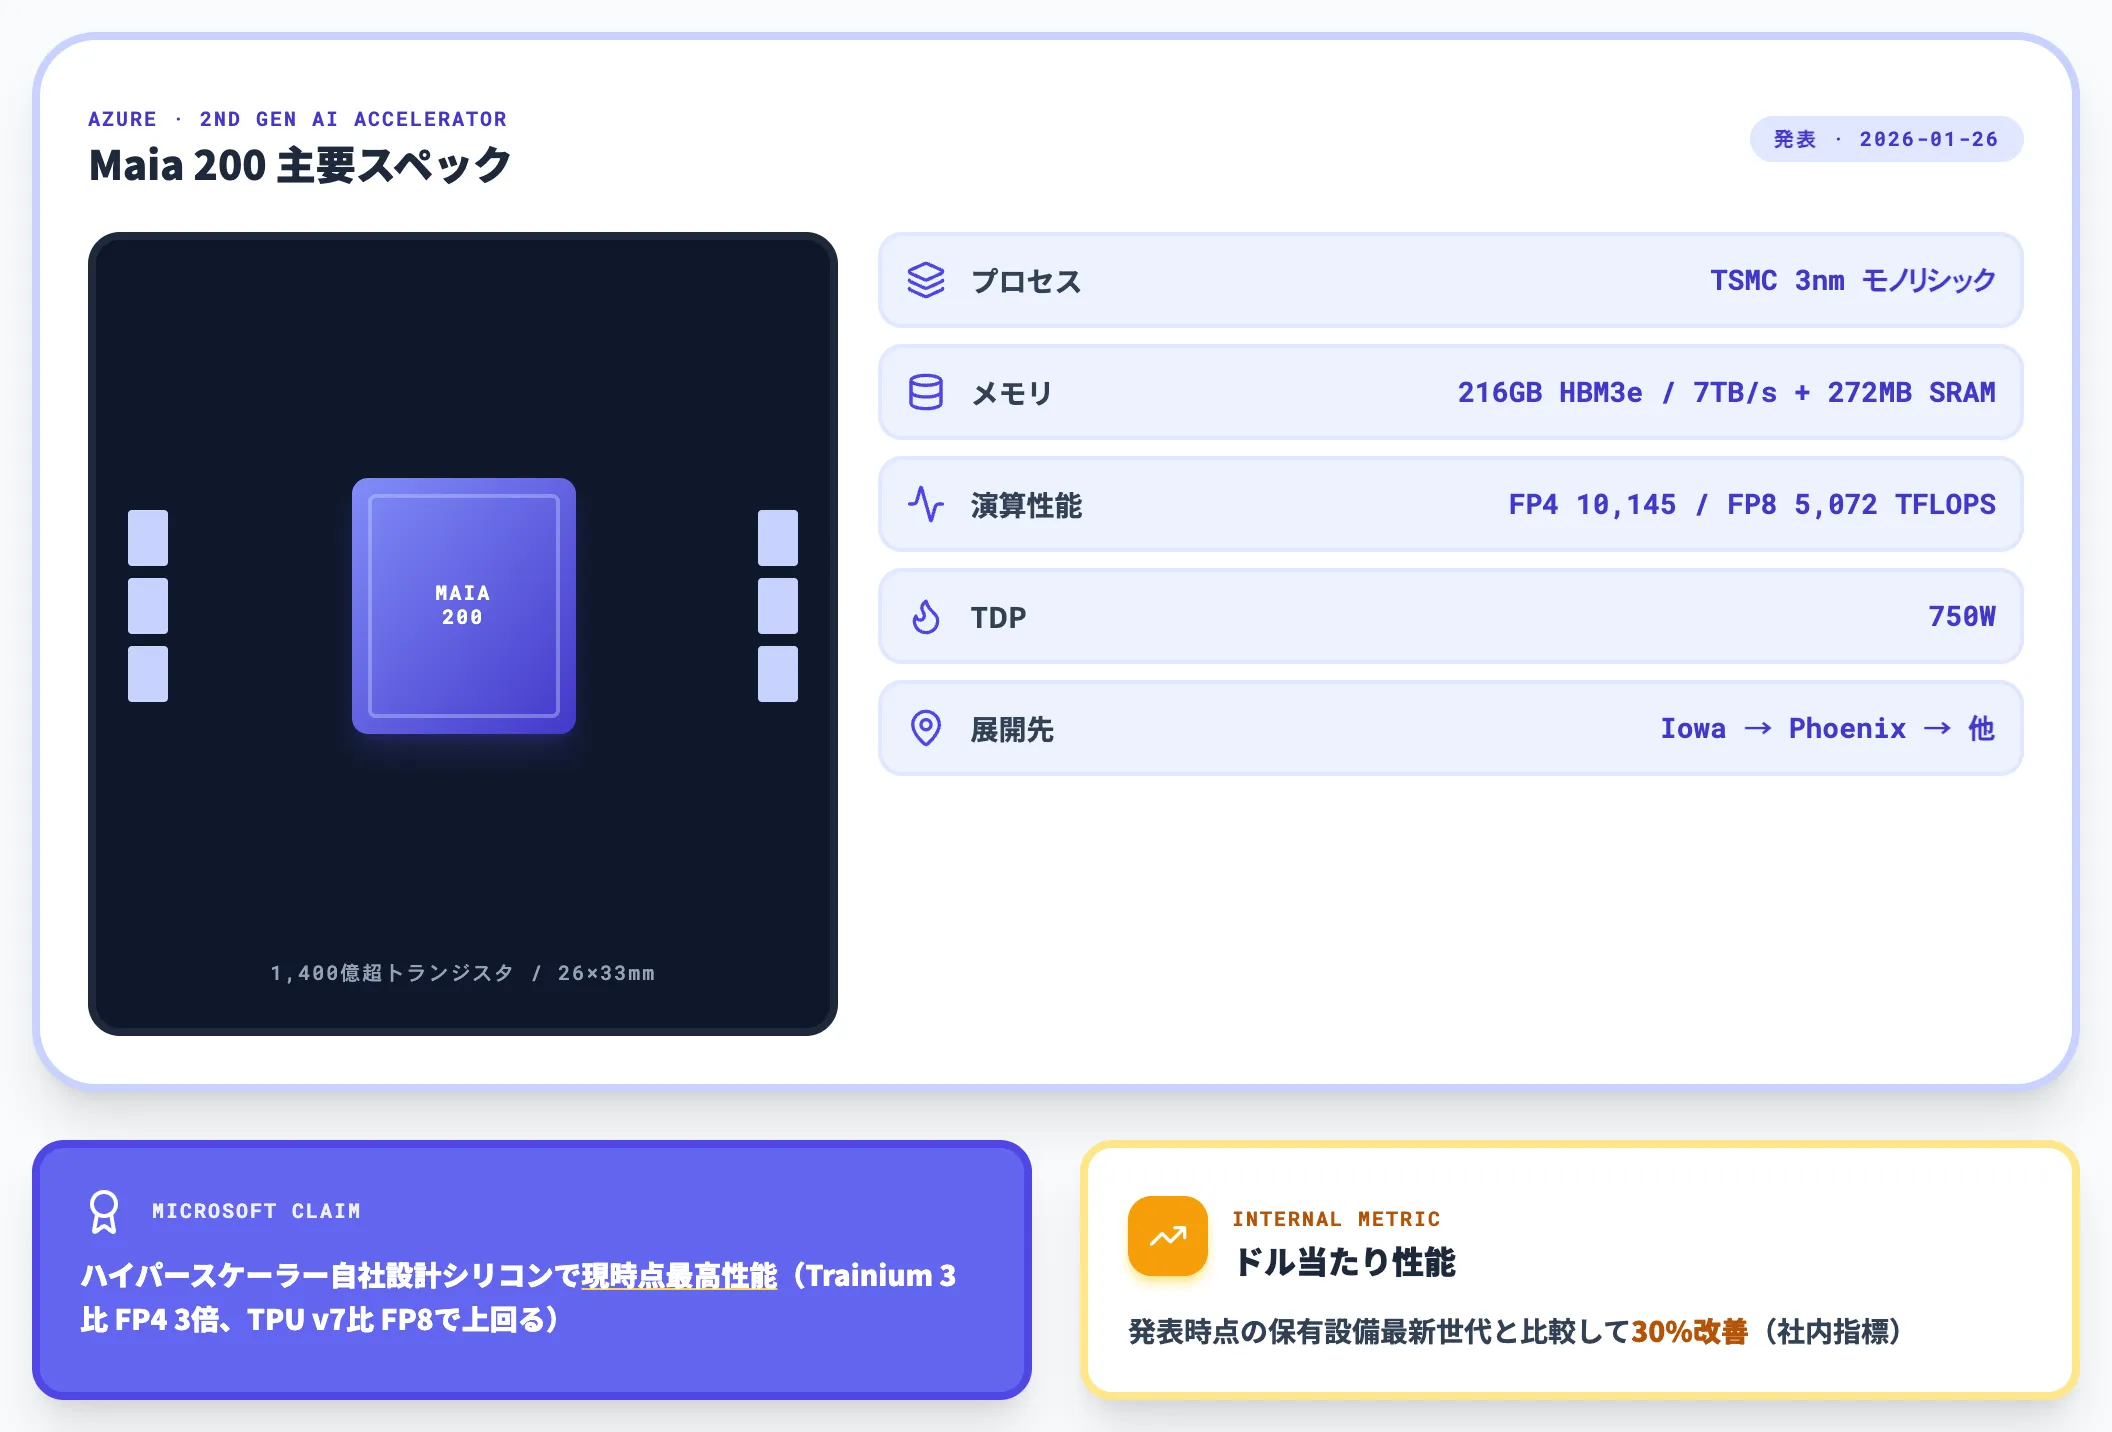
Microsoftは2026年1月26日の公式ブログで、第2世代AI推論アクセラレータMaia 200を発表しました(一般顧客向けGAではなく、社内展開+SDKプレビュー段階)。
- プロセス: TSMC 3nm、1,400億超のトランジスタ(レチクルサイズ級モノリシックダイ 26×33mm)
- メモリ: 216GB HBM3e(6スタック構成)、帯域7TB/s、オンチップSRAM 272MB
- 演算性能: FP4で10,145 TFLOPS、FP8で5,072 TFLOPS
- TDP: 750W
- 展開先: 米Iowa(Des Moines)、Phoenix、以降は追加リージョン
Microsoftは「Maia 200はハイパースケーラー自社設計シリコンで現時点最高性能で、Trainium 3比でFP4性能3倍、Google TPU v7比でFP8性能で上回る」と公表しています。社内指標として「発表時点の保有設備の最新世代と比較してドルあたり性能30%改善」とも説明しています。
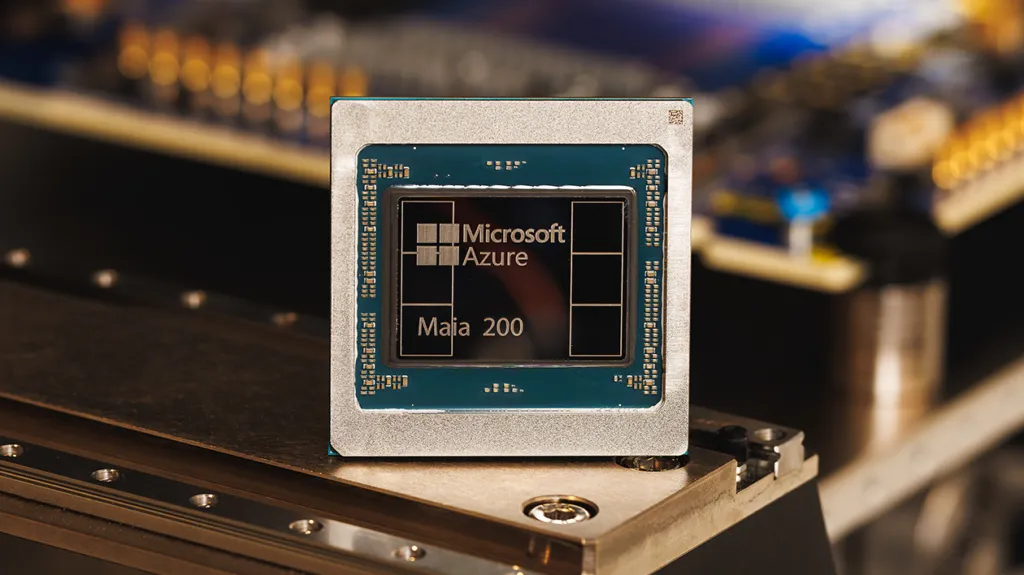
Azure Maia 200のチップ本体(出典:Microsoft Blog)
チップ上面の中央に大きな演算ダイが載り、周囲に6つのHBM3eスタックが配置される構造が見えます。Microsoftは2026年1月の発表時点でMaia 200をIowa(Des Moines)のUS Centralリージョンに先行展開しており、2026年中にPhoenix(US West 3)と追加リージョンへの展開を予定しています。
captive silicon化がユーザーに意味すること
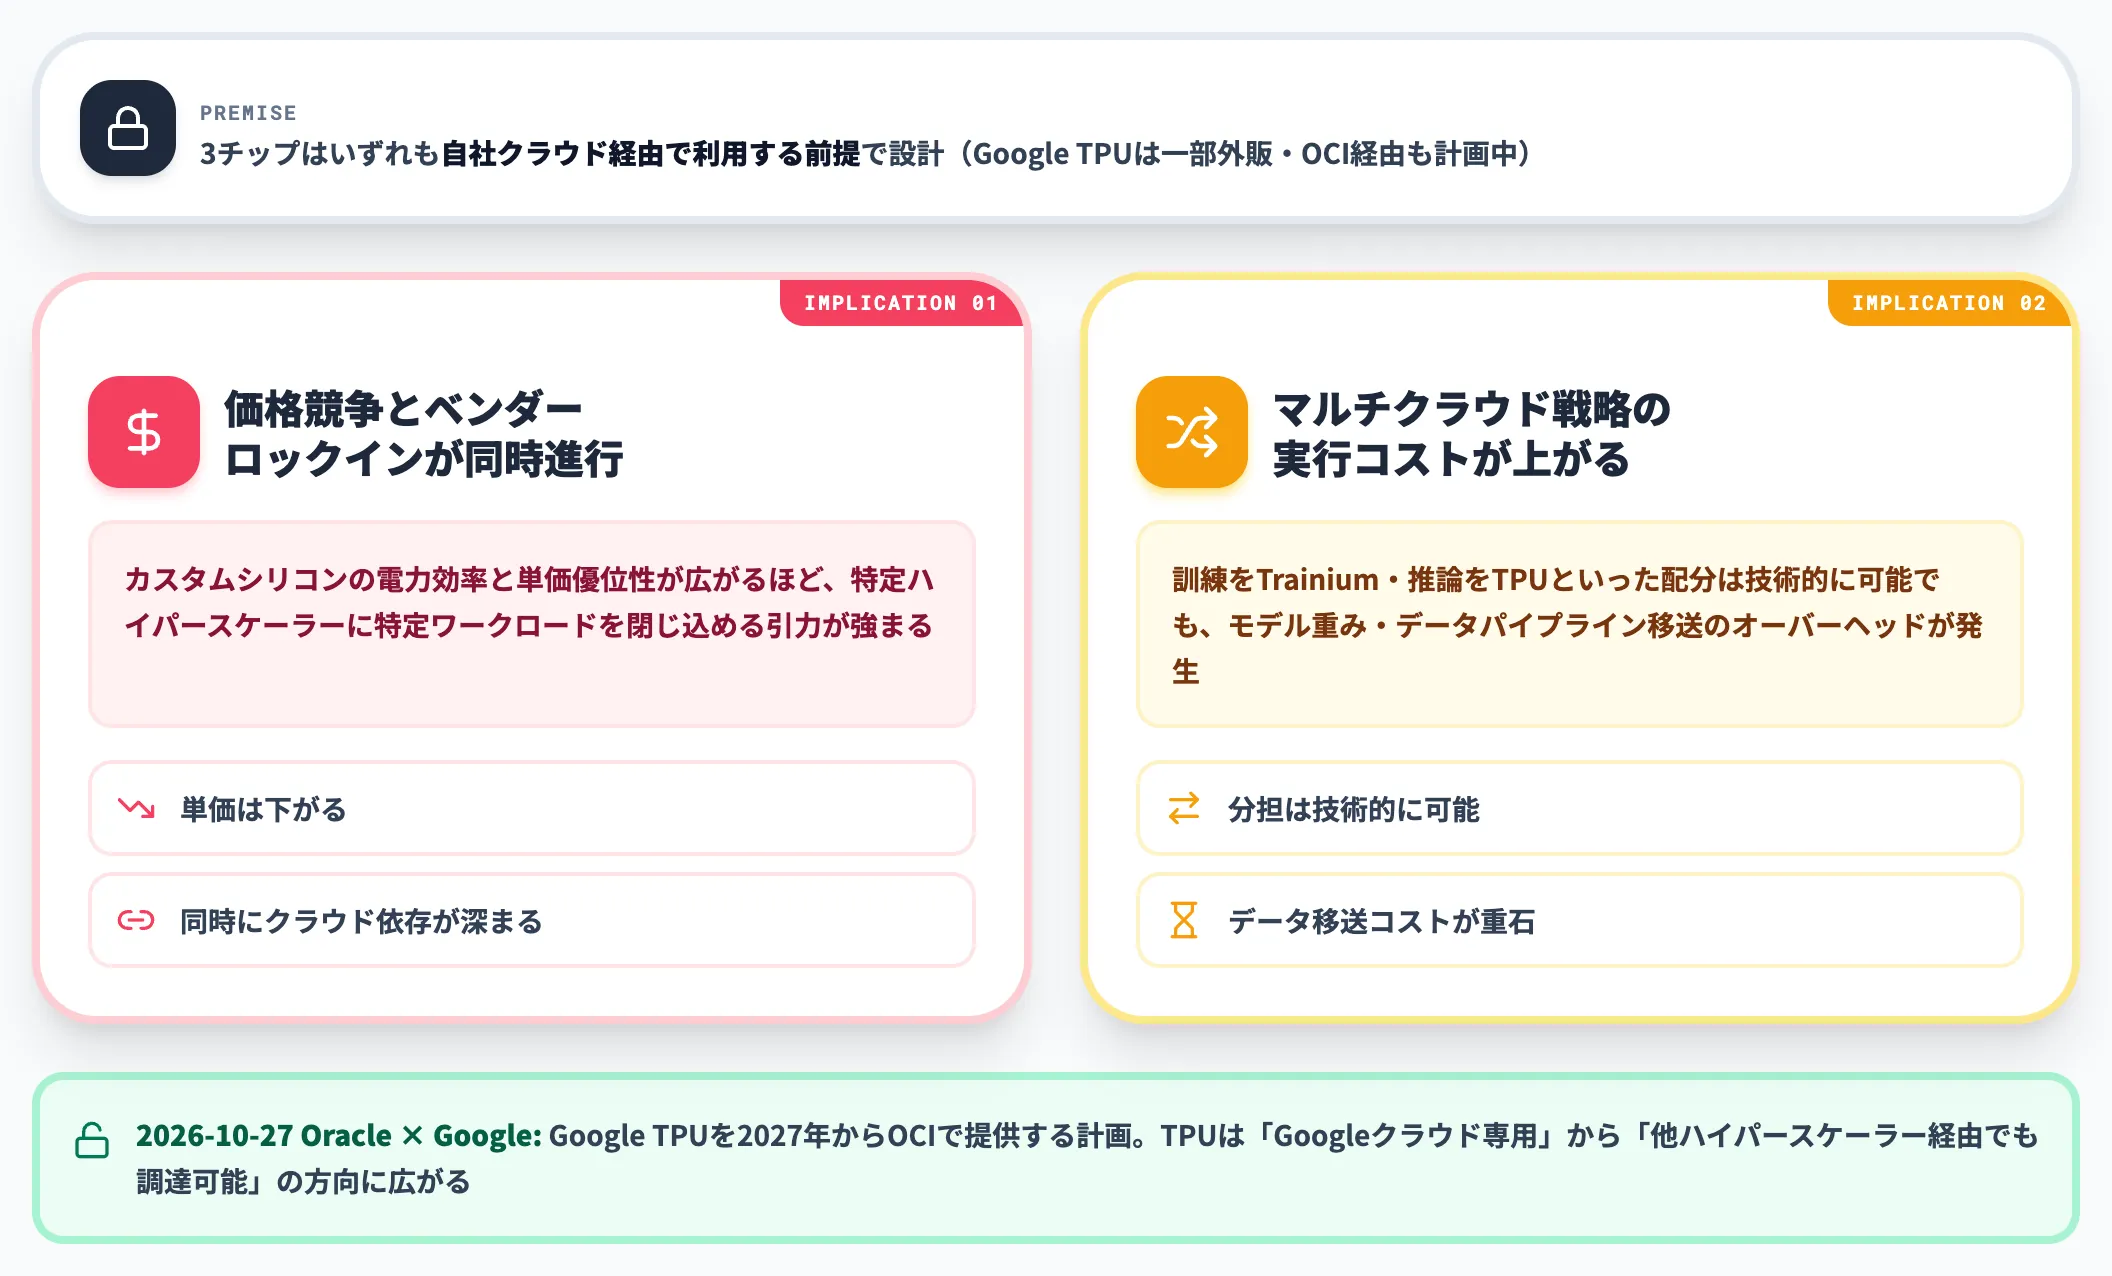
AWS Trainium 3・Google TPU Ironwood・Microsoft Maia 200の3チップはいずれも基本的に自社クラウド経由で利用する前提で設計されており、NVIDIA GPUのように複数ベンダー経由で汎用的に調達できる構造ではありません(ただしGoogleは一部TPUシステムを顧客データセンターへ外販しており、「完全な囲い込み」ではない点に注意)。
さらに2026年10月27日、OracleとGoogleがGoogle TPUをOracle Cloud Infrastructure(OCI)で2027年から提供する計画を発表しており、TPUは「Googleクラウド専用」から「他ハイパースケーラー経由でも調達可能」の方向に広がる流れです。
この構造がユーザーに意味することは2点あります。
1点目は、価格競争とベンダーロックインが同時に進むことです。カスタムシリコンの電力効率と単価優位性が広がるほど、特定ハイパースケーラーに特定ワークロードを閉じ込める引力が強まります。
2点目は、マルチクラウド戦略の実行コストが上がることです。訓練をTrainium 3で、推論をTPU Ironwoodでといった配分は技術的には可能でも、各クラウド間でモデル重み・データパイプラインを移すオーバーヘッドが発生します。実務では「このワークロードはどのハイパースケーラーの自社シリコンに乗せるか」という設計判断が、2026年以降のアーキテクチャ論点の中心に移りつつあります。
ハイパースケーラーとAIラボ提携の最新地図
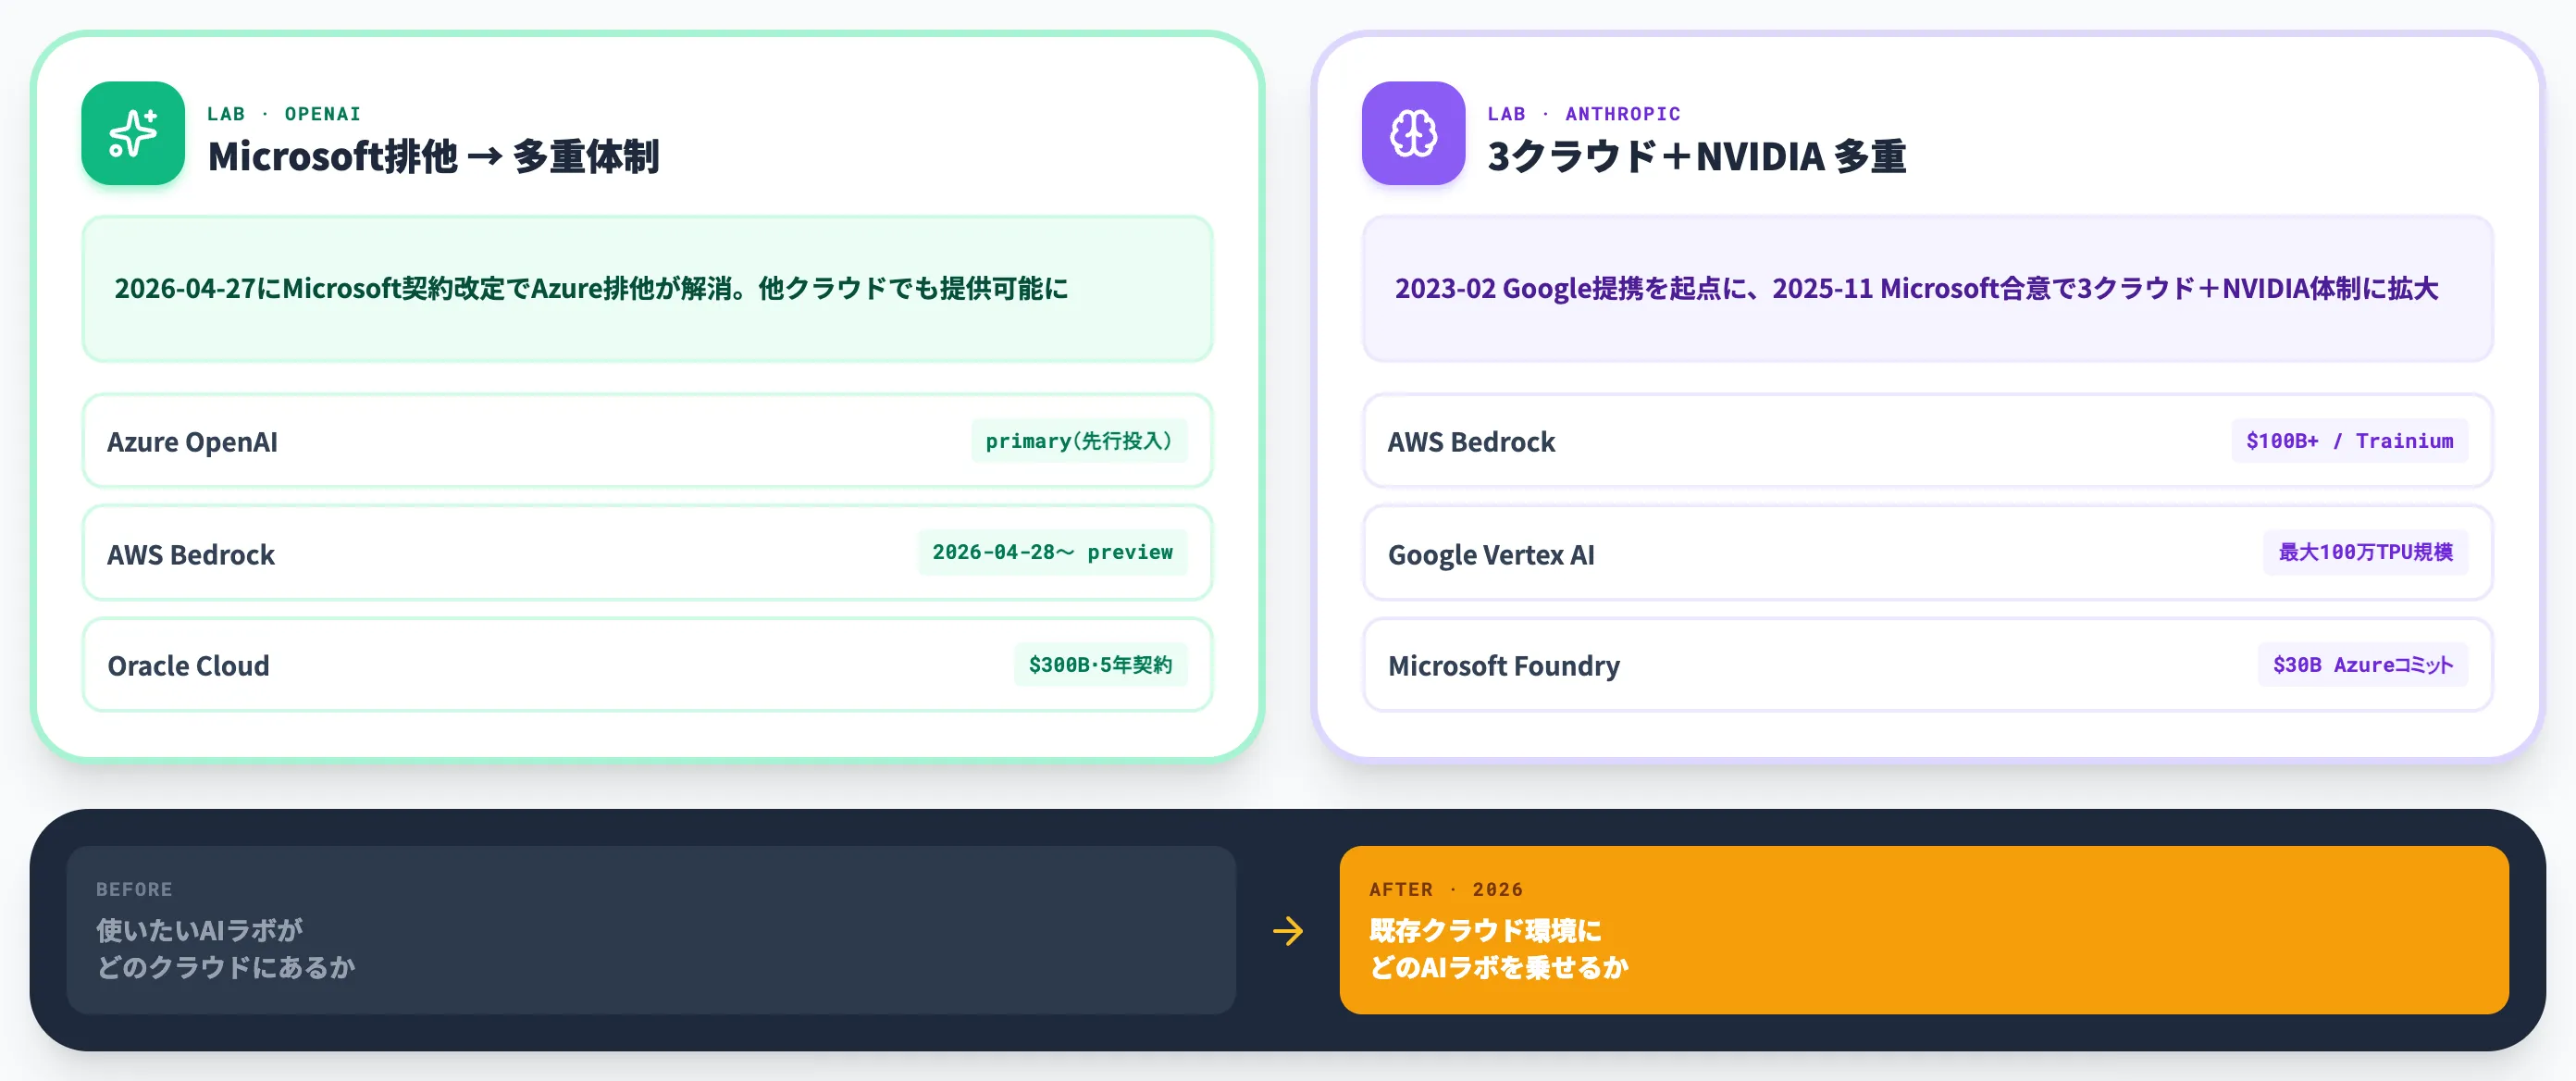
2026年のハイパースケーラー産業で動いたのが、OpenAI・Anthropicという主要AIラボとの提携関係です。OpenAIはMicrosoft排他が2026年4月27日の契約改定で解消され、Anthropicは2023年2月のGoogle Cloud提携を起点に3社+NVIDIAへの多重体制を広げました。
両ラボはそれぞれ異なる経緯で、複数ハイパースケーラーで提供される構造に至っています。
本セクションでは、提携関係の変化と、ユーザーが受ける影響を整理します。
OpenAI——AWS/Oracle拡大と2026年4月のMicrosoft排他解消
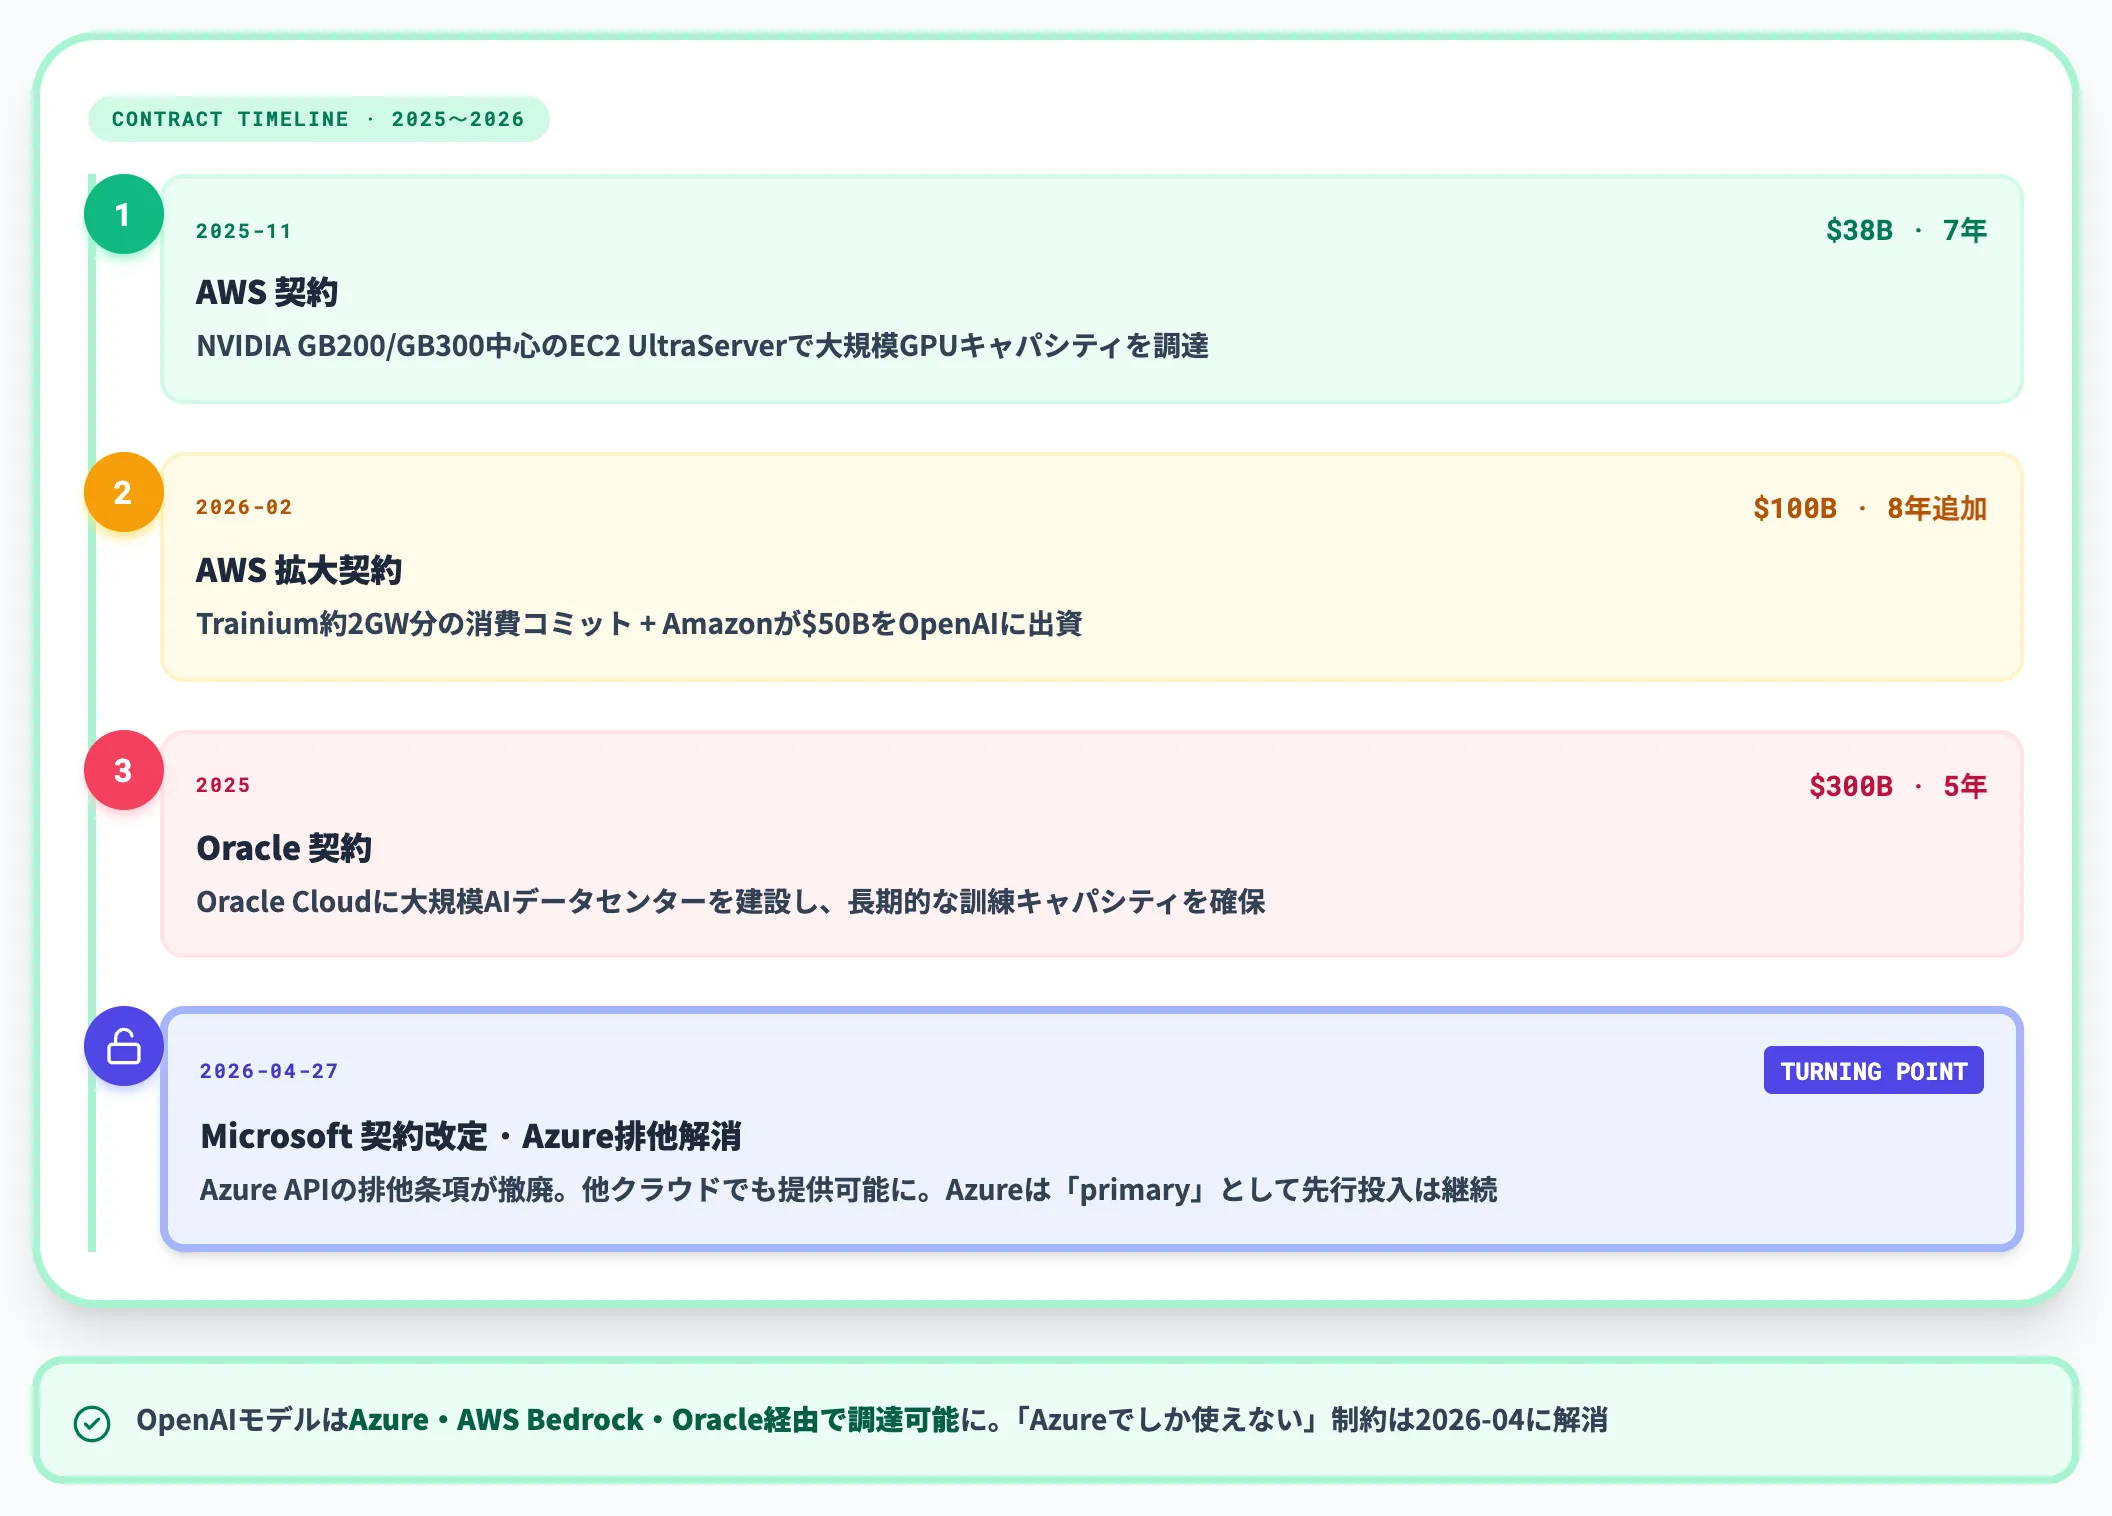
OpenAIは2025年〜2026年にかけて計算資源とモデル販売経路の両面で契約を組み替え、Azure排他の構造を解消しました。
主な契約の構造は以下のとおりです。
-
AWS契約(2025年11月、$38B・7年)
NVIDIA GB200/GB300を中心としたEC2 UltraServerで大規模GPUキャパシティを調達
-
AWS拡大(2026年2月、$100B・8年追加)
Trainiumキャパシティ約2GW分の消費コミットを含む拡大契約。Amazonは併せて$50BをOpenAIに出資
-
Oracle契約(2025年、$300B・5年)
Oracle Cloudに大規模AIデータセンターを建設し、長期的な訓練キャパシティを確保
-
Microsoft契約改定(2026年4月27日)
Azure APIの排他条項が撤廃され、OpenAIのモデルが他クラウドでも提供可能に。Microsoft Azureは引き続き「primary」パートナーの位置づけで、OpenAI製品はAzureに先行投入される
この構造変化の意味は、OpenAIのモデルがAzureだけでなくAWS・Oracle経由でも調達できるようになったという点です。
ユーザー企業にとっては「Azure OpenAI Serviceでしか使えない」制約が2026年4月に解消され、Amazon Bedrockでは4月28日からOpenAIモデルがlimited previewで提供開始、以降は複数クラウドで同じモデルを呼び出せる体制が整いつつあります。
Anthropic——2023年のGoogle提携から3社+NVIDIA体制へ
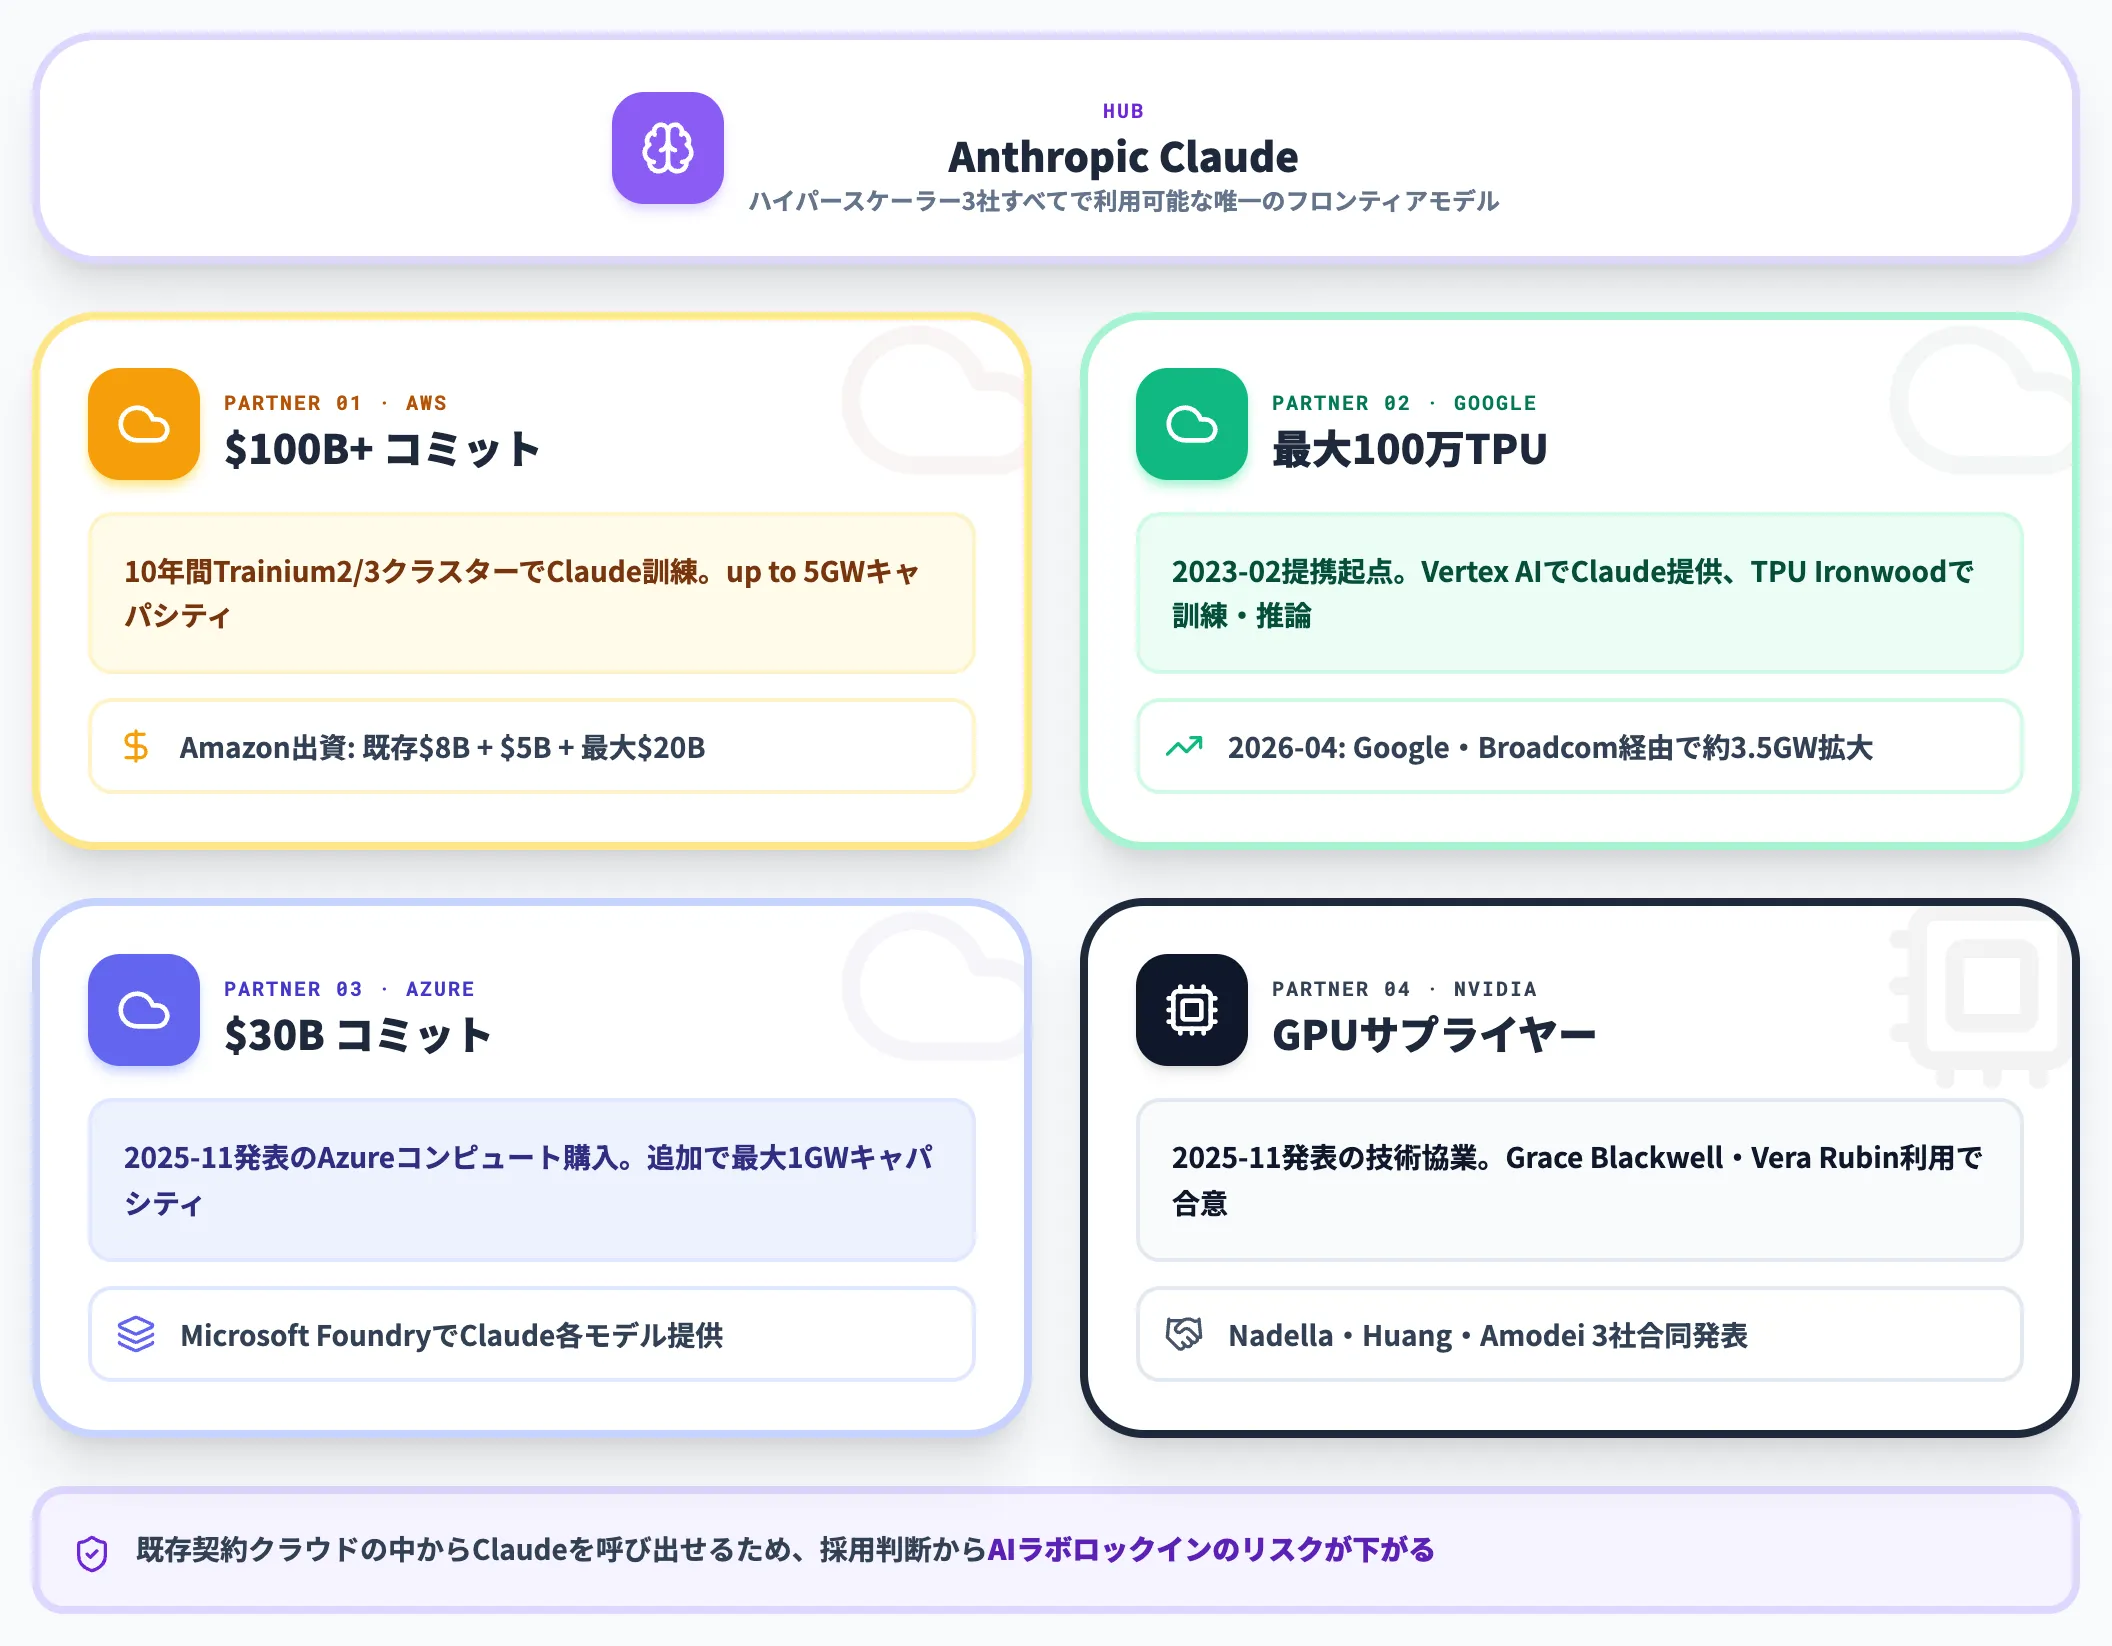
Anthropicは「2025年末から急に排他性が崩壊した」のではなく、2023年2月に Google Cloud を preferred cloud provider に選定した段階から複数クラウドを前提にしており、OpenAIの経緯とは系統が別です。
契約を出資(投資)とクラウド購入コミットで分けて整理すると以下のとおりです。
| 相手 | 契約の種別と規模 | 内容 |
|---|---|---|
| AWS | AWS購入コミット: 10年間で$100B超(2026年4月拡大)/Amazon出資: 既存$8B+2026年4月$5B+将来最大$20B(条件付き) | Trainium2/3クラスターでClaude訓練、up to 5GWキャパシティ、Amazon BedrockでClaude提供 |
| Google Cloud | 2023年2月提携(約$300M出資)、2025年10月に最大100万TPU規模の利用拡大契約、2026年4月にはGoogle・Broadcom経由で約3.5GWのTPUキャパシティ拡大発表(主に2027年以降稼働) | Vertex AIでClaude提供、TPU Ironwoodで訓練・推論 |
| Microsoft Azure | 2025年11月、$30B Azureコンピュート購入コミット(追加で最大1GWキャパシティ契約) | Microsoft FoundryでClaude各モデルを提供(発表当時のモデル名はSonnet 4.5・Opus 4.1・Haiku 4.5。Opus 4.1は2026年8月5日に提供終了済みでOpus 5系列が後継) |
この表が示すのは、Claudeがハイパースケーラー3社すべてで利用可能な唯一のフロンティアモデルになったという事実です。
Oracleのみ提携から外れていますが、残り3社では企業が既存契約しているクラウドの中からClaudeを呼び出せる体制が整いました。
AI総研の支援現場でも、Anthropic 3社対応は「どのクラウドを選んでもClaudeが使える」という安心材料として、ハイパースケーラー採用判断の論点から「AIラボロックイン」のリスクを下げる効果が出ています。
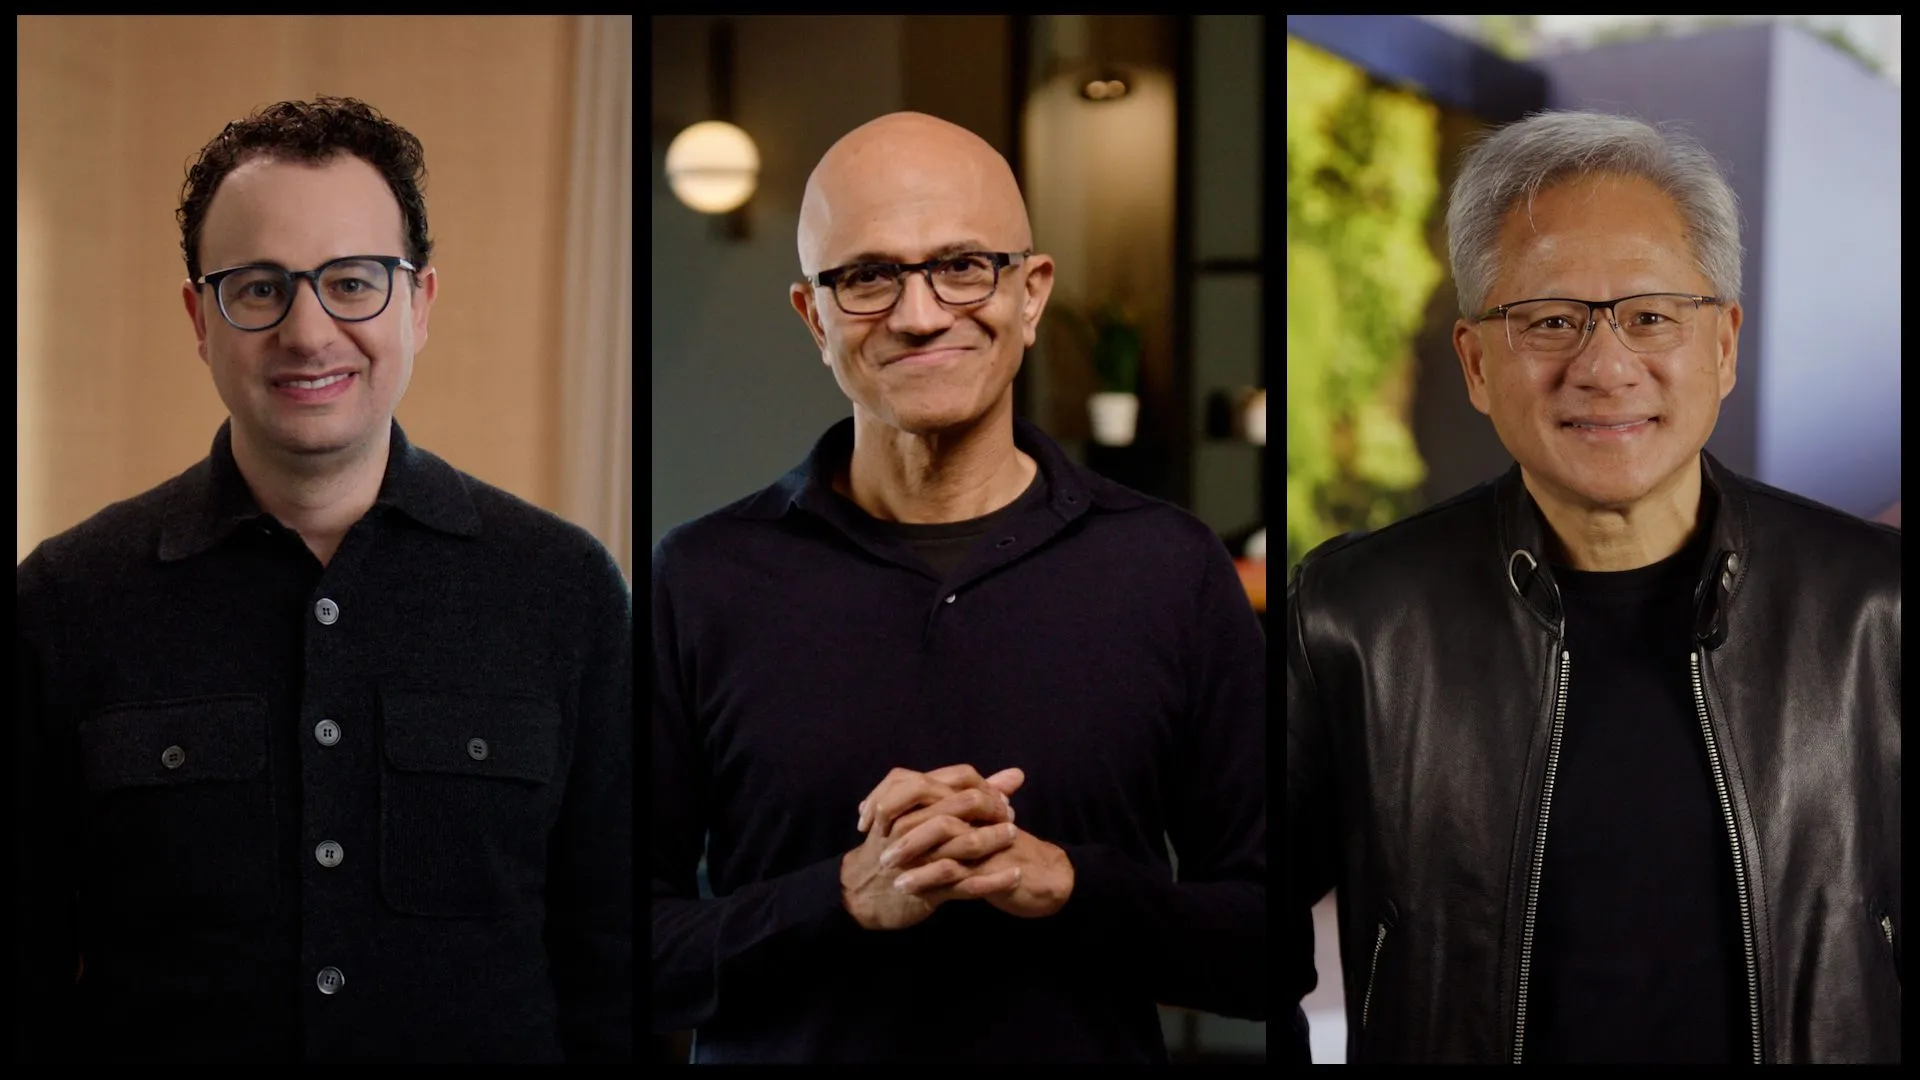
Anthropic・Microsoft・NVIDIA 3社戦略的パートナーシップ発表(出典:Anthropic News)
2025年11月の合同発表では、Dario Amodei(Anthropic CEO)・Satya Nadella(Microsoft CEO)・Jensen Huang(NVIDIA CEO)が揃って登場しました。
この場でAnthropicはAzureのMicrosoft Foundry向けに$30Bのコンピュート購入コミットを結び、NVIDIAとは技術協業とGrace Blackwell・Vera Rubinの利用について合意しています。
既存のAWS Trainium・Google TPU Ironwood契約と合わせると、Claudeは3大ハイパースケーラー+NVIDIA GPU+Googleカスタムシリコンという多重のバックエンドで動く構造です。
マルチクラウド化がユーザー企業に意味すること
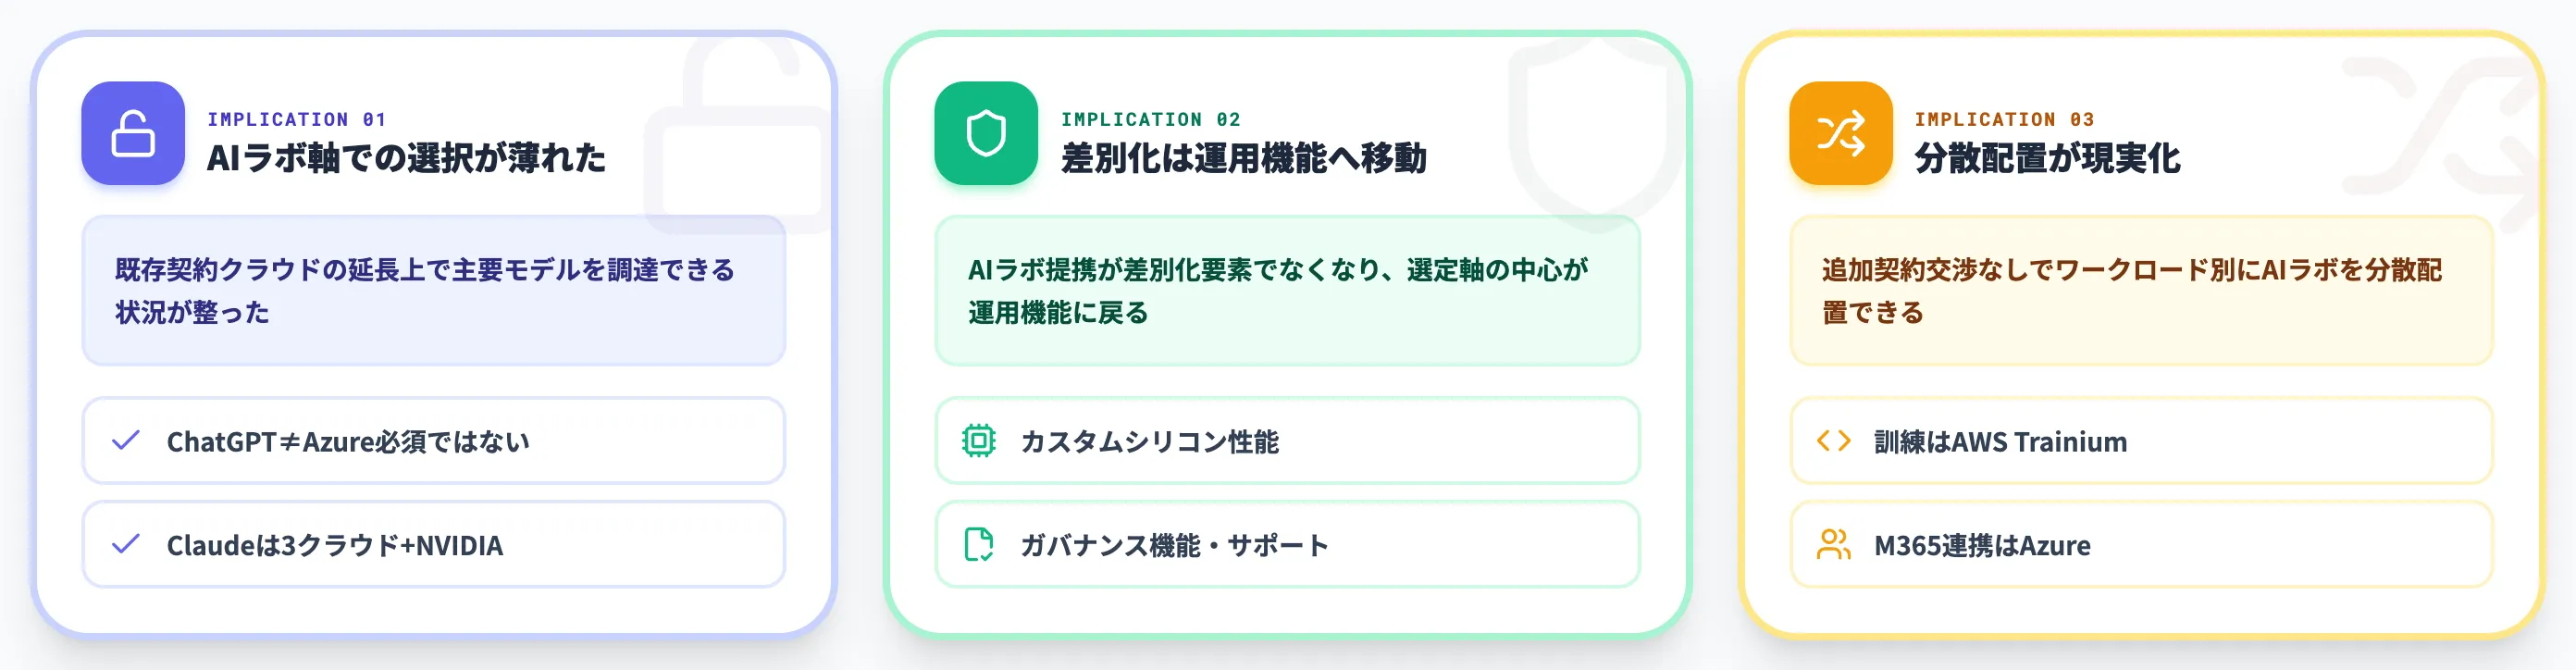
OpenAIの2026年4月の契約改定と、Anthropicがもともと複数クラウドで展開してきた経緯が重なり、企業のクラウド選定には3つの含意が生まれています。
-
AIラボ軸でハイパースケーラーを選ぶ必要が薄れた
OpenAIが「ChatGPT使うならAzure」から他クラウドでも調達できる状態になり、Anthropicは2023年2月のGoogle Cloud提携を起点に、2025年11月のMicrosoft Azure・NVIDIA提携発表以降に3クラウド+NVIDIAの多重体制まで広がりました。既存契約クラウドの延長上で主要モデルを調達できる状況が整いました
-
ハイパースケーラー間の差別化はシリコン・ネットワーク・運用機能に移る
AIラボ提携が差別化要素でなくなった結果、カスタムシリコン性能・リージョン展開・サポート品質・ガバナンス機能が選定軸の中心に戻る
-
マルチクラウドでAIラボを分散配置する運用が現実化
訓練はAWS Trainium、推論はGoogle TPU、M365連携はAzureと分担する構成が、追加の契約交渉なしに取れるようになった
ハイパースケーラーを選ぶ際、「使いたいAIラボがそのクラウドにあるか」ではなく、「自社の既存クラウド環境にどのAIラボを乗せるか」が主語に変わったことを押さえておく必要があります。
ハイパースケーラーとNeocloud・ソブリンクラウドの使い分け
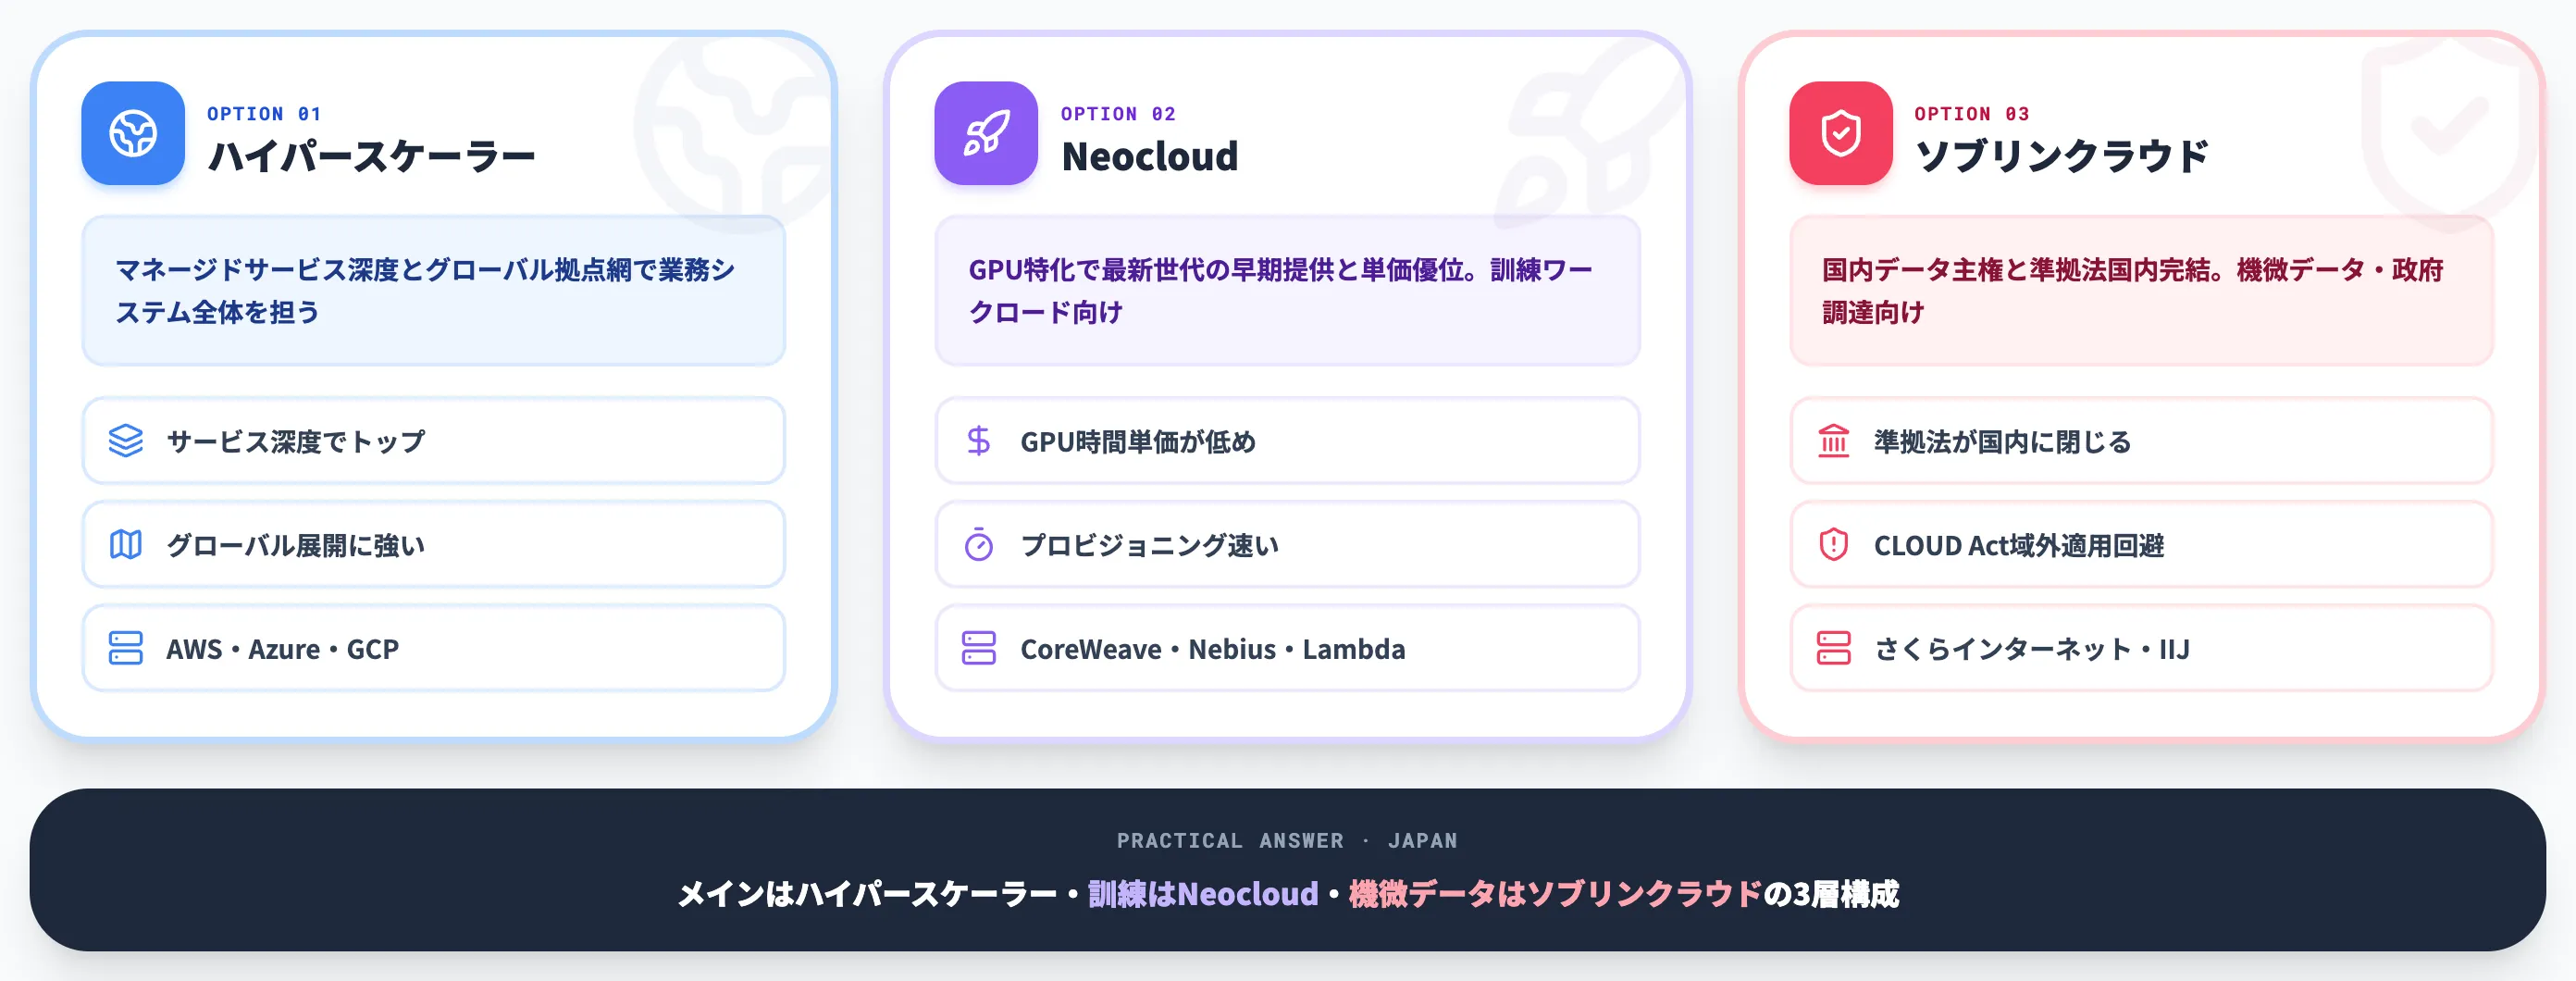
2026年のクラウド選定で見逃せないのが、ハイパースケーラー以外の選択肢の台頭です。GPUに特化したNeocloud(CoreWeave・Lambda・Nebius等)と、国内データ主権を重視するソブリンクラウド(さくらインターネット・IIJ等)が、特定用途でハイパースケーラーを明確に上回る領域を広げています。
本セクションでは、Neocloudとソブリンクラウドの特徴と、ハイパースケーラーとの使い分けパターンを整理します。
Neocloud——GPU特化クラウドの価格・調達優位
Neocloudとは、GPUインフラに特化し、NVIDIA Blackwell等の最新アクセラレータを大量調達して提供する新興クラウド事業者です。代表格がCoreWeaveで、2025年3月にNasdaqに上場(CRWV)し、2026年Q2時点で$104Bのバックログを抱える規模まで成長しています。
主要Neocloud事業者を比較すると、特徴は以下のとおりです。
| 事業者 | 強み | 主要顧客 |
|---|---|---|
| CoreWeave | NVIDIA GB300・Vera Rubin NVL72の業界初ブリングアップ、GPU特化スタック | OpenAI・Meta($21B契約)・NVIDIA |
| Nebius | 欧州拠点・Blackwell早期展開 | 欧州AIスタートアップ |
| Lambda | 個人開発者〜中規模チーム向け、UIシンプル | スタートアップ中心 |
| Crusoe | 再生可能エネルギー電源・排熱利用 | 環境意識の高い企業 |
Neocloudの共通点は、GPU時間単価がハイパースケーラーより低い水準に設定されやすく、最新GPU世代の早期提供とプロビジョニング速度に優位性がある点です。
ハイパースケーラーでは数週間〜数か月のキャパシティ予約が必要なケースが珍しくない一方、Neocloudは最新世代の投入とユーザー向け提供を短サイクルで回しています。具体的な単価差・プロビジョニング時間は事業者ごと・時期ごとに差があるため、採用検討時には各社の料金ページとSLAで確認する必要があります。
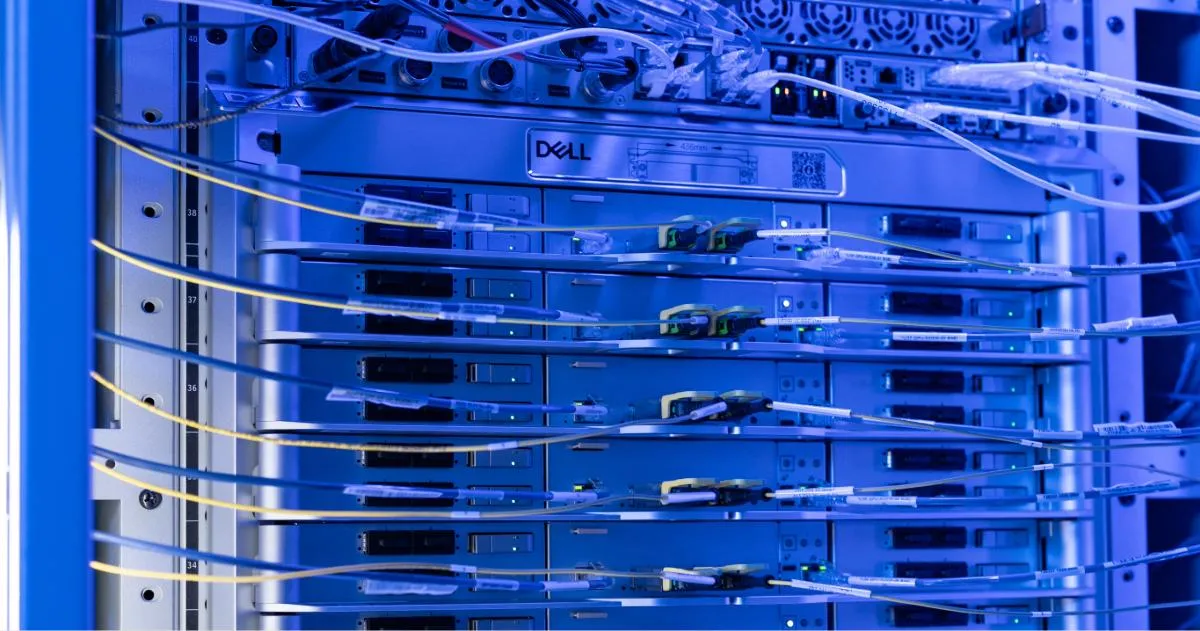
CoreWeaveデータセンターに設置されたNVIDIA Vera Rubin NVL72ラック(出典:CoreWeave Blog)
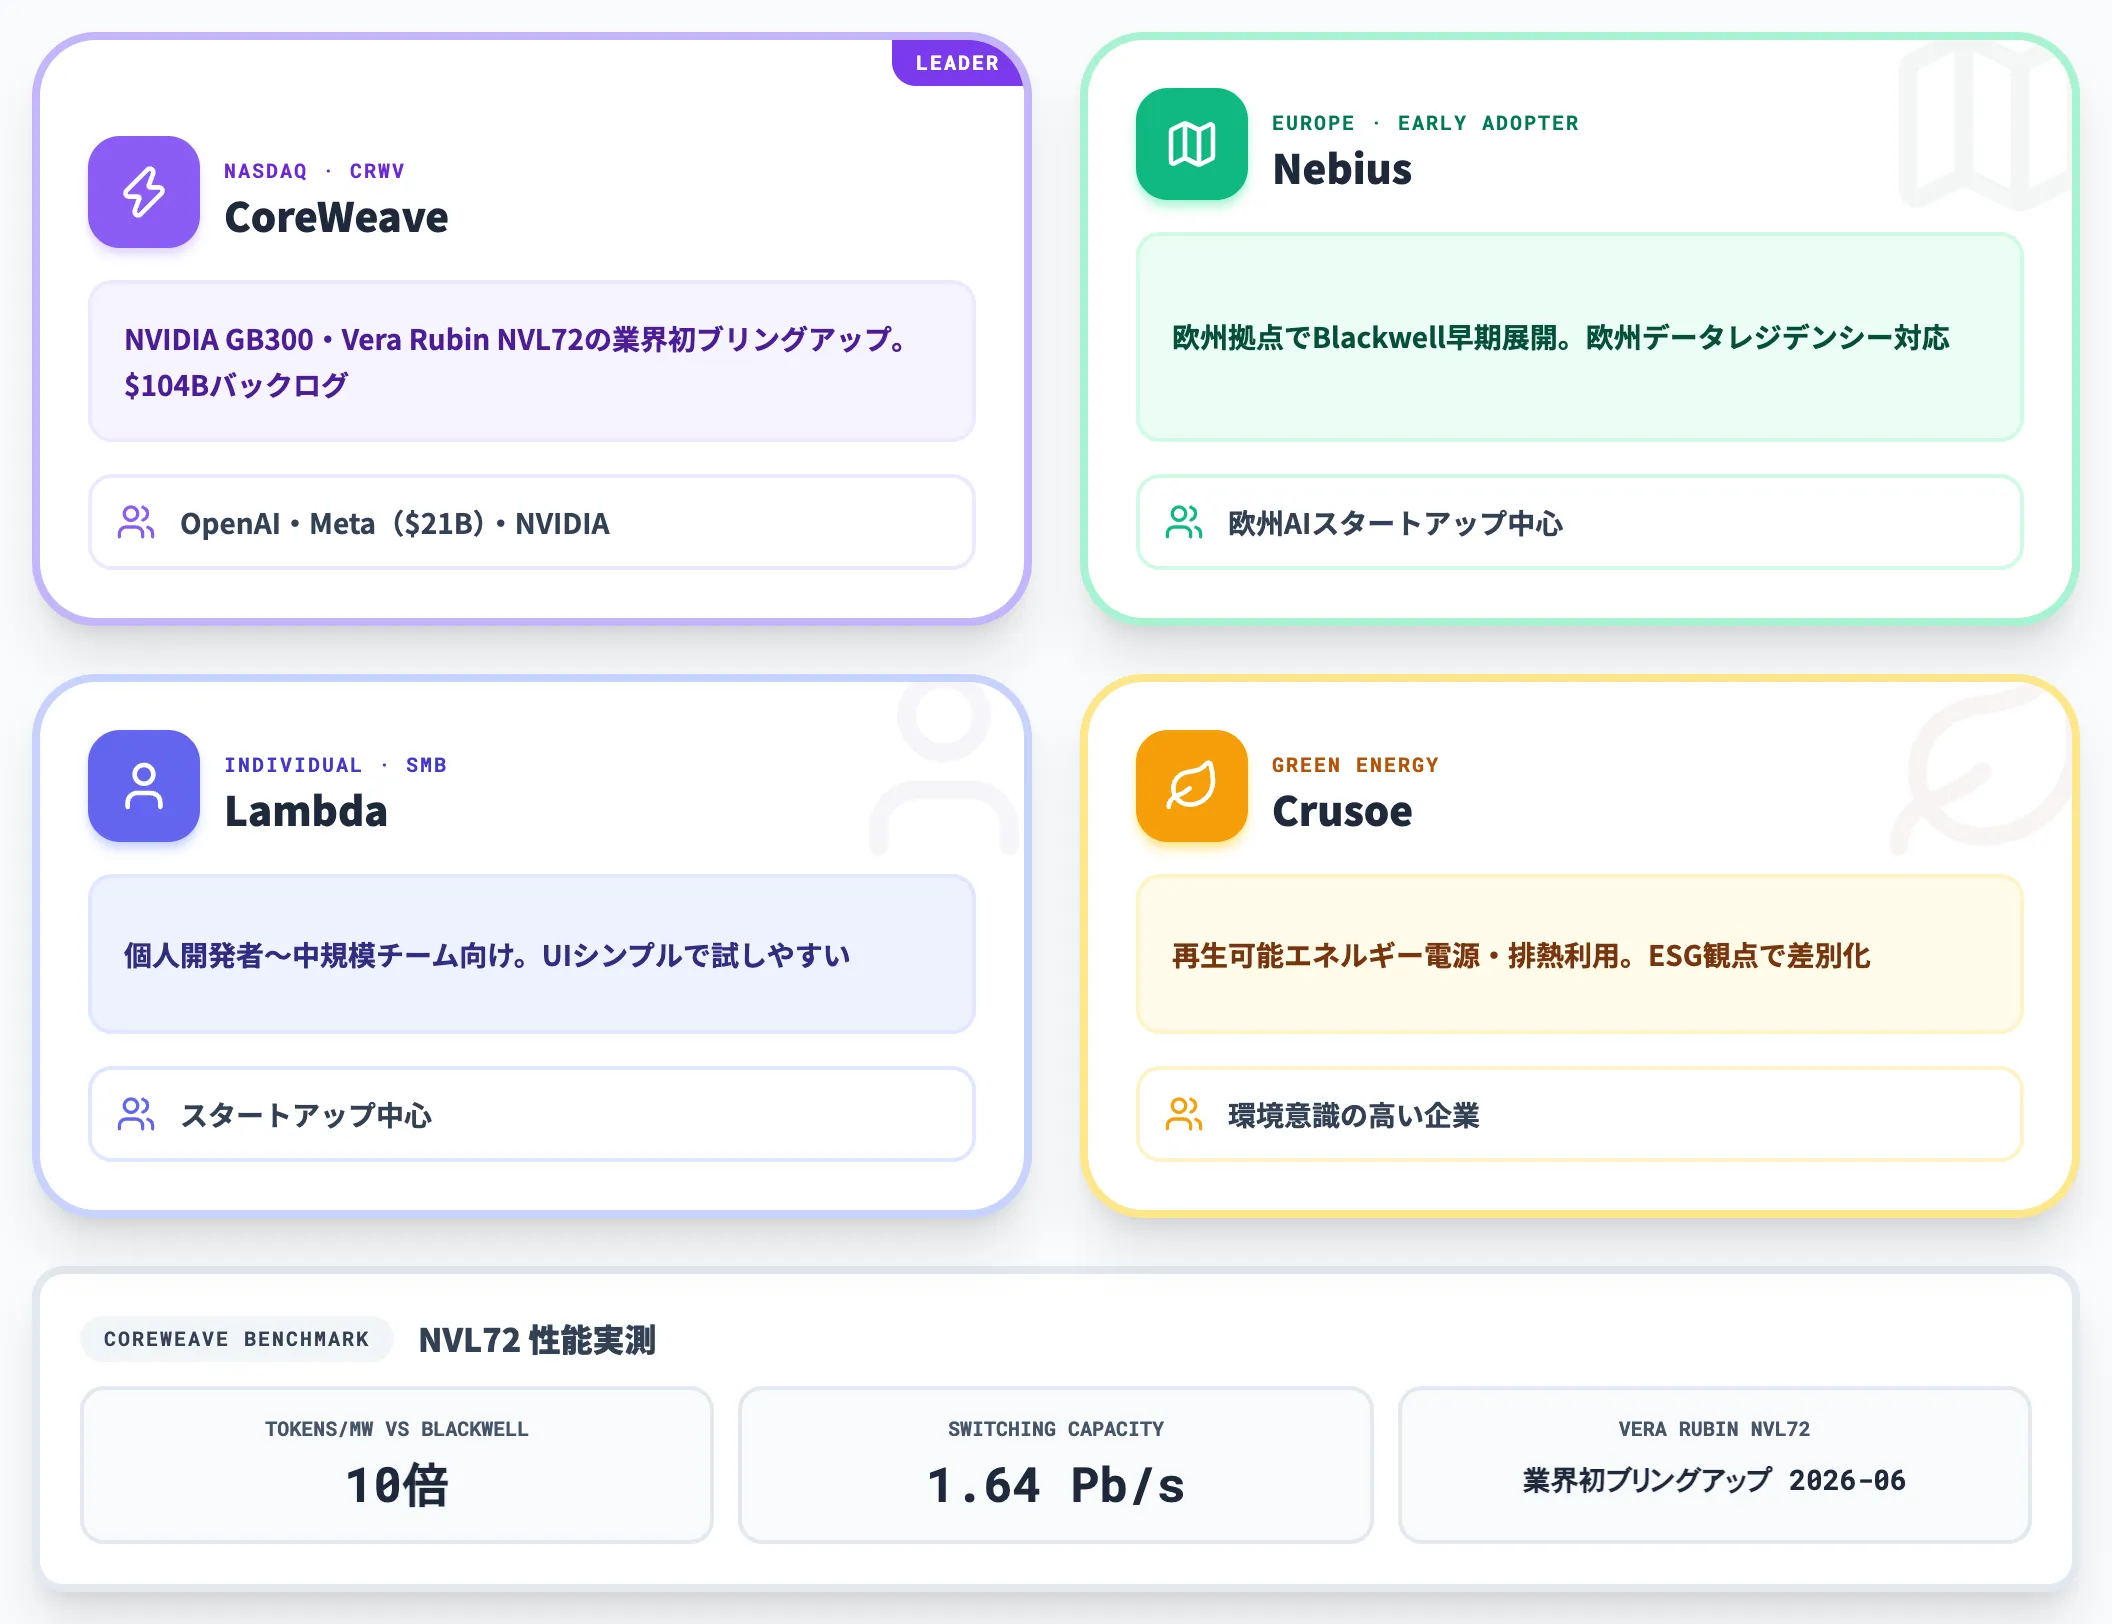
CoreWeaveは2026年6月にNVIDIA Vera Rubin NVL72の業界初ブリングアップを完了し、DeepSeek R1を同等の応答性条件で測定した結果、Blackwell NVL72比で10倍のトークン/MWを実測しました。
写真はDell製の計算ラックで、別途液冷SN6600-LDスイッチを16台搭載したネットワークラックが1.64 Pb/sの総スイッチング容量を提供します。
ハイパースケーラーより先に最新GPU世代の実運用を立ち上げられるのが、Neocloudの構造的な強みです。
ハイブリッド運用——訓練はNeocloud、本番はハイパースケーラーという構成例
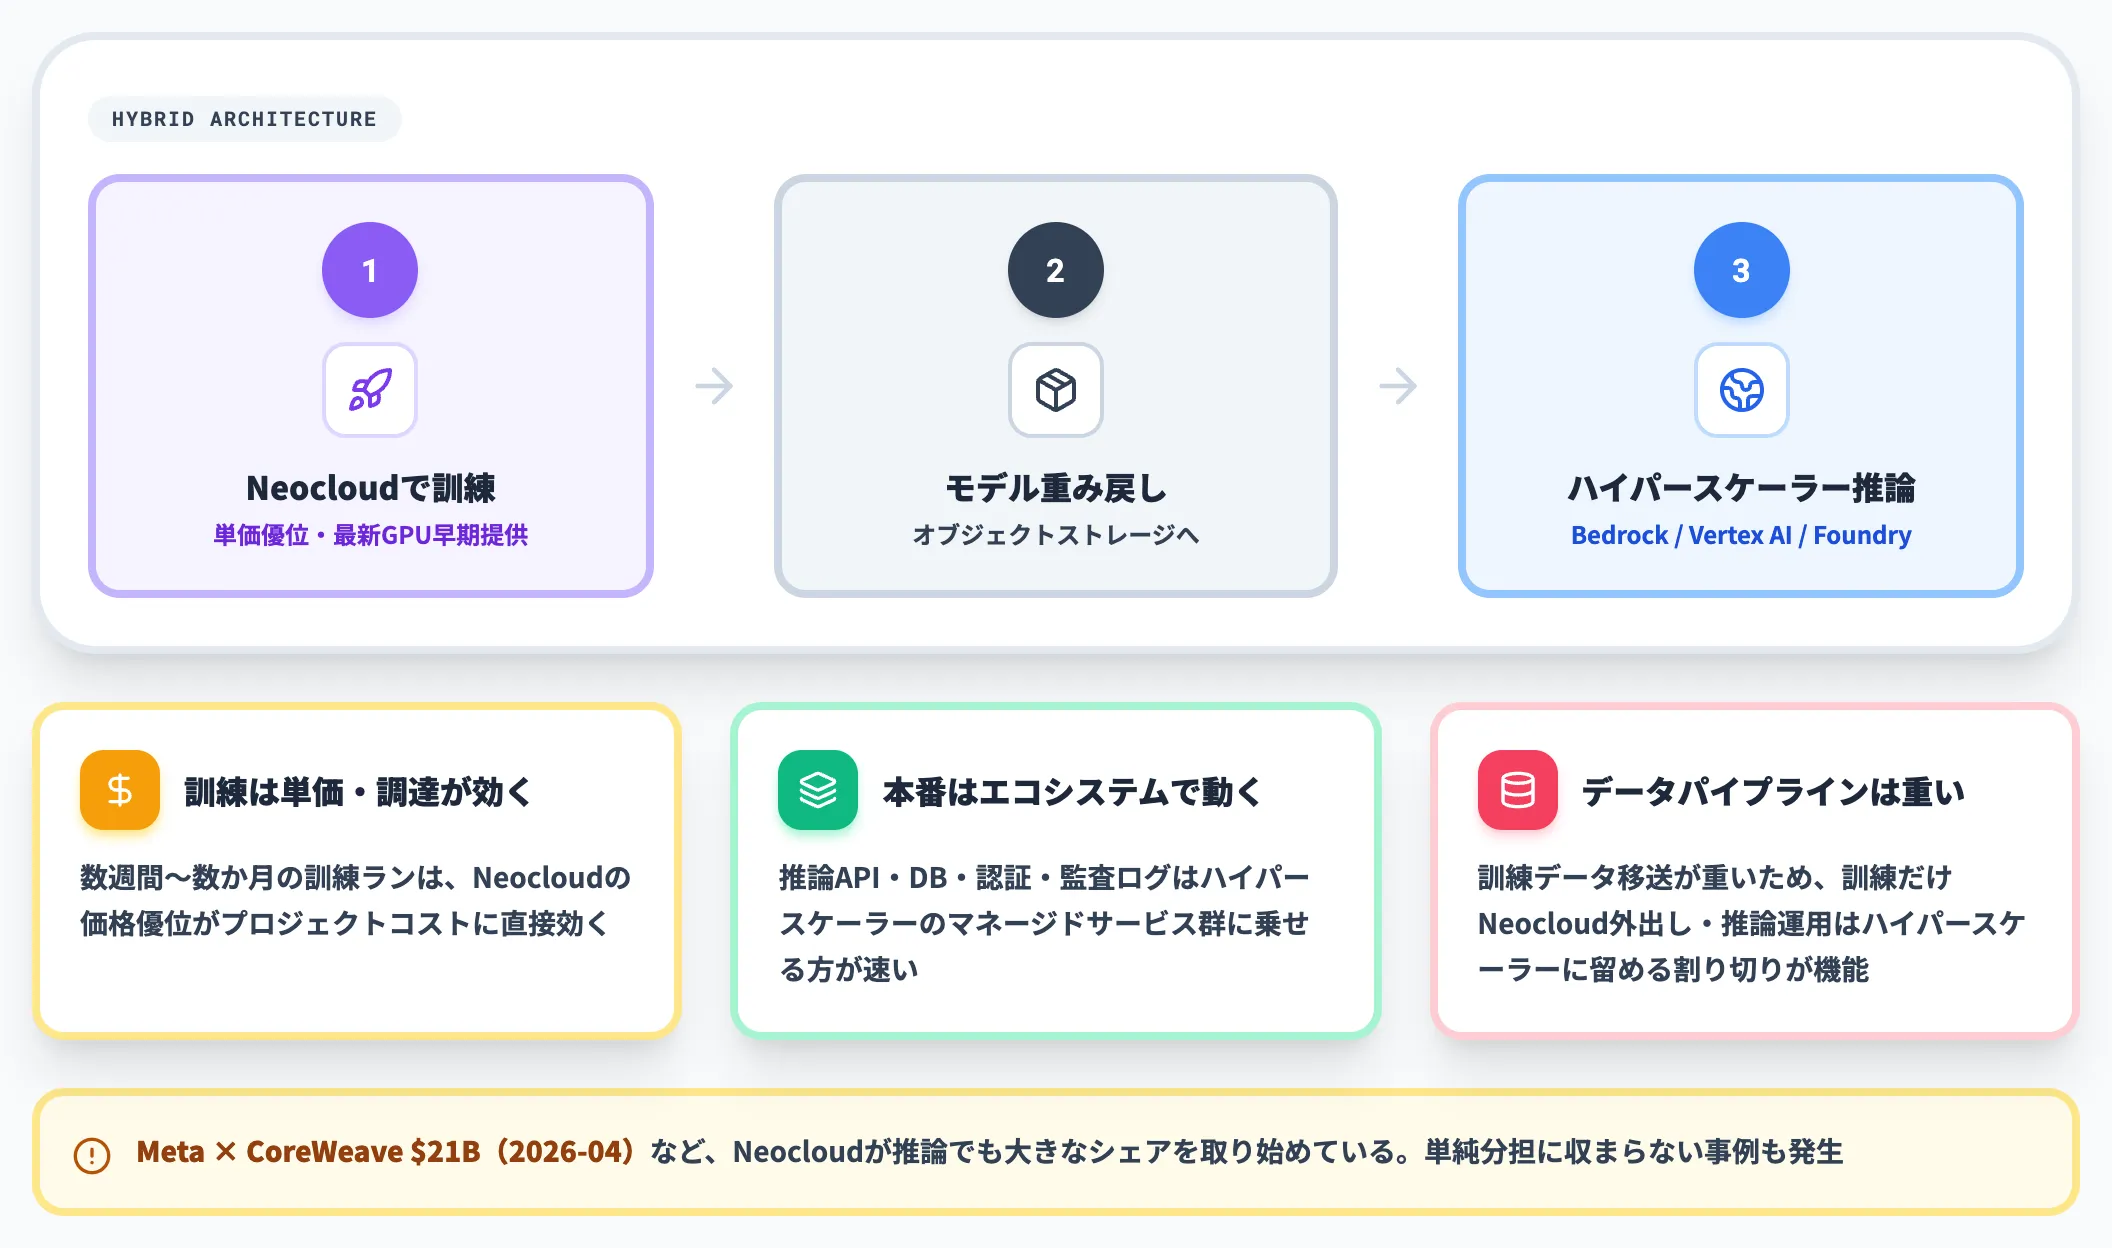
Neocloudとハイパースケーラーの使い分けで、理論的に合理性があるのが「訓練はNeocloud・本番運用はハイパースケーラー」というハイブリッド構成です。
採用比率を定量化した業界調査は現時点では限定的ですが、以下の3条件がそろうと有力な選択肢になります。
-
訓練はGPU単価と調達速度の影響が大きい
数週間〜数か月の訓練ランで、Neocloudの価格優位と最新GPU世代の早期投入がプロジェクトコストに効く
-
本番運用はエコシステムで動く
推論APIを呼び出すアプリ・データベース・認証・監査ログは、ハイパースケーラーの既存マネージドサービス群に乗せる方が圧倒的に速い
-
データパイプラインは重い
訓練データを別クラウドに移すオーバーヘッドが大きいため、訓練用途だけNeocloudに外出しし、推論・運用はハイパースケーラーに留める割り切りが機能する
一方、Neocloud自体が推論用途でも大きなシェアを取り始めている点にも注意が必要です。
2026年4月に発表されたMeta × CoreWeaveの$21B追加契約はCoreWeaveでの推論ワークロード拡大を含んでおり、「訓練はNeocloud・本番はハイパースケーラー」という単純な役割分担には収まらない事例も出ています。構成例としては、「Neocloudで訓練 → 完成モデルをハイパースケーラーのオブジェクトストレージに戻し → ハイパースケーラーの推論基盤(Bedrock・Vertex AI・Foundry)で提供」という流れが一つのパターンとして機能します。
ソブリンクラウド——データ主権と国産運用
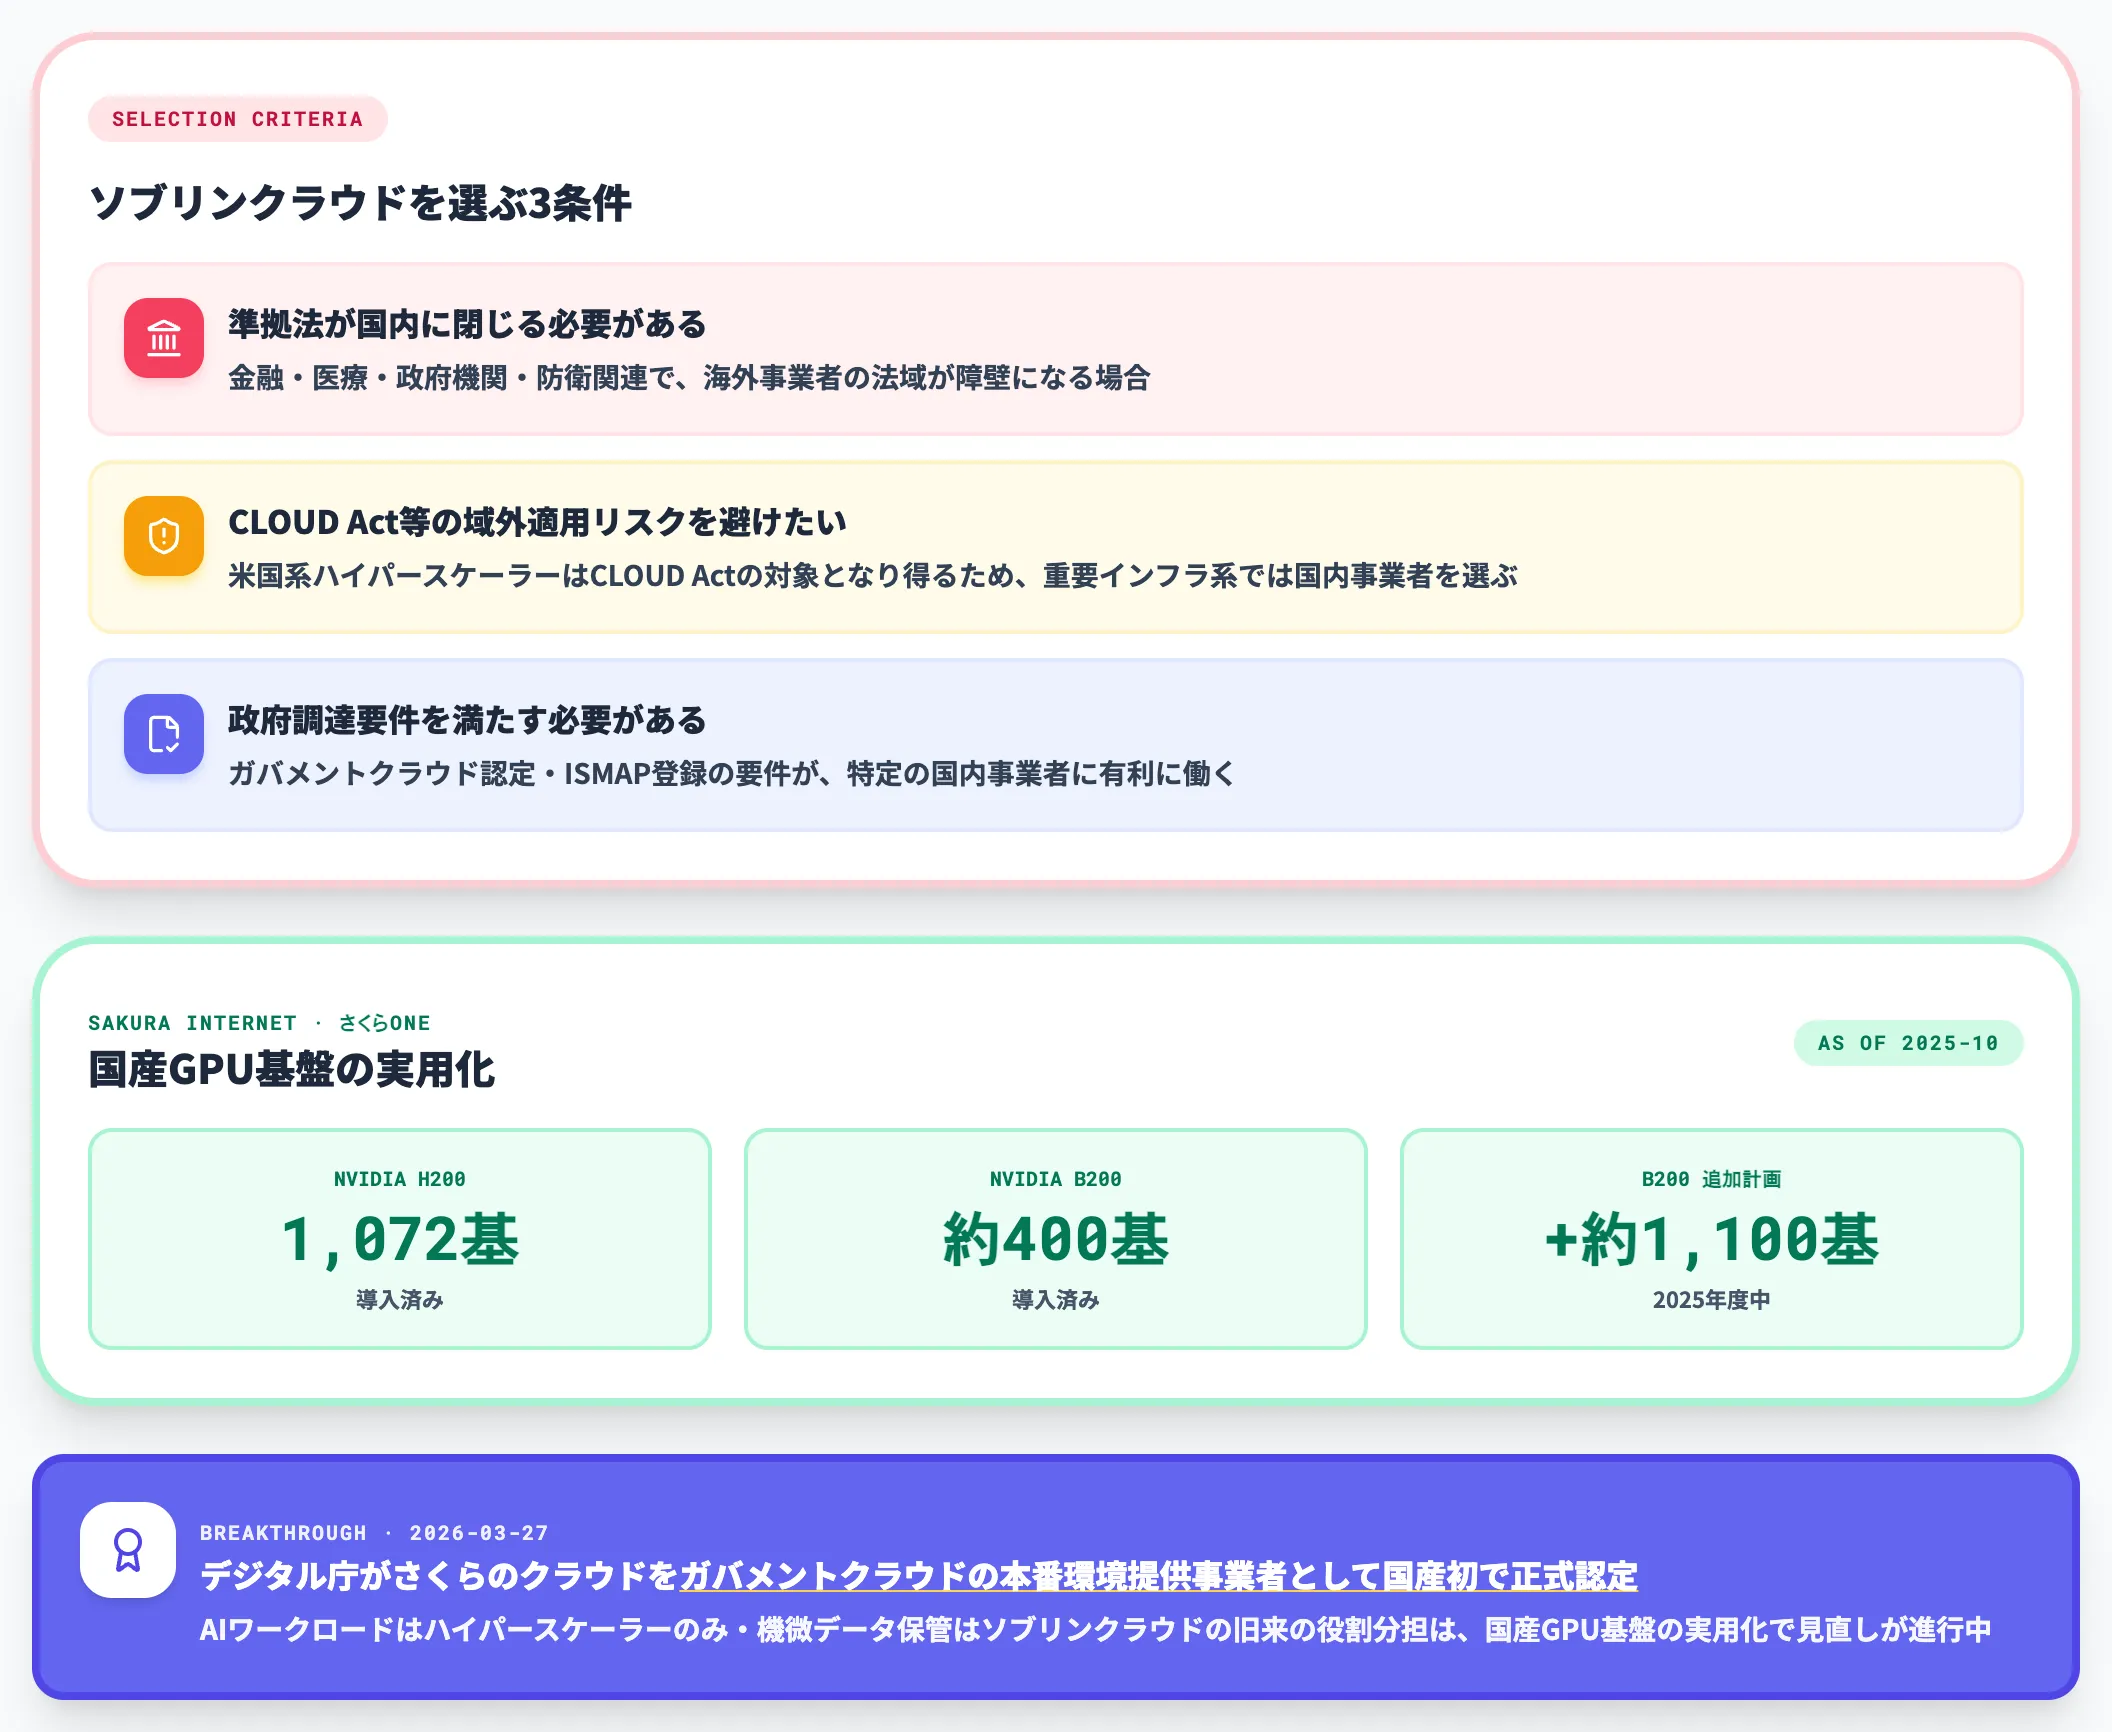
もう一つの選択肢が、国内データ主権と準拠法の国内完結を重視するソブリンクラウドです。日本ではさくらインターネット、IIJ・NTTドコモビジネスのガバメント向け基盤、富士通のUvanceクラウドなどが該当します。
ソブリンクラウドを選ぶ場面は、以下のような条件に集約されます。
-
準拠法が国内に閉じる必要がある
金融業界・医療・政府機関・防衛関連で、海外事業者の法域が障壁になる場合
-
CLOUD Act等の域外適用リスクを避けたい
米国系ハイパースケーラーのサービスはCLOUD Actの対象になり得るため、重要インフラ系では国内事業者を選ぶ判断が働く
-
政府調達要件を満たす必要がある
ガバメントクラウド認定・ISMAP登録の要件が、特定の国内事業者に有利に働く
GPU基盤の面でも、国内事業者の存在感が増しています。さくらインターネットは「さくらONE」で2025年10月時点でNVIDIA H200を1,072基・B200を約400基導入済みで、2025年度中にB200を約1,100基追加する計画を公表しています。
また2026年3月27日にはデジタル庁がさくらのクラウドをガバメントクラウドの本番環境提供事業者として国産初で正式認定しており、「ガバメントクラウドに国内事業者を加える方針」ではなく、既に本番採用の段階に進んでいます。「AIワークロードはハイパースケーラーのみ・機微データ保管はソブリンクラウド」という旧来の役割分担は、国産GPU基盤の実用化で見直しが進んでいる状況です。
ハイパースケーラー採用の判断軸と日本企業の実務
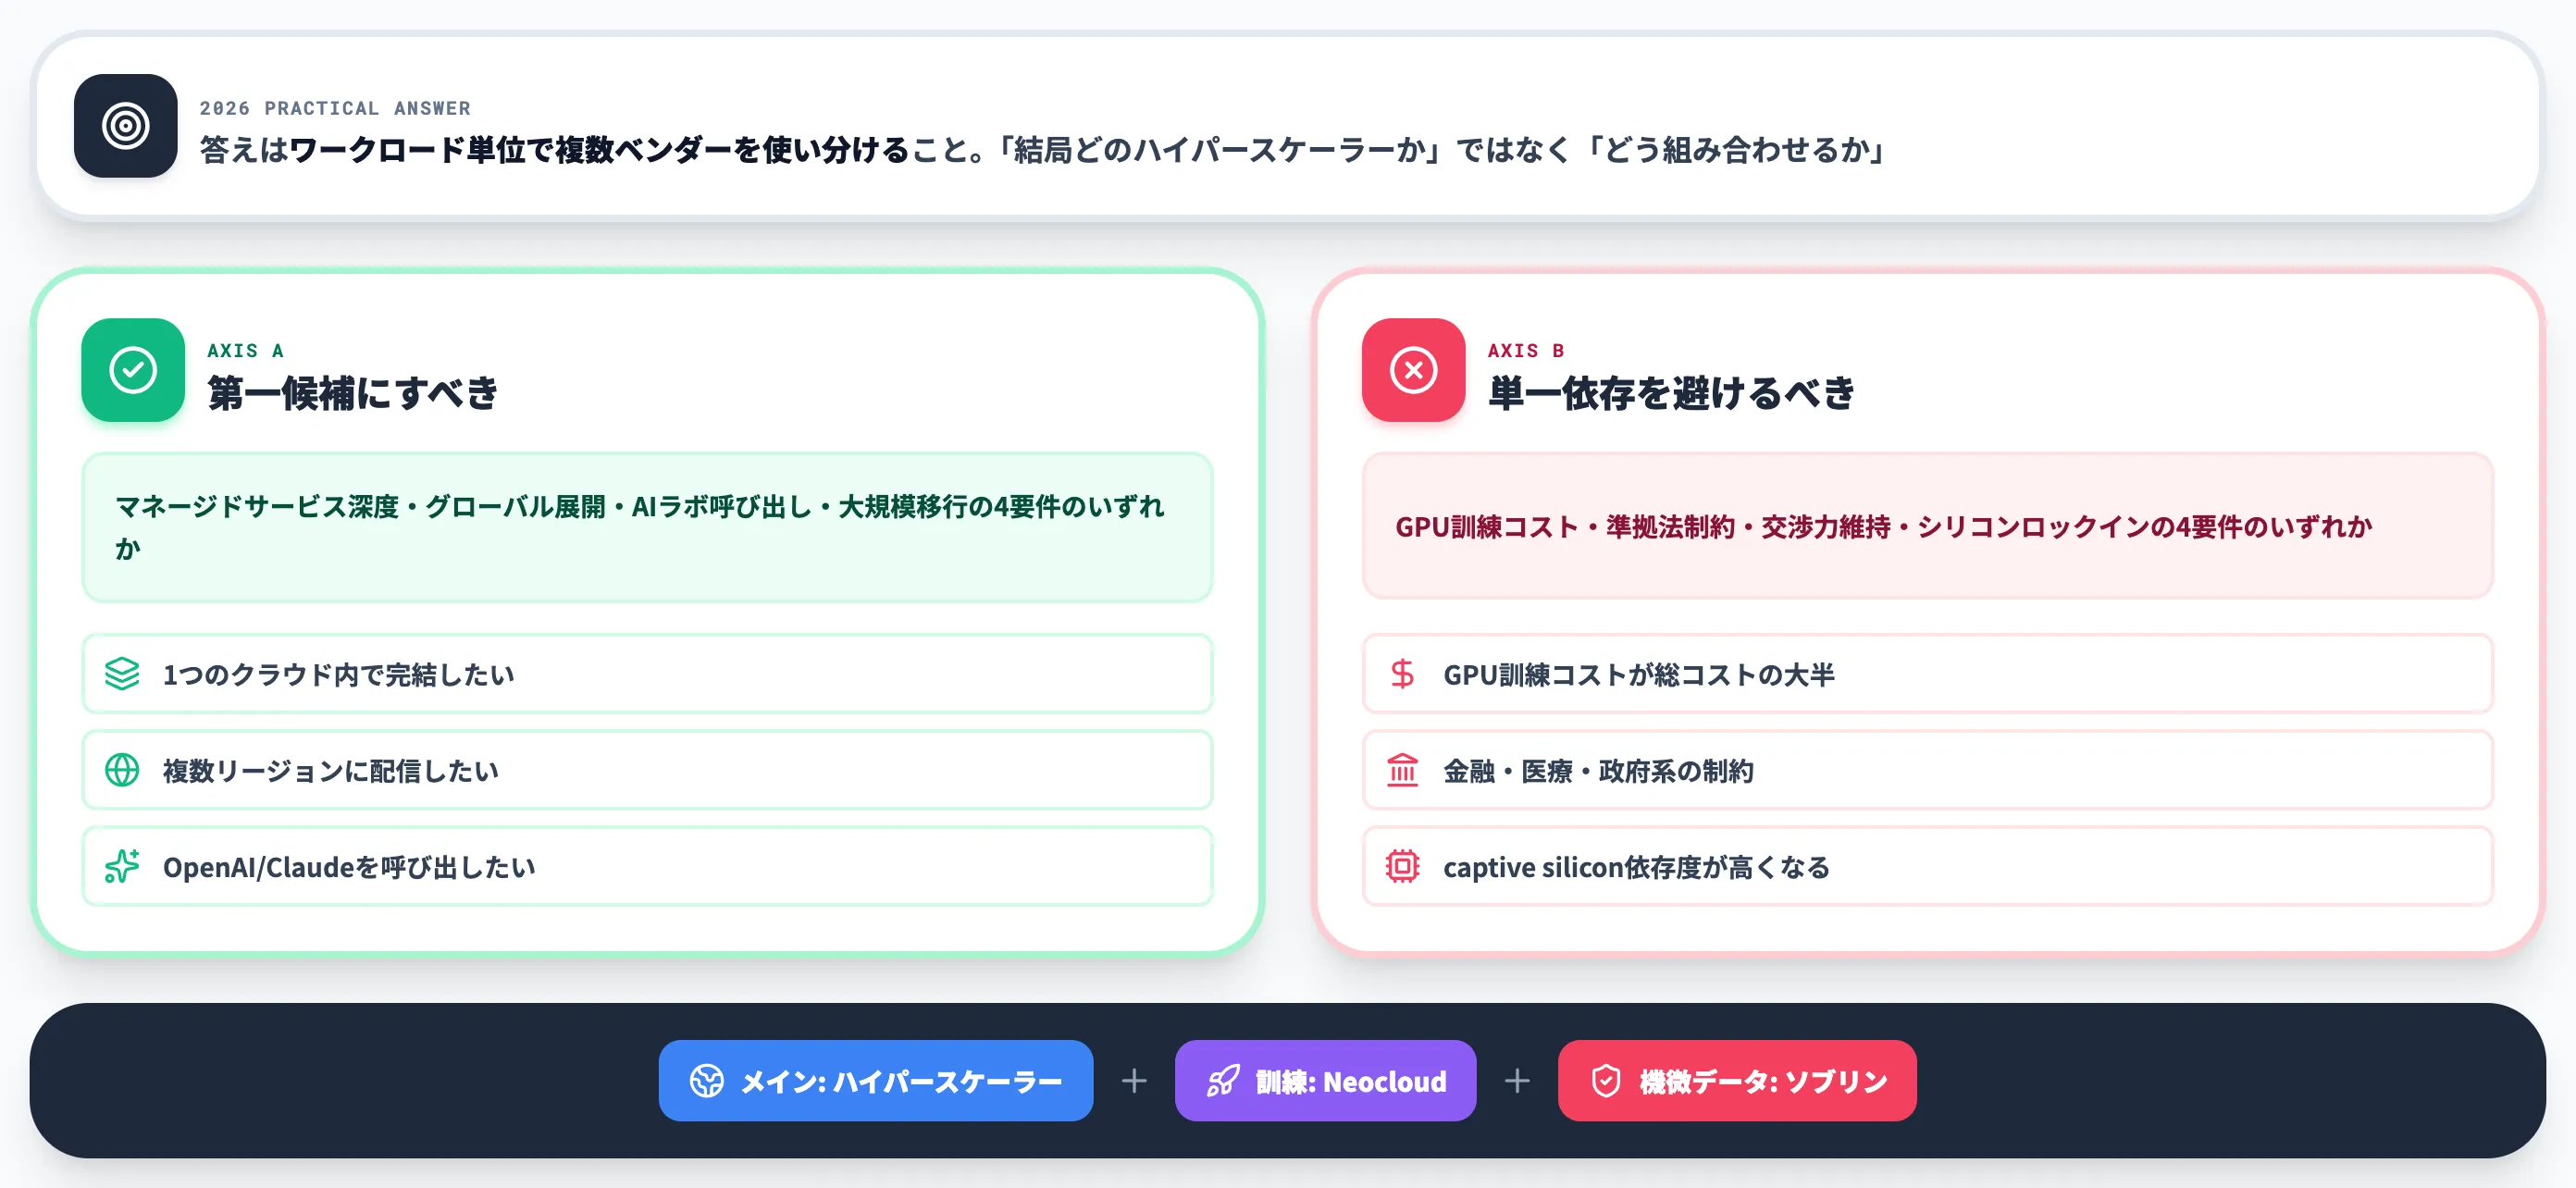
ここまで整理してきた2026年のハイパースケーラー産業の変化を踏まえ、企業がハイパースケーラーを選定する際の実務的な判断軸と、日本企業特有の論点を整理します。
AI総合研究所の導入支援現場でも、「結局どのハイパースケーラーを選べばいいか」という相談は増え続けていますが、答えはワークロード単位で複数ベンダーを使い分けるのが2026年の実務解です。
ハイパースケーラーを第一候補にすべきケース
以下に該当する場合、ハイパースケーラー(AWS・Azure・Google Cloudのいずれか)を第一候補として検討するのが現実的です。
-
多様なマネージドサービスを横断して使いたい
データベース・分析・AI・認証・監査を1つのクラウド内で完結させたい場合、サービス深度でハイパースケーラーに勝る選択肢は現時点存在しない
-
グローバル展開が必要なワークロード
複数リージョンでの低レイテンシ配信・データレジデンシー対応は、拠点数で圧倒的に有利
-
フロンティアAIラボを呼び出したい
OpenAI・Anthropicの主要モデルをAmazon Bedrock・Vertex AI・Microsoft Foundry経由で使うには、どちらにせよハイパースケーラーが起点になる。
エージェント基盤を乗せる場合はMicrosoft Foundry Agent Service・Vertex AI Agent Builder・Amazon Bedrock Agentsの3系統が選択肢になる
-
大規模な業務システムをクラウド移行する
オンプレ資産の全面リフト&シフトでは、エンタープライズ向けの移行ツール・サポート体制がハイパースケーラーに集中している
これらの要件を複数満たすワークロードは、ハイパースケーラー一本化の方が運用コストが低く済むケースが多いです。
単一ハイパースケーラー依存を避けるべきケース
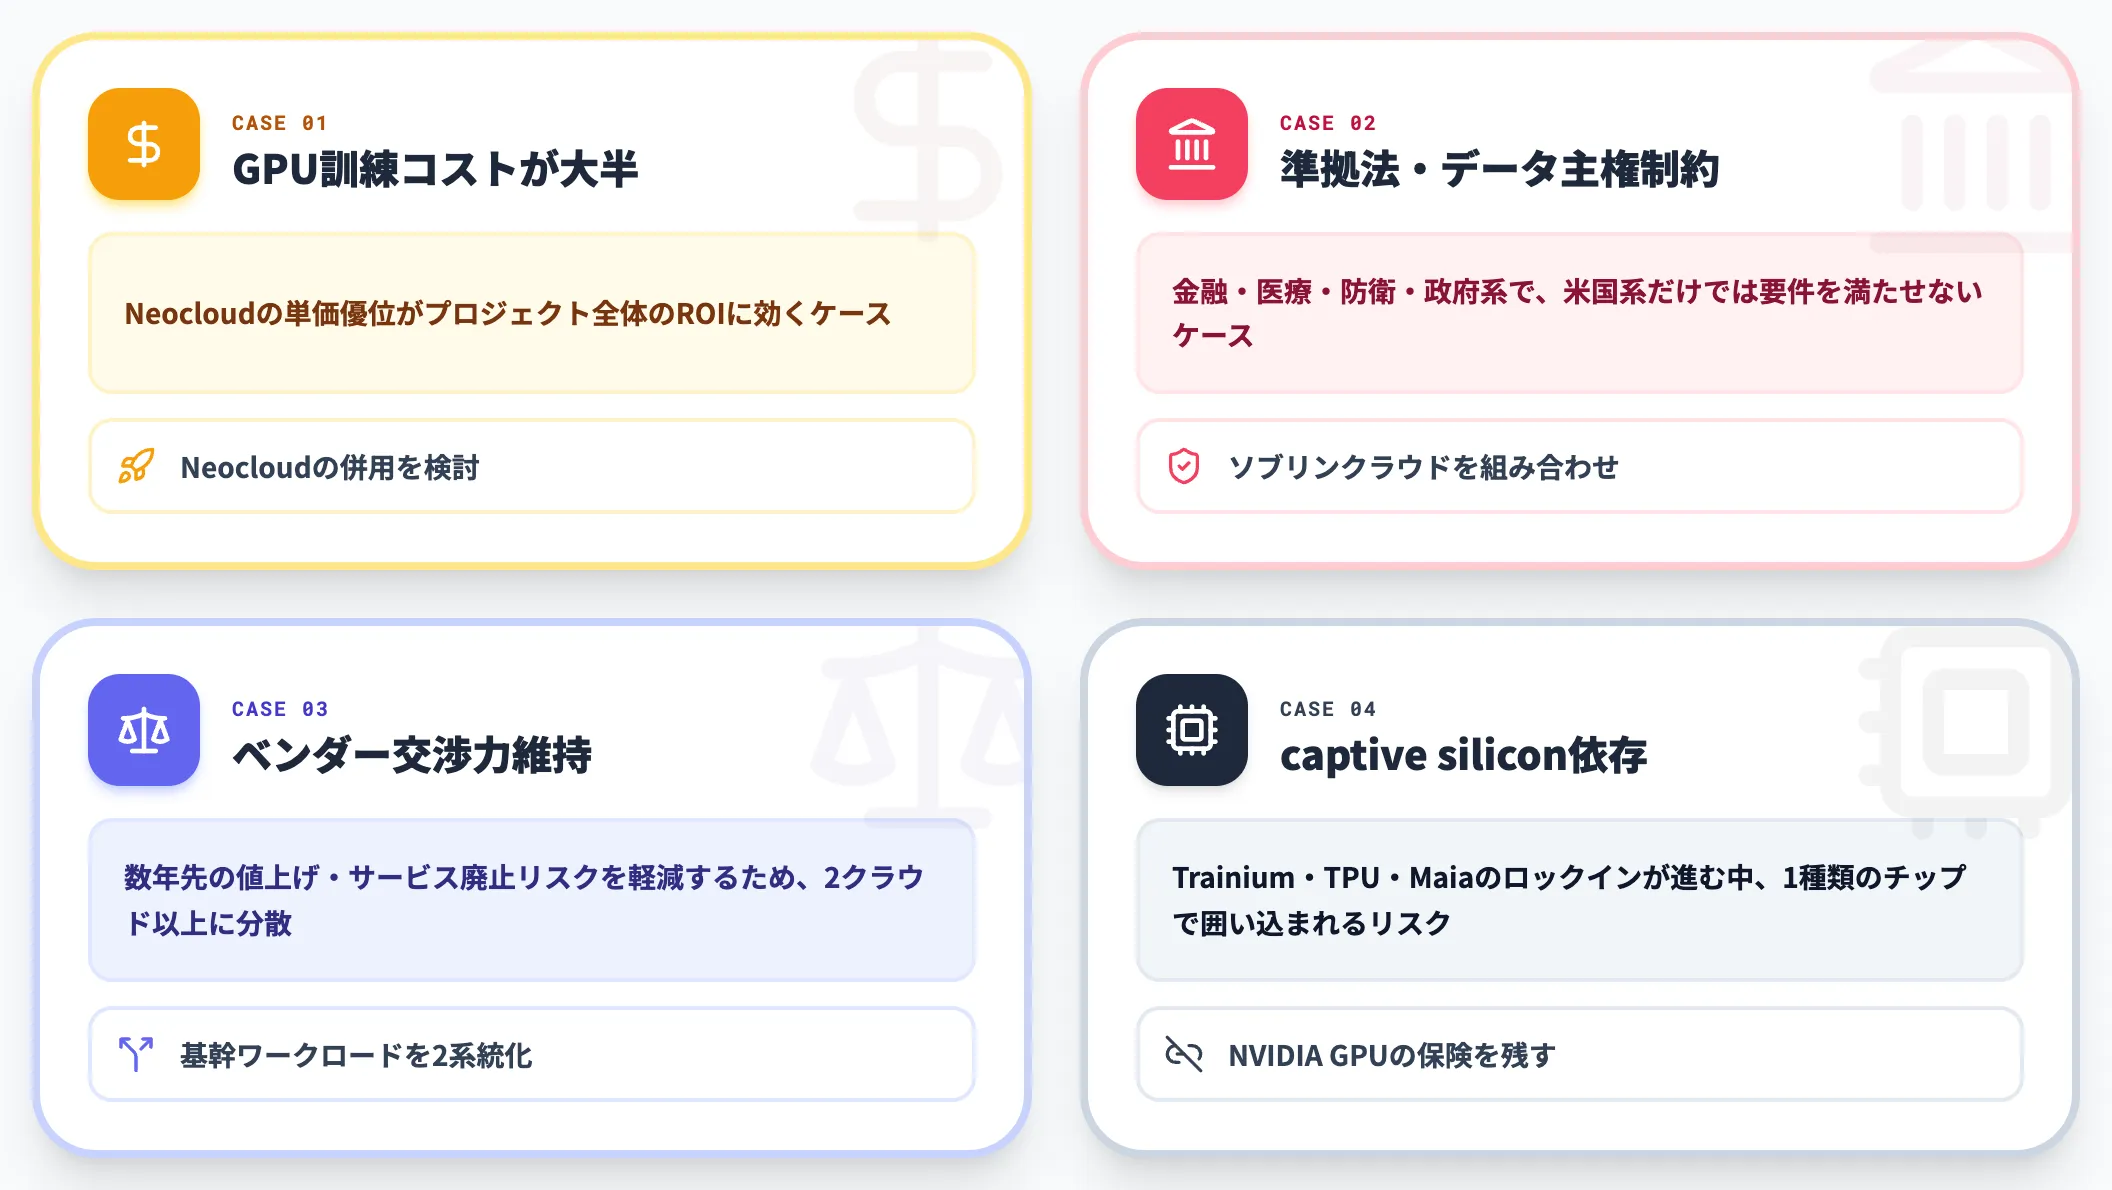
一方、以下に該当する場合は、単一ハイパースケーラー依存を避け、Neocloudやソブリンクラウドを組み合わせる方が合理的です。
-
GPU訓練コストが総コストの大半を占める
NeocloudはハイパースケーラーよりGPU時間単価が低く設定されやすく、訓練プロジェクト全体のROIに効く。実際の差は事業者・時期・契約量で変動するため、採用判断時に各社の料金ページで必ず確認する
-
準拠法・データ主権の制約がある
金融・医療・防衛・政府系で、米国系ハイパースケーラーだけでは要件を満たせない
-
ベンダー交渉力を維持したい
数年先の値上げリスク・サービス廃止リスクを軽減するには、2クラウド以上に基幹ワークロードを分散しておく必要がある
-
カスタムシリコン依存度が高くなる見通し
Trainium・TPU・Maiaのcaptive silicon化が進む中、特定クラウドに1種類のチップで囲い込まれる構造はリスク
こうしたケースでは、メインはハイパースケーラー・訓練はNeocloud・機微データはソブリンクラウドという3層構成が実務解になります。
日本企業の選定ステップ——Japan Eastリージョンとガバナンス優先
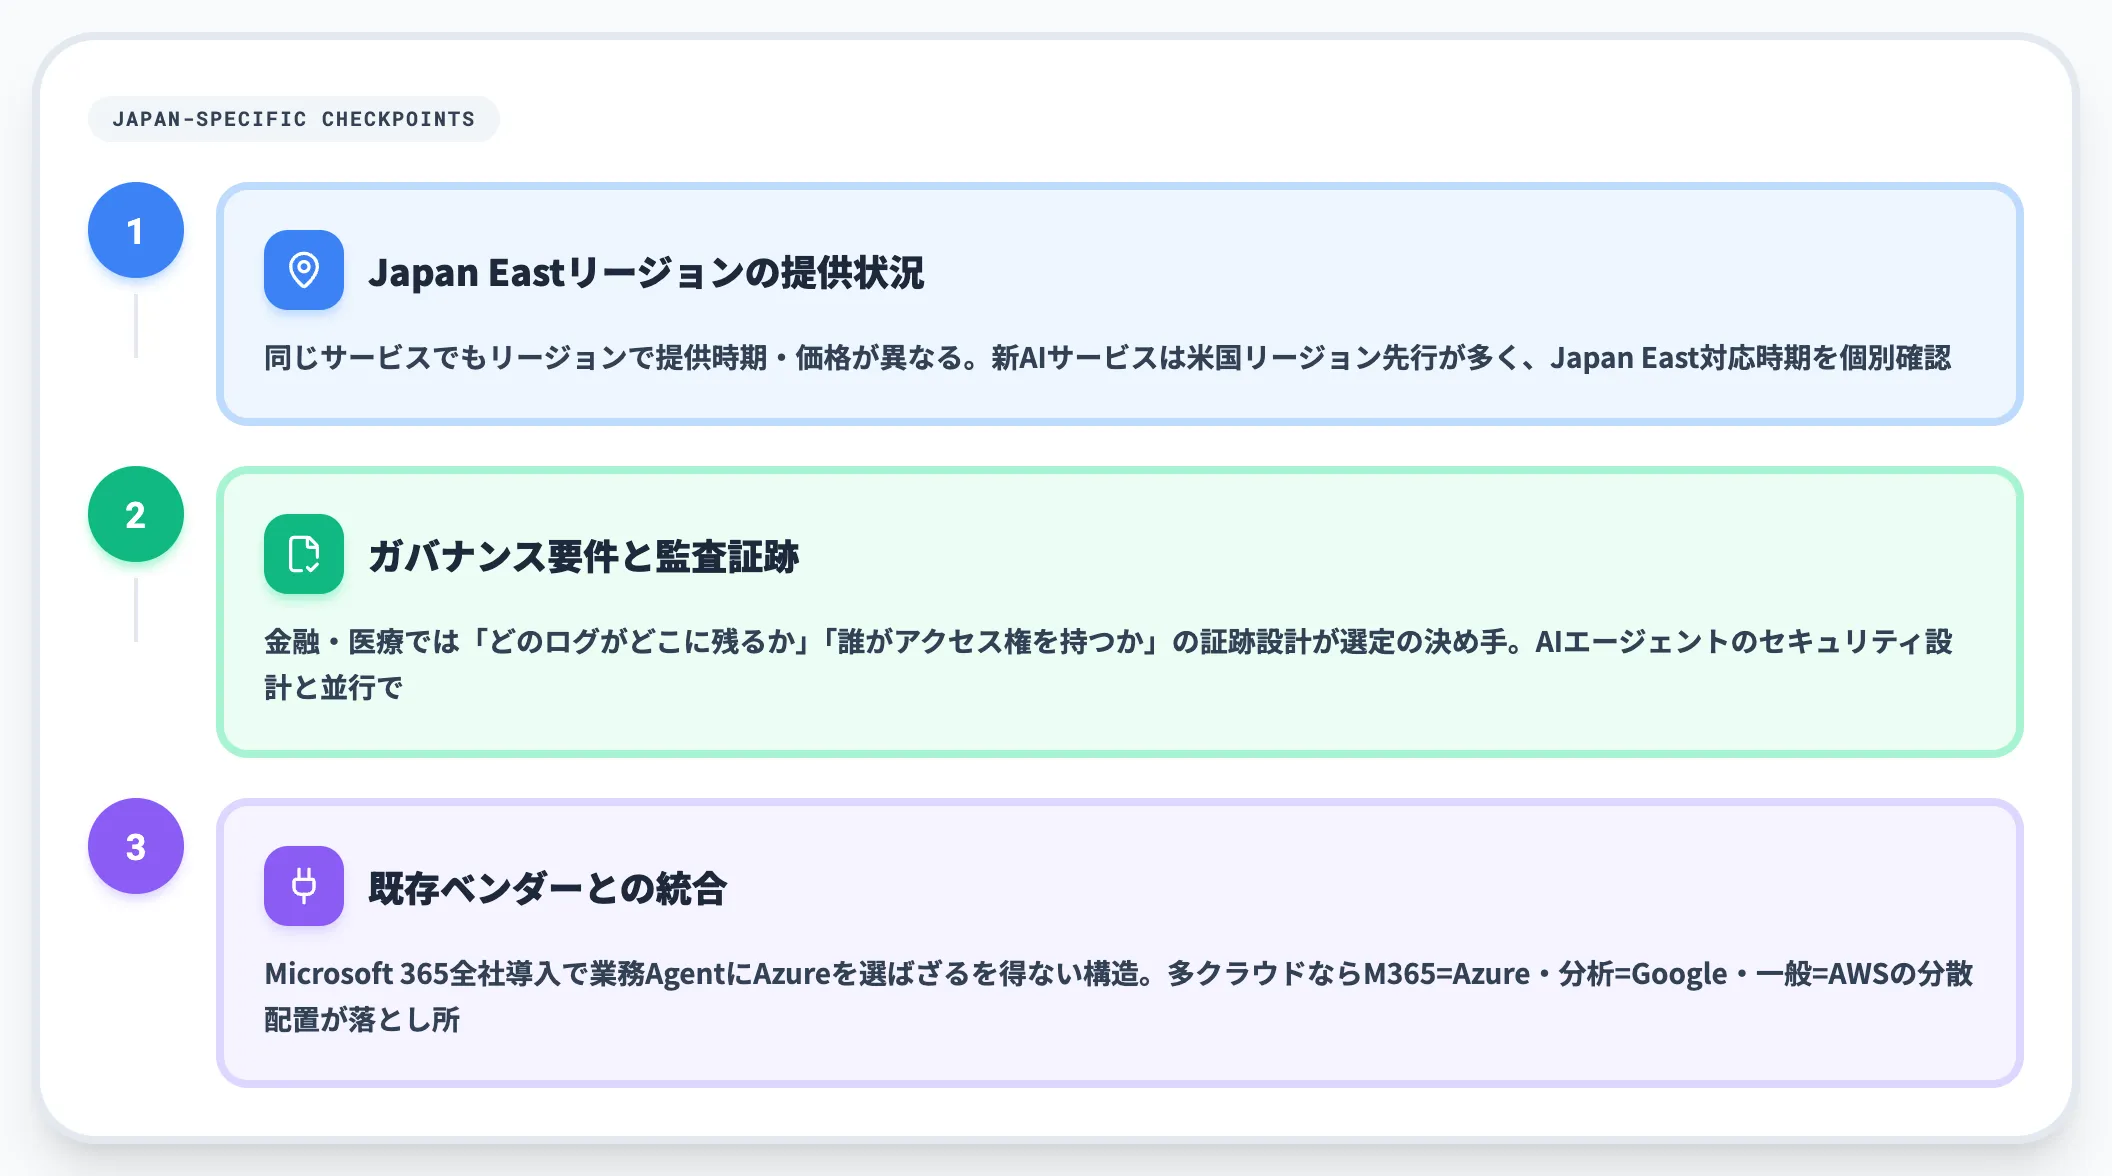
日本企業がハイパースケーラーを採用する際、海外企業と異なる実務論点が3つあります。
1点目はJapan East(東日本)リージョンの提供状況です。Azureの料金ページ等でも示されているとおり、同じサービスでもリージョンによって提供時期・価格が異なります。新しいAIサービス(カスタムシリコンインスタンス・最新AIラボモデル)は米国リージョンで先行提供されるケースが多く、Japan Eastでの提供可否・提供時期は採用判断時に各サービスのリージョン対応表で個別に確認する必要があります。
2点目はガバナンス要件と監査証跡です。AI総合研究所の支援現場でも、金融業界・医療業界では「どのログがどこに残るか」「誰がアクセス権を持つか」の証跡設計がハイパースケーラー選定の決め手になるケースが増えています。
AIエージェントのセキュリティ設計と並行して、ハイパースケーラー側のアクセスログ・監査基盤をどう使うかの事前設計が重要です。
3点目は既存ベンダーとの統合です。日本企業の多くはMicrosoft 365をすでに全社導入しており、AIエージェントを業務プロセスに組み込む際にAzureを第一候補にせざるを得ない構造があります。
一方、データ分析基盤はGoogle Cloud、Web配信はAWSという多クラウド構成も実務では珍しくなく、「M365連携はAzure・分析系はGoogle・一般ワークロードはAWS」の分散配置が落とし所になるケースが多くあります。
ハイパースケーラー採用で詰まる3つの論点
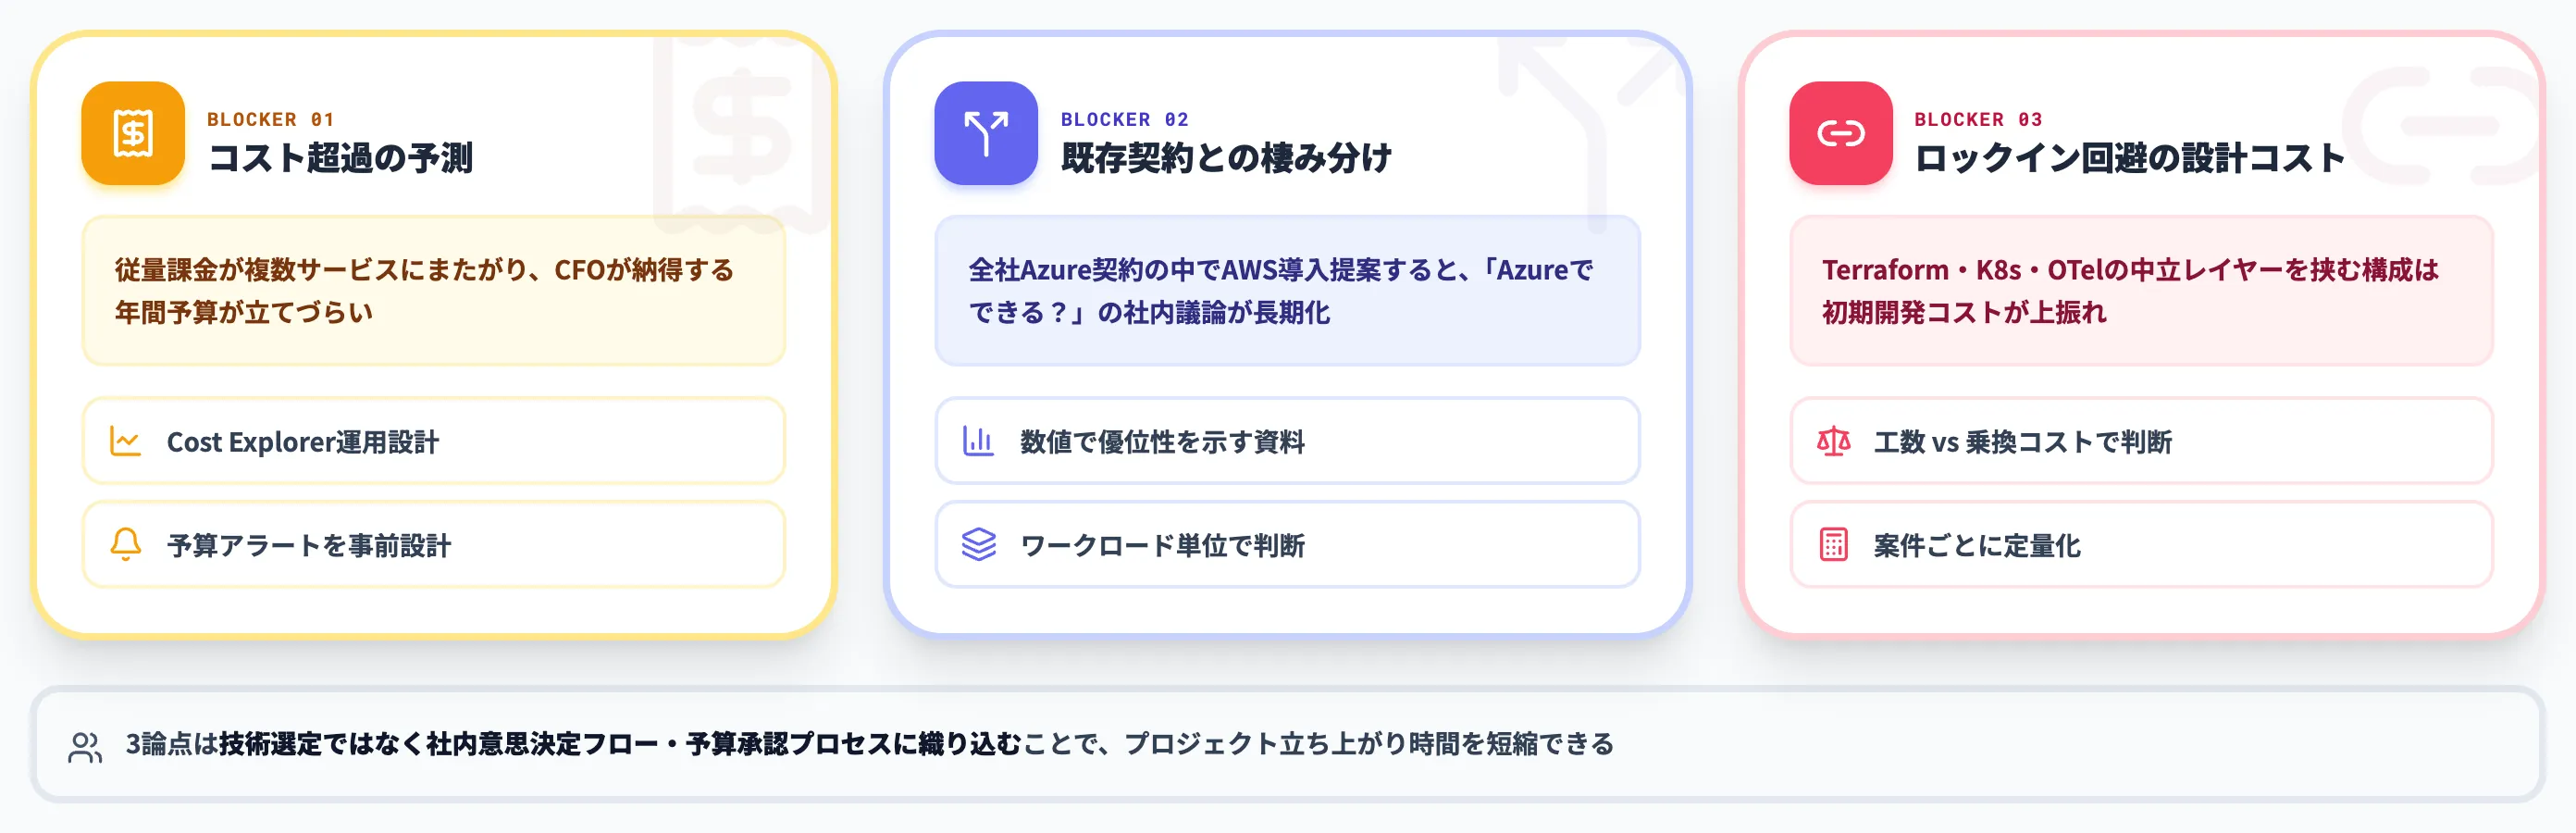
採用判断で実際に詰まるのは、以下の3論点です。
-
コスト超過の予測が難しい
従量課金が複数サービスにまたがり、CFOが納得する年間予算が立てづらい。コスト管理ツール(AWS Cost Explorer・Azure Cost Management・Google Cloud Billing)の運用設計を事前に組む必要がある
-
既存契約との棲み分け
全社でAzure契約がある中でAWS導入を提案すると、「Azureでできるのでは?」という社内議論が長期化しやすい。ワークロード単位で優位性を数値で示す資料が必要
-
ロックイン回避の設計コスト
Terraform・Kubernetes・OpenTelemetry等の中立レイヤーを挟む構成は、特定クラウドのマネージドサービスを直接使う構成と比べて初期開発コストが上振れしがち。「ロックイン回避の工数 vs 将来の乗り換えコスト」のトレードオフを個別案件ごとに定量化する必要がある
これらの論点は、技術選定の段階ではなく、社内の意思決定フローと予算承認プロセスに織り込んでおくことで、プロジェクトの立ち上がり時間を大きく短縮できます。AI総研の支援現場では、技術検討と並行して予算・ガバナンス設計を進めるケースが成功例として多く見られます。
ハイパースケーラー横断の業務AIエージェント基盤を整えるなら
ハイパースケーラー産業は2026年、「どこを選ぶか」から「どう組み合わせるか」のフェーズに移りました。AWS・Azure・Google Cloudそれぞれにカスタムシリコン・AIラボ・マネージドサービスが載り、企業は複数クラウドをまたぐワークロード設計を迫られています。
一方、業務プロセスの観点では、どのハイパースケーラーに何が乗っていても、現場が使う入口は1つに統一する必要があります。マルチクラウドの裏側を意識させず、Teamsや既存業務システムからシームレスにAIエージェントを呼び出せる基盤が求められる状況です。
AI総合研究所のAI Agent Hubは、業務特化Agent群を自社Azureテナント内で統合管理し、ハイパースケーラー横断の運用基盤として機能します。
-
ハイパースケーラー横断のモデル選択
Azure上のGPT・AWS Bedrock上のClaude・Google Vertex上のGeminiを、Agent単位で選択。業務プロセス側は裏側のクラウドを意識せずに呼び出せます
-
モデル世代交代とクラウド移行を吸収する管理層
Trainium 3 → Trainium 4、TPU Ironwood → TPU 8t/8iのような短サイクルの世代交代、ハイパースケーラー間のワークロード移動も、業務Agent側は不変の設計で継続できます
-
Agent単位で権限・監査証跡を1画面統制
どのAgentがどのハイパースケーラーに繋がっているかを可視化し、誰が何を照会したかを不変ログで残します。マルチクラウドの監査対応がそのまま提出できる形で保管されます
-
データは100%自社Azureテナント内に保持
処理データはAIの学習対象から完全除外。Azure Managed Applicationsとして自社テナント内で動作が完了する設計で、ハイパースケーラーを跨いでも機微データが外に出ません
AI総合研究所の専任チームが、ハイパースケーラー選定から業務Agent基盤の統合設計、マルチクラウド運用まで一貫して支援します。AI Agent Hubのサービスページで、ハイパースケーラー時代の業務Agent実装例をご確認ください。
ハイパースケーラー基盤に業務AIエージェントを乗せる

マルチクラウド時代の業務Agent運用を1画面で統合する
AWS・Azure・Google Cloudそれぞれにまたがるワークロードを統括するには、業務Agent層で意思決定・権限・監査を一元化する必要があります。AI Agent HubはTeamsから呼び出せる業務特化Agent群を自社Azureテナント内で統合管理し、ハイパースケーラー横断の運用基盤として機能します。
まとめ
本記事では、ハイパースケーラーの定義から3社の市場シェア、2026年の設備投資規模、カスタムAIシリコン、AIラボ提携の最新地図、Neocloud・ソブリンクラウドとの使い分け、そして日本企業の採用判断軸までを、2026年10月時点の最新情報で解説しました。
2026年のハイパースケーラー産業を押さえておくべきポイントは次の3つです。
- ハイパースケーラー3社(AWS・Azure・Google Cloud)がSynergy Research Q3 2026で市場の61%を占める寡占構造(AWS 26%・Azure 19%・GCP 16%、市場規模$167.7B・+55%YoY)、カスタムAIシリコン・AIラボ提携・設備投資規模の全領域で動いており、2026年の全社CapExは4社合計で約$730B規模(全社CapExであってAI専用額ではない点に注意)、2027年にはOracleを加えた主要5社合計で$1.2T予想
- AWS Trainium 3・Google TPU Ironwood・Microsoft Maia 200のカスタムシリコン展開とOpenAI 2026年4月のAzure排他解消・Anthropicの3社+NVIDIA体制で、「どのクラウドでどのAIラボを使うか」の選定自由度が広がった
- 日本企業の実務解は単一ハイパースケーラー依存ではなく、ワークロード単位の分散配置。さくらONEのH200/B200・2026年3月のガバメントクラウド正式認定で、国産GPU基盤とソブリンクラウドの選択肢も実用段階に入った
ハイパースケーラーの選定は、2026年以降「どれか1社」ではなく「どう組み合わせるか」の設計問題に変わりました。既存のAzure・AWS契約を前提に、ワークロード別の最適配置を描き直すところから着手するのが、最も実用的な第一歩になります。