この記事のポイント
 GPT-6.1 Solの98%性能・40%コスト、Claude Opus 5.5の96%性能・5%コストでフロンティア帯コーディング単価を一段下げた本命モデル
- Code 2は複雑な本番用タスク、Flashは日常高頻度タスクの線引きが明確で、Flashは12Bアクティブパラメータ・1Mコンテキスト
- プロモ価格は入力$0.50・出力$2.50(100万トークン)で2027年5月17日まで、以降は入力$1.00・出力$5.00の標準価格に移行
- GitHub Copilot Pro/Pro+/Max/Business/Enterpriseで利用可能、FlashはFree/Studentにも対応し全プランでアクセス可能
- Copilot Fusion Standardに組み込まれたことで、モデルピッカーで明示選択しなくてもタスクによって自動的に呼び出される
Microsoft MVP・AIパートナー。LinkX Japan株式会社 代表取締役。東京工業大学大学院にて自然言語処理・金融工学を研究。NHK放送技術研究所でAI・ブロックチェーンの研究開発に従事し、国際学会・ジャーナルでの発表多数。経営情報学会 優秀賞受賞。シンガポールでWeb3企業を創業後、現在は企業向けAI導入・DX推進を支援。
MAI Code 2(マイ・コード・ツー)は、Microsoft AIが2026年11月17日のIgnite 2026で発表したコーディング特化のフロンティアモデルです。
GPT-6.1 Solの98%の性能を40%のコストで、Claude Opus 5.5の96%の性能をわずか5%のコストで提供し、同日からGitHub Copilotで利用可能になりました。軽量版「MAI Code 2 Flash」も同時発表され、Free/Studentプランを含めた全プランで利用できます。
本記事では、性能ベンチマークと競合モデルとの比較、Flashとの使い分け、料金体系、GitHub Copilotでの利用方法、導入判断で迷う論点を2026年11月時点の最新情報で解説します。
目次
MAI Code 2とは?Microsoft AIがGitHub Copilot経由で投入したコーディング特化モデル
MAI Code 2とMAI Code 2 Flashの使い分け
MAI Code 2とは?Microsoft AIがGitHub Copilot経由で投入したコーディング特化モデル
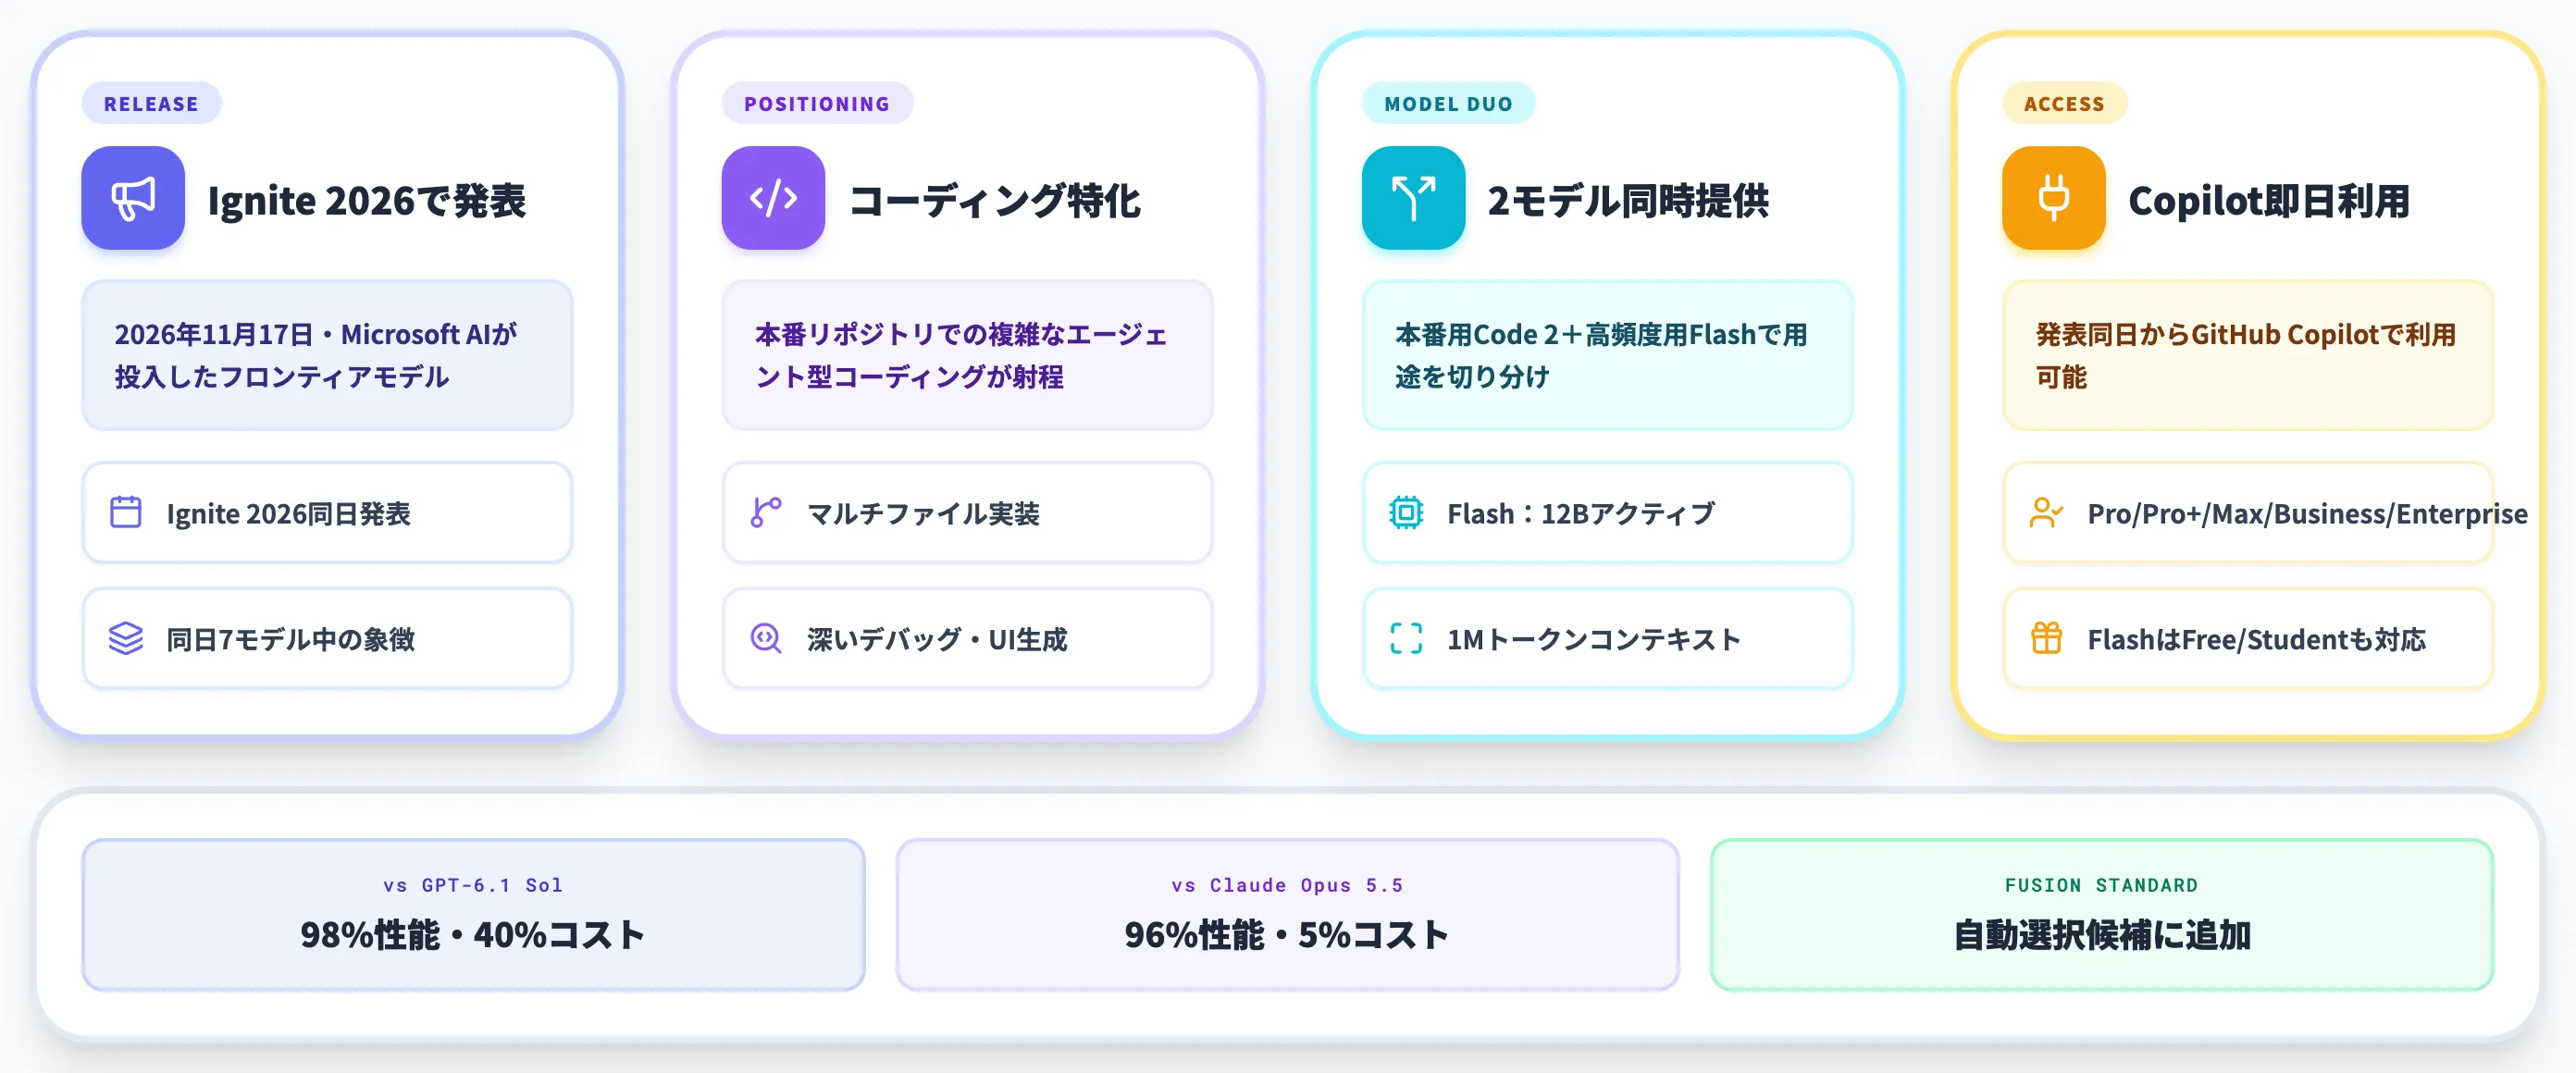
MAI Code 2は、Microsoft AIが2026年11月17日のIgnite 2026で発表した、GitHub Copilot上で使えるコーディング特化のフロンティアモデルです。
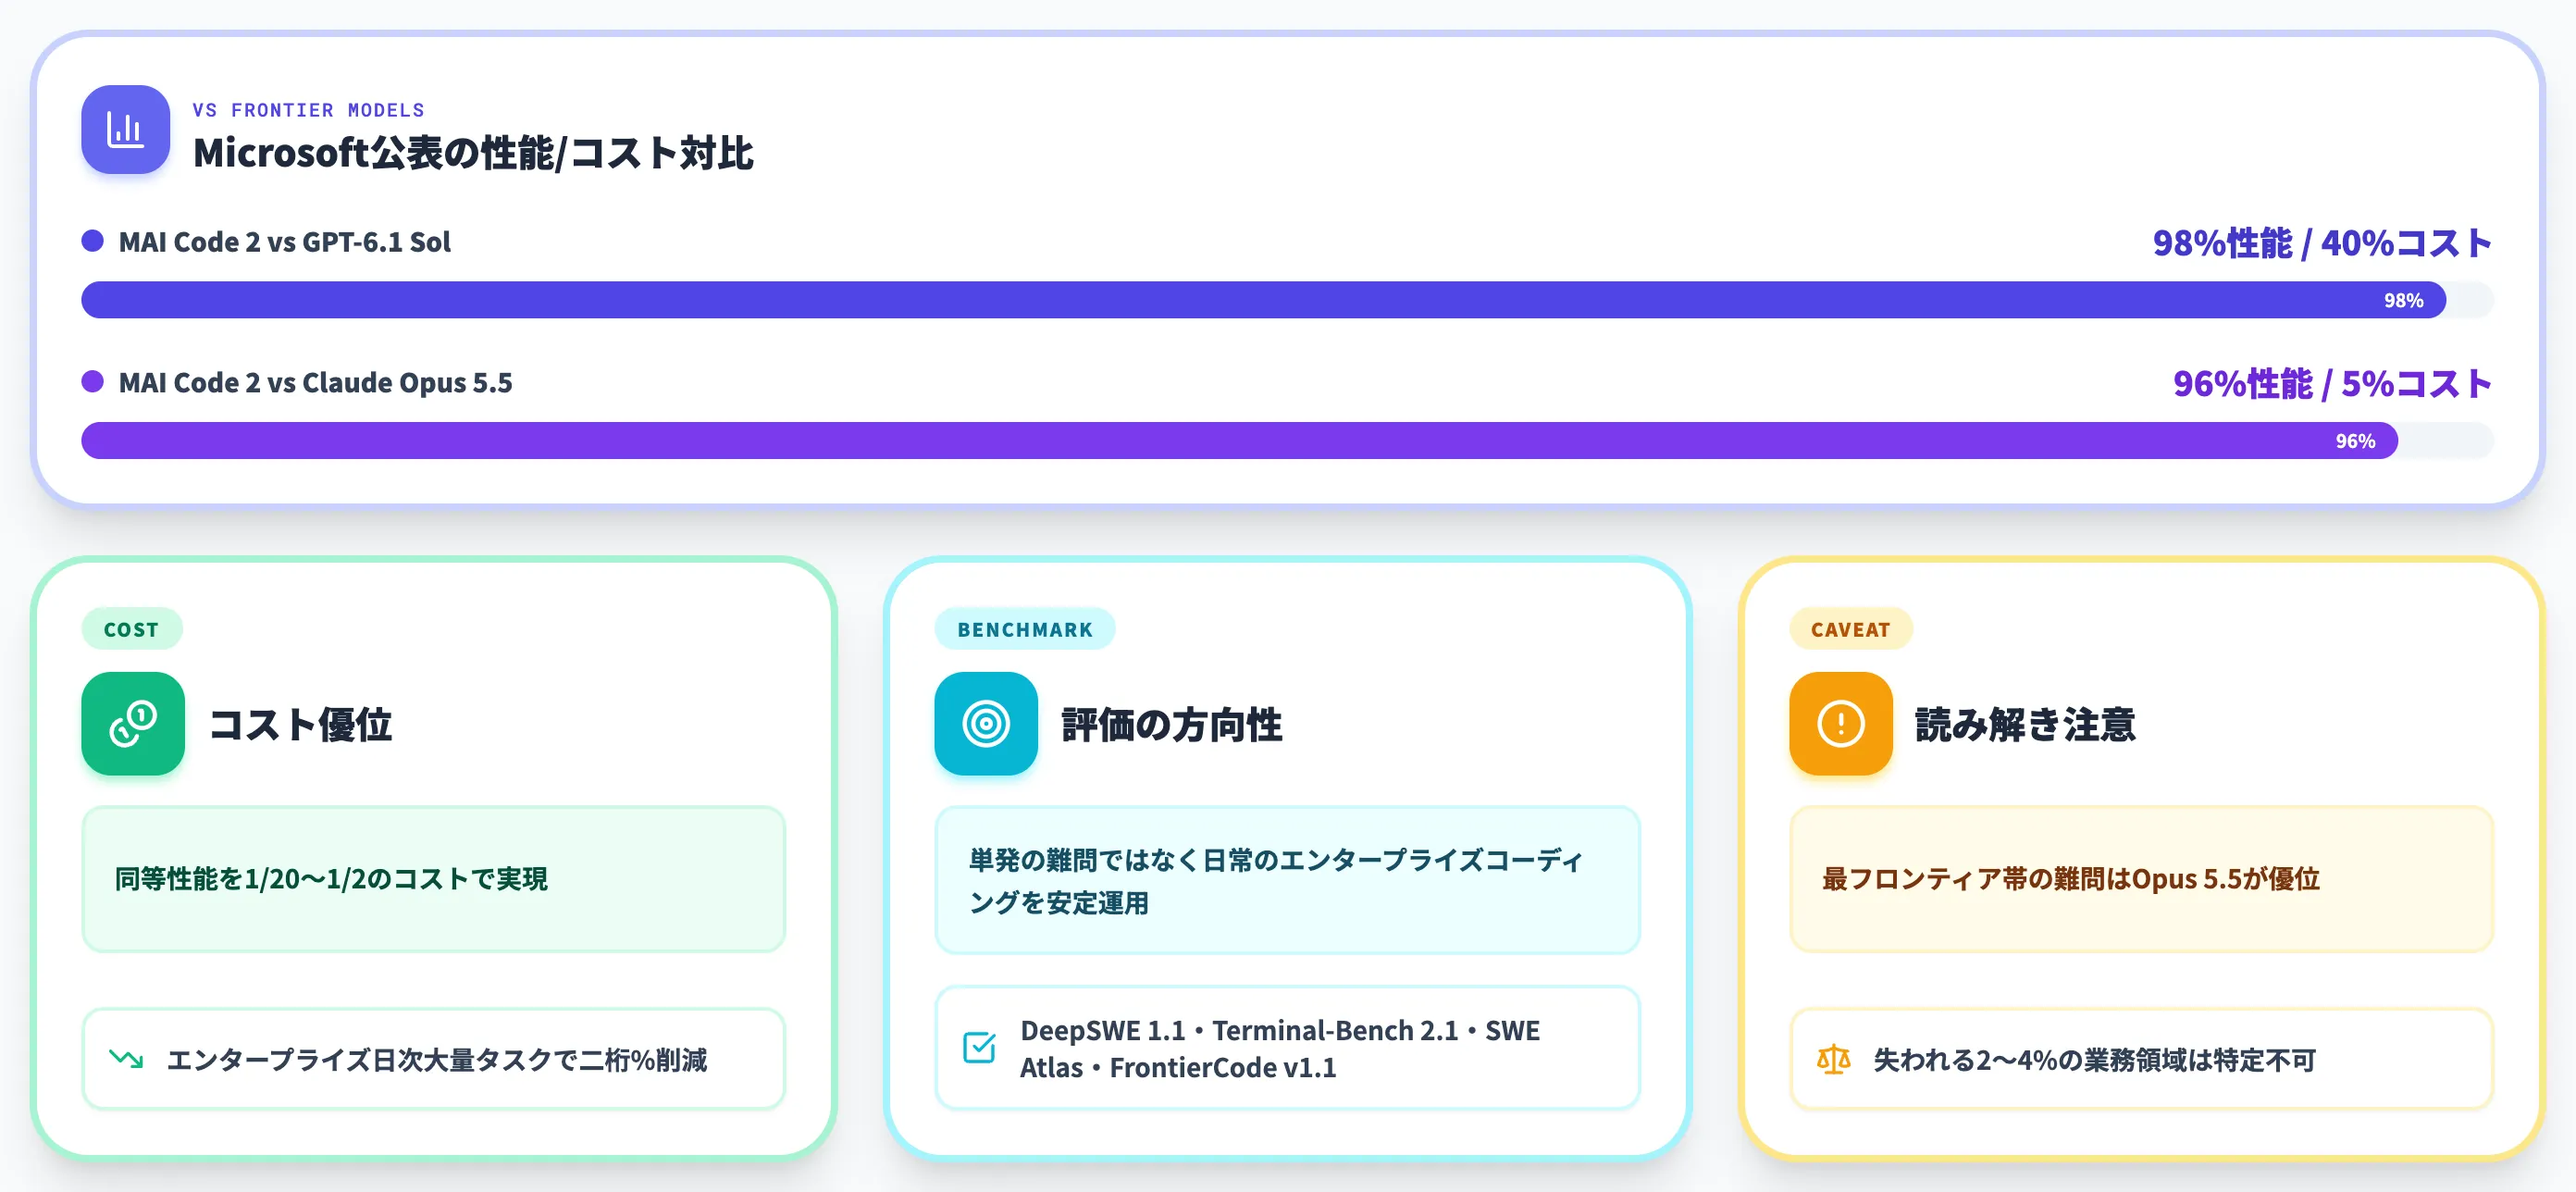
Microsoftによれば、4つのエンタープライズ向けコーディングベンチマーク平均でGPT-6.1 Solの98%の性能を40%のコストで、Claude Opus 5.5の96%の性能をわずか5%のコストで提供する水準に達しています。
MAI Code 2は、本番環境に投入するコード変更、複数ファイルにまたがる実装、深いデバッグ、リポジトリ全体を踏まえた推論、ダッシュボードやUIの生成といった実装側でフロンティアモデルが求められる用途を正面に置いたモデルです。
同時に発表された軽量版「MAI Code 2 Flash」は、コード解説・ターゲット修正・定型的なルーチン修正などを低単価・高頻度で回す用途に振られており、2モデルで役割を分けています。
MAI Code 2の公式キービジュアル(出典:Microsoft AI)
初代MAI-CodeからMAI Code 2への進化
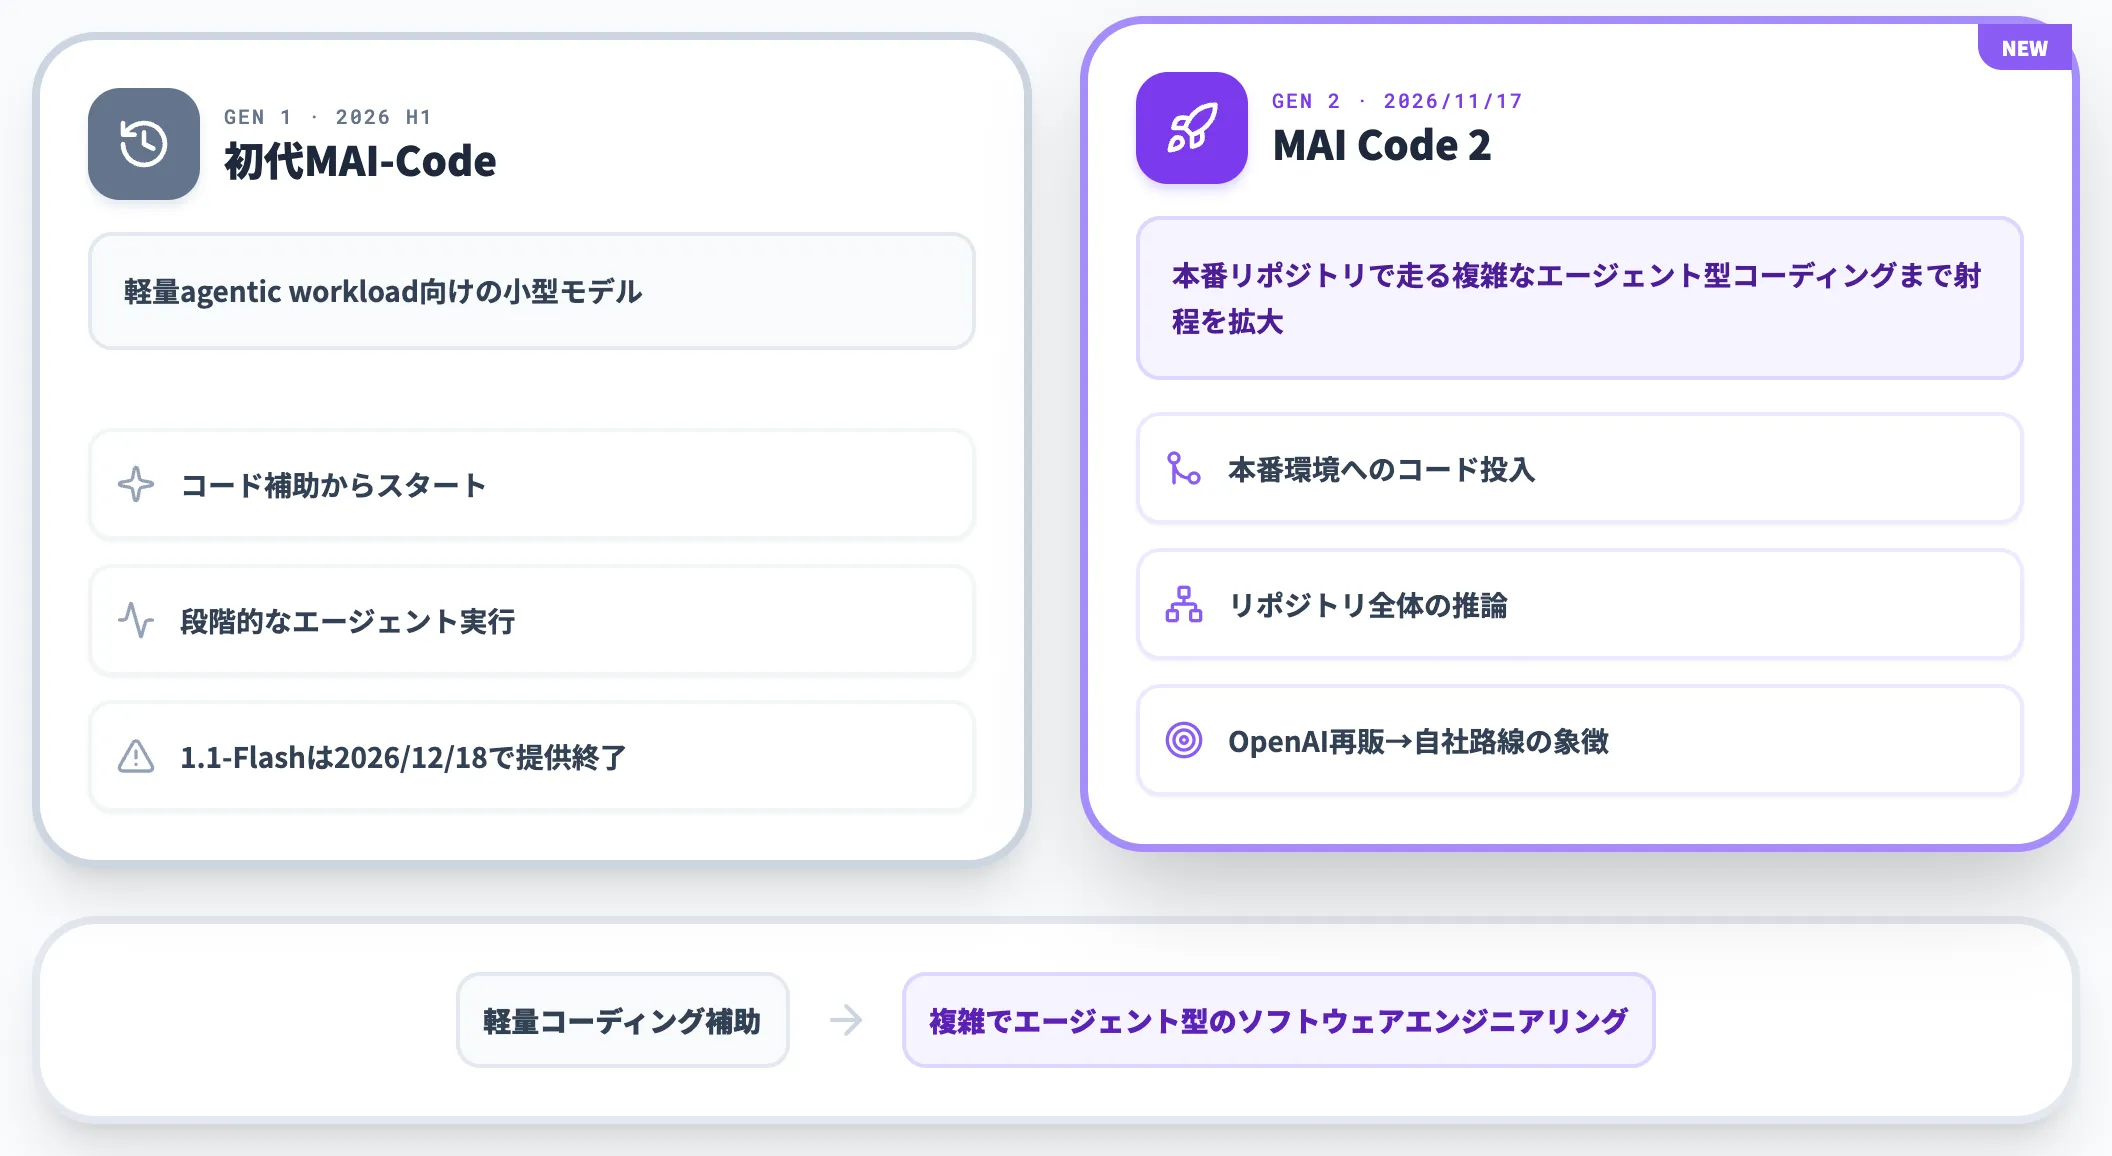
MAI Codeは初代が2026年前半に軽量なagentic workload向け小型モデルとして登場し、コード補助から段階的なエージェント実行までカバーしていました。
2世代目のMAI Code 2は、本番リポジトリで走る複雑なエージェント型コーディングまで射程を広げた点が大きな違いです。
Microsoftは、Code 2を「軽量なコーディング補助から、複雑でエージェント型のソフトウェアエンジニアリングへの大きな一歩」と説明しています。
同日発表の7モデル(MAI Cyber 2 Flash・MAI Image 2.7・MAI Realtime 1・MAI Transcribe 2・MAI Decision 1.1)の中でも、Code 2はMicrosoftがOpenAI再販姿勢から自社モデル路線へ軸足を移した象徴的な位置を占めるモデルになっています。
MAI Code 2の性能ベンチマークと競合モデルとの比較
ここでは、Microsoftが公開した4つのコーディングベンチマークの平均値と、GPT-6.1 Sol・Claude Opus 5.5との比較を整理します。
MicrosoftはCode 2の性能評価に、エンタープライズ業務で実際に出てくるコーディングタスクに近い4つのベンチマーク(DeepSWE 1.1、Terminal-Bench 2.1、SWE Atlas、FrontierCode v1.1)の平均値を採用しました。
この基準は、単発スポットの難問を解く能力ではなく、日常のエンタープライズコーディングを安定して回す能力を測る方向に寄せています。
4つのコーディングベンチマーク平均値
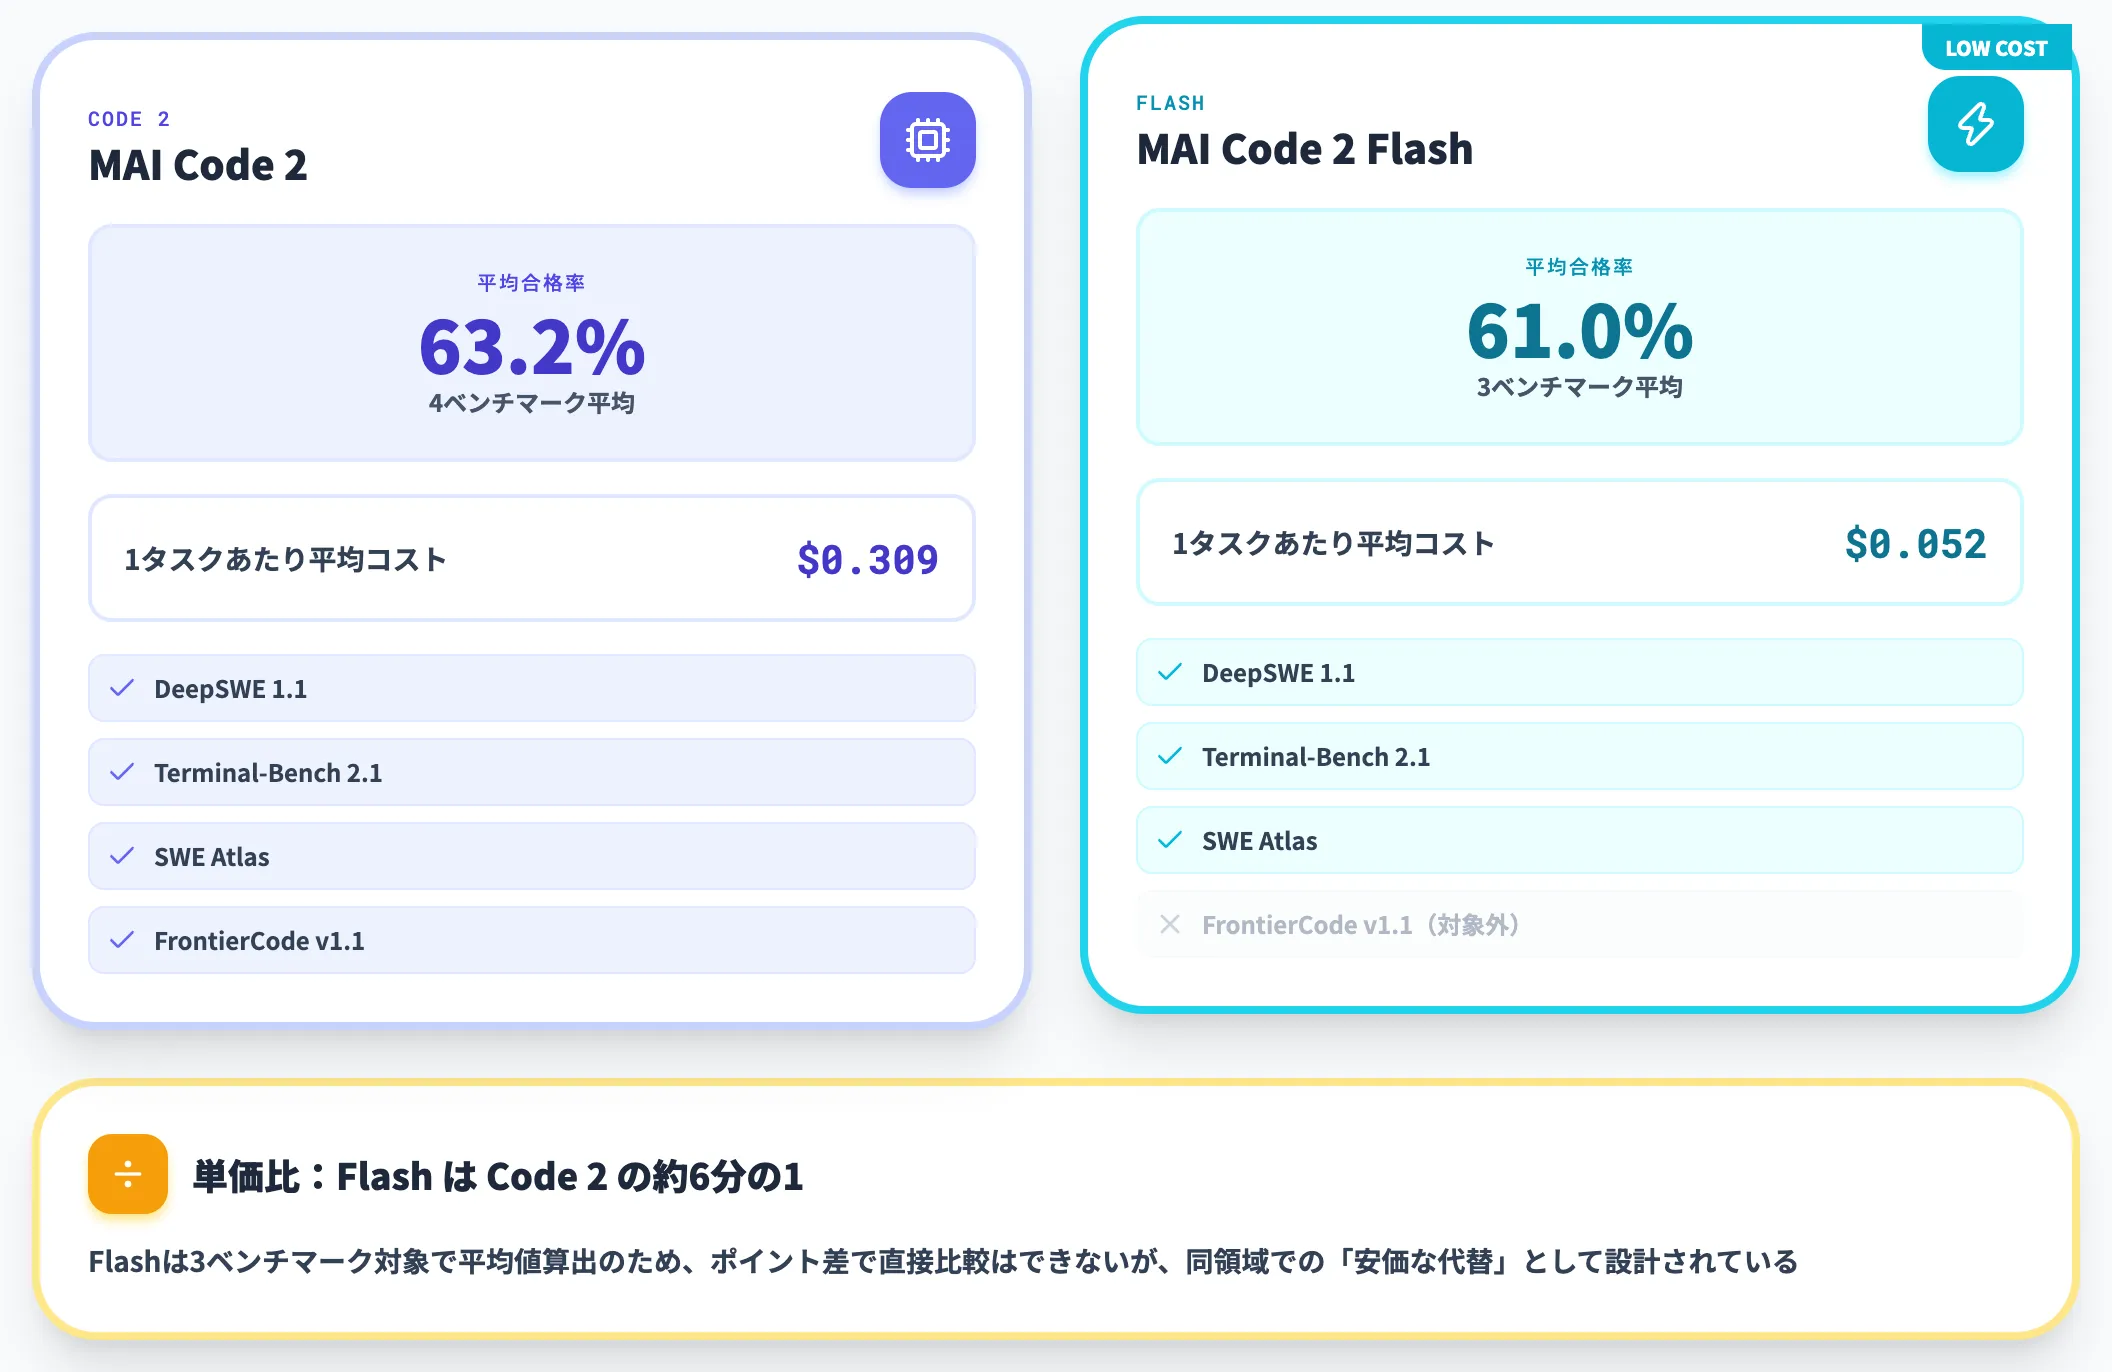
以下の表で、Microsoftが公表しているMAI Code 2とMAI Code 2 Flashの平均ベンチマーク結果を整理しました。
| モデル | 平均合格率 | 1タスクあたり平均コスト | 対象ベンチマーク |
|---|---|---|---|
| MAI Code 2 | 63.2% | $0.309 | DeepSWE 1.1 / Terminal-Bench 2.1 / SWE Atlas / FrontierCode v1.1 |
| MAI Code 2 Flash | 61.0% | $0.052 | DeepSWE 1.1 / Terminal-Bench 2.1 / SWE Atlas |
注目したいのは、1タスクあたりの平均コストです。Code 2が$0.309、Flashが$0.052と、FlashはCode 2の約6分の1のコストでタスクを完了させています。
平均合格率はCode 2が63.2%、Flashが61.0%ですが、Code 2は4ベンチマーク(DeepSWE 1.1・Terminal-Bench 2.1・SWE Atlas・FrontierCode v1.1)、Flashは3ベンチマーク(DeepSWE 1.1・Terminal-Bench 2.1・SWE Atlas)の平均値で、対象が異なるため直接のポイント差では比較できません。
日常高頻度タスクに絞って回すならFlash、より難度の高いタスクも含めて安定運用したいならCode 2、という設計意図が数字に表れています。
さらにMicrosoftは、Code 2がGPT-6.1 Solの98%の性能を40%のコストで、Claude Opus 5.5の96%の性能をわずか5%のコストで実現すると公表しています。
Claude Opus 5.5との5%コスト比較の読み解き
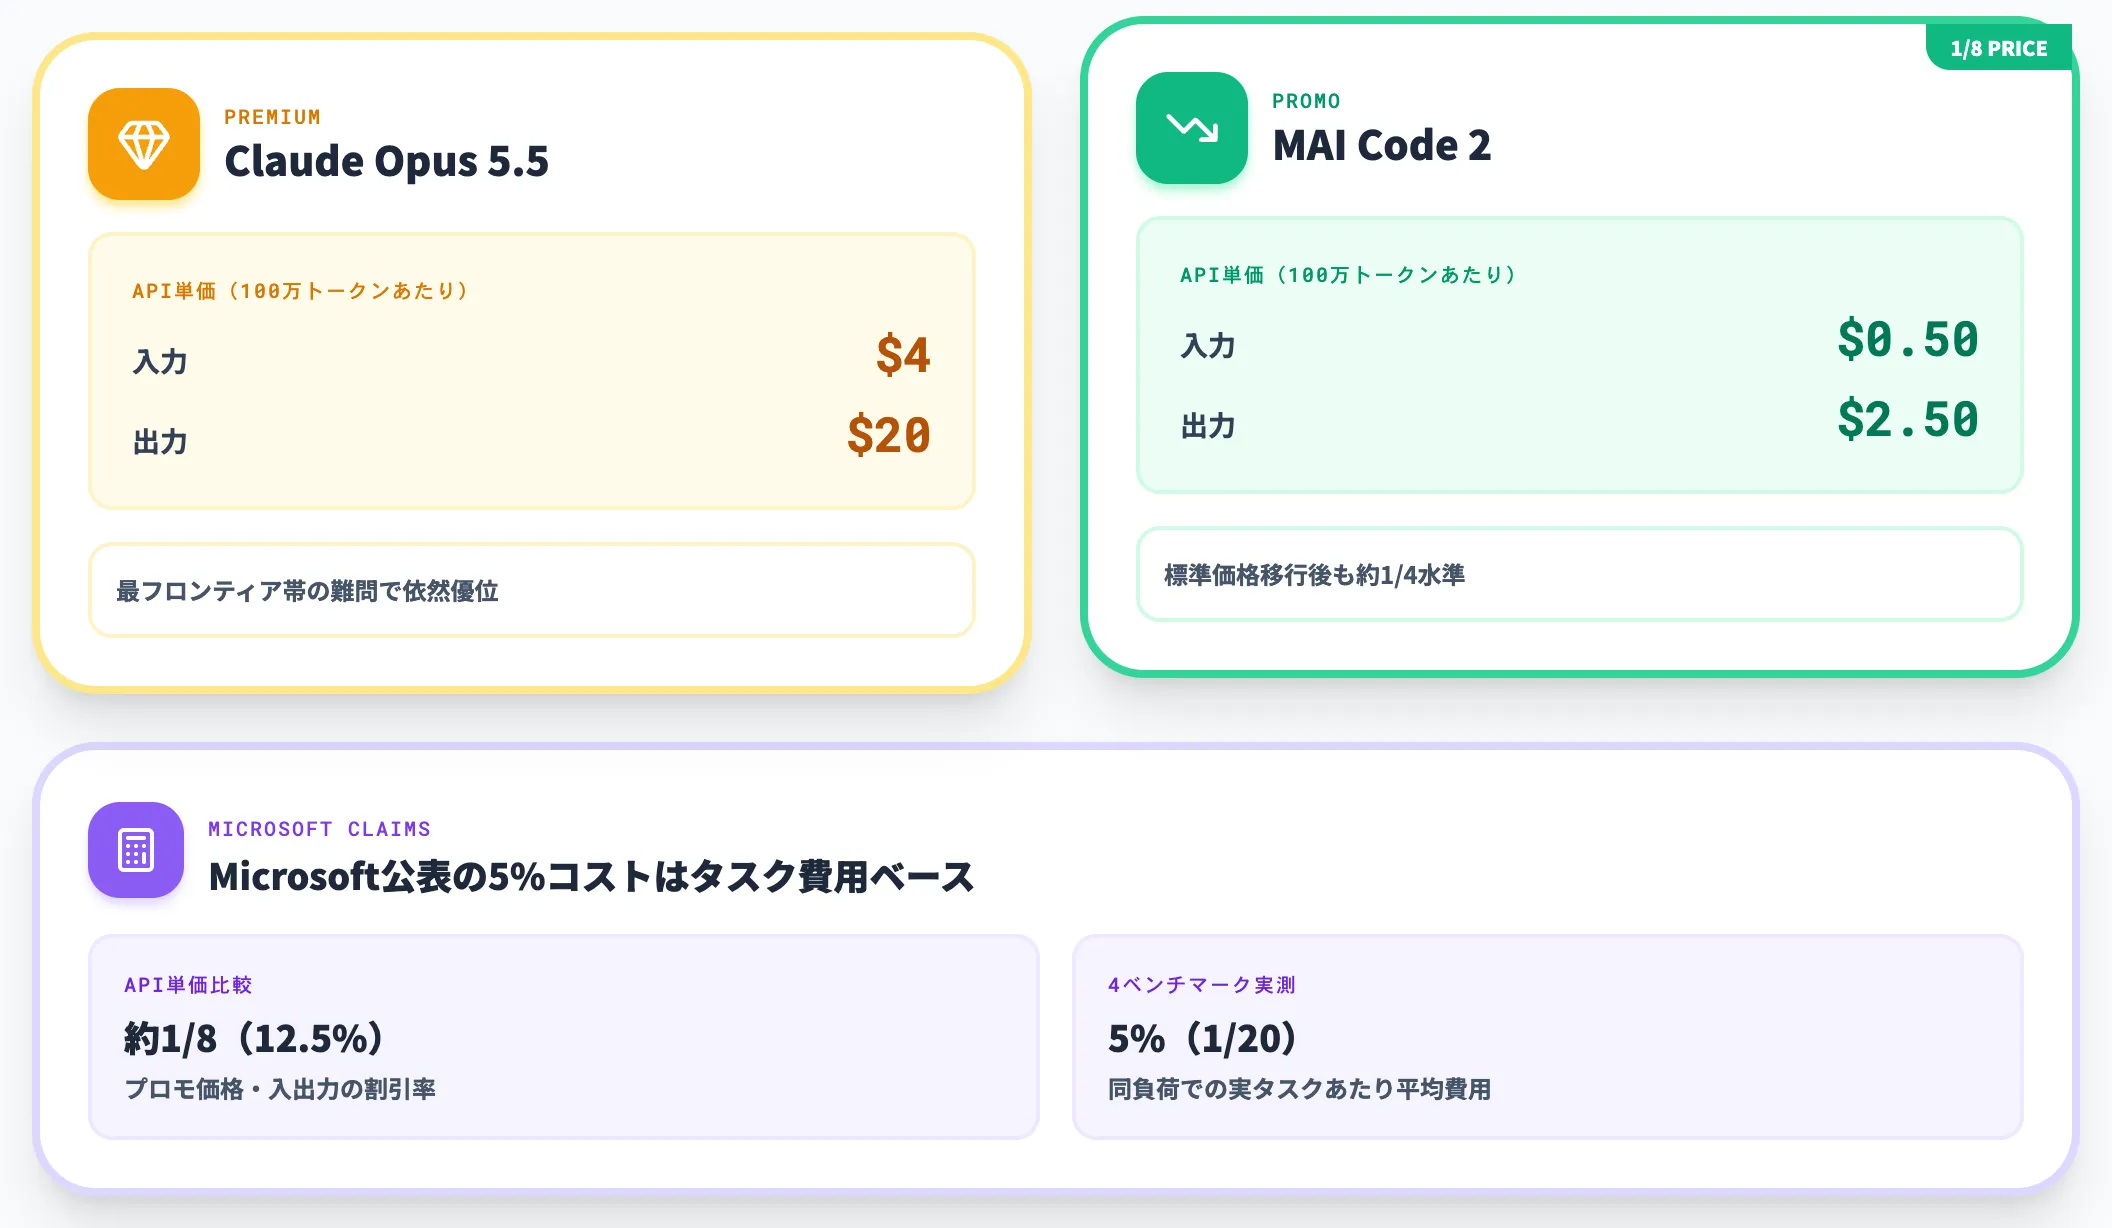
性能数値よりもインパクトが大きいのが、Claude Opus 5.5の5%コストという点です。
Claude Opus 5.5のAPI価格は入力$4・出力$20(100万トークンあたり)で、MAI Code 2のプロモ価格は入力$0.50・出力$2.50です。
API単価だけで比較するとOpus 5.5の約1/8(約12.5%)で、標準価格に移行しても約1/4の水準に収まります。ただし、Microsoftが公表している「5%コスト」は、4ベンチマークの実測タスクあたり平均費用での比較値で、API単価の割引率とは別の指標として扱う必要があります。
Microsoftの比較条件に沿えば、同じベンチマーク負荷なら性能96%を1/20のコストでさばけることになります。実運用での削減幅はプロンプト長やキャッシュ効率次第で変動しますが、エンタープライズで日次大量タスクを回す場合はモデル費用に二桁%以上のインパクトが見込めます。
同時にMicrosoftは「最フロンティア帯の難問はClaude Opus 5.5のほうが取れる」ことを否定していません。ベンチマーク平均で失われる2〜4%がどの業務領域で効くかは公開ベンチマークからは特定できていません。クリティカル度の高い設計判断・レビューでは、評価を並走させる判断が無難です。
258アノテータのA/B評価——UI品質で64%選好
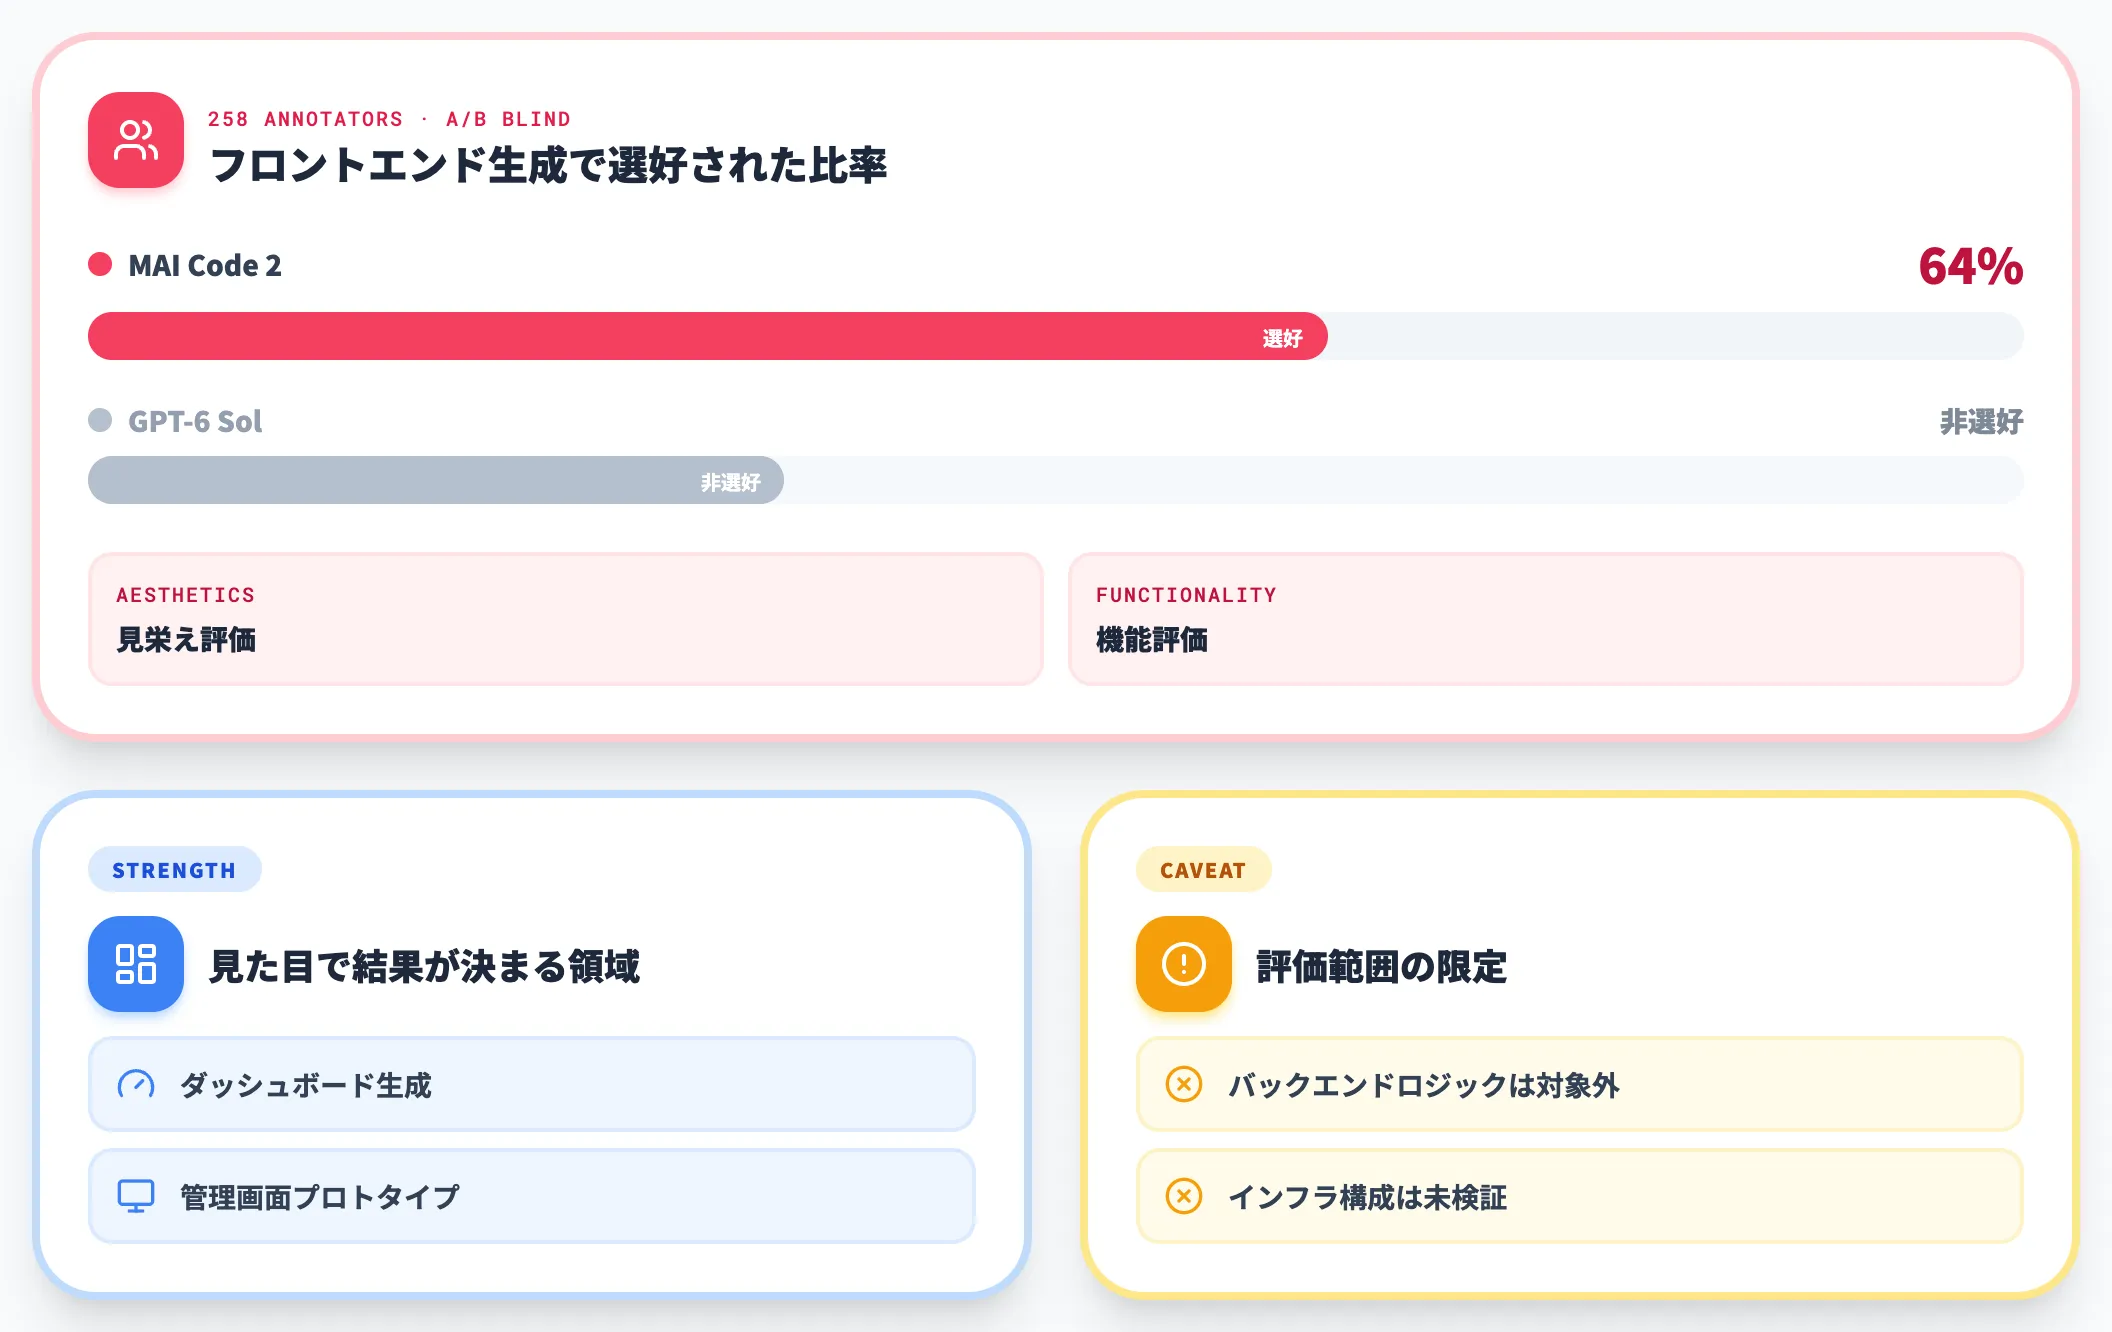
ベンチマーク以外の評価として、Microsoftは258人のアノテータによる匿名A/B評価も公開しています。
フロントエンド生成のaesthetics(見栄え)とfunctionality(機能)の2軸で、MAI Code 2の出力をGPT-6 Solの出力と比較評価させた結果、64%の確率でMAI Code 2を選好したと報告しています。
この64%という数字は、ダッシュボード・管理画面・プロトタイプUIなどの「見た目で結果が決まる領域」でMAI Code 2が実装者の意図を汲みやすいことを示します。
ベンチマーク平均のポイント差だけでは見えない、生成物の質感に関わる優位性です。
ただし、評価対象はフロントエンド領域に絞られている点に注意が必要です。バックエンドのロジック設計やインフラ構成で同じ選好率が出るとは限りません。
MAI Code 2とMAI Code 2 Flashの使い分け
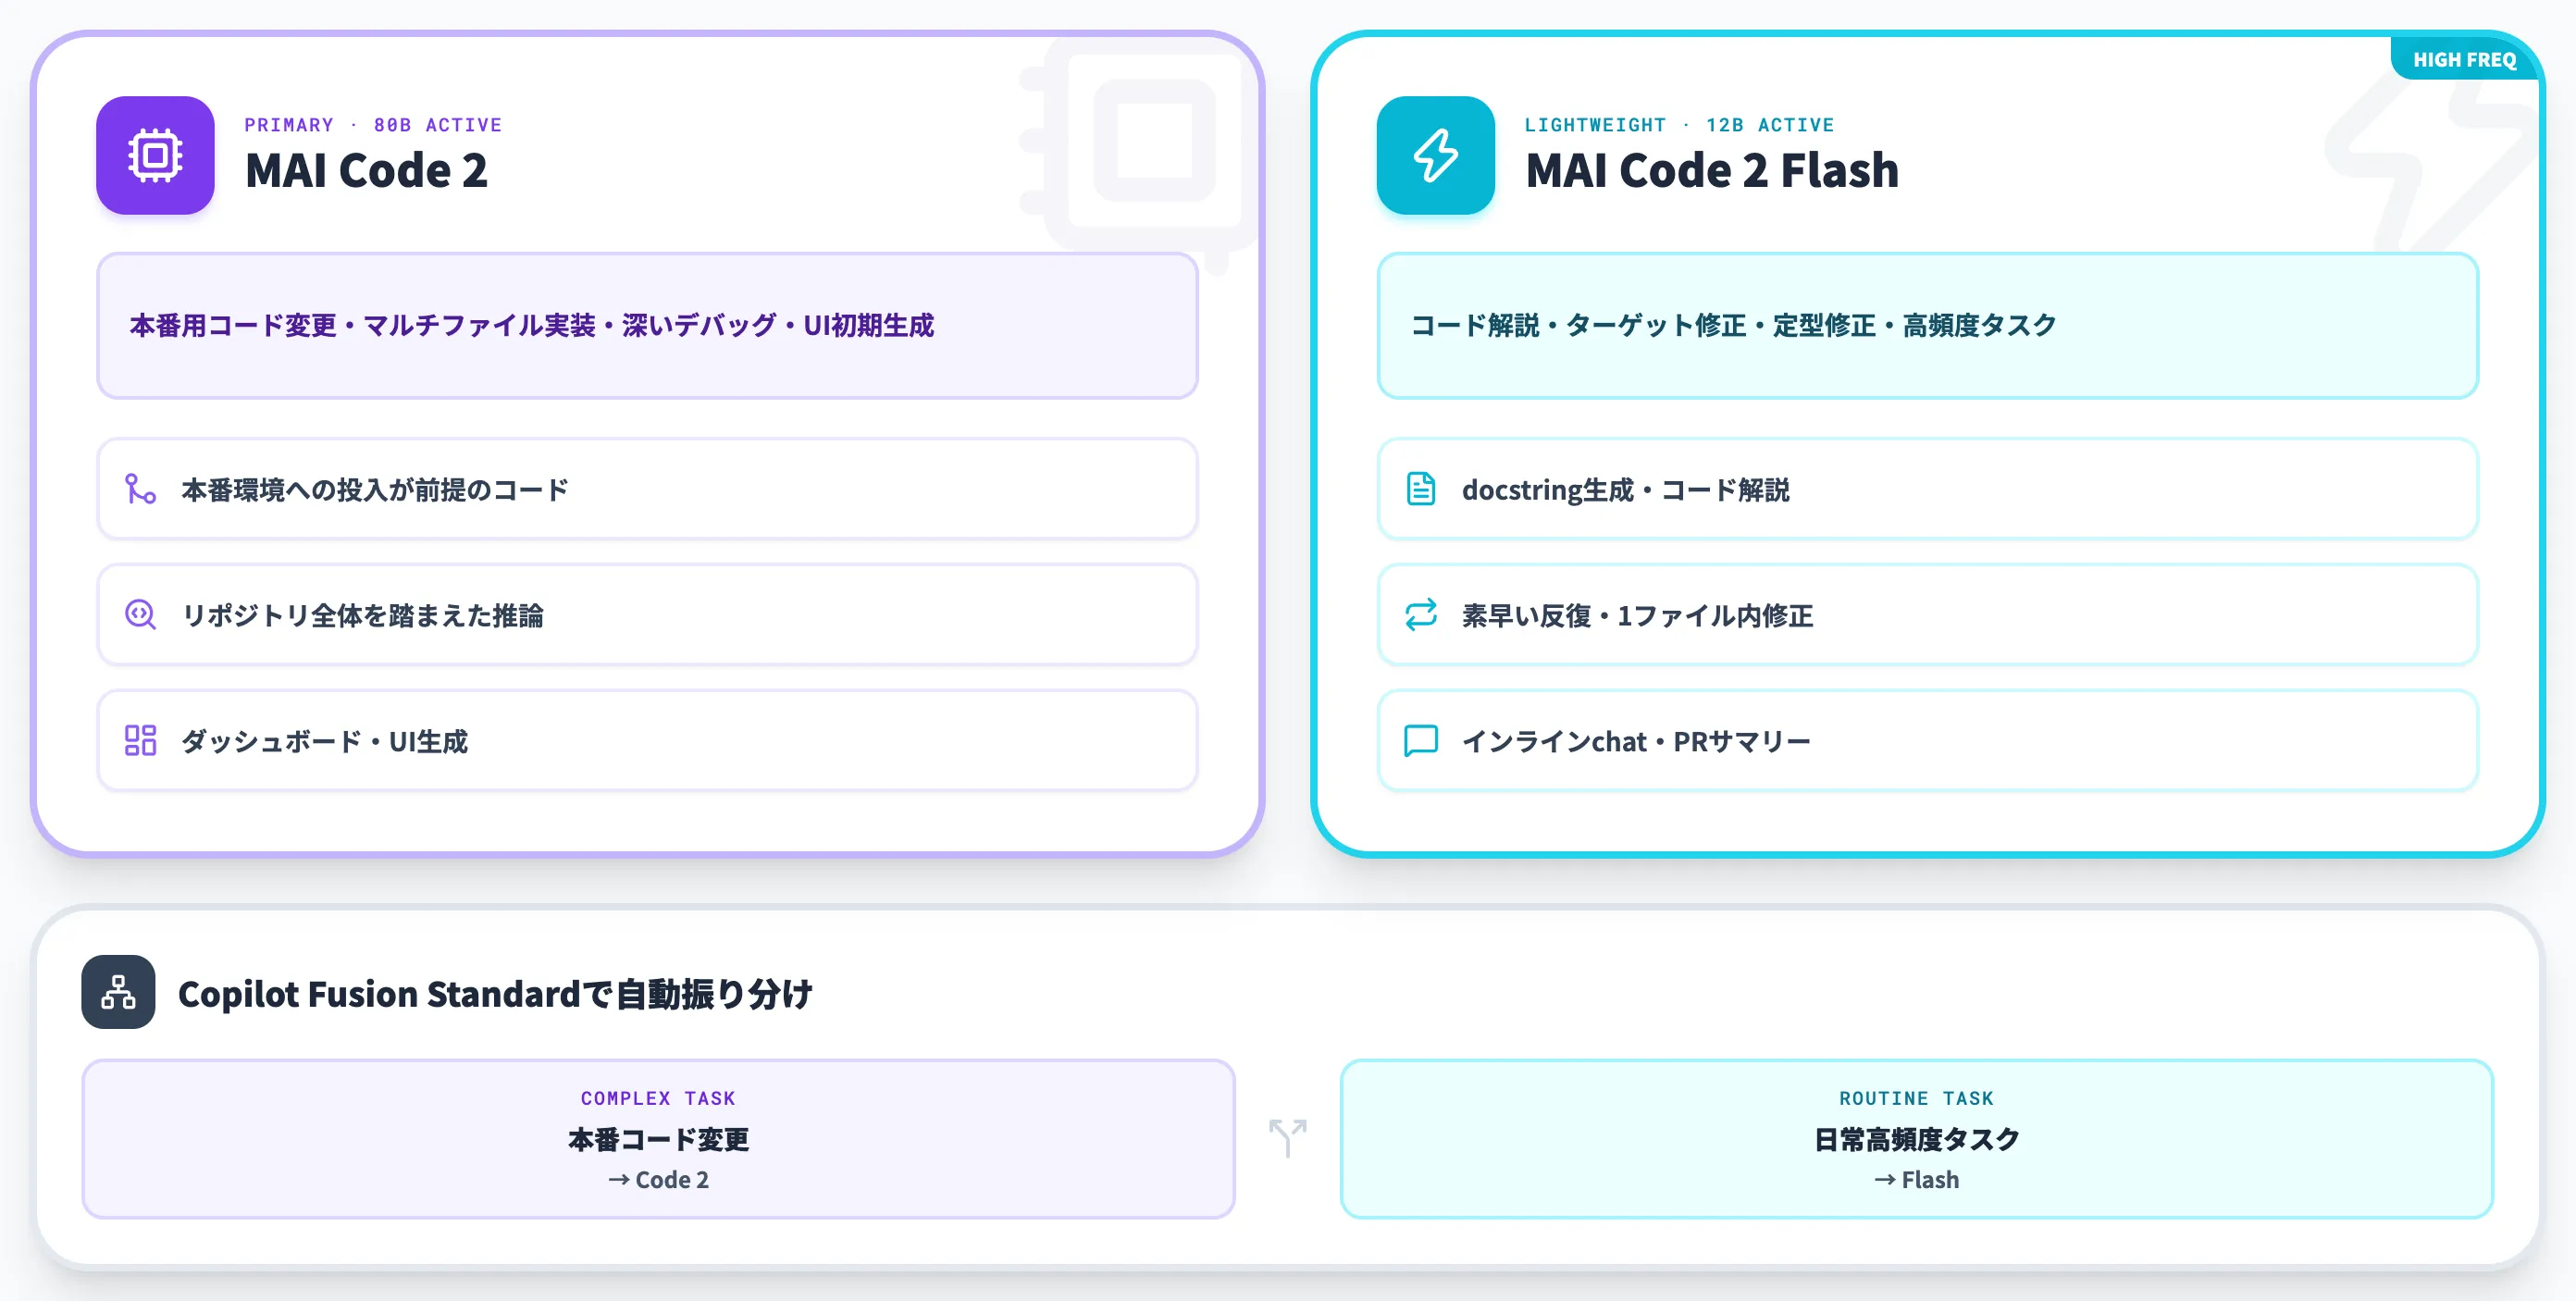
MAI Code 2とMAI Code 2 Flashは「2モデルセット」で発表されており、用途を分けて同時に提供される前提で設計されています。
本セクションでは2モデルの設計意図と選び分けの基準を整理します。
2モデルの用途と設計差
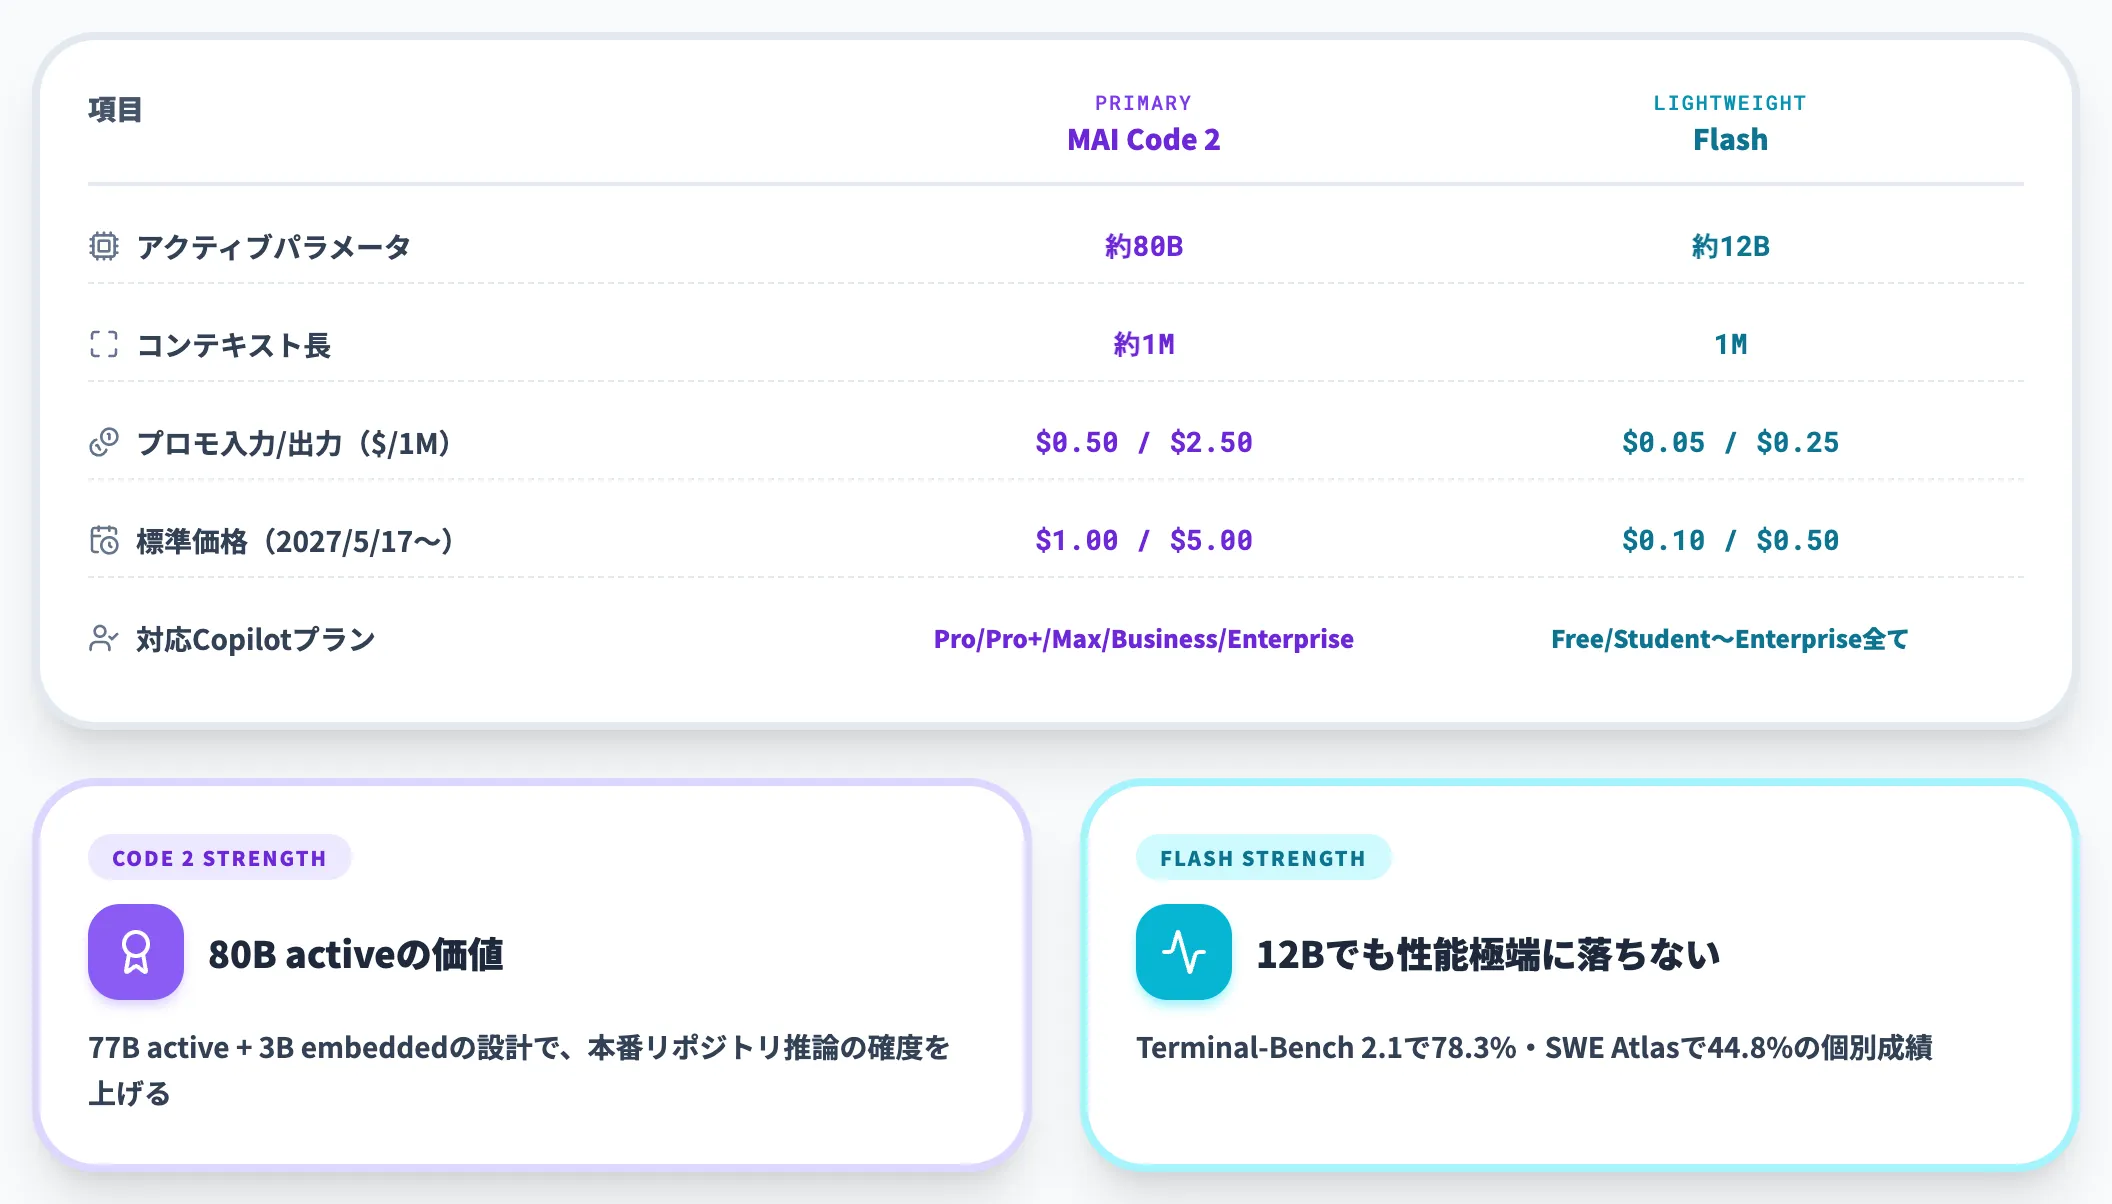
以下の表で、Microsoftの公式位置づけに沿って2モデルの用途差を整理しました。
| 項目 | MAI Code 2 | MAI Code 2 Flash |
|---|---|---|
| 想定用途 | 本番環境へのコード投入、深いデバッグ、マルチファイル実装、リポジトリ全体の推論、UI生成 | コード解説、ターゲット修正、定型修正、素早い反復、高頻度タスク |
| アクティブパラメータ | 約80B(77B active + 3B embedded・公式モデルカード) | 約12B |
| コンテキスト長 | 約1Mトークン | 1Mトークン |
| プロモ価格(入力/出力) | $0.50 / $2.50 | $0.05 / $0.25 |
| 標準価格(2027年5月17日以降) | $1.00 / $5.00 | $0.10 / $0.50 |
| 対応Copilotプラン | Pro/Pro+/Max/Business/Enterprise | Free/Student/Pro/Pro+/Max/Business/Enterprise |
この表から読み取れる最大のポイントは、Flashの単価がCode 2の約10分の1であることです。
Flashは12Bアクティブ・1Mトークンのコンテキストウィンドウで、Code 2は公式モデルカードで80B active(77B active + 3B embedded)相当・約1Mコンテキストと公表されており、2モデルで規模感を切り替える設計になっています。
Flash単独でも、公式モデルカードではTerminal-Bench 2.1で78.3%・SWE Atlasで44.8%という個別成績が報告されており、3ベンチマーク平均では61.0%に届きます。
「軽量だから性能が極端に落ちる」というポジショニングではありません。
どちらをデフォルトに据えるべきか
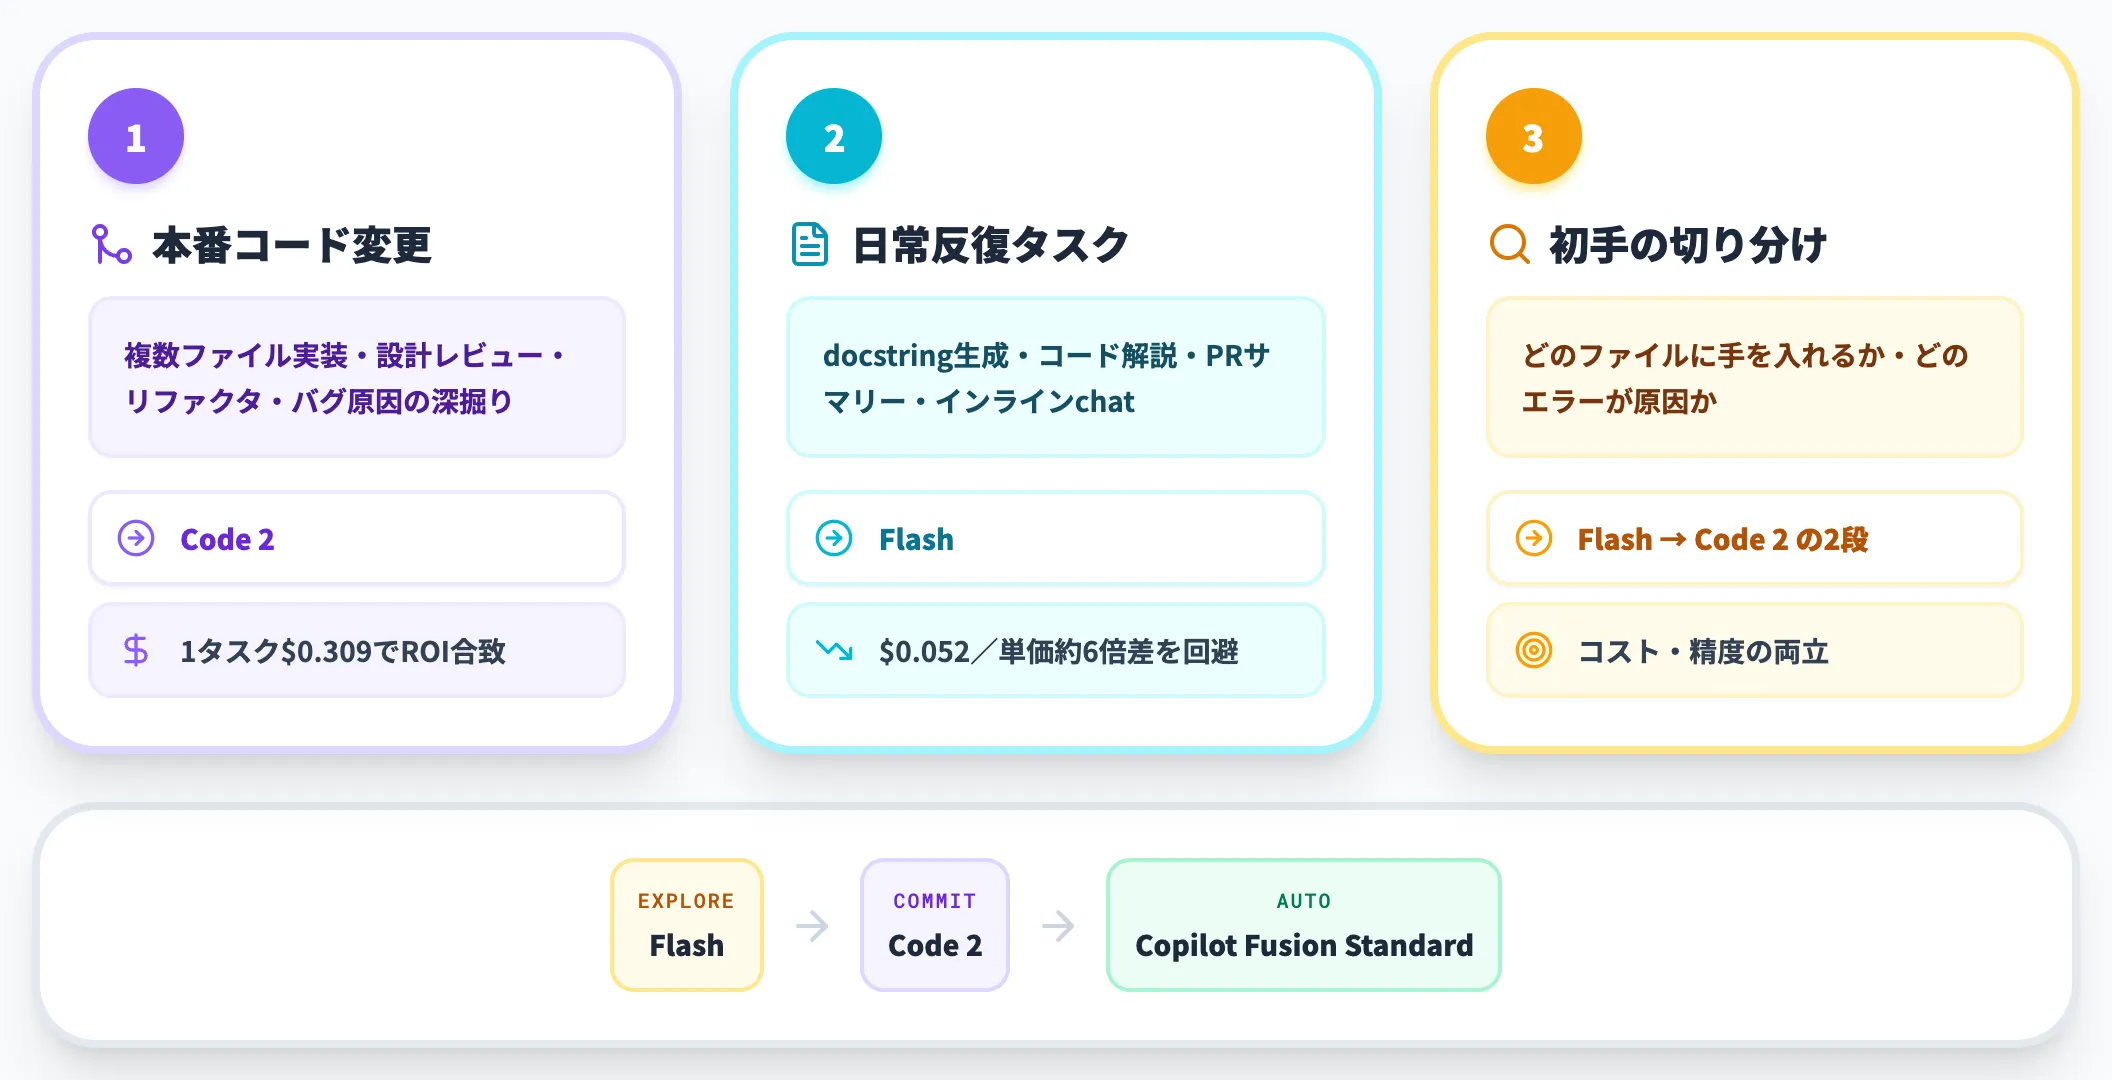
「いつCode 2、いつFlash」の判断軸はシンプルに2つに集約できます。
-
本番リポジトリに直接コミットするコード変更、複数ファイルを横断する実装、設計レビュー → Code 2
機能追加・リファクタリング・バグ原因の深掘りなど「人間がレビューしてマージする品質」が要求されるタスク。1タスクあたり$0.3前後でもROIが合う領域です。
-
コード解説、docstring生成、1ファイル内の局所的な修正、PRのサマリー、インラインchat → Flash
1日に数百回走るような反復タスク。1タスク$0.05に対してCode 2は約$0.309と単価比で約6倍。これを全件Code 2で回すと費用が大きく膨らみます。
-
初手の切り分け
「どのファイルに手を入れるか」「どのエラーが原因か」のような探索的タスクはまずFlashで走らせ、本番変更の生成はCode 2に切り替える2段運用が、コスト・精度の両面で現実的です。
GitHub Copilotでは、Copilot Fusionの「Fusion Standard」の選択肢にMAI Code 2が追加されています。
タスクの性質に応じてCopilotが候補モデルから選ぶ仕組みで、Code 2とFlashの振り分けルールは公式に明記されていないため、どのモデルが走るかは実行時のCopilot判断に委ねられる設計です。
MAI Code 2の料金とコスト構造
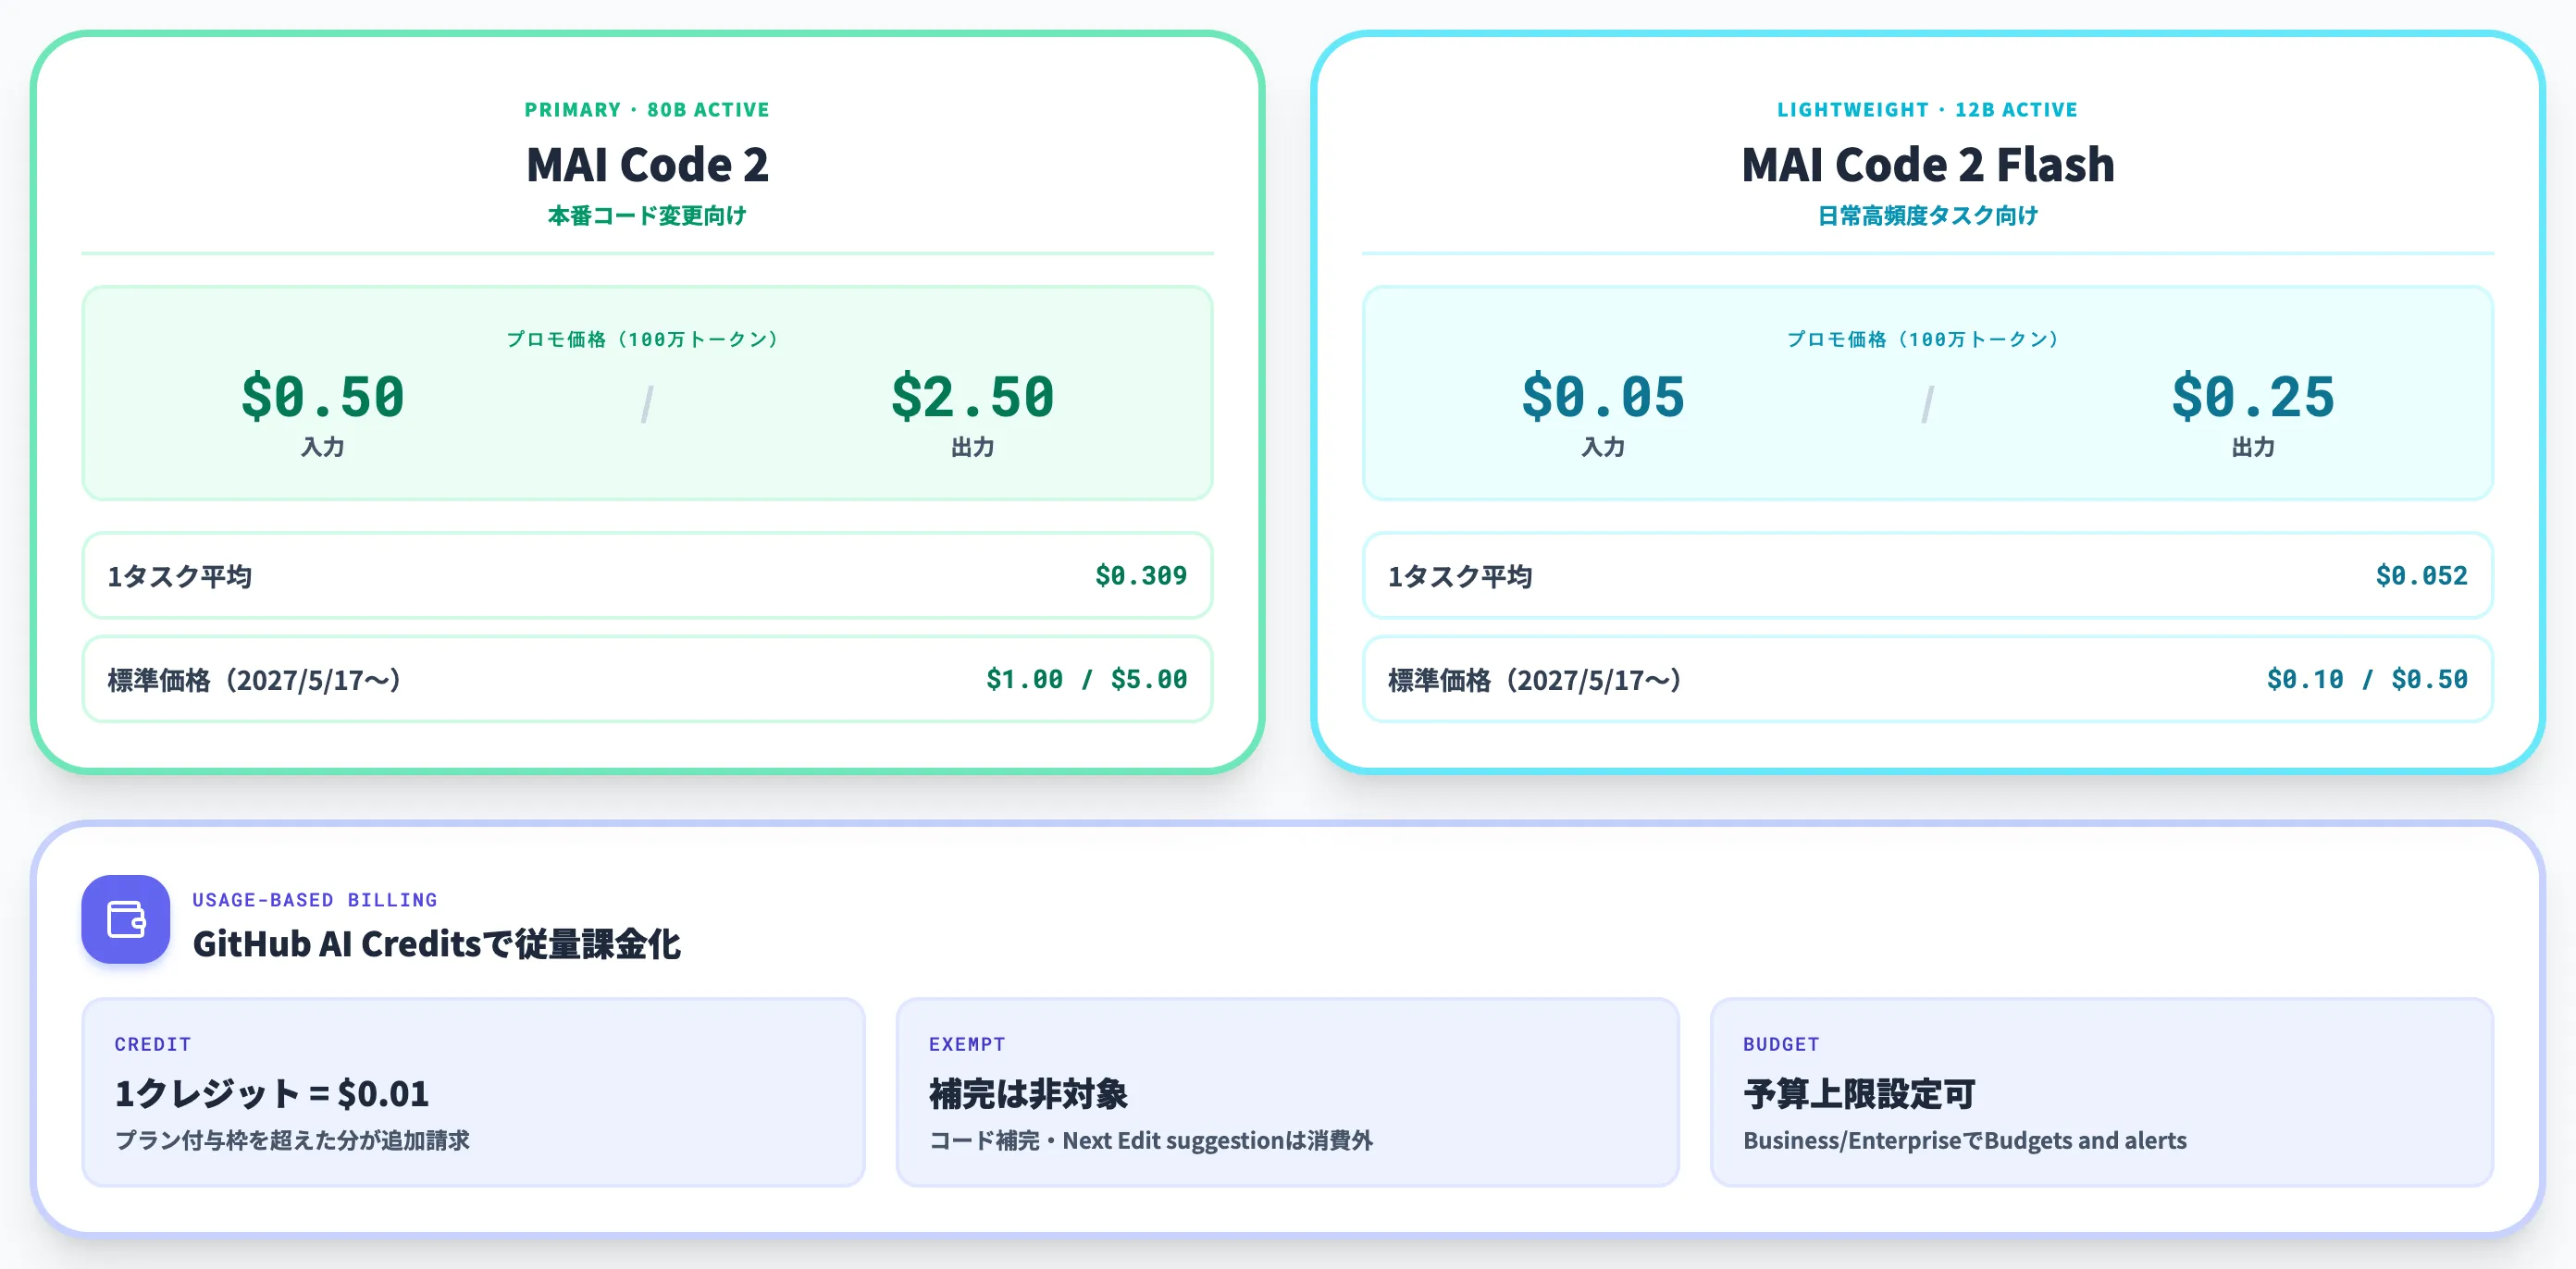
MAI Code 2はCopilotの従量課金で提供されており、2027年5月17日までのプロモーション価格と、以降の標準価格の2段階設計になっています。
本セクションではCopilot内での課金ルールと、API単価の実務インパクトを整理します。
プロモ価格と標準価格
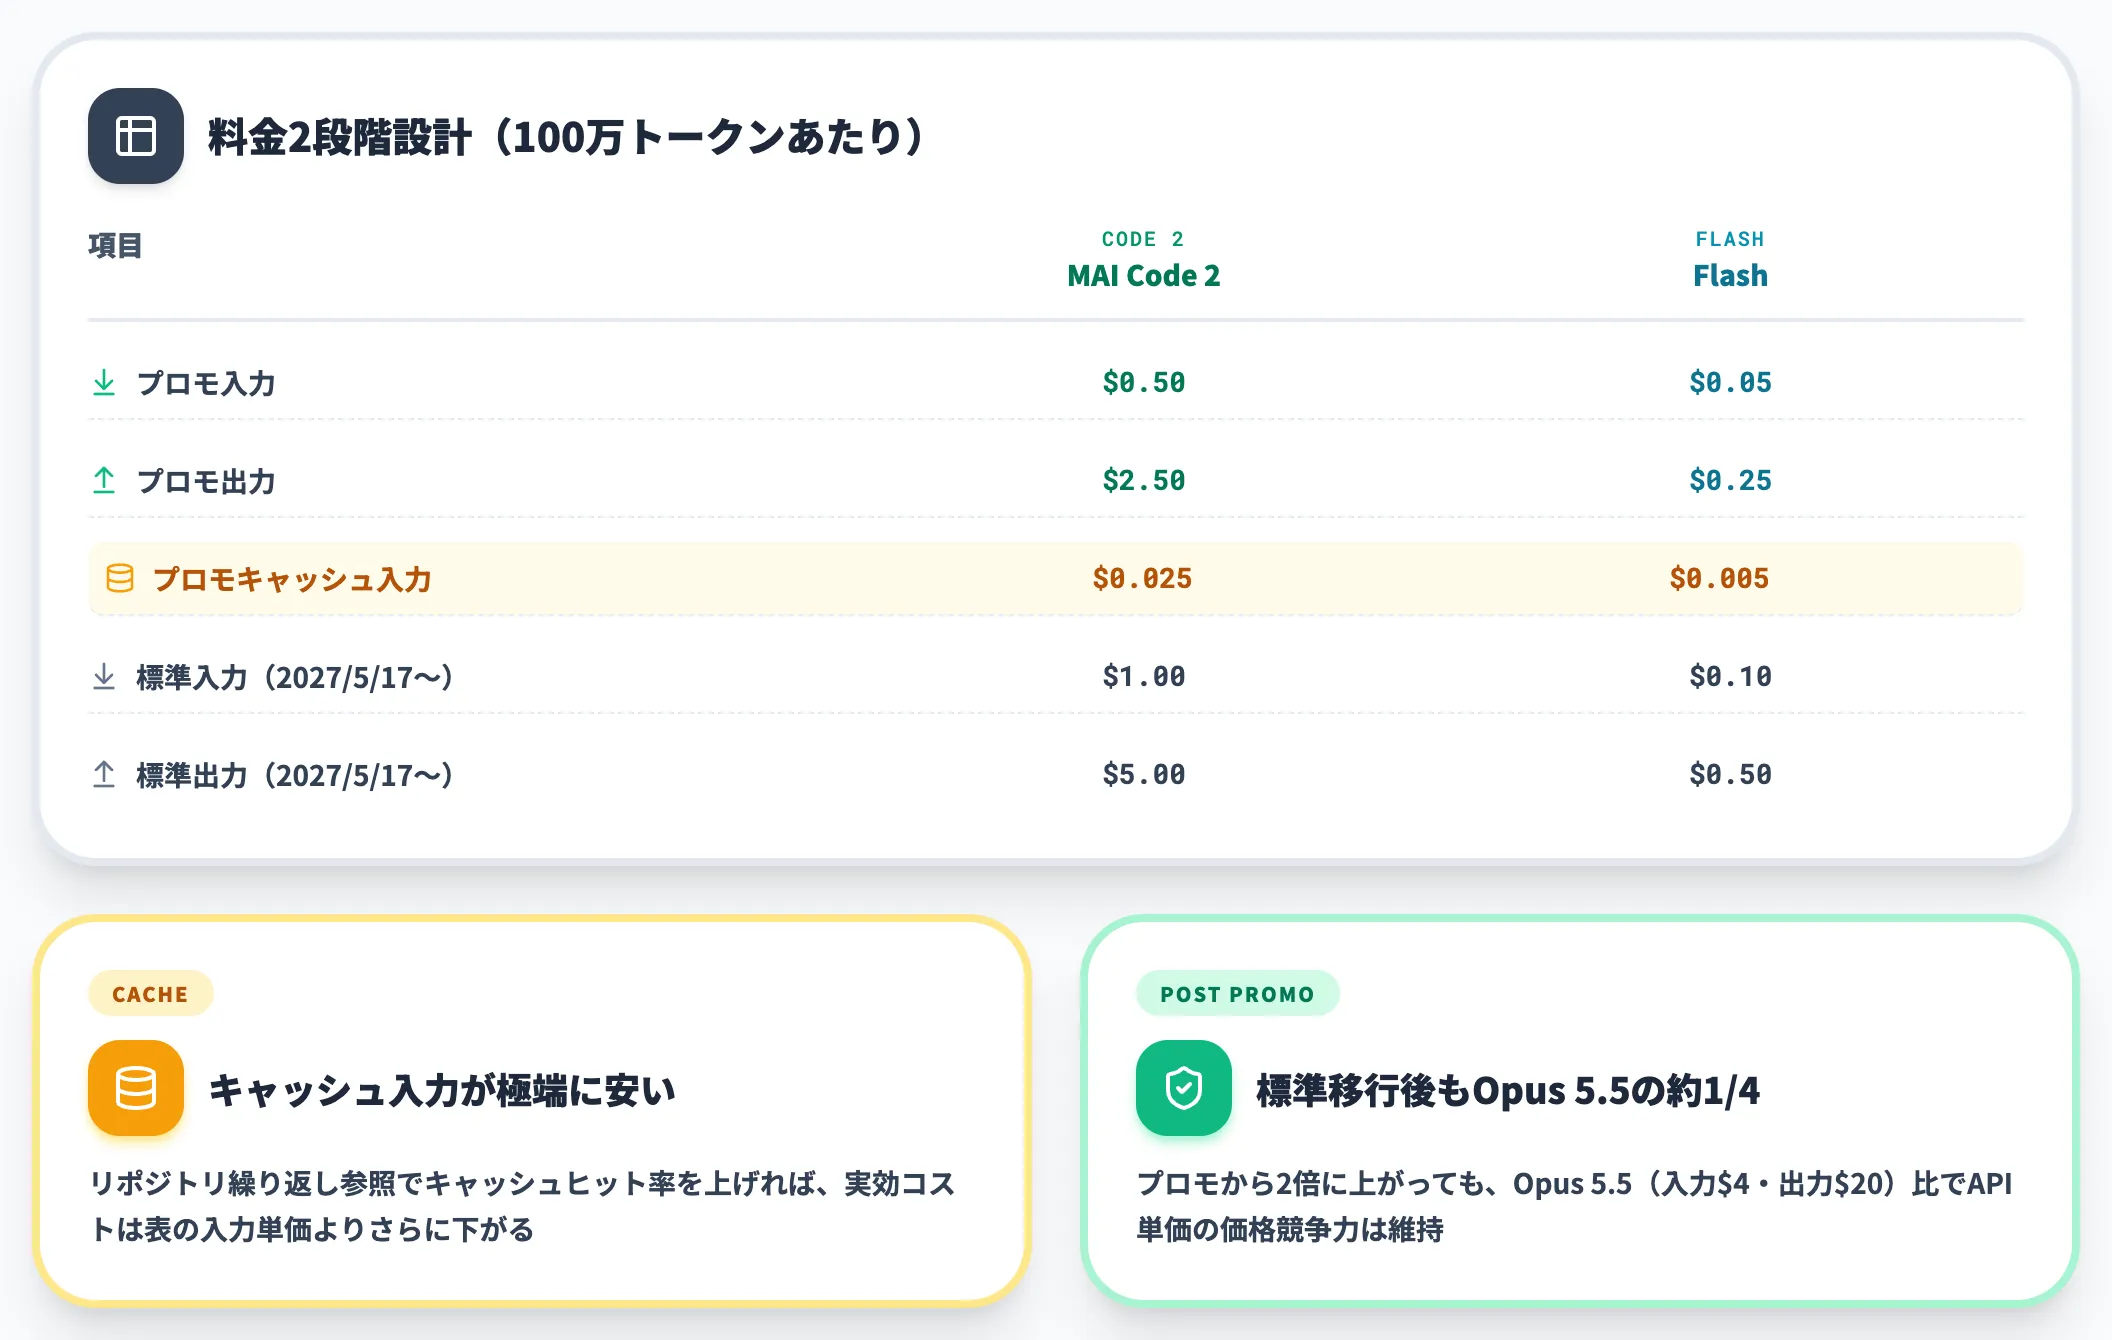
以下の表で、GitHub公式のCopilot課金ドキュメントで明示されている単価を整理しました。
| 項目 | MAI Code 2 | MAI Code 2 Flash |
|---|---|---|
| プロモ入力(100万トークン) | $0.50 | $0.05 |
| プロモ出力(100万トークン) | $2.50 | $0.25 |
| プロモキャッシュ入力 | $0.025 | $0.005 |
| プロモ期間 | 2027年5月17日まで | 2027年5月17日まで |
| 標準入力(2027年5月17日以降) | $1.00 | $0.10 |
| 標準出力(2027年5月17日以降) | $5.00 | $0.50 |
注目したいのは、キャッシュ入力の単価がプロモ中は$0.025(Code 2)・$0.005(Flash)と極端に安い点です。
同じリポジトリを繰り返し参照する「リポジトリ全体の推論」タスクでキャッシュヒット率を上げられれば、実効コストは表の入力単価よりさらに下がる可能性があります。
標準価格に移行する2027年5月17日以降は単価がプロモから2倍に上がりますが、それでもClaude Opus 5.5の入力$4・出力$20と比べるとAPI単価で約1/4の水準で、価格競争力は維持されます。
1タスク$0.30で何ができるか
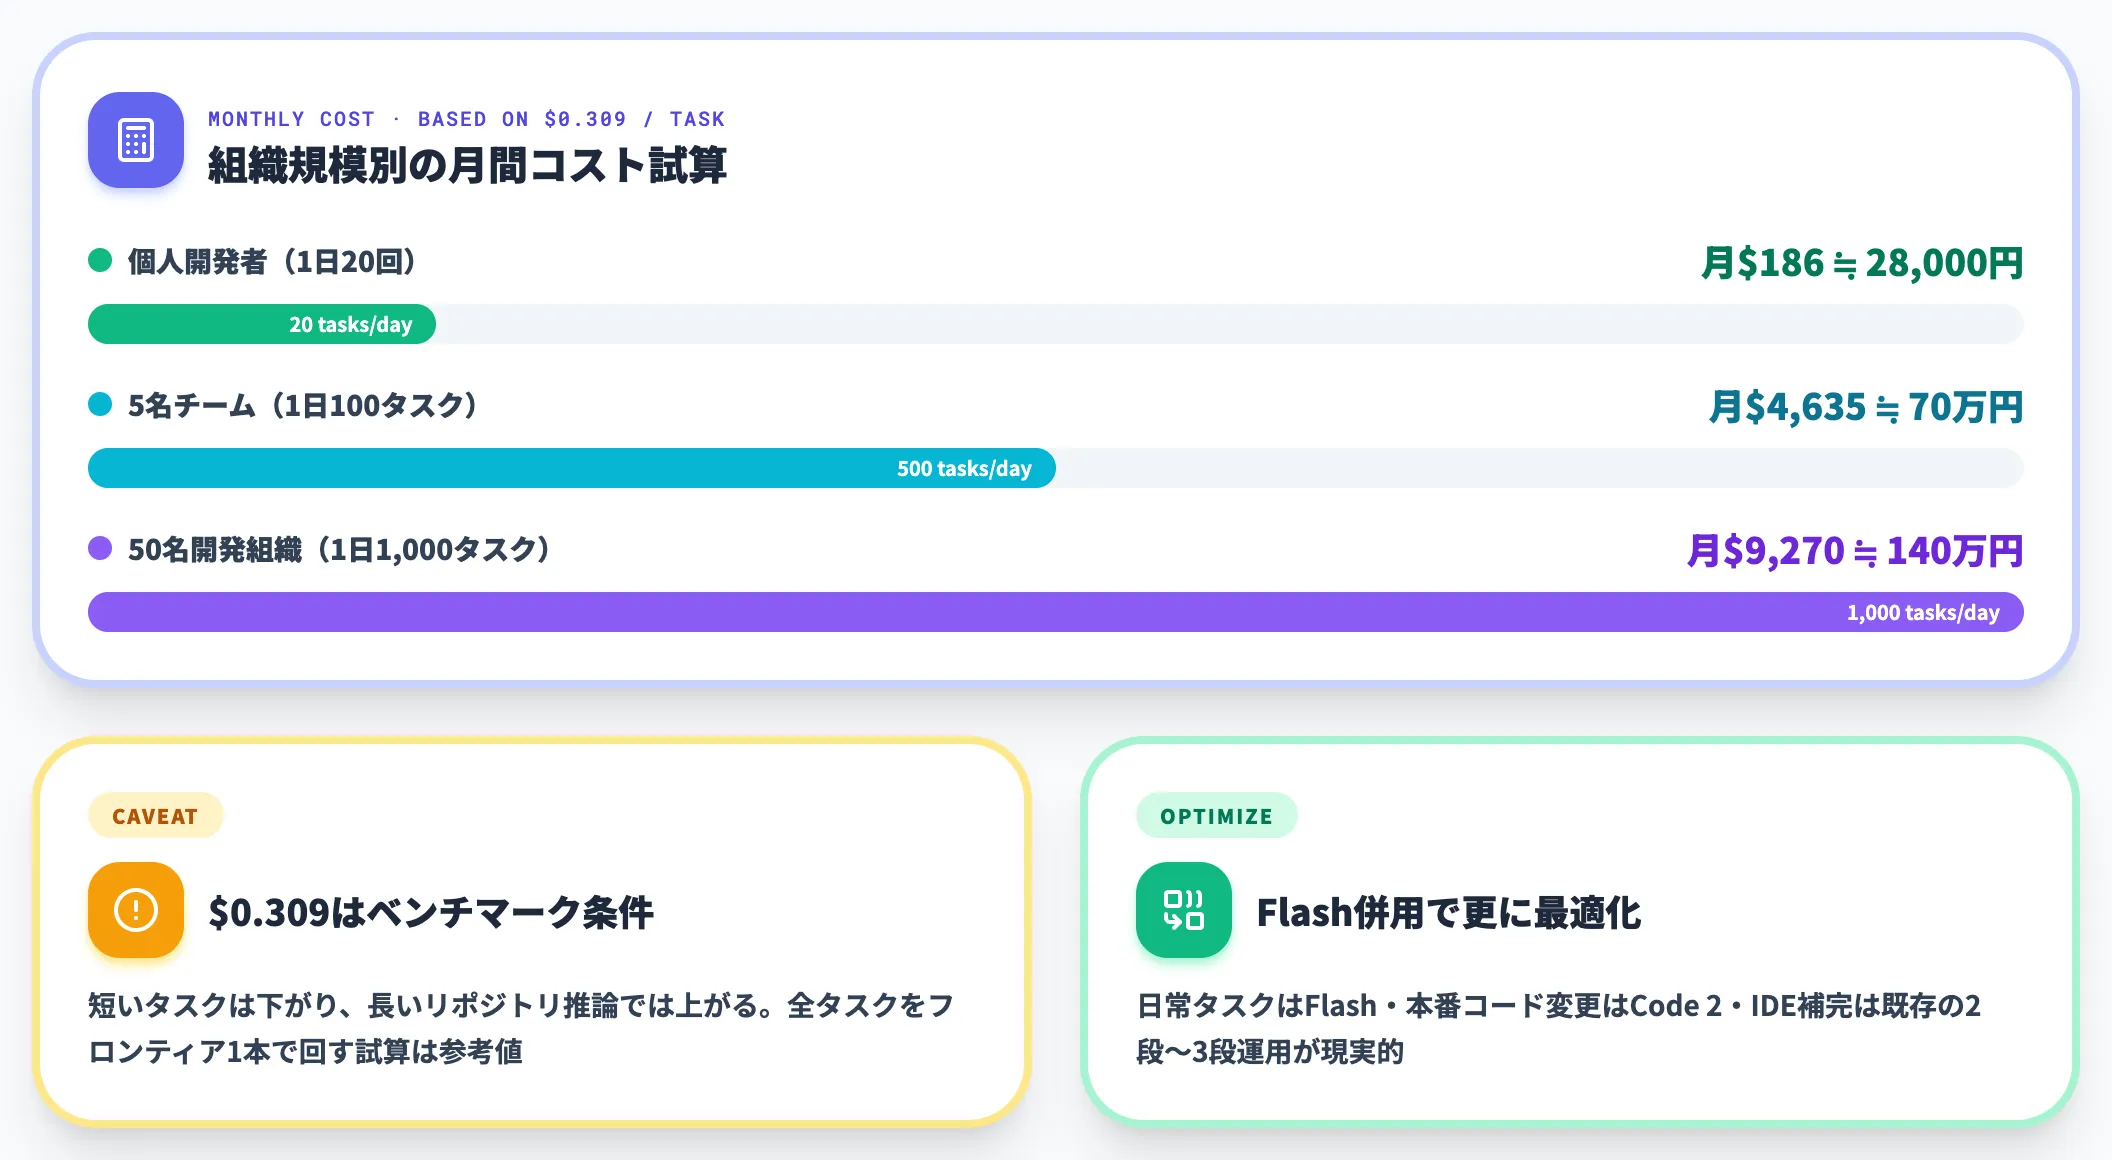
Microsoftが公表する「1タスクあたり$0.309(Code 2)」という数字を、月間コストに置き換えると以下のレンジになります。
- 個人開発者が1日20回Code 2を呼び出す場合: 月間約$186(約28,000円)
- 5名のチームが1日100タスク(合計500タスク)で回す場合: 月間約$4,635(約70万円)
- 50名規模の開発組織で1日1,000タスクを走らせる場合: 月間約$9,270(約140万円)
なお、$0.309はMicrosoftが公表したベンチマーク条件下の平均タスク費用であり、実運用では短いタスクほど下がり長いリポジトリ推論では上がる前提です。
全タスクをフロンティアモデル1本で回す試算は参考値にとどめ、実運用ではFlashと組み合わせた2段運用、既存IDE補完との併用でさらに最適化できます。
Copilot従量課金としての組み込み方
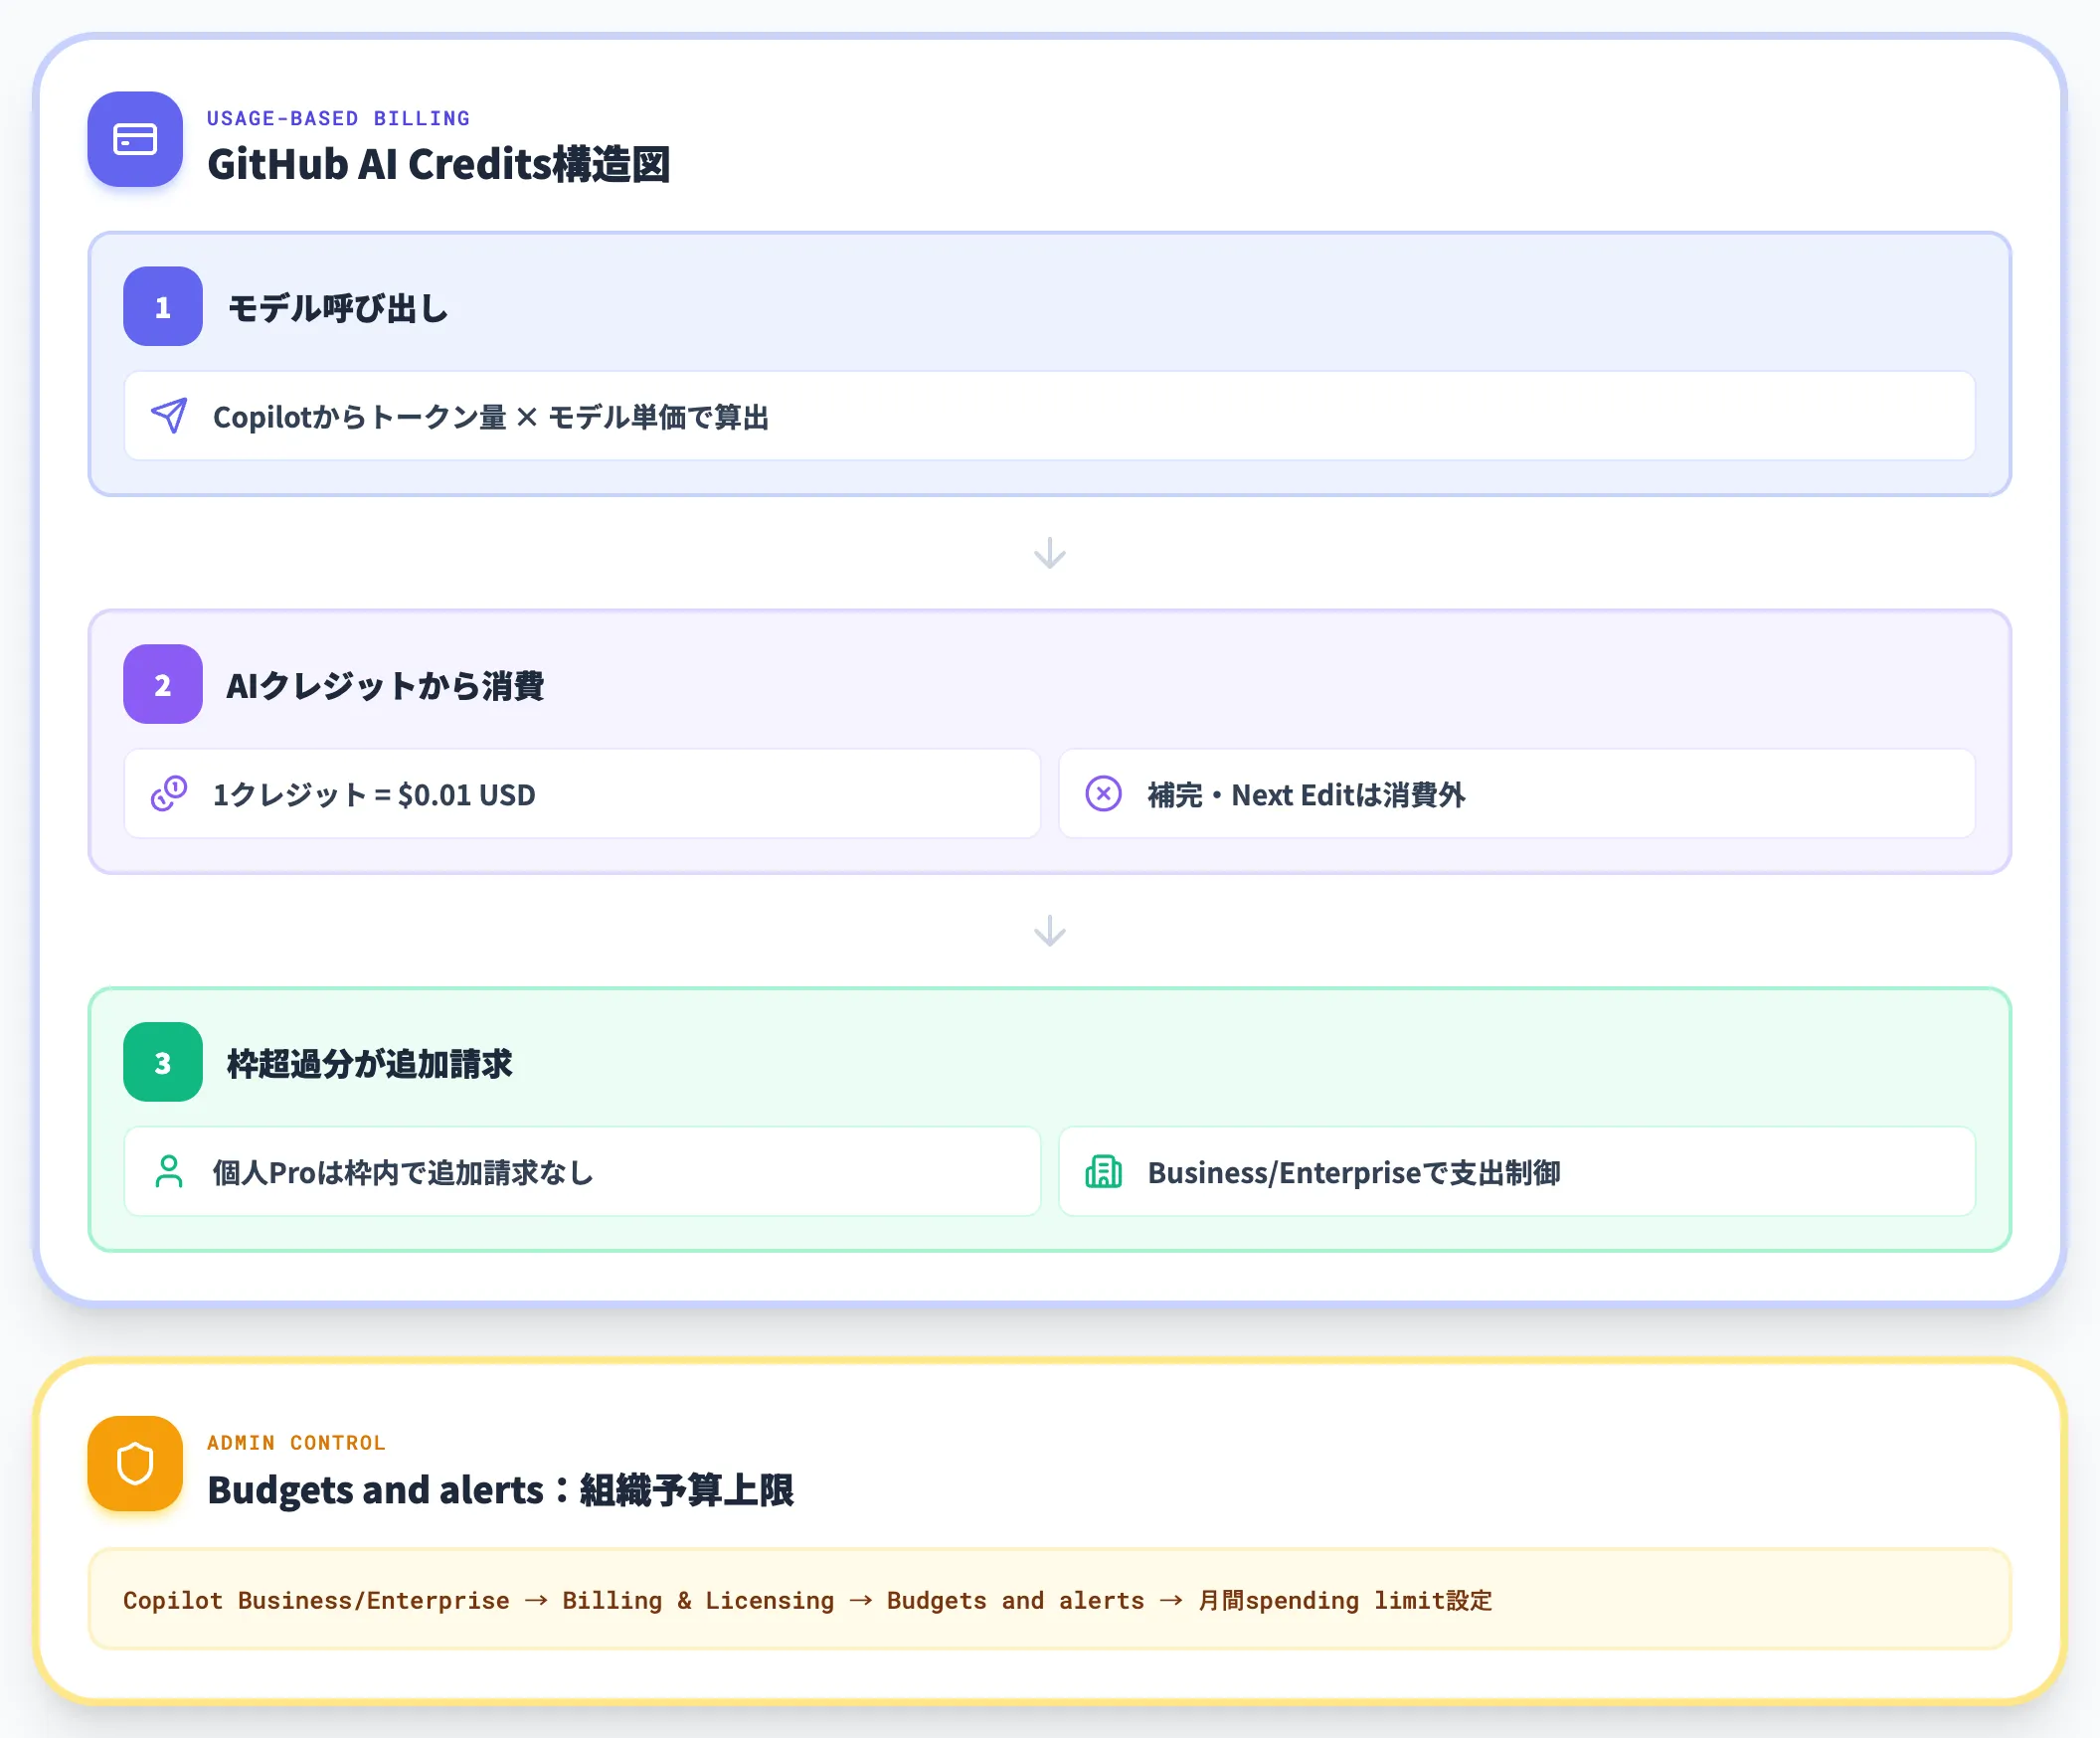
MAI Code 2のトークン課金はCopilotの「usage-based billing」で請求されます。2026年6月1日以降、GitHub Copilotは旧来のPremium requests(PRUs)に代わりGitHub AI Creditsを利用枠として採用しており、モデル呼び出しごとにトークン量×モデル単価で算出された分がAIクレジットから消費されます。
1クレジット=$0.01 USDで、各プランに付与されたクレジット枠を超えた分が追加請求される仕組みです(コード補完・Next Edit suggestionはクレジット消費対象外)。
管理者はCopilot Business/Enterpriseの「Billing & Licensing → Budgets and alerts」設定で、組織単位の月間支出上限(spending limit)を設けて予算超過を抑えられます。
個人のCopilot Pro契約でも、付与されたAIクレジット枠内であれば追加請求は発生しません。チーム利用を想定する場合は、Businessプラン以上で組織の支出コントロールを効かせる運用が現実的です。
GitHub Copilotでの利用方法
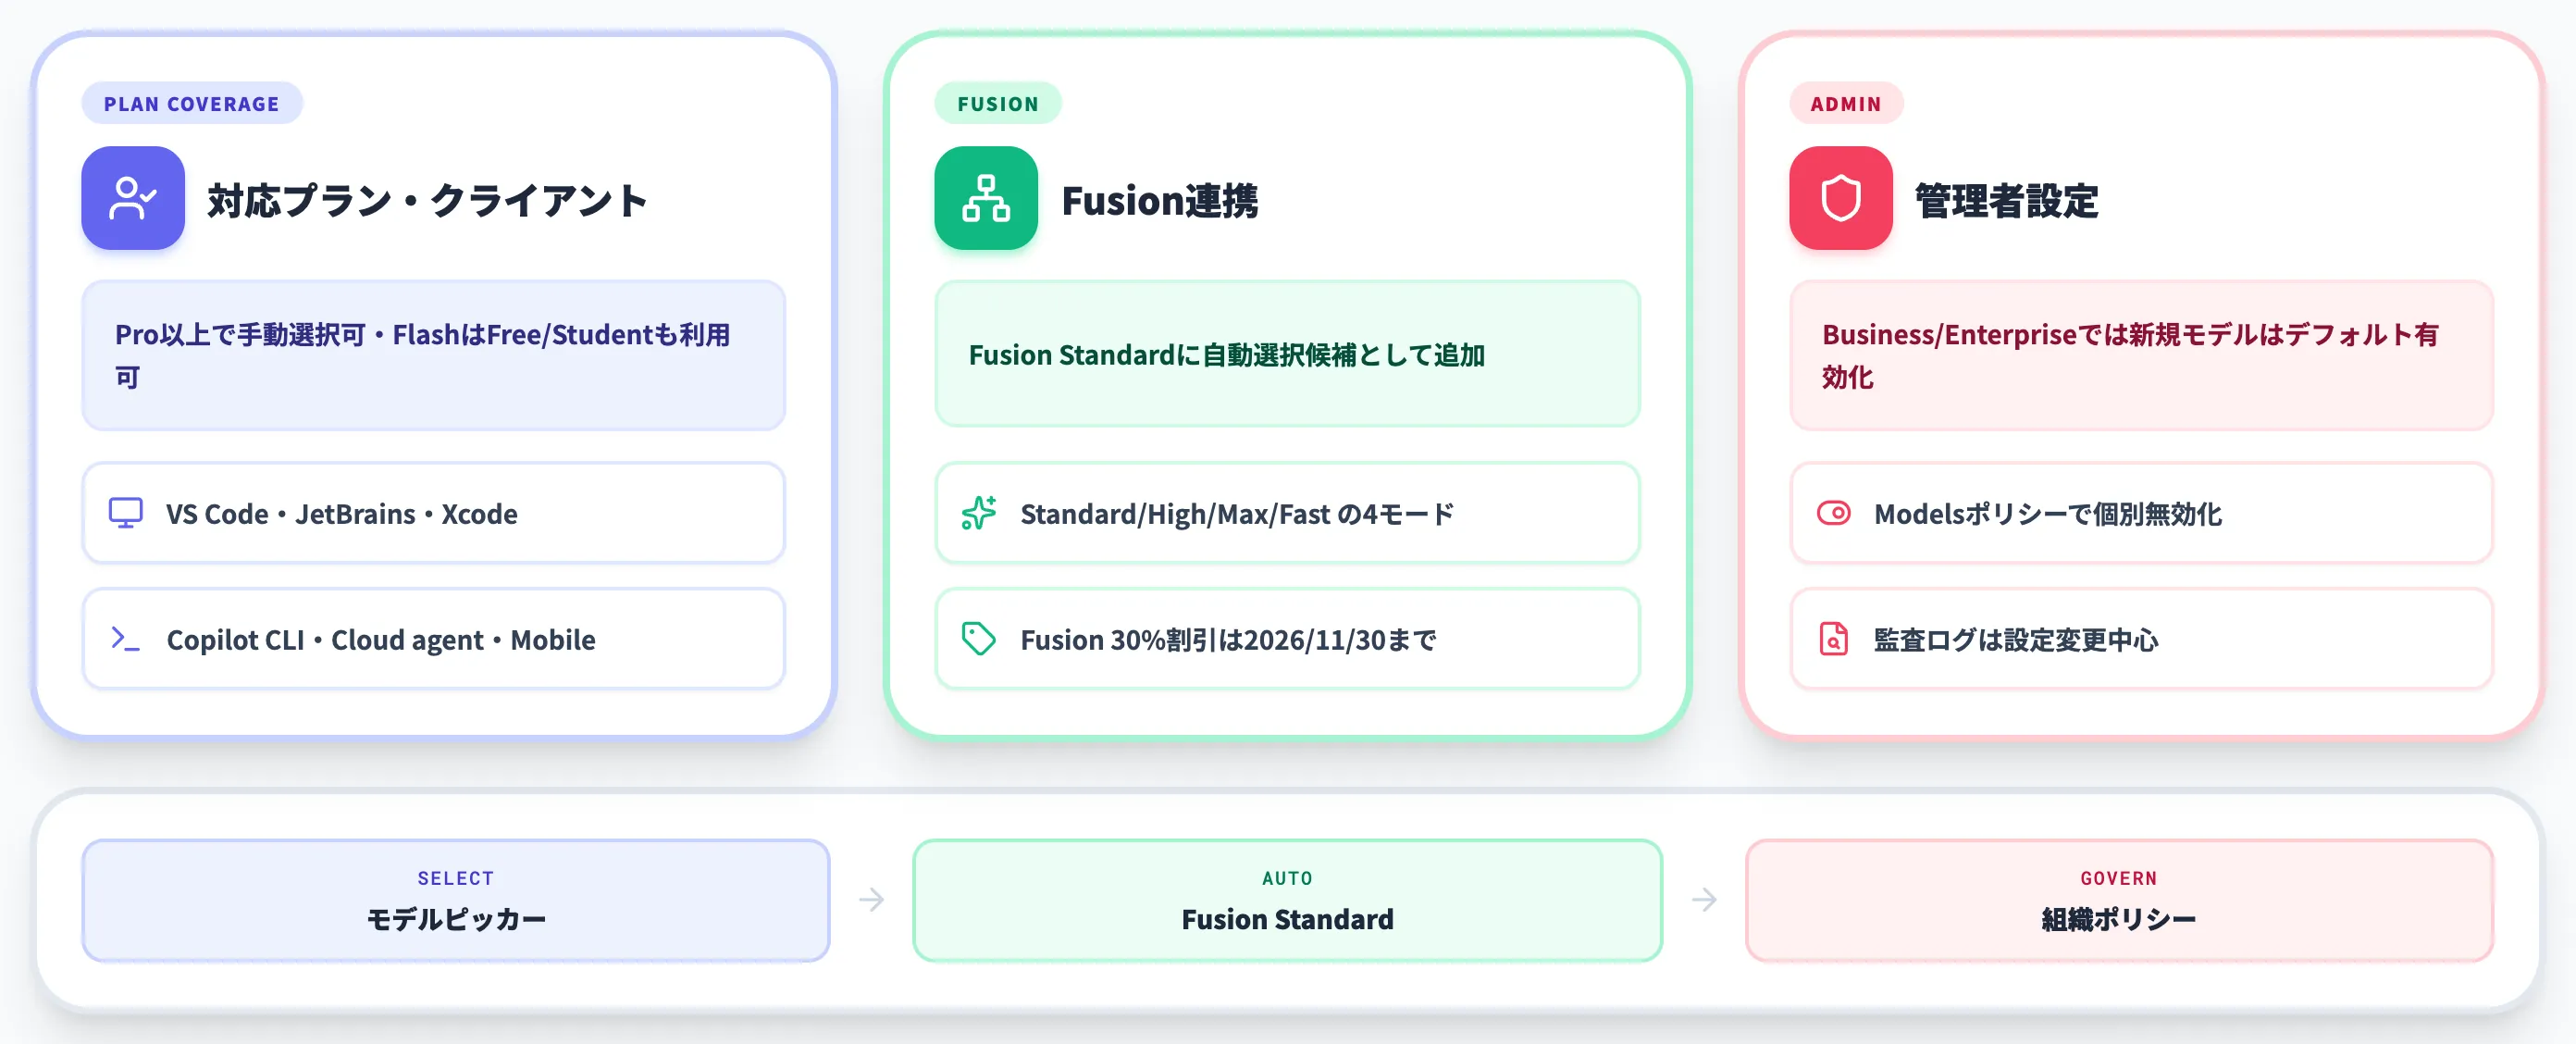
MAI Code 2は、GitHub Copilotの各種クライアントからモデルピッカー経由で呼び出せます。本セクションでは対応プラン・対応クライアント・Fusion連携・管理者設定の4点を整理します。
対応プランとクライアントの一覧
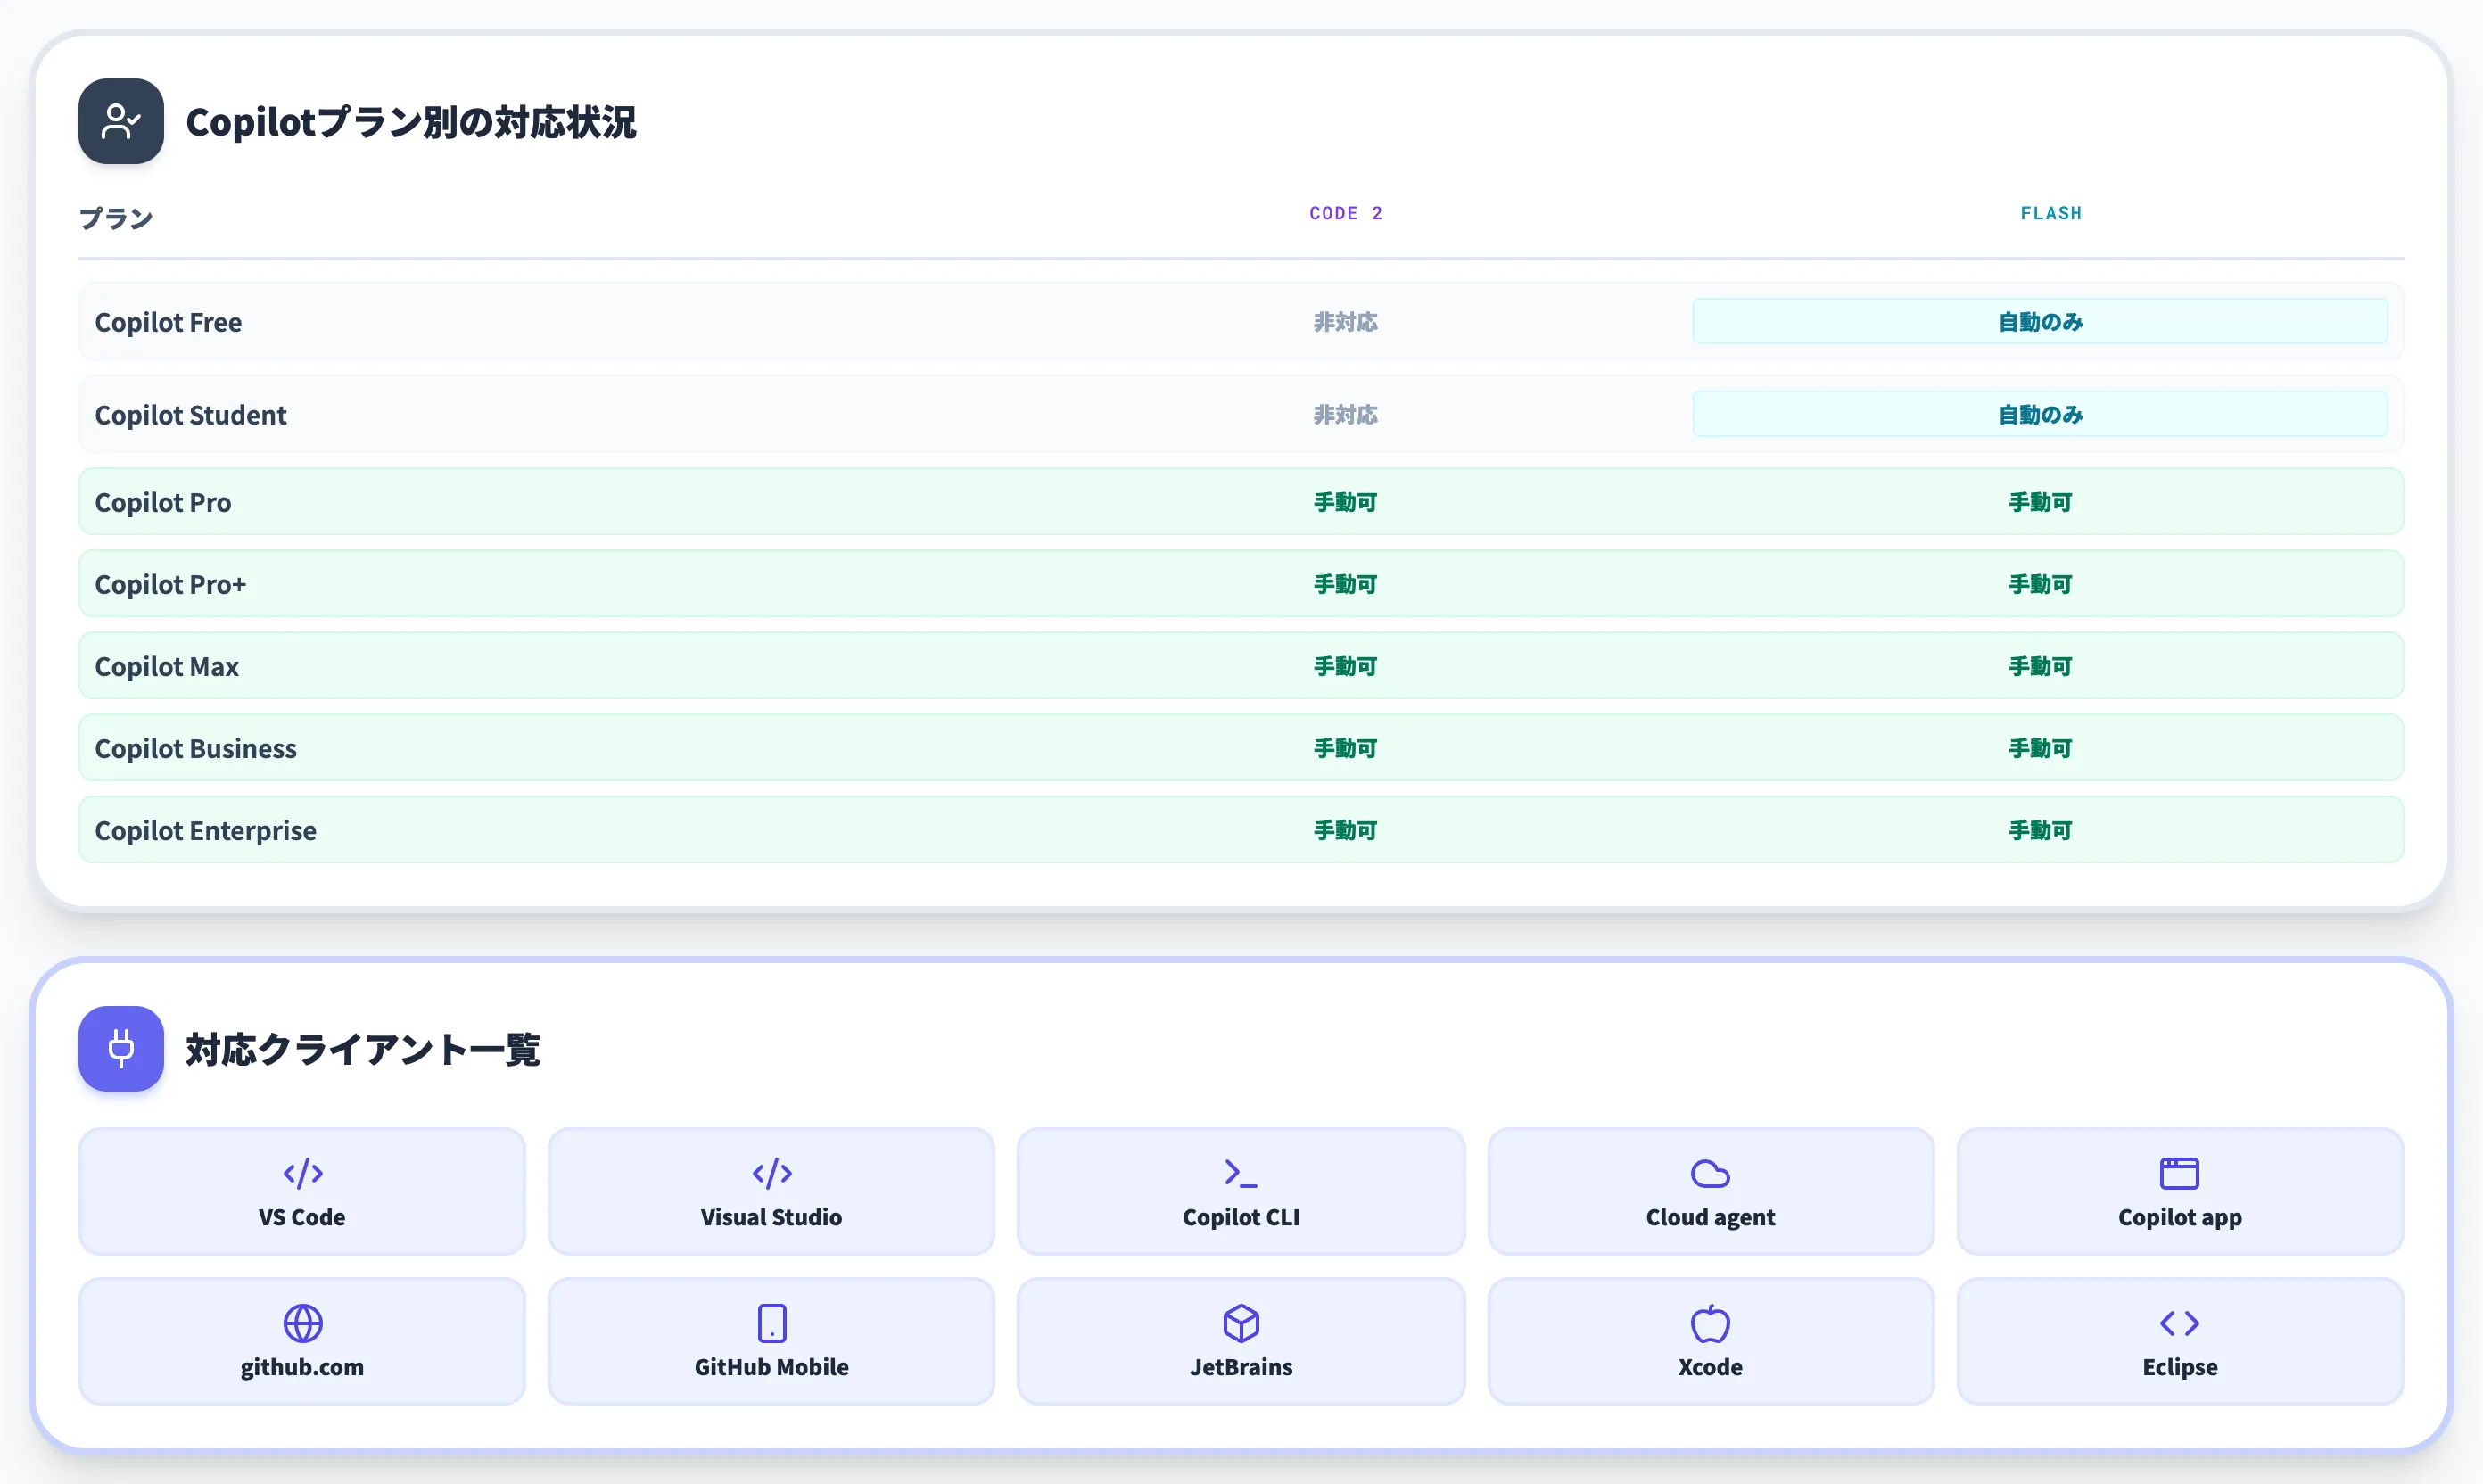
以下の表で、Code 2とFlashのプラン別・クライアント別対応状況を整理しました。
| 項目 | MAI Code 2 | MAI Code 2 Flash |
|---|---|---|
| Copilot Free | 非対応 | 対応(自動モデル選択のみ) |
| Copilot Student | 非対応 | 対応(自動モデル選択のみ) |
| Copilot Pro | 対応(手動選択可) | 対応(手動選択可) |
| Copilot Pro+ | 対応(手動選択可) | 対応(手動選択可) |
| Copilot Max | 対応(手動選択可) | 対応(手動選択可) |
| Copilot Business | 対応(手動選択可) | 対応(手動選択可) |
| Copilot Enterprise | 対応(手動選択可) | 対応(手動選択可) |
| 契約条件 | 発表ページで年間契約への言及あり | 発表ページで年間契約への言及あり |
Free/Studentプランは自動モデル選択の経路でMAI Code 2 Flashが使われる仕様で、モデルピッカーからの明示選択はできません。
手動でモデルを選ぶ運用は有料プラン(Pro以上)が前提です。
Code 2本体は有料プラン向けで、発表ページでは年間契約に関する言及が付いているため、月額契約での利用可否は契約時に確認する価値があります。
対応クライアントは、以下のとおり主要IDE・エディタ・モバイルを網羅しています。
- Visual Studio Code
- Visual Studio
- Copilot CLI
- GitHub Copilot cloud agent
- GitHub Copilot app
- github.com(Web)
- GitHub Mobile(iOS/Android)
- JetBrains
- Xcode
- Eclipse
特にCopilot CLIでCode 2を使えるのは、Claude CodeやGitHub Copilot Coding Agentのようなエージェント型ワークフローでの実装自動化に直結します。ターミナル経由でリポジトリ全体をスキャンして複数ファイルを修正するタスクは、まさにCode 2が得意とする領域です。
Copilot Fusion Standardへの組み込み
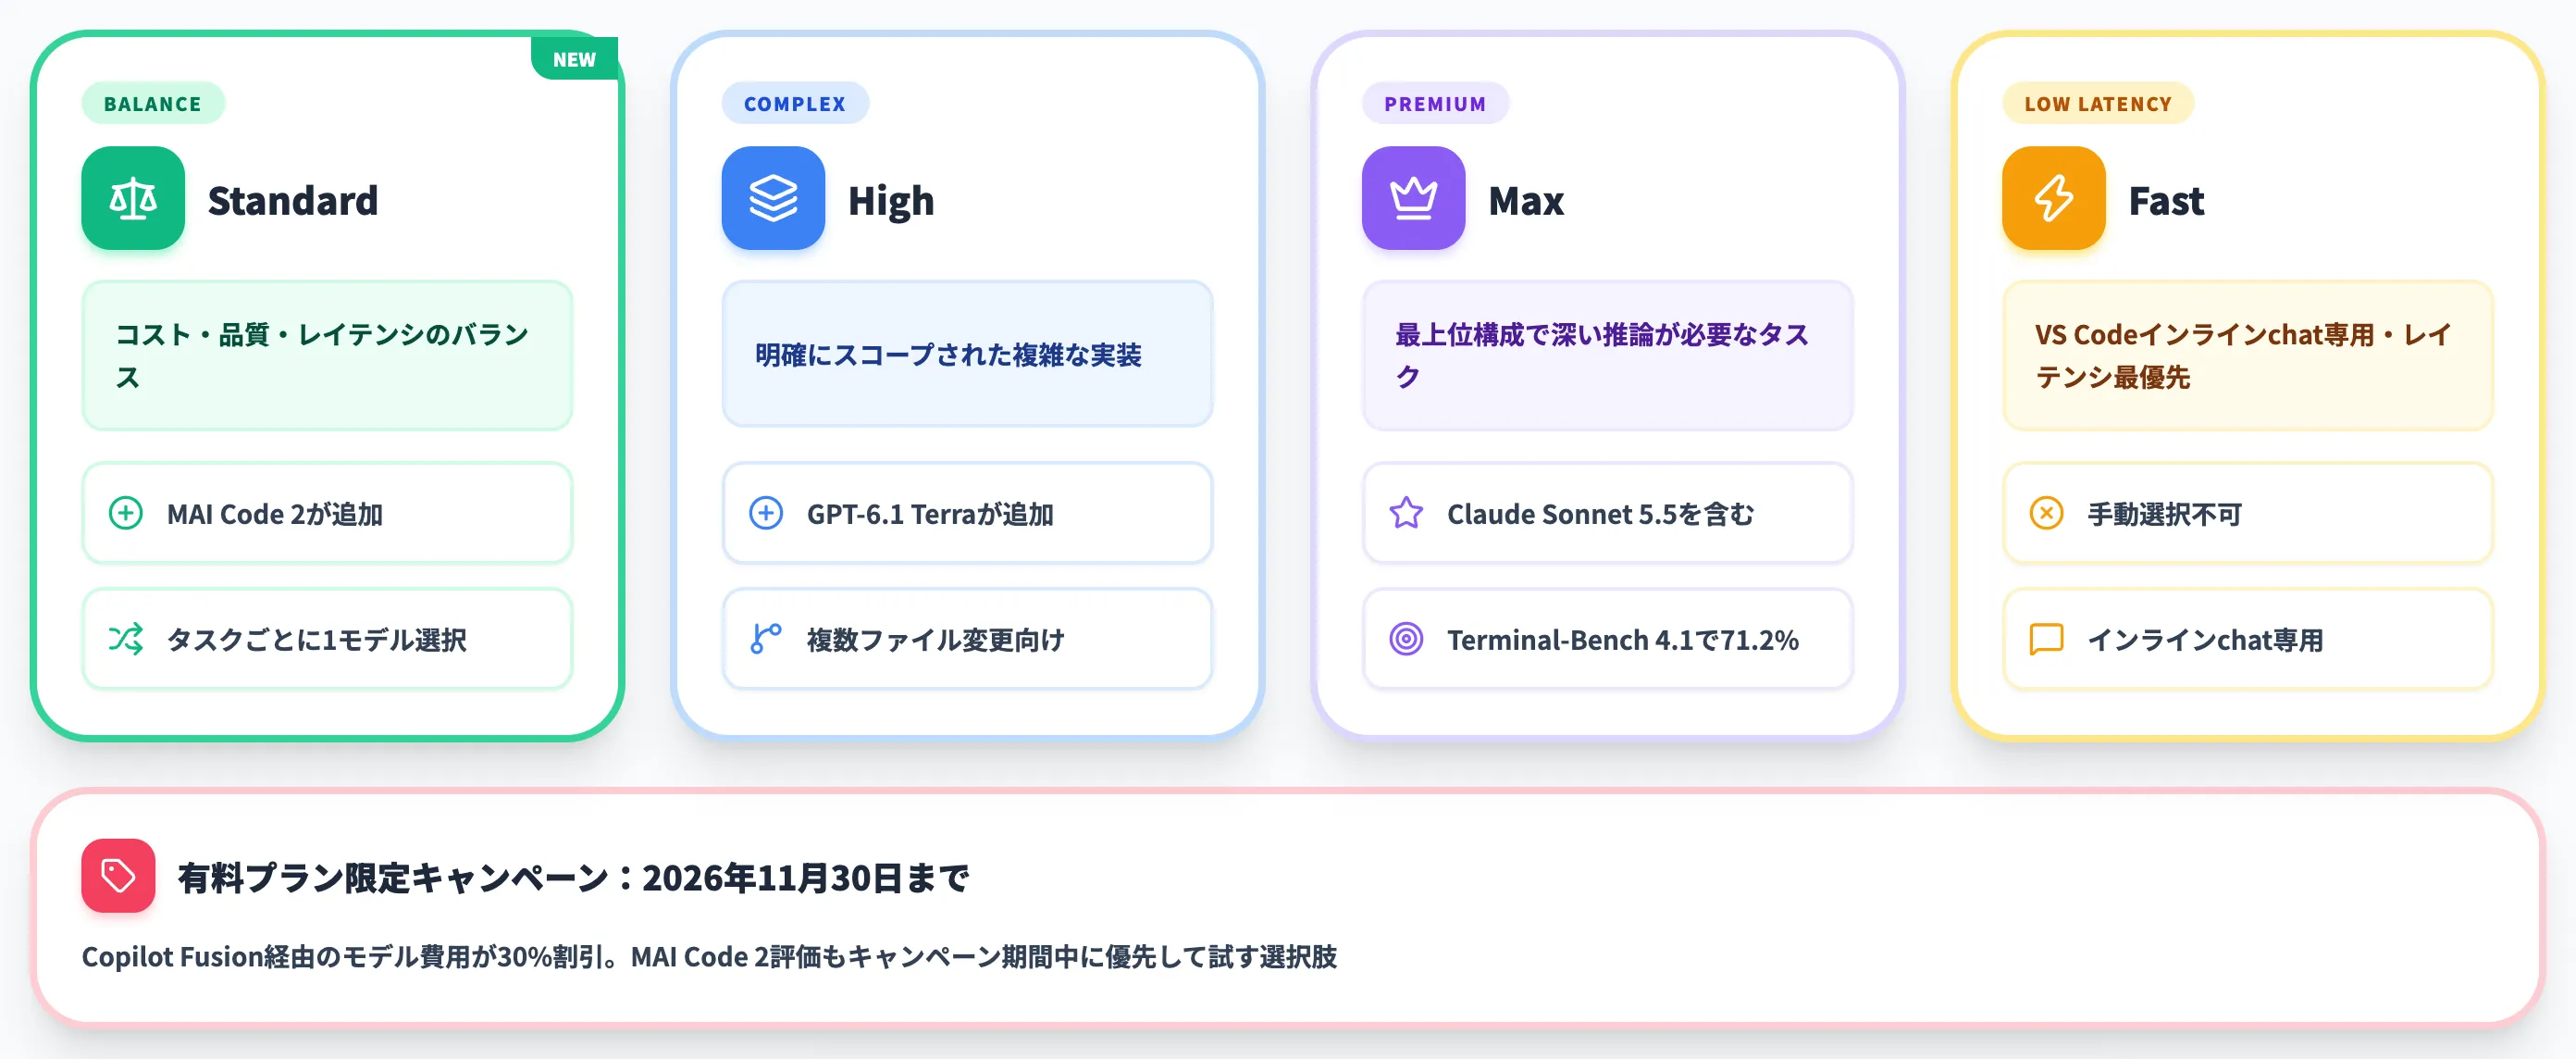
GitHub Copilot Fusionは、タスクの性質に応じて複数のモデルを自動選択・組み合わせる仕組みです。2026年11月17日のアップデートで、MAI Code 2がFusion Standardに組み込まれました。
Fusionには負荷レベル別に4種類のモードがあります。
-
Fusion Standard
コスト・品質・レイテンシのバランスを取り、タスクごとに1モデルを選択。MAI Code 2が新規追加されたのはここ。
-
Fusion High
GPT-6.1 Terraが追加され、明確にスコープされた複雑な実装や複数ファイル変更を対象にする。
-
Fusion Max
Claude Sonnet 5.5を含む最上位構成で、Terminal-Bench 4.1で71.2%の解決率を達成。深い推論が必要なタスク向け。
-
Fusion Fast
VS Codeのインラインchat専用で、手動選択はできない。レイテンシ最優先。
開発者はFusion Standardを選ぶだけで、追加された候補モデル(MAI Code 2を含む)からCopilotが実行時に選びます。具体的な振り分けルールは公式に明記されていないため、どのモデルが走るかはCopilotの判断に委ねられる設計です。モデルを手動選択する運用との使い分けは、組織のポリシーに合わせて調整します。
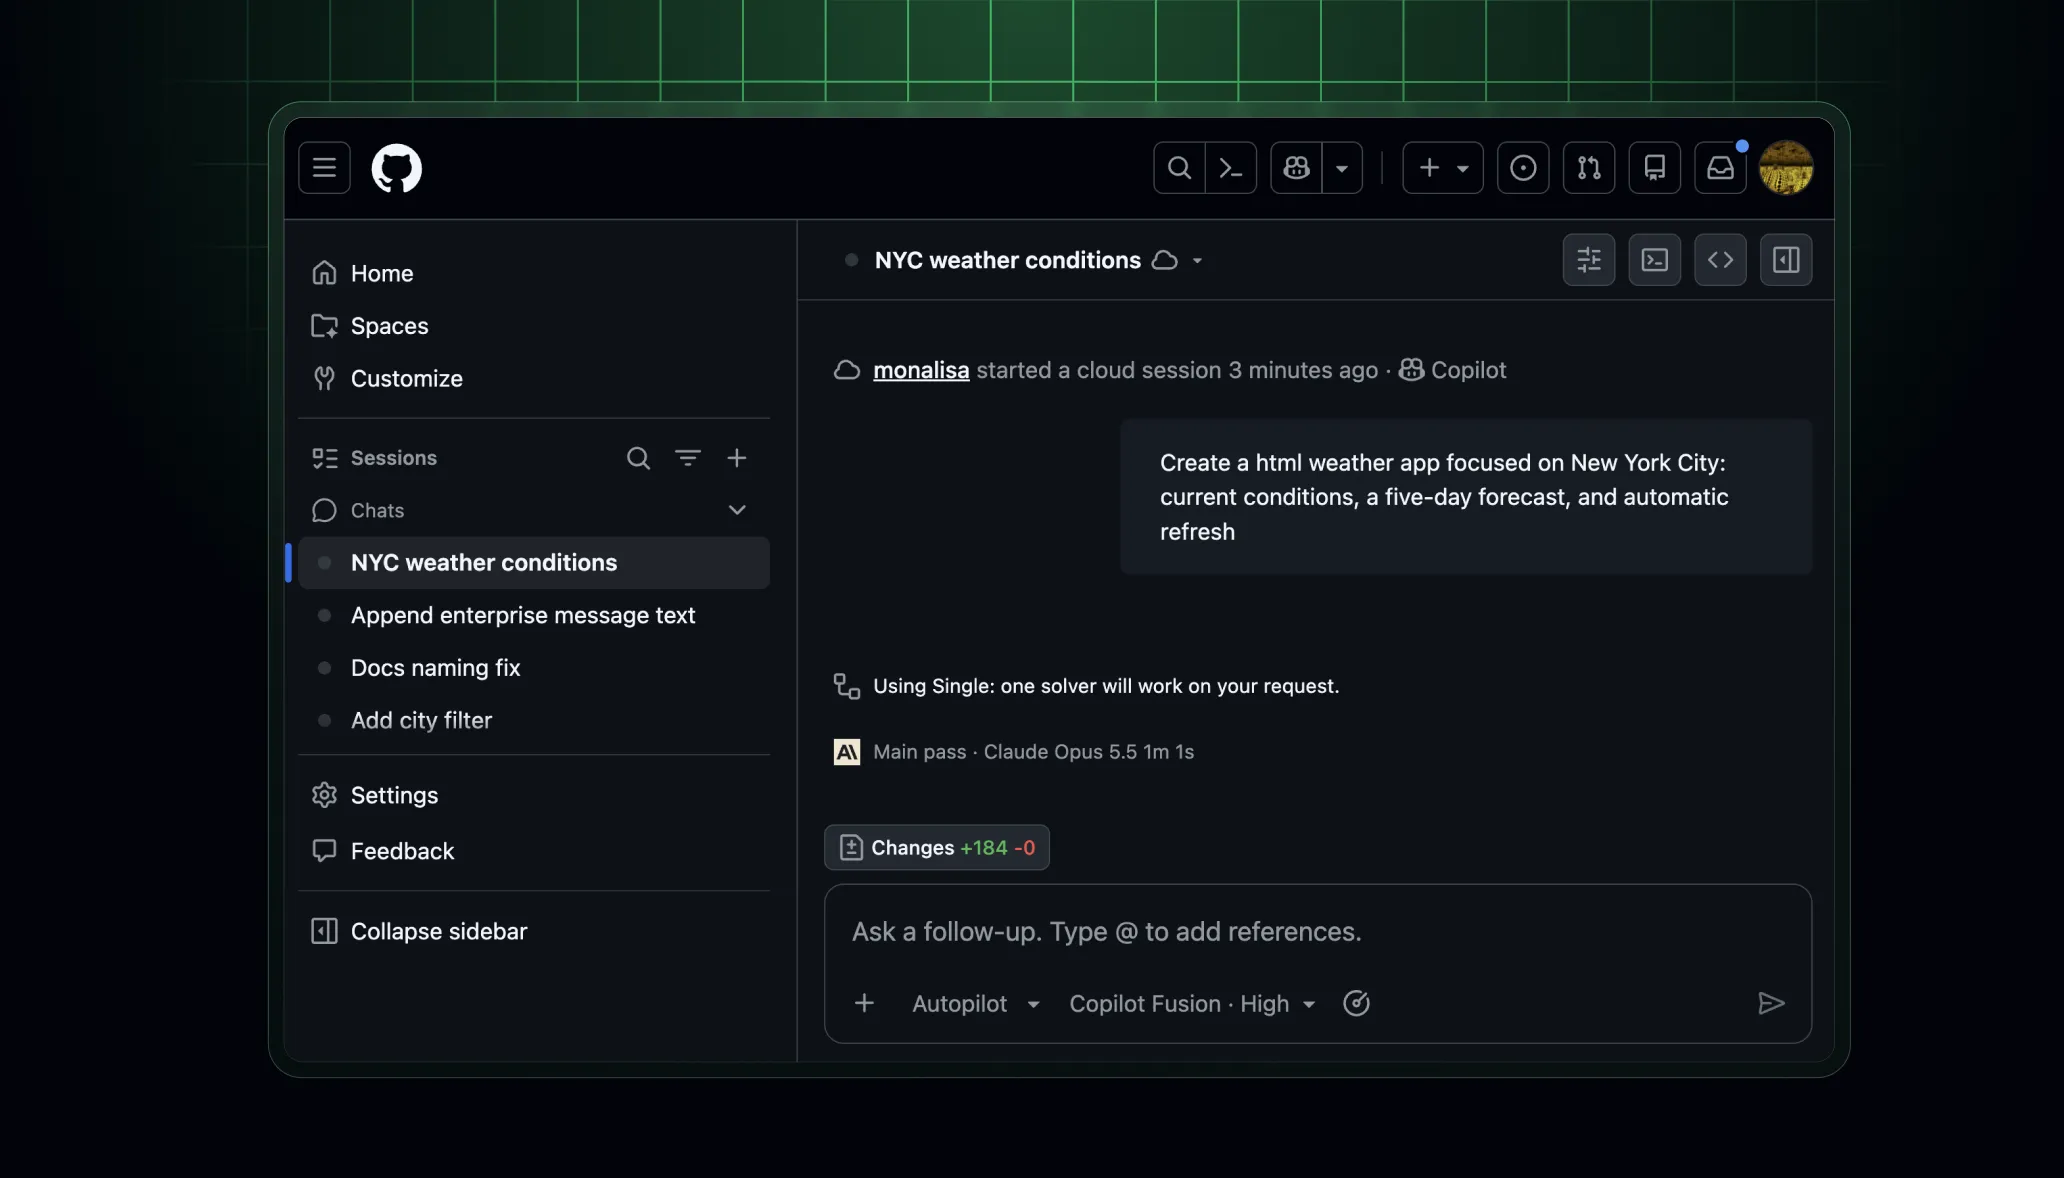
Copilot Fusion HighモードでClaude Opus 5.5を呼び出したGitHub Copilot Chatの実UI(出典:GitHub Changelog)
管理者による有効化・無効化
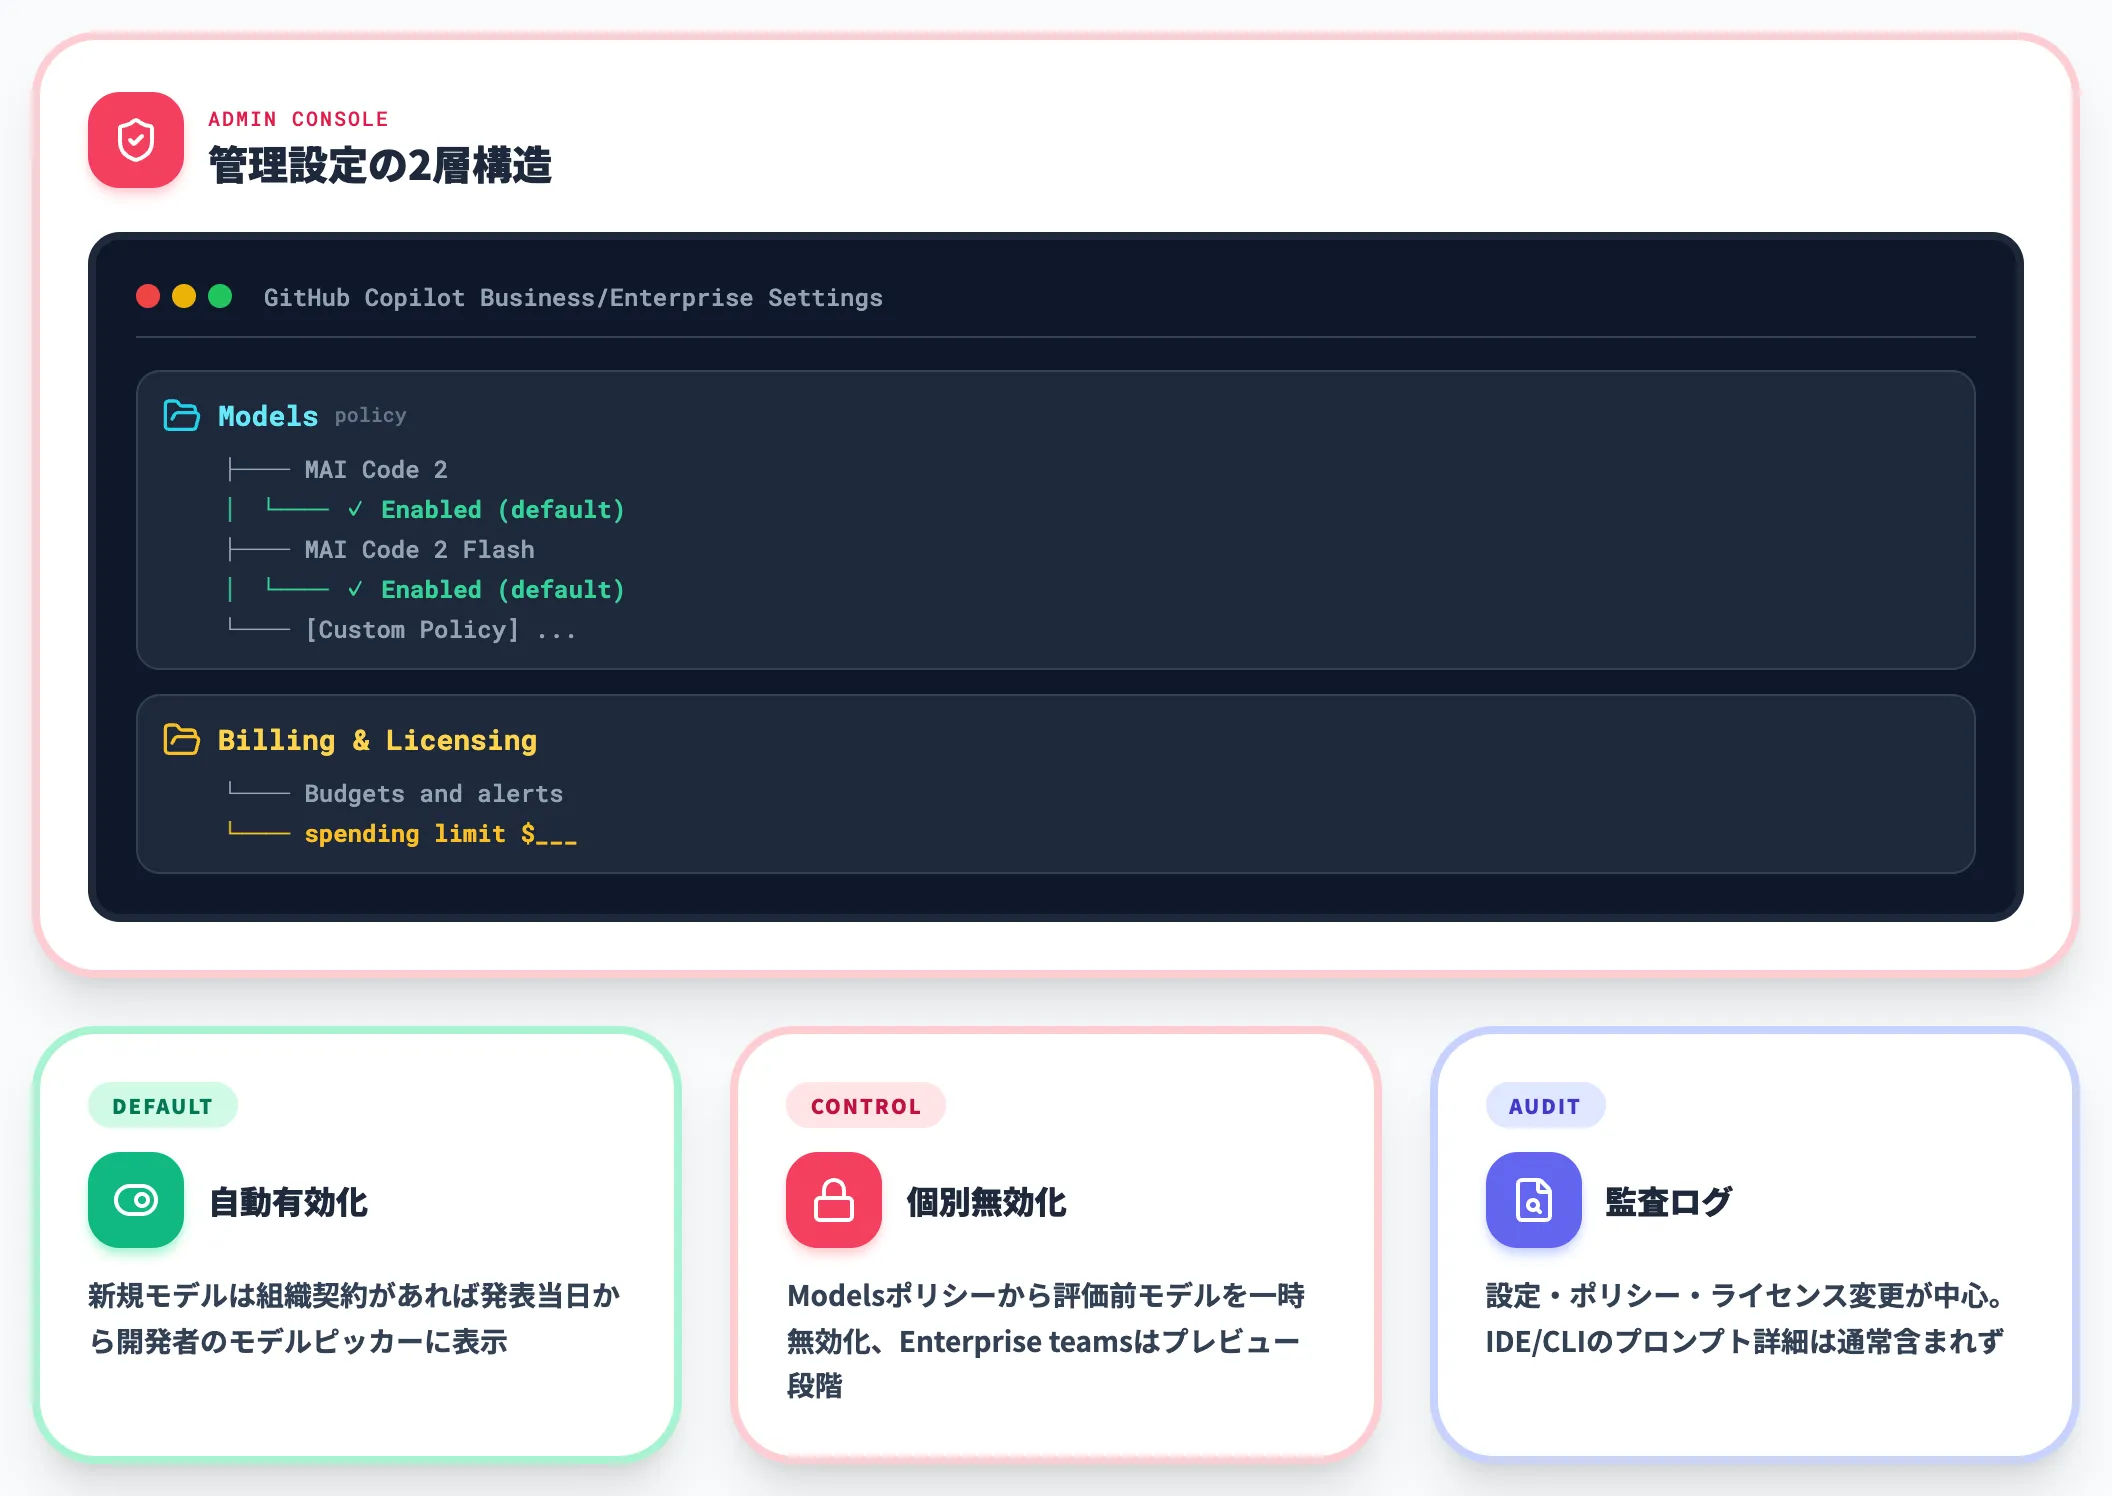
GitHub Copilot Business/Enterpriseでは、新規モデルはデフォルトで自動有効化されます。MAI Code 2およびFlashも、組織契約があれば発表当日から開発者のモデルピッカーに表示されている状態です。
一方で、管理者はCopilot設定画面の「Models」ポリシーからモデル単位でアクセスを制御できます。社内でまだ評価していないモデルを一時無効化する運用が可能で、支出管理は別途「Billing & Licensing → Budgets and alerts」設定で組織単位の上限を設けます(Modelsポリシーと予算制御は別の管理枠です)。
チーム単位でモデル許可を分ける制御はEnterprise teamsのプレビュー段階にあり、前提条件は公式ドキュメントで確認してください。
Copilot Enterpriseの監査ログで追跡できるのは、設定・ポリシー・ライセンス変更と、GitHub上で動くエージェント操作などの確認可能な操作イベントが中心です。
IDE・CLIなどクライアント側のプロンプトやセッション詳細は通常の監査ログに含まれません。
モデル単位・リポジトリ単位・メンバー単位の詳細API利用記録は、条件付きプレビューや追加のレポート連携が必要になるケースが多く、対象範囲はGitHub公式のAudit log eventsで確認してから運用設計するのが無難です。
MAI Code 2の選定で迷う3つの論点
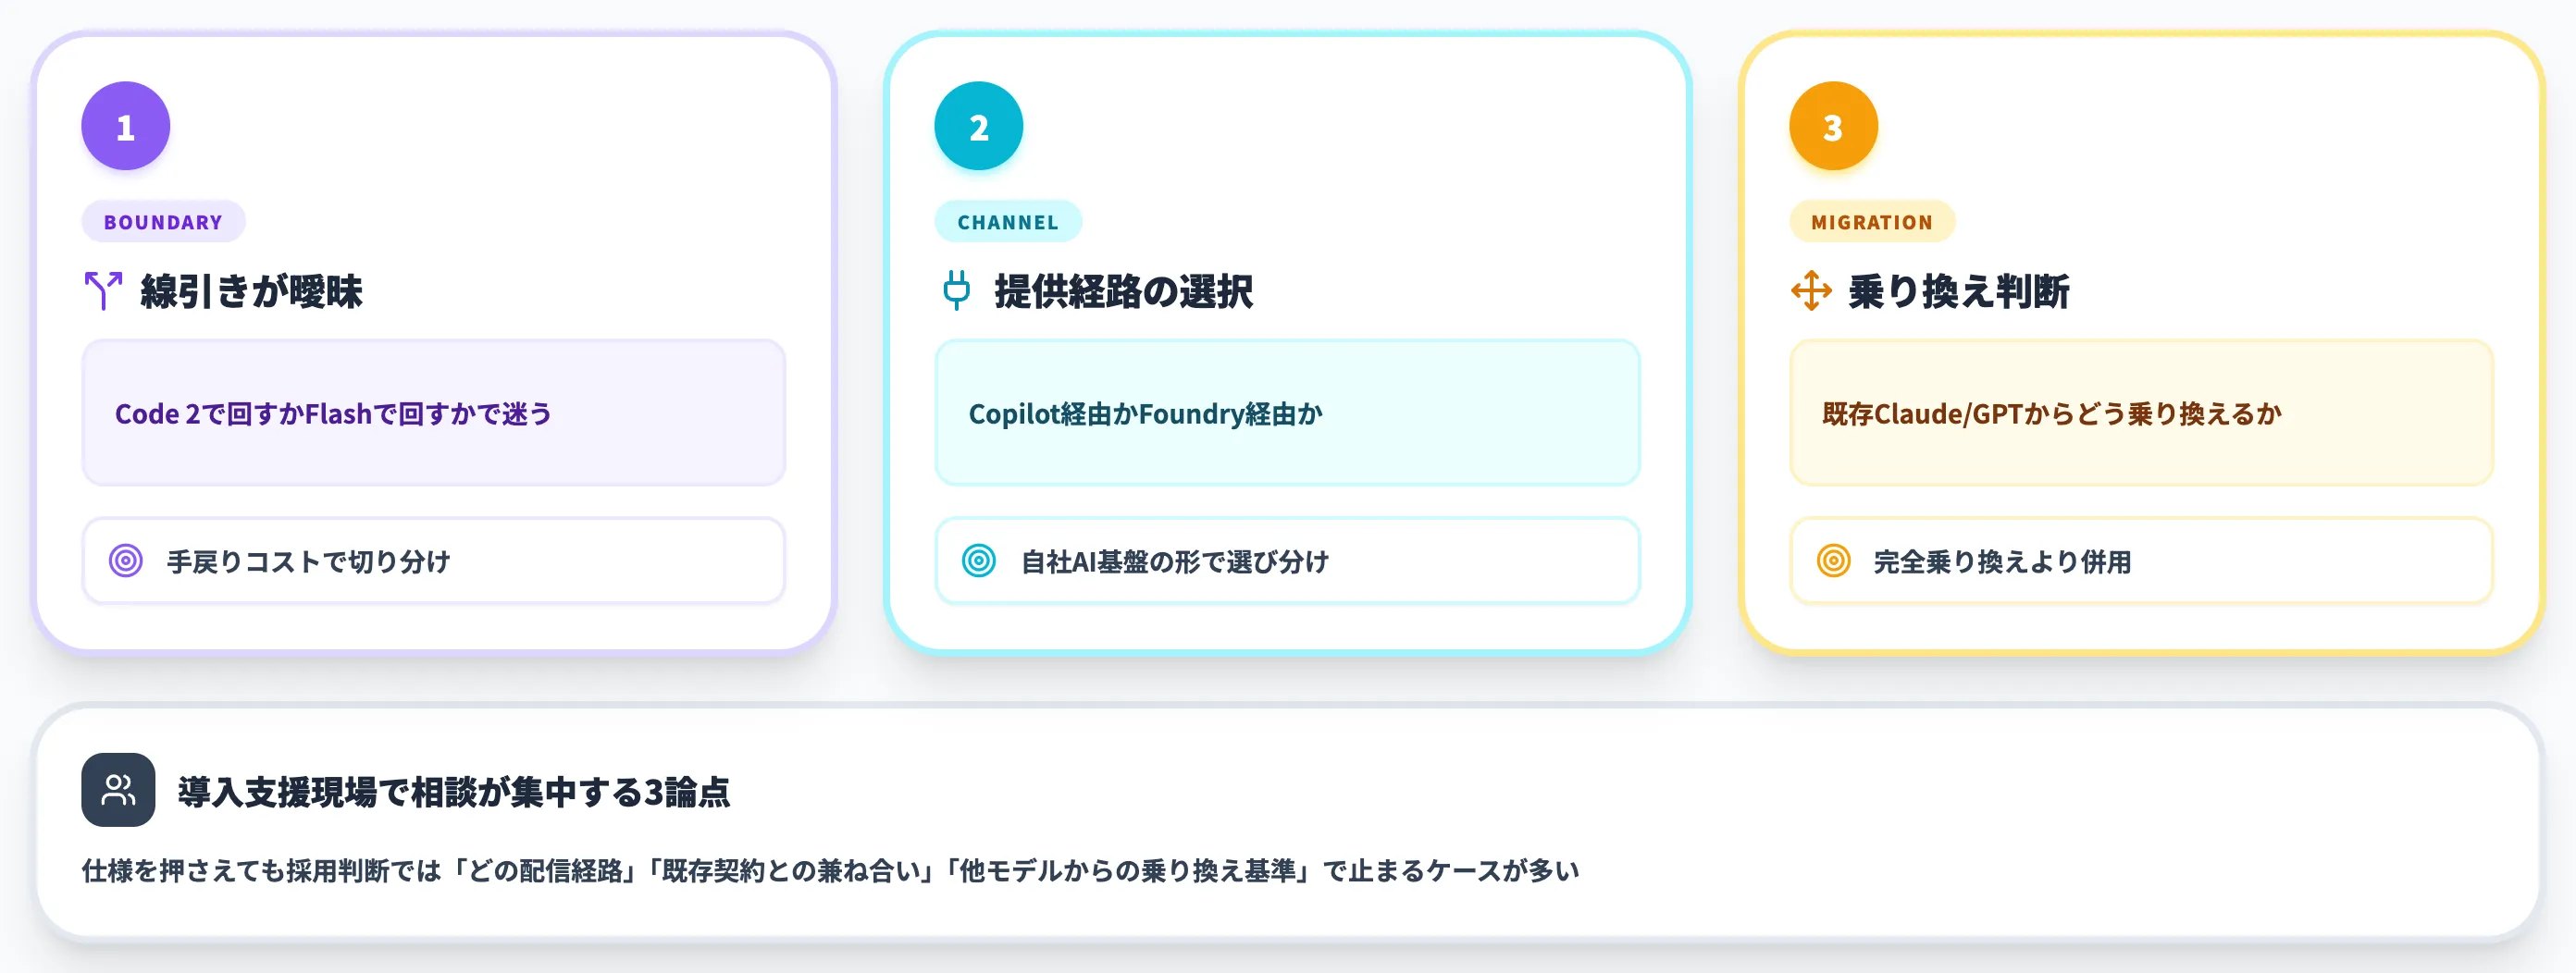
Code 2単体の仕様を押さえても、実際の採用判断では「どの配信経路で使うか」「既存契約との兼ね合い」「他モデルからの乗り換え基準」で迷うケースが出てきます。
本セクションでは、導入支援現場で実際に相談が集中する3つの論点を整理します。
Code 2とFlashの線引きが曖昧な場合
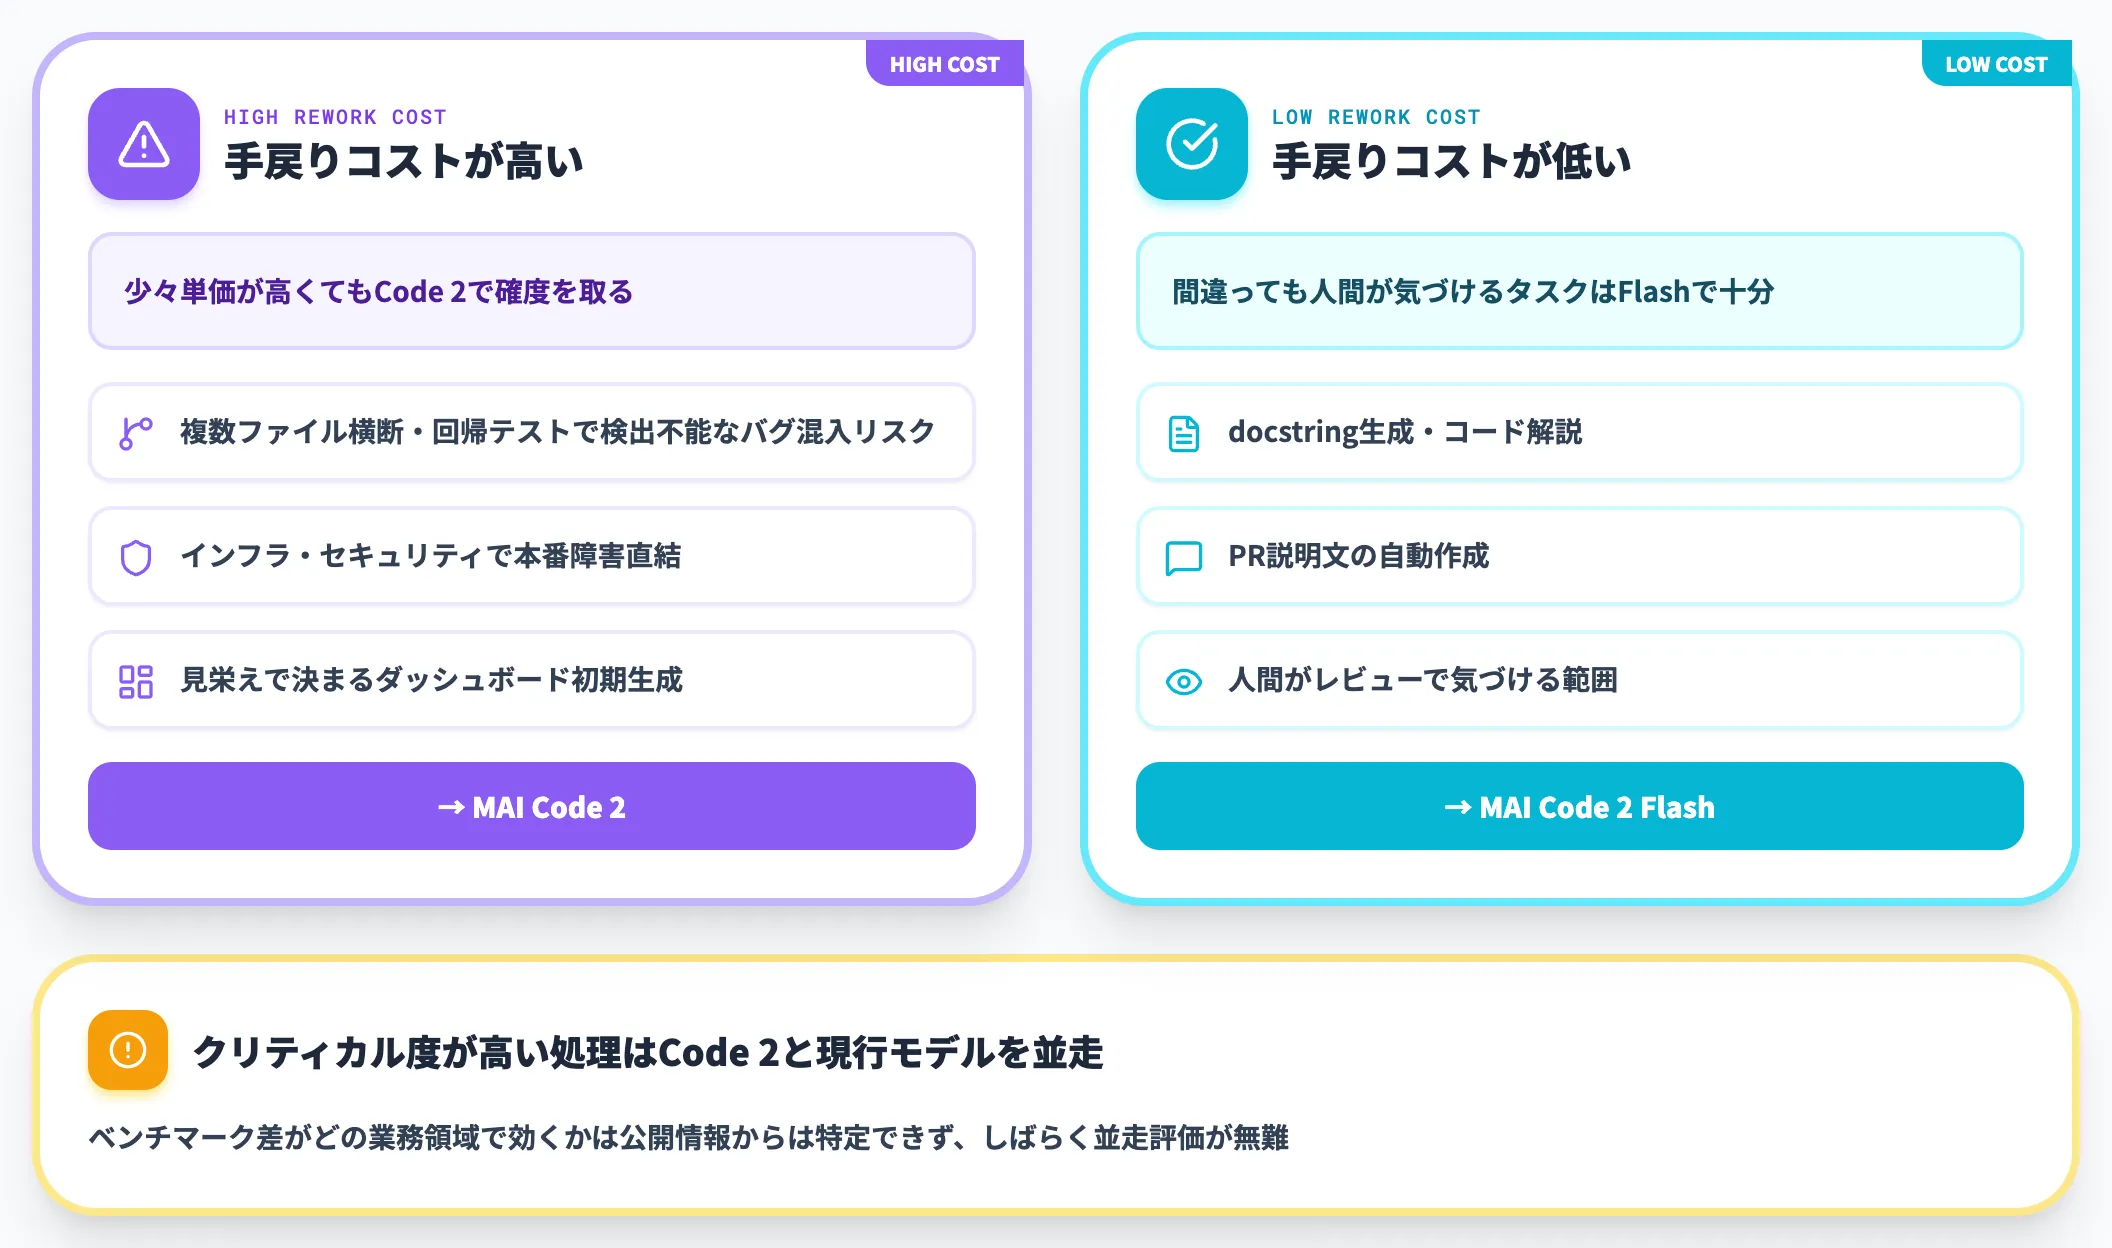
1つ目は、「Code 2で回すか、Flashで回すか」の境界で止まるケースです。
公式平均合格率はCode 2が4ベンチマークで63.2%、Flashが3ベンチマークで61.0%ですが、対象ベンチマーク数が異なるため直接のポイント差で比較はできません。
それでも失敗した場合に生じる手戻りコストで切り分けると、どちらに寄せるべきかは明確になります。
手戻りコストが高いタスクは、以下のような特徴を持ちます。
- 複数ファイルにまたがる実装で、1つ間違えると回帰テストで検出できないバグが混入する
- インフラ設定やセキュリティ関連コードで、修正ミスが本番障害に直結する
- UIの見栄えで評価が決まるダッシュボード・管理画面の初期生成(アノテータ64%選好の領域)
これらは少々単価が高くてもCode 2で確度を取るほうが、人手レビュー時間と本番障害リスクを合算した総コストで安くなります。
一方、docstring生成やコード解説、PR説明文の自動作成など「間違っても人間が気づける」タスクはFlashで十分です。
Copilot経由とFoundry経由の使い分け
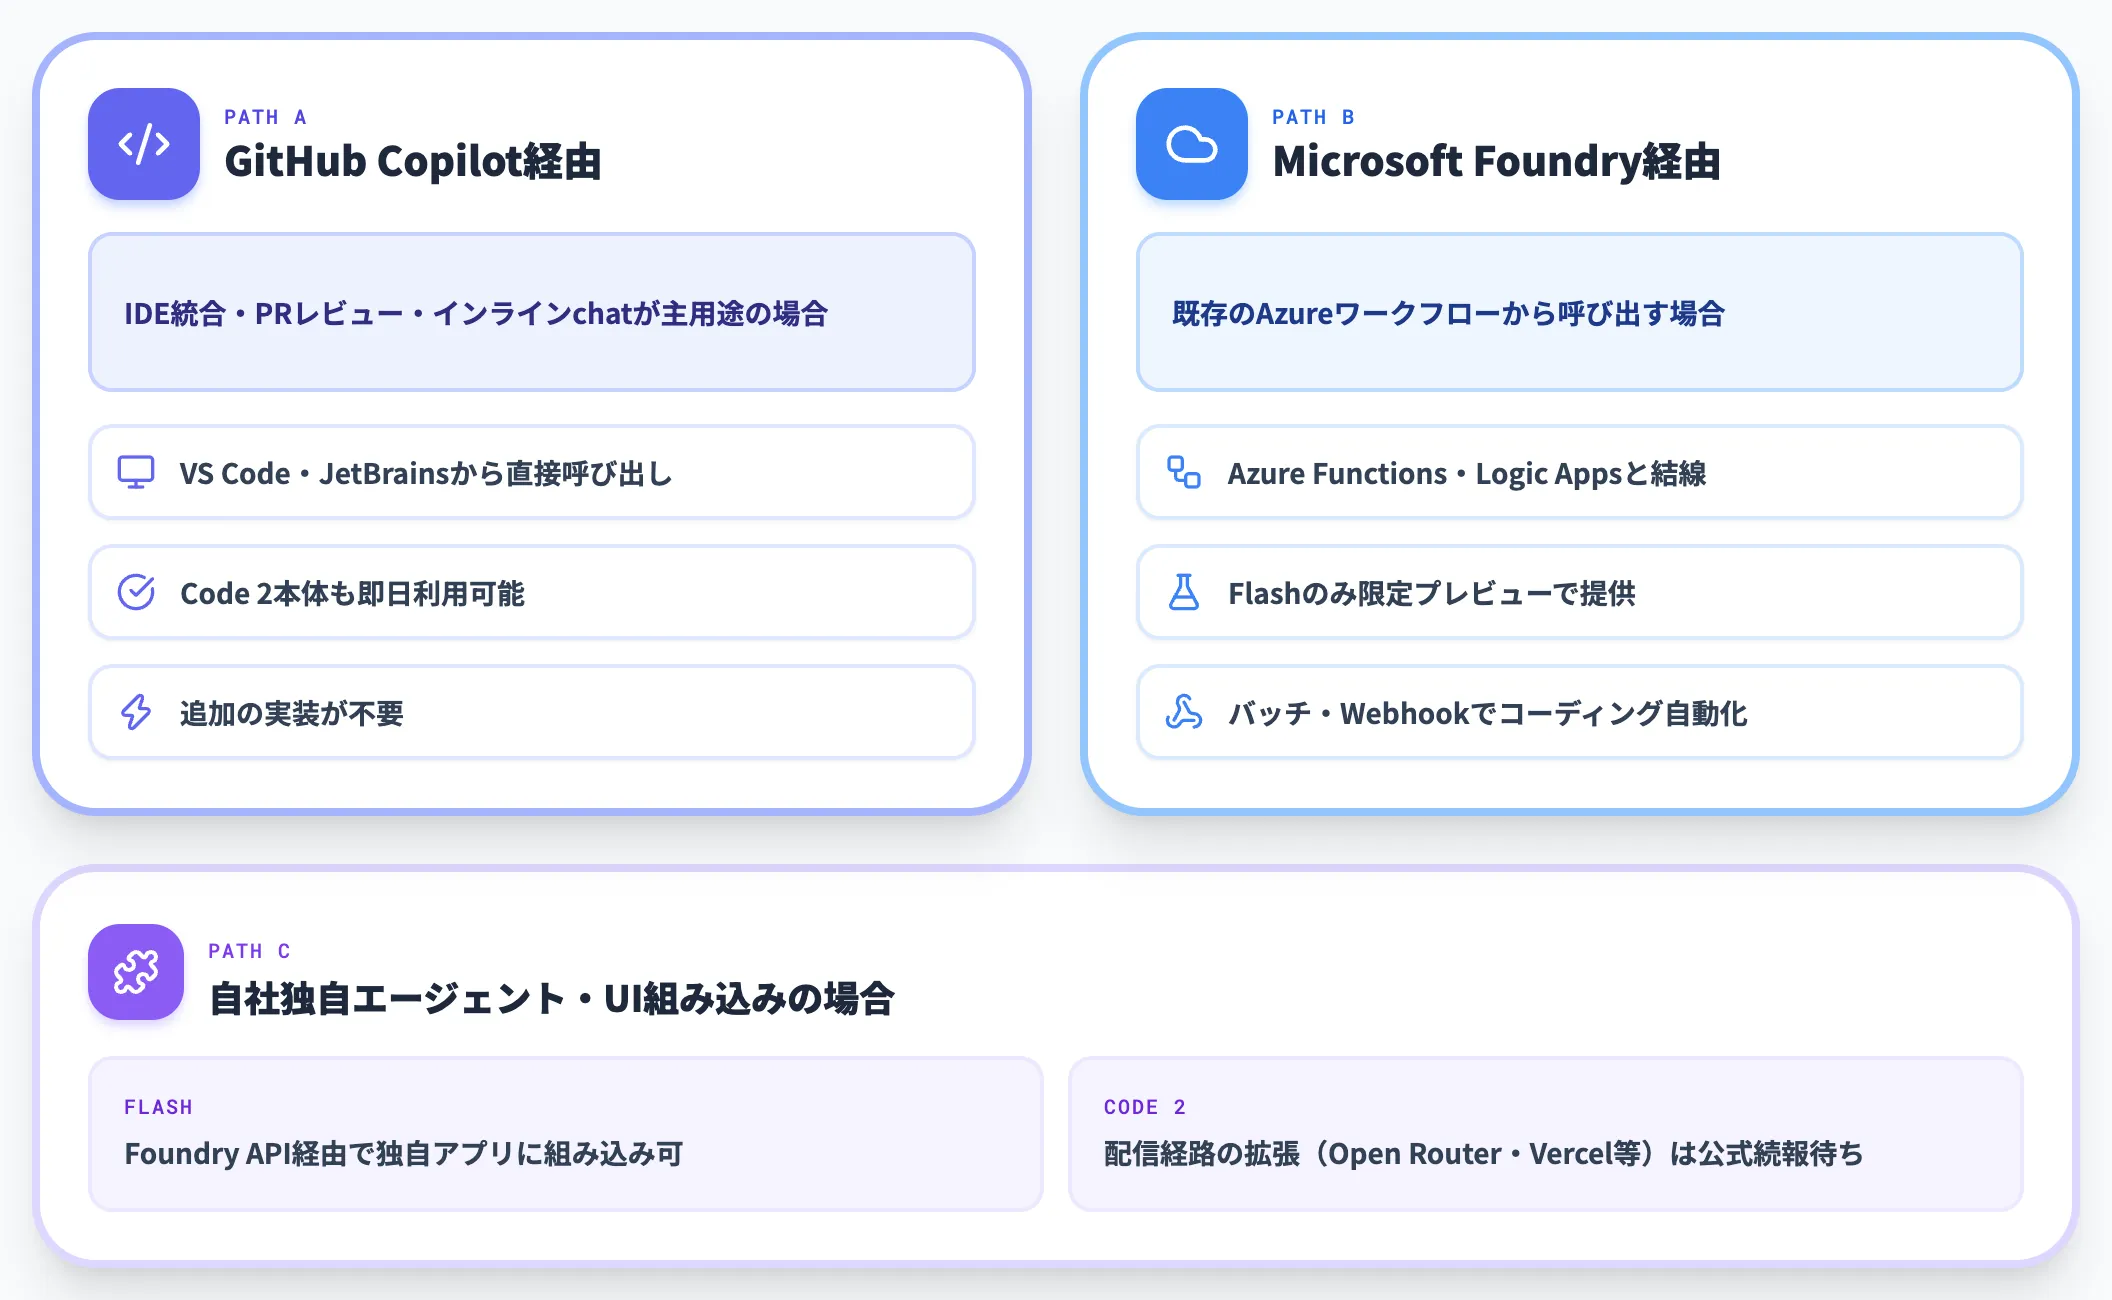
2つ目は、提供経路の選択です。MAI Code 2 FlashはGitHub Copilotだけでなく、Microsoft Foundryの限定プレビューでも提供されます。
Code 2本体の配信経路は2026年11月17日時点ではGitHub Copilotが中心で、他プラットフォームでの提供時期は公式には明示されていません。
選び方の軸は以下の3点に集約されます。
-
IDE統合・PRレビュー・インラインchatが主用途 → GitHub Copilot経由
VS CodeやJetBrainsから直接呼び出す運用に最適化されており、追加の実装は不要。
-
既存のAzureワークフロー・Azure Functions・Logic Appsから呼び出す → Microsoft Foundry経由
Azure内の既存システムと結線して、バッチ処理やWebhookで走らせるコーディング自動化に向きます。MAI Code 2 Flashは限定プレビューのFoundry APIから独自アプリやエージェントへそのまま組み込めます。
-
自社の独自エージェント・独自UIに組み込む → Flashは現時点でFoundry API経由が可、Code 2本体は配信経路の拡張待ち
MicrosoftはMAIモデルファミリーをOpen Router・Vercel等でも提供することをアナウンスしており、Code 2本体の対象タイミング・対象モデルについては公式続報の確認が必要です。
Copilotが現状の第一候補ではあるものの、既にAzure上で業務AI基盤を構築している組織はFoundry経由(Flash)を選ぶほうが運用統合が楽になるケースも多く、自社のAI基盤の形で選び分けるのが実際的です。
既存のClaude/GPT利用者が乗り換える判断軸
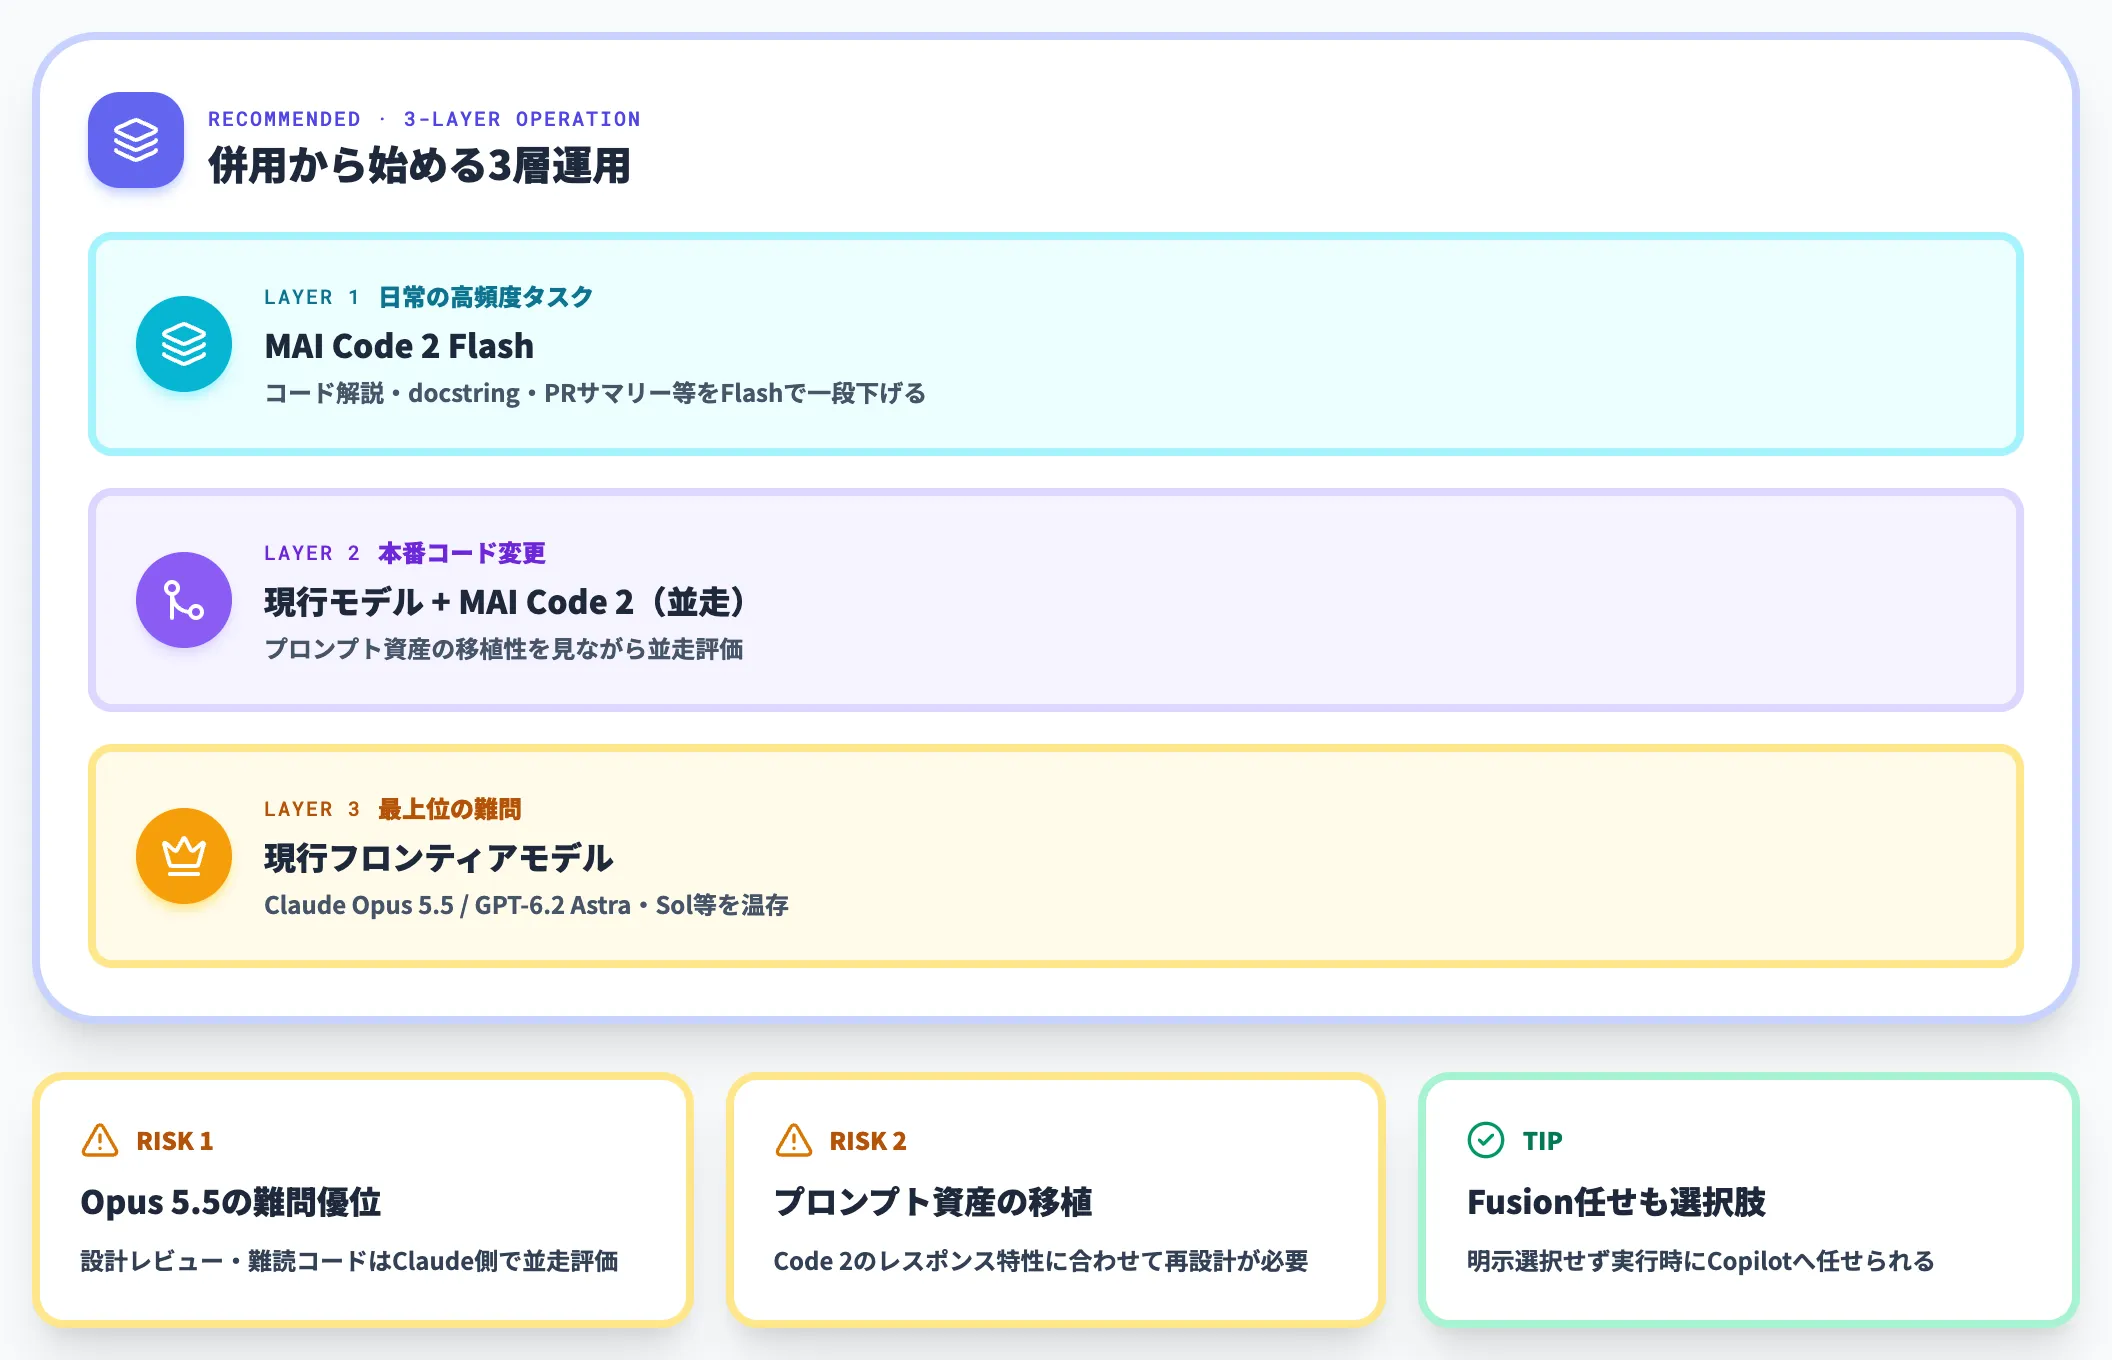
3つ目は、すでにClaude Opus 5.5やGPT-6.1 Solを業務コーディングに使っている組織の乗り換え判断です。
結論から言えば、完全乗り換えより併用から始めるのが現実的です。理由は3つあります。
1つ目は、Claude Opus 5.5が最フロンティア帯の難問で依然として優位であること。ベンチマーク平均の性能差がどの業務領域で効くかは公開情報からは特定できていないため、設計レビュー・難読コードのリファクタリングなどクリティカル度の高い処理はClaude側で評価を並走させるのが無難です。
2つ目は、既存のプロンプトライブラリ・エージェント設定・ワークフローの資産がすぐに移植できないこと。MAI Code 2のレスポンス特性(焦点を絞った応答・不要なラリーが少ない設計)に合わせてプロンプトを再設計する必要があり、単純な置き換えでは真価が出ません。
3つ目は、Copilot Fusion経由であれば明示的なモデル選択をせずに実行時にCopilotへ任せられること。Fusion Standardの選択肢にはMAI Code 2が追加されており、Fusion MaxにはClaude Sonnet 5.5が含まれるという候補モデル構成は公式に示されていますが、タスクごとに実際どのモデルが走るかはCopilotの判断に委ねられる設計です。
当面の推奨は「日常の高頻度タスクはMAI Code 2 Flash、本番コード変更は現行モデルとMAI Code 2を並行評価、最上位の難問は現行フロンティアモデル」の3層運用です。Ignite 2026同日に発表されたGPT-6.2 Astra・SolもCodex経由で評価候補に含めると、乗り換え先・併用先の選択肢がさらに広がります。
MAI Code 2世代のコスト構造を業務Agentに組み込むなら
MAI Code 2の登場で、フロンティア帯の性能がかつてなく低いAPI単価で利用できるようになりました。Copilot経由で個別タスクを安く回せるようになった一方、社内の開発ワークフローや業務プロセス全体にAIを組み込むには、モデル単体の選定とは別の層の設計が必要です。コード生成から業務適用までを実装するには、業務Agent・権限・監査・UIを一括で管理する基盤が並行して必要になります。
AI総合研究所のAI Agent Hubは、自社Azureテナント内で動く業務Agentを統合管理する基盤として、モデル世代交代を吸収しながら業務プロセスに載せる運用を支援します。
-
現行モデルとMAI Code 2を並行評価しながら業務Agentを構築
Teams上から呼び出せるコードレビューAgent・リポジトリ監視Agent・社内ドキュメント更新Agentなど、業務用途ごとに最適なモデルをバックエンドに据えて即起動できます。モデル選定の試行をプロダクトのPoC期間に閉じ込める設計です。
-
モデル世代交代をAgent設計で吸収
Claude Opus 5.5 → MAI Code 2のように価格帯が大きく動くモデル選定変更が起きても、業務Agent側のインターフェースは不変。特定モデルロックインを避けて移行コストを抑えます。
-
Agent単位でセキュリティ統制を1画面で管理
コードや脆弱性情報を扱うAgentごとにアクセス範囲・利用履歴・監査ログを設計。誰がどのAgentで何を照会したかを不変ログで残し、監査対応をそのまま提出できる形で保管します。
-
データは100%自社Azureテナント内に保持
コード・設計情報・社内ドキュメントはAIの学習対象から完全除外。Azure Managed Applicationsとして自社テナント内で動作が完了する設計です。
AI総合研究所の専任チームが、フロンティアモデル選定から業務Agent基盤の統合設計まで一貫して支援します。AI Agent HubのサービスページでMAI Code 2世代を見据えた業務Agent実装例をご確認ください。
Copilot上の新モデルを業務Agentに載せる

MAI Code 2世代のコスト構造を業務に落とす
MAI Code 2のようにフロンティア帯のコーディングモデルが一段安い単価で提供される流れが続くなかで、業務Agentの設計もモデル世代交代を吸収できる形に組み直す必要があります。AI Agent Hubは、モデル選定からAzure上での業務Agent運用まで一括で支援する基盤として機能します。
まとめ
本記事では、MAI Code 2について、性能ベンチマーク・Flashとの使い分け・料金・GitHub Copilotでの利用方法・導入判断の論点までを、2026年11月時点の最新情報で解説しました。
2026年11月時点で押さえておくべきポイントは次の3つです。
- MAI Code 2はGPT-6.1 Solの98%性能を40%コストで、Claude Opus 5.5の96%性能を5%コストで提供するフロンティア帯コーディングモデルで、GitHub Copilot Pro/Business/Enterpriseで即日利用可能
- Flash(12Bアクティブ・1Mコンテキスト)と80B active級のCode 2との2モデル構成で用途を分け、Copilot Fusion StandardにMAI Code 2が追加(具体的な振り分けはCopilot判断)
- プロモ価格(入力$0.50/出力$2.50)は2027年5月17日まで、既存のClaude/GPT利用者は完全乗り換えより併用から始め、日常タスクをFlash・本番コード変更をCode 2・最上位難問を現行フロンティアモデルの3層運用が現実的
開発組織の経営・CTO層にとってMAI Code 2は、「どのモデルを選ぶか」よりも「フロンティア帯の性能が一段安く提供されるようになった市場で、自社の開発ワークフローをどう再設計するか」を迫られる発表です。まずはCopilot FusionでMAI Code 2を既存の開発フローに差し込み、Flashで日常タスクのコストを一段下げる取り組みから着手するのが、最も実用的な第一歩になります。