この記事のポイント
 KVキャッシュ有無で過去トークンのKey/Value投影の再計算量が三角形(O(N²))から線形(O(N))に変わる
- KVキャッシュはモデル重みと別領域を消費し、長文・並列でGPUメモリの支配的要因になる
- 削減手法は「注意機構レベル(MQA・GQA・MLA)」「メモリ管理・圧縮」「推論エンジン再利用」の3層で理解する
- 商用APIのプロンプトキャッシュはKVキャッシュと同発想でPrefix処理結果を再利用するマネージド機能で、割引率・TTL・最小トークンに違いがある
- 定常大量リクエストは自社推論、Prefix固定・後半可変の業務は商用APIプロンプトキャッシュが第一候補
Microsoft MVP・AIパートナー。LinkX Japan株式会社 代表取締役。東京工業大学大学院にて自然言語処理・金融工学を研究。NHK放送技術研究所でAI・ブロックチェーンの研究開発に従事し、国際学会・ジャーナルでの発表多数。経営情報学会 優秀賞受賞。シンガポールでWeb3企業を創業後、現在は企業向けAI導入・DX推進を支援。
KVキャッシュ(Key-Value Cache)は、Transformer型LLMが過去トークンのKey・Valueベクトルを保存し、生成ステップごとの再計算を消してくれる中核メモリです。
モデル重みとは別の領域を消費し、コンテキストが長くなるほどGPUメモリの支配的な要因として振る舞うため、いまや推論コストの実質的な決定要因として扱われるようになっています。
本記事では、原理・メモリコストの見積、注意機構レベル・メモリ管理レベル・推論エンジンレベルの3層で進む削減手法、商用APIのプロンプトキャッシュとの階層関係、自社推論と商用API利用の判断軸、実装で見落とされやすい前提を2026年9月時点で整理します。
目次
MLA(Multi-head Latent Attention)——KVを潜在空間に圧縮
メモリ管理と量子化でKVを圧縮する3手法(PagedAttention・KV量子化・TurboQuant)
PagedAttention——OS仮想メモリ発想でフラグメントを4%以下に
KVキャッシュ量子化——4bit・8bitで容量を半減以下に
TurboQuant——3bit量子化でメモリ6倍削減・H100でAttention logits計算が最大8倍高速化
推論エンジン別のKV再利用戦略(Prefix Caching・RadixAttention)
Prefix Caching——共通プレフィックスを自動で使い回す
RadixAttention——SGLangのRadix treeでマルチターンを最適化
長文コンテキスト(100K超)はMLA採用モデルかGeminiのコンテキストキャッシュ
KVキャッシュとは?LLM推論の再計算を消す中核メモリ
KVキャッシュ(Key-Value Cache)は、Transformer型のLLMが自己回帰的にテキストを生成する際、過去トークンのKey・Valueベクトルを保存し、生成ステップごとの再計算を消してくれる主にGPU上のメモリ領域です(vLLMなどではCPUメモリへのオフロードにも対応します)。
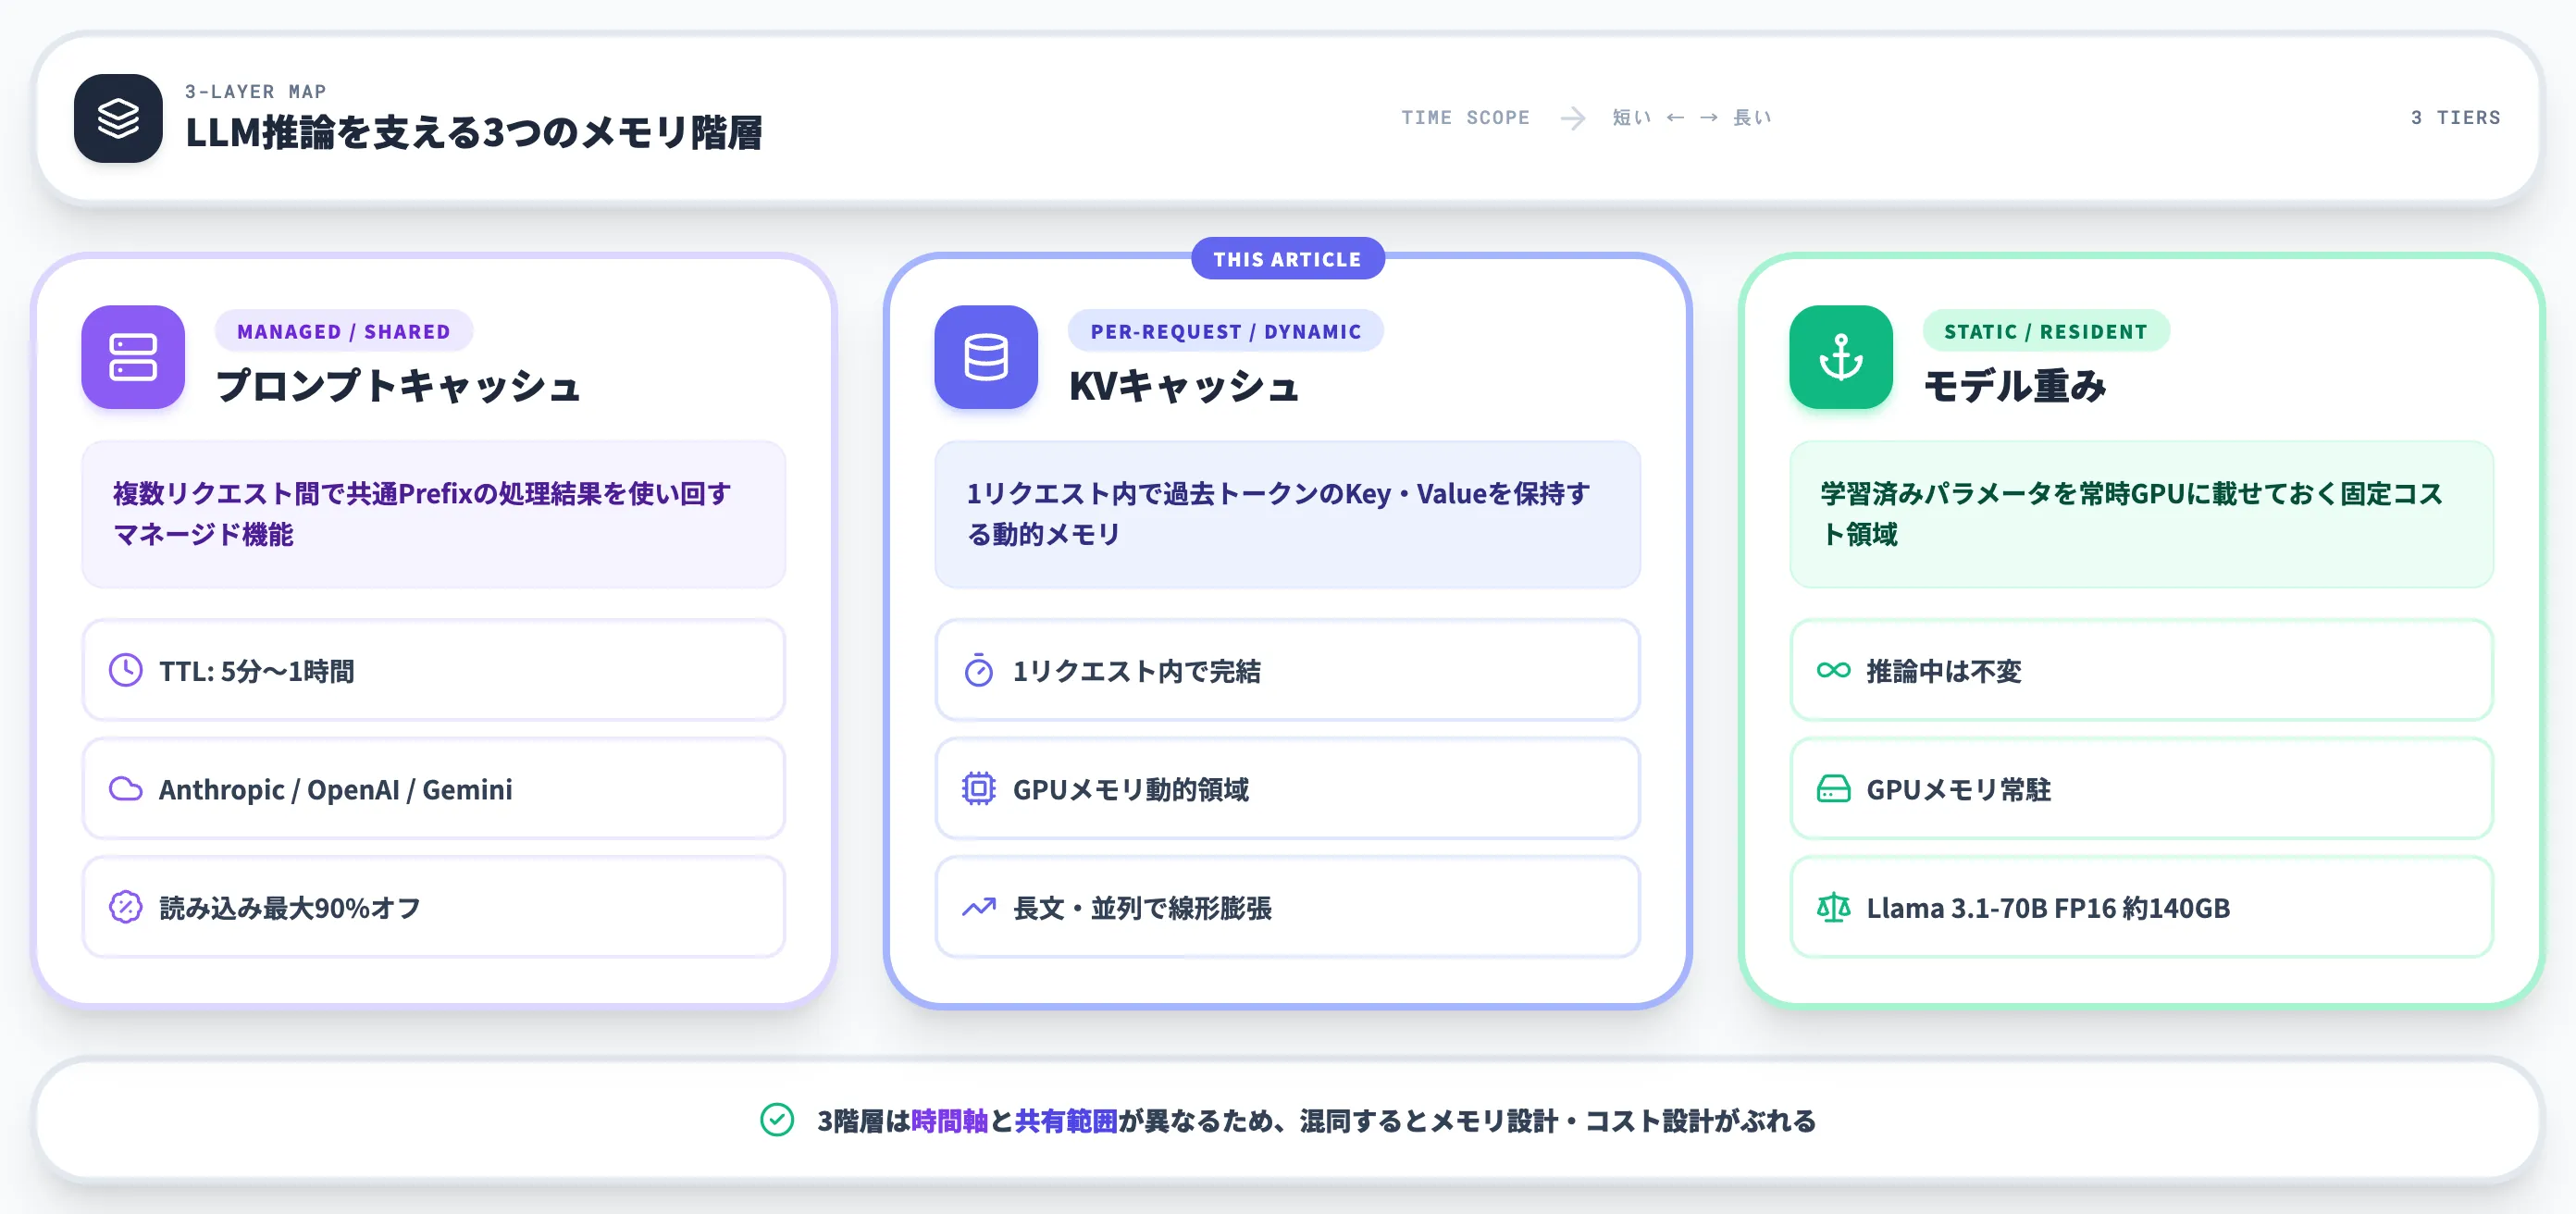
KVキャッシュは、モデル重みや商用APIのプロンプトキャッシュとは別階層で動く、1リクエスト内の一時メモリとして位置づけられます。3つの階層の切り分けを最初に押さえておくと、後段で扱うメモリ設計・削減手法の判断軸が理解しやすくなります。
モデル重み・KVキャッシュ・プロンプトキャッシュの位置関係
3階層の関係を整理すると、以下のようになります。
-
モデル重み
学習で得たパラメータ。推論中は基本的に変わらず、常にGPUメモリに載っている固定コスト。Llama 3.1-70BのFP16重みは約140GBで、GPU2〜4枚分を占有する。
-
KVキャッシュ
1リクエスト内の「過去トークンのKey・Value」を保持する動的メモリ。トークン生成が進むほど線形に膨らみ、長文コンテキスト・並列リクエストで爆発する。モデル重みとは別領域を圧迫する。
-
プロンプトキャッシュ(商用API層)
Anthropic・OpenAI・Googleが提供するマネージド機能。共通Prefixの処理結果を複数リクエスト間で使い回す層で、KVキャッシュとは扱う時間軸が異なる。
「KVキャッシュ=技術原理・単一リクエスト内」「プロンプトキャッシュ=商用サービス機能・複数リクエスト横断」という切り分けを最初に押さえておくと、後段で扱う削減手法や商用APIの判断軸が理解しやすくなります。
KVキャッシュが消す推論の再計算コスト
KVキャッシュがなければ、LLMは1トークン生成するたびに過去すべてのトークンを最初から読み直します。
自己回帰生成の構造上、これは避けられない挙動です。ここではその「毎ステップの再計算」がどのように発生し、KVキャッシュが何をショートカットしているのかを整理します。
自己回帰生成が抱える再計算構造
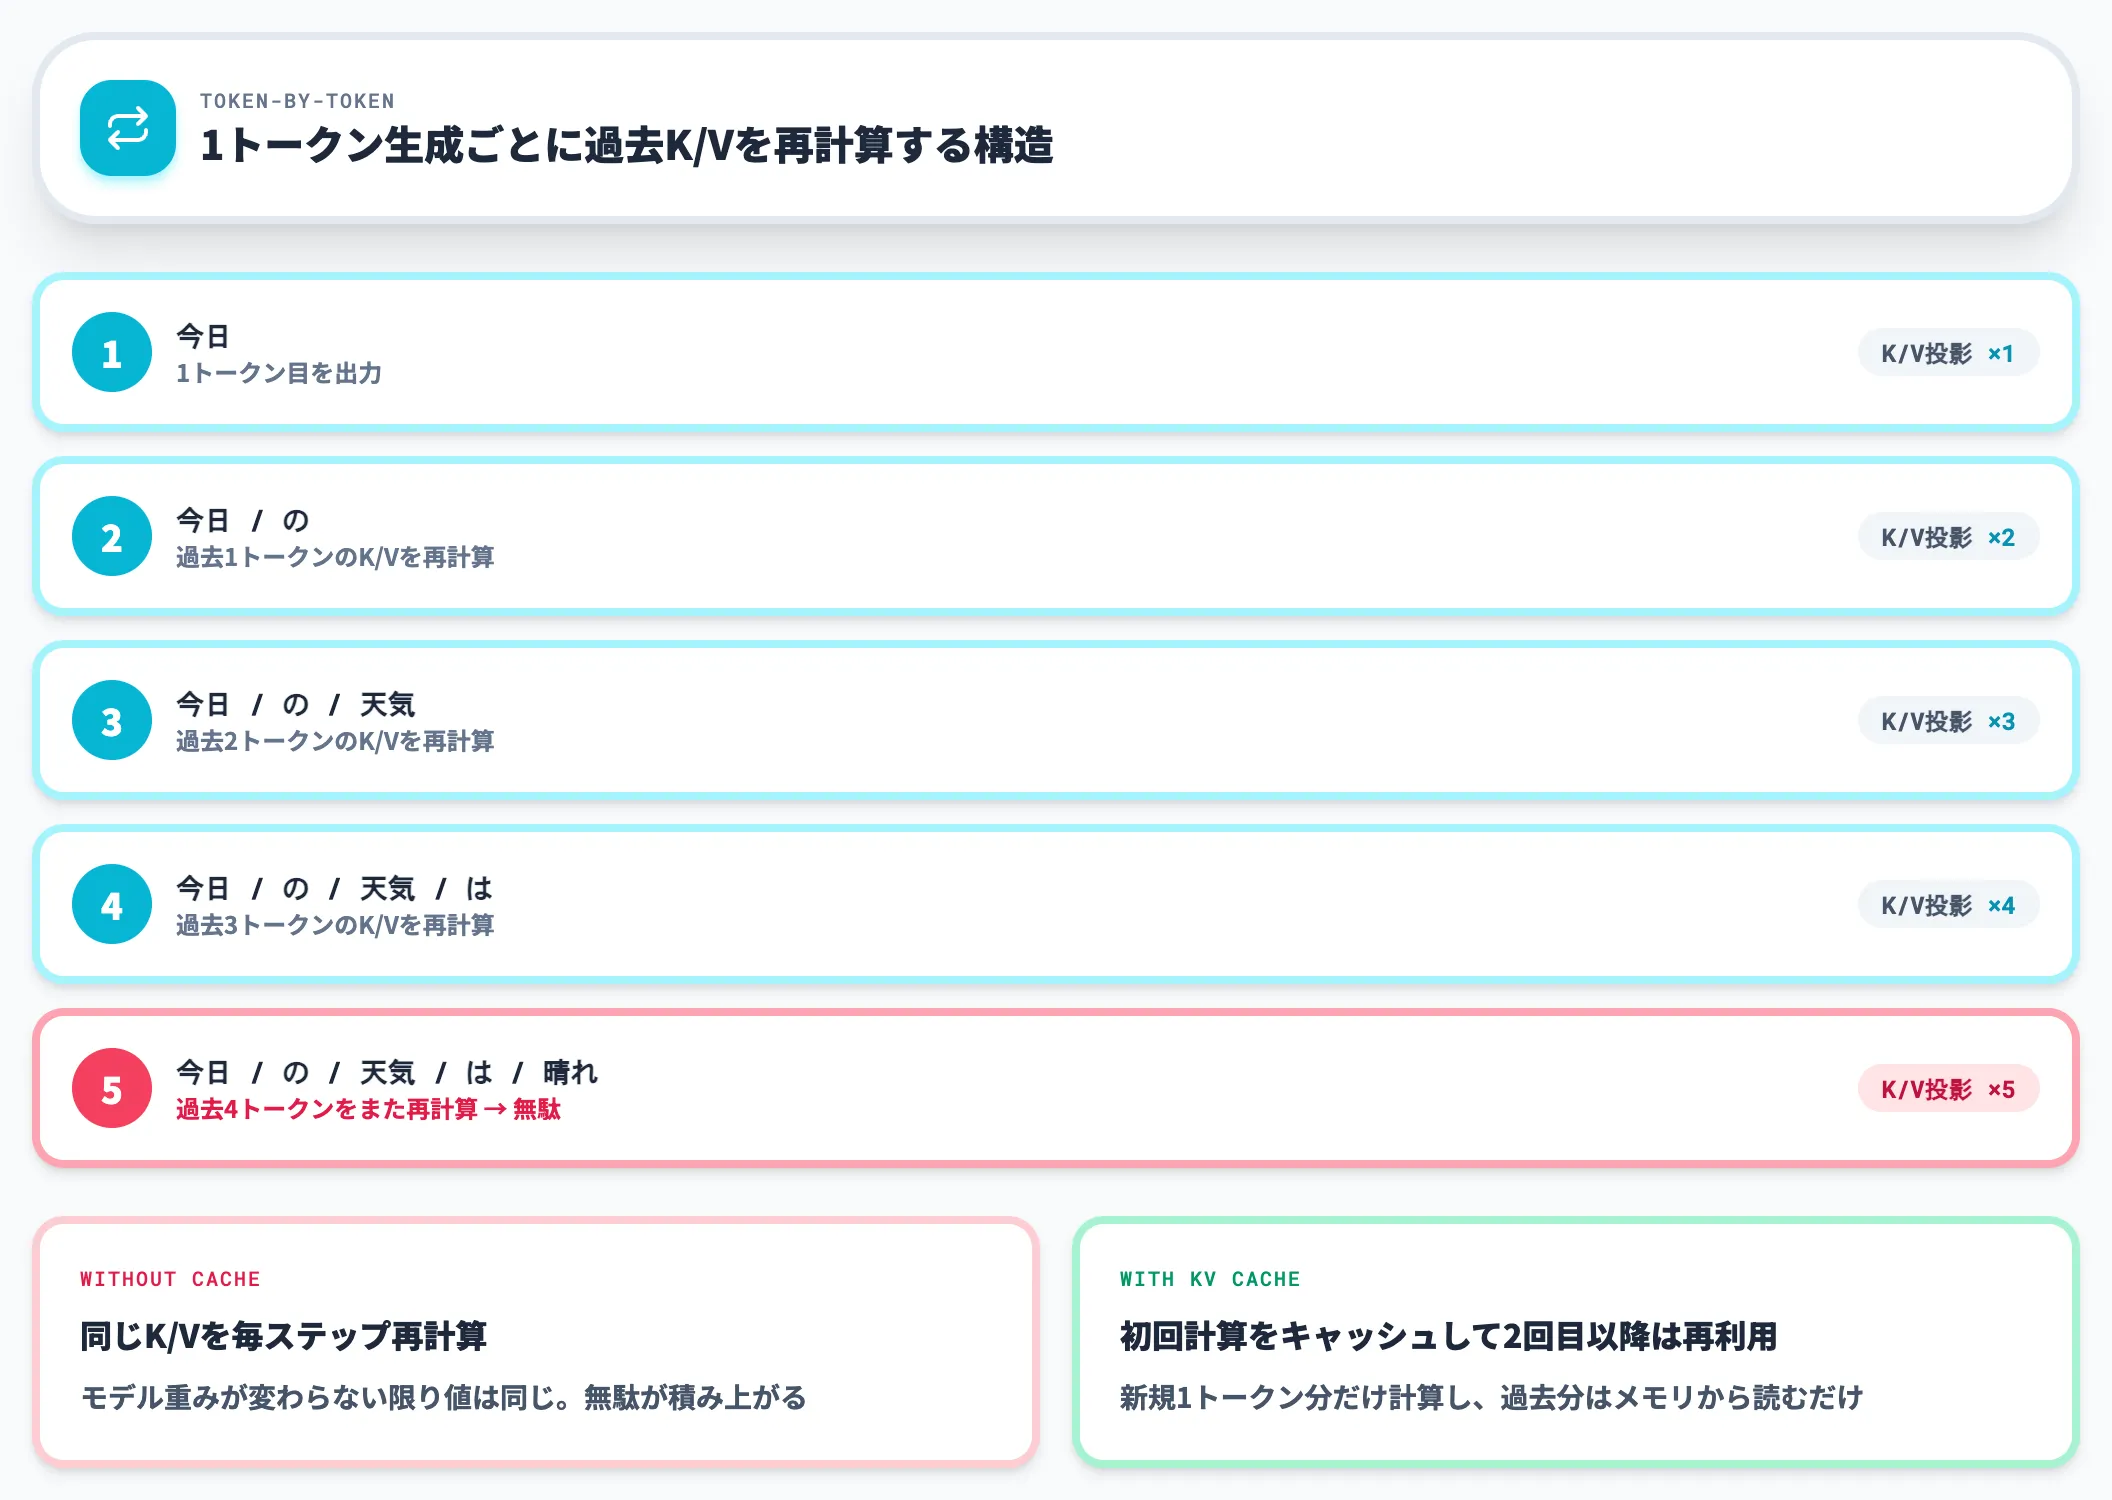
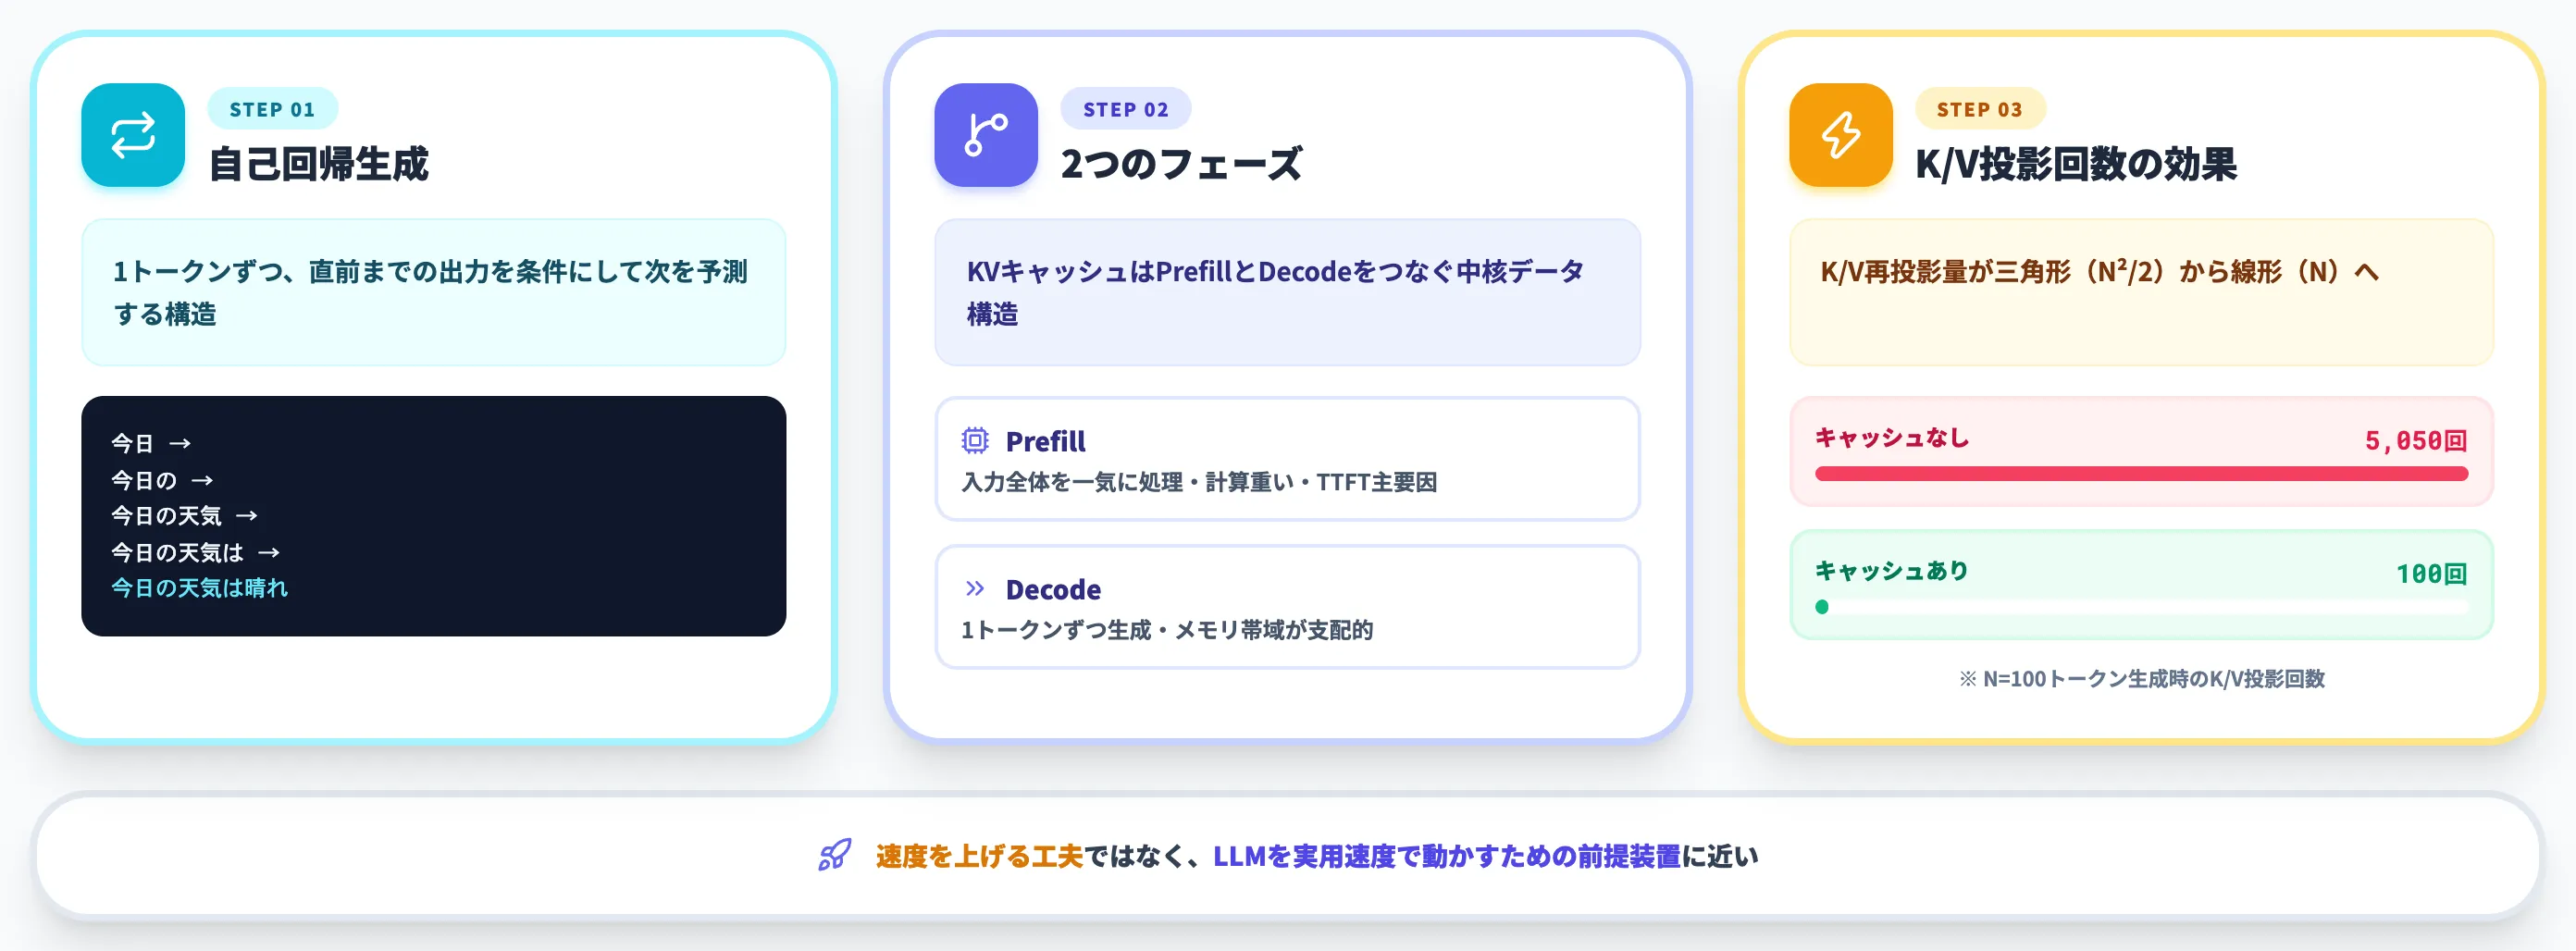
自己回帰生成とは、モデルが1トークンずつ、直前までの出力を条件にして次のトークンを予測する方式です。
たとえば「今日の天気は」から続きを生成させる場合、モデルは「今日」→「今日の」→「今日の天気」→「今日の天気は」→「今日の天気は晴れ」…と1トークンずつ順番に生成していきます。
各ステップで、モデルは過去に生成したすべてのトークンを参照してAttention計算を行います。素朴に実装すると、5トークン目を生成する時点で「今日/の/天気/は」の4トークン分のKeyとValueを再度計算し直すことになります。
過去トークンのKey・Valueは、モデル重みが変わらない限り「同じ入力に対して常に同じ値」を返します。同じものを何度も計算するのは無駄なので、初回計算時にキャッシュしておいて2回目以降は再利用する——これがKVキャッシュの発想です。
Prefill と Decode の2フェーズ
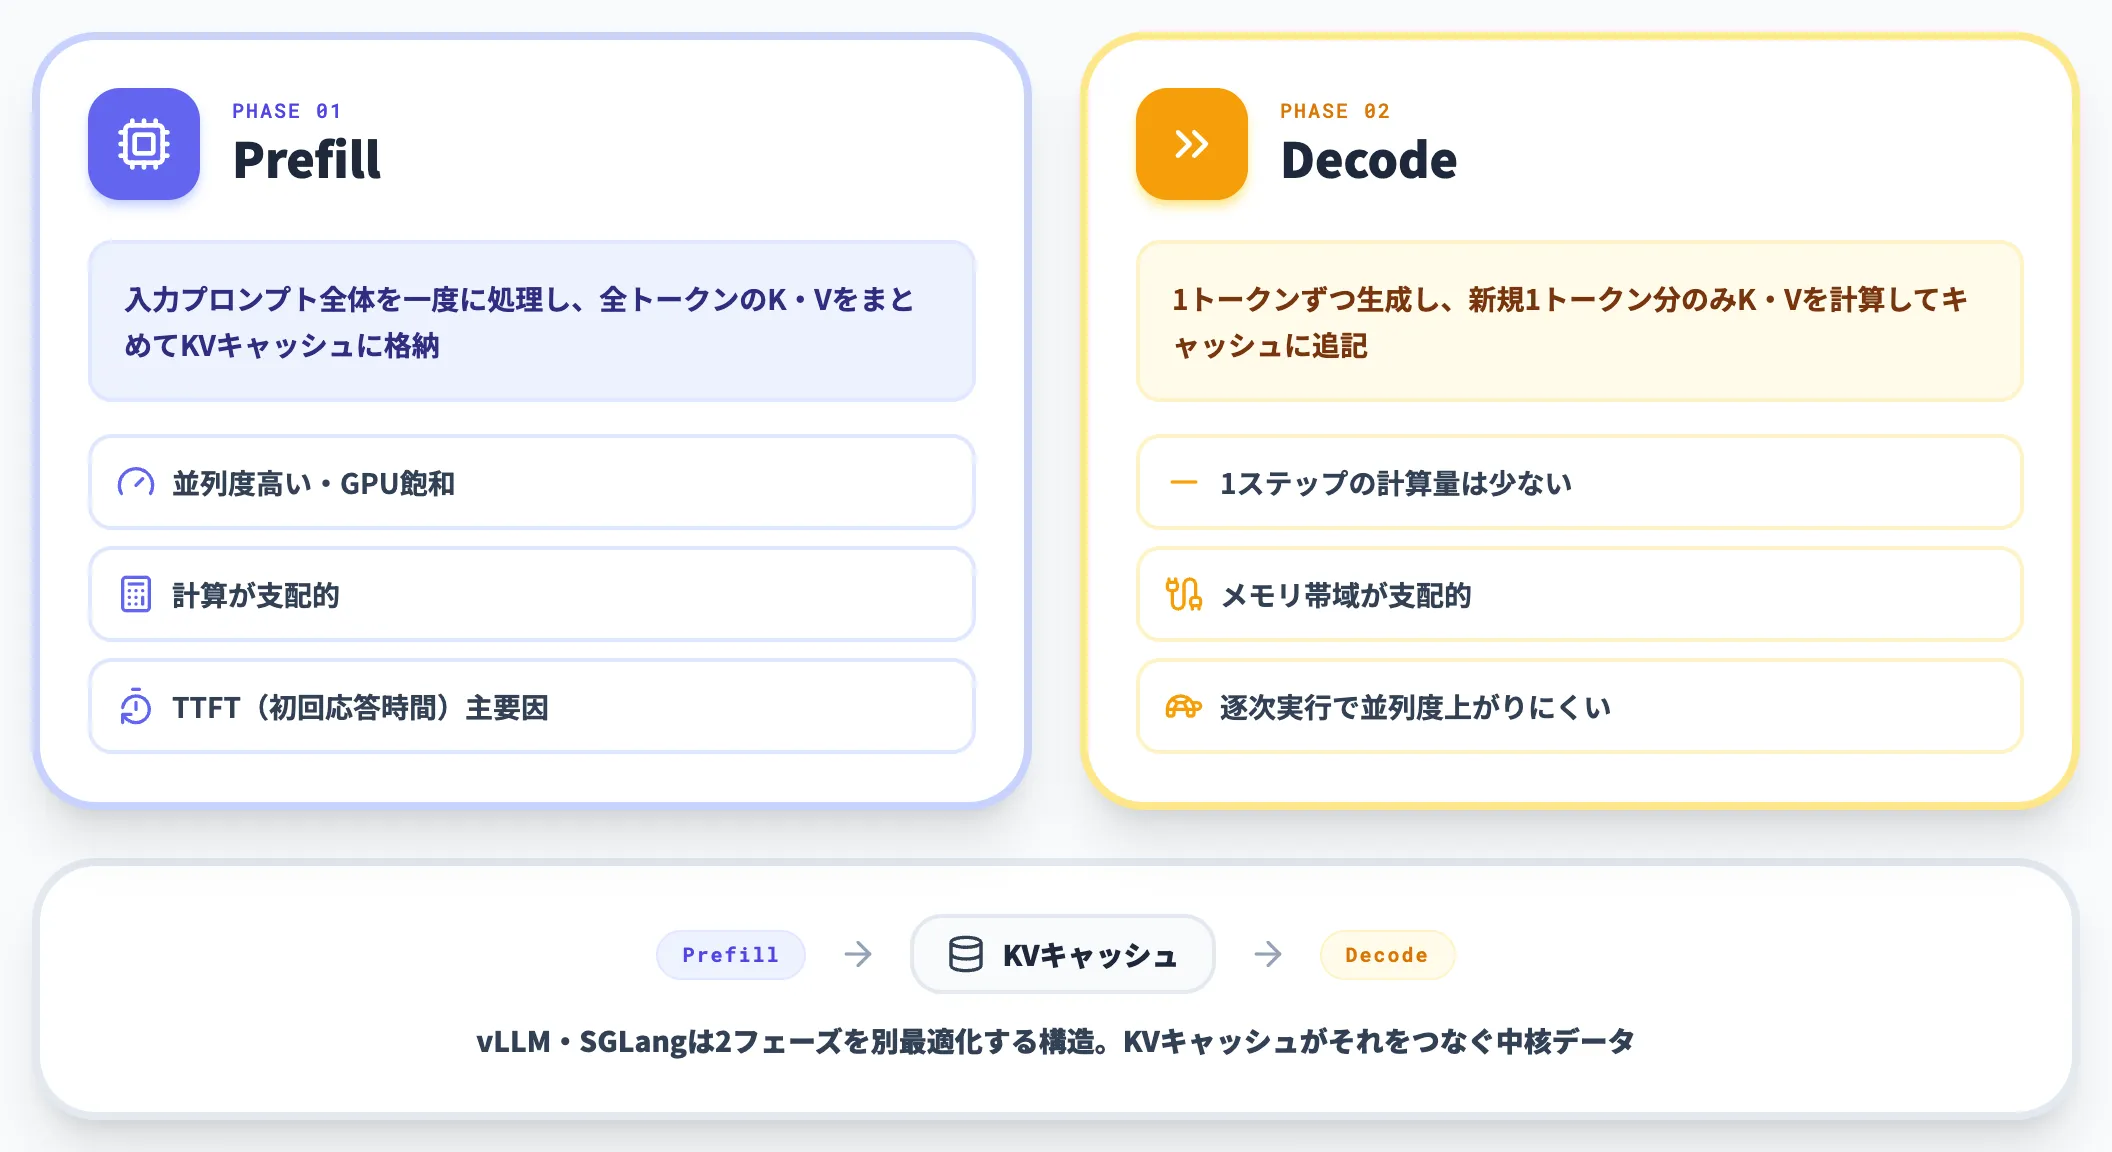
LLM推論は、KVキャッシュとの関係で2つのフェーズに分かれます。
-
Prefillフェーズ
入力プロンプト全体を一度に処理し、全トークンのKey・Valueをまとめて計算してKVキャッシュに格納する。並列度が高くGPUを飽和させやすい。長いプロンプトほどここに時間がかかるため、「最初のトークンが返るまでの時間(TTFT)」の主要因になる。
-
Decodeフェーズ
1トークンずつ生成する。KVキャッシュから過去分を読み出し、新しく生成したトークン1つ分だけKey・Valueを計算して追記する。1ステップあたりの計算量は少ないが、順番に走らせるためGPUの並列度が上がりにくく、メモリ帯域が支配的になる。
Prefillは「計算が重い」、Decodeは「メモリ帯域が重い」と負荷特性が異なるため、vLLMやSGLangなど近年の推論エンジンはこの2フェーズを別々に最適化する構造を採ります。KVキャッシュはこの2フェーズをつなぐ中核データ構造の役割を担います。
Key/Value再計算量が三角形(N²)から線形(N)へ
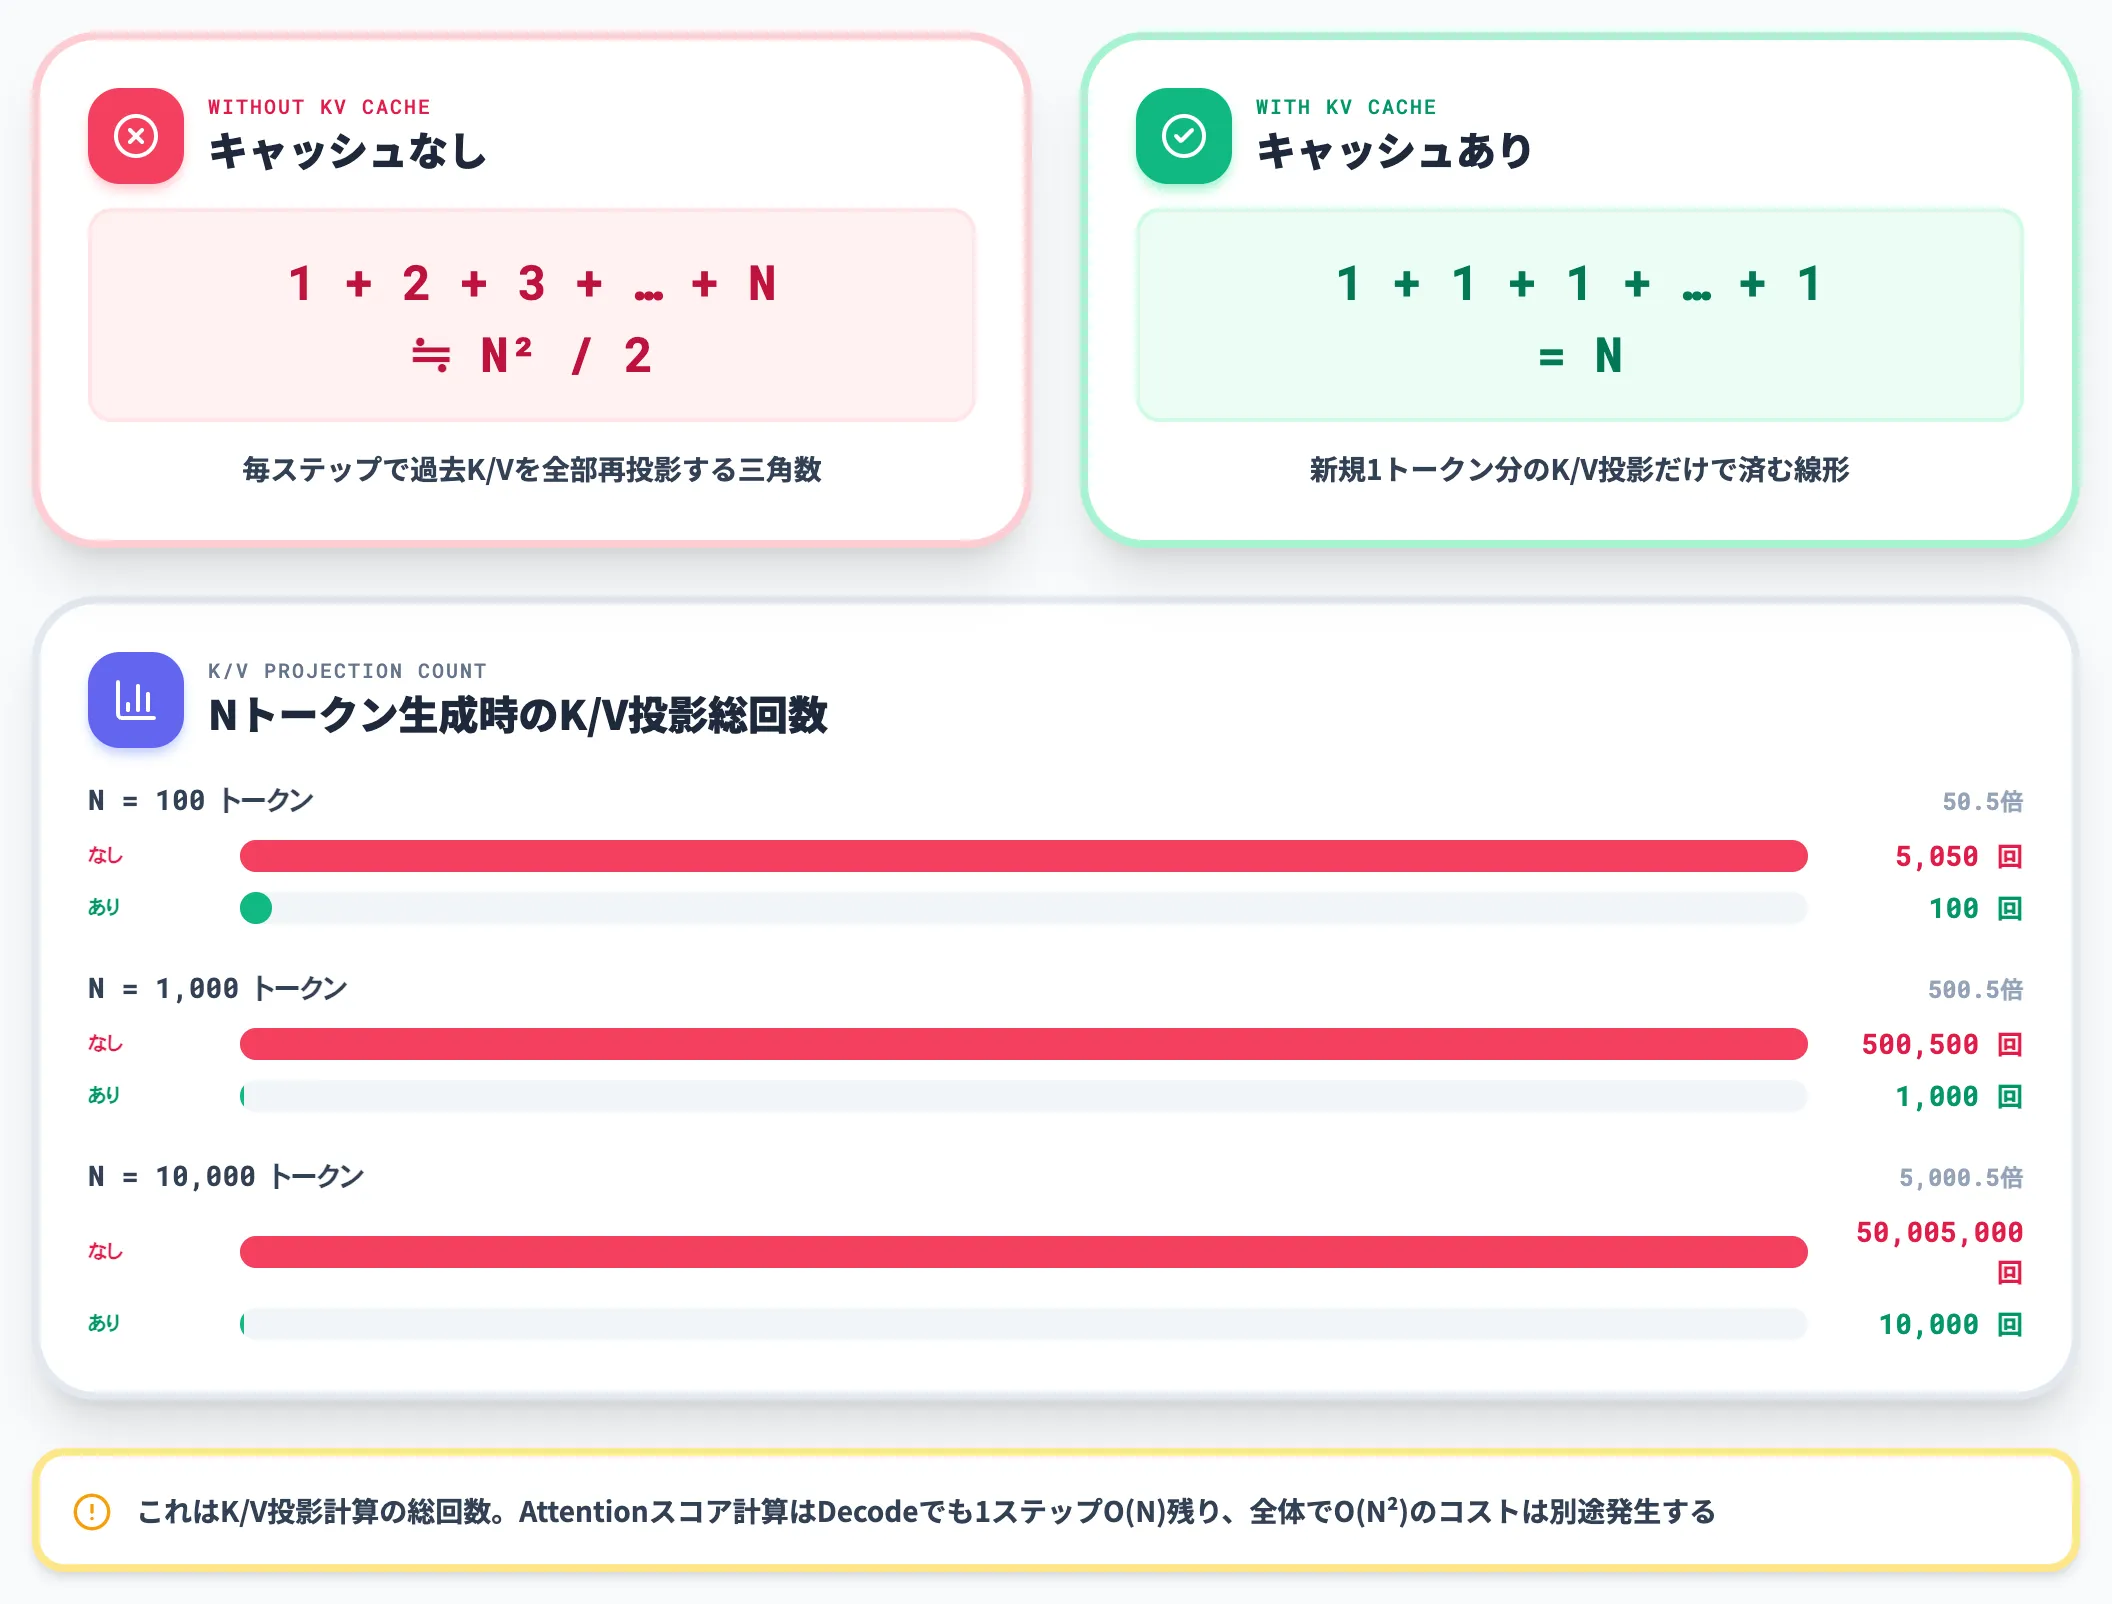
KVキャッシュ有無で「過去トークンのK/V投影を何回やり直すか」の伸び方が変わる様子は、シンプルな数式で表現できます。
N個のトークンを生成する場合、KVキャッシュなしなら各ステップで過去すべてのK/V投影を再計算するため、K/V投影の総回数は「1+2+3+…+N ≒ N²/2」に比例します。KVキャッシュありなら各ステップで新しい1トークン分だけK/Vを計算すればよいため、K/V投影の総回数は「1+1+1+…+1 = N」に比例します(Decodeステップで残る「過去のK/VとのAttentionスコア計算」は1ステップ当たりO(N)・Nトークン全体ではO(N²)のコストが残るため、KVキャッシュはモデル重みを通した投影計算部分を消す効果に絞られます)。
この差が、LLM推論が実用的な速度で動く前提条件です。100トークン生成するだけで、キャッシュなしなら約5,050回のK/V投影が必要になり、ありなら100回で済みます。長文生成になるほどこの差は急激に開き、キャッシュなしの推論は事実上成立しません。
つまりKVキャッシュは「速度を上げる工夫」ではなく、「LLMを実用速度で動かすための前提装置」に近い位置づけです。
KVキャッシュのメモリコストが推論の壁になる理由
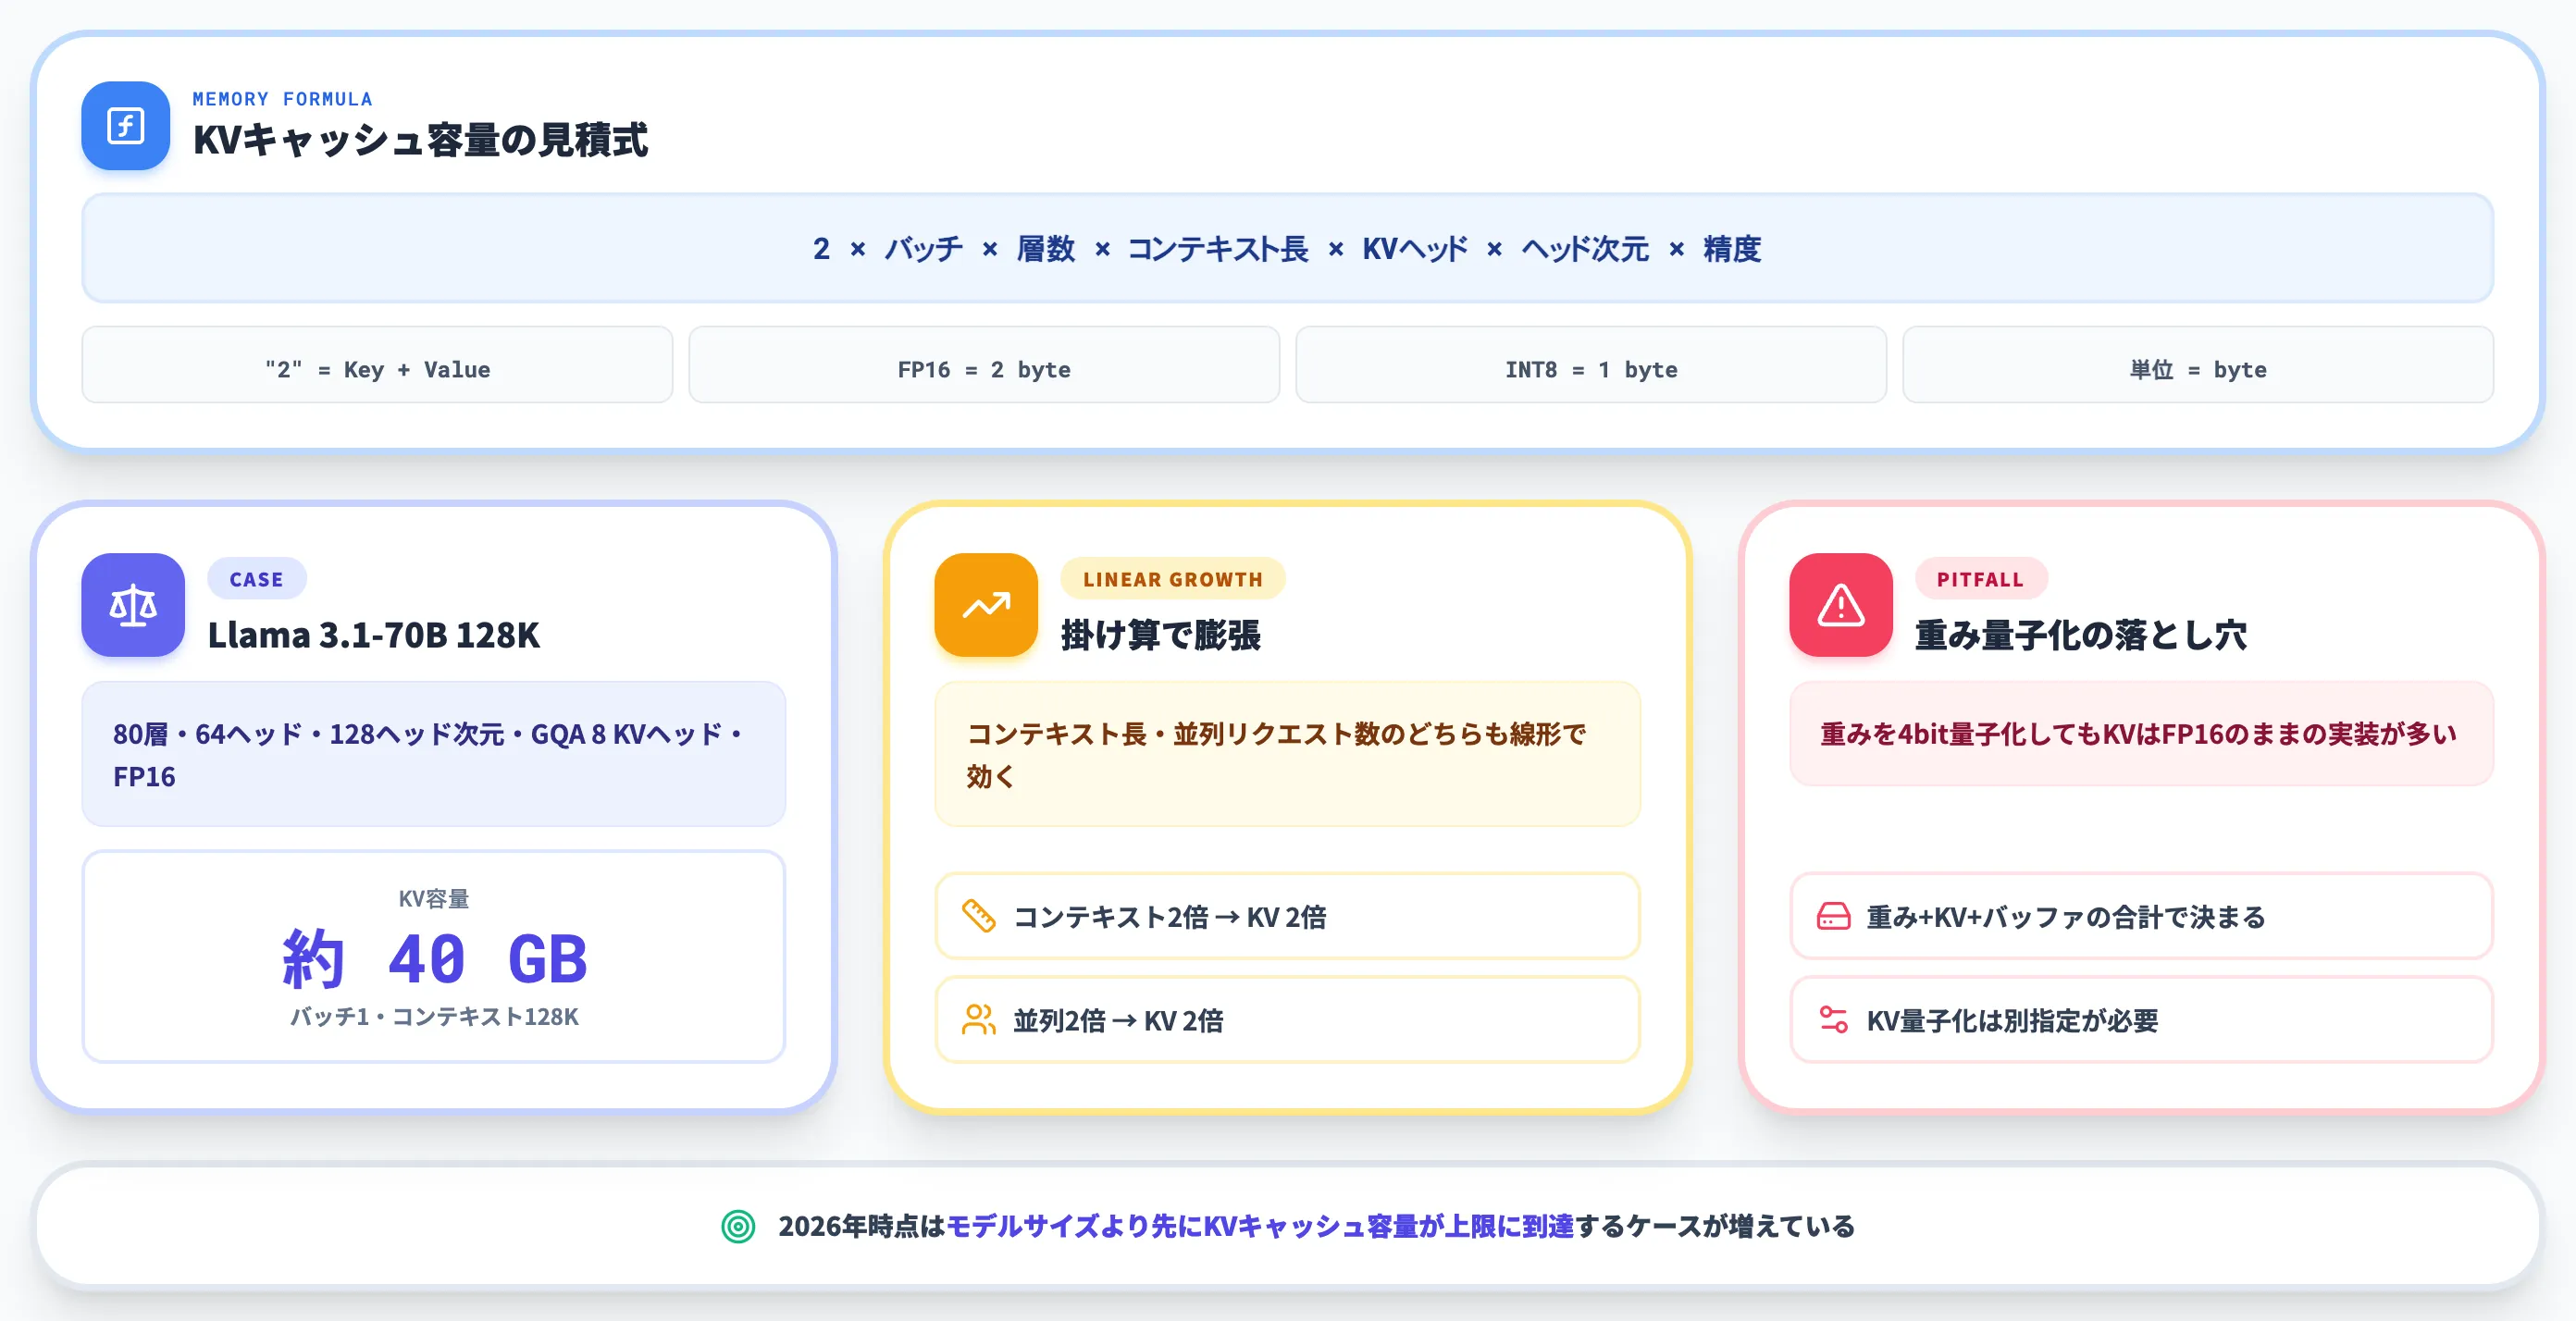
KVキャッシュは計算量を劇的に減らす一方で、その代償としてGPUメモリを線形に食い潰していきます。
長文コンテキスト・大量並列リクエストが当たり前になった2026年時点では、モデル重みよりKVキャッシュの方が先にメモリの上限に到達するケースが増えています。
KVキャッシュのメモリ見積式
1リクエストあたりのKVキャッシュ容量は、以下の式で概算できます。
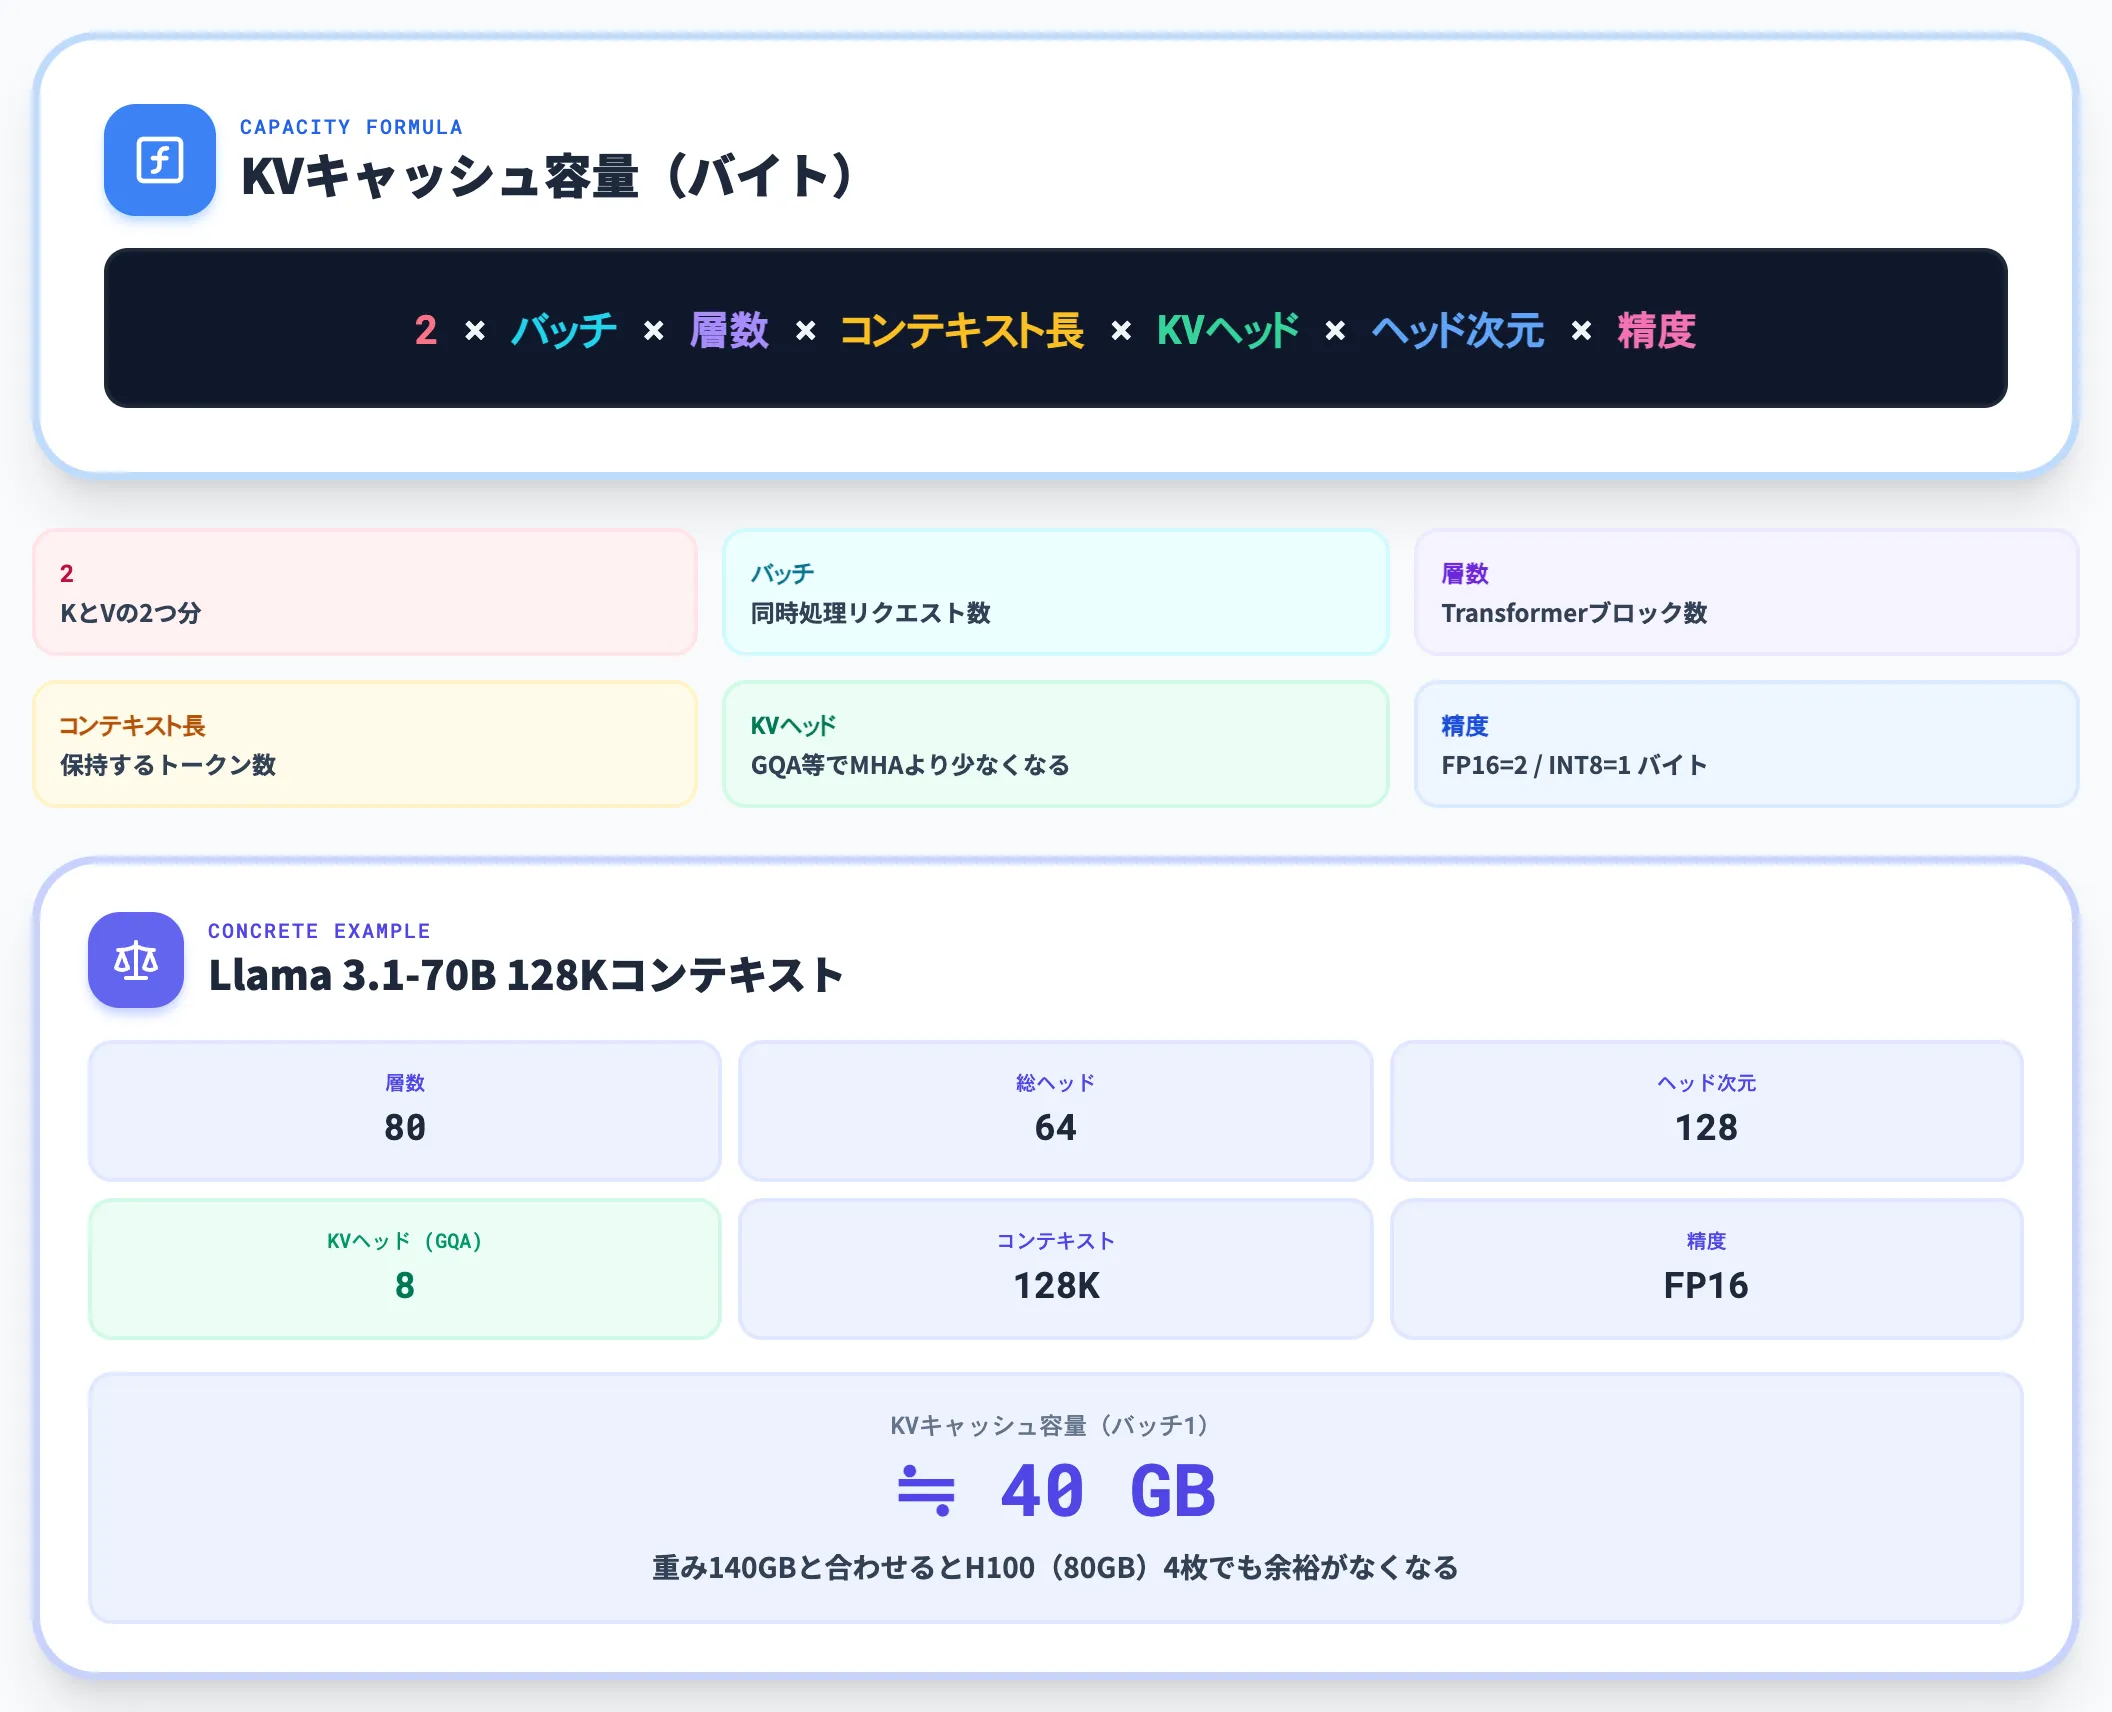
KVキャッシュ容量 = 2 × バッチサイズ × 層数 × コンテキスト長 × KVヘッド数 × ヘッド次元 × 精度(単位:バイト)
先頭の「2」はKeyとValueの2つを保持するため、精度はFP16なら2バイト、INT8なら1バイトです。この式で分かるのは、コンテキスト長とバッチサイズが線形に効いてくる点です。
具体例として、Llama 3.1-70B(80層・64ヘッド・128ヘッド次元、GQAで8 KVヘッド)で128Kコンテキスト・バッチ1・FP16の場合、KVキャッシュだけで約40GBを消費します。モデル重み(約140GB)と合わせると、H100(80GB)4枚を用意してもコンテキストを増やすほど余裕がなくなる計算です。
同じモデルでもコンテキスト長を2倍にすればKVは2倍、並列リクエスト数を2倍にすればKVも2倍と、掛け算で増えていきます。これがKVキャッシュを「長文・並列で爆発する」と表現する根拠です。
モデル重みとは別領域を圧迫する
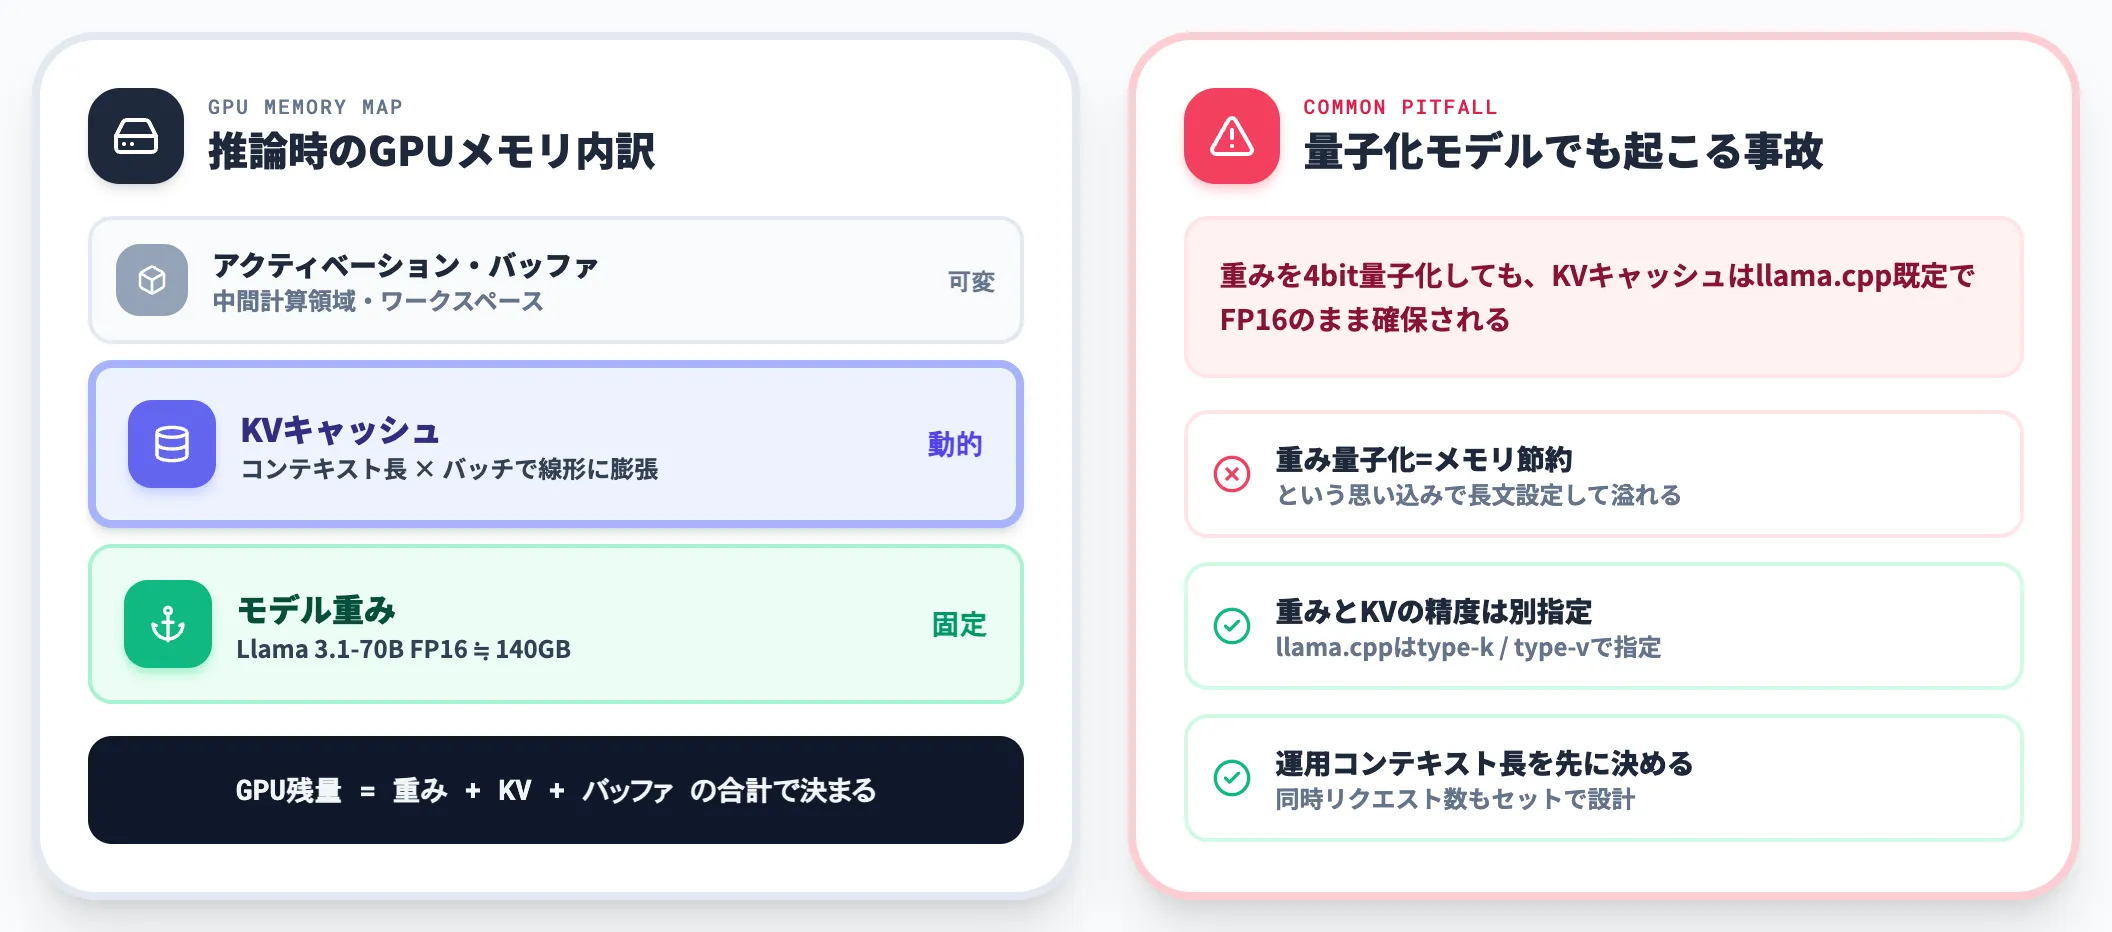
KVキャッシュを「モデル重みに含まれる領域」だと誤解すると、メモリ設計を大きく外します。
重みを4bit量子化してモデルを小さくしても、KVキャッシュはllama.cppの既定設定などではFP16のまま確保されるため、量子化モデルで運用してもコンテキスト長を伸ばすとメモリが足りなくなる、というのは実務でよくある事故パターンです。Qiitaのエンジニアレポートでも、llama-benchを使った実測で「重みは4bitだが、KVキャッシュの型は別で指定する必要がある」ことが指摘されています。
GPUメモリの残量は「重み+KVキャッシュ+各種バッファ」の合計で決まるため、モデル選定と同じくらい「どのコンテキスト長・どの同時リクエスト数で運用するか」を先に決めておく必要があります。
長文コンテキスト時代のLLM運用は、モデルサイズよりもKVキャッシュ容量が実務上の制約になっているケースが多く、コンテキストエンジニアリングの観点からも「入れるコンテキストの量とKV設計」をセットで考える発想が要ります。
注意機構でKVを削減する3手法:MQA・GQA・MLA
KVキャッシュ削減の第1層は、Attentionアーキテクチャそのものを変えて「そもそもKVを小さくする」アプローチです。モデル構造そのものに関わるため、既存モデルへの適用には変換・追加学習が必要になり(GQA論文では既存MHAチェックポイントを追加学習でGQAへ変換した例が示されています)、実務上はモデル選定段階で決まる要素になります。
MHA・MQA・GQAの発展
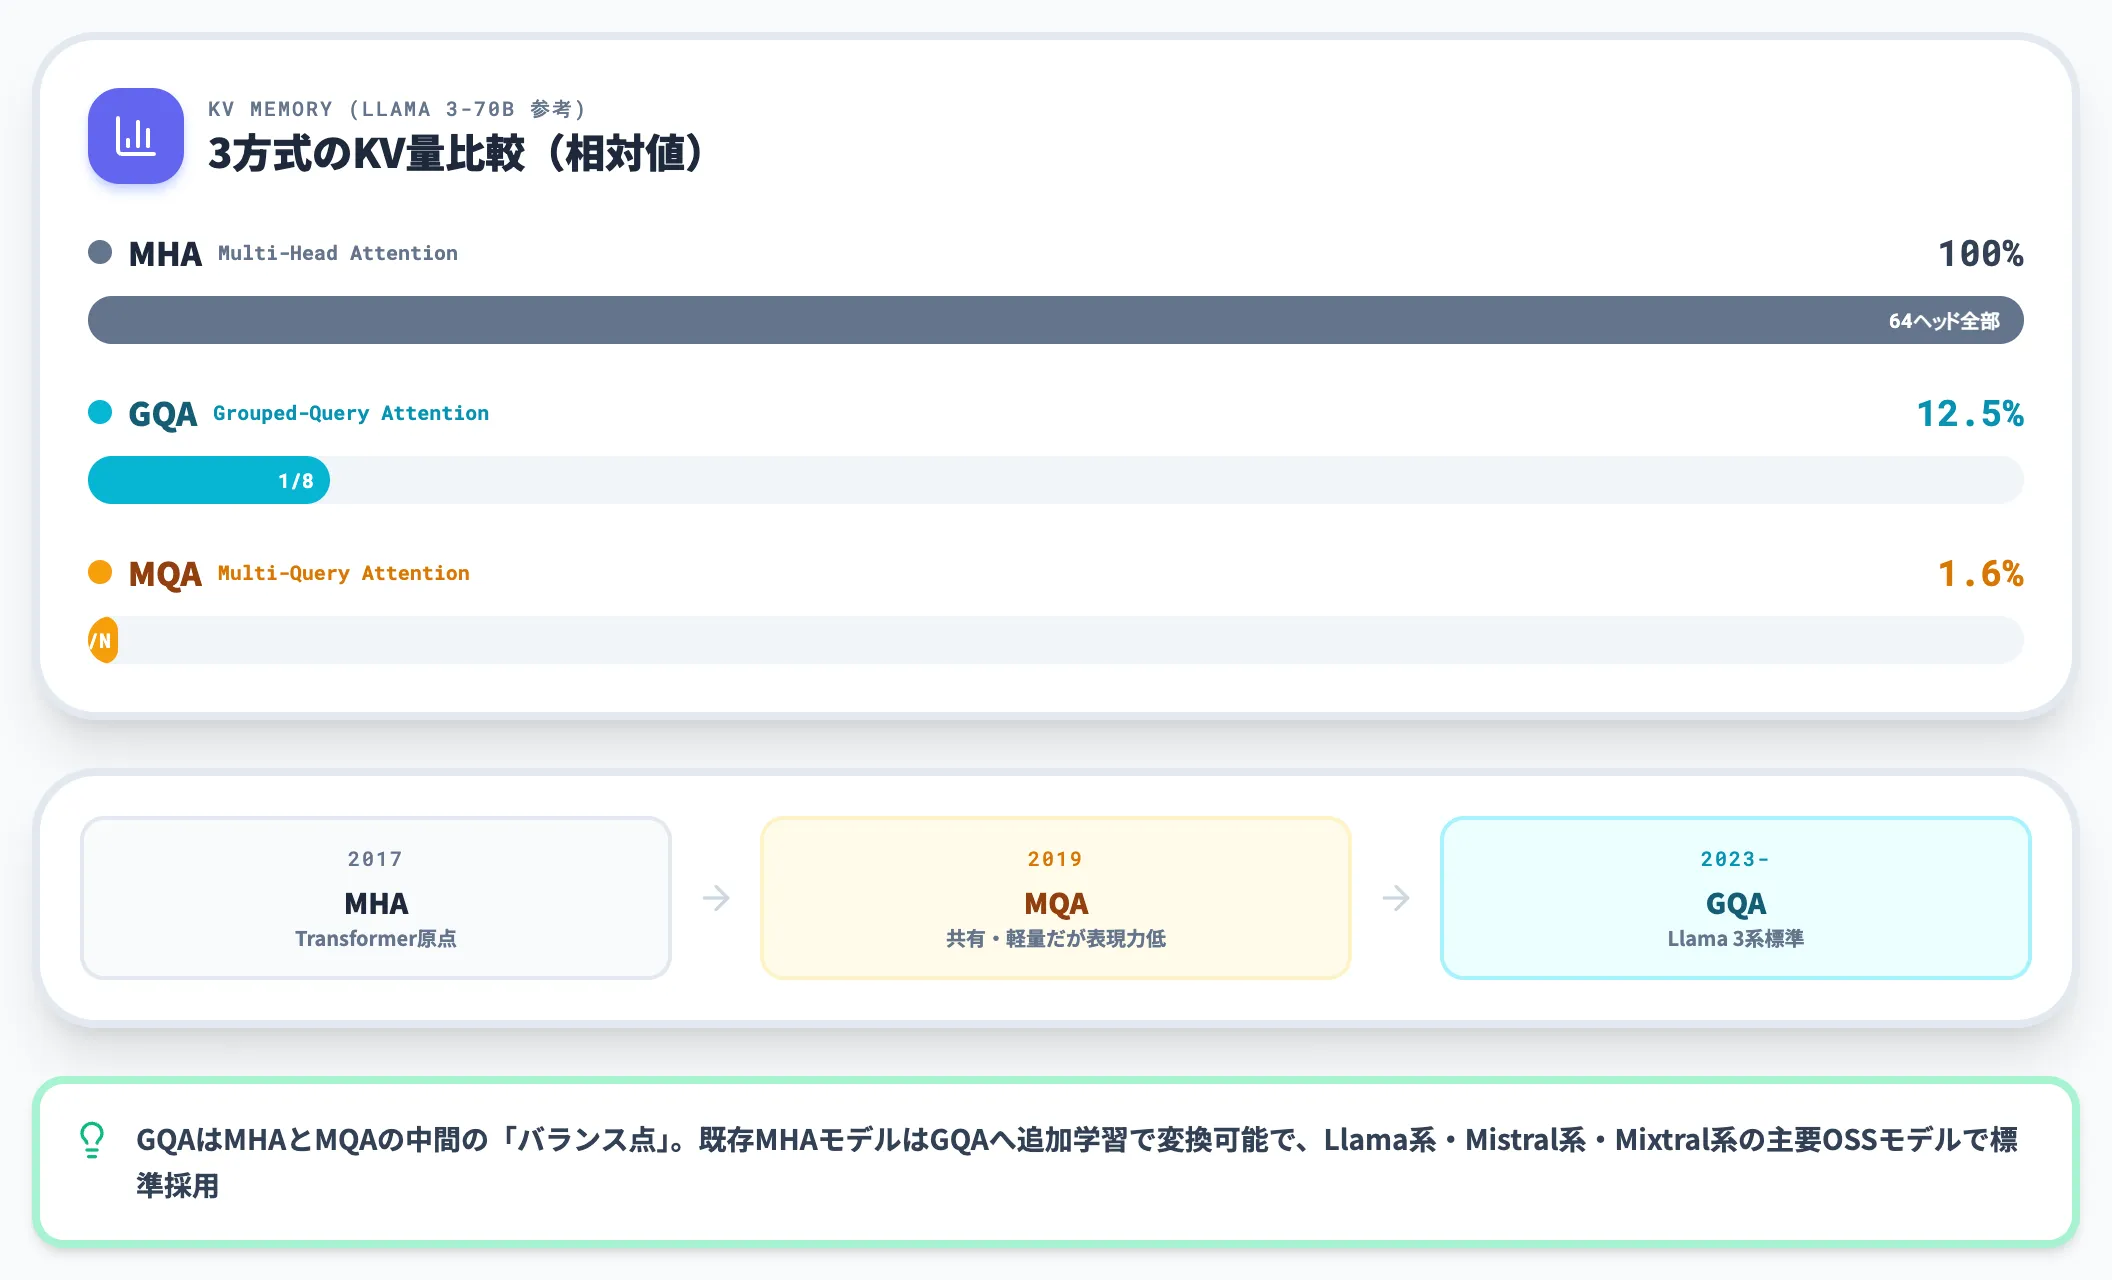
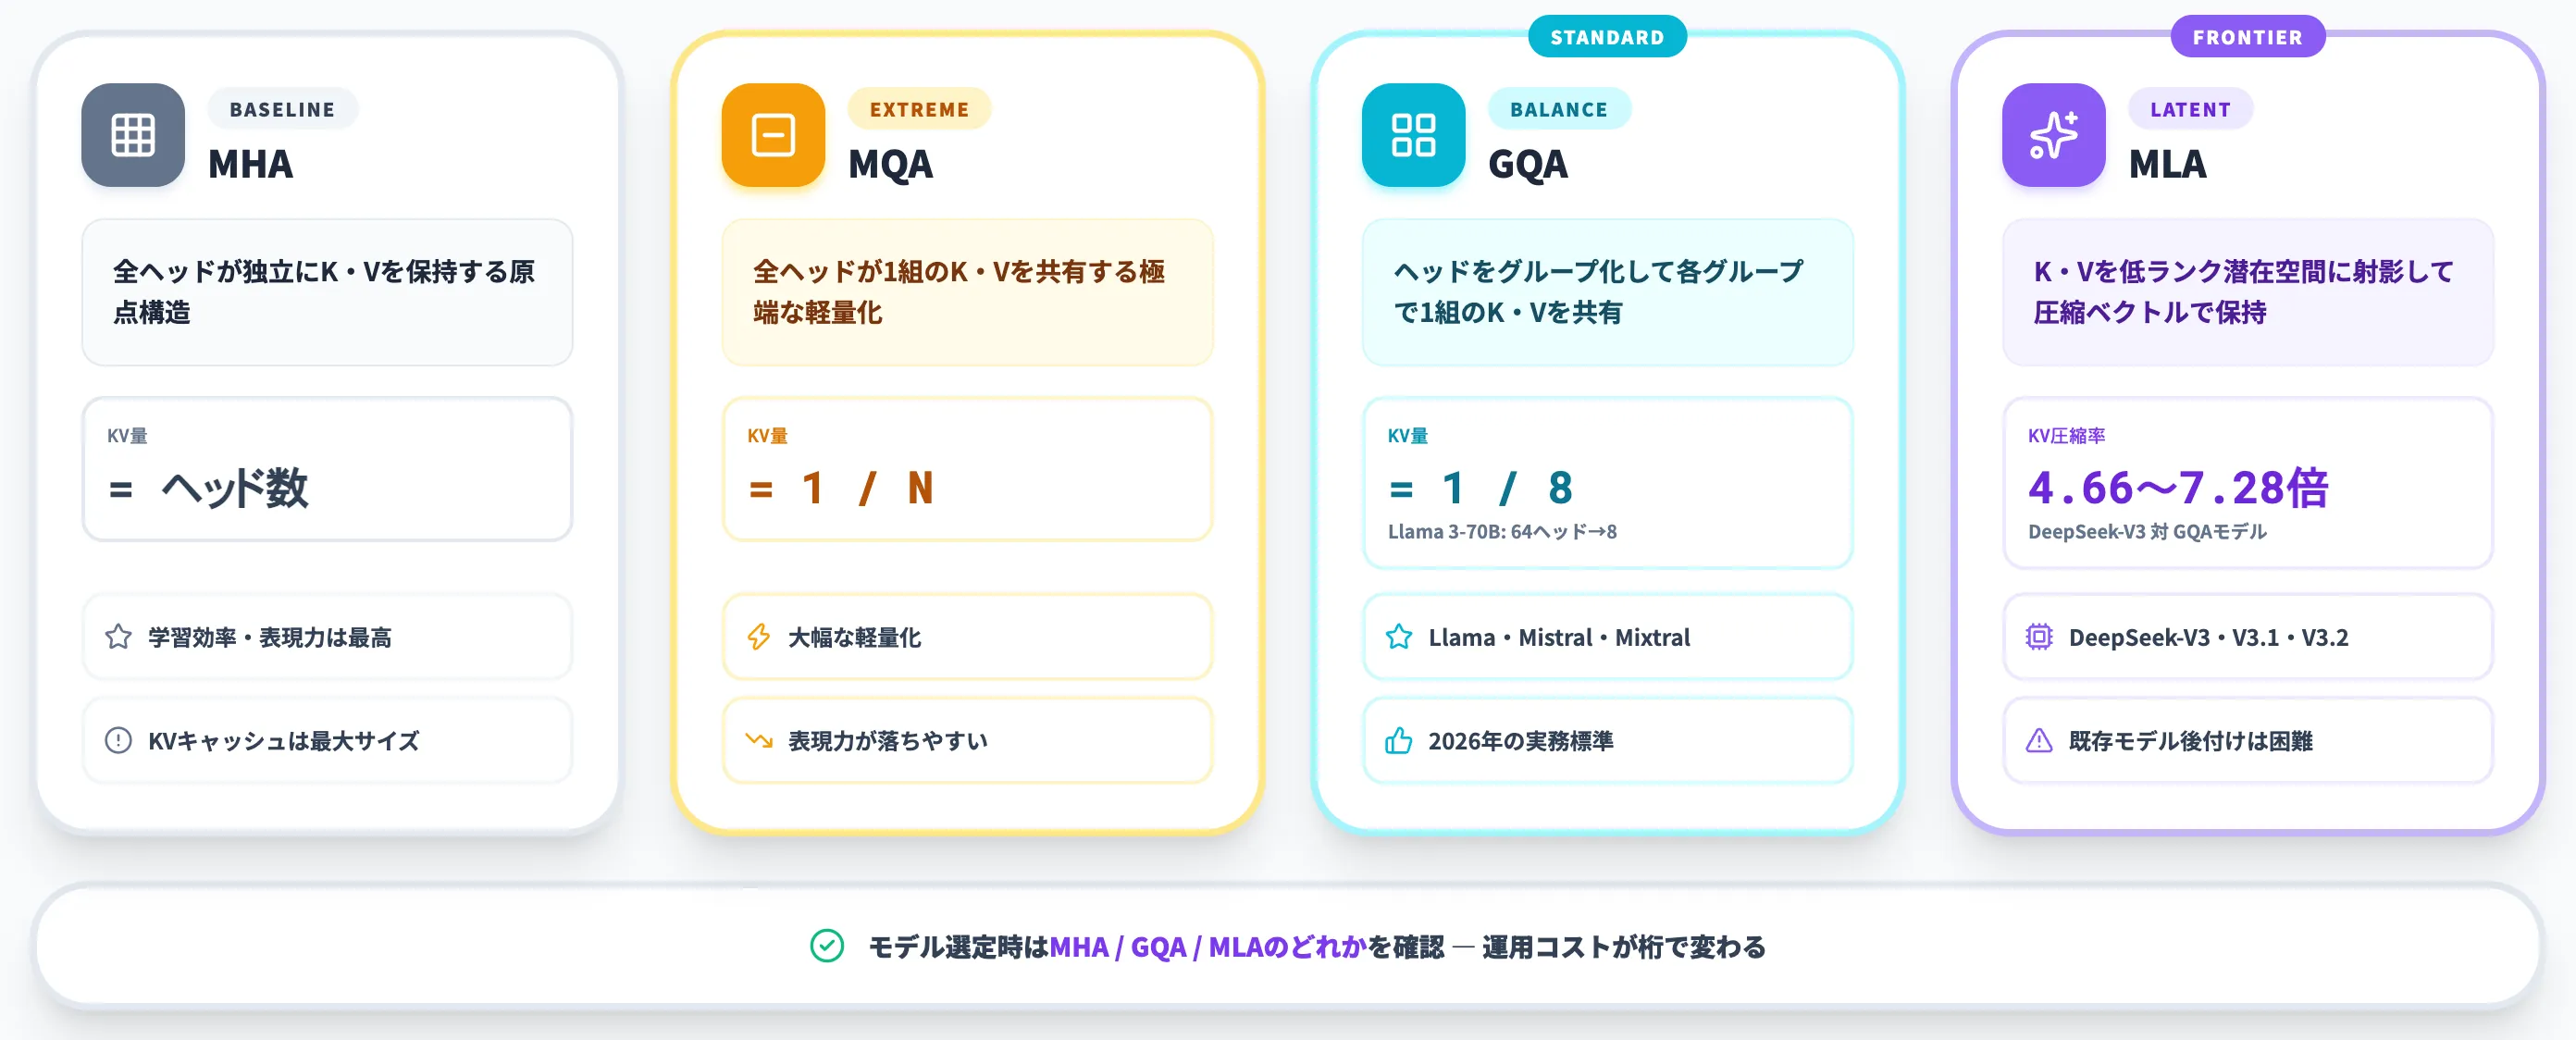
もともとのTransformerは、ヘッド数と同じだけのKeyとValueを持つMulti-Head Attention(MHA)が標準でした。しかし推論時のKVキャッシュ量はヘッド数に比例するため、ヘッド数を減らすほど、あるいは複数ヘッドでKVを共有するほど、KVキャッシュを小さくできます。
-
MHA(Multi-Head Attention)
各ヘッドが独立にKeyとValueを持つ。KV量はヘッド数に比例。学習効率・表現力は高いが、KVキャッシュは最大サイズになる。
-
MQA(Multi-Query Attention)
全ヘッドが1組のKeyとValueを共有する。KV量が「ヘッド数分の1」に激減する。極端に軽量だが表現力が落ちやすい。
-
GQA(Grouped-Query Attention)
ヘッドをグループに分け、グループ内で1組のKV を共有する。MHAとMQAの中間で、Llama 3系・Mistral系・Mixtral系など主要オープンモデルの標準になっている。
MQAは表現力の代償が大きすぎたため、実務ではGQAが「バランス点」として広く採用されています。Llama 3-70Bの場合、64ヘッド → 8 KVヘッドの構成でKVを1/8に削減しています。
MLA(Multi-head Latent Attention)——KVを潜在空間に圧縮
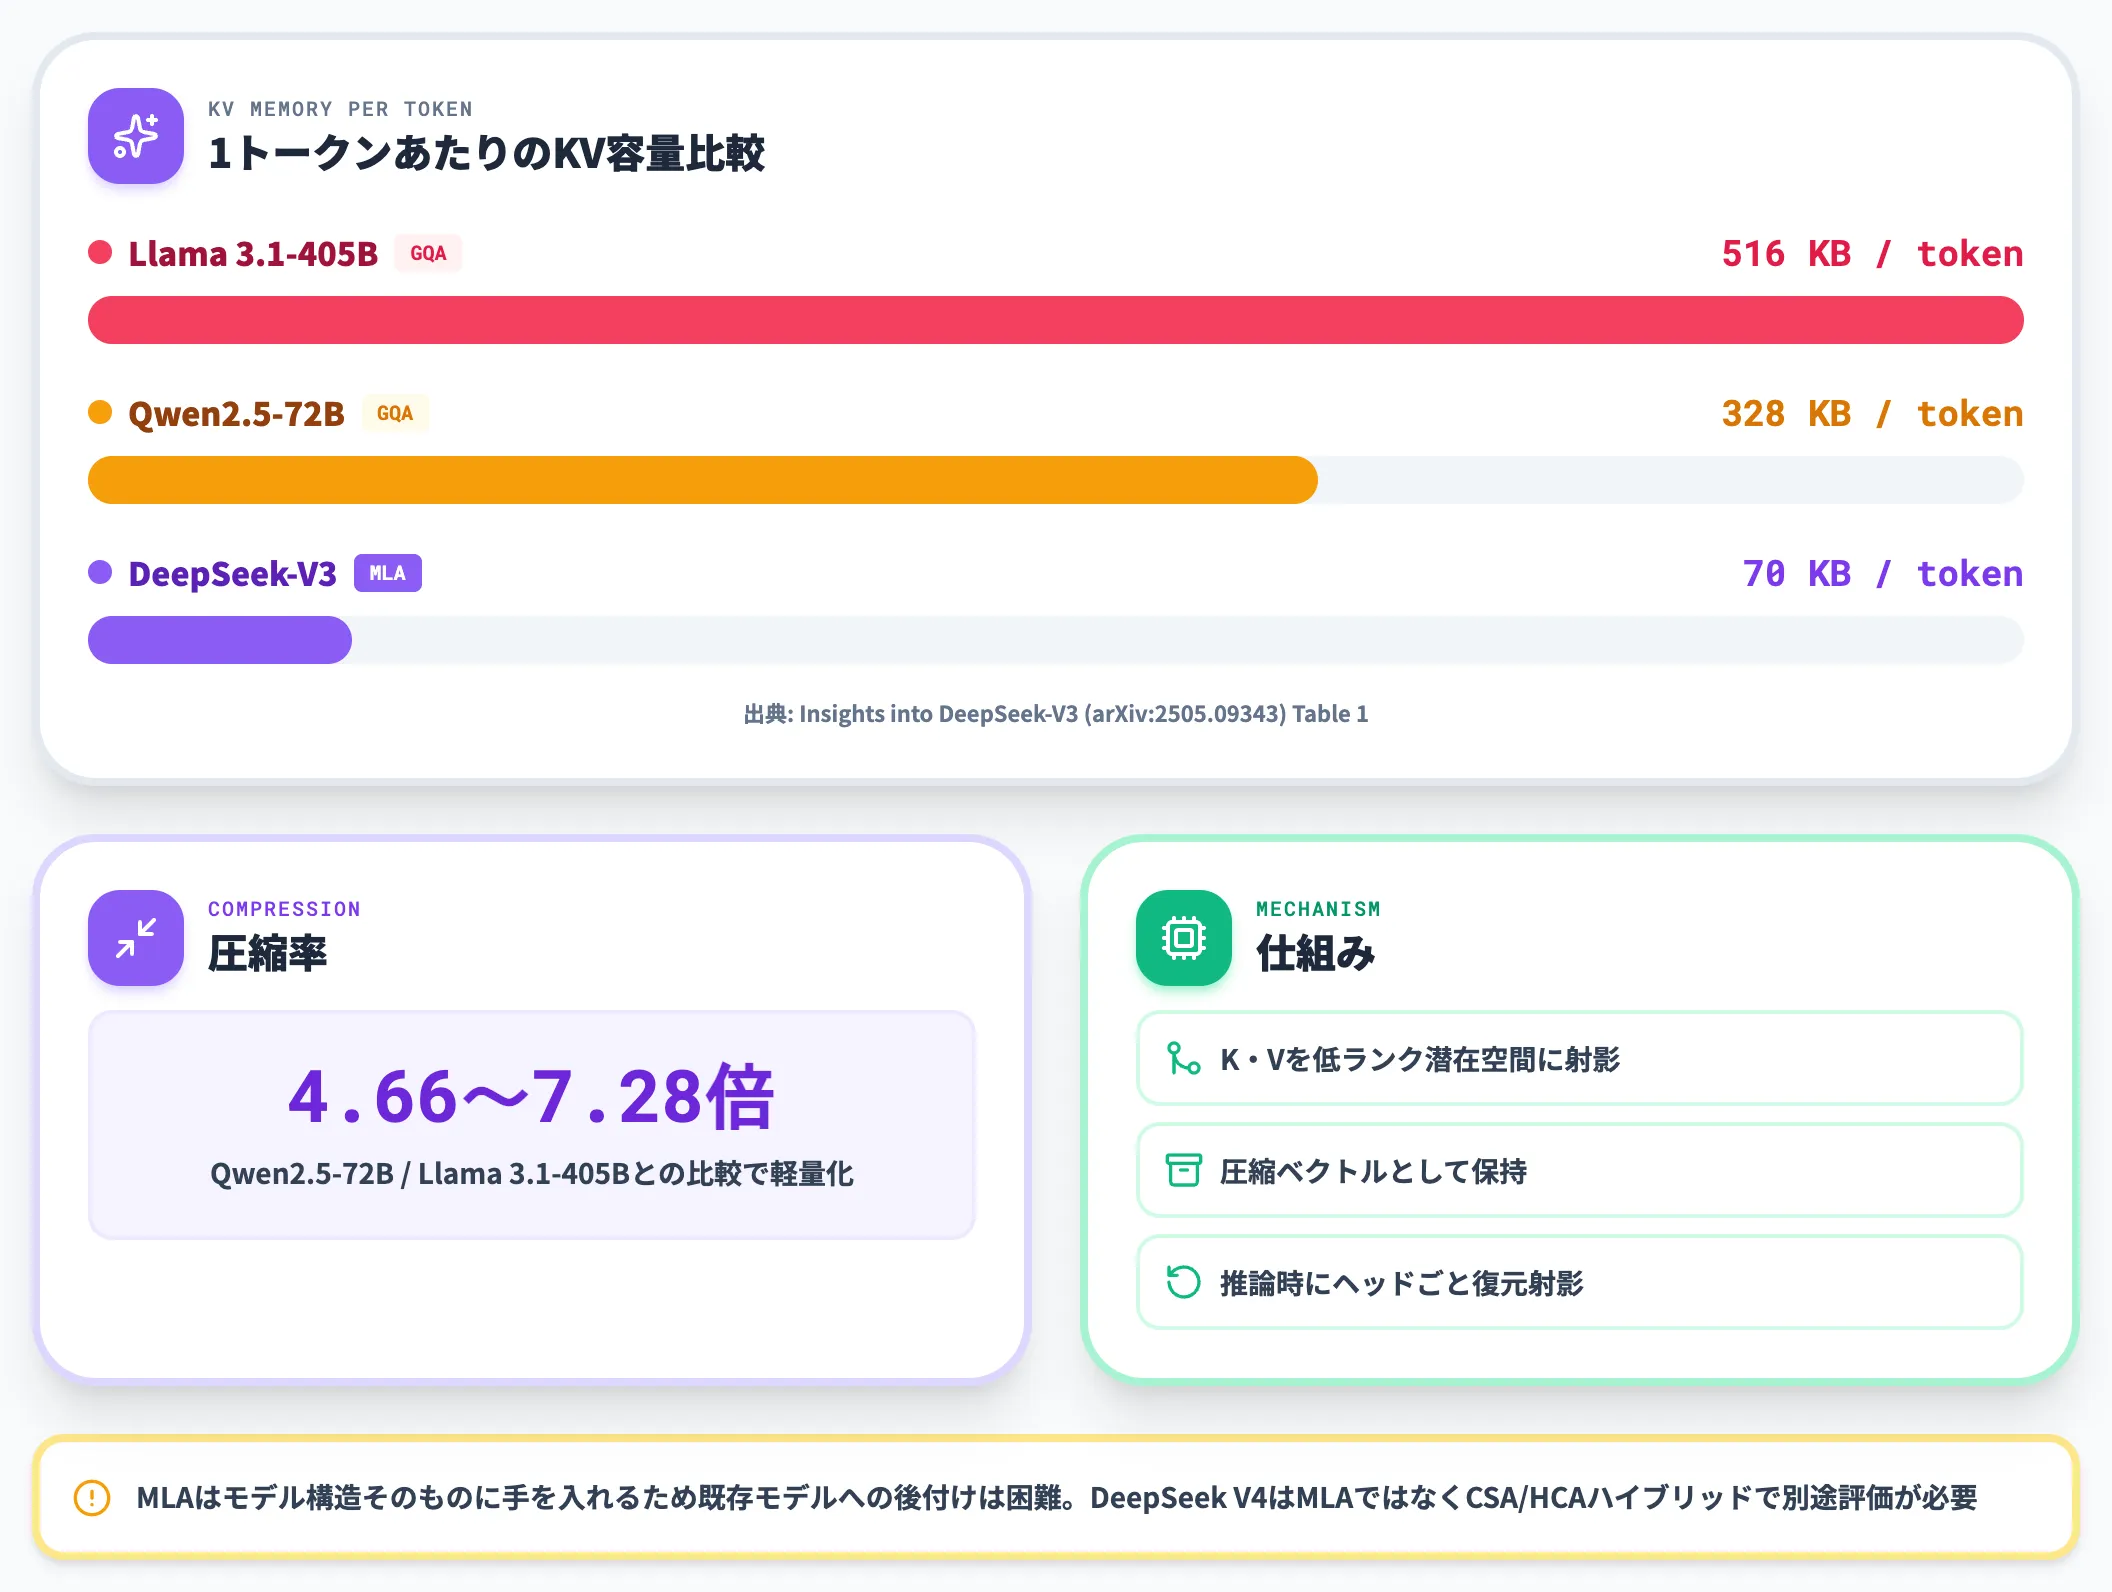
2024年末から急速に注目を集めているのが、DeepSeekがV3系で採用したMulti-head Latent Attention(MLA)です。
MLAは、KeyとValueをそのまま保持する代わりに、両者を共通の低ランク潜在空間に射影して圧縮ベクトルとして保持します。推論時にヘッドごとの復元射影を挟むことで、必要なKV情報を再構築する仕組みです。
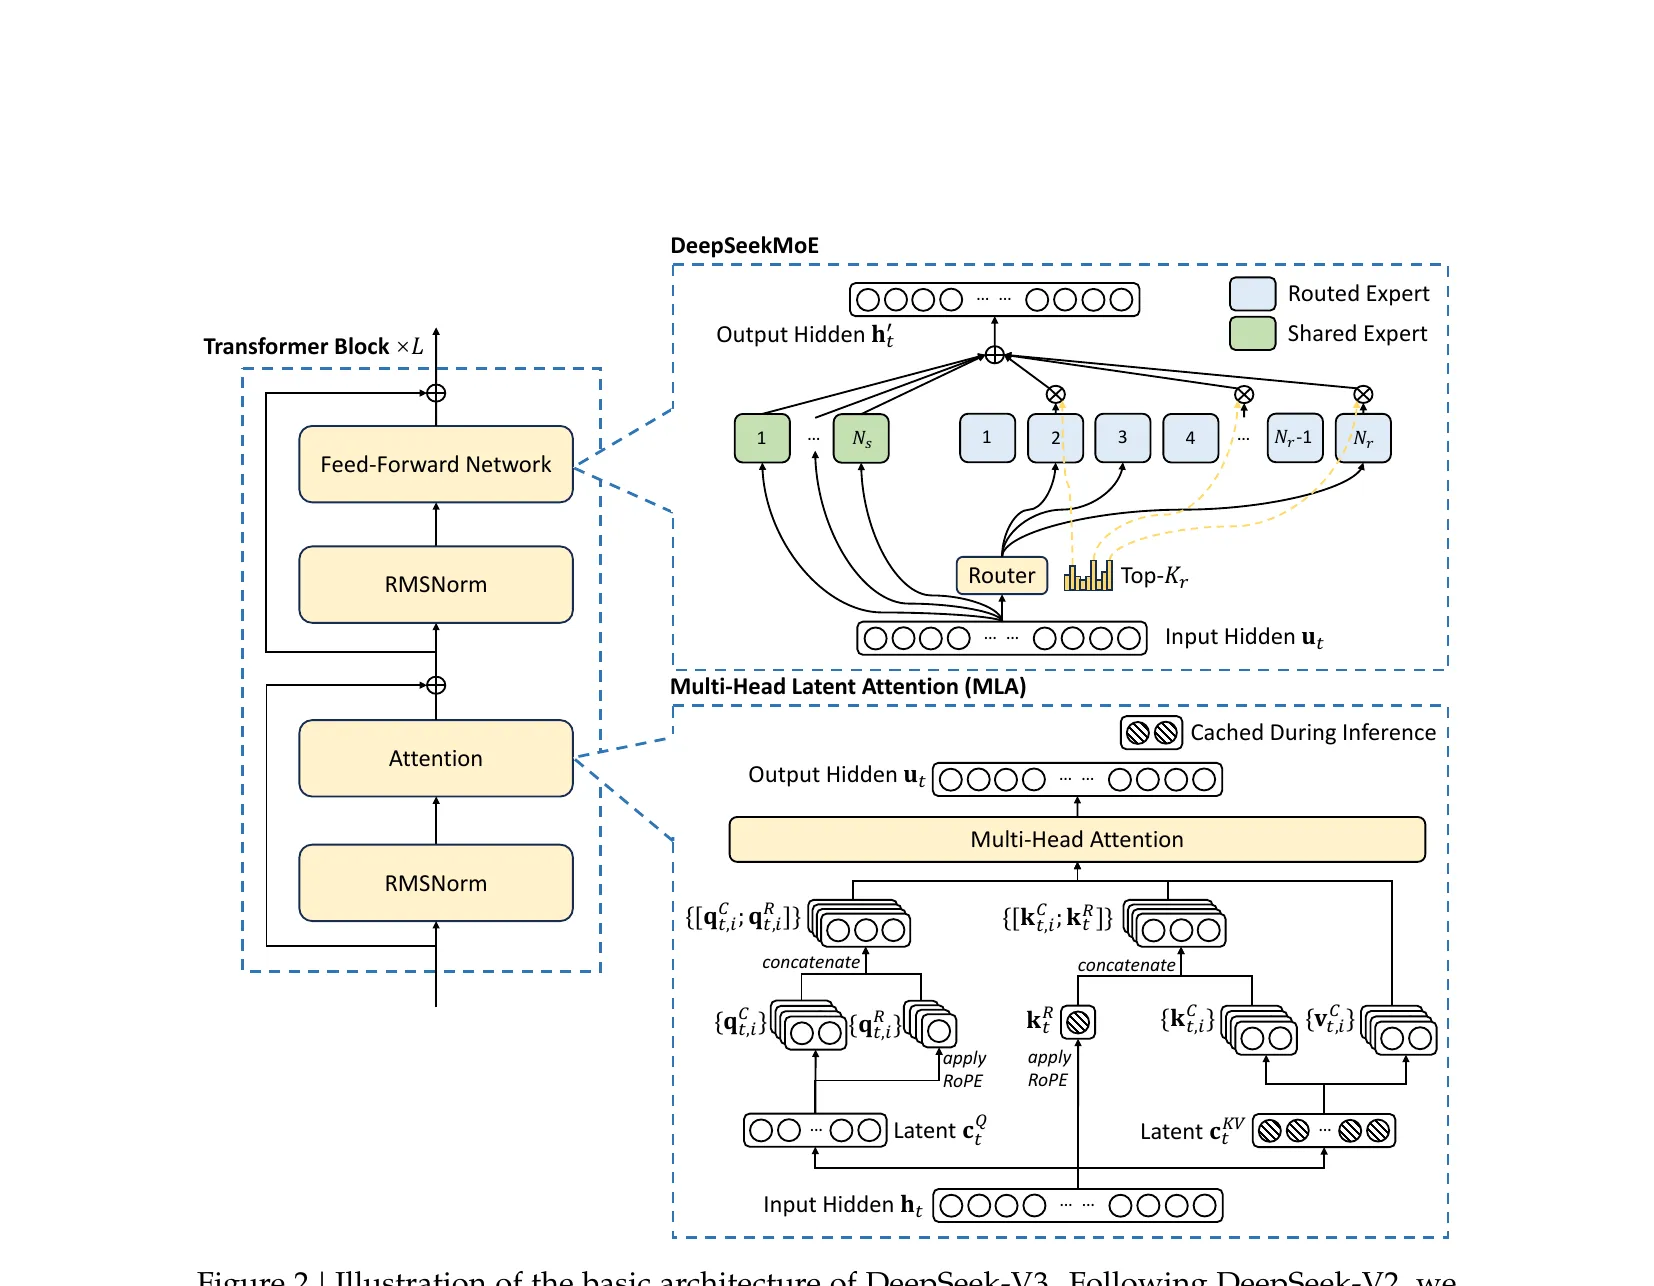
DeepSeek-V3のMulti-Head Latent Attention構造とCached During Inference位置(出典:DeepSeek-V3論文)
図の右下ブロックがMLAの内部で、下側のInput Hiddenから中央のLatent(青いバンド)への射影が KV圧縮の核になります。図中「Cached During Inference」と示された部分は、圧縮された潜在ベクトル(c_t^KV)とRoPE用に分離されたキー成分(k_t^R)を保持しており、Multi-Head Attentionが必要な瞬間にヘッドごとに復元されます。KV全体をそのまま持たず潜在表現+RoPE成分だけで済ませる設計が、後述する70KB/tokenまで絞り込む根拠です。
効果は明確で、DeepSeek-V3のMLAは1トークンあたり70.272KBのKVで済み、Insights into DeepSeek-V3論文(arXiv:2505.09343)Table 1ではGQA採用のQwen2.5-72Bが327.680KB/token、Llama 3.1-405Bが516.096KB/tokenを要するのに対して約4.66〜7.28倍の圧縮率と報告されています。長文コンテキストや大量並列で効くため、GPUメモリ制約が厳しい環境ほど採用価値が上がります。
一方でMLAはモデル構造そのものに手を入れるため、既存モデルへの後付けは容易ではありません。2026年時点ではDeepSeek-V3・V3.1・V3.2系がMLAを採用しており、他のオープンモデルでも研究レベルではMLA互換への変換手法が提案され始めています。なおDeepSeek V4はMLAではなくCSA/HCAを組み合わせたハイブリッドAttentionを採用しているため、KV削減効果はV3系とは別途評価する必要があります。
モデル選定時に「MHA/GQA/MLAのどれか」を確認することは、KVキャッシュ観点でのメモリ効率を予測するうえで避けて通れないチェック項目です。同じMoE構造のMoEモデル同士でも、KV設計の違いで運用コストが大きく変わります。
メモリ管理と量子化でKVを圧縮する3手法(PagedAttention・KV量子化・TurboQuant)
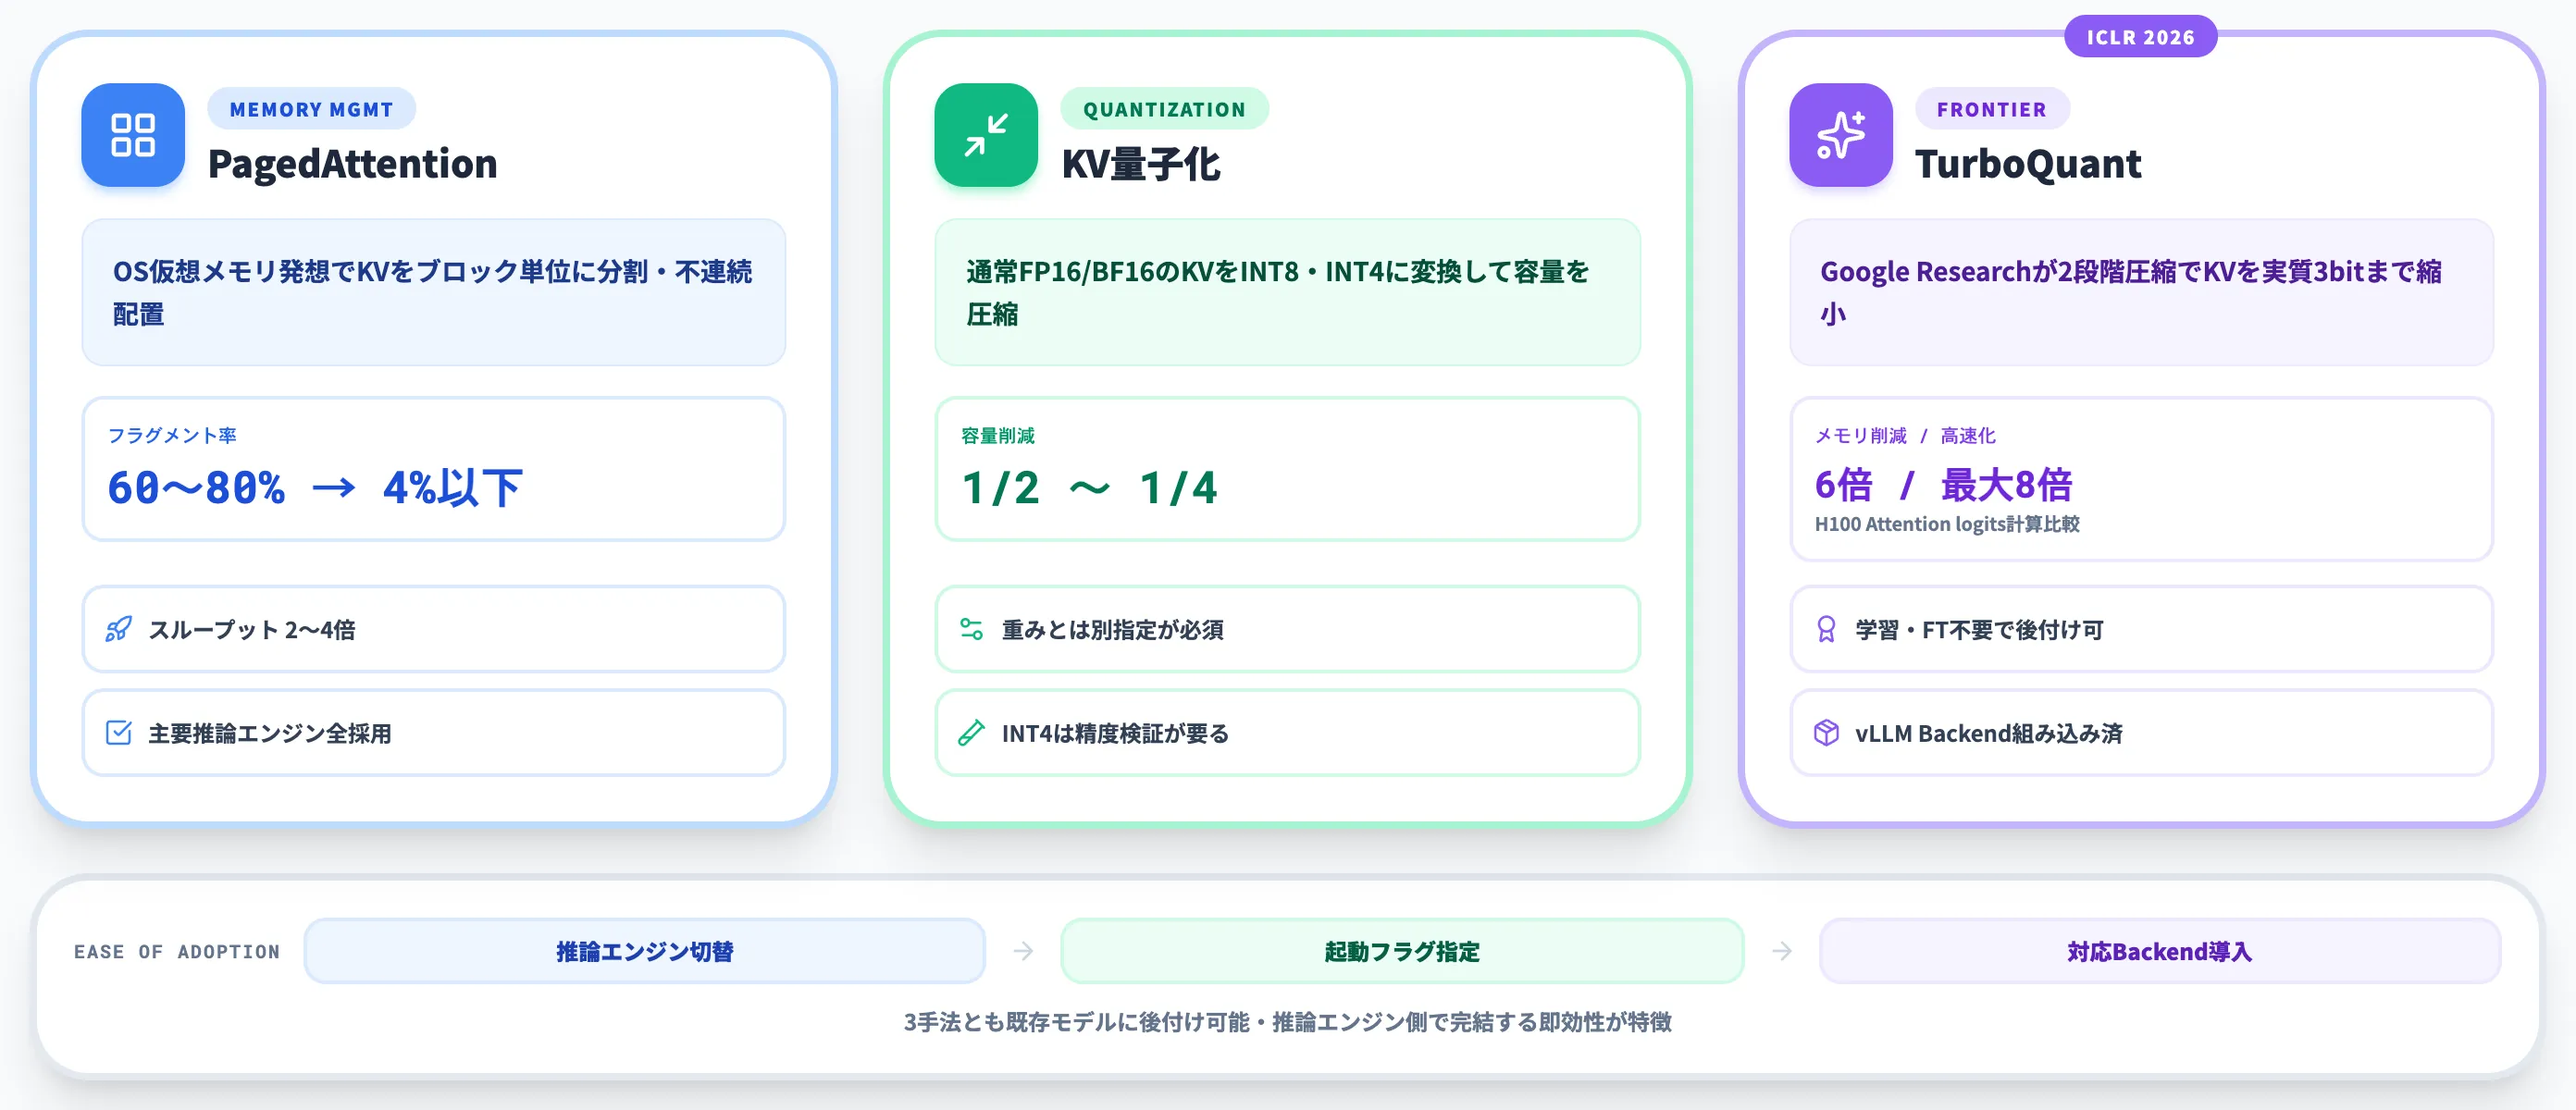
削減の第2層は、モデル構造は触らずに「保持しているKVをどう詰めるか」を最適化するアプローチです。既存モデルに対して推論エンジン側で適用できるため、実装コストが低く即効性があります。
PagedAttention——OS仮想メモリ発想でフラグメントを4%以下に
PagedAttentionは、vLLMプロジェクトがSOSP 2023で発表したメモリ管理アルゴリズムで、OSの仮想メモリ・ページングの発想をKVキャッシュに持ち込んだものです。
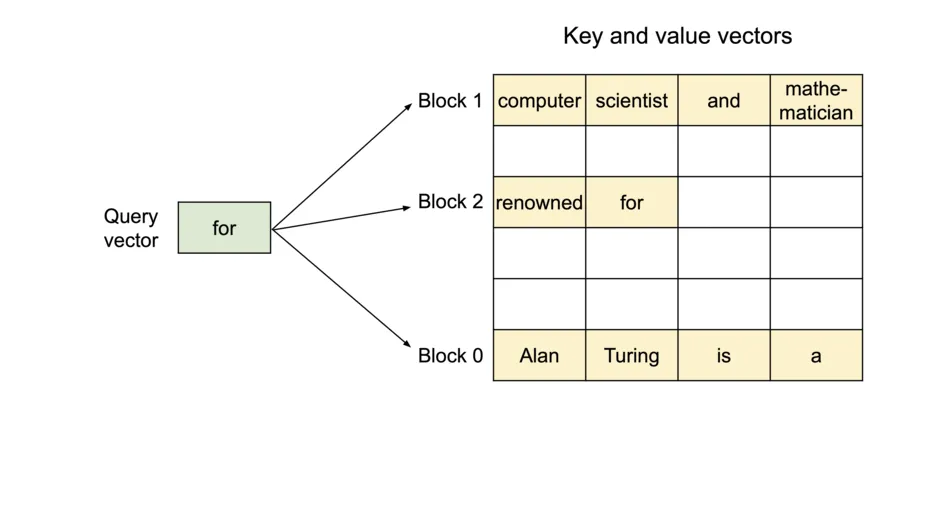
Query vectorがBlock単位に分割されたKey/Valueへアクセスする様子(出典:vLLM公式blog)
図では、生成中のトークン「for」が過去のトークン列「Alan Turing is a renowned computer scientist and mathematician」に対応するKey/Valueをブロック単位で参照している構造が見えます。Block 0/1/2は物理メモリ上で連続している必要がなく、リクエストごとに空きブロックを飛び飛びに使えるため、KVを長さの異なるリクエストで安全に詰め込めます。
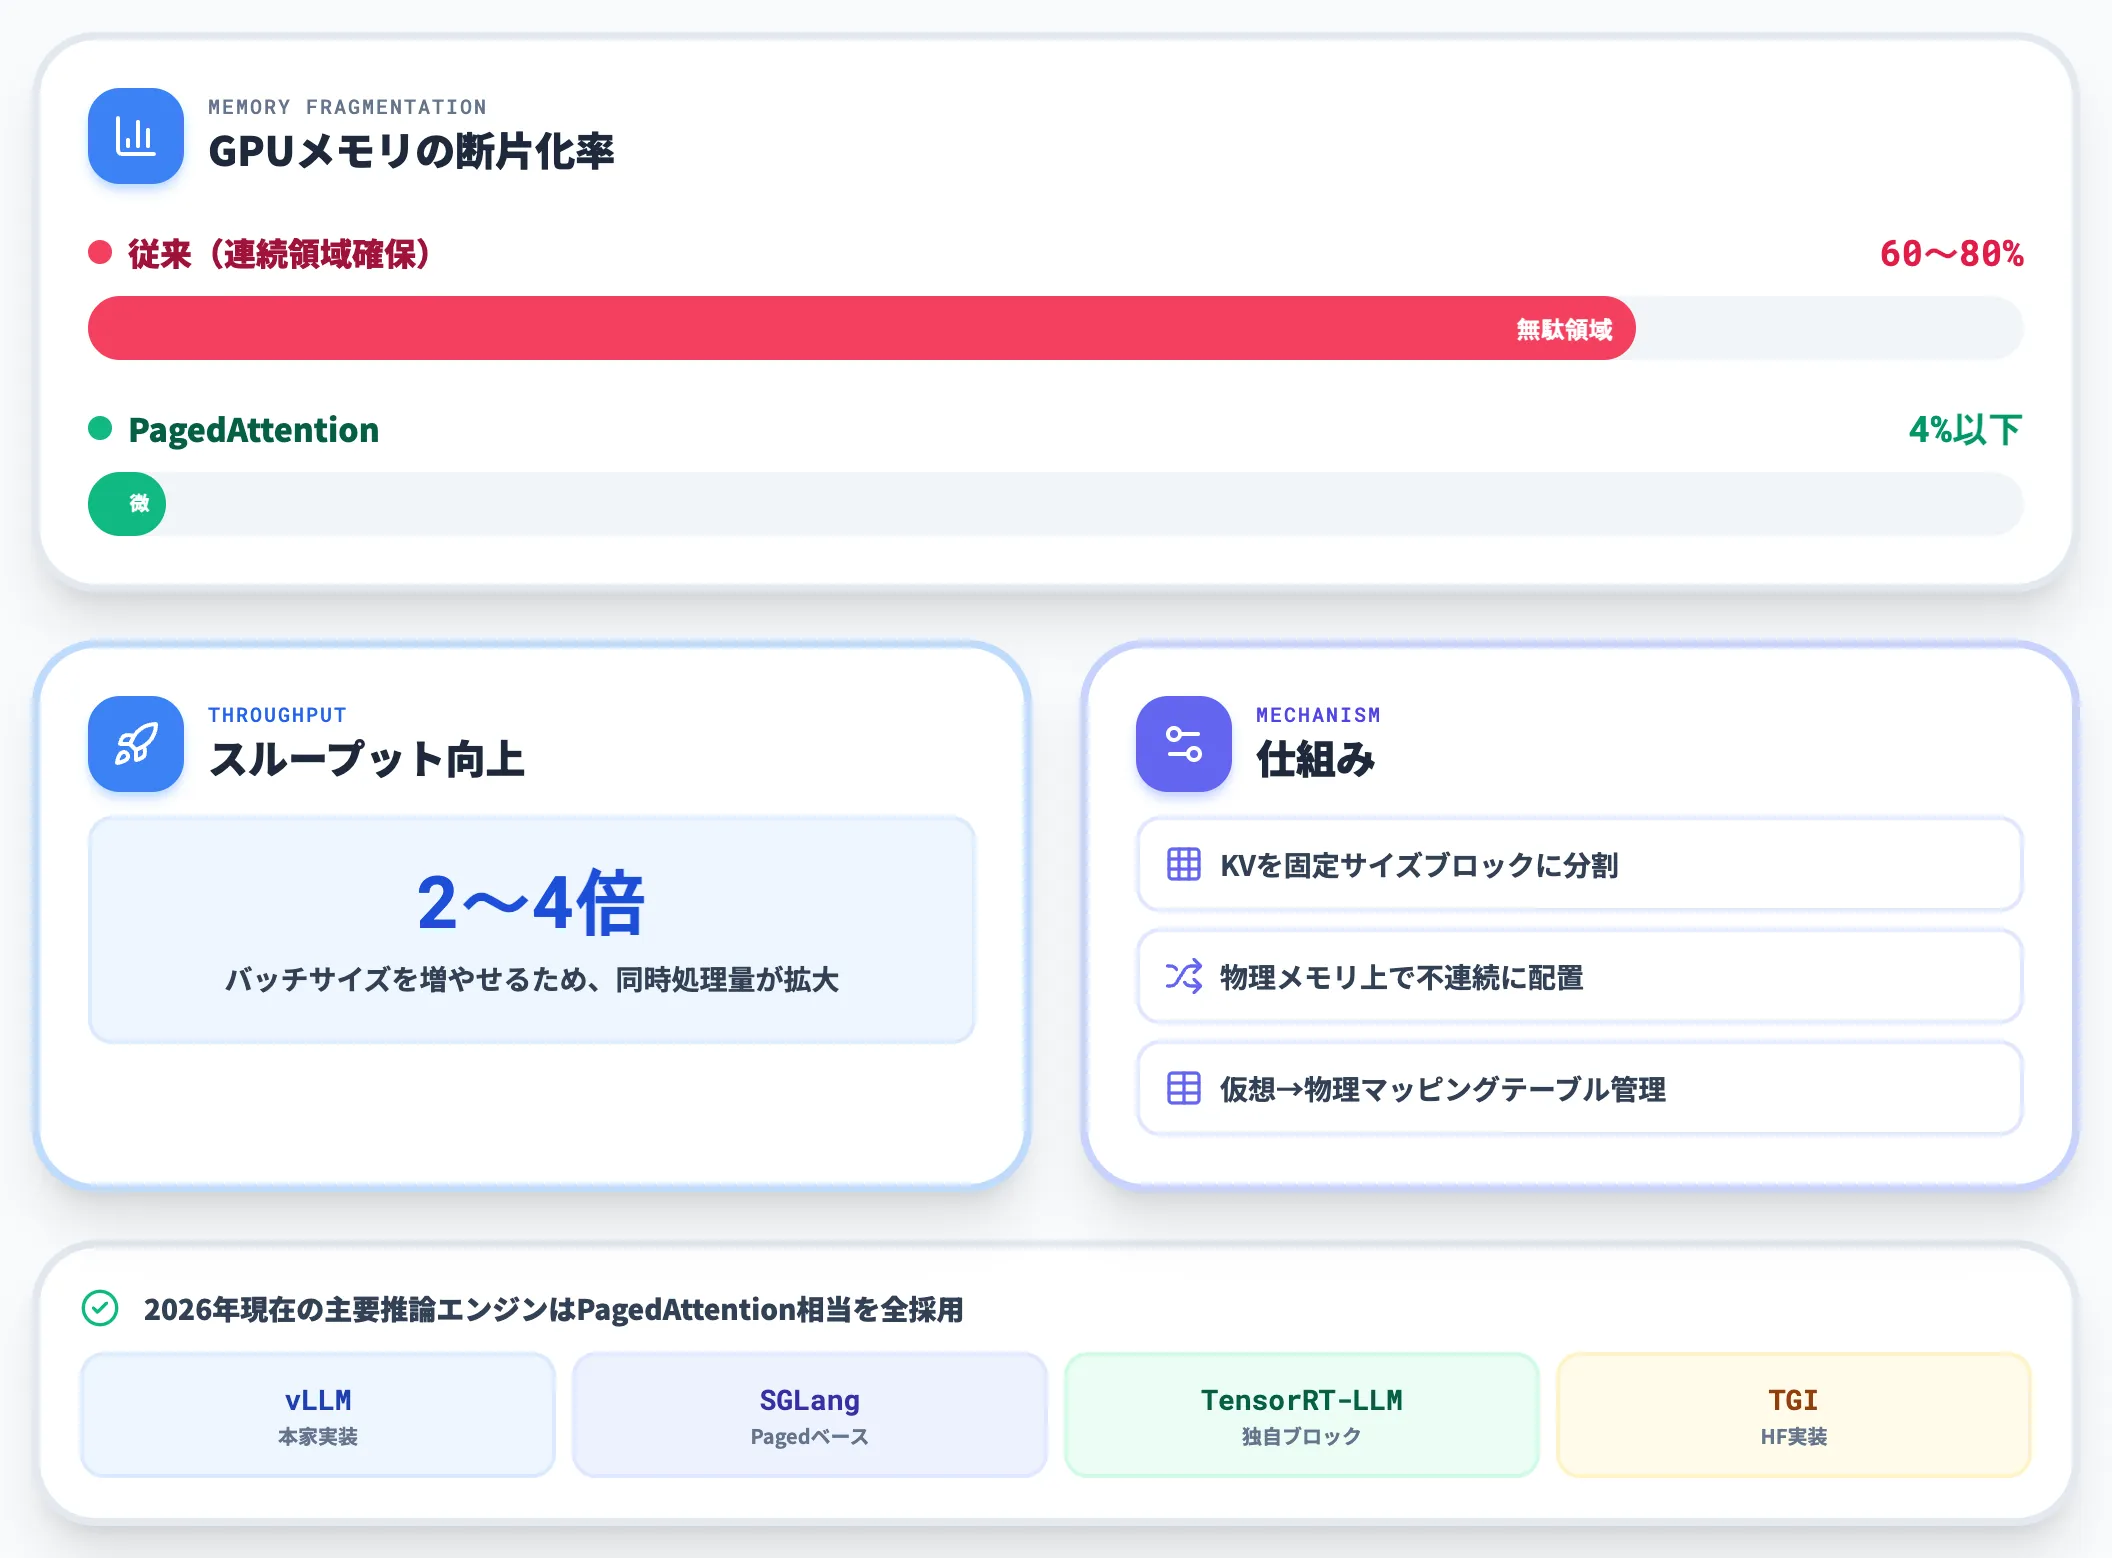
従来のKVキャッシュは「1リクエスト分をまとめて連続領域に確保」する設計だったため、リクエストの長さがまちまちだとGPUメモリに大きな断片が発生していました。実測で60〜80%が無駄になっているケースもあった、と論文中で報告されています。
PagedAttentionはKVキャッシュを固定サイズのブロックに分割し、物理メモリ上で不連続に配置できるようにします。仮想アドレス↔物理ブロックのマッピングテーブルで管理するため、フラグメントは4%以下に抑えられ、同時に扱えるバッチサイズが増えてスループットは2〜4倍に改善します。
現在の推論エンジンの主流であるvLLM・SGLang・TensorRT-LLM・TGIはいずれも、PagedAttention相当のブロック単位管理を採用しています。
KVキャッシュ量子化——4bit・8bitで容量を半減以下に
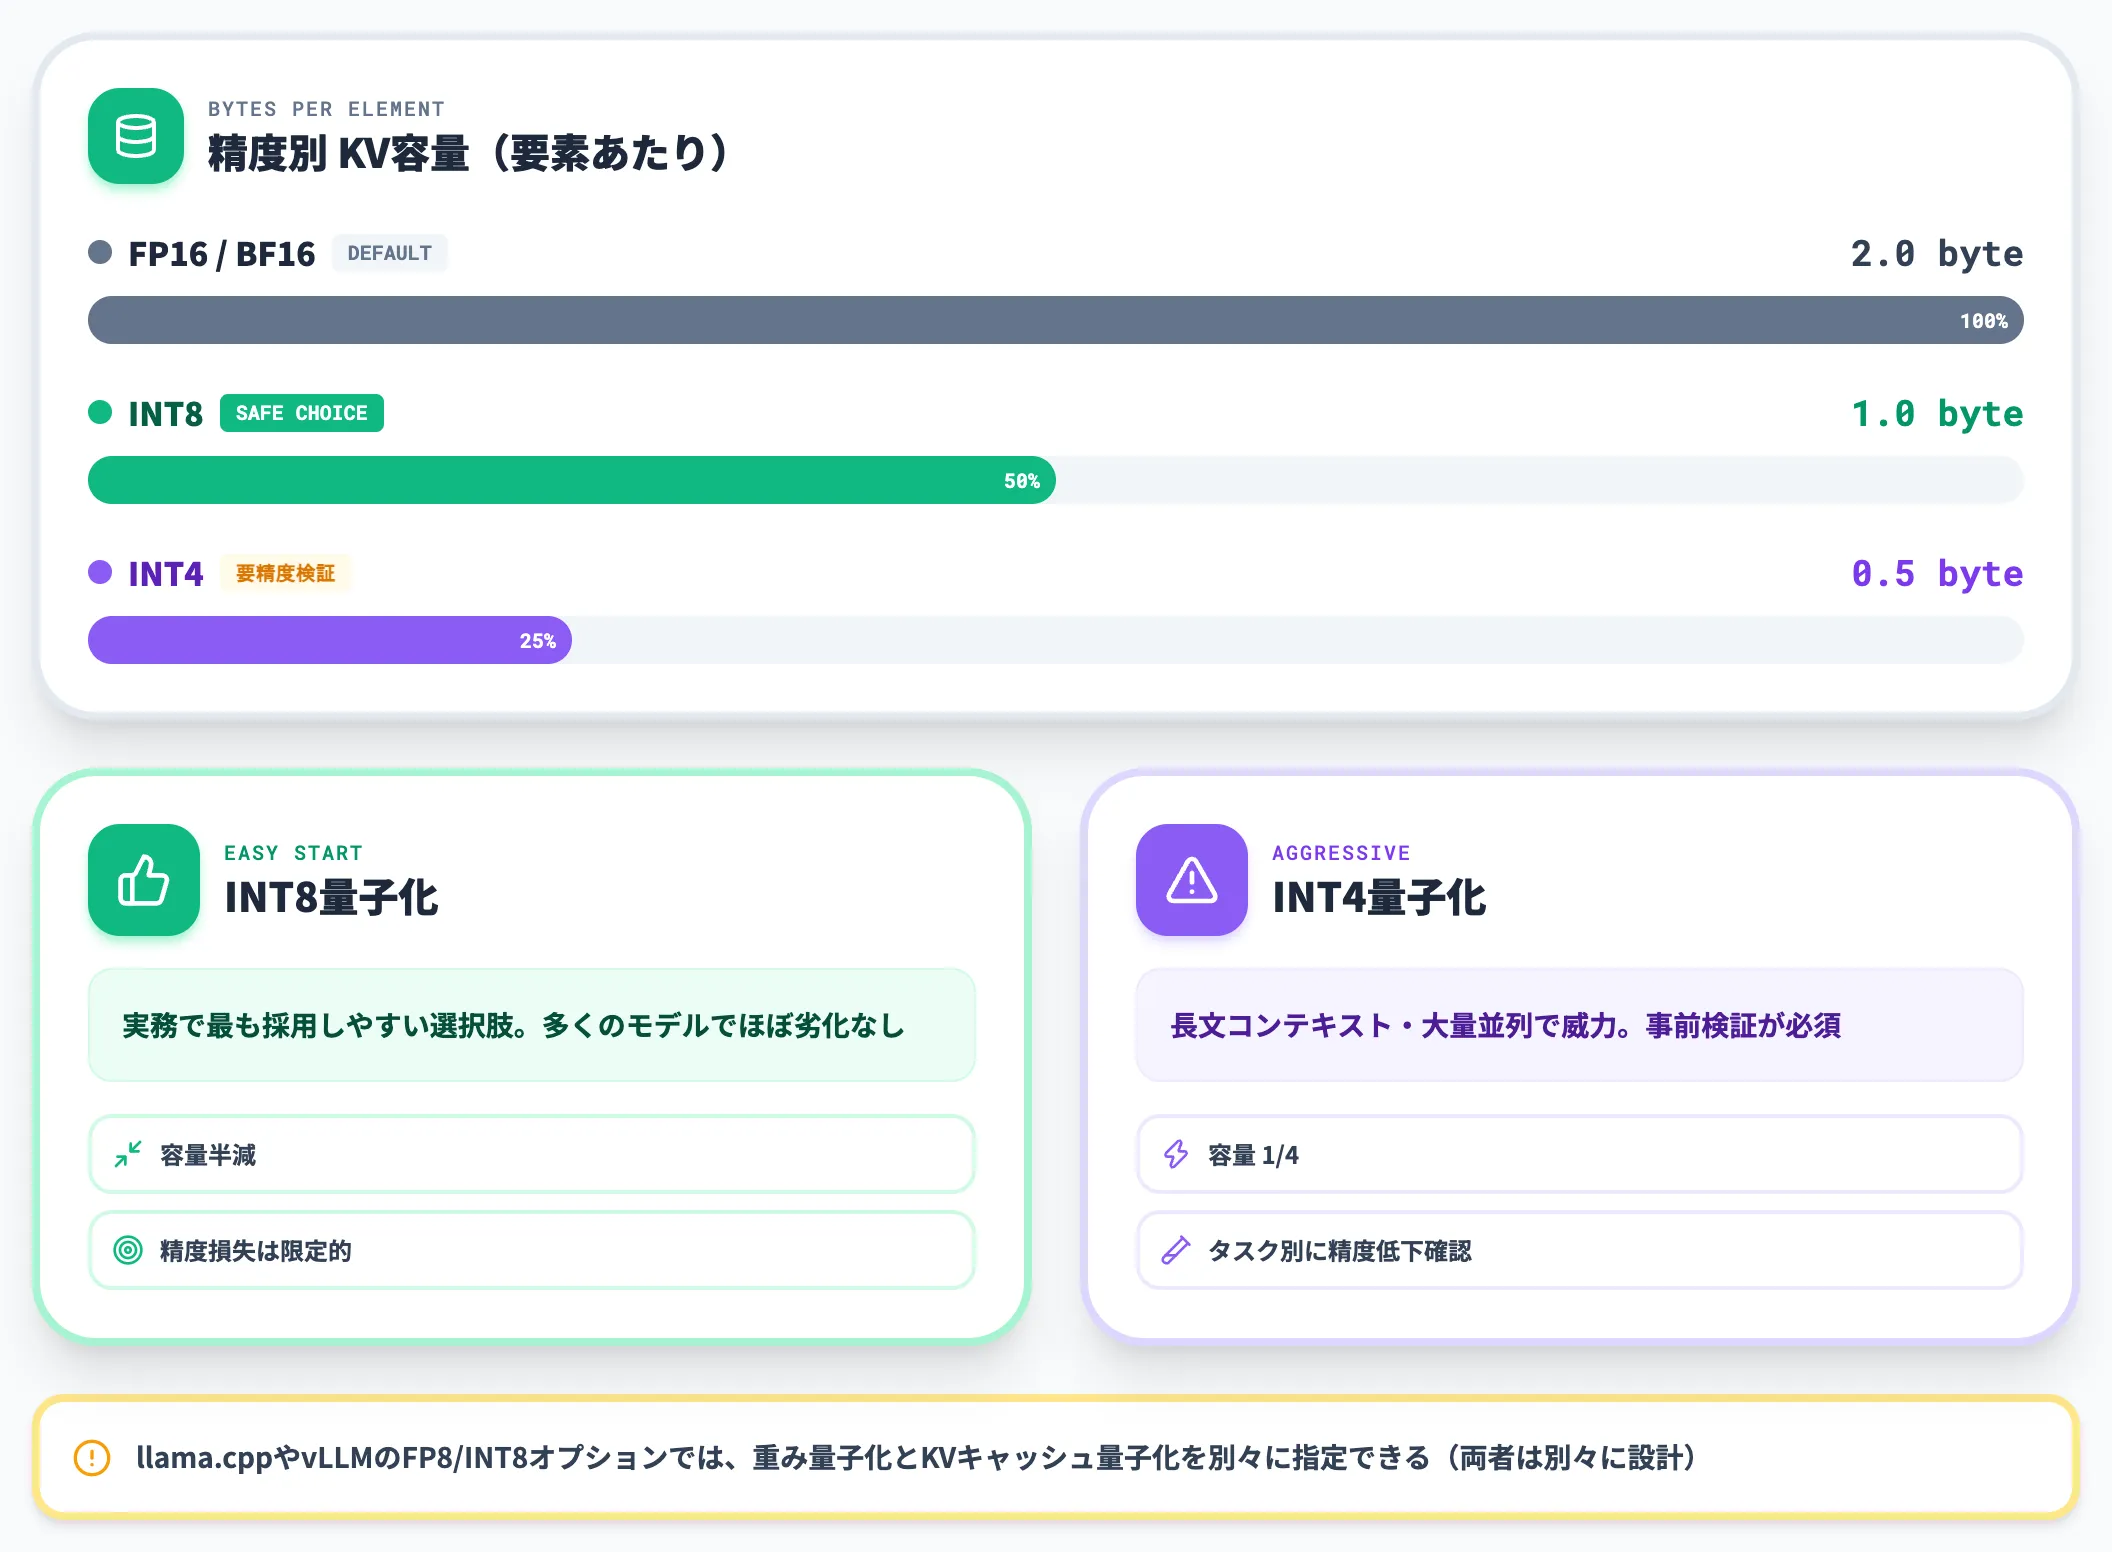
KVキャッシュは通常FP16/BF16(2バイト/要素)で保持されますが、これをINT8(1バイト)やINT4(0.5バイト)に量子化すれば、単純に容量を半分以下に削減できます。
-
INT8量子化
容量が半分になり、精度損失も限定的なため、実務で最も採用しやすい選択肢。多くのモデルで「実効的にはほぼ劣化なし」で運用できる。
-
INT4量子化
容量が1/4になり、長文コンテキストや大量並列で威力を発揮。ただしタスクによっては精度低下が観察されるため、事前に自社ユースケースでの検証が必要。
llama.cppのllama-benchや、vLLMのFP8/INT8 KVキャッシュオプションでは、量子化タイプを重みとは別に指定できます。重みを4bit量子化してもKVキャッシュがFP16のままだと結局メモリが足りない、という失敗を避けるため、両者は別々に設計する必要があります。
TurboQuant——3bit量子化でメモリ6倍削減・H100でAttention logits計算が最大8倍高速化
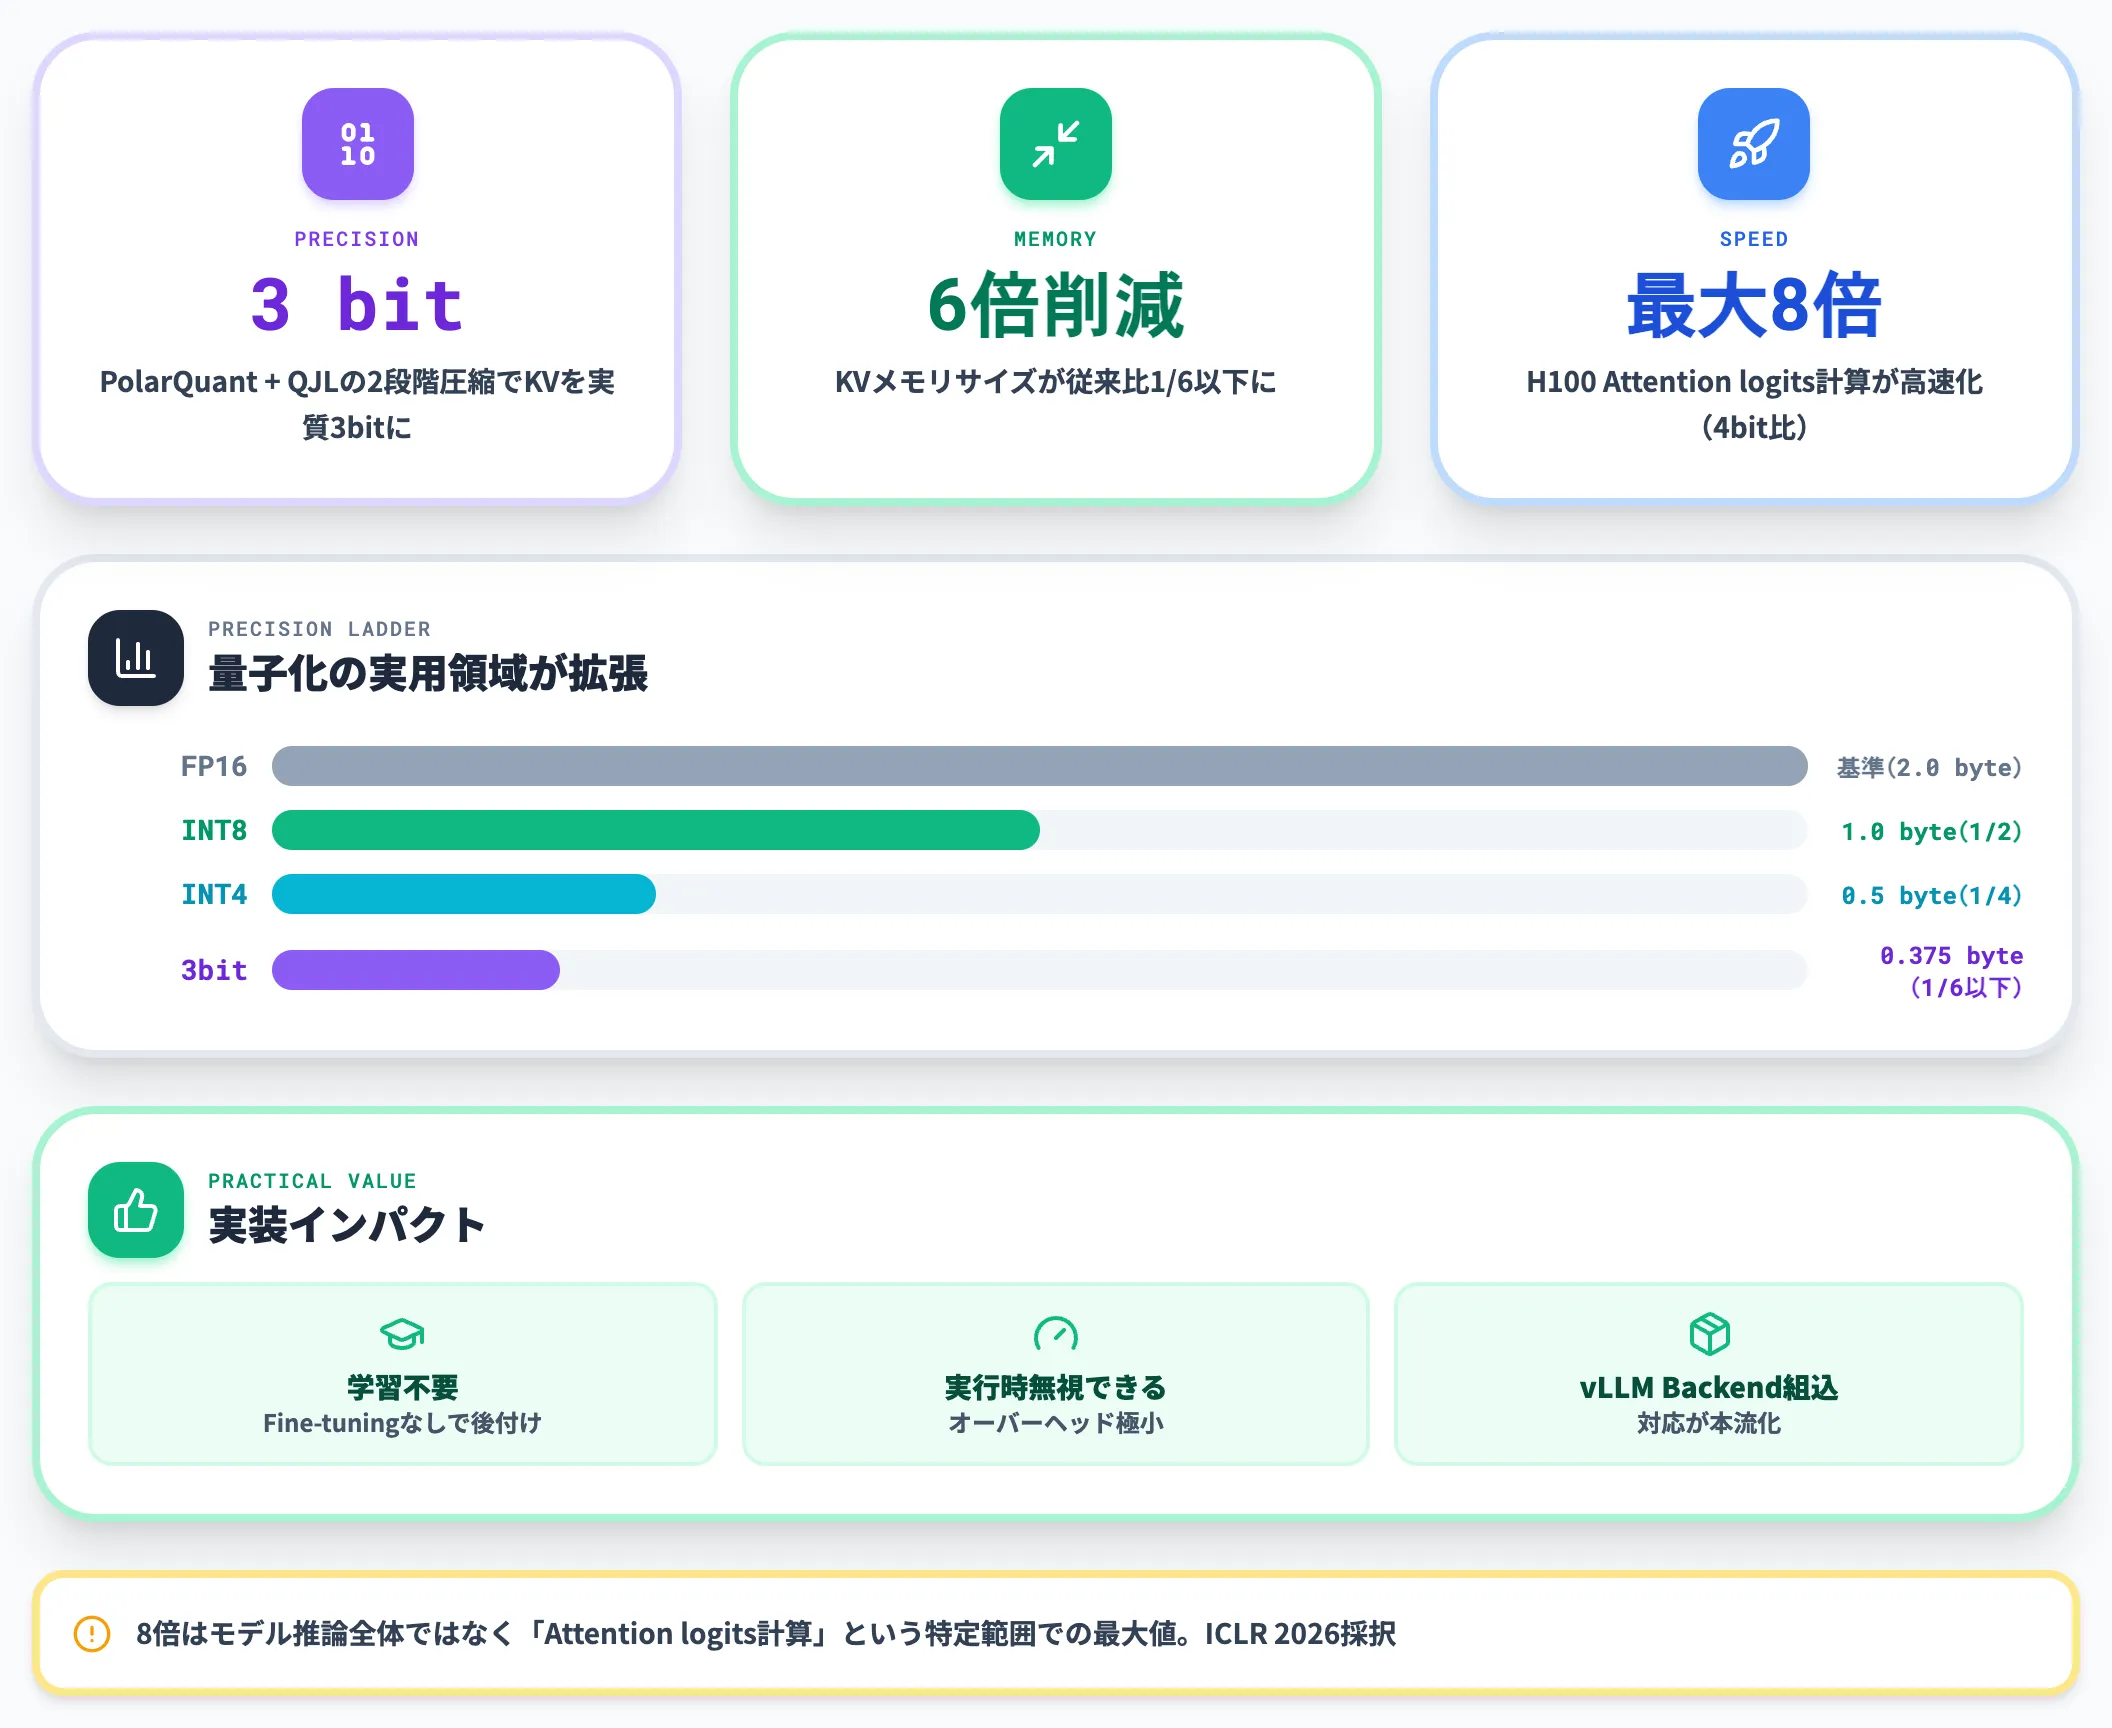
2026年の最新動向として押さえておきたいのが、Google Researchが発表したTurboQuantです。ICLR 2026で発表された量子化アルゴリズムで、PolarQuantとQJLを組み合わせた2段階の圧縮でKVキャッシュを実質3bitまで圧縮します。
Google Researchが2026年3月24日に公開した公式ブログでは、標準ベンチマーク上で精度低下がほぼゼロのままKVメモリサイズが6分の1以下、NVIDIA H100上のAttention logits計算が非量子化32bit Keyと比較して最大8倍高速化(4bit TurboQuant適用時)と報告されています。モデル推論全体が8倍になるわけではなく、Attention logits計算という特定範囲での最大値である点に注意が要ります。
「学習不要・ファインチューニング不要・実行時オーバーヘッド無視できるレベル」で成立している点が実務上インパクトが大きく、既存モデルにそのまま後付けできる想定です。推論エンジン側の対応も進んでおり、vLLM本体にはTurboQuant Backendが組み込まれ、コミュニティもPyTorch・Triton向けの実装やllama.cpp向けの検討を進めています。
TurboQuantの登場で、量子化はINT8・INT4に加えて3bitまで実用領域が広がりました。長文コンテキスト運用のコスト構造そのものを変える技術として、次世代の推論エンジンに組み込まれていく流れです。TurboQuantの詳細な仕組みや対応状況はGoogle TurboQuantとは?KVキャッシュ圧縮の仕組みやGPTQとの違いを解説で扱っています。
推論エンジン別のKV再利用戦略(Prefix Caching・RadixAttention)
削減の第3層は、1リクエスト内で完結せず「複数リクエスト間・複数ターン間でKVを再利用する」アプローチです。同じシステムプロンプトや会話履歴を何度も送るケースで、Prefill時間そのものを消せる効果があります。
Prefix Caching——共通プレフィックスを自動で使い回す
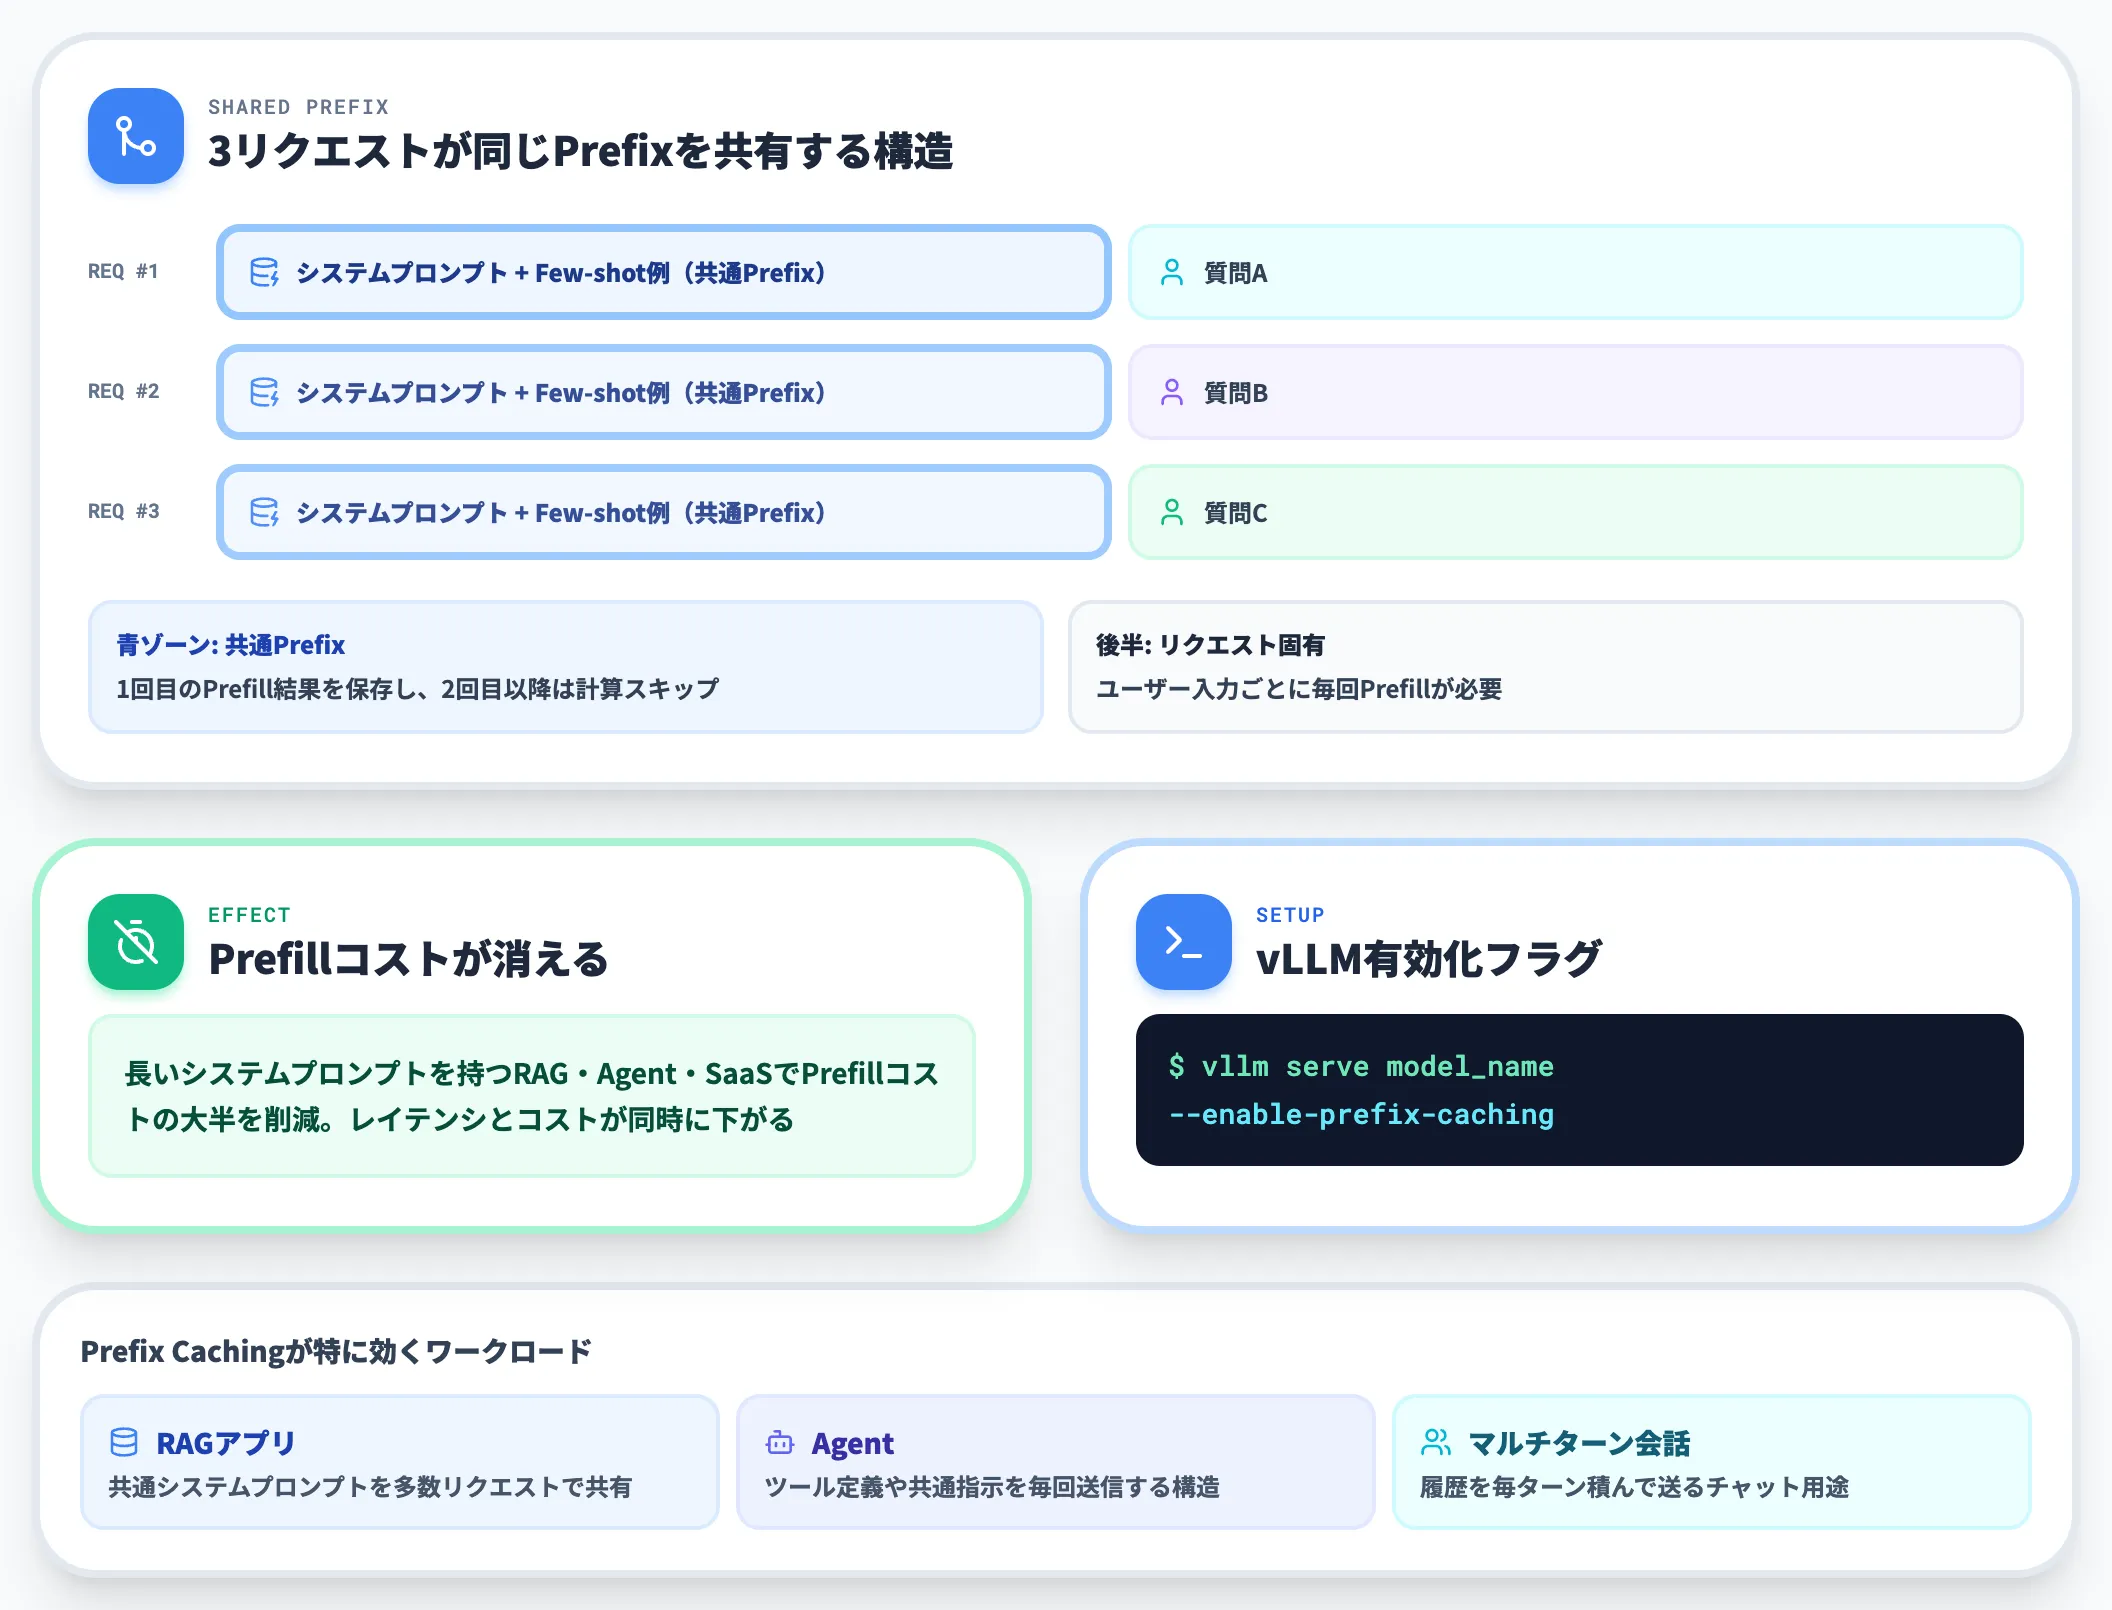
Prefix Cachingは、リクエスト間で共通する先頭部分(システムプロンプト・共通の指示・共通のFew-shot例)を検出し、そのKVキャッシュを次のリクエストで再利用する仕組みです。vLLMでは--enable-prefix-cachingフラグで有効化できます。
長いシステムプロンプトを持つRAGアプリやAgentのように、多数のリクエストが同じ先頭を共有するケースでは、Prefillコストの大半を消せます。
Prefix Cachingが効くワークロード(マルチターン会話・共通システムプロンプトを使うSaaS用途)では、Prefill時間の削減がそのままレイテンシ・コストの改善につながります。効果はワークロード次第ですが、Agent用途・RAG用途では最も費用対効果の高い最適化の1つです。
RadixAttention——SGLangのRadix treeでマルチターンを最適化
RadixAttentionは、SGLangが提案・実装したPrefix Cachingの発展形で、キャッシュ済みのKVをRadix tree(基数木)で管理する方式です。
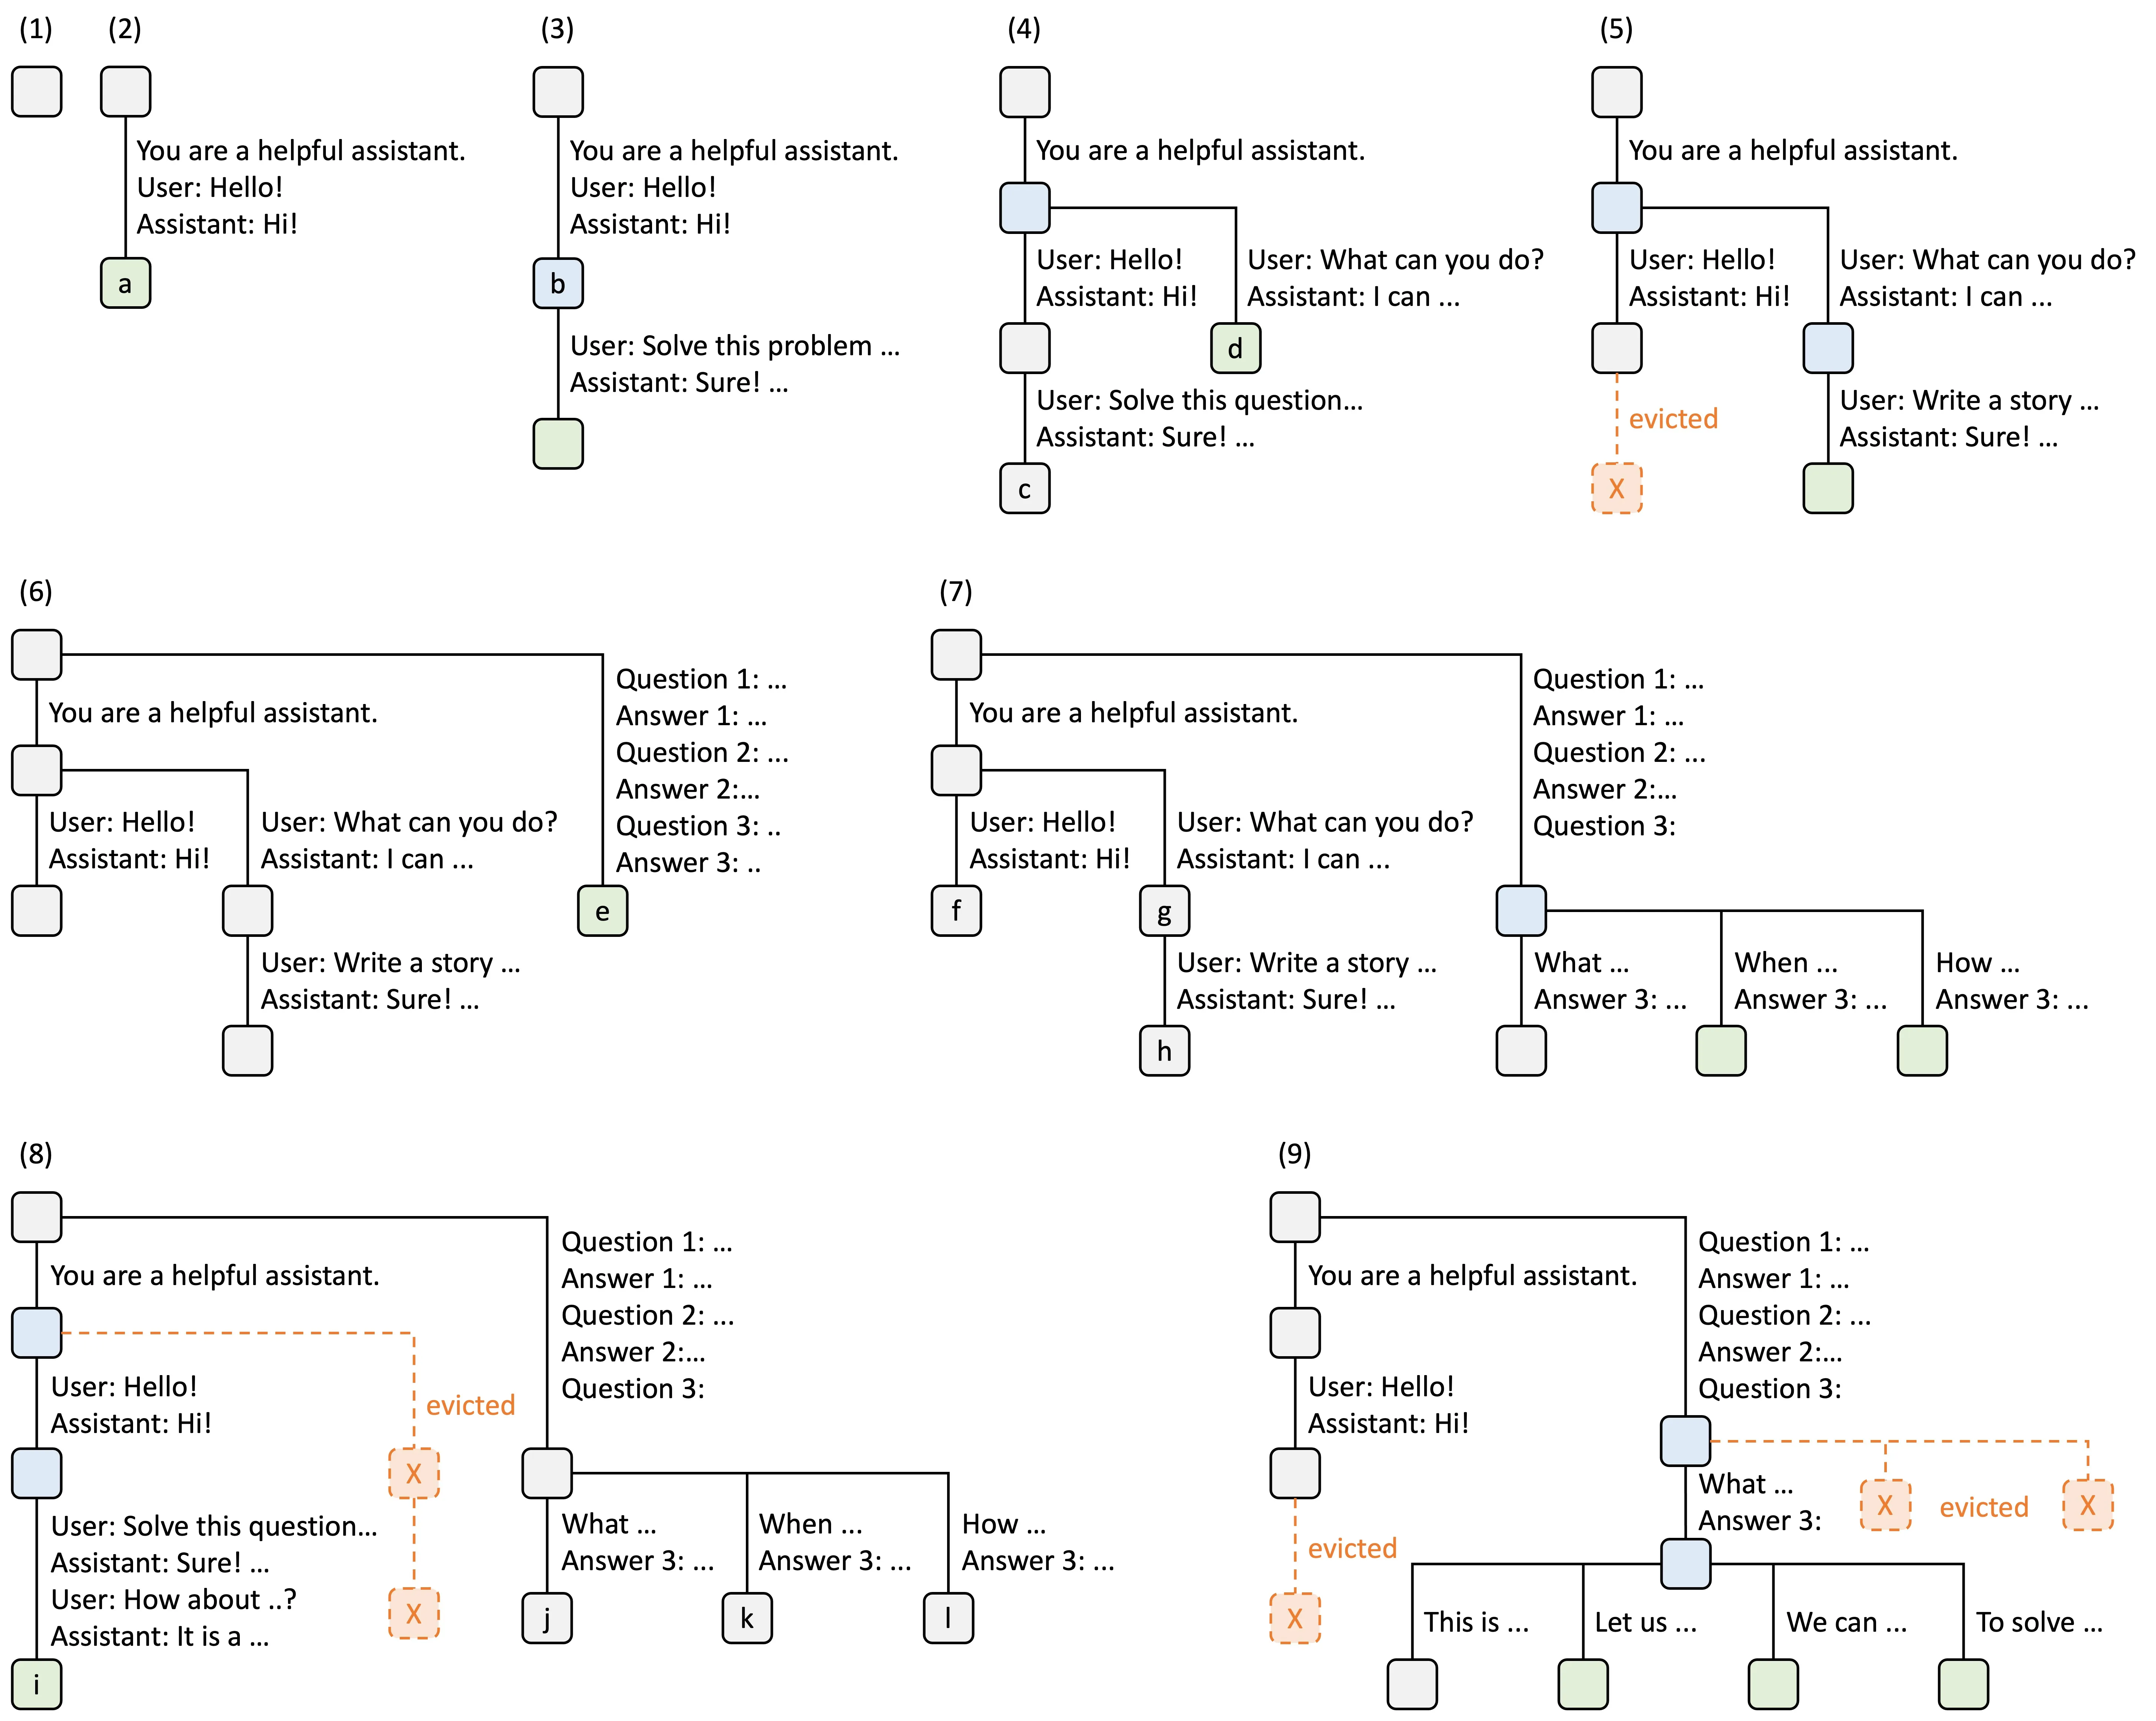
RadixAttentionのRadix treeが会話履歴とともに成長・evictされる9段階の状態遷移(出典:LMSYS Org公式blog)
図の(1)から(9)までの9段階は、Radix treeが会話履歴を溜め込みながらevictionしていく様子を示しています。共通のシステムプロンプト「You are a helpful assistant.」を全リクエストで共有しつつ、ユーザーごとの会話・タスク文脈は枝分かれで保持され、キャッシュ容量が上限に達すると使われていない葉ノードから順にevict(追い出し)される仕組みです。
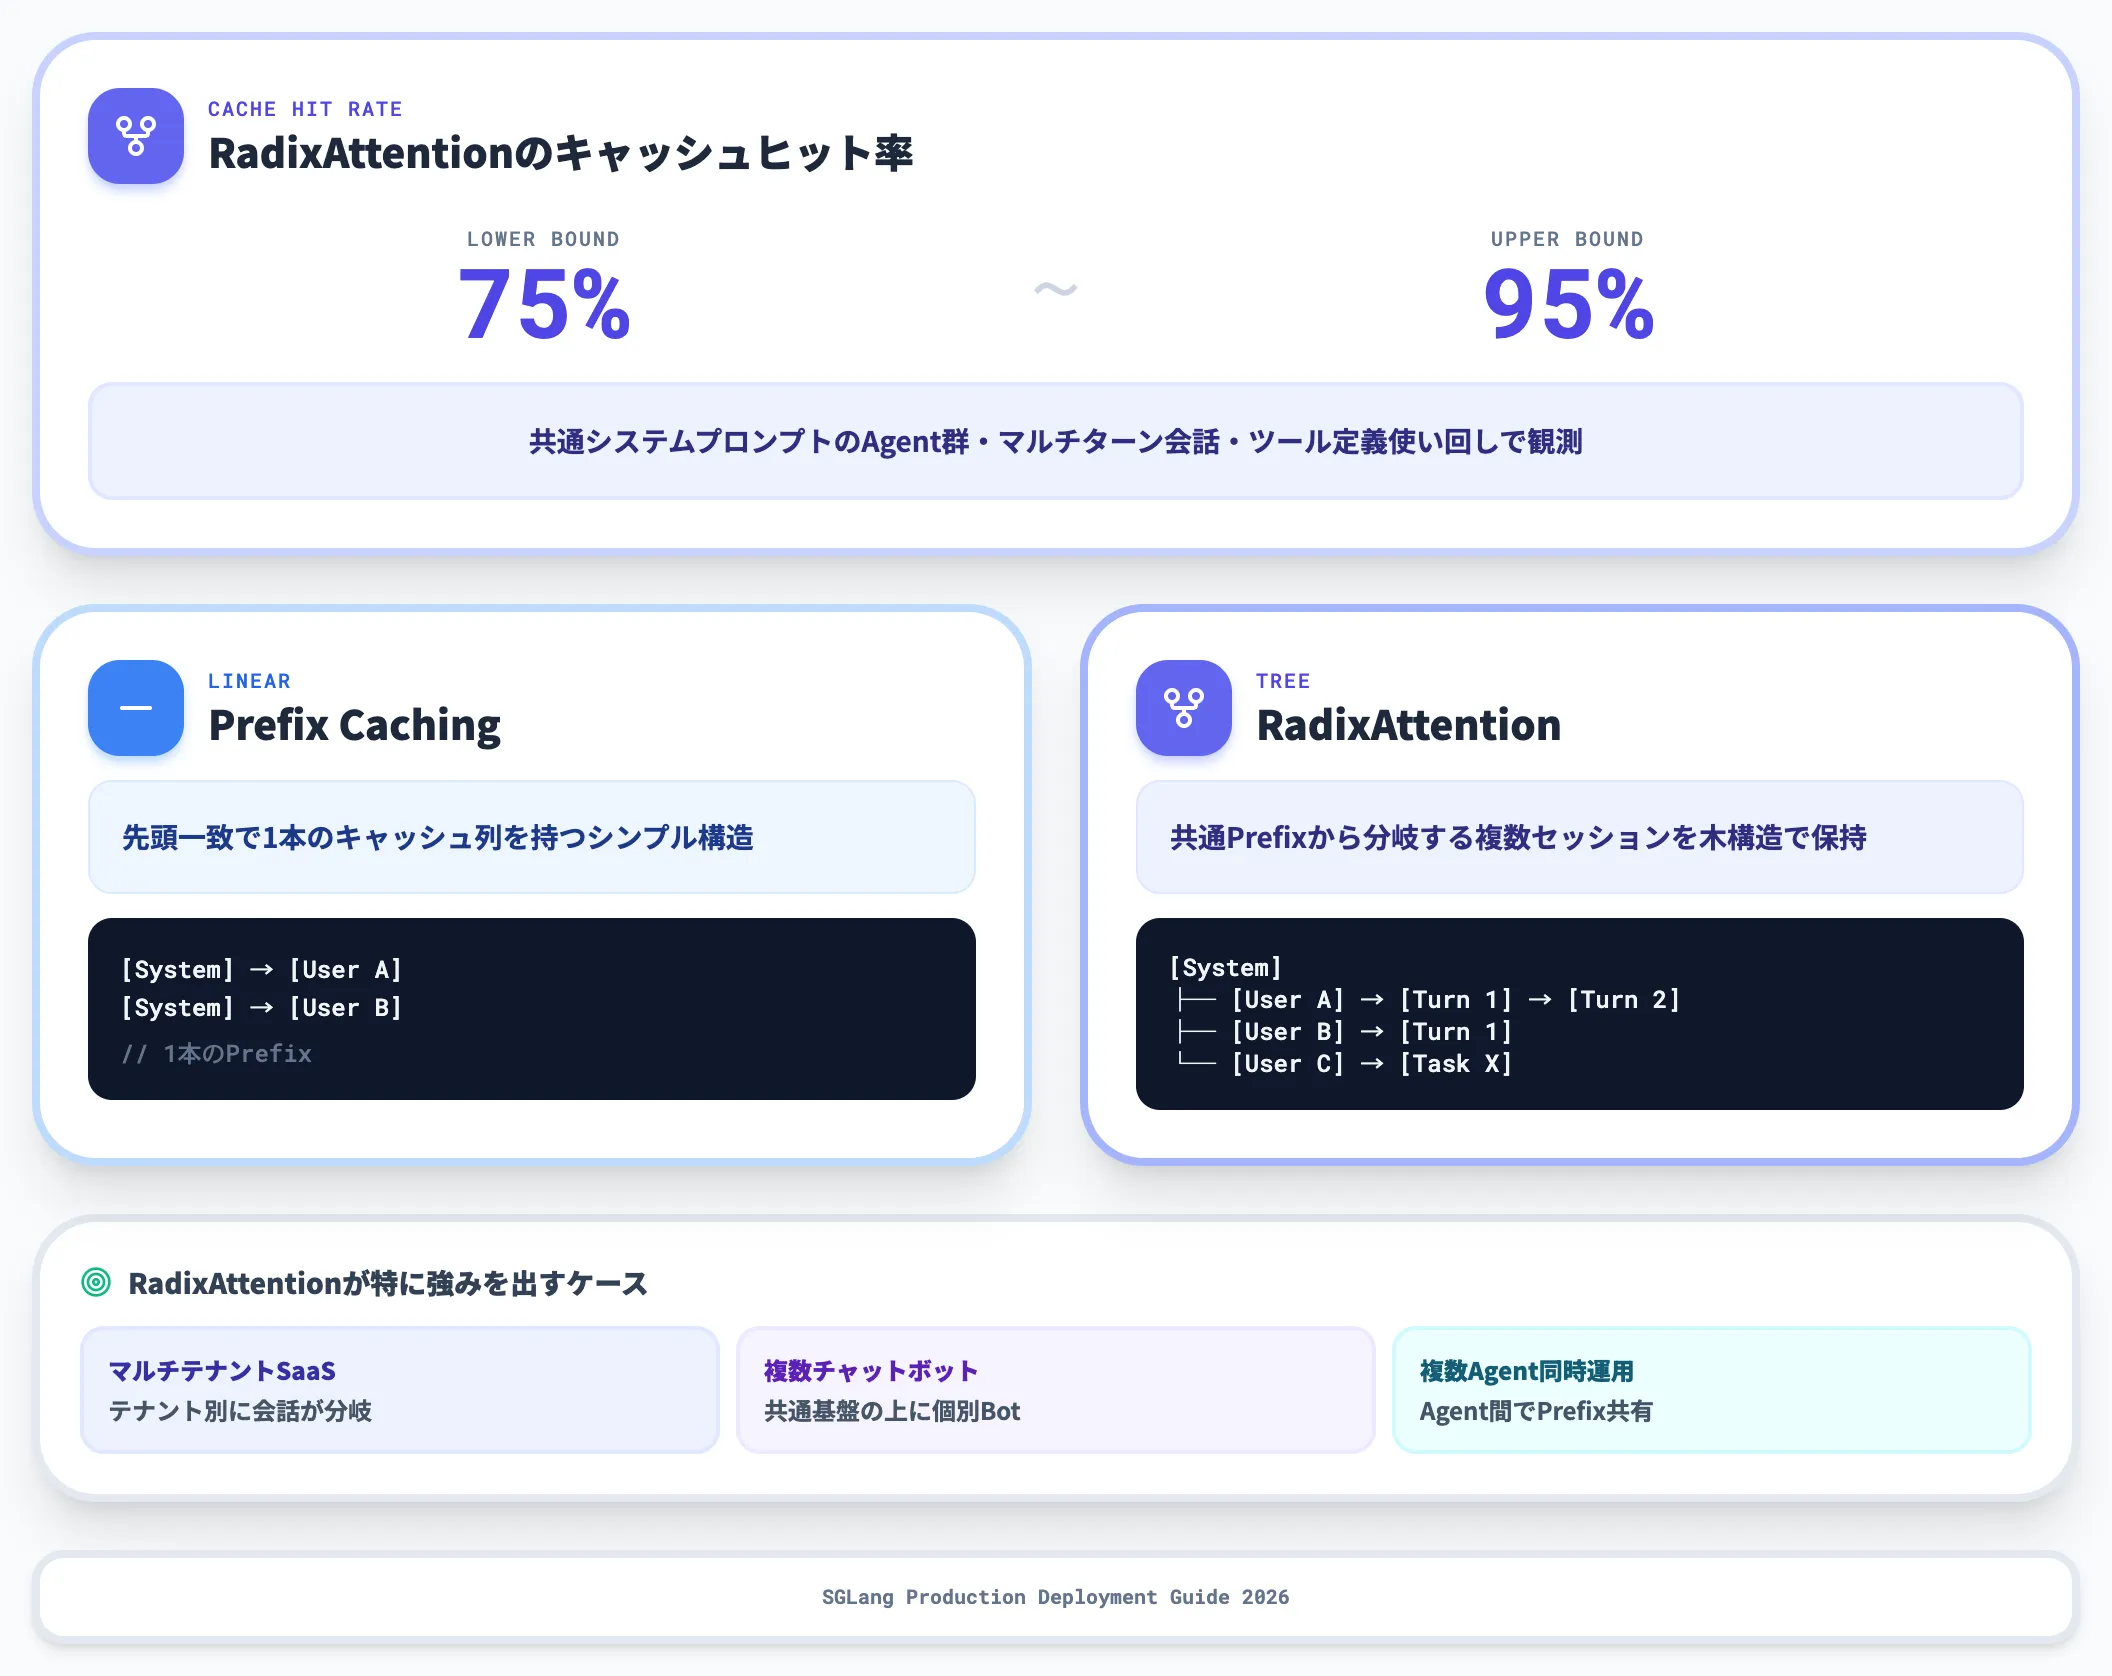
新しいリクエストが来ると、SGLangはRadix treeを辿って「既にキャッシュされている最長プレフィックス」を探し、そこから計算を再開します。この設計により、システムプロンプトが共通なAgent群・マルチターン会話・ツール定義の使い回しで75〜95%のキャッシュヒット率が観測されています(SGLang Production Deployment Guide 2026)。
Prefix Cachingが「先頭一致で1本のキャッシュ列を持つ」のに対し、RadixAttentionは「共通プレフィックスから分岐する複数のセッションを木構造で保持する」ため、マルチテナントSaaS・複数チャットボット・複数Agent同時運用で強みが出ます。
推論エンジン別のKV戦略比較
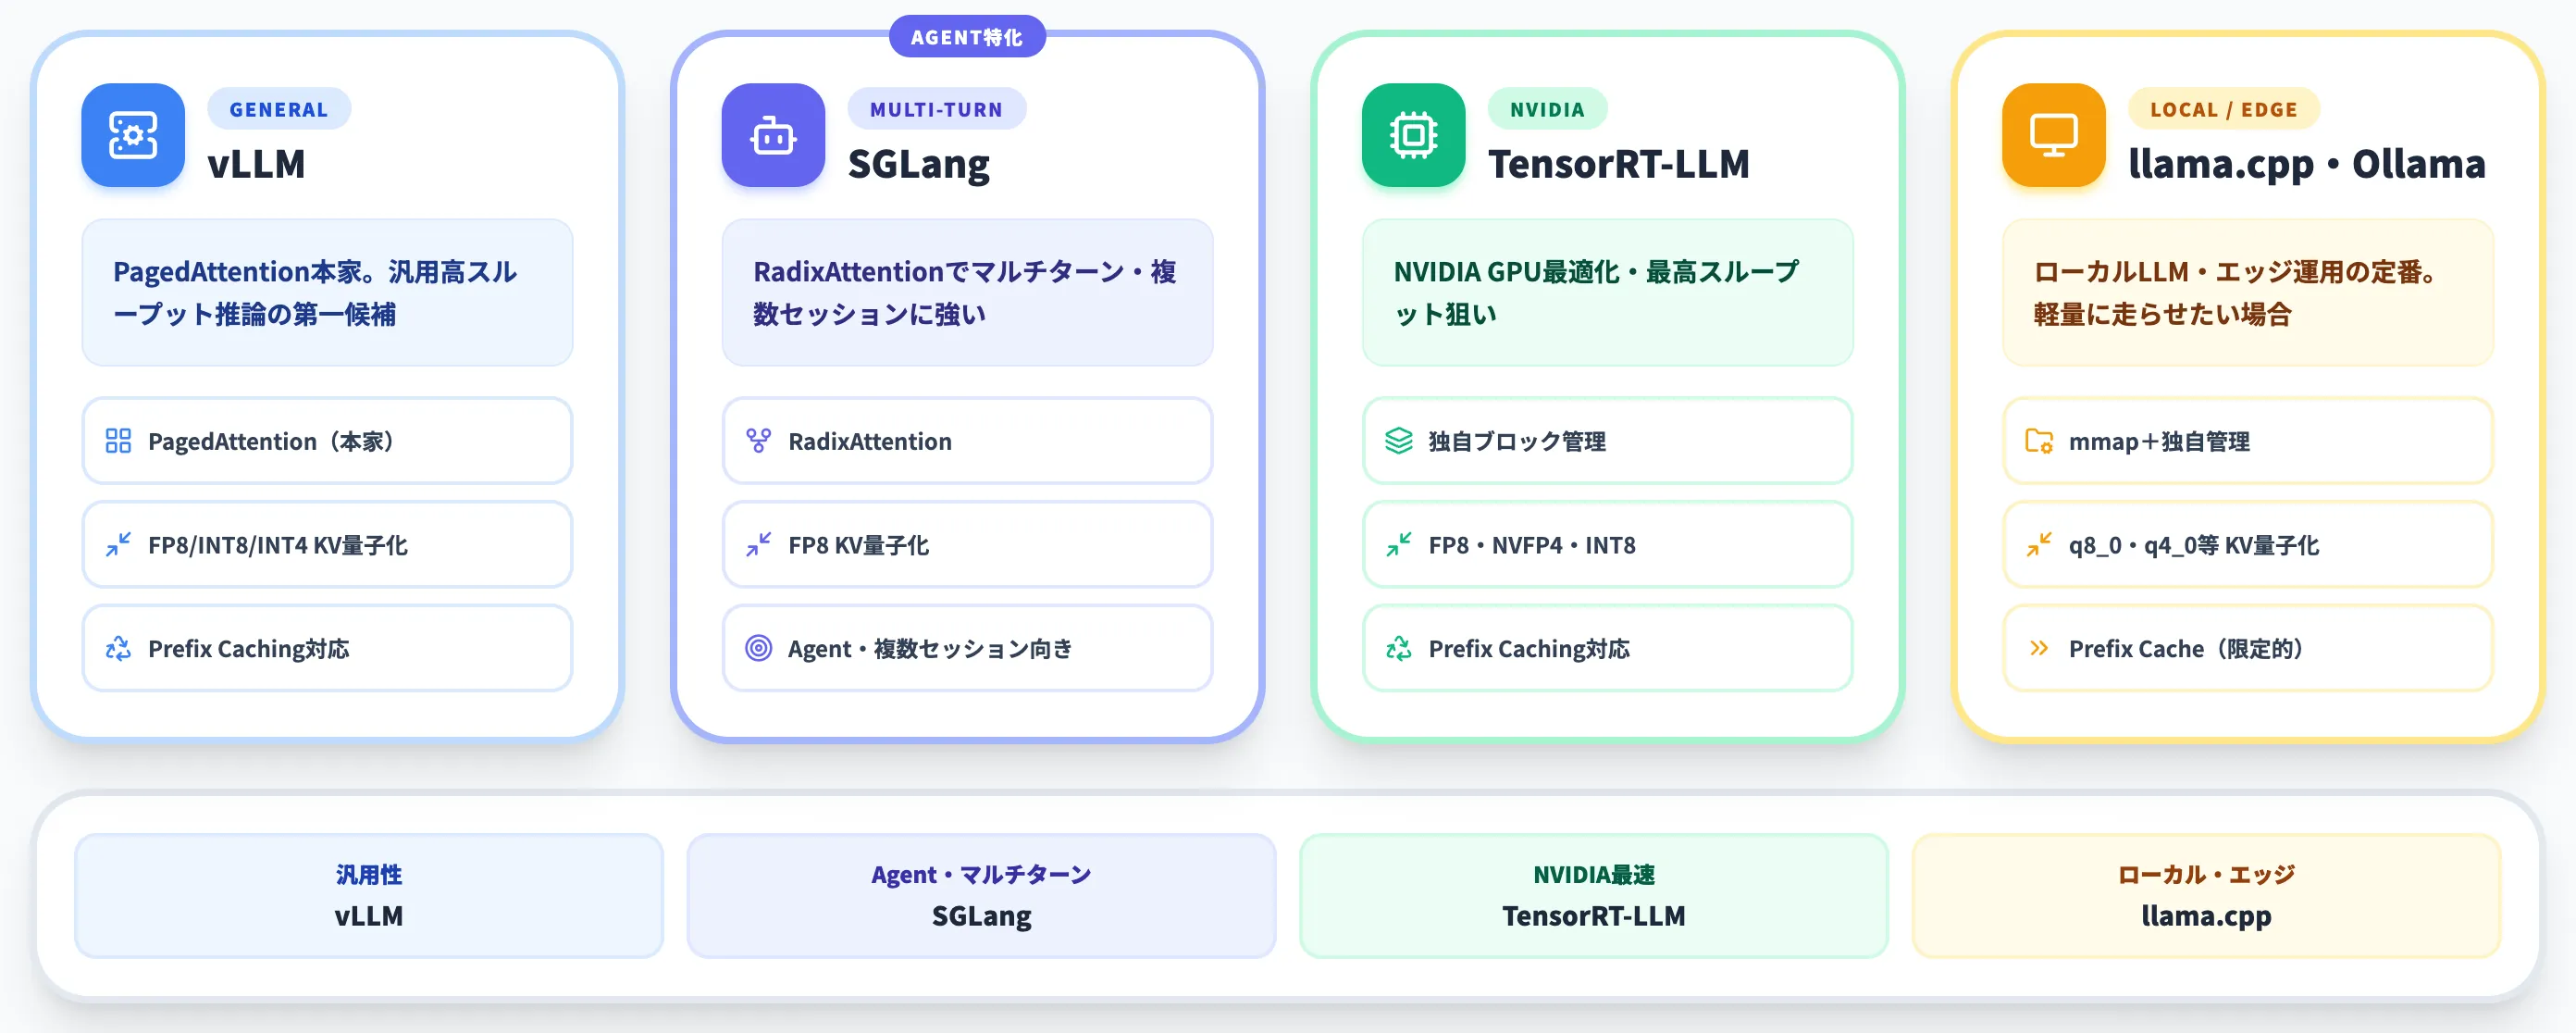
主要な推論エンジンでKV機能がどう組み合わさっているかを整理しました。この表を見ながら、自社ユースケースで「どの層を重視するか」を決めるのが実務的な選び方になります。
| 推論エンジン | メモリ管理 | 量子化 | 再利用戦略 | 主な用途 |
|---|---|---|---|---|
| vLLM | PagedAttention(本家) | FP8・INT8・INT4 KV量子化対応 | Prefix Caching・KV Offloading Connector | 汎用高スループット推論 |
| SGLang | PagedAttentionベース | FP8 KV量子化 | RadixAttention(マルチターン強力) | Agent・マルチターン・複数セッション |
| TensorRT-LLM | 独自ブロック管理 | FP8・NVFP4・INT8 | Prefix Caching対応 | NVIDIA最適化・最高スループット |
| llama.cpp・Ollama | mmap+独自管理 | q8_0・q4_0等のKV量子化タイプ | Prefix Cache(限定的) | ローカルLLM・エッジ運用 |
Agent系ワークロードでSGLangを選ぶ、NVIDIA GPUで最速を狙うならTensorRT-LLM、汎用性ならvLLM、というのが2026年時点の一般的な使い分けです。ローカルLLMで軽量に走らせたい場合はllama.cpp・Ollama系が選択肢になります。
商用APIのプロンプトキャッシュとKVキャッシュの関係
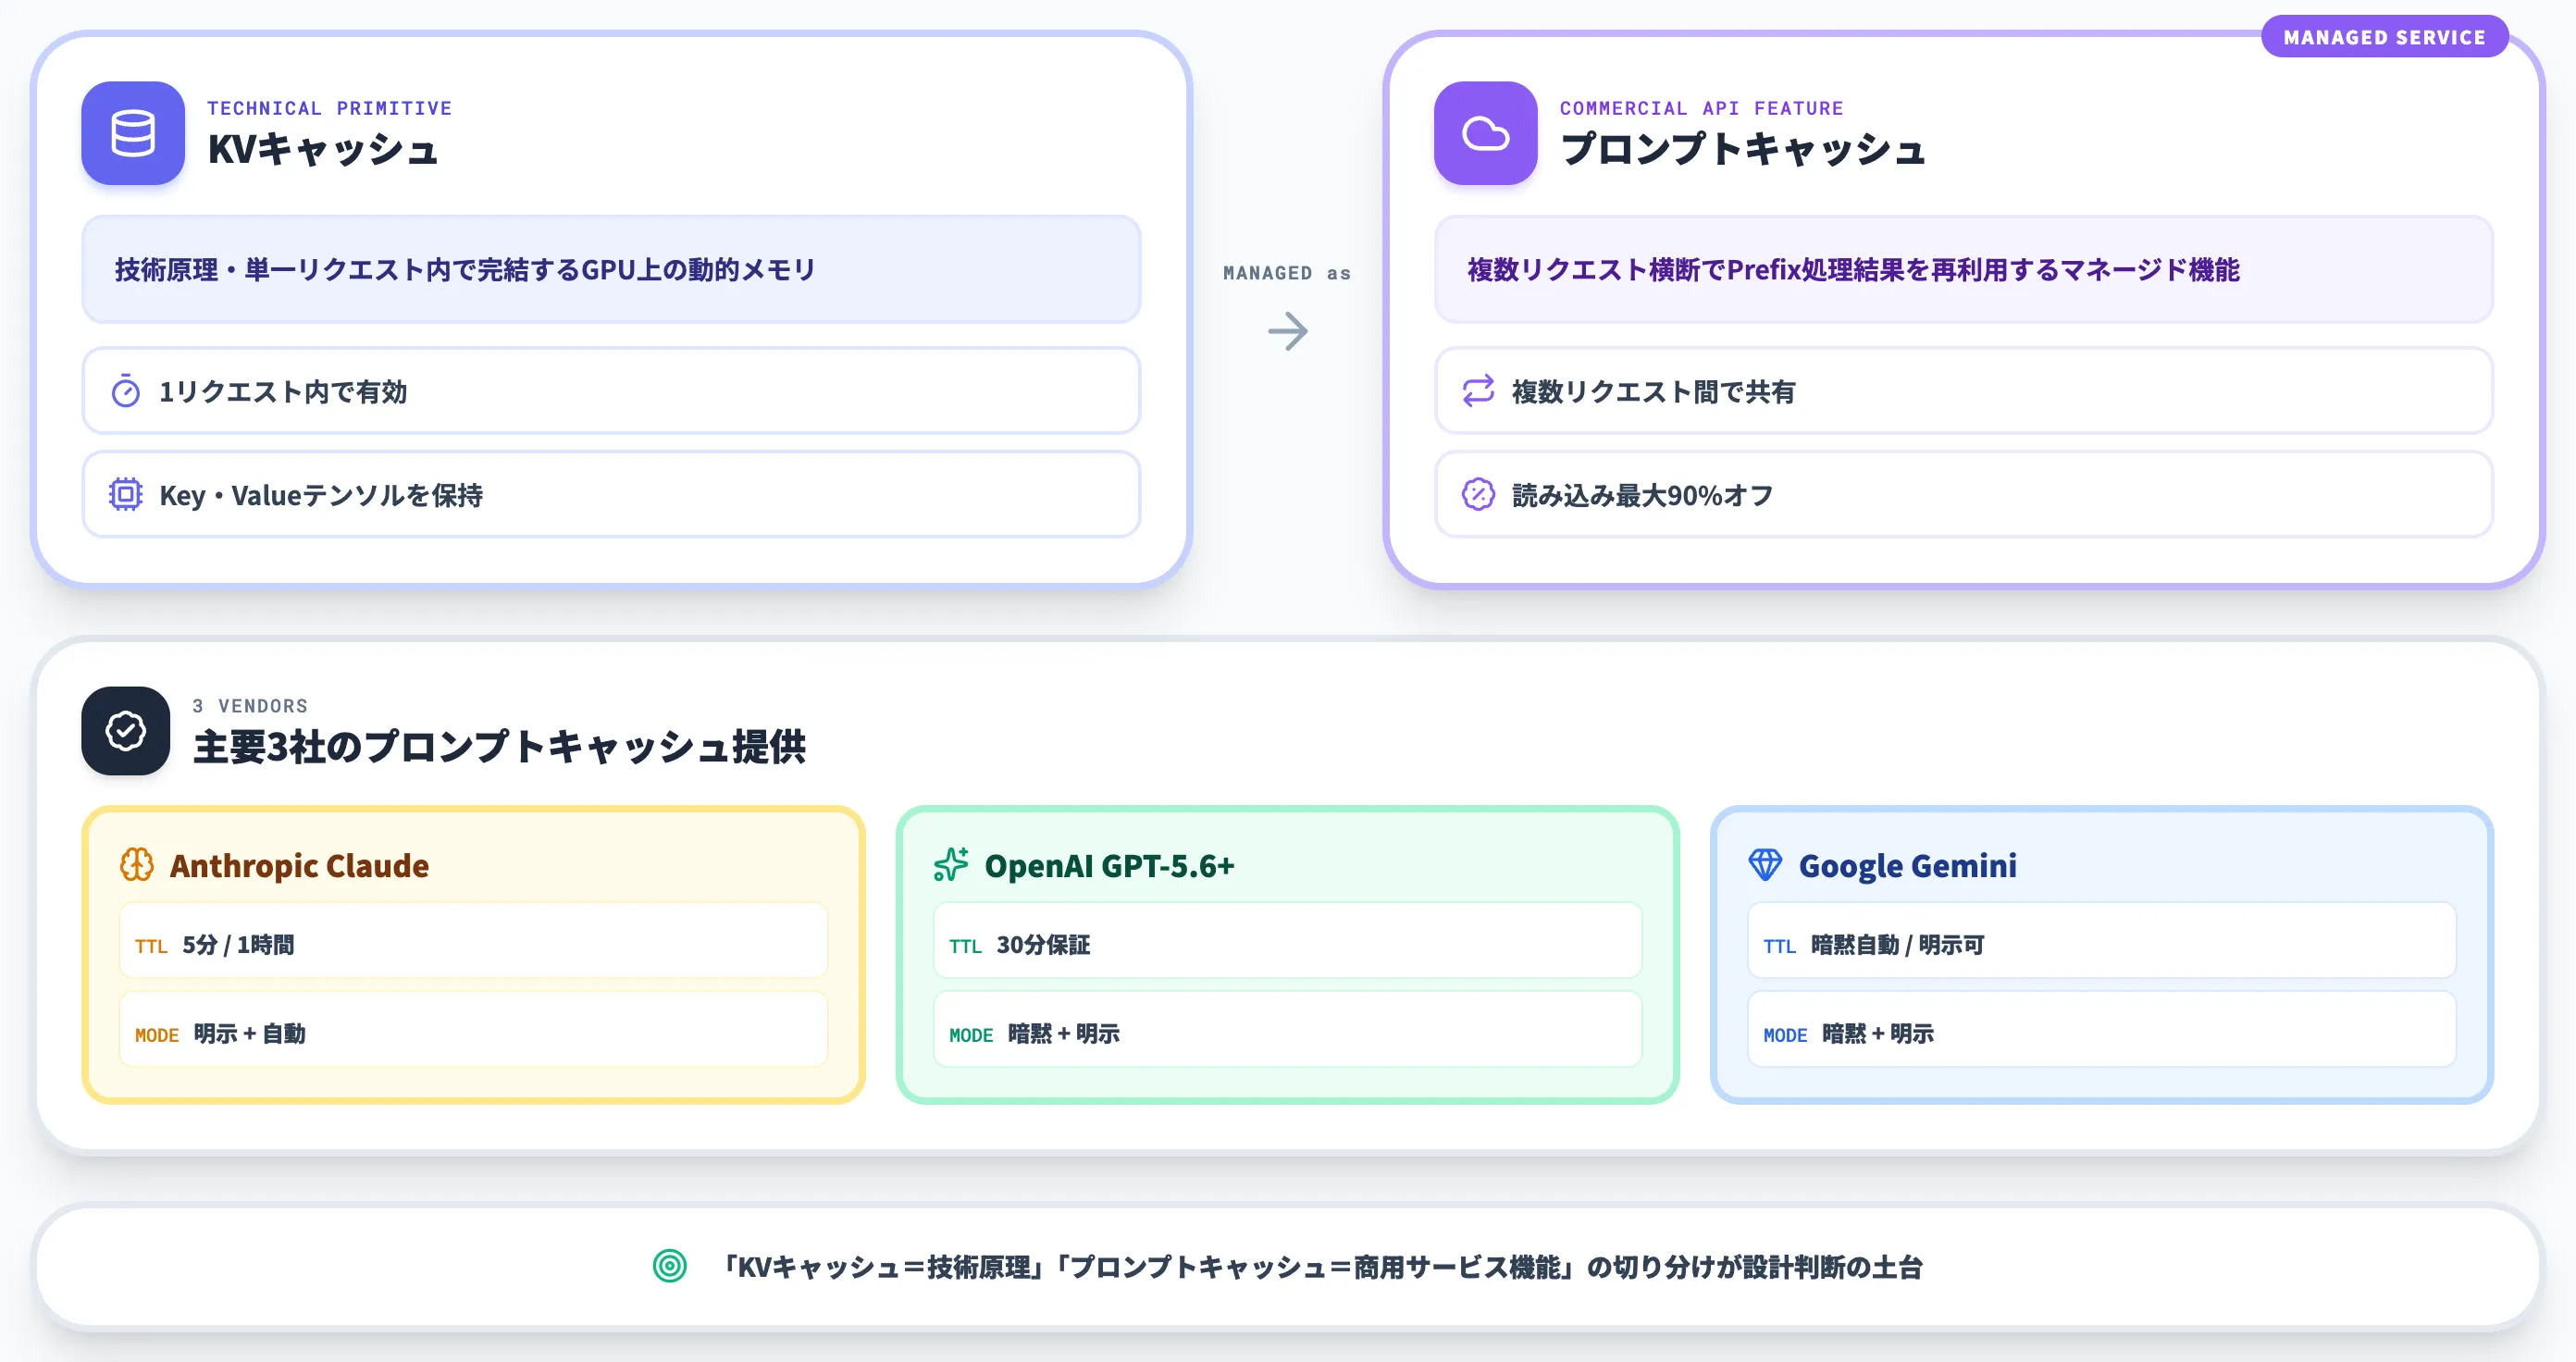
Anthropic・OpenAI・Googleの3社が提供する「プロンプトキャッシュ」機能は、KVキャッシュと同じ発想で、共通Prefixの処理結果を複数リクエスト間で使い回せるようにマネージド化した仕組みです(内部実装として明確に「K/Vテンソルを保持する」と公開しているのは現時点ではOpenAIのみで、Anthropic・GoogleはPrefix処理結果の再利用としてのみ仕様を公開しています)。技術原理を押さえたうえで、商用API側の設計を確認しておくと選定が正確になります。
3社のプロンプトキャッシュ仕様比較
以下の表で、主要3社のプロンプトキャッシュ仕様を並べました。値は2026年9月時点のAnthropic公式ドキュメント、OpenAI Developers Prompt Caching、Google AI Gemini API Cachingを参照しています。
| 提供元 | キャッシュ方式 | TTL(生存時間) | キャッシュ読み込み割引・書き込みコスト | 最小キャッシュトークン数 |
|---|---|---|---|---|
| Anthropic Claude | 明示(cache_control指定)+自動 | 5分(デフォルト)/1時間(拡張) | 読み込み90%オフ(Fable/Mythos 5.1は97.5%オフ)/書き込みは5分TTL 1.25倍・1時間TTL 2倍 | 512〜4,096(モデルで異なる) |
| OpenAI GPT-5.6以降 | 暗黙(自動)+明示 | 最低30分保持を保証 | 読み込み90%オフ/書き込みは暗黙・明示とも1.25倍 | 1,024(GPT-5.6以降) |
| Google Gemini | 暗黙(自動)+明示(手動作成) | 暗黙は自動管理/明示はユーザー指定 | 読み込み90%オフ(キャッシュヒットは保証されない) | 2,048(2.5系)/4,096(3系) |
3社とも多くのモデルでキャッシュヒット時に90%割引が入ります(Anthropicの一部モデル=Fable/Mythos 5.1は97.5%オフ)。方式(明示 vs 自動)・TTL・最小トークン・キャッシュ書き込みコストが違うため、プロンプト設計とアーキテクチャによって効きやすさが変わります。
商用プロンプトキャッシュの向き不向き
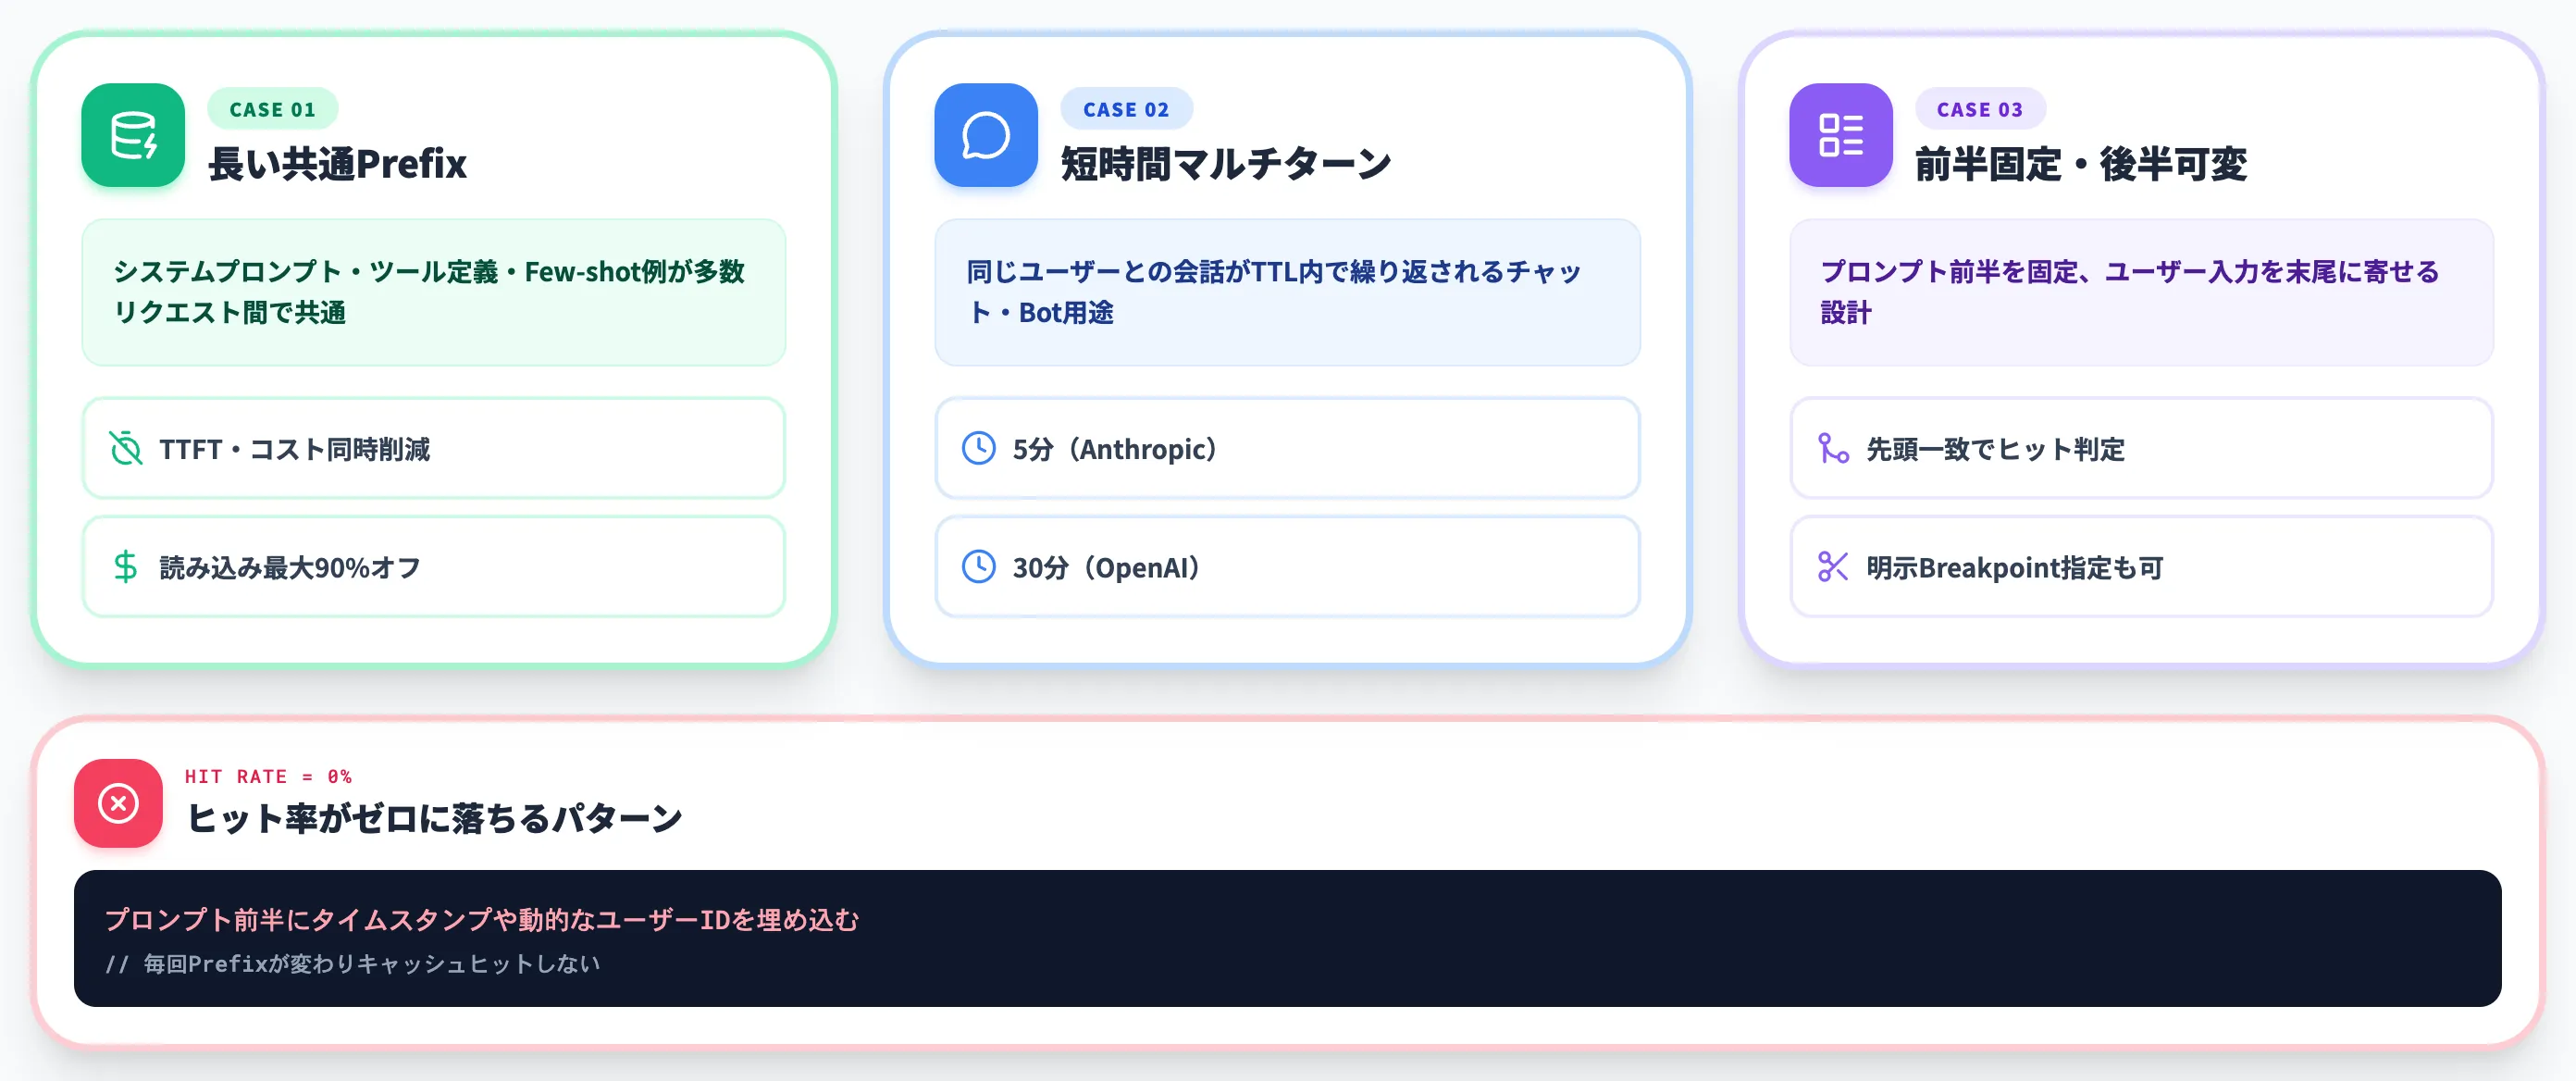
商用APIのプロンプトキャッシュが「効く」のは、以下の条件が揃うワークロードです。
-
システムプロンプト・ツール定義・共通のFew-shot例が長く、多数のリクエストで共通
Prefill時間を大幅に削減できるため、TTFTとコストの両方が下がる
-
同じユーザーとのマルチターン会話が短時間で繰り返される
5分(Anthropic)または30分(OpenAI)のTTL内でヒットするため、コスト削減の恩恵を受けやすい
-
プロンプト前半が固定・後半だけがユーザー入力ごとに変わる構造
先頭一致が前提でキャッシュヒットの割引が効く。OpenAI GPT-5.6以降の暗黙キャッシュでは、固定部分の後ろに可変内容が続く構成だと固定直後にキャッシュ境界が作られずヒットしないケースがあり、明示的なBreakpoint指定が必要になる場合がある
逆にプロンプト前半にタイムスタンプや動的なユーザーIDを埋め込むと、毎回Prefixが変わってヒット率がゼロに落ちます。プロンプトキャッシュを効かせるための設計原則や実装のコツは、プロンプトキャッシング(プロンプトキャッシュ)とは?主要LLMの仕組みや料金、実装のコツを徹底解説でさらに詳しく整理しています。
自社推論と商用API、KV最適化の判断軸
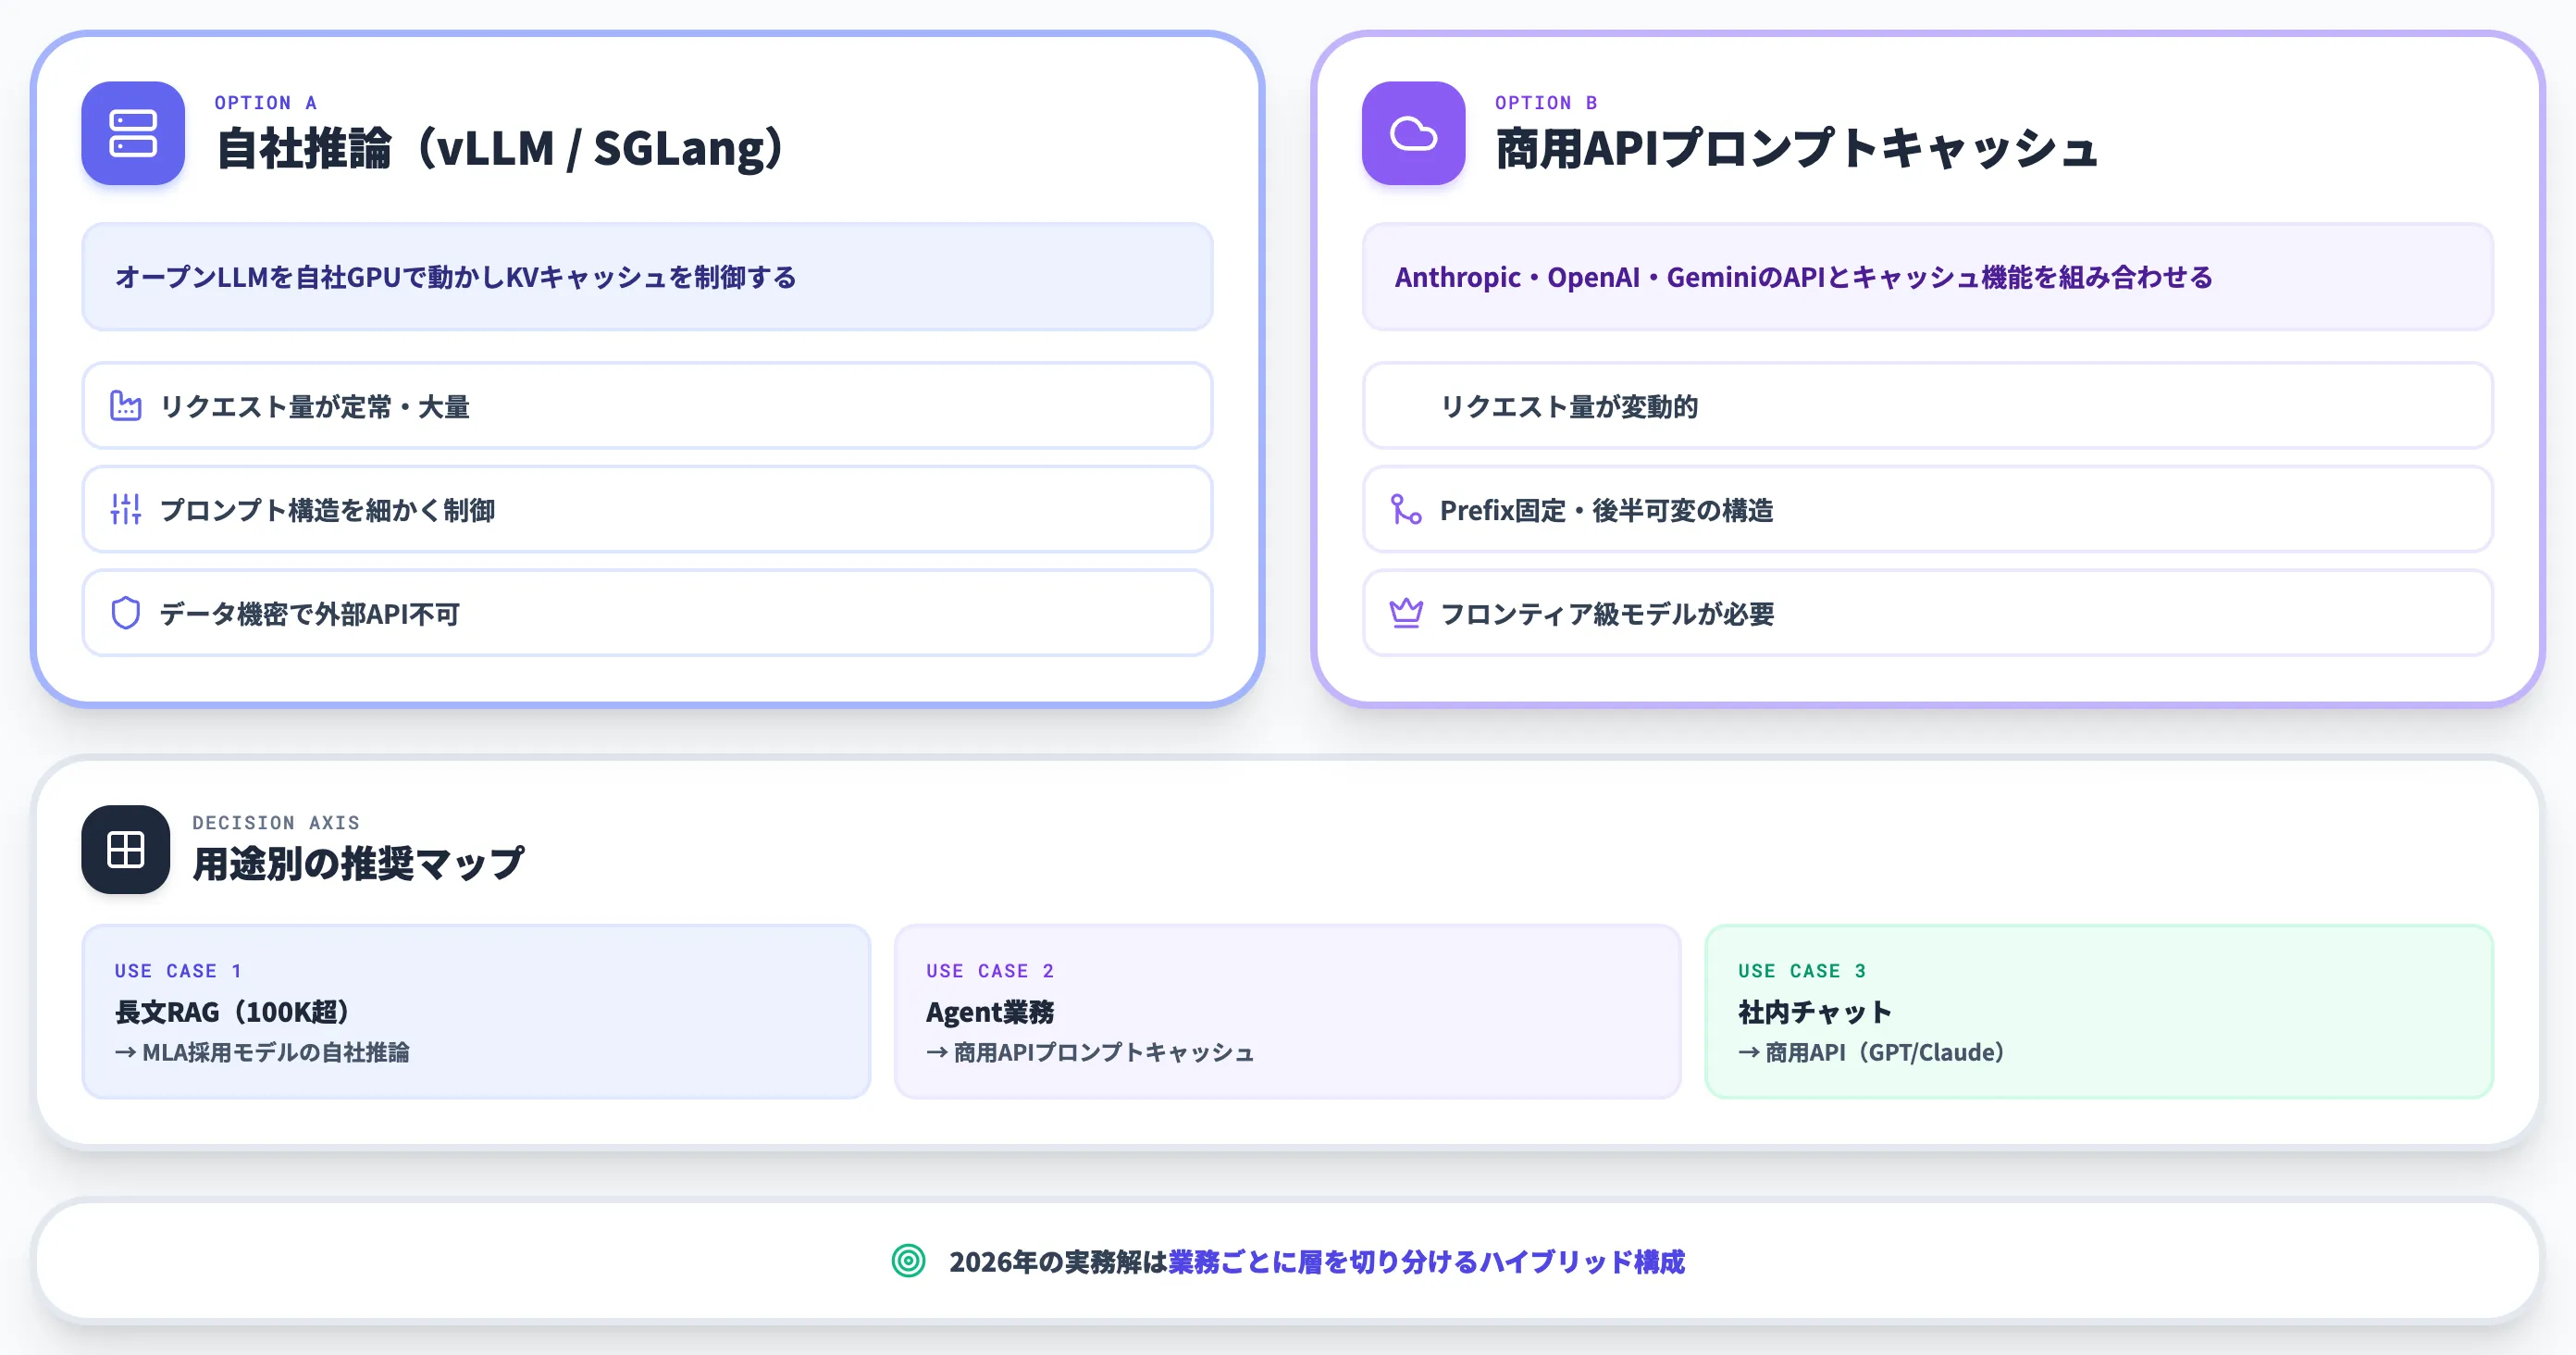
KVキャッシュの原理と削減手法・商用APIの仕様を踏まえると、企業がLLMを業務で使うときの選択肢は「自社推論でKVを最適化する」か「商用APIのプロンプトキャッシュを活かす」の2択に整理できます。実務では両者の使い分けが判断軸になります。
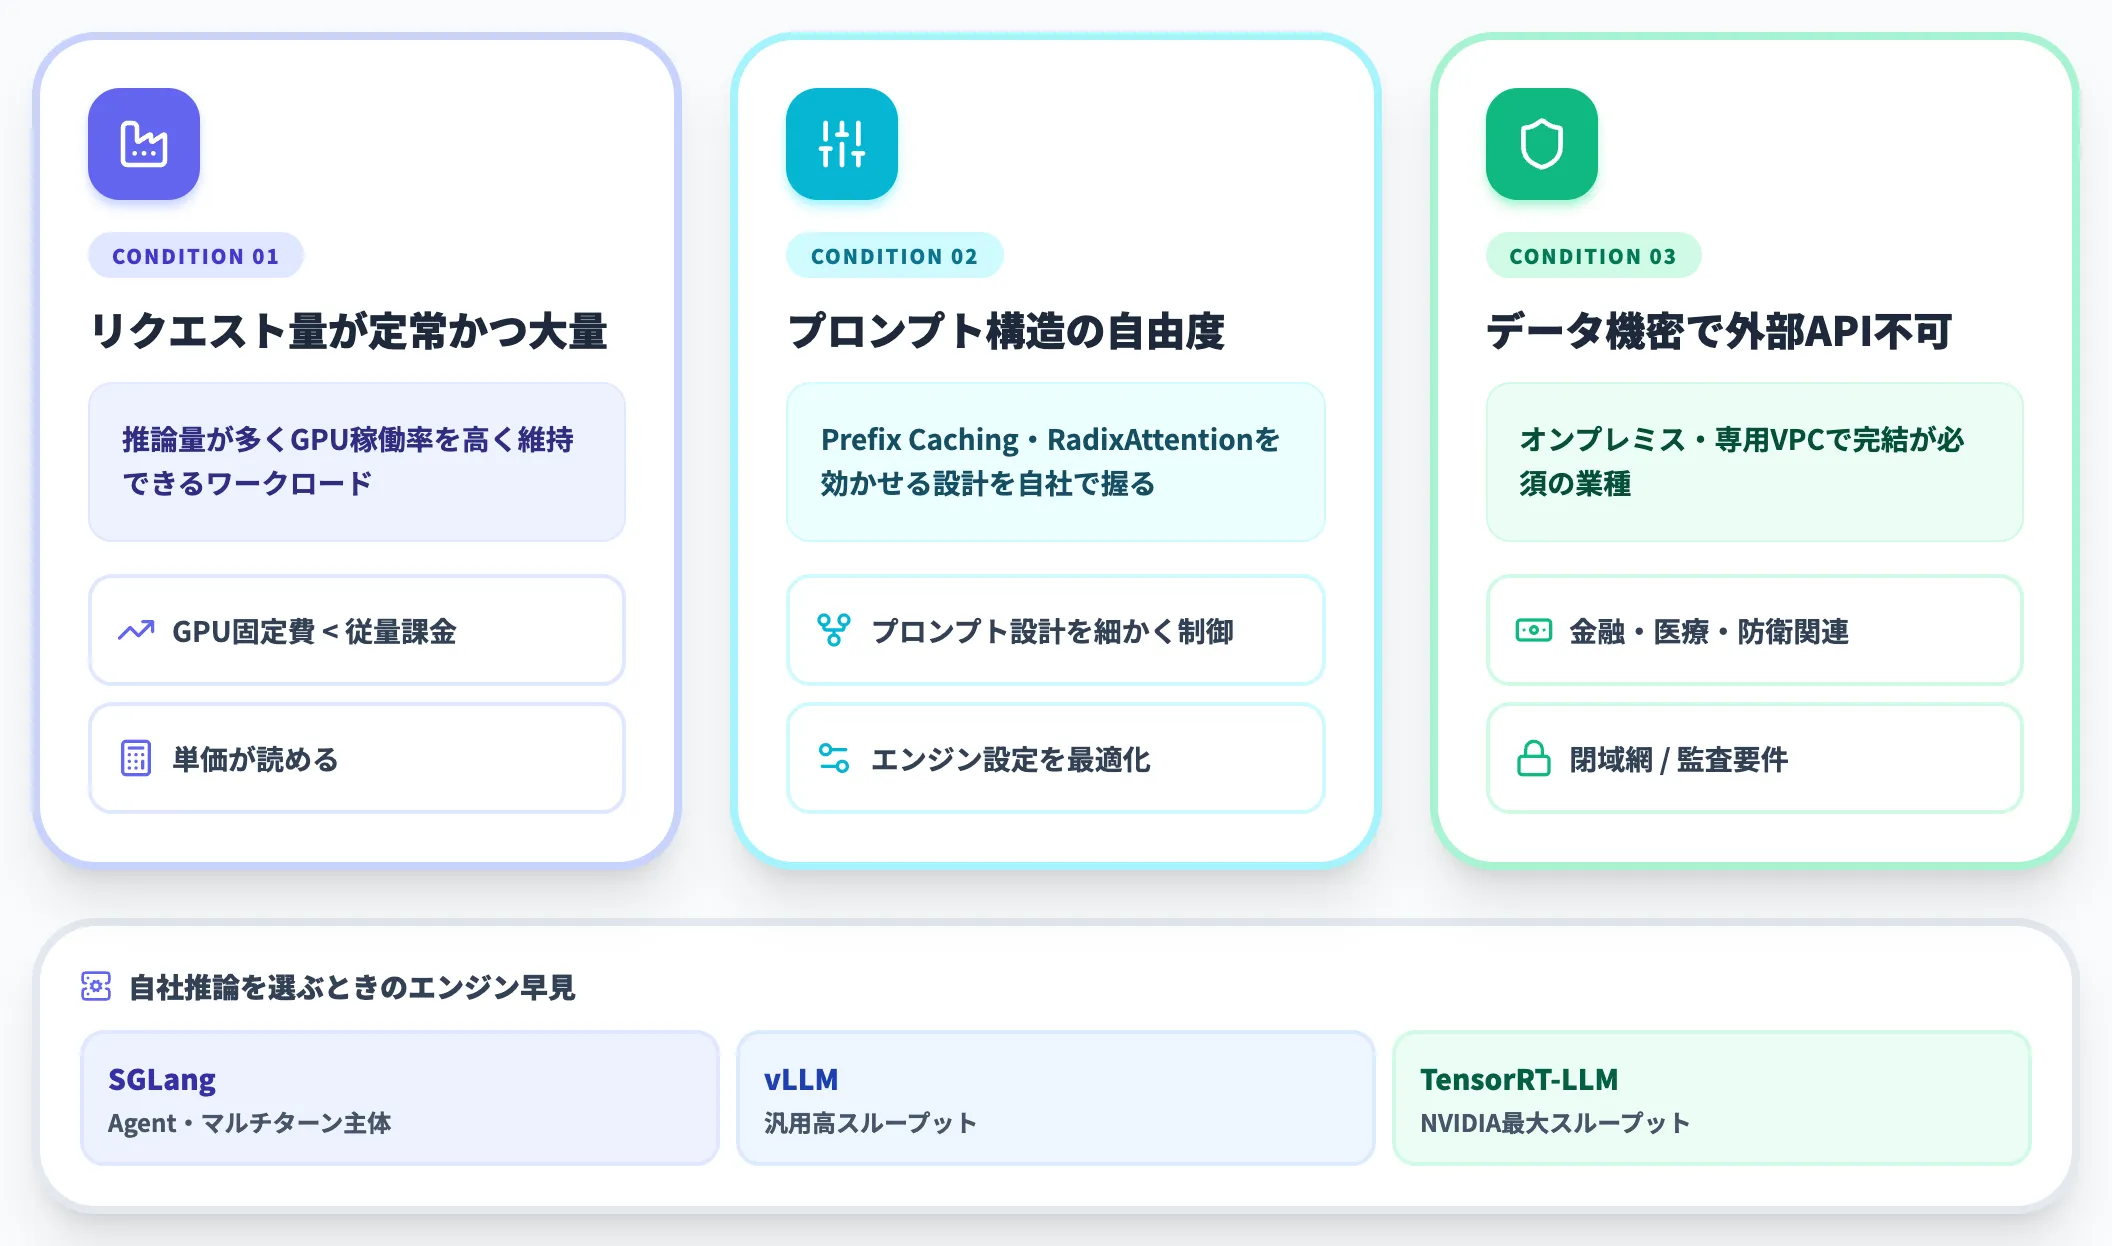
自社推論(vLLM・SGLang)が有利になる条件
以下の条件が揃う業務では、自社GPUでオープンソースLLMを動かしてKVキャッシュを制御する方が、単価と柔軟性の両方で有利になります。
-
リクエスト量が定常かつ大量
推論量が多くGPU稼働率を高く維持できる場合、GPUの固定費が商用API従量課金を下回るケースが出てくる
-
プロンプト構造の自由度を確保したい
Prefix Caching・RadixAttentionを効かせるためのプロンプト設計を自社で細かく制御したい
-
データ機密上、外部API送信ができない
オンプレミスや専用VPCでの完結が必須の業種(金融・医療・防衛関連)
この場合、モデル選定ではMLA採用のDeepSeek系や、GQA採用のSLMがKVコスト面で有利です。推論エンジンは、Agent・マルチターン主体ならSGLang、汎用ならvLLM、最大スループットならTensorRT-LLMを選びます。
商用APIプロンプトキャッシュが有利になる条件
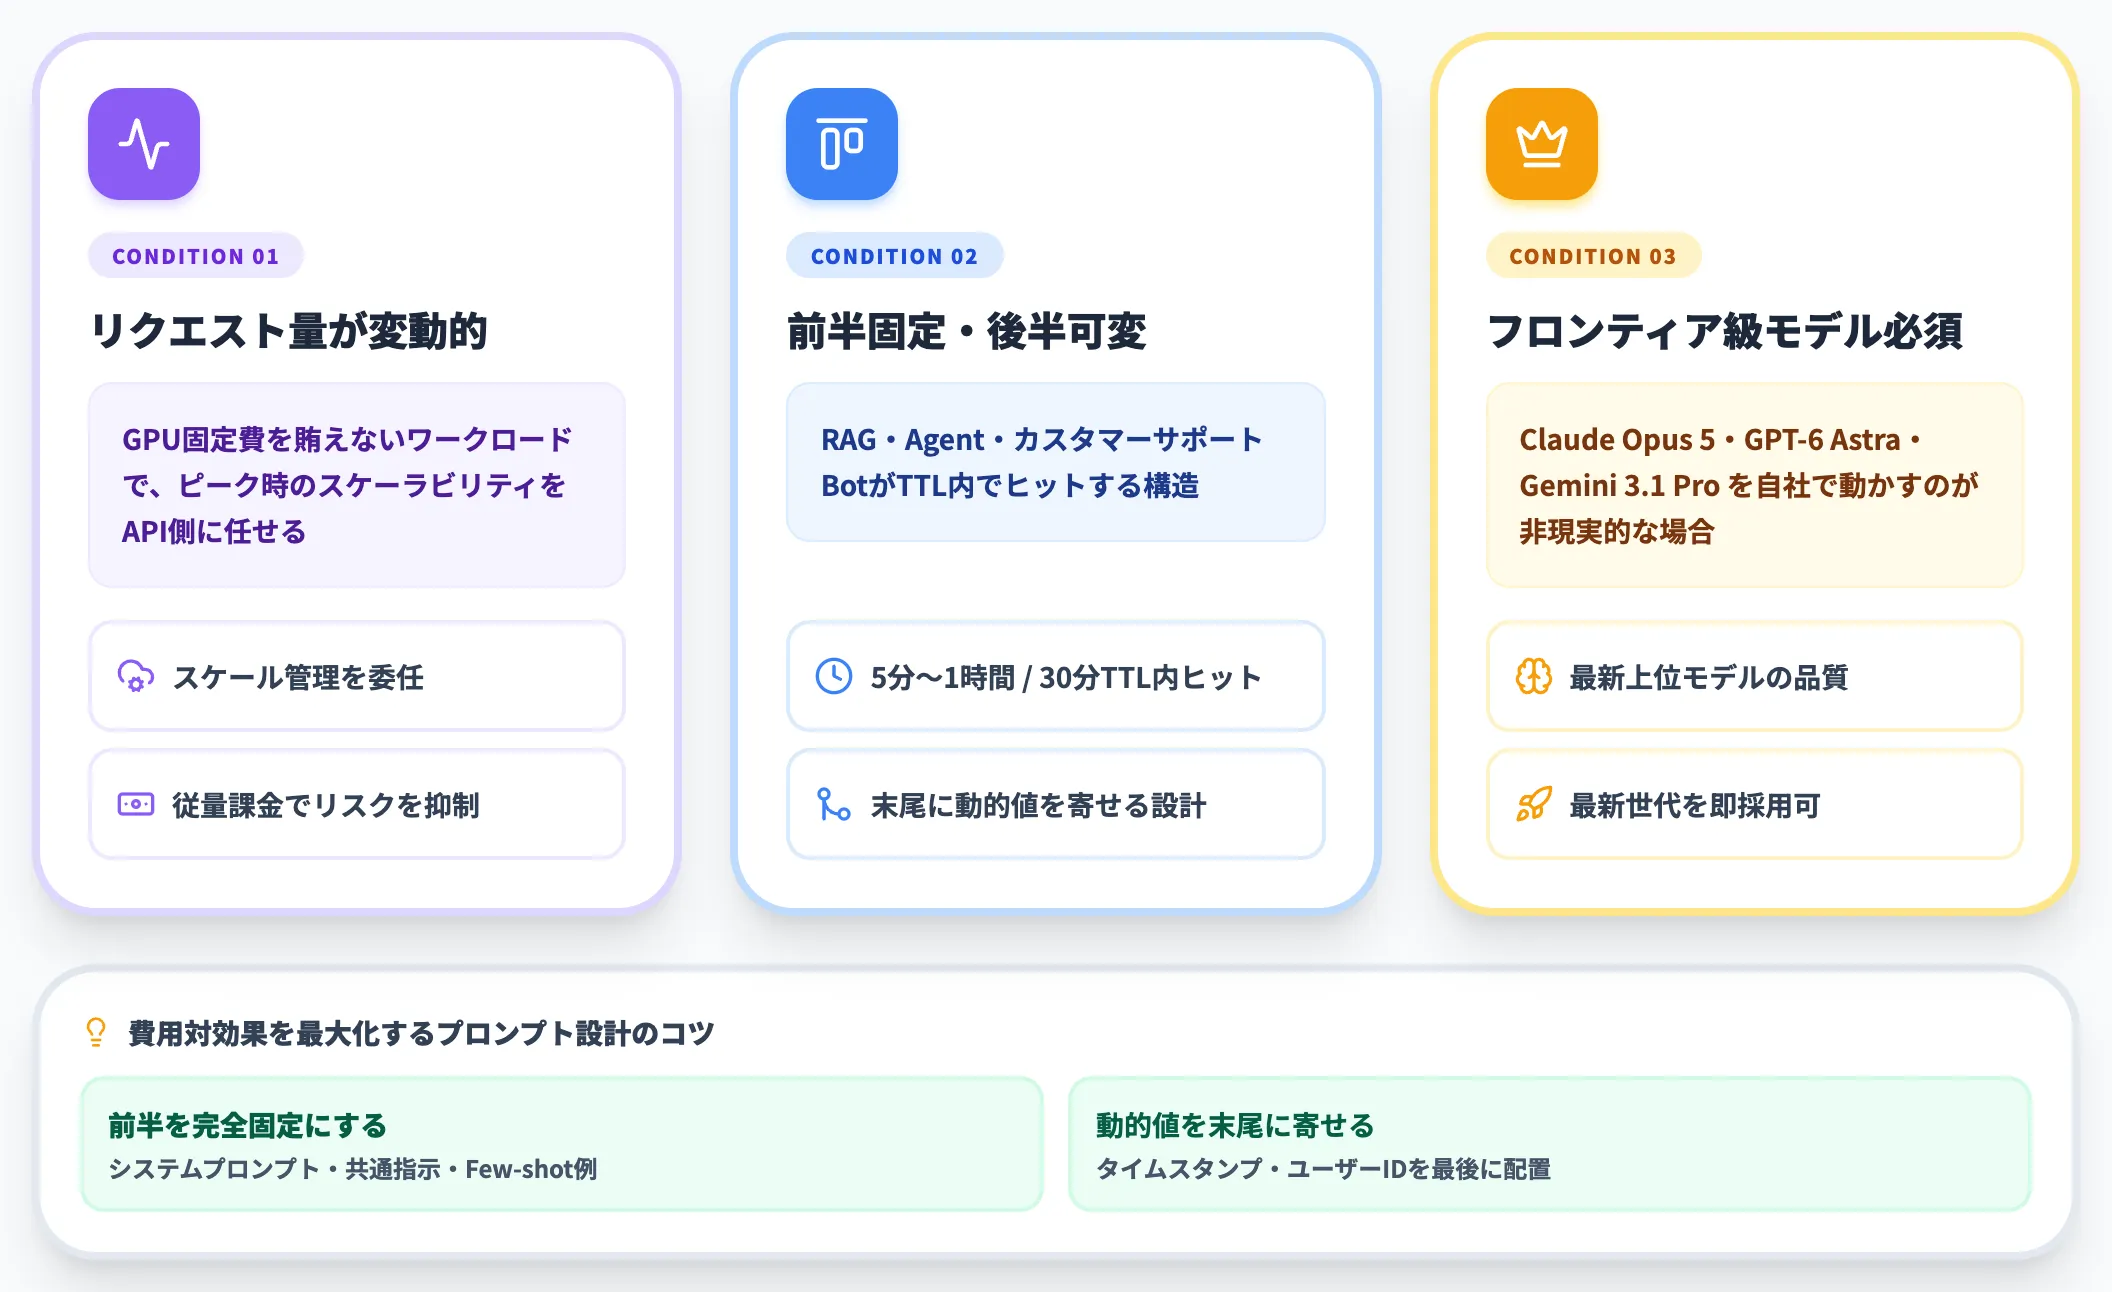
一方で、以下の条件では商用APIのプロンプトキャッシュを使う方が総コストで有利になります。
-
リクエスト量が変動的で、GPU固定費を賄えない
ピーク時のスケーラビリティを商用API側に任せられる
-
プロンプト前半が固定・後半が可変の構造
RAG・Agent・カスタマーサポートBotなど、Anthropicの5分/1時間TTL、OpenAIの30分TTL内でヒットするワークロード
-
フロンティア級モデルの性能が必要
Claude Opus 5・GPT-6 Astra・Gemini 3.1 Pro Previewなど各社の最新上位モデルを、自社で動かすのが現実的でない場合
この場合、プロンプトの前半(システムプロンプト・共通指示・Few-shot例)をキャッシュ可能な単位で固定化し、後半(ユーザー入力・可変コンテキスト)をキャッシュ対象外にする設計が費用対効果を最大化します。実装現場では、Prefix変更のトリガーになる動的値(タイムスタンプ・ユーザーID)を末尾側に寄せることで、ヒット率を高い水準に維持しているケースがあります。
長文コンテキスト(100K超)はMLA採用モデルかGeminiのコンテキストキャッシュ
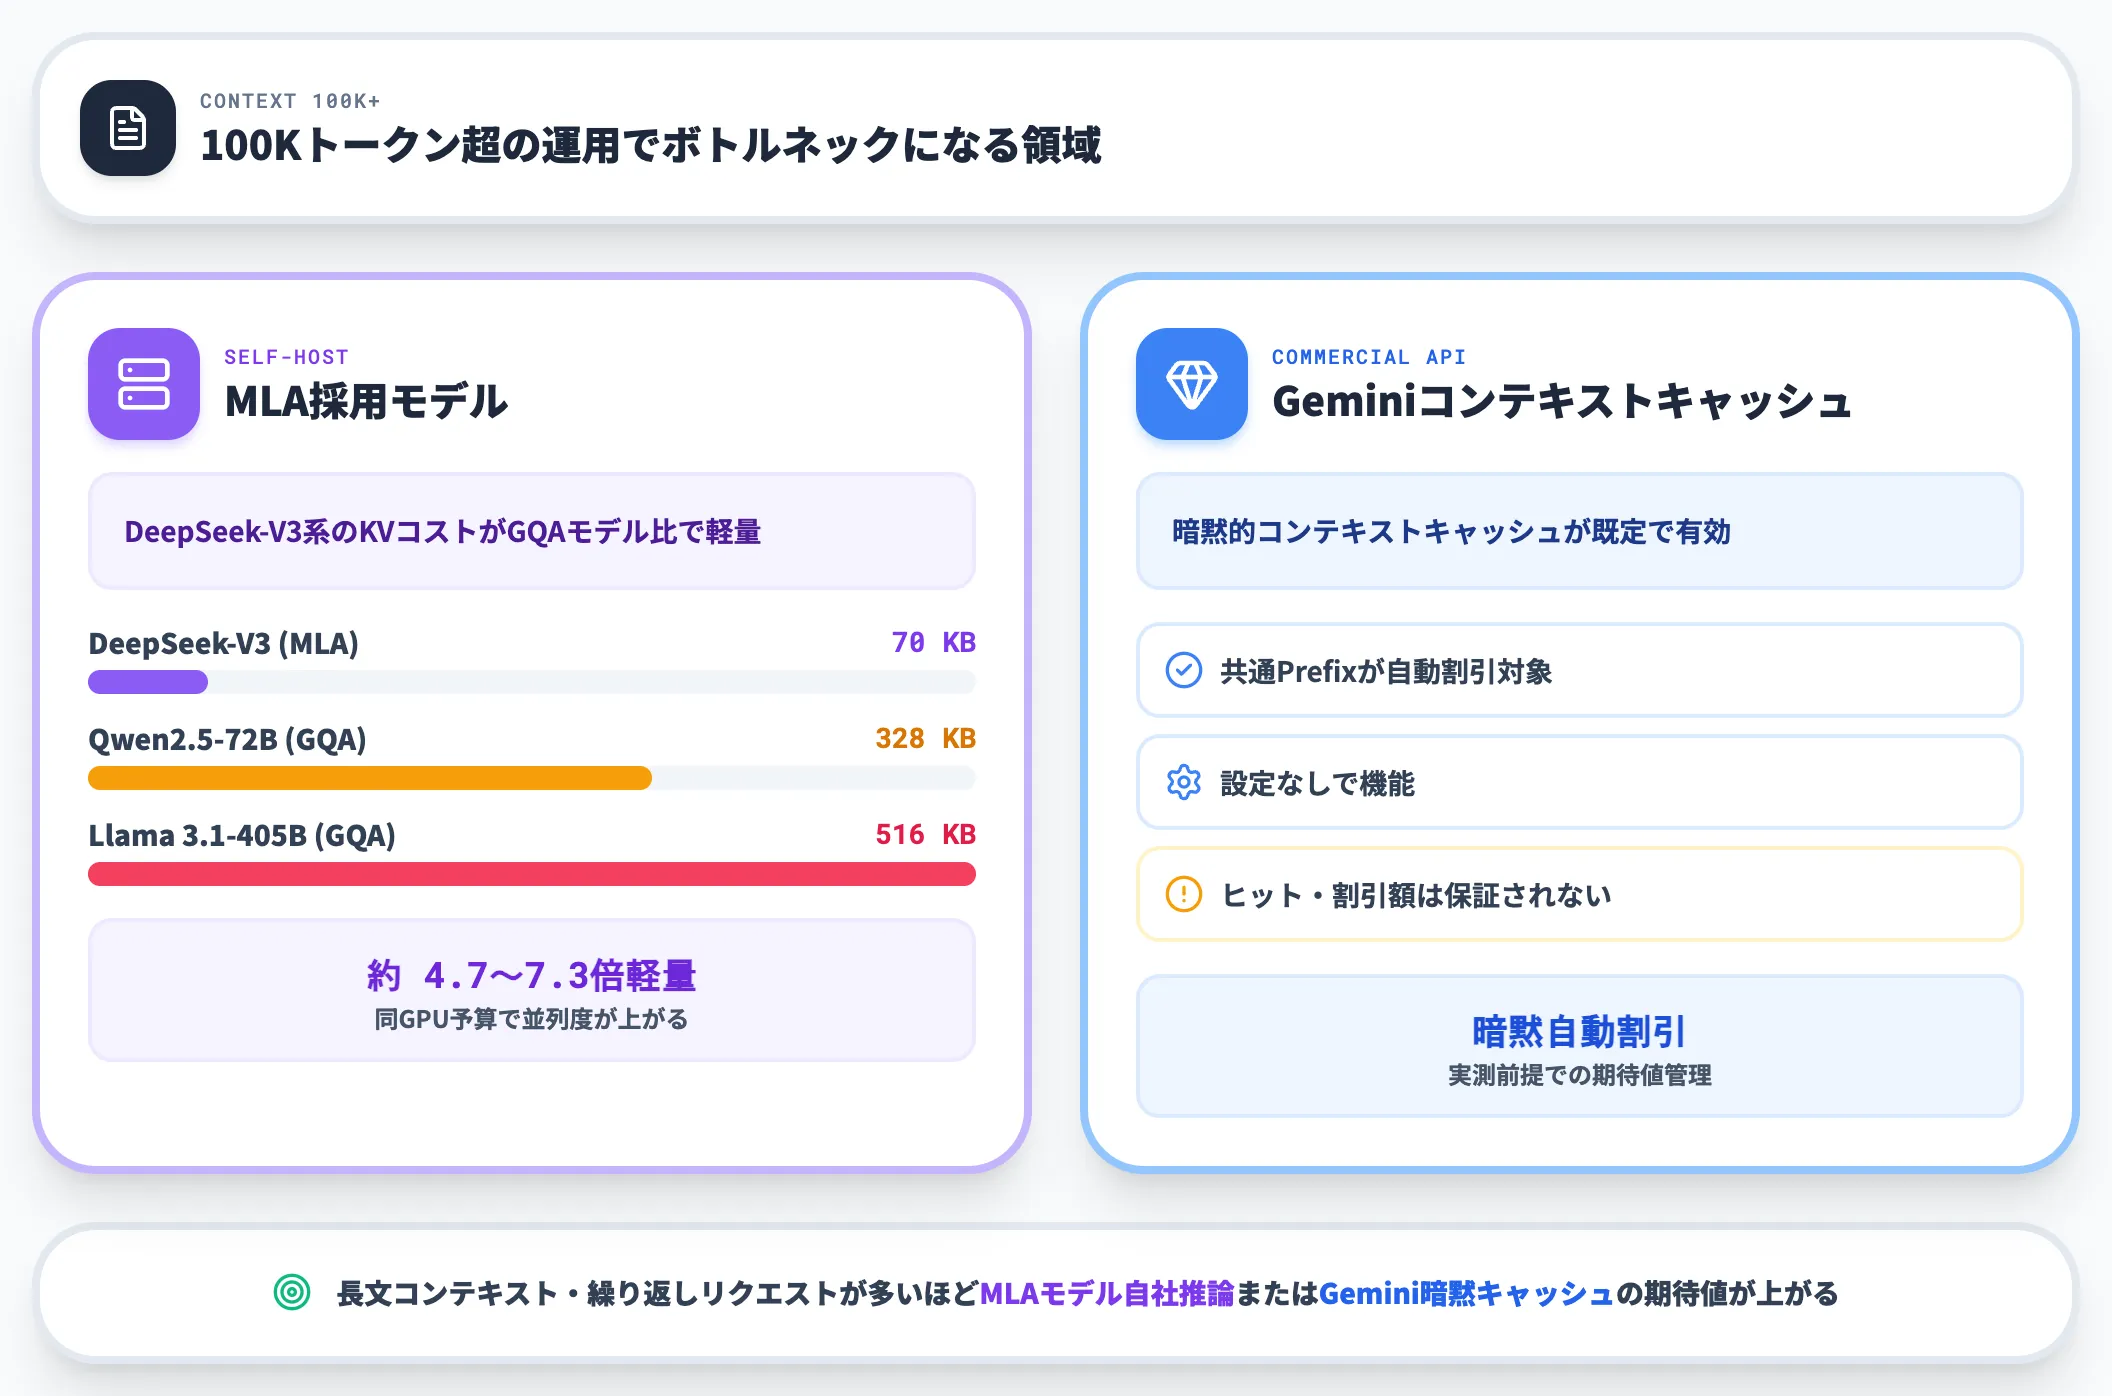
100Kトークンを超えるような長文コンテキストで効かせたい場合、KVキャッシュ容量そのものがボトルネックになるため、以下の選択肢が実務的です。
自社推論なら、上記のGQAモデル(Qwen2.5-72B・Llama 3.1-405B)との比較ではMLA採用モデル(DeepSeek-V3系)の方がKVコストが約4.7〜7.3倍軽く、同じGPU予算で扱える並列度が上がります。商用APIなら、Geminiの暗黙的コンテキストキャッシュは既定で有効なため、共通Prefixが再利用可能な構造なら設定なしで割引対象になり得ます(キャッシュヒットや割引額は保証されないため実測が前提)。長文コンテキスト・繰り返しリクエストが多いワークロードほど期待値が上がる設計です。
複数のLLM導入案件を進めるなかで、AI総研では「Agent業務は商用APIプロンプトキャッシュ、長文RAGはMLA採用モデルの自社推論、社内チャットは商用API」というハイブリッド構成の相談が増えています。技術原理を押さえたうえで、業務ごとに層を切り分けるのが2026年時点の実務的なアプローチです。
KVキャッシュ最適化で見落とされやすい3つの前提
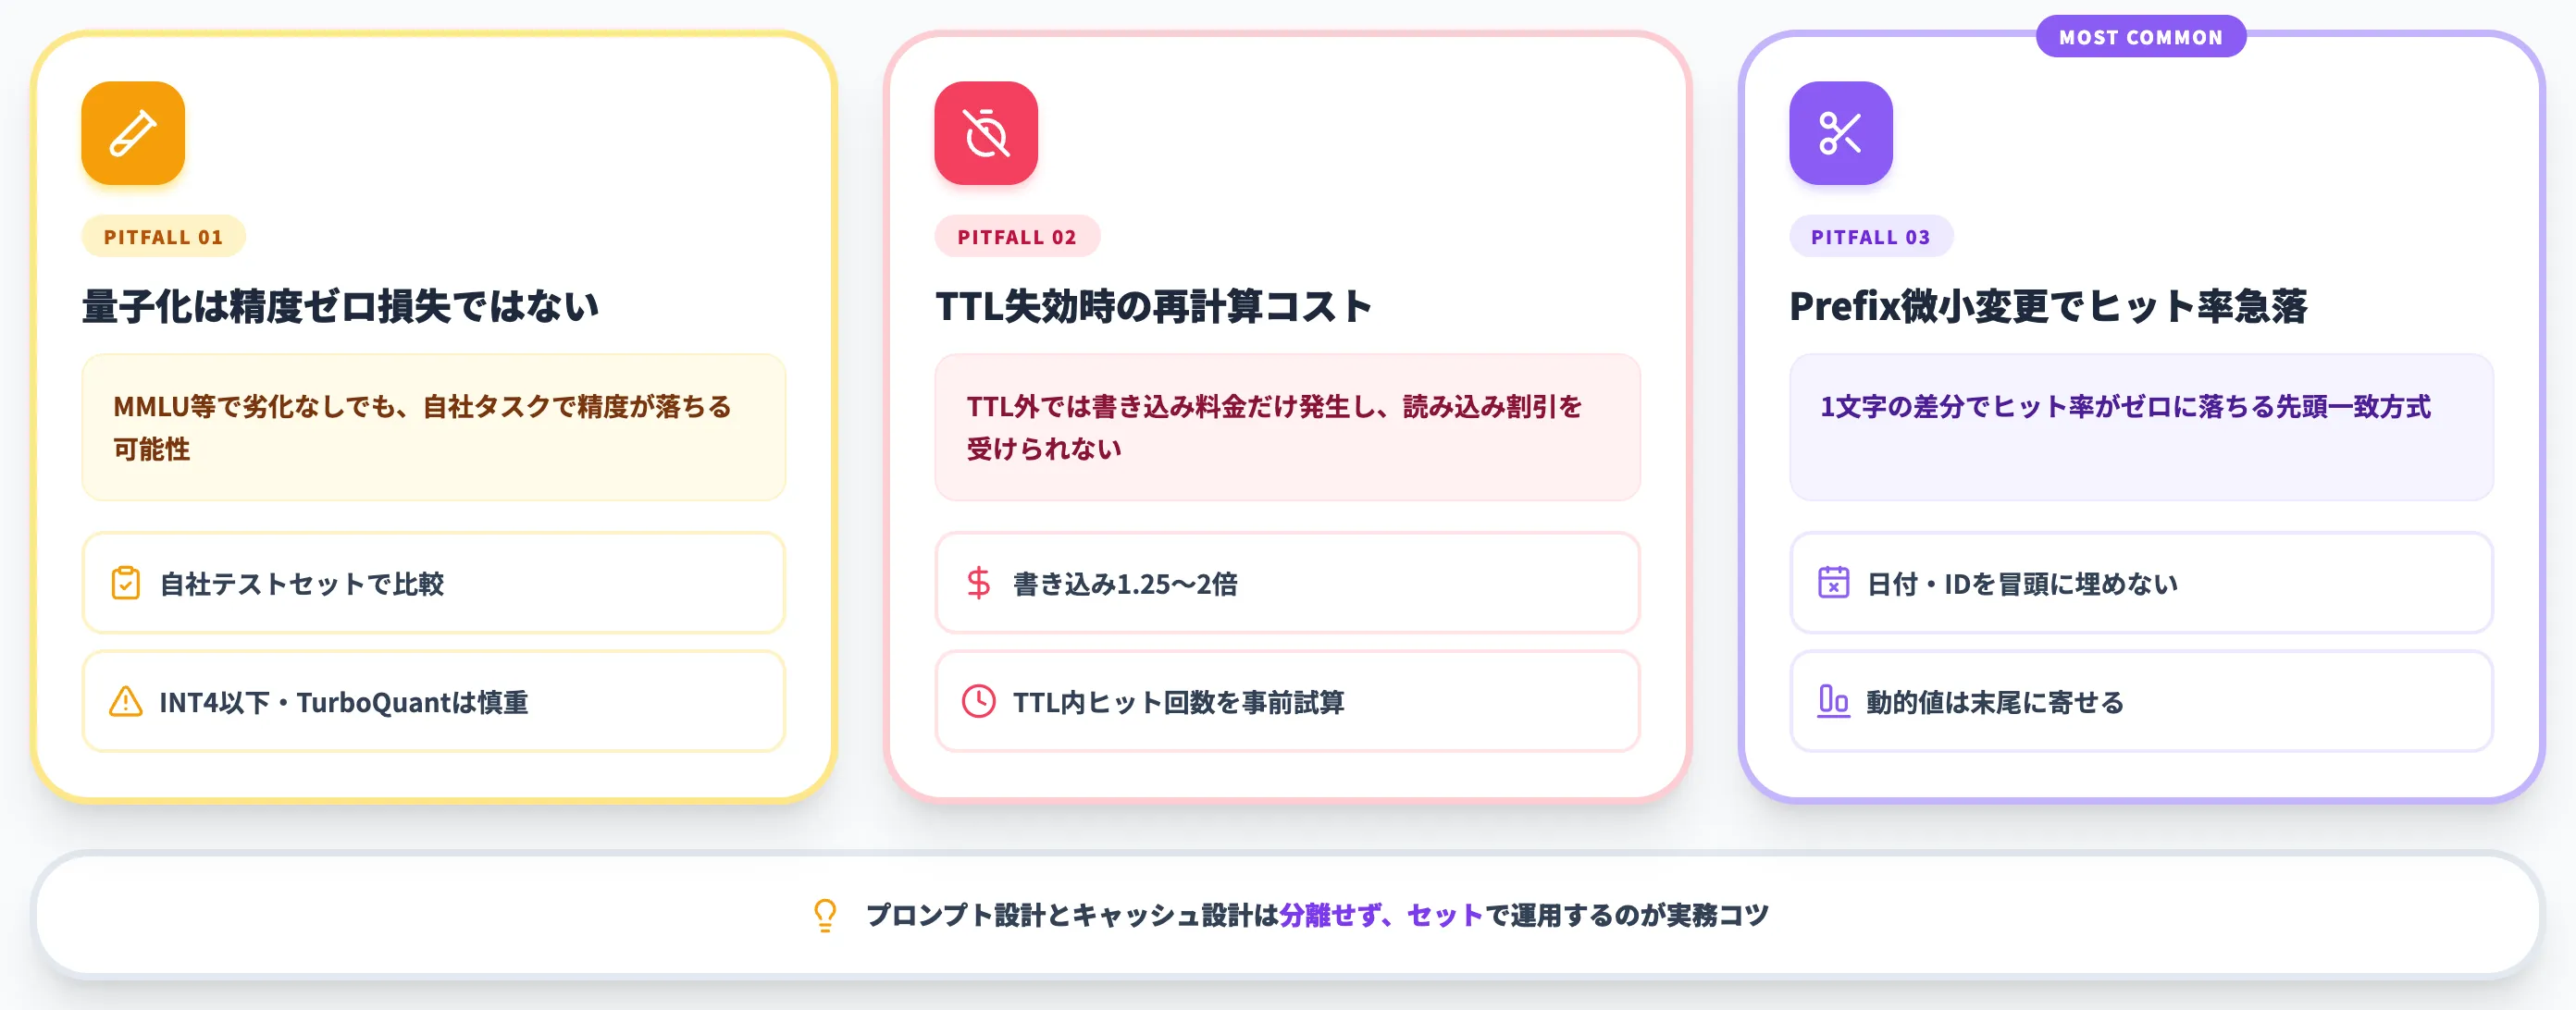
KVキャッシュ関連の最適化は効果が大きい反面、実装段階でハマりやすい前提がいくつかあります。事前に押さえておくと、PoCから本番運用への移行で足を止められません。
量子化・圧縮は精度損失ゼロではないタスクもある
TurboQuantが「精度損失ほぼゼロ」と報告している通り、量子化技術は年々精度が上がっています。それでも「自社の特定タスクで劣化が出ないか」は事前検証が必須です。
一般的な精度指標(MMLU・HumanEval等)で劣化がなくても、実運用で扱うタスクの特性次第で精度が落ちる可能性は残ります。INT4以下やTurboQuantを本番導入する前に、自社の代表的なテストセットで精度・出力品質を比較しておくことが安全策です。
TTL失効時に発生する再計算コスト
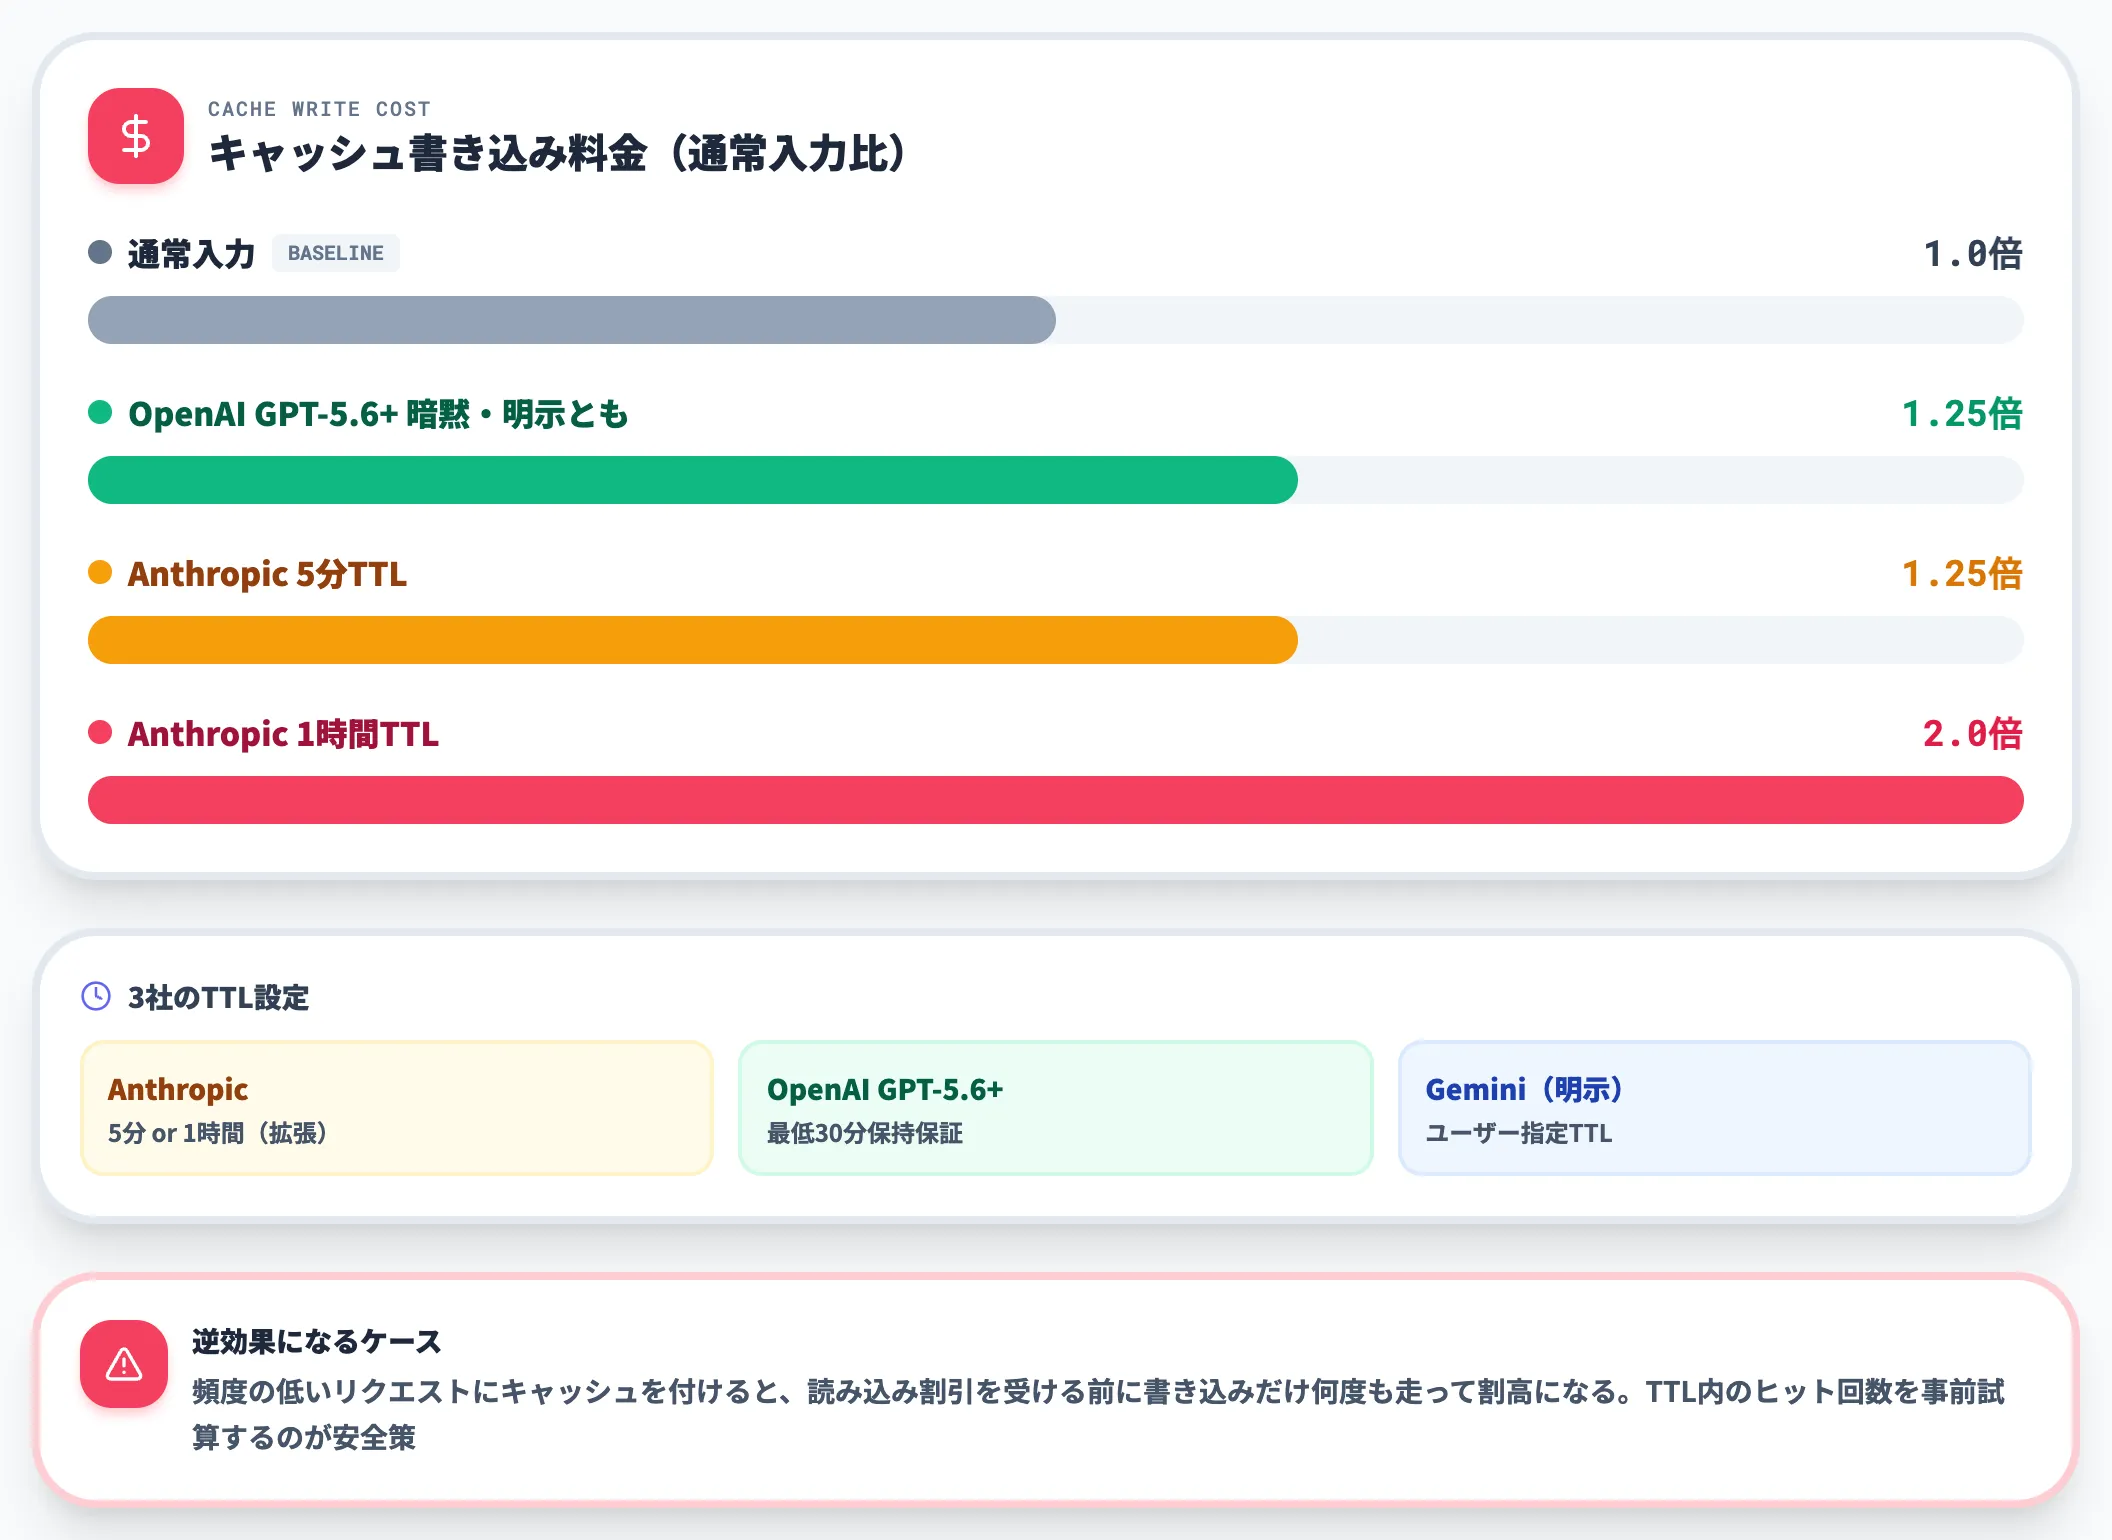
商用APIのプロンプトキャッシュにはTTL(生存時間)があります。Anthropicは5分または1時間、OpenAIは最低30分保証、Geminiの明示的キャッシュはユーザー指定です。
TTL内にヒットしなかったリクエストでは読み込み割引が適用されず、サービスによってはキャッシュ書き込み料金が発生します。OpenAI GPT-5.6以降は暗黙・明示とも書き込みが通常入力の1.25倍、Anthropicは5分TTLで1.25倍・1時間TTLで2倍と別料金体系になっており、頻度の低いリクエストにキャッシュを付けると「読み込み割引を受ける前に書き込みだけ何度も走って割高になる」逆効果があります。
キャッシュを付ける前に、その部分が「TTL内に何回ヒットする見込みか」を試算しておく必要があります。キャッシュTTLより長い間隔でしか来ないワークロードにキャッシュを付けても、ほぼ書き込み料金だけを払うことになります。
Prefixの微小変更でヒット率が急落する
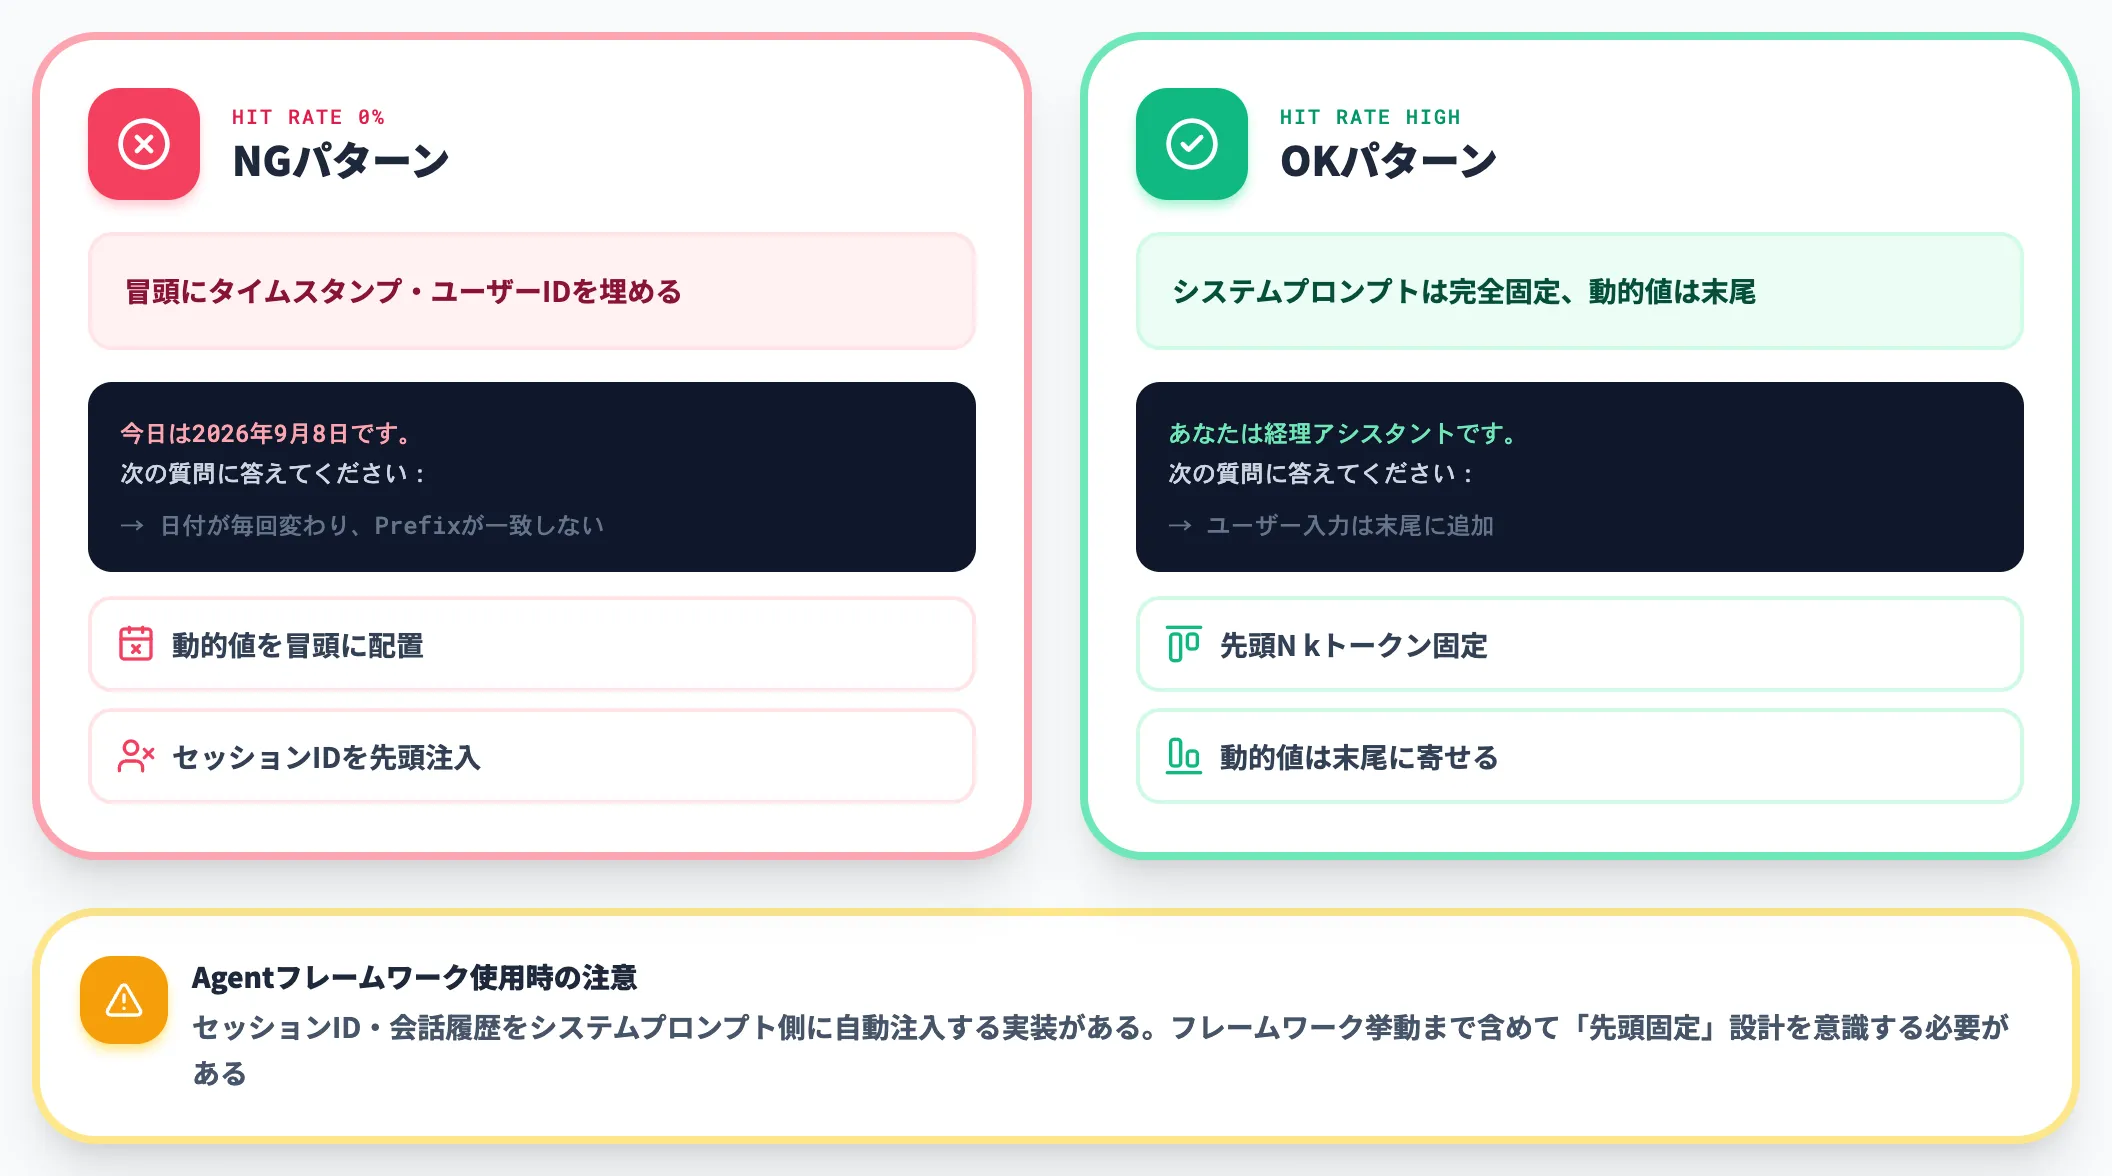
Prefix Caching・RadixAttention・商用プロンプトキャッシュはいずれも「先頭一致」でキャッシュを判定します。プロンプト先頭にたった1文字の差分(日付・ユーザーID・ランダムなセッションID)を挟むだけで、ヒット率がゼロに落ちます。
-
NGパターン
「今日は2026年9月8日です。次の質問に答えてください:」のように、システムプロンプト冒頭にタイムスタンプを埋め込む
-
OKパターン
システムプロンプトは完全固定にし、日付や動的情報はユーザーメッセージ側や末尾に寄せる
Agent系のフレームワークは、便利のために自動でセッションIDや会話履歴をシステムプロンプト側に注入する実装があります。プロンプトキャッシュを効かせるには、こうしたフレームワークの挙動も含めて「先頭N kトークンを固定」する設計を意識する必要があります。
導入現場で最もヒット率を落としているのはこの前提3で、原理を理解しているエンジニアでも実装コードを追わないと見逃す領域です。プロンプト設計とキャッシュ設計を分離して考えず、セットで運用するのが実務的なコツになります。
KVキャッシュとプロンプトキャッシュを効かせる基盤設計で詰まる論点を、実装事例から逆算して整理する
KVキャッシュ最適化を業務Agentに落とし込む現場では、公式ドキュメントだけでは決めきれない論点が並びます。
- 自社推論(vLLM/SGLang)と商用APIプロンプトキャッシュのどちらでどのワークロードを回すか
- MLA採用DeepSeek系・GQA採用Llama系のモデル選定とvLLM/SGLang/TensorRT-LLM/llama.cppの推論エンジン選定をどう組み合わせるか
- 複数Agent間でプロンプト構造を標準化してヒット率と書き込み料金試算をどう両立するか
- タイムスタンプ・セッションID等の動的値を末尾に寄せる設計とTurboQuant等の量子化検証をどう回すか
ワークロード切り分け・モデル/エンジン選定・プロンプト構造標準化・キャッシュヒット率モニタリングまで含めてKVキャッシュ最適化の実装可能性を棚卸ししたいなら、単体機能の解説記事ではなく、実装事例と組み合わせて話せる相手と一度整理するのが早道です。
AI Agent Hubは、業務特化Agentのプロンプト構造を標準化し商用APIプロンプトキャッシュを最大限効かせながらモデル世代交代を吸収するエンタープライズAI基盤で、ワークロード切り分け・モデル/エンジン選定・プロンプト構造標準化・キャッシュヒット率モニタリングのいずれの入口からでも、実装から逆算した論点整理をご相談いただけます。
KVキャッシュを効かせる基盤設計を実装から逆算

ワークロード切分・モデル/エンジン選定・Prefix標準化・ヒット率監視
KVキャッシュ最適化は、自社推論vs商用APIの切り分け・MLA/GQA/推論エンジン選定・複数Agentのプロンプト標準化・ヒット率と書き込み料金の実測が絡み合います。AI Agent Hubのサービスページで、プロンプトキャッシュを最大限効かせながらモデル世代交代を吸収する実装例をご確認ください。
まとめ
本記事では、KVキャッシュの原理から2026年時点の最新削減手法、商用APIとの関係、企業のLLM選定判断軸までを整理しました。要点を1行ずつ振り返ります。
- KVキャッシュはTransformer型LLMが自己回帰生成する際にKey・Valueを保存する中核メモリで、モデル重み・プロンプトキャッシュとは別階層で動く
- KVキャッシュ有無で過去トークンのK/V投影の再計算量が三角形(N²)から線形(N)に変わり、実用速度で動くための前提装置になっている
- コンテキスト長・並列数に比例してGPUメモリを消費し、長文・並列運用ではモデル重みより先にメモリ上限に到達する
- 削減手法は「注意機構レベル(MQA・GQA・MLA)」「メモリ管理・量子化(PagedAttention・INT8/INT4・TurboQuant)」「推論エンジン再利用(Prefix Caching・RadixAttention)」の3層で理解する
- 商用APIのプロンプトキャッシュはKVキャッシュと同発想でPrefix処理結果を再利用するマネージド機能で、Anthropic 5分/1時間・OpenAI 30分・Gemini暗黙といったTTLと、多くのモデルで90%オフ・Anthropic一部モデルで97.5%オフといった割引の設計に違いがある
- 自社推論はvLLM/SGLangでKVを制御、商用APIはPrefix固定・後半可変の業務向け、長文コンテキストはMLA採用モデルかGeminiのコンテキストキャッシュ、というハイブリッド構成が2026年時点の現実解
KVキャッシュはLLM推論のコスト構造そのものを変える技術で、原理を押さえたうえで自社ユースケースの層を選ぶことが、コスト・速度・スケーラビリティの3つを同時に最適化する近道になります。