この記事のポイント
 コーディングAgent基盤の候補モデルなら、SWE-bench Pro 62.5でOpus 4.6を上回るFlash-Nextが有力候補
- 総パラ125B・アクティブ6Bで、Qwen 3.8-Maxの約1/13単価で動く長コンテキスト対応MoE
- QwenCloudの入力$0.15・出力$0.47(100万トークンあたり)は、Kimi K3・Opus 5比で単価が1〜2桁安い低単価帯
- Qwen Community License 1.0はMaaSと、コーディング/オフィス支援を主要用途とする独立型AI製品には別ライセンスが必要、社内利用・バックエンド組み込みは原則自由
- Claude Codeは環境変数、Codexは設定ファイル(model-catalog+config.toml)で連携し、YaRNで1Mコンテキストへ拡張可能
Microsoft MVP・AIパートナー。LinkX Japan株式会社 代表取締役。東京工業大学大学院にて自然言語処理・金融工学を研究。NHK放送技術研究所でAI・ブロックチェーンの研究開発に従事し、国際学会・ジャーナルでの発表多数。経営情報学会 優秀賞受賞。シンガポールでWeb3企業を創業後、現在は企業向けAI導入・DX推進を支援。
Qwen3.8-Flash-Next(クウェン3.8-フラッシュ-ネクスト)は、AlibabaのQwen Teamが2026年8月26日に公開した、Qwen4シリーズで採用予定の主要アーキテクチャ要素を先取り実装したマルチモーダルMoE基盤モデルです。
総パラメータ125Bに対して1トークンあたりのアクティブは6Bのみという極端な稀疏化を採用し、Qwen4完成前に新アーキだけを先出しして評価する位置づけです。
本記事では、Qwen4先取りアーキの中身、Opus 4.6を上回るコーディング性能、料金と商用制約、他モデルとの使い分けまでを、2026年8月時点の公式一次情報で整理します。
目次
Qwen3.8-Flash-Nextとは?AlibabaがQwen4アーキテクチャを先取り実装したマルチモーダルMoE基盤
Residual: Gated Residualの4分岐拡張
Embedding: 51B N-gram Embedding
Optimization: Muon Optimizer採用
Qwen3.8-Flash-Nextのベンチマーク性能——Claude Opus 4.6を上回るコーディング・office task
コーディング系——SWE-bench Pro 62.5でOpus超え
Agent・office work——CoWorkBench 73.9
Qwen3.8-Flash-Nextの料金・提供チャネル・ライセンス
Qwen Community License 1.0の商用条件
Qwen 3.8-Max / DeepSeek V4-Flash / Kimi K3との使い分け
Qwen3.8-Flash-Nextを業務Agent基盤に載せる判断——ケース別実装アプローチ
Qwen3.8-Flash-Nextとは?AlibabaがQwen4アーキテクチャを先取り実装したマルチモーダルMoE基盤
Qwen3.8-Flash-Next(クウェン3.8-フラッシュ-ネクスト)は、AlibabaのQwen Teamが2026年8月26日に公開した、Qwen4シリーズで採用予定の主要アーキテクチャ要素を先取り実装したマルチモーダルMoE基盤モデルです。
総パラメータ125Bに対して1トークンあたりのアクティブは6Bのみという極端な稀疏化を採用し、262K(YaRNで最大1M)のコンテキスト長で長文タスクを扱えます。
Qwen Teamはこの位置づけを「A New Architecture, Towards Ultimate Cost-Efficiency」と説明しており、Qwen3-Nextで採った「先出しアーキ→本体世代」の手順(当時のハイブリッドGDN+Gated Attention設計はその後Qwen3.5〜Qwen3.8シリーズへ継承)を、Qwen4に向けて再び踏んだ形になっています。
Qwen Teamが2026年8月26日に公開した「Qwen3.8-Flash-Next: Now Open Weights」の発表バナー(出典:Qwen Team blog)
Qwenシリーズの中でのFlash-Nextの位置関係
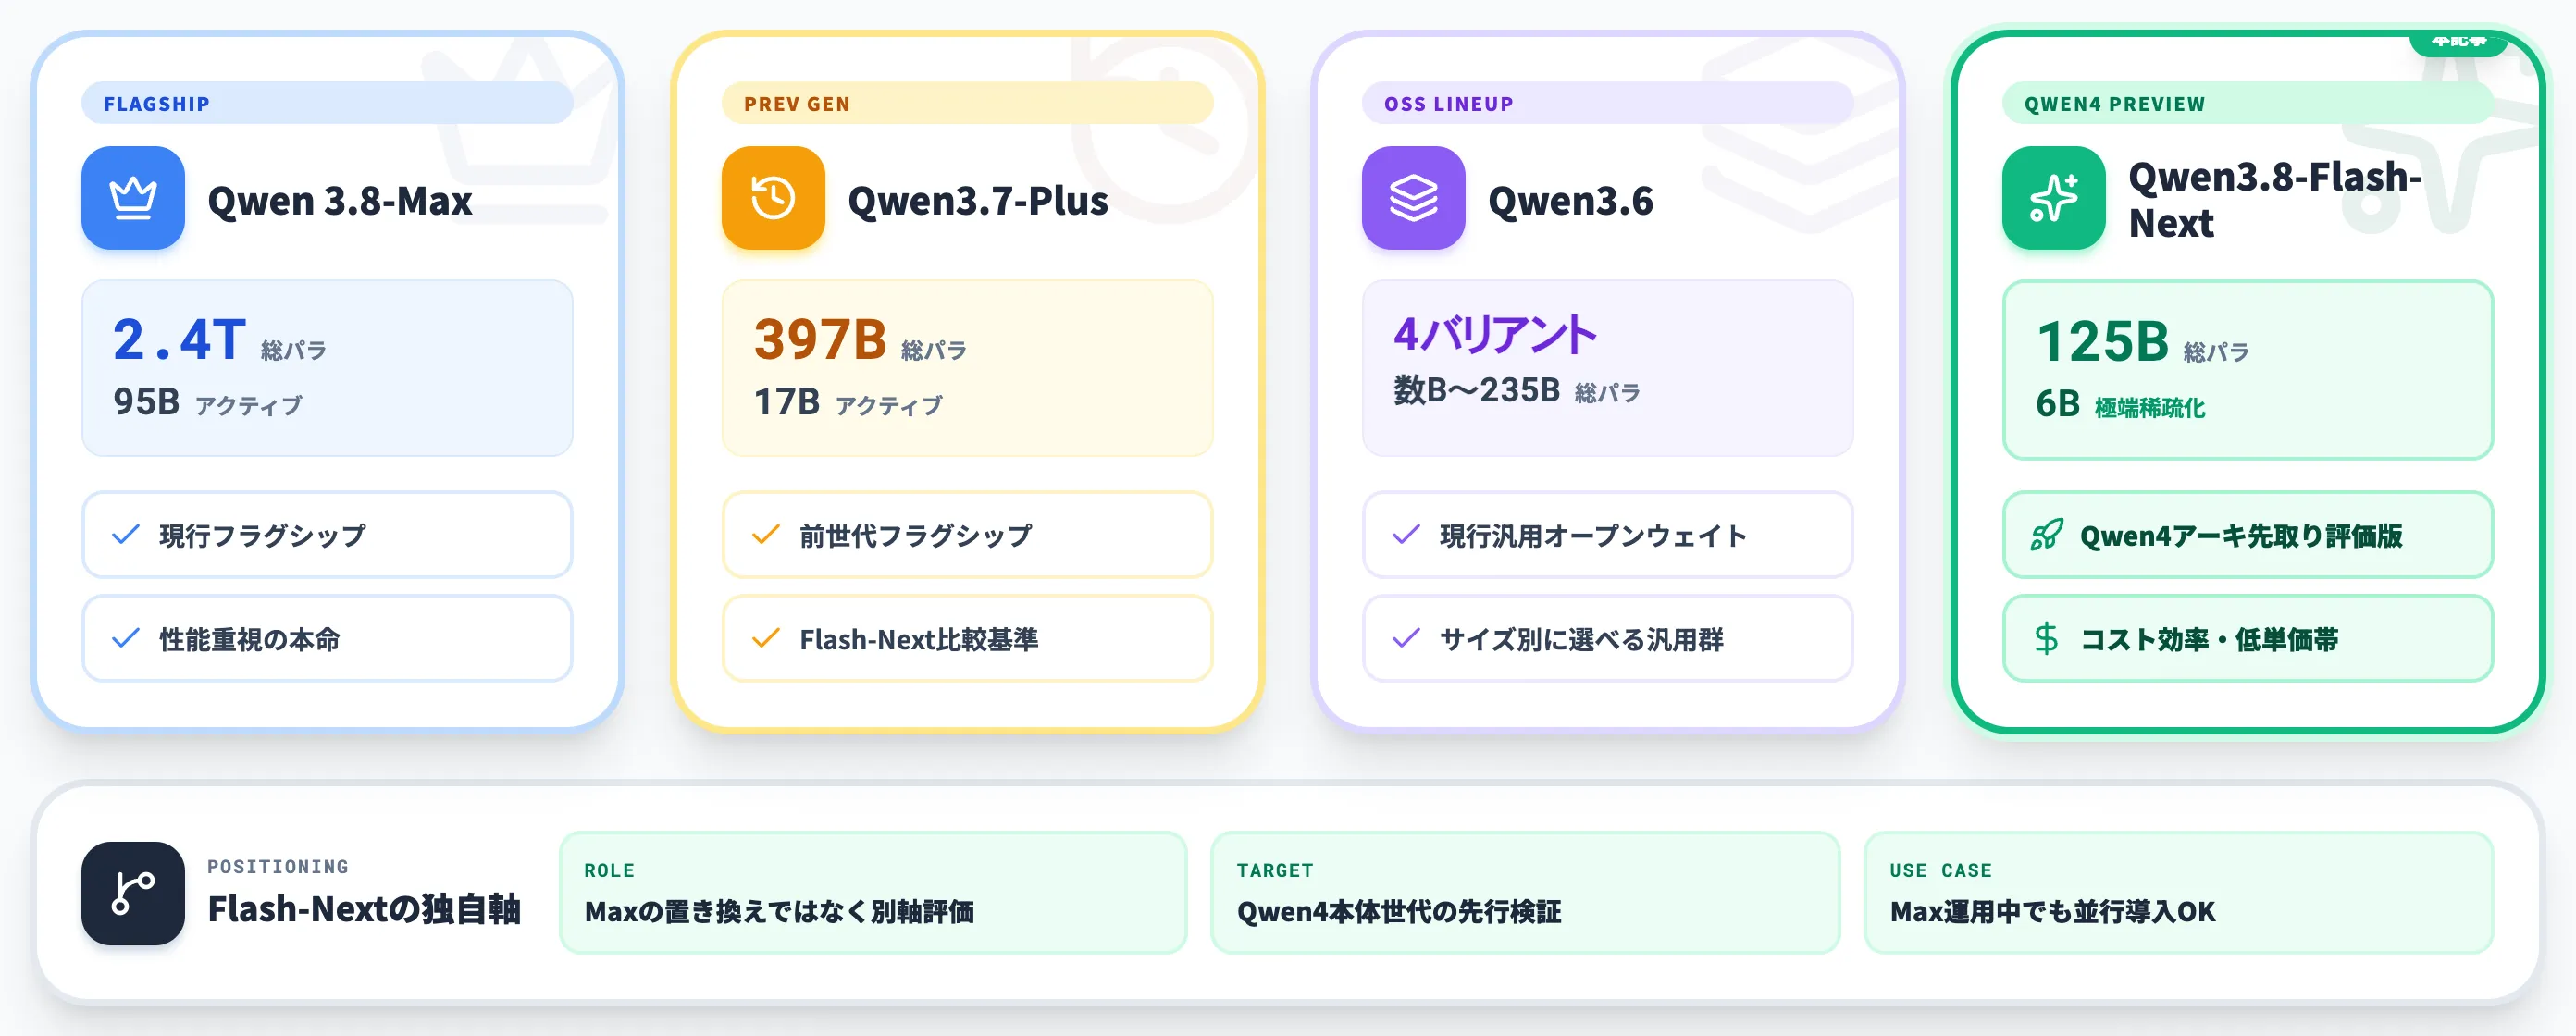
Flash-Nextは、既存のQwenシリーズの下位互換ではなく、先行して公開されたQwen3-Next(Qwen3.5世代の先出しアーキ)と同じ役割で、Qwen4本体世代の設計を先に触れる評価用モデルとして位置づけられます。
以下の表で、現行Qwenシリーズ主要モデルとFlash-Nextの位置関係を整理しました。
| モデル | 総パラメータ | アクティブ | 位置づけ |
|---|---|---|---|
| Qwen 3.8-Max | 2.4T | 95B | 現行フラグシップ(性能重視) |
| Qwen3.7-Plus | 397B | 17B | 前世代フラグシップ |
| Qwen3.6 | 4バリアント(数B〜235B) | — | 現行汎用オープンウェイト |
| Qwen3.8-Flash-Next | 125B | 6B | Qwen4アーキ先取り(コスト効率) |
ここで押さえておきたいのは、Flash-Nextは3.8-Maxを性能で置き換える存在ではなく、フラグシップMaxとは別軸で、Qwen4世代のアーキテクチャ設計を先に触れる評価用モデルという位置づけです。したがって既存の3.8-Maxを本番運用中の環境でも、コスト圧縮や長コンテキスト検証の目的で並行導入する使い方が現実的な選択になります。
ただしFlash-Nextと3.8-Maxを同一条件で計測した公式比較データは公開されていないため、性能差の断定は避けて自社ワークロードでの並行検証で判断する。
Qwen3.8-Flash-Nextのアーキテクチャ革新
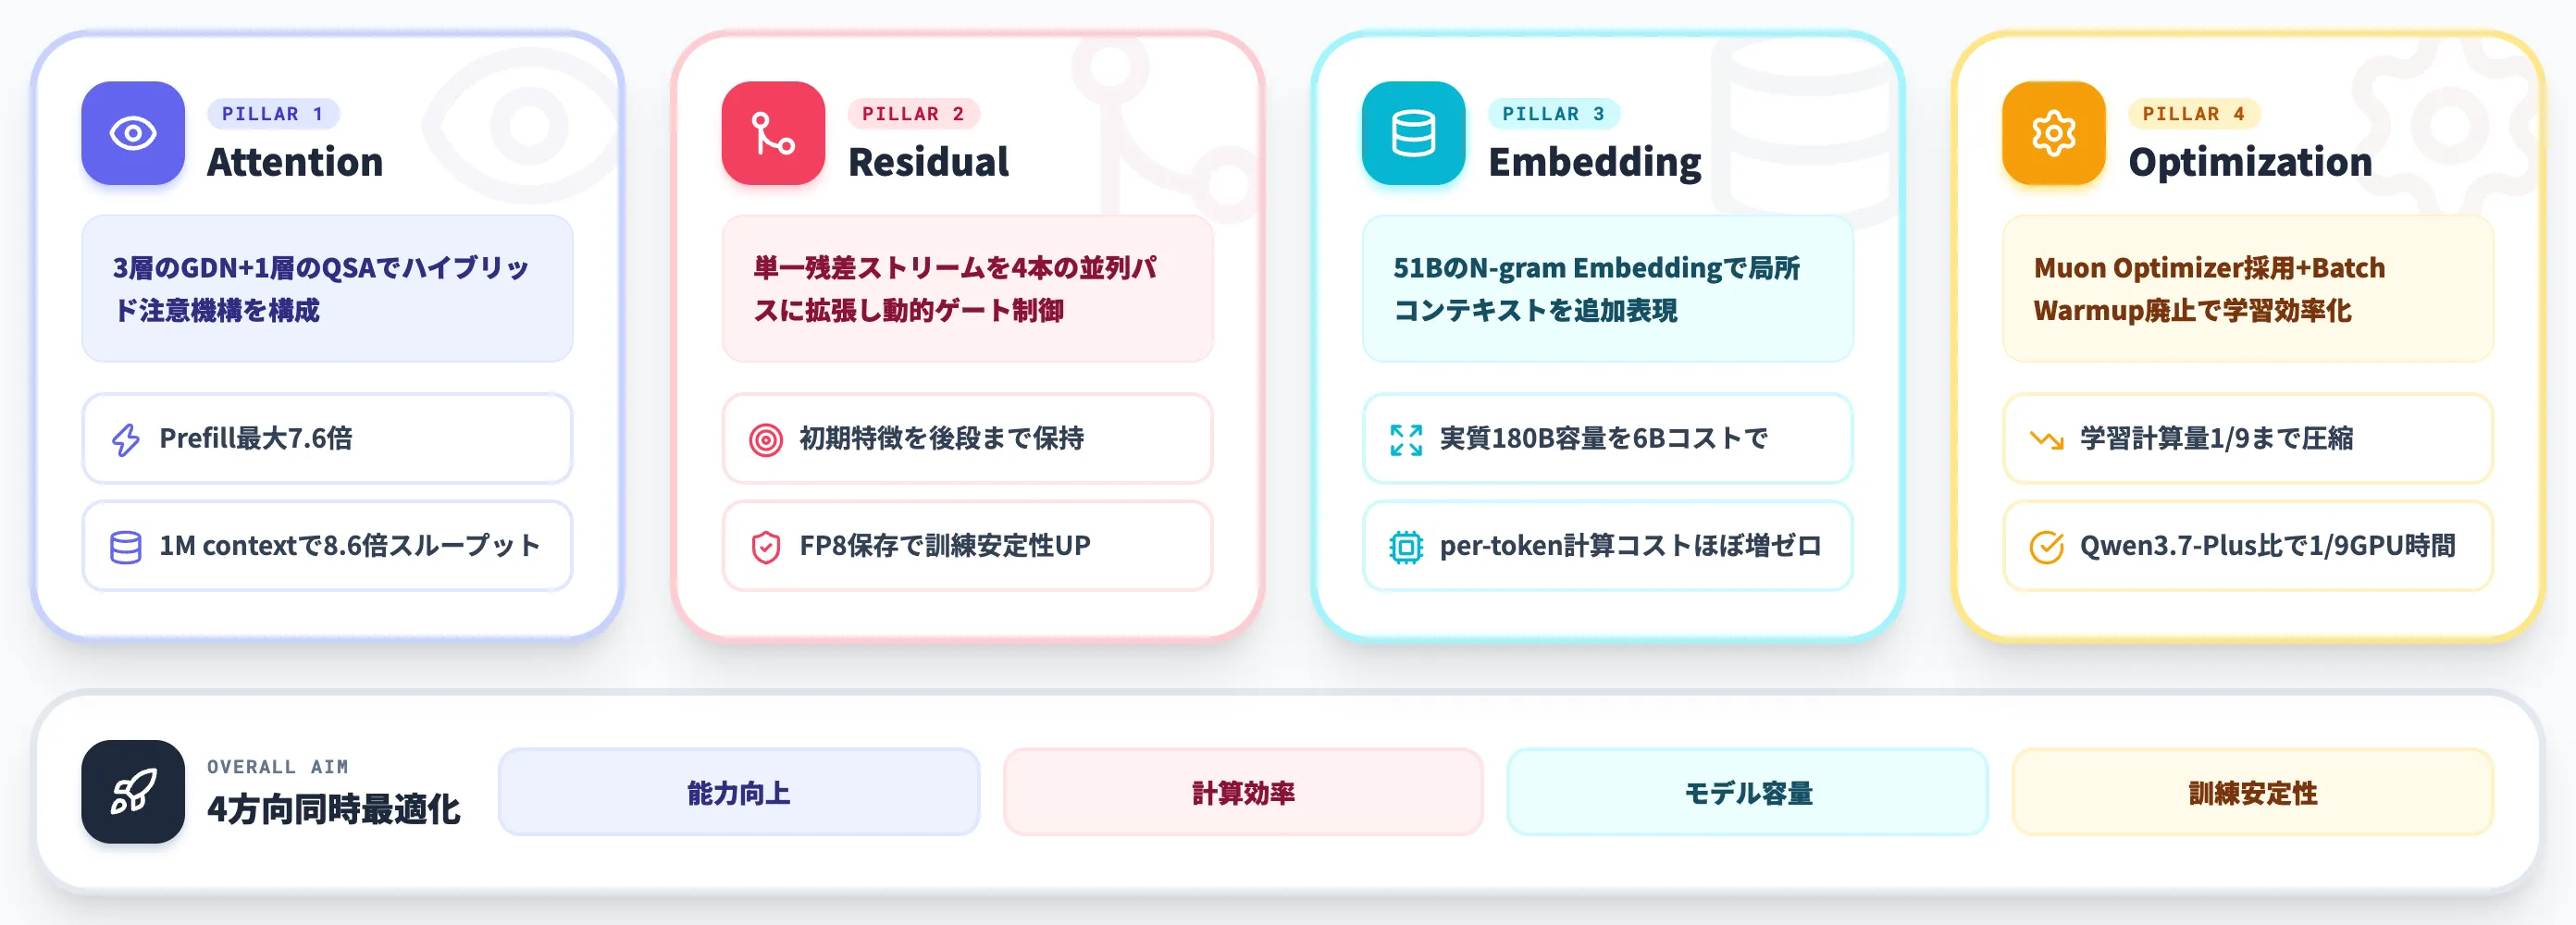
Flash-Nextの中核は、Qwen4世代で本格採用される予定の4つのアーキテクチャ革新——Attention(注意機構)・Residual(残差ストリーム)・Embedding(埋め込み)・Optimization(最適化)——を、実運用可能な状態で先出ししている点にあります。
Qwen Teamは公式blogで「improving model capability while further optimizing computational efficiency, model capacity and training stability」と、能力向上・計算効率・モデル容量・訓練安定性の4方向を同時に最適化する狙いを明示しています。以下、4本柱を順に整理します。
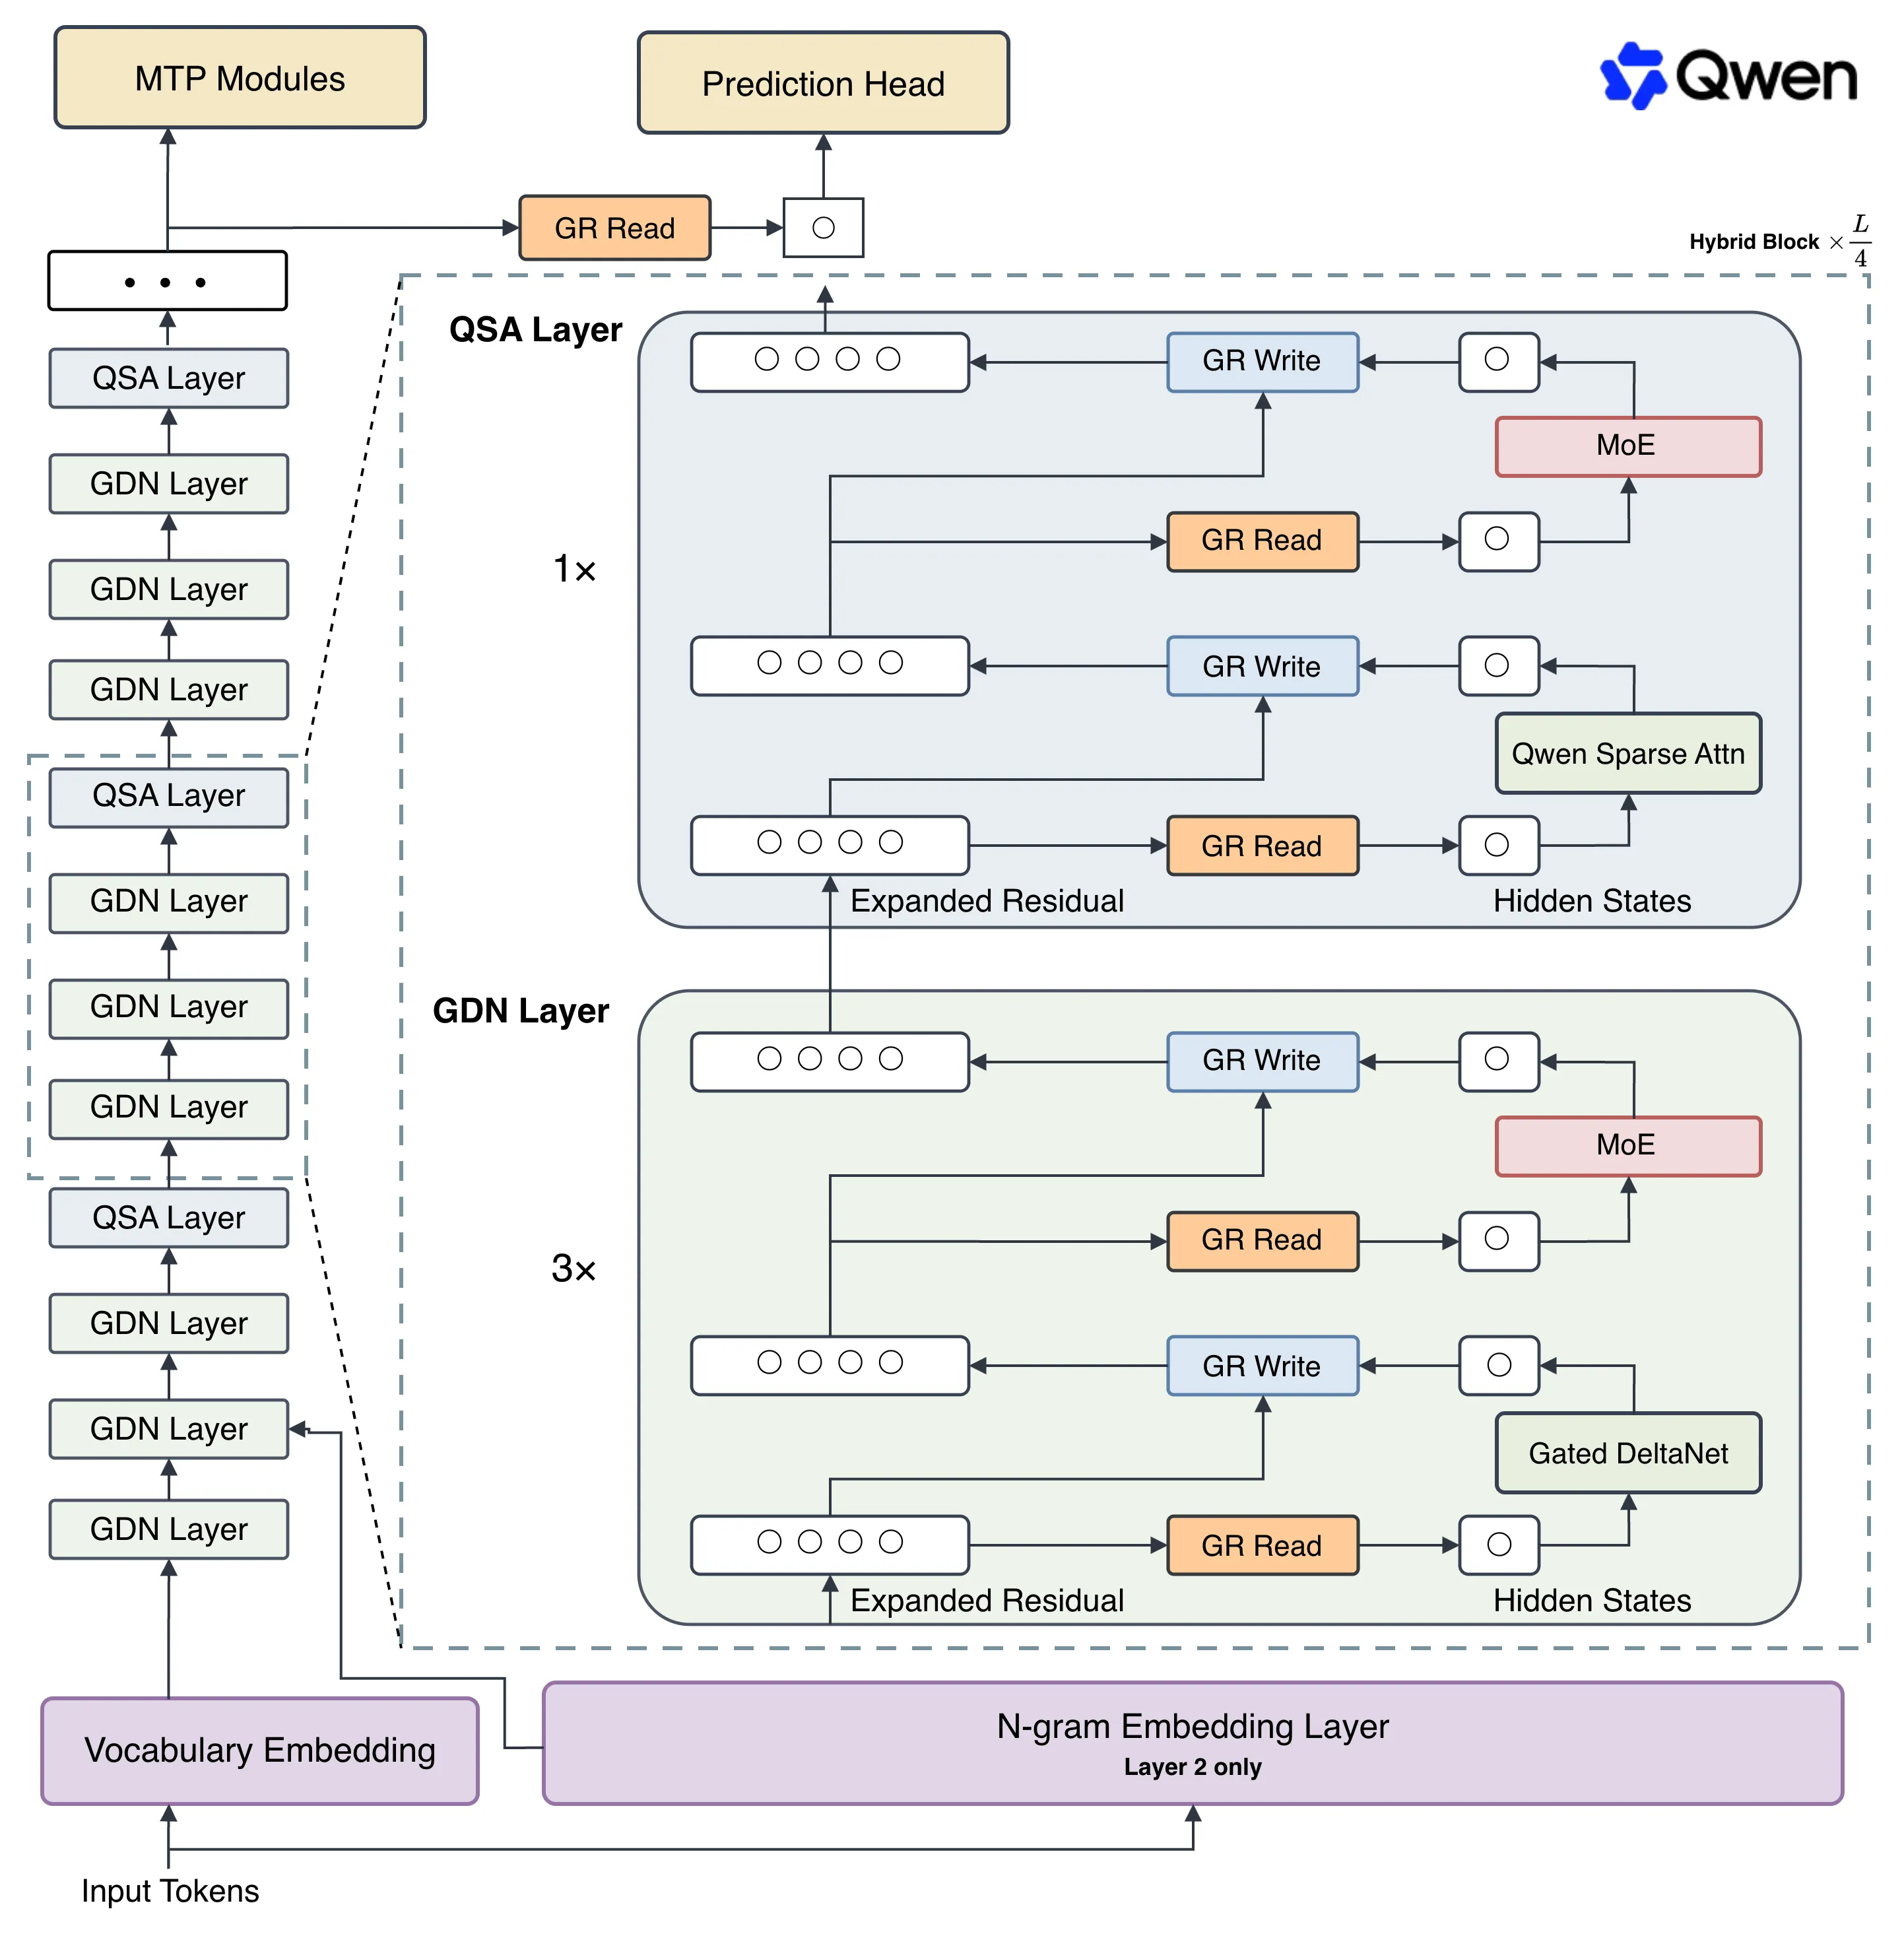
Qwen3.8-Flash-Nextの内部構造。3層のGDN Layer+1層のQSA Layerで構成されるハイブリッドブロックがL/4回繰り返される左側の縦積みと、右側の各Layer内部(GR Read/Write・MoE・Gated DeltaNet / Qwen Sparse Attn)、下段のN-gram Embedding Layer、上段のMTP ModulesとPrediction Headまでが1枚に統合されている(出典:Qwen Team blog)
Attention: GDN+QSAハイブリッド注意機構
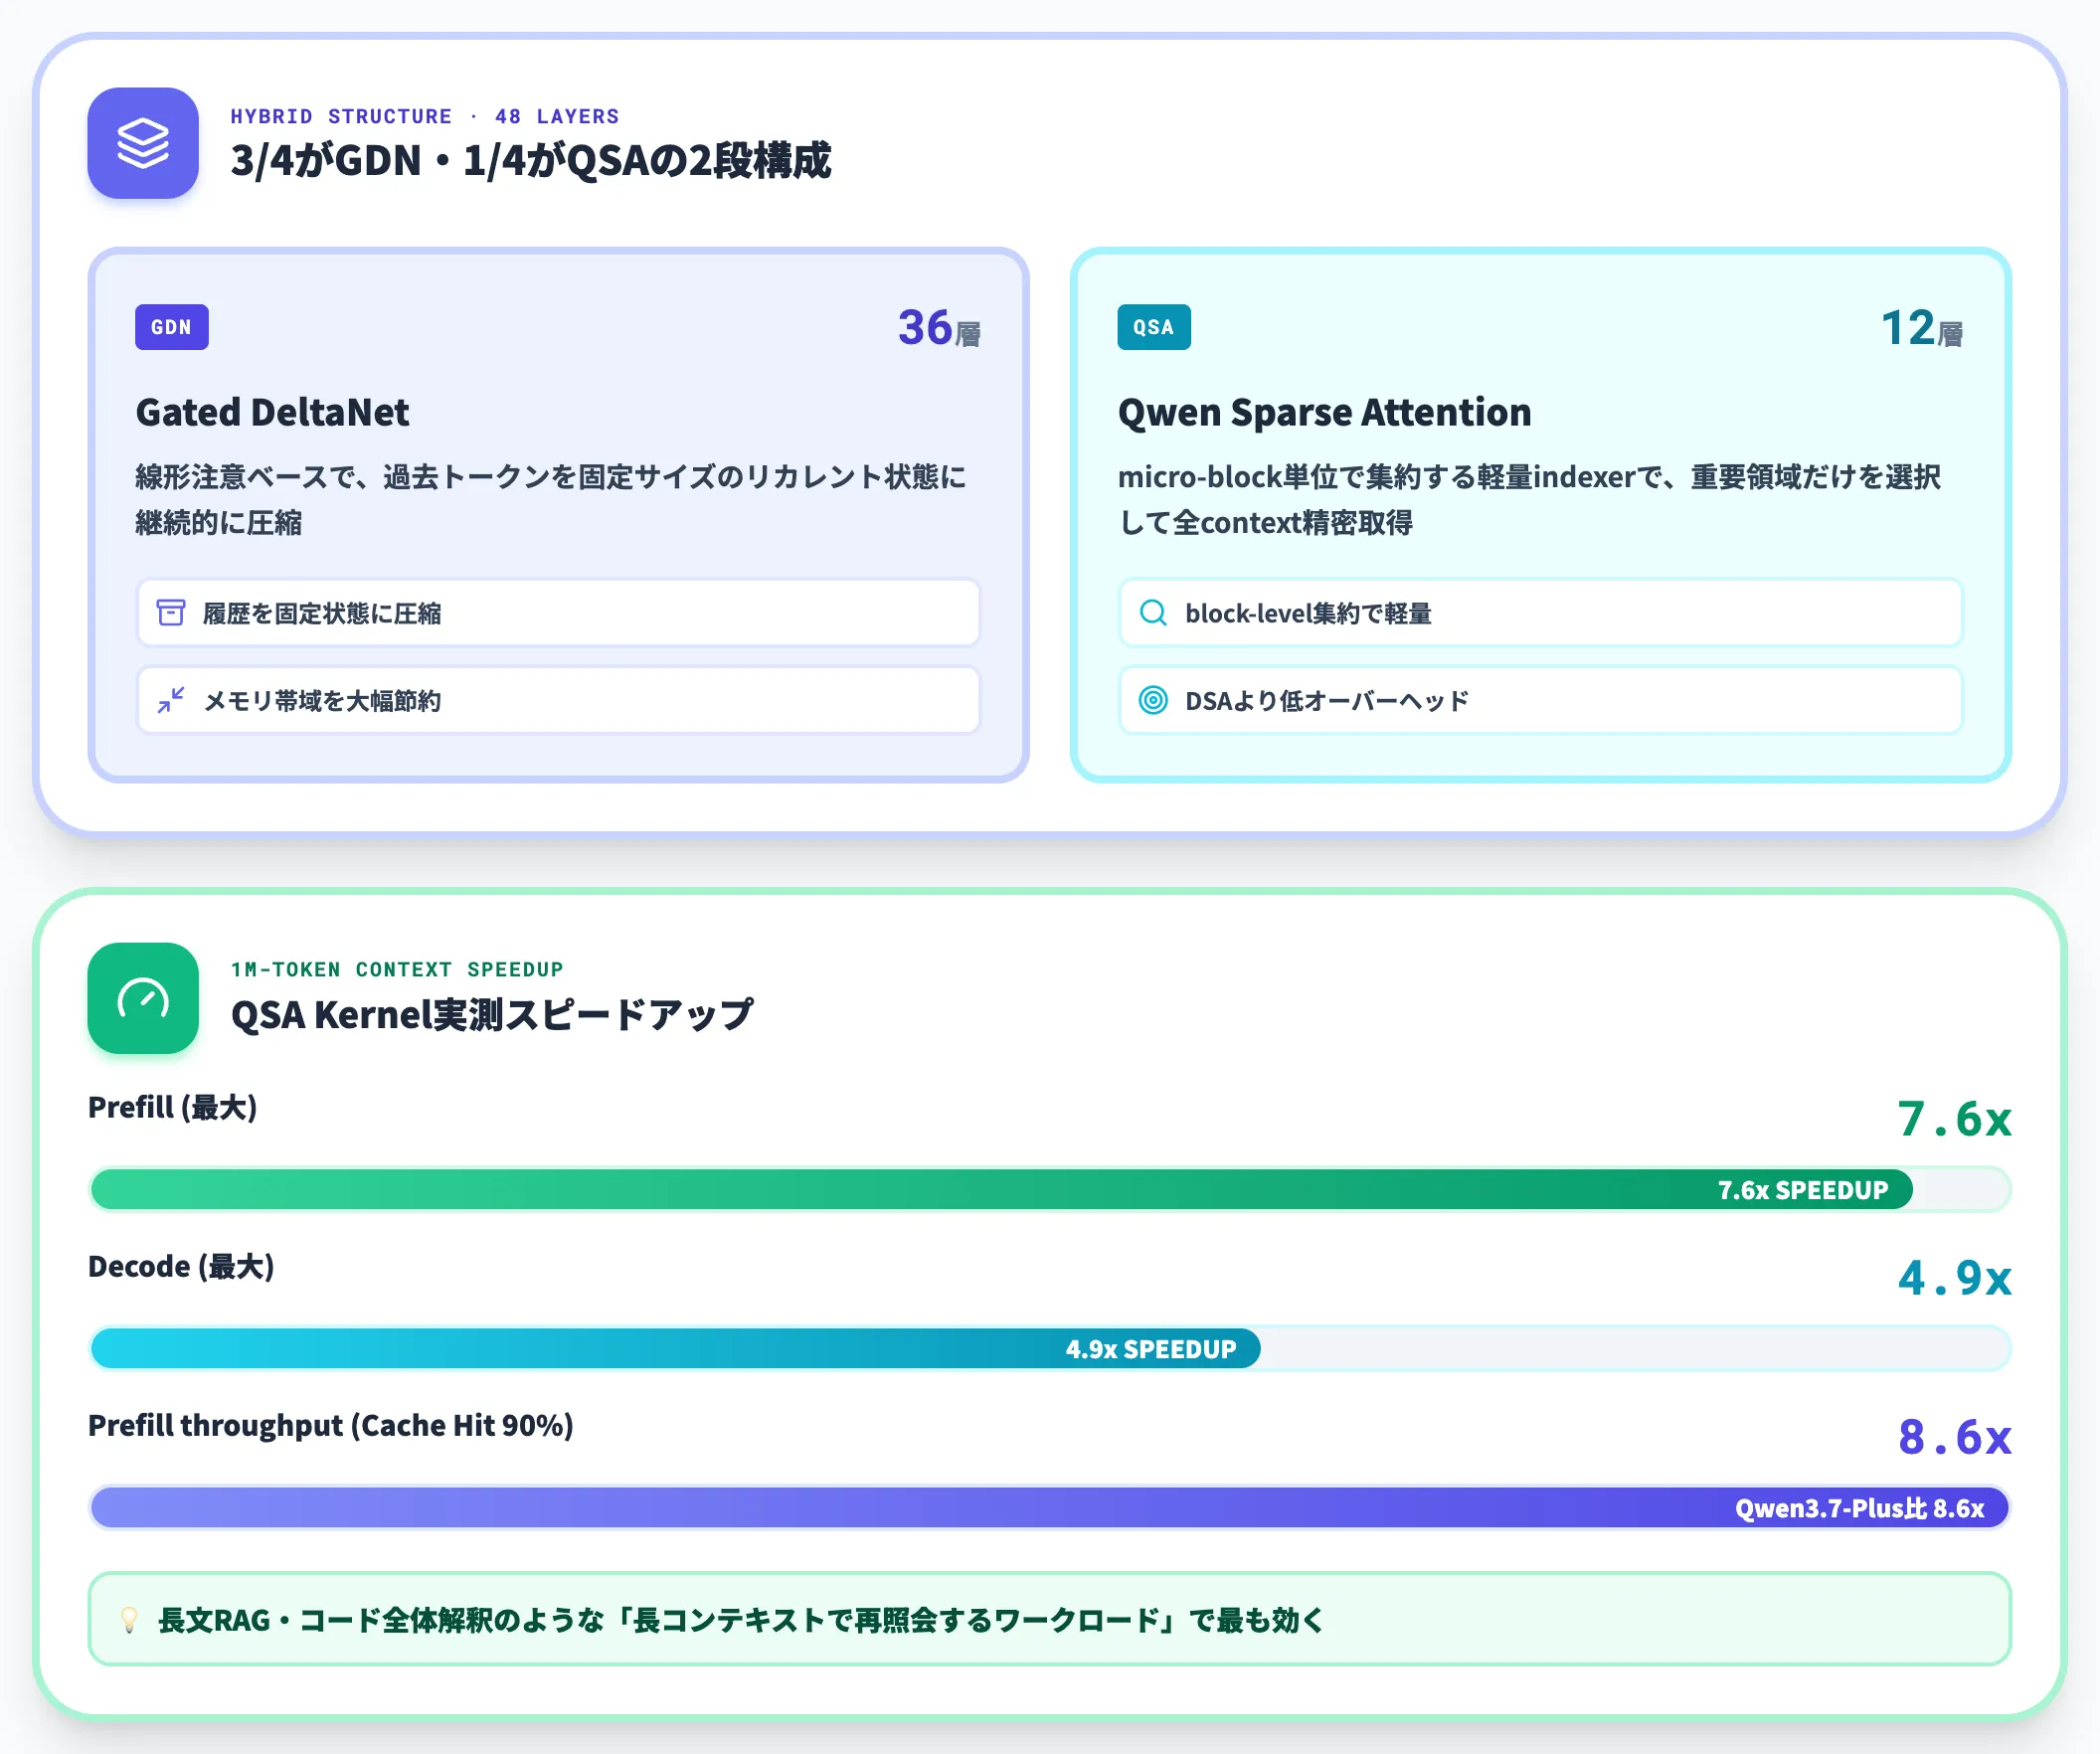
Flash-Nextの注意機構は、3層のGated DeltaNet(GDN)で履歴を固定サイズの状態に圧縮し、残り1層のQwen Sparse Attention(QSA)で全context精密取得するというハイブリッド構成です。
-
Gated DeltaNet(GDN)
線形注意ベースで、過去のトークンを固定サイズのリカレント状態に継続的に圧縮する。48層のうち3/4(36層)がGDN。
-
Qwen Sparse Attention(QSA)
残り1/4(12層)でグローバル注意を担当。ただし通常のFull Attentionではなく、シーケンスをmicro-block単位に集約する軽量indexerで重要領域だけを選択して計算量を削減する。
-
DSA(DeepSeek Sparse Attention)との違い
既存のsparse attention手法はtoken-levelのindexerを使うため、コンテキストが長くなるほどindexer自体の計算コストが無視できなくなる。QSAはblock-levelで集約するため、indexer自体のオーバーヘッドも同時に抑えられる。
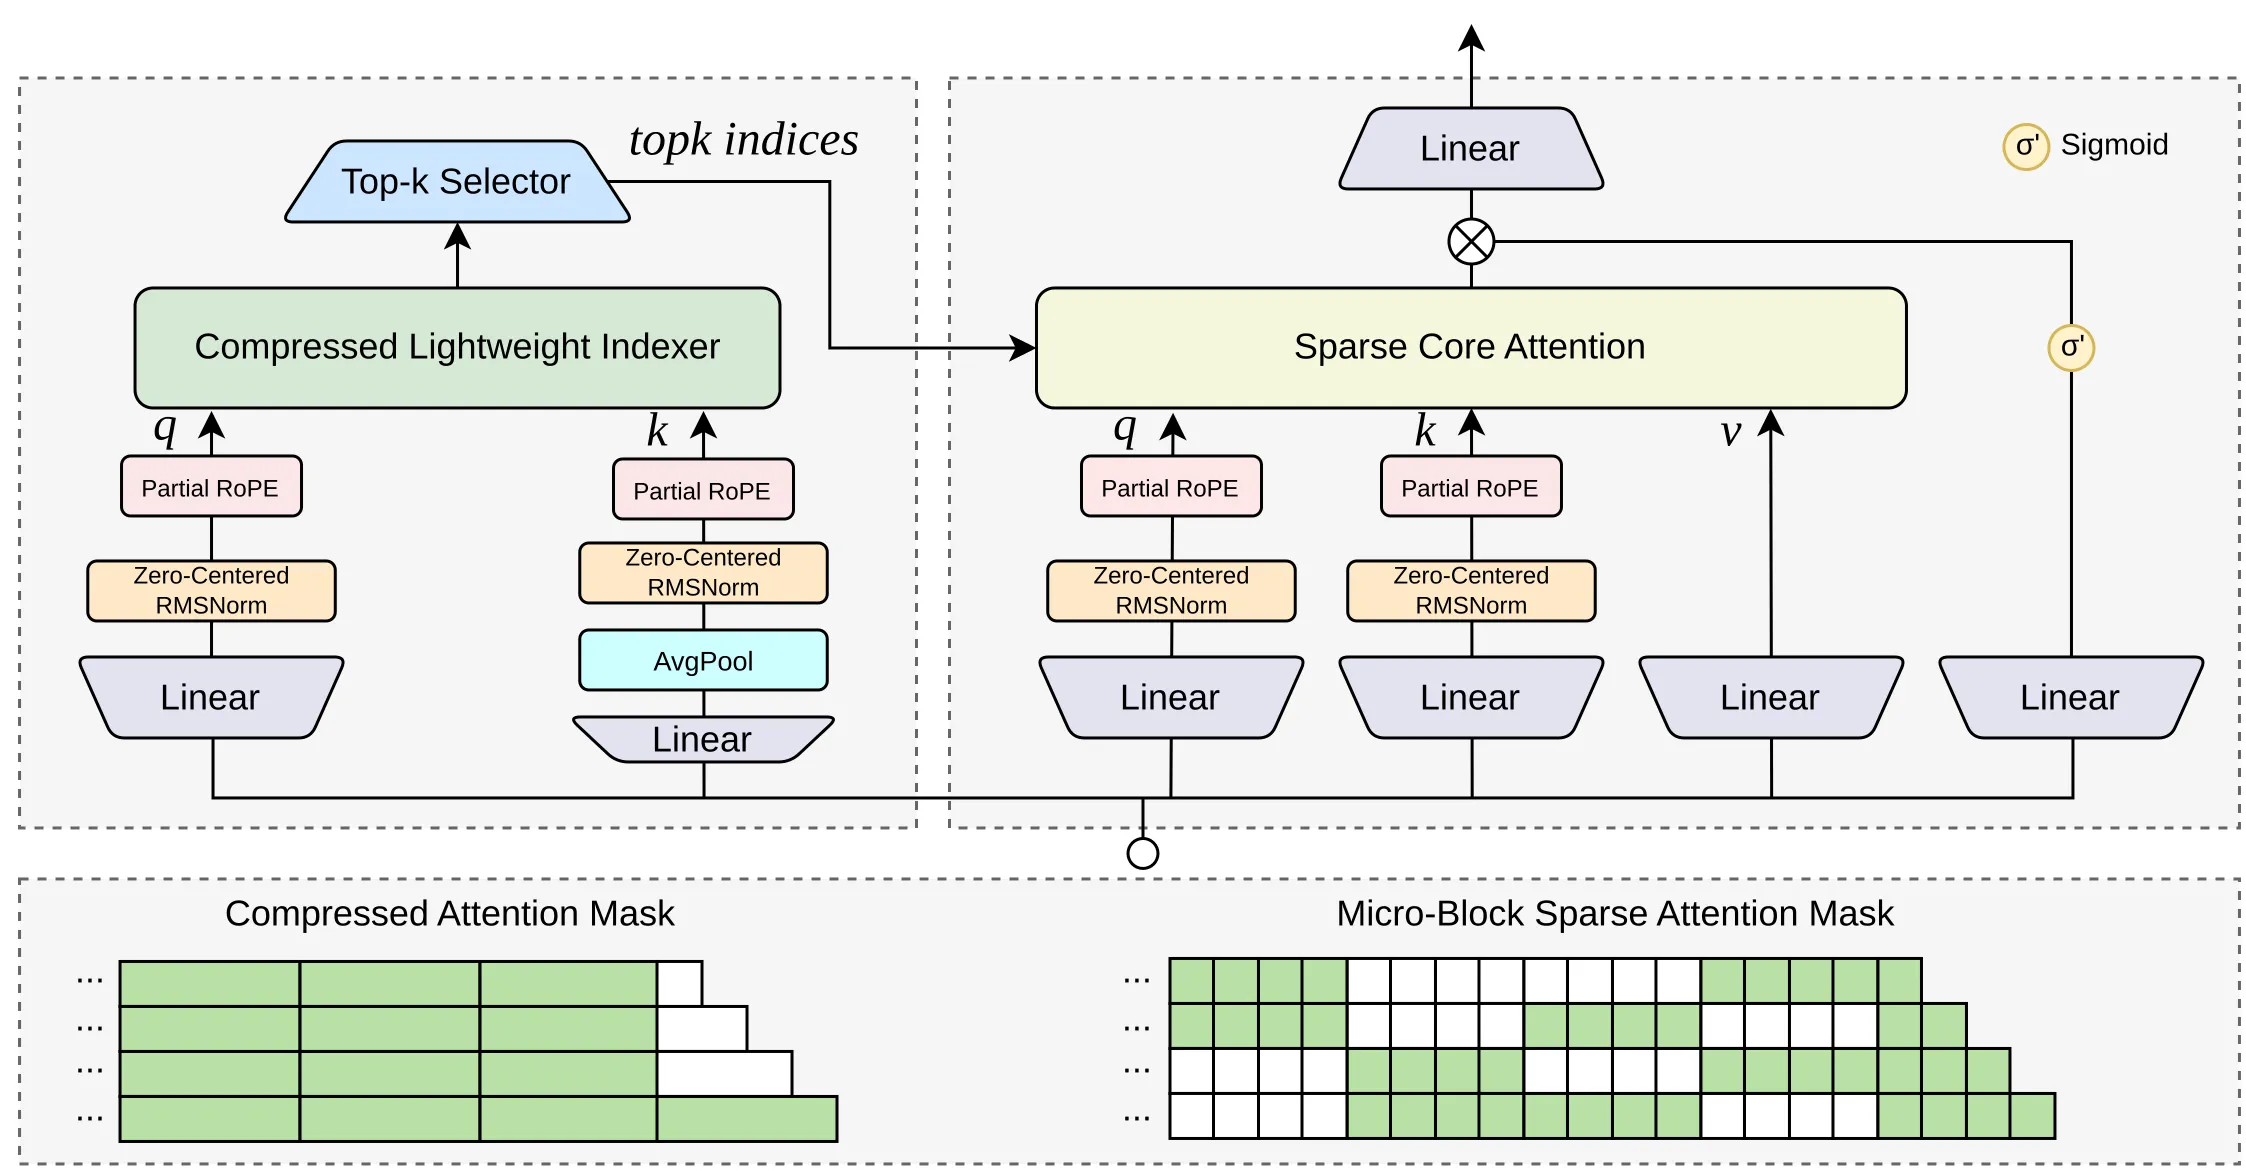
QSAの内部構造。左のCompressed Lightweight Indexerがシーケンスをmicro-blockに集約してTop-k Selectorで重要領域だけを選び、右のSparse Core Attentionが選ばれた領域のみを対象に注意計算を実行する。下段はCompressed Attention MaskとMicro-Block Sparse Attention Maskの適用イメージ(出典:Qwen Team blog)
このハイブリッド構成の効果は、公式blogで 1Mトークン時に、QSAのAttention KernelがPrefillで最大7.6倍・Decodeで最大4.9倍のスピードアップを達成したと報告されています。さらに実運用に近いキャッシュ再利用シナリオ(Prefix Cacheヒット率90%)では、1M-token contextでQwen3.7-Plus比のPrefillスループット8.6倍という数値も示されています。
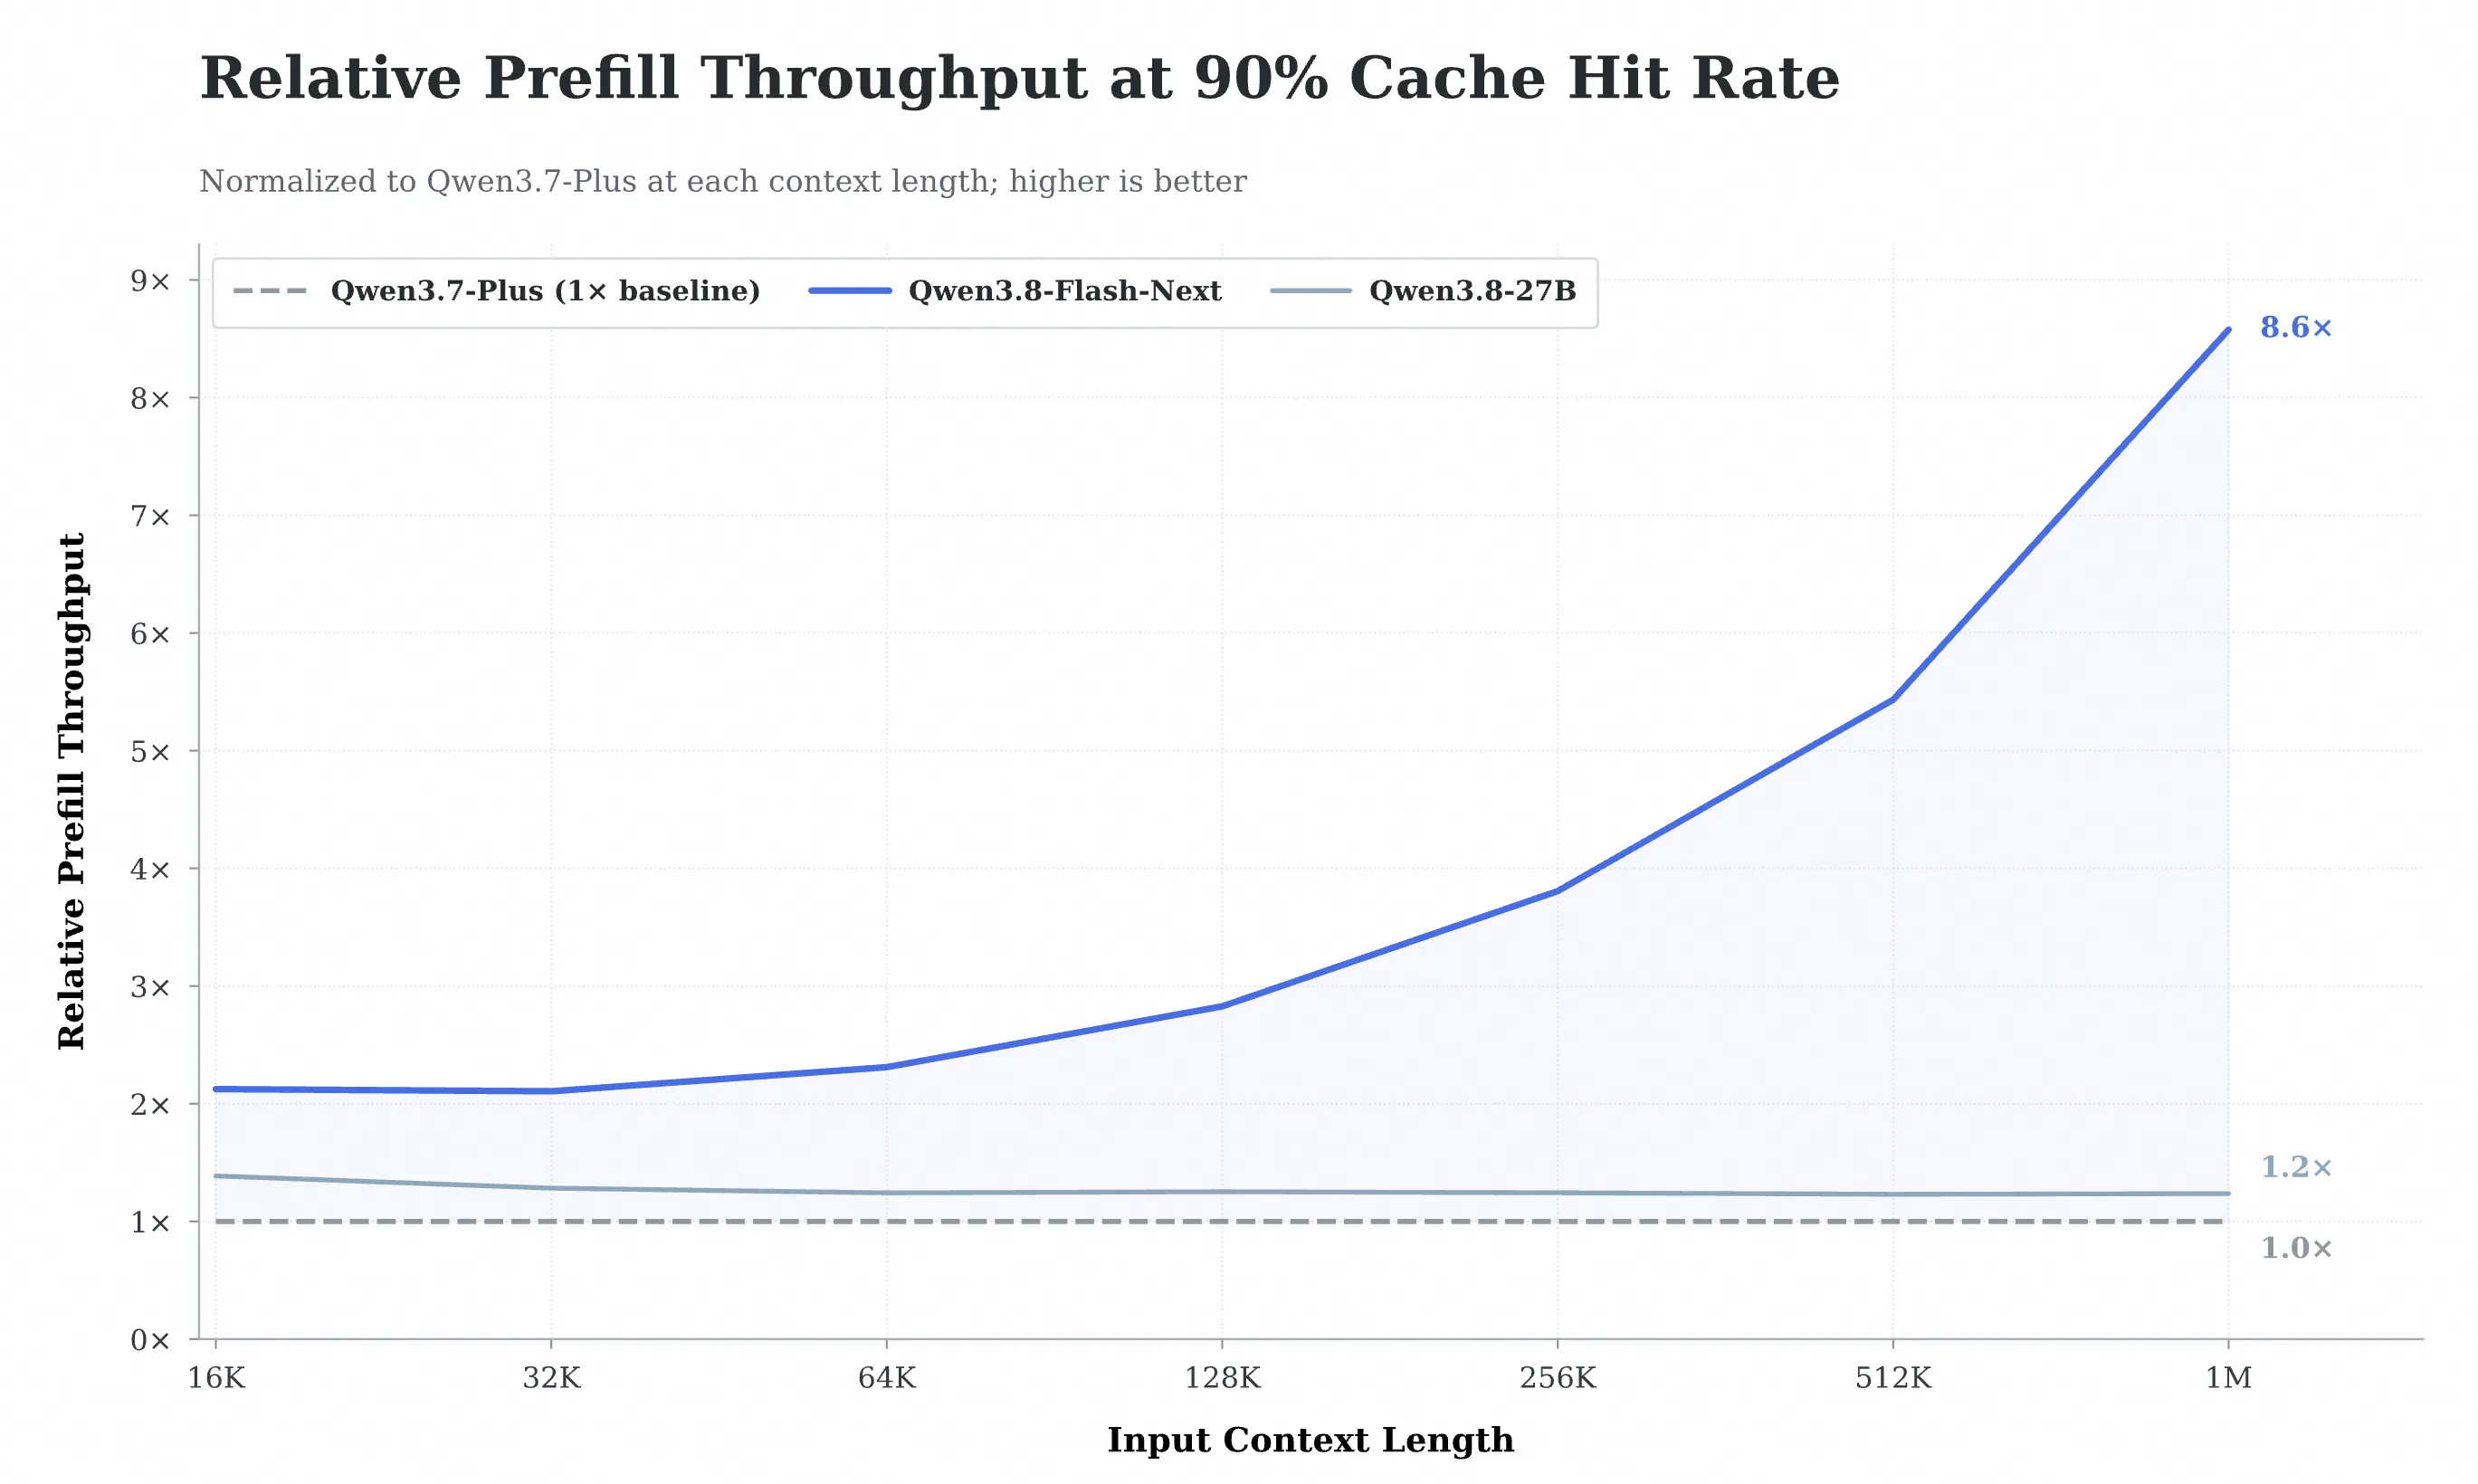
90% Cache Hit Rate時の相対Prefillスループット。1M contextではQwen3.7-Plus(1x baseline)に対しQwen3.8-Flash-Nextが8.6倍まで伸びる一方、Qwen3.8-27Bは1.2xで頭打ちになり、コンテキスト長を伸ばすほどFlash-Nextの優位性が拡大する(出典:Qwen Team blog)
長文RAGやコード全体解釈のように「長いコンテキストで少しずつ再照会するワークロード」で、Flash-Nextが特に効いてきます。
Residual: Gated Residualの4分岐拡張
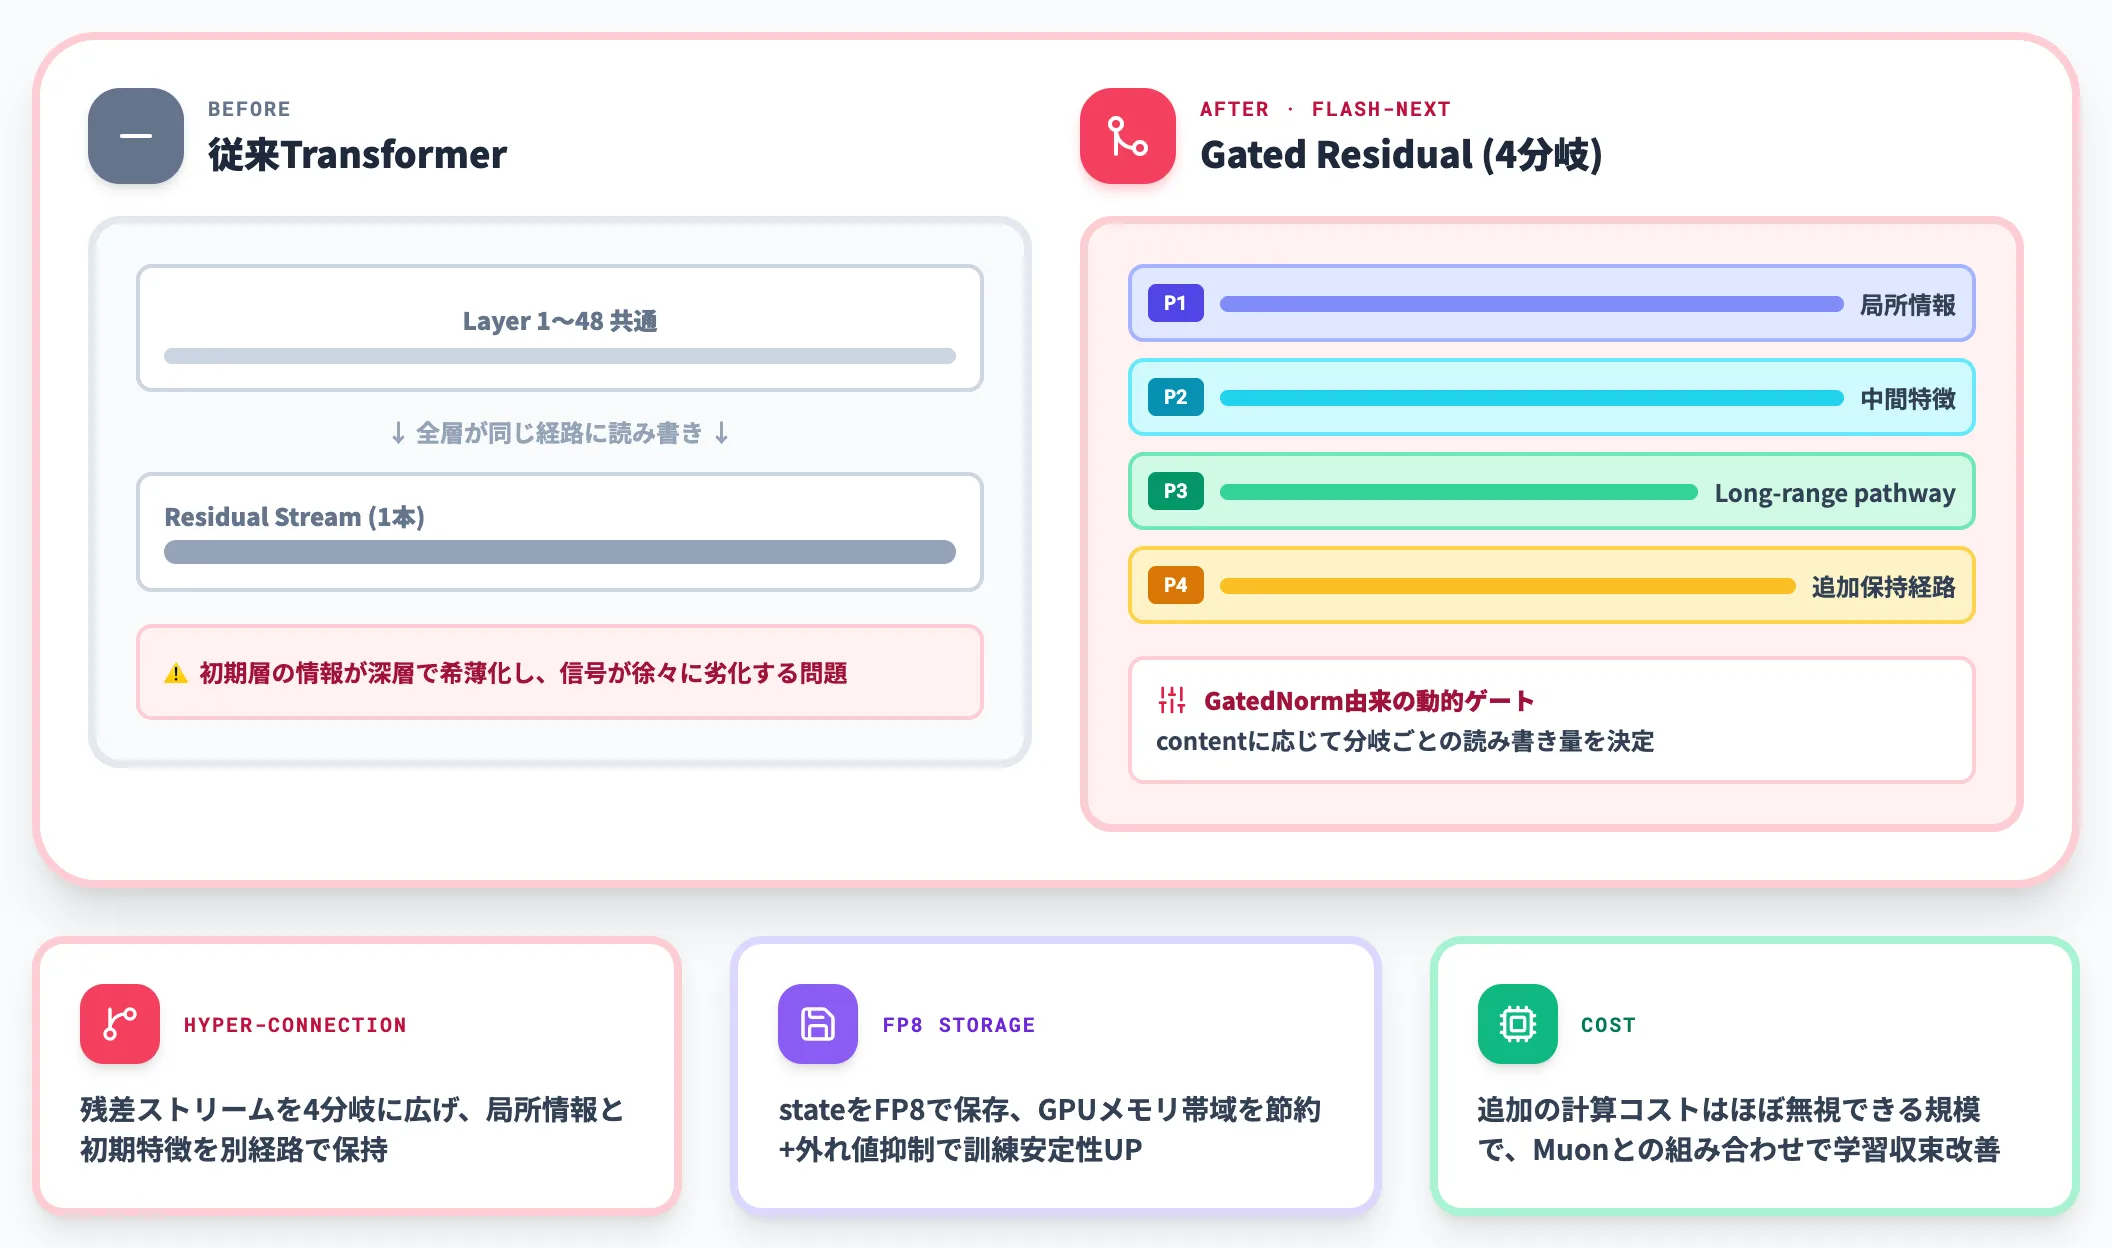
従来のTransformerでは、全層が同じ残差ストリーム(Residual Stream)に対して読み書きするため、深いネットワークになるほど初期層の情報が後段の情報と何度も混合され、重要な信号が徐々に希薄化する問題が知られていました。
Gated Residual(GR) は、この単一の残差ストリームを4本の並列パスに拡張し、要素ごとの動的ゲートで各分岐への読み書き量を制御する仕組みです。
-
Hyper-Connection由来の分岐化
残差ストリームを4分岐に広げ、一部の分岐は局所情報の流れを担当し、他の分岐は初期特徴を後段まで直接保持する。
-
GatedNorm由来の動的ゲート
現在のcontent(トークンごとの意味)に応じて、どの分岐からどれだけ読み、どの分岐にどれだけ書き込むかを動的に決定する。実験ではこの分岐の1本が自然にlong-range pathwayとして機能し、最初のAttention層から中盤・後半の多くの層を直接繋ぐ役割を担うことが観察された。
-
FP8 storage対応
Gated Residualのstate は FP8で保存できるため、メモリアクセスコストがさらに削減される。ゲートは activation outliers(外れ値)の抑制にも寄与し、訓練安定性を高める。
Gated Residualは追加の計算コストがほぼ無視できる規模で、GPUメモリ帯域の節約と訓練安定性向上を両立できるのが特徴です。深いLLMでは「安定して学習を進められること自体が価値」であり、Muon optimizerとの組み合わせで学習収束効率がさらに改善しています。
Embedding: 51B N-gram Embedding
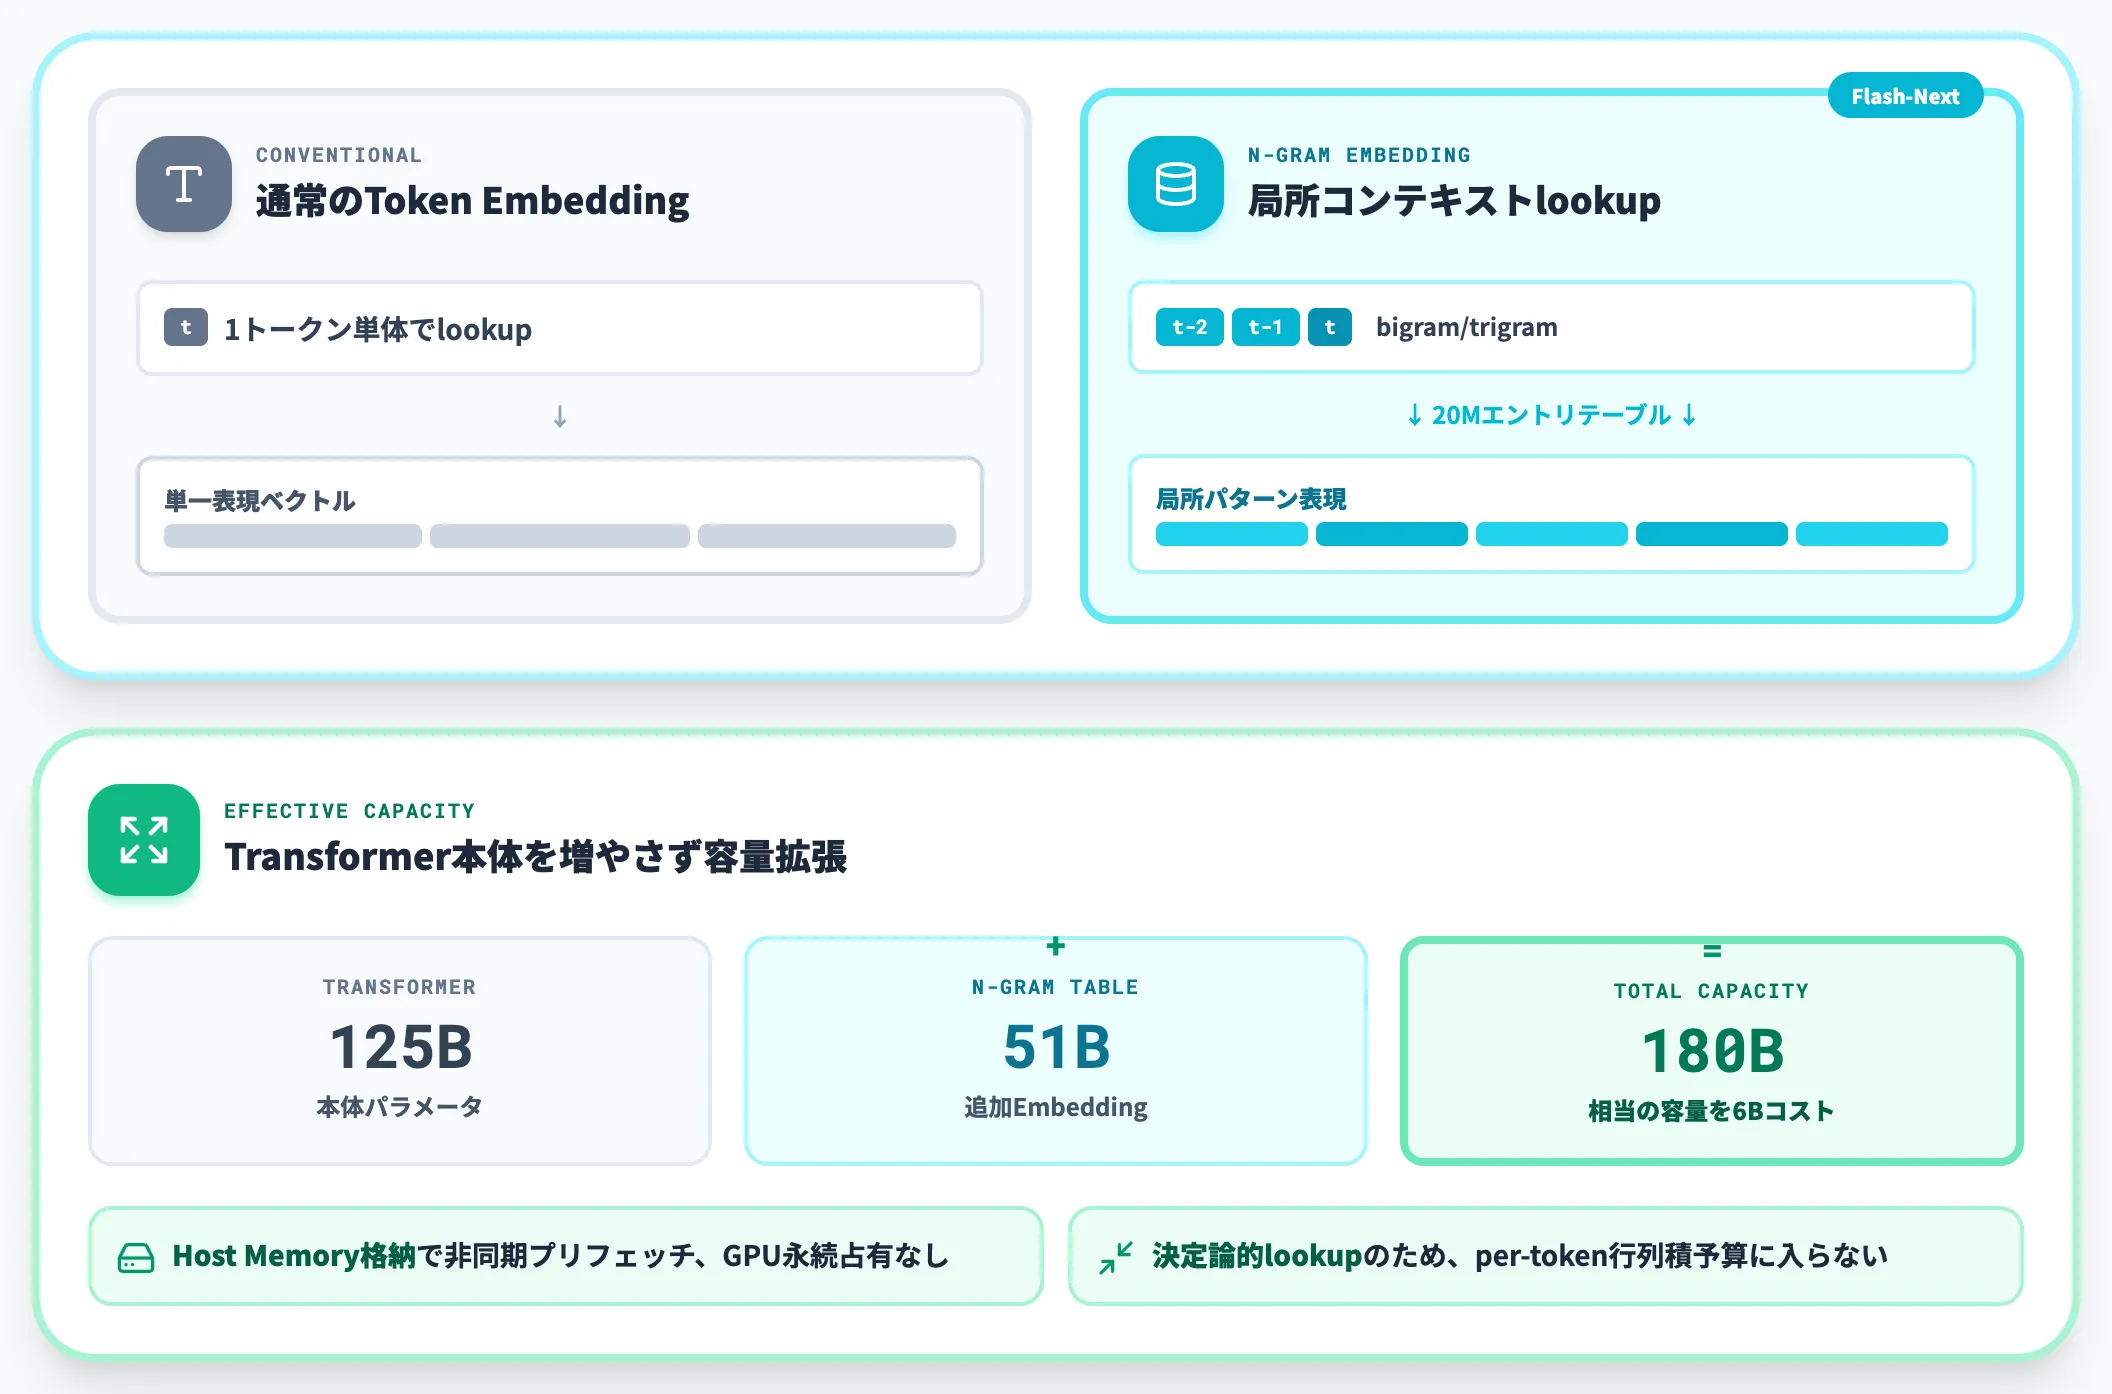
Flash-Nextには通常の Token Embeddingに加えて、51BパラメータのN-gram Embeddingが追加で搭載されています。
これは、Gemma 3nの「Per-Layer Embedding」やDeepSeekの「Engram」に着想を得た手法で、Transformer本体のパラメータ数を増やさずにモデル容量を拡張する仕組みです。
-
通常のEmbeddingとの違い
通常のEmbeddingは1トークン単体でlookupするのに対し、N-gram Embeddingは現在のトークンと直前数個のトークンで構成される「局所コンテキスト」でlookupする。よく現れる語句や局所パターンに対する追加表現を持たせられる。
-
20MエントリのN-gram table
Flash-Nextはlayer 2でbigram/trigramベースの20Mエントリテーブル(合計51Bパラメータ)を1つだけ配置している。参照位置は事前に決まるため、GPUメモリを永続的に占有せずHost Memory(システムRAM)に格納し、モデル計算と並行して非同期プリフェッチできる。
-
トークンあたり計算量はほぼゼロ
このN-gram Embeddingは決定論的にアドレス指定される単なるlookupであり、per-tokenの行列積予算には入らない。**「大量のパラメータを追加しても、per-tokenの計算コストはほぼ増えない」**という設計思想。
N-gram Embeddingを使うことで、Flash-Nextは「Transformer本体は125Bだが、モデル全体としては180B相当の容量」を、6Bアクティブ相当のコストで扱えます。VRAMの制約が厳しいエッジ推論や、低コスト推論を目指す運用シナリオでは大きな追い風になります。
Optimization: Muon Optimizer採用
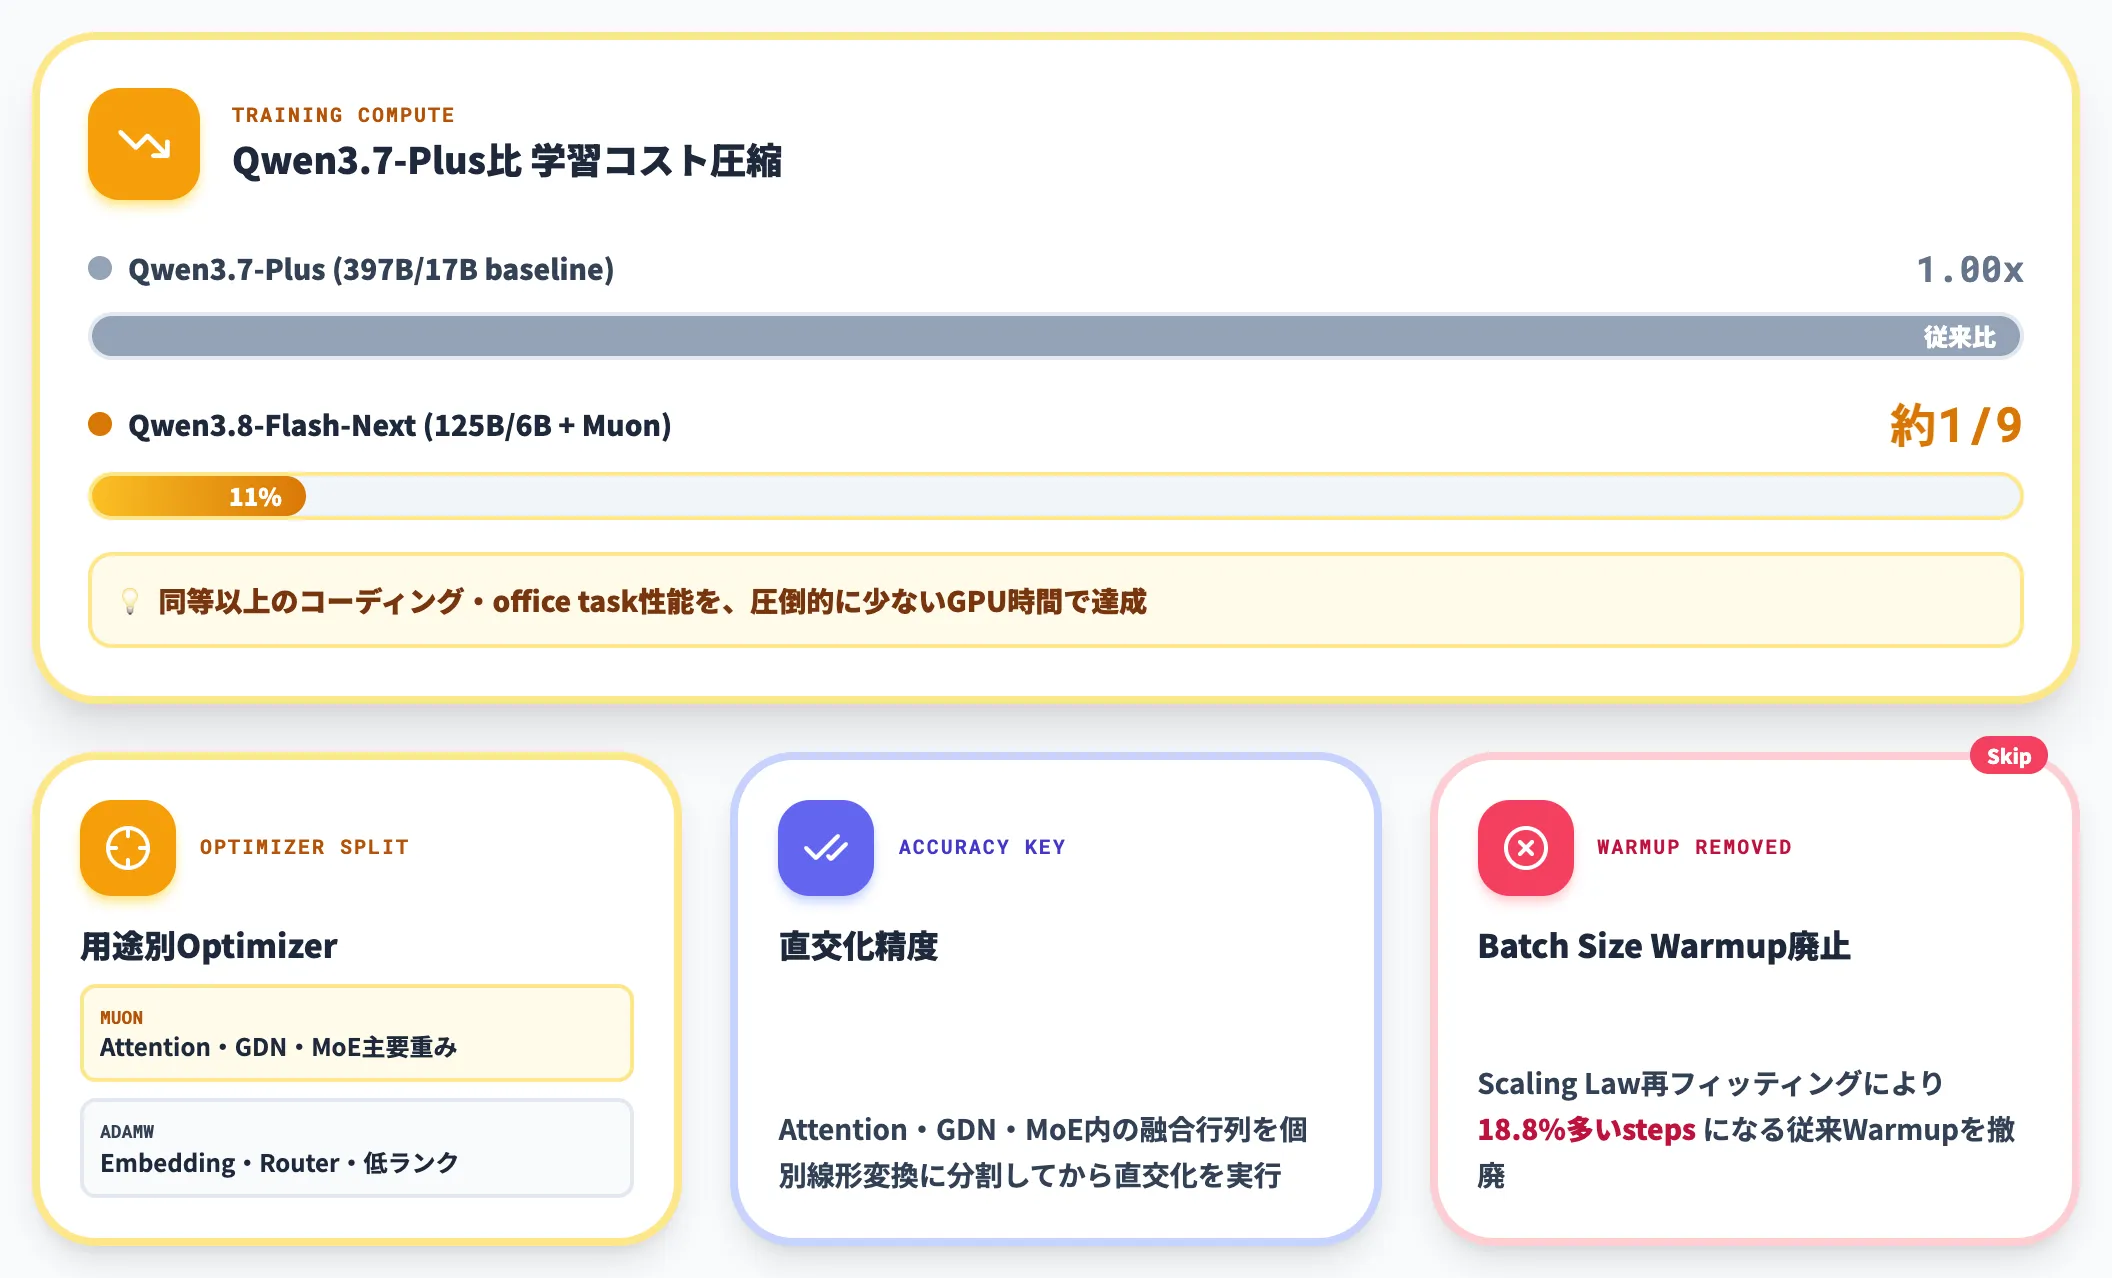
Flash-Nextの学習にはMuon Optimizerが採用されており、Attention・GDN・MoEエキスパートの主要重みなど「2次元線形写像として機能する」パラメータにMuonを、Embedding・MoE Router・GRの低ランクパラメータにはAdamWを使い分ける設計になっています。
-
Orthogonalization accuracy
Muonをlarge-scale学習で安定させる鍵はorthogonalization(直交化)精度で、Flash-NextではAttention・GDN・MoE内の融合された行列を個別の線形変換に分割してから直交化を行う。
-
Batch Size Warmupの廃止
従来の大規模学習では小さなbatchから目標batchへ徐々に増やすBatch Size Warmupが標準だったが、Flash-NextではScaling Law再フィッティングにより、Warmupを使うと逆に18.8%多くのoptimizer stepsが必要になり、Warmupを省いても最終結果は劣化しないことが確認された。
-
学習コスト1/9への圧縮
これらの最適化の総合効果で、Qwen3.7-Plus(397B総パラ・17Bアクティブ)比で学習に必要な計算量は約1/9まで圧縮されている。Qwen3.7-Plusと同等以上のコーディング・office task性能を、圧倒的に少ないGPU時間で達成した。
この学習コスト圧縮は主に事前学習段階の話であり、ファインチューニングでの効率がどこまで再現できるかは公式には示されていない。業務ドメインへのSFT・DPO・GRPOで同水準の圧縮が得られるかは、実装検証で個別に確認する領域になる。
Qwen3.8-Flash-Nextのベンチマーク性能——Claude Opus 4.6を上回るコーディング・office task
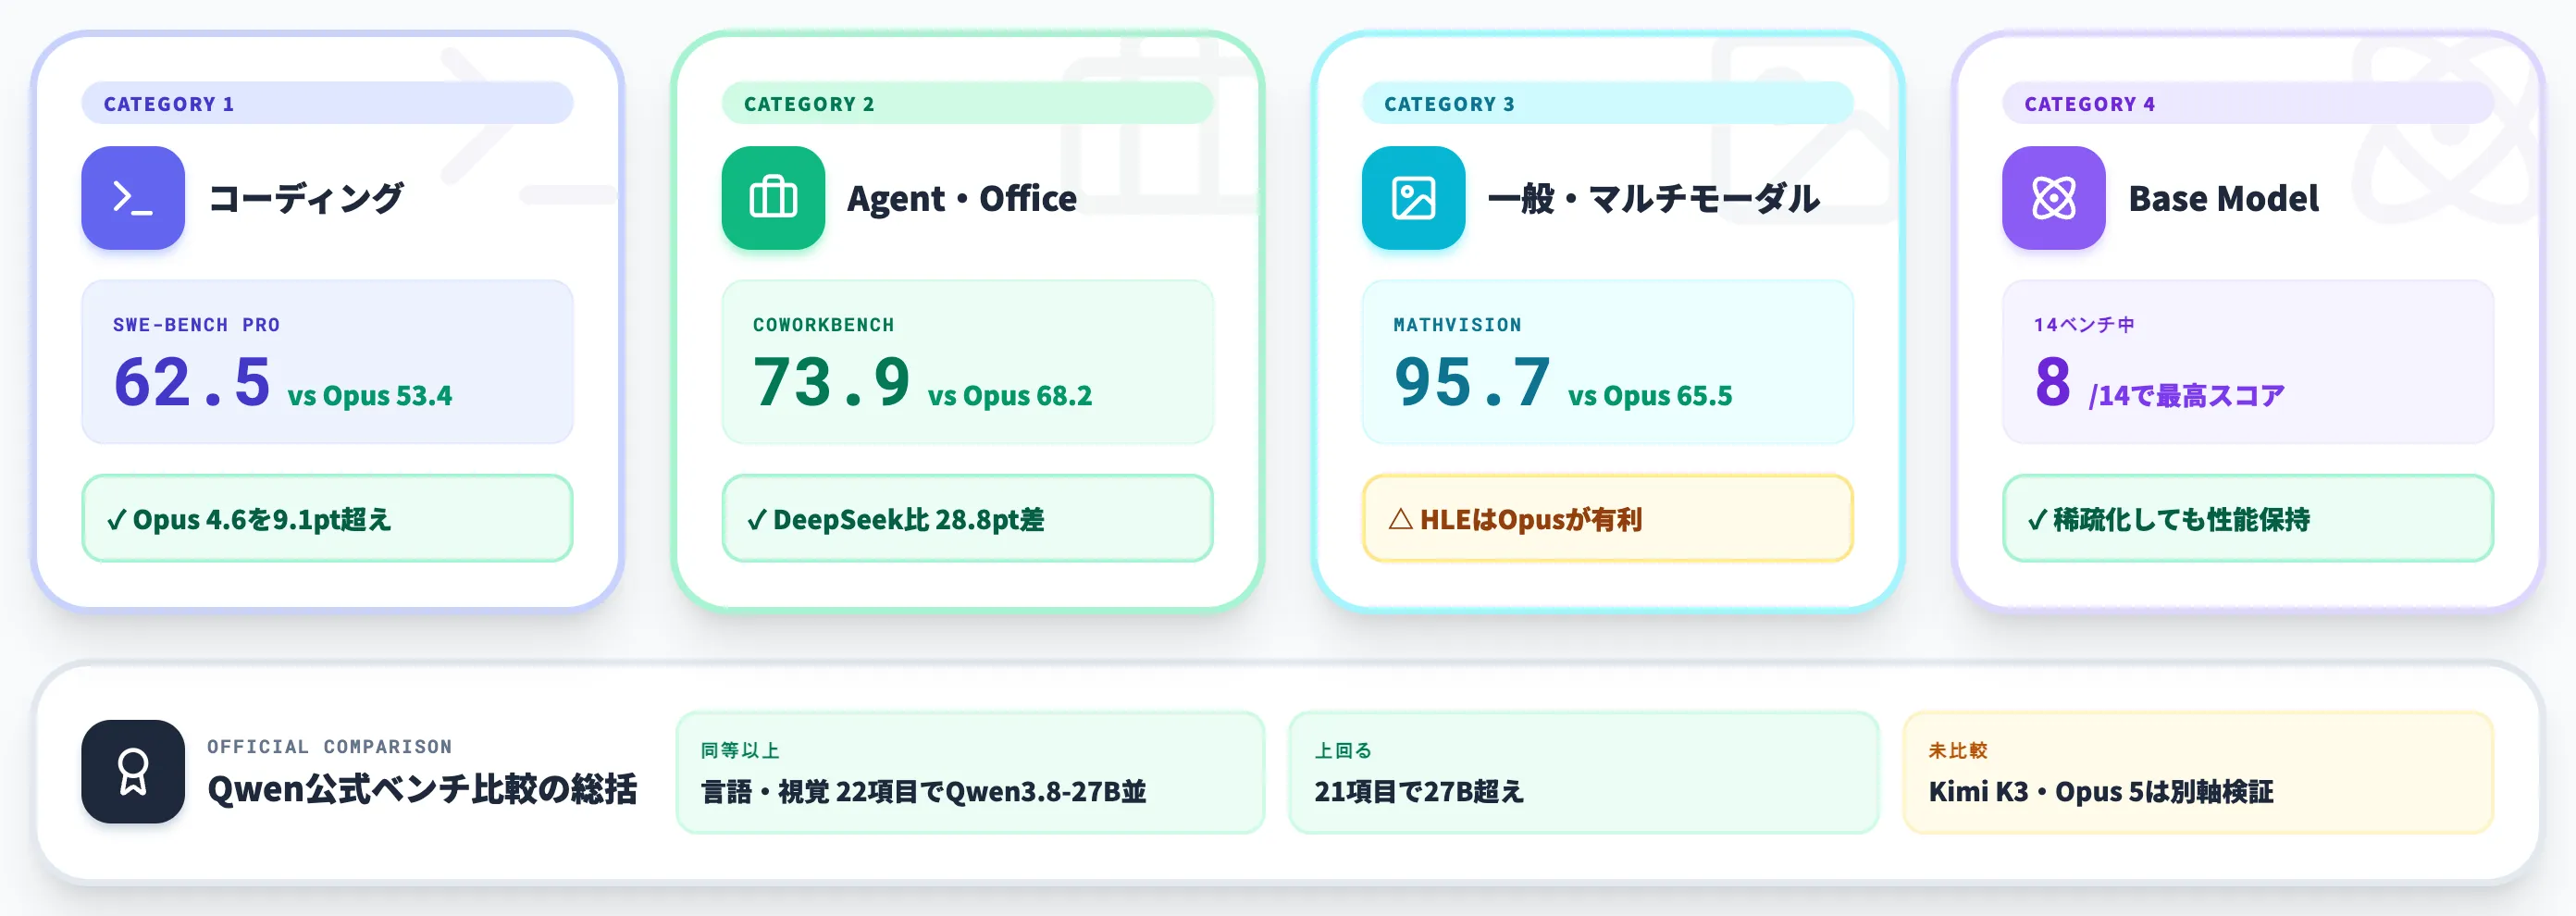
Flash-Nextのベンチマーク結果は、公式blogで Qwen3.8-27B(同社の27B密モデル)・Qwen3.7-Plus(前世代フラグシップ397B/17B)・DeepSeek-V4-Flash-0731・Claude-Opus-4.6 (Max) の4モデルとの並列比較で公表されています。
Qwen Teamが「言語・視覚あわせて22項目でQwen3.8-27B同等以上、21項目で上回る」と主張しているとおり、6Bアクティブという極端な稀疏化にもかかわらず、実用範囲では既存のフラグシップ帯と同等の水準に達しています。以下、分野別に整理します。
コーディング系——SWE-bench Pro 62.5でOpus超え
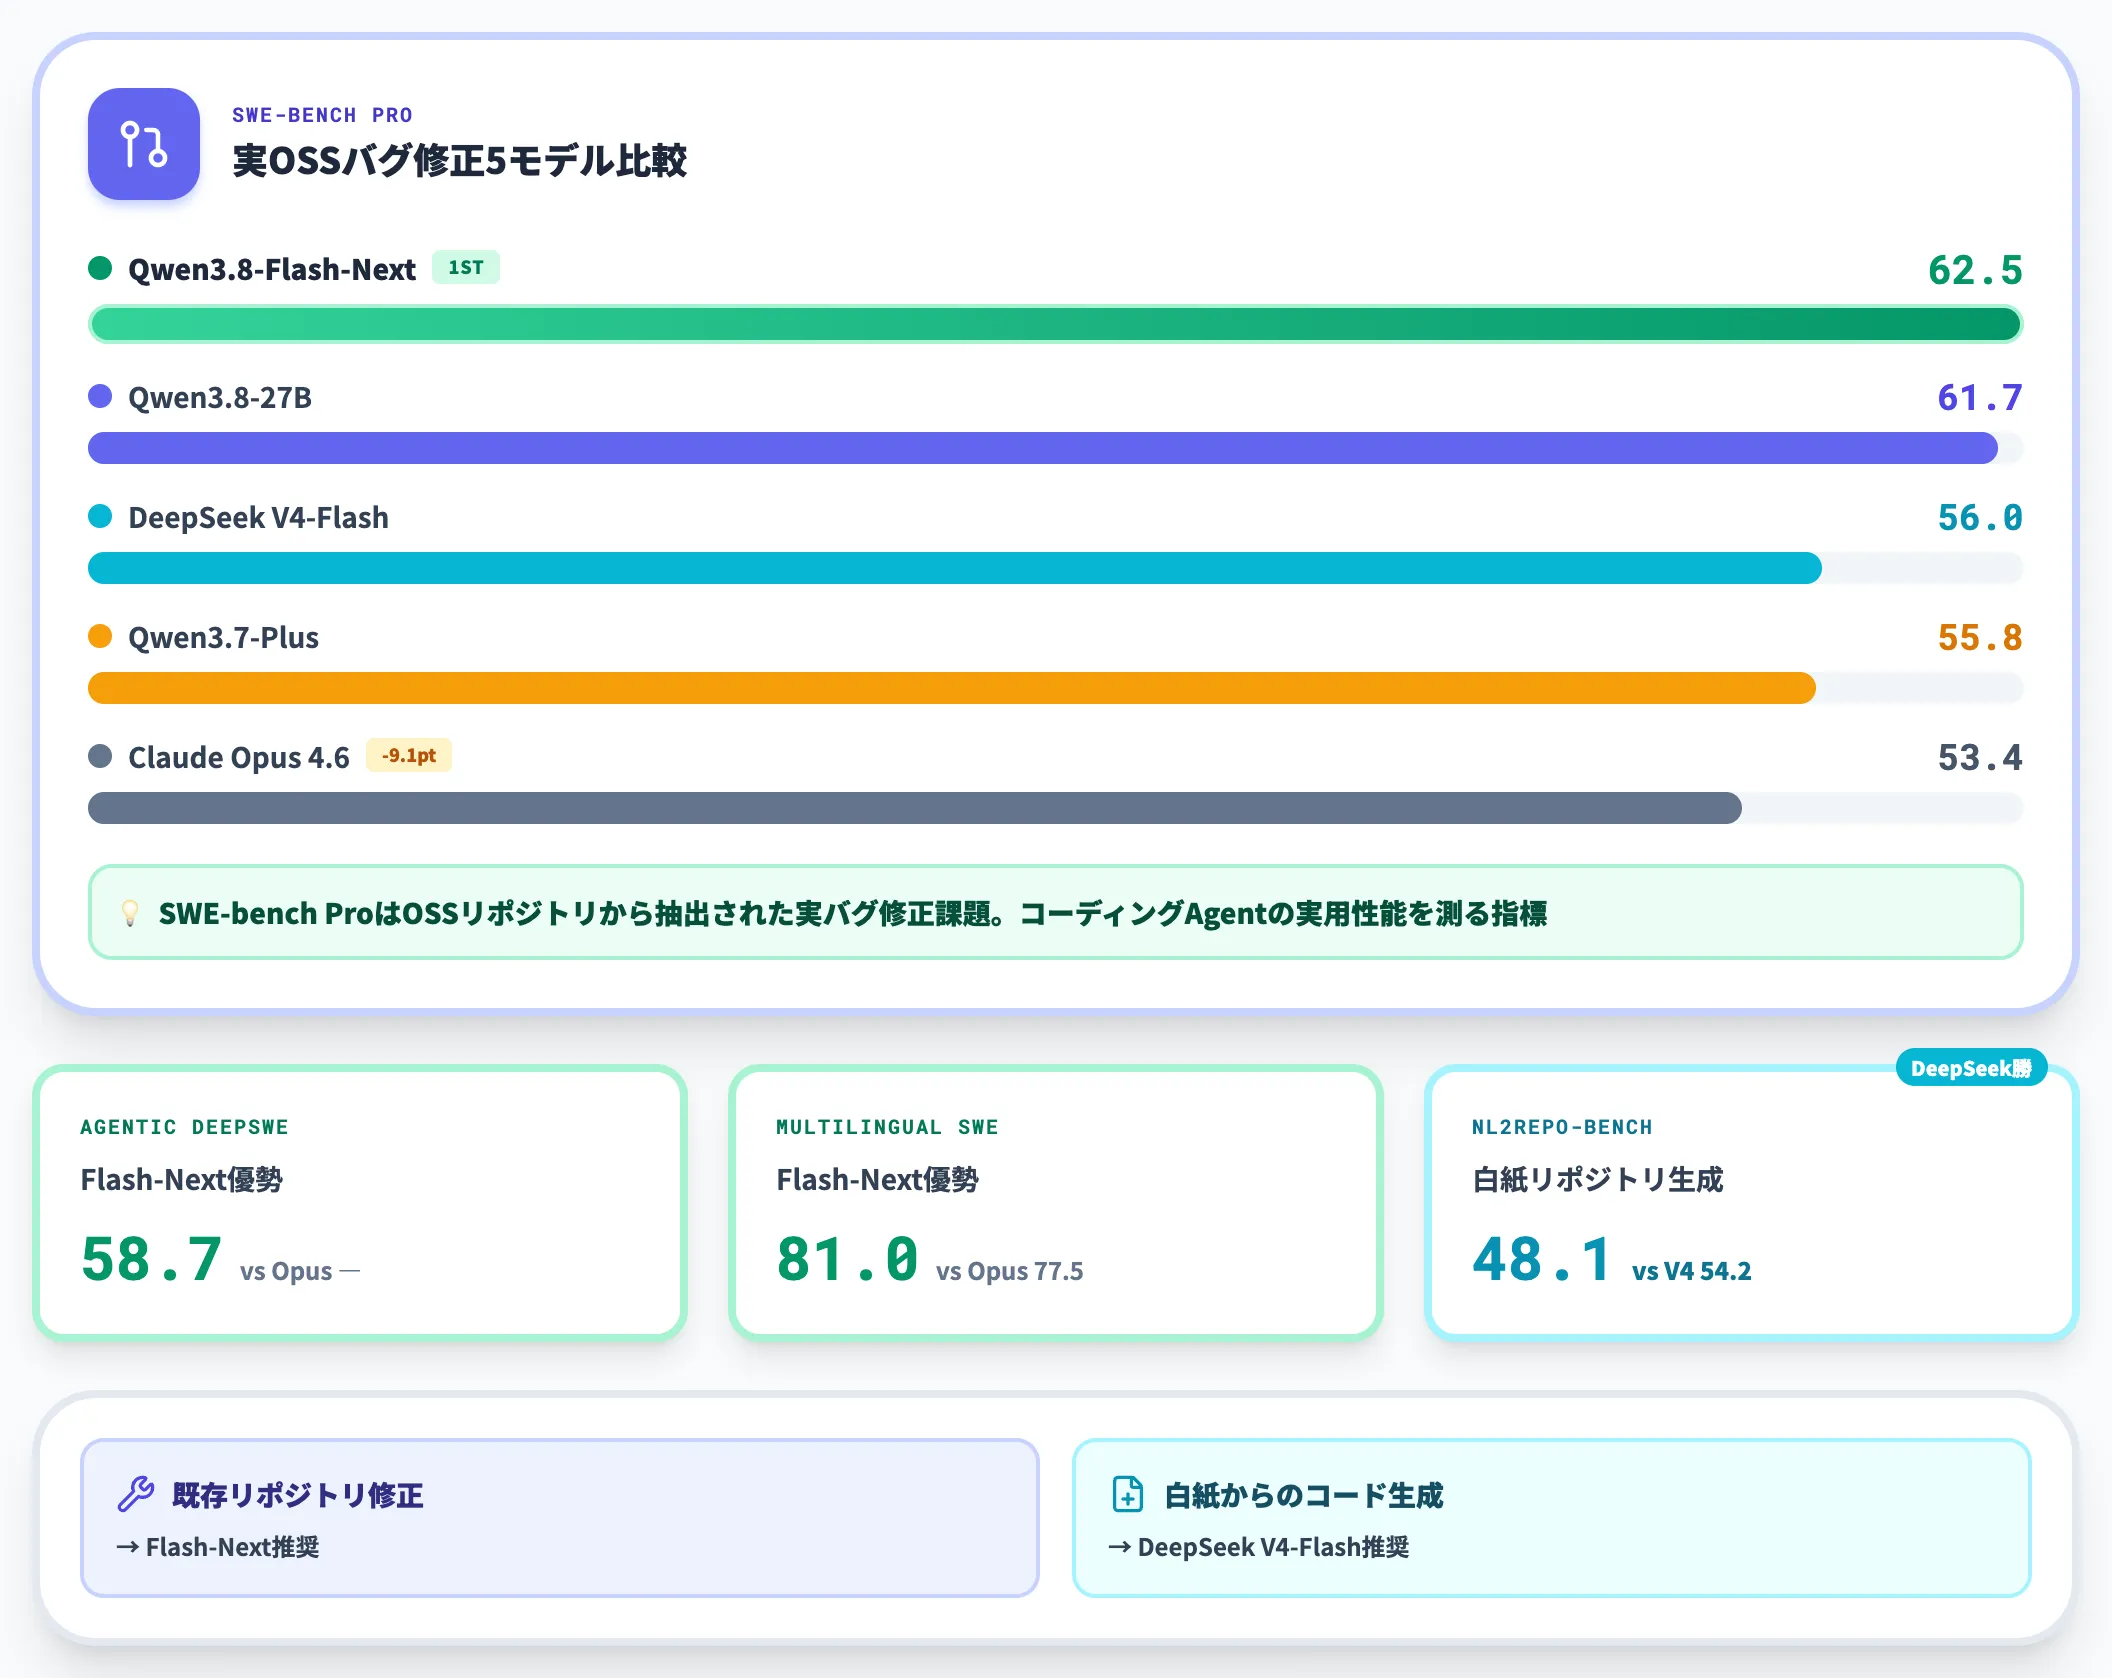
以下の表で、コーディング系ベンチマークの主要スコアを比較しました(公式blog記載値、太字がFlash-Next優勢)。
| ベンチマーク | Qwen3.8-Flash-Next | Qwen3.8-27B | Qwen3.7-Plus | DeepSeek-V4-Flash-0731 | Claude Opus 4.6 |
|---|---|---|---|---|---|
| Agentic coding DeepSWE 1.1 | 58.7 | 42.2 | 16.5 | 54.4 | — |
| Agentic coding SWE-bench Pro | 62.5 | 61.7 | 55.8 | 56.0 | 53.4 |
| Multilingual SWE-bench | 81.0 | 73.8 | 75.8 | — | 77.5 |
| Repo-level NL2Repo-Bench | 48.1 | 42.3 | 41.1 | 54.2 | 47.6 |
| Competitive LiveCodeBench v6 | 91.9 | 90.3 | 89.6 | 90.6 | 88.8 |
特に注目したいのは、SWE-bench Proでの 62.5% vs Opus 4.6の53.4% という9.1ポイント差です。SWE-bench Proは実際のOSSリポジトリから抽出されたバグ修正課題で、コーディングAgentの実用性能を測る指標として重視されています。Flash-NextがOpus 4.6を上回っている事実は、コーディングAgent基盤の選定において自社ワークロードで検証する価値のある情報になります(ベンチマーク値が自社リポジトリの完走率にどこまで反映されるかは実装検証で確認する)。
一方でRepo-level(リポジトリ全体を書き起こす)NL2Repo-BenchではDeepSeek V4-Flashの54.2に対しFlash-Nextは48.1と負けているため、「既存リポジトリの修正はFlash-Next、白紙からのコード生成はDeepSeek V4-Flash」のような用途別使い分けが実務判断として成立します。
Agent・office work——CoWorkBench 73.9
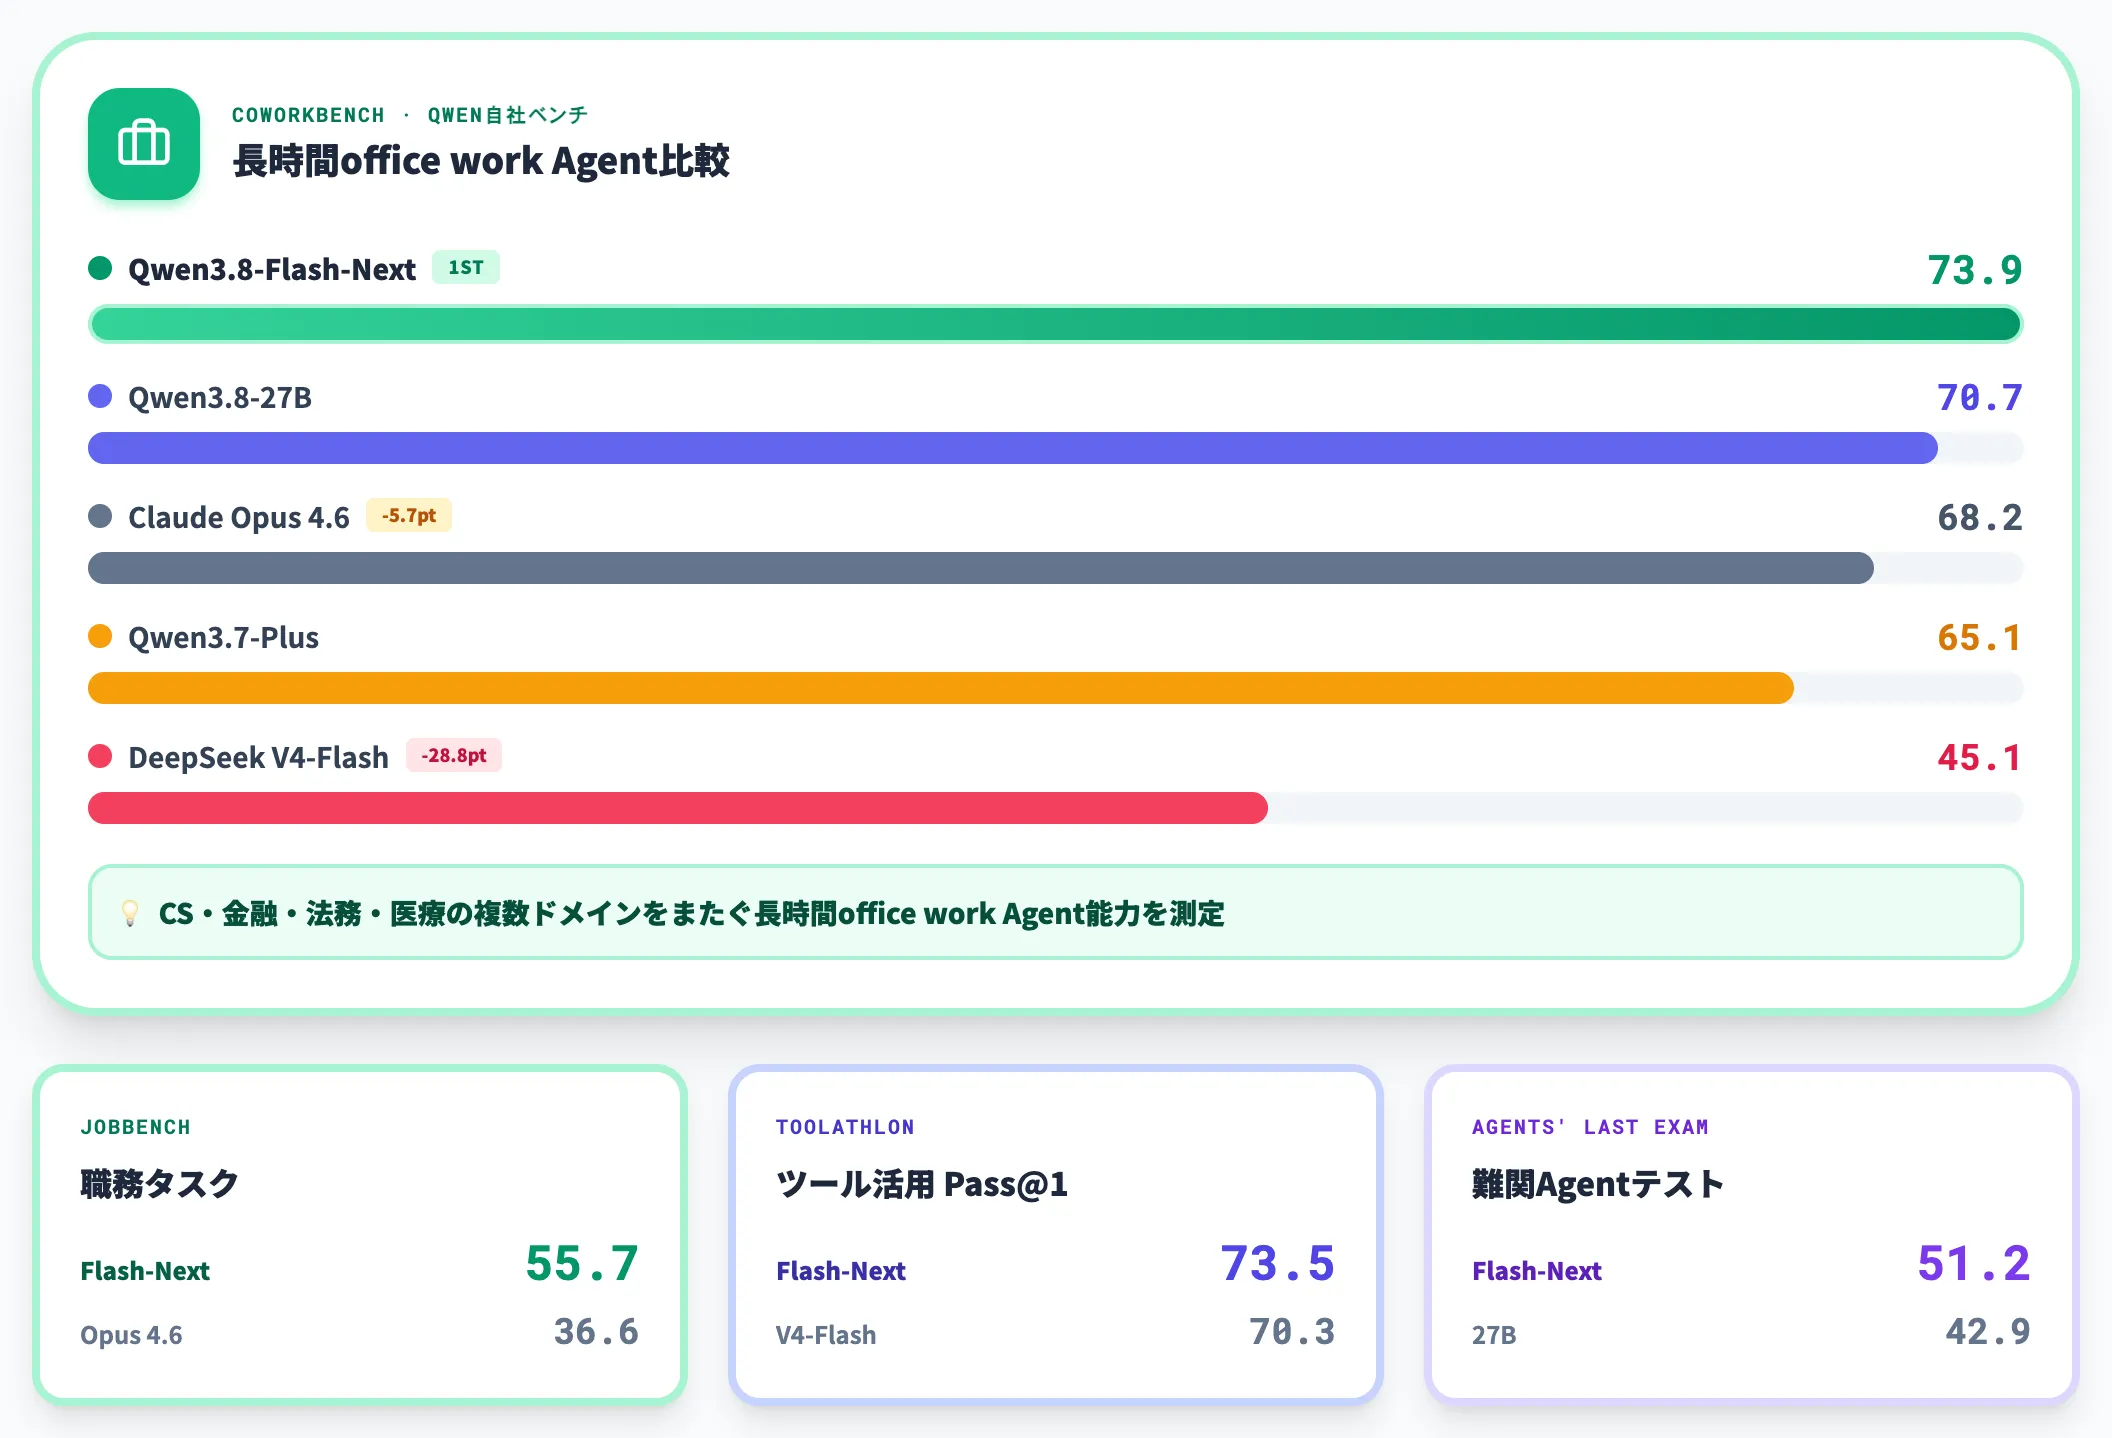
Agent系ベンチマークは、単一質問回答ではなく複数ツールを使いながら数十ステップにわたって作業を進める能力を測ります。以下の表で主要スコアを整理しました。
| ベンチマーク | Qwen3.8-Flash-Next | Qwen3.8-27B | Qwen3.7-Plus | DeepSeek V4-Flash | Claude Opus 4.6 |
|---|---|---|---|---|---|
| CoWorkBench(長時間office work) | 73.9 | 70.7 | 65.1 | 45.1 | 68.2 |
| JobBench(職務タスク) | 55.7 | 33.4 | 27.6 | 41.3 | 36.6 |
| Toolathlon Verified(Pass@1) | 73.5 | 67.1 | 50.6 | 70.3 | — |
| Agents' Last Exam(Score) | 51.2 | 42.9 | 33.6 | — | — |
CoWorkBenchは、コンピュータサイエンス・金融・法務・医療などの複数ドメインをまたぐ長時間office work Agentタスクを評価するQwen Team自社ベンチです。Flash-Nextの73.9はOpus 4.6の68.2を5.7ポイント上回っており、DeepSeek V4-Flashの45.1とは28.8ポイントの大差がついています。
JobBench 55.7も、Opus 4.6の36.6・DeepSeek V4-Flashの41.3を大きく引き離しています。「1つの案件を数時間かけて調べて資料化する」ような長時間タスクを任せるoffice work Agent基盤では、Flash-Nextがコスト面(後述)とあわせて有力候補に入ります。
一般タスク・マルチモーダル系のスコア
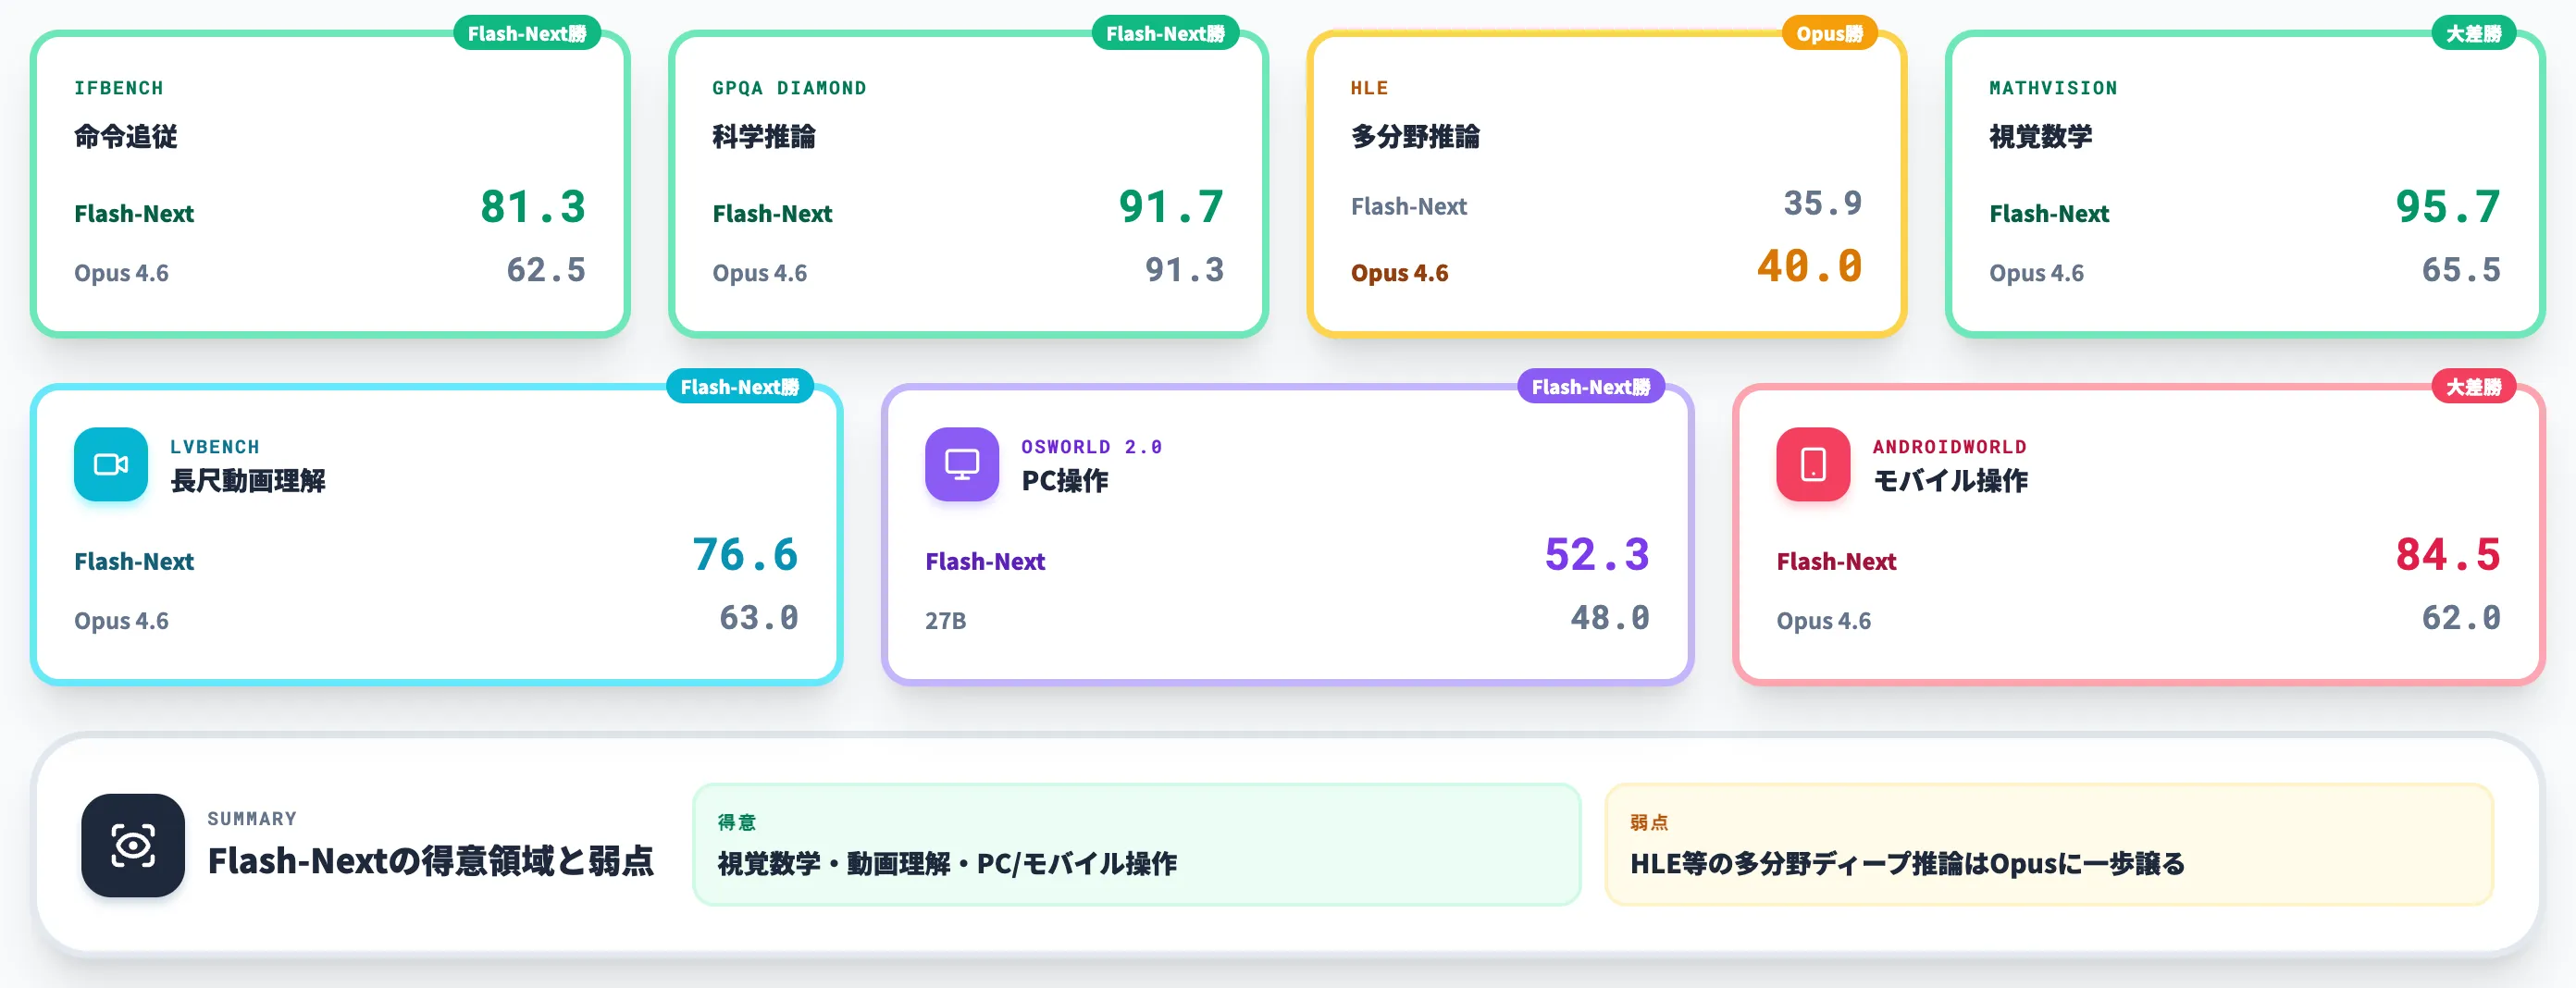
以下の表で、一般タスクとマルチモーダル系の主要スコアを整理しました。
| ベンチマーク | Qwen3.8-Flash-Next | Qwen3.8-27B | Qwen3.7-Plus | DeepSeek V4-Flash | Claude Opus 4.6 |
|---|---|---|---|---|---|
| Instruction following IFBench | 81.3 | 79.5 | 79.1 | 79.2 | 62.5 |
| Scientific reasoning GPQA Diamond | 91.7 | 89.2 | 90.3 | 90.8 | 91.3 |
| Multidisciplinary reasoning HLE | 35.9 | 30.8 | 34.7 | 33.8 | 40.0 |
| Visual math MathVision(With CI) | 95.7 | 94.6 | 88.7 | — | 65.5 |
| Long video LVBench | 76.6 | 72.4 | 76.2 | — | 63.0 |
| Computer use OSWorld 2.0(Partial) | 52.3 | 48.0 | 21.5 | — | — |
| Mobile use AndroidWorld | 84.5 | 81.9 | 81.0 | — | 62.0 |
HLEではClaude Opus 4.6の40.0にFlash-Nextの35.9が及ばず、多分野推論のディープな部分では現行フラグシップに一歩譲る領域も残っています。
ただし視覚数学(MathVision 95.7 vs Opus 4.6 65.5)・長尺動画理解(LVBench 76.6 vs 63.0)・PC/モバイル操作(OSWorld・AndroidWorld)ではOpus 4.6を上回っており、Qwen公式ベンチ表の比較モデル範囲では、マルチモーダル・Agent・長尺コンテキスト系ベンチでFlash-Nextが有利な結果を示しています。Kimi K3・Opus 5との同条件比較は公式表にないため、これらとの品質比較は別途評価が必要になります。
Base Model——14ベンチ中8つ最高
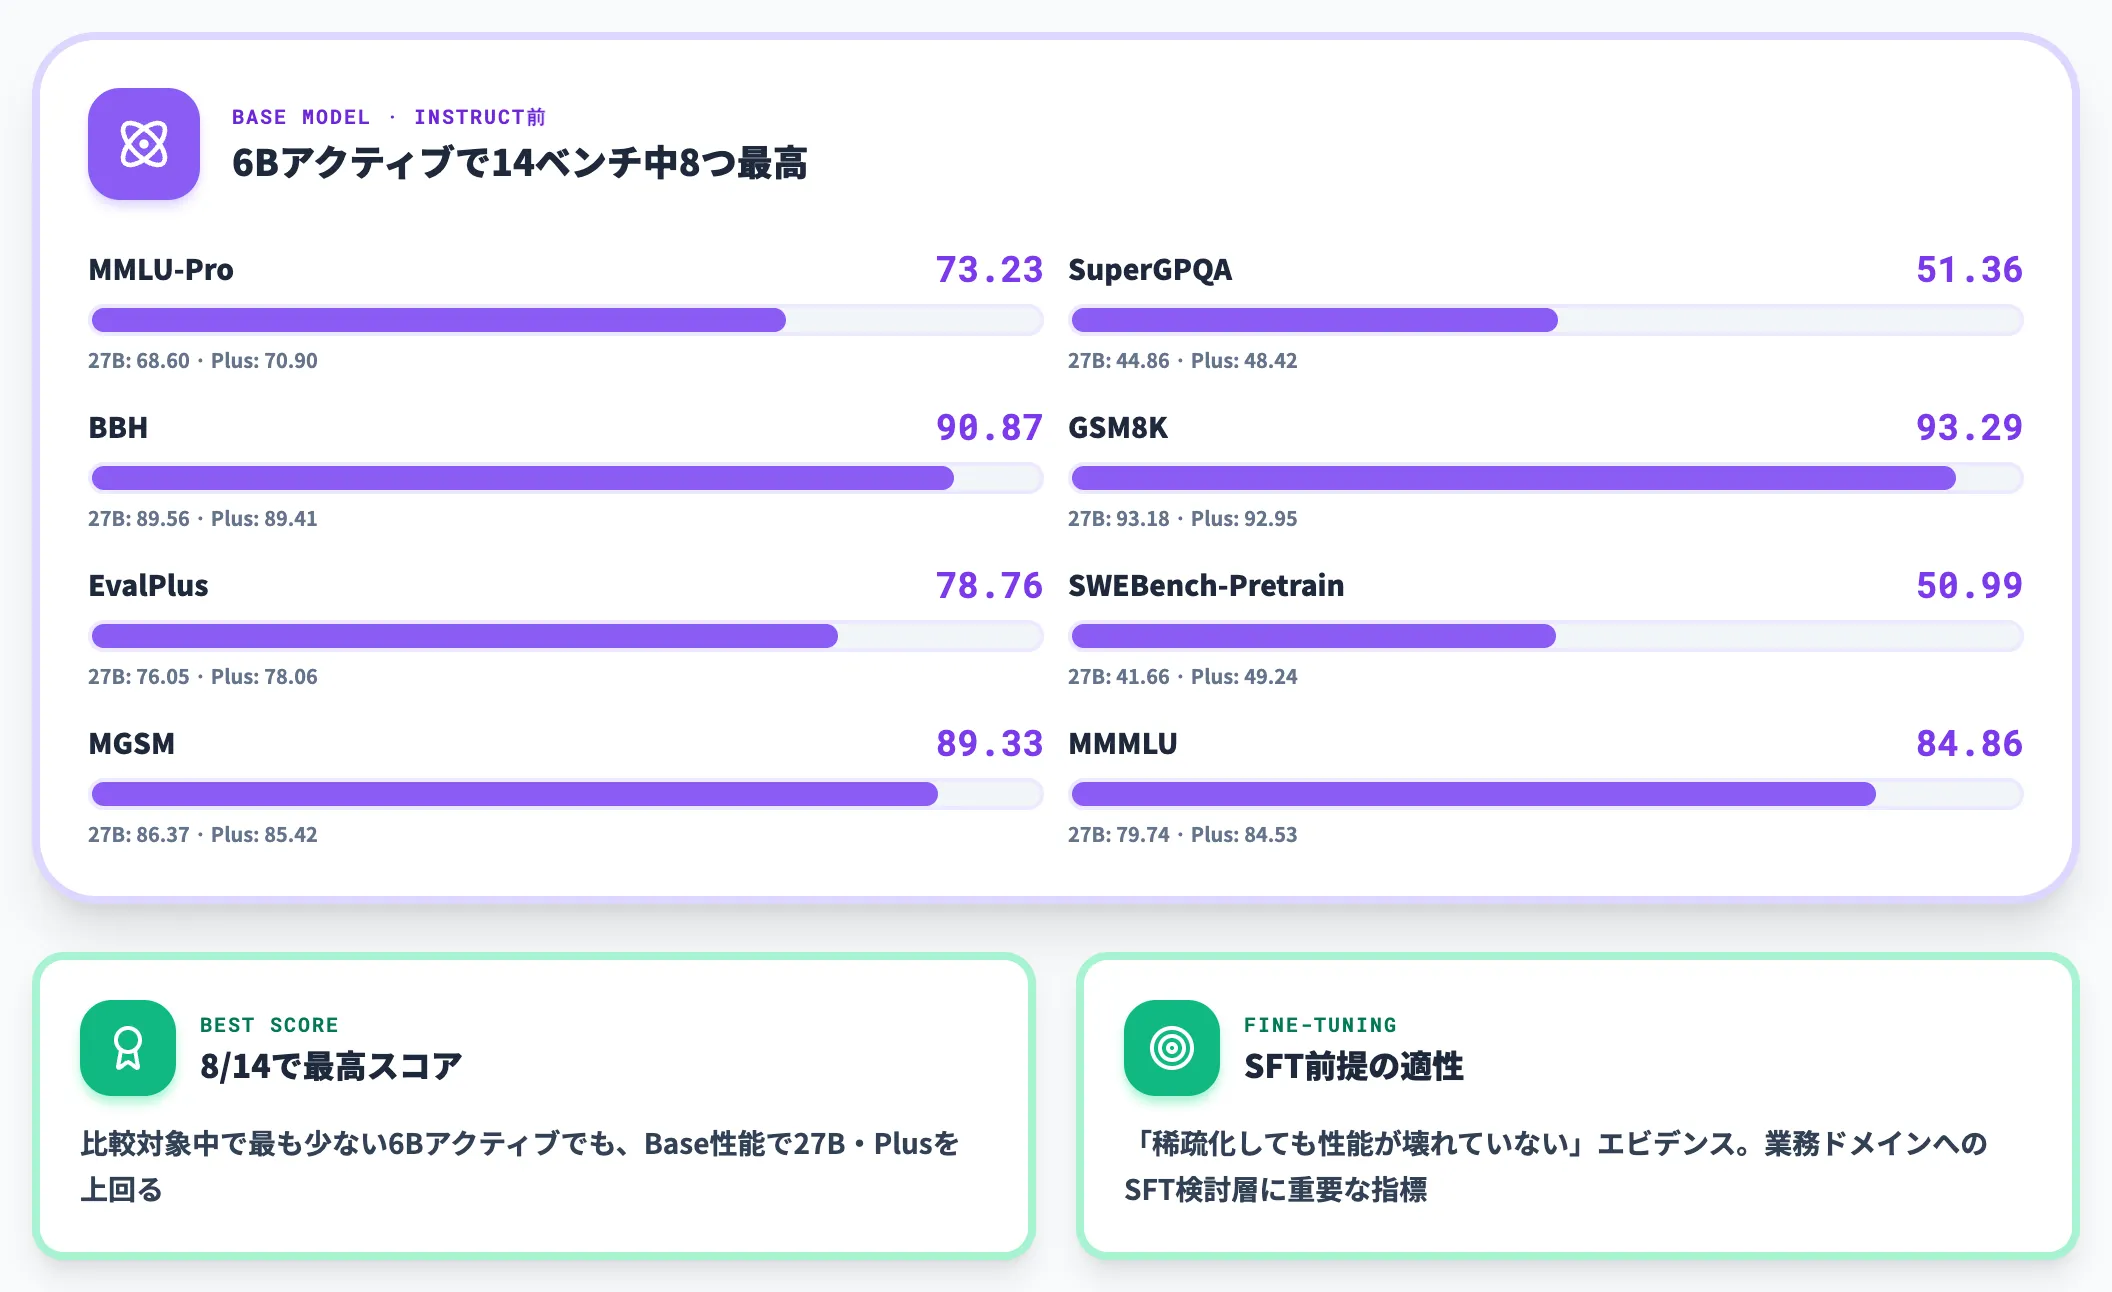
Flash-Nextは Instructチューニング前のBase Model性能でも、以下のような結果を残しています。
| ベンチマーク | Qwen3.8-Flash-Next-Base | Qwen3.8-27B-Base | Qwen3.7-Plus-Base |
|---|---|---|---|
| MMLU-Pro | 73.23 | 68.60 | 70.90 |
| SuperGPQA | 51.36 | 44.86 | 48.42 |
| BBH | 90.87 | 89.56 | 89.41 |
| GSM8K | 93.29 | 93.18 | 92.95 |
| EvalPlus | 78.76 | 76.05 | 78.06 |
| SWEBench-Pretrain | 50.99 | 41.66 | 49.24 |
| MGSM | 89.33 | 86.37 | 85.42 |
| MMMLU | 84.86 | 79.74 | 84.53 |
比較対象中で最も少ない6Bアクティブという活性化にもかかわらず、Base Modelの14ベンチのうち8つで最高スコア、残りの6項目でも397B/17BアクティブのQwen3.7-Plus-Baseに肉薄しています。
「稀疏化しすぎて性能が壊れていない」ことのエビデンスとして、業務でファインチューニングを検討する層にとって重要な指標です。
Qwen3.8-Flash-Nextの料金・提供チャネル・ライセンス
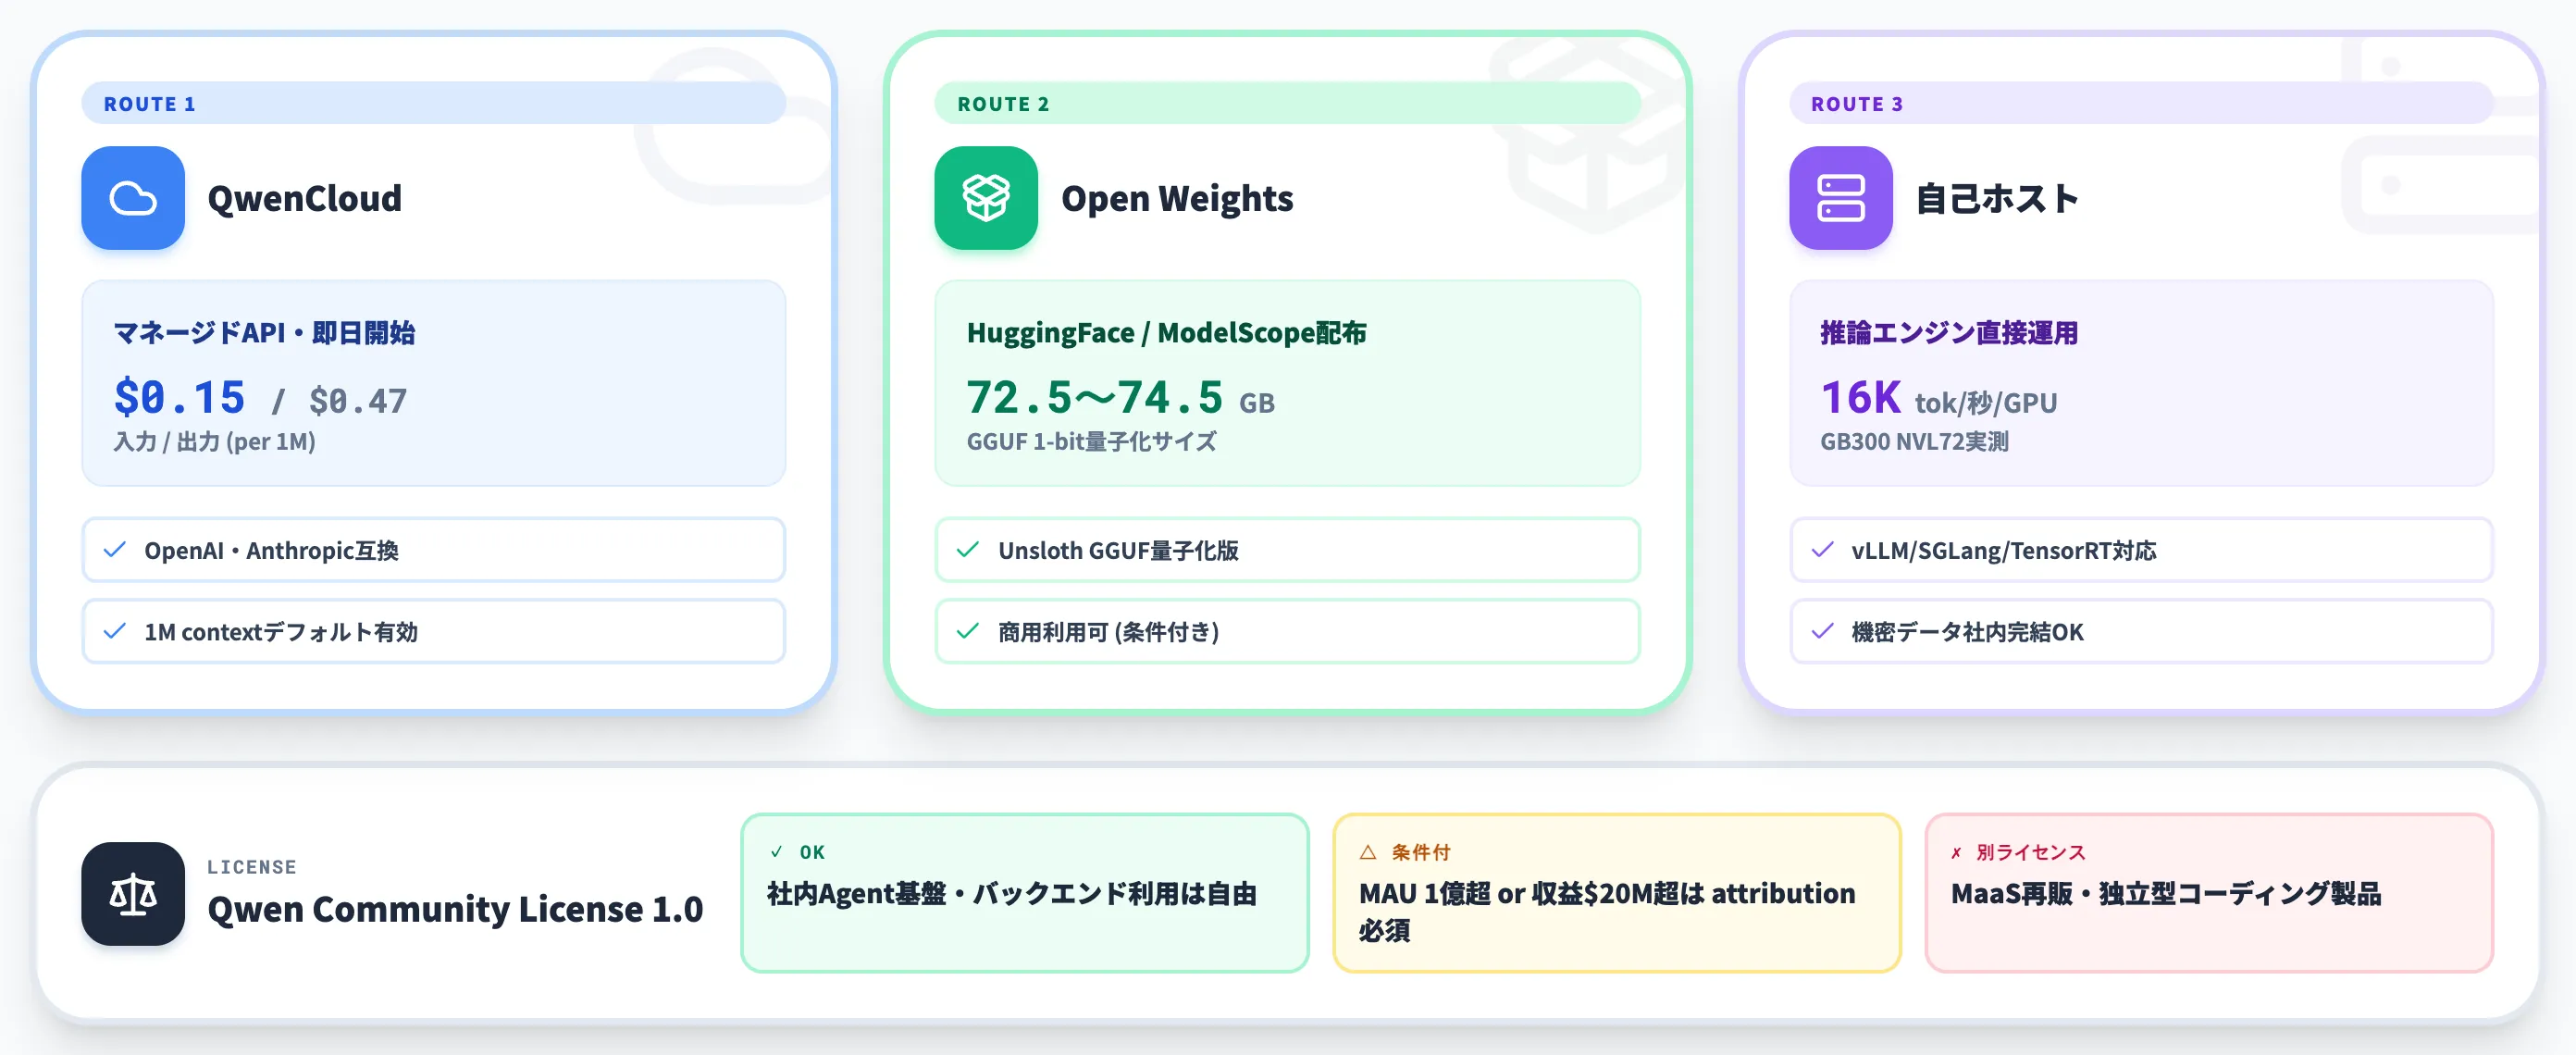
Flash-Nextの提供形態は、QwenCloud経由のマネージドAPI・Hugging Face/ModelScope経由のオープンウェイト配布・主要ローカル推論エンジン対応の3ルートに整理されます。
それぞれのコスト構造とライセンス条件が実務判断に直結するため、ここでまとめて整理します。
QwenCloud料金——入力$0.15/出力$0.47
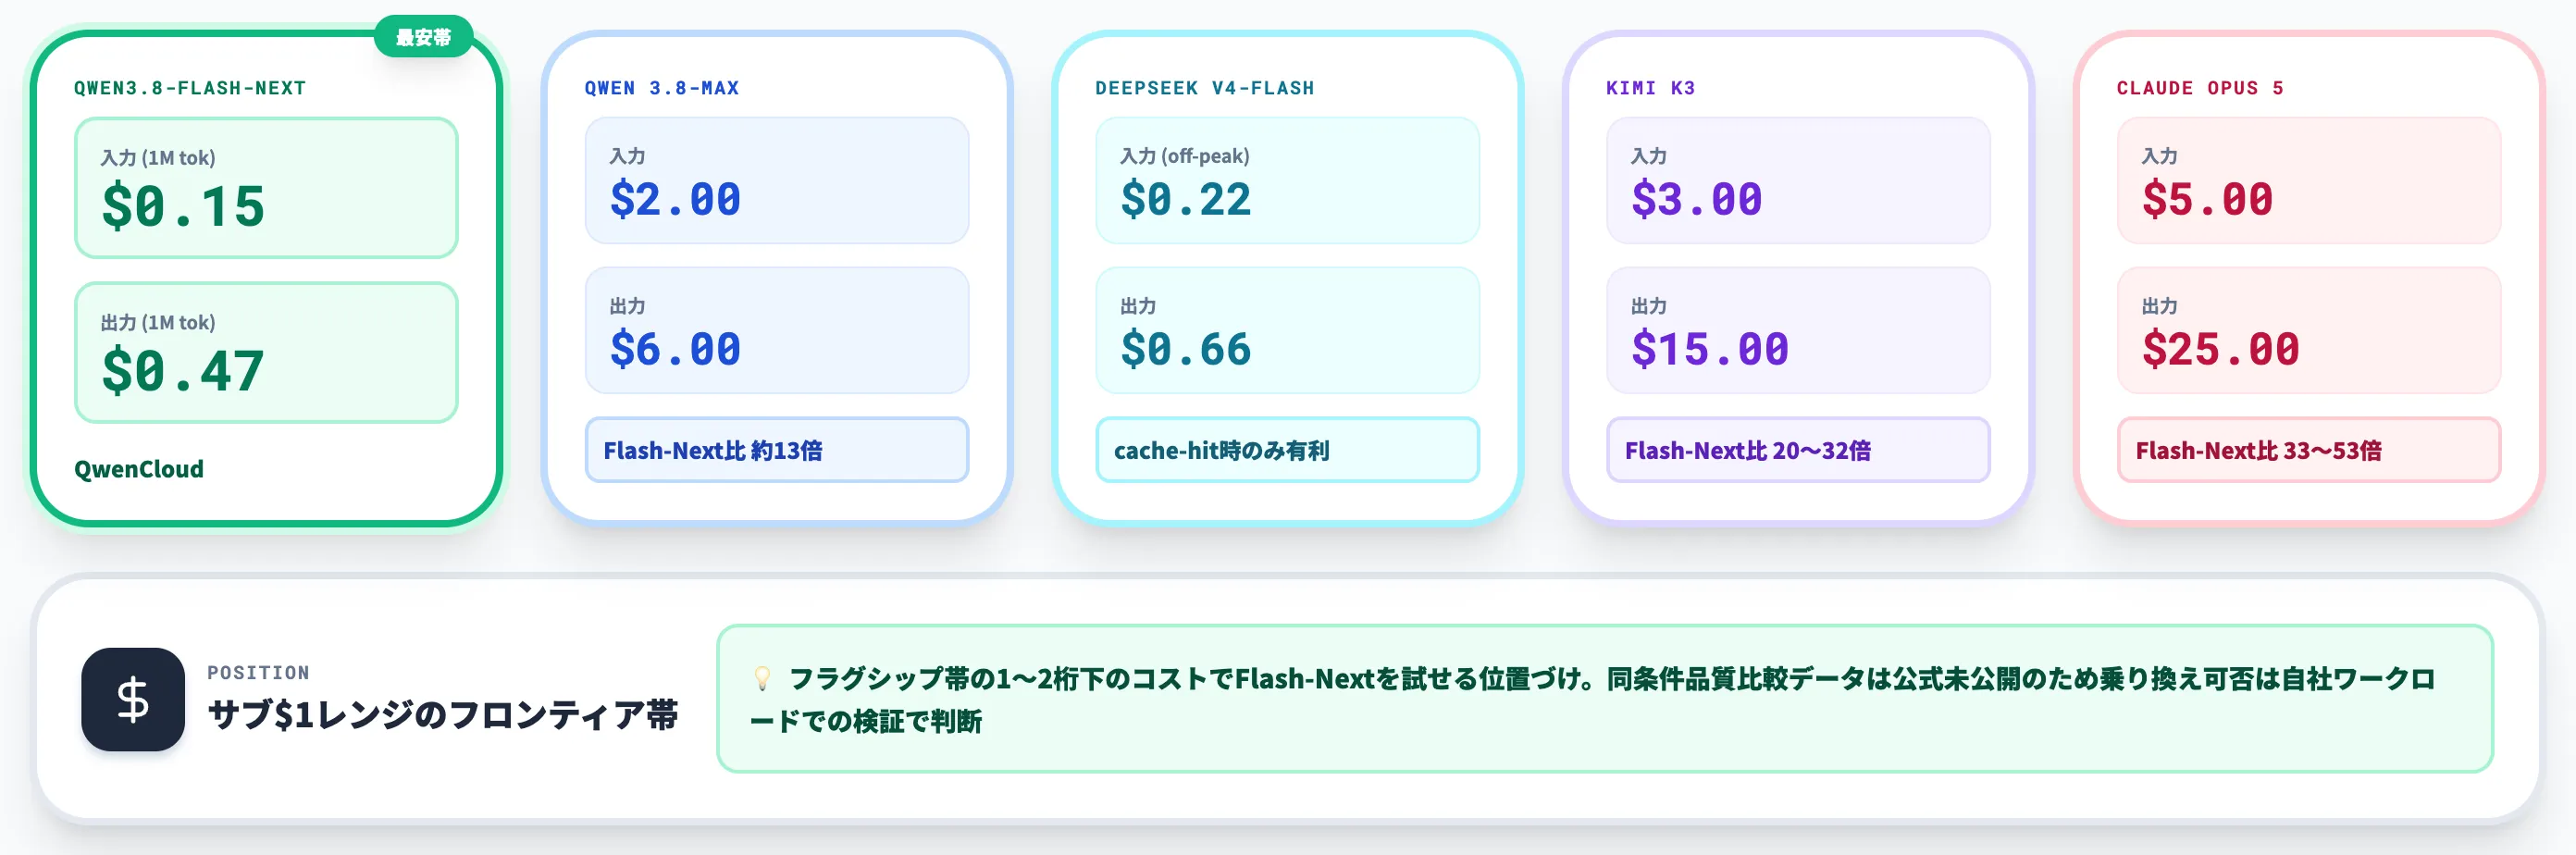
QwenCloudでの料金は、100万トークンあたり入力$0.15 / 出力$0.47(QwenCloud製品ページ・2026年8月時点)です。
Qwen Team公式blogのリリース時価格は入力$0.16でしたが、その後$0.15に改定されています。
同一クラスの競合モデル・および同社上位モデルとの単価比較を以下の表で整理しました。
| モデル | 入力($/1Mトークン) | 出力($/1Mトークン) | 参考 |
|---|---|---|---|
| Qwen3.8-Flash-Next | $0.15 | $0.47 | QwenCloud |
| Qwen 3.8-Max | $2.00 | $6.00 | QwenCloud(同社フラグシップ) |
| DeepSeek V4-Flash(off-peak・cache-miss) | $0.22 | $0.66 | DeepSeek API(cache-hit入力は$0.007) |
| Kimi K3 | $3.00 | $15.00 | Moonshot AI |
| Claude Opus 5 | $5.00 | $25.00 | Anthropic |
Flash-NextはQwen 3.8-Max比で入力側約13倍・出力側12.8倍安く、DeepSeek V4-Flash(同じFlashクラス競合)とは、cache-miss入力時にはFlash-Nextが約32%・出力側で29%安い一方、cache-hit率が高いワークロードではDeepSeek V4-Flashの入力$0.007が有利になる区間があります。
Claude Opus 5比では単価で入力約33倍・出力約53倍、Kimi K3比では入力約20倍・出力約32倍安く、フラグシップ帯の1〜2桁下のコストでFlash-Nextを試せる位置づけになります(品質同等の同条件比較データは公式には示されていないため、乗り換え可否は自社ワークロードでの検証で判断する必要あり)。
提供チャネル——マネージド・OSS・自己ホスト
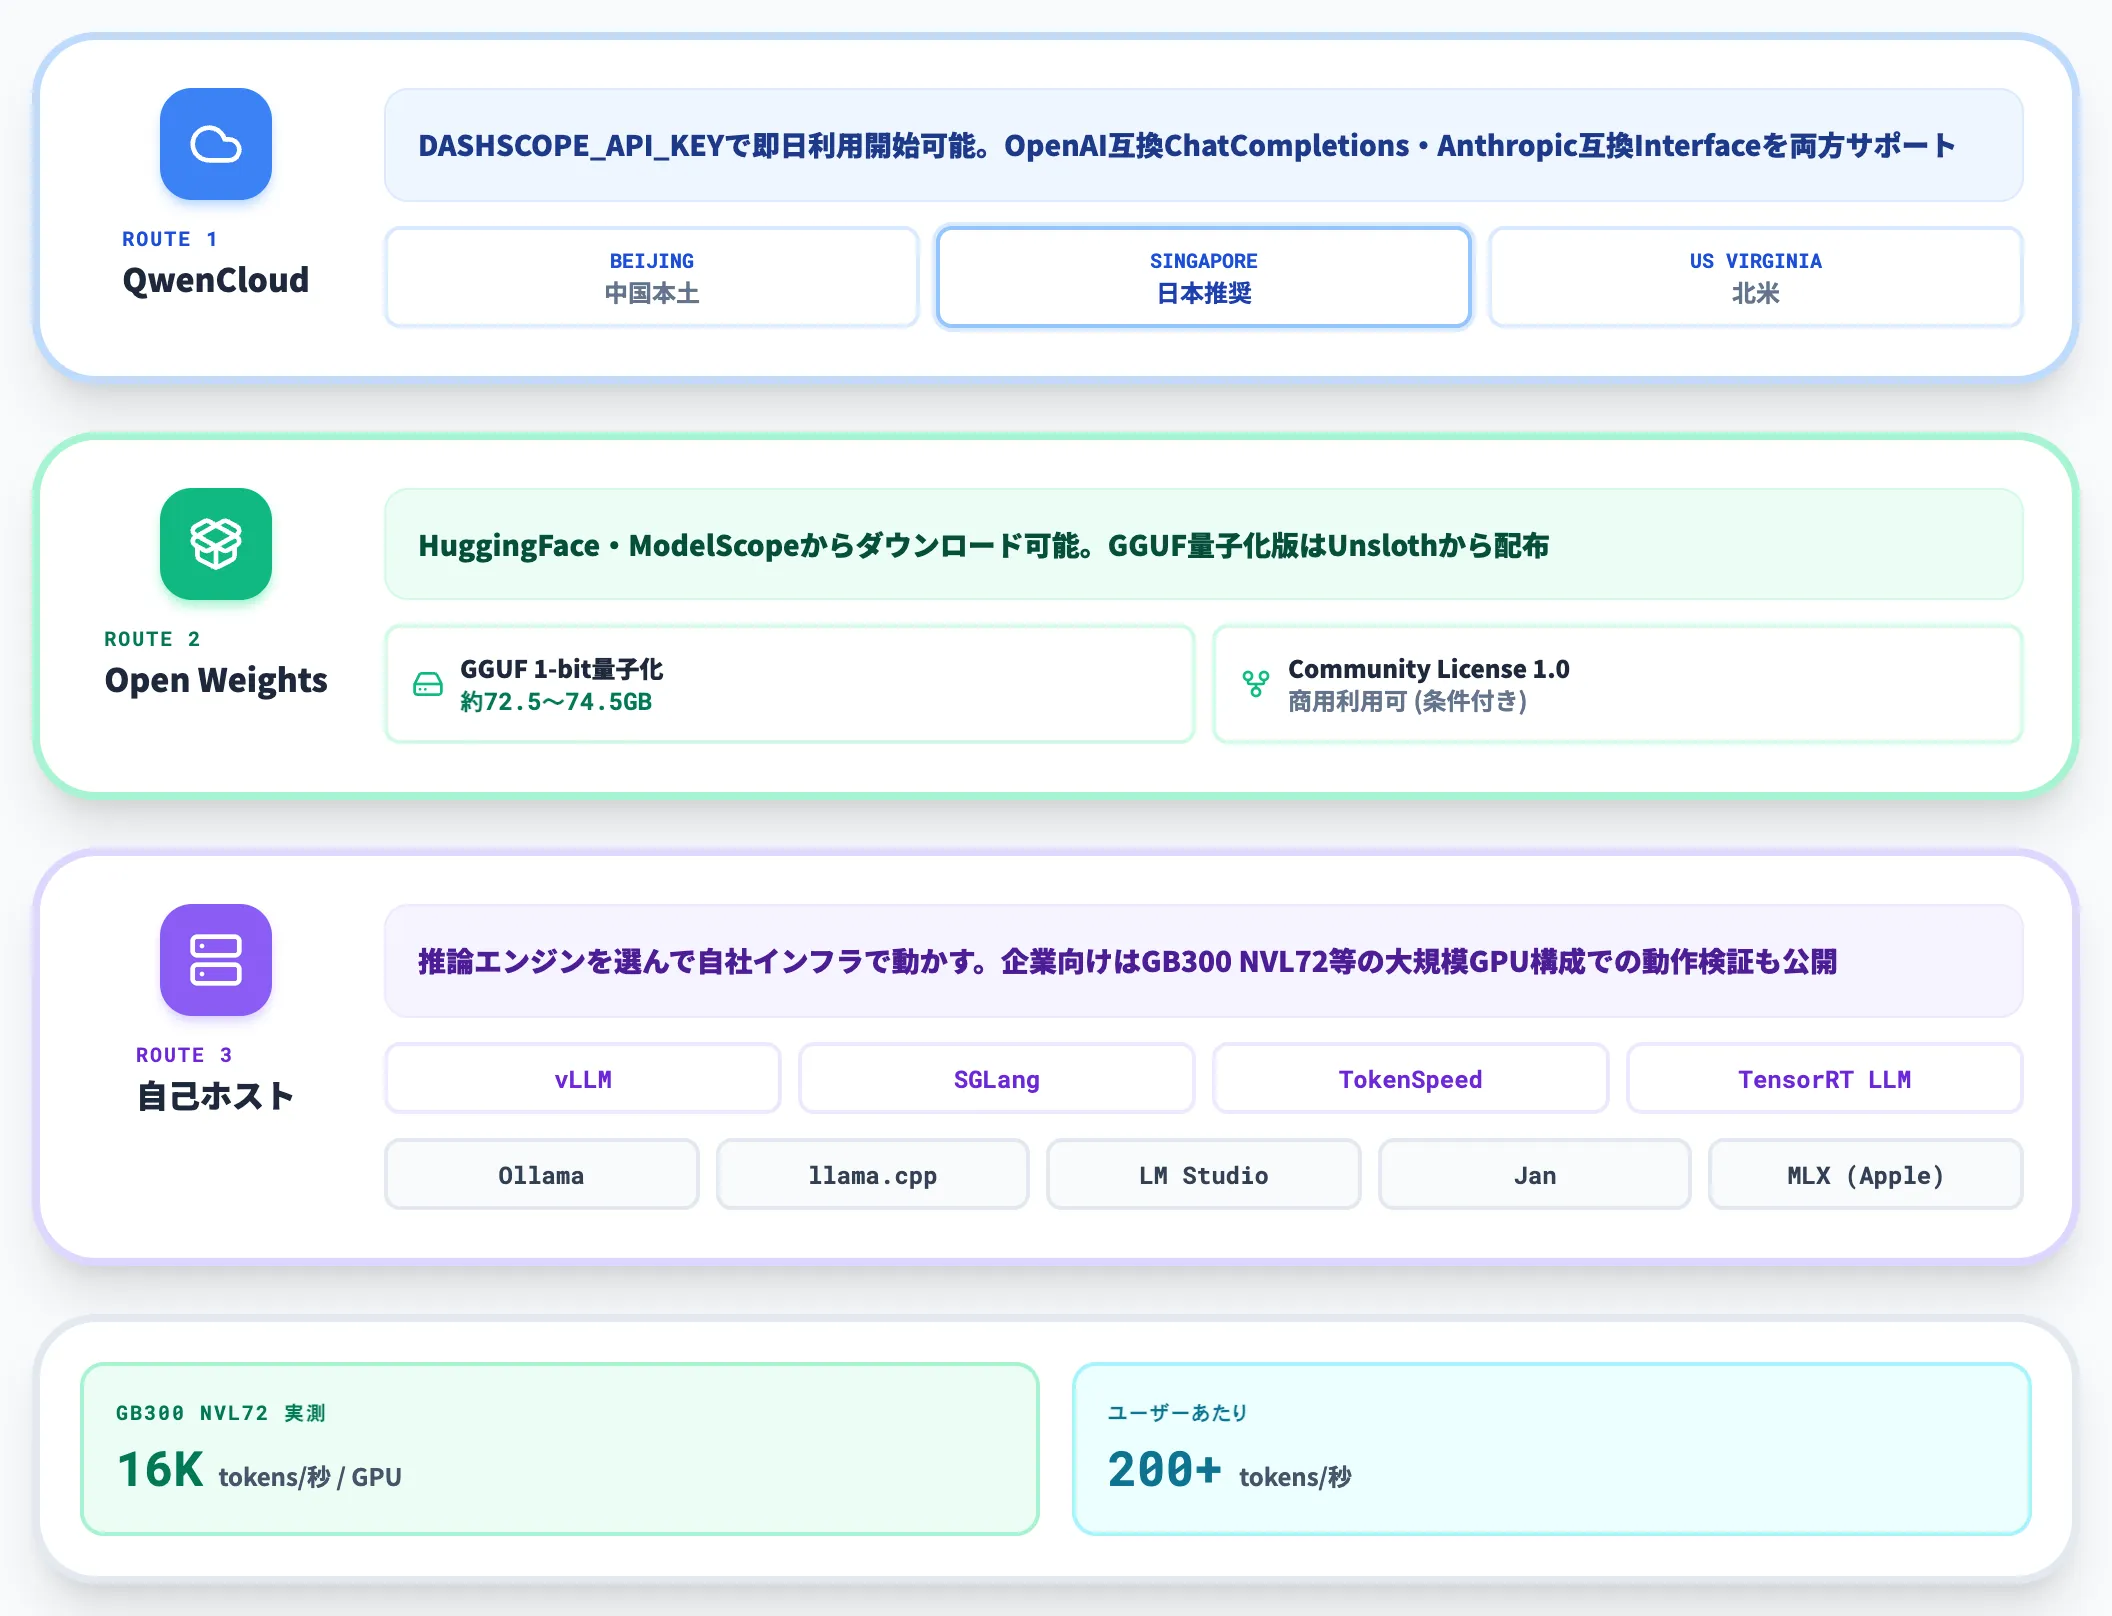
Flash-Nextは、以下の3ルートで利用可能です。用途と組織のガバナンス要件に応じて選び分けます。
-
QwenCloud(マネージドAPI)
DASHSCOPE_API_KEYで即日利用開始可能。OpenAI互換ChatCompletions・Anthropic互換のInterfaceを両方サポート。Beijing / Singapore / US(Virginia)の3リージョンから選択でき、日本からはSingaporeエンドポイントが実用的。1M contextはデフォルト有効。
-
オープンウェイト(Hugging Face / ModelScope)
Hugging Face公式コレクション・ModelScope公式コレクションからダウンロード可能。GGUF量子化版(Unsloth GGUF)は1-bit量子化ファイルが約72.5〜74.5GB(RAM/VRAM動作要件は環境依存で別途確認)。
-
自己ホスト(推論エンジン)
vLLM・SGLang・TokenSpeed・TensorRT LLMがネイティブ対応。ローカル運用ではOllama・llama.cpp・LM Studio・Jan・MLX(Apple Silicon対応)から選べる。企業運用ではNVIDIA GB300 NVL72・DGX Station・DGX Spark・RTX PRO 6000 Blackwell Max-Q ×4 台構成での動作検証もNVIDIAの開発者ブログで公開されている。
GB300 NVL72の実測では GPUあたり16Kトークン/秒・ユーザーあたり200トークン/秒以上のスループット が確認されており、大規模並列推論を組む際の基準値として参考にできます。
Qwen Community License 1.0の商用条件
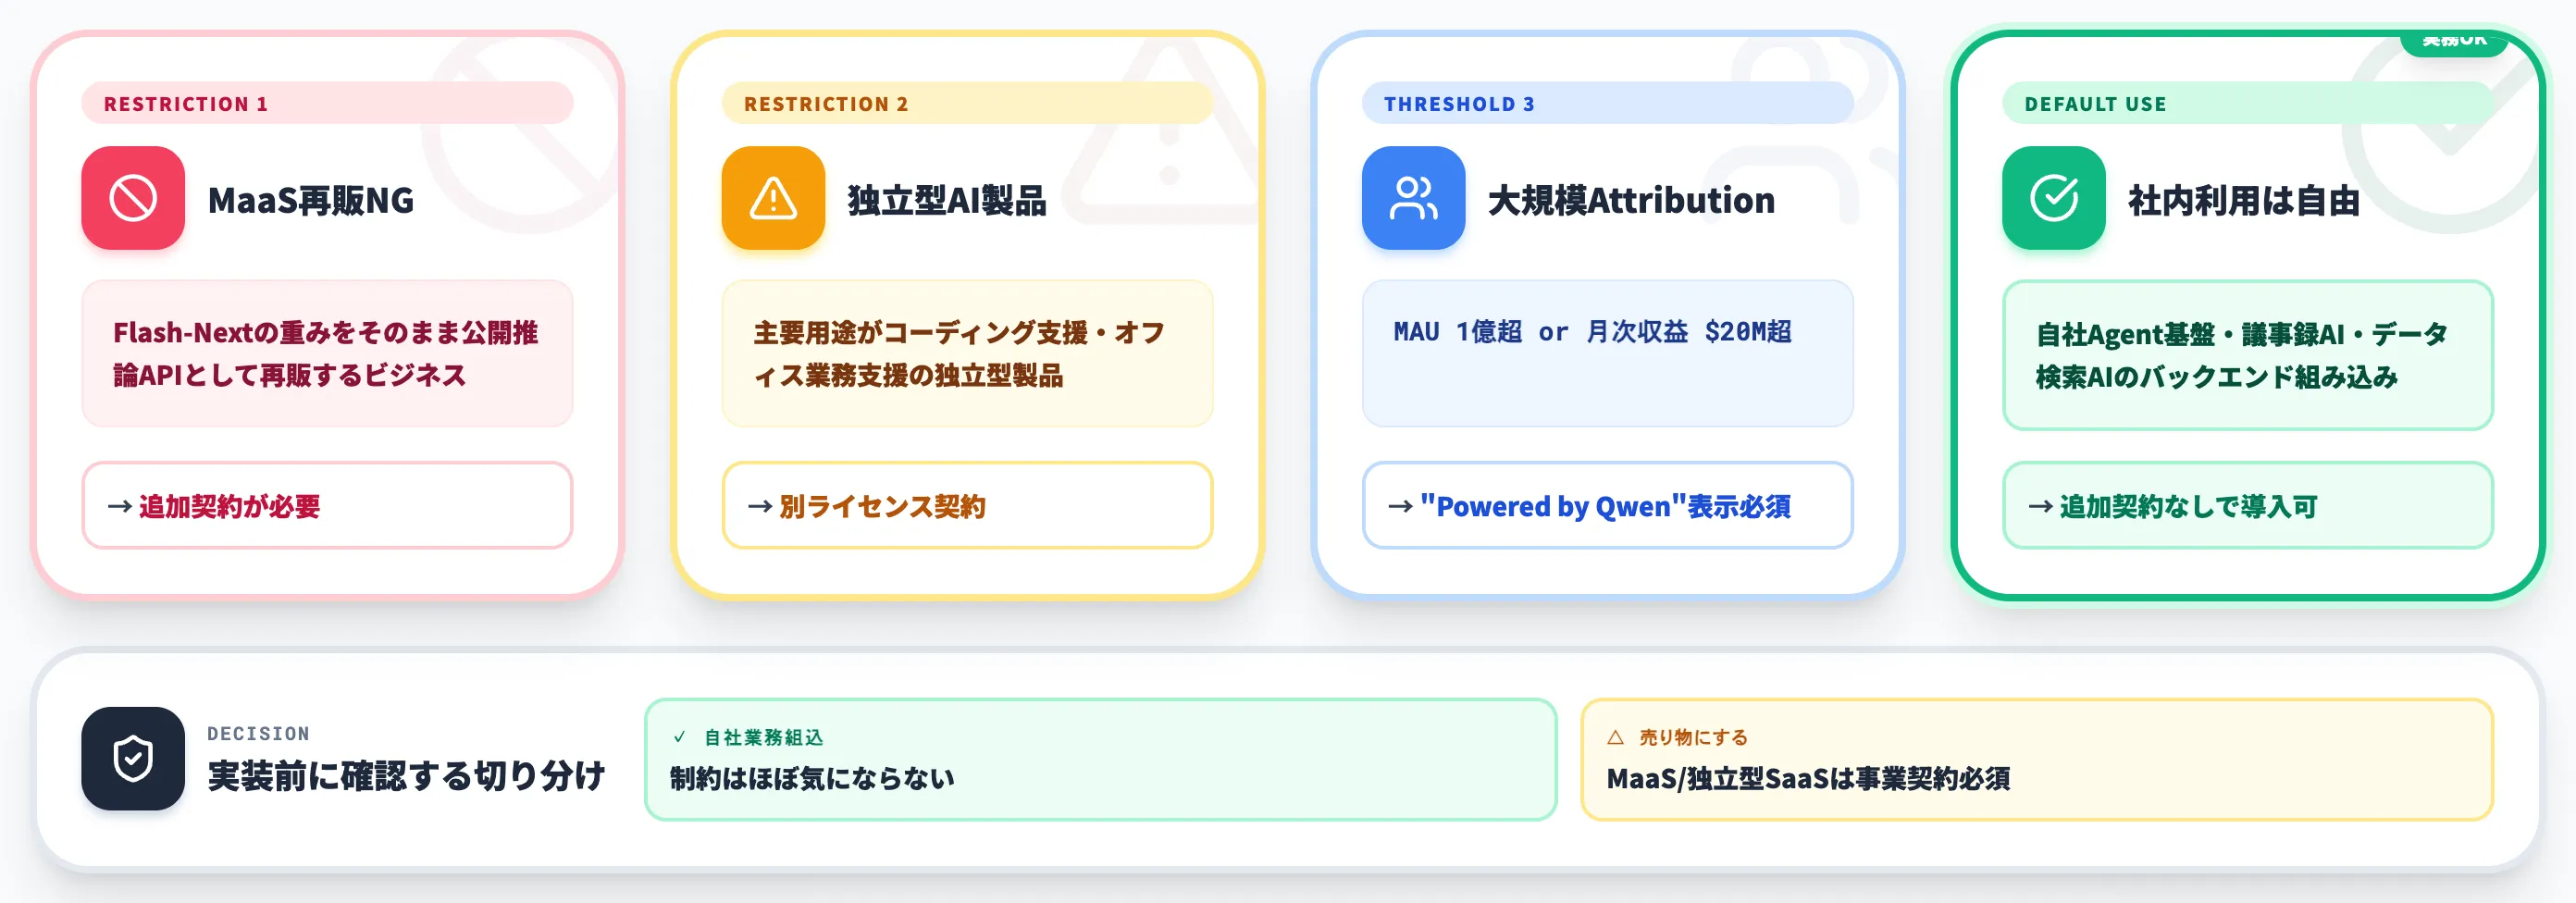
Flash-Nextのオープンウェイトは Qwen Community License 1.0 で提供されており、原則として商用利用も含めて無料で使えます。ただし、条件はApache 2.0やMITライセンスほど緩くはなく、以下の条項に注意が必要です。
-
MaaS(Model as a Service)プロバイダーは対象外
Flash-Nextの重みをそのまま公開推論APIとして再販するビジネスモデルは、追加契約が必要になる。
-
独立型のAIコーディング・AIオフィス支援製品は別ライセンス対象
Flash-Nextを主要用途として搭載した独立型のコーディング支援・オフィス業務支援製品は、別ライセンス契約が必要になる(他分野向けAIや別用途製品に付属する機能、単目的ツールは対象外)。
-
月間1億MAU / 月次$20M収益超は attribution 必須
サービス規模がこの閾値を超えた場合、製品UI上に「Powered by Qwen」相当の帰属表示(attribution)が要求される。
-
社内利用・自社サービスへのバックエンド組み込みは原則自由
自社内のAgent基盤・議事録AI・データ検索AI等でFlash-Nextを推論エンジンとして使う分には、上記条件に該当しなければ追加契約なしで導入可能。
つまり、「自社の業務にAI Agentを組み込む」用途では制約はほぼ気にならず、「Flash-Nextを直接売り物にするMaaS・主要用途がコーディング支援である独立型SaaS」を作る場合は事業契約が要る、という切り分けになります。
実装前にライセンス原文(HuggingFaceのモデルカードから遷移可能)を確認し、法務判断を経ることを推奨します。
Qwen3.8-Flash-Nextの使い方
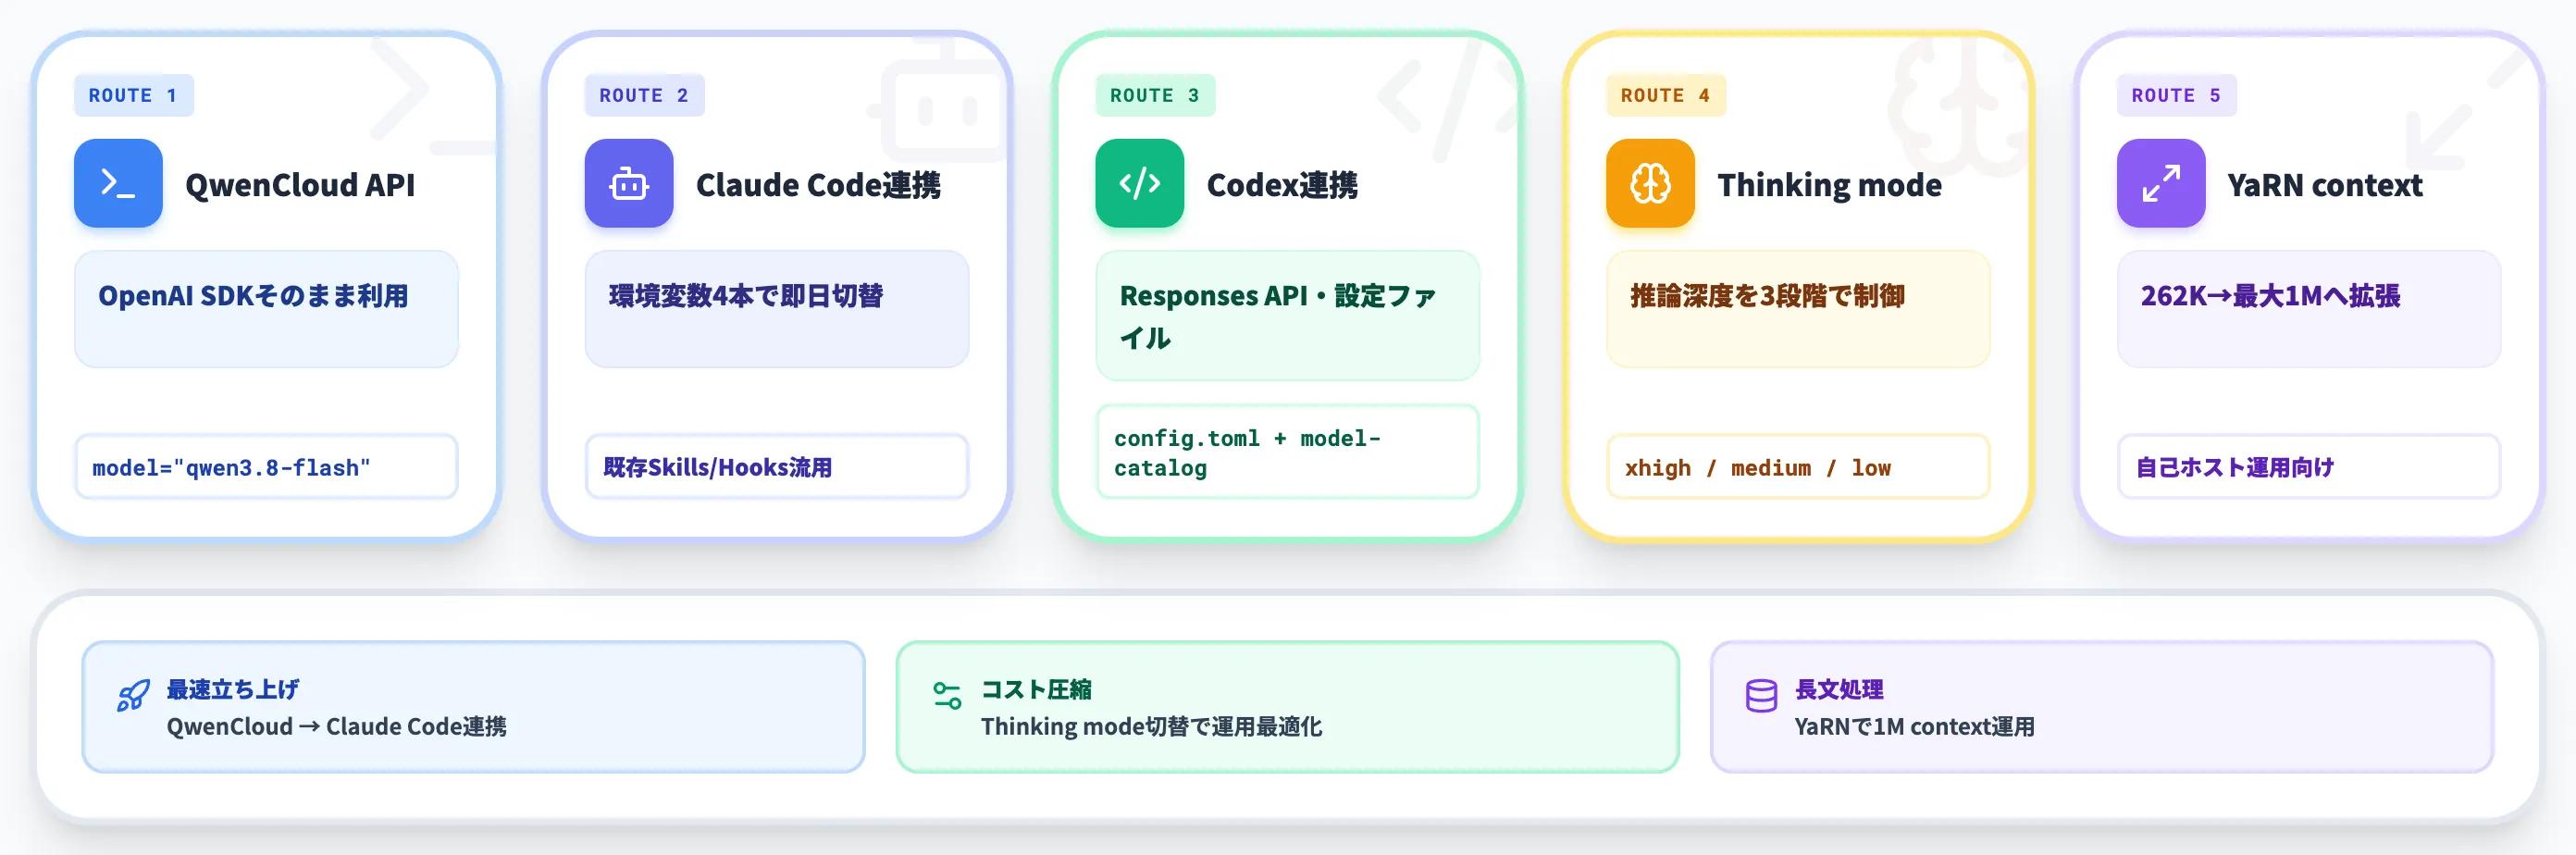
Flash-Nextの実運用ルートは、QwenCloudのマネージドAPI呼び出し・Claude Code連携・Codex連携・thinking mode制御・YaRNによる1Mコンテキスト運用の5つが基本になります。それぞれの実装ポイントを整理します。
QwenCloud APIコール
QwenCloudでは、モデル名 qwen3.8-flash としてFlash-Nextの本番版が提供されます。OpenAI互換のChat Completions API・Anthropic互換のInterface両方をサポートしており、既存のSDKをそのまま使えます。
以下は、QwenCloud経由でFlash-Nextを呼び出す最小限のPython実装例です(Qwen Team公式blog記載のサンプルをベース)。
from openai import OpenAI
import os

client = OpenAI(
    api_key=os.environ["DASHSCOPE_API_KEY"],
    base_url=os.environ.get(
        "DASHSCOPE_BASE_URL",
        "https://dashscope-intl.aliyuncs.com/compatible-mode/v1",
    ),
)

messages = [{"role": "user", "content": "Write a Python function to merge two sorted linked lists."}]

completion = client.chat.completions.create(
    model="qwen3.8-flash",
    messages=messages,
    extra_body={"enable_thinking": True},
    reasoning_effort="xhigh",  # xhigh / medium / low
    stream=True,
)
このサンプルの利点は複数あります。1つ目は、既存のOpenAI SDKをそのまま流用できるため、既存のOpenAI/Anthropic系実装からの移行コストが最小限で済む点です。2つ目は、reasoning_effort パラメータで思考深度を明示的に制御でき、コストと応答時間のトレードオフを実装側で調整できる点です。BaseURLは日本からは dashscope-intl.aliyuncs.com(Singapore)を使うのが実用的な選択になります。
Claude Code連携——環境変数4本で即日動作
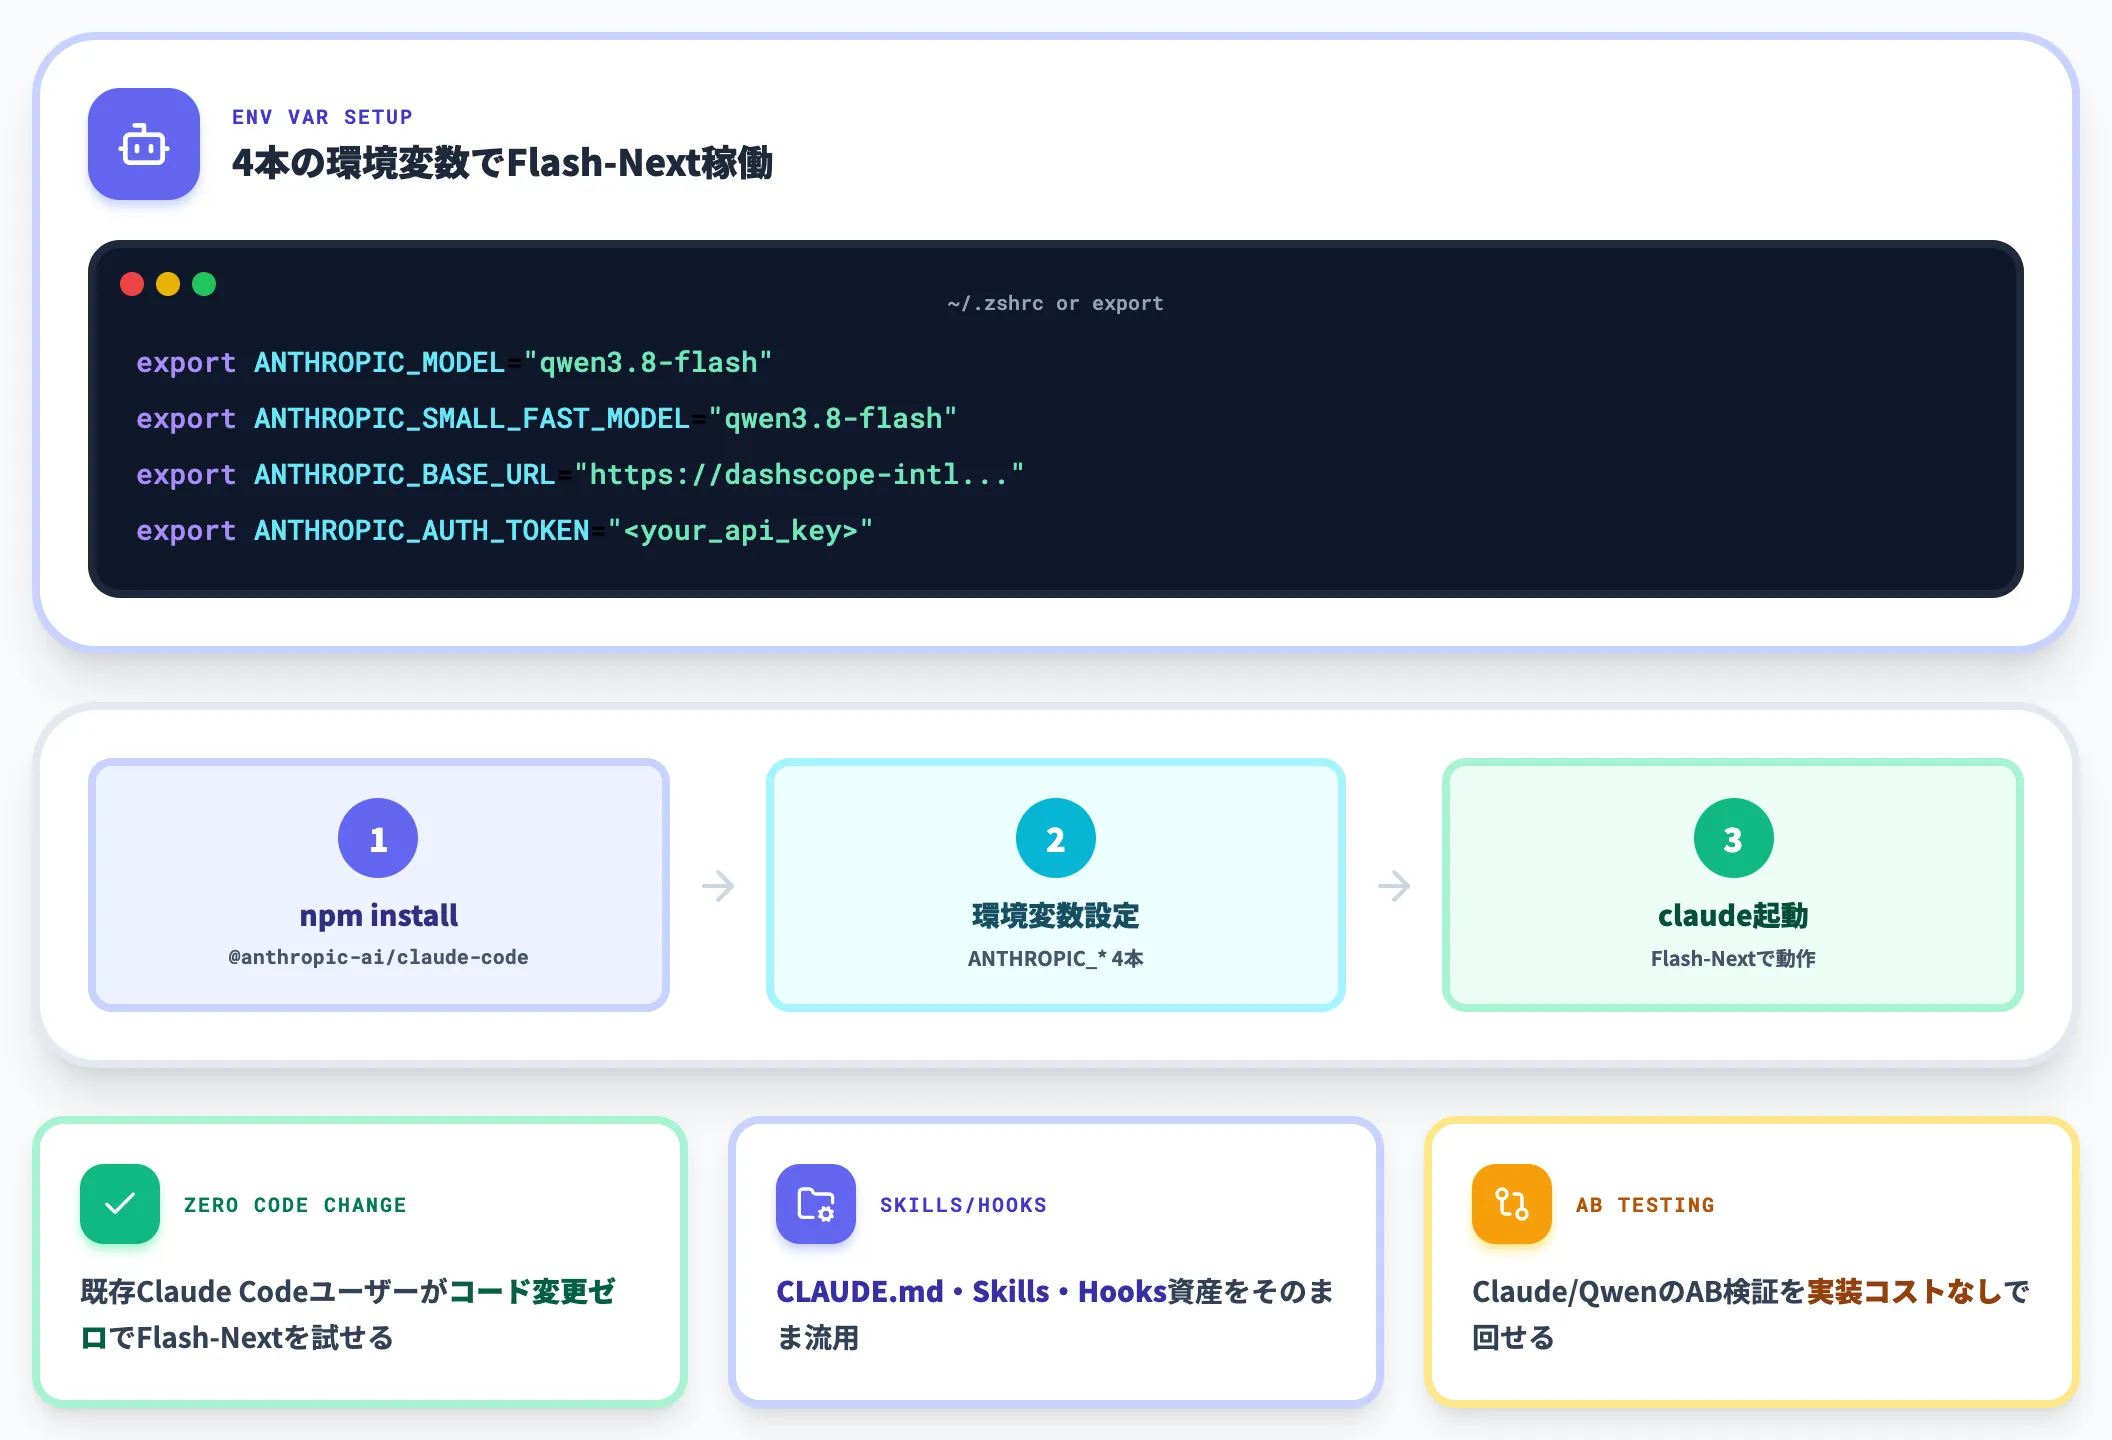
QwenCloud APIはAnthropicプロトコルもサポートするため、Claude Codeから直接Flash-Nextを呼び出せます。
以下の環境変数を設定するだけで、Claude Code側のUI・CLI・Hooks・Skillsをそのまま使いながら、内部の推論をFlash-Nextに切り替えできます。
npm install -g @anthropic-ai/claude-code

export ANTHROPIC_MODEL="qwen3.8-flash"
export ANTHROPIC_SMALL_FAST_MODEL="qwen3.8-flash"
export ANTHROPIC_BASE_URL="https://dashscope-intl.aliyuncs.com/apps/anthropic"
export ANTHROPIC_AUTH_TOKEN="<your_api_key>"

claude
このアプローチの実務的メリットは、Claude Code既存ユーザーがコード変更ゼロでFlash-Nextを試せる点です。
SWE-bench Proでの62.5というスコアがそのままエージェント作業に反映されるかを、既存のCLAUDE.md・Skills・Hooksの資産を使って検証できます。Claude/QwenのモデルAB検証を実装コストなしで回せるのは、モデル選定期の企業にとって重要な機能です。
Codex連携(Responses API)
OpenAI Responses APIプロトコルにも対応しているため、Codexからも直接呼び出せます。設定ファイルは以下のように書きます。
~/.codex/model-catalog.local.json:
{
  "models": [
    {
      "slug": "qwen3.8-flash",
      "display_name": "qwen3.8-flash",
      "description": "QwenCloud: Qwen3.8-Flash",
      "default_reasoning_level": "xhigh",
      "context_window": 983616,
      "effective_context_window_percent": 95,
      "supports_parallel_tool_calls": false,
      "input_modalities": ["text", "image"]
    }
  ]
}
~/.codex/config.toml:
model_catalog_json = "~/.codex/model-catalog.local.json"
model_provider = "QwenCloud"
model = "qwen3.8-flash"

[model_providers.QwenCloud]
name = "QwenCloud"
base_url = "https://dashscope-intl.aliyuncs.com/compatible-mode/v1"
env_key = "OPENAI_API_KEY"
wire_api = "responses"
Codex経由の運用では、context_window: 983616 がCodex側の公式推奨メタデータ値になります(QwenCloud側の実効入力上限は通常991K・thinkingモード983Kトークンで、Codexの context_window とは別レイヤーの数値である点に注意)。
QwenCloudの入力上限内であれば大規模コードベースを直接contextに載せる運用が可能で、上限を超える規模ではRAG・分割検索・要約による前処理が引き続き必要になります。
Thinking modeの3段階制御
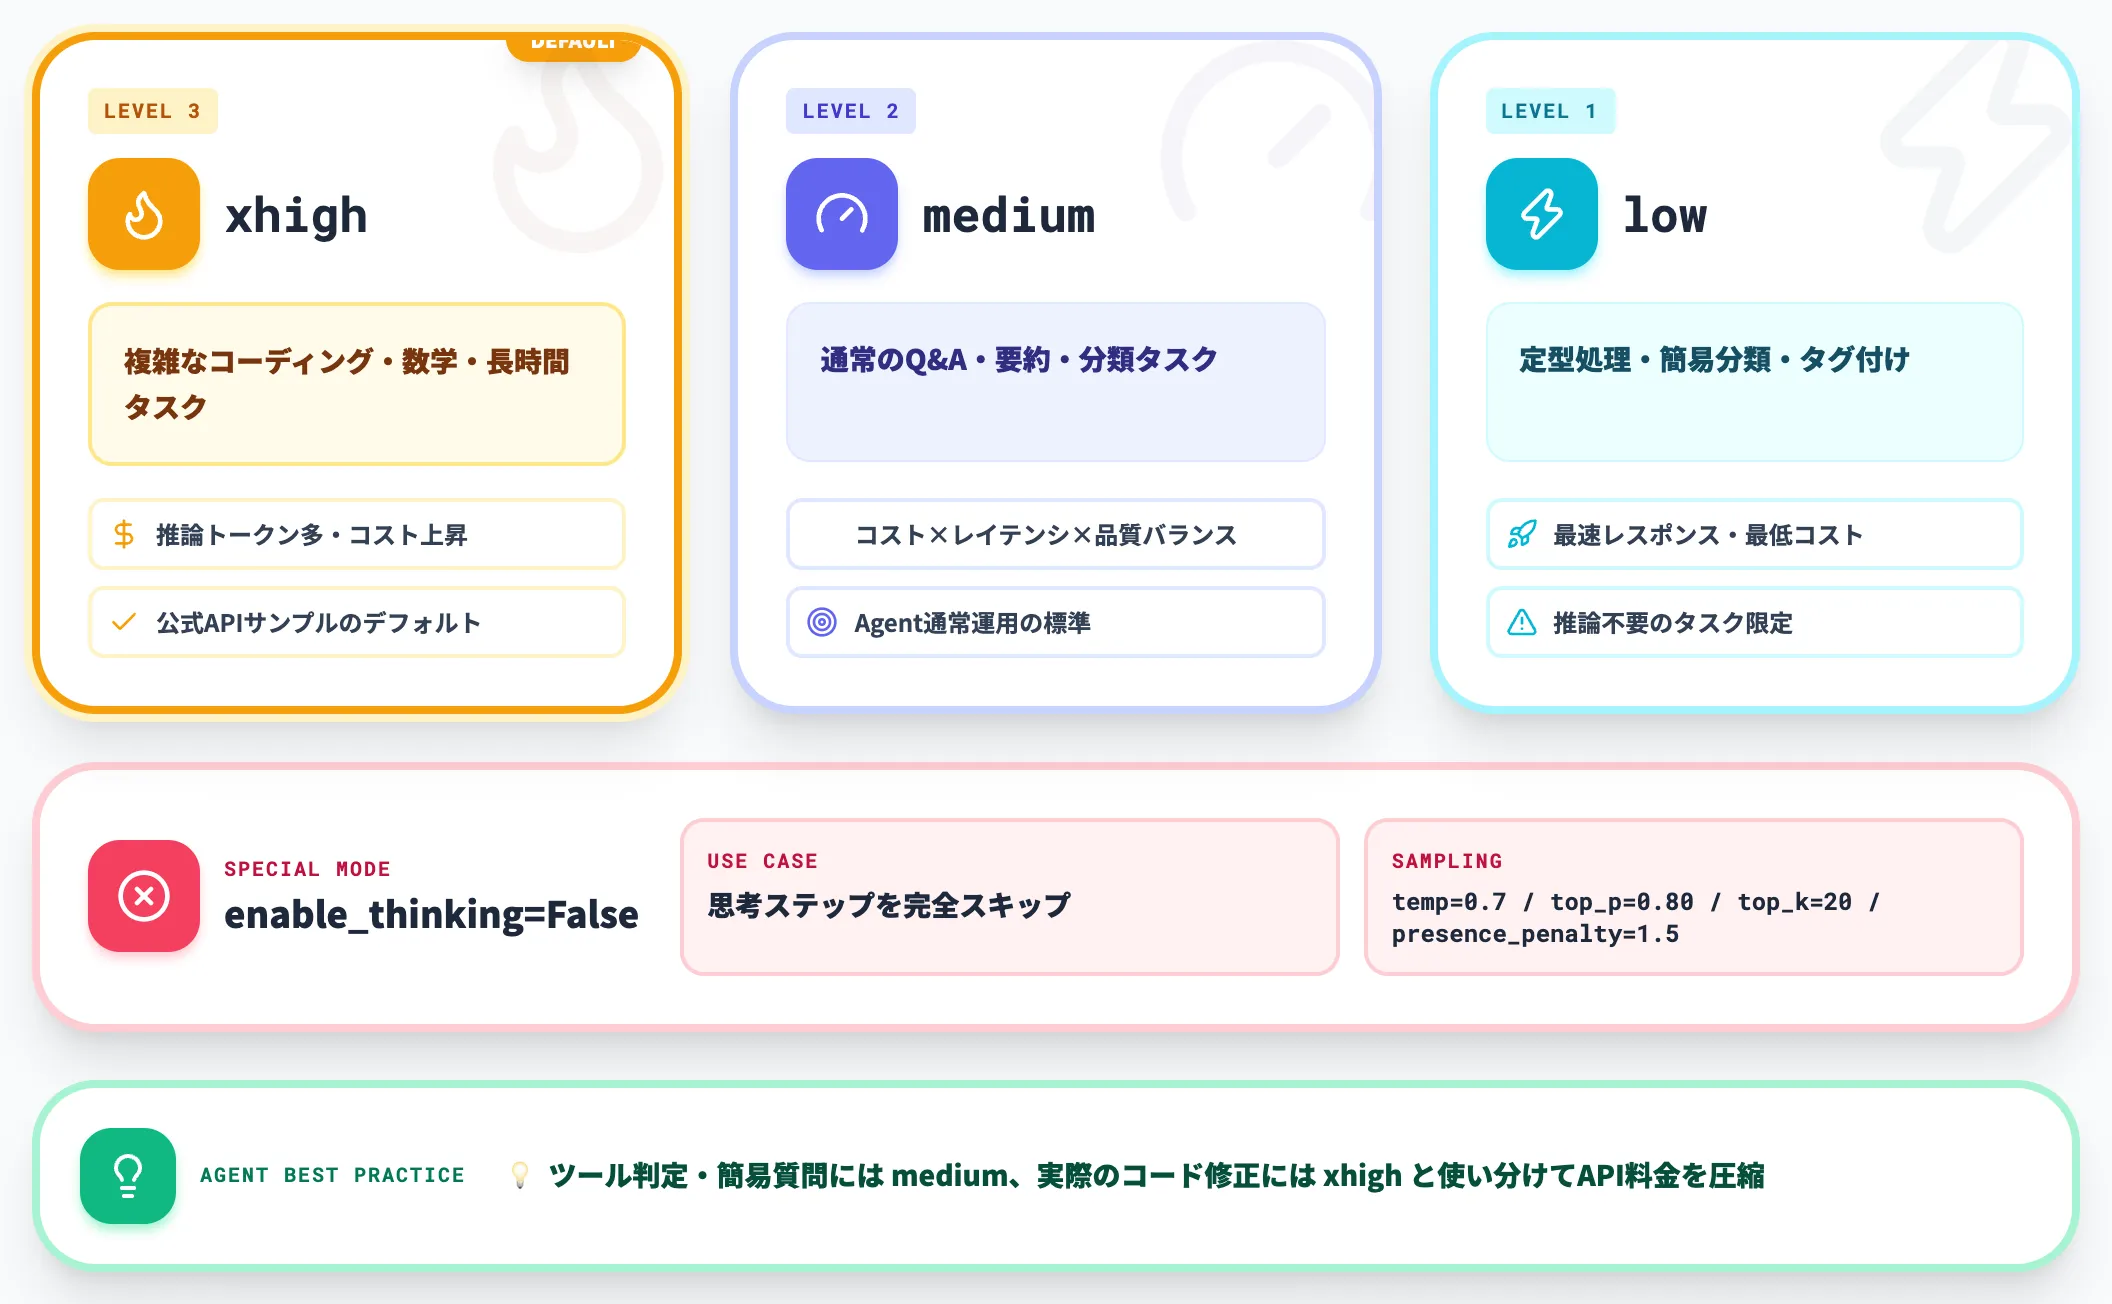
Flash-Nextはデフォルトでthinking modeが有効化されており、推論深度を reasoning_effort パラメータで制御できます。実務的な使い分けは以下のとおりです。
-
xhigh(デフォルト)
複雑なコーディング・数学・長時間タスクで使う。推論トークンが増えるためコストは上がる。Qwen公式のAPIサンプルコードでもxhighがデフォルト(SWE-bench Pro 62.5の公式評価条件はClaude Codeハーネス・temp=1.0・top_p=0.95・256K contextの記載で、reasoning_effortは公式脚注に明記されていない)。
-
medium
通常のQ&A・要約・分類タスク。コスト・レイテンシと品質のバランス型。
-
low
定型的な処理・簡易分類・タグ付けなど推論不要のタスク向け。軽量推論用途で使う。
-
enable_thinking=False
思考ステップを完全にスキップしたい場合。ただし推奨sampling値がtemp=0.7, top_p=0.80, top_k=20, presence_penalty=1.5と thinking mode時(temp=1.0)と異なる点に注意。
Agentワークロードでは、ツール判定・簡易質問には medium、実際のコード修正には xhigh と使い分けることで、API料金の圧縮を狙えます。
ただし低い reasoning_effort では失敗・再試行によりトークン消費が増える場合があるとQwen公式は注記しているため、タスク別に効果を検証したうえで採用します。
YaRNで262K → 1Mコンテキスト拡張
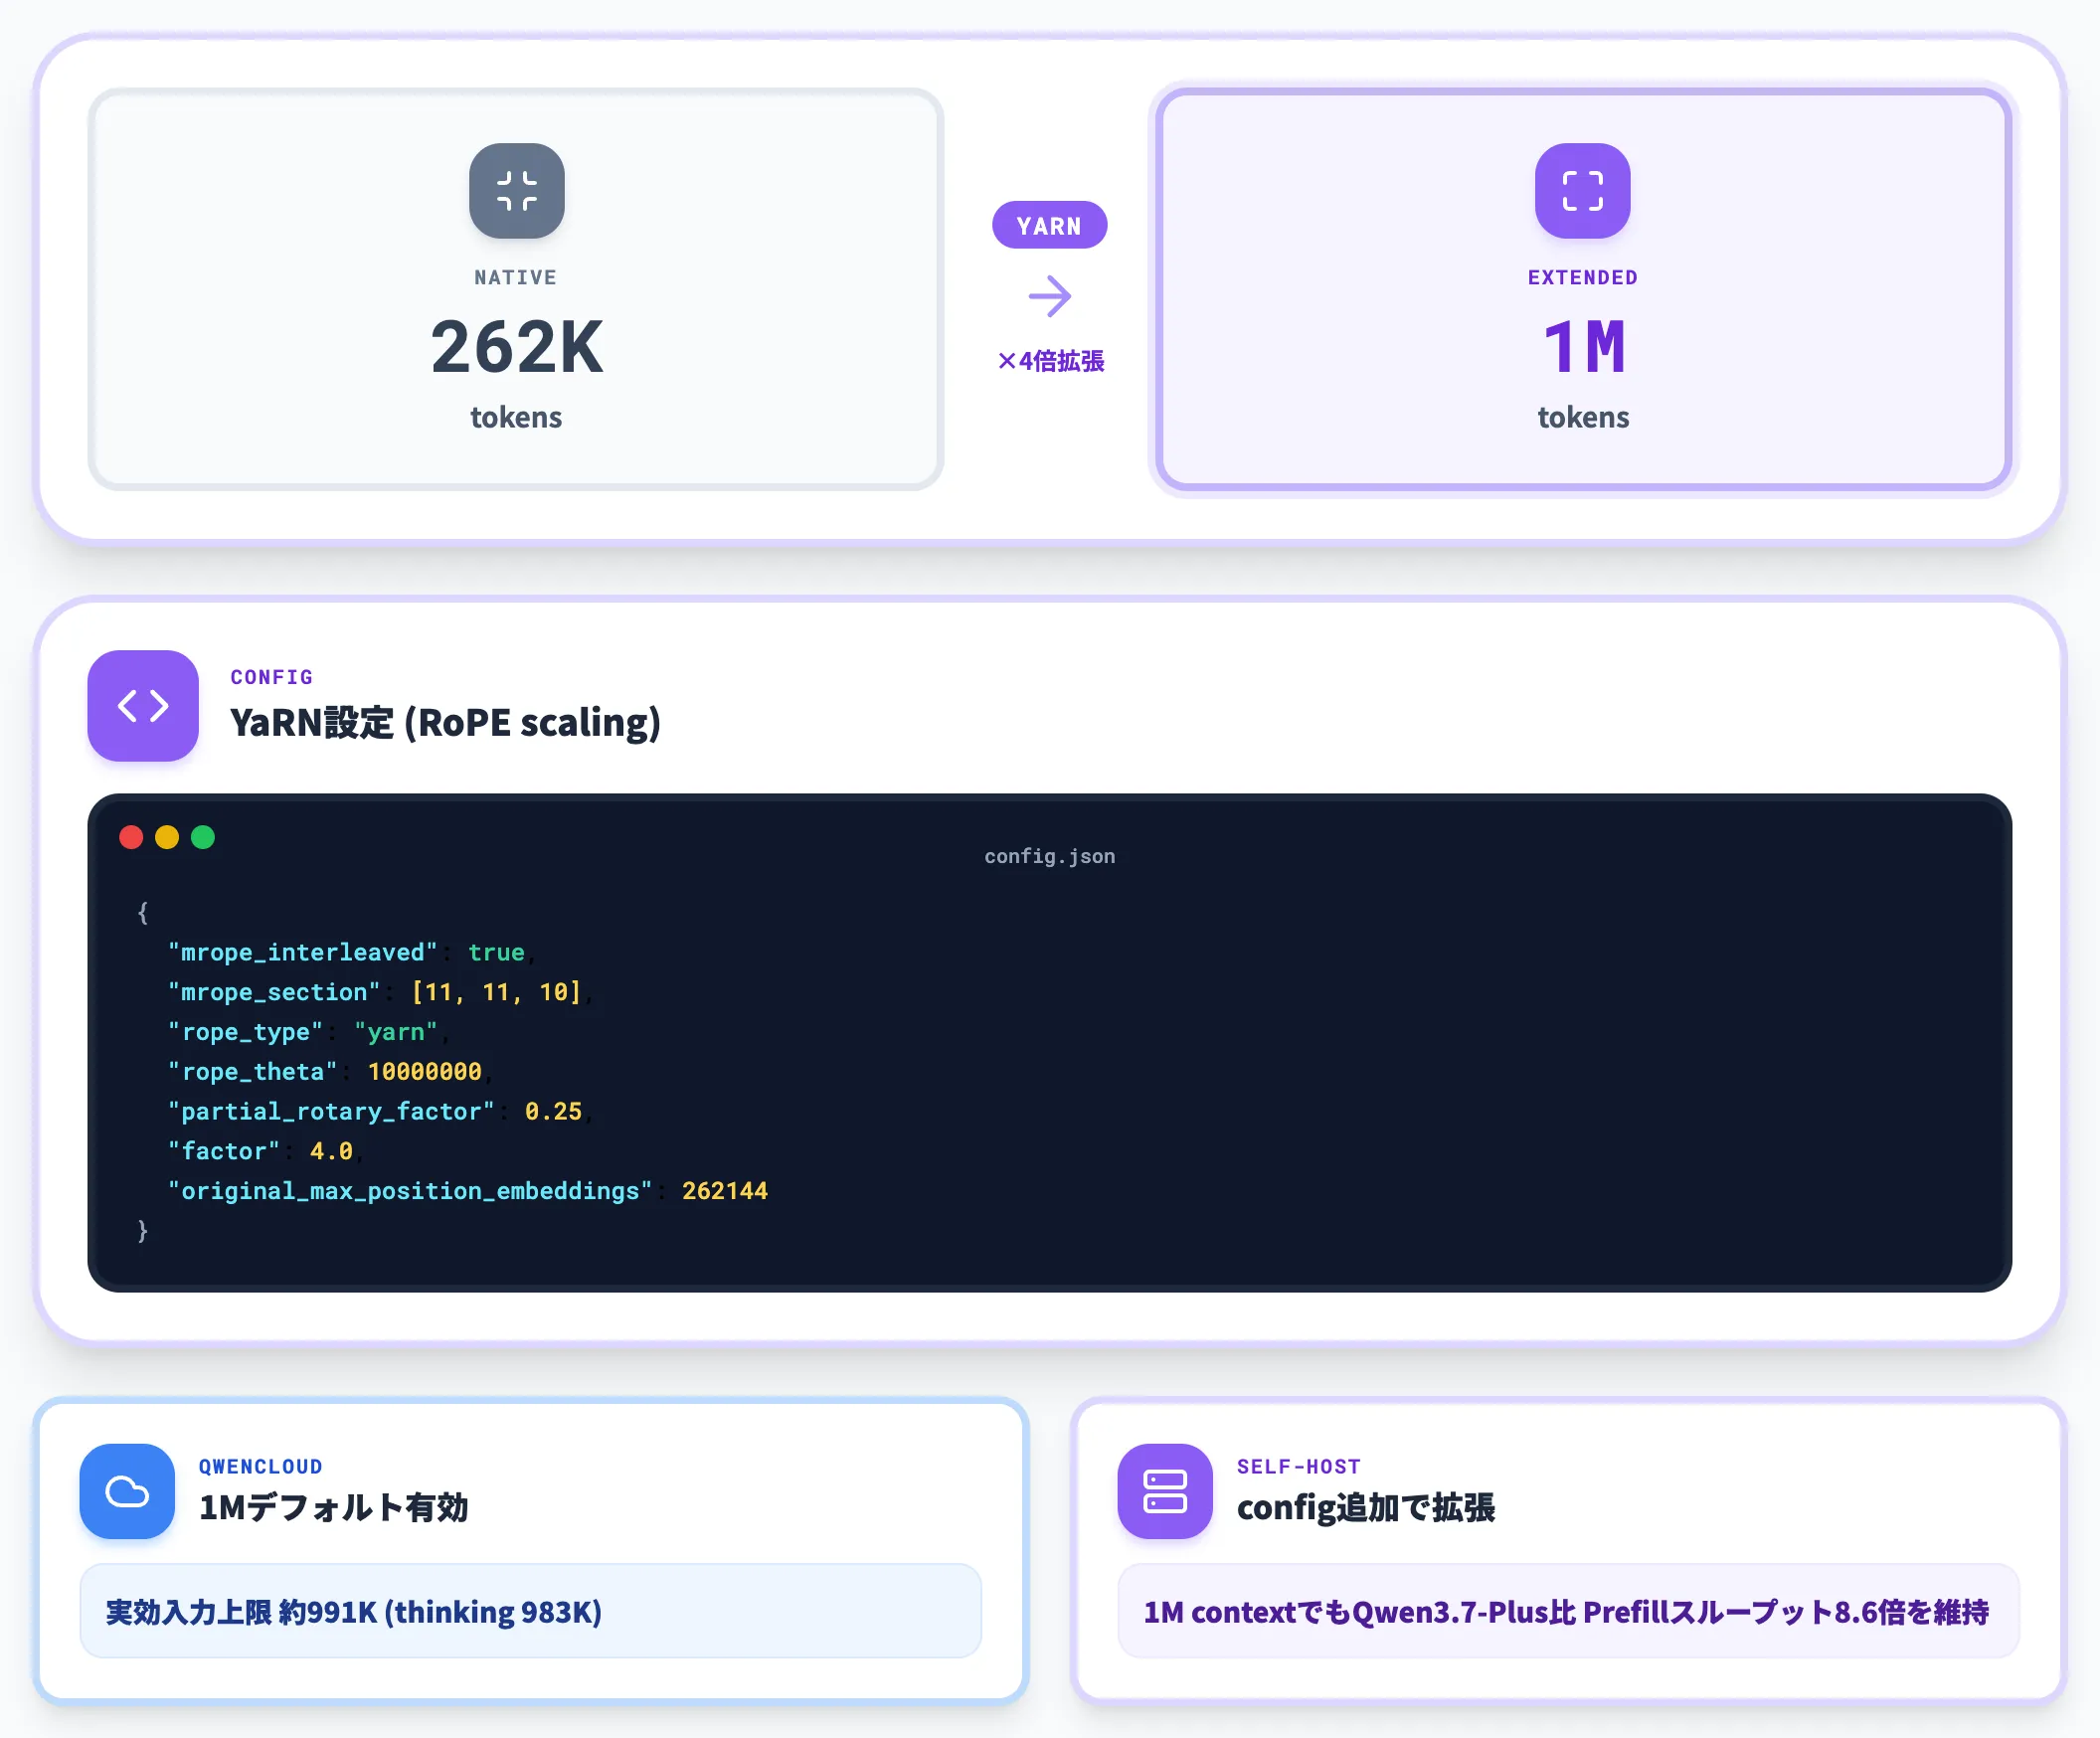
Flash-Nextの native context lengthは262,144トークンですが、YaRN(RoPE scaling手法)でconfigに以下を追加することで最大1Mトークンまで拡張できます。
{
    "mrope_interleaved": true,
    "mrope_section": [11, 11, 10],
    "rope_type": "yarn",
    "rope_theta": 10000000,
    "partial_rotary_factor": 0.25,
    "factor": 4.0,
    "original_max_position_embeddings": 262144
}
QwenCloudの本番版 qwen3.8-flash はデフォルトで1M contextが有効ですが、実効入力上限は約991Kトークン(thinkingモードでは約983K)なので、自己ホスト運用時のみこのconfig追加を検討します。
QSA + GDNの効果で、1M contextでもQwen3.7-Plus比で Prefillスループット8.6倍(Prefix cache hit 90%時)を維持できるため、入力上限内であれば長文RAGを圧縮する運用や、大規模コードベースを直接contextに載せる使い方が実装可能になります。
Qwen 3.8-Max / DeepSeek V4-Flash / Kimi K3との使い分け
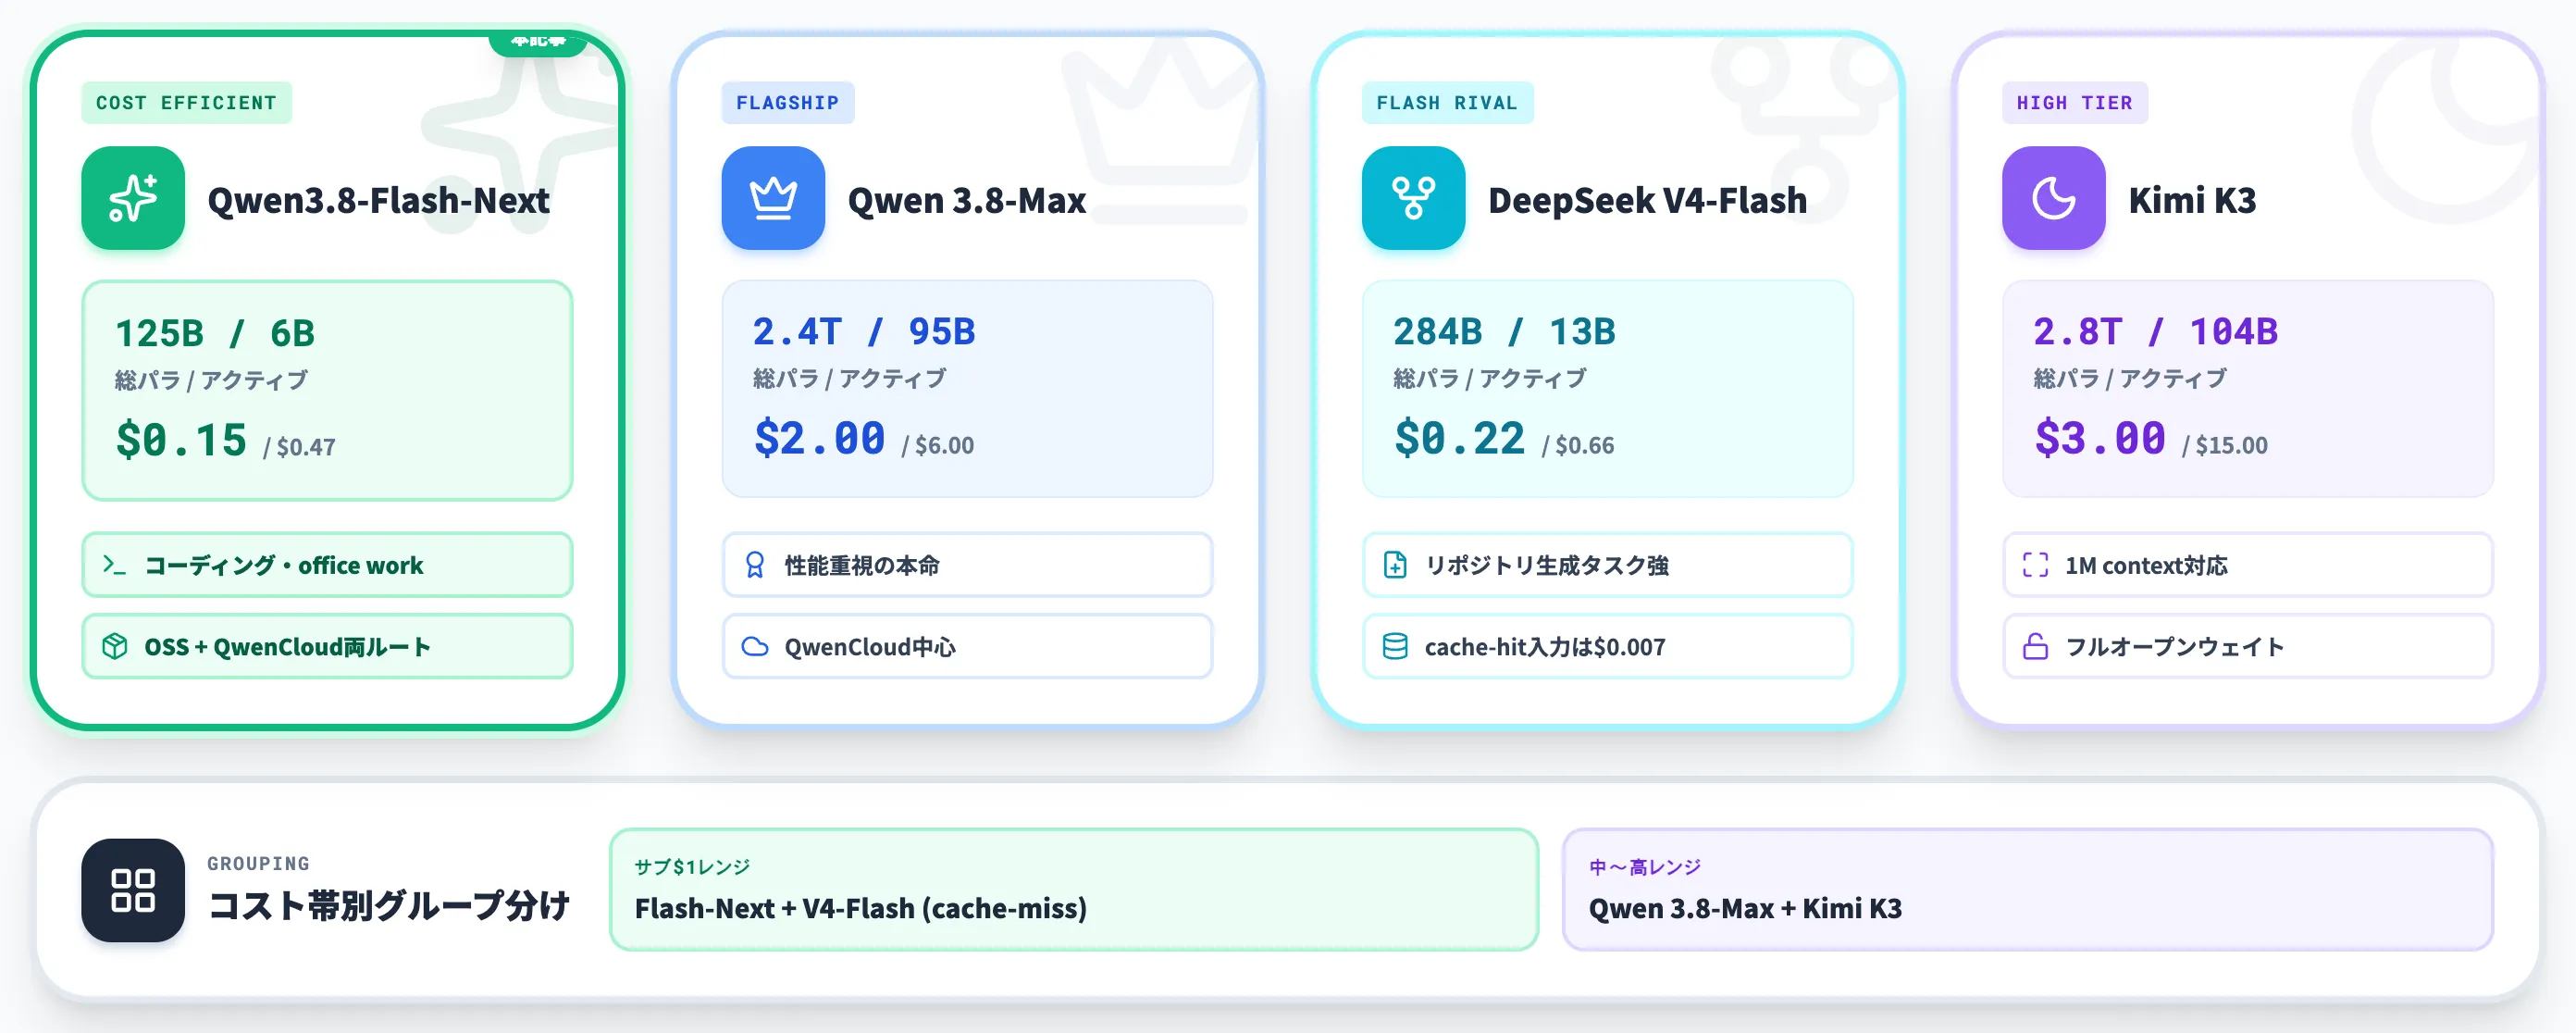
Flash-Nextの位置づけをより明確にするため、同じMoE系フロンティアモデル3本との使い分けを整理します。単価軸・性能軸・提供形態軸の3軸で判断すると、実務での選定基準が立てやすくなります。
単価と性能の対比
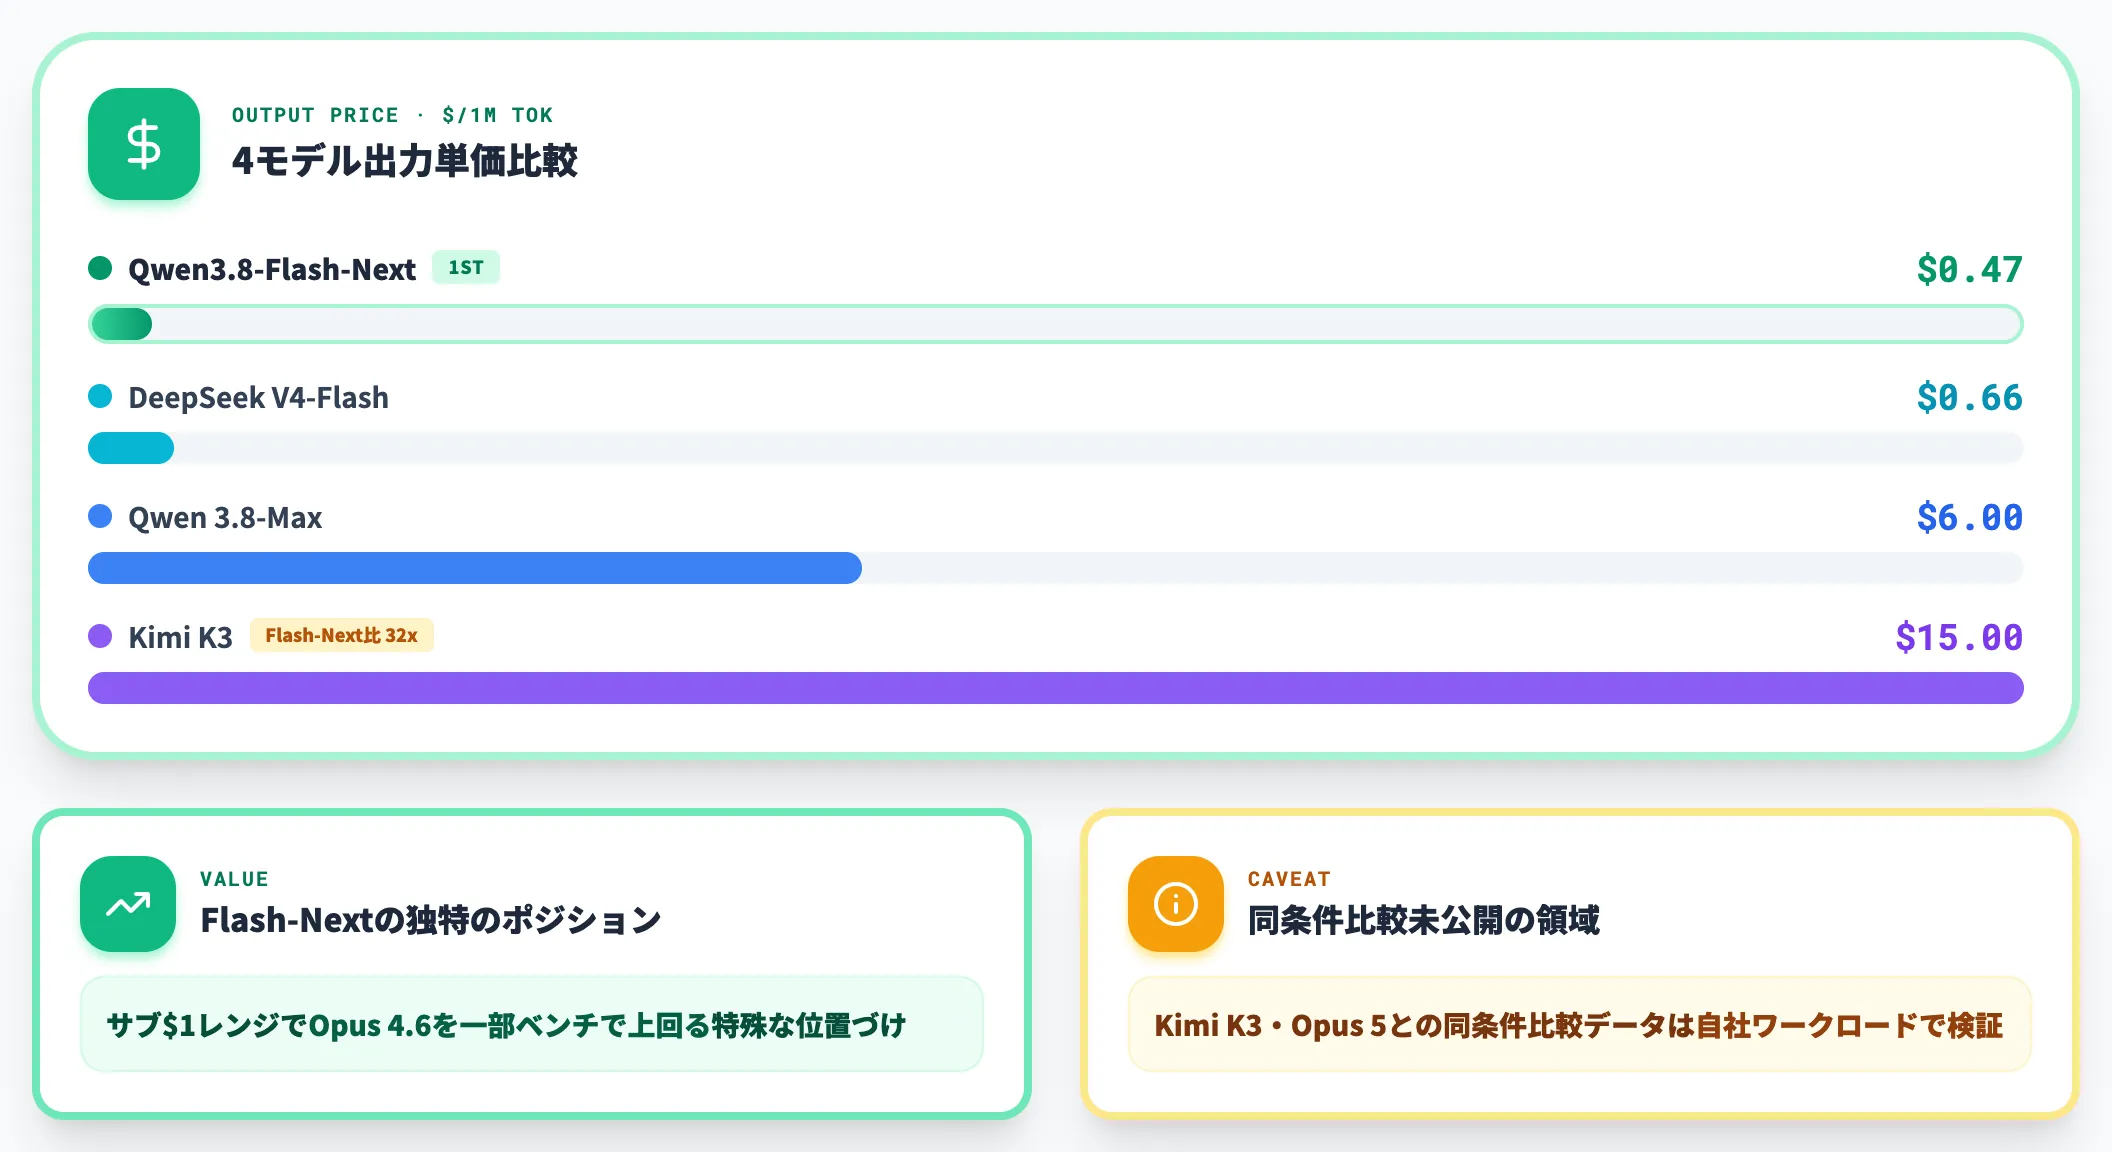
以下の表で、4モデルの基本仕様と単価を並べて整理しました。
| モデル | 総パラ / アクティブ | コンテキスト | 入力単価 | 出力単価 | 提供形態 |
|---|---|---|---|---|---|
| Qwen3.8-Flash-Next | 125B / 6B | 262K(1M可) | $0.15 | $0.47 | オープンウェイト+QwenCloud |
| Qwen 3.8-Max | 2.4T / 95B | 1M | $2.00 | $6.00 | QwenCloud(一部OSS版あり) |
| DeepSeek V4-Flash(off-peak・cache-miss) | 284B / 13B | 1M | $0.22 | $0.66 | オープンウェイト+DeepSeek API |
| Kimi K3 | 2.8T / 104B | 1M | $3.00 | $15.00 | Moonshot API(フルオープンウェイト) |
単価だけ見るとoff-peak条件ではFlash-NextとDeepSeek V4-Flash(cache-miss)が同帯(サブ$1レンジ)、Qwen 3.8-MaxとKimi K3が中〜高レンジ、というグルーピングになります。
ただし性能ベンチマークの傾向を重ねると、Flash-Nextはサブ$1レンジで、Qwen公式ベンチ表の比較対象であるOpus 4.6を一部の性能ベンチで上回るという独特のポジションが見えてきます(Kimi K3・Opus 5との同条件比較は公式表に含まれていないため、これらとの品質比較は自社検証で確認する)。
用途別の選定軸
支援経験から見ると、以下のケース別に有力候補が変わります。
コーディングAgent基盤(Claude Code / Cline経由)
Flash-Nextが有力候補。SWE-bench Pro 62.5でOpus 4.6を上回るベンチスコアが、自社リポジトリの完走率にどこまで反映されるかは検証で確認する必要がある。
既存Claude Codeユーザーは環境変数4本の設定で切り替えでき、AB検証コストが低い。
リポジトリ全体を白紙から生成するタスク
DeepSeek V4-Flashが有力候補。NL2Repo-Bench 54.2でFlash-Nextの48.1を上回っている。「新規サービスの雛形をゼロから起こす」ような用途はDeepSeek V4-Flashで検証する価値がある。
長時間office work Agent(議事録・調査資料化・法務ドキュメント検討)
Flash-Nextが有力候補。CoWorkBench 73.9(CoWorkBenchはQwen自社ベンチ)・JobBench 55.7は、Opus 4.6の68.2・36.6を明確に上回っており、数十倍の単価差を踏まえて公式ベンチ上の優位を自社ワークロードで検証する価値がある。
極めて厳しい多分野推論・高難度アカデミック質問
Claude Opus 4.6が有力候補(Qwen公式ベンチ表の比較対象モデル)。HLE 40.0はFlash-Nextの35.9を上回っており、多分野推論の絶対性能では現行フラグシップ帯に一歩譲る。
より上位のOpus 5や高難度タスク特化モデルへアクセスがあれば、コスト差(Opus 5比:単価では入力約33倍・出力約53倍、後述の月次試算条件では約45倍)とタスク頻度を踏まえて並行検討する。
1Mコンテキスト×マルチモーダル(長尺動画理解・大規模ドキュメント検索)
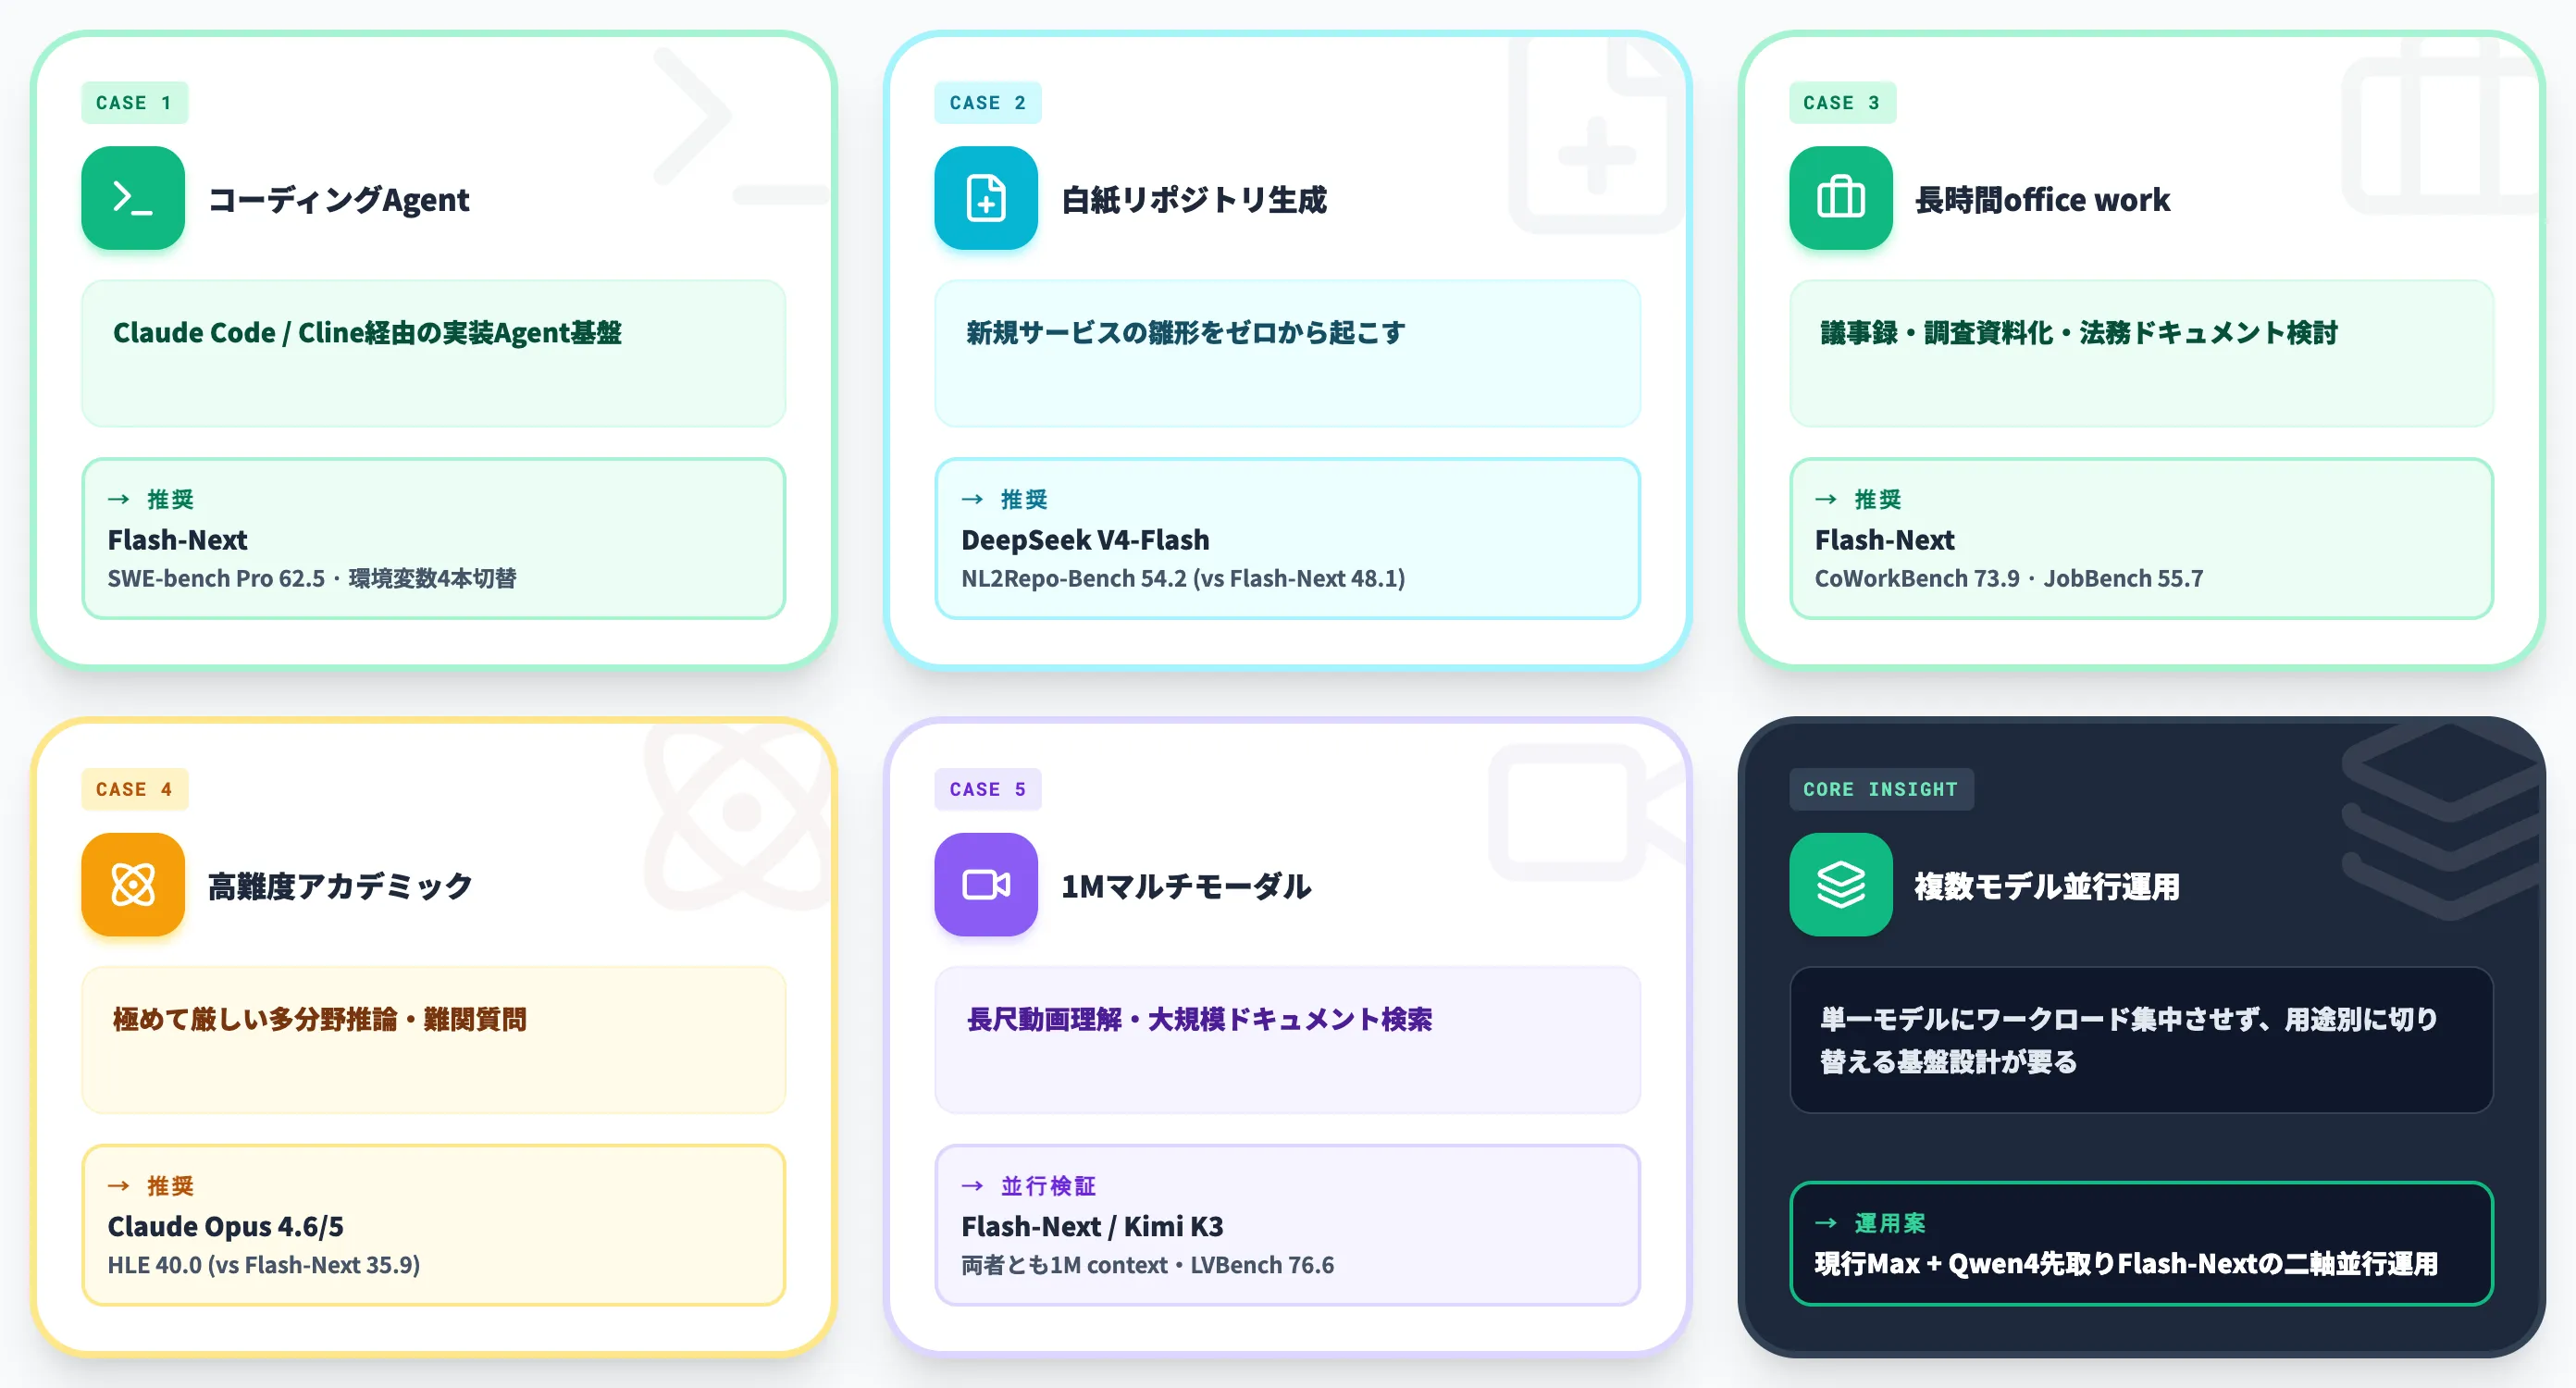
Flash-NextとKimi K3が候補。両者とも1M contextを提供するが、Flash-NextのLVBench 76.6(Qwen公式ベンチ計測)とKimi K3の同ベンチ結果を同じハーネスで比較したデータは公式からは示されていないため、ベンチ数値そのままでは判断できない。
コスト面ではFlash-Nextが単価で入力約20倍・出力約32倍安いため、動画理解ワークロードで両者を並行検証する価値がある。
このような使い分けをする前提として、単一モデルに全ワークロードを集中させず、用途別に複数モデルを並行運用する基盤設計が要るという点があります。
特にコーディング・office work・多分野推論を1つのAgentで扱おうとすると、いずれかの領域でスコアが伸びない実装になります。
Qwen 3.8-Maxとの棲み分けは記事冒頭のシリーズ位置関係で整理したとおりで、「現行フラグシップ = Max / Qwen4アーキ先取り = Flash-Next」の二軸を並行運用するのが本記事での運用案です。
Qwen3.8-Flash-Nextを業務Agent基盤に載せる判断——ケース別実装アプローチ
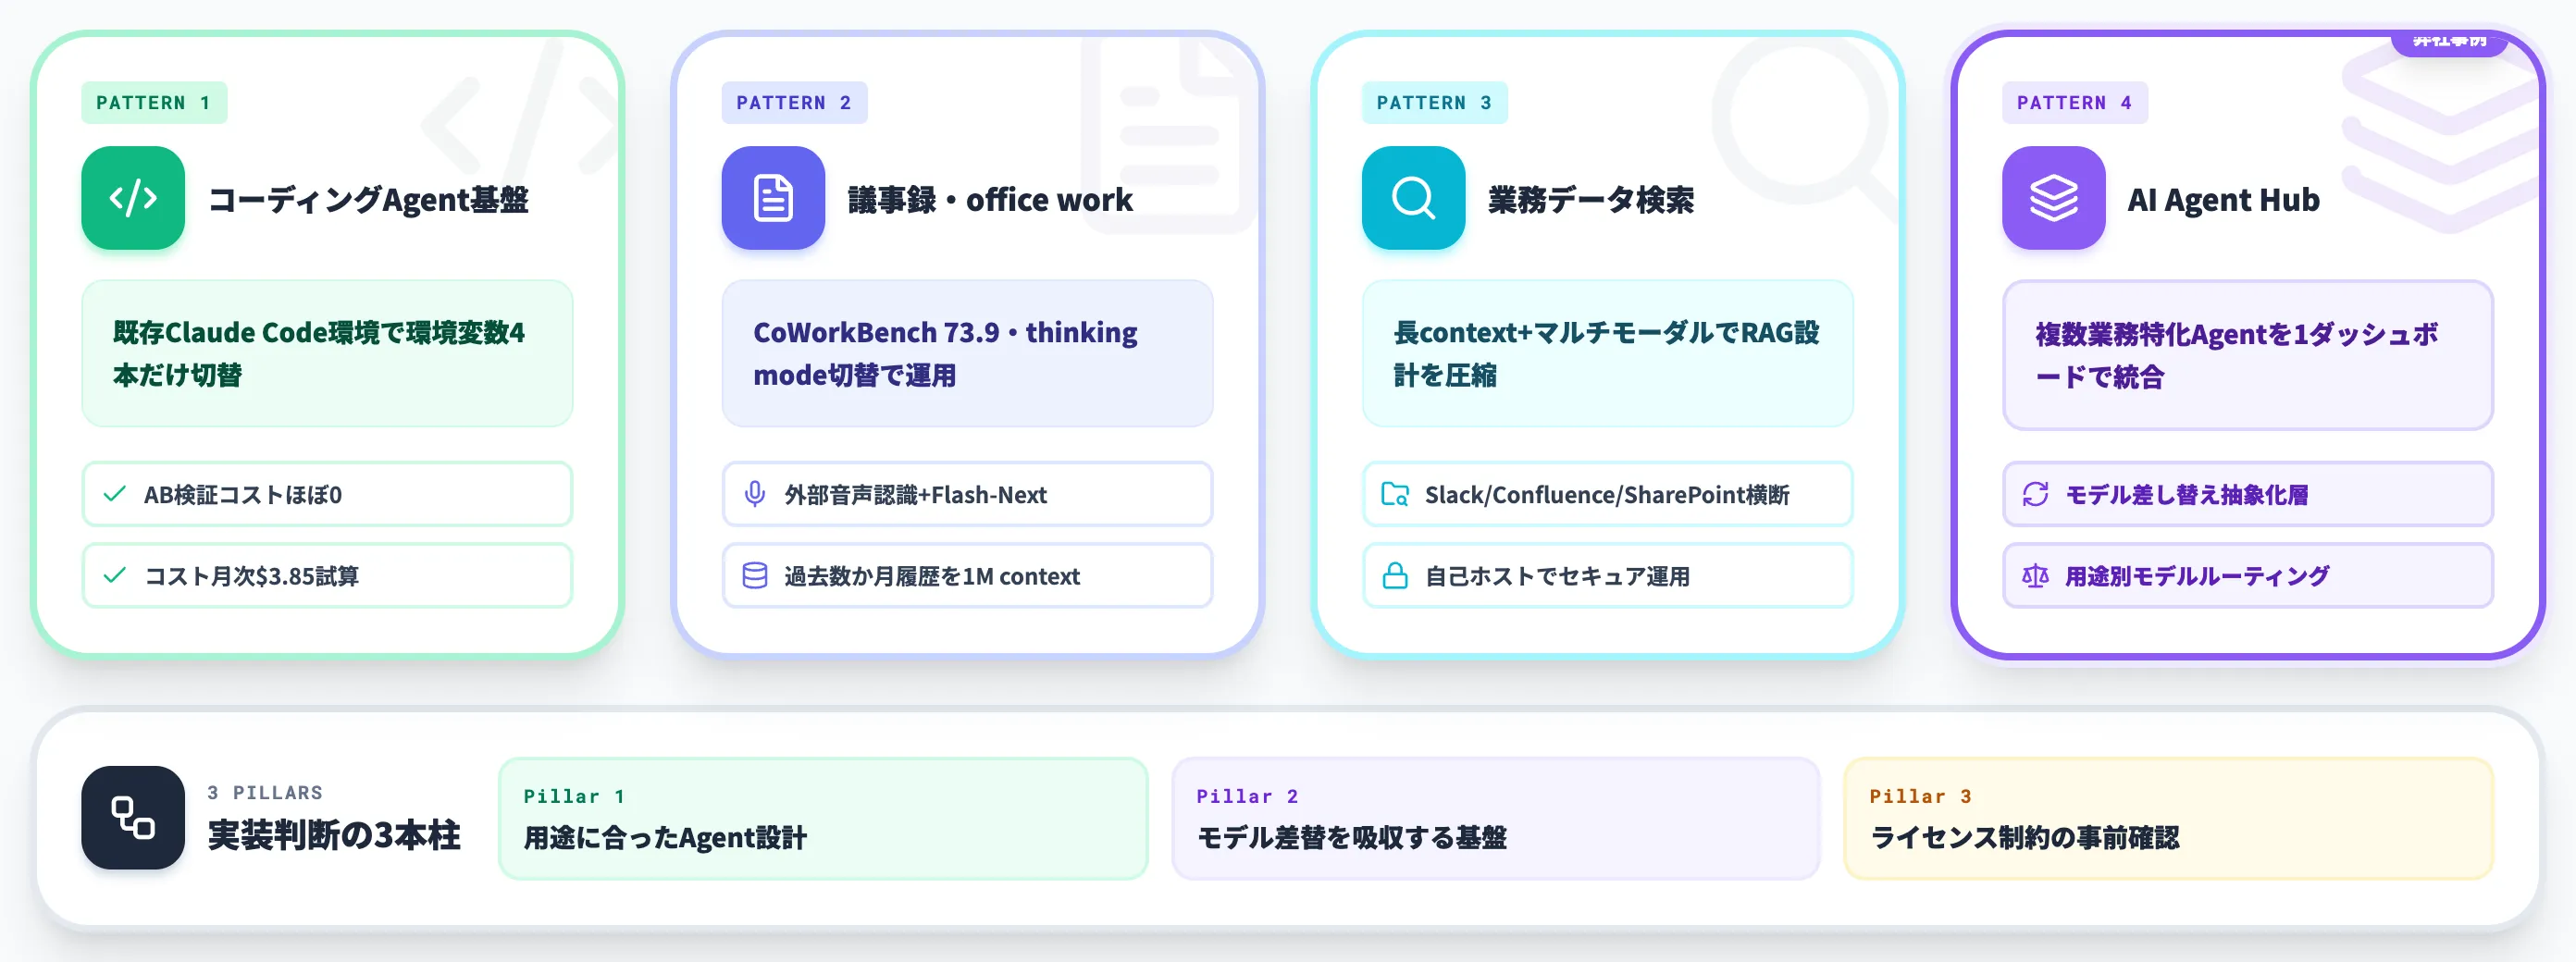
Flash-Nextを実業務のAI Agent基盤に組み込む際、単に「安くて速いから採用」で決めると、後段で運用課題に直面します。
用途に合ったAgent設計・モデル差し替えを吸収する基盤設計・ライセンス制約の事前確認が実装判断の3本柱になります。
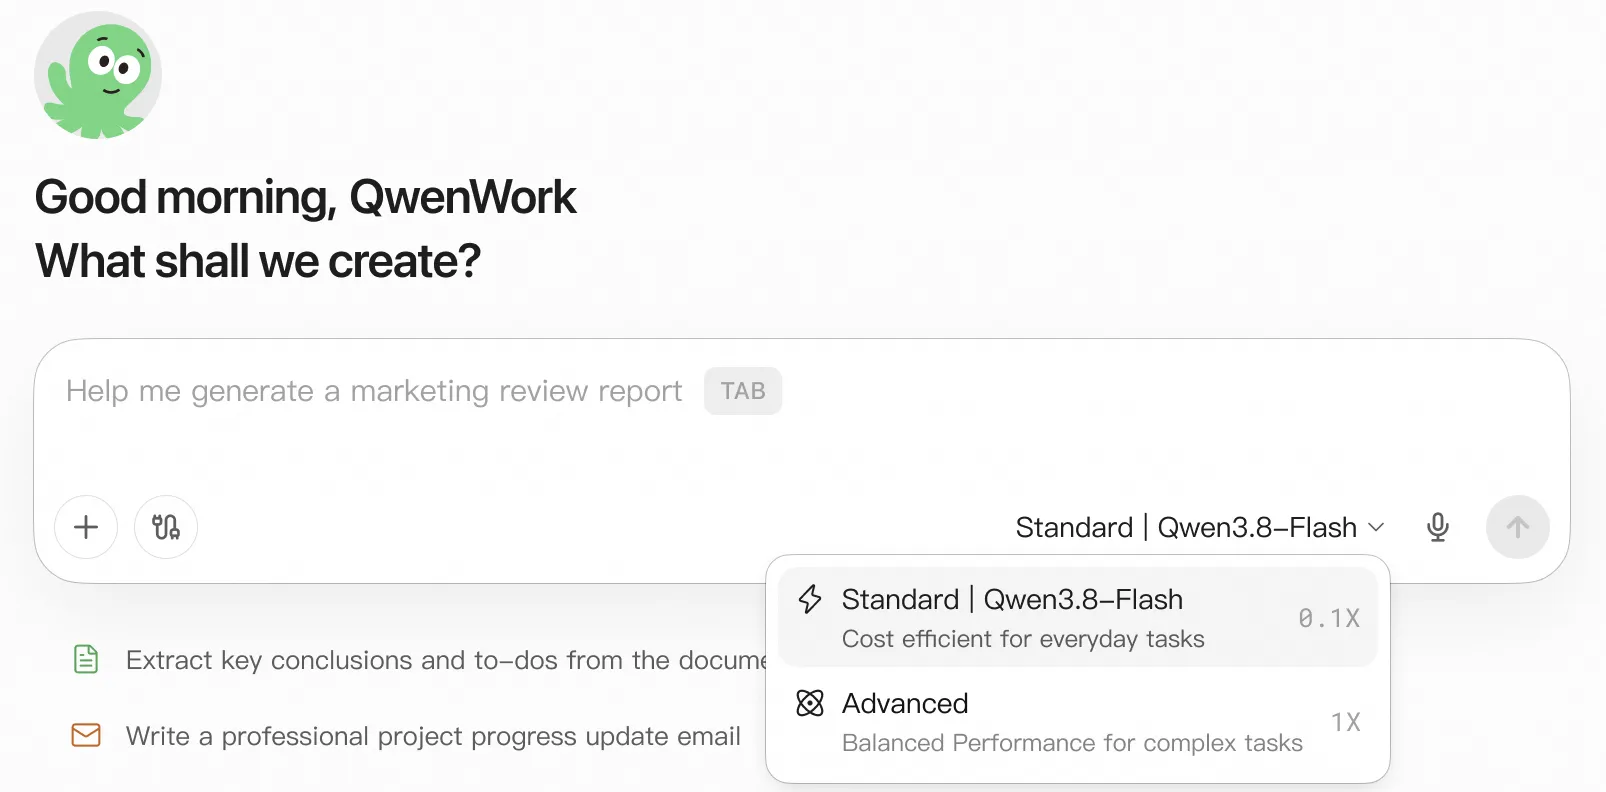
Alibaba公式AI productivity platform「QwenWork」のStandard modeにQwen3.8-Flashが組み込まれた実装例。日常タスクはStandard(Qwen3.8-Flash・「Cost efficient for everyday tasks」)、複雑タスクはAdvancedにモデルを切り替える運用UIになっており、用途別モデルルーティングの参考実装として読み取れる(出典:Qwen Team blog)
コーディングAgent基盤への組み込み
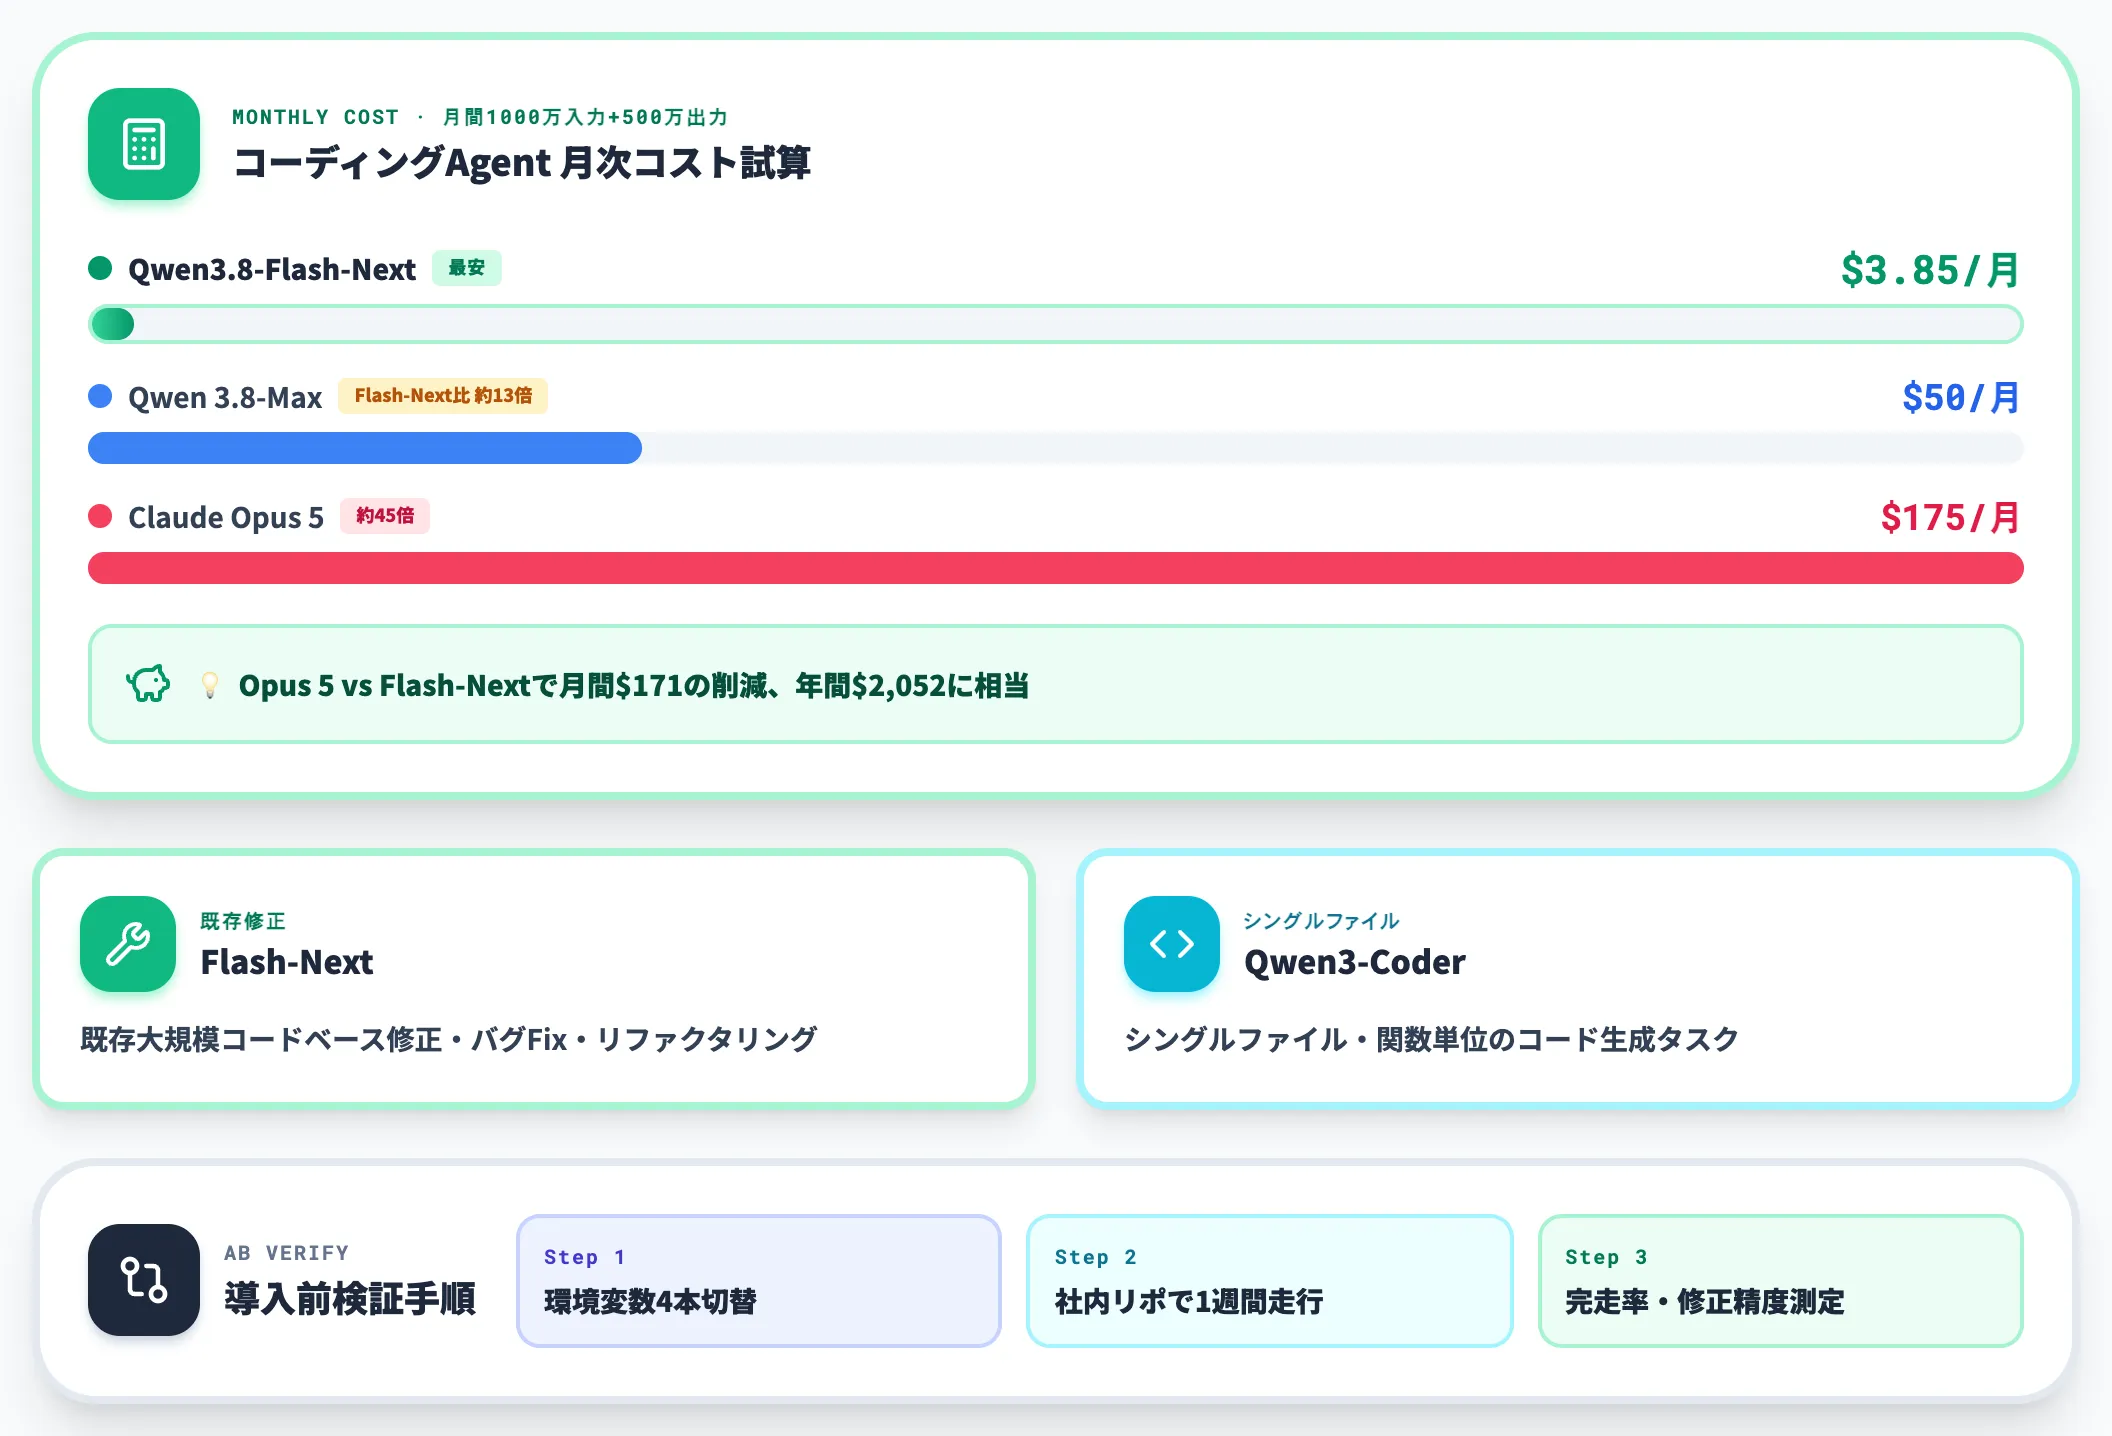
コーディング用途では、Claude Code・Cline・Codexといった既存のエージェントハーネスを流用し、モデル部分だけFlash-Nextに差し替える構成が最速で本番稼働まで到達できます。
-
既存Claude Code環境でのAB検証
前述のQwenCloud向け環境変数4本(ANTHROPIC_MODEL・ANTHROPIC_SMALL_FAST_MODEL・ANTHROPIC_BASE_URL・ANTHROPIC_AUTH_TOKEN)を設定すれば、既存のCLAUDE.md・Skills・Hooks資産をそのまま使いながら性能を比較できる。まず社内リポジトリで1週間走らせて完走率・修正精度を測定する。
-
Qwen3-Coderとの使い分け
Qwen3-Coder(コーディング特化モデル)とFlash-Next(汎用MoE)は、リポジトリの規模とタスクの性質で使い分ける。既存の大規模コードベース修正はFlash-Next、シングルファイル・関数単位のコード生成はQwen3-Coder、というのが実務での使い分けの目安。
-
コスト削減インパクトの試算
月間1,000万トークン入力・500万トークン出力のコーディングAgentワークロードの場合、Flash-Nextは月次**$3.85**($0.15×10 + $0.47×5)で運用でき、Claude Opus 5比では**$175(約45倍差)、Qwen 3.8-Max比では$50(約13倍差)**という試算になる。
議事録・office work Agentへの組み込み
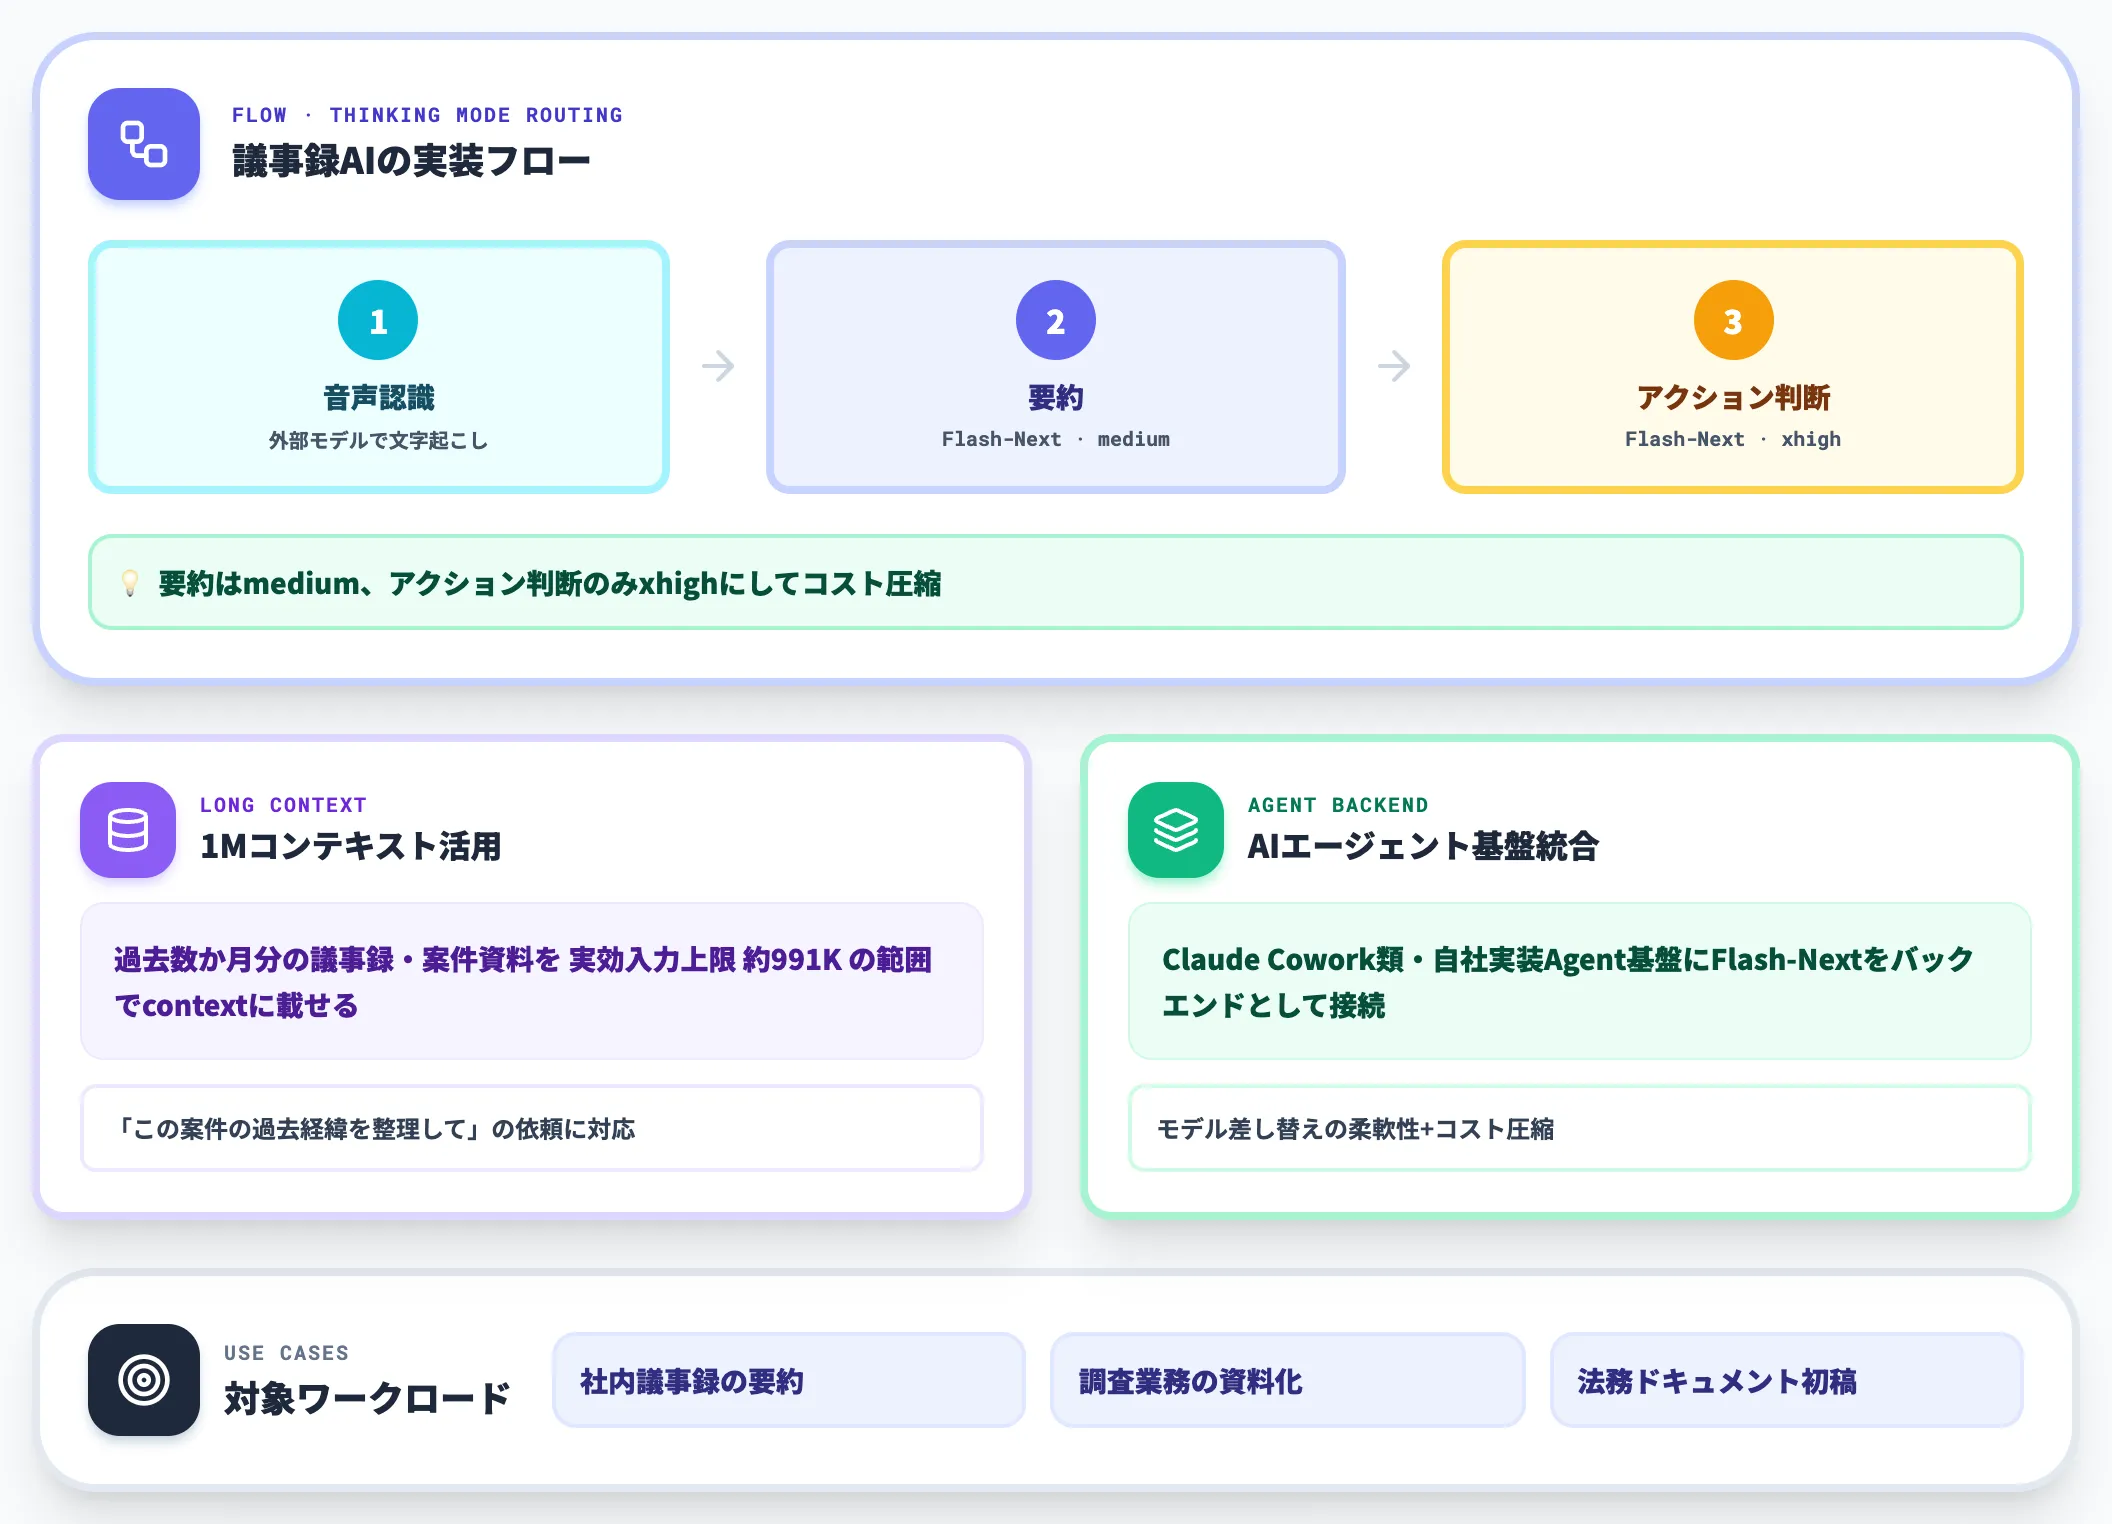
社内議事録の要約・調査業務の資料化・法務ドキュメントの初稿作成といったoffice work Agent用途では、CoWorkBench 73.9(CoWorkBenchはQwen自社ベンチ)・JobBench 55.7が選定の参考指標として使えます。ただし実業務での品質は自社データでの検証が必須です。
-
長時間タスクの実装パターン
議事録AIなら、外部の音声認識モデルで録音を文字起こししたうえで、その後の要約・アクションアイテム抽出をFlash-Nextで実行できる(Flash-Next自体はテキスト・画像・動画入力対応で、音声入力には非対応)。thinking mode medium でコスト圧縮を狙いつつ、最終アクション判断のみ xhigh に切り替える設計が実務的。
-
1Mコンテキストの活用
過去数か月分の議事録・案件資料を、実効入力上限(約991Kトークン)に収まる範囲でcontextに載せて「この案件の過去経緯を整理して」のような依頼に対応できる。上限を超える履歴を扱う場合は、RAG基盤や分割検索を組み合わせる設計が引き続き必要になる。
-
AIエージェント基盤との統合
汎用AIエージェント基盤(Claude Cowork類・自社実装)にFlash-Nextをバックエンドとして接続する設計が、モデル差し替えの柔軟性を残しながらコストを圧縮できる。
業務データ検索Agentへの組み込み
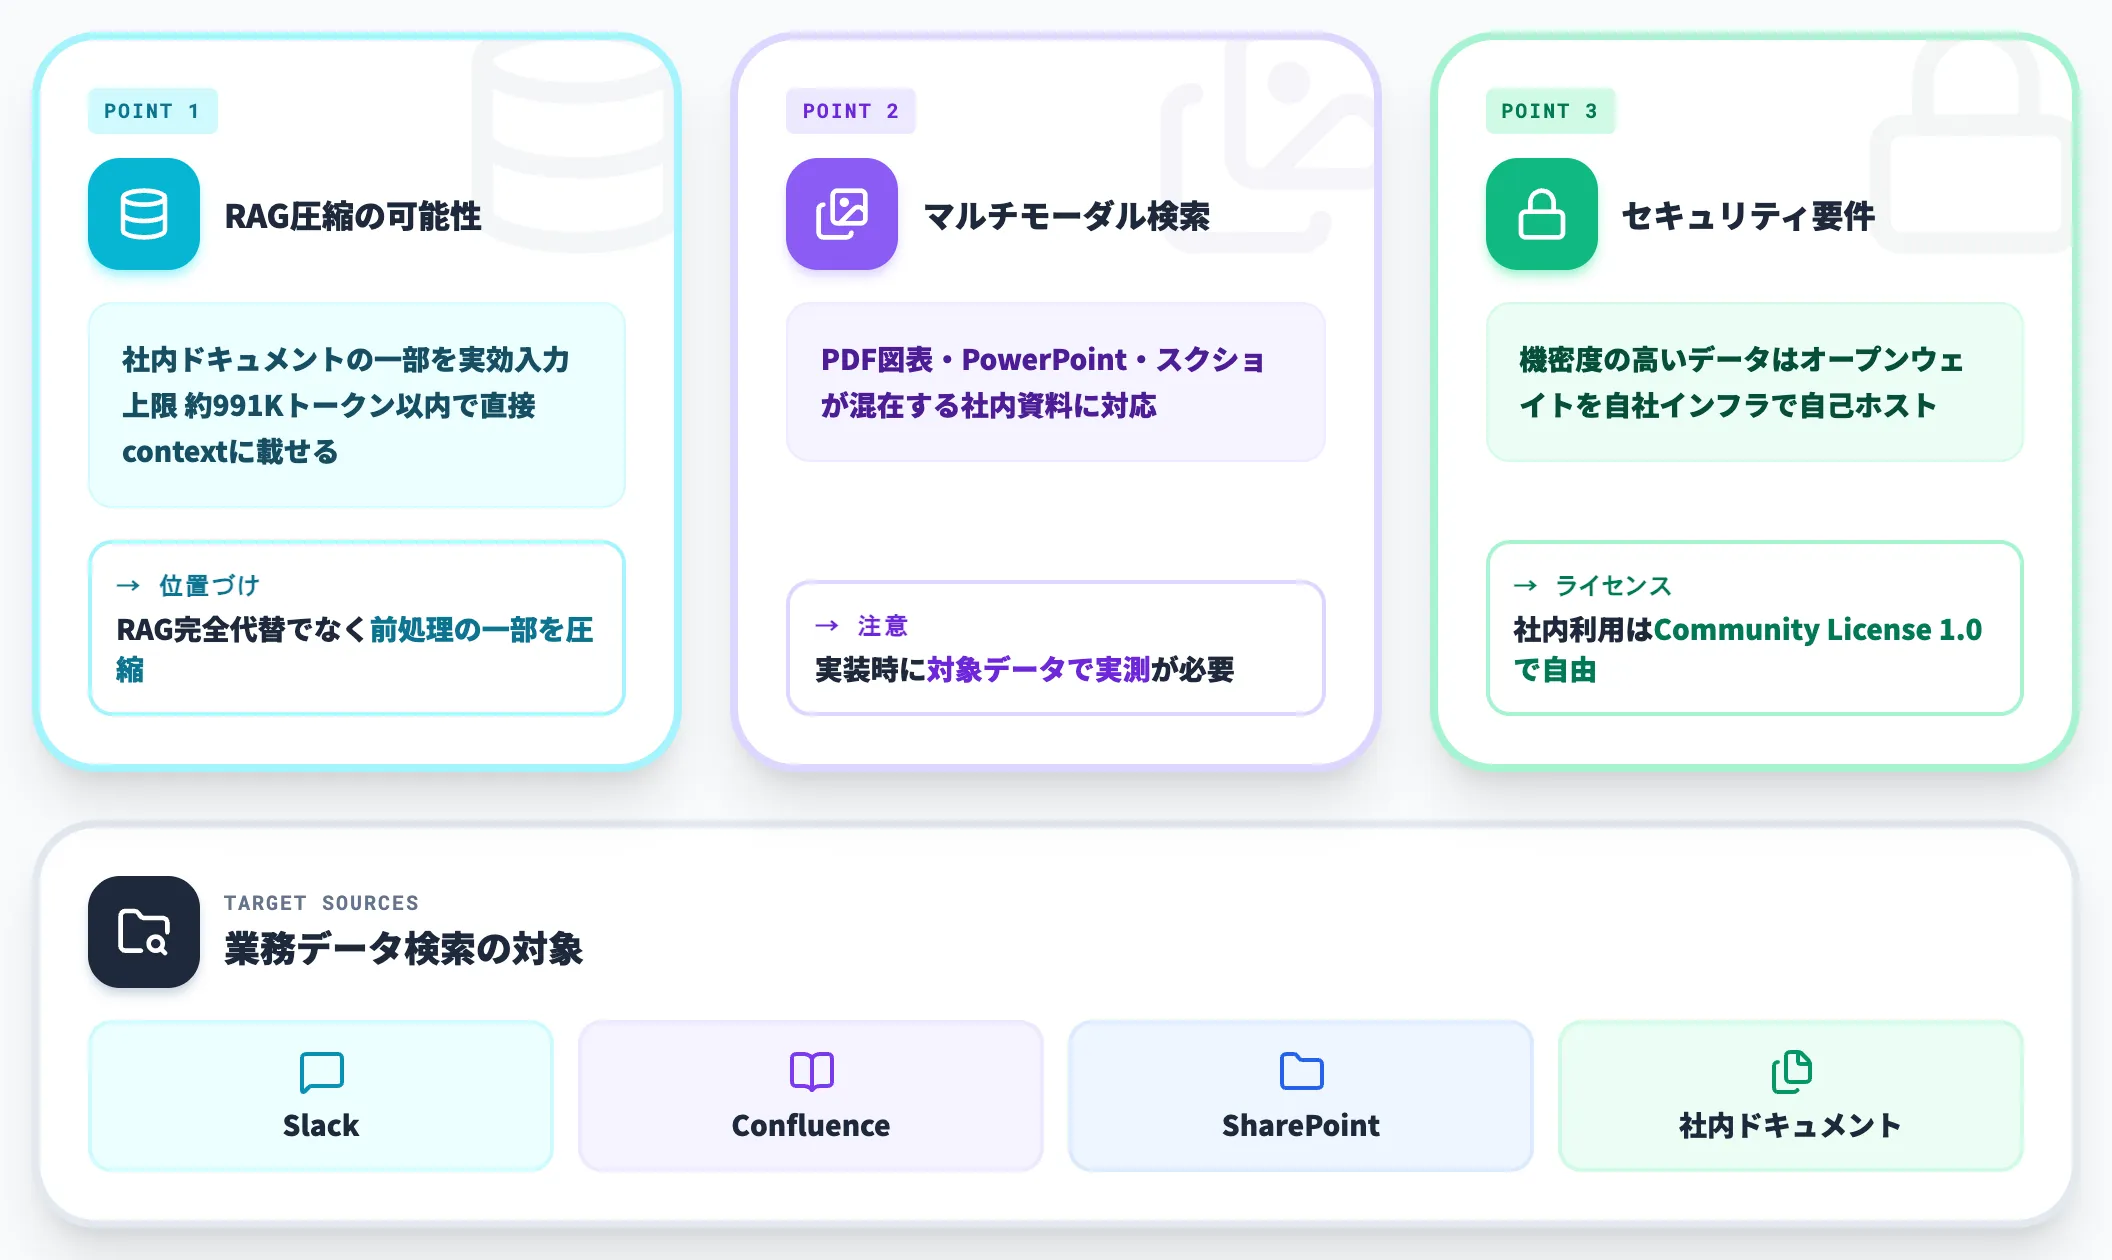
業務データ検索Agent(社内ドキュメント・Slack・Confluence・SharePoint横断検索)では、Flash-Nextの262K native context(YaRN拡張時1M)が従来のRAG設計を一部代替できる可能性があります。
LVBenchのような視覚系ベンチはマルチモーダル理解の参考値であり、文書検索の再現率や精度を直接示す指標ではないため、業務検索用途では別途対象データでの実測が必要です。
-
RAG圧縮の可能性
社内ドキュメントの一部(実効入力上限の約991Kトークン以内)を直接contextに載せ、ベクトルDBを介さずにLLMに問い合わせる設計を試せる。ただし数百MB〜GB規模のドキュメント全体を扱うにはRAG基盤やチャンキング設計が引き続き必要で、Flash-Nextの長コンテキストはRAGの完全代替ではなく前処理の一部を圧縮する位置づけになる。
-
マルチモーダル業務検索
社内資料にPDF図表・PowerPoint・スクリーンショットが混在する環境で、Flash-Nextのマルチモーダル理解能力(MathVision 95.7・LVBench 76.6)は「テキスト以外の情報も扱える」ことの参考値になる。ただしこれらは視覚数学・動画理解ベンチであり業務データ検索の再現率を保証するものではないため、実装時に対象データでの実測が必要になる。
-
セキュリティ要件との整合
機密度の高い業務データを扱う場合、QwenCloud経由でなくオープンウェイトを自社インフラで自己ホストするルートが選択肢に入る。ライセンス条項(社内利用は原則自由)とも整合する。
Qwen3.8-Flash-Nextを業務Agentに載せるなら
Qwen3.8-Flash-Nextのようなコスト効率の高いMoEモデルを業務Agentに組み込む際は、モデル差し替えを前提とした基盤設計が不可欠です。
Flash-NextはQwen4本体世代への布石で、今後Qwen4本体版・次世代への差し替えが発生する見通しです。単一モデルに依存した実装では毎回の差し替えコストが積み上がるため、Adapter層・用途別モデルルーティング・ライセンスチェックの3点を前提としたAgent基盤設計が実務での立ち上がりを早くします。
AI Agent Hubは業務特化Agent(議事録・経費精算・調達・製造業DX等)を1つのダッシュボードで統合管理し、Flash-Next含む複数のフロンティアモデルを用途別に切り替える運用に対応します。「モデル選定は済んだが、実装・運用設計で詰まっている」フェーズであれば、次の一歩の参考にしてください。
Qwen3.8-Flash-Nextを業務Agentに載せるなら

モデル世代交代を吸収する業務Agent基盤
Qwen3.8-Flash-Nextのようなコスト効率の高いMoEモデルを業務Agentに組み込む際は、モデル差し替えを前提とした基盤設計が要ります。AI Agent Hubは業務特化Agentを1つのダッシュボードで統合管理し、Flash-Next含む複数モデルを用途別に切り替える運用に対応します。
まとめ
Qwen3.8-Flash-Nextは、AlibabaのQwen Teamが2026年8月26日に公開したQwen4アーキテクチャ先取り版のマルチモーダルMoE基盤モデルで、既存Qwenファミリーとは別軸に位置します。
- Qwen4先取り4本柱(GDN+QSA/Gated Residual/N-gram Embedding/Muon)で125B総パラ・6Bアクティブを成立
- SWE-bench Pro 62.5・CoWorkBench 73.9でOpus 4.6を上回り、コーディングAgent・office work用途の候補として公式ベンチで有利な結果を示している
- QwenCloud単価$0.15/$0.47の低単価帯で、Qwen 3.8-Max比約13倍・Opus 5比では単価で入力約33倍/出力約53倍安く、Claude Code即日連携可
コーディングAgent基盤の候補モデル選定を進めている段階なら、既存Claude Code環境で環境変数4本を切り替えるだけでFlash-Nextを試せます。自社の実業務ワークロードで1週間走らせ、SWE-bench Pro 62.5が自社の完走率にどう反映されるかを確認するところから始めるのが実務的な入り口になります。