この記事のポイント
 Jevはテキスト生成を捨て判断のみ返すSystem Oneモデル、40〜200倍高速・入力$0.042/1Mで判断コスト構造が変わる
- 3プリミティブ(Choice/Score/Noul)で分類・スコアリング・Yes/No判定を型定義でき、Choice/Scoreは信頼度付き、NoulはYes確率のみを並列で受け取れる
- 精度はGPT-5.6 TerraとほぼタイでSol/Opus 5には劣るため、置き換え対象はLLM-as-judge・ルーティング・ガードレール等に絞る
- RLCD訓練で確率キャリブレーションを最適化しているため、閾値の意味を揃えたうえで自社データでの検証を通して業務ロジックに組み込める
- Vercel AI Gateway対応で既存パイプラインへの差し込みは容易、ただし本番運用はモデルバージョンのピン留めが前提
Microsoft MVP・AIパートナー。LinkX Japan株式会社 代表取締役。東京工業大学大学院にて自然言語処理・金融工学を研究。NHK放送技術研究所でAI・ブロックチェーンの研究開発に従事し、国際学会・ジャーナルでの発表多数。経営情報学会 優秀賞受賞。シンガポールでWeb3企業を創業後、現在は企業向けAI導入・DX推進を支援。
Jev(ジェブ)は、テキストを1トークンも生成せずに構造化された判断だけを確率付きで返す新種のAIモデルで、TypeSafe AIが2026年9月15日にアーリーアクセスを開始しました。
OpenAI元研究者でInstructGPTの共同著者でありRLHFやChatGPTの基盤研究に携わったDiogo Almeida氏が約2年のステルス開発を経て公開し、シードラウンドで$40MをDCVCリードで調達しています。
本記事では、System Oneモデルの位置づけ、Choice・Score・Noulの3プリミティブ、RLCD訓練法、料金・速度・精度の定量比較、既存の構造化出力ツール/SLMとの使い分け、既存パイプラインへの組込み場所、注意点、Python/TypeScript SDKでの実装例までを2026年9月時点で体系的に解説します。
目次
Jevとは?OpenAI元研究者が2年開発したテキストを生成しないAI
Jevの入出力プリミティブ——Choice・Score・Noulの3種類
RLCD——確率キャリブレーションを最適化する新しい強化学習
Jevの料金・速度・精度——フロンティアLLMとの4指標比較
既存のStructured Outputs・SLMとの使い分け
OpenAI Structured Outputs・Anthropic Structured Outputsとの違い
XGrammar・Outlines・Instructorとの違い
Phi-4・Qwen3.5 Smallなど小型モデルとの違い
Jevとは?OpenAI元研究者が2年開発したテキストを生成しないAI
Jev(ジェブ)は、テキストを1トークンも生成せずに、構造化された判断だけを確率付きで返す新種のAIモデルです。TypeSafe AIが2026年9月15日にアーリーアクセスを開始しました。
Jevが従来の大規模言語モデル(LLM)と根本的に違うのは、テキスト生成という工程そのものを放棄している点です。分類・スコアリング・Yes/No判定といった「型が事前に決まる判断タスク」に用途を絞り、選択肢の確率分布を並列に返す設計になっています。
TypeSafeはこのモデルクラスをIntroducing System One Models & Jevで「System Oneモデル」と呼び、既存のLLMを「System Two」に対比させる形で位置づけました。
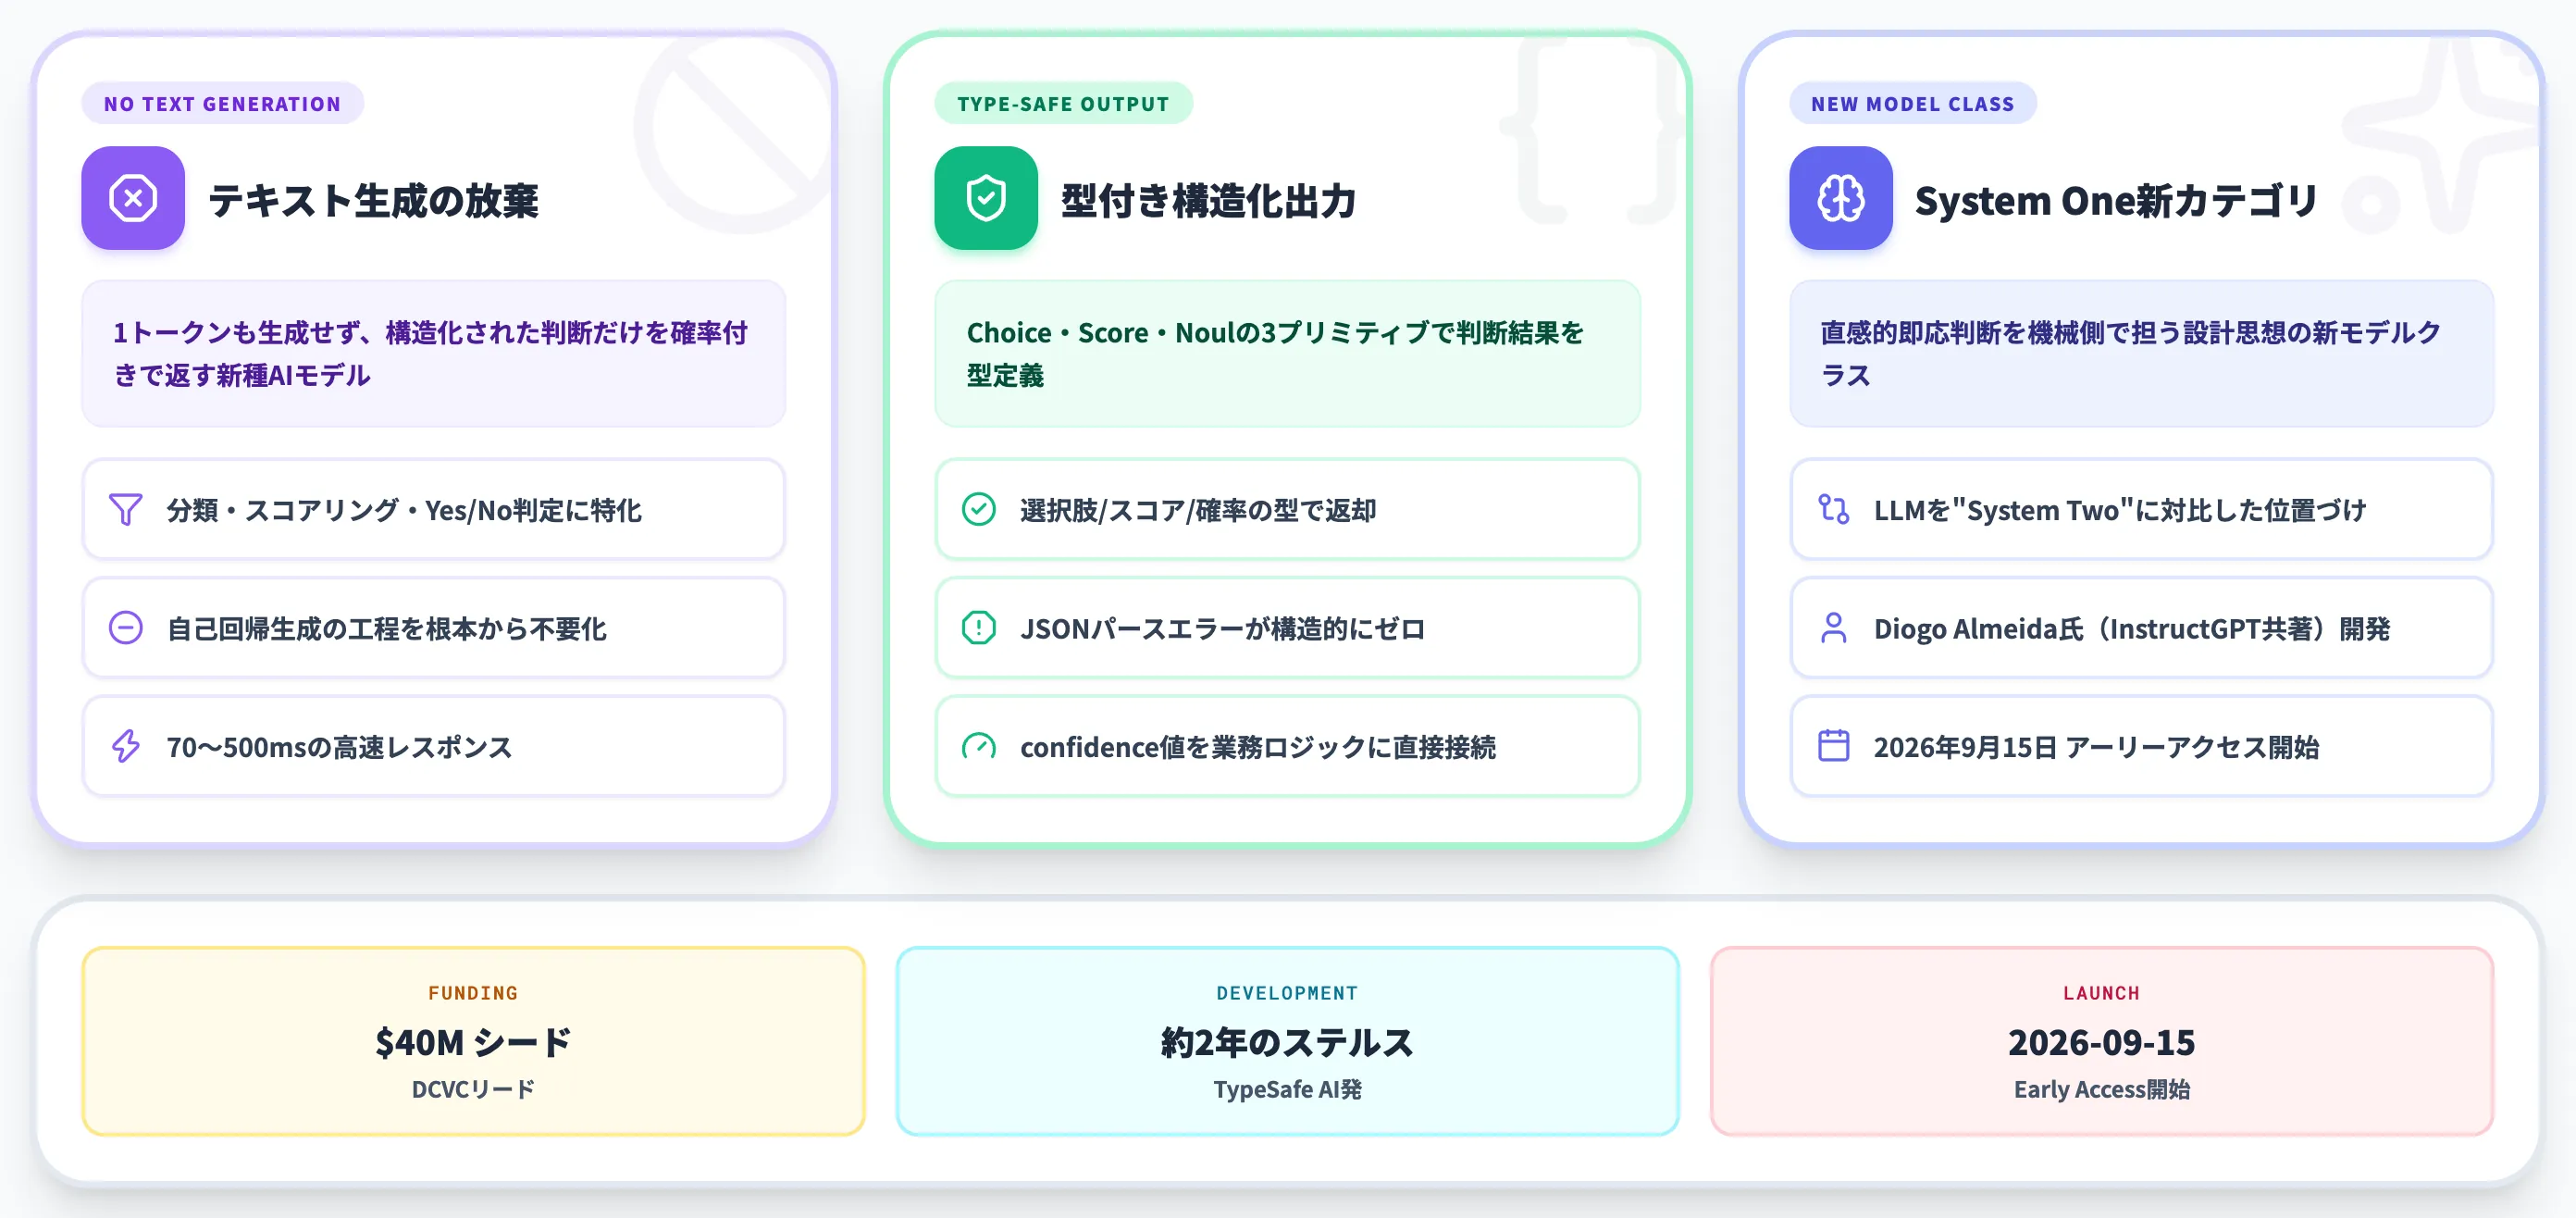
Jevの3つの特徴——テキスト生成の放棄・型付き構造化出力・System Oneモデルという新カテゴリ
System Oneモデルという新カテゴリ
System Oneモデルは、ソフトウェアのなかで「決めるだけ」を担う専用モデル、とTypeSafeは説明しています。人間の直感的な即応判断(システム1)を機械側で担う設計思想からの命名で、時間をかけて論理を組み立てるLLM(システム2)とは目的が異なります。
もう少し具体的に書くと、以下の3点で既存LLMと明確に切り分けられます。
-
入力の形式
自然言語の対話履歴に限らず、事前に型が決まった「プログラム状態」を受け取ります。文字列・JSONオブジェクト・配列いずれも扱えるため、既存アプリケーションのなかから直接呼び出せます。
-
出力の形式
生成テキストではなく、あらかじめ定義した型に沿った値と各選択肢の確率が返ります。文字列パースやJSONバリデーションは不要です。
-
担当する仕事の粒度
LLMのように「1回の呼び出しでレポートを書く」用途ではなく、「1リクエスト70〜500msで1件の判断を返す」粒度で運用します。バッチ処理やリアルタイムUIにそのまま埋め込める設計です。
System Oneモデルという新カテゴリの登場は、LLMがすべてを担う設計から「LLM+判断特化モデルの役割分担」へと、業務AIの実装レイヤーが変わり始める合図です。AIエージェントを実運用に載せてきた企業ほど、この分業構造の意味を感じ取りやすい発表になっています。
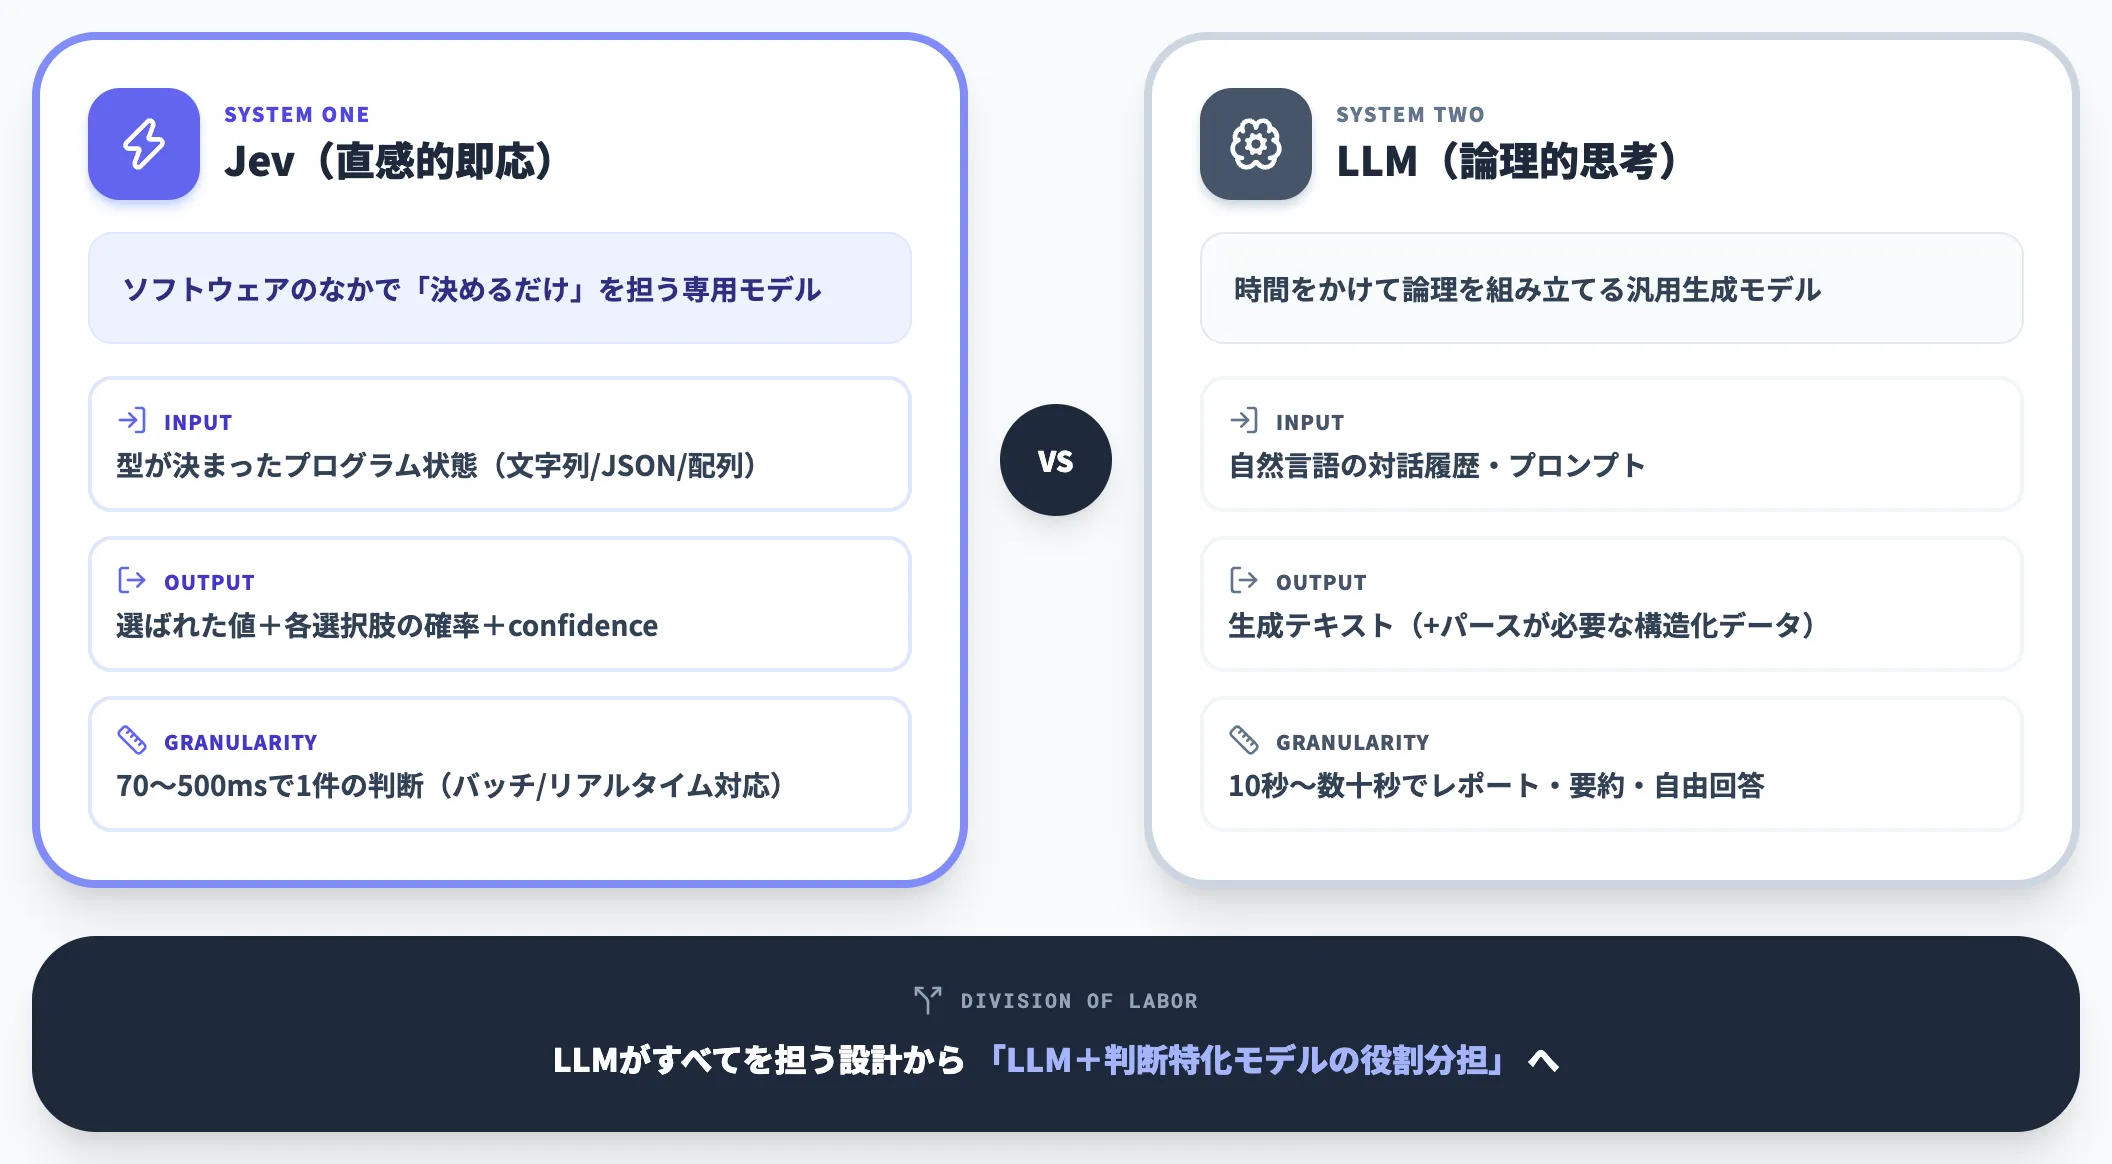
System One(Jev)とSystem Two(LLM)の分業構造——入力形式・出力形式・仕事の粒度の3観点で切り分けられる新モデルクラス
Jevの入出力プリミティブ——Choice・Score・Noulの3種類
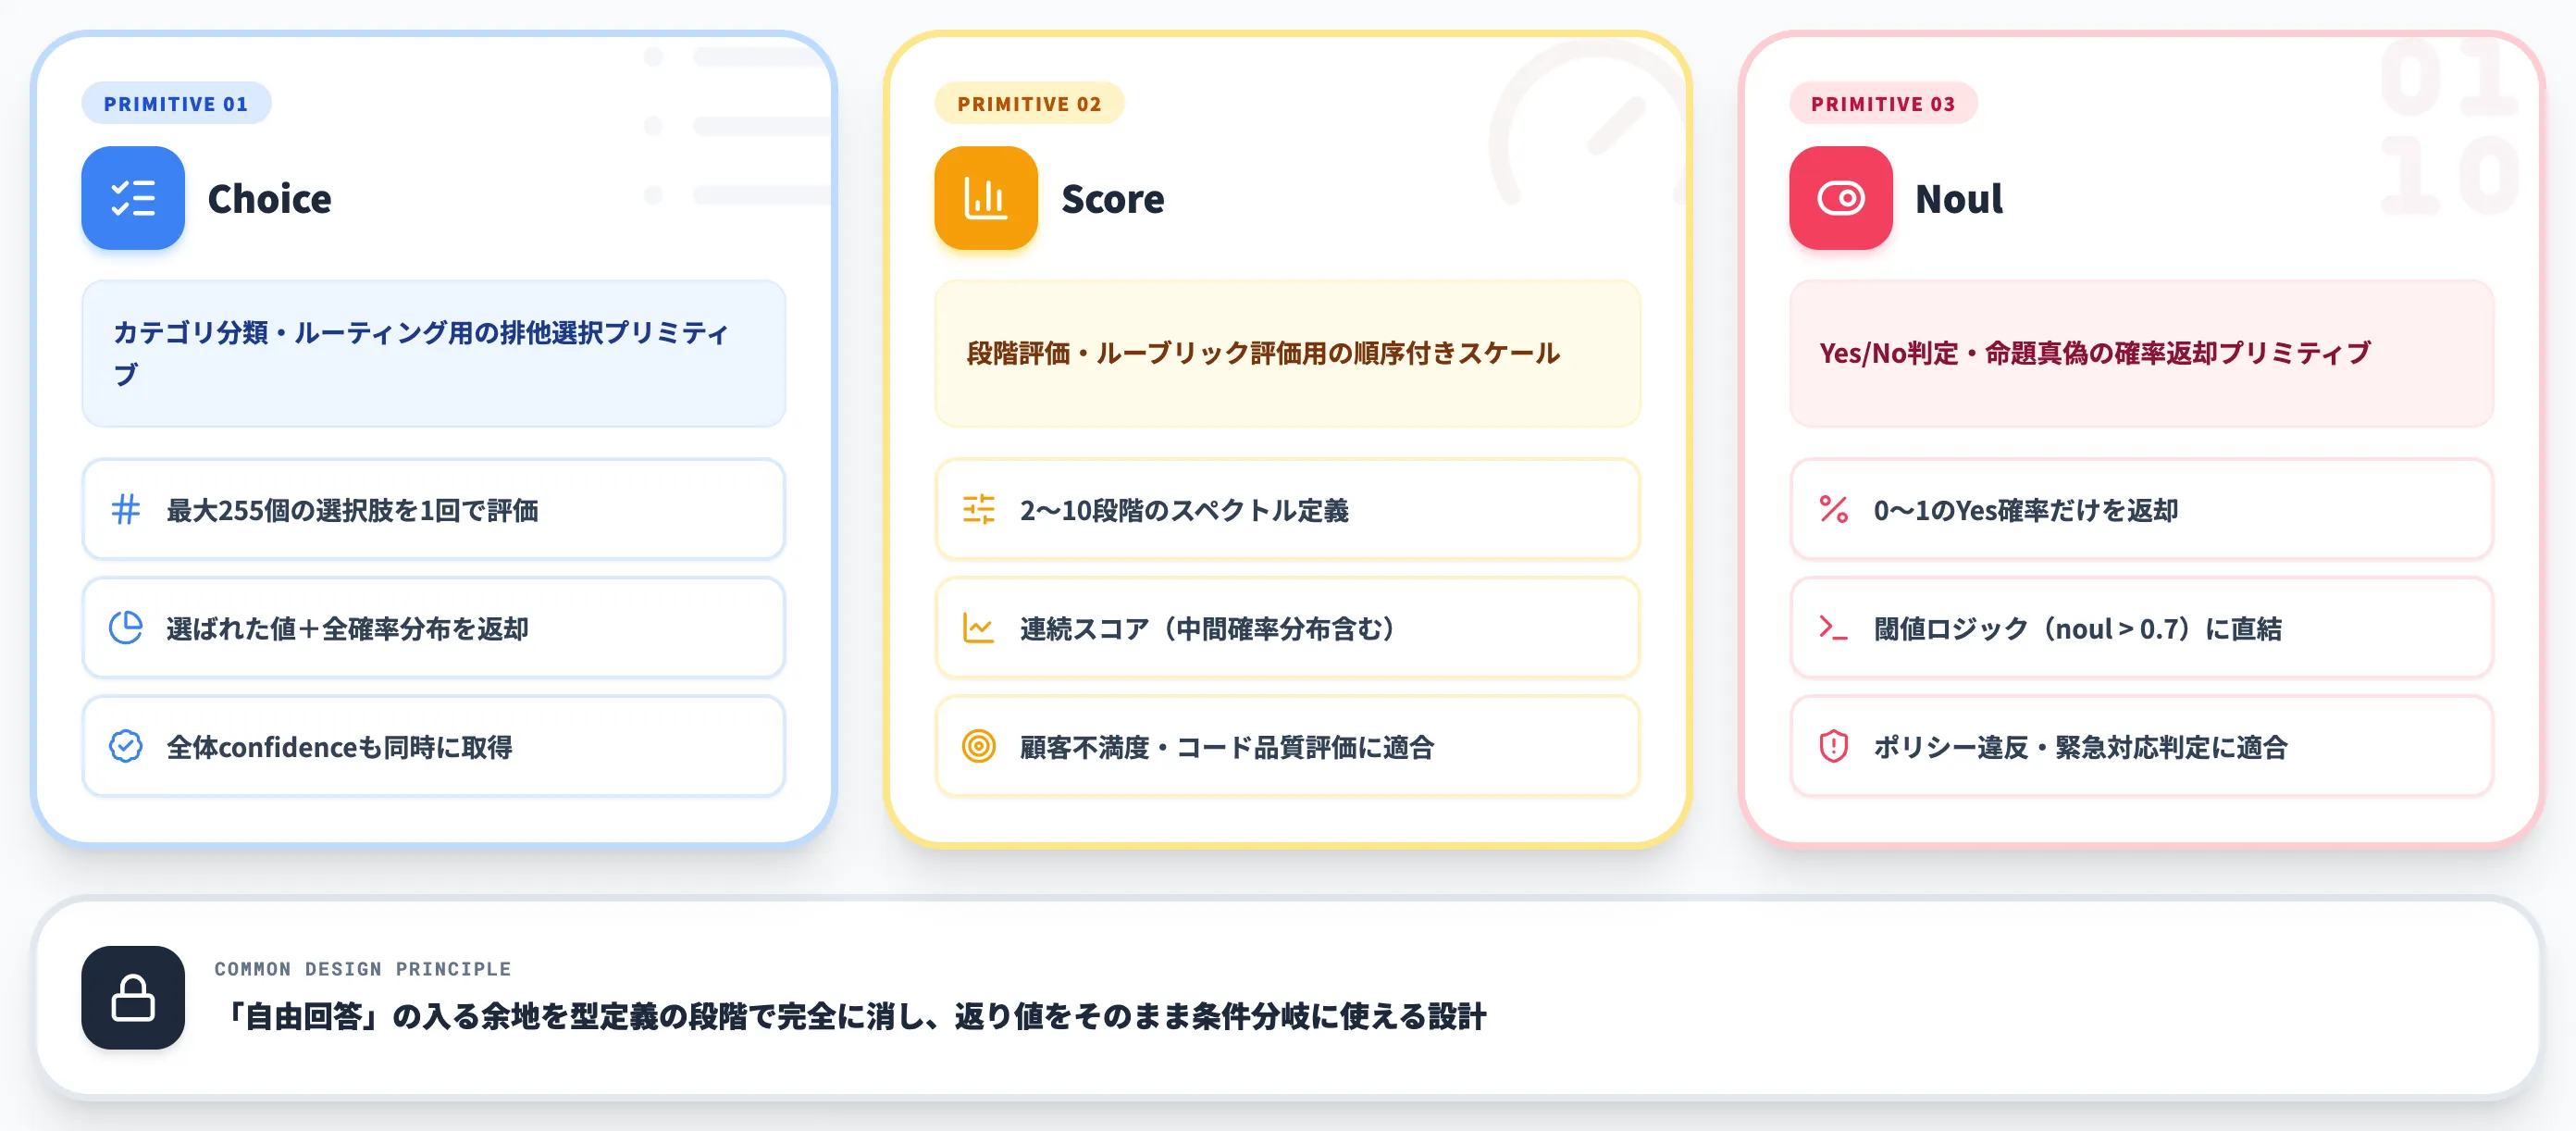
Choice(排他分類)・Score(順序スケール)・Noul(Yes確率)の3プリミティブ俯瞰——「自由回答」の入る余地を型定義段階で消す共通設計
Jevで扱える判断は、Choice・Score・Noulの3種類のプリミティブに整理されています。SDKで型定義を書けば、Jevはその型に沿った値と確率だけを返す設計です。
以下の表で、3プリミティブの用途と入出力を整理しました。
| プリミティブ | 用途 | 入力の書き方 | 出力 |
|---|---|---|---|
| Choice | カテゴリ分類・ルーティング | 選択肢を最大255個まで列挙し、各選択肢に説明文を添える | 選ばれた選択肢/各選択肢の確率/全体のconfidence |
| Score | 数値スコア・ルーブリック評価 | 2〜10段階のスケール(例:Calm / Frustrated / Very angry) | 各段階の確率分布から求めた連続スコア/全体のconfidence |
| Noul | Yes/No・確率判定 | 判定したい命題(例:「返金を要求しているか」) | 0〜1のYes確率のみ(confidenceは返らない) |
3プリミティブに共通するのは、自由回答の入る余地を型定義の段階で完全に消していることです。読み解きに人間が介在する余白がないため、返ってきた値をそのまま条件分岐に使えます。
Choice——最大255オプションの排他分類
Choiceは、複数の選択肢のうちどれか1つを選ぶタスク用のプリミティブです。カスタマーサポートのチケット振り分け、営業リードのカテゴリ判定、ドキュメント分類などが典型的な用途になります。
TypeSafe公式のChoice仕様では、最大255個の選択肢を1回のクエリで評価できると明記されています。GPT-5.6のような自己回帰型モデルなら選択肢の数に応じて出力トークンが増えますが、Jevは最大255個までを1回のAPI呼び出しの並列処理で全確率を返します。
たとえば「請求/技術/営業」の3つに分けるルーティングをJevで書くと、返り値は選ばれたキーと「{"billing": 0.08, "technical": 0.85, "sales": 0.07}」のような確率分布、そして全体のconfidenceがセットで届く形になります。
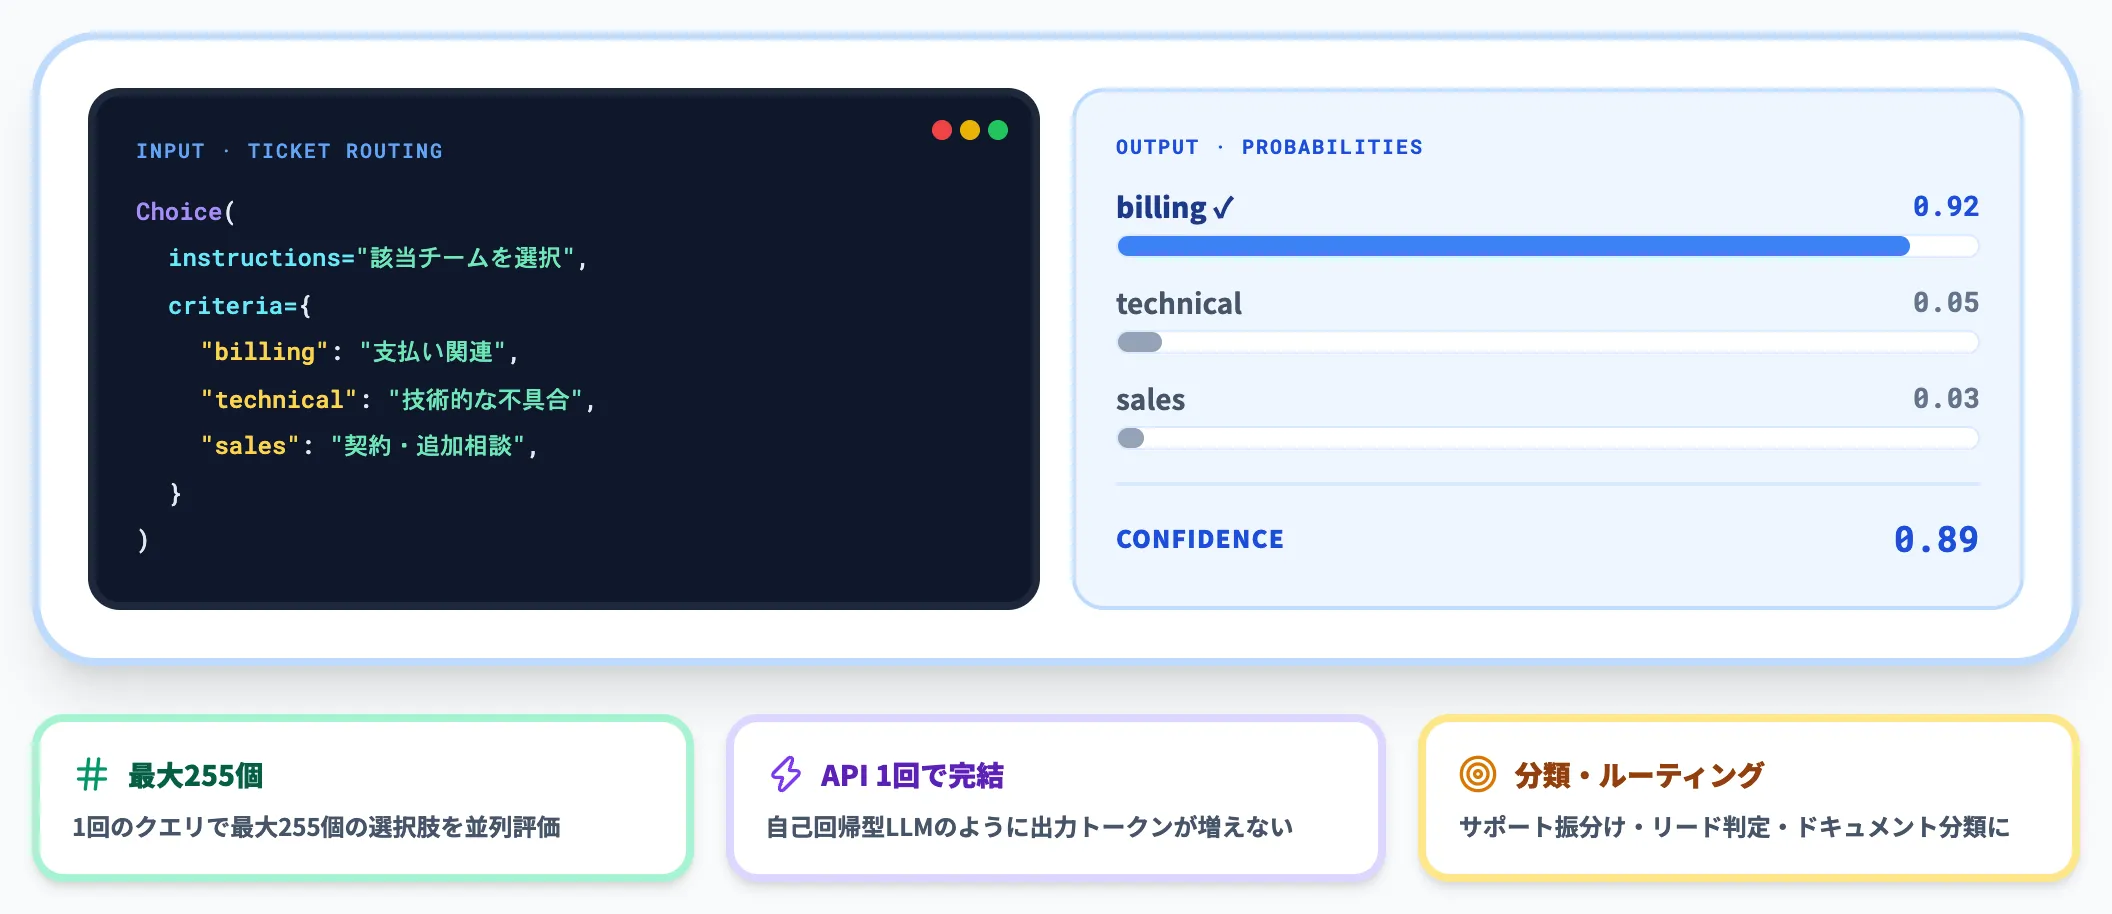
サポートチケット振分けの実装イメージ——入力型定義と全確率+confidenceのレスポンスが1回のAPIで返る
Score——2〜10段階のスケール評価
Scoreは、順序が意味を持つ段階評価に使うプリミティブです。顧客不満度の10段階評価、コード品質のS/A/B/C判定、リスクレベルのlow/medium/highなど、選択肢に順序関係があるケースで使います。
Choiceとの違いは、Scoreでは選択肢を「基準の羅列」ではなく「スペクトルの各点」として扱う点にあります。「Calm → Neutral → Frustrated → Very angry」のような一次元の並びで、モデルはその中間の確率分布も返します。
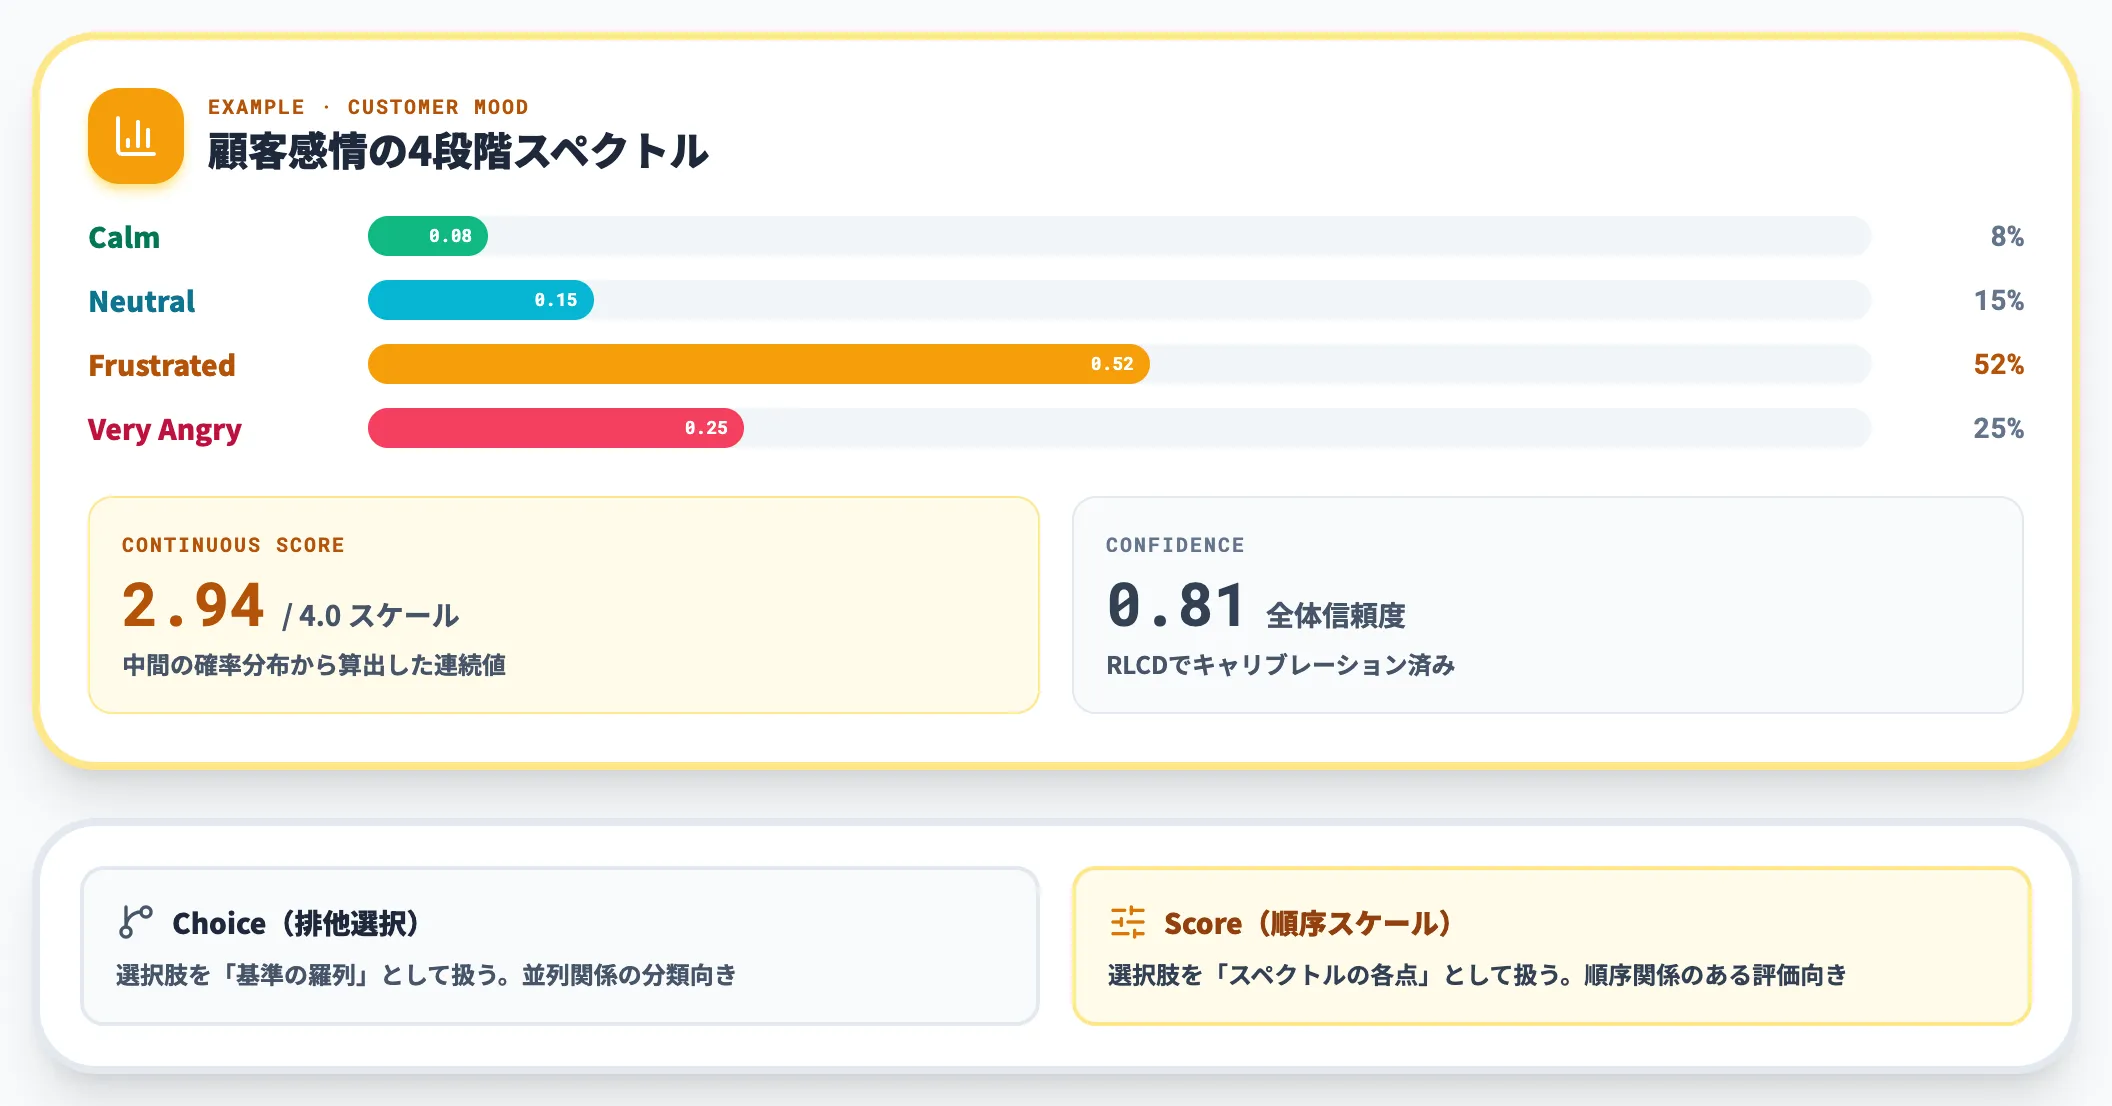
顧客感情4段階(Calm→Neutral→Frustrated→Very Angry)のスペクトル可視化——連続スコアとconfidenceを併せて返却
Noul——Yes/No確率とその使い所
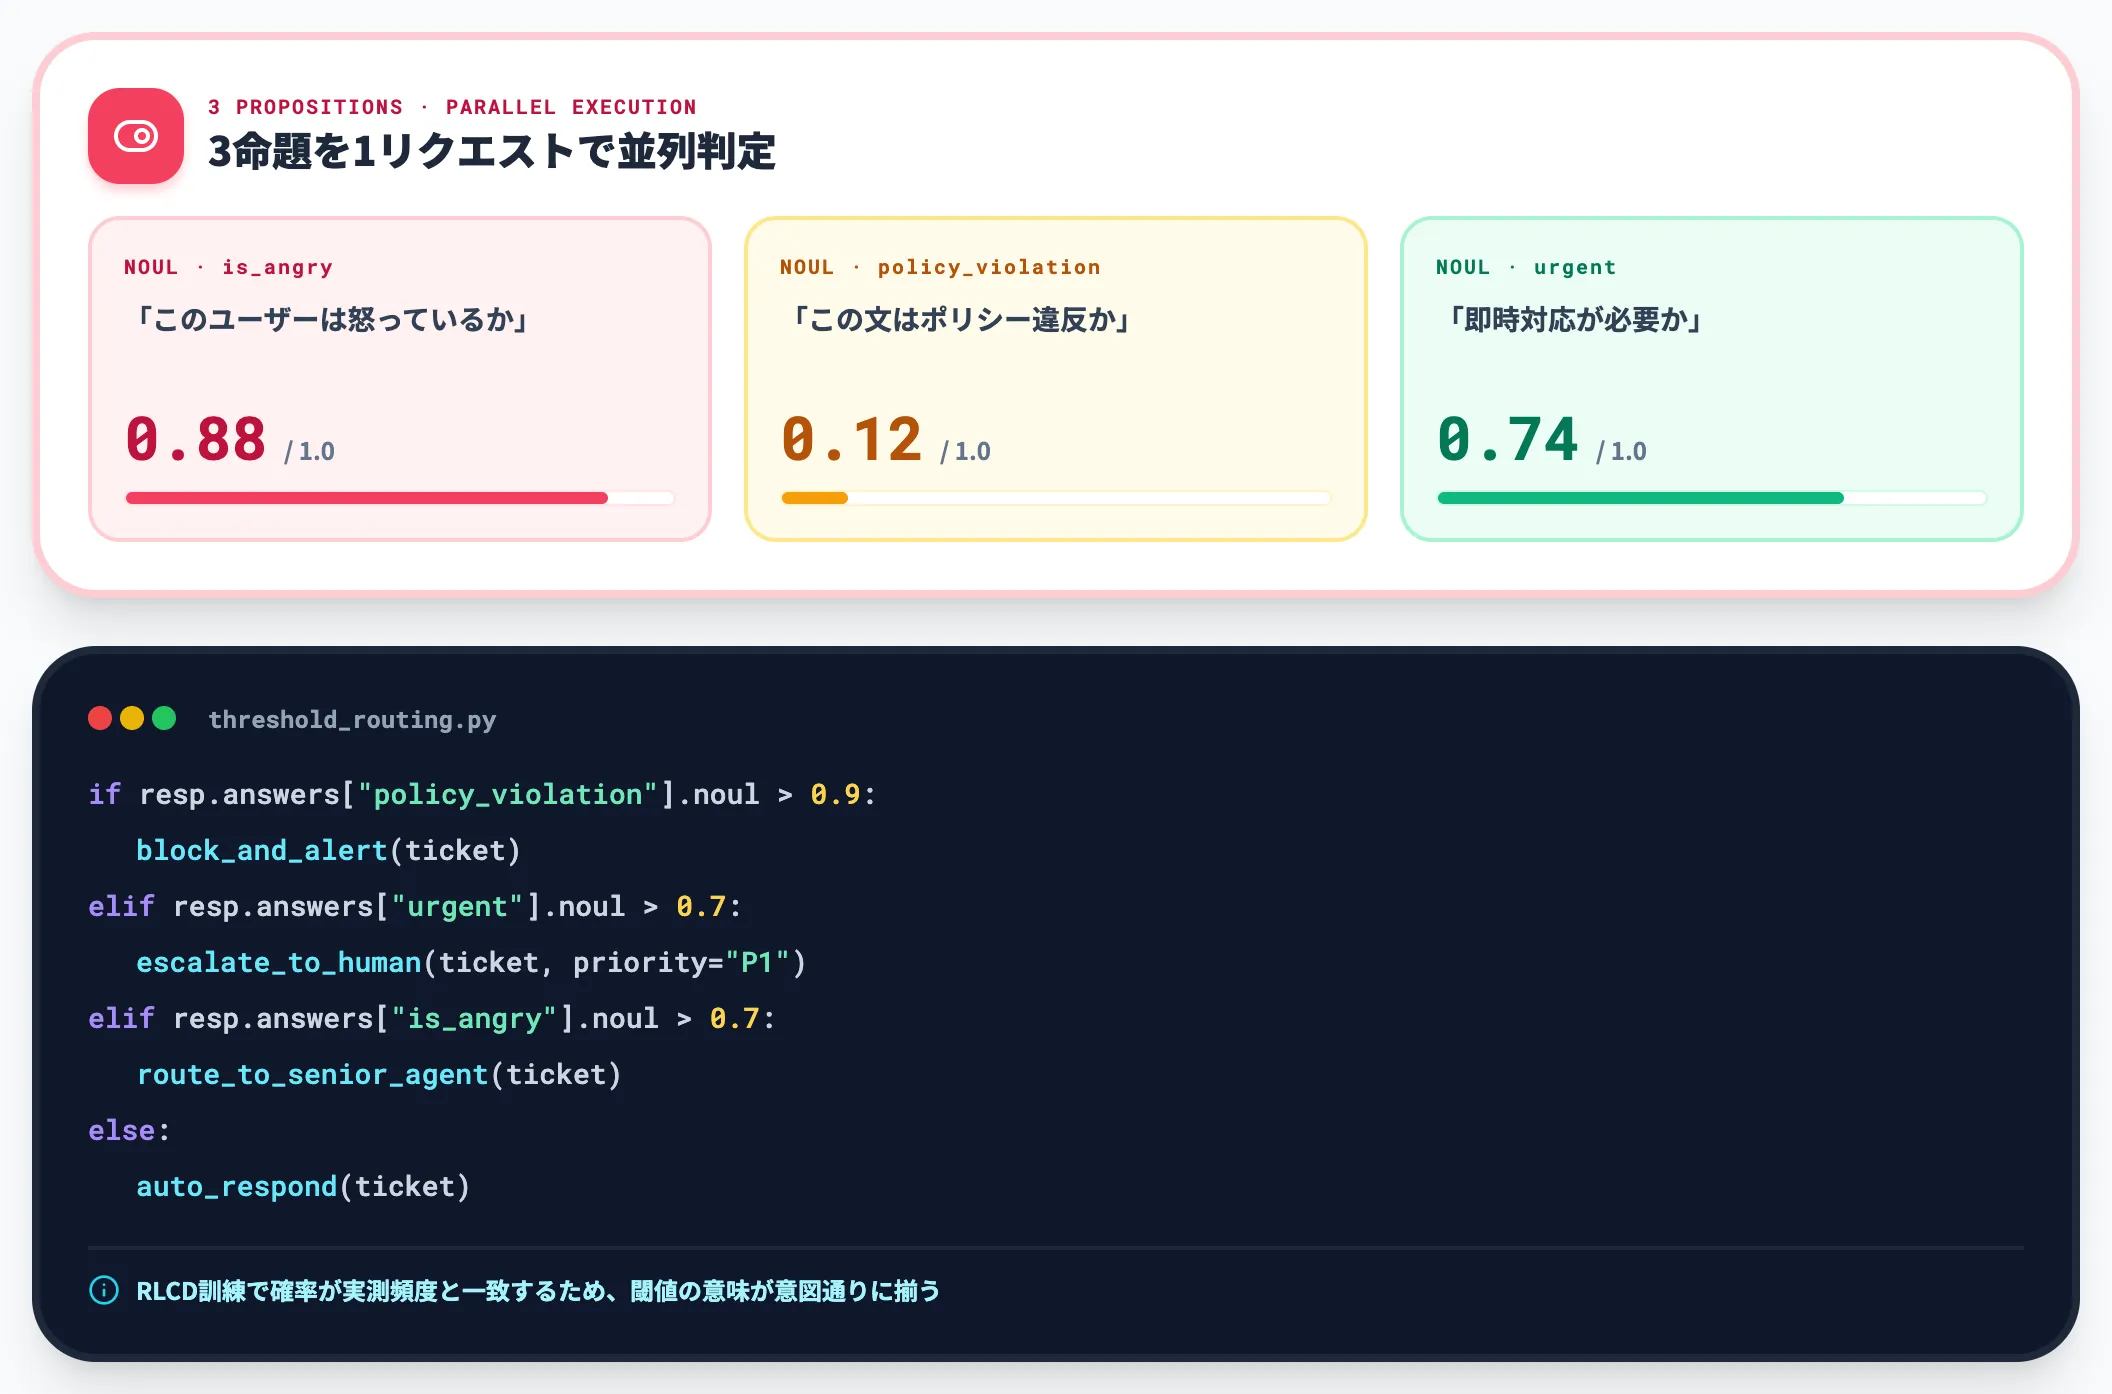
3命題を並列判定→閾値ロジックへ直結するコード例——RLCD訓練で確率が実測頻度と一致するため意図通り動く
Noulは、命題が真である確率を返すプリミティブです。「このユーザーは怒っているか」「この文はポリシー違反か」「このクエリは緊急対応が必要か」といったYes/No型の判定に使います。
一般的なLLMでYes/Noを返させると、Yes/No文字列と別途「self-reported confidence: 0.9」のような自己申告値が混ざります。Noulは最初から0〜1の実数だけを返す設計のため、そのまま「noul > 0.7」のような閾値ロジックにつなげられます。
TypeSafe公式ブログは、これら3プリミティブの組み合わせで「ソフトウェアのなかでLLMが担っていた曖昧なif文」を代替できると位置づけています。
RLCD——確率キャリブレーションを最適化する新しい強化学習
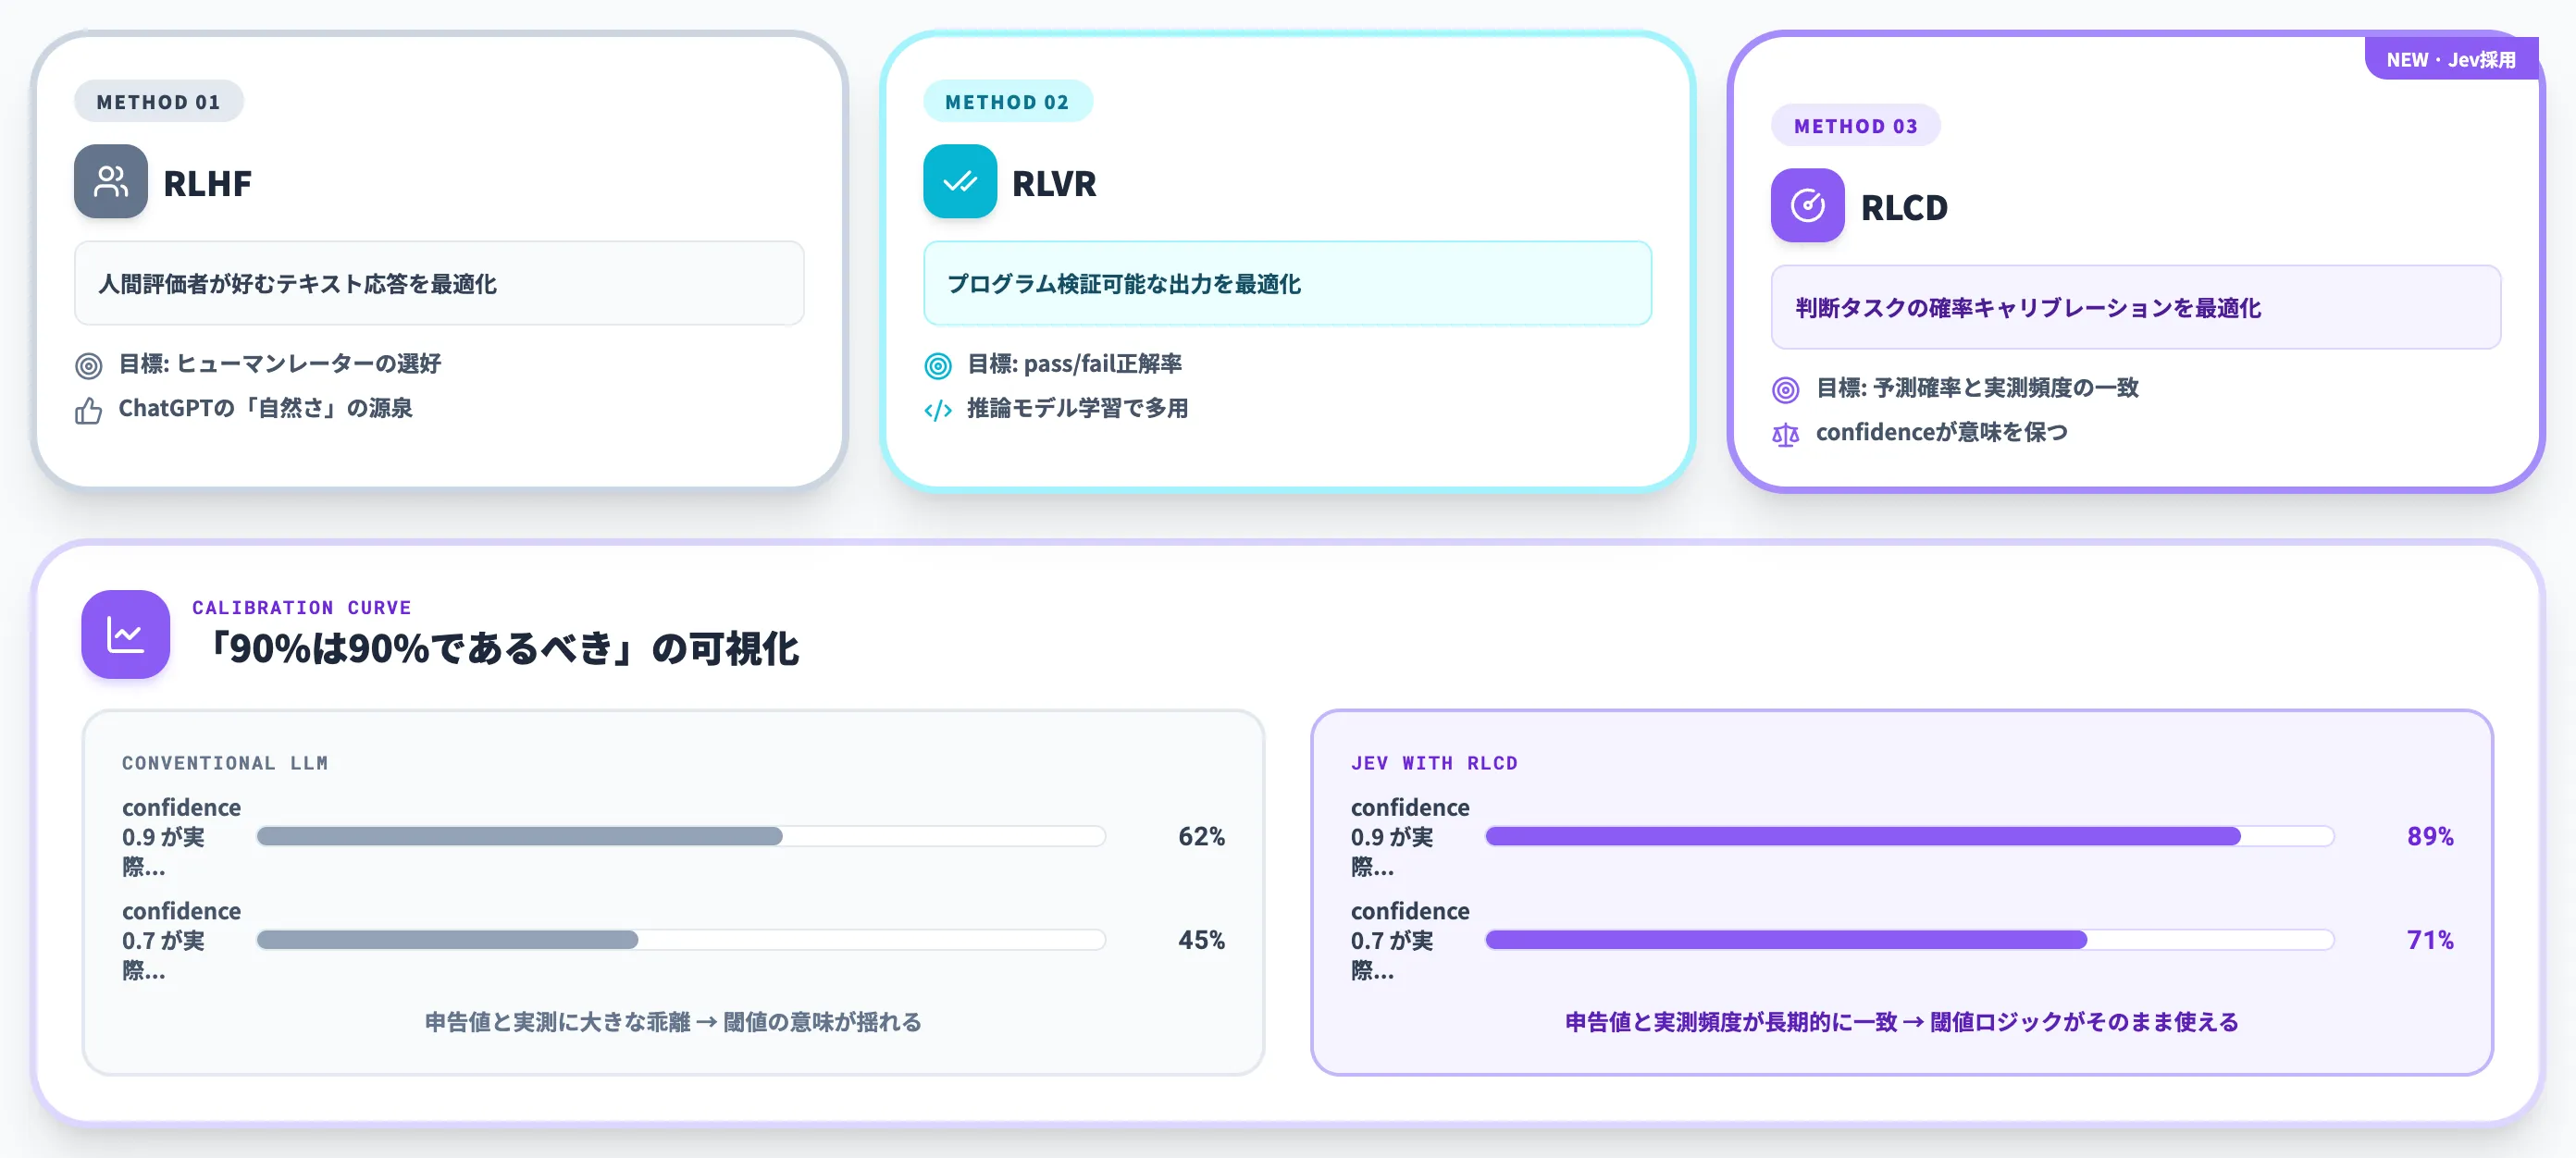
RLHF/RLVR/RLCDの目的差とキャリブレーション曲線——Jevの「0.85」は実測正解率と長期一致する統計的意味を持つ
Jevの学習には、RLCD(Reinforcement Learning for Calibrated Decisions)という新しい強化学習手法が使われています。既存のRLHF・RLVRとは最適化の目標が異なる点が最大の特徴です。
以下の表で、3つの強化学習手法の最適化対象を整理しました。
| 手法 | 何を最適化しているか | 出力の質の測り方 |
|---|---|---|
| RLHF | 人間評価者が好むテキスト応答 | ヒューマンレーターのペアワイズ選好 |
| RLVR | プログラムが検証可能な出力(コード実行成否・数式正誤等) | 検証プログラムのpass/fail |
| RLCD | 判断タスクにおける確率キャリブレーション | 予測確率と実測正解率の一致度 |
RLHFは人間の選好、RLVRは検証プログラムが判定できる正しさを最適化するのに対し、RLCDは「確率が実際の頻度と一致しているか」を報酬関数の中心に据えます。この目的の違いが、Jevのconfidence(Choice/Score)や Noul の Yes 確率を業務ロジックの閾値として扱いやすい形にしています。ただし具体の閾値は自社データで検証してから確定させる、という運用は他モデルと変わりません。
RLHF・RLVRとの目的の違い
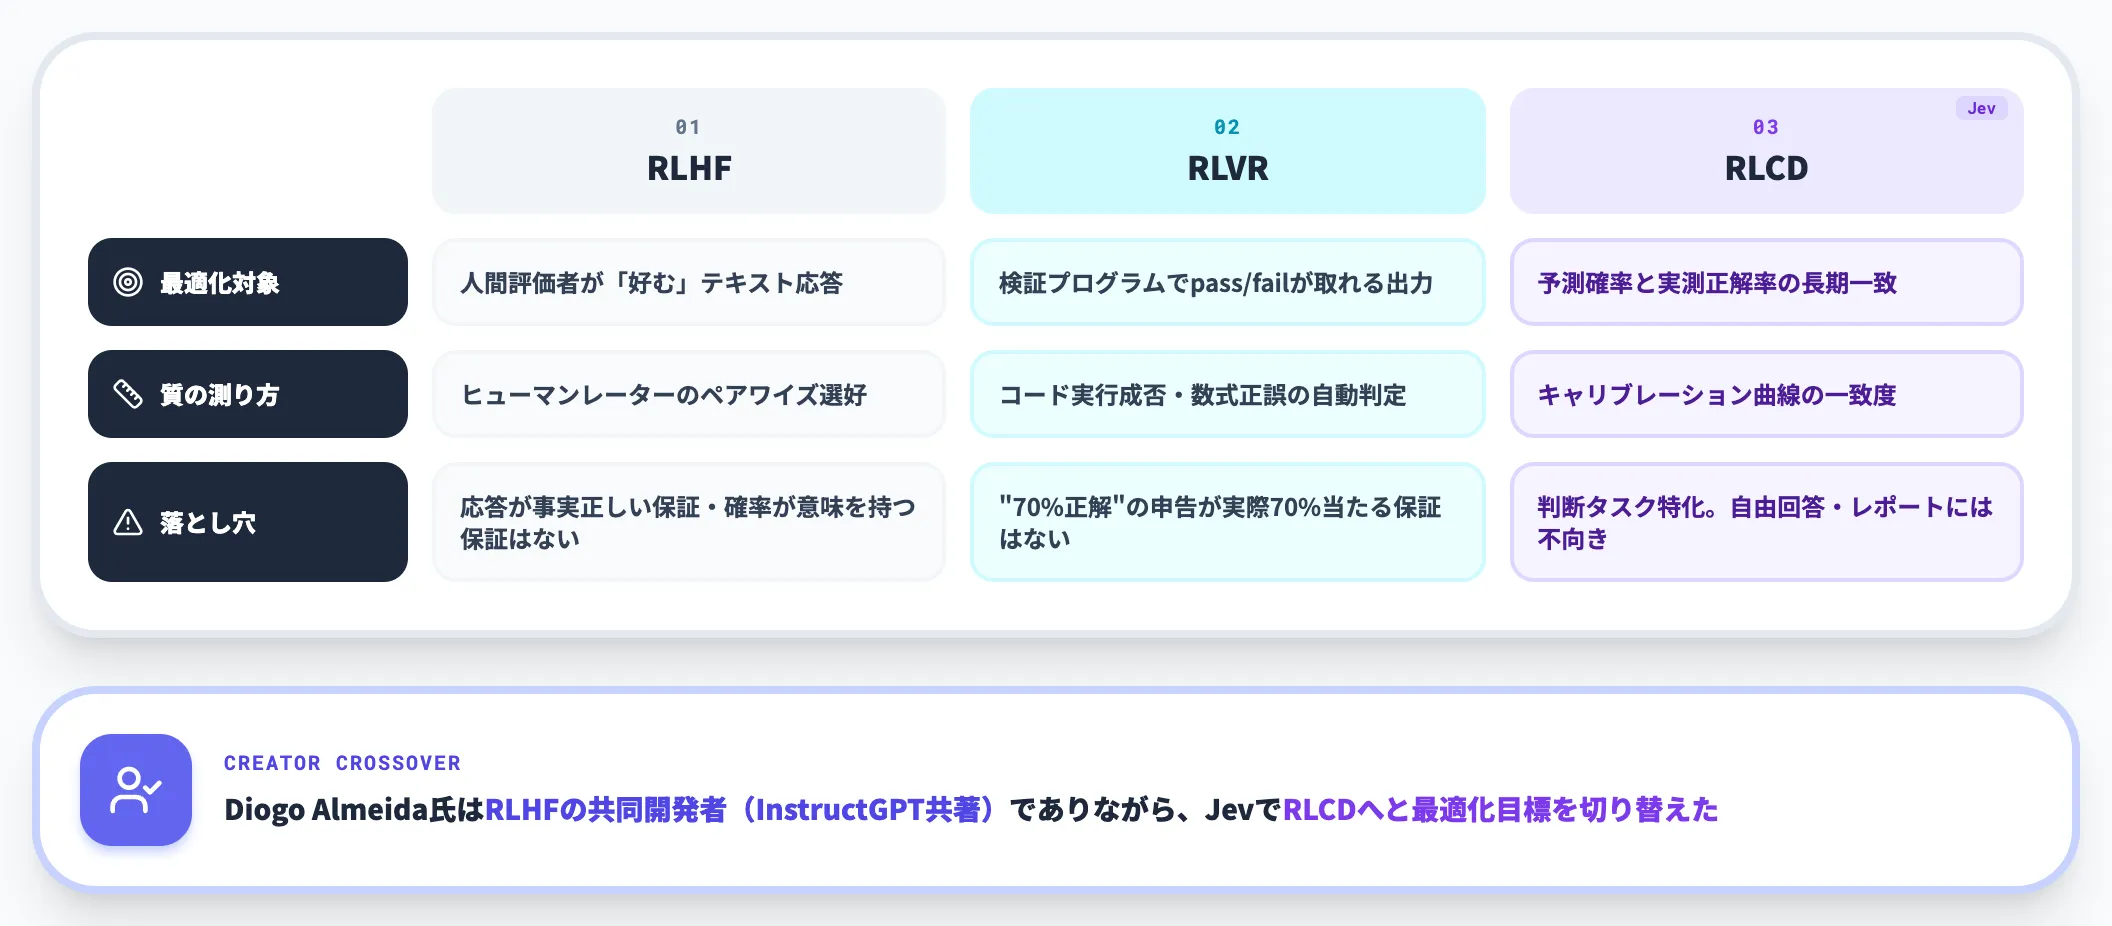
3手法の最適化対象・質の測り方・落とし穴を横並びで比較——Diogo Almeida氏はRLHF共同開発者からRLCDへ目標を切り替えた
RLHFは、Diogo Almeida氏自身がInstructGPTの共著者としてOpenAIで基盤研究に携わった学習手法で、ChatGPTの「自然な会話らしさ」を作り上げた立役者です。ただしRLHFが最適化するのは「人が読んで気持ちのいい応答」であり、応答が事実として正しい保証や、確率スコアが実際の頻度と一致する保証はありません。
RLVRは、コード実行・数学問題のようにプログラム側で正解可否を判定できるタスクで使われる強化学習で、フロンティア推論モデルの学習に多用されています。ただしこの手法も「正解率」を上げるだけで、モデルが「70%の確率で正解」と申告した予測が本当に70%当たるかは保証しません。
RLCDは、判断タスクに絞ったうえで「予測確率と実測正解率が長期的に一致すること」を報酬関数の中心に据えます。結果として、Jevが返す「0.85」という確率は、100件同じスコアが返るケースで実際に約85件正解する、という統計的な意味を持ちます。
「90%は90%であるべき」というキャリブレーションの意味
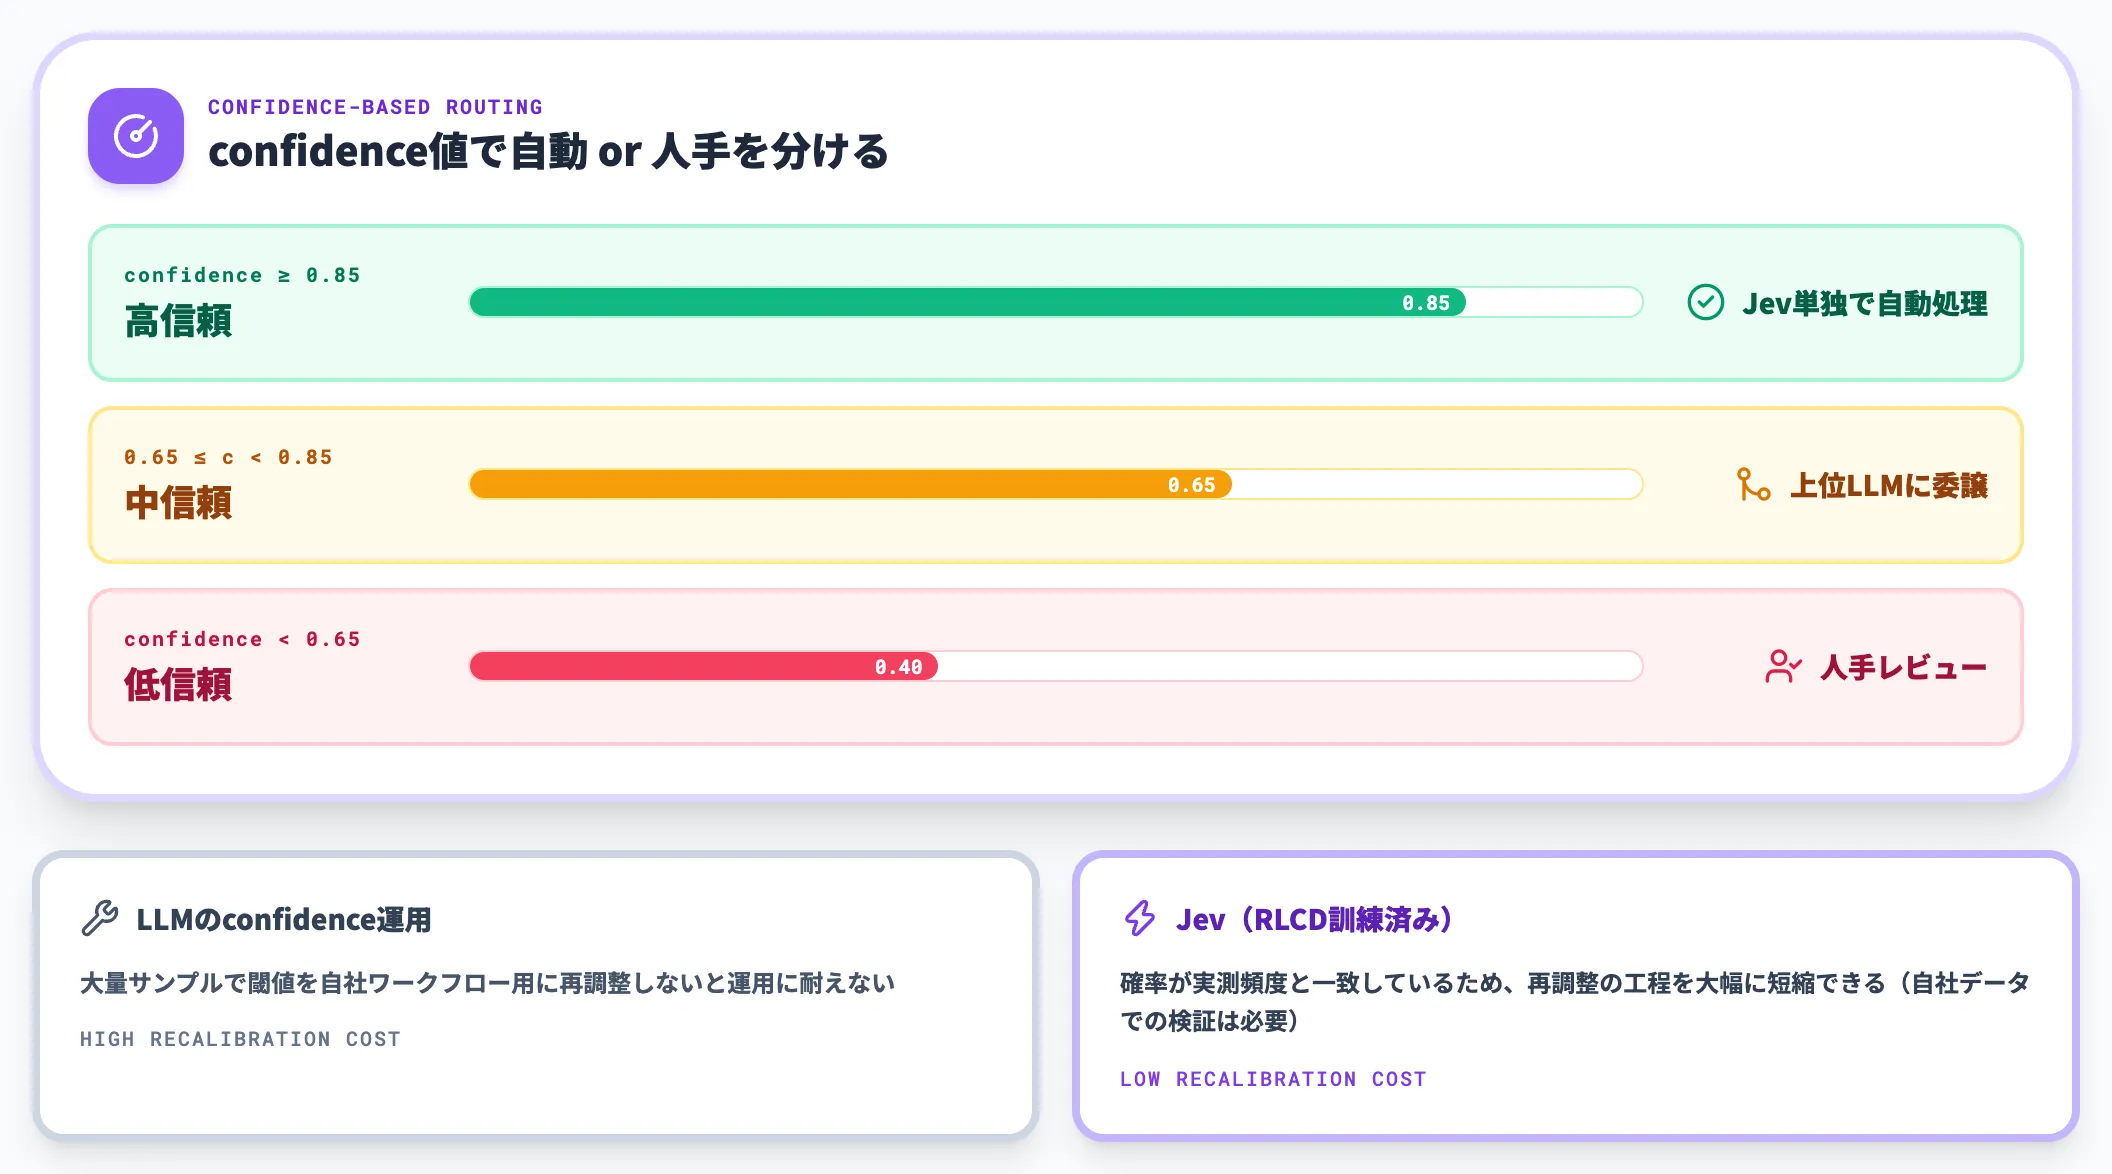
confidence閾値で高信頼/中信頼/低信頼を分岐——RLCD訓練済みなら閾値の意味が揃うため再調整工程を大幅に短縮
The NeuronのJev解説記事は、RLCDが目指すキャリブレーションを次のように説明しています。「90%の信頼度と55%の信頼度は、実務のなかで意味の違うシグナルであるべき」。
これがなぜ重要かというと、Jevのconfidence(Choice/Score)や Noul の Yes 確率を「意味の揃った閾値」として業務ロジックに落とし込めるからです。「confidence 0.8以上ならJev単独で自動処理、0.8未満なら人手レビューにエスカレーション」という設計方針が引きやすくなります。ただし具体の閾値は、自社データでの検証を経てから確定させる必要がある点は他モデルと同じです。
一般的なLLMでは、モデルが返す確率値は「見た目のそれっぽさ」にすぎず、大量にサンプルを取って自社ワークフローに合わせて閾値を再調整しないと、実運用に耐える境界線が引けません。RLCDで訓練されたJevは、この再調整工程を大幅に短縮できる設計になっています。
Jevの料金・速度・精度——フロンティアLLMとの4指標比較
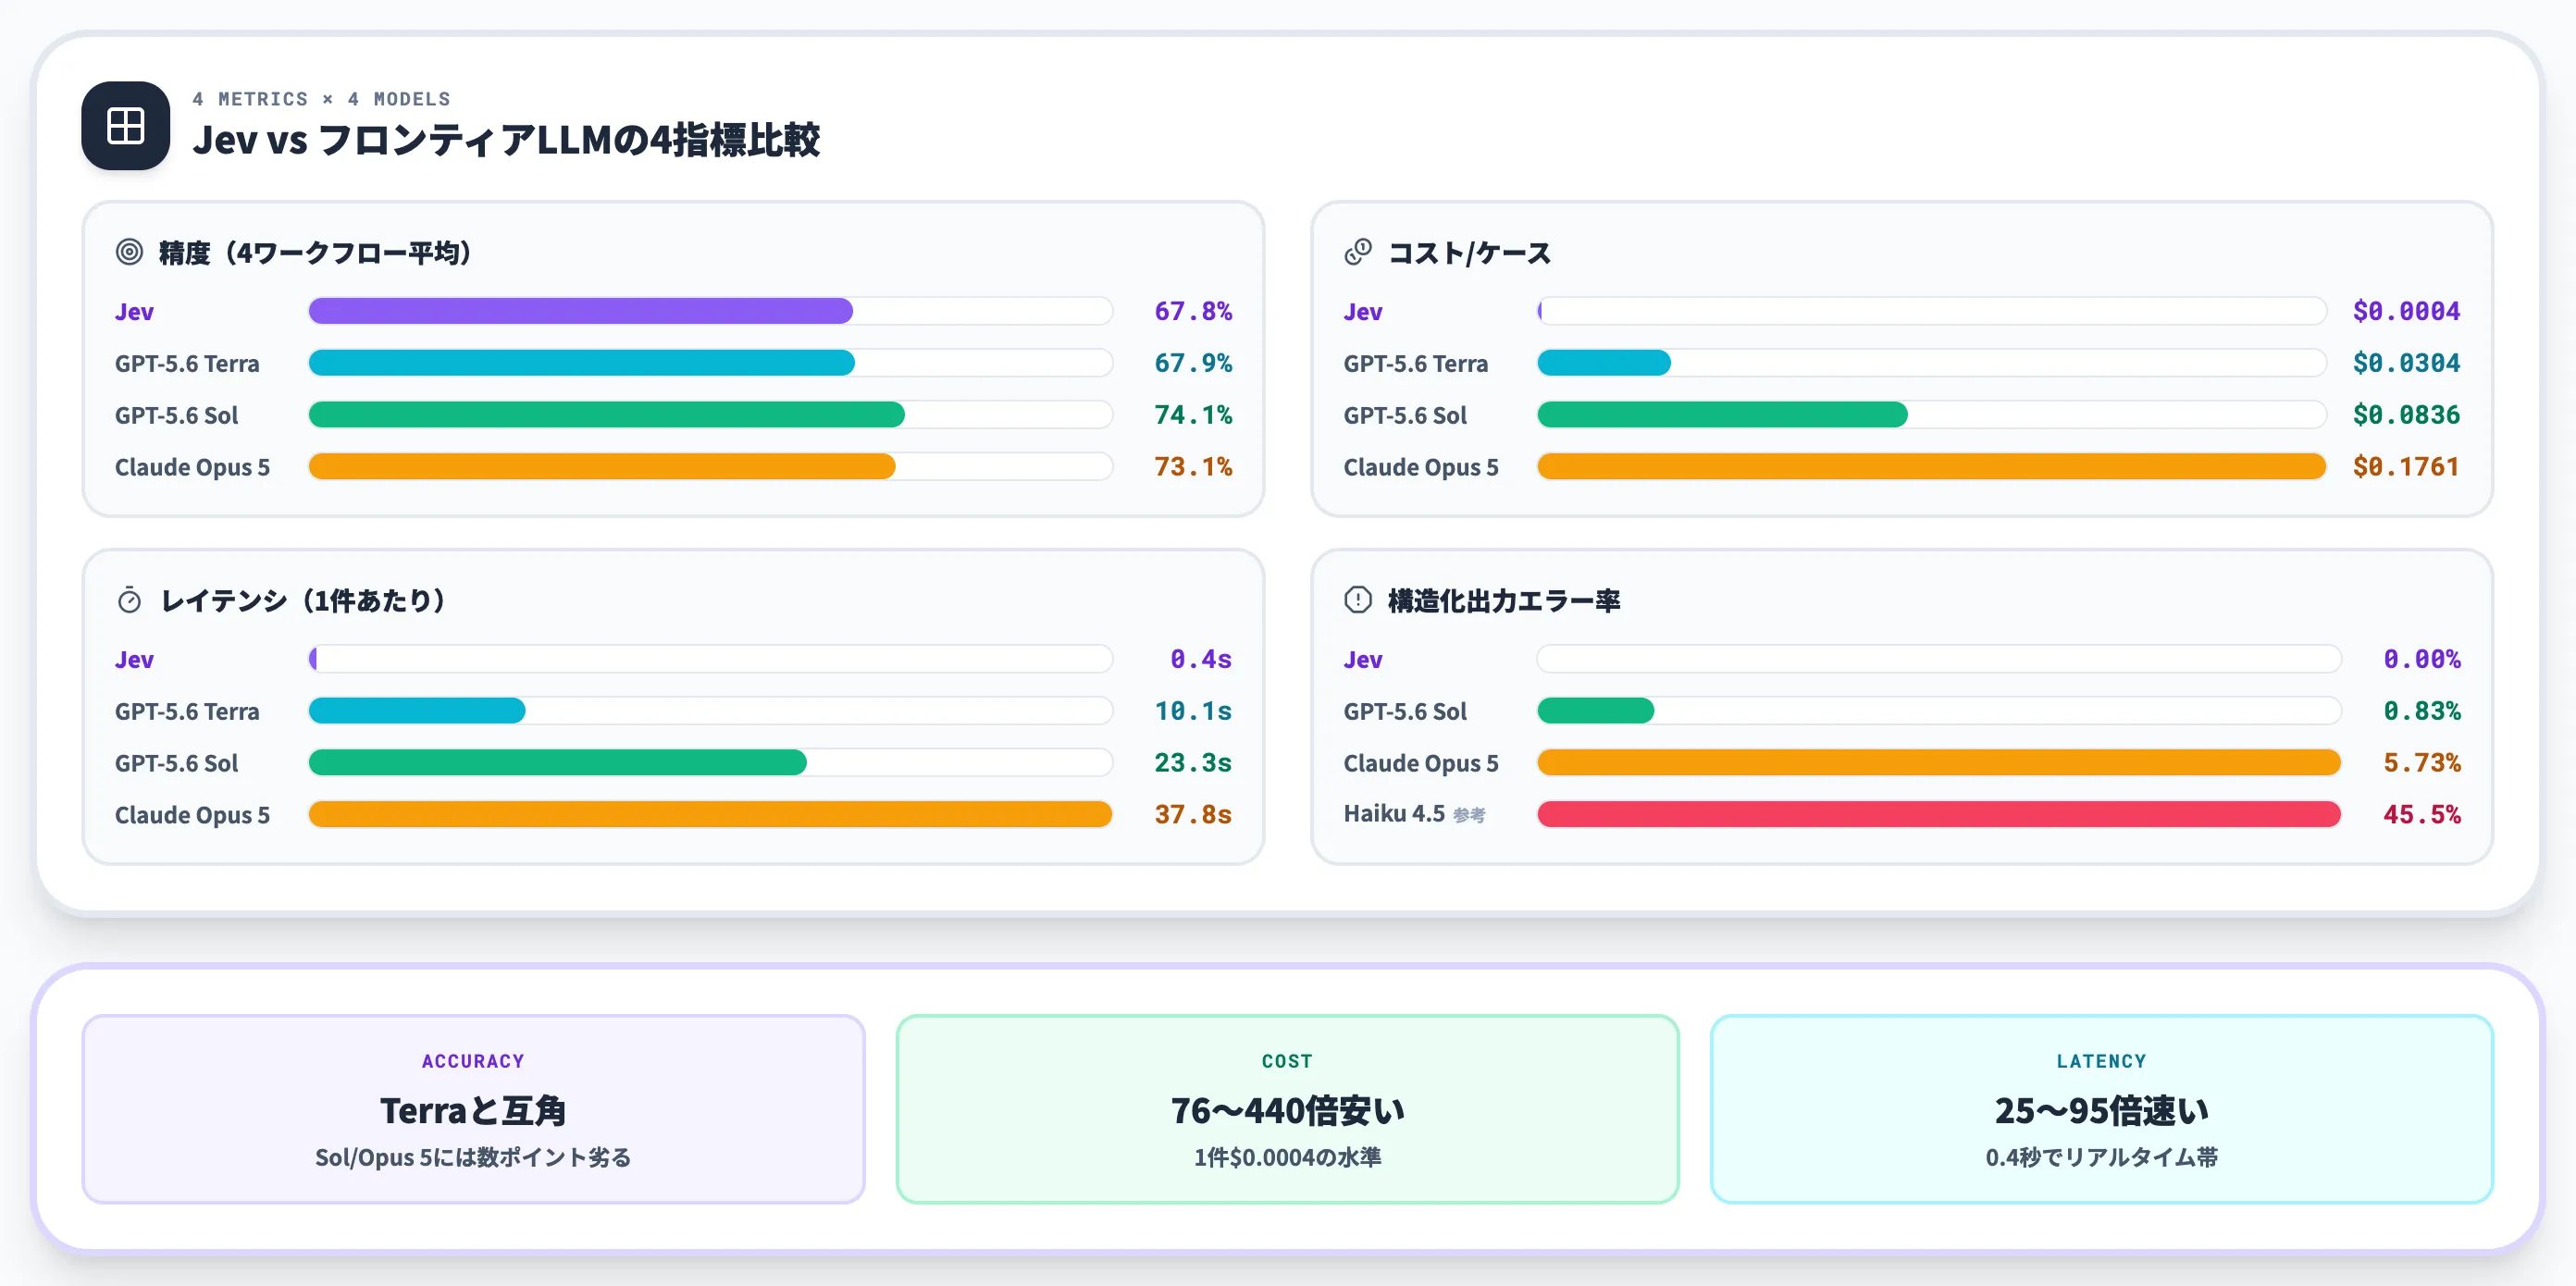
Jev vs GPT-5.6 Terra/Sol・Claude Opus 5の4指標比較——精度Terra同等・コスト76〜440倍安・レイテンシ25〜95倍速
Jevの実務価値を測るには、料金・レイテンシ・精度・構造化出力エラー率の4指標をフロンティアLLMと並べて見る必要があります。TypeSafeが公表した「4ワークフロー評価」のデータを、そのまま整理します。
料金・レイテンシ・精度・エラー率の4指標比較
以下の表は、TypeSafeが自社ベンチマークで公表したJevと主要フロンティアLLMの比較です(DataCamp解説記事より)。精度列は独立の正解ラベルではなく、GPT-6 Astra と Claude Fable 5.1 の出力平均を参照ラベルとした一致率である点に注意してください。
| 指標 | Jev | GPT-5.6 Terra | GPT-5.6 Sol | Claude Opus 5 |
|---|---|---|---|---|
| 精度(4ワークフロー平均・Astra/Fable 5.1平均を参照ラベルとした一致率) | 67.8% | 67.9% | 74.1% | 73.1% |
| コスト/ケース | $0.0004 | $0.0304 | $0.0836 | $0.1761 |
| レイテンシ | 0.4秒 | 10.1秒 | 23.3秒 | 37.8秒 |
| 構造化出力エラー率 | 0% | — | 0.83% | 5.73% |
この4指標を並べると、Jevの立ち位置ははっきりします。精度はGPT-5.6 Terraと互角、Sol/Opus 5には数ポイント劣る一方、コストは76〜440倍安く、レイテンシは25〜95倍速いという設計です。参考値ですがClaude Haiku 4.5の構造化出力エラー率は45.5%とも報告されており、Jevの0%は運用工数の想定を大きく変えます。
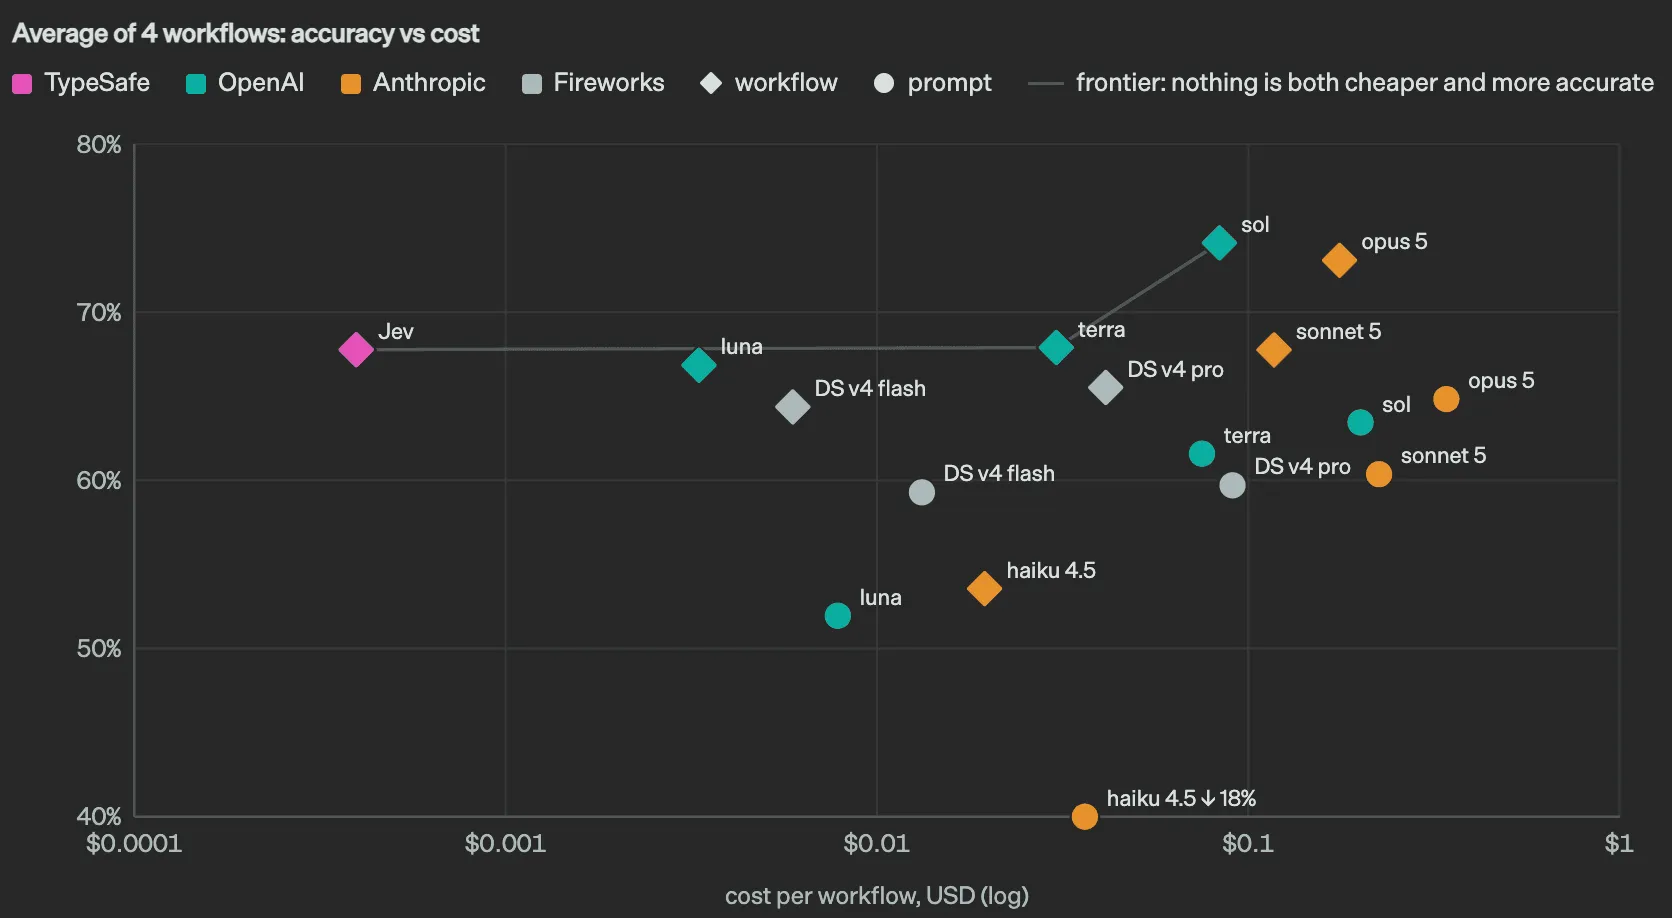
4ワークフロー平均のコスト対精度比較——Jevは$0.0004/ケース水準で67.8%を確保しfrontier線上に位置する(出典:Introducing System One Models & Jev)
散布図の中で、Jevは同図の比較対象のうちfrontier線(これより安くて精度も高いモデルは存在しない、というライン)の左上端に位置しています。
左隣を見るとGPT-5.6 lunaが約$0.003で67%前後、Terraが約$0.03で68%前後の位置にあり、Jevが確保している$0.0004帯には同図の比較対象で並ぶモデルがありません。右上のSolとOpus 5は74%前後の精度を出しているものの、コストはJevの約200〜400倍という水準です。
入力$0.042/1M・出力無料の内訳
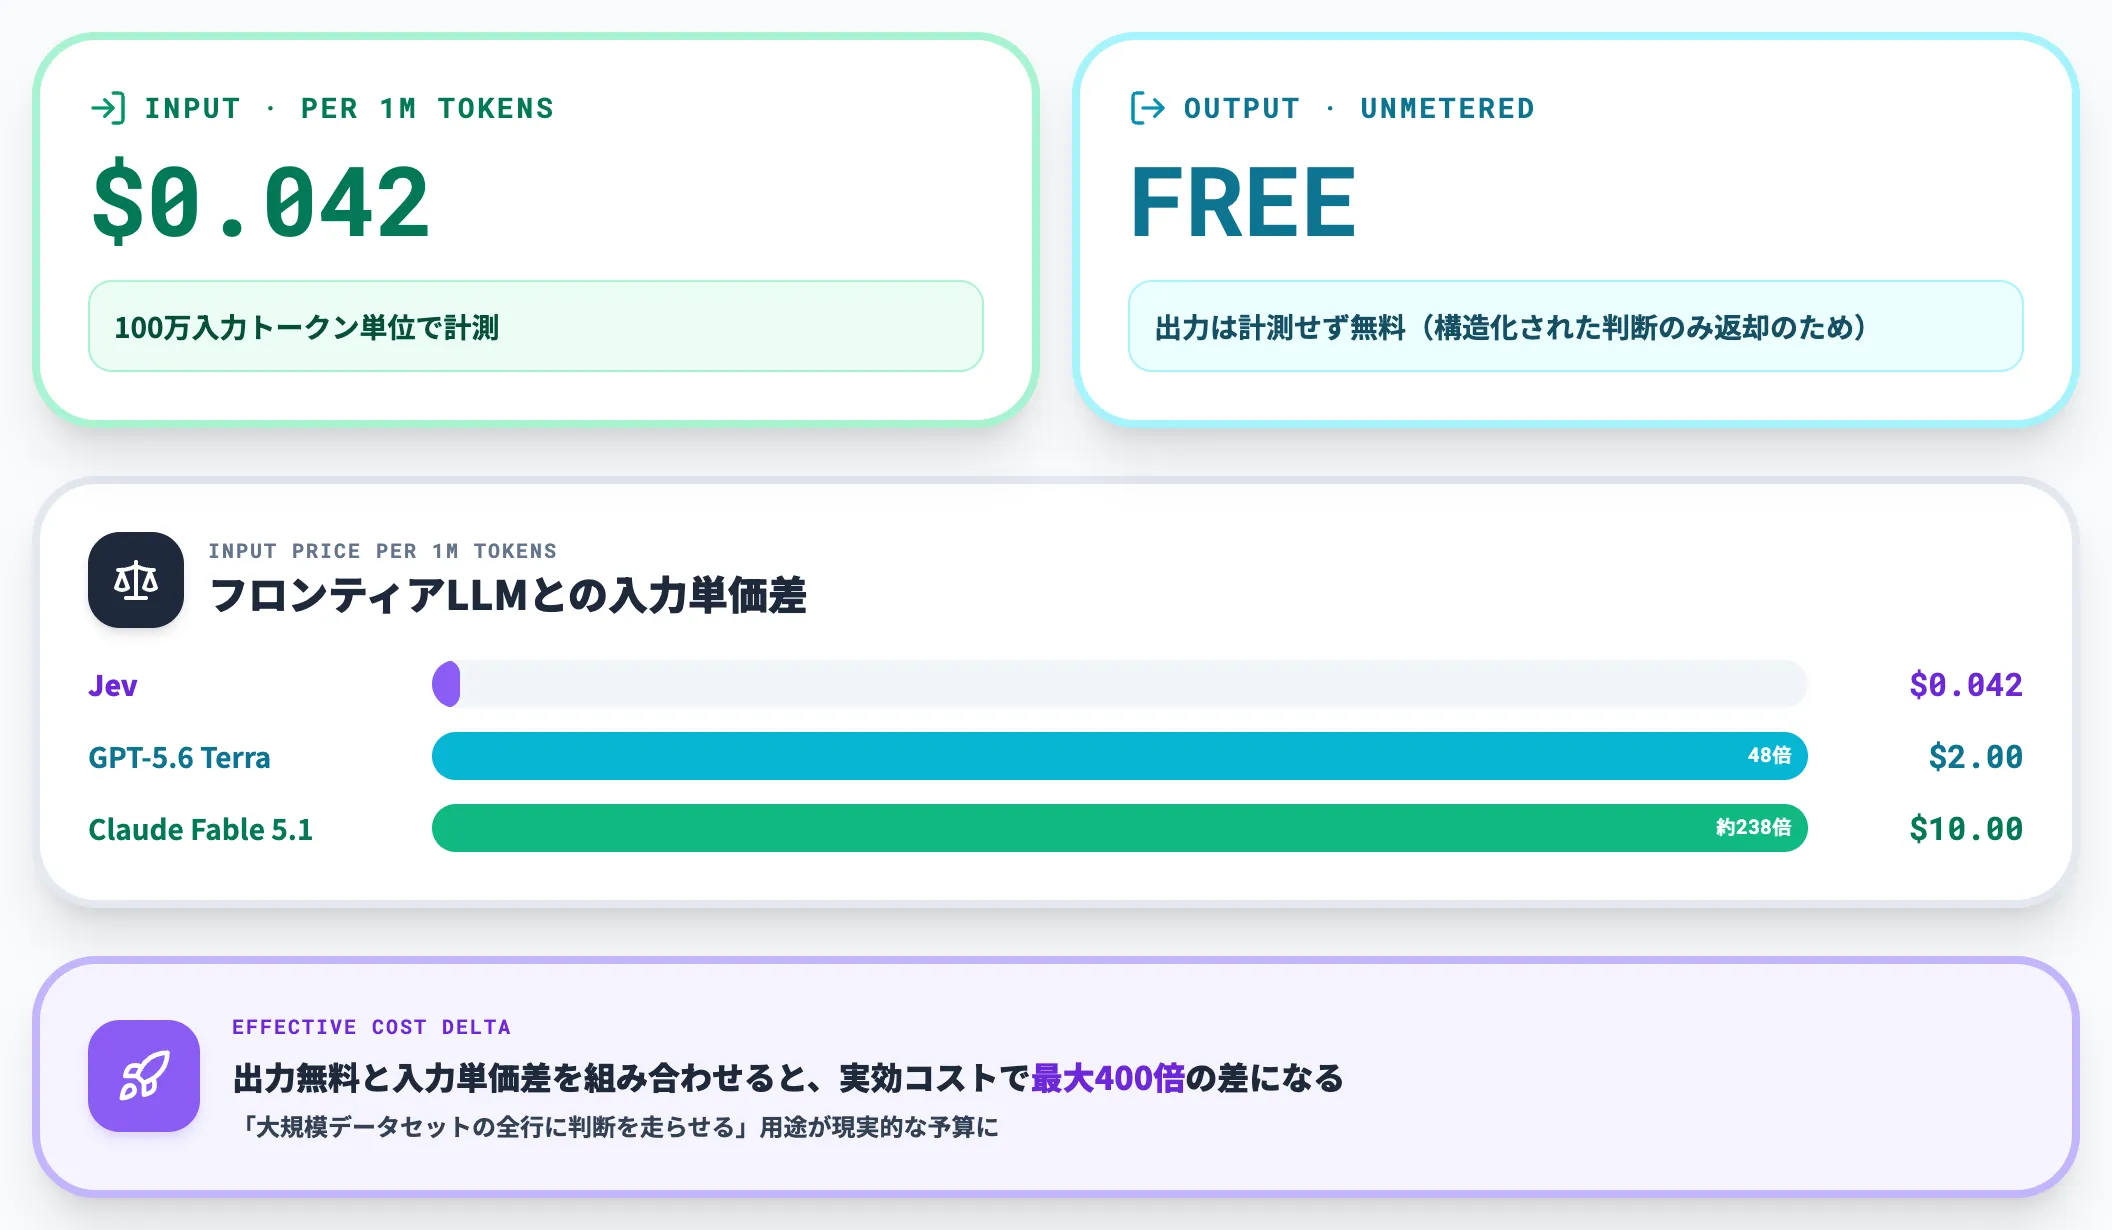
入力単価$0.042/1M+出力無料の内訳——Terra比48倍・Fable5.1比238倍安、実効コストで最大400倍差
Jevの料金は、入力トークンが100万トークンあたり$0.042、出力トークンは「unmetered and free(計測せず無料)」となっています。GPT-5.6 Terraの入力$2.00/1M・出力$12/1Mと比べると、入力単価で約48倍、実効コストで最大400倍程度の差が出ます。
Claude Fable 5.1と比較しても、TypeSafe公式によれば約238倍安価とされています。判断1件あたりのコストが$0.0004という水準は、「大規模データセットの全行に対して判断を走らせる」といった、これまでフロンティアLLMではコスト的に諦めていた用途を現実的にします。
70-500msというレイテンシの読み方
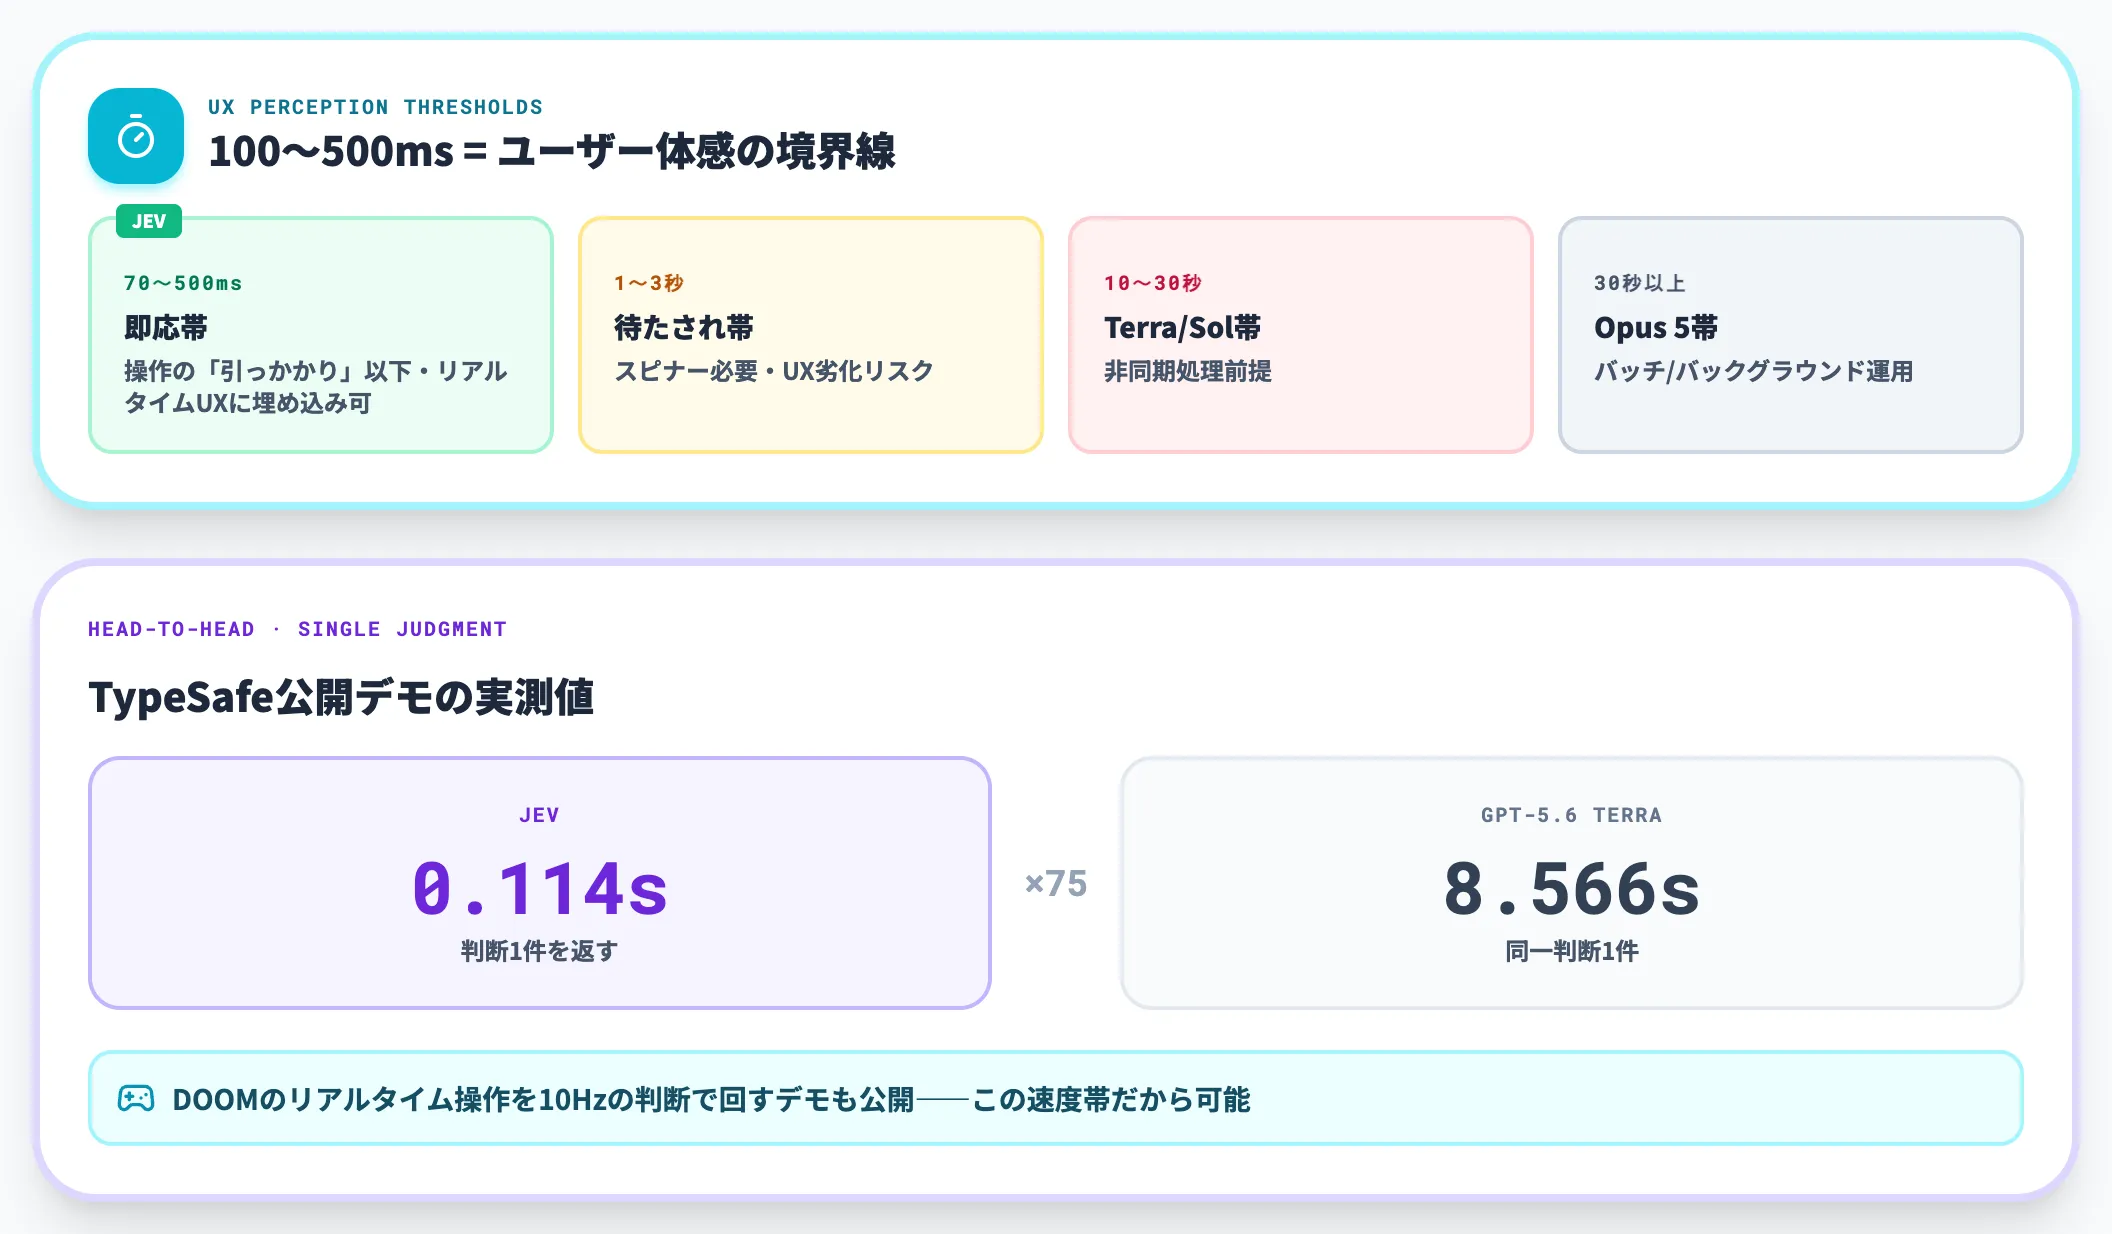
UX体感境界線とJev/Terraの実測比較——即応帯70〜500msに収まるためリアルタイムUIに埋め込み可能
Jevのエンドツーエンド応答時間は70-500msで、これは自己回帰型のLLM推論とは根本的に違う値です。GPT-5.6 Terraが同じ判断タスクを完了するのに10.1秒かかるのに対し、Jevは0.4秒で返します。デモではJev 0.114秒 vs GPT-5.6 Terra 8.566秒という数値も公開されています(TypeSafe公式サイト)。
100〜500msというレイテンシ帯は、ユーザーが操作の合間に体感できる「引っかかり」の境界線です。この帯域に判断ステップが収まると、リアルタイムUXにAI判断を挟むことが現実的な設計になります。DOOMのリアルタイム操作を10Hzの判断で回すデモは、この速度帯の意味を象徴しています。
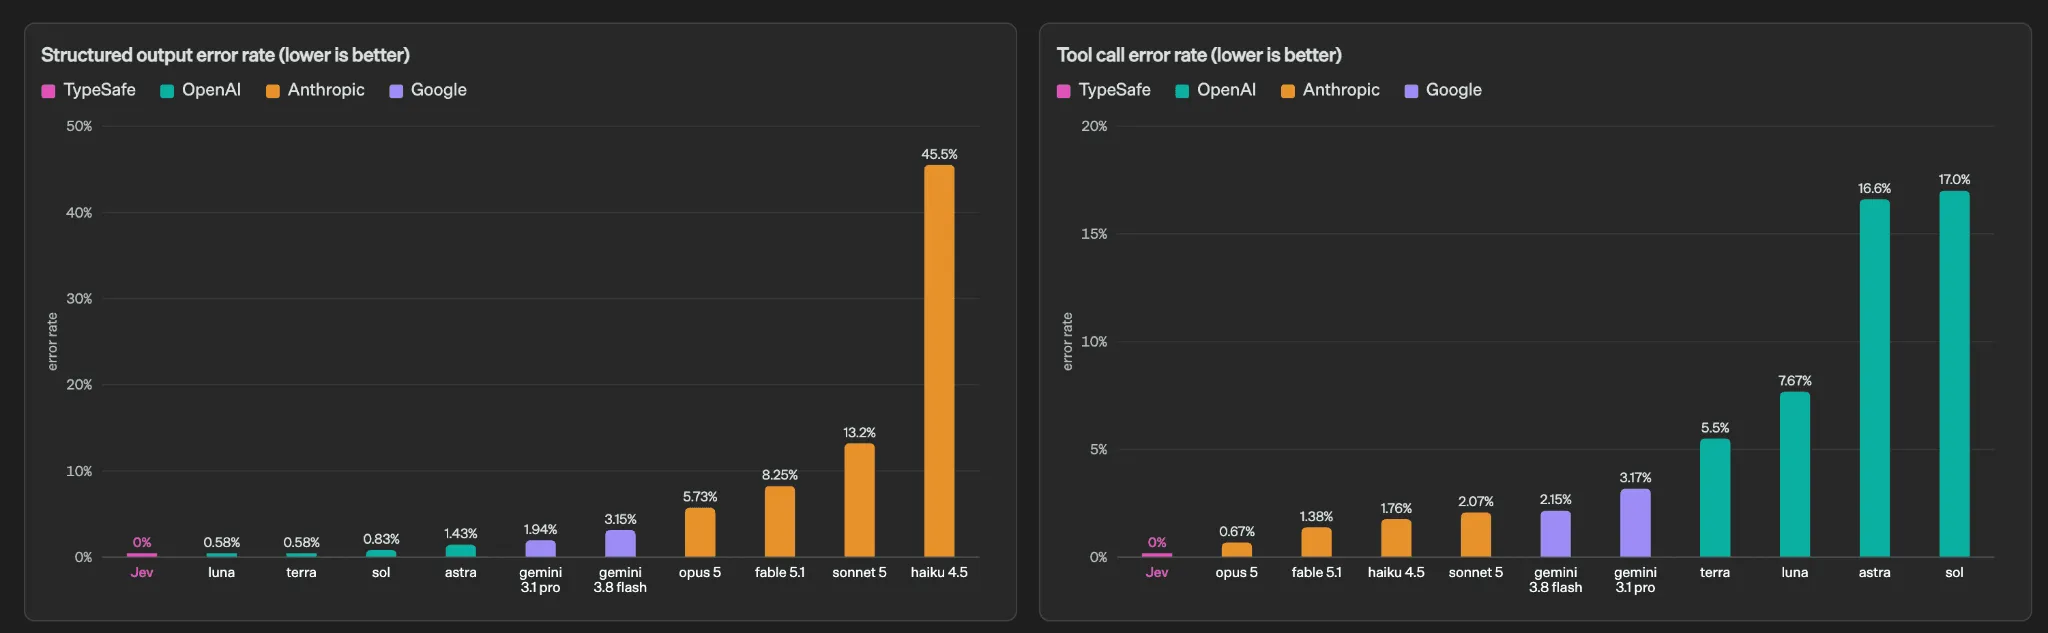
Jevの構造化出力・ツールコールエラー率はいずれも0%——構造化出力ではHaiku 4.5の45.5%、ツールコールではSolの17.0%と桁違いに低い(出典:Introducing System One Models & Jev)
グラフ左側の構造化出力エラー率で目を引くのはHaiku 4.5の45.5%で、次点のSonnet 5(13.2%)・Fable 5.1(8.25%)と比べても抜けています。右側のツールコールエラー率は指標が別で、Sol 17.0%・Astra 16.6%が上位に来ます。Sol は構造化出力エラーだけを見れば 0.83% とかなり低い一方、ツールを呼ぶ判断の失敗率は跳ね上がるため、Jev の 0%/0% がパイプライン全体でどう効くかが読み取れます。JSON parseエラーやツール呼び出し失敗の防御コードを削れるかどうかは、判断ロジックの複雑さより「モデルが型を絶対に守るか」で決まる、という実装現場の感覚が数字に表れています。
精度67.8%はどう解釈すべきか
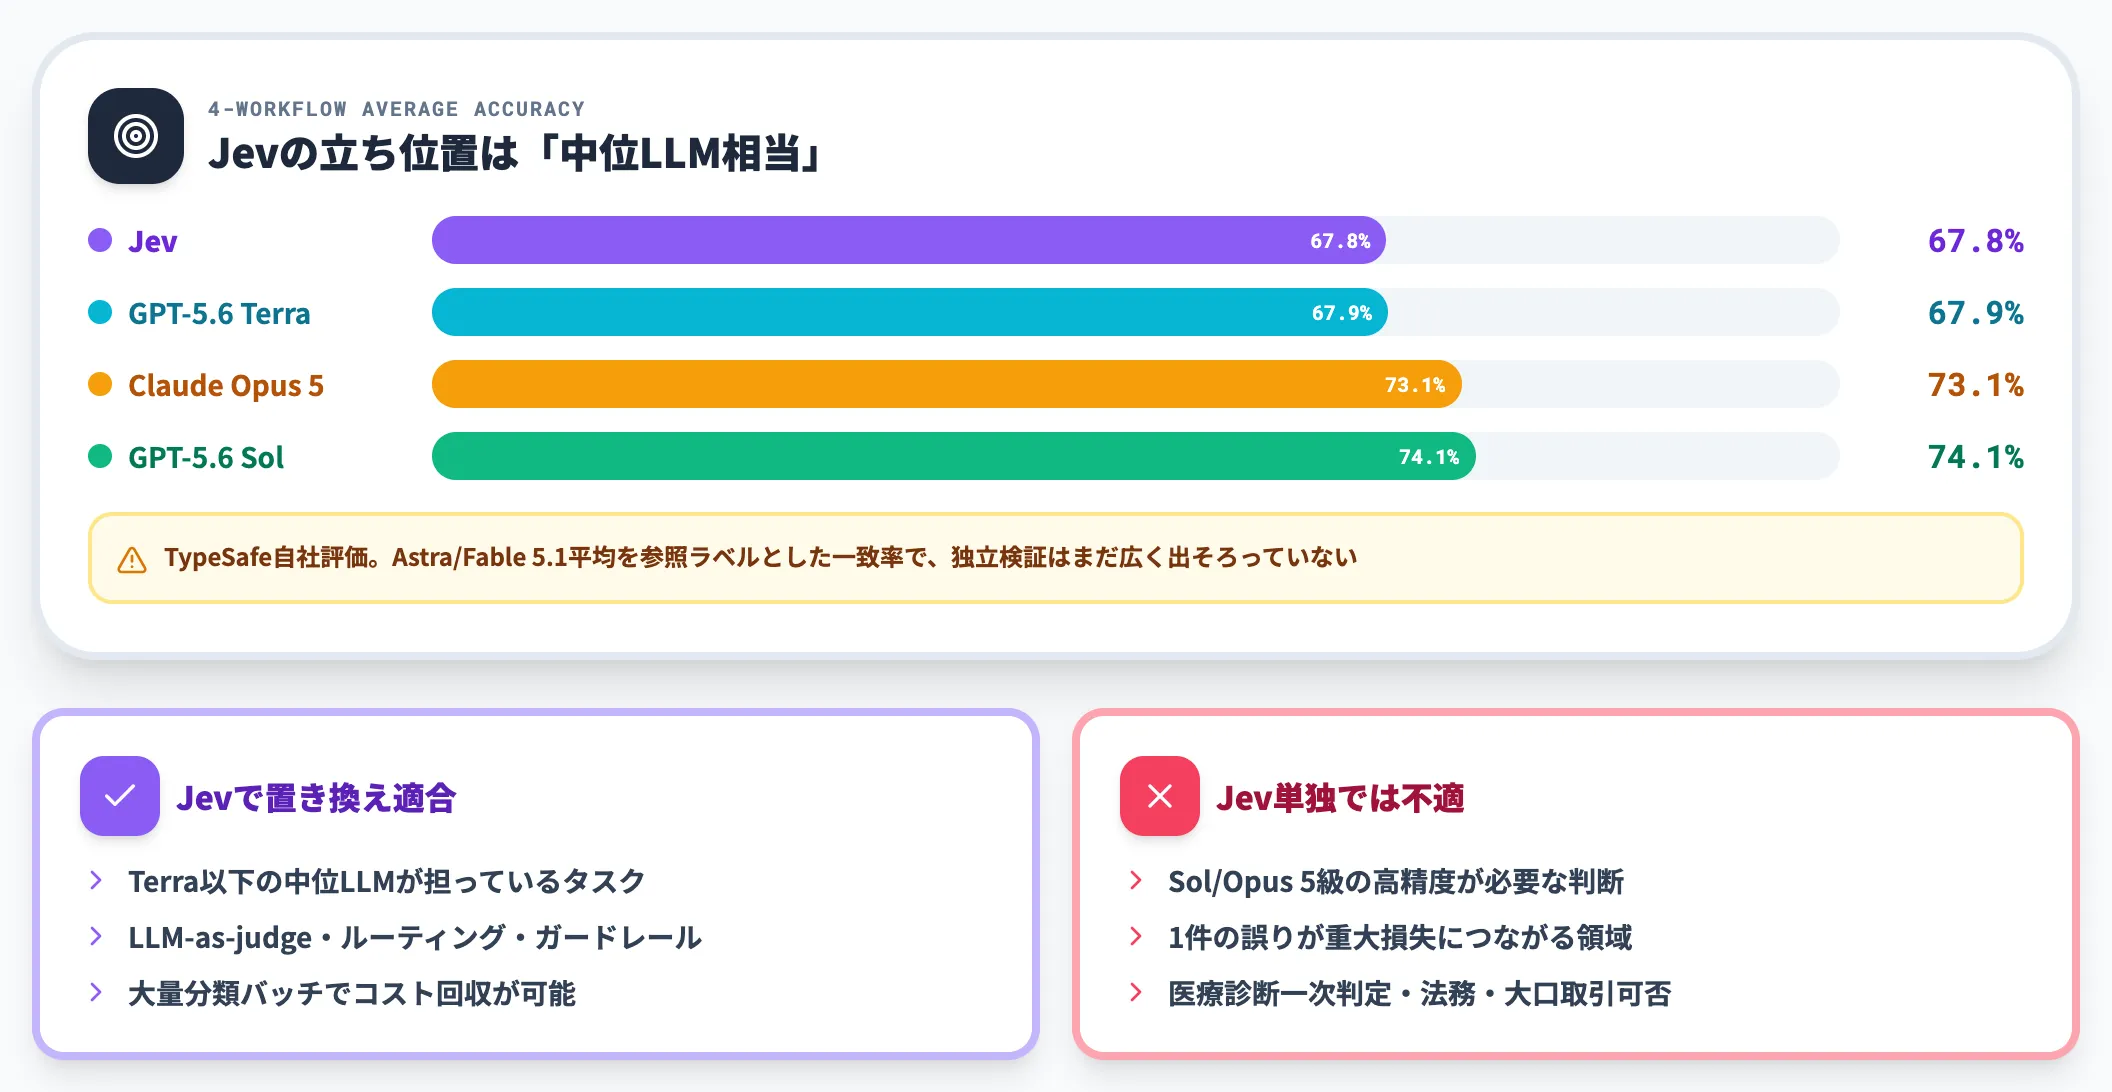
4モデルの精度%バーとJevの適用可否分岐——Terra以下の中位LLM置換に絞り、Sol/Opus 5級精度が要る領域は避ける
一方で、注意深く見るべきは精度の数字です。Jevの4ワークフロー平均精度67.8%はGPT-5.6 Terra(67.9%)とほぼ同等ですが、GPT-5.6 Sol(74.1%)・Claude Opus 5(73.1%)とは6ポイント前後の差があります。
つまりJevは「最上位フロンティアLLM並みの精度」ではありません。Terra以下の中位LLMをコスト・速度で置き換える設計であって、Sol/Opus 5が担っていた高精度が必要なタスクには適用しにくい、というのが4指標を並べた際の実務的な結論になります。
なお、公表数値はTypeSafeが自社で選んだ4ワークフローの結果であり、独立検証はまだ広く出そろっていません。DataCampのJev解説記事も「精度比較は独立評価が積み上がるまで割り引いて読むべき」と指摘しています。
既存のStructured Outputs・SLMとの使い分け
Jevが登場する前から、「LLMに構造化された答えを返させる」ためのアプローチは複数存在してきました。Jevを検討するときは、これらの既存ソリューションとの違いを整理したうえで、置き換える価値があるかを判断する必要があります。
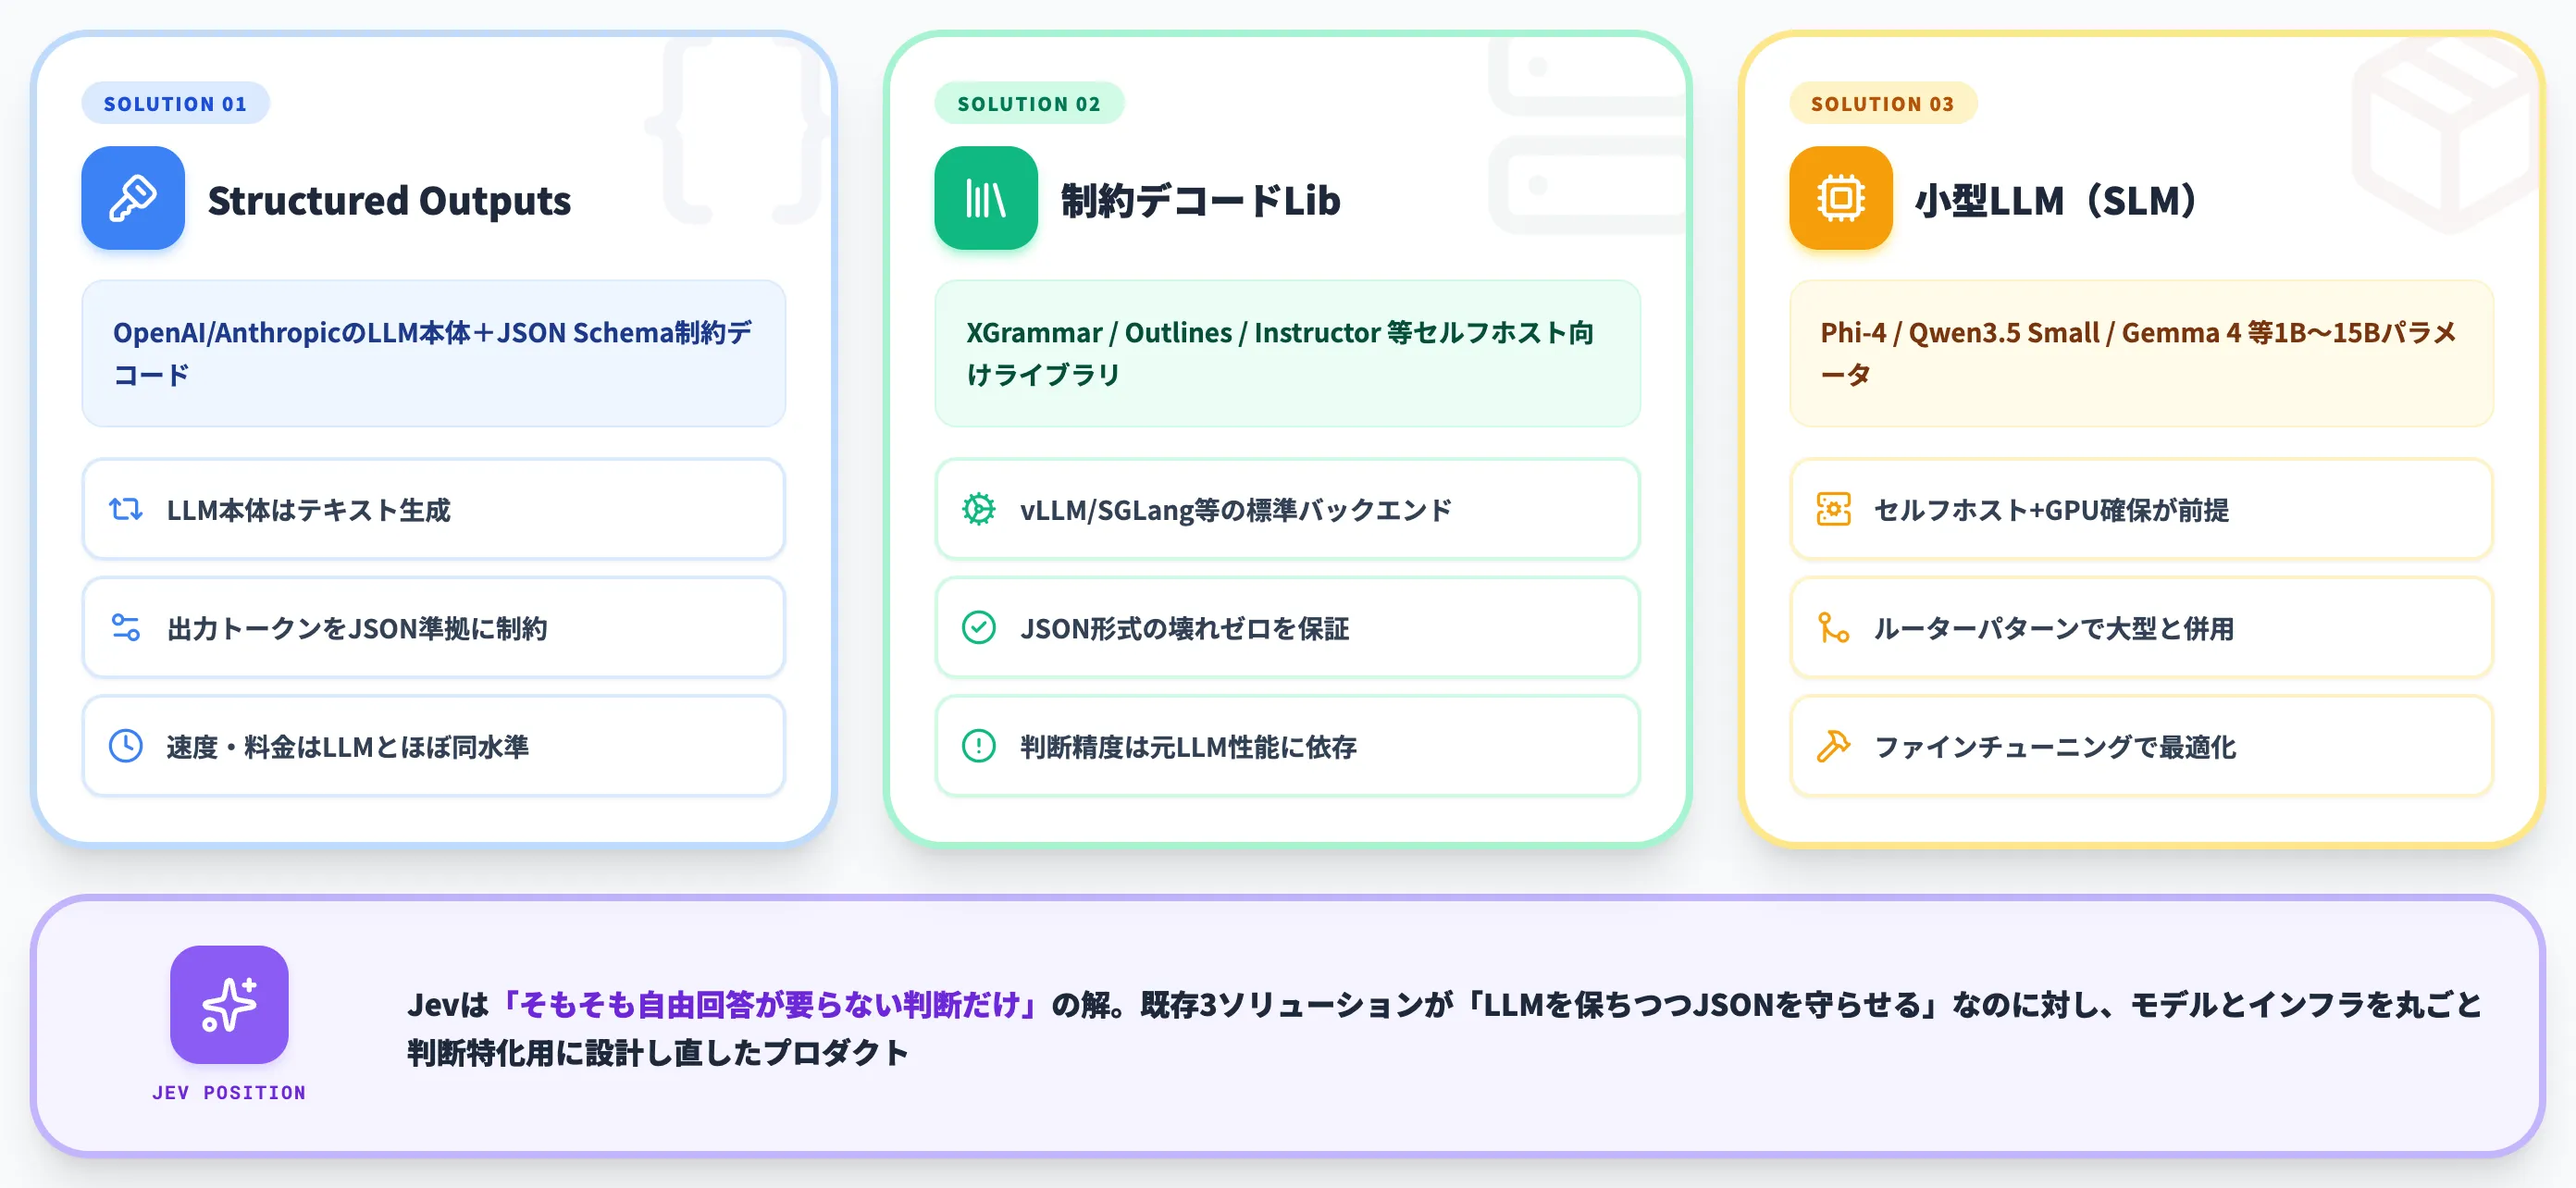
Structured Outputs/XGrammar系/小型LLMとJevの俯瞰マップ——Jevは「そもそも自由回答が要らない判断だけ」を担う位置づけ
OpenAI Structured Outputs・Anthropic Structured Outputsとの違い
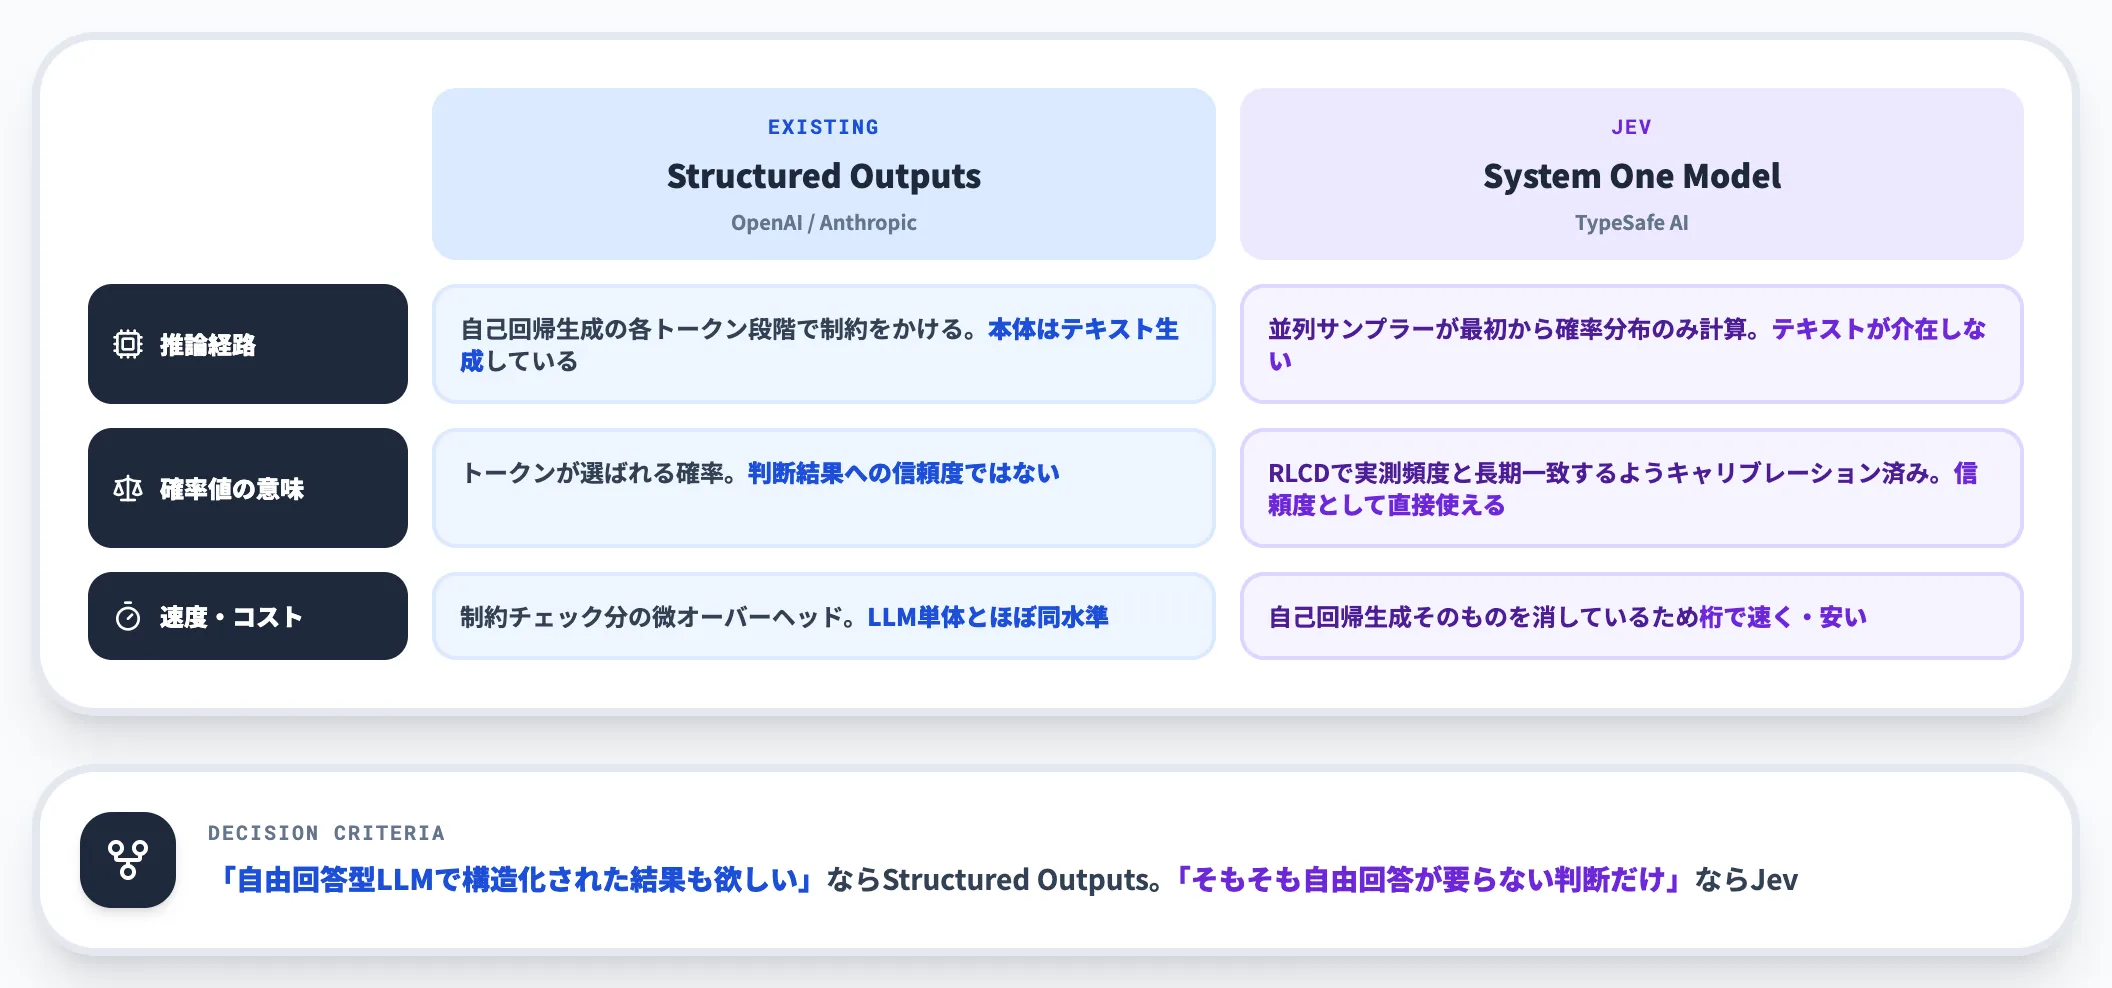
3観点(推論経路/確率値の意味/速度コスト)比較——LLM本体はテキスト生成のStructured Outputsに対し、Jevは並列サンプラーで確率のみ計算
OpenAIのStructured OutputsやAnthropicのStructured Outputs(JSON outputs/strict tool use)は、LLM本体はテキストを生成しつつ、その出力をJSON Schemaに沿った形に制約する仕組みです。両社とも裏側ではconstrained decodingを用い、無効なトークンをマスキングして正しいJSONやツール引数だけを吐き出させる設計だと公式に説明しています。
Jevとの本質的な違いは、以下の3点にあります。
-
推論経路の違い
Structured Outputsは自己回帰生成の各トークン段階で制約をかけるだけで、モデル本体はテキスト生成しています。Jevは並列サンプラーが最初から確率分布だけを計算するため、テキストが介在しません。
-
確率値の意味の違い
LLMのStructured Outputsで得られるトークン確率は、そのトークンが選ばれる確率であって、判断結果への信頼度ではありません。RLCDで訓練されたJevは選択肢の確率分布そのものが実測頻度と長期一致するようキャリブレーションされており、その分布から算出される confidence を確実性のシグナルとして扱いやすくなります(具体の閾値は自社データで検証したうえで確定させます)。
-
速度・コストの桁の違い
Structured Outputsは制約チェックが追加されるぶんLLM推論の上に微オーバーヘッドが乗るため、レイテンシと料金はLLM単体とほぼ同じ水準です。Jevは自己回帰生成そのものを消しているので、桁で速く・安くなります。
Structured Outputsは「自由回答型のLLMで構造化された結果も欲しい」場合の解、Jevは「そもそも自由回答が要らない判断だけ」の解、という切り分けになります。Function Calling経由でLLMを呼んでいるパイプラインなら、そのなかで「判断だけの関数呼び出し」を切り出せるかどうかがJev適合の判定基準です。
XGrammar・Outlines・Instructorとの違い
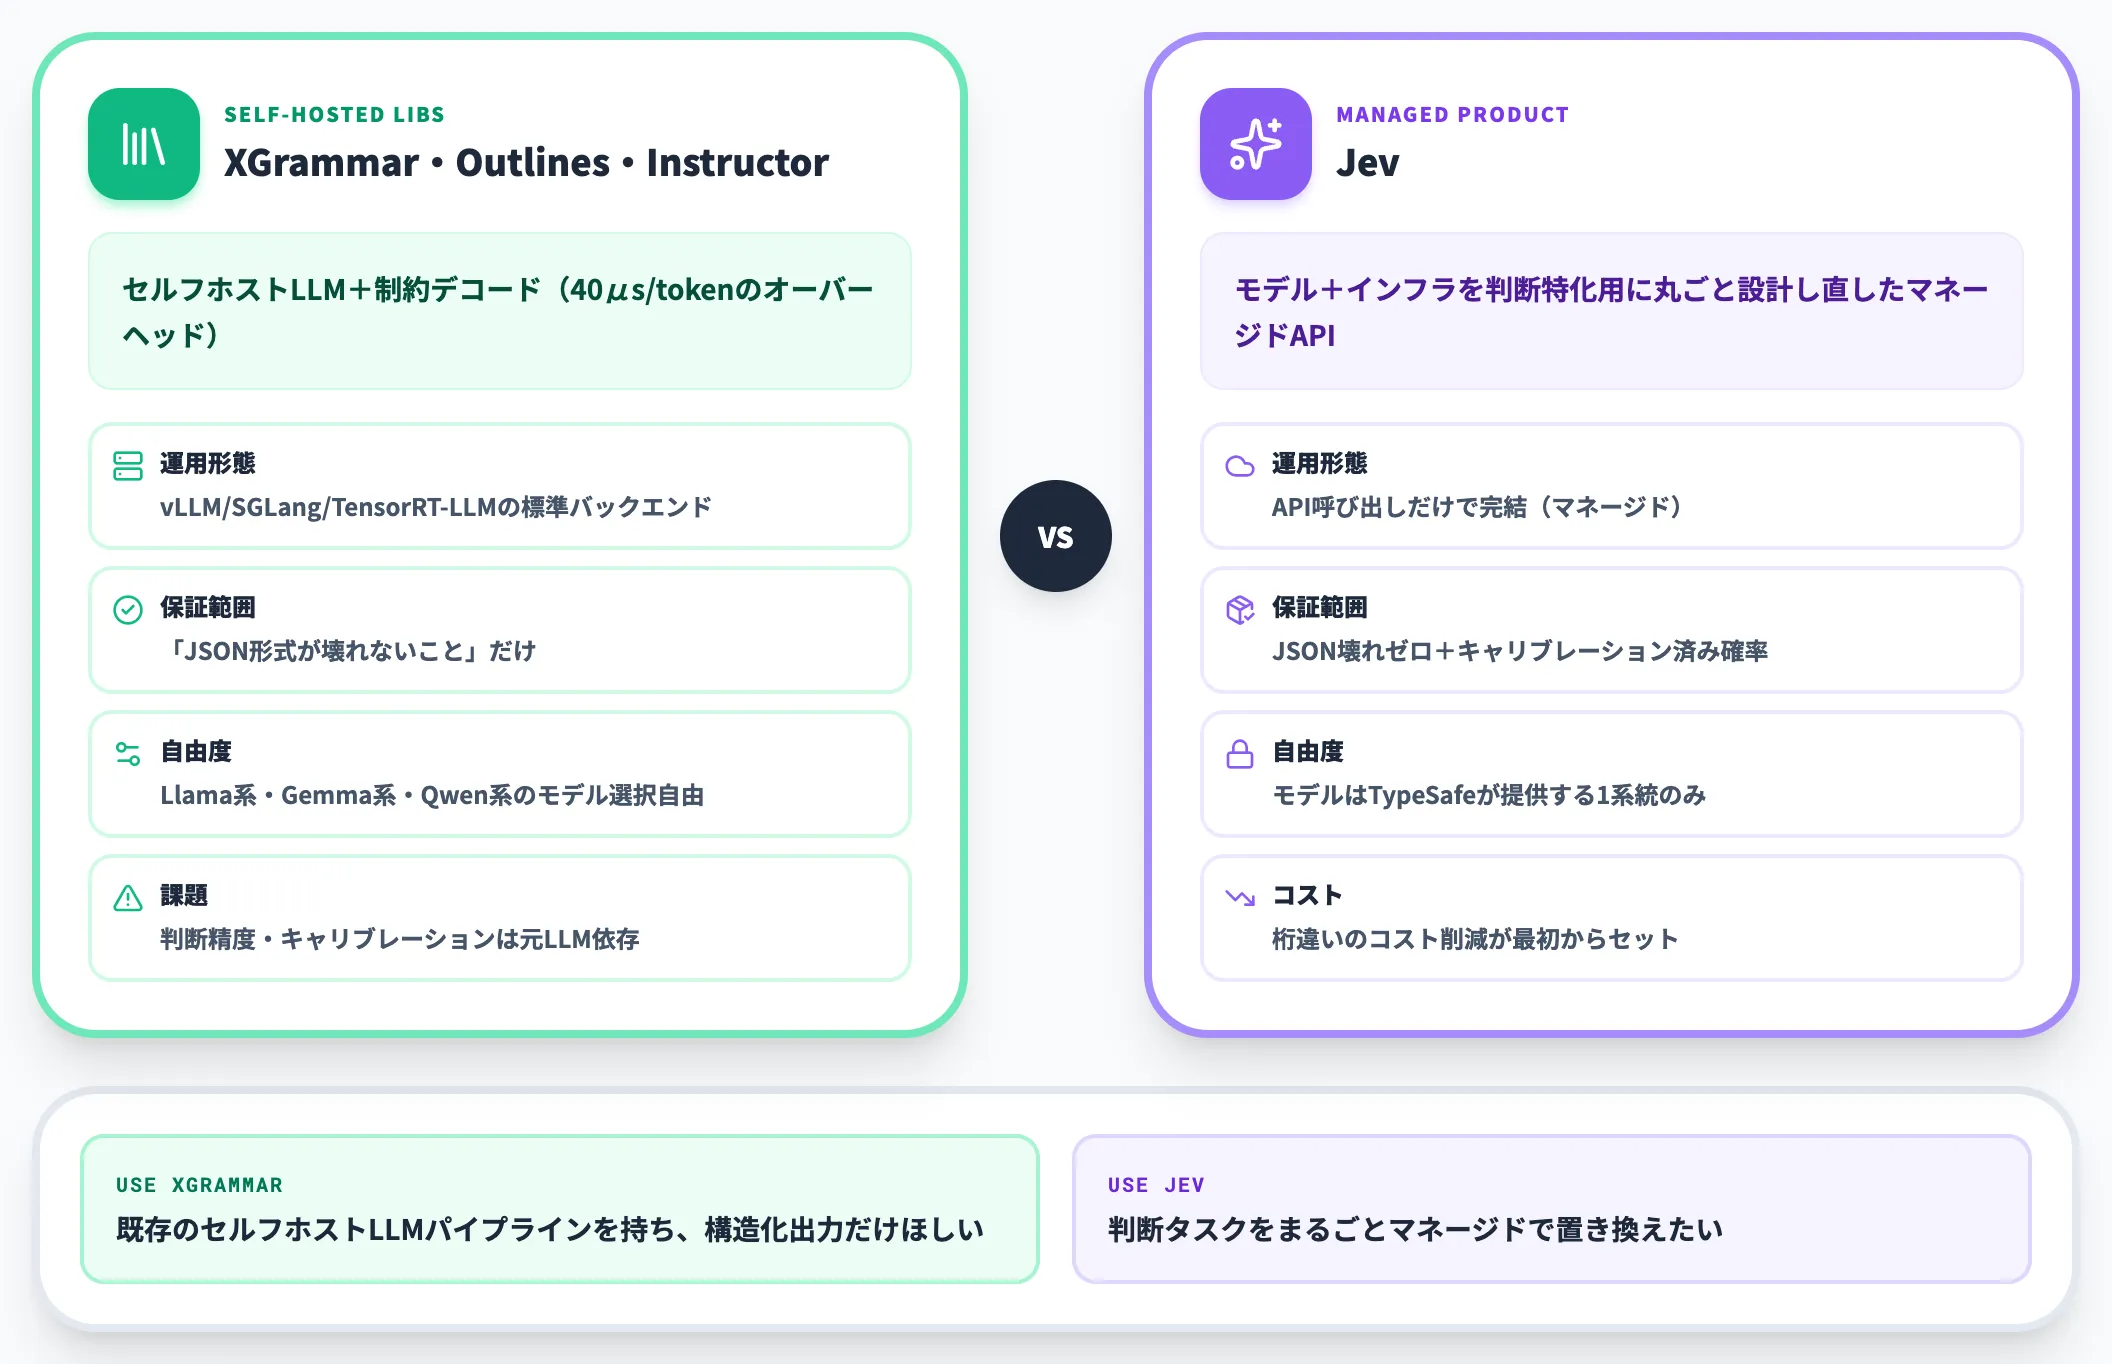
セルフホスト制約デコードLib vs Jevマネージド——保証範囲・自由度・コストで差が出る
セルフホストLLM運用の世界では、XGrammar・Outlinesといったconstrained decodingライブラリが2026年の標準になりつつあります。XGrammarはvLLM・SGLang・TensorRT-LLMの標準バックエンドとして採用され、40μs/tokenのオーバーヘッドでJSON生成の妥当性を保証します。Instructorはこれらとは系統が異なり、既存LLM APIの上でPydantic型定義・バリデーション・自動再試行を担うクライアント側のライブラリです。
これらのライブラリを使えば、対応するオープンソースLLM(Llama系・Gemma系・Qwen系)でも構造化出力を確実に得られます。ただしそこで得られるのは「JSON形式が壊れないこと」の保証であって、モデル自体の判断精度やキャリブレーションは元のLLMの性能に依存します。
Jevは「モデルとインフラを丸ごと判断特化用に設計しなおした」プロダクトなので、XGrammar系ライブラリと比べると、選べる自由度は下がりますが、キャリブレーションと0%エラー率と桁違いのコスト削減が最初からセットで手に入ります。既存のセルフホストLLMパイプラインを持っていて構造化出力だけほしいならXGrammar、判断タスクをまるごとマネージドで置き換えたいならJev、という使い分けになります。
Phi-4・Qwen3.5 Smallなど小型モデルとの違い
Phi-4・Qwen3.5 Small・Gemma 4など1B〜15Bパラメータ帯の小型LLMも、classificationやrouting用途で近年注目を集めてきました。「多くの処理をSLMで行い、難しいケースだけ大型LLMに回す」というルーターパターンは、2026年時点の実装パターンの一つです。
Jevと小型LLMの違いは、次の2点で判断できます。
-
モデルの担当粒度
小型LLMは依然として自己回帰生成モデルなので、テキスト生成もできれば分類もこなす汎用モデルです。Jevはテキスト生成能力自体がありません。判断だけを担当します。
-
本番運用のオペレーションコスト
小型LLMをセルフホストで動かすには、GPU確保・vLLM/SGLang等の運用・XGrammarの導入・キャリブレーション調整といった運用工程がすべて載ってきます。JevはTypeSafeのマネージドAPIなので、API呼び出しだけで完結します。
自社でLLMインフラを持っていて小型LLMのファインチューニングを回せる組織なら、Phi-4系のセルフホスト運用に軍配が上がる場面もあります。逆に「判断ステップを1本のAPIで済ませたい」なら、Jevのマネージド提供のほうが実装工数は短くなります。
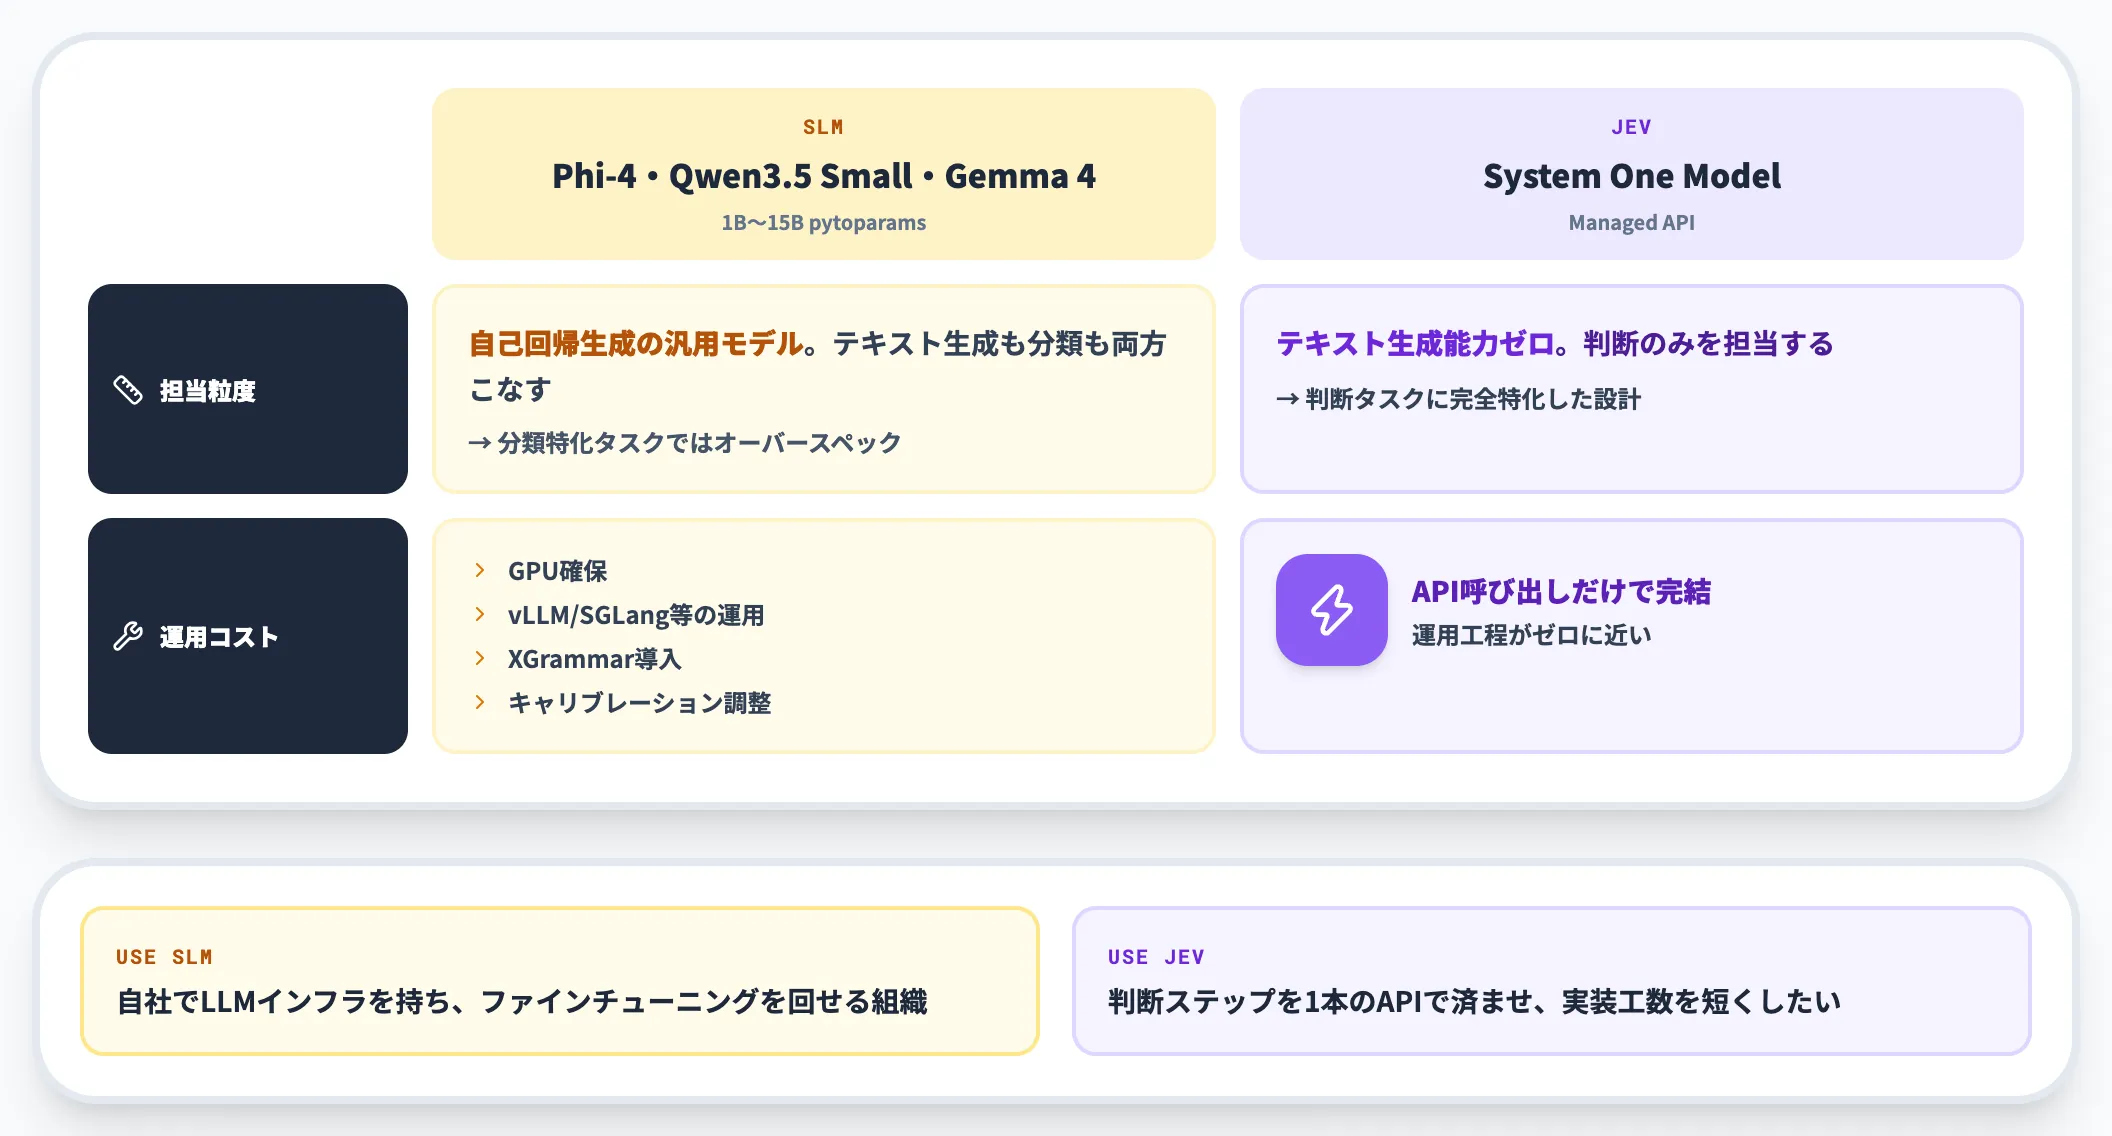
小型LLM(セルフホスト) vs Jev(マネージドAPI)——担当粒度と運用工程の差で使い分けが決まる
既存パイプラインでJevを差し込める5つの場所
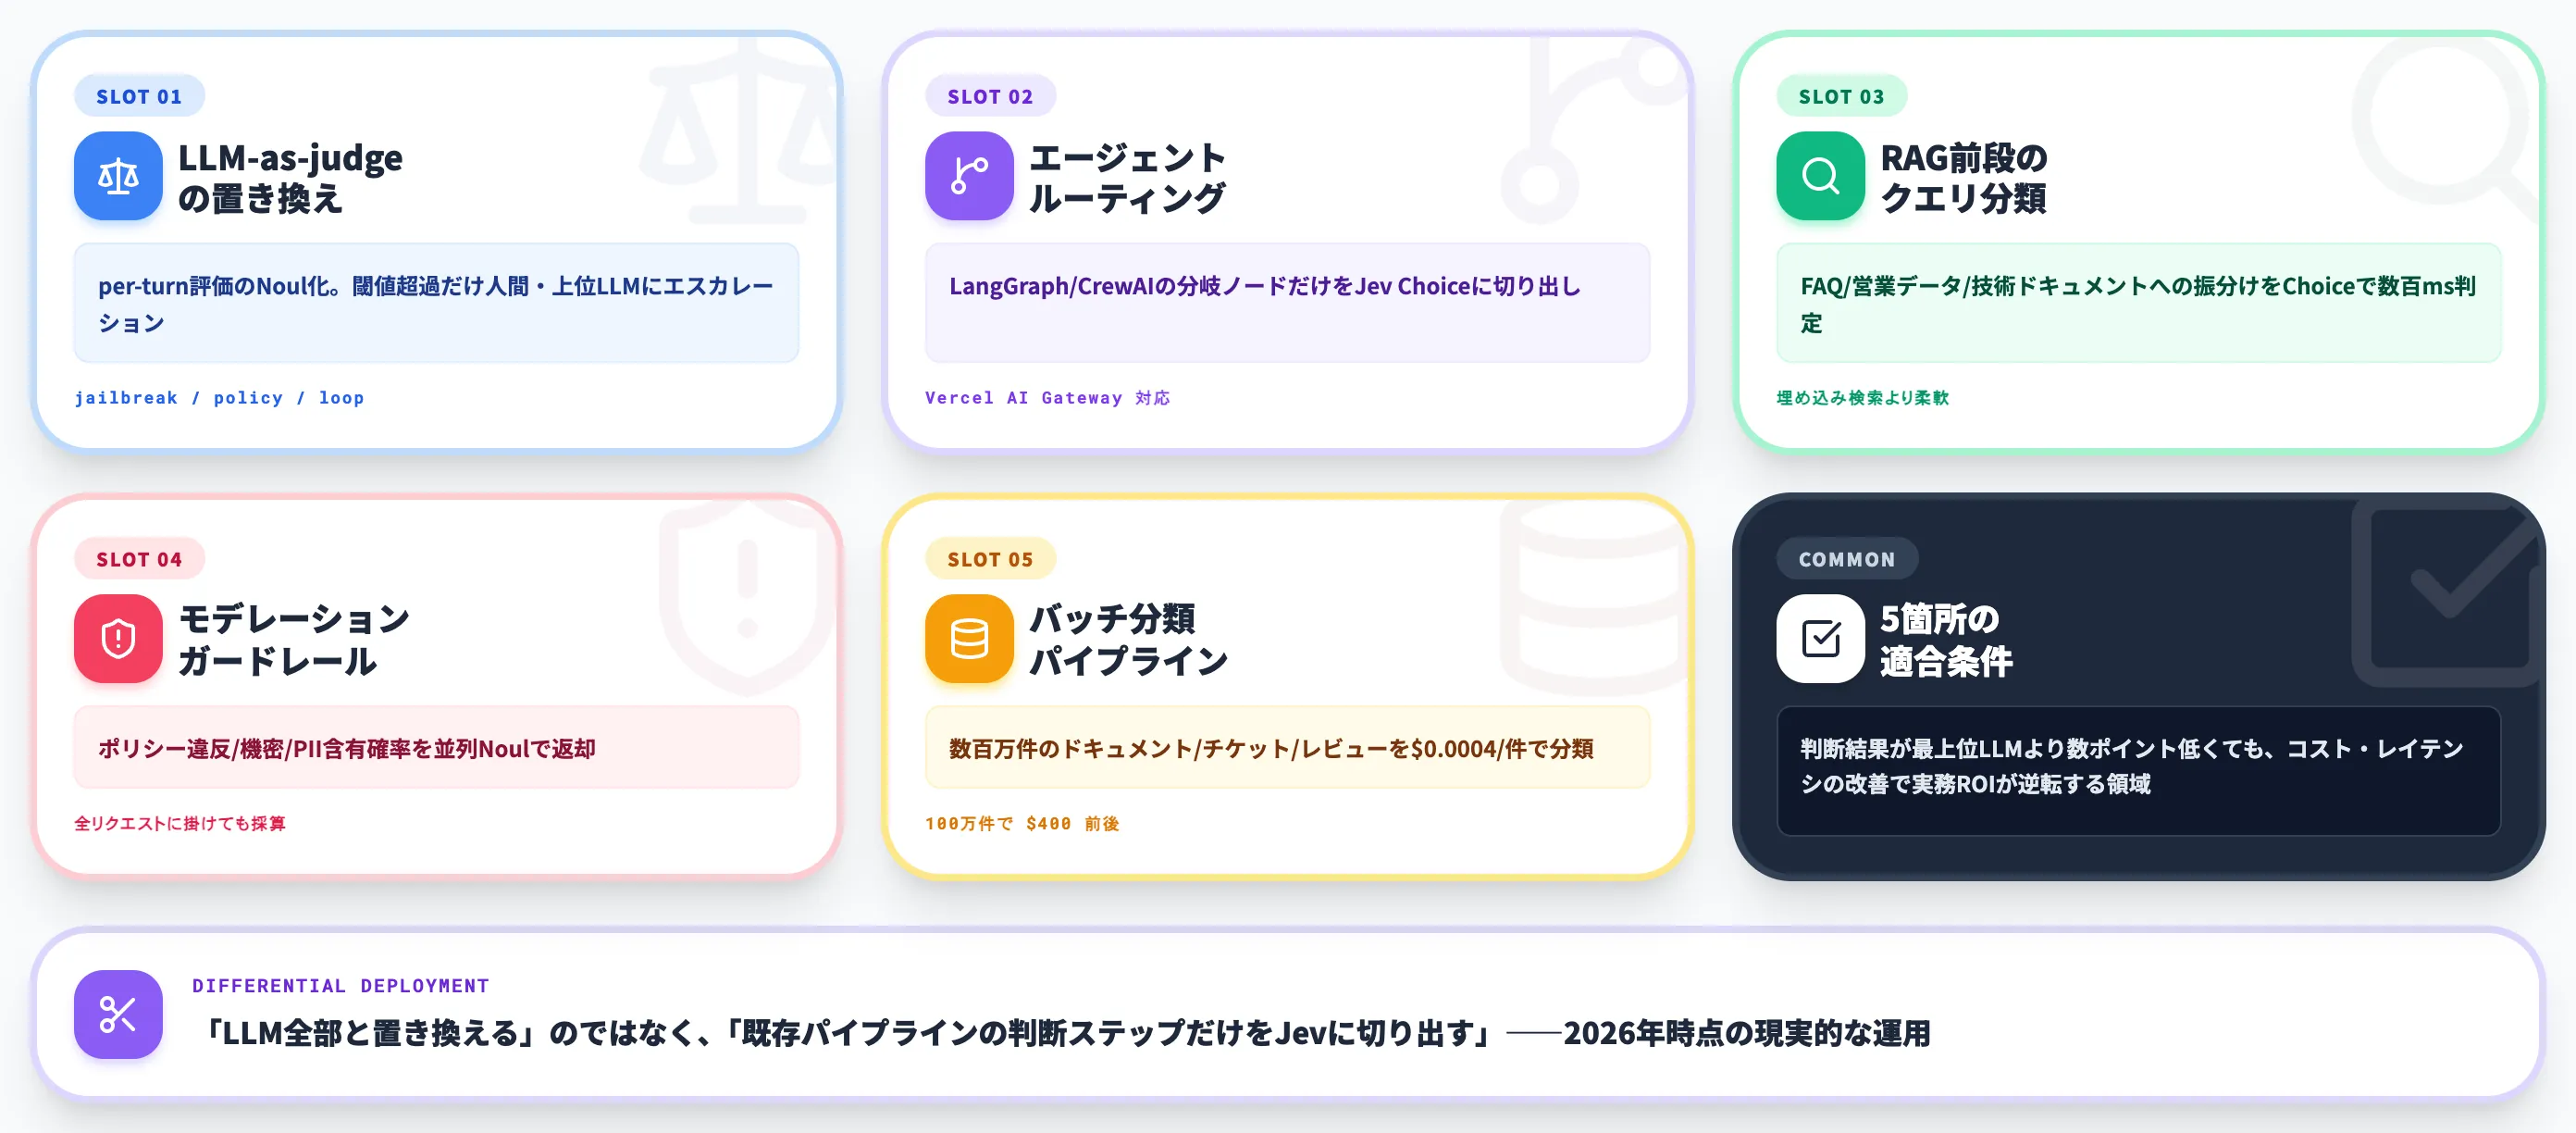
5つの差し込みポイント(LLM-as-judge/ルーティング/RAG前段/ガードレール/バッチ分類)俯瞰——精度差より単価とレイテンシ改善で実務ROIが逆転する領域
Jevを「LLM全部と置き換える」のではなく、「既存パイプラインの判断ステップだけをJevに切り出す」という差し込み型で使うのが、2026年時点の現実的な運用方針です。
以下はセキュリティインシデント対応の4段階フローです。
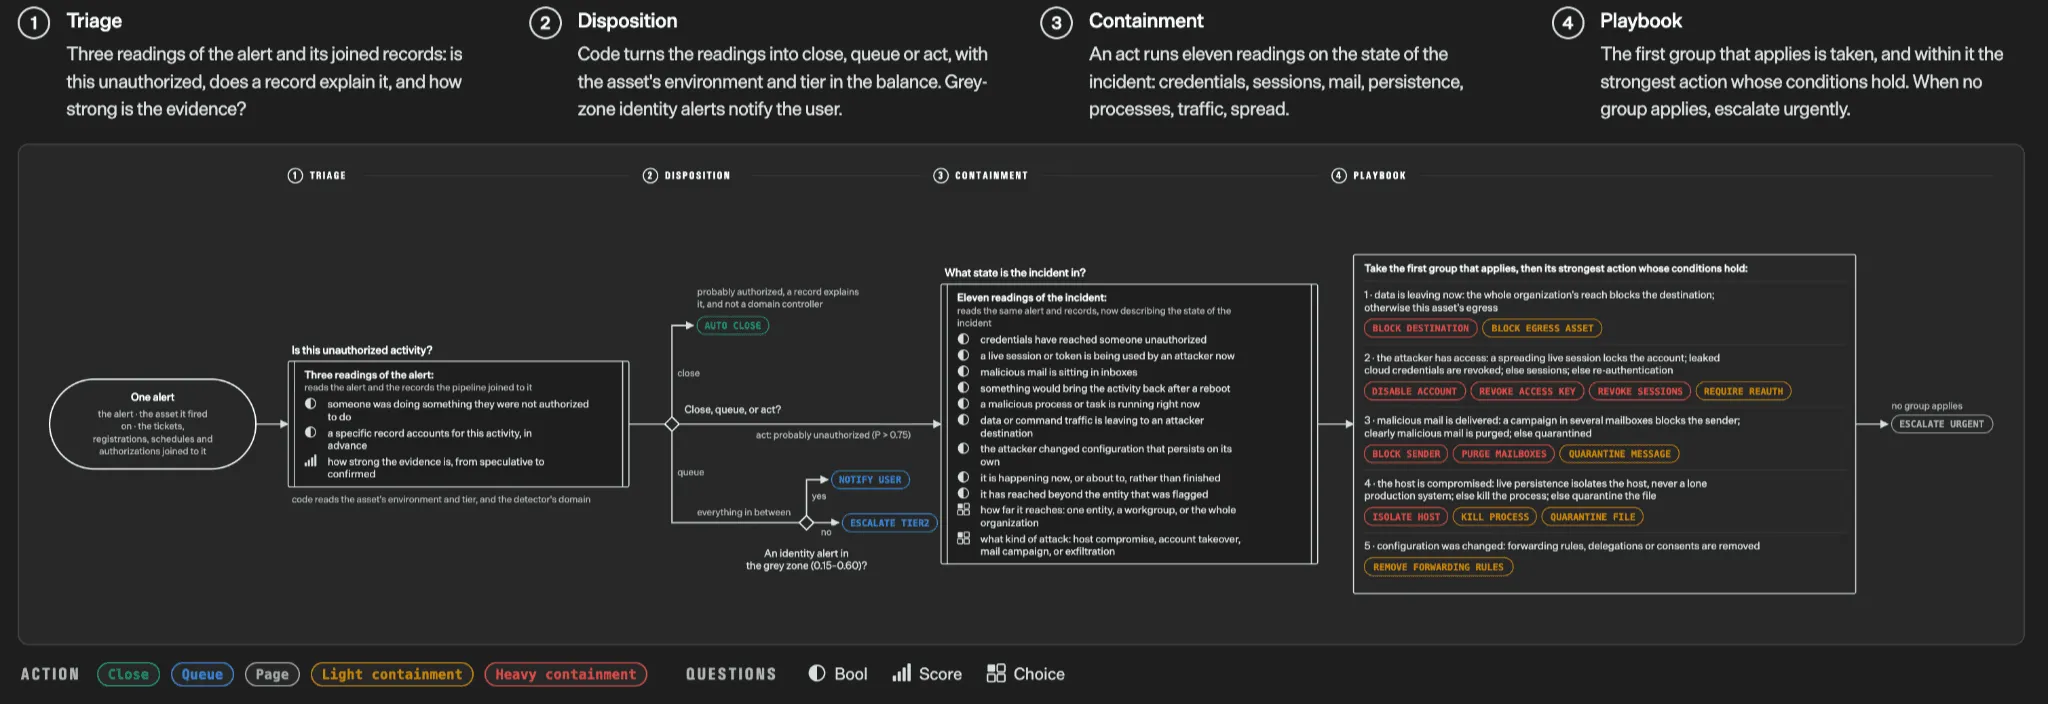
JevをTriage→Disposition→Containment→Playbookの4段階でセキュリティインシデント対応に組み込んだ実装例(出典:Introducing System One Models & Jev)
4段階の起点はTriage(分類)で、アラートに対して「不正か」「記録が説明するか」「証拠強度は何段階か」の3つをBool・Score・Choiceで並列判定します。次のDispositionでコードが結果をClose/Queue/Actに振り分け、Containmentでは11個のNoulでインシデント状態を細かく読み取ります。最後のPlaybookで条件を満たしたアクション(BLOCK DESTINATION・DISABLE ACCOUNT・ISOLATE HOST等)を実行する構成で、Jevは各判定ノードにだけ差し込まれ、フロー全体の分岐と実行はコード側が担っています。差し込みポイントの粒度感覚をつかむのに、実装例としてそのまま参考にできます。
LLM-as-judgeの置き換え
エージェントやプロンプトの品質評価にLLM-as-judge(LLMに評価役を任せる手法)を使う運用は広まっていますが、per-turnで毎回LLMを呼ぶのはコストとレイテンシの両面で厳しくなります。
Jevで置き換えるのは「jailbreak_attemptか否か」「policy_violationの有無」「is_agent_loopingか」といったYes/No型のper-turn評価です。Noulで確率を返せば、閾値を超えたケースだけ人間や上位LLMにエスカレーションできます。反復的な大量判断を担うレイヤーとして、単価とレイテンシの両面でLLM-as-judgeの負荷を吸収できる位置づけです。
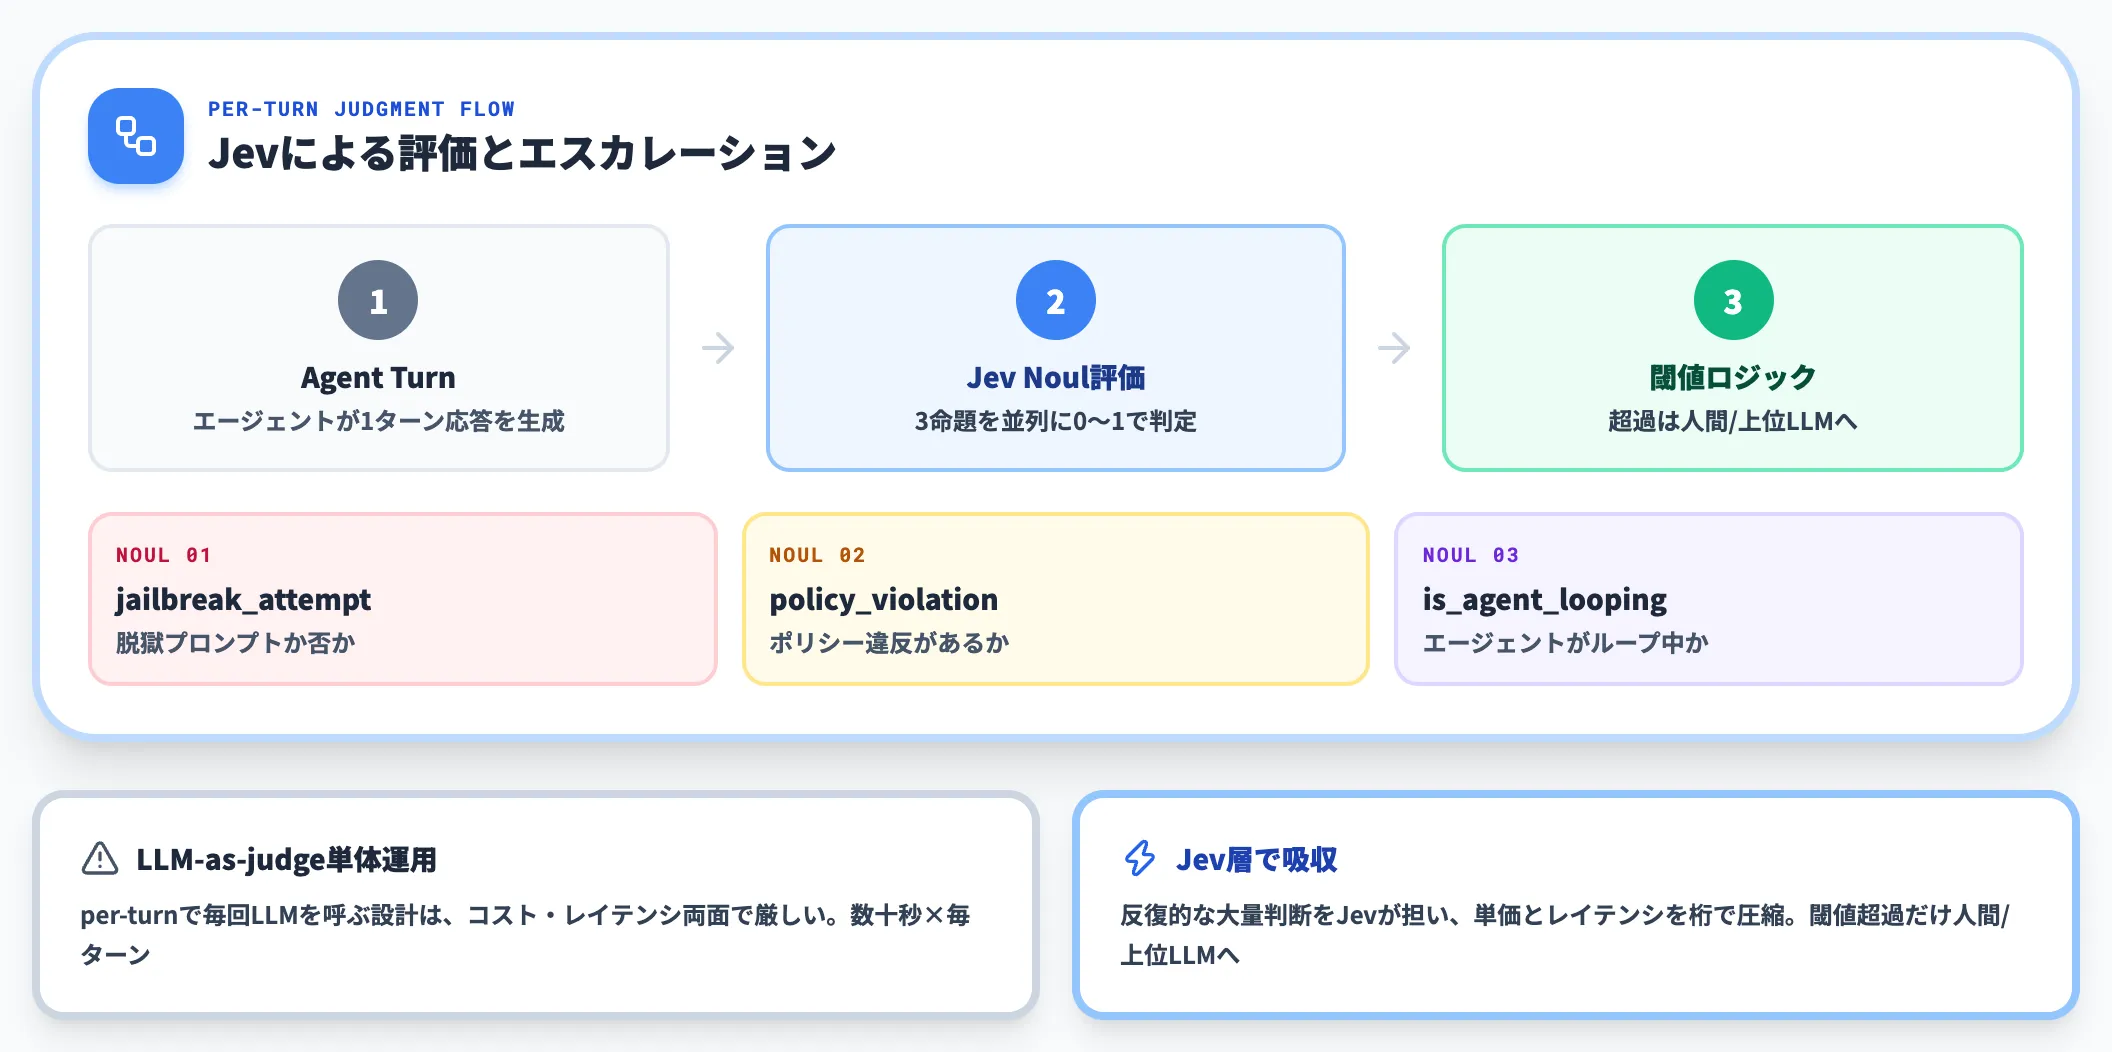
Agent Turn→Jev Noul評価→閾値ロジックの3段フロー——3命題(jailbreak/policy/loop)を並列判定してper-turn負荷を吸収
エージェントのルーティングノード
LangGraphやCrewAIで組んだエージェントのフローでは、「次にどのノードに行くか」を判断する分岐点を設けることがあります。この分岐にフロンティアLLMを呼ぶと、レイテンシと料金が重くなります。
JevはChoiceでこの分岐を担えます。フロー全体の推論本体はGPT-5.6 Solなど強力なLLMに任せ、ルーティング判断だけをJevに切り出す構成にすれば、全体のレイテンシと料金を大きく圧縮できます。Vercel AI Gateway経由なら、AI SDK 7の evaluate API越しに既存のLangGraphノードから直接呼び出せます。
Vercel AI GatewayでTypeSafe Jevが利用可能に。AI SDK 7のevaluate API経由で既存パイプラインから呼び出せる(出典:TypeSafe AI's Jev now available on AI Gateway)
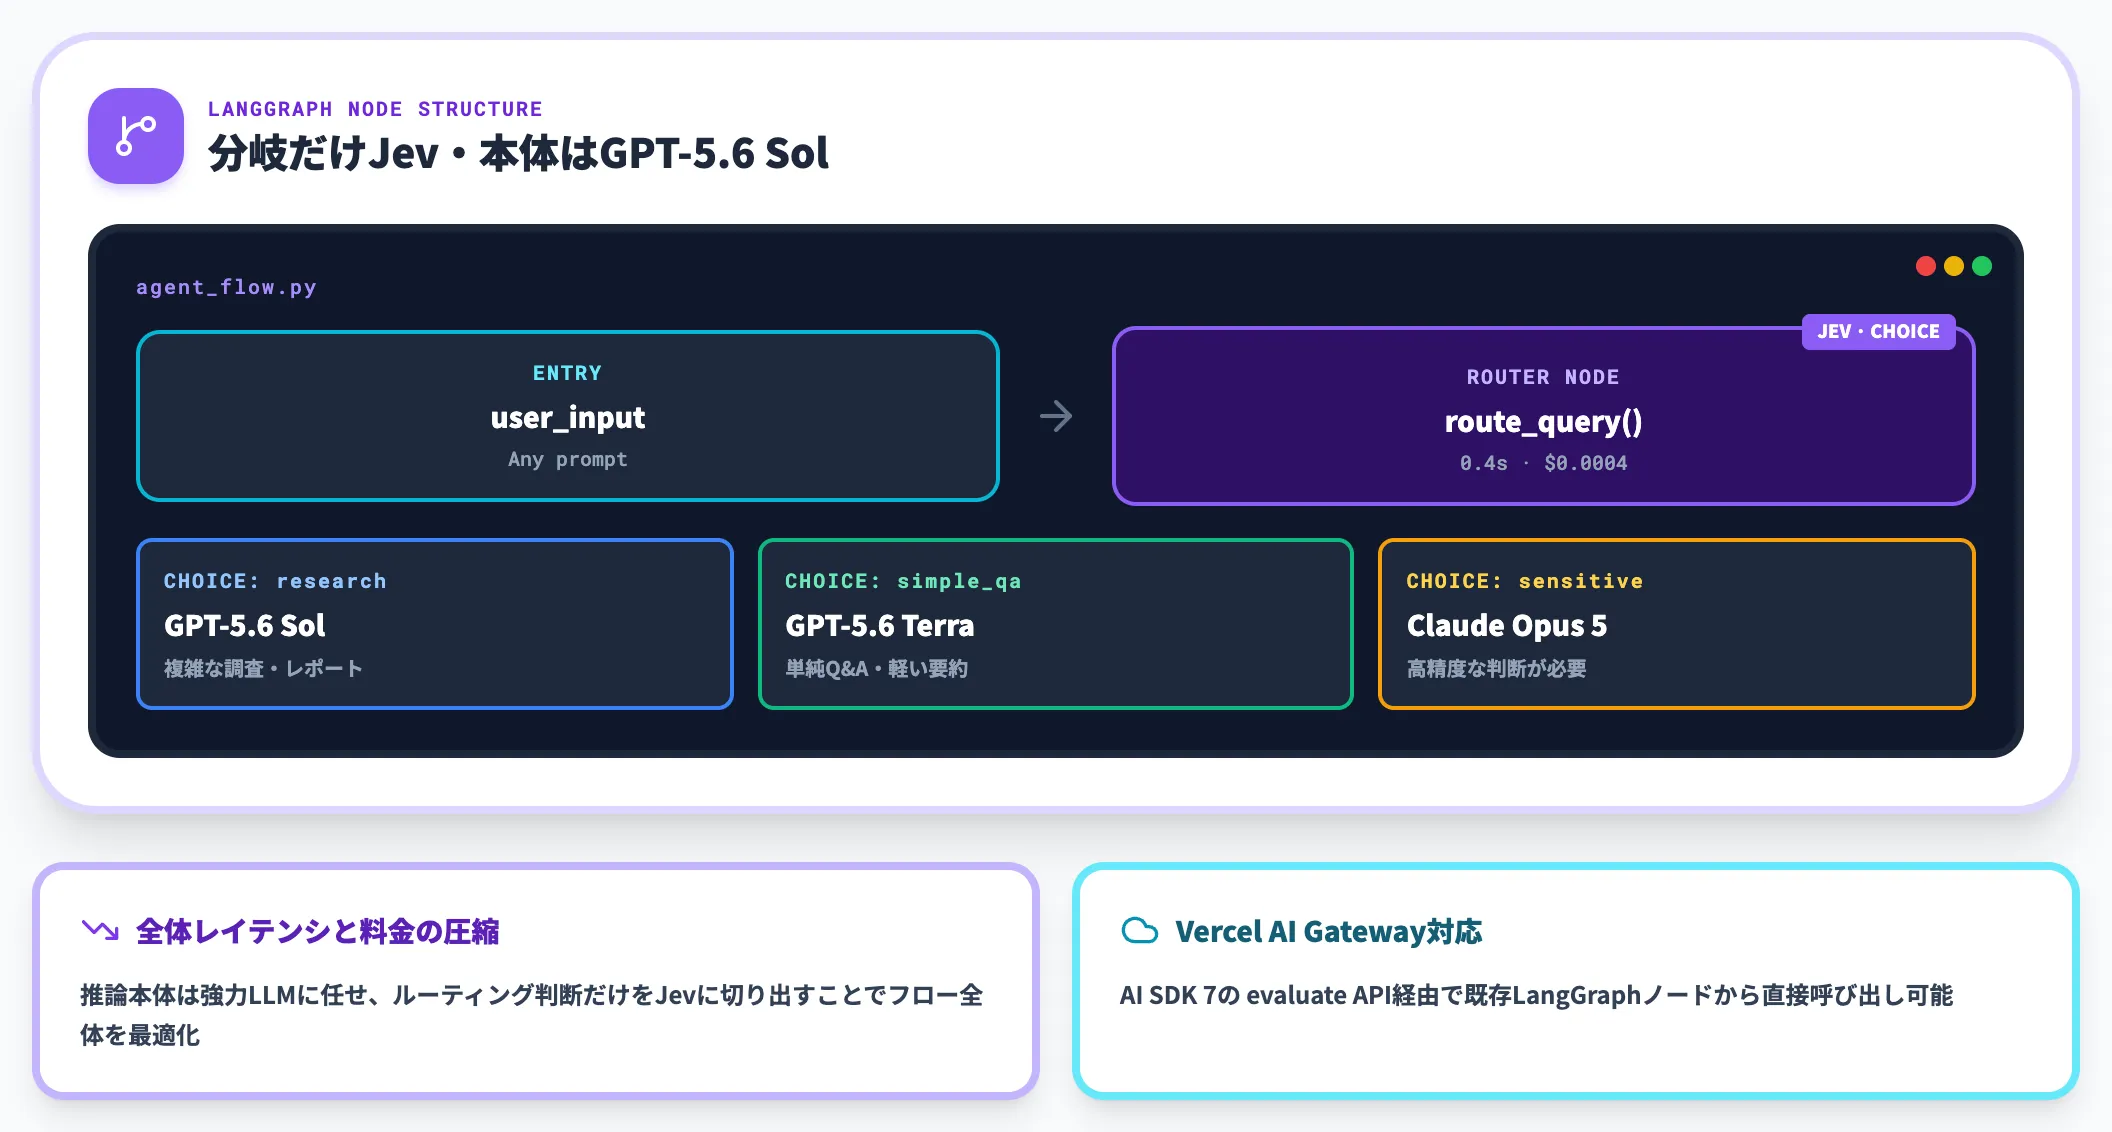
LangGraph分岐ノード模擬図——ルーティング判断だけをJev Choiceに切り出し、本体推論はGPT-5.6 Sol/Terra/Opus 5に振り分け
RAG前段のクエリ分類
RAGを組んだ社内Q&Aや検索システムには、「このクエリはFAQで済むか」「営業データを引くべきか」「技術ドキュメントに投げるべきか」を判定する前段が必要です。
この分類をJevのChoiceに任せると、埋め込み検索より柔軟で、LLM本体より圧倒的に速い分岐が組めます。特に社内システムのように応答速度が体感品質を左右する場面で、数百ms級の分岐は大きな武器になります。
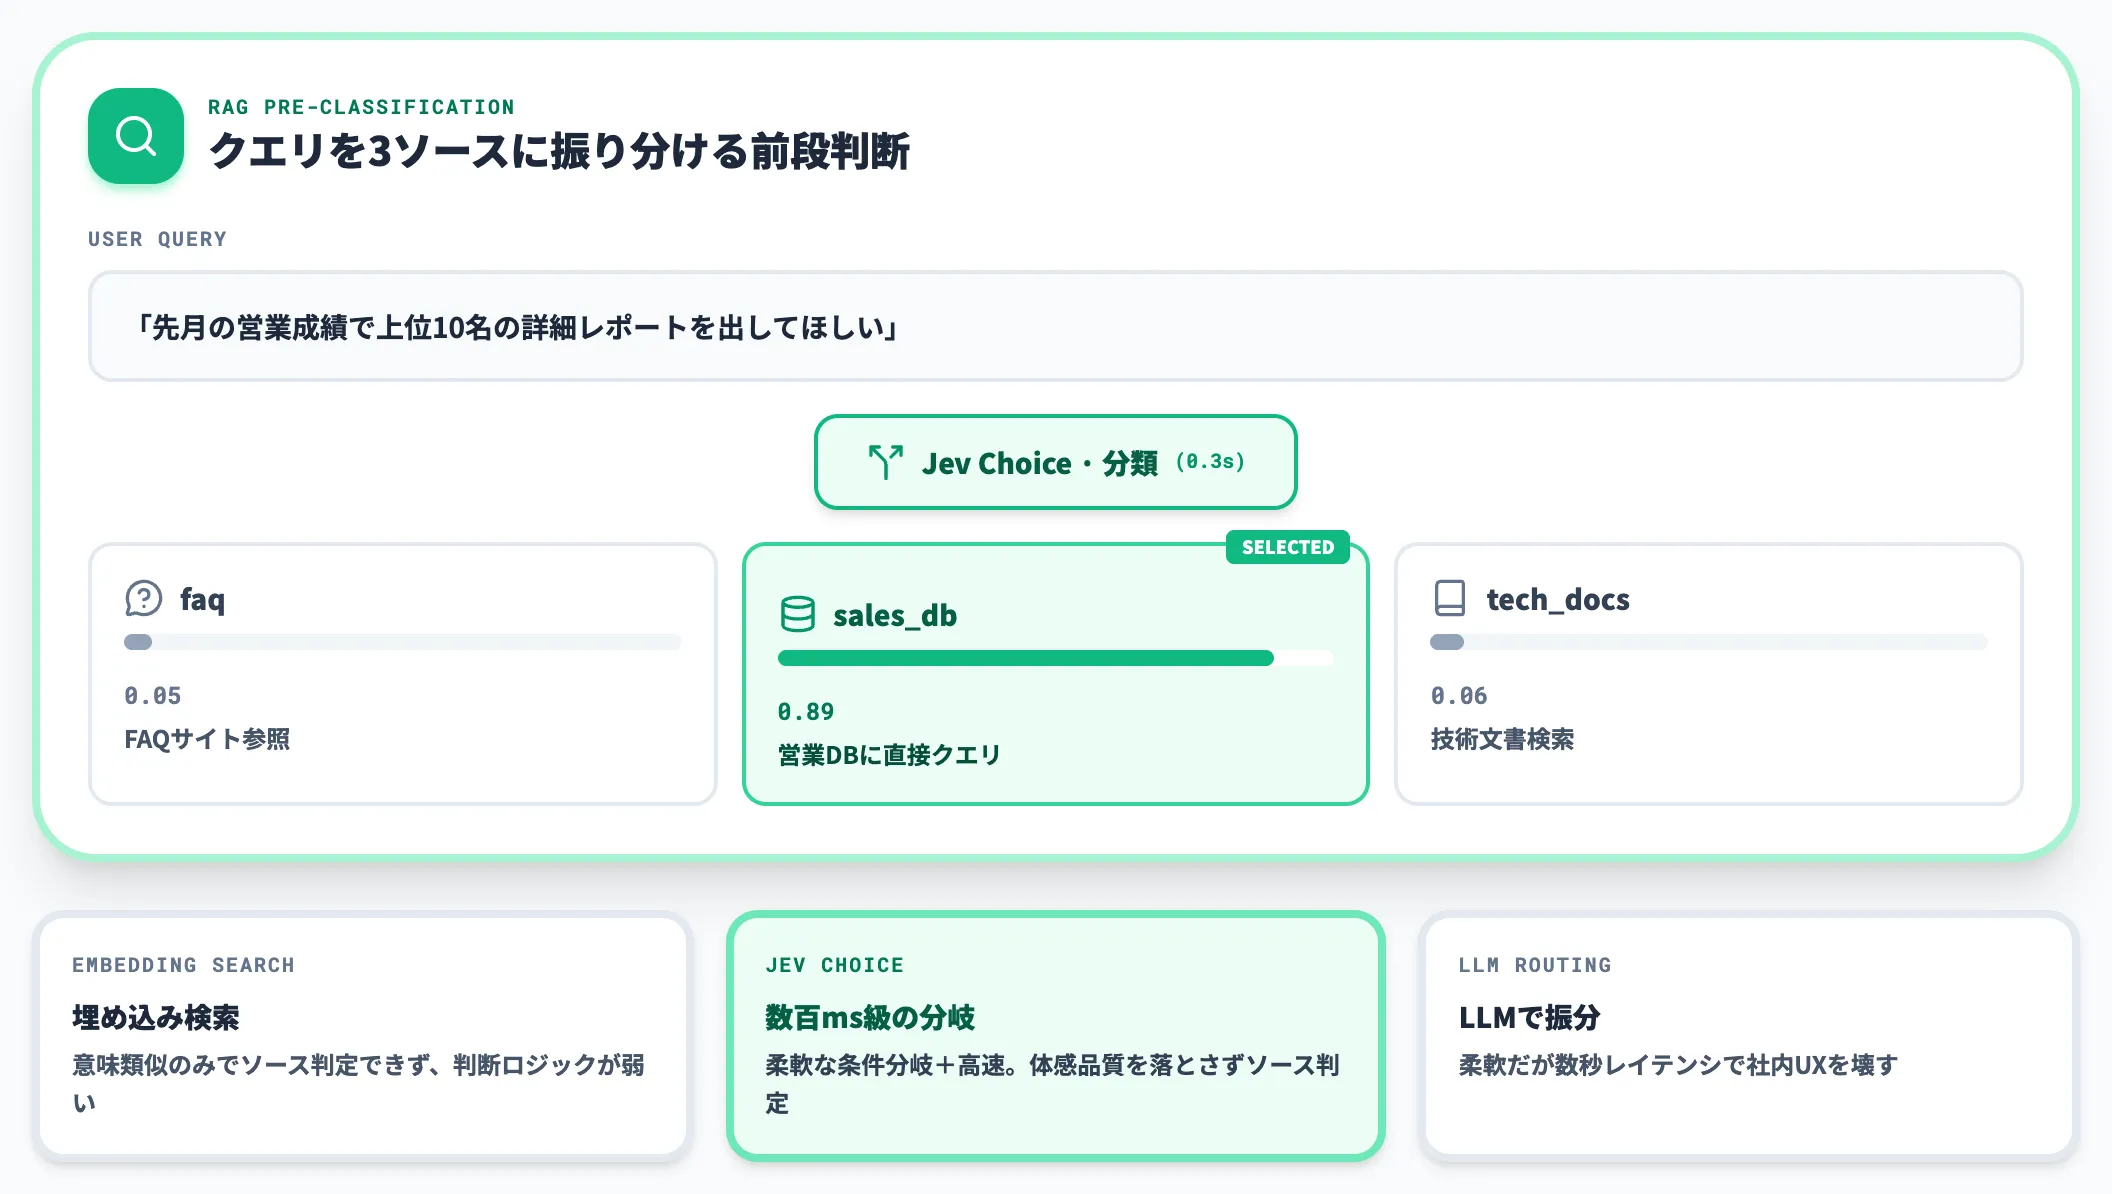
ユーザークエリ→Jev Choice→FAQ/営業DB/技術ドキュメントの3分岐——0.3秒の分岐判定で埋め込み検索より柔軟に振り分け
モデレーション・ガードレール
出力ガードレール(有害・機密情報が出ていないかのチェック)は、判断1回あたりの単価が積み重なる領域です。フロンティアLLMを毎リクエスト呼ぶと、判断コストが本体の応答生成コストを上回ることさえあります。
JevのNoulで「ポリシー違反確率」「機密情報含有確率」「PII含有確率」を並列に返させれば、$0.0004/件のコスト帯で全リクエストにガードレールを掛けられます。ここも精度差より「毎リクエスト走らせても採算が取れるか」が支配的な判断軸になります。
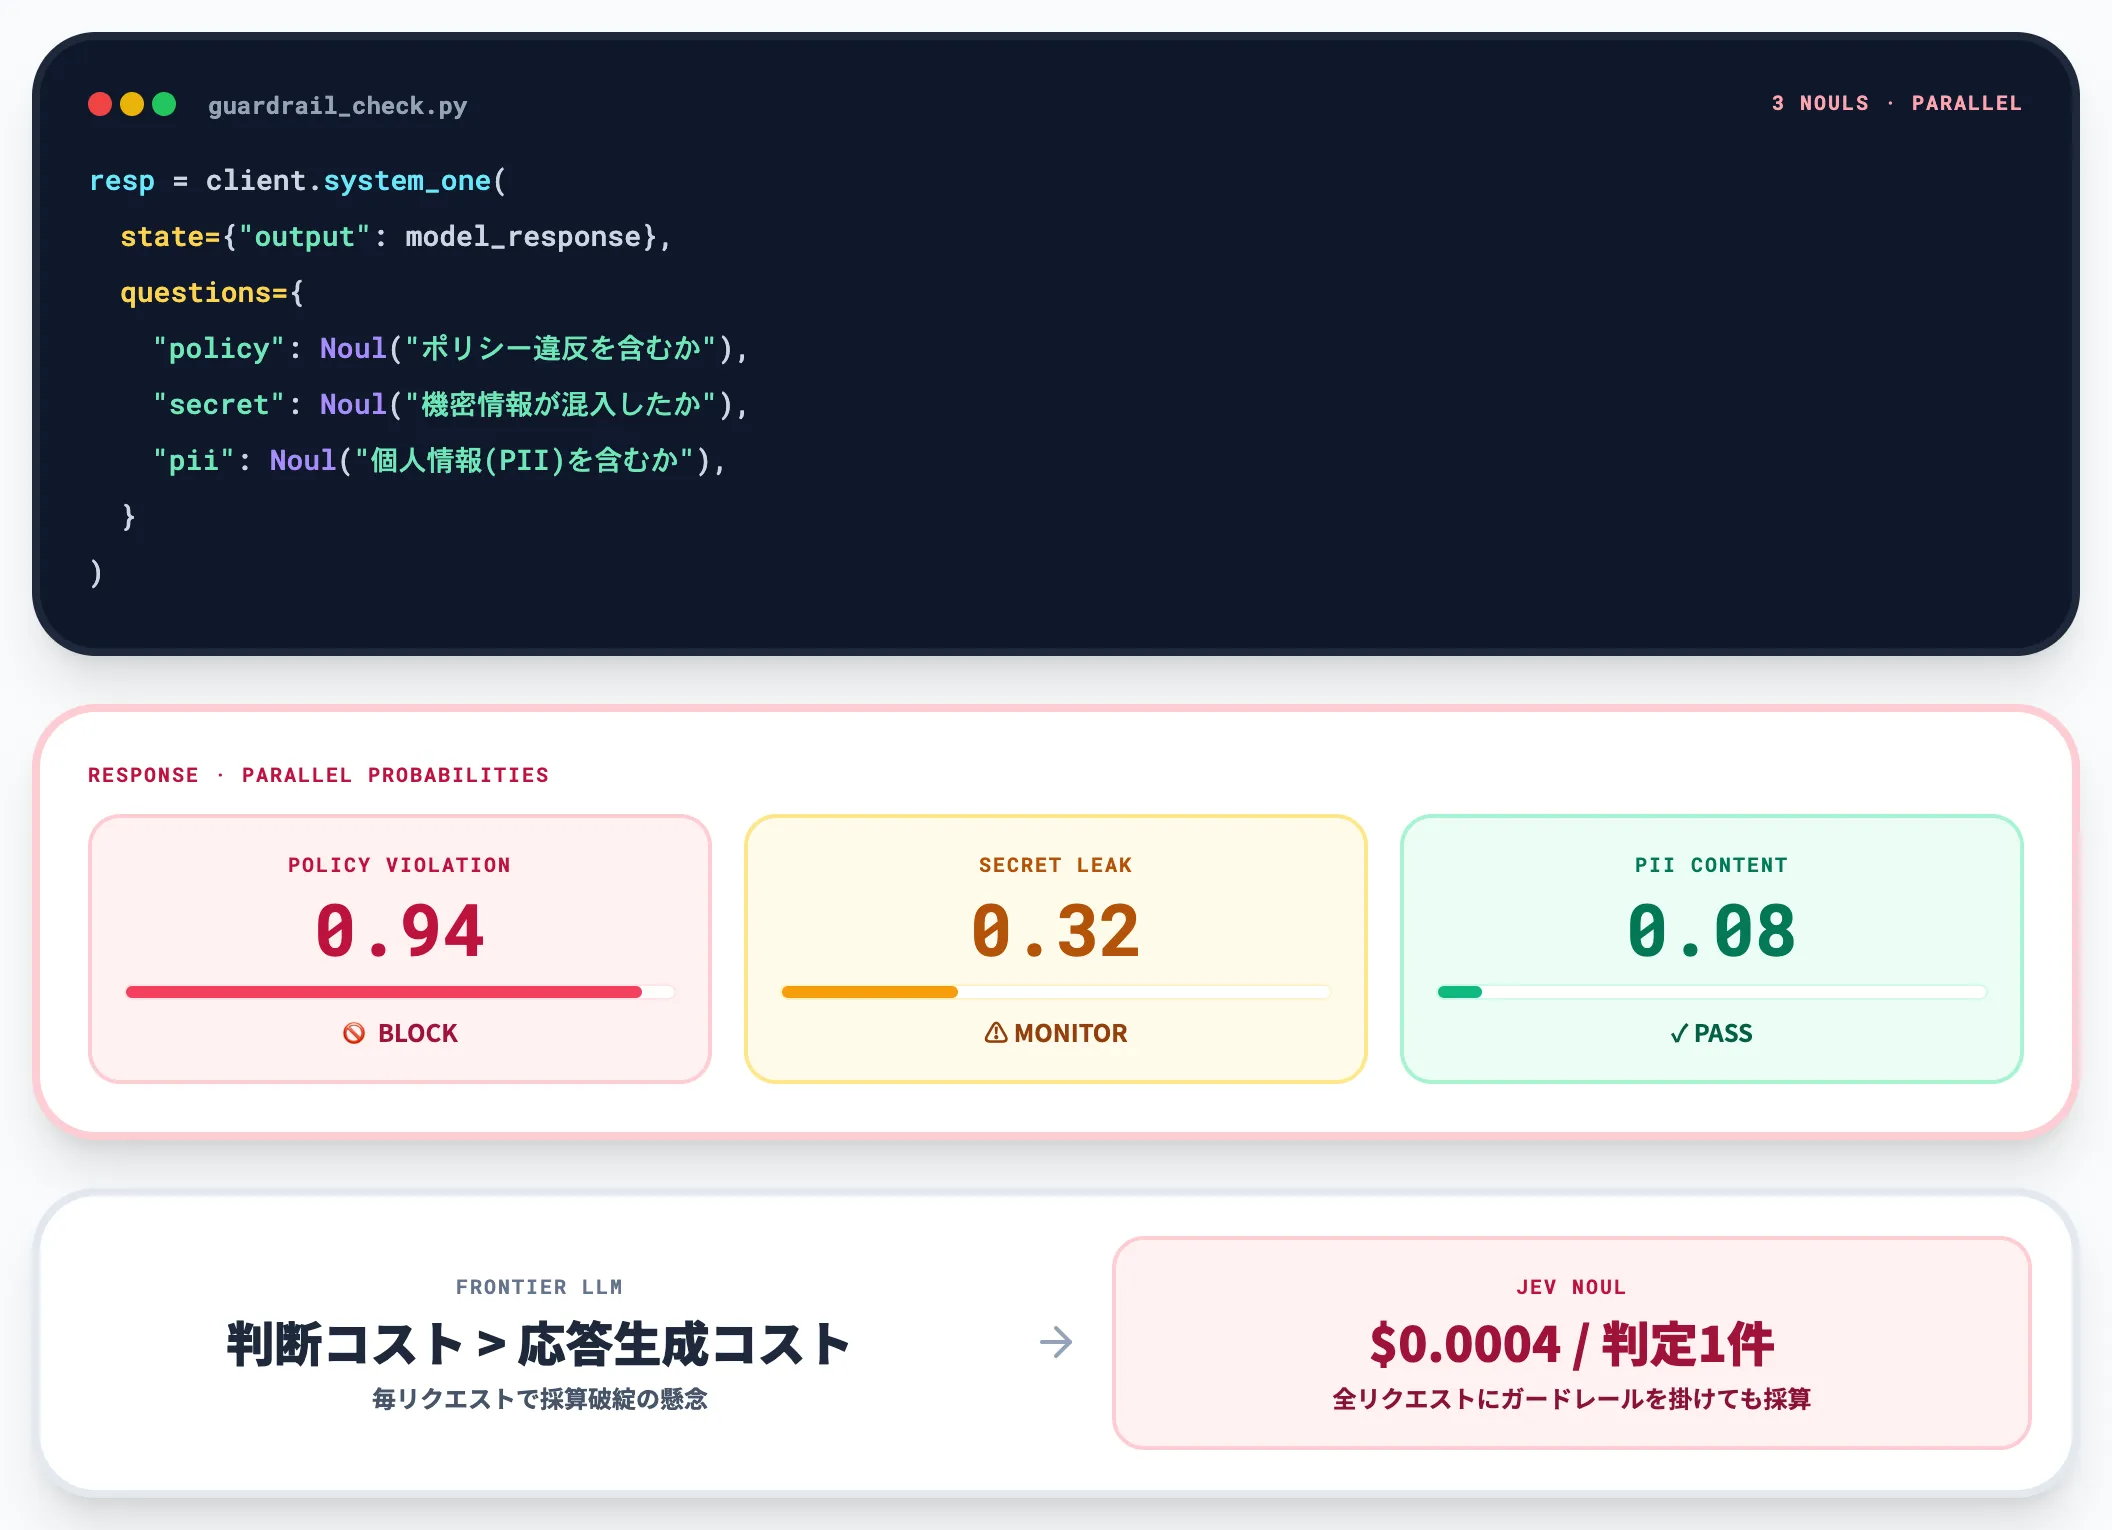
3並列Noul(policy/secret/pii)のコードモックと確率結果——判断コストが応答生成コストを上回る問題をJevで吸収
バッチ分類パイプライン
数百万件のドキュメント・チケット・レビューを分類するバッチ処理は、フロンティアLLMでは選ぶモデルによって1件あたり数円〜数十円かかるため、規模が大きくなるほど検討段階で予算が破綻します。
Jevは1件$0.0004・0.4秒の水準(4ワークフロー平均)なので、公式評価と同程度の入力長なら100万件の分類でも$400前後で見積もれます。処理時間は入力長・並列度・Rate Limit次第で、デフォルト上限(1,200 req/min)ですら理論最短で約14時間、カスタム/Enterpriseプランで Rate Limit を緩和すればさらに短縮できる、というレンジで組み立てます。判断精度が最上位LLMより数ポイント下がっても、規模の経済で回収できる典型例です。
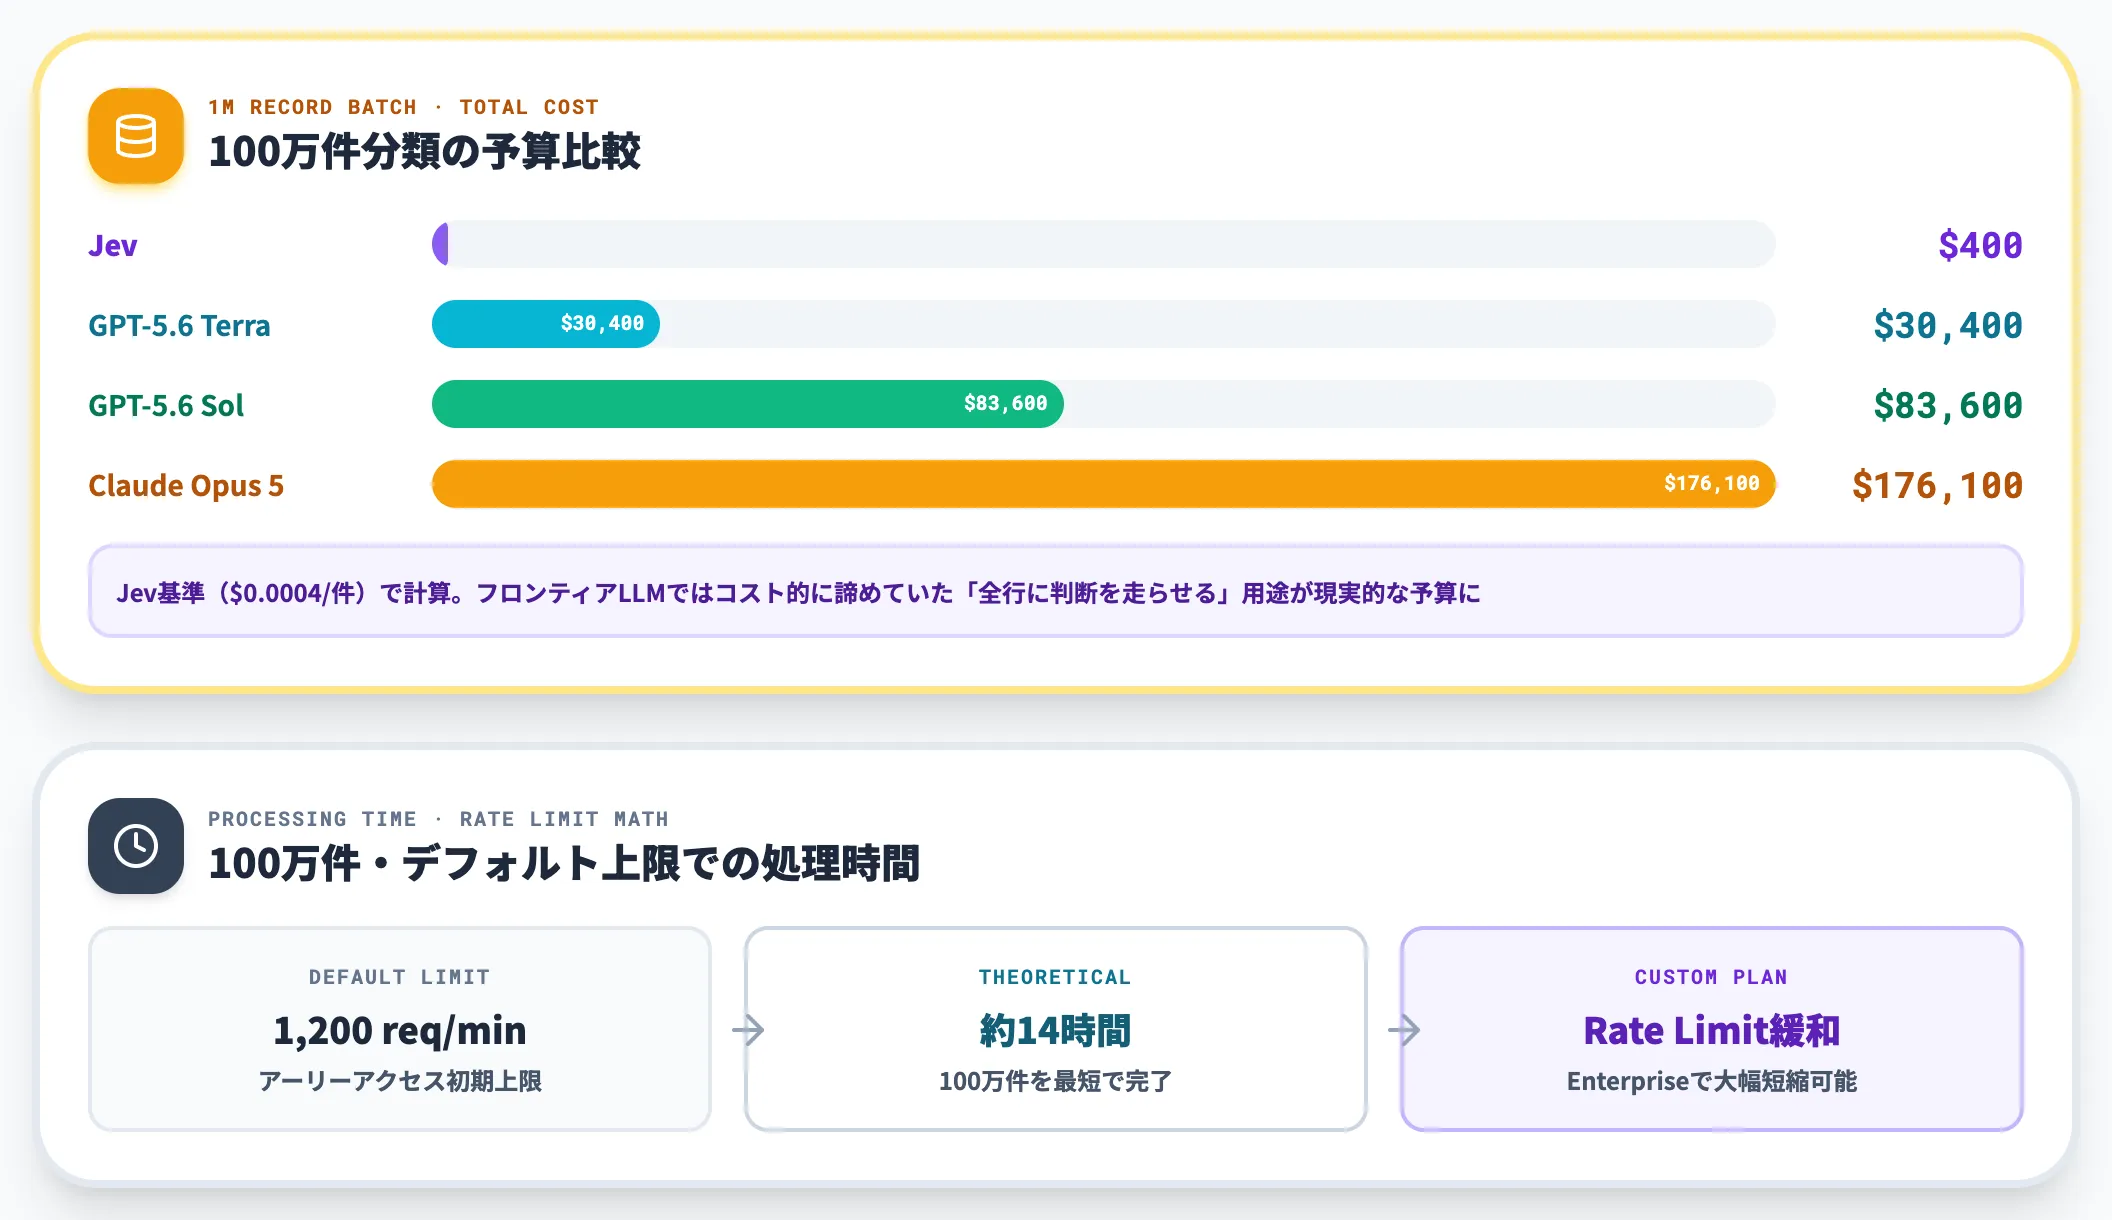
100万件処理コストの4モデル比較($400〜$176,100)と処理時間の見積もり——規模の経済でJevの精度差が回収できる典型例
これら5箇所に共通するのは、判断結果が最上位LLMより数ポイント低くても、コスト・レイテンシの改善で実務上のROIが逆転する領域という点です。逆にレポート生成・要約・自由回答が必要な工程は、既存のLLMに残す判断が引き続き有効です。
Jevを使う前に確認したい注意点
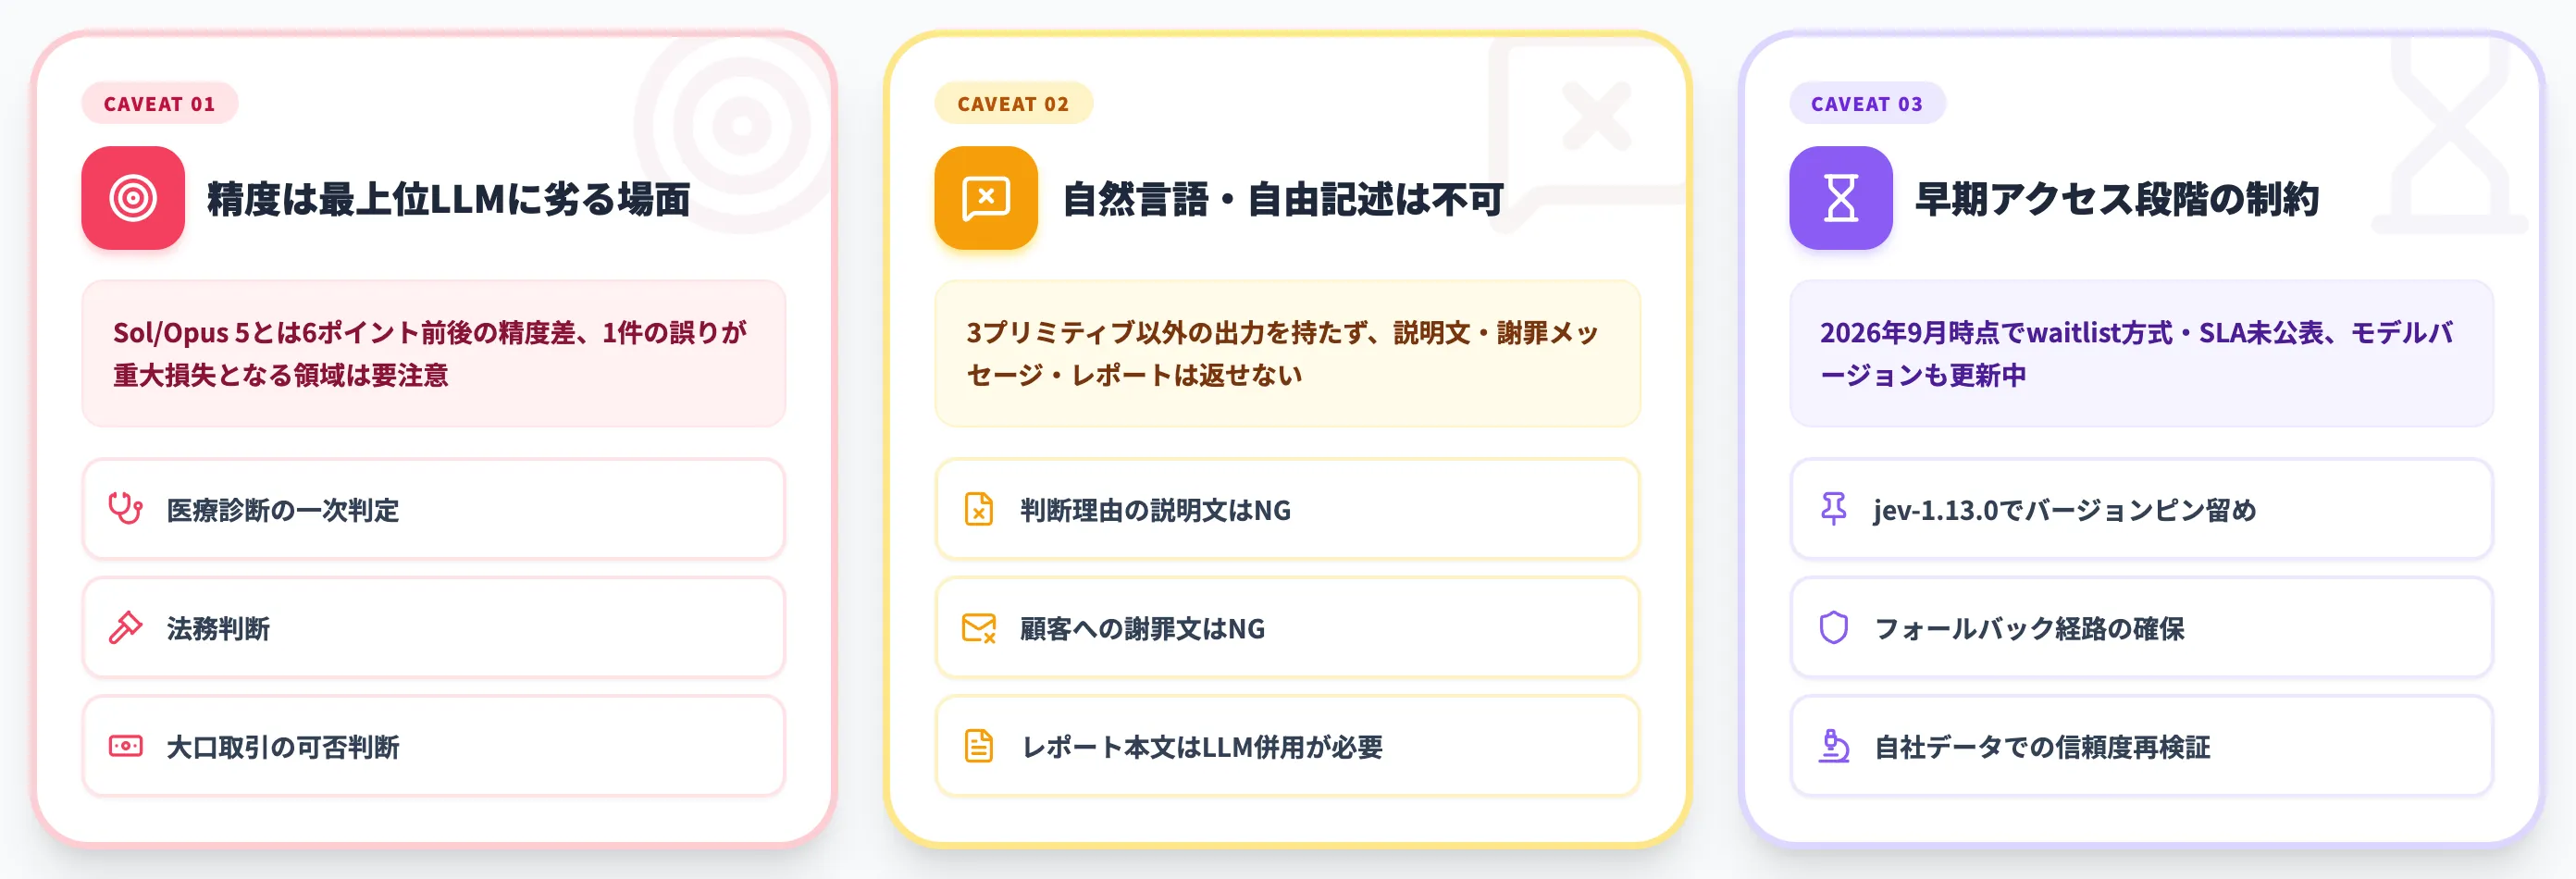
3つの制約(精度差/自由記述なし/早期アクセス)の俯瞰——適用領域を誤ると本番投入後に顕在化するリスク
Jevの数値を鵜呑みにする前に、確認すべき制約が3つあります。適用領域を誤ると、精度低下・機能不足・運用リスクが本番投入後に顕在化します。
精度は最上位LLMに劣る場面も
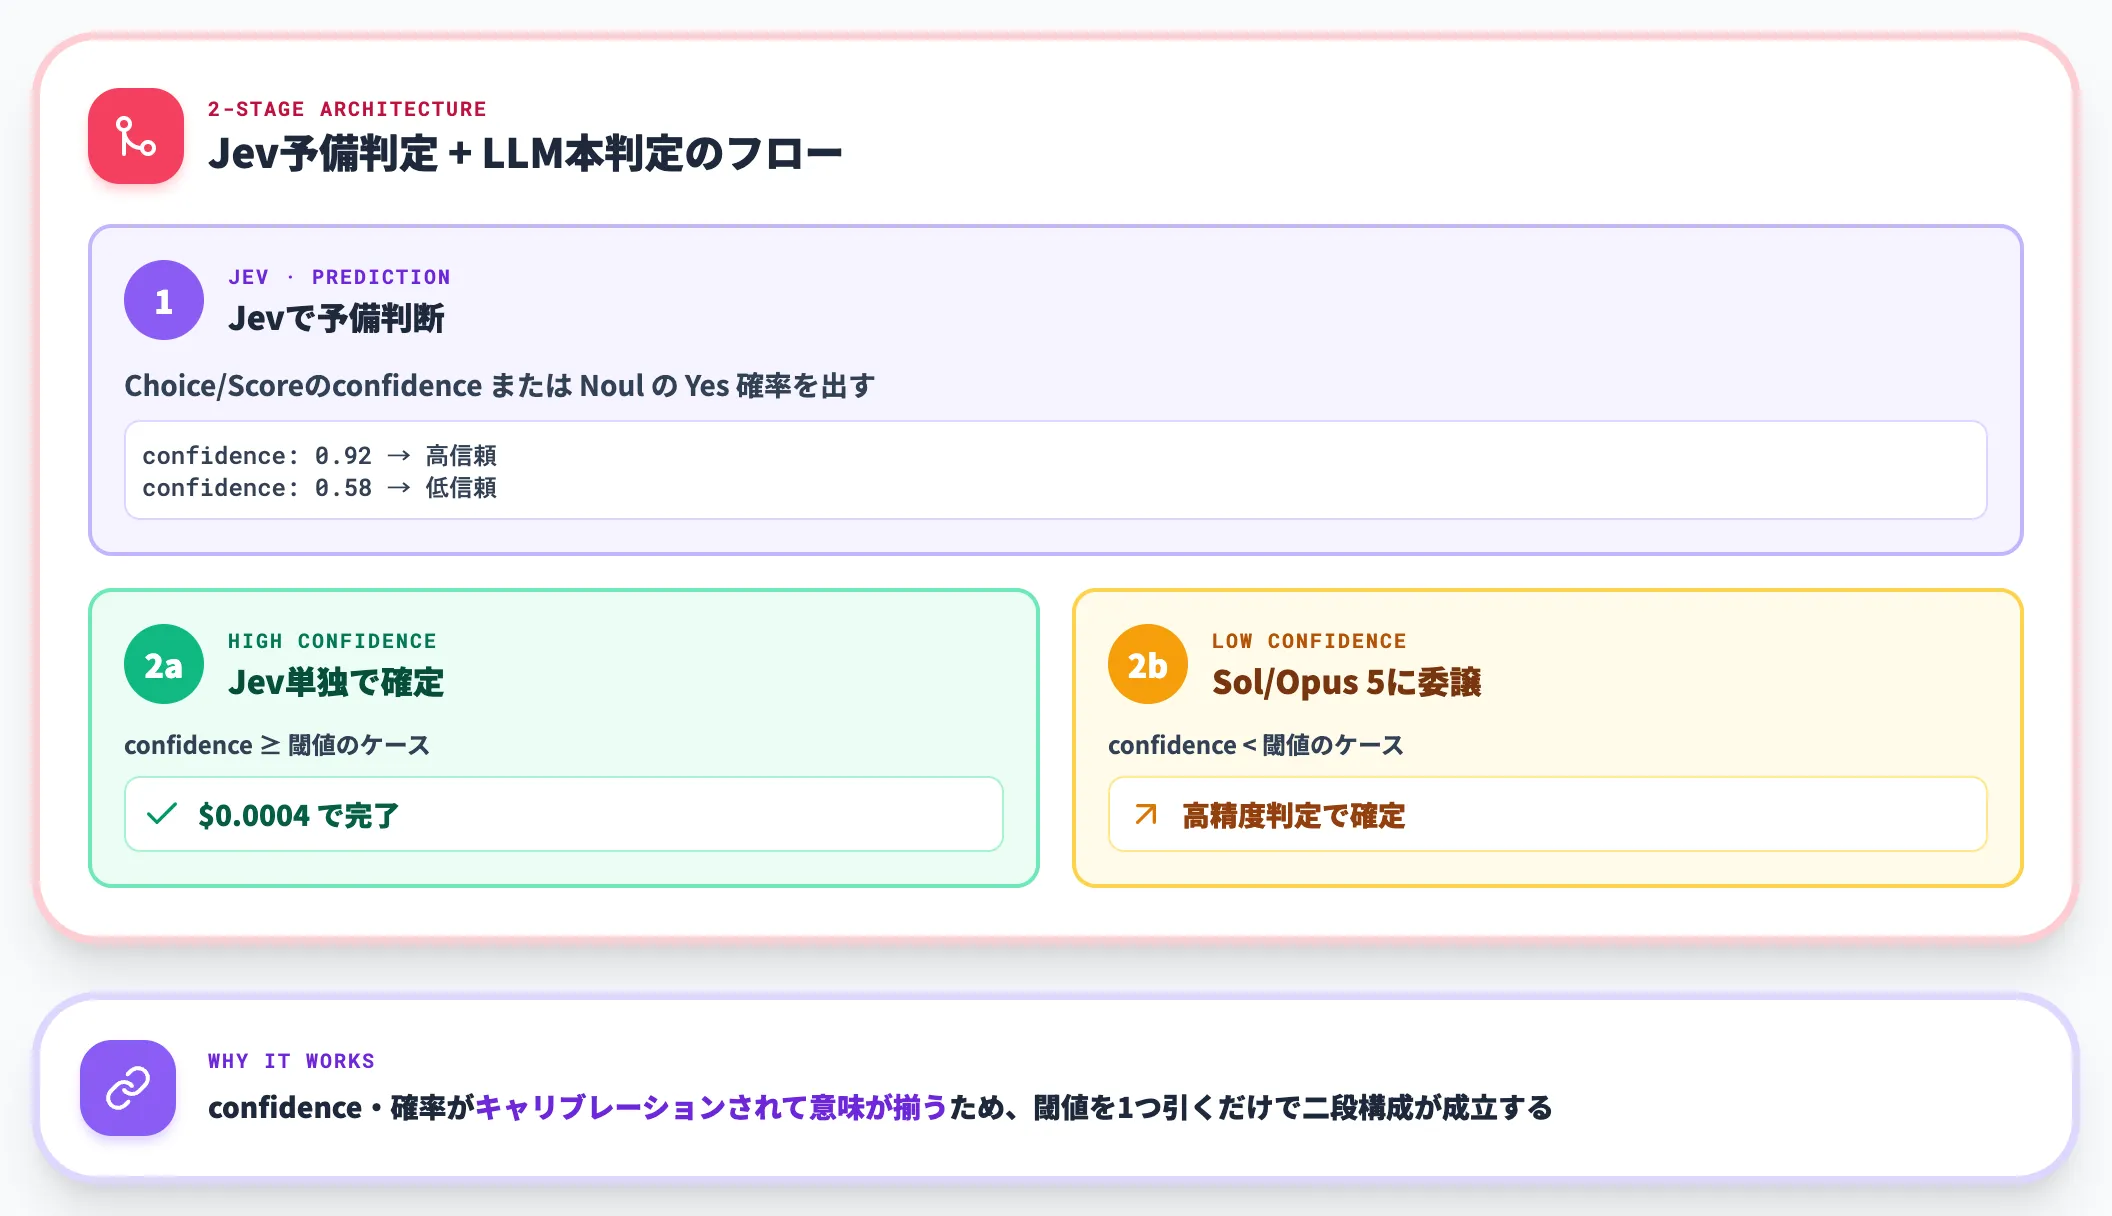
Jev予備判断→confidence閾値→高信頼はJev単独/低信頼はSol/Opus 5委譲の2段フロー——キャリブレーション済み確率が接続を成立させる
TypeSafe公表の4ワークフロー評価では、Jevの精度は67.8%とGPT-5.6 Terraとほぼタイでしたが、Sol(74.1%)・Opus 5(73.1%)とは6ポイント前後の差があります。判断1件が誤ると重大な損失につながる領域(医療診断の一次判定・法務判断・大口取引の可否など)では、Jev単独ではなくSol/Opus 5と組み合わせた多段構成が現実的です。
具体的には、Jevで予備判断(Choice/Scoreのconfidence or NoulのYes確率)を出し、値が閾値以下のケースだけをSol/GPT-6 Astra/Opus 5に回す、というフローが典型です。confidence・確率がキャリブレーションされていて意味を揃えられる点が、この二段構成を成立させています。
自然言語・自由記述は返せない
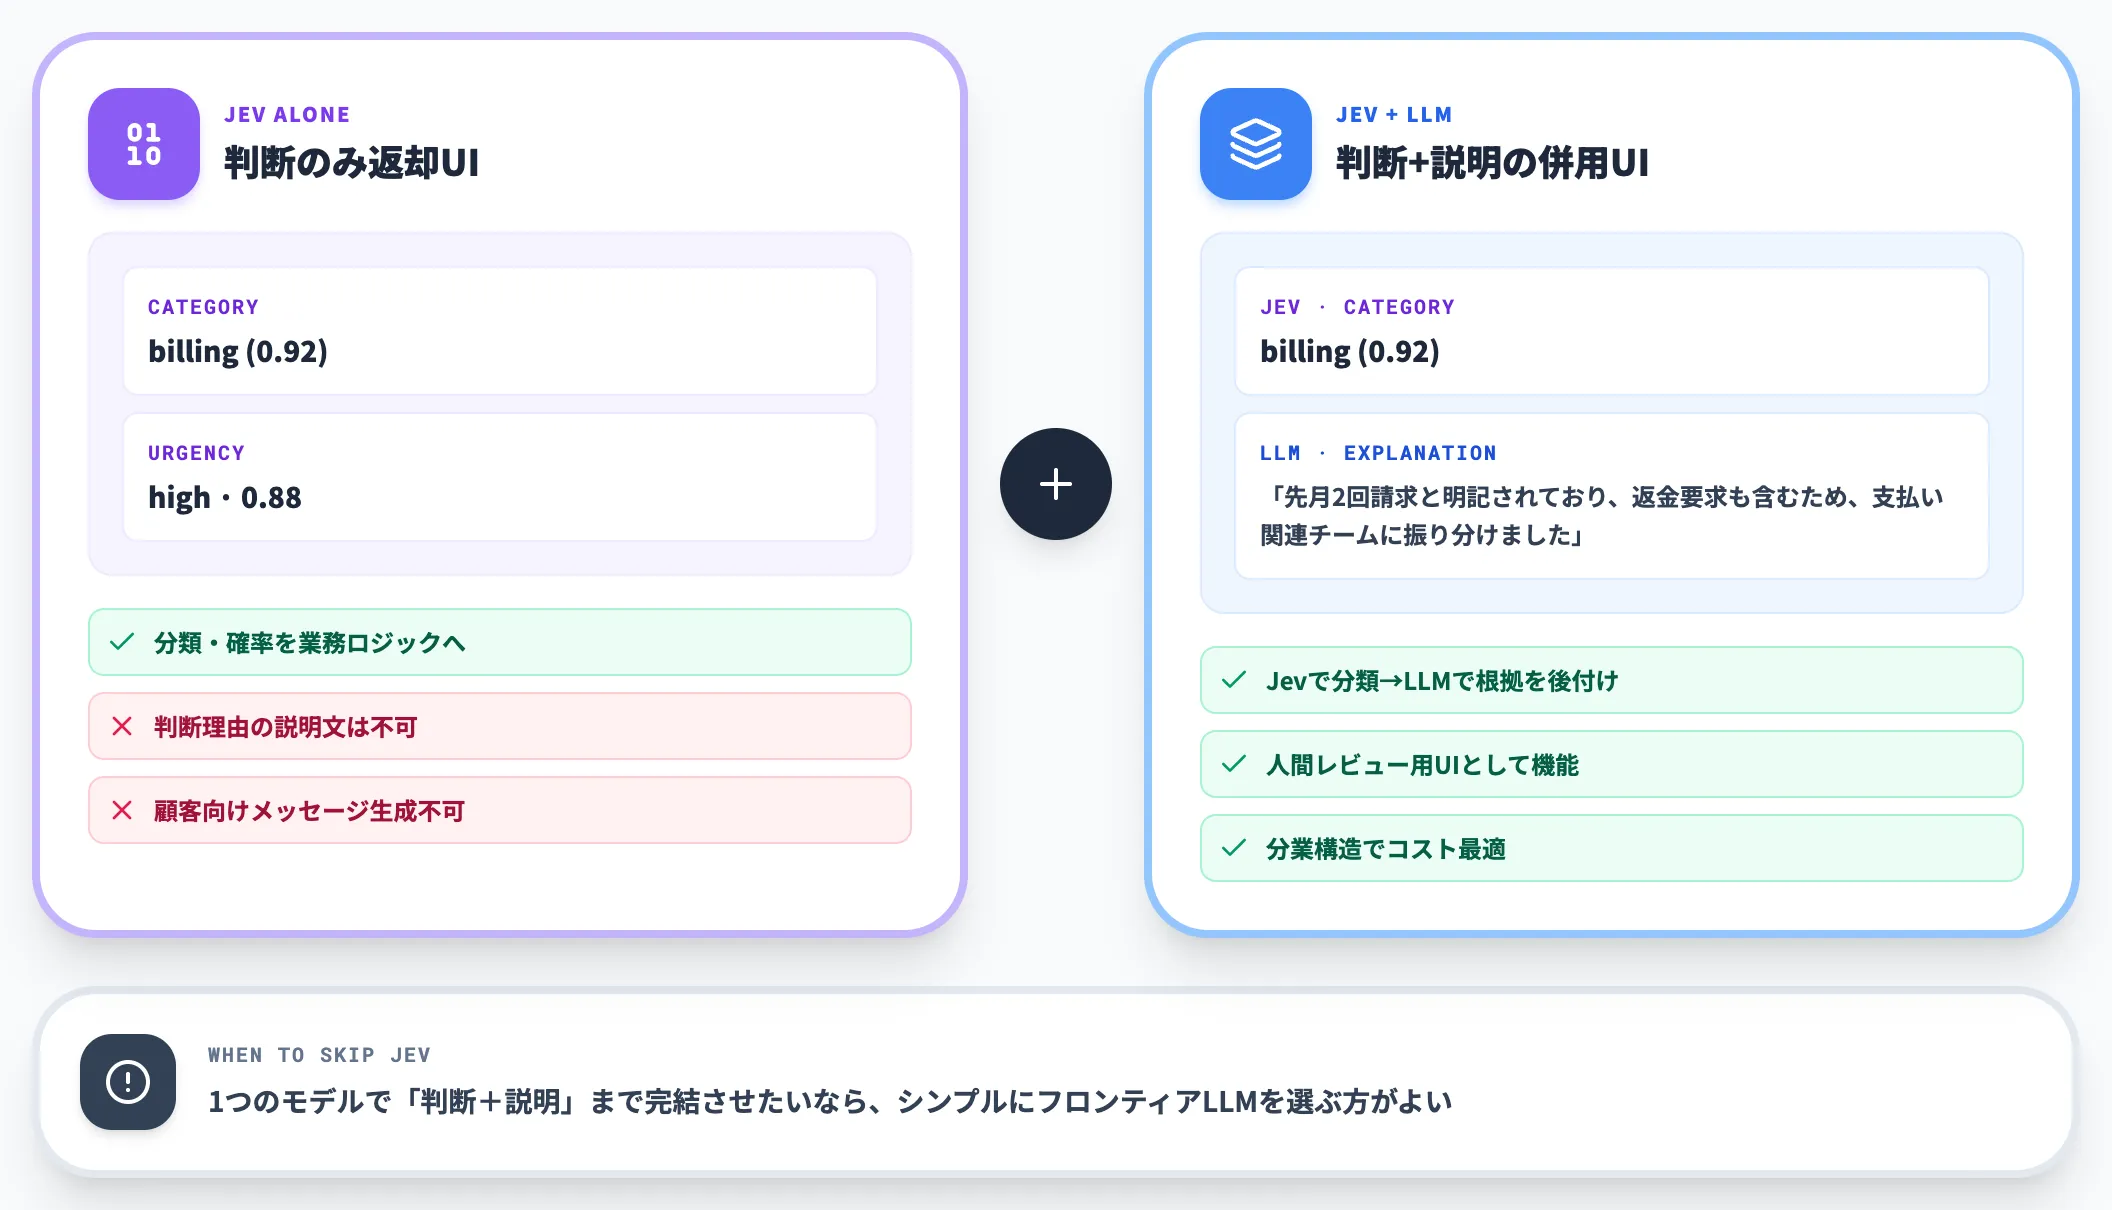
Jev単独UI vs Jev+LLM併用UIの比較——判断+説明を1モデルで済ませたいならフロンティアLLMがシンプル
Jevは3プリミティブ(Choice/Score/Noul)以外の出力を持ちません。「なぜその判断に至ったかの説明文」「顧客への謝罪メッセージ」「レポート本文」などの自由記述は返しません。
このため、Jevの出力を人間が確認するUIを作る場合は、「Jevが判断した選択肢と確率だけを表示し、必要ならその後にLLMで説明文を生成する」構成にする必要があります。1つのモデルで「判断+説明」まで完結させたいなら、フロンティアLLMを選ぶほうがシンプルです。
早期アクセス段階の制約
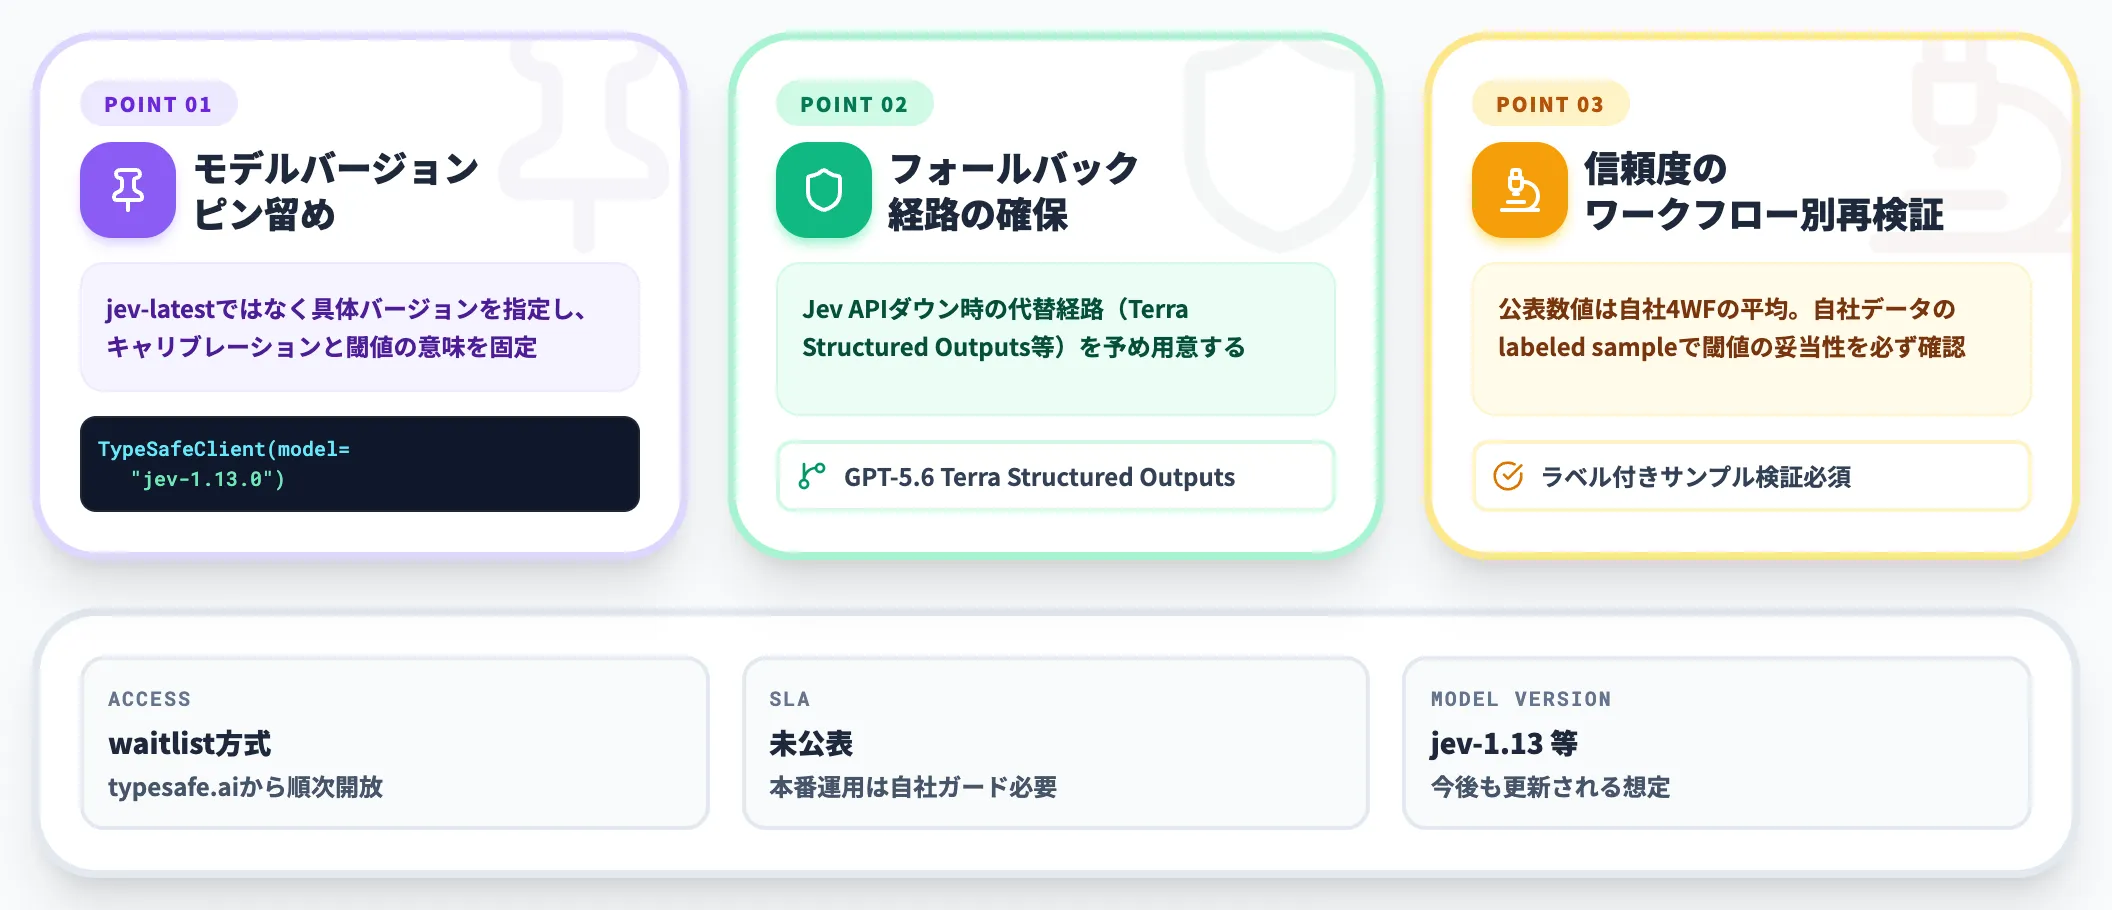
運用設計3ポイント(バージョンピン留め/フォールバック経路/信頼度再検証)——waitlist方式・SLA未公表の現況を織り込む
2026年9月時点でJevはアーリーアクセスのwaitlist方式で、typesafe.aiから順次開放される段階です。SLAは明示公表されておらず、モデルバージョン(jev-1.13等)も更新されていく想定です。
本番運用でJevを組み込むなら、以下の3点を運用設計に織り込む必要があります。
-
モデルバージョンのピン留め
jev-latestではなく jev-1.13.0 のように具体バージョンを指定し、キャリブレーションと信頼度閾値の意味を固定する。
-
フォールバック経路の確保
Jev APIがダウンした場合の代替経路(GPT-5.6 TerraのStructured Outputs等)を用意しておく。
-
信頼度のワークフロー別再検証
公表数値はTypeSafeの4ワークフロー平均。自社データで実際に閾値が意図した通り機能するか、labeled sampleで必ず検証する。
Python/TypeScript SDKでの実装例
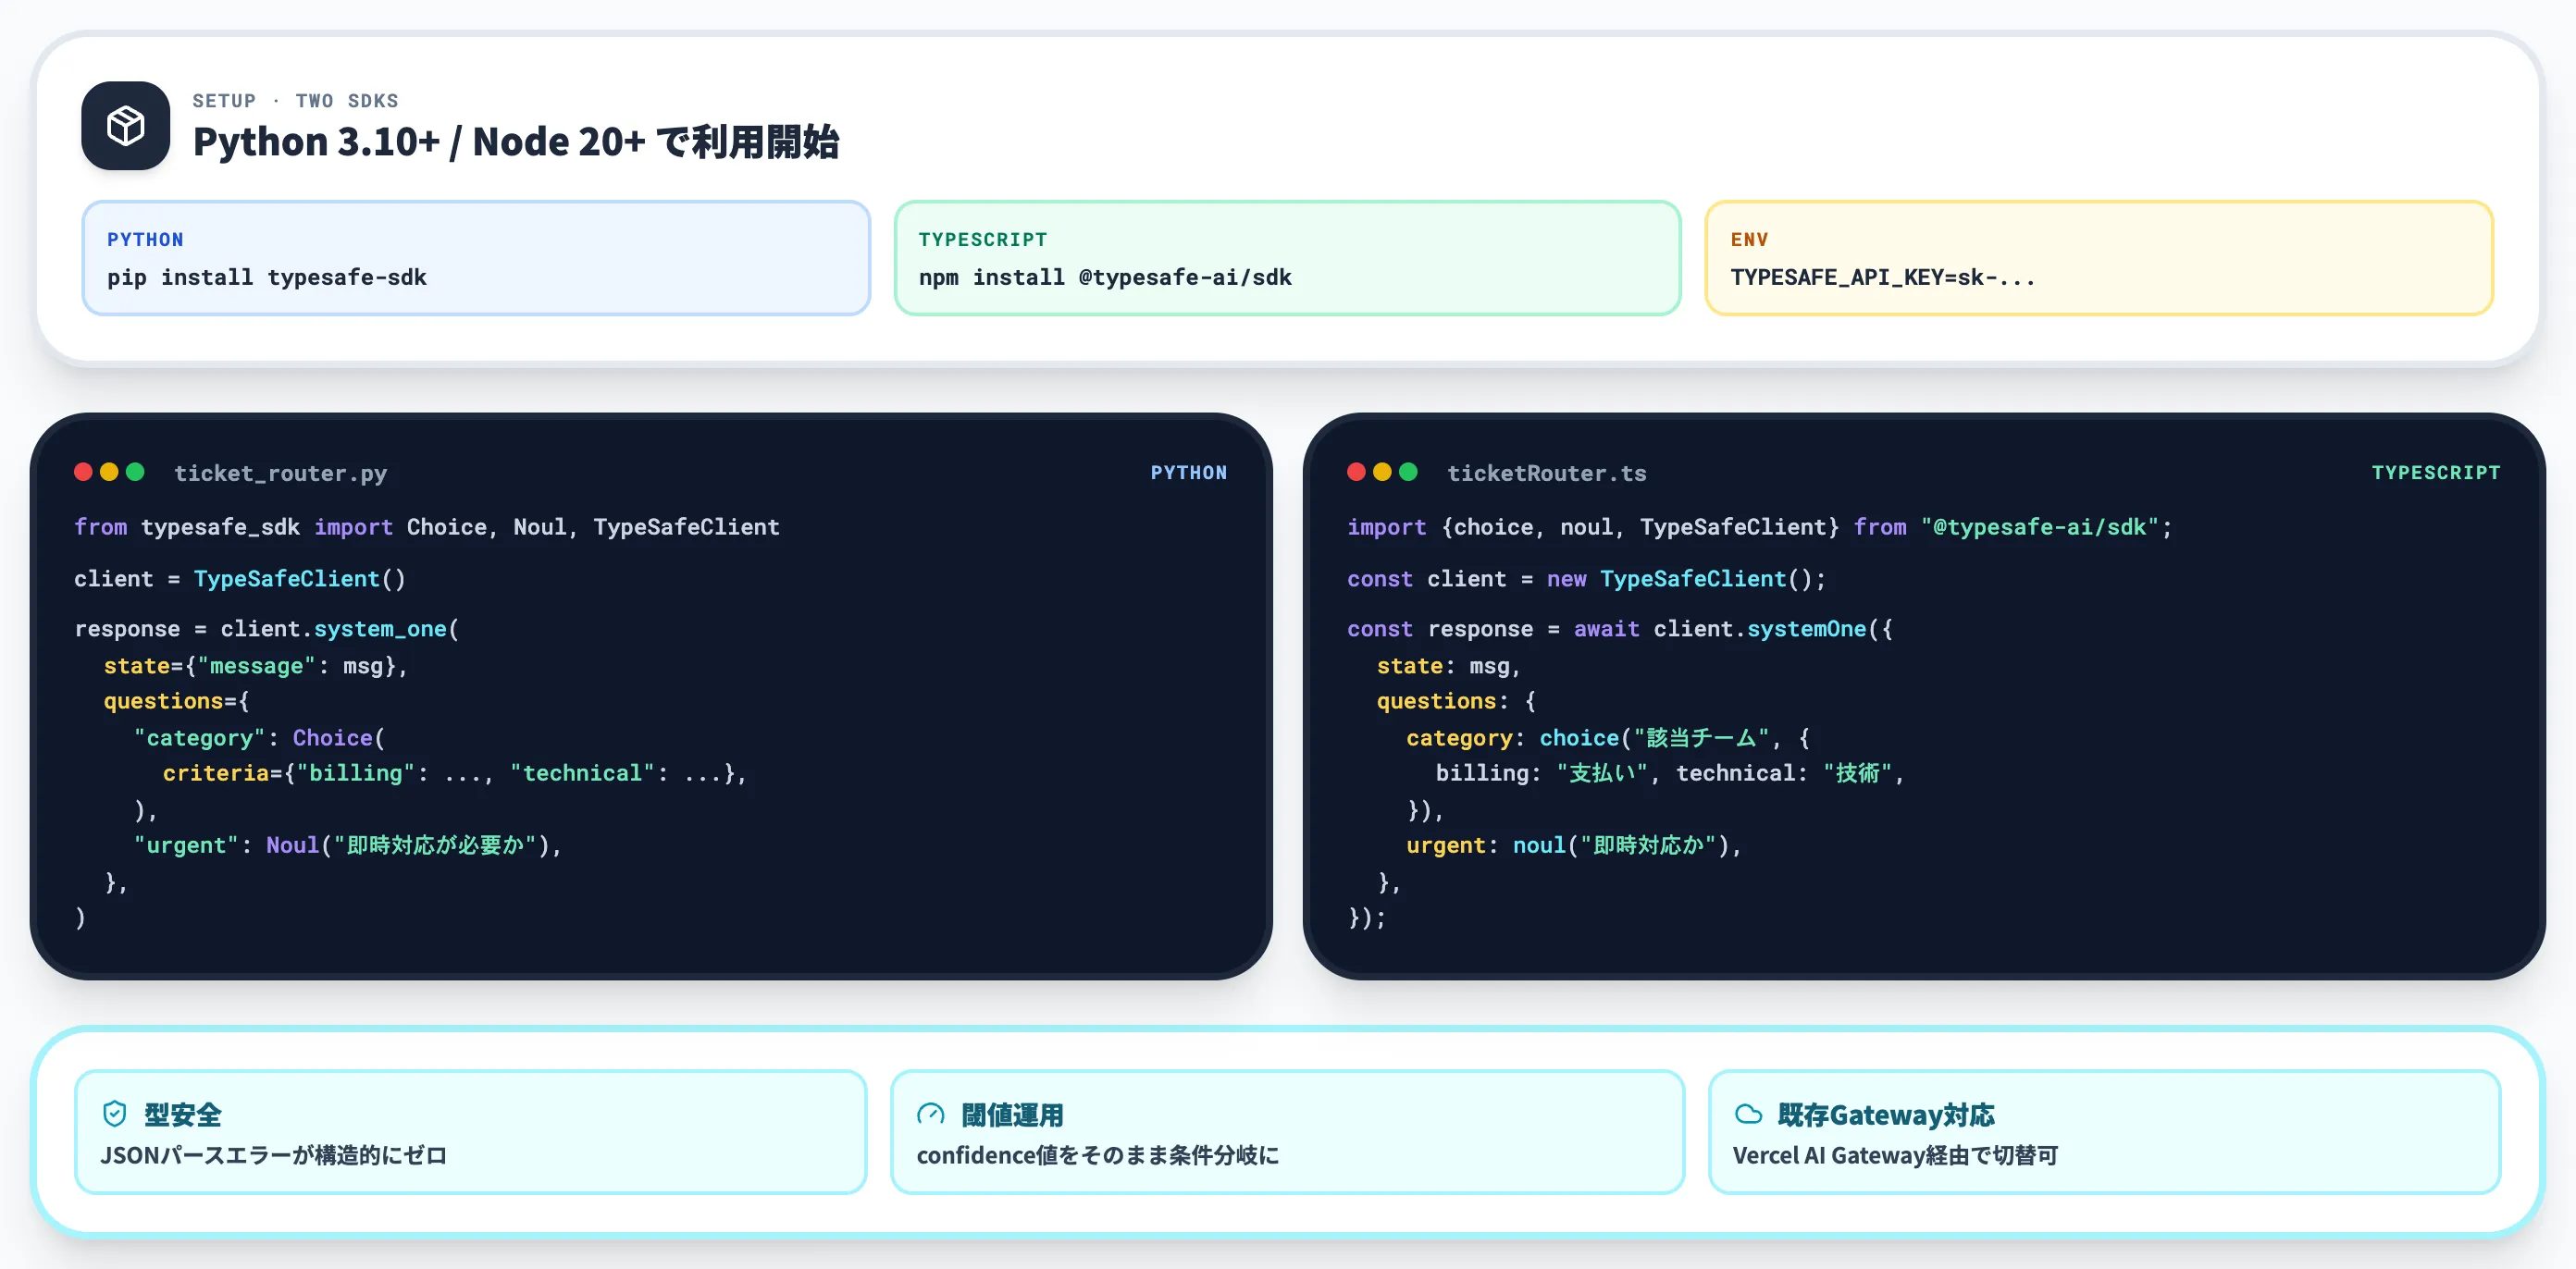
Python/TypeScript両SDKのコード並列俯瞰——型安全・閾値運用・Vercel AI Gateway対応の3利点が共通
Jevの実装は、PythonとTypeScriptの公式SDKがそれぞれ提供されています。既存のLLMライブラリと比べると、型定義の書き方以外は大きく変わりません。
セットアップと認証
Pythonなら3.10以降、TypeScriptならNode 20以降で利用できます。APIキーは typesafe.ai のearly accessから順次発行され、console.typesafe.ai/settings/keys で管理します。
# Python
pip install typesafe-sdk

# TypeScript
npm install @typesafe-ai/sdk

# 環境変数
export TYPESAFE_API_KEY="sk-..."
環境変数 TYPESAFE_API_KEY を読み込む形が標準で、明示指定しない場合は自動的に jev-latest モデルが選択されます。
Pythonでの最小実装
以下は、カスタマーサポートのチケットを「請求/技術/営業」の3カテゴリに分類しつつ、緊急対応の要否をNoulで並列に判定する最小実装です。
from typesafe_sdk import Choice, Noul, TypeSafeClient

client = TypeSafeClient()

response = client.system_one(
    state={"message": "先月と今月で2回請求されている。すぐ返金してほしい。"},
    questions={
        "category": Choice(
            instructions="このメッセージが該当するチームを選んでください",
            criteria={
                "billing": "支払い・請求関連の問い合わせ",
                "technical": "技術的なバグ・不具合の報告",
                "sales": "新規契約・アップグレードの相談",
            },
        ),
        "urgent": Noul(instructions="即時対応が必要な内容か"),
    },
)

print(response.answers["category"].choice)         # → "billing"
print(response.answers["category"].probabilities)  # → {"billing": 0.92, ...}
print(response.answers["urgent"].noul)             # → 0.88
このアプローチの利点は複数あります。
JSONパースエラーが構造的に発生しません。Choiceの返り値は事前定義したキーのいずれかであることが型システムで保証されるため、try/except json.JSONDecodeError のような防御コードが不要になります。
確率値をそのまま閾値ロジックに使えます。response.answers["urgent"].noul > 0.7 のような分岐が意味を保った状態で書けるのは、RLCDで訓練された確率が実測正解率と長期一致するように最適化されているためです。具体の閾値は自社データでラベル付き検証を行ってから確定させます。
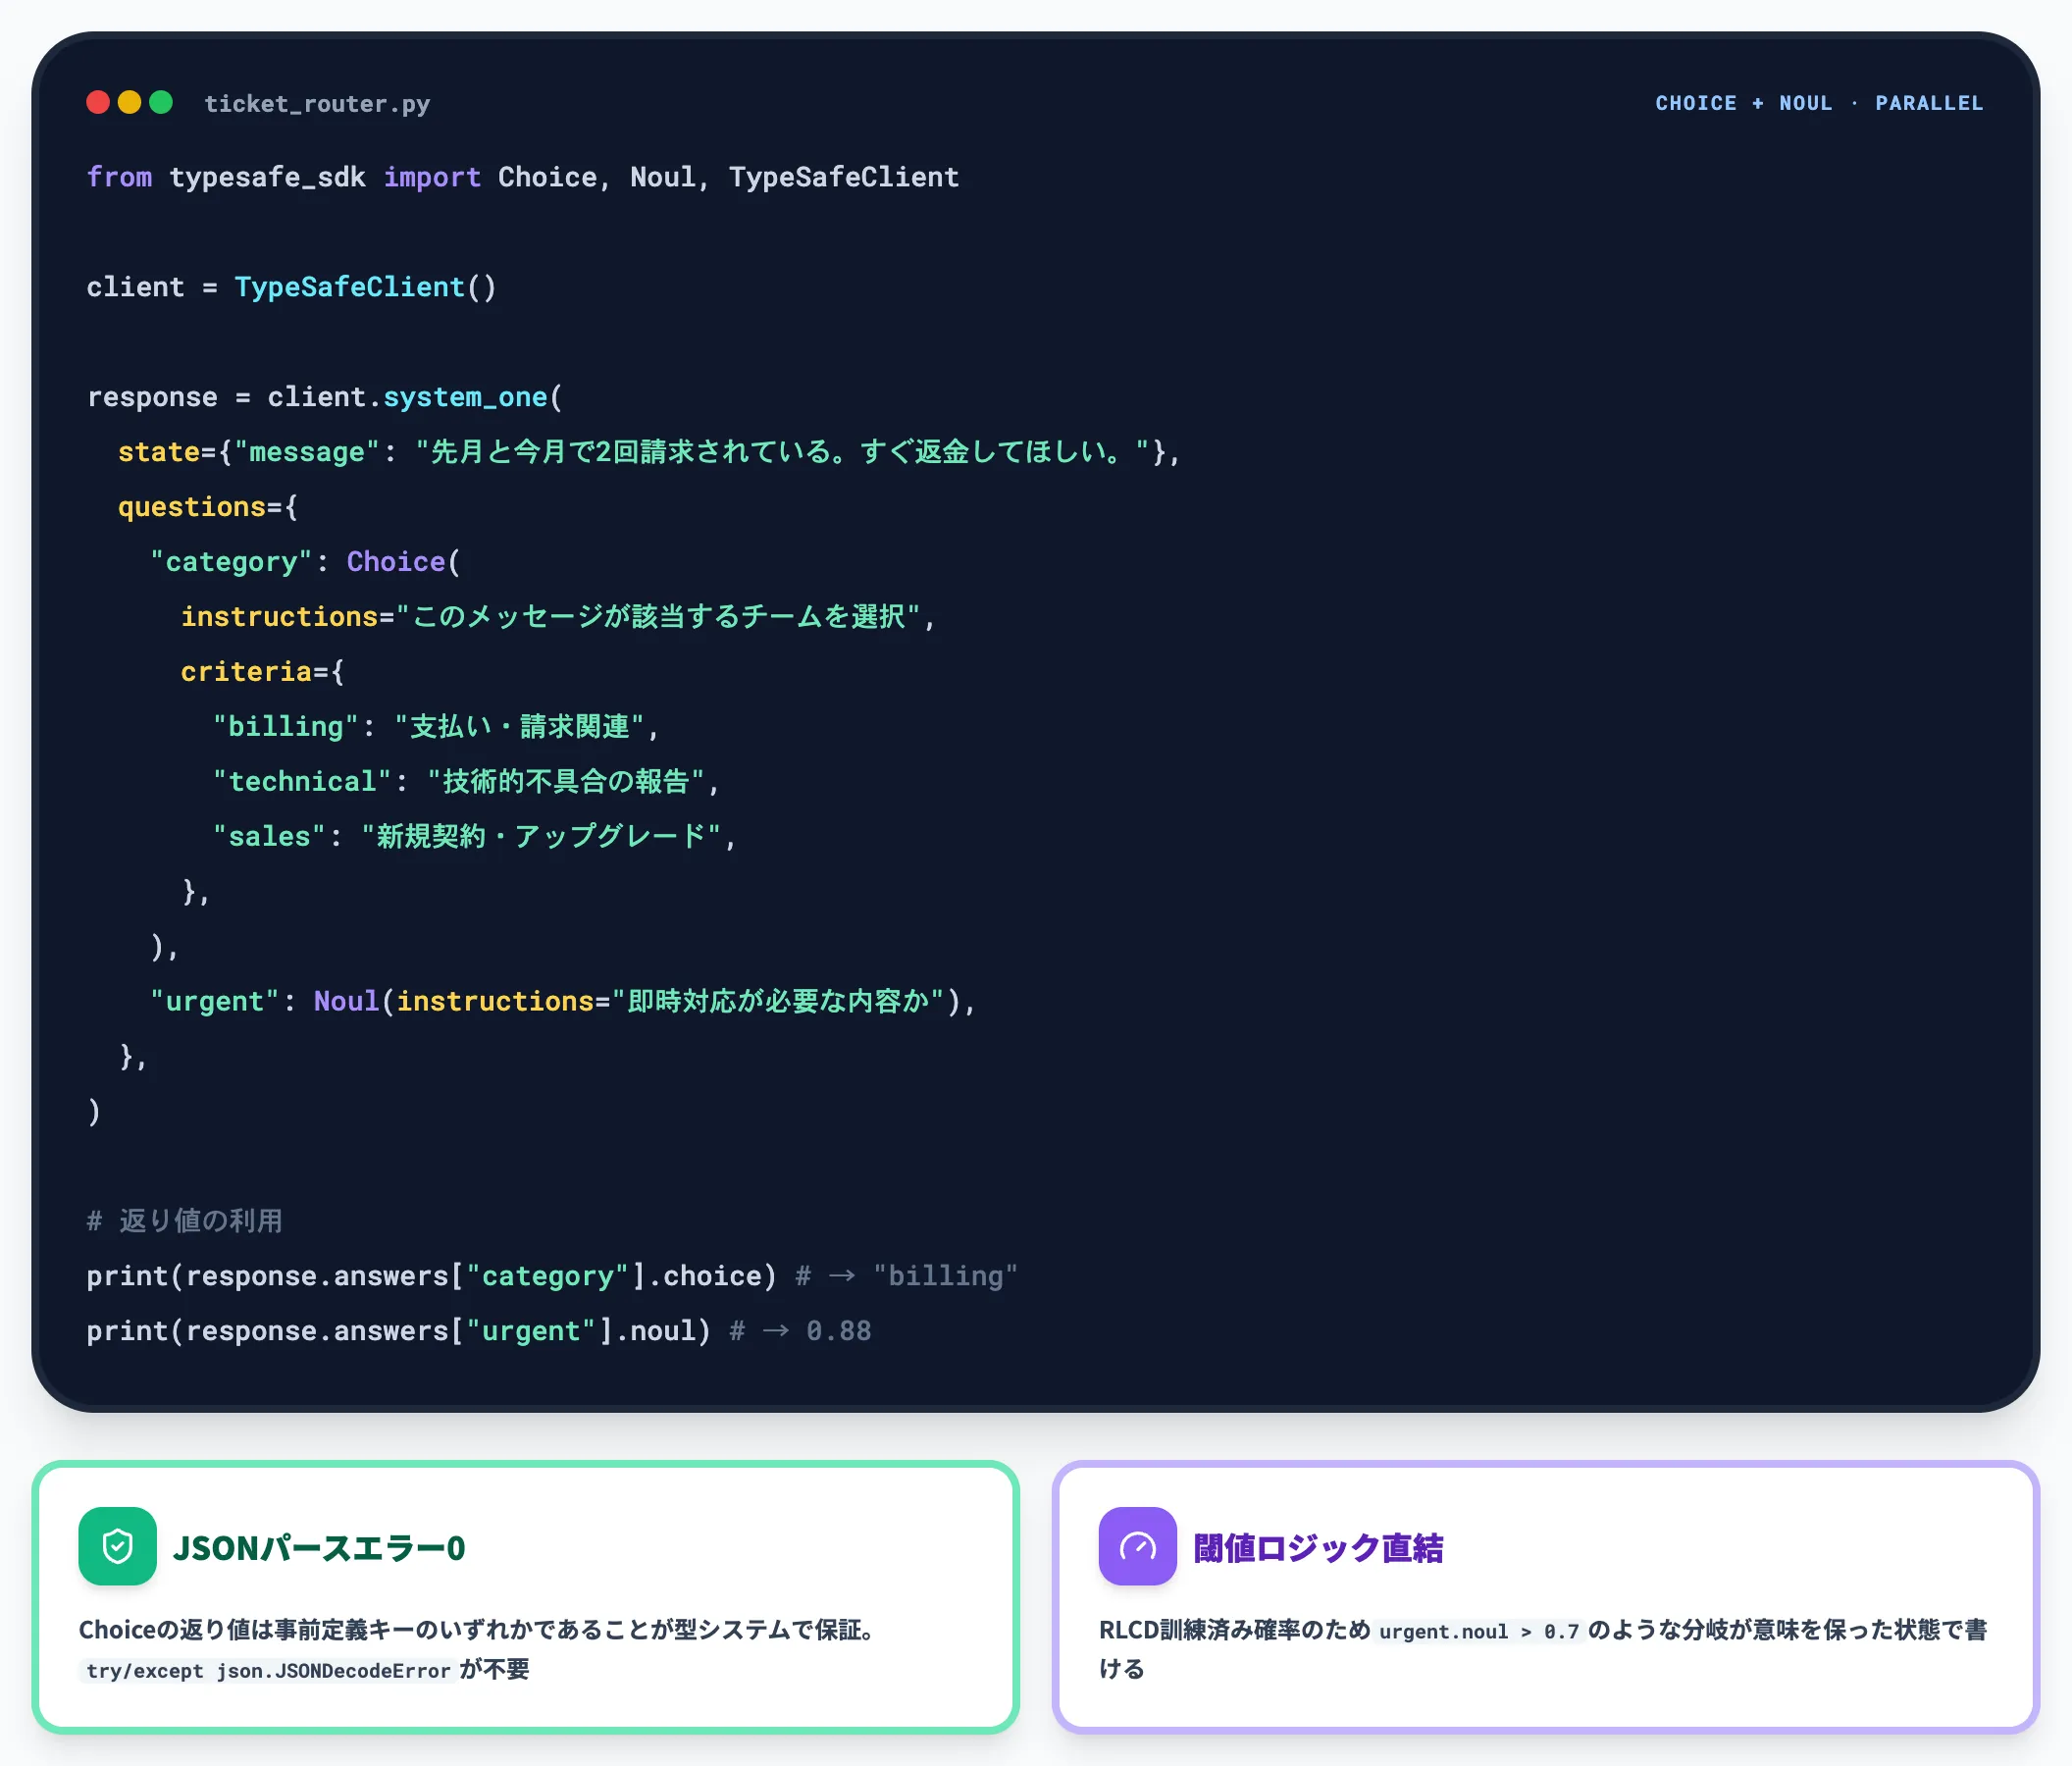
サポートチケット振分けのPython実装——Choice(3カテゴリ)+Noul(緊急対応)を1回のsystem_oneで並列取得、JSONパースエラー0で閾値ロジック直結
TypeScriptでの最小実装
TypeScript側の記述は、SDKの命名規則がキャメルケースになる以外はPythonと同じです。
import { choice, noul, TypeSafeClient } from "@typesafe-ai/sdk";

const client = new TypeSafeClient();

const response = await client.systemOne({
    state: "先月と今月で2回請求されている。すぐ返金してほしい。",
    questions: {
        category: choice("該当するチーム", {
            billing: "支払い関連",
            technical: "技術的な問題",
            sales: "契約関連",
        }),
        urgent: noul("即時対応が必要か"),
    },
});

console.log(response.answers.category.choice);       // → "billing"
console.log(response.answers.urgent.noul);           // → 0.88
VercelのAI Gateway経由でも呼び出せるため、既存のAI SDK 7の evaluate APIを使っているプロジェクトなら、モデル名を切り替えるだけで導入できます。
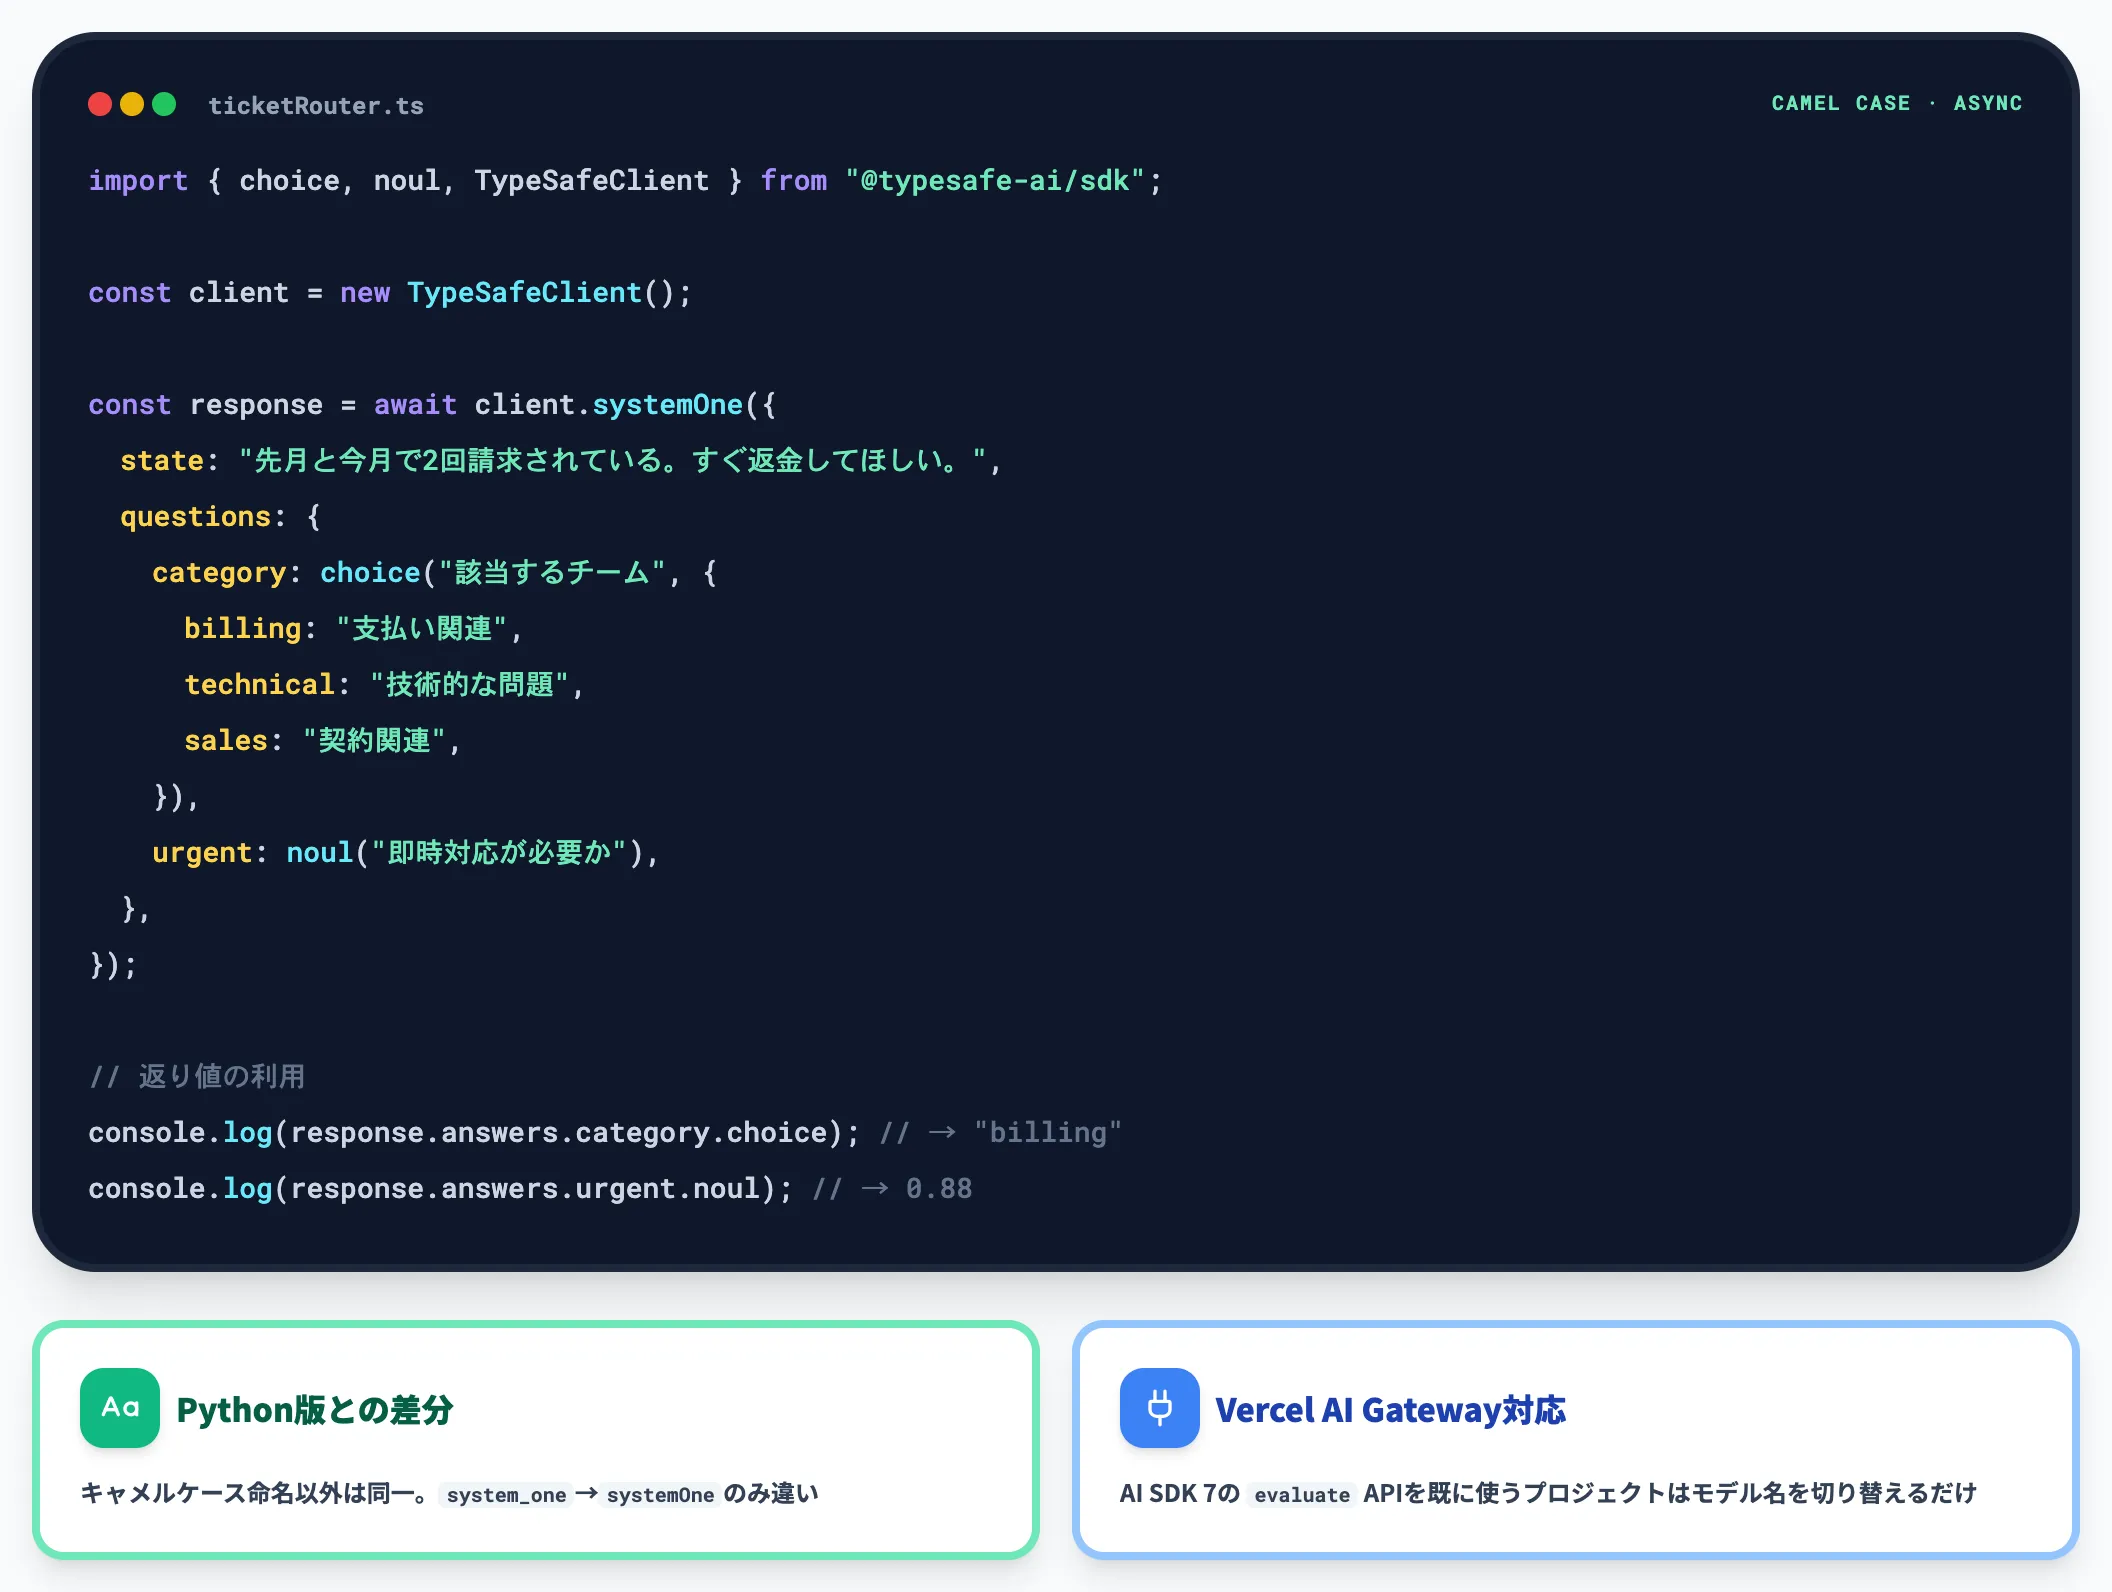
TypeScript版の最小実装——キャメルケース命名以外Pythonと同一構造、Vercel AI Gateway経由でも呼び出し可能
本番投入時のバージョンピン留め
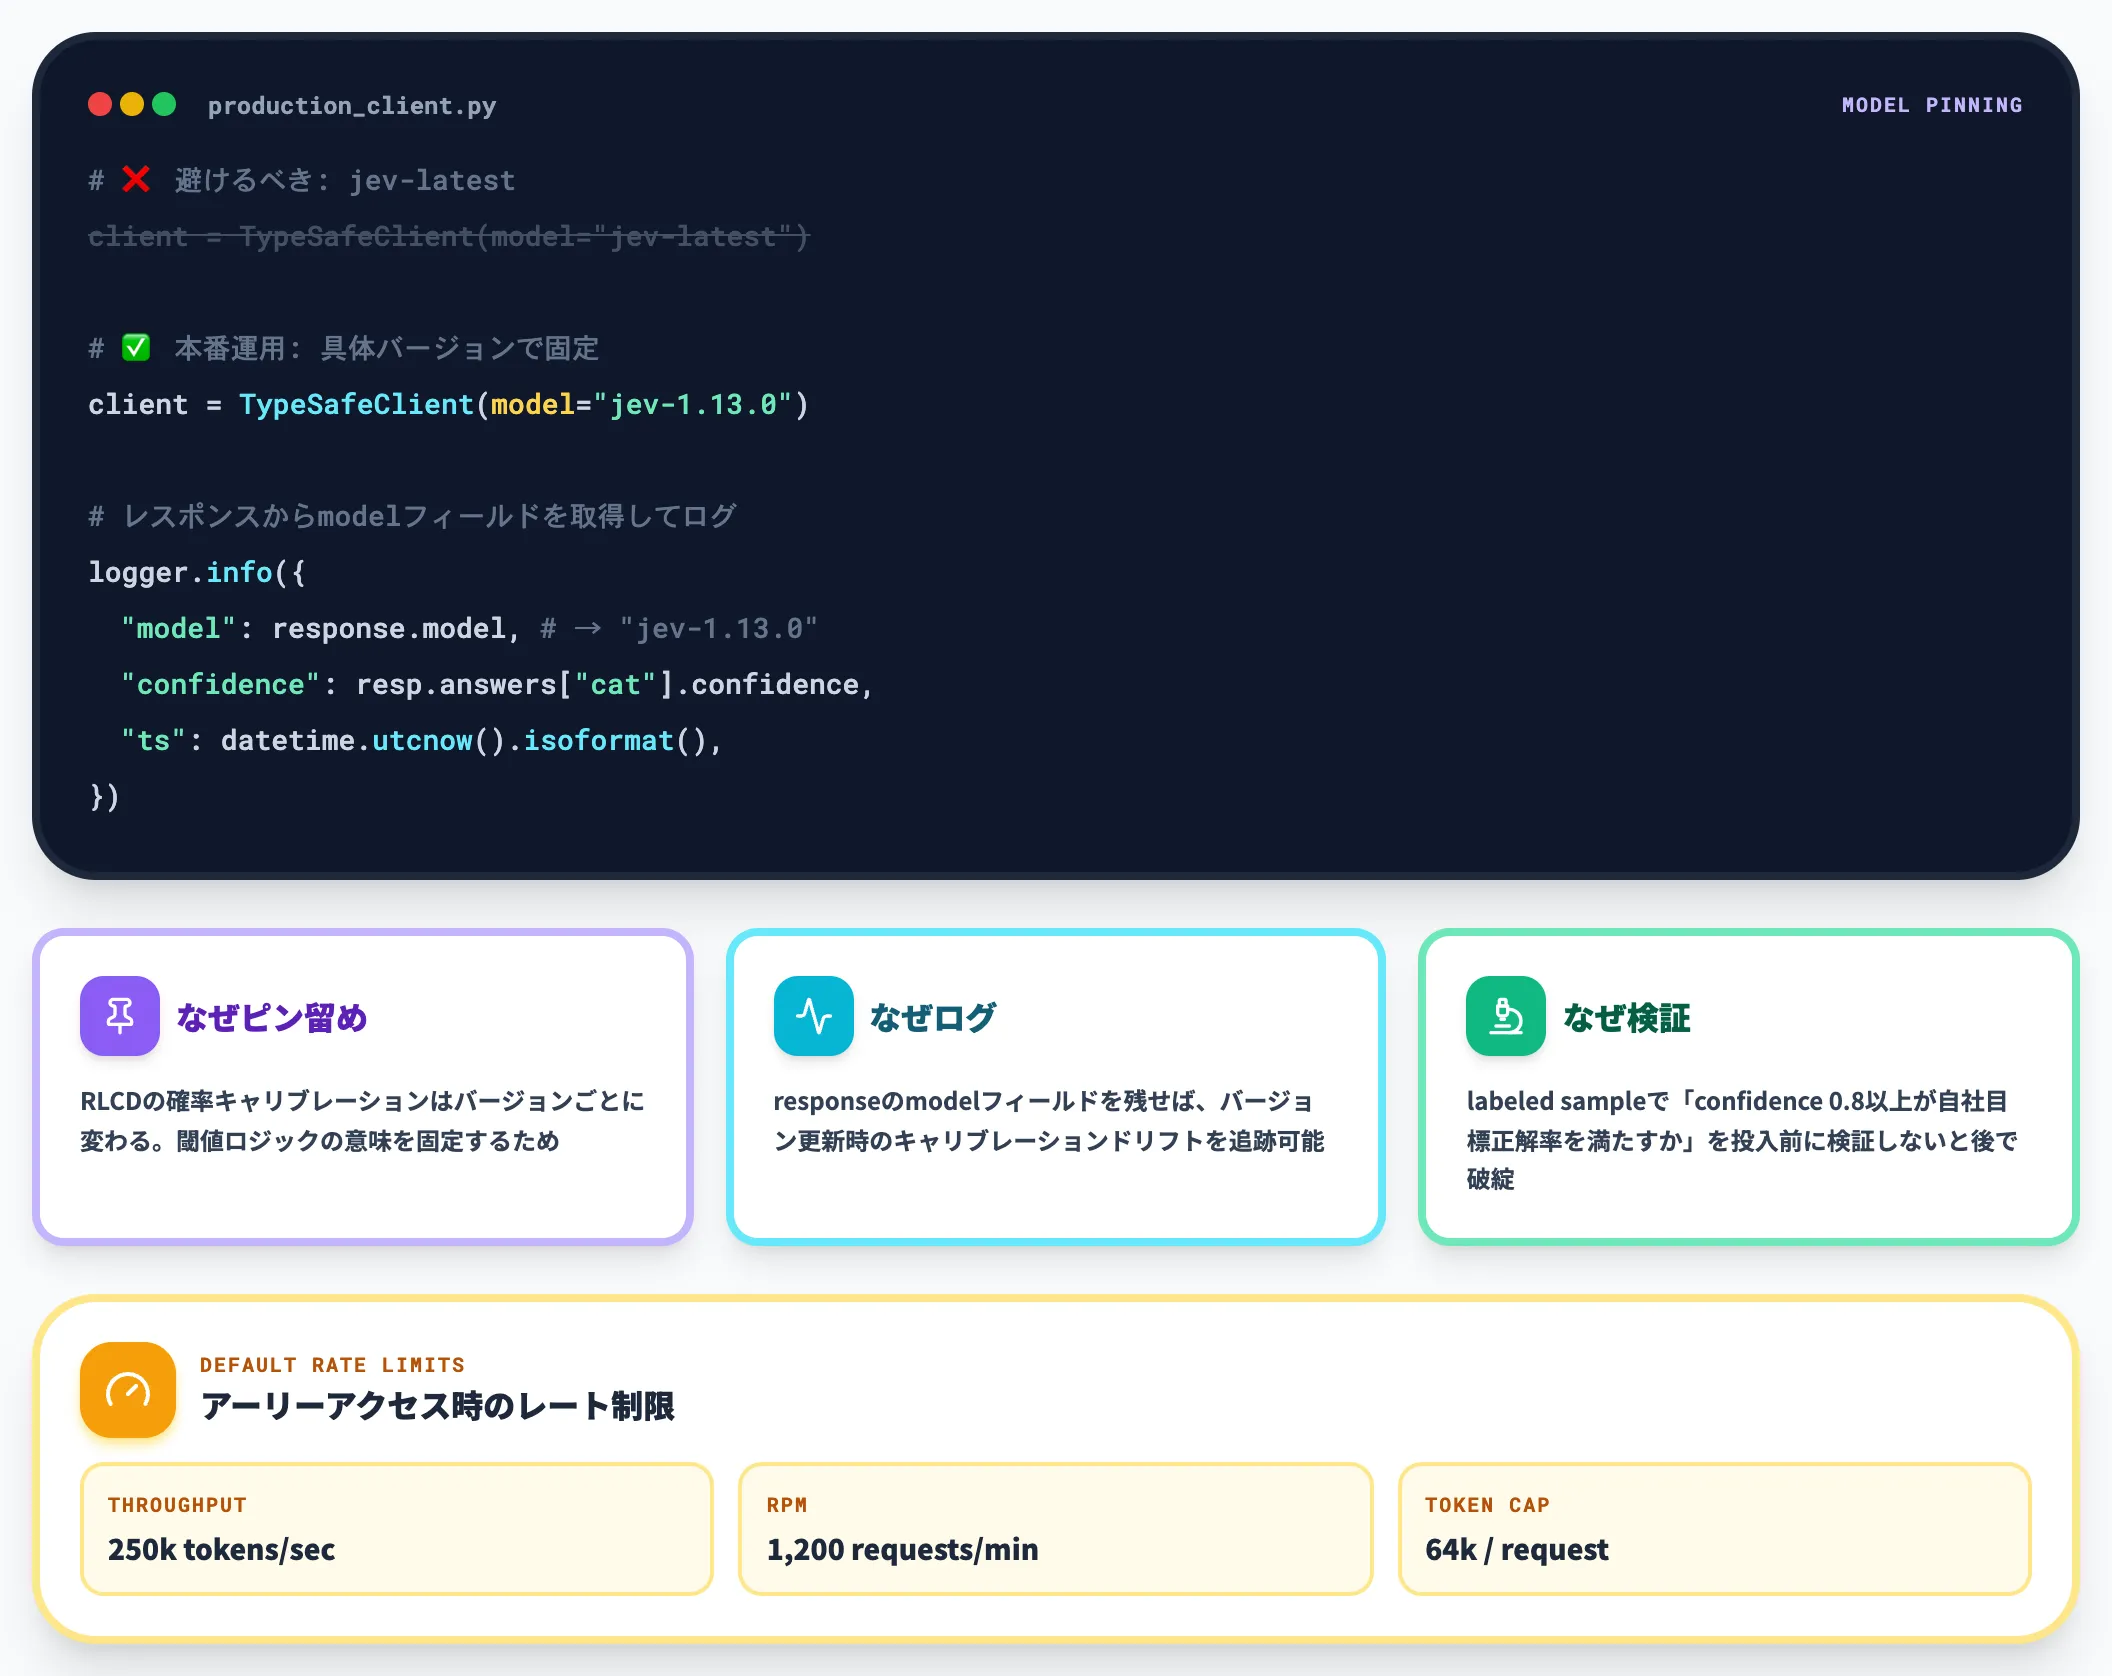
jev-1.13.0のバージョンピン留めコード+3ポイント(なぜピン留め/なぜログ/なぜ検証)+Rate Limitのまとめ
本番運用では jev-latest ではなく、具体バージョンを指定します。RLCDの確率キャリブレーションはモデルバージョンごとに変わるため、閾値ロジックの意味を固定する必要があるからです。
client = TypeSafeClient(model="jev-1.13.0")
加えて、レスポンスから返る model フィールドをログに残しておくと、バージョン更新時にキャリブレーションのドリフトを追跡できます。実運用に載せる前に、labeled sampleを使って「Jevの confidence 0.8以上が自社の目標正解率を満たすか」を検証しておくと、閾値ロジックが後から破綻するリスクを下げられます。
なお、Rate Limitはデフォルトで250k tokens/sec・1,200 requests/minute。トークン上限は「1リクエスト全体で最大64kトークン、state と最長の question の合計が32k以内」という制約です。大規模バッチで叩く場合はRate Limit緩和の申請が必要になります。
Jev判断特化モデル導入で詰まる論点を、実装事例から逆算して整理する
Jevを既存パイプラインに組み込むかを検討する現場では、公式ドキュメントだけでは決めきれない論点が並びます。
- LLM-as-judge・ルーティング・RAG前段・ガードレール・バッチ分類の5箇所のどこから差し込むか
- Jev単独で回す判断とSol/Opus 5級LLMへエスカレーションする判断を、confidence閾値でどう切り分けるか
- confidenceキャリブレーションの閾値意味を自社データでどう検証し、ラベル付き検証をどう回すか
- Structured Outputs・XGrammar・Phi-4等の小型SLMとJevをどう使い分け、Vercel AI Gateway/直APIのどちらで運用するか
差し込み場所選定・LLMとの二段構成設計・キャリブレーション閾値検証・フォールバック設計まで含めてJev導入の実装可能性を棚卸ししたいなら、単体機能の解説記事ではなく、実装事例と組み合わせて話せる相手と一度整理するのが早道です。
AI Agent Hubは、Jev・GPT-6 Astra・Claude Opus 5など複数モデルを業務Agent単位で統合管理するエンタープライズAI基盤で、差し込み場所選定・二段構成設計・キャリブレーション検証・フォールバック設計のいずれの入口からでも、実装から逆算した論点整理をご相談いただけます。
Jev判断特化モデル導入の論点を実装から逆算

差し込み場所・二段構成・キャリブレーション・フォールバック
Jev導入は、5つの差し込み場所選定・Sol/Opus 5との二段構成・キャリブレーション閾値の自社検証・early access段階のフォールバック設計が絡み合います。AI Agent Hubのサービスページで、Jevを含む複数モデルを業務プロセスに載せる実装例をご確認ください。
まとめ
本記事では、Jevについて、System Oneモデルの位置づけ・3プリミティブ・RLCD訓練法・料金/速度/精度の定量比較・既存Structured Outputs/SLMとの使い分け・組込み場所5つ・注意点・SDK実装例までを、2026年9月時点の最新情報で解説しました。
2026年時点で押さえておくべきポイントは次の3つです。
- テキスト生成を捨てて判断だけを返すSystem Oneモデル、Choice・Score・Noulの3プリミティブとRLCDで訓練された確率キャリブレーションが最大の差別化
- 精度はGPT-5.6 TerraとほぼタイでSol・Opus 5には数ポイント劣る、置き換えはLLM-as-judge・ルーティング・ガードレールに絞り生成系タスクは既存LLMに残す設計が現実的
- 料金$0.042/1M・出力無料・0.4秒レイテンシで判断単価とリアルタイム性の桁を1段下げる、TypeSafe公表値のため本番前に独立検証とモデルバージョンピン留めが前提
Jevは「LLMで全部やらせる」時代の終わりと「LLM+判断特化モデルの役割分担」時代の始まりを示す動きです。まずは既存パイプラインのなかでLLM-as-judge・ルーティング・ガードレールの3ポイントをJevで置き換えられないか、labeled sampleを使って検証するところから始めるのが、最も実用的な第一歩になります。