この記事のポイント
 TimesFM-3は時系列予測FM分野で多変量・共変量ネイティブ対応を実現した第3世代モデル
- GIFT-Eval・FEV-Bench・TIMEの3大ベンチマークでポイント・確率両指標で総合1位を達成
- ライセンスが非商用(Non-Commercial v1.0)に転換、商用利用は前世代TimesFM 2.5(Apache-2.0)が代替
- BigQuery AI.FORECASTは現行TimesFM 2.0/2.5対応、TimesFM 3.0対応は「今後数週間」とGoogle公式が公表
- Chronos-2やToto 2.0は対等な競合、商用選定はTimesFM 2.5・Chronos-2・Toto 2.0など商用可能モデルで進めるのが安全
Microsoft MVP・AIパートナー。LinkX Japan株式会社 代表取締役。東京工業大学大学院にて自然言語処理・金融工学を研究。NHK放送技術研究所でAI・ブロックチェーンの研究開発に従事し、国際学会・ジャーナルでの発表多数。経営情報学会 優秀賞受賞。シンガポールでWeb3企業を創業後、現在は企業向けAI導入・DX推進を支援。
Google Researchが2026年8月31日に公開したTimesFM-3は、時系列予測のファウンデーションモデル分野で多変量ネイティブ対応を実現した第3世代モデルです。
単変量に限定されていた前世代TimesFM 2.5から一歩進み、複数の関連系列と過去・未来の共変量を1回のforward passで同時に扱えるようになりました。
本記事では、TimesFM-3の技術的な変化点、アーキテクチャ、ベンチマーク結果、Python実装、非商用ライセンスの制約と商用代替、Chronos-2やToto 2.0との比較、BigQuery/Vertex AIでの運用パスを、2026年9月時点の最新情報で解説します。
目次
TimesFM-3とは?Googleが公開した多変量対応の時系列予測ファウンデーションモデル
TimesFM-3のベンチマーク結果——GIFT-Eval・FEV-Bench・TIMEで全て首位
TimesFM-3の使い方——HuggingFaceからのインストールとPython実装
TimesFM-3と競合モデルの比較——Chronos-2 / Toto 2.0 / Moirai 2.0
TimesFM-3をBigQuery/Vertex AIで運用する方法
TimesFM-3とは?Googleが公開した多変量対応の時系列予測ファウンデーションモデル
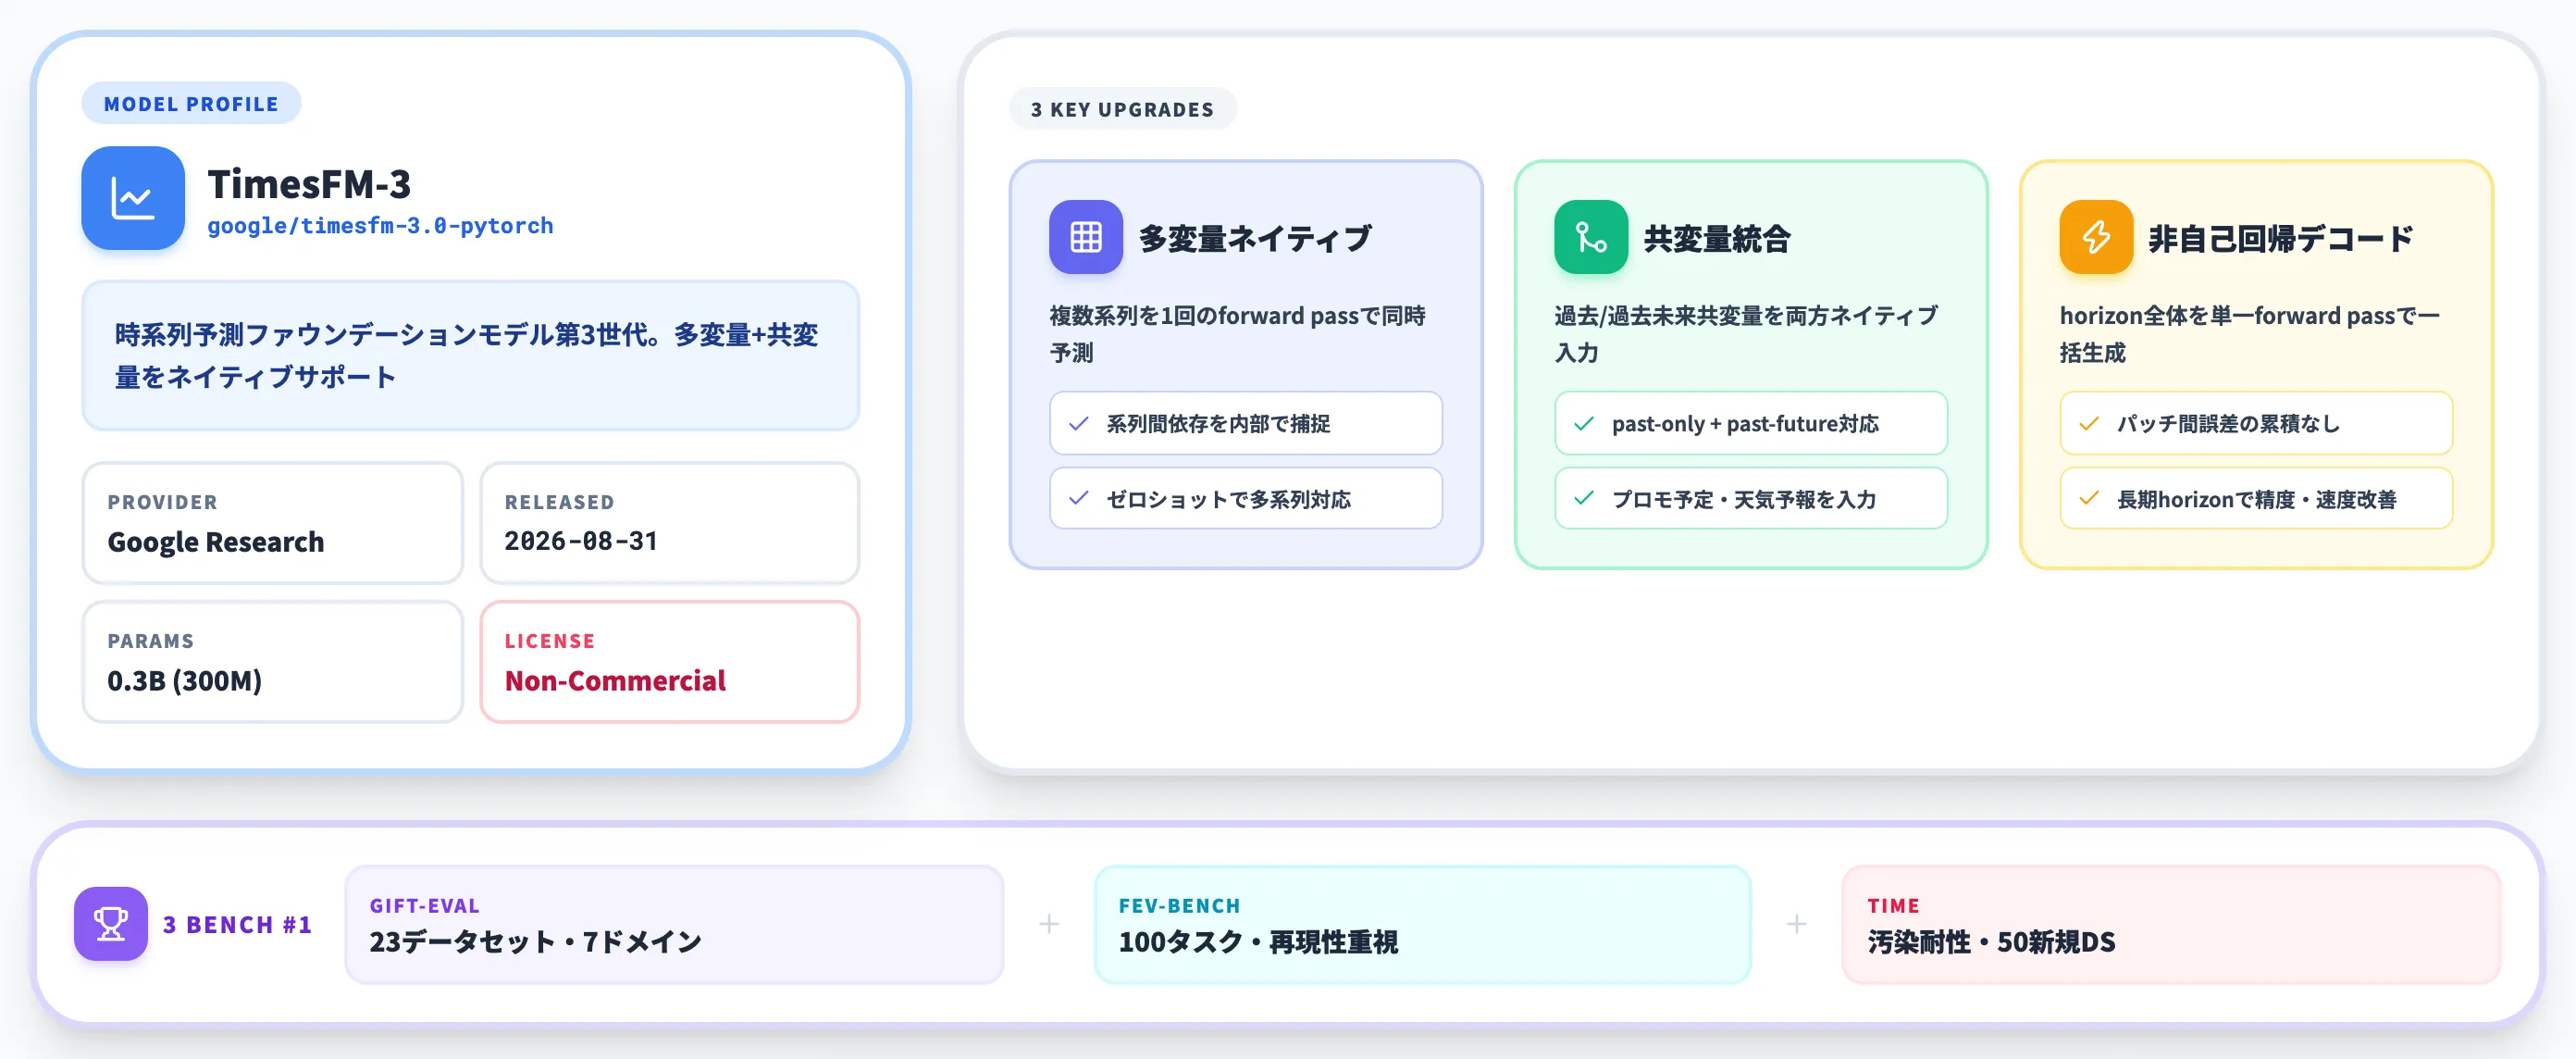
Googleが2026年8月31日に公開したTimesFM-3は、時系列予測のファウンデーションモデル分野で多変量ネイティブ対応を実現した第3世代モデルです。
パラメータ数は約3億(0.3B)、実世界と合成データ合わせて1兆以上の時間ポイントで事前学習された時系列基盤モデルとして位置づけられています。
TimesFM 1.0からTimesFM-3までの世代変化
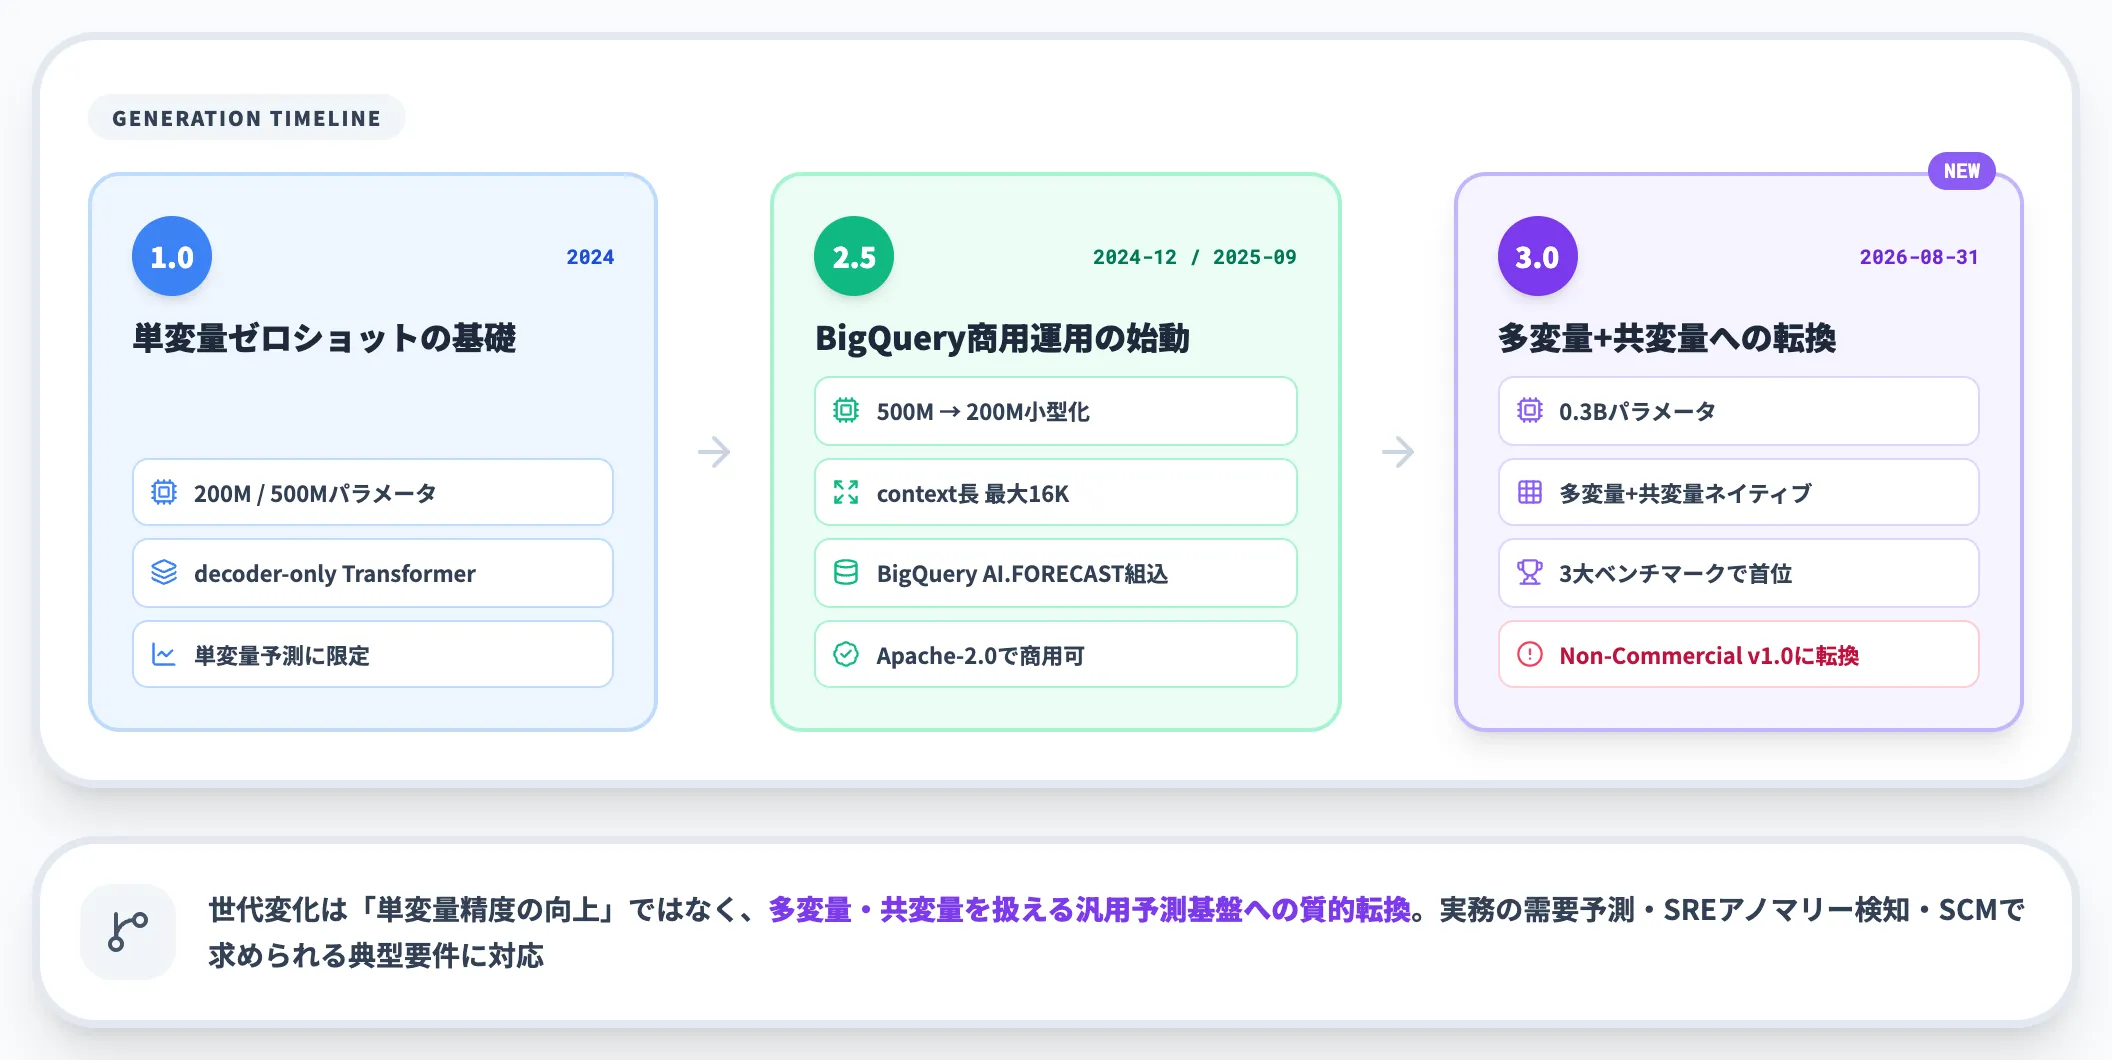
TimesFMは2023年10月の初代論文公開以来、約2年で3世代のモデルを重ねてきました。各世代の主な変化を整理します。
-
TimesFM 1.0(2024年発表)
200M・500Mパラメータのdecoder-only Transformer。パッチ化された時系列を言語モデル同様に扱う設計で、単変量ゼロショット予測の基礎を築いた世代。
-
TimesFM 2.0 / 2.5(2.0=2024年12月30日/2.5=2025年9月15日)
500M(2.0)から200M(2.5)へ小型化しつつcontext長を最大16Kに拡張し、Google Cloud経由の実運用パスが整った世代。
-
TimesFM-3(2026年8月31日)
0.3Bパラメータで、TimesFMシリーズとして多変量・共変量ネイティブ対応の質的転換を果たした第3世代。
実務観点で見ると、この世代変化は「単変量精度の向上」ではなく「多変量・共変量を扱える汎用予測基盤への転換」という質的な変化を意味します。TimesFM-3が扱えるようになった「複数系列を関係ごと予測する」設計は、実務の需要予測・SREアノマリー検知・小売SCMなどで求められる典型的な要件でもあります。
TimesFM 2.5から変わった3つのポイント
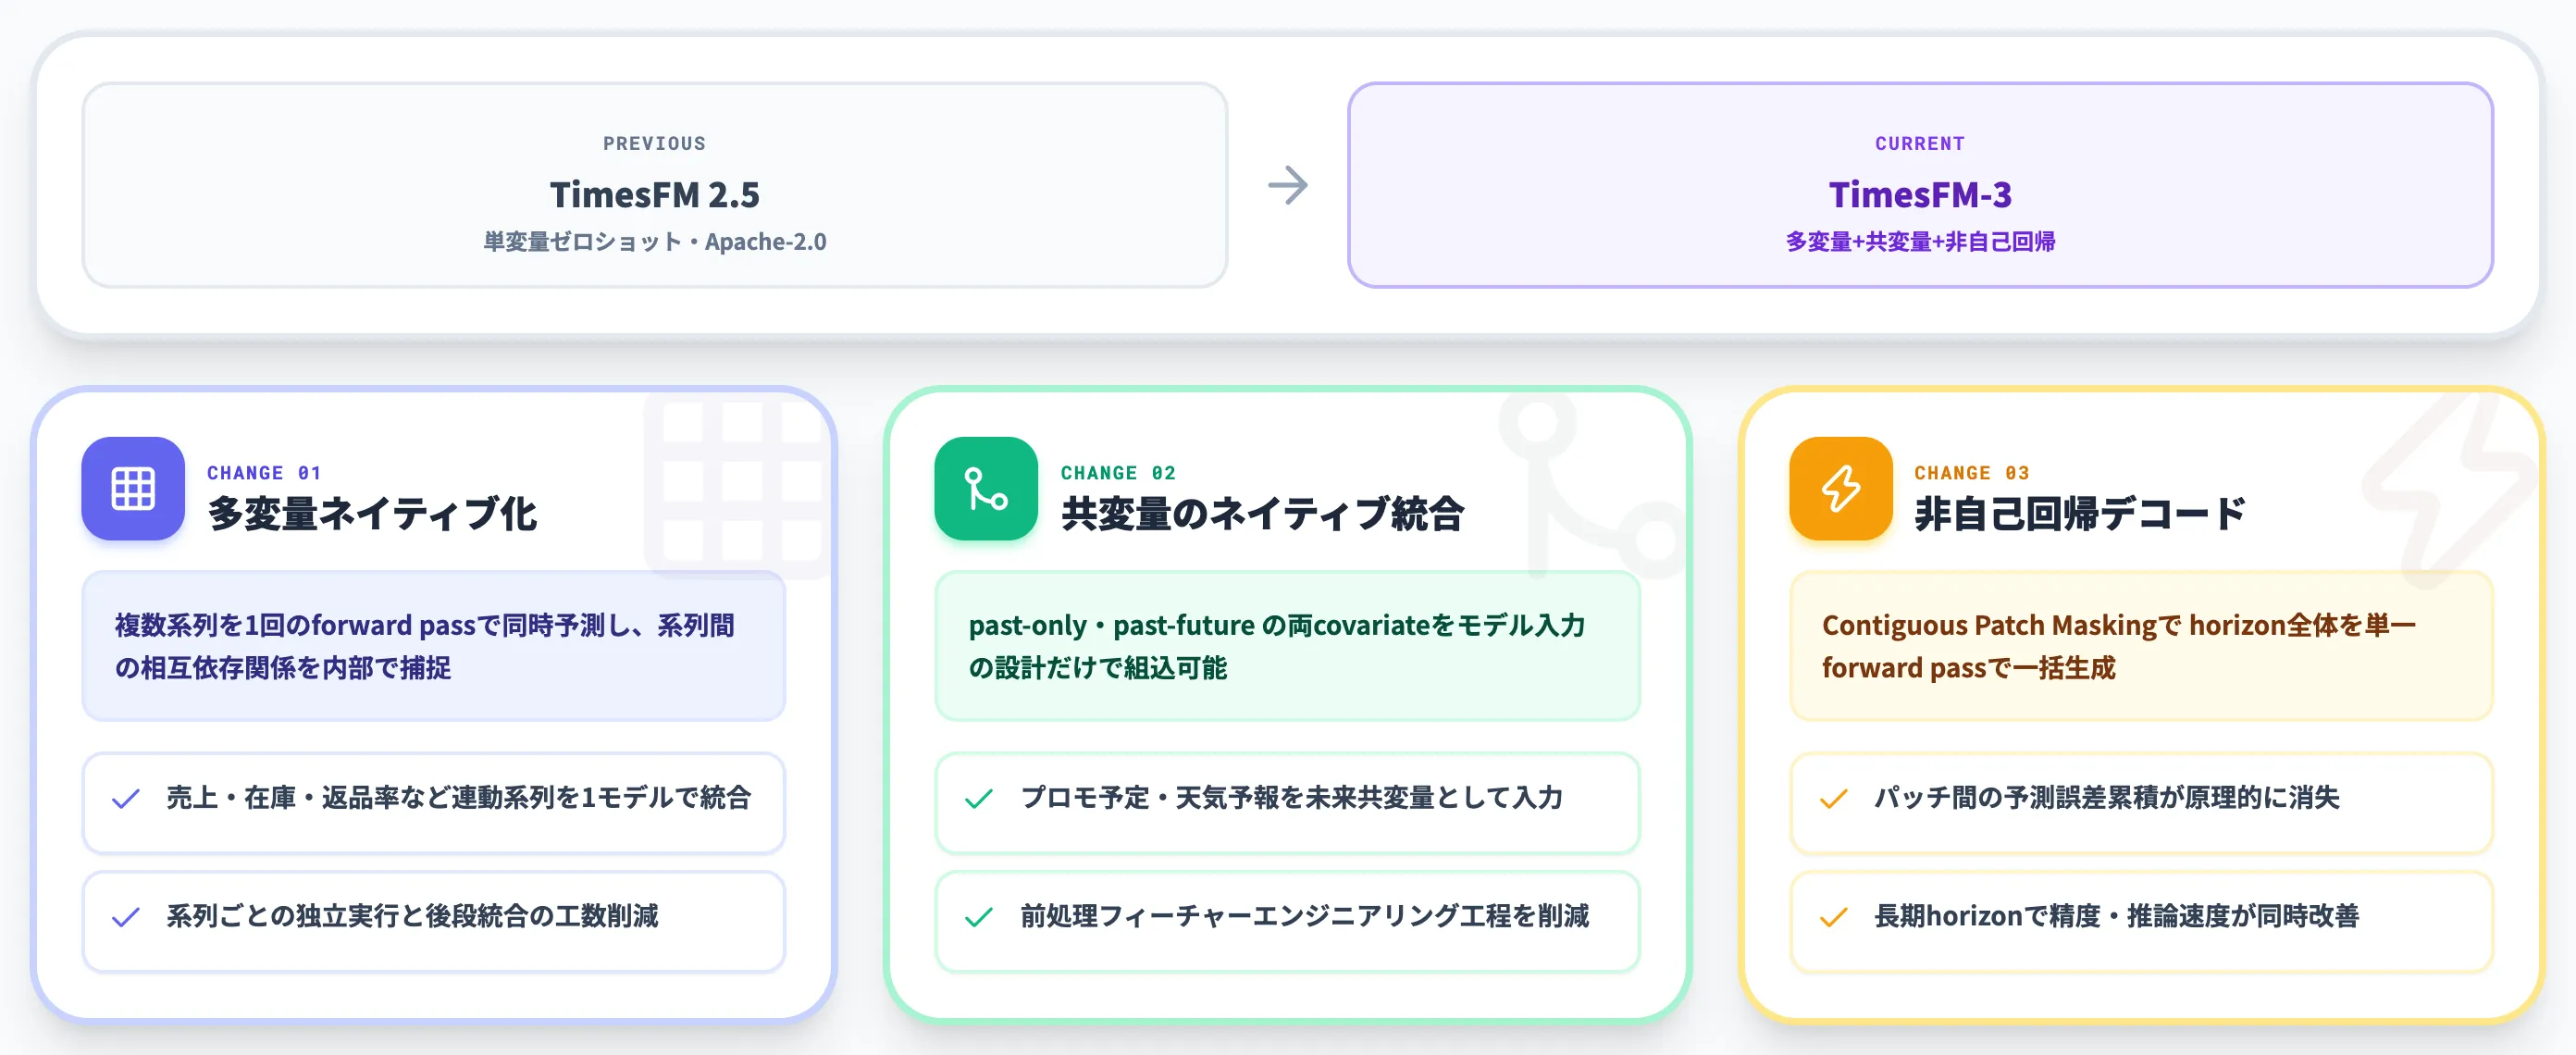
TimesFM-3の実務価値は、前世代TimesFM 2.5からの3つの変化に集約されます。ここでは技術詳細に踏み込む前に、それぞれが実務でどんな効果をもたらすかを俯瞰します。
以下の表で、TimesFM 2.5とTimesFM-3の主要な差分を整理しました。
| 観点 | TimesFM 2.5 | TimesFM-3 |
|---|---|---|
| 対象タスク | 単変量予測のみ | 単変量+多変量+共変量統合 |
| 共変量サポート | XReg拡張(2025年10月追加)で限定対応 | 過去のみ・過去未来の両covariateをネイティブサポート |
| デコード方式 | 自己回帰(パッチごとに予測) | 非自己回帰(全horizon単一forward pass) |
| ライセンス | Apache-2.0 | Non-Commercial v1.0 |
| ベンチマーク首位 | FEV-Benchで首位(TiRexと同格) | GIFT-Eval・FEV-Bench・TIMEで単独首位 |
この差分を見ると、多変量ネイティブ化・共変量のネイティブ統合・非自己回帰デコードの3点が実質的な進化ポイントです。各項目の実務効果を順に見ていきます。
多変量ネイティブ化
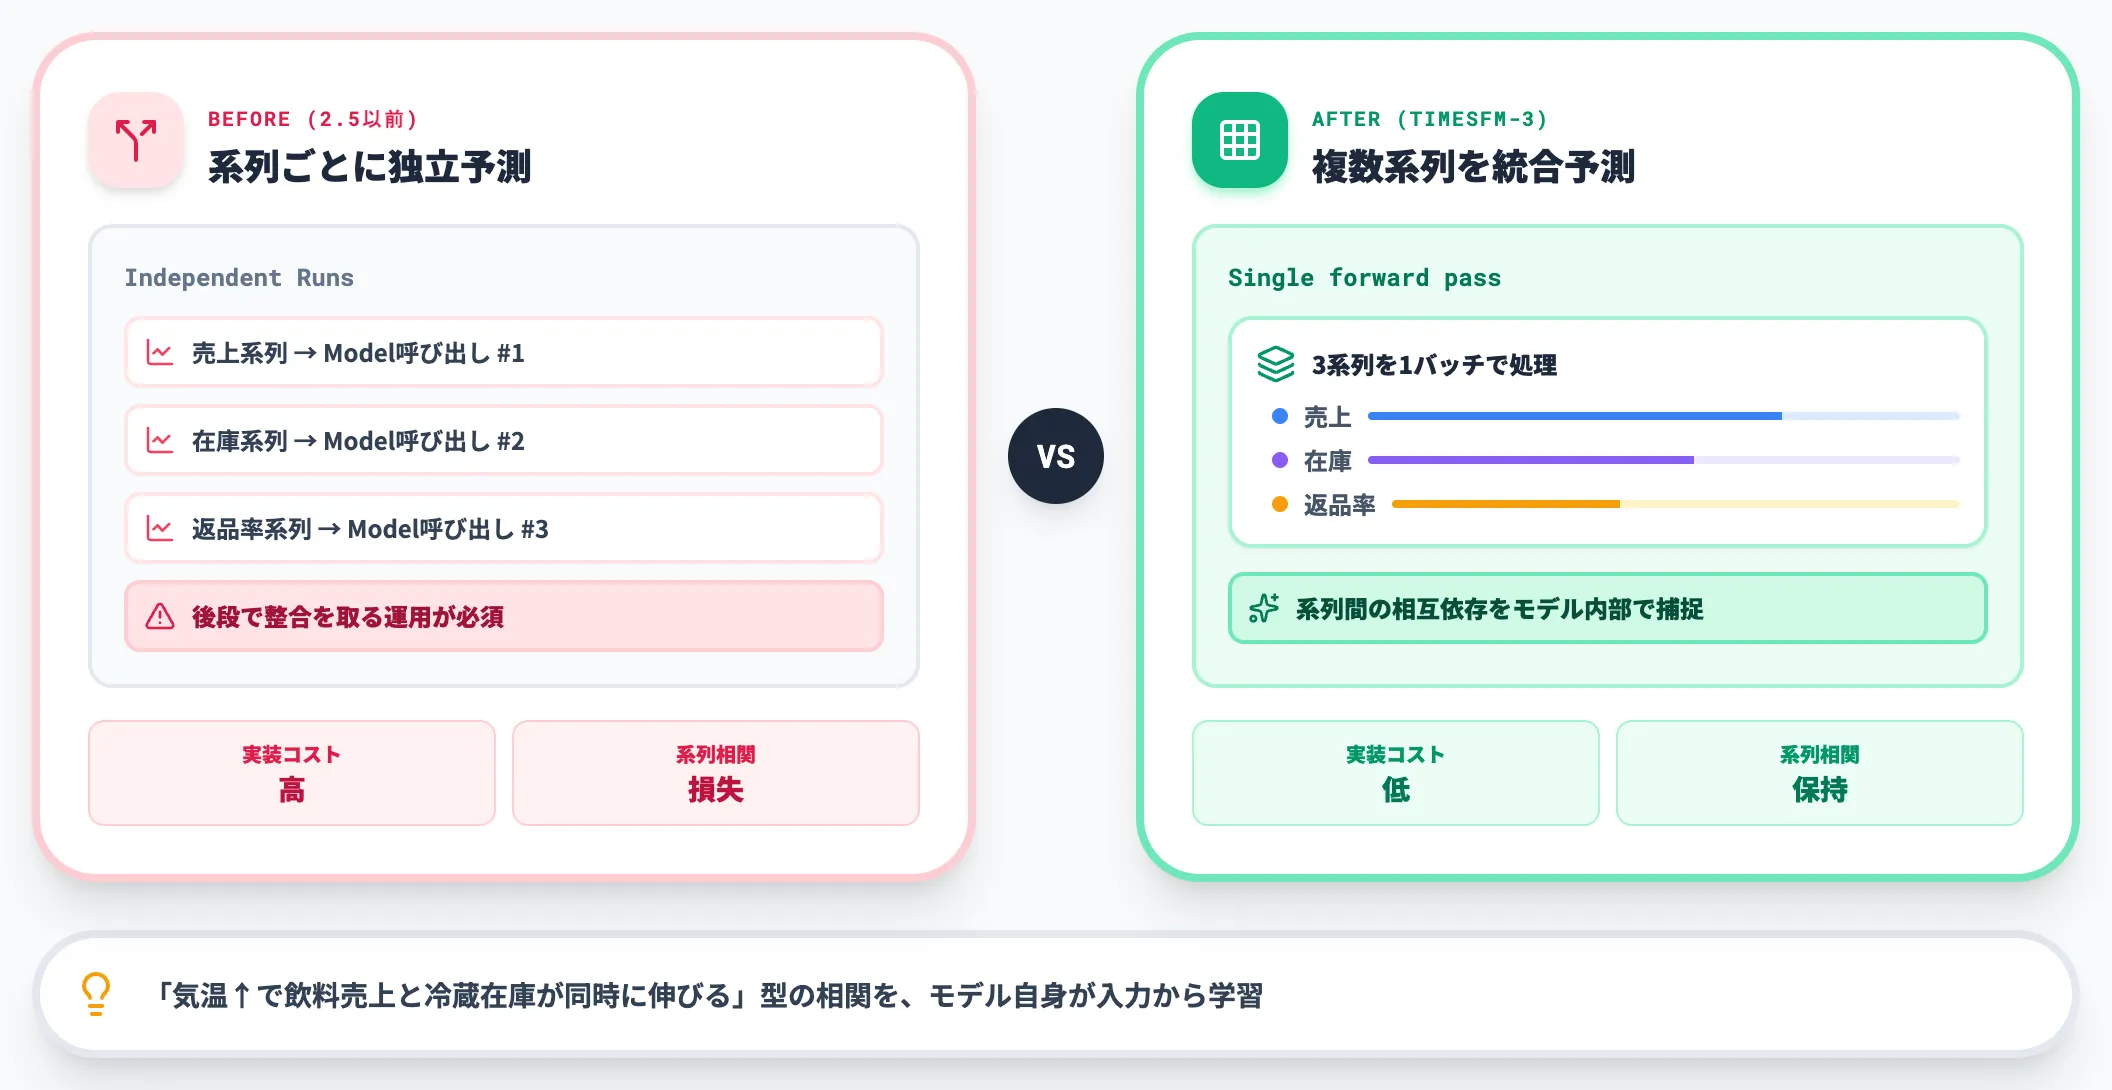
前世代までは、複数の関連系列を予測する場合、系列ごとに独立してモデルを走らせる必要がありました。売上・在庫・返品率のように相互に影響する系列を、それぞれ独立に予測してから後段で整合を取る運用は、実装コストも精度もネックになります。
TimesFM-3は複数系列を1つのforward passで同時に予測し、系列間の相互依存関係を内部で捕捉します。たとえば「気温が上がると飲料の売上と冷蔵在庫の消費が同時に伸びる」といった相関を、モデル自身が入力から学習して予測に反映します。
実務観点で言えば、需要予測・在庫最適化・SREのマルチメトリクス監視のように「複数指標が連動して動く」領域で、系列ごとの独立予測から一段進んだ精度を狙える設計です。ゼロショット(追加学習なし)でこれが可能な点も重要で、系列ごとにパイプラインを組む工数を削減できます。
共変量のネイティブ統合
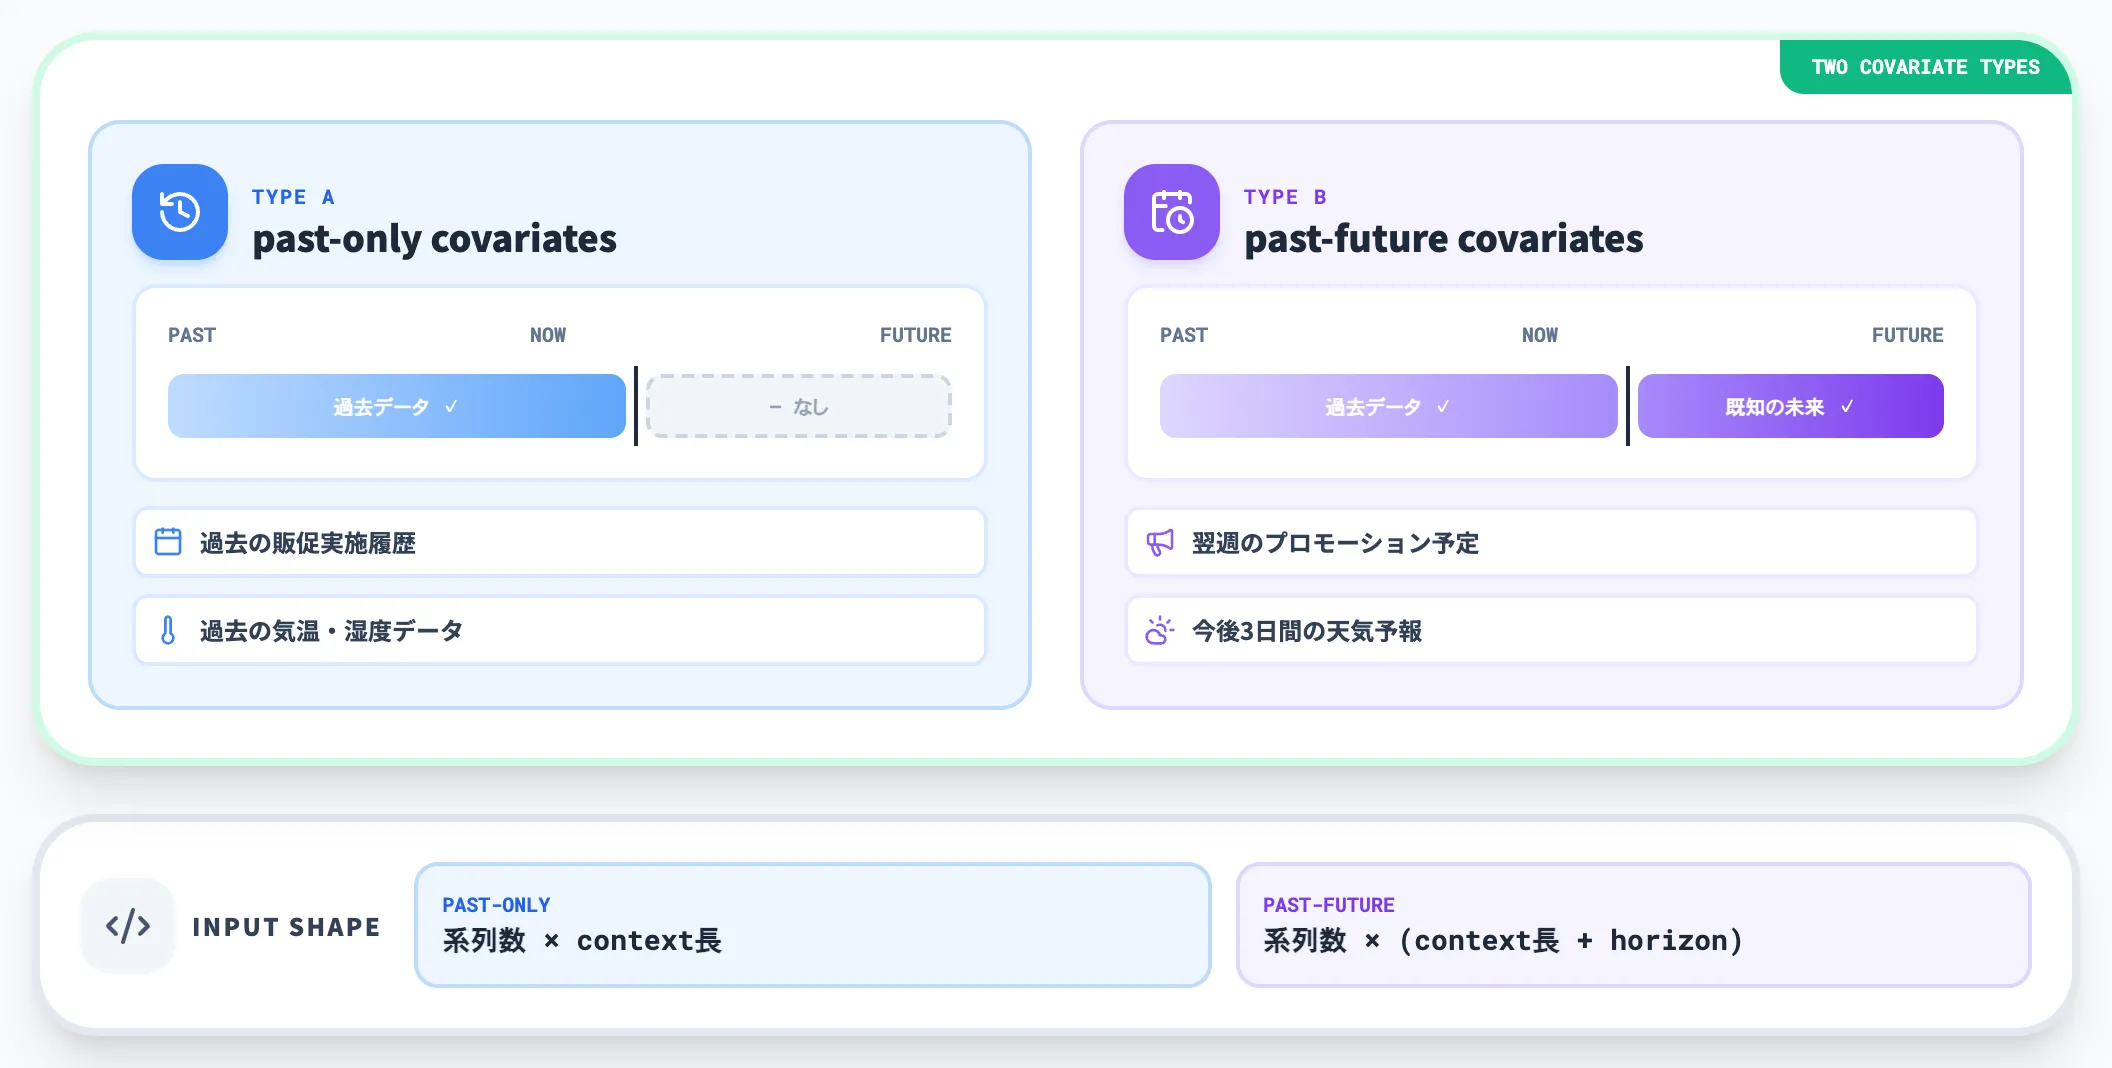
外部要因(共変量)を予測に組み込むと精度が上がることは古典から知られていますが、既存の時系列基盤モデルでは共変量サポートが後付けの拡張機能に留まるケースが多く、実装が煩雑でした。
TimesFM-3は「過去のみ共変量」(past-only covariates)と「過去未来共変量」(past-future covariates)の両方をネイティブでサポートします。前者は「過去の販促実施履歴・過去の気温データ」、後者は「翌週のプロモ予定・天気予報」のように既知の未来情報を指します。
具体的には、Googleの公式ブログでは「翌月のプロモ予定が売上予測に既知の未来として使え、当週の販促効果を織り込んで来週の売上を予測する」といった使い方が示されています。
実務で外部要因を予測に取り込む一連のフィーチャーエンジニアリング工程が、モデル入力の設計だけで済むようになります。
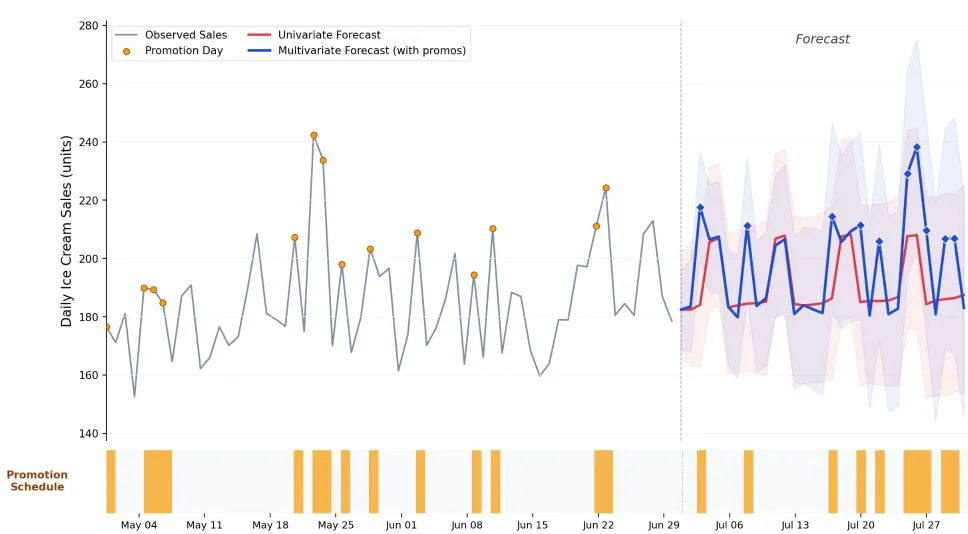
アイスクリーム売上予測におけるプロモーション共変量の効果。プロモ予定を過去未来共変量として与えた多変量予測(青)は、単変量予測(赤)よりもプロモ日に反応した上振れを予測している(出典:Google Research Blog)
Google Researchが公開した実例では、単変量予測(赤線)が予測区間内でほぼ平坦に推移するのに対し、プロモスケジュールを共変量として与えた多変量予測(青線)ではプロモ日に反応して上振れの予測を示しています。実務の需要予測でも、外部イベントの予定情報を予測モデルに直接与えられる設計は、フィーチャーエンジニアリング工程の負荷を下げる方向に効きます。
非自己回帰デコード
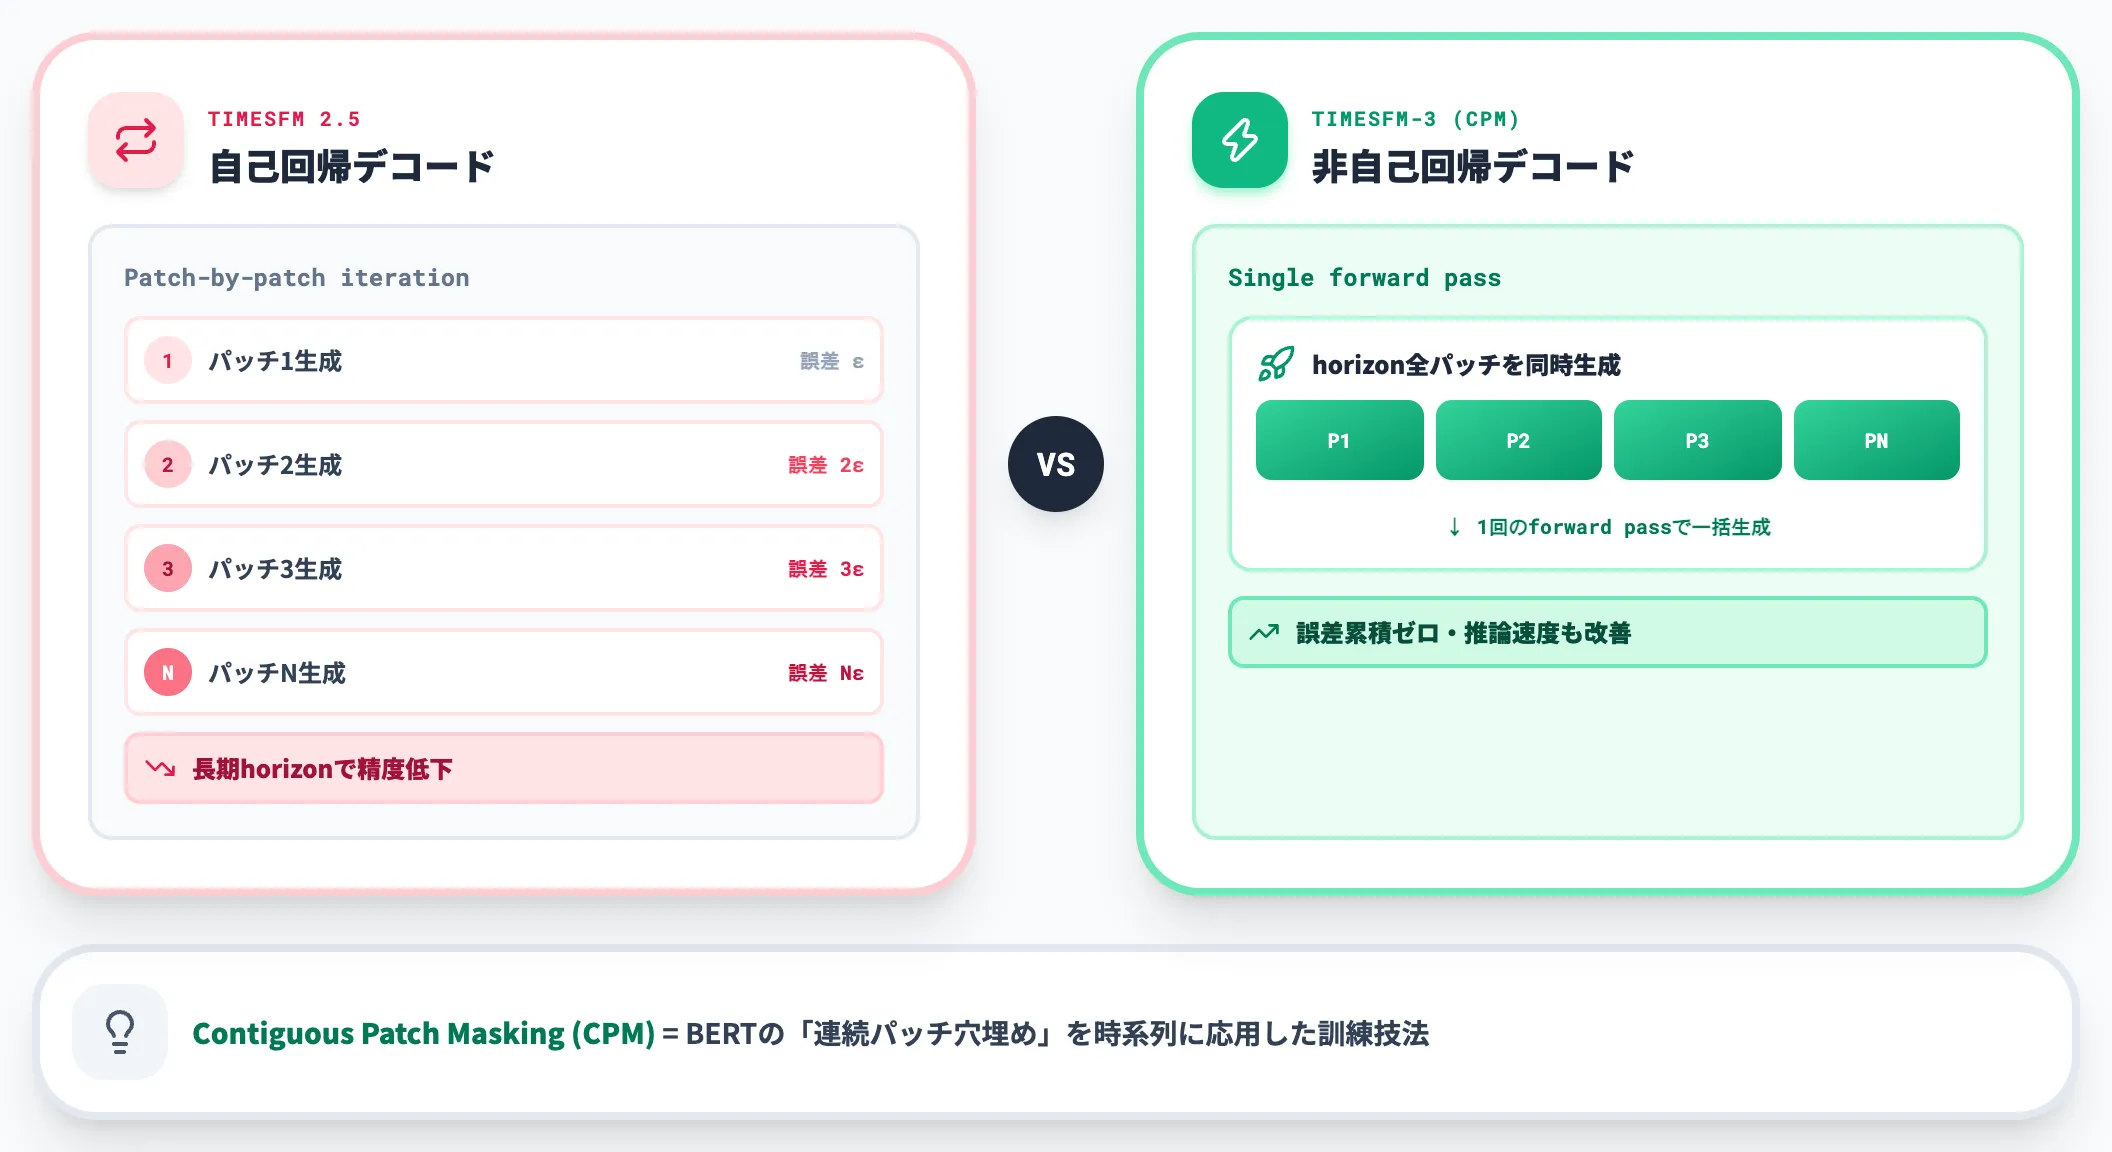
前世代のTimesFM 2.5は、予測horizonを複数パッチに分けて自己回帰的に生成していました。この方式では、パッチが後ろに進むほど過去の予測誤差が累積し、長期horizonでの精度が落ちる問題がありました。
TimesFM-3はContiguous Patch Maskingという独自の非自己回帰デコード方式を採用し、予測horizon全体を1回のforward passで一括生成します。パッチ間の誤差累積が原理的に発生しないため、長期horizonの精度と推論速度が同時に改善します。
設計上、予測horizonをパッチごとに反復して生成する必要がなくなるため、長期horizonでも精度低下と応答時間の両方を抑えられる構造になっています。実装面では自己回帰生成に固有のループ処理が不要になり、モデル呼び出しの内部処理がシンプルになる点も運用上のメリットです。
TimesFM-3のアーキテクチャ
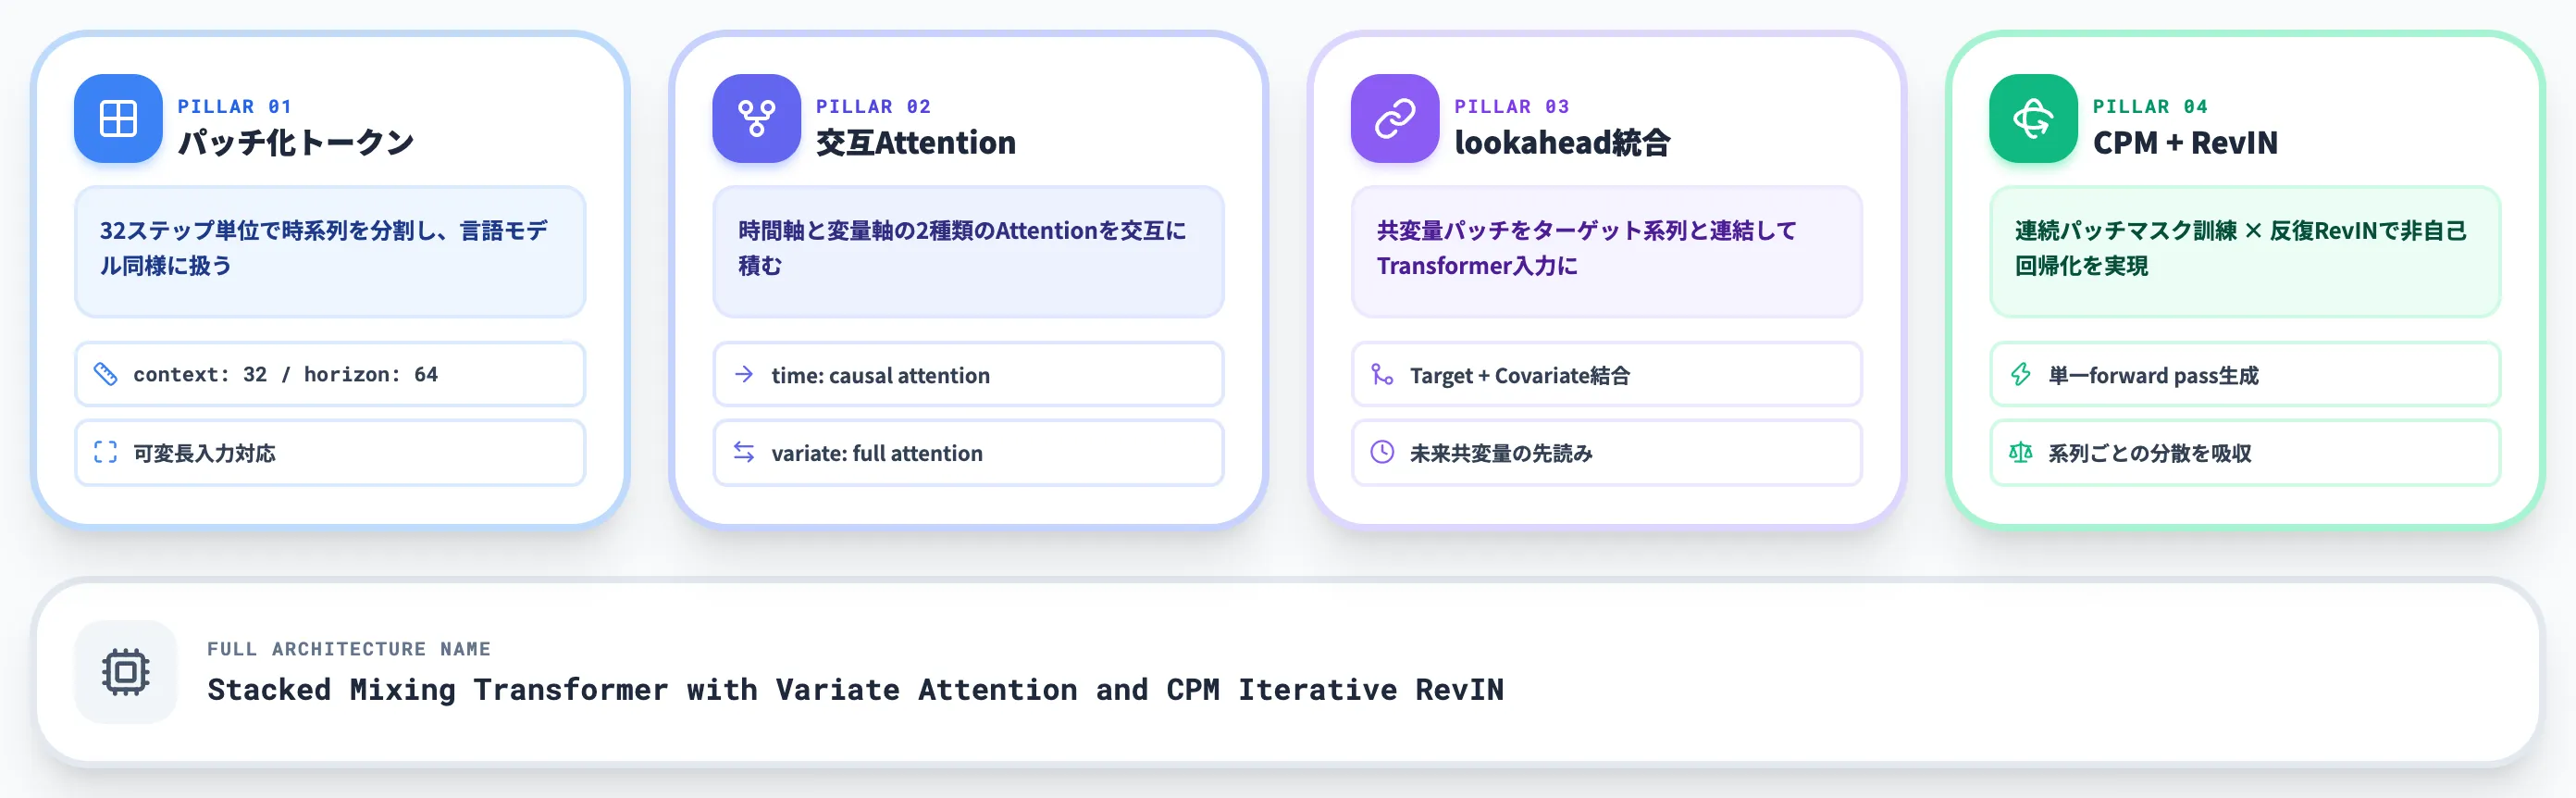
前セクションで紹介した3つの進化点は、モデル内部の設計変更によって実現されています。
ここではTimesFM-3のアーキテクチャを、Hugging FaceのモデルカードとGoogle Researchの公式ブログの情報をもとに整理します。
モデル構造とパラメータ
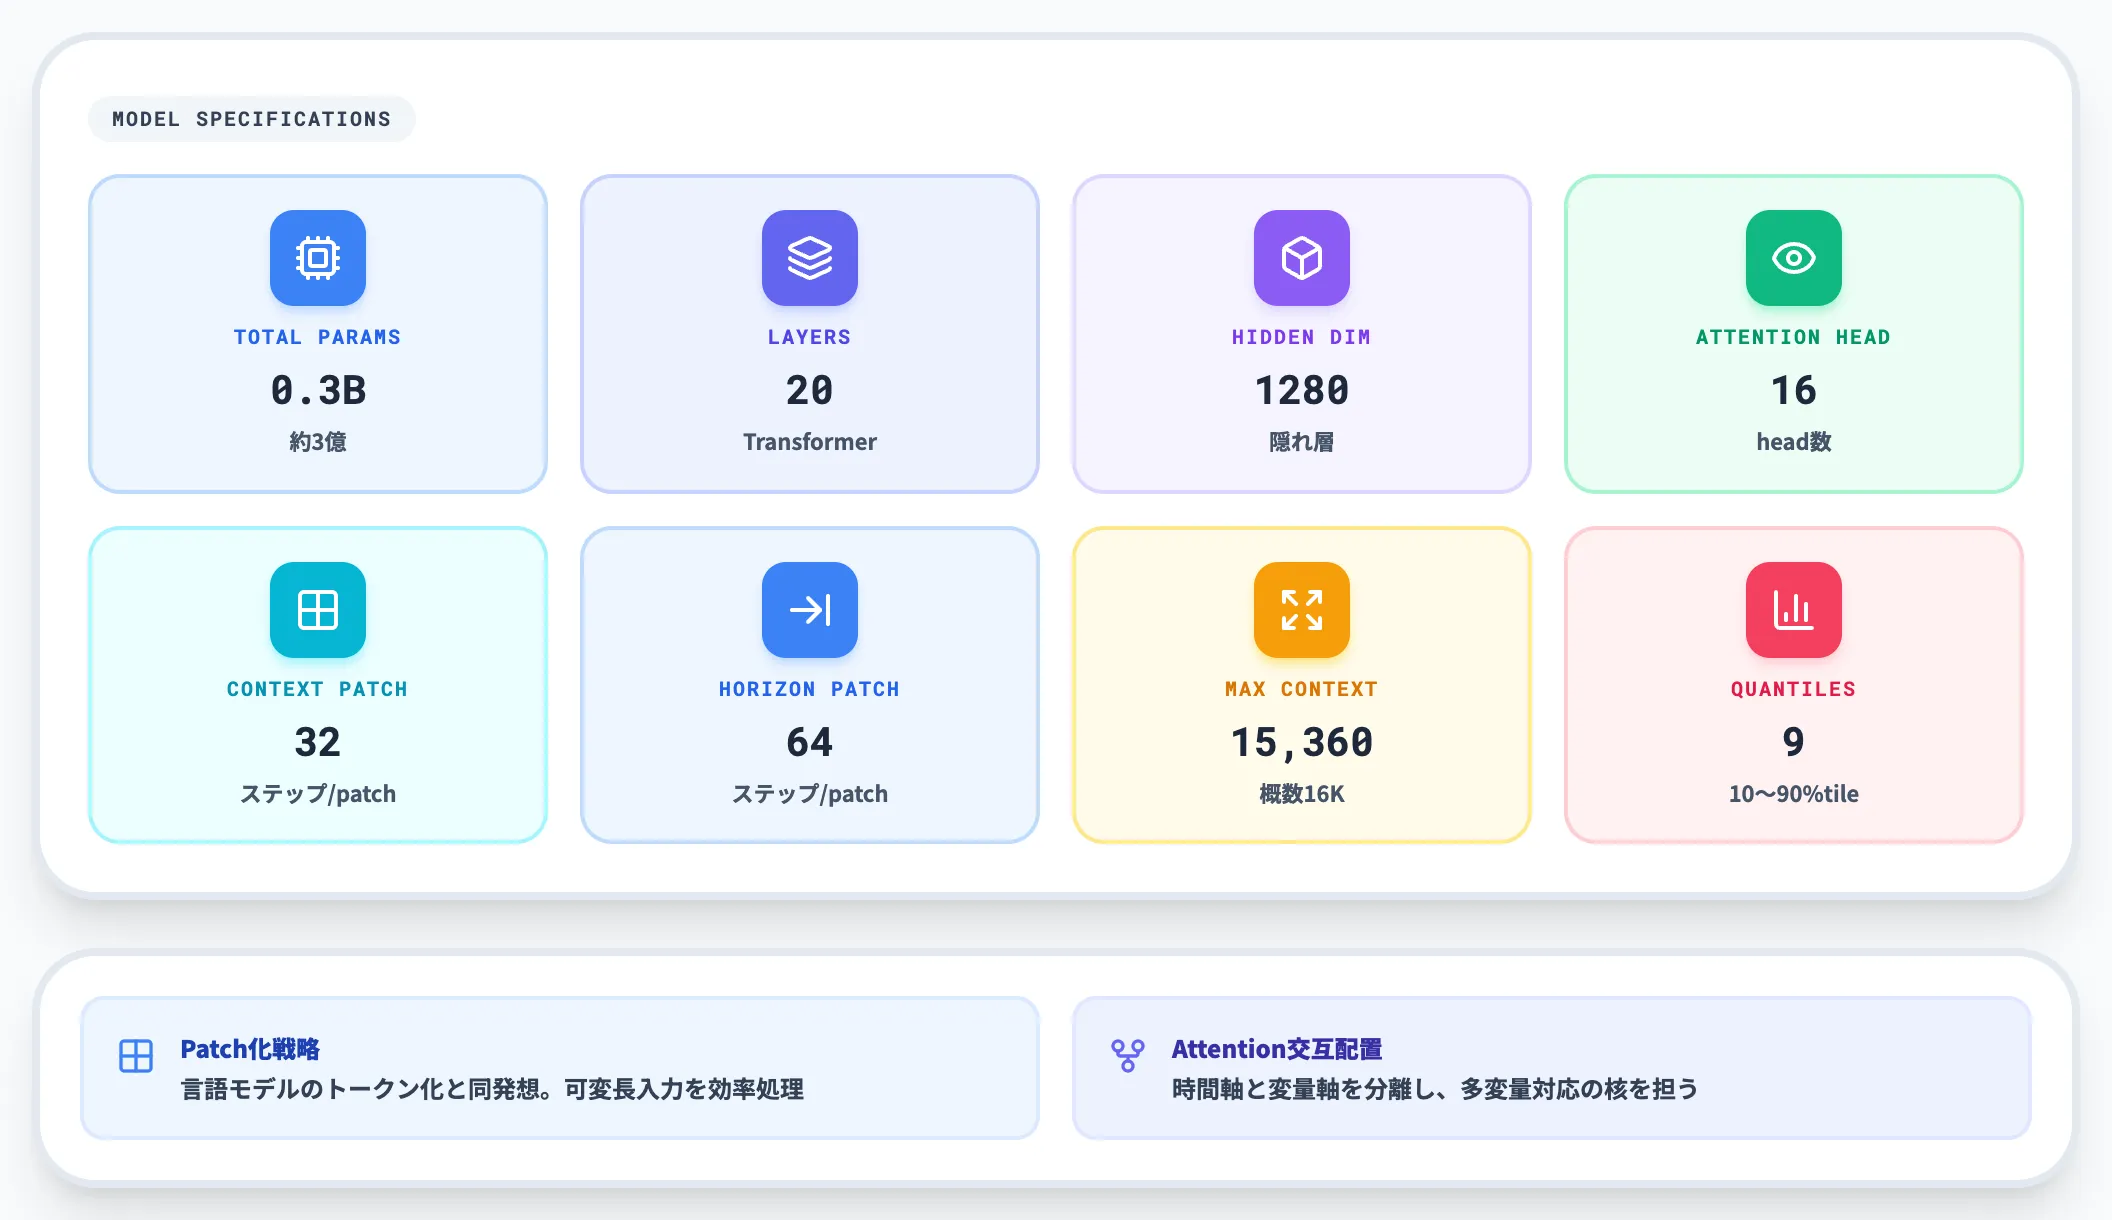
TimesFM-3は「Stacked Mixing Transformer with Variate Attention and CPM Iterative RevIN」というアーキテクチャで構成されています。主要スペックは以下のとおりです。
以下の表で、TimesFM-3の主要な内部構成を整理しました。
| パラメータ | 値 |
|---|---|
| 総パラメータ数 | 約3億(0.3B) |
| Transformer層数 | 20層 |
| 隠れ層次元 | 1280 |
| Attention head数 | 16 |
| Context patchサイズ | 32ステップ |
| Forecast horizon patchサイズ | 64ステップ |
| 最大context長 | 15,360(公式実装値・概数16K) |
| 出力分位数 | 9つ(10〜90パーセンタイル) |
特徴的なのは、時系列を32ステップのパッチに区切って処理する点と、Attention機構が2種類交互に配置されている点です。前者は言語モデルがトークンを扱うのと同じ発想で、可変長の入力を効率的に扱うための設計。後者が多変量対応の核になります。
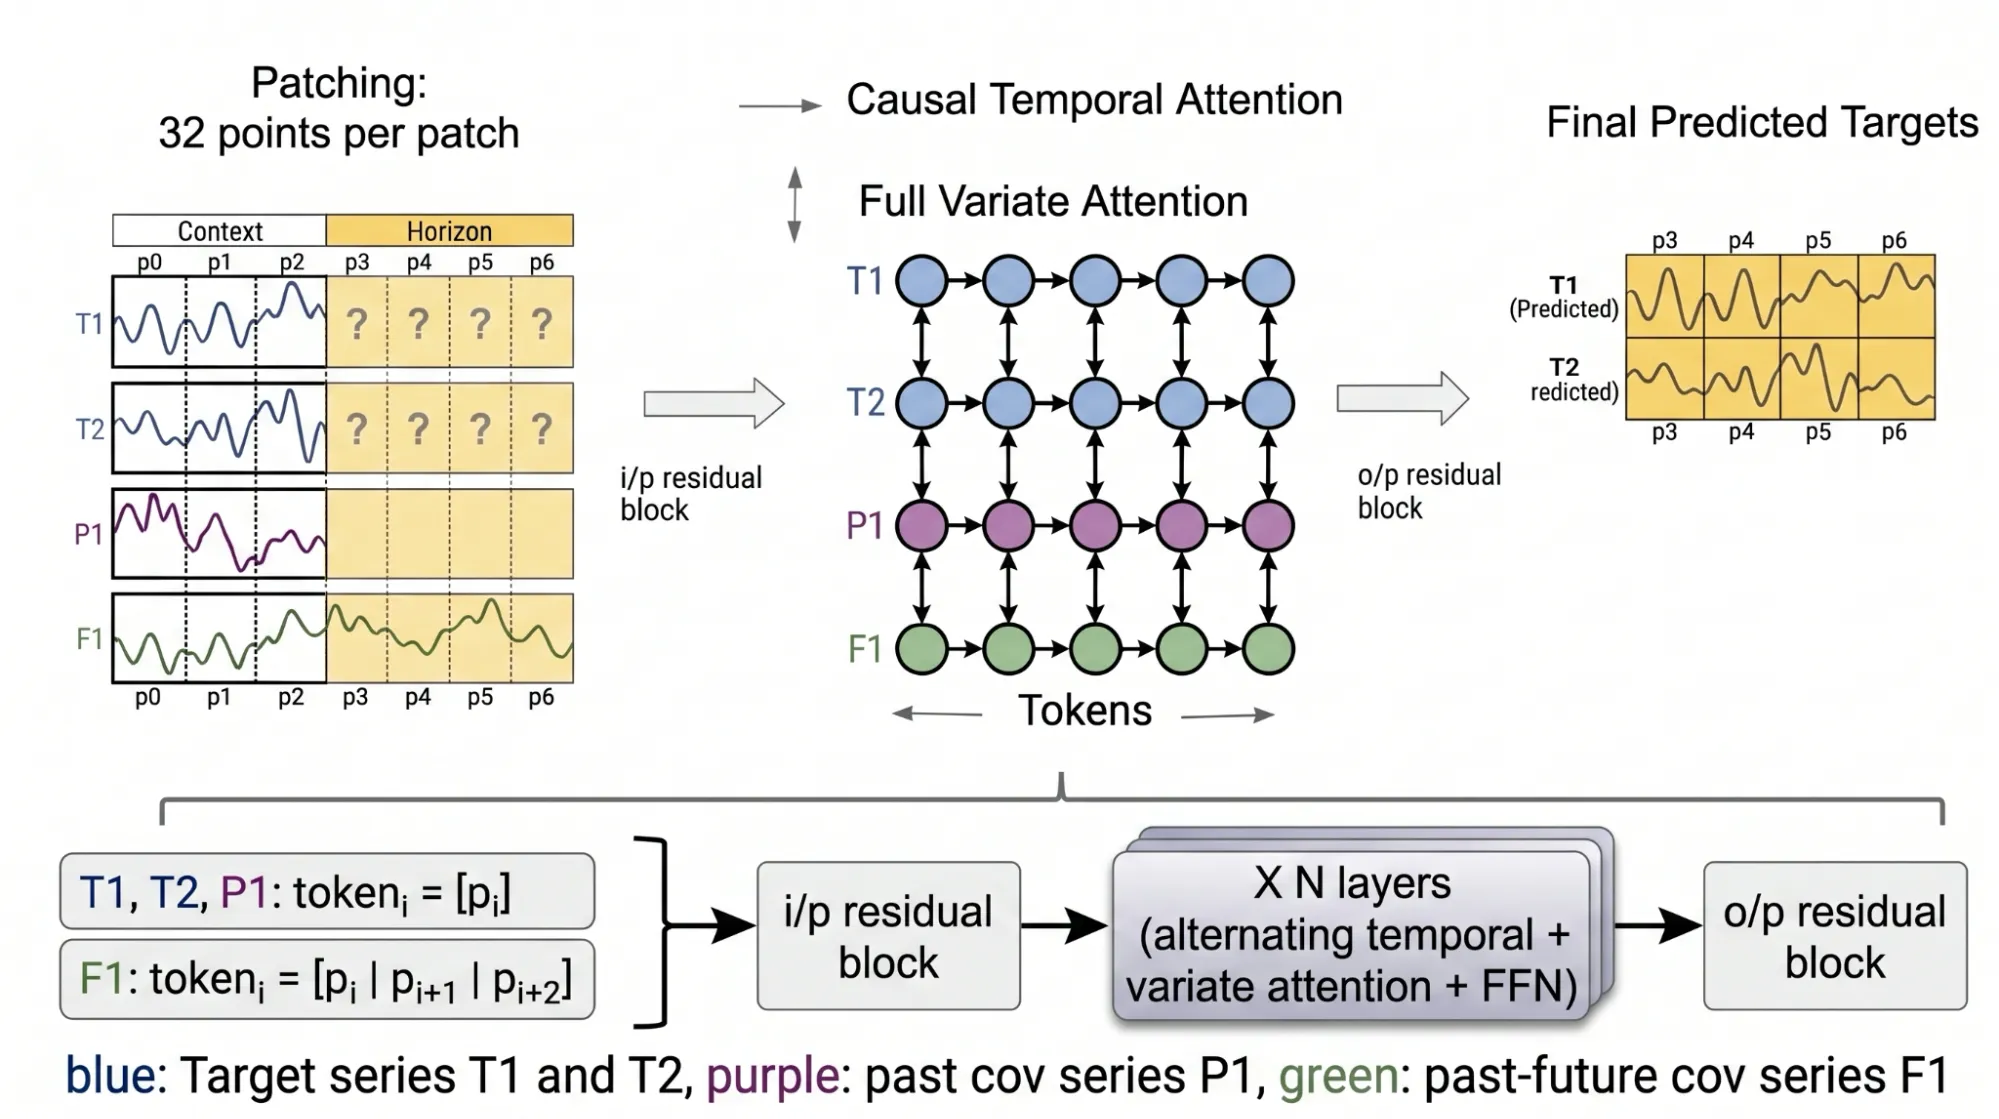
TimesFM-3のアーキテクチャ全体像。32ポイント/パッチで時系列をトークン化し、Causal Temporal AttentionとFull Variate Attentionを交互に積んだN層のTransformerで、Target系列(T1/T2)・過去共変量(P1)・過去未来共変量(F1)を統合する(出典:Google Research Blog)
図の左側で示されているのは、Target系列(T1・T2)と過去共変量(P1)は現在パッチ単一で、過去未来共変量(F1)は現在+2先パッチを連結する「lookahead」入力形式です。中央のトークン列がN層のTransformerで処理され、右側でTarget系列2本の予測が同時出力される流れが1枚に凝縮されています。
交互Attention機構
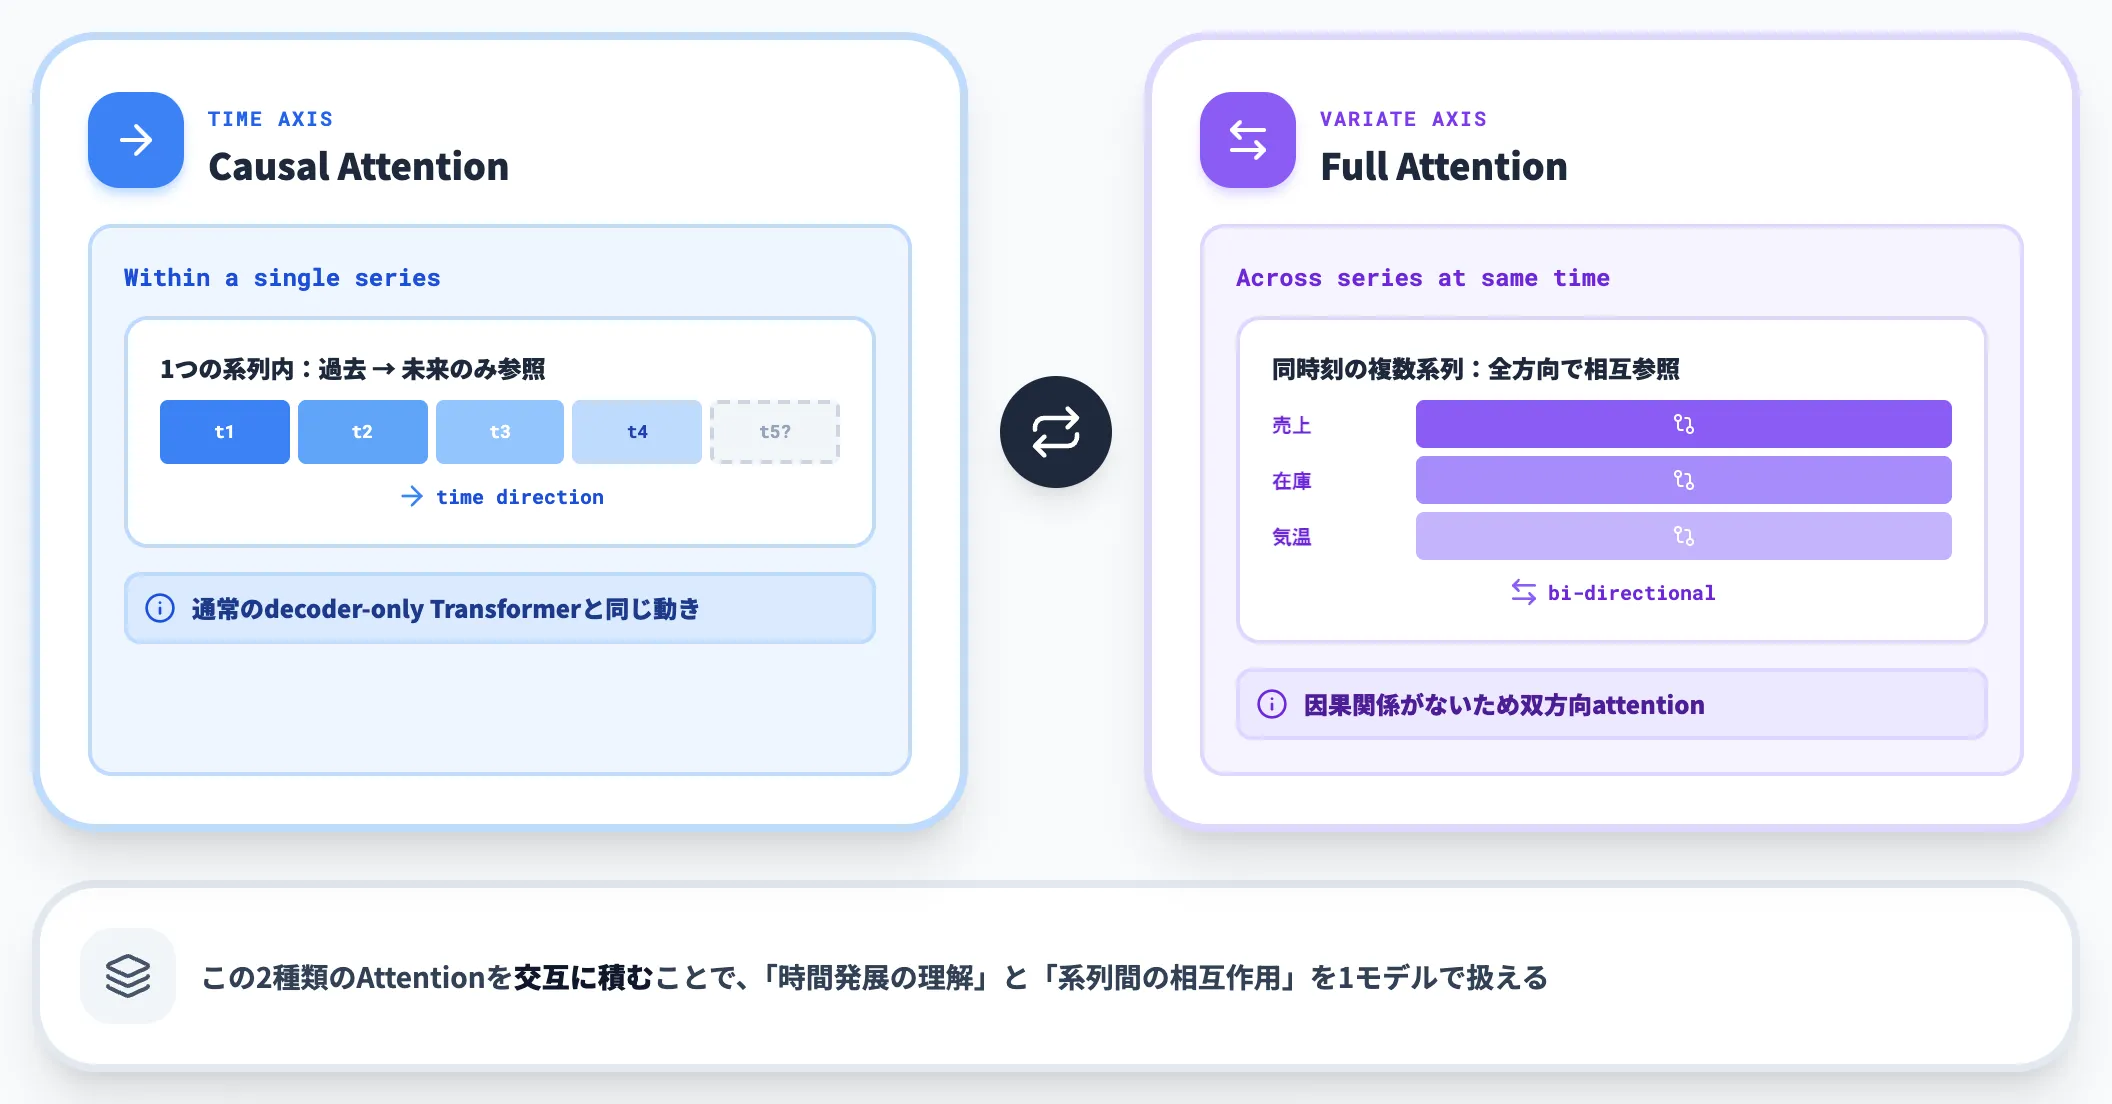
多変量時系列の難しさは、「時間方向の依存関係」と「変量間の依存関係」を同時に捕捉しなければならない点にあります。TimesFM-3はこの2種類の依存関係を、Attention層で明示的に分離しています。
-
時間軸方向の因果的Attention(causal temporal attention)
1つの系列内で、過去のパッチから未来のパッチへの因果関係を捉える。通常のdecoder-only Transformerと同じ動き。
-
変量軸方向のfull Attention(full variate attention)
同じ時刻における複数系列の相互関係を捉える。ここでは因果関係がないため双方向attention。
この2種類のAttentionを交互に積むことで、「時間発展の理解」と「系列間の相互作用」を1モデルで扱えるようになります。従来の時系列モデルが「まず1系列ずつ処理して後段で統合」というアプローチだったのに対し、TimesFM-3は最初から両方向を同時に見る構造に踏み込んだ点が革新的です。
共変量統合とlookahead戦略
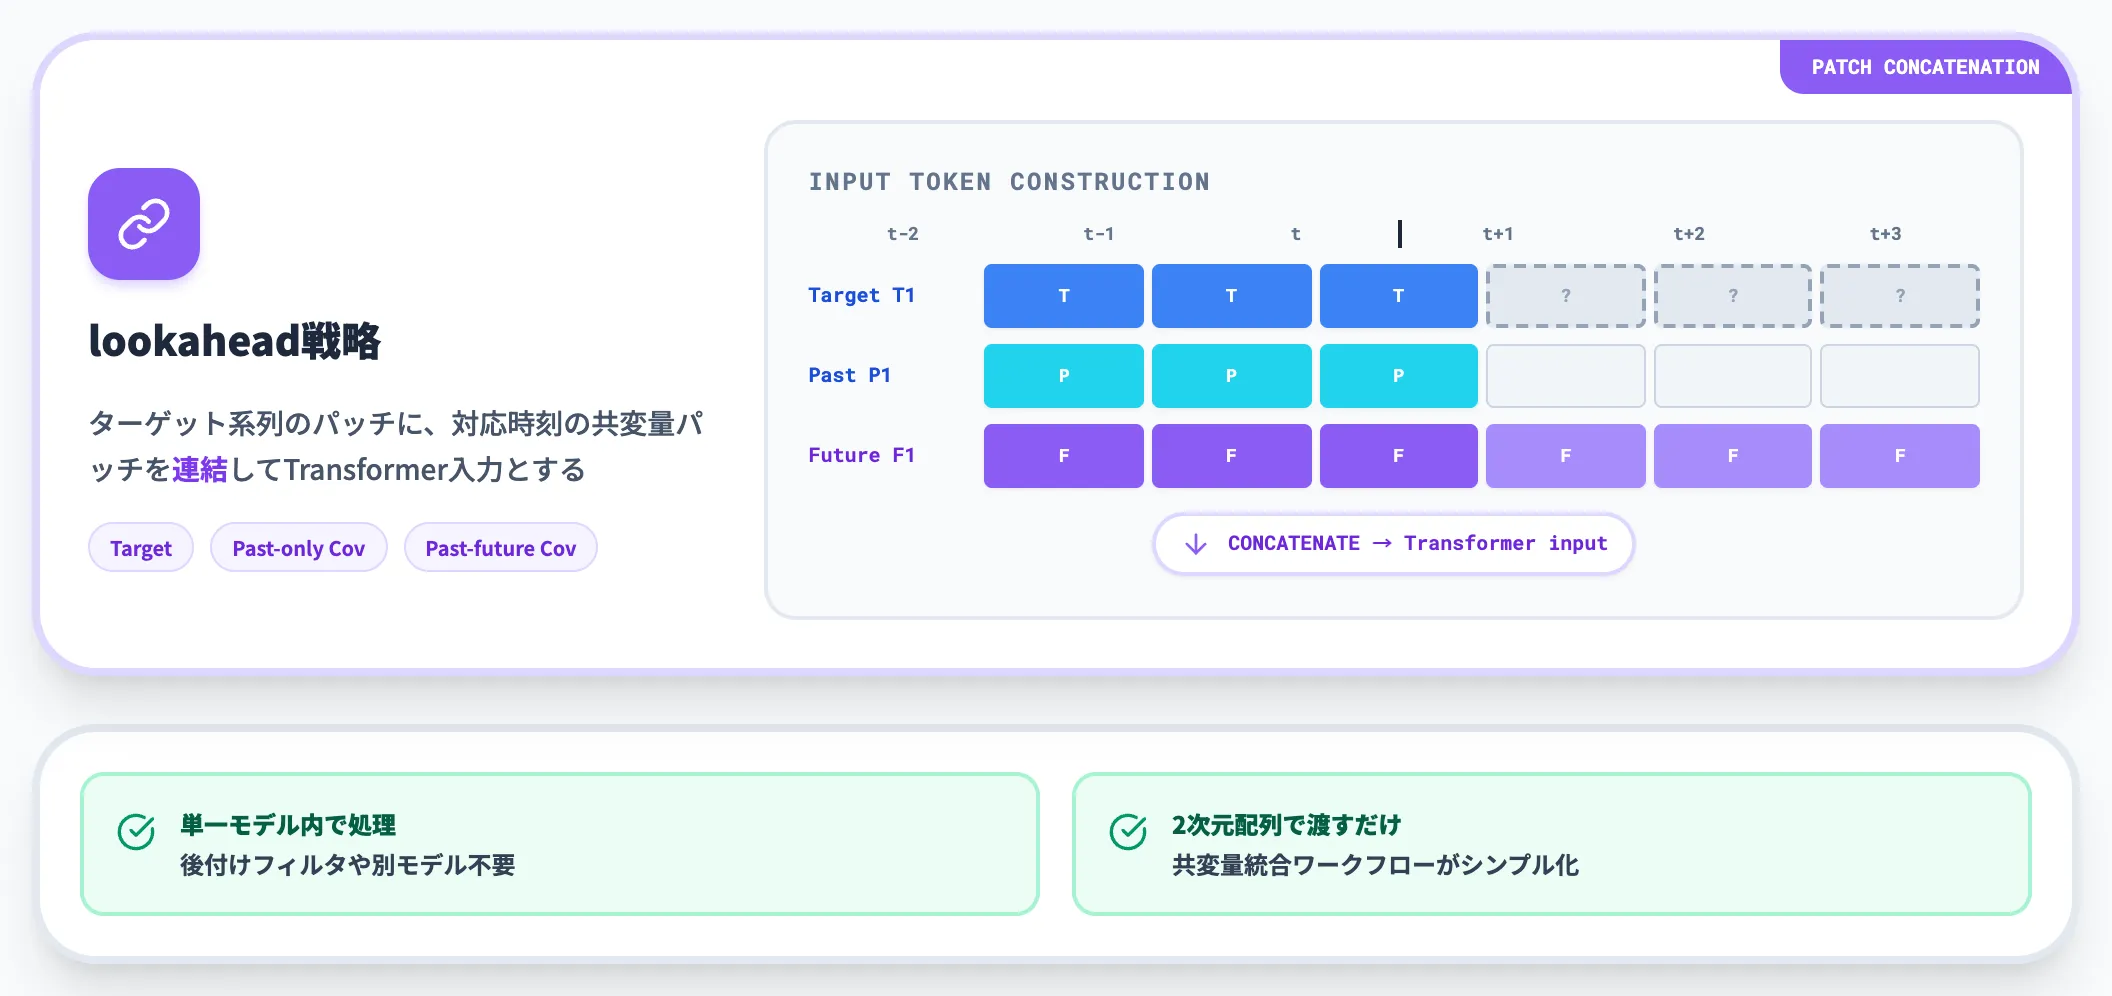
過去未来共変量(既知の未来情報)をどうモデルに与えるかは、時系列予測FMの実装上の難所です。TimesFM-3では「lookahead戦略」と呼ばれる方式で、未来の共変量パッチをターゲット系列のパッチと連結してTransformerに入力します。
具体的には、ターゲット系列の各パッチに対して、対応する時刻の共変量パッチを連結したベクトルを構築し、それを入力トークンとして扱います。過去未来共変量については、予測horizonの各時刻について「その時点で既知の未来情報」を先読みしてトークン化する処理を行います。
この方式によって、共変量を後付けのフィルタや別モデルで処理する必要がなくなり、単一モデル内で共変量の影響を吸収できます。実装上は、ターゲットと過去共変量を系列数×context長、過去未来共変量を系列数×(context長+horizon)の2次元配列として個別に渡すだけで済むため、多変量+共変量の予測ワークフローが大きくシンプルになります。
Contiguous Patch Masking
前セクションで触れた非自己回帰デコードは、Contiguous Patch Masking(CPM)と呼ばれる訓練技法で実現されています。訓練時にターゲット系列の連続するパッチをまとめてマスクし、そのマスク領域全体を1回のforward passで復元するタスクを学習します。
推論時には、予測horizonをマスク領域として与え、モデルが全パッチを同時に生成します。RevIN(Reversible Instance Normalization)のiterativeな適用と組み合わせることで、系列ごとの分散スケールを吸収しながら安定した予測を可能にしています。
この訓練技法は、BERTのMasked Language Modelingの時系列版と考えると理解しやすい設計です。ただしBERTが「単一トークンの穴埋め」なのに対し、CPMは「連続する複数パッチの一括復元」を学ぶ点で、時系列固有の長期依存関係の学習に効いています。
TimesFM-3のベンチマーク結果——GIFT-Eval・FEV-Bench・TIMEで全て首位
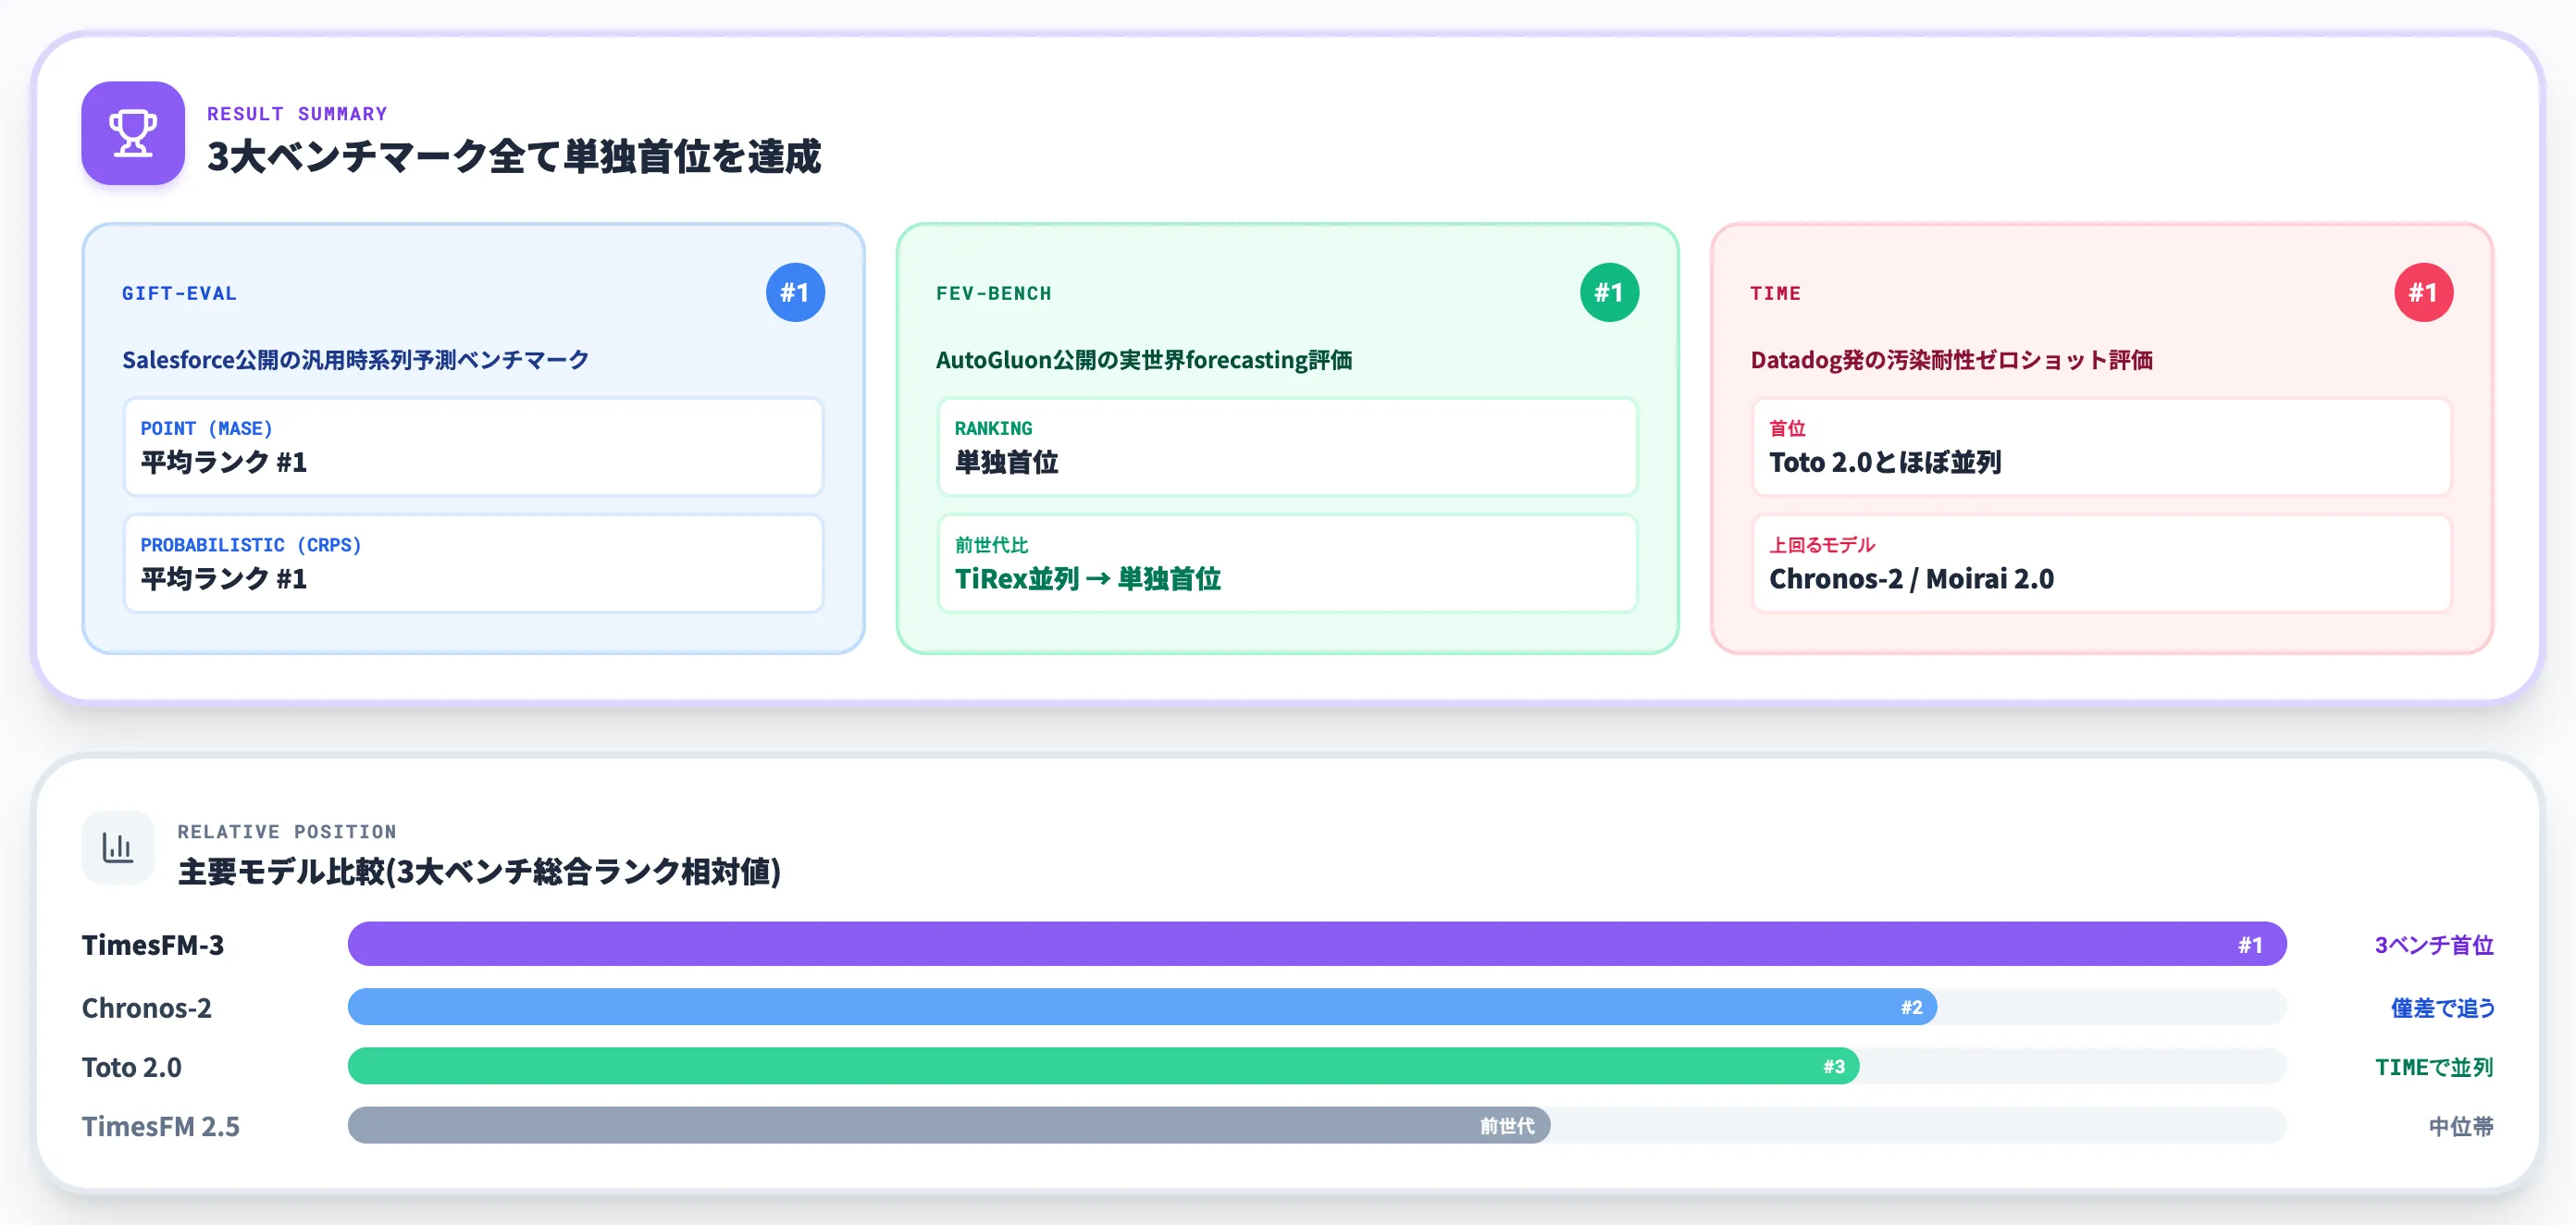
TimesFM-3のリリース時にGoogle Researchが公開した主要ベンチマーク結果は、GIFT-Eval・FEV-Bench・TIMEの3つで、いずれもポイント予測・確率予測の両指標で公開ファウンデーションモデル中の首位を取っています。
各ベンチマークの位置づけと結果を整理します。
3ベンチマークの概要と評価対象
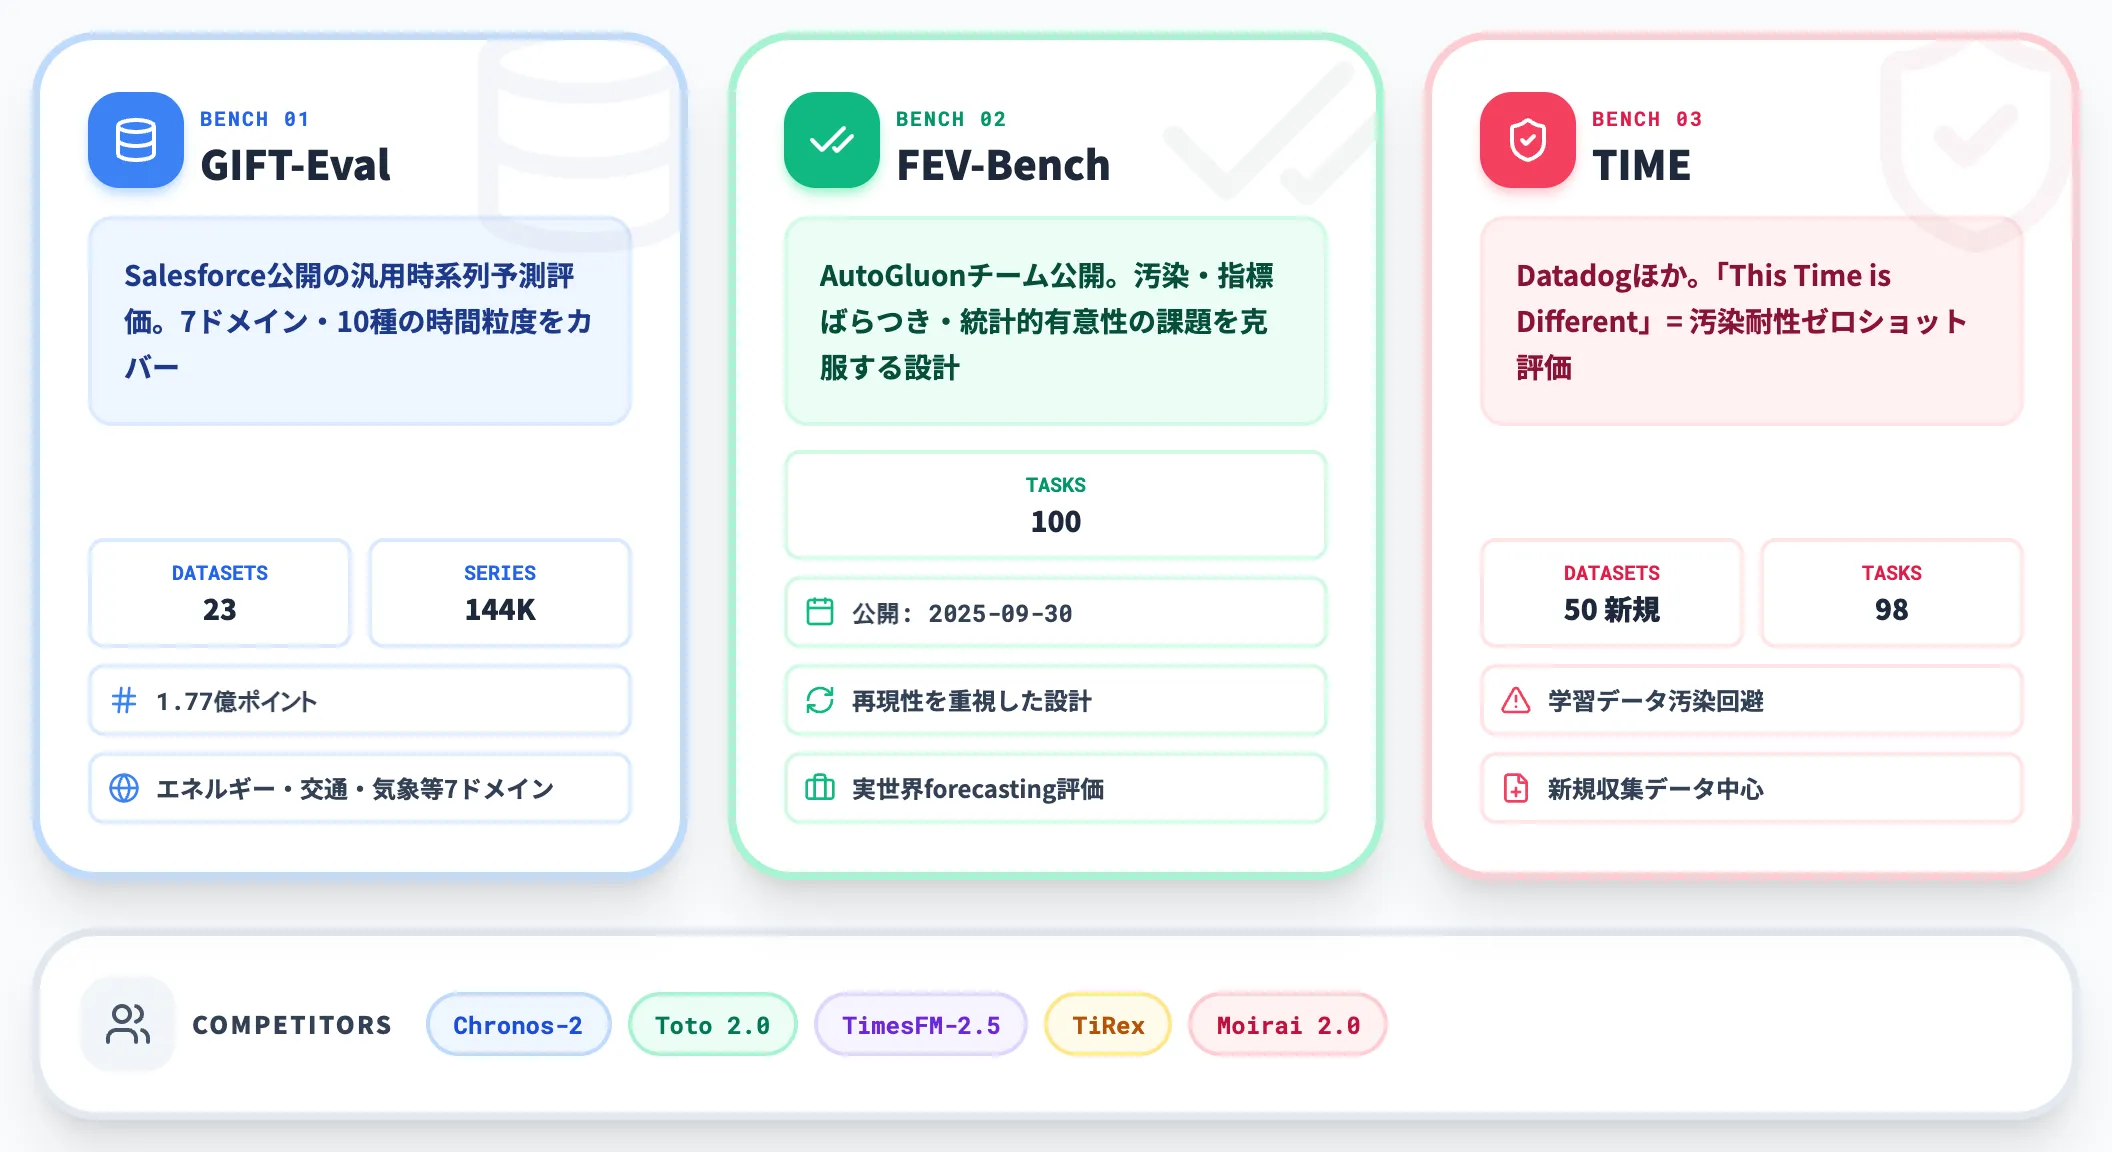
3つのベンチマークは目的とデータ規模が異なり、それぞれ異なる観点からモデルの汎化性能を測ります。
以下の表で、3ベンチマークの特徴を整理しました。
| ベンチマーク | 提供元 | 対象 | 規模 |
|---|---|---|---|
| GIFT-Eval | Salesforce | 汎用時系列予測評価 | 23データセット・144K系列・1.77億ポイント・7ドメイン |
| FEV-Bench | AutoGluon | 実世界forecasting評価 | 100タスク・再現性重視 |
| TIME | Datadogほか | 汚染耐性ゼロショット評価 | 50の新規データセット・98タスク・新規収集データ中心 |
この3ベンチマークの比較対象には、Chronos-2(Amazon)、Toto 2.0(Datadog)、TimesFM-2.5(前世代)、TiRexなど直近の主要時系列基盤モデルが含まれています。同世代の多変量対応モデルとの直接比較で首位を取っている点が重要です。
GIFT-Evalでの評価結果
GIFT-Evalは汎用時系列予測の標準ベンチマークで、7ドメイン(エネルギー・交通・気象・小売など)・10種類の時間粒度(時間・日次・週次など)・多変量入力・短期〜長期horizonをカバーする97設定の総合評価です。
TimesFM-3はこのGIFT-Evalで、ポイント予測(MASE基準)・確率予測(CRPS基準)ともに、公開ファウンデーションモデル中の平均ランク首位を達成しています。特に注目すべきは、単変量モードでも他モデルと同等以上のスコアを維持している点で、「多変量対応にリソースを割いた副作用で単変量性能が落ちる」というトレードオフが発生していません。
公開されているランキングはHugging FaceのGIFT-Eval leaderboardで確認できます。
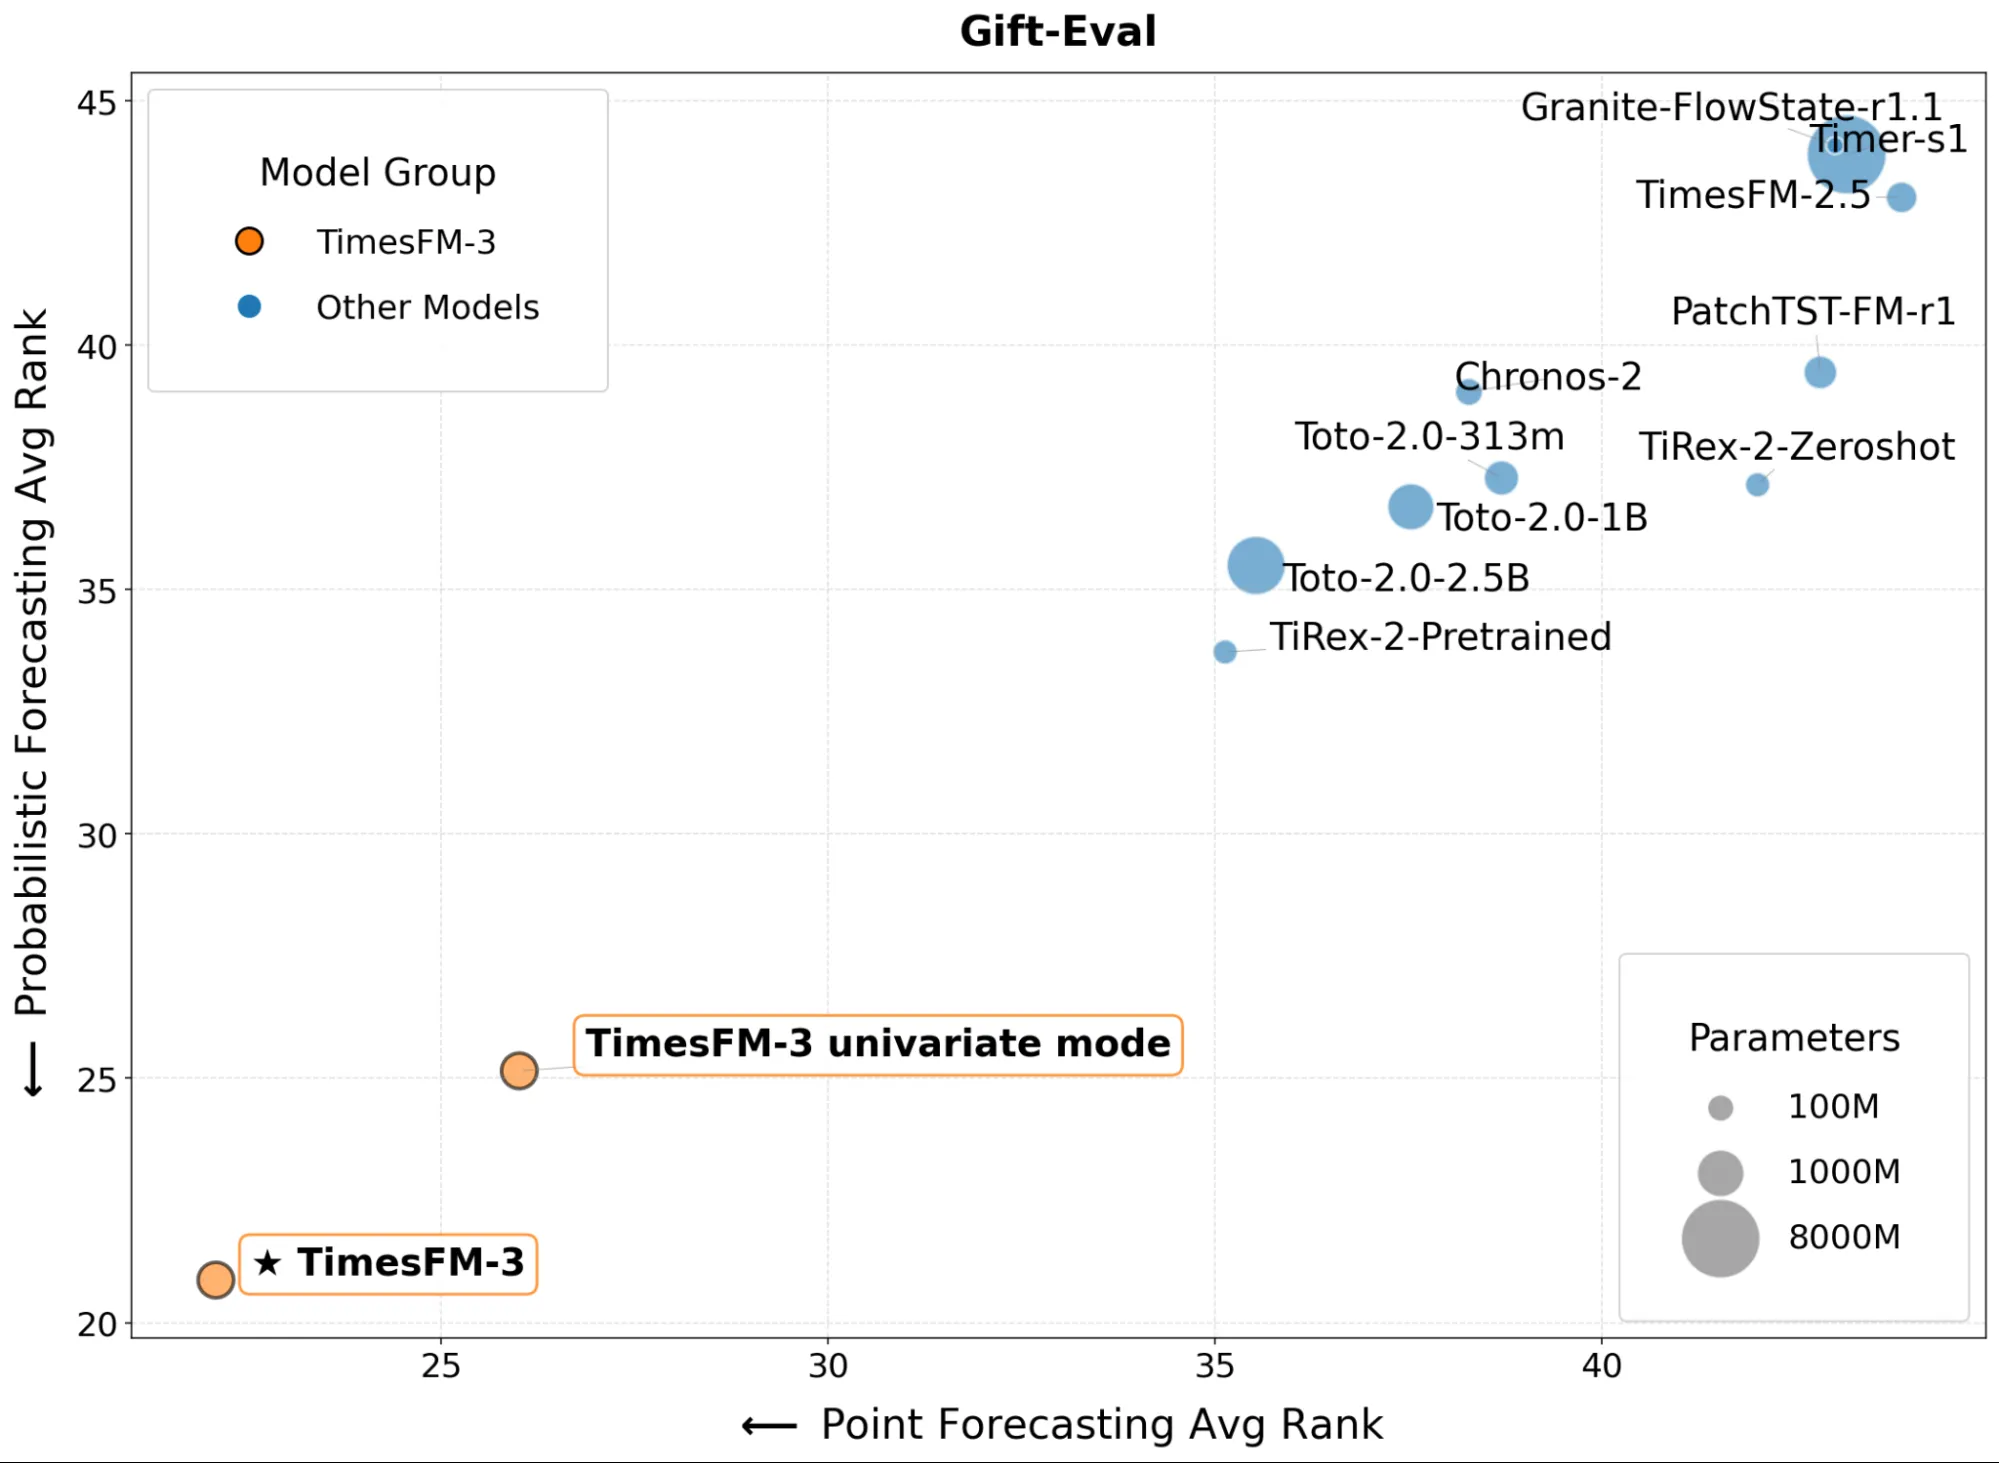
GIFT-EvalでのTimesFM-3(★)と主要基盤モデルの比較。ポイント予測・確率予測の両軸で左下=最良、単変量モードでも2位を維持(出典:Google Research Blog)
散布図の左下ほど成績が良く、TimesFM-3(★)はPoint Forecasting Avg Rank・Probabilistic Forecasting Avg Rankの両軸で最良位置にあります。Chronos-2・Toto-2.0-2.5B・TiRex-2-Zeroshot・PatchTST-FM-r1・TimesFM-2.5などが右上に並び、多変量ネイティブ対応の差がスコアに反映された形です。
FEV-Benchでの評価結果
FEV-Benchは、既存ベンチマークの限界(データセット汚染・評価指標のばらつき・統計的有意性の不足)を克服するためにAutoGluonチームが2025年9月30日に公開した100タスクのベンチマークです。
TimesFM-3はFEV-BenchでもTiRex・Chronos-2・Toto 2.0を抑えて総合1位を取っています。前世代TimesFM-2.5は「TiRexと並んで首位グループ」の位置でしたが、TimesFM-3では単独首位に浮上した形です。
詳細なランキングはHugging FaceのFEV leaderboardで常時更新されており、新モデル追加のたびに順位が動く可能性があります。
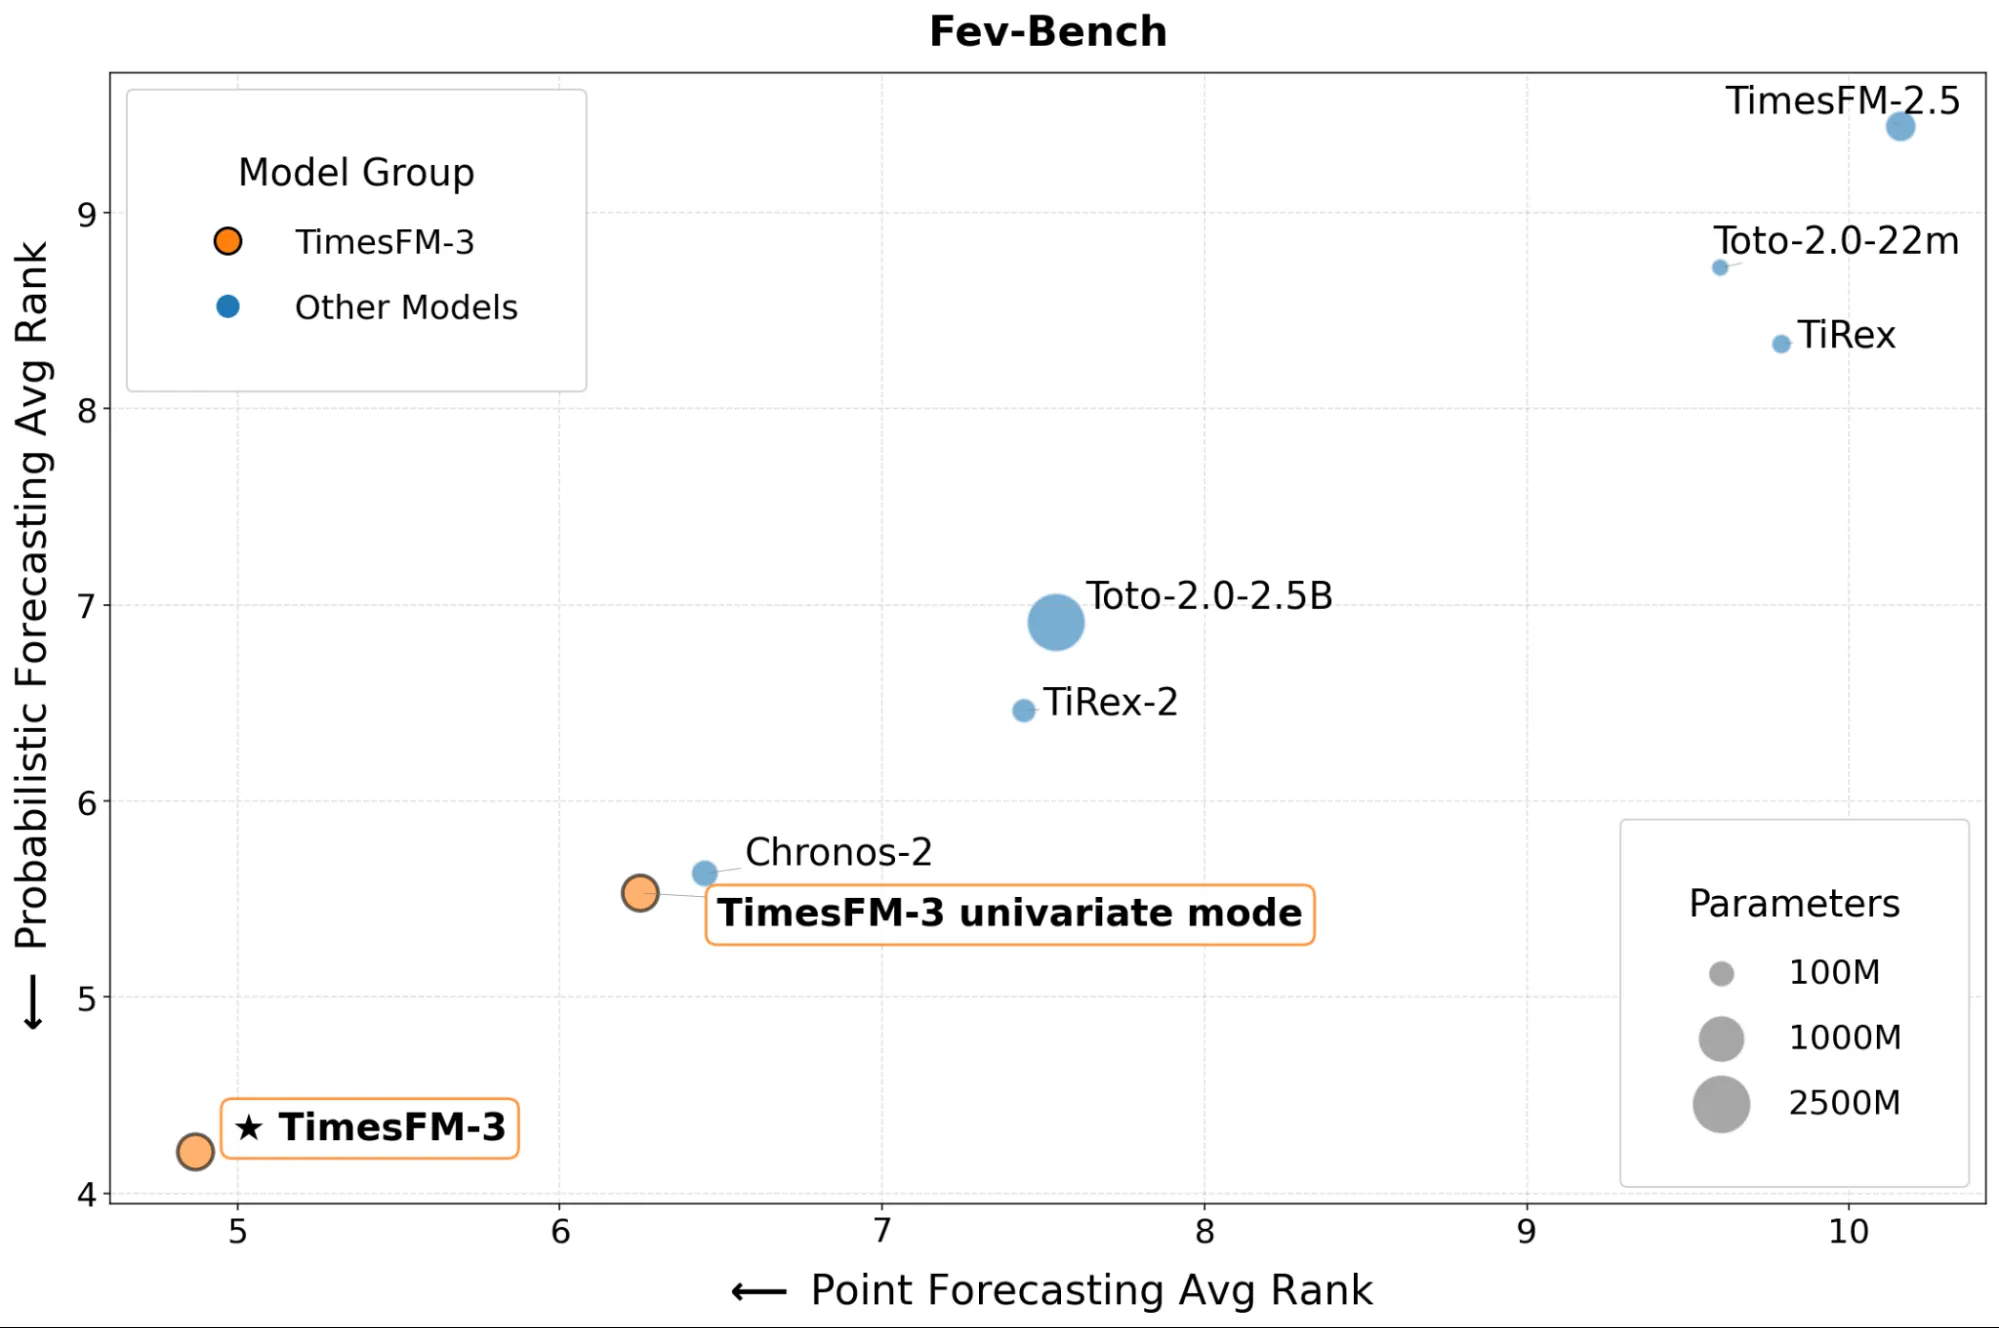
FEV-BenchでのTimesFM-3(★)と主要基盤モデルの比較。TimesFM-3が最良位置、Chronos-2やTimesFM-3 univariate modeが僅差で続く(出典:Google Research Blog)
FEV-BenchはAutoGluonチームが公開した100タスクの実世界forecasting評価で、TimesFM-3の性能優位が単一データセット依存ではないことを裏付けています。特にTimesFM-3の単変量モードがChronos-2とほぼ同点で並んでいる点は、「多変量ネイティブ化のために単変量性能が犠牲になっていない」ことの直接的な証拠になります。
TIMEベンチマークでの評価結果
TIME(This Time is Different)は、時系列基盤モデルのデータ汚染問題を回避するために設計された比較的新しいベンチマークです。学習データに含まれていない可能性が高い新規収集データを中心に、50の新規データセット・98タスクで評価します。
TimesFM-3はこのTIMEでも首位を取っており、Datadog Toto 2.0とほぼ並ぶ位置で、Chronos-2・Moirai 2.0を上回っています。汚染耐性ベンチマークで強い性能を示せている点は、「単に既存ベンチマークに過学習しているだけではない」ことの間接的な裏付けになります。
ただしベンチマークスコアは実データでの性能を保証するものではありません。実務では自社データでのバックテスト検証を必ず行い、ドメイン適合性を確認したうえで採用モデルを決めるのが原則です。特に日本語カレンダー・和暦・独自の休日体系など、ドメイン特有の要因が絡む場合はゼロショット精度に差が出ることがあります。
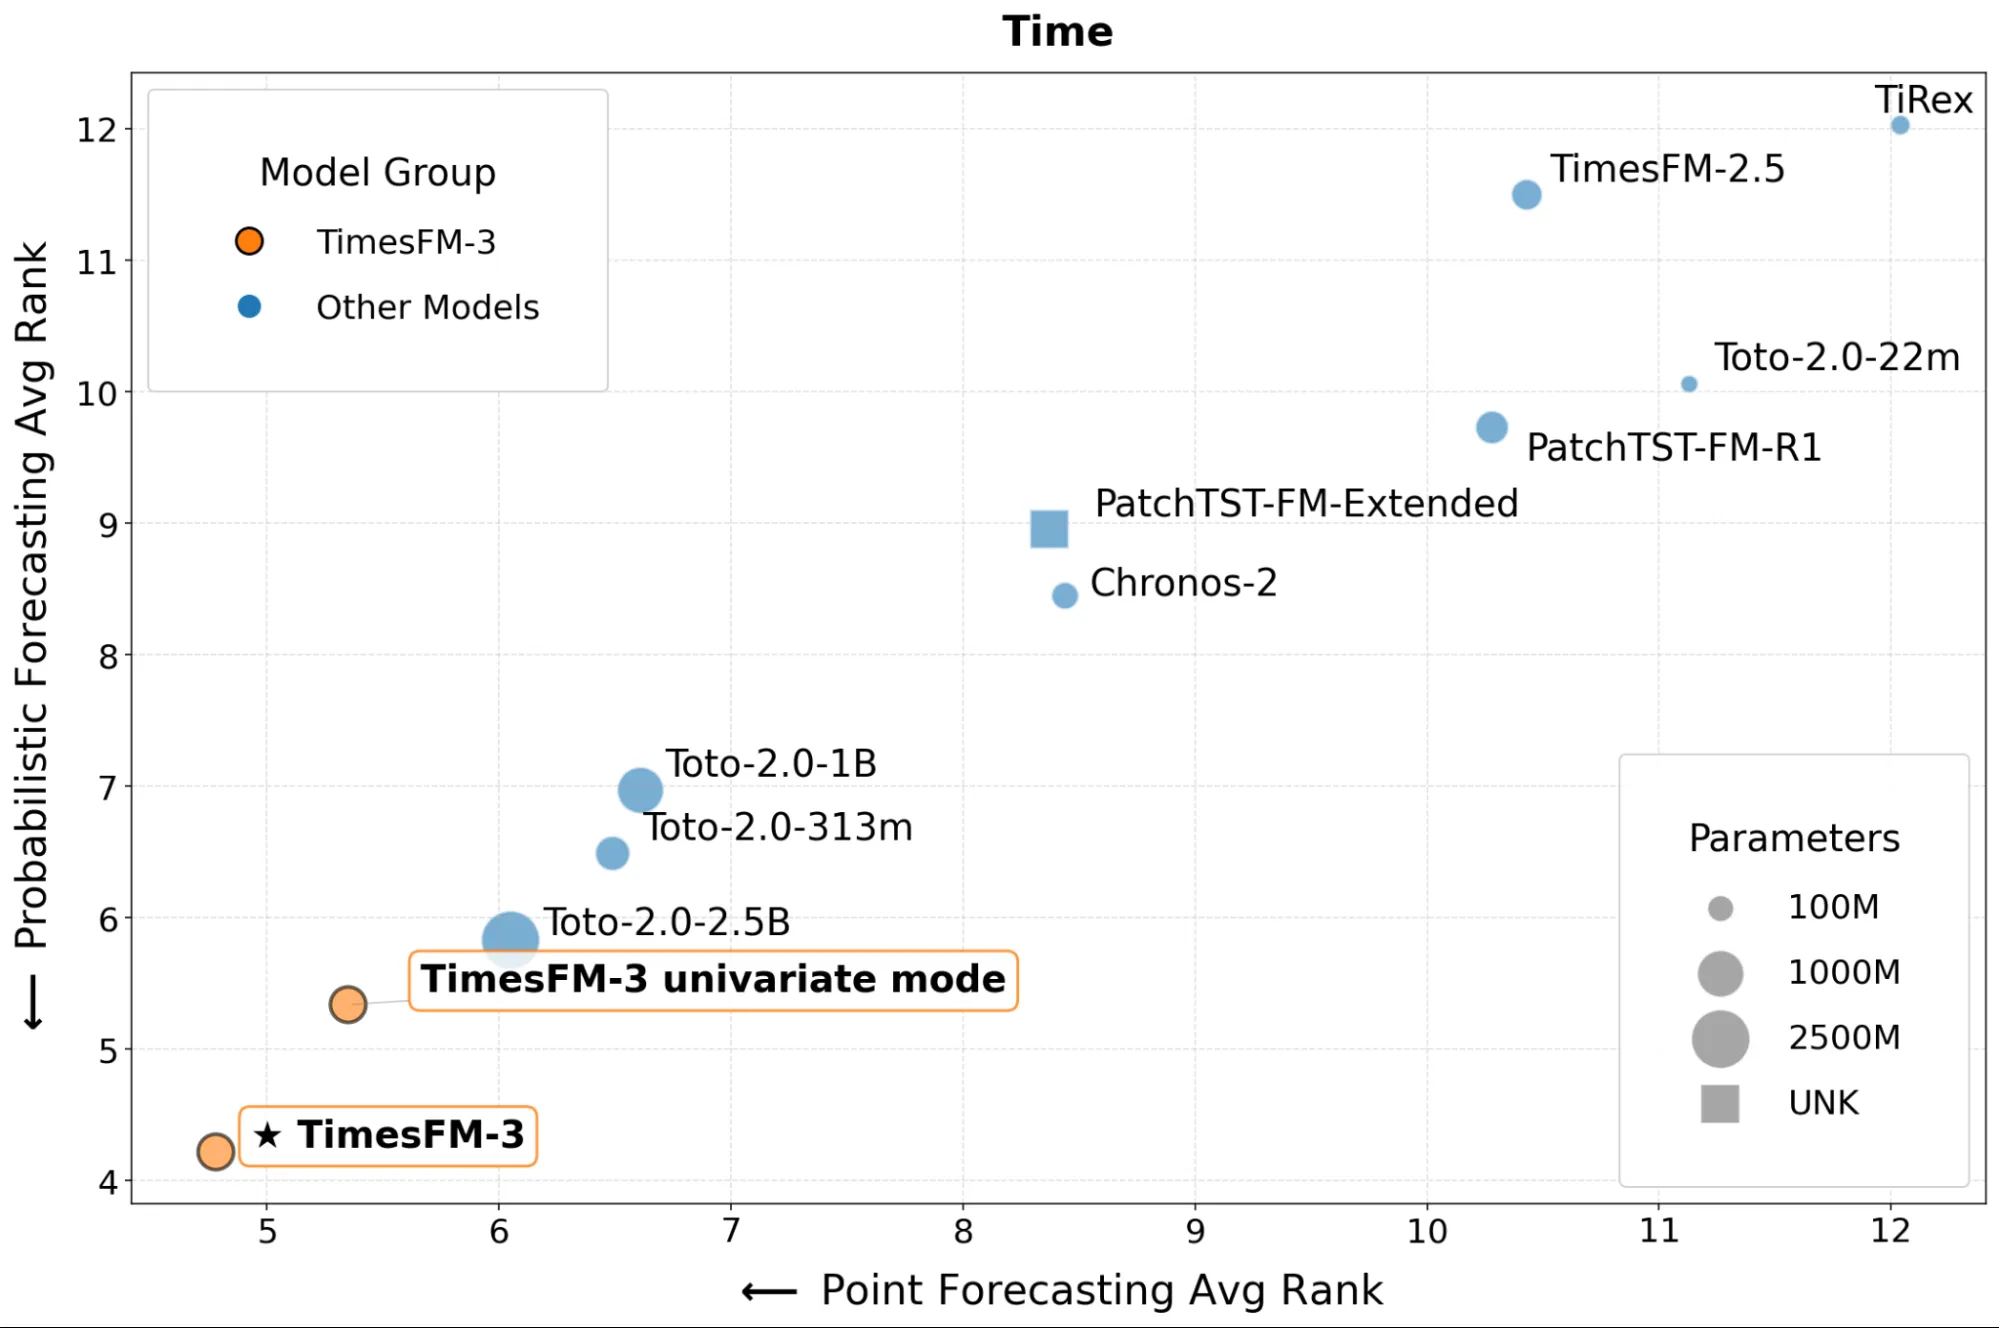
汚染耐性ベンチマークTIMEでのTimesFM-3(★)と主要基盤モデルの比較。TimesFM-3が最良、Toto-2.0-2.5Bが僅差で続き、Chronos-2やTimesFM-2.5は上位帯からは離れる(出典:Google Research Blog)
TIMEは新規収集データ中心の設計で、既存ベンチマークで発生しがちな「学習データ汚染による過学習」の疑念を排除できる評価軸です。散布図の位置関係から、TimesFM-3とToto-2.0-2.5Bが並び、Chronos-2・PatchTST-FM-Extended・TimesFM-2.5が中位帯、TiRexが右上に落ちる序列が確認できます。
TimesFM-3の使い方——HuggingFaceからのインストールとPython実装
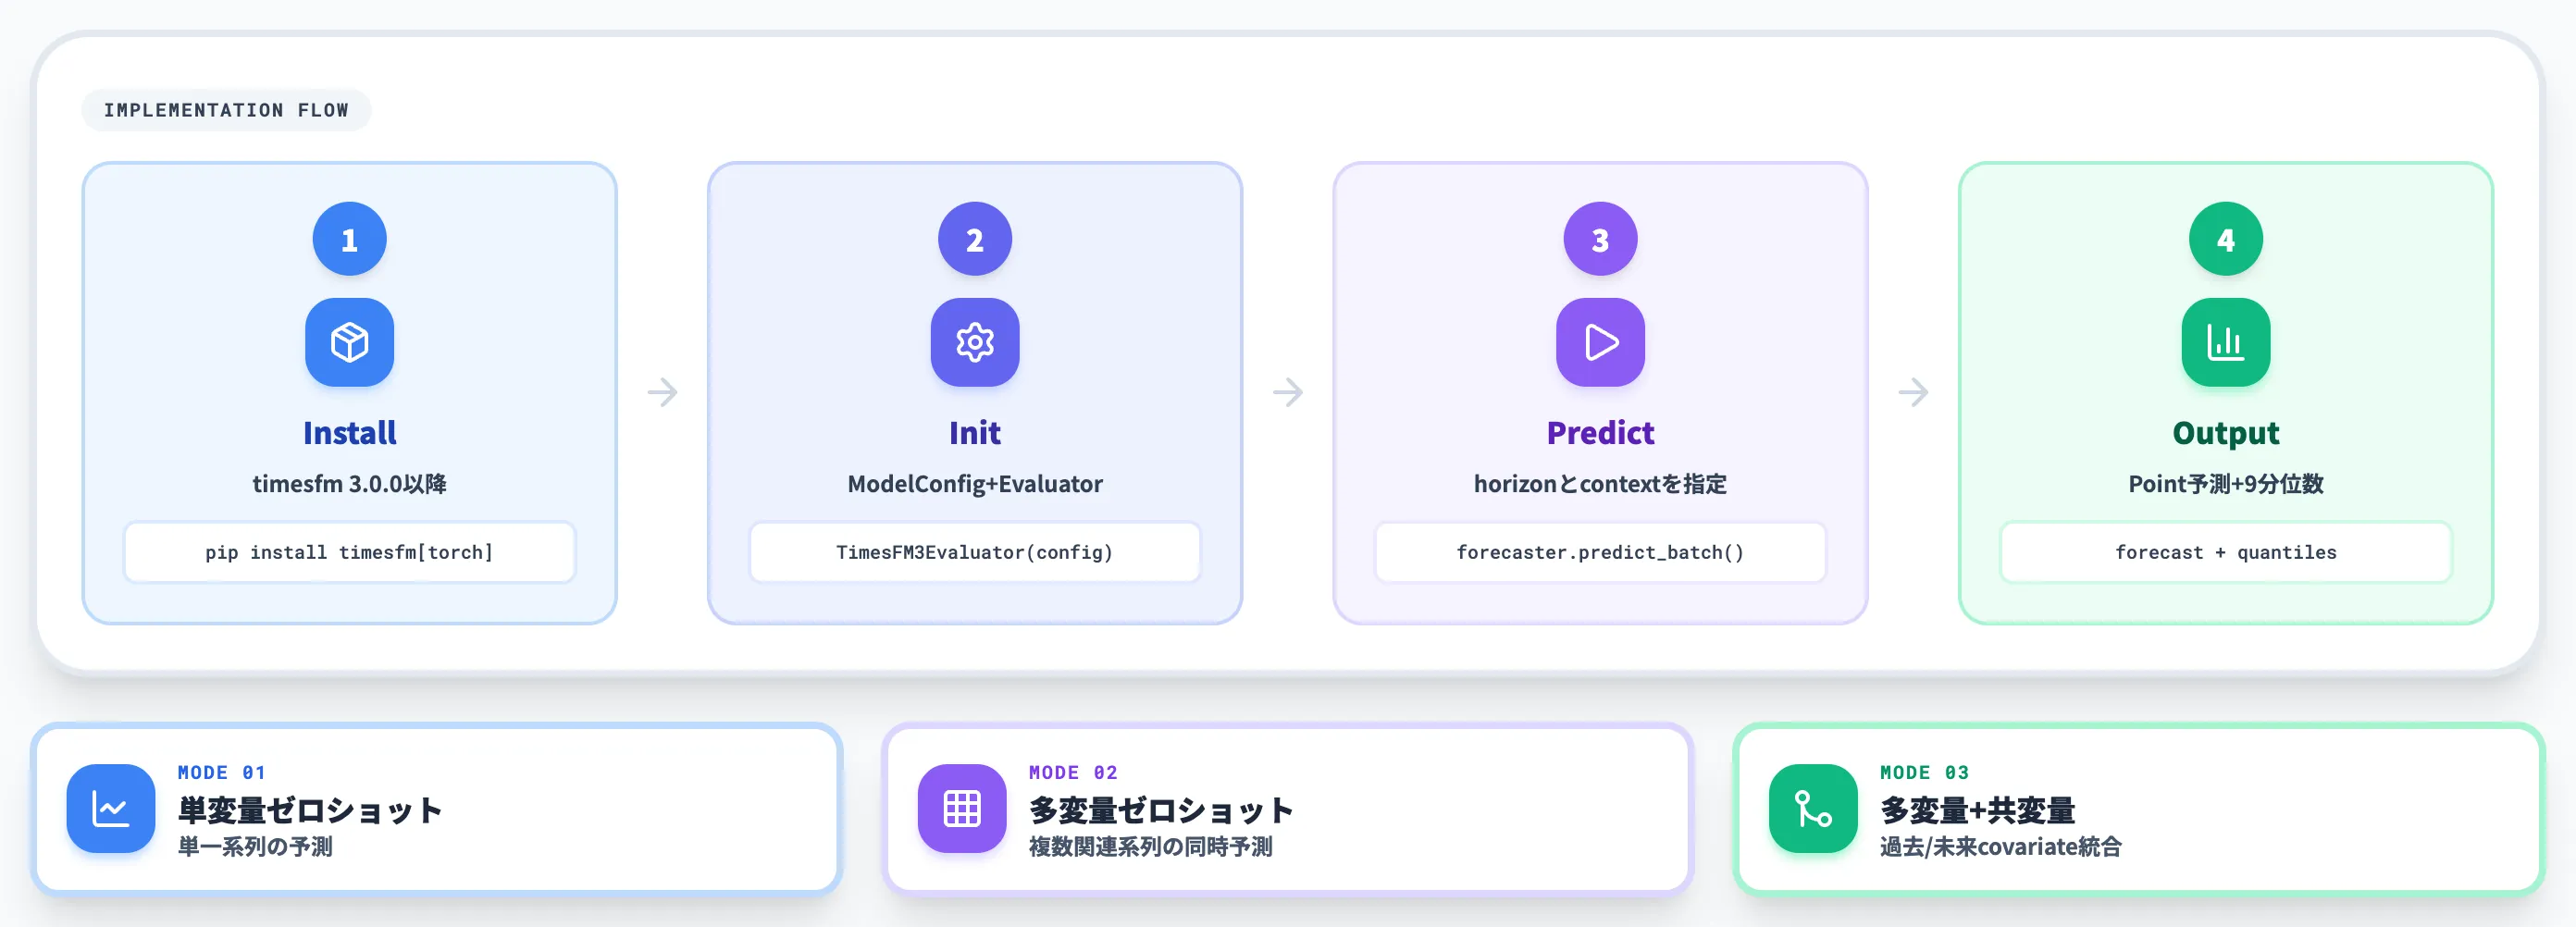
TimesFM-3はHugging Faceのgoogle/timesfm-3.0-pytorchで公開されており、timesfm PyPIパッケージの3.0.0(2026年8月28日リリース)から利用できます。ここでは実装コードを段階的に紹介します。
インストールと環境準備
TimesFM-3の実行にはPython 3.10以上とPyTorchが必要です。GPU環境が推奨ですが、CPUでも小規模データなら動作します。
PyTorch環境へのインストールは以下のコマンドで完了します。
pip install timesfm[torch]
TimesFM-3は多変量・共変量サポートを本体APIに内蔵しており、追加の拡張パッケージなしで過去共変量・過去未来共変量を扱えます(XRegはTimesFM 2.5向けに提供されている拡張機能で、TimesFM-3には不要)。ローカルからリポジトリをクローンして開発版を試したい場合は、GitHubからuvベースのセットアップも公式に案内されています。
単変量予測の基本コード
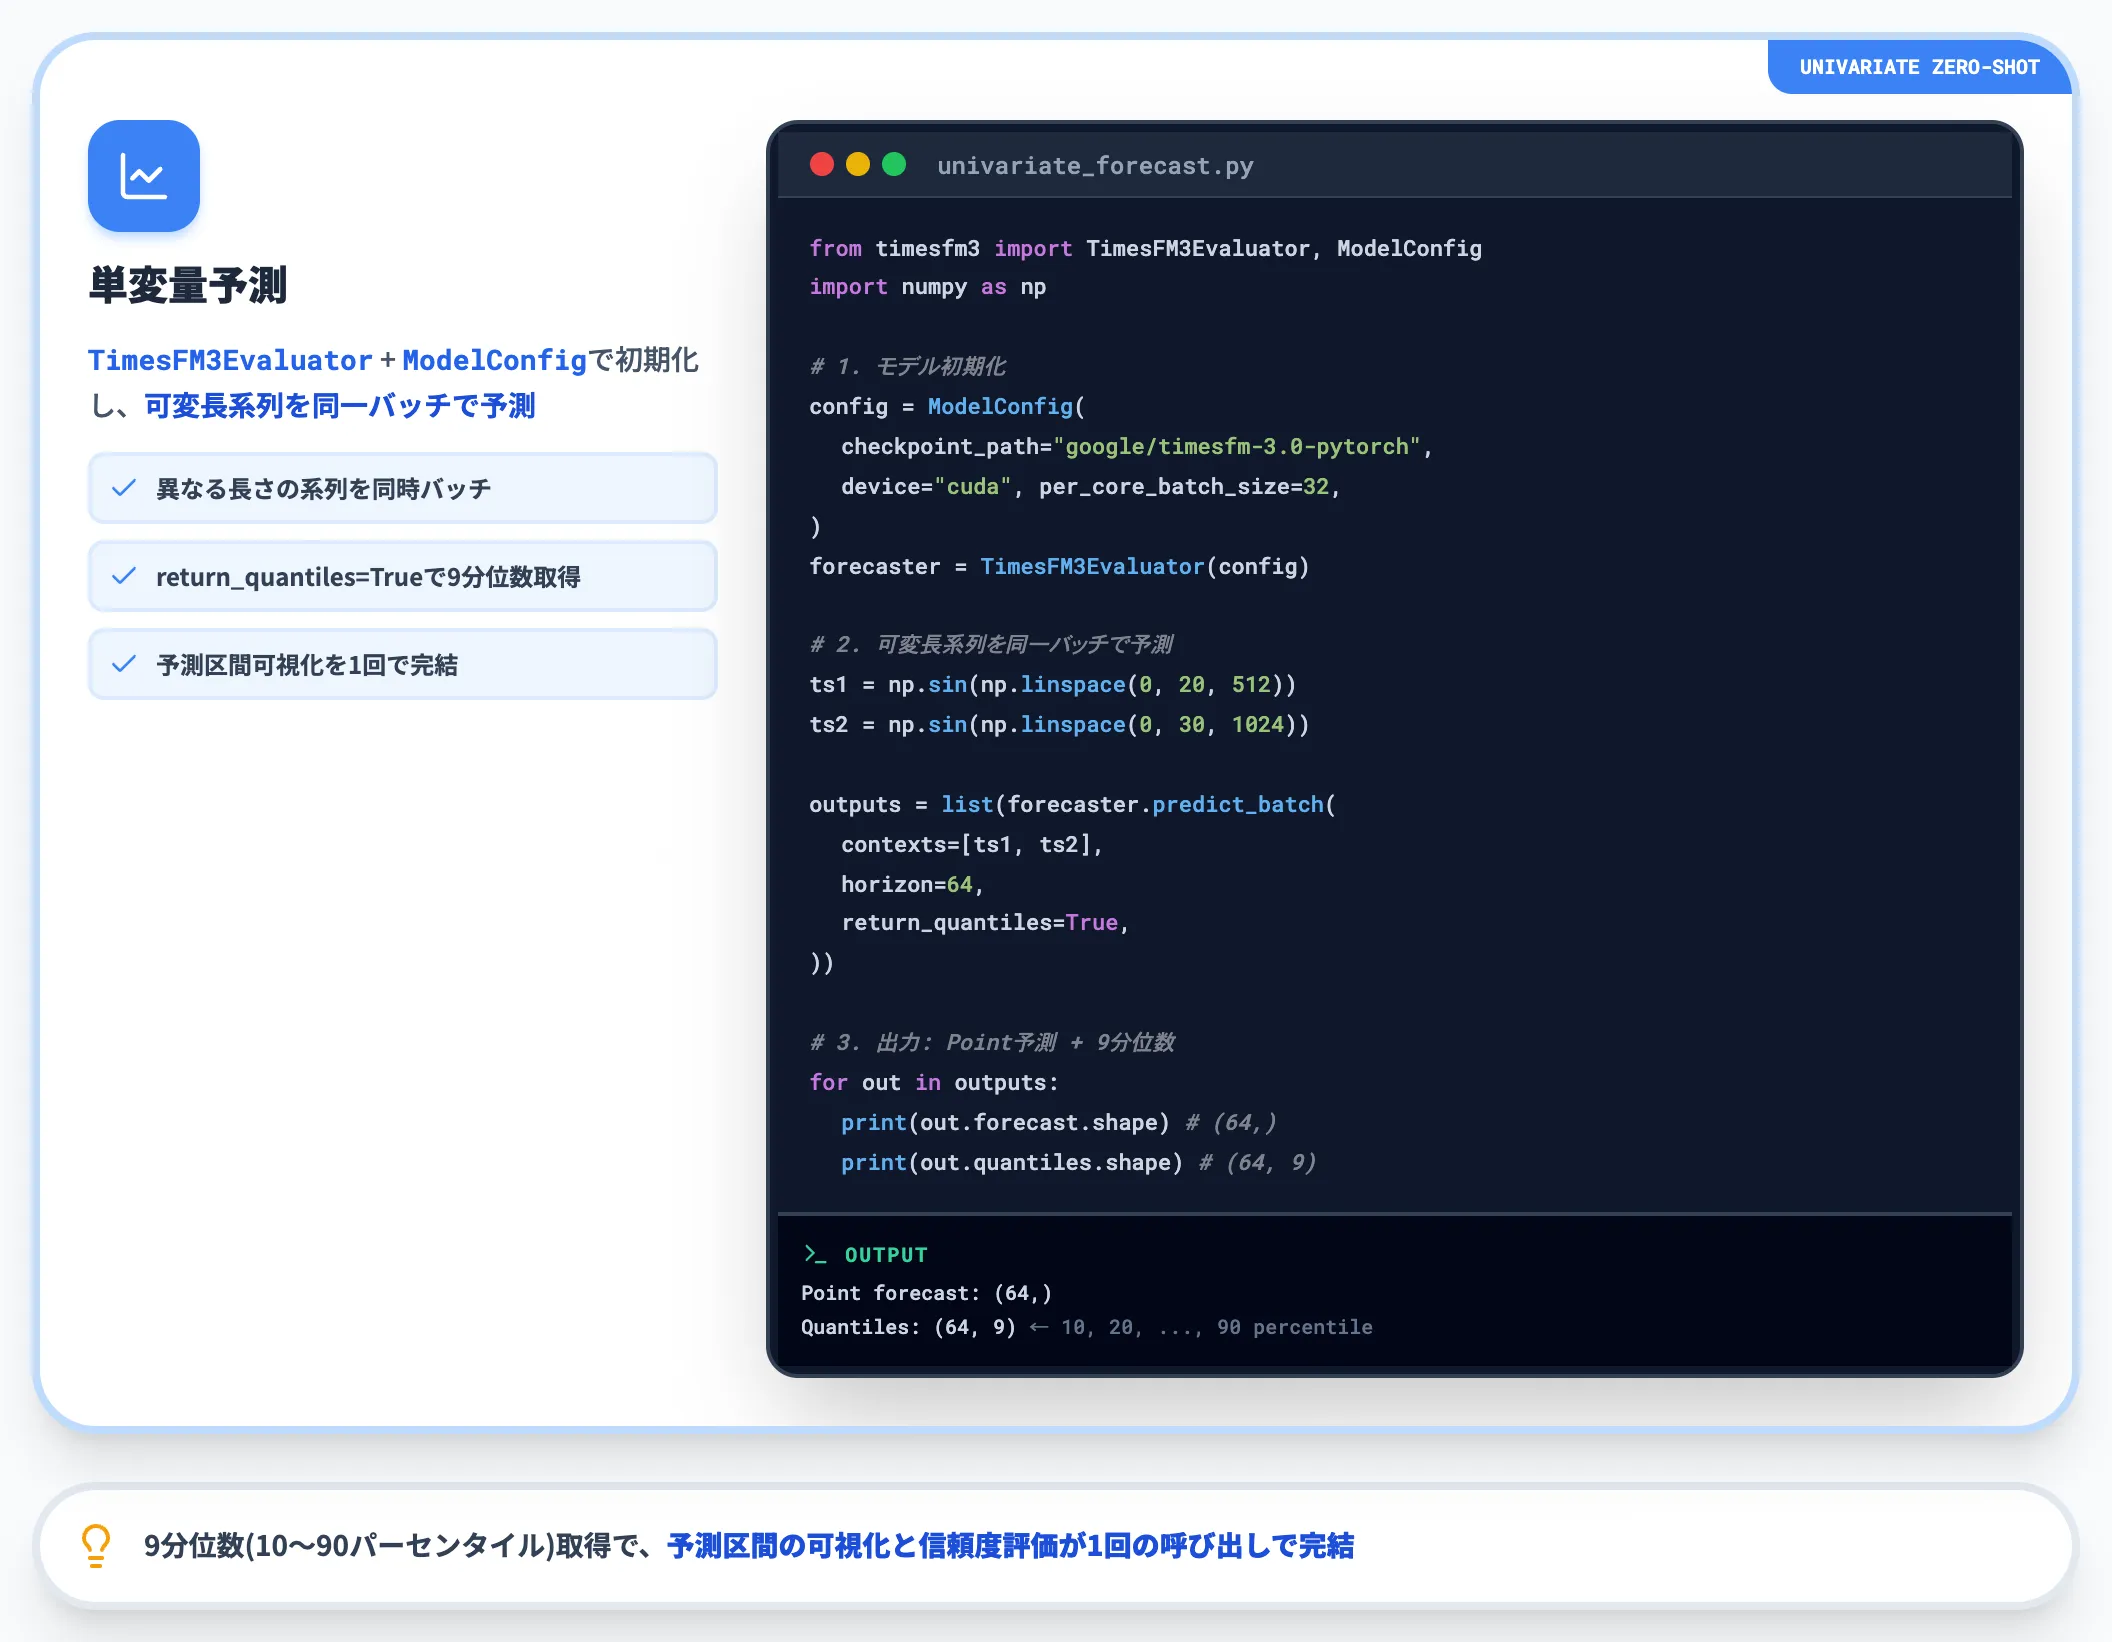
まずは単一系列のゼロショット予測を実装します。TimesFM-3のPython APIはTimesFM3EvaluatorクラスとModelConfigで初期化する構成です。
from timesfm3 import TimesFM3Evaluator, ModelConfig
import numpy as np

# モデル初期化
config = ModelConfig(
    checkpoint_path="google/timesfm-3.0-pytorch",
    device="cuda",  # CPUなら "cpu"
    per_core_batch_size=32,
)
forecaster = TimesFM3Evaluator(config)

# 予測対象の時系列(可変長でOK)
ts1 = np.sin(np.linspace(0, 20, 512))  # 512ステップの正弦波
ts2 = np.sin(np.linspace(0, 30, 1024)) # 1024ステップの正弦波

# 予測実行
outputs = list(forecaster.predict_batch(
    contexts=[ts1, ts2],
    horizon=64,
    return_quantiles=True,
))

# 出力はforecast(ポイント予測)とquantiles(9分位数)を含む
for out in outputs:
    print("Point forecast:", out.forecast.shape)   # (64,)
    print("Quantiles:", out.quantiles.shape)       # (64, 9)
このコードの利点は複数あります。第一に、系列ごとに長さが異なっていても同じバッチで予測できる点。第二に、return_quantiles=Trueを指定するだけで9分位数(10〜90パーセンタイル)が同時に取れるため、予測区間の可視化と信頼度評価が1回の呼び出しで済む点です。
多変量+共変量予測の実装
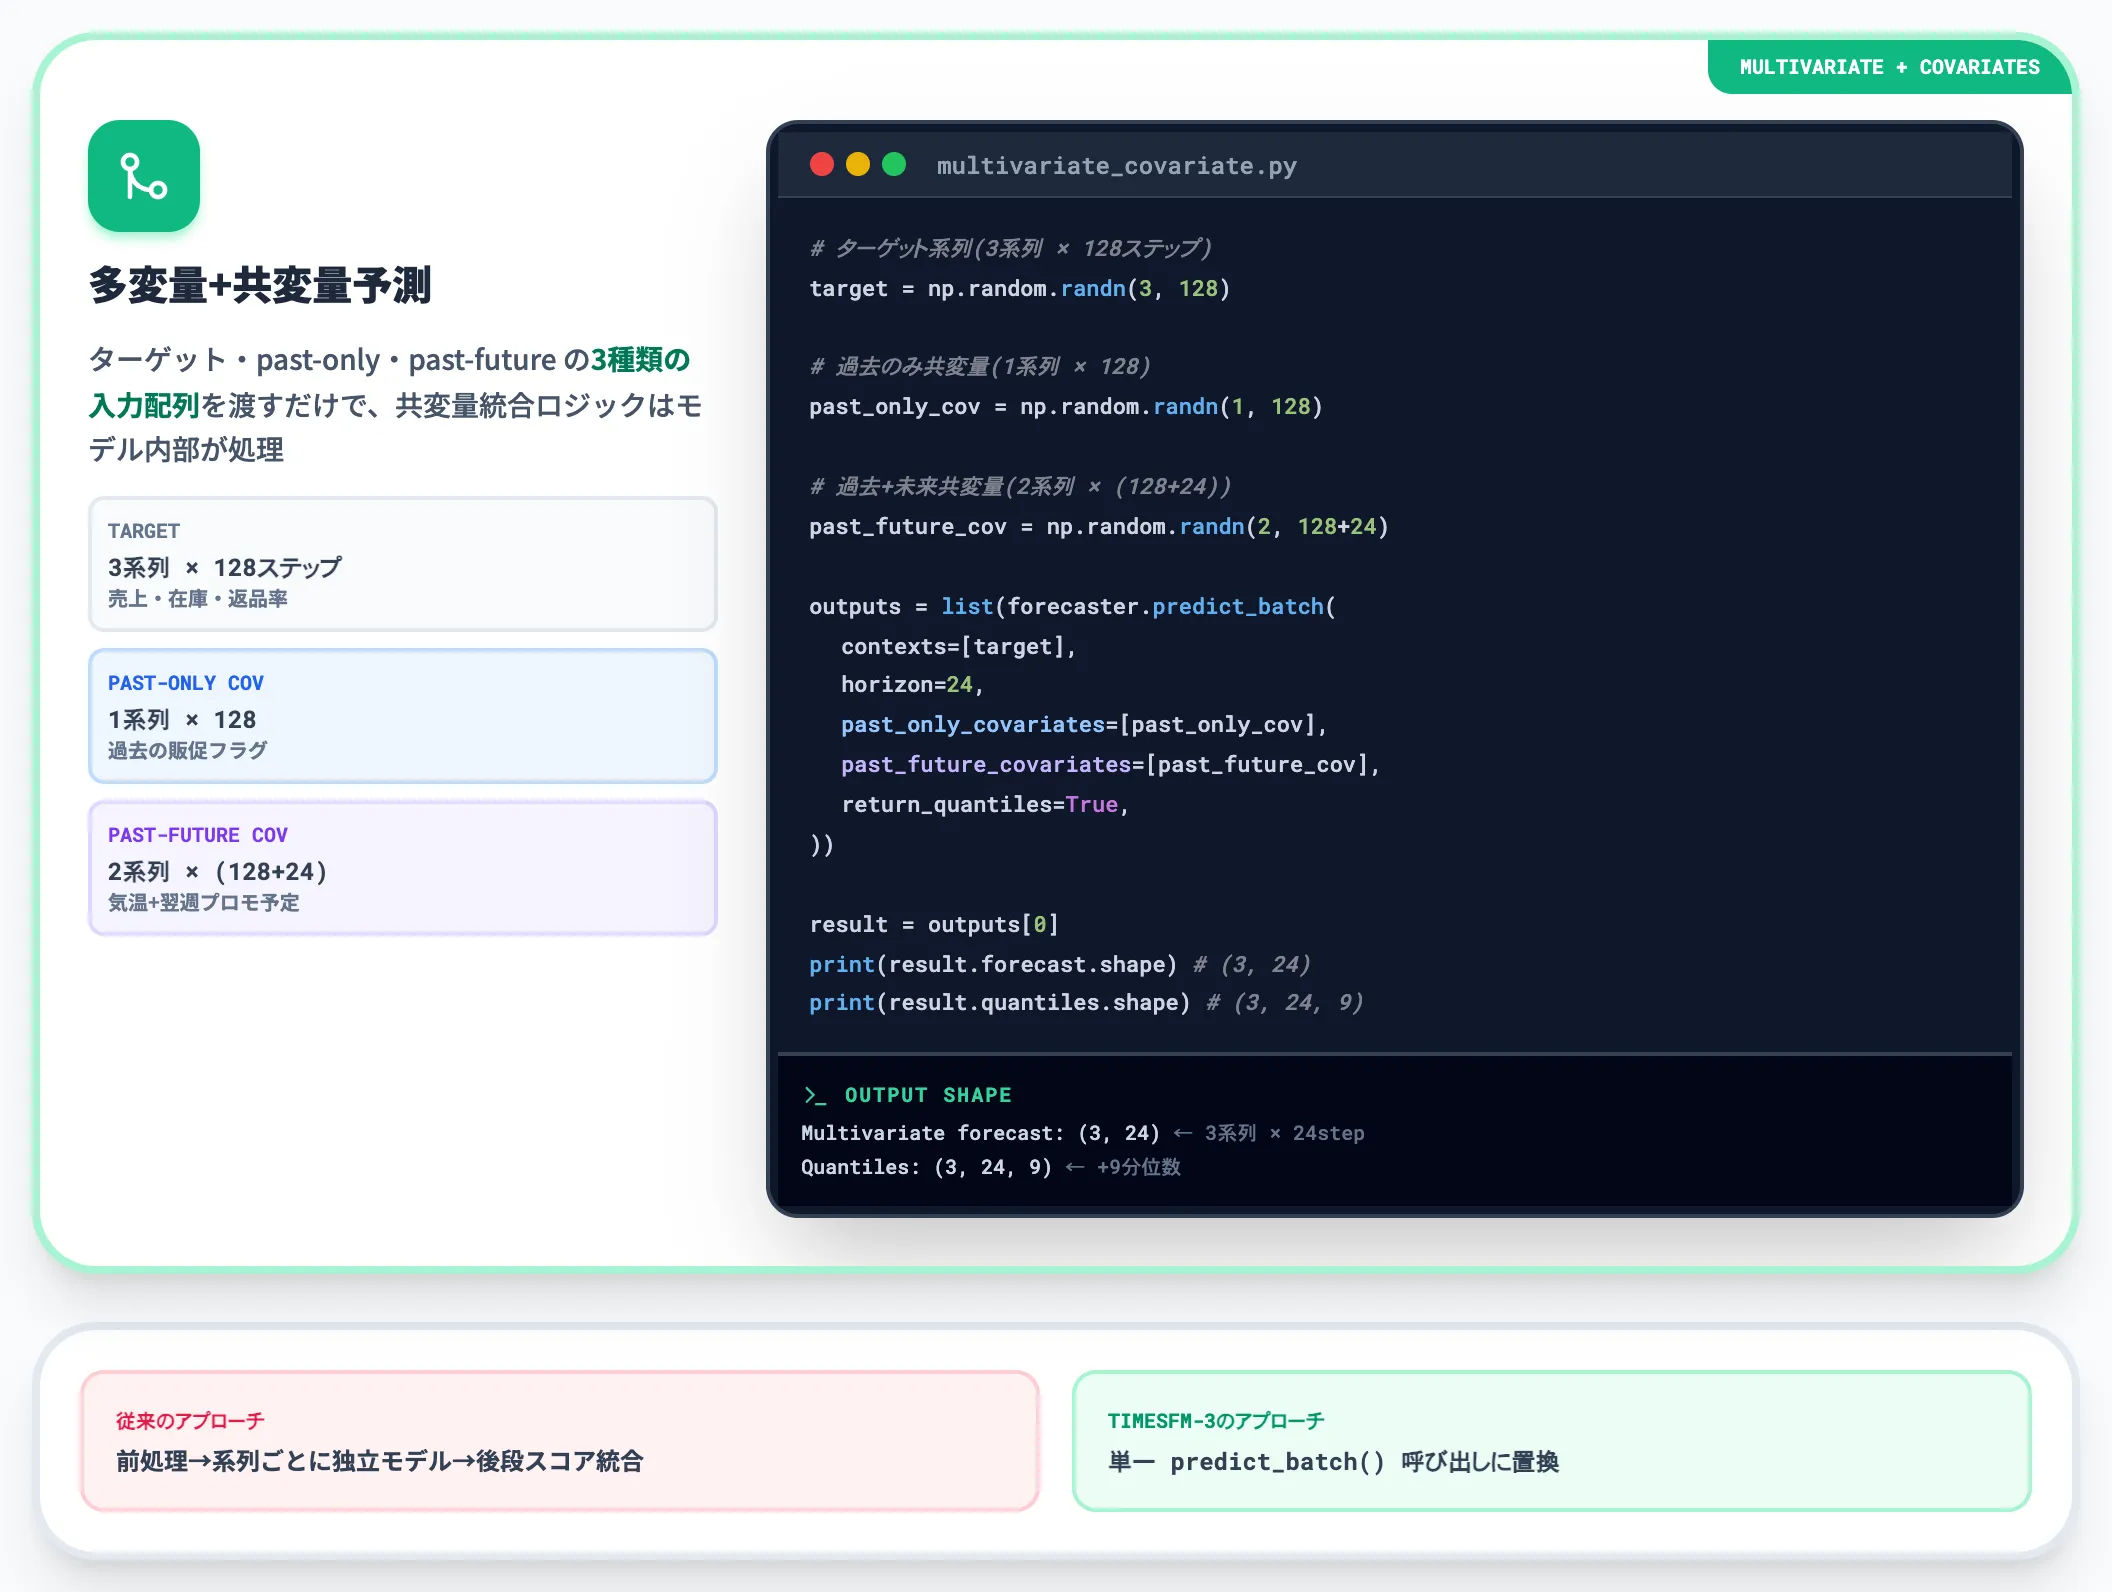
TimesFM-3の本領は多変量+共変量予測です。ターゲット系列と共変量を配列として渡すだけで、モデルが内部で相互依存を捕捉します。
import numpy as np
from timesfm3 import TimesFM3Evaluator, ModelConfig

config = ModelConfig(checkpoint_path="google/timesfm-3.0-pytorch", device="cuda")
forecaster = TimesFM3Evaluator(config)

# ターゲット系列(3系列 × 128ステップ)
# 例: 売上・在庫・返品率の同時予測
target = np.random.randn(3, 128)

# 過去のみ共変量(1系列 × 128ステップ)
# 例: 過去のプロモーション実施フラグ
past_only_cov = np.random.randn(1, 128)

# 過去+未来共変量(2系列 × (128+24)=152ステップ)
# 例: 気温・翌週プロモ予定などhorizon分の未来情報を含む
past_future_cov = np.random.randn(2, 128 + 24)

outputs = list(forecaster.predict_batch(
    contexts=[target],
    horizon=24,
    past_only_covariates=[past_only_cov],
    past_future_covariates=[past_future_cov],
    return_quantiles=True,
))

result = outputs[0]
print("Multivariate forecast:", result.forecast.shape)  # (3, 24)
print("Quantiles:", result.quantiles.shape)             # (3, 24, 9)
このアプローチの実務価値は、共変量の統合ロジックを自前で書かなくて済む点です。
従来は「共変量を特徴量エンジニアリングで前処理→系列ごとに独立モデル→後段でスコア統合」というパイプラインが必要でしたが、TimesFM-3では単一のpredict_batch呼び出しに置き換わります。
Fine-tuningの実装(LoRA+PEFT)
ゼロショットで精度が足りない場合、LoRA fine-tuningの選択肢があります。ただし公式リポジトリの timesfm-forecasting/examples/finetuning/ に公開されているサンプルnotebookはTimesFM 2.5向けの実装で、TimesFM-3への直接適用の公式サンプルは現時点で提供されていません。TimesFM-3をfine-tuningするには2.5向けサンプルを参考に独自実装が必要です。
加えてTimesFM-3が非商用ライセンスである以上、fine-tuningした重みも派生物として同ライセンスに従うと解釈するのが安全です。商用利用が視野にあるなら、fine-tuningは公式サンプルが揃っているTimesFM 2.5(Apache-2.0)側で試すのが実務的な判断になります。
TimesFM-3のライセンスと商用利用の制約
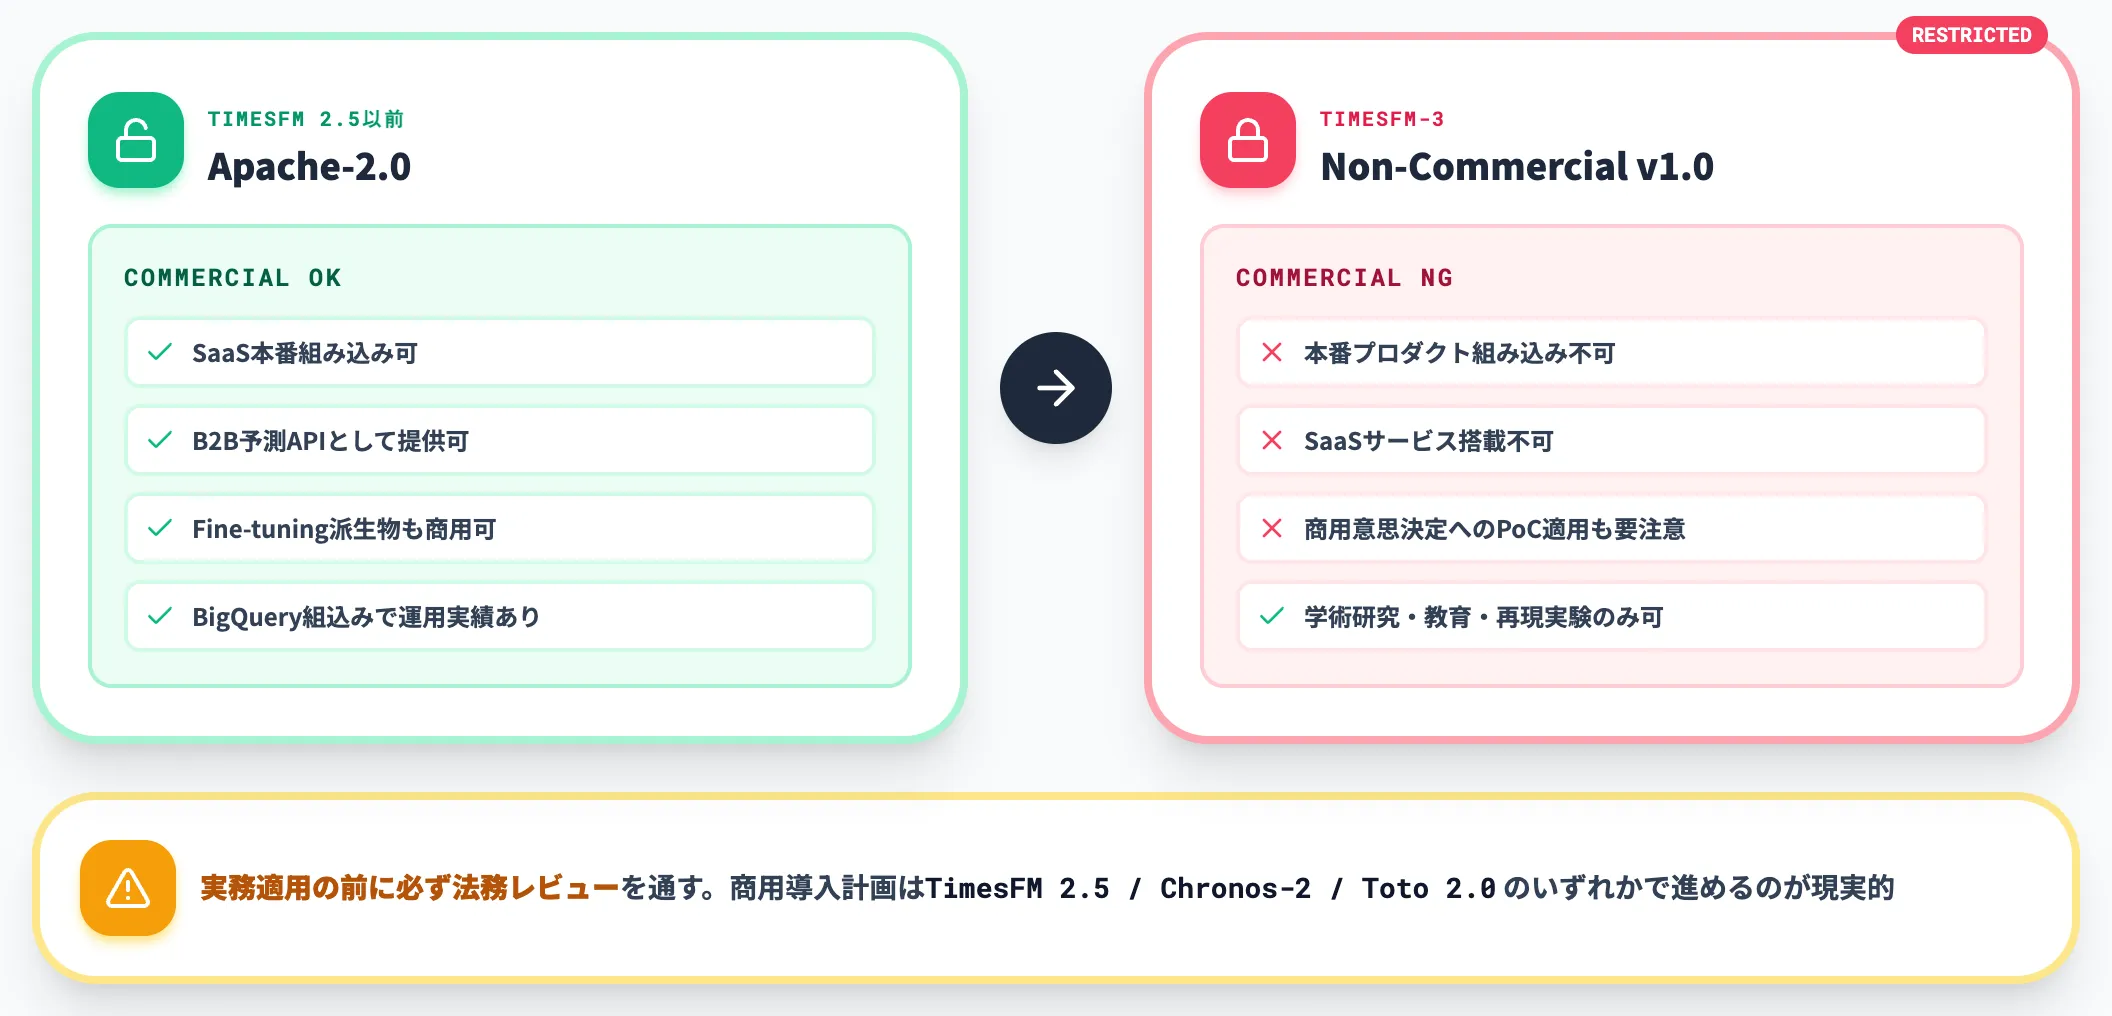
TimesFM-3の運用検討で最大の論点はライセンスです。前世代までのTimesFMがApache-2.0で商用利用可能だったのに対し、TimesFM-3は非商用ライセンスに転換しました。
非商用ライセンスの適用範囲
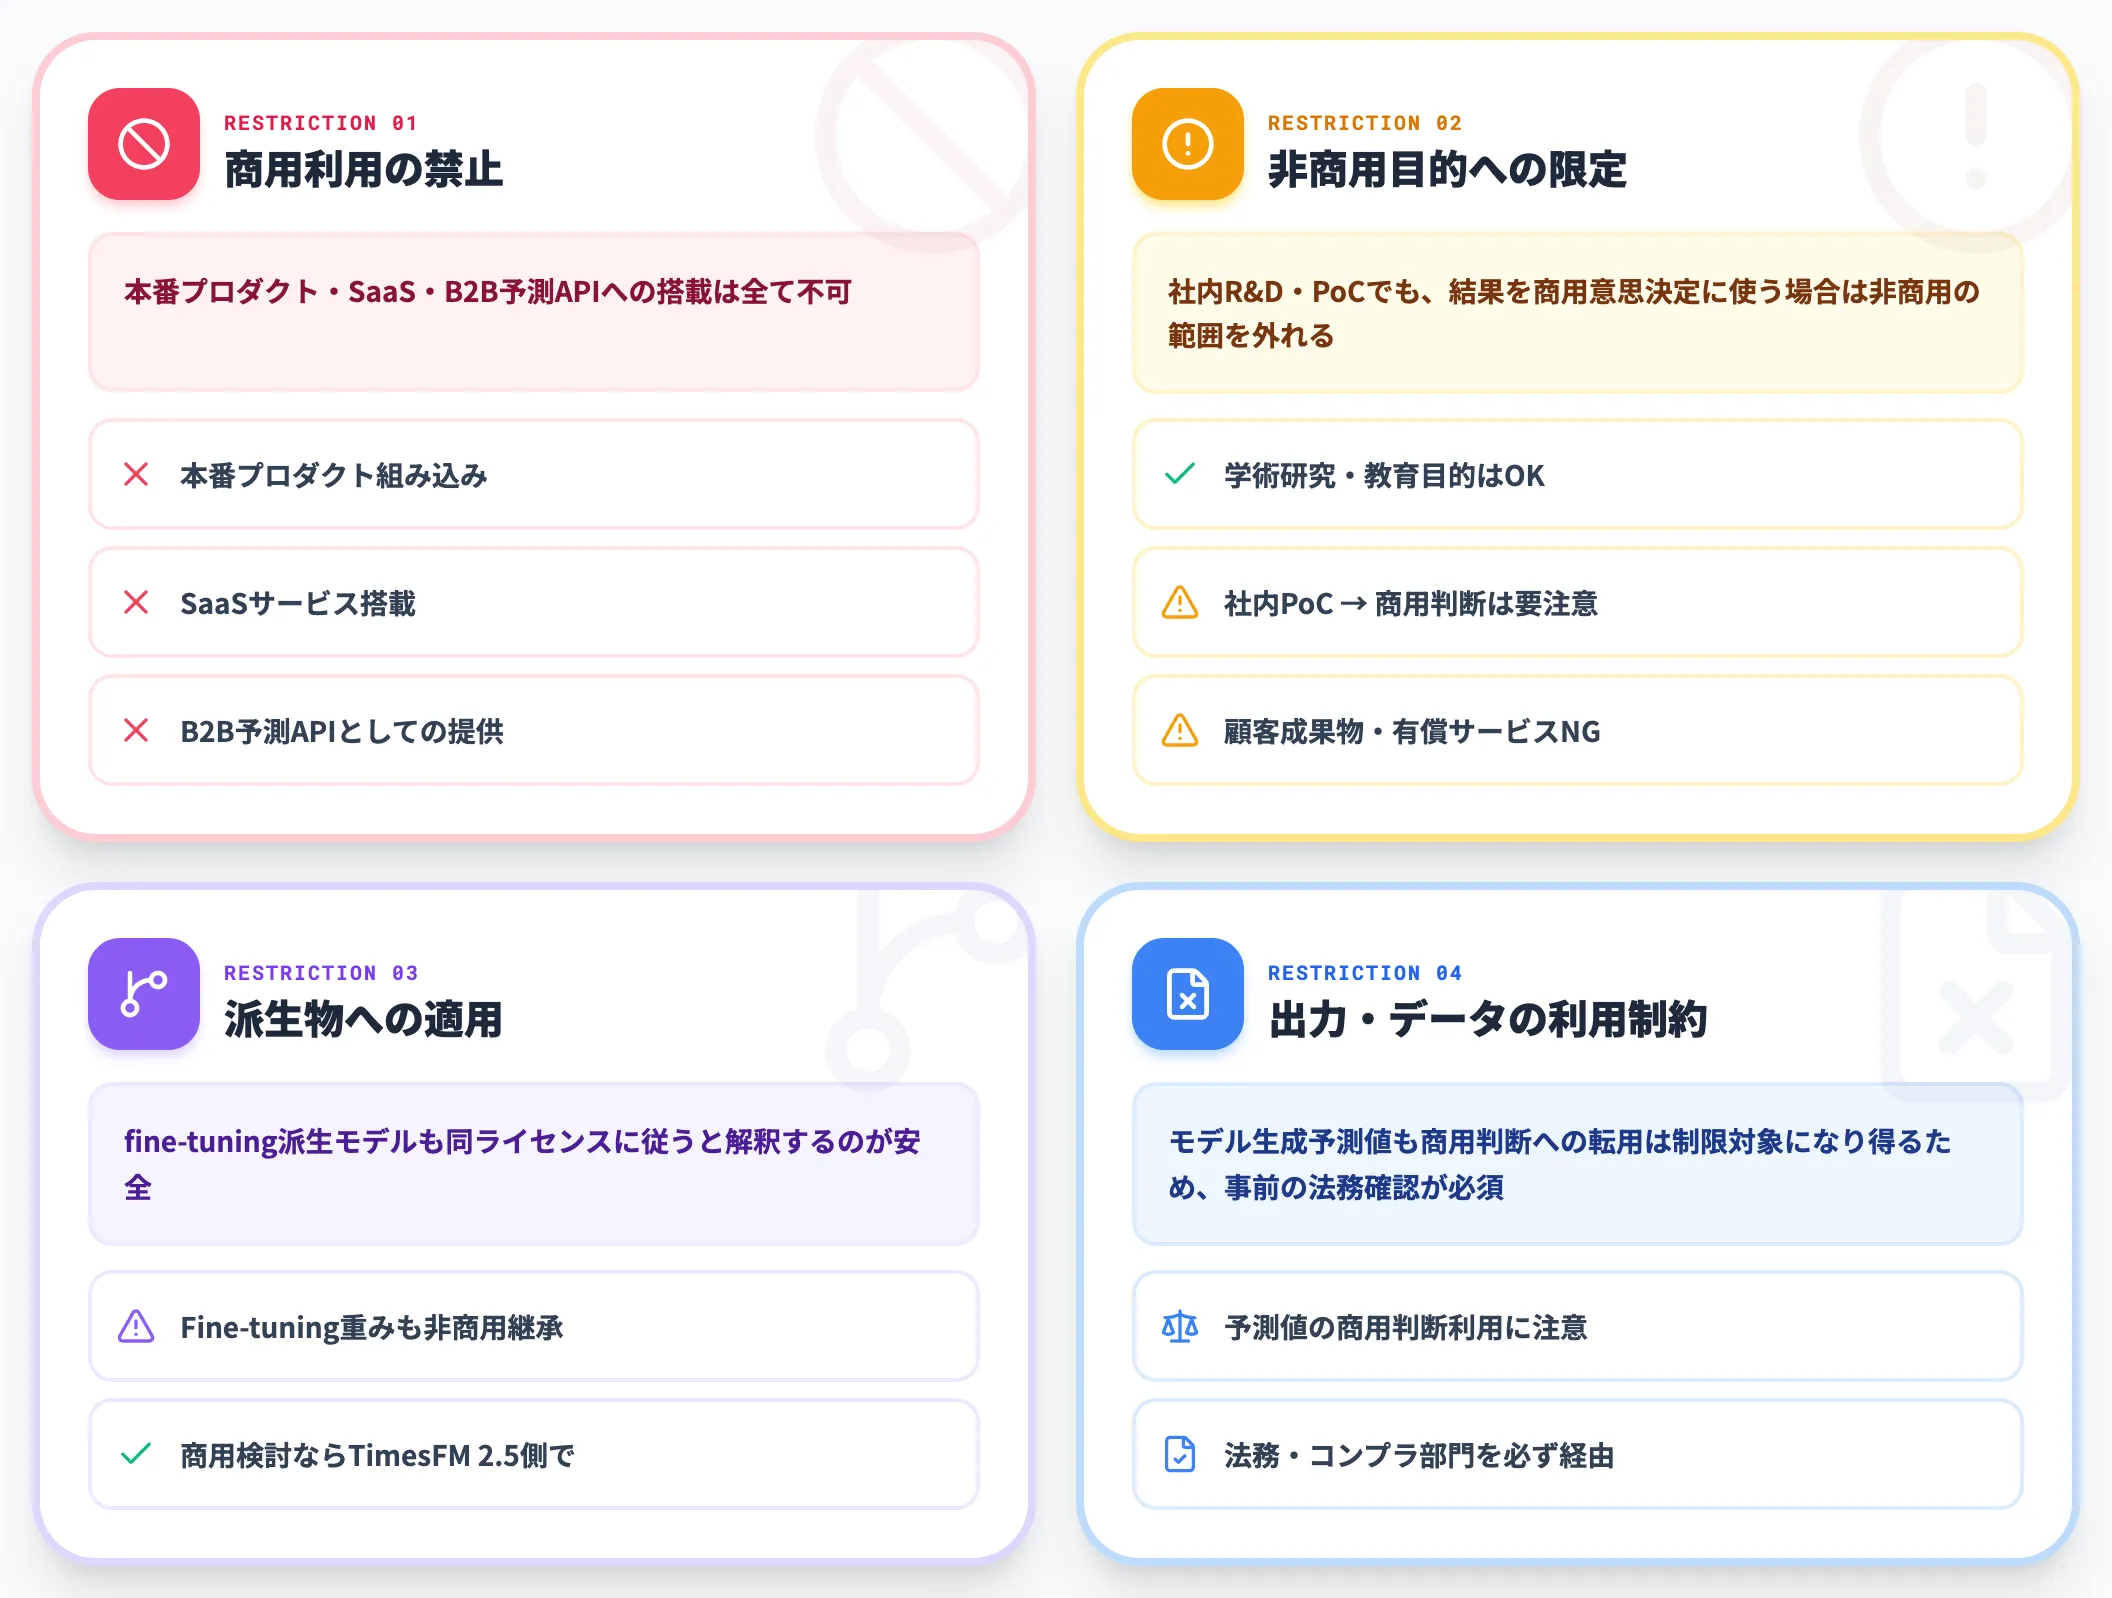
Hugging Faceのgoogle/timesfm-3.0-pytorchモデルカードには、事前学習済み重みが「timesfm-non-commercial-license-v1.0」で配布されると明記されています。このライセンスは以下の制限を含みます。
-
商用利用の禁止
本番プロダクトへの組み込み、SaaSサービスへの搭載、B2B予測APIとしての提供は全て不可
-
非商用目的への限定
学術研究・教育目的が典型例。社内R&D・ベンチマーク検証・PoCであっても、その結果を商用上の意思決定・顧客成果物・有償サービス・本番運用の判断に使う場合は非商用の範囲を外れる
-
モデル重み・派生物への適用
fine-tuningした派生モデルも同ライセンスに従うと解釈するのが安全
-
出力・データの利用制約
モデルが生成した予測値そのものについても、商用/本番判断に転用する用途は制限対象になり得るため、実務適用の前に必ず法務確認を取る
ライセンス条文の詳細は公式Hugging Faceページで随時更新される可能性があるため、実務適用の前に必ず最新版を法務レビューにかけてください。「PoCなら自由に使える」といった軽い運用判断は避け、社内の法務・コンプライアンス部門を必ず経由します。
商用利用の代替パス
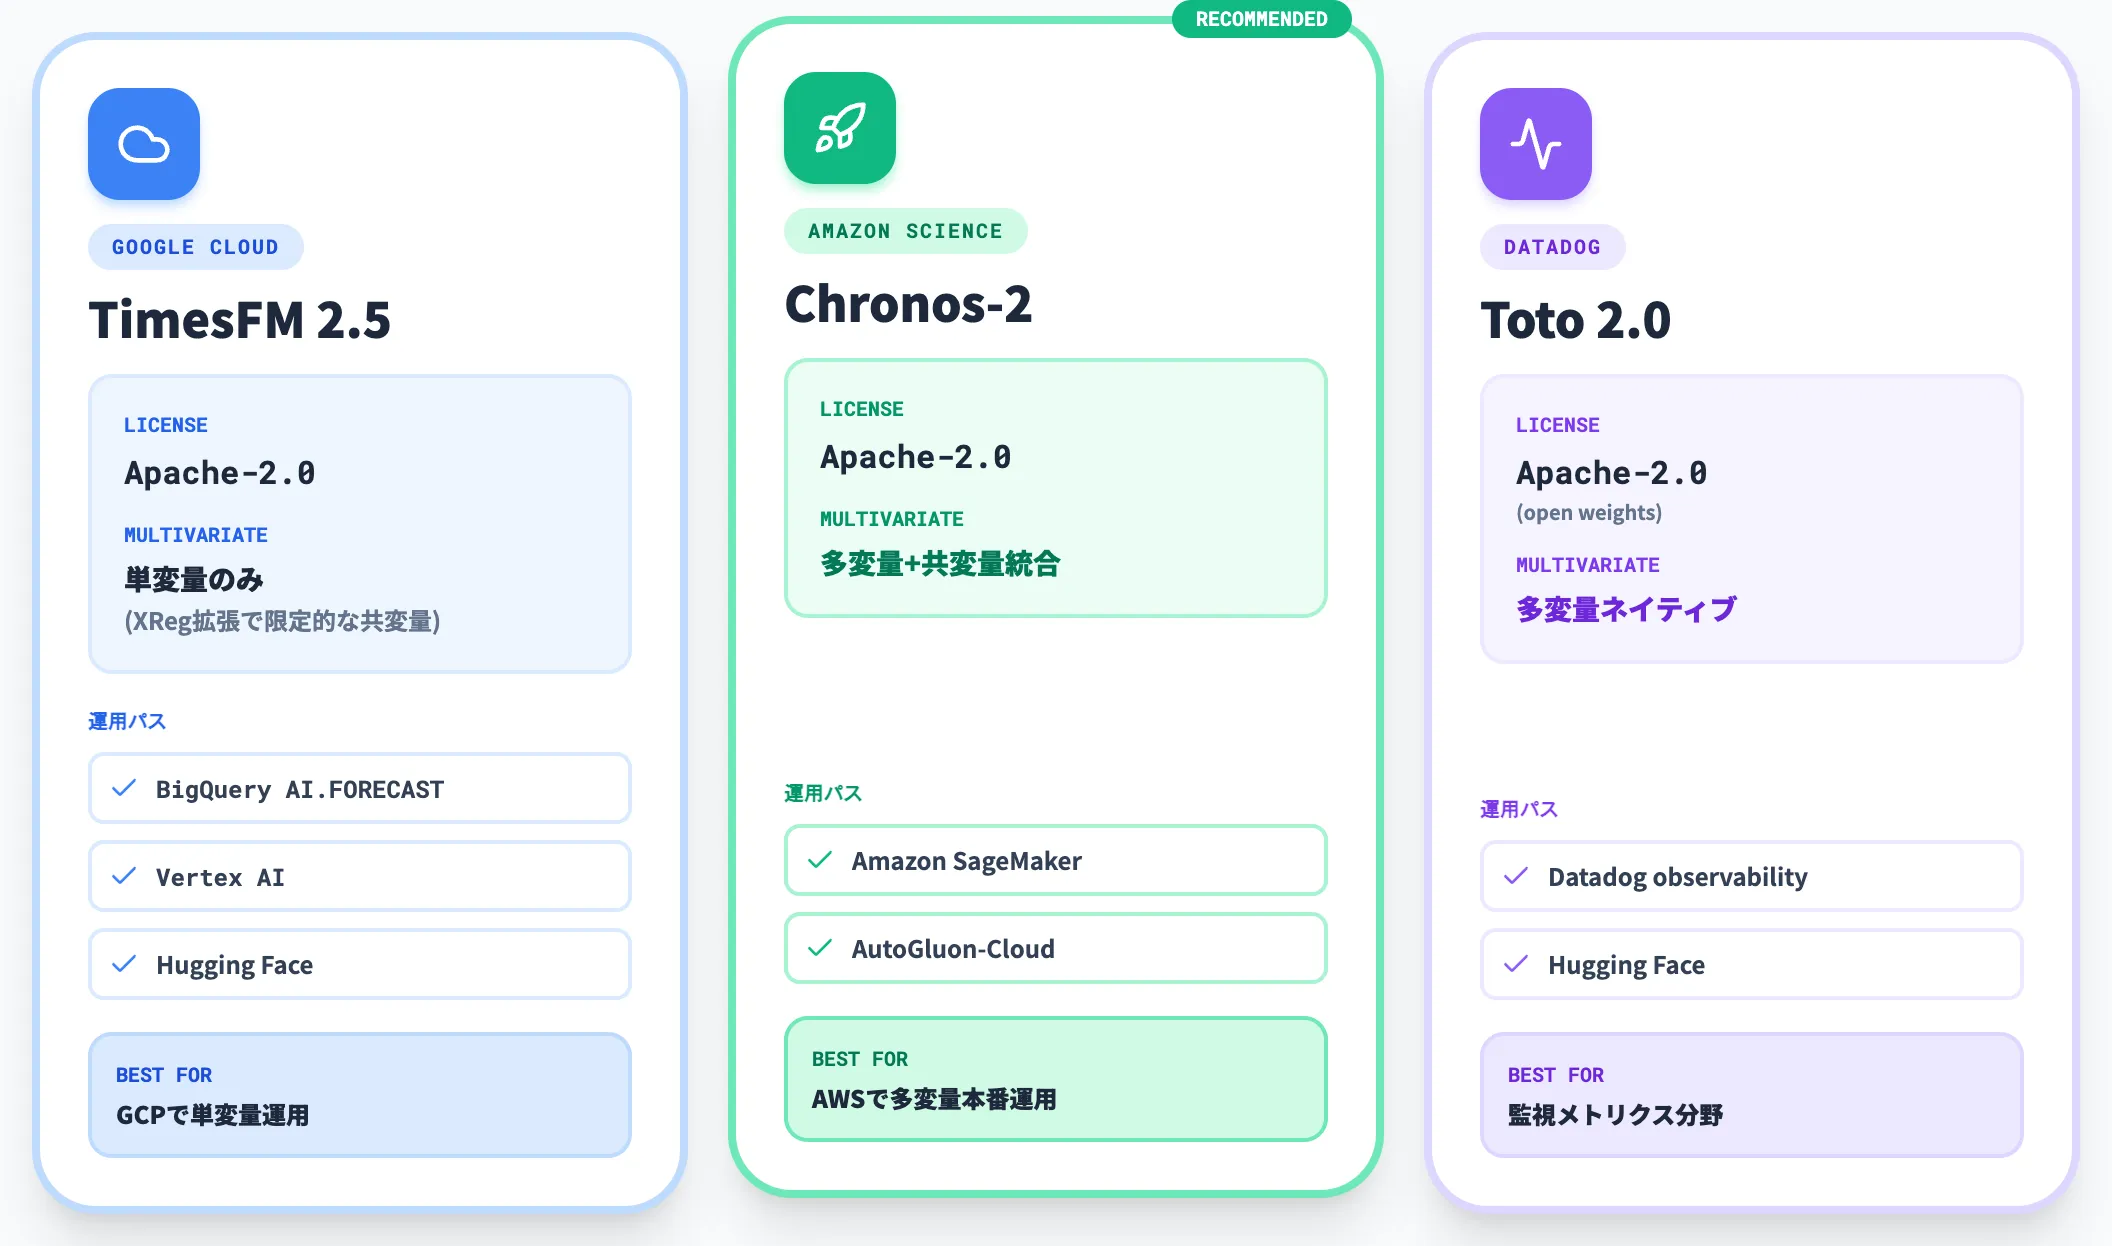
TimesFM-3を本番導入したい場合、現時点では以下の代替パスから選ぶことになります。
以下の表で、商用利用可能な主要時系列基盤モデルを整理しました。
| モデル | ライセンス | 多変量対応 | 主な運用パス |
|---|---|---|---|
| TimesFM 2.5 | Apache-2.0 | 単変量のみ(XReg拡張で限定的な共変量) | BigQuery AI.FORECAST/Vertex AI/Hugging Face |
| Chronos-2 | Apache-2.0 | univariate+multivariate+covariate統合 | Amazon SageMaker/AutoGluon-Cloud |
| Toto 2.0 | Apache-2.0(open weights) | 多変量ネイティブ | Datadog observability経路/HuggingFace |
TimesFM 2.5は「Google Cloudエコシステムで運用したい・単変量でも十分」なケース、Chronos-2は「AWSで運用したい・多変量が必要」なケース、Toto 2.0は「observability(監視メトリクス)分野で使う」ケースに向きます。実務での選定基準は後段の競合比較セクションで詳しく扱います。
非商用ライセンス下でのTimesFM-3の使いどころ
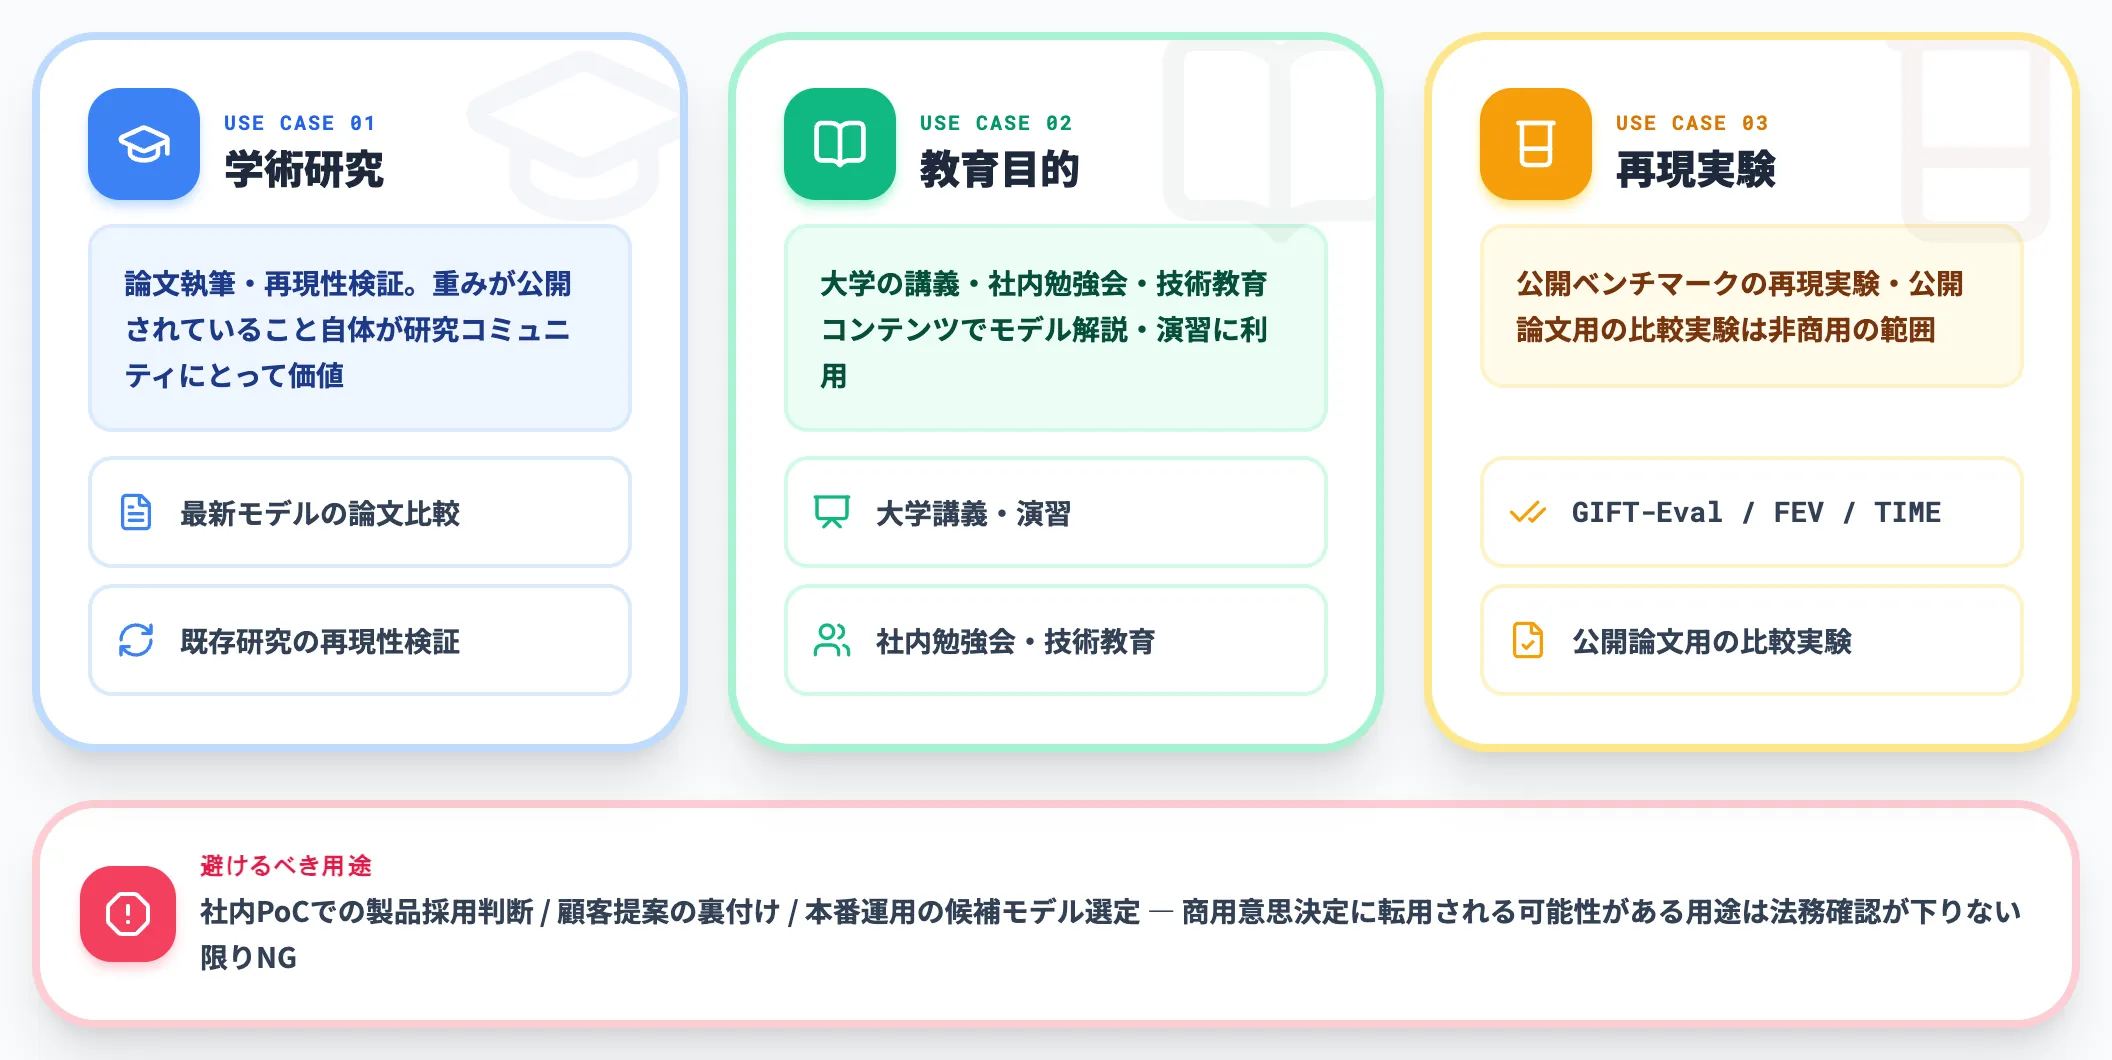
非商用制約があっても、TimesFM-3が活きる場面は残ります。ただしいずれのケースでも「その用途が本ライセンスの許諾範囲か」を法務確認する前提です。
-
学術研究・論文執筆: 時系列予測研究では最新モデルの再現性検証が必須で、TimesFM-3の重みが公開されていること自体が研究コミュニティにとって大きな価値になります
-
教育目的: 大学の講義・社内勉強会・技術教育コンテンツでのモデル解説・演習
-
公開ベンチマークへの再現実験: GIFT-Eval・FEV-Bench・TIME等の再現実験、公開論文用の比較実験
逆に、商用の意思決定に転用される可能性がある用途(社内PoCでの製品採用判断・顧客提案の裏付け・本番運用の候補モデル選定 等)は非商用ライセンスの範囲を外れる可能性が高く、法務確認が下りない限り実施しない判断が安全です。今後、Googleが商用ライセンス版を別途提供する可能性はありますが、公式アナウンスは現時点でありません。商用導入計画がある場合はTimesFM 2.5または競合の商用可能モデルで進める判断が現実的です。
TimesFM-3と競合モデルの比較——Chronos-2 / Toto 2.0 / Moirai 2.0
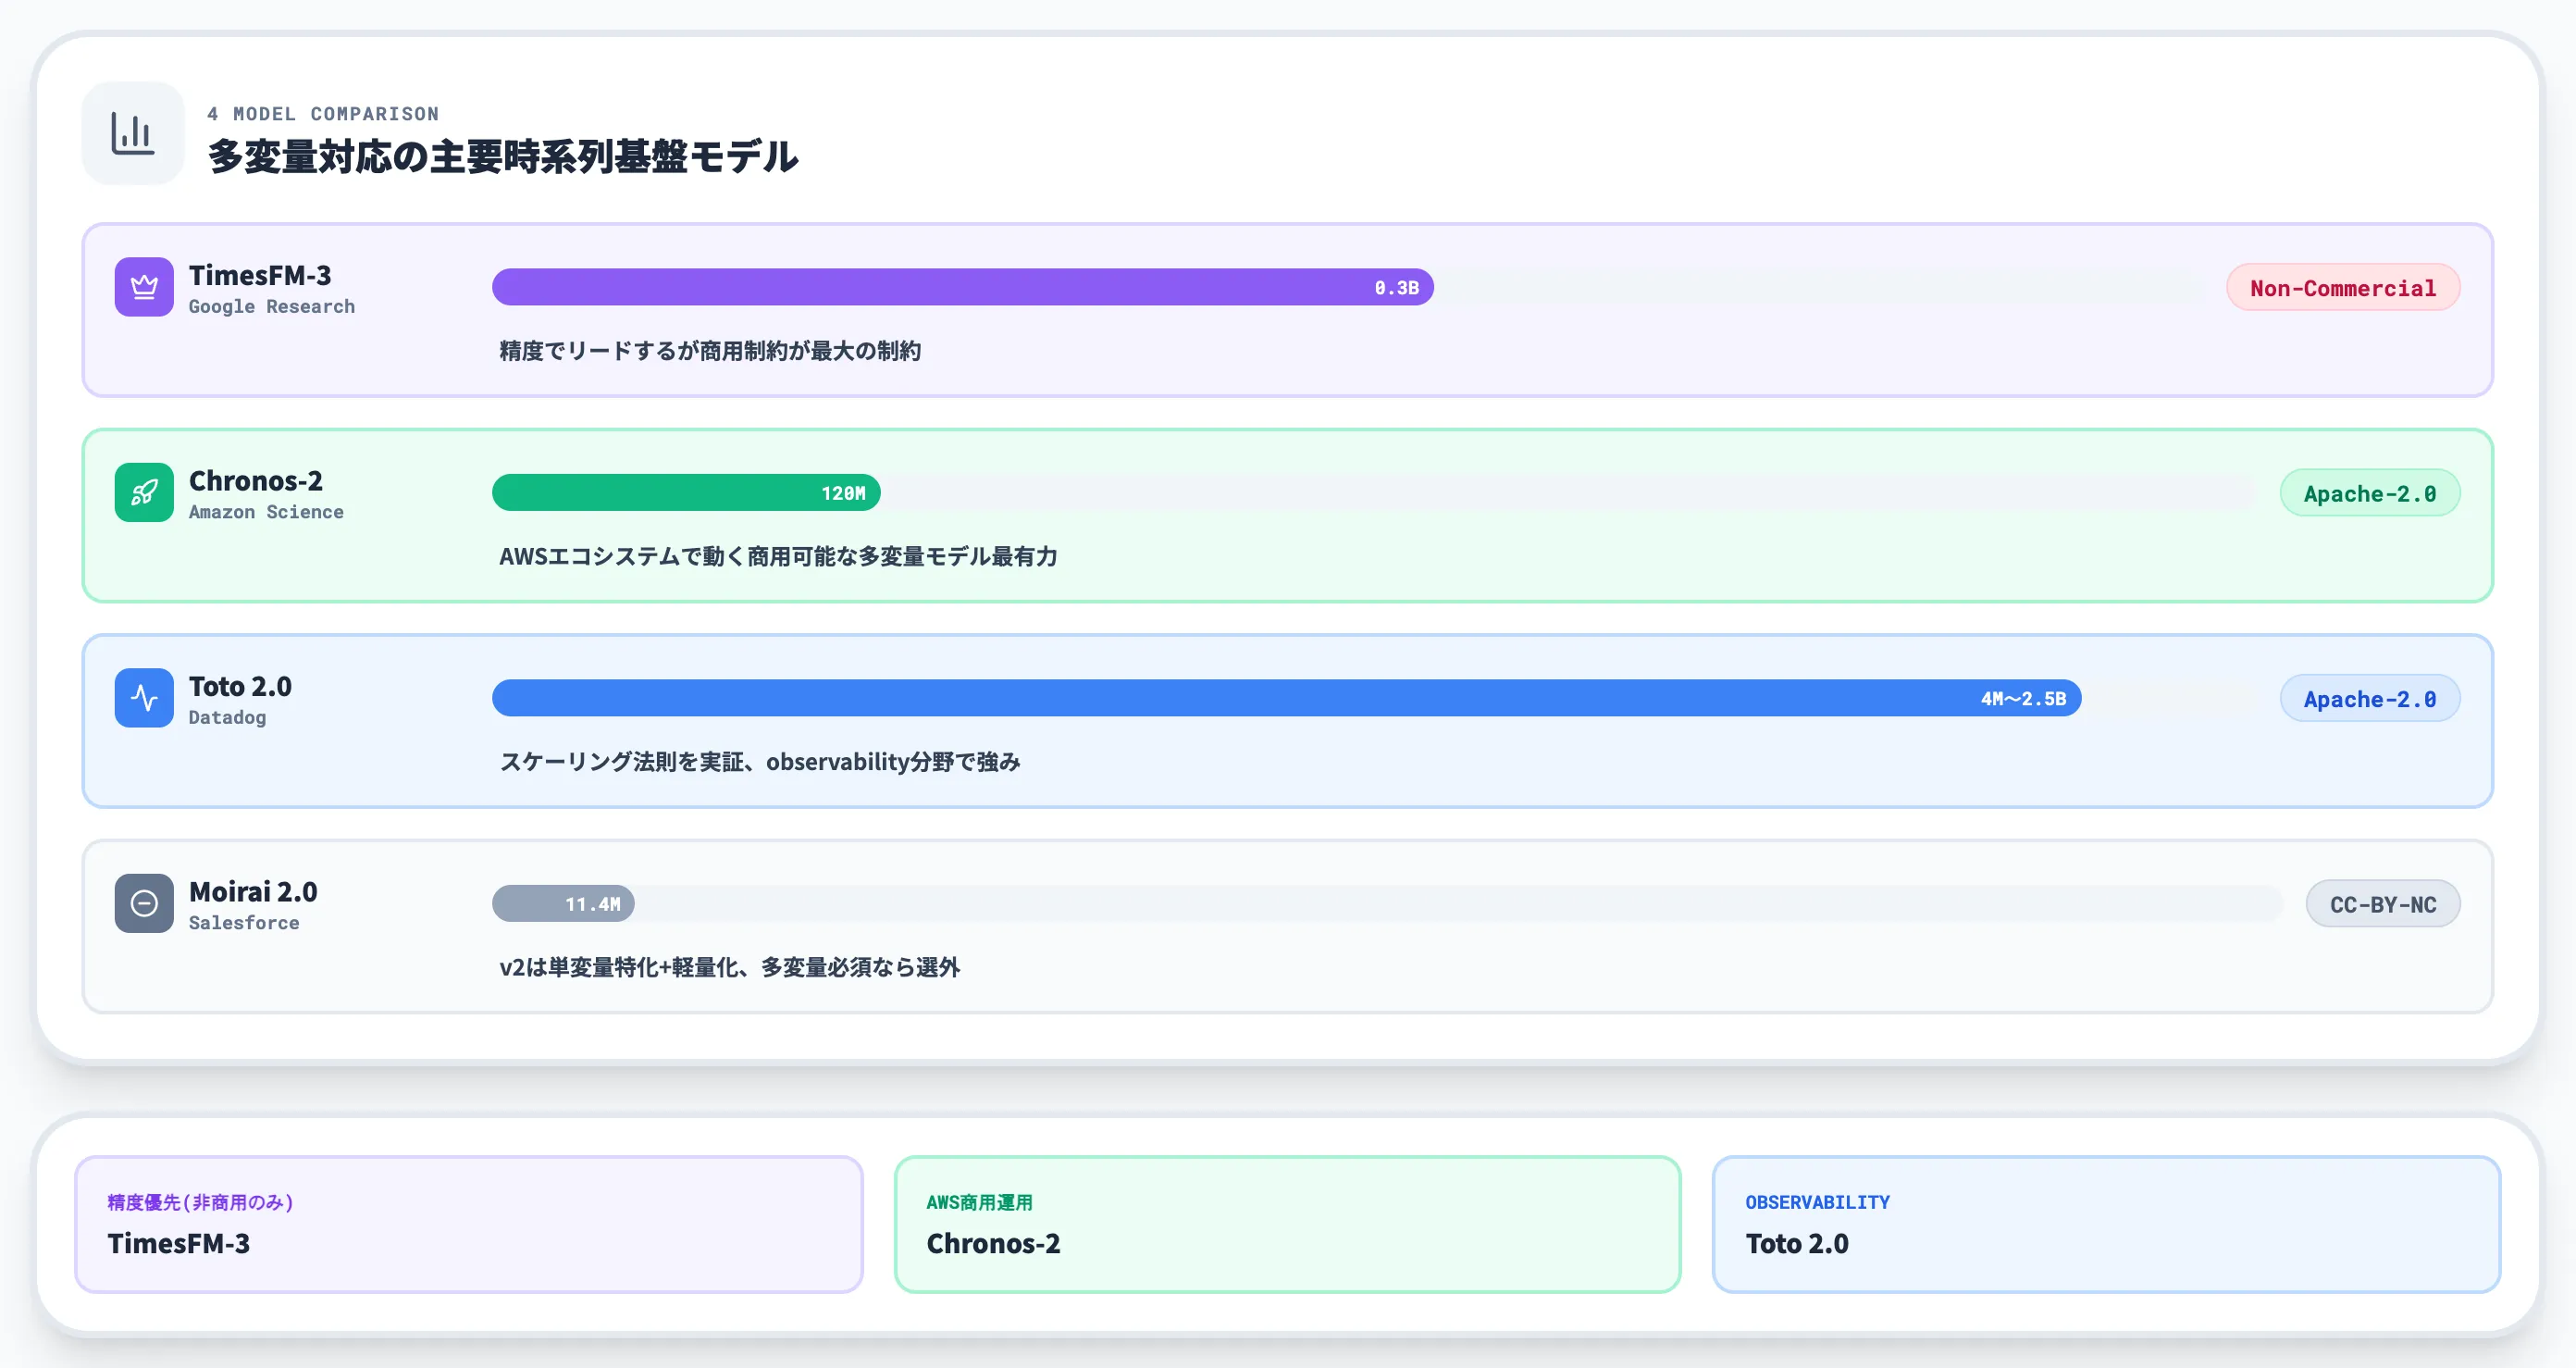
TimesFM-3は多変量対応の時系列基盤モデルとして先行するChronos-2、Toto 2.0、Moirai 2.0と直接競合します。ここでは各モデルの位置づけと使い分けを整理します。
4モデルの主要スペック比較
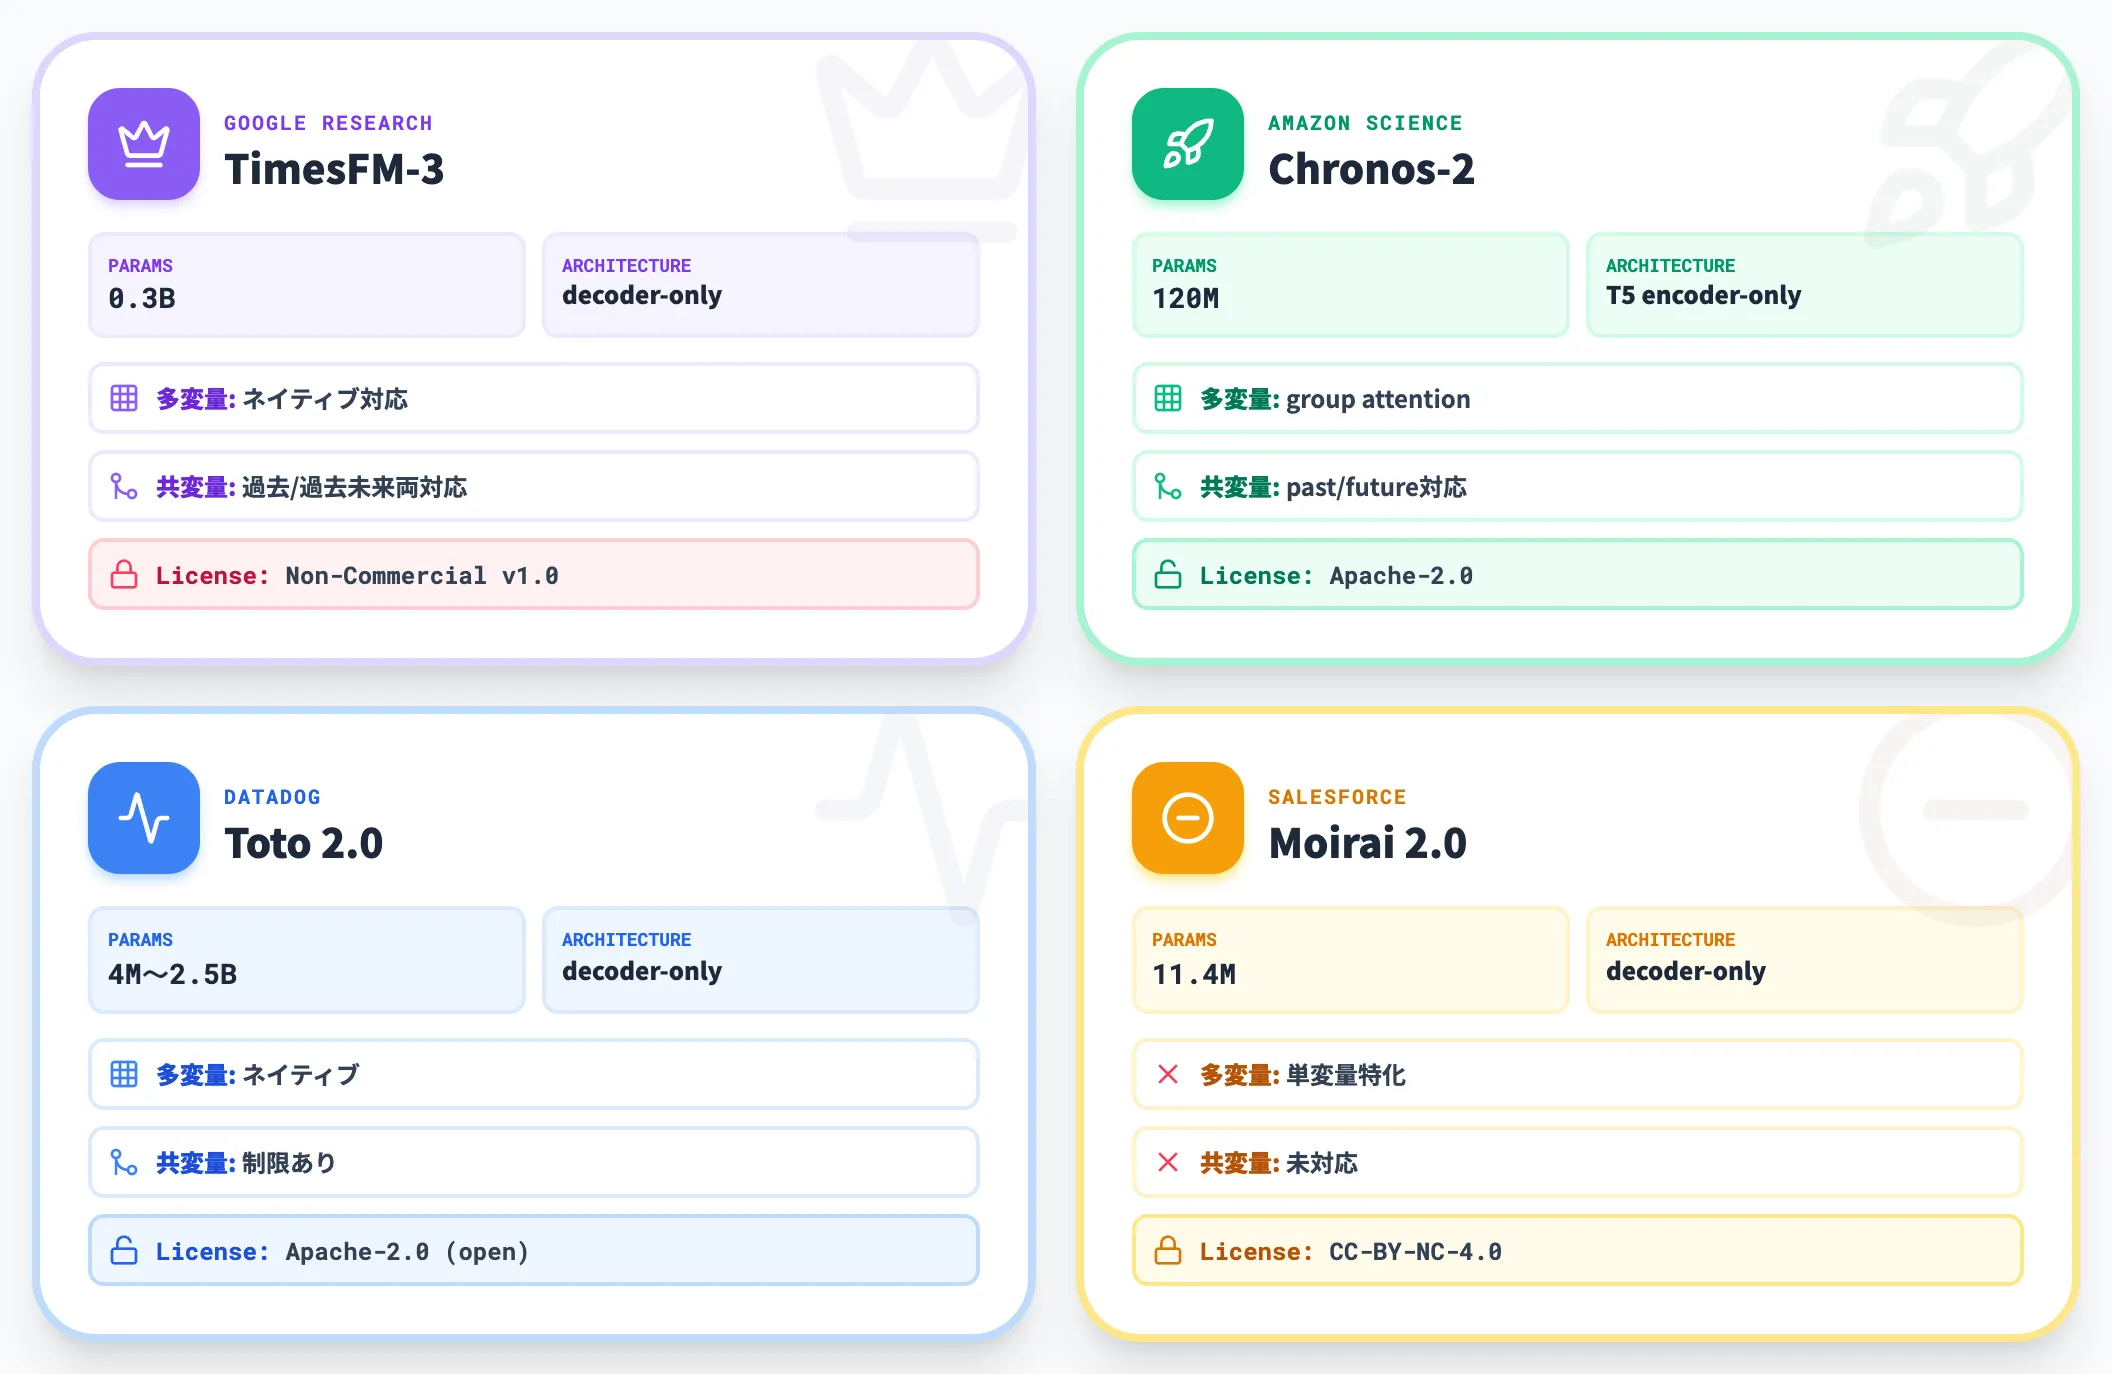
以下の表で、多変量対応の主要時系列基盤モデル4本を横並びで整理しました。
| モデル | 提供元 | パラメータ数 | アーキテクチャ | 多変量 | 共変量 | ライセンス |
|---|---|---|---|---|---|---|
| TimesFM-3 | Google Research | 0.3B | Stacked Mixing Transformer(decoder-only) | ネイティブ | 過去/過去未来両対応 | Non-Commercial v1.0 |
| Chronos-2 | Amazon Science | 120M | T5ベースencoder-only | ネイティブ(group attention) | past/future共に対応 | Apache-2.0 |
| Toto 2.0 | Datadog | 4M〜2.5B | decoder-only Transformer | ネイティブ | 制限あり | Apache-2.0(open weights) |
| Moirai 2.0 | Salesforce | 11.4M(R-small公開版) | decoder-only | 単変量特化(クロス系列を扱わない) | — | CC-BY-NC-4.0 |
この比較から見えるのは、TimesFM-3は精度でリードするが商用制約が最大の制約、Chronos-2はAWSエコシステムで動く多変量対応の商用可能モデルとして最有力の代替、Toto 2.0はスケーラビリティ研究で先行しobservabilityに強いという3すくみの構図です。
Chronos-2との違い
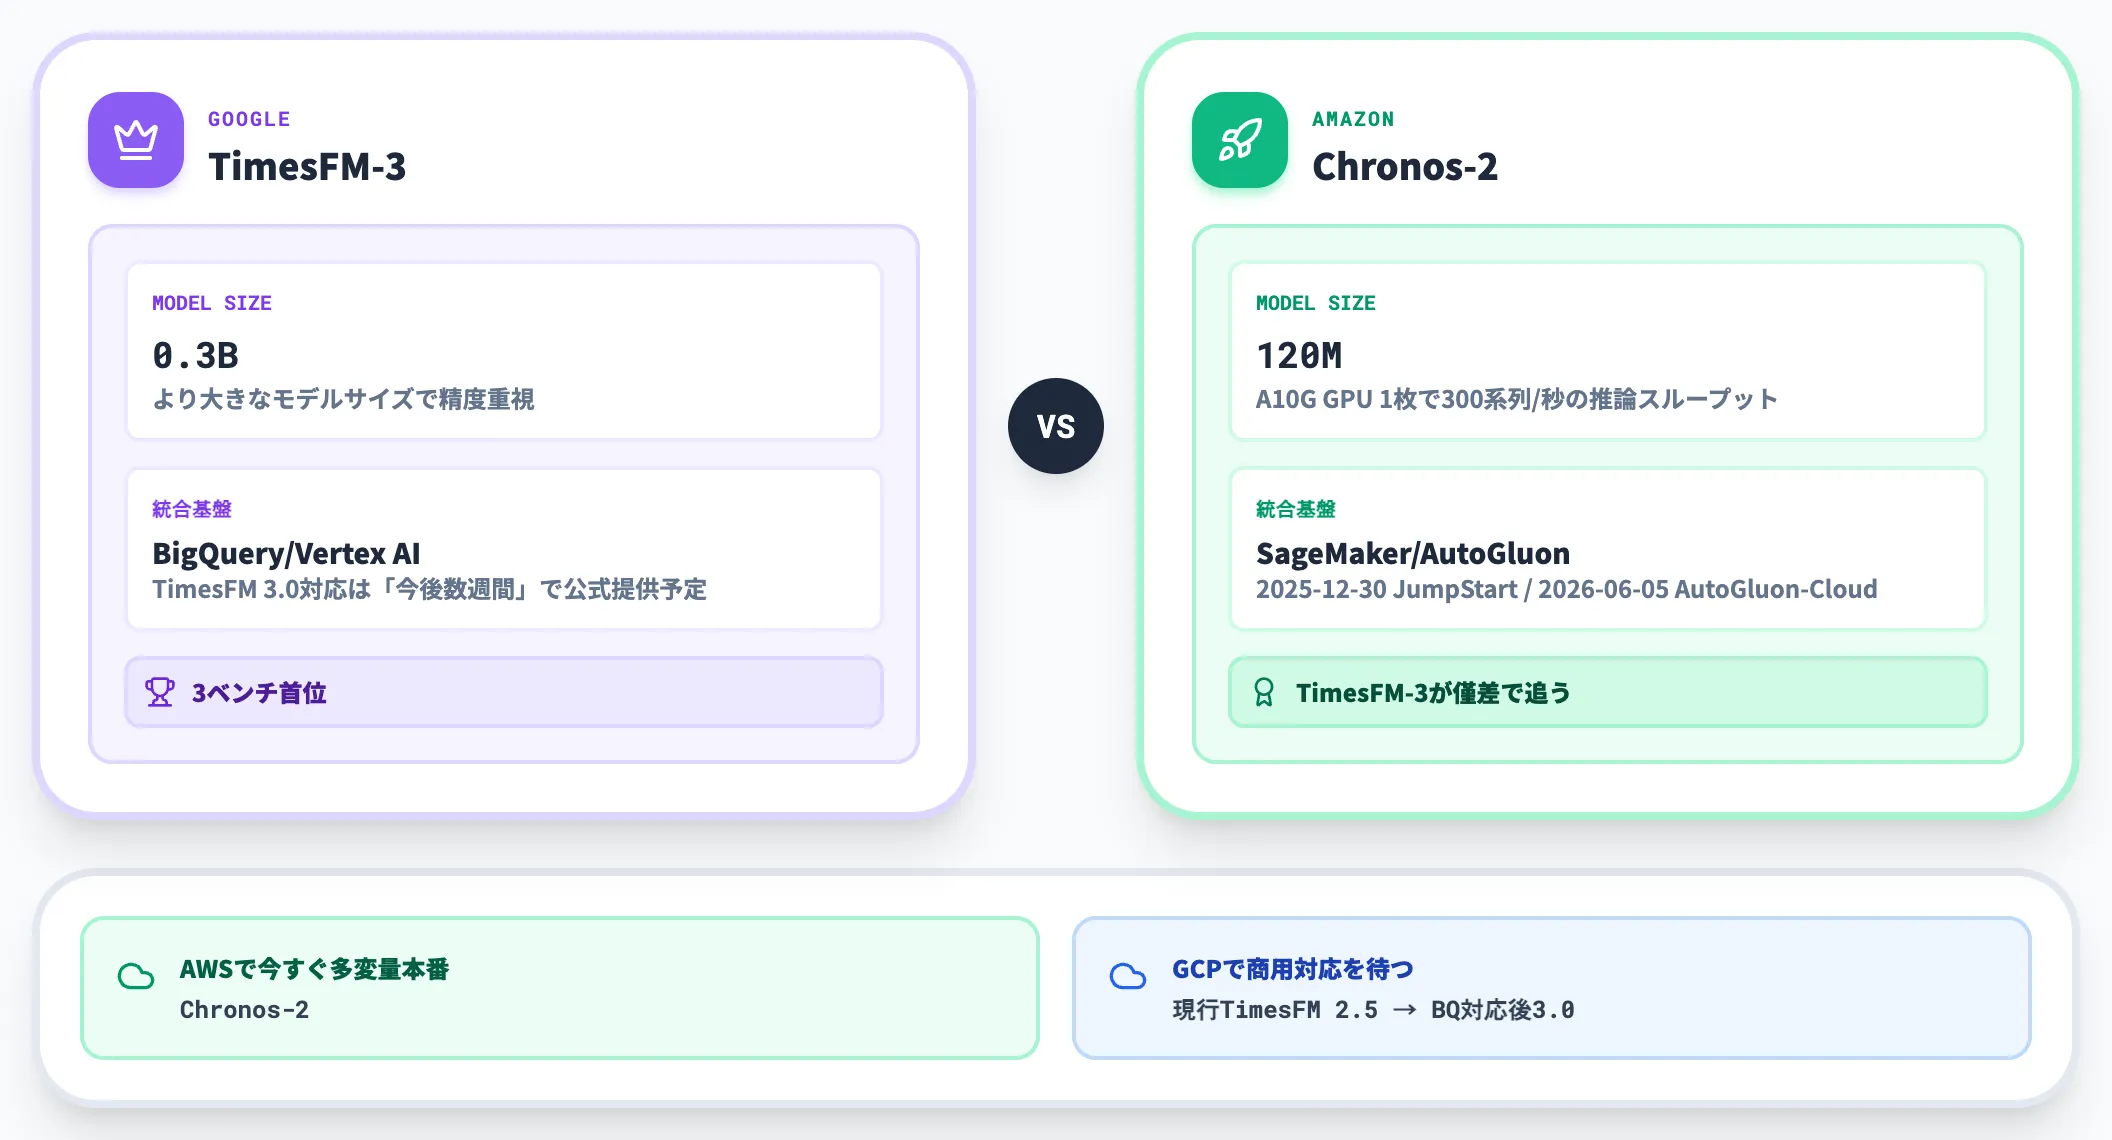
Chronos-2はAmazon Scienceが2025年10月20日に公開した120Mパラメータのencoder-onlyモデルで、TimesFM-3の直接的な競合です。共通点も多いですが、以下の点で違いが出ます。
-
モデルサイズと推論構成
Chronos-2は120Mでコンパクトな構成、公式は「A10G GPU 1枚で300系列/秒」の推論スループットを公表しており、GPU・CPU両方の運用に対応。TimesFM-3(0.3B)はより大きなモデルサイズで精度を狙う設計。両者の直接的なレイテンシ比較は公開一次情報では確認できないため、実運用ではPoCでの実測比較が必要。
-
統合基盤
Chronos-2はAmazon SageMaker JumpStartに2025年12月30日、AutoGluon-Cloudに2026年6月5日から提供され、AWS環境での本番運用がすぐに始められる。TimesFM-3はGoogle Cloud側の統合待ち。
-
ベンチマーク成績
GIFT-Eval・FEV-Bench・Chronos Benchmark IIでSOTA(TimesFM-3リリース前)。TimesFM-3公開後は「TimesFM-3が上位、Chronos-2が僅差で追う」という位置関係。
AWS環境で今すぐ多変量予測を本番導入したいならChronos-2、Google Cloud環境で商用対応を待って導入したいなら現行のTimesFM 2.5(BigQuery AI.FORECAST GA)を選び、TimesFM 3.0対応のBigQuery公式提供を待って再検討する、という使い分けが実務的です。
Toto 2.0との違い
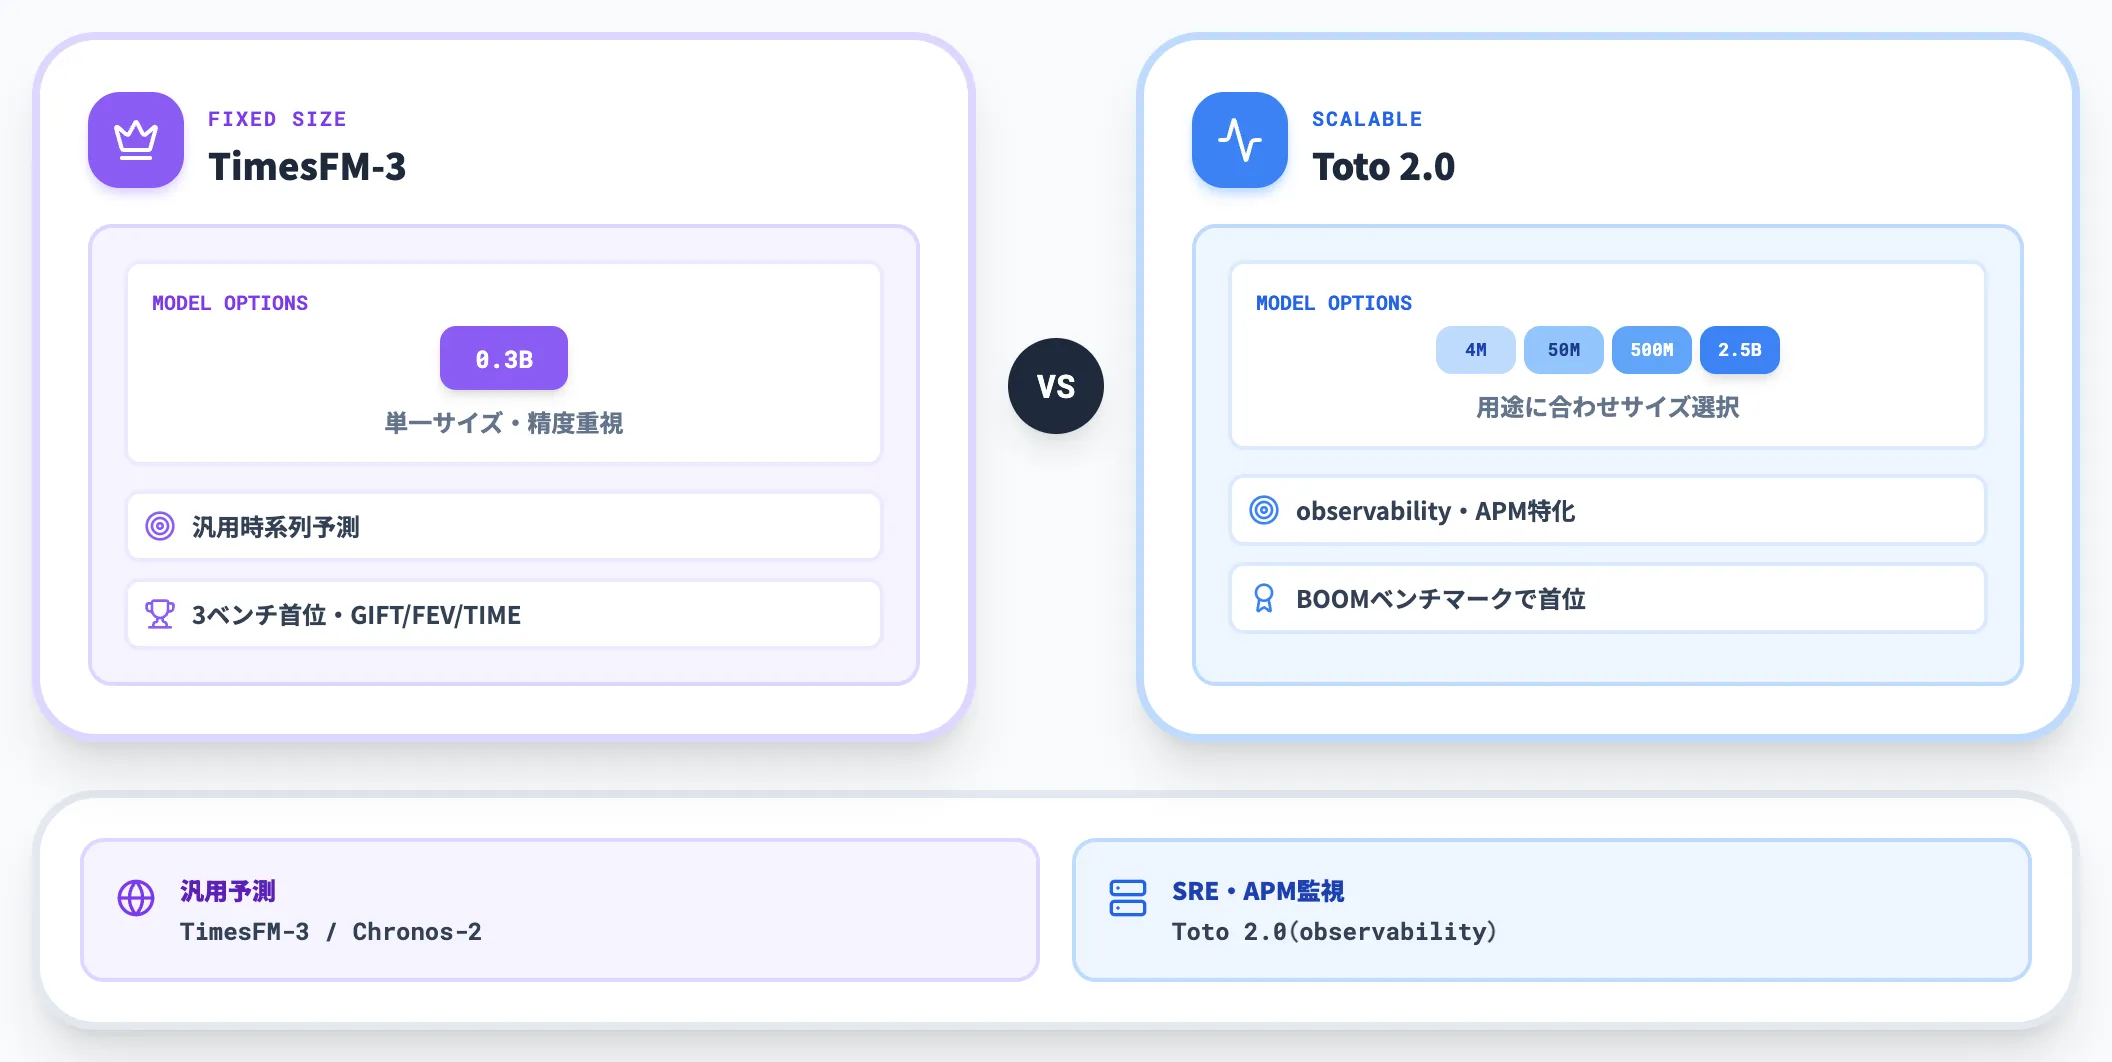
Toto 2.0はDatadogが2026年に発表した4M〜2.5Bパラメータの時系列基盤モデルで、時系列予測FMで初めてスケーリング法則(モデルサイズを大きくすれば精度が上がる)が成り立つことを実証した点で注目されています。
TimesFM-3が0.3B固定サイズでベンチマーク首位を取るのに対し、Toto 2.0は4M〜2.5Bのラインナップから用途に合ったサイズを選べる柔軟性があります。Datadogの主戦場はobservability(サーバー監視・SREメトリクス)で、observability向けのBOOMベンチマークでも首位を取っています。
汎用予測ならTimesFM-3・Chronos-2が有利、SREアノマリー検知・APM(Application Performance Monitoring)といったobservability領域ならToto 2.0公式発表が有力、という棲み分けです。observability領域での強さは他モデルと明確に差がついています。
Moirai 2.0との違い
Moirai 2.0はSalesforceが「Less Is More」というコンセプトで開発した第2世代モデルです。初代Moiraiは多変量any-variate attentionを推していましたが、v2では単変量特化+パラメータ削減の方向に舵を切っています。
多変量が必須ならMoirai 2.0は選択肢から外れ、TimesFM-3・Chronos-2・Toto 2.0のいずれかに絞られます。単変量で軽量な運用を求めるならMoirai 2.0が候補になりますが、その場合はTimesFM 2.5(Apache-2.0・200M)の方が選択肢として自然です。
TimesFM-3をBigQuery/Vertex AIで運用する方法
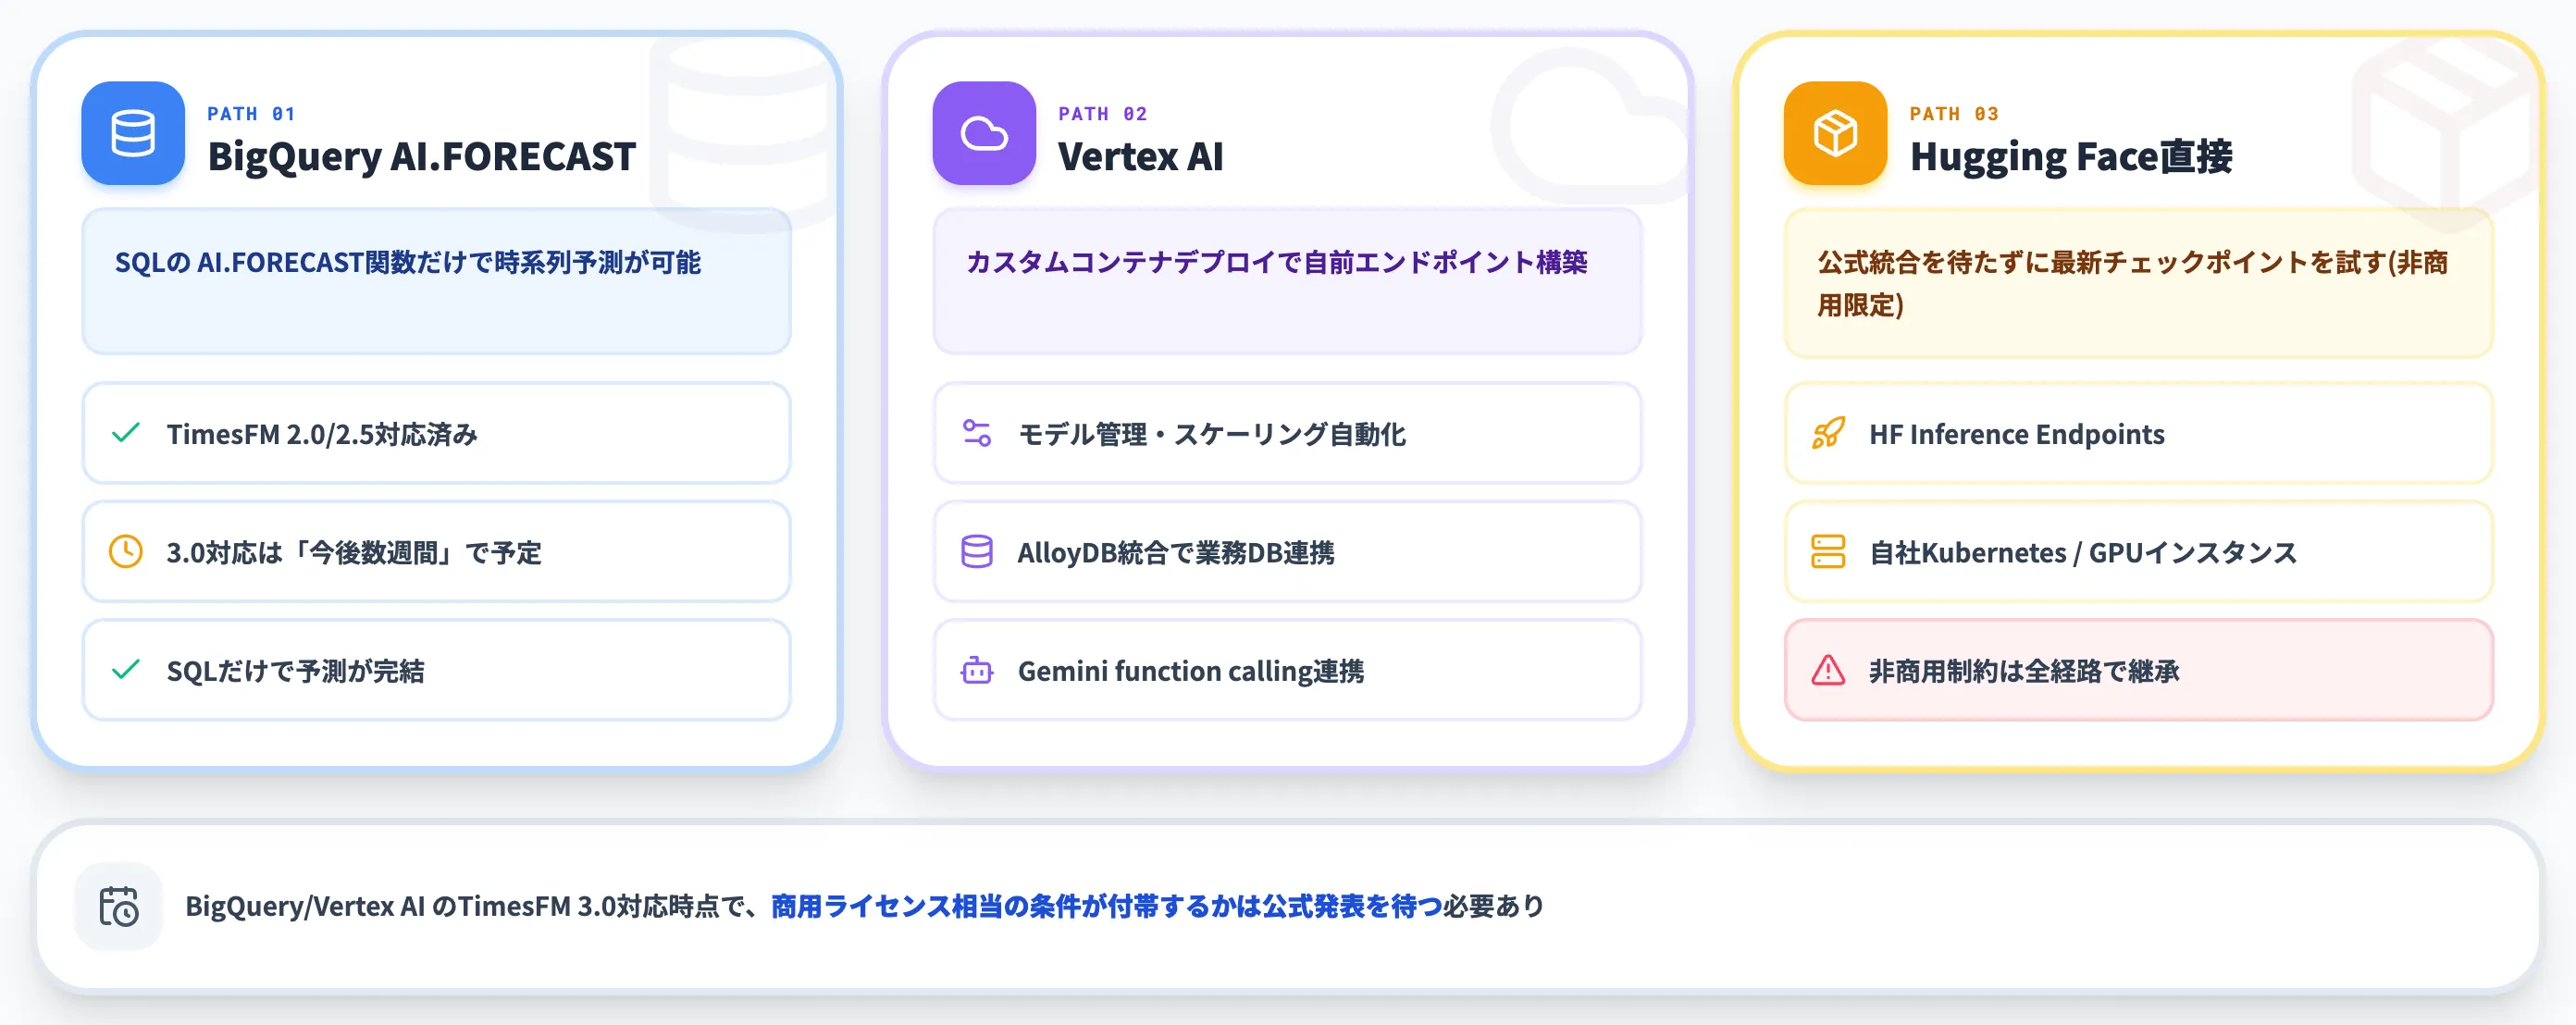
TimesFM-3の運用パスは、モデル本体の非商用制約と、既存のGoogle Cloud統合(TimesFM 2.5対応)の温度差を理解しておく必要があります。ここではGoogle Cloud環境での具体的な運用オプションを整理します。
BigQuery AI.FORECAST
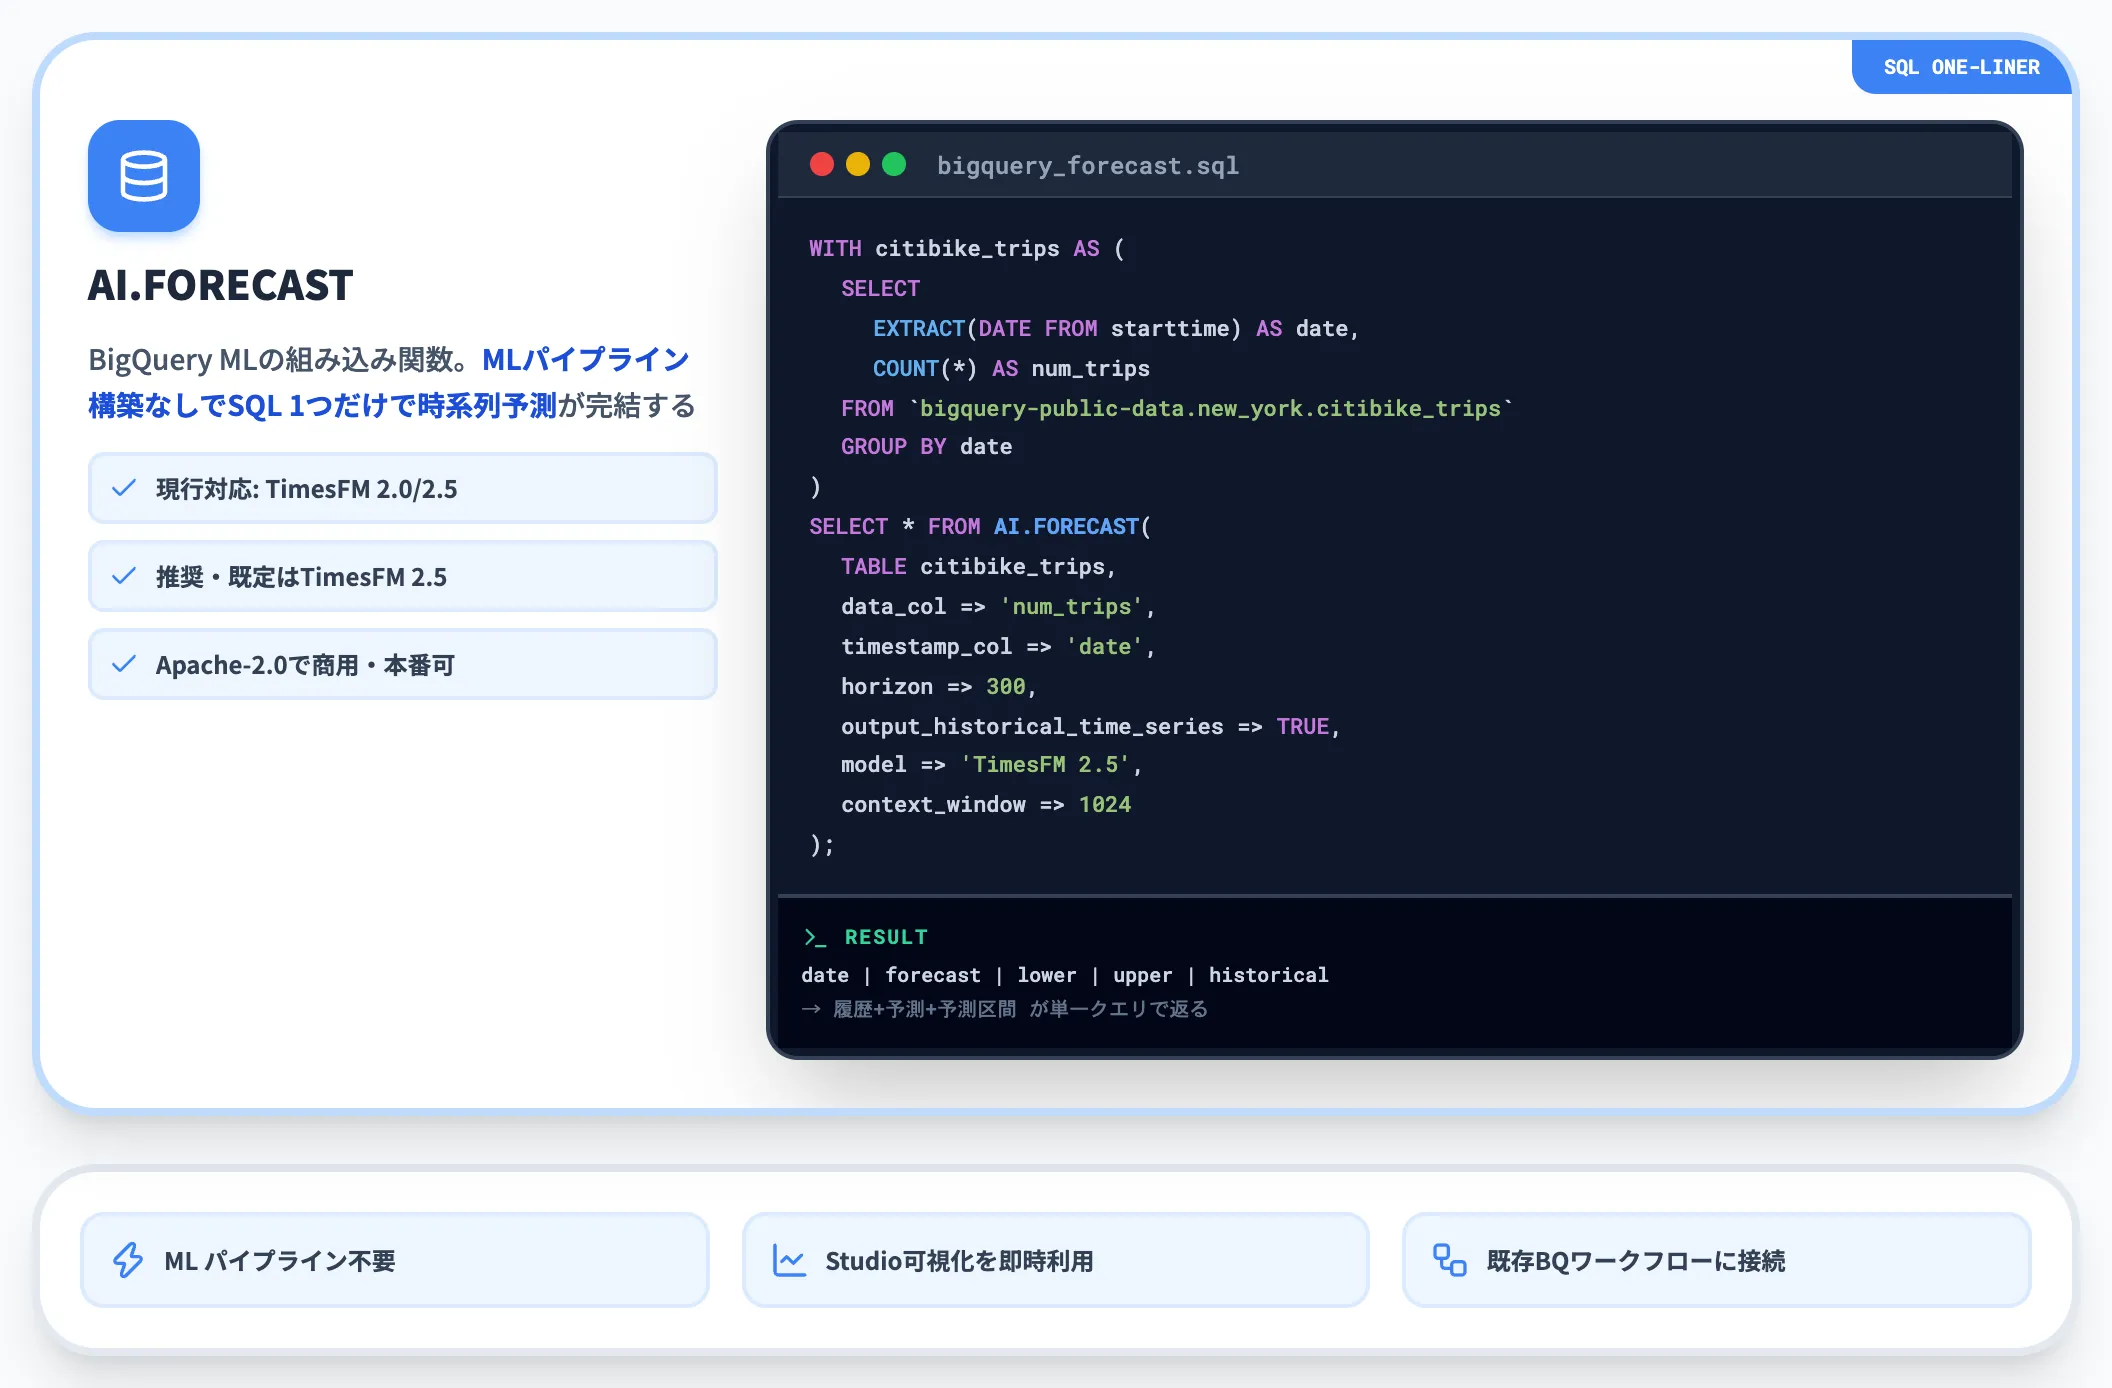
BigQuery MLはTimesFMシリーズを組み込みモデルとして提供しており、SQLのAI.FORECAST関数だけで時系列予測ができます。現行対応はTimesFM 2.0とTimesFM 2.5で、推奨・既定はTimesFM 2.5です。両方ともApache-2.0で、モデルライセンス上は商用・本番利用が可能です(BigQueryサービス規約・データ管理・運用設計は別途確認が必要)。
Google Research公式ブログは「今後数週間でBigQuery AI.FORECASTのTimesFM 3.0対応を予定」と明記しており、BigQuery組み込みは近く提供される見込みです。ただし非商用ライセンスに関しては、BigQuery組み込み時点で商用ライセンス相当の条件が付帯するかどうかは公式発表を待って個別確認が必要です。
以下のようなSQLで時系列予測が実行できます。
WITH citibike_trips AS (
  SELECT EXTRACT(DATE FROM starttime) AS date, COUNT(*) AS num_trips
  FROM `bigquery-public-data.new_york.citibike_trips`
  GROUP BY date
)
SELECT * FROM AI.FORECAST(
  TABLE citibike_trips,
  data_col => 'num_trips',
  timestamp_col => 'date',
  horizon => 300,
  output_historical_time_series => TRUE,
  model => 'TimesFM 2.5',
  context_window => 1024
);
このアプローチの利点は、専用のMLパイプラインを構築せずにSQLだけで予測が回る点です。
既存のBigQueryユーザーは、モデル管理・インフラ運用の負荷なしに時系列予測を業務ワークフローに組み込めます。BigQuery全体の位置づけはBigQueryとは?機能や始め方、料金、他DWHとの違いを解説で詳しく整理しています。
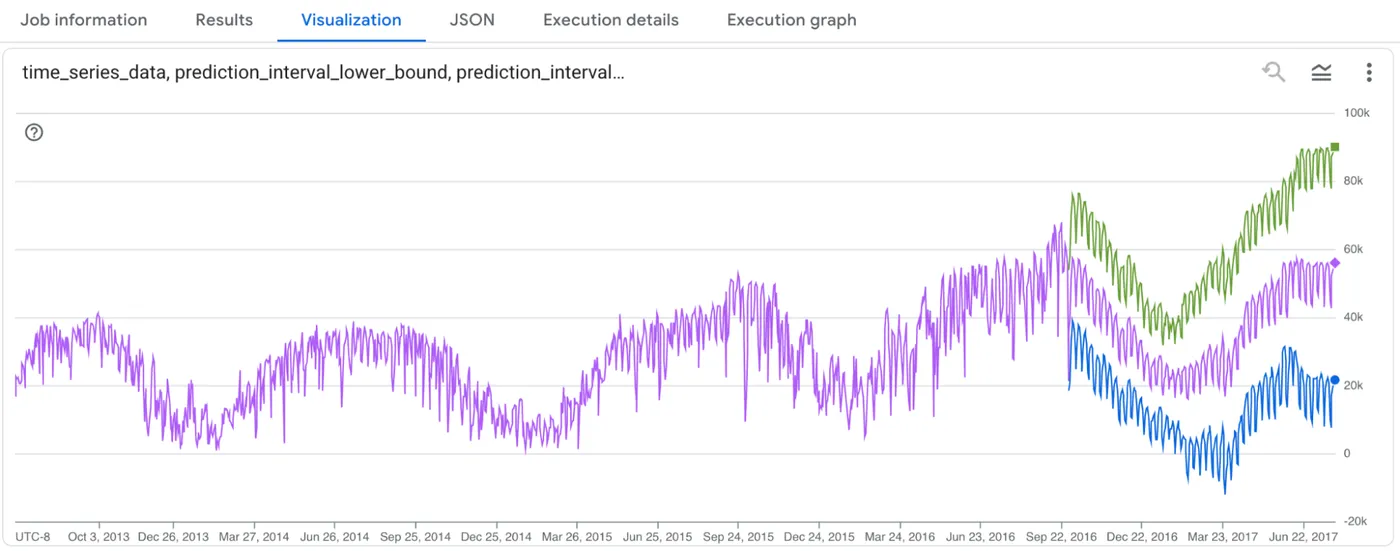
BigQuery StudioでのAI.FORECAST予測結果の可視化。履歴・予測値・予測区間の上下限が1画面に並び、SQLクエリの出力からそのままグラフで確認できる(出典:Google Cloud Blog)
BigQuery StudioのVisualizationタブでは、AI.FORECASTの出力(履歴・予測値・予測区間の下限/上限)がSQLクエリの結果画面上で即座にグラフ化されます。
実務担当者にとっては、モデルデプロイ・API呼び出し・可視化ダッシュボード構築の各工程を1つのSQLに畳み込める点が最大の運用効果で、需要予測やKPIモニタリングを既存のBigQueryワークフローに接続する際のリードタイムが大幅に縮まります。
Vertex AIのカスタムコンテナ
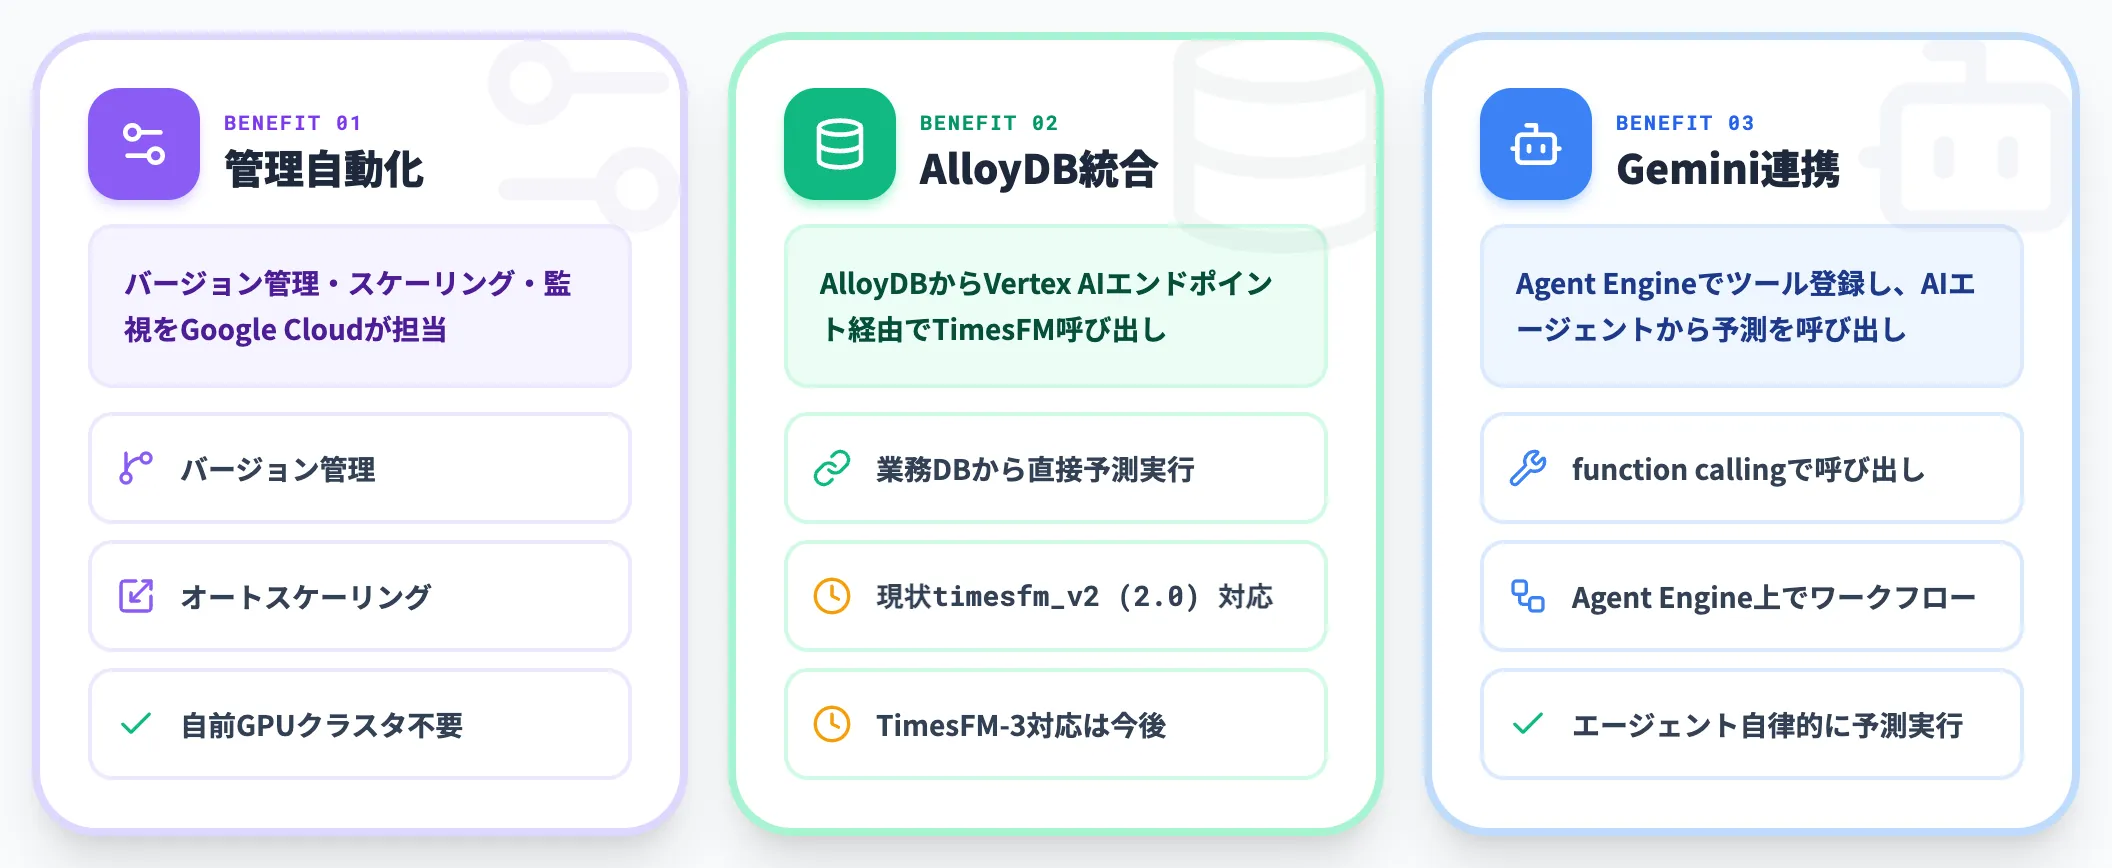
TimesFM-3をGoogle Cloud側のインフラで動かしたい場合、Vertex AIのカスタムコンテナデプロイ手順を使って自前でエンドポイントを構築する経路が現時点の選択肢です。TimesFM-3固有のワンクリック対応や公式マネージドエンドポイント提供は現在確認できないため、Dockerイメージの構成・エンドポイントのスケーリング設定は利用者側で組み立てます。
Vertex AI経由で運用する場合、以下のメリットがあります。
-
モデル管理の自動化
バージョン管理・スケーリング・監視をGoogle Cloudが担当。自前でGPUクラスタを組む必要がない。
-
AlloyDB統合
AlloyDBからVertex AIエンドポイントを介してTimesFMを呼び出す統合が提供されており、業務データベース内から予測を実行できる。
-
Gemini function callingとの連携
Vertex AI Agent Engine(旧称: Reasoning Engine)でTimesFMをツールとして登録し、AIエージェントが必要に応じて予測を呼び出すワークフローが組める。
Vertex AI全体の機能はVertex AIとは?主要機能・料金体系・他Googleサービスとの違いを徹底解説で詳しく解説しています。AlloyDBの公式手順は現状 timesfm_v2(TimesFM 2.0)を対象としており、TimesFM-3対応は将来の公式アップデート待ちです。
Hugging Face直接デプロイ
Google Cloudの公式統合を待たずに、Hugging Faceから直接モデルを取得して自前デプロイする経路もあります。この方式ならTimesFM-3の最新チェックポイントをすぐに試せるため、学術研究・教育目的・公開ベンチマーク再現などの非商用利用で選択肢になります。
デプロイ先の選択肢は以下のとおりです。
-
Hugging Face Inference Endpoints
HFのマネージド推論エンドポイント。TimesFM-3はInference Providerに未対応のため、カスタムコンテナを準備して独自にエンドポイントを構成する必要がある
-
AWS SageMaker / Google Cloud Vertex AI Custom Container
Docker化してマネージド推論として運用
-
自社Kubernetes / GPUインスタンス
オンプレ・IaaS環境での自前運用。最も柔軟だが運用工数が最大
非商用ライセンスは本番SaaSへの組み込みや商用サービスとしての提供を許諾しないため、いずれの経路でも同じ制約が及びます。「Hugging Faceから取ってきて自前デプロイすれば本番運用できる」わけではない点に注意が必要です。Hugging Faceとは?モデル一覧や使い方・実用性まで徹底解説でHugging Faceの基本操作を整理しています。
TimesFM-3の導入判断で押さえたい3つの実務観点
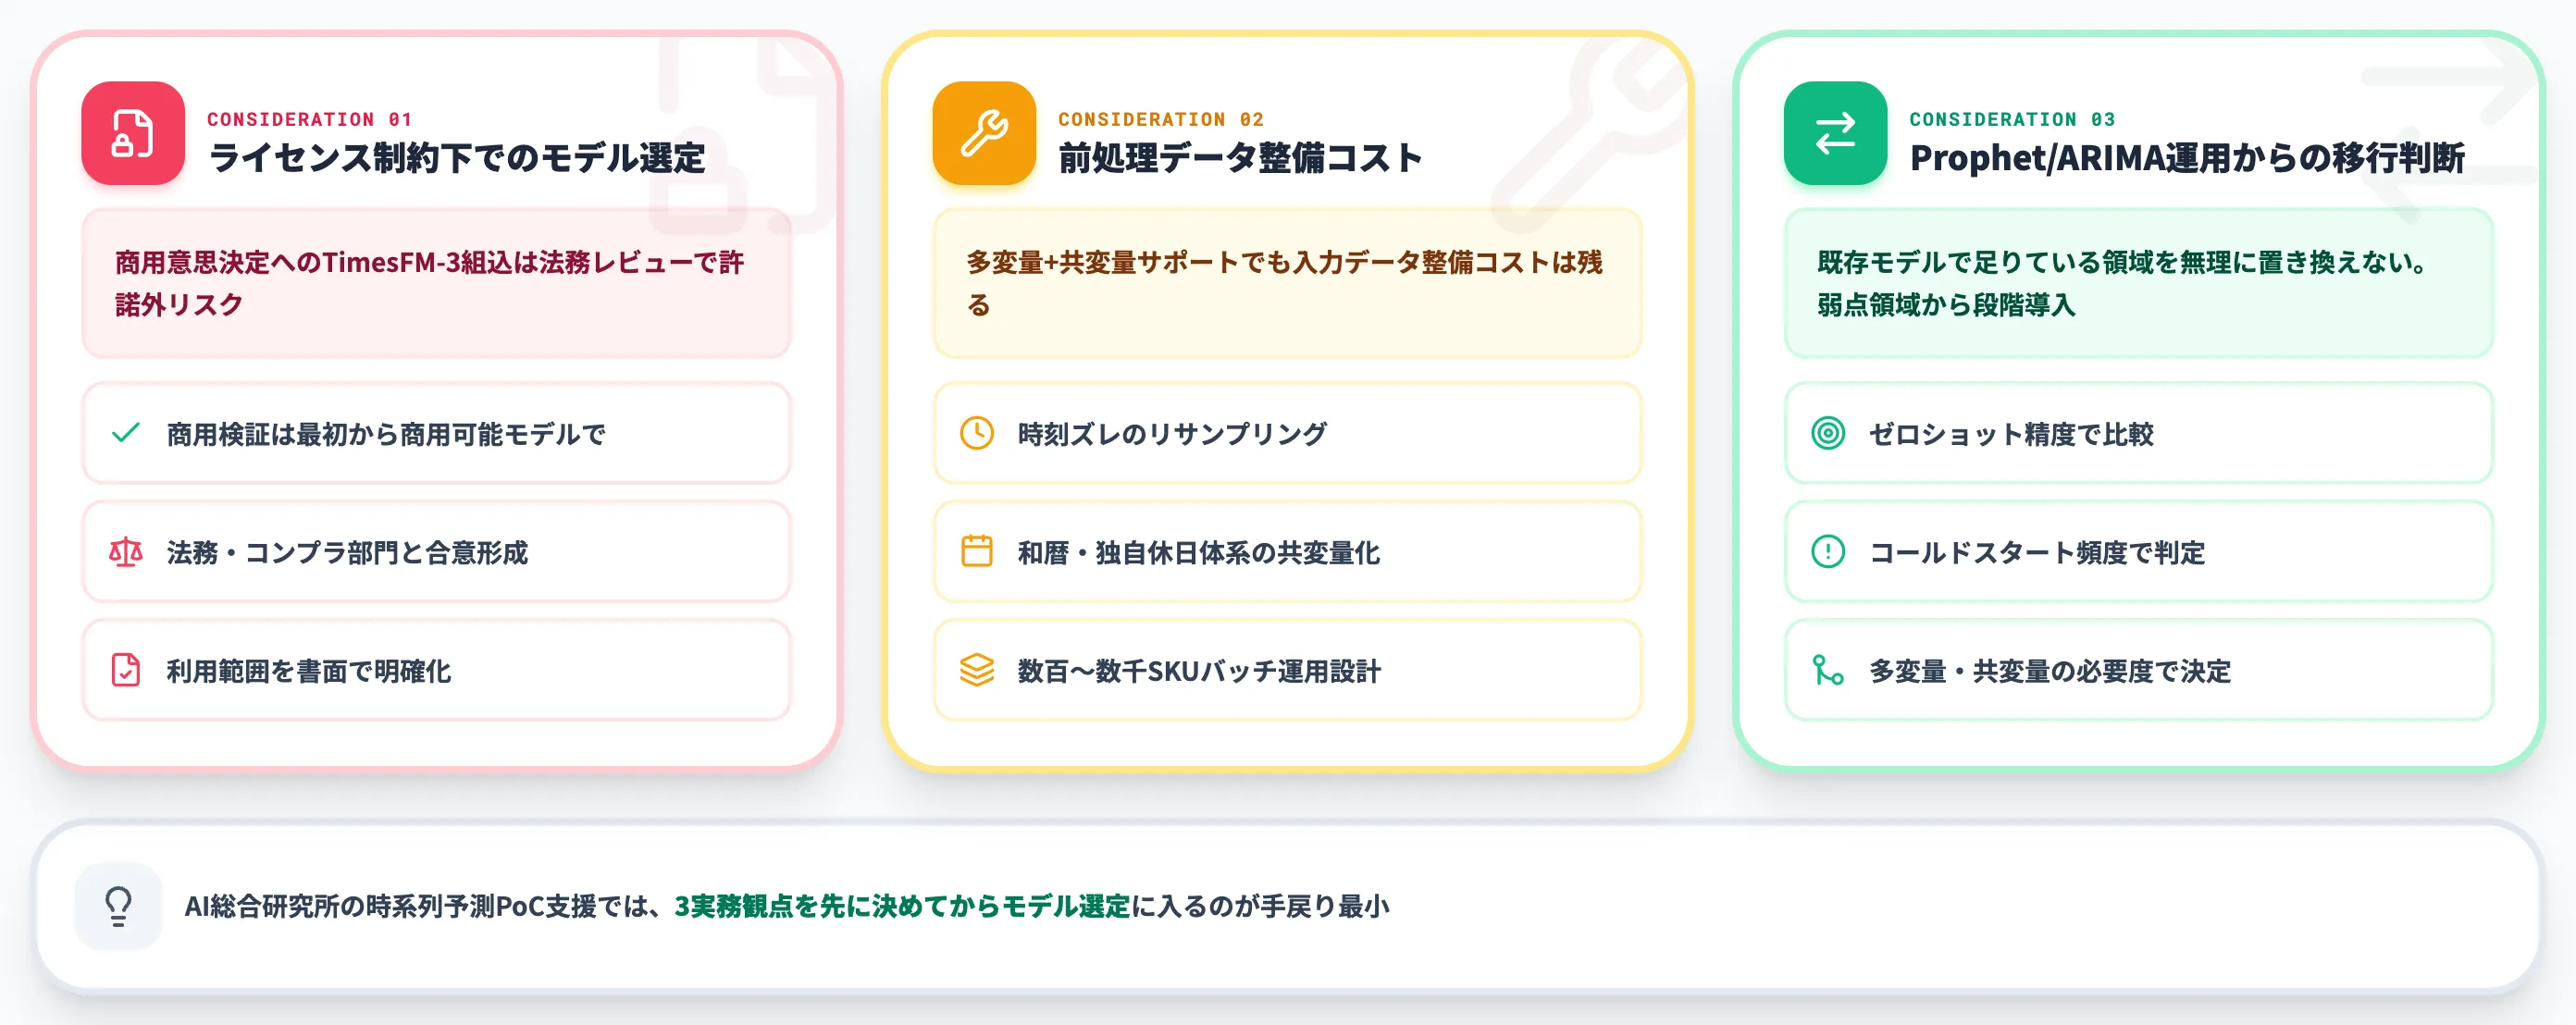
ここまでTimesFM-3の技術詳細・ライセンス・運用パスを整理してきましたが、実際に採用検討を進める際に迷いやすい論点があります。AI総合研究所の時系列予測PoC支援の現場で、導入判断のボトルネックになりやすい3つの実務観点を提示します。
ライセンス制約下でのモデル選定と本番運用の切り分け
TimesFM-3の非商用ライセンスは、モデル選定・本番運用の意思決定にTimesFM-3を組み込む用途を許諾しないと解釈するのが安全です。「PoCで最新モデルを検証してから本番モデルを決める」といった商用の意思決定を伴うプロセスにTimesFM-3を使うのは、法務レビューで許諾範囲外と判断されるリスクが高い運用になります。
具体的な選定フローとしては、商用検証(製品採用判断のためのベンチマーク・本番モデル選定)は最初からTimesFM 2.5・Chronos-2・Toto 2.0など商用可能なモデルだけで行い、TimesFM-3は学術研究・教育目的・公開ベンチマークの再現実験など、非商用の枠に確実に収まる用途に限定するのが安全な運用です。
「PoCなら大丈夫」「社内利用なら大丈夫」といった軽い判断でTimesFM-3を商用検証に組み込むと、後日のライセンス指摘に対して弁明が難しくなります。プロジェクト設計の段階で法務・コンプライアンス部門とライセンス解釈を合意しておき、TimesFM-3の利用範囲を書面で明確化しておくのが安全です。
多変量・共変量の前処理データ整備コスト
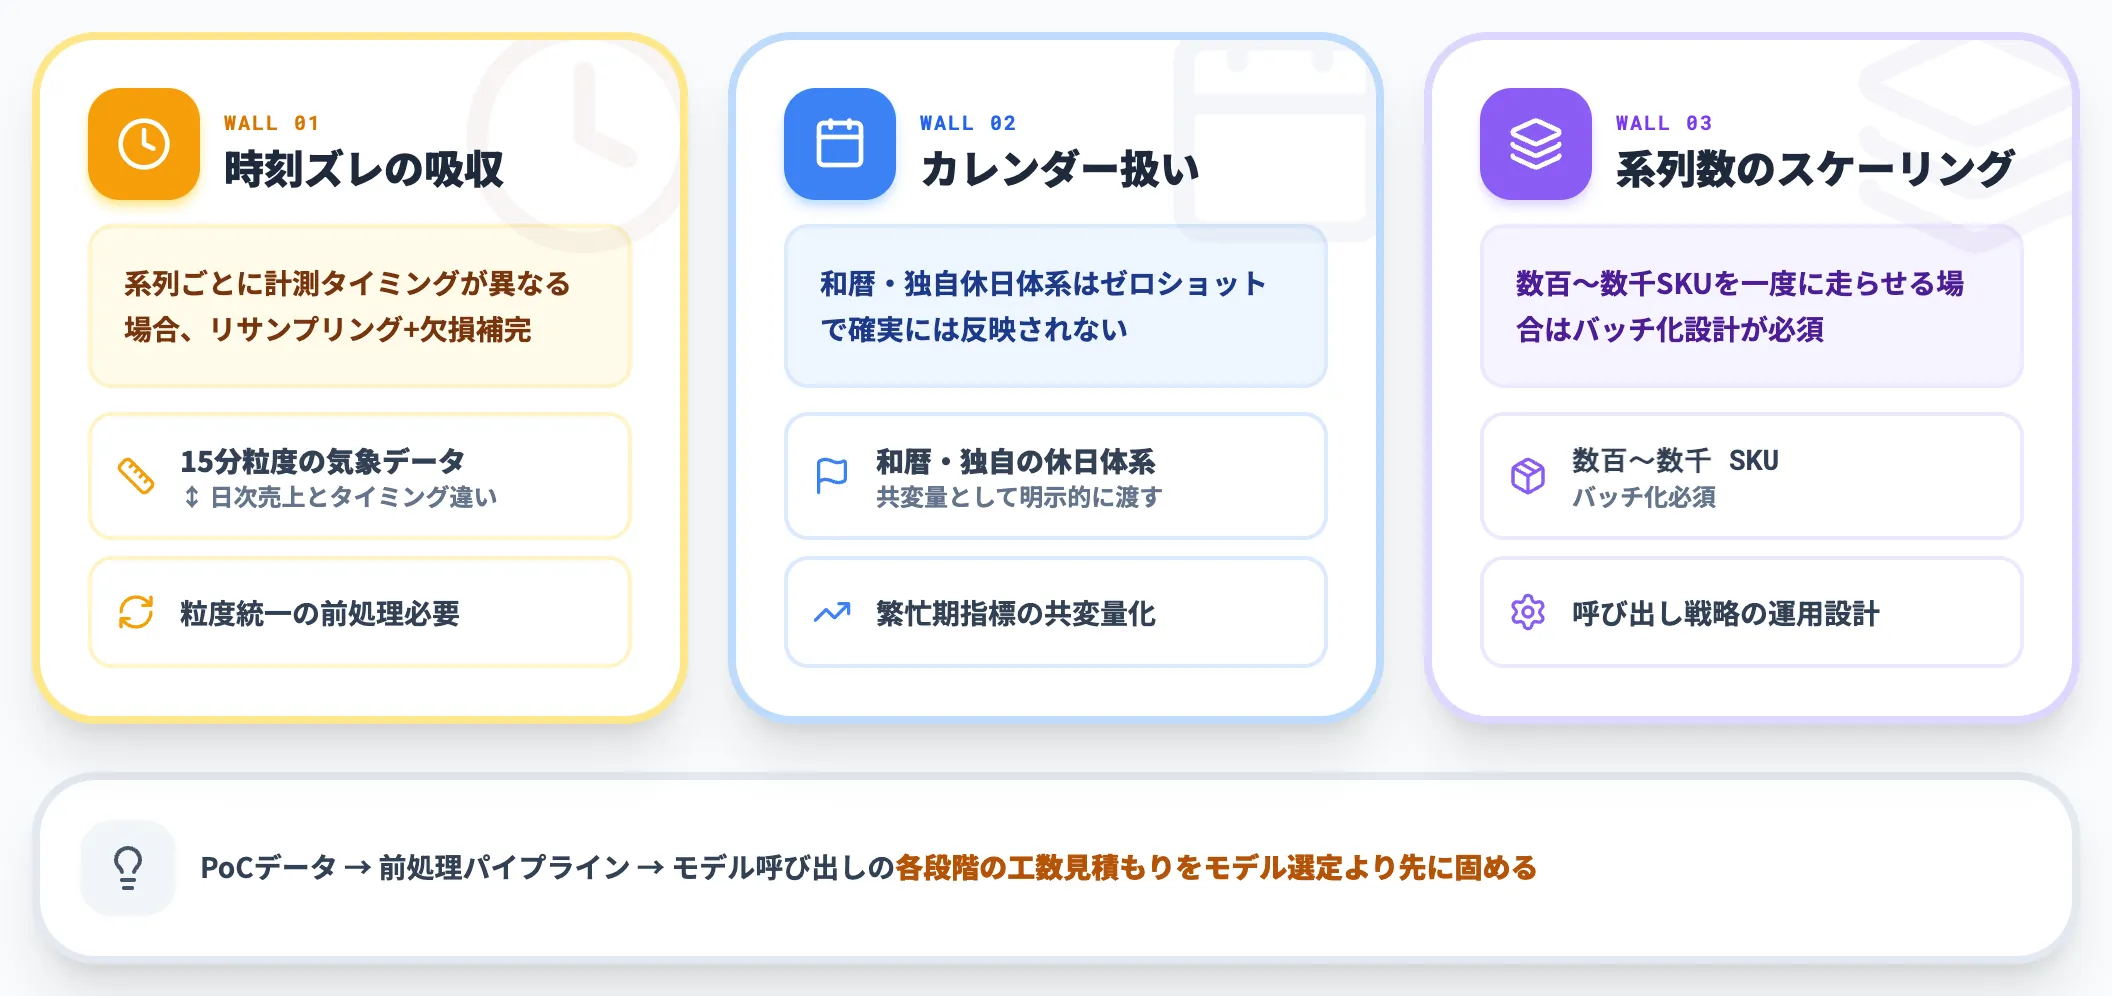
TimesFM-3が多変量+共変量をネイティブサポートするといっても、入力データを整えるコストはゼロになりません。特に日本の業務データでは以下の壁があります。
-
時刻ズレの吸収
複数系列で計測タイミングが異なる場合(15分ごとの気象データと日次の売上データなど)、モデル入力前にリサンプリングと欠損補完を揃える必要がある
-
カレンダー扱い
和暦・独自の休日体系・繁忙期指標などをどう共変量化するか。ゼロショットモデルは業務固有のカレンダー要因を確実に反映できないため、明示的な特徴量として渡す必要がある
-
系列数のスケーリング
数百〜数千SKUの需要予測を一度に走らせる場合、モデル呼び出しをバッチ化する運用設計が必要
これらの前処理はTimesFM-3特有の問題ではなく、時系列基盤モデル全般に共通しますが、多変量化で系列数が増えるほど負荷が上がる関係にあります。実務では「PoCデータ→前処理パイプライン→モデル呼び出し」の各段階の工数見積もりを、モデル選定より先に固めておくのが手戻りを避ける鍵になります。
既存のProphet/ARIMA運用からの移行判断軸
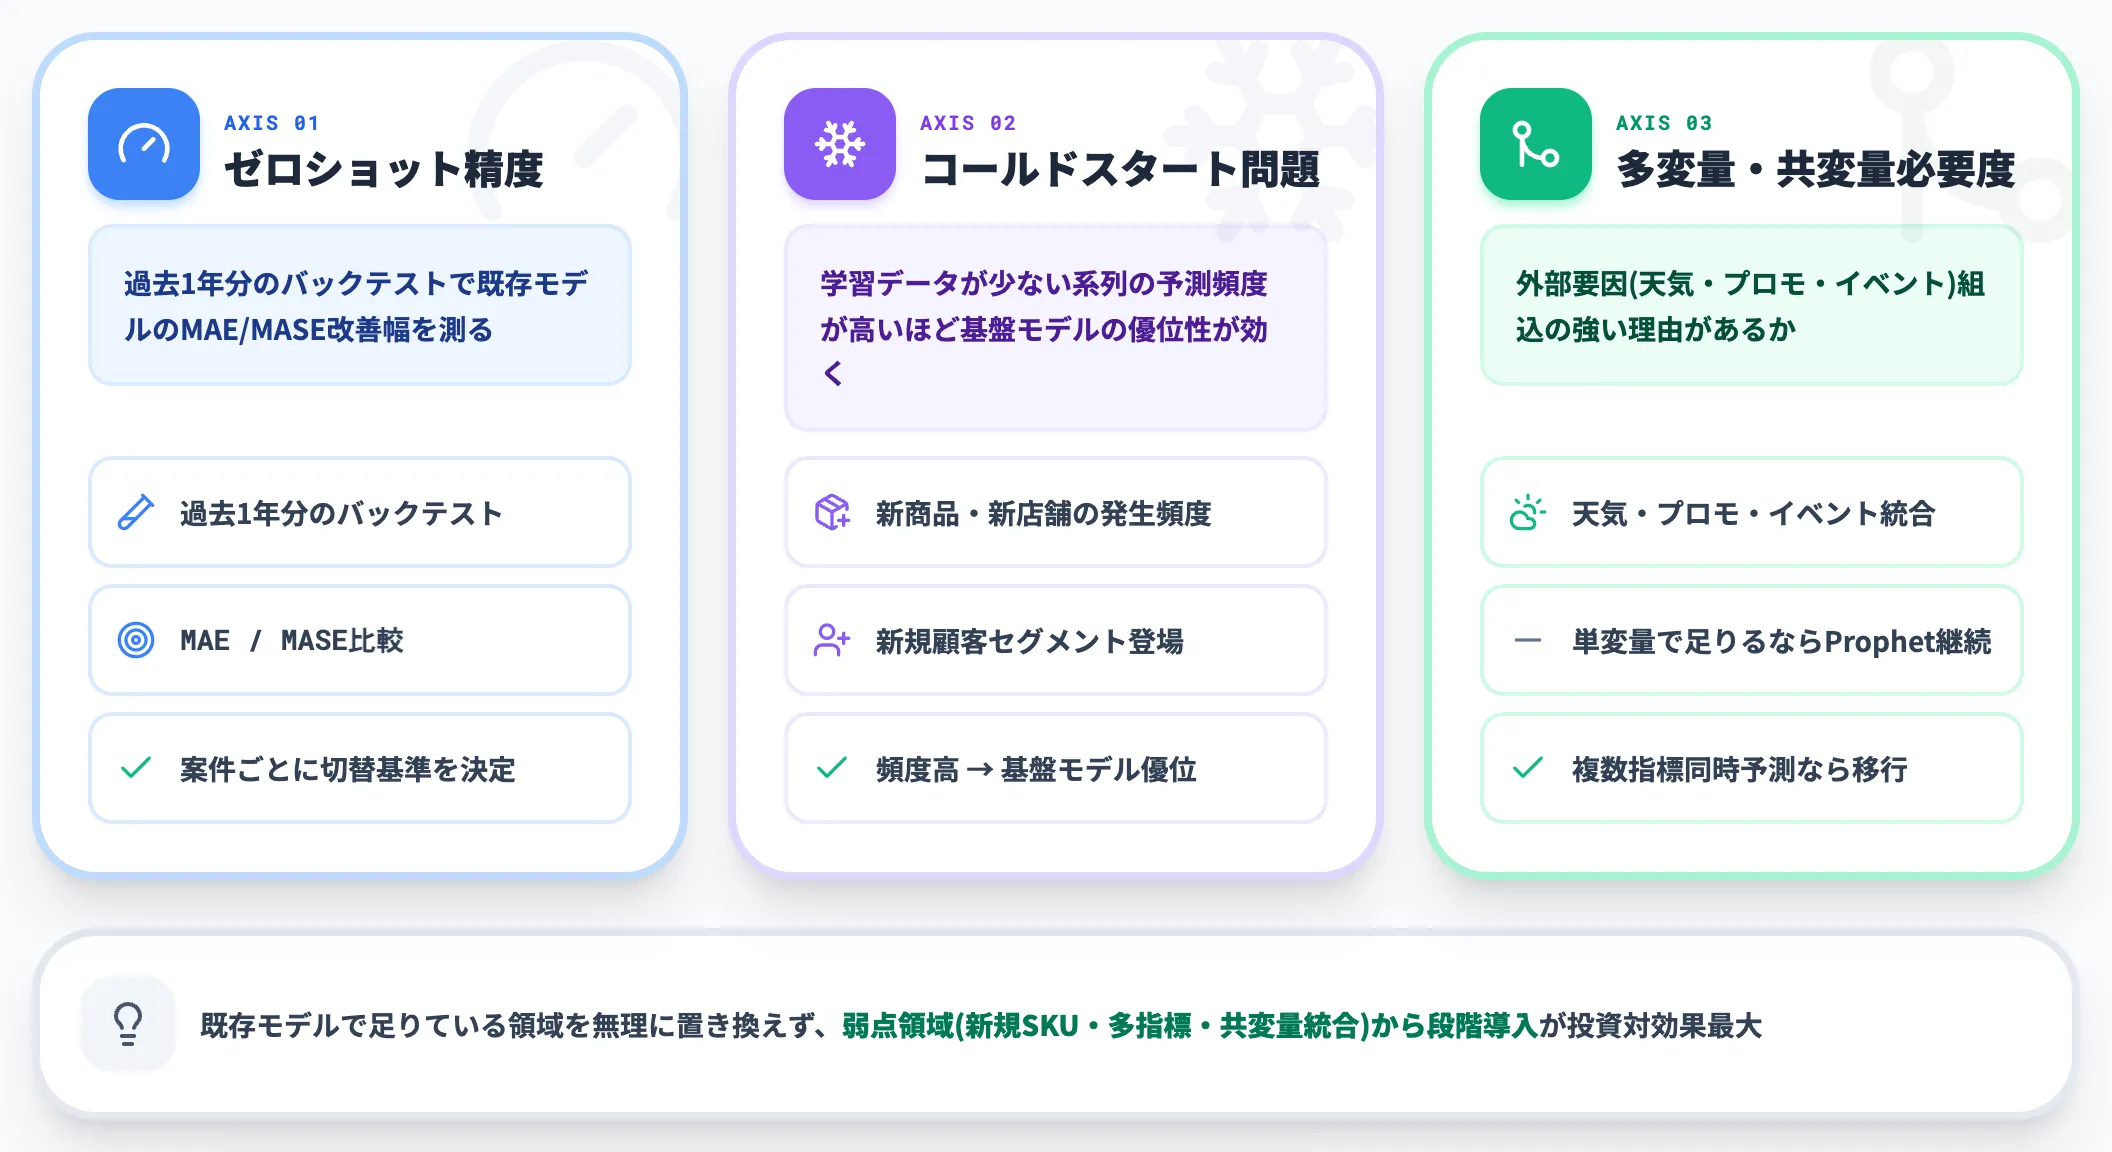
多くの企業ではすでにProphet・ARIMA・LSTMなどの既存時系列モデルで需要予測・KPI予測を運用しています。TimesFM 2.5または商用利用可能な競合モデル(Chronos-2/Toto 2.0)に切り替える判断は、以下の3つの観点で見るのが実務的です。
-
ゼロショット精度が既存モデルを上回るか
過去1年分のバックテストで、既存モデルのMAE/MASEをどの程度改善できるか。必要な改善幅は切替コスト・業務影響を踏まえて案件ごとに定める
-
コールドスタート問題の頻度
新商品・新店舗・新規顧客セグメントのように「学習データが少ない系列」の予測が業務上どれだけ発生するか。頻度が高いほど基盤モデルの優位性が効く
-
多変量・共変量の必要度
現状の予測に外部要因(天気・プロモ・イベント)を組み込みたい強い理由があるか。単変量で足りているならPython実装の時系列予測や既存Prophet運用の継続が合理的な場合も多い
実務観点で言えば、既存モデルで十分な精度が出ている領域を無理に置き換えるより、「新規SKU追加時のコールドスタート」「複数指標の同時予測」「共変量統合が必要な高度予測」といった既存モデルの弱点領域から段階的にTimesFM 2.5または商用利用可能な競合モデルを導入する方が投資対効果が出やすい傾向があります。
汎用的な需要予測AIの導入検討フローとも整合します。
時系列基盤モデル導入で詰まる論点を、実装事例から逆算して整理する
TimesFM-3世代の時系列基盤モデルを業務に組み込む現場では、公式ドキュメントだけでは決めきれない論点が並びます。
- TimesFM-3の非商用制約下でTimesFM 2.5・Chronos-2・Toto 2.0の中からどう商用モデルを選定するか
- 時刻ズレ吸収・和暦カレンダー・数百SKU規模の多変量共変量前処理をどう設計するか
- 既存Prophet/ARIMA運用からの移行をゼロショット改善幅・コールドスタート頻度・多変量必要度でどう判定するか
- BigQuery AI.FORECAST・Vertex AI Custom Container・SageMaker JumpStartのどの運用基盤で本番投入し在庫発注や仕入れ判断につなげるか
モデル選定・多変量前処理・運用基盤選定・業務Agent接続まで含めて時系列予測業務組み込みの実装可能性を棚卸ししたいなら、単体機能の解説記事ではなく、実装事例と組み合わせて話せる相手と一度整理するのが早道です。
AI Agent Hubは、時系列予測モデルを業務Agent単位で統合管理し在庫最適化・アノマリー検知まで意思決定フローに接続するエンタープライズAI基盤で、モデル選定・多変量前処理・運用基盤選定・業務Agent接続のいずれの入口からでも、実装から逆算した論点整理をご相談いただけます。
時系列基盤モデル導入の論点を実装から逆算

モデル選定・前処理・運用基盤・業務Agent接続
TimesFM-3世代の時系列予測導入は、非商用制約下でのモデル選定・多変量共変量の前処理設計・BigQuery/Vertex AI/SageMakerの運用基盤選定・在庫発注や仕入れ判断への業務Agent接続が絡み合います。AI Agent Hubのサービスページで、多変量予測を業務プロセスに載せる実装例をご確認ください。
まとめ
本記事では、TimesFM-3について、TimesFM 2.5からの変化点・アーキテクチャ・ベンチマーク結果・Python実装・非商用ライセンスと商用代替・Chronos-2/Toto 2.0との比較・BigQuery/Vertex AIでの運用パスまでを、2026年9月時点の最新情報で解説しました。
2026年時点で押さえておくべきポイントは次の3つです。
- 多変量ネイティブ対応と非自己回帰デコードを両立した第3世代モデル、GIFT-Eval・FEV-Bench・TIMEの3ベンチマークで単独首位を獲得
- モデル重みは非商用ライセンスに転換したため、本番運用はApache-2.0のTimesFM 2.5・Chronos-2・Toto 2.0のいずれかが実務的な代替パス
- BigQuery AI.FORECASTは現行2.0/2.5対応で3.0対応は数週間内と公式公表、業務利用時はライセンス条件を必ず法務レビューにかける
TimesFM-3の登場は「多変量・共変量を1モデルで扱う」という時系列基盤モデルの新しい標準が確立された節目です。商用検証・本番モデル選定はTimesFM 2.5・Chronos-2・Toto 2.0など商用可能なモデルで進めつつ、TimesFM-3のBigQuery組み込み・商用ライセンス提供といった公式アップデートを追いかけて、条件が整った段階で採用を再検討するのが現実的な進め方です。