この記事のポイント
 Decisions APIは「有限の選択肢から1つ選ぶ」ことに特化した新API。長文生成を捨てて公称約150msの高速判断に振り切った設計
- プロンプト+JSON Schema+後処理で自作しdeていた分類・ルーティング実装を、有限回答空間を制約する専用APIに置き換えられる可能性がある
- Structured Outputsが「生成する文字列の形」を制約するのに対し、Decisions APIは「モデルが選べる回答空間」そのものを一段手前で制約する
- Agents APIとの併用は本記事の独自アーキ案として整理(公式推奨構成ではなく、System 1系×System 2系の分担例)
- 限定プレビュー段階で料金は未公開。GPT-6 Luna単体は標準処理の基本単価が入力$0.10/出力$0.50(100万トークンあたり)、広範提供・正式仕様の開示時点で確定単価と対象条件を再確認する必要
Microsoft MVP・AIパートナー。LinkX Japan株式会社 代表取締役。東京工業大学大学院にて自然言語処理・金融工学を研究。NHK放送技術研究所でAI・ブロックチェーンの研究開発に従事し、国際学会・ジャーナルでの発表多数。経営情報学会 優秀賞受賞。シンガポールでWeb3企業を創業後、現在は企業向けAI導入・DX推進を支援。
OpenAI Decisions APIは、OpenAI DevDay 2026で発表された、GPT-6 Lunaの特化版で有限の選択肢から1つを公称約150msで返す新APIです。
従来はプロンプト+JSON Schema+後処理で自作していた分類・ルーティング実装が、有限選択肢からの判断に特化した単一エンドポイントとして提供される方向性が示されました(フィールド名・レスポンス形状等の詳細仕様は正式公開待ち)。
本記事では、Decisions APIの定義から、Structured Outputs/Function Callingとの違い、4ステップの実装イメージ、主要ユースケース、Jev(TypeSafe社)との比較、Agents APIとの併用設計案、料金体系、既存の自作Classifierからの移行判断までを2026年9月時点で解説します。
目次
Decisions APIとは?GPT-6 Lunaを有限選択肢の高速判断に特化させた新API
Decisions APIとAPI・Structured Outputs・Function Callingの違い
Decisions APIの4ステップワークフローとコード例
Decisions APIとJev(TypeSafe)の比較—
Decisions APIとAgents APIを組み合わせる独自アーキテクチャ案
Decisions API導入で詰まる論点——実装事例から逆算した判断軸
Decisions APIとは?GPT-6 Lunaを有限選択肢の高速判断に特化させた新API
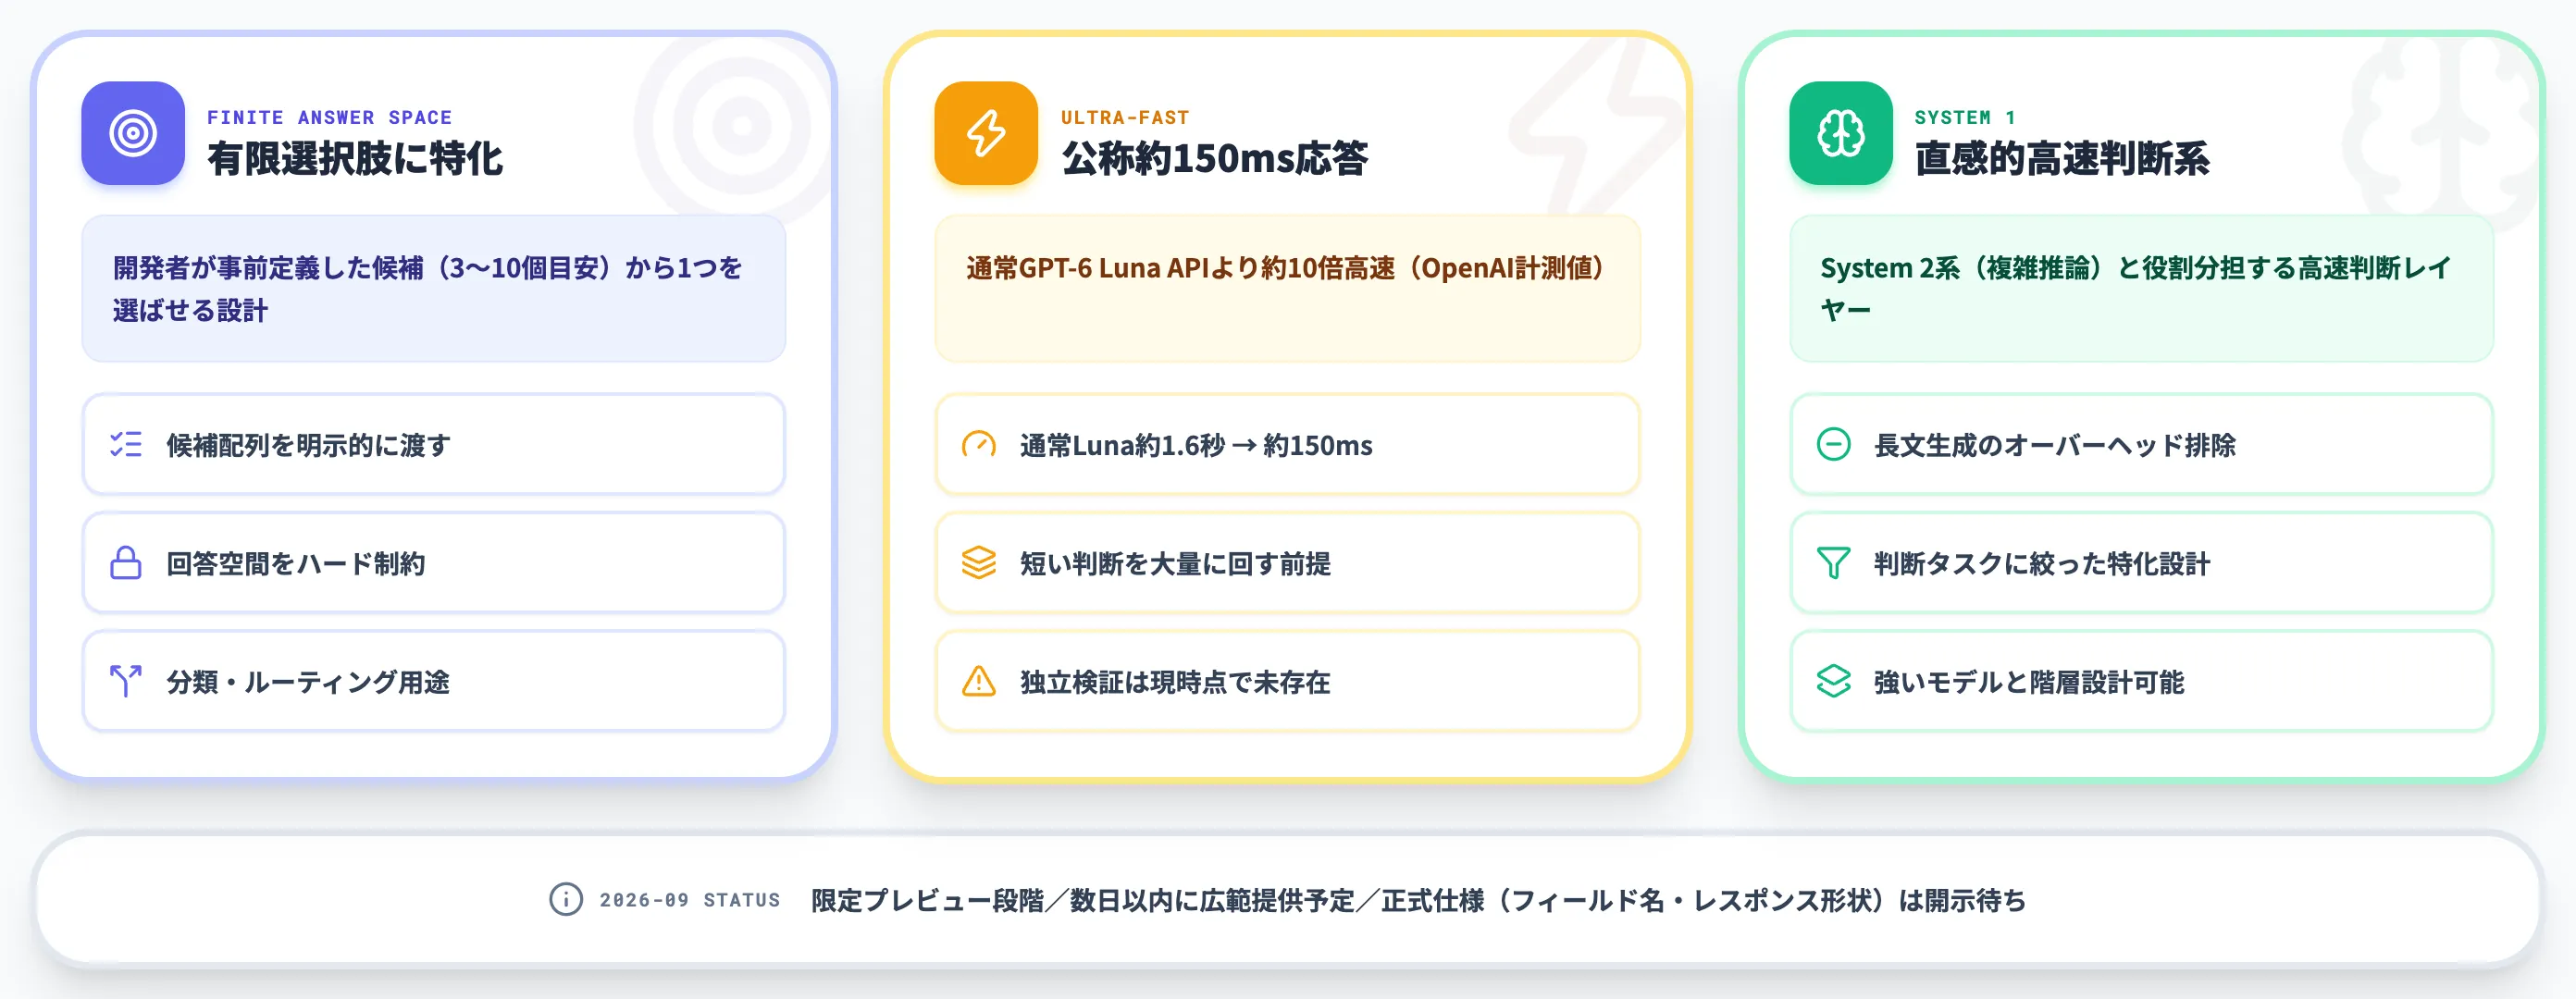
OpenAI Decisions APIは、GPT-6 Lunaの特化版を用いて事前定義した有限の選択肢から1つを高速で返すことに絞ったAPIです。
通常のチャットAPIが自由文の応答を返すのに対し、Decisions APIは開発者が定義した回答空間(例:refund_review/technical_support/account_security)からLunaに1つを選ばせ、選択結果を返します(二次情報では信頼度スコアが併記されるとされていますが、公式仕様は未公表です)。
OpenAIの計測では、通常のGPT-6 Luna APIより約10倍高速で、1コール150ms程度で応答が返ることが公表されています。
分類、ルーティング、エージェントの次アクション選択のように「短い判断を大量に回す」ワークロード向けに設計された、いわゆるSystem 1系(直感的高速判断系)のAPIです。
Decisions APIの発表キービジュアル。副題「Take action in near real-time」がリアルタイム性を訴求している(出典:OpenAI DevDay 2026 Recap)
Decisions APIが引き受ける判断の性格
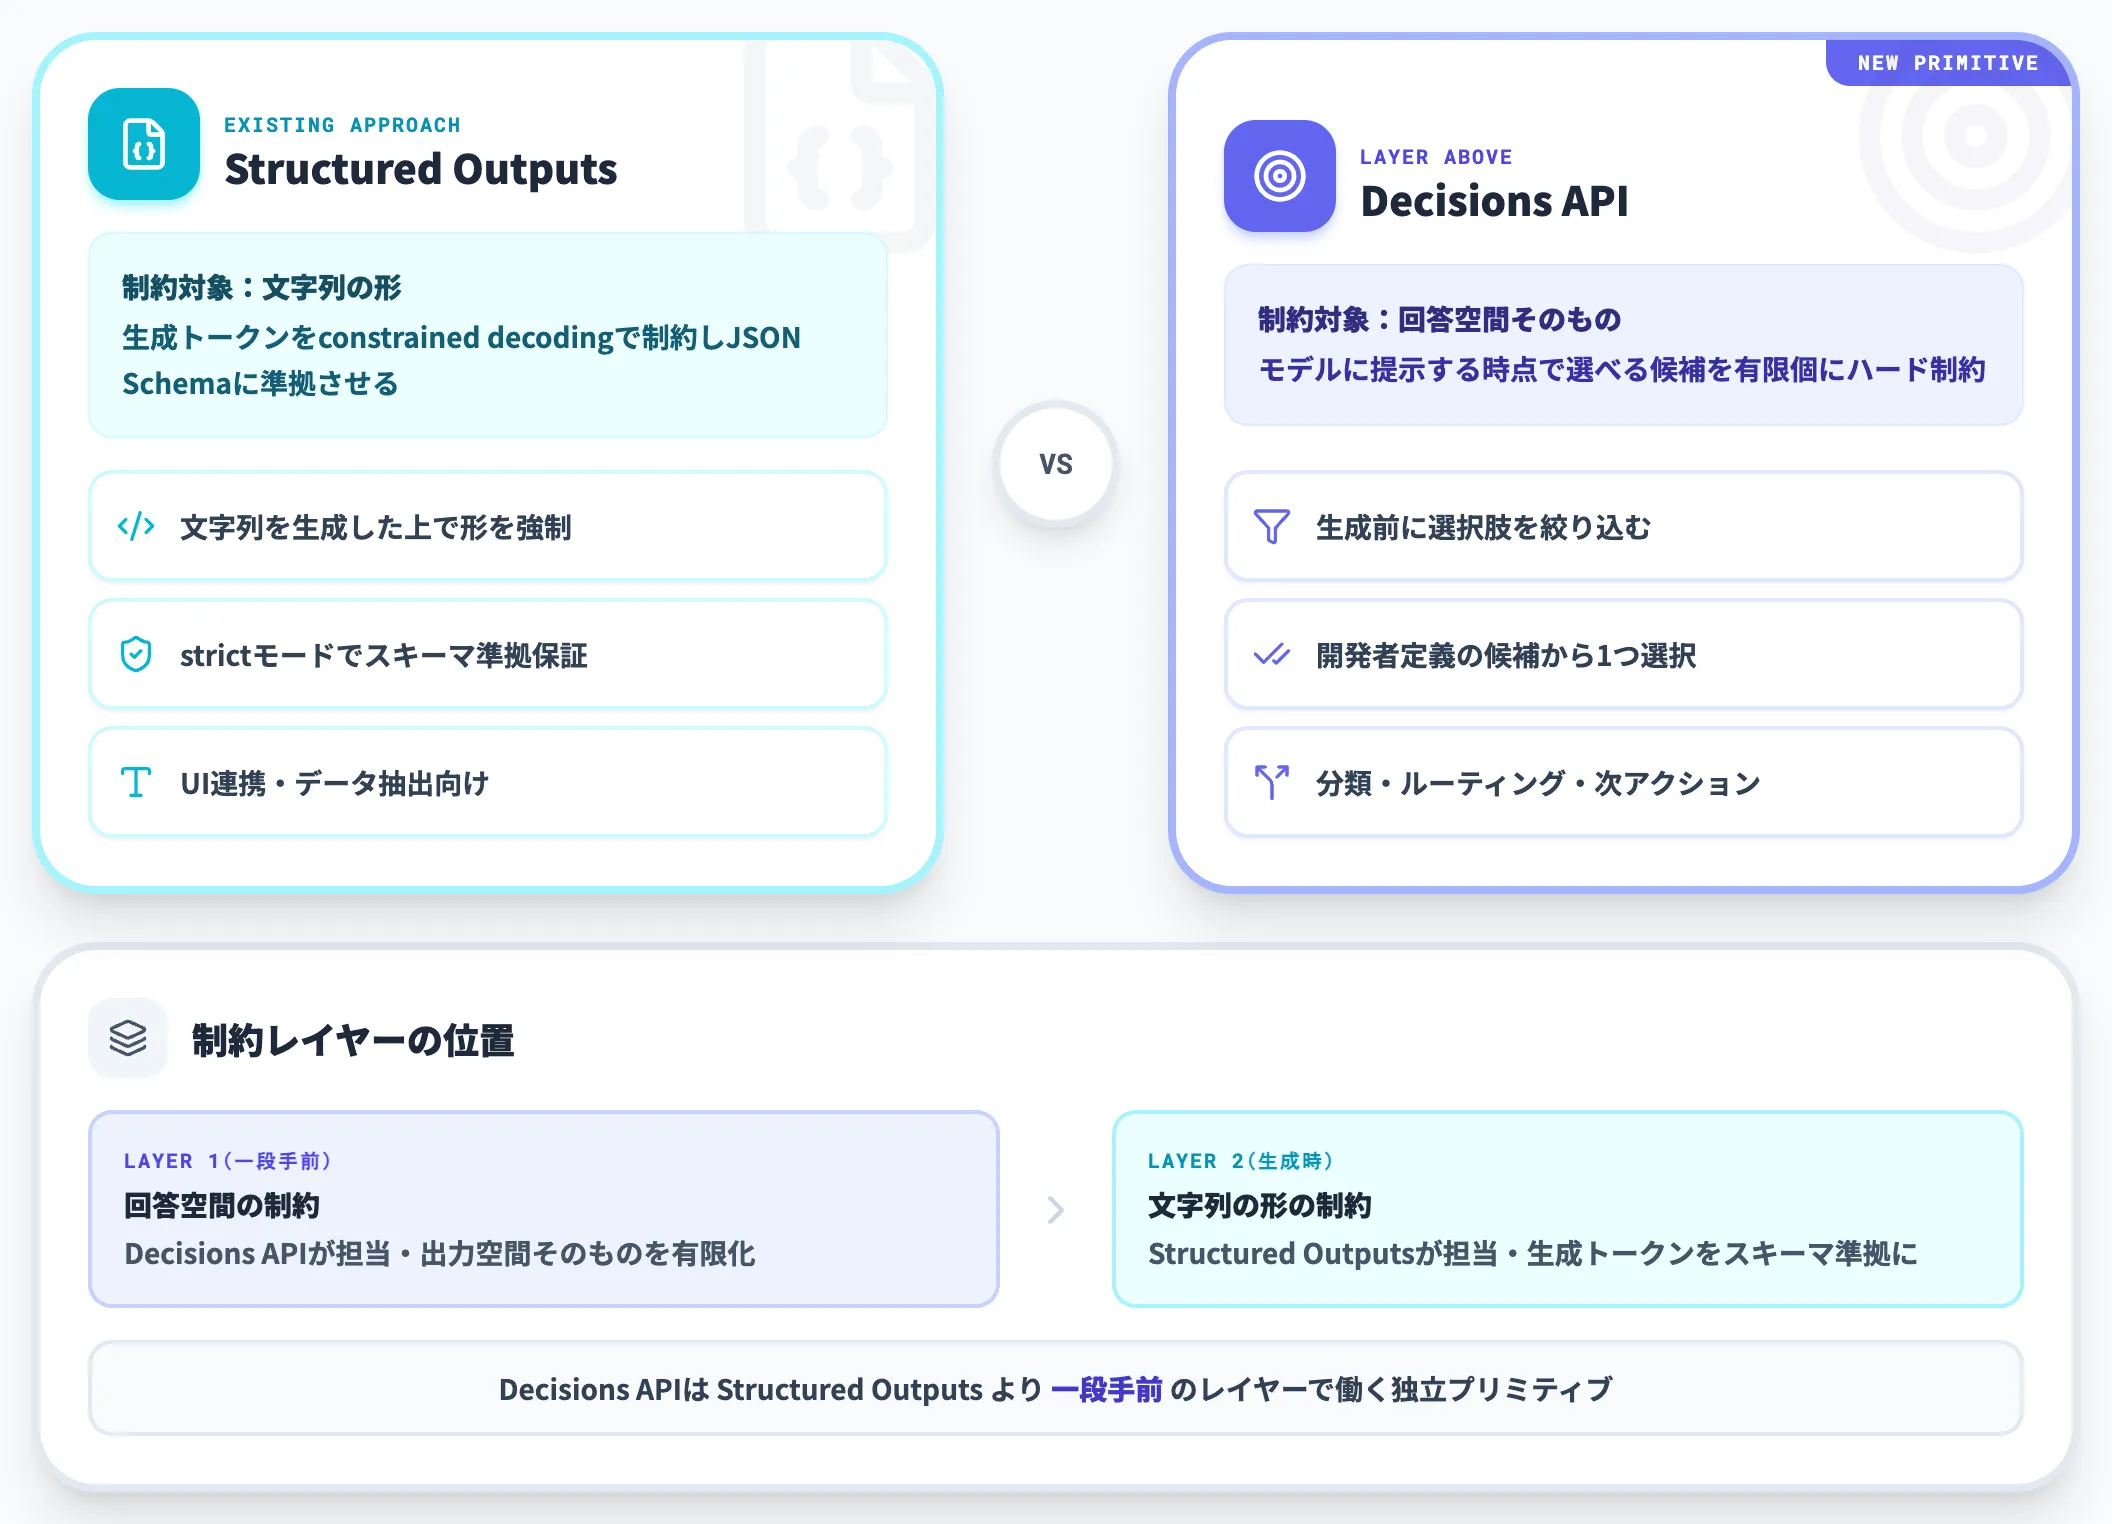
Decisions APIが従来のLLM APIと決定的に違うのは、出力空間そのものを開発者が事前に絞り込む点にあります。
通常のチャットAPIは自由文を生成し、Structured Outputsは生成時にトークンを制約するconstrained decodingでJSONスキーマに従った文字列を組み立てます。対してDecisions APIは、モデルに提示する時点で選択肢そのものを有限個の候補にハード制約した上で1つを選ばせる設計です。
生成される文字列自体を制約するStructured Outputsに対し、Decisions APIは制約する対象が「文字列の形」ではなく「モデルが選べる回答空間」そのものである点が違います。返ってくるのは「開発者が定義した候補のいずれか」で、二次情報の実装ガイドではこれに信頼度スコアが併記される想定が示されています(信頼度スコアの公式仕様・算出方法・意味論は未公表)。
Structured Outputsが「生成する文字列の形状」を制約するのに対し、Decisions APIは「選択できる回答空間」を一段階手前で制約する構造だと整理できます。
Decisions APIとAPI・Structured Outputs・Function Callingの違い
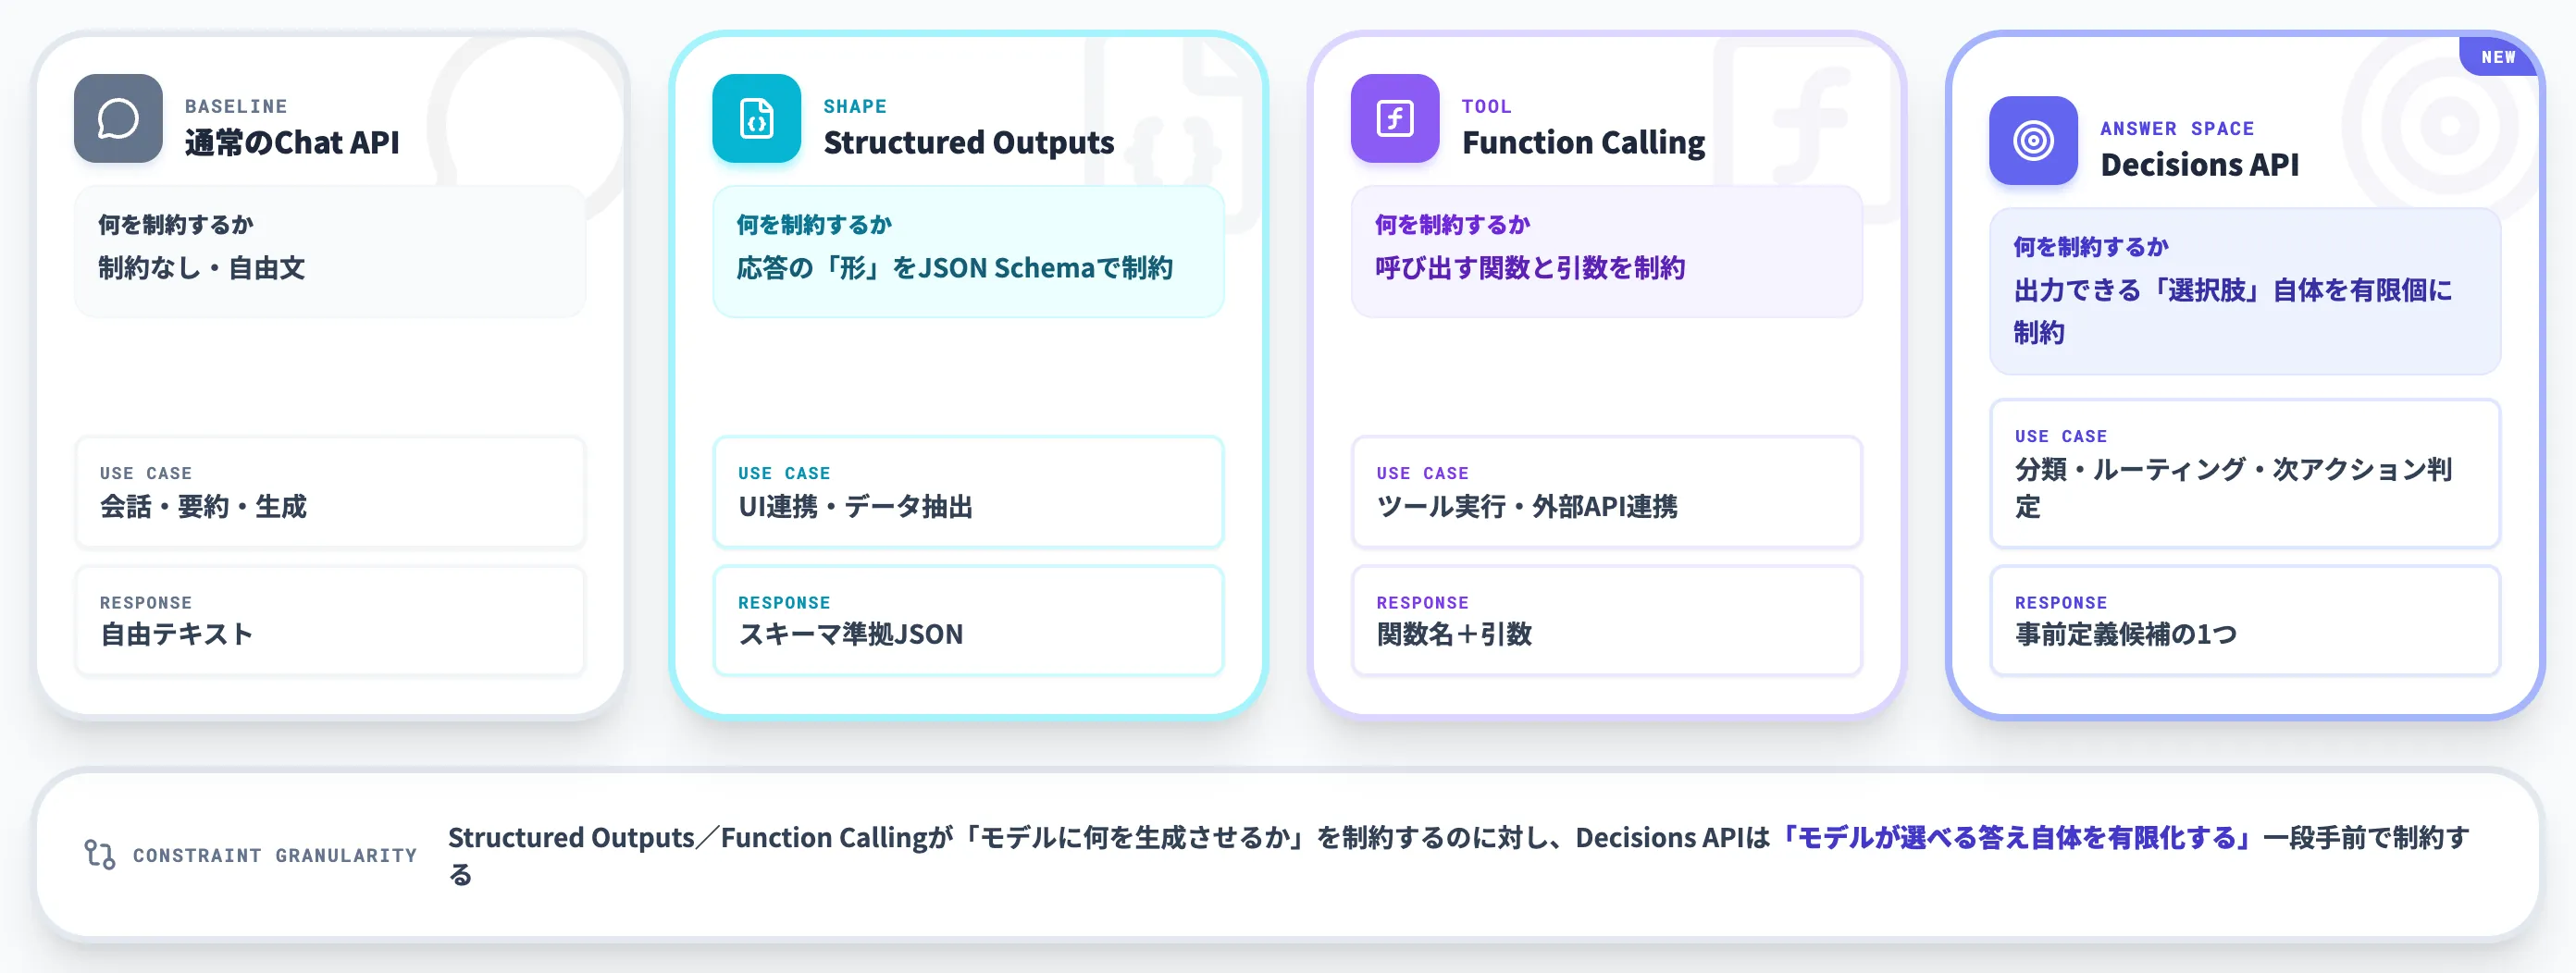
Decisions APIを検討する前に、本記事で比較する既存3つの仕組み(通常のChat API/Structured Outputs/Function Calling)との位置関係を整理しておくと、採用判断がはるかに明確になります(「4つのプリミティブ」はOpenAI公式の分類ではなく、本記事の編集上の整理です)。
「なぜ既存のStructured Outputsで組んでいた分類実装を、わざわざDecisions APIに置き換える必要があるのか」という論点は、この4つの設計思想の違いを押さえないと決めきれません。
本記事で比較する4つの仕組みの担当領域
以下の表で、本記事が比較対象とする4つの仕組みがそれぞれ何を制約するかを整理しました(OpenAI公式の分類ではなく、本記事の編集上の整理です)。
| 仕組み | 何を制約するか | 典型的な用途 | 応答形式 |
|---|---|---|---|
| 通常のChat API | 制約なし(自由文) | 会話・要約・生成 | 自由テキスト |
| Structured Outputs | 応答の「形」を JSON Schema で制約 | UI連携・データ抽出 | 定義スキーマに従うJSON |
| Function Calling | 呼び出す関数と引数を制約 | ツール実行・外部API連携 | 関数名+引数 |
| Decisions API | 出力できる「選択肢」自体を有限個に制約 | 分類・ルーティング・次アクション判定 | 事前定義候補の1つ(二次情報では信頼度スコア併記の想定・公式仕様未公表) |
この表から読み取れるのは、Structured OutputsとFunction Callingが「モデルに何を生成させるか」を制約するのに対し、Decisions APIは「モデルが選べる答え自体を有限化する」という一段階手前で制約する点です。
Structured Outputsでbilling/technical/abuseのようなenum型で応答形式を強制した経験がある開発者は、「それはDecisions APIと同じでは?」と感じるかもしれません。実際、機能面では近い部分もあります。
Decisions APIがStructured Outputsに対して優位性を持ちうる観点は以下の3点です。
-
応答速度の一桁改善
分類タスクに特化した低レイテンシ設計により、通常Lunaの1.6秒に対し約150msに短縮
-
信頼度スコアの併記(二次情報ベース)
Hugging Face実装ガイドの想定インターフェース例では、選択結果に加えて信頼度スコアが返るとされている。閾値を切って人間レビューに回すフォールバック設計に使える可能性がある(公式仕様は未公表)
-
画像コンテキストの入力対応
公式Recapでは、テキストに加えて画像も文脈として渡せる仕様が示されている(例:スクリーンショットのUI状態判定)
逆に、応答が長文である必要がある、ツール呼び出しが必要、動的に選択肢が変わるケースでは、Structured OutputsやFunction Callingの方が引き続き適切です。
制約する対象の違い——「文字列の形」と「回答空間」
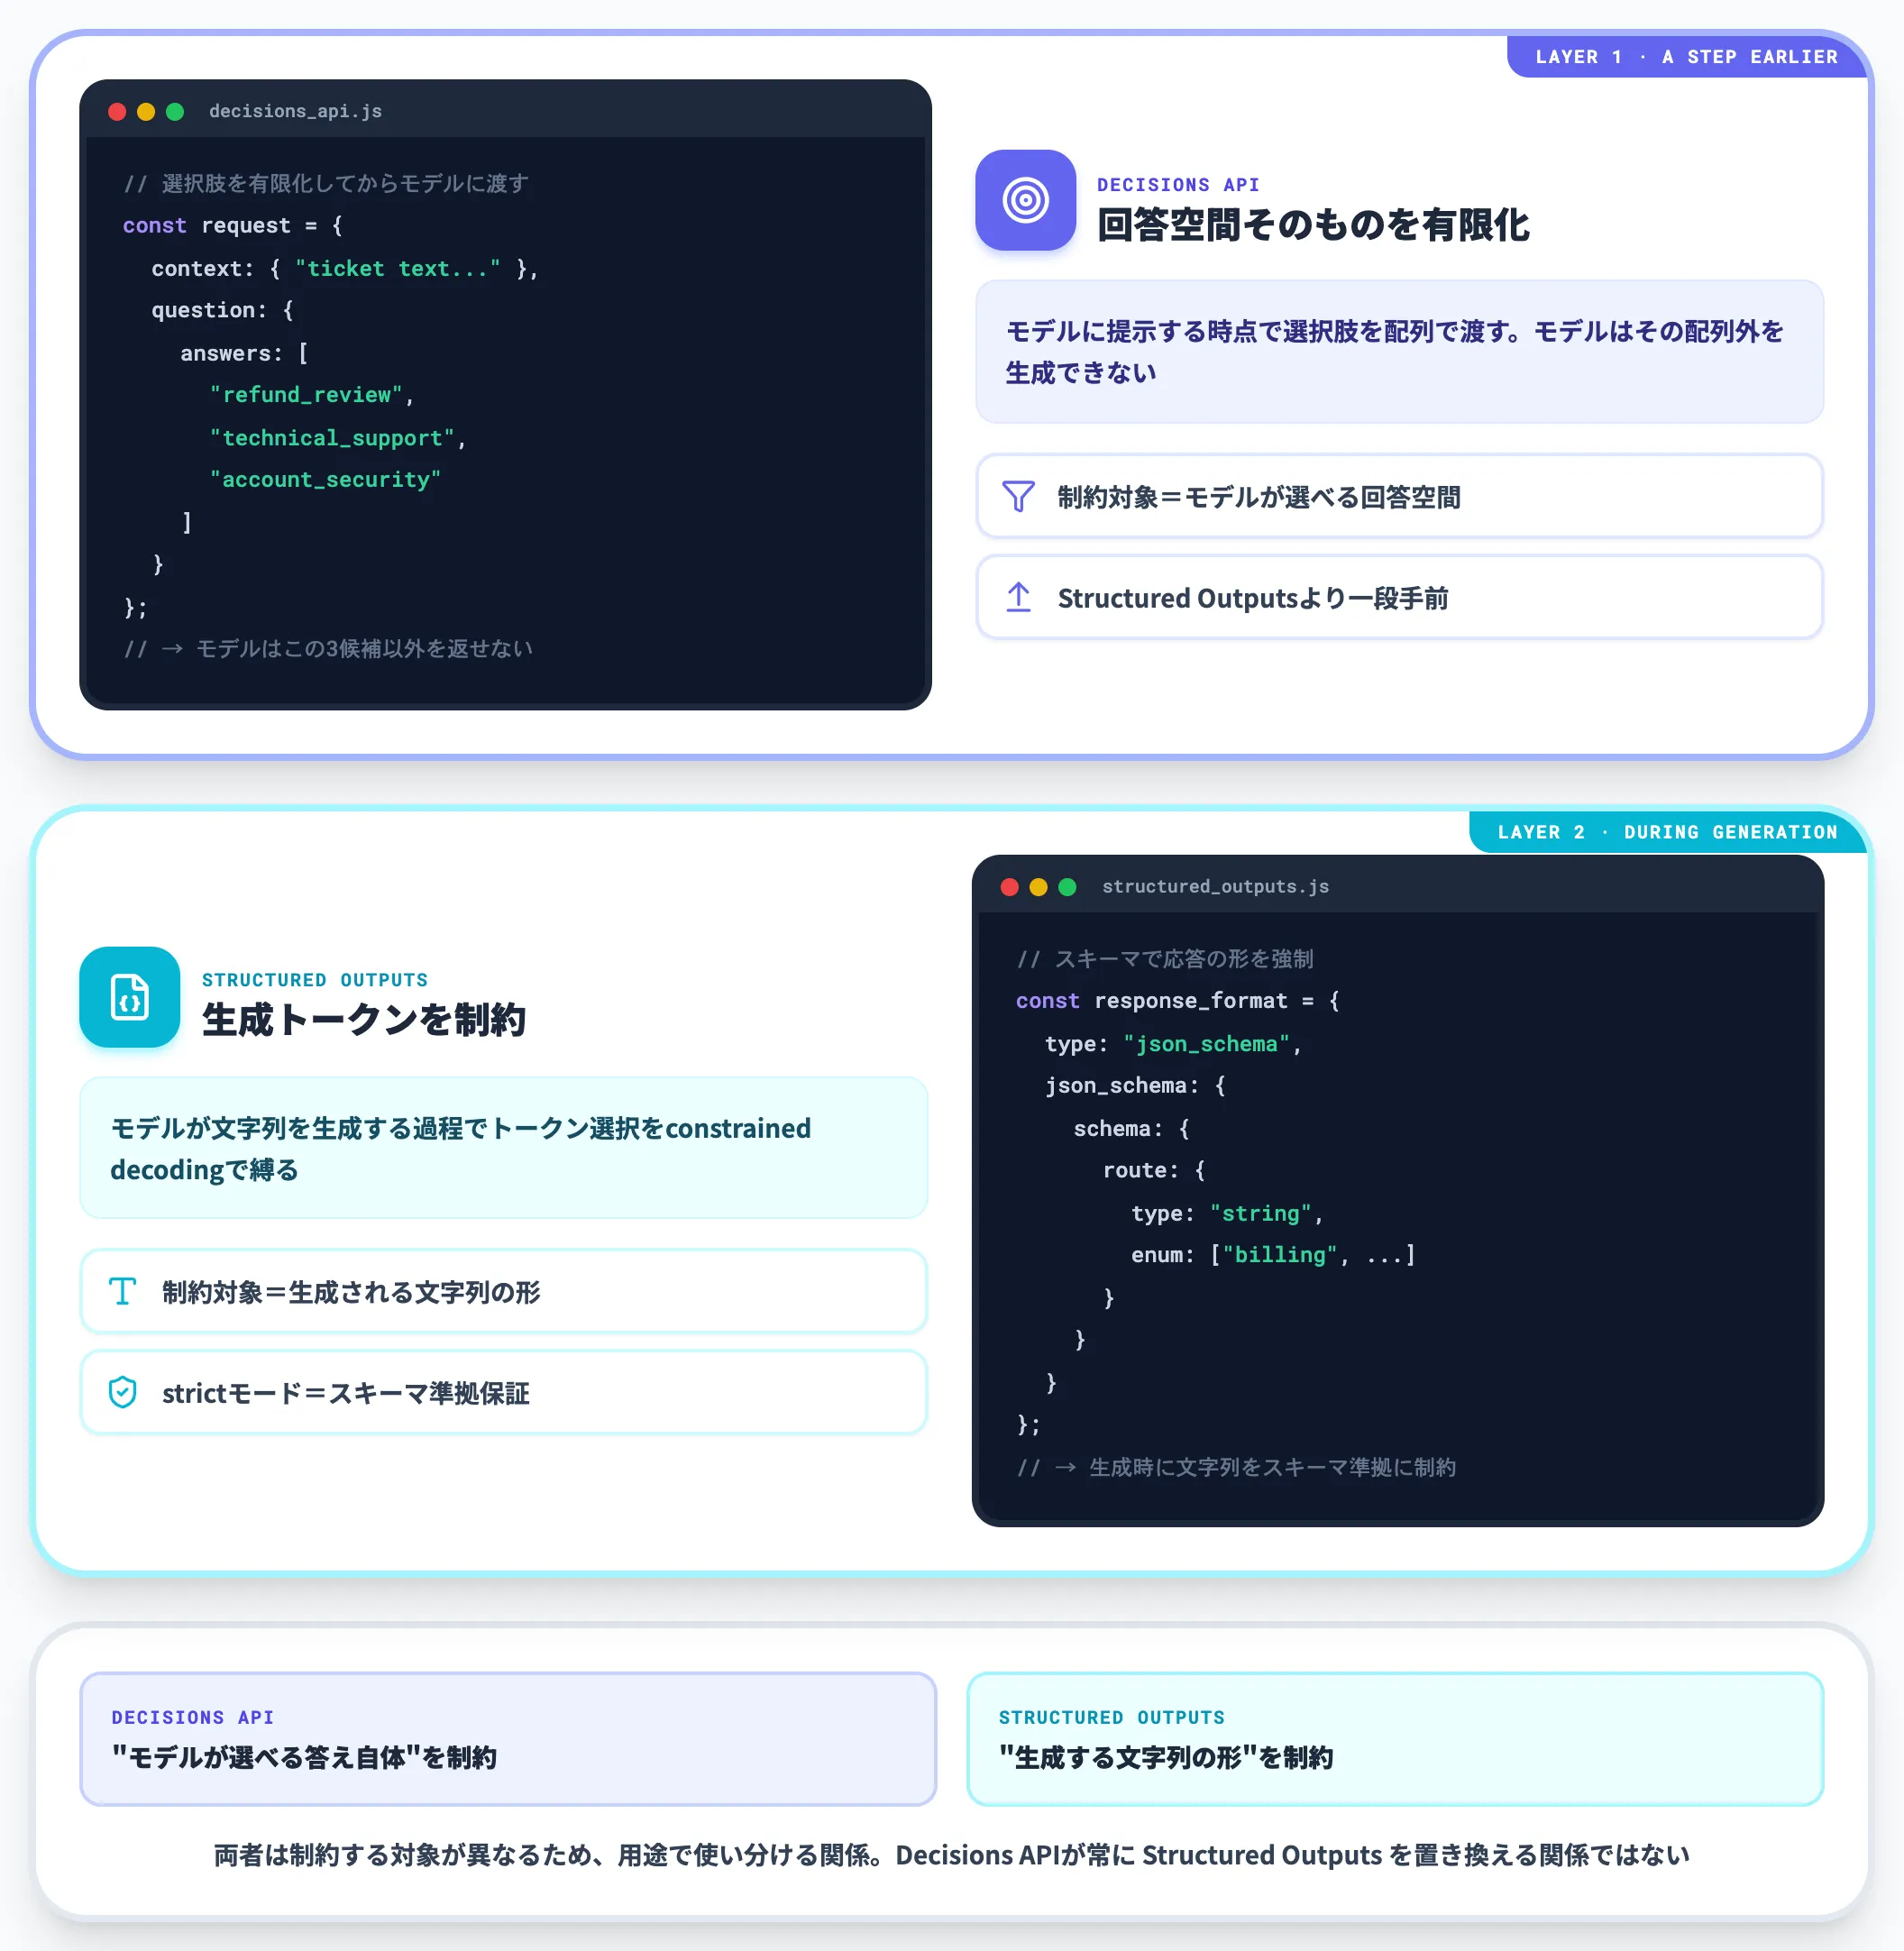
Decisions APIをJSON modeやStructured Outputsの延長として扱うと、設計上の本質を取り違えます。両者は制約する対象が異なるという点で整理すると理解しやすくなります。
Structured Outputsは、モデルに文字列を生成させた上で、生成時のトークン選択をconstrained decodingで制約し、JSONスキーマに準拠した文字列を返します。strictモード利用時はスキーマ準拠が保証されるため、壊れたJSONやenum外の値が通常フローで返ってくることは基本的にありません(拒否・出力打ち切り等は別途考慮が必要)。
Decisions APIは、モデルに提示する時点で選択肢を有限個に絞り、その中から1つを選ばせる設計です。制約されるのは「モデルが生成する文字列」ではなく「モデルが選べる回答空間そのもの」で、レイヤーが一段手前になります。
実務上、この差は用途で使い分けるべき対象であり、Decisions APIが常にStructured Outputsを置き換える関係ではありません。分類・ルーティング・次アクション選択のように「有限の選択肢から1つを高速に選ぶ」タスクに絞り込まれた設計の一次API化、というのがDecisions APIの立ち位置です。
Decisions APIの4ステップワークフローとコード例
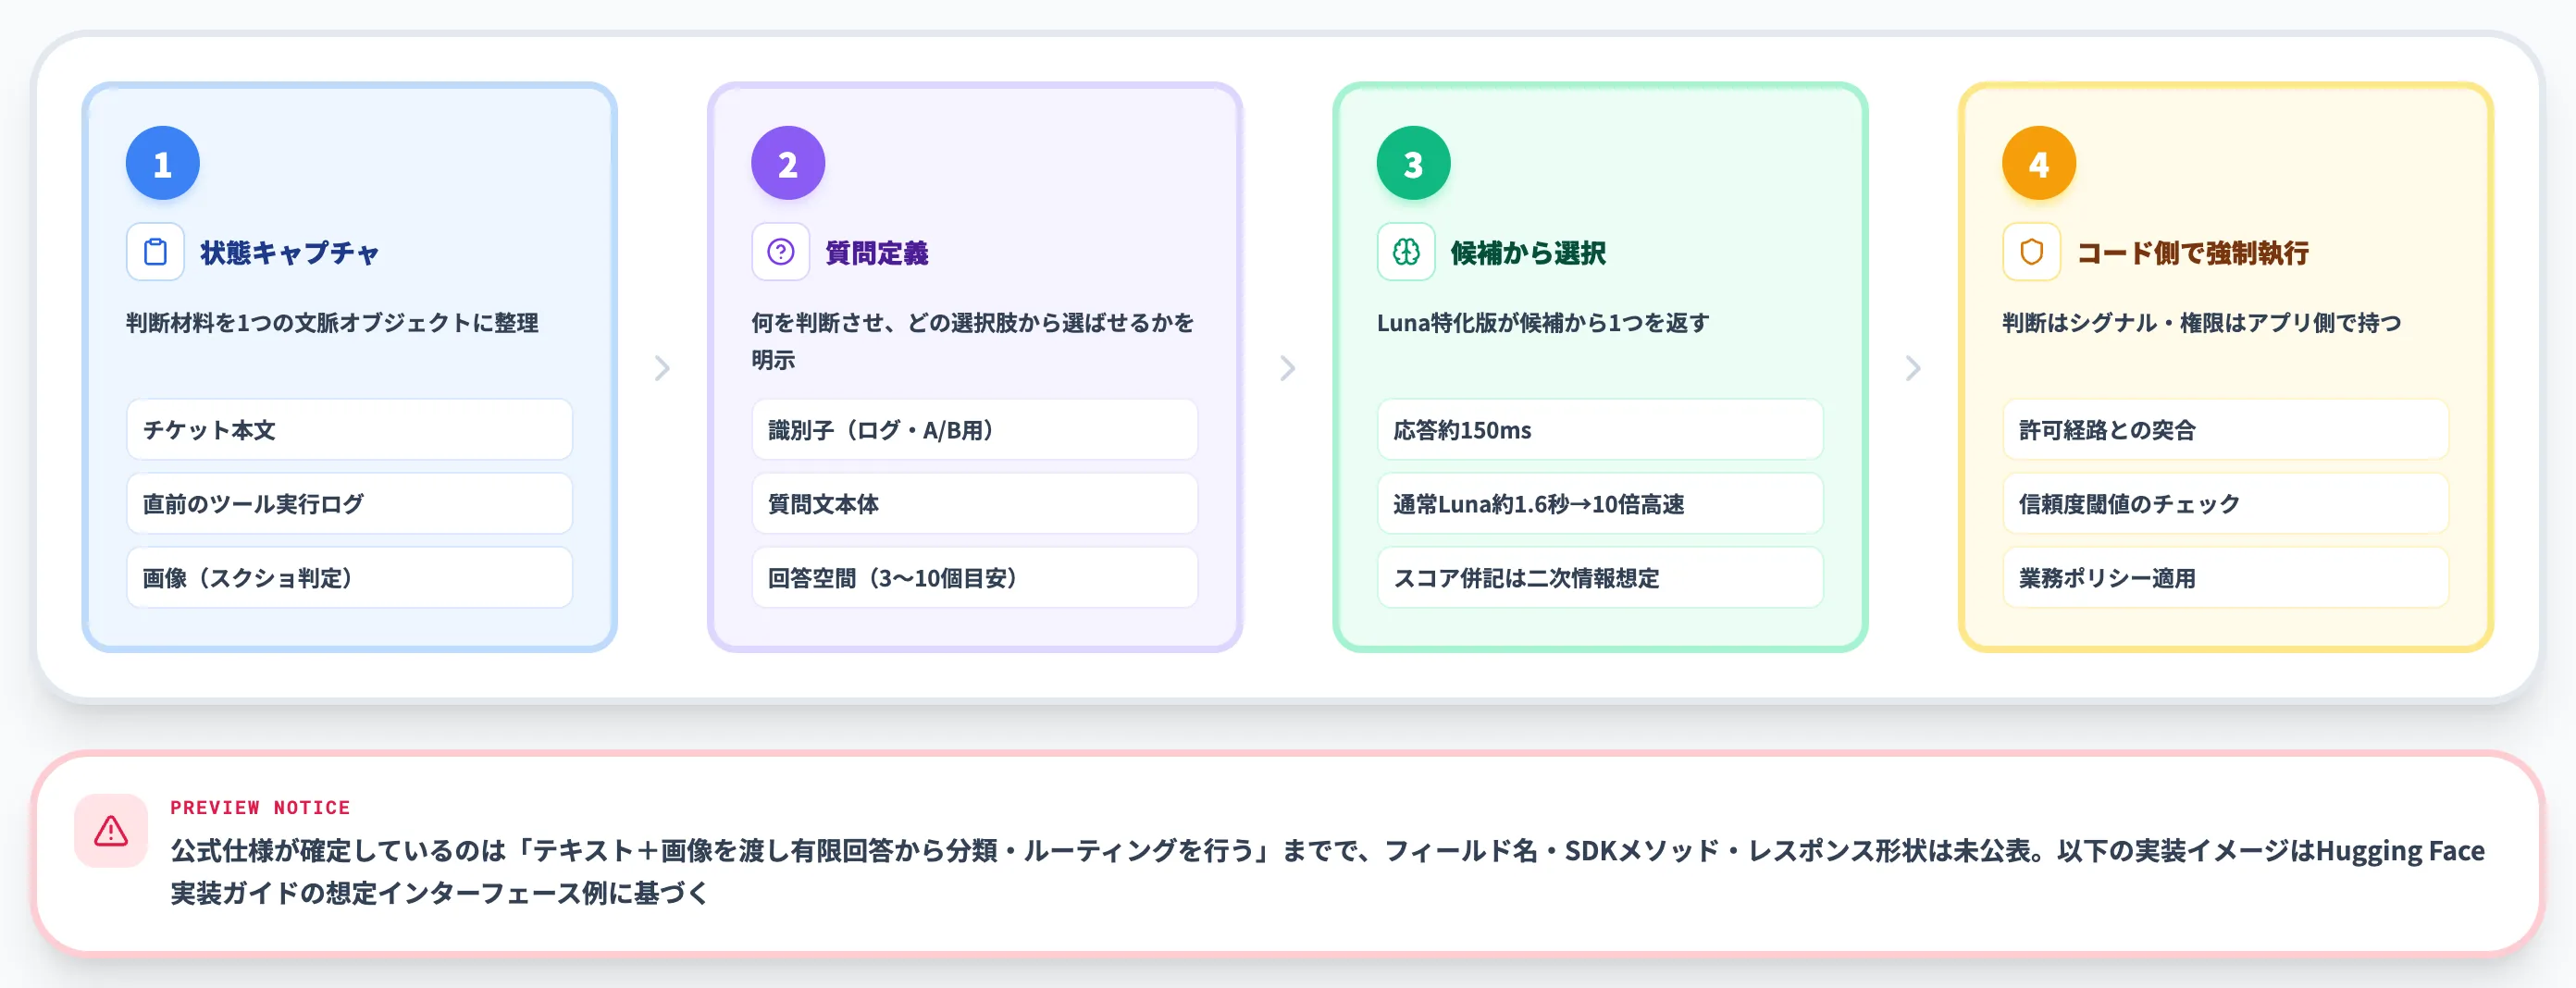
Decisions APIの実装は概念レベルで4つのステップに整理できます。確定した公式仕様が公開されているのは「テキストと画像を文脈として渡し、ユーザー定義の有限回答から分類・ルーティングなどを行う」までで、フィールド名・SDKメソッド・レスポンス形状は現時点で未公表です。
以下ではHugging Faceの実装ガイドが「例示用疑似コード」として提示した想定インターフェース例を参照しつつ、実装フローの構造だけを押さえていきます。
判断対象の状態をキャプチャする
まず、判断の材料となる情報をアプリケーション側で集めます。サポートチケット、メール本文、直前のツール実行ログ、ユーザープロファイルなど、判断根拠になる情報を1つの文脈オブジェクトに整理します。
自作実装ではこの部分をプロンプト本文に詰め込むケースが多いですが、公式Recapによれば、Decisions APIはテキストに加えて画像も文脈として渡せる仕様が予告されており、スクリーンショットベースの判定にも対応する見込みです。
有限の質問と回答空間を定義する
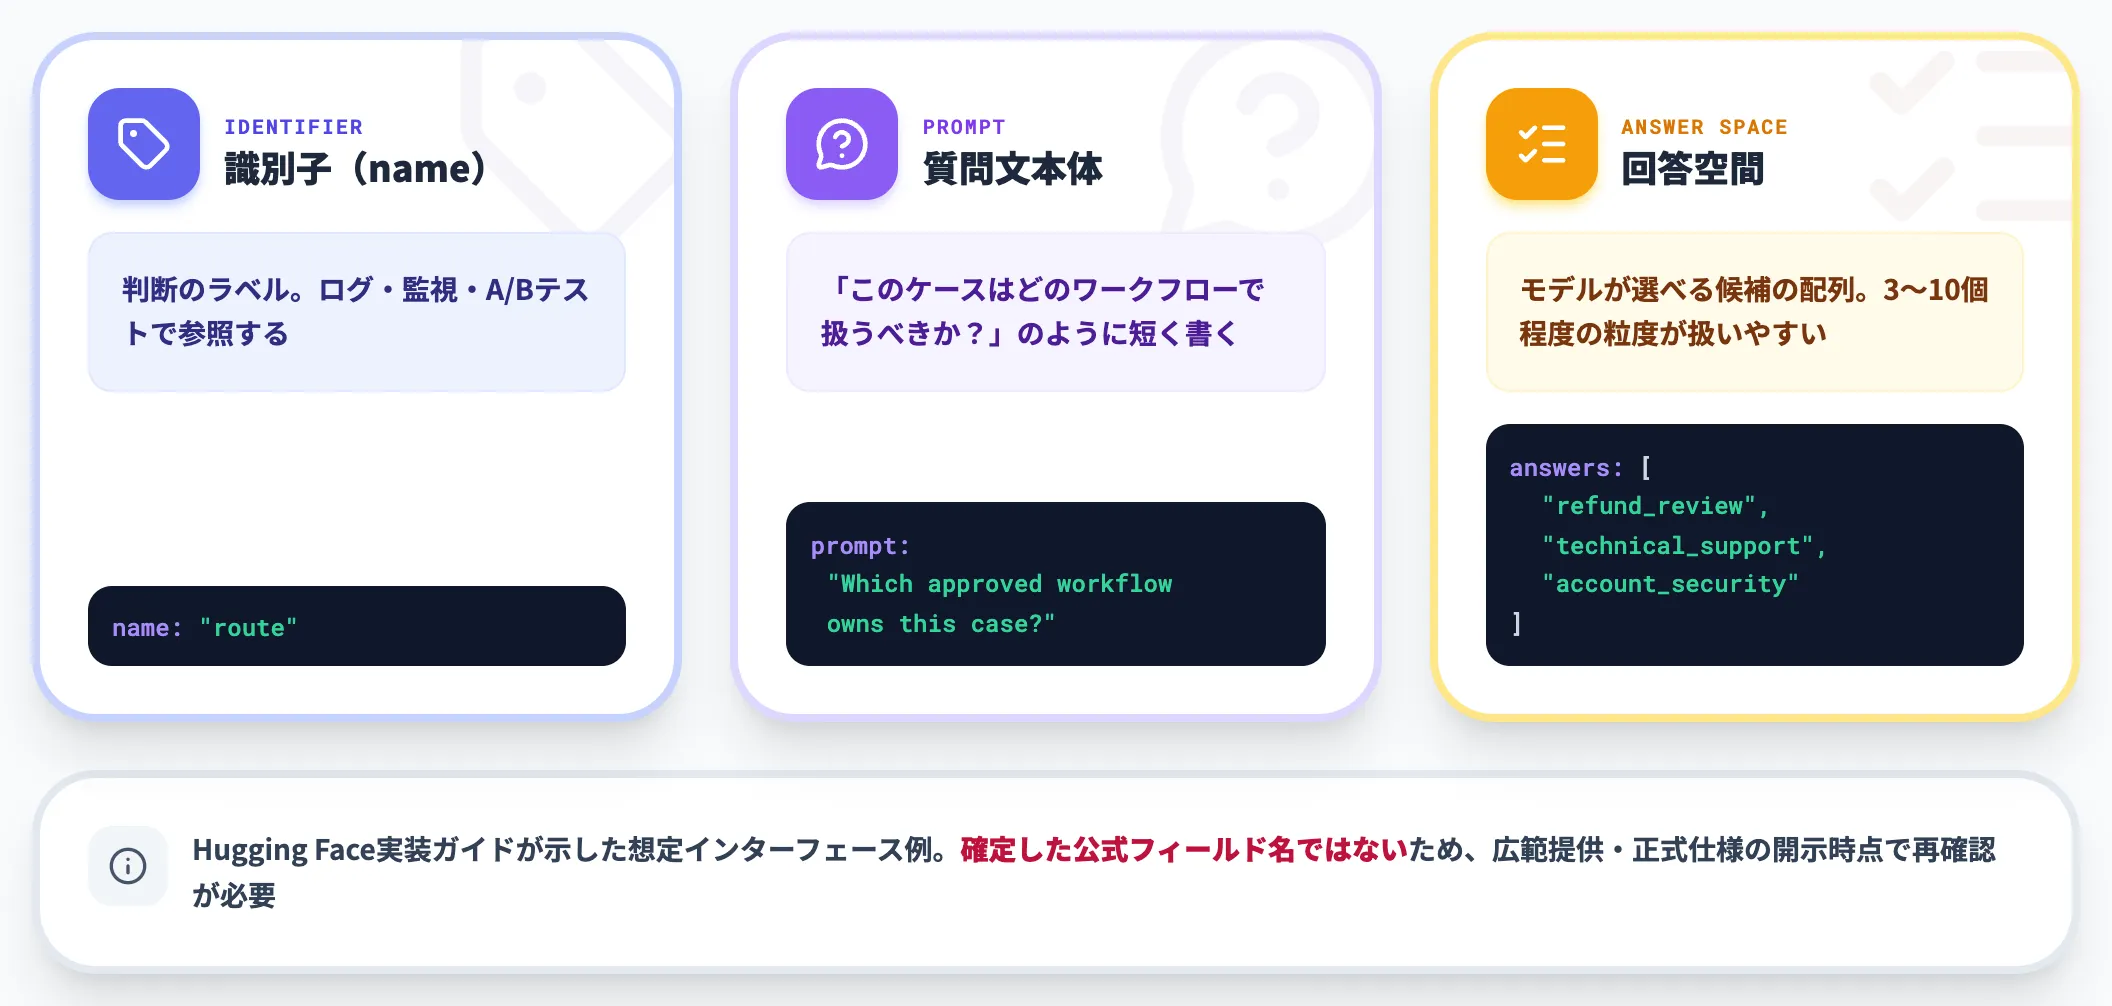
次に、開発者側で「モデルに何を判断させ、どの選択肢から選ばせるか」を明示します。
Hugging Faceの実装ガイドが示した想定インターフェース例では、以下3つの要素で質問を構成する形が提案されています(確定した公式フィールド名ではありません)。
-
質問名に相当する識別子
判断のラベル。ログ・監視・A/Bテストで参照する識別子として機能する
-
質問文の本体
「このケースはどのワークフローで扱うべきか?」のように短く書く
-
回答空間の定義
モデルが選べる候補の配列。3〜10個程度の粒度が扱いやすい
Lunaが候補から1つを選ぶ
Decisions APIが特化GPT-6 Lunaで判断を実行し、選ばれた候補を返します。応答は概ね150ms前後で返り、通常のLunaコール(約1.6秒)と比べて桁違いの応答速度です。
二次情報の実装ガイドでは、選択結果に加えて信頼度スコアが併せて返るとされていますが、公式Recapではスコアの意味論・値域・校正状態のいずれも公表されていません。
コード側で結果を強制執行する
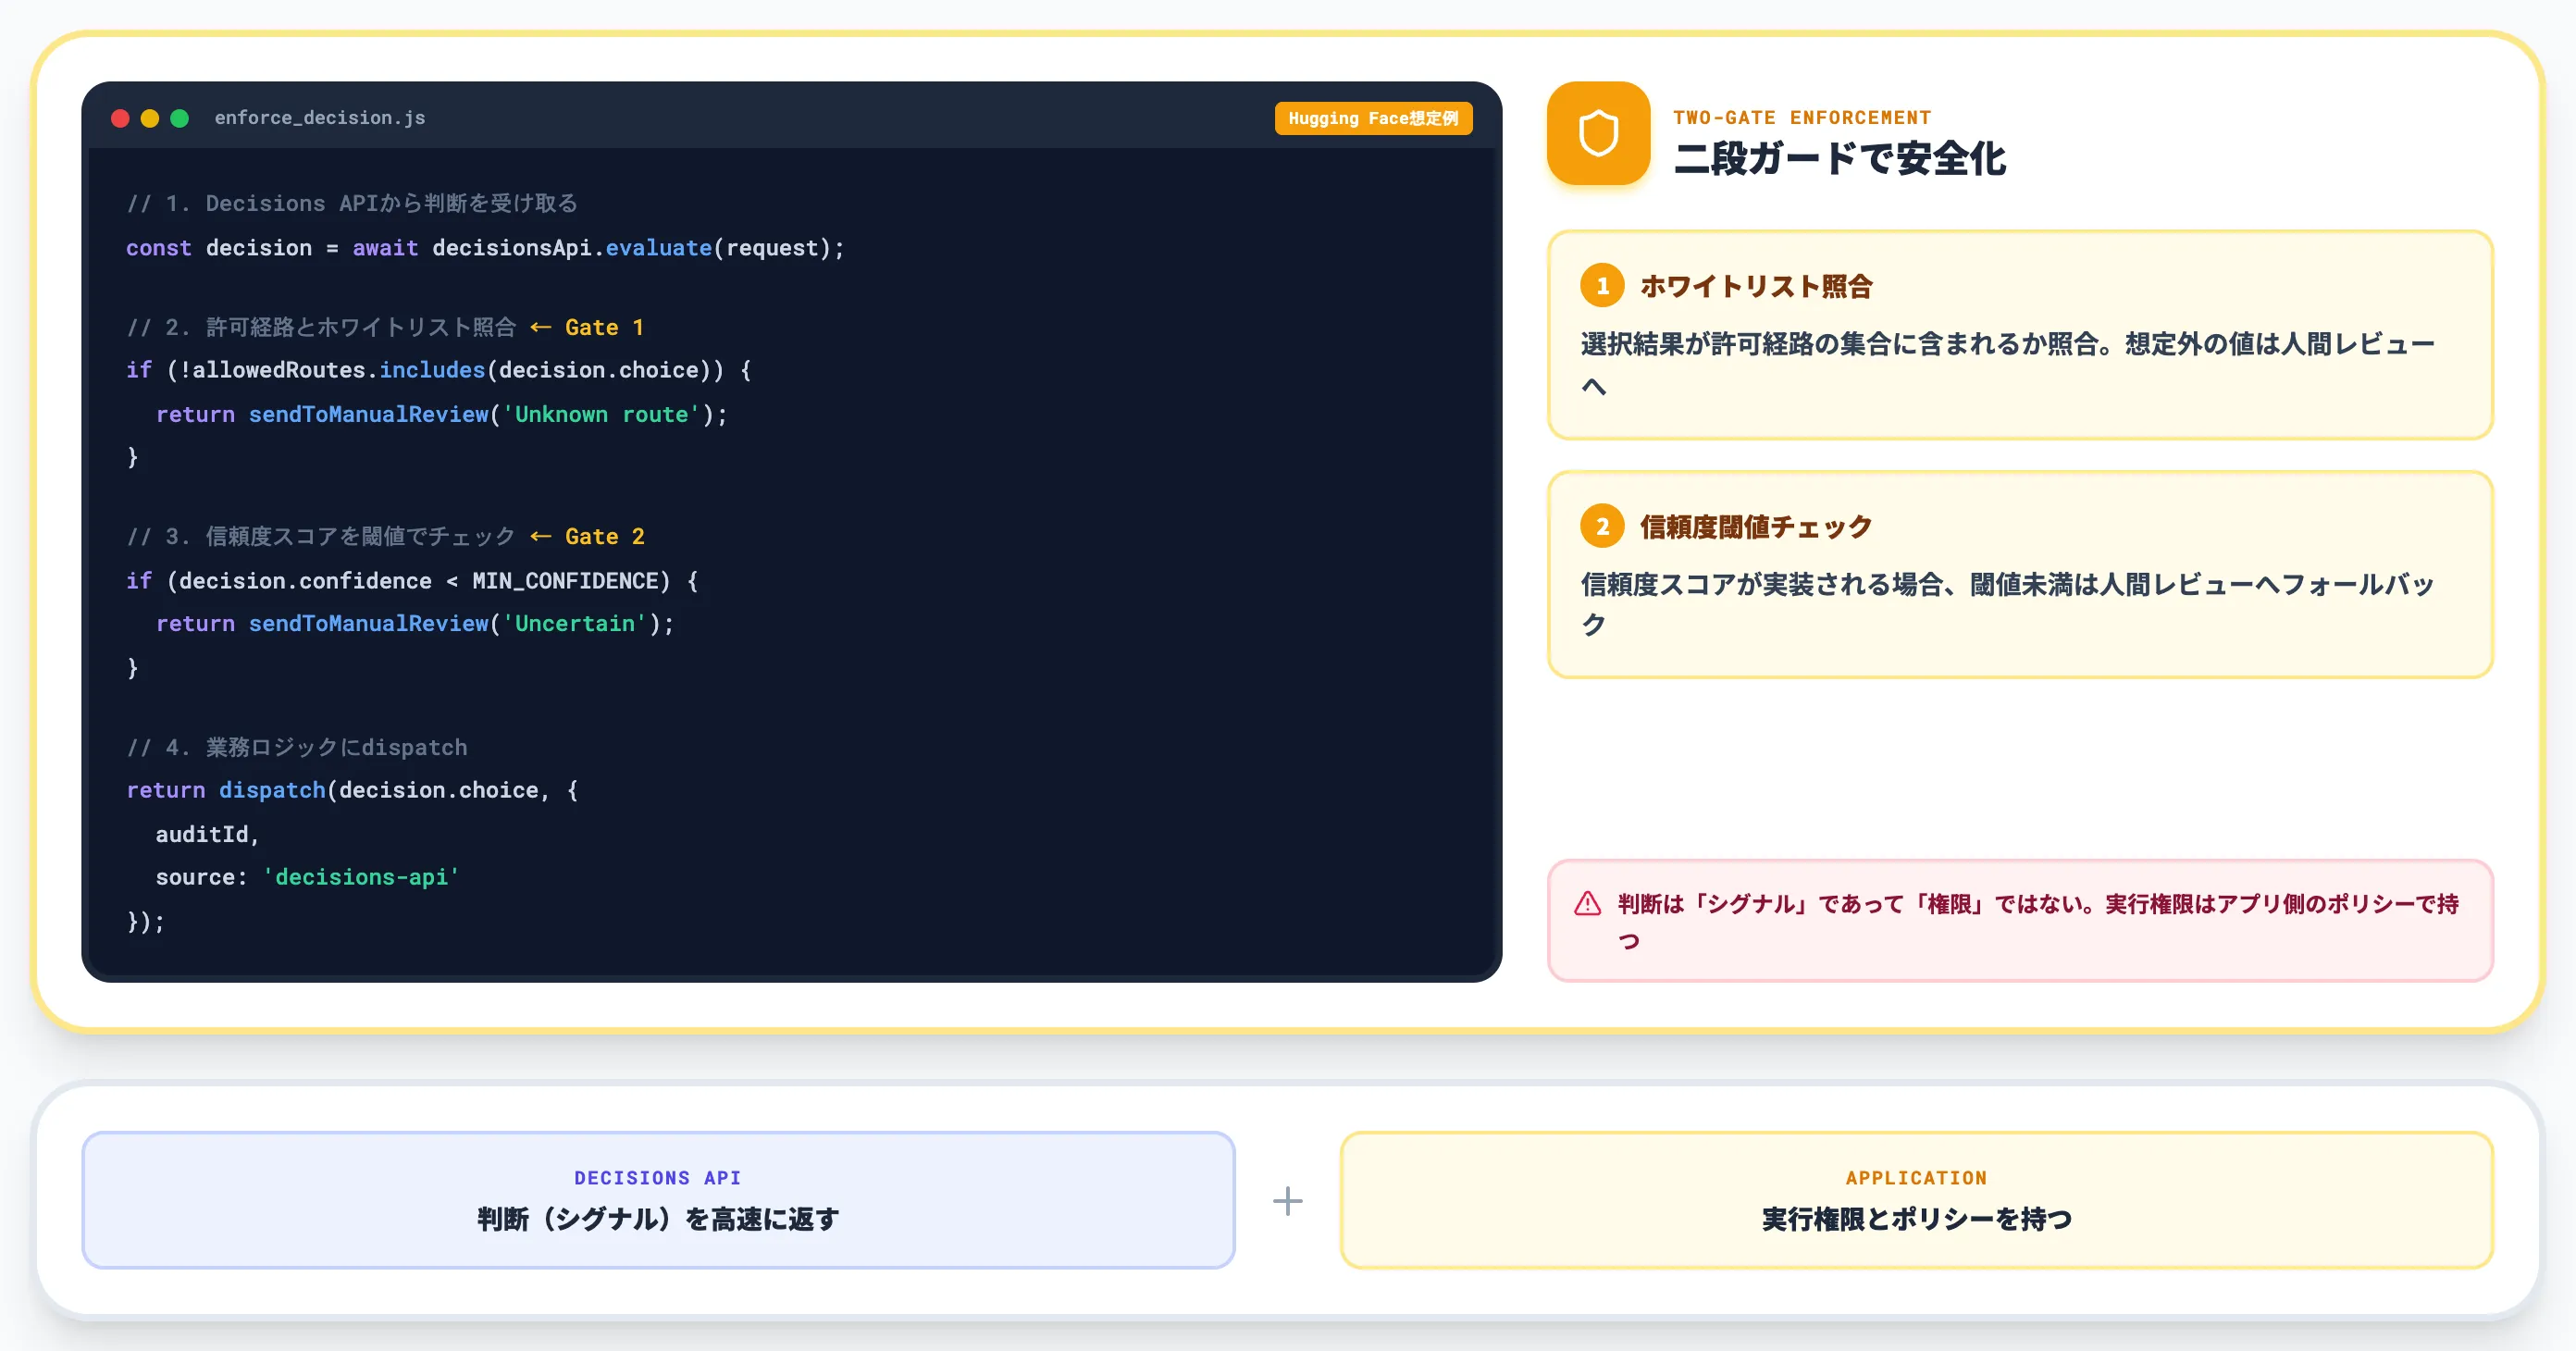
返ってきた判断結果は、あくまで「シグナル」であって「権限」ではありません。
アプリケーション側で信頼度閾値のチェック(信頼度スコアが実装される場合)、許可された経路との突合、業務ポリシーの適用を必ず行います。
以下は、Hugging Faceの実装ガイドで提示された例示用疑似コードです。フィールド名・SDKメソッド名・レスポンス形状はいずれも同ガイドの想定であり、実際の公式インターフェースとは異なる可能性があります。
// 【注意】以下は Hugging Face 実装ガイドが提示した想定例。
// 公式のフィールド名・SDK API・レスポンス形状ではありません。
const request = {
  context: {
    ticket: "The customer was charged twice.",
    account_tier: "business",
    recent_events: ["payment_succeeded", "payment_succeeded"]
  },
  question: {
    name: "route",
    prompt: "Which approved workflow owns this case?",
    answers: ["refund_review", "technical_support", "account_security"]
  }
};

const decision = await decisionsApi.evaluate(request);

if (!allowedRoutes.includes(decision.choice)) {
  return sendToManualReview('Unknown route');
}

if (decision.confidence < MIN_CONFIDENCE) {
  return sendToManualReview('Uncertain decision');
}

return dispatch(decision.choice, { auditId, source: 'decisions-api' });
この例示コードから読み取れる設計思想は、選択結果を許可経路とホワイトリスト照合してから業務ロジックに流す点、信頼度スコアを閾値で切って人間レビューへのフォールバックを段階化する点の2つです。信頼度スコアの校正状態は未公表のため、閾値の初期値は自社のシャドウトラフィックで実測した後に決めることが推奨されます。
Decisions APIの想定ユースケース
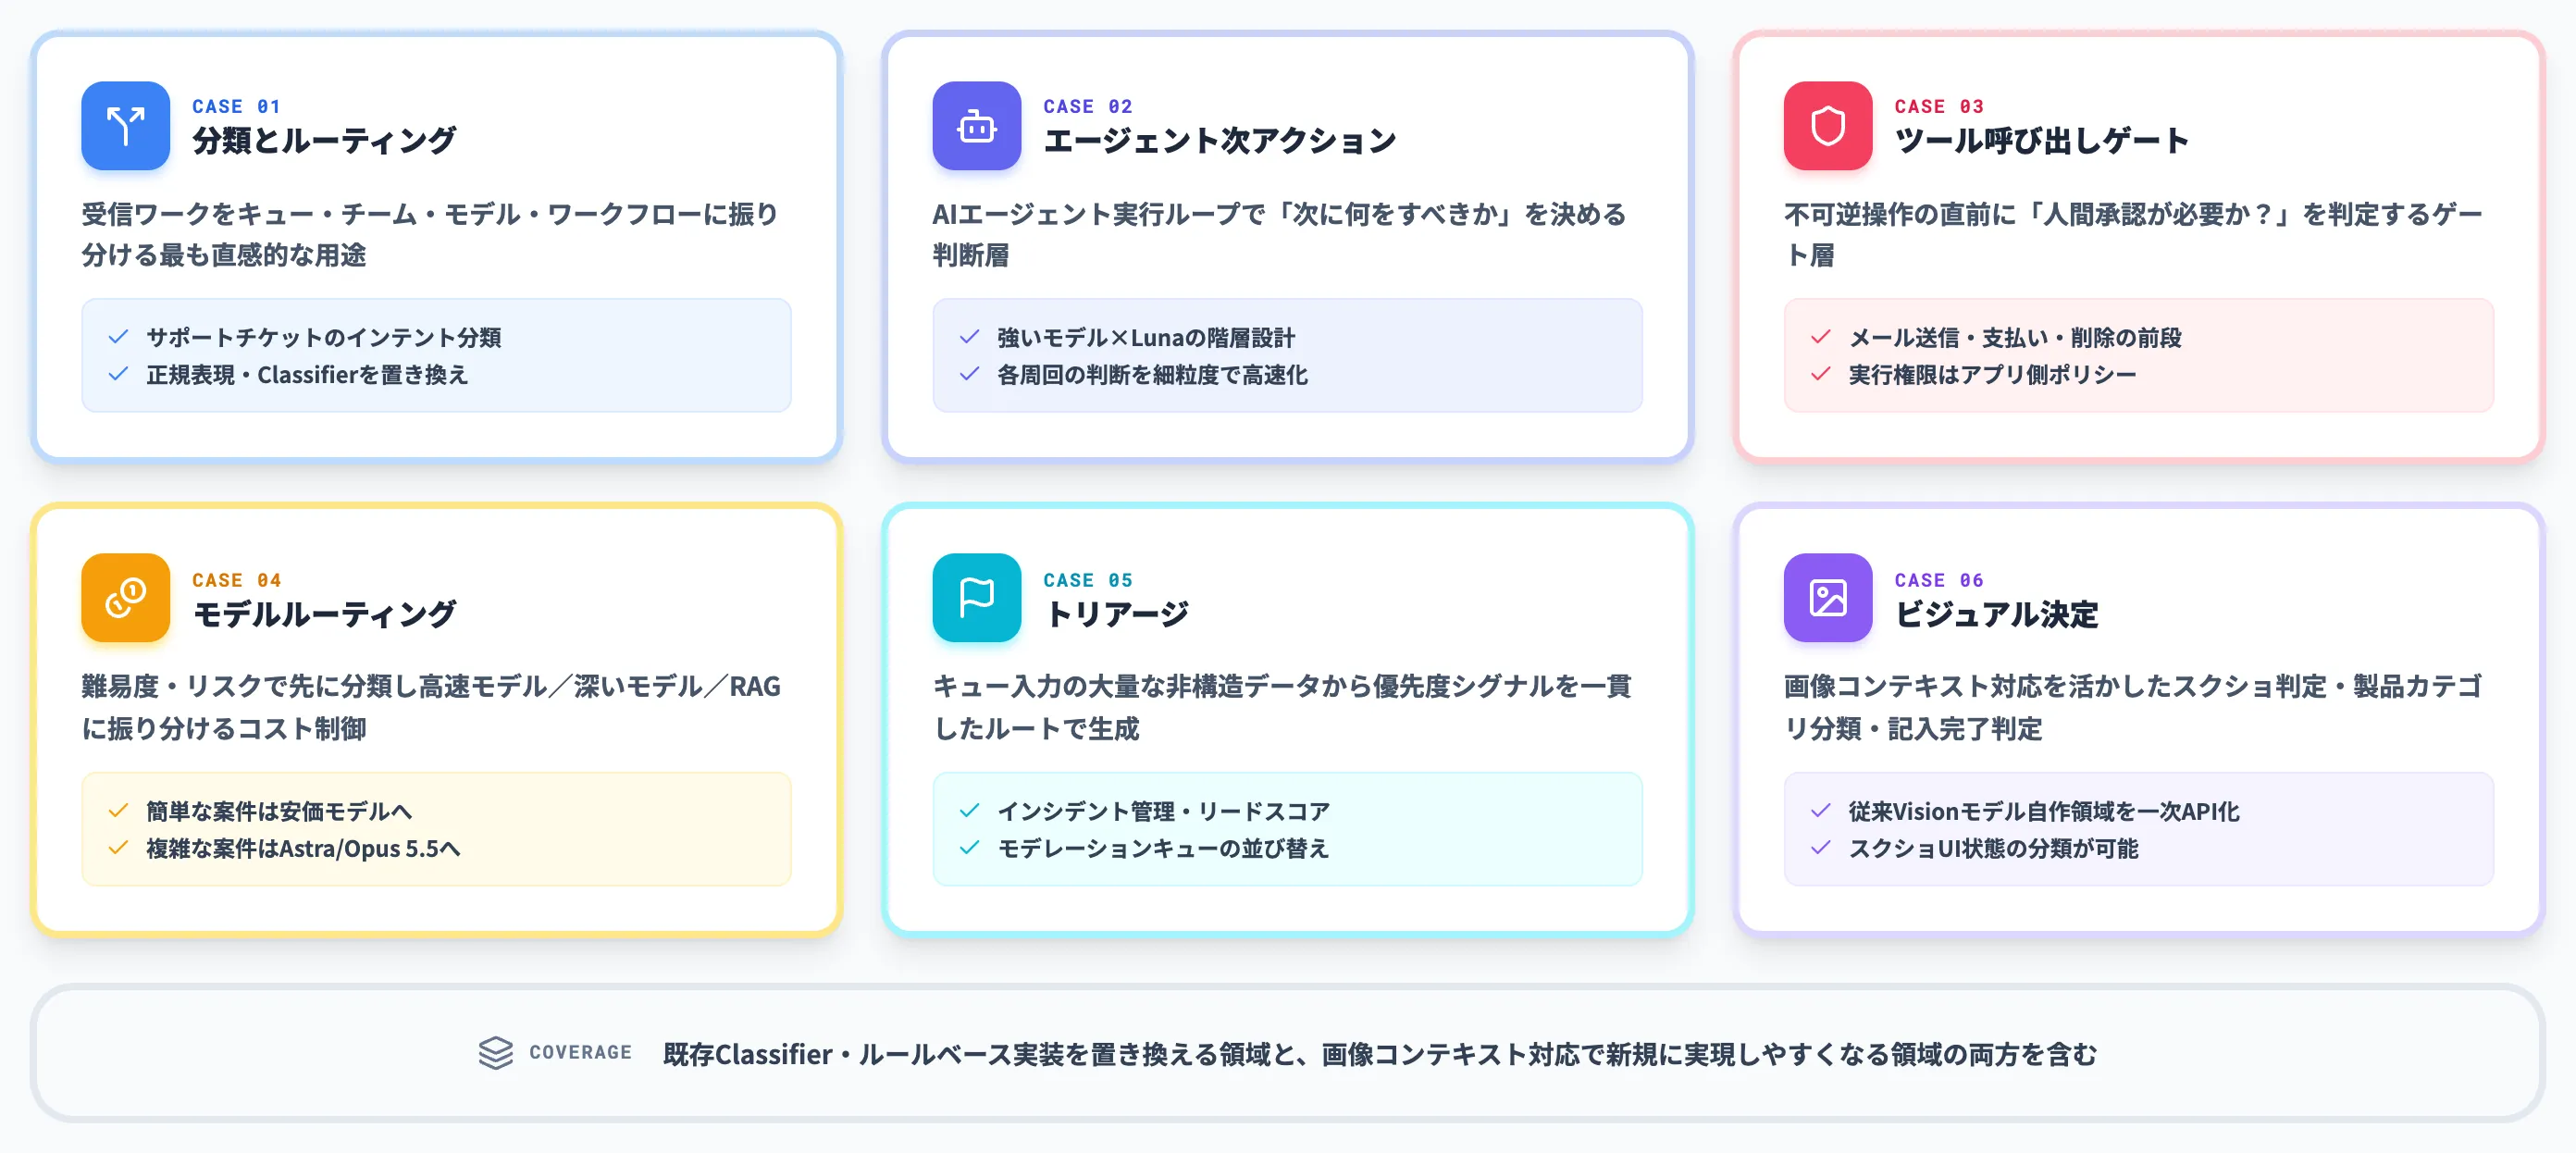
Decisions APIが想定する用途は6パターンに整理できます。既存のClassifierやルールベース実装を置き換えられる領域と、新たに実現しやすくなる領域の両方が含まれます。
分類とルーティング
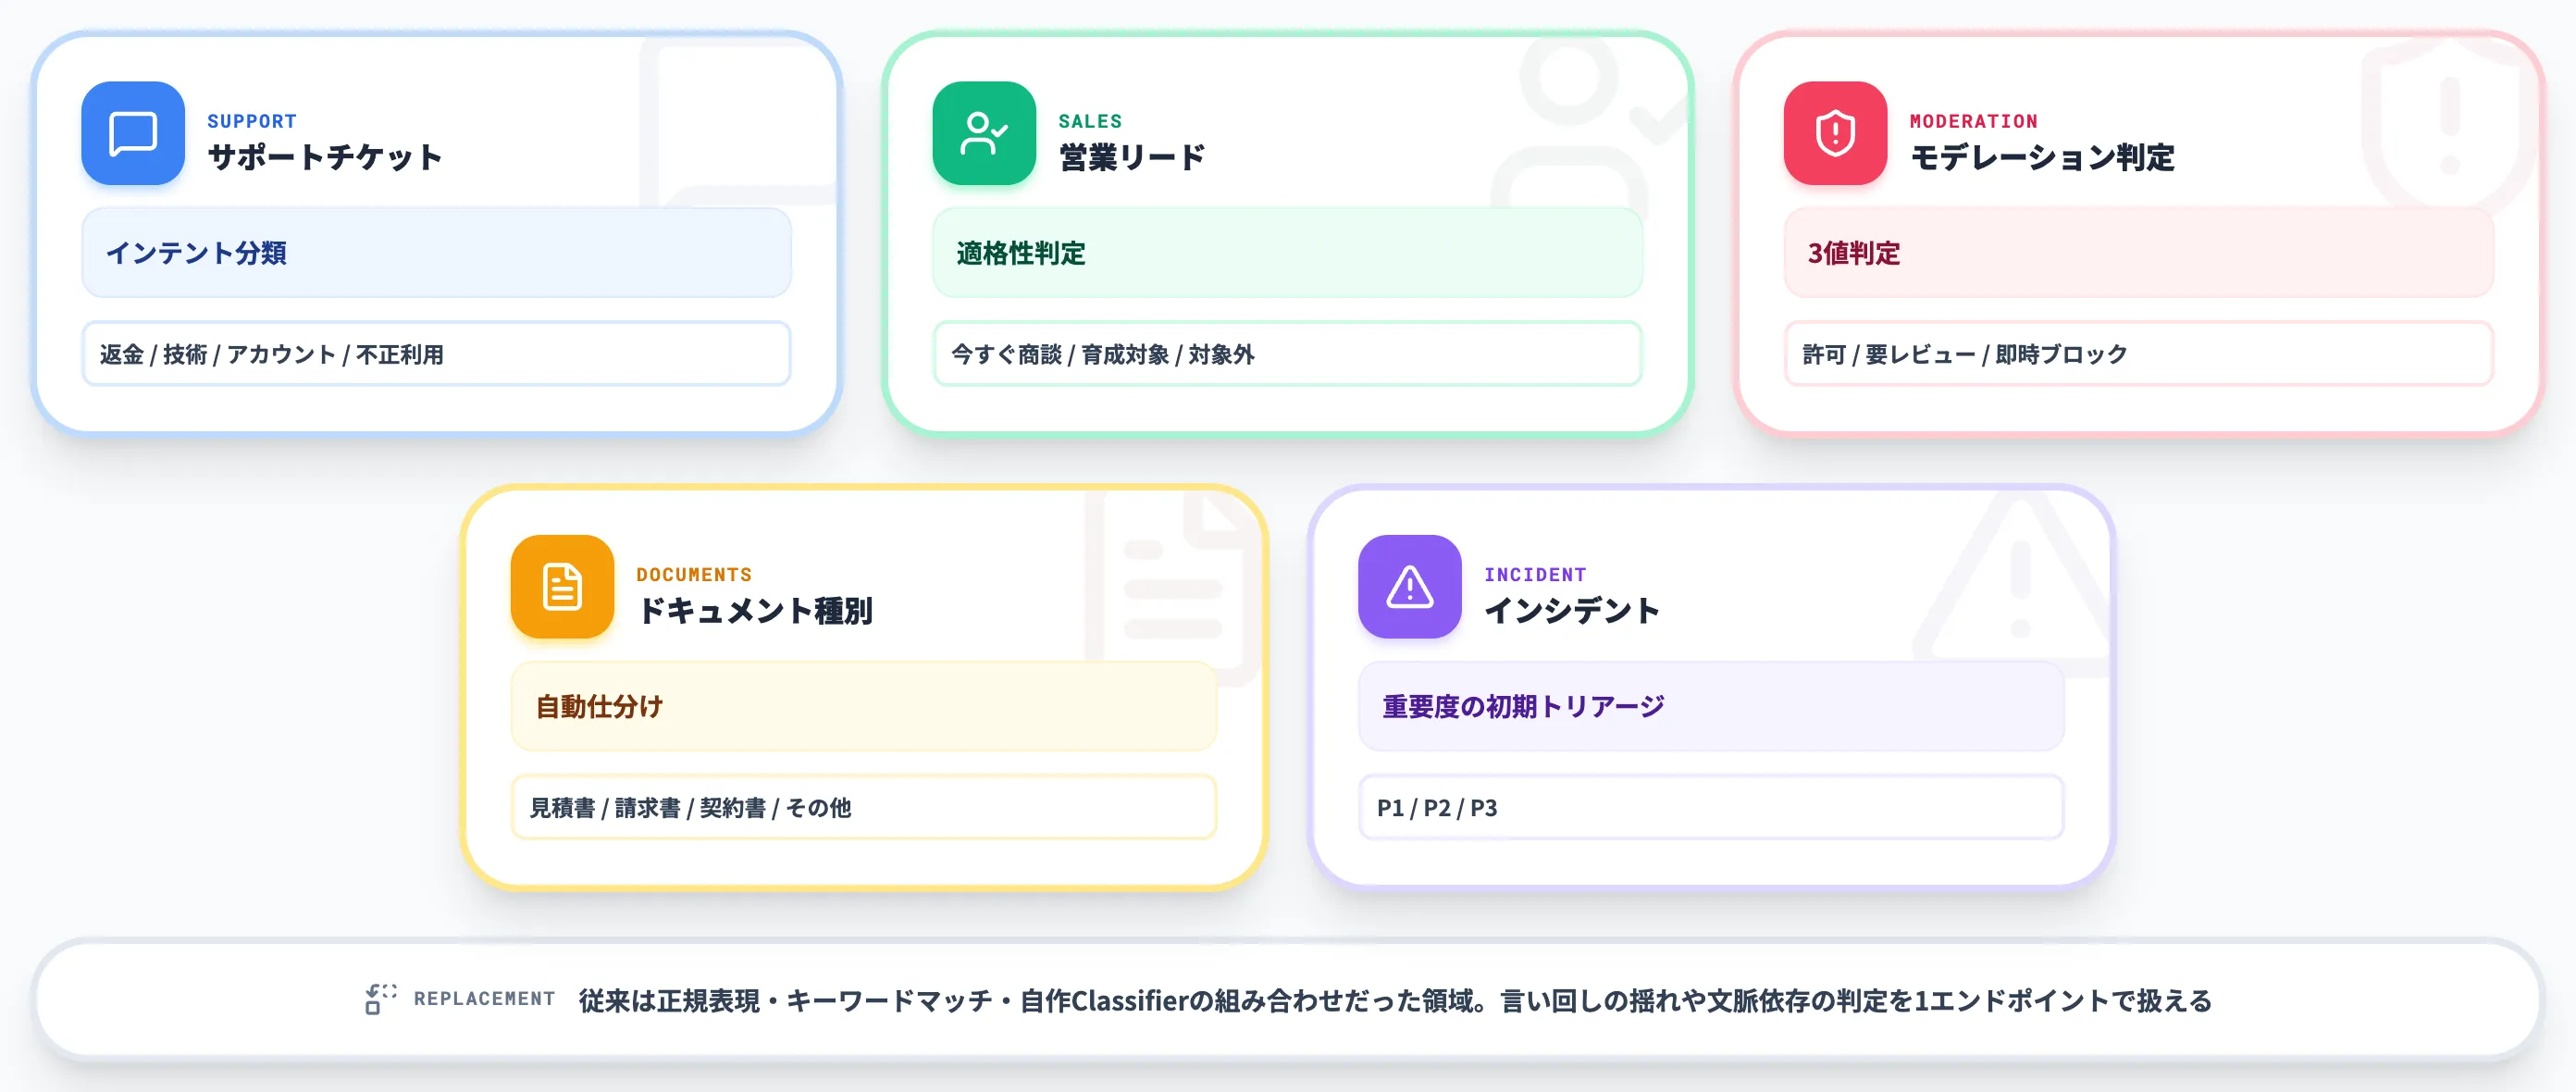
最も直感的な用途が、受信ワークをキュー・チーム・モデル・リージョン・ワークフローに振り分ける分類ルーティングです。
- サポートチケットのインテント分類(返金/技術/アカウント/不正利用)
- 営業リードの適格性判定(今すぐ商談/育成対象/対象外)
- モデレーション判定(許可/要レビュー/即時ブロック)
- ドキュメント種別の自動仕分け(見積書/請求書/契約書/その他)
- インシデント重要度の初期トリアージ(P1/P2/P3)
これらは従来、正規表現・キーワードマッチ・自作Classifierの組み合わせで実装されてきた領域です。Decisions APIに置き換えると、言い回しの揺れや文脈依存の判定を1エンドポイントで扱えるようになります。
エージェント次アクション選択
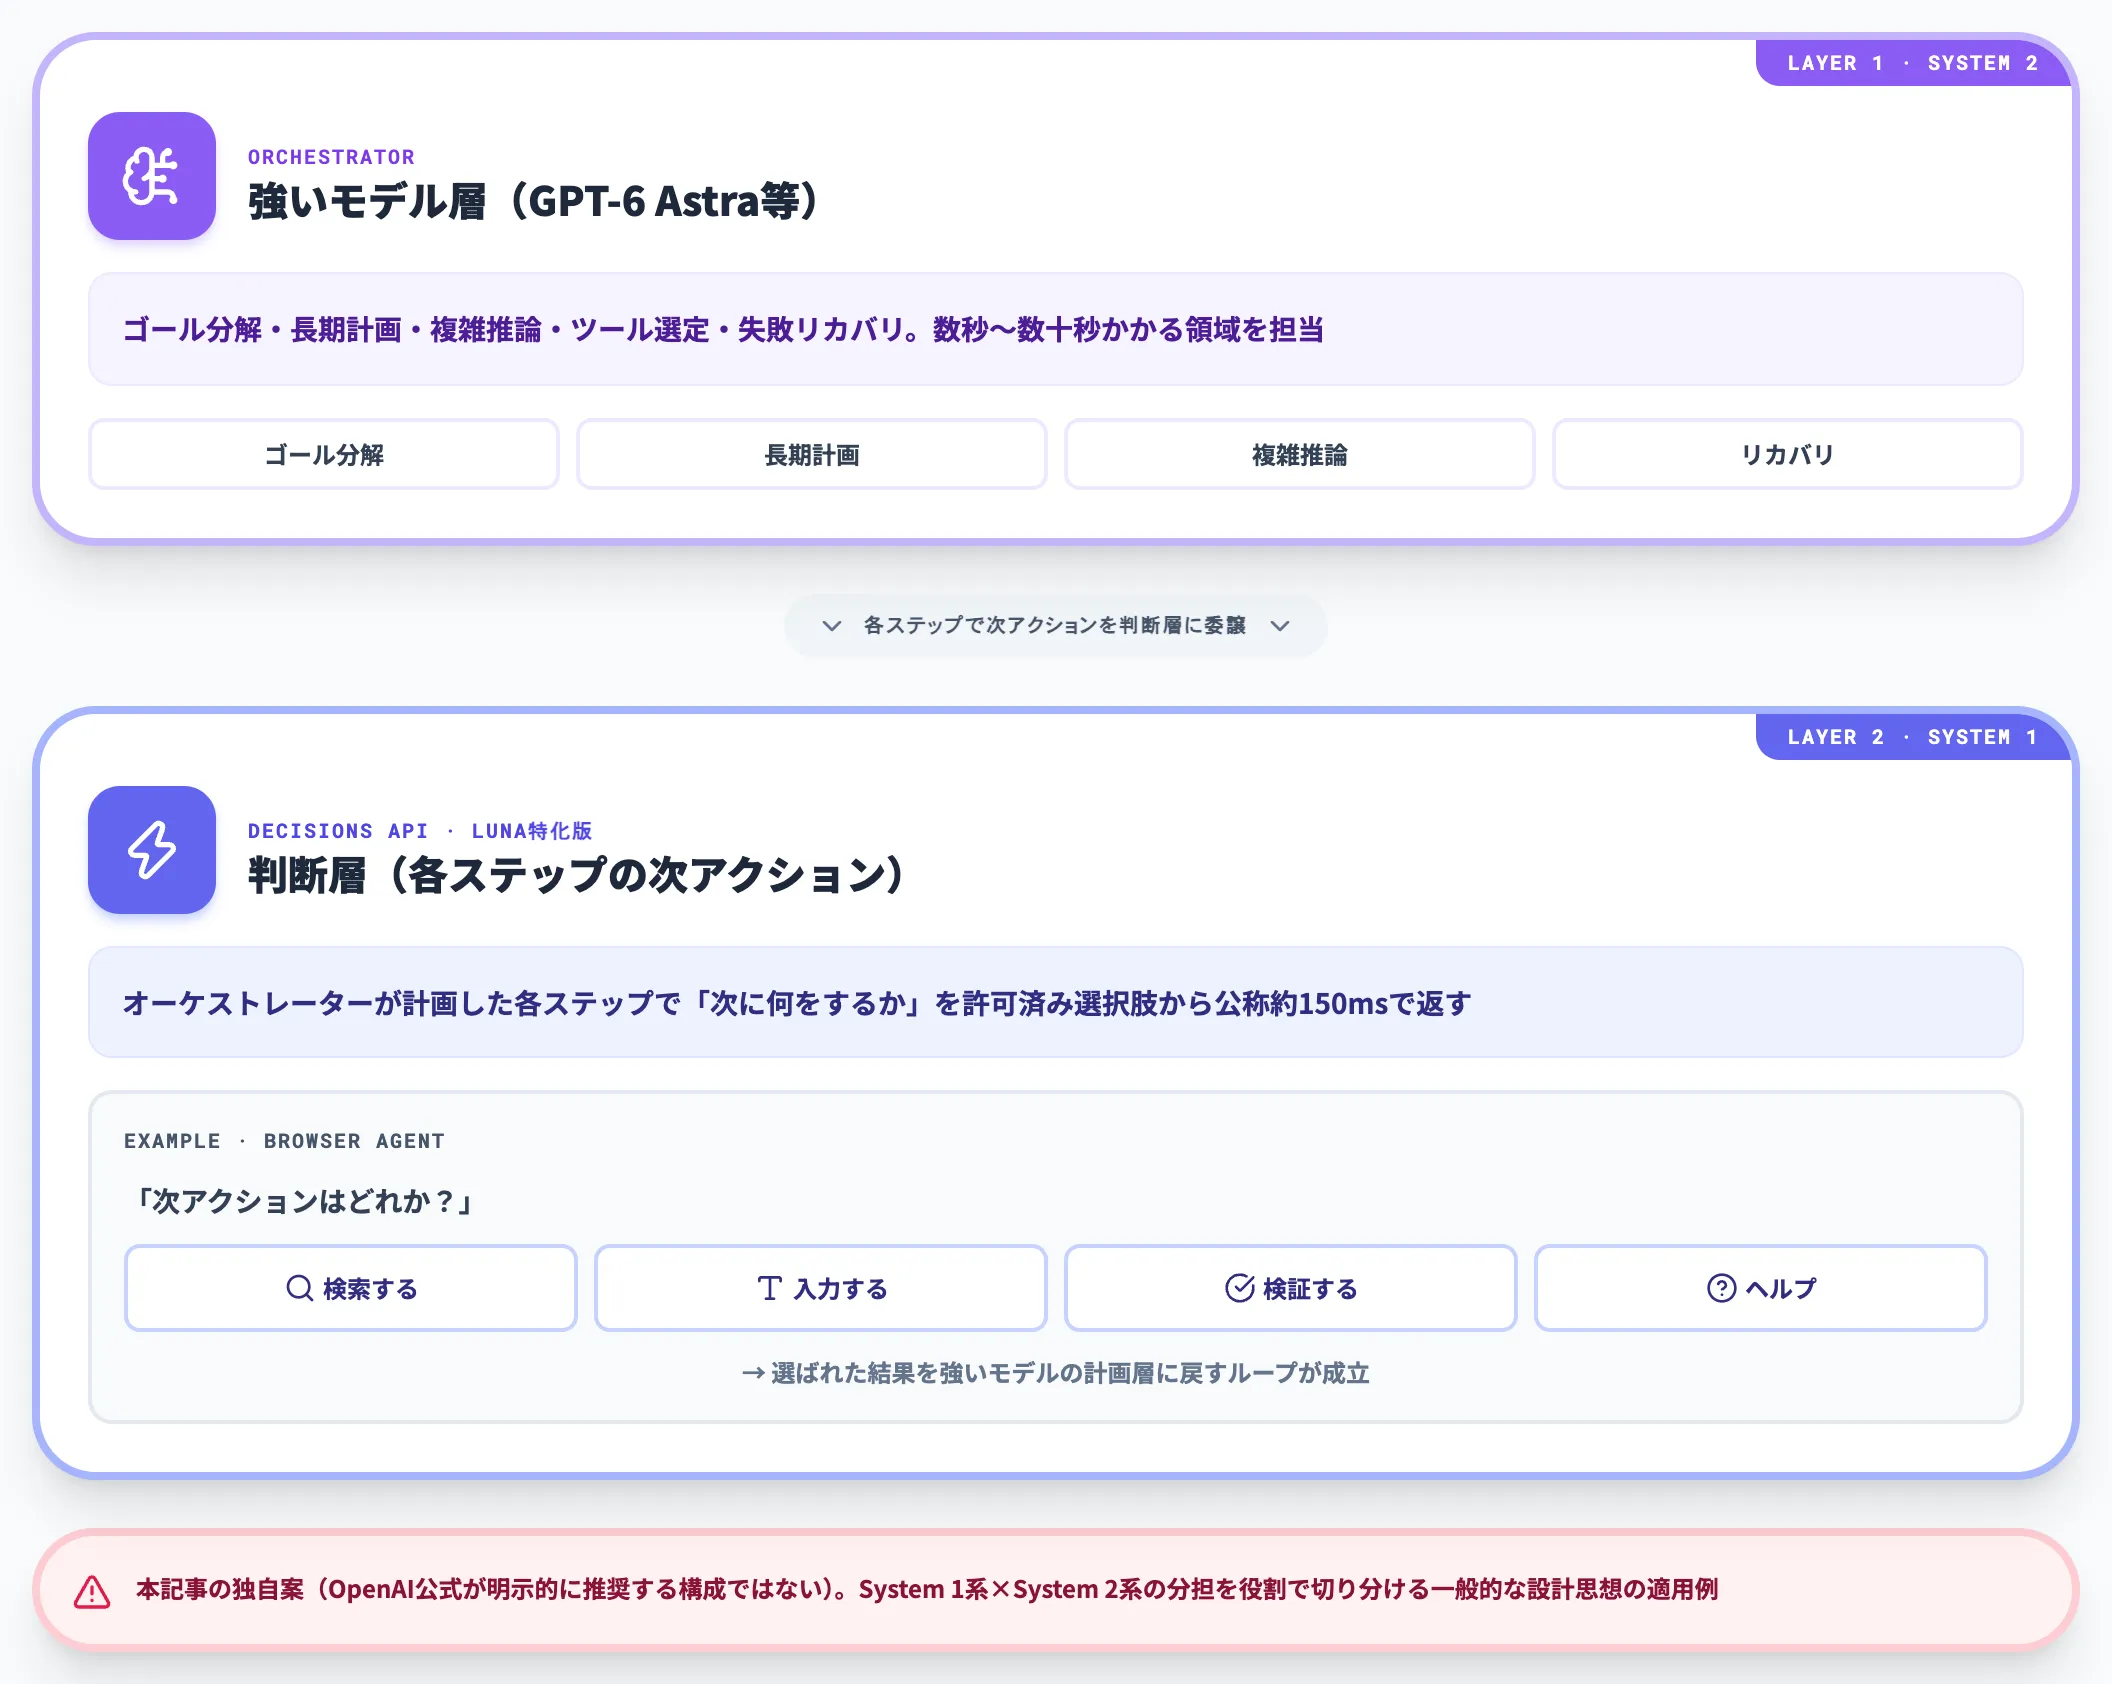
AIエージェントの実行ループで、「次に何をすべきか」を決める判断層としても機能します。
強いモデル(GPT-6 Astraなど)でゴールと計画を組み立て、各ステップでの具体的な次アクションはDecisions APIで許可された選択肢から選ぶ、という階層設計は本記事で紹介する実装例です(OpenAI公式が明示的に推奨する構成ではありません)。
例えばブラウザ操作エージェントであれば、「検索する/入力する/検証する/ヘルプを呼ぶ」から次アクションをDecisions APIが公称約150msで決定し、その決定を強いモデルの計画層に戻すループが成立します。
ツール呼び出しゲート
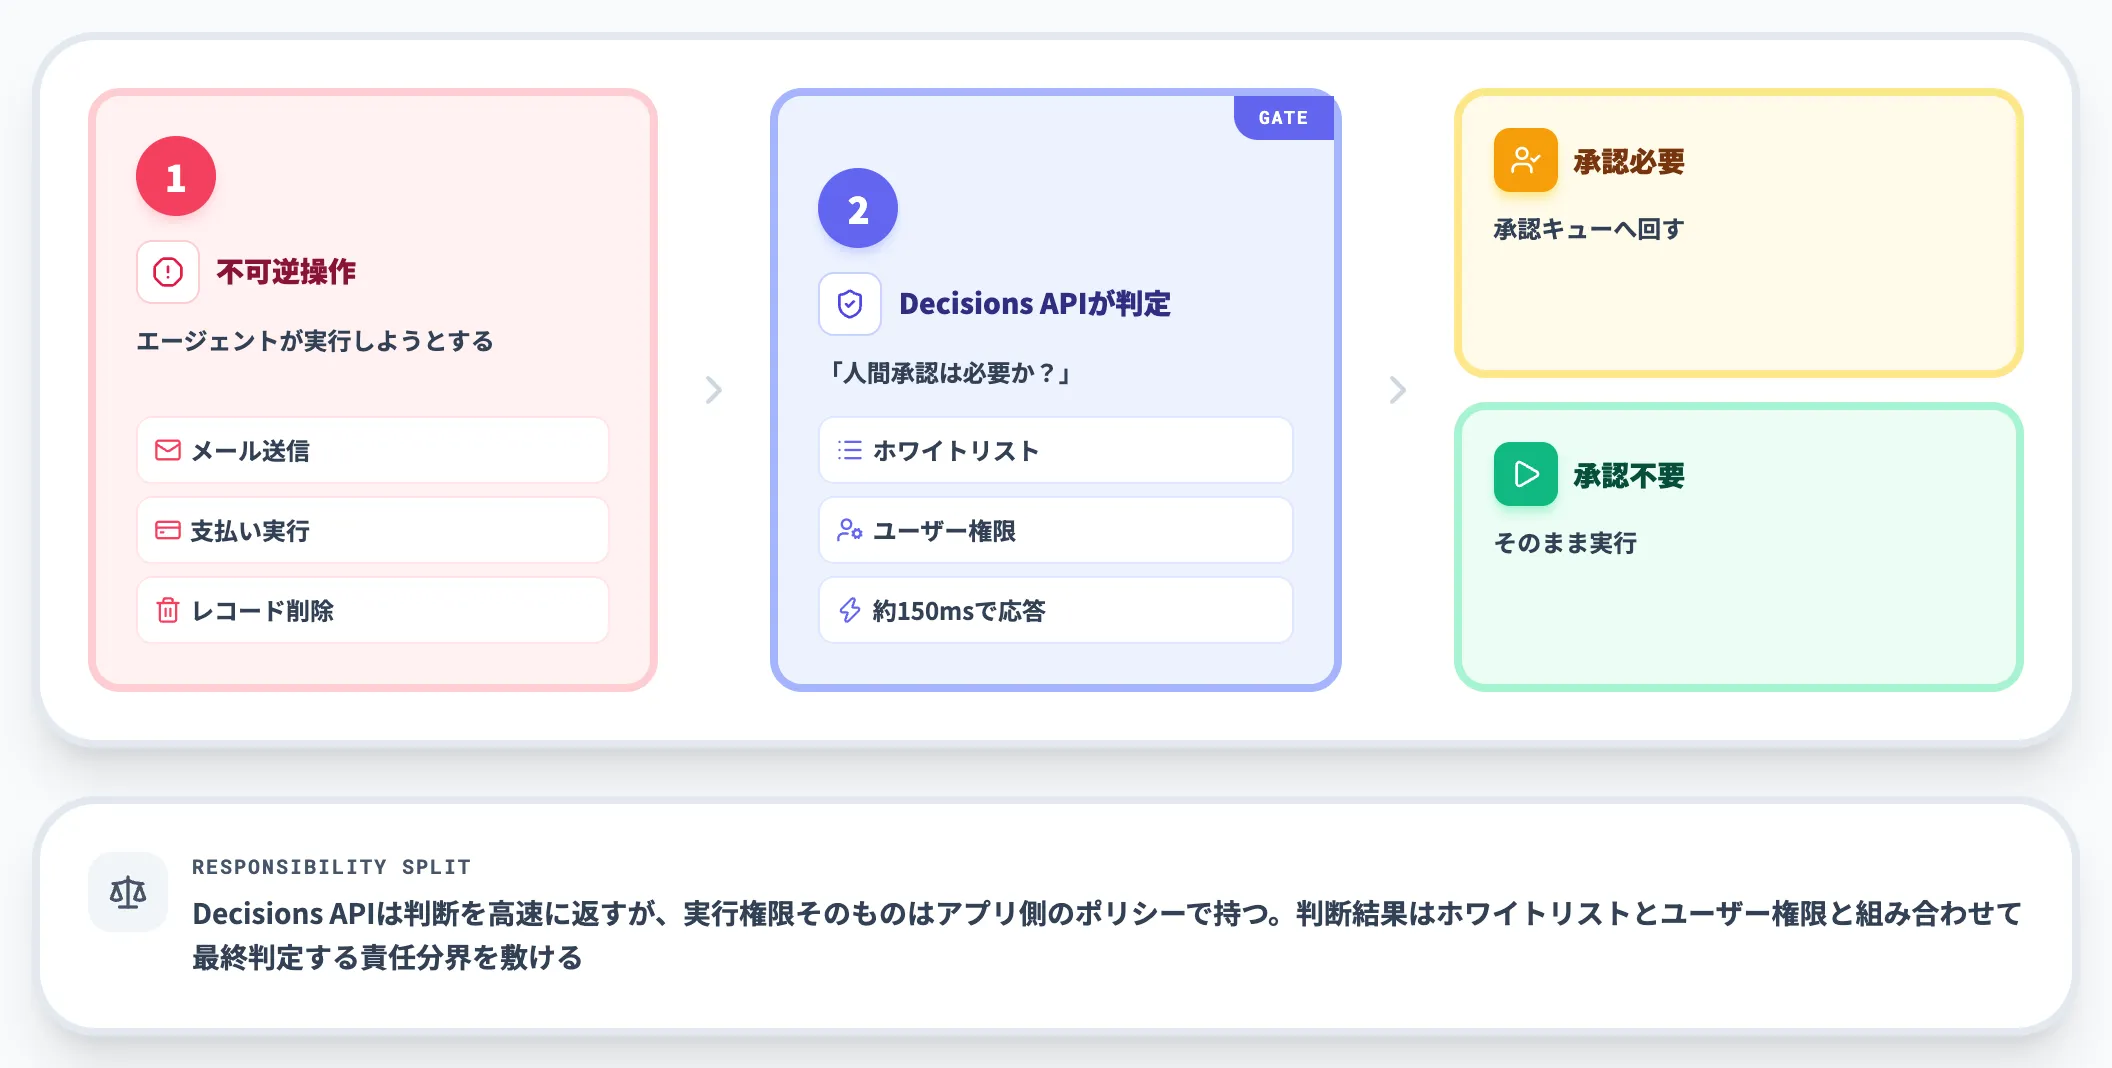
エージェントがメール送信・支払い実行・レコード削除・アカウント変更のような不可逆操作を行う直前に、「このアクションは人間の承認が必要か?」を判定するゲート層としての用途です。
判断結果を、ホワイトリストとユーザー権限と組み合わせて最終判定します。Decisions APIは判断を高速に返しますが、実行権限そのものはアプリ側のポリシーで持つ、という責任分界を明確に敷けます。
モデルルーティングとコスト制御
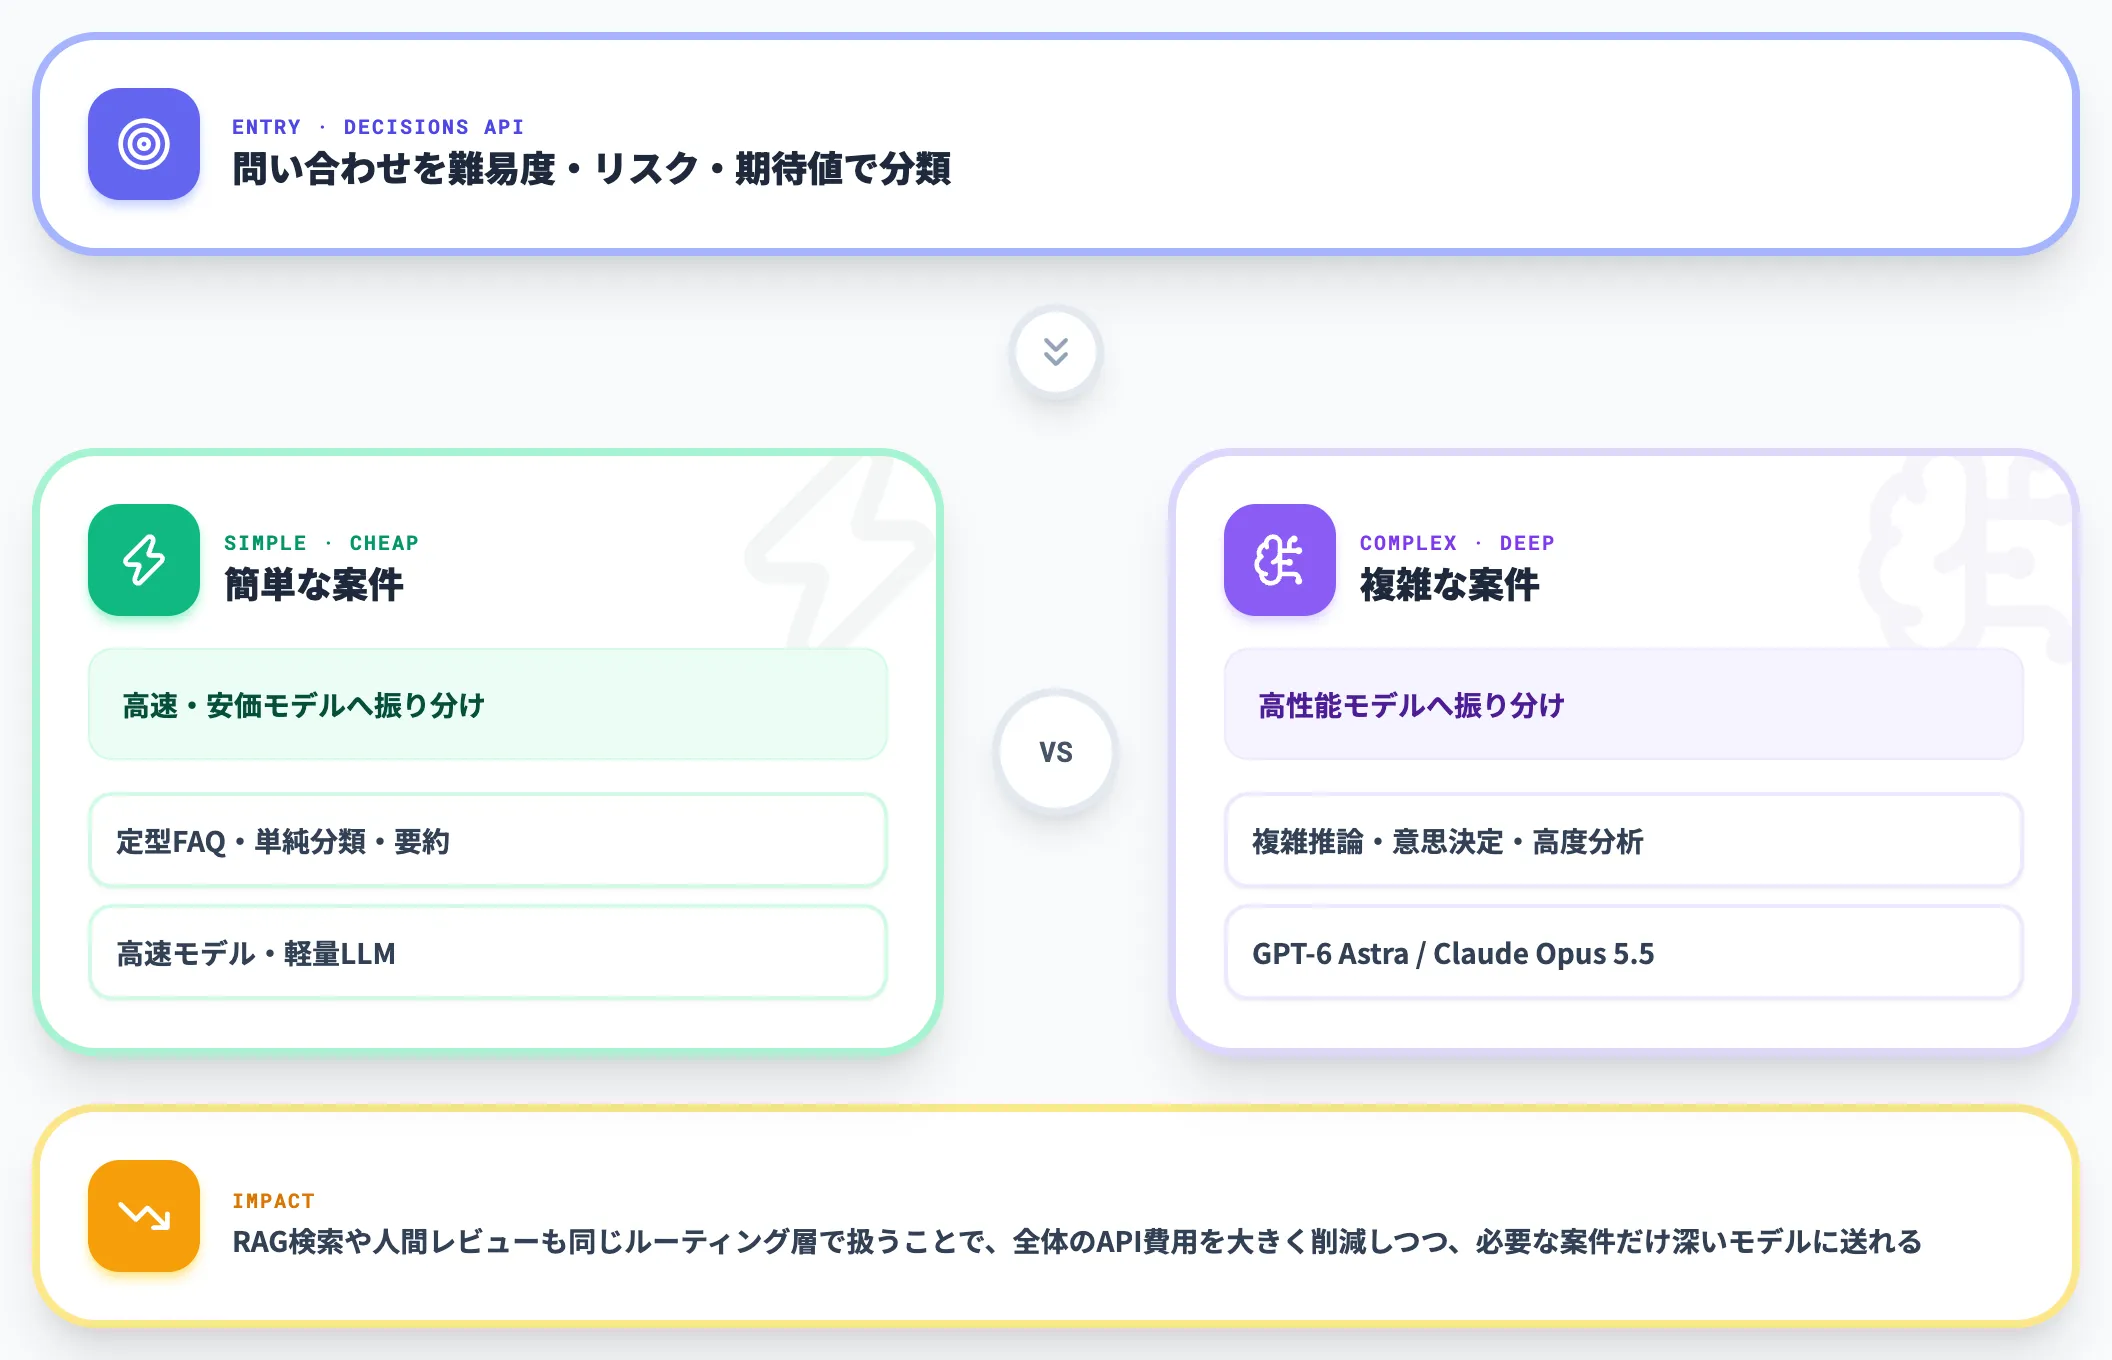
問い合わせの難易度・リスク・期待値をDecisions APIで先に分類し、その結果に応じて「高速モデル/深いモデル/RAG検索/人間レビュー」を振り分けるモデルルーティング層です。
簡単な案件を安価なモデルに、複雑な案件をGPT-6 AstraやClaude Opus 5.5などの高性能モデルに送る運用で、全体のAPI費用を大きく削減できます。
トリアージと優先順位付け
キューシステムに入ってくる大量の非構造データから、優先度シグナルを一貫したルートで生成する用途です。
インシデント管理、営業リードのスコアリング、コンテンツモデレーションキューの並び替えなど、「大量に来るものに優先度をつけたい」領域全般に適用できます。
ビジュアル決定
画像コンテキスト対応を活かした用途として、スクリーンショットが既知のUI状態を示しているかの判定、画像ベースの製品カテゴリ分類、フォーム画像の記入完了判定などが挙げられます。
これは従来、独自のビジョンモデルを構築するか、Structured Outputs付きのVisionモデルでコストをかけて実装していた領域で、Decisions APIによって一次API化される部分です。
Decisions APIとJev(TypeSafe)の比較—
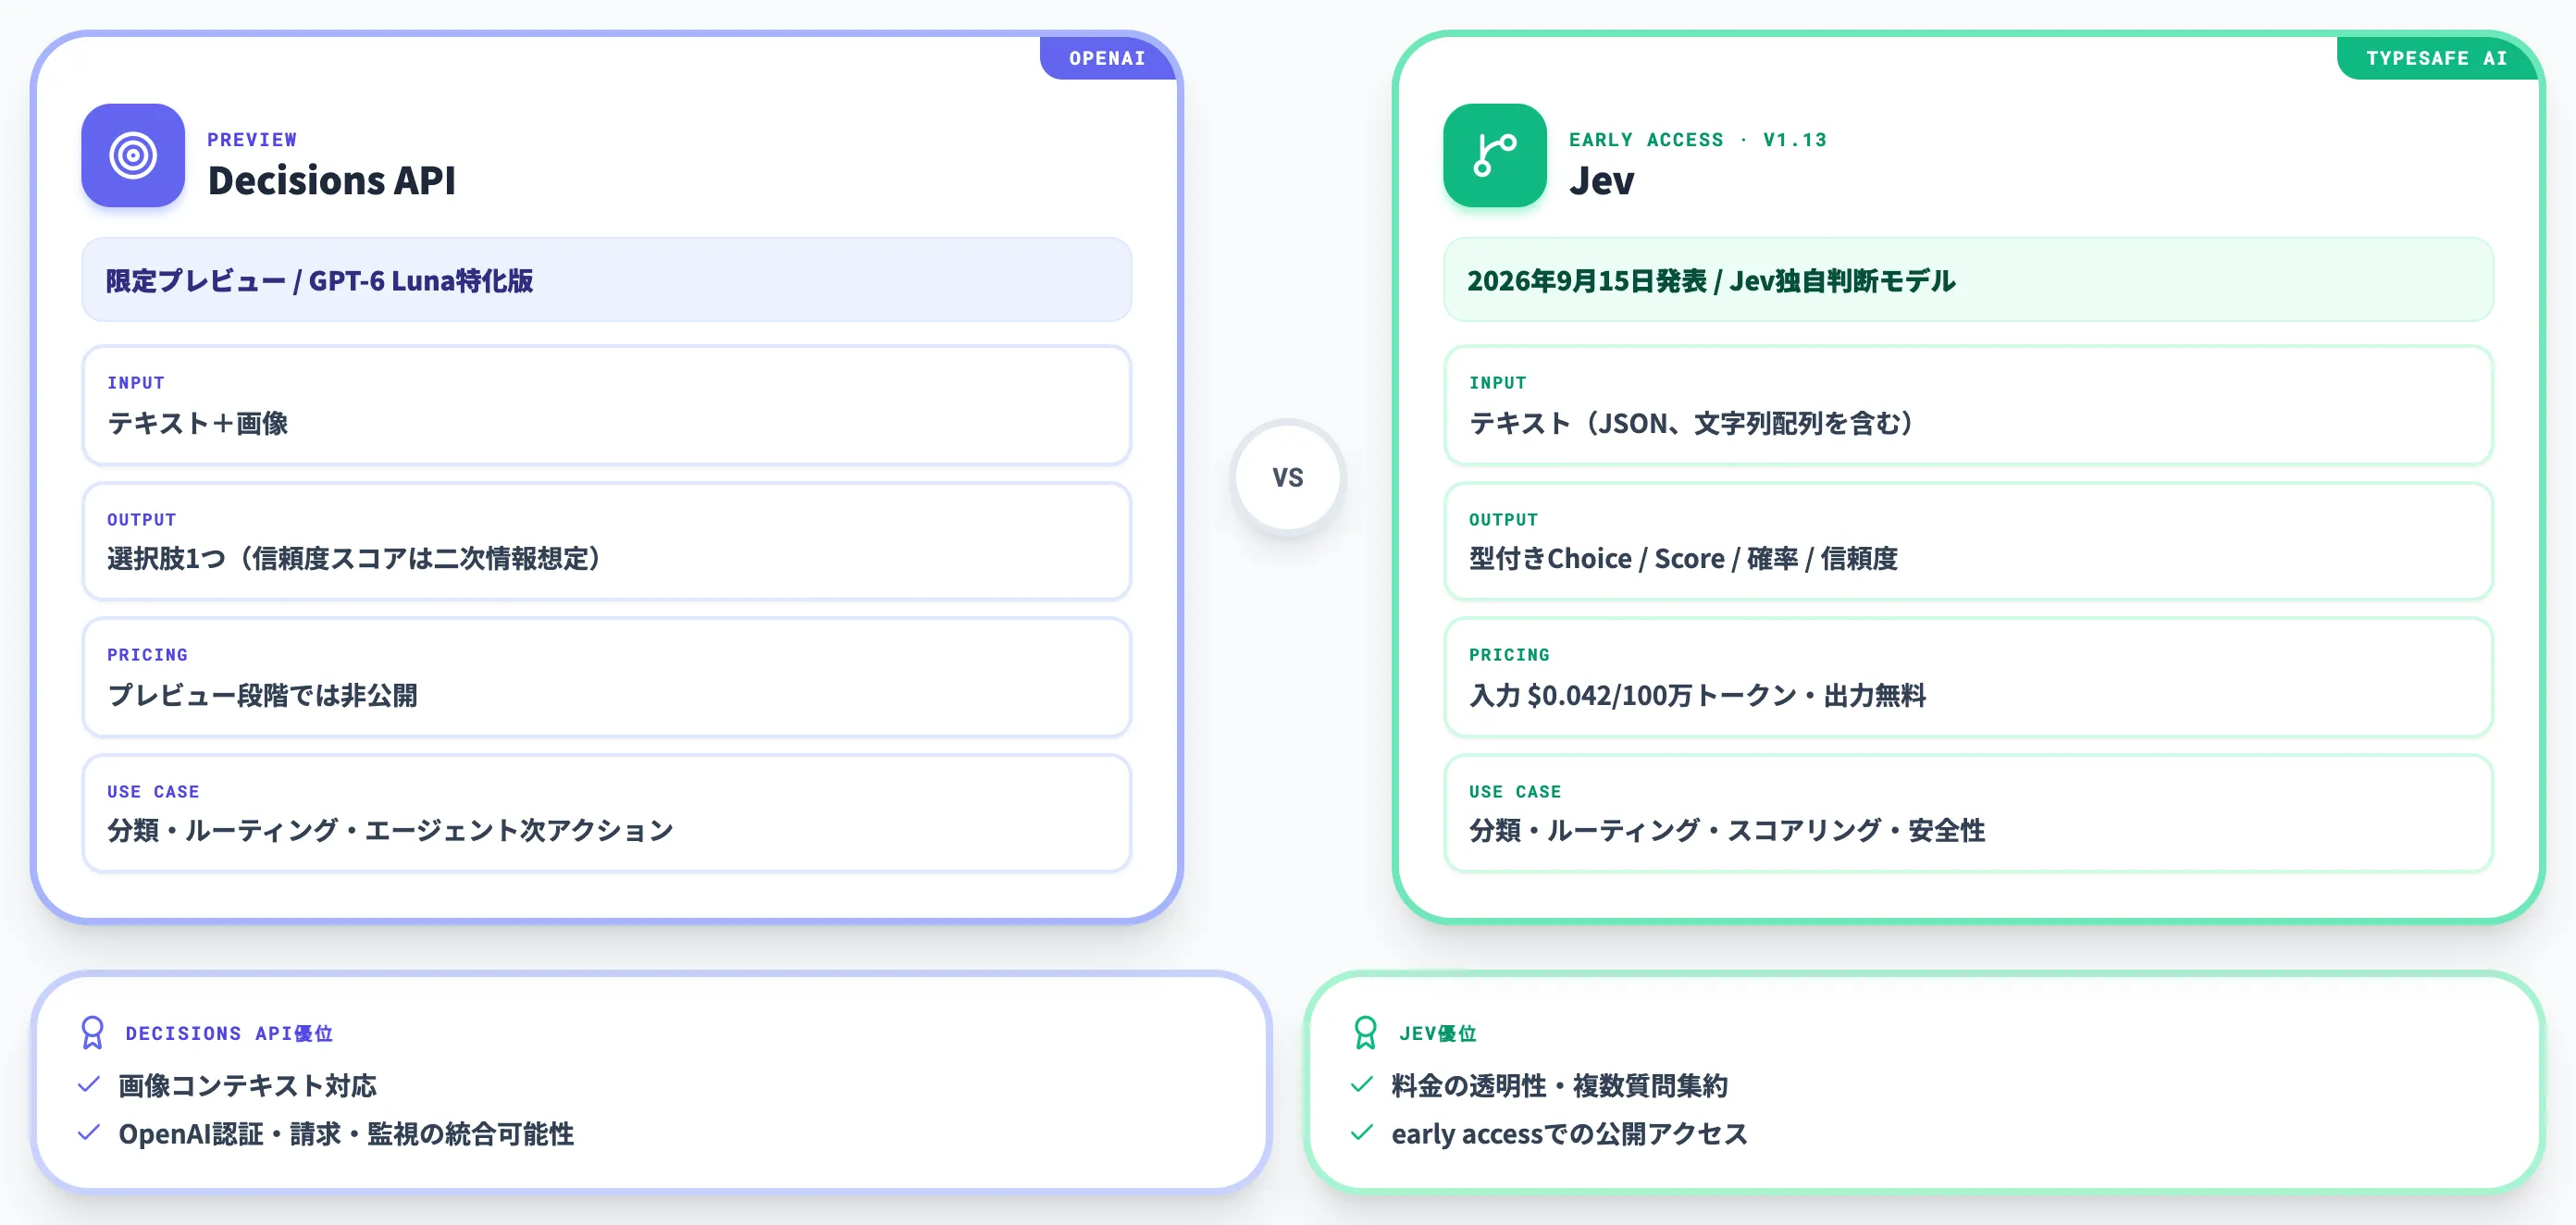
Decisions APIには先行の類似APIとして、TypeSafe AI社のJev(および同社の類似APIであるCriteria)が存在します。
以下の表で、Decisions API(プレビュー)とJev(1.13)の主要仕様を整理しました。
| 項目 | Decisions API | Jev(TypeSafe AI) |
|---|---|---|
| 提供状況 | 限定プレビュー | early access(2026年9月15日発表) |
| 基盤モデル | GPT-6 Luna特化版 | Jev独自の判断モデル |
| 入力形式 | テキスト+画像 | テキスト(JSON、文字列配列を含む) |
| 出力 | 選択肢1つ(二次情報ベースでは信頼度スコア併記の想定・公式仕様未公表) | 型付きChoice、Score、確率と信頼度 |
| 複数質問の集約 | 未公表 | サポート(1リクエストで独立した複数質問) |
| 料金 | プレビュー段階では非公開 | 入力$0.042/100万トークン、出力無料 |
| 想定用途 | 分類・ルーティング・エージェント次アクション | 分類・ルーティング・スコアリング・安全性チェック |
スペック上、現時点でJevが優位に見えるのは料金の透明性・複数質問集約・early accessでの公開アクセスという3点です。
逆にDecisions APIが優位に見える点は、公式Recapで示された画像コンテキスト対応と、OpenAIエコシステム内で認証・請求・監視を一体化できる可能性の2点です(Astra/Sol/Luna・Agents API・Codexとの直接統合は公式には未確認)。
選定の判断軸
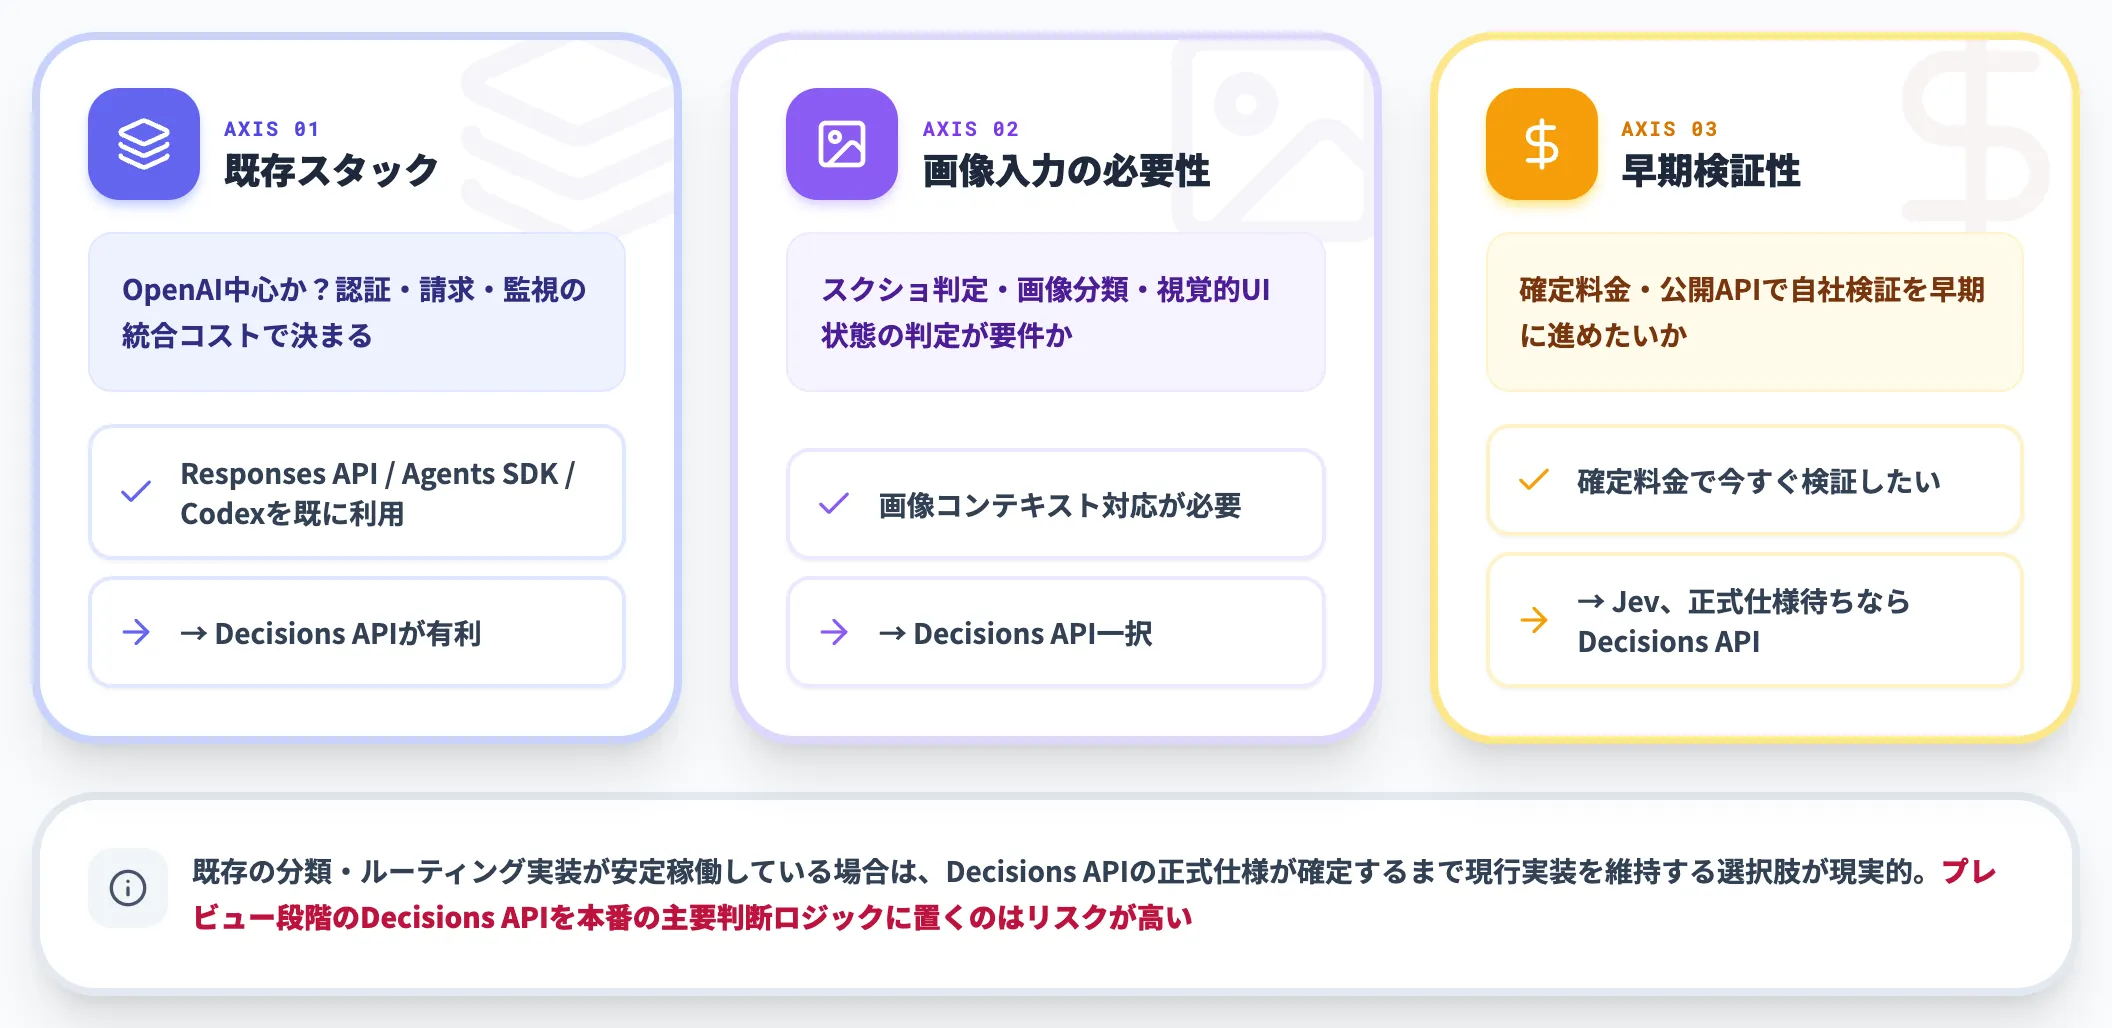
実務でDecisions APIとJevのどちらを選ぶかは、以下の3つの軸で決まります。
-
既存スタックがOpenAI中心かどうか
Responses API・Agents SDK・Codexを既に使っているなら、認証・請求・監視の統合コストが低いDecisions APIが有利
-
画像入力の必要性
スクリーンショット判定・画像分類・視覚的UI状態の判定が必要なら現時点でDecisions API一択
-
確定料金・公開APIで検証を進めたいか
確定した料金体系と公開されたAPIで自社検証を早期に進めたいならJev、広範提供後の正式仕様確定と料金開示を待って統合したいならDecisions API。プレビュー段階のDecisions APIを本番の主要判断ロジックに置くのはリスクが高い
一般的な移行判断としては、既存の分類・ルーティング実装が安定稼働している場合、Decisions APIの正式仕様が確定するまでは現行実装を維持する選択肢が現実的です。これから新規で分類・ルーティング層を組む案件、または画像コンテキストが必要な案件では、Decisions APIのプレビュー参加を早めに検討する価値があります。
独立検証の観点
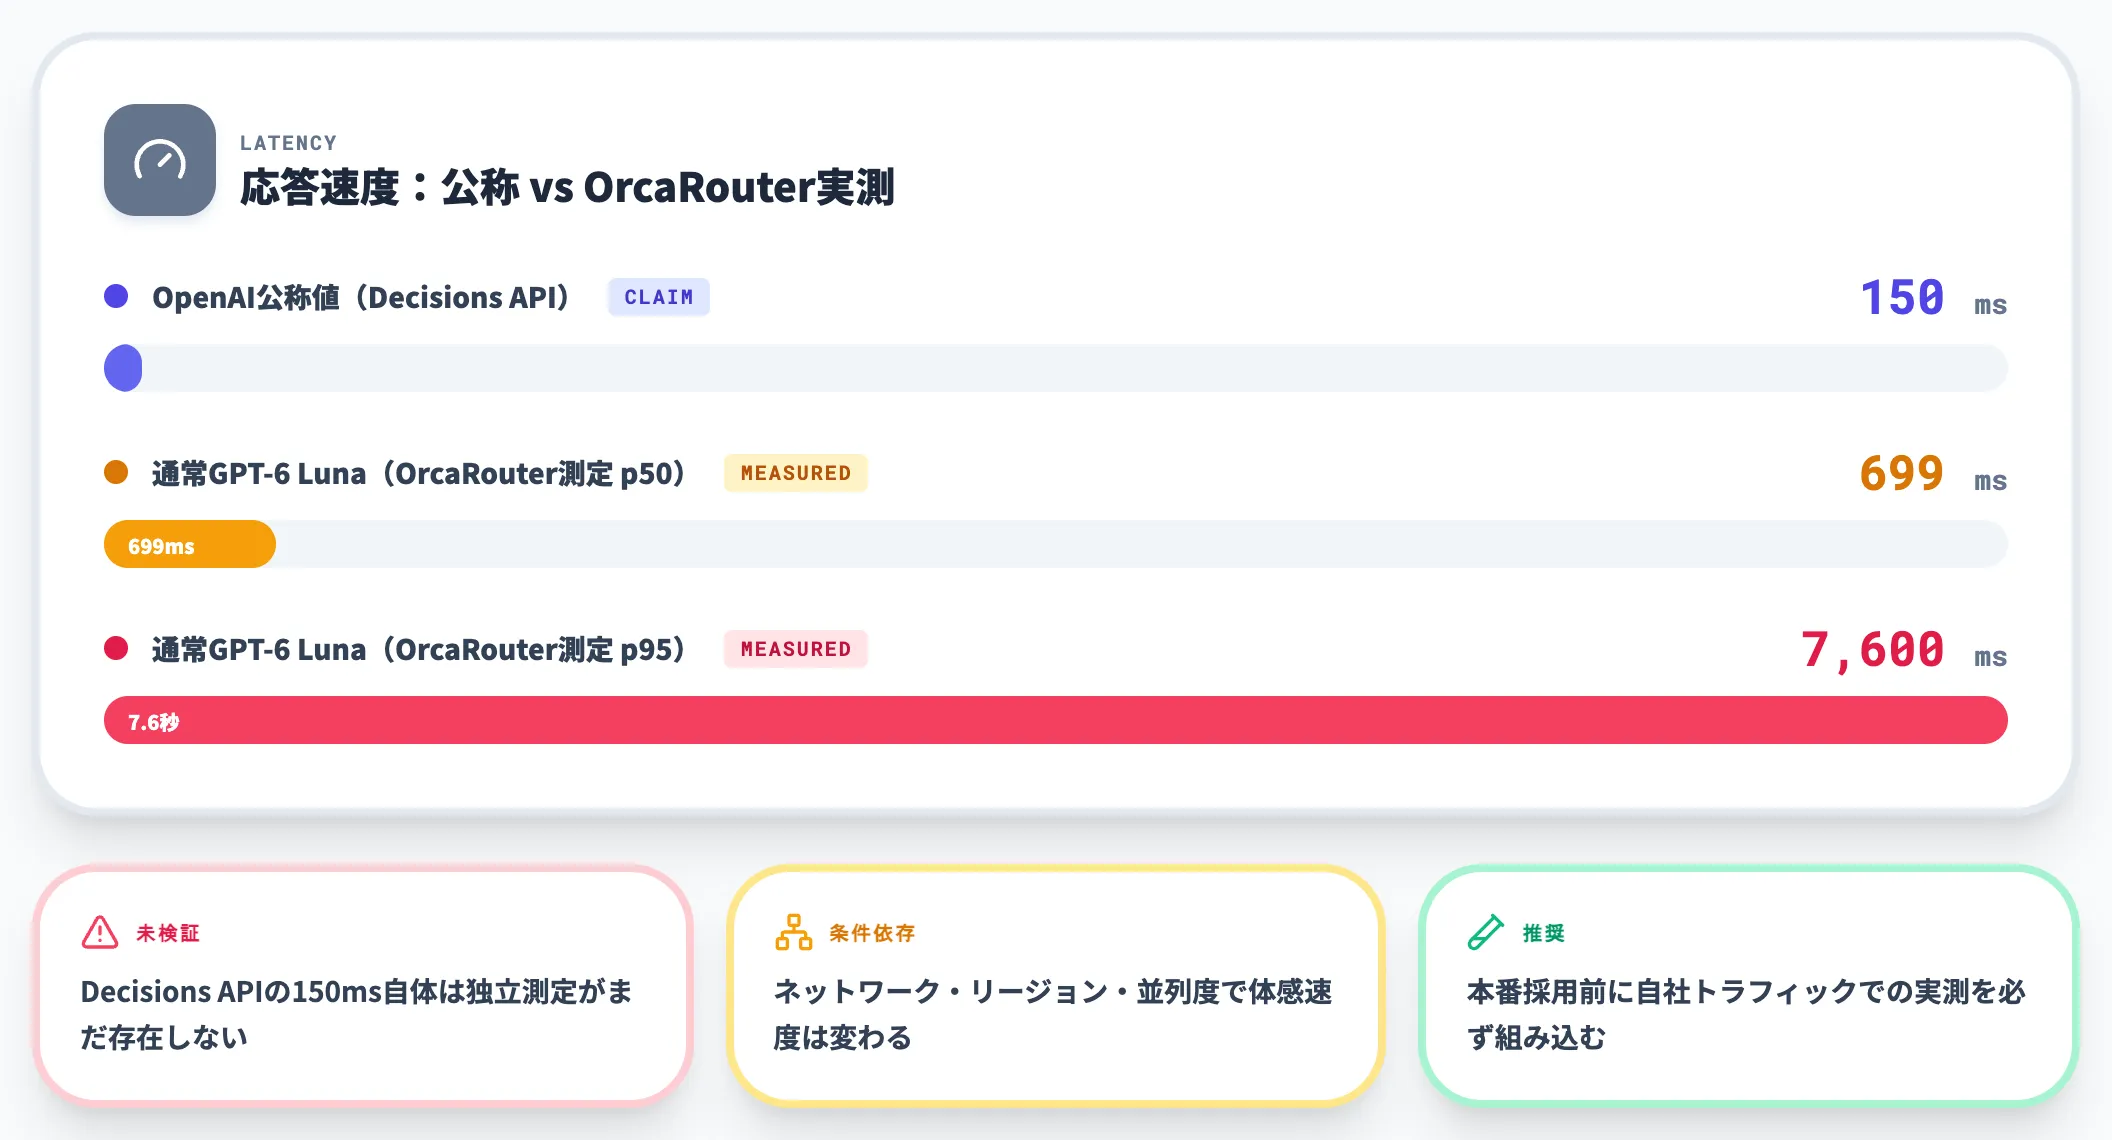
OrcaRouterの分析は、Decisions APIの「150ms」という速度主張について、独立した測定がまだ存在しない点を指摘しています。同社の実運用測定では通常のGPT-6 Lunaコールでp50=699ms、p95=7.6秒という値も観測されており、ネットワーク条件・リージョン・並列度によって体感速度は変わり得ます。
本番採用前には、自社のトラフィックプロファイルで実測する工程を必ず組み込むことが推奨されます。
Decisions APIとAgents APIを組み合わせる独自アーキテクチャ案
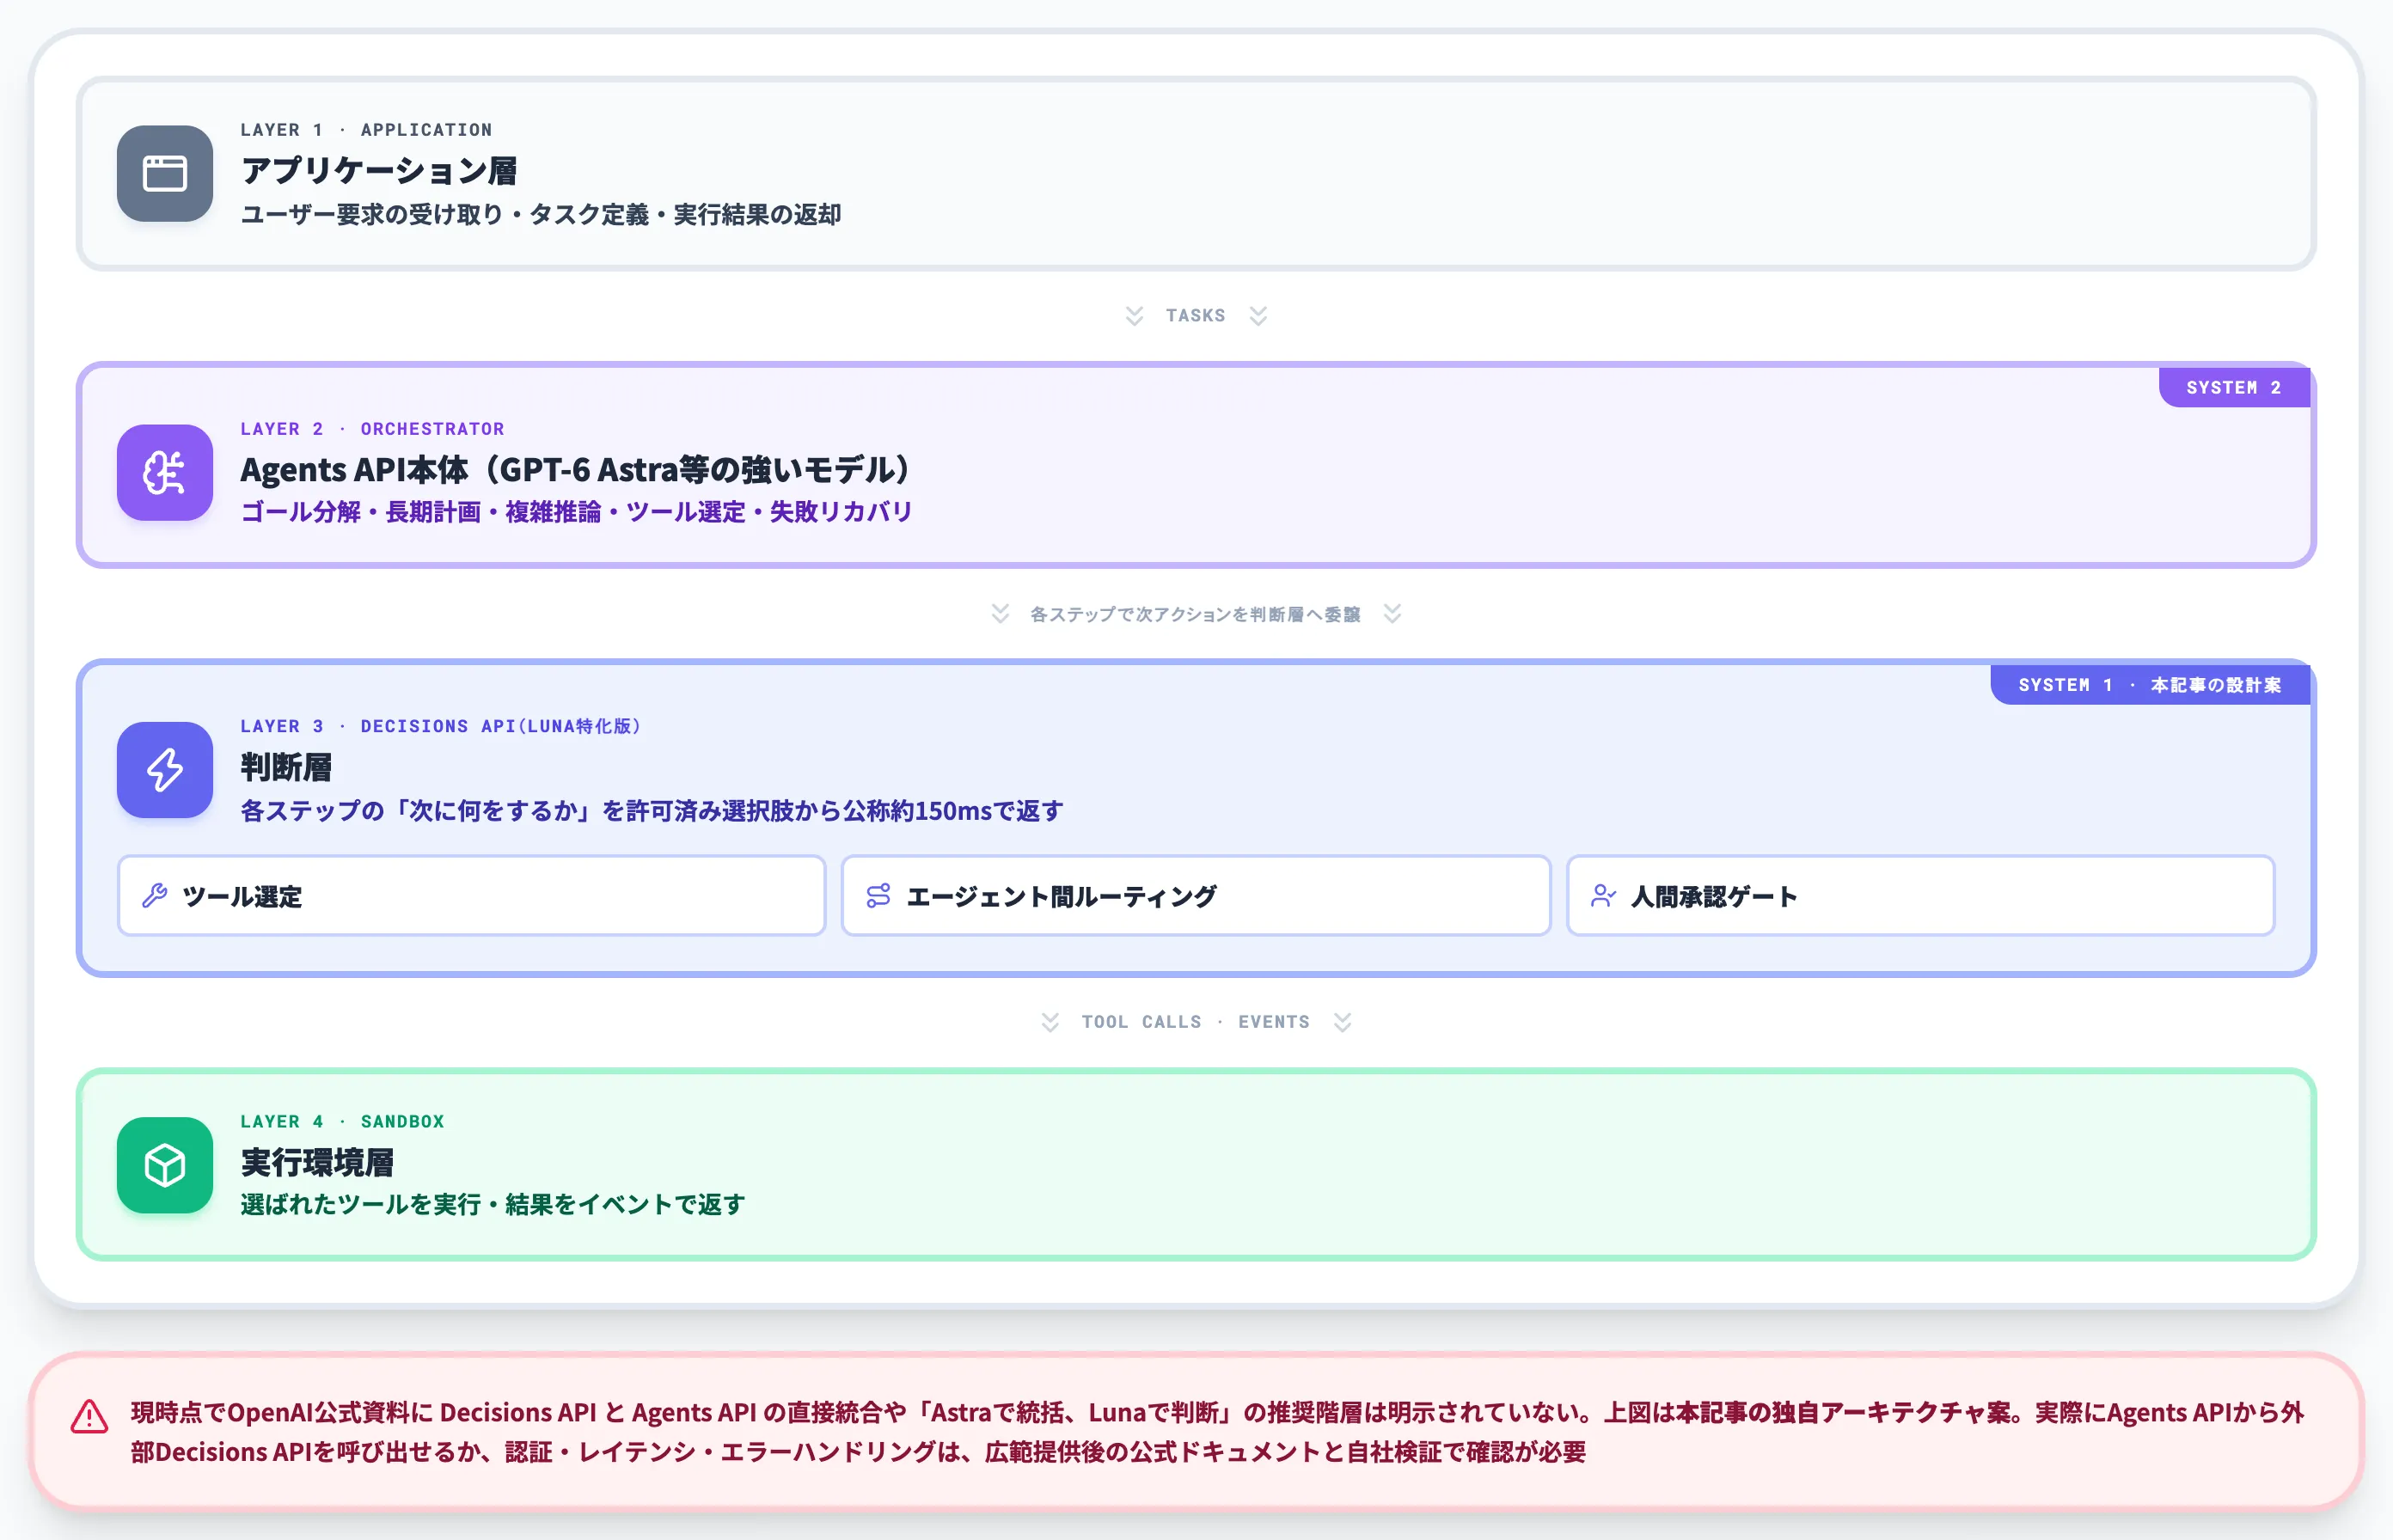
Decisions APIをエージェント実装に組み込むとき、Agents API(2026年9月10日にpublic betaとして発表、DevDay 2026でcomputer use対応などが追加)の中で判断層として使う設計が有力な選択肢になります。
ただし現時点で、OpenAI公式資料にDecisions APIとAgents APIの直接統合や「Astraで統括、Lunaで判断」という推奨階層は明示されていません。以下は本記事の独自アーキテクチャ案として整理したものです。
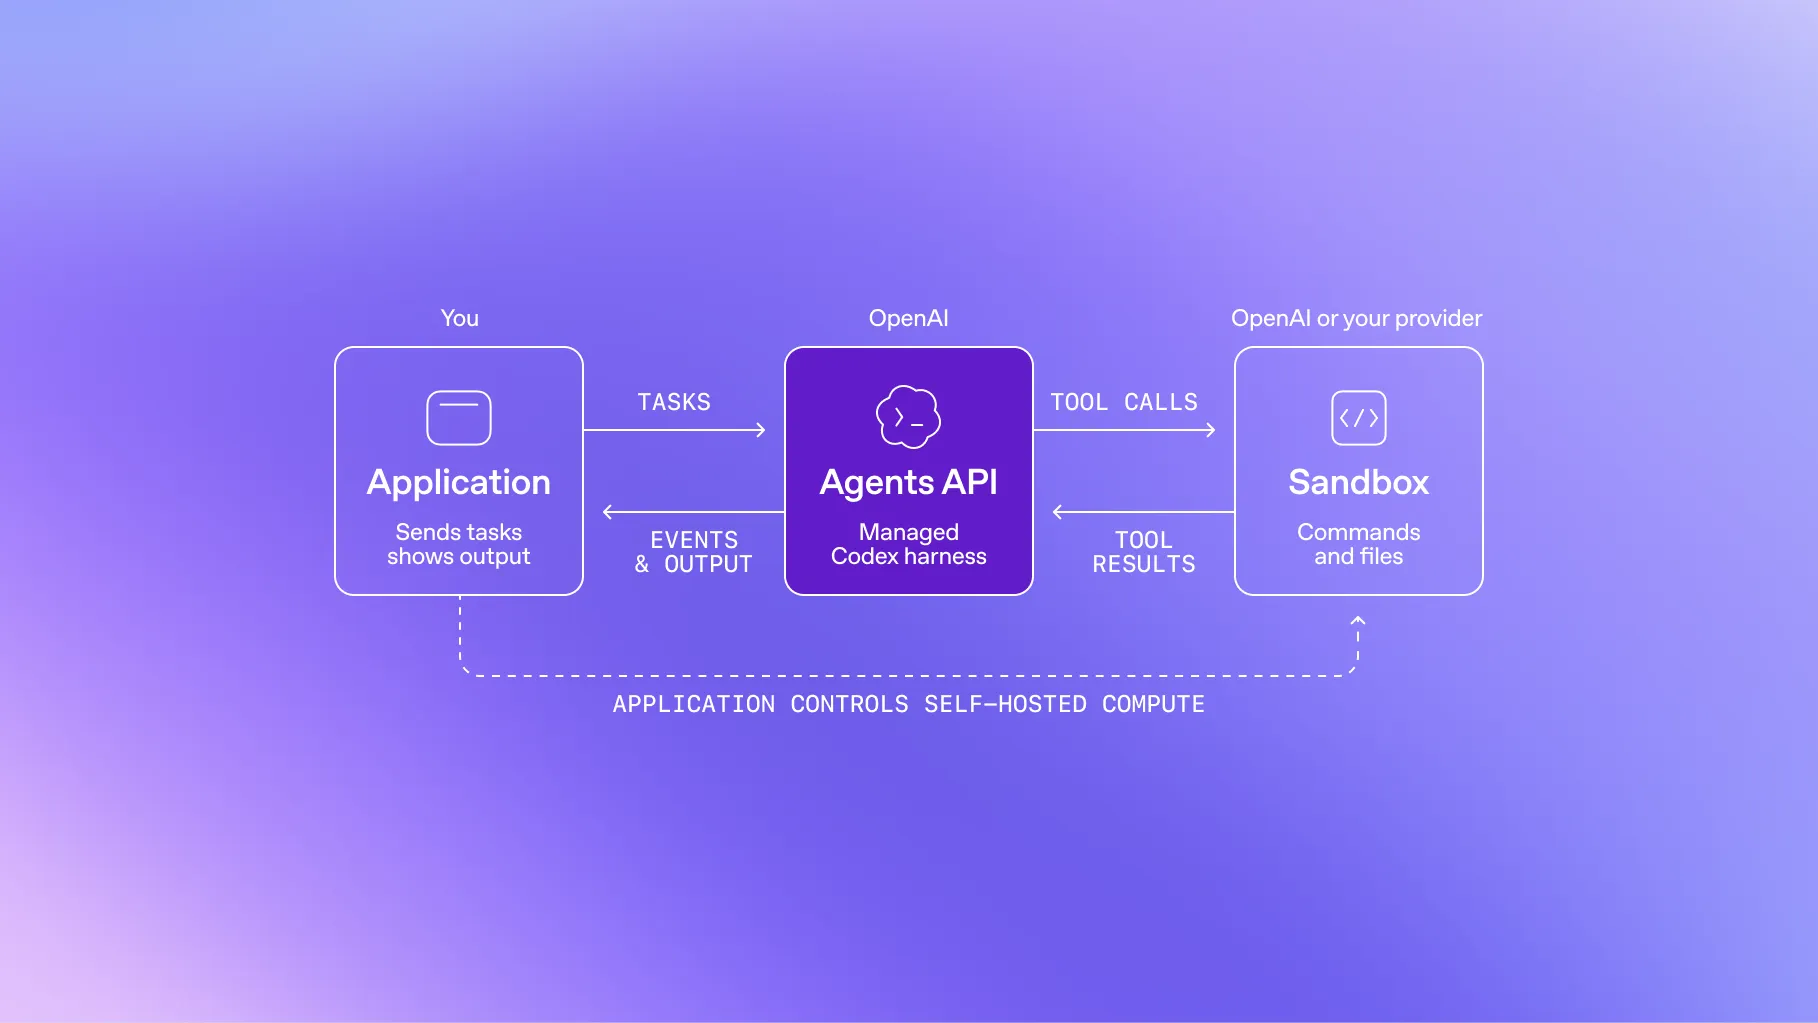
Agents APIの三層構成——Application/Agents API本体/Sandboxがtasks・tool calls・eventsで連携する構造(出典:OpenAI DevDay 2026 Recap)
上図はAgents APIがApplication・Agents API本体・Sandboxの三層でタスクとツール呼び出しを交換する構成を示しています。この構造の中でDecisions APIを判断層として組み込む設計を、本記事では以下のように整理します。
階層モデルの設計案
本記事で提案する階層設計は、強いモデルでオーケストレーション、Lunaで個別判断の分担です。この分担はOpenAI公式の推奨構成ではなく、System 1系(高速判断)とSystem 2系(複雑推論)を役割で切り分けるという一般的な設計思想の適用例として提示します。
-
オーケストレーター層(GPT-6 Astra等の強いモデル)
ゴール分解、長期計画、複雑な推論、ツール選定、失敗時のリカバリ。1タスクに数秒〜数十秒かかっても構わない領域を担当
-
判断層(Decisions API=GPT-6 Luna特化版)
オーケストレーターが計画した各ステップで「次に何をするか」を高速に返す。ループの各周回で発生する判断を細粒度で回す
この分担が有効なのは、エージェントのループで発生する短い判断を、都度重いモデルに投げないで済むためです。実運用でのスループット改善幅は、判断のコール数・入力コンテキスト長・並列度に依存するため、本番投入前に自社トラフィックでの実測が必要です。
具体的な組み込みパターン(本記事の設計案)
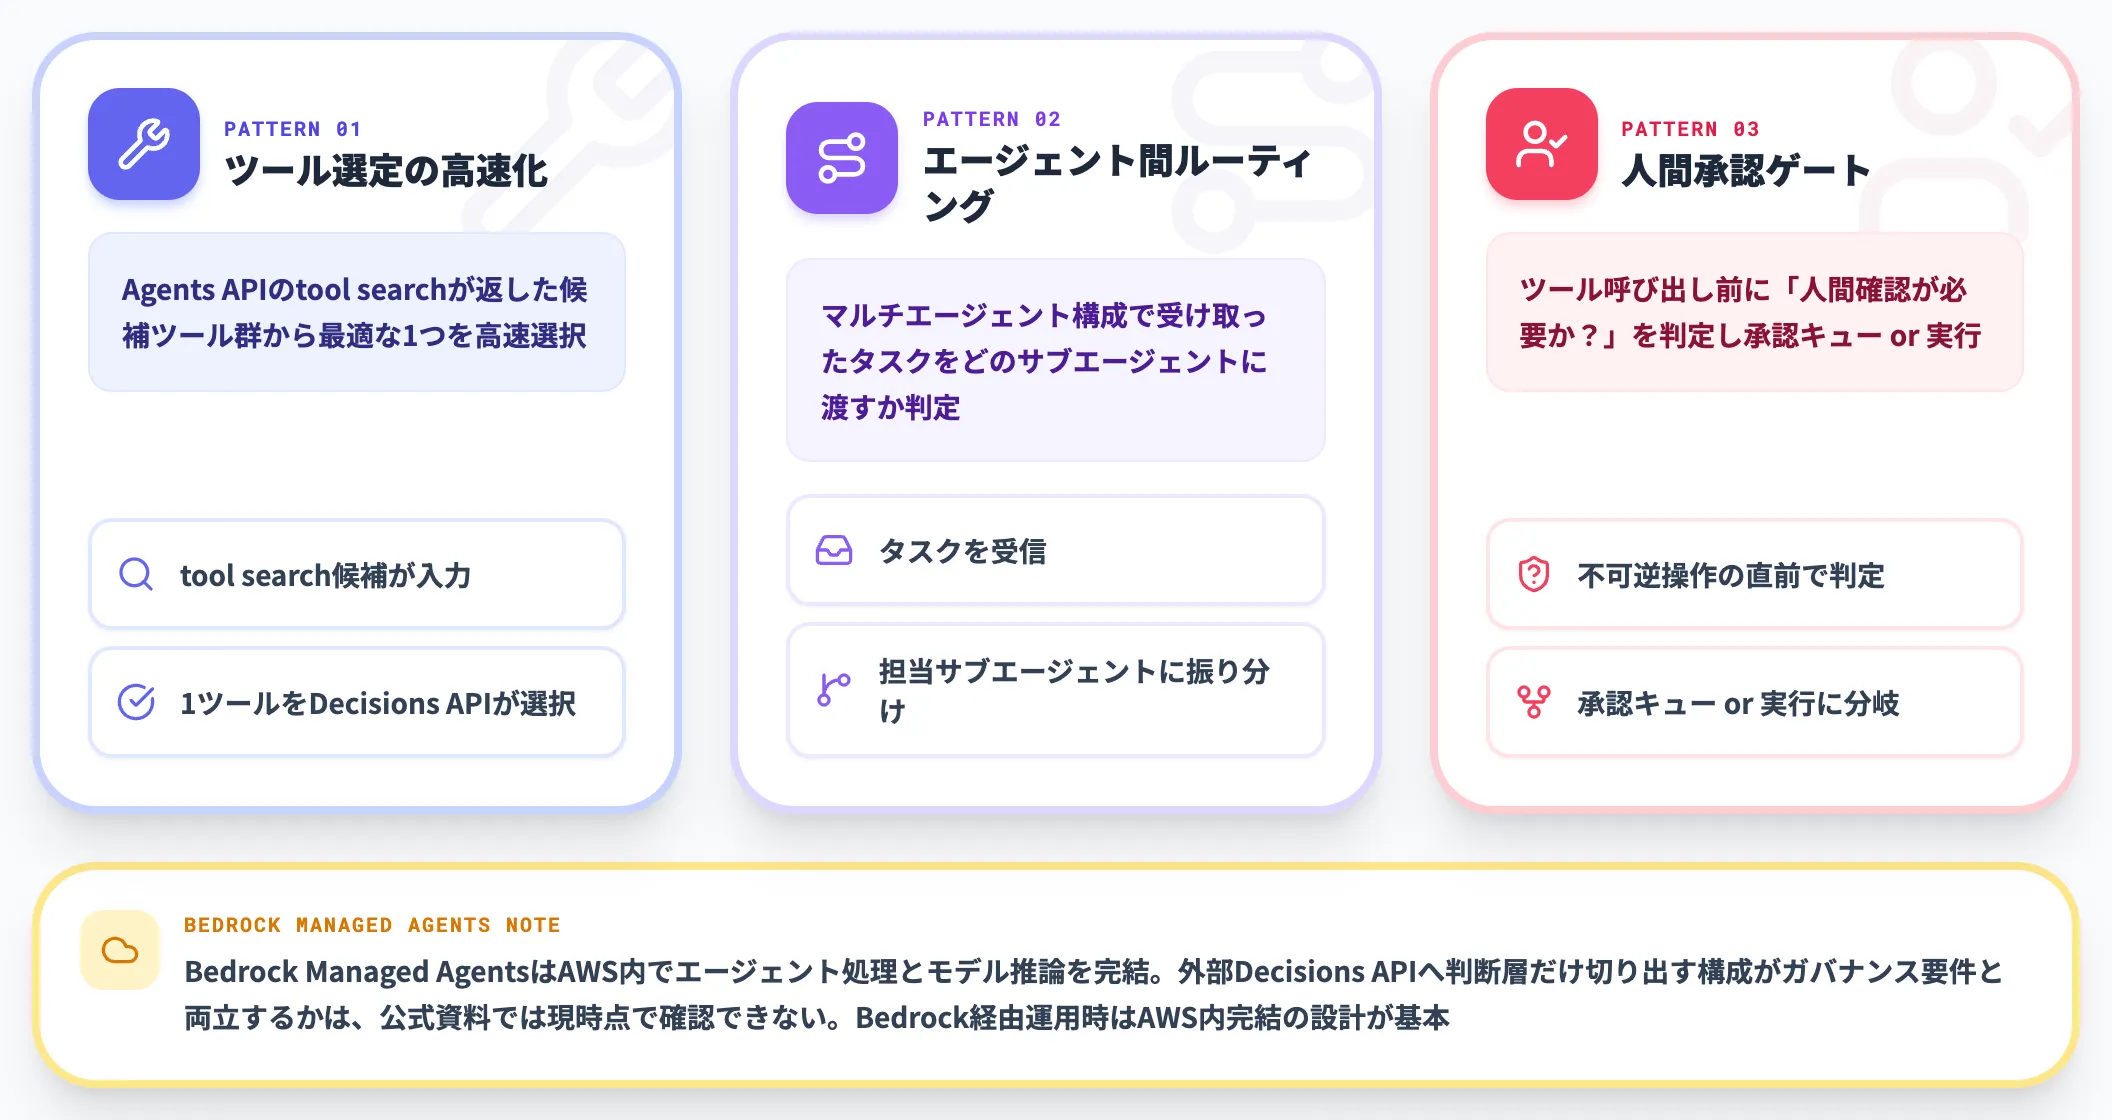
Agents API内でDecisions APIを使うと想定できる組み込みポイントは以下の3箇所です。いずれもOpenAI公式が推奨する構成ではなく、本記事が実装案として提示するものです。実際にAgents APIから外部のDecisions APIを呼び出せるか、認証・レイテンシ・エラーハンドリングをどう扱うかは、広範提供後の公式ドキュメントと自社検証で確認する必要があります。
-
ツール選定の高速化
Agents APIのtool searchが返した候補ツール群から、Decisions APIで最適な1つを高速に選ぶ
-
エージェント間ルーティング
マルチエージェント構成で、受け取ったタスクをどのサブエージェントに渡すかをDecisions APIが判定
-
人間承認ゲート
ツール呼び出し前に「これは人間確認が必要か?」をDecisions APIで判定し、必要なら承認キューへ、不要ならそのまま実行
なお、Bedrock Managed AgentsはAWS内でエージェント処理とモデル推論を完結させることを特徴としています。外部のDecisions APIへ判断層だけを切り出す構成がガバナンス要件と両立するかどうかは、公式資料では現時点で確認できません。Bedrock経由で運用する場合は、AWS内完結の設計を基本にし、外部API併用は個別に検討する必要があります。
Decisions APIの料金と提供状況
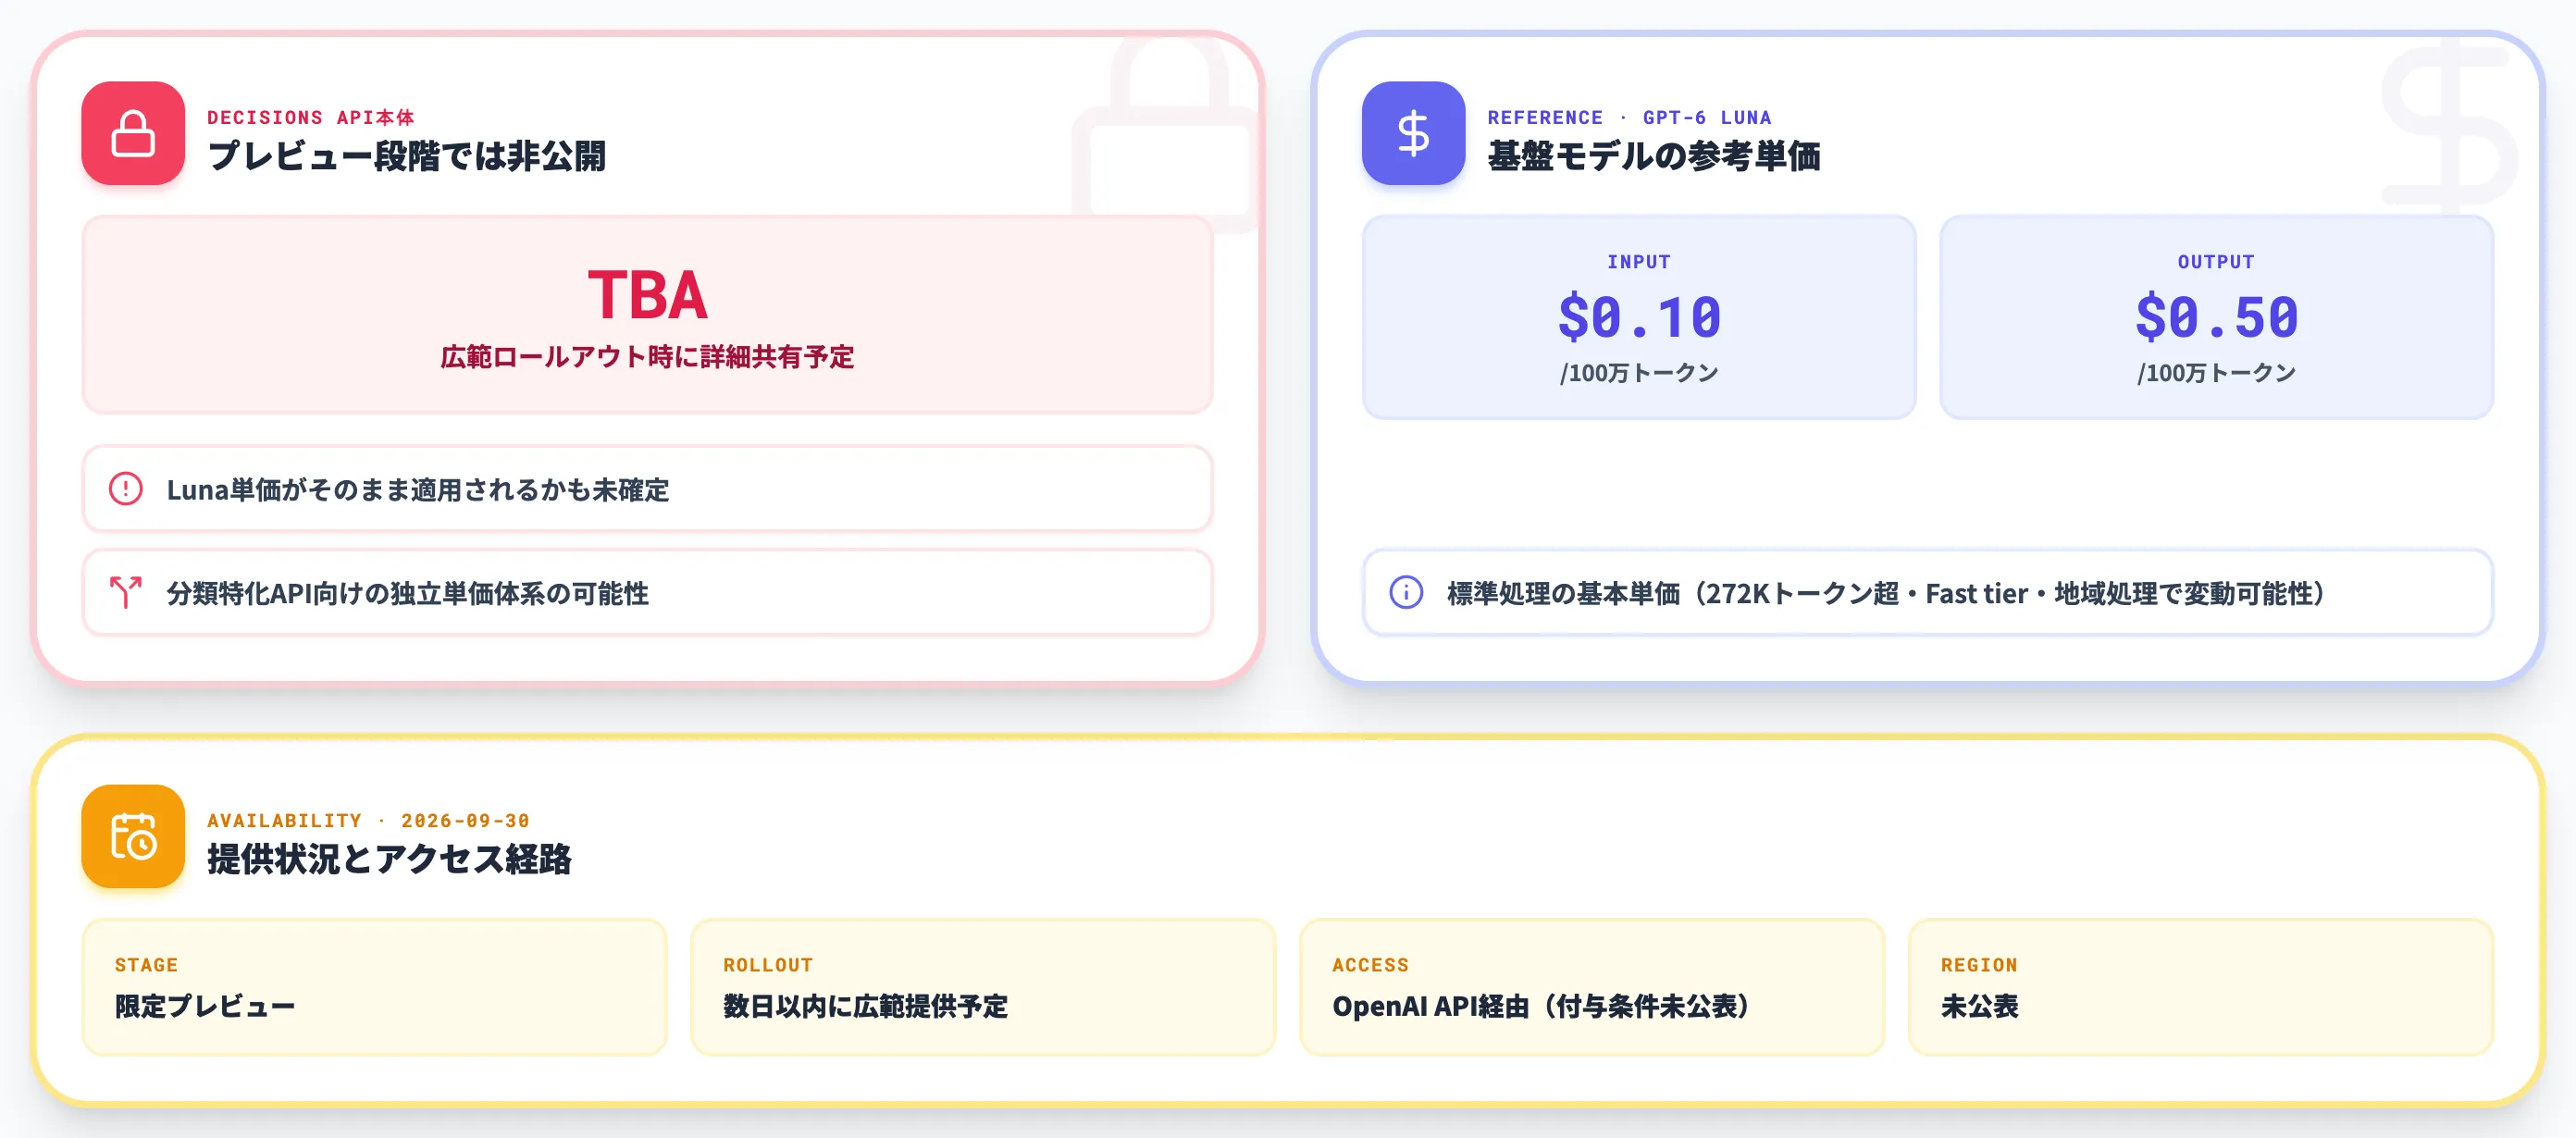
Decisions APIの料金と提供状況は、DevDay 2026時点では未確定要素が多く残ります。プレビュー段階でどこまで見えているかを整理します。
料金体系(2026年9月時点)
Decisions API自体の料金は、プレビュー段階では公開されていません。The New Stackの取材に対し、OpenAI広報は「広範ロールアウト時に詳細を共有する」と回答しています。
参考として、基盤となるGPT-6 Luna単体の標準処理の基本単価は入力$0.10/出力$0.50(100万トークンあたり)ですが、272Kトークン超の入力・Fast tier・地域処理などでは料金が変わる可能性があり、この単価がそのままDecisions APIに適用されるかも未確定です。
Decisions APIは通常の生成タスクではなく、有限選択肢からの分類タスクという設計のため、単価体系そのものが異なる可能性があります。
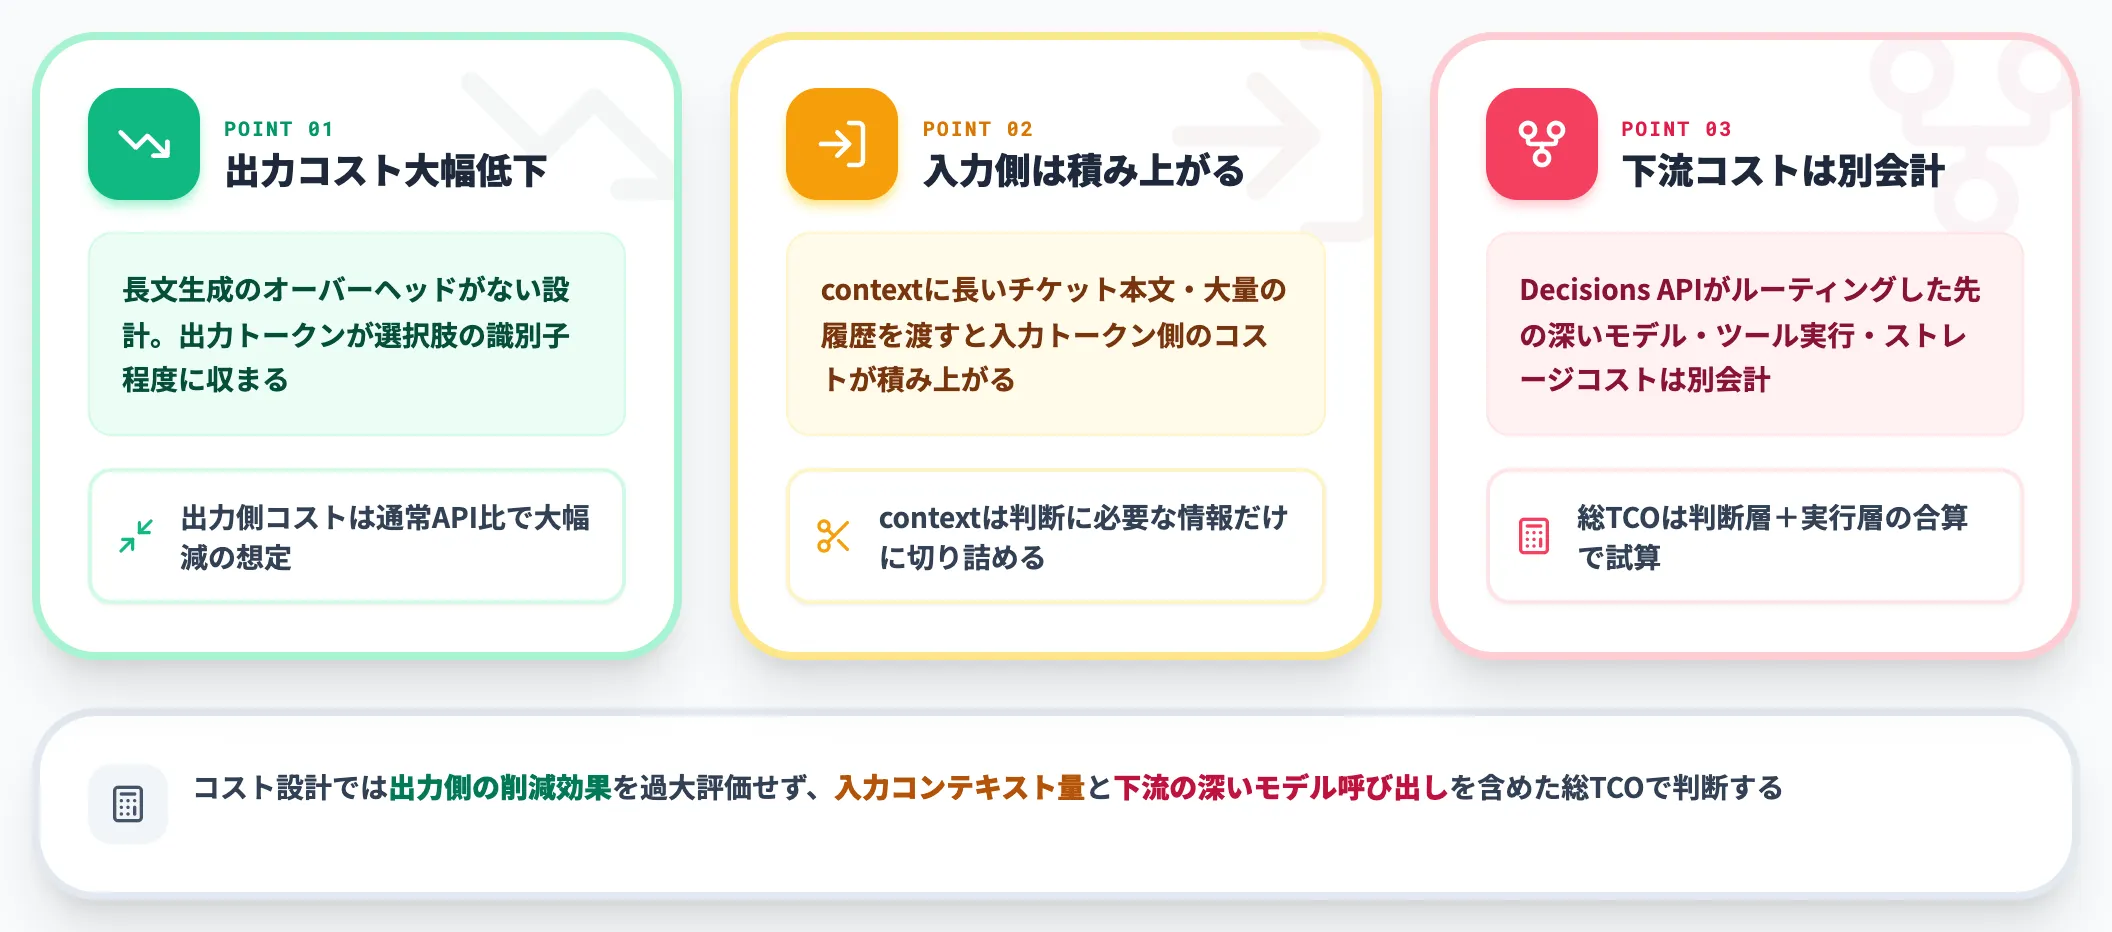
コスト設計時に念頭に置くべきポイントは以下の通りです。
-
長文生成のオーバーヘッドがない
出力トークンが選択肢の識別子程度に収まるため、通常APIより出力側コストは大幅に低くなる想定
-
入力コンテキストのコストは別途発生
context に長いチケット本文・大量の履歴を渡すと、入力トークン側のコストが積み上がる
-
下流モデル・ツール実行のコストは含まれない
Decisions APIがルーティングした先の深いモデルコール・ツール実行・ストレージコストは別会計
提供状況とアクセス経路
現時点(2026年9月30日)で公表されている提供状況は以下の通りです。
- 段階: 限定プレビュー
- 広範提供: DevDay発表から「数日以内」を予定と公式Recapで公表
- アクセス方法: OpenAI API経由(既存OpenAI開発者アカウントへの付与手順・条件は未公表)
- リージョン: 未公表
プレビュー段階のため、エンドポイントの命名、認証スコープの粒度、レートリミット、モデル識別子、信頼度スコアの意味論(0-1の連続値か、離散カテゴリか等)はいずれも広範提供・正式仕様の開示時点で変更される可能性があります。
本番採用を検討するチームは、まずダッシュボードで自社アカウントへの付与状況を確認し、プレビュー期間中は非本番のシャドウトラフィックで検証する運用が推奨されます。
Decisions API導入で詰まる論点——実装事例から逆算した判断軸
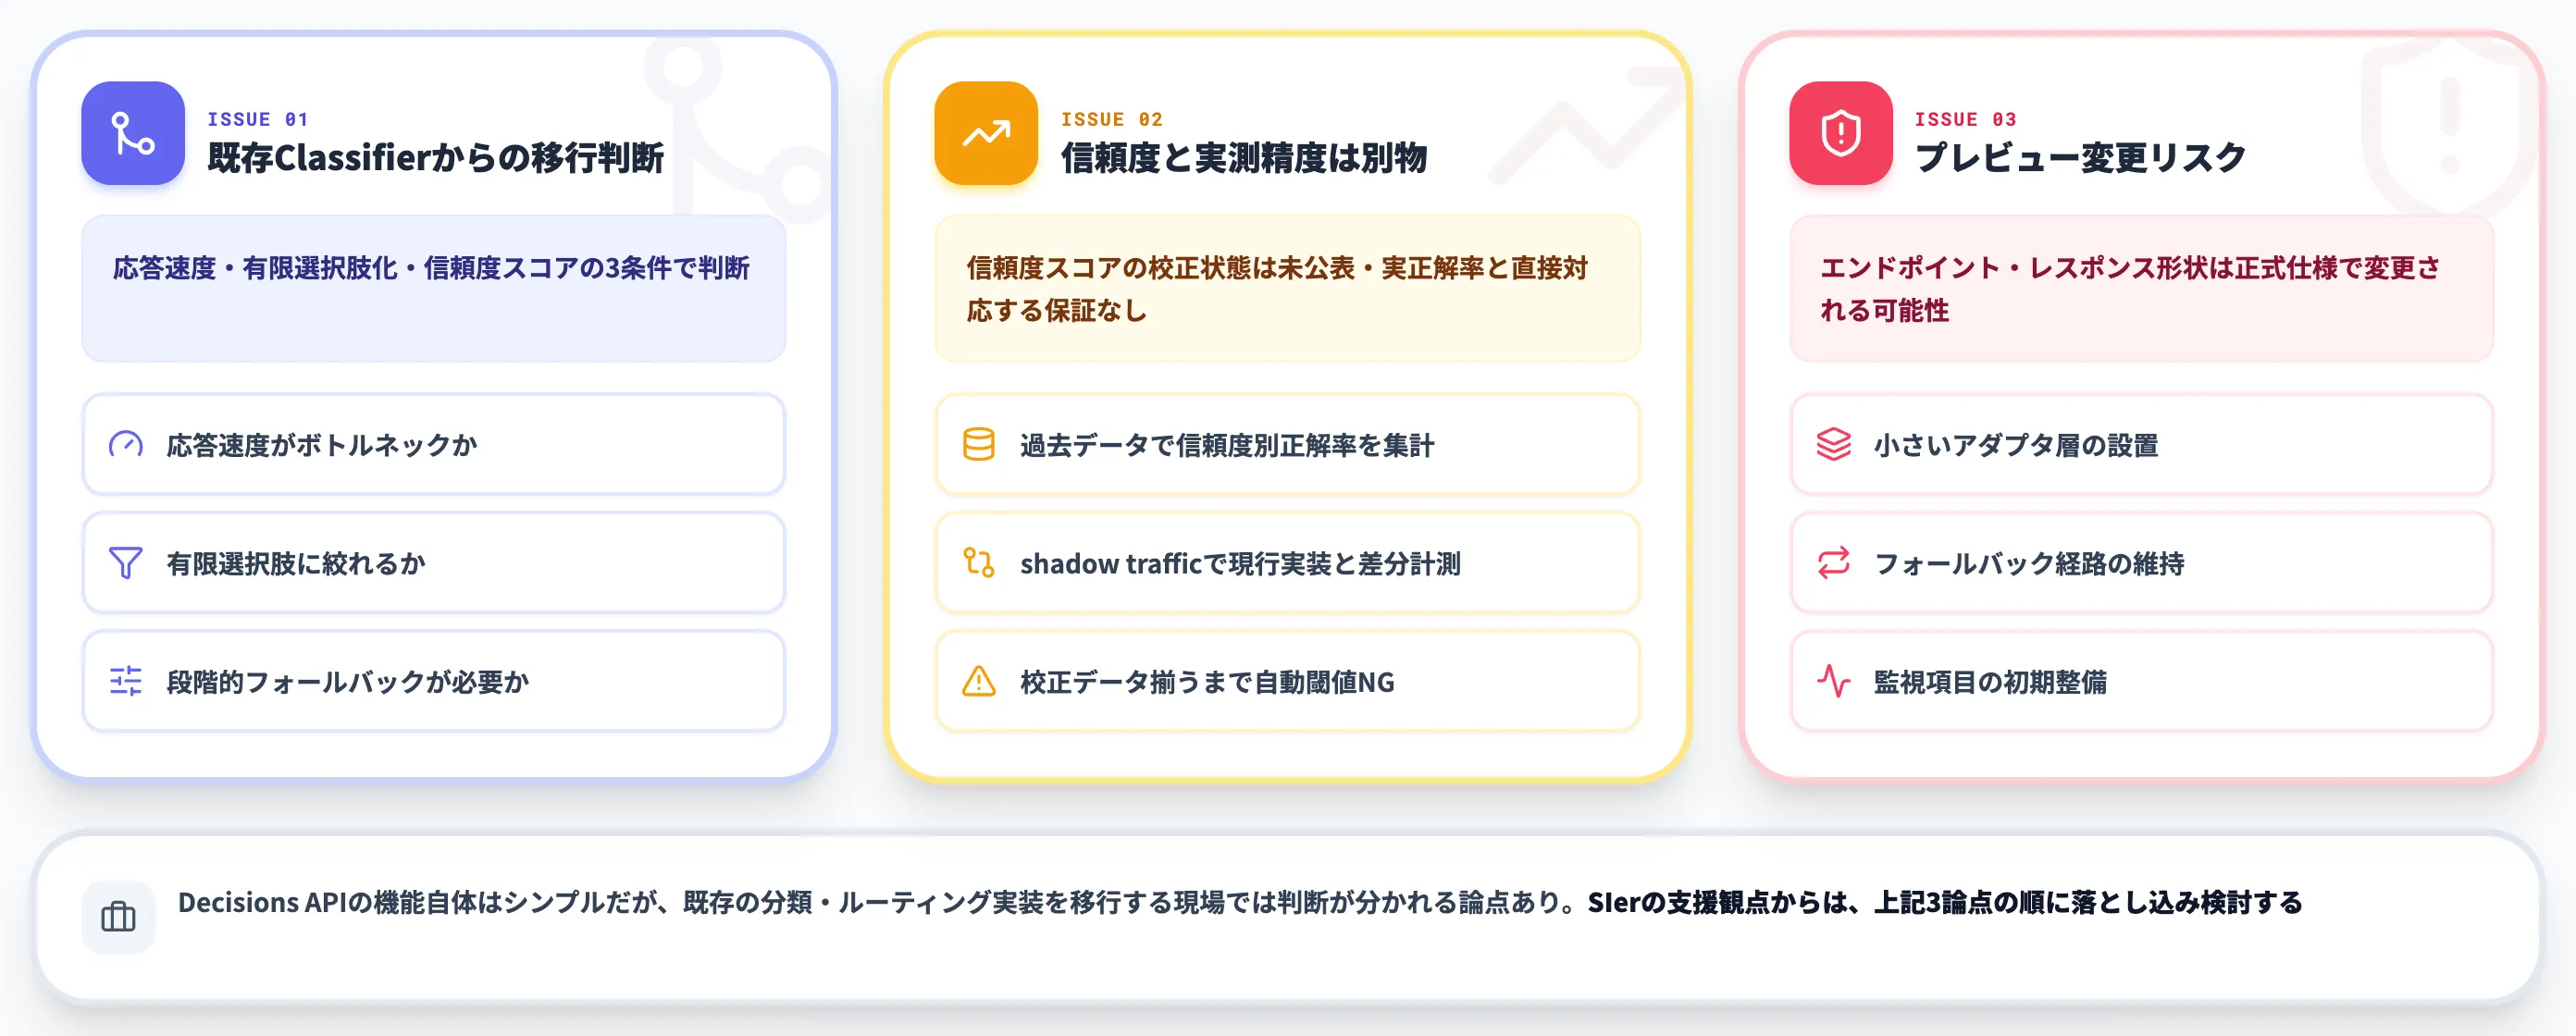
Decisions APIの機能自体はシンプルですが、既存の分類・ルーティング実装を移行する現場では判断が分かれる論点がいくつかあります。
プレビュー段階で見えてきた実装リスクを、SIerとしての支援観点から整理します。
既存Classifierからの移行判断3条件
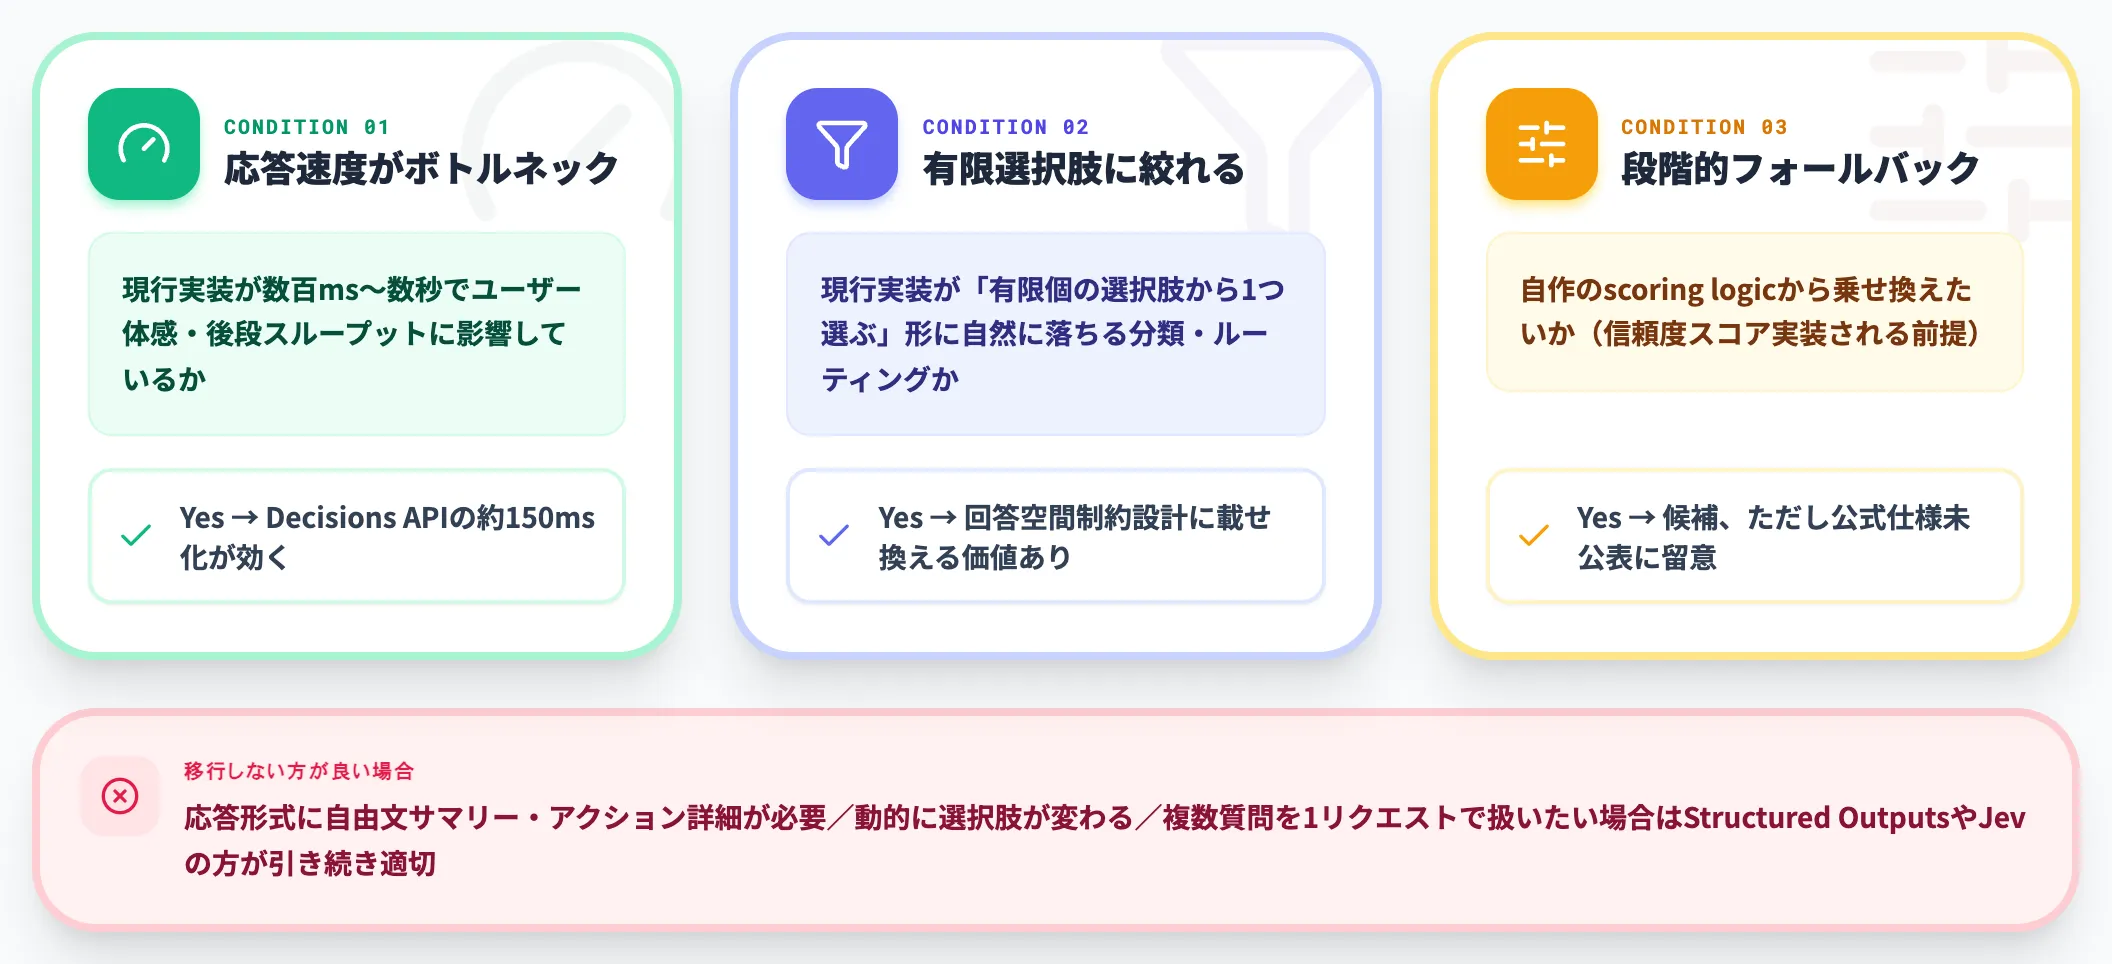
プロンプト+JSON Schema+後処理で組んだ既存のClassifierをDecisions APIに置き換えるかどうかは、以下の3条件で判断できます。
-
応答速度が業務ボトルネックか
現行実装が数百ms〜数秒の分類レイテンシで、ユーザー体感や後段処理のスループットに影響しているならDecisions APIの公称約150ms化が効く
-
有限選択肢に絞れる分類か
現行実装が「有限個の選択肢から1つ選ぶ」形に自然に落ちる分類・ルーティングであれば、Decisions APIの回答空間制約設計に載せ換える価値がある
-
信頼度スコアで段階的フォールバックを組みたいか
Hugging Face等の二次情報では信頼度スコアが返る想定が示されており、自作のscoring logicから乗せ換えたい場合は候補になる(信頼度スコアの公式仕様・算出方法・意味論・校正状態はいずれも未公表)
逆に、応答形式に自由文サマリーやアクション詳細が必要、動的に選択肢が変わる、複数質問を1リクエストで扱いたい場合は、Structured OutputsやJevの方が引き続き適切な場合があります。
信頼度スコアと実測精度は別物
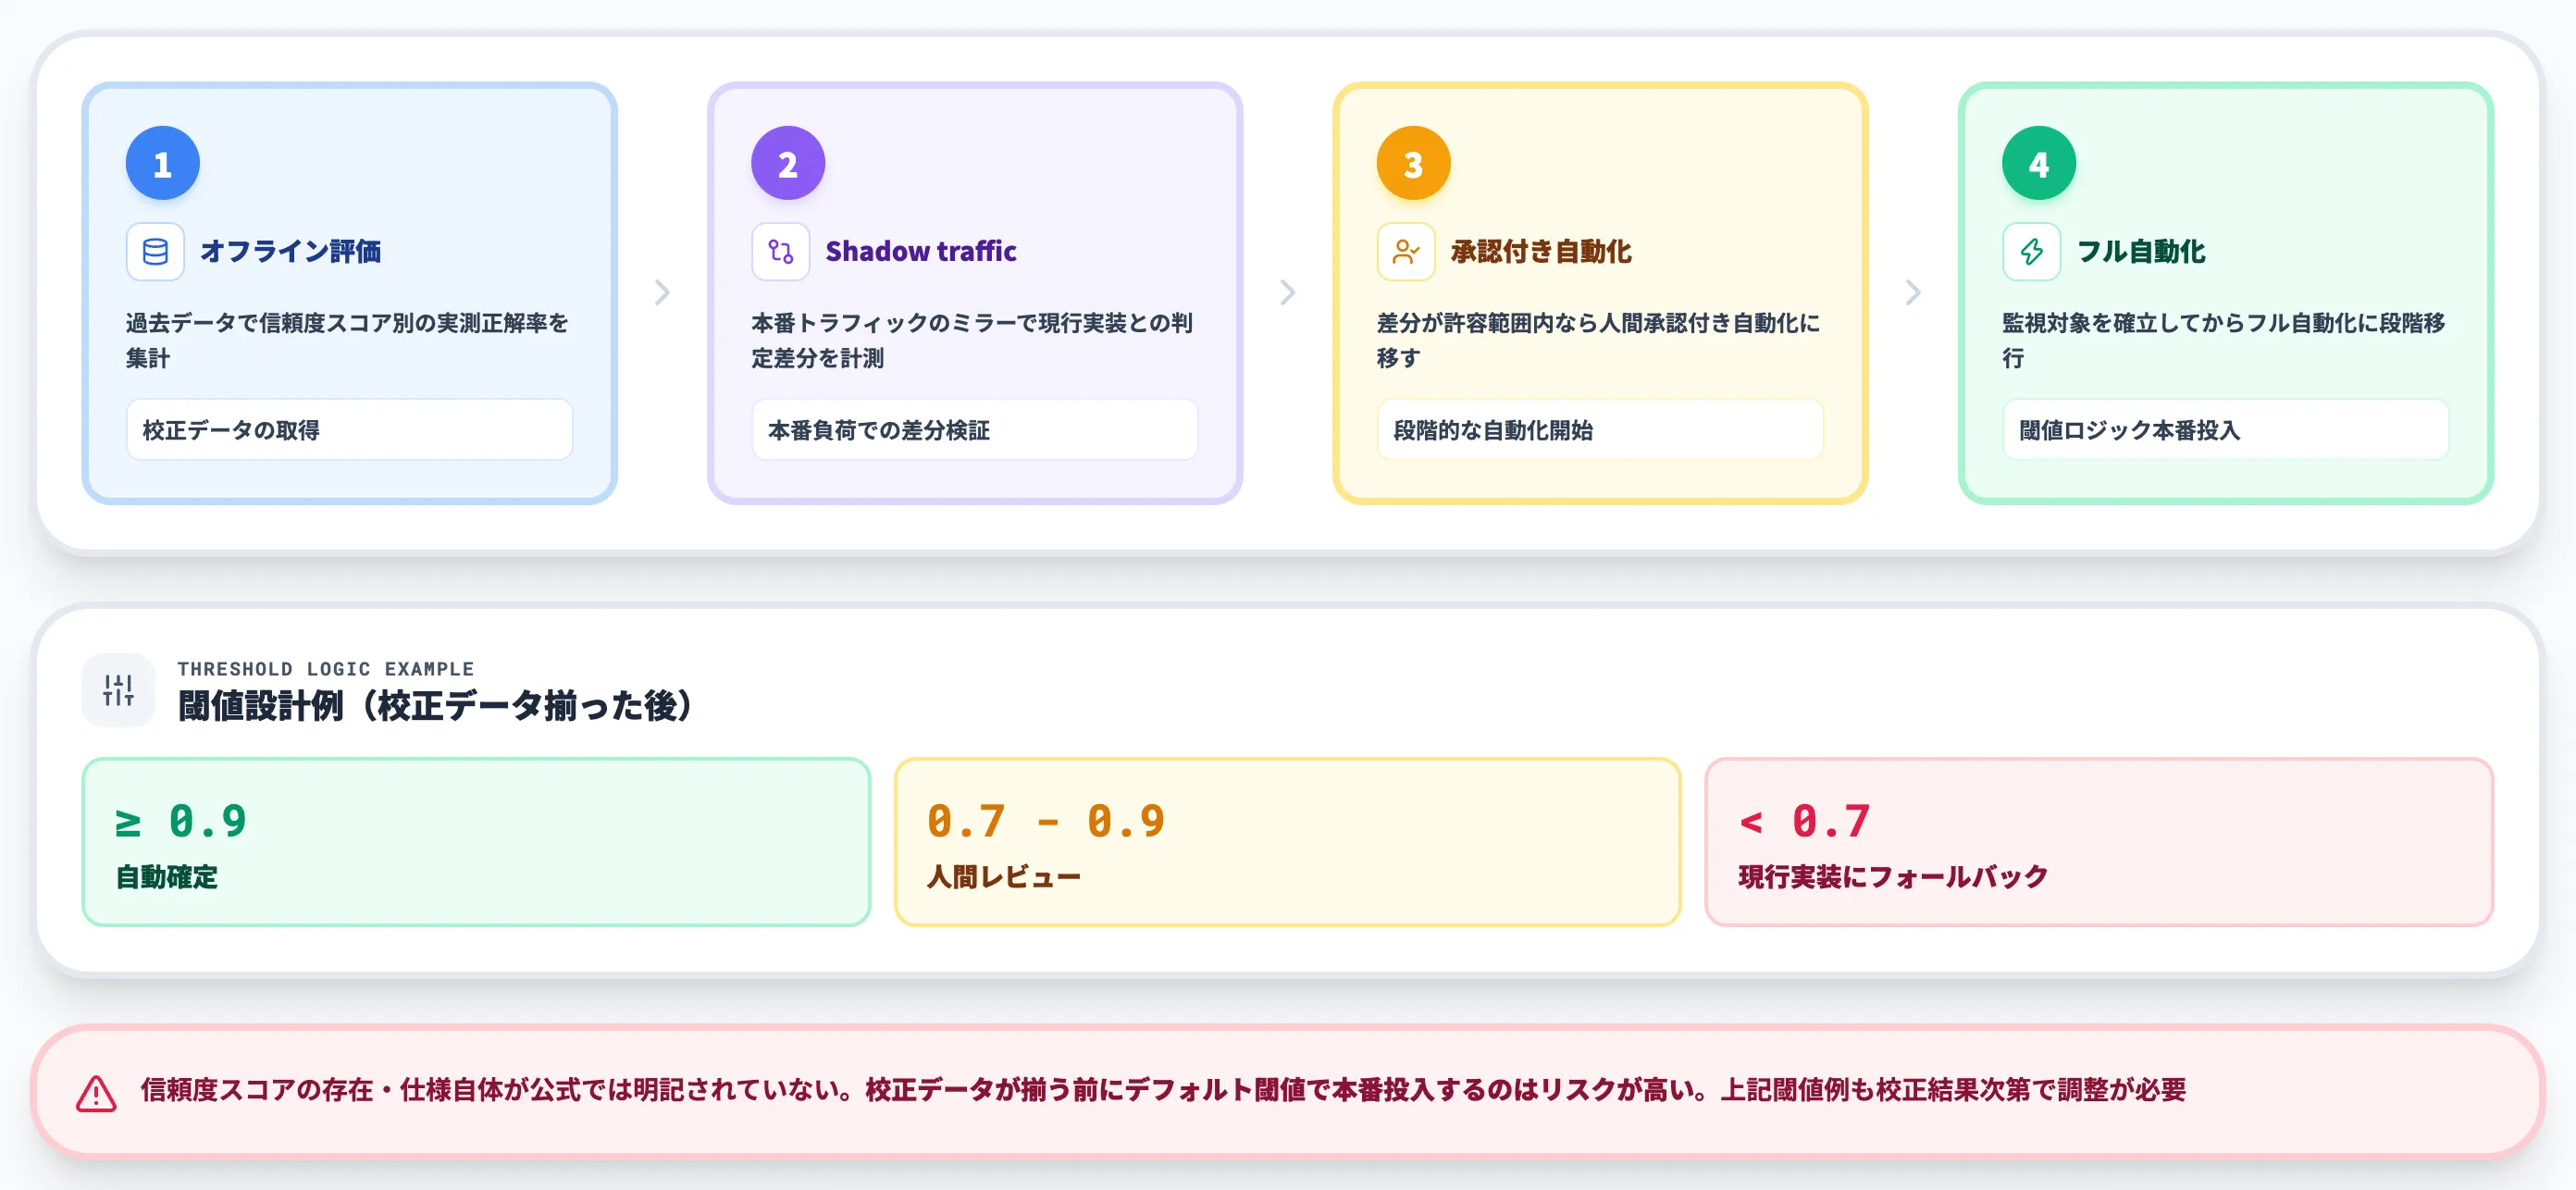
Decisions APIの信頼度スコアは、二次情報ベースの実装ガイドで「モデルの正解確率」として扱われがちですが、これは正確ではありません。そもそも信頼度スコアの存在・仕様自体がOpenAI公式では明記されていない点に注意が必要です。
信頼度スコアが実装される場合でも、算出方法・意味論・校正状態はOpenAI公式では未公表であり、実際の正解率と直接対応する保証はありません
。Hugging Faceの実装ガイドも、想定インターフェースの信頼度スコアを校正済み確率として扱わないよう注意を促しています。
本番運用では、以下のロールアウト設計が推奨されます。
- 過去データでのオフライン評価で、信頼度スコア別の実測正解率を集計する
- 本番のshadow trafficで、現行実装との判定差分を計測する
- 差分が許容範囲内であることを確認してから、人間承認付きの自動化に移す
- 監視対象を確立してからフル自動化に段階移行する
「信頼度0.9以上は自動確定、0.7〜0.9は人間レビュー、0.7未満は現行実装にフォールバック」のような閾値ロジックは、この校正データが揃ってから決めるべきで、いきなりデフォルト閾値で本番投入するのはリスクが高くなります。
プレビュー段階の変更リスクへの備え
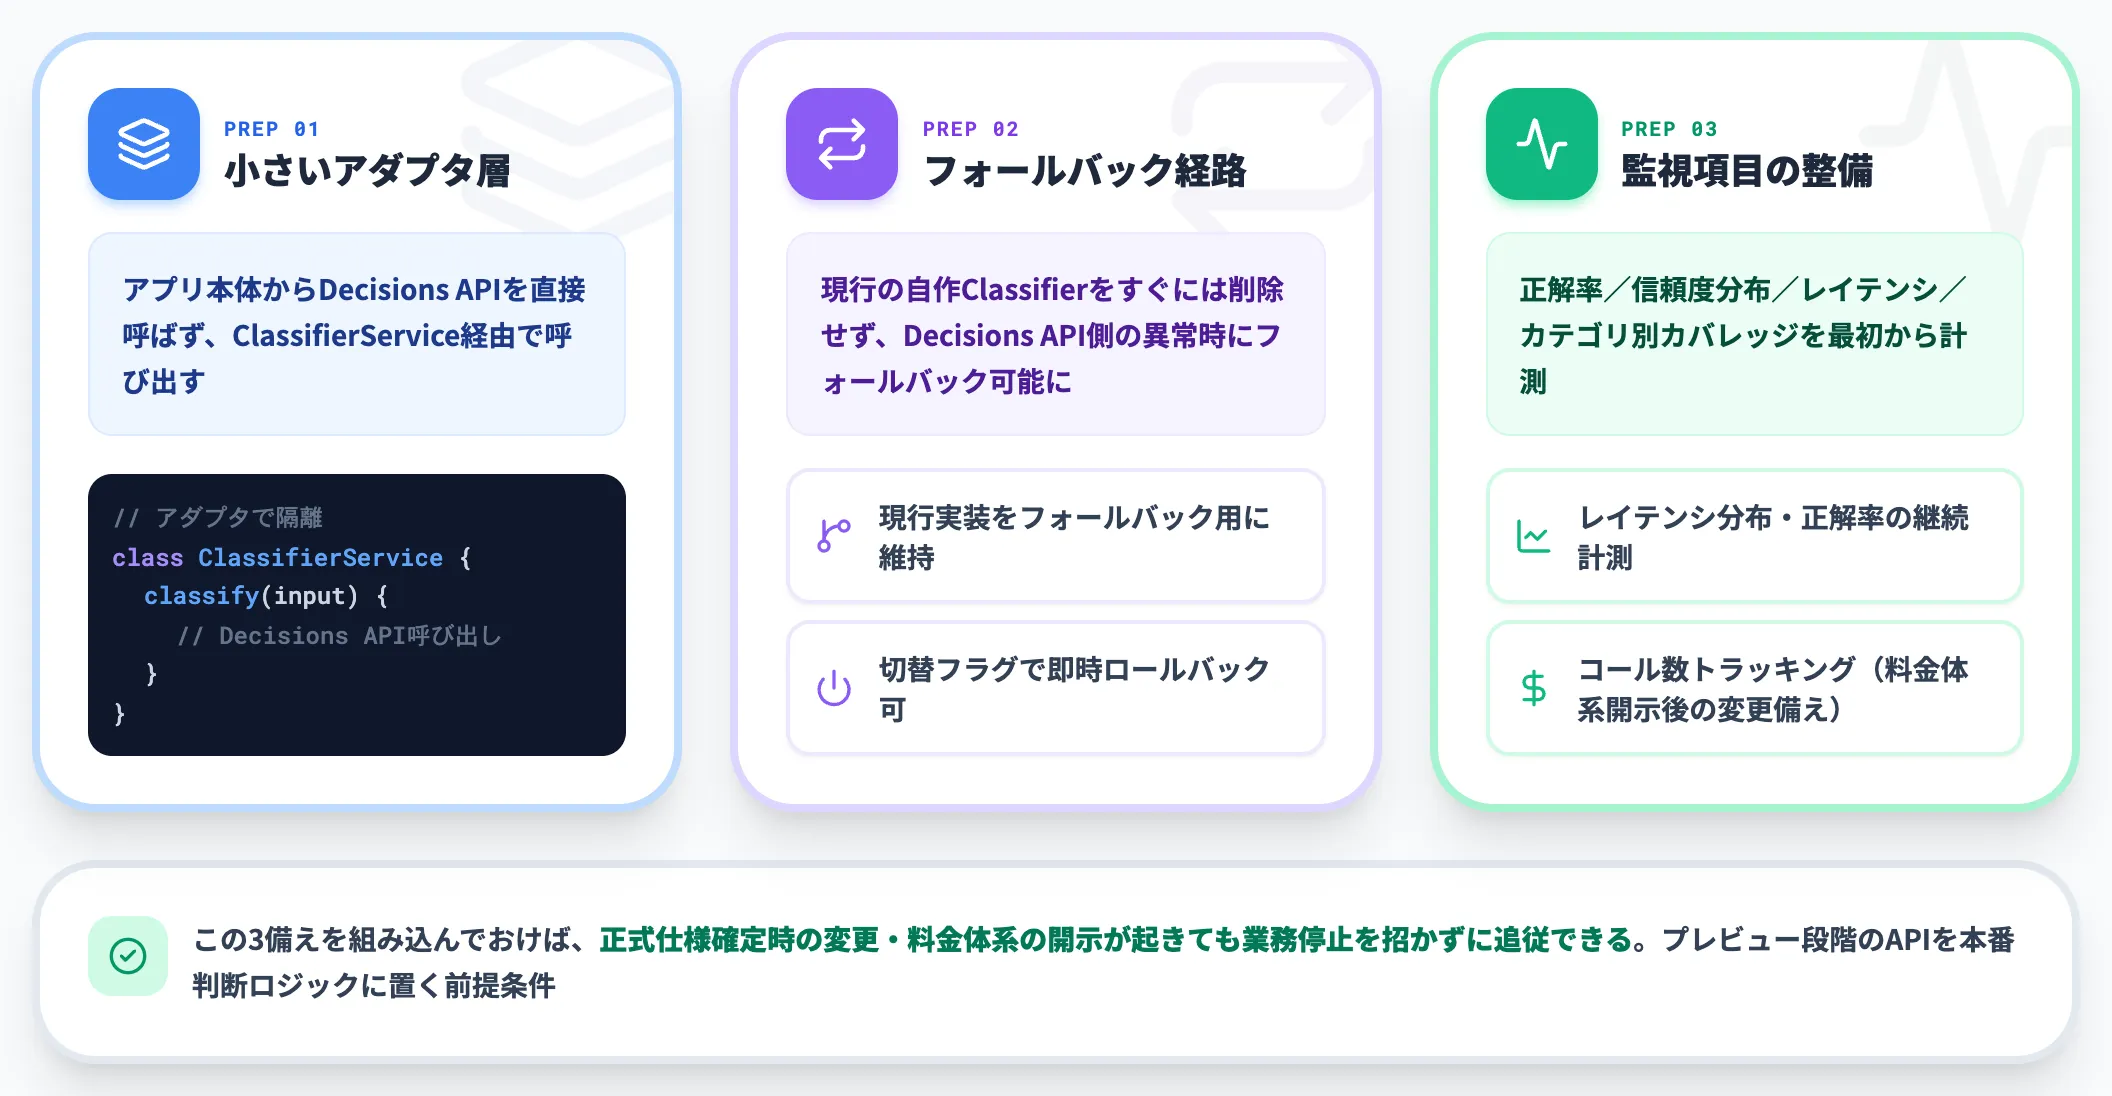
プレビュー段階のAPIを本番の判断ロジックに組み込む場合、広範提供・正式仕様の開示時点での仕様変更に耐える設計が重要です。
-
小さいアダプタ層の設置
アプリケーション本体からDecisions APIを直接呼ばず、ClassifierServiceのようなアダプタクラスを経由して呼び出す。エンドポイント・レスポンス形式が変わっても、アダプタだけを差し替えれば済む
-
フォールバック経路の維持
現行の自作Classifierをすぐには削除せず、Decisions API側で異常が出たらフォールバックできる構造を残す
-
監視項目の初期整備
正解率、信頼度分布(実装される場合)、レイテンシ分布、カテゴリ別カバレッジを最初から計測する。料金体系開示後の変更に備え、コール数のトラッキングも欠かせない
これらの備えを組み込んでおけば、正式仕様確定時の変更や料金体系の開示が起きても、業務停止を招かずに追従できます。
Decisions API導入で詰まる論点を、実装事例から逆算して整理する
Decisions APIを検討する現場では、公式ドキュメントだけでは決めきれない論点が並びます。
- 現行の自作Classifier(プロンプト+JSON Schema+後処理)とDecisions APIを、応答速度・信頼度スコア校正・フォールバック経路の3軸でどのタスクから段階置換するか
- Decisions API・Structured Outputs・Function Callingを、生成する文字列の形と回答空間そのものの制約レイヤーの違いに応じてどう分担させるか
- GPT-6 Astra等の強いモデルによるオーケストレーションとDecisions API(Luna特化版)による高速判断層を、どのループ粒度で階層化するか
- プレビュー段階の仕様変更・料金開示・信頼度スコア意味論未公表に耐えるアダプタ層と監視項目をどう設計するか
Classifier段階置換・プリミティブ分担設計・強いモデル×判断層階層化・プレビュー変更耐性まで含めてDecisions API導入の実装可能性を棚卸ししたいなら、単体機能の解説記事ではなく、実装事例と組み合わせて話せる相手と一度整理するのが早道です。
AI Agent Hubは、Decisions APIを含むOpenAIプリミティブを業務Agent単位で統合管理するエンタープライズAI基盤で、Classifier段階置換・プリミティブ分担設計・強いモデル×判断層階層化・プレビュー変更耐性のいずれの入口からでも、実装から逆算した論点整理をご相談いただけます。
Decisions API導入の論点を実装から逆算

Classifier段階置換・プリミティブ分担設計・強いモデル×判断層階層化・プレビュー変更耐性
Decisions API導入は、Classifier段階置換・プリミティブ分担設計・強いモデル×判断層階層化・プレビュー変更耐性が絡み合います。AI Agent Hubのサービスページで、Decisions APIを業務Agentのルーティング層に載せる実装例をご確認ください。
まとめ
本記事では、Decisions APIについて、Structured Outputs/Function Callingとの違い・4ステップワークフロー・ユースケース・Jevとの比較・Agents API併用の独自アーキテクチャ案・料金・移行判断までを、2026年10月時点の一次情報で解説しました。
2026年10月時点で押さえておくべきポイントは次の3つです。
- GPT-6 Luna特化版で有限選択肢に絞り公称約150msで判断を返す新API、Structured Outputsが文字列の形を制約するのに対し「モデルが選べる回答空間」自体を一段手前で制約する設計
- 4ステップ(状態キャプチャ→質問定義→候補選択→コード側で強制)で判断ロジックを実装、分類・ルーティング・次アクション・ツールゲート・モデルルーティング・トリアージ・ビジュアル決定の6パターンをカバー
- プレビュー料金未公開・GPT-6 Luna単体は入力$0.10/出力$0.50、Jev比ではOpenAIエコシステム統合と画像入力対応が優位で既存Classifier移行は応答速度・有限選択肢化・信頼度スコアの3条件で判断
Decisions APIは限定プレビュー段階のため、本番の主要判断ロジックに置くにはまだ早い局面です。ただし有限選択肢からの判断を専用APIとして切り出した設計は、Structured OutputsやFunction Callingとは別レイヤーで分類・ルーティングを扱う選択肢を増やします。数日以内の広範提供と正式仕様の開示を待ち、既存の自作Classifierを段階的に置き換える準備を進めておくことが、実務上の現実的な次の一歩になります。