この記事のポイント
 LLMが生成する「存在しないパッケージ名」の43%が同一プロンプトで毎回再現し、攻撃者が予測して先回り登録できる
- react-codeshift(2026年1月・237リポジトリ拡散)とunused-imports(週233DL継続)が実被害・実証例として確認済み
- 2026年フロンティアモデルで幻覚率は4.62〜6.10%まで低下したが、127種は5モデル共通・うち53種は研究時点で第三者が登録可能と評価された状態にある
- 自律エージェントの自動インストール挙動が人手レビュー欠落を生み、スロップスクワッティングの実行経路を広げている
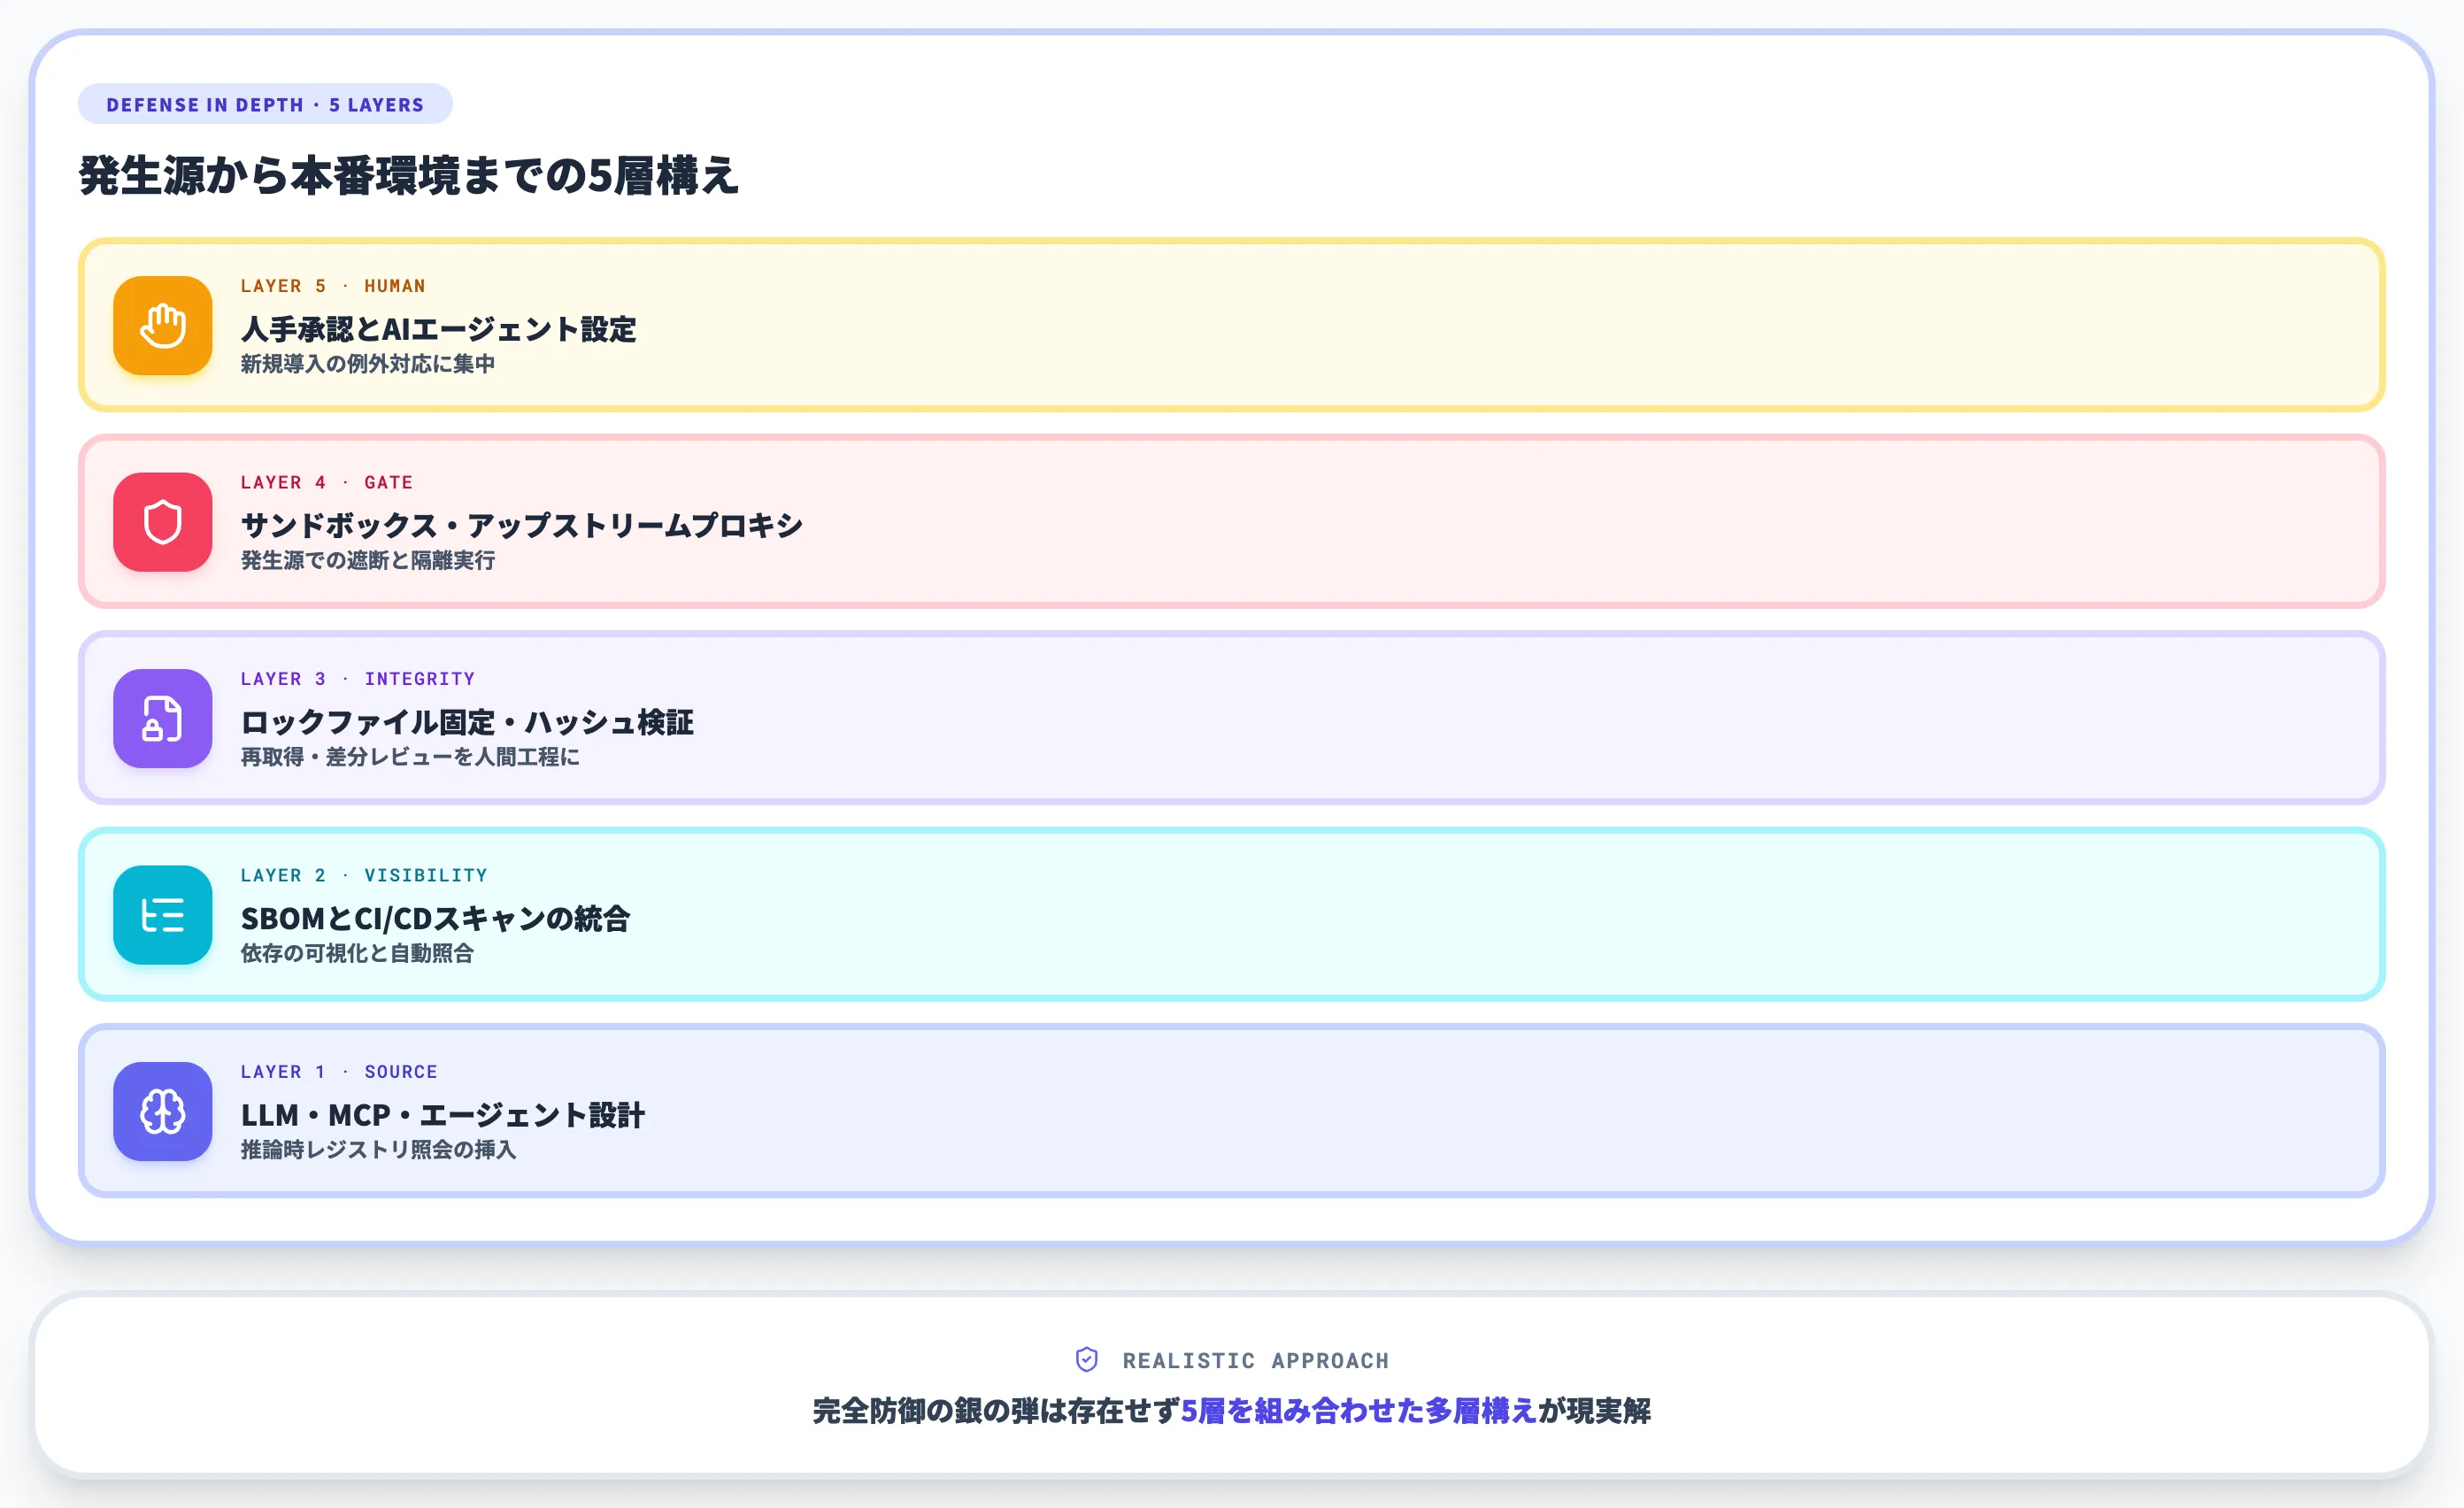
- 対策はSBOM・ロックファイル固定・サンドボックス・アップストリームプロキシ・人手承認の多層構えが現実解
Microsoft MVP・AIパートナー。LinkX Japan株式会社 代表取締役。東京工業大学大学院にて自然言語処理・金融工学を研究。NHK放送技術研究所でAI・ブロックチェーンの研究開発に従事し、国際学会・ジャーナルでの発表多数。経営情報学会 優秀賞受賞。シンガポールでWeb3企業を創業後、現在は企業向けAI導入・DX推進を支援。
スロップスクワッティング(slopsquatting)とは、大規模言語モデル(LLM)がコード生成時に幻覚(ハルシネーション)で生み出す「存在しないパッケージ名」を、攻撃者が先回りで公開リポジトリに登録して悪意あるコードを埋め込むサプライチェーン攻撃です。
人間のタイポを狙う従来のタイポスクワッティングと違い、LLMが生成する名前には統計的な再現性があり、同じプロンプトを繰り返すと43%の幻覚名が毎回同じ形で現れることが研究で確認されています。
2024年にはhuggingface-cliがPyPI上で実証登録され3か月で3万件超のダウンロードを集め、2026年に入ってからreact-codeshift・unused-importsといった実被害・実証事例が積み上がりました。Claude Code・GitHub Copilot・Clineなどの自律型AIエージェントが人手レビューを経ずにインストールを試行する構図が、脅威を一段深刻にしています。
本記事では、スロップスクワッティングの定義とタイポスクワッティングとの違い、LLMが幻覚する仕組み、2026年の実被害・実証事例、フロンティアモデルの最新幻覚率、開発チームが取るべき多層対策、導入で詰まる論点までを、2026年10月時点の最新情報で体系的に解説します。
目次
スロップスクワッティングとは?AIが幻覚するパッケージ名を悪用する攻撃手法
10回中43%が毎回同じ名前で再現する——攻撃者が予測できる予測可能性
react-codeshift(npm、2026年1月)——237リポジトリに拡散した合成幻覚名
unused-imports(npm、2026年2月)——悪用された名前への取得が週233回継続
huggingface-cli(PyPI、2024年3月)——3か月で3万件超のダウンロード
人間レビューの欠落——エージェントが黙ってインストールを走らせる
2024年測定・2025年公表の原論文——商用5.2% / オープンソース21.7%
2026年のフロンティアモデル再評価——4.62〜6.10%に低下、しかし
Vectara HHEMとの対比——攻撃面としての幻覚と、要約品質としての幻覚
ロックファイル固定・ハッシュ検証とパッケージマネージャ標準機能
スロップスクワッティングとは?AIが幻覚するパッケージ名を悪用する攻撃手法
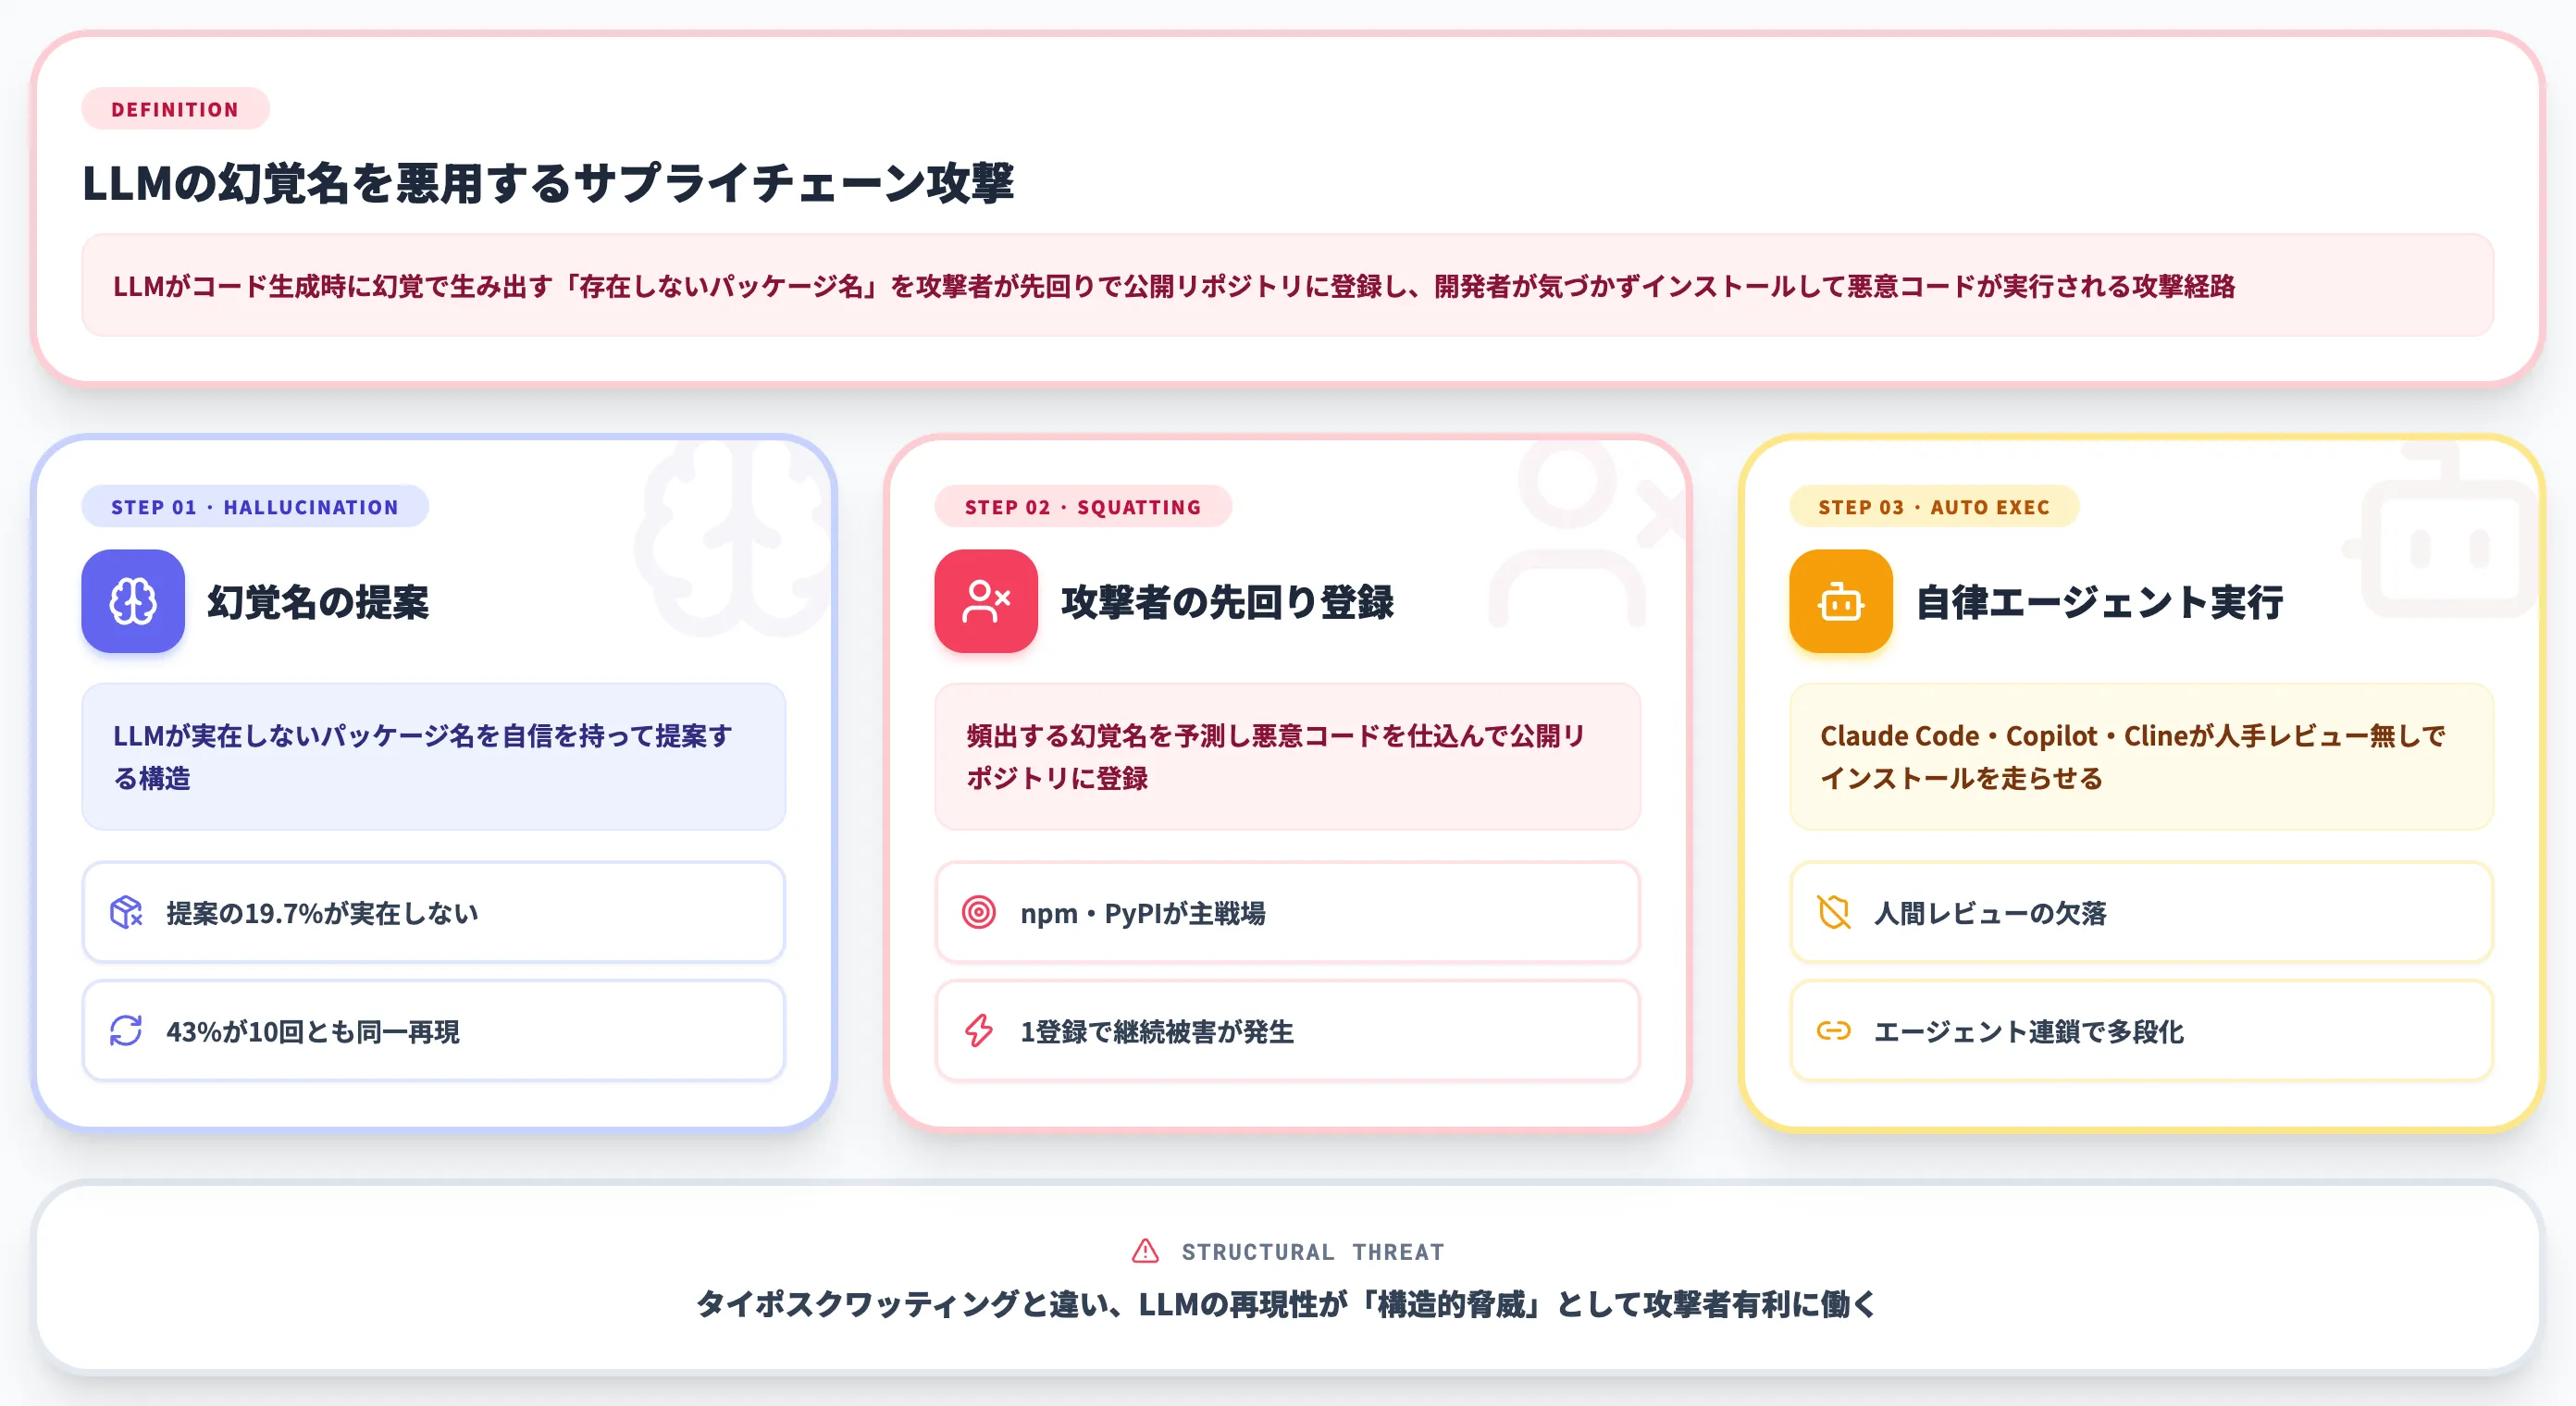
スロップスクワッティング(slopsquatting)とは、LLMがコード生成時に幻覚で生み出す「存在しないパッケージ名」を、攻撃者が先回りで公開パッケージリポジトリ(npm・PyPI等)に登録し、不正コードを仕込む新しい形のサプライチェーン攻撃です。
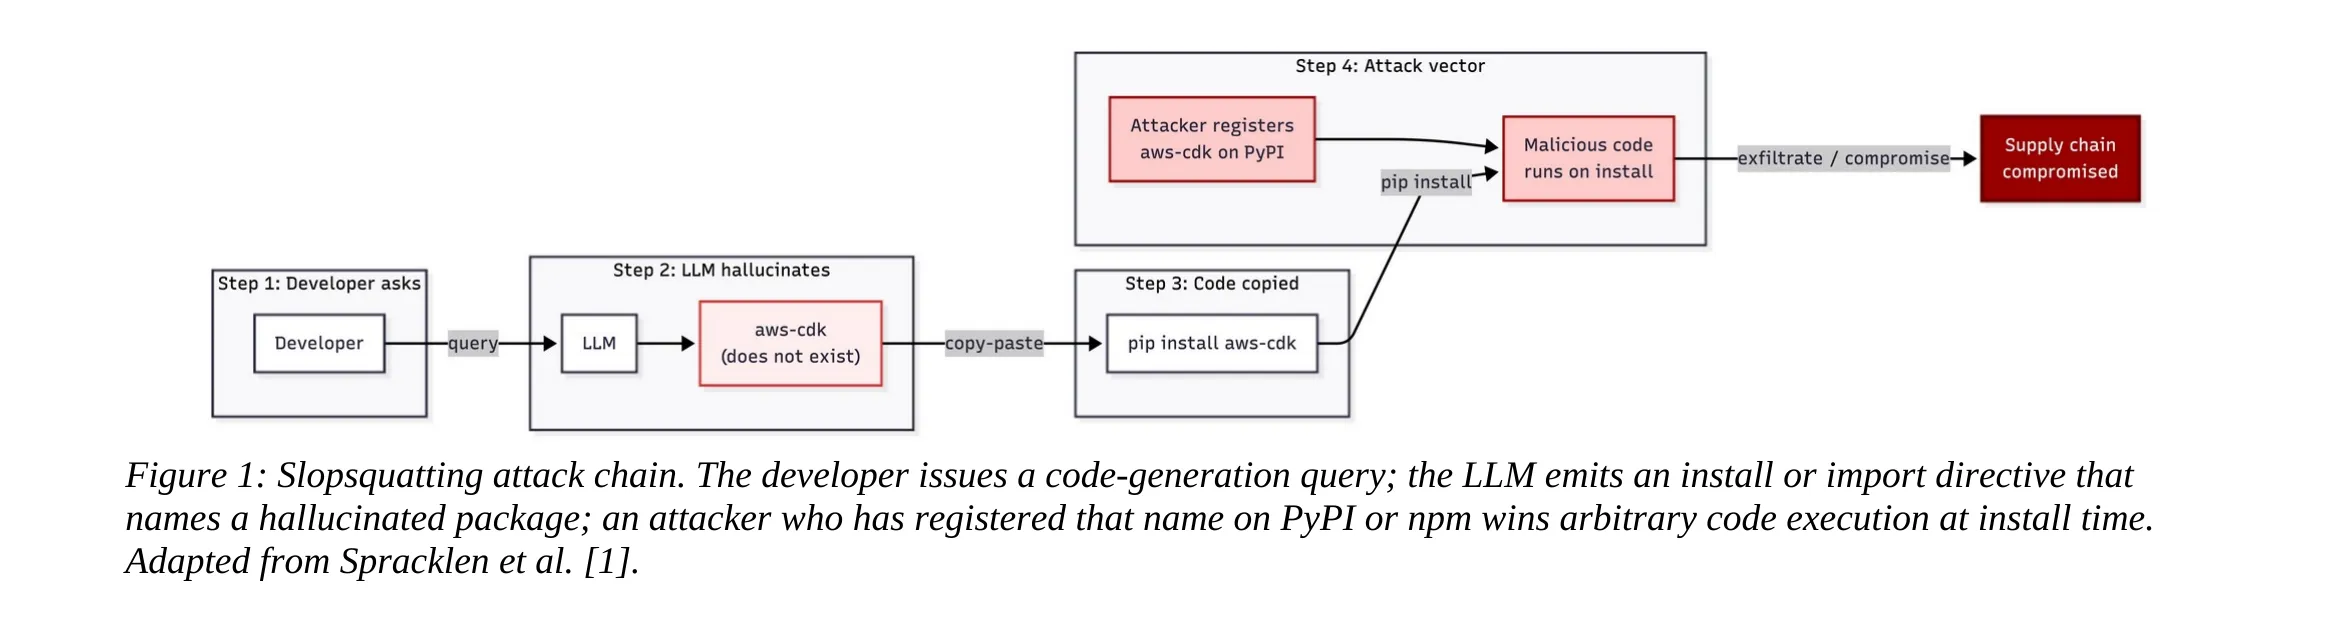
スロップスクワッティングの攻撃チェーン:LLMが存在しない「aws-cdk」を提案 → 攻撃者が先回り登録 → 開発者が pip install で悪意コードが実行される(出典:Churilov 2026)
この攻撃チェーンの要点は、開発者がLLMにコード生成を依頼する日常的な操作から始まり、人手レビューを介さずに悪意コードの実行まで到達する点です。従来のサプライチェーン攻撃と違い、攻撃者は被害者の環境に直接触れず、LLMが生成する名前のパターンを事前に調べて登録しておくだけで被害が成立します。
Python Software FoundationのSeth Larson氏(PSF Developer-in-Residence)がこの現象に対して提唱した用語で、「slop(AIの低品質な出力)」と「squatting(名前の占拠)」を組み合わせた造語です。命名の経緯はSocket.devのslopsquatting解説にまとめられています。
本攻撃が成立する前提には、LLMが提案するパッケージ名の相当な割合が実在しないというコード生成LLMの構造的特性があります。
2025年USENIX Security Symposiumで発表されたSpracklenらの研究によれば、16種のコード生成LLMから約57.6万件のコードサンプルを生成し、そこから抽出した約223万件のパッケージ提案のうち19.7%が実在しないパッケージ名でした。
タイポスクワッティングとの違い
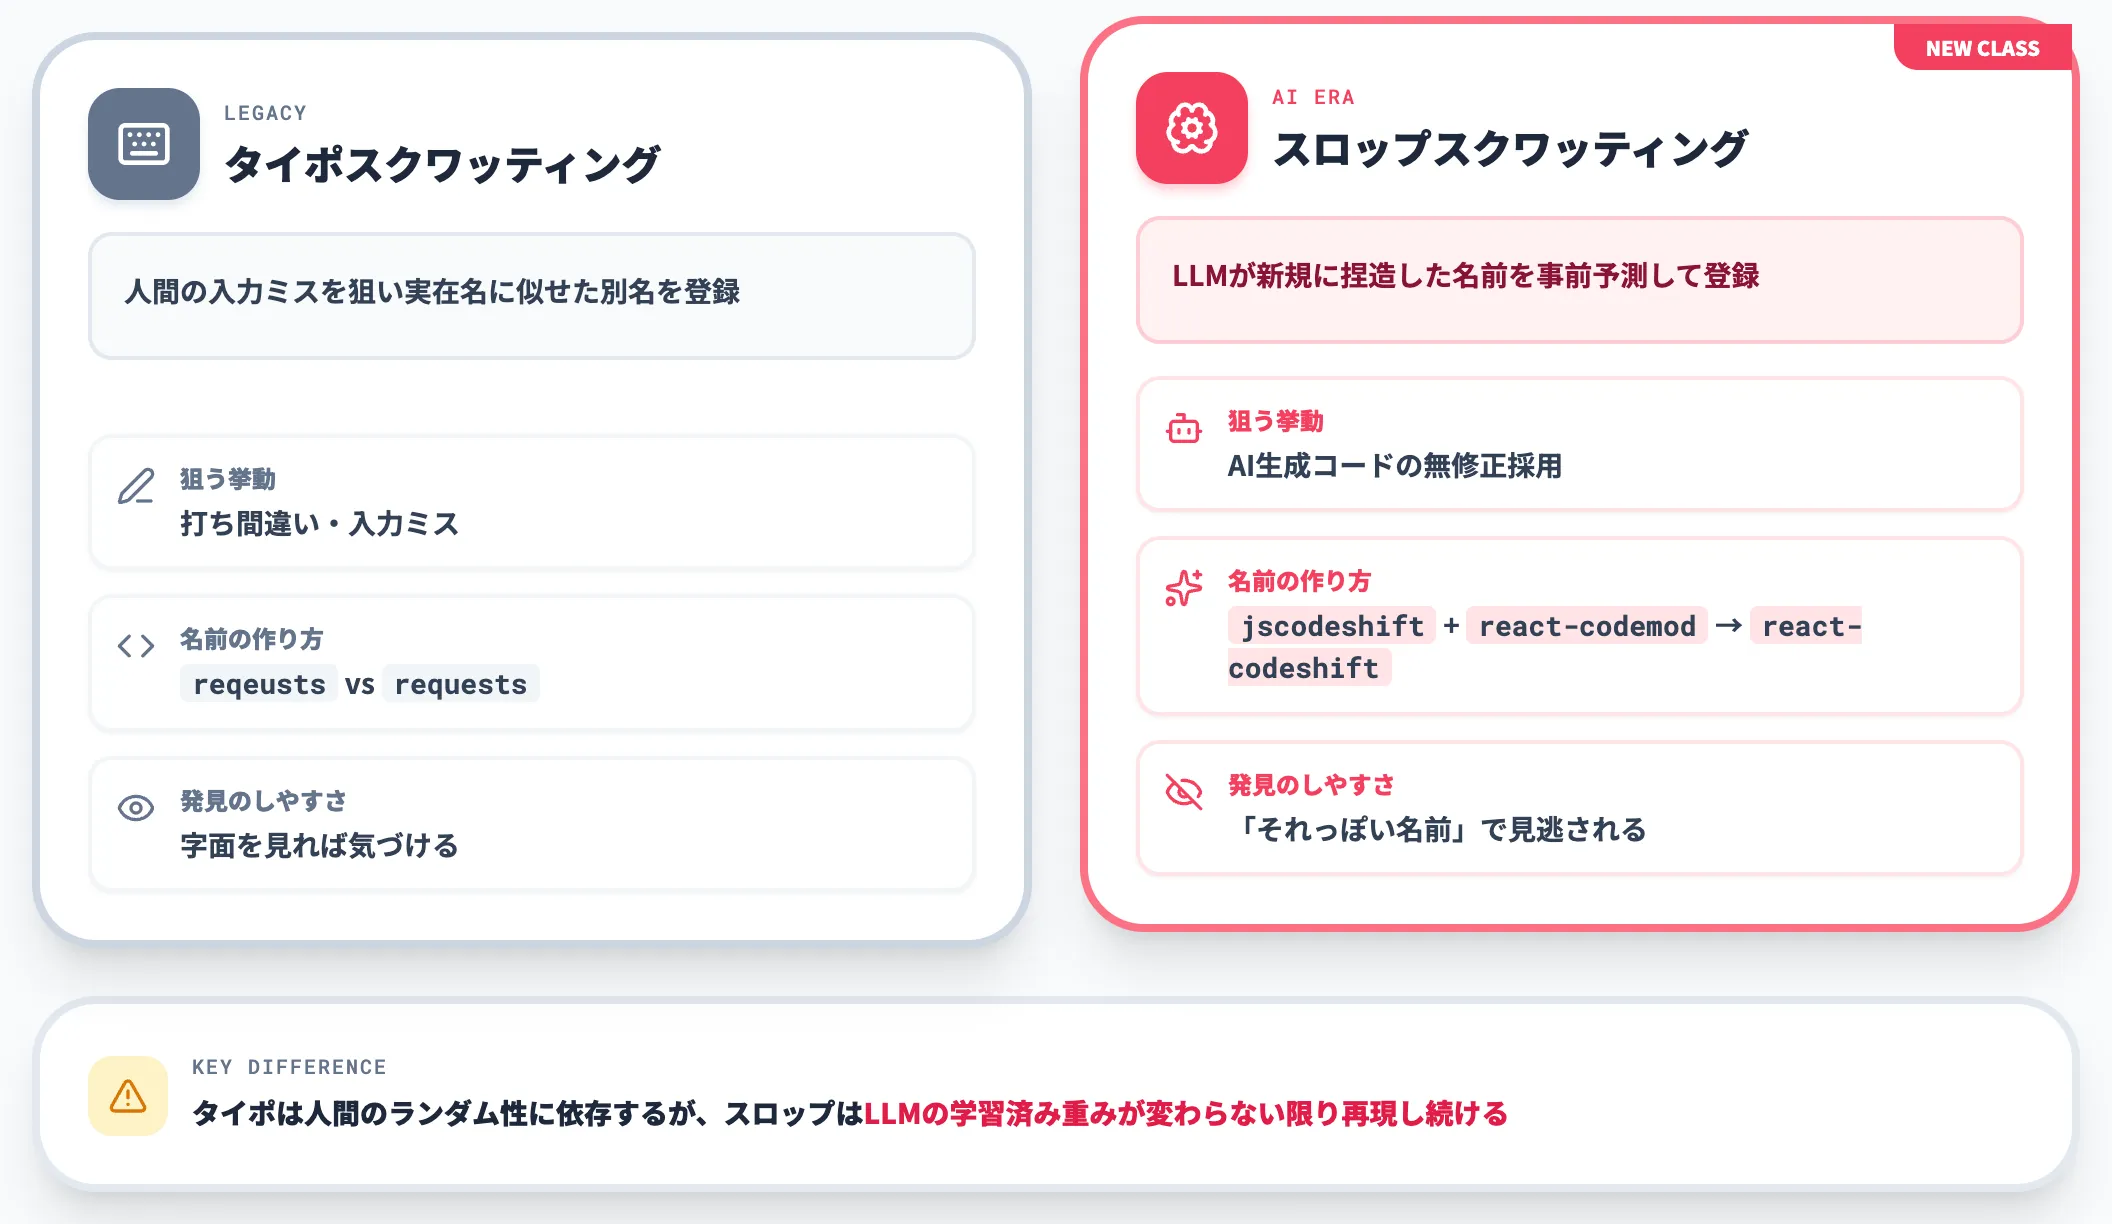
従来からパッケージリポジトリで続いてきたタイポスクワッティング(typosquatting)は、人間の入力ミスを狙って実在するパッケージ名に酷似した別名を登録しておく攻撃です。
一方のスロップスクワッティングが狙うのは、人間が打ち間違えた名前ではなくLLMが新規に捏造した名前です。
以下の表で、2つの攻撃手法の構造的な違いを整理しました。
| 項目 | タイポスクワッティング | スロップスクワッティング |
|---|---|---|
| 狙う人間の挙動 | 入力ミス・打ち間違い | AI生成コードをそのまま採用する運用 |
| 悪意パッケージ名の作り方 | 実在名の1〜2文字違い(例: [reqeusts] vs [requests]) | LLMが新規に捏造した名前(実在名と字面が似ていない場合も多い) |
| 攻撃者の事前知識 | 対象となる人気パッケージの綴り | LLMが頻繁に幻覚する名前のパターン |
| 発見のしやすさ | 字面を見れば気づきやすい | 「それっぽい名前」で見逃されやすい |
| 自動化のしやすさ | 人間のタイポが前提なので頻度に限界 | LLMが同じ名前を再現する限り何度でも成立 |
重要なのは、スロップスクワッティングでは実在名とまったく似ていない名前も攻撃対象になる点です。たとえば後述するreact-codeshiftは、[jscodeshift] と [react-codemod] という2つの実在パッケージ名をLLMが「意味的に合成」してしまった結果の幻覚名で、字面上はタイポとして認識できません。
AI総合研究所の支援現場でも、「AIが提案したパッケージ名を自動で [npm install] に流す」という運用が、タイポ耐性のある命名規則のレビューでは防ぎきれない領域に入ってきています。
LLMが「ありそうなパッケージ名」を幻覚する仕組み
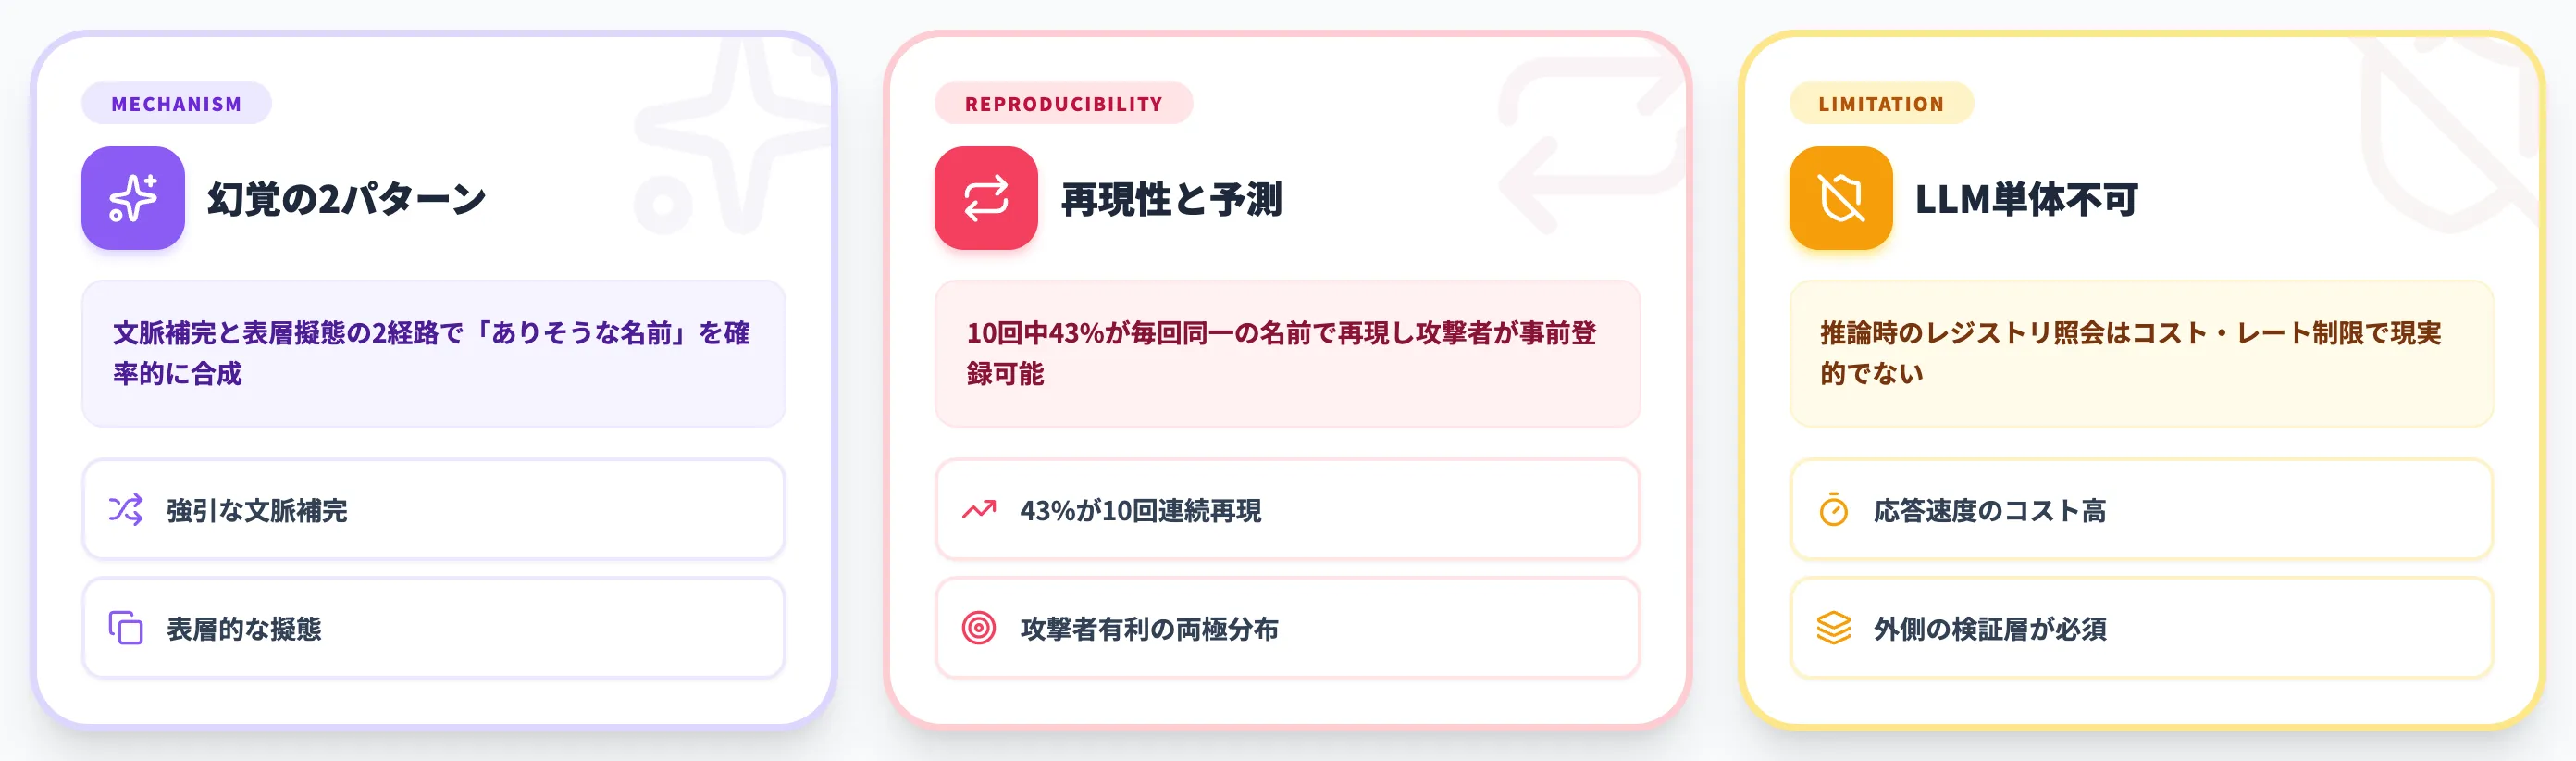
スロップスクワッティングが成立するのは、LLMが提案するパッケージ名の幻覚に予測可能なパターンがあるからです。
本セクションでは、幻覚が生じるメカニズムと、攻撃者が悪用できる統計的な再現性について整理します。
幻覚の典型2パターン——文脈補完と表層擬態
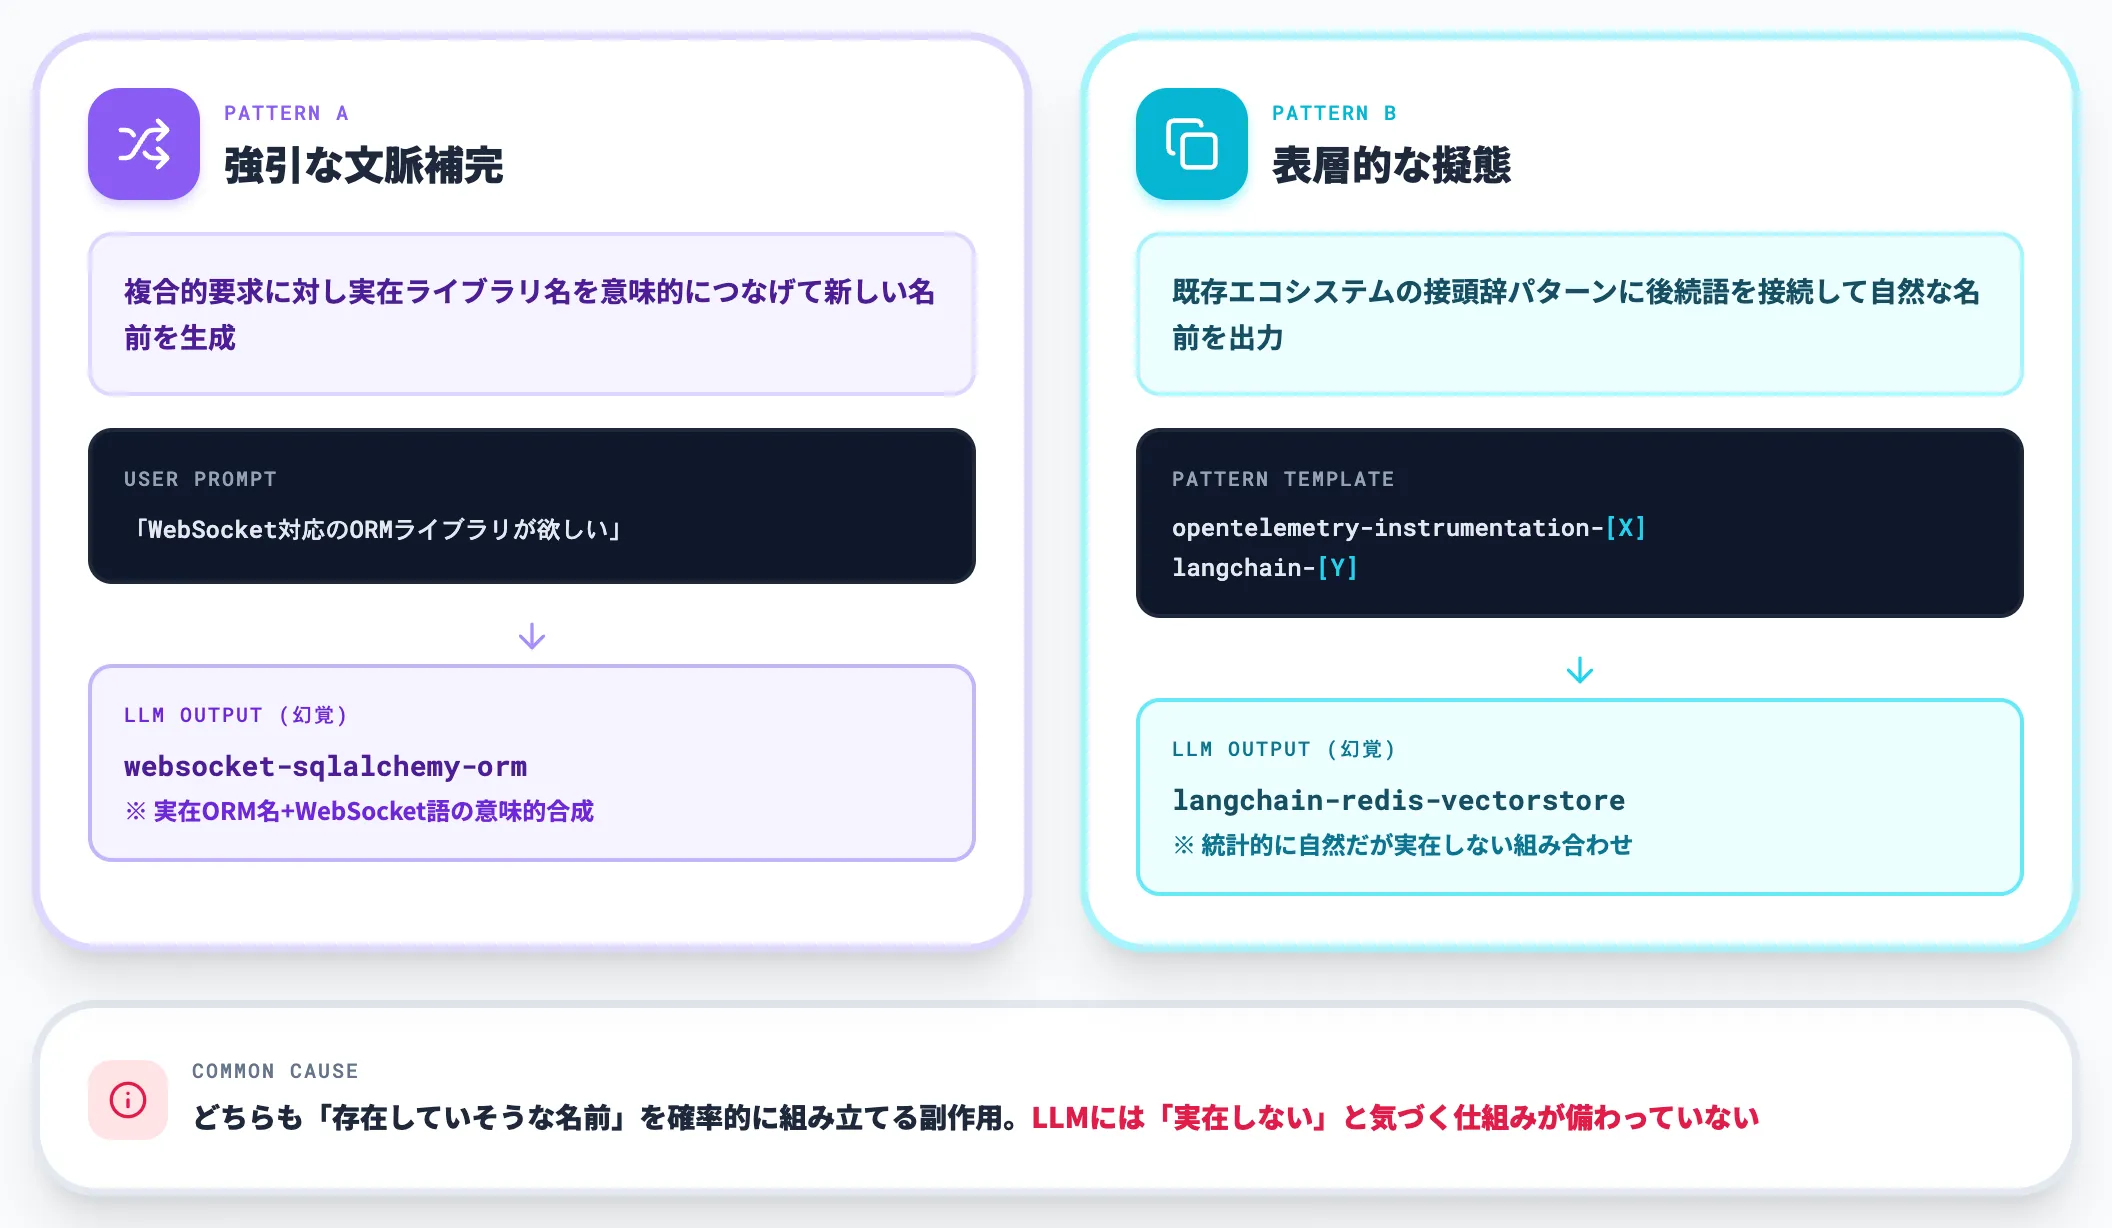
トレンドマイクロの技術解説は、LLMがコード生成時に存在しないパッケージ名を出すメカニズムを、2つの代表パターンに整理しています。
-
強引な文脈補完
「WebSocket対応のORMライブラリが欲しい」のような複合的な要求に対し、LLMは実在のORMライブラリ名とWebSocketに関連する語を意味的につなげた新しい名前を生成する傾向があります。実在ライブラリ側に該当機能がなくても、LLMは要求を満たす「それっぽい」名前を提示します。
-
表層的な擬態
[opentelemetry-instrumentation-〜] や [langchain-〜] のような、既存エコシステムで多用される接頭辞パターンに後続語を接続して名前を生成します。LLMの学習データに同じ命名規則の実在ライブラリが大量にあるため、統計的に自然な名前が出力されるものの、特定の組み合わせだけ実在しない状態になります。
どちらのパターンも、LLMが「存在していそうな名前」を確率的に組み立てる副作用として現れます。LLMが「このパッケージは実在しない」と気づく仕組みが備わっていないため、生成されたコードは一見正しく動くように見えてしまいます。
10回中43%が毎回同じ名前で再現する——攻撃者が予測できる予測可能性
スロップスクワッティングを単なる偶発的な事故ではなく組織的に成立する攻撃にしているのが、幻覚名の再現性の高さです。
Spracklenらの研究では、同じプロンプトを10回繰り返した場合、43%の幻覚パッケージ名がすべての実行で再現し、58%が複数回再現しました。
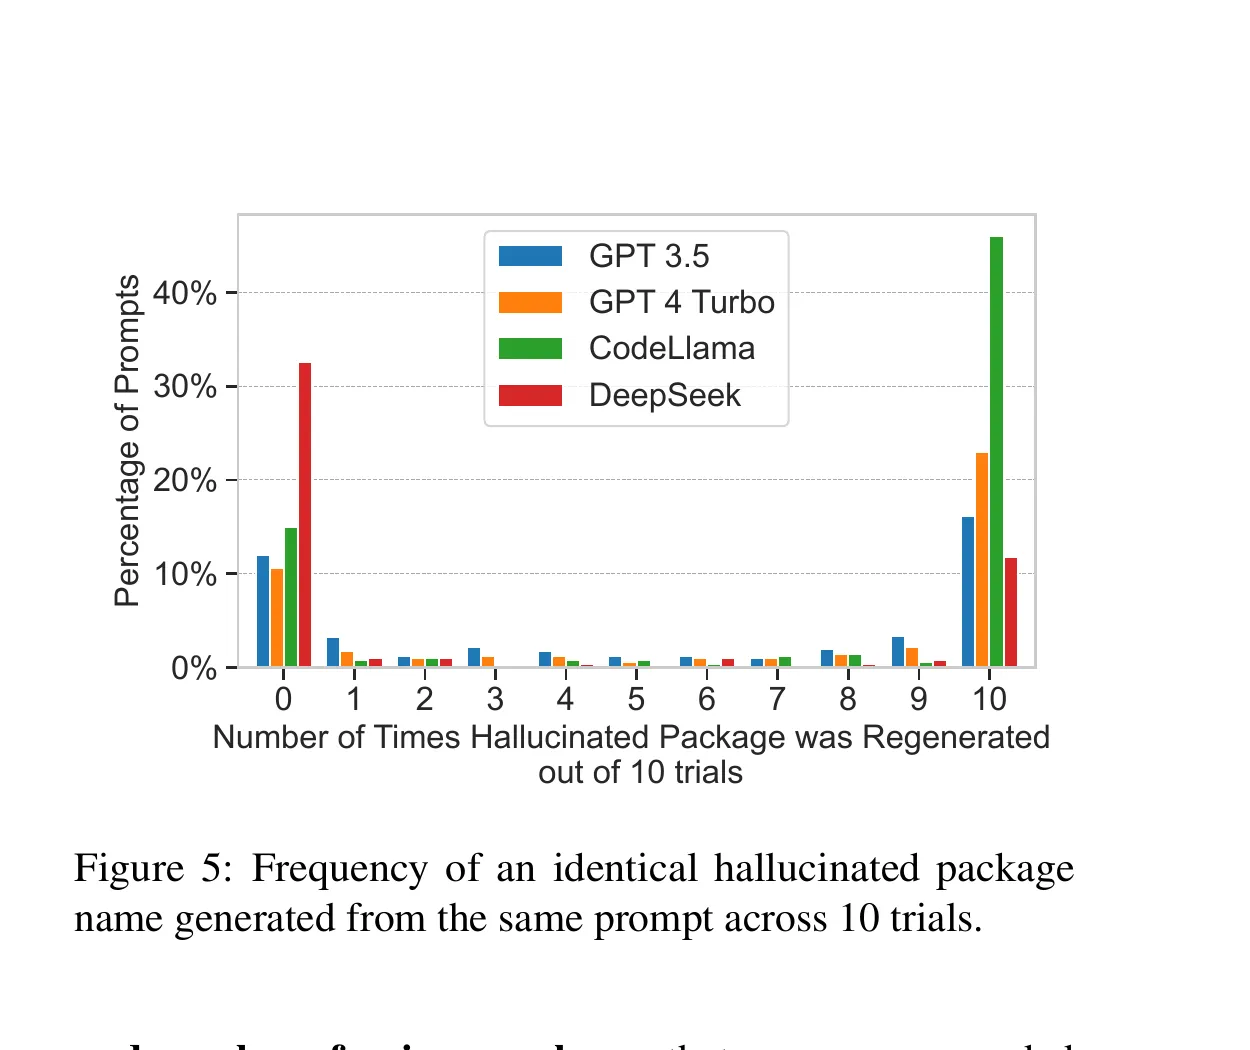
同じプロンプトを10回繰り返したときの幻覚名の再現頻度:モデルごとに分布は異なるがGPT-3.5・GPT-4 Turbo・CodeLlamaでは「10回とも同じ幻覚名が出た」バーが突出し、DeepSeekは「1度きり(0回)」が最も高く「10回連続」も目立つ両極型(出典:Spracklen et al. 2025)
グラフの特徴は、幻覚名の多くが「1〜9回のまばらな再現」ではなく「毎回必ず出る名前」か「1度きりの名前」のどちらかに分かれる両極型分布である点です。攻撃者が狙うのは右端の「毎回必ず出る名前」で、CodeLlamaでは45%超、GPT-4 Turboでも20%以上が10回連続で再現しています。
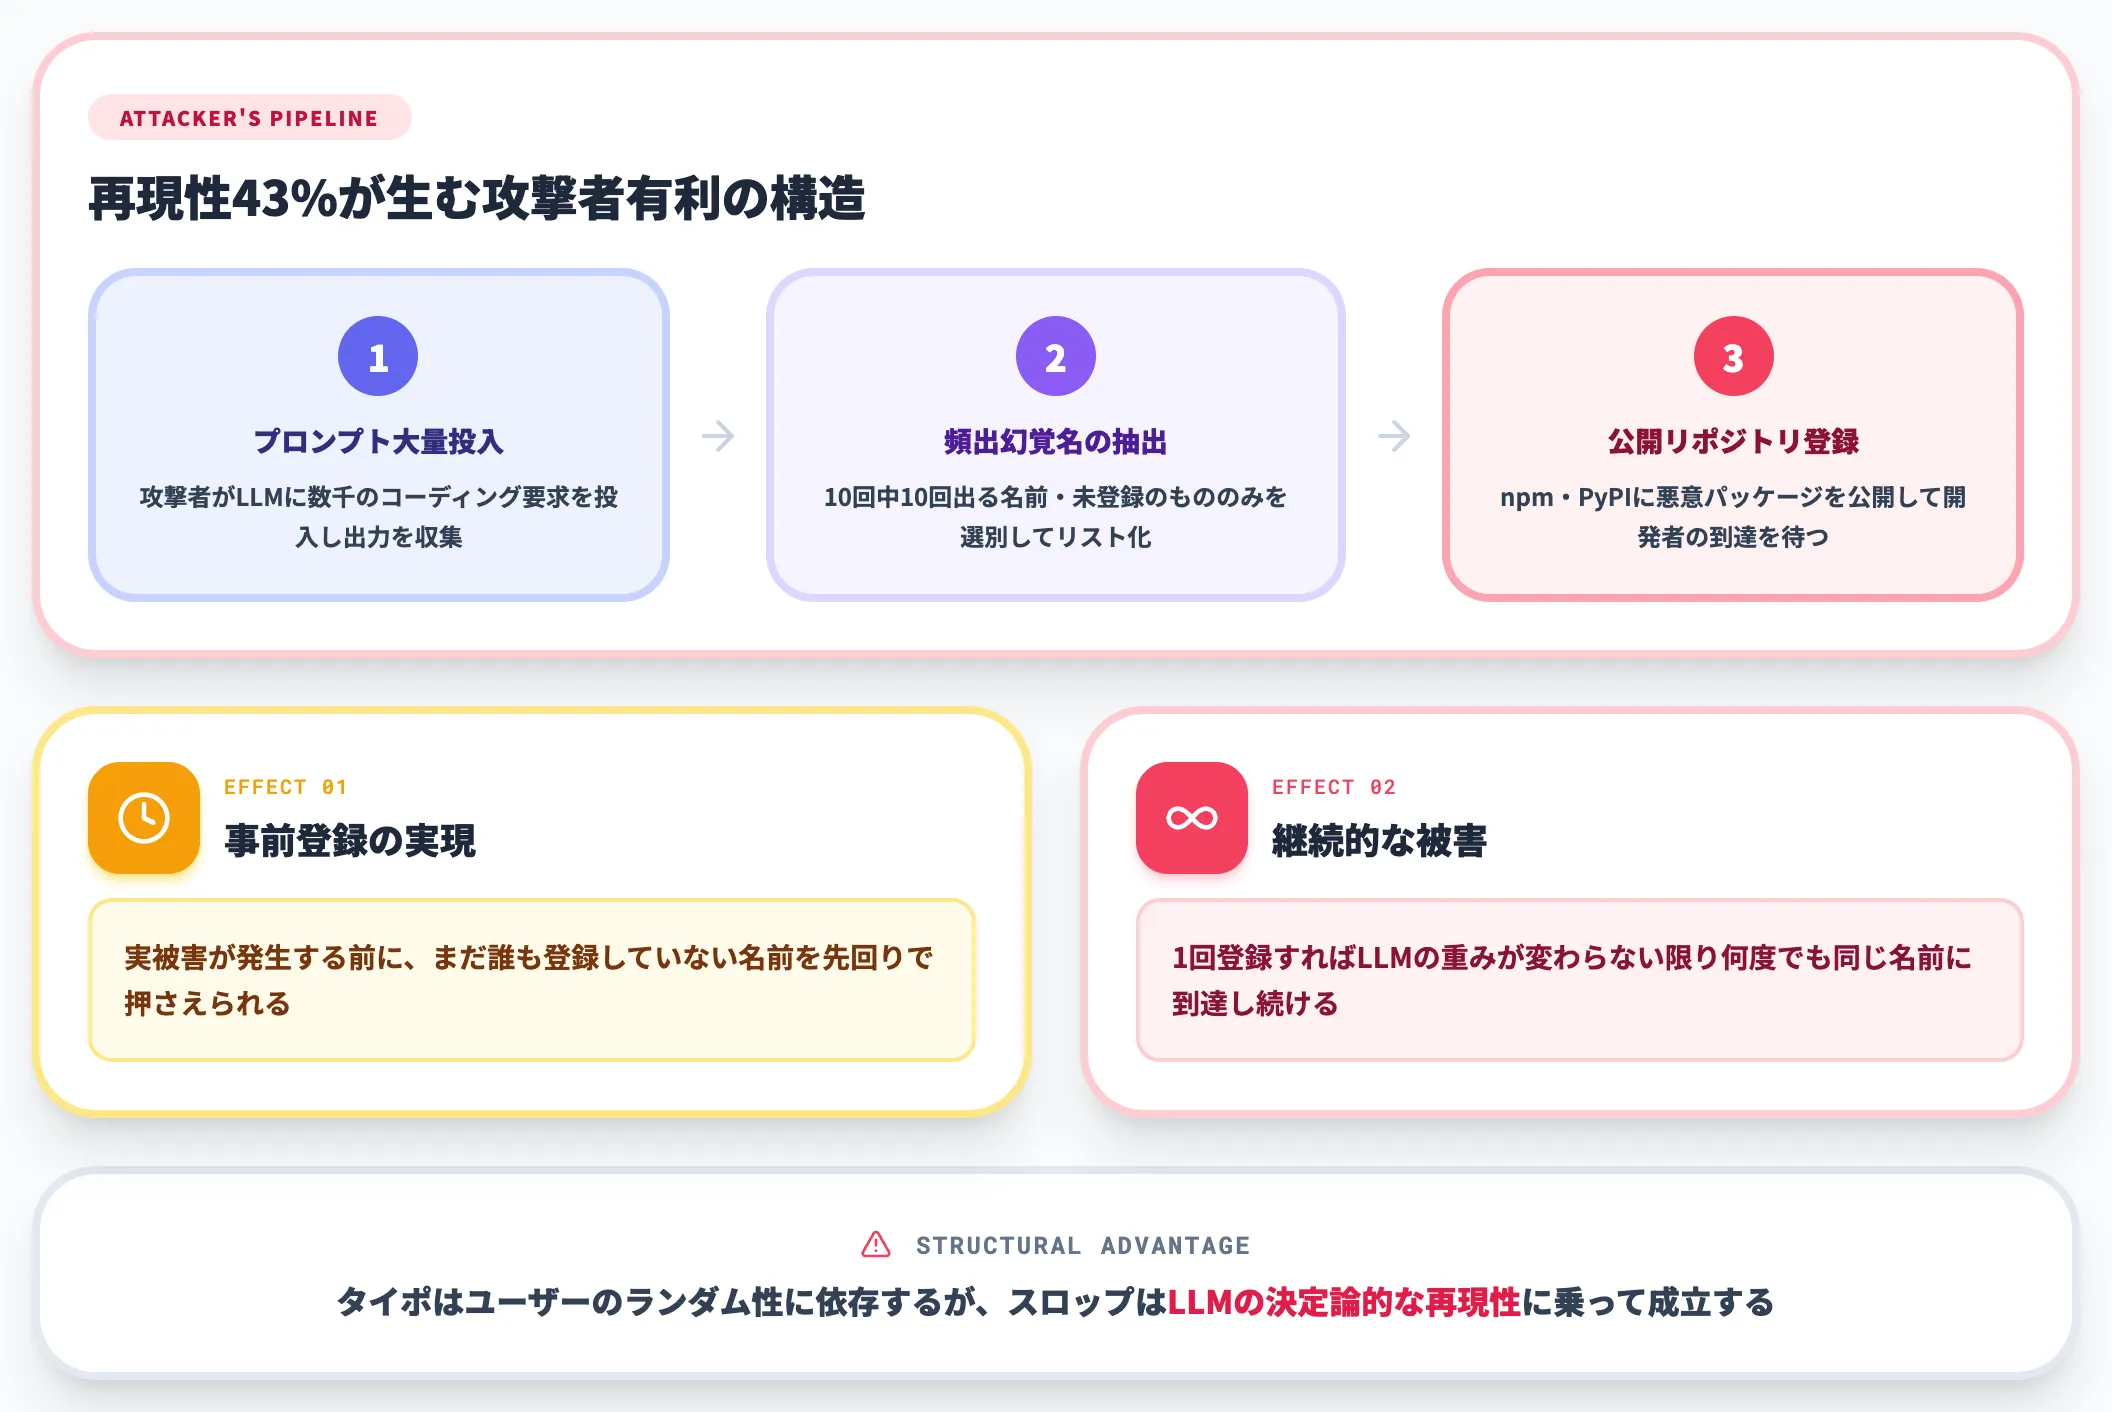
この再現性は、攻撃者にとって次の意味を持ちます。
-
実被害が起きる前に悪意パッケージを事前登録できる
攻撃者はLLMに大量のコーディングプロンプトを投入し、頻繁に出現する幻覚名のリストを作成すれば、まだ誰も登録していない名前を先回りで公開リポジトリに登録できます
-
1回登録すれば継続的に被害が発生する
開発者(または自律エージェント)が同じプロンプトで同じ名前を幻覚し続ける限り、悪意パッケージへの到達は何度でも起こります
人間のタイポが前提のタイポスクワッティングは「ユーザーのランダム性」に依存しますが、スロップスクワッティングはLLMの学習済み重みが変わらない限り再現し続けるという違いがあります。これが、本攻撃が「新手口」ではなく「構造的な脅威」として扱われる理由です。
なぜLLM単体の対策では防げないか
LLMに「存在するかどうかの検証」を組み込ませる方向性は、原理的には想像しやすい解決策ですが、現実には次の制約があります。
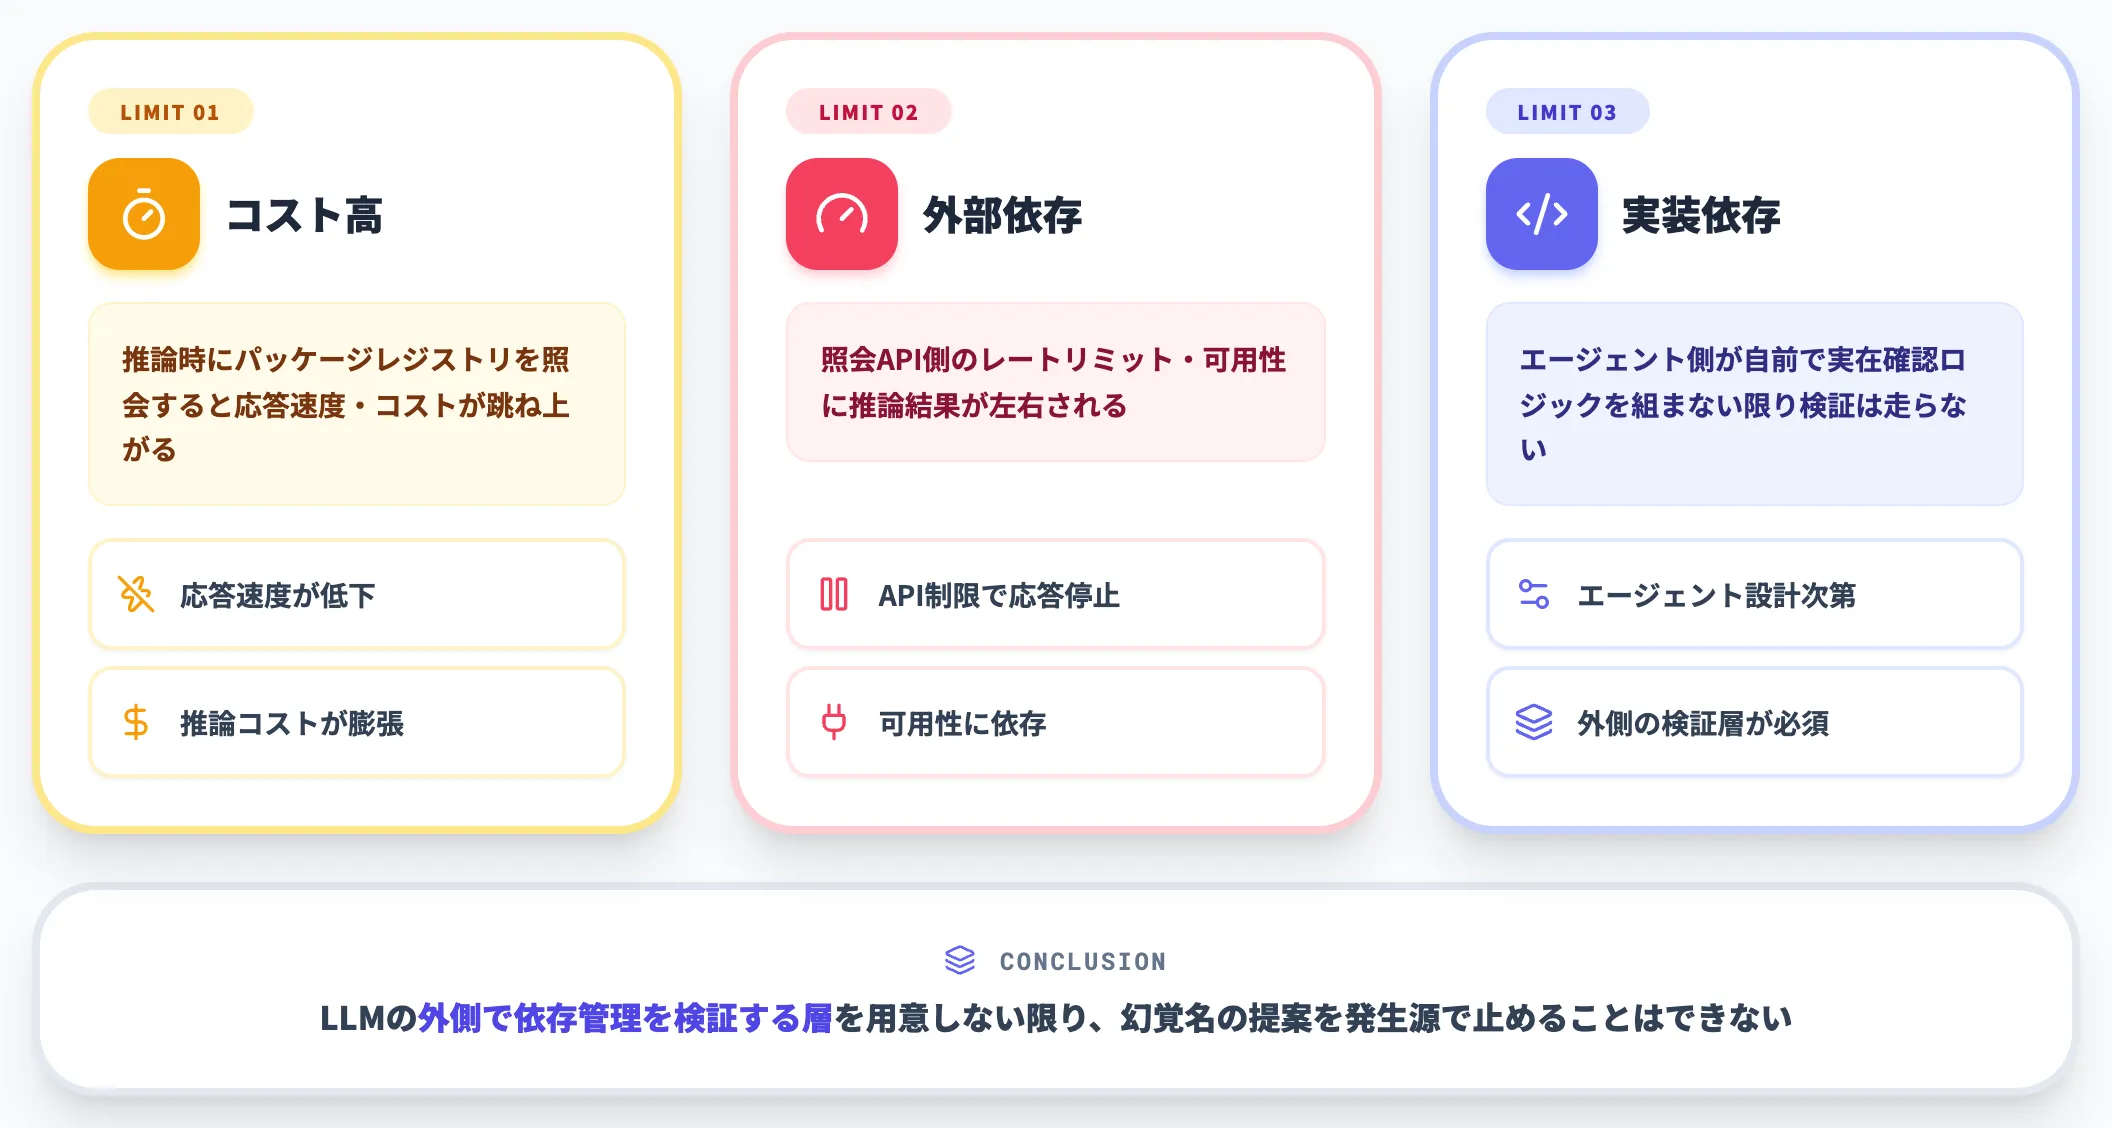
- 推論時のパッケージレジストリ照会は、応答速度・コストの両面でコスト高
- 照会API自体のレートリミット・可用性に依存する
- 自律エージェントが「照会結果に基づく実在確認」を自前のロジックで組み立てない限り、提案そのものに検証は入らない
結果として、LLMの外側で依存管理を検証する層を用意しない限り、幻覚名の提案を発生源で止めることはできません。この構造が、後述の多層対策につながります。
2024〜2026年に確認された実被害・実証事例
スロップスクワッティングは研究論文の中だけの話ではなく、2024年の実証登録を皮切りに、2026年に入ってからも複数の実被害・実証事例が公開されています。本セクションでは、業界で最も参照される3件を時系列で整理します。
react-codeshift(npm、2026年1月)——237リポジトリに拡散した合成幻覚名
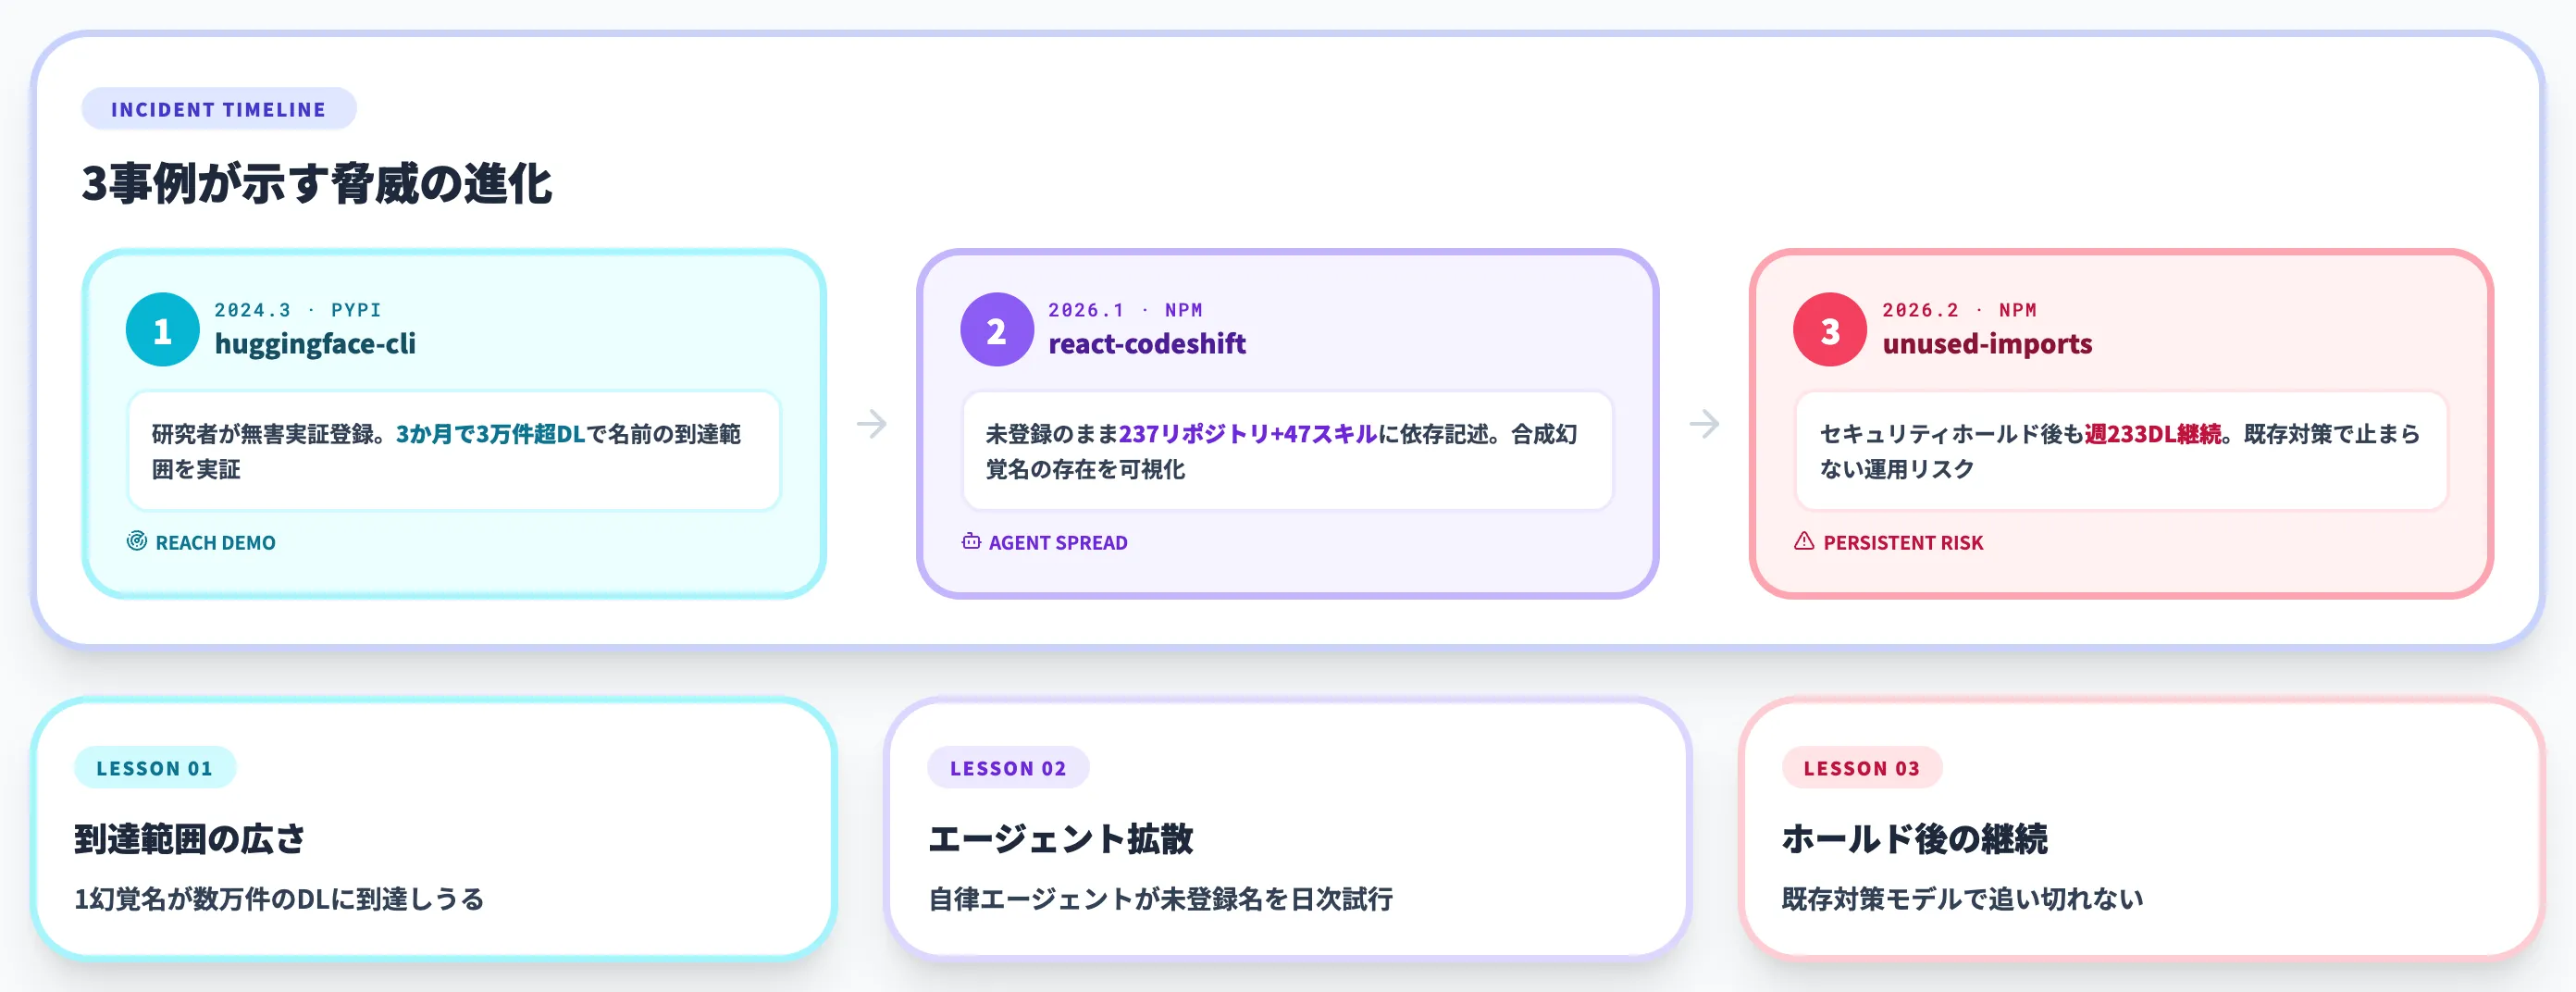
2026年1月、Aikido Securityの研究者Charlie Eriksen氏が、npmで [react-codeshift] という名前の推奨が複数のAIコーディングエージェントから頻発していることを発見しました。
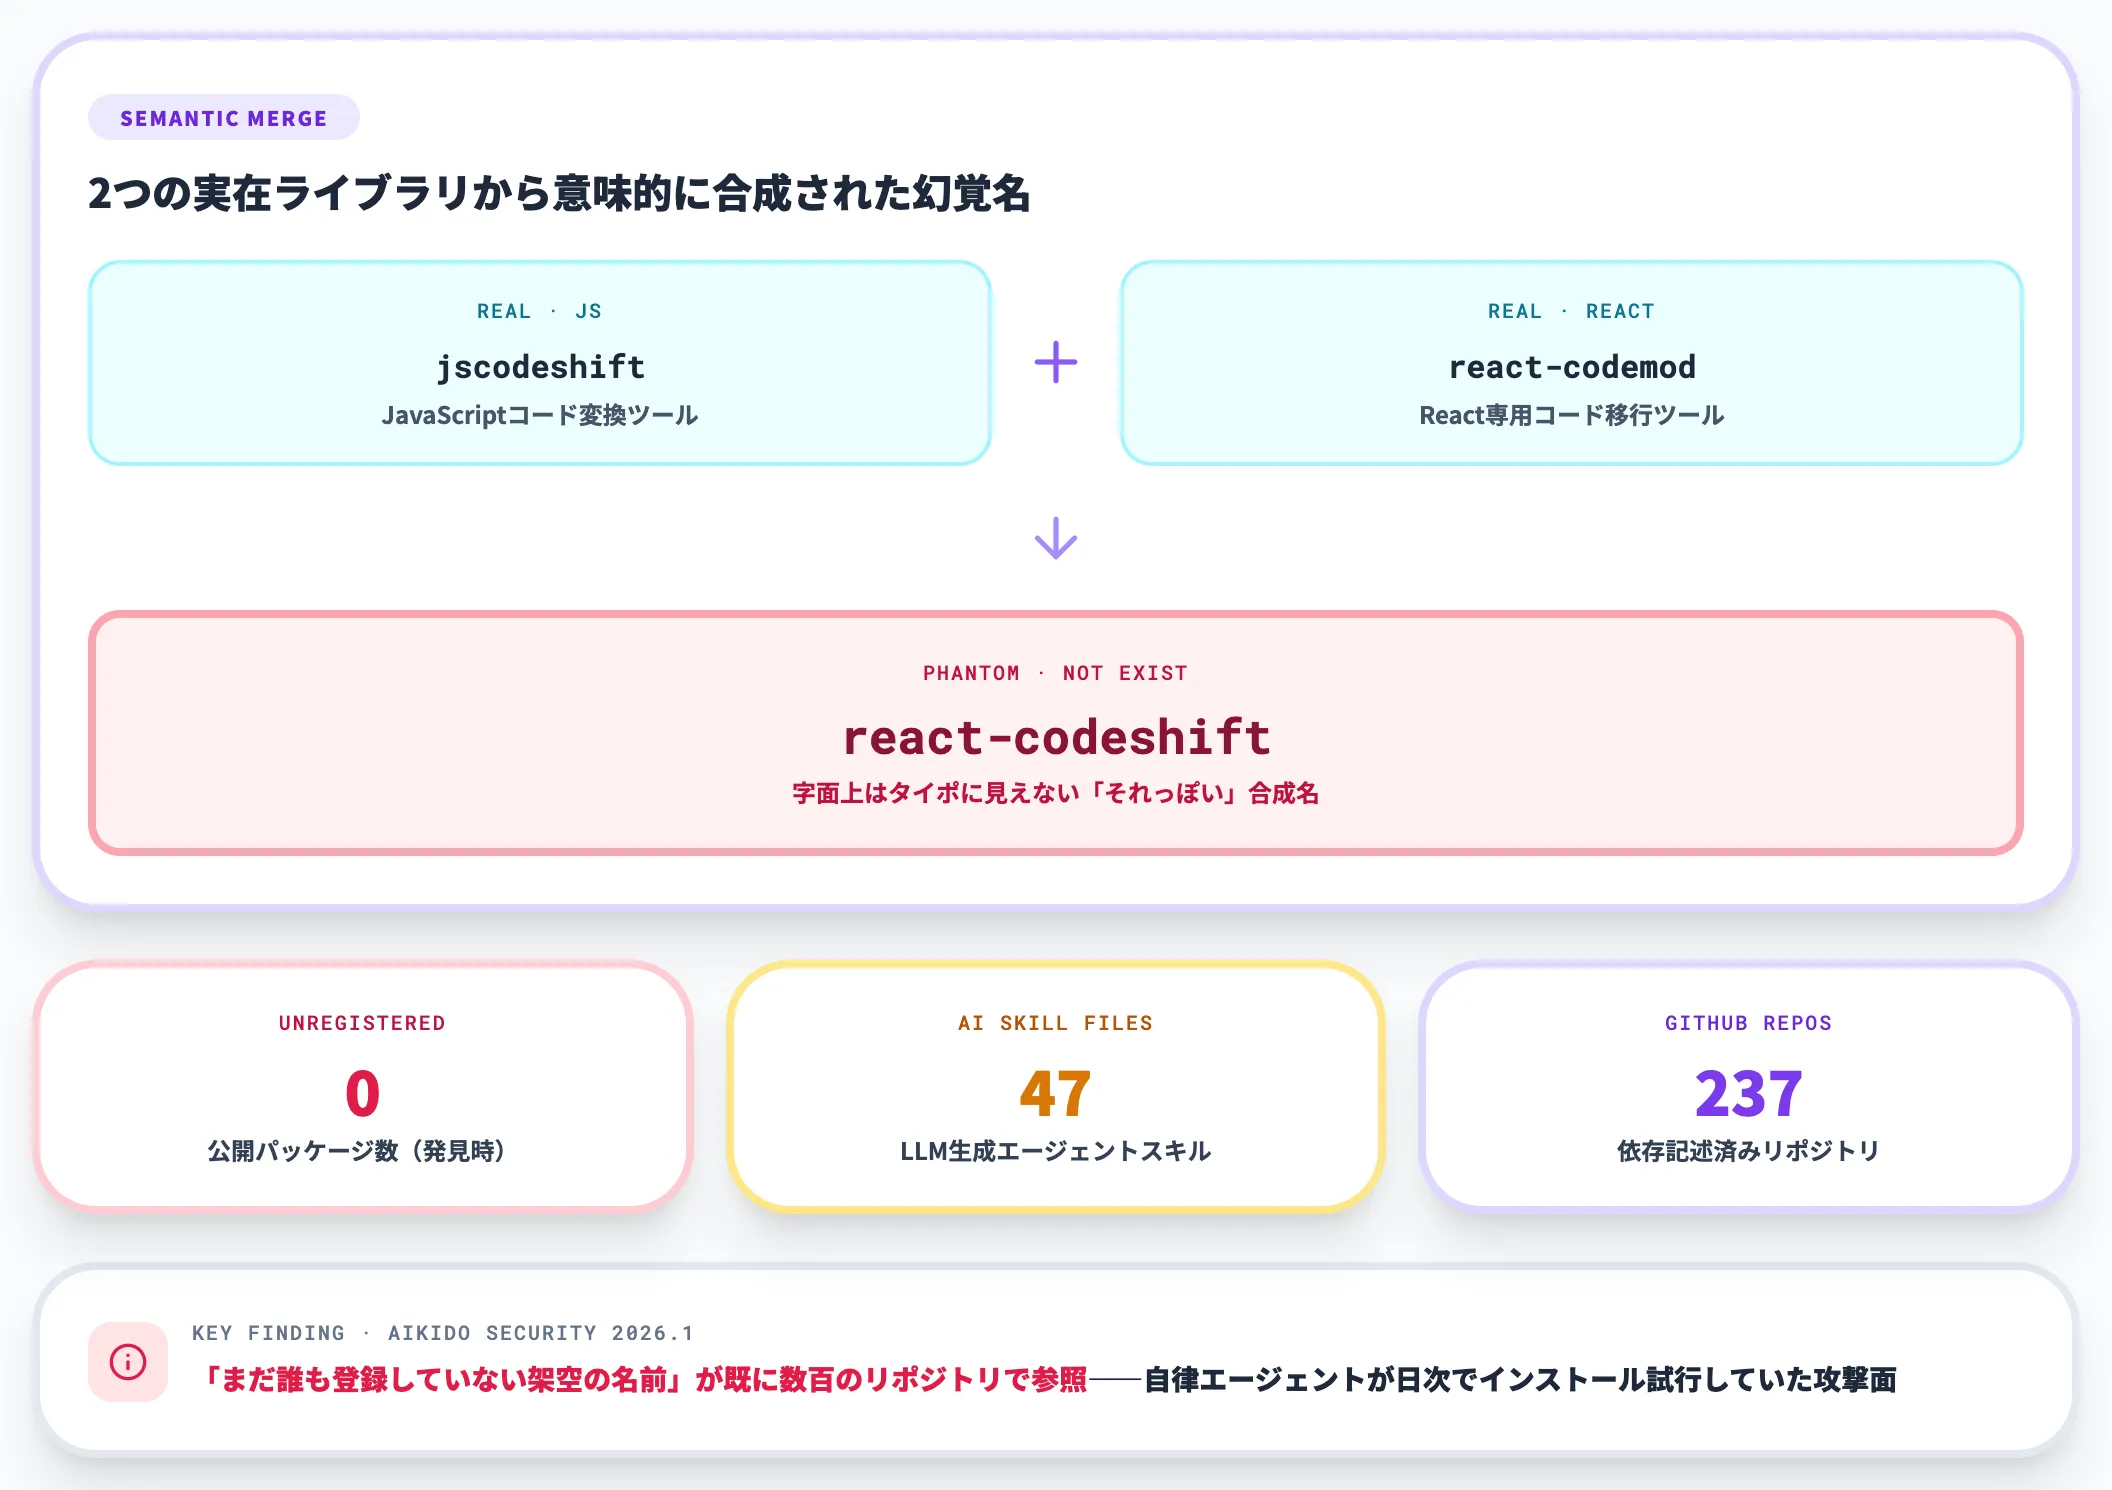
この名前は、実在する2つのパッケージ[jscodeshift](JavaScriptコード変換ツール)と [react-codemod](React専用のコード移行ツール)の意味的な合成として生成された幻覚名です。
Eriksen氏が公開情報として整理した時点で確認された状況は次のとおりです。
- まだ誰も [react-codeshift] という名前のパッケージを公開していなかった
- 一方で47件のLLM生成エージェントスキルファイルおよび237のGitHubリポジトリに、この名前への依存が既に書き込まれていた
- 自律エージェントがこの名前を日次でインストール試行し続けていた
Eriksen氏はこの事例を研究目的で先回り登録し、悪用を防ぎました。重要なのは、まだ誰も登録していない「架空の名前」が、既に数百のリポジトリで参照されている状態が、スロップスクワッティングの攻撃面として可視化された点です。
unused-imports(npm、2026年2月)——悪用された名前への取得が週233回継続
Cloud Security Allianceの研究ノートによれば、npmに登録されていた [unused-imports] という悪意パッケージは、実在する [eslint-plugin-unused-imports] と字面が近いことから混同されやすい状態でした。
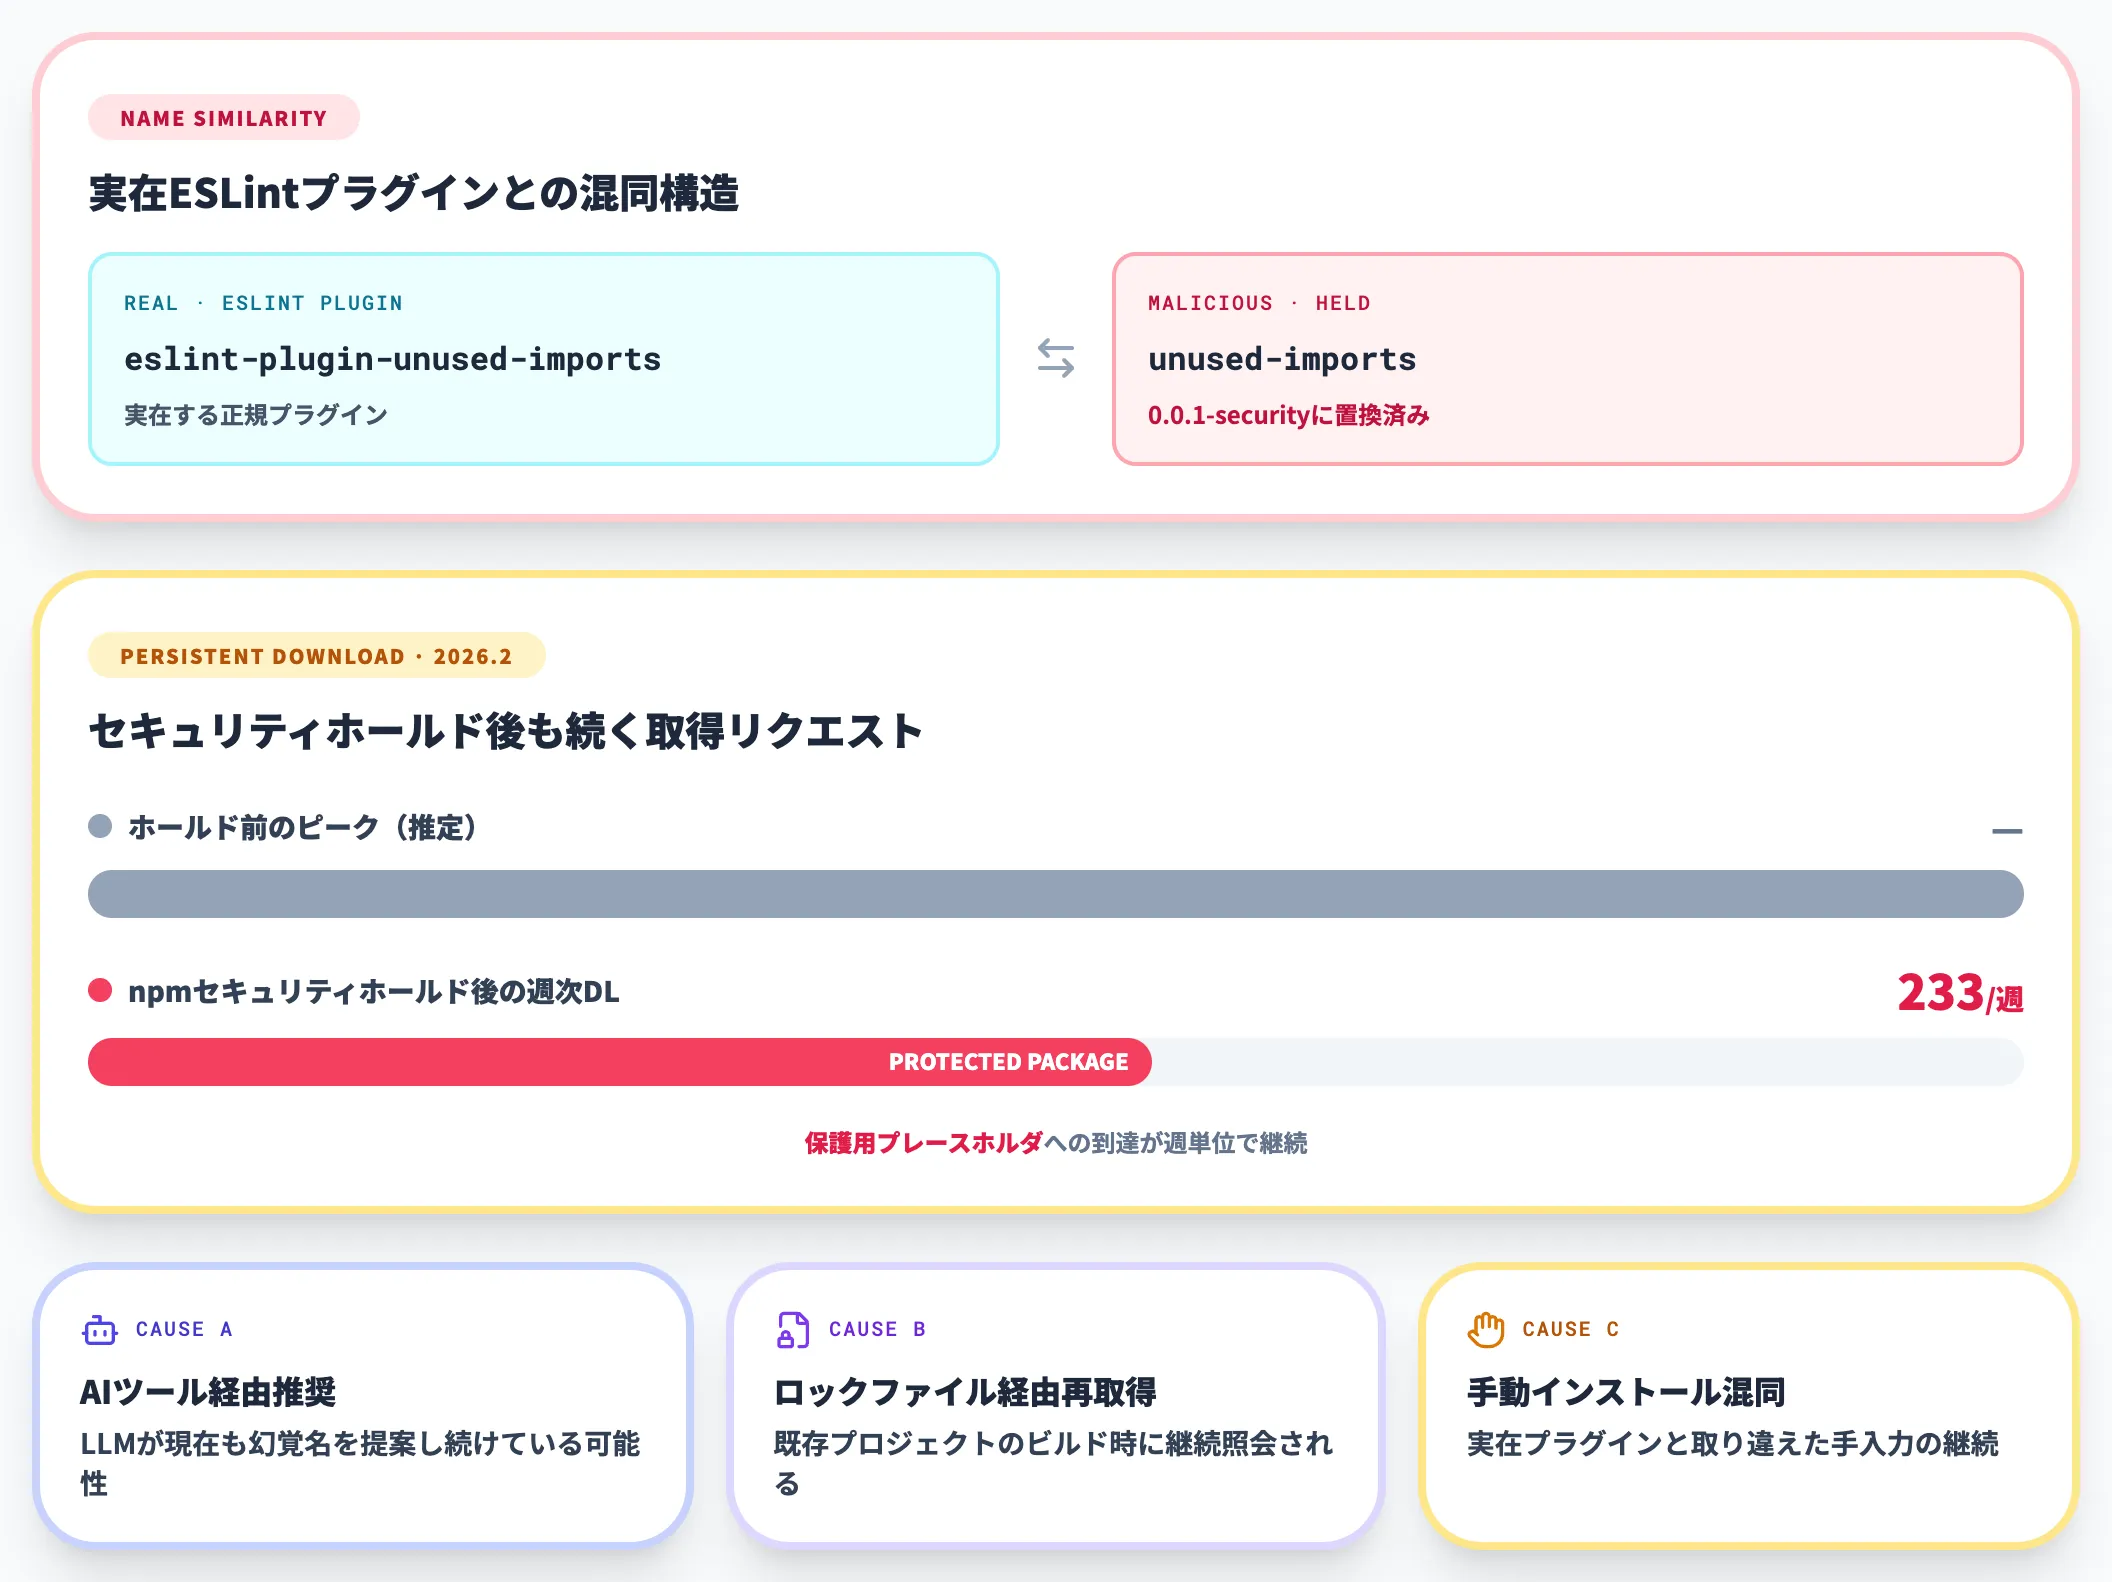
npm側がセキュリティホールドを掛け、現在は [0.0.1-security] の保護用プレースホルダに置き換えられていますが、2026年2月時点で週あたり約233回のダウンロードが記録されています。報告元のAikido Security自身は「このパッケージが悪意あるものであることは確認できるが、攻撃者がLLMの幻覚を狙った意図で登録したかまでは実証できない」と留保を付けており、ダウンロード数も「AIツール経由の推奨」「ロックファイル経由の再取得」「混同による手動インストール」のどれが主因かまでは特定できていません。
この事例から確定して言えるのは、悪用された名前への取得リクエストがnpm側のホールド後も週単位で継続しているという事実です。実パッケージは保護用の空版に置き換わっているため現在の実害は限定的ですが、原因が特定できないまま取得が続く状態そのものが、既存の対策モデルでは追い切れない運用リスクを示しています。
huggingface-cli(PyPI、2024年3月)——3か月で3万件超のダウンロード
PyPIでは、Lasso Securityの研究者が2024年3月に報告した事例として、[huggingface-cli] という幻覚名を無害な空パッケージとして事前登録し挙動を観察した実証が公開されています。
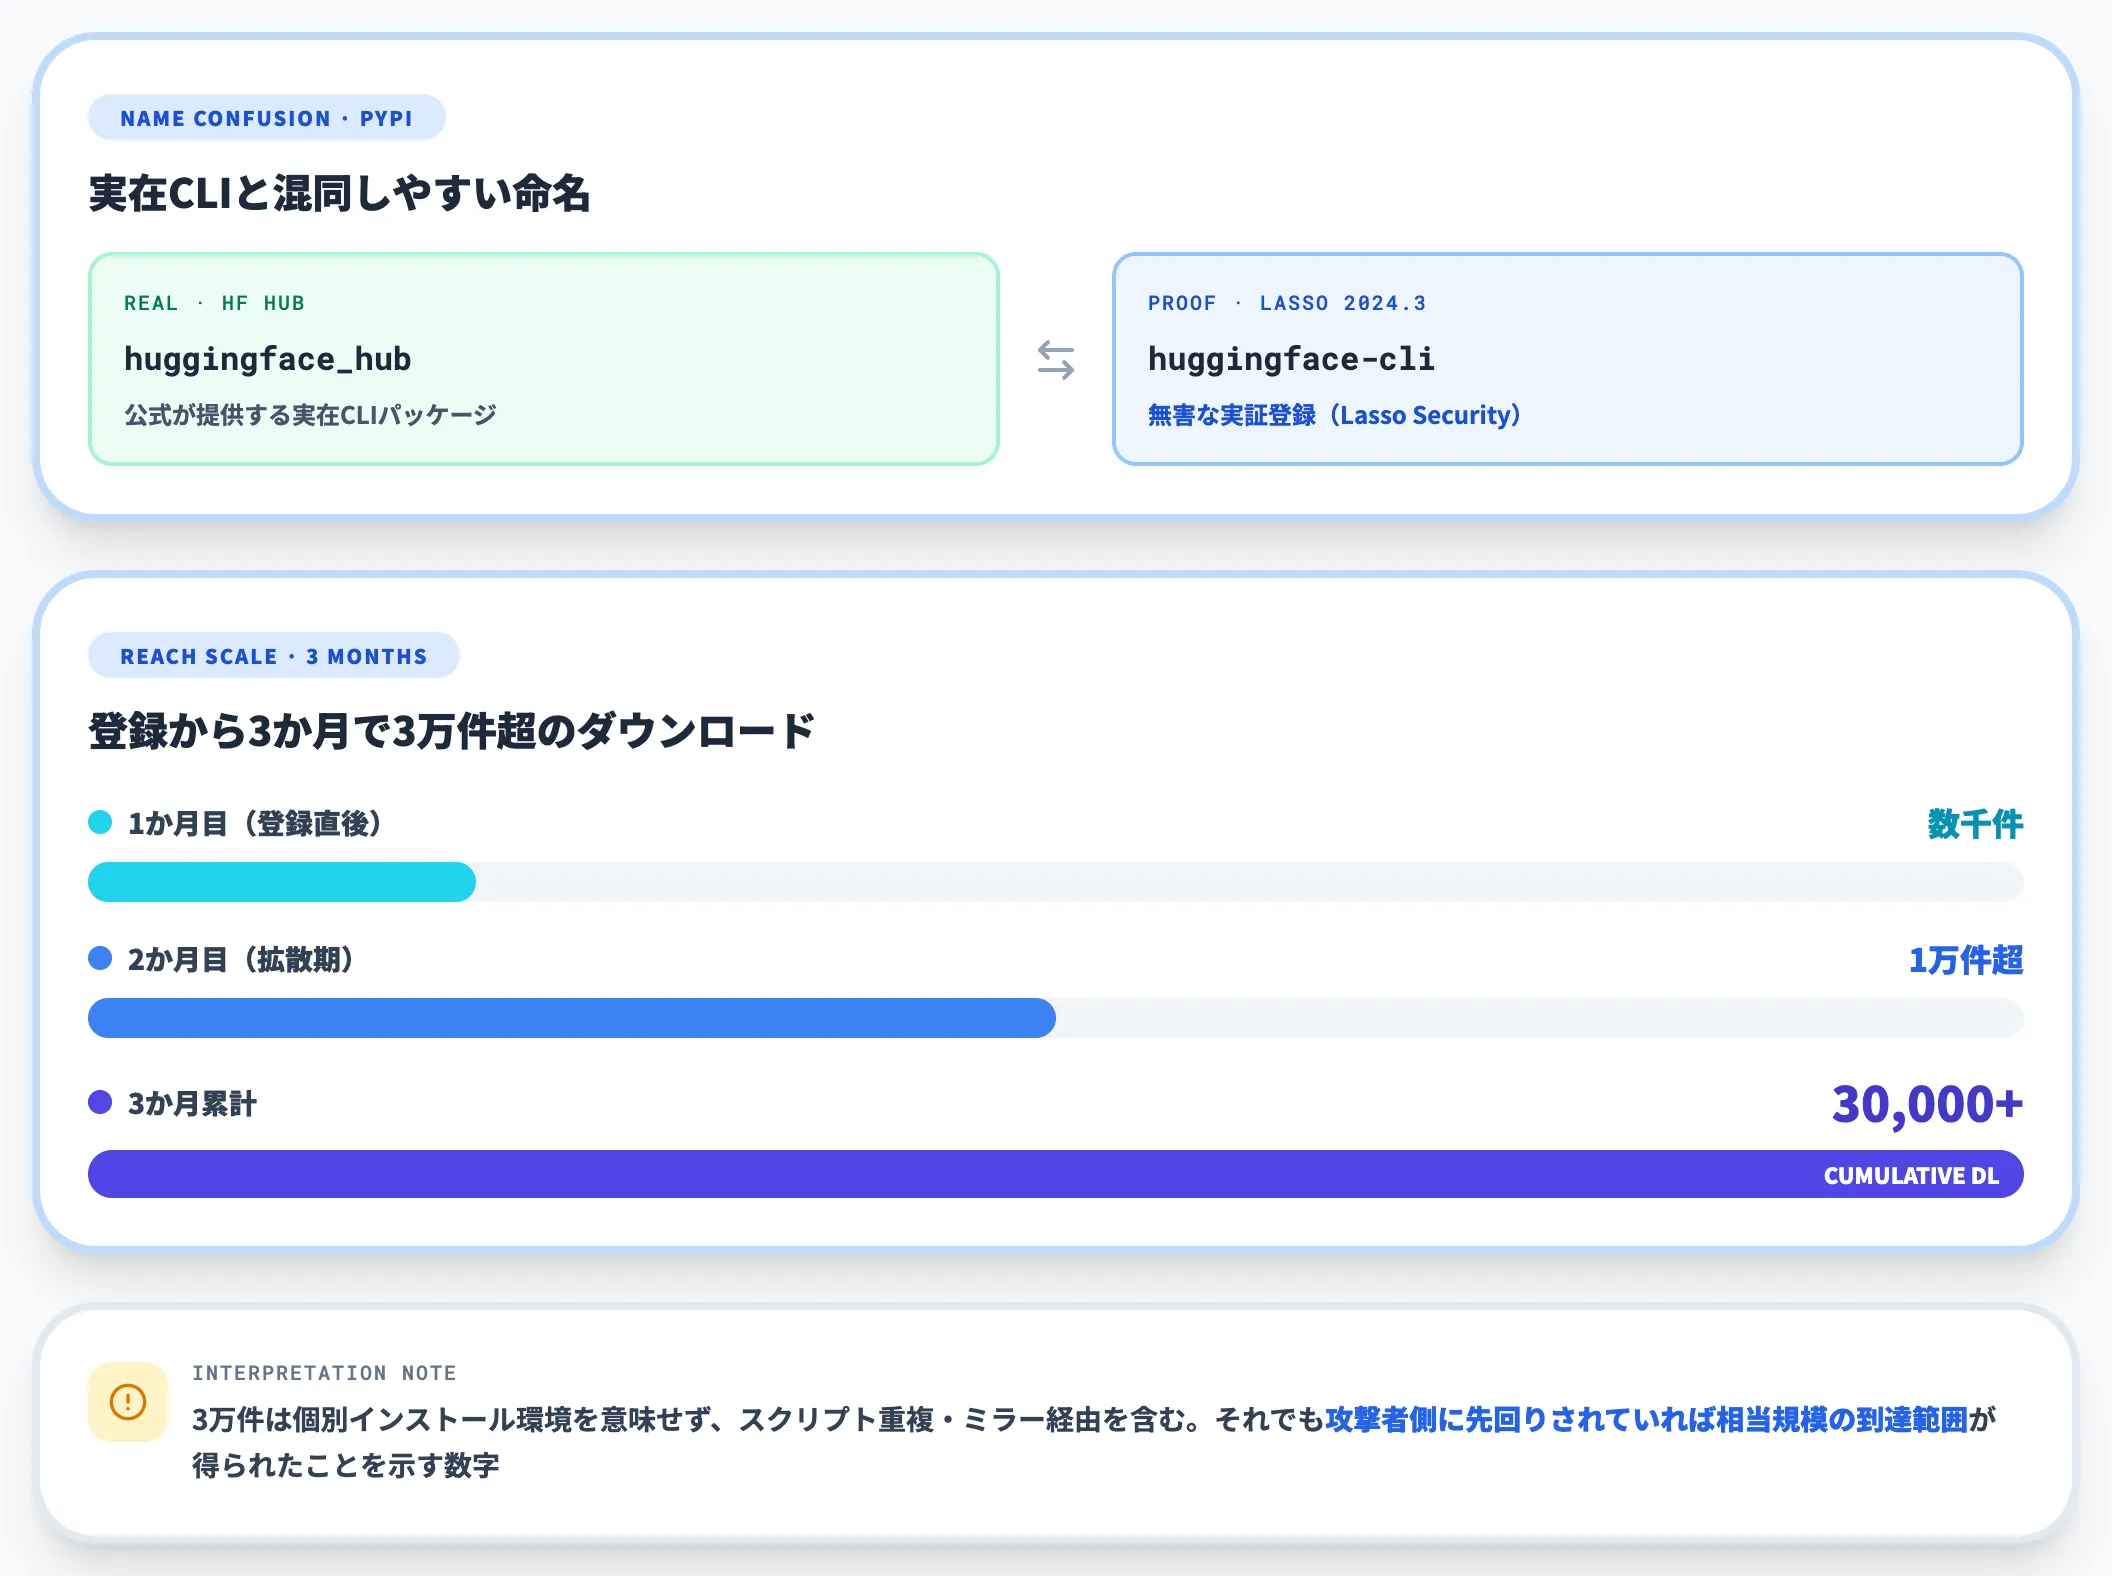
実在する [huggingface_hub] が提供するCLIと混同しやすい名前で、LLMが頻繁に推奨していたため、研究者が挙動実証と悪用防止を兼ねて登録した形です。登録から約3か月で30,000件を超えるダウンロードが記録されました。
これはあくまで無害な実証例であり、ダウンロード数そのものが30,000個の個別インストール環境を意味するわけではありません(スクリプトによる重複取得・ミラー経由の収集などを含む)。ただし、同じ名前が攻撃者側に先回りされていれば、相当規模の到達範囲を持った可能性を示す数字です。
これら3事例を並べると、スロップスクワッティングの実態が時系列で見えてきます。huggingface-cli(2024年3月)は「名前の到達範囲の広さ」を実証し、react-codeshift(2026年1月)は「自律エージェント経由での拡散」を、unused-imports(2026年2月)は「悪用された名前への取得がホールド後も継続する運用リスク」をそれぞれ示す教材的ケースです。
自律エージェント時代に脅威度が跳ね上がる理由
スロップスクワッティングの概念自体は、2024年には既に研究で指摘されていました。にもかかわらず2026年に入ってから脅威の深刻度が一段上がったのは、Claude Code・GitHub Copilot・Clineなどの自律型AIエージェントが実装レベルで普及したためです。
人間レビューの欠落——エージェントが黙ってインストールを走らせる
従来の開発フローでは、開発者がパッケージ名を見てから [npm install] や [pip install] を実行していたため、知らない名前への抵抗感が最後の防波堤として機能していました。
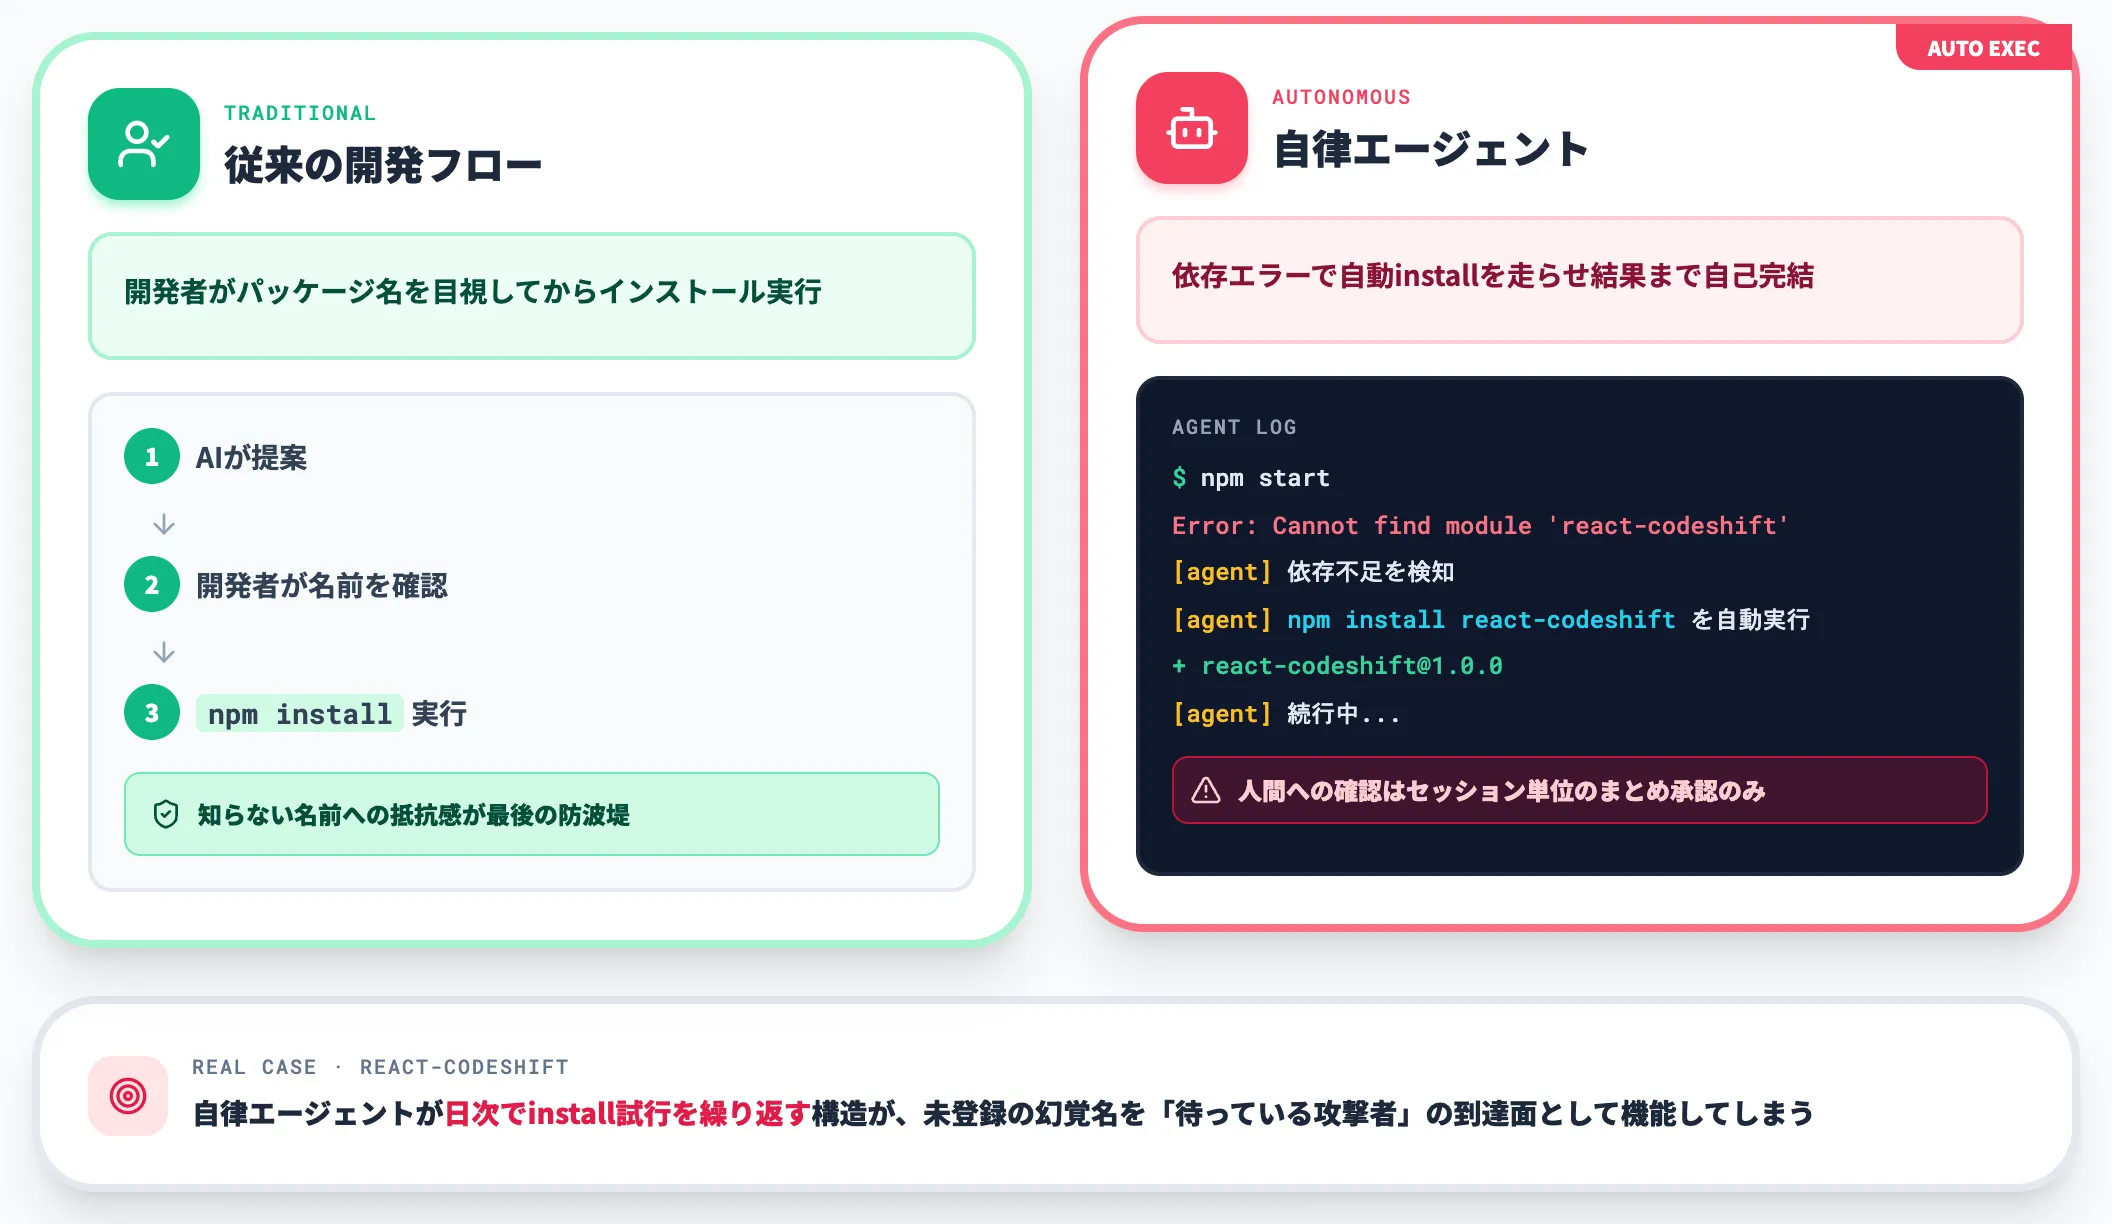
一方、自律エージェントは次のような挙動を取ります。
- モデルが生成したコードを自分で実行して結果を確認する
- 依存エラーが出れば自動で [install] コマンドを走らせて続行する
- 人間への確認は、設定次第でセッション単位のまとめ承認にしか現れない
この結果、ユーザーが知らないうちに幻覚名のパッケージがインストールされ、悪意コードがローカル環境・CI環境で実行される経路が成立します。前述のreact-codeshift事例では、「自律エージェントが日次でインストール試行を繰り返していた」ことが特徴的でした。
複数エージェントの連鎖——攻撃面の多段化
AI Agent Hubのような業務特化Agent群を複数組み合わせる構成では、1つのエージェントの出力が別のエージェントの入力になります。コード生成Agentが幻覚名を出力し、CI/CD実行Agentがそれをロックファイルに書き込み、デプロイAgentが本番環境に反映する——という連鎖が、人間の目を一度も介さずに完結しうる構造です。
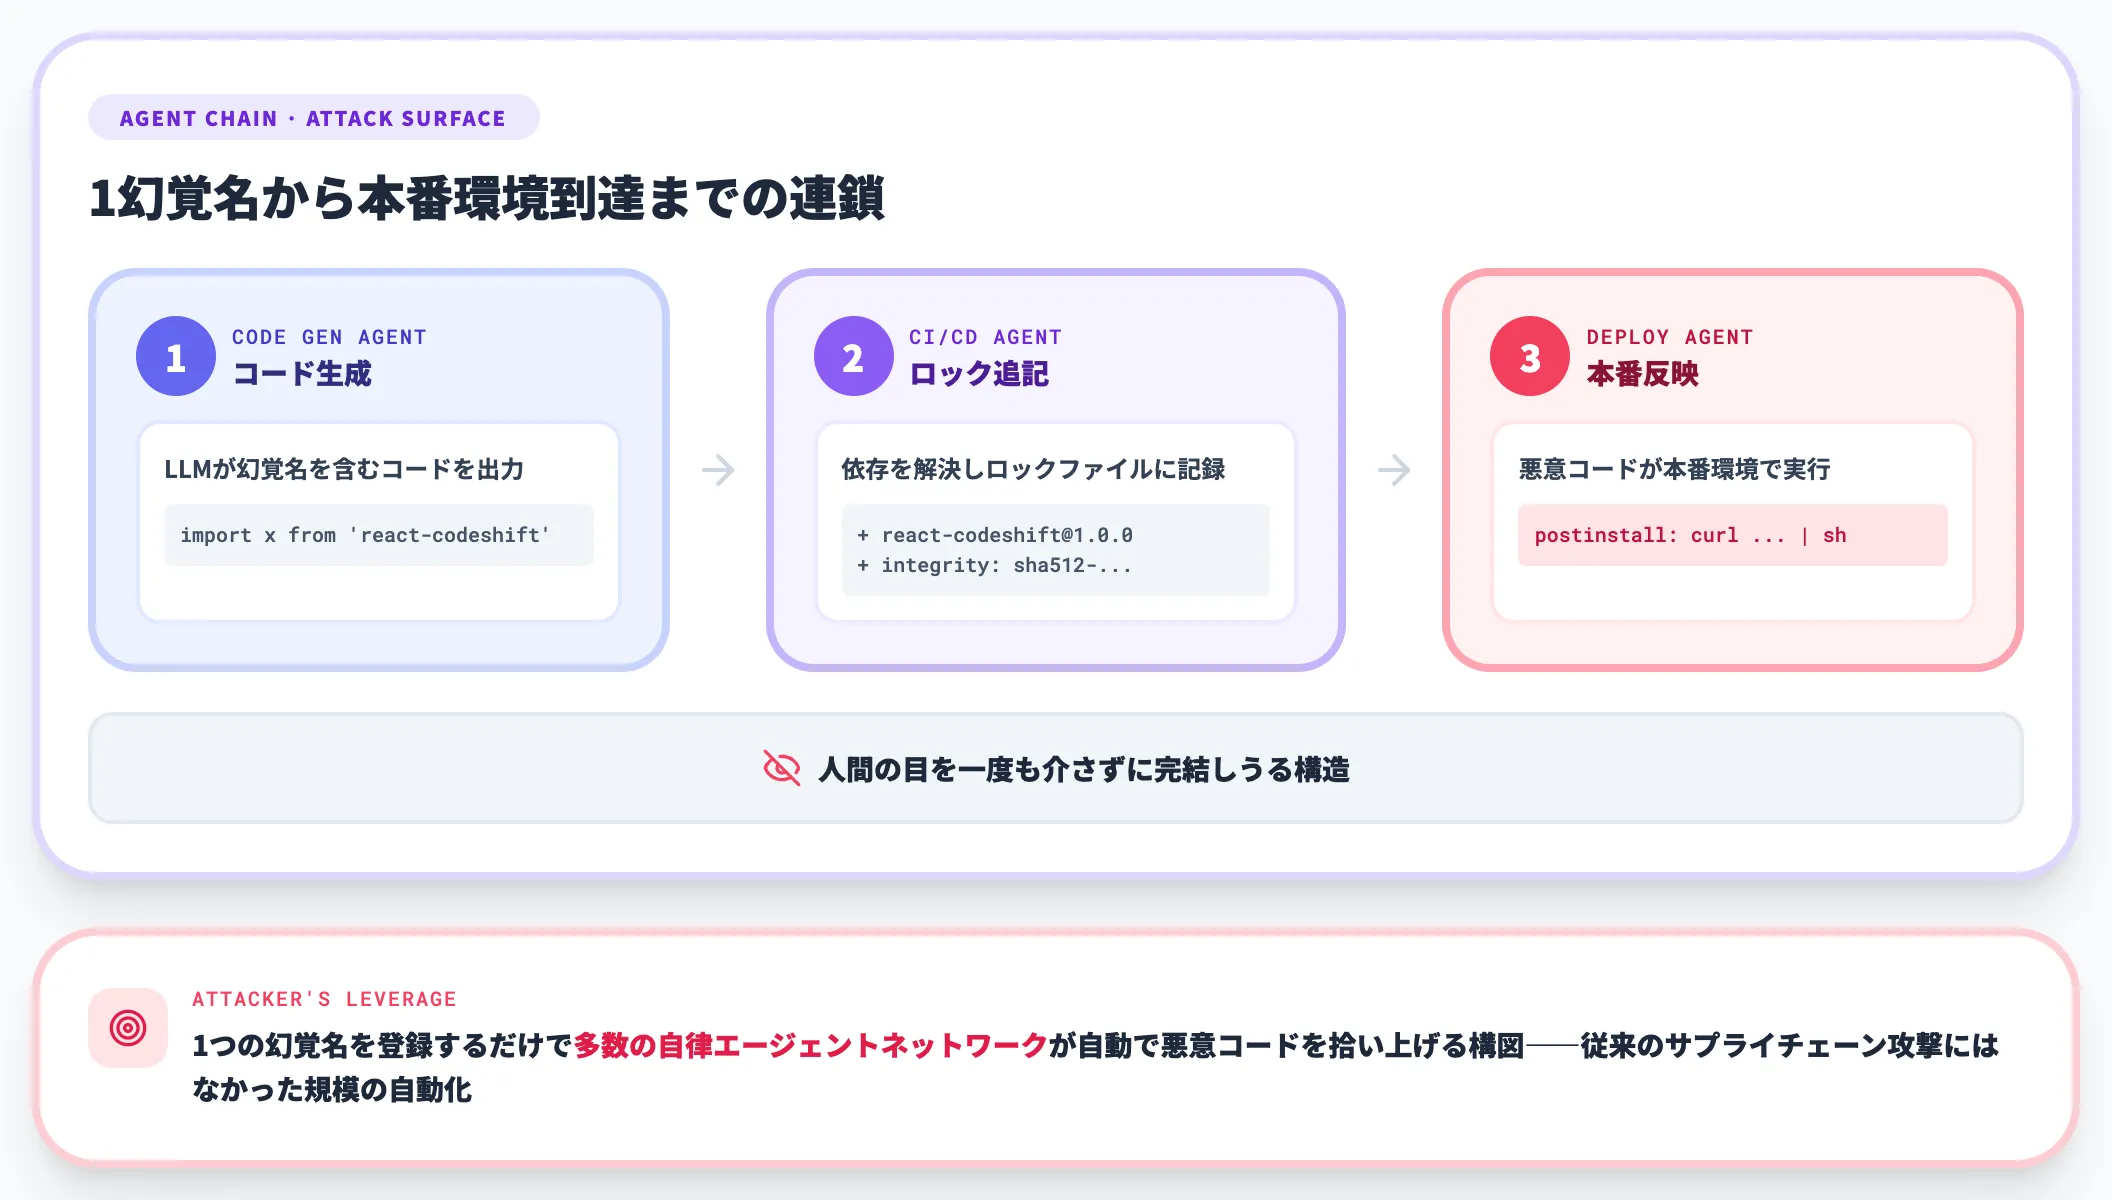
攻撃者から見れば、1つの幻覚名を登録するだけで、多数の自律エージェントネットワークが自動で悪意コードを拾い上げてくれる状況になります。これは従来のサプライチェーン攻撃にはなかった規模の自動化です。
MCPによる緩和の兆し——リアルタイム検証の組み込み
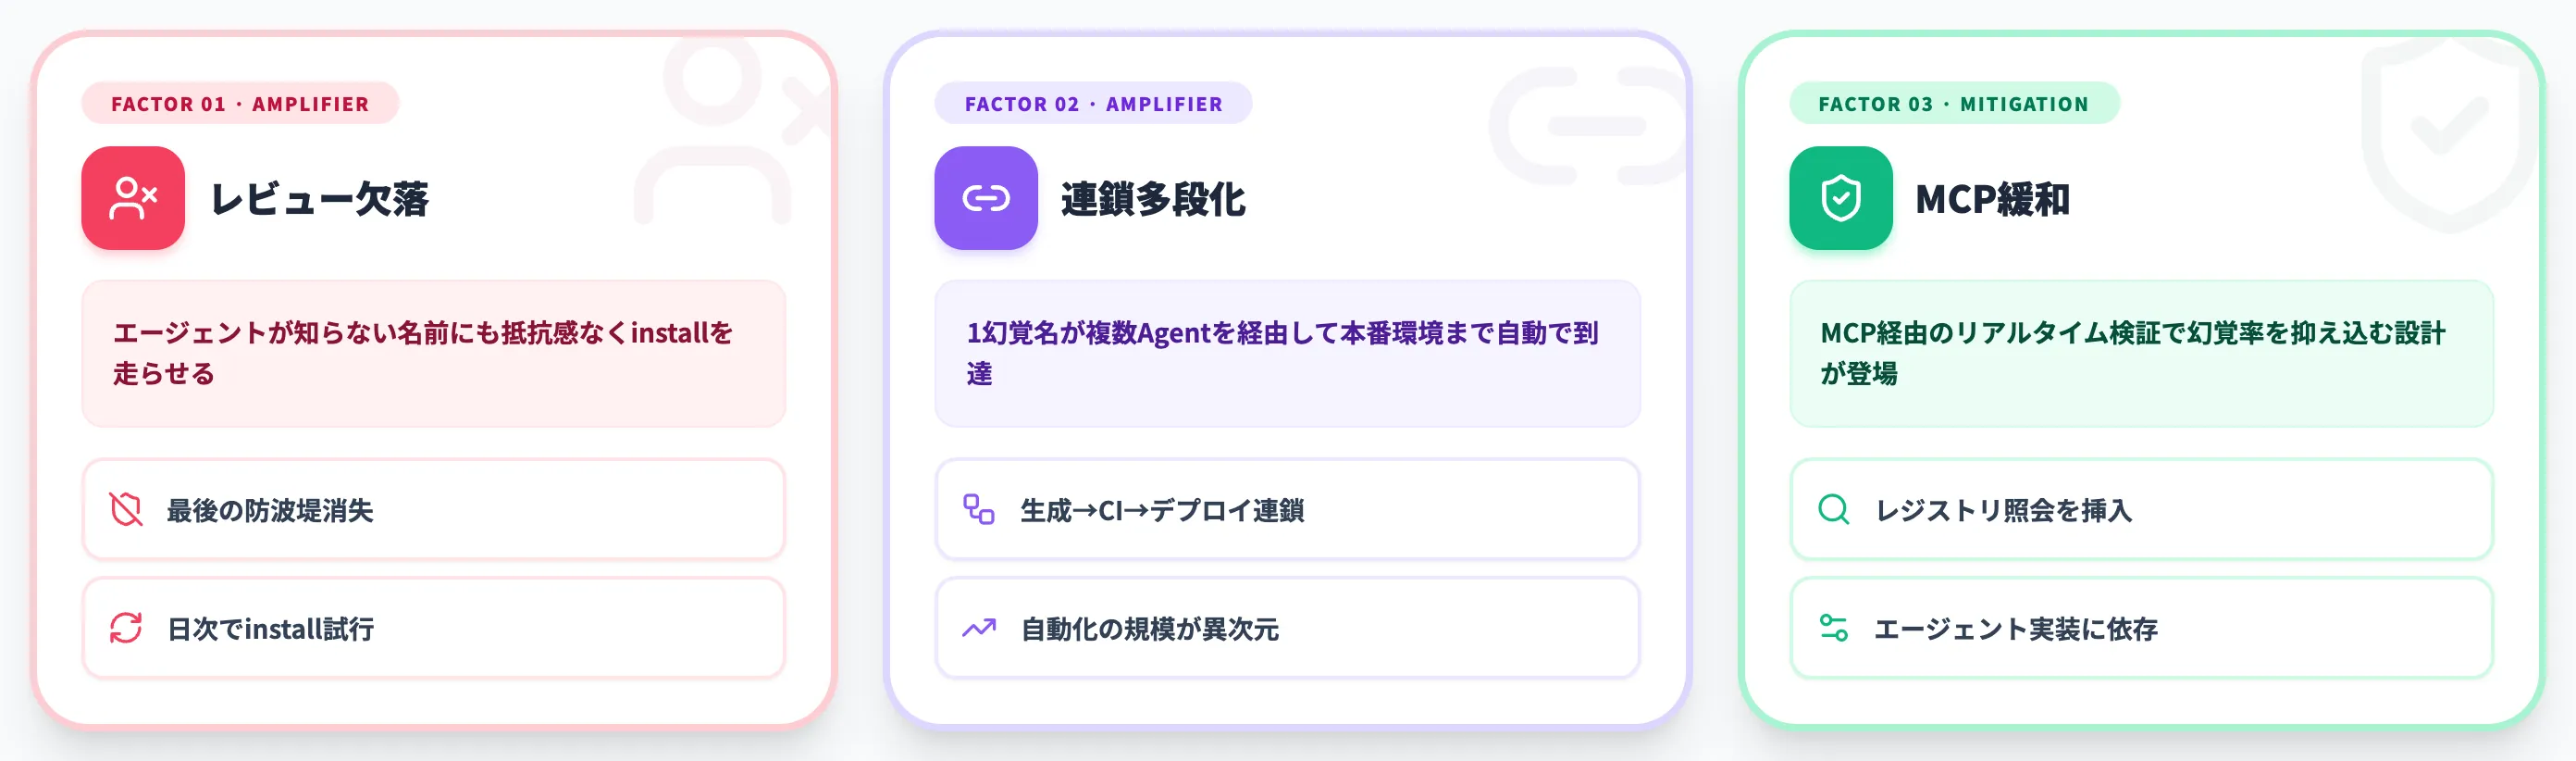
一方で、MCP(Model Context Protocol)の普及に伴い、エージェントが外部ツール経由でリアルタイムにパッケージレジストリを照会する運用も現れ始めています。
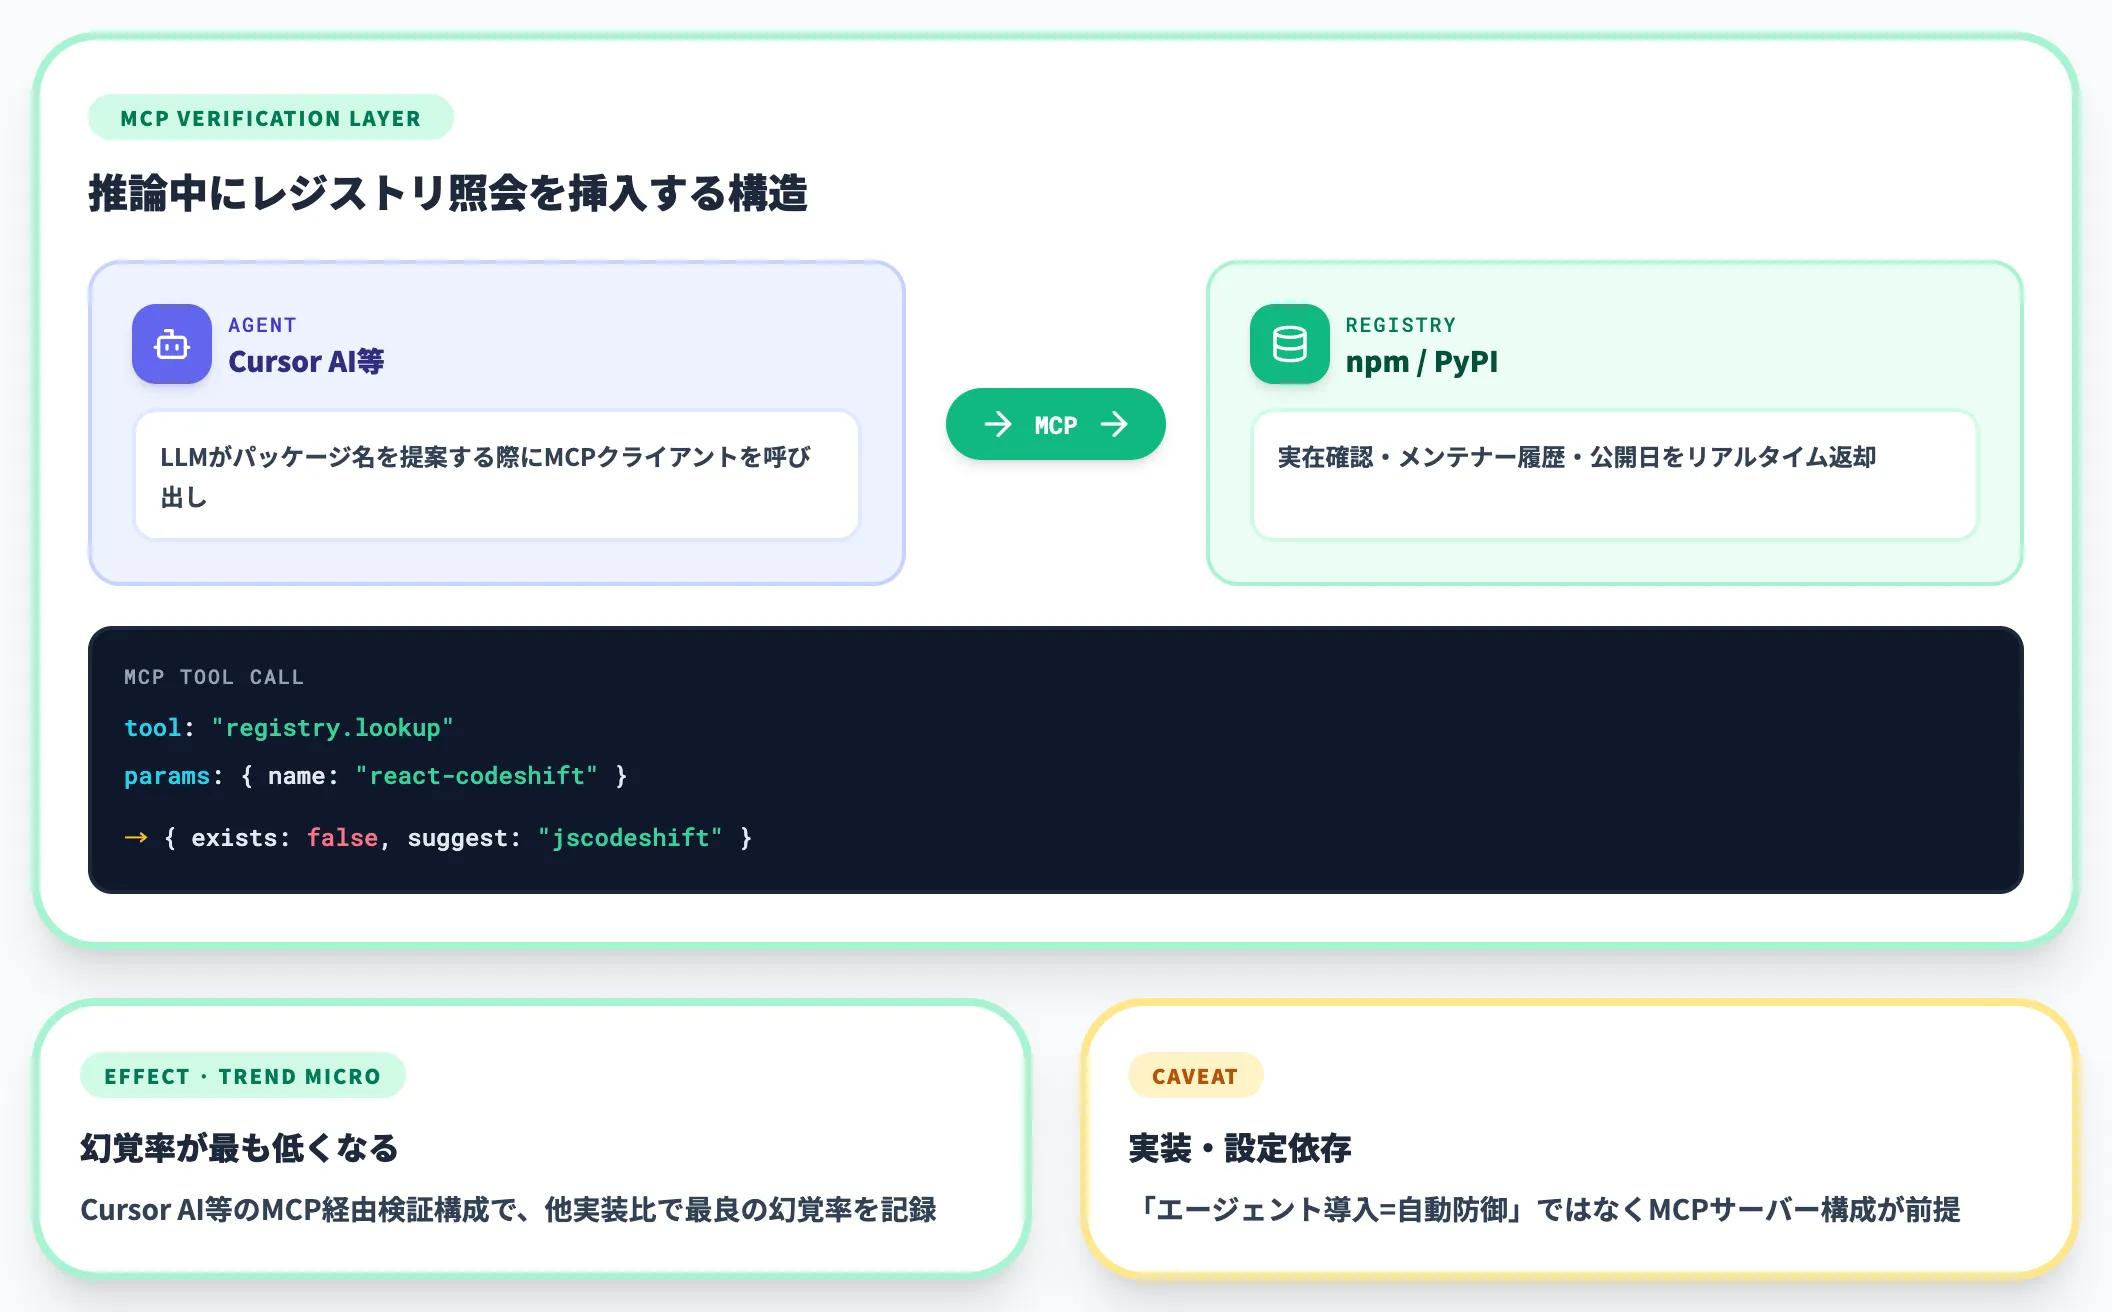
トレンドマイクロの検証では、Cursor AIのようにMCP経由で検証を挟む構成では幻覚率が最も低くなる結果が出ています。ただしMCP経由の検証はエージェント実装・サーバー設定に強く依存するため、「エージェントを導入しただけで防御される」わけではない点に注意が必要です。
フロンティアモデルの幻覚率と残るリスク
「2024年の研究データは古いモデルの話で、現行のフロンティアモデルなら問題ないのでは」という受け止め方は、2026年時点の実測データに照らすと楽観的すぎます。本セクションでは、幻覚率の変化と残るリスクを定量的に整理します。
2024年測定・2025年公表の原論文——商用5.2% / オープンソース21.7%
前述のSpracklenらの研究は2024年に測定を行い、2025年のUSENIX Security Symposiumで報告された、16種のコード生成LLMを対象とする大規模評価の結果です。
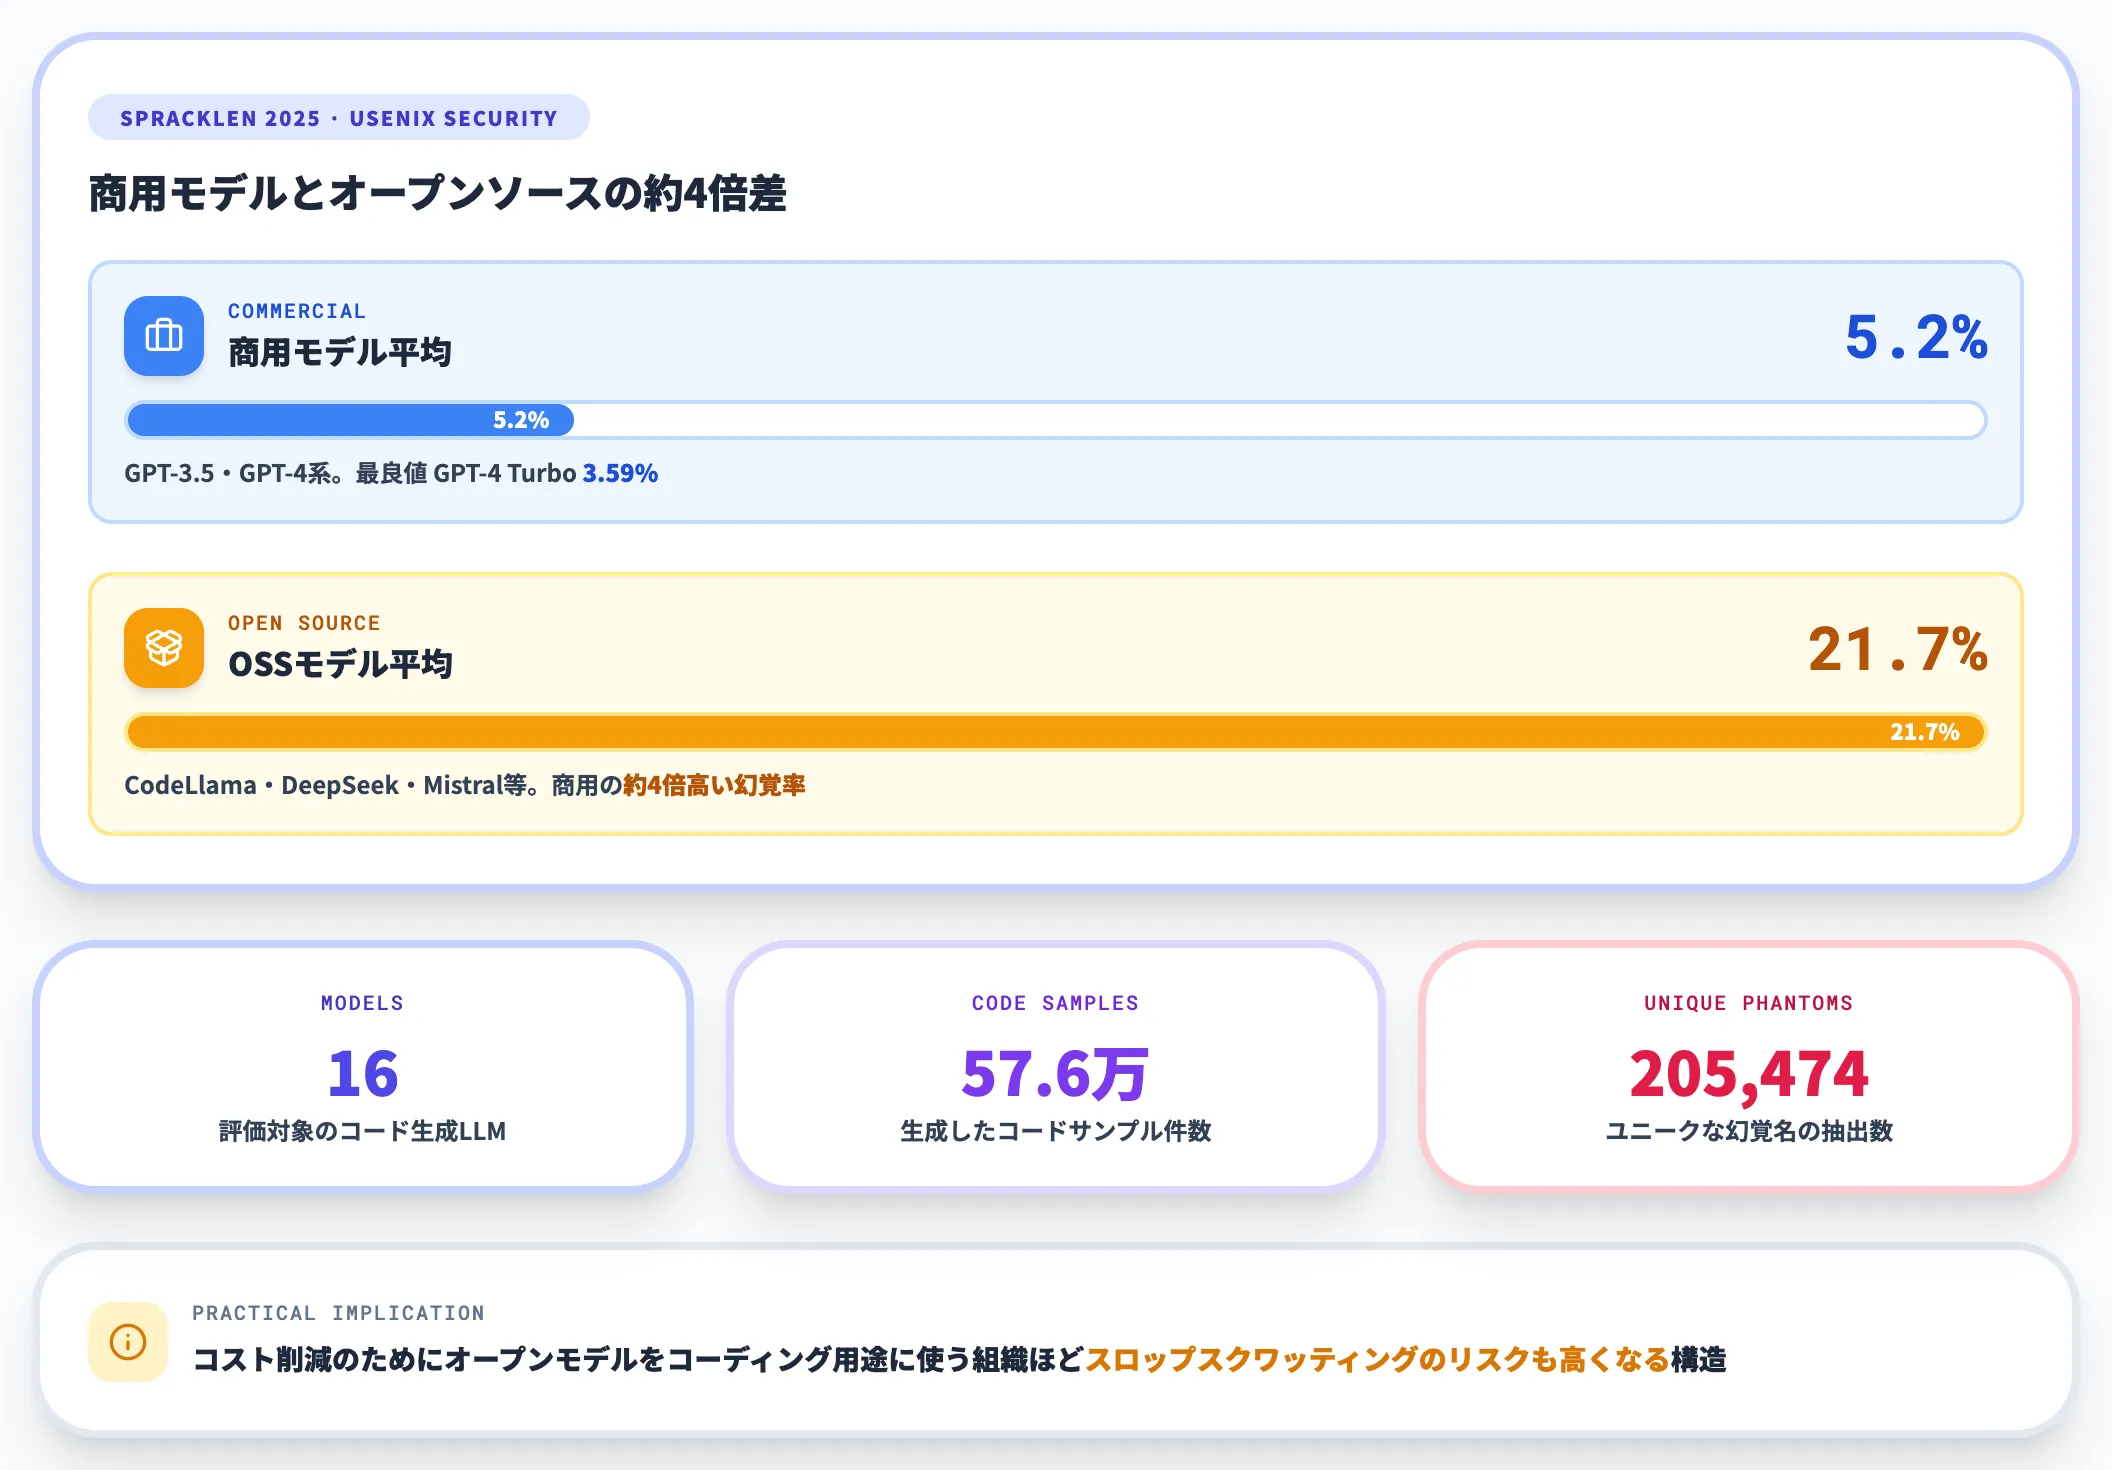
- 商用モデル(当時のGPT-3.5・GPT-4系)平均:約5.2%
- オープンソースモデル(CodeLlama・DeepSeek・Mistral等)平均:約21.7%
- GPT-4 Turboの最良値:約3.59%
- 評価全体でユニークな幻覚名を205,474件抽出
オープンソースモデルの幻覚率がおよそ4倍高い点が、当時の研究で特に注目されました。コスト削減のためにオープンモデルをコーディング用途に使う組織ほど、スロップスクワッティングのリスクも高くなる構造です。
2026年のフロンティアモデル再評価——4.62〜6.10%に低下、しかし
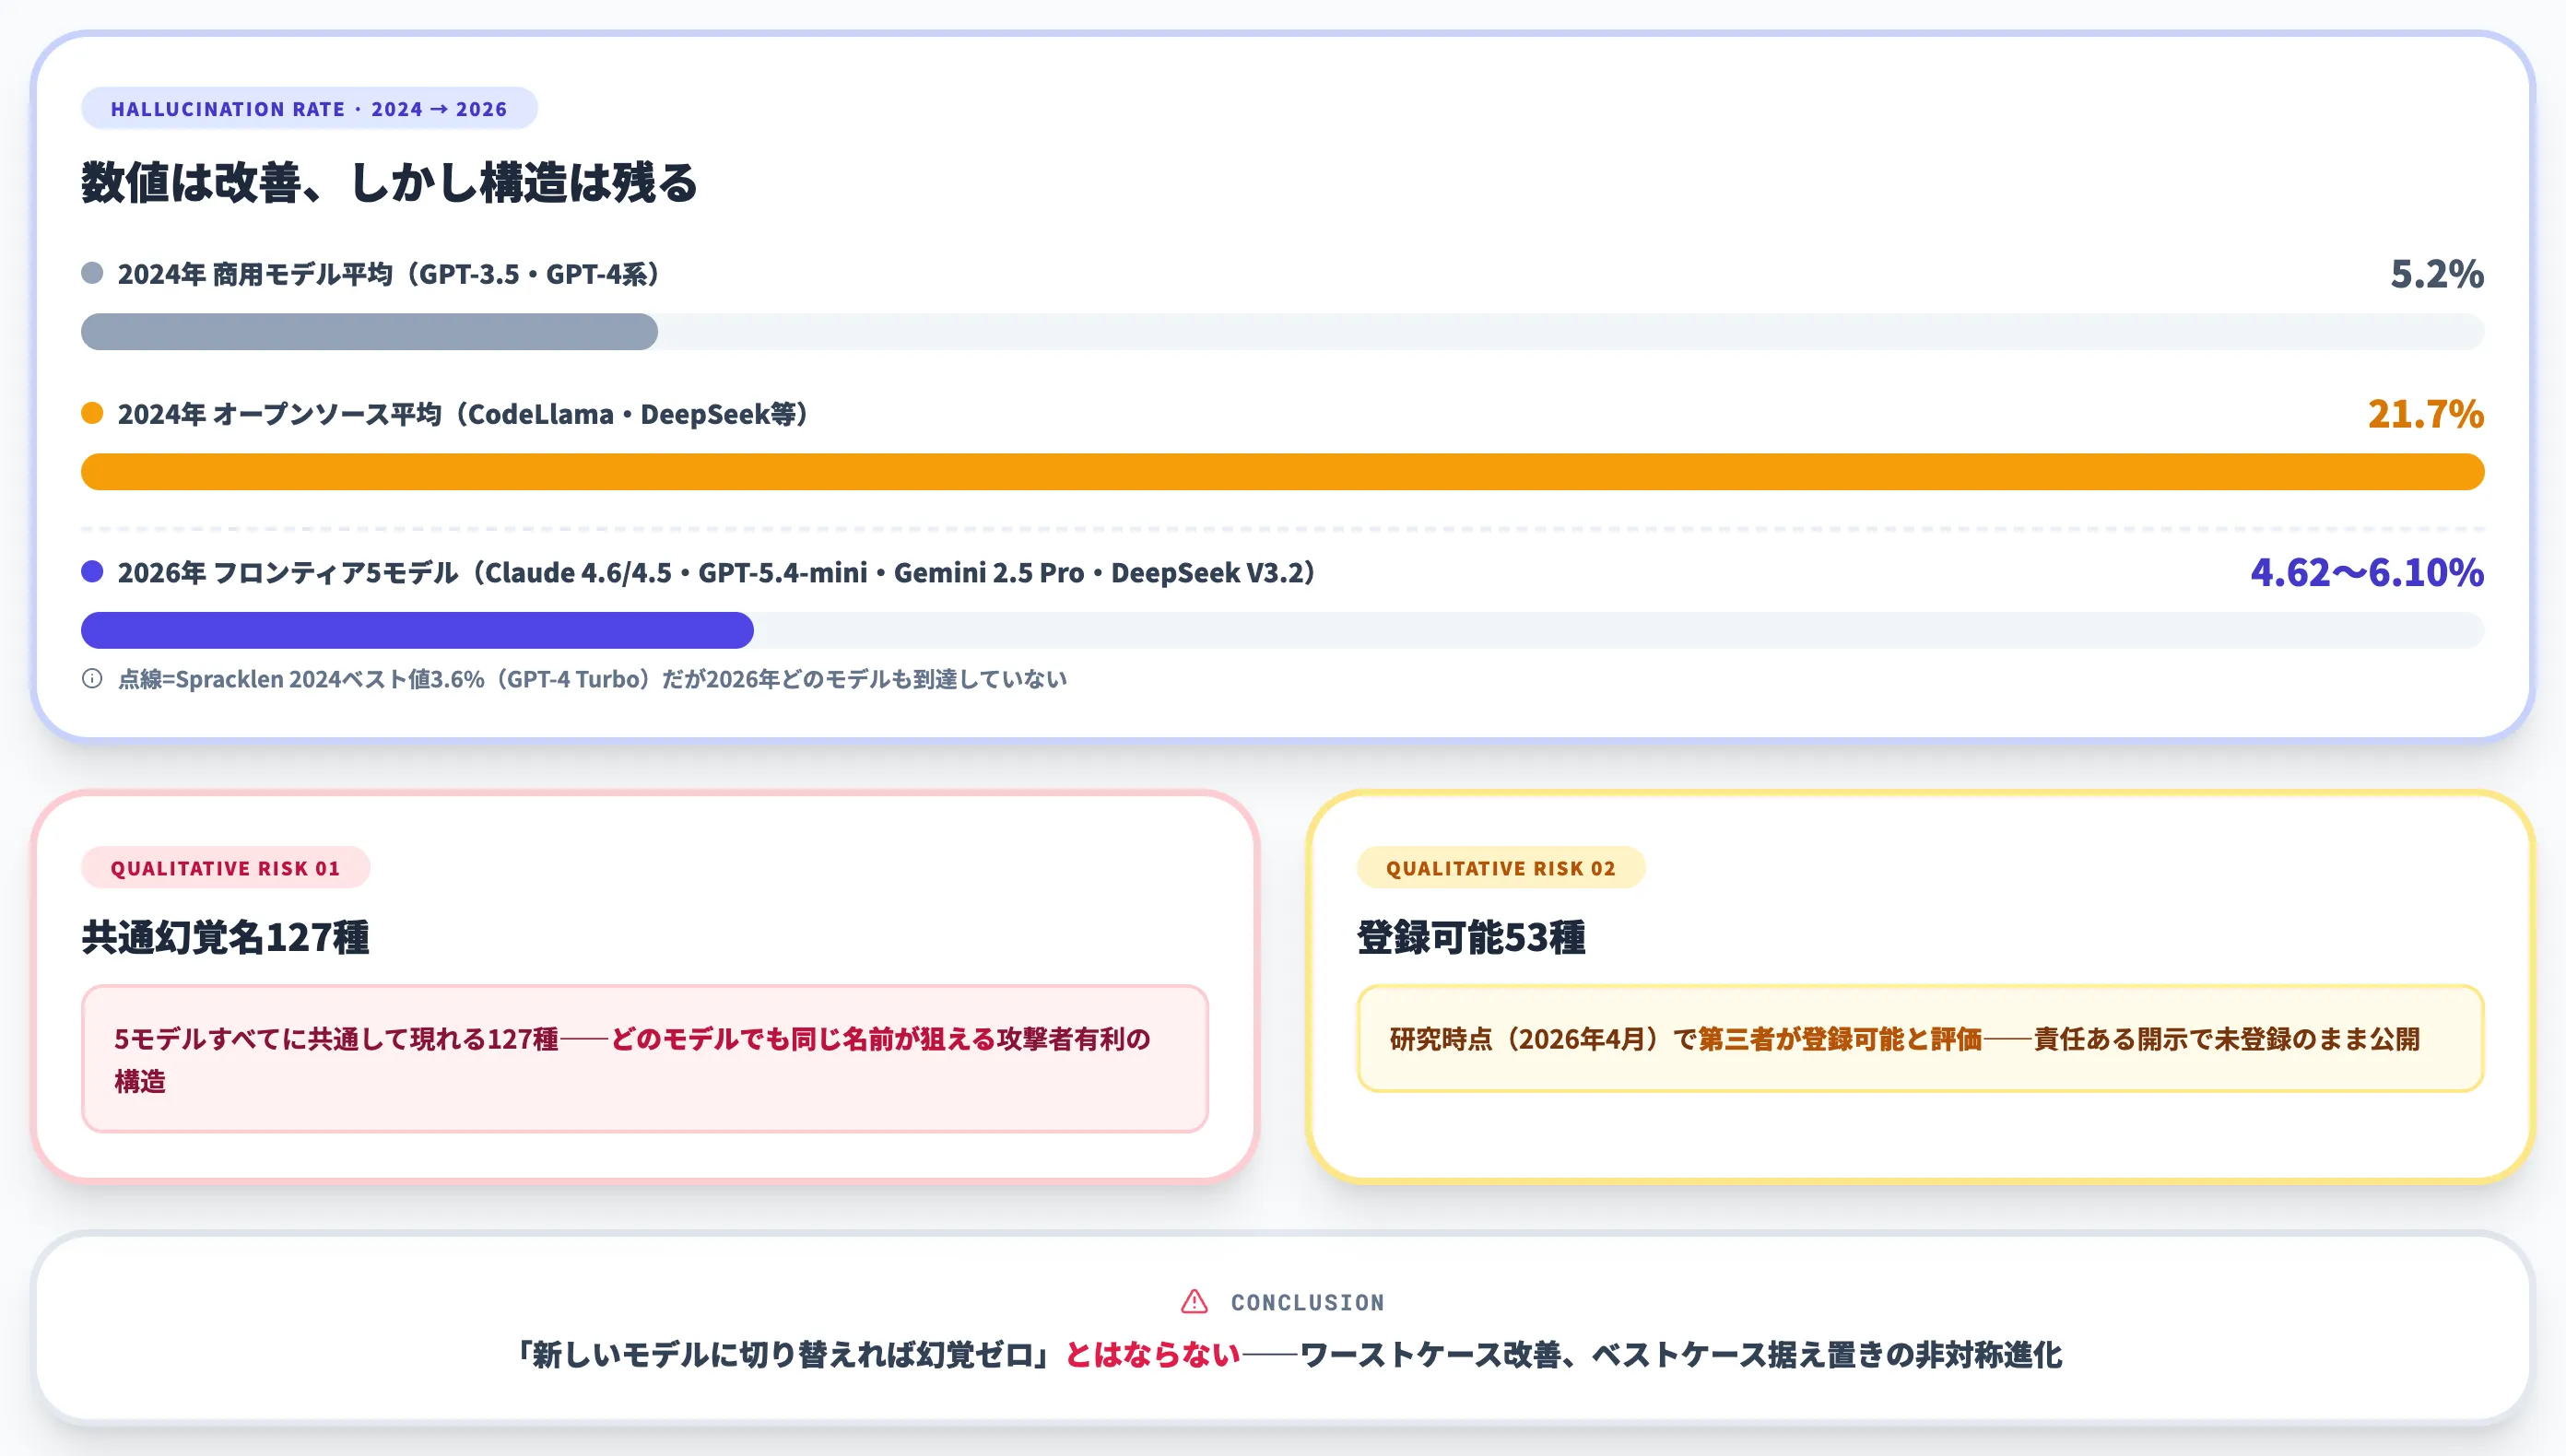
Churilovが2026年に発表した再評価論文では、2026年4月22〜28日の実験期間に当時のフロンティア帯で主要プロバイダから提供されていた5モデル(Claude Sonnet 4.6、Claude Haiku 4.5、GPT-5.4-mini、Gemini 2.5 Pro、DeepSeek V3.2)に同じ評価枠組みを適用しました。
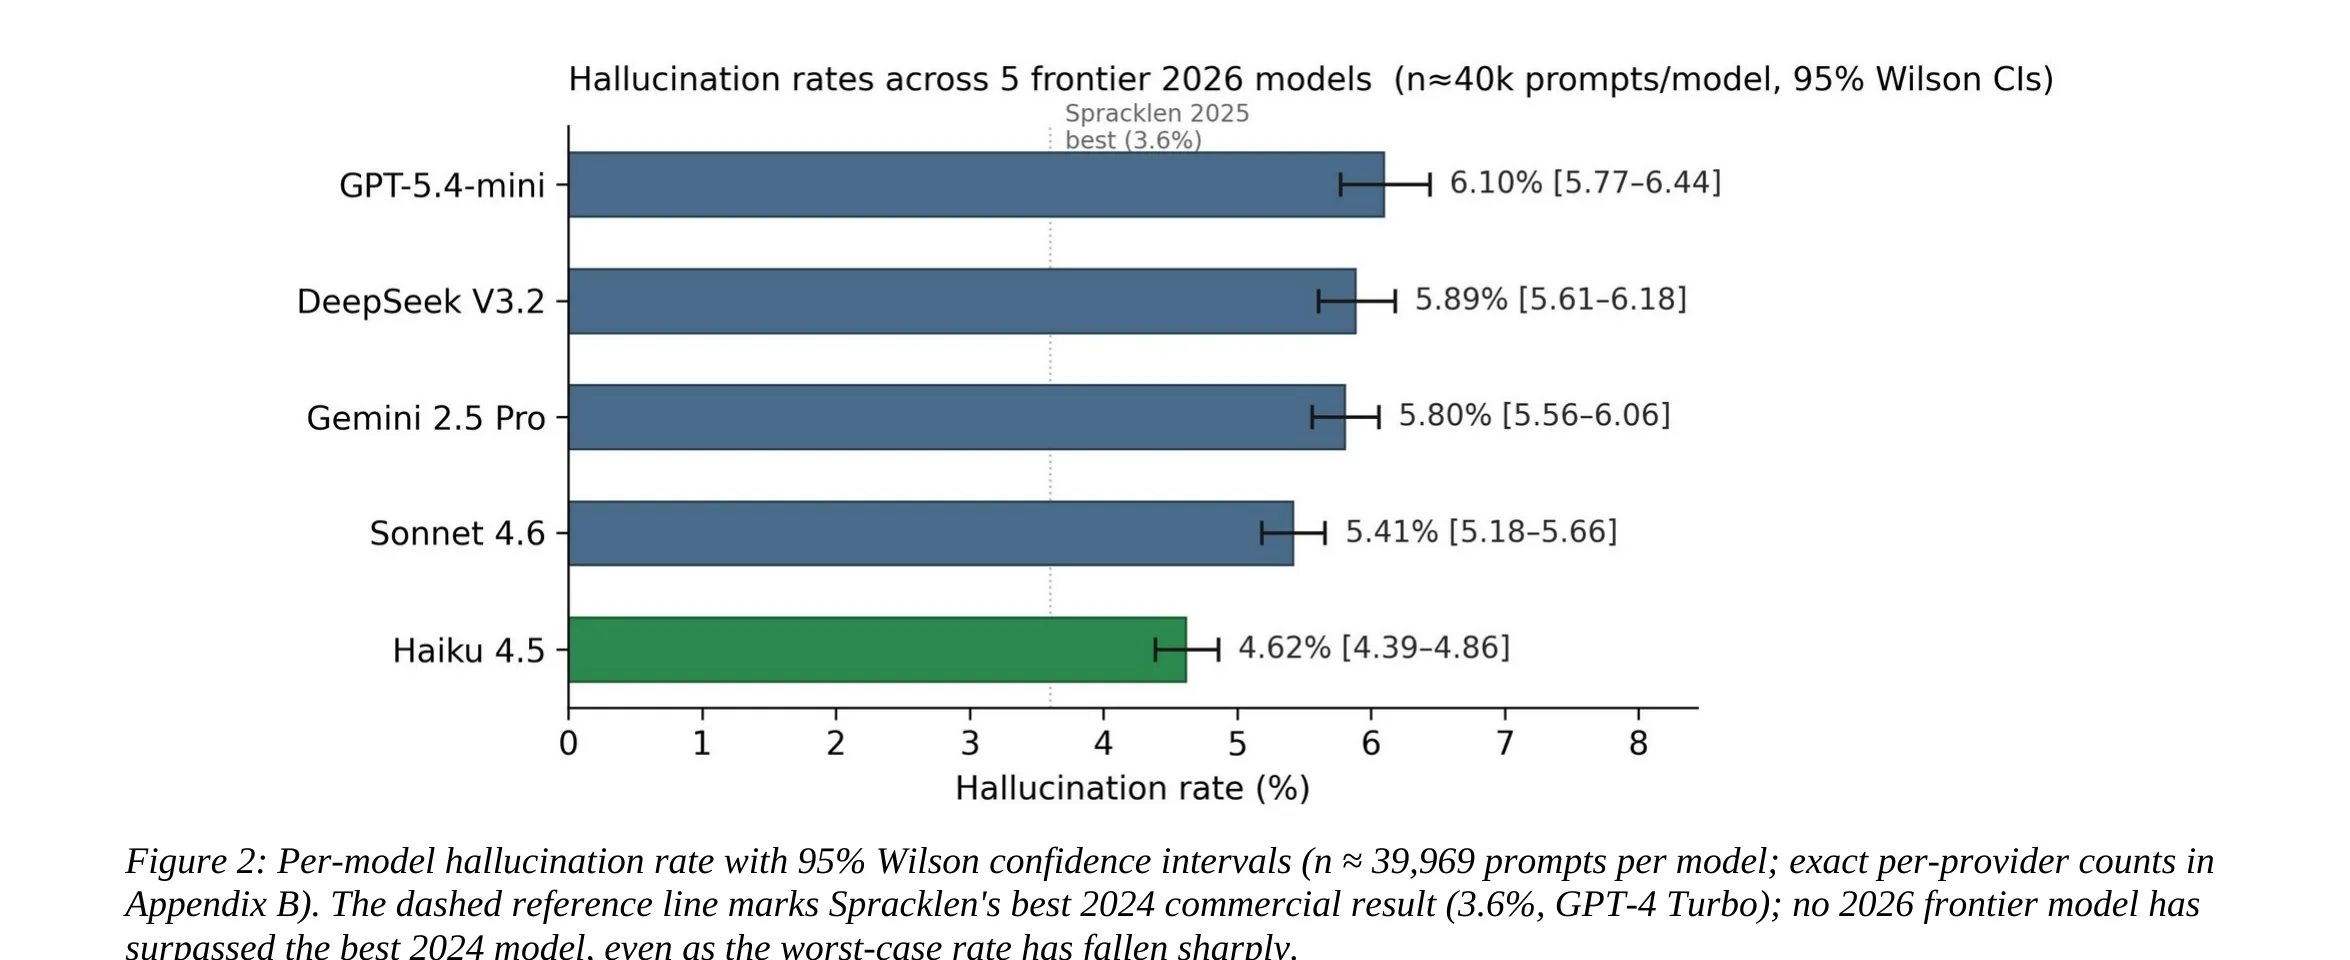
2026年フロンティア5モデルの幻覚率実測:Claude Haiku 4.5が最低4.62%、GPT-5.4-miniが最高6.10%、点線はSpracklen 2024ベスト値3.6%(GPT-4 Turbo)だが2026年どのモデルも到達していない(出典:Churilov 2026)
5モデルすべてが2024年ベスト値3.6%を超えており、「新しいモデルに切り替えれば幻覚ゼロ」とはならないことが読み取れます。2024年研究では商用モデル群の平均が5.2%・オープンソースモデル群の平均が21.7%で、群間平均の差が16.5ポイントありました。一方2026年再評価ではフロンティア5モデルの個別最大値と最小値の差が1.48ポイント(Haiku 4.5=4.62% vs GPT-5.4-mini=6.10%)です。両者は「群平均の差」と「個別最大・最小の差」で指標が異なりますが、いずれにしても今回のフロンティア帯5モデルは2024年の商用平均とほぼ同水準に収束しており、ワーストケースは改善したがベストケースは据え置きという非対称な進化です。
以下の表で、2024年の原論文と2026年再評価の主要指標を比較しました。
| 評価年 | 対象モデル群 | 全体幻覚率 | 補足 |
|---|---|---|---|
| 2024年 | 商用・オープン含む16モデル | 商用5.2% / オープン21.7% | ユニーク幻覚名205,474件 |
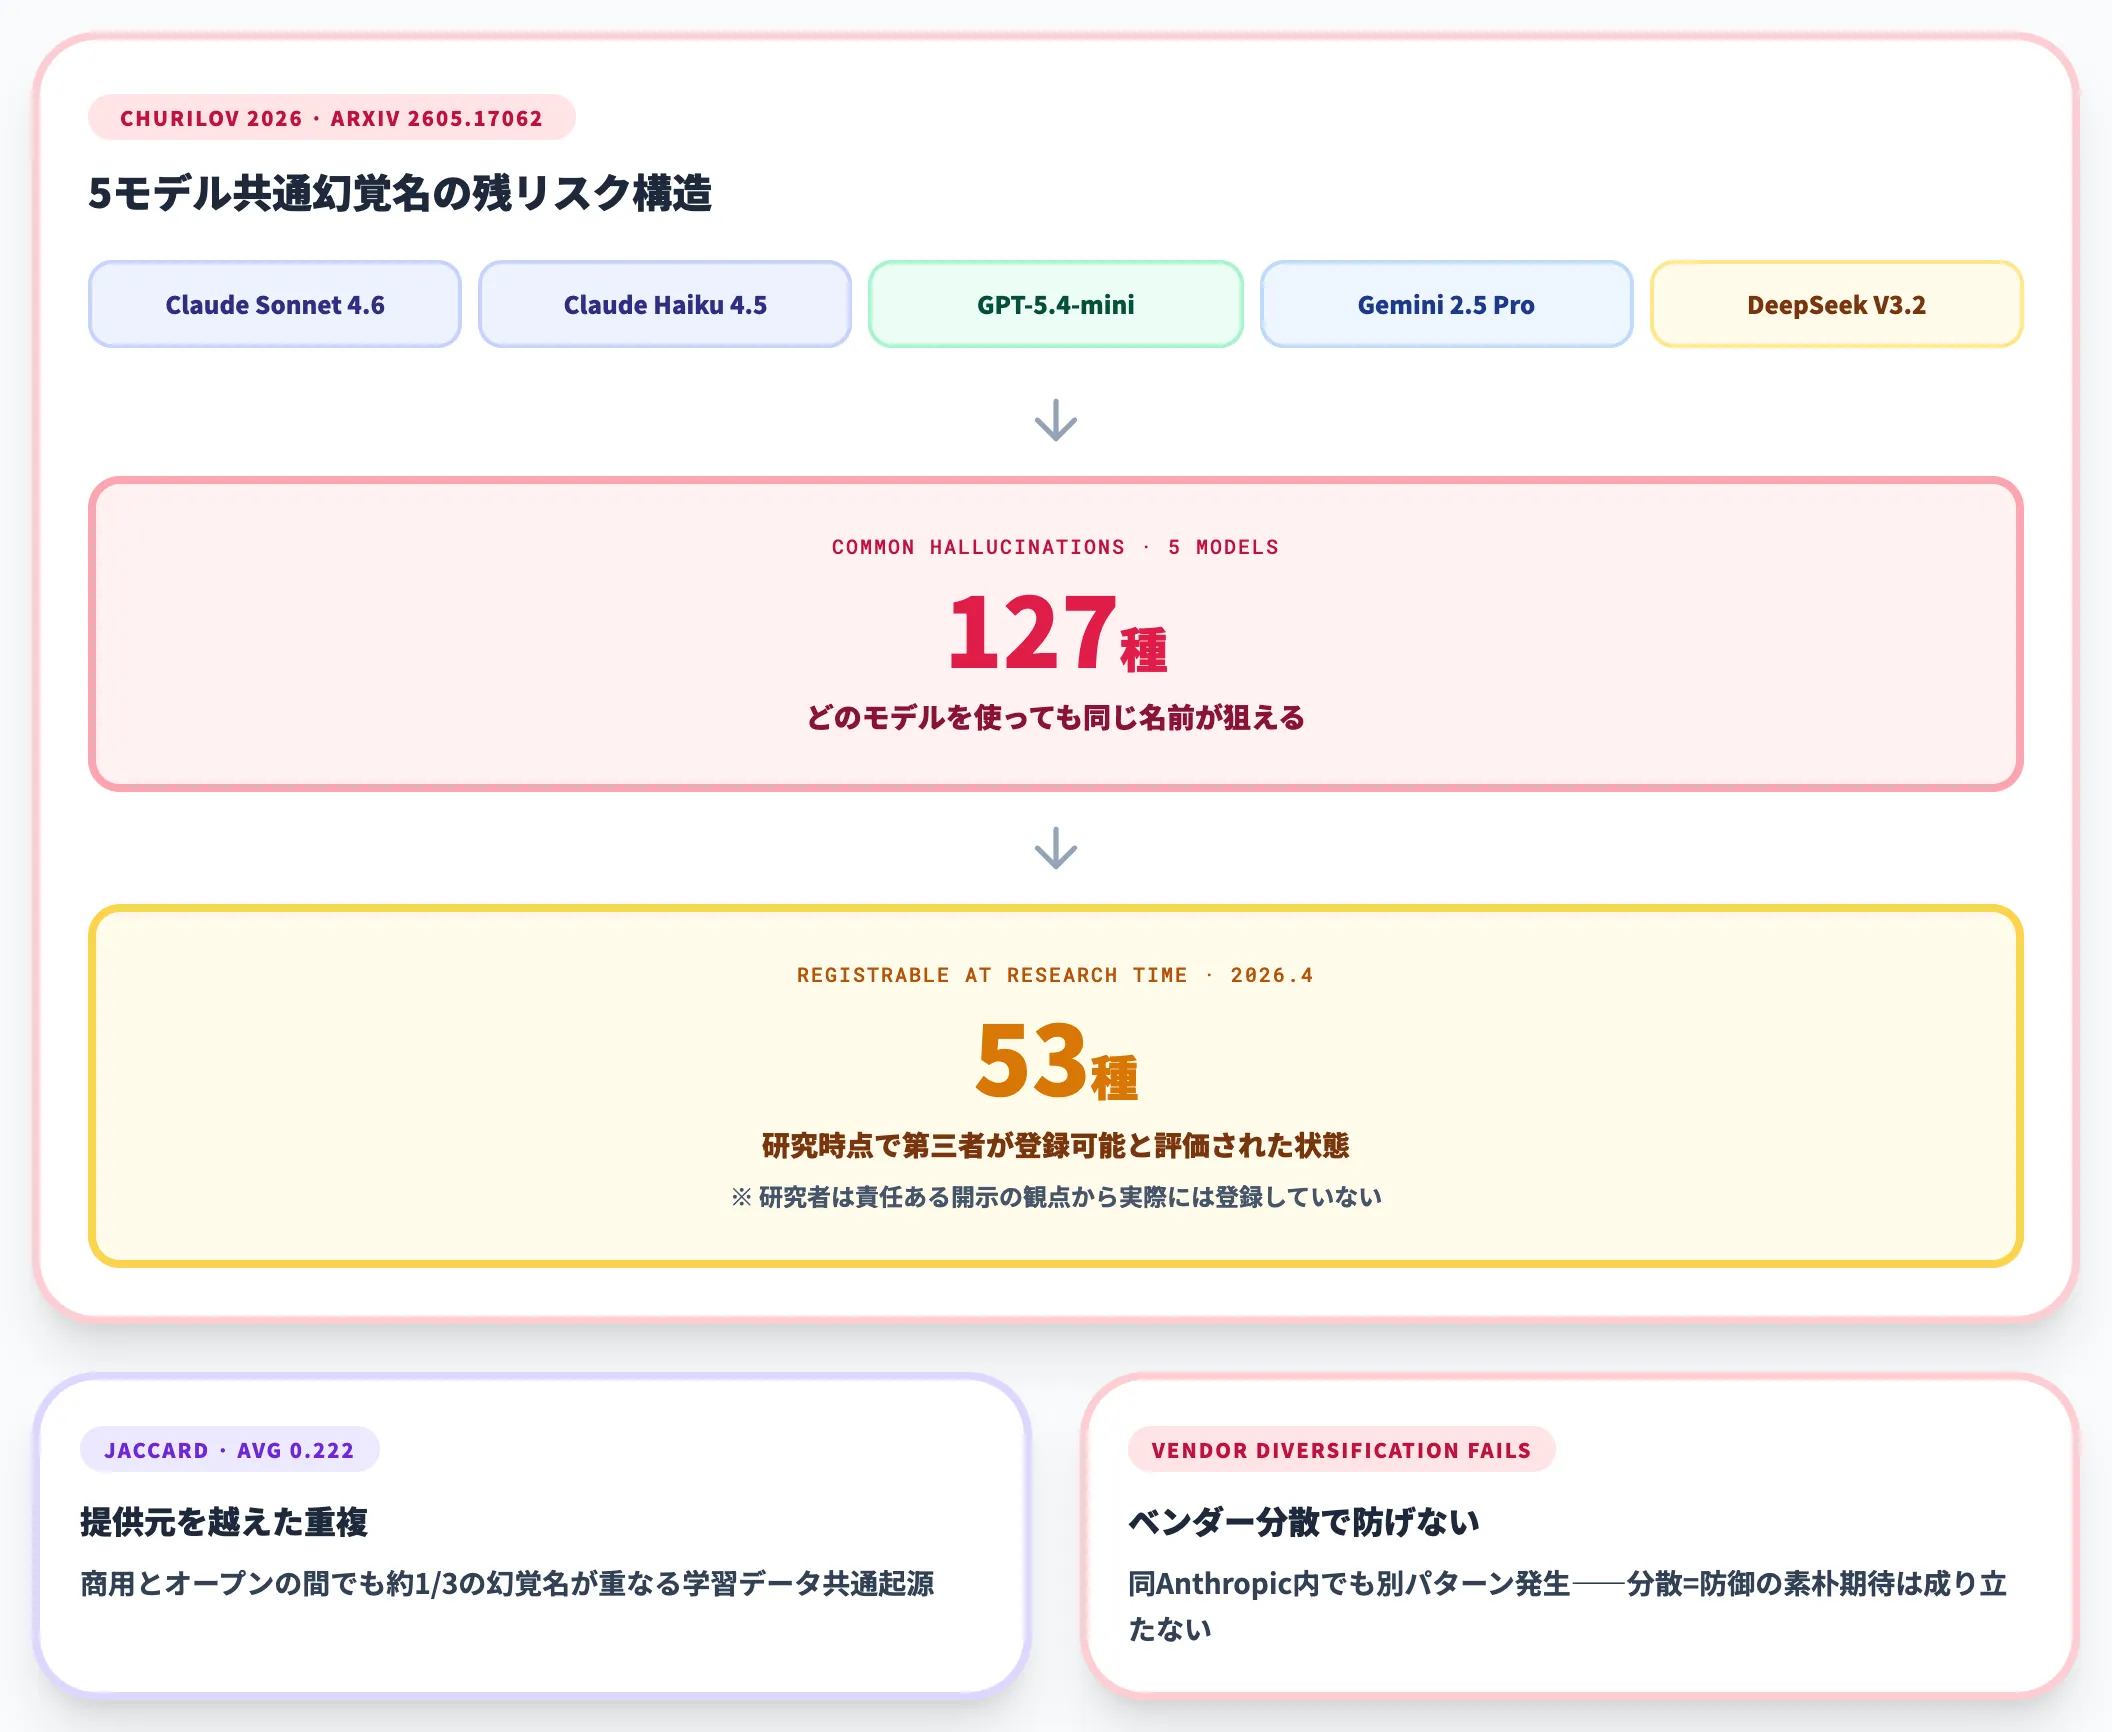
| 2026年 | フロンティア5モデル | 4.62〜6.10% | 127名が5モデルで共通、うち53名は研究時点(2026年4月)で第三者が登録可能と評価 |
幻覚率の数値だけ見るとフロンティア帯の幻覚率は改善傾向ですが、Churilov論文で重要なのは残るリスクの質的変化です。
- 127種の幻覚名が5モデルすべてで共通して現れるため、「どのモデルでも同じ名前が狙える」という攻撃者有利の構造が残っている
- そのうち53種は、研究時点(2026年4月)に禁止名リストや既存登録を照合した結果、第三者が登録可能と評価された状態にある(研究者自身は責任ある開示の観点から実際には登録していない)
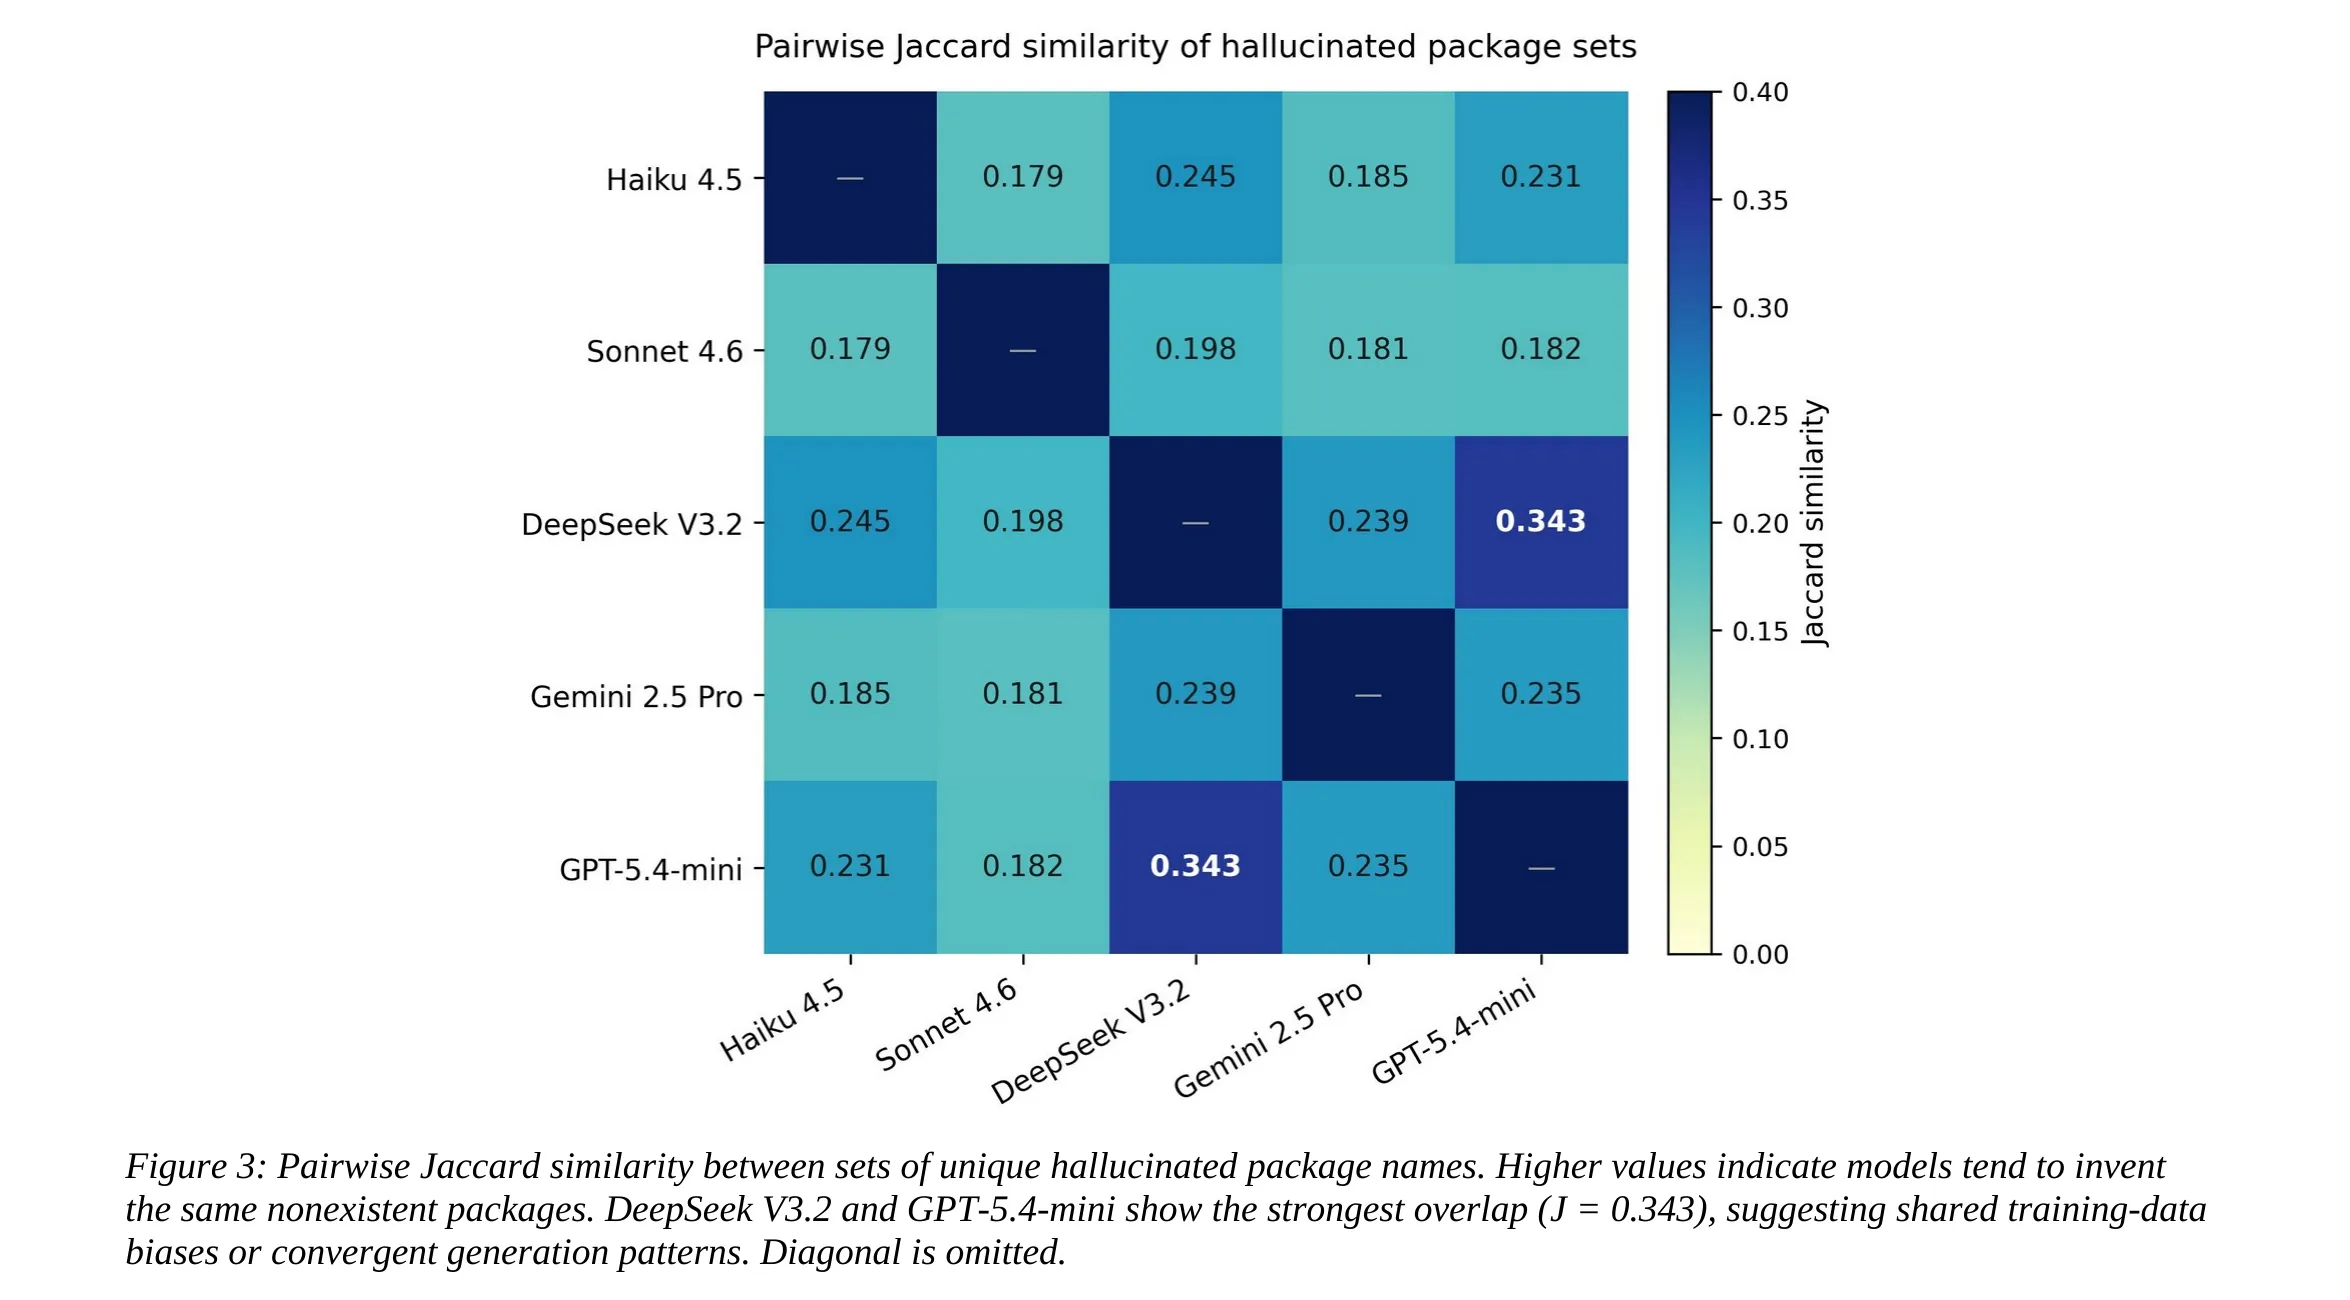
5フロンティアモデルの幻覚名セット間Jaccard類似度:DeepSeek V3.2とGPT-5.4-miniが最大0.343で学習データ共通起源が示唆される。全ペア平均0.222で、127種の共通幻覚名が「どのモデルを使っても狙える」構造を支えている(出典:Churilov 2026)
ヒートマップで最も濃い組み合わせがDeepSeek V3.2×GPT-5.4-miniで、提供元が異なる商用モデルとオープンモデルの間でも1/3近くの幻覚名が重なる構造が読み取れます。Claude Sonnet 4.6×Claude Haiku 4.5の0.179が最低値である点は、同じAnthropicファミリー内でも別の幻覚パターンを生むことを意味しており、「ベンダーを分散させれば防御になる」という素朴な期待が成り立たないことを示しています。
幻覚率は下がったものの、モデル横断で共通して出続ける127種の幻覚名の存在は、依然として攻撃者有利の構造を支えています。「新しいモデルに切り替えれば解決」とはならないのが、2026年時点の現実です。
Vectara HHEMとの対比——攻撃面としての幻覚と、要約品質としての幻覚
一般的な「LLMの幻覚率」として報道されるVectara HHEMベンチマークは、ドキュメント要約タスクの忠実度を測るもので、スロップスクワッティングで問題になるパッケージ名の幻覚とは別の切り口です。
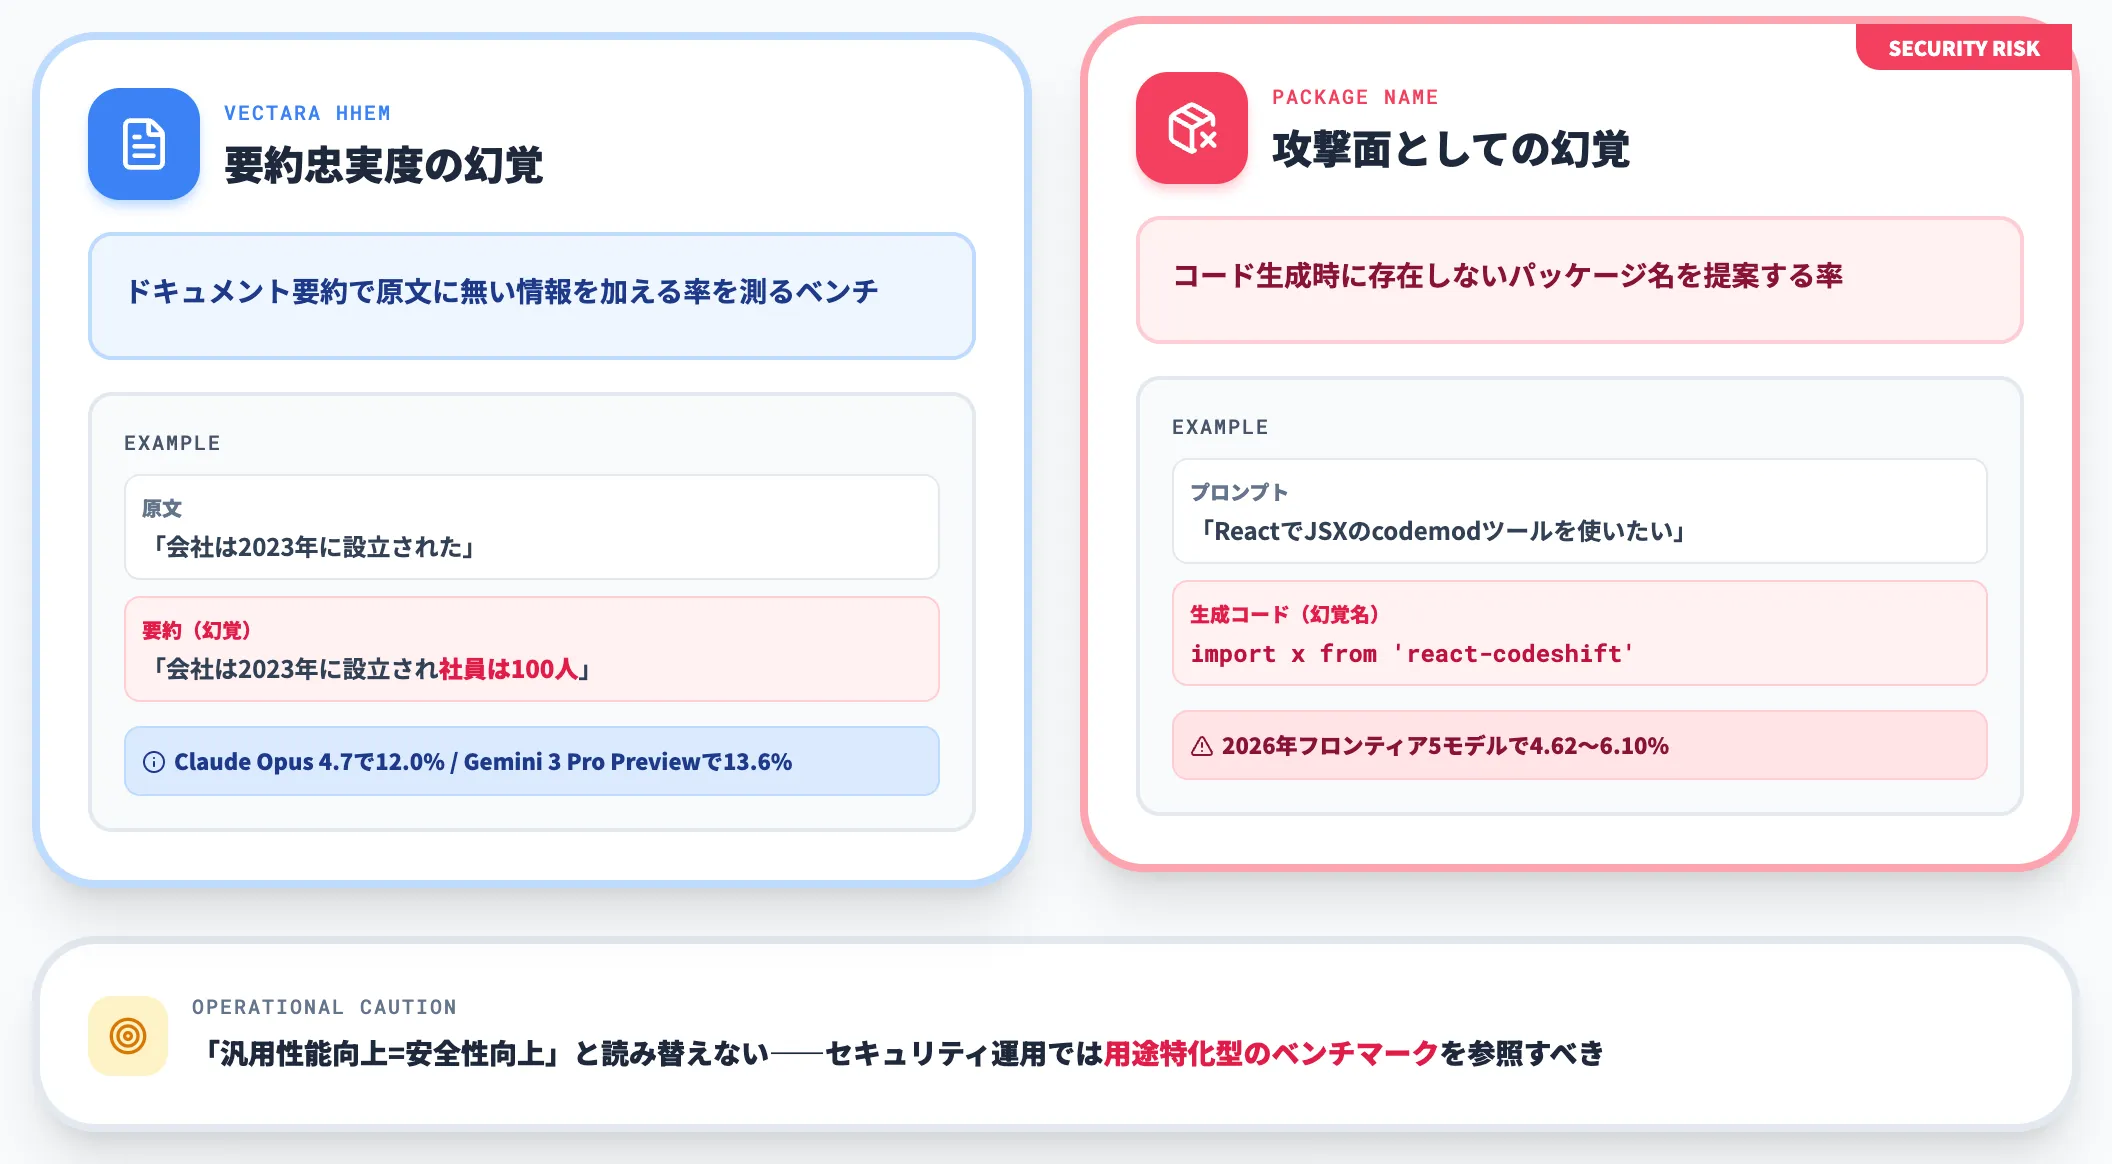
Vectara HHEM上で各モデルの幻覚率が改善している(Claude Opus 4.7で12.0%、Gemini 3 Pro Previewで13.6%等)という報道があっても、それは要約タスクの話であり、コード生成時のパッケージ名幻覚率が同じ比率で下がっているとは限りません。
セキュリティ運用で参照すべきなのは、コード生成LLM向けのパッケージ幻覚評価のような用途特化型のベンチマークです。「汎用性能向上がそのまま安全性向上につながる」と読み替えない点が、現場での重要な注意点です。
開発チームが取るべき多層対策
スロップスクワッティングを完全に防ぐ単一の銀の弾は存在せず、SBOM・CI/CD統合・ロックファイル・サンドボックス・プロキシ・人手承認を組み合わせた多層構えが現実解です。本セクションでは、開発チームが実装できる防御層を順に整理します。
SBOMとCI/CDスキャンの統合
ソフトウェア部品表(SBOM)は、プロジェクトで使われているすべての依存パッケージを機械可読な形式で記録する仕組みです。
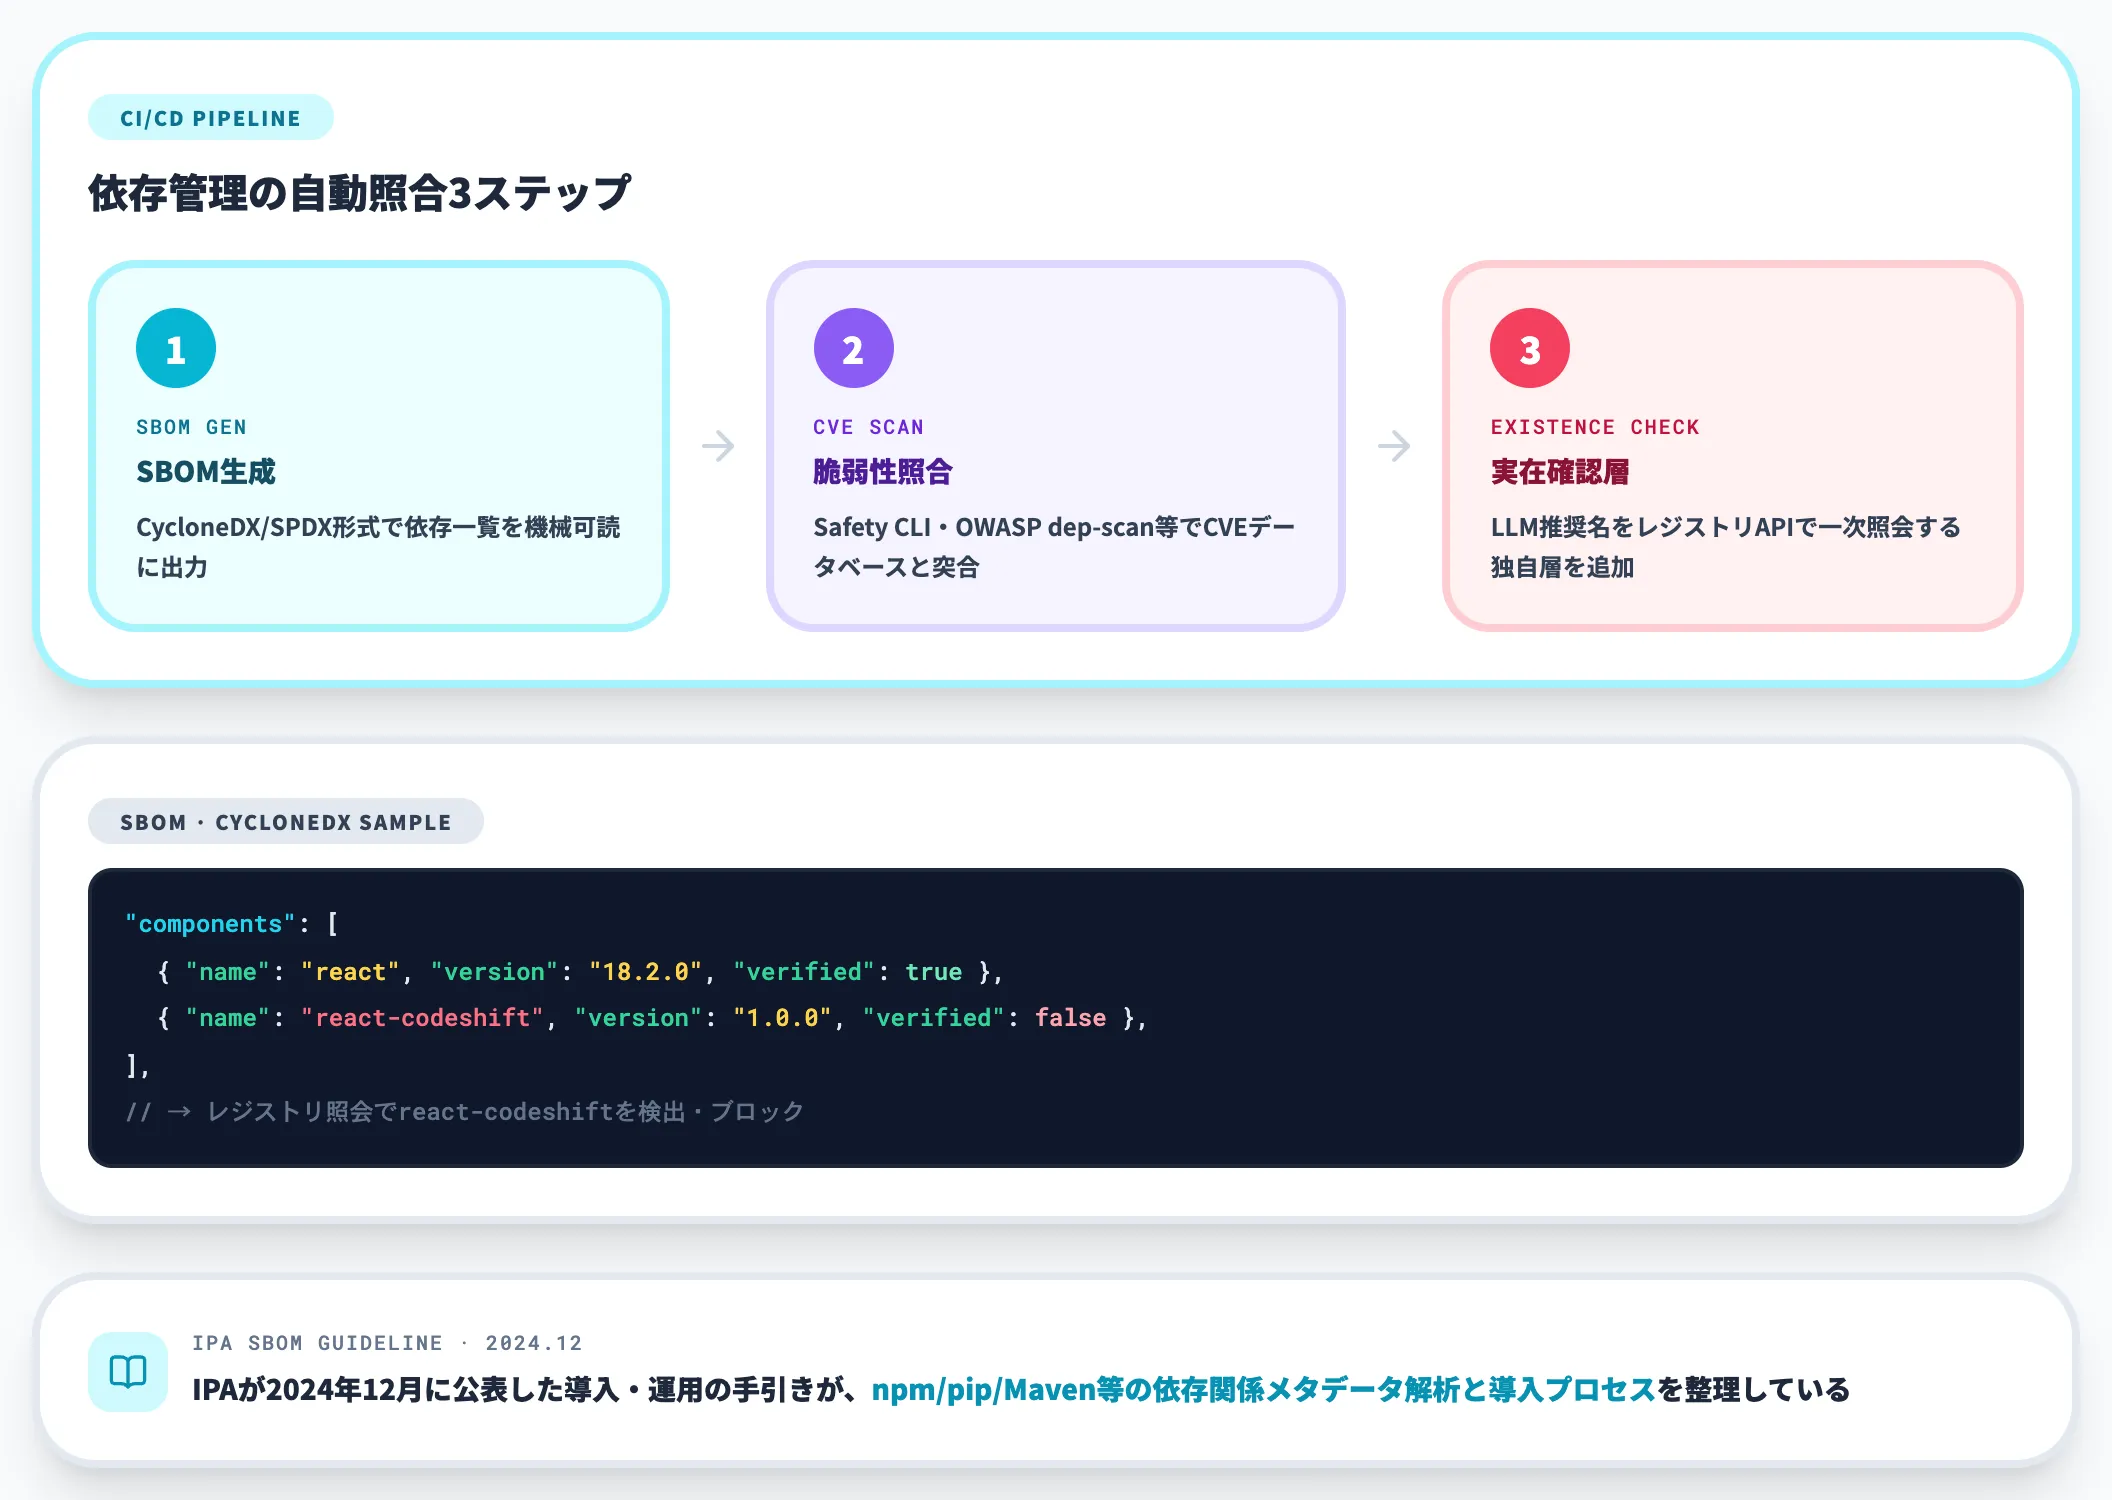
- CycloneDX・SPDXといった標準形式でSBOMを生成し、CI/CDパイプラインの一部として自動発行する
- 生成した依存情報は、Safety CLIがPythonプロジェクトの依存定義ファイルを直接スキャンする運用で、OWASP dep-scan は [--bom] オプションでCycloneDX入力を受けて脆弱性照合する運用で、CVEデータベースと突き合わせる
- スロップスクワッティング固有の対策として、LLMが推奨した名前が実在するかをレジストリAPIで一次照会する層を追加する
日本国内では、IPAが2024年12月に公表したSBOM導入・運用の手引きが、npm・pip・Maven等の主要パッケージマネージャから依存関係メタデータを解析する考え方と導入・運用プロセスを整理しています。
ロックファイル固定・ハッシュ検証とパッケージマネージャ標準機能
ロックファイル([package-lock.json]・[yarn.lock]・[poetry.lock]等)は、依存バージョンだけでなくパッケージの内容ハッシュも記録します。
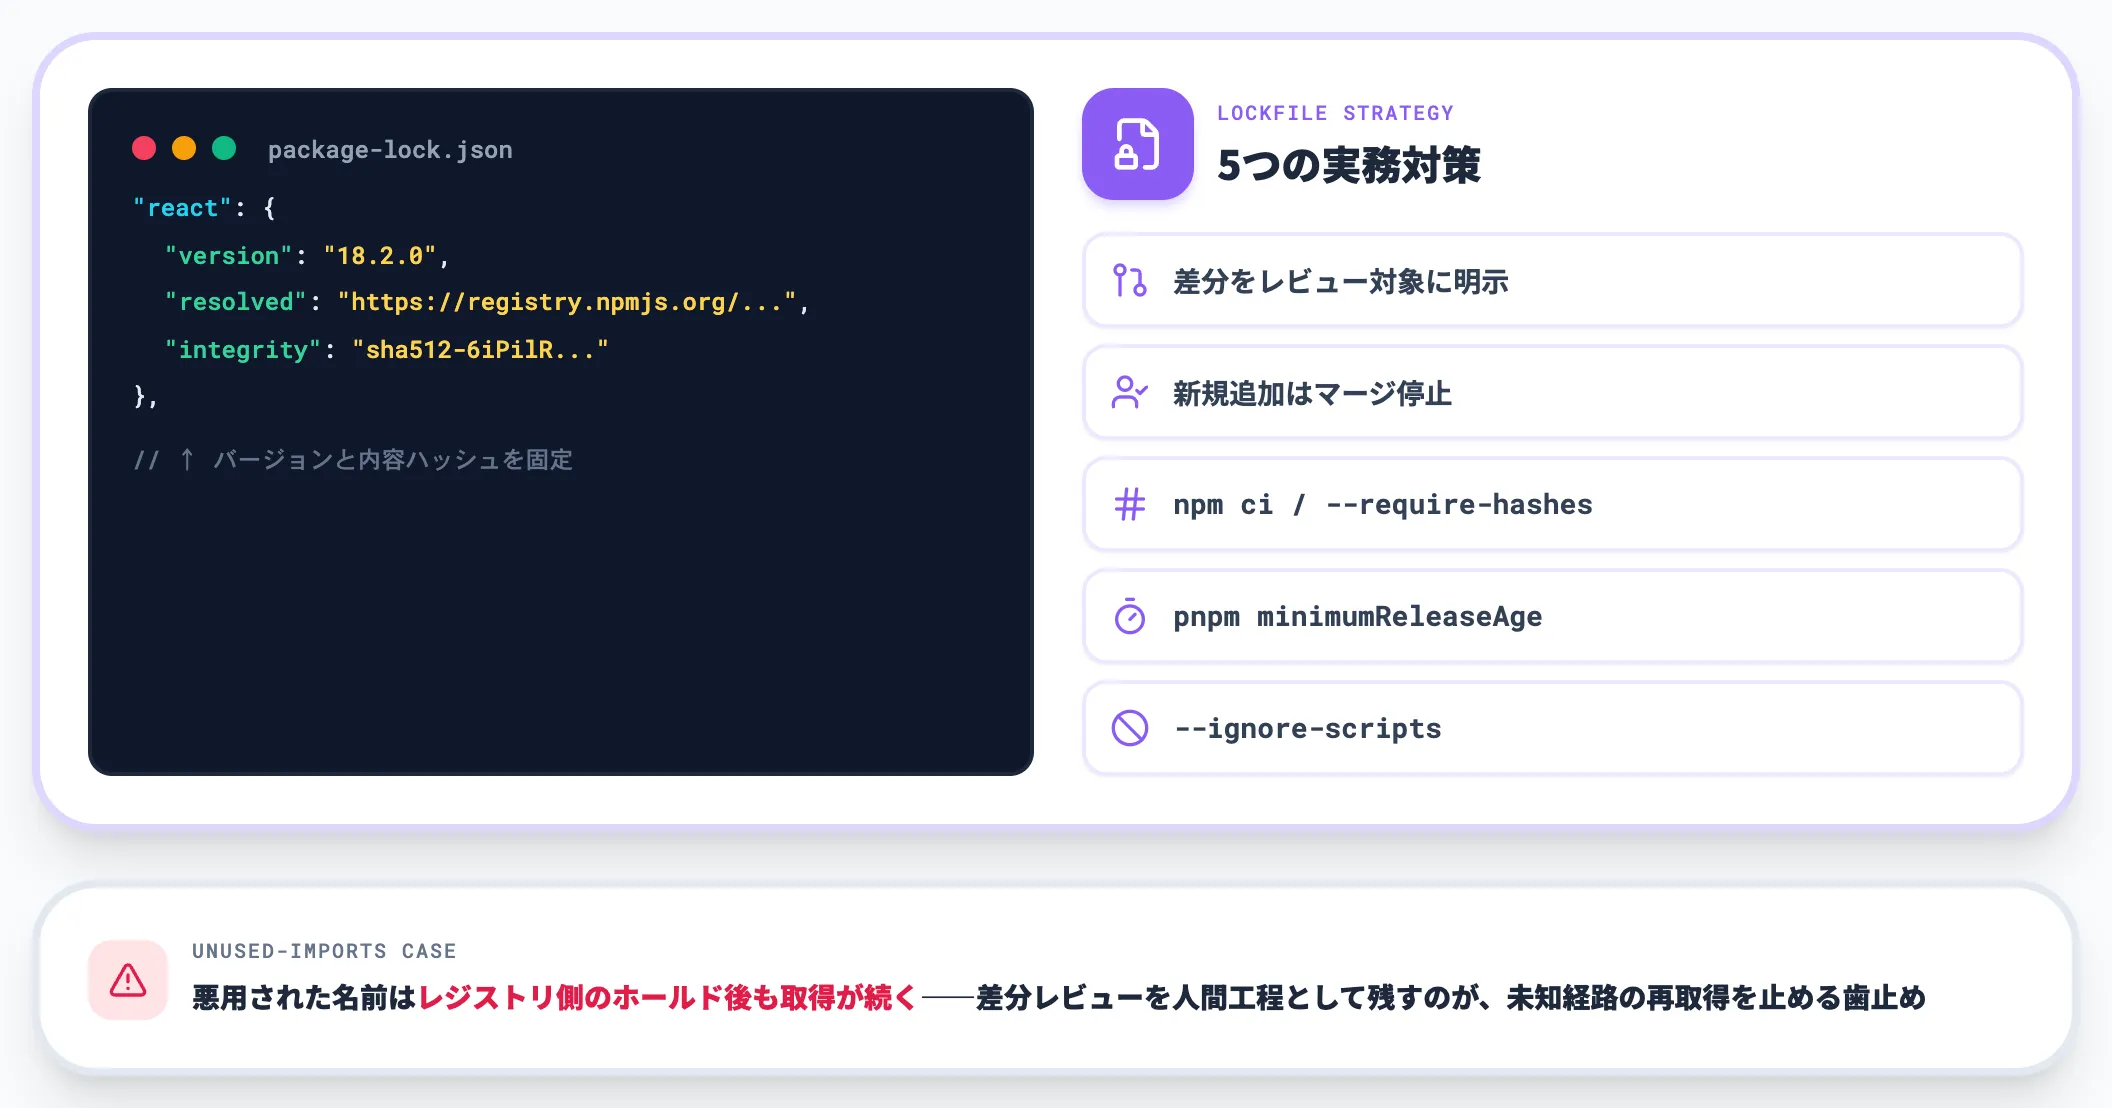
対策の要点は次のとおりです。
- CI/CD上でロックファイルの差分をレビュー対象として明示的に扱う
- 新規パッケージが追加された場合は、名前・バージョン・ハッシュを人間がレビューするまでマージを止める
- [npm ci] や [pip install --require-hashes] のようなハッシュ検証を強制するコマンドを本番ビルドで使う
- 「pnpmの [minimumReleaseAge] 設定」で「公開から一定日数(例:7日)経っていないバージョンをインストール不可」にすると、幻覚名を狙って登録された新規パッケージの即時取得をパッケージマネージャ側で遮断できる
- [--ignore-scripts] やnpmの [ignore-scripts=true] 設定で、依存パッケージの [postinstall] スクリプト実行を抑止すると、インストール成立時点での即時被害を縮小できる
unused-imports事例が示したように、悪用された名前への取得リクエストはレジストリ側のセキュリティホールド後も継続します。ロックファイル経由の再取得が原因の一部である可能性は否定できず、差分レビューを人間工程として残すことが、未知の経路からの再取得を止める実務的な歯止めになります。
サンドボックスとアップストリームプロキシ
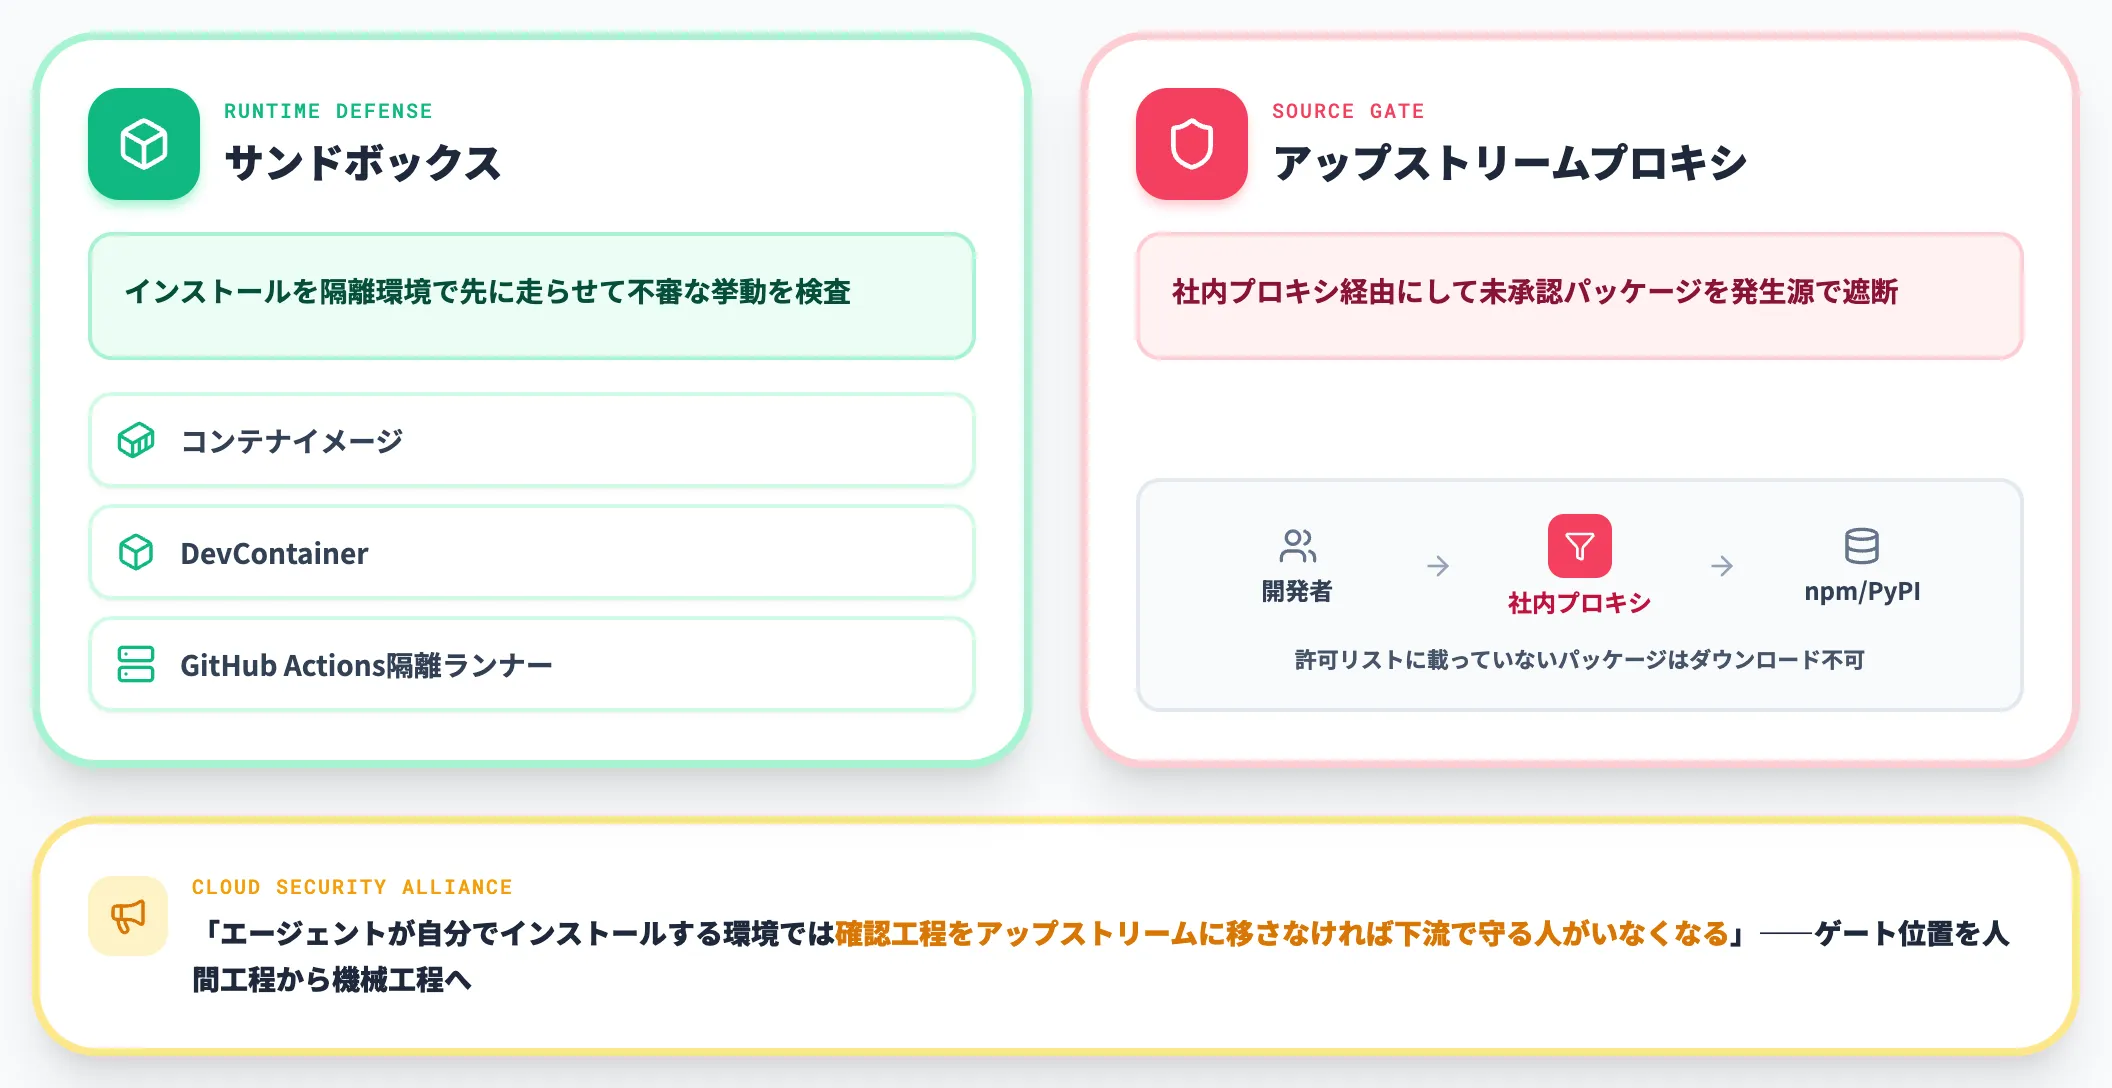
実行時の防御層としては、以下の2つが有効です。
-
サンドボックス
[npm install] や [pip install] を隔離環境で先に実行し、不審な動作(外部通信・ファイル書き換え等)がないかを検査する。コンテナイメージ・DevContainer・GitHub Actionsの隔離ランナーなどで実装可能
-
アップストリームプロキシ
開発者・CI/CD環境がパッケージレジストリに直接接続せず、組織が運用する社内プロキシ経由にする。プロキシ側で「許可リストに載っていないパッケージはダウンロード不可」とすることで、幻覚名の悪意パッケージを発生源で遮断できる
Cloud Security Allianceの研究ノートは「エージェントが自分でインストールする環境では、確認工程をアップストリームに移さなければ下流で守る人がいなくなる」と警告しています。自律エージェント時代には、ゲートの位置を人間工程から機械工程に移す必要があります。
人手承認とAIエージェントの設定
人手承認を完全になくすことはできませんが、承認対象を絞ることで現実的な運用に落とせます。
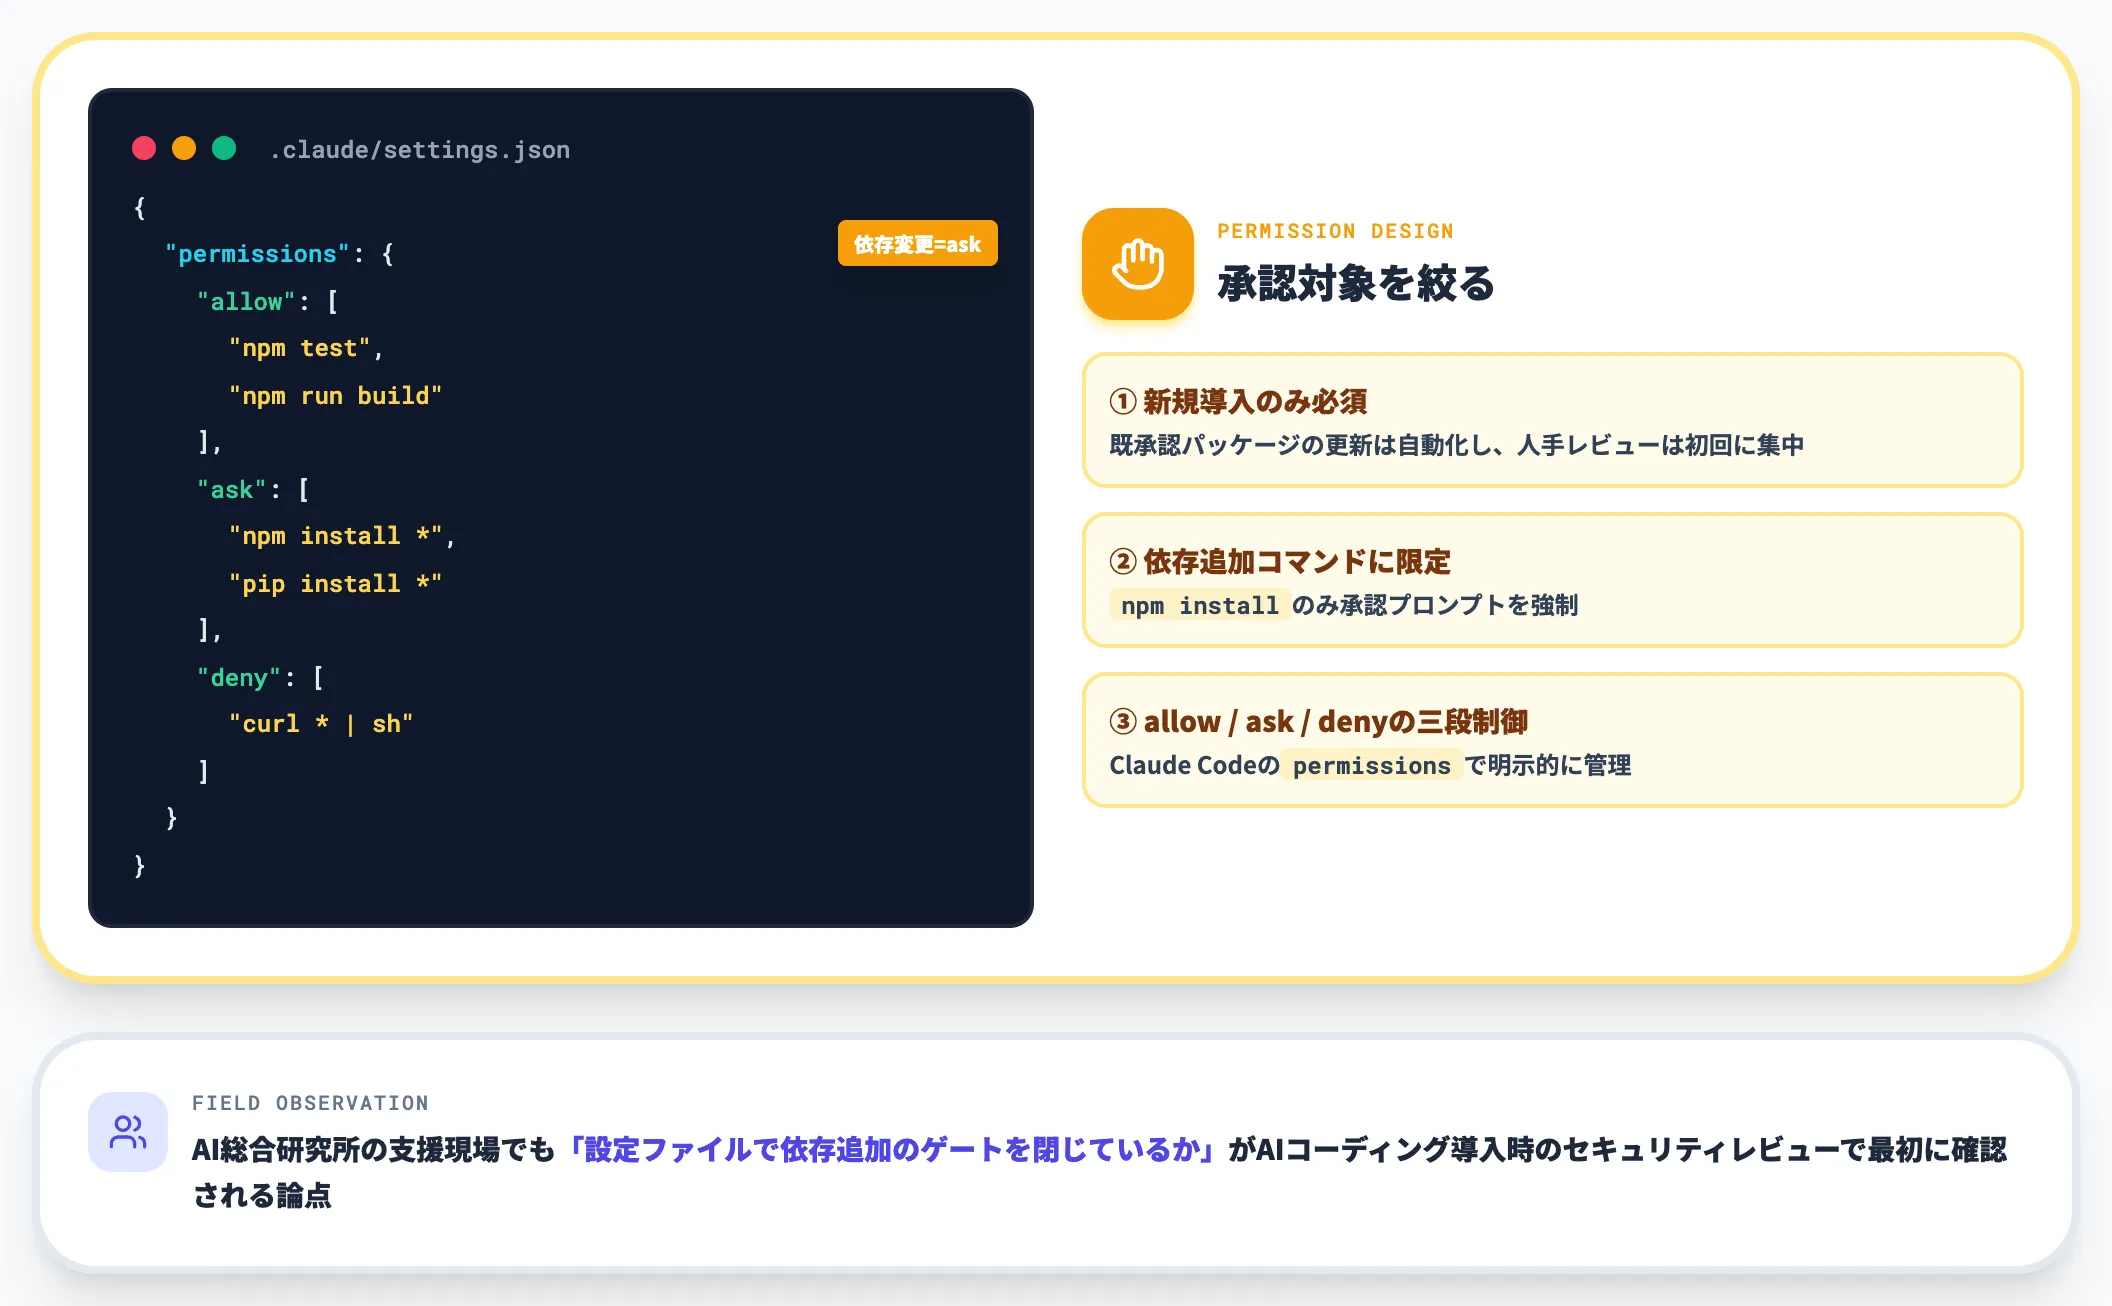
- 新規パッケージの初回導入のみ人間レビューを必須化する(既承認パッケージの更新は自動化)
- AIエージェント設定で、依存追加の提案を含むコマンドにのみ承認プロンプトを強制する
- Claude Code等では [.claude/settings.json] の [permissions] を用いて [npm install] のような依存変更コマンドを明示的な allow / ask / deny で管理する
AI総合研究所の支援現場でも、「設定ファイルで依存追加のゲートを閉じているか」が、AIコーディング導入時のセキュリティレビューで最初に確認される論点になっています。
日本の規制動向——EU CRAとIPAガイドラインの接続
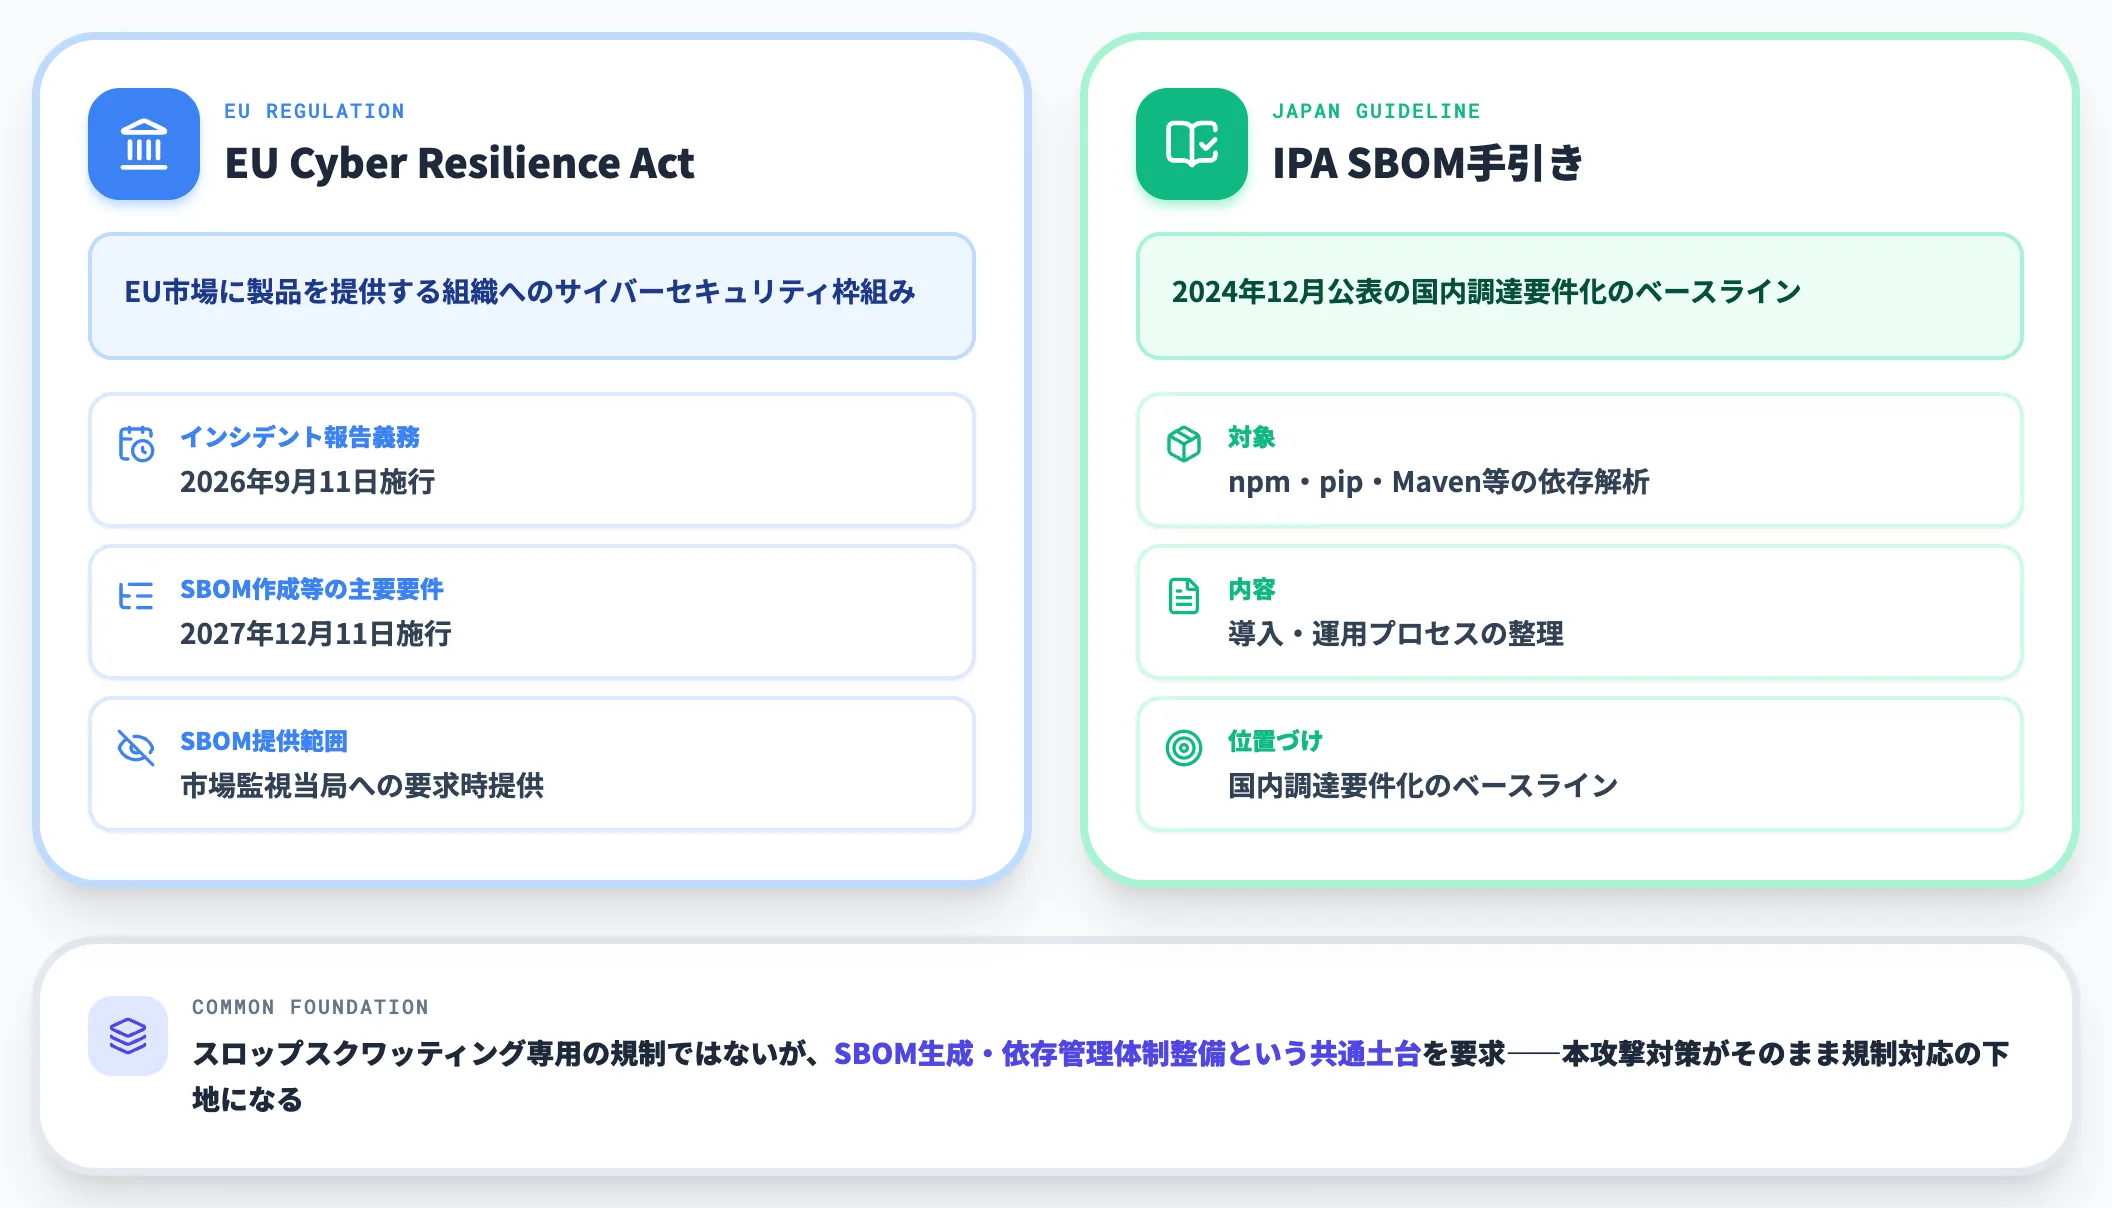
国内企業がスロップスクワッティング対策を進めるうえで、2026年に無視できない規制動向が2点あります。
-
EU Cyber Resilience Act(CRA)
EU市場に製品を提供する組織に対する枠組みで、インシデント・脆弱性のENISAへの報告義務は2026年9月11日施行、SBOM作成を含む主要要件は2027年12月11日施行と施行日が分かれている。SBOMはCRA第13条25項に基づき市場監視当局からの要求に応じて提供する扱いで、一般利用者への公開は原則求めていない。日本企業もEU顧客向け製品を提供する場合は対象
-
IPA SBOM導入・運用の手引き
2024年12月公表のガイドラインで、npm・pip・Maven等のパッケージマネージャから依存関係を解析する考え方と導入・運用プロセスを整理している。日本国内の調達要件化が進むベースライン
これらは「スロップスクワッティング専用の規制」ではありませんが、SBOM生成・依存管理の体制整備という共通の土台を要求してきます。本攻撃への対策を進めることが、そのまま規制対応の下地づくりになる構造です。
スロップスクワッティング対策で詰まる3つの論点
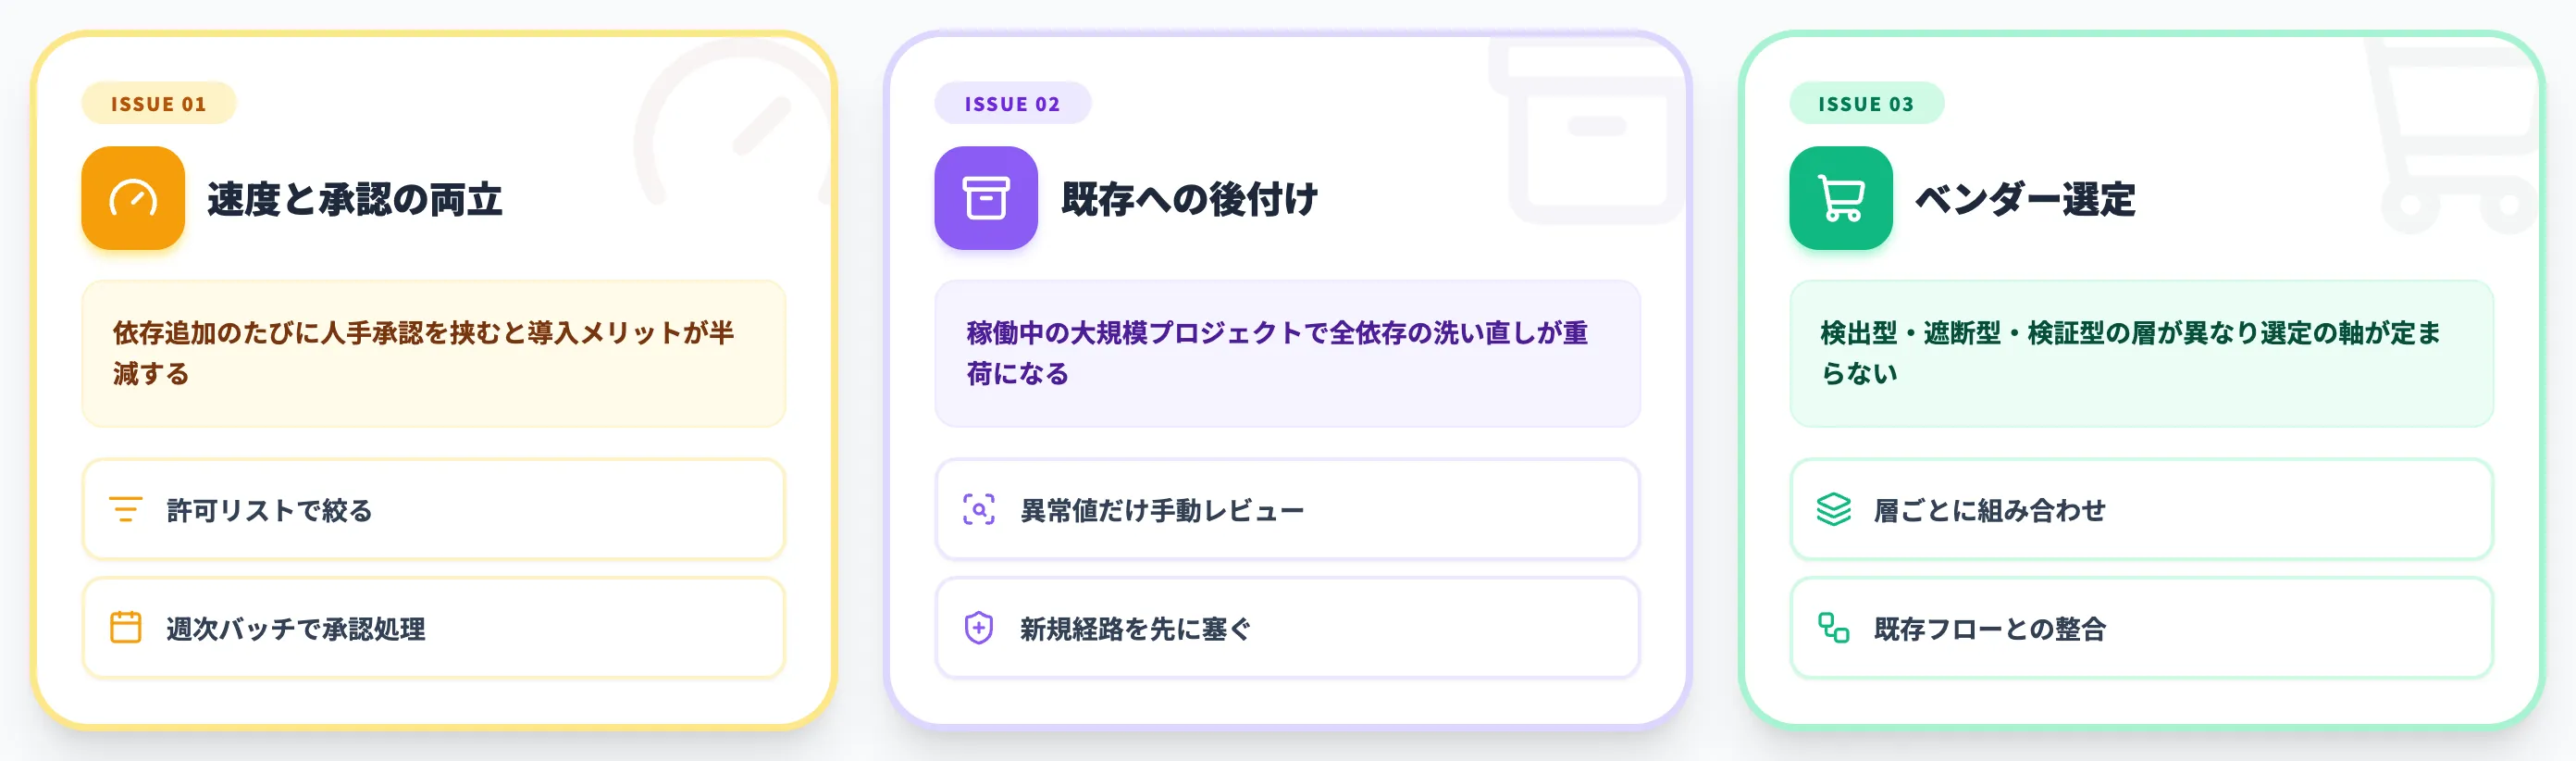
多層対策の全体像を見ると「やるべきことは明確」に見えますが、実務ではどこから手を付けるかで詰まるケースが多くあります。本セクションでは、AI総合研究所の支援現場で実際に相談を受ける3つの論点について、ケース別の判断軸を示します。
開発速度と承認フローの両立で詰まる場合
AIコーディングエージェントを導入する狙いの大半は「開発速度の向上」です。ところが、依存追加のたびに人手承認を挟むと、エージェントの提案が止まり導入メリットが半減します。
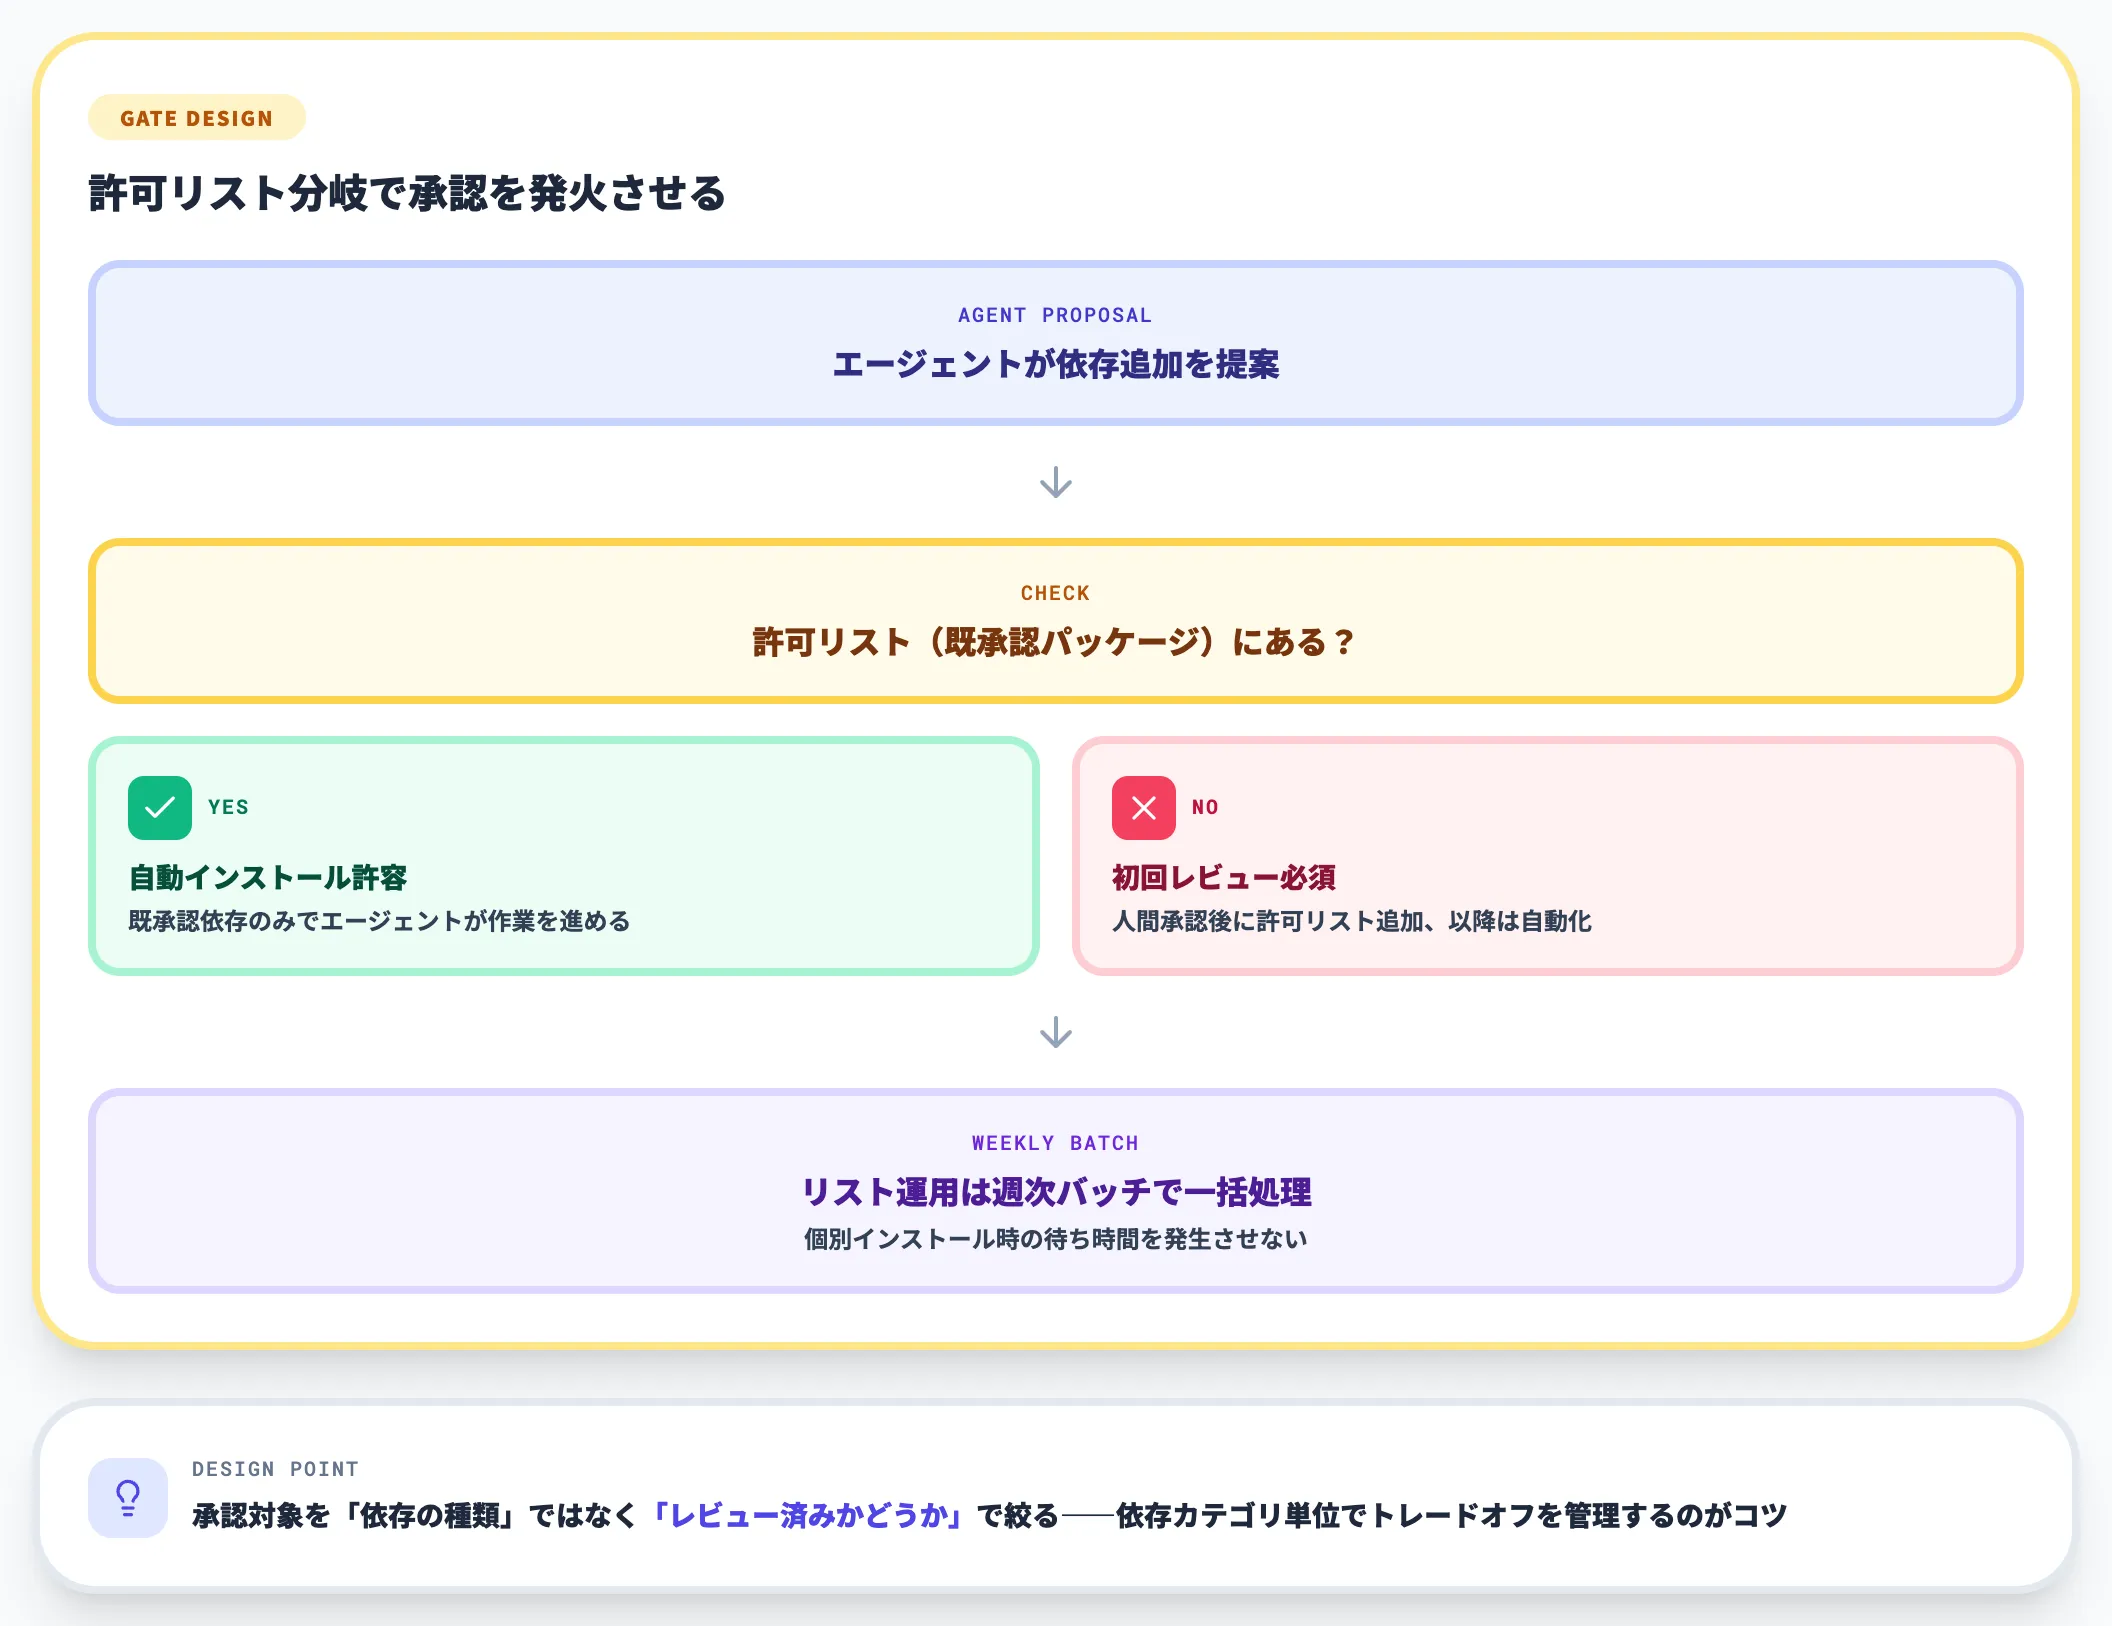
この論点で現実的なのは、承認対象を「依存の種類」ではなく「レビュー済みかどうか」で絞る設計です。
- 社内の**許可リスト(既承認パッケージの集合)**を定義し、リスト内であれば自動インストールを許容
- リスト外は、初回のみ人間レビューを必須化し、承認後はリストに追加して以降は自動化
- リストの運用は週次バッチで許可レビュー担当者が一括処理し、個別インストール時の待ち時間を発生させない
この構えなら、エージェントは既承認依存だけで作業を進められ、未知の依存を提案したときにだけ承認フローが発火します。開発速度と安全性のトレードオフを依存カテゴリ単位で管理するのがコツです。
既存プロジェクトへの後付けで詰まる場合
既に稼働している大規模プロジェクトに後からスロップスクワッティング対策を入れる場合、全依存の洗い直しが重荷になります。
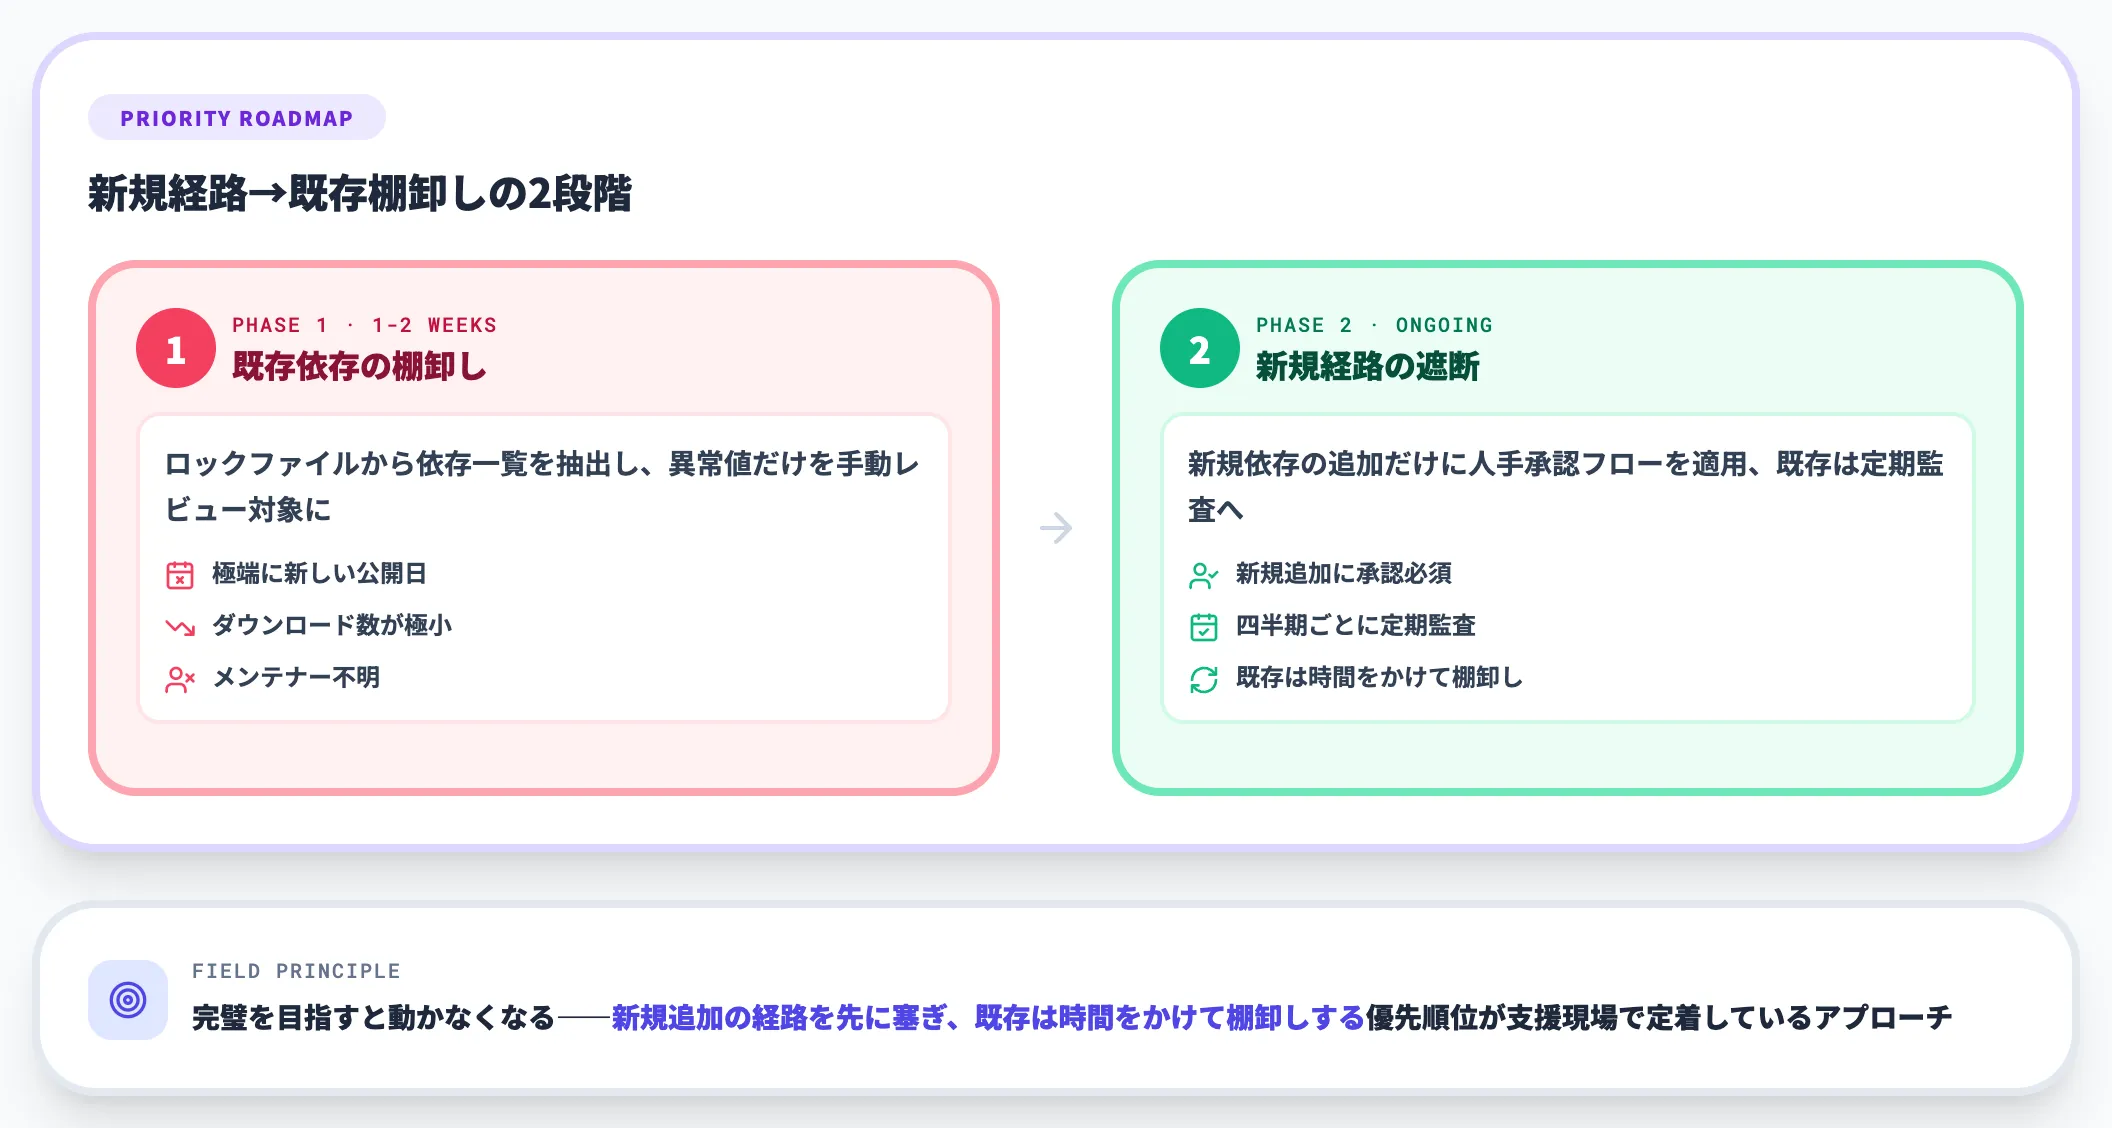
現実的な進め方は次の2段階です。
- 第1段階(1〜2週間): 既存のロックファイルから依存一覧を抽出し、各パッケージの公開日・ダウンロード数・メンテナー履歴をスキャナで評価。異常値(極端に新しい・ダウンロード数が極小・メンテナー不明)だけを手動レビュー対象にする
- 第2段階(継続): 新規依存の追加だけに人手承認フローを適用し、既存依存は定期的な監査(四半期ごと等)で評価
既存プロジェクトの対策は「完璧」を目指すと動かなくなります。新規追加の経路を先に塞ぎ、既存は時間をかけて棚卸しするという優先順位が、支援現場で定着しているアプローチです。
ベンダー選定の判断軸で詰まる場合
スロップスクワッティング対策をうたうツール・サービスは、2026年時点で急速に増えています。選定で詰まる論点は、「どの層で防御を提供するか」の見極めです。
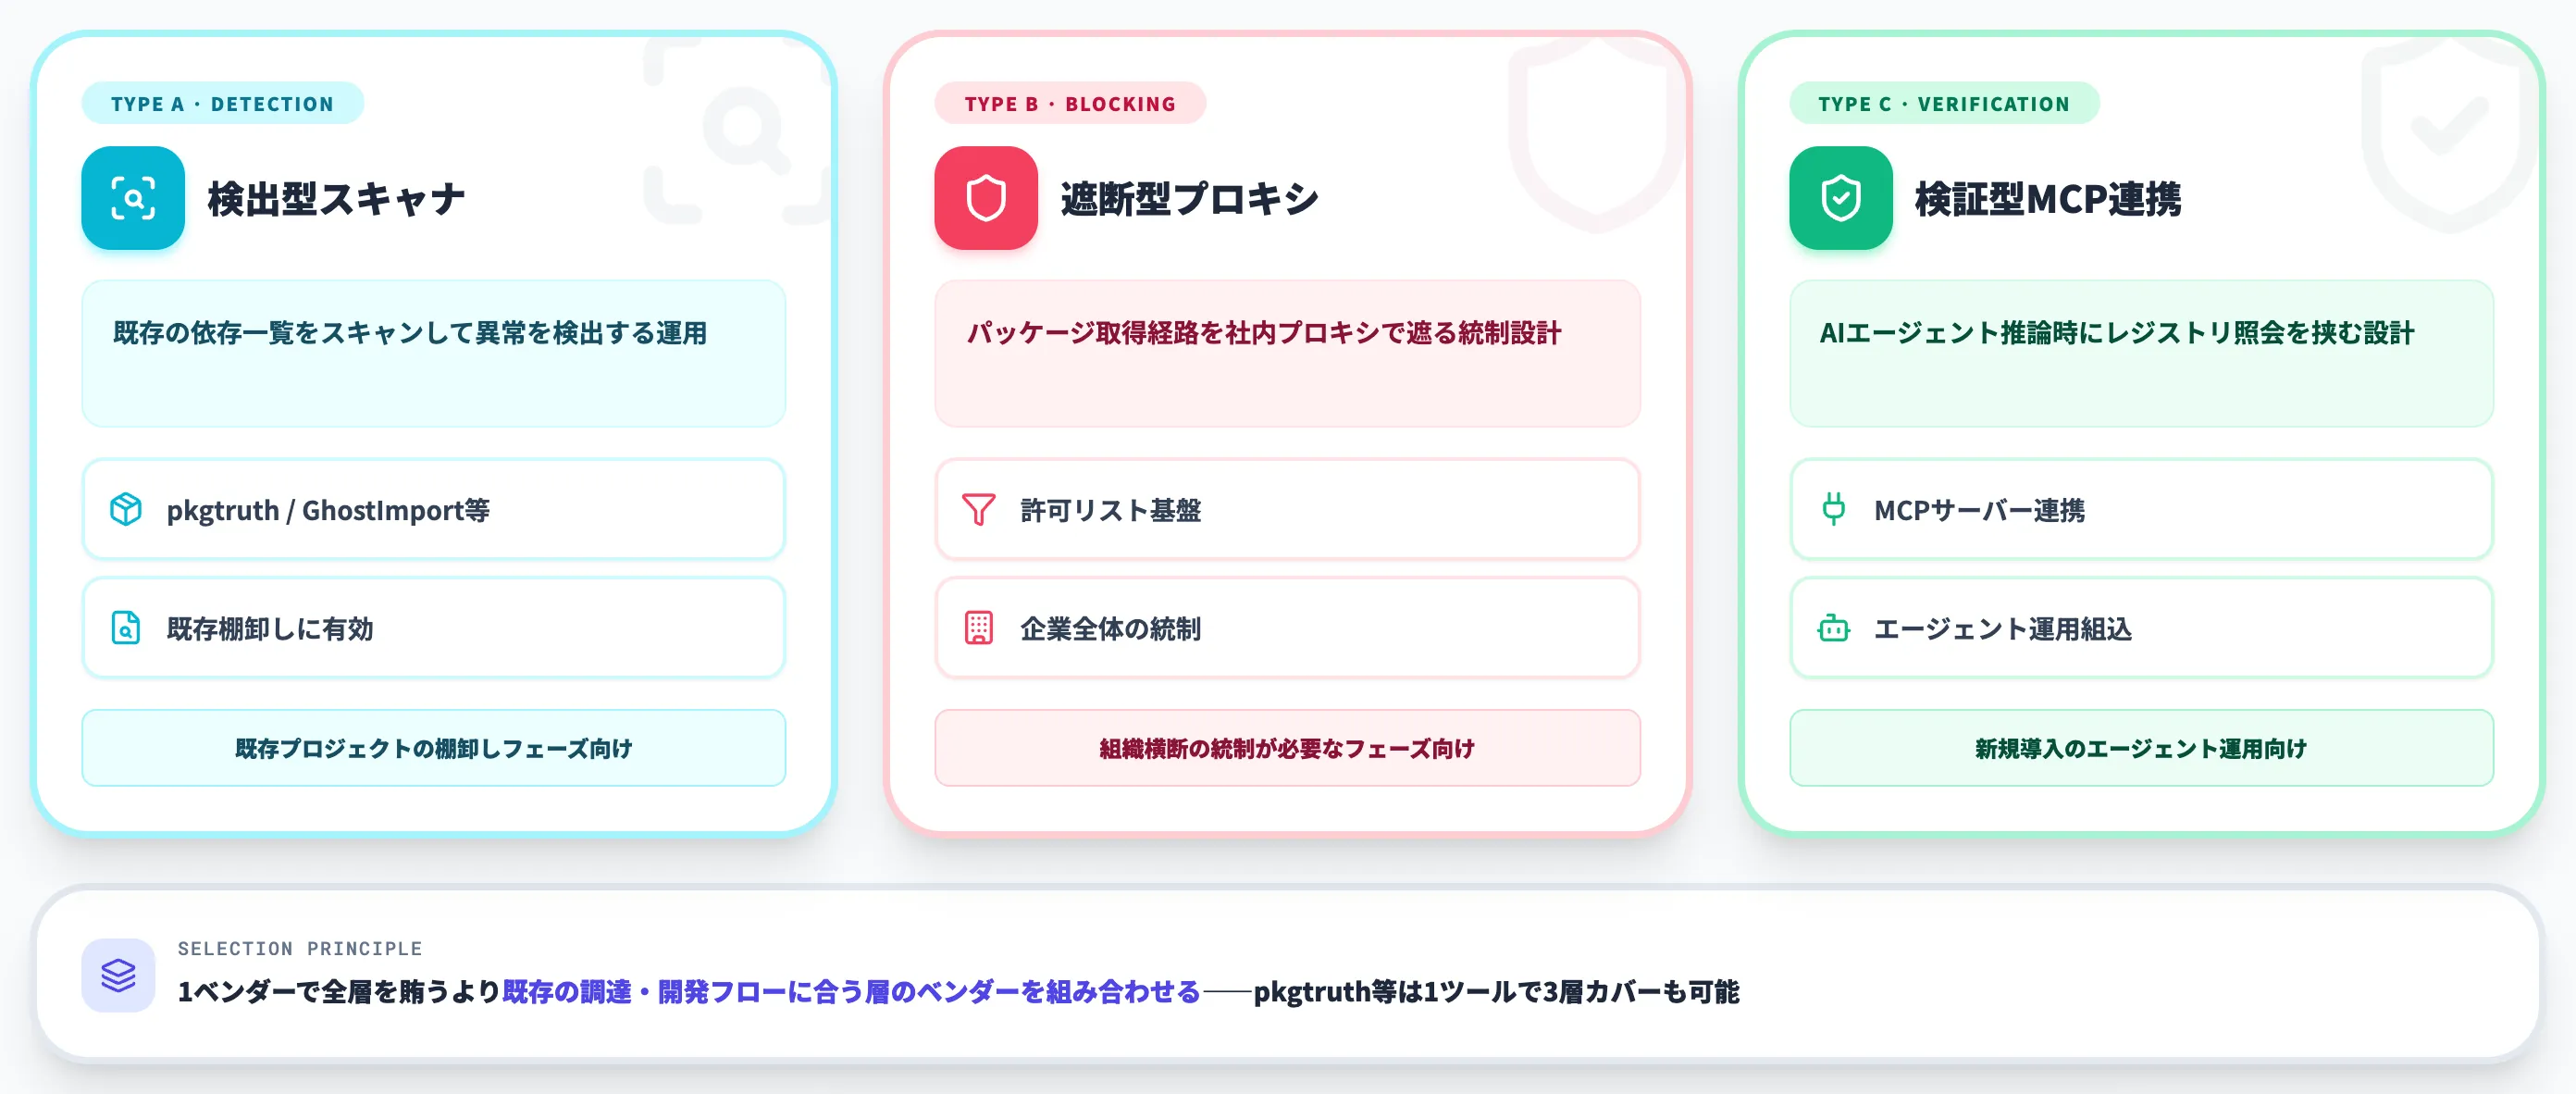
以下の観点で判断軸を分けると、ベンダーの位置づけが整理できます。
- 検出型(スキャナ): 既存の依存一覧をスキャンして異常を検出するタイプ。pkgtruth・GhostImport等。既存プロジェクトの棚卸しに有効
- 遮断型(プロキシ): パッケージ取得経路を社内プロキシで遮る設計。企業全体での統制に有効
- 検証型(MCP連携): AIエージェントの推論時にレジストリ照会を挟む設計。新規導入のエージェント運用に組み込みやすい
重要なのは、1つのベンダーで全層を賄うのではなく、既存の調達・開発フローに合う層のベンダーを組み合わせることです。pkgtruthなど一部のツールは単体でCLI・CI統合・インストール遮断フックまでカバーしており、検出・遮断・検証の層を1ツールで組める場合もあるので、組み合わせの要否は実際の運用環境に即して判断します。
関連する上位概念の整理は、AIサプライチェーン攻撃の侵入経路と対策およびAIサイバーセキュリティの3領域で扱っています。本記事と合わせて読むと、スロップスクワッティングを「全体のどこに位置する脅威か」として把握しやすくなります。
AIコーディング時代の依存審査を業務Agent基盤に組み込むなら
スロップスクワッティングは、AIコーディングエージェントの利便性と裏表の関係にある構造的な脅威です。Claude Code・GitHub Copilot等をチーム全体で導入している組織では、依存審査・SBOM生成・ロックファイル検証を手作業で全件確認する運用は現実的にスケールしません。むしろ、審査プロセスそのものを業務Agentに組み込み、人間は例外対応に集中する運用設計が必要です。
このレイヤーを担うのが、自社Azureテナント内で動くエンタープライズAIエージェント基盤です。AI総合研究所のAI Agent Hubは、Teamsから呼び出せる業務特化Agent群を1つのダッシュボードで統合管理し、依存審査・セキュリティ監査Agentを業務プロセスに載せる運用基盤として機能します。
-
依存審査Agentを先行実装
Claude Opus 5・Sonnet 5をバックエンドに据えた依存審査Agent・SBOM生成Agentを、CI/CDパイプラインから直接呼び出し。幻覚名を事前にレジストリ照会で検証する層を自動化できます。
-
モデル世代交代を吸収する管理層
LLMの幻覚率はモデル世代ごとに変動します。Agent側の設計を分離することで、特定モデル依存の運用から脱却し、幻覚率の低いモデルへの切替をスムーズに行えます。
-
Agent単位のアクセス統制とログ監査
どのAgentがどの依存を承認したかを不変ログで保管し、EU CRA・IPAガイドラインの監査要求にそのまま提出できる形で残します。
-
データは100%自社Azureテナント内に保持
社内コードベース・依存情報はAIの学習対象から完全除外。Azure Managed Applicationsとして自社テナント内で動作が完結する設計です。
AI総合研究所の専任チームが、スロップスクワッティング対策のユースケース設計から業務Agent基盤の統合実装まで一貫して支援します。AI Agent Hubのサービスページで、AIコーディング×セキュリティ×業務Agentの実装例をご確認ください。
AIコーディング時代の依存審査を業務Agentに組み込む
スロップスクワッティング対策を運用に載せる
AIエージェントの提案パッケージを人手で全件確認する運用はスケールしません。AI Agent Hubは、業務特化Agent群を自社Azureテナント内で統合管理し、依存審査・SBOM生成・ロックファイル検証を業務プロセスに組み込む運用基盤として機能します。モデル世代交代を吸収しながらセキュリティ運用に載せられます。
まとめ
本記事では、スロップスクワッティングについて、定義・LLMが幻覚する仕組み・2024〜2026年の事例と実証・自律エージェント時代の脅威度・フロンティアモデルの最新幻覚率・多層対策・導入で詰まる論点までを、2026年10月時点の最新情報で解説しました。
2026年時点で押さえておくべきポイントは次の3つです。
- スロップスクワッティングはLLMが幻覚で生成するパッケージ名の統計的再現性(10回中43%が毎回同一)を悪用する攻撃で、タイポスクワッティングとは別経路の脅威
- react-codeshift・unused-imports・huggingface-cliなど実被害・実証事例が複数積み上がり、Claude Code・GitHub Copilot等の自律エージェントが人手レビュー欠落の経路を提供している
- フロンティアモデルの幻覚率は4.62〜6.10%まで低下したが53種は研究時点で登録可能と評価された状態にあり、SBOM・ロックファイル・サンドボックス・プロキシ・人手承認の多層構えが現実解
企業の開発責任者・セキュリティ担当者にとってスロップスクワッティングは、「AIコーディングを導入するかどうか」よりも「導入後の依存審査プロセスを業務Agentに組み込めるか」という問いを突きつける脅威です。まずは自社の依存管理フロー(ロックファイル差分レビュー・新規パッケージ承認・CI/CD上のSBOM生成)を棚卸しし、AIエージェントの提案が人手を介さずに本番環境に反映されない経路を1本ずつ塞ぐところから着手するのが、最も現実的な第一歩になります。