この記事のポイント
 Claude Opus 5単独で約30%(ARC Prize公式・High reasoning)、AVOとの組み合わせでpublic set 100.00 RHAE と別条件で報告されており、モデル選定と並行して足回りの設計も議論に載せるべきシグナル
- 公開一次ソースではAVO本体の公式コード/API提供は確認できず、実務での直接利用手段は明示されていない
- GPUカーネル最適化の7日連続実験で40カーネル版を生成しFlashAttention-4を最大10.5%上回るなど、長時間タスクの自律継続力そのものが中核価値
- ARC-AGI-3の100%はpublic set限定・NVIDIA独自再実装での測定で、ARC Prize公式リーダーボードには現時点で未掲載
- 自社実装は永続メモリ→スーパーバイザー→反復ループの順で組むと投資対効果が読みやすい
Microsoft MVP・AIパートナー。LinkX Japan株式会社 代表取締役。東京工業大学大学院にて自然言語処理・金融工学を研究。NHK放送技術研究所でAI・ブロックチェーンの研究開発に従事し、国際学会・ジャーナルでの発表多数。経営情報学会 優秀賞受賞。シンガポールでWeb3企業を創業後、現在は企業向けAI導入・DX推進を支援。
NVIDIA AVO(Agentic Variation Operators)とは、NVIDIA Researchが2026年3月に論文発表し、8月にARC-AGI-3ベンチマーク公開セットで100%を報告した汎用の自律コーディングエージェント基盤です。
従来の進化的探索が使ってきた固定的な変異・交叉オペレーターを、LLMベースの自律エージェントで置き換える発想で設計されており、GPUカーネル最適化の7日連続実験からARC-AGI-3の未知ゲーム推論まで、同じアーキテクチャで解いてしまう汎用性が特徴です。
本記事では、AVOの定義、3つの中核メカニズム、GPUカーネル最適化とARC-AGI-3ベンチマークでの実績、Claude Opus 5との組み合わせが示唆する「モデル選定より、ハーネス設計」への転換、限界と過大評価すべきでない理由、そして実務者が自社エージェント設計に活かすべき原則までを、2026年8月時点の一次情報で体系的に整理します。
目次
NVIDIA AVOとは?進化的探索と自律コーディングエージェントを融合した汎用ハーネス
AVOが「進化的変異オペレーター」を名乗る理由——遺伝的アルゴリズムからの発展
AVOの3つの中核メカニズム——永続メモリ・スーパーバイザー・反復ループ
AVOのGPUカーネル最適化での実績——7日連続稼働で40カーネル、cuDNN・FlashAttention-4超え
Grouped-Query Attentionへの30分での高速転移
AVOのARC-AGI-3ベンチマーク公開セット完全制覇——Claude Opus 5と組み合わせて100.00 RHAEを報告
AVOが達成した100%スコアと6,624アクションの効率性
NVIDIA AVOとは?進化的探索と自律コーディングエージェントを融合した汎用ハーネス
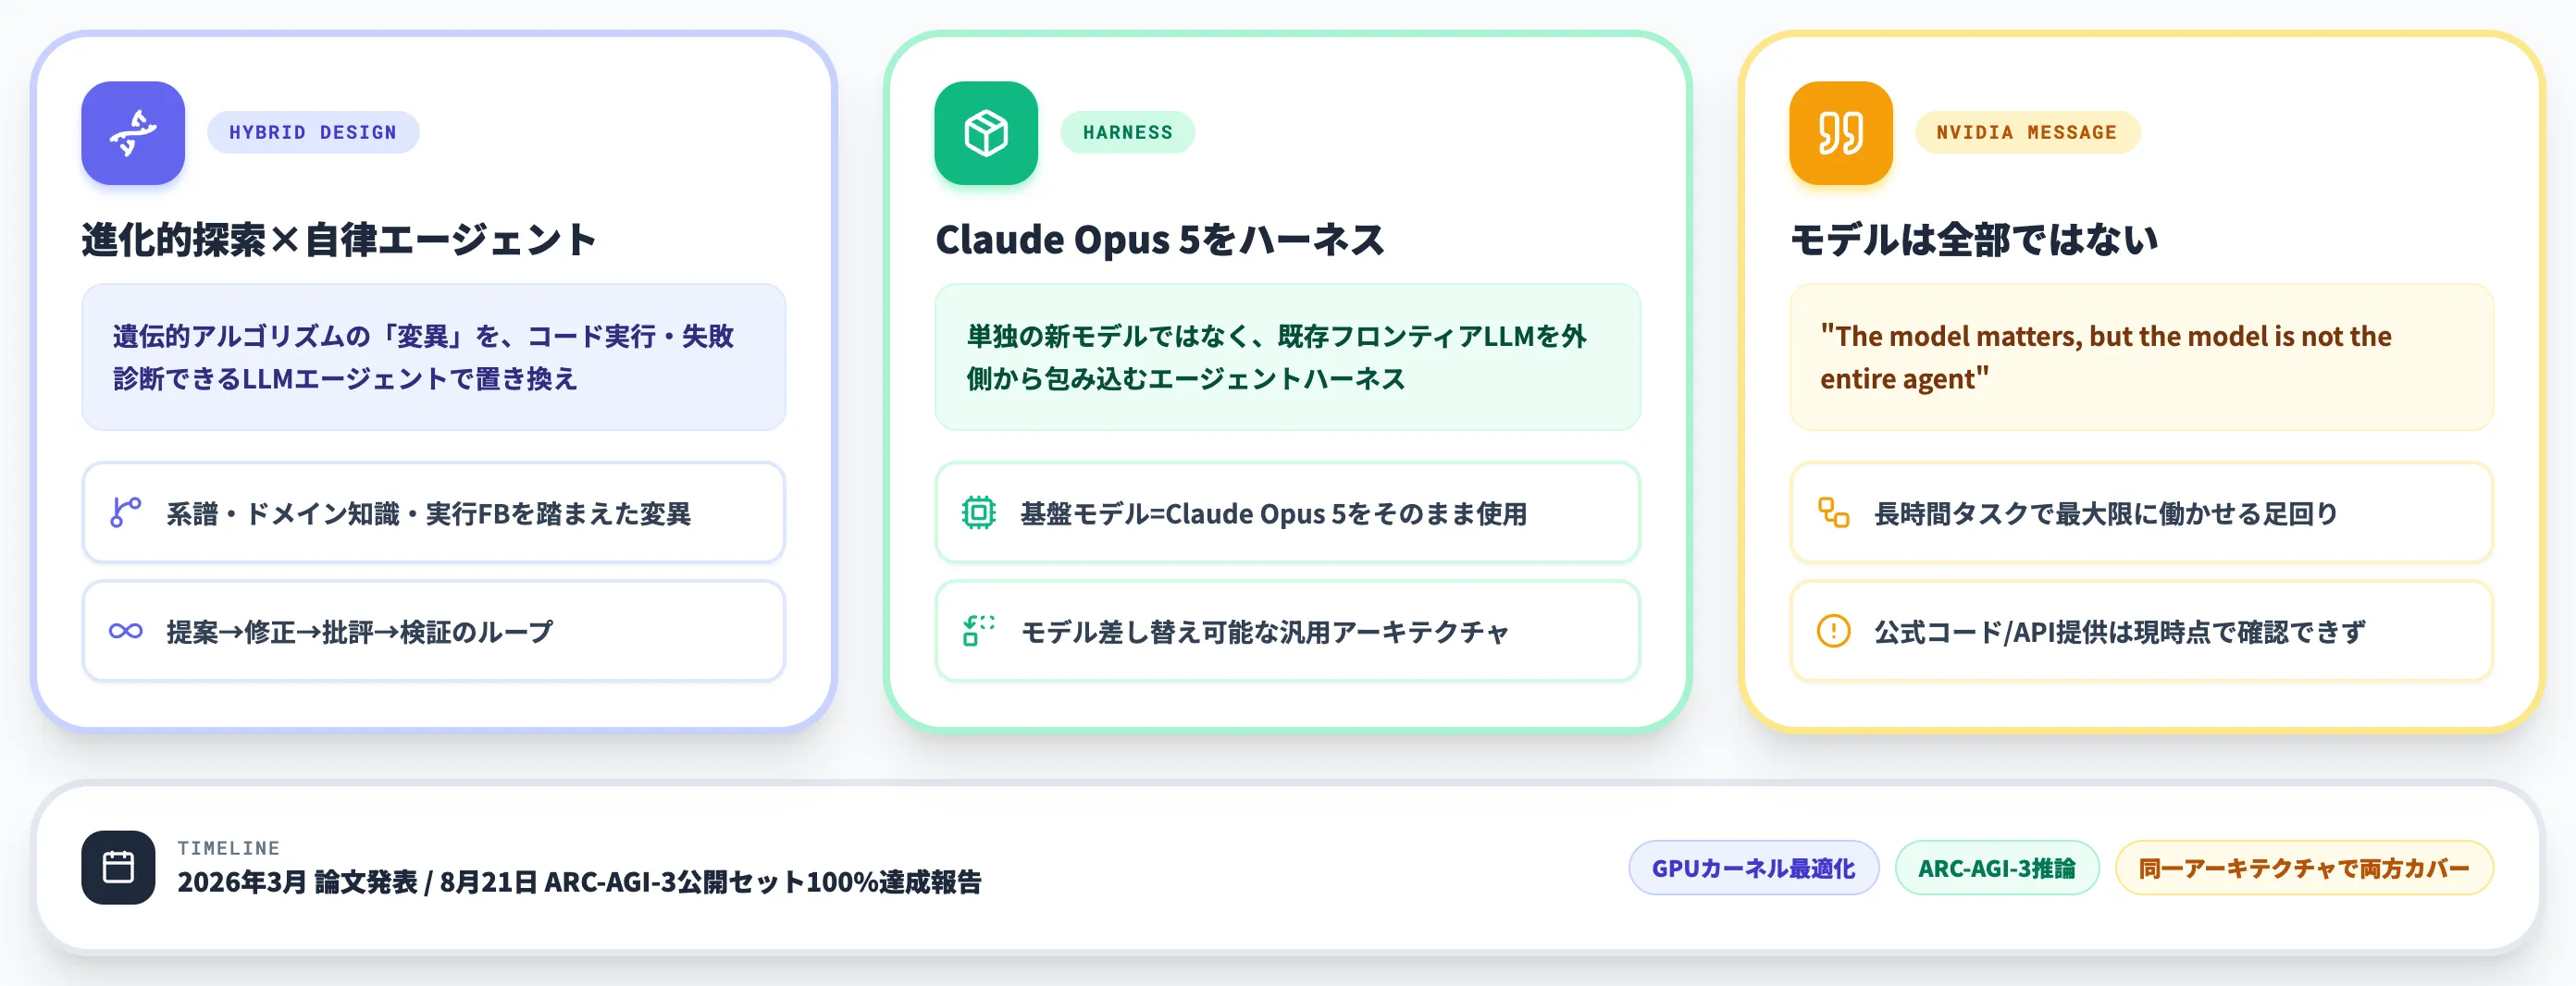
NVIDIA AVO(Agentic Variation Operators、エージェント型変異オペレーター)とは、NVIDIA Researchが2026年3月に発表した、汎用の自律コーディングエージェント基盤です。
もっとも特徴的なのは、これが単独の新モデルではなく、既存のフロンティアLLMを外側から包み込んで働かせる「エージェントハーネス」の設計であるという点です。
実際、NVIDIAのARC-AGI-3実験では基盤モデルにAnthropicのClaude Opus 5がそのまま使われており、AVO自体はモデルを差し替えても動く汎用アーキテクチャとして提示されています。
NVIDIA公式のメッセージも「モデルは重要だが、モデルはエージェントの全部ではない」(The model matters, but the model is not the entire agent)と明快です。NVIDIAブログでは、public set全体の測定はClaude Opus 5で行い、GPT-5.6 Solとの組み合わせは一部ゲームでの予備実験段階と注記されています。
AVOが「進化的変異オペレーター」を名乗る理由——遺伝的アルゴリズムからの発展
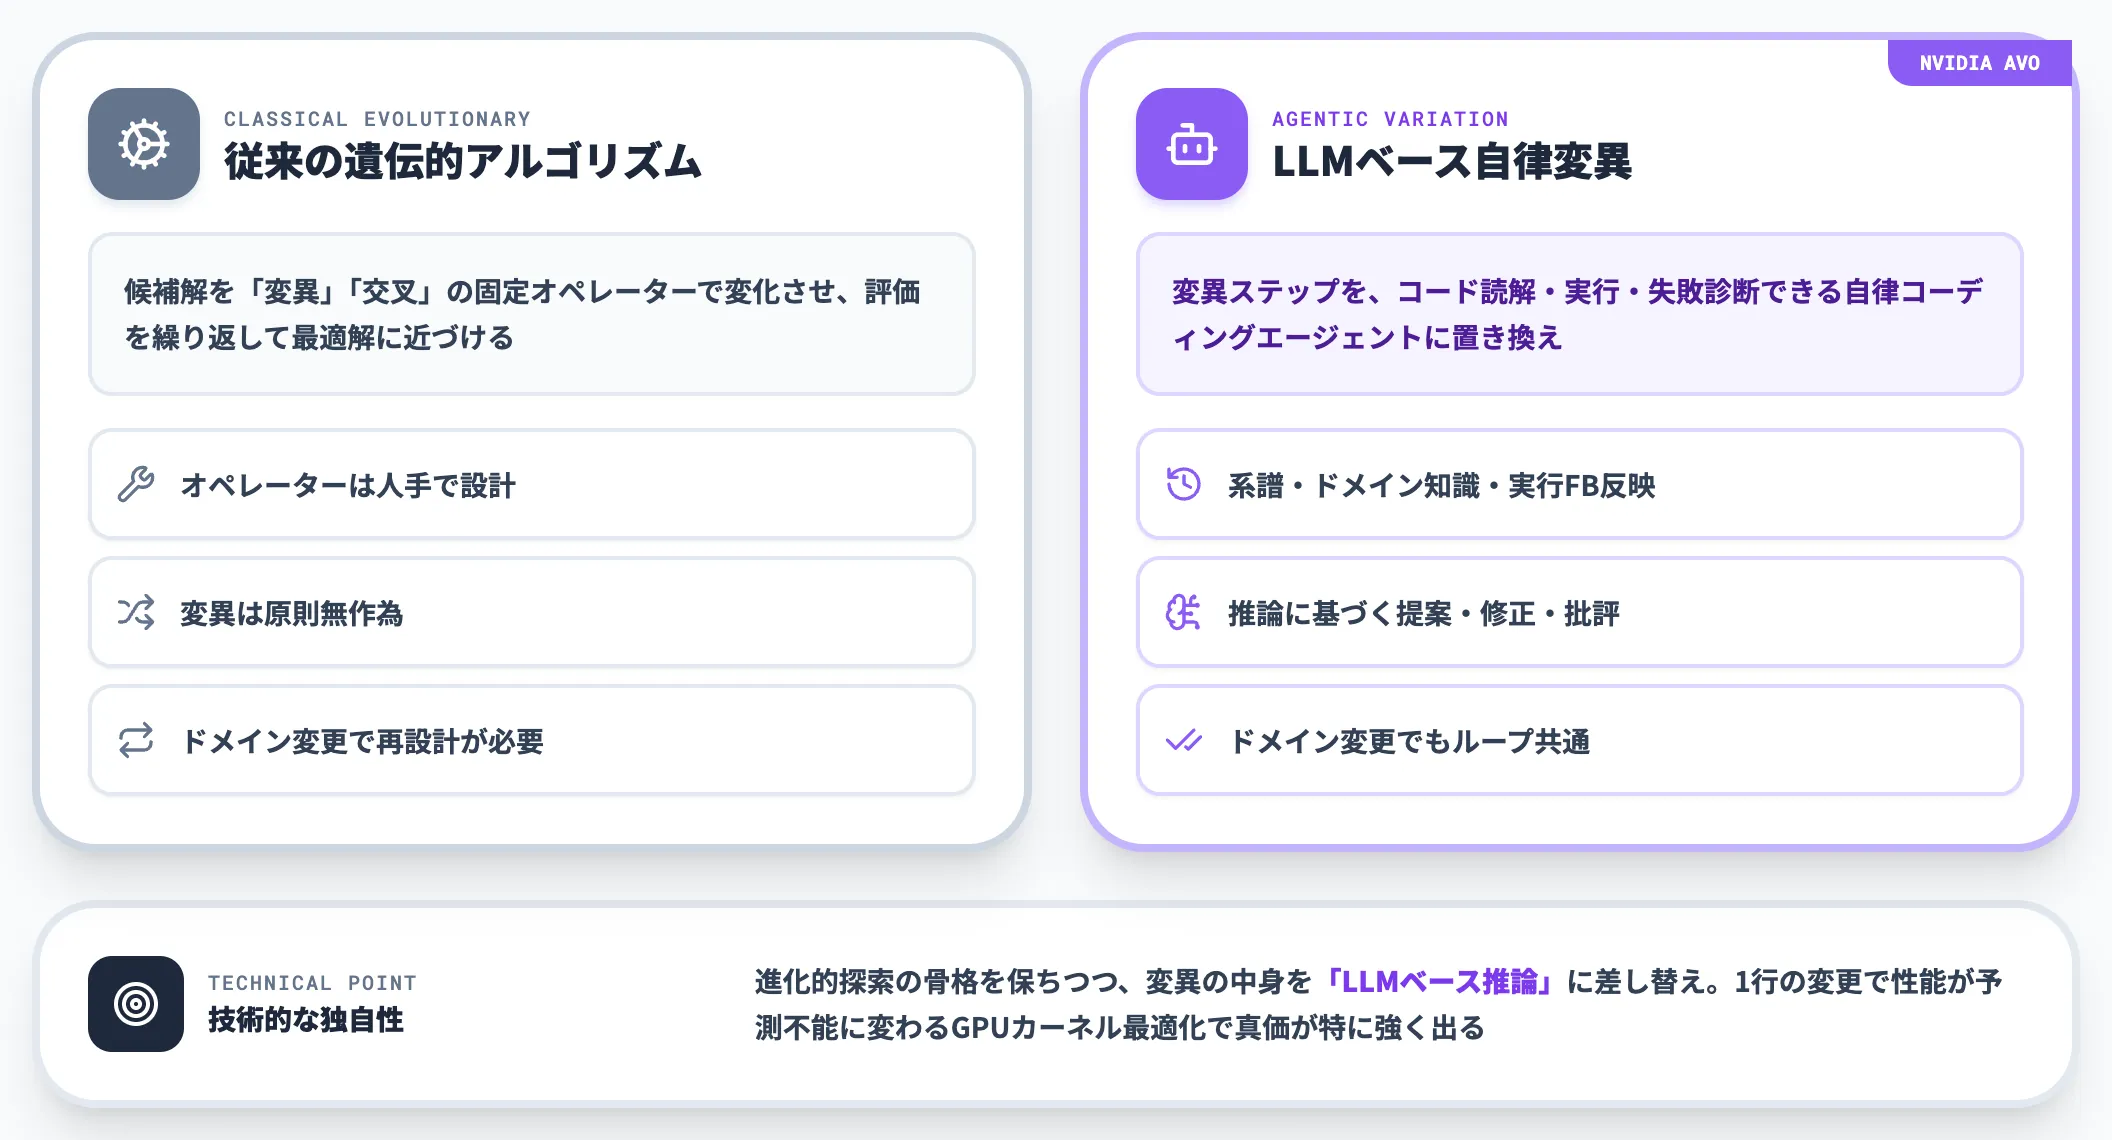
「Agentic Variation Operators」という命名は、進化計算(Evolutionary Computation)の系譜から来ています。
従来の遺伝的アルゴリズムは、候補解を「変異(mutation)」「交叉(crossover)」といった固定的オペレーターで少しずつ変えながら評価を繰り返し、最適解に近づけていく手法でした。ただしこれらのオペレーターは人手で設計する必要があり、ドメインを変えるたびに設計し直しになるという弱点があります。
AVOはこの「固定オペレーター」を、コードを読み・実行し・失敗を診断できる自律コーディングエージェントで置き換えました。変異は無作為ではなく、過去の系譜(lineage)・ドメイン固有知識・実行フィードバックを踏まえた提案・修正・批評・検証のループとして進みます。
進化的探索の骨格を保ちつつ、変異の中身を「LLMベースの推論」に差し替えた——これがAVOの技術的な独自性です。
GPUカーネル最適化のような、たった1行の変更で性能・正確性・スケジューリングが予測不能に変わる領域で、その真価が特に強く出ます。
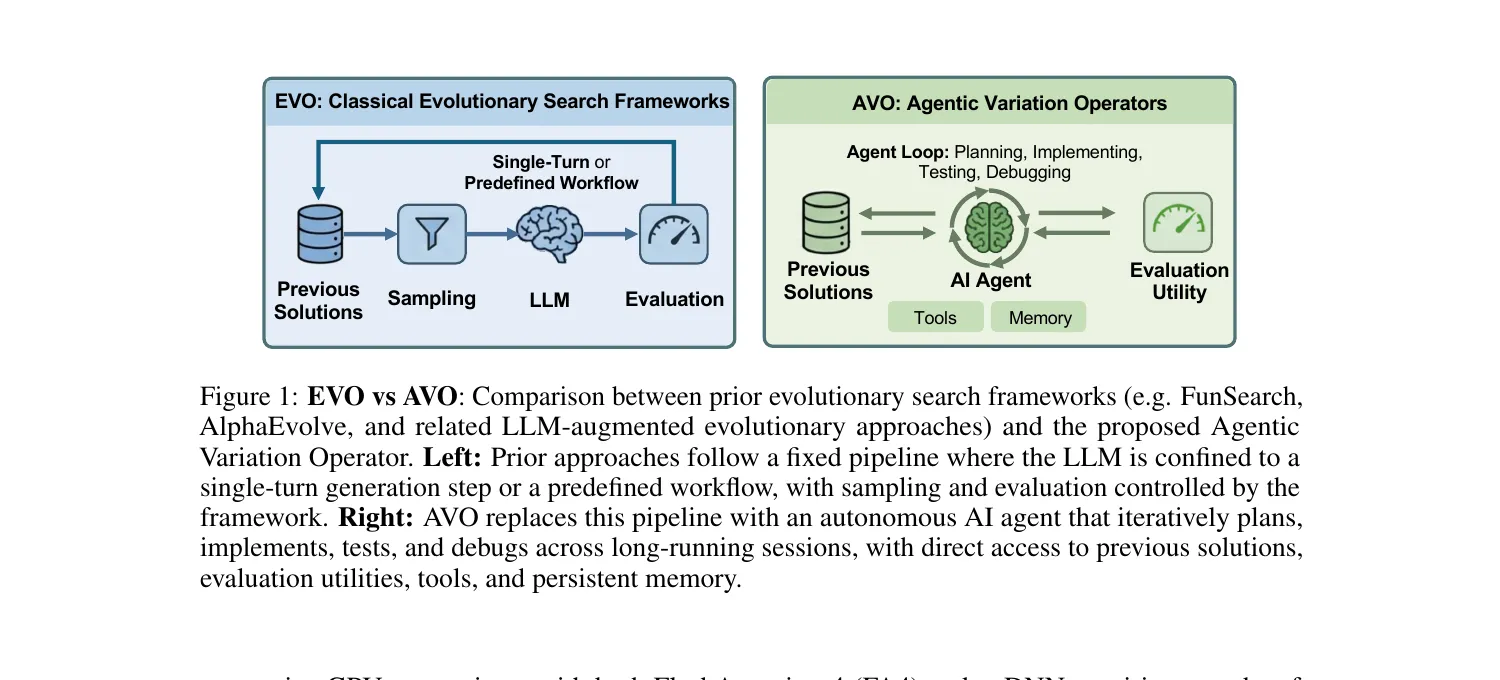
従来の進化的探索フレームワーク(左)とAVOの変異ステップ設計(右)の違い(出典:AVO論文 arXiv:2603.24517)
図の左側にあるFunSearchやAlphaEvolveのような従来型は、Previous Solutions → Sampling → LLM → Evaluation という単一ターンの固定パイプラインで動きます。
右側のAVOは、同じ入出力の枠に見えつつも、中央のAI Agentが Planning・Implementing・Testing・Debugging を自律的に回し、Tools・Memoryを引き出しながら評価ユーティリティにアクセスする構造に置き換わっています。この設計の違いが、次章で見る7日連続稼働を可能にする土台になります。
AVOの3つの中核メカニズム——永続メモリ・スーパーバイザー・反復ループ
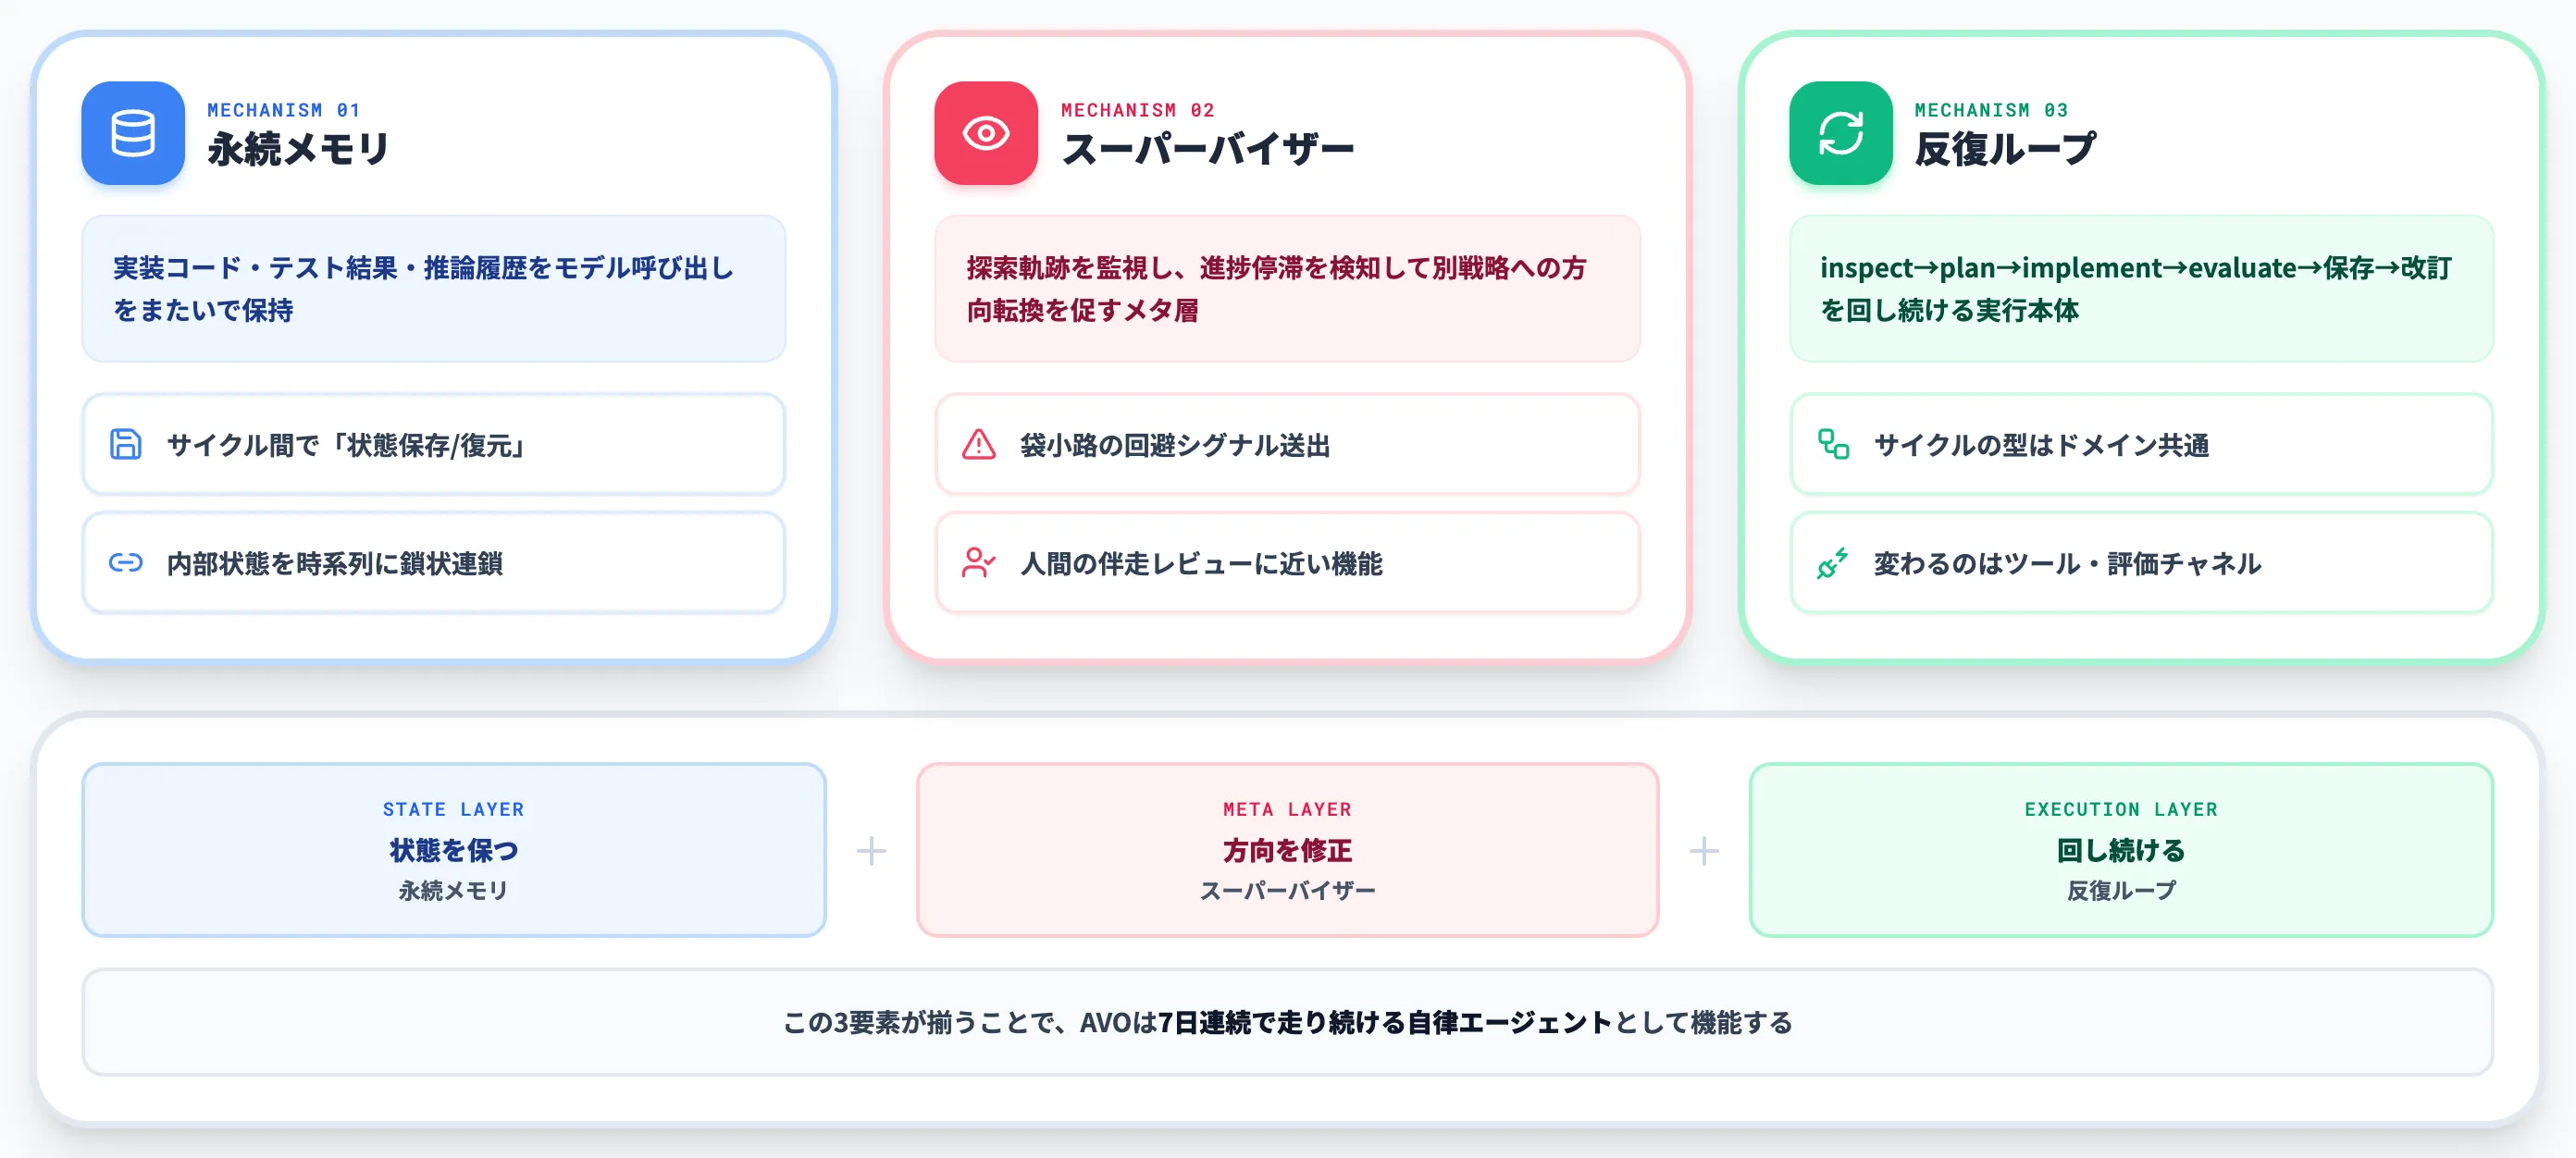
AVOが長時間タスクを走り切れるのは、モデルの性能だけではなく、モデルを取り巻く3つのメカニズムがセットで働くからです。
NVIDIA Developer Blogでは「持続的な自律動作は、持続的メモリと監督機構が担う」と説明されており、AVO論文でもこの3要素が中核として繰り返し登場します。ここでは各要素の役割を分解して見ていきます。
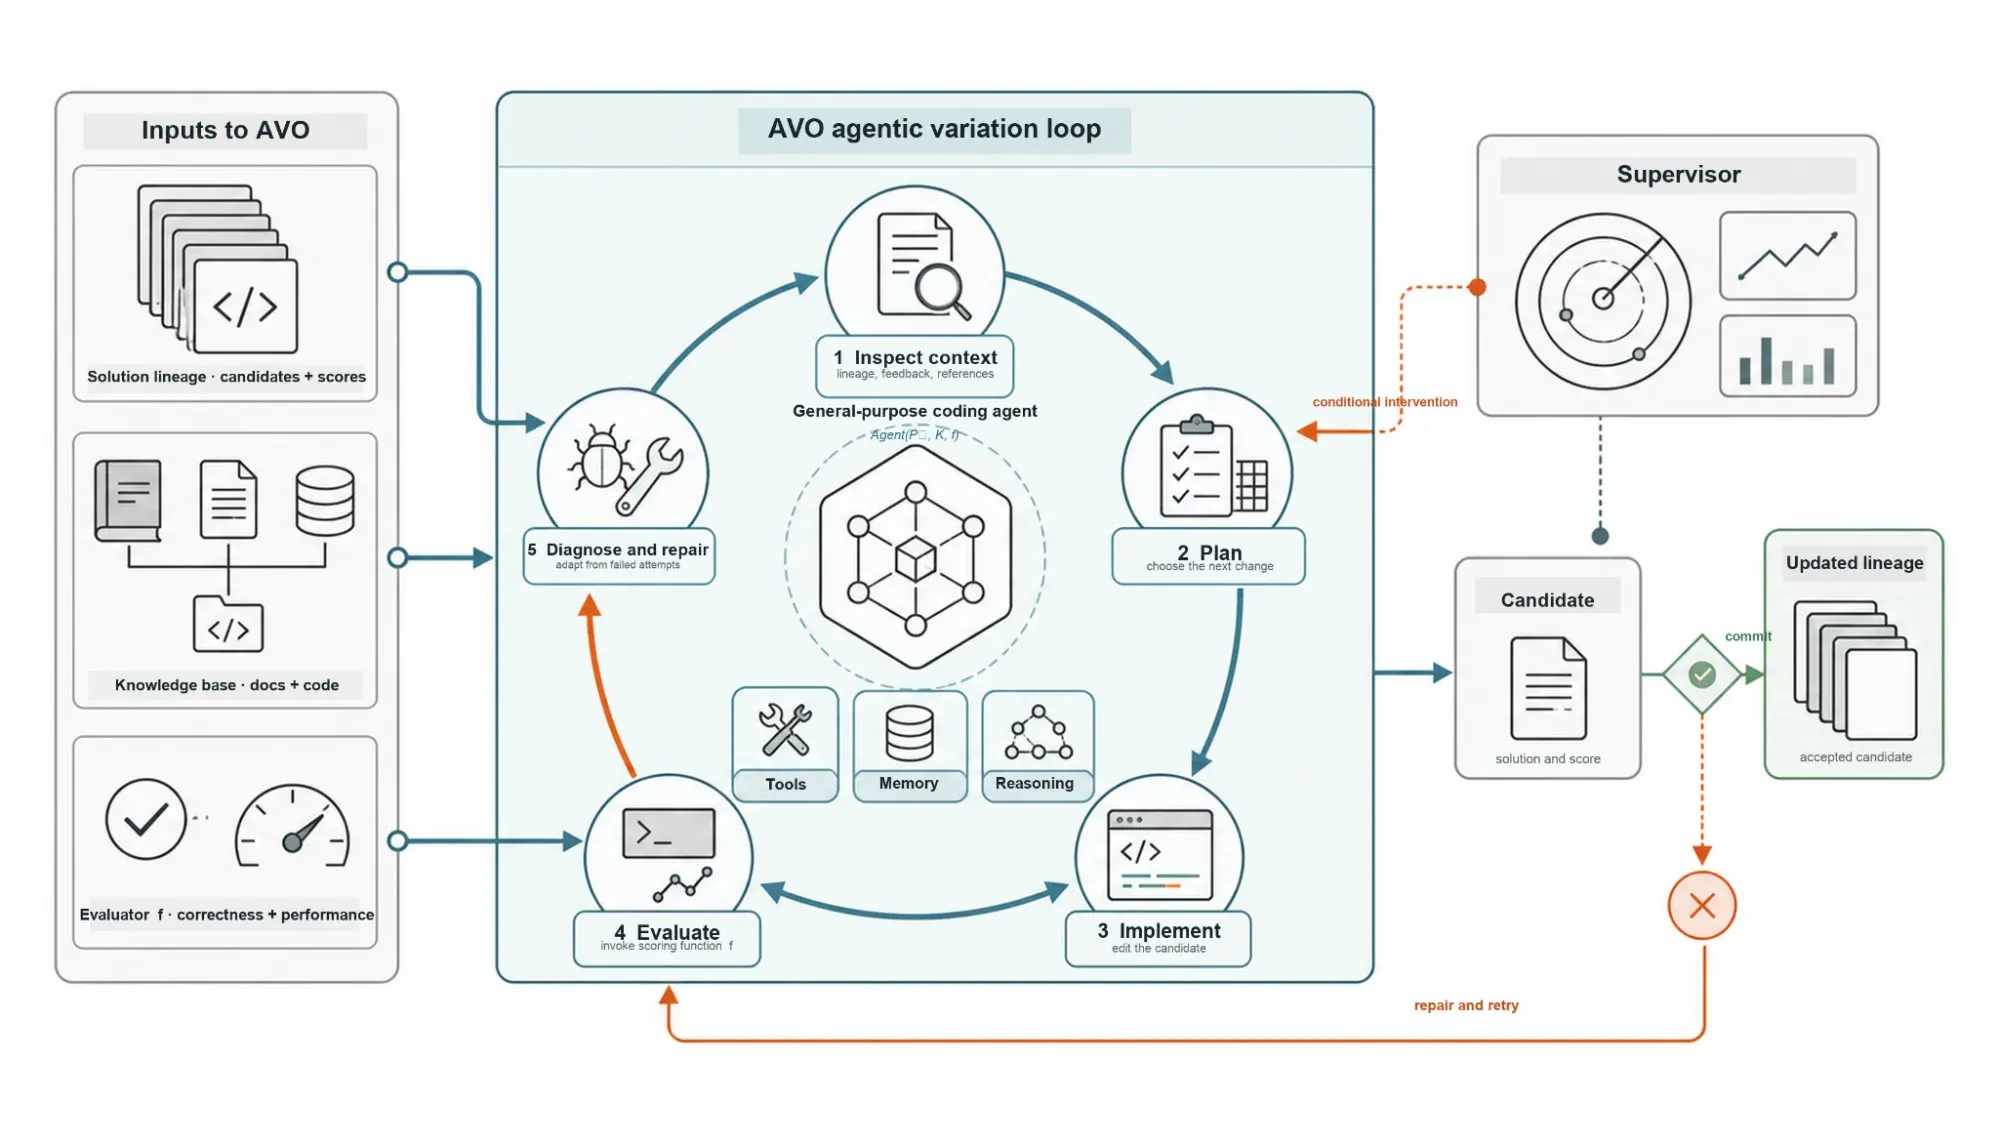
AVOアーキテクチャの全体像。永続メモリ・スーパーバイザー・反復ループが1つのシステムに統合されている(出典:NVIDIA Developer Blog)
アーキテクチャ全体を左から見ると、Solution lineage・Knowledge base・Evaluatorという3種のInputsが中央のAVO agentic variation loopに供給されます。
ループ内では「1 Inspect context → 2 Plan → 3 Implement → 4 Evaluate → 5 Diagnose and repair」が円を描き、中央にはTools・Memory・Reasoningがモジュールとして常駐しています。右側のSupervisorはループを外側から観察して条件付き介入(conditional intervention)を発行し、承認されたCandidateはUpdated lineageに蓄積されていく設計です。
この配置図が、以降で分解する3要素の関係を最も端的に示しています。
永続メモリ——コンテキスト境界を越えて実装・評価履歴を保つ
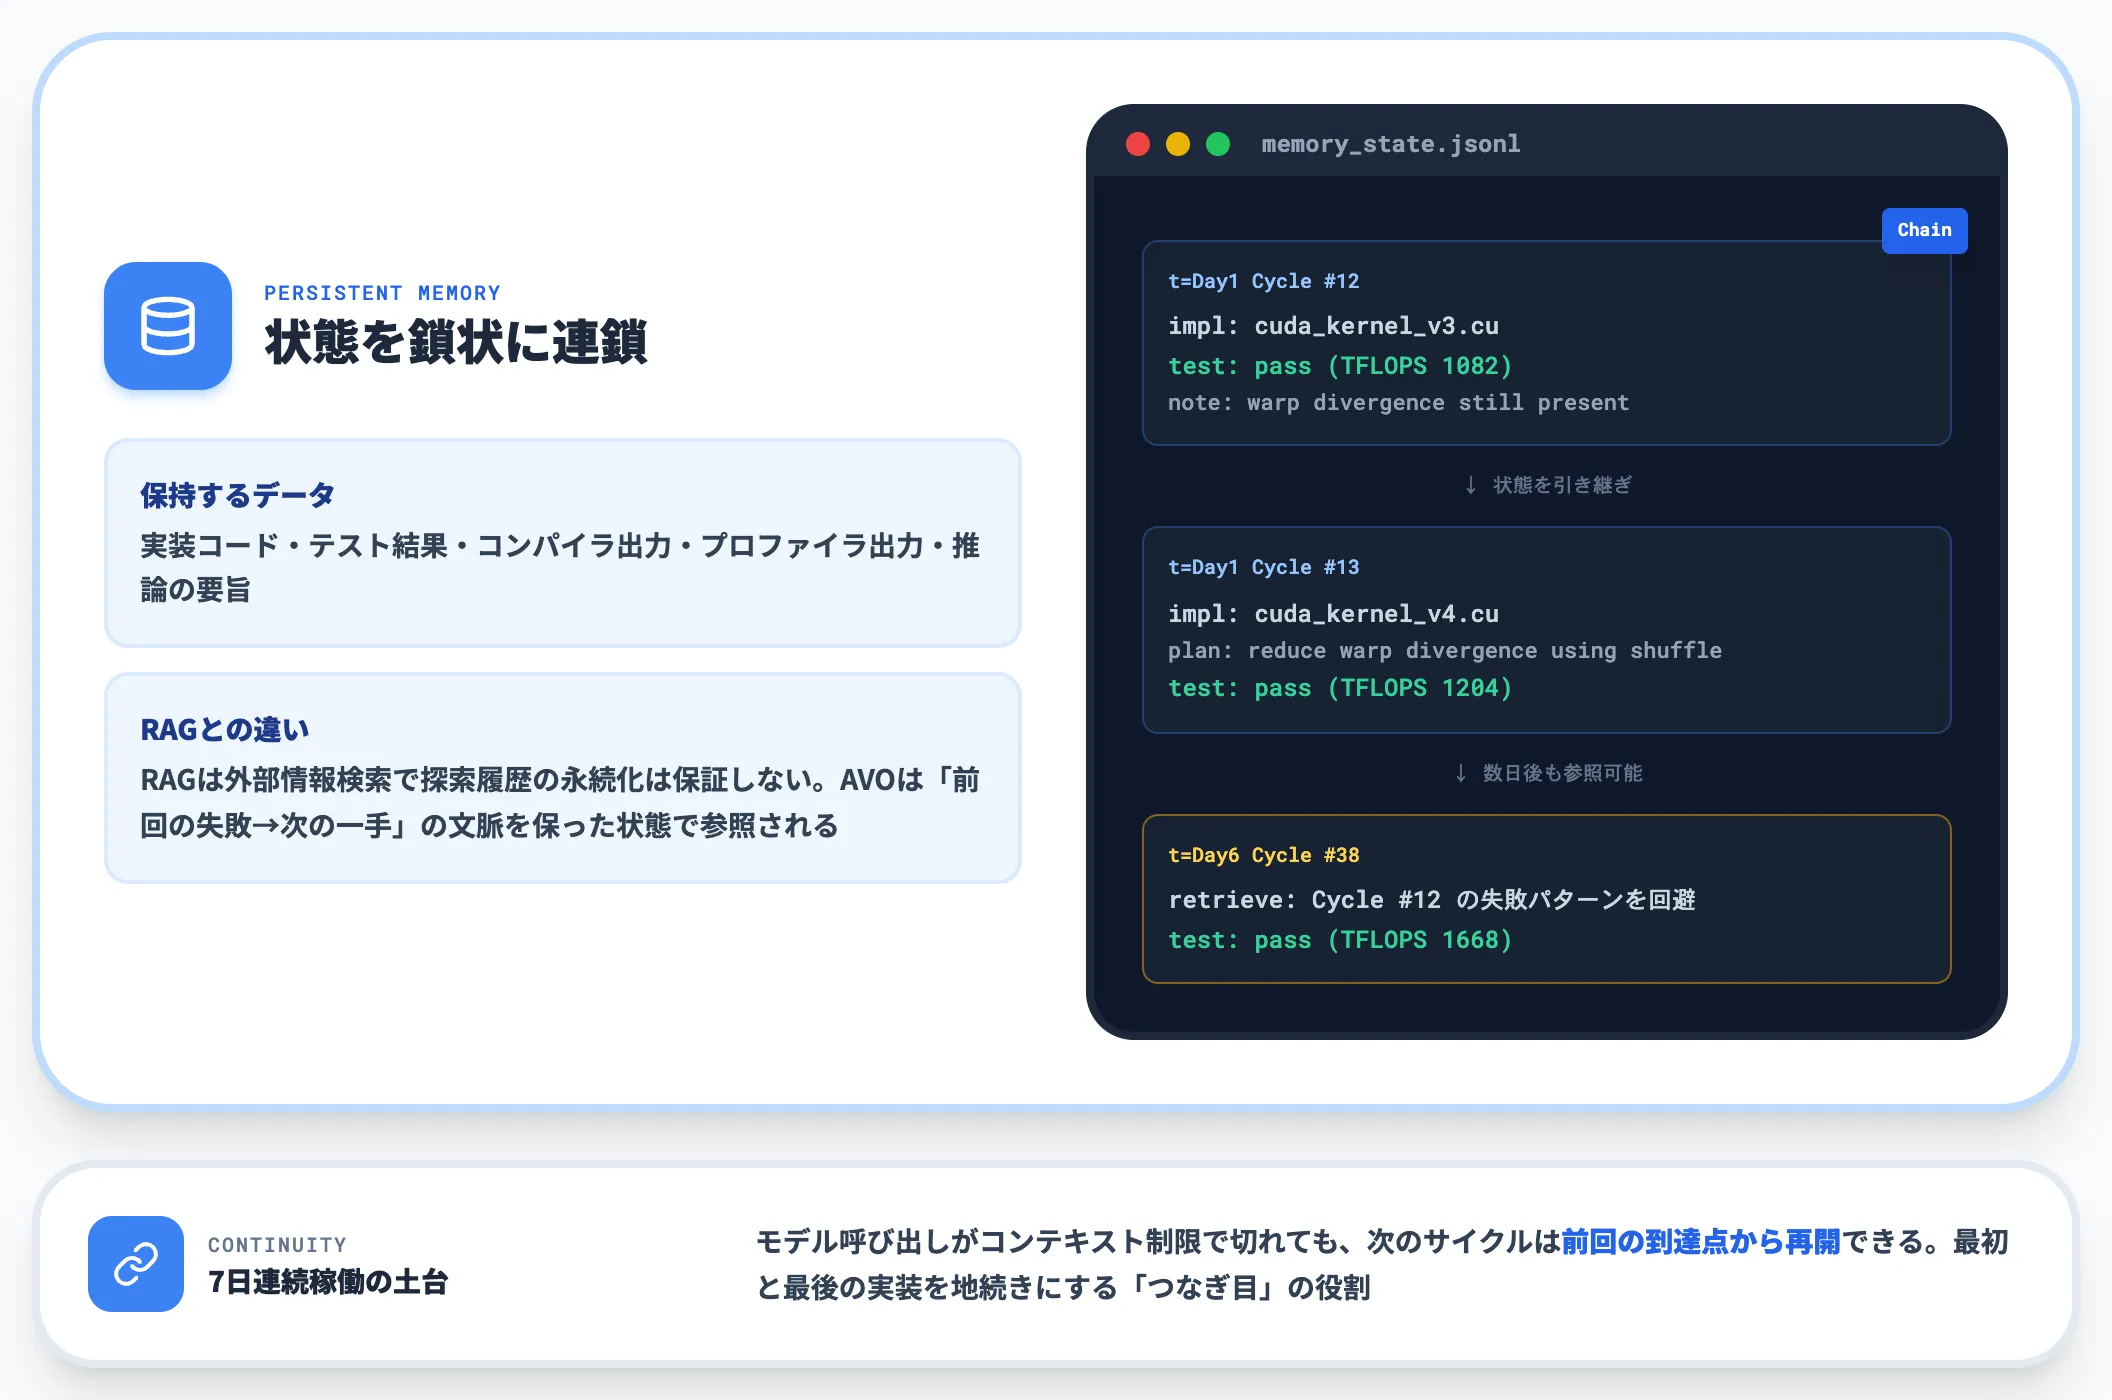
第1の要素が永続メモリ(Persistent Memory)です。
これは、過去の実装コード・テスト結果・コンパイラ出力・プロファイラ出力・推論の要旨などを、モデル呼び出しをまたいで継続的に保持する仕組みです。反復ループの各サイクルで「現在の状態」を復元するために使われ、モデル呼び出しがコンテキスト制限で切れても、次のサイクルは前回の到達点から再開できるようになります。
単なるRAG(Retrieval-Augmented Generation)と違うのは、内部状態が時系列に鎖状につながっているという点です。
RAG自体は外部情報検索の方式であって、探索履歴の永続化を自動的には保証しません。AVOのメモリは「前回の失敗はこう、そこから何を試して、次にどこを見るべきか」という文脈を保った状態で参照される設計として組み込まれています。
7日間走らせても最初と最後の実装が地続きになる、そのつなぎ目の役割を担うのがこの層です。
スーパーバイザー——探索の停滞を検知して方向転換を促す
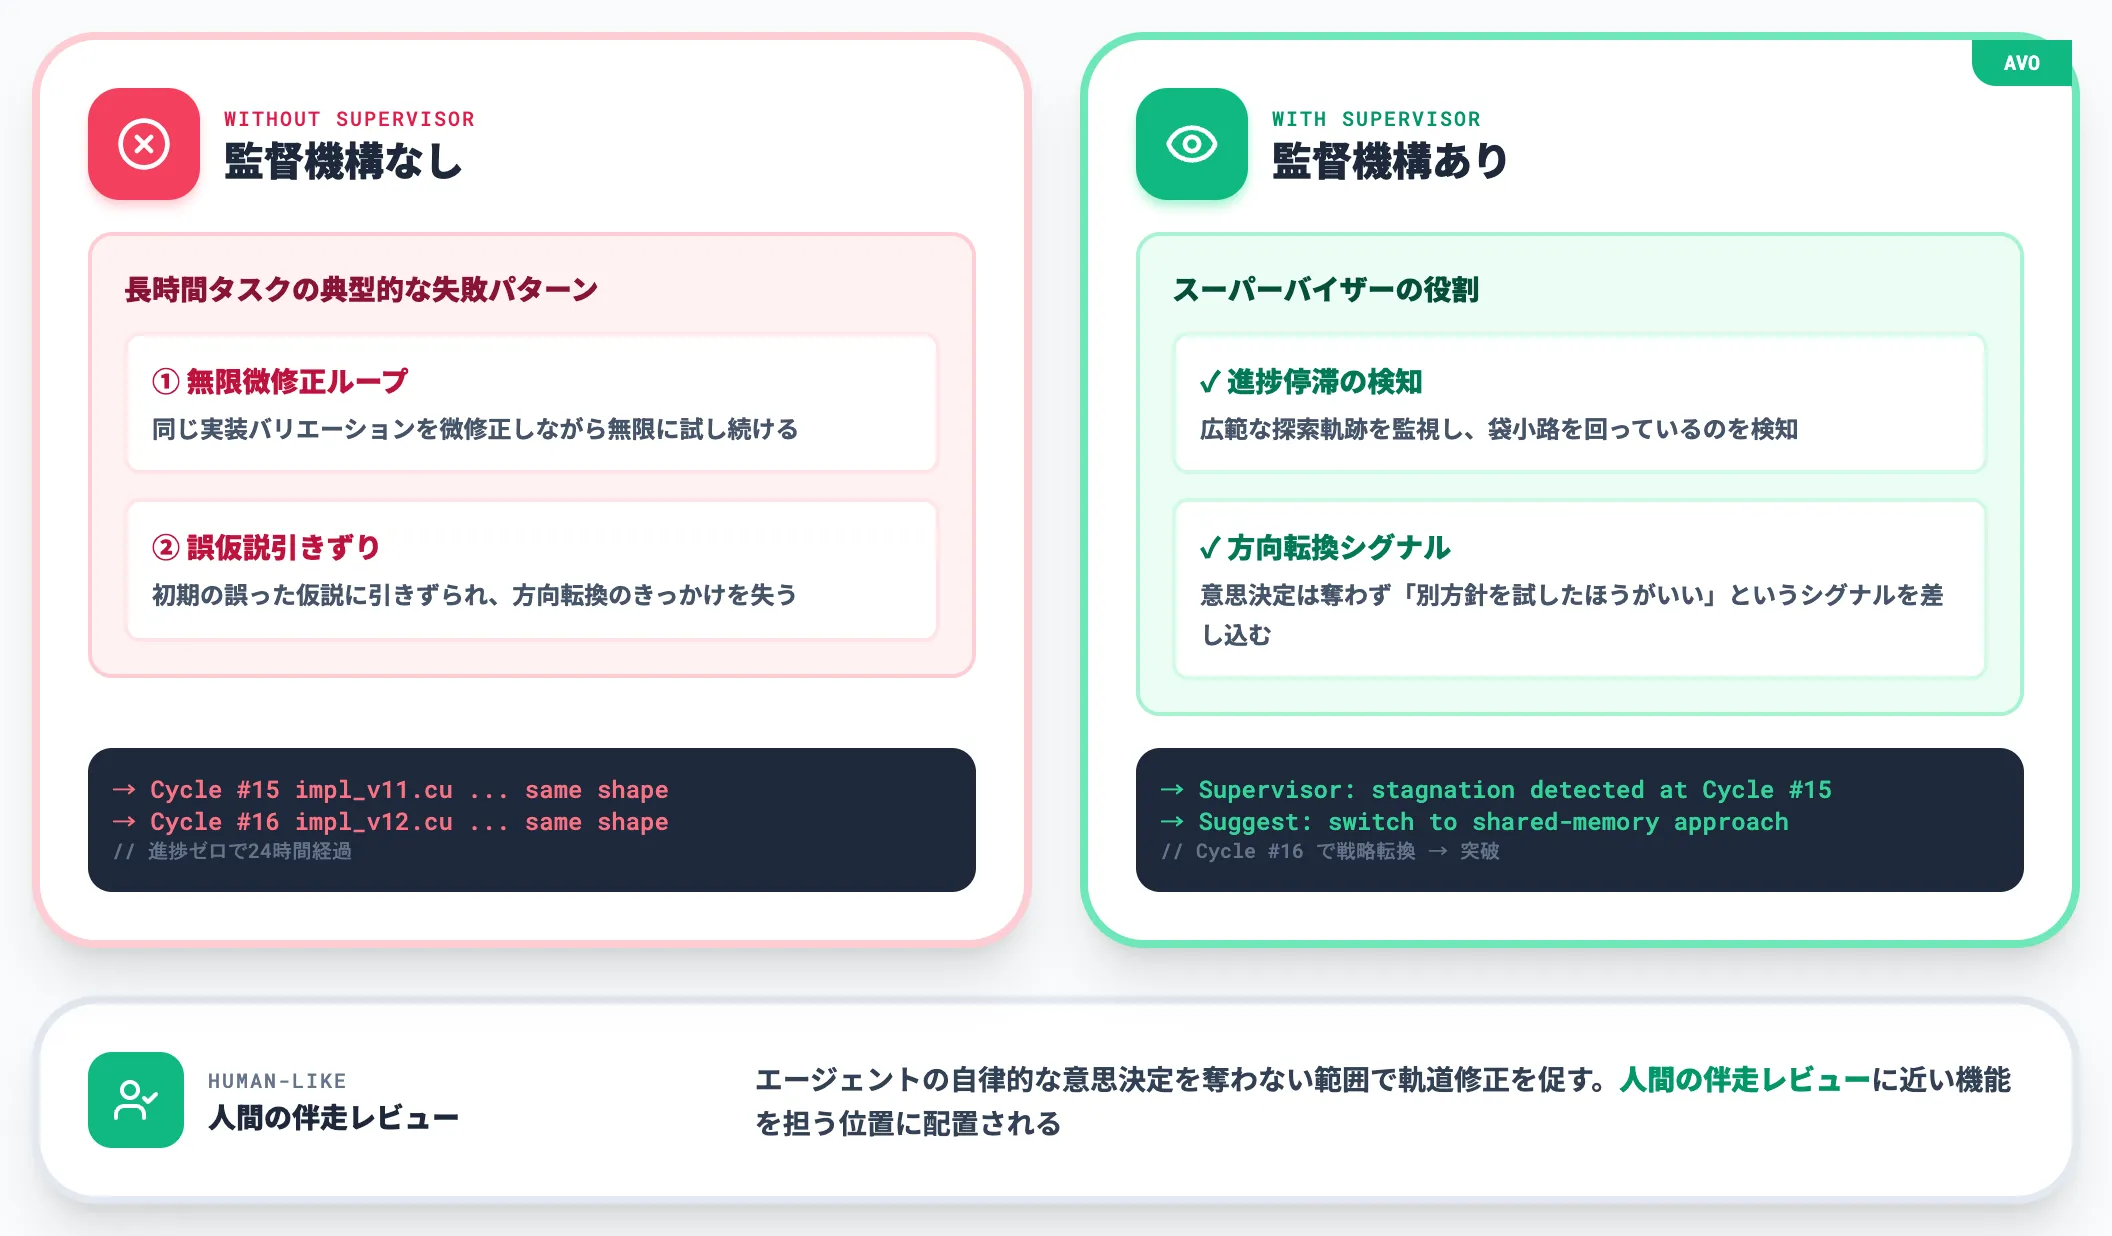
第2の要素がスーパーバイザー(Supervisor)です。
これは、メインエージェントが実行する広範な探索軌跡を監視し、進捗が停滞したら別戦略へ方向転換を促すメタ層のモジュールです。探索が同じ袋小路を回り続けているのを検知し、方針を切り替えるトリガーを送る役目を担います。
この監督機構が入っていないと、長時間タスクは典型的に2つの失敗パターンに陥ります。1つは、同じ実装バリエーションを微修正しながら無限に試し続けるパターン、もう1つは、初期の誤った仮説に引きずられて方向転換のきっかけを失うパターンです。
スーパーバイザーは、エージェントの自律的な意思決定を奪わない範囲で「そろそろ別の方針を試したほうがいい」というシグナルを差し込む位置に配置されており、ここが人間の伴走レビューに近い機能を担います。
反復ループ——仮説→行動→観察→保存→改訂のサイクル
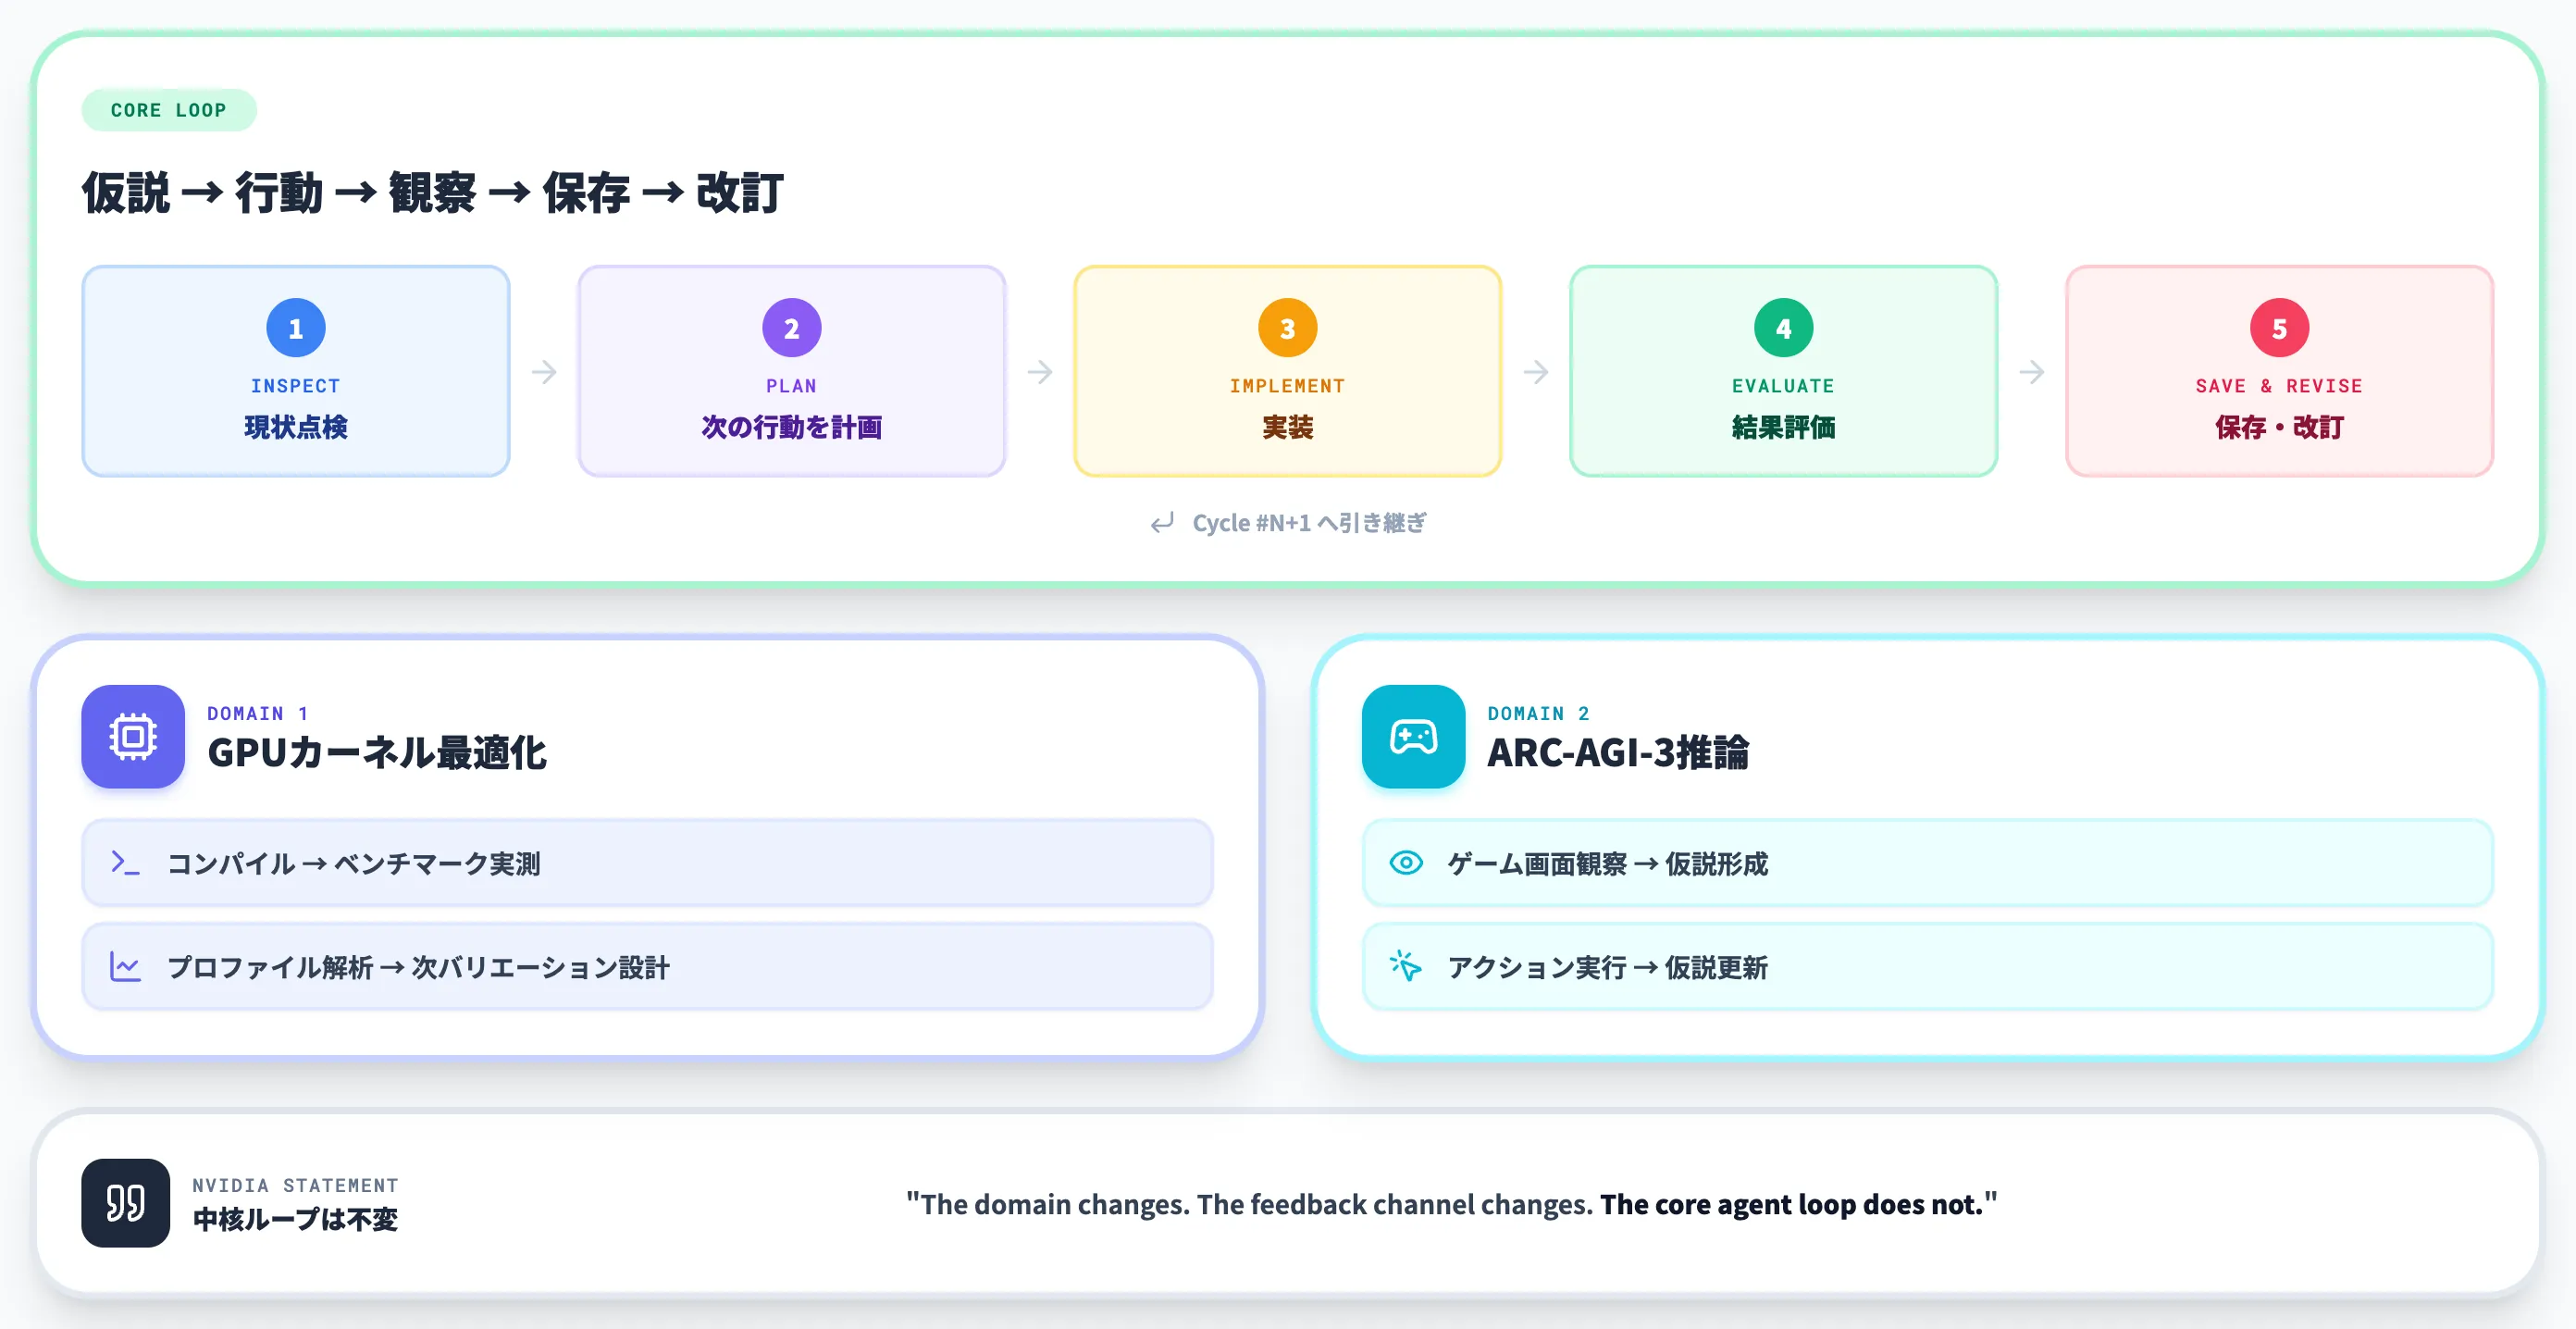
第3の要素が反復ループ(Iterative Loop)そのものです。
AVOは「inspect(現状点検)→ plan(次の行動を計画)→ implement(実装)→ evaluate(結果評価)→ 状態保存 → 問題モデルの改訂」というサイクルを回し続けます。GPUカーネル最適化なら「コンパイル→ベンチマーク実測→プロファイル解析→次のバリエーション設計」、ARC-AGI-3ならば「ゲーム画面観察→仮説形成→アクション実行→フィードバック取得→仮説更新」が具体的なサイクル内容にあたります。
ここで重要なのは、サイクルの型(inspect→plan→implement→evaluate)は共通で、変わるのはツール接続と評価チャネルだけである点です。
NVIDIA自身も「ドメインは変わる。フィードバックのチャネルも変わる。しかしエージェントの中核ループは変わらない」(The domain changes. The feedback channel changes. The core agent loop does not.)と明言しています。
この共通ループを、以下の表で3つの要素の役割と対応づけて整理しました。
| 要素 | 役割 | サイクル内での位置 |
|---|---|---|
| 永続メモリ | 実装・評価・推論履歴の保持 | 各サイクルの「状態保存」「復元」を担う |
| スーパーバイザー | 探索停滞の検知と方向転換 | 「問題モデルの改訂」を横から促す |
| 反復ループ | inspect→plan→implement→evaluate | メインエージェントが回す実行本体 |
この3要素の分業構造が、AVOを「一度きりのLLM呼び出し」ではなく「7日走り続ける自律エージェント」として組み立てる土台になっています。要素が欠けた設計だと、長時間走行の途中で状態が失われる・探索が同じ場所を回る・リソースを浪費するといったリスクが高まりやすい、というのが実装現場で意識されるポイントです。
AVOのGPUカーネル最適化での実績——7日連続稼働で40カーネル、cuDNN・FlashAttention-4超え
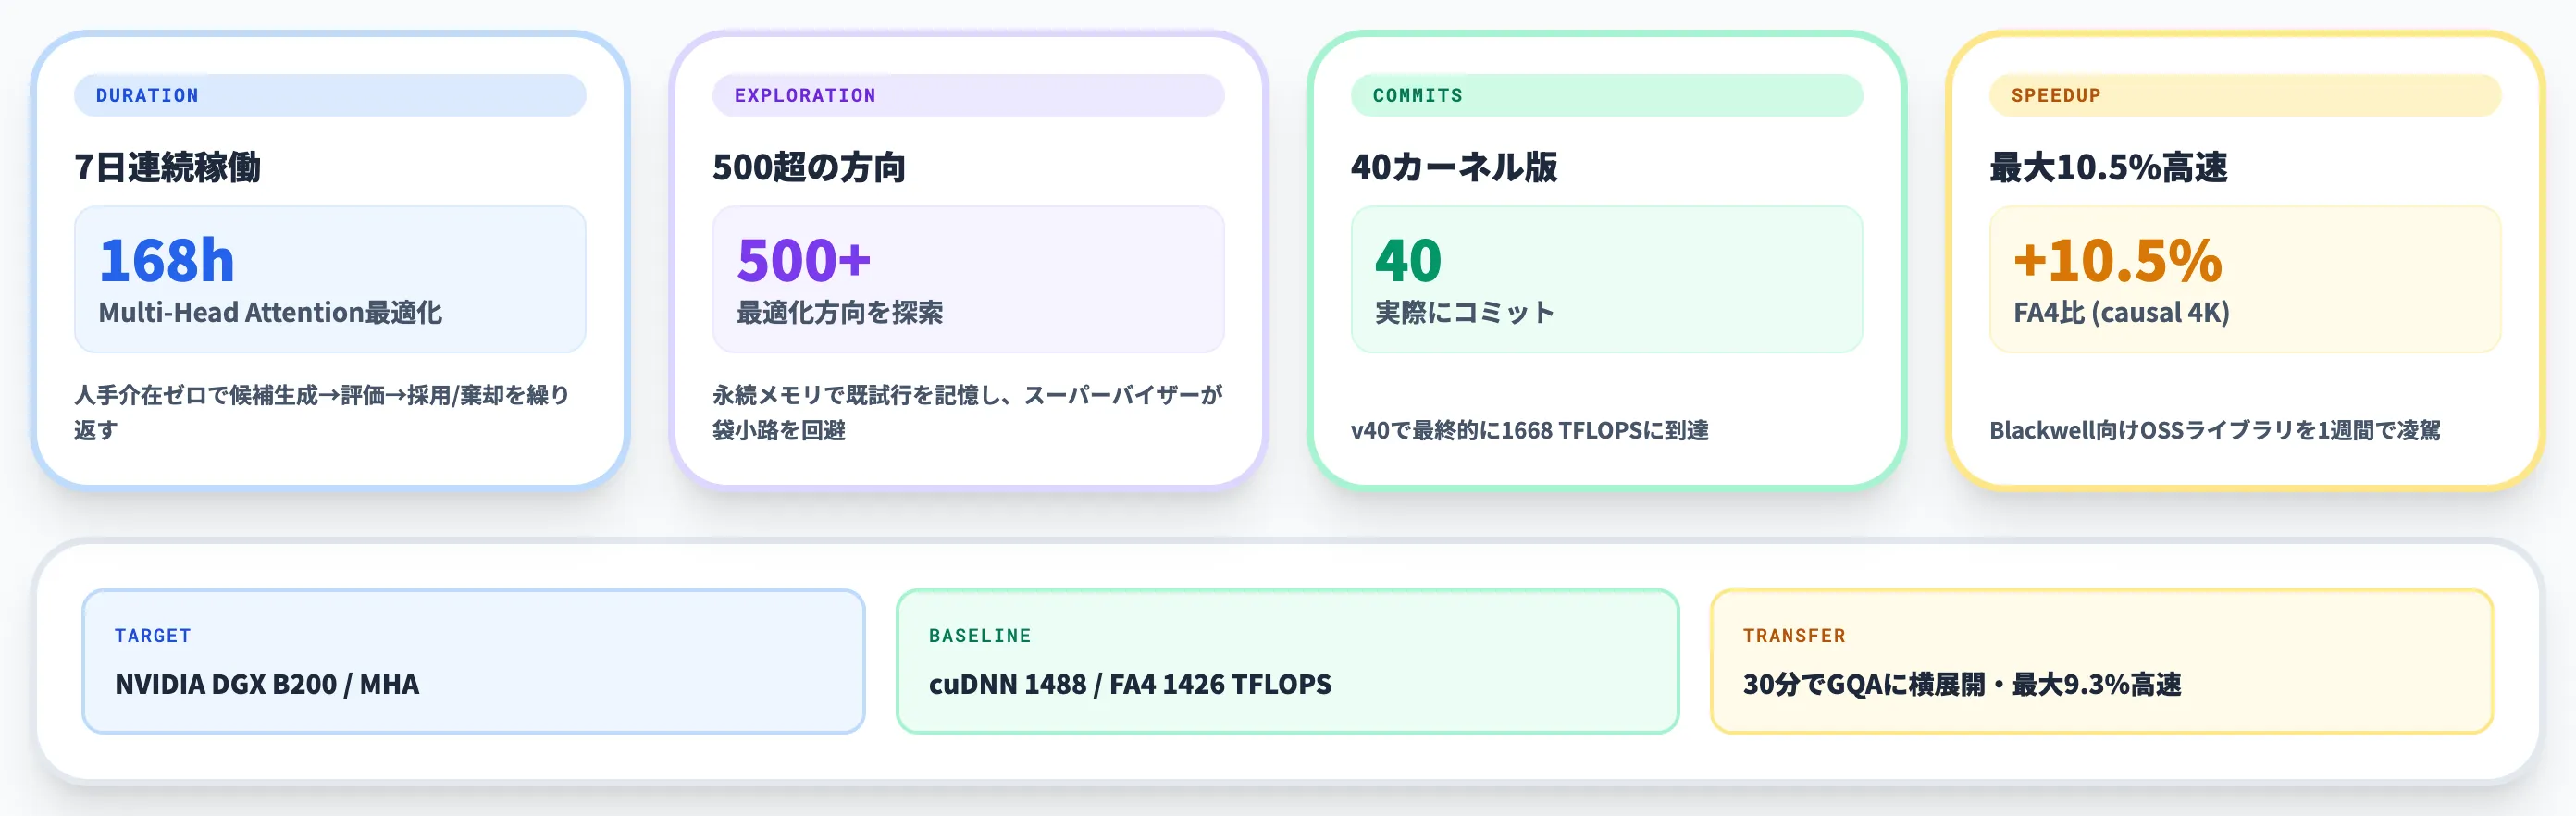
AVOがまず実証されたのは、GPUカーネル最適化という「ミリ秒単位の性能差が積み上がる領域」でした。
NVIDIAによれば、AVOはNVIDIA CUDAスタック上のMulti-Head Attentionカーネルを対象に、7日間連続で自律的に最適化を続けました。ここでは実験設計と数値を分解して見ていきます。
7日連続稼働で500超の最適化方向を探索
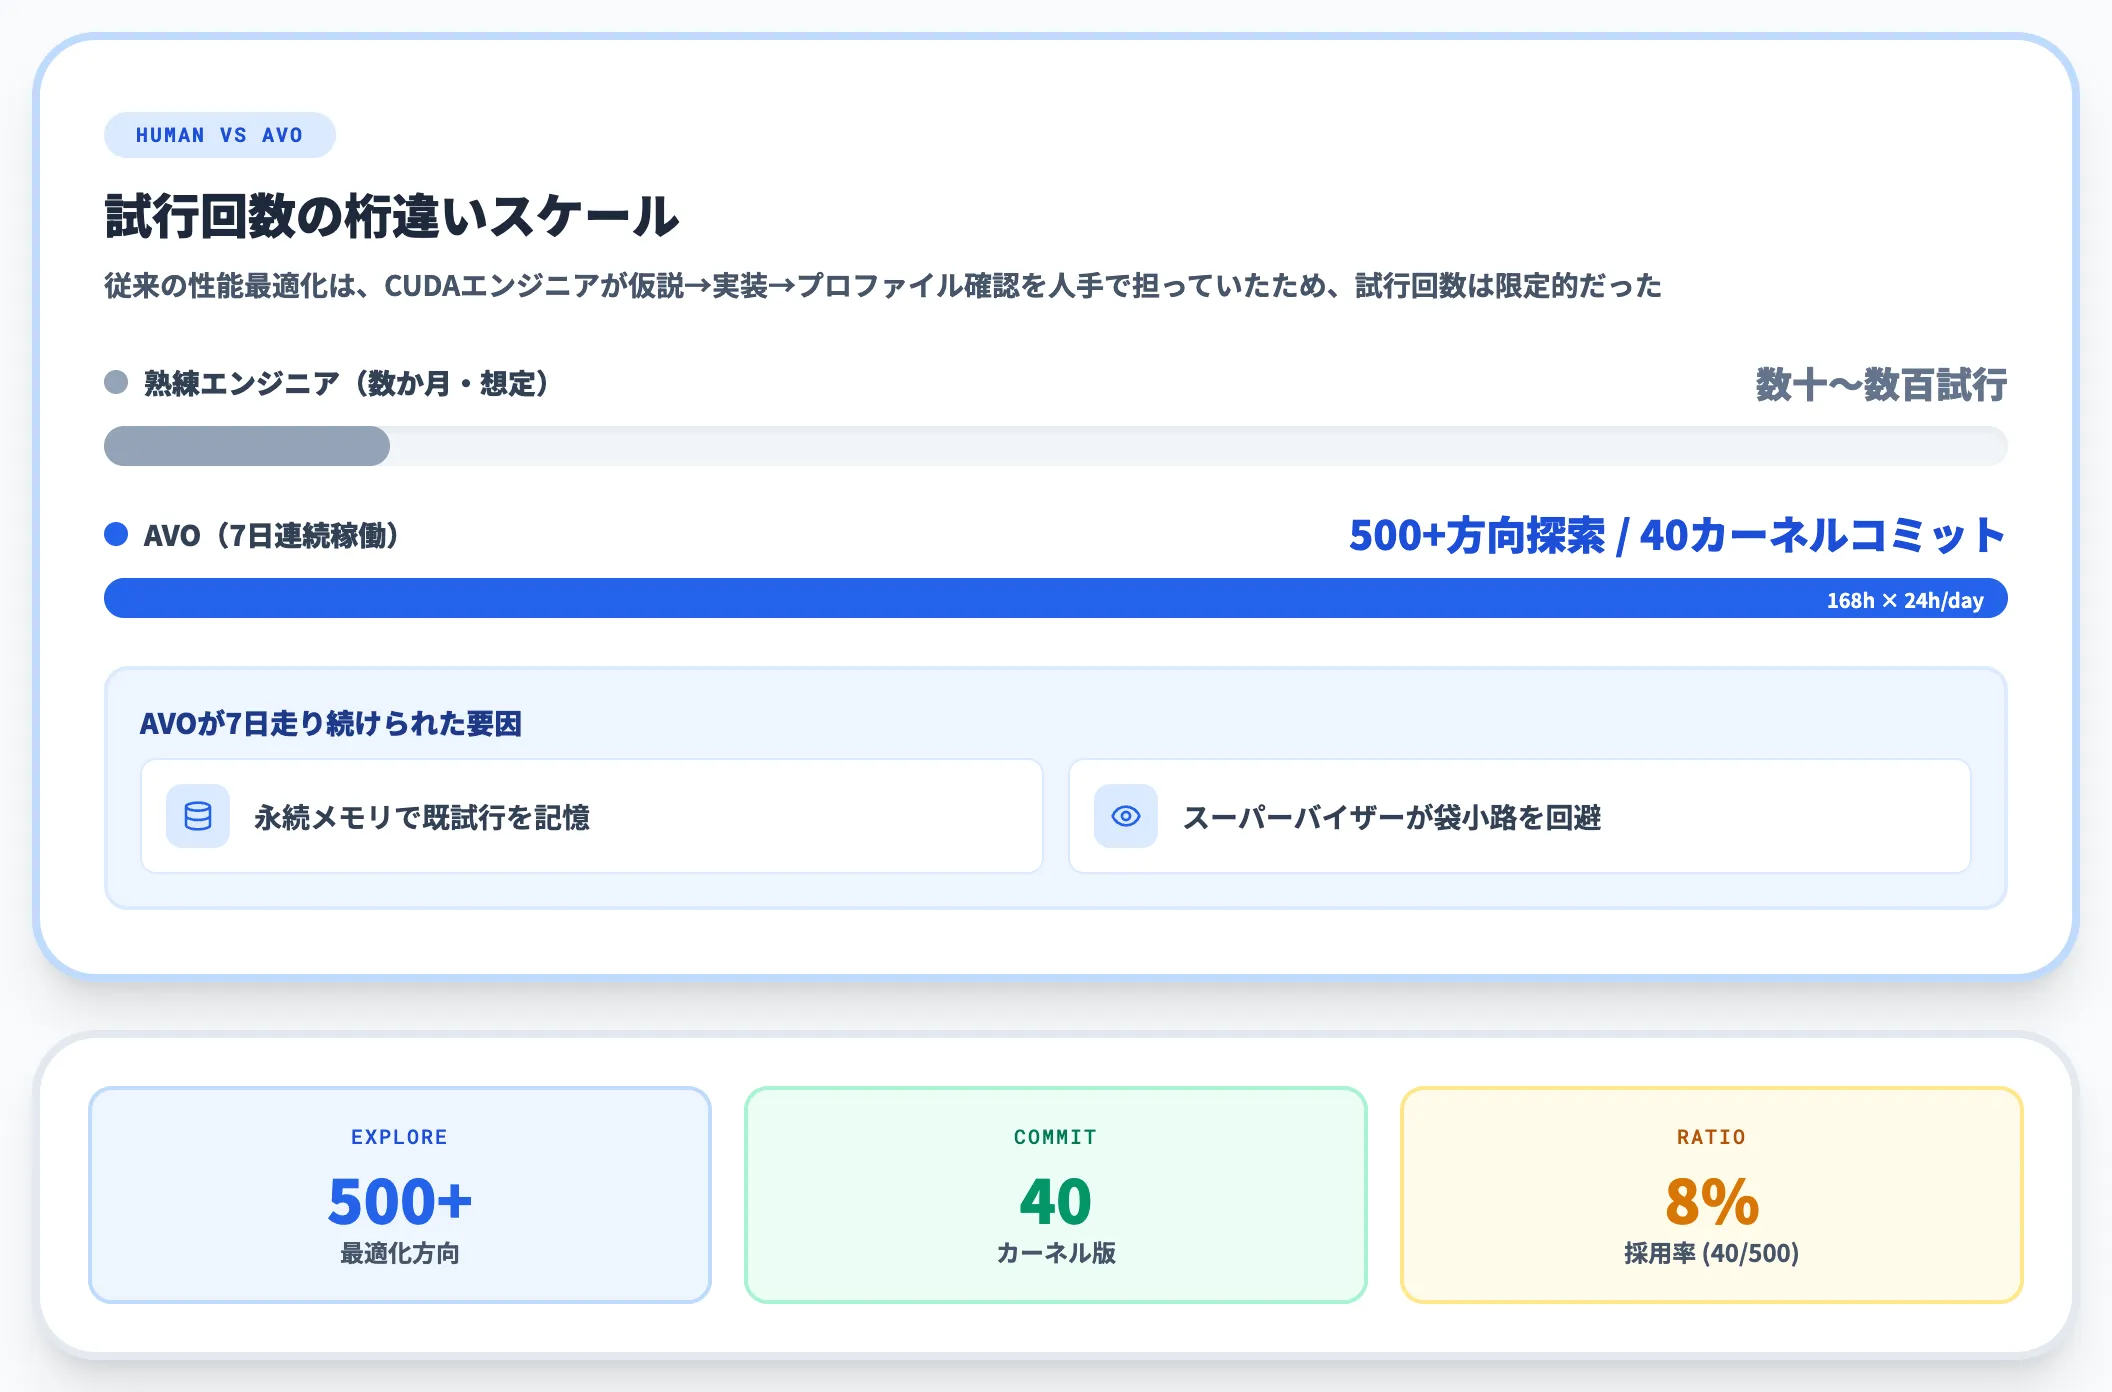
AVOは7日間の連続稼働で、500以上の最適化方向を探索し、40個のカーネルバージョンを実際にコミットしています。
「500方向の探索」「40カーネルのコミット」という数字が示すのは、AVOが候補生成→評価→棄却or採用の判断を人手を挟まずに繰り返せるという点です。従来の性能最適化は、CUDAエンジニアが仮説を立てて実装し、プロファイラで確認して次の一手を考える——この反復を人間が担っていたため、実施できる試行回数はどうしても限られていました。
AVOが7日間走り続けられた背景には、前セクションで見た永続メモリ・スーパーバイザー・反復ループの3要素があります。特に「500方向の探索」を意味あるものにするうえでは、既に試した方向を記憶しておく永続メモリと、同じ袋小路を回避するスーパーバイザーが重要な役割を果たしていました。
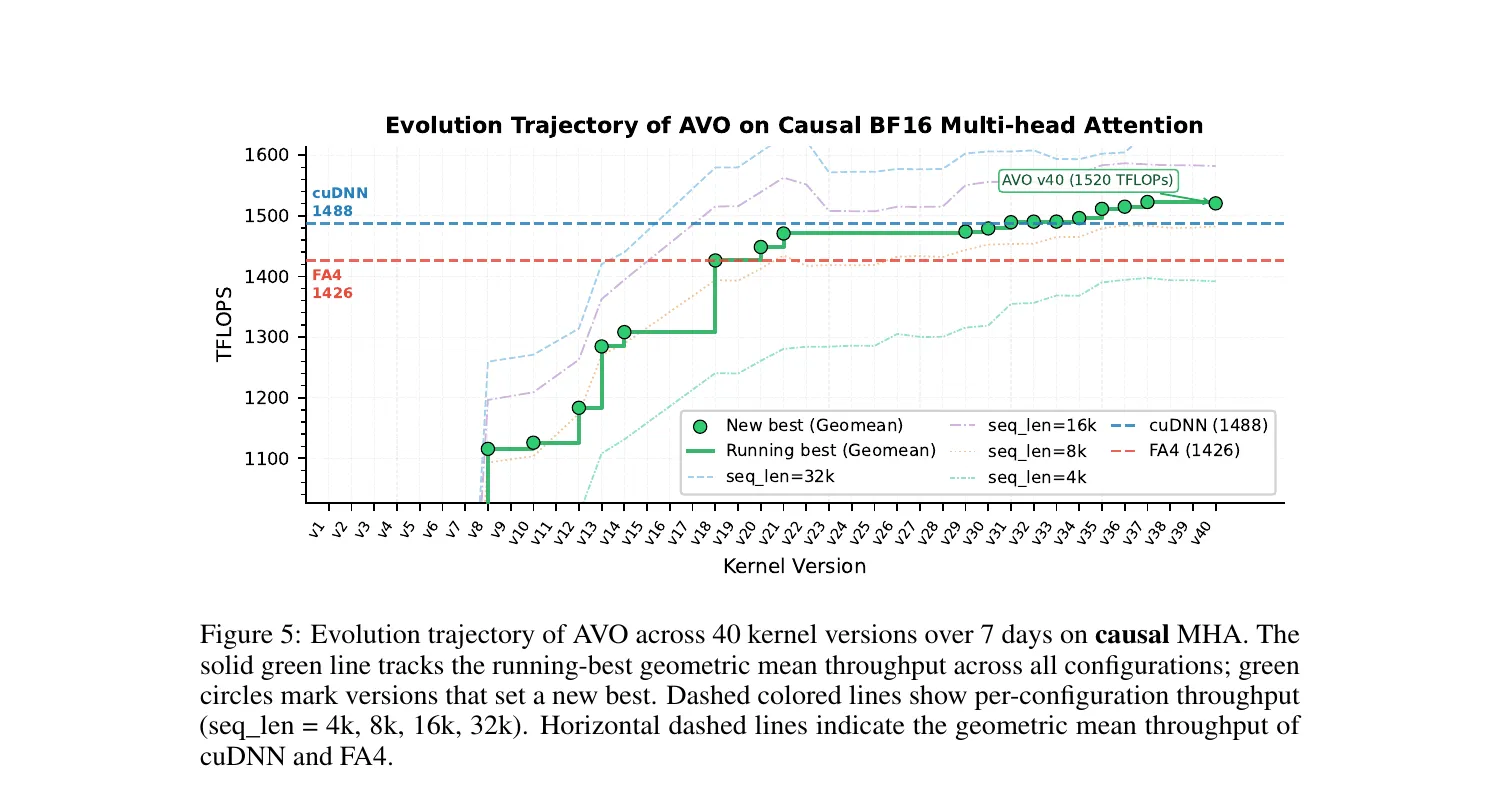
AVOが7日間で生成した40カーネル版のTFLOPS推移。破線がcuDNN(1488)とFlashAttention-4(1426)の基準線(出典:AVO論文 arXiv:2603.24517)
グラフの緑実線が「Running best」(そのバージョン時点での最良スコア)で、緑丸が新記録を出したバージョンを示します。v1〜v11はまだ立ち上がりで基準線に届いていない状態、v14〜v18でFA4(1426 TFLOPS)ラインを突破し、v32付近でcuDNN(1488 TFLOPS)ラインも越え、最終的にv40で1520 TFLOPSに到達しました。
図の横軸はカーネル版数で、各版がいつ生成されたかの経過日との対応は論文中に示されていない点は補足しておきます。
FlashAttention-4・cuDNNとの性能比較
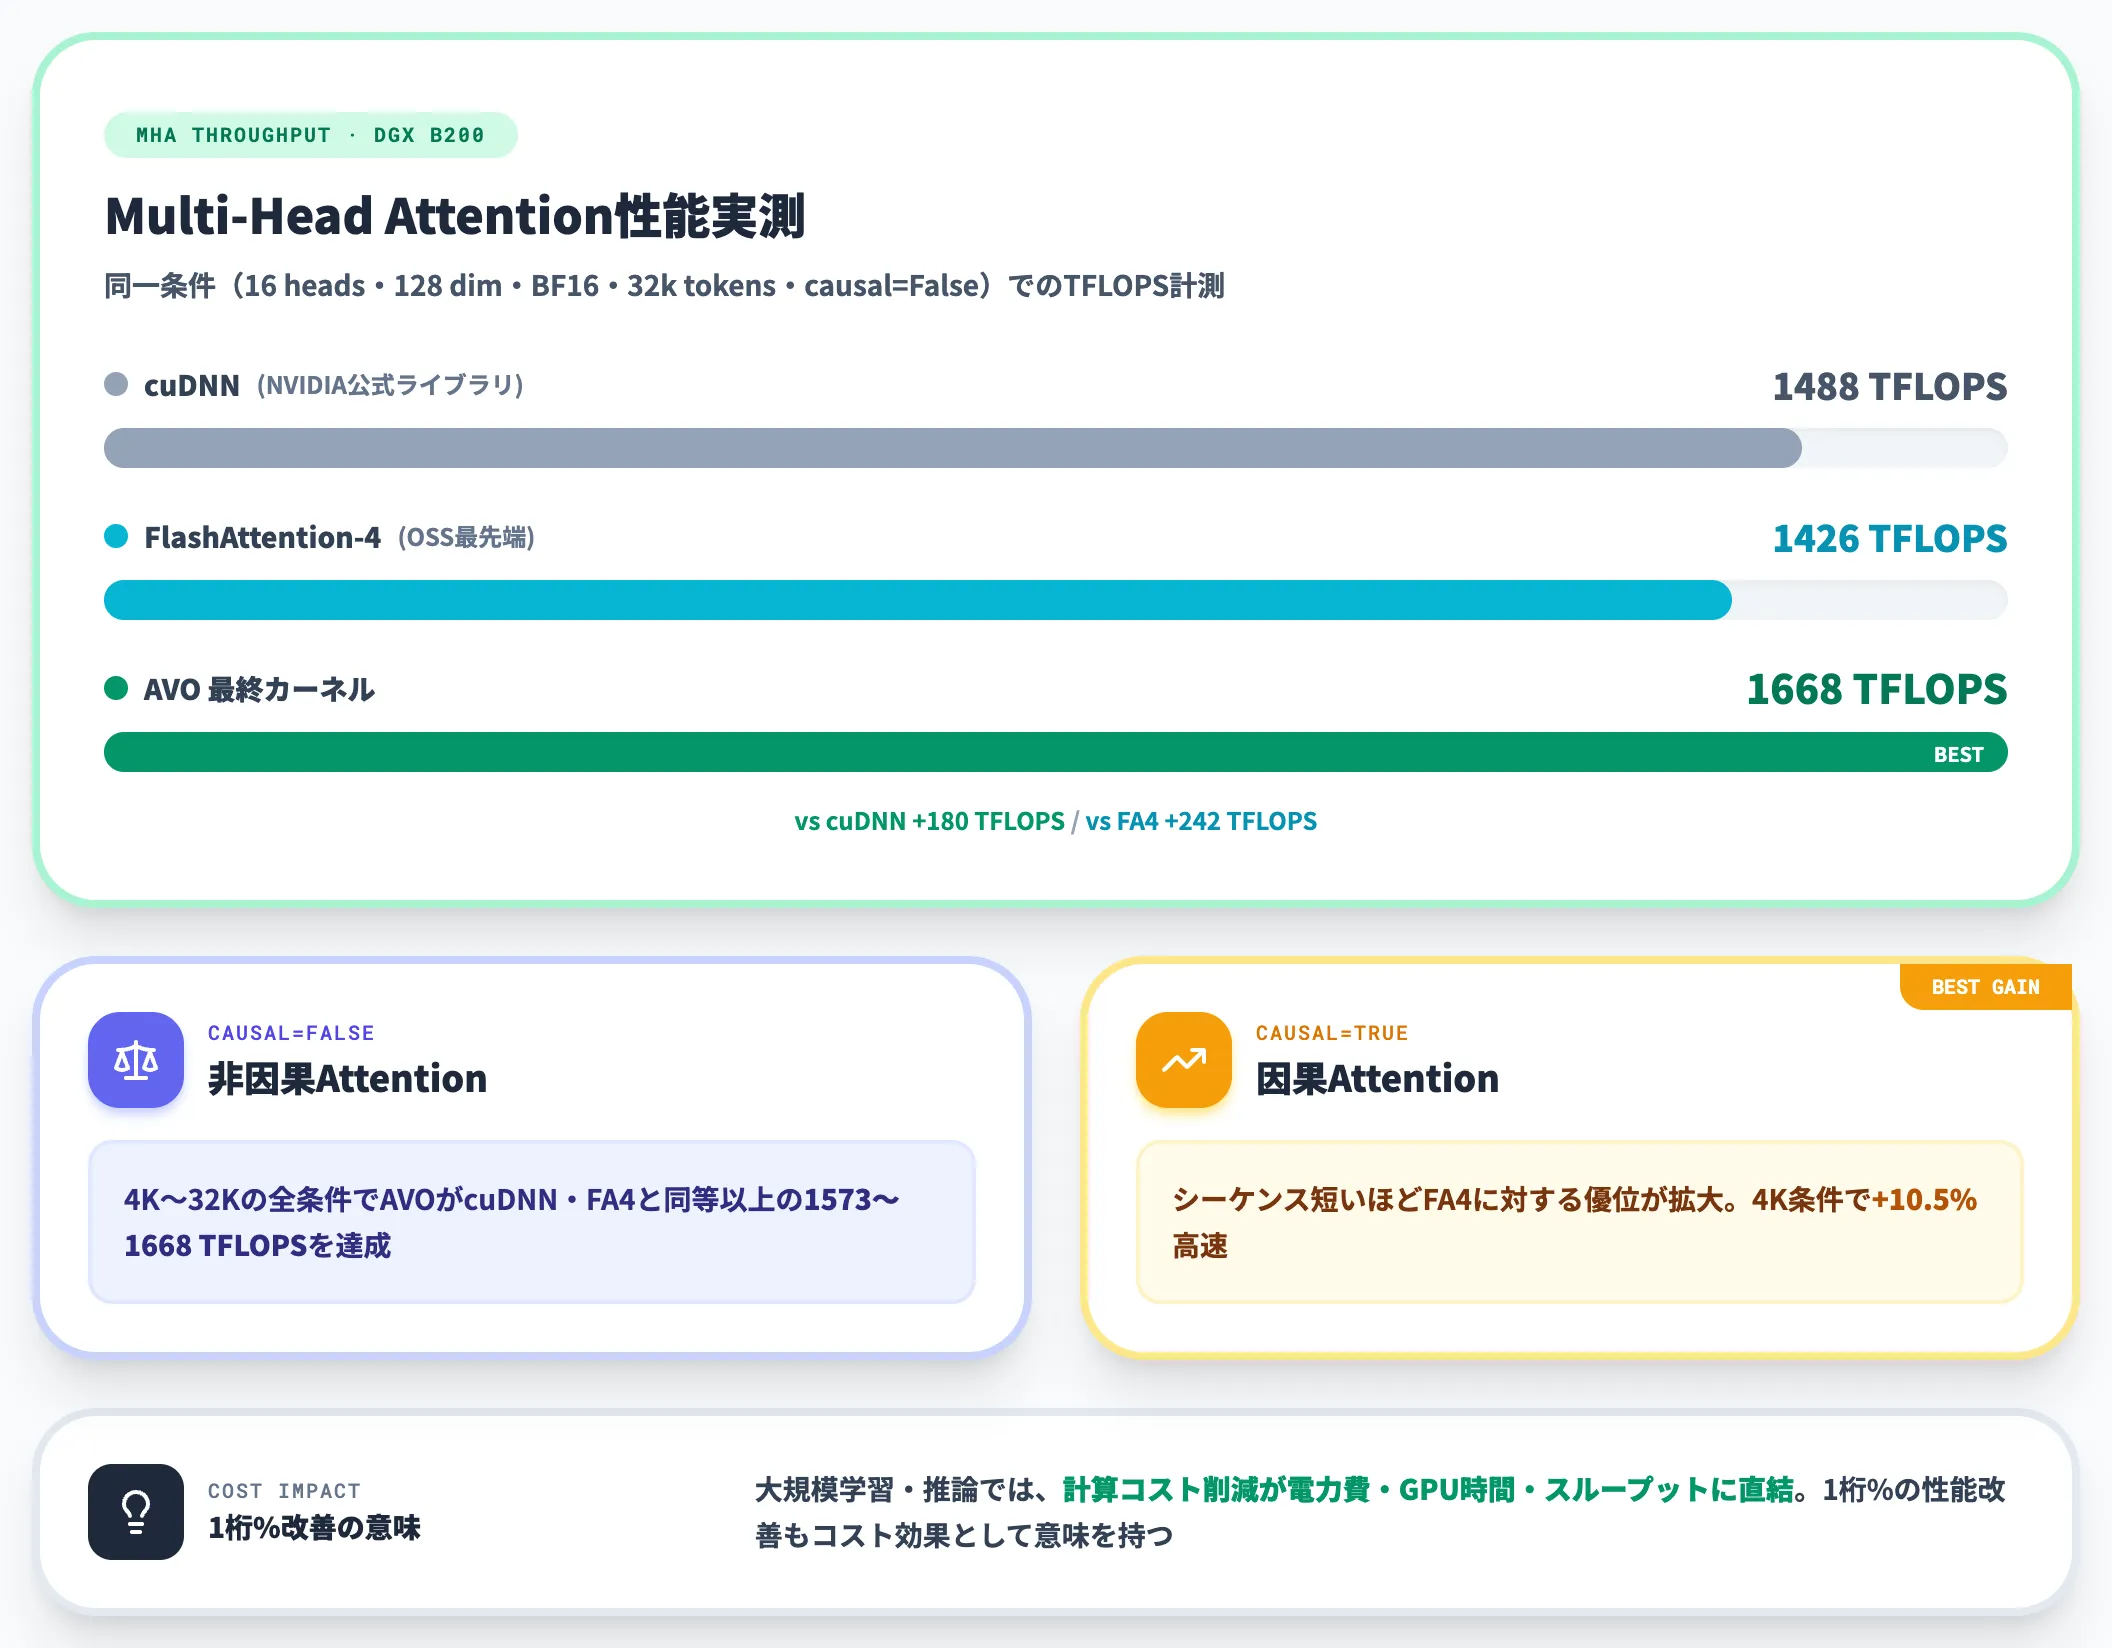
AVOが生成した最終的なMulti-Head Attentionカーネルは、NVIDIA DGX B200システム上で実測1668 TFLOPSに到達しました。
同一条件(16 heads・128 dim・BF16・32k tokens・causal=False)でのcuDNN・FlashAttention-4の実測値は次項のグラフに整理しており、AVOはこれらのベースラインを超えた形になっています。
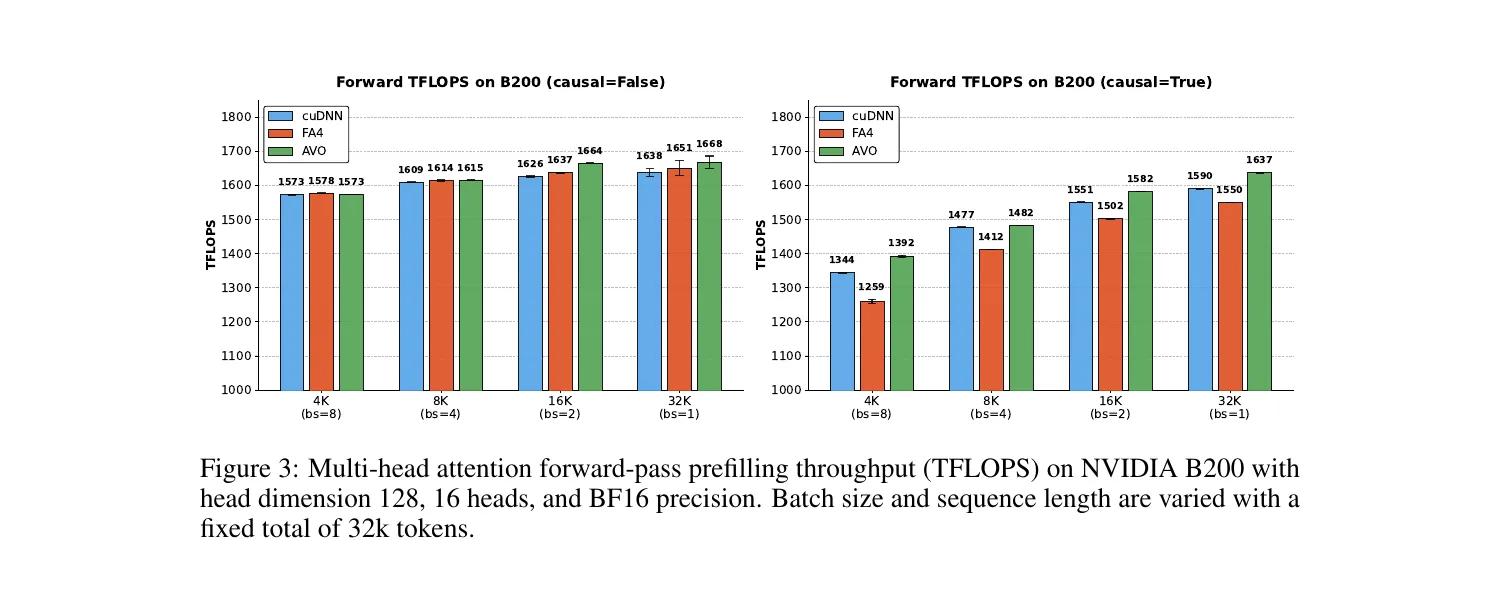
NVIDIA B200上でのMulti-Head Attention forward-pass throughput。左が causal=False、右が causal=True。各グループがcuDNN・FA4・AVOの順(出典:AVO論文 arXiv:2603.24517)
グラフを横軸で見ると、シーケンス長4K・8K・16K・32Kの4条件で計測しています。causal=False側(左)ではAVOが全条件でcuDNN・FA4と同等以上の1573〜1668 TFLOPSを叩き、causal=True側(右)ではAVOが1392・1482・1582・1637 TFLOPSと、FA4を最大10.5%(4K条件)上回りました。特にcausal Attention側でシーケンス長が短いほどFA4に対する優位が拡大する傾向が読み取れます。
以下の表で、AVOが達成した性能差を主要ベースラインと比較しました。
| 比較対象 | 対象カーネル | AVOの優位性 |
|---|---|---|
| FlashAttention-4 | Causal Multi-Head Attention | 最大10.5%高速 |
| cuDNN | Multi-Head Attention全般 | 最大3.5%高速 |
| AVO最終カーネル実測 | Multi-Head Attention | 1668 TFLOPS(DGX B200) |
ここで注目すべきは、cuDNNがNVIDIA製の業界標準ライブラリである一方、FlashAttention-4はBlackwell向けに最適化された最先端のオープンソース実装(専門家設計)であるという点です。
この2系統のベースラインを7日連続の自律最適化だけで最大10.5%上回れたという事実は、「熟練エンジニアが数か月かける最適化を、AIエージェントが1週間で追いつき、追い越し得る」という段階に入りつつあることを示唆しています。
わずか3%〜10%の性能改善に見えるかもしれませんが、大規模学習・推論では計算コスト削減がそのまま電力費・GPU時間・スループット改善に跳ね返るため、「1桁パーセントの最適化」であってもコスト効果として意味を持ちうる領域です。
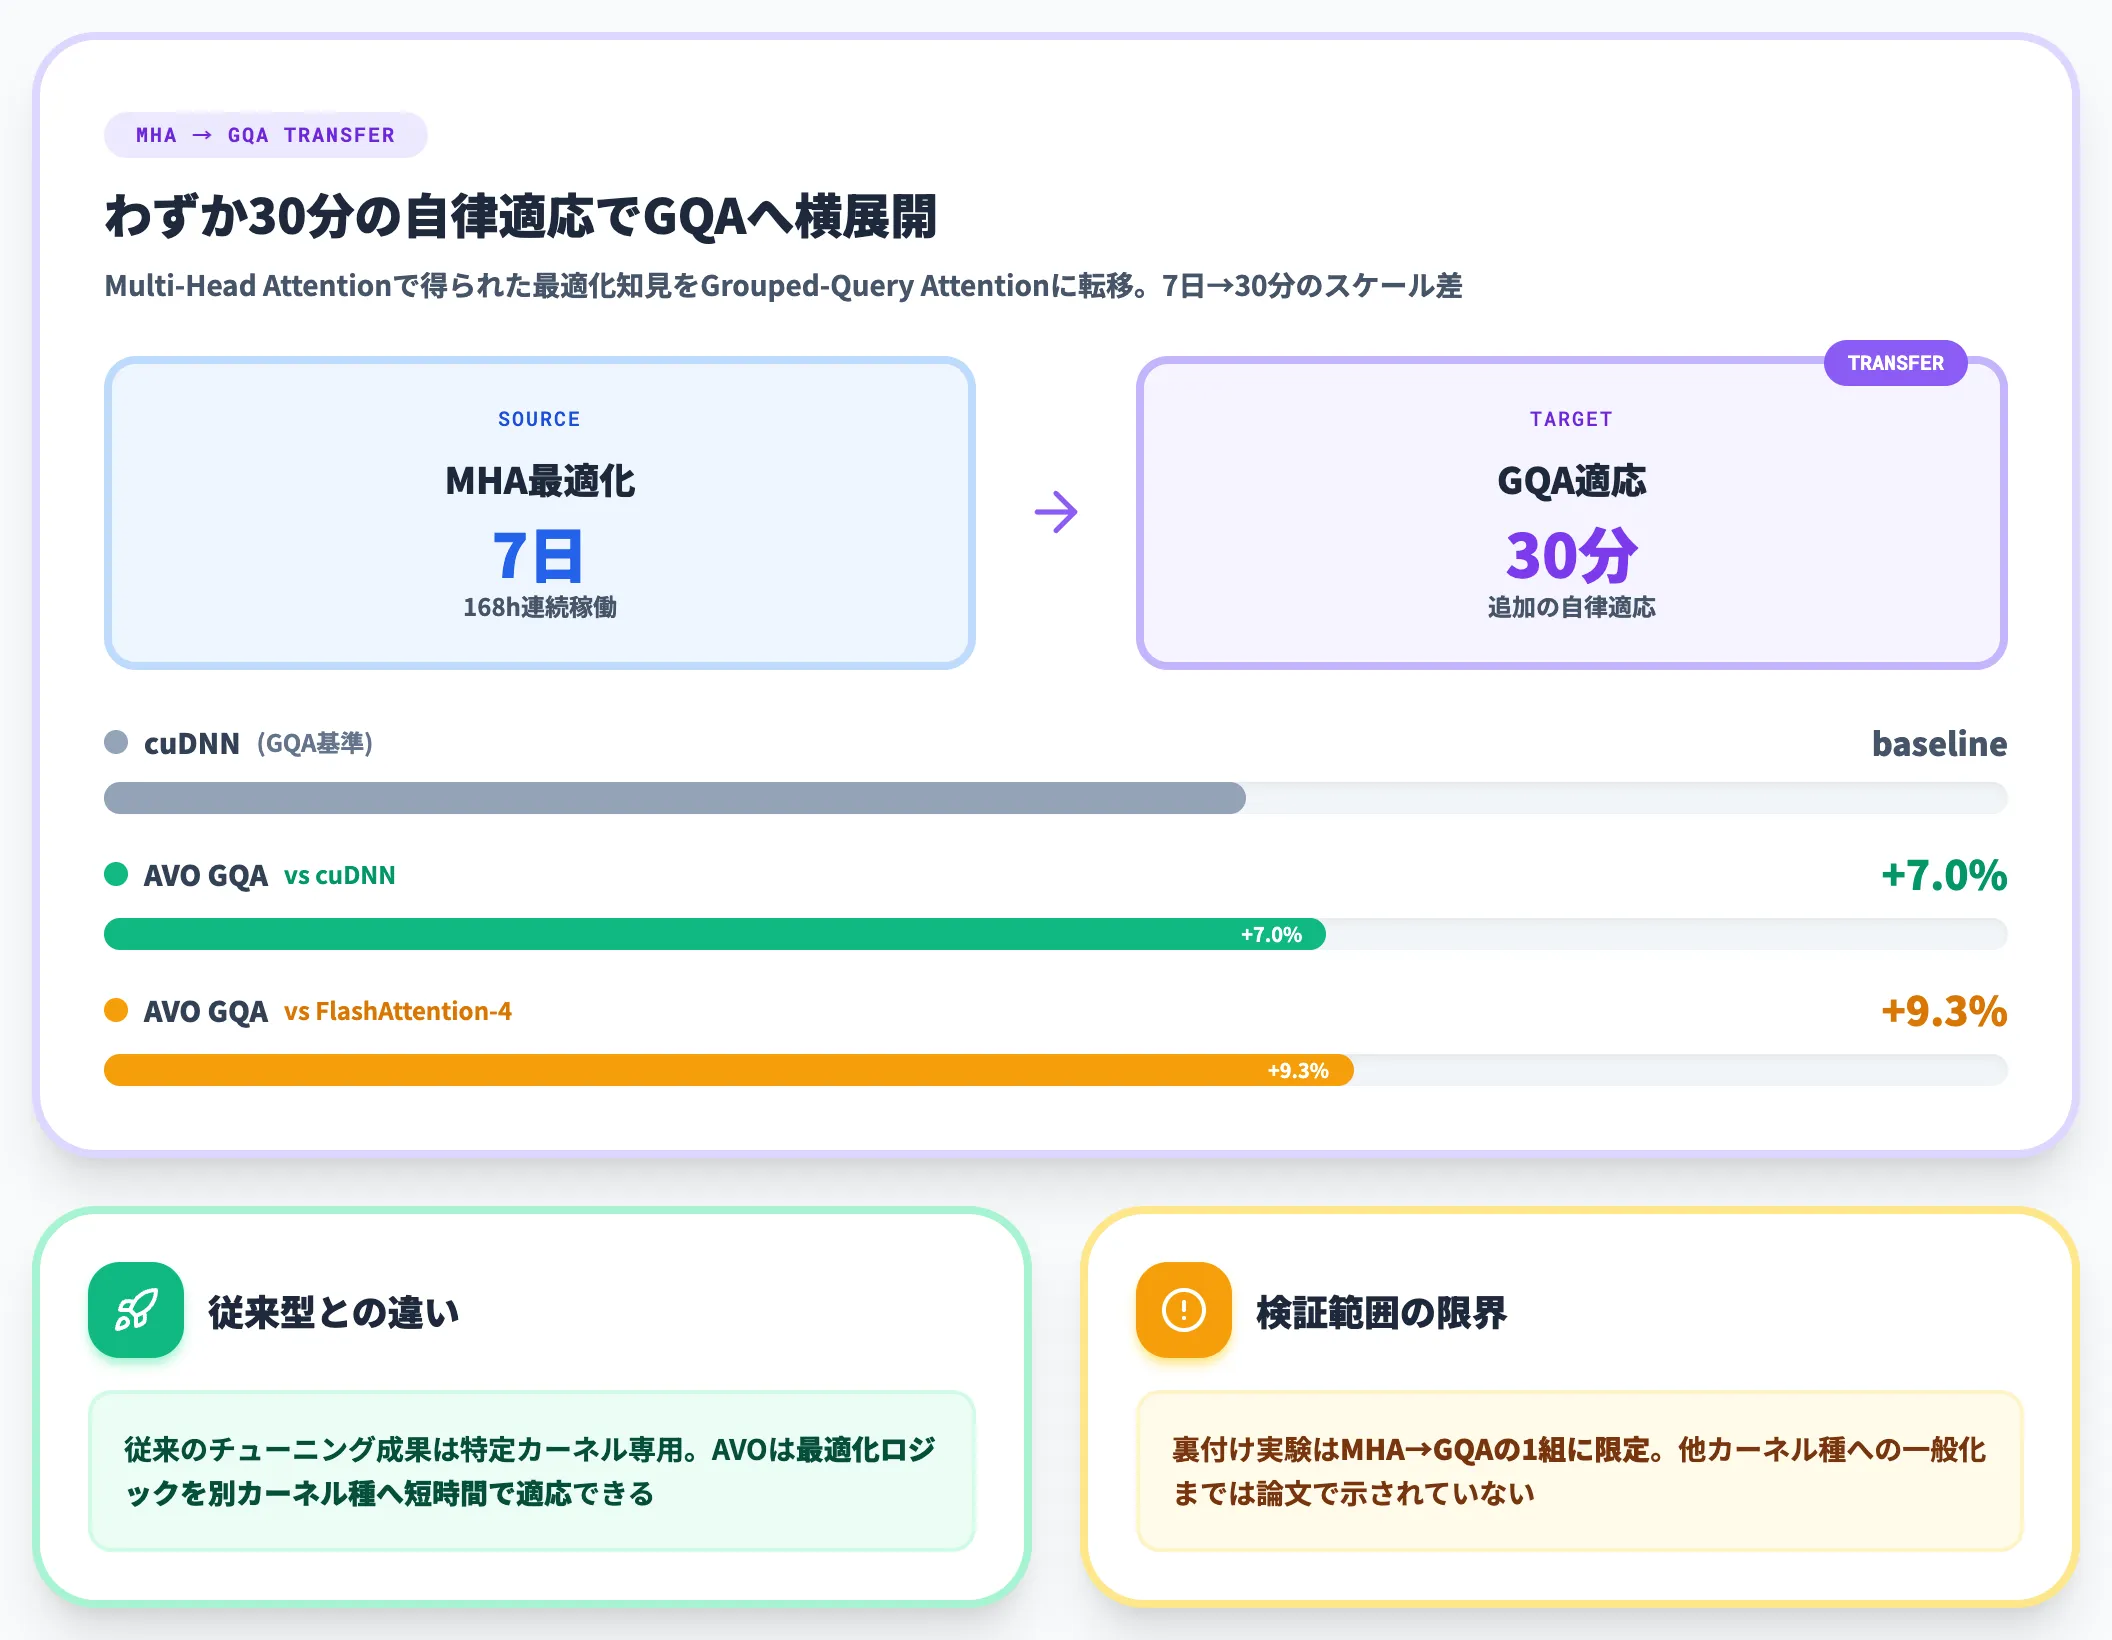
Grouped-Query Attentionへの30分での高速転移
AVOのもう1つの実務的な強みが、発見した最適化を関連タスクに素早く横展開できる点です。
AVO論文によれば、Multi-Head Attentionで得られた最適化知見は、追加でわずか30分の自律適応でGrouped-Query Attention(GQA)に転移し、cuDNN比で最大7.0%、FlashAttention-4比で最大9.3%の性能ゲインを実現しました。
これは、「一度作った最適化ロジックが特定カーネル専用で終わる」従来のチューニング成果とは異なる示唆を含んでいます。進化させたカーネルを別カーネル種(今回はGQA)へ短時間で適応できたという事実が、AVOのアプローチが関連タスクへ横展開できる可能性を示したと読み解けます。
裏付けの実験はMHA→GQAの1組に限られるため、他カーネル種への一般化までは論文で示されていない点は補足しておきます。
AVOのARC-AGI-3ベンチマーク公開セット完全制覇——Claude Opus 5と組み合わせて100.00 RHAEを報告
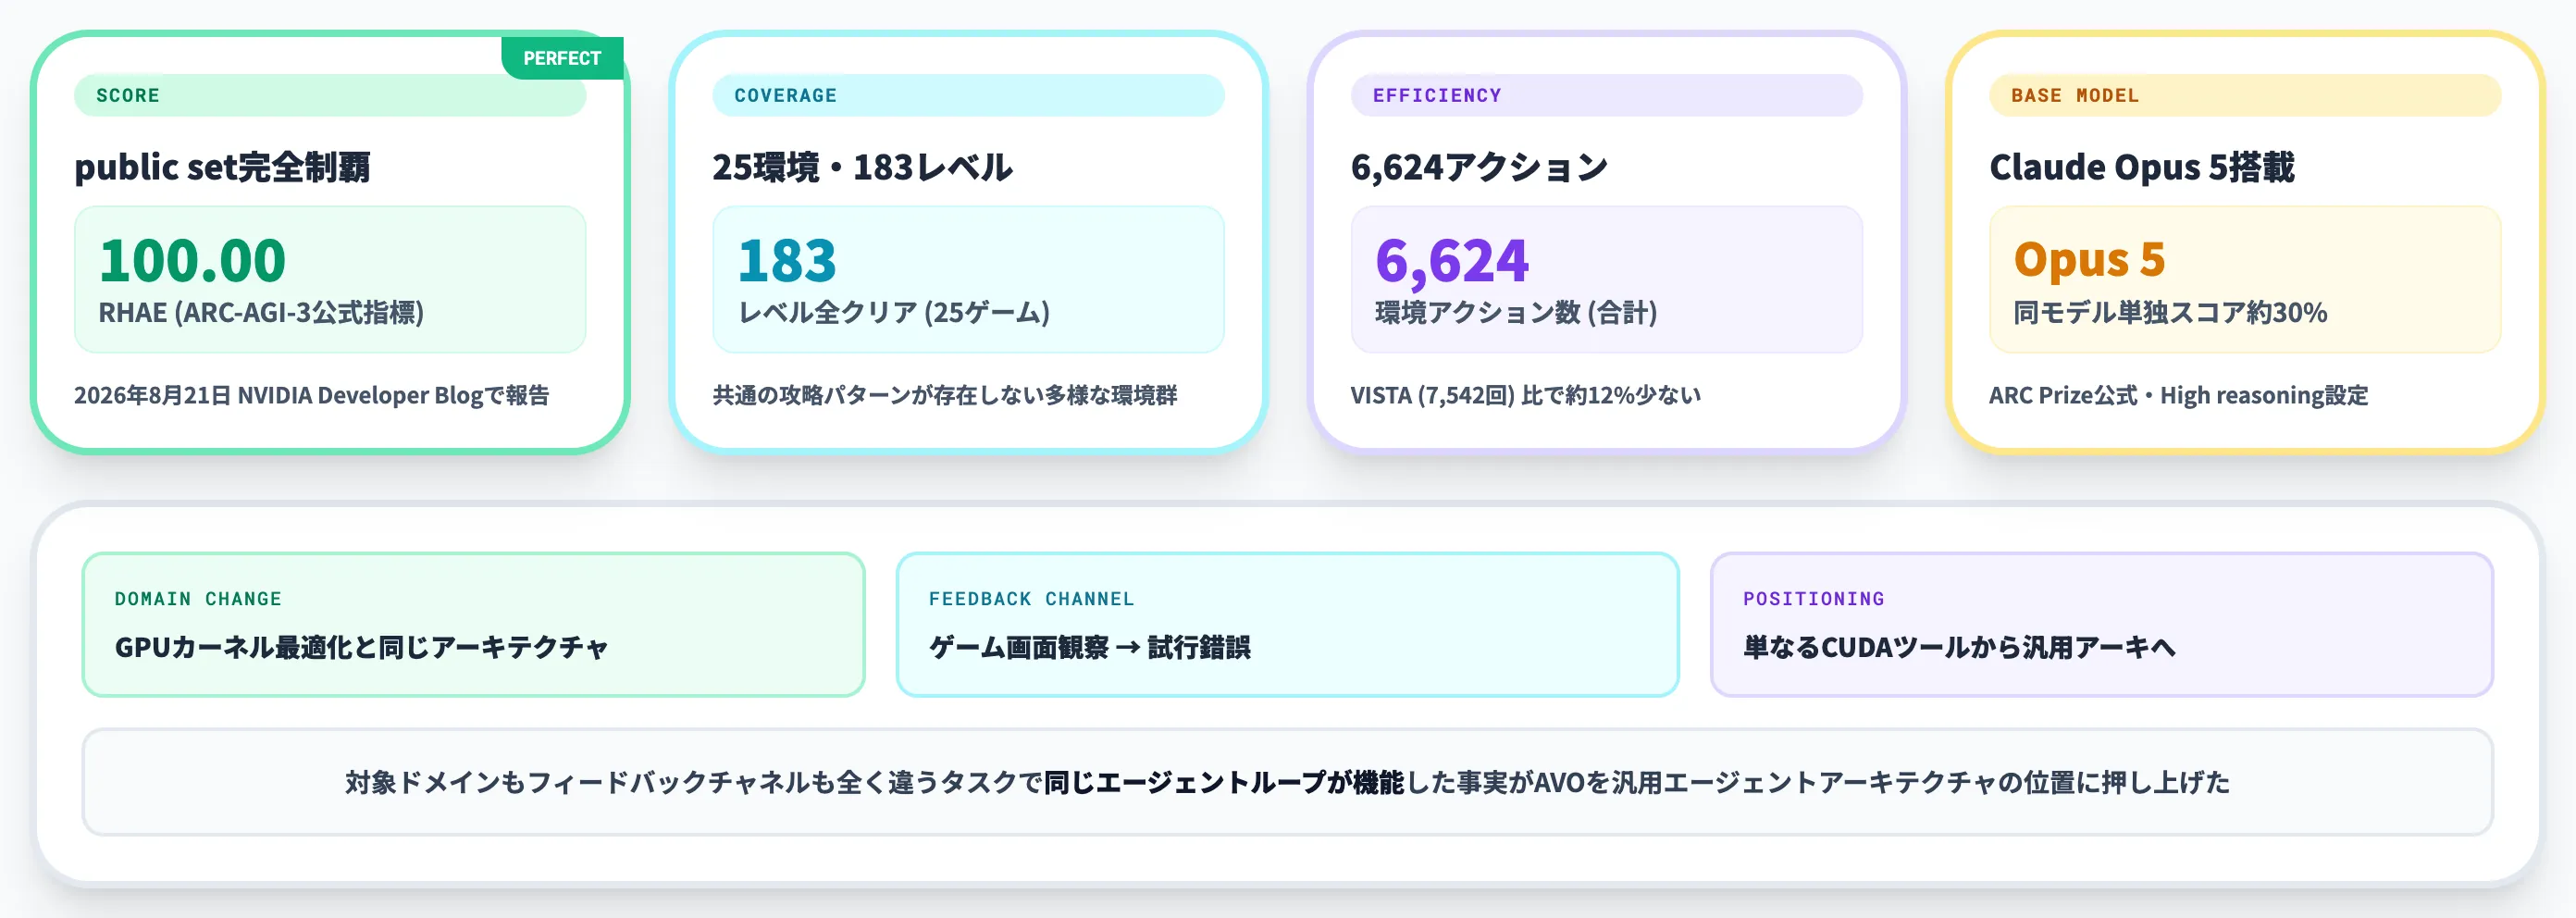
AVOが業界の注目を一気に集めたのは、GPUカーネル最適化と同じアーキテクチャでARC-AGI-3ベンチマークに挑み、100%スコアを報告した2026年8月21日の発表でした。
対象ドメインもフィードバックチャネルも全く違うタスクで同じエージェントループが機能したという事実が、AVOを「単なるCUDA最適化ツール」から「汎用エージェントアーキテクチャ」の位置に押し上げています。
ARC-AGI-3ベンチマークの性質と難易度
まず前提として、ARC-AGI-3が何を測るベンチマークかを整理しておきます。
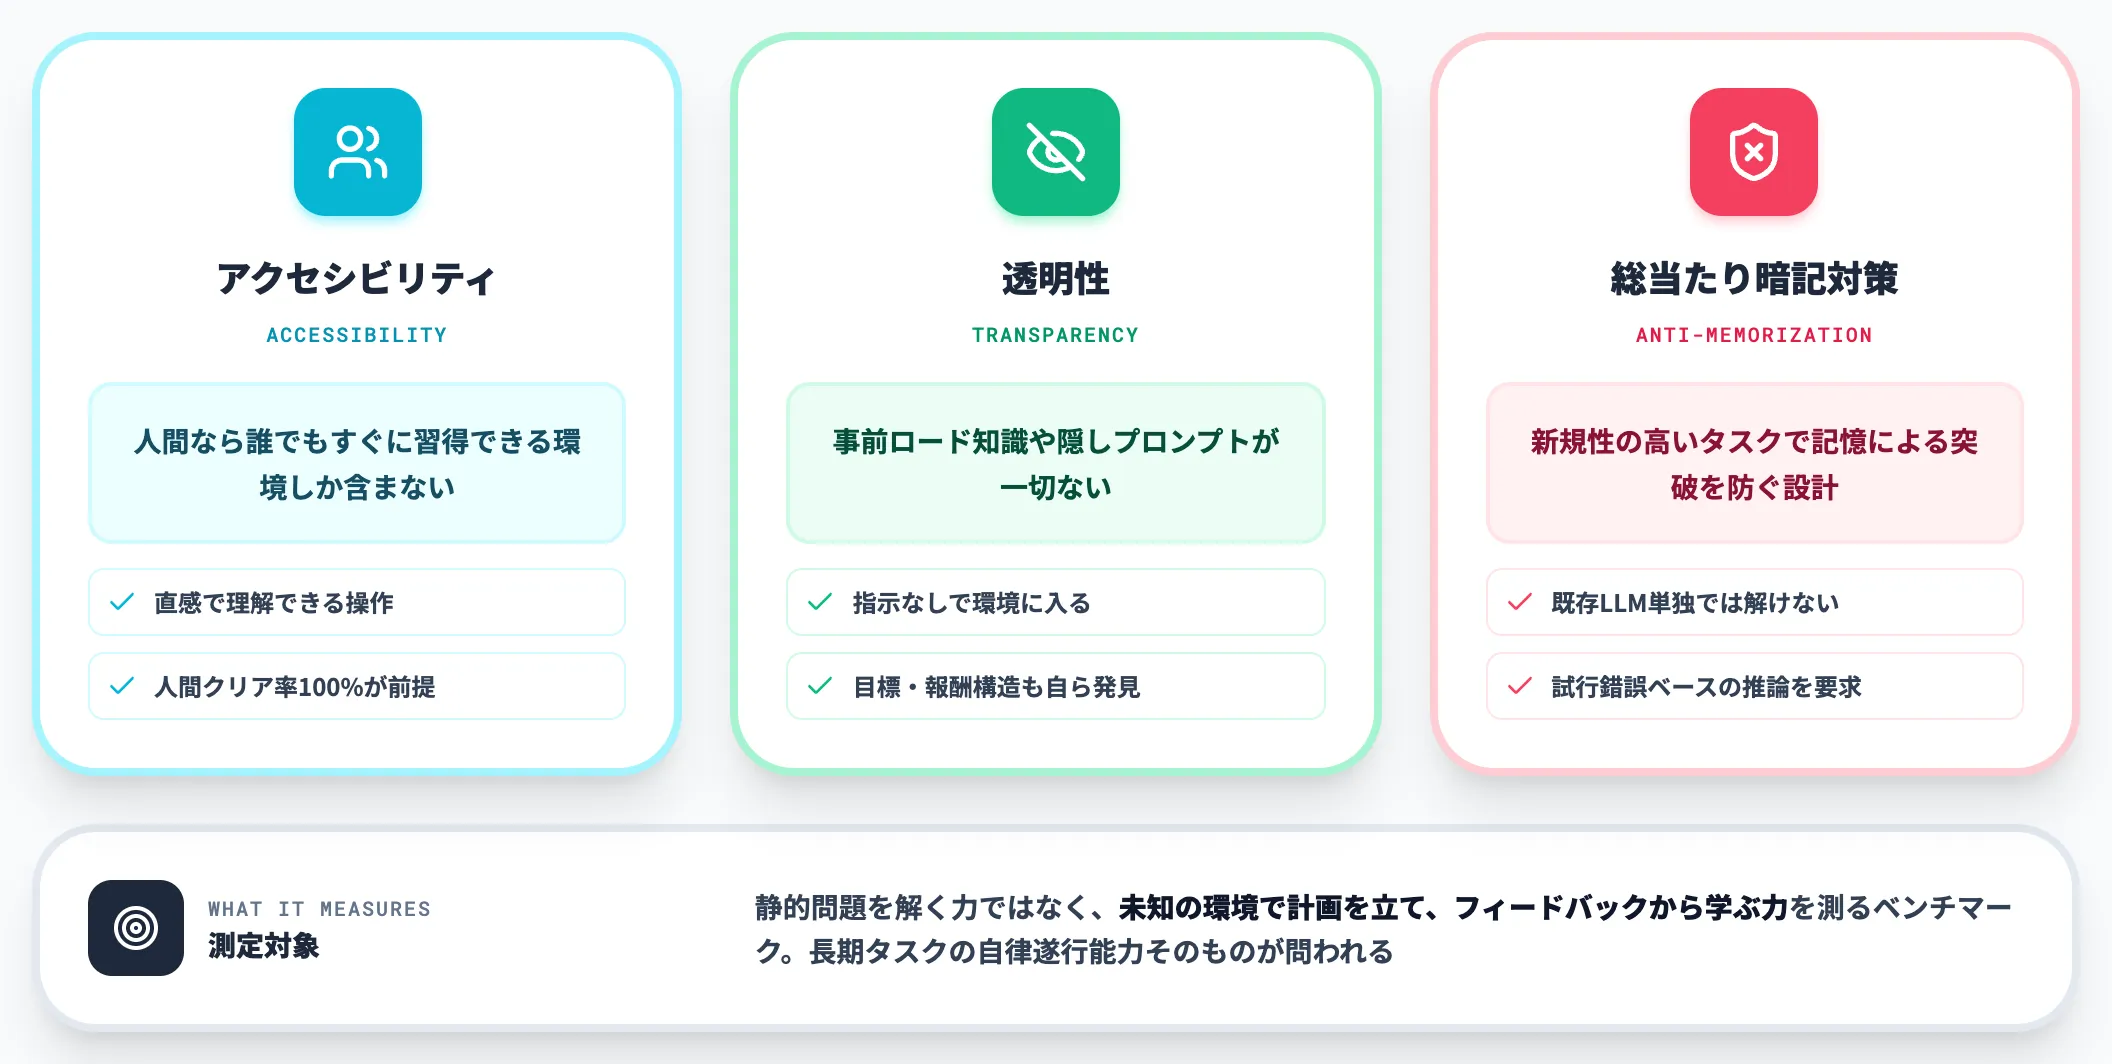
ARC Prize Foundationの公式説明によれば、ARC-AGI-3はインタラクティブな推論ベンチマークとして設計されており、モデルは指示なしに未知のゲーム環境に入り、試行錯誤を通じて自ら操作方法・目標・報酬構造を発見しなければなりません。
人間なら100%解ける環境である一方、既存のフロンティアLLMは単独では解けないという性質を持ちます。
特徴は次の3点にまとまります。
-
アクセシビリティ
人間なら誰でもすぐに習得できる環境しか含まれない
-
透明性
事前ロード知識・隠しプロンプトなし
-
総当たり暗記対策
新規性の高いタスクで、記憶による突破を防ぐ設計
この性質から、ARC-AGI-3は「静的な問題を解く力」ではなく、「未知の環境で計画を立て、フィードバックから学ぶ力」を測るベンチマークとして扱われています。
長期タスクの自律遂行能力そのものが問われるという点で、AVOのようなエージェントハーネスの評価に本質的にマッチする土俵です。
ARC-AGI-3公開セットは25のゲーム環境・合計183レベルで構成されており、各ゲームには6〜10レベル、レベルごとに難易度も跳ね上がる設計です。25ゲームはそれぞれ全く異なるルール・アイテム配置・目標構造を持ち、共通の攻略パターンは存在しません。
AVOはこの多様な環境群を、事前知識ゼロから試行錯誤だけで全クリアしています。
AVOが達成した100%スコアと6,624アクションの効率性
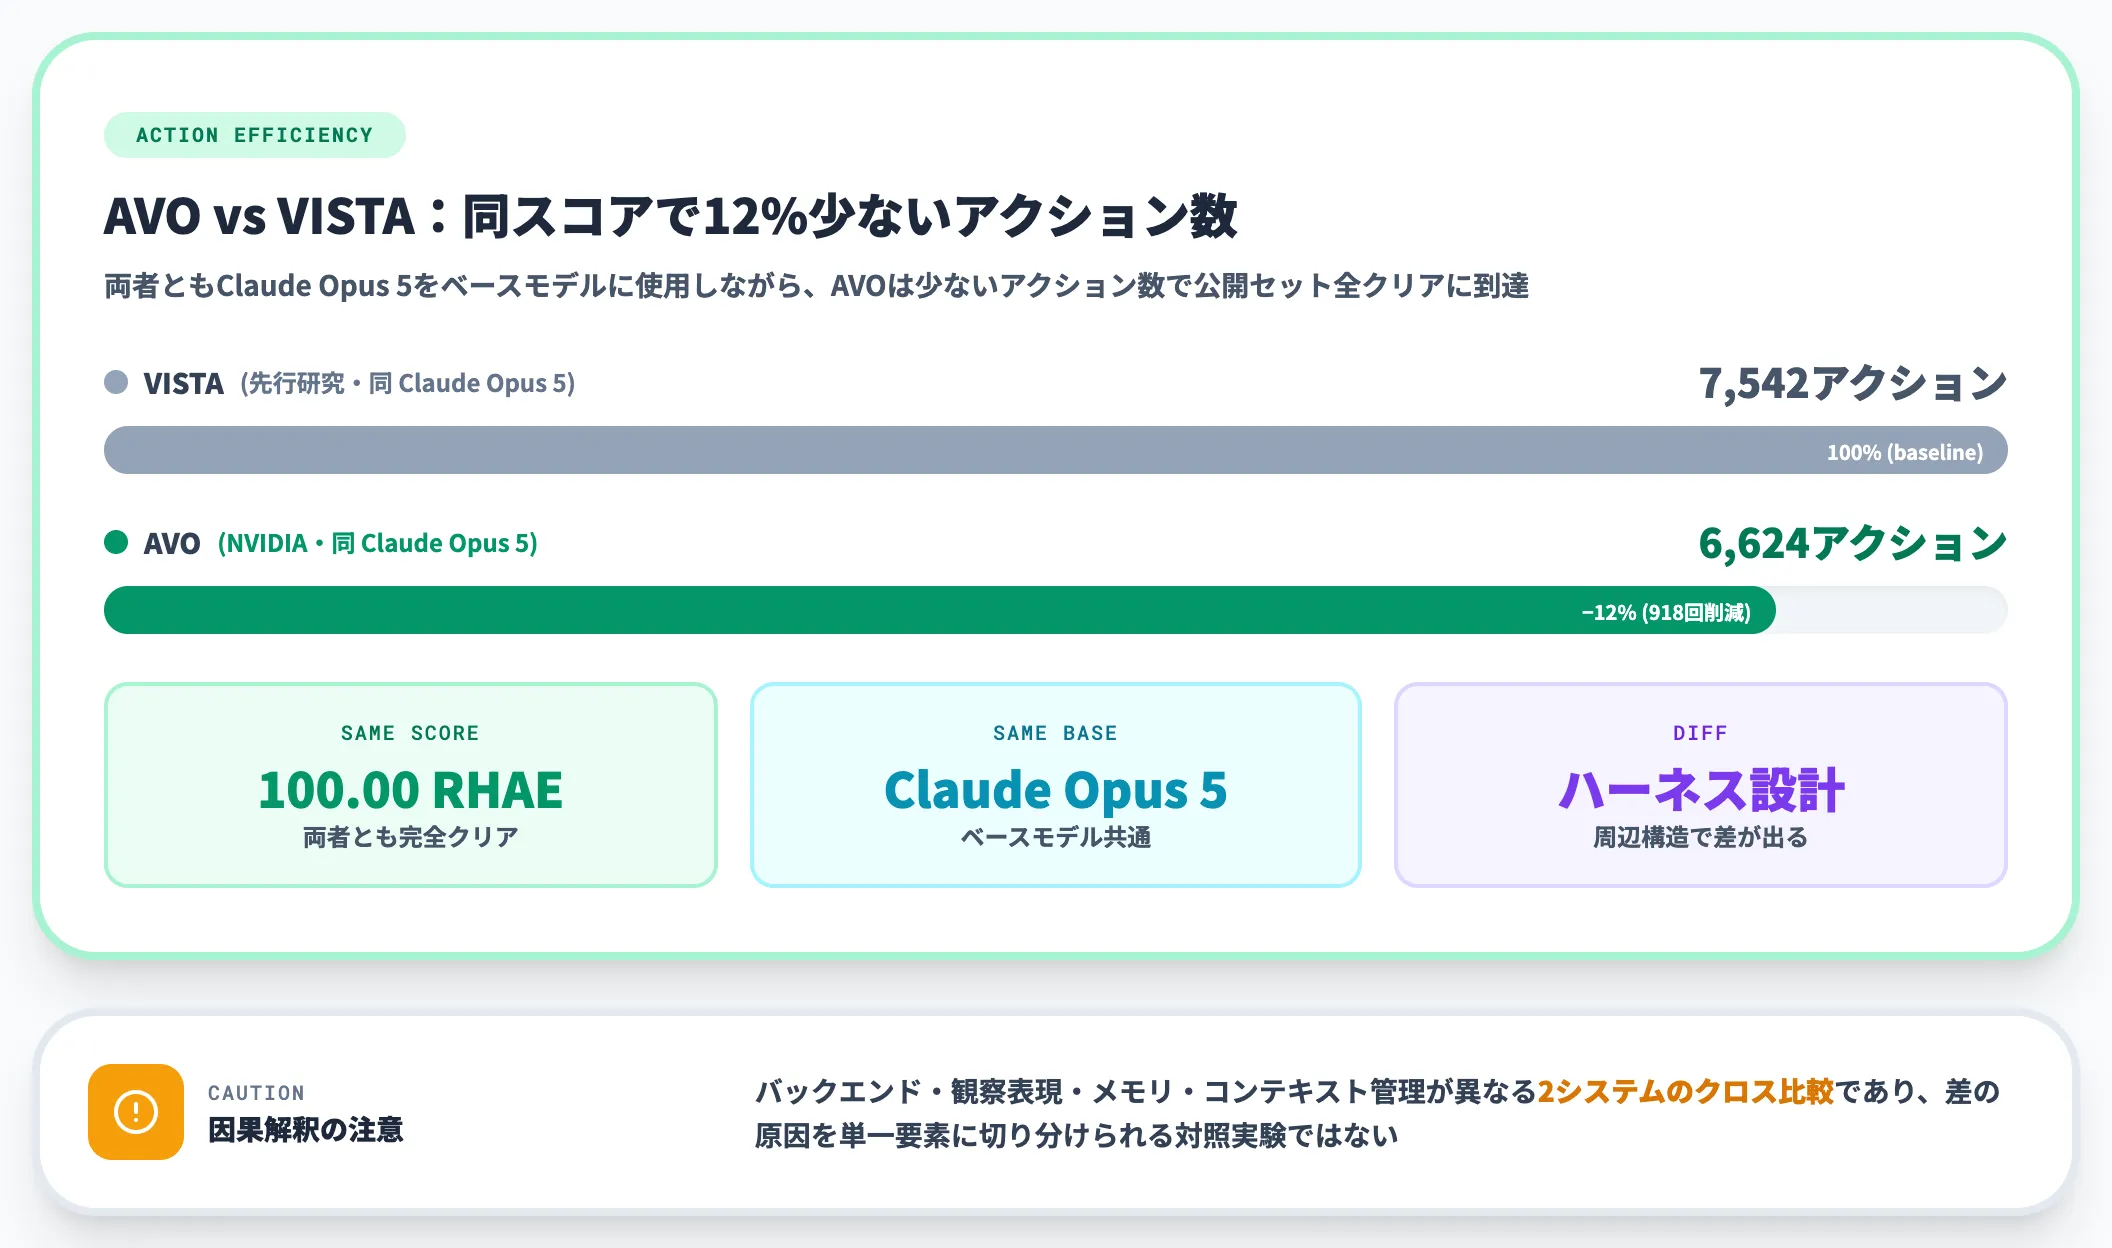
NVIDIAのDeveloper Blogによれば、AVOはARC-AGI-3のpublic setにおいて25のゲーム環境183レベル全てを完全クリアし、100.00 RHAE(ARC-AGI-3の公式スコア指標)を達成しました。
合計環境アクション数は6,624回で、これは同じClaude Opus 5を使った先行研究VISTAの7,542アクションよりも約12%少ない数値です。
以下の表で、主要な数値を1か所に整理しました。
| 指標 | AVOの記録 | 位置づけ |
|---|---|---|
| ARC-AGI-3 public setスコア | 100.00 RHAE | 25環境・183レベル完全クリア |
| 使用アクション数 | 6,624回 | VISTA(7,542回)比で約12%少ない |
| 使用ベースモデル | Claude Opus 5 | 同モデル単独スコアは約30%(ARC Prize公式測定) |
| 発表日 | 2026年8月21日 | NVIDIA Developer Blogで報告 |
ここで整理しておきたいのは、AVO(Claude Opus 5搭載)の100.00 RHAEと、ARC Prize公式が公開しているClaude Opus 5単独の約30%は、推論設定・エージェントシステム・評価環境がいずれも異なる別条件の測定であるという点です。
ARC Prizeが公開している約30%はHigh reasoning effort設定でのスコアで、NVIDIA自身も「AVOの寄与を測る対照実験ではない」と明記しています。
数値そのものは並べて把握しつつ、「AVO単独の効果で70ポイント上がった」という因果として読み解くのは避けるのが正確です。
VISTAとの比較で見える設計差
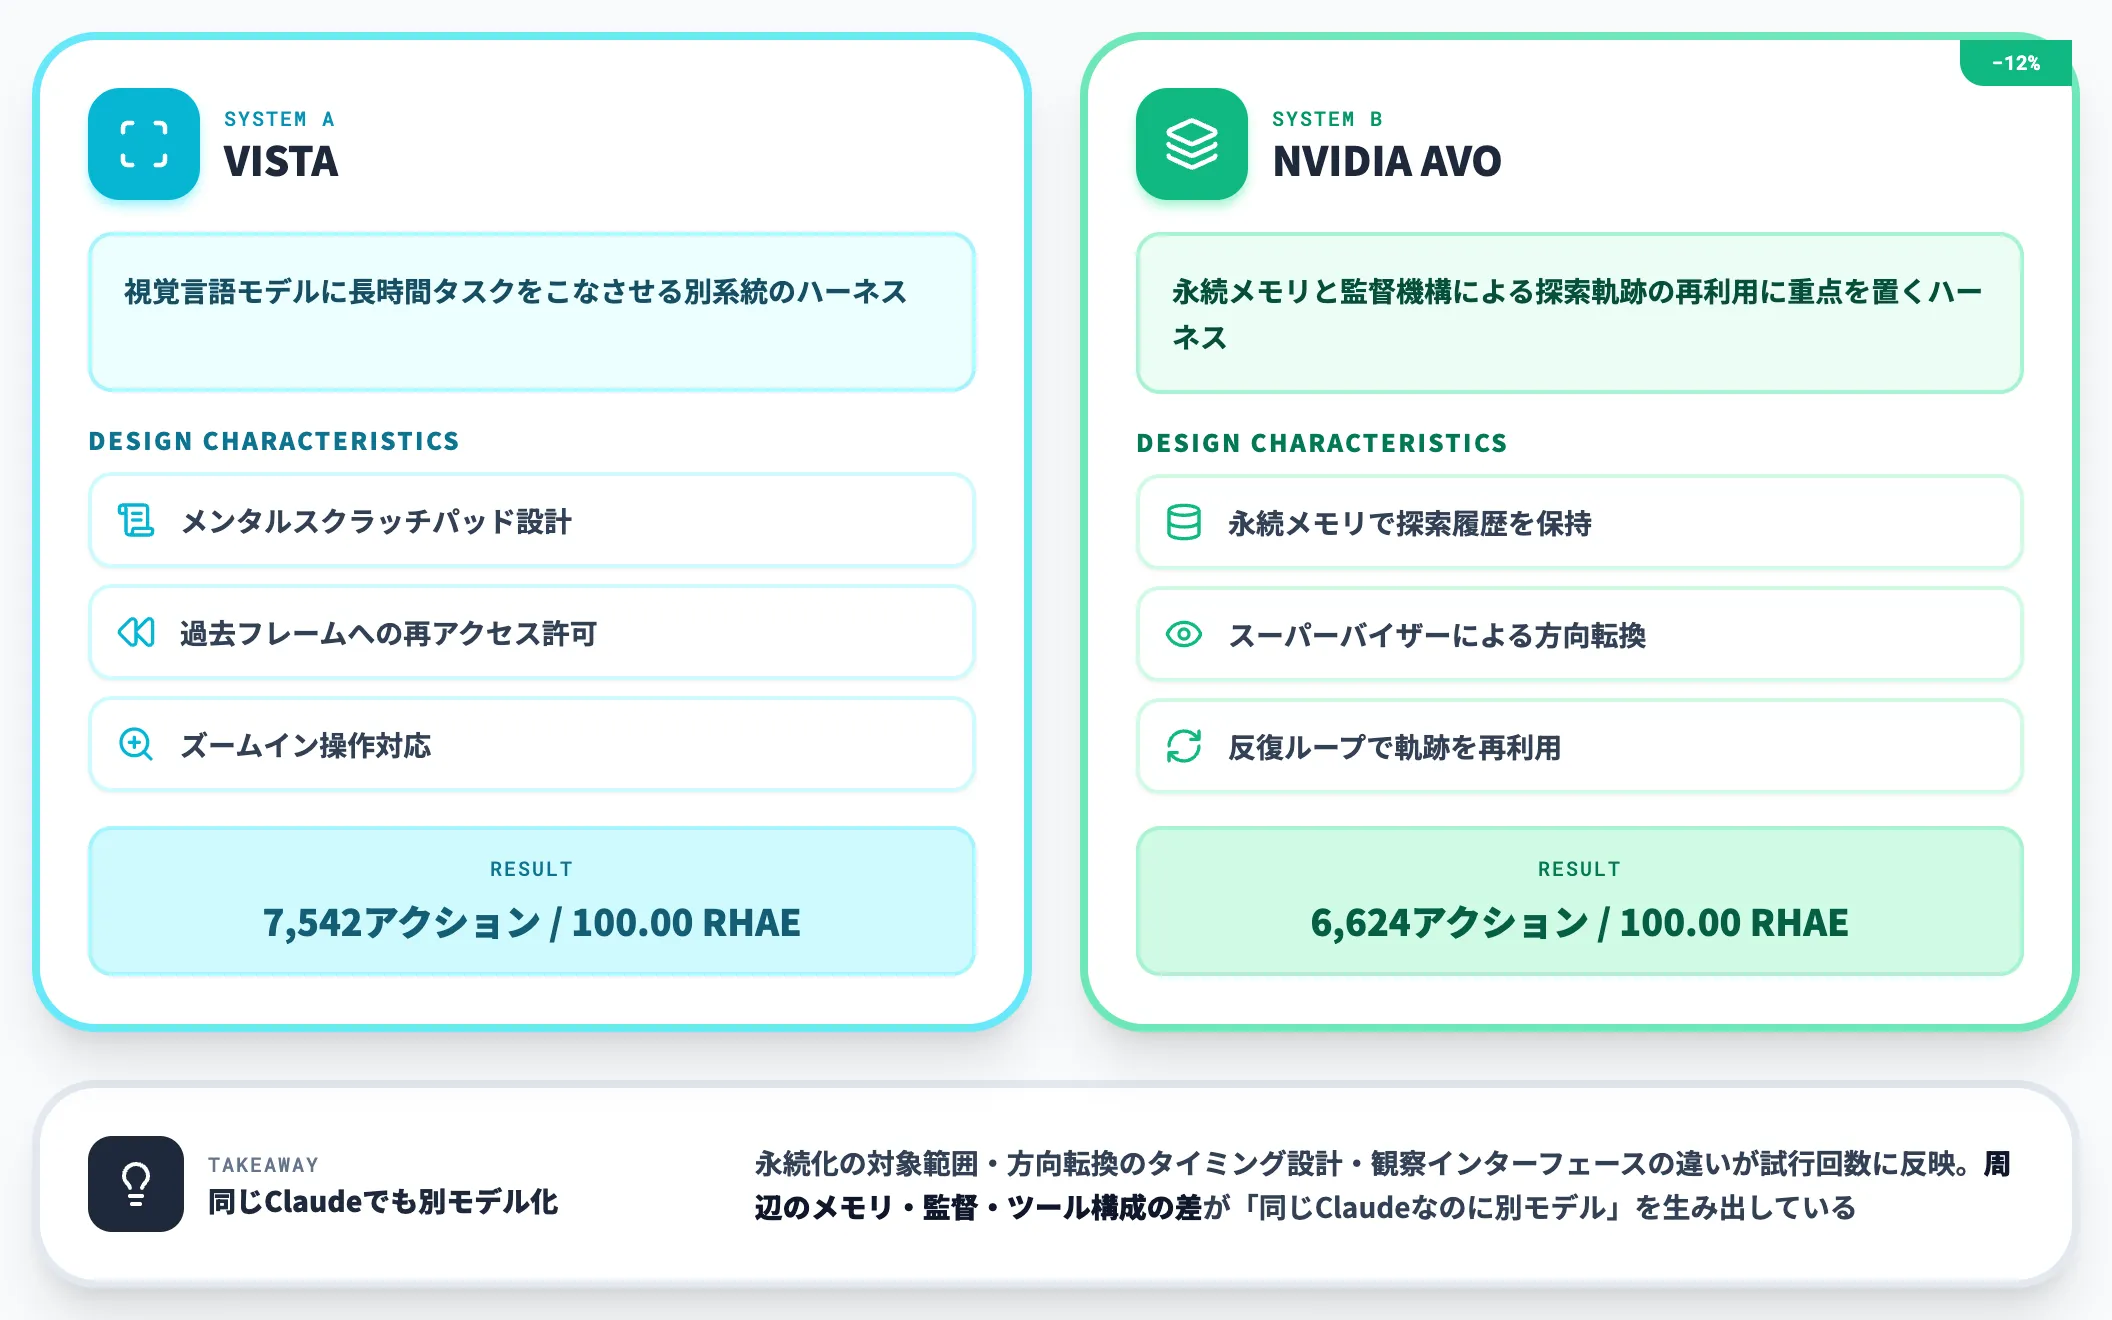
同じClaude Opus 5を使いながらAVOが12%少ないアクションで完走したという事実は目を引きますが、これはあくまでバックエンド・観察表現・メモリ・コンテキスト管理などが異なる2システムのクロスシステム比較であり、差の原因を単一要素に切り分けられる対照実験ではありません。
VISTAは視覚言語モデルに長時間タスクをこなさせるための別系統のハーネスで、過去フレームへの再アクセスやズームインを許すことで「メンタルスクラッチパッド」を実現する設計として知られます。AVOはこれとは違うアプローチで、永続メモリと監督機構による探索軌跡の再利用に重点を置いています。
両者が同スコア(100%)を達成しながら試行回数に12%の差が出た背景には、永続化の対象範囲・方向転換のタイミング設計・観察インターフェースなど複数の要素の違いが絡んでいると考えられます。
数値の差そのものは把握しつつ、単一要因に還元して読み解くのは避けるのが正確な整理です。
自社でLLMベースのエージェントを走らせている方なら、「同じClaudeなのに社内実装だとまるで別モデルの応答をする」という現象に心当たりがあるかもしれません。
それは仕様やプロンプトの問題ではなく、周辺のメモリ・監督・ツール構成の差が出ているサインかもしれません。
AVOが示す「モデル選定より、ハーネス設計」という設計思想の転換
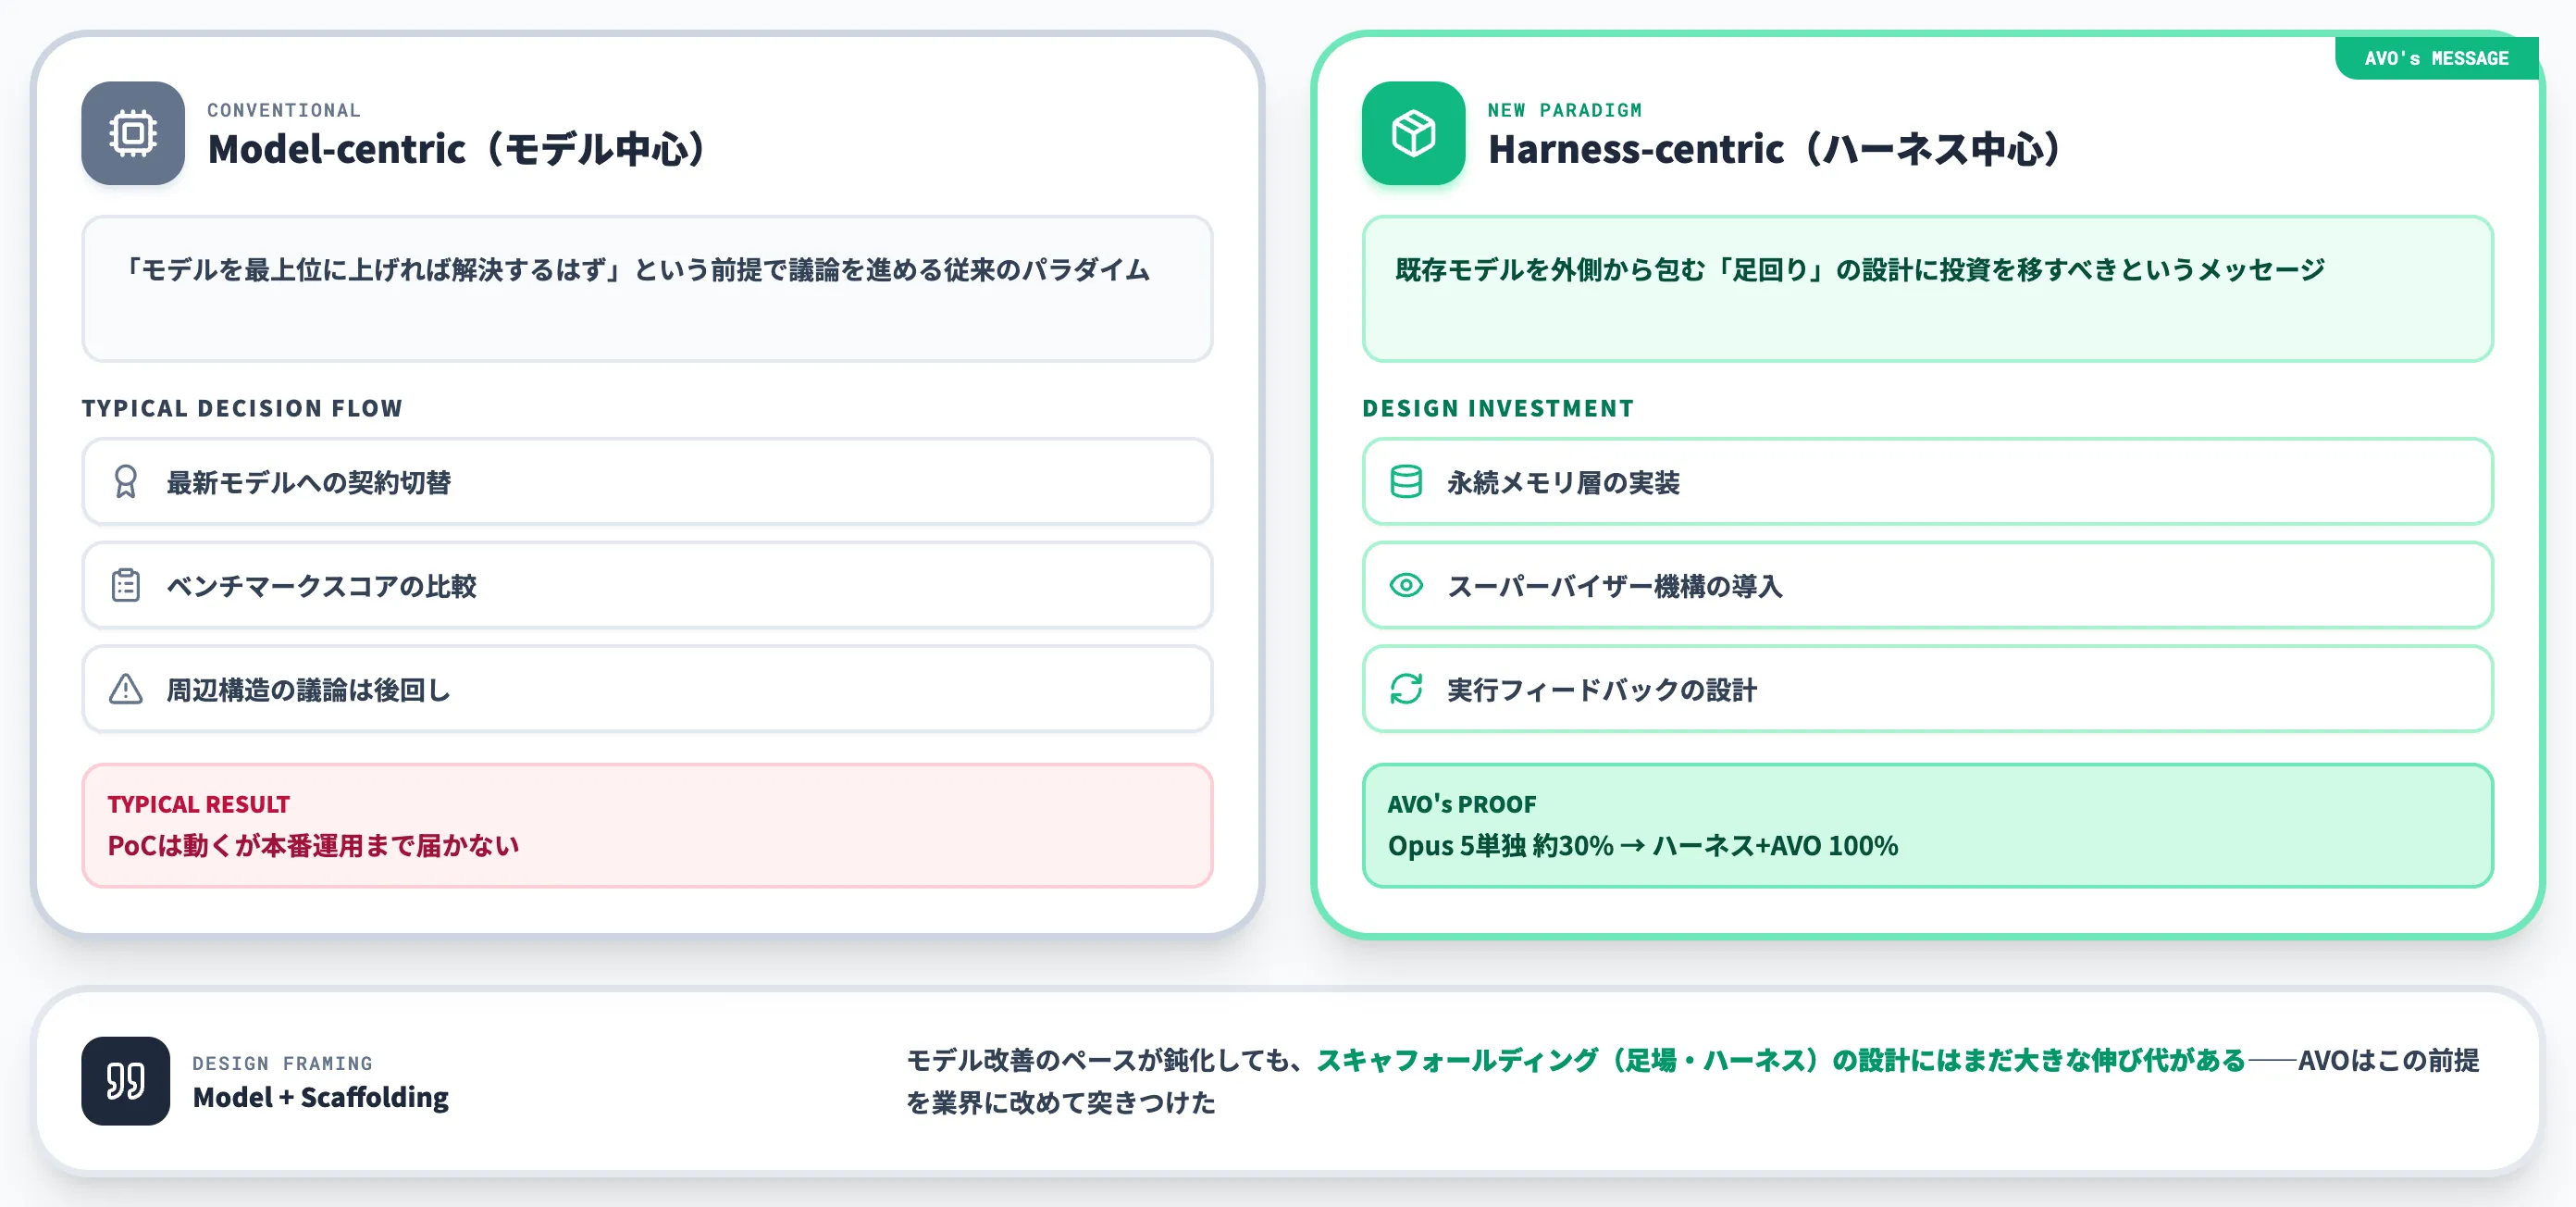
ここまでで見えてきたAVOのもう1つの本質は、業界がモデル選定に注ぎ込んできた議論の多くを、ハーネス設計側に移すべきというメッセージを含んでいるという点です。
このセクションでは、AVOが実証したこの設計思想の転換を、数値・エンプラAI導入の現状・実務判断の観点から掘り下げます。
モデル単独評価とエージェントシステム評価は別物
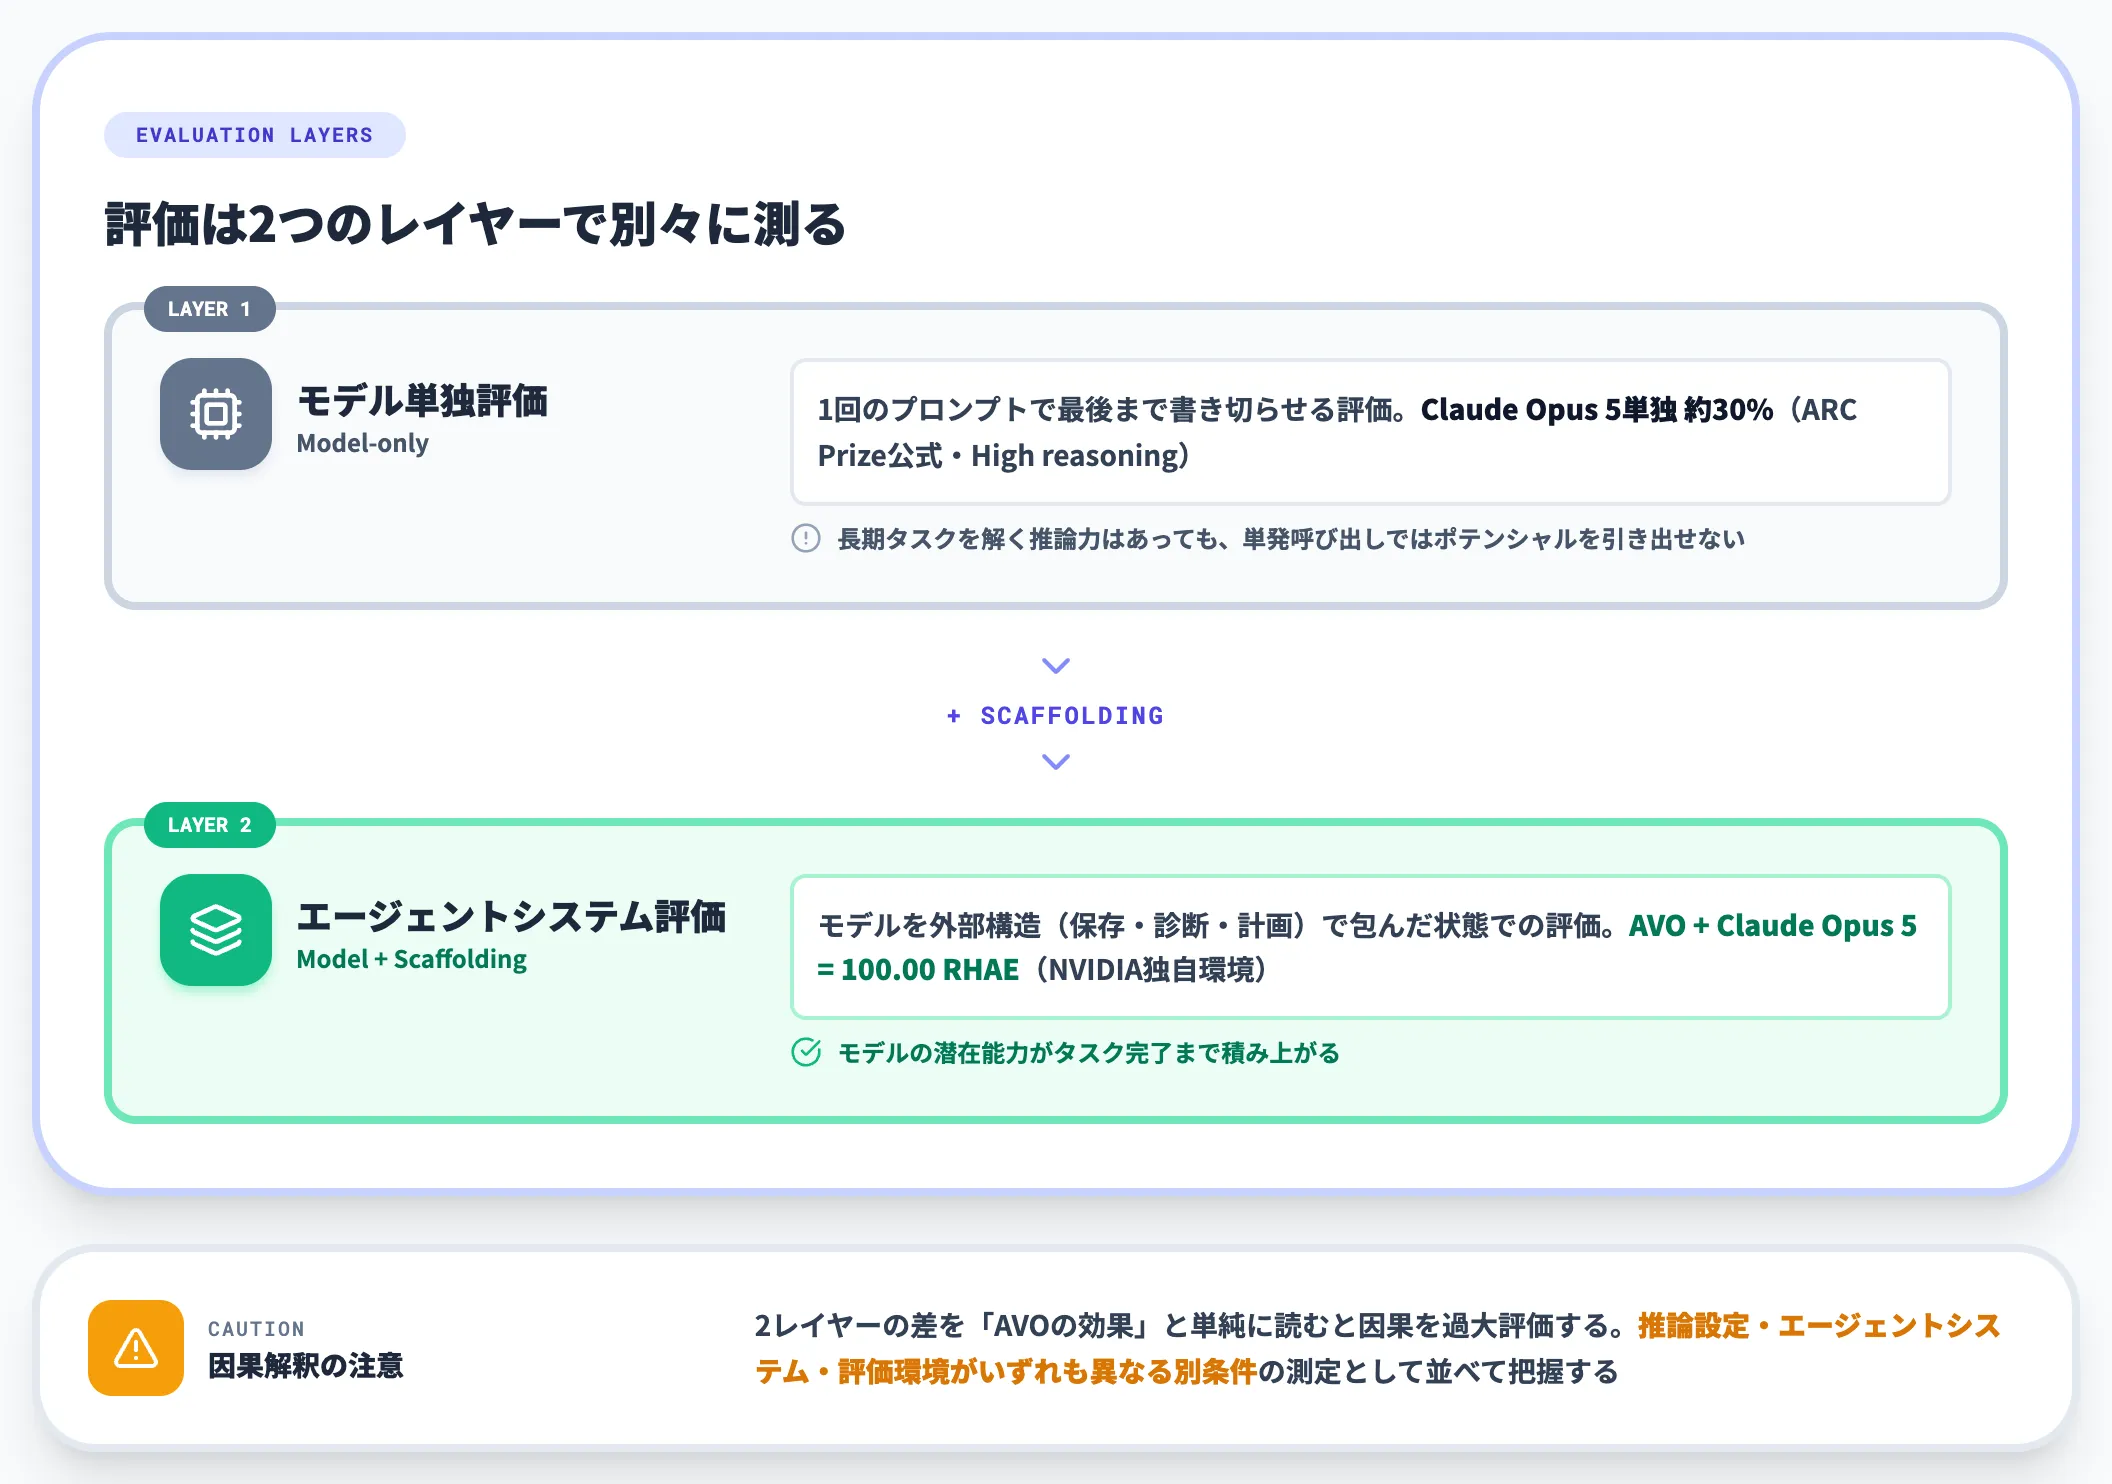
ARC Prize公式が公開しているClaude Opus 5単独の約30%と、AVOと組み合わせて報告された100.00 RHAEは、条件の異なる別測定として並んでいます。
両者の差をそのまま「AVOの効果」と読むと因果を過大評価してしまうため、まず「モデル単独の評価と、モデルを含むエージェントシステム全体の評価は別のレイヤーである」という前提を押さえるのが出発点です。
フロンティアLLMは、長期タスクを解く推論力を既に備えていても、それを引き出すには「1回のプロンプトで最後まで書き切らせる」という前提を捨てる必要があります。モデルの出力を保存し、失敗を診断し、次の試行を計画する外部構造を伴った状態で初めて、モデルの潜在能力がタスク完了まで積み上がる形になります。
この構造は、自律型AIエージェントの設計論として近年繰り返し言われてきた「Model + Scaffolding」の考え方に対応します。モデルの改善ペースが鈍化しても、スキャフォールディング(足場・ハーネス)の設計にはまだ大きな伸び代がある——AVOの発表はこの前提を業界に改めて突きつけた例と位置づけるのが妥当です。
エンタープライズAIの5%成功率と設計層の不在
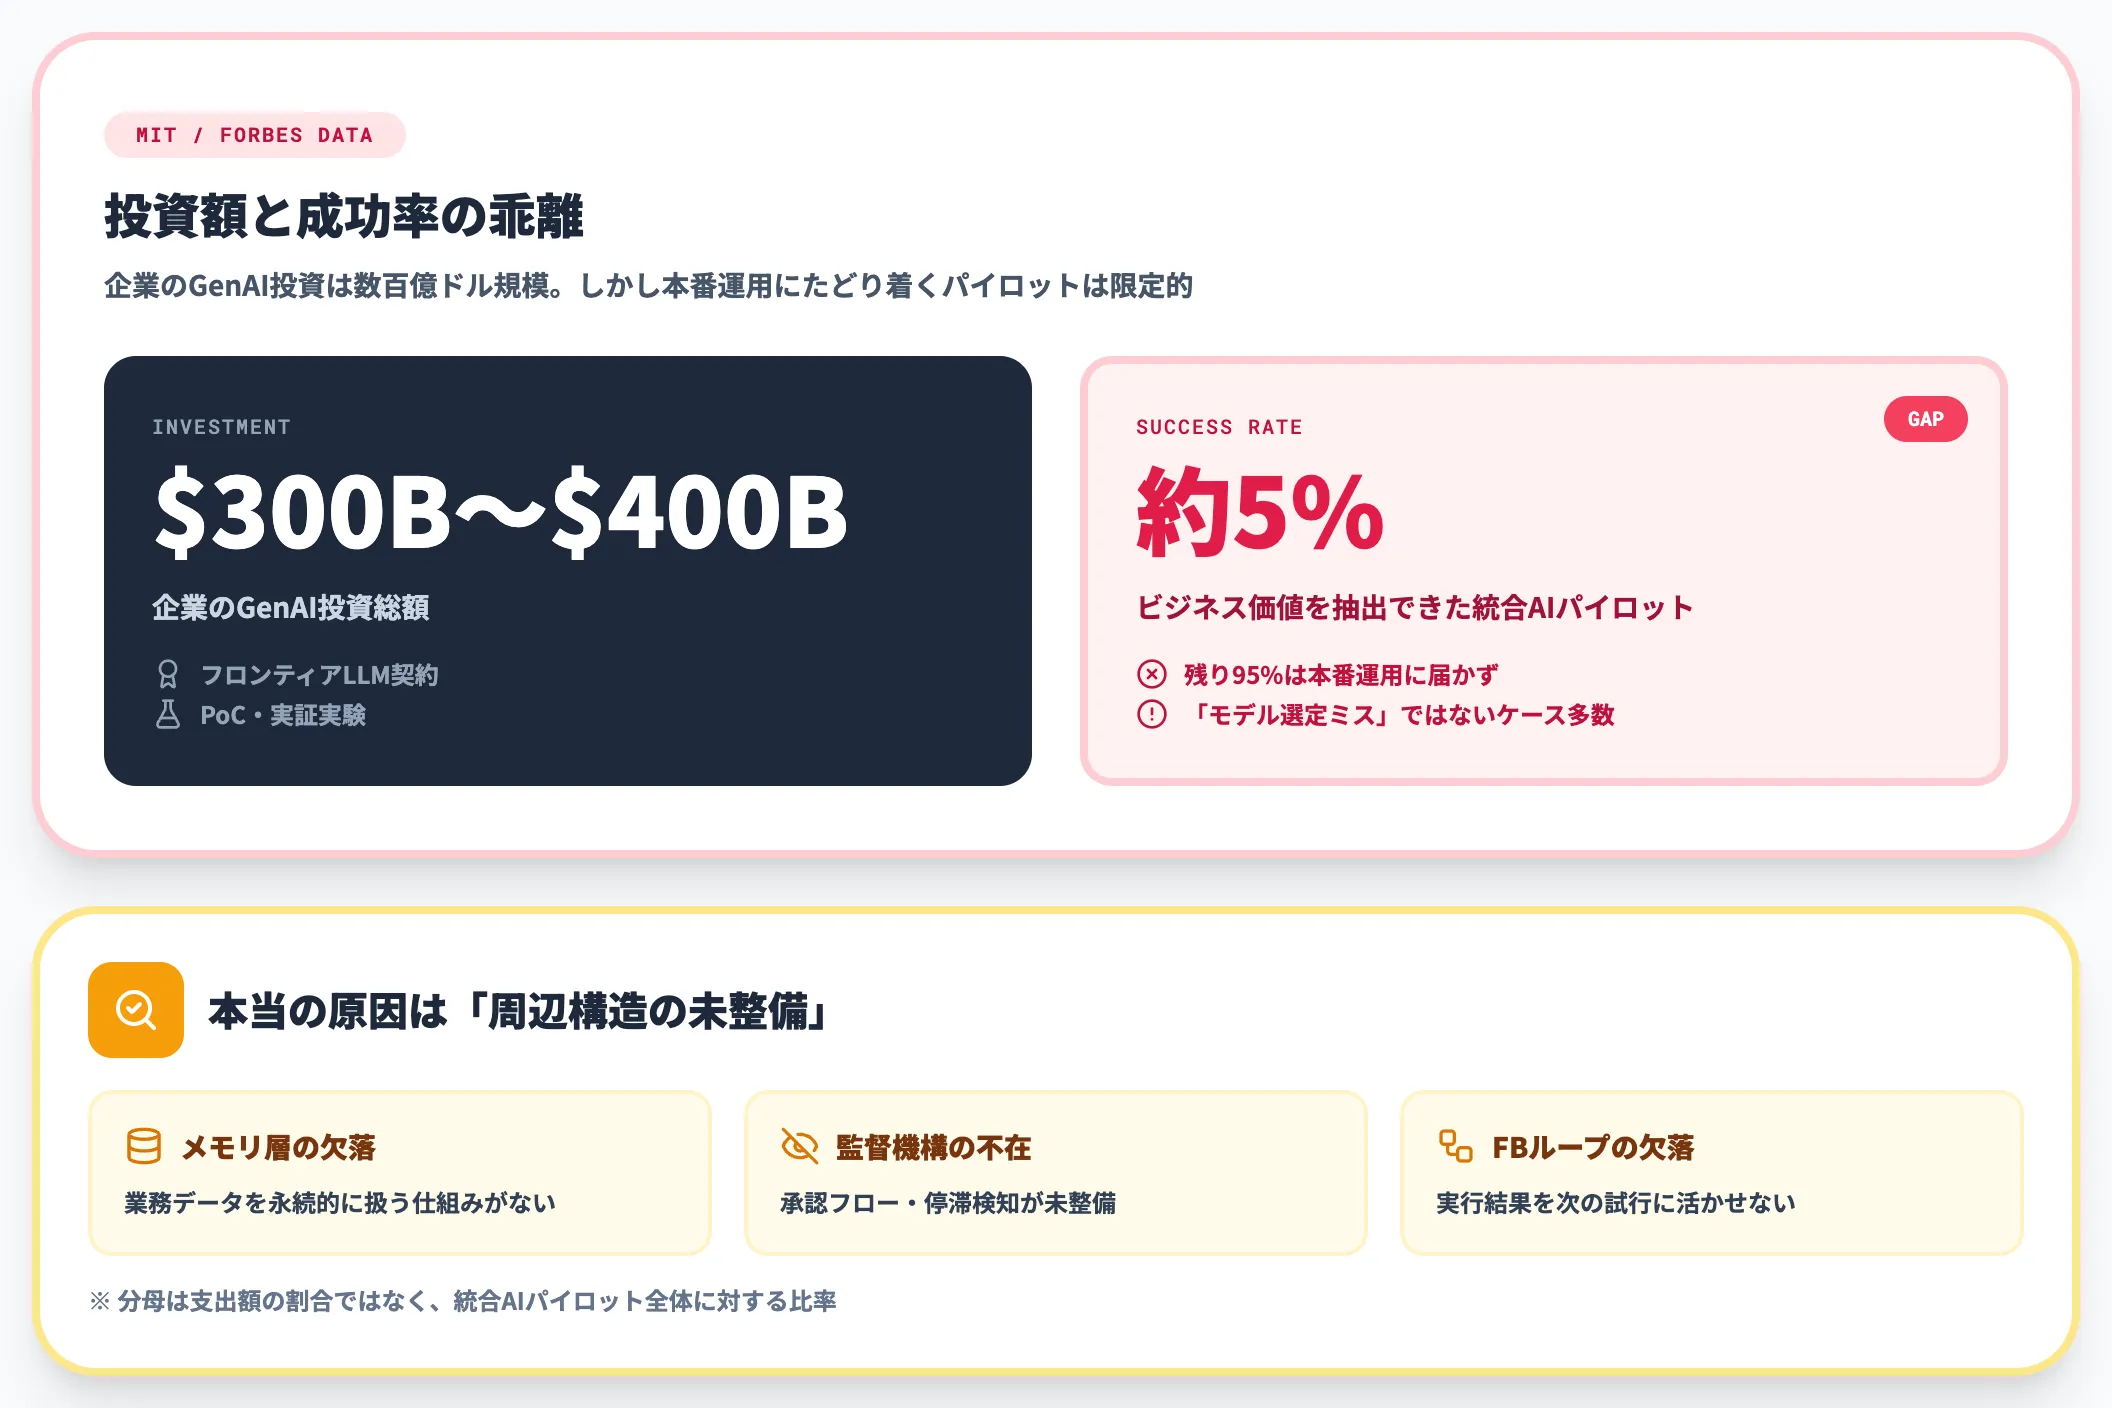
ハーネス設計の重要性を裏付ける外部データが、MITの調査結果としてForbes記事内で紹介されている「企業のGenAI投資が$300億〜$400億に達する一方、測定可能なビジネス価値を抽出できた統合AIパイロットは約5%にとどまる」という数字です(分母は支出額の割合ではなく、統合AIパイロット全体に対する比率)。
多くの企業がフロンティアLLMを契約し、PoCを走らせ、それでも本番運用にたどり着けていない——その原因は「モデル選定ミス」ではなく、業務コンテキストにモデルを載せる周辺構造(メモリ・監督・実行フィードバック)が未整備という側面が大きいと解釈できます。
「モデルを最上位に上げれば解決するはず」という前提で議論が始まるケースは少なくありませんが、実際には業務データを永続的に扱う仕組みや承認フローの整備を先に進めるほうが本番運用に近づきやすい場面もあります。
AVOが示したのは、この「モデルより設計層で差が付く」構造がベンチマーク上でも再現しうるという点です。
ベンチマーク優位性をどう評価すべきか
一方、AVOのような結果を見て「うちも早くOpus 5を採用しよう」「AVO相当を作ろう」と直線的に動くのは、ハーネス設計の議論に入る前の飛び越しになりがちです。
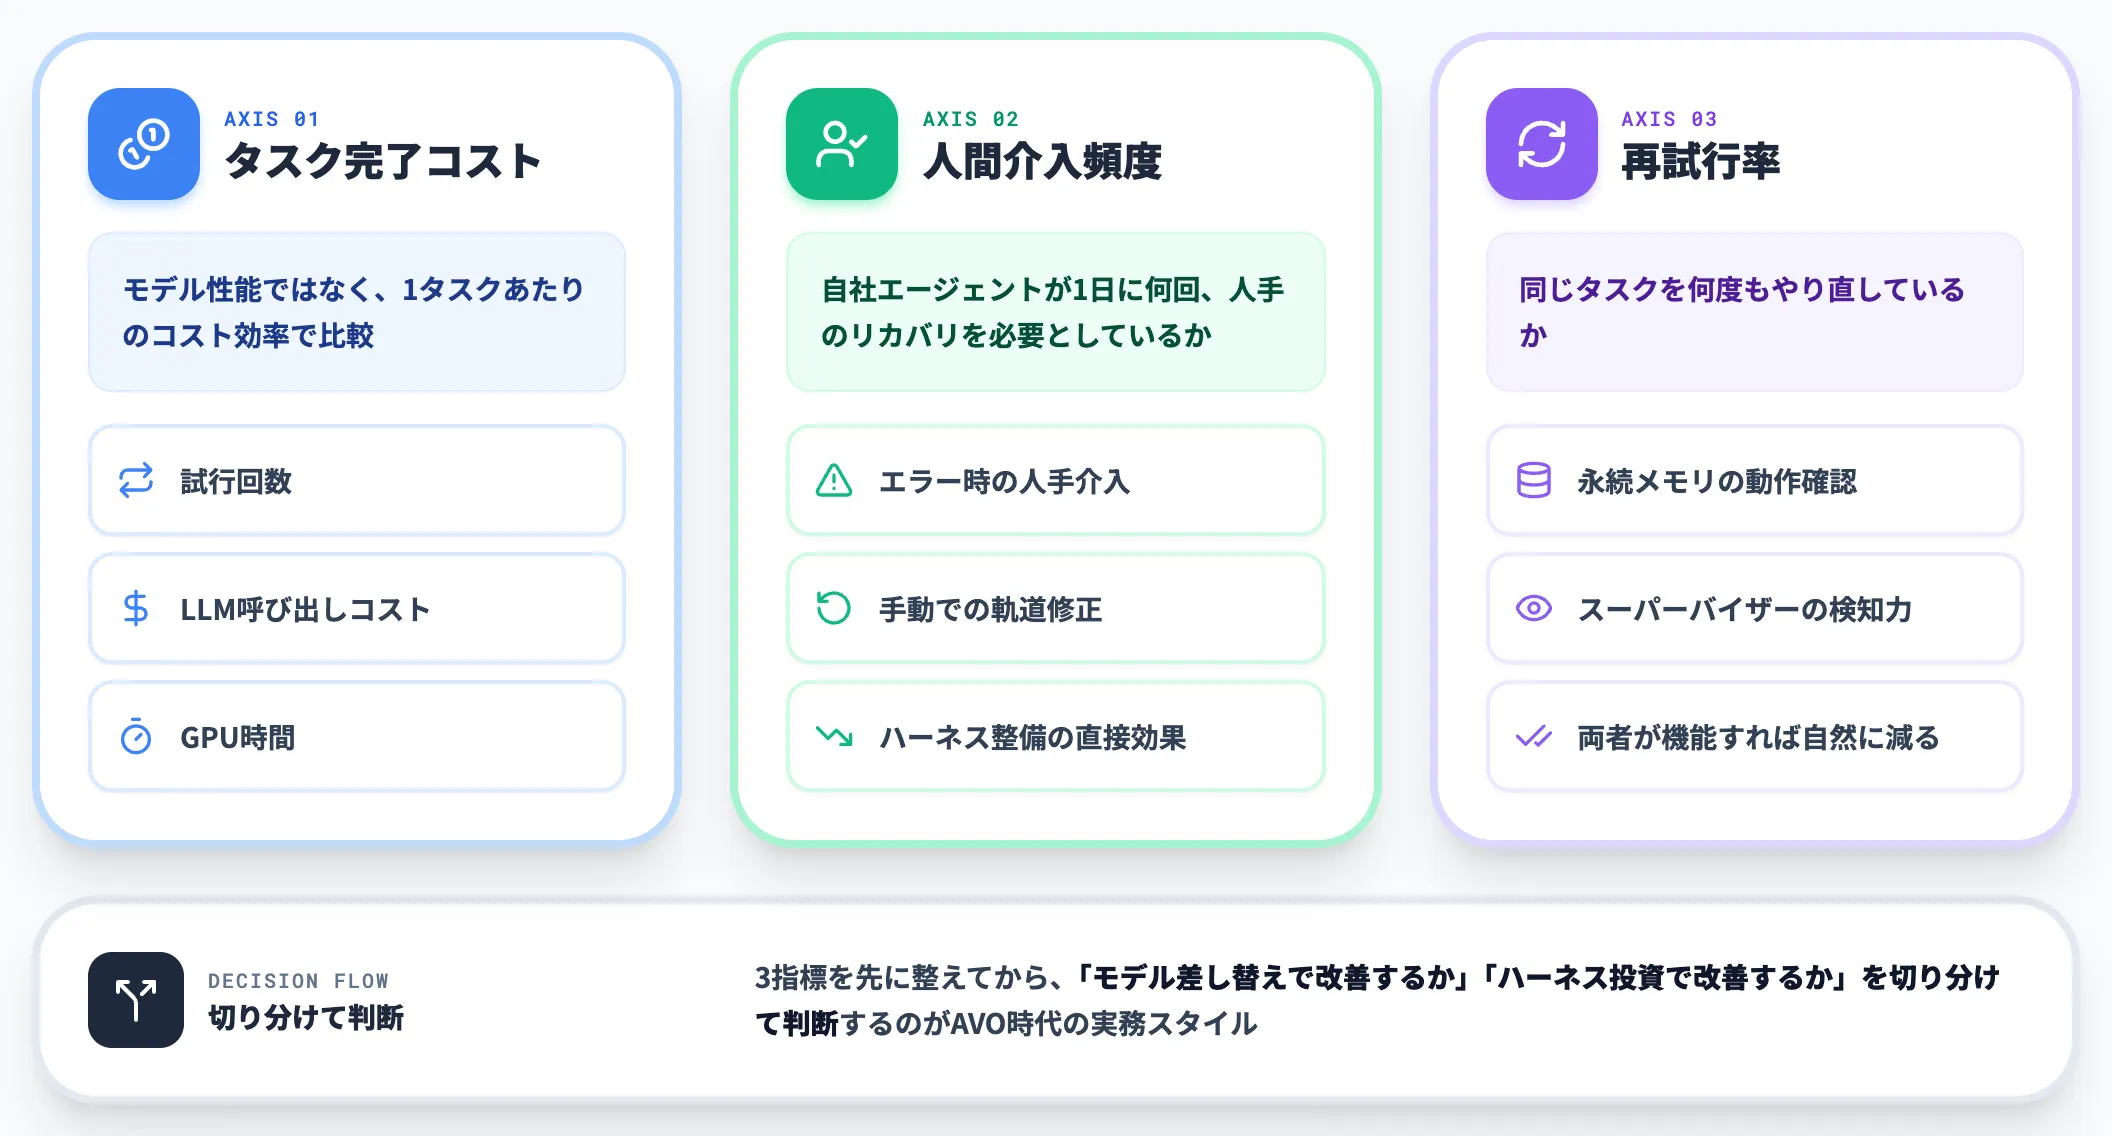
現実的な判断軸としては、次の3点が実務での重心になります。
-
タスク完了コスト
1タスクあたりの試行回数・LLM呼び出しコスト・GPU時間を計測し、モデル性能ではなくコスト効率で比較する
-
人間介入頻度
自社エージェントが1日に何回、人手のリカバリを必要としているか。この数字を下げるのがハーネス整備の直接効果
-
再試行率
同じタスクを何度もやり直しているか。永続メモリ・スーパーバイザーが機能していれば、再試行は自然と減る
これらの指標を先に整えてから、「モデル差し替えで改善するか」「ハーネス側の投資で改善するか」を切り分けて判断するのが、AVO時代の実務スタイルとして筋がよくなります。
AVOの限界と過大評価すべきでない理由
AVOの100%達成報告は強烈なインパクトを持ちますが、実務適用を考えるなら、この結果の測定条件・検証範囲・入手可能性について冷静に押さえておく必要があります。
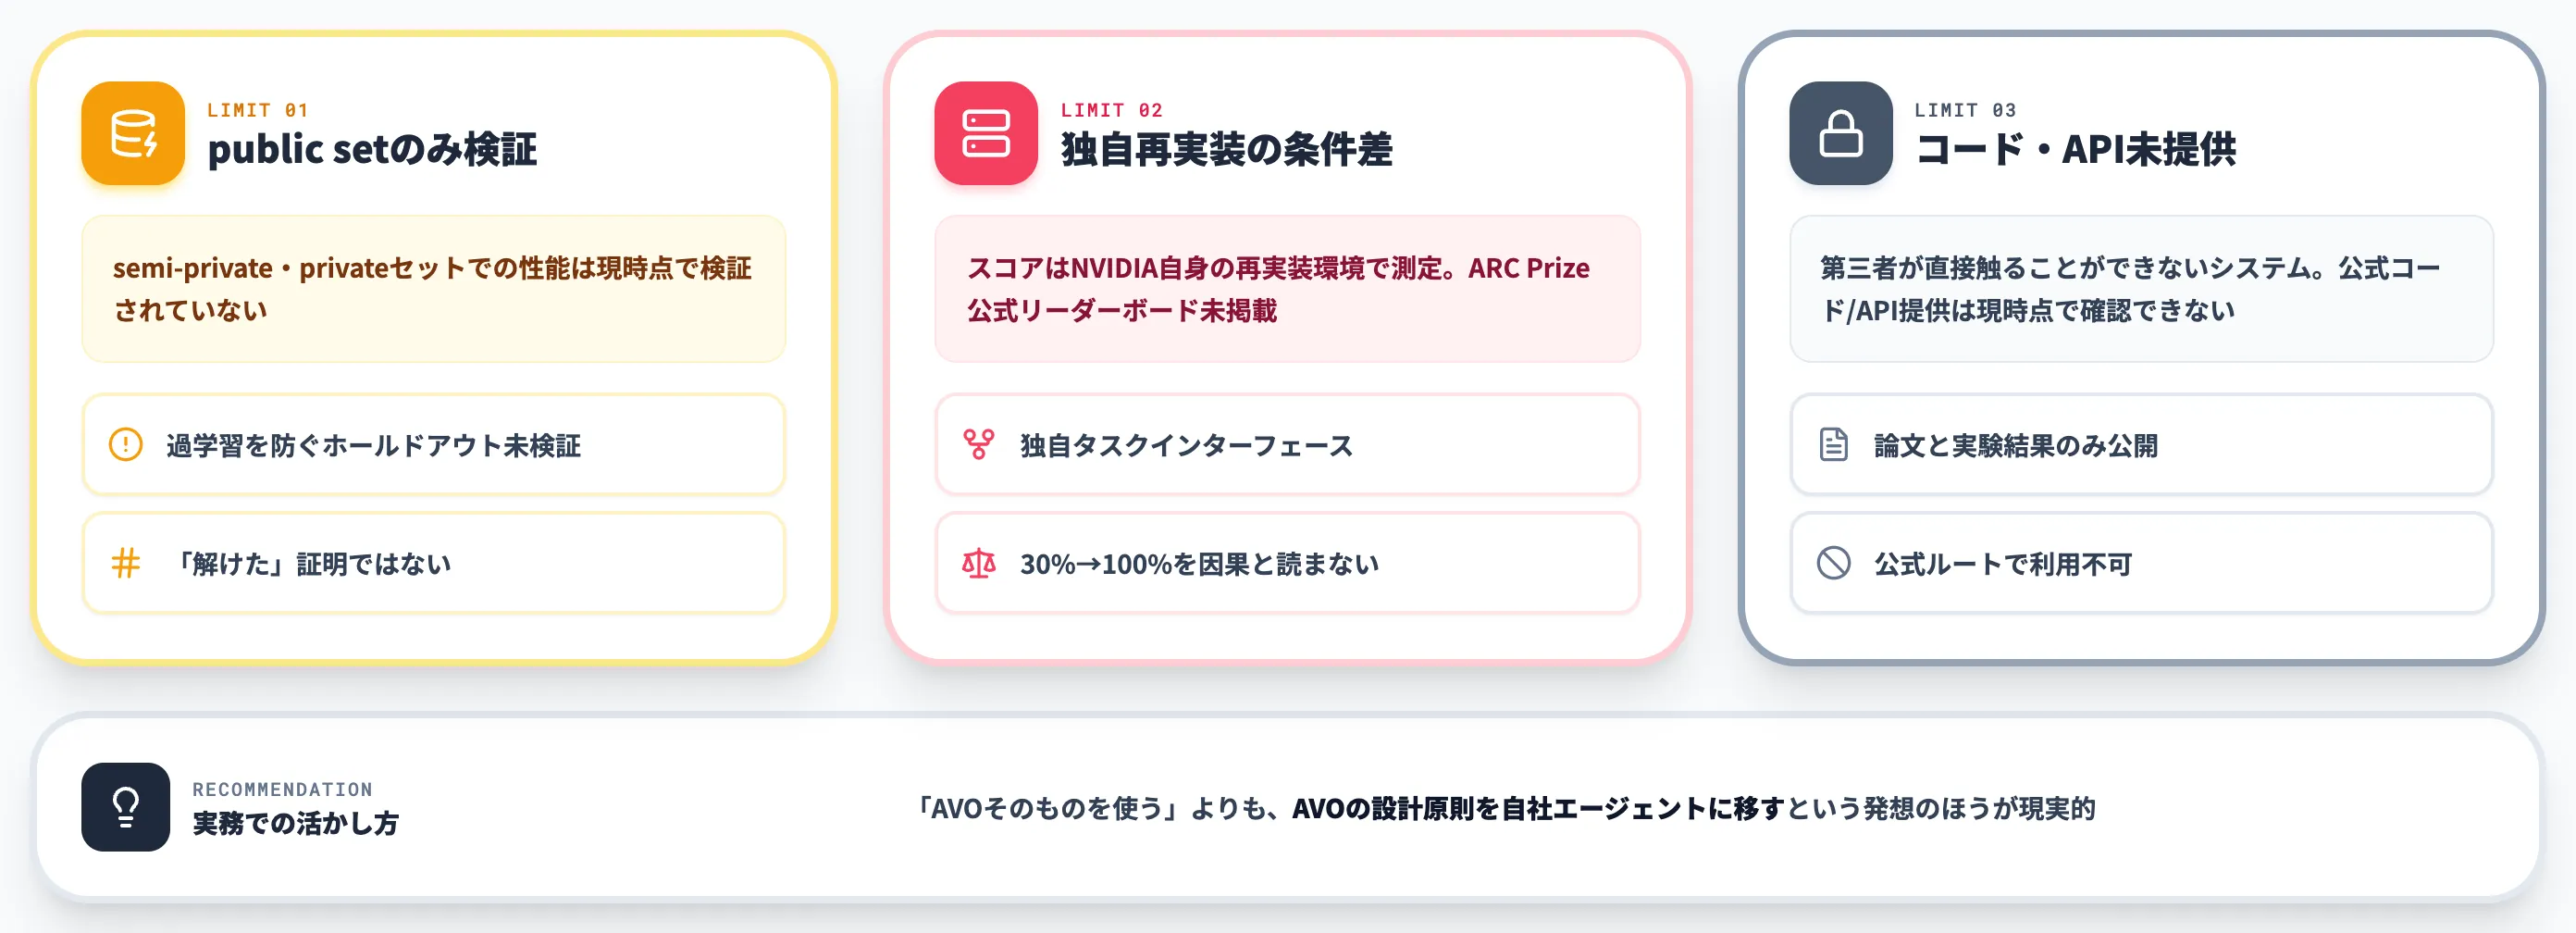
このセクションでは、AVOを過大評価しないための3つの論点を整理します。
検証済みなのはARC-AGI-3のpublic setのみ
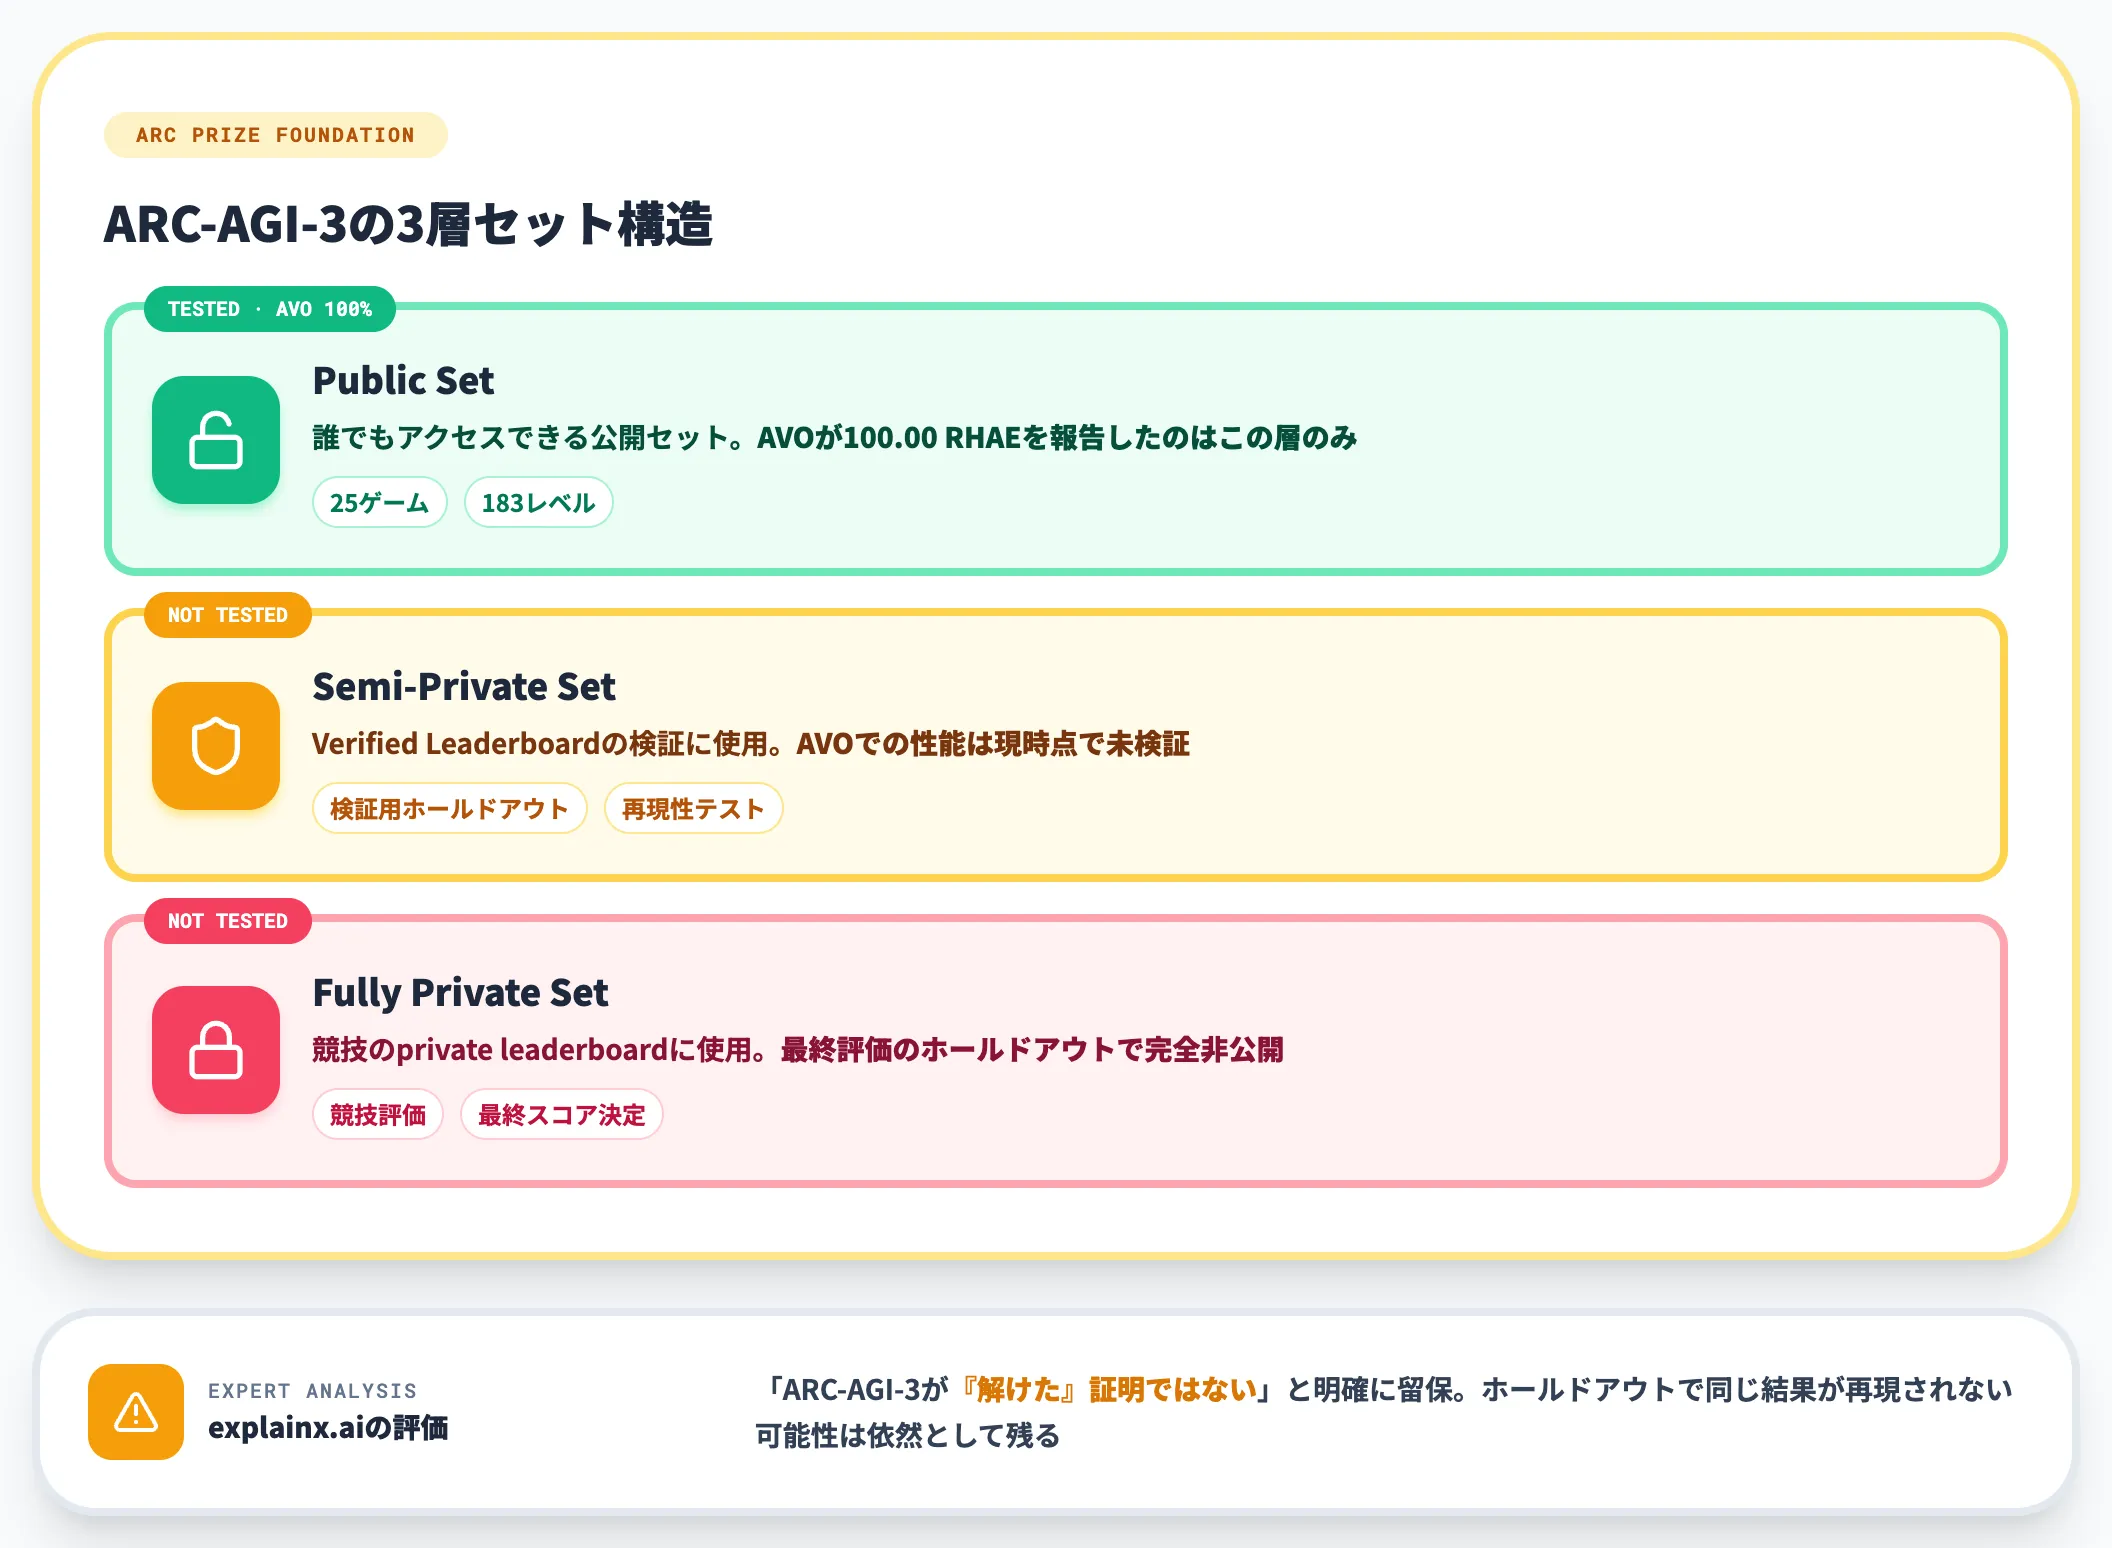
まず最重要の限界は、AVOが100%を達成したのはARC-AGI-3のpublic setのみであるという点です。
ARC Prize Foundationは、モデルの過学習を防ぐためにpublic set以外にsemi-privateセットとprivateセットを保持しており、ARC Prize公式ポリシーによればVerified Leaderboardの検証にはsemi-privateセット、競技のprivate leaderboardにはfully privateセットが使われる運用です。
AVOが達成した100%はNVIDIAのブログでも「public setのみ」と明記されており、semi-private・privateセットでの性能は現時点で検証されていません。
explainx.aiの分析でも「ARC-AGI-3が『解けた』証明ではない」と明確に留保が付けられており、この点はAVOを評価するうえで避けて通れない条件です。ホールドアウトセットで同じ結果が再現されない可能性は依然として残っています。
独自再実装での測定という条件差
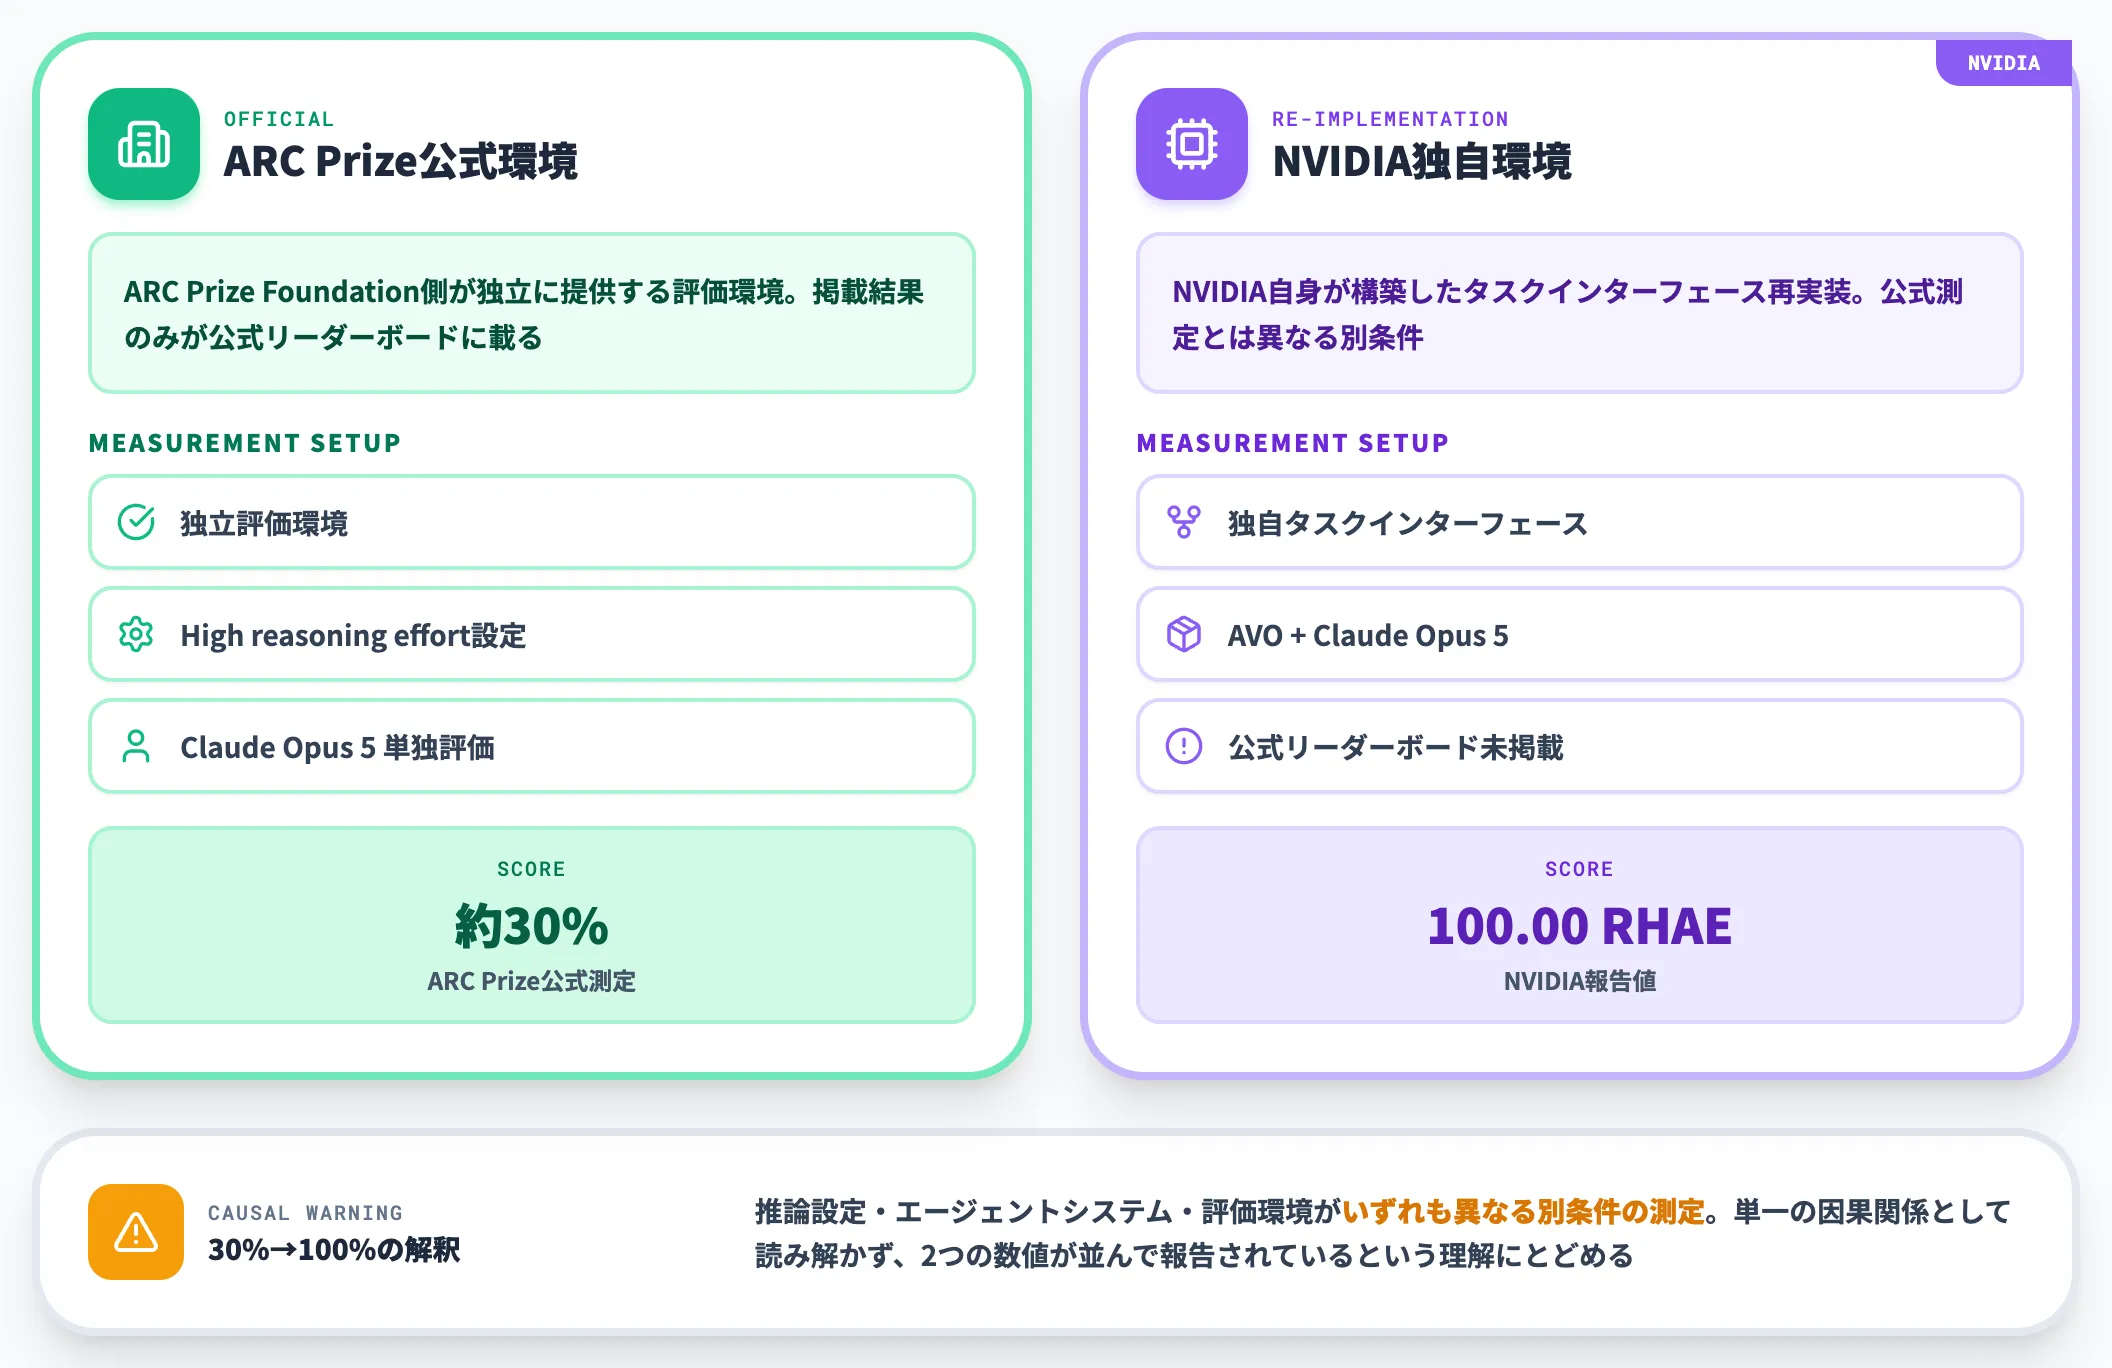
第2の論点は、AVOのスコアがNVIDIA自身の再実装環境で測定されたものであり、ARC Prize公式リーダーボードには現時点で掲載されていないという事実です。
公式リーダーボードは、ARC Prize Foundation側が独立に評価環境を提供し、そこで測定した結果のみを掲載する運用になっています。
NVIDIAは「AVOの結果はNVIDIA独自のタスクインターフェース再実装で得られたもので、公式測定とは異なる」と自ら注記しています。
ARC Prize公式測定でのClaude Opus 5スコアは約30%(High reasoning effort設定)とされていますが、NVIDIA報告の100%とは推論設定・エージェントシステム・評価環境がいずれも異なる別条件の測定です。
「30%→100%」を単一の因果関係として読み解かず、条件の異なる2つの数値が並んで報告されているという理解にとどめるのが正確です。
コード・APIとも公式提供は確認できない
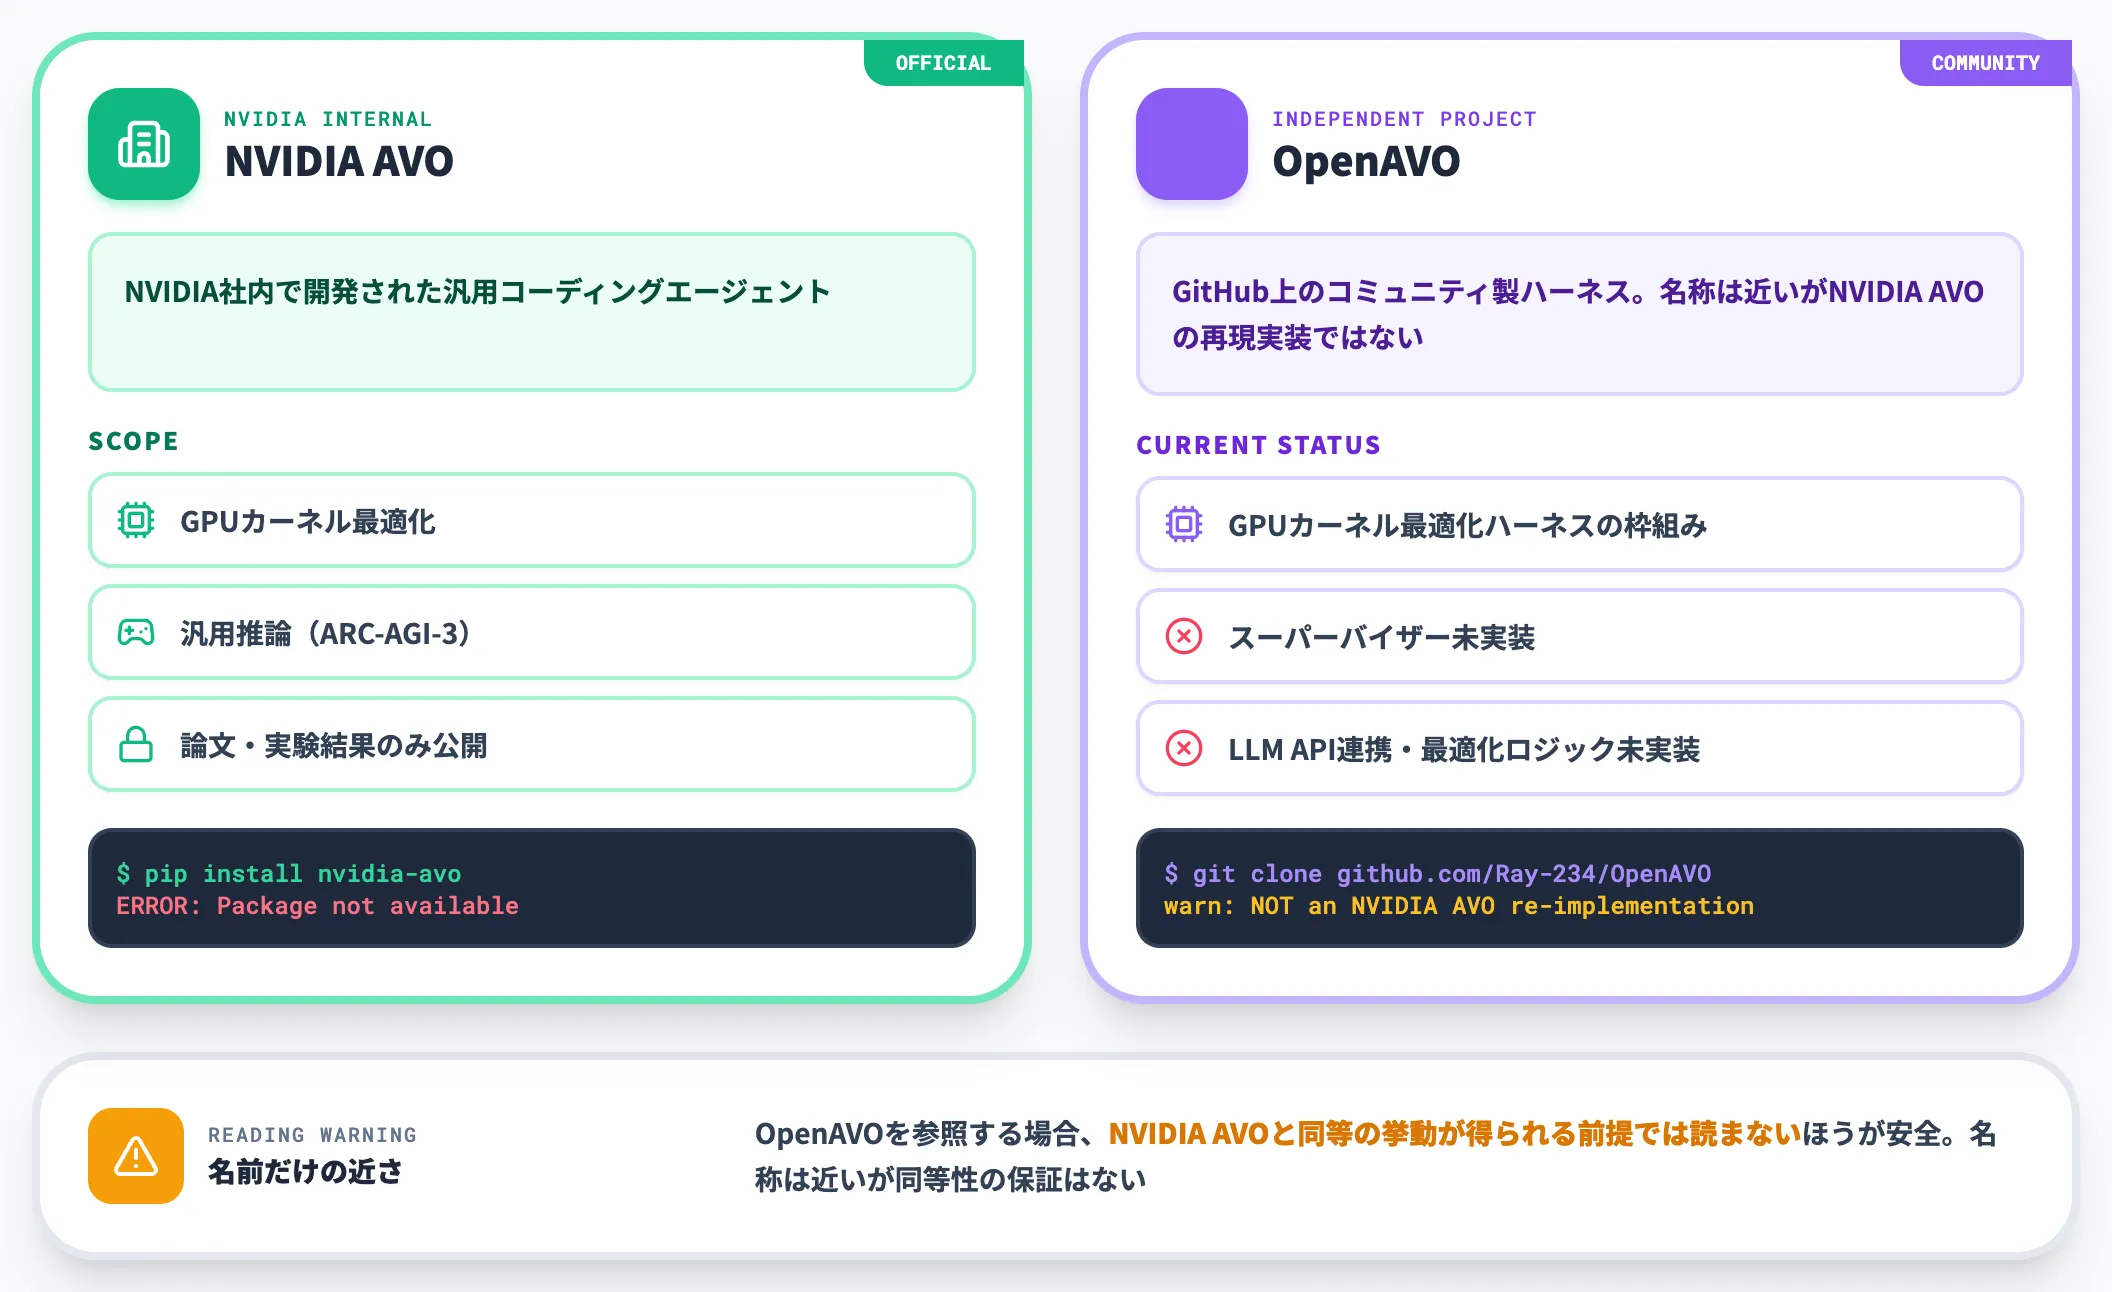
第3の論点は、AVOが現時点で第三者が直接触ることができないシステムである点です。
NVIDIA Developer Blogで公開されているのはあくまで研究論文と実験結果のみで、公開一次ソースではコード・APIの公式提供を確認できません。
「使ってみたい」と思っても、公式ルートは存在しないのが2026年8月時点の状況です。
関連するオープンソース活動として、GitHub上に別展開の「Autonomous Vary-Optimize」を名乗るOpenAVOというプロジェクトが存在します。
ただしこれはNVIDIA AVOの再現実装ではなく独立したコミュニティ製ハーネスで、現行READMEではスーパーバイザー・LLM API連携・カーネル最適化ロジック自体が未実装です。
以下の表で、両者の位置関係を整理します。
| 実装 | 対象 | 位置づけ |
|---|---|---|
| NVIDIA AVO | GPUカーネル最適化・汎用推論 | NVIDIA社内開発。公式コード/API提供は現時点で確認できない |
| OpenAVO | GPUカーネル最適化ハーネス(B200/Blackwell対応の枠組み) | 独立したコミュニティ製ハーネス。名称は近いがNVIDIA AVOの再現実装ではなく、同等性の保証もない |
実務で採用を検討するなら、「AVOそのものを使う」よりも「AVOの設計原則を自社エージェントに移す」という発想のほうが現実的です。OpenAVOを含む外部プロジェクトを参照する場合も、NVIDIA AVOと同等の挙動が得られる前提では読まないほうが安全です。
AVOから学ぶべき設計原則と、現実的な実装アプローチ
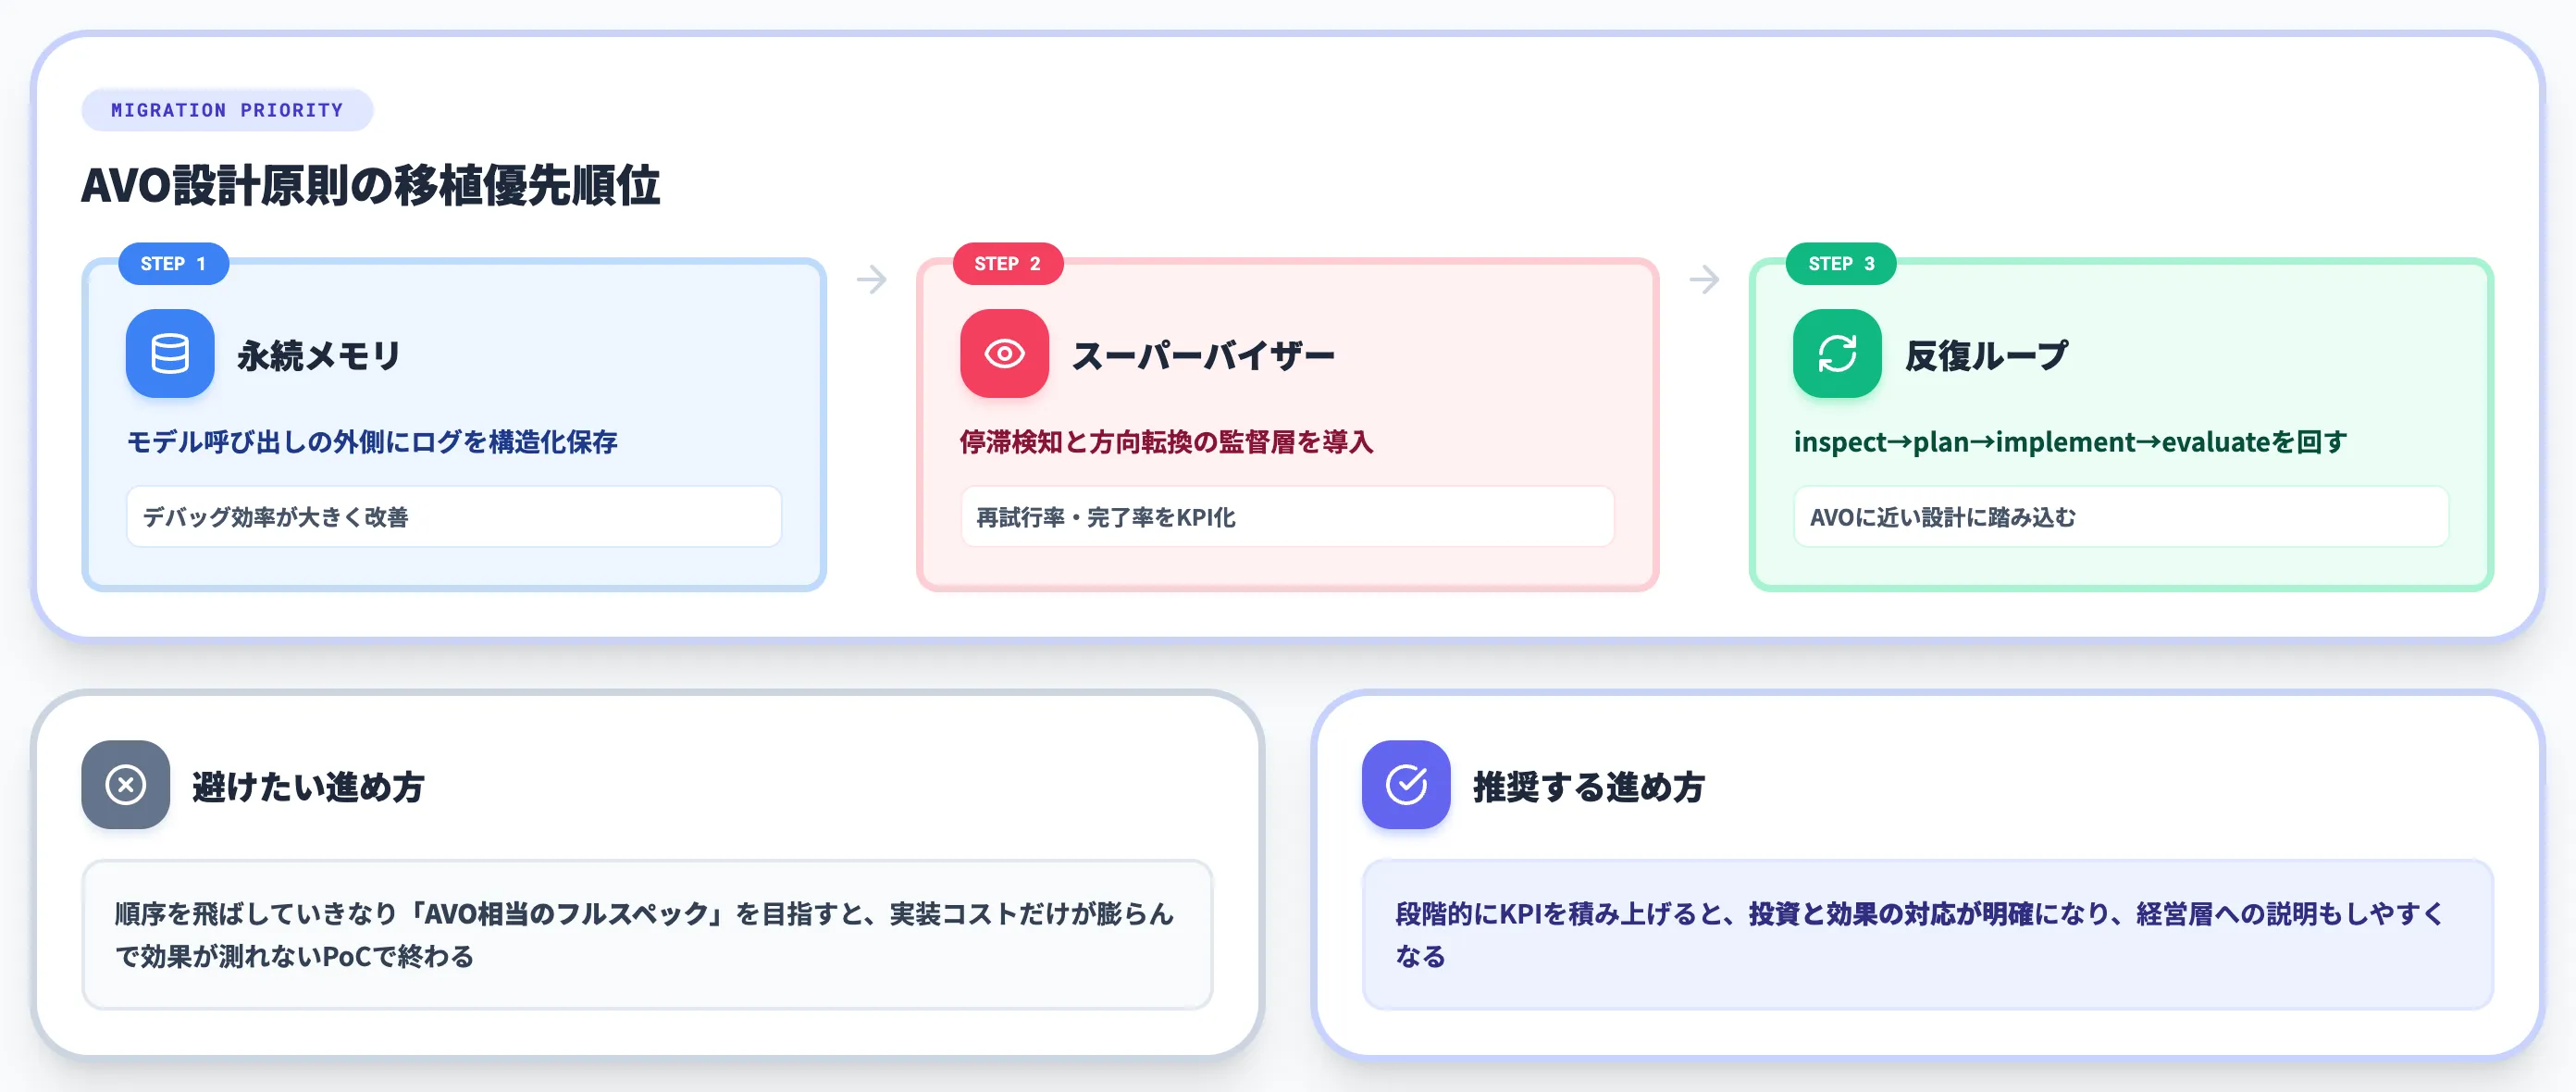
AVOは直接触れないシステムですが、その設計原則そのものは、企業が既に運用しているエージェント基盤の改善に十分応用できます。
このセクションでは、AI総研の支援現場で「モデルを変えても効かないPoC」に何度も向き合ってきた経験を踏まえて、AVOから学んだ設計原則を自社エージェントに移す優先順位を整理します。
永続メモリ層をどう設計するか
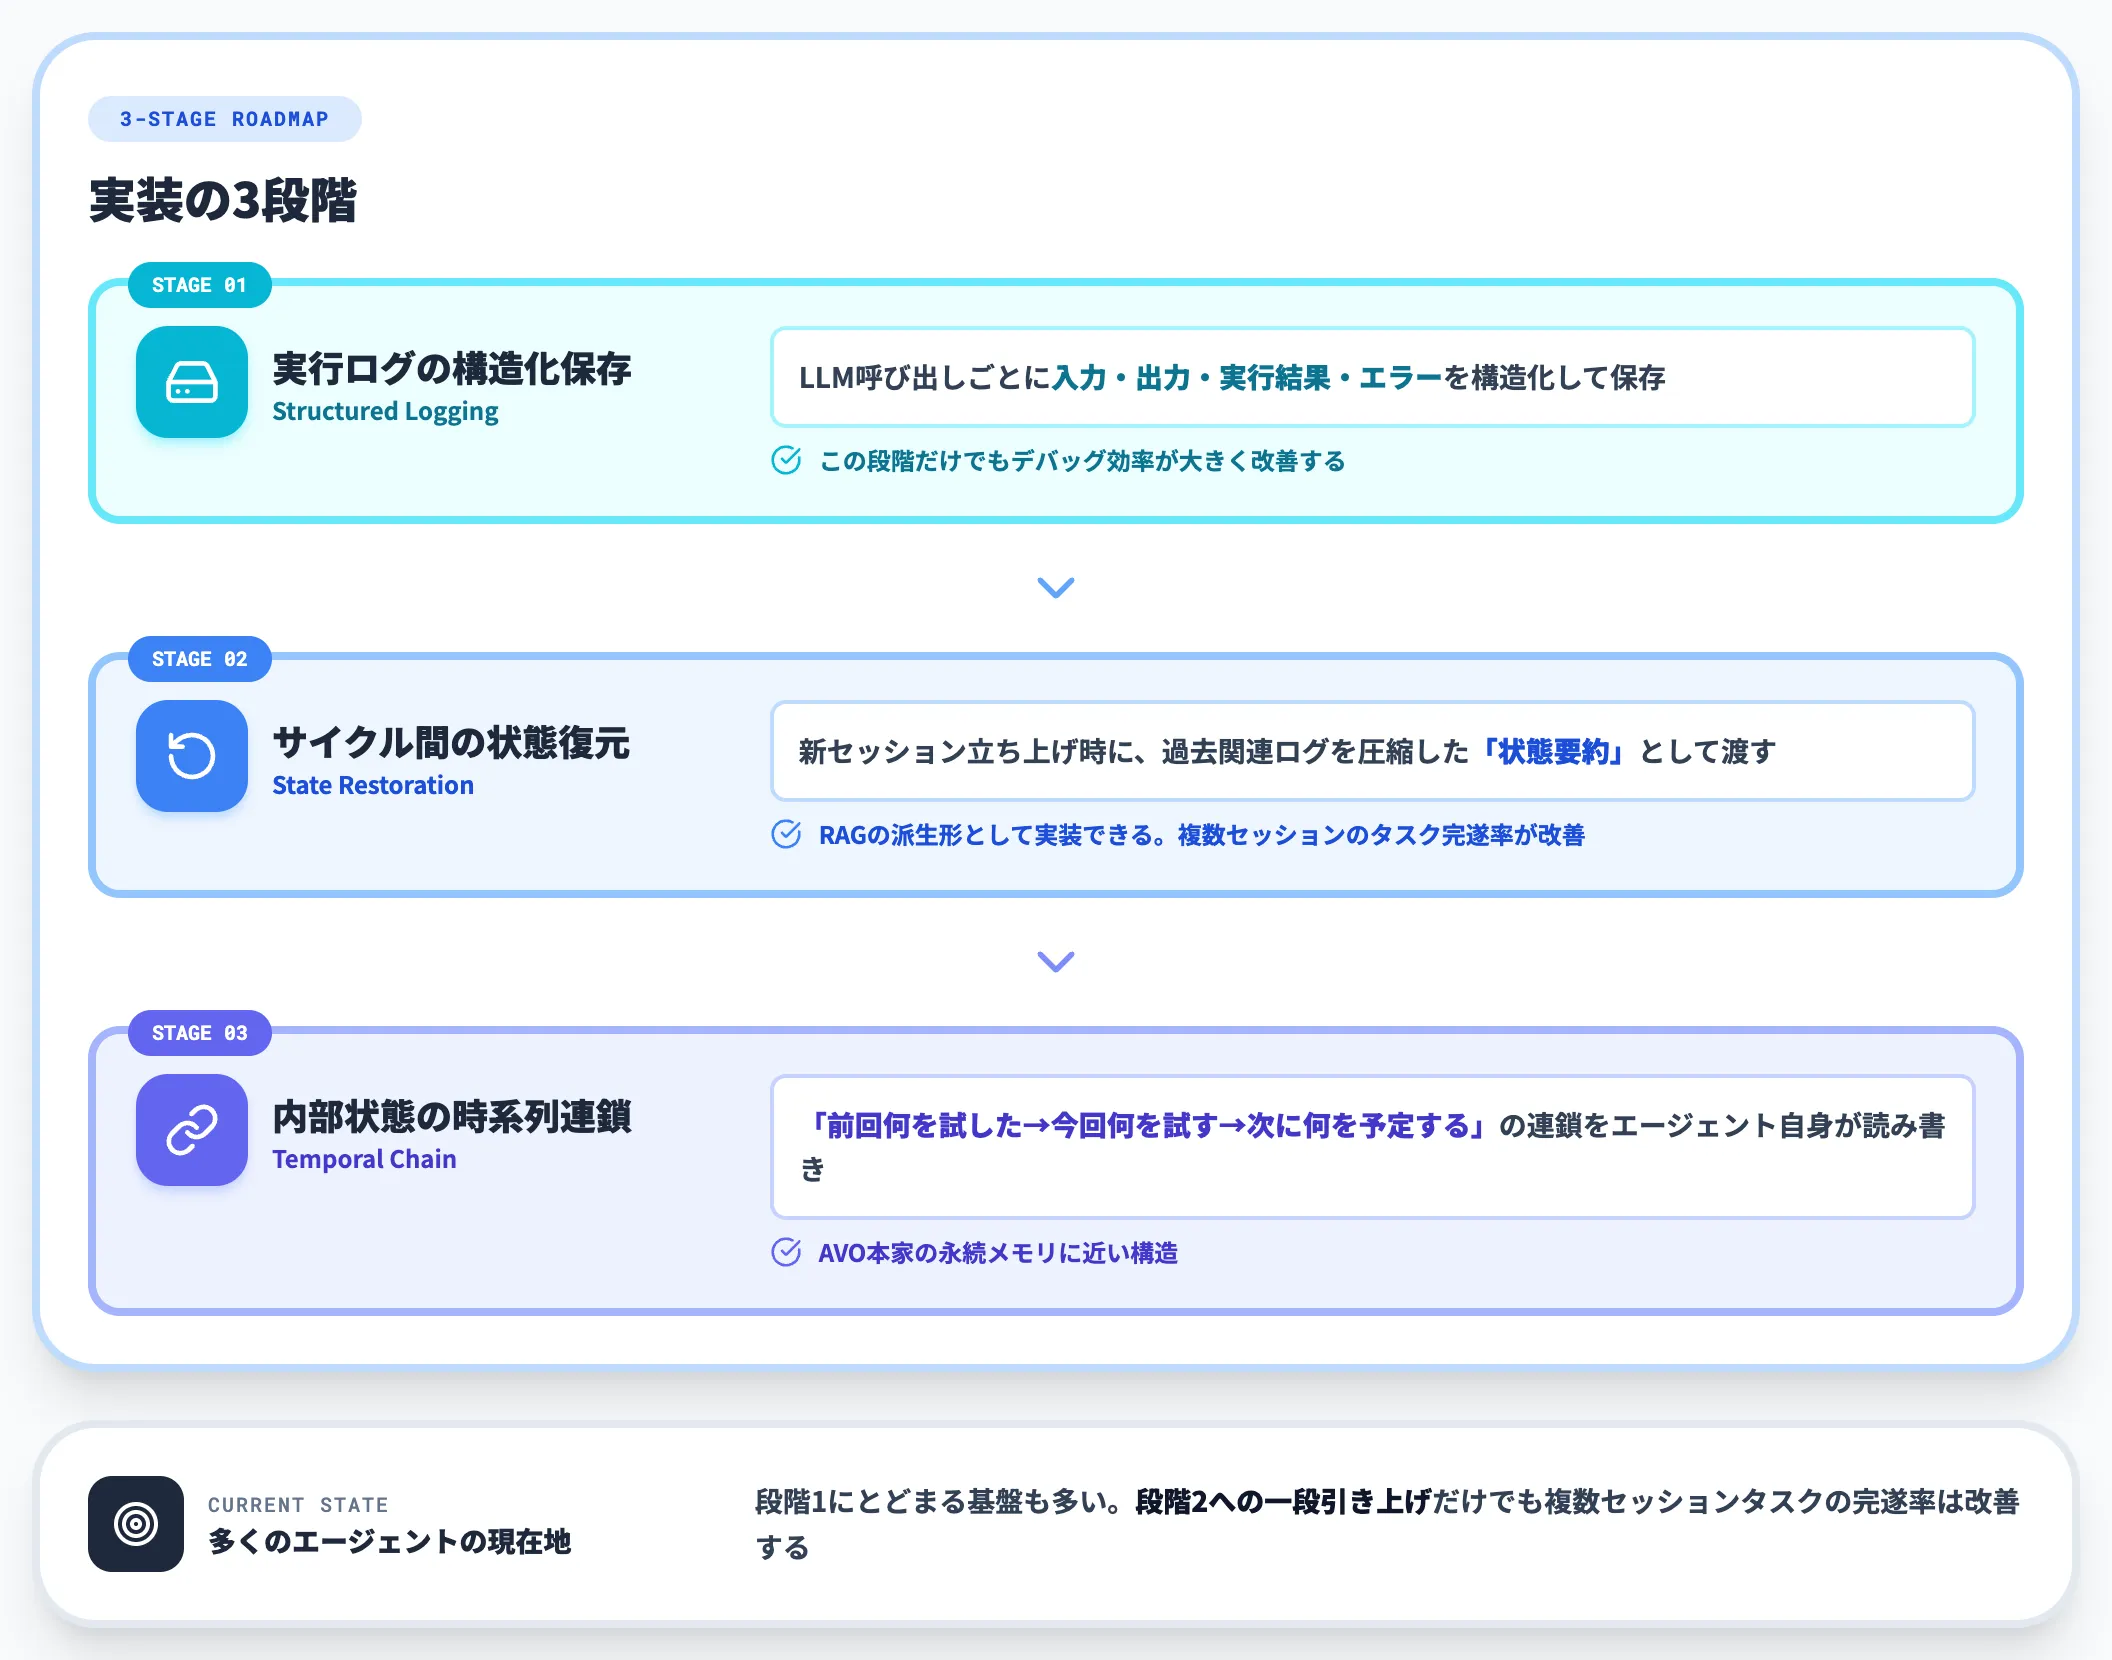
最初に手を付けるべきは、モデル呼び出しの外側にある永続メモリ層です。
現状のLLMベースエージェントの多くは、コンテキストウィンドウ内の会話履歴だけで動いており、セッションが切れれば実装・失敗・学びは全て消えます。
この状態では、AVOの長期運用を支える重要な要素が欠けているため、7日連続稼働のような使い方には踏み出しにくくなります。
実装の優先順位としては次の3段階が現実的です。
-
段階1: 実行ログの構造化保存
LLM呼び出しごとに入力・出力・実行結果・エラーを構造化して保存する。この段階だけでもデバッグ効率が大きく改善する
-
段階2: サイクル間の状態復元
新しいセッションを立ち上げるときに、過去の関連ログを圧縮した「状態要約」として渡す。RAGの派生形として実装できる
-
段階3: 内部状態の時系列連鎖
「前回何を試した→今回何を試す→次に何を予定する」の連鎖をエージェント自身が読み書きできる構造として持たせる
段階1にとどまっている状態のエージェント基盤も多く見られ、段階2への一段引き上げだけでも、複数セッションにまたがるタスクの完遂率が改善するケースがあります。
スーパーバイザー機構を実装する2つの選択肢
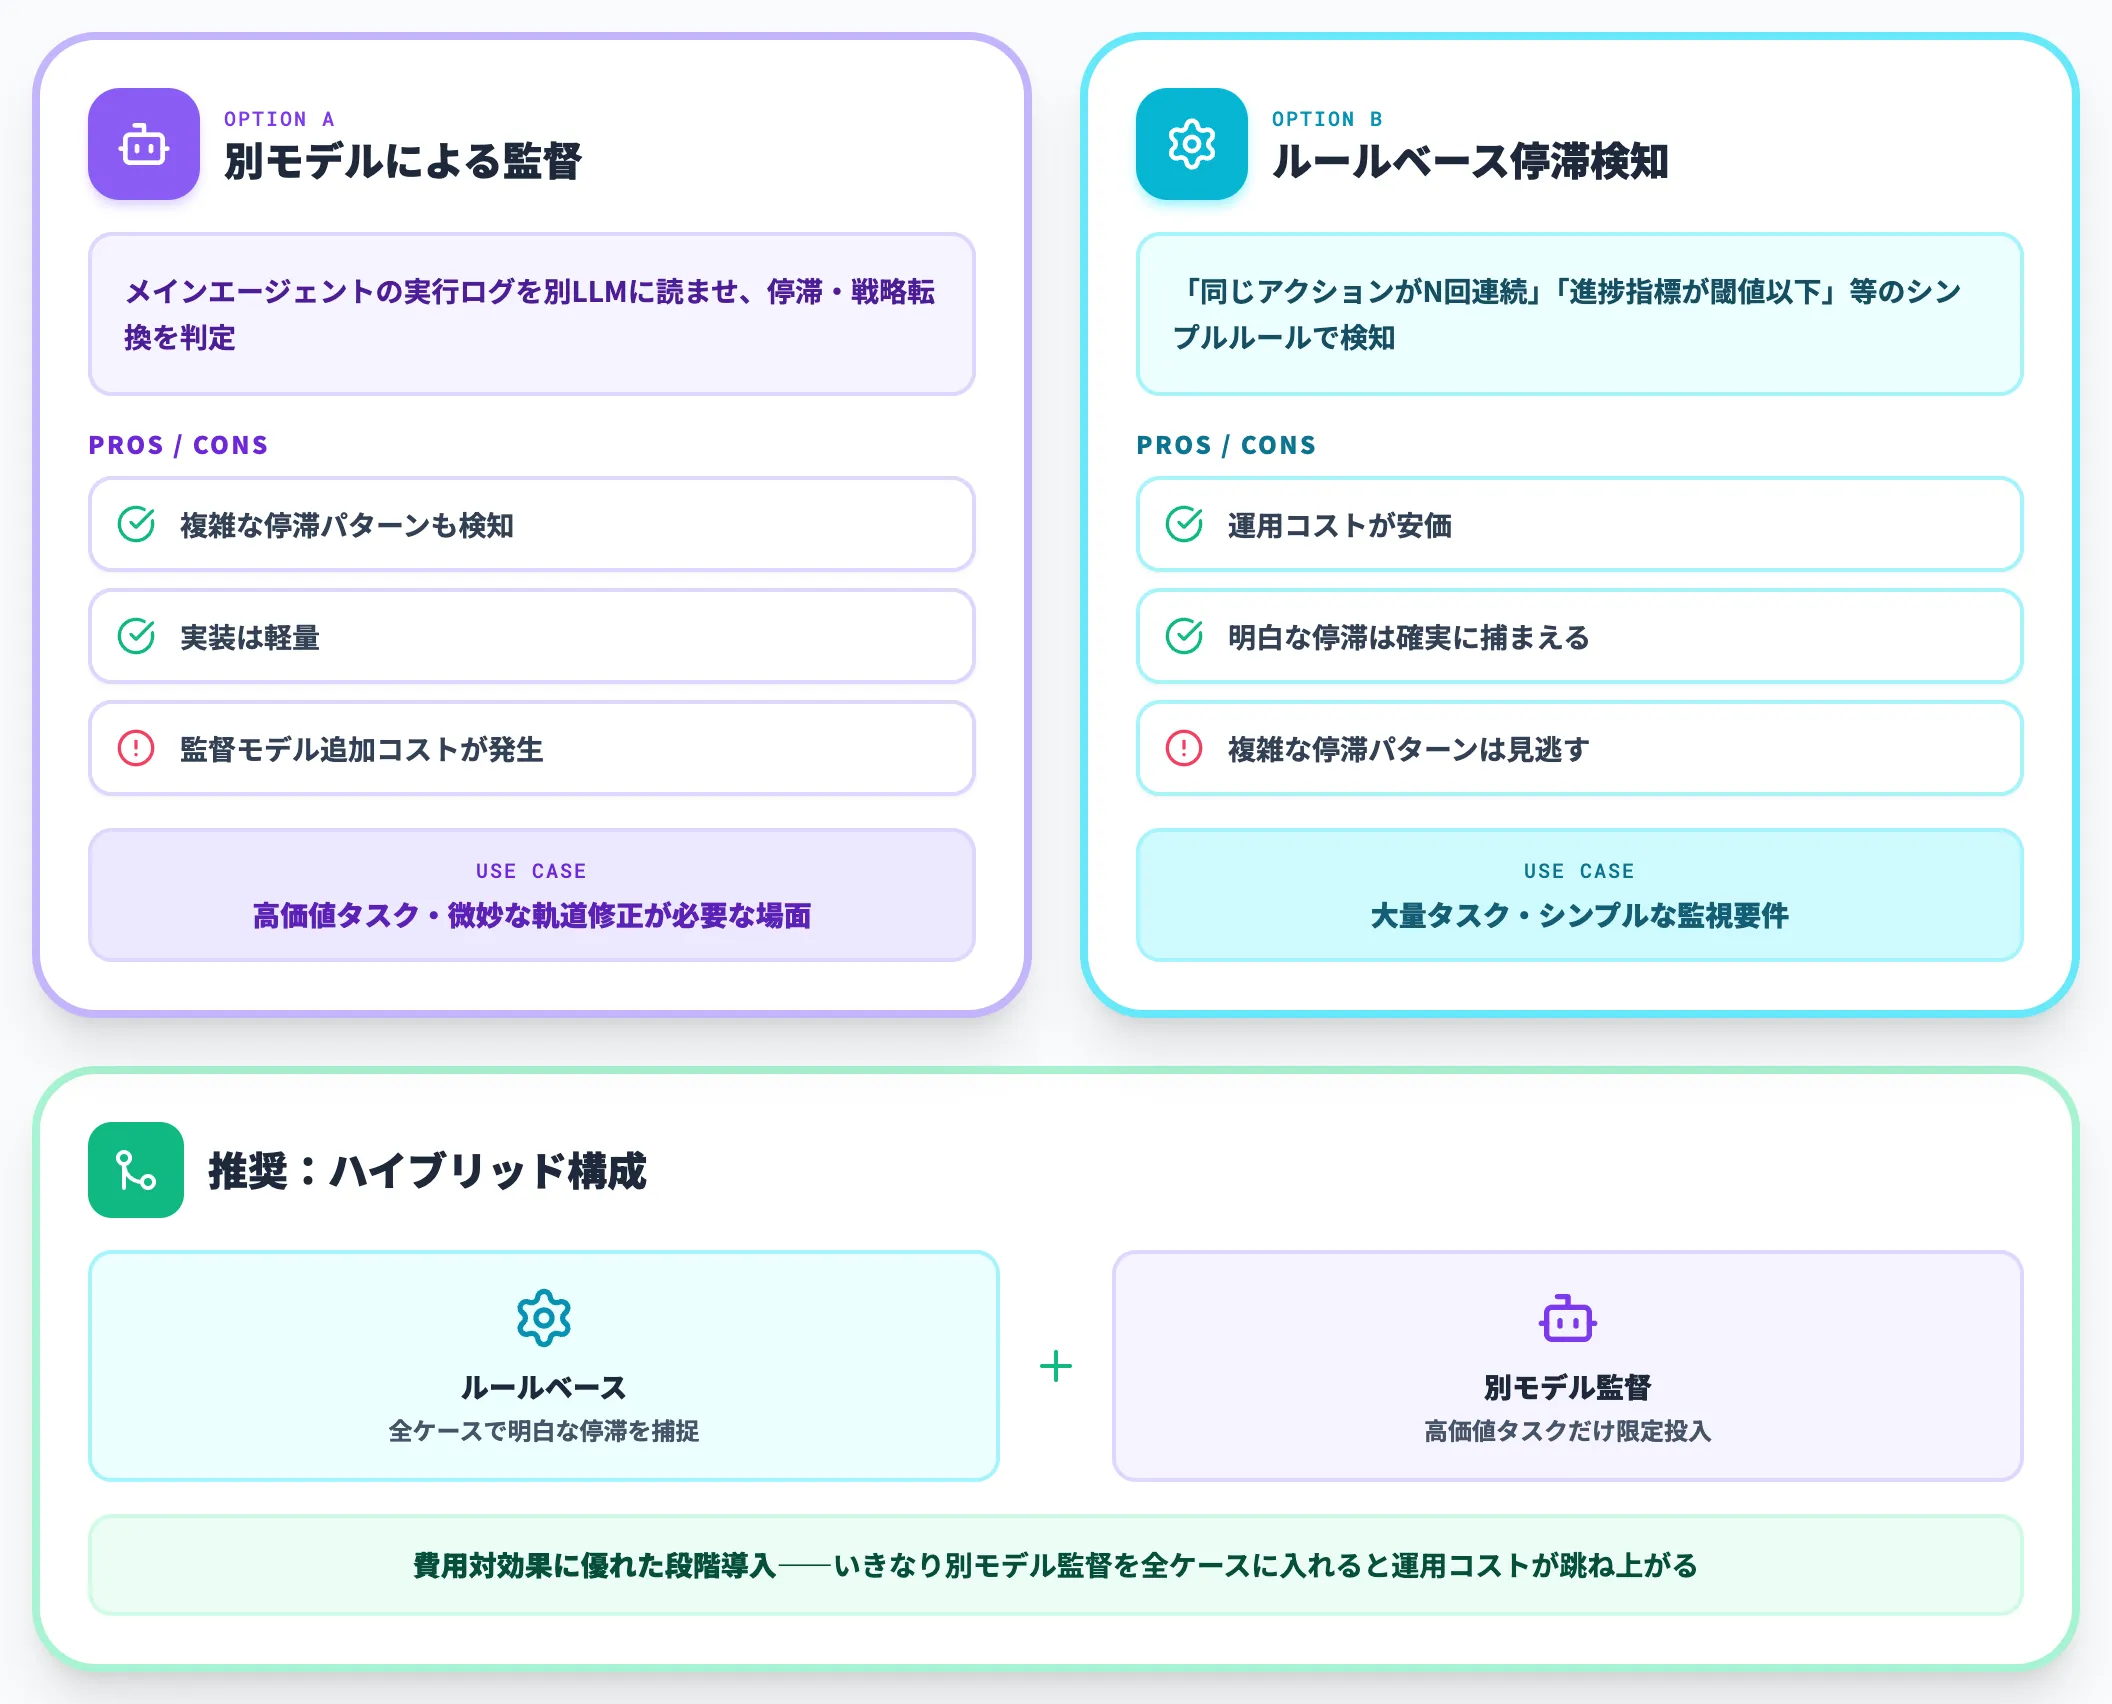
第2に手を付けるべきが、スーパーバイザー機構、すなわち探索の停滞を検知する監督層です。
大きく2つの実装アプローチがあります。
-
別モデルによる監督
メインエージェントの実行ログを別のLLMに定期的に読ませ、「進捗が停滞していないか」「戦略転換が必要か」を判定させる方式。実装は軽いが、監督モデルの追加コストがかかる
-
ルールベースの停滞検知
「同じアクションがN回連続」「進捗指標が閾値以下」などのシンプルなルールでフラグを立てる方式。安価だが、複雑な停滞パターンは見逃しやすい
実務では、ルールベース検知で明白な停滞を捕まえつつ、微妙な軌道修正が必要な場面だけ別モデル監督を呼ぶハイブリッド構成が費用対効果に優れます。いきなり別モデル監督を全ケースに入れると運用コストが跳ね上がるため、段階的な導入が現実解です。
自社エージェント基盤への転移で優先すべき順序
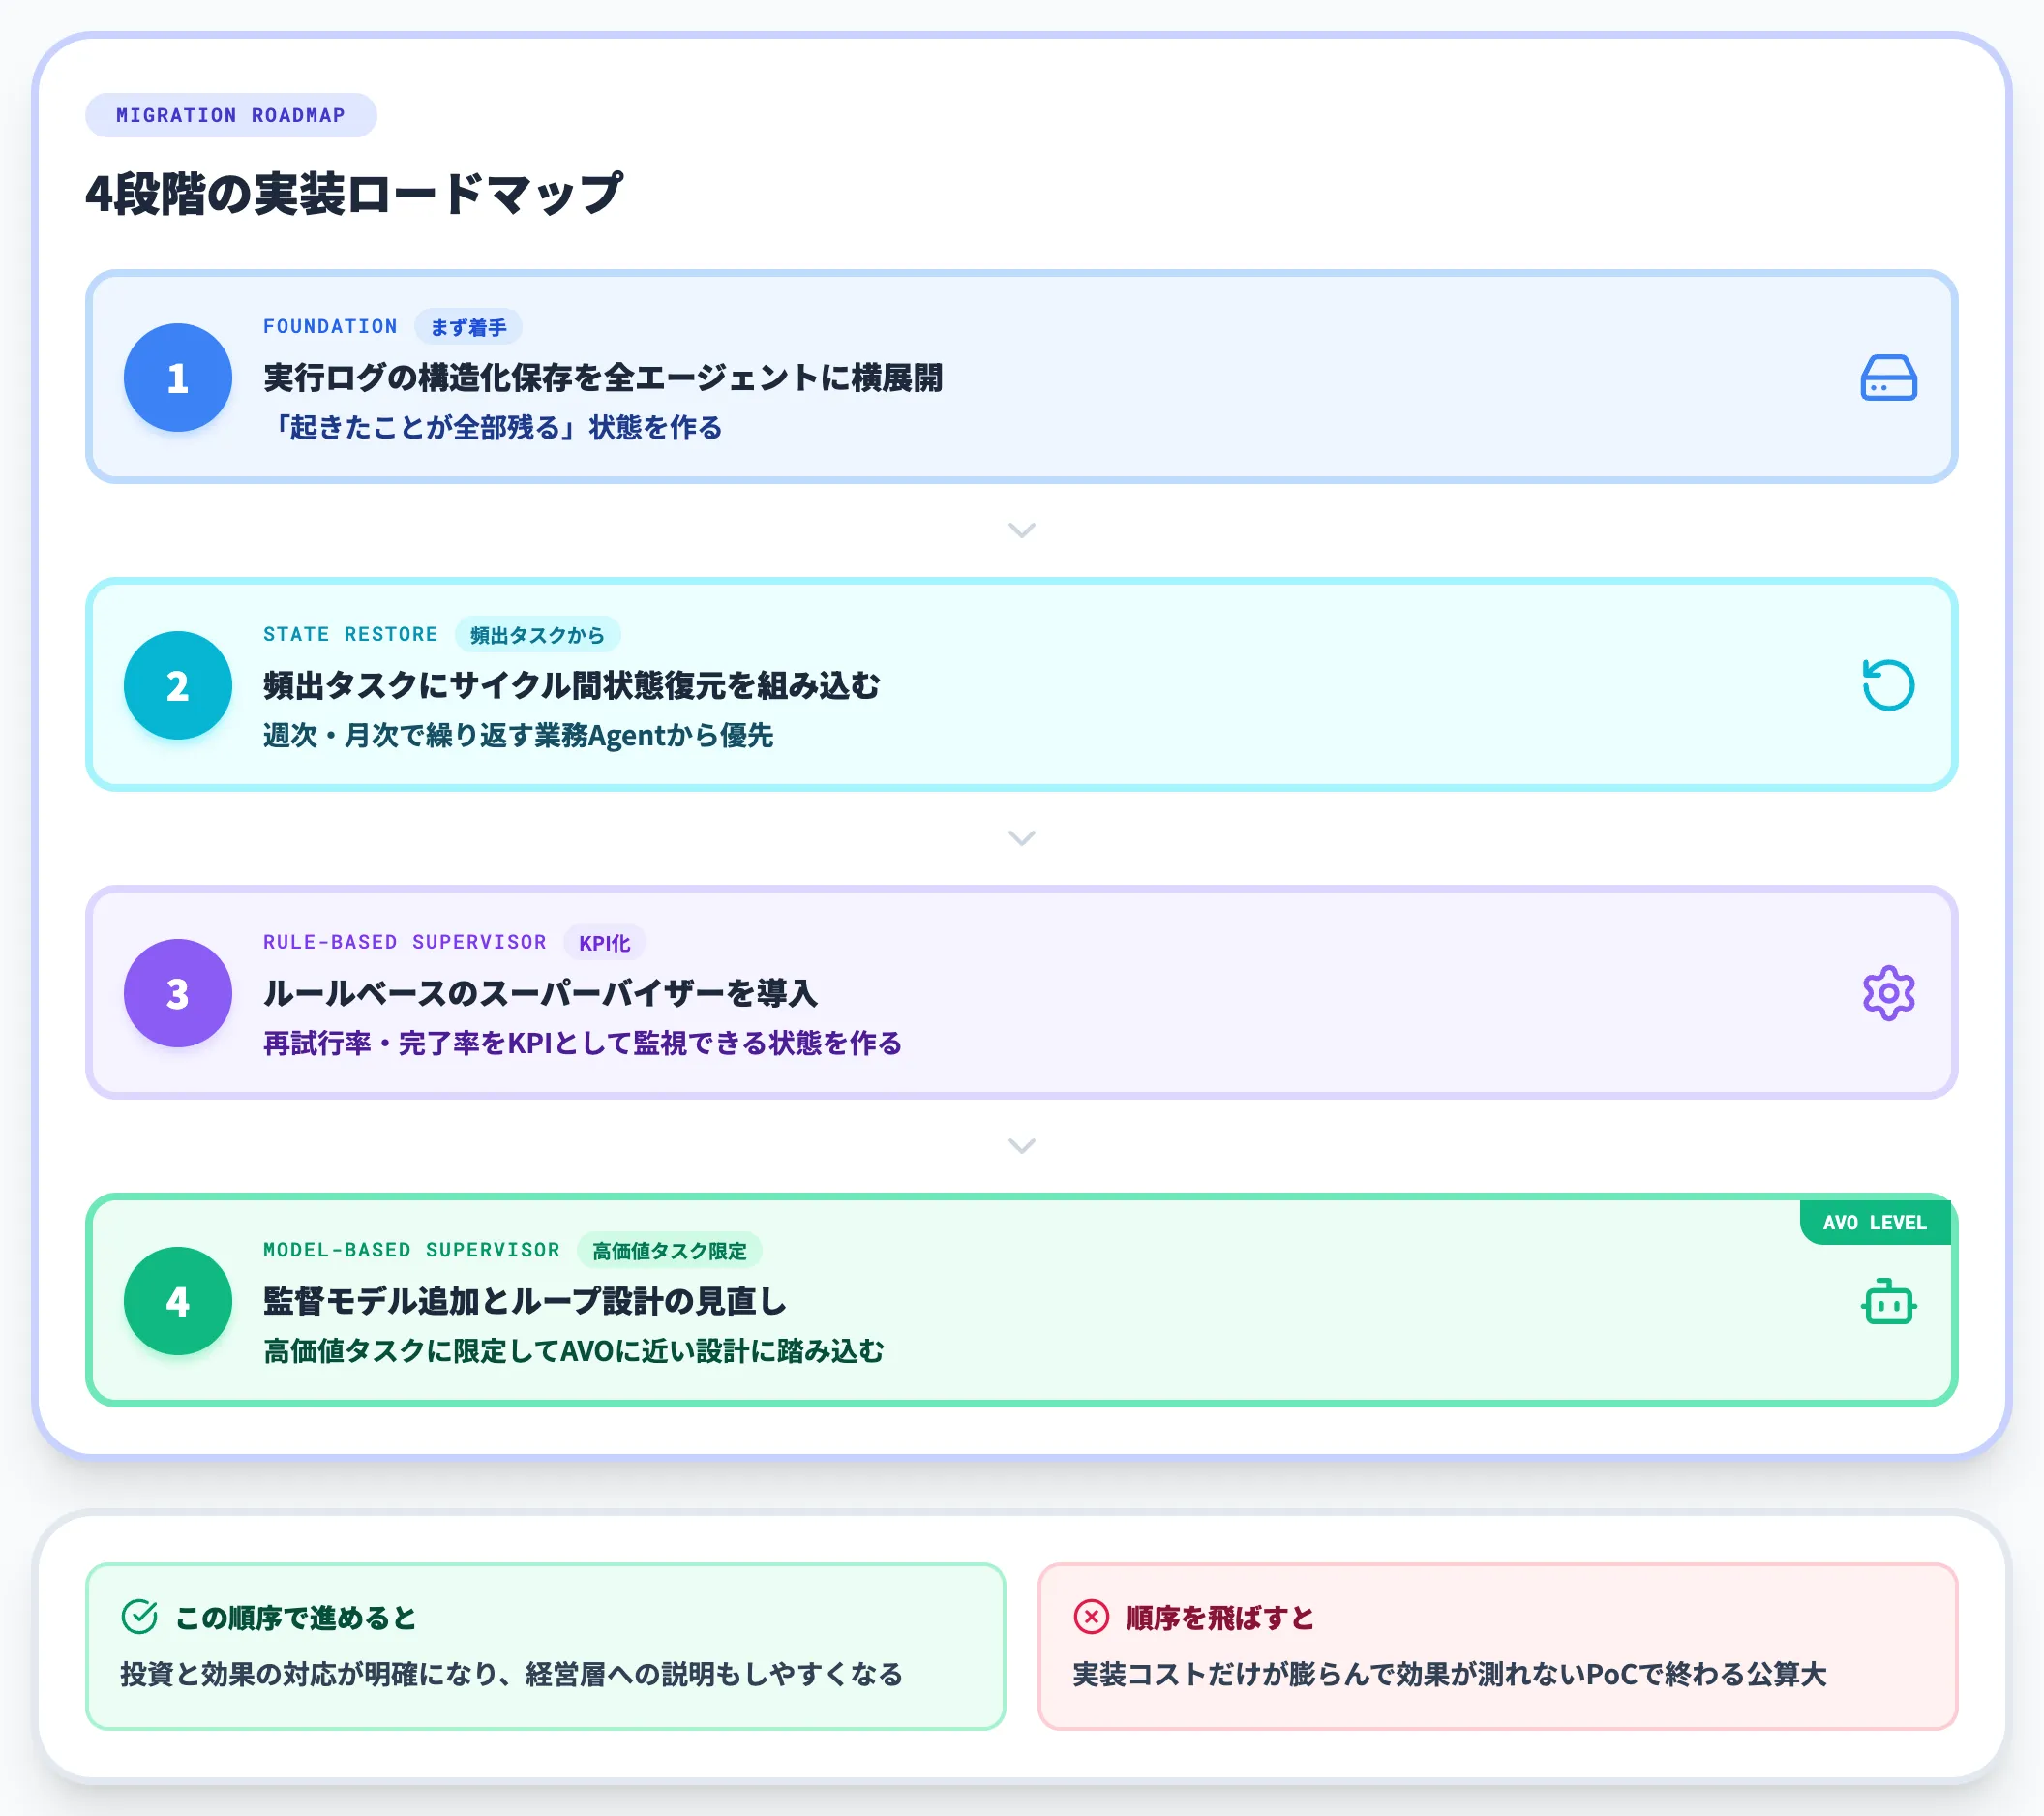
最後に、AVO由来の設計原則を自社エージェントに移す順序を1本の道筋にまとめます。
-
順序1: 実行ログの構造化保存を全エージェントに横展開する
まず「起きたことが全部残る」状態を作る
-
順序2: 頻出タスクにサイクル間状態復元を組み込む
特に週次・月次で繰り返す業務Agentから優先する
-
順序3: ルールベースのスーパーバイザーを導入する
再試行率・完了率をKPIとして監視できる状態を作る
-
順序4: 監督モデル追加とループ設計の見直しを行う
高価値タスクに限定して、AVOに近い設計に踏み込む
この順序で進めると、投資と効果の対応が明確になり、経営層への説明もしやすくなります。逆に、順序を飛ばして最初から「AVO相当のフルスペック」を目指すと、実装コストだけが膨らんで効果が測れないPoCで終わる公算が大きくなります。
社内でエージェント基盤を運用していて、「モデルを最新に上げても業務Agentのタスク完了率がなかなか上がらない」と感じているなら、それはモデルの問題ではなく、周辺構造の設計に投資すべきタイミングというサインかもしれません。
モデルを上げても業務Agentの完了率が伸びないと感じたら
AVO本体はコードやAPIの公式提供が確認できませんが、その設計原則は自社の業務Agentに移せます。移すときの出発点は、実行ログの保存を全エージェントに広げることと、人の介入頻度や再試行率を測れるようにすることです。モデルとハーネスのどちらに投資するかは、この記録がそろって初めて判断できます。
その記録を、実際の業務でAgentを動かしながらそろえていけるのが、自社のAzureテナント内でAgentを一元管理し、Teamsから呼び出せるようにするAI Agent Hubです。
- 全Agentの実行を同じ形で記録
どの部署で作ったAgentも1つのダッシュボードに集まるため、記録の取り方がAgentごとにばらつかず、誰がどのAgentで何を処理したかを同じ形で追えます。
- 人の介入を承認フローに組み込む
Agentの判定に対して担当者がTeamsで承認・差し戻しをする流れを組めるので、人がどの場面で何回介入したかも履歴から数えられます。
- 月次で繰り返す業務から始められる
経費申請や請求書の受領には専用のAgentがあるため、頻度が高く効果を測りやすい週次・月次の定型業務から手を付けられます。
AI総合研究所の専任チームが、どの業務から記録と承認をそろえるかの設計から、効果を測れるかたちでの本番運用まで伴走します。
業務Agentの足回りから整える

実行ログと承認の記録を先にそろえる
AVOの設計原則を業務Agentに移すなら、モデルを替える前に、実行ログと人の承認の記録をそろえておくと投資先を判断しやすくなります。AI Agent Hubのサービスページでは、バックオフィスやERP連携の業務Agentをデモで確かめられます。
まとめ|NVIDIA AVOをどう受け止め、自社にどう活かすか
本記事では、NVIDIA AVO(Agentic Variation Operators)を「進化的探索×自律コーディングエージェント」の融合として定義し、3つの中核メカニズム・GPUカーネル最適化とARC-AGI-3の実績・「モデル選定よりハーネス設計」への転換・限界・実務者への設計原則までを整理しました。
2026年8月時点で押さえておくべきポイントは次の3つです。
- AVOは既存のLLMを外側から包むハーネスの設計であり、中核のループを変えずにGPUカーネル最適化とARC-AGI-3の両方で結果を出した
- AVO本体は公式のコードもAPIも確認できないため、実務では永続メモリ・スーパーバイザー・反復ループの設計原則を自社エージェントに移すのが現実的
- ARC-AGI-3の100%はpublic set限定・独自再実装での結果で、Claude Opus 5単独の約30%との差をAVOの効果とは言い切れない
実務者としての次の一歩は、AVOそのものを追いかけるより、自社の業務Agentが今どの段階で止まっているかを棚卸しし、次の1段階に投資判断を集中させることです。
まずは全エージェントの実行ログを構造化して残し、そのうえで週次・月次で繰り返す業務Agentからサイクル間の状態復元を組み込みます。
続いて、ルールベースのスーパーバイザーで再試行率と完了率を監視し、改善を確かめてから高価値タスクに限って監督モデルの追加とループ設計の見直しに進むのが、投資と効果を対応づけやすい順序です。
AVOが突きつけたのは、議論の重心をモデルの選定から、モデルを包む足回りの設計へ移すべきだというメッセージです。
AI総合研究所の支援経験からも、足回りを段階的に整えるアプローチが「モデル差し替えでは超えられなかった壁」を最も安く越える道筋になっています。