この記事のポイント
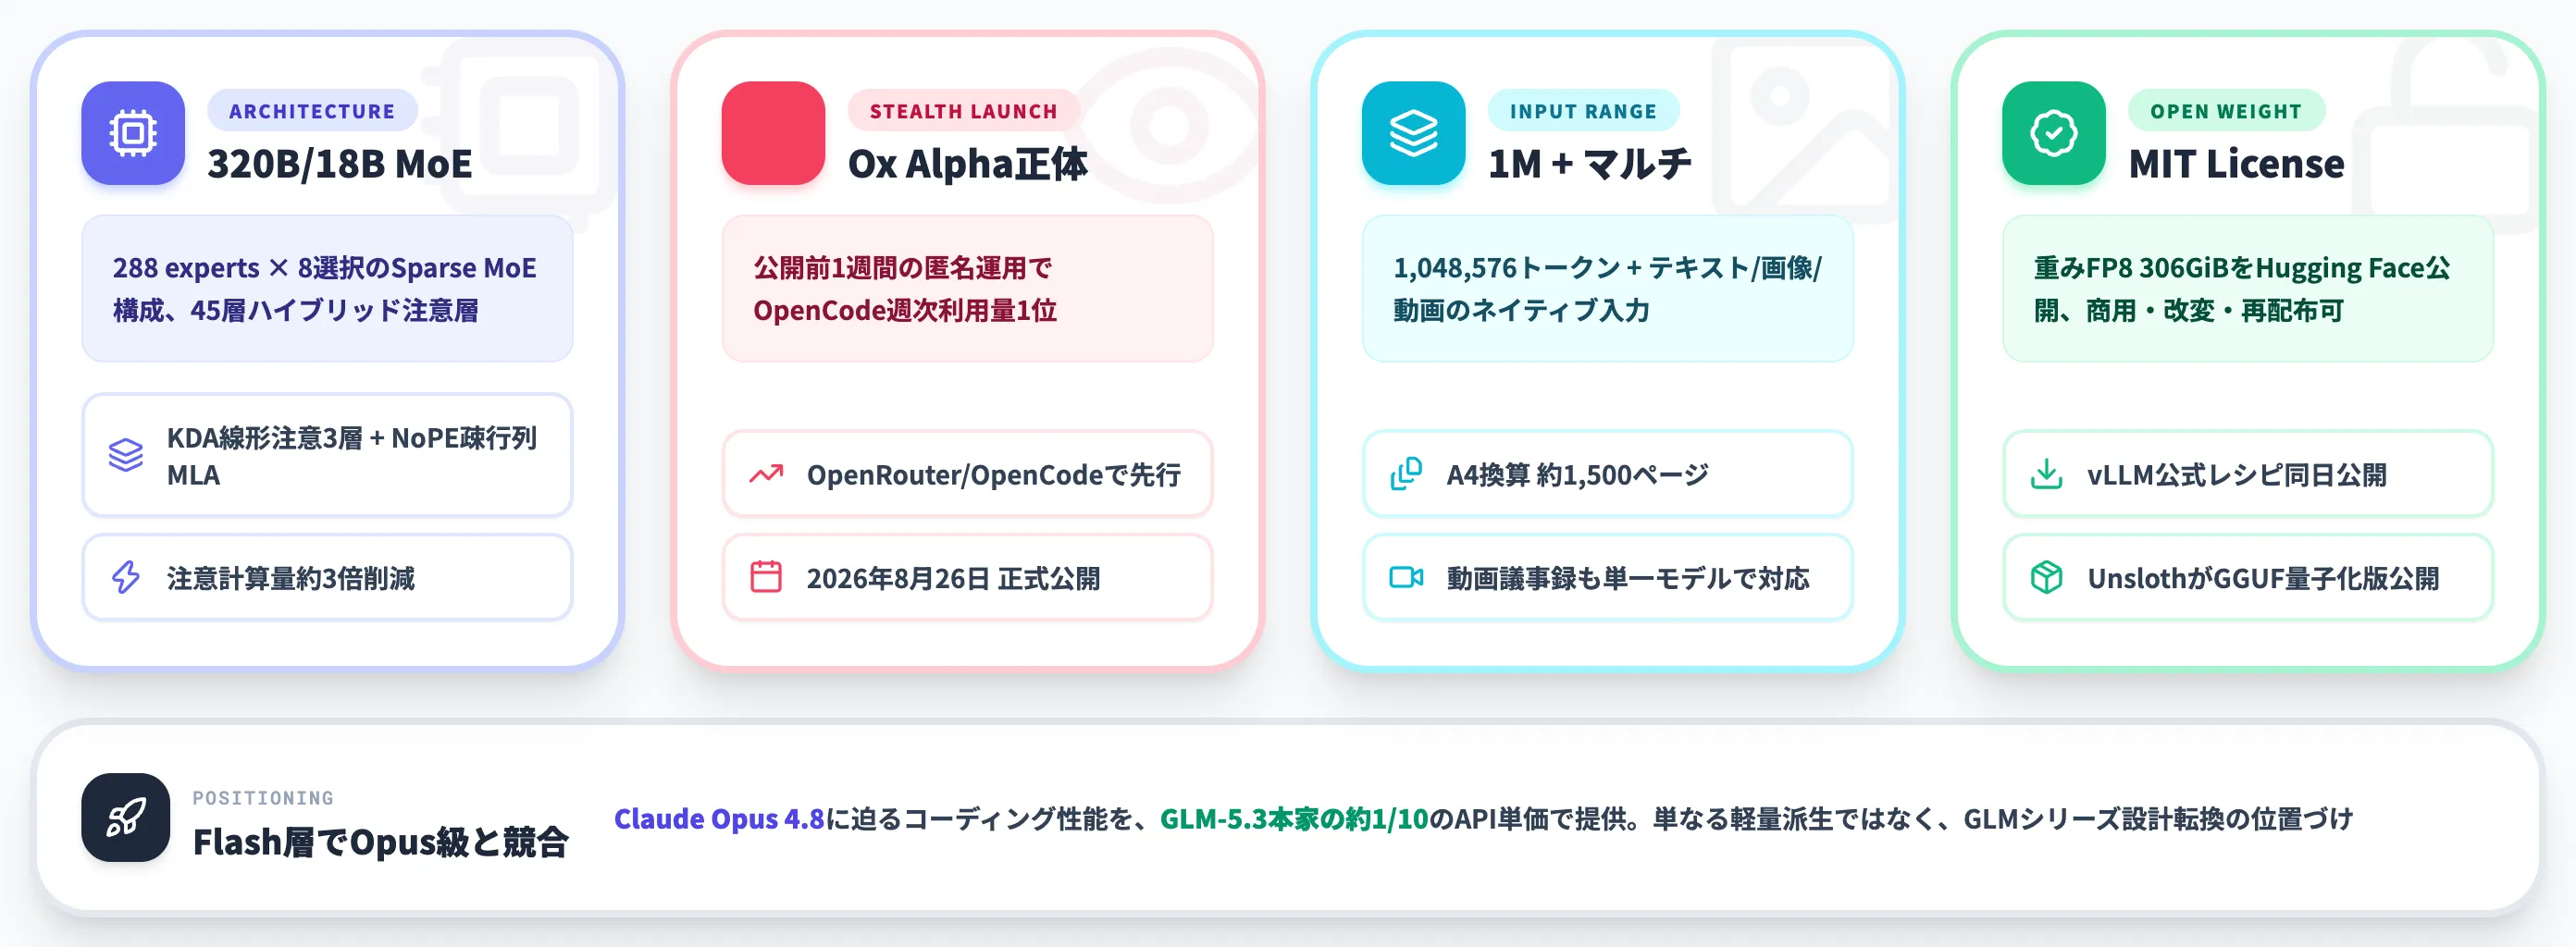
 Ox Alphaの正体はGLM-5.3-Flash、公開前の1週間の匿名運用でOpenCodeの直近週利用量1位を記録
- 320B/18B MoEでKDA線形注意3層+NoPE疎行列MLA 1層の周期配置を採用、1Mコンテキスト・ネイティブマルチモーダル入力
- API $0.15/$0.50でGLM-5.3本家の約1/10、初期50%割引期間は$0.075/$0.25、キャッシュ入力$0.03
- Terminal-Bench 84.3・Z.ai Code Bench 29.0でClaude Opus 4.8に肉薄、AA Intelligence Indexは同クラス3位
- MITライセンスでHugging Face公開、Claude Code・Cline・OpenCode等主要コーディングエージェントに公式手順で接続
Microsoft MVP・AIパートナー。LinkX Japan株式会社 代表取締役。東京工業大学大学院にて自然言語処理・金融工学を研究。NHK放送技術研究所でAI・ブロックチェーンの研究開発に従事し、国際学会・ジャーナルでの発表多数。経営情報学会 優秀賞受賞。シンガポールでWeb3企業を創業後、現在は企業向けAI導入・DX推進を支援。
GLM-5.3-Flashは、Zhipu AI(Z.ai)が2026年8月26日に公開した、320B総パラメータ・18Bアクティブのマルチモーダル・オープンMoEモデルです。
公開前の1週間、"Ox Alpha"というコードネームでOpenRouter/OpenCodeに匿名提供され、OpenCodeの直近週利用量で1位を記録しました。
正体判明後は、Claude Opus 4.8に迫るコーディング・エージェント性能をGLM-5.3本家の約1/10のAPI単価で提供する構成となり、MITライセンスで重みも公開されています。
本記事では、GLM-5.3-Flashのアーキテクチャ・性能ベンチマーク・料金体系・Claude CodeやClineでの統合手順・GLM-5.3本家や他中華Flash系との使い分けを、2026年8月時点の一次情報で整理します。
目次
GLM-5.3-Flashとは?Ox Alphaの正体として公開された320Bマルチモーダル・オープンMoEモデル
GLM-5.3-Flashのベンチマーク性能——Claude Opus 4.8に肉薄
GLM-5.3-FlashをClaude Code・Cline・OpenCodeで使う方法
GLM-5.3-Flashと他モデルの使い分け——GLM-5.3本家・Qwen3.8-Flash-Next・DeepSeek V4-Pro
GLM-5.3-Flashとは?Ox Alphaの正体として公開された320Bマルチモーダル・オープンMoEモデル
GLM-5.3-Flashのローンチキービジュアル——320B総/18Bアクティブ、1Mコンテキスト、ネイティブマルチモーダル(出典:MarkTechPost)
GLM-5.3-Flash(ジーエルエム・ゴーテンサン・フラッシュ)とは、Zhipu AIが2026年8月26日に公開した、GLM-5系で初めてネイティブにマルチモーダル対応したオープンMoEモデルです。
総パラメータ320B・アクティブパラメータ18BのMoE(Mixture-of-Experts、専門家混合)構成で、1,048,576トークン(約1M)のコンテキスト長と、テキスト・画像・動画の入力に対応します。
正式リリース前の1週間、GLM-5.3-Flashは"Ox Alpha"というコードネームでOpenRouter/OpenCodeに匿名提供されており、Z.ai公式ブログによれば、OpenCodeの直近週利用量で1位を記録しました。
Zhipu AIは同時に、Apache/MIT系の中でも最も緩いMITライセンスでモデル重みをHugging Faceの公式リポジトリに公開しており、商用利用・改変・再配布のすべてが許諾されています。
Zhipu AIのFlash層としての立ち位置
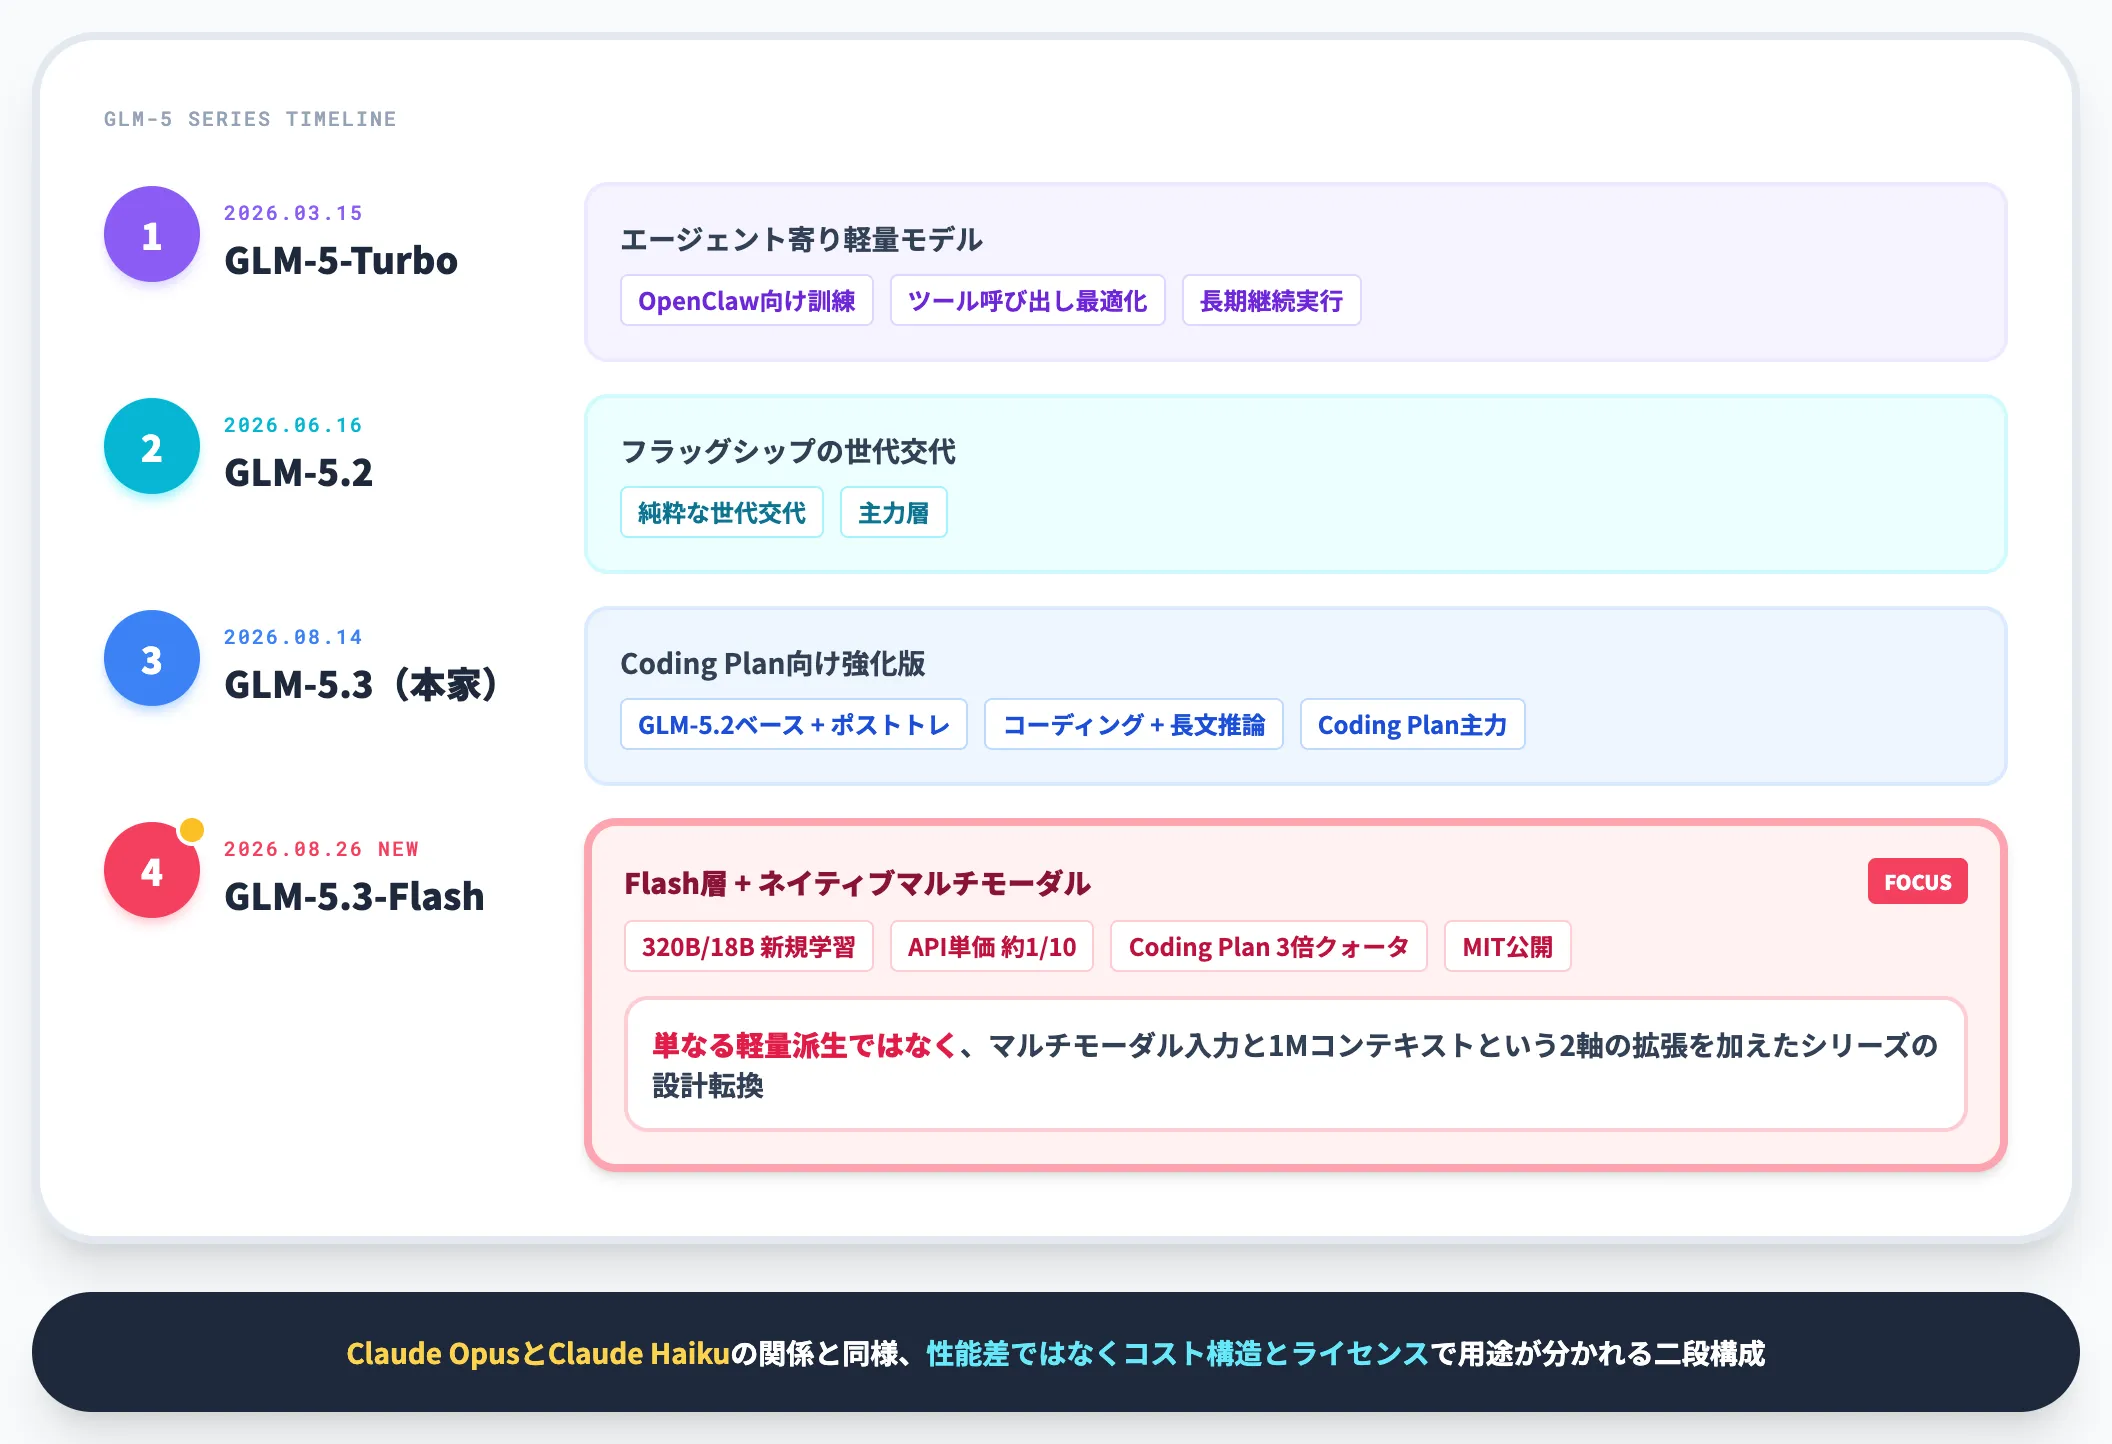
GLM-5系は、Zhipu AIが2026年上期から続けてリリースしているオープンMoEシリーズで、GLM-5.3-Flashは以下の系譜の中で「フラッシュ層」として位置づけられます。
-
GLM-5.2
2026年6月16日リリースのフラッグシップ。以前のGLM系からの純粋な世代交代。
-
GLM-5.3(本家)
2026年8月14日リリース。GLM-5.2と同一ベースモデルにポストトレーニングを重ねた強化版で、コーディングと長文推論を主な改善対象としたCoding Plan向けの主力モデル。
-
GLM-5-Turbo
2026年3月15日リリース。OpenClaw向けに訓練段階から最適化された、ツール呼び出し・長期継続・長チェーン実行向けのエージェント寄りモデル。
-
GLM-5.3-Flash
2026年8月26日リリース。GLM-5系で新規に学習された320B/18Bのベースモデルで、GLM-5系初のネイティブマルチモーダル対応。API単価は本家の約1/10、GLM Coding Planでは標準クォータの3倍で提供される。
GLM-5.3-Flashは、GLM-5.2を上回りClaude Opus 4.8に迫るコーディング・エージェント性能を、GLM-5.3の約1/10の標準API単価で提供し、MITライセンスで公開されています。
GLM-5.3-Flashはこの流れを引き継ぎつつ、マルチモーダル入力と1Mコンテキストという2軸の拡張を加えた点で、単なる軽量派生ではなく系全体の設計転換を含んでいます。
GLM-5.3-Flashのアーキテクチャと主要スペック
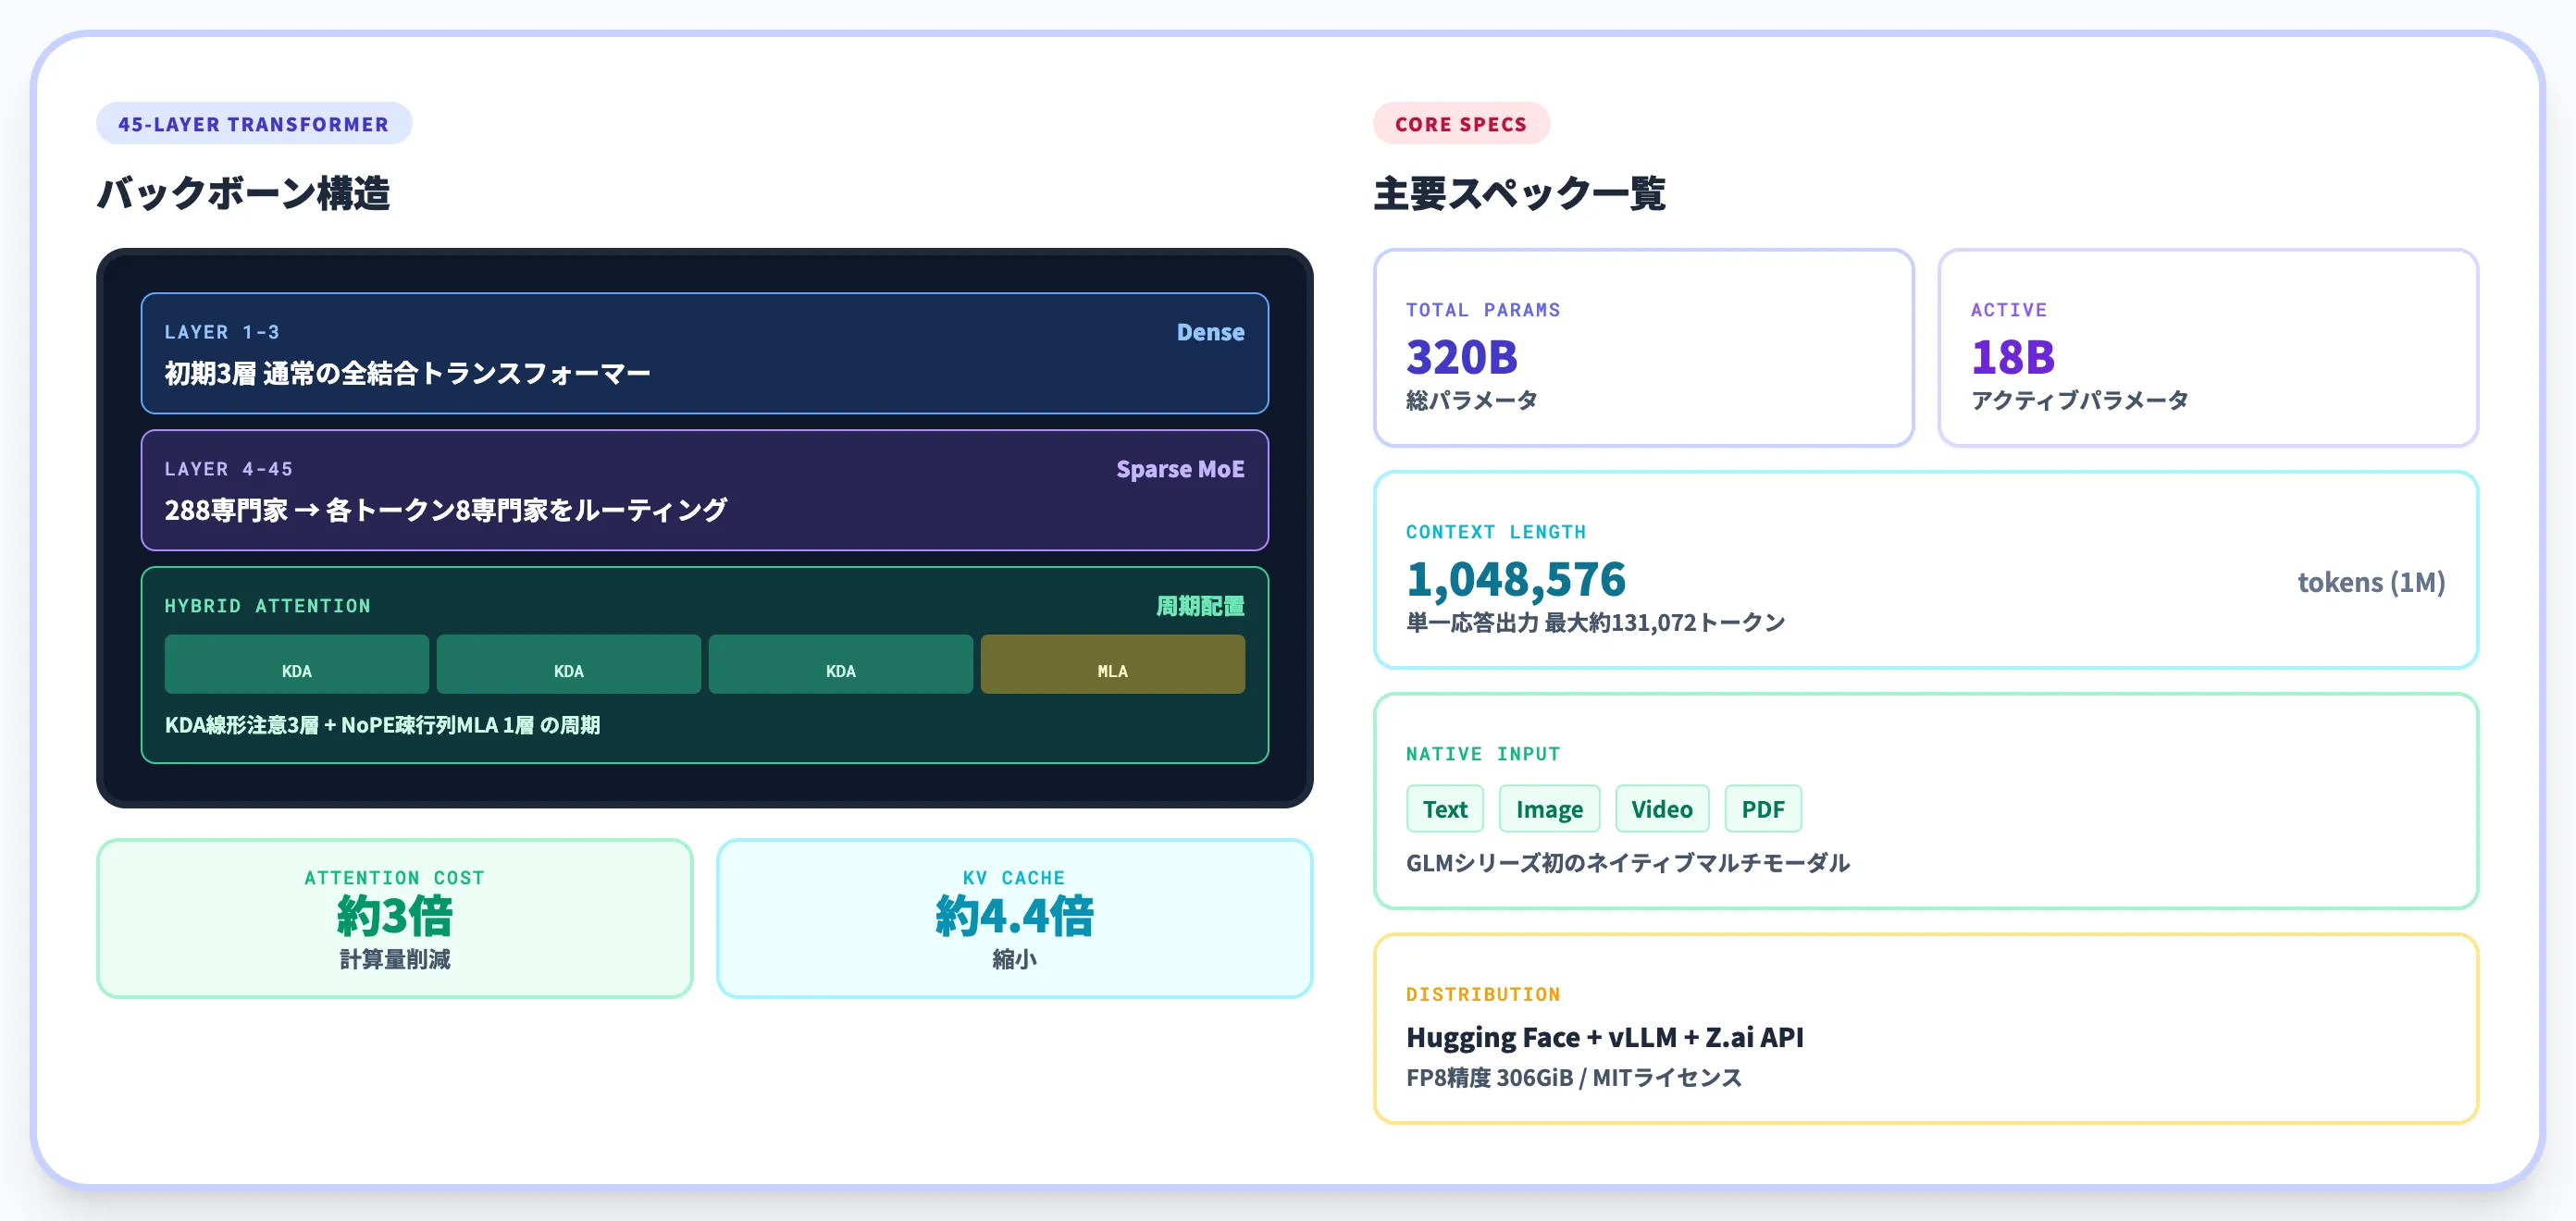
ここからは、GLM-5.3-Flashの内部構造とスペックを、Z.ai公式ブログ・公式モデルカードとArtificial Analysisの第三者計測を突き合わせながら整理します。
Zhipu AIは、GLM-5.3-Flashを「GLMシリーズで初めて、疎行列注意と線形注意を組み合わせたハイブリッド構成を採用したモデル」として位置づけており、単なるMoEのスケール拡張とは別軸の設計変更が入っています。
320B/18B MoEとハイブリッド注意層の設計
GLM-5.3-Flashのバックボーンは45層のトランスフォーマーで、最初の3層はDense、以降のSparse MoE層では288の専門家(experts)から各トークン8専門家がルーティングされます。
注意機構では、KDA線形注意3層とNoPE疎行列MLA 1層を周期的に配置する「Hybrid Attention」構成が採用されています。この配置により、長コンテキスト時の計算量とKVキャッシュサイズが従来のGLM-5系と比べて大きく圧縮されました。
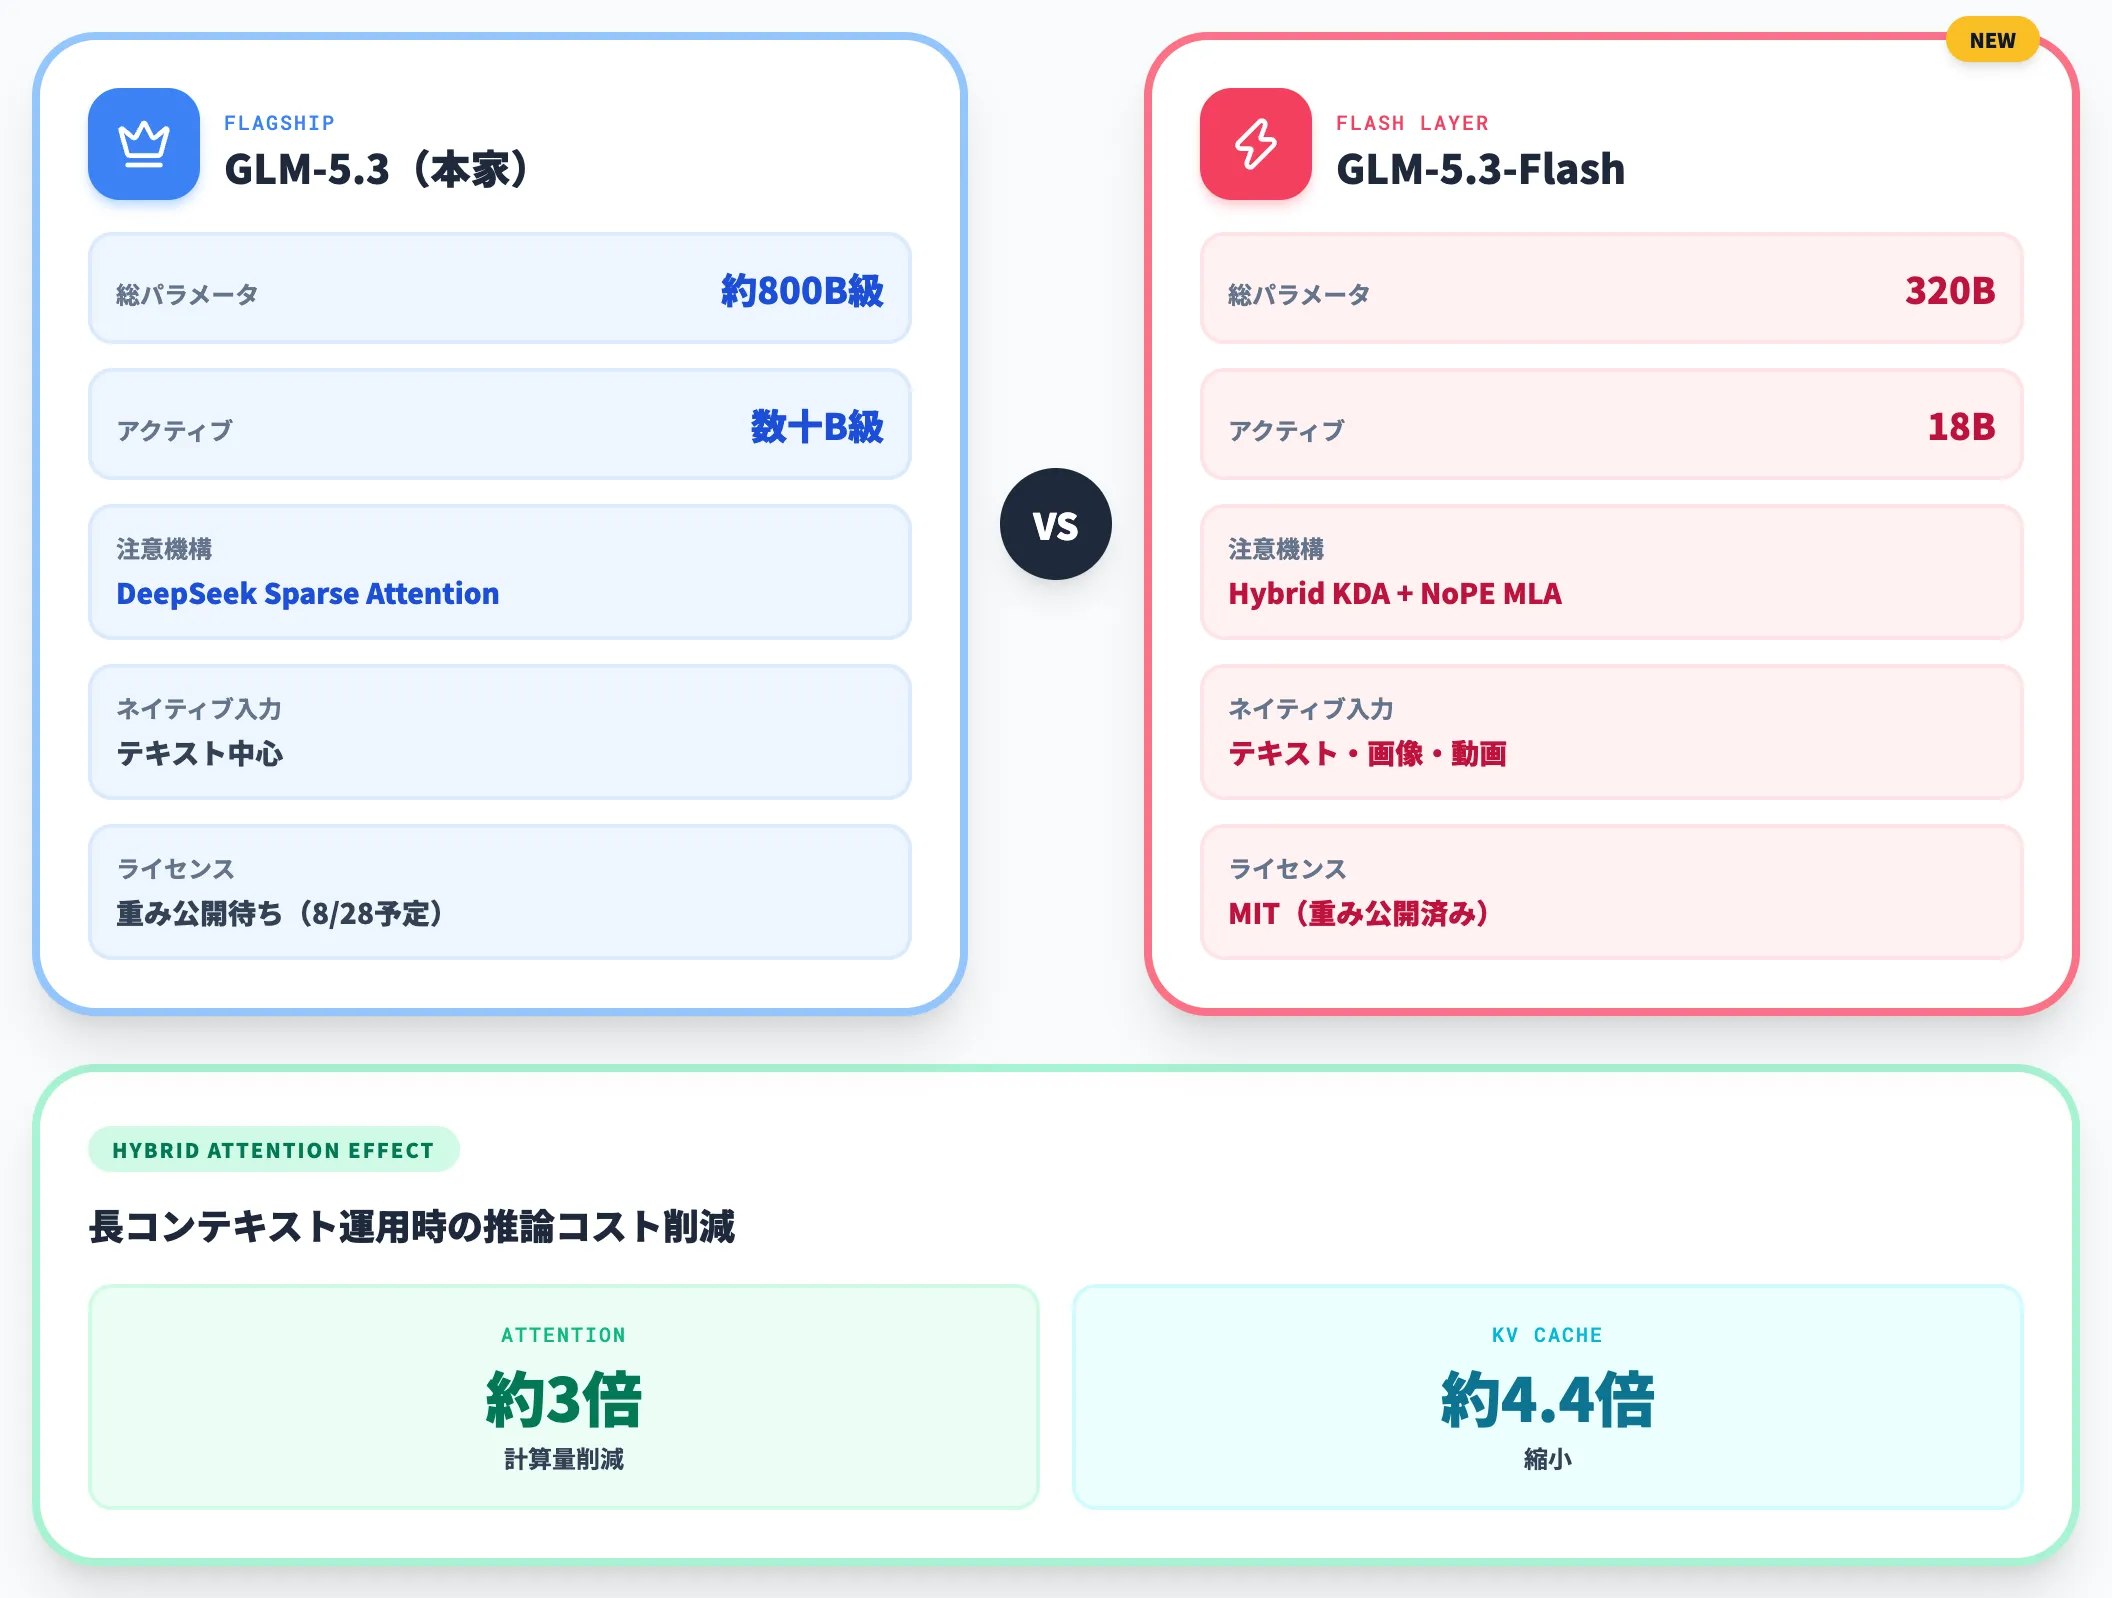
以下の表で、GLM-5.3本家との主要スペック差分を整理しました。
| 項目 | GLM-5.3(本家) | GLM-5.3-Flash |
|---|---|---|
| 総パラメータ | 約800B級 | 320B |
| アクティブパラメータ | 数十B級 | 18B |
| 注意機構 | DeepSeek Sparse Attention(DSA) | Hybrid(KDA linear + NoPE sparse MLA) |
| コンテキスト長 | 1M | 1,048,576(1M) |
| ネイティブ入力 | テキスト中心 | テキスト・画像・動画 |
| ライセンス | 重み公開待ち(2026年8月28日予定)・ライセンス未掲示 | MIT |
特に注意計算量が約3倍削減、KVキャッシュが約4.4倍縮小されているという公式の記述は、長コンテキスト運用時の推論コストに直接効く数字です。
1Mコンテキストのモデルは他ベンダーにも複数存在しますが、それを「サービス提供事業者側の推論コストが乗るライン」まで下げてきた点が、GLM-5.3-Flashの技術的な差別化ポイントになっています。
1Mコンテキストとマルチモーダル対応
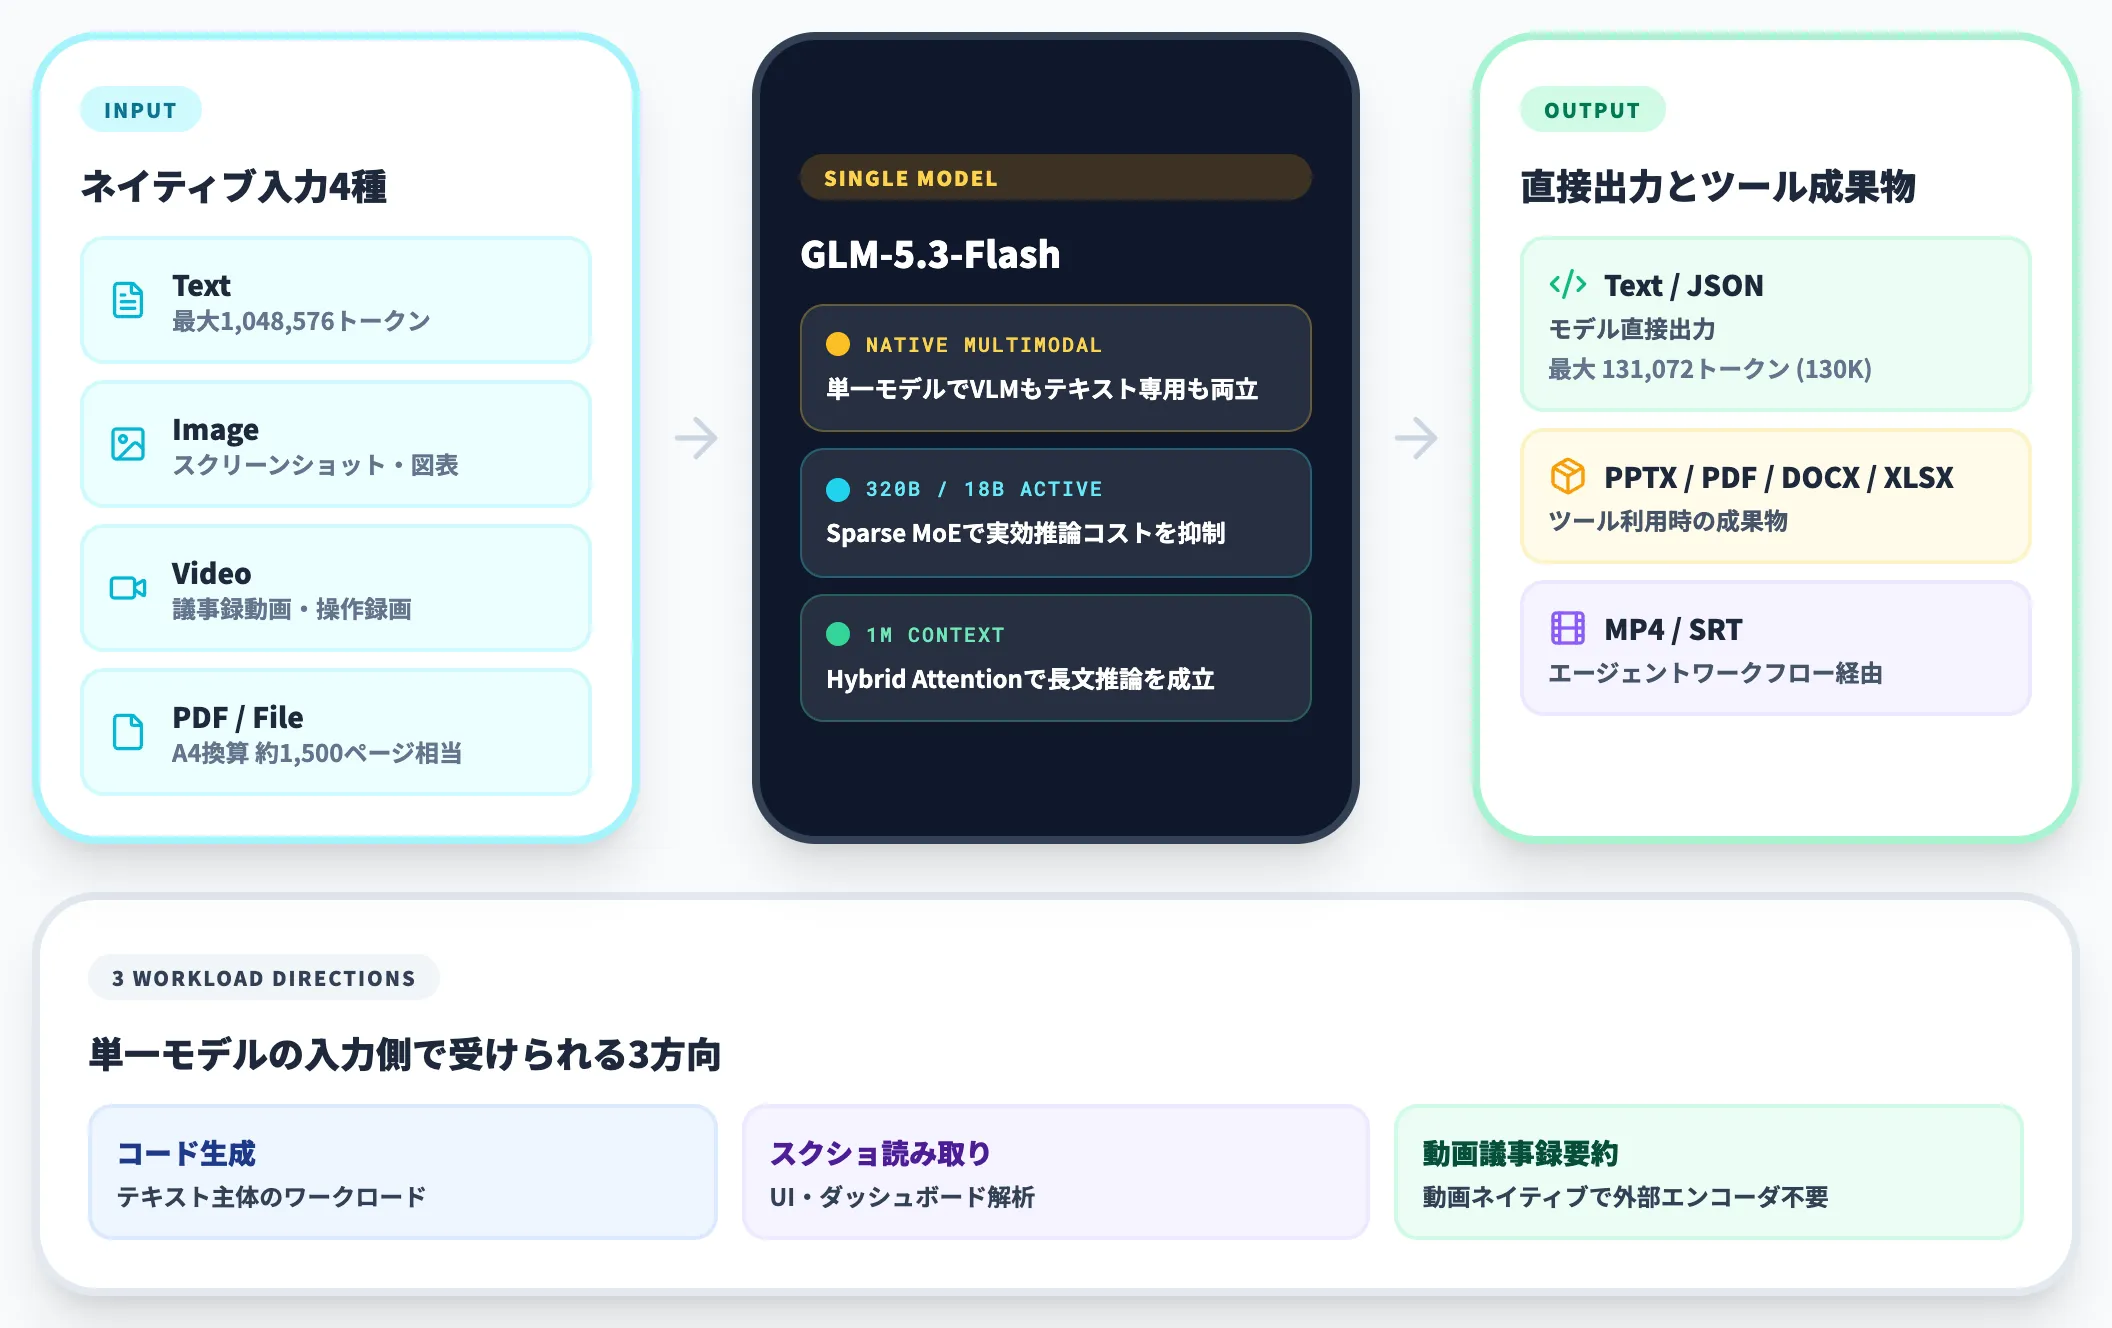
コンテキスト長は最大1,048,576トークン、単一応答の出力は最大約131,072トークン(130K)まで許容されます。1Mコンテキストは、A4換算で約1,500ページ相当の資料を単一プロンプトに載せる規模です。
入力側は、テキストに加え、画像・動画・ファイル(PDF等)を受け付けます。モデルの直接出力はテキストおよびJSON等の構造化テキストで、PPTX・PDF・DOCX・XLSXやMP4・SRT等のファイルは、ツールを利用するエージェントワークフローの成果物として生成する構成になります。
この入力範囲は、コード生成・スクリーンショット読み取り・議事録動画からの要約という3方向のワークロードを、単一モデルの入力側で受けられる設計につながっています。
Vision-Language Model単独では動画対応が弱いケースが多いなか、動画入力を含めて標準対応している点は、エージェント運用の外部依存を減らす方向で効いてきます。
モデル配布形態と実行環境
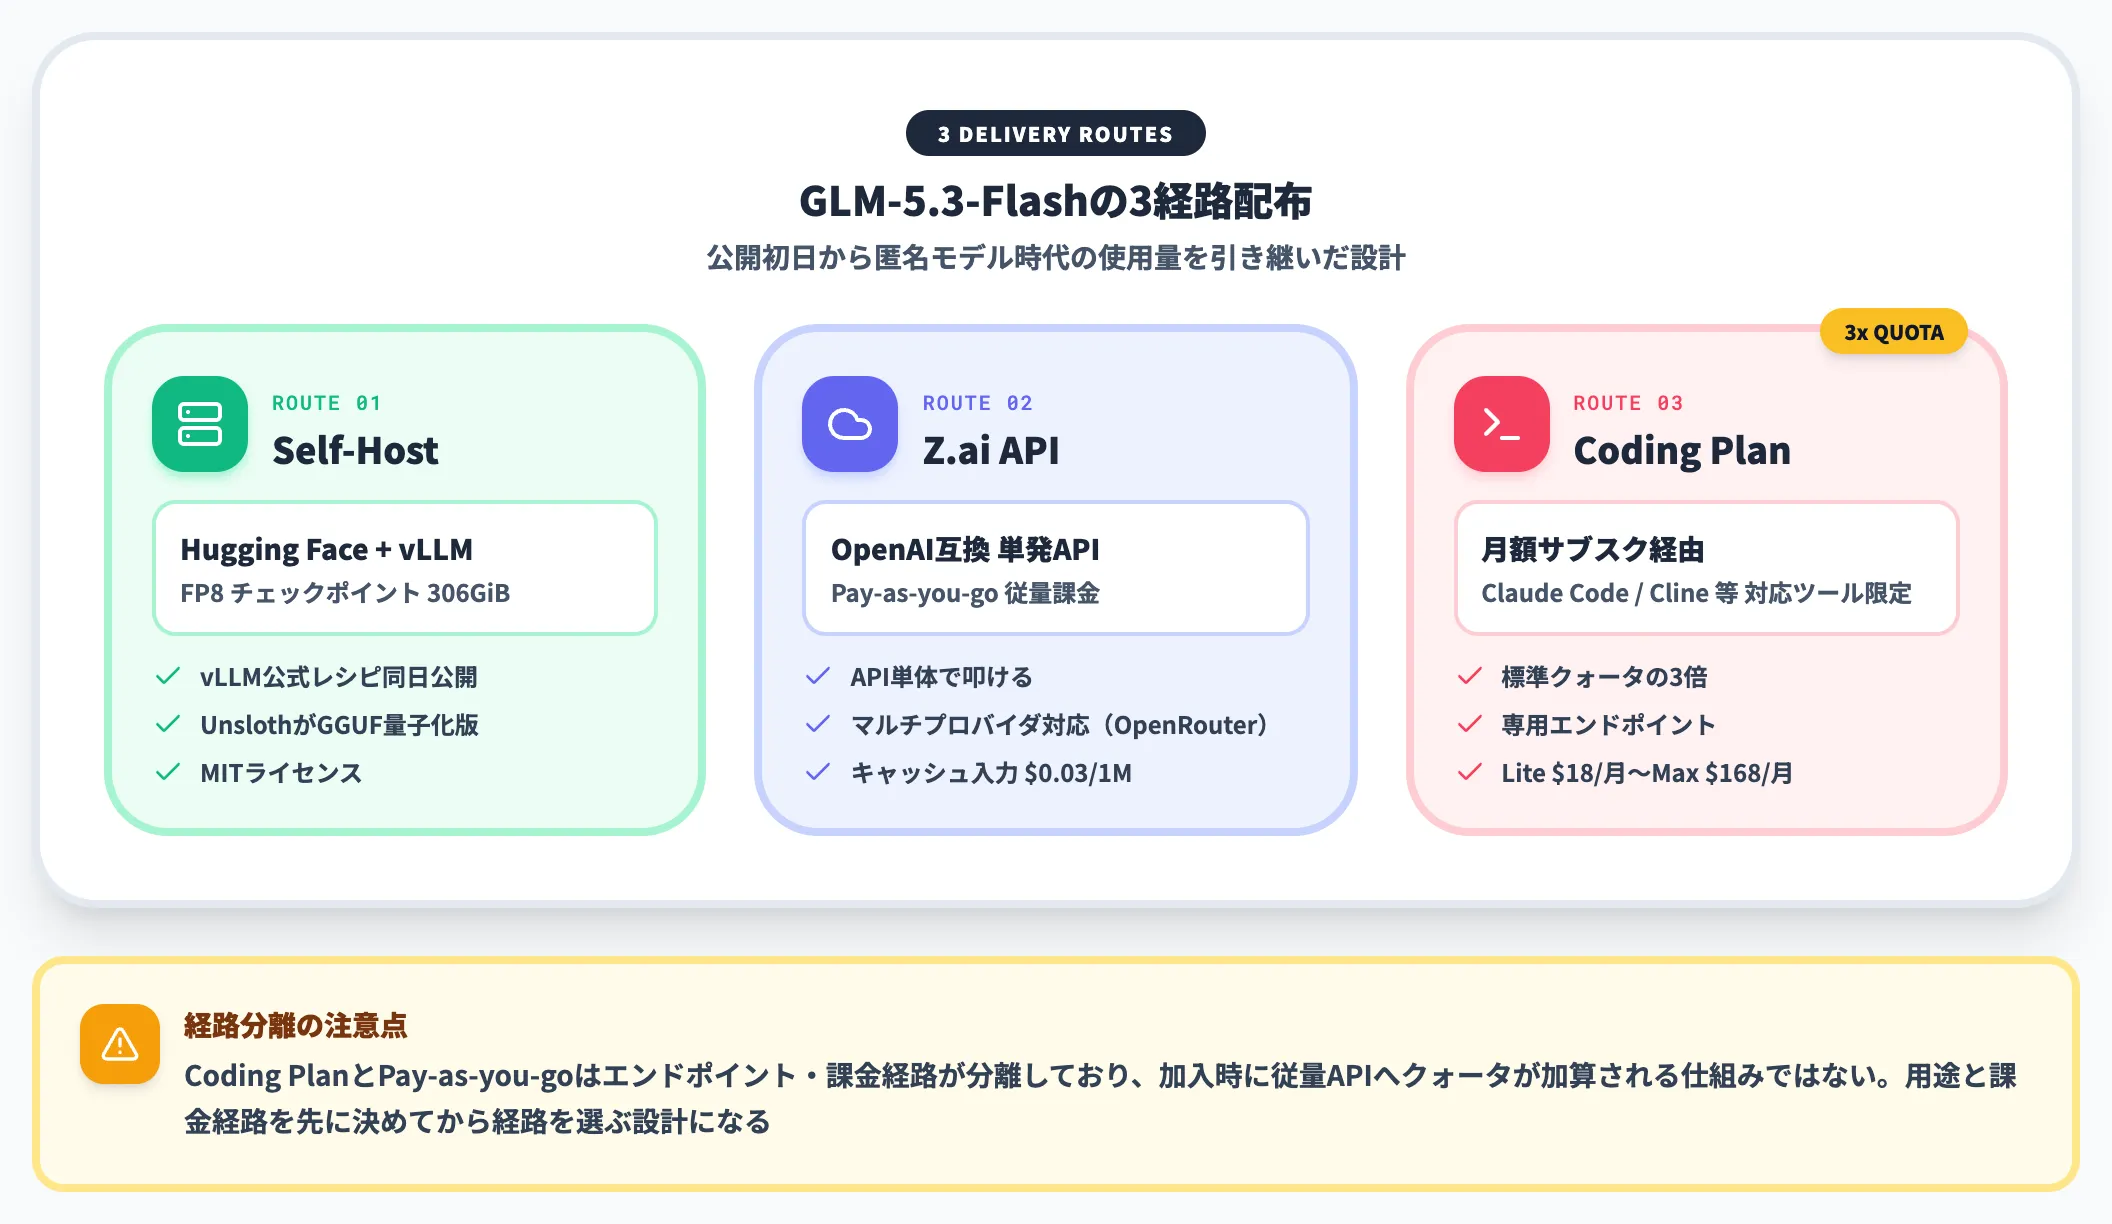
GLM-5.3-Flashの重みは、Hugging Face上のzai-org/GLM-5.3-Flashで公開されています。FP8精度のチェックポイントで306GiB、MITライセンスの下で商用利用と再配布が可能です。
Hugging Face上のGLM-5.3-Flash公式モデルカード。ハイブリッドスパース+線形注意アーキテクチャの説明が最上段に置かれている(出典:Hugging Face)
推論エンジンとしては、vLLMの公式レシピが同日公開されており、セルフホストで動かす場合はvLLM経由が現時点の第一候補になります。UnslothがGGUFの量子化版を公開しているため、単一マシンでのローカル推論もオプションに入ります。
公式APIホスト版はZ.aiが提供し、GLM Coding Planの対応ツール経由で使う経路と、Pay-as-you-goのOpenAI互換APIとして単体で叩く経路の2つが用意されています。両者はエンドポイントとクォータが分離されており、Coding Planは対応ツール(Claude Code・Cline等)と専用エンドポイントに限定されるため、加入時に従量APIへクォータが加算される仕組みではありません。
セルフホスト・APIホスト版・Coding Plan経由という3経路が同時に開いた状態でリリースされたことは、公開初日から匿名モデル時代の使用量を引き継げた一因になったと考えられます。
GLM-5.3-Flashのベンチマーク性能——Claude Opus 4.8に肉薄
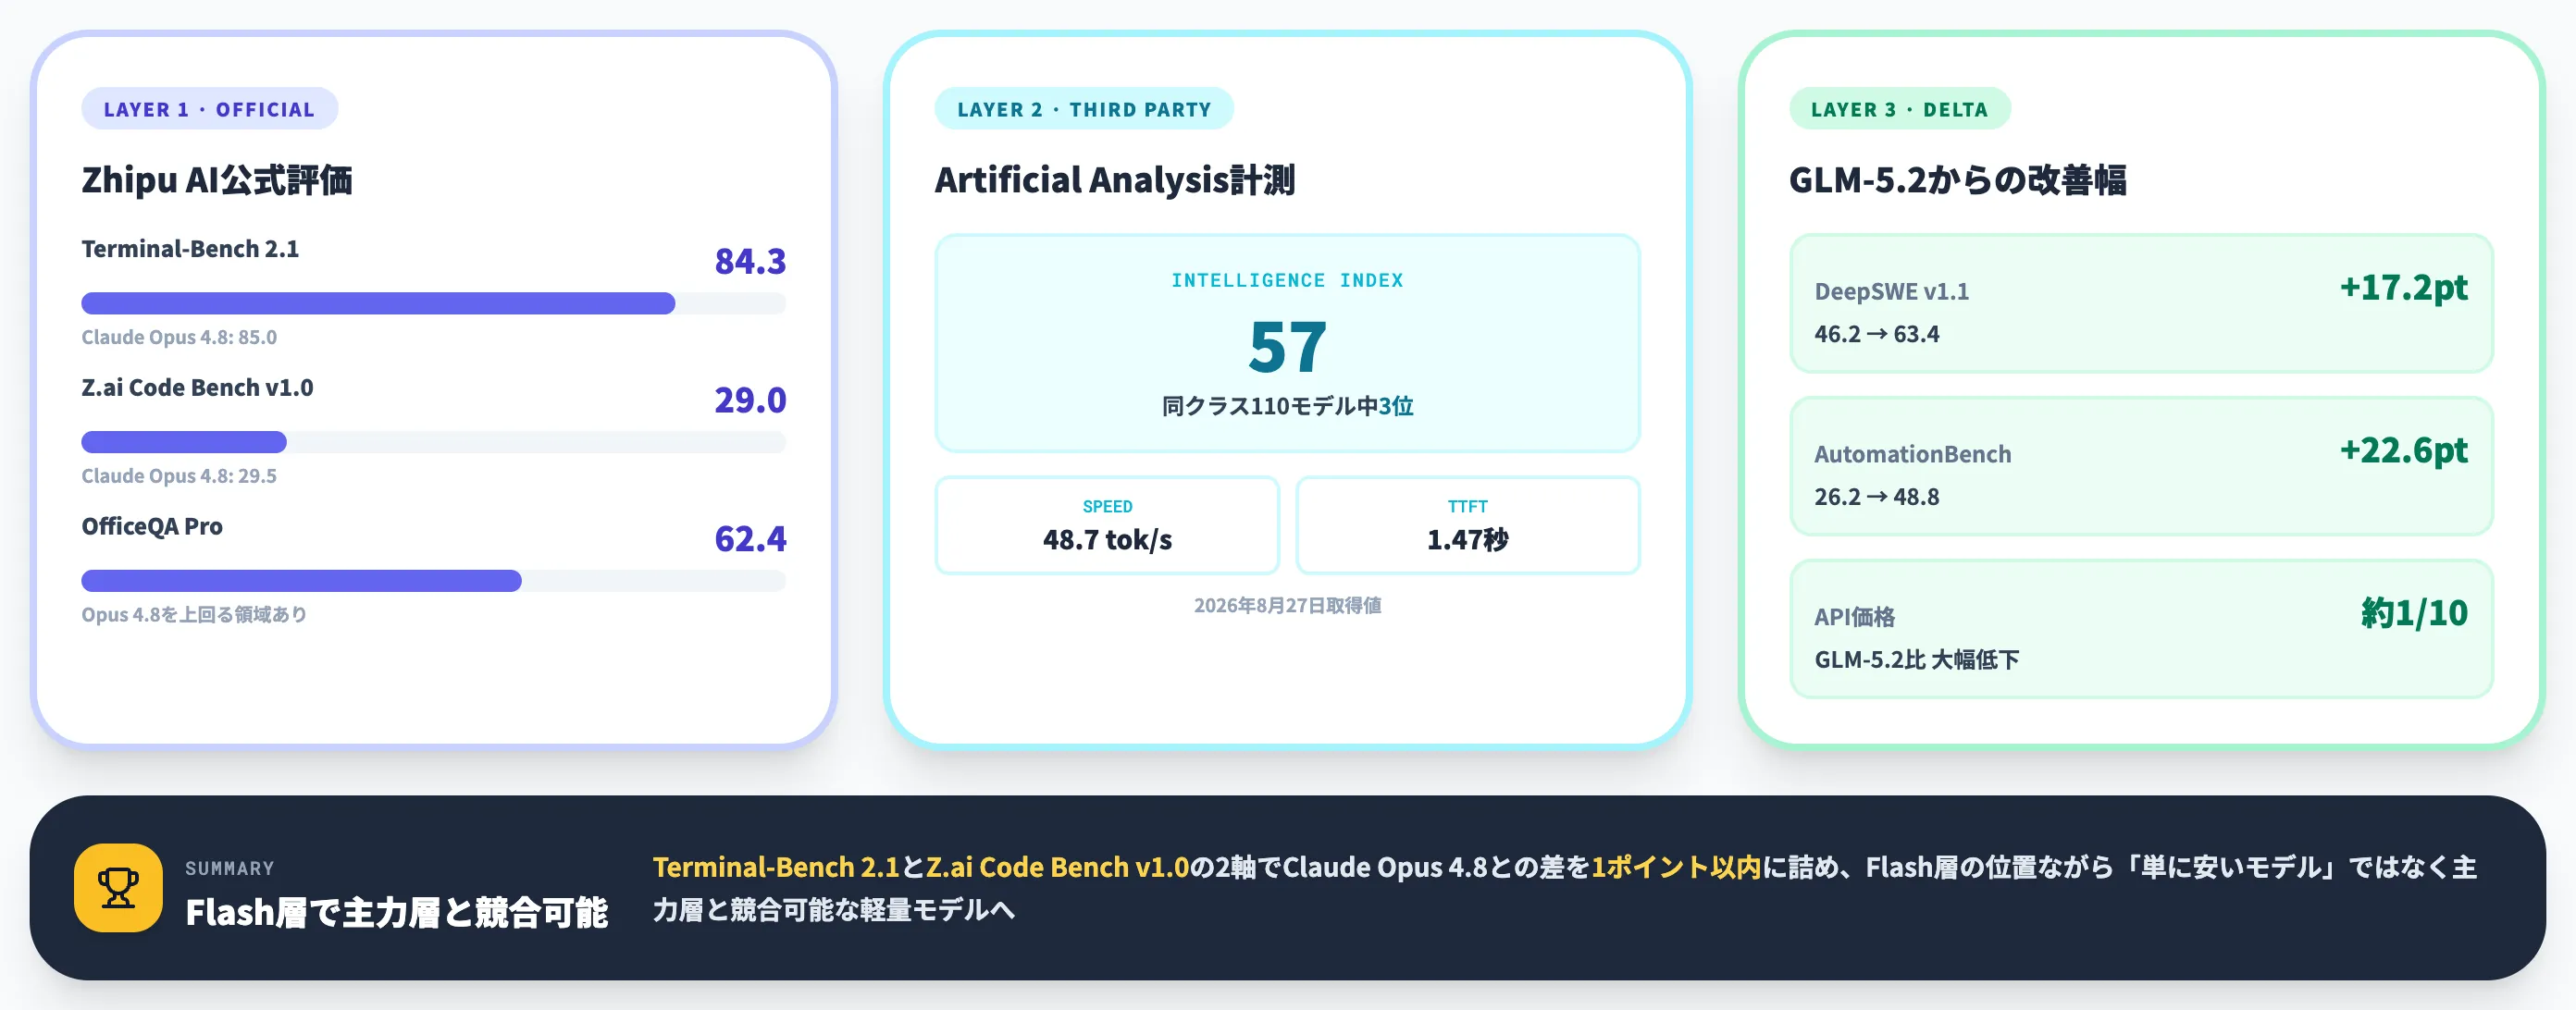
GLM-5.3-Flashの性能評価は、Zhipu AI自社ベンチマーク・第三者計測・GLM-5.2からの改善幅の3層で見ると全体像が掴めます。
本セクションでは、コーディングとエージェント能力に焦点を当てた主要スコアを、Zhipu AI公式カードとArtificial Analysisの分析を突き合わせながら整理します。
公式ベンチマークとOpus 4.8との距離
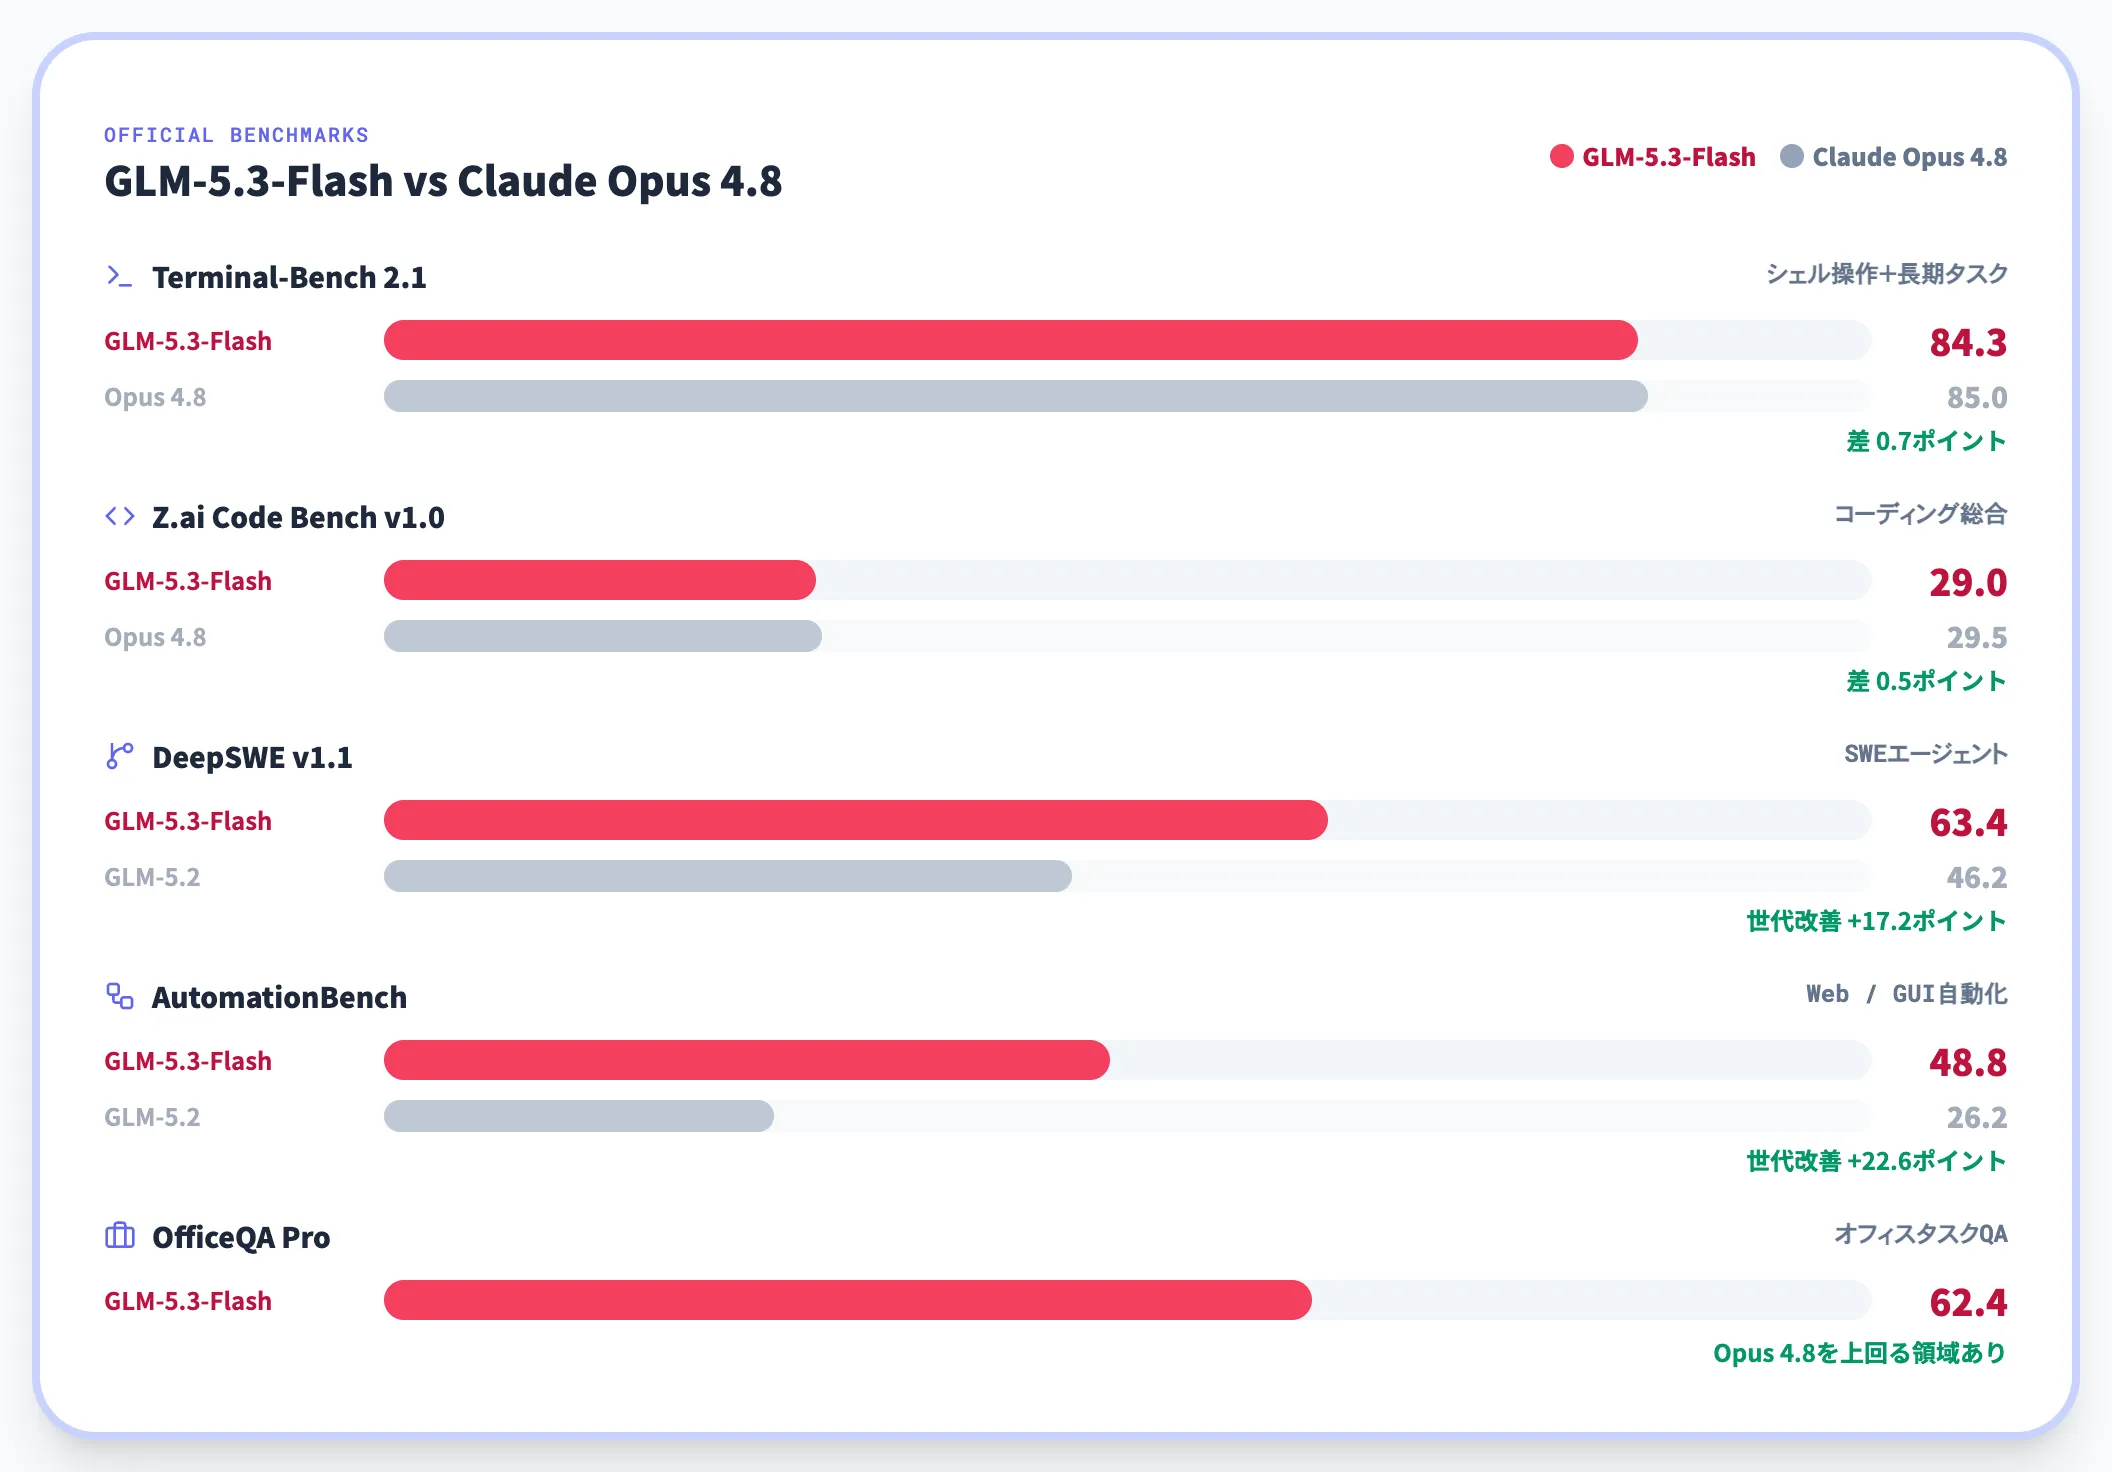
Z.aiが公式カードで公開している主要ベンチマークは、コーディングとエージェント能力に寄せた構成です。
| ベンチマーク | GLM-5.3-Flash | 参考スコア |
|---|---|---|
| Terminal-Bench 2.1 | 84.3 | Claude Opus 4.8: 85.0 |
| Z.ai Code Bench v1.0 | 29.0 | Claude Opus 4.8: 29.5 |
| DeepSWE v1.1 | 63.4 | GLM-5.2: 46.2 |
| AutomationBench | 48.8 | GLM-5.2: 26.2 |
| OfficeQA Pro | 62.4 | Claude Opus 4.8を上回る領域あり |
Terminal-Bench 2.1とZ.ai Code Bench v1.0の2軸で、GLM-5.3-FlashはClaude Opus 4.8との差を1ポイント以内に詰めています。
特にTerminal-Bench 2.1のようなシェル操作+長期タスクを含むベンチマークで肉薄している点は、コーディングエージェント選定時の判断材料になります。
Artificial Analysisの第三者評価
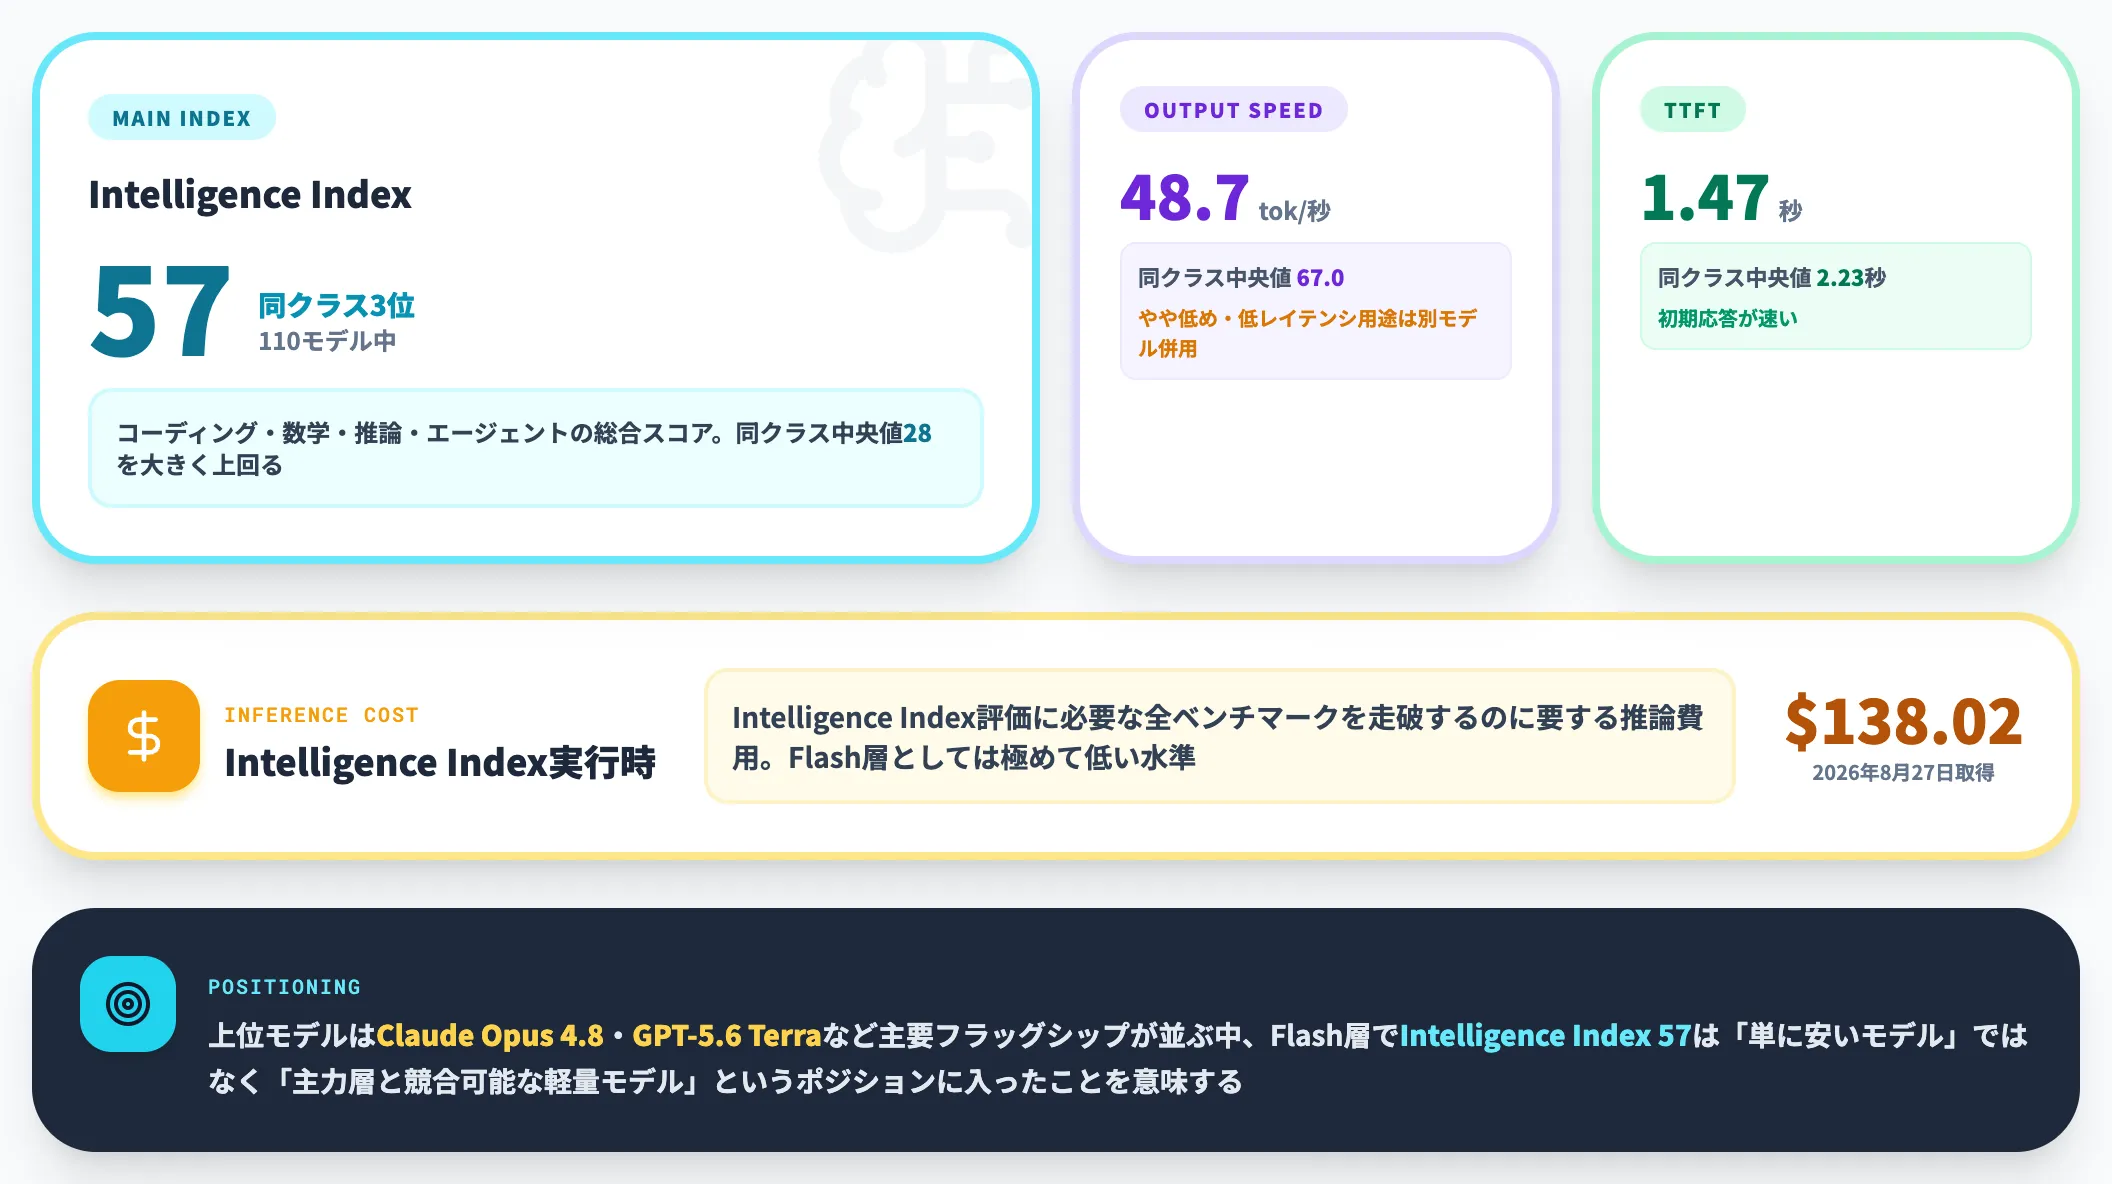
第三者計測では、Artificial AnalysisがGLM-5.3-Flashを公開直後に評価し、Intelligence Index 57という結果を出しました。
- Artificial Analysis Intelligence Index: 57(同クラス110モデル中3位、同クラス中央値28を大きく上回る/2026年8月27日取得)
- 出力速度: 48.7 tokens/秒(同クラス中央値67.0 tokens/秒よりやや低い/2026年8月27日取得)
- TTFT(Time to First Token): 1.47秒(同クラス中央値2.23秒より短い/2026年8月27日取得)
- 推論コスト(Intelligence Index実行時): $138.02(2026年8月27日取得)
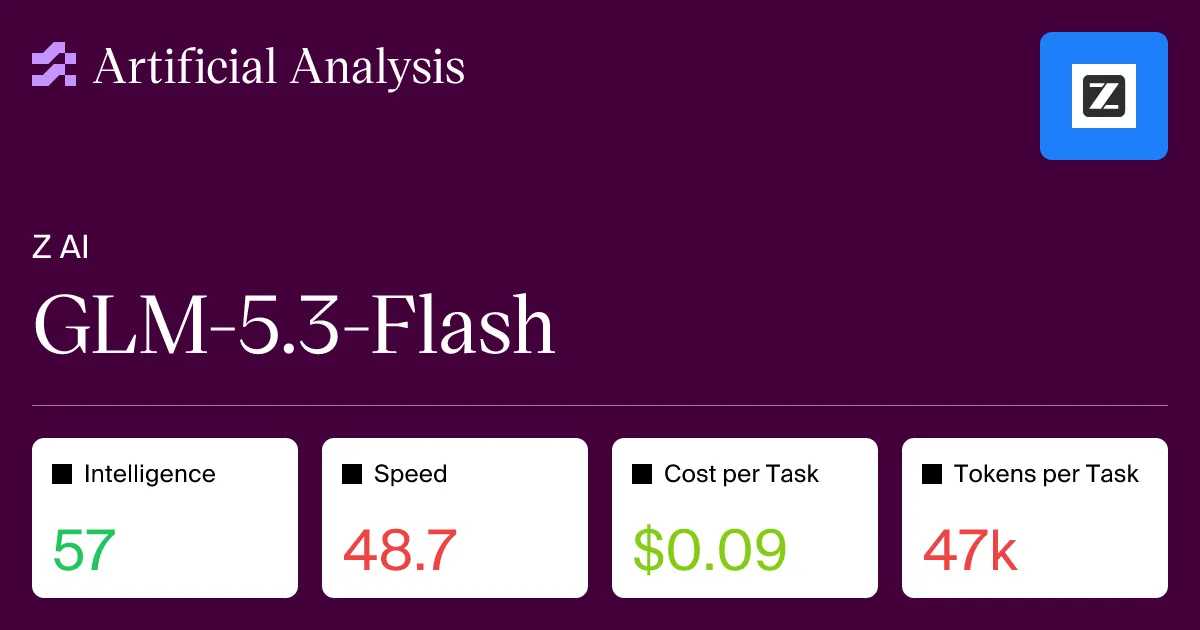
Artificial AnalysisのGLM-5.3-Flashメトリクスサマリー。Intelligence・Speed・Cost per Task・Tokens per Taskが1画面で確認できる(出典:Artificial Analysis)
Intelligence Indexは、複数のベンチマーク(コーディング・数学・推論・エージェント)の総合スコアで、上位モデルはClaude Opus 4.8やGPT-5.6 Terraなど主要フラッグシップが並びます。
Flash層のモデルで57というスコアを取ってきた点は、単に「安いモデル」ではなく「主力層と競合可能な軽量モデル」というポジションに入ったことを意味します。同時に、出力速度は同クラスの中央値をやや下回っており、超低レイテンシが必須のリアルタイム用途では別モデルとの併用も選択肢になります。
GLM-5.2からの改善幅と得意領域
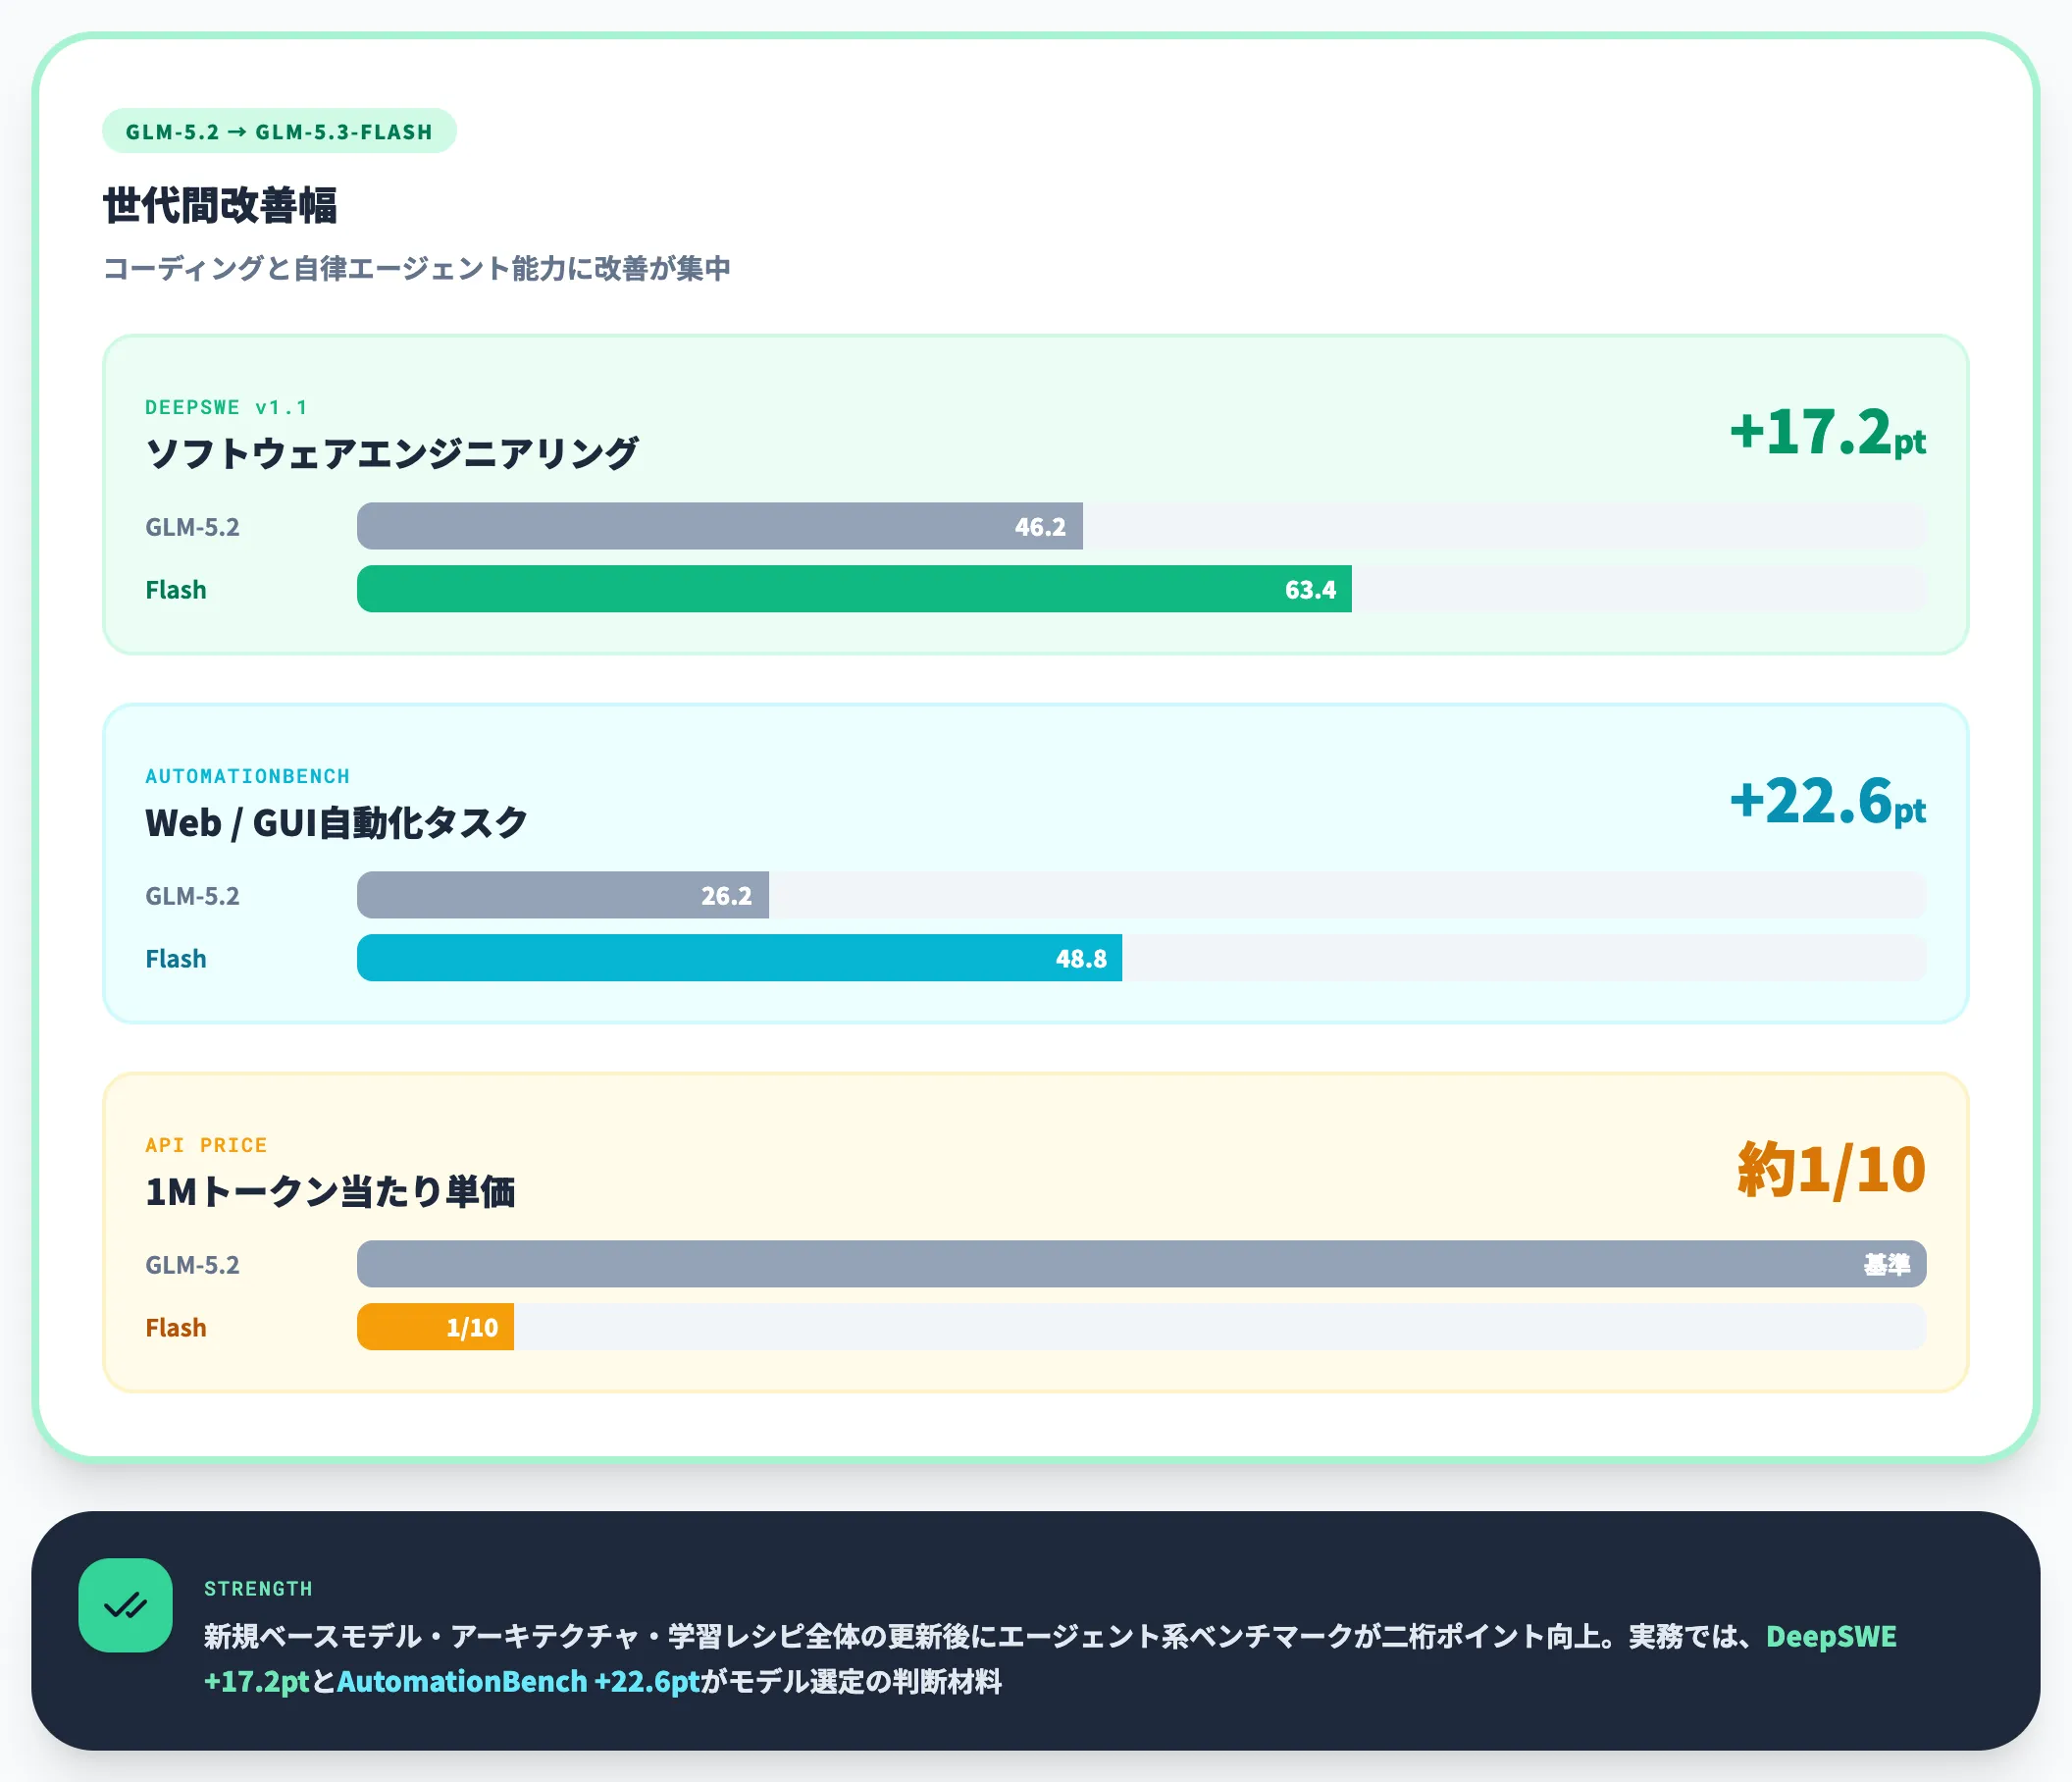
GLM-5.2からGLM-5.3-Flashへの改善幅は、コーディングと自律エージェント能力に集中しています。
- DeepSWE v1.1: 46.2 → 63.4(+17.2ポイント)
- AutomationBench: 26.2 → 48.8(+22.6ポイント)
- API価格: GLM-5.3-FlashはGLM-5.2比で概ね1/10の水準まで低下
DeepSWEはソフトウェアエンジニアリング系のエージェントタスク、AutomationBenchはWebブラウザ・GUIを含む自動化タスクを評価するベンチマークです。
いずれもFlash層でGLM-5.2から二桁ポイント改善したことは、新規ベースモデル・アーキテクチャ・学習レシピ全体の更新後にエージェント系ベンチマークが向上したことを示しています。
実務では、DeepSWEで+17.2ポイント・AutomationBenchで+22.6ポイントというベンチマーク改善幅を、モデル選定の判断材料として使えます。
GLM-5.3-Flashの料金と入手経路
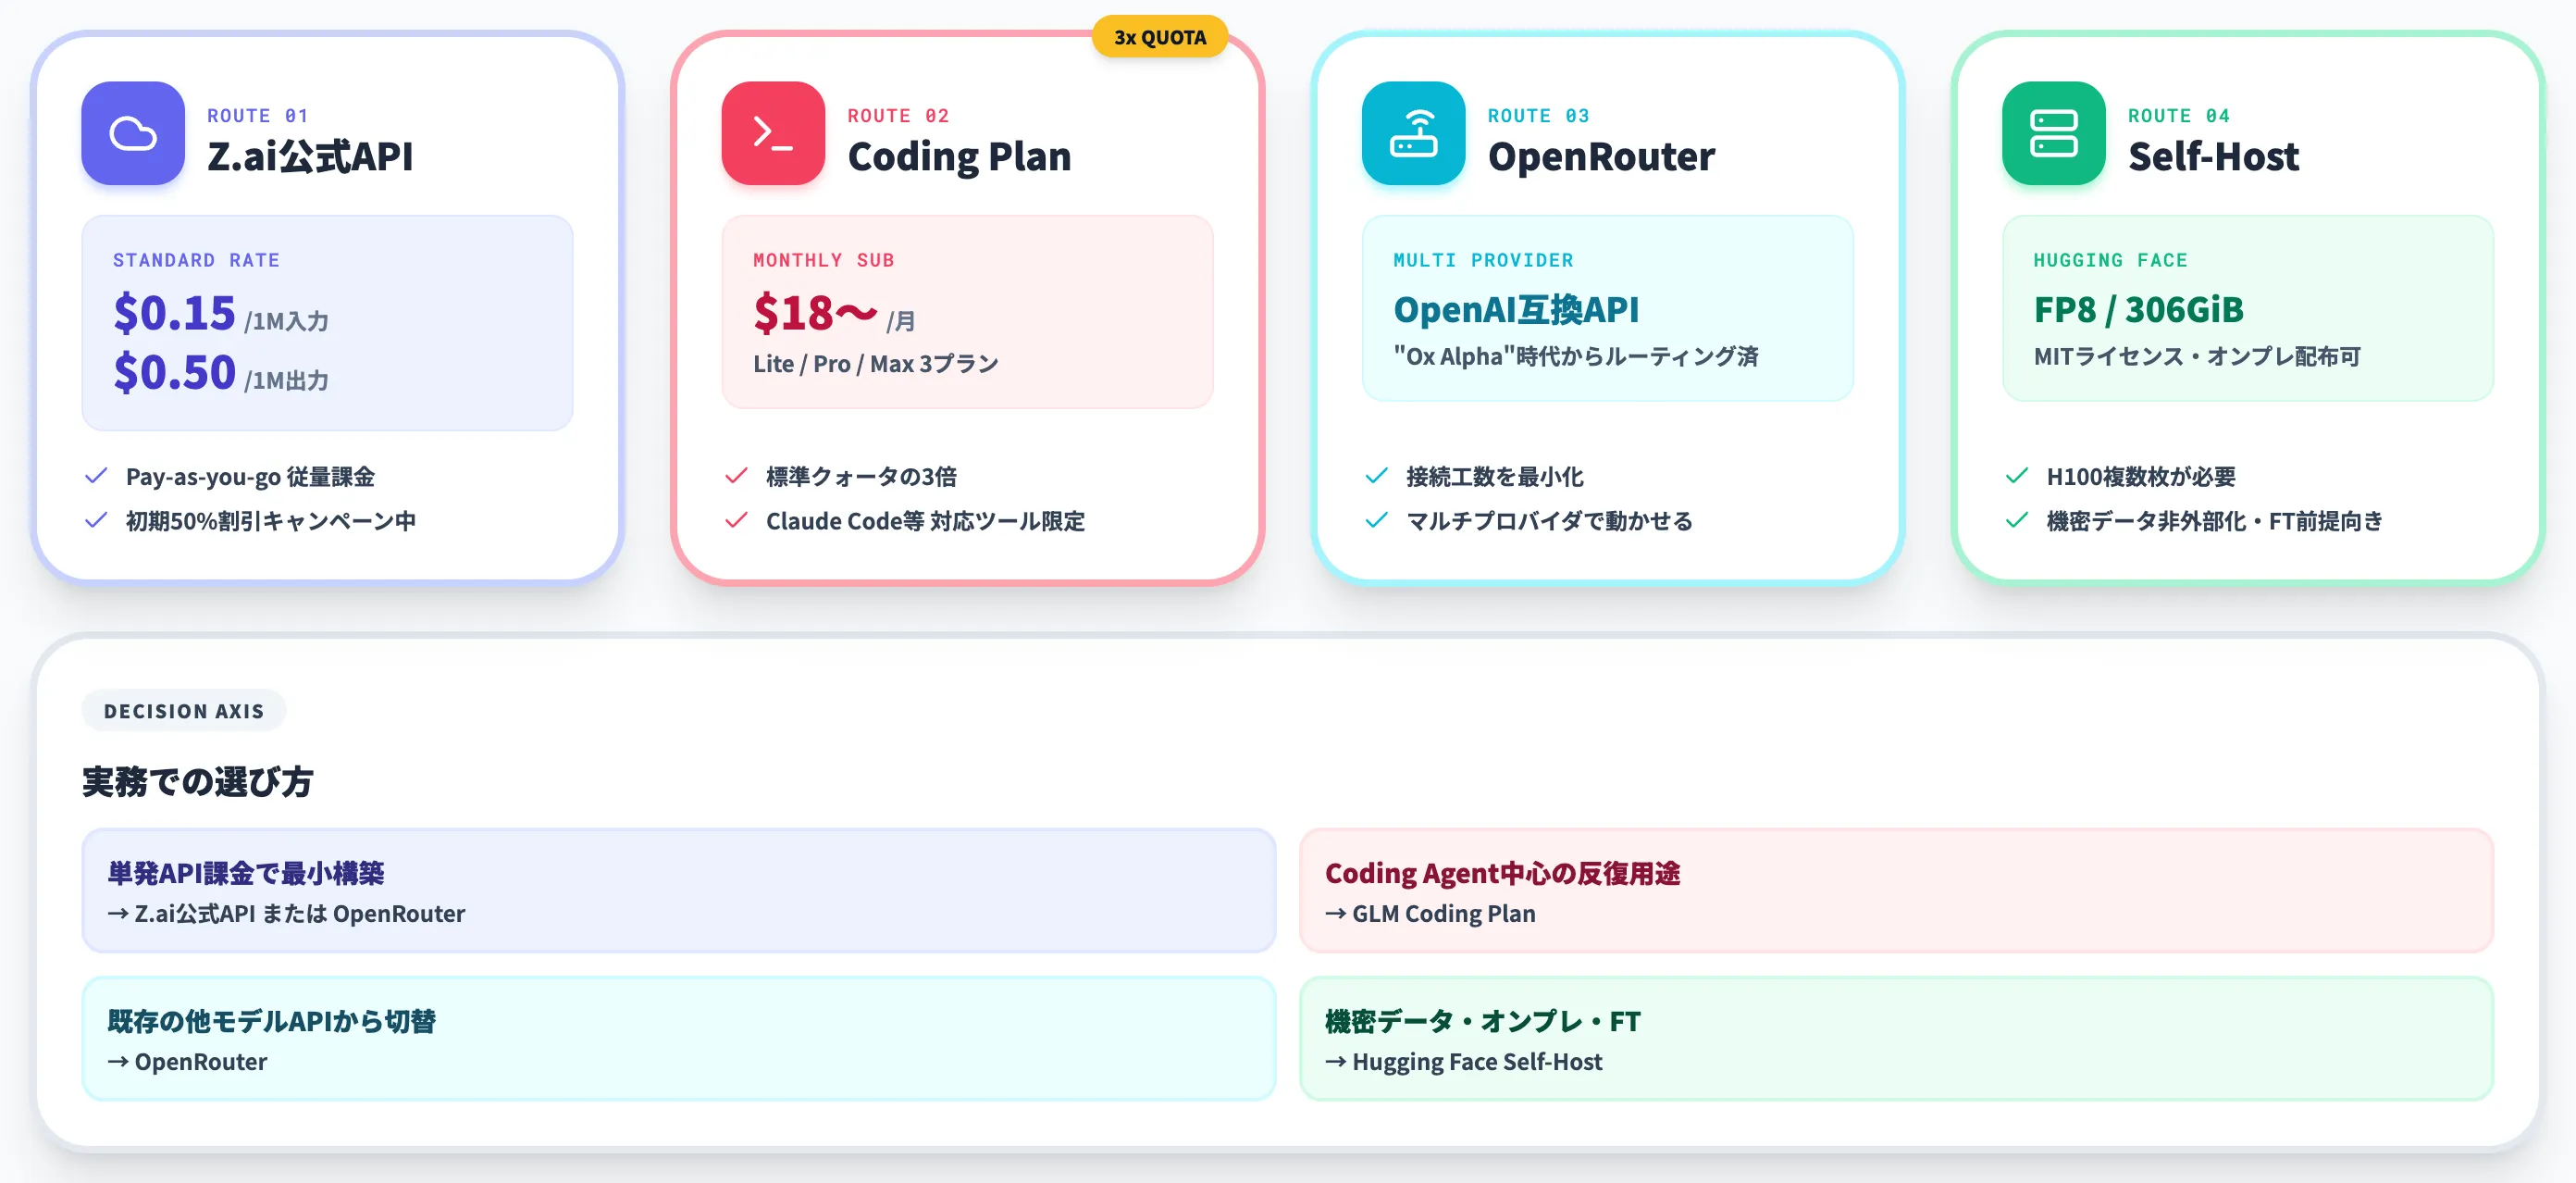
GLM-5.3-Flashの入手経路は、Z.ai直APIとGLM Coding Plan、OpenRouter経由、Hugging Faceからのセルフホストの4つに分かれます。それぞれで料金体系と制約が違うため、用途に合わせて選ぶ設計になっています。
本セクションでは、それぞれの経路の料金と、実務で選ぶ際の判断軸を整理します。
Z.ai公式API料金と初期50%割引キャンペーン
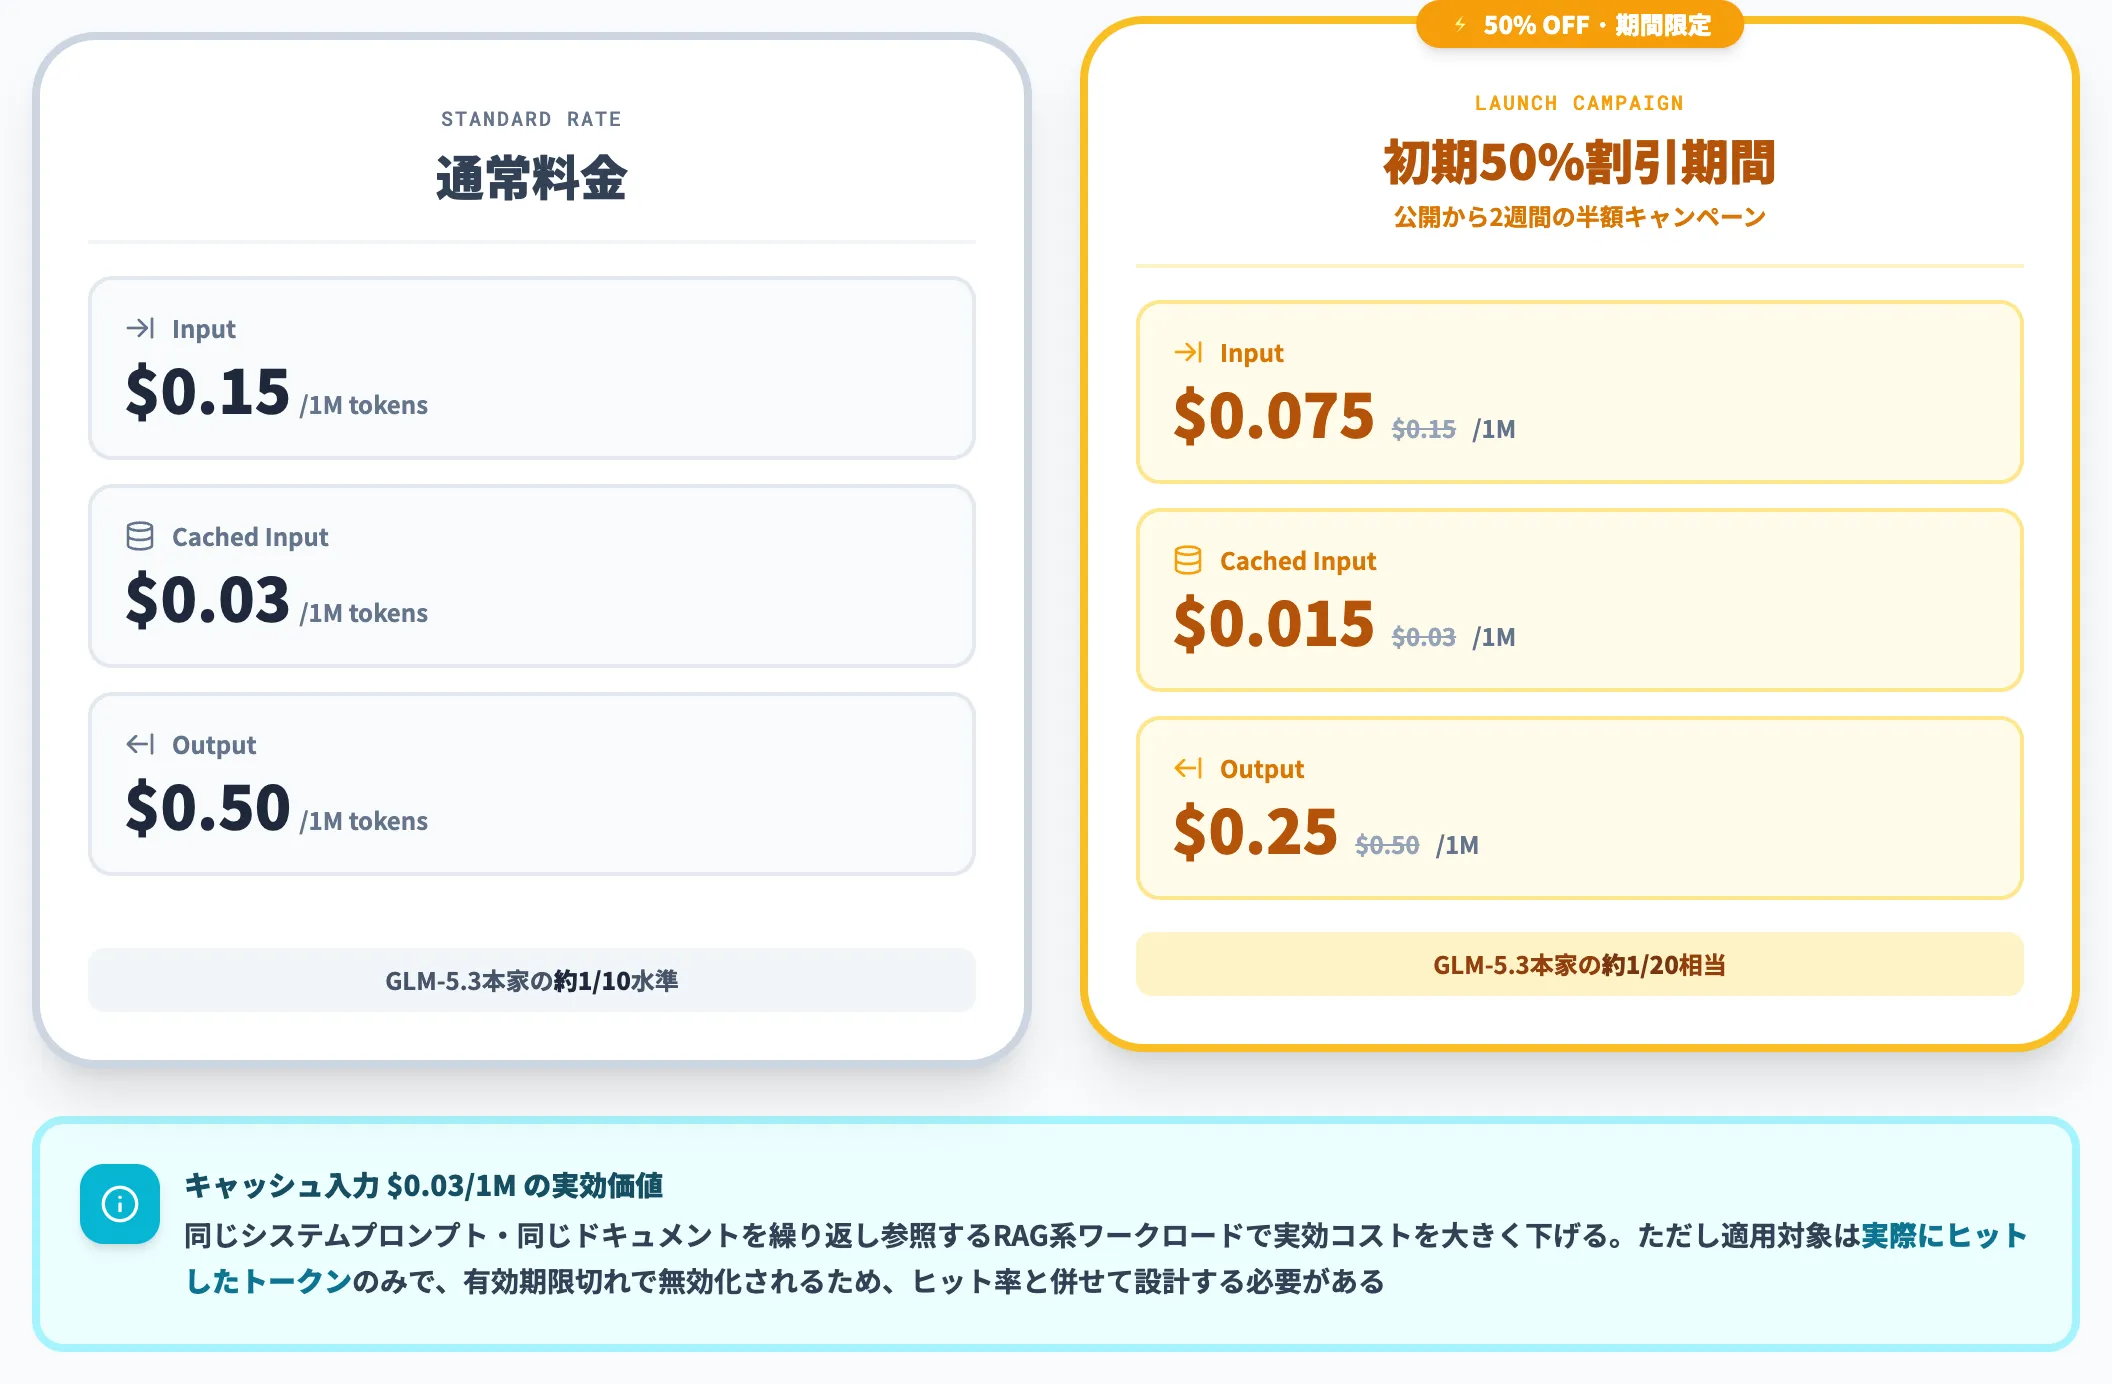
Z.ai公式APIの料金は、100万トークンあたりの入力・出力単価で以下のとおりです。
| 項目 | 標準料金 | 初期50%割引期間 |
|---|---|---|
| 入力(1M tokens) | $0.15 | $0.075 |
| キャッシュ入力(1M tokens) | $0.03 | $0.015 |
| 出力(1M tokens) | $0.50 | $0.25 |
GLM-5.3本家のAPI単価と比べて概ね1/10の水準で、初期の割引期間中は1/20相当まで下がります。GIGAZINEの報道では、この割引を「公開から2週間の半額キャンペーン」として整理しており、期間限定である点は選定時に確認が必要です。
キャッシュ入力が$0.03/1Mと極端に低いのは、同じシステムプロンプト・同じドキュメントを繰り返し参照するRAG(Retrieval-Augmented Generation、検索拡張生成)系のワークロードで、実効コストを大きく下げます。
ただしキャッシュ料金の適用対象は実際にヒットしたトークンだけで、有効期限切れで無効化される点がZ.aiの公式仕様に明示されており、実効コストの見積もりはヒット率と併せて設計する必要があります。
GLM Coding Planでの3倍クォータ運用
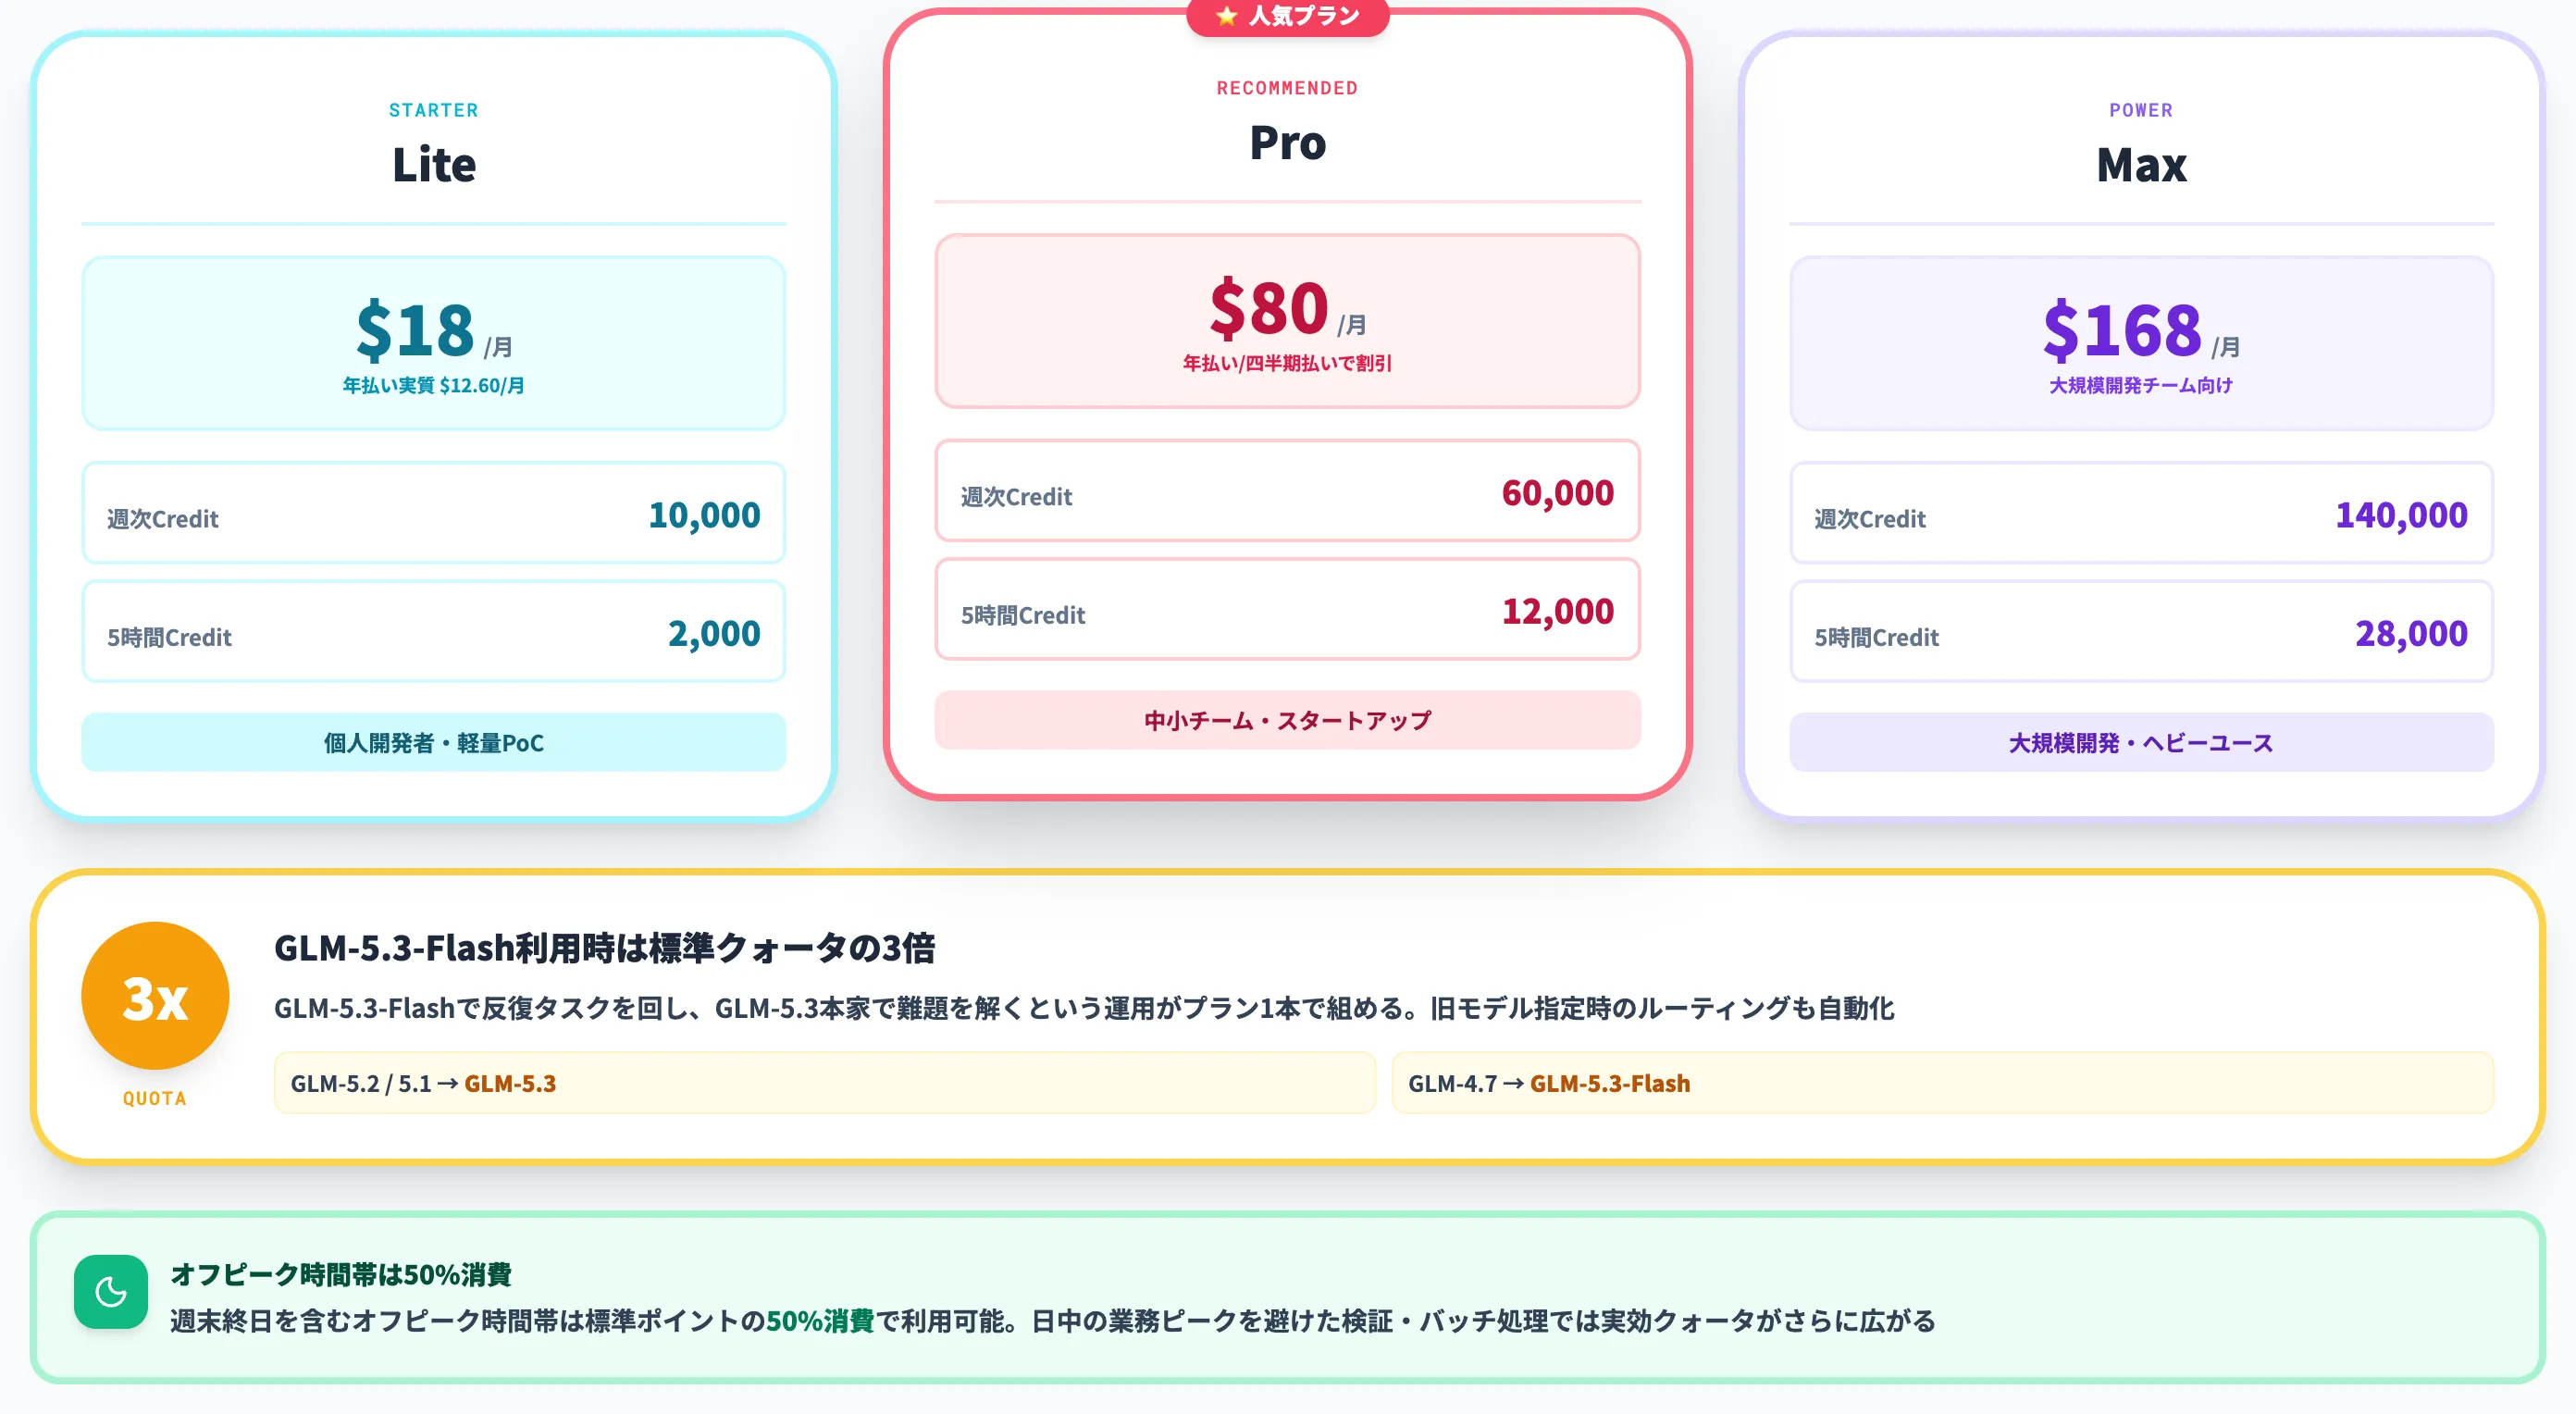
Zhipu AIは、月額サブスクリプションのGLM Coding Planを提供しており、GLM-5.3-Flashを使う場合、標準クォータの3倍が同一プランで利用可能になります。
| プラン | 月額 | 週次Credit | 5時間Credit |
|---|---|---|---|
| Lite | $18 | 10,000 | 2,000 |
| Pro | $80 | 60,000 | 12,000 |
| Max | $168 | 140,000 | 28,000 |
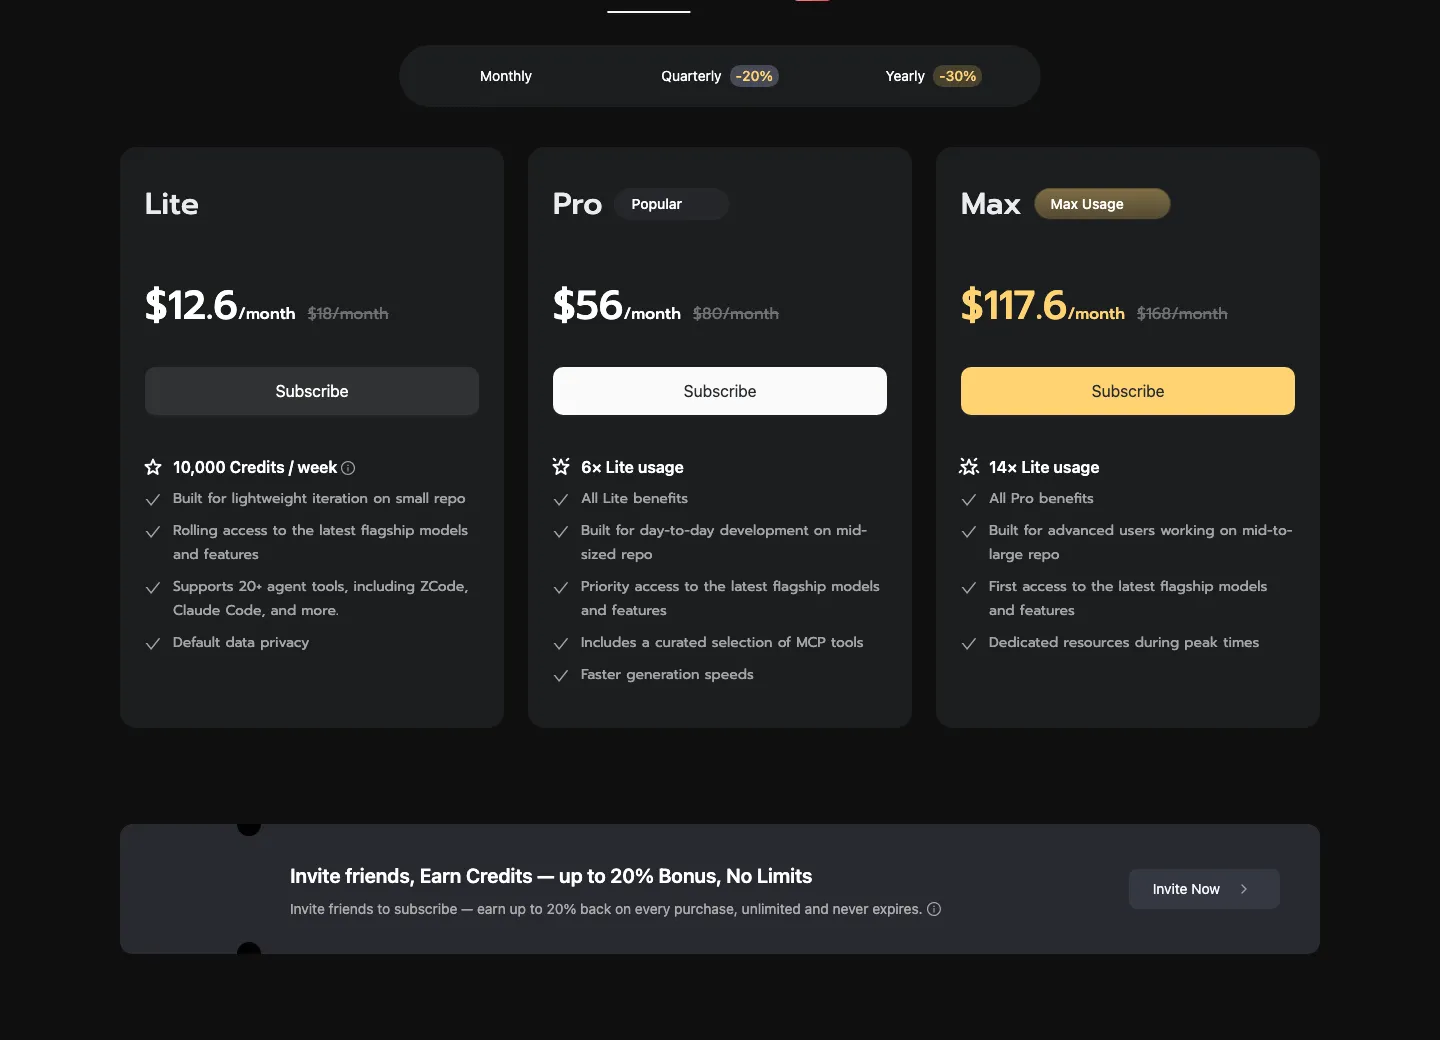
Z.ai公式のGLM Coding Plan料金ページ(画像はYearlyタブ選択時の年払い30%OFF価格が表示された状態。斜線付きで月額基準の$18/$80/$168も併記されている)(出典:Z.ai公式)
年払いを選ぶと30%OFF(Liteは実質$12.60/月)、四半期払いで20%OFFの割引が適用されます。現行のCoding Plan対応モデルはGLM-5.3本家とGLM-5.3-Flashの2つで、旧モデル名を指定した場合はGLM-5.2/GLM-5.1がGLM-5.3へ、GLM-4.7がGLM-5.3-Flashへそれぞれ自動ルーティングされる仕様のため、Flashで反復タスクを回し、本家で難題を解くという運用がプラン1本で組めます。
Coding Planはオフピーク時間帯(週末終日を含む)に標準ポイントの50%消費で利用できる仕組みも組み込まれており、日中の業務ピークを避けた検証・バッチ処理では実効クォータがさらに広がります。
OpenRouter・Hugging Face経由での入手
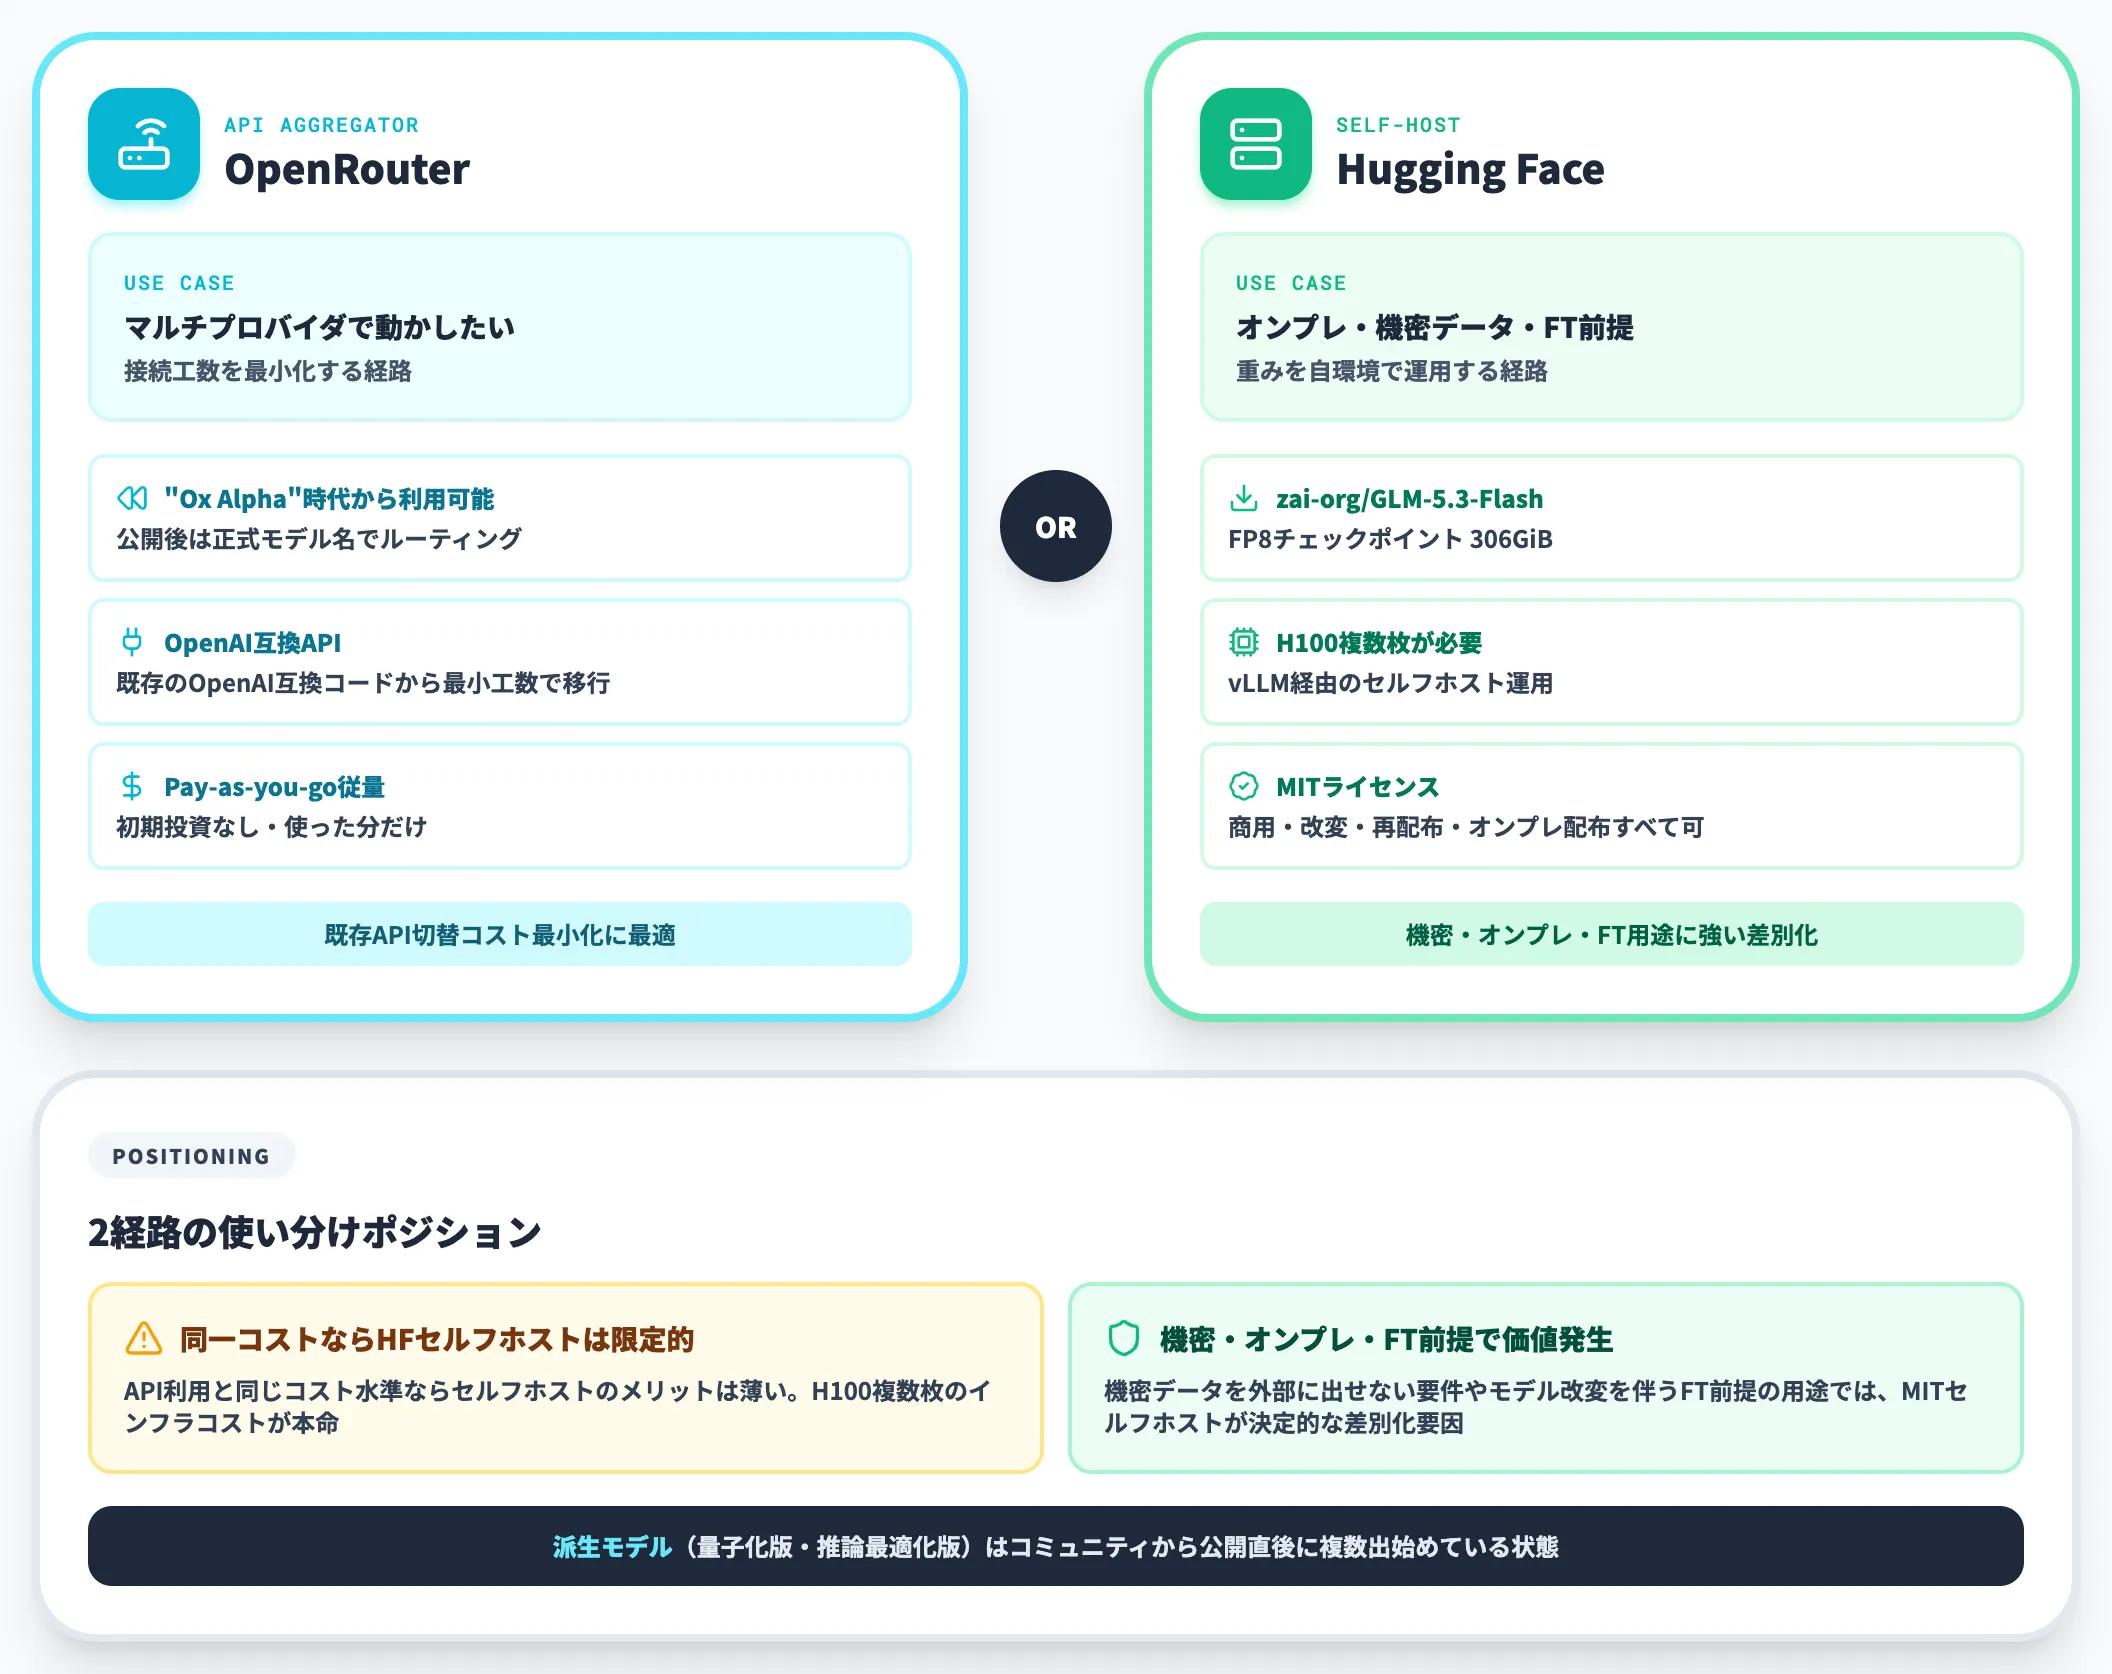
OpenRouterでは"Ox Alpha"時代からGLM-5.3-Flashを利用可能で、公開後は正式モデル名でルーティングが張られています。OpenAI互換APIとしてマルチプロバイダで動かしたい場合は、OpenRouter経由が接続工数を最小化できます。
Hugging Faceのzai-org/GLM-5.3-Flashからは、FP8チェックポイント(306GiB)が入手可能です。vLLM経由でセルフホストする場合、H100クラスのGPUが複数枚必要になるため、API利用と同じコストで運用したい場合はセルフホストのメリットは限定的です。
一方で、機密データを外部に出せないオンプレ運用や、モデル改変を伴うファインチューニング前提の用途では、MITライセンスでセルフホスト可能な点が強い差別化要因になります。
GLM-5.3-Flashをベースにした量子化版や推論最適化版などの派生モデルは、公開直後から複数のコミュニティ実装が出始めている状態です。
GLM-5.3-FlashをClaude Code・Cline・OpenCodeで使う方法
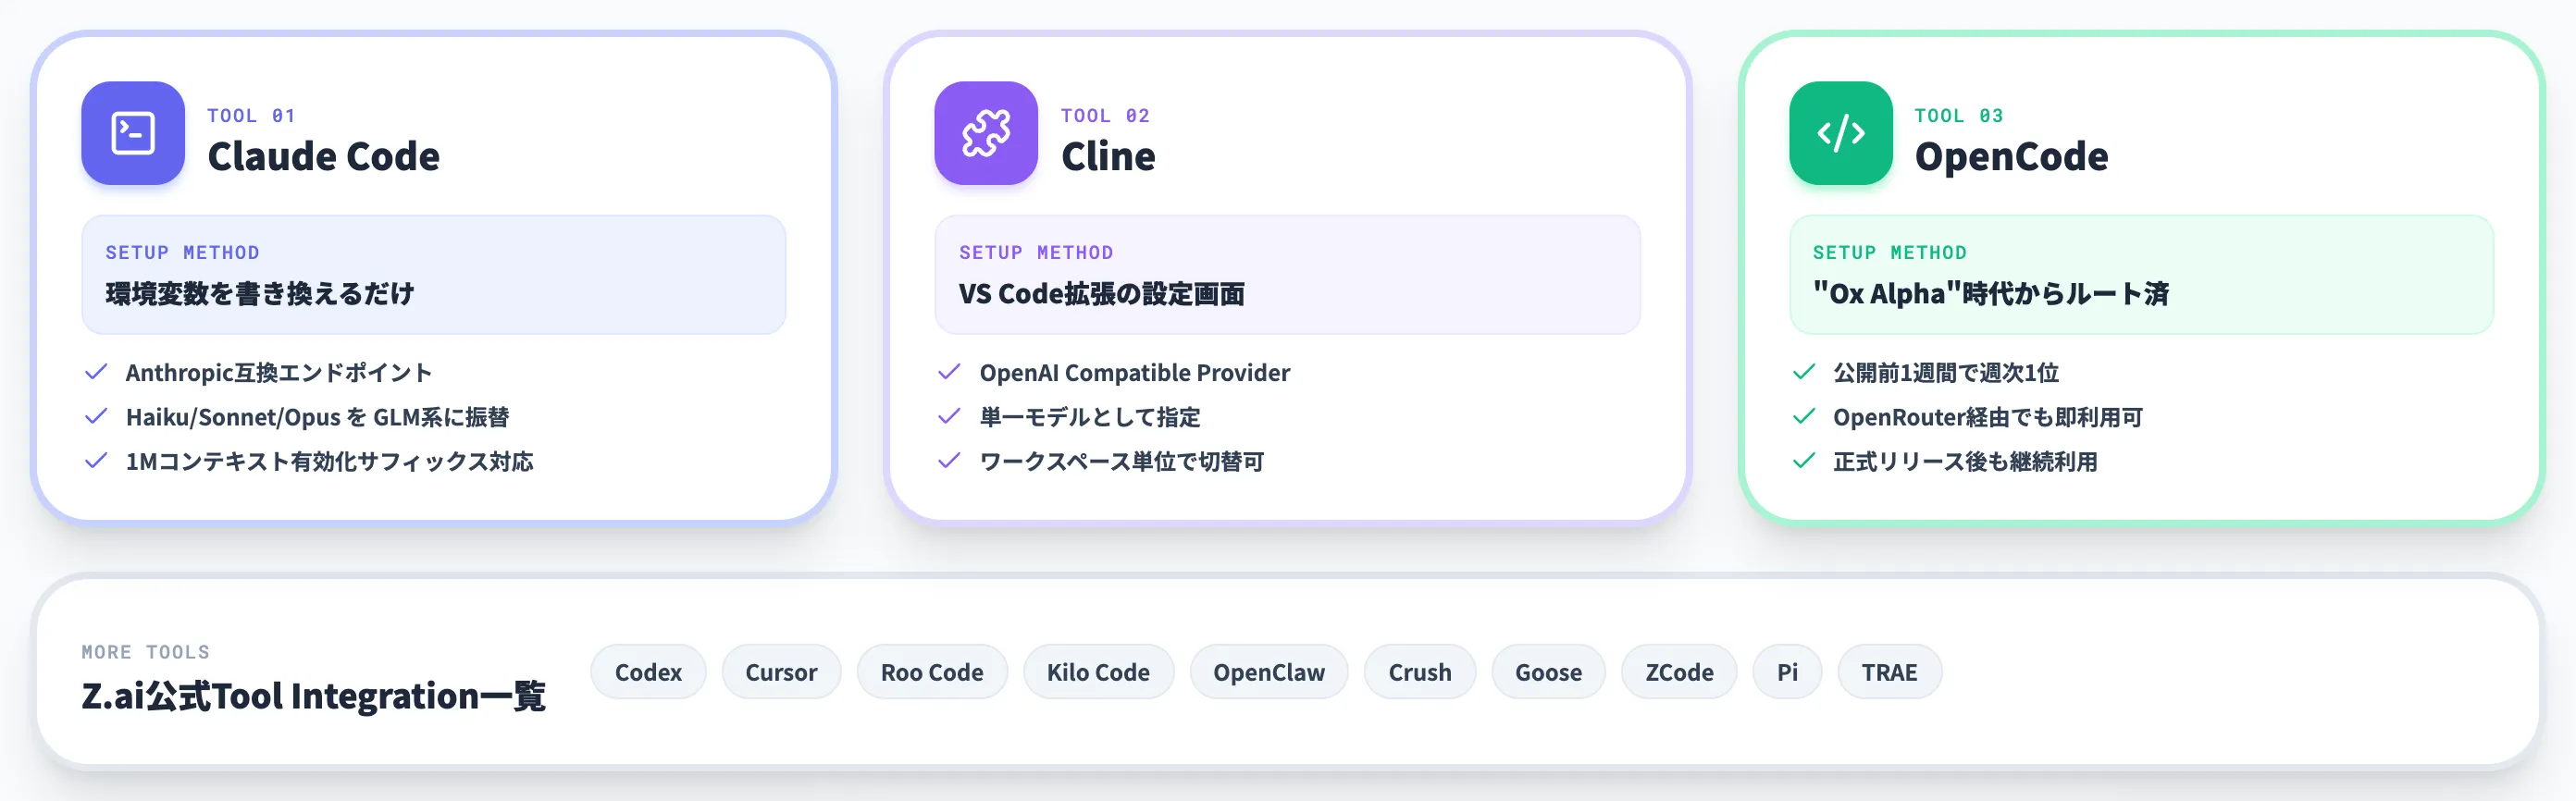
GLM-5.3-Flashは、Z.ai公式のTool Integration一覧で確認できるとおり、主要なコーディングエージェントに広く統合されています。例として、Claude Code・Cline・OpenCode・Codex・Cursor・Roo Code・Kilo Code・OpenClaw・Crush・Goose・ZCode・Pi・TRAE等がサポート対象に含まれます。
本セクションでは、実務でよく使われる3つのエージェント(Claude Code・Cline・OpenCode)での接続手順と、セットアップで詰まる箇所を整理します。
Claude Codeでの環境変数指定
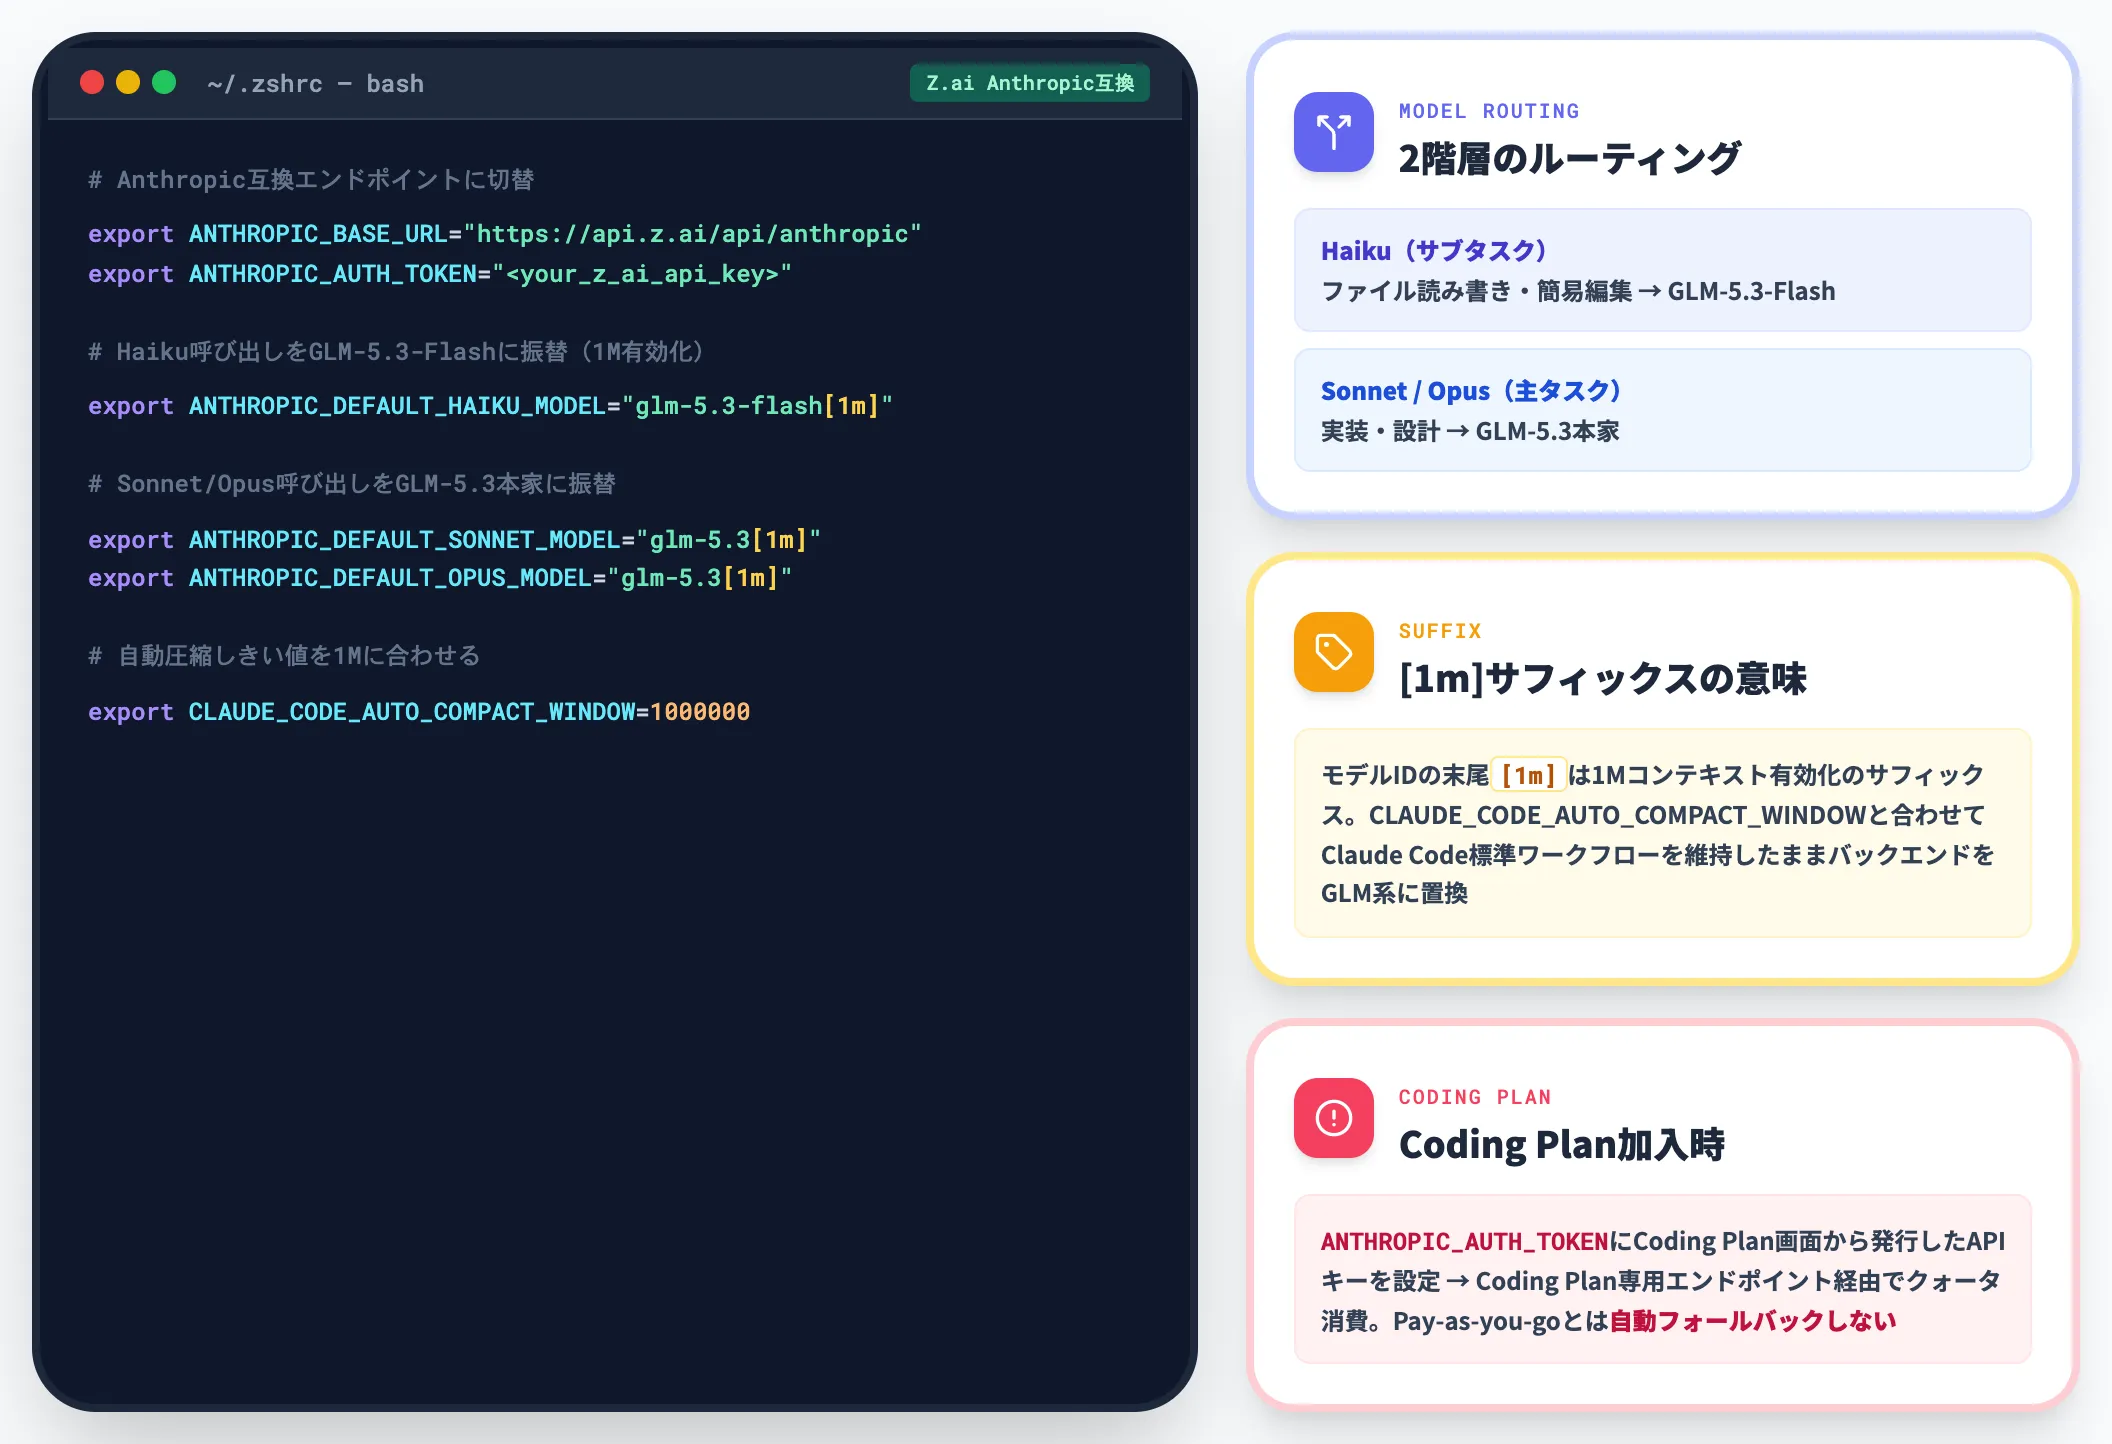
Claude Codeは、Anthropicが提供するターミナル型コーディングエージェントです。GLM-5.3-FlashをClaude Codeから呼ぶには、環境変数を書き換えるだけで済みます。
export ANTHROPIC_BASE_URL=https://api.z.ai/api/anthropic
export ANTHROPIC_AUTH_TOKEN=<your_z_ai_api_key>
export ANTHROPIC_DEFAULT_HAIKU_MODEL=glm-5.3-flash[1m]
export ANTHROPIC_DEFAULT_SONNET_MODEL=glm-5.3[1m]
export ANTHROPIC_DEFAULT_OPUS_MODEL=glm-5.3[1m]
export CLAUDE_CODE_AUTO_COMPACT_WINDOW=1000000
モデルIDの末尾「[1m]」は1Mコンテキスト有効化のサフィックス、「CLAUDE_CODE_AUTO_COMPACT_WINDOW」はClaude Codeの自動圧縮しきい値を1Mトークンに合わせる設定で、いずれもZ.ai公式のClaude Code統合手順に沿ったものです。この設定では、Claude CodeがHaikuを呼び出すサブタスク(ファイル読み書き・簡易編集)をGLM-5.3-Flashに、Sonnet/Opus相当の主タスクをGLM-5.3本家にルーティングします。結果としてClaude Codeの標準ワークフローを維持したまま、実質のバックエンドをGLM系に置き換える運用になります。
Coding Planに加入している場合は、「ANTHROPIC_AUTH_TOKEN」にCoding Plan画面から発行したAPIキーを設定すると、Coding Plan専用エンドポイント経由でCoding Plan側のクォータが消費されます。Pay-as-you-goのAPIとは対応エンドポイント・課金経路が分離されており、両者は自動フォールバックしない点に注意が必要です。
ClineでのOpenAI互換設定
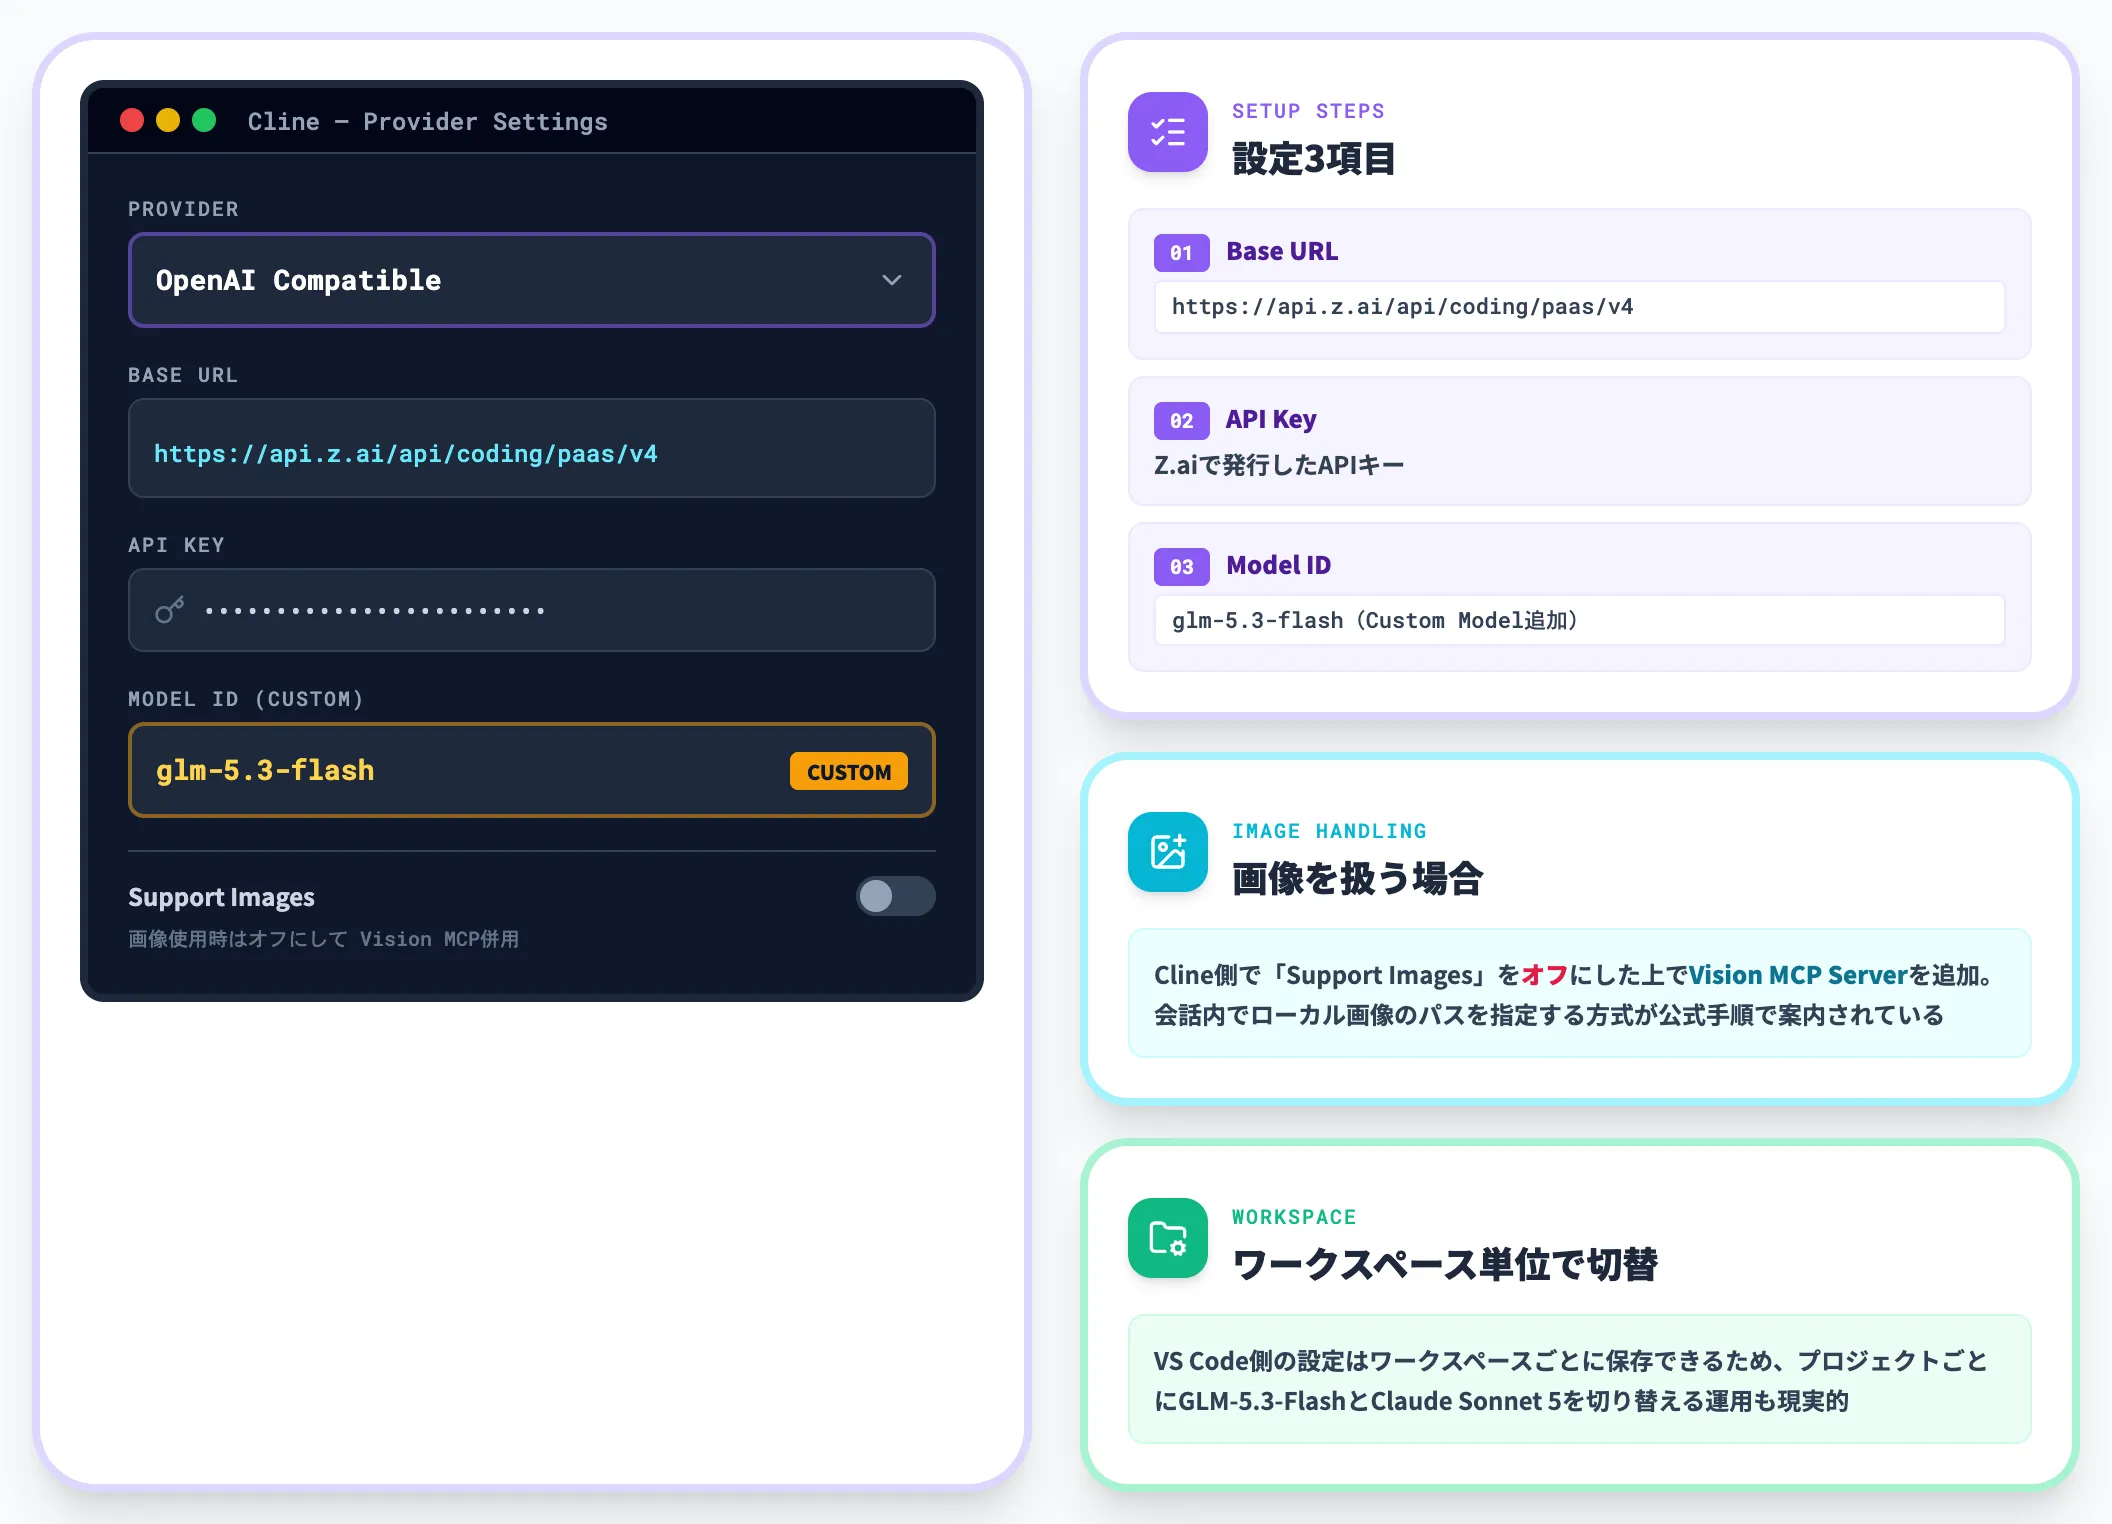
Clineは、VS Code拡張として動くコーディングエージェントです。GLM-5.3-Flashを呼ぶには、Provider選択で「OpenAI Compatible」を選び、以下を設定します。
- Base URL: 「https://api.z.ai/api/coding/paas/v4」
- API Key: Z.aiのAPIキー
- Model ID: 「glm-5.3-flash」(Custom Modelから追加)
ClineはClaude Codeと違い、モデル呼び出しをSonnet/Haikuの2階層で分けない設計のため、単一モデルとしてGLM-5.3-Flashを指定します。
画像を扱う場合は、Cline側で「Support Images」をオフにした上でVision MCP Serverを追加し、会話内でローカル画像のパスを指定する方式が公式手順で案内されています。
VS Code側の設定はワークスペースごとに保存できるため、プロジェクトごとにGLM-5.3-FlashとClaude Sonnet 5を切り替える運用も現実的です。
セットアップで詰まる3つの落とし穴
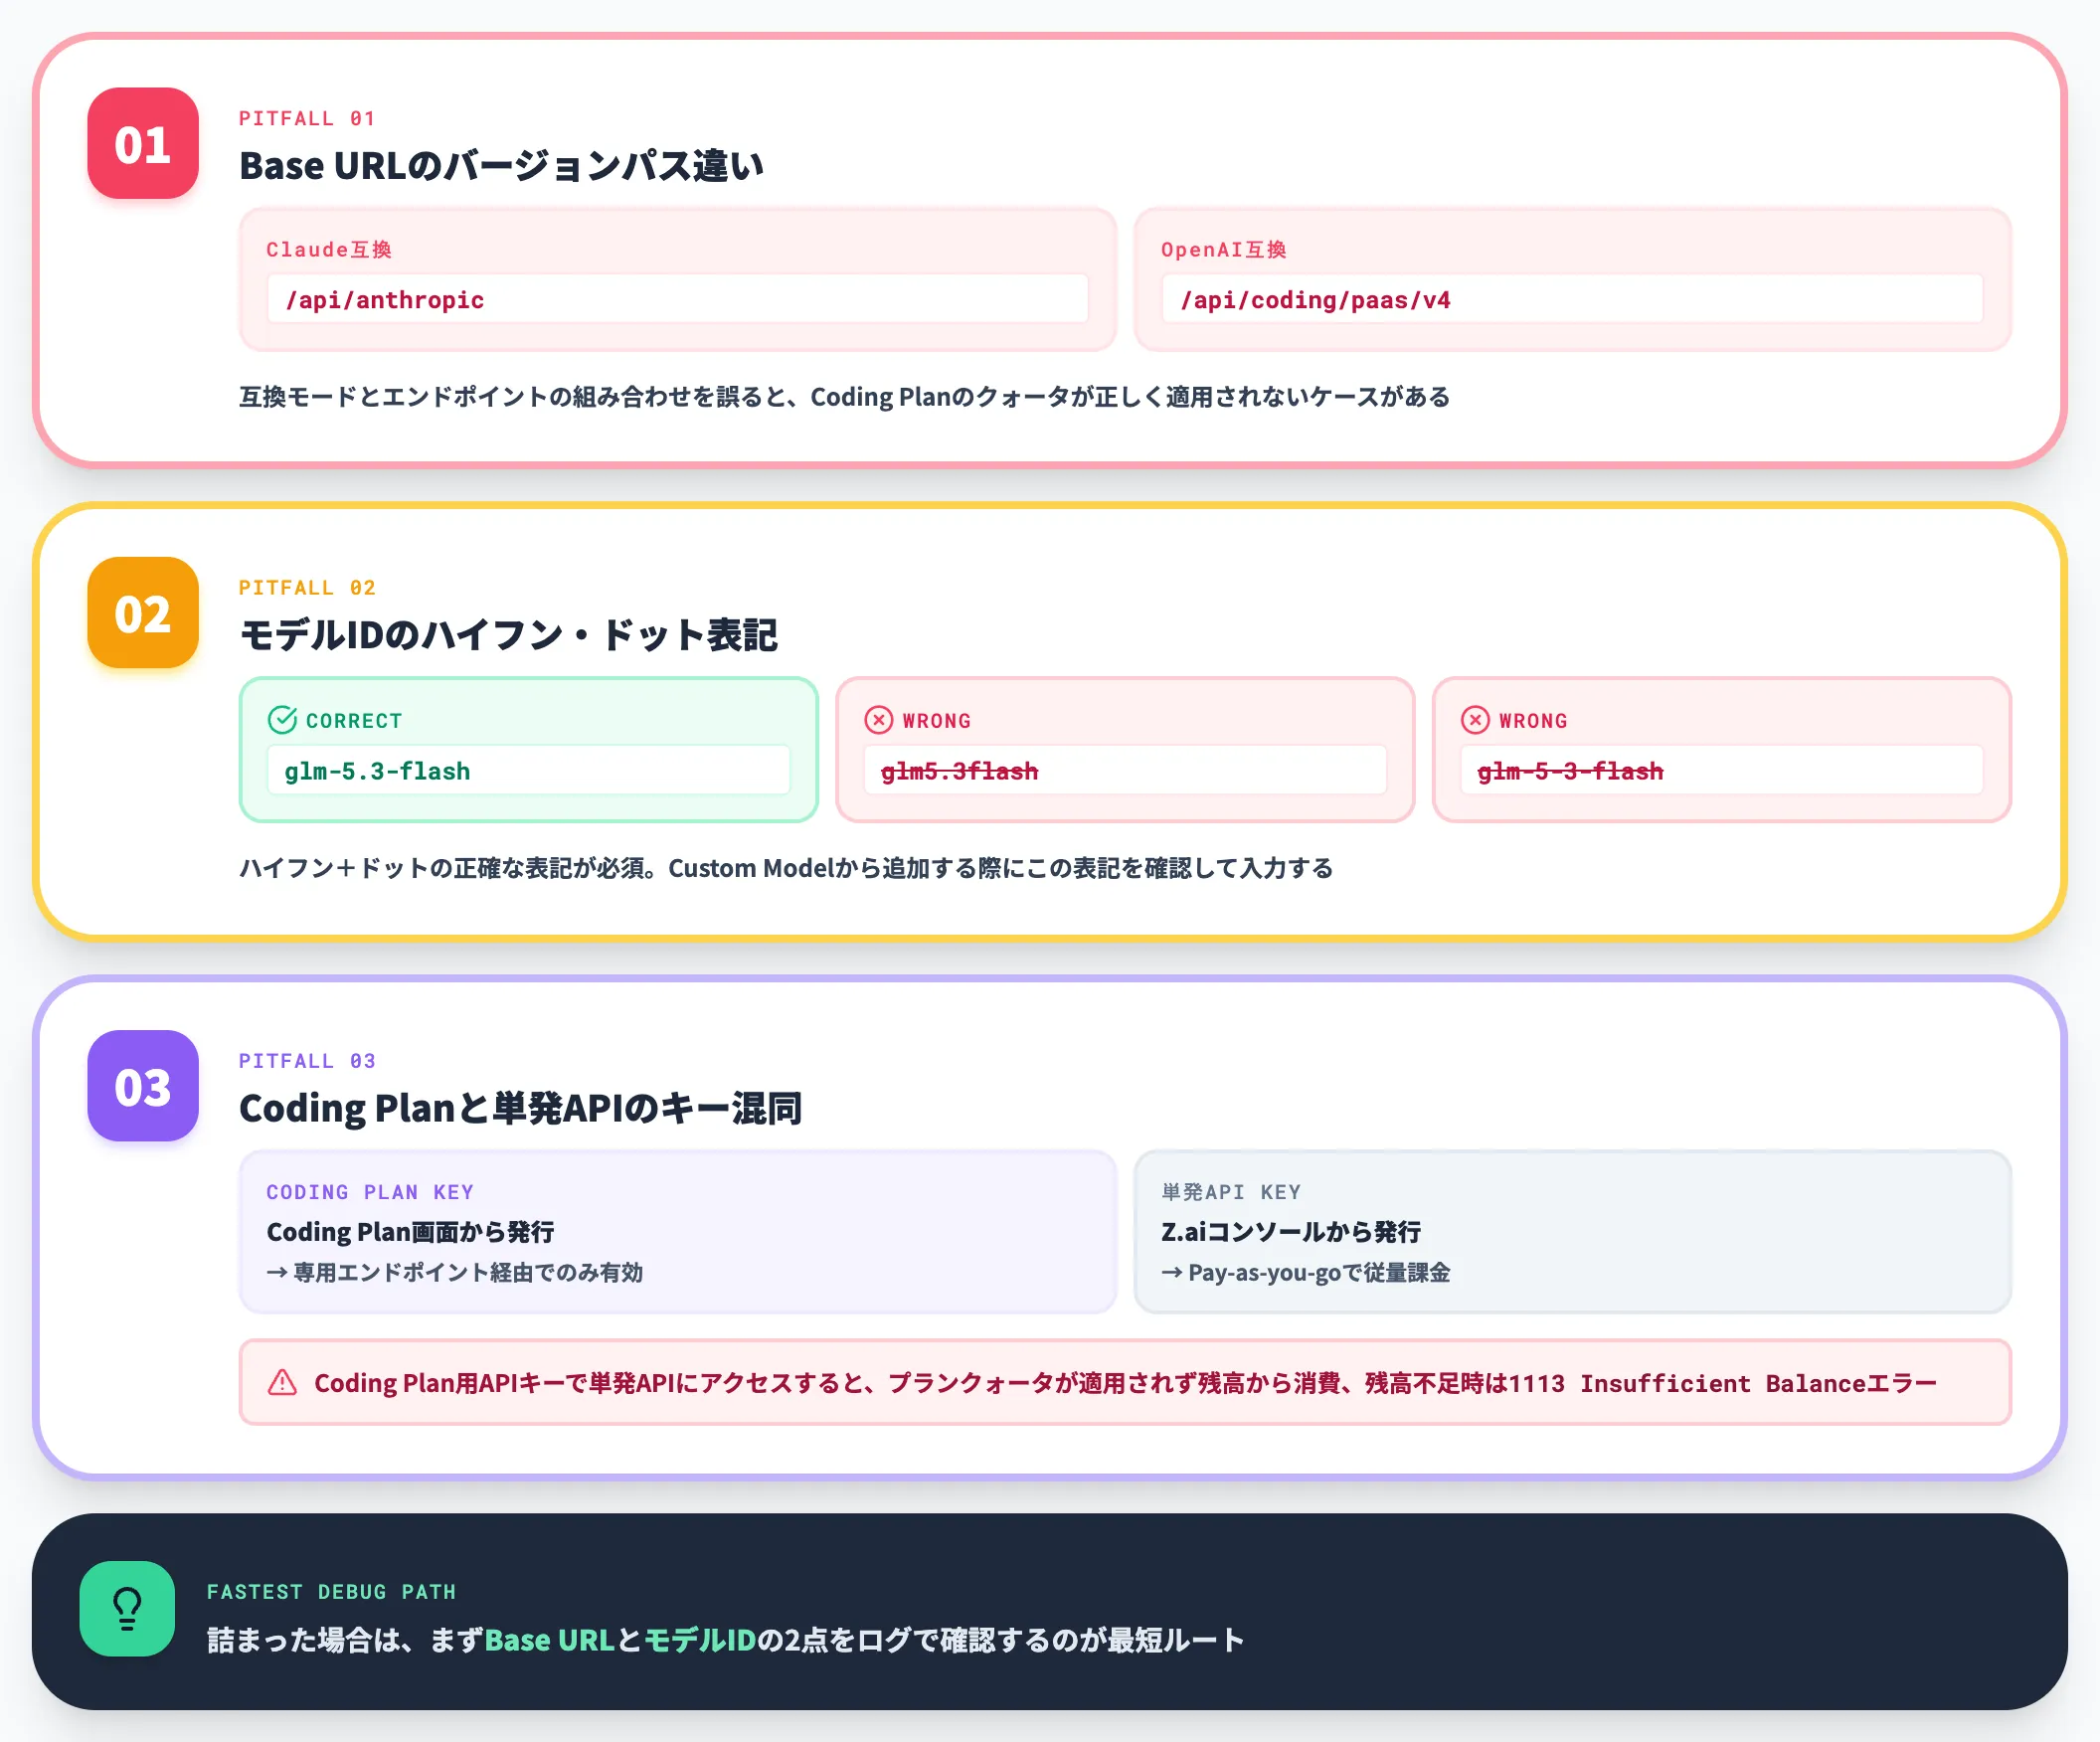
Claude Code・Cline・OpenCodeいずれの経路でも、セットアップ時に共通で詰まる箇所が3つあります。事前に押さえておくと、初期の試行錯誤コストを削減できます。
-
Base URLのバージョンパス違い
Z.aiのAPIエンドポイントは、「/api/anthropic」(Claude互換)と「/api/coding/paas/v4」(OpenAI互換)でパスが違います。互換モードとエンドポイントの組み合わせを誤ると、Coding Planのクォータが正しく適用されないケースがあります。
-
モデルIDのハイフン・ドット表記
モデルIDは「glm-5.3-flash」(ハイフン+ドット)で、「glm5.3flash」や「glm-5-3-flash」と書くと解決されません。Custom Modelから追加する場合、この表記を確認して入力します。
-
Coding Planと単発APIのキー混同
Coding Plan(特にTeam Plan)で発行したAPIキーは、他のZ.AI APIキーと互換性がなく、Coding Plan専用エンドポイント経由で使う必要があります。同じZ.aiアカウントでも、Coding Plan用APIキーで単発API課金経路にアクセスすると、プランクォータが適用されずに残高から消費される、あるいは残高不足時は「1113 Insufficient Balance」エラーになる場合があります。切り替え時はAPIキー発行画面で経路を確認します。
これらは公式ドキュメントに個別に記載されていますが、Claude Codeなど別ツール経由でセットアップする際に見落とされやすい箇所です。詰まった場合は、まずBase URLとモデルIDの2点をログで確認するのが最短ルートになります。
GLM-5.3-Flashと他モデルの使い分け——GLM-5.3本家・Qwen3.8-Flash-Next・DeepSeek V4-Pro
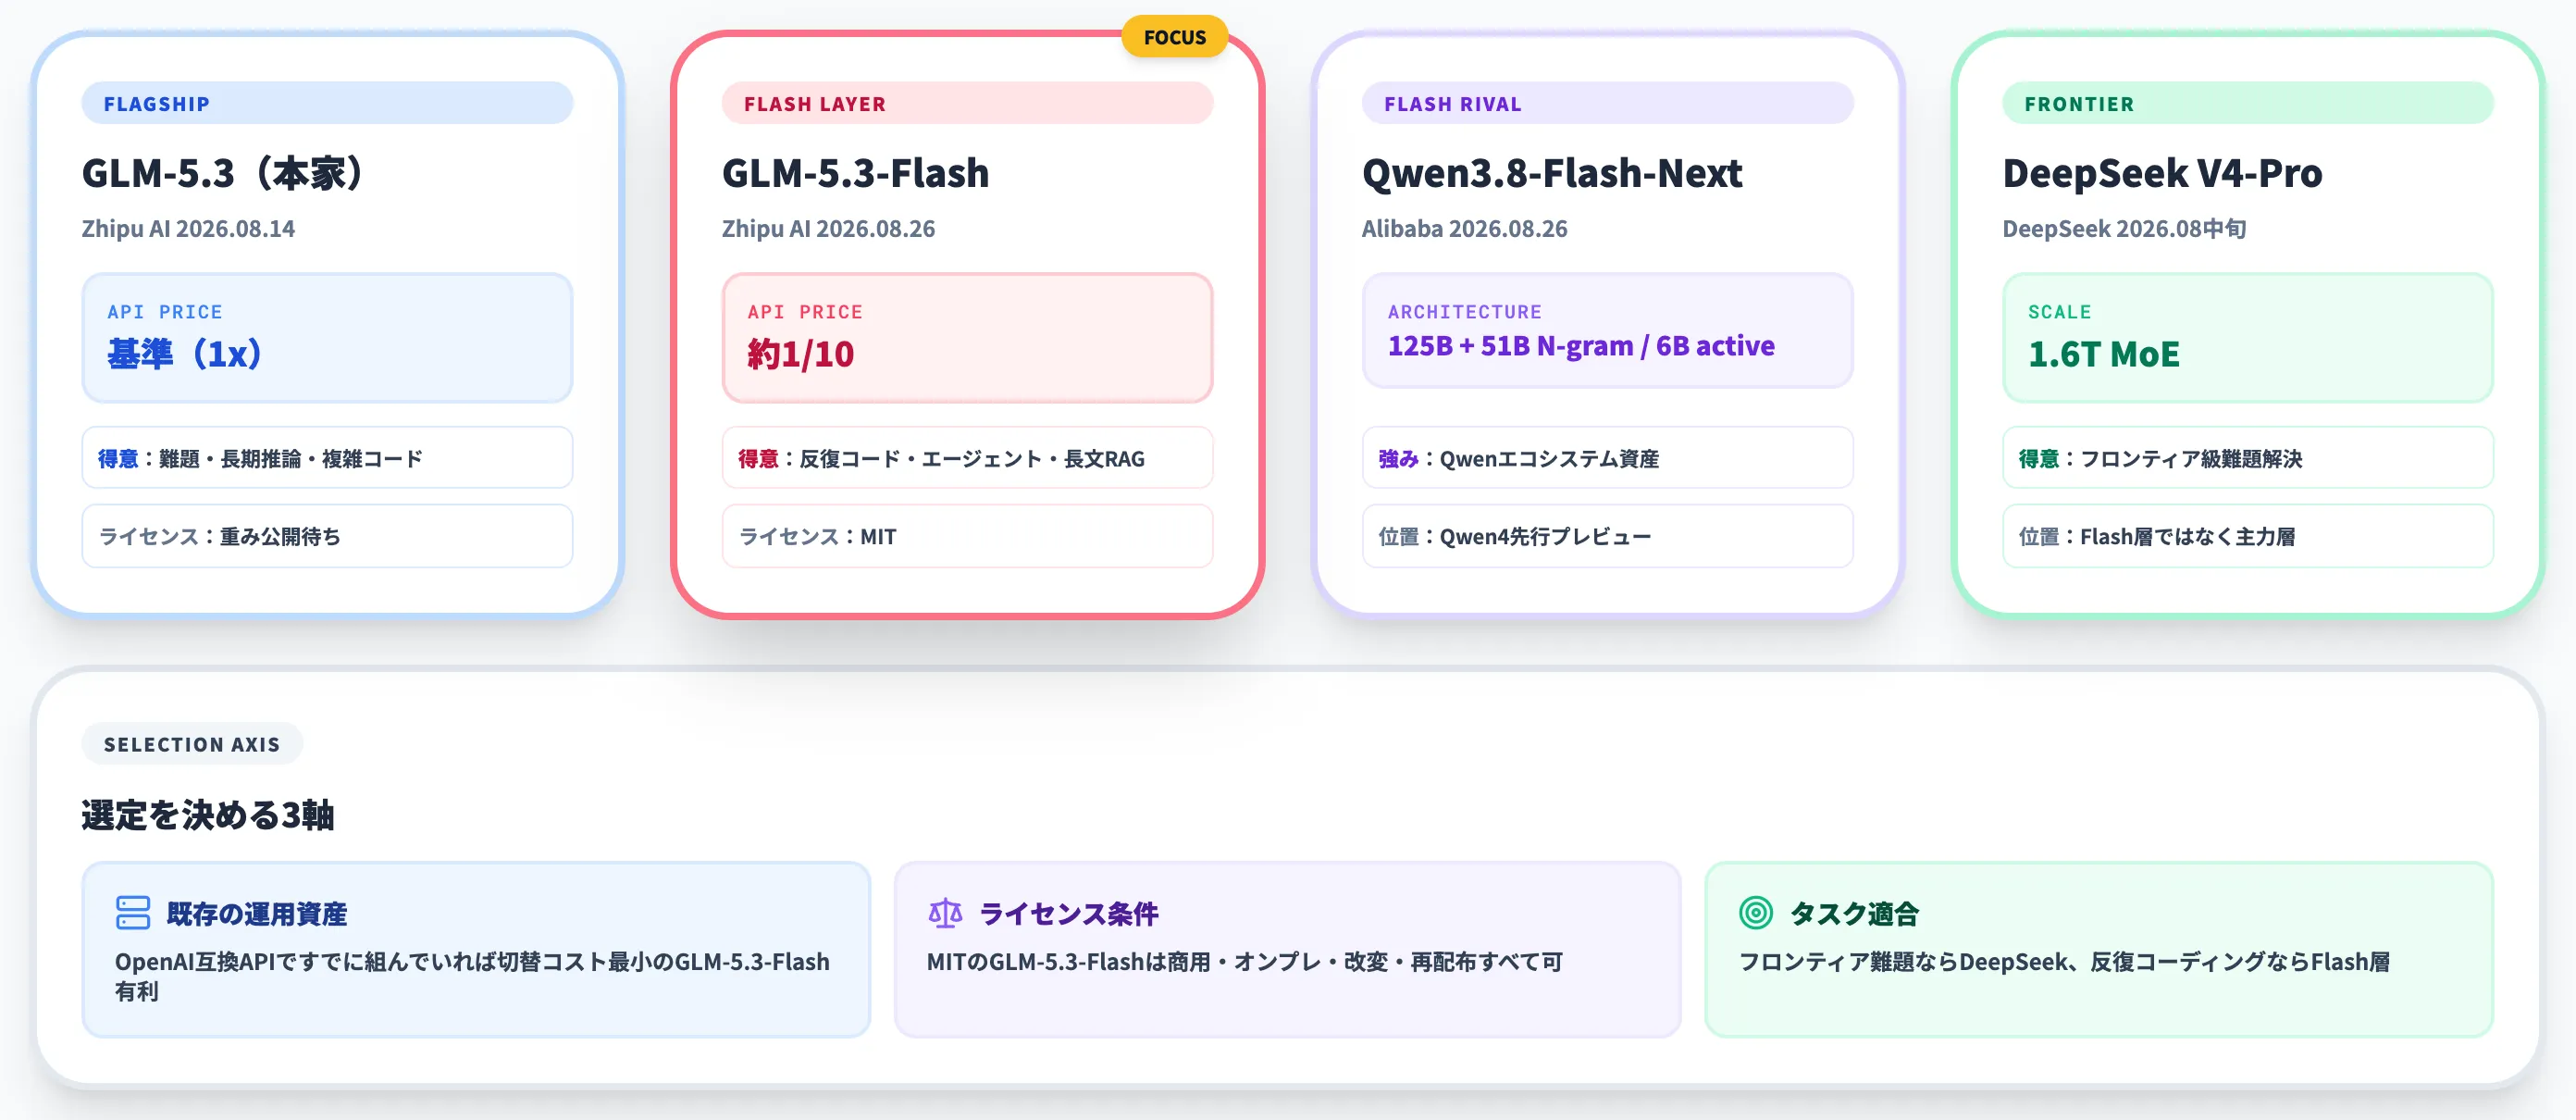
GLM-5.3-Flashの立ち位置を、既存の主力モデルと同時期にリリースされた他中華Flash系との関係で整理しておくと、実務での選定判断がしやすくなります。
本セクションでは、GLM-5.3本家との住み分け・同日リリースのQwen3.8-Flash-Next・8月中旬のDeepSeek V4-Proとの比較を、料金・性能・提供形態の3軸で見ていきます。
GLM-5.3本家との住み分け
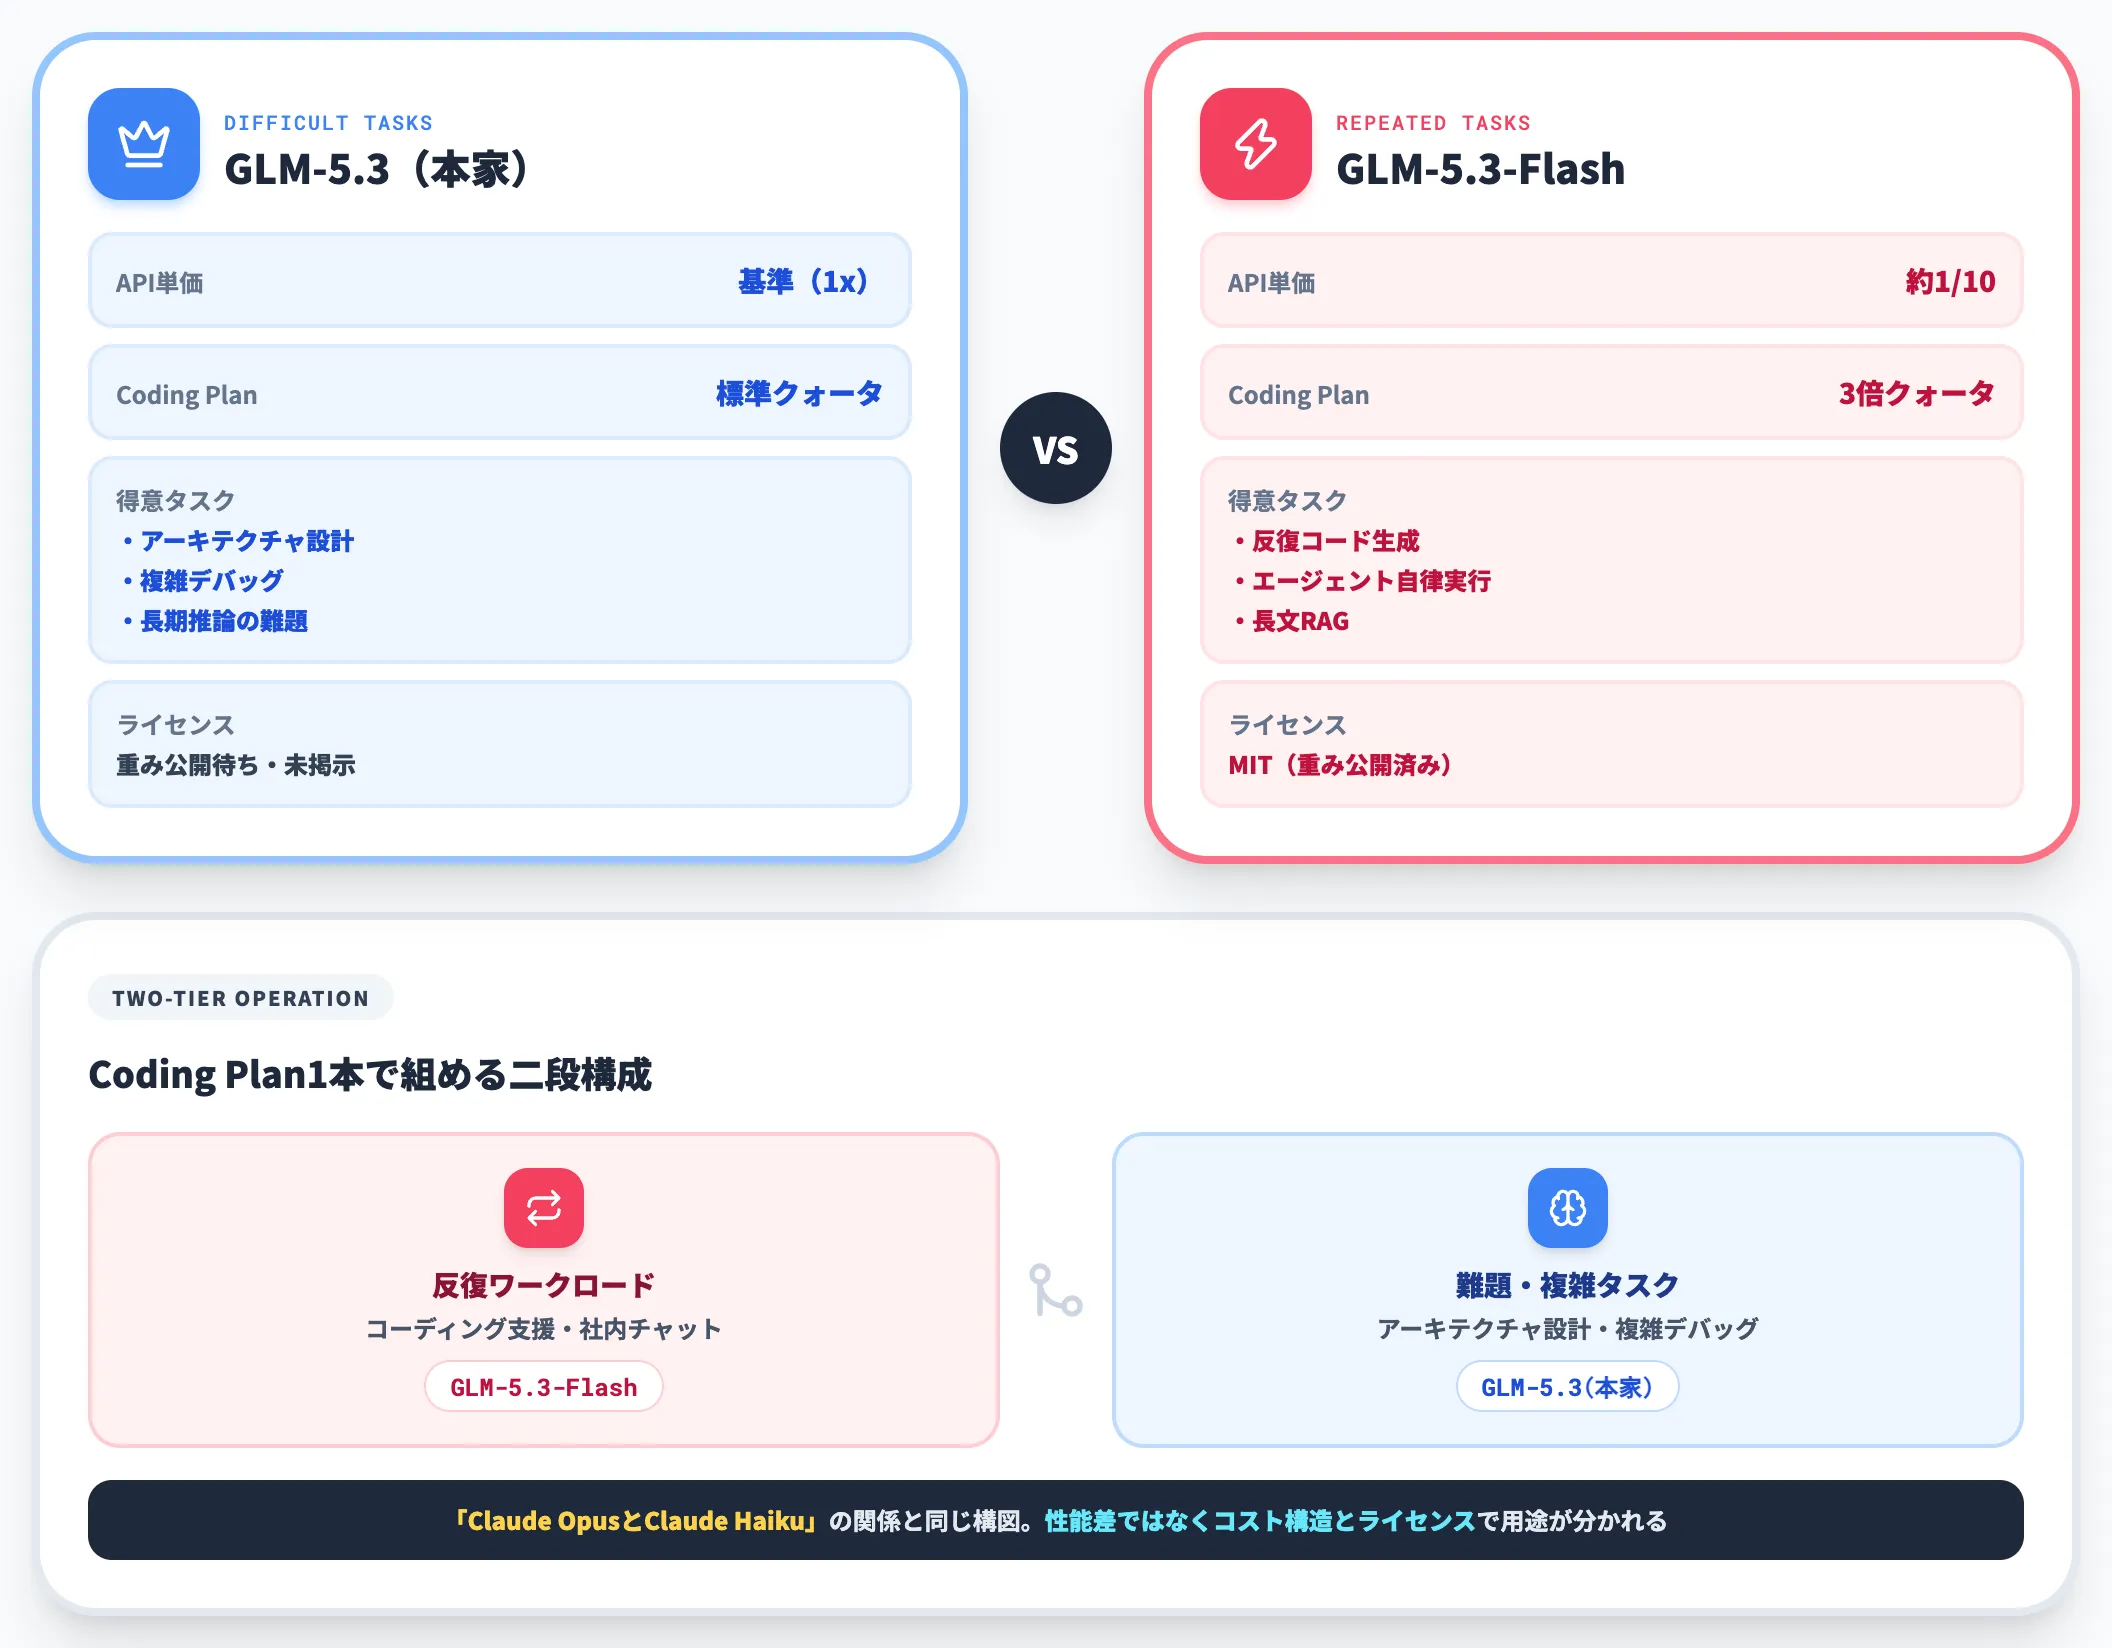
GLM-5.3本家とGLM-5.3-Flashは、同一系譜の中で「フラッグシップとFlash層」として役割が分かれます。
| 観点 | GLM-5.3(本家) | GLM-5.3-Flash |
|---|---|---|
| API単価 | 1(基準) | 約1/10 |
| コンテキスト長 | 1M | 1M |
| ネイティブ入力 | テキスト中心 | テキスト・画像・動画 |
| 得意タスク | 難題・長期推論・複雑コード生成 | 反復コード生成・エージェント自律実行・長文RAG |
| Coding Planクォータ | 標準 | 3倍 |
| ライセンス | 公開待ち・未掲示 | MIT |
両者の関係は「Claude OpusとClaude Haiku」の関係に近く、単純な性能差ではなく、コスト構造とライセンスで用途が分かれます。
コーディング支援や社内チャットのような反復ワークロードはGLM-5.3-Flashで回し、アーキテクチャ設計や複雑なデバッグは本家に渡すという二段構成が、Coding Plan1本で組める点が実務的な利点です。ライセンス面でも、Flash側はMITなので、オンプレ配布・改変・再配布の自由度を確保できます。
他中華Flash系との位置関係
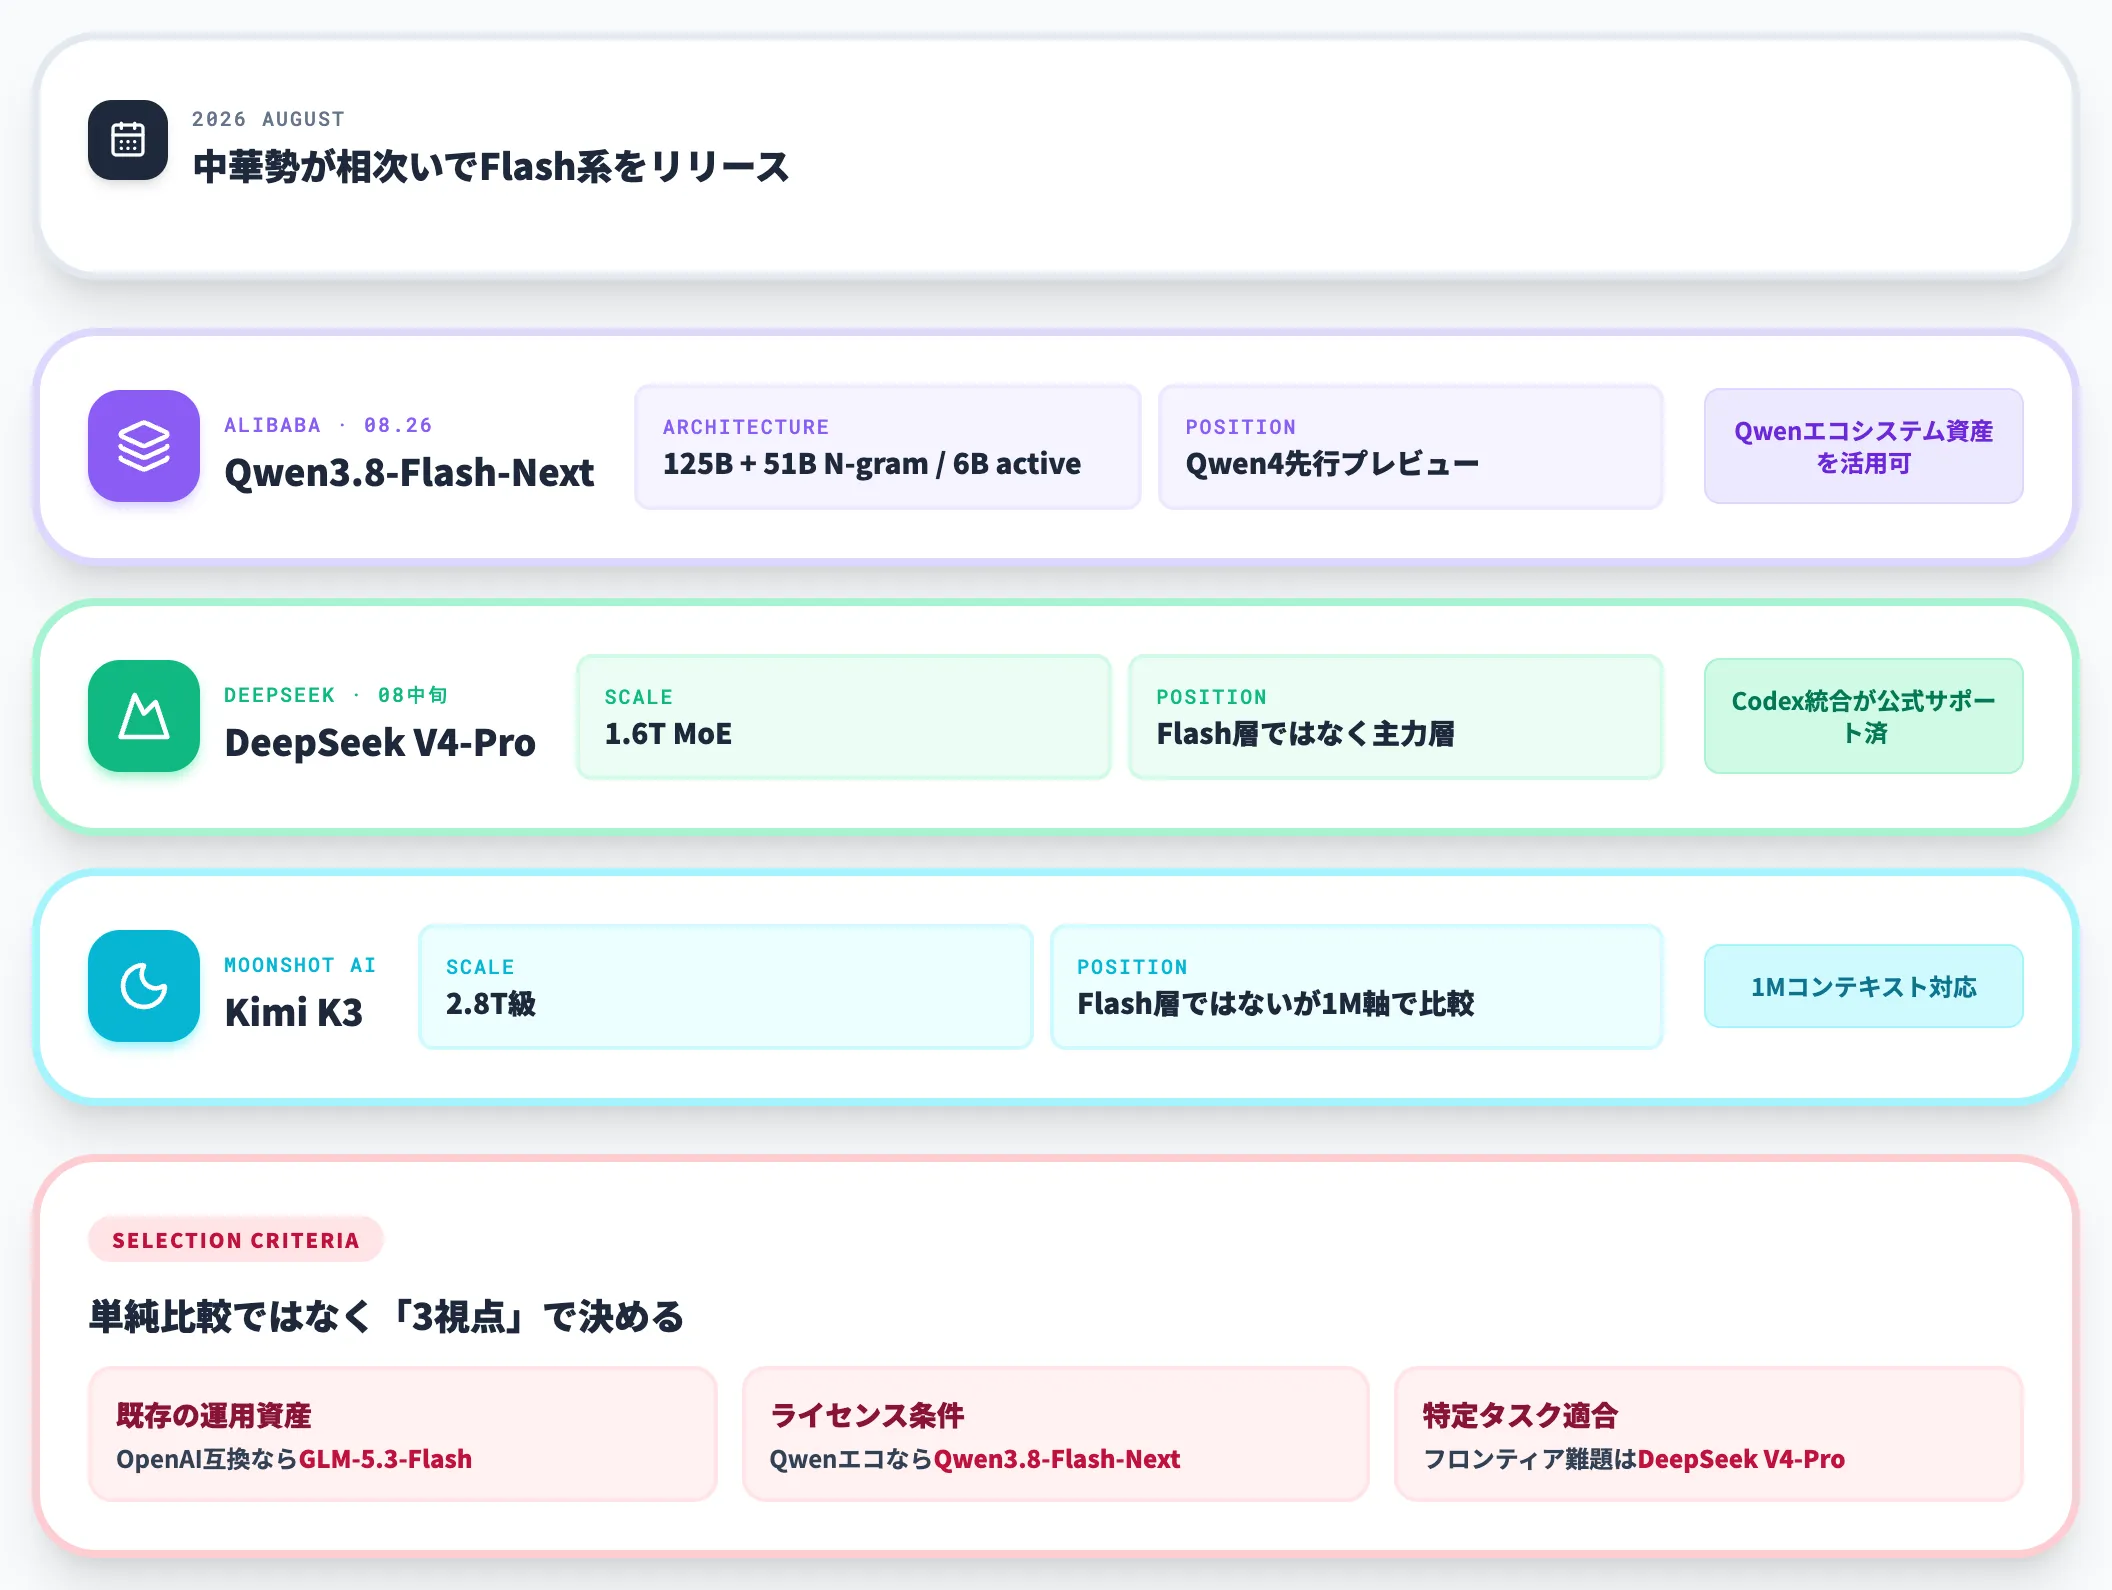
2026年8月は、中華勢が相次いでFlash系をリリースした月でした。GLM-5.3-Flashと同日にはAlibabaがQwen3.8-Flash-Nextを、8月中旬にはDeepSeek V4-Proがそれぞれ公開されています。
- Qwen3.8-Flash-Next
Qwen4アーキテクチャの先行プレビューで、125B本体+51B N-gram embeddings、6B activeという構成。
8/26同日リリースで、Qwen系の広範なライブラリ資産をそのまま活用できる点が強み。GLM-5.3-Flashと真正面から競合するFlash層。
-
DeepSeek V4-Pro
1.6T MoEでフロンティア級エージェント性能を持つオープンウェイトLLM。Codex統合が公式サポート済みで、8月中旬のDeepSeek API価格改定以降も基盤モデルとしての地位を維持。ただしFlash層ではなく、性能を優先する構成。
-
Kimi K3
Moonshot AIの2.8T級モデルで、1Mコンテキストに対応。Flash層ではないもののGLM-5.3-Flashと1Mコンテキストという軸で比較されるケースが多い。
この3モデルとGLM-5.3-Flashの選定は、単純な性能比較ではなく、「既存の運用資産・ライセンス条件・特定タスクへの適合」の3点で決まります。
すでにOpenAI互換APIでコーディングエージェントを組んでいて、切替コストを最小化したい場合はGLM-5.3-Flashが有利です。Qwenエコシステム(Qwen-Agent・Qwen-VL)を活用している場合はQwen3.8-Flash-Next、フロンティア級の難題解決を優先する場合はDeepSeek V4-Proが第一候補になります。
ケース別の推奨と使い分け軸
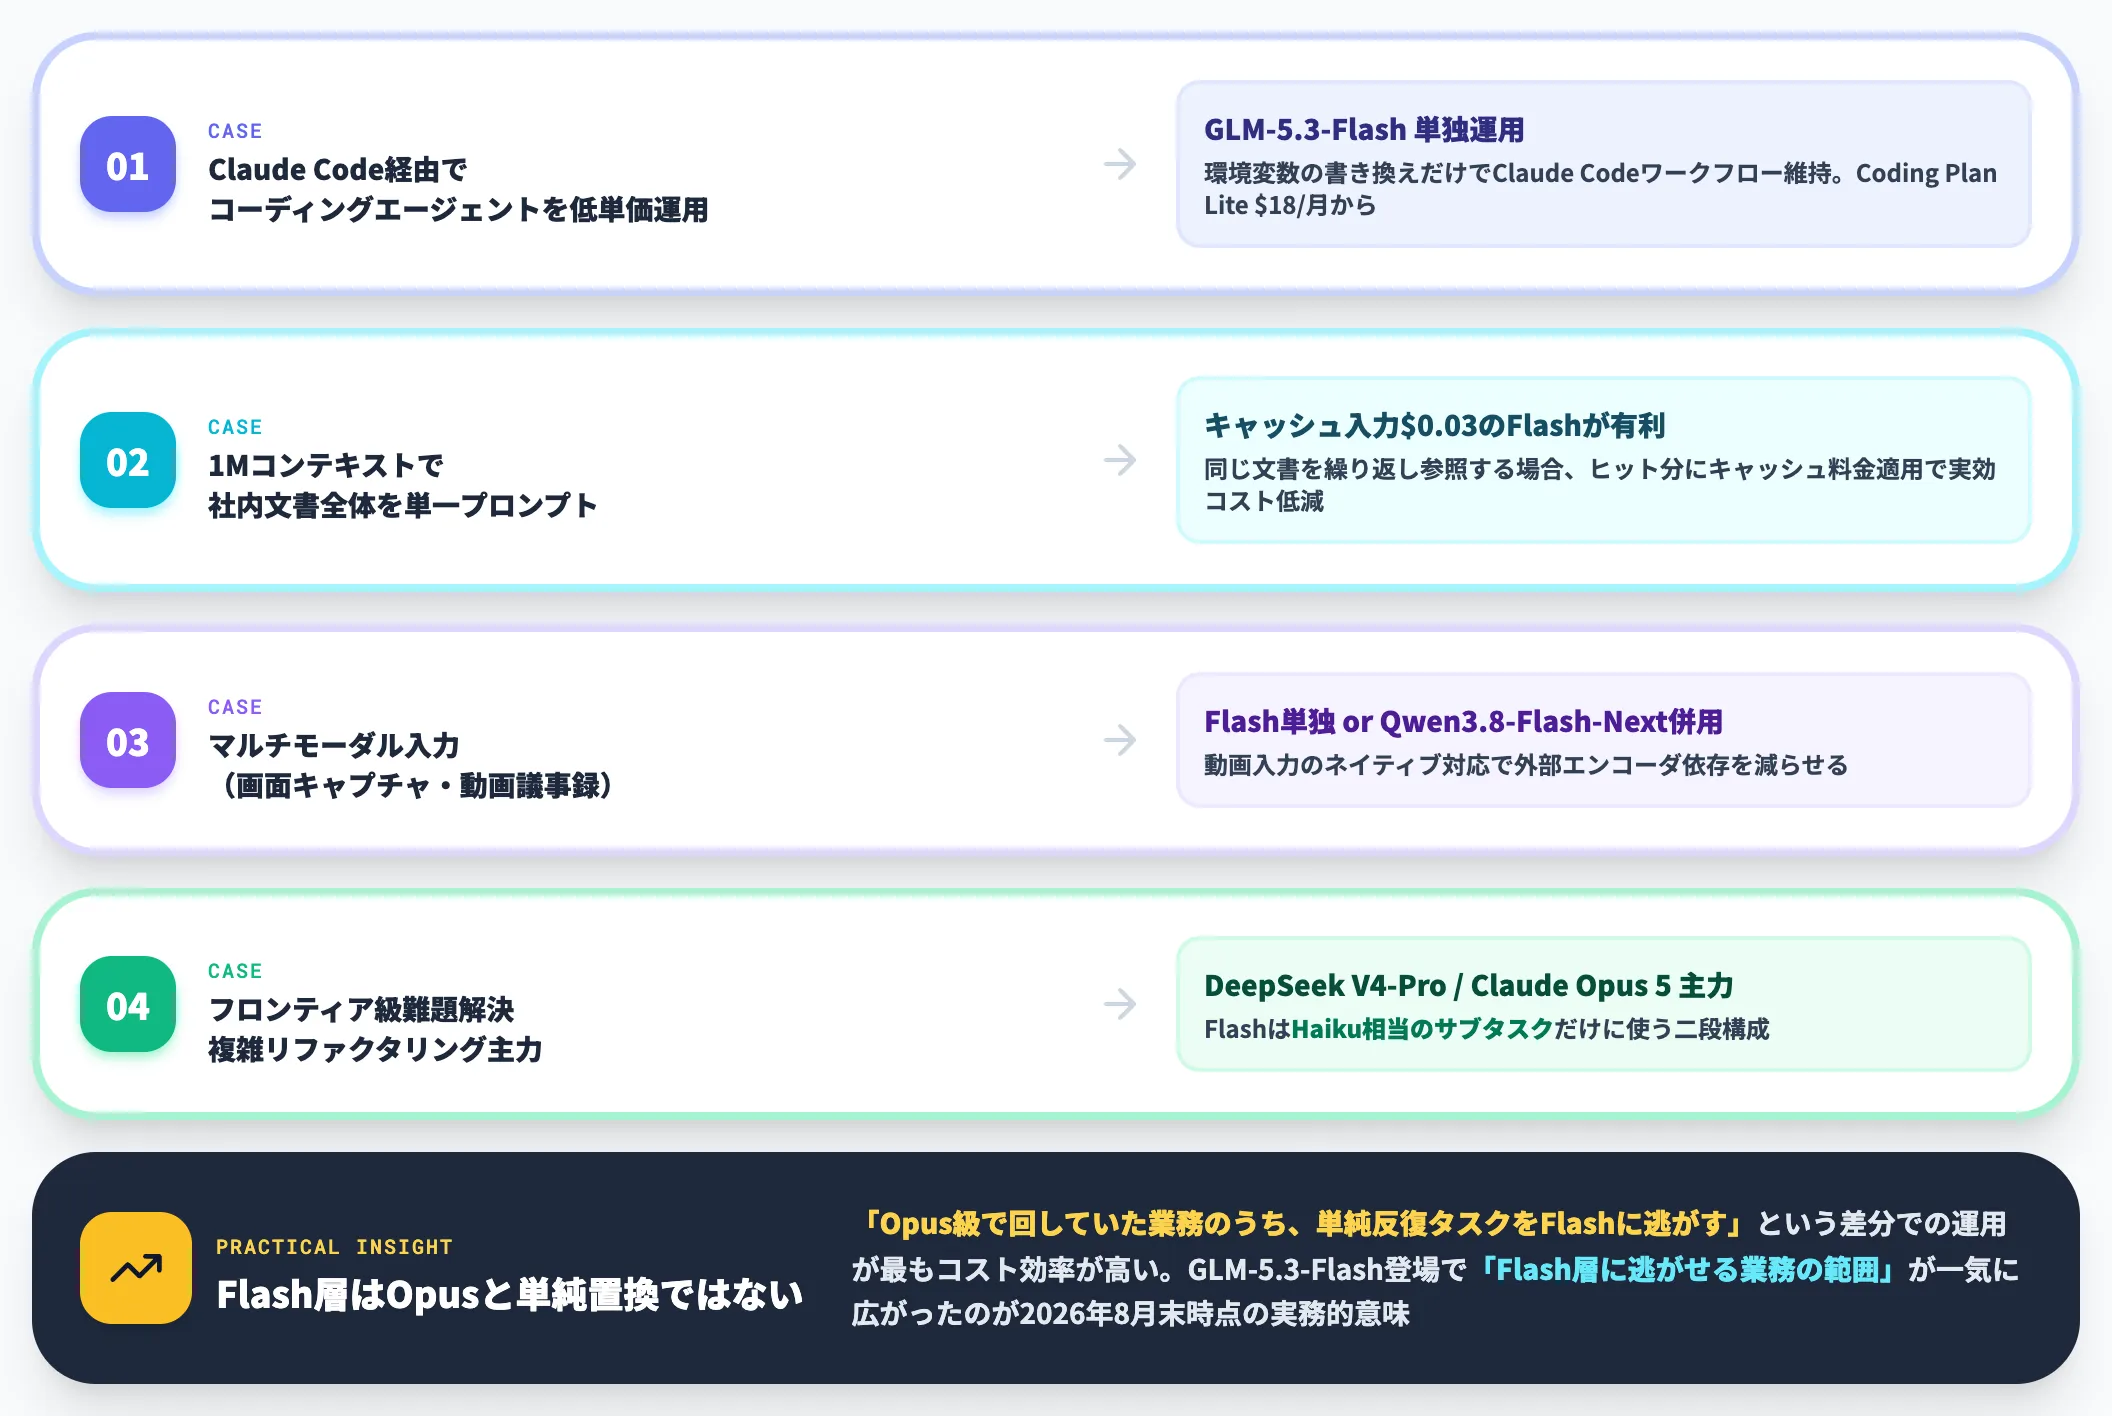
AI総合研究所が企業のAI導入を支援する立場から見ると、GLM-5.3-Flashを主力として使うべきケースと、他モデルを併用すべきケースは以下のように分かれます。
-
Claude Code経由のコーディングエージェントを低単価で回したいケース
GLM-5.3-Flash単独運用が第一候補。環境変数の書き換えだけで既存Claude Codeワークフローを維持でき、Coding Plan Lite $18/月から始められる。
-
1Mコンテキストで社内文書全体を単一プロンプトに乗せたいケース
キャッシュ入力$0.03のGLM-5.3-Flashが有利。同じ文書を繰り返し参照するワークロードでは、ヒット分のトークンにキャッシュ料金が適用されるため実効コストが標準入力単価より低く抑えられる。
-
マルチモーダル入力(画面キャプチャ・動画議事録)を単一モデルで扱いたいケース
GLM-5.3-Flash単独 or Qwen3.8-Flash-Next併用が現実的。動画入力のネイティブ対応で外部エンコーダ依存を減らせる。
-
フロンティア級の難題解決・複雑リファクタリングを主力にしたいケース
DeepSeek V4-Pro・Claude Opus 5を主力に据え、GLM-5.3-FlashはHaiku相当のサブタスクだけに使う二段構成が向く。
Flash層のモデルは、Opus級モデルと単純に置き換えるものではなく、「Opus級で回していた業務のうち、単純反復タスクをFlashに逃がす」という差分での運用が最もコスト効率が高くなります。
GLM-5.3-Flashが8月26日に登場したことで、この「Flash層に逃がせる業務の範囲」が一気に広がった、というのが2026年8月末時点の中華Flash競争の実務的な意味合いです。
件数の多い処理をGLM-5.3-Flashに任せ、難題は主力モデルに残す
GLM-5.3-Flashは、Claude Opus 4.8に迫るコーディング性能を、GLM-5.3本家の約1/10のAPI単価で出します。単純な反復作業をFlashに逃がす使い方は、コーディングに限らず、領収書や請求書の読み取りのように件数の多い業務に当てはまります。ただ、どの処理まで任せてよいかはベンチマークの数字だけでは見えないため、実際の帳票で確かめながら、主力モデルとの分担を決めるのが現実的です。
その分担を処理の流れに反映できるのが、業務特化のAgentを組み合わせるAIエージェント基盤です。AI総合研究所のAI Agent Hubは、経費精算や請求書の受領を、読み取りや申請内容のチェックといった段階に分け、それぞれを専用のAgentが担います。
- 判断の重さに合わせてモデルを分ける
領収書を読み取るAgentには画像やPDFを扱えるGLM-5.3-Flashを使い、社内規定と照らし合わせる段階には主力モデルを充てます。
- 呼び出し先はデータの機密度で決める
n8nで組むAgentからZ.aiのOpenAI互換APIを使えるよう、要件に応じて接続を設計・構築し、社外に出せないデータを扱う処理には、MITライセンスの重みを自社の環境に置く構成を選べます。
- 自社の帳票で試してから本番に出す
本番の前にAgentをサンドボックス環境で動かし、手元の領収書や請求書で読み取りの精度を確かめてから、Flash系に切り替えます。
AI総合研究所の専任チームが、Flash系に任せる処理の候補選びから、Agentごとのモデルの割り当てまで支援します。
件数の多い処理をFlash系に任せる

読み取りの精度を自社の帳票で確かめる
GLM-5.3-FlashのようなFlash系モデルには、領収書や請求書の読み取りのように件数の多い処理から任せ、難題は主力モデルに残すと、処理コストを抑えやすくなります。AI Agent Hubでは、Agentごとに呼び出すモデルを分け、本番の前にサンドボックス環境で、自社の帳票を使って精度を確かめます。
まとめ
本記事では、GLM-5.3-Flashを「Zhipu AIのFlash層にあたる、マルチモーダル対応のオープンMoEモデル」として整理し、Ox Alphaとしての匿名提供・アーキテクチャ・ベンチマーク・料金と入手経路・Claude CodeやClineでの使い方・他モデルとの比較を解説しました。
2026年8月時点で押さえておくべきポイントは次の3つです。
- GLM-5系で初めて動画を含むマルチモーダル入力に対応し、議事録動画の要約のような処理で、外部のエンコーダへの依存を減らせるようになった
- 既存のコーディングエージェントにつなぐなら、同時期のQwen系やDeepSeekより、乗り換えの手間が小さいGLM-5.3-Flashが有利になる
- 出力速度は同クラスの中央値をやや下回るため、超低レイテンシが欠かせないリアルタイム用途では、別のモデルとの併用を前提に組む必要がある
GLM-5.3-Flashを導入する際、AI総合研究所が先に固めるのは、接続の設定と費用の見積もりです。
まずは、Claude Codeの環境変数を書き換えてHaiku相当のサブタスクをGLM-5.3-Flashに振り、Base URLとモデルIDが正しく指定されているかをログで点検します。
続いて、Coding Plan用と従量API用のどちらのキーで呼んでいるかを整理したうえで、割引期間が終わった後の単価とキャッシュのヒット率から実効コストを見積もります。
Flash層の競争は、単価の引き下げに加えて、長いコンテキストを安く扱うための設計で差がつく段階に入っています。
GLM-5.3-Flashは、疎行列注意と線形注意を組み合わせてその設計を形にしたモデルとして、相次いで登場した中華勢のFlash系を比べる際の基準になります。