この記事のポイント
 Kimi K3.1 ProはK3と同じ2.8T total/104B activeのMoE構成、改善はポスト学習側に集中し幻覚率が23.4%から8.3%へ縮小
- API料金は入力$2/出力$10(1Mトークンあたり)とK3から1/3値下げ、Opus 5.5のトークン単価と比べると約半額、AA計測のタスク単価では約1/3
- 思考モードはK3から継承したlow/high/maxの3段構成、temperature=1.0・top_p=0.95固定の仕様もK3から継続
- Terminal-Bench 4.0は65.7%でOpus 5.5(66.4%)に0.7pt差まで接近、xdev-bench-hardはpass@3で81.0%
- オープンウェイトは2026年11月4日までに公開予定、ライセンス条件はウェイト公開時に合わせて公表される見込み、ハッキング関連の訓練データは事前削除された状態での公開
Microsoft MVP・AIパートナー。LinkX Japan株式会社 代表取締役。東京工業大学大学院にて自然言語処理・金融工学を研究。NHK放送技術研究所でAI・ブロックチェーンの研究開発に従事し、国際学会・ジャーナルでの発表多数。経営情報学会 優秀賞受賞。シンガポールでWeb3企業を創業後、現在は企業向けAI導入・DX推進を支援。
Kimi K3.1 Pro(キミ・ケイサンイチ・プロ)は、Moonshot AIが2026年10月23日に発表したオープンウェイトのフロンティアLLMです。
Artificial AnalysisのIntelligence Indexで55点を記録し、Claude Opus 5.5(58点)に次ぐ4位にランクイン、オープンウェイト勢ではトップに立ちました。
本記事では、Kimi K3との差分、ベンチマークと競合モデルとの位置関係、$2/$10に下がった料金とHighspeed版、提供チャネル、11月4日公開予定のオープンウェイトの扱い、そしてどのケースで採用すべきかまでを2026年10月時点の最新情報で解説します。
目次
Kimi K3.1 Proとは?Opus 5.5に迫るオープンウェイトフロンティアLLM
Kimi K3.1 Proの変更点——幻覚率1/3・コーディング伸長
サンプリングはtemperature=1.0・top_p=0.95固定
Kimi K3.1 Proのベンチマークと競合モデルとの位置関係
Artificial Analysisで世界4位にランクイン
Kimi K3.1 Proの料金とHighspeed版のコスト構造
Kimi K3.1 Proのオープンウェイト公開と選定時の注意点
どのケースでKimi K3.1 Proを選ぶか——他モデルとの使い分け
Kimi K3.1 Proとは?Opus 5.5に迫るオープンウェイトフロンティアLLM
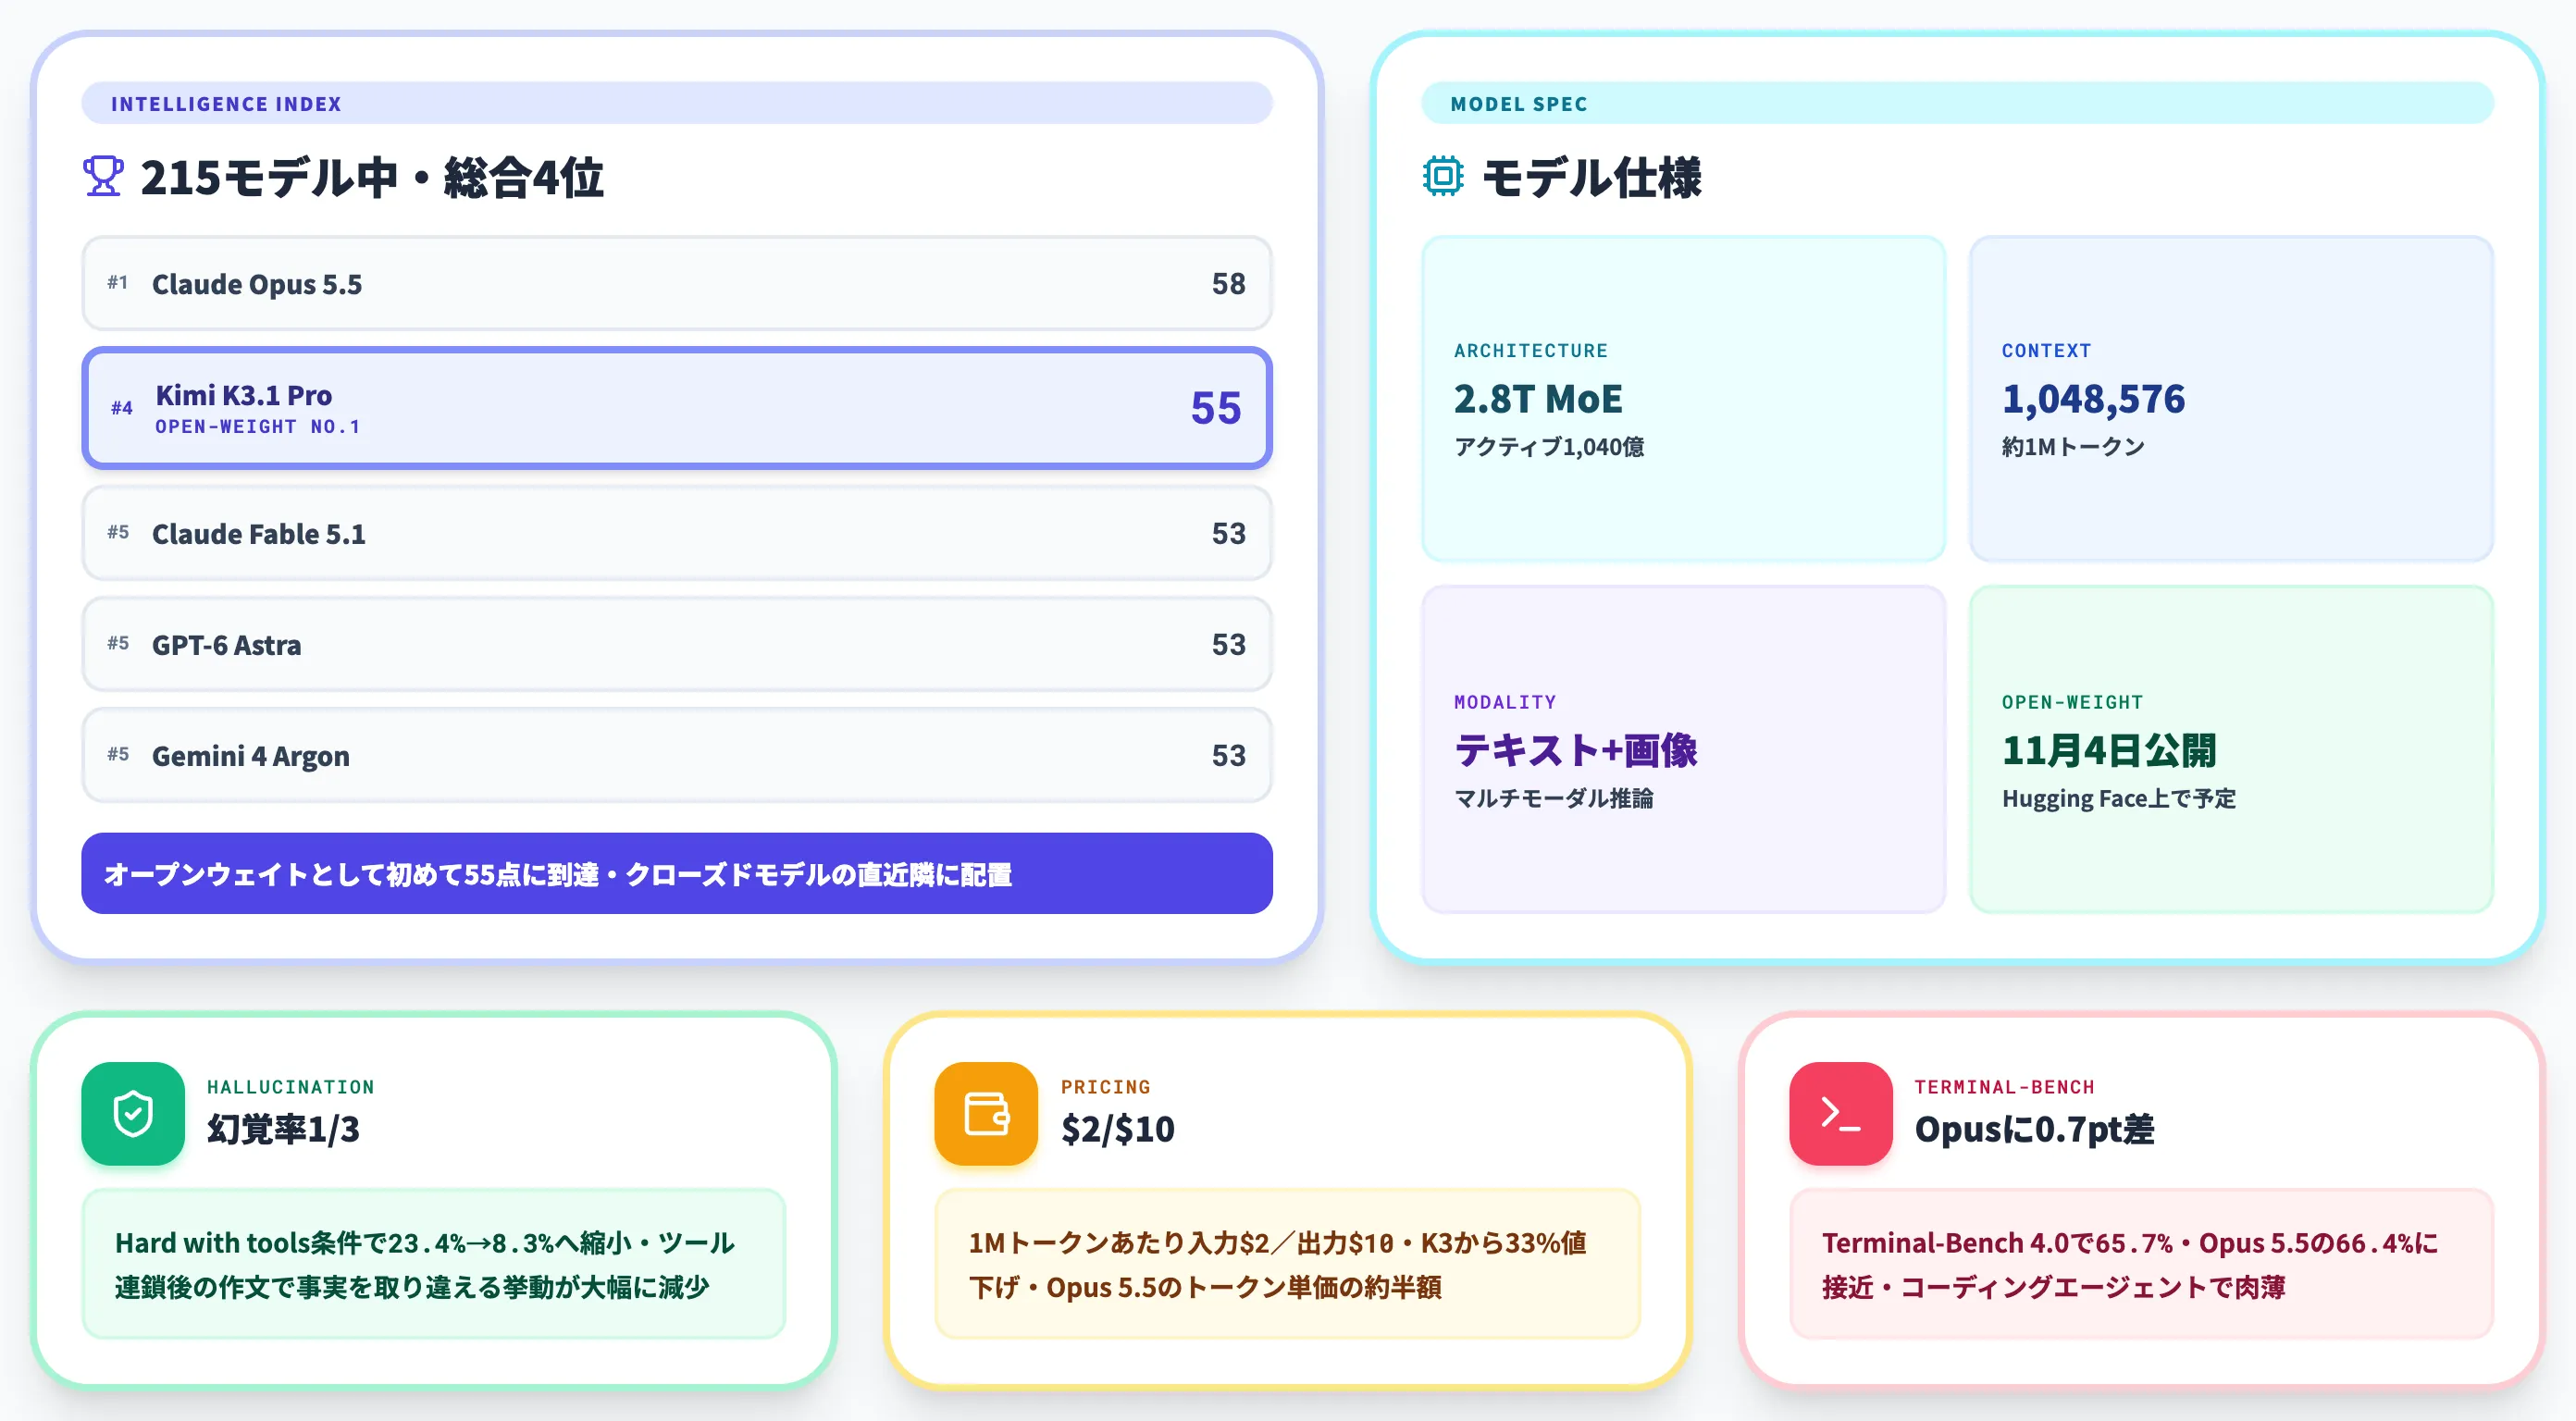
Kimi K3.1 Proとは、中国のMoonshot AIが2026年10月23日に公開したオープンウェイトのフロンティア大規模言語モデルです。
同社の既存モデルKimi K3(2026年7月16日発表)をベースに、強化学習を中心としたポスト学習を重ねた後継版として位置づけられています。
Kimi K3.1 Proのローンチキービジュアル(出典:Kimi公式ブログ)
ArtificialAnalysis.aiのIntelligence Indexで55点を獲得し、Claude Opus 5.5(58点)に次ぐ4位にランクインしました。
GPT-6 Astra・Claude Fable 5.1・Gemini 4 Argon(いずれも53点)を上回り、オープンウェイトモデルとしては世界トップに立っています。
モデルウェイトは2026年11月4日までにHugging Face上で公開される予定で、ライセンス条件はウェイト公開時に合わせて公表される見込みです。
Kimi K3系列の中での位置づけ
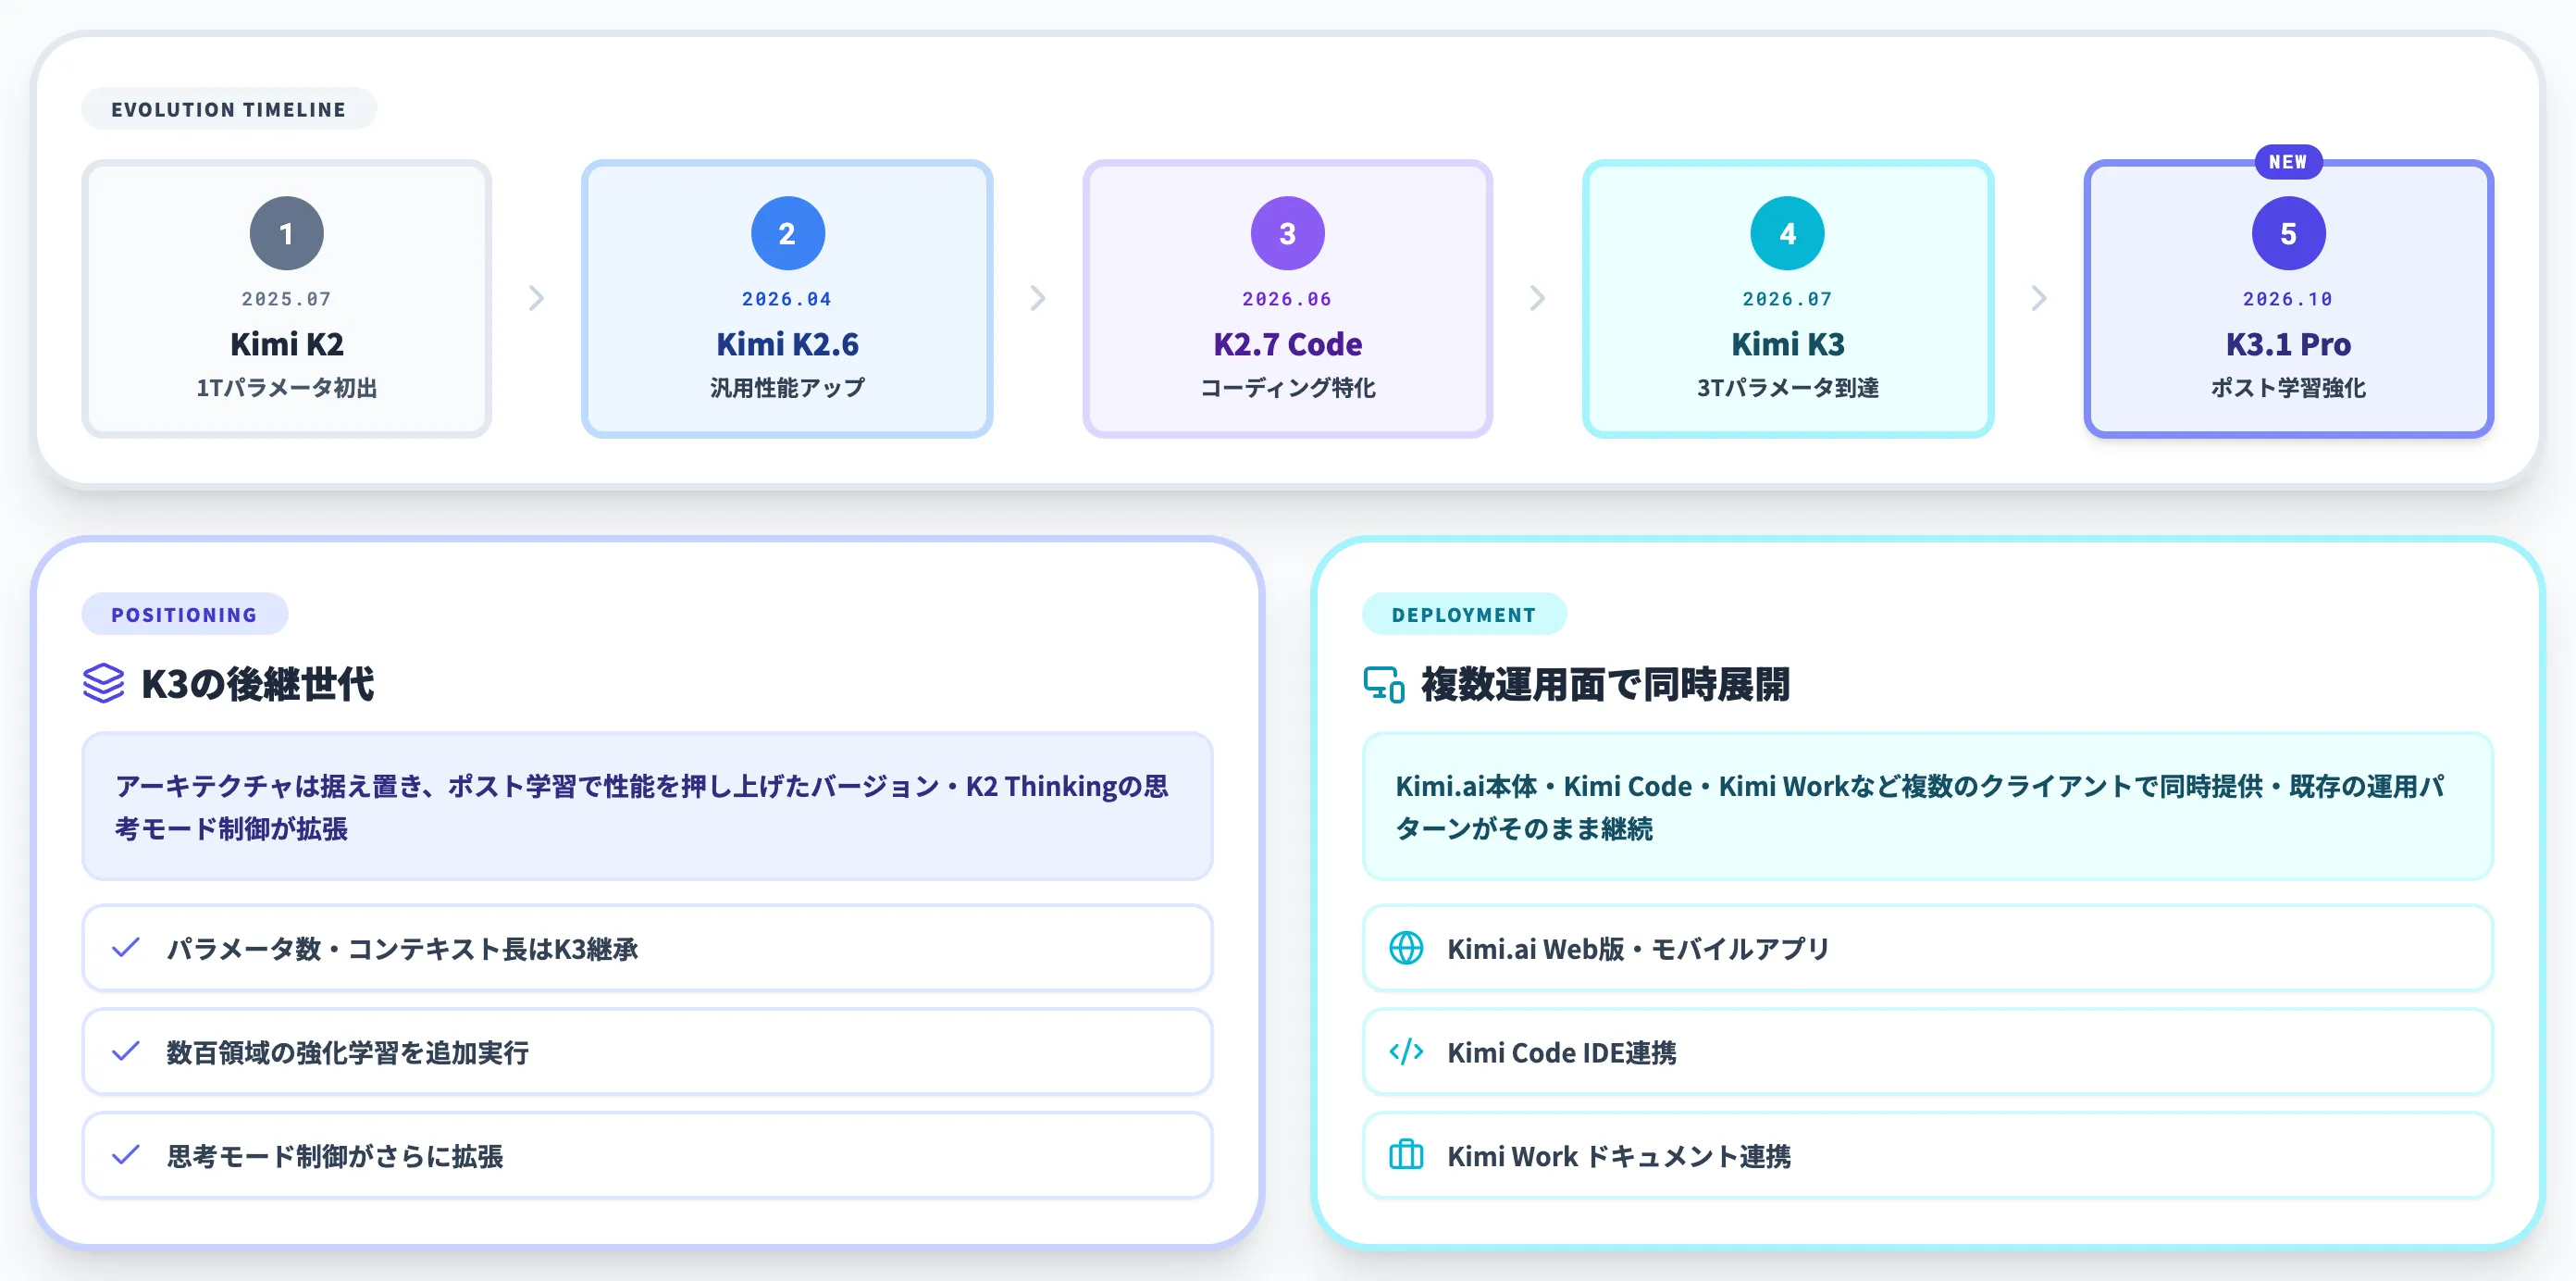
Moonshotのオープンウェイト系列は、2025年7月のKimi K2(1兆パラメータ)からK2.6(2026年4月)、コーディング特化のK2.7 Code(2026年6月)を経て、2026年7月に3兆パラメータ級のKimi K3へ到達した経緯があります。
K3.1 Proはこの系譜の中で「K3の後継世代として、アーキテクチャは据え置きつつポスト学習で性能を押し上げたバージョン」という位置づけです。
Kimi K2 Thinkingで導入された思考モード制御がさらに拡張され、Kimi.ai本体およびKimi Code、Kimi Workなど複数の運用面で同時展開されています。
Moonshot AIのプロダクト全体像はKimiとは?モデルラインナップや料金、Moonshot AIの使い方を解説にまとめているため、系列全体を押さえたい場合は合わせて参照してください。
Kimi K3.1 Proの変更点——幻覚率1/3・コーディング伸長
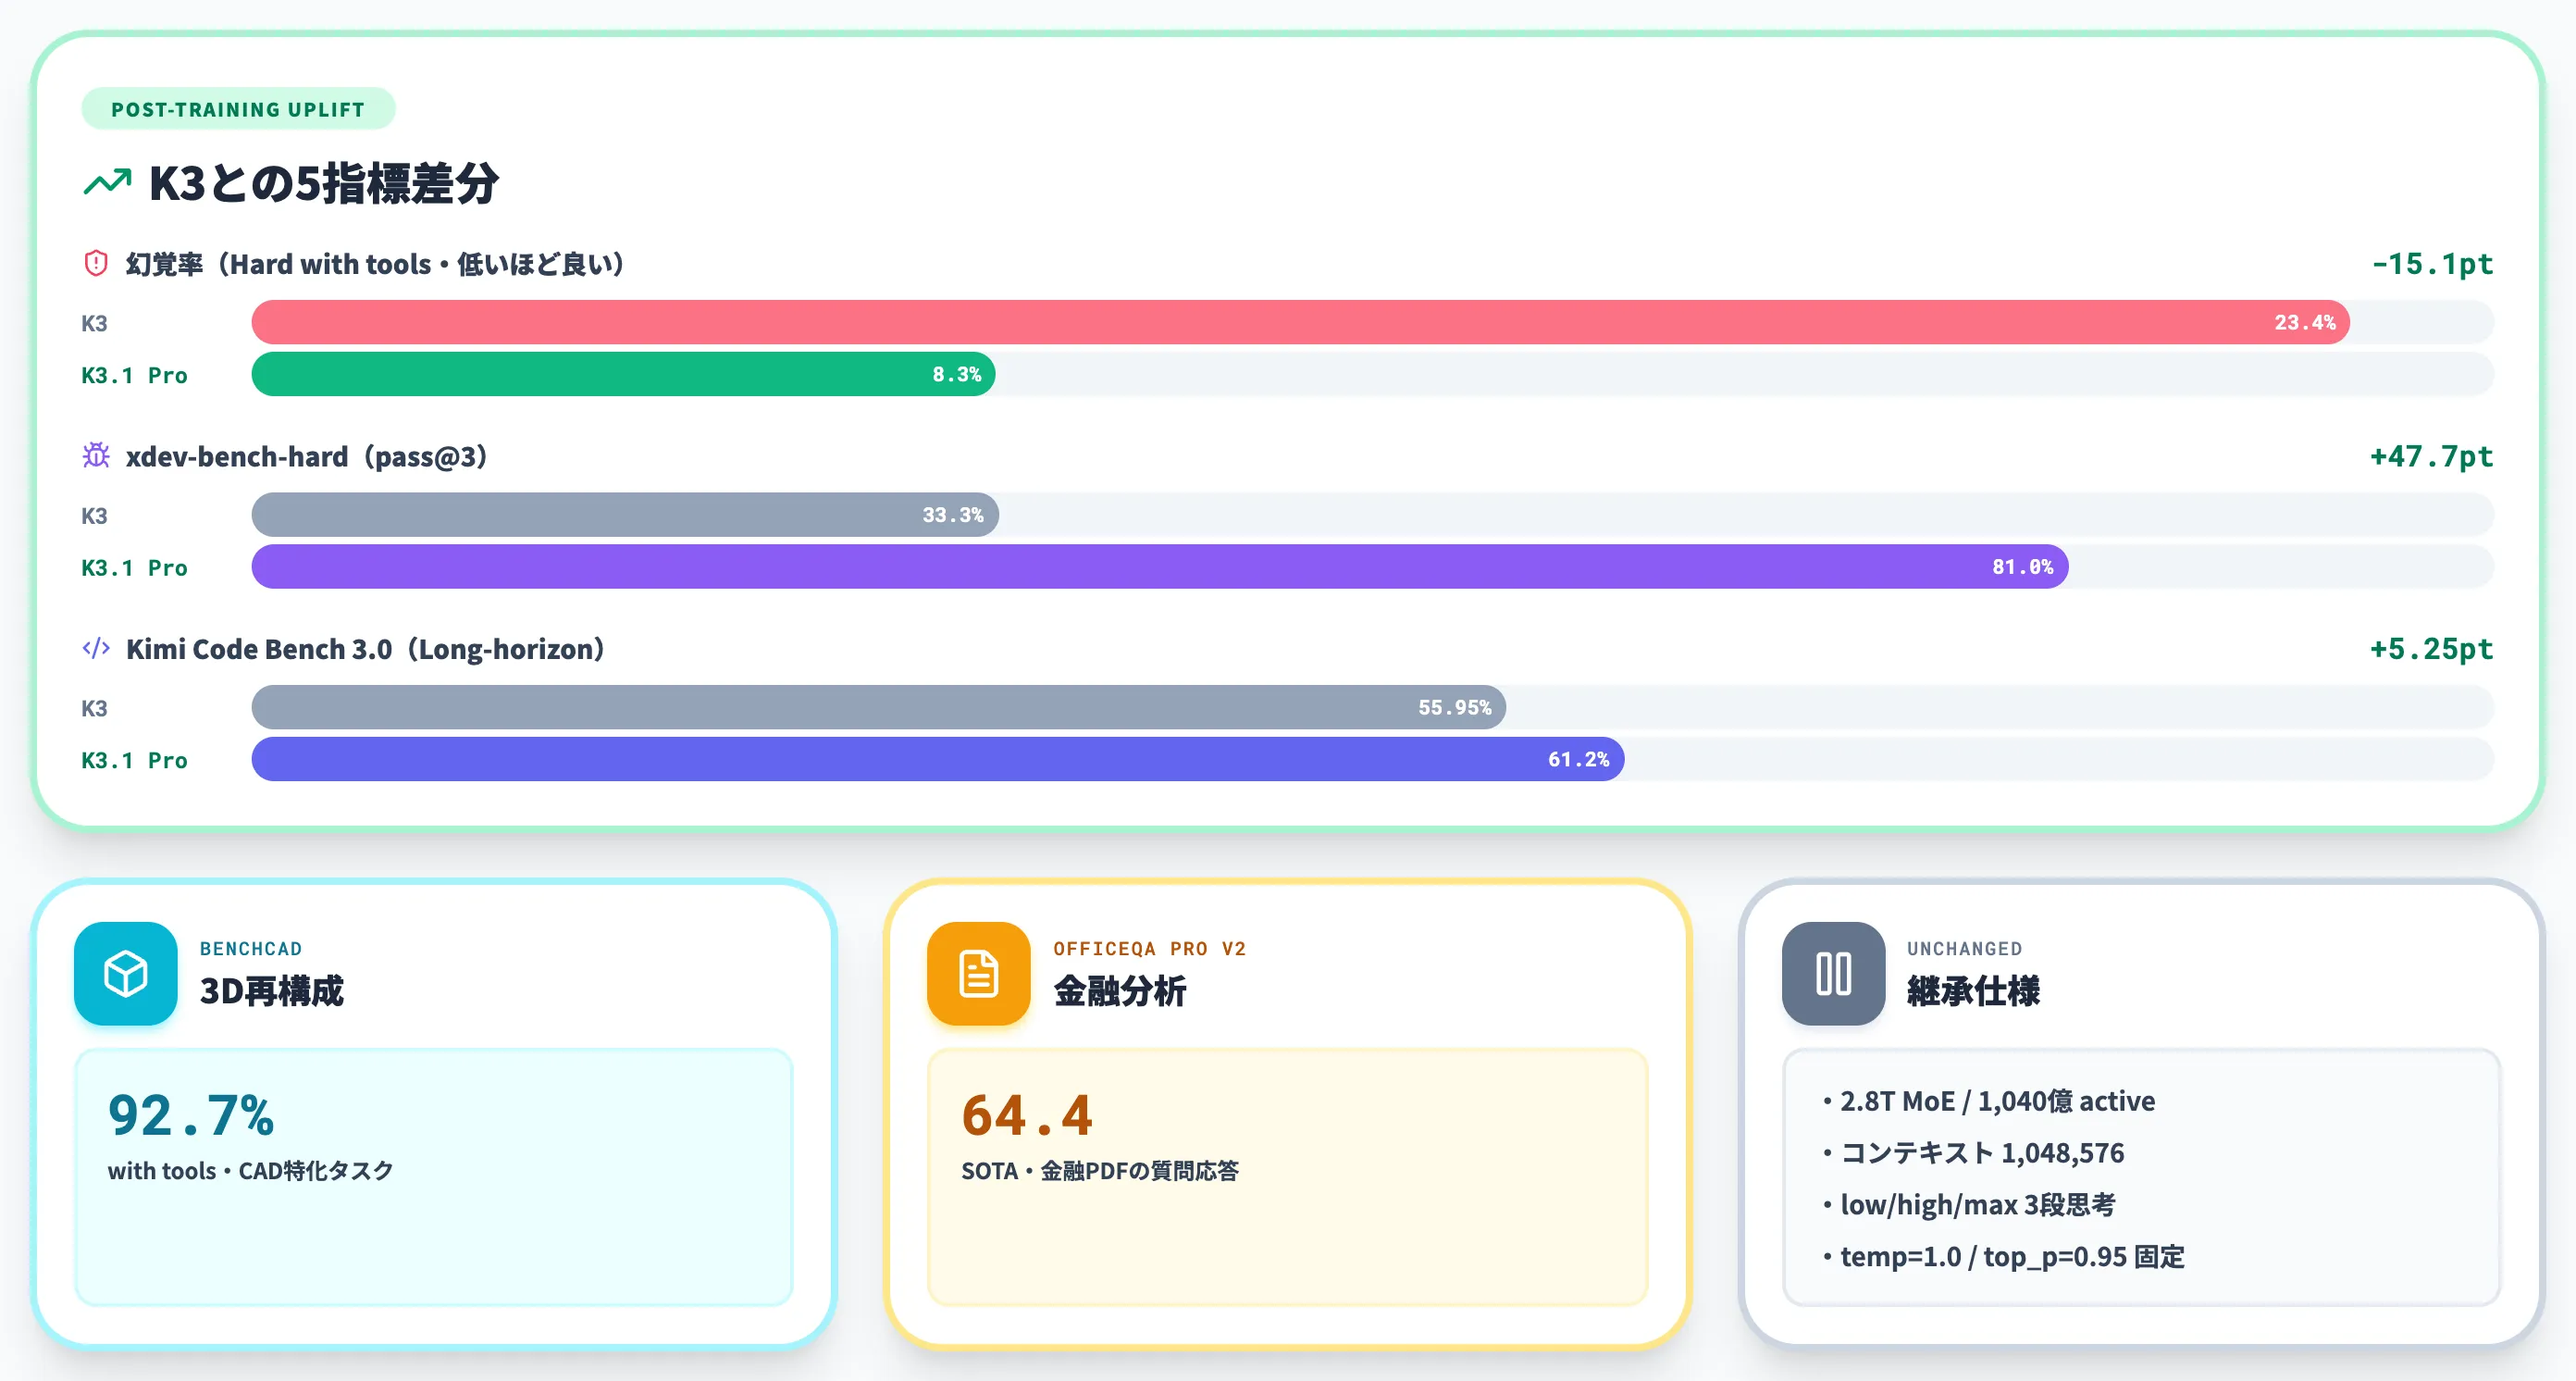
Kimi K3.1 ProはKimi K3のアーキテクチャ・パラメータ数・コンテキスト長をそのまま継承しており、ハードウェア側の違いはありません。
一方で、Moonshot公式が公開した差分は「ポスト学習によって引き上げられた性能」が中心で、思考モードやサンプリングパラメータの仕様はK3から継承されています。本セクションでは、変化のある性能面と、継続している仕様面の両方を整理します。
ポスト学習がもたらした能力ブースト
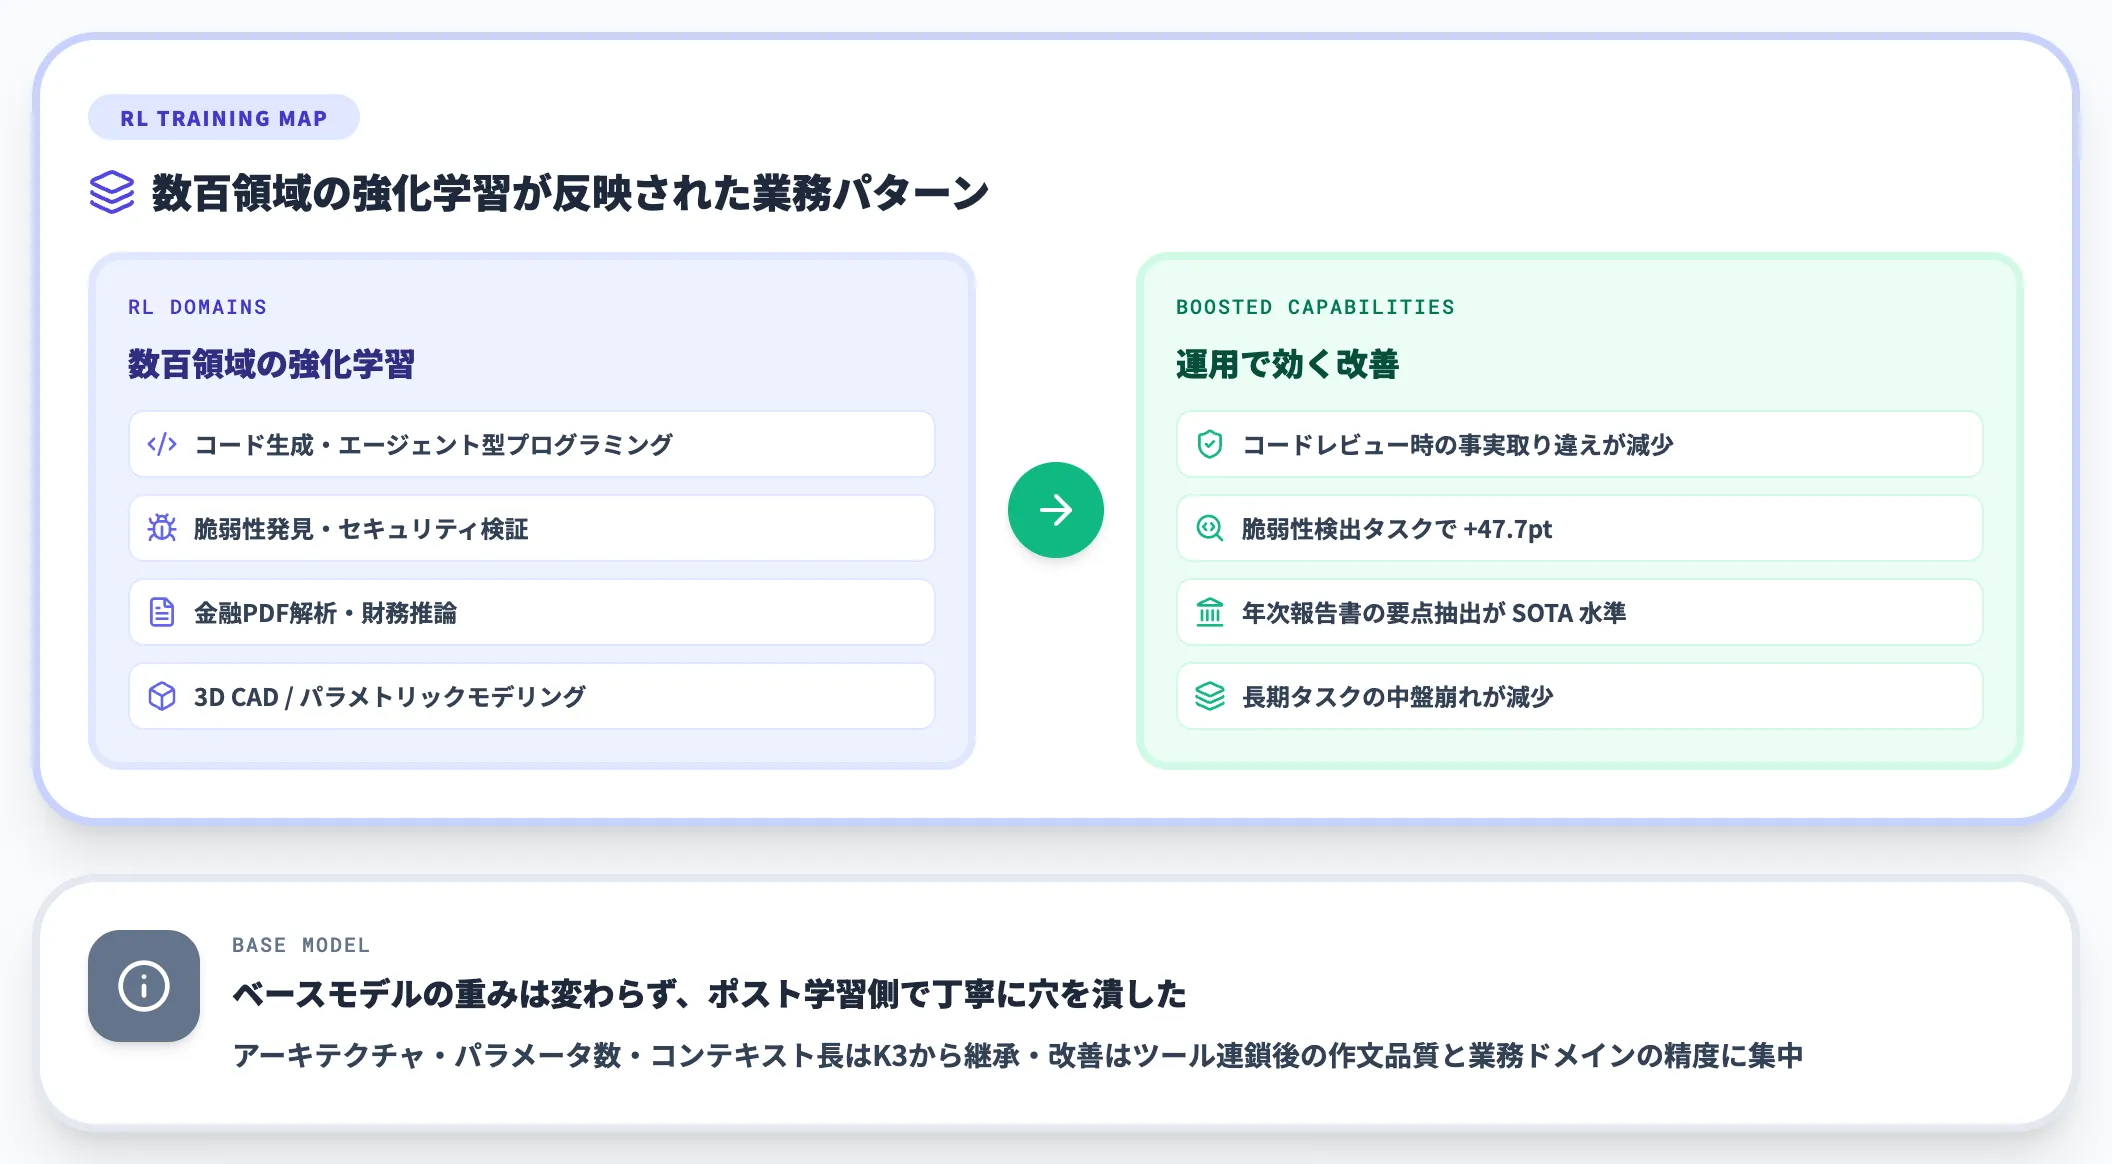
ベースモデルの重みは変わりませんが、OrcaRouter blogの解説によれば、Moonshotは数百領域に及ぶ強化学習をK3に対して追加実行しています。この結果として、具体的な数値改善が報告されています。
以下の表で、Moonshotが公式に示したK3との差分指標を整理しました。
| 指標 | Kimi K3 | Kimi K3.1 Pro | 改善幅 |
|---|---|---|---|
| 幻覚率(with tools) | 23.4% | 8.3% | ‑15.1pt |
| Kimi Code Bench 3.0 Long-horizon | 55.95% | 61.2% | +5.25pt |
| xdev-bench-hard(pass@3) | 33.3% | 81.0% | +47.7pt |
| BenchCAD(with tools) | — | 92.7% | ‑ |
| OfficeQA Pro v2(金融分析) | — | 64.4(SOTA) | ‑ |
特に大きいのが、ツール呼び出しありの状態での幻覚率が3分の1近くに縮んだ点です。
LLMエージェントの実運用で問題になるのは「ツール結果を踏まえた後の作文で事実を取り違える」挙動なので、23.4%から8.3%への改善はコードレビュー・金融リサーチ・長期タスク系ワークロードで直接効いてきます。
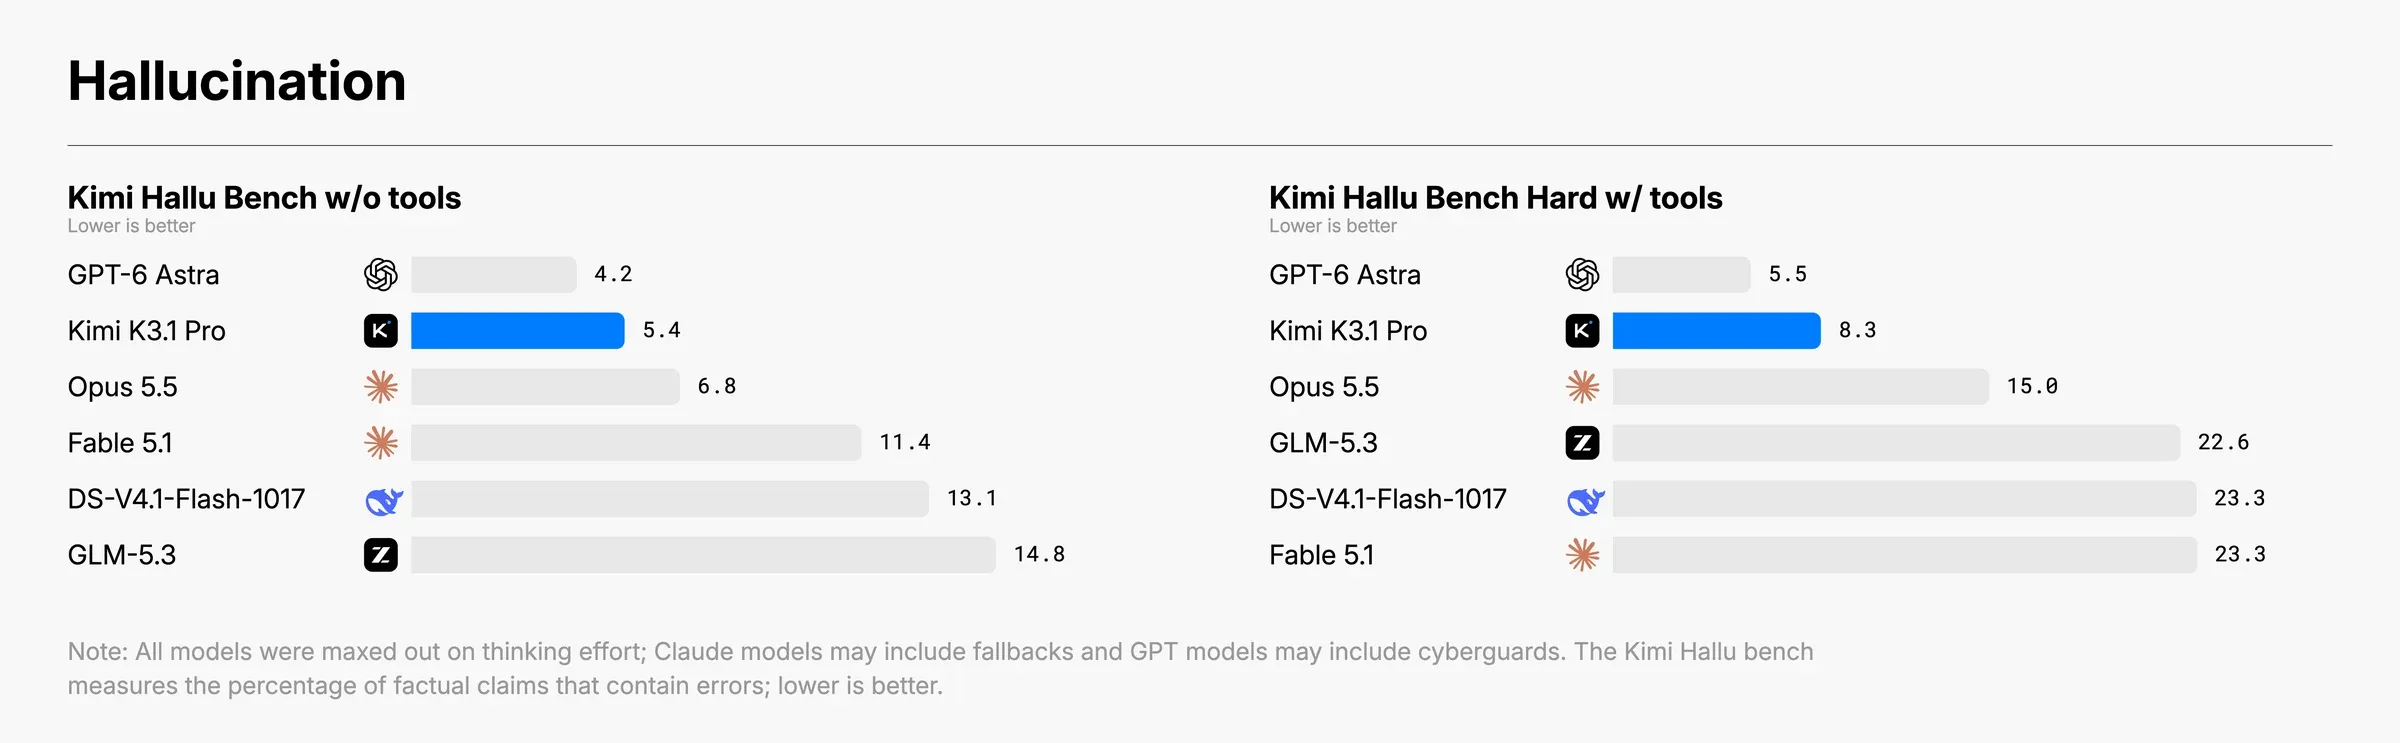
Kimi Hallu Benchでの幻覚率比較(低いほど良い。Hard with tools条件でKimi K3.1 Proは8.3、Opus 5.5=15.0、Fable 5.1とDS-V4.1-Flash-1017=23.3)(出典:Kimi公式ブログ)
xdev-bench-hardはソフトウェアの脆弱性発見・悪用タスクに関するベンチマークで、K3の33.3%から81.0%への跳躍は「ポスト学習側で丁寧に穴を潰した」結果と解釈されています。
セキュリティ検証系ワークフローでエージェントを回す場合、K3世代から大きく挙動が変わる水準です。
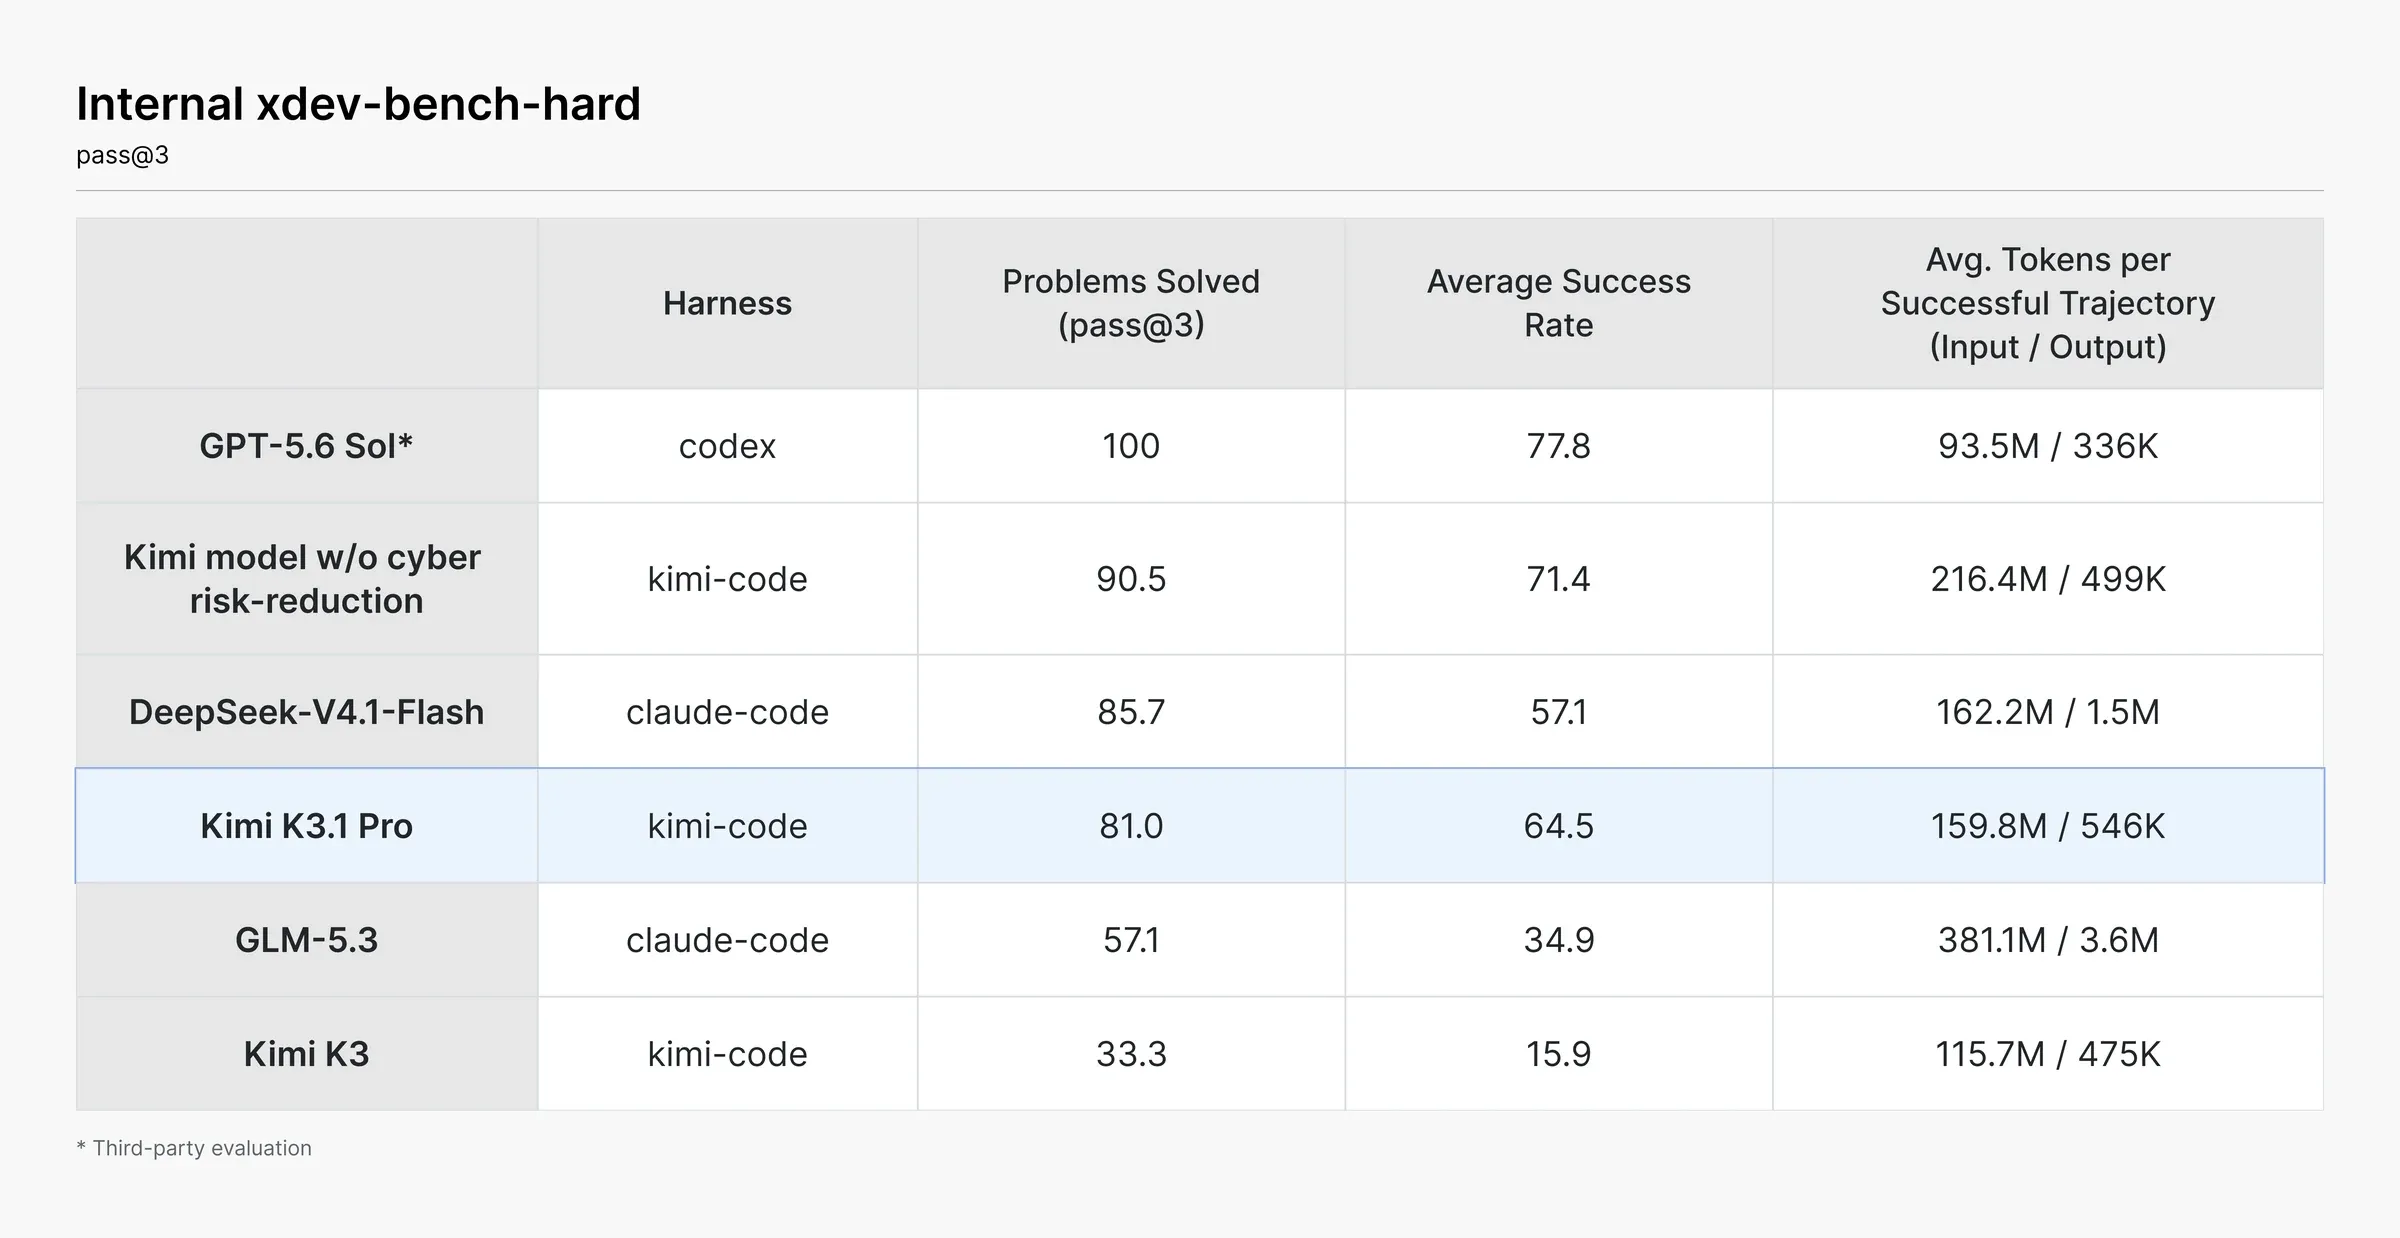
xdev-bench-hard pass@3のモデル別スコア(Kimi K3=33.3→K3.1 Pro=81.0・DeepSeek-V4.1-Flash=85.7・GPT-5.6 Sol*=100)(出典:Kimi公式ブログ)
思考モードはlow/high/maxの3段を踏襲
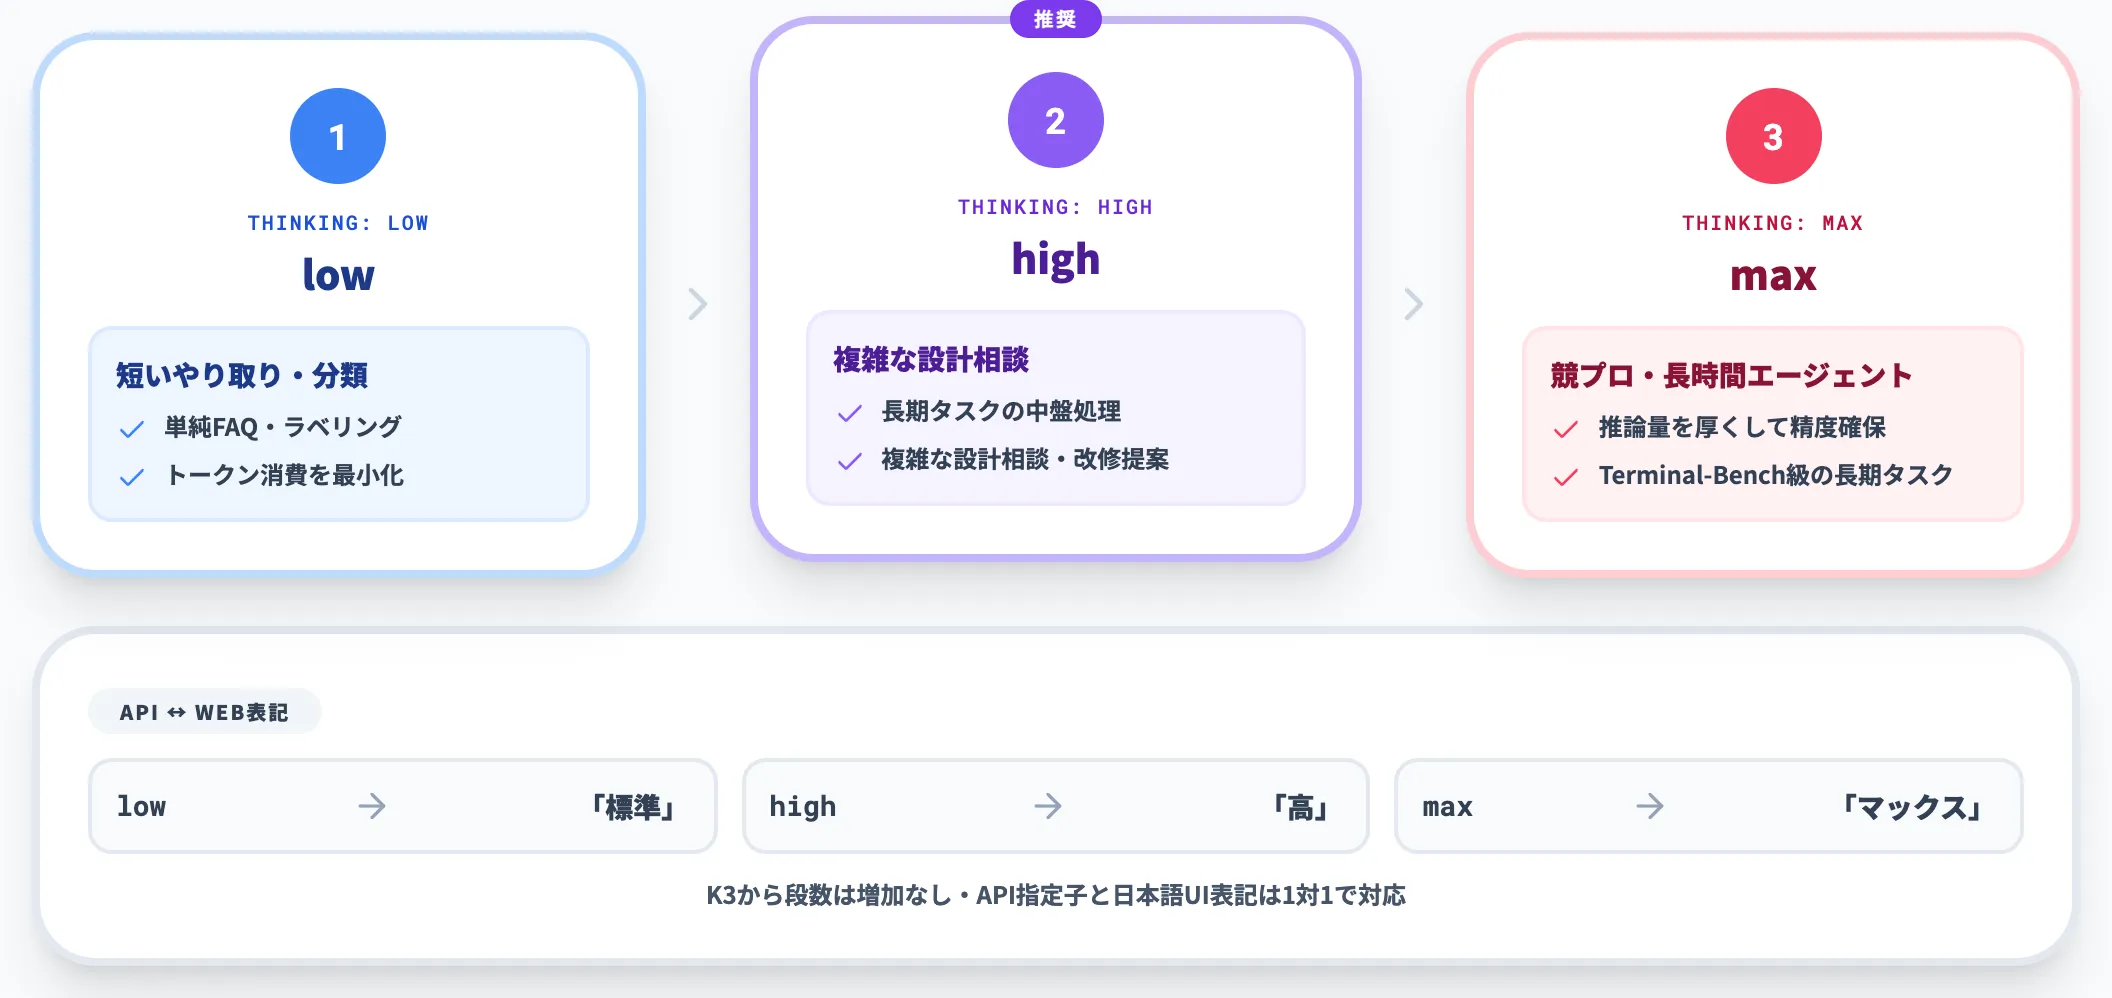
Kimi K3.1 ProのAPIで指定できる思考強度は、Kimi K3から変わらずlow / high / maxの3段構成です。本リリースで段数が増えたわけではありません。
- low: 短いやり取り・分類タスク向け。トークン消費を最小化
- high: 複雑な設計相談・長期タスクの中盤処理に推奨
- max: 競技プログラミング・長時間のエージェントタスクなど、推論量を厚くしても精度を取りに行くシナリオ向け
Web版(kimi.ai)では「標準」「高」「マックス」という日本語表記で3段が並び、APIの low/high/max に対応します。
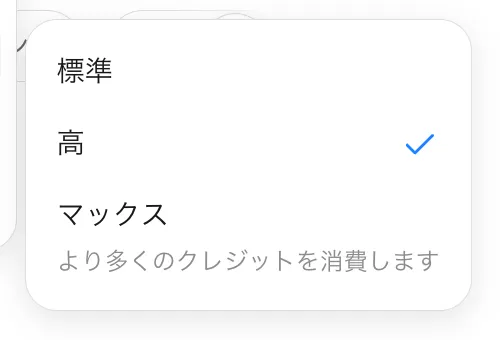
Kimi K3.1 ProのWeb版で表示された思考強度メニュー(2026年10月24日撮影)。APIと同じ3段構成が「標準/高/マックス」の表記で並ぶ
サンプリングはtemperature=1.0・top_p=0.95固定
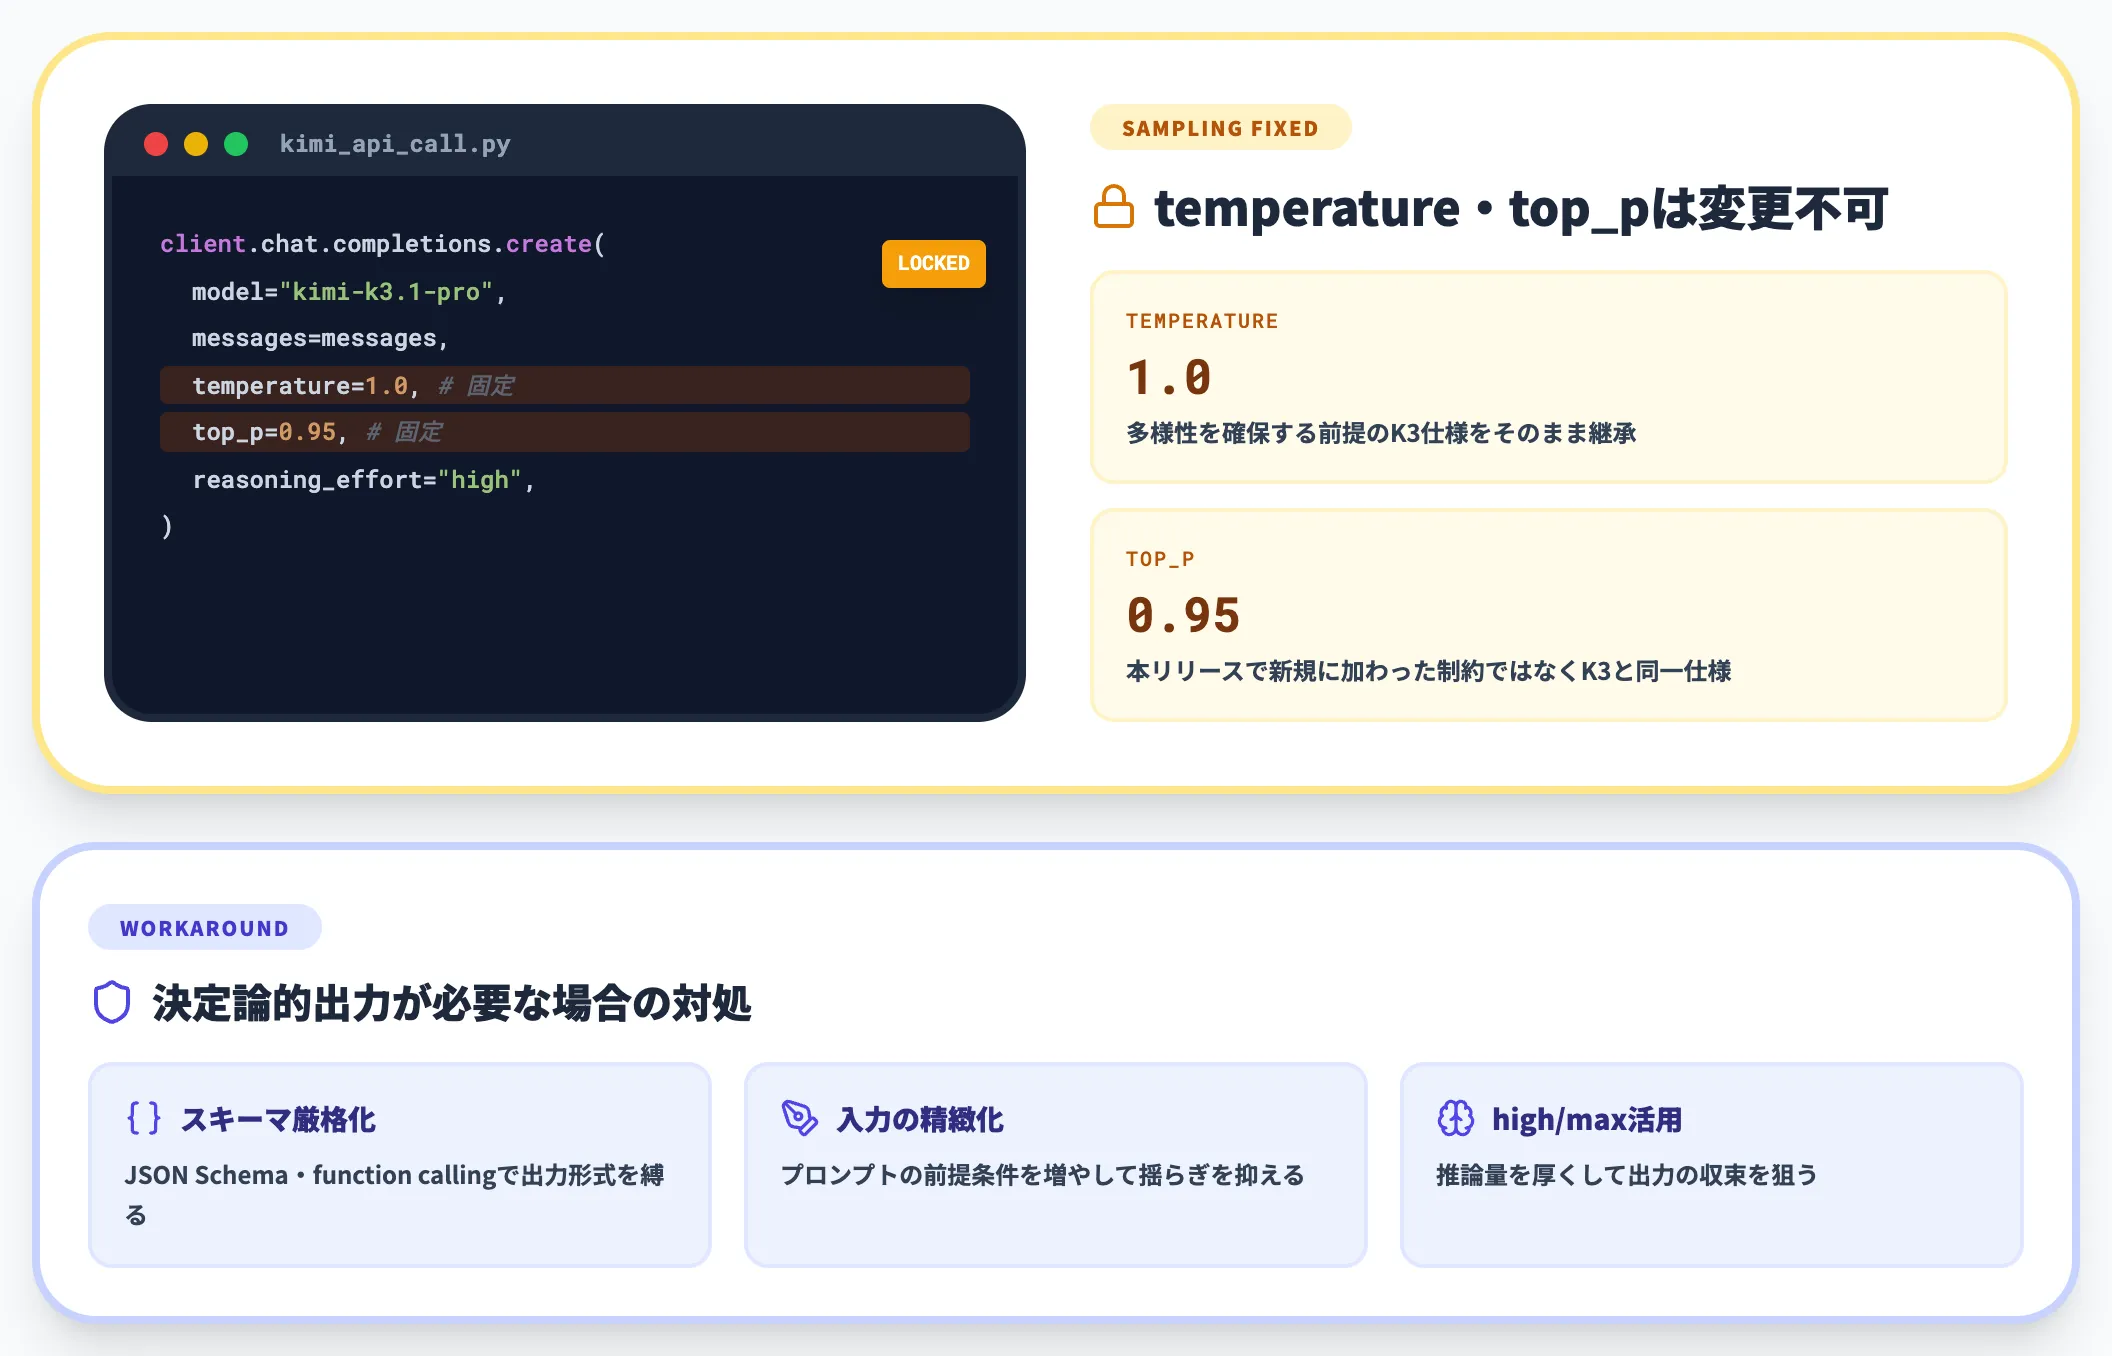
K3.1 Proはサンプリングパラメータがtemperature=1.0 / top_p=0.95で固定されています。
これはK3と同じ仕様で、本リリースで新規に加わった制約ではありません。
決定論的な出力が必要なワークロードでは、以下の対処が有効です。
- プロンプト側で出力スキーマを厳格化する(JSON Schema・function calling)
- 入力の精緻化で揺らぎを抑える
- 必要に応じてhigh/maxモードで出力の収束を狙う
サンプリングパラメータの指定条件はK3と共通のため、K3から乗り換える際にこの点で挙動が変わることはありません。
Kimi K3.1 Proのベンチマークと競合モデルとの位置関係
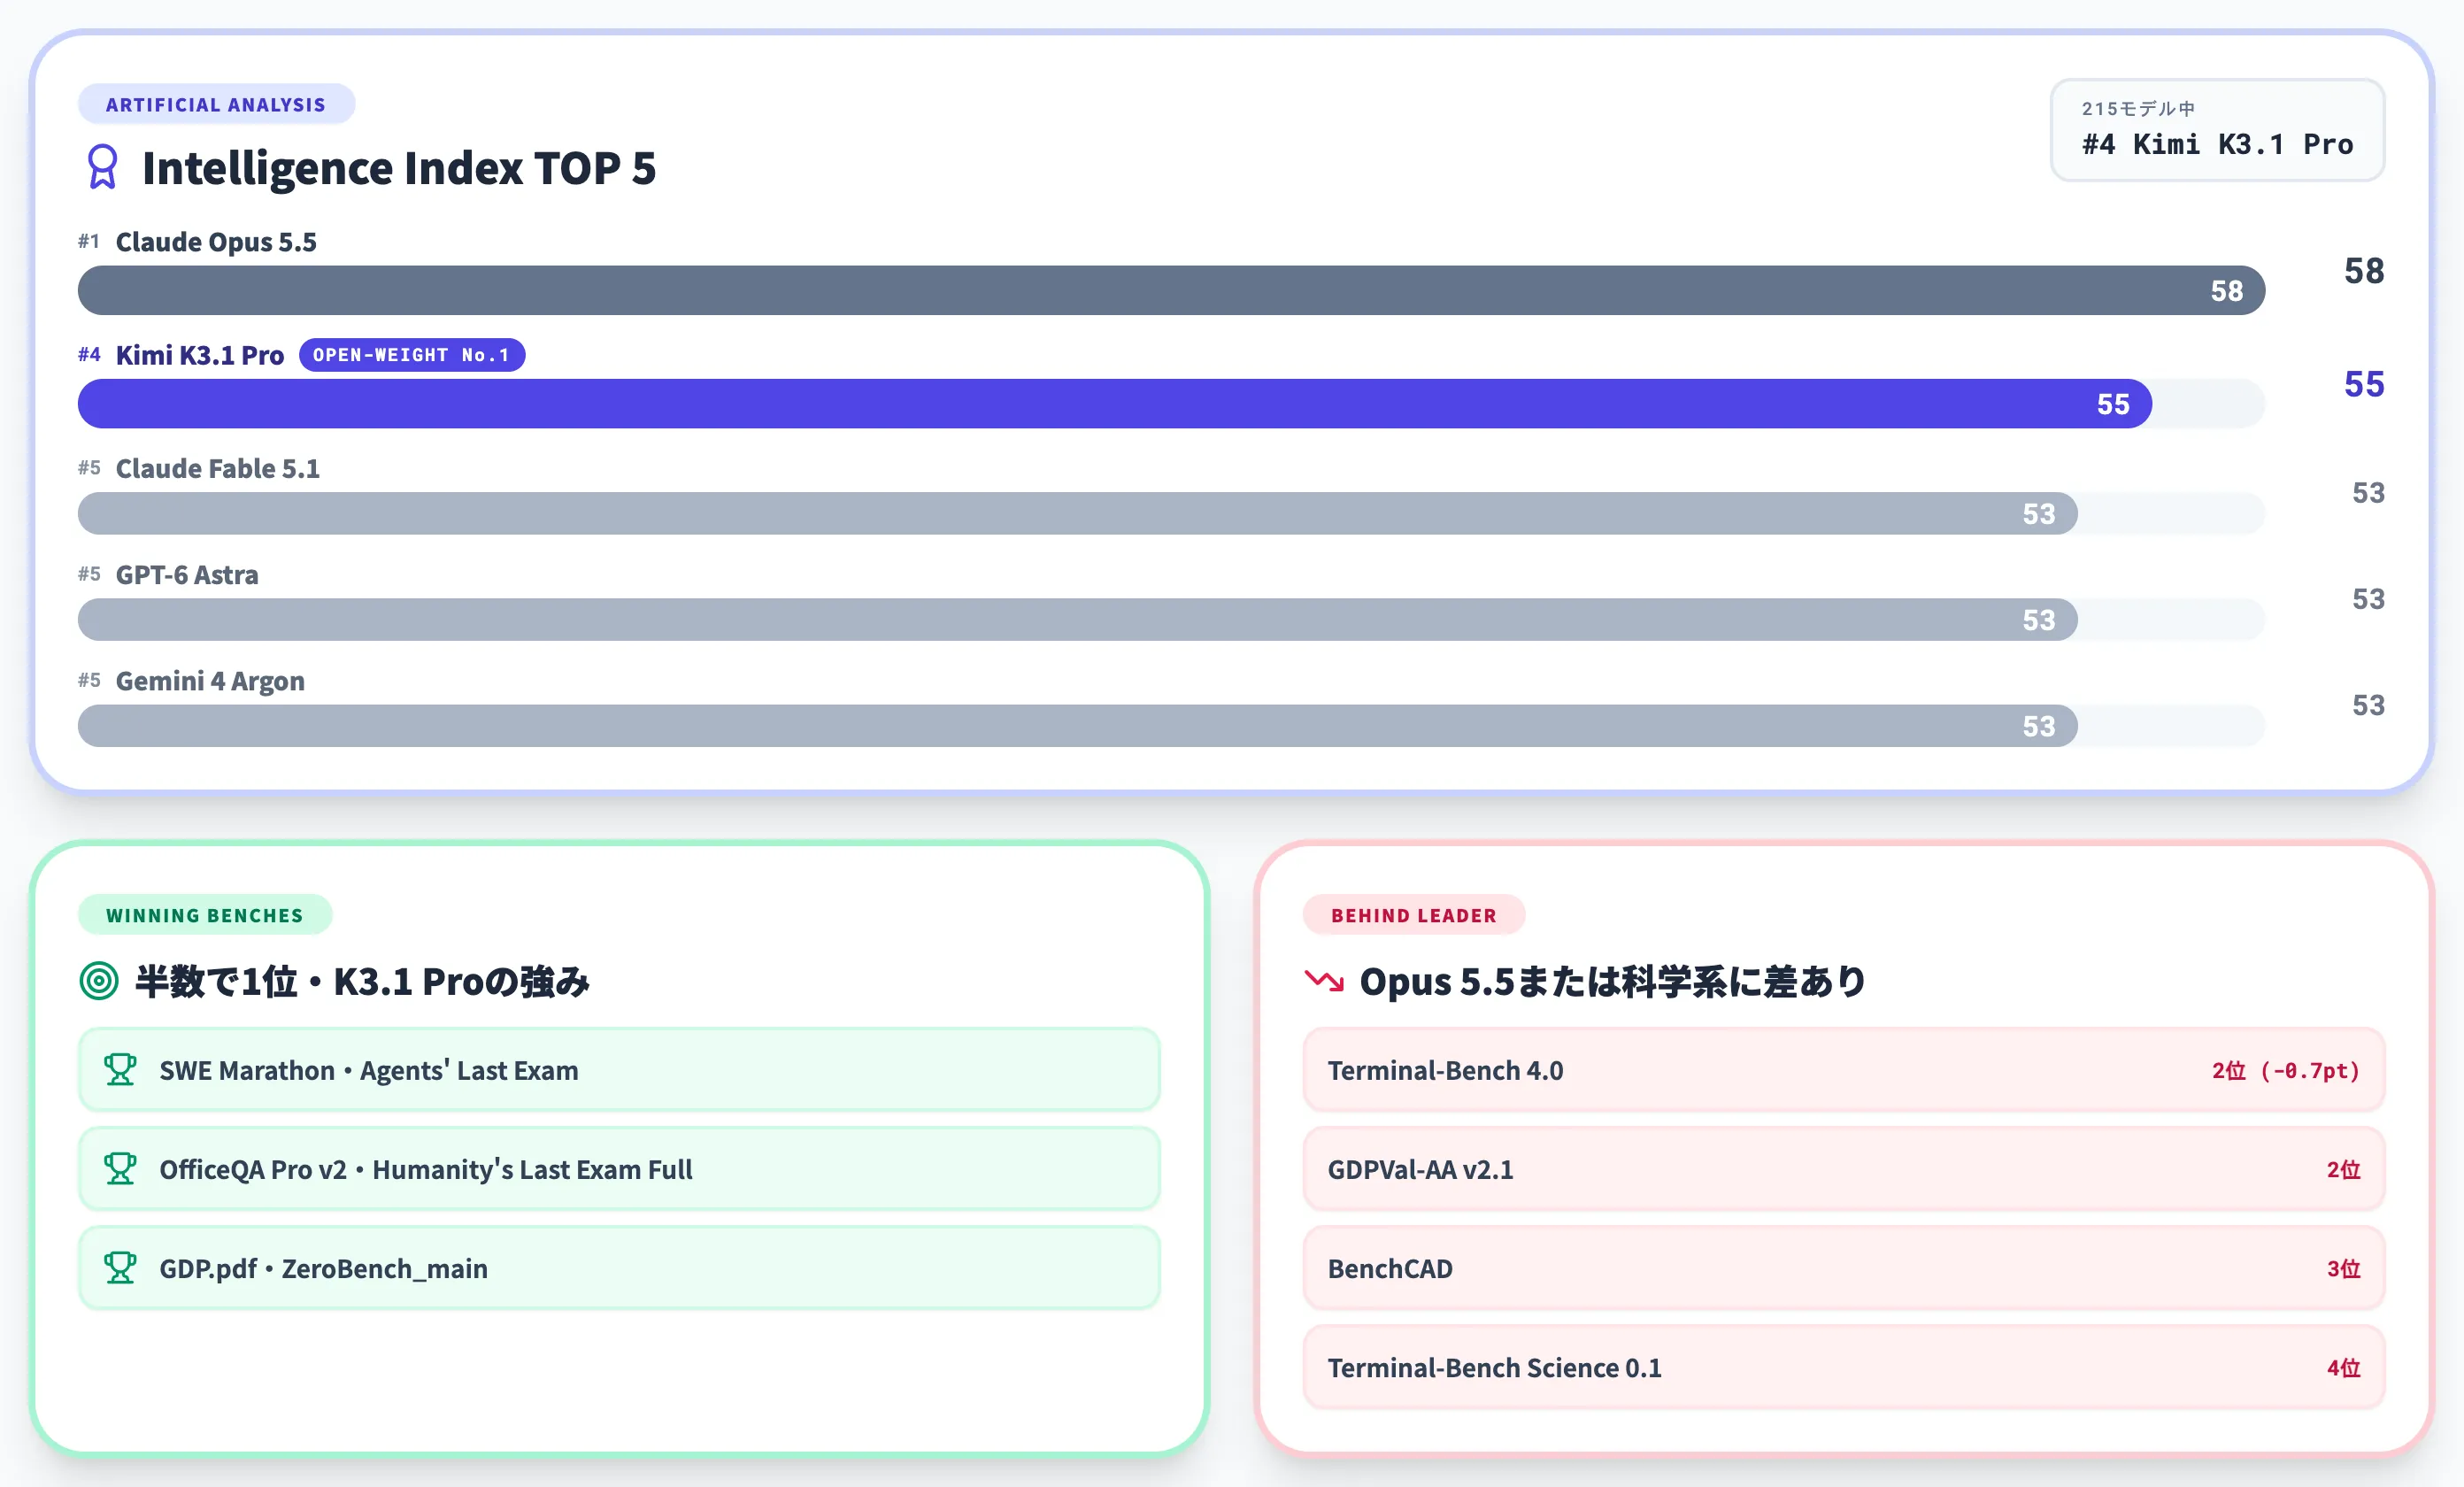
Kimi K3.1 Proの外部評価は、ArtificialAnalysis.aiの総合指標と、Moonshotが公表したドメイン別ベンチマークの2系統で確認できます。
Opus 5.5・GPT-6 Astra・Gemini 4 Argonと同じ土俵で比較できる数字が出ているので、採用判断の起点として押さえる価値があります。
Artificial Analysisで世界4位にランクイン
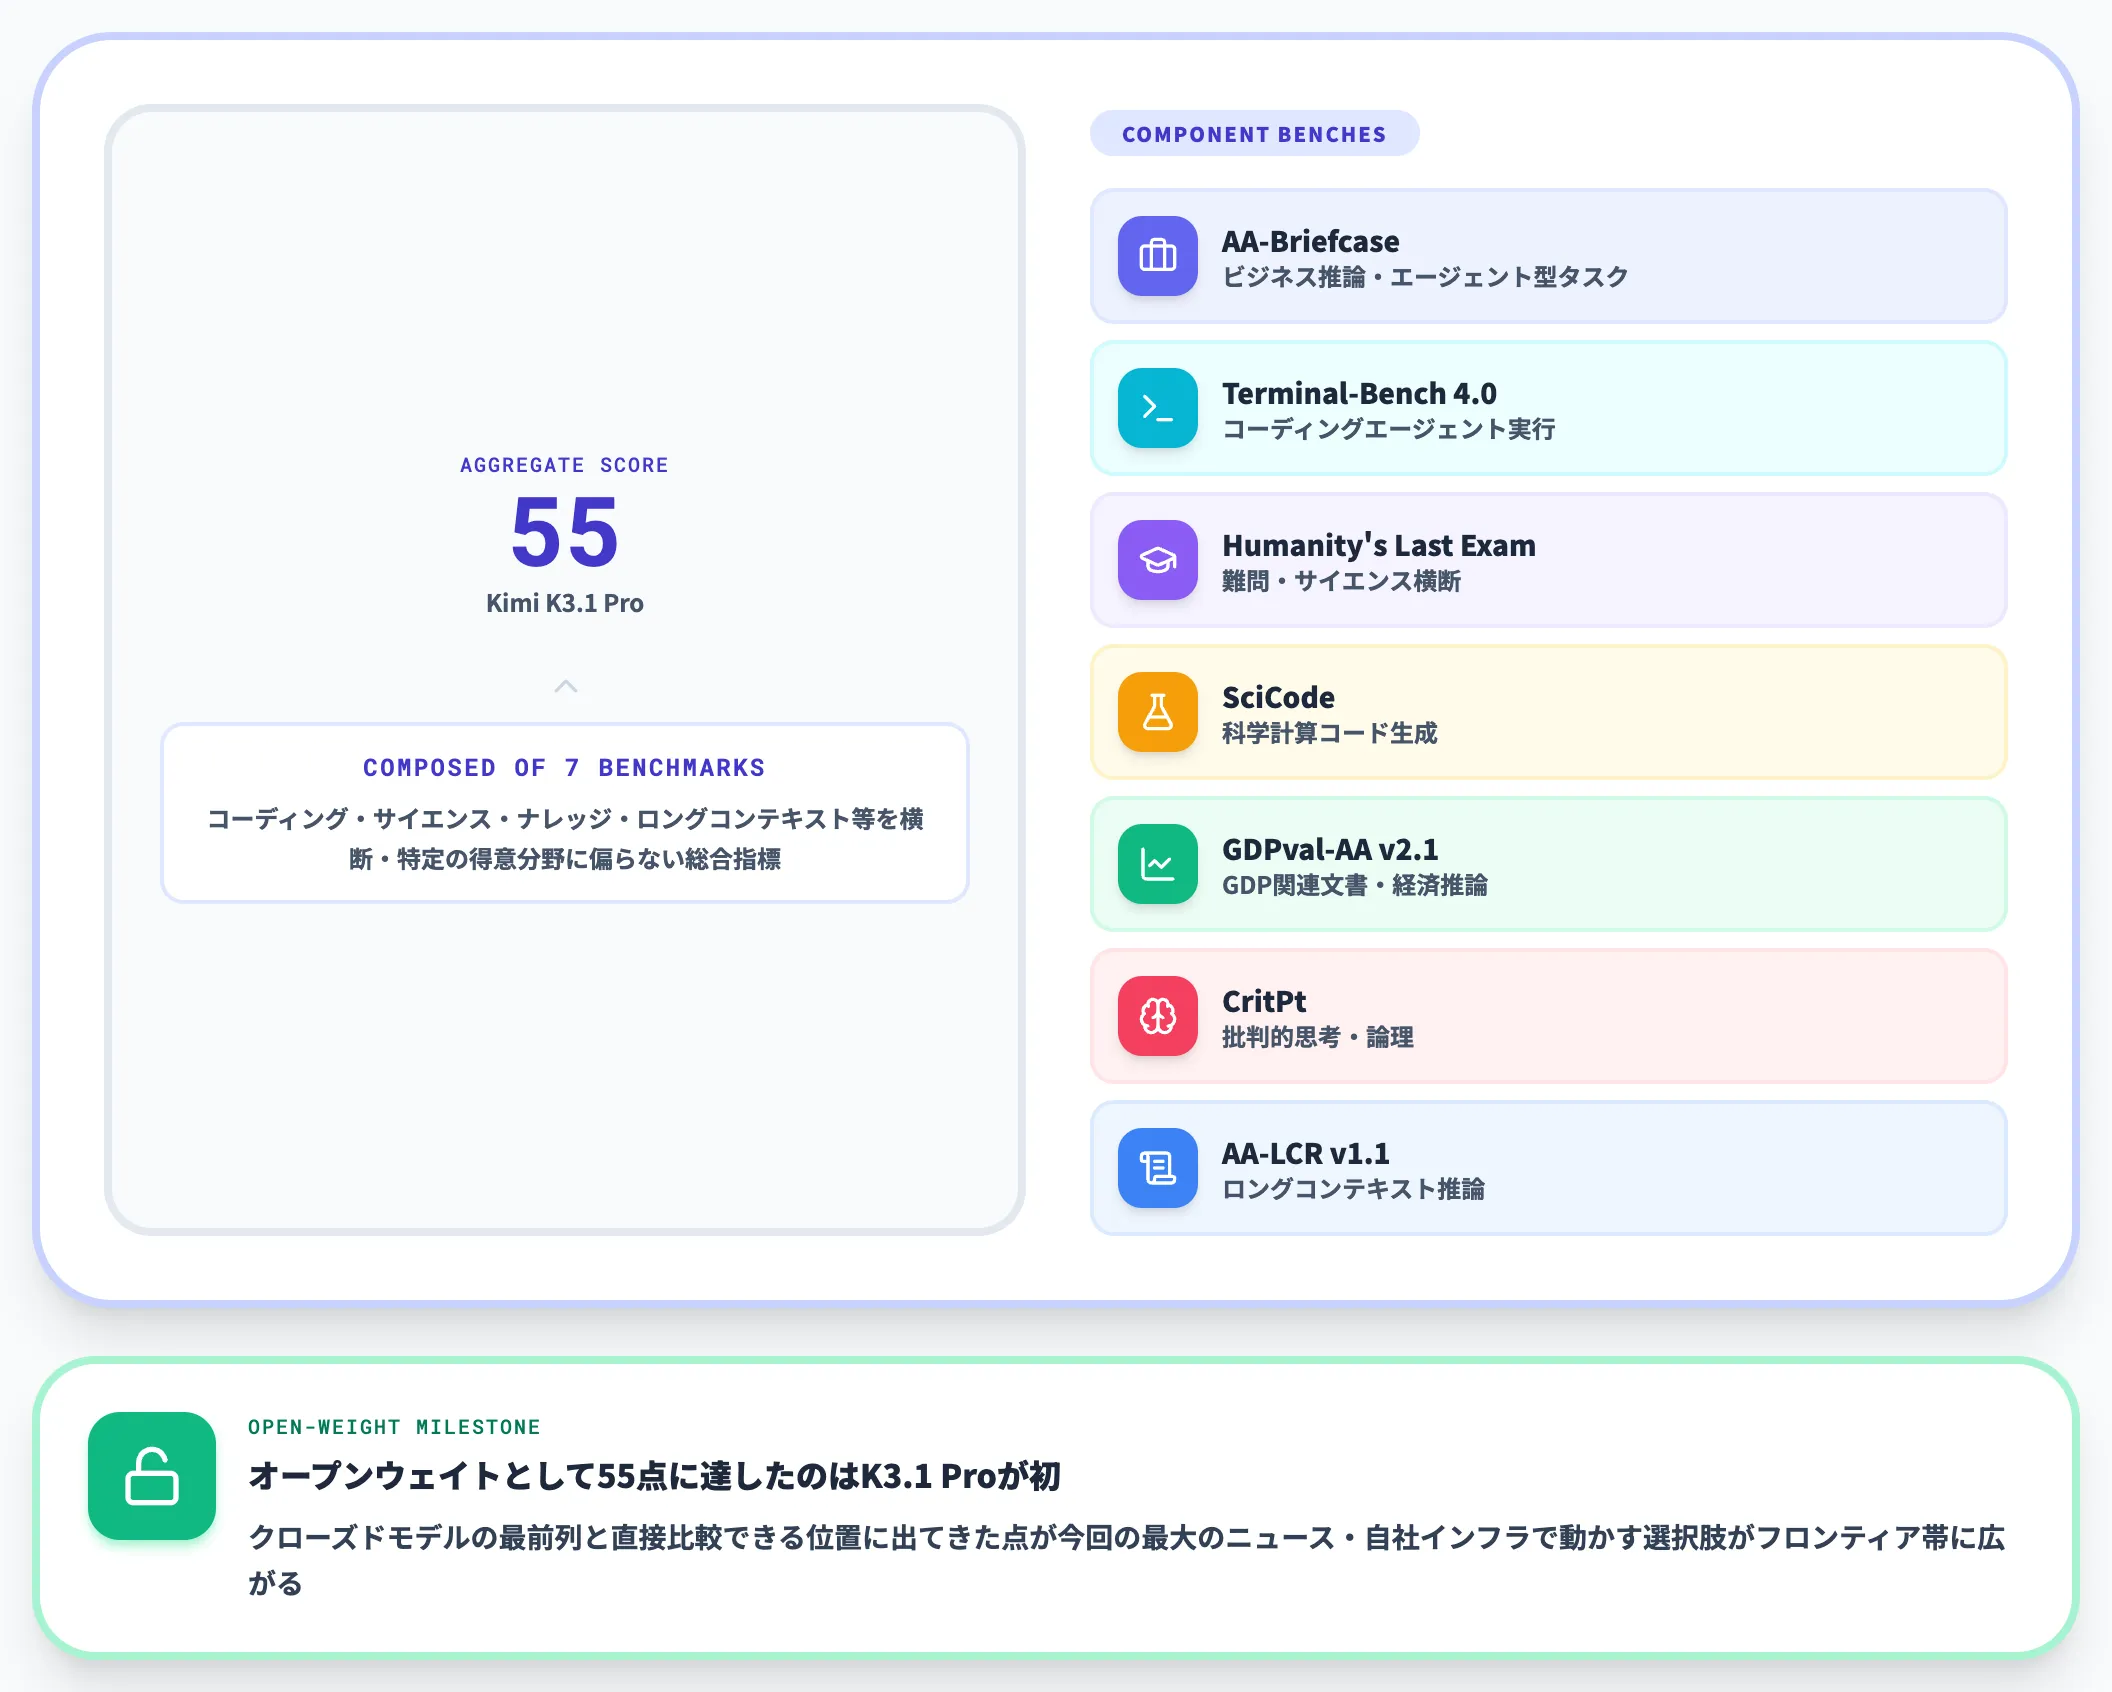
ArtificialAnalysis.aiが公開しているKimi K3.1 Pro Intelligence Analysisの順位は、全215モデル中4位です。
- Claude Opus 5.5:58点
- Kimi K3.1 Pro:55点
- Claude Fable 5.1:53点
- GPT-6 Astra:53点
- Gemini 4 Argon:53点
オープンウェイトとして55点に達したのはK3.1 Proが初めてで、クローズドモデルと直接比較できる位置に出てきた点が今回の最大のニュースです。
ArtificialAnalysisのIndexは、AA-Briefcase・Terminal-Bench 4.0・Humanity's Last Exam・SciCode・GDPval-AA v2.1・CritPt・AA-LCR v1.1など複数のベンチマークを合成した総合指標で、特定の得意分野に偏らない評価になっています。
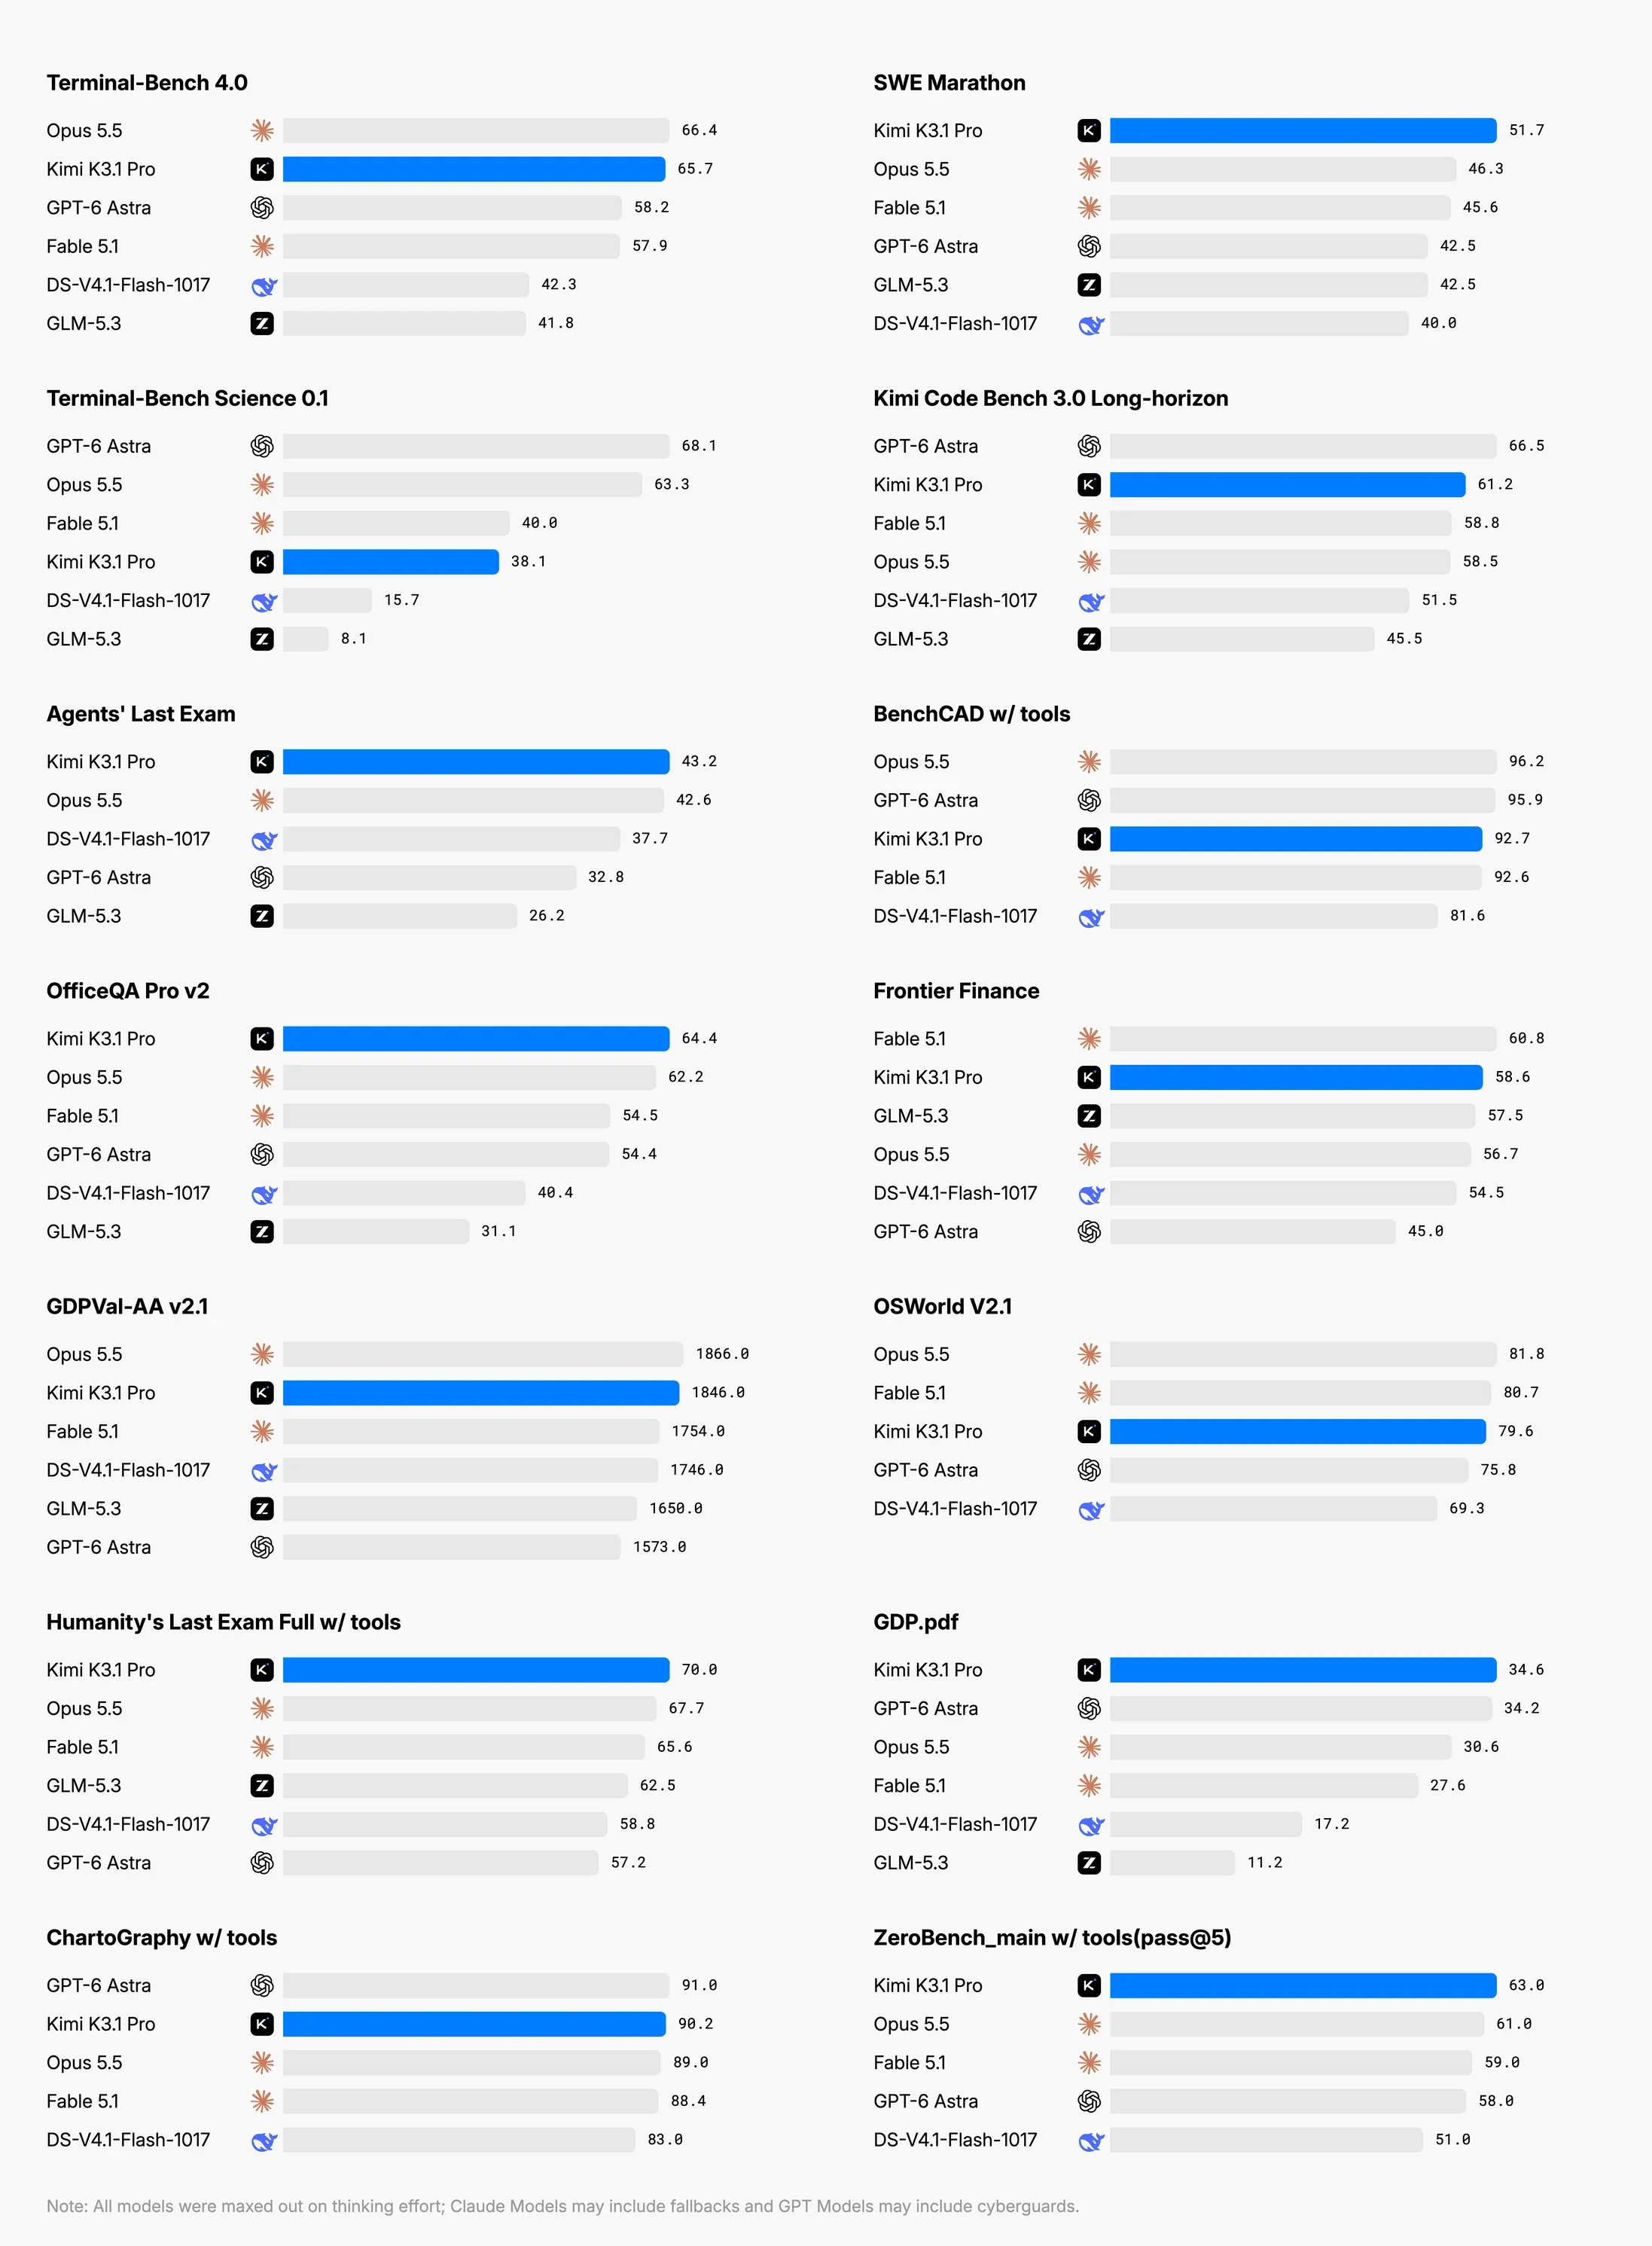
Kimi K3.1 Proと競合モデルの14ベンチマーク比較。コーディング(Terminal-Bench 4.0・SWE Marathon・Kimi Code Bench 3.0)、サイエンス(Agents' Last Exam・Humanity's Last Exam Full)、ナレッジワーク(OfficeQA Pro v2・GDPval-AA v2.1)を横断(出典:Kimi公式ブログ)
図の14本のうちSWE Marathon・Agents' Last Exam・OfficeQA Pro v2・Humanity's Last Exam Full(ツール使用時)・GDP.pdf・ZeroBench_mainなど、半数前後のベンチマークでK3.1 Pro(青帯)が1位を取っています。Terminal-Bench 4.0とGDPVal-AA v2.1とKimi Code Bench 3.0 Long-horizonはOpus 5.5またはGPT-6 Astraに続く2位、BenchCADは3位、Terminal-Bench Science 0.1は4位と、科学系ベンチでは差が開く結果です。
Terminal-Bench 4.0と長期タスクの数値
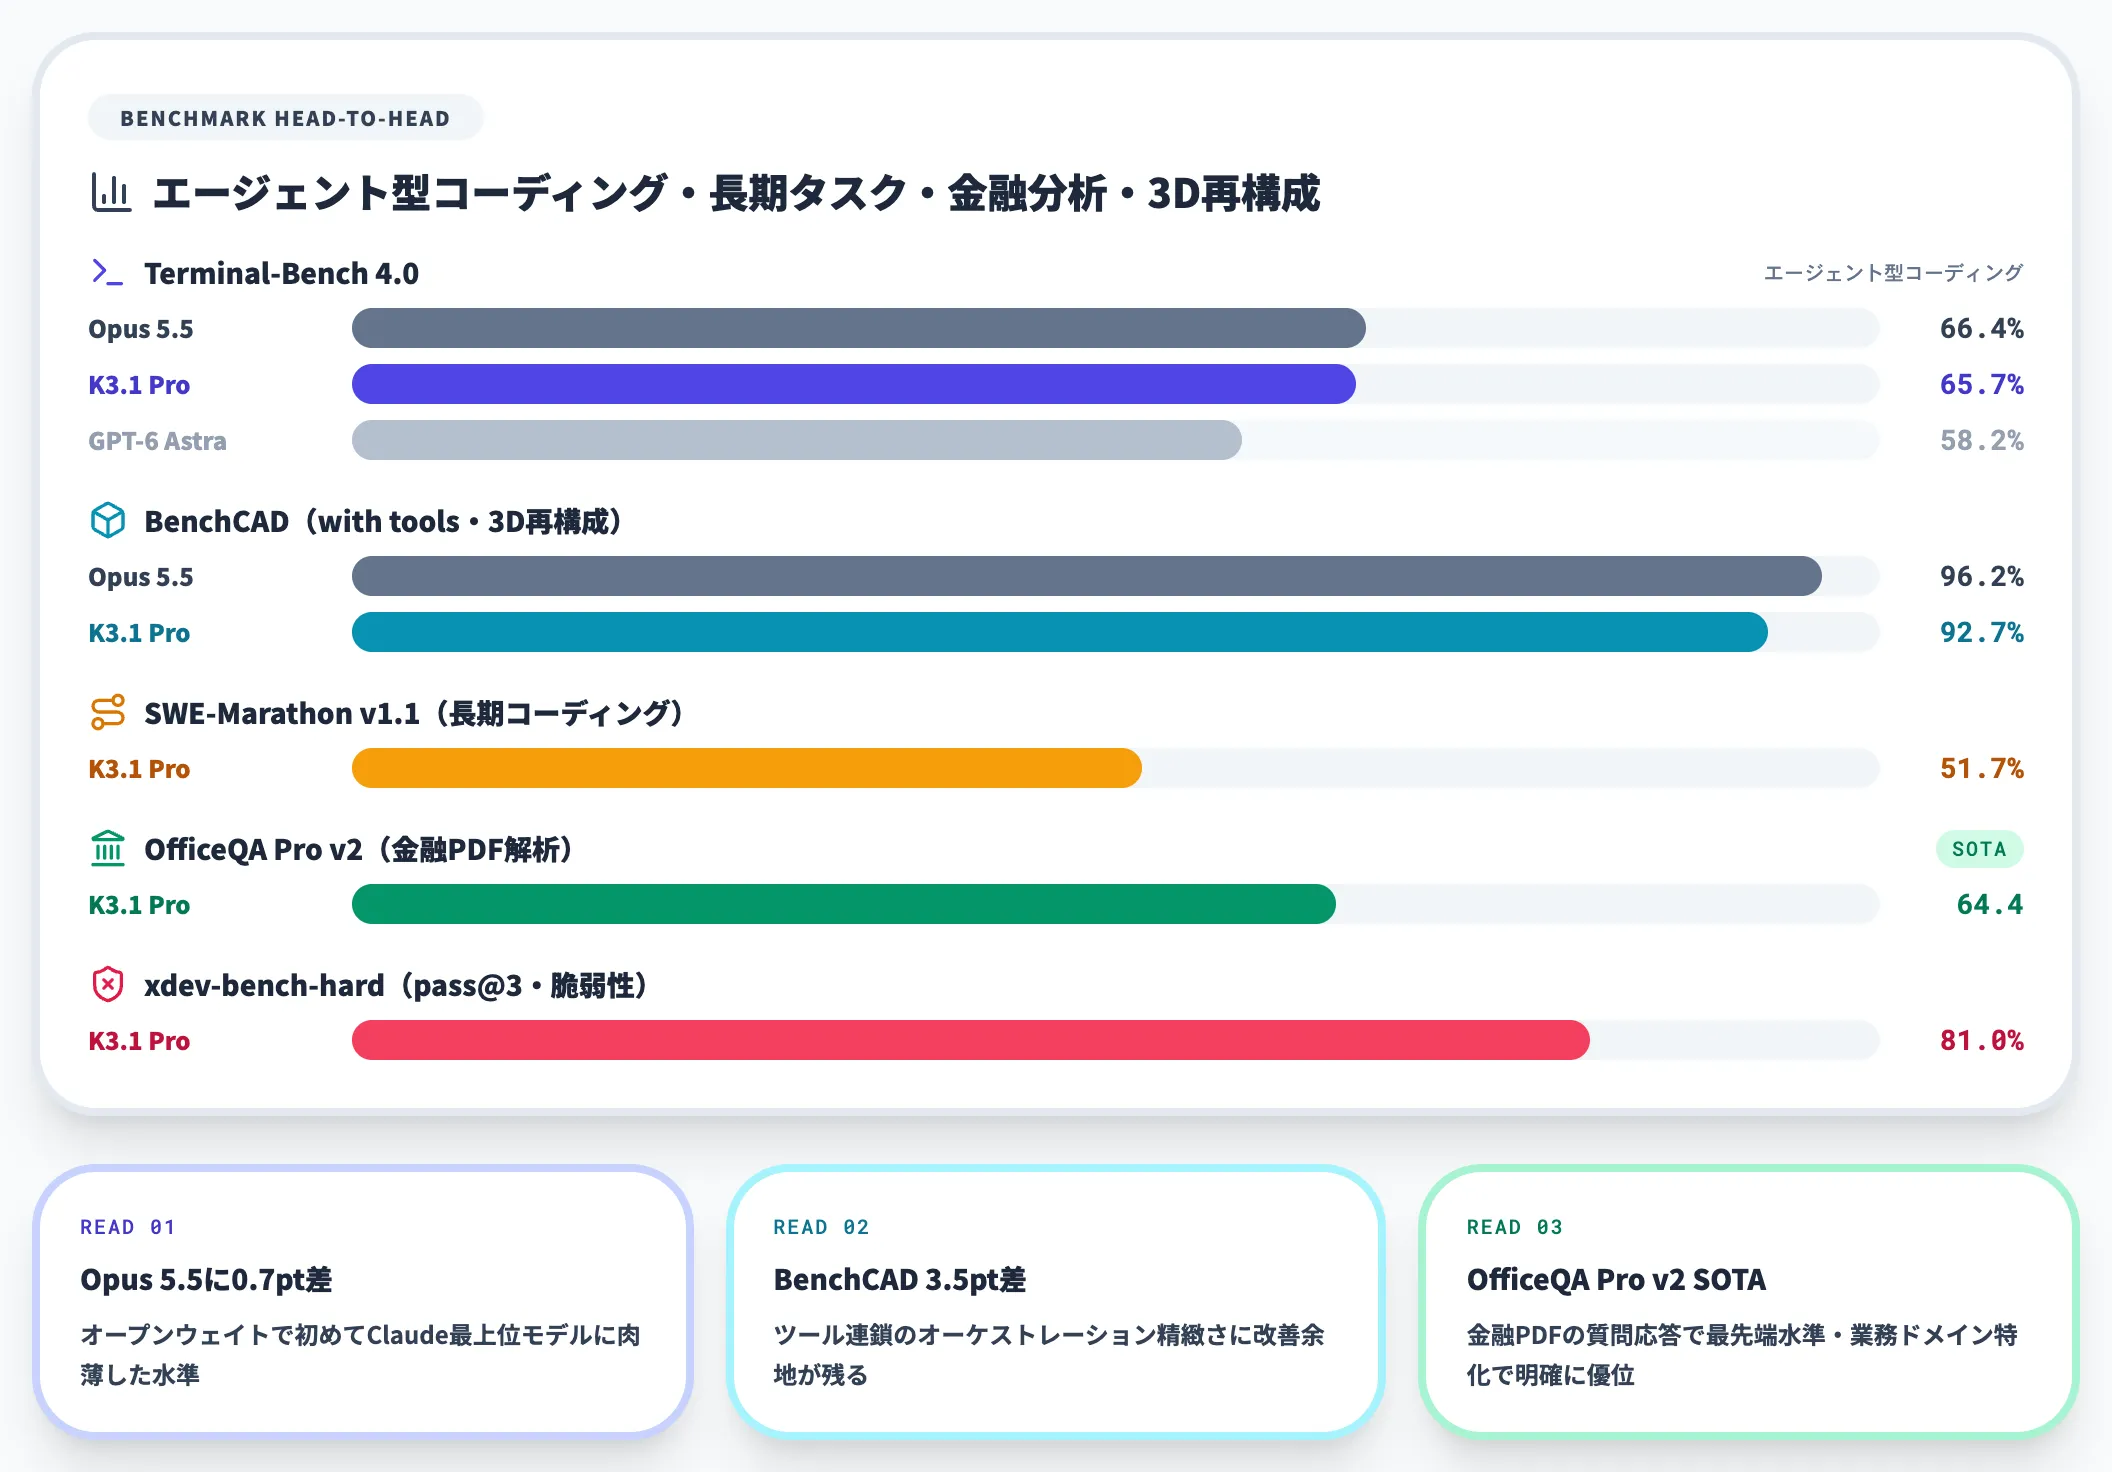
Moonshot自身が公表しているベンチマーク結果は、エージェント型コーディング・長期タスク・金融分析・3Dモデリングに重点が置かれています。
以下の表で、同クラスのモデルとのベンチマークスコアを並べました。
| ベンチマーク | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra |
|---|---|---|---|
| Terminal-Bench 4.0 | 65.7% | 66.4% | 58.2% |
| SWE-Marathon v1.1 | 51.7% | — | — |
| BenchCAD(with tools・3D再構成) | 92.7% | 96.2% | — |
| OfficeQA Pro v2(金融PDF解析) | 64.4 | — | — |
| xdev-bench-hard(pass@3) | 81.0% | — | — |
Terminal-Benchはターミナル環境でコーディングエージェントを動かし、タスクをどこまで自律的に完遂できるかを測るベンチマークです。Kimi K3.1 ProはOpus 5.5に0.7ポイント差まで接近しており、「オープンウェイトで初めてClaude最上位モデルに肉薄した」水準に到達しています。
BenchCADは物理CADモデルの3D再構成タスクで、ツール使用を含めるとOpus 5.5まで3.5ポイント差。OfficeQA Pro v2は金融PDFからの質問応答で、64.4は現時点でのSOTA(最先端)値と報告されています。
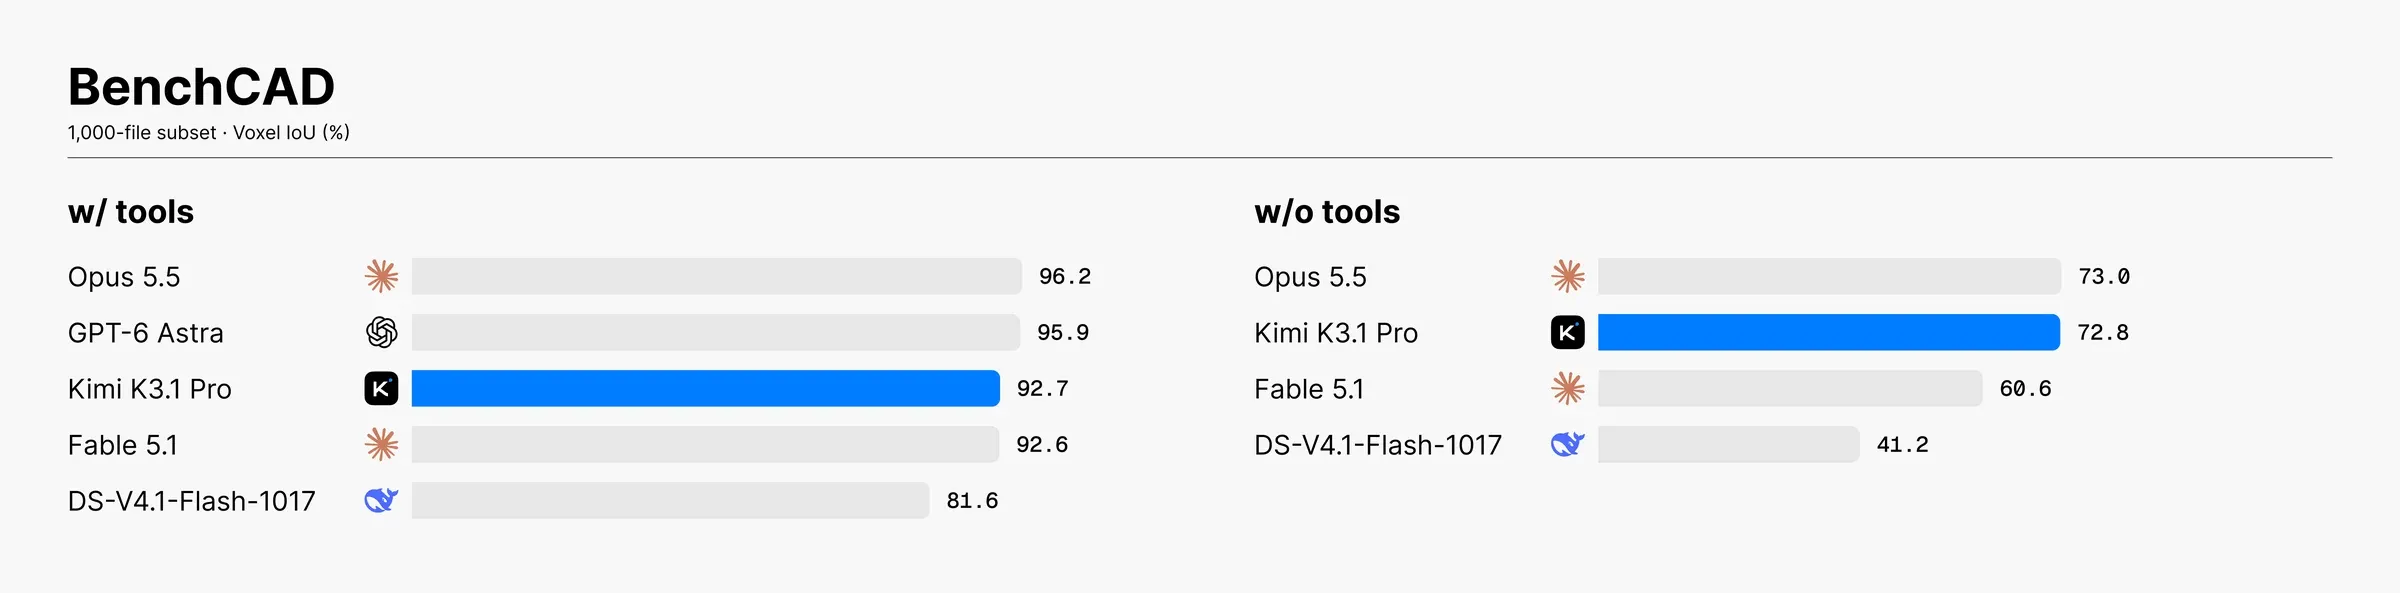
BenchCAD(1,000ファイルサブセット・Voxel IoU)での性能比較。ツール使用時はKimi K3.1 Pro=92.7でOpus 5.5=96.2に続き、ツール非使用時は72.8でOpus 5.5=73.0とほぼ同等(出典:Kimi公式ブログ)
ツール非使用時のスコアに注目すると、K3.1 Proの72.8はOpus 5.5の73.0と0.2ポイント差です。ツール使用時の3.5ポイント差は「ツール連鎖のオーケストレーションの精緻さ」の差とも読め、エージェントハーネスの改善余地が残っている水準と見ることができます。
ツール使用時と単独時の性能差
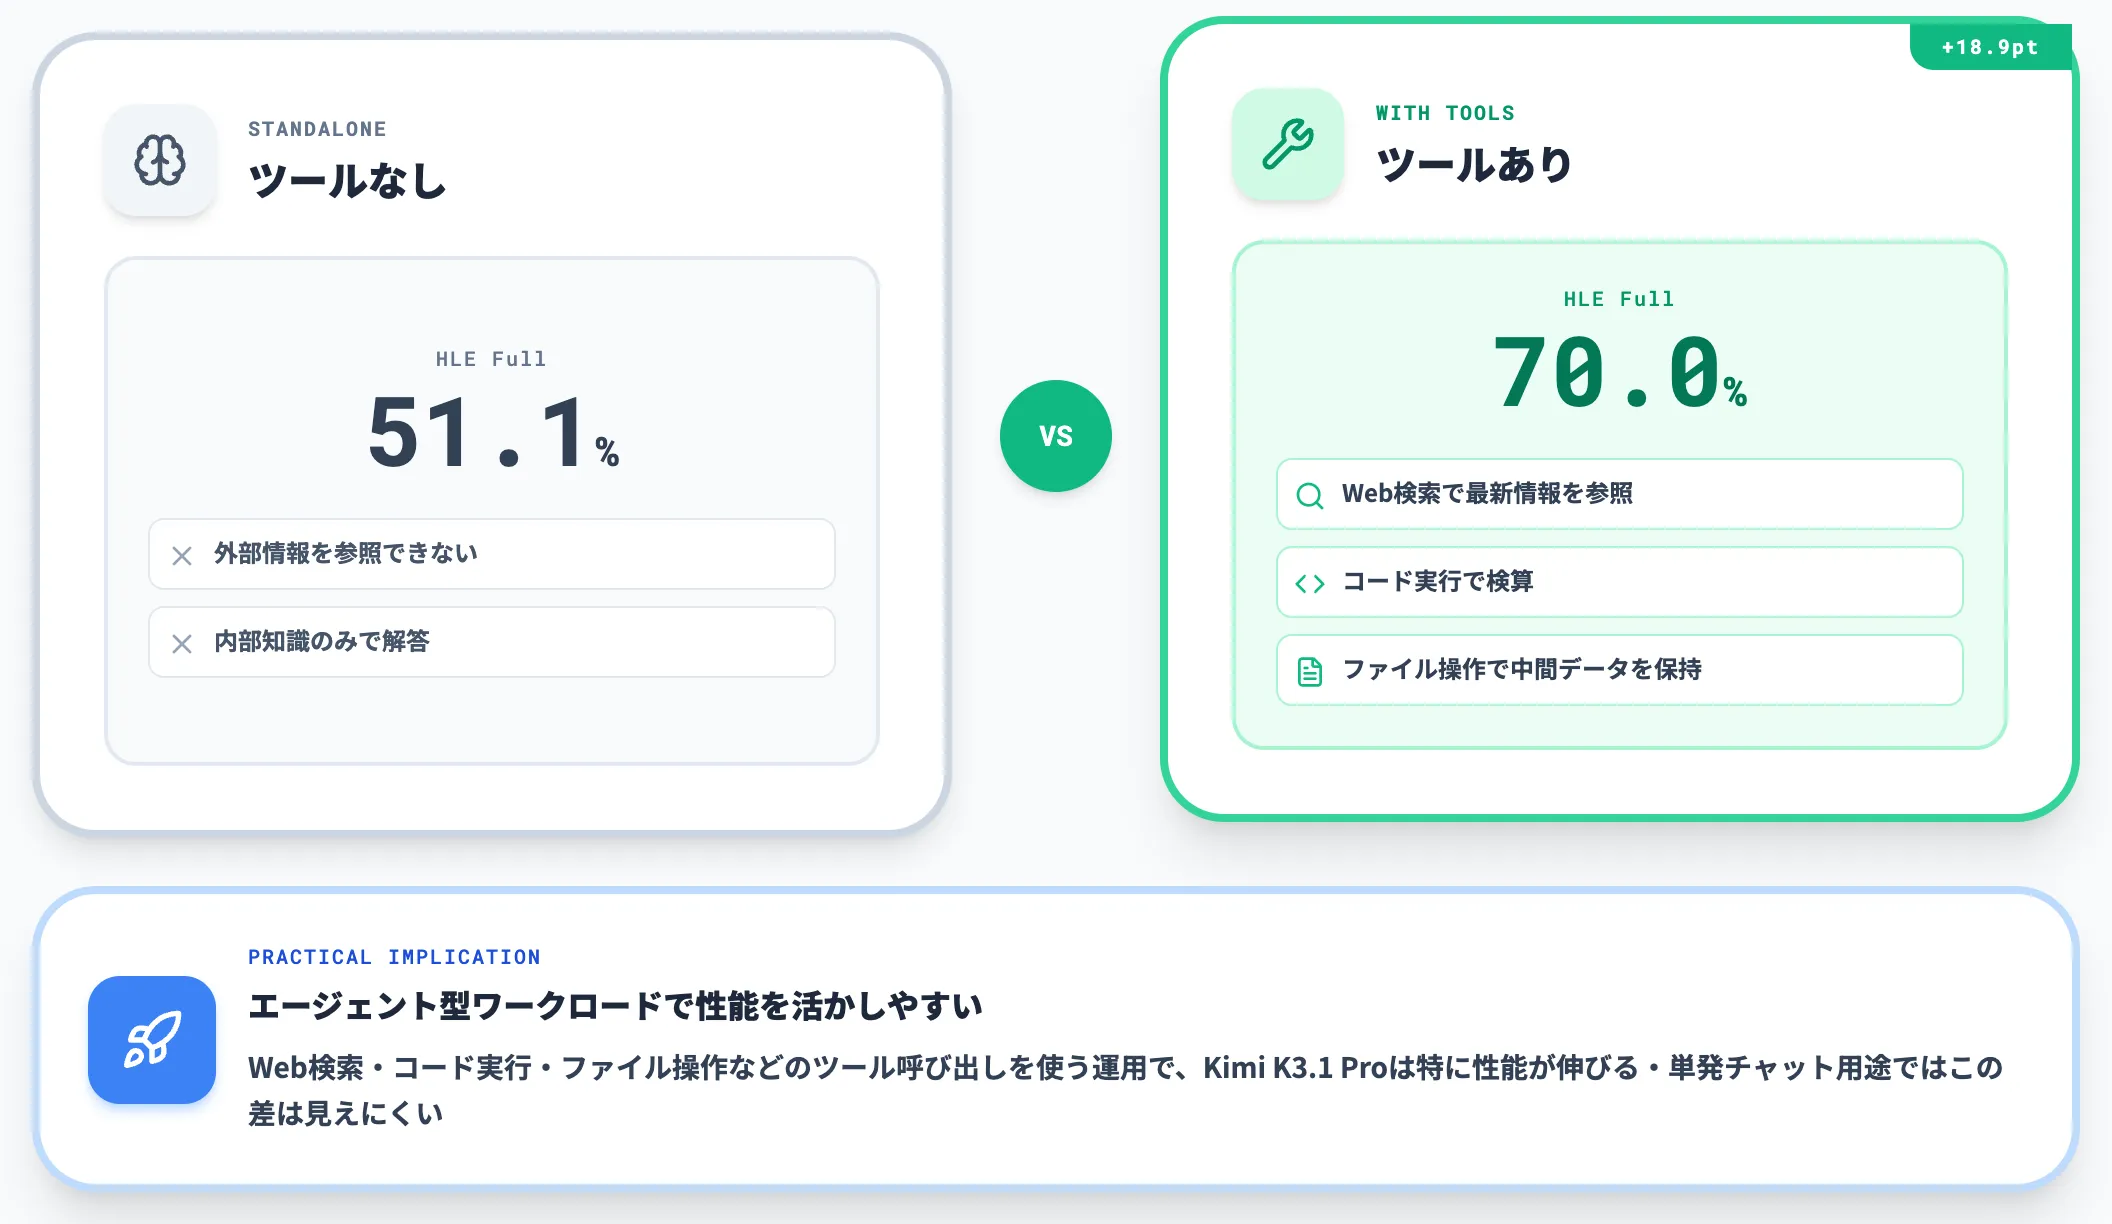
K3.1 Proの特徴として、ツール使用の有無でスコアが大きく変わる点が挙げられます。
Moonshot公式ブログ掲載のHumanity's Last Exam Full では**ツールあり70.0%/ツールなし51.1%**という差が出ており、ツール連鎖を使う運用で性能が大きく伸びることが数字に表れています。
ここから読み取れるのは、Kimi K3.1 ProはWeb検索・コード実行・ファイル操作などのツール呼び出しを使うエージェント型ワークロードで、特に性能を活かしやすいという点です。
Kimi K3.1 Proの料金とHighspeed版のコスト構造
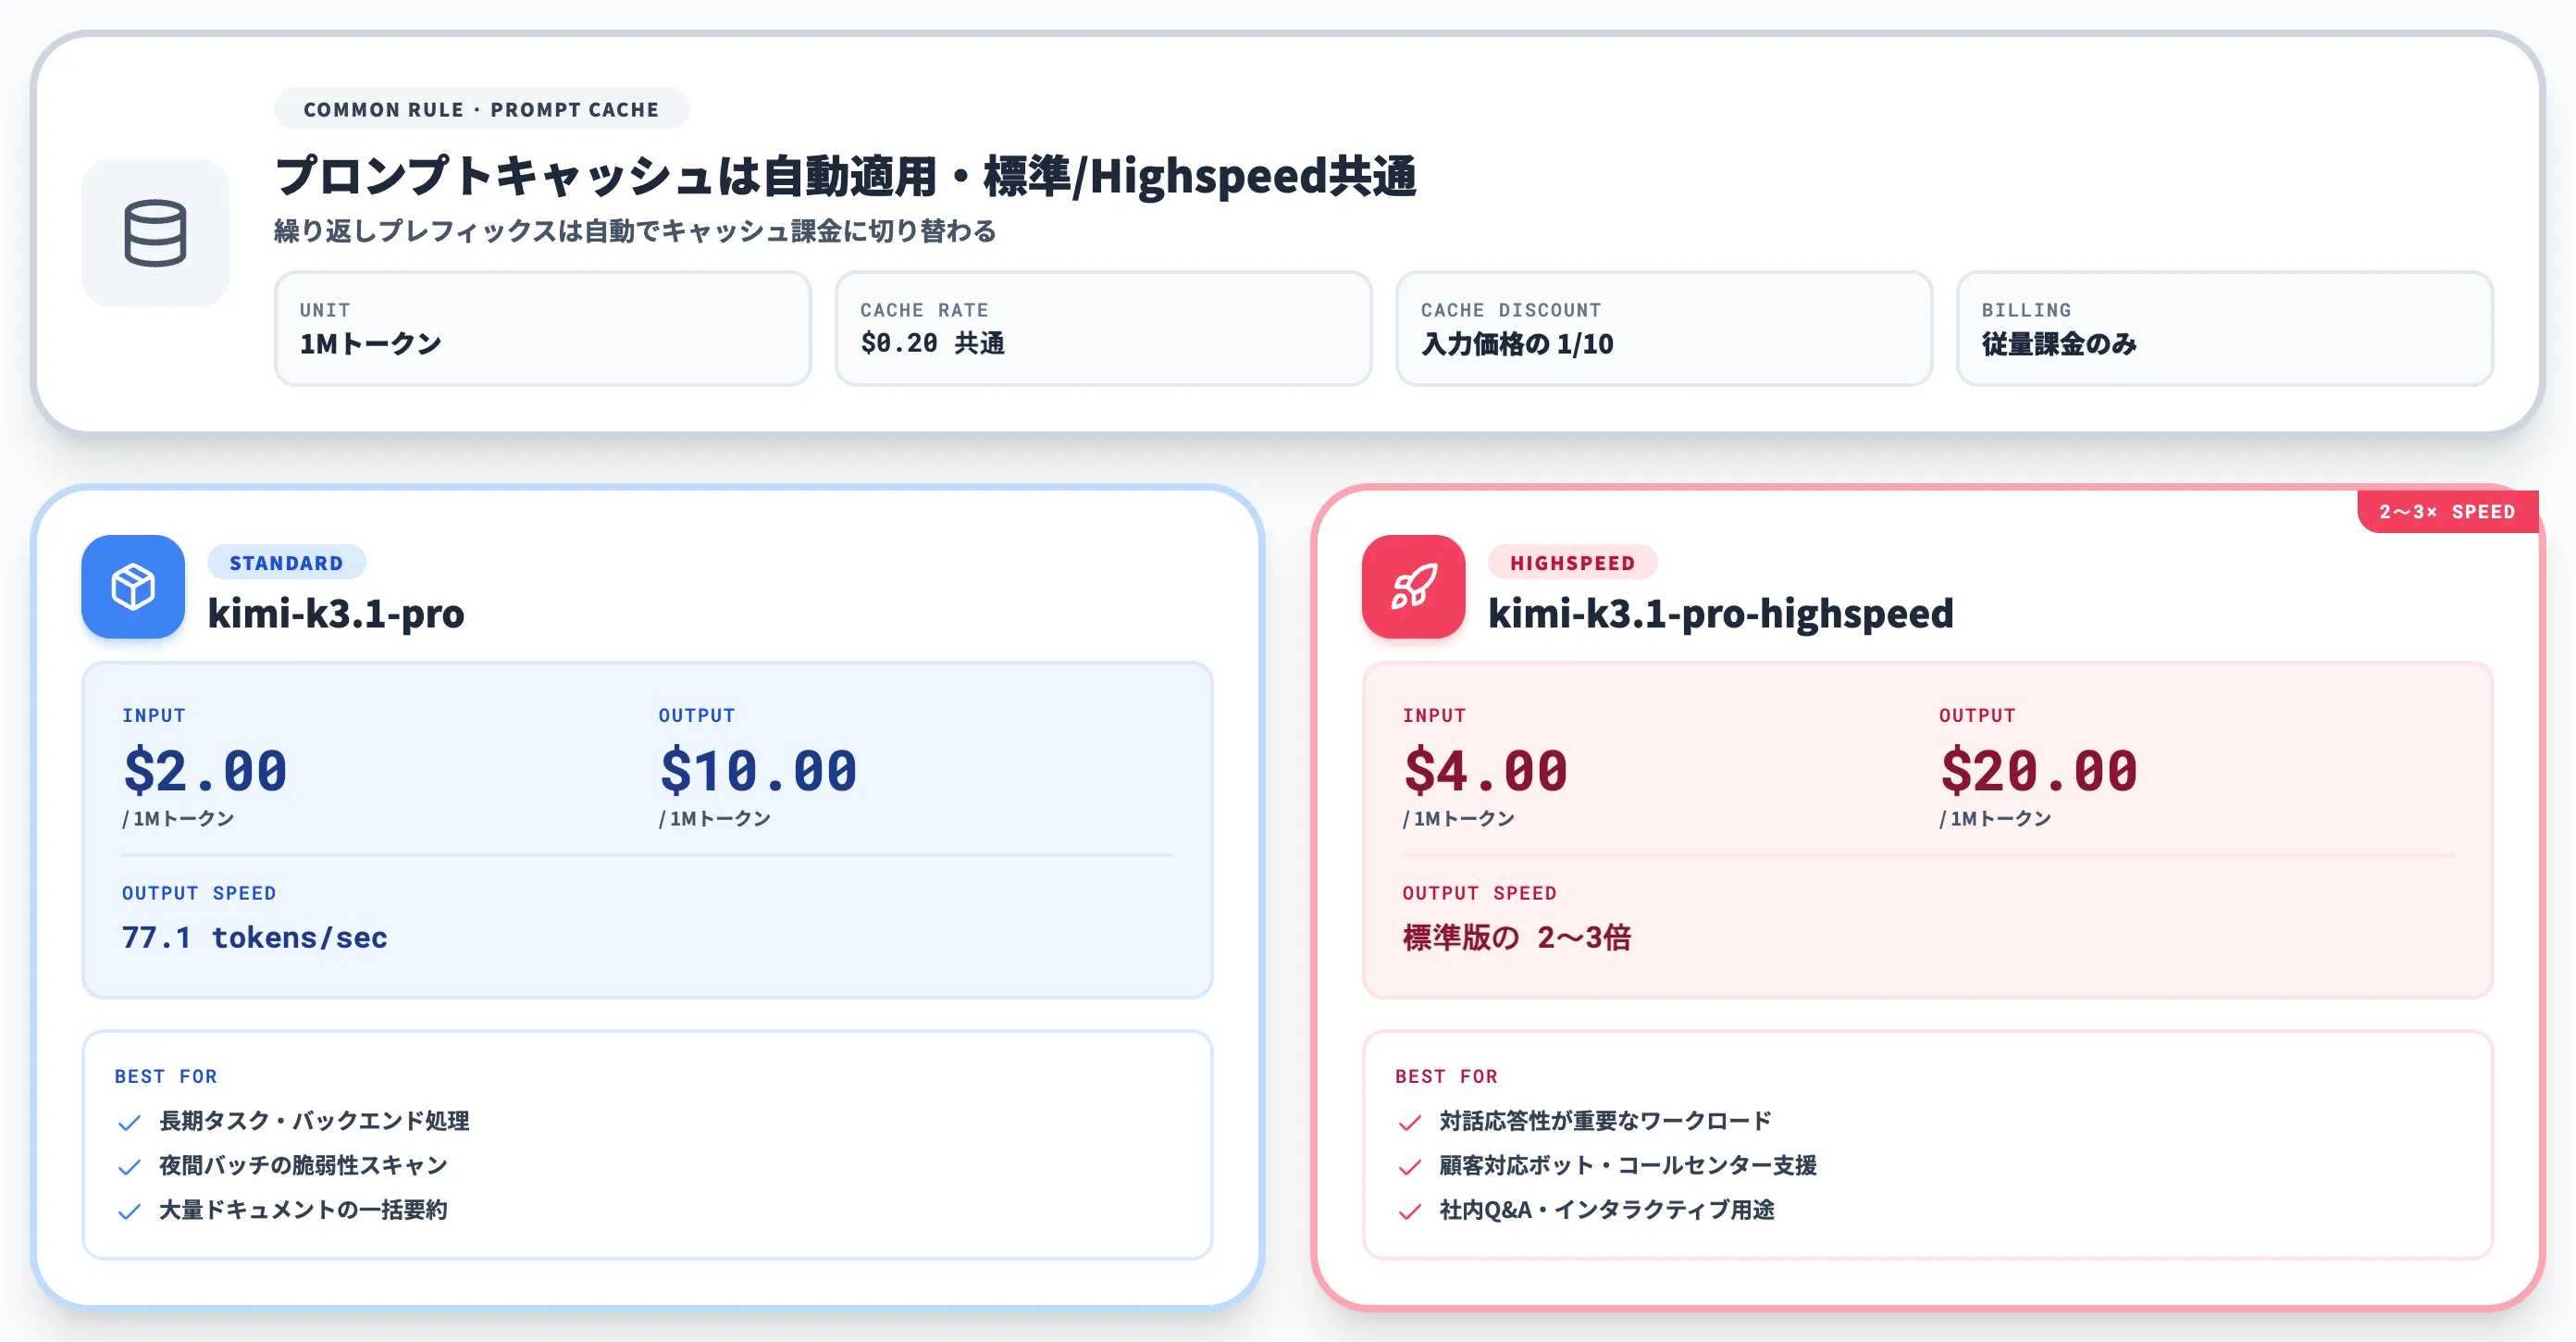
MoonshotはKimi K3.1 Pro vs Kimi K3の料金比較でK3から約3割の値下げを公表しました。
Highspeed版という高速な派生ティアも同時提供されており、通常版とHighspeed版をどう使い分けるかが運用設計の論点になります。
標準API価格はK3から1/3値下げ
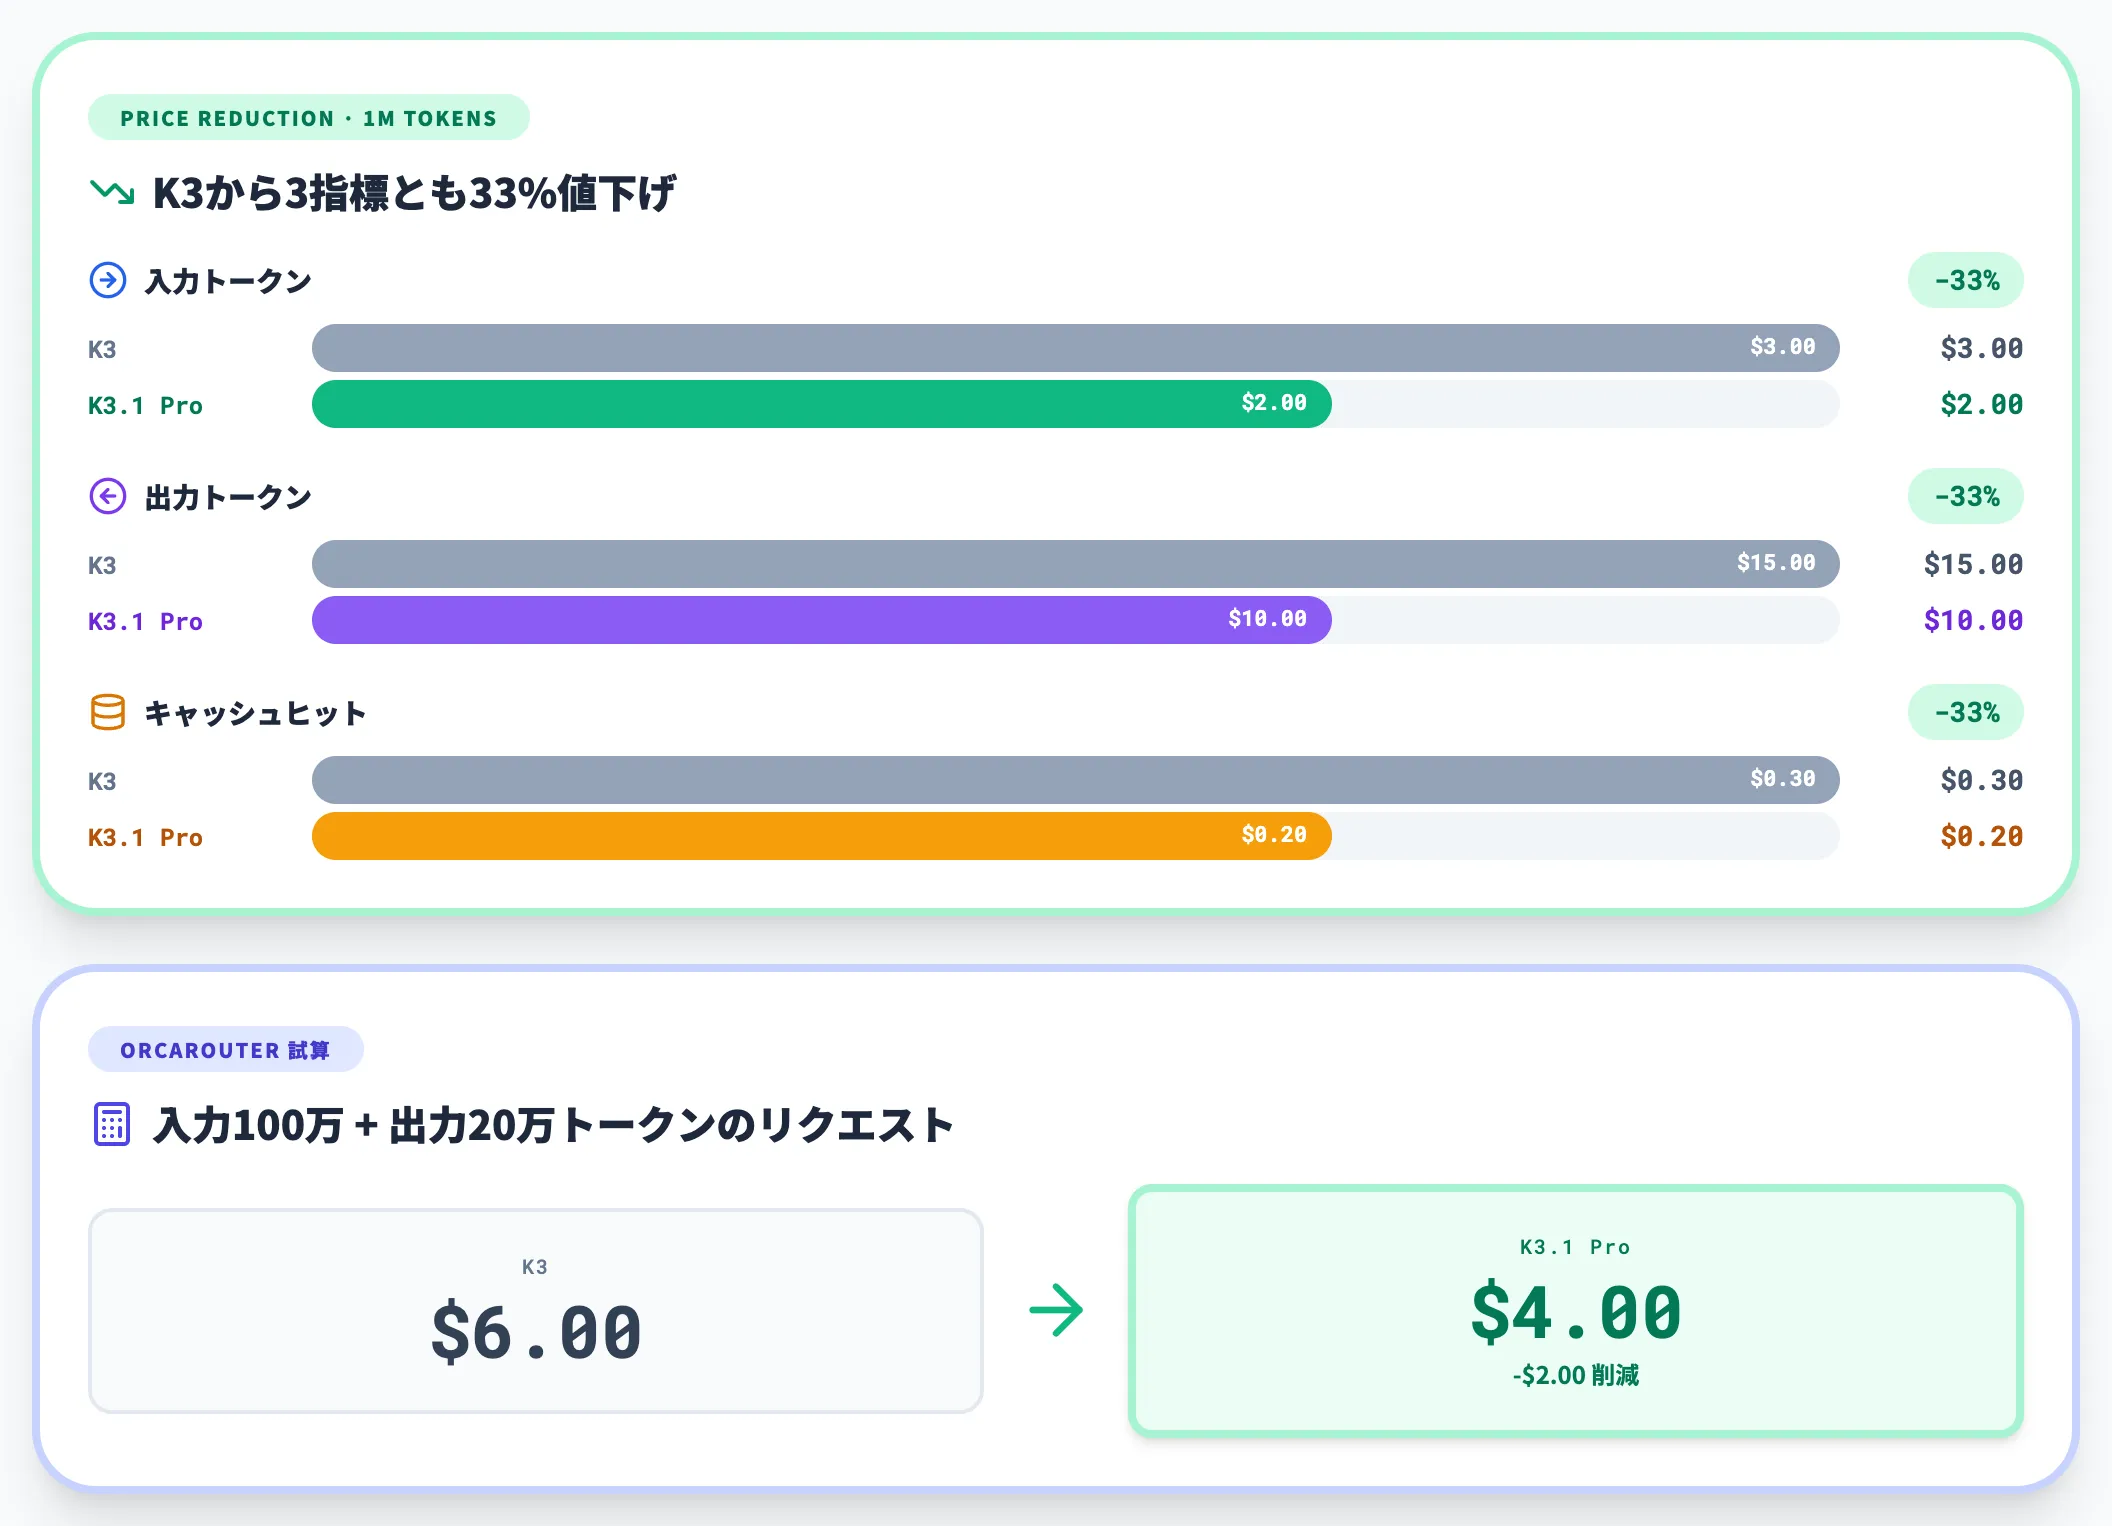
標準版Kimi K3.1 Proの価格は以下のとおりです(2026年10月時点、1Mトークンあたり)。
| 種別 | Kimi K3.1 Pro | Kimi K3 | 値下げ幅 |
|---|---|---|---|
| 入力トークン | $2.00 | $3.00 | ‑33% |
| 出力トークン | $10.00 | $15.00 | ‑33% |
| キャッシュヒット | $0.20 | $0.30 | ‑33% |
キャッシュヒット時は入力価格の10分の1まで下がる設計で、platform.kimi.aiによれば繰り返しプレフィックスは自動でキャッシュ課金に切り替わる仕組みです。長文のシステムプロンプト・ドキュメント参照型のエージェントでは、ランニングコストを一段抑えやすい構造になっています。
OrcaRouter blogの試算では、入力100万トークン+出力20万トークンのリクエストで、K3の$6.00に対してK3.1 Proは$4.00に収まる計算です。
Highspeed版は2倍価格で2〜3倍速
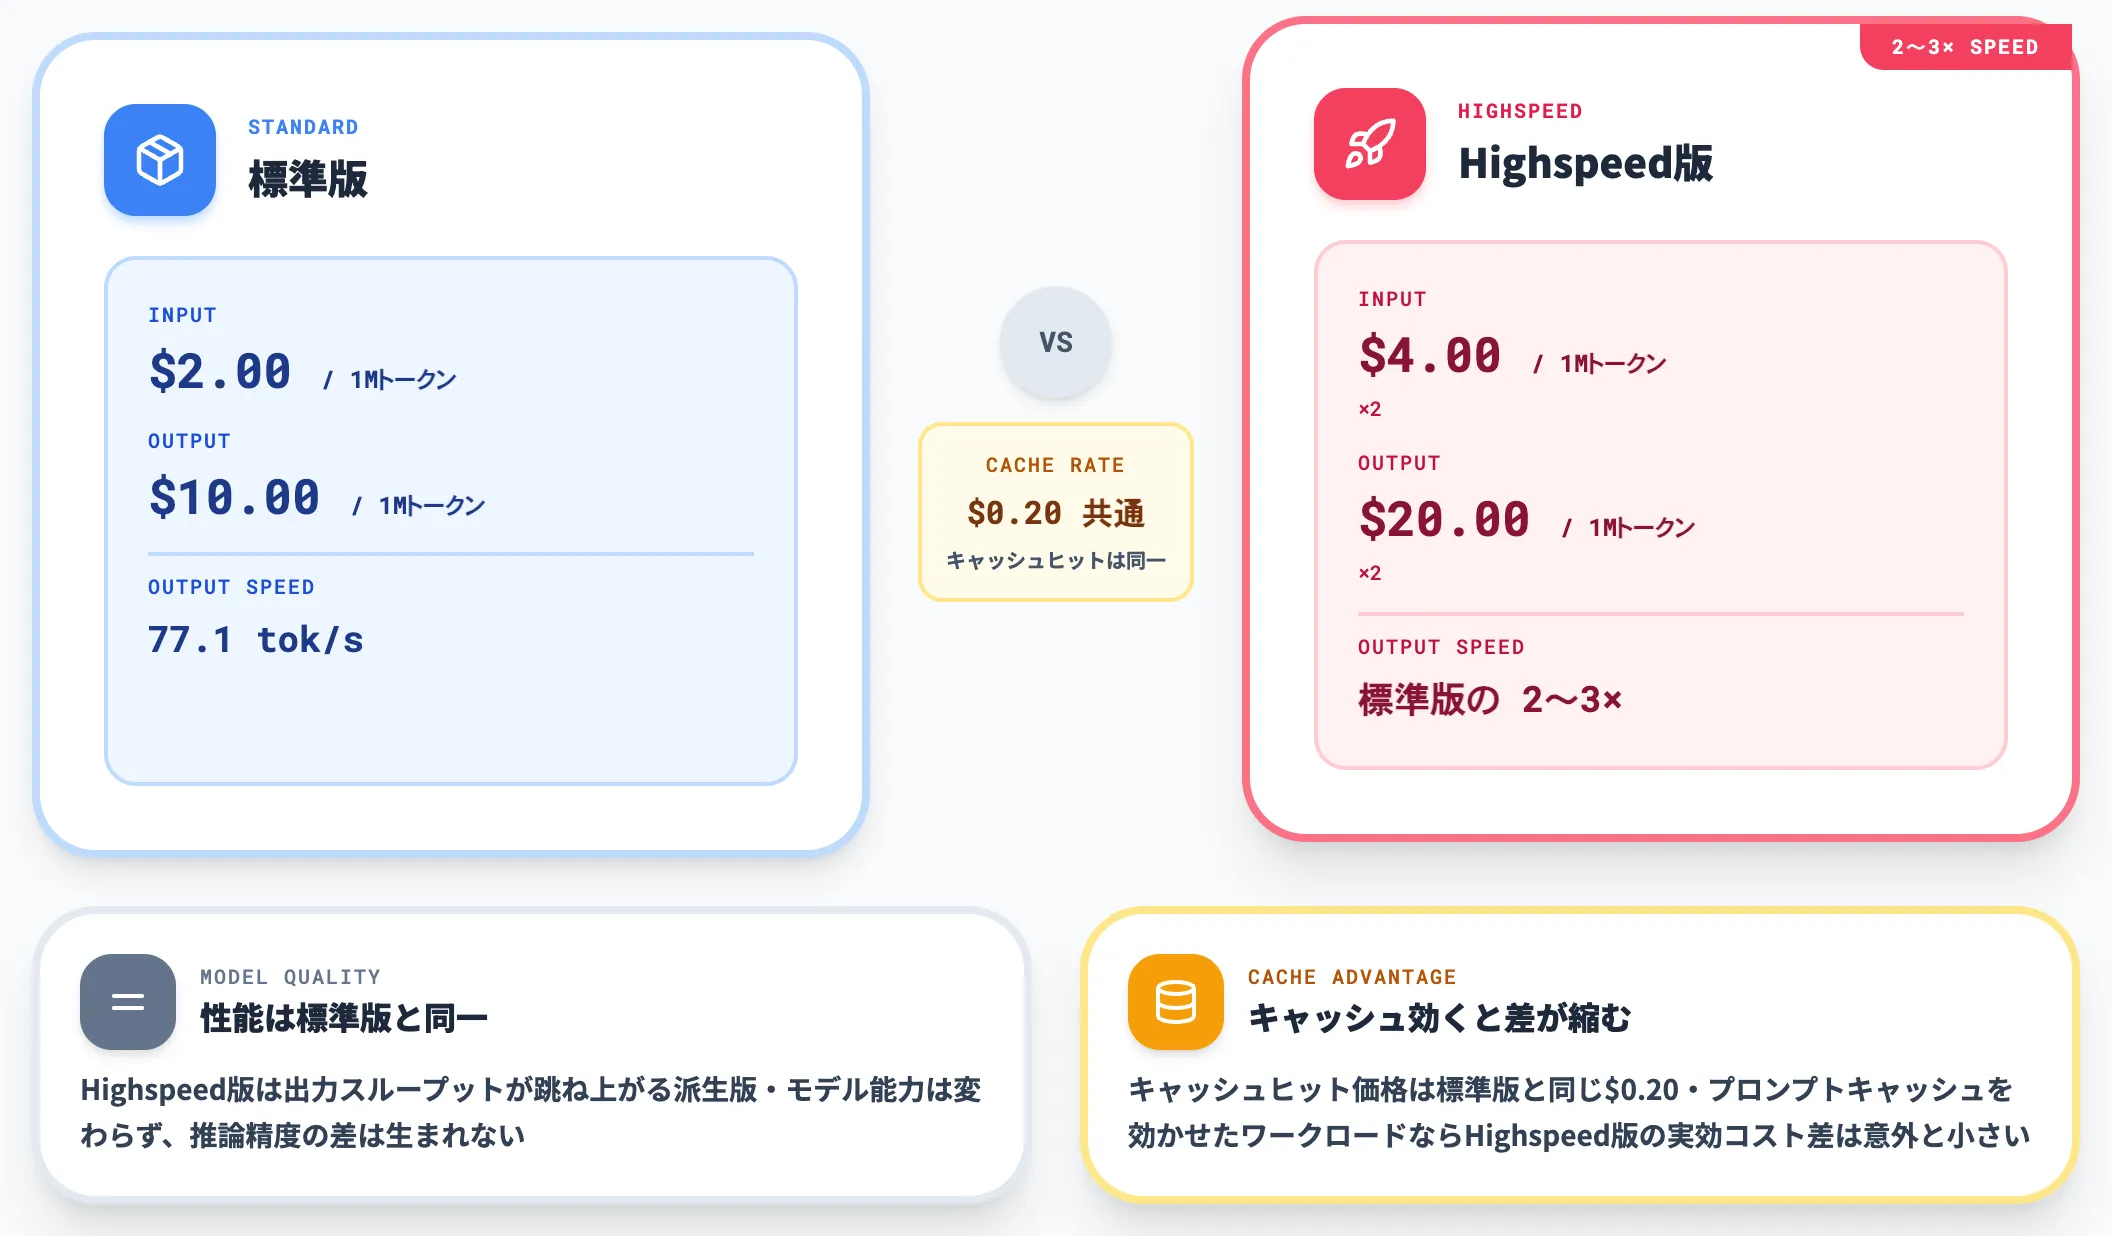
Moonshotは標準版と並行して「Kimi K3.1 Pro Highspeed」も提供しています。モデルの性能は標準版と同一のまま、出力スループットが2〜3倍に跳ね上がる派生版です。
| 種別 | 標準版 | Highspeed版 |
|---|---|---|
| 入力 | $2.00 | $4.00 |
| 出力 | $10.00 | $20.00 |
| キャッシュヒット | $0.20 | $0.20 |
| 出力速度 | 77.1 tokens/sec | 標準版の2〜3倍 |
キャッシュヒットの価格だけは標準版と同じ$0.20で据え置かれており、プロンプトキャッシュを効かせたワークロードならHighspeed版の実効コスト差は意外と小さくなります。
一方で素のスループットが遅いとされる標準版(Artificial Analysisの計測で77.1 tok/s)に対し、Highspeed版はインタラクティブな用途でレスポンス待ちのストレスを減らせます。顧客対応ボットのような「待たせられない」ワークロードはHighspeed、長期タスクのバックエンド処理は標準版、という切り分けが現実的です。
タスク単価$2.11とOpus 5.5の約1/3
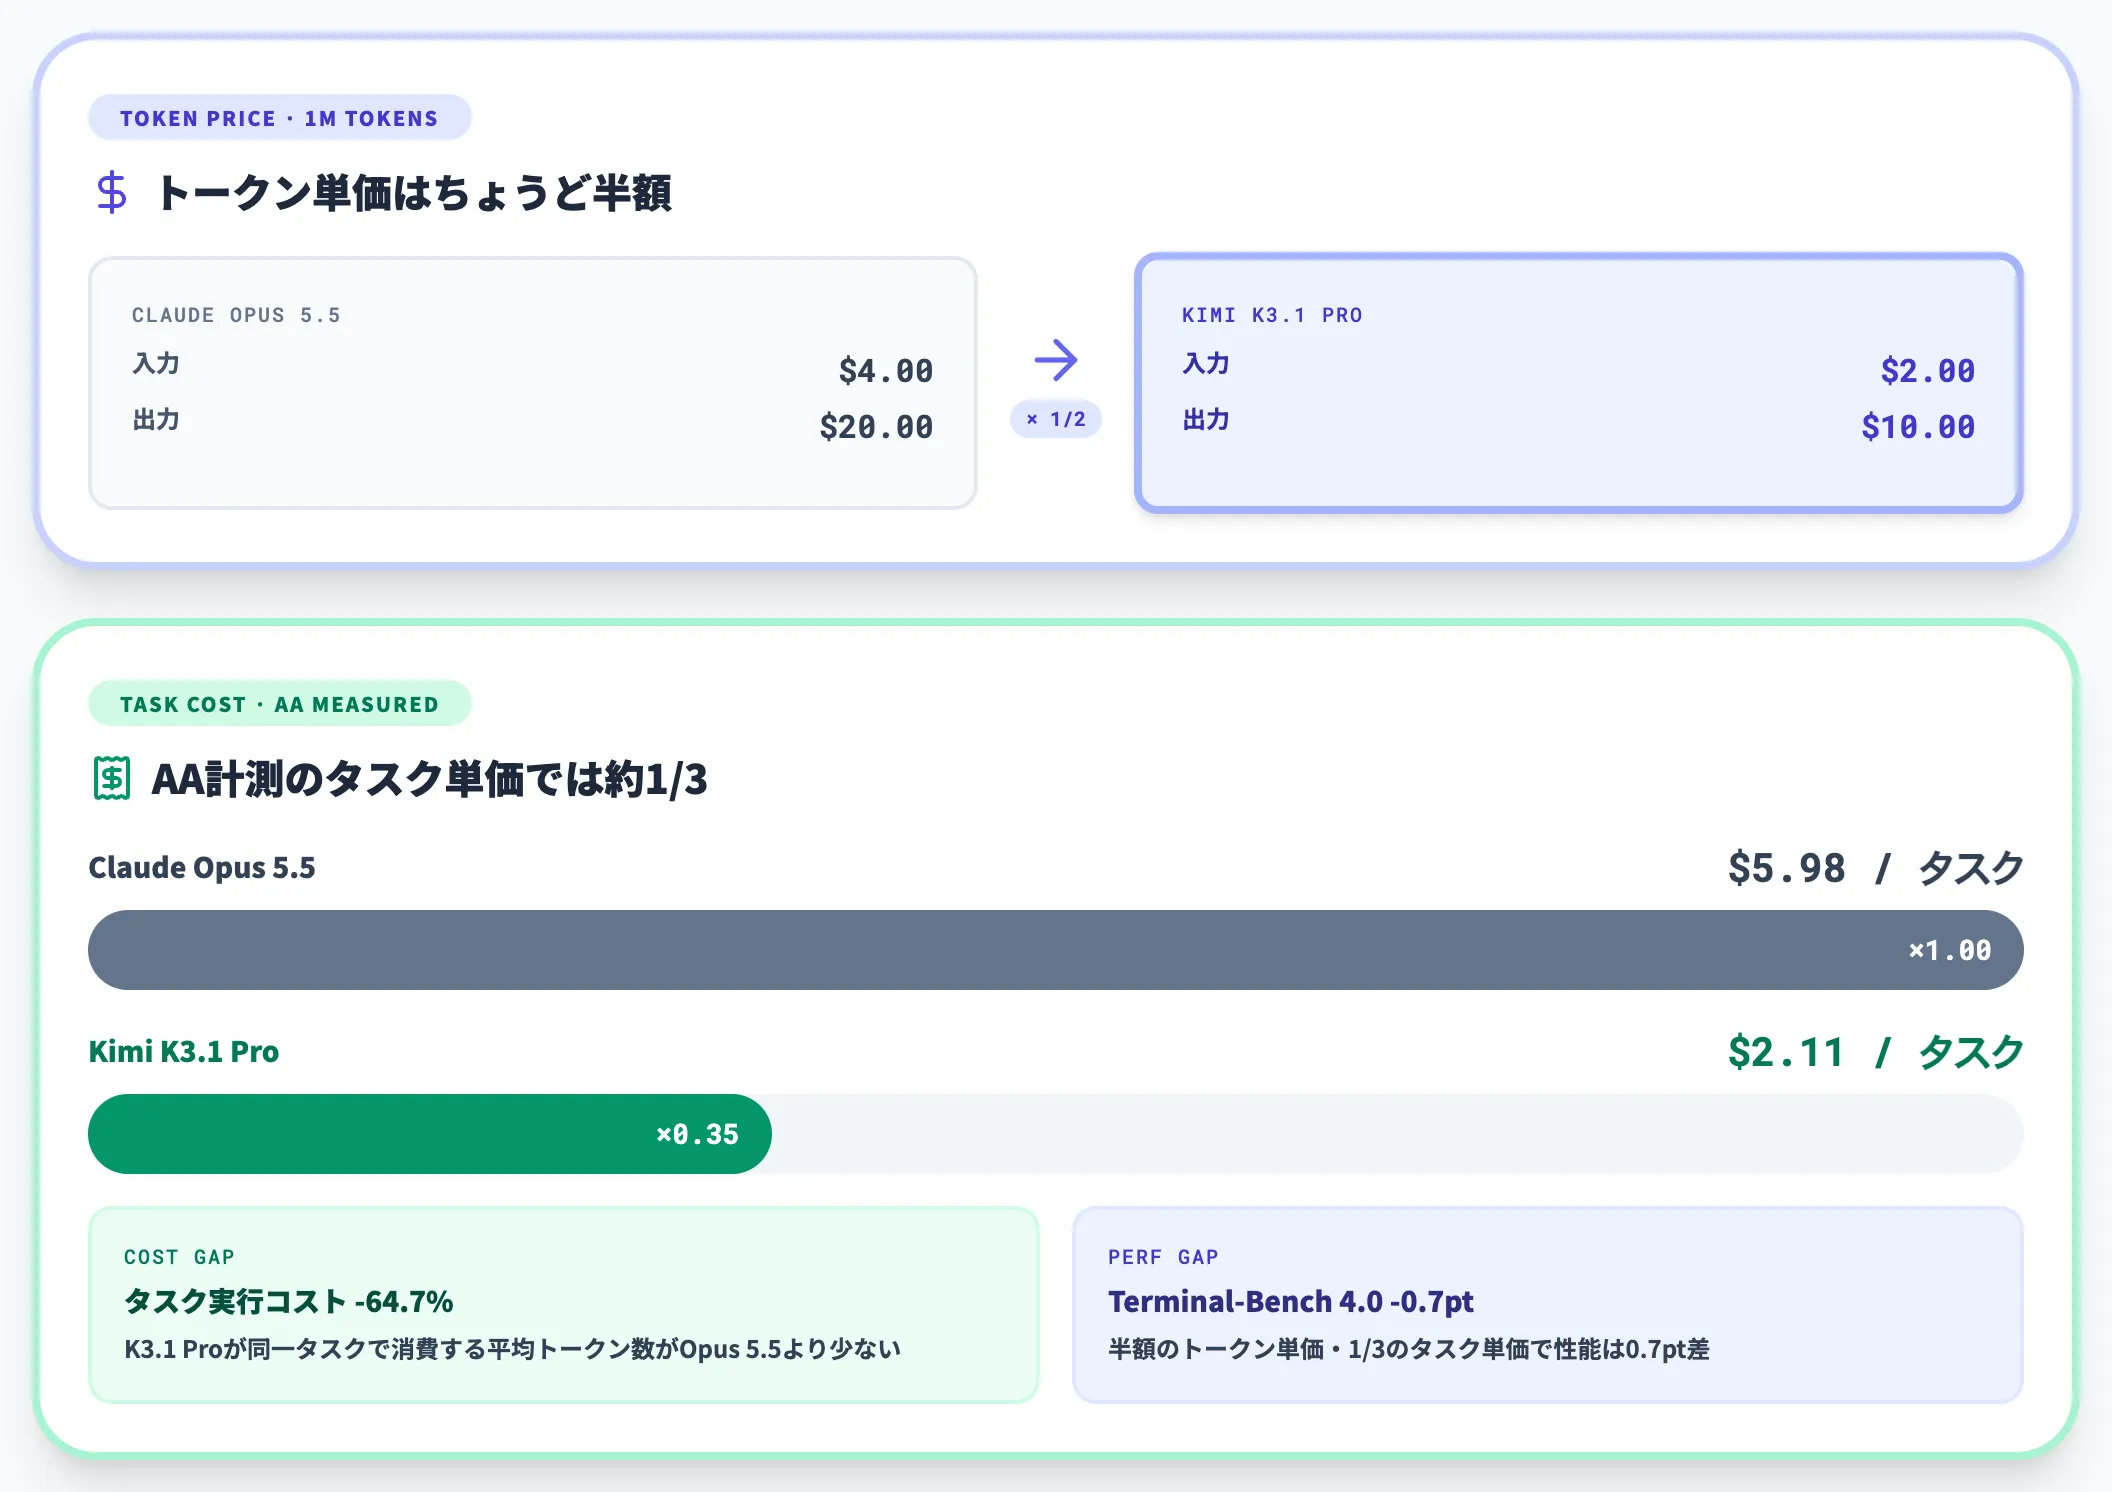
Claude Opus 5.5の公式API料金は入力$4/出力$20(1Mトークンあたり)で、Kimi K3.1 Proの$2/$10はちょうどその半額に相当します。トークン単価ベースではおよそ2倍のコスト差です。
一方、ArtificialAnalysisがベンチマークスイート実行で測ったタスク単価では、Kimi K3.1 Pro:$2.11/タスクに対しClaude Opus 5.5は$5.98/タスクで、約3分の1の水準です。
これはK3.1 Proが同一タスクで消費する平均トークン数がOpus 5.5より少ないことによる差で、トークン単価の2倍差より実行コストの3倍差の方が運用に効くシナリオもあります。
Terminal-Bench 4.0で0.7ポイント差(65.7% vs 66.4%)に収まる性能で、タスク単価が3分の1に下がる構造が、K3.1 Proの立ち位置を特徴づけています。
「*Opusクラスの性能を半額のトークン単価・3分の1のタスク単価で」という選択肢がオープンウェイト側に現れたのが今回の変化です。
Kimi K3.1 Proの使い方と提供チャネル
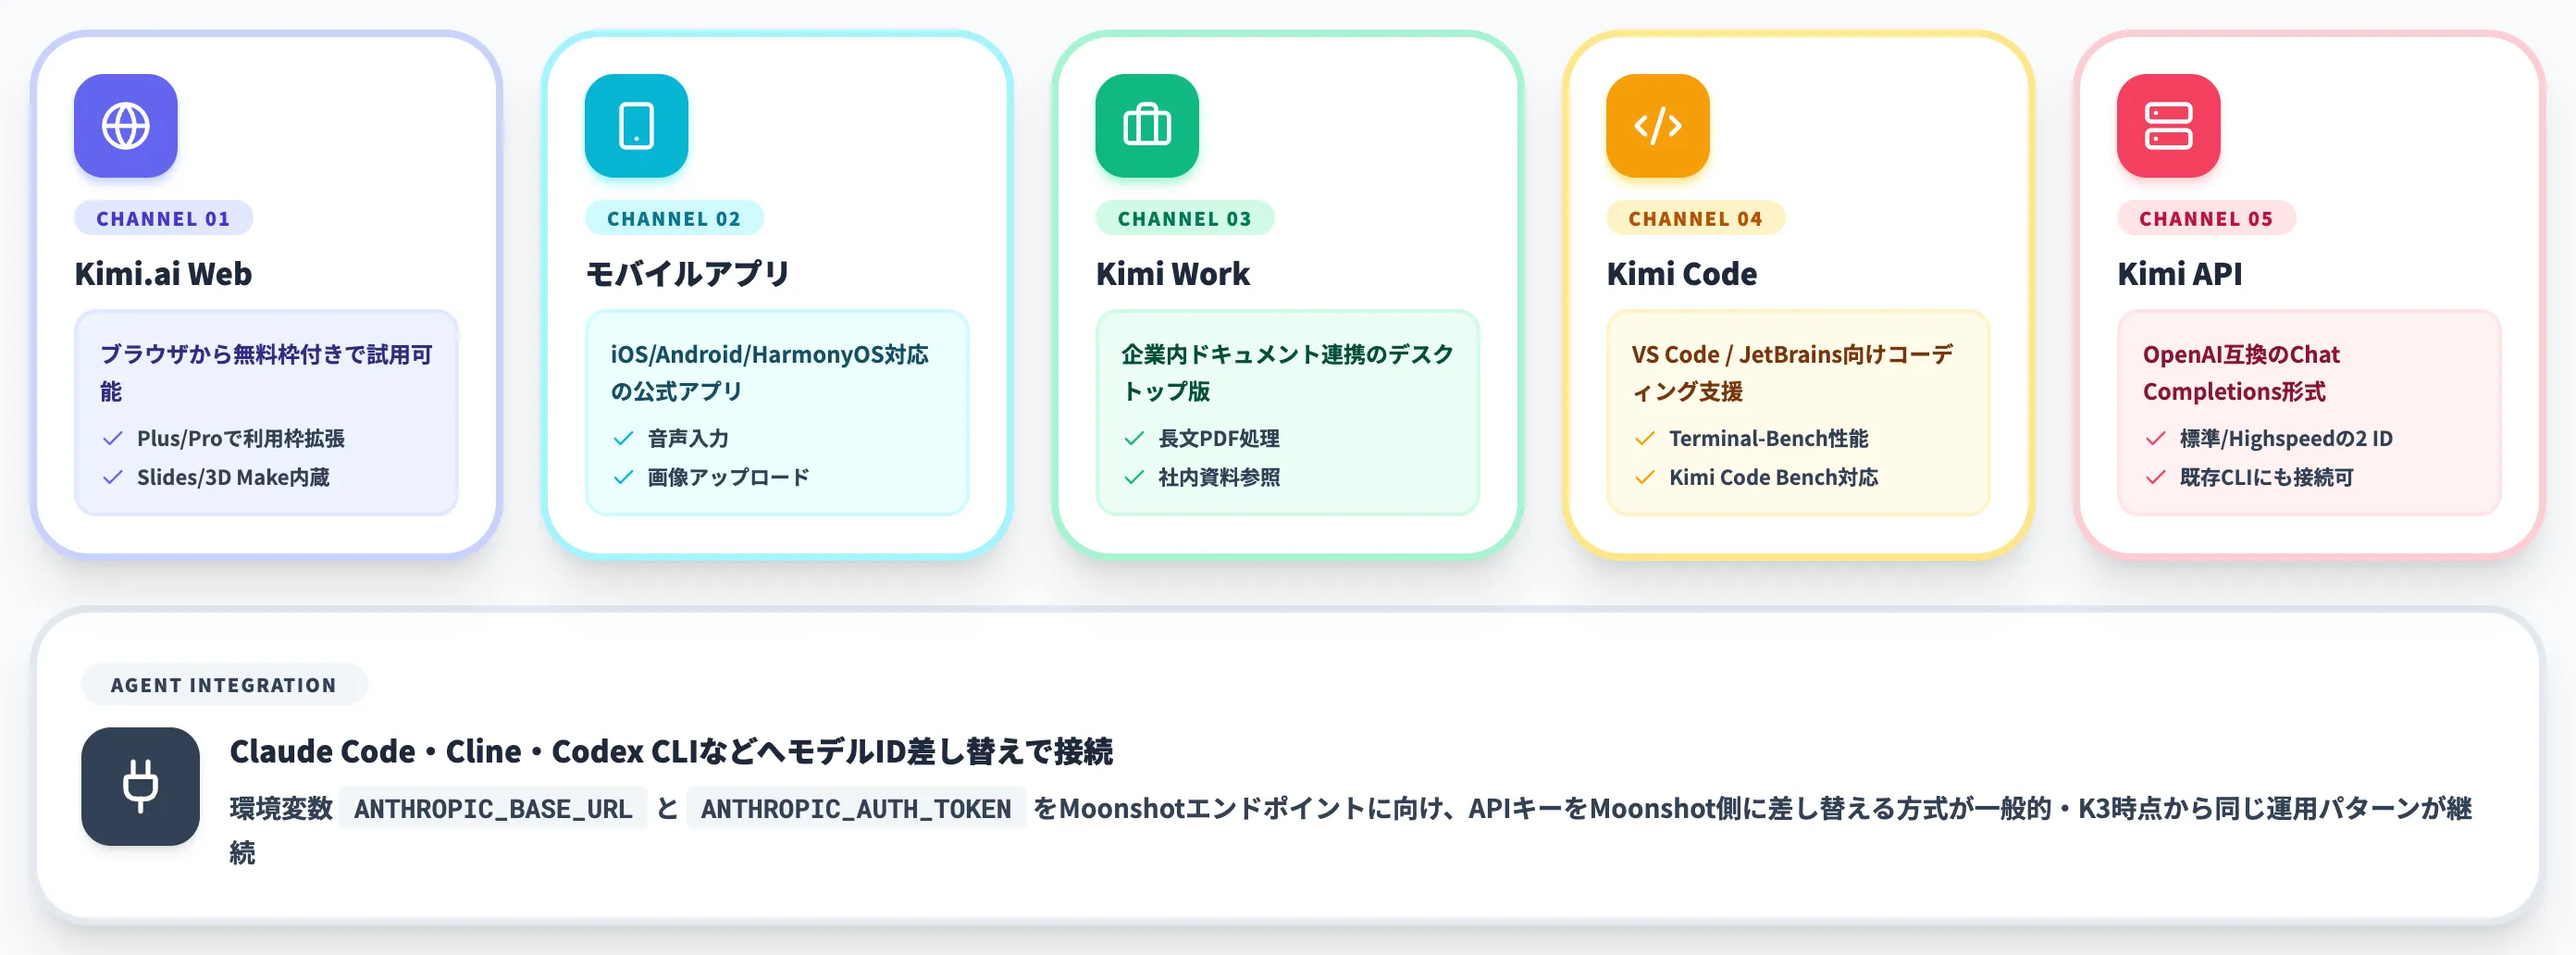
Kimi K3.1 Proは5つのチャネルから利用できます。既存のKimi K3利用者であればインターフェースはそのまま、モデル識別子を切り替えるだけで乗り換え可能です。
Web版のKimi.aiでは、入力欄右側のモデル名から選択メニューを開けます。K3.1 ProのほかにK2.8などが並び、下部には思考強度・チャットの長さ・速度の設定があります。
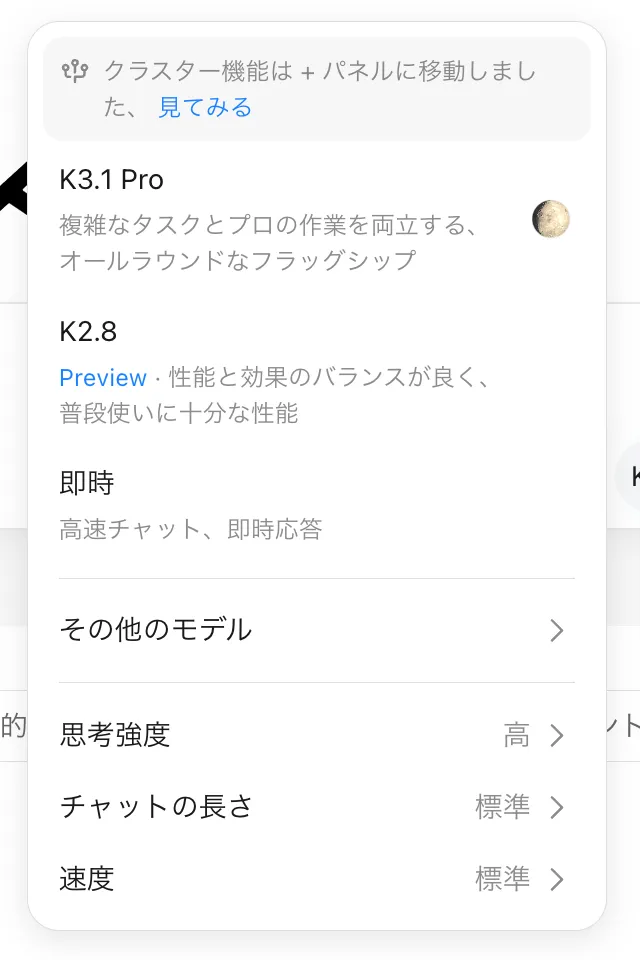
Web版のモデル選択メニュー。K3.1 Proと各種設定を確認できる(2026年10月24日撮影)。
利用可能な5つのプラットフォーム
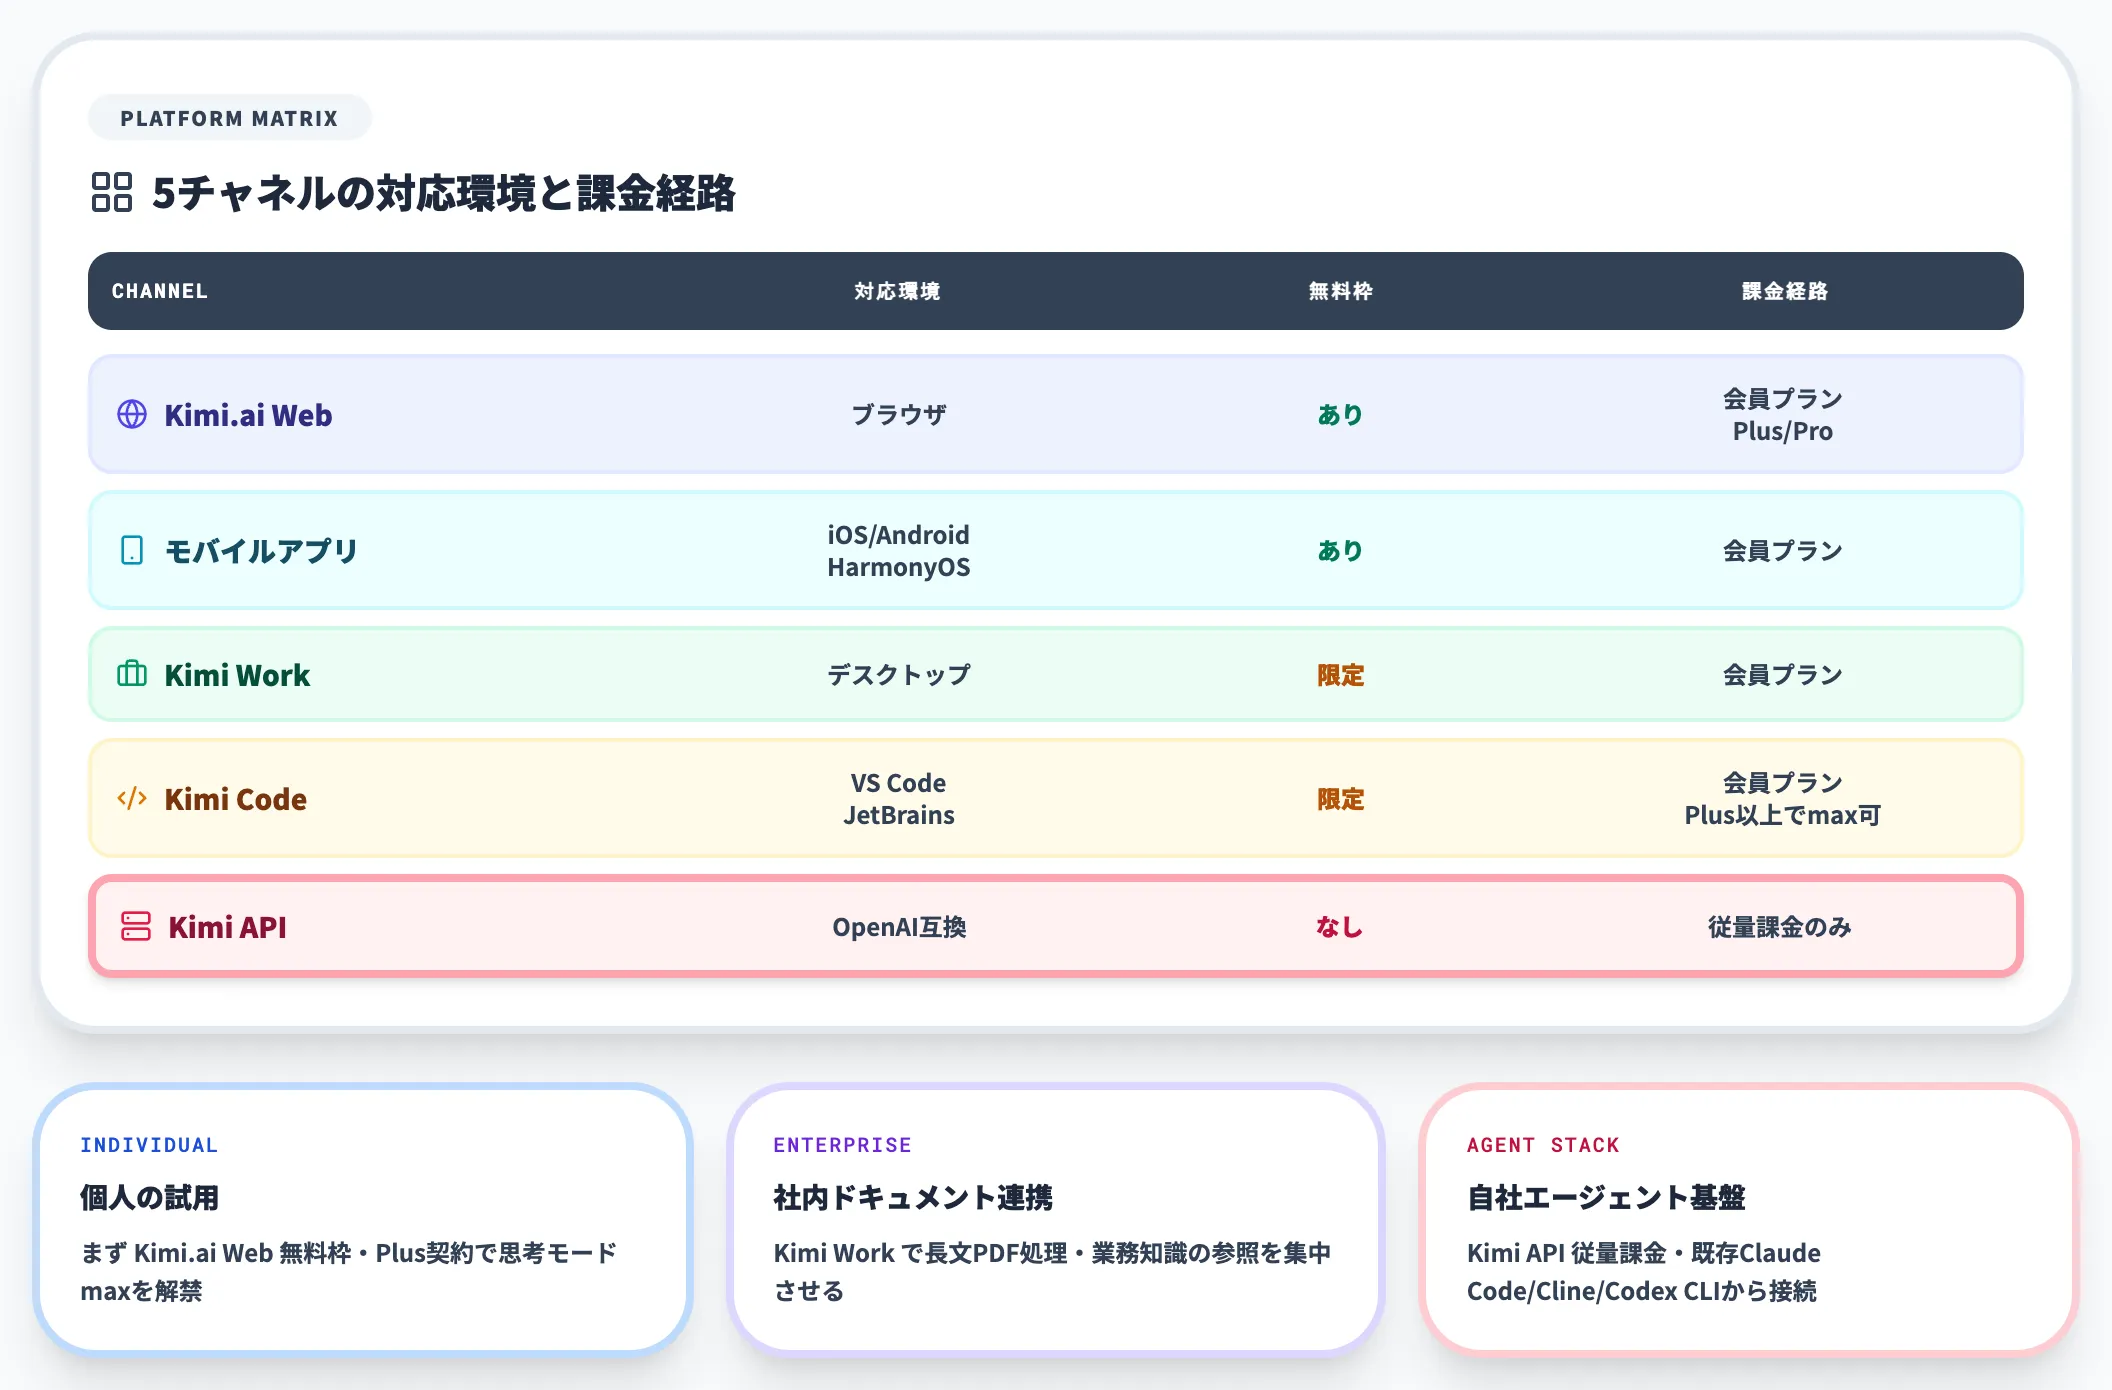
Moonshotは標準版・Highspeed版を以下のチャネルで提供しています。
-
Kimi.ai
Web版チャット。ブラウザから無料枠付きで試用可能で、Plus・Proティアで利用枠を拡張。
-
モバイルアプリ
iOS・Android・HarmonyOS向けの公式アプリ。音声入力や画像アップロードを含む。
-
Kimi Work
企業内ドキュメント連携・業務向けのデスクトップ版。長文PDFの処理や社内資料の参照に特化。
-
Kimi Code
VS Code/JetBrains向けのコーディング用クライアント。Terminal-BenchやKimi Code Benchで示された性能をIDE上で利用可能。
-
Kimi API
モデルID「kimi-k3.1-pro」「kimi-k3.1-pro-highspeed」の2つをplatform.kimi.ai経由で呼び出し。OpenAI互換のChat Completions形式。
Kimi API経由であれば、Claude Code・Cline・Codex CLIなどの既存エージェント型コーディングツールにもモデルIDや接続設定の変更で接続できる設計です。Claude Codeで利用する場合は、環境変数「ANTHROPIC_BASE_URL」と「ANTHROPIC_AUTH_TOKEN」をMoonshotのエンドポイントに向け、APIキーをMoonshot側に差し替える方式が一般的で、Kimi K3時点から同じ運用パターンが継続しています。
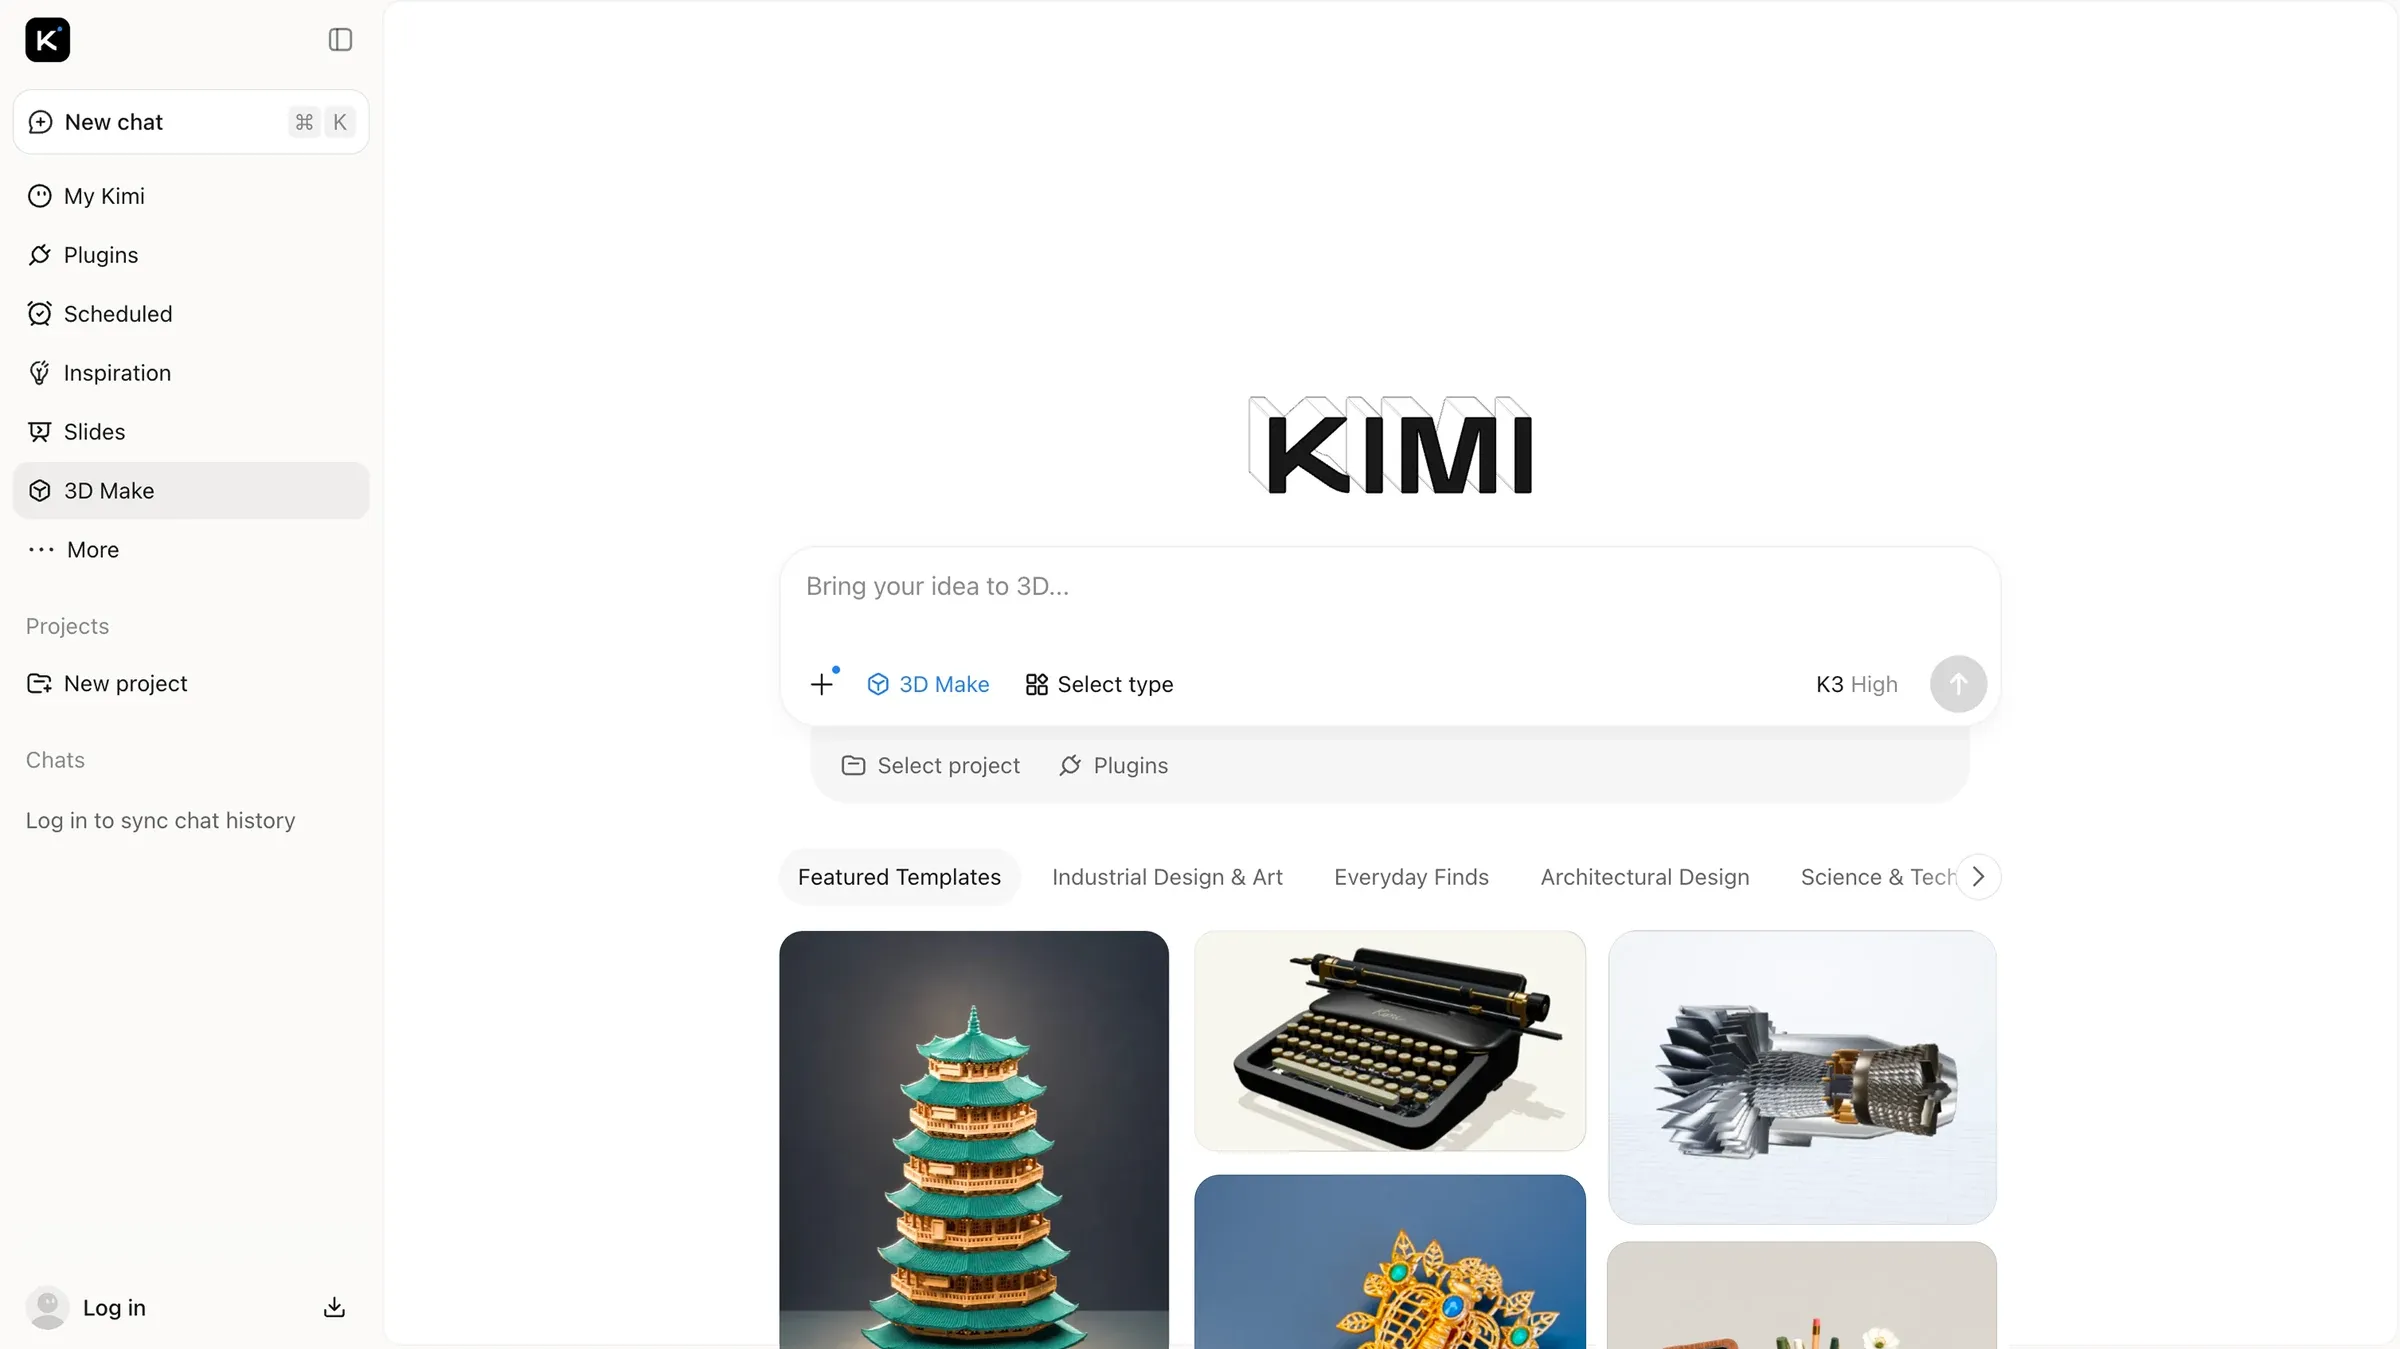
Kimi.aiの3D Make機能のインターフェース。Chats・Plugins・Scheduled・Slides・3D Makeなどのメニューがサイドバーに並び、プロンプトから3Dモデルを生成するテンプレートが用意されている(出典:Kimi公式ブログ)
Kimi.aiにはテキスト対話に加えて、スライド生成(Slides)や3Dモデル生成(3D Make)が別メニューとして組み込まれており、Kimi K3.1 ProのマルチモーダルかつBenchCAD上位のパフォーマンスがそのまま機能として利用できる構造です。業務プロンプトを打つ画面と、CADライクな3D生成を試す画面が同じインターフェースにまとまっています。
APIモデルIDと会員プランの違い
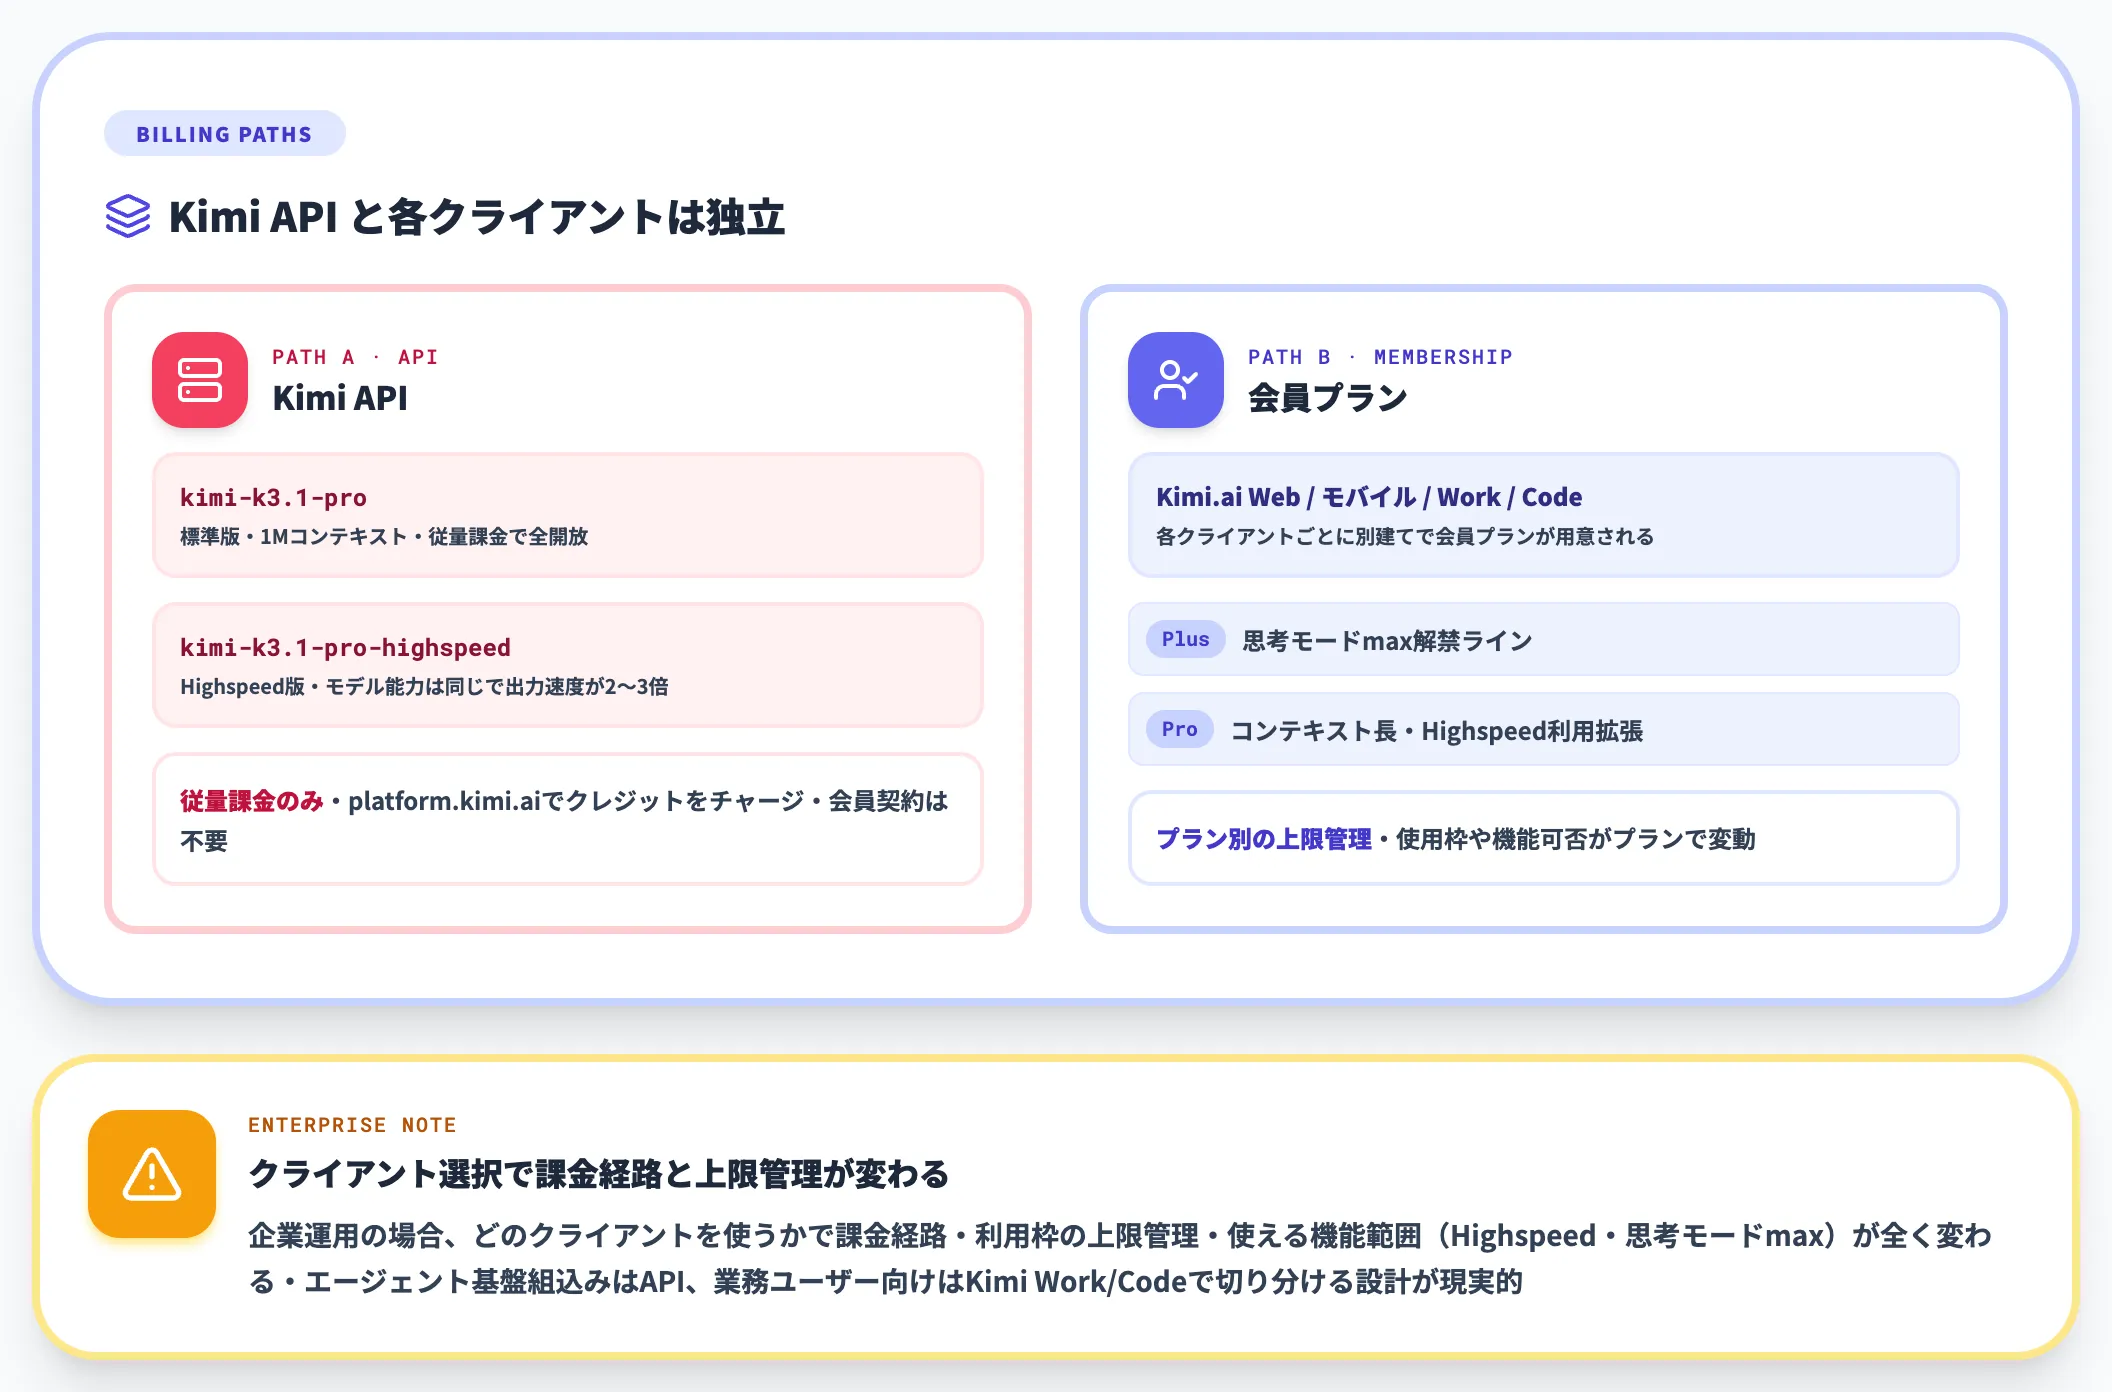
Kimi APIは以下のモデルIDで呼び分けます。
-
kimi-k3.1-pro
標準版。1Mコンテキスト・従量課金で全開放
-
kimi-k3.1-pro-highspeed
Highspeed版。モデル能力は同じで出力速度が2〜3倍。従量課金
APIは入力・出力トークンの従量課金制で、会員契約を前提にしません。platform.kimi.aiでアカウントを作成し、アカウント画面に表示される決済方法でクレジットをチャージして利用します。
一方で、Kimi.ai(Web版)・Kimi Work・Kimi Code の各クライアントには別建てで会員プラン(Plus・Proなど)があり、Kimi Codeではプランに応じて使えるコンテキスト長やHighspeed版の利用可否が変わります(思考モードはPlus以上であればmaxまで指定可能)。企業で運用する場合、どのクライアントを使うかで課金経路と上限管理の設計が変わる点に注意が必要です。
Highspeed版をどのケースで使い分けるか
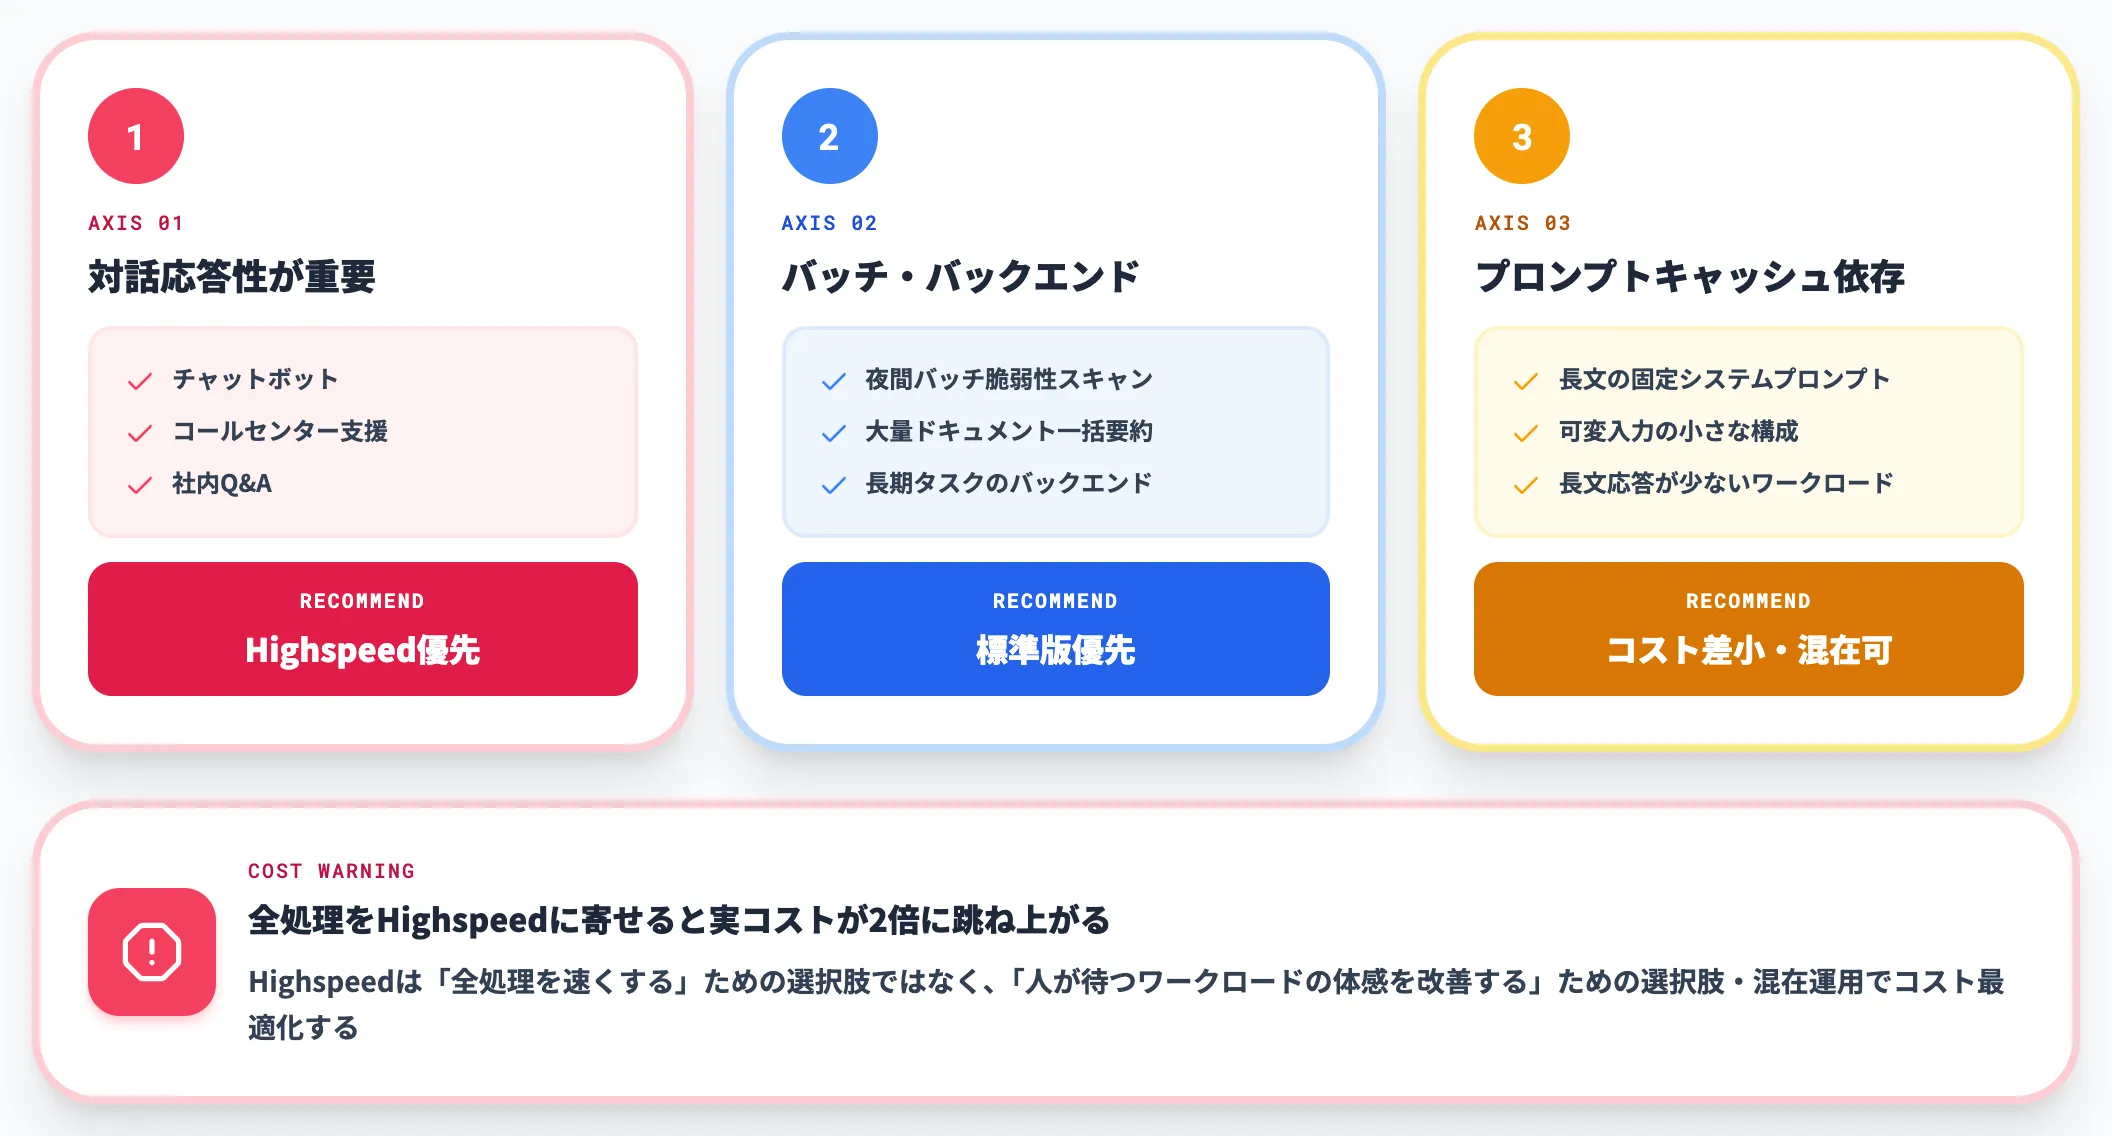
標準版とHighspeed版の価格差は入出力の数量次第で変動しますが、意思決定の基準は3つに整理できます。
- 対話応答性が重要
チャットボット・コールセンター支援・社内Q&Aのように、1リクエストの応答までが短くないと体験が崩れるケース→Highspeed優先
- バッチ処理・バックエンド
夜間バッチの脆弱性スキャン・大量ドキュメントの一括要約など、スループットよりコストが効くケース→標準版優先
- プロンプトキャッシュ依存度が高い
長文の固定システムプロンプト+可変入力の構成であれば、キャッシュヒット価格は同一の$0.20で入力側の差は小さく抑えられます。ただし出力側では$10/1Mトークンの差が残るため、長文応答が多いワークロードはコスト影響が大きい点に注意
Highspeedは「全処理を速くする」ための選択肢ではなく、「人が待つワークロードの体感を改善する」ための選択肢です。すべてをHighspeedに寄せるとコストが2倍に跳ね上がる点は要注意です。
Kimi K3.1 Proのオープンウェイト公開と選定時の注意点
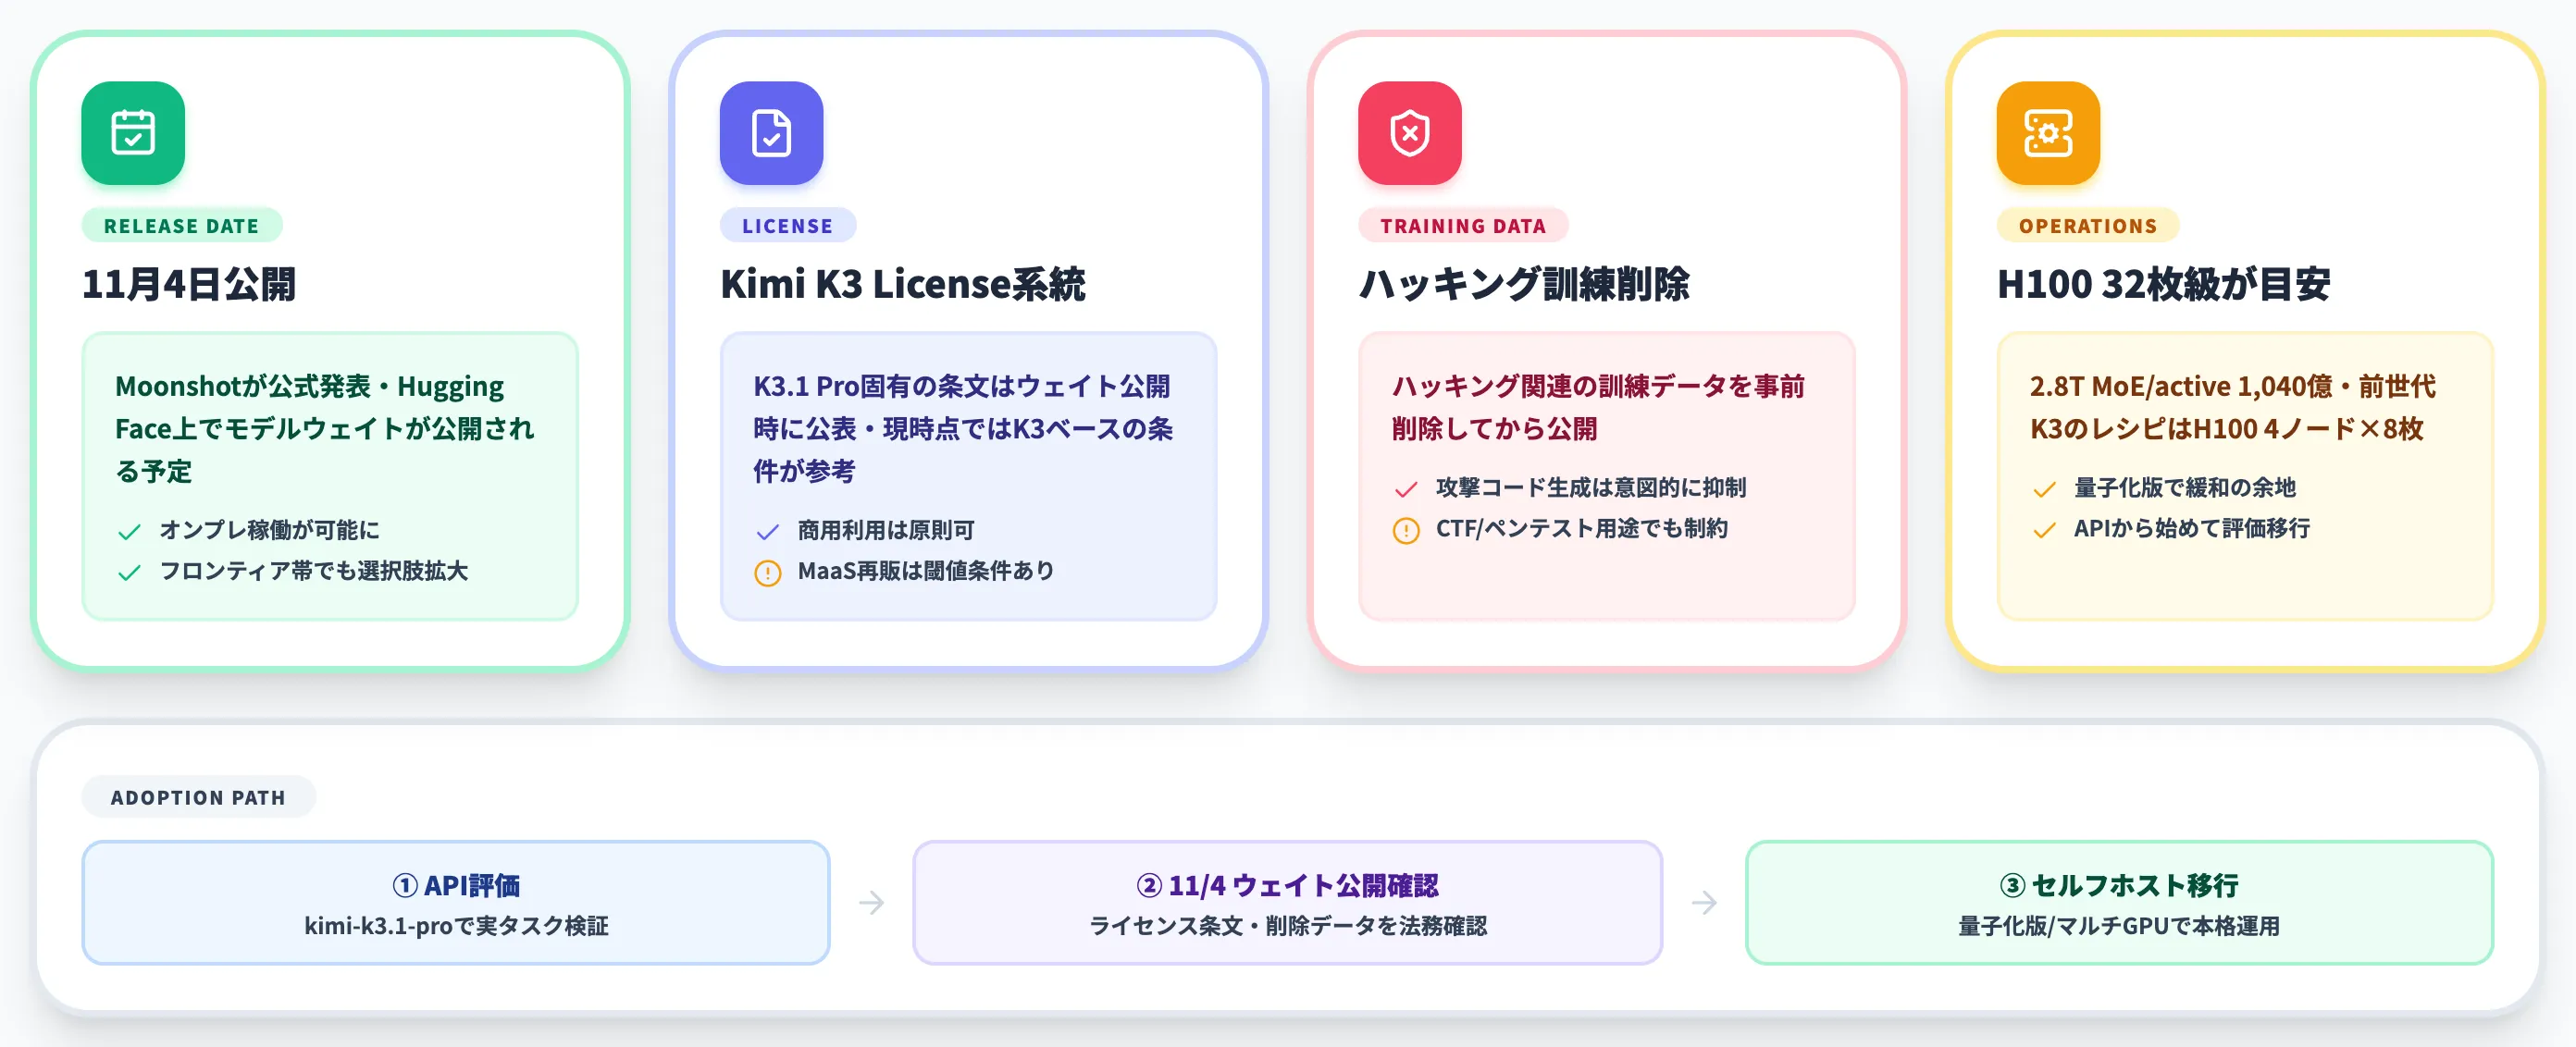
Moonshotは「K3.1 Proのモデルウェイトを2026年11月4日までに公開する」と公式発表しています。クローズドモデル中心のフロンティア帯で、11月初旬にオンプレ稼働まで含めた選択肢が拡がる点が今回のリリースのもう1つの軸です。
11月4日公開予定とKimi K3 License
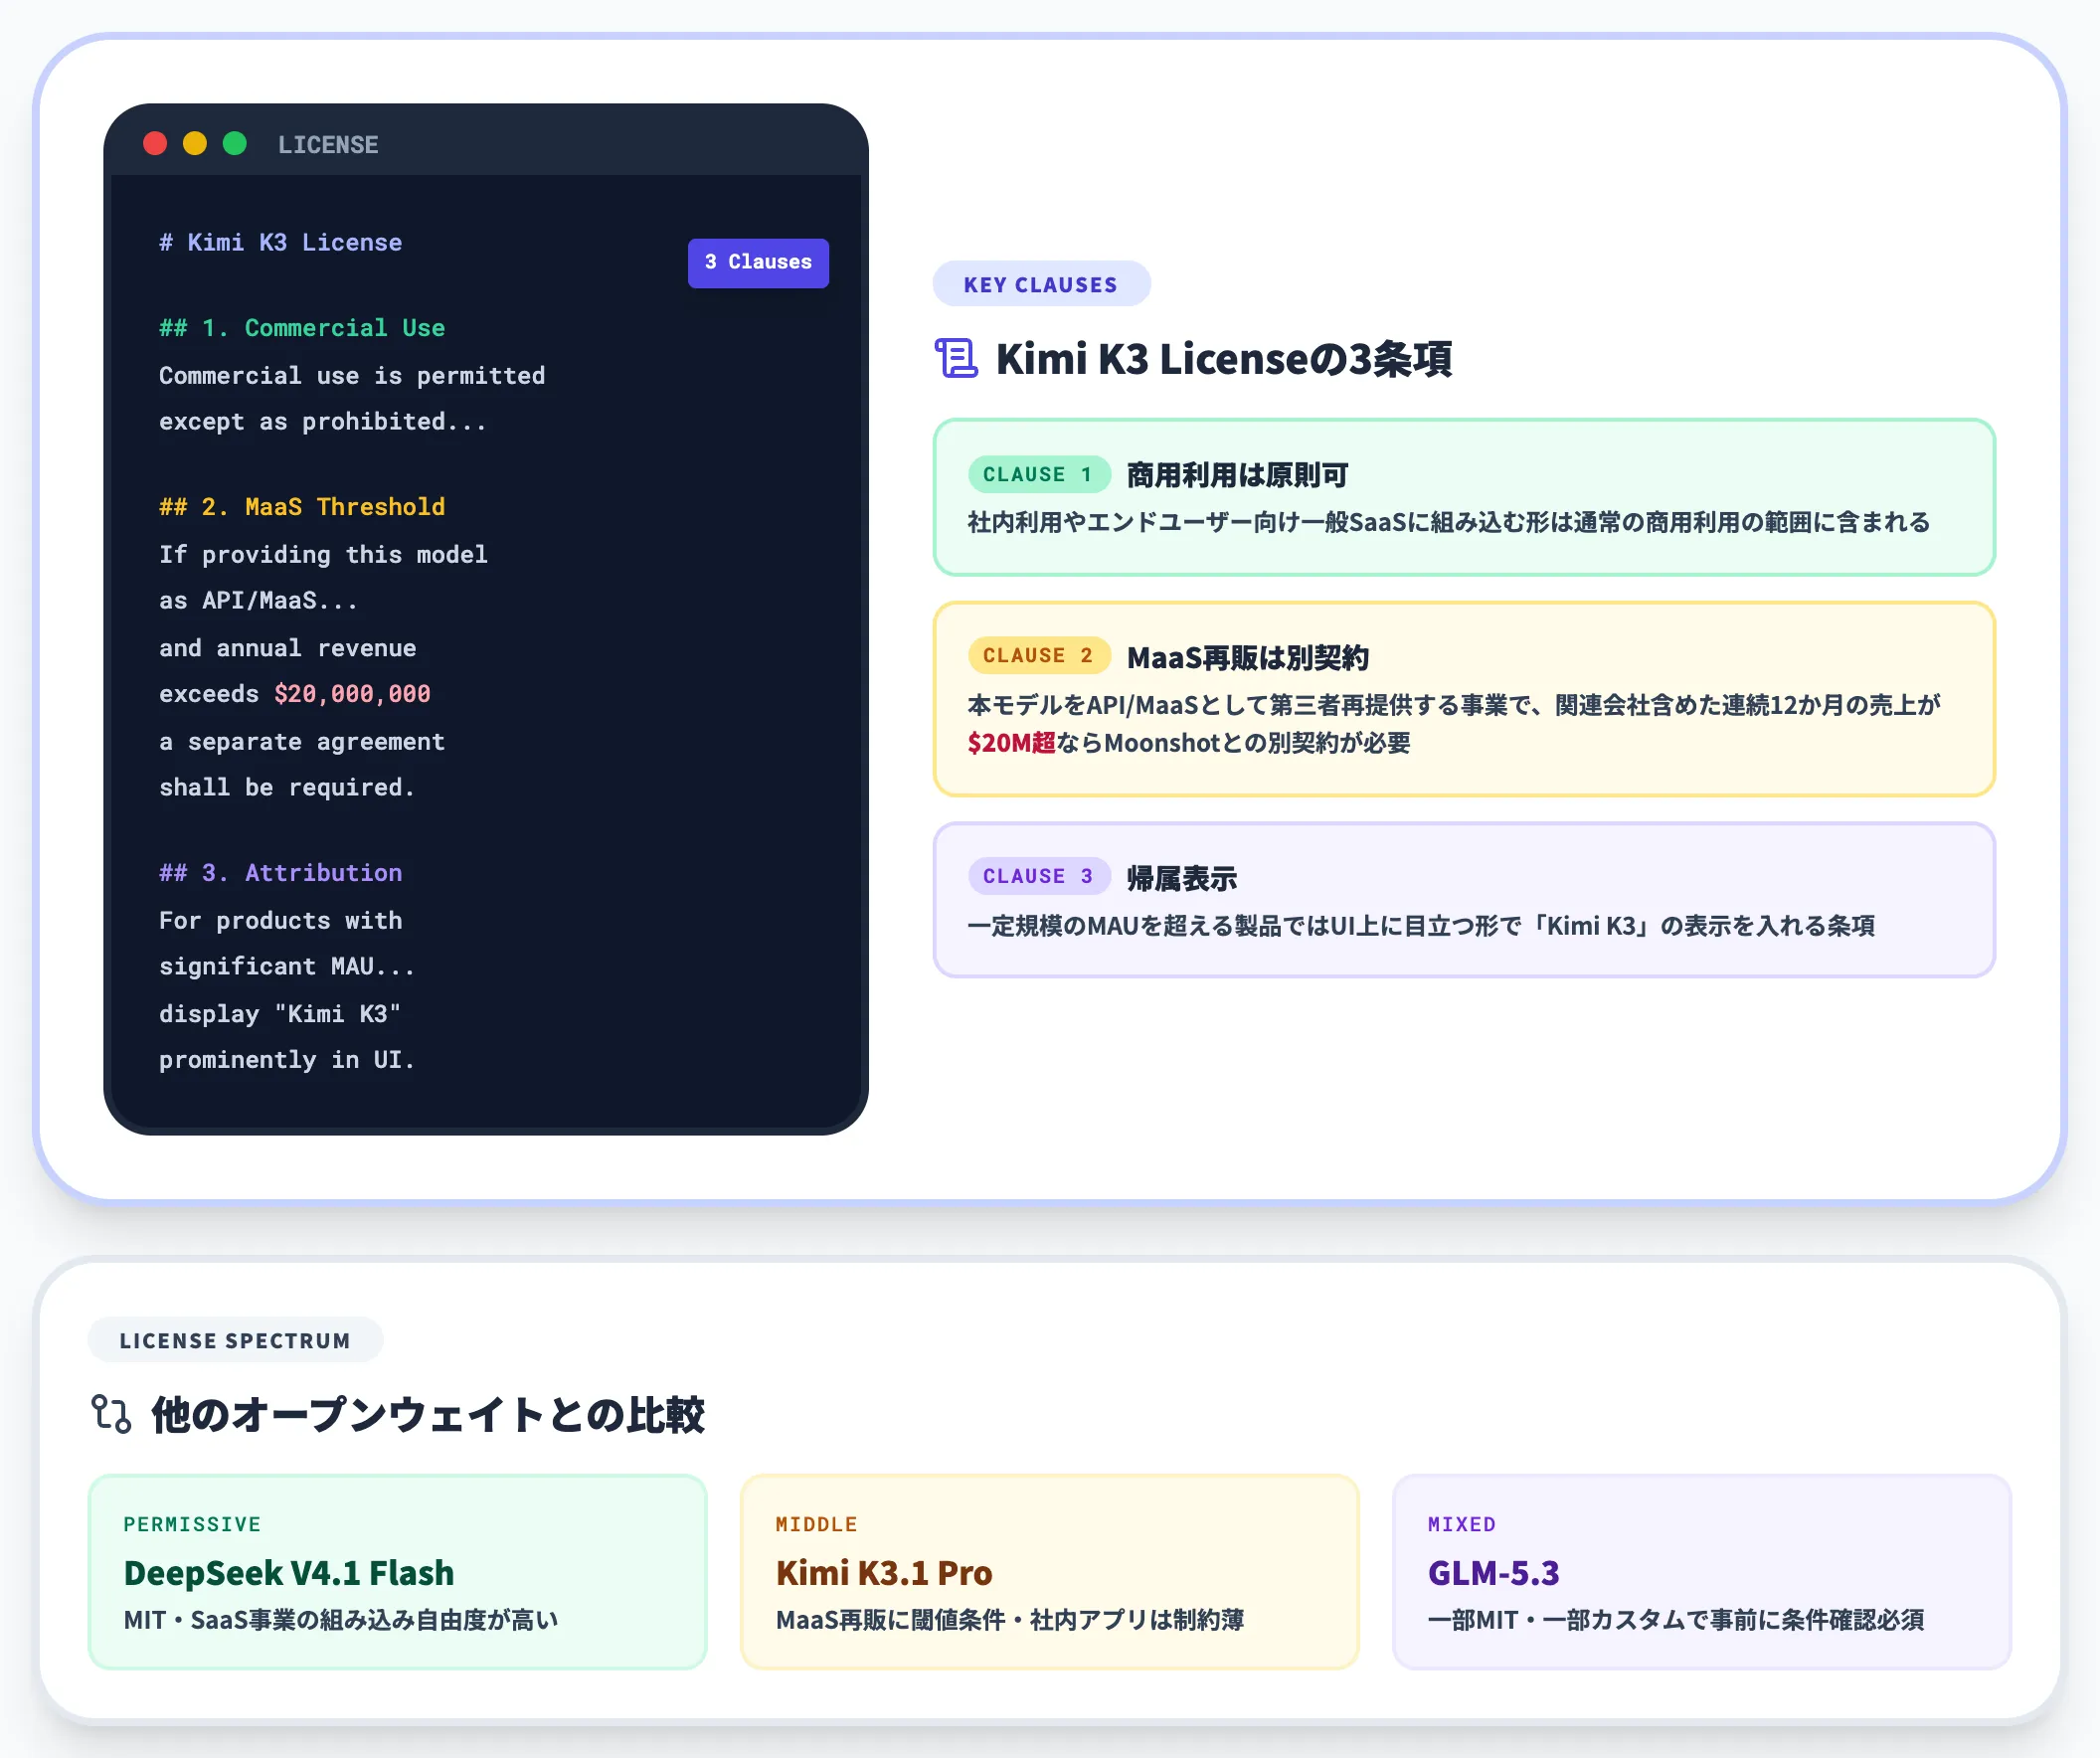
K3.1 Proのウェイトは、Kimi K3と同じKimi K3 License系統で公開される見込みで、K3.1 Pro固有のライセンス全文はウェイト公開時に合わせて公表されると見られます。
Kimi K3 License本文で確認できる主なポイントは以下のとおりです。
- 商用利用は原則可
社内利用やエンドユーザー向けの一般SaaSに組み込む形は、通常の商用利用の範囲に含まれる
- MaaS/API再販で別契約が必要になるケース
本モデルをAPI/MaaSとして第三者に再提供する事業で、関連会社を含めた連続12か月の売上が2,000万ドルを超える場合、Moonshotとの別途ライセンス契約を結ぶ条件が規定されている
- 帰属表示
一定規模の月間アクティブユーザー数(MAU)を超える製品では、UI上に目立つ形で「Kimi K3」の表示を入れる条項が含まれる
社内アプリやエンドユーザー向けサービスでの利用は通常の商用利用の範囲に収まりますが、本モデルをAPI/MaaSとして第三者再販する事業では、閾値条件と別契約の要否を法務で確認する必要があります。
DeepSeek V4.1 Flash(MIT)やGLM-5.3(一部MIT・一部カスタム)と比べると、Kimi K3.1 ProのライセンスはMaaS再販事業への組み込み時に法務確認が必要な層に位置します。
ハッキング訓練データ事前削除の意味
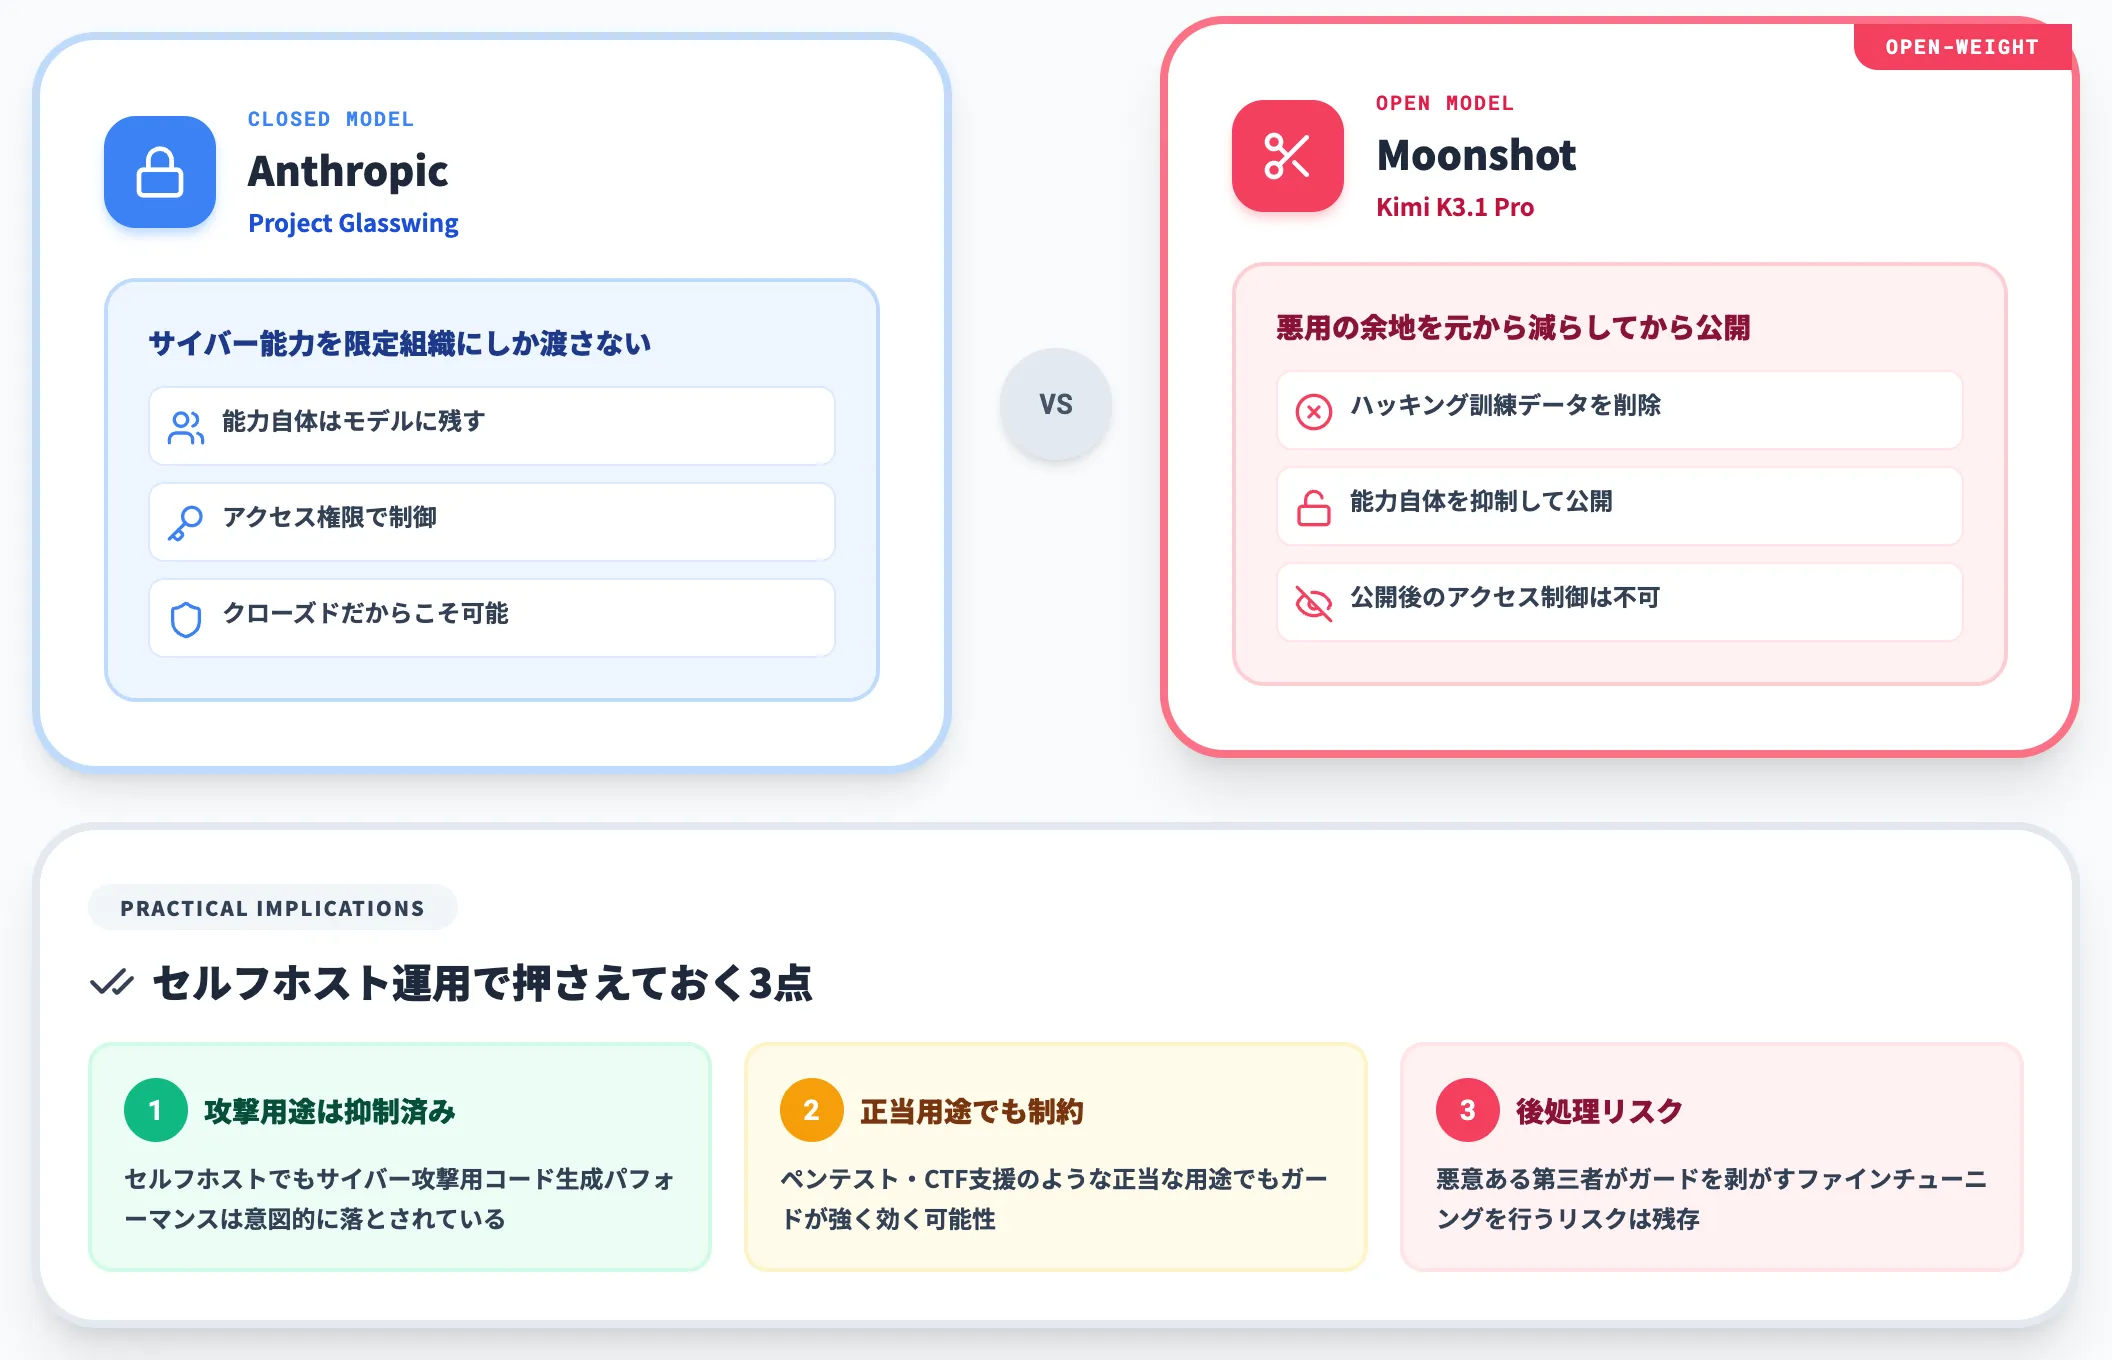
Moonshotは今回のオープンウェイト公開に先立ち、「ハッキング関連の訓練データを事前に削除した」とTNWの報道で公表しています。
AnthropicのClaude Mythos・Project Glasswingが、クローズドモデルで「サイバー能力を限定組織にしか渡さない」方針を取ったのと対照的に、Moonshotは「悪用の余地を元から減らしてからオープンウェイトで公開する」ルートを選んでいます。
実務的な意味は3点あります。
- セルフホスト運用でも、サイバー攻撃用のコード生成パフォーマンスは意図的に落とされている
- 一方で、ペネトレーションテスト・CTF支援のような正当な用途でもガードが強く効く可能性がある
- 悪意ある第三者が同じガードを剥がす後処理(ファインチューニング)を行うリスクは残る
セルフホストで検討する際は、「このモデルの訓練段階でどのカテゴリが削除されているか」をMoonshotの公式技術ブログで確認し、自社の運用に支障がないかを事前に検証する必要があります。
セルフホストで検討すべき運用要件
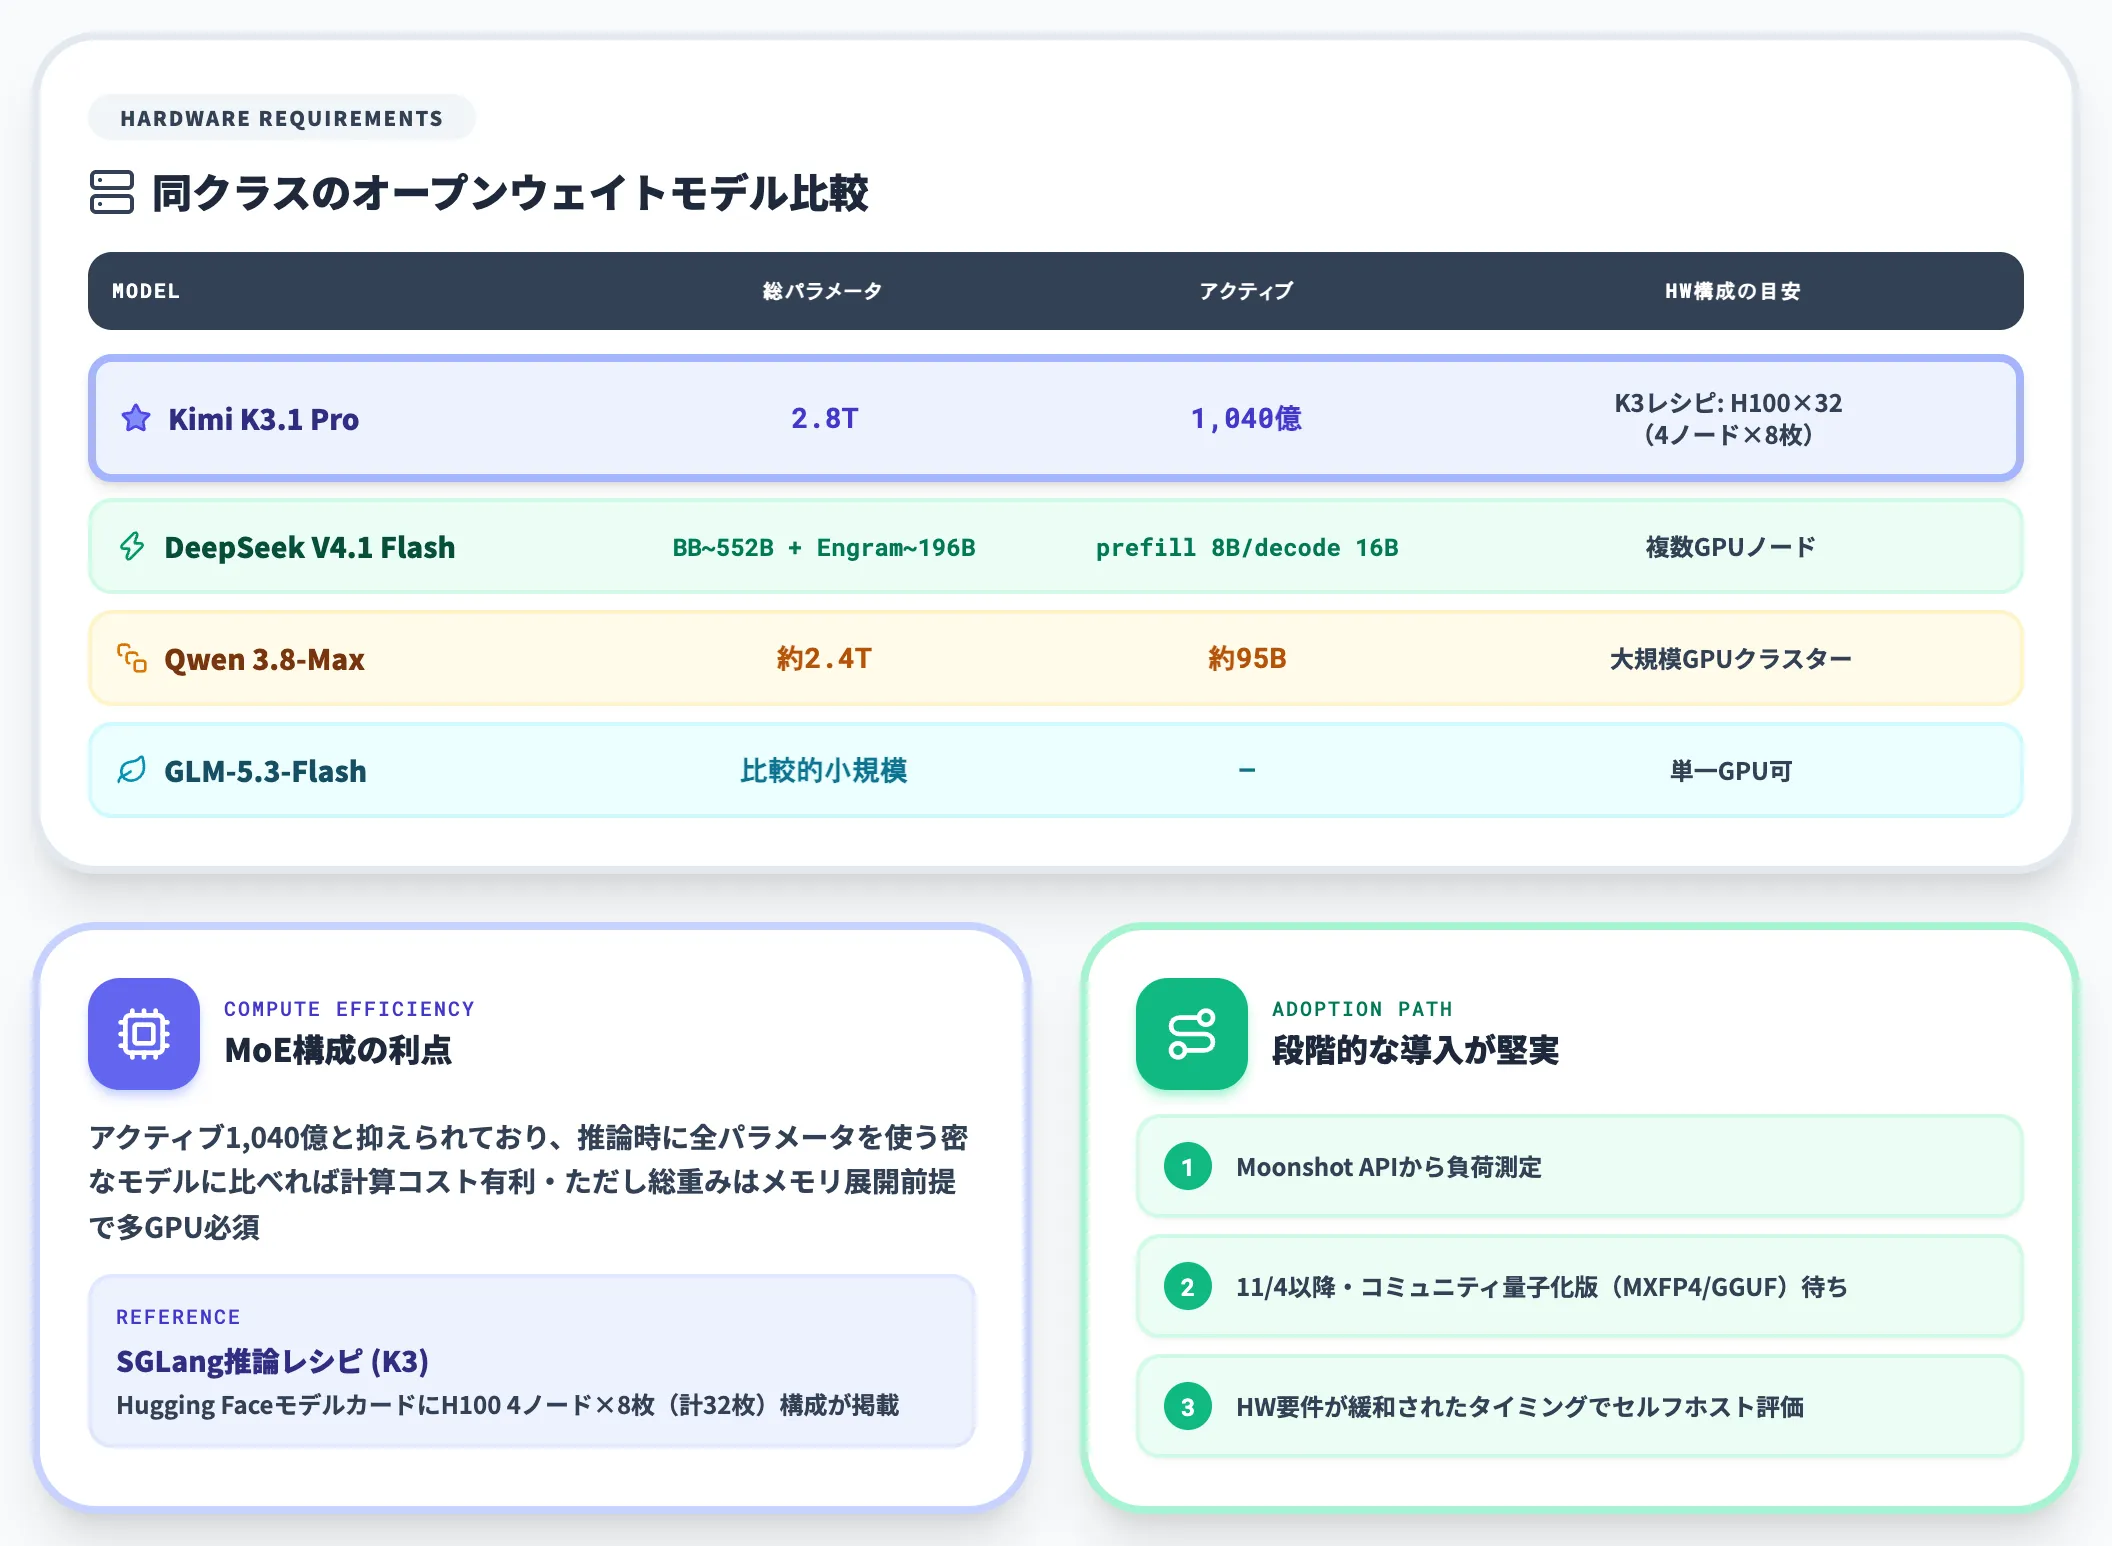
Kimi K3.1 Proを自社インフラで動かす場合、2.8TパラメータのMoE構成(アクティブ104B)という規模感が運用設計を決めます。参考までに、同クラスのオープンウェイトモデルを並べました。
| モデル | 総パラメータ | アクティブ | ハードウェア構成の目安 |
|---|---|---|---|
| Kimi K3.1 Pro | 2.8T | 1,040億 | K3.1 Pro固有の正式要件は公開待ち(K3は後述のとおり32枚級レシピあり) |
| DeepSeek V4.1 Flash | バックボーン約552B + Engram約196B | prefill 8B / decode 16B | 複数GPUノード |
| Qwen 3.8-Max | 約2.4T | 約95B | 大規模GPUクラスター |
| GLM-5.3-Flash | 比較的小規模 | — | 単一GPU可 |
K3.1 ProはMoE構成でアクティブパラメータが1,040億と抑えられており、推論時に全パラメータを使う密な大規模モデルと比べれば計算コストは有利です。
ただしトータル2.8兆パラメータの重みをメモリに展開する前提では、複数GPUサーバーが必要になります。参考までに、前世代Kimi K3のHugging Faceモデルカードに掲載されているSGLang推論レシピはH100を4ノード×8枚(計32枚)で動かす構成で、K3.1 Proもまずはこの規模で検証するのが現実的です。
社内の限定ユースケースでスループットが低くてもよい場合は、Moonshotの提供するAPI経由から始めて、負荷が見えてからセルフホスト評価に移るのが堅実です。
11月4日までのウェイト公開後は、Hugging Face上でコミュニティによる量子化版(MXFP4・GGUF等)が出てくる想定なので、ハードウェア要件はさらに緩和される余地があります。
どのケースでKimi K3.1 Proを選ぶか——他モデルとの使い分け
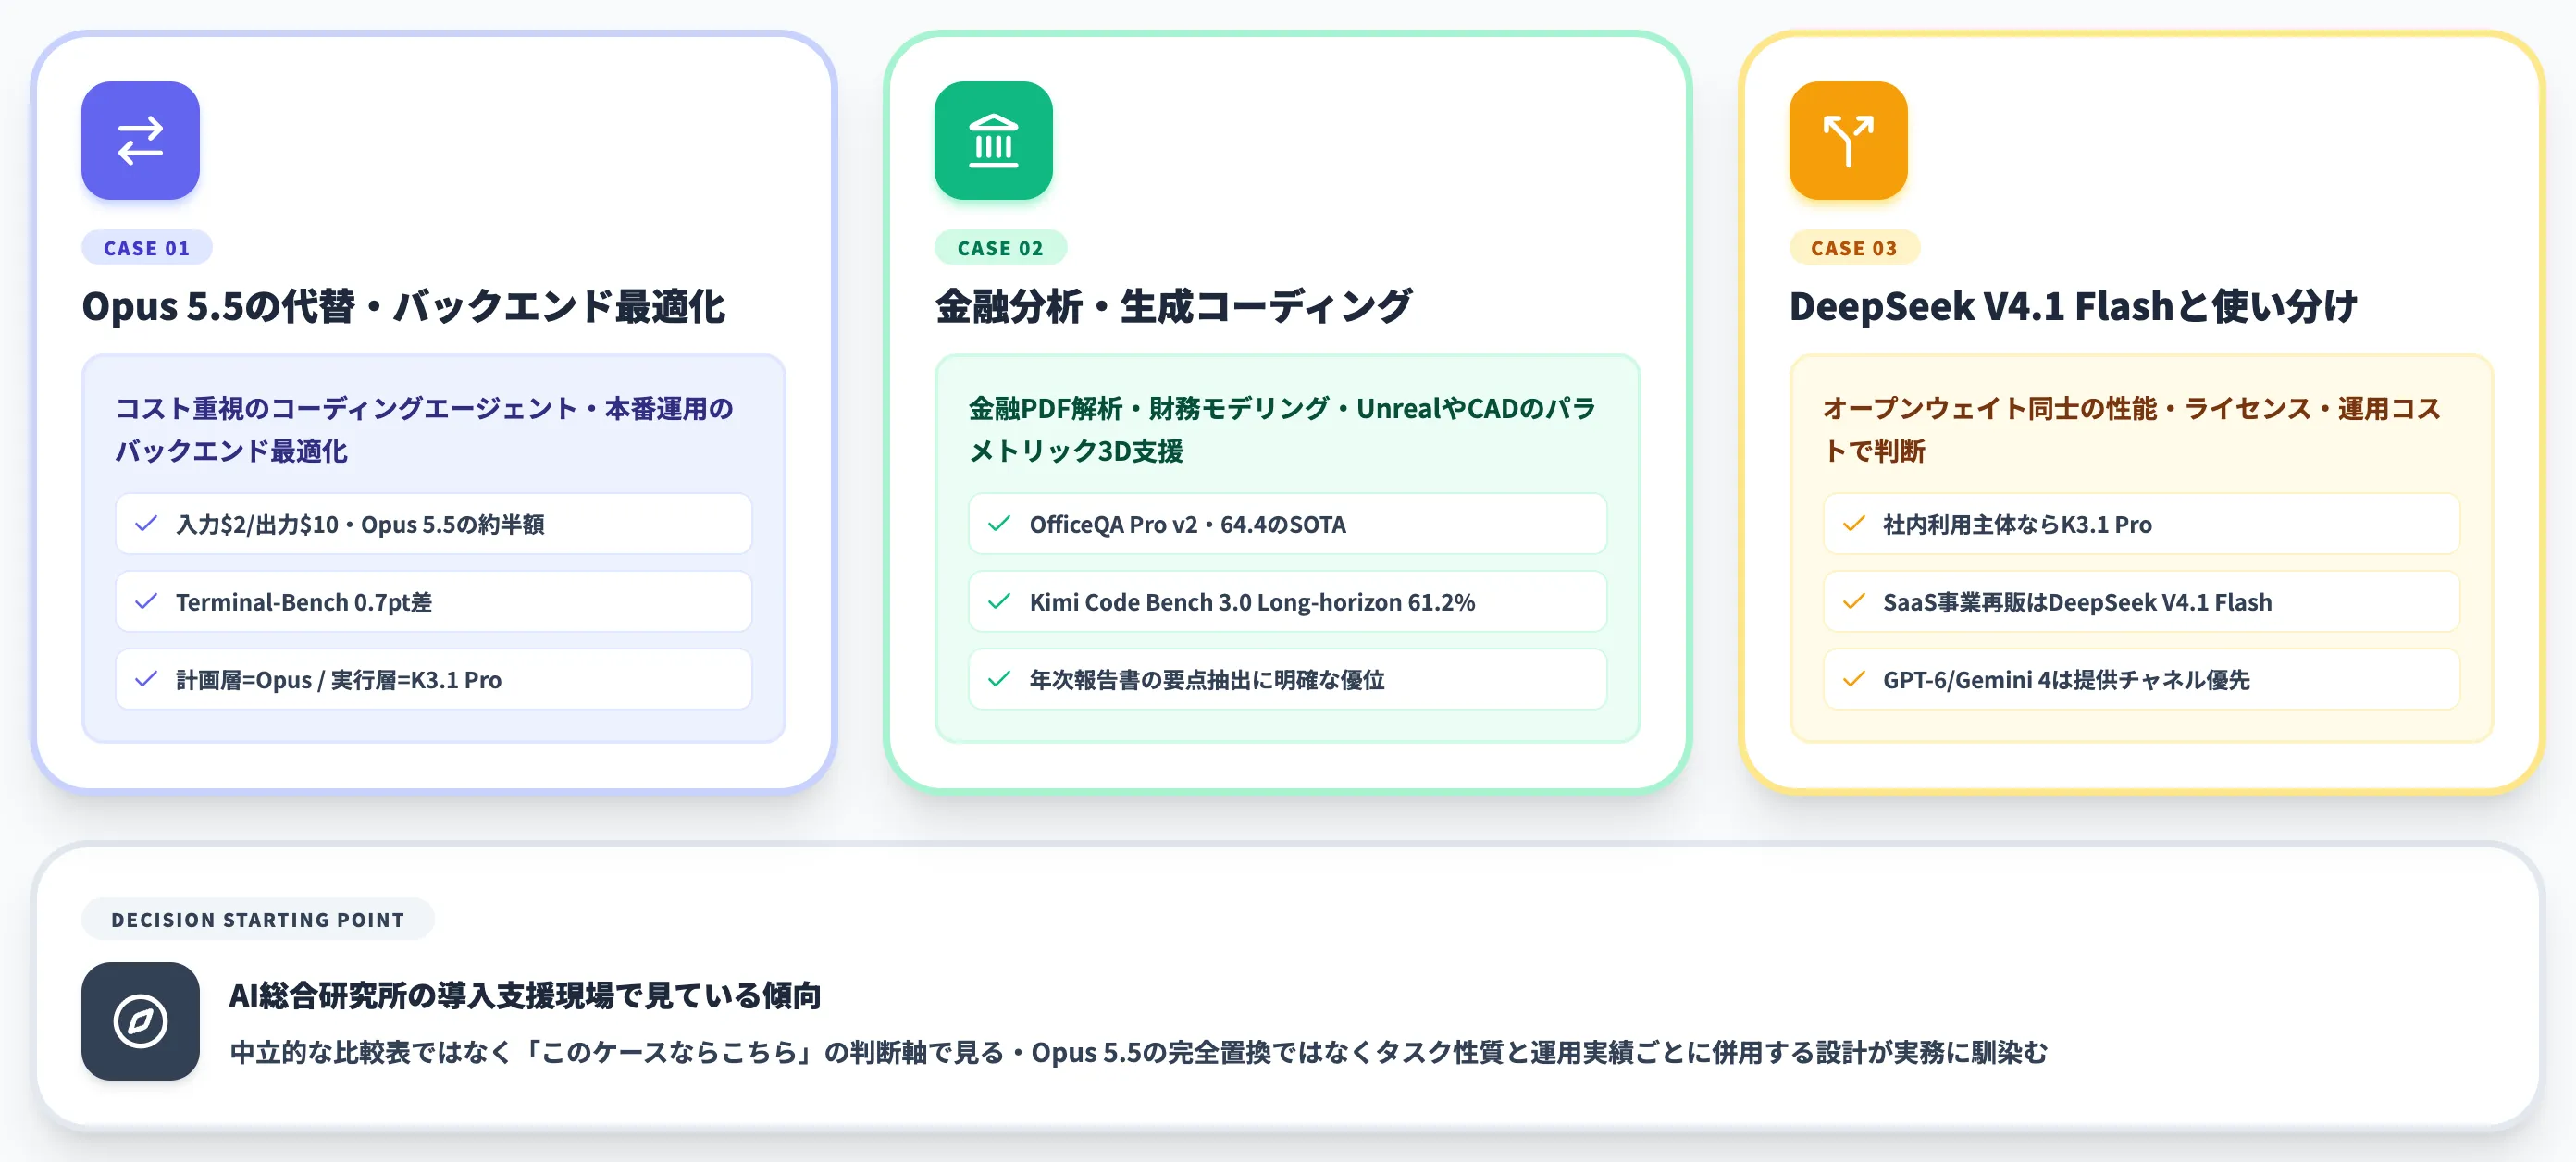
Kimi K3.1 Proをどのワークロードに充てるべきかを、AI総合研究所の導入支援現場で見ている傾向も踏まえてケース別に整理します。中立的な比較表ではなく、「このケースならこちら」の判断軸を示すスタイルで扱います。
Opus 5.5の代替としての位置
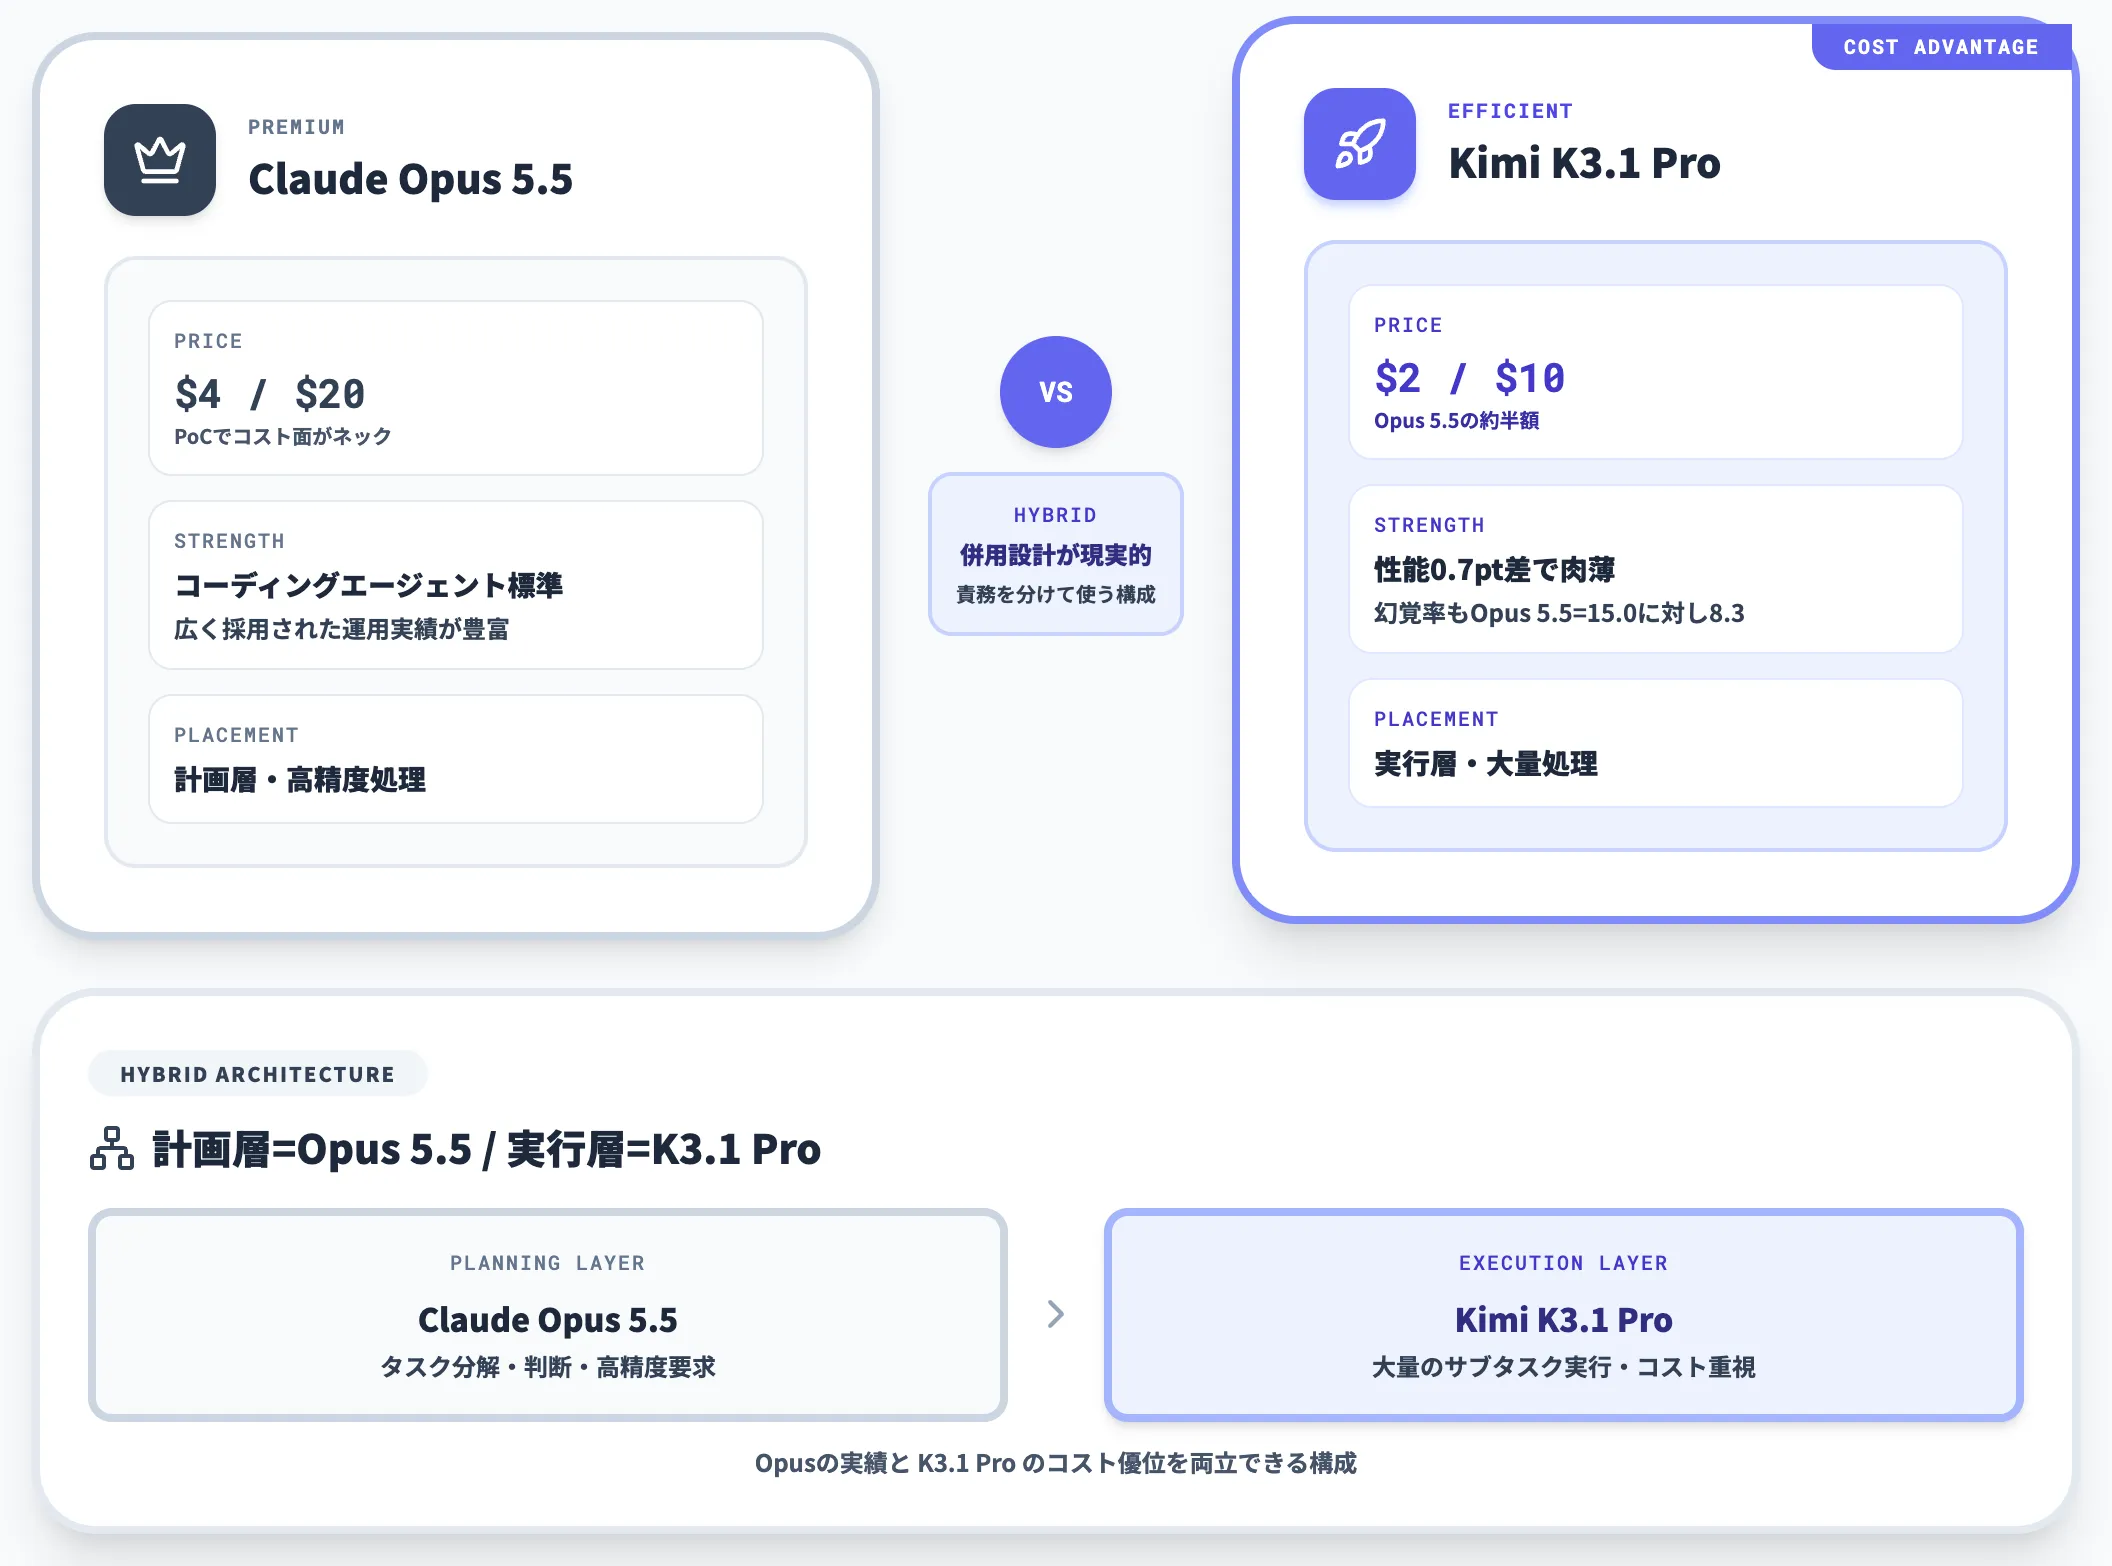
Claude Opus 5.5はコーディングエージェントの標準として広く使われていますが、入力$4/出力$20の価格帯はPoC規模ではコスト面がネックになることがあります。
K3.1 Proはこのワークロードに対して、入力$2/出力$10(Opus 5.5の約半額)でTerminal-Bench 4.0で0.7ポイント以内の性能を提示できる構成です。
コーディングエージェントの選定基準をコスト重視で見ている企業や、本番運用のバックエンドをコスト最適化したいケースでは、K3.1 Proが有力候補になります。幻覚率もHard with tools条件ではKimi K3.1 Pro=8.3でOpus 5.5=15.0を下回っており、ツールを使うワークロードでは信頼性の面でも遜色ありません。
ただし、長期タスクの実運用知見がまだ少ない点を踏まえると、Opusからの完全置換ではなく、タスクの性質に応じて併用する設計が現実的です。
計画層はOpus 5.5、実行層はK3.1 Proのように責務を分けて使う構成であれば、Opusの実績と K3.1 Pro のコスト優位を両立できます。
金融分析とフロントコーディングの強み
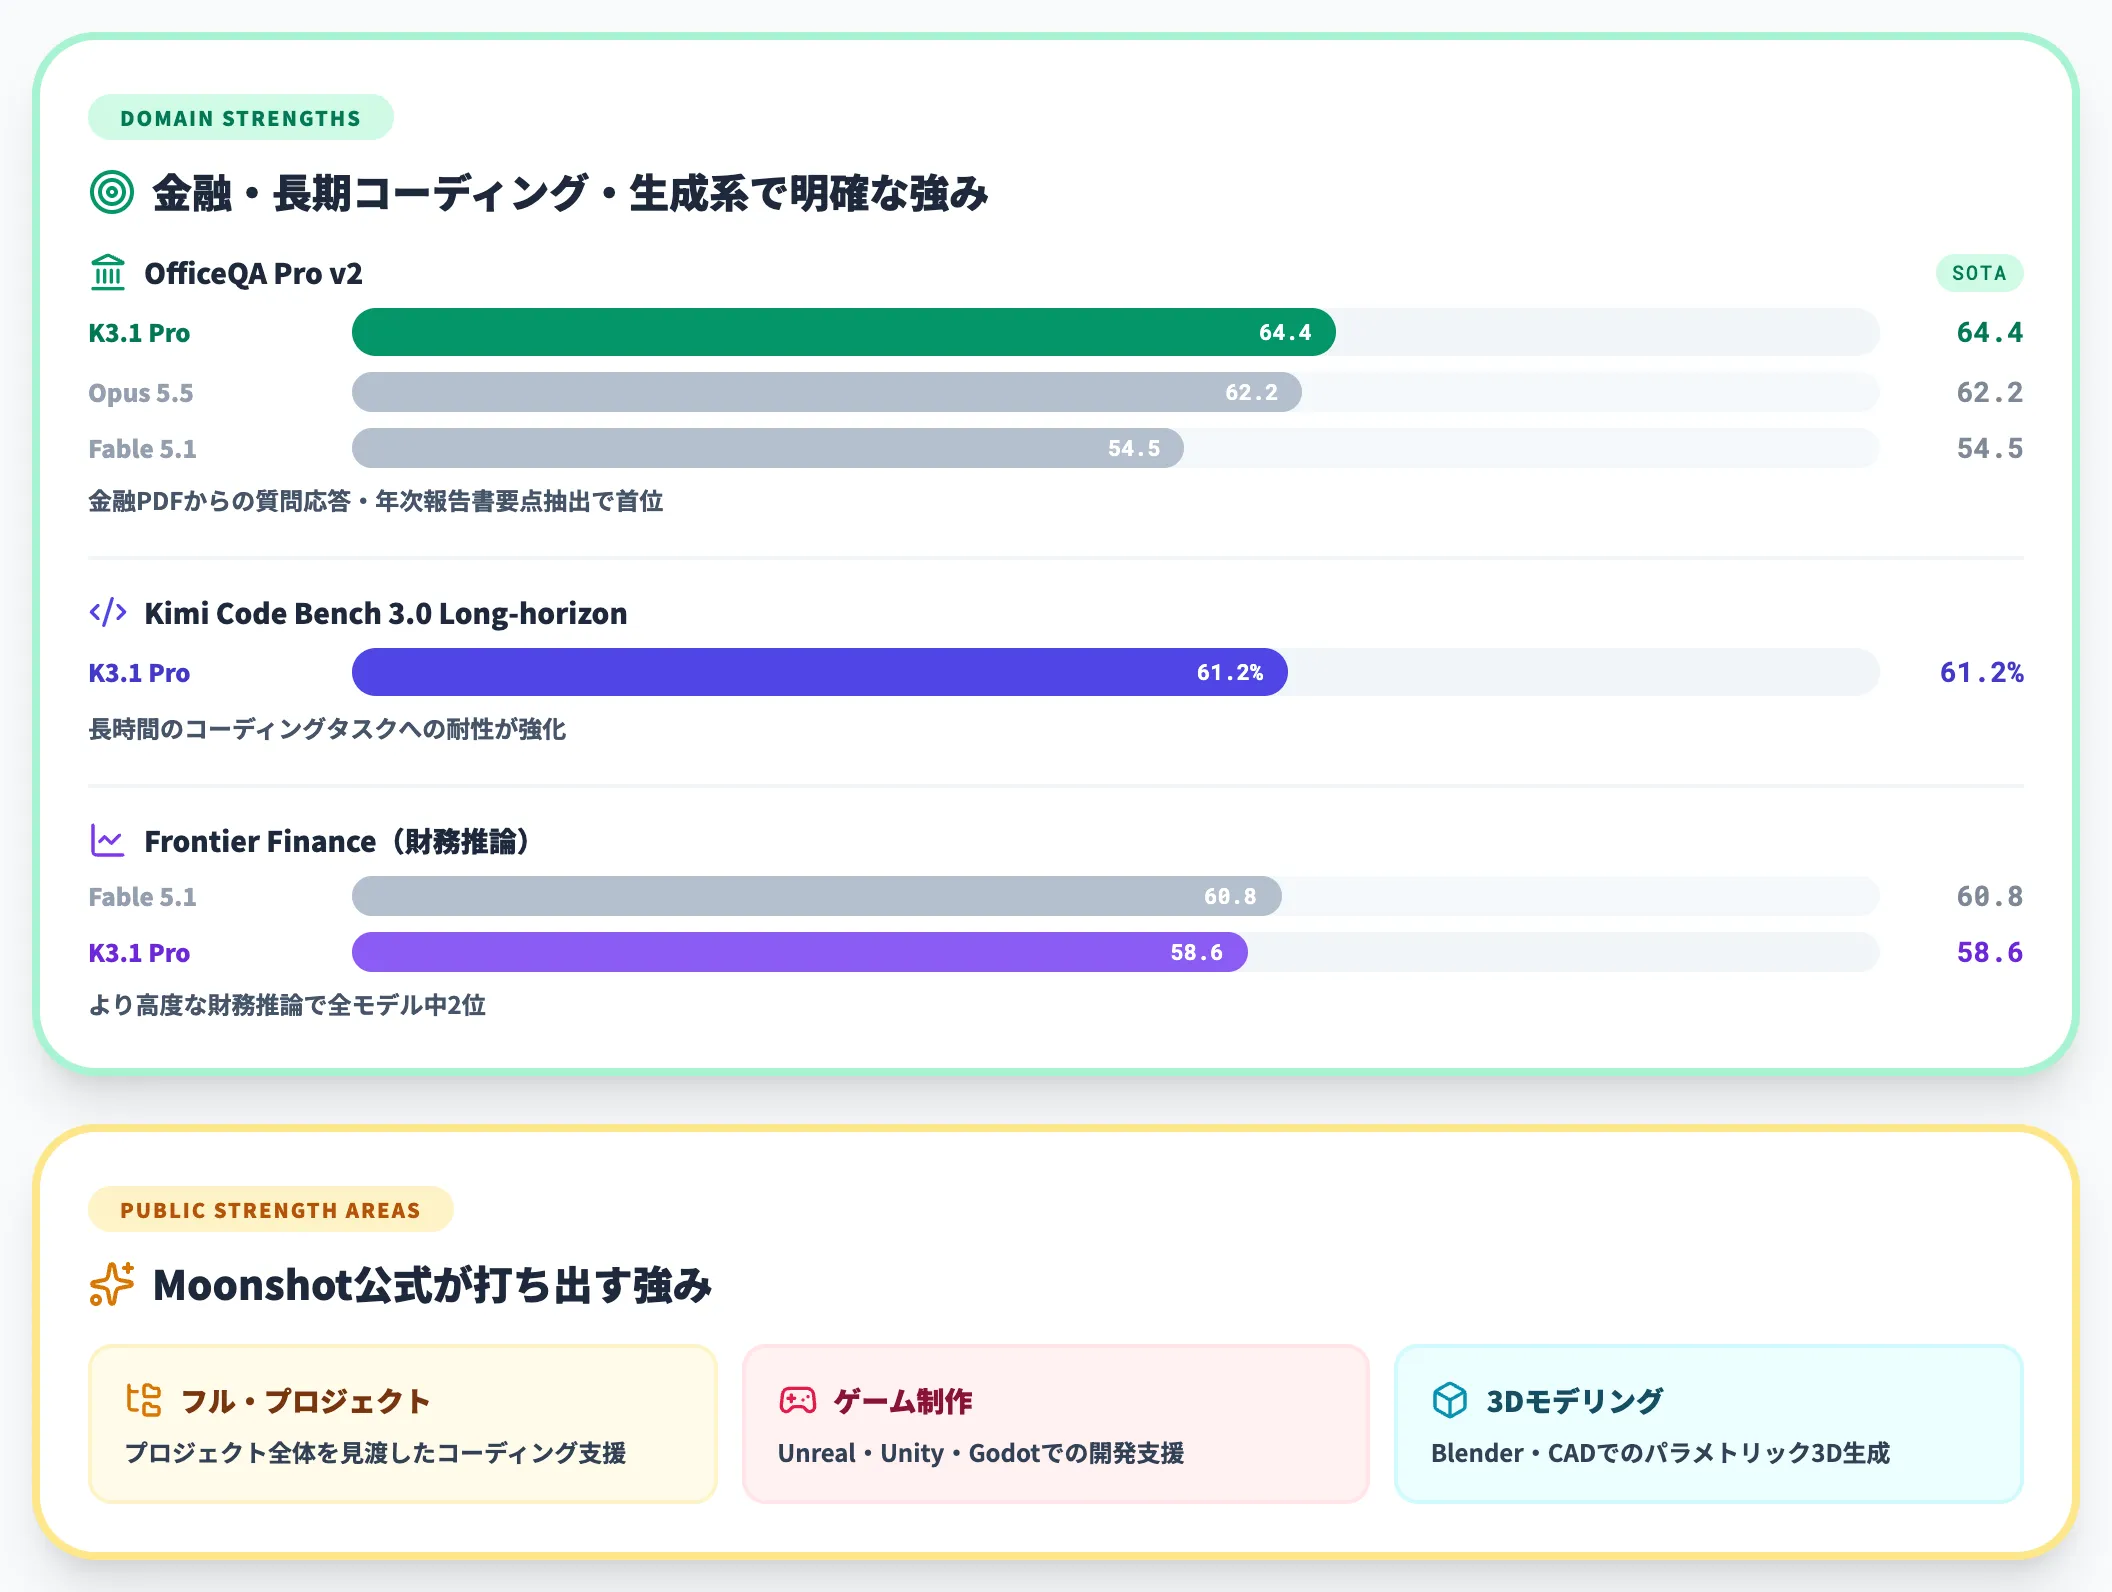
K3.1 ProはOfficeQA Pro v2で64.4のSOTA値を記録しており、金融PDFの質問応答・財務モデリング・年次報告書の要点抽出といった業務での性能が明確に高い水準です。
同じく、Kimi Code Bench 3.0のLong-horizon指標で61.2%と、長時間のコーディングタスクへの耐性も強化されています。
Moonshot自身は公式ブログで「フル・プロジェクトのコーディング」「UnrealやUnity、Godotでのゲーム制作」「BlenderとCADでのパラメトリック3Dモデリング」を強みとして打ち出しており、生成系・3D系のコーディング支援が得意領域と位置付けられています。
生成コーディングや金融PDF解析のワークロードはK3.1 Proの得意領域、既存の運用知見が蓄積されているバックエンド・DevOps系の自律ループはOpus 5.5といった形で、タスク性質と運用実績ごとに使い分ける設計が実務に馴染みやすい構成です。
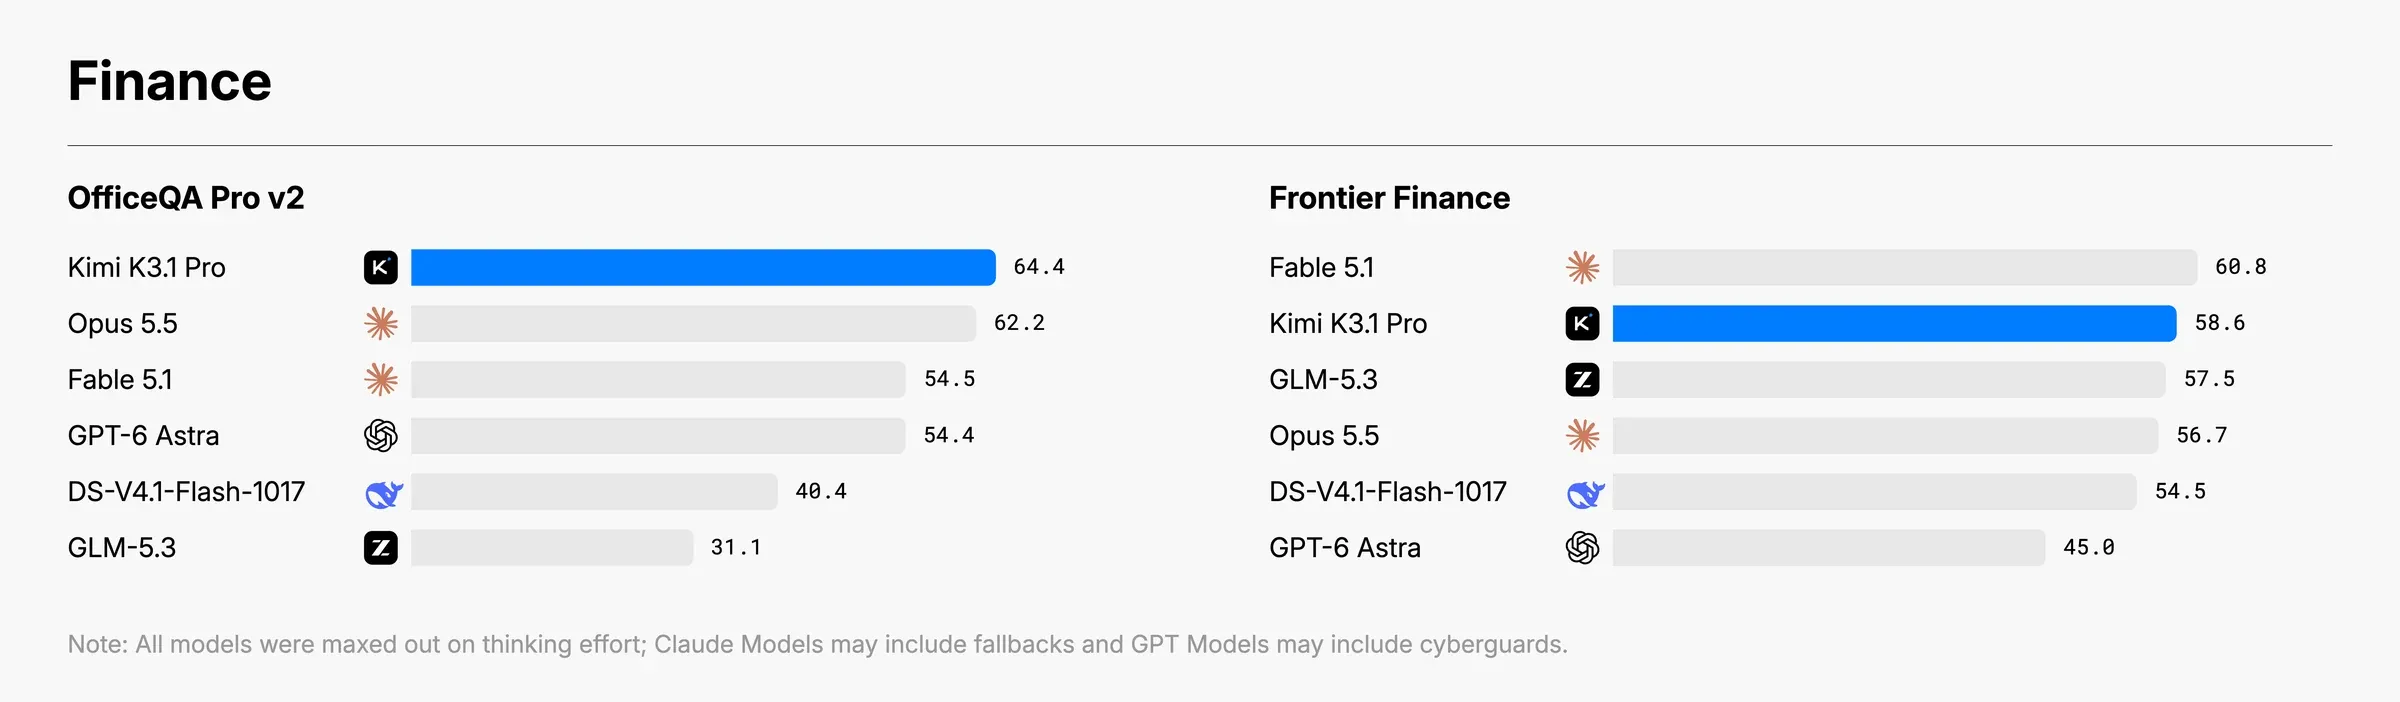
金融系の2ベンチマーク比較。OfficeQA Pro v2ではKimi K3.1 Pro=64.4で首位(Opus 5.5=62.2・Fable 5.1=54.5)、Frontier FinanceではFable 5.1=60.8に次ぐ58.6(出典:Kimi公式ブログ)
OfficeQA Pro v2は金融PDF群を対象とした質問応答ベンチマークで、K3.1 ProはOpus 5.5より2.2ポイント上。Frontier Financeはより高度な財務推論を扱うベンチで、Fable 5.1に2.2ポイント差ながら全モデル中2位です。金融分析ワークロードでクローズドモデルの上位候補を狙える位置にK3.1 Proが来た点は、既存プロダクトでOpus 5.5を使っている金融系チームにとって乗り換え検討の起点になります。
DeepSeek V4.1 Flashとの使い分け
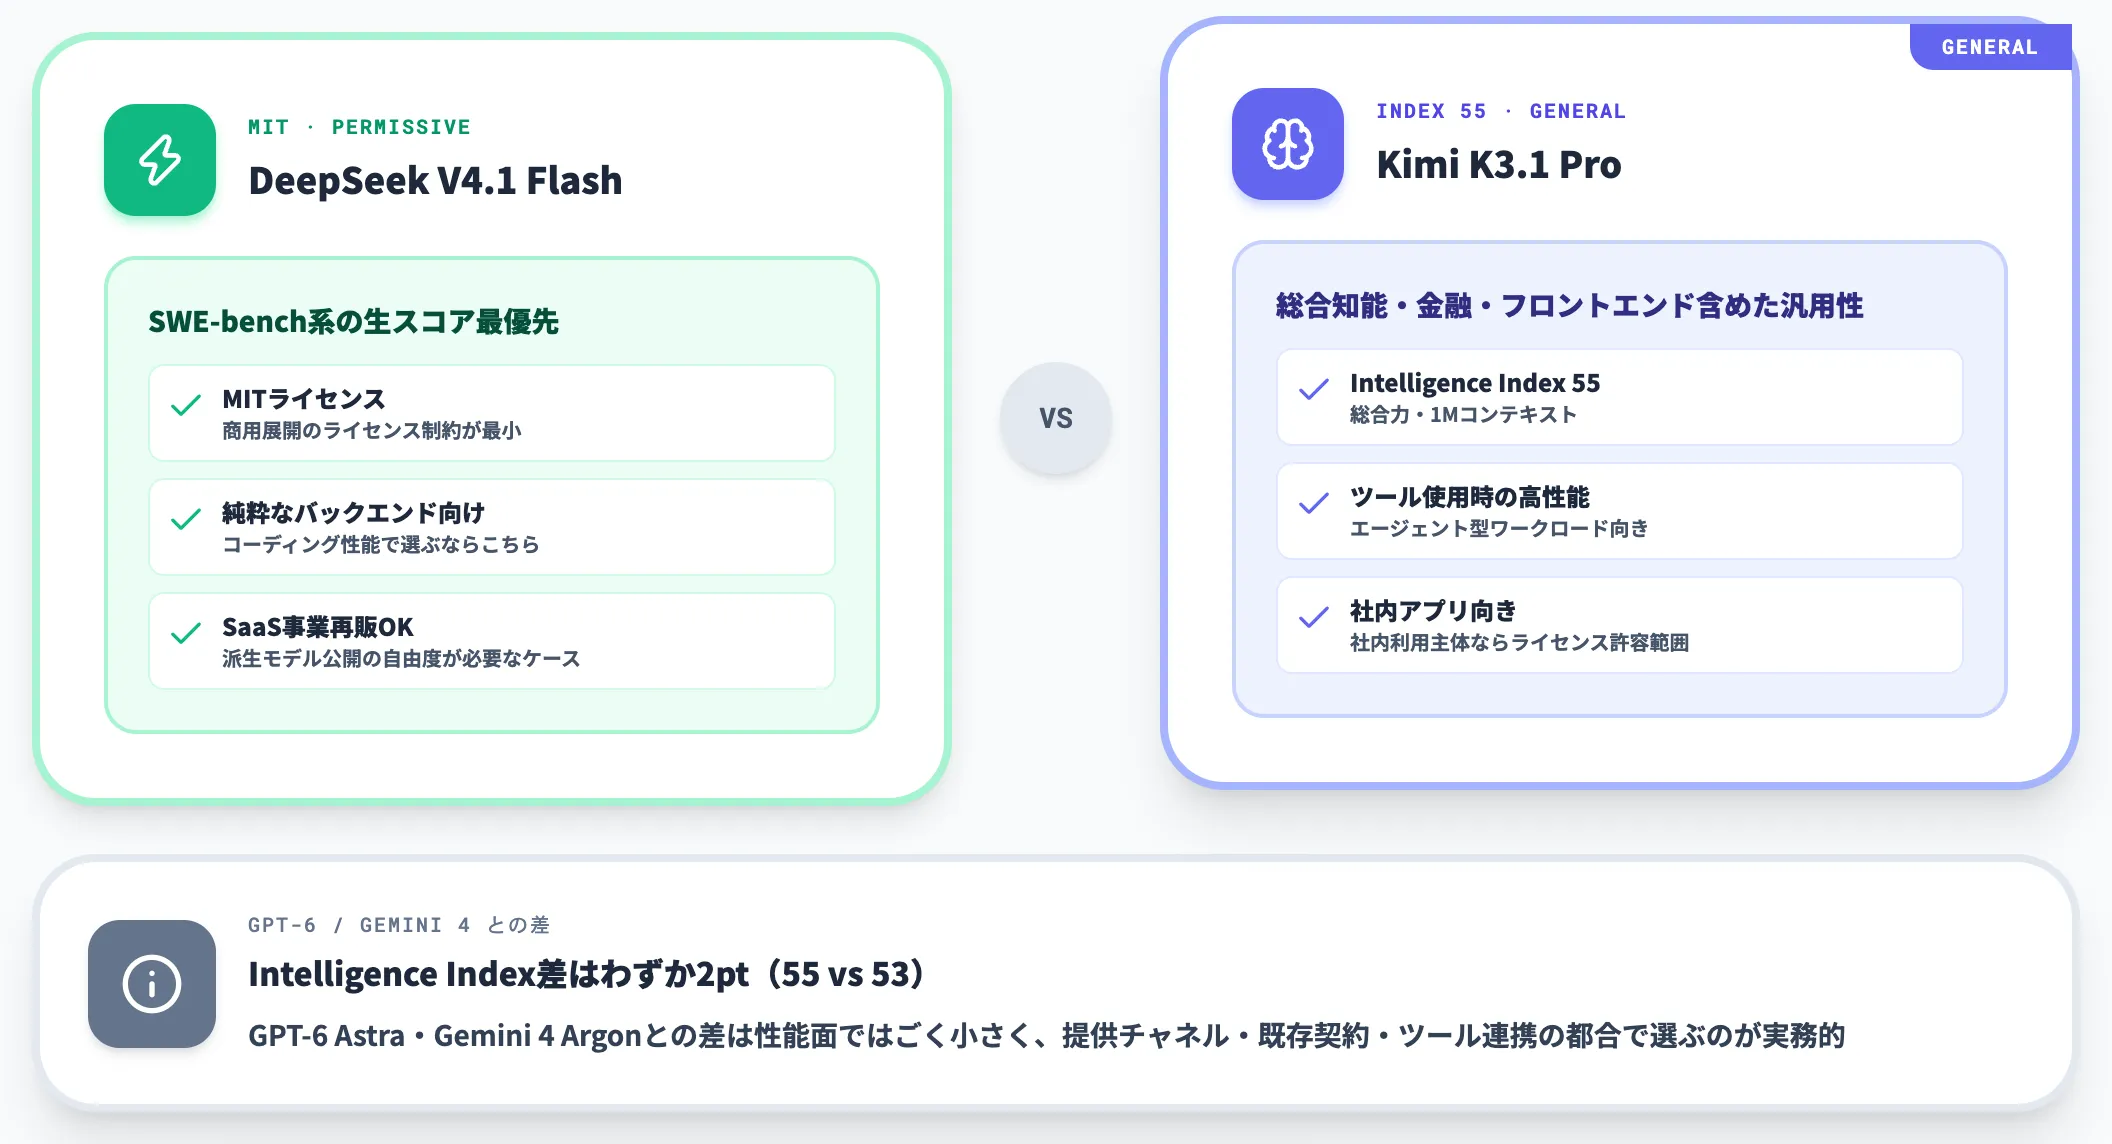
オープンウェイトのコーディング用途ではDeepSeek V4.1 Flashも強力な選択肢です。MITライセンスで導入ハードルが低く、SWE-bench系で安定したスコアを出しています。
K3.1 ProとDeepSeek V4.1 Flashの使い分けは、以下の基準で切り分けると意思決定しやすくなります。
- SWE-bench系の生スコア最優先
→ DeepSeek V4.1 Flash: MITライセンスで商用展開のライセンス制約がなく、純粋なバックエンドコーディング性能で選ぶならこちら
- 総合知能・金融分析・フロントエンド含めた汎用性
→ Kimi K3.1 Pro: Intelligence Index 55の総合力と、1Mコンテキスト・ツール使用時の高い性能を重視するケース
- ライセンス制約の寛容さ
→ DeepSeek V4.1 Flash: SaaS事業への組み込み・派生モデル公開など、ライセンス面の自由度が必要なケース
どちらを選ぶかは「どの指標をKPIに置くか」で決まります。
開発者向け補助ツールのような社内利用主体ならK3.1 Proのライセンス制約は許容範囲、SaaS事業の裏側で薄く広く展開するならDeepSeek V4.1 Flashの方が運用コストが低く収まります。
GPT-6 AstraやGemini 4 Argonとの差は、Intelligence Indexで2ポイント差(55 vs 53)とごく小さいため、提供チャネル・既存契約・ツール連携の都合で選ぶのが実務的です。
Kimi K3.1 Pro世代のモデルを業務Agent基盤で扱うなら
Kimi K3.1 ProやClaude Opus 5.5、DeepSeek V4.1 Flashのように、同クラスのオープン/クローズドモデルが同時に走る時代になり、「どのモデルを選ぶか」から「複数モデルをどう統合管理するか」が実務の焦点になっています。モデル単体の選定だけでは、業務Agentを安全に動かすための実行層・権限・監査が揃いません。
AI総合研究所のAI Agent Hubは、自社Azureテナント内で業務特化Agent群を1つのダッシュボードで統合管理する基盤です。Opus 5.5・K3.1 Pro・DeepSeek V4.1 Flashといったモデル世代交代を吸収しながら、業務プロセスに載せる運用レイヤーを提供します。
-
Kimi K3.1 Pro世代をバックエンドに接続
Opus 5.5の約半額のトークン単価で動く K3.1 Pro を業務Agentの実行層に組み込み、既存のOpus 5.5運用はエージェント計画層や高精度処理に温存。モデル差し替えのコスト構造を可視化しながら切替できます。
-
モデル世代交代を吸収する管理層
2026年に入ってから半年単位でフロンティアLLMの世代が入れ替わる状況でも、業務Agent側の設計は不変。特定モデルへの依存を避けつつ、新モデルのリリース時に差し替えだけで評価できます。
-
Agent単位でセキュリティ統制を1画面統制
顧客情報・財務データ・ソースコードを扱うAgentごとにアクセス範囲を設計。誰がどのAgentで何を照会したかを不変ログで残し、監査対応をそのまま提出できる形で保管します。
-
データは100%自社Azureテナント内に保持
入力・出力・社内ドキュメントはAIの学習対象から完全除外。Azure Managed Applicationsとして自社テナント内で動作が完了する設計です。
AI総合研究所の専任チームが、フロンティアモデル選定から業務Agent基盤の統合設計まで一貫して支援します。AI Agent Hubのサービスページで、Kimi K3.1 Pro世代を含めた複数モデル運用の実装例をご確認ください。
オープンウェイトLLMを業務Agentに安全に載せるなら
世代交代を吸収する業務Agent基盤
Kimi K3.1 Proのようなオープンウェイトモデルも、Claude Opus 5.5のようなクローズドモデルも、業務に載せるには実行層・権限・監査を切り分けた基盤が要ります。AI Agent Hubは自社Azureテナント内でモデルを切り替えながら、業務特化Agent群を1つのダッシュボードで統合管理できる構成です。
まとめ
本記事では、Kimi K3.1 ProについてK3との差分・ベンチマーク・料金・使い方・オープンウェイト公開と選定時の注意点・ケース別の使い分けを、2026年10月時点の最新情報で解説しました。
2026年10月時点で押さえておくべきポイントは次の3つです。
- Kimi K3.1 ProはArtificial Analysis Intelligence Index 55で総合4位、Claude Opus 5.5まで3ポイント・Terminal-Bench 4.0で0.7ポイント差に接近
- API料金は$2/$10でOpus 5.5のトークン単価の約半額、AA計測のタスク単価では約1/3、幻覚率はK3の23.4%から8.3%へ大幅縮小
- オープンウェイトは2026年11月4日までに公開予定、ライセンス条件はウェイト公開時に合わせて公表される見込み、ハッキング訓練データが事前削除された状態での提供となる
企業の開発責任者・AI基盤担当にとってKimi K3.1 Proは、「Opus 5.5級の性能を1/3のコストで、オープンウェイトとして入手できる選択肢が出てきた」という節目を意味します。まずはKimi API経由で既存のコーディングエージェント・社内ワークフローに差し替えて評価を回し、11月4日のウェイト公開後にセルフホスト評価に進むのが、段階的で現実的な第一歩になります。