この記事のポイント
 EU AI Actの高リスクAI技術文書化はAnnex III=2027年12月・Annex I=2028年8月から適用、CISA・G7の2026年5月ガイダンスと合わせAI-SBOMは調達参照軸として注目度が上昇
- SBOMからAI-SBOMへの拡張は、モデル識別・学習データ来歴・重み・ファインチューニング・インフラ・性能指標の6要素追加
- CycloneDX ML-BOMはCI/CD内製向け、SPDX 3.0 AI Profileは調達・監査文書向けで使い分けるのが実務的な正解
- 試作はOWASP AIBOM Generatorが最短、Hugging Faceモデル名を入れるだけでCycloneDX JSONと完全性スコアが出る
- 商用ツールはSnyk・Mend・JFrog等SBOM基盤に統合する系統と、Manifest Cyber・Wiz等AIBOMを独立領域として扱う系統の2方向で選ぶ
Microsoft MVP・AIパートナー。LinkX Japan株式会社 代表取締役。東京工業大学大学院にて自然言語処理・金融工学を研究。NHK放送技術研究所でAI・ブロックチェーンの研究開発に従事し、国際学会・ジャーナルでの発表多数。経営情報学会 優秀賞受賞。シンガポールでWeb3企業を創業後、現在は企業向けAI導入・DX推進を支援。
AI-SBOM(AI Bill of Materials)とは、AIシステムに組み込まれたモデル・学習データ・依存コンポーネントを一覧化した部品表です。従来のSBOMをAI向けに拡張し、モデル重みや学習データの来歴、ファインチューニング履歴まで追跡できる形に拡張したものを指します。
2026年に入り、EU AI Actが一般的な適用に入り(高リスクAIの技術文書化義務はAnnex IIIが2027年12月、Annex Iが2028年8月から適用)、CISAとG7が5月に公表した「Software Bill of Materials for AI – Minimum Elements」、CycloneDX 1.7のECMA-424 2nd Edition(2025年12月)が揃い、AI-SBOMは「あると便利」から「調達・サプライヤー評価の文脈で参照される参照軸」へと位置づけが変わりつつあります。
本記事では、AI-SBOMの定義と用語整理、SBOMに追加される6つの要素、CycloneDX ML-BOMとSPDX 3.0 AI Profileの選び方、OWASP AIBOM Generatorで試す5ステップ、対応ツールの系統別比較、日本の経産省・NCO(内閣官房国家サイバー統括室)動向、導入でつまずく3つの論点を2026年10月時点の最新情報で解説します。
目次
AI-SBOM(AI Bill of Materials)とは
用語の揺れ:AI-BOM/AIBOM/AI-SBOM/ML-BOMの違い
EU AI Act Article 11と高リスクAI技術文書化義務の適用時期
CISAとG7が「Software Bill of Materials for AI」を2026年5月に公表
AIサプライチェーン攻撃の実被害が「作らないリスク」を押し上げ
標準フォーマット:CycloneDX ML-BOMとSPDX 3.0 AI Profileの違い
CycloneDX ML-BOM:CI/CD内製向けのデファクト
SPDX 3.0 AI Profile:調達・監査文書向けの枠組み
AI-SBOMの作り方:OWASP AIBOM Generatorで試す5ステップ
1.対象モデルを選び、Hugging FaceのモデルIDを特定する
3.モデルIDを入力してCycloneDX JSONを生成する
5.CI/CDパイプラインに組み込み、更新サイクルを定義する
AI-SBOM対応ツール比較:OSS・SCA統合・AIBOMプラットフォームの3系統
日本の規制動向:経産省・NCO(国家サイバー統括室)の国際ガイダンス共同署名
2025年9月:SBOM共同ビジョン国際ガイダンスに15か国で署名
2026年7月:SBOM Minimum Elementsの改訂版が公表され、AI利用も対象範囲に
経産省の「SBOM導入の手引ver2.0」が国際ガイダンスに事例採用
AI-SBOM(AI Bill of Materials)とは
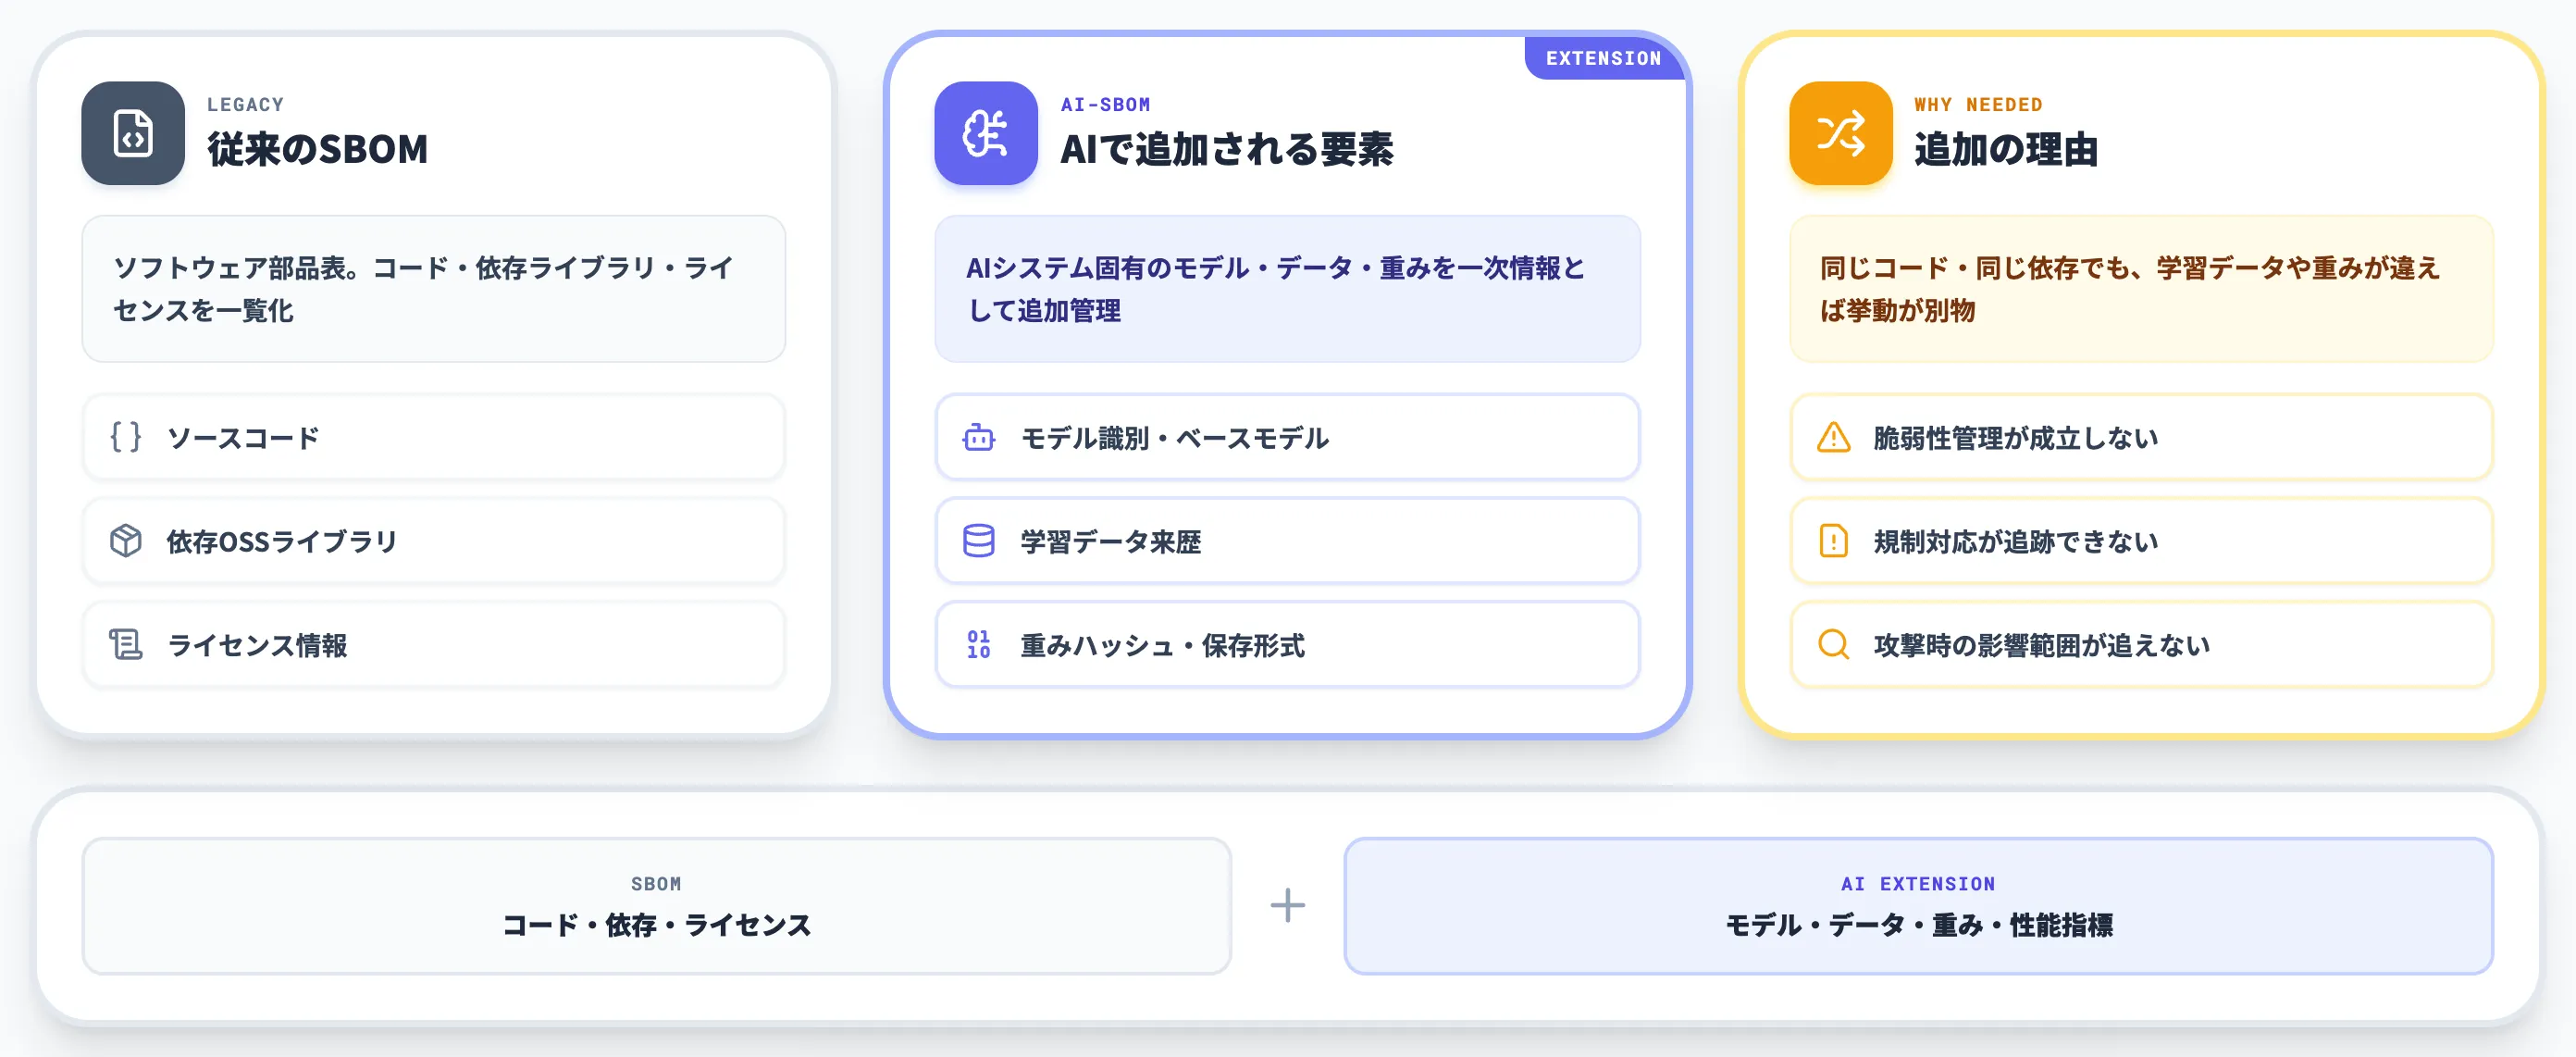
AI-SBOM(AI Bill of Materials)とは、AIシステムに組み込まれたモデル・学習データ・依存コンポーネントを一覧化した部品表です。
ソフトウェア部品表であるSBOM(Software Bill of Materials)をAI向けに拡張し、モデルの識別情報・学習データの来歴・モデル重み・ファインチューニングの有無など、AIシステム固有の構成要素まで追跡できる形にしたものを指します。
AI-SBOMが従来のSBOMと根本的に違うのは、ソフトウェア部品だけでなくモデルとデータを一次情報として管理する点です。
AIシステムは「同じコード・同じ依存ライブラリでも、学習データや重みが違えば挙動が別物」になる性質を持ちます。従来のSBOMがコード・依存関係・ライセンスを対象にしていたのに対し、AI-SBOMはそこにモデルとデータという可変要素を加えないと、脆弱性管理も規制対応も実質的に成立しないという前提から生まれました。
用語の揺れ:AI-BOM/AIBOM/AI-SBOM/ML-BOMの違い
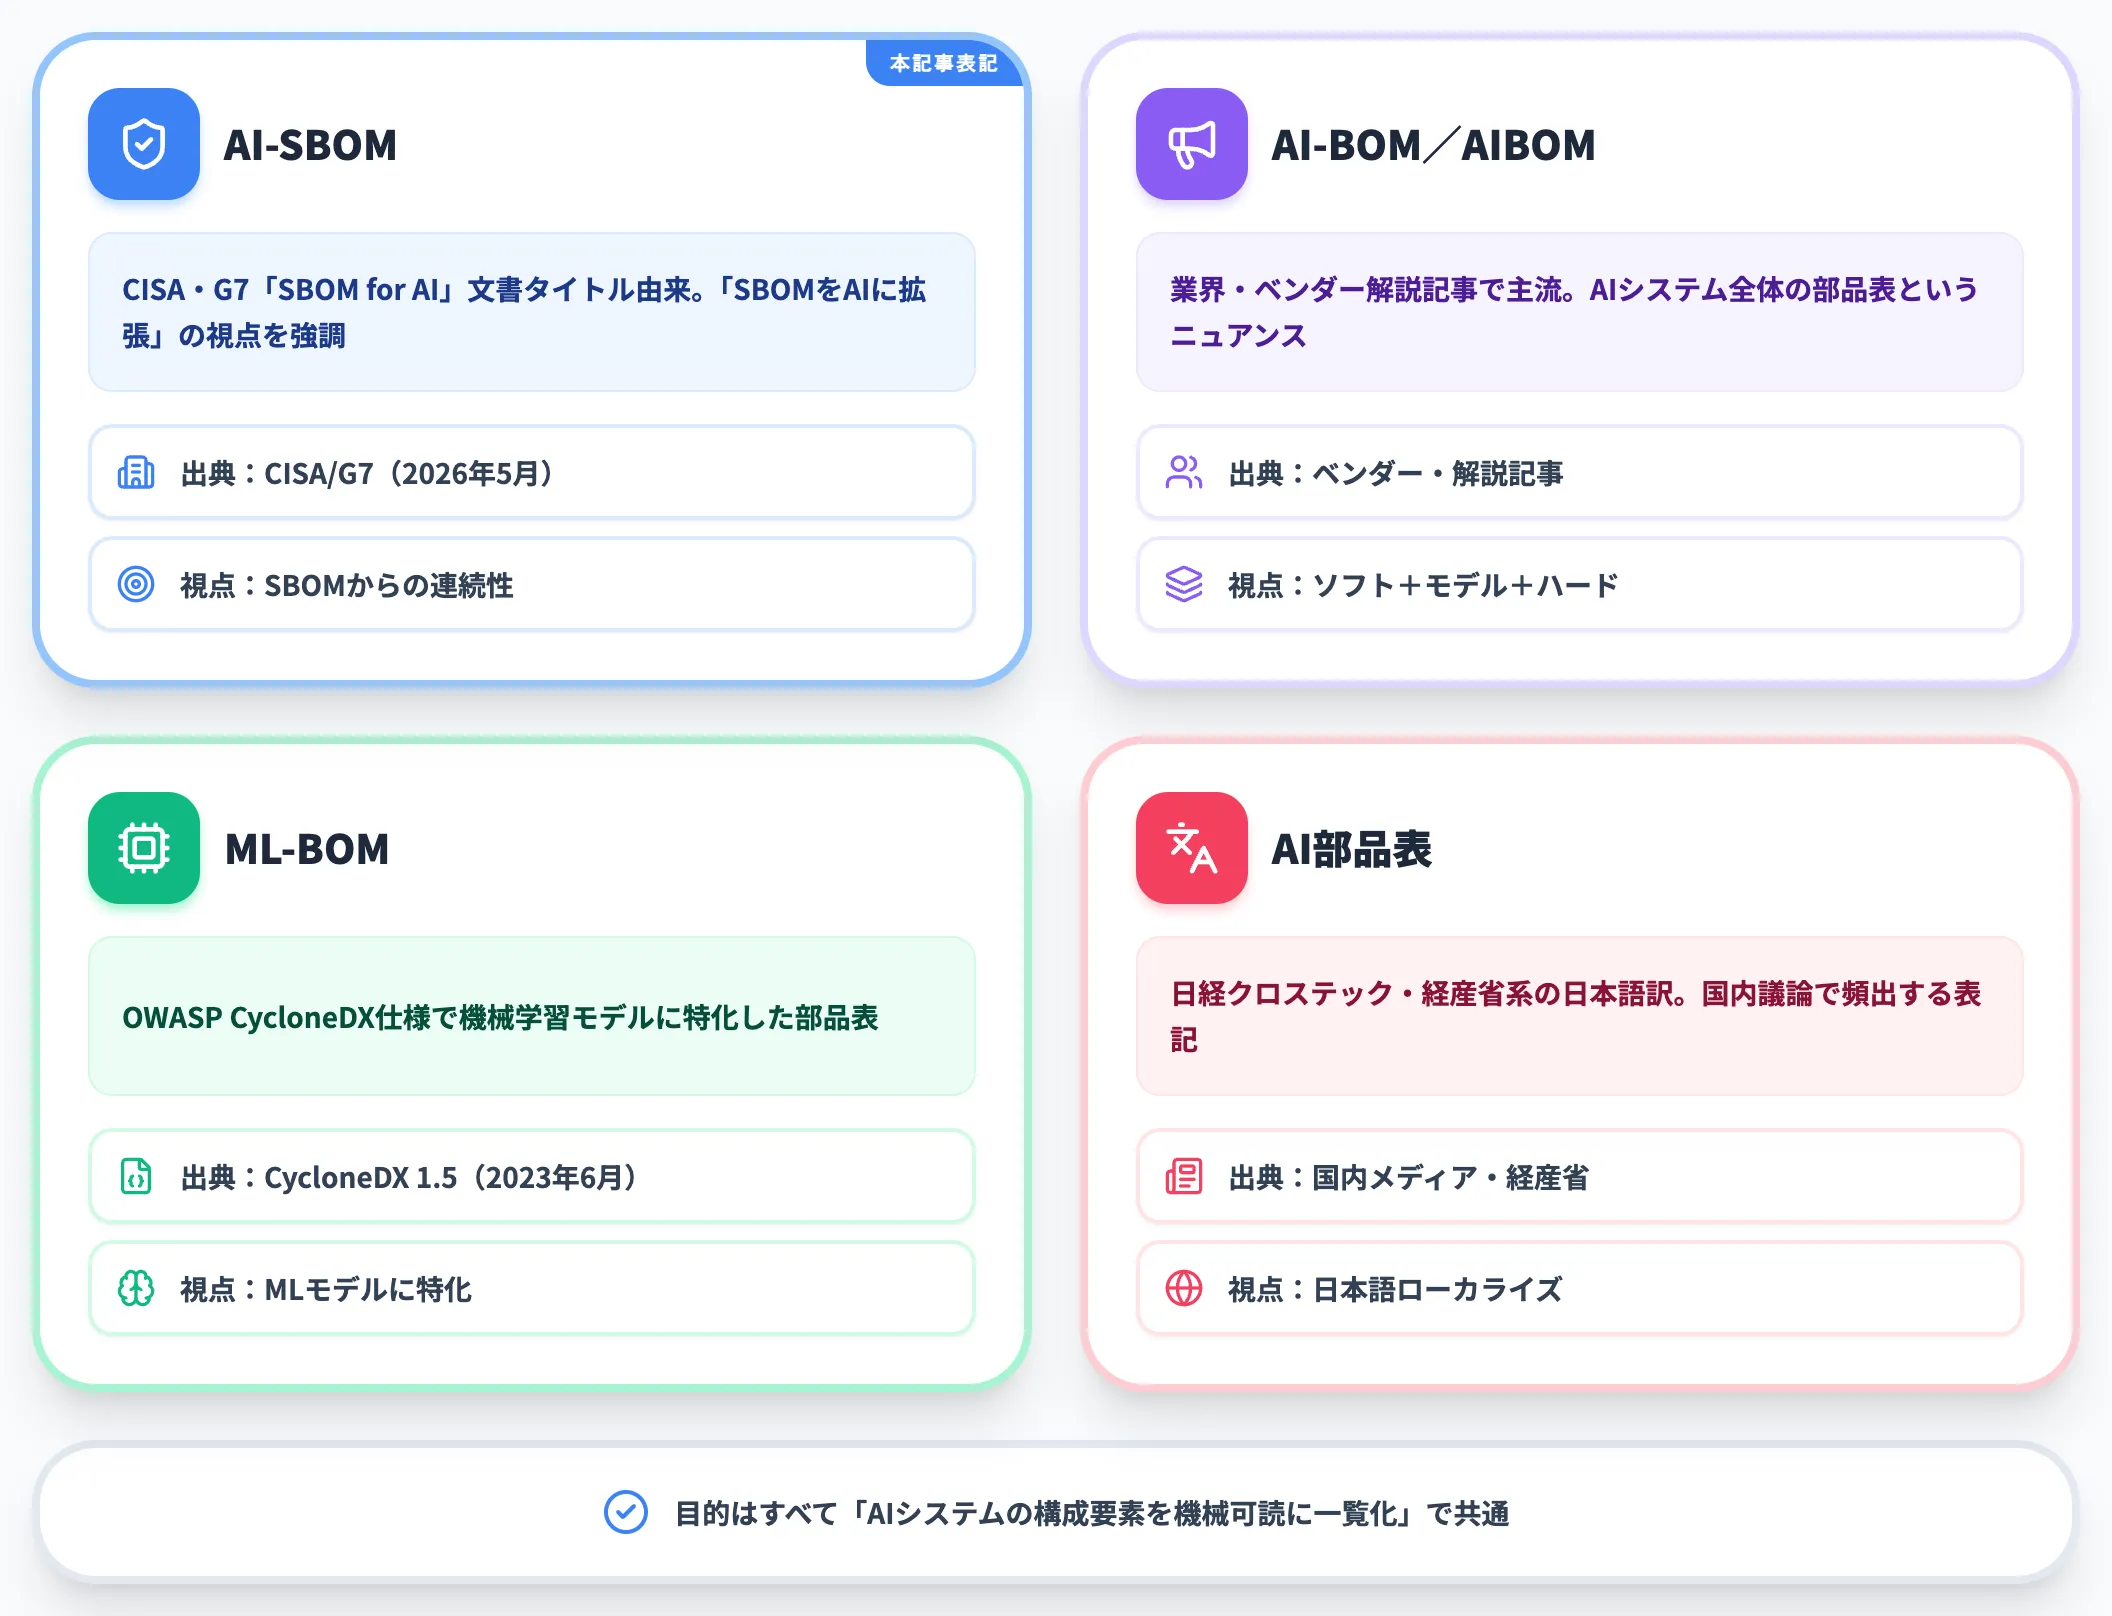
AI部品表を指す言葉は、2026年時点で業界内でも揺れています。本記事では「AI-SBOM」をタイトル語として用いますが、同じ対象を指す呼称が複数あることを先に整理しておきます。
-
AI-SBOM
米CISAとG7(日本・ドイツ・カナダ・フランス・イタリア・英国・EU)が2026年5月に共同公表した「Software Bill of Materials for AI – Minimum Elements」の文書タイトルに由来する呼称(原文表記は「SBOM for AI」)。「SBOMをAI向けに拡張」という視点を強調する
-
AI-BOM/AIBOM
業界やベンダーの解説記事で主流の表記。ソフトウェアだけでなくモデル・データ・ハードウェア含めた「AIシステム全体の部品表」というニュアンスで使われることが多い
-
ML-BOM
OWASP CycloneDX仕様で機械学習モデルに特化した部品表を指す用語。CycloneDX 1.5(2023年6月)で導入され、1.7(2025年10月、ECMA-424 2nd Edition)でAIガバナンス向けの拡張が揃った
-
AI部品表
日経クロステックや経済産業省系の日本語訳。概念としてはAI-BOM/AI-SBOMと同義で、国内議論ではこの表記も頻出
どの呼称も「AIシステムの構成要素を機械可読な形で一覧化する」という目的は共通しています。本記事ではCISA・G7の文書タイトル「SBOM for AI」に近い表記として「AI-SBOM」で統一し、ベンダー製品の固有名称が「AI-BOM」「AIBOM」の場合はそのまま併記します。
AI-SBOMが2026年に注目される3つの背景
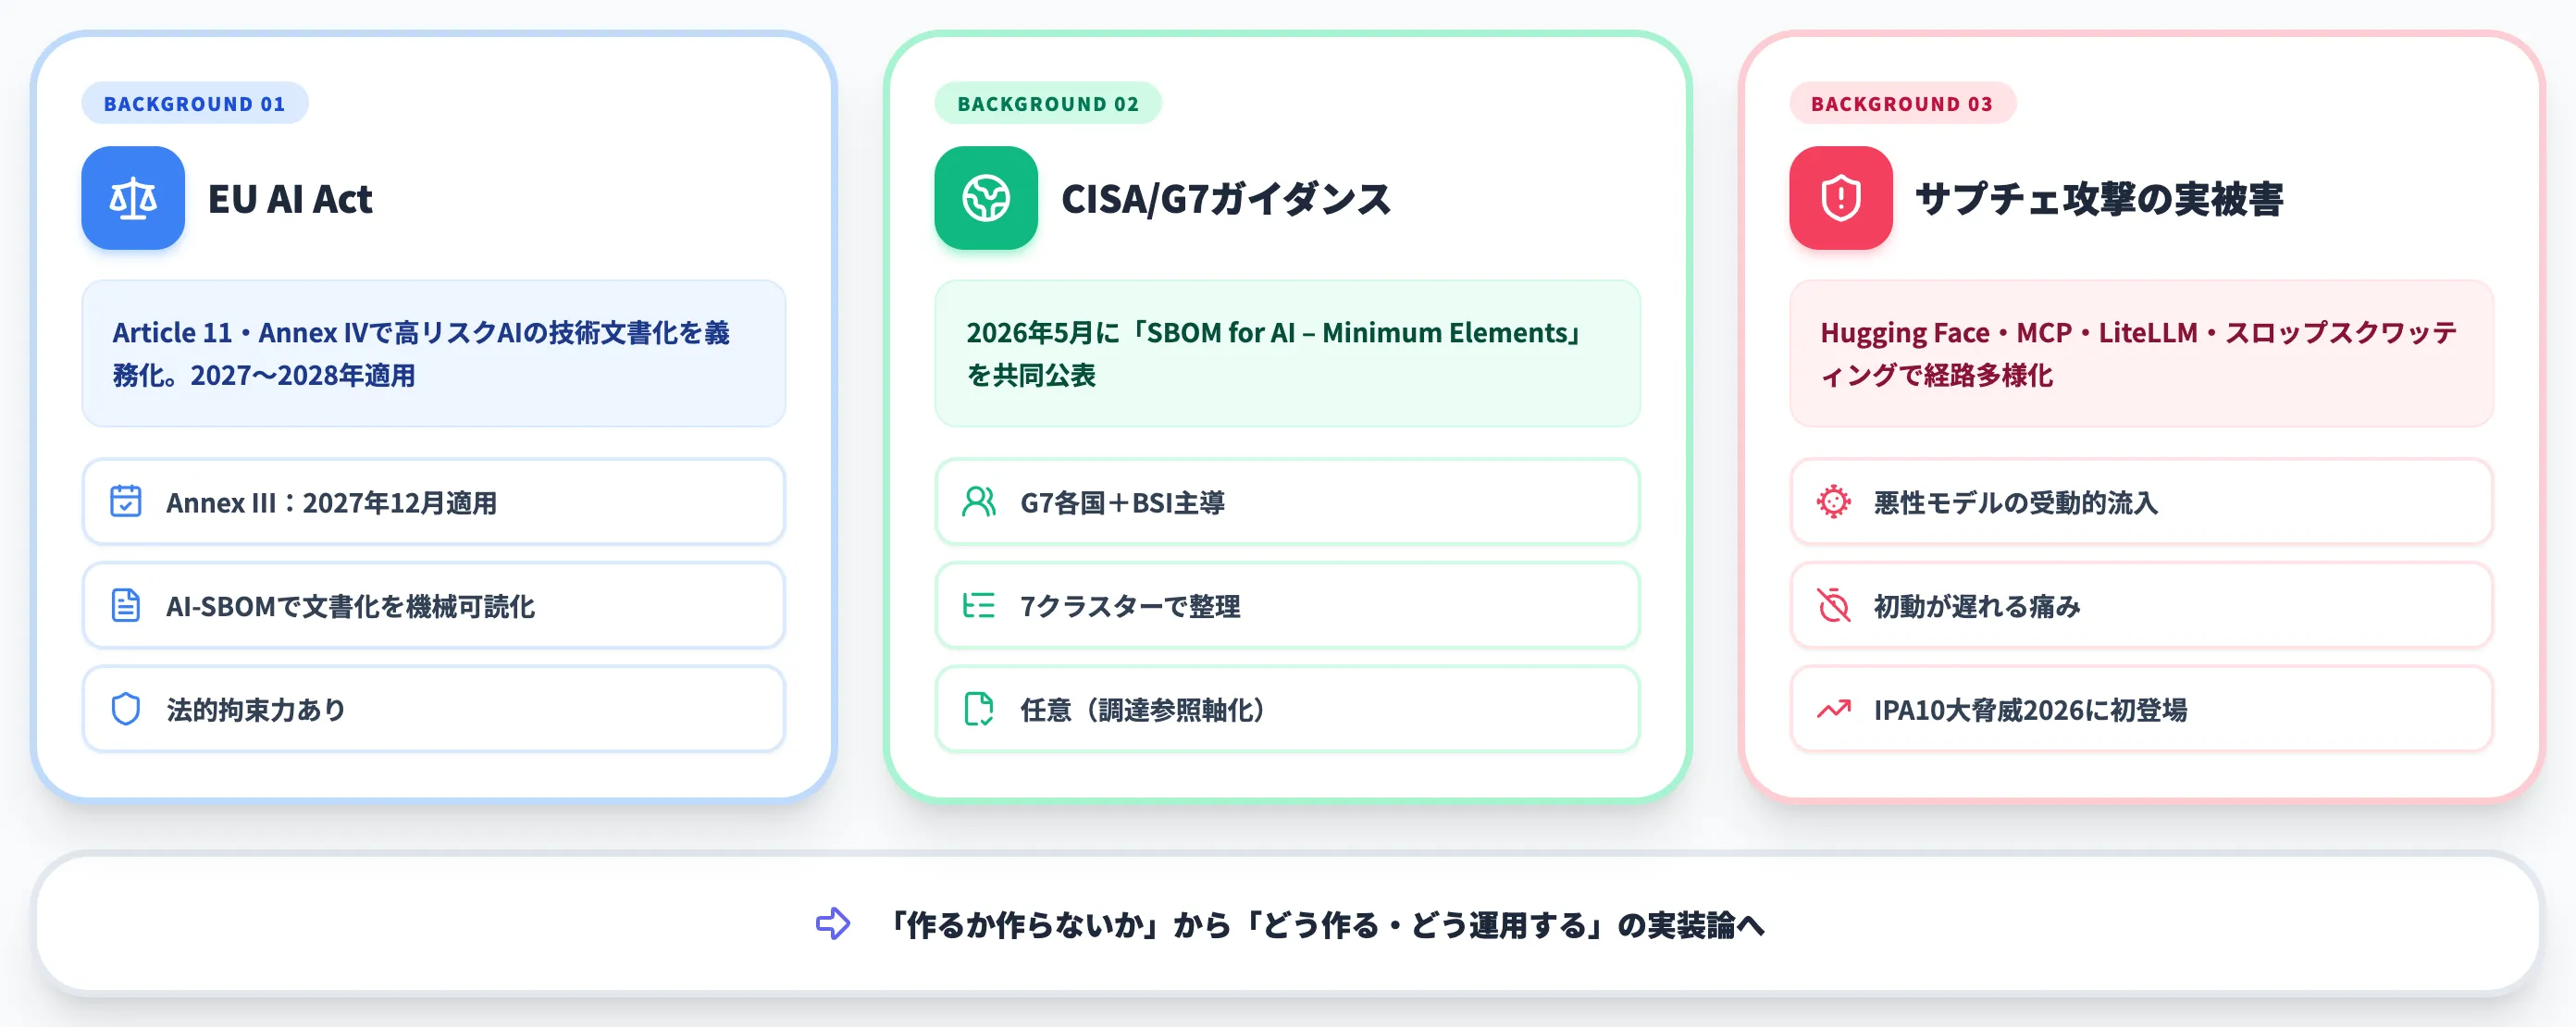
AI-SBOMという言葉自体はCycloneDX 1.5(2023年6月)に遡りますが、「調達・サプライヤー評価の文脈で参照されるようになった」のは2026年です。
本セクションでは、AI-SBOMが2026年に大きく動いた3つの具体的ドライバーを整理します。
EU AI Act Article 11と高リスクAI技術文書化義務の適用時期
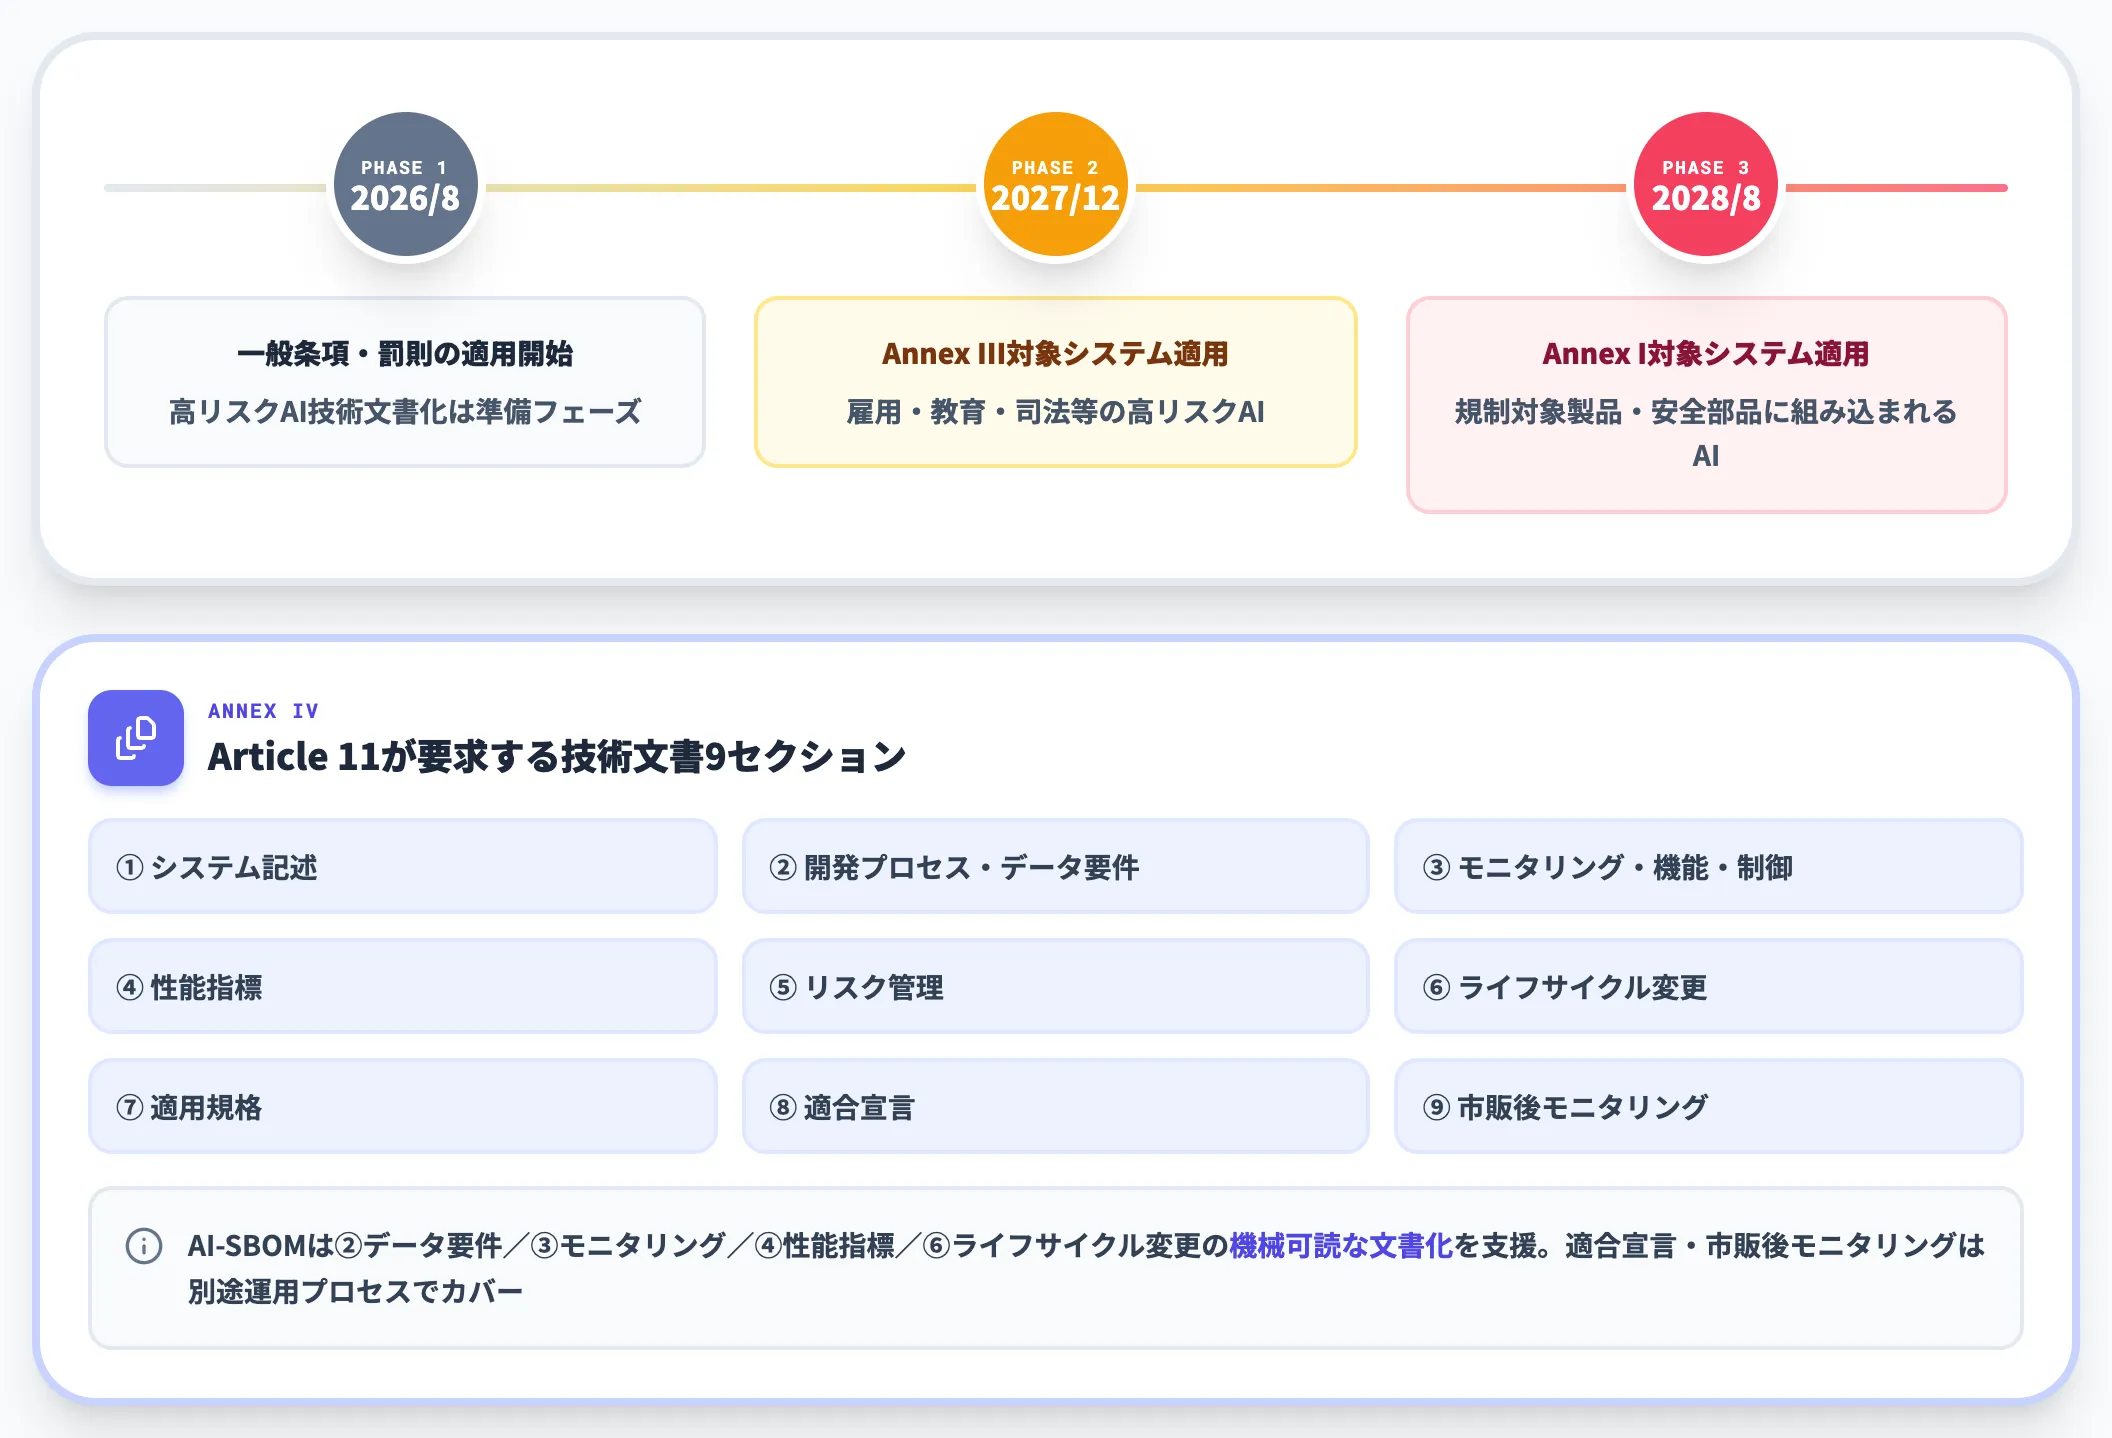
AI-SBOMを「作るか作らないか」の判断を変えつつあるのは、EU AI Actの技術文書化要件です。
Article 11は、高リスクAIシステムを市場投入する前に技術文書を作成し、継続更新することを義務付けています。Annex IVはその最小構成要素を9セクションで定めており、システム記述・開発プロセス・モニタリング/機能/制御・性能指標・リスク管理・ライフサイクル変更・適用規格・適合宣言・市販後モニタリング計画が含まれます(データ要件は第2項の下位項目2(d)として整理されています)。
AI-SBOMはこのAnnex IVのうち、モデル・データセット・依存関係・性能/セキュリティ指標といった構成情報の文書化を機械可読に支援する位置づけです。適合宣言・市販後モニタリング計画・リスク管理プロセスはAI-SBOM単独では充足せず、別途の文書化・運用プロセスが必要になります。
適用時期については、Article 113により、Article 11を含むChapter III Section 2(高リスクAI義務)はAnnex III対象のAIシステムが2027年12月2日、Annex I対象(AIシステム自体が規制対象製品の場合、または規制対象製品の安全部品の場合)が2028年8月2日から適用されます(2026年のRegulation (EU) 2026/1744 Digital Omnibusによる延期後)。2026年8月2日時点では一般条項と一部の罰則規定が適用され、高リスクAIの技術文書化は上記2027〜2028年に向けた準備フェーズです。CycloneDX ML-BOMとSPDX 3.0 AI Profileという標準フォーマットが揃ったことで、適用までの猶予期間に調達・運用への組み込みを進める組織が増えています。
CISAとG7が「Software Bill of Materials for AI」を2026年5月に公表
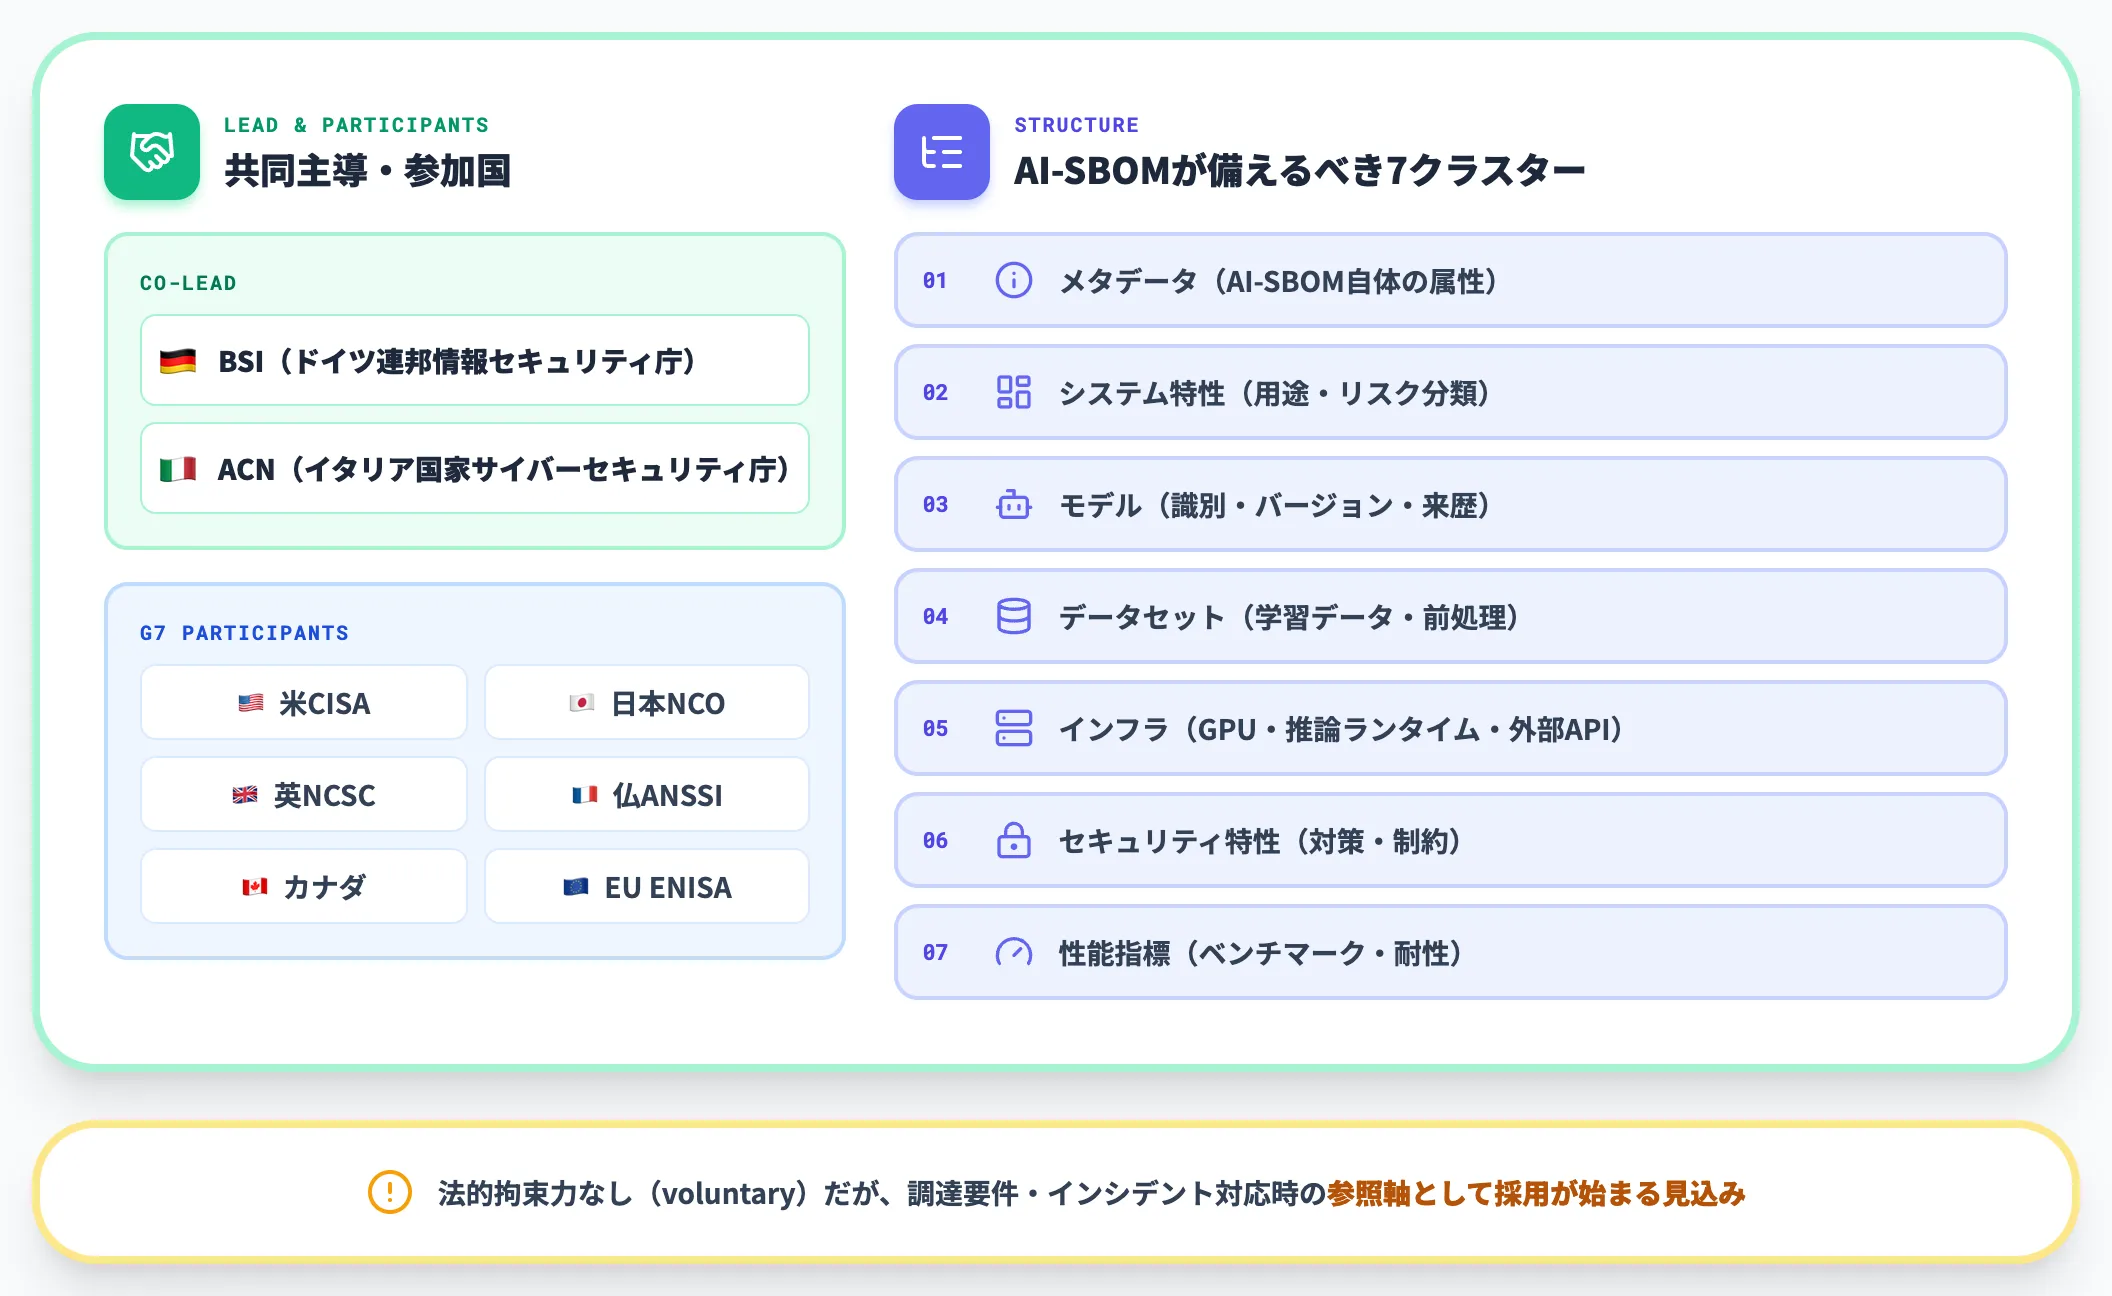
2つ目のドライバーは、G7各国が2026年5月に共同公表した「Software Bill of Materials for AI – Minimum Elements」ガイダンスです。
このガイダンスは、原文表記によればドイツBSI(連邦情報セキュリティ庁)とイタリアACN(国家サイバーセキュリティ庁)が共同主導し、米CISAをはじめとするG7各国サイバーセキュリティ機関が参加した国際文書です。
日本側は内閣官房国家サイバー統括室(NCO)が共同公表機関として列挙されています。AI-SBOMが備えるべき最小構成要素を7クラスターに整理し、従来のSBOMがソフトウェア部品に閉じていたのに対し、本ガイダンスはモデル・データセット・インフラ依存・性能指標・セキュリティ特性までを「追加で記述すべき領域」として位置づけました。
重要なのは、本ガイダンスが任意(voluntary)であり、原文では官民向けの透明性・セキュリティ指針として位置づけられている点です。
EU AI Actのような法的拘束力はありませんが、調達要件・サプライヤー評価・インシデント対応時の説明責任が問われる場面で「このガイダンスに準拠しているか」が参照軸として使われ始める可能性があります。公表は2026年5月ですが、実際の採用開始は各国の調達基準・業界ガイドラインへの取り込みを経て段階的に進む見込みで、2026年10月時点では採用事例はまだ限定的です。
AIサプライチェーン攻撃の実被害が「作らないリスク」を押し上げ
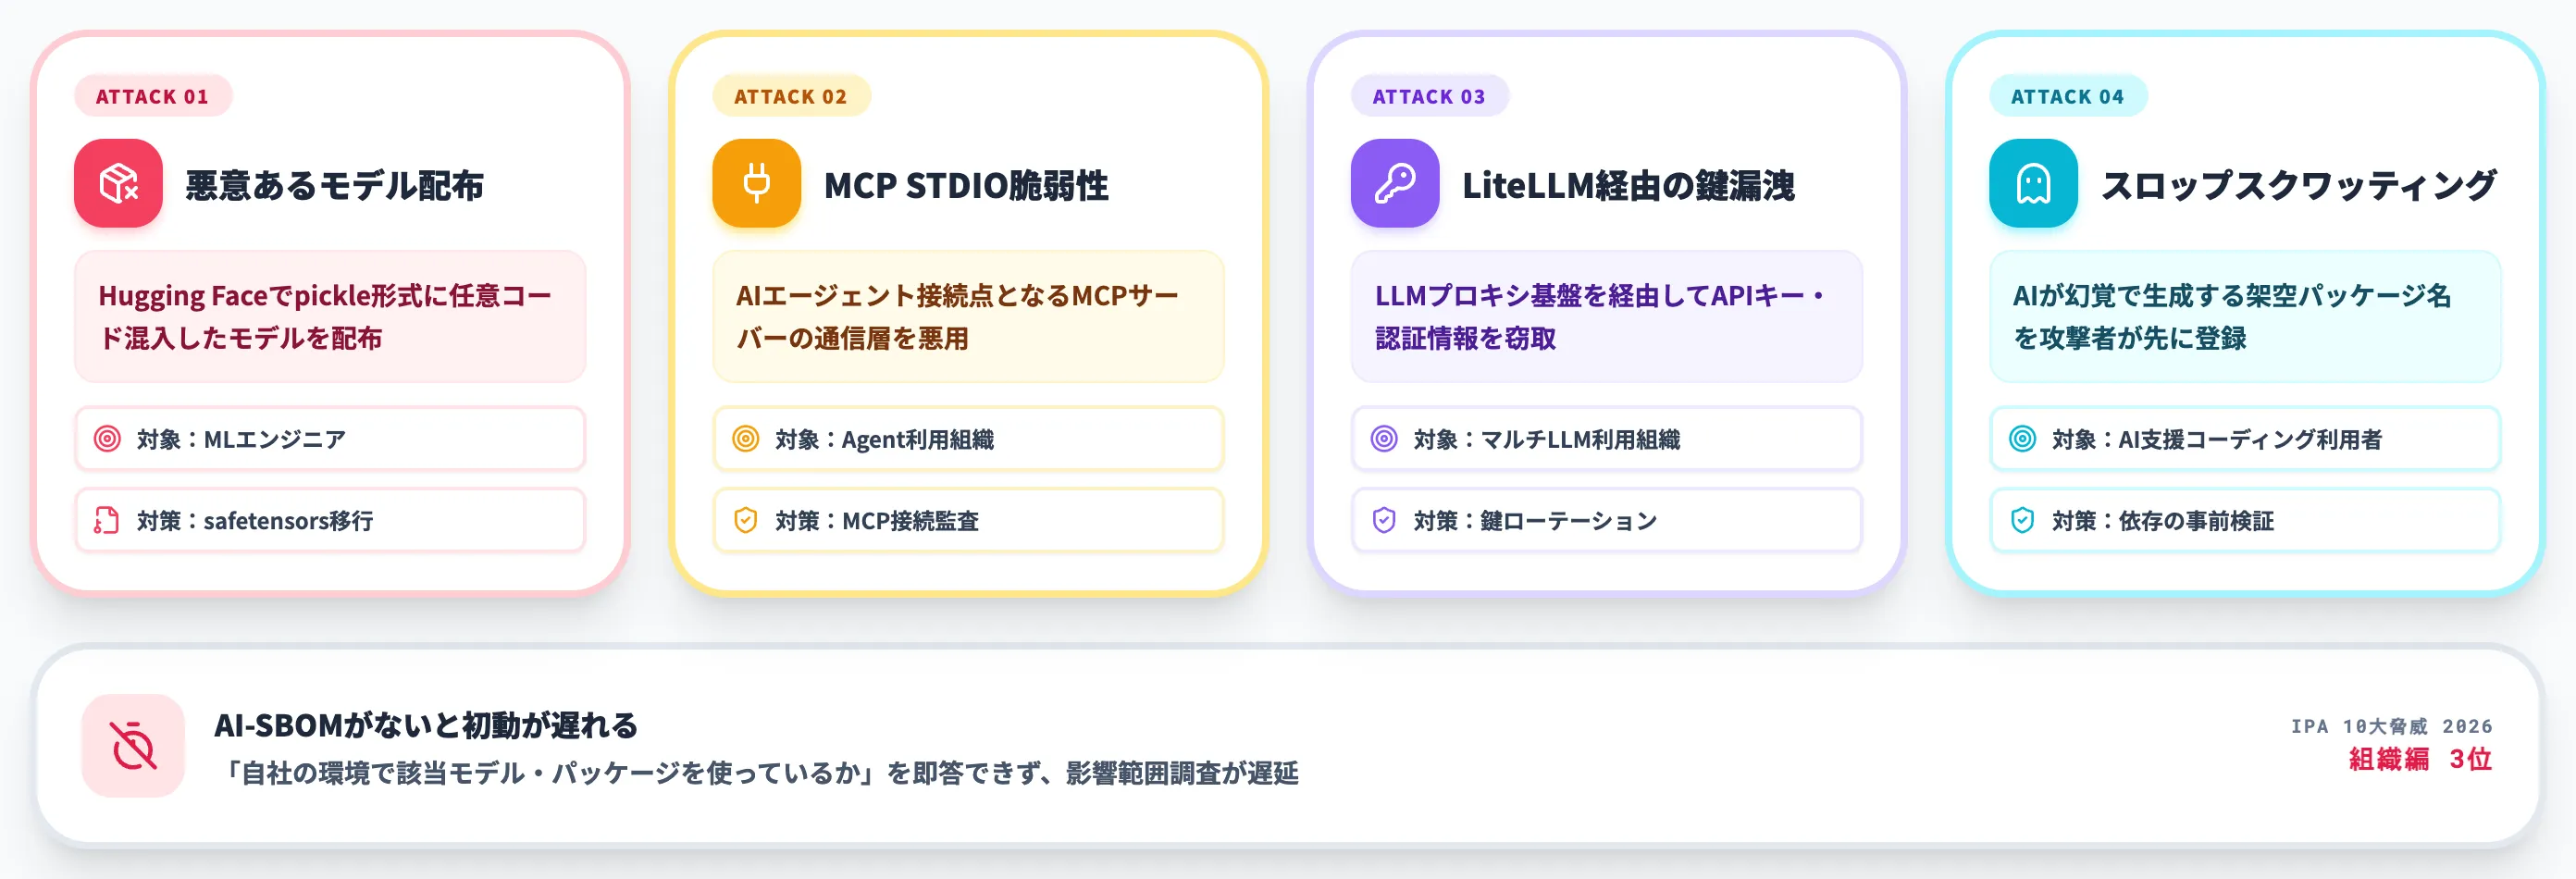
3つ目のドライバーは、AIサプライチェーン攻撃の実被害が2026年に表面化したことです。
Hugging Faceでの悪意あるモデル配布、MCPサーバーのSTDIO脆弱性、LiteLLM経由の鍵漏洩、スロップスクワッティング(AIが幻覚で生成する架空パッケージを攻撃者が先に登録する手口)など、AI利用企業が受動的に巻き込まれる経路が多様化しました。詳細はAIサプライチェーン攻撃とは?攻撃経路や2026年の事例、AI-SBOMまで徹底解説で整理しています。
AI-SBOMがないと、こうした攻撃が報告された際に「自社の環境で該当モデル・該当パッケージを使っているか」をすぐに答えられず、初動が遅れるという具体的な痛みが現れました。
従来のSBOMで「使っているOSSライブラリ」までは把握できても、「どのモデルをどのプロジェクトで使い、どのデータで学習させたか」はAI-SBOMがないと追えません。
IPAは2026年1月29日に情報セキュリティ10大脅威 2026を公表し、「AIの利用をめぐるサイバーリスク」を組織編に初めてランクインさせました(組織編3位、組織編解説書は3月12日公開)。選考根拠は2025年に発生した事故・攻撃状況のため、本記事で挙げたような2026年の個別事例ではなく、2025年の累積的なリスク増加の反映です。
EU AI Act・CISA/G7ガイダンス・AIサプライチェーン攻撃という3つの外圧が2026年に揃った結果、AI-SBOMは「作るかどうかの議論」から「どう作るか・どう運用するか」の実装論に移行しました。
AI-SBOMがSBOMに追加する6つの要素
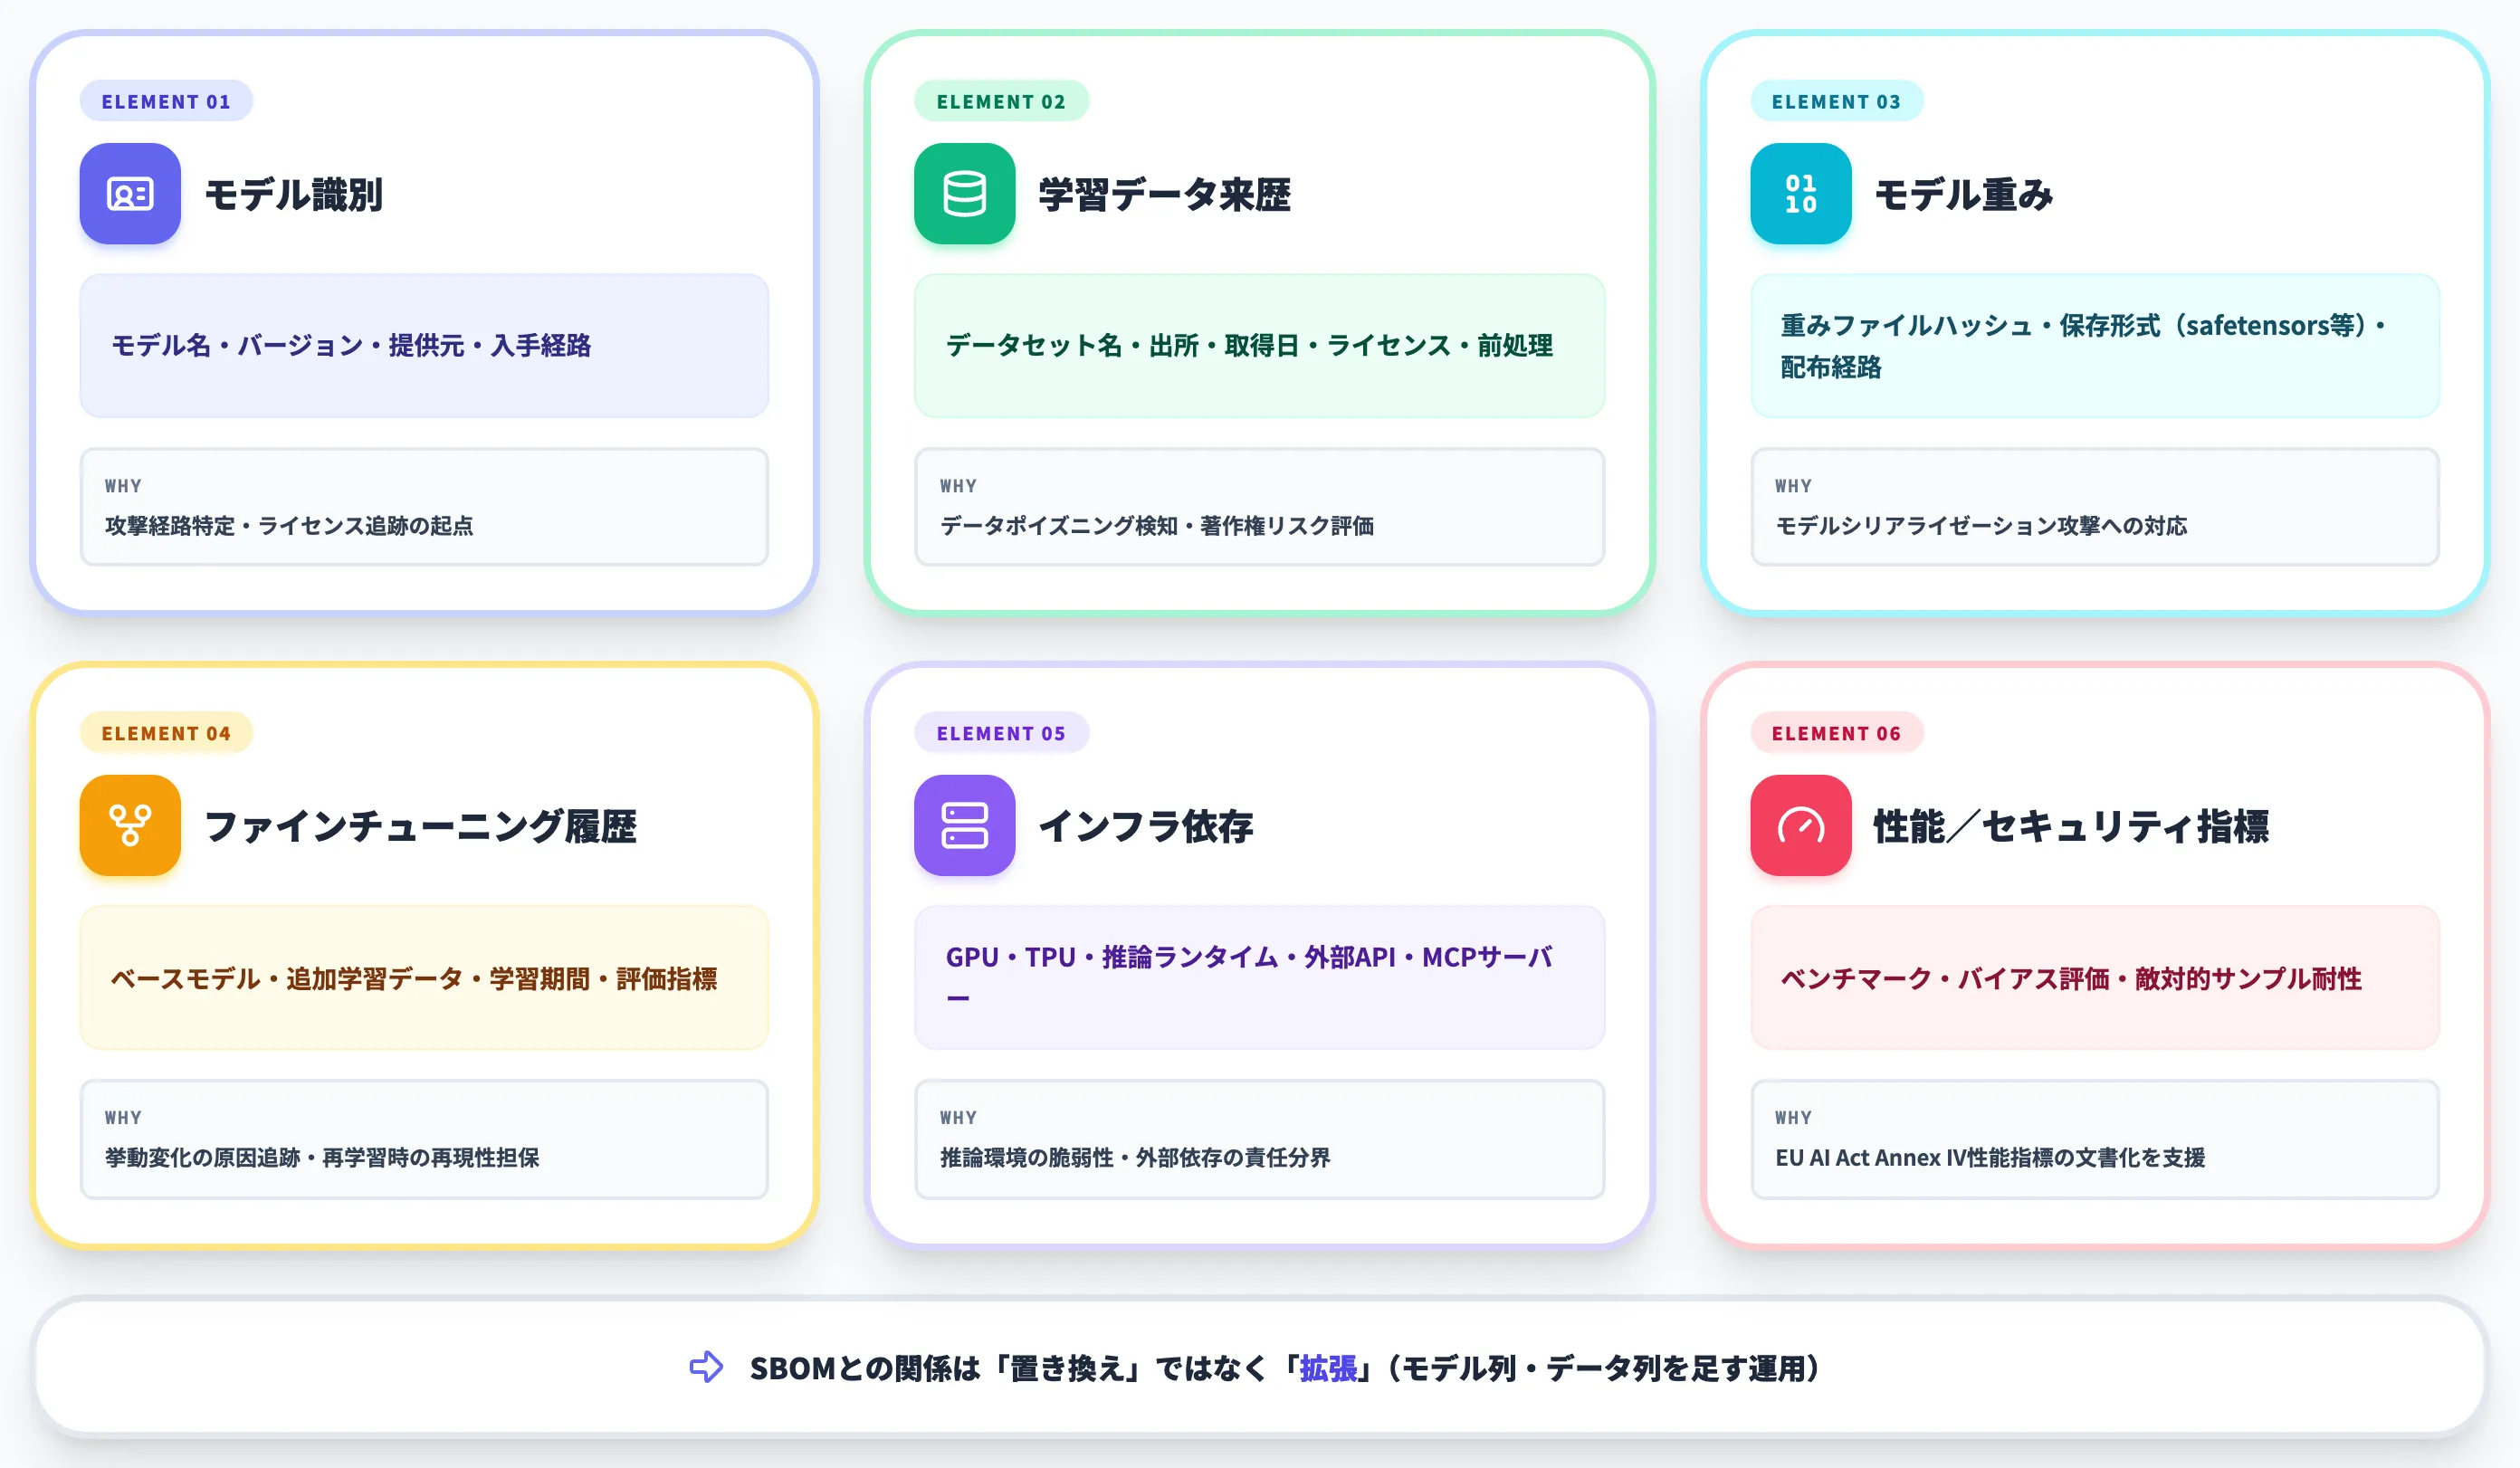
AI-SBOMが従来のSBOMと何が違うのかを、具体的な記述項目レベルで整理します。
CISA・G7の2026年5月ガイダンスでは、AI-SBOMを7クラスター(メタデータ/システム特性/モデル/データセット/インフラ/セキュリティ特性/性能指標)に分けて整理していますが、「SBOMにすでにある領域」を除いて実質的に追加される要素は6つに集約されます。
CycloneDX ML-BOM仕様では、機械学習モデルのコンポーネントをModel Card構造の中にModel Parameters・Quantitative Analysis・Considerationsの3カテゴリで整理しています。
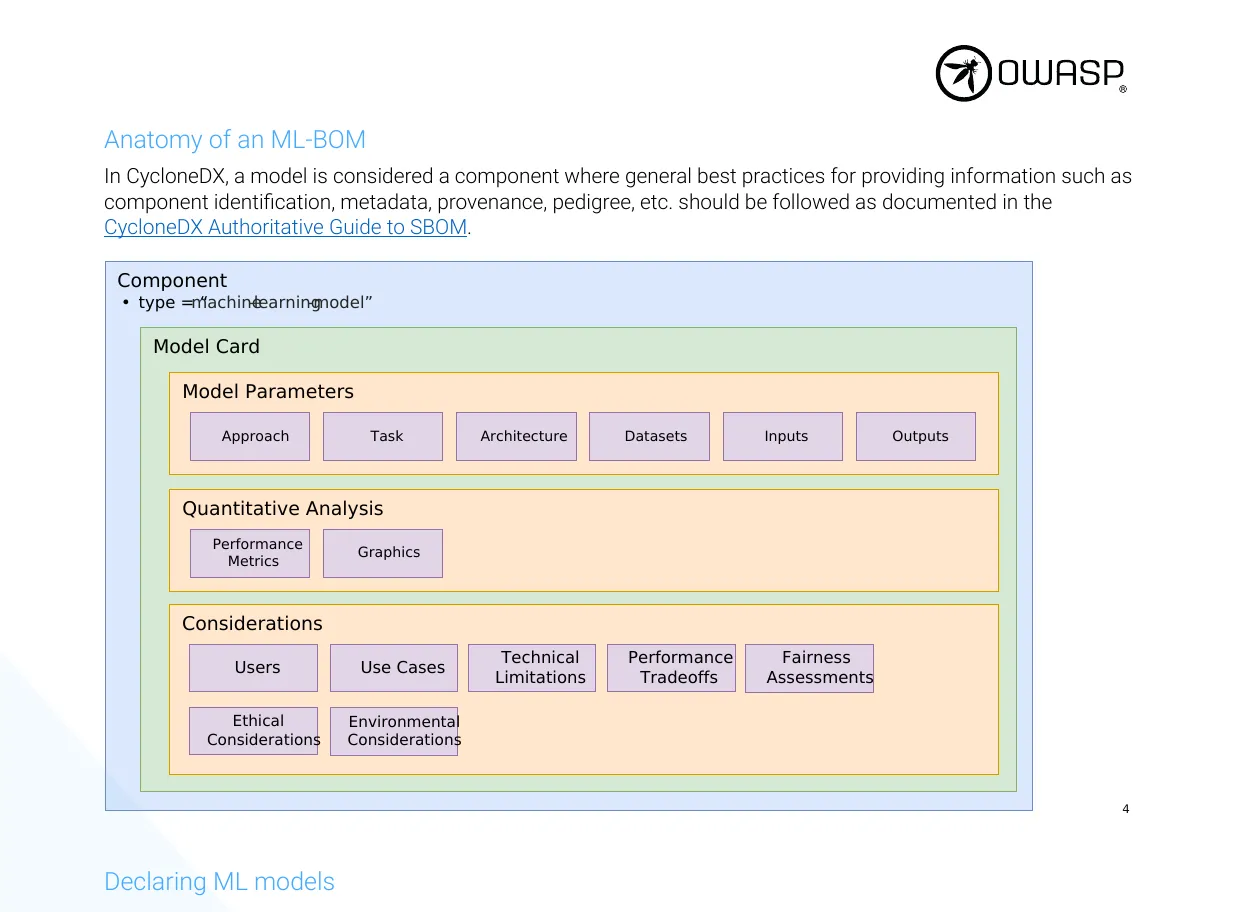
CycloneDX ML-BOMが規定するMachine Learning Componentの構造(Model Card/Model Parameters/Quantitative Analysis/Considerations)(出典:OWASP CycloneDX ML/AI-BOM)
公式図のModel Parametersが本記事の「モデル識別・学習データ来歴」、Quantitative Analysisが「性能/セキュリティ指標」、ConsiderationsがEU AI Act Annex IVの「リスク評価・倫理的制約」に対応します。
以下の表で、SBOMとAI-SBOMの対応関係を整理しました。
| 領域 | 従来のSBOM | AI-SBOMで追加される要素 | 追加される理由 |
|---|---|---|---|
| コード・依存関係 | 対象 | ─ | SBOMと共通。CycloneDX・SPDXで既存運用を流用 |
| モデル識別 | 対象外 | モデル名・バージョン・提供元・入手経路(Hugging Face/自社学習/商用API) | 攻撃経路特定・ライセンス追跡の起点 |
| 学習データ来歴 | 対象外 | データセット名・出所・取得日・ライセンス・前処理条件 | データポイズニング検知・著作権リスク評価の根拠 |
| モデル重み | 対象外 | 重みファイルのハッシュ・保存形式(safetensors/pickle等)・配布経路 | モデルシリアライゼーション攻撃への対応 |
| ファインチューニング履歴 | 対象外 | ベースモデル・追加学習データ・学習期間・評価指標 | 挙動変化の原因追跡・再学習時の再現性担保 |
| インフラ依存 | 一部対象 | GPU/TPU・推論ランタイム・外部API(OpenAI/Anthropic)・MCPサーバー | 推論環境の脆弱性・外部依存の責任分界明確化 |
| 性能/セキュリティ指標 | 対象外 | ベンチマークスコア・バイアス評価・敵対的サンプル耐性・プロンプトインジェクション対策 | EU AI Act Annex IV(性能指標・リスク管理関連)の文書化を支援 |
この表が示す通り、AI-SBOMで追加される要素は「モデルとデータが可変であるAIシステム固有の特性」を記録する項目に集中しています。
とくに学習データ来歴とファインチューニング履歴の2つは、同じモデル名でも挙動が別物になる根拠を残すための中核情報です。たとえば「Llama 3 70B」というモデル名だけでは、どの会社が何のデータで追加学習したかが分からず、同名モデル同士で挙動差が出た際の原因追跡ができません。
モデル重みのハッシュと保存形式を記録する理由は、Pickle形式のモデルファイルに任意コードが混入する攻撃が実際に報告されているためです。safetensors形式への移行履歴まで記録しておくことで、過去にpickleで配布していた期間の脆弱性を特定できます。
これらの要素は、EU AI Act Annex IVの「データ要件」「モニタリング・機能・制御」「性能指標」「ライフサイクル変更」といった構成情報関連セクションに向けた機械可読な文書化を支援します。
適合宣言や市販後モニタリング計画・リスク管理プロセスなどはAI-SBOM単独では充足せず、別途の運用プロセスでカバーする設計です。
CISA・G7ガイダンスの7クラスターも同じ趣旨で、SBOMとAI-SBOMの関係は「置き換え」ではなく「拡張」です。SBOMを既に運用している組織であれば、AI-SBOMはそこにモデル列とデータ列を足す作業として位置づけられます。
標準フォーマット:CycloneDX ML-BOMとSPDX 3.0 AI Profileの違い
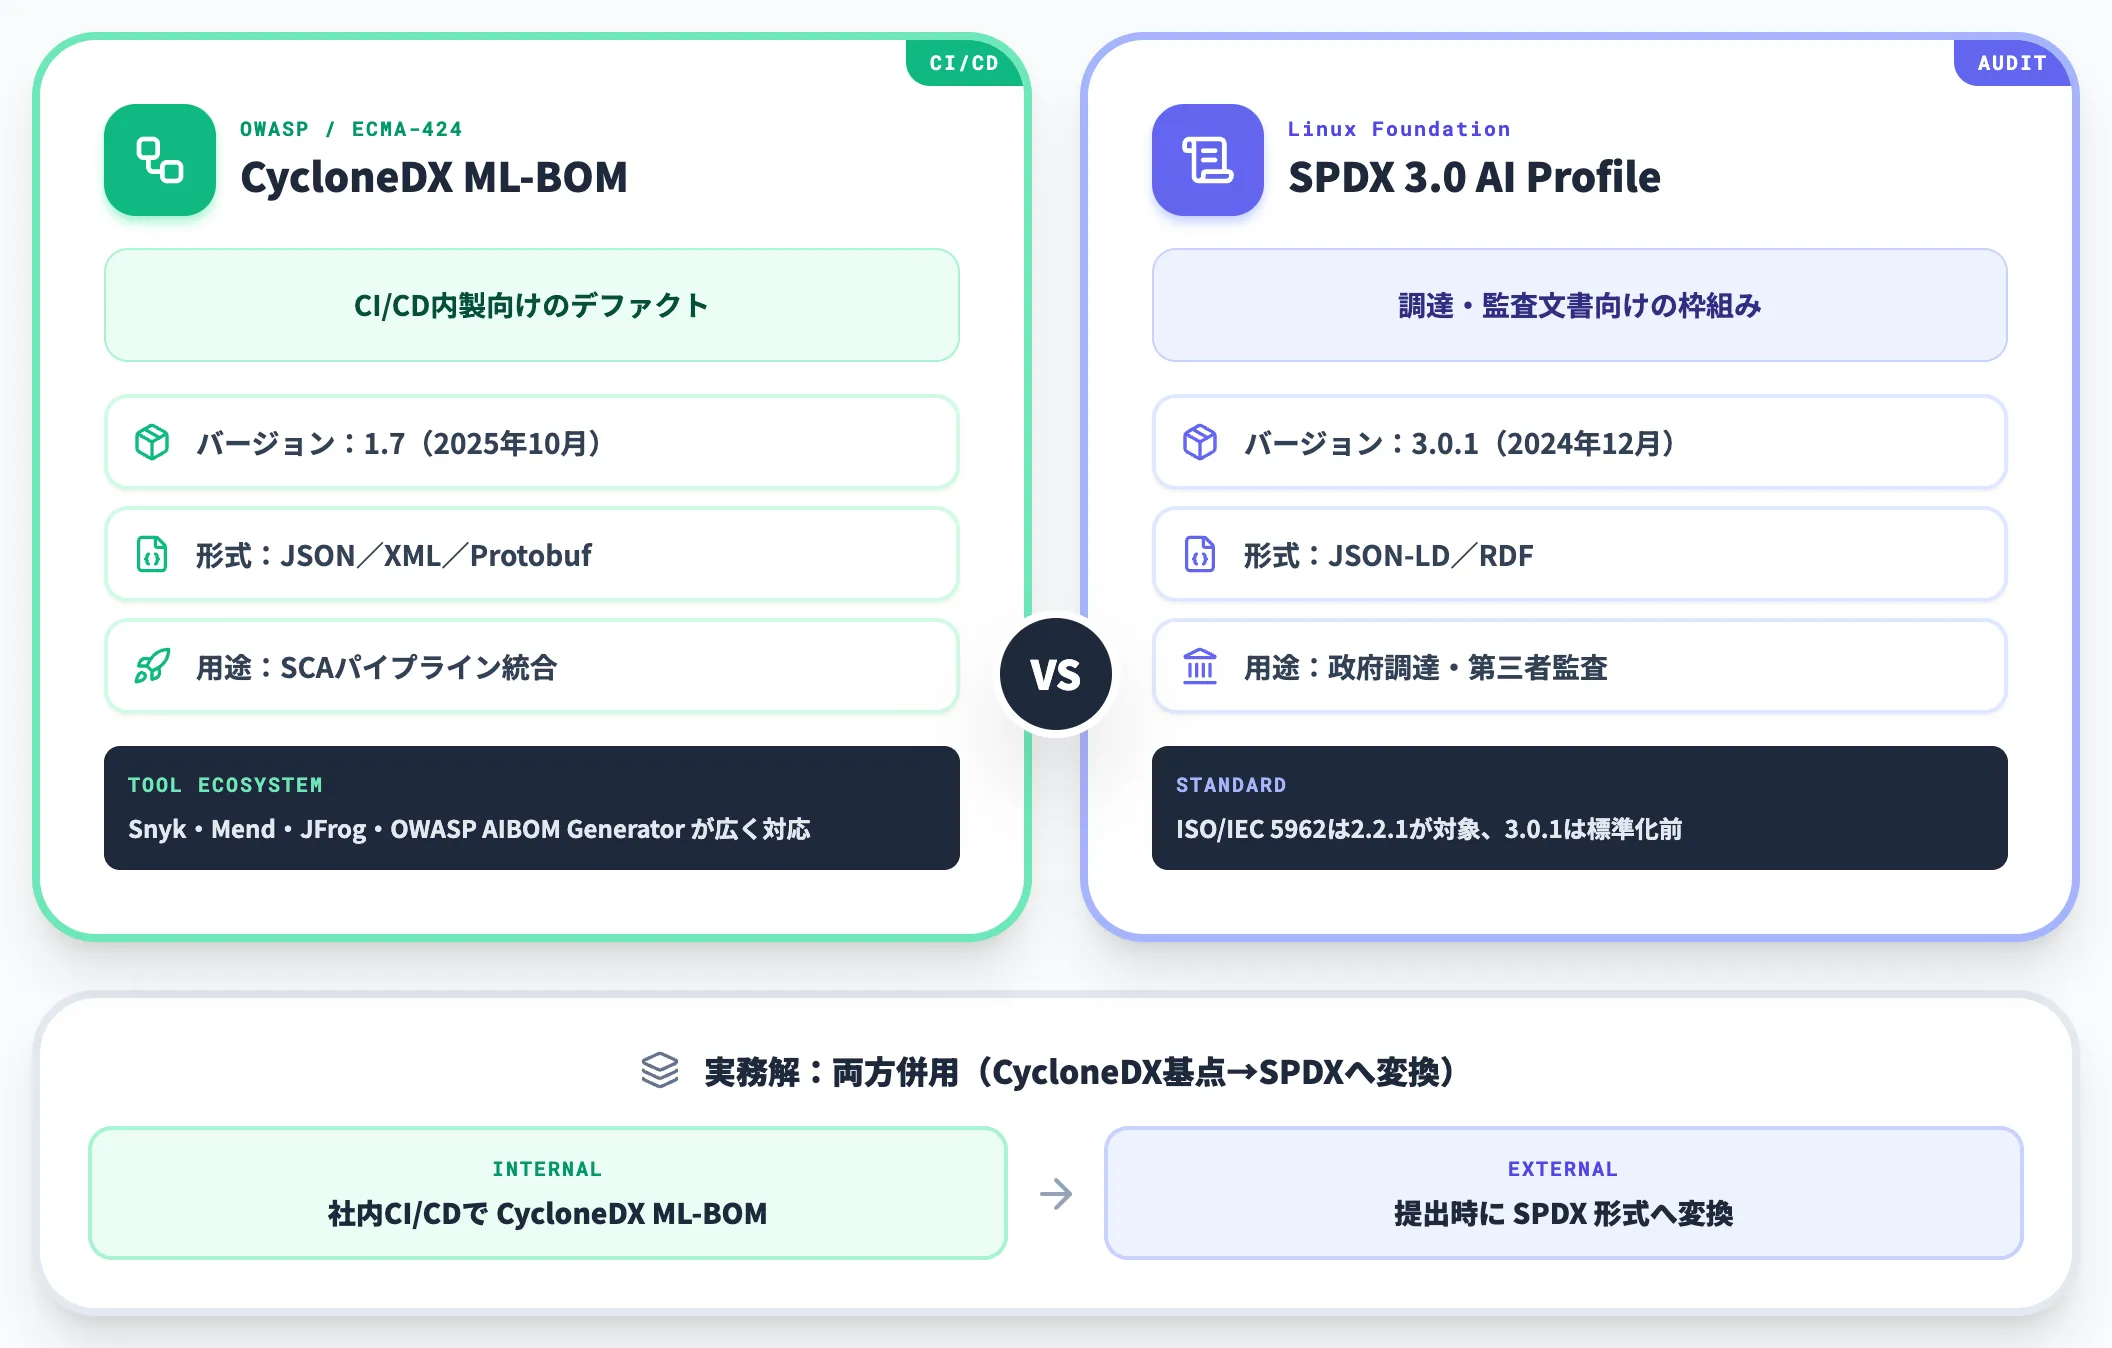
AI-SBOMには、業界デファクトになっている標準フォーマットが2つあります。CycloneDX ML-BOMとSPDX 3.0 AI Profileです。
どちらを採用するかで運用スタイルと規制対応の重心が変わるため、違いを押さえてから選定する必要があります。
CycloneDX ML-BOM:CI/CD内製向けのデファクト
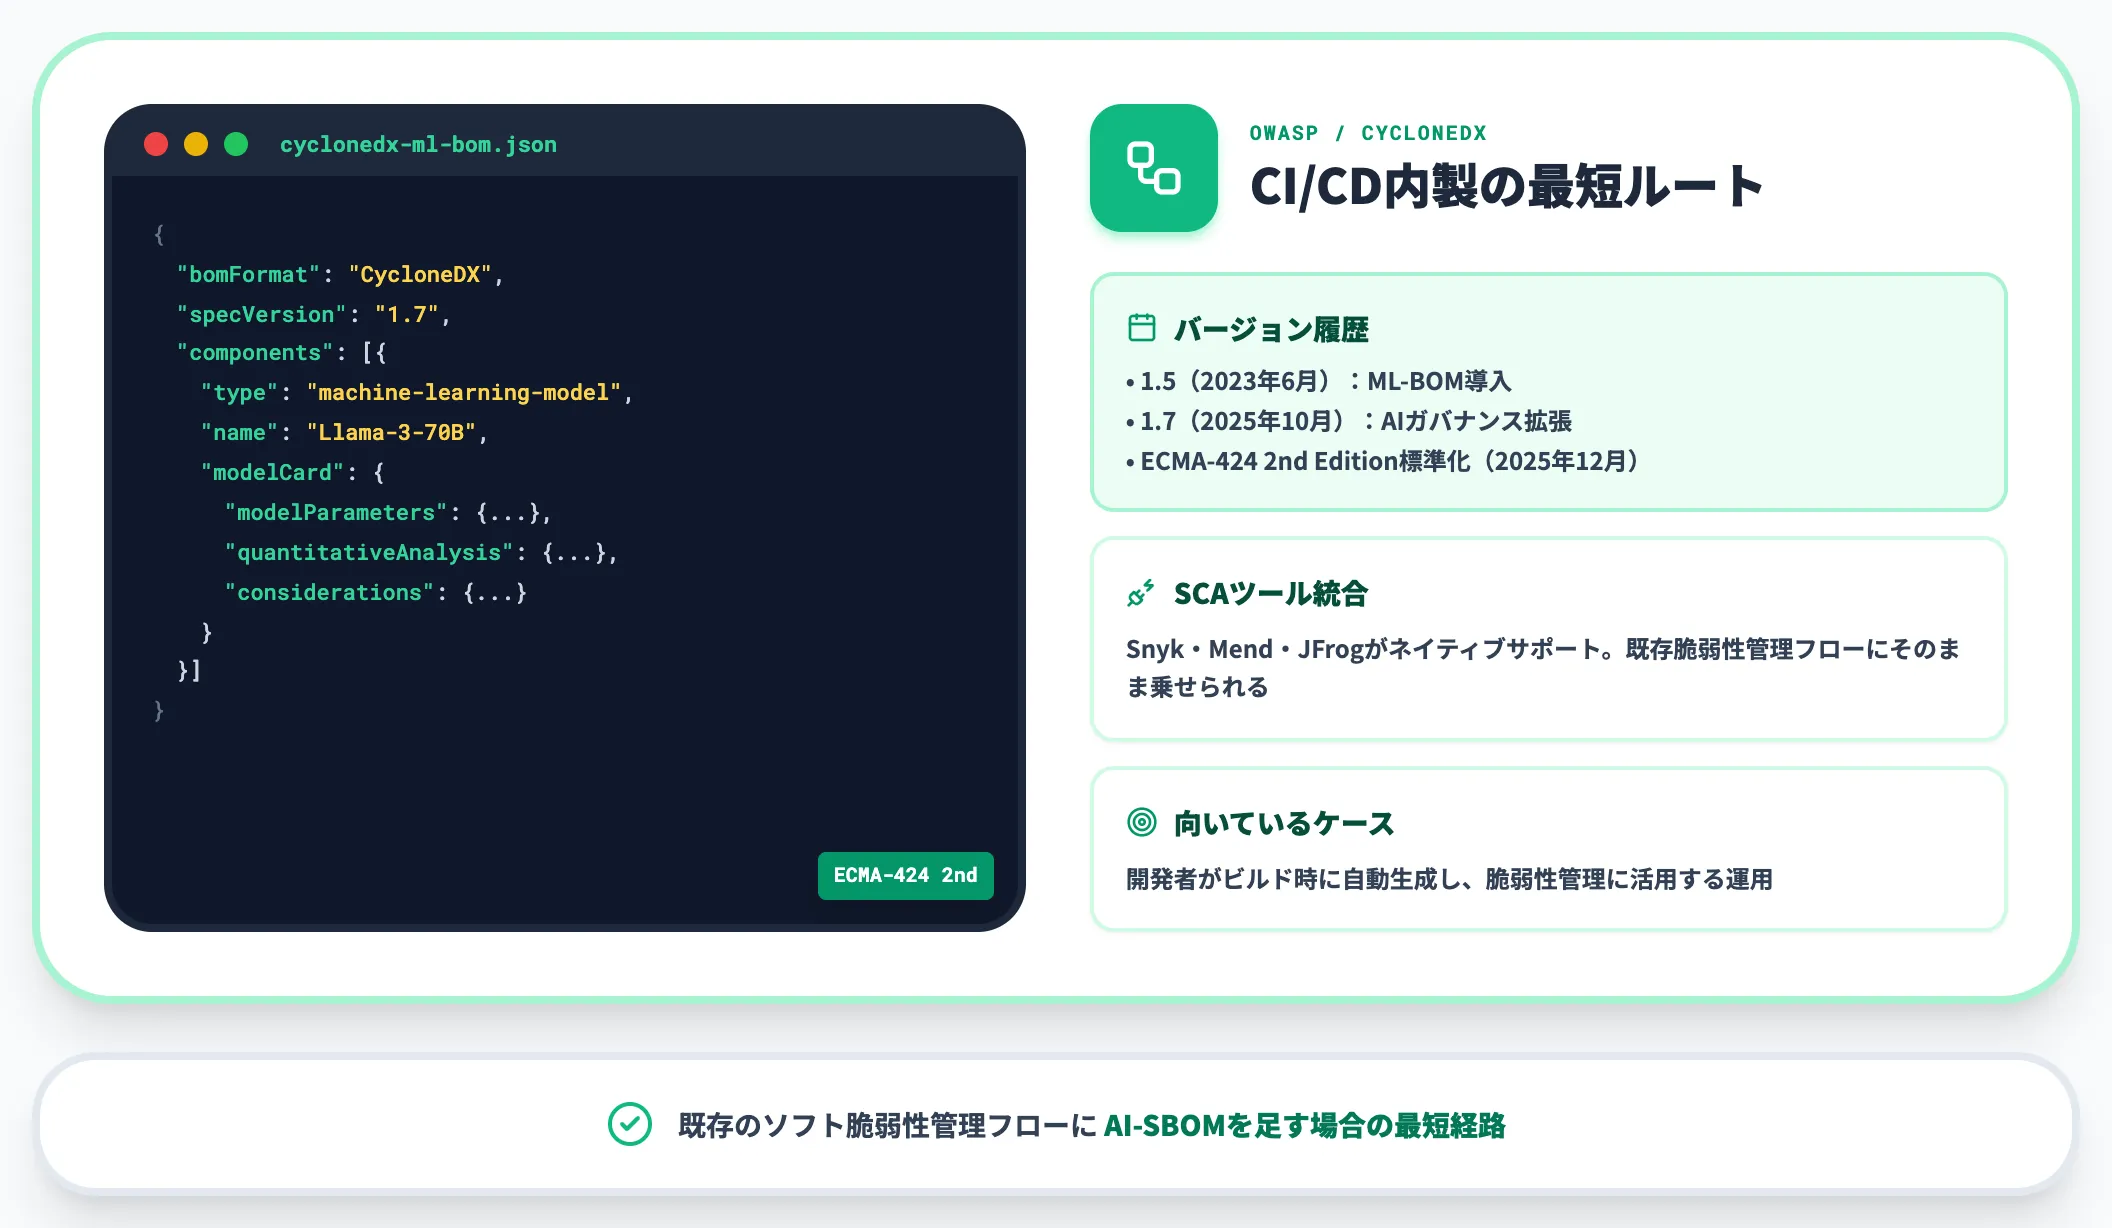
CycloneDX ML-BOMは、OWASPが維持しているBOM標準CycloneDXが機械学習向けに提供する仕様です。
2023年6月のCycloneDX 1.5で導入され、2025年10月21日に公開されたCycloneDX 1.7が2025年12月10日にECMA-424 2nd Editionとして標準化されました。1.7はCycloneDXの1.x系最終リリースで、暗号BOM(CBOM)やハードウェアBOM(HBOM)も含めたフルスタックBOM標準の到達点です。
CycloneDXが選ばれる理由は、CI/CDパイプラインに組み込みやすいJSON形式と、豊富なツールエコシステムにあります。
Snyk・Mend・JFrogなどのSCA(Software Composition Analysis)ツールの多くがCycloneDXをネイティブサポートしており、既存のソフトウェア脆弱性管理フローにAI-SBOMを足す場合は、CycloneDX ML-BOMを採用するのが最短です。
開発者がビルド時に自動生成し、SCAパイプラインに取り込んで依存コンポーネントの脆弱性管理に活用する運用に向きます。
SPDX 3.0 AI Profile:調達・監査文書向けの枠組み
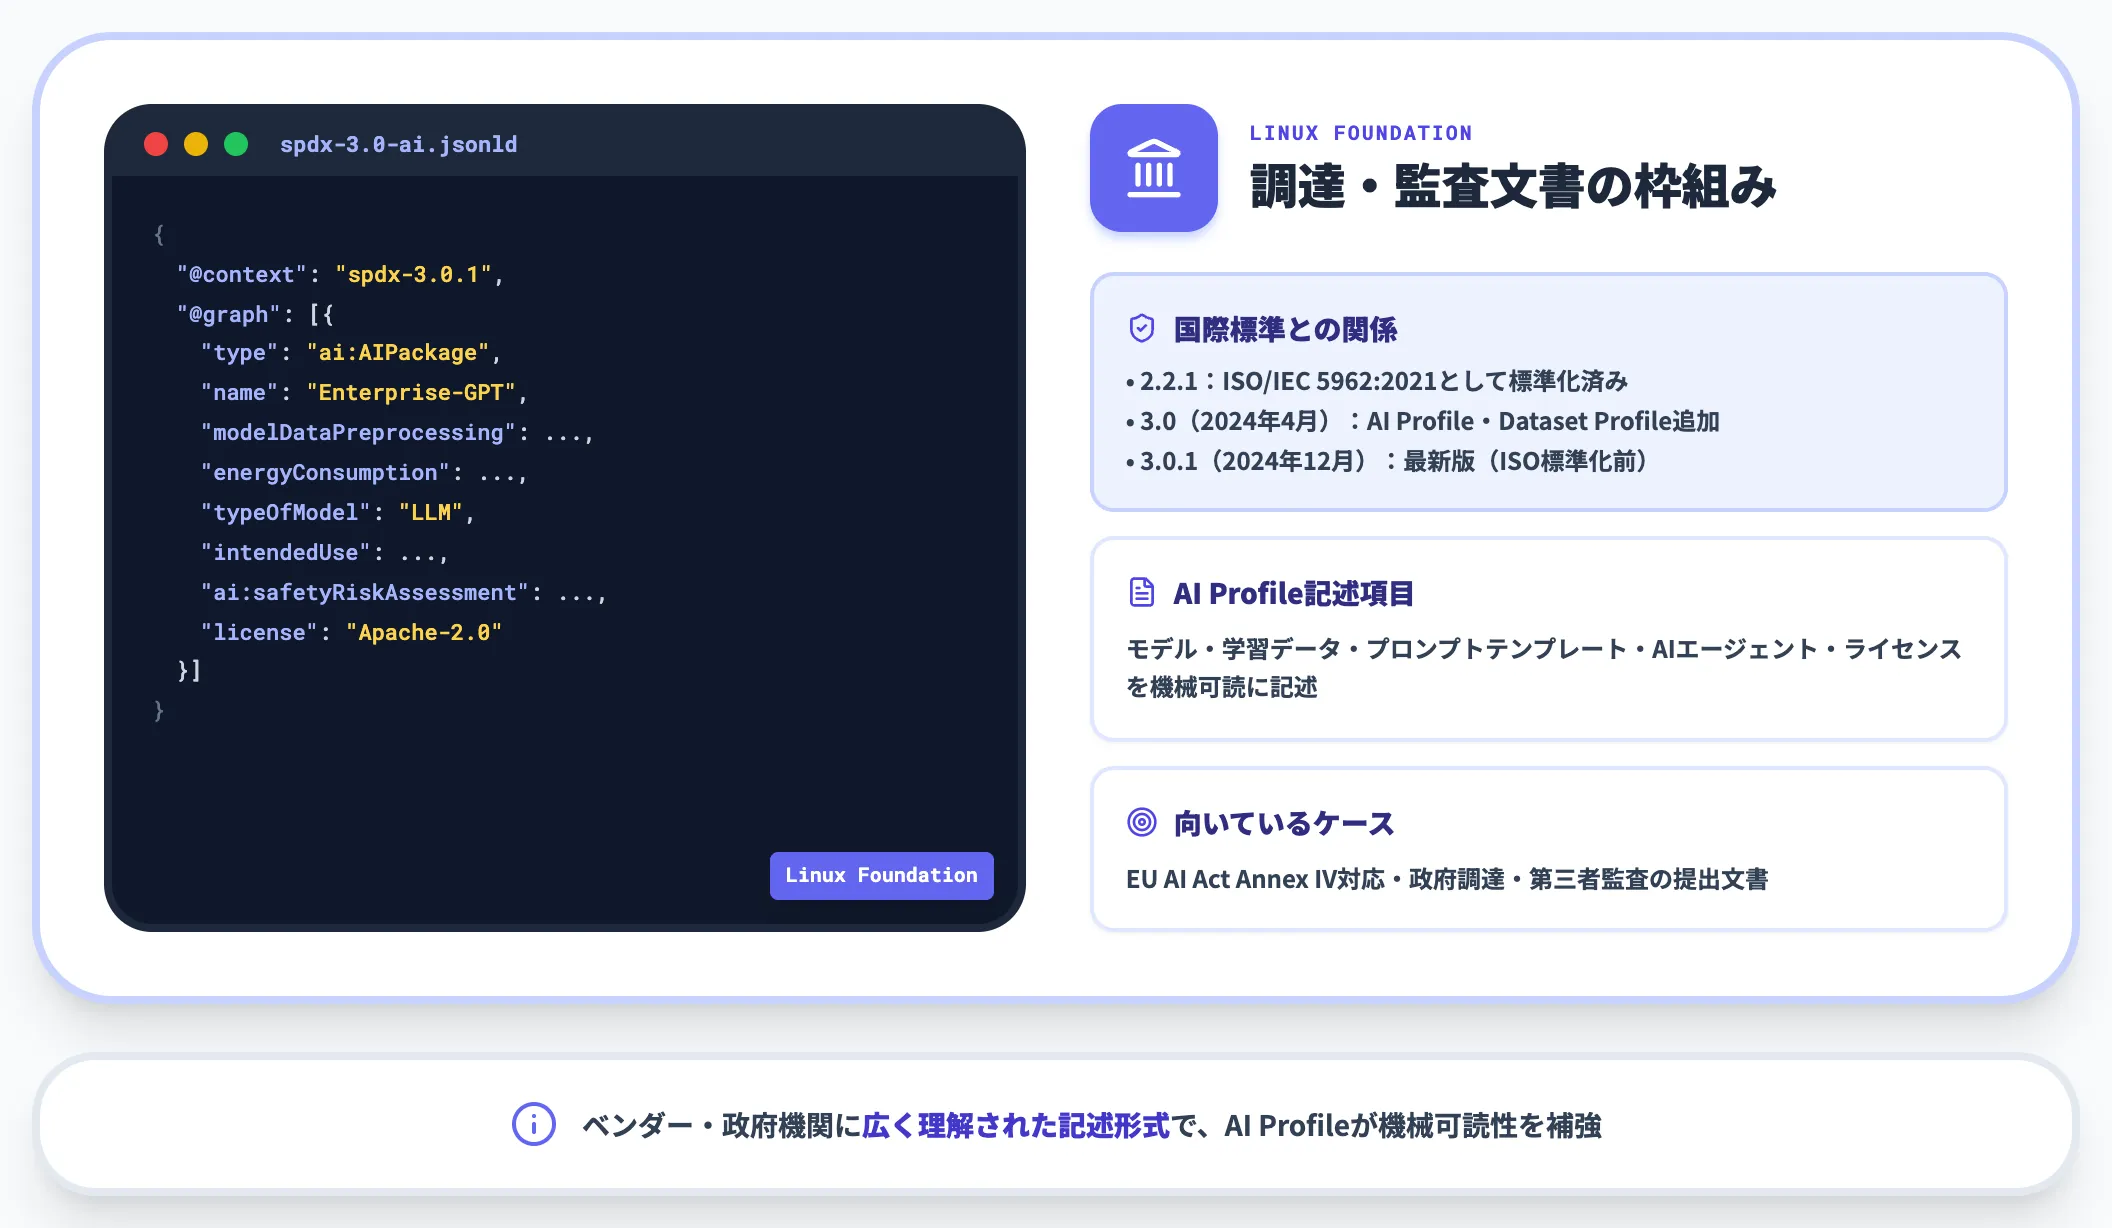
もう一方のSPDX 3.0 AI Profileは、Linux Foundation配下のSPDXプロジェクトが提供する仕様です。
SPDXの旧仕様である2.2.1がISO/IEC 5962:2021として国際標準化されており、2024年4月にSPDX 3.0でAI Profile・Dataset Profileが追加されました(最新は3.0.1、2024年12月公開)。AI Profileはモデル・学習データ・プロンプトテンプレート・AIエージェント・ライセンスを文書化する枠組みで、ベンダー調達・規制監査の現場で参照されることが多い標準です。
なお、SPDX 3.0.1はまだISO標準化前であり、ISO/IEC 5962が規定するのは2.2.1である点に留意が必要です。
SPDX 3.0 AI Profileが選ばれる理由は、SPDX系が持つ長年の調達・監査文書のユースケース蓄積と、AI Profileで追加された機械可読なAIメタデータの併用にあります。
EU AI Act Annex IVに対する技術文書化、政府調達プロセス、第三者監査などの文脈では、SPDX系の記述形式がベンダー・政府機関に広く理解されており、AI Profileで追加されたフィールドをその枠組みに乗せられる点が実務的な利点です。CycloneDXと比べると開発者が日常的に扱うSCAツールへの対応は限定的ですが、調達担当者・コンプライアンス部門が参照する文書として採用されやすい設計です。
どちらを選ぶか:両方併用が実務的な正解
以下の表で、CycloneDX ML-BOMとSPDX 3.0 AI Profileの違いを整理しました。
| 項目 | CycloneDX ML-BOM | SPDX 3.0 AI Profile |
|---|---|---|
| 最新バージョン | 1.7(2025年10月公開、ECMA-424 2nd Edition 2025年12月標準化) | 3.0.1(2024年12月) |
| 標準化団体 | OWASP/ECMA International(1.7は2nd Edition標準化済み) | Linux Foundation/ISO/IEC 5962は2.2.1が対象、3.0.1は標準化前 |
| 主な用途 | CI/CD自動化・SCAパイプライン統合 | 調達・監査文書 |
| フォーマット | JSON/XML/Protobuf | JSON-LD/RDF |
| ツールサポート | Snyk・Mend・JFrog・OWASP AIBOM Generator等が広く対応 | 公式リファレンス実装中心 |
| 強み | CI/CDへの統合・開発者フレンドリー | 調達・監査文書で参照されやすい記述形式 |
この比較から見えてくるのは、両者は競合というより役割分担の関係という点です。
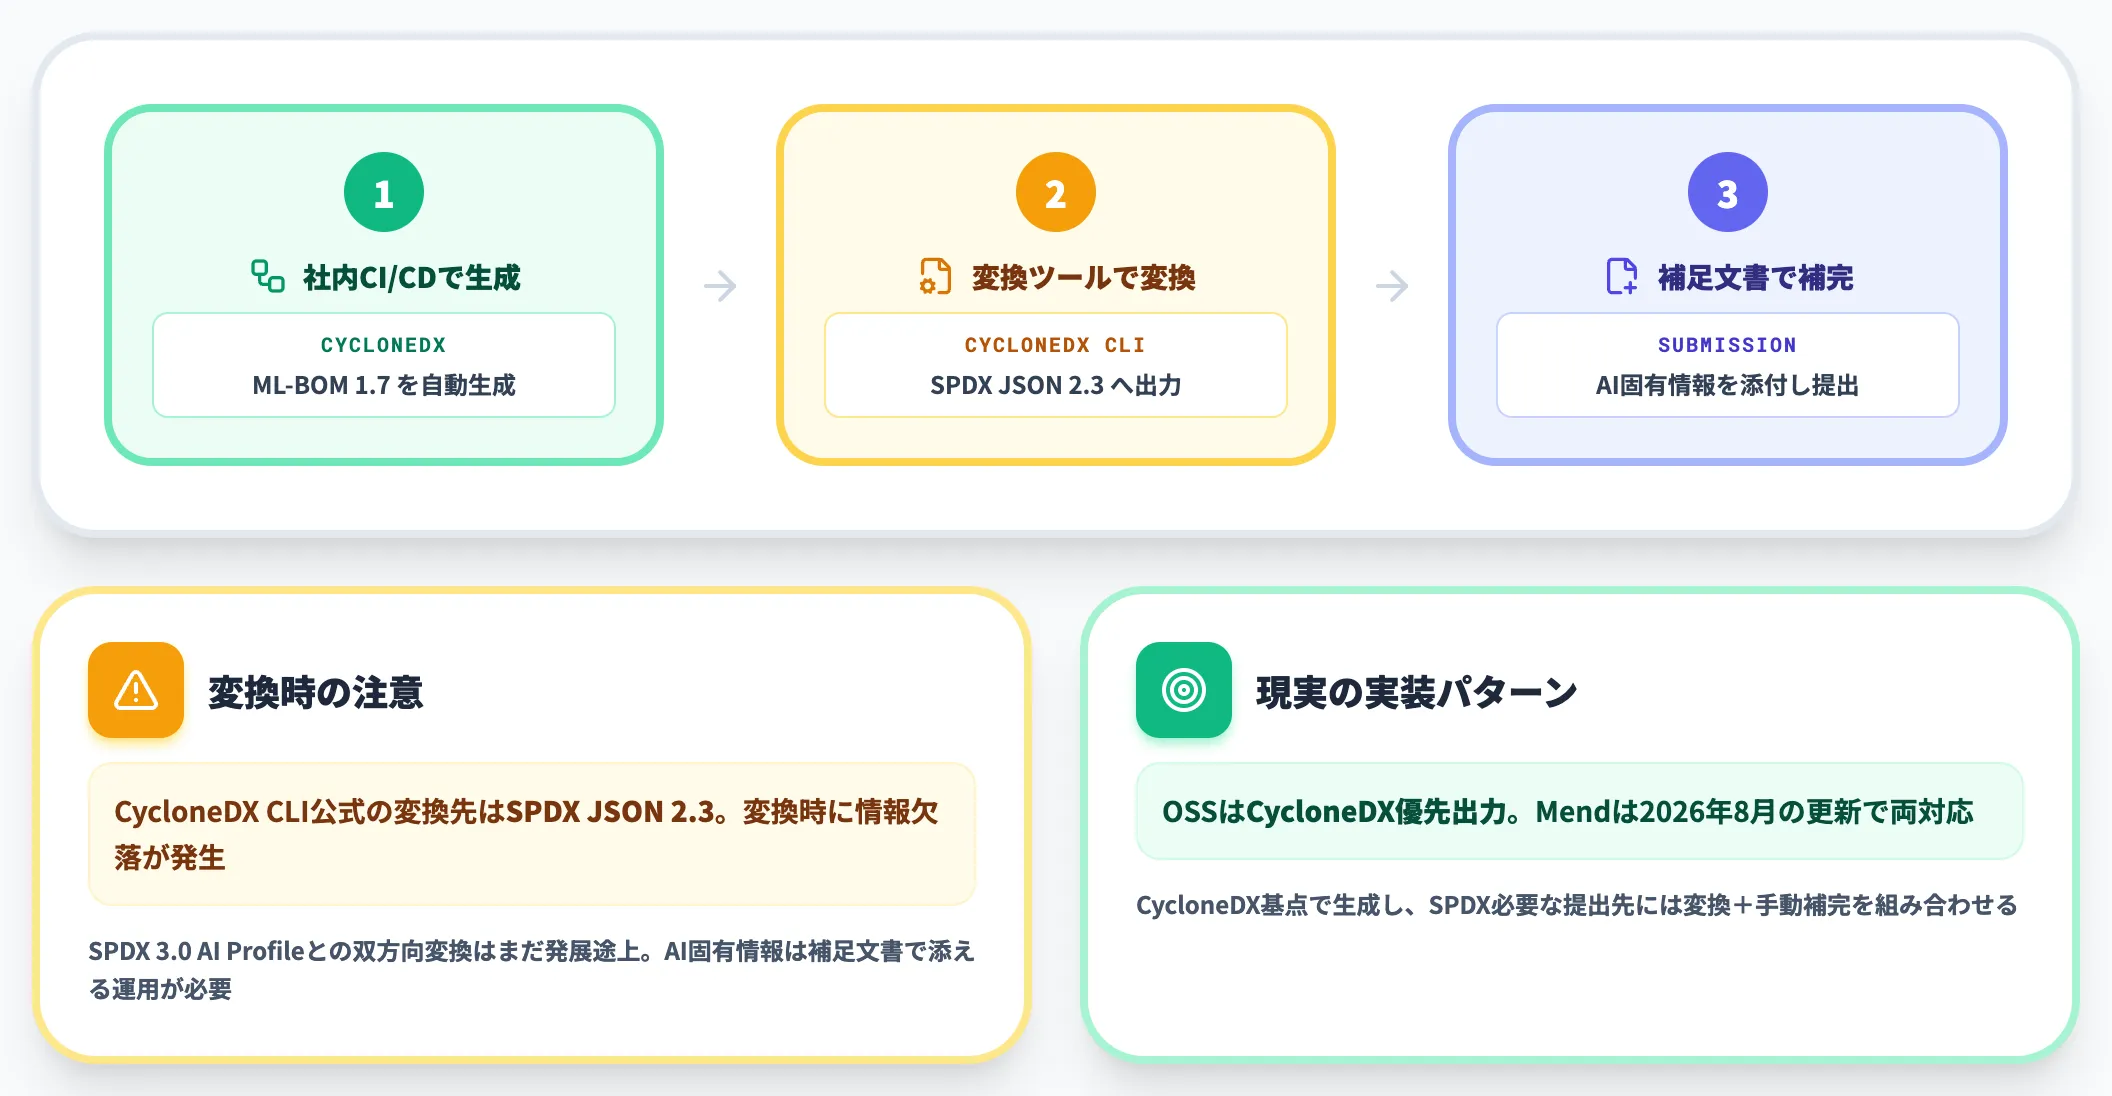
実務的には「社内のCI/CDではCycloneDX ML-BOMで自動生成し、外部ベンダー・政府案件・監査提出時にはSPDX系の記述形式を使う」という併用が現実解になります。
ただしCycloneDX公式CLIによる変換先はSPDX JSON 2.3で、変換時に情報欠落が発生することがCycloneDX CLI公式リポジトリに明記されています。
SPDX 3.0 AI Profileとの双方向変換はまだ発展途上であり、「CycloneDXで作ってSPDX 2.3に変換、AI固有情報は補足文書で添える」運用が2026年10月時点で現実的です。
OWASP AIBOM GeneratorなどのOSSツールはCycloneDXを優先出力する設計で、Mendは2026年8月24日の更新でCycloneDX 1.7・SPDX 3.0.1双方のAI-BOM出力に対応しました。
CycloneDX基点で生成しつつ、SPDX系が必要な提出先には変換ツールと手動補完を組み合わせるのが運用上の現実解です。
AI-SBOMの作り方:OWASP AIBOM Generatorで試す5ステップ
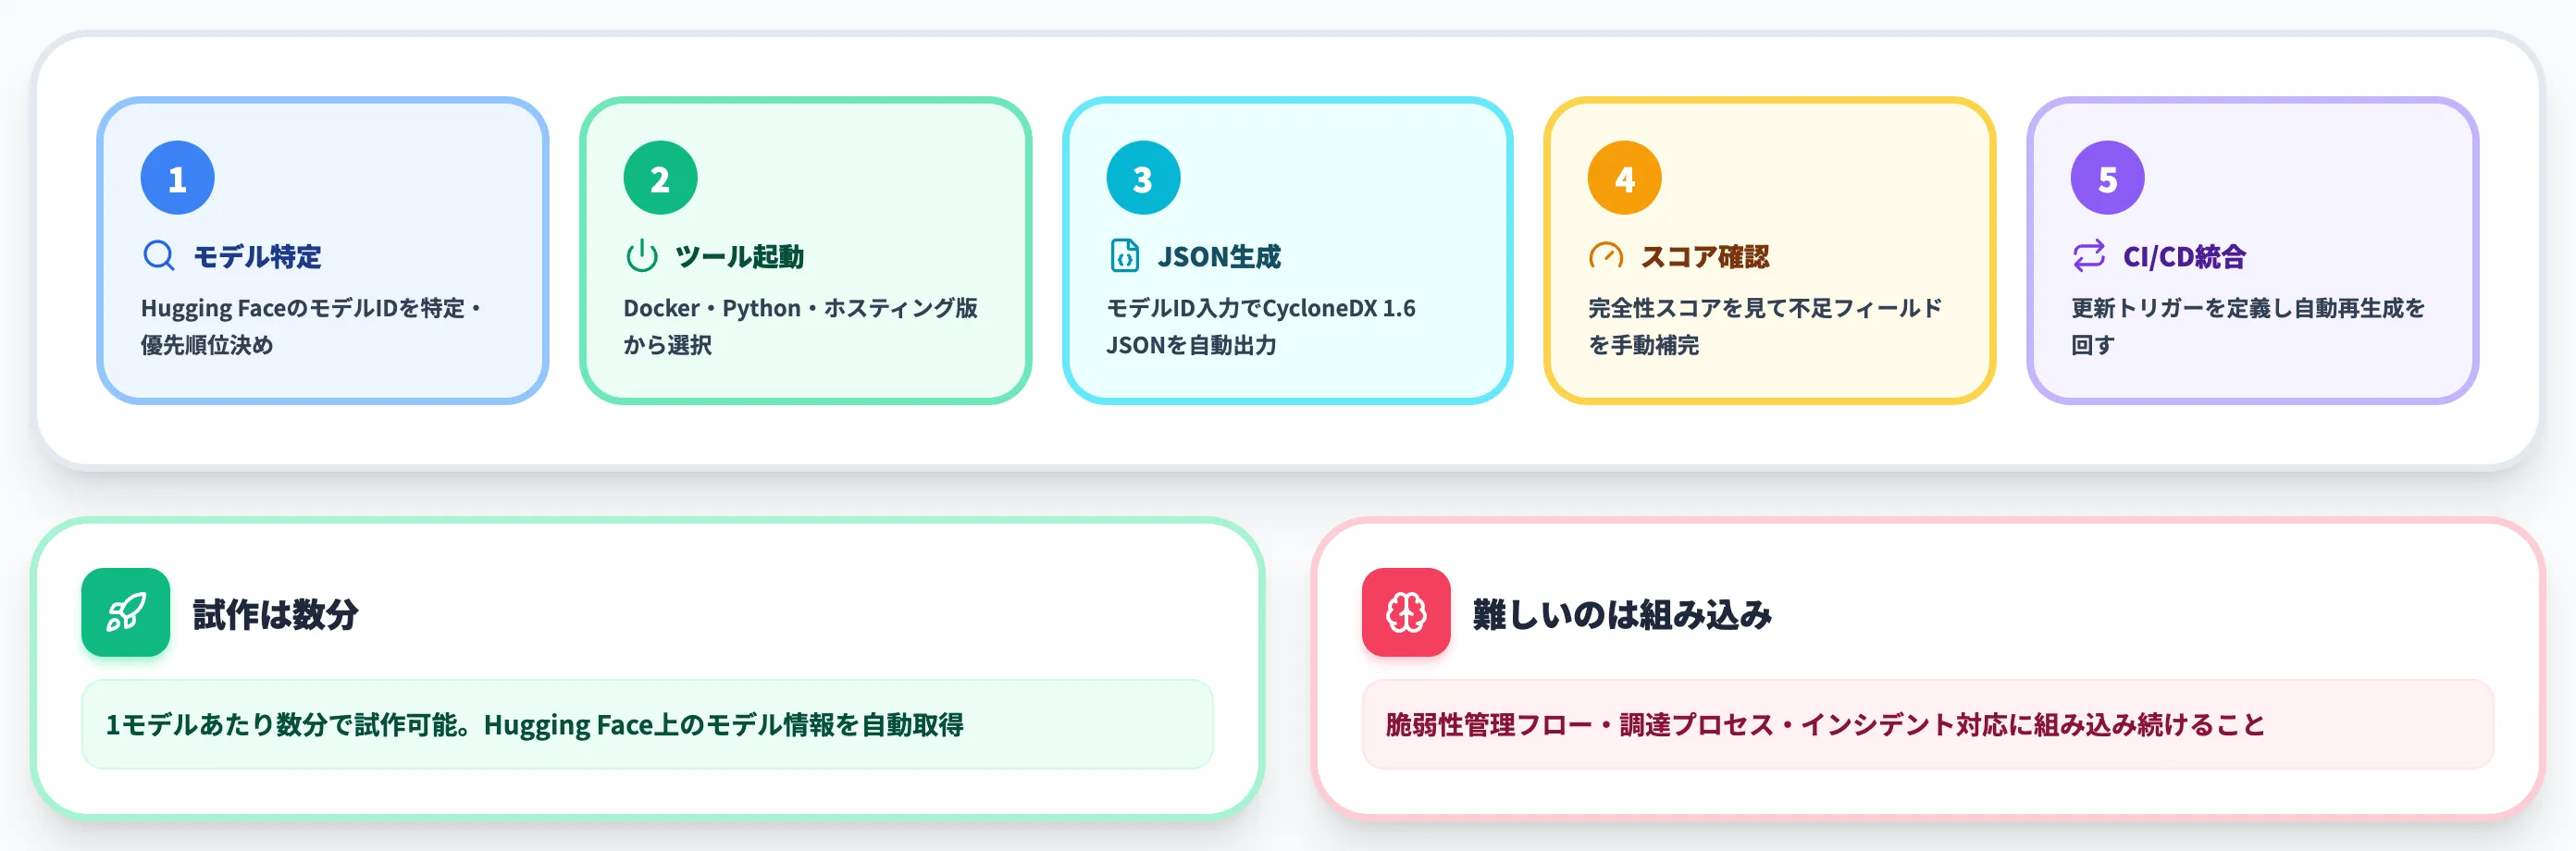
AI-SBOMの試作で最短の経路は、OWASP AIBOM Generatorを使うことです。
OWASP AIBOM Generatorは、Hugging Face上のモデル情報を読み込み、CycloneDX 1.6 JSON形式のAI-SBOMを自動生成するOSSツールです。2025年のRSAC(世界的なセキュリティ会議)で発表され、2025年12月17日にOWASP GenAI Security Projectへ正式に寄贈されています。
1.対象モデルを選び、Hugging FaceのモデルIDを特定する
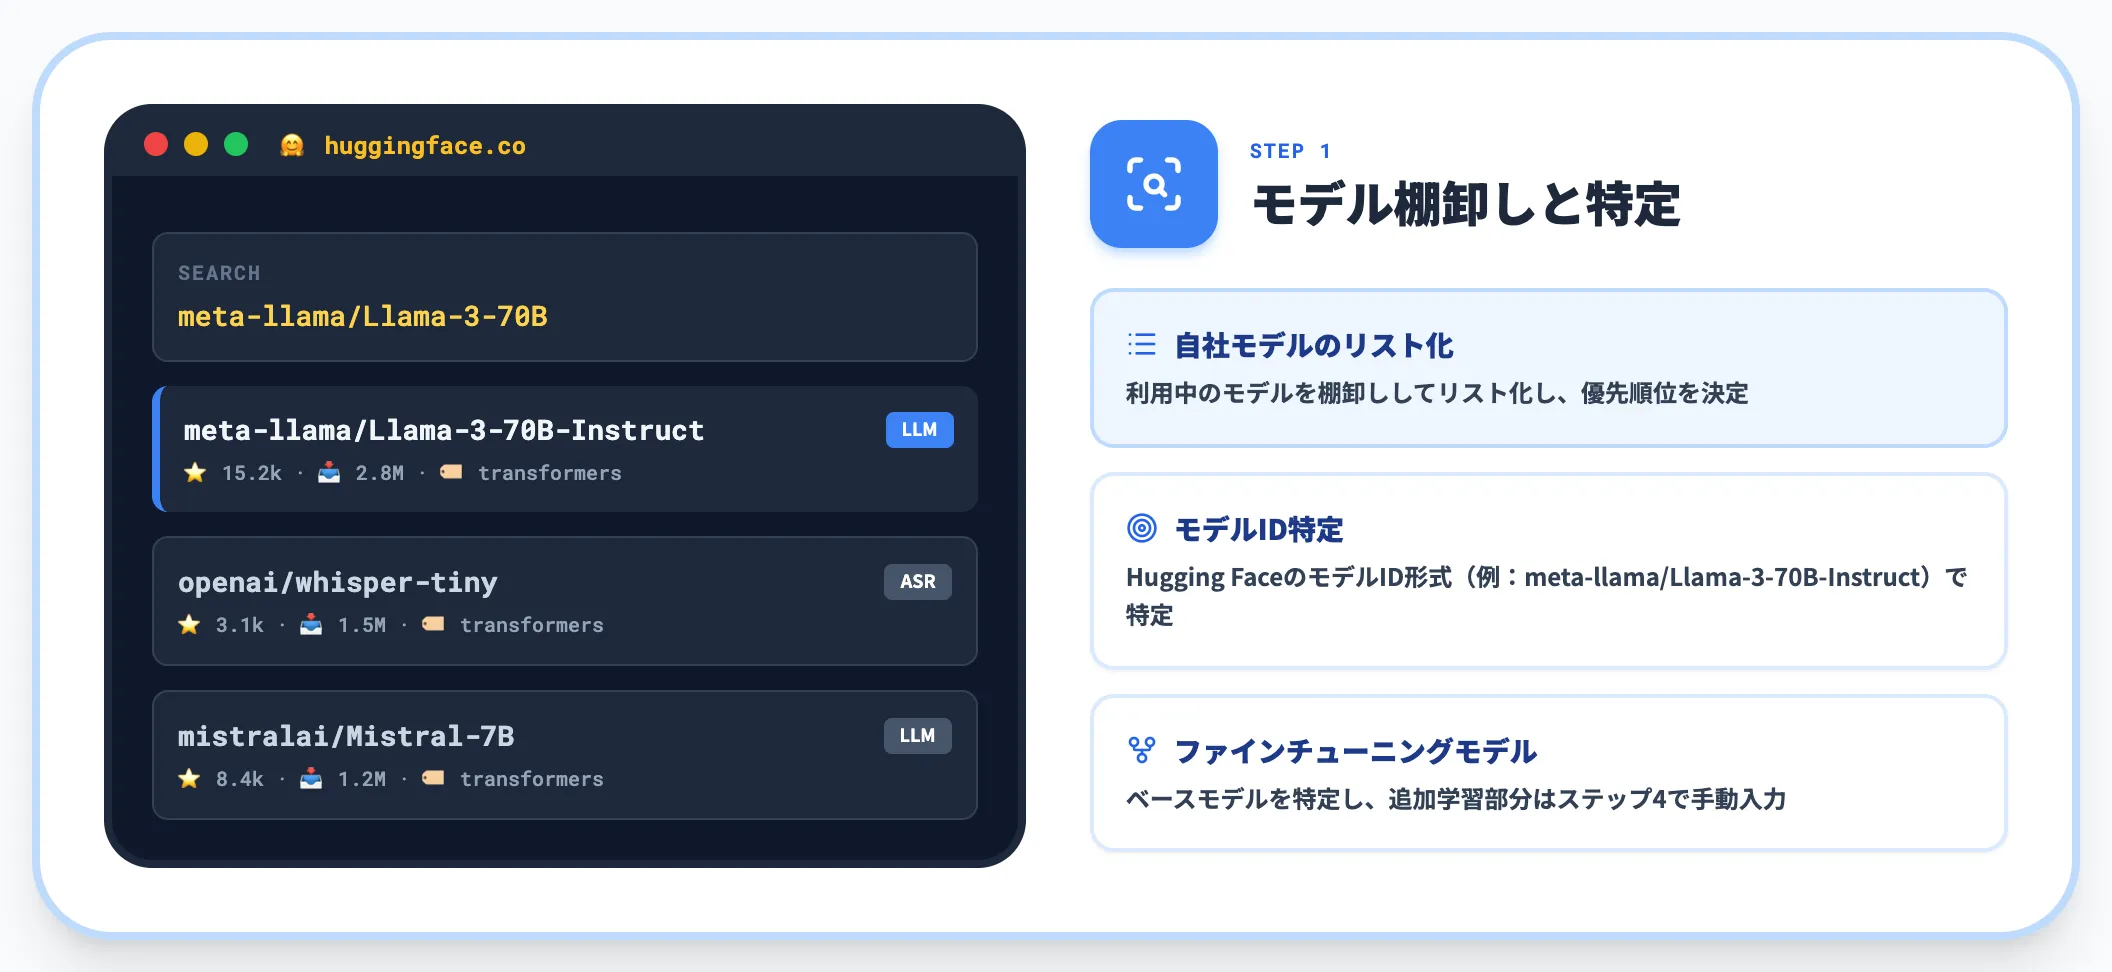
AI-SBOMの対象になるモデルを選び、Hugging FaceのモデルID(例:meta-llama/Llama-3-70B-Instruct)を特定します。
自社で利用中のモデルを棚卸ししてリスト化し、優先順位をつけて1モデルずつ生成する流れが現実的です。社内環境でファインチューニングしたモデルの場合はベースモデルをHugging Face上で特定し、追加学習部分は後述のステップ4で手動入力します。
2.OWASP AIBOM Generatorを起動する
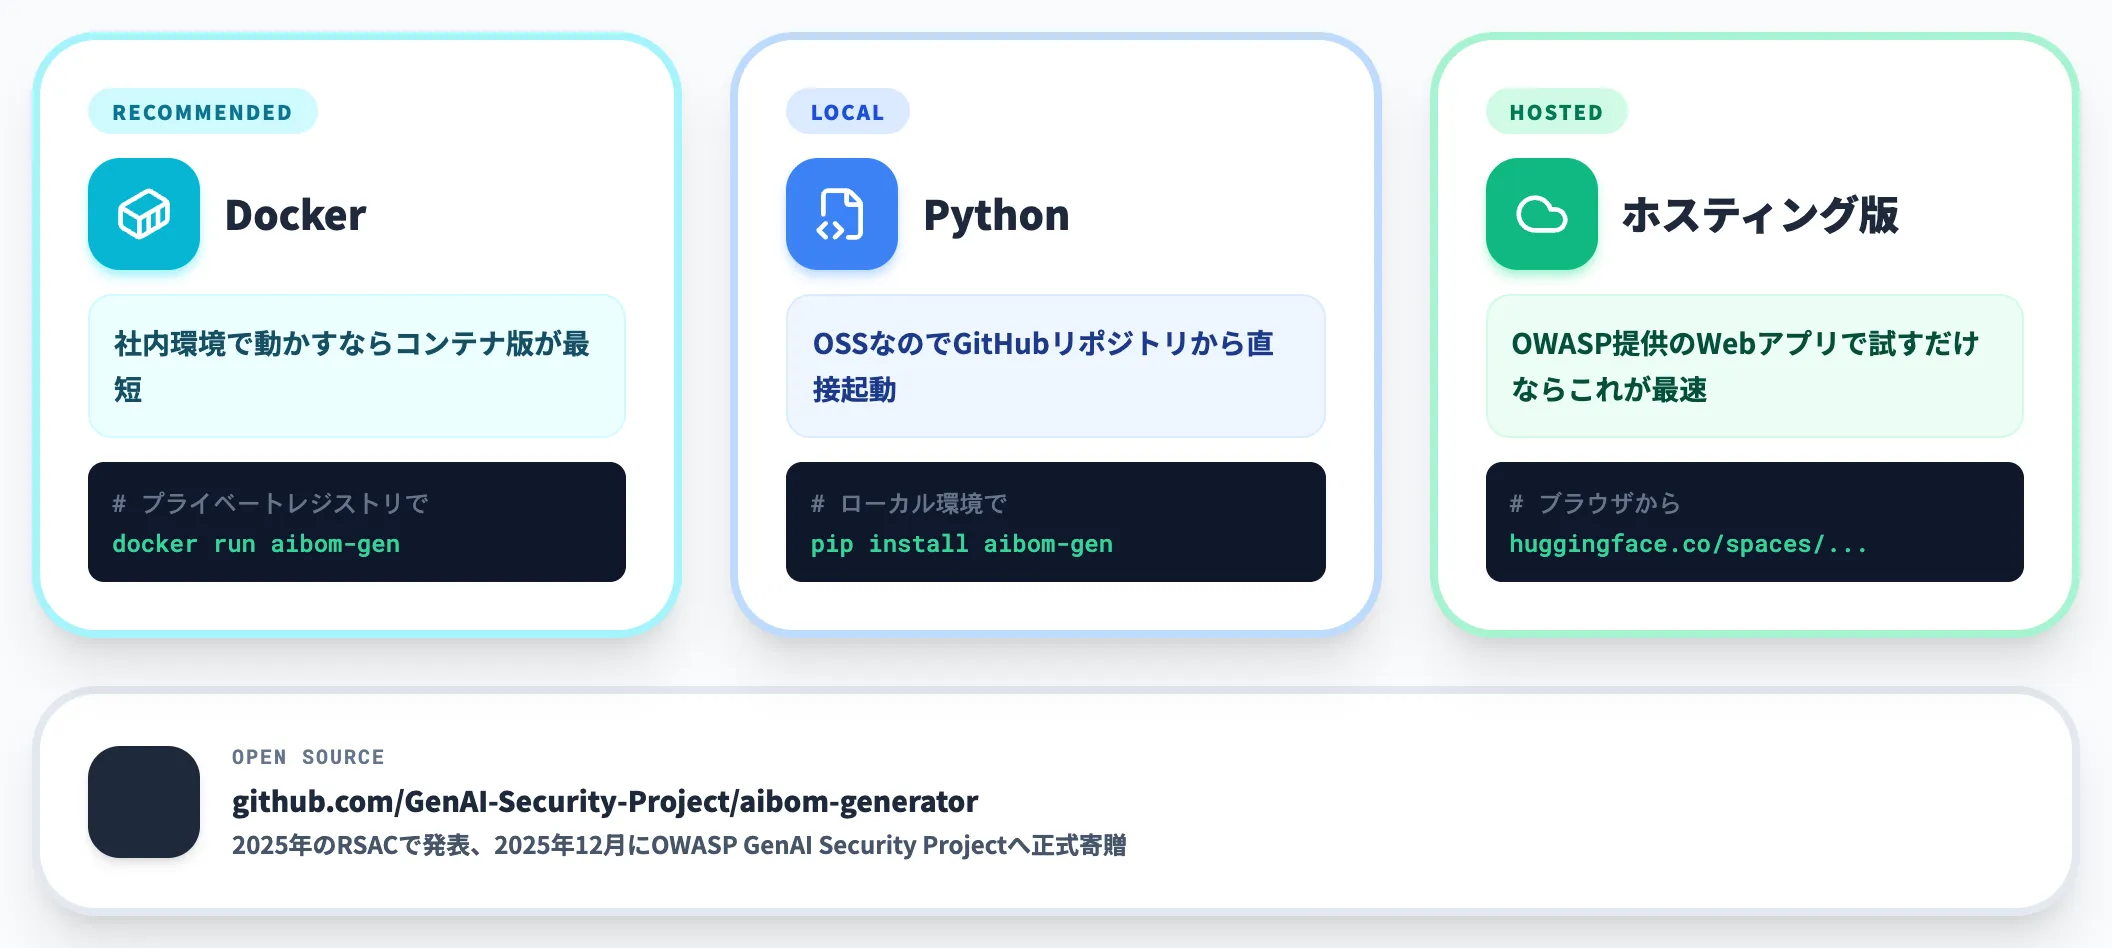
OWASP AIBOM Generatorは、OSSとしてGitHubリポジトリで公開されており、PythonやDockerでローカル起動できます。
社内環境で動かす場合はコンテナ版を使うのが最短で、プライベートレジストリに置いたコンテナを継続的に実行する構成にすれば、Hugging Face上のモデル情報を定期的に取り込める運用になります。クラウドで試すだけならOWASPが提供するホスティング版もあります。
3.モデルIDを入力してCycloneDX JSONを生成する
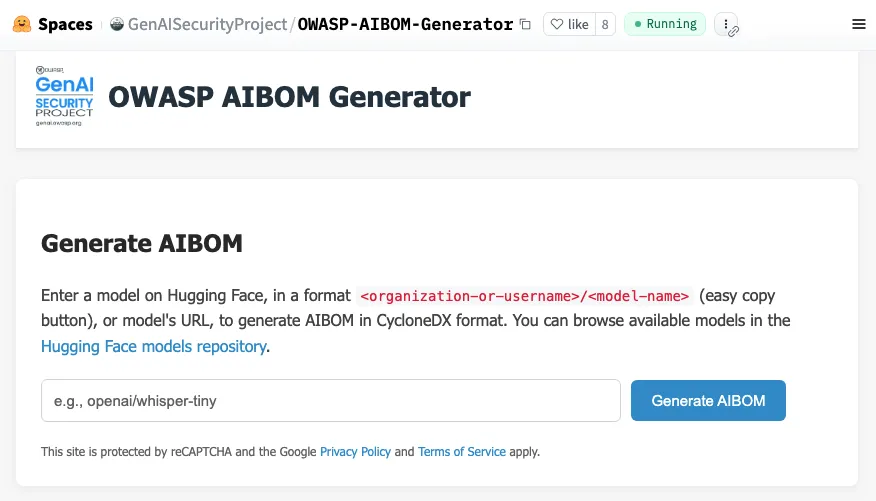
OWASP AIBOM Generator(Hugging Face Space)のモデルID入力画面(出典:OWASP GenAI Security Project)
画面中央の入力欄にHugging FaceのモデルID(例: openai/whisper-tiny)を入れて「Generate AIBOM」ボタンを押すだけで生成が始まります。対象モデルのIDを入力すると、OWASP AIBOM GeneratorがHugging Face上のモデルカード・ライセンス・データセット情報を自動取得し、CycloneDX 1.6形式のJSONを出力します。
このJSONには、モデル名・バージョン・ベースモデル・ライセンス・著者・学習データ参照・性能メトリクスなどが含まれます。モデル提供者が公開していないフィールドは空欄のままですが、埋まったフィールドだけで一次的なAI-SBOMとして成立します。
4.完全性スコアを確認し、不足フィールドを埋める
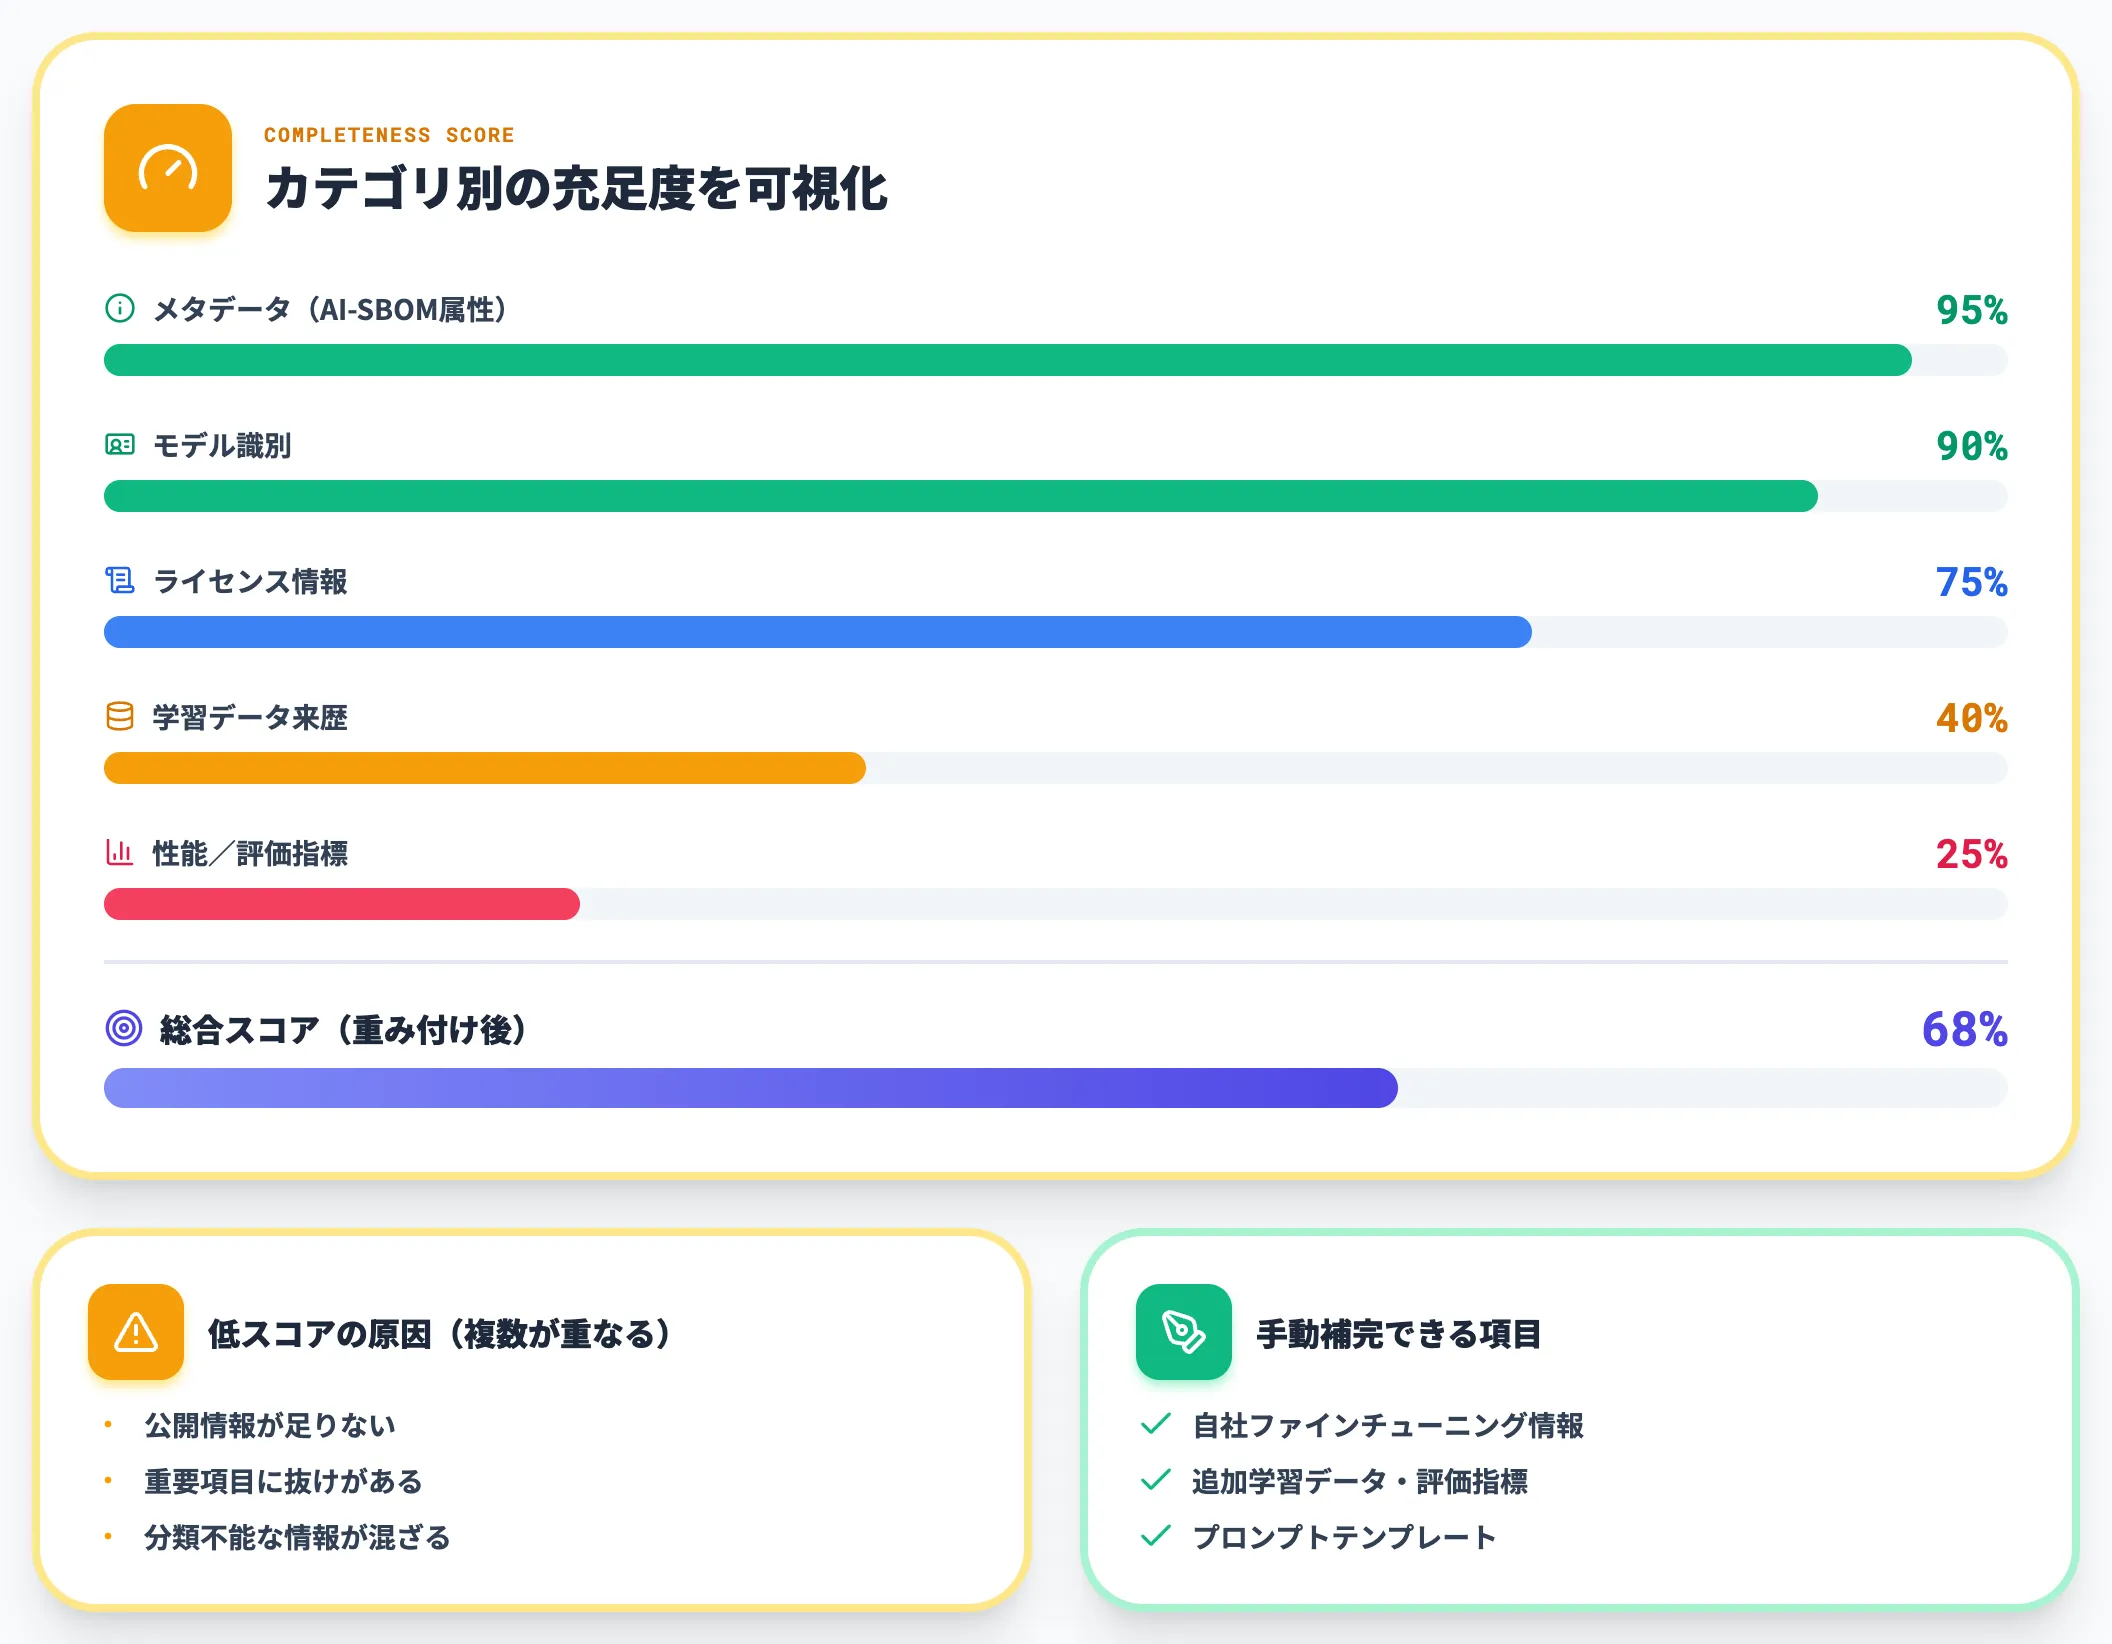
OWASP AIBOM Generatorは、生成したAI-SBOMの完全性スコアを自動で算出します。
このスコアは公式実装上、ツールが定義する項目群の充足度にカテゴリ別の重み付けと欠落項目の減点を適用した値です。単純な「埋まっているフィールドの百分率」ではないため、低スコアは「公開情報が足りない」「ツールの重要項目に抜けがある」「分類不能な情報が混ざっている」など複数の原因が重なった結果と解釈するのが正確です。モデル提供者の情報公開不足だけに還元せず、スコアの内訳(どのカテゴリで減点されたか)を見た上で、自社ファインチューニング部分や社内で把握している追加学習データ・評価指標・プロンプトテンプレートなどを手動で追記して完全性を上げます。
5.CI/CDパイプラインに組み込み、更新サイクルを定義する
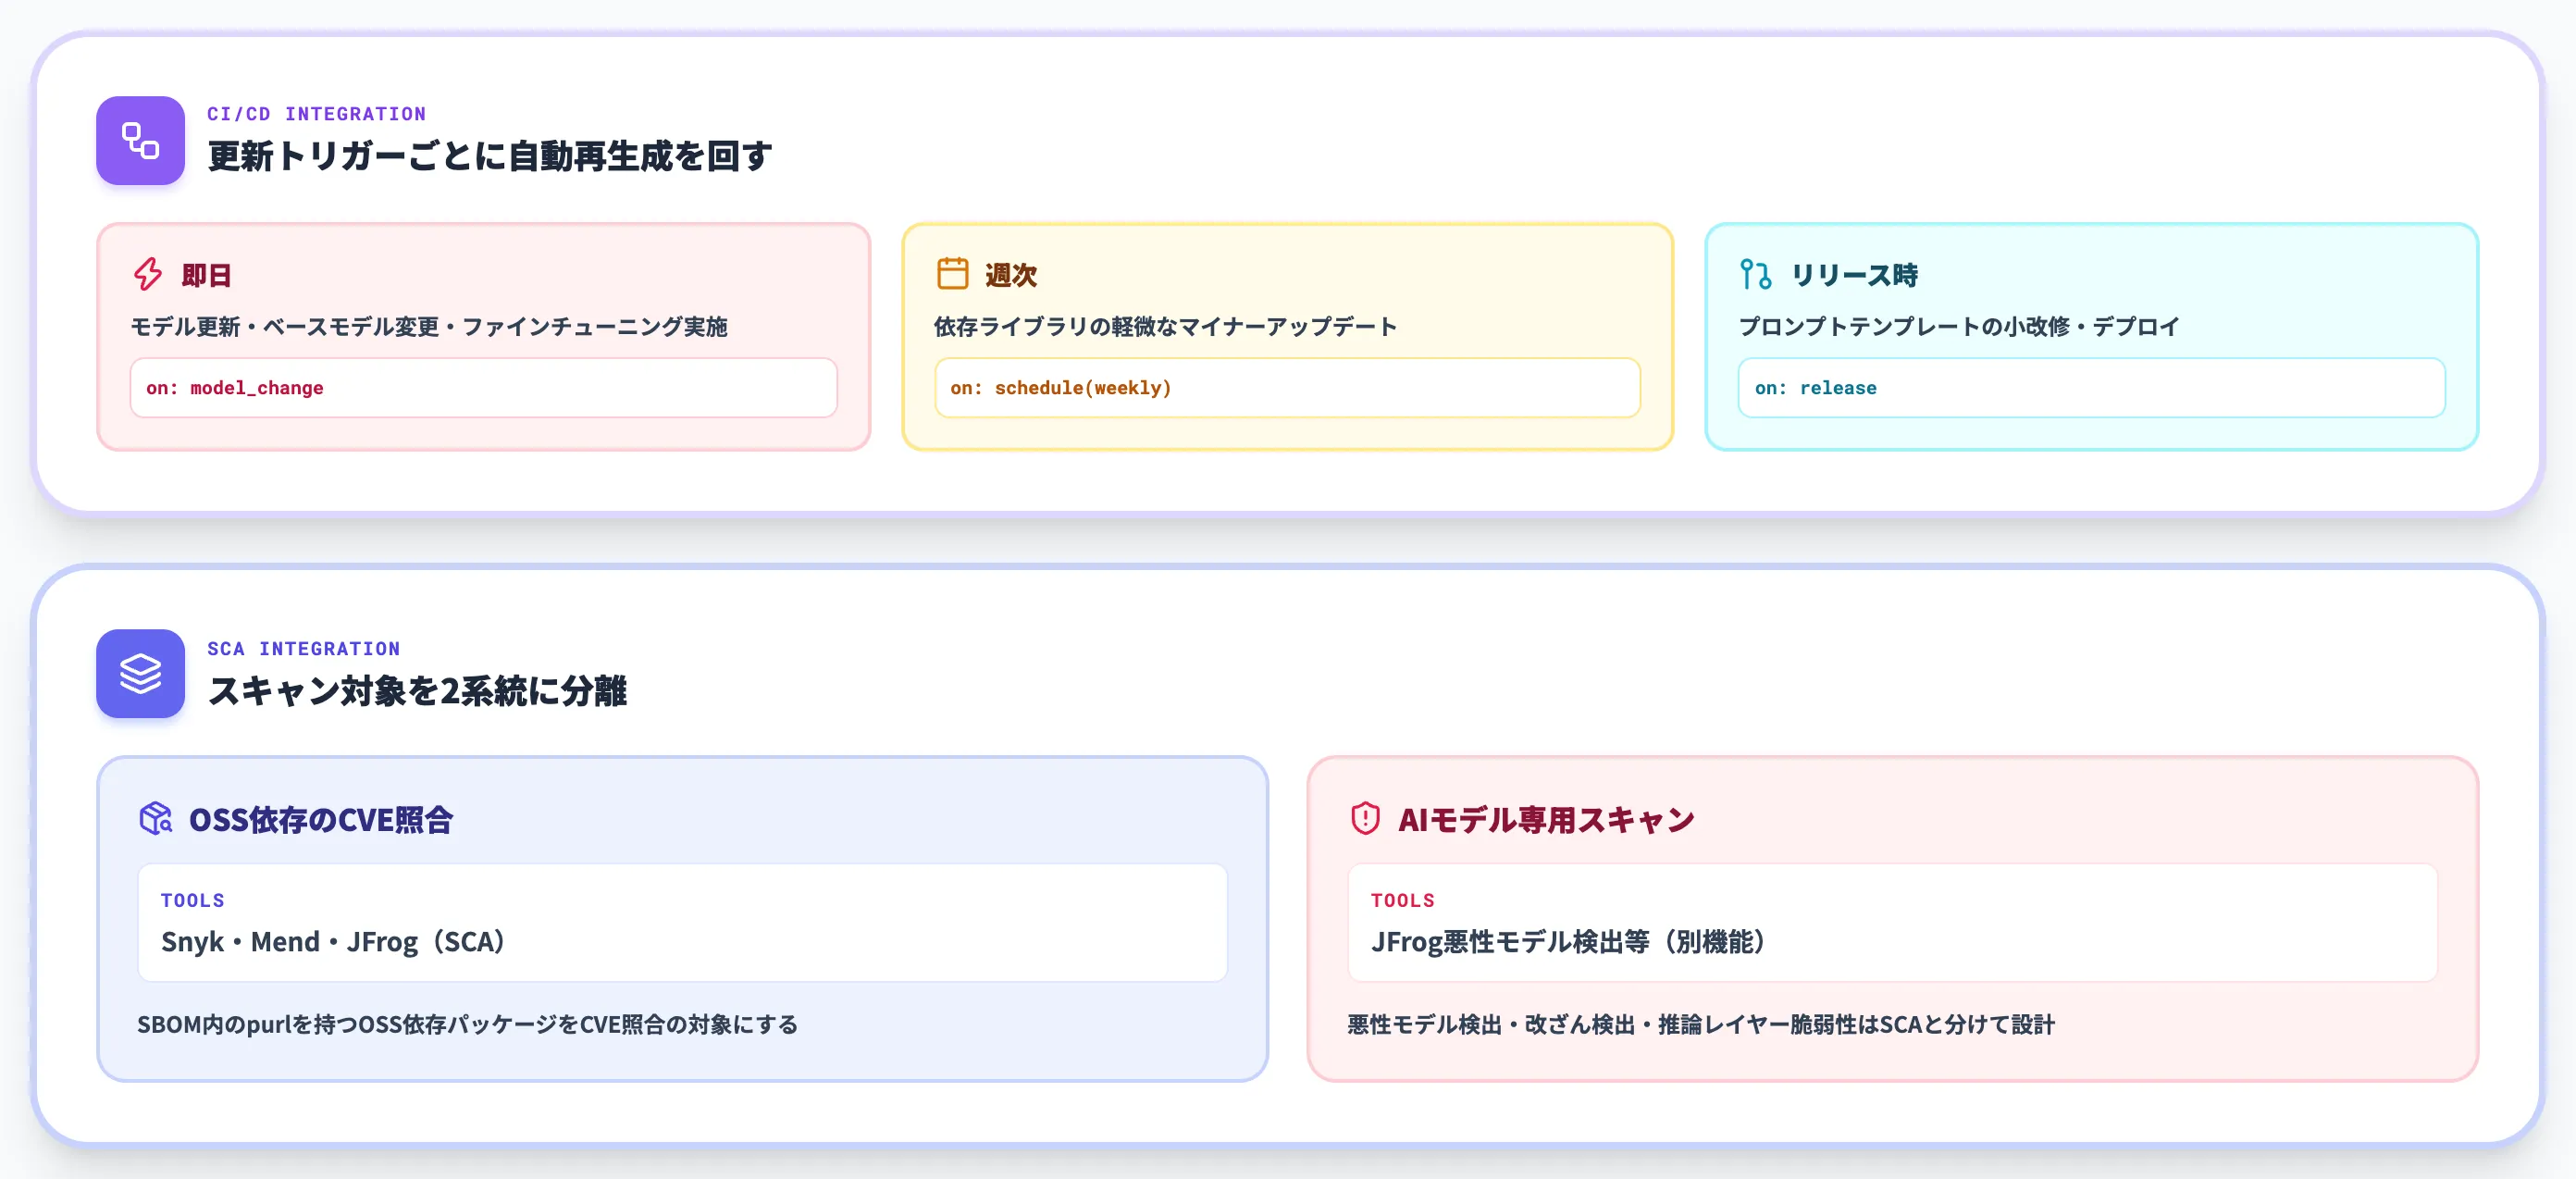
試作が完了したら、CI/CDに組み込んでモデル更新時・依存ライブラリ更新時・ファインチューニング実施時にAI-SBOMを自動再生成する運用に移行します。
生成されたAI-SBOMは、Snyk・Mend・JFrogなどのSCAツールに取り込み、SBOM内に含まれる対応するpurlを持つOSS依存パッケージをCVE照合の対象にします。
AIモデル自体の脆弱性スキャン(悪性モデル検出・モデル改ざん検出・推論レイヤーの脆弱性)はSCAのパッケージスキャンとは別機能で、JFrogの悪性モデル検出など、各製品の対応機能に分けて設計する必要があります。更新頻度は「モデルを更新したら即日」「依存ライブラリの定期スキャンに合わせて週次」のように、変更の種類ごとに設定するのが実務的です。
この5ステップで、Hugging Face上のモデルに対するAI-SBOMは1モデルあたり数分で試作できます。難しいのは「作ること」ではなく、生成したAI-SBOMを脆弱性管理フロー・調達プロセス・インシデント対応に組み込んで使い続けることです。
OWASP AIBOM Generator自体の制約として、プライベートモデル・プロンプトテンプレート・AIエージェント構成の全体像までは自動取得できません。これらは手動入力か、後述の商用ツール(Snyk・Mend等)での補完が必要になります。
AI-SBOM対応ツール比較:OSS・SCA統合・AIBOMプラットフォームの3系統
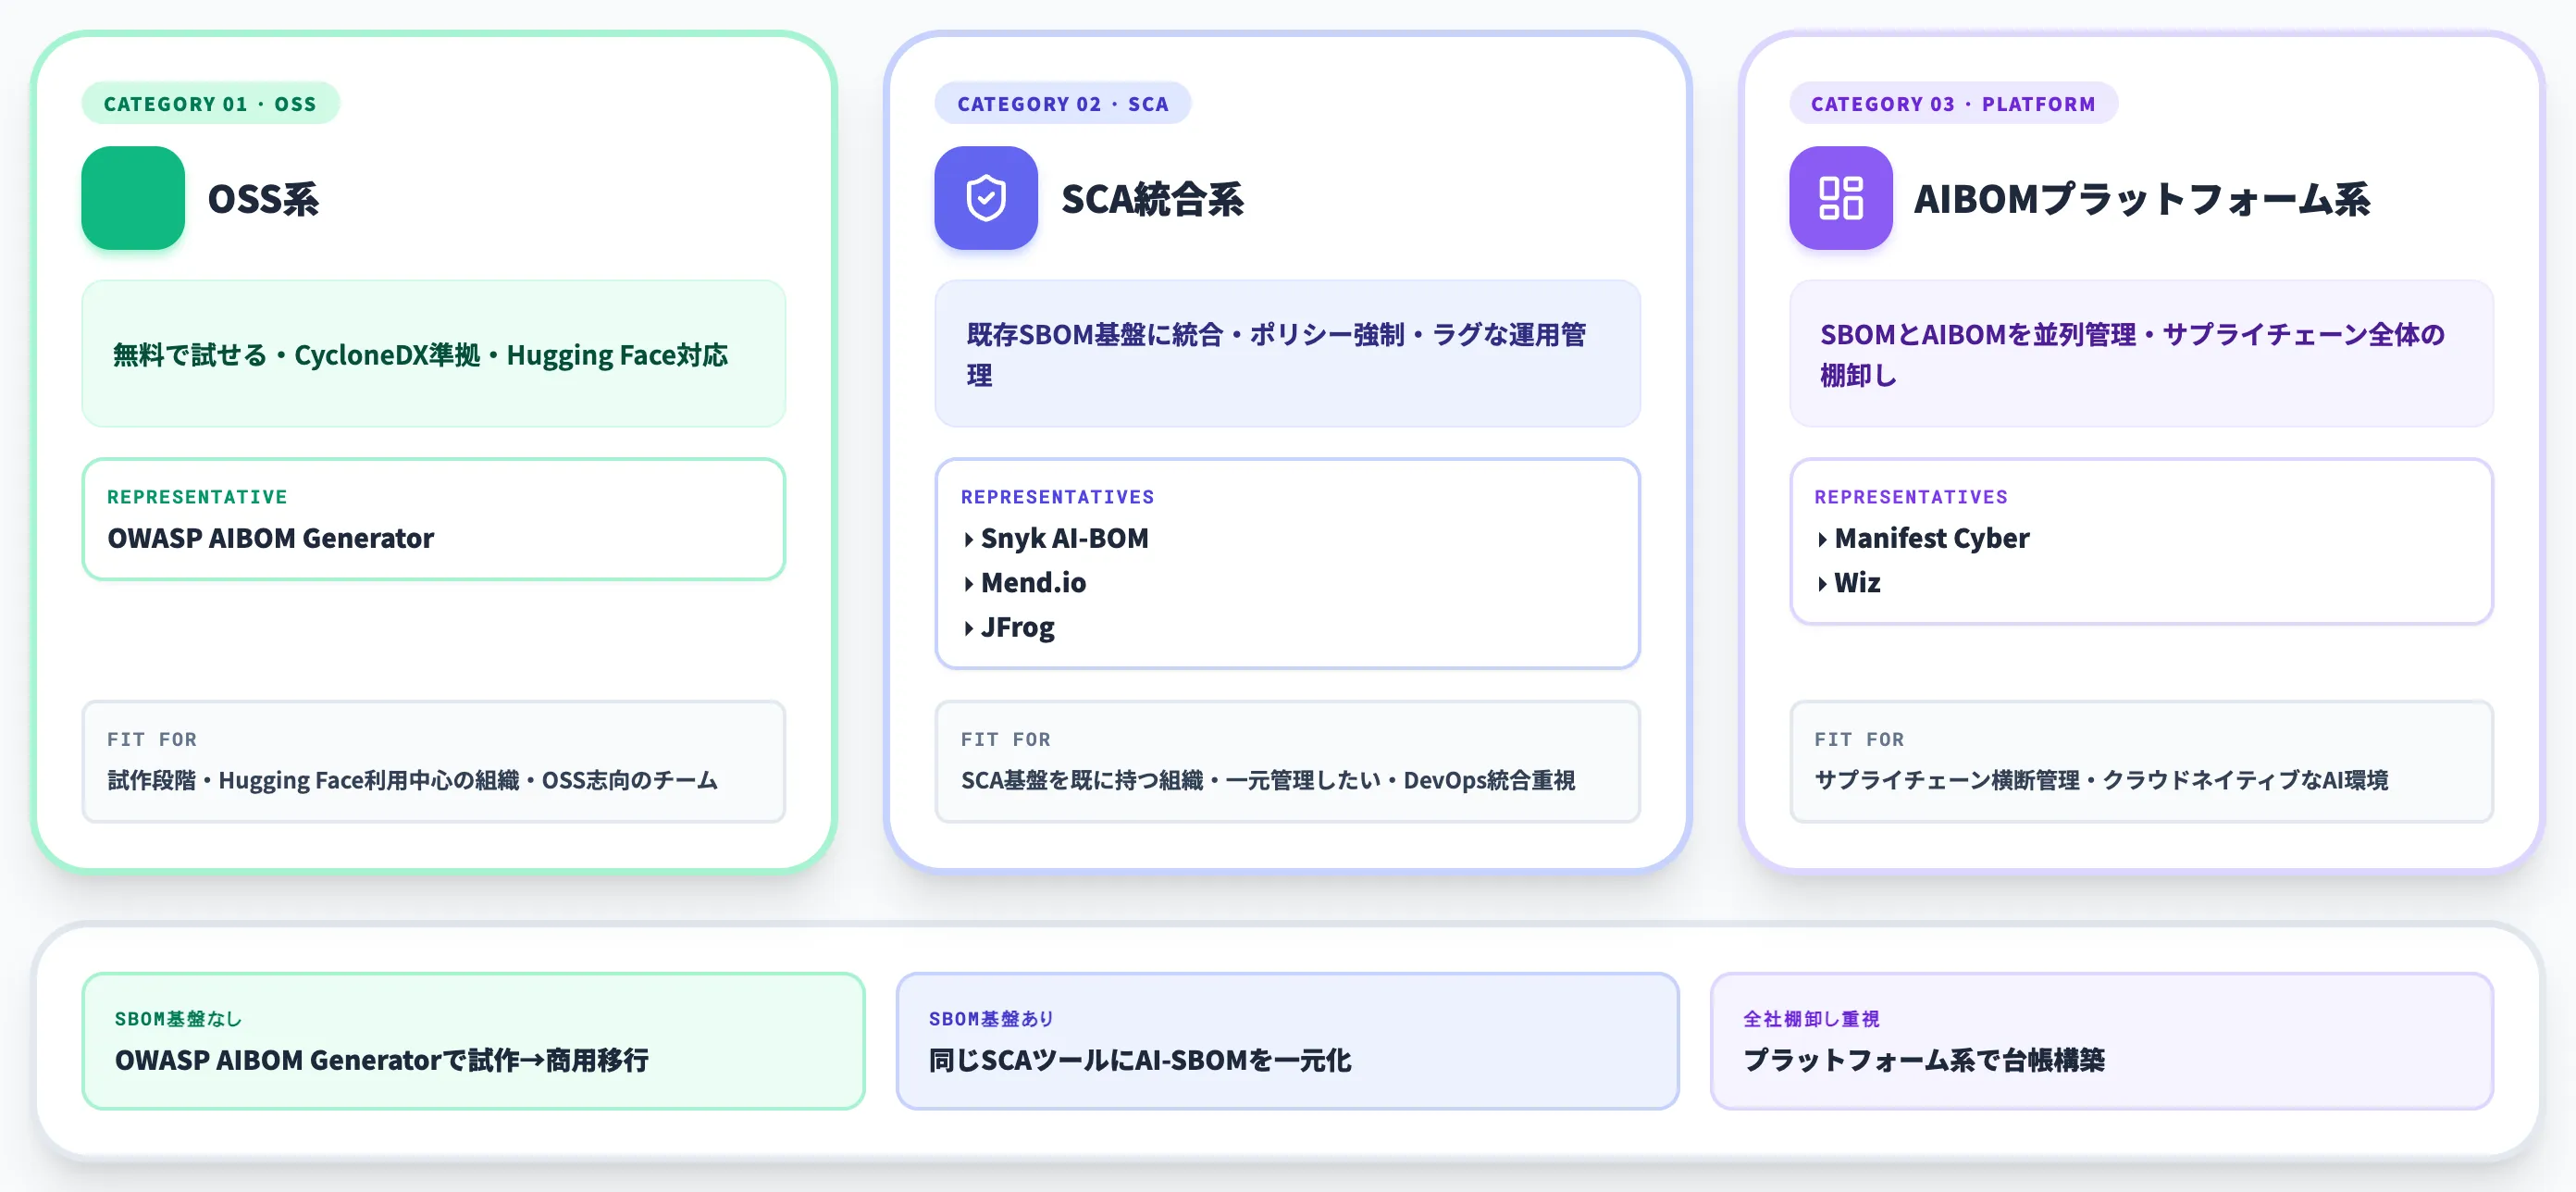
AI-SBOMの生成・管理ツールは、2026年時点で大きく3系統に分かれます。
- OSS系(OWASP AIBOM Generator等)
- SCA統合系(Snyk AI-BOM・Mend.io・JFrog等)
- AIBOMプラットフォーム系(Manifest Cyber・Wiz等)
以下の表で、代表的なツールの立ち位置を整理しました。
| 系統 | 代表ツール | 強み | 向いているケース |
|---|---|---|---|
| OSS系 | OWASP AIBOM Generator | 無料で試せる・CycloneDX準拠・Hugging Face対応 | 試作段階・Hugging Face利用中心の組織・OSS志向のチーム |
| SCA統合系 | Snyk AI-BOM | snyk aibom CLIで既存SCA基盤と統合・MCP接続可視化・Python/Java/JavaScript/Go対応 | 対応言語のプロジェクト中心・Snykを既に使っている組織 |
| SCA統合系 | Mend.io | モデル・AIエージェント・RAG・MCPを自動検出・2026年8月24日の更新でCycloneDX 1.7・SPDX 3.0.1でのAI-BOM出力に対応 | SCAと一元管理したい組織・ポリシー強制を効かせたい場合 |
| SCA統合系 | JFrog | Xray/Artifactoryとの統合・悪性モデル検出とCVE検出を分けて扱う設計 | DevOps基盤をJFrogで統一している組織 |
| AIBOMプラットフォーム系 | Manifest Cyber | SBOMとAIBOMを統合管理するプラットフォーム・多様なソースからの自動収集 | SBOM/AIBOMを並列に扱いたい・サプライチェーン全体の棚卸し重視 |
| AIBOMプラットフォーム系 | Wiz | クラウドセキュリティ製品にAI-BOMを統合・AIサービスの推論環境まで可視化 | クラウドネイティブなAI環境・Wizを既に使っている組織 |
この表から見える選定の実務的な正解は、「既存のSBOM基盤やSCAツールがあるかどうか」で分岐する点です。
Snyk・Mend・JFrogをすでに使っている組織なら、同じツール上でAI-SBOMを一元管理するのが運用負荷を最小化できます。
SCA基盤がない中小企業や、AIを本格的に扱い始めたばかりの組織であれば、まずはOWASP AIBOM Generatorで試作→必要に応じて商用ツールへ移行する順序が現実的です。
AIBOMプラットフォーム系のManifest Cyberは、SBOMとAIBOMを並列に扱えるプラットフォーム設計で、「SBOM/AIBOMを独立したガバナンス領域として管理したい」「サプライチェーン全体の棚卸しを横断的にやりたい」ケースに向きます。
Wizはクラウドセキュリティ製品のAI-BOM統合機能で、クラウド上のAIサービス運用に強みがあります。SCA統合系とは併用可能で、「SCA基盤で日常的なスキャンを回しつつ、プラットフォーム側で全社の棚卸し台帳を作る」といった役割分担も現実の選択肢です。
重要なのは、どのツールを選んでも「AI-SBOMを生成した後、脆弱性管理・調達・インシデント対応にどう組み込むか」のプロセス設計の方が難しい点です。ツール選定自体は「既存基盤に合わせる」で8割決まるので、組み込み設計に時間を割いた方が実装の成功率は上がります。
日本の規制動向:経産省・NCO(国家サイバー統括室)の国際ガイダンス共同署名
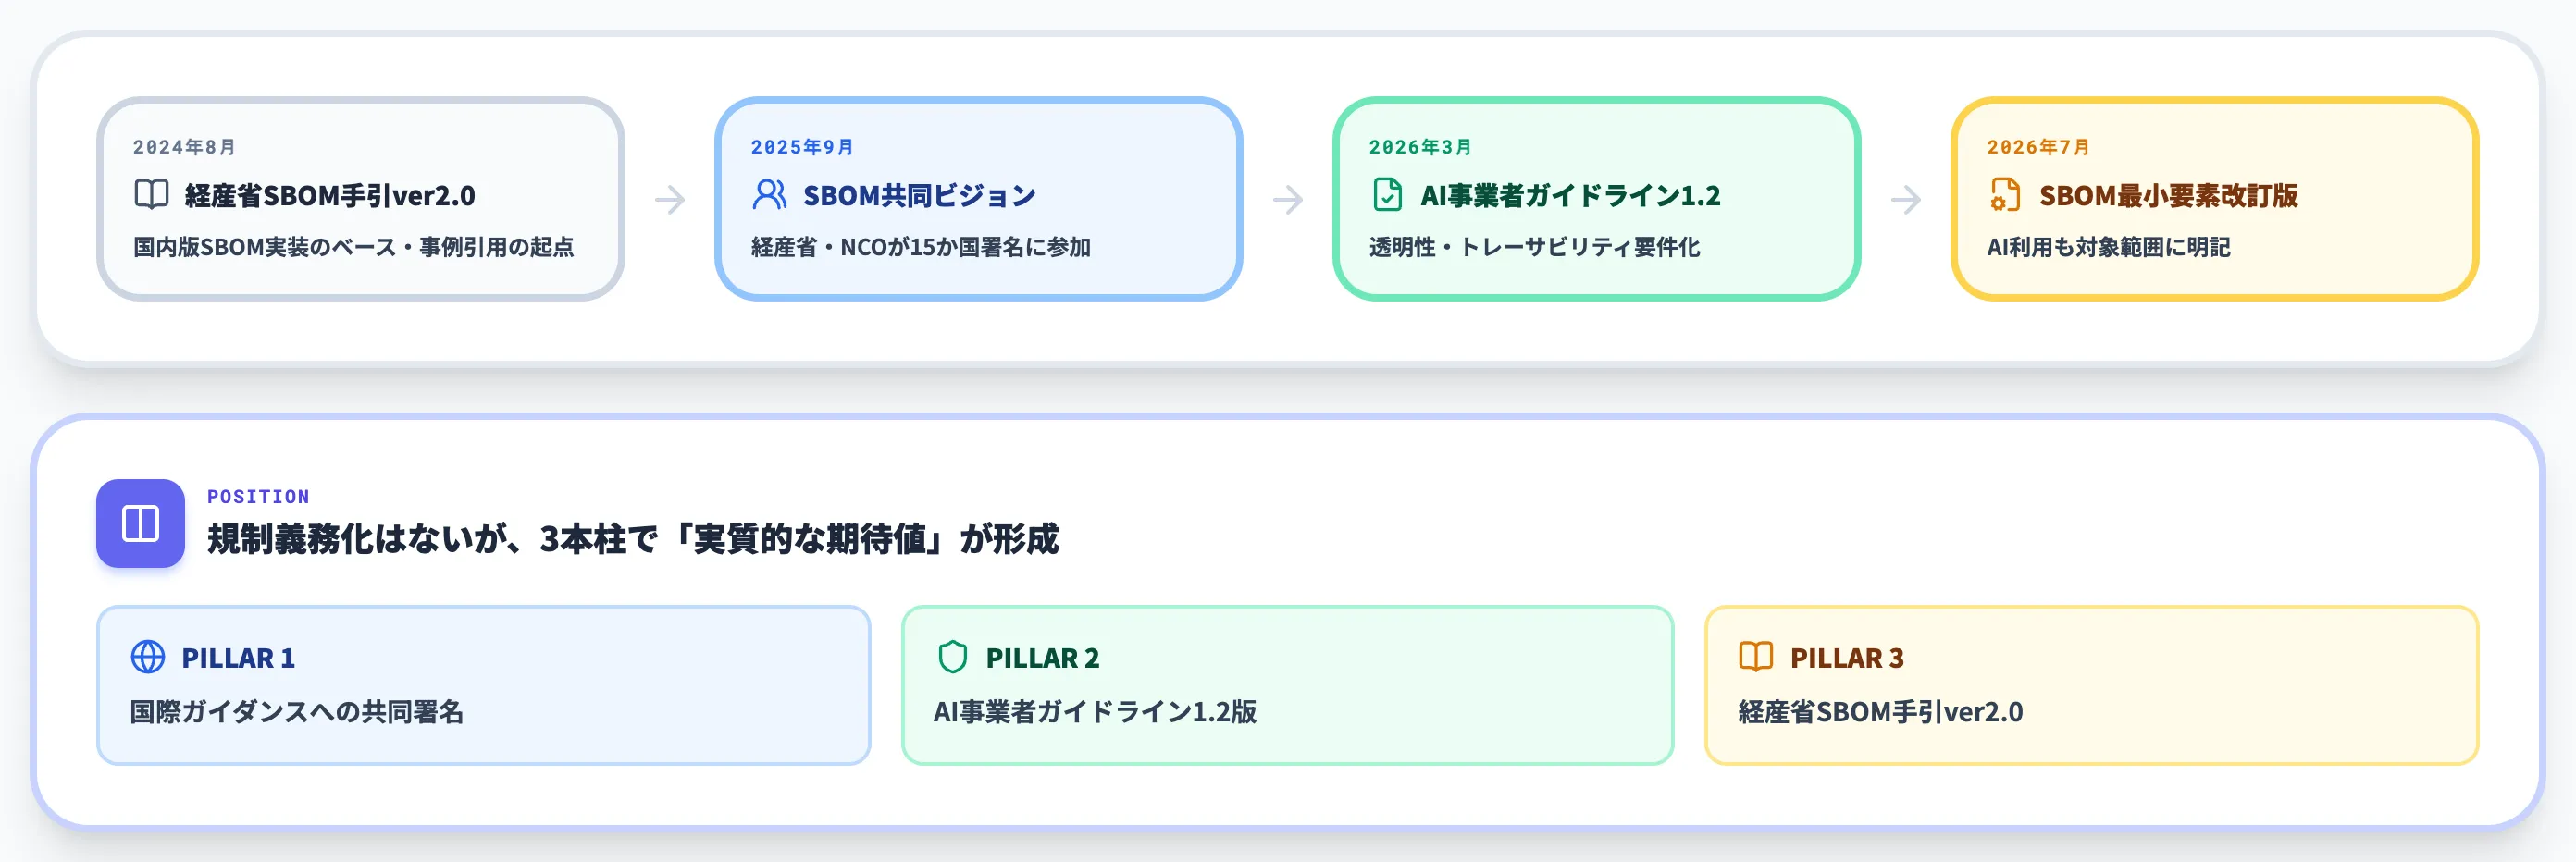
日本国内のAI-SBOM動向は、経済産業省と内閣官房国家サイバー統括室(NCO、National Cybersecurity Office)が主導する国際ガイダンス共同署名の流れに沿って進んでいます。NCOは2025年7月1日に発足し、旧NISC(内閣サイバーセキュリティセンター)の機能を引き継ぎ強化した組織です。
2025年9月:SBOM共同ビジョン国際ガイダンスに15か国で署名
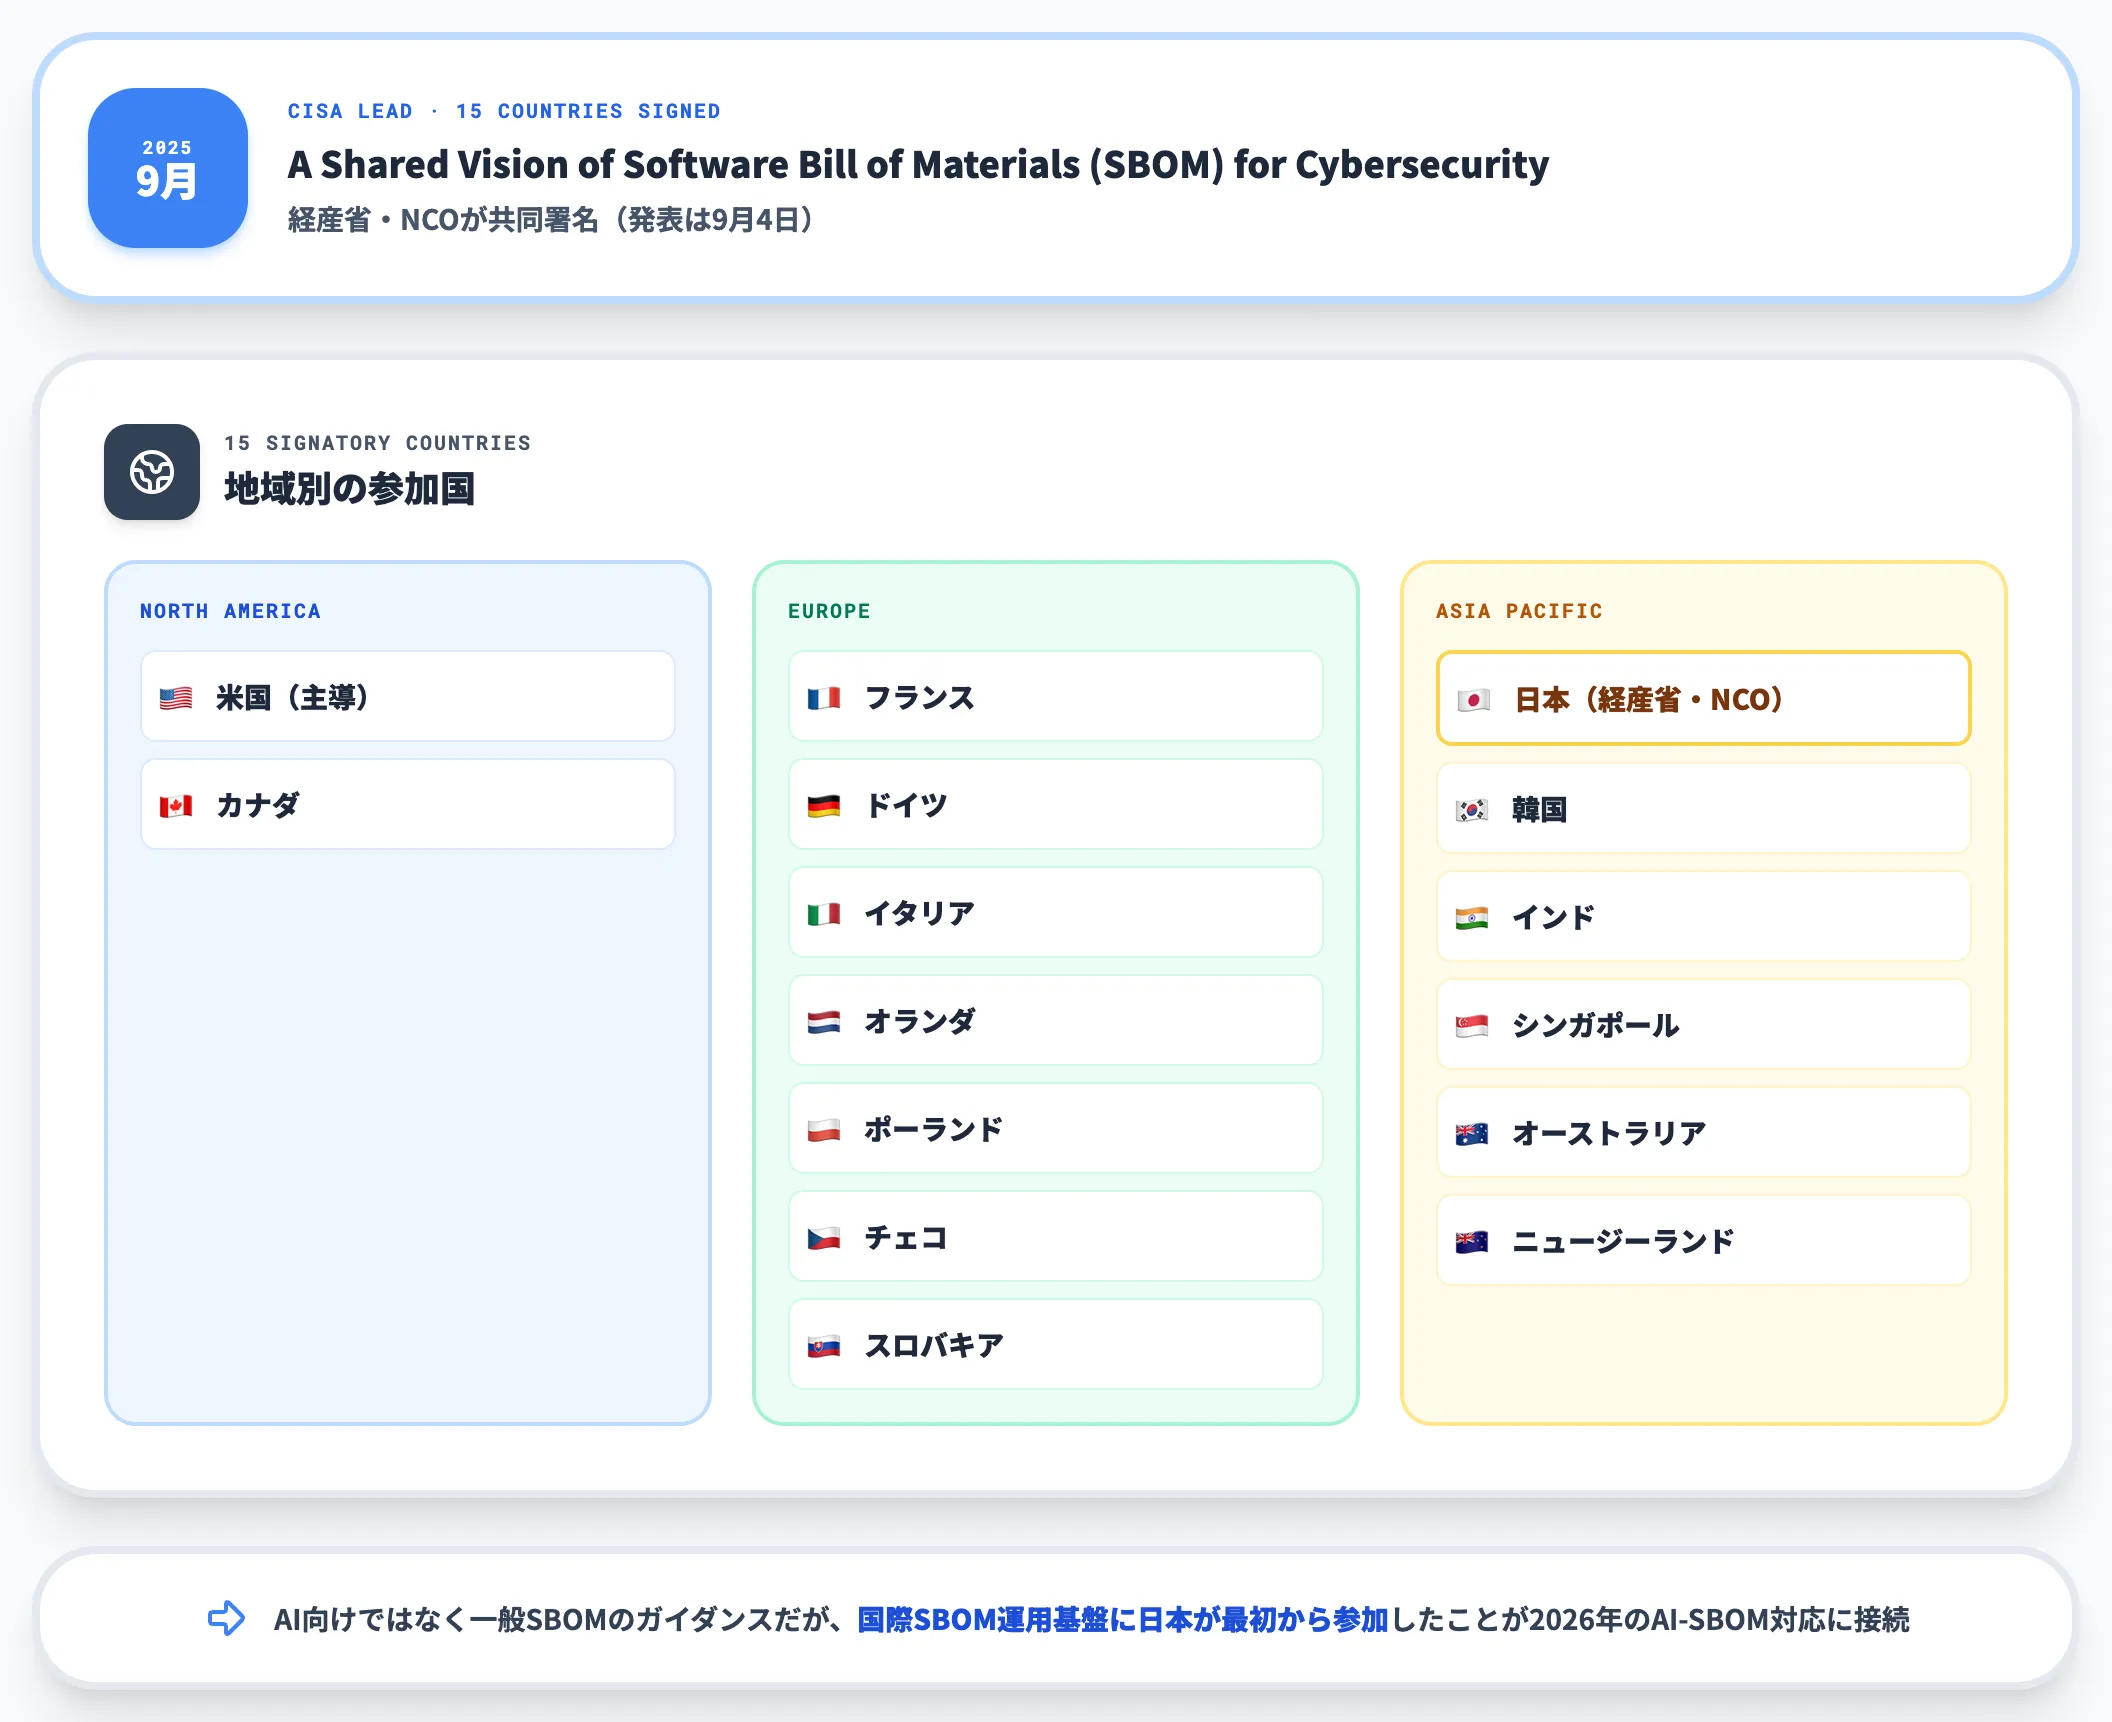
経済産業省とNCOは2025年9月3日に米CISA主導の国際ガイダンス「A Shared Vision of Software Bill of Materials (SBOM) for Cybersecurity」に共同署名しました(発表は9月4日)。
参加国は日米仏独伊、オランダ、カナダ、オーストラリア、ニュージーランド、インド、シンガポール、韓国、ポーランド、チェコ、スロバキアの15か国です。
この時点ではAI向けではなく一般SBOMのガイダンスですが、国際的なSBOM運用基盤に日本が最初から加わったことが2026年のAI-SBOM対応にそのまま接続しています。
2026年7月:SBOM Minimum Elementsの改訂版が公表され、AI利用も対象範囲に
2026年7月29日に公表された「2026 Minimum Elements for a Software Bill of Materials」は、CISAと国際パートナーが2021年版を全面改訂した最新版です。
本文内でAI利用ソフトウェアやSaaS環境では追加要素が必要になる可能性が明記され、2026年5月の「Software Bill of Materials for AI – Minimum Elements」と対になる位置づけで整備されました。
経産省は7月30日にこの最小要素ガイダンスへ共同署名しており、日本の政策文書上もAI向け拡張を射程に収めた形です。
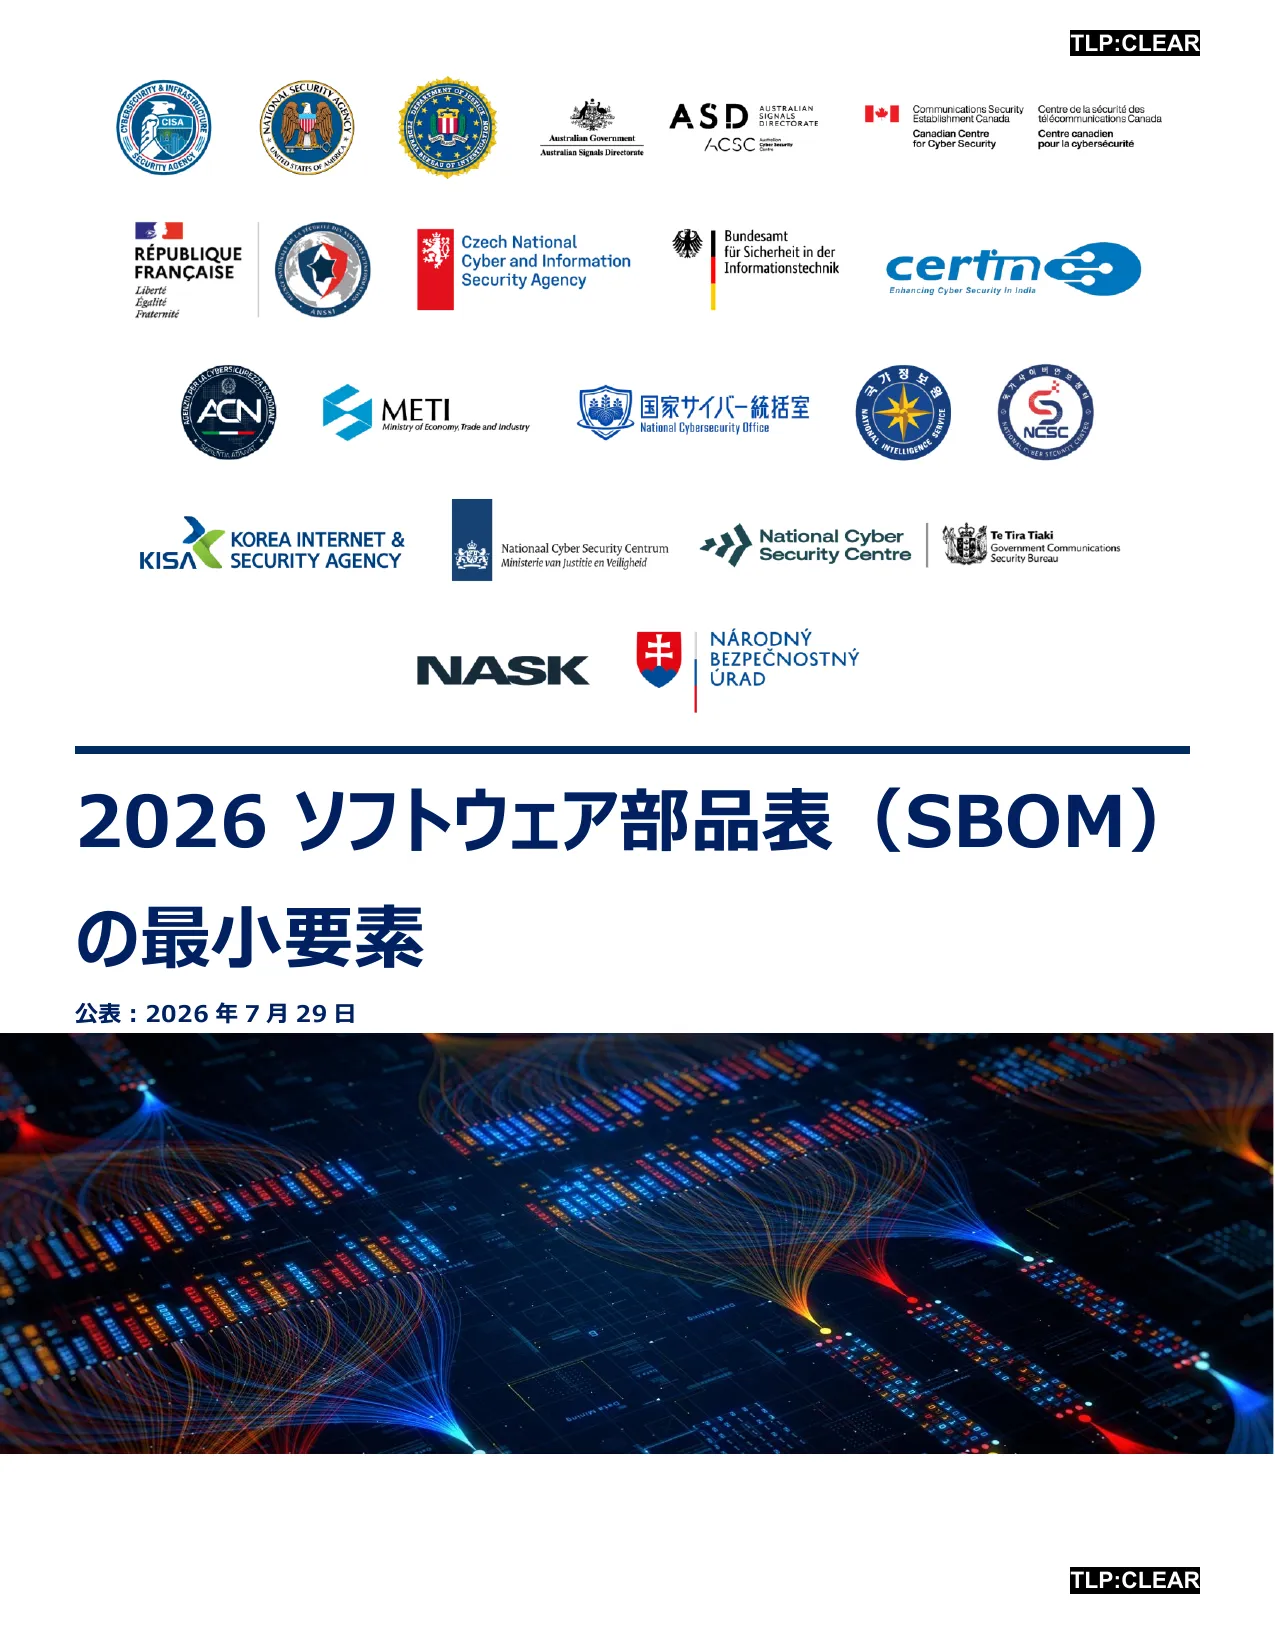
内閣官房NISC・経産省が2026年7月に署名した「2026 ソフトウェア部品表(SBOM)の最小要素」国内版(出典:内閣官房国家サイバー統括室)
経産省の「SBOM導入の手引ver2.0」が国際ガイダンスに事例採用
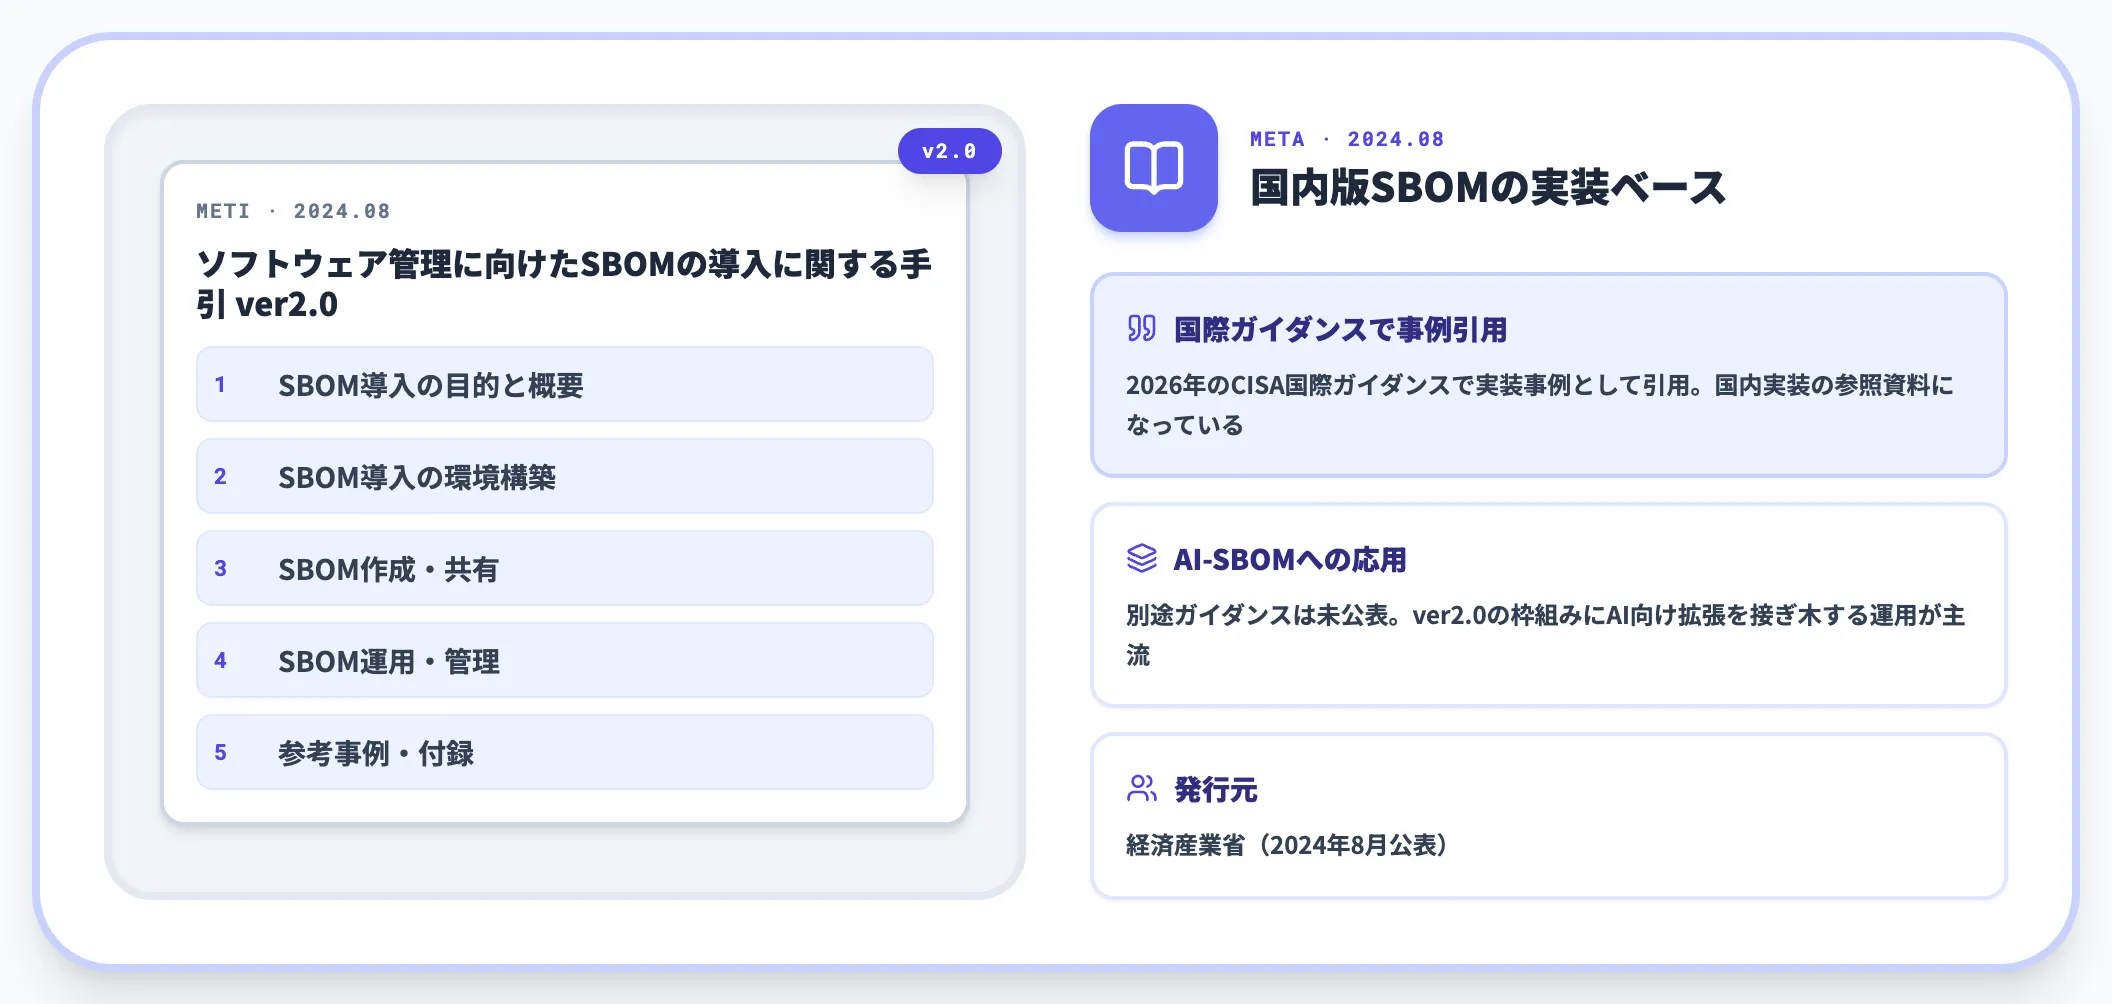
経済産業省は2024年8月にソフトウェア管理に向けたSBOM(Software Bill of Materials)の導入に関する手引ver2.0を公表しており、企業がSBOMを導入する際の実務指針を整理しています。
この手引ver2.0は2026年のCISA国際ガイダンスで事例として引用されており、国内版SBOM実装のベースとして実質的な参照資料になっています。
AI-SBOMについては別途のガイダンスは2026年10月時点では公表されていませんが、ver2.0の枠組みにAI向け拡張を接ぎ木する運用が主流になりそうです。
AI事業者ガイドライン1.2版との連携
総務省・経済産業省が2026年3月31日に公表したAI事業者ガイドライン第1.2版は、国内のAI開発・提供・利用事業者に対するガバナンス指針です。
AI事業者ガイドライン第1.2版(総務省・経済産業省、2026年3月31日公表)(出典:経済産業省)
AI事業者ガイドライン1.2版は直接「AI-SBOMを作れ」とは書いていませんが、「透明性」「トレーサビリティ」「サプライチェーン管理」の要件を満たす実装手段としてAI-SBOMが自然な選択肢になります。また、総務省のAIセキュリティガイドラインはプロンプトインジェクションやDoS対策を中心に扱っており、AI-SBOMはこれらの対策を「どのモデルに適用したか」を記録する層として接続します。
日本国内の立ち位置を一言でまとめると、規制としてAI-SBOMを明示的に義務化していないが、国際ガイダンス・AI事業者ガイドライン1.2版・経産省SBOM手引ver2.0の3本柱で「実質的な期待値」が形成されつつあるという段階です。
EU AI Act準拠の必要がある日本企業(EU域内で製品・サービスを提供する企業)は、2026年8月の施行に合わせてすでに対応を進めています。国内中心の事業者であっても、サプライヤー評価や官公庁調達の文脈で「AI-SBOMを提出できるか」が問われる場面が今後増えていきます。
AI-SBOM導入でつまずく3つの論点
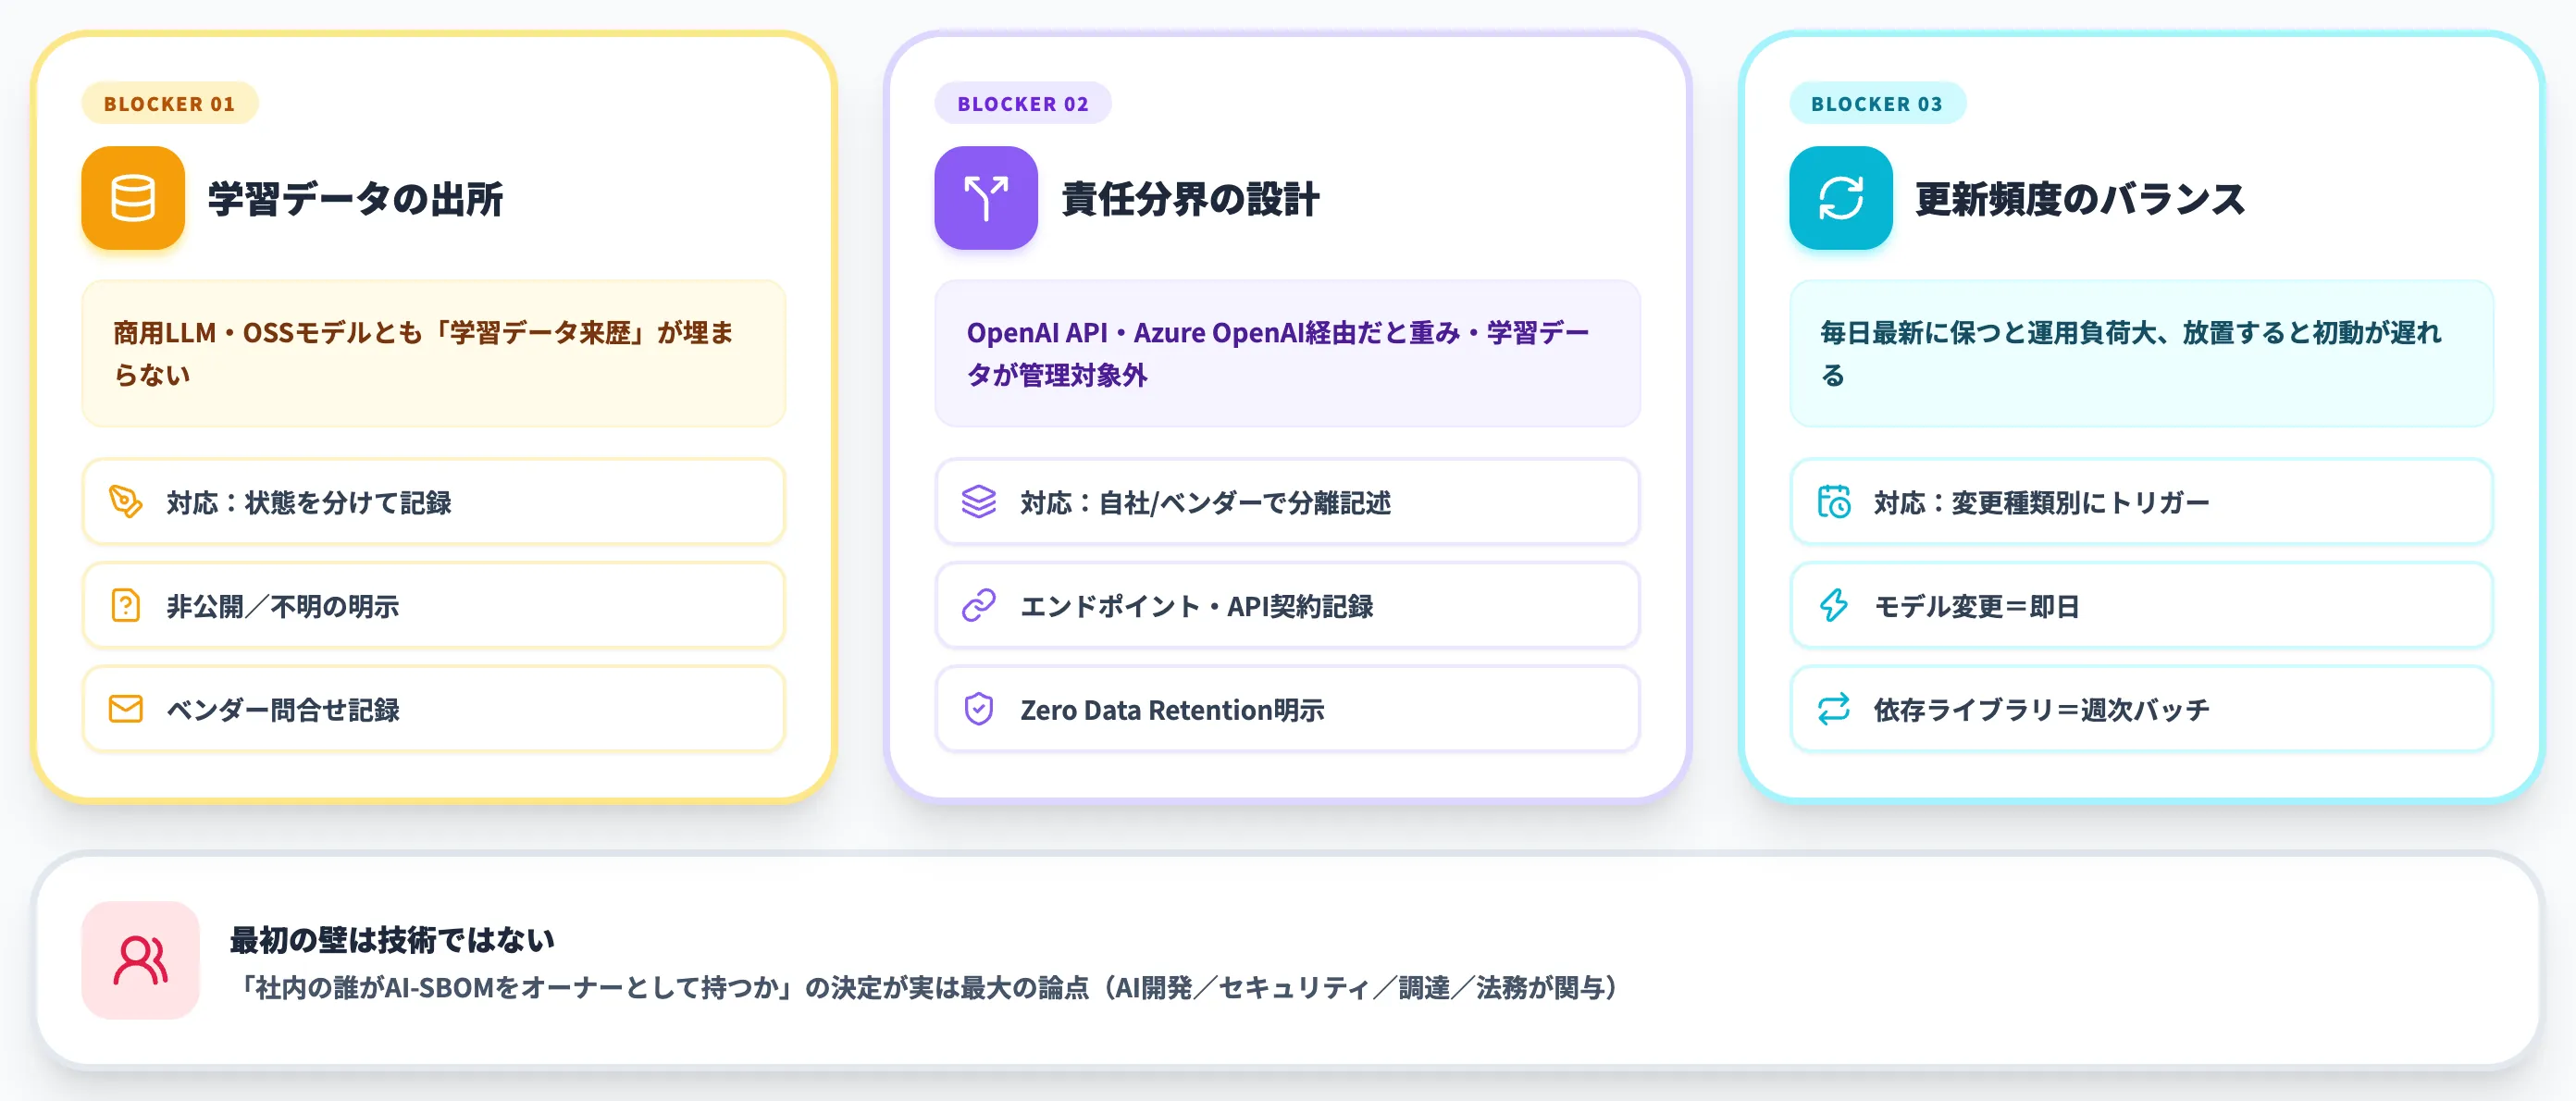
AI-SBOMの標準規格もツールも揃った2026年ですが、導入現場で実際に手が止まるのは、規格やツールの選定ではなく運用設計の論点です。
AI総合研究所が企業のAI導入を支援する現場でも、以下の3論点で止まるケースを繰り返し見ています。本セクションではそれぞれの詰まり方と、ケース別の進め方を整理します。
学習データの出所がわからないモデルをどう扱うか
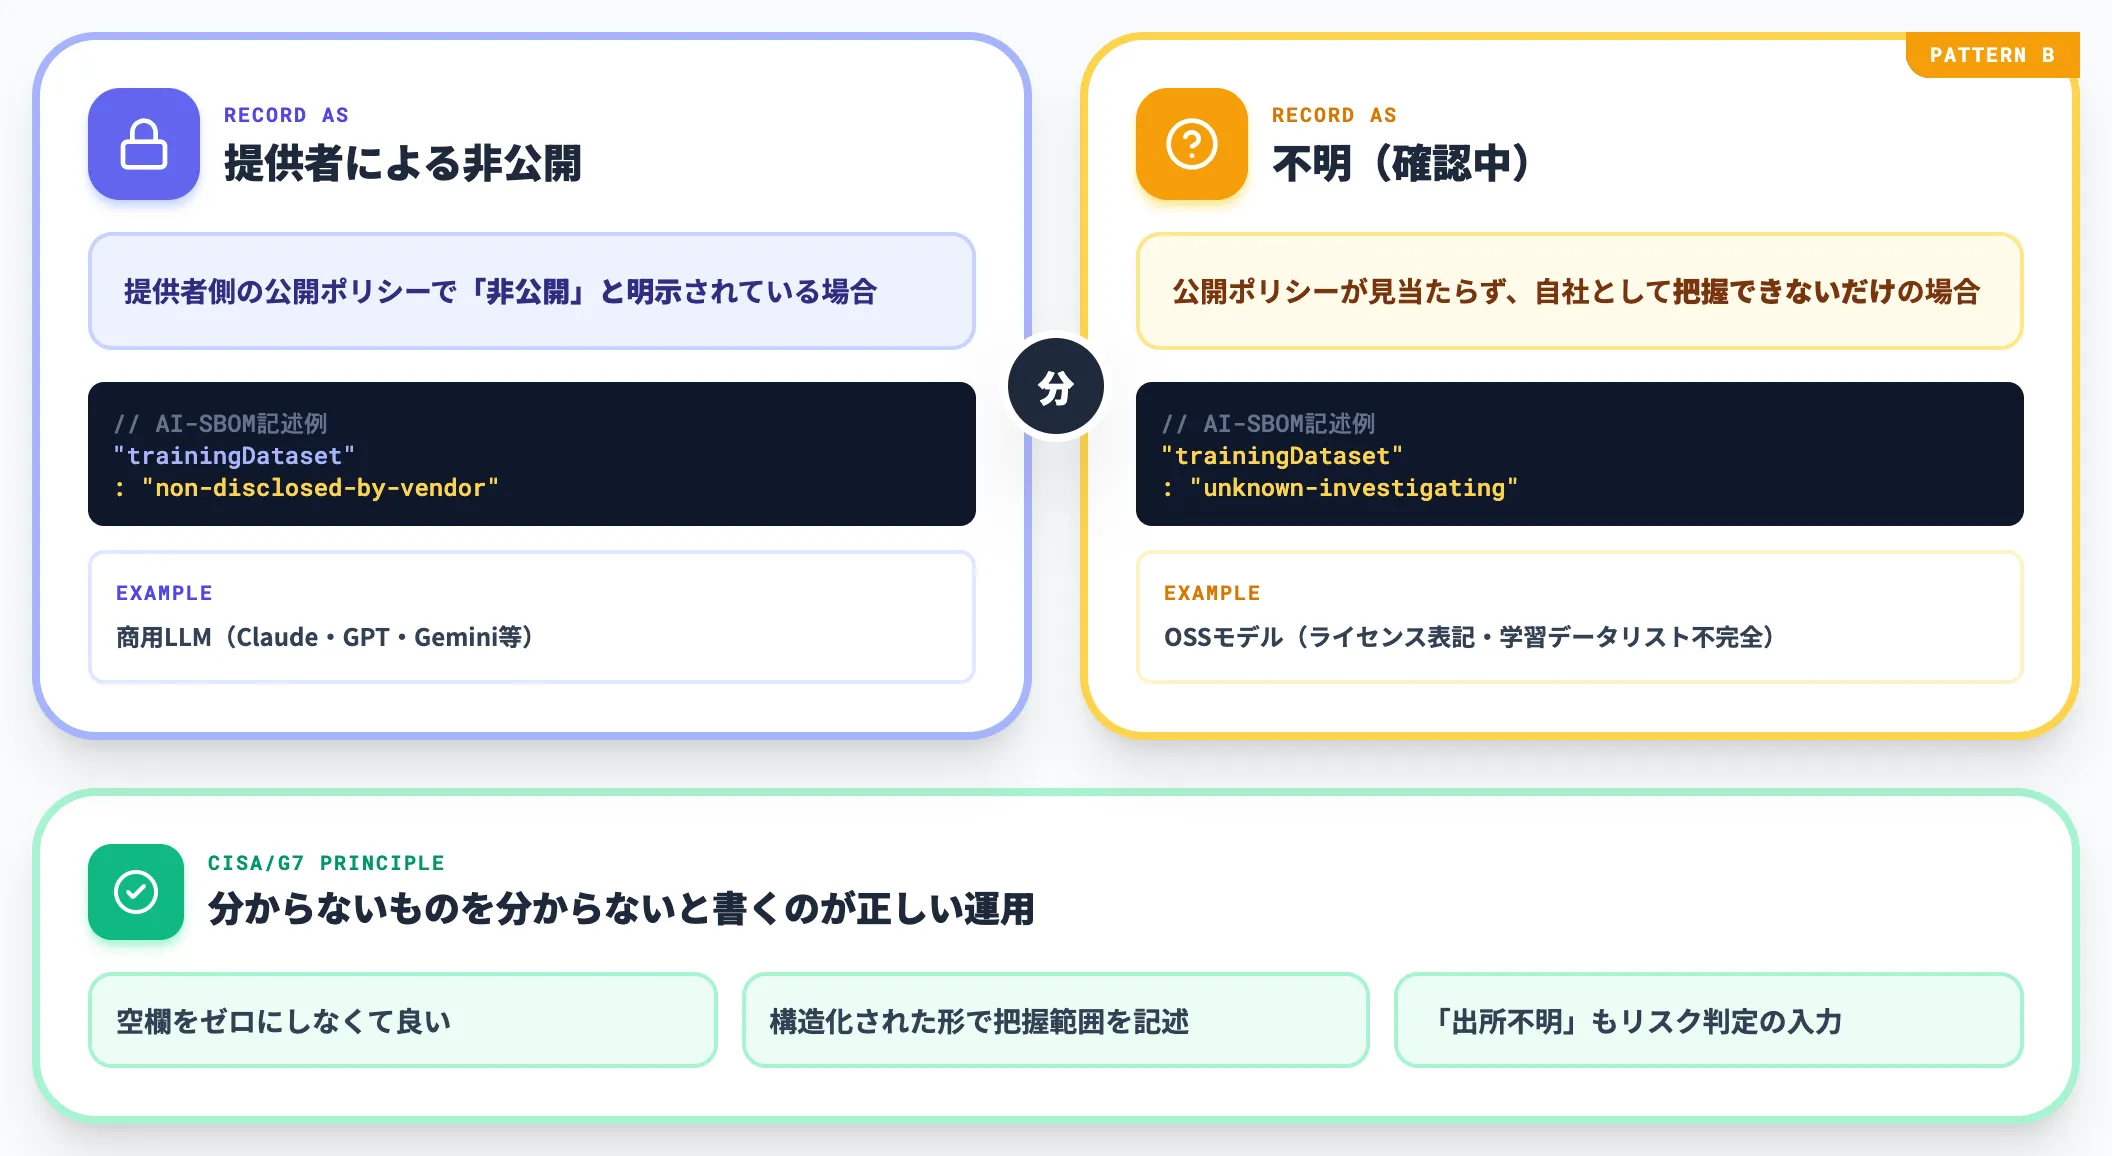
最も現場で止まるのが、学習データの出所を明記できないモデルです。
商用LLM(Claude・GPT-5.5・Gemini等)の多くは、公式ドキュメントに「どのデータで学習したか」が十分に書かれていません。OSSモデルでもライセンス表記や学習データリストが不完全なものが多く、AI-SBOMの「学習データ来歴」フィールドを埋めようとすると空欄が目立ちます。
現実的な進め方は、「提供者側の情報の限界をAI-SBOM上で明示する」ことです。
出所情報は、提供者側の公開ポリシーで「非公開」と明示されている場合は「提供者による非公開」、公開ポリシーが見当たらず自社として把握できないだけの場合は「不明(確認中)」のように状態を分けて記録します。ベンダーに追加情報を求めた記録・求めた時期を残し、追加情報が得られた時点で更新する運用です。
CISA・G7ガイダンスも、空欄をゼロにすることではなく「構造化された形で把握している範囲を記述すること」を要求しており、分からないものを分からないと書くこと自体がAI-SBOMとしては正しい運用です。
データポイズニングのような学習データ由来のリスクを評価する際も、「出所不明」という情報自体がリスク判定の入力になります。
外部API・SaaS利用時の責任分界をどう設計するか
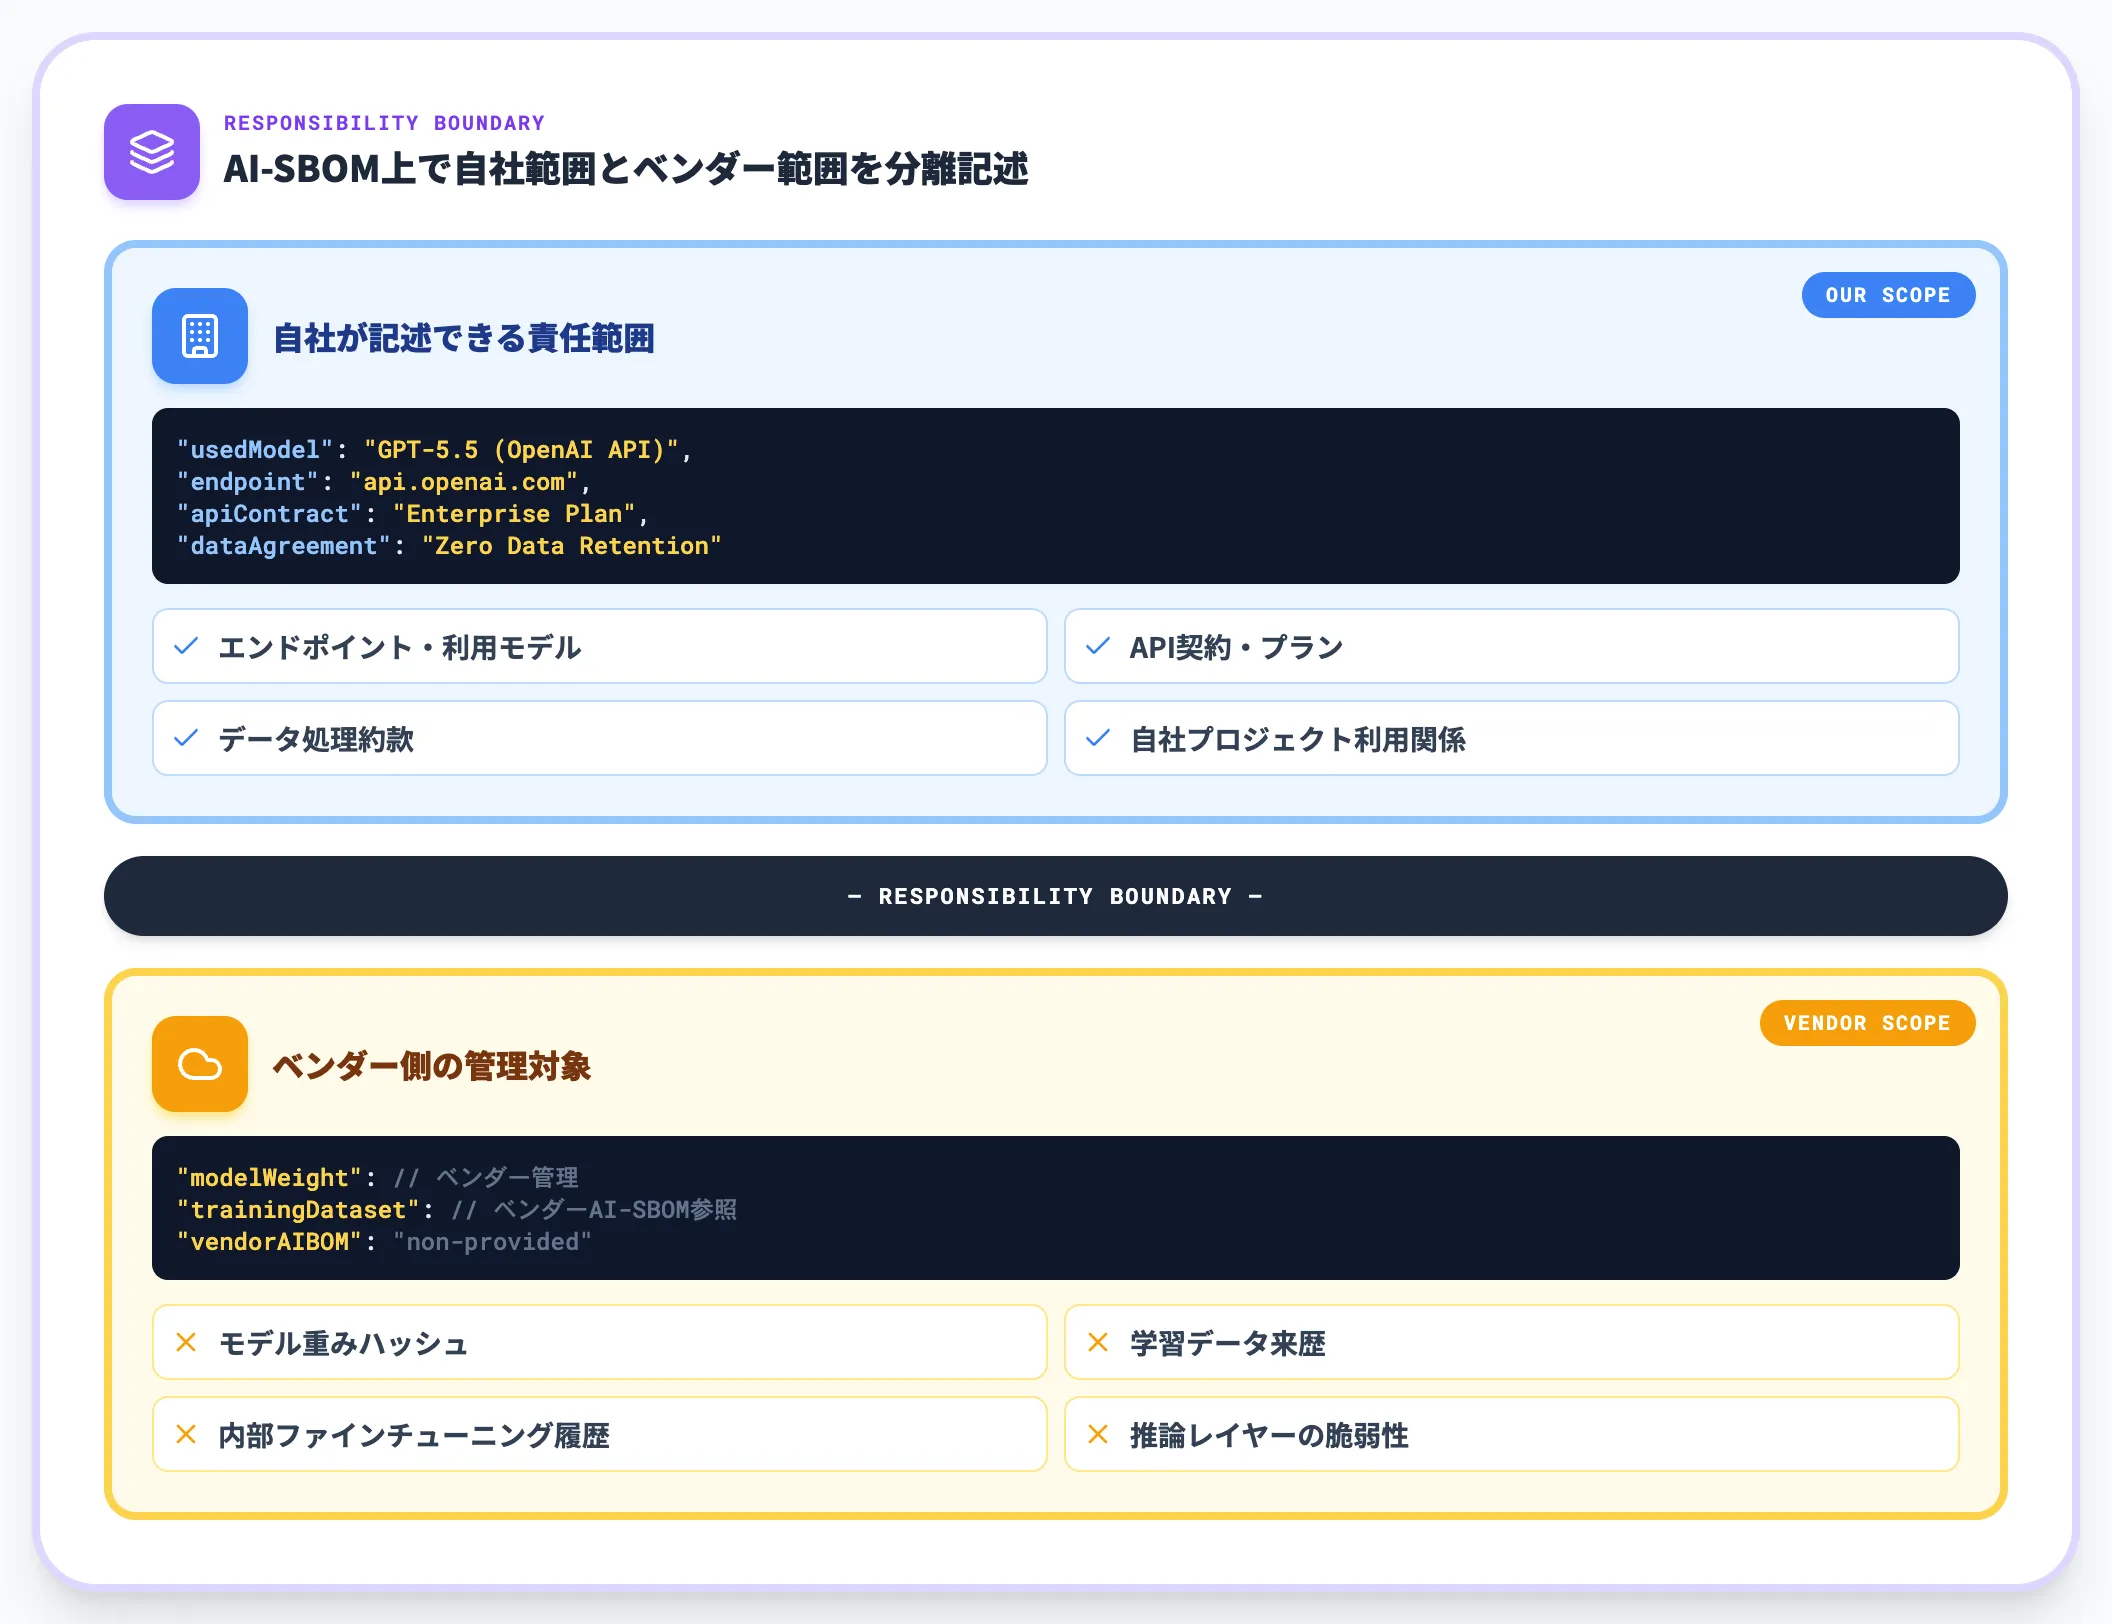
次に止まるのが、OpenAI API・Anthropic API・Microsoft Azure OpenAI経由でモデルを使っている場合のAI-SBOMです。
自社でモデルをホストしているわけではないので、モデル重みのハッシュや学習データ来歴は自社の管理対象外になります。しかし「AIサプライチェーン攻撃が起きた際に自社のどのプロジェクトが影響を受けるか」を特定するには、外部API経由であってもモデル利用関係を記録しておく必要があります。
この場合の実装は、「自社が記述できる責任範囲」と「ベンダーが提供するAPI契約・SLA」を分けて記述するのが実務的な正解です。
AI-SBOMの中では「使用モデル:GPT-5.5(OpenAI API経由)」「エンドポイント:api.openai.com」「API契約:企業プラン」「データ処理約款:Zero Data Retention適用」のように、自社が確認できる契約条件を記録します。モデル内部の構成情報はベンダー側のAI-SBOM(提供されていない場合は「未公開」)を参照する形にして、責任分界をAI-SBOM上で明示します。
更新頻度と運用負荷のバランスをどう取るか
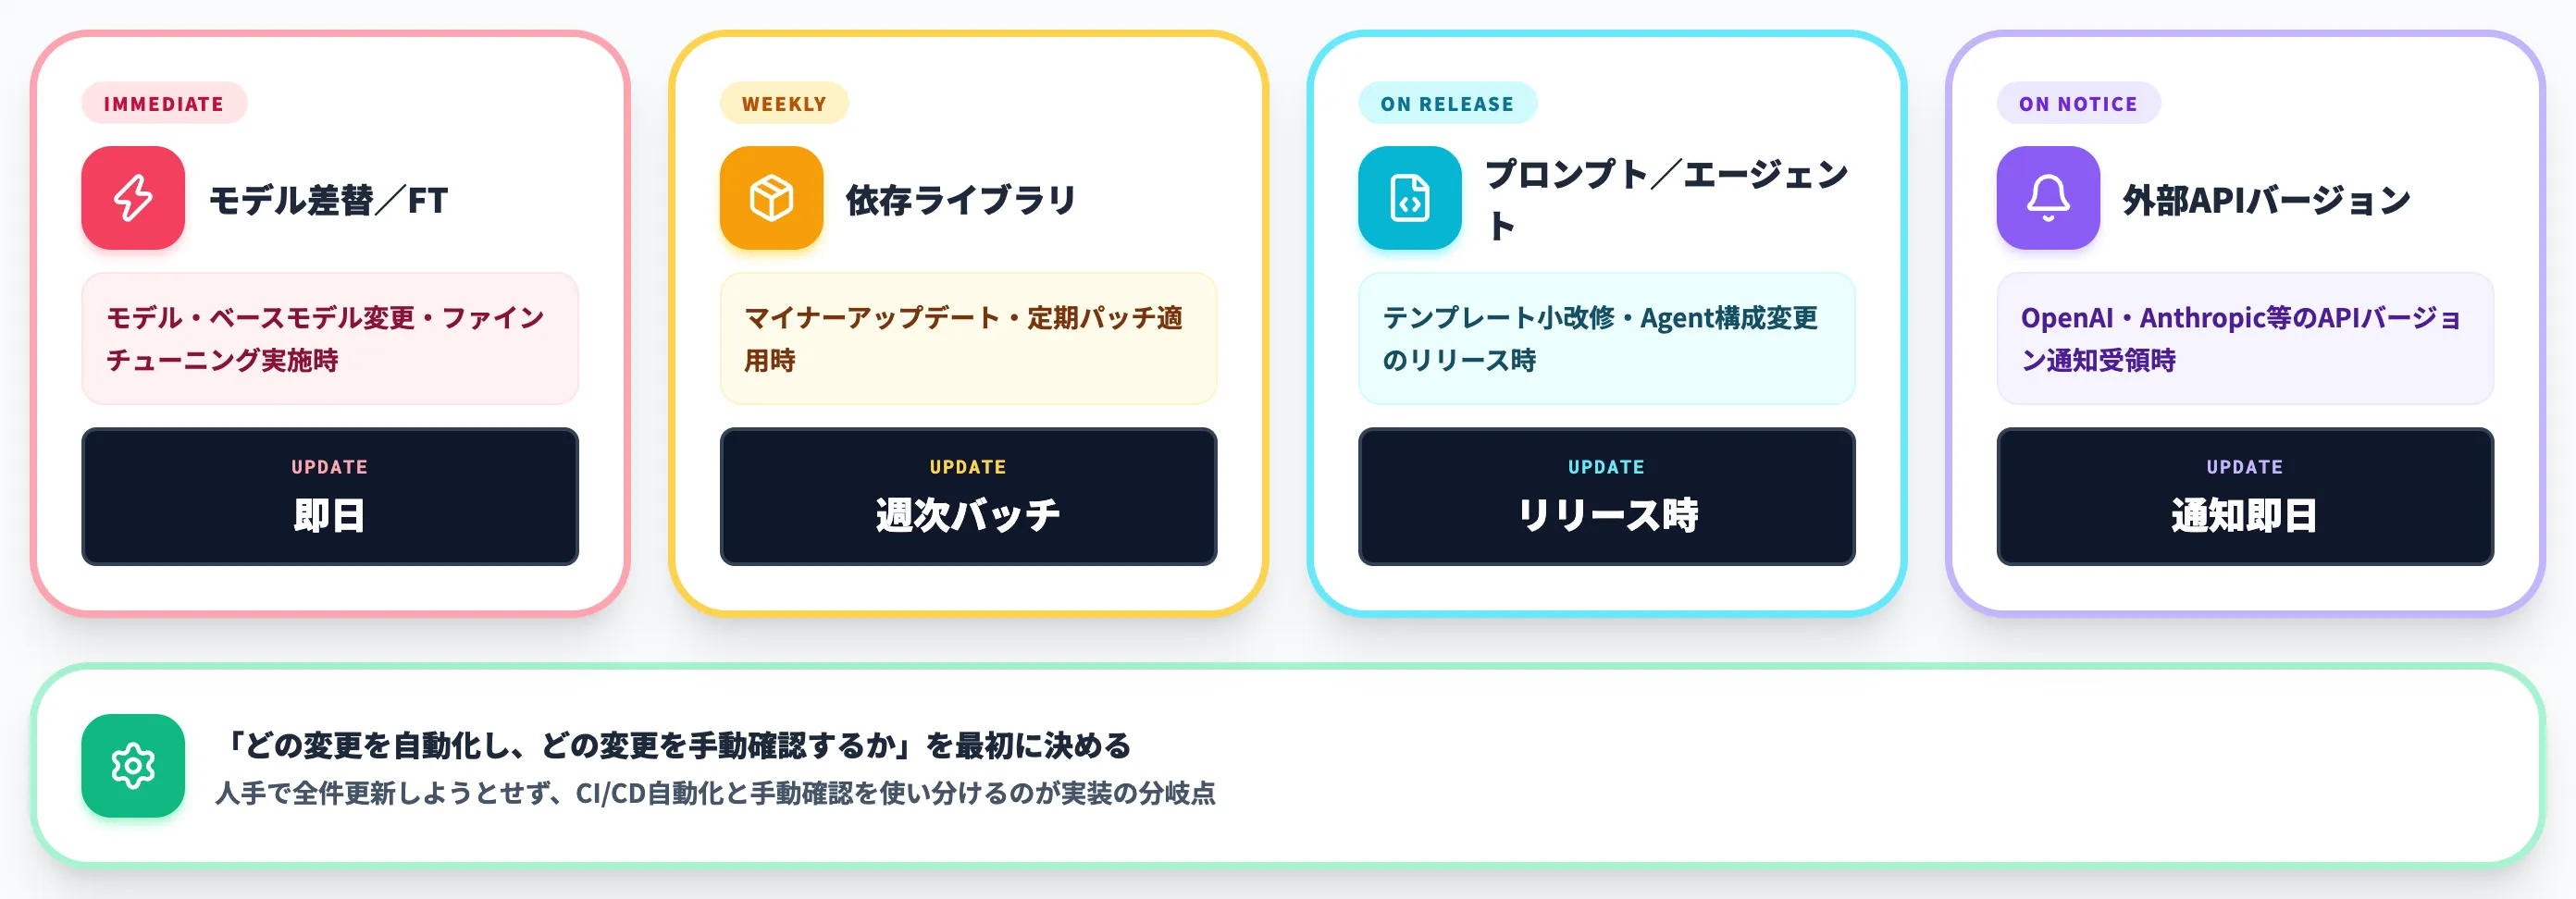
3つ目は、AI-SBOMの更新頻度です。
モデル・依存ライブラリ・プロンプトテンプレート・外部APIバージョン・学習データが常に動くAIシステムで、SBOMを「毎日最新」に保とうとすると運用負荷が大きくなります。一方で、脆弱性報告への初動を速くするには、ある程度の鮮度は必要です。
AI総研の支援現場で推奨している進め方は、「変更の種類ごとに更新トリガーを分ける」設計です。
モデル差し替え・ベースモデル変更・ファインチューニング実施時は即日更新、依存ライブラリの軽微なマイナーアップデートは週次バッチ、プロンプトテンプレートの小改修はリリース時、といった具合に粒度を変えます。CI/CDに組み込めば自動化できる部分も多いため、人手で全部更新しようとせず「どの変更を自動化し、どの変更を手動確認するか」を最初に決めるのが実装の分岐点です。
ケース別の導入順序
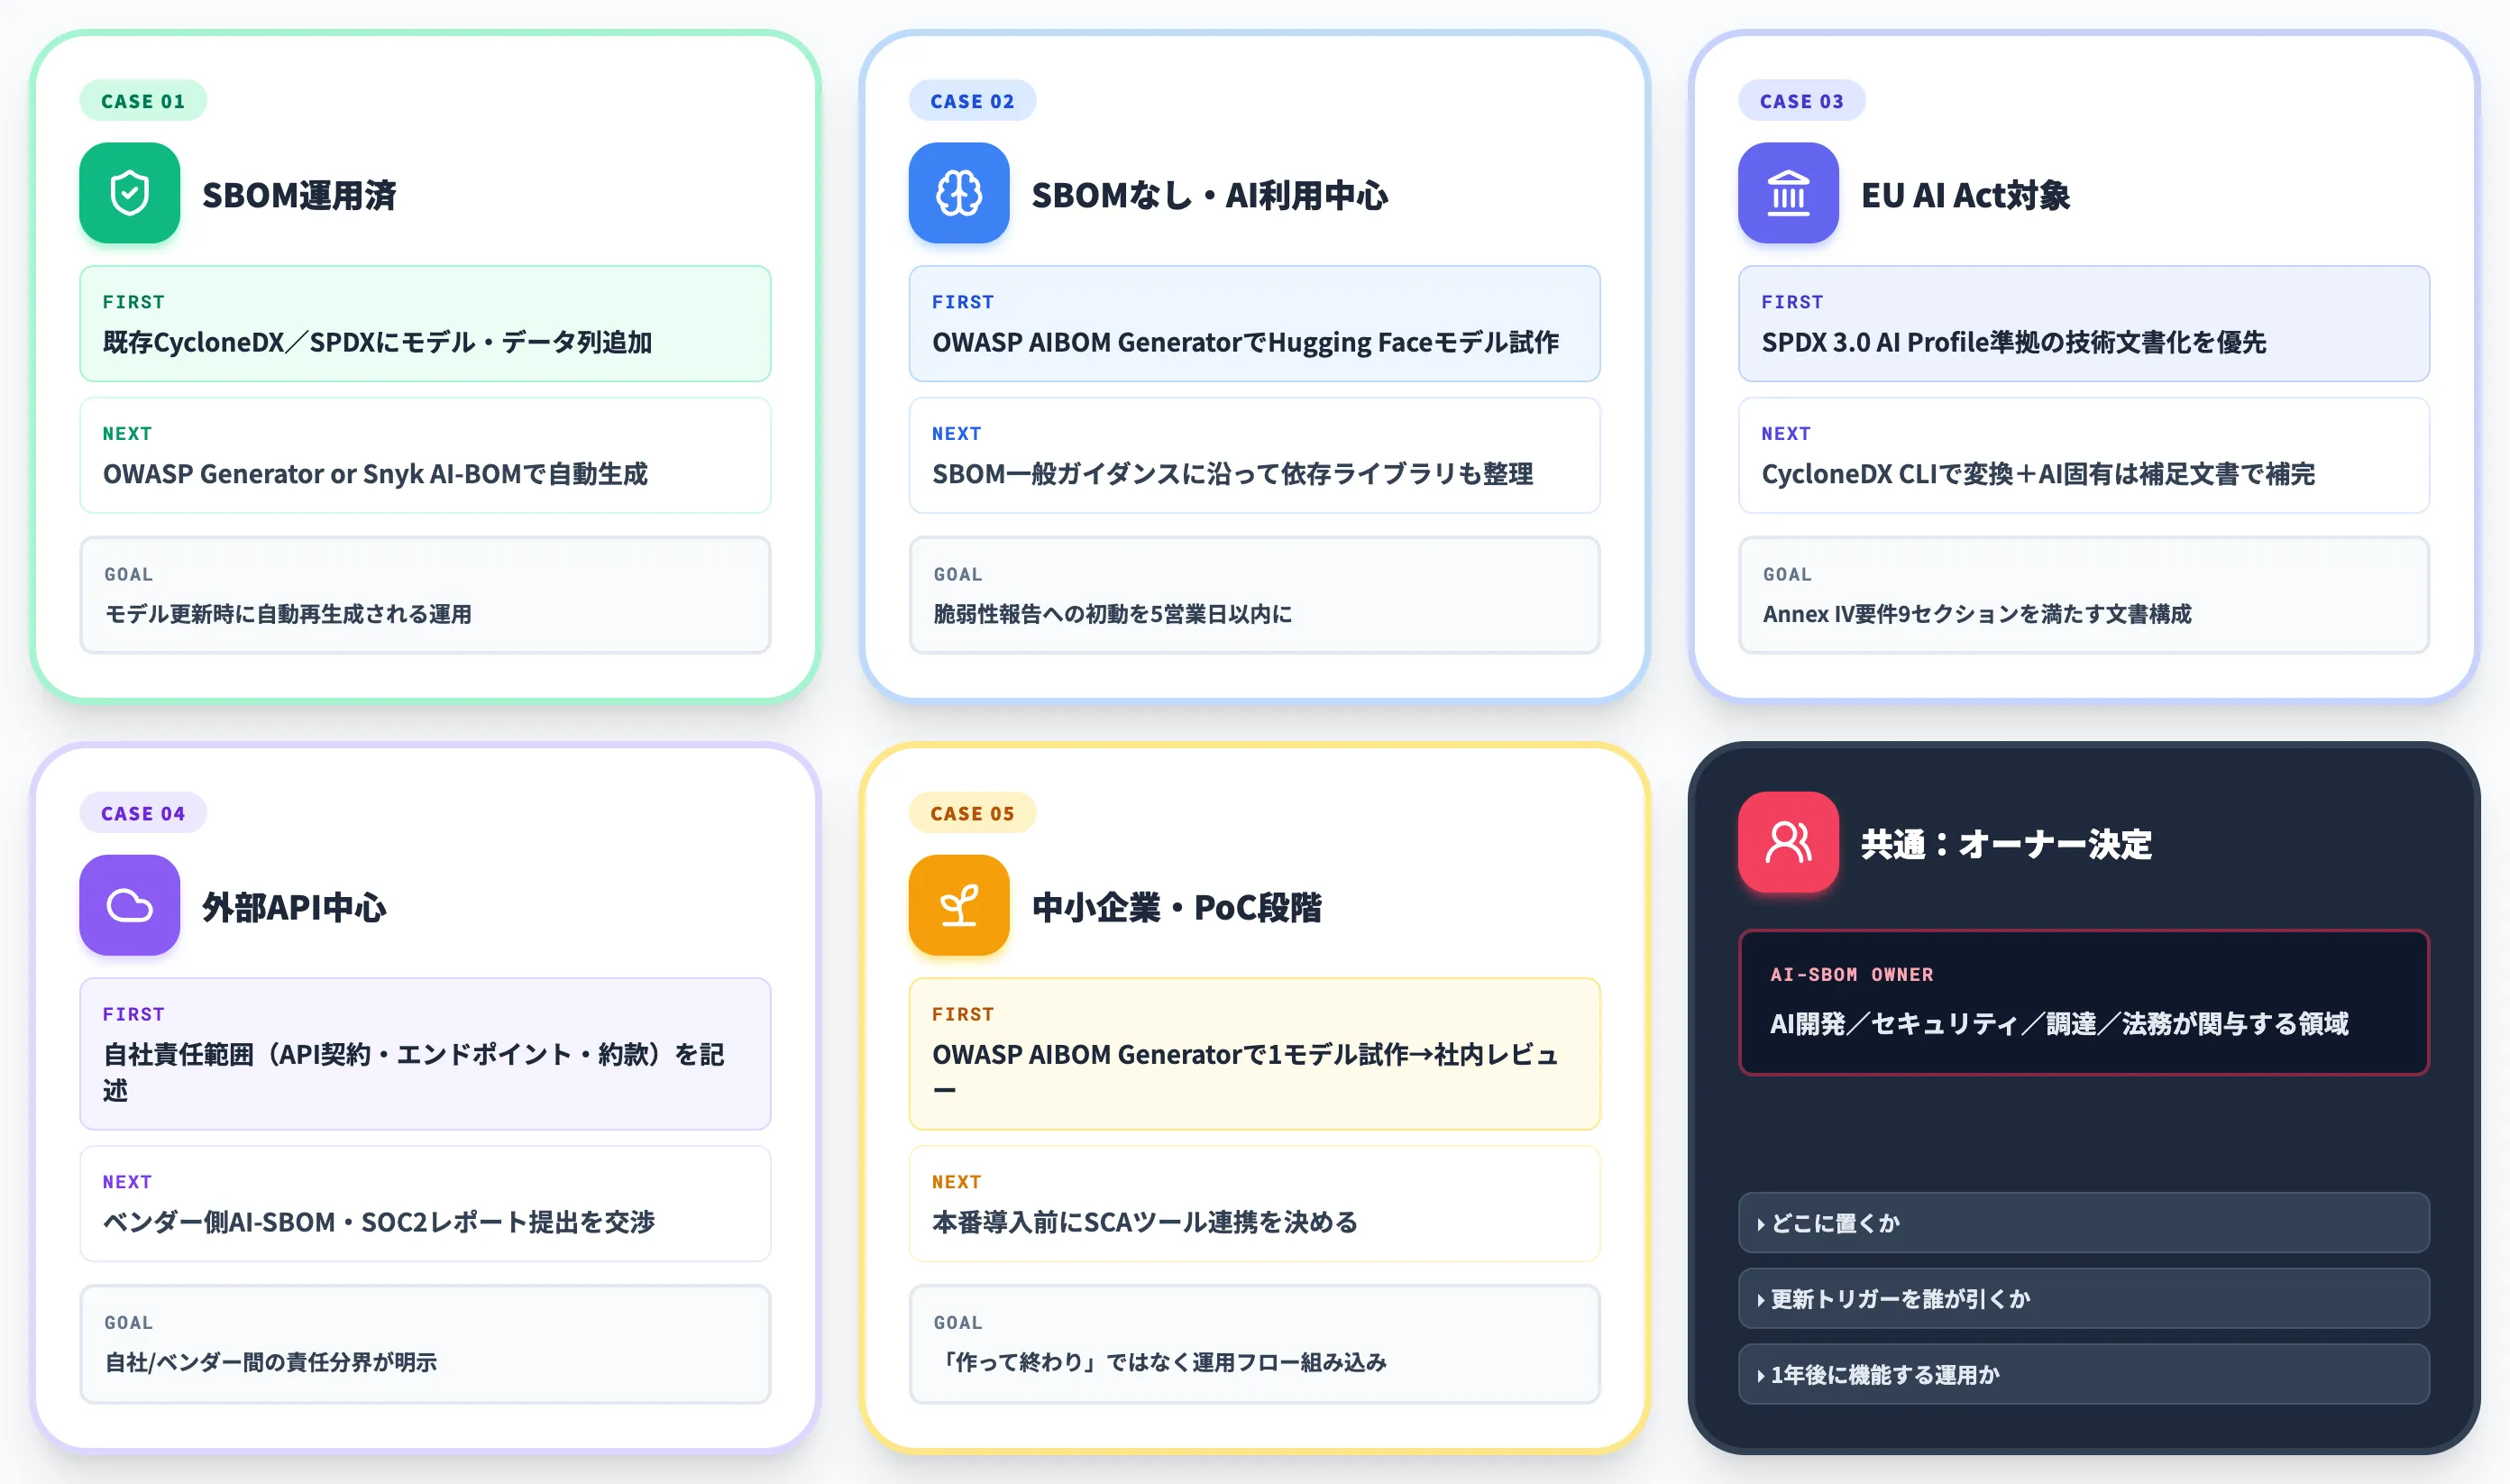
以下の表で、企業タイプ別のAI-SBOM導入順序を整理しました。
| 対象企業 | 最初にやること | 次にやること | AI-SBOM成熟度の判断基準 |
|---|---|---|---|
| SBOMをすでに運用している企業 | 既存CycloneDX/SPDXにモデル・データ列を追加 | OWASP AIBOM Generator or Snyk AI-BOMで自動生成を試す | モデル更新時にAI-SBOMが自動再生成される運用になっているか |
| SBOMがない企業(AI利用中心) | OWASP AIBOM GeneratorでHugging Faceモデルから試作 | SBOMの一般ガイダンスに沿って依存ライブラリも整理 | AI-SBOMを使って脆弱性報告への初動が5営業日以内に取れるか |
| EU AI Act対象企業 | SPDX 3.0 AI Profile準拠の技術文書化を優先 | CycloneDX CLIでSPDX JSON 2.3へ変換し、AI固有情報は補足文書で補完する運用を整備 | Annex IV要件9セクションを満たす文書構成になっているか |
| 外部API中心の企業 | 自社の責任範囲(API契約・エンドポイント・データ約款)を記述 | ベンダー側のAI-SBOM・SOC2レポート等の提出を交渉 | 自社AI-SBOMと外部ベンダー情報の責任分界が明示されているか |
| 中小企業・PoC段階 | OWASP AIBOM Generatorで1モデル試作→社内レビュー | 本番導入前にSCAツール連携を決める | AI-SBOMが「作って終わり」ではなく運用フローに組み込まれているか |
この表の読み解きとしてAI総研が実務で見ている傾向は、最初の壁は「AI-SBOMを作る技術」ではなく、「社内の誰がAI-SBOMをオーナーとして持つか」の決定にあるという点です。
SBOMがソフトウェア開発責任者の管轄だったのに対し、AI-SBOMはモデル選定・学習データ・外部API利用・プロンプト設計までカバーするため、AI開発担当者・セキュリティ担当者・調達担当者・法務担当者が関わります。オーナー不在のまま「とりあえず生成だけ」は走っても、更新サイクルが止まって陳腐化するケースをよく見ます。
ツール選定より先に、「AI-SBOMのオーナー部署をどこに置くか」「更新トリガーを誰が引くか」を決めてから着手するのが、1年後に機能するAI-SBOM運用を立ち上げる現実的な順序です。
AI-SBOMに、業務エージェントの追加や変更を反映し続ける
AI-SBOMは試作より更新が難しく、OWASP AIBOM GeneratorもAIエージェント構成の全体像までは自動で取得できません。業務部門で作られるエージェントの追加や変更を、AI-SBOMのオーナーが知る仕組みがないまま運用を始めると、その部分は手作業で追いかけることになり、更新が止まる原因になります。
追加と変更を1か所で受け止める役目を持つのが、エージェントの管理基盤です。AI総合研究所のAI Agent Hubは、Copilot Studioとn8nのどちらで作ったAgentも、1つの管理画面で扱います。
- 新しいAgentを登録の時点で拾う
社員に配るAgentは管理画面に登録してから使われ始めるため、AI-SBOMに書き足すべきAgentを、使われる前の段階で把握できます。
- 更新の記録を見直しのきっかけにする
Agentごとにバージョンを管理できるため、どのAgentがいつ更新されたかを、AI-SBOMの記述を見直すきっかけとして使えます。
- データの扱いを責任分界に書き込む
業務データは自社のAzureテナントの中で扱われ、AIの学習にも使われないため、外部APIの約款を記録するのと同じように、自社側の条件としてAI-SBOMに書き込めます。
AI総合研究所の専任チームが、業務エージェントの登録と更新の流れを、AI-SBOMで決めた更新トリガーとずれないように一緒に設計します。
業務エージェントもAI-SBOMで追う
Agentの追加と更新を1か所で拾う
AI-SBOMは作ったあとの更新が難しく、業務部門で作られるAIエージェントの追加や変更も、オーナーが把握できなければ追いきれません。AI Agent Hubのサービスページでは、ワークフローをJSON形式で書き出してバージョン管理に使えることを、よくある質問の中でご紹介しています。
まとめ
本記事では、AI-SBOM(AI Bill of Materials)を「AIシステムに組み込まれたモデル・学習データ・依存コンポーネントを一覧化した部品表」として整理し、2026年に注目される背景・SBOMに追加される要素・標準フォーマットの違い・作り方・対応ツール・日本の規制動向・導入でつまずく論点を解説しました。
2026年10月時点で押さえておくべきポイントは次の3つです。
- 同じコードでも学習データや重みが違えば挙動が変わるため、SBOMをモデルとデータの来歴まで拡張しないと、AIの脆弱性管理も規制対応も成り立たない
- EU AI Act・CISAとG7のガイダンス・標準規格がそろい、AI-SBOMは調達やサプライヤー評価で参照される軸になりつつある
- 試作はOWASP AIBOM Generatorで手早く作れるが、実際につまずくのは誰がオーナーになり、いつ更新するかという運用の設計にある
AI総合研究所の支援現場で勧めているのは、小さく試作しながら運用の決めごとを先に固める進め方です。
まずは社内でAI-SBOMのオーナー部署を決め、そのうえでOWASP AIBOM Generatorを使って主要モデル1件の試作から始めます。
続いて、更新のタイミングを変更の種類ごとに決めてCI/CDに組み込んでから対象のモデルを広げていくのが、作ったAI-SBOMを陳腐化させない順序です。
商用LLMの多くが学習データを十分に開示していない以上、AI-SBOMに求められるのは空欄のない台帳ではなく、把握できている範囲とできない範囲を分けて示すことです。
AI-SBOMは「AIサプライチェーン攻撃の影響範囲を5営業日以内に特定できるか」「監査・調達の説明責任を機械可読な形で果たせるか」という2つの実務問題を支援する枠組みです。