この記事のポイント
 MITオープンウェイトでDeepSWE 77.0を記録、同時点のClaude Opus 5(74.0)・GPT-5.6 Sol(73.0)をコーディングベンチで上回る
- Causal Encoder-Decoder(CED)で40層を20+20に分割、prefill 8B・decode 16Bの非対称activationで推論コストを下げている
- deepseek-flashを指定するだけで利用可能だが、旧deepseek-v4-flash等が裏でV4.1 Flashに silent routing されている点に注意
- 入力$0.15・出力$0.60は据え置き、オフピーク時間帯・キャッシュヒット$0.003で1Mコンテキスト活用のコスト妥当性が高い
- Search・Fetch APIは2026年10月31日16:00 UTC(日本時間11月1日01:00)でHarness/Claude Code/Codex経由の無料期間が終了、$0.75/1,000 successful requestsで統一課金
Microsoft MVP・AIパートナー。LinkX Japan株式会社 代表取締役。東京工業大学大学院にて自然言語処理・金融工学を研究。NHK放送技術研究所でAI・ブロックチェーンの研究開発に従事し、国際学会・ジャーナルでの発表多数。経営情報学会 優秀賞受賞。シンガポールでWeb3企業を創業後、現在は企業向けAI導入・DX推進を支援。
DeepSeek-V4.1-Flash-1017は、DeepSeekが2026年10月17日にdeepseek-flash APIとHugging Faceへ同時投入したV4.1 Flashのsnapshotです。
Causal Encoder-Decoder(CED)という新アーキテクチャを採用し、コーディング特化ベンチマーク「DeepSWE v1.1」で77.0を記録、Claude Opus 5の74.0を上回りました。
本記事では、1017アップデートで動いた性能数値、CEDが実現したKV cache圧縮の実装、deepseek-flash APIの呼び分けとsilent routing、時間帯別料金とキャッシュヒット単価、10月31日16:00 UTCで無料期間が終了するSearch/Fetch API、Opus 5.5・GPT-6 Solなど競合比較、日本企業の実務判断ポイントまでを、2026年10月時点の最新情報で体系的に解説します。
目次
DeepSeek-V4.1-Flash-1017とは?V4.1 Flashを10/17 snapshotで刷新したMoE最新版
V4.1 Flashシリーズでの1017 snapshotの役割
1017アップデートが詰めてきた性能差分——DeepSWE 77.0でClaude Opus 5超え
Causal Encoder-Decoder(CED)アーキテクチャの新規性
prefill 8B・decode 16Bの非対称activation
Search・Fetch APIの開放と10月31日からの課金開始
競合モデルとの比較と選定軸——Opus 5.5・GPT-6 Sol・Qwen3.8
日本企業がV4.1 Flash 1017を使うときの判断ポイント
DeepSeek-V4.1-Flash-1017とは?V4.1 Flashを10/17 snapshotで刷新したMoE最新版
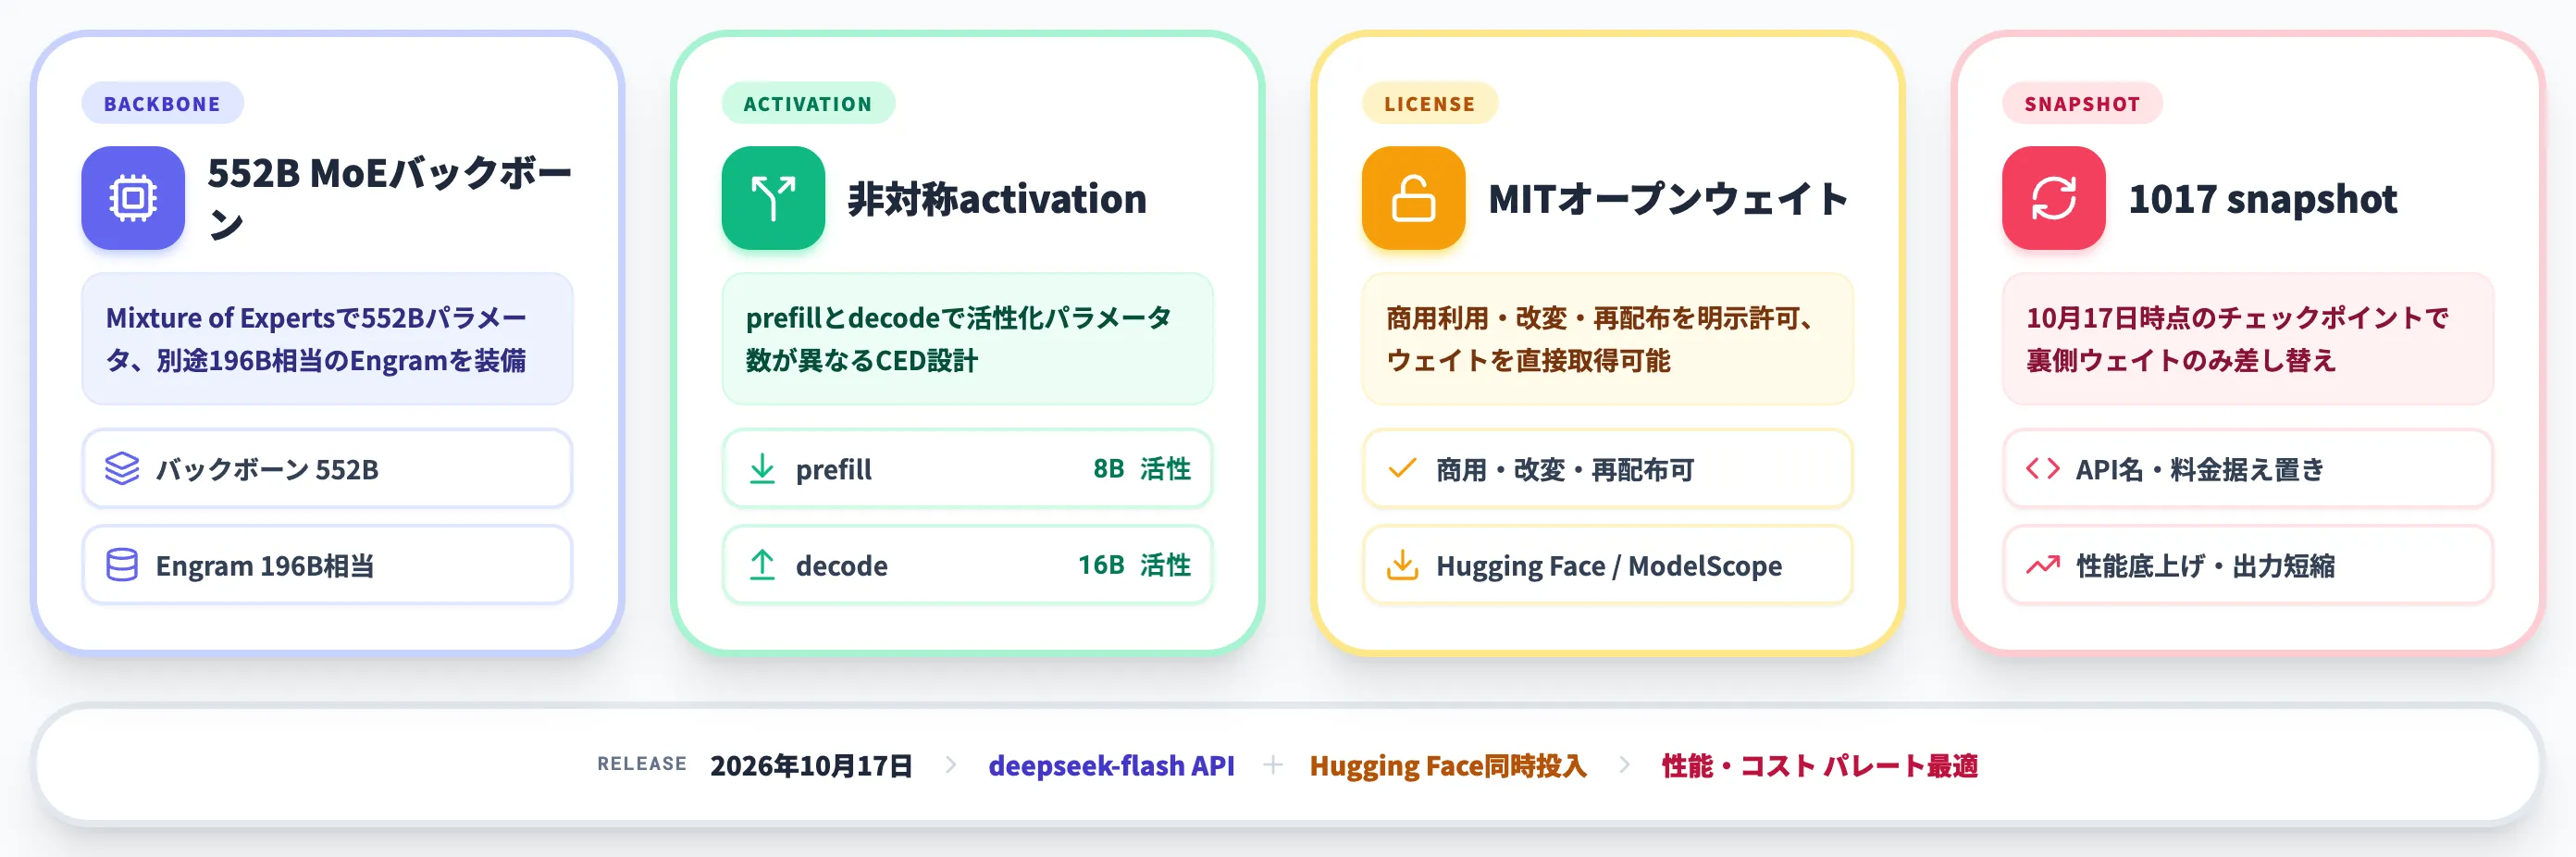
DeepSeek-V4.1-Flash-1017は、DeepSeekが2026年10月17日にdeepseek-flash APIとHugging Faceへ同時投入した、V4.1 Flashのsnapshotモデルです。
バックボーン552BパラメータのMoE(Mixture of Experts)モデルで、別途196B相当のEngramコンポーネントを備え、入力時(prefill)は8B・出力時(decode)は16Bのパラメータだけが活性化する非対称動作が特徴です。
V4.1 Flashシリーズでの1017 snapshotの役割
1017 snapshotは、V4.1 Flashシリーズを「性能ベンチの底上げ」と「出力の短縮」という2軸で動かすための中間アップデートです。
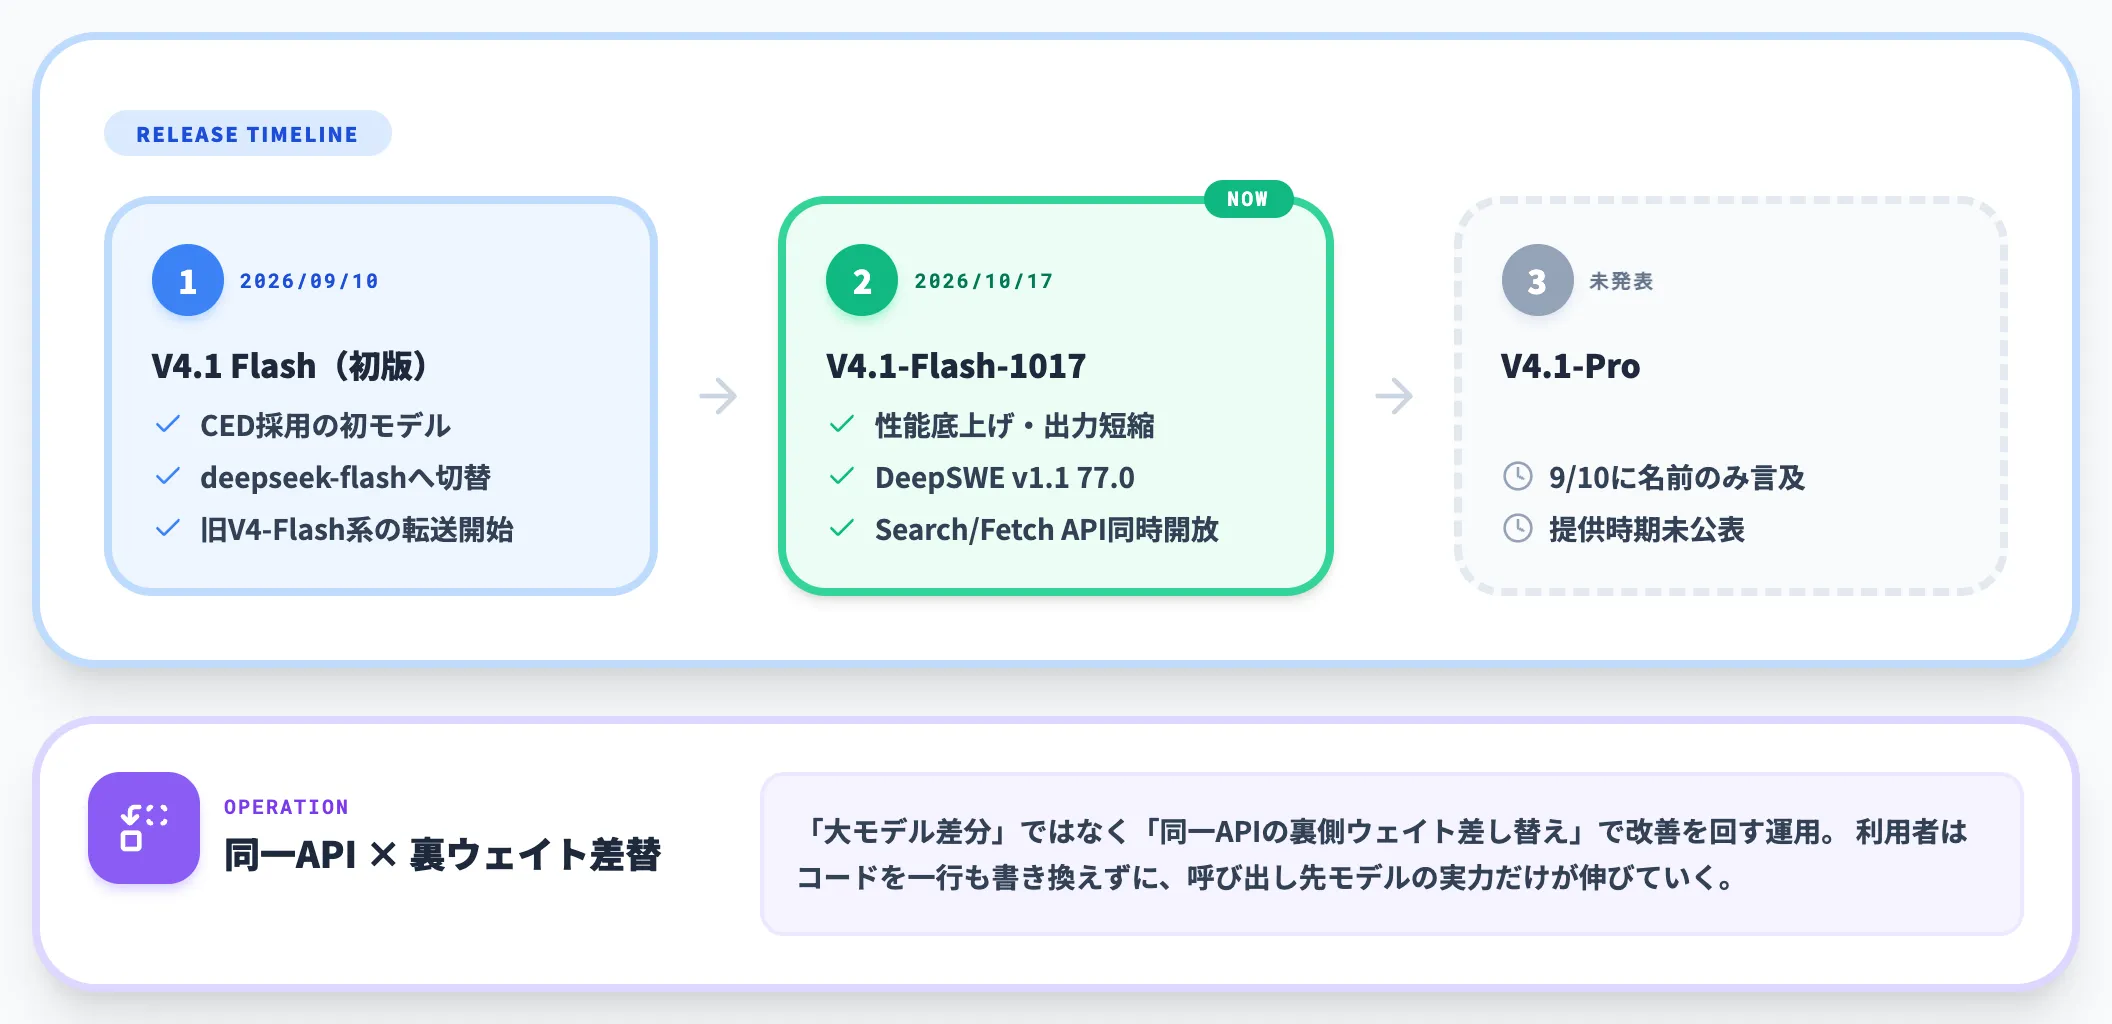
DeepSeek公式の更新履歴では、1017を「a new performance–cost Pareto optimum(新しい性能・コストのパレート最適)」と位置づけており、推論能力・コーディング・エージェント実行・画像理解の全領域で改善が入ったと説明されています。
以下の表で、V4.1 Flashシリーズの各リリースを時系列で整理しました。
| リリース日 | モデル名 | 位置づけ |
|---|---|---|
| 2026年9月10日 | DeepSeek-V4.1-Flash(初版) | CEDアーキ採用の初モデル、「deepseek-flash」 APIへ切替。旧 「deepseek-v4-flash」 / 「deepseek-v4-flash-vision-exp」 をV4.1 Flashへ転送する運用を同日告知 |
| 2026年10月17日 | DeepSeek-V4.1-Flash-1017 | 性能底上げ・出力短縮・Search/Fetch API同時開放 |
| 未発表 | DeepSeek-V4.1-Pro | 9月10日のアナウンスで名前のみ言及、提供時期未公表 |
この表が示すのは、DeepSeekが「大モデル差分」ではなく「同一APIの裏側ウェイト差し替え」で改善を回す運用に入ったことです。利用者はコードを一行も書き換えずに、呼び出し先モデルの実力だけが伸びていきます。
一方で後述するとおり、モデル名が変わらないまま挙動が変わるという副作用もあり、品質ベースラインを運用側で持つ必要があります。
1017アップデートが詰めてきた性能差分——DeepSWE 77.0でClaude Opus 5超え
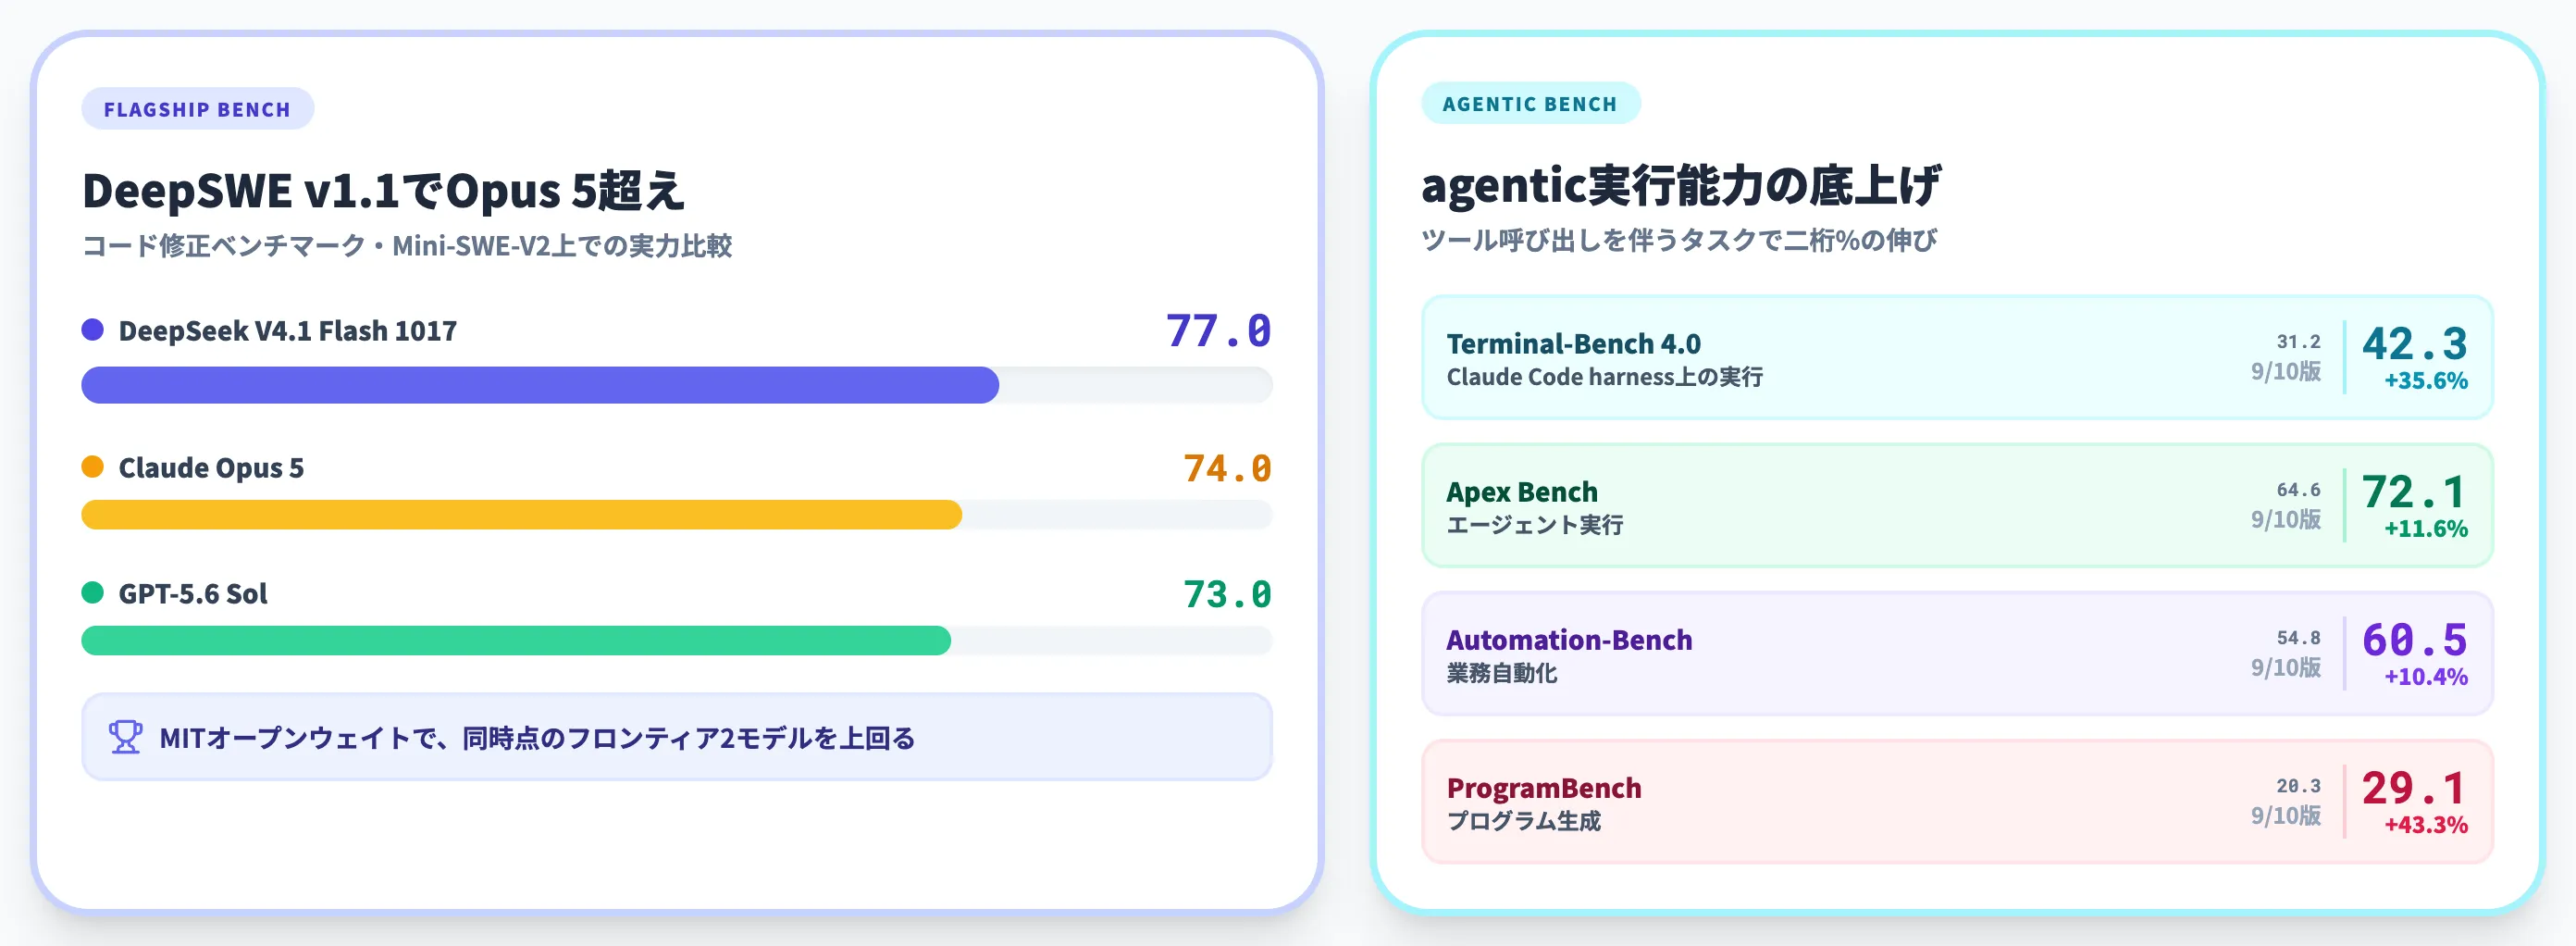
1017 snapshotで最も注目されたのは、コーディング特化ベンチ「DeepSWE v1.1」で77.0を記録し、Claude Opus 5の74.0・GPT-5.6 Solの73.0を上回った点です。
評価ハーネスは、DeepSWE v1.1がMini-SWE-V2、Terminal-Bench 4.0がClaude Codeハーネス上で実行されたと公式モデルカードに明記されています。
「素のモデル比較」ではなく「エージェント実行環境での実力比較」である点が特徴です。
全ベンチマーク数値——前バージョンからのスコア差分
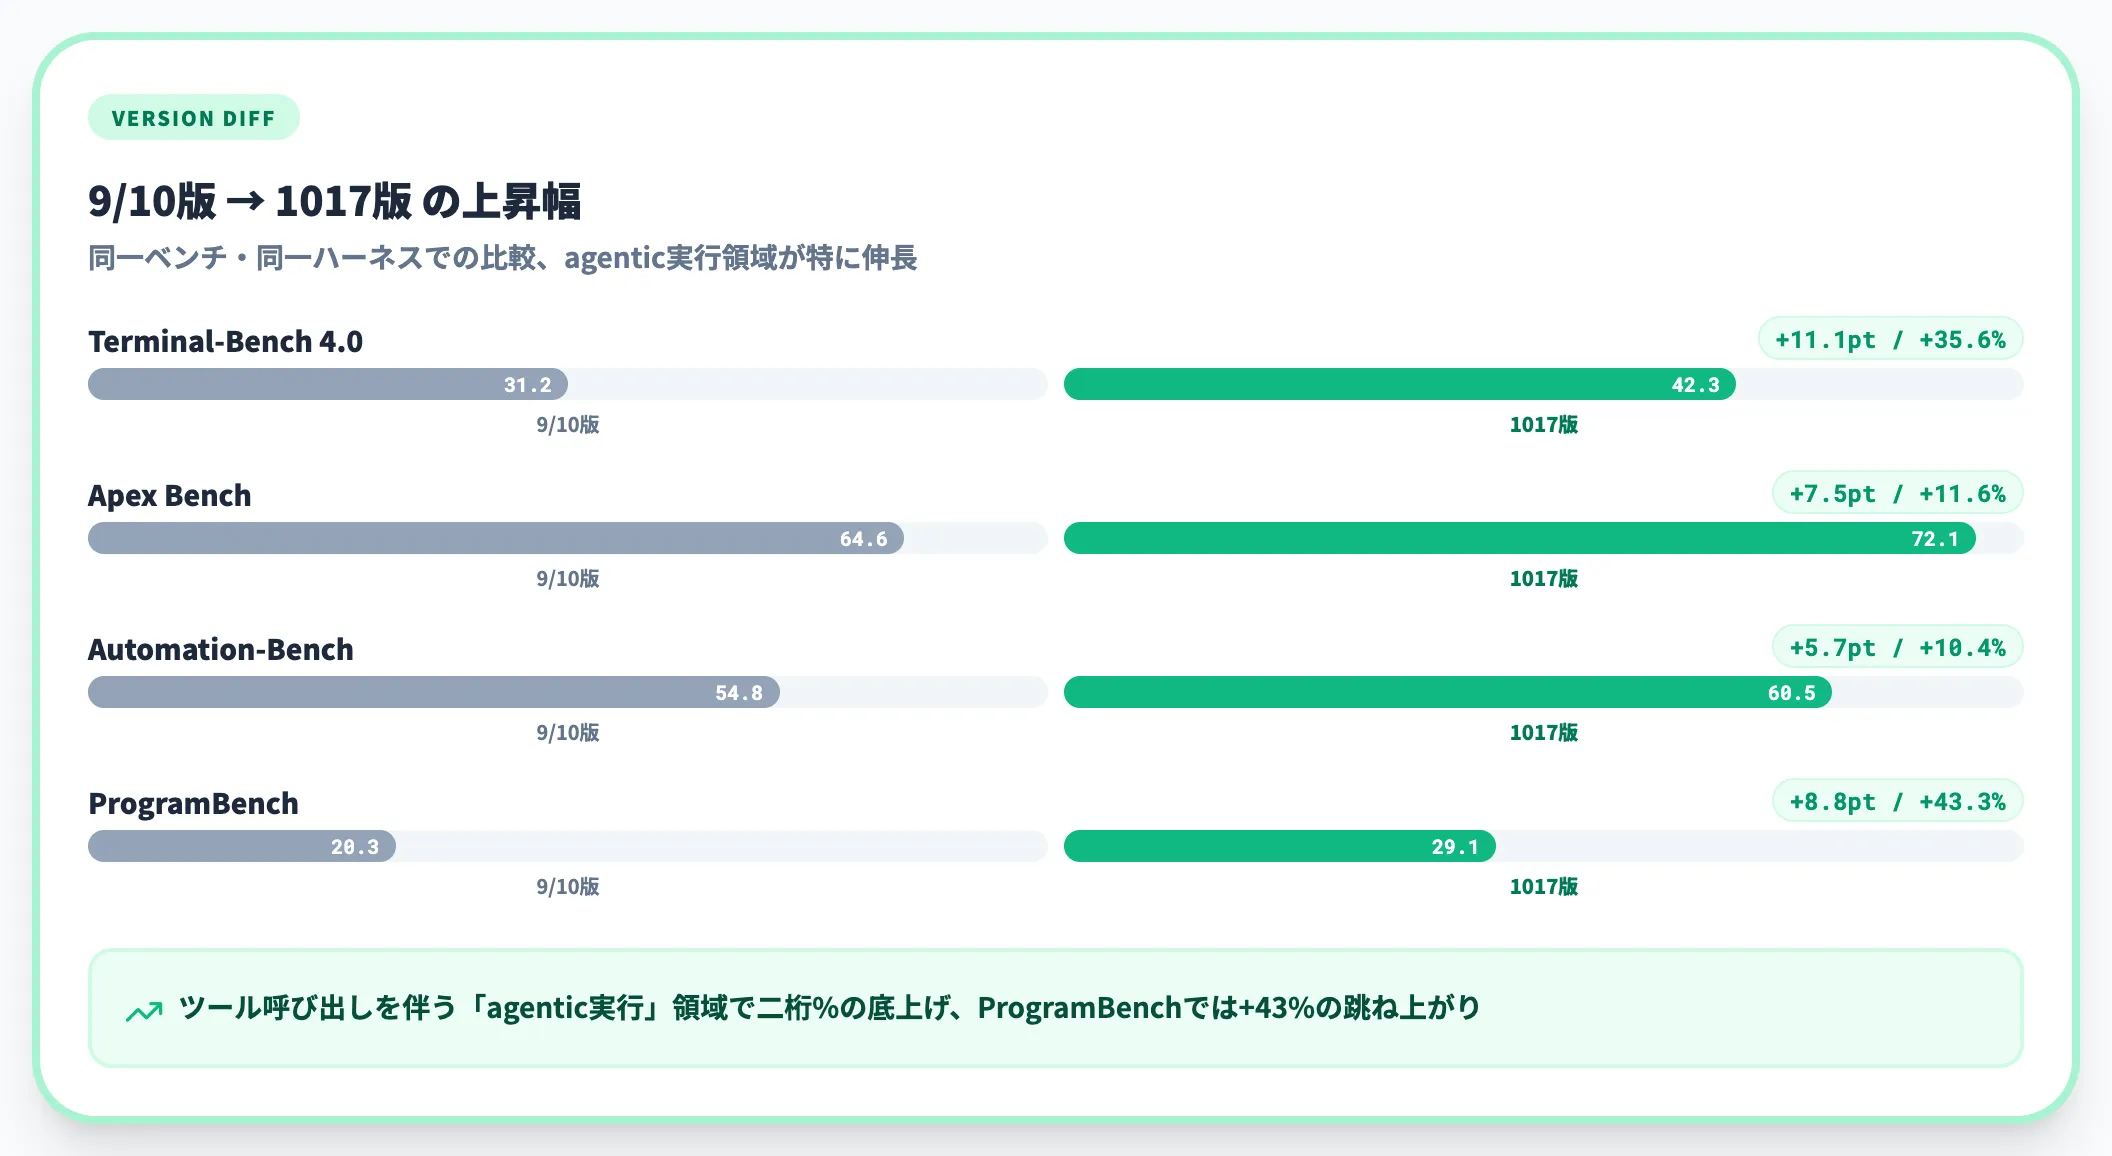
以下の表で、DeepSeek公式の更新履歴とモデルカードに掲載されたベンチマーク結果を、前バージョン・比較モデルと並べました。
| ベンチマーク | V4.1 Flash(9/10版) | V4.1-Flash-1017 | 比較モデル |
|---|---|---|---|
| DeepSWE v1.1(コード修正) | — | 77.0 | Opus 5: 74.0 / GPT-5.6 Sol: 73.0 |
| Terminal-Bench 4.0(Claude Code harness) | 31.2 | 42.3 | Opus 5: 51.8 |
| ProgramBench(プログラム生成) | 20.3 | 29.1 | — |
| HLE(Humanity's Last Exam・ツールなし) | — | 42.6 | — |
| Automation-Bench(業務自動化) | 54.8 | 60.5 | — |
| Apex Bench(エージェント実行) | 64.6 | 72.1 | — |
この表の数値を読み解くと、agentic実行能力(Terminal-Bench・Apex Bench・Automation-Bench)の伸びが特に大きいことがわかります。Terminal-Bench 4.0は31.2→42.3(+35.6%)、Apex Benchは64.6→72.1(+11.6%)、Automation-Benchは54.8→60.5(+10.4%)と、ツール呼び出しを伴うタスクで二桁%の底上げが入っています。
ベンチの絶対値だけで競合モデルとの優劣を判定するには、同一ハーネス・同一評価条件で比較する必要があります。
公式が示した1017の優位性(DeepSWE v1.1=77.0でClaude Opus 5=74.0・GPT-5.6 Sol=73.0を上回る)は、評価条件が揃った同一ベンチでの結果です。純粋なターミナル操作ベンチで競合モデルの最新版と直接比較するには、各モデルの公式モデルカードを別途参照する必要があります。
出力短縮と実行速度の改善
1017アップデートで性能数値と並んで強調されているのが、タスク実行時間と出力トークン数の削減です。
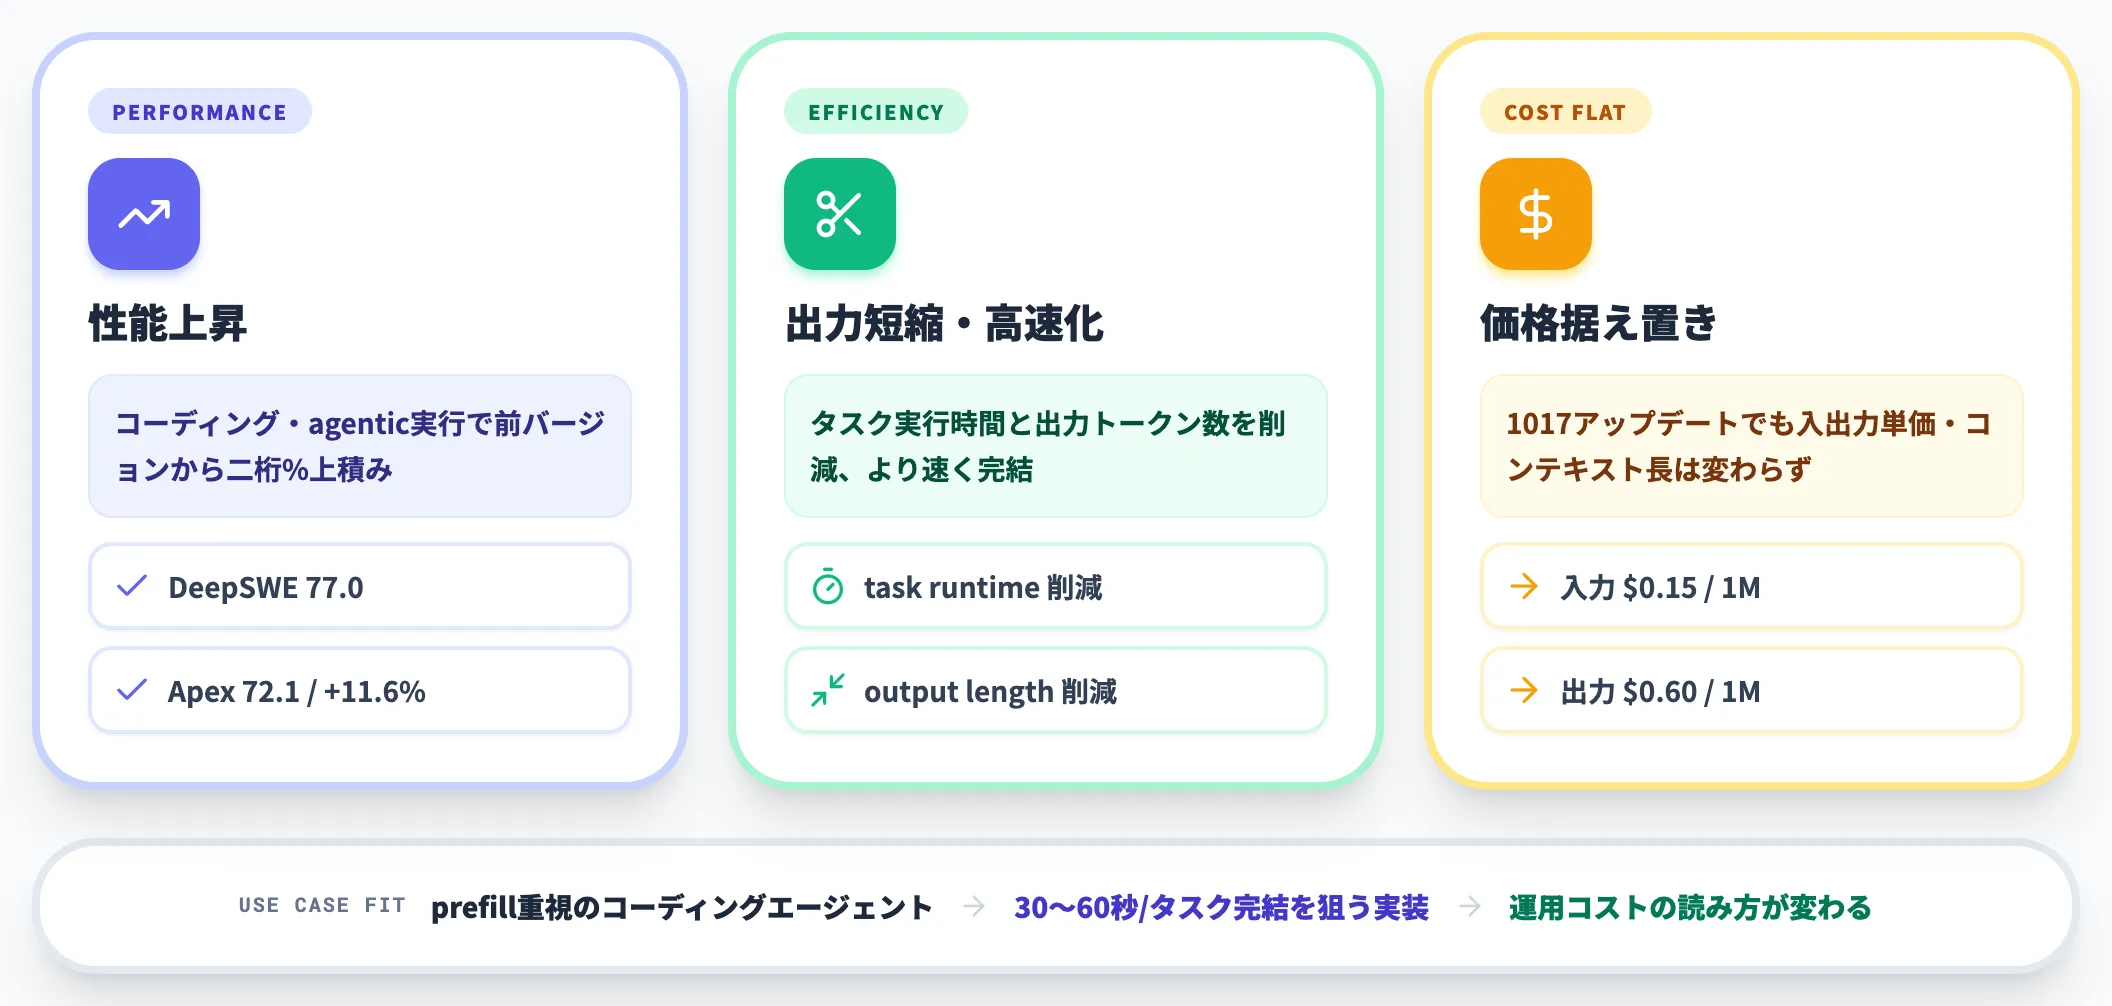
DeepSeek公式は1017を「reduce task runtime and output length, enabling users to complete tasks at lower cost and higher speed(タスク実行時間と出力長を削減し、より低コスト・高速に完了できる)」と説明しており、ベンチ数値と組み合わせて「性能上昇+出力短縮+価格据え置き」の三位一体をうたっています。
コーディングエージェントは「プロンプトを長文で読み込ませる+短い修正パッチを返す」というprefill重視のワークロードが中心で、1017の設計はこの用途に最適化されています。Basetenなどサードパーティ推論基盤でも、prefill効率の高さがV4.1 Flashの特徴として整理されています。
Causal Encoder-Decoder(CED)アーキテクチャの新規性
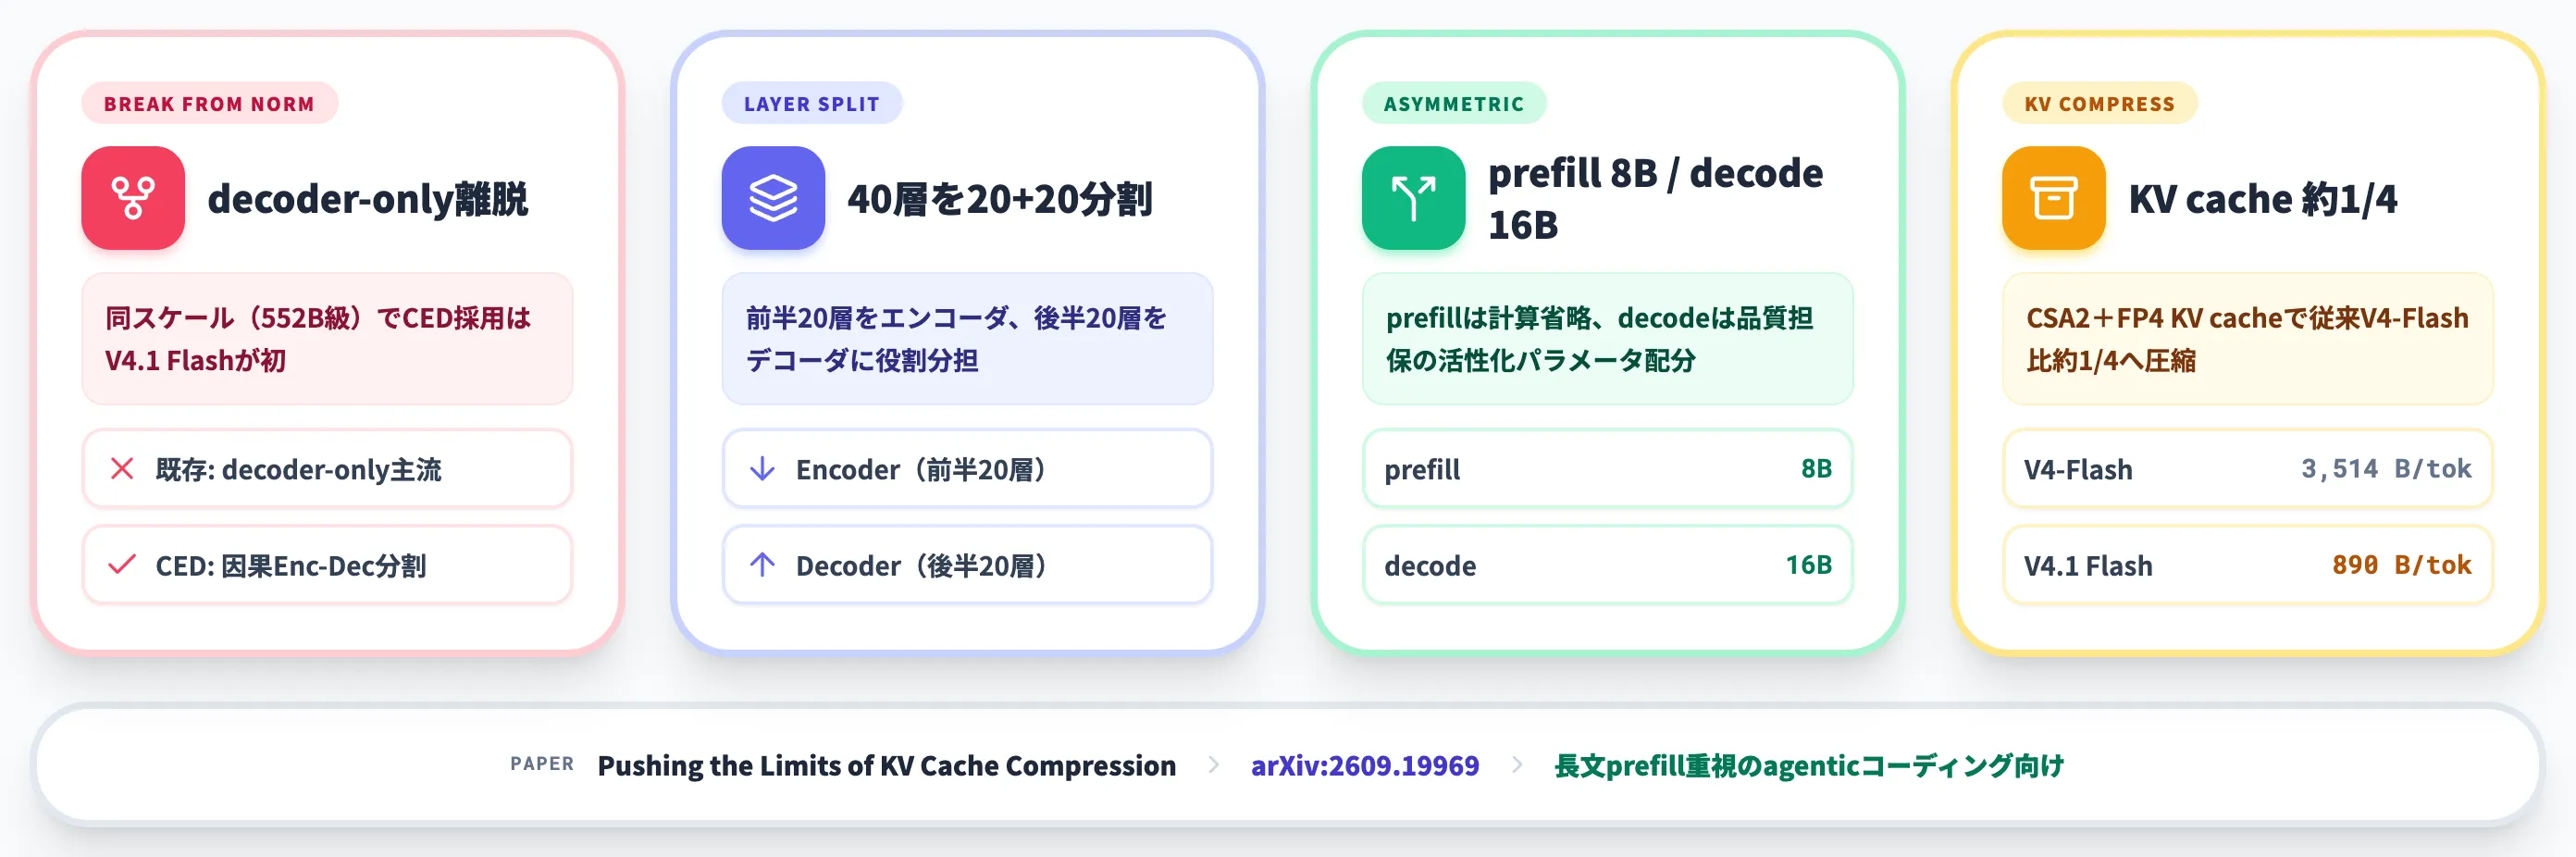
V4.1 Flashシリーズの最大の設計上の特徴は、decoder-onlyではなくCausal Encoder-Decoder(CED、因果エンコーダ・デコーダ)という独自アーキテクチャを採用した点です。
CEDはDeepSeek-V4.1-Flash: Pushing the Limits of KV Cache Compressionという論文として公開されており、同スケール(バックボーン552B級)でCEDを採用したモデルはV4.1 Flashが初です。
40層を20層エンコーダ+20層デコーダに分割
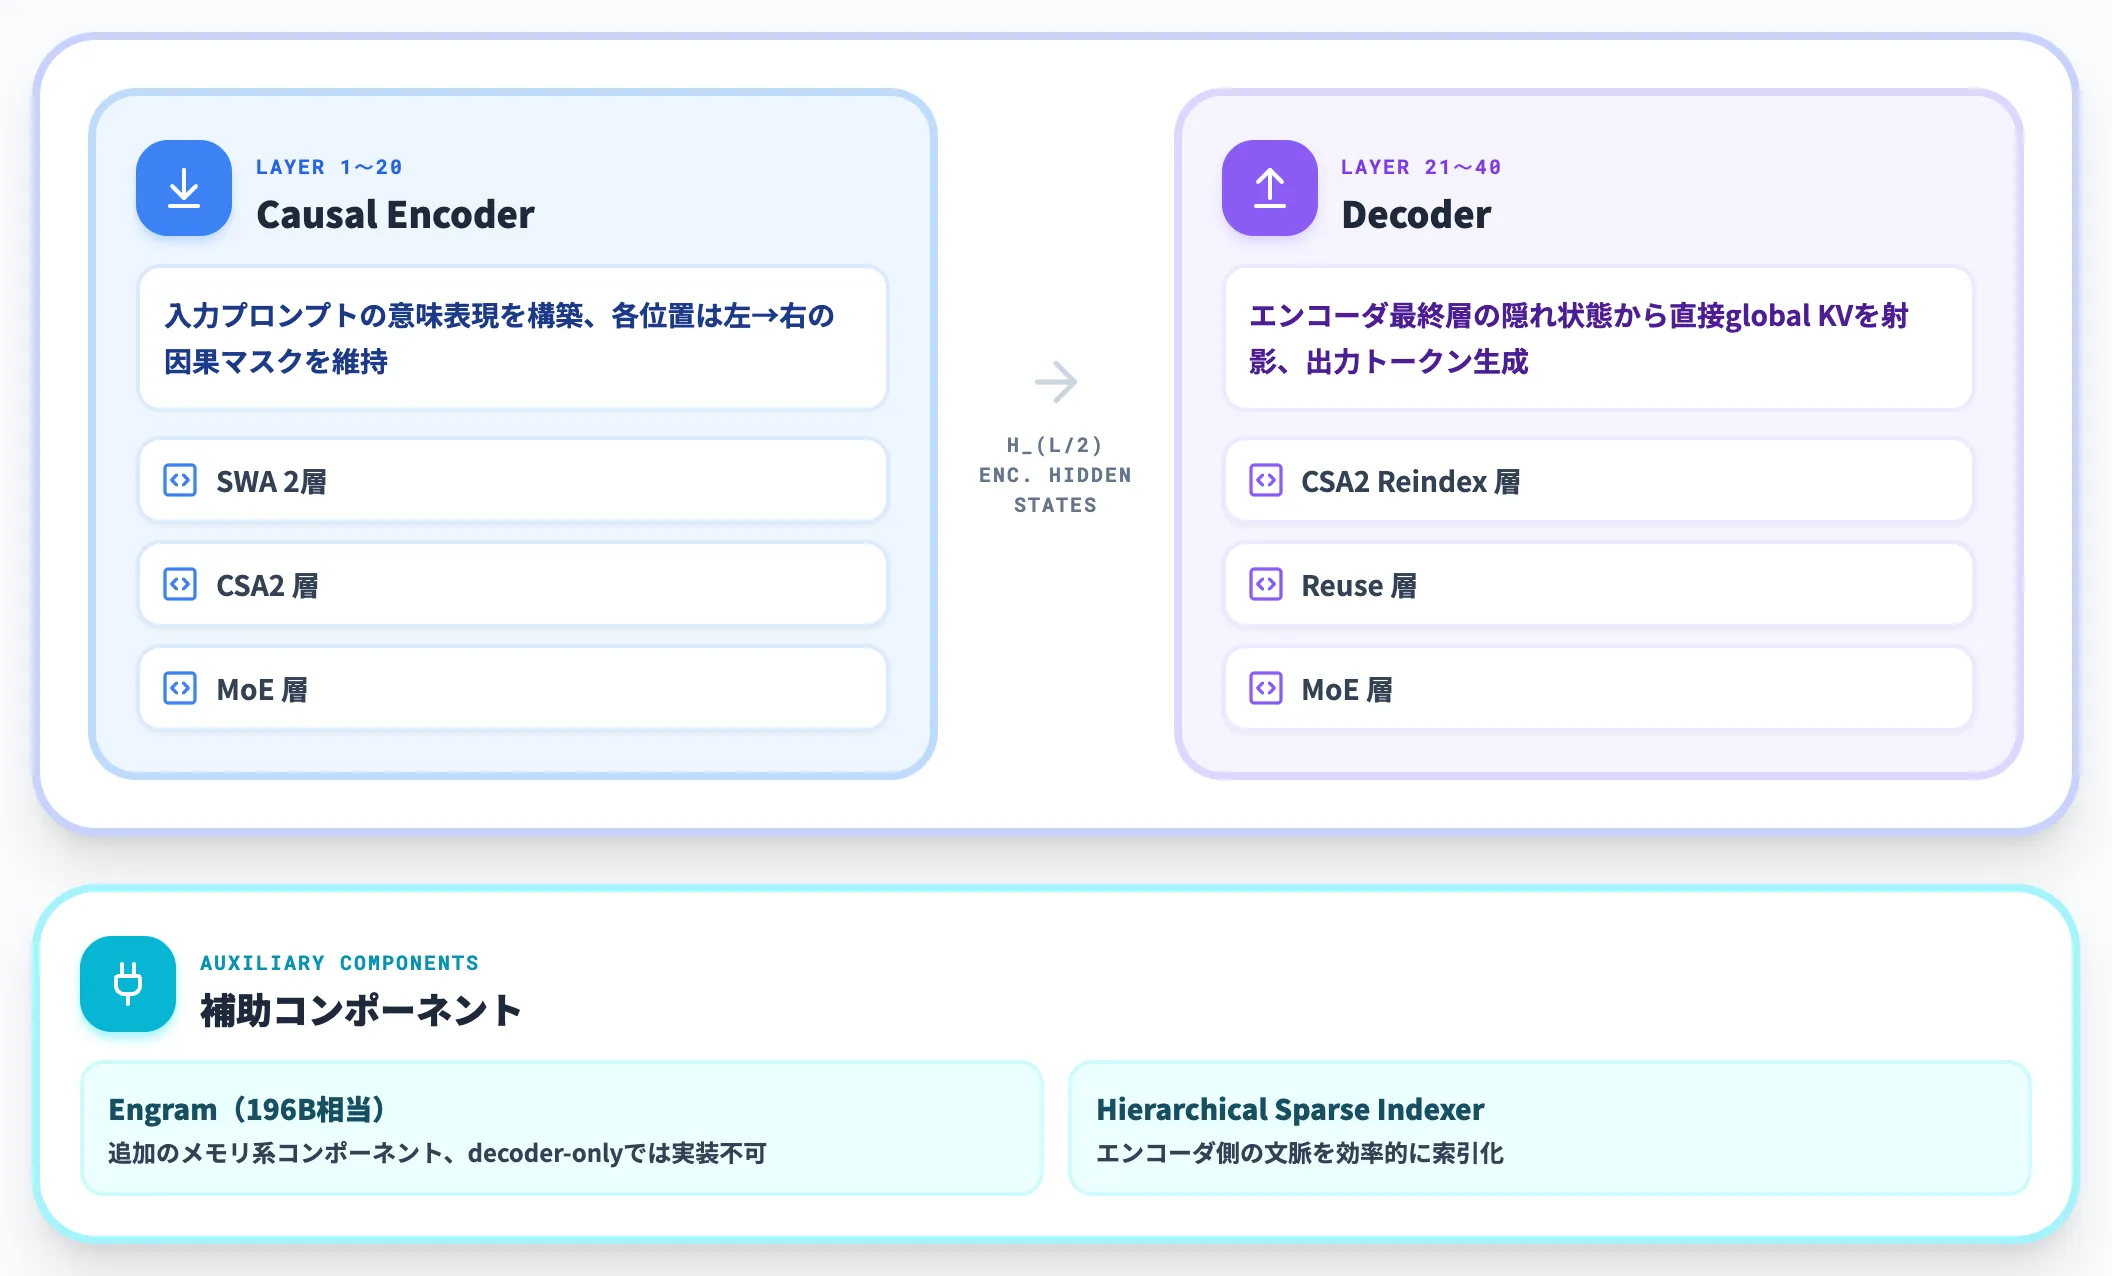
CEDは、40層の因果Transformer(左から右へのcausal mask付き)を、前半20層をエンコーダ、後半20層をデコーダとして役割分担させる構造です。
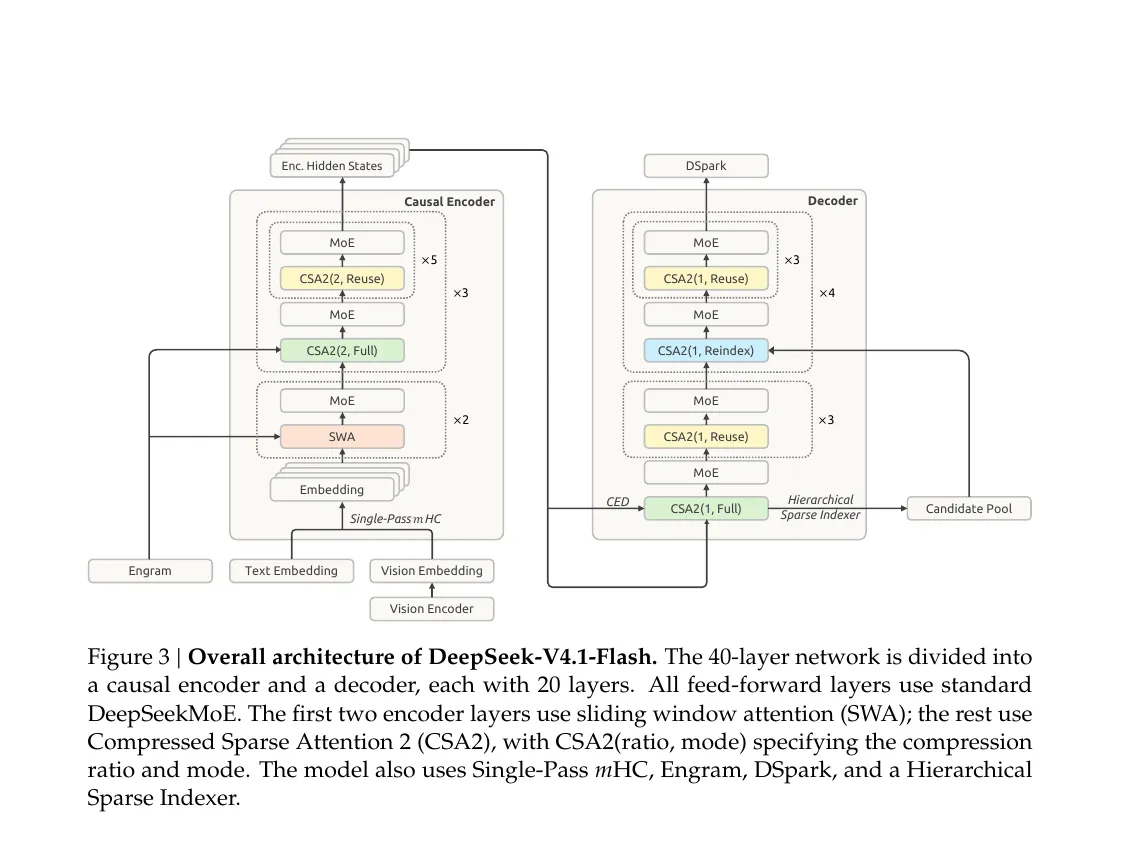
DeepSeek-V4.1-Flashの全体アーキテクチャ。40層ネットワークを20層のCausal Encoderと20層のDecoderに分割(出典:arXiv:2609.19969)
アーキテクチャ図で示されているとおり、エンコーダ側は入力トークン(Text / Vision Embedding)を受け取ってSWA(Sliding Window Attention)2層+CSA2(Compressed Sparse Attention 2)層+MoEを積み重ね、デコーダ側はエンコーダ最終層の隠れ状態(Enc. Hidden States)を受け取ってCSA2 Reindex層・Reuse層・MoE層を回していく構造です。
EngramやHierarchical Sparse Indexerといった補助コンポーネントも組み込まれており、decoder-onlyでは実装できない「エンコーダで文脈を固めてからデコーダで生成する」役割分担が成立します。
-
エンコーダ側(前半20層)
入力プロンプトの意味表現を構築する。各位置は自分より前の位置だけを参照できる左→右の因果マスクを維持しており、decoder-onlyと同じ扱い。
-
デコーダ側(後半20層)
エンコーダ最終層の隠れ状態 「H_(L/2)」 から直接 global KV エントリを射影し、出力トークンを生成する。
見かけは単なるTransformerの前後半分割ですが、prefillとdecodeで異なる計算量・活性化パラメータを使う設計になっており、ここが従来のdecoder-onlyモデルと根本的に異なります。
prefill 8B・decode 16Bの非対称activation
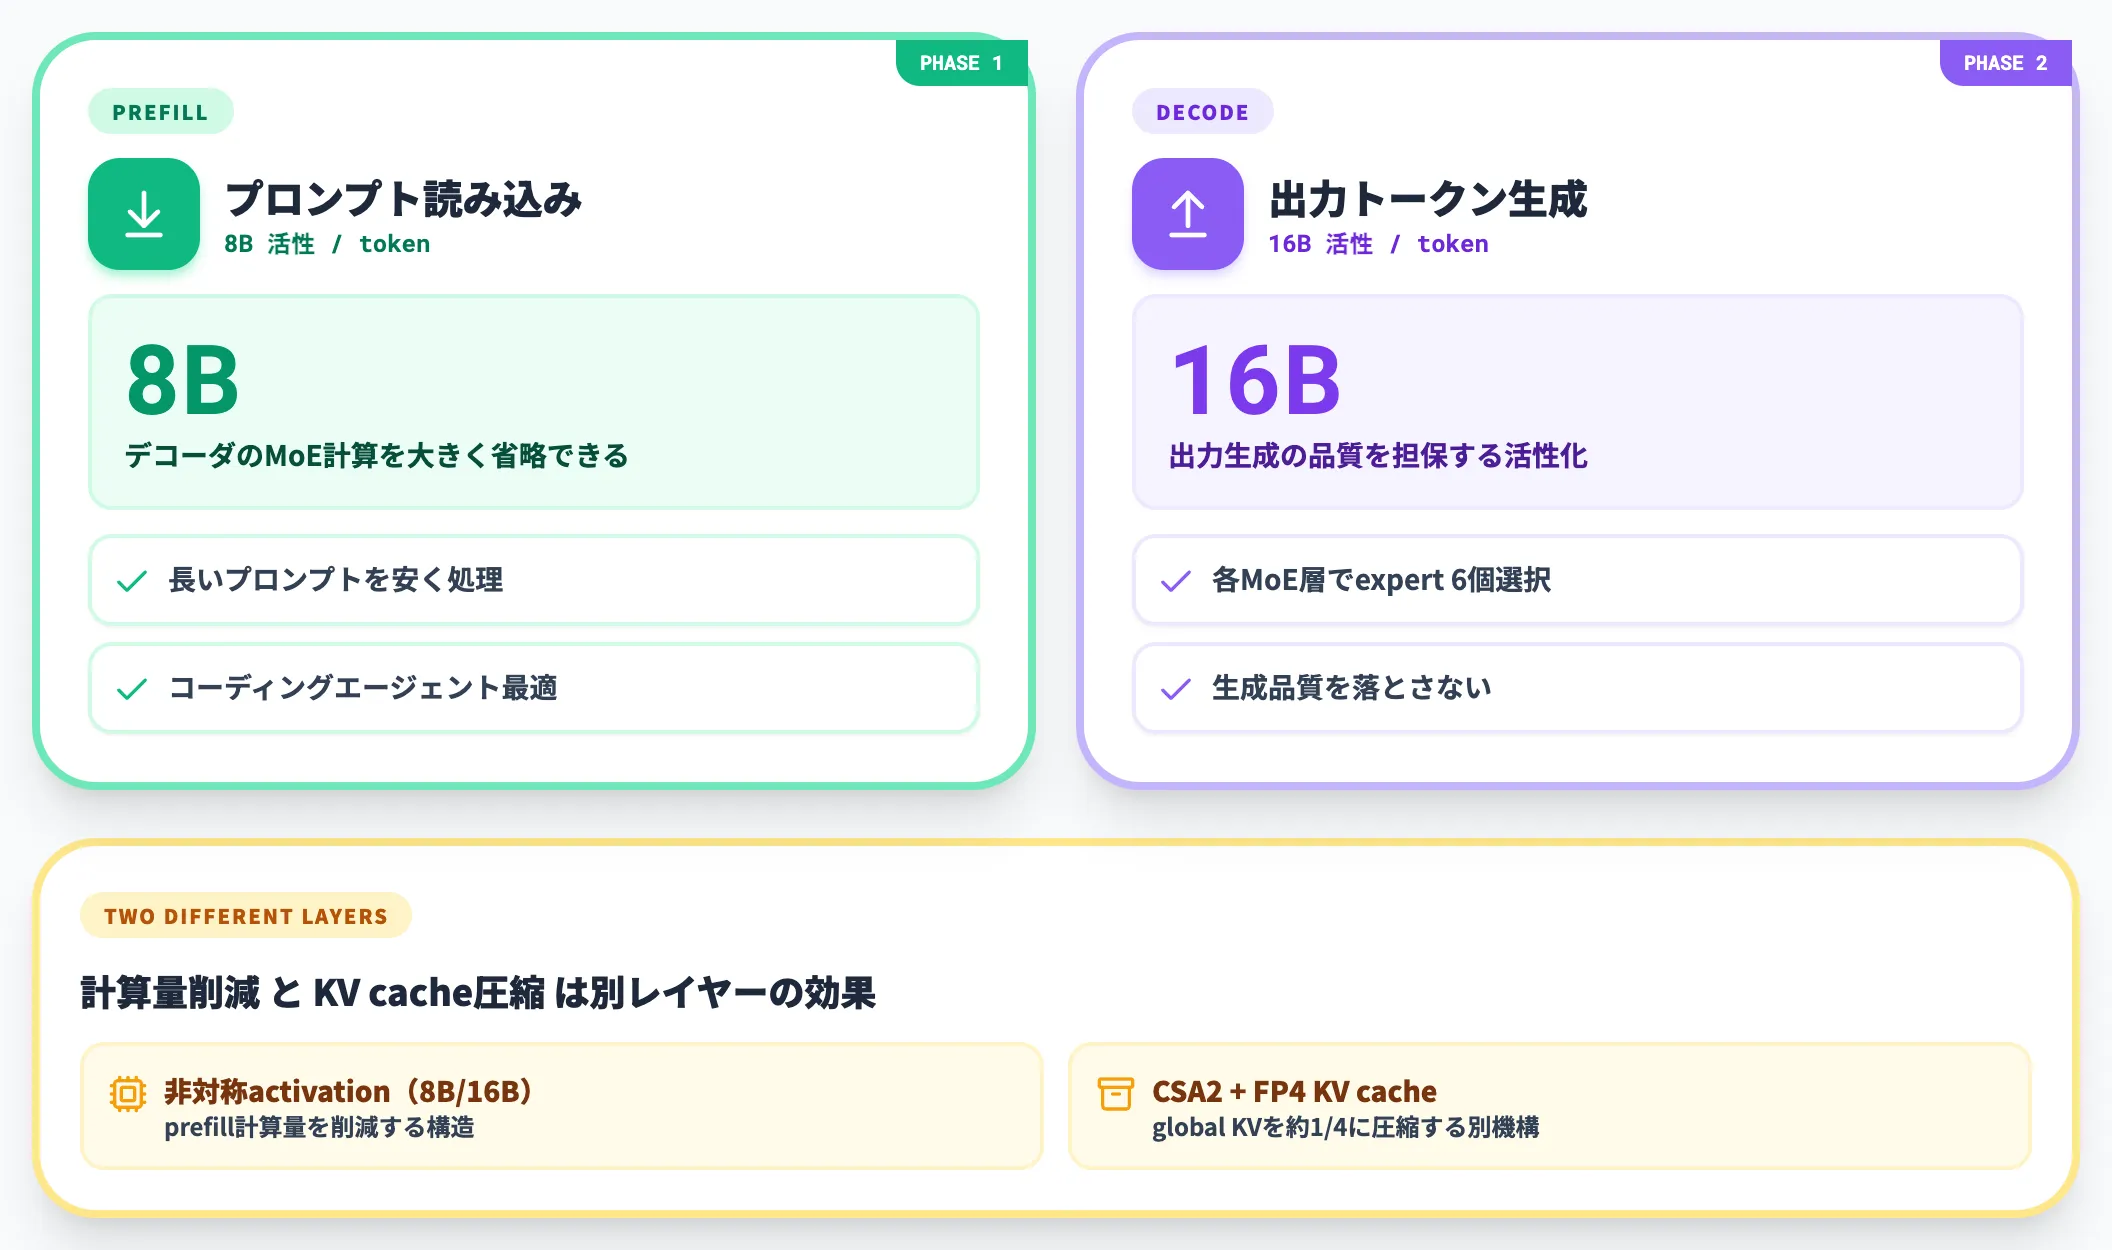
CEDの核心は、prefillでデコーダ側の計算を大きく省略できる構造にあります。
エンコーダ最終層の隠れ状態からデコーダ側のKVを射影する仕組みにより、prefill段階ではデコーダのMoE計算を回す必要が減り、長いプロンプトを安く処理できるようになります。各MoE層ではrouted expertを6個選ぶ構成が論文で明示されています。
- prefill時: 1トークンあたり8Bパラメータが活性化
- decode時: 1トークンあたり16Bパラメータが活性化(出力生成の品質を担保)
従来V4-Flash(活性13B想定)と比べて、prefillの活性パラメータが8Bに縮小しており、CEDの構造的な省略と合わせて計算コスト削減に寄与しています。
これに加えてCSA2(Compressed Sparse Attention 2)とFP4 KV cacheの寄与でglobal KV cacheを従来V4-Flashの約1/4まで圧縮しています(計算量削減とKV cache圧縮は別レイヤーの効果である点に注意)。
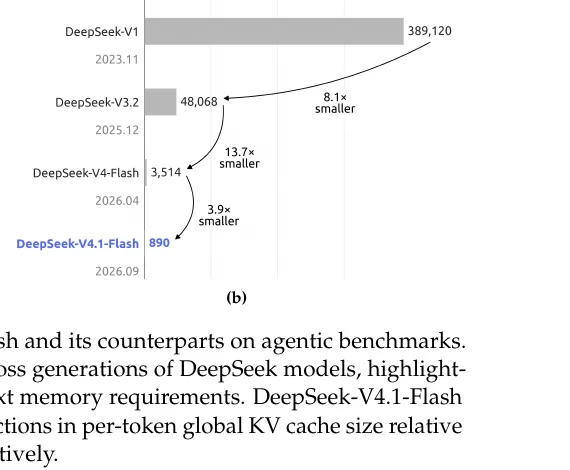
1トークンあたりglobal KV cacheサイズのDeepSeek世代別推移。V1=389,120バイト、V3.2=48,068バイト、V4-Flash=3,514バイト、V4.1-Flash=890バイトでV4-Flash比約1/4、V1比約437倍の圧縮(出典:arXiv:2609.19969)
グラフの右端で主張されているのは、V4.1-Flashが890バイト/トークンまで圧縮し、直前世代のV4-Flashと比べて約3.9倍(=1/4)、約3年前のV1と比べると実に437倍のメモリ削減を実現している点です。
1Mトークンの文脈を扱うワークロードで、GPUメモリの大半を占めていたKV cache領域が圧縮された意味は大きく、同じGPU台数でより多くの並列セッションを捌けるようになります。
これは「読み込ませる文脈は長いが、出力は短い」というコーディングエージェント・リポジトリ解析・契約書レビューといった用途、とくに長い未キャッシュ入力が多い条件下で効きます。
1Mコンテキストを使う実装では、prefillコストが運用総コストの大半を占めるため、CEDによる計算省略のインパクトが大きくなります。
CEDが解いた制約領域
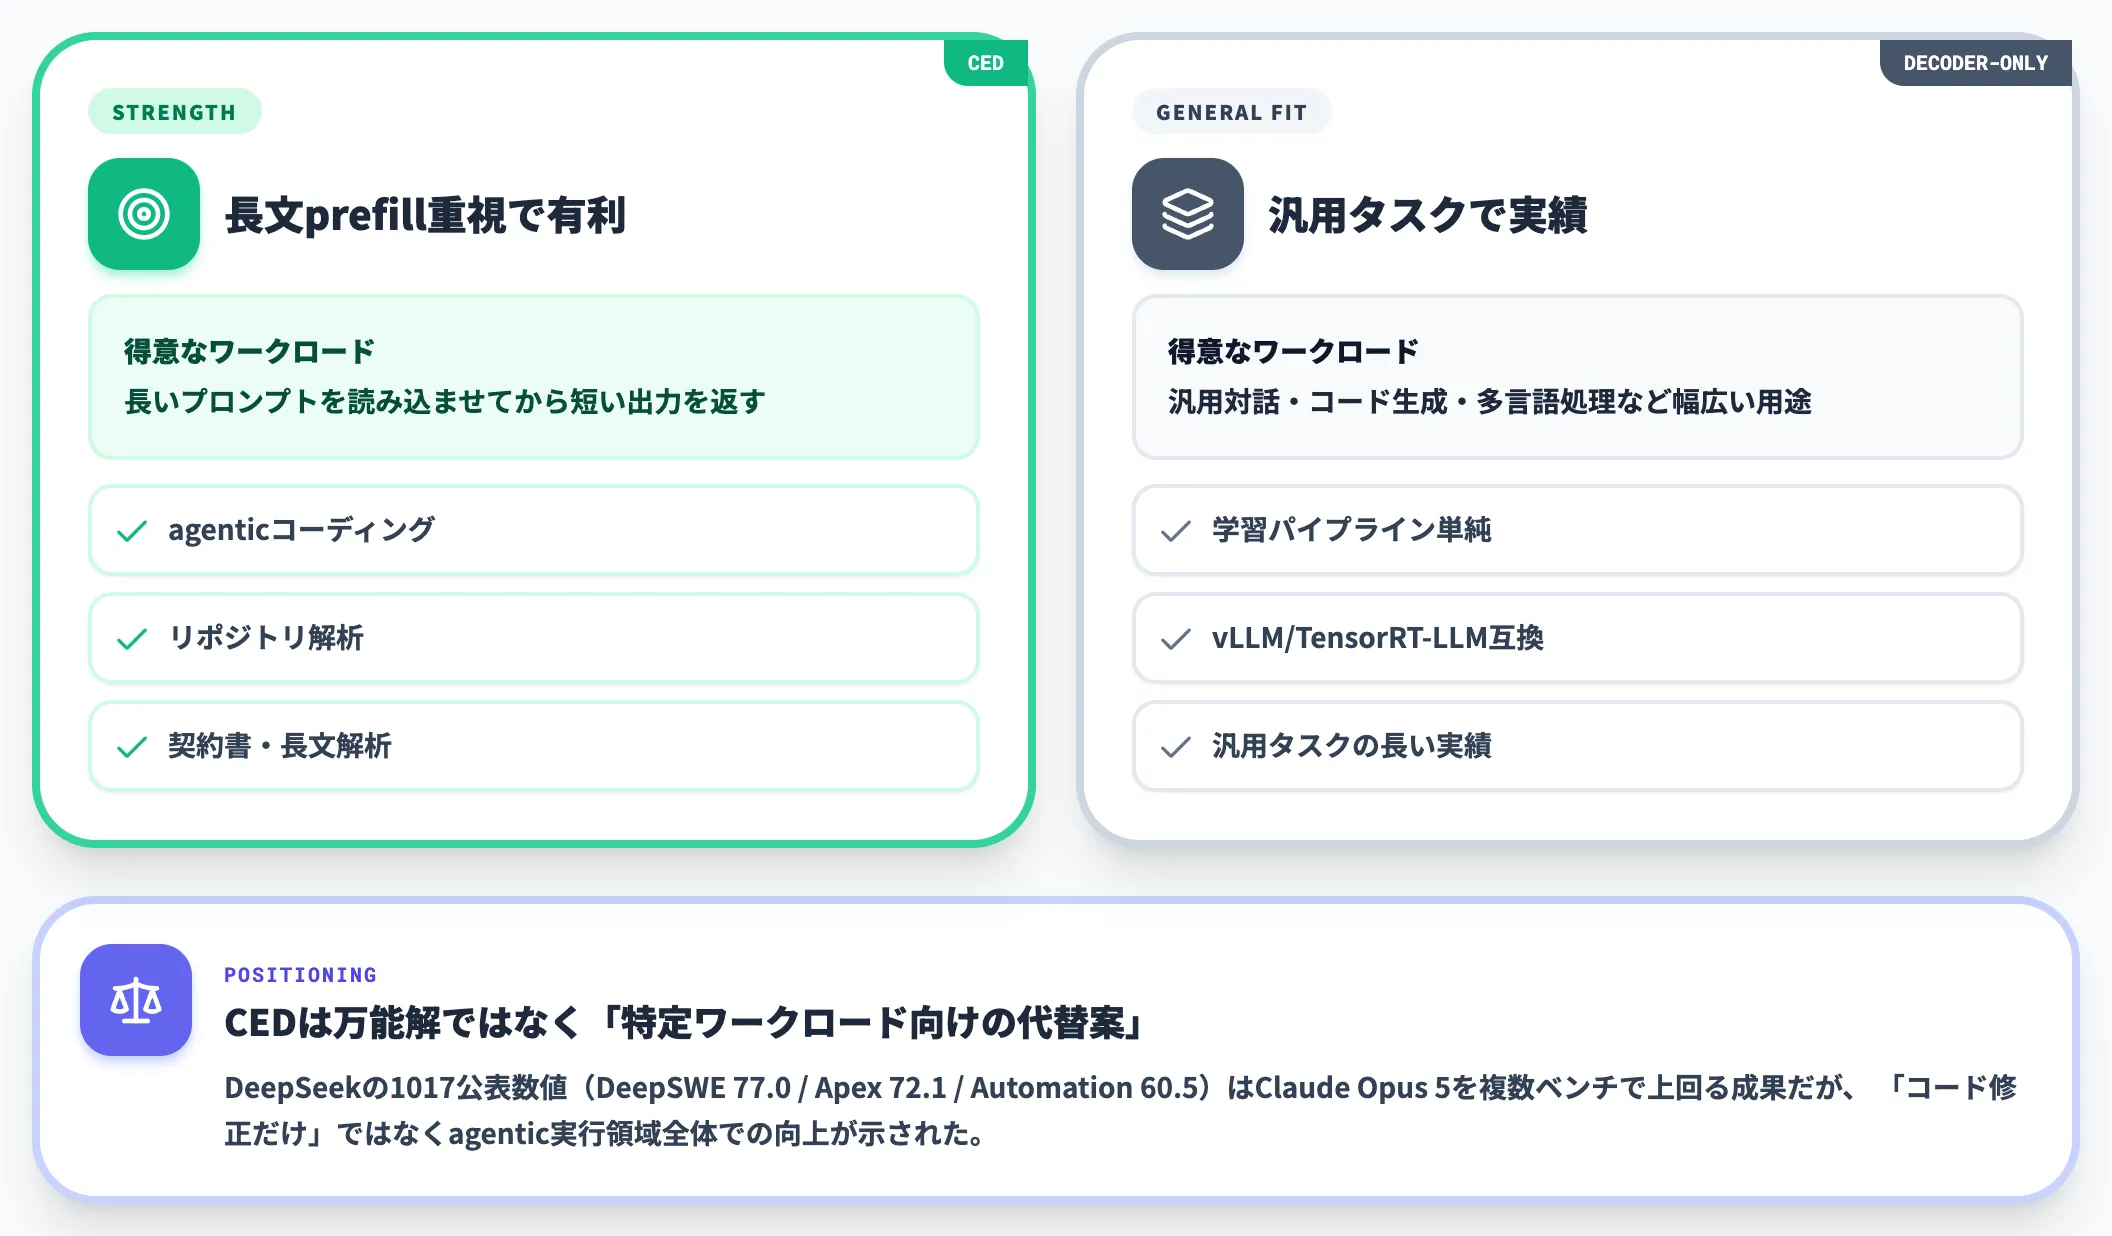
CEDは「KV cache圧縮と長文prefillコスト」という具体的な制約領域に焦点を絞った設計です。agenticコーディング・リポジトリ解析・長文解析のように、長いプロンプトを読み込ませてから短い出力を返すワークロードで強みが出ます。
decoder-only構造は現時点でも多くのLLMが採用しており、学習パイプラインの単純さ・既存推論ランタイム(vLLM・TensorRT-LLM等)との互換性・汎用タスクでの実績という利点があります。CEDは万能解ではなく「特定ワークロードでdecoder-onlyを上回る代替案」と位置づけるのが正しい理解です。
DeepSeekの1017公表数値では、Automation-Bench 60.5・Apex Bench 72.1・DeepSWE v1.1 77.0など複数ベンチでClaude Opus 5を上回っており、「コード修正だけ」ではなくagentic実行領域全体での向上が示されています。
deepseek-flash APIと使い方
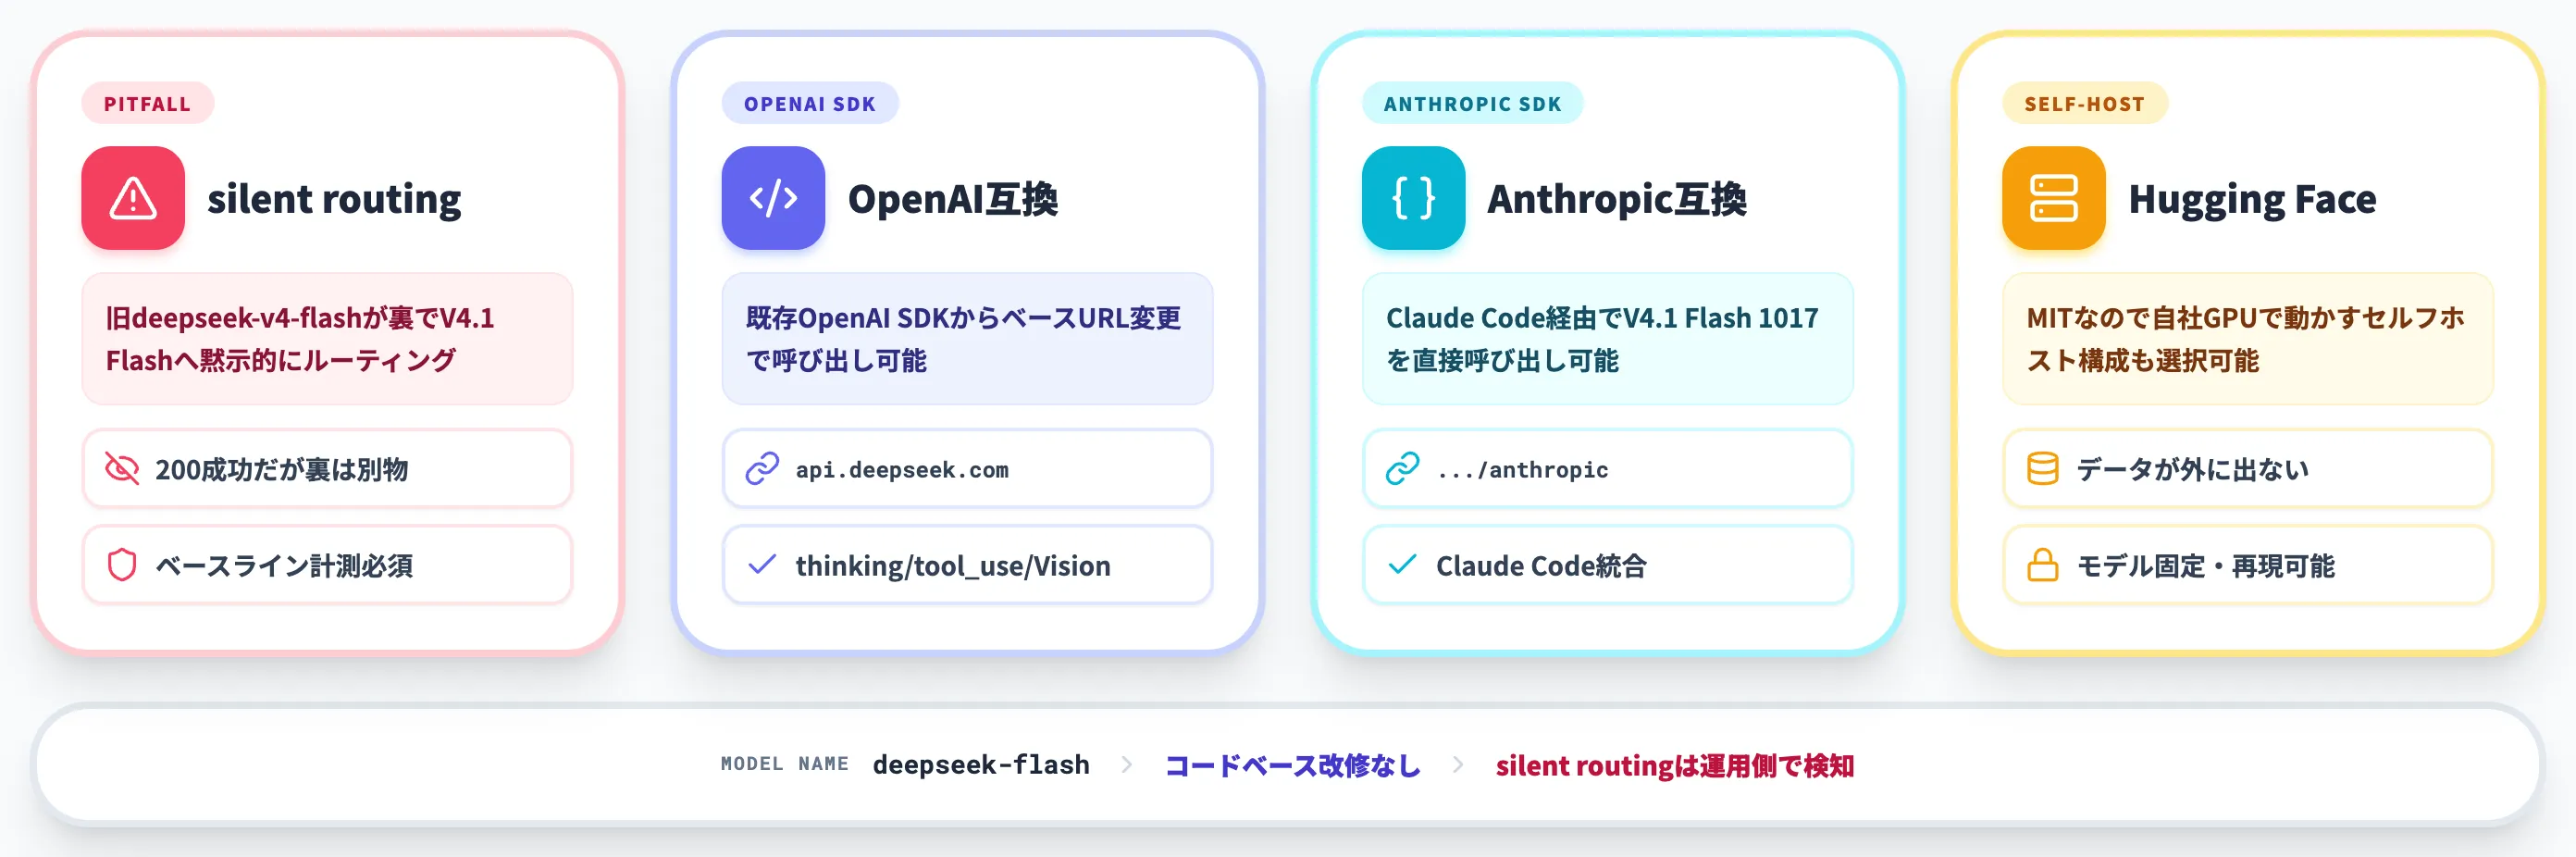
V4.1 Flash 1017の利用は、DeepSeek公式APIで 「deepseek-flash」 というモデル名を指定するだけで始められます。コードベースの改修は不要です。
ただし、過去バージョン(V4-Flash・V4-Flash-Vision-Exp)を使っていた既存コードには、silent routing(黙示的ルーティング)という落とし穴があります。
旧モデル名が裏でV4.1 Flashへ転送される仕様
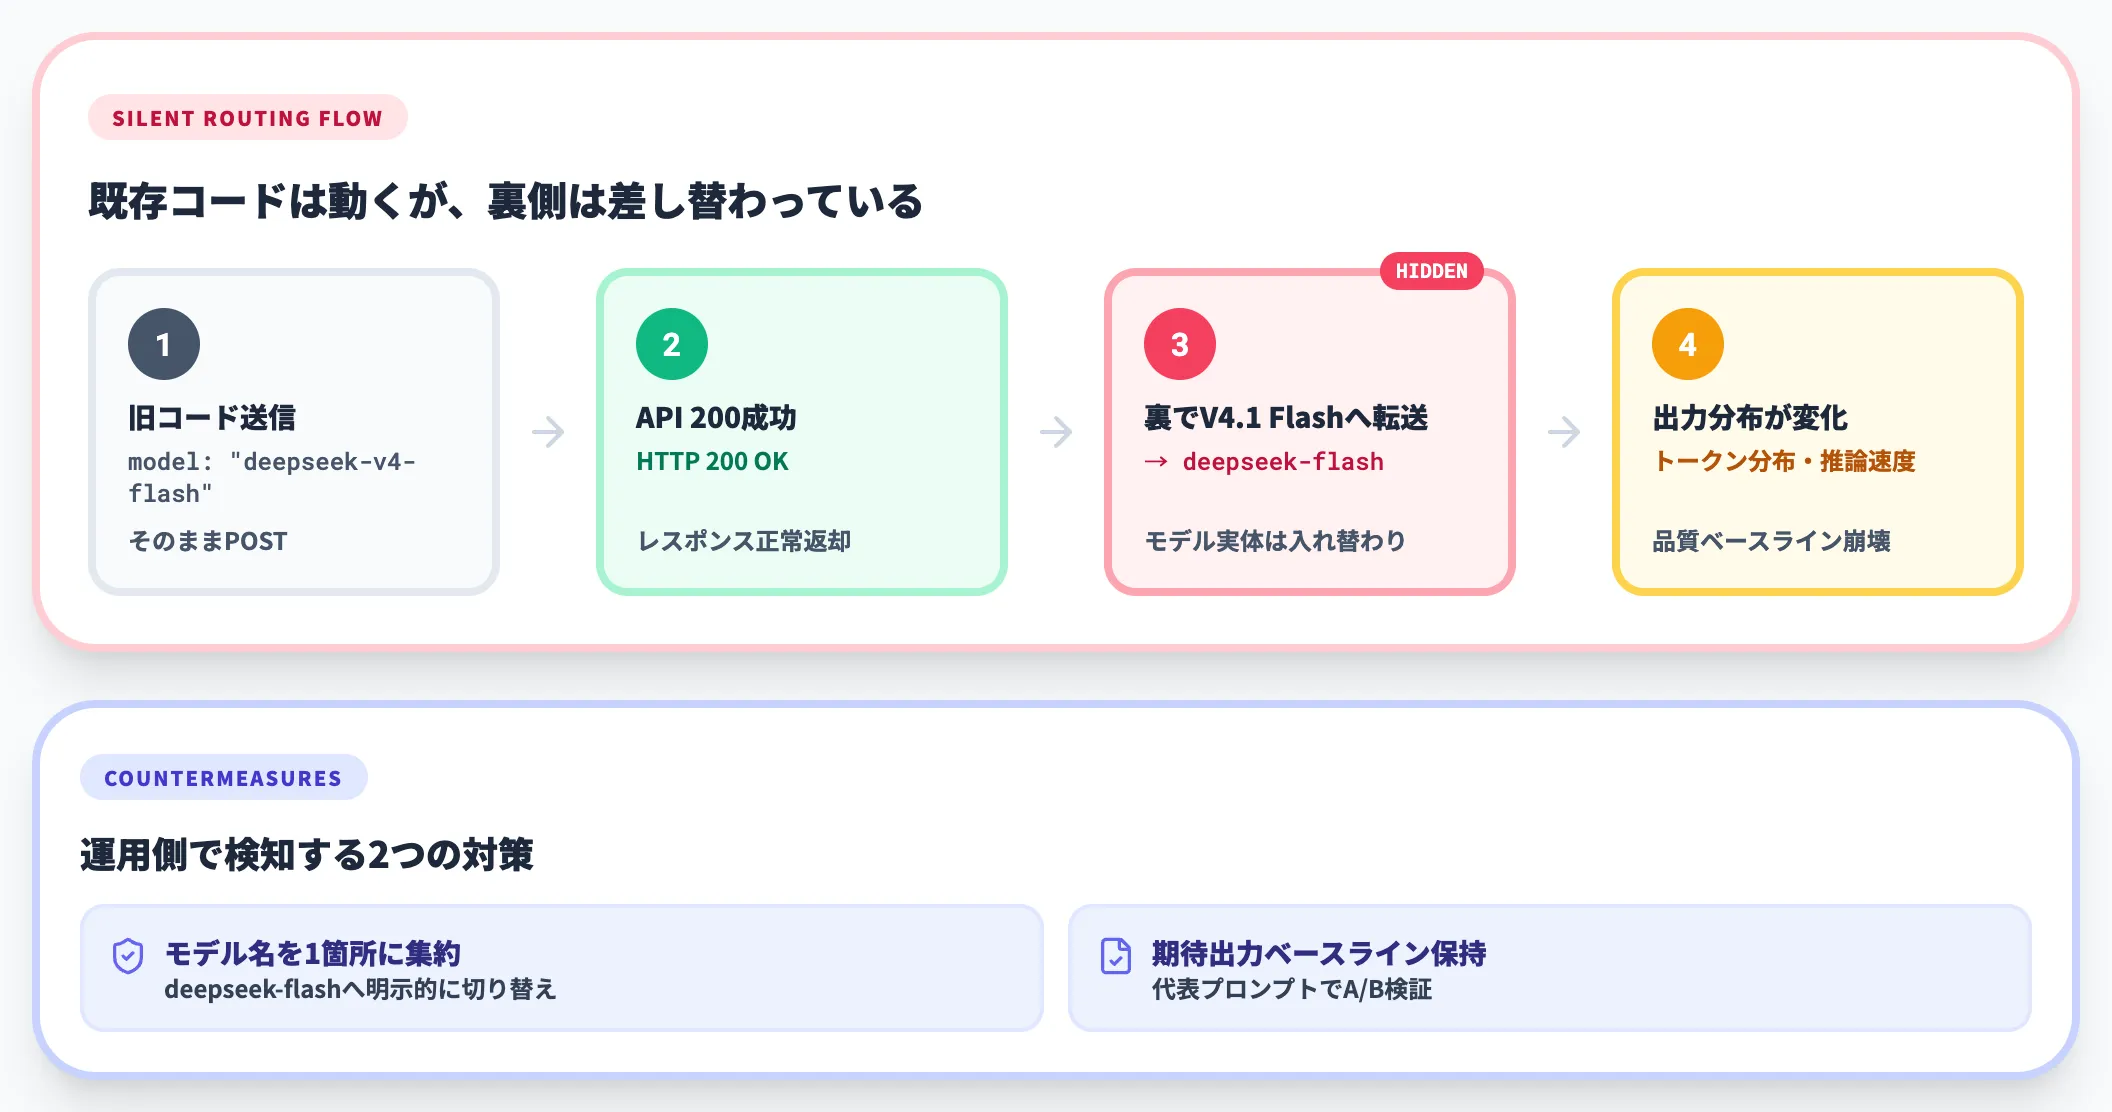
DeepSeek公式更新履歴によれば、2026年9月10日のV4.1 Flash公開と同時に、旧モデル名の 「deepseek-v4-flash」 と 「deepseek-v4-flash-vision-exp」 は廃止され、互換性のため暫定でV4.1 Flashへルーティングされる運用に切り替わっています。
fyve.co.jpの分析で指摘されているとおり、この仕様の実務上の問題はAPIコール自体は200成功を返す点にあります。
- 既存コードは 「deepseek-v4-flash」 のまま動き続ける
- レスポンスステータスも成功を返す
- しかし裏側のモデルは別物(V4.1 Flash)に差し替わっている
- 出力トークン分布・推論速度・ベンチ特性が黙って変わる
結果として、「システムは動いているが、出力品質が過去と微妙に違う」という状態が発生し、A/Bテスト・ベースライン計測を持たない運用では変化そのものに気づけないことになります。
対策はシンプルで、モデル名を1箇所に集約し、「deepseek-flash」 へ明示的に切り替えること、そして代表的なプロンプトに対する期待出力のベースラインを運用側で保持することです。モデル差替えを検知できる仕組みを持たない限り、オープンウェイト系サプライヤーの「同一API・裏ウェイト差替え」運用に飲まれていきます。
OpenAI互換・Anthropic互換の両エンドポイント
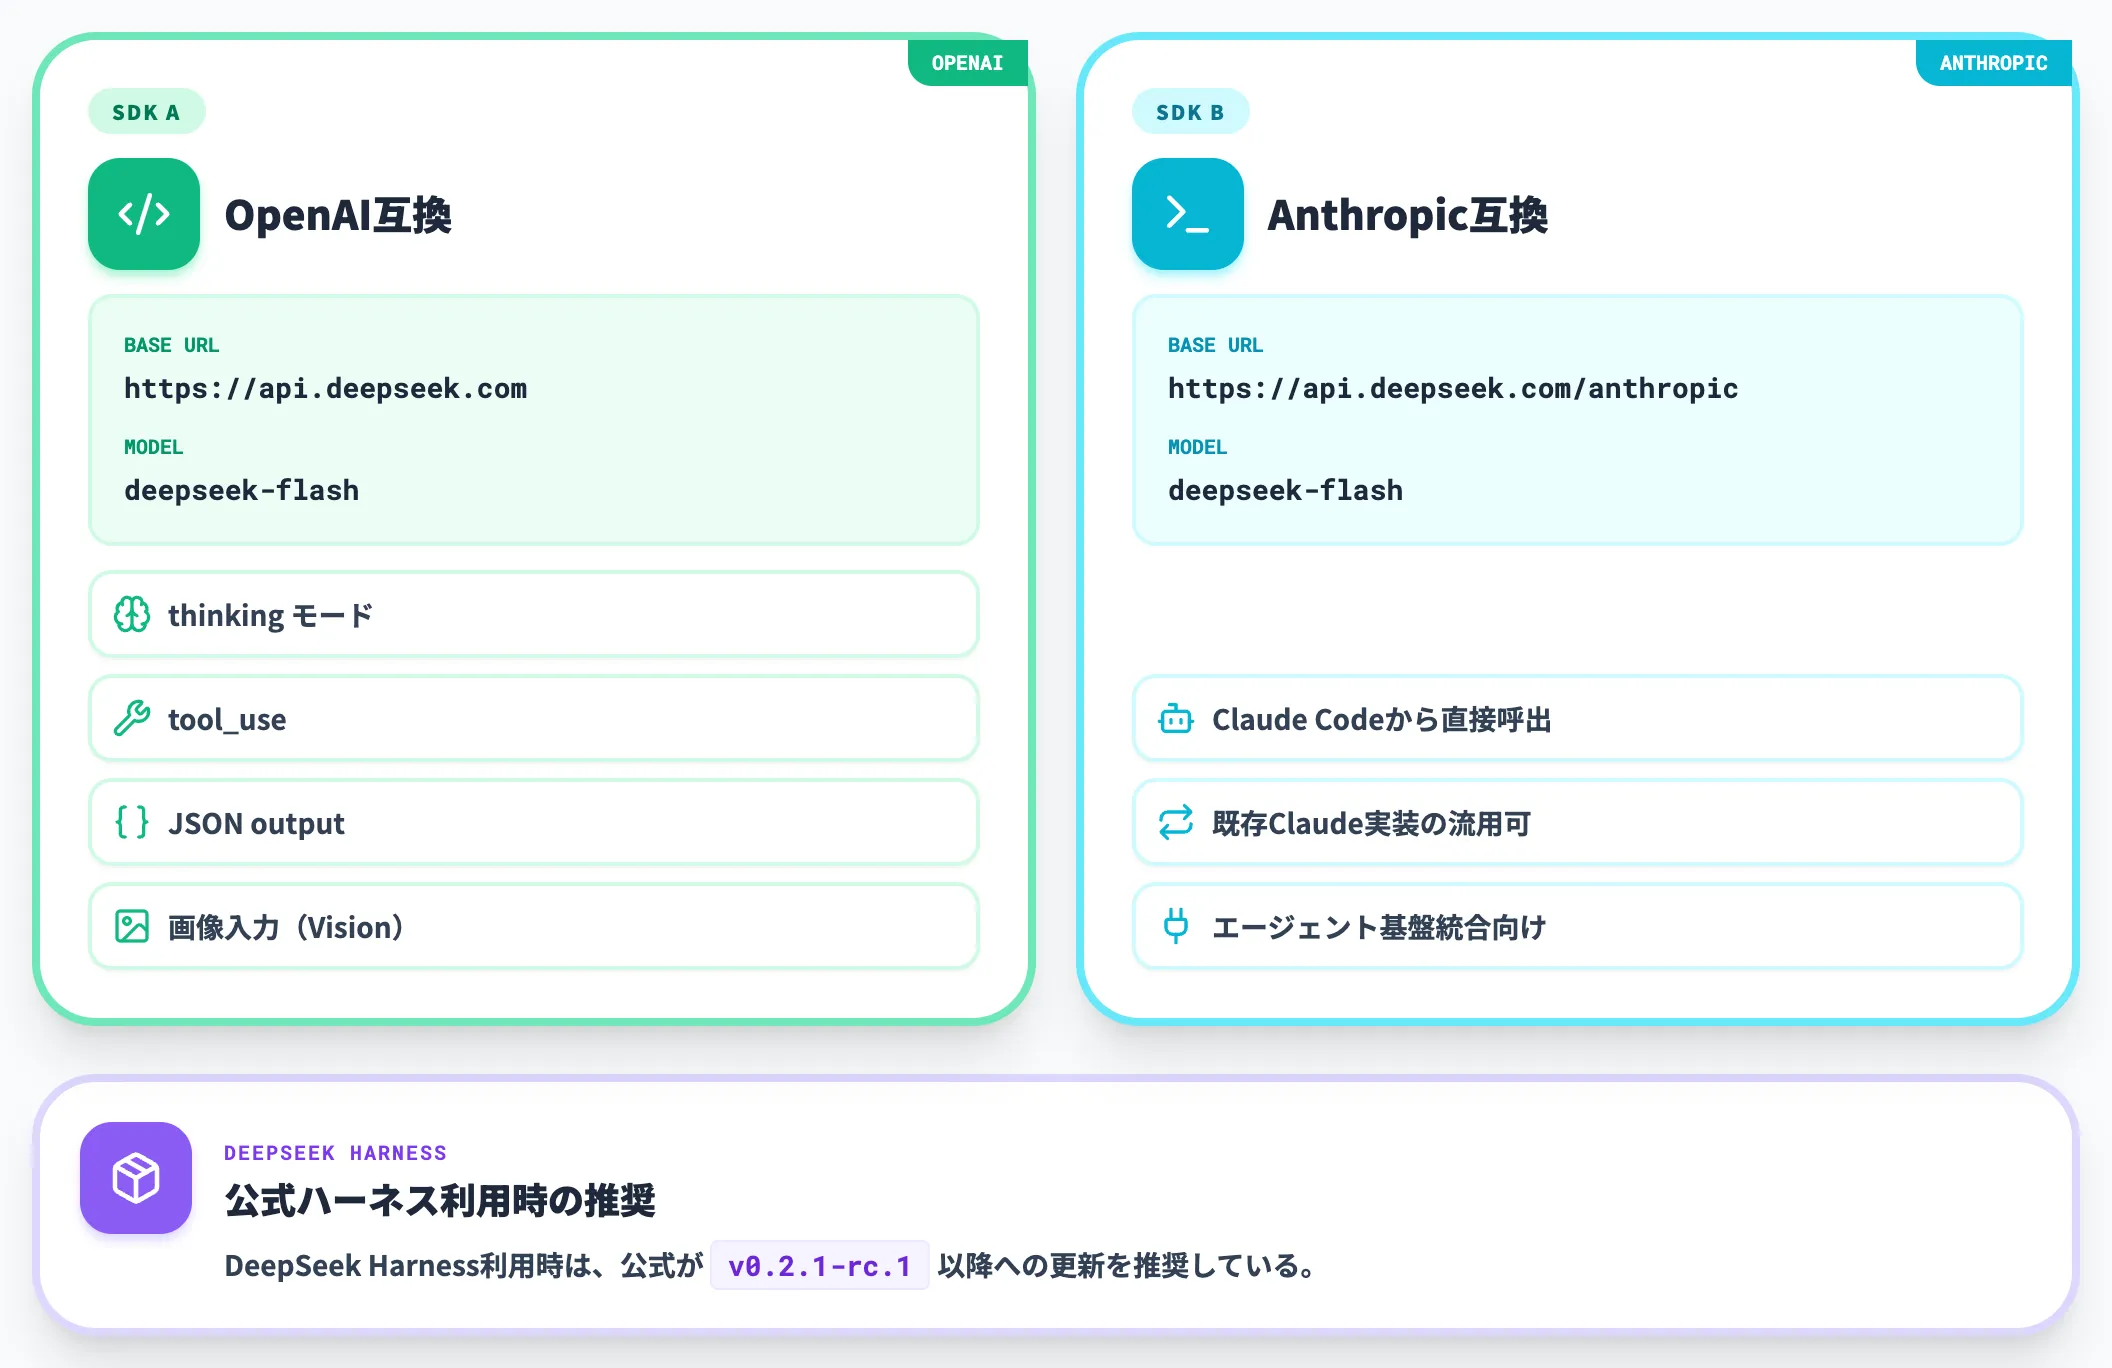
DeepSeek APIはOpenAI SDKとAnthropic SDKの両方と互換性を持たせており、既存の実装からの移植コストを下げています。
| SDKスタイル | ベースURL | モデル名 |
|---|---|---|
| OpenAI互換 | 「https://api.deepseek.com」 | 「deepseek-flash」 |
| Anthropic互換 | 「https://api.deepseek.com/anthropic」 | 「deepseek-flash」 |
OpenAI互換側は「thinking」モード・「tool_use」・「JSON output」・画像入力(Vision)に対応しています。Anthropic互換側はClaude Code経由でそのままV4.1 Flash 1017を呼び出す構成が組めます。
DeepSeek Harness(DeepSeek公式のエージェントハーネス)を使う場合は、公式がv0.2.1-rc.1以降への更新を推奨しています。
Hugging Face経由でセルフホストする構成
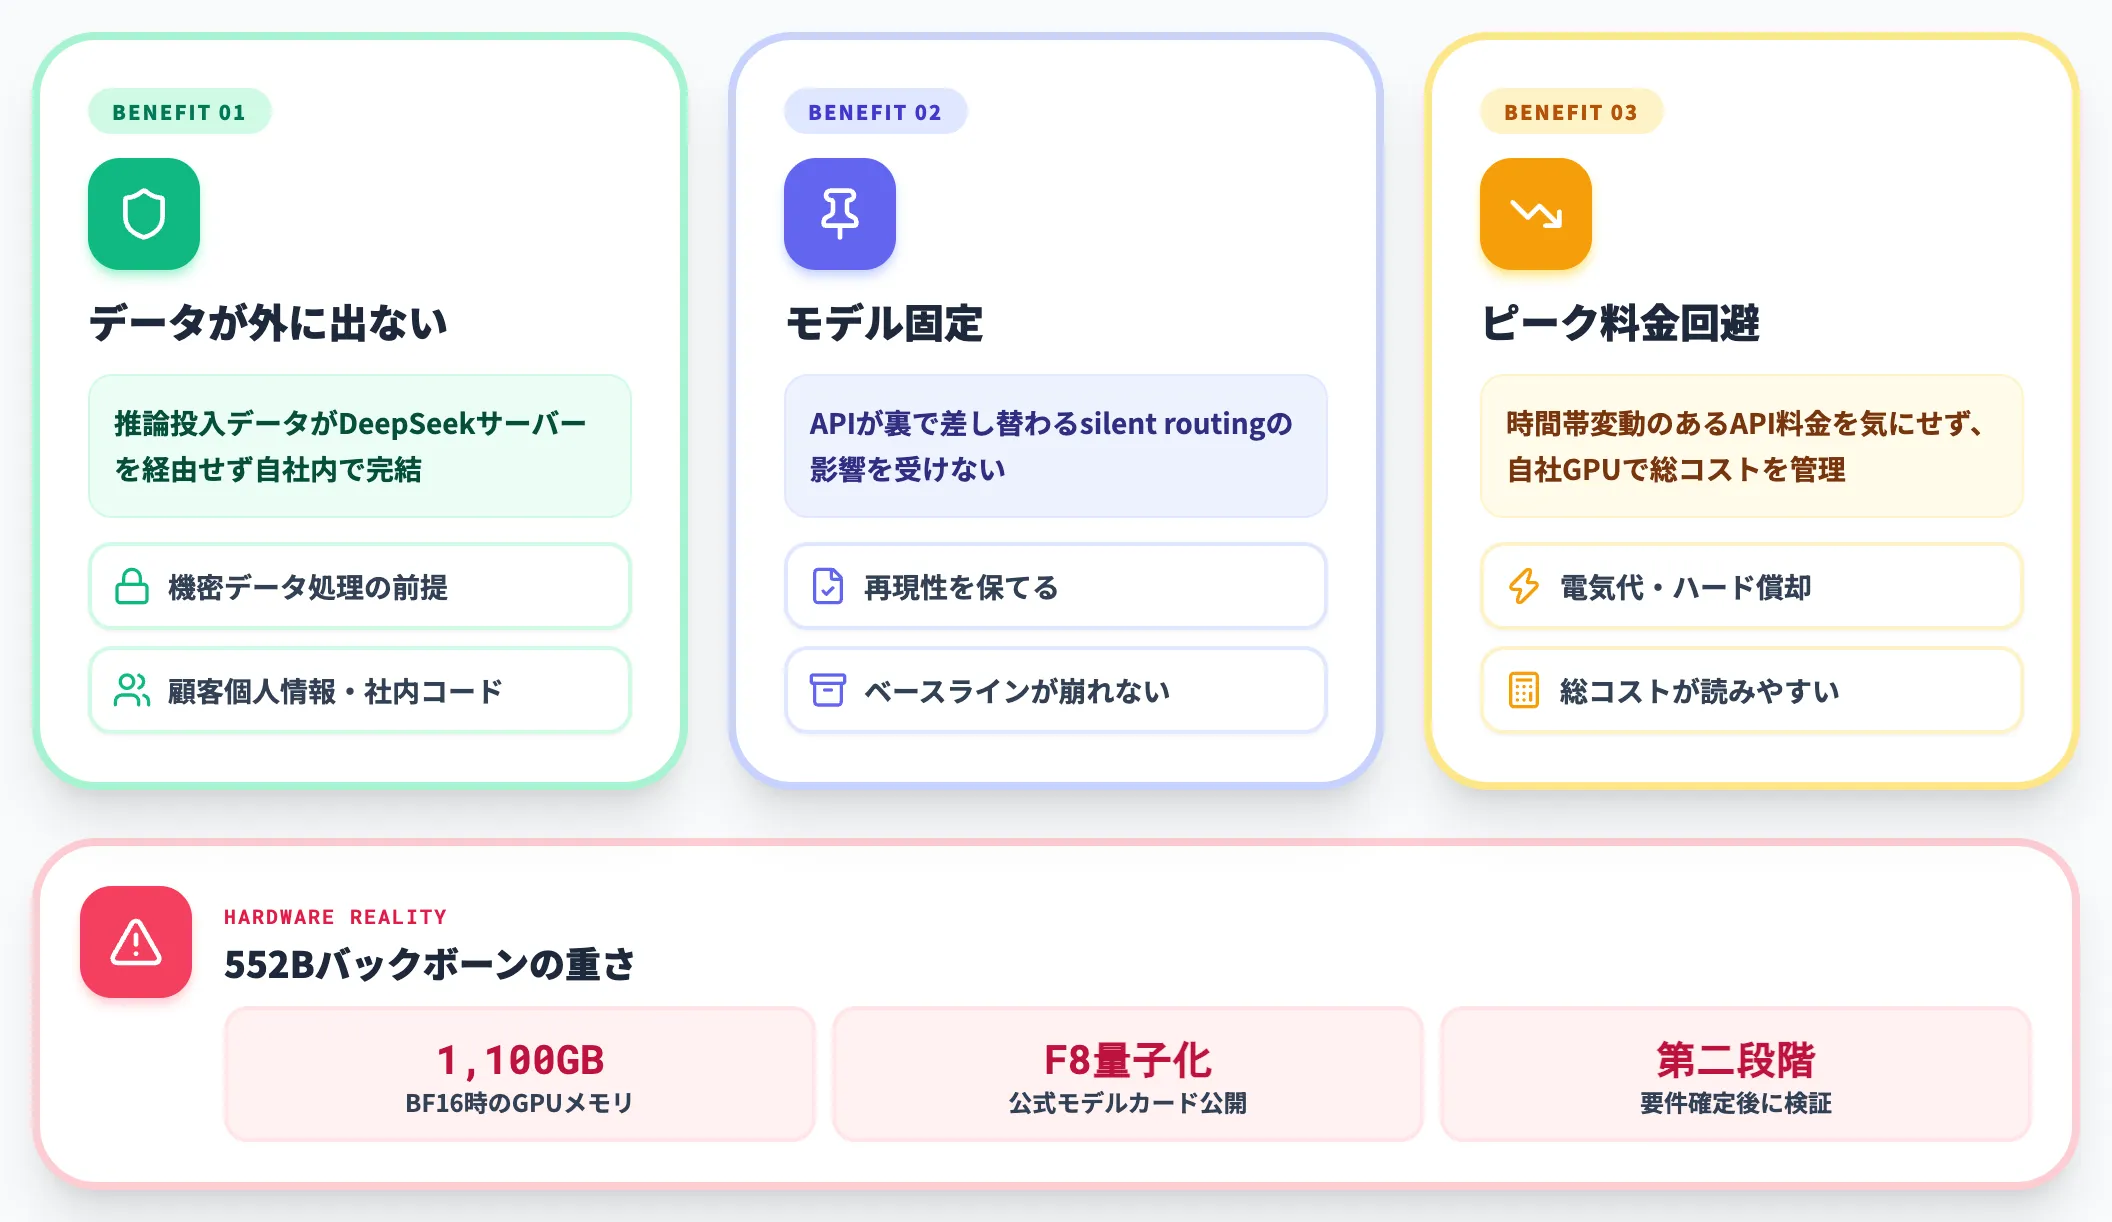
MITオープンウェイトなので、Hugging Faceから直接ウェイトをダウンロードして自社GPUで動かす構成も可能です。
ただしCEDは独自アーキテクチャで、Hugging Face Transformersの標準パス(「AutoModelForCausalLM.from_pretrained」)だけでは読み込めません。公式モデルカードでは、推論・プロンプト処理の公式資料として以下が案内されています。
-
検証・ローカル推論
公式リポジトリの 「inference/README.md」 の手順に従って、ウェイト変換(weight conversion)とローカル推論スクリプトを実行する
-
本番向けプロンプト処理
公式が別途公開している 「deepseek-recipe」(Rust+Python bindingsのツールキット)を使い、Messages / Chat Completions / Responses API形式のリクエストをDeepSeek V4/V4.1プロンプトに変換する。モデル推論・ツール実行・HTTP転送は呼び出し側で実装する
-
Prompt format
Jinja形式のchat templateは同梱されていないため、プロンプトエンコーディングは公式リポジトリの 「encoding/README.md」 に含まれる「encoding.py」(マルチターン対話・ツール呼び出し・thinking mode・画像入力のテストケース付き)を参照する
セルフホスト経路を取るアプローチの利点は、以下のとおりです。
-
データが外に出ない
推論に投入するプロンプト・レスポンスがDeepSeekサーバーを経由せず、自社インフラ内で完結する。機密データ・顧客個人情報・社内コードの処理で前提となる。
-
モデルの固定
APIが裏で差し替わる silent routing の影響を受けない。「このウェイトでこの出力」という再現性を保てる。
-
ピーク時料金の回避
API料金は時間帯で変動するが、自社GPU上なら電気代・ハード償却費・運用保守費などで、総コストが読みやすい。
ただしバックボーン552Bパラメータ級の推論には、BF16で動かすと重みだけで約1,100GB相当のGPUメモリが必要になります。F8量子化(モデルカード公開)やオフロード構成を組み合わせることでハードルは下がりますが、「API呼び出しの延長で手軽に試す」というスケールではありません。日本企業で現実的に検証するなら、まずはAPI経由でPoCを回し、Hugging Faceウェイトのセルフホストはデータ主権要件が確定した後の第二段階として位置づけるのが実務的です。
V4.1 Flash 1017の料金
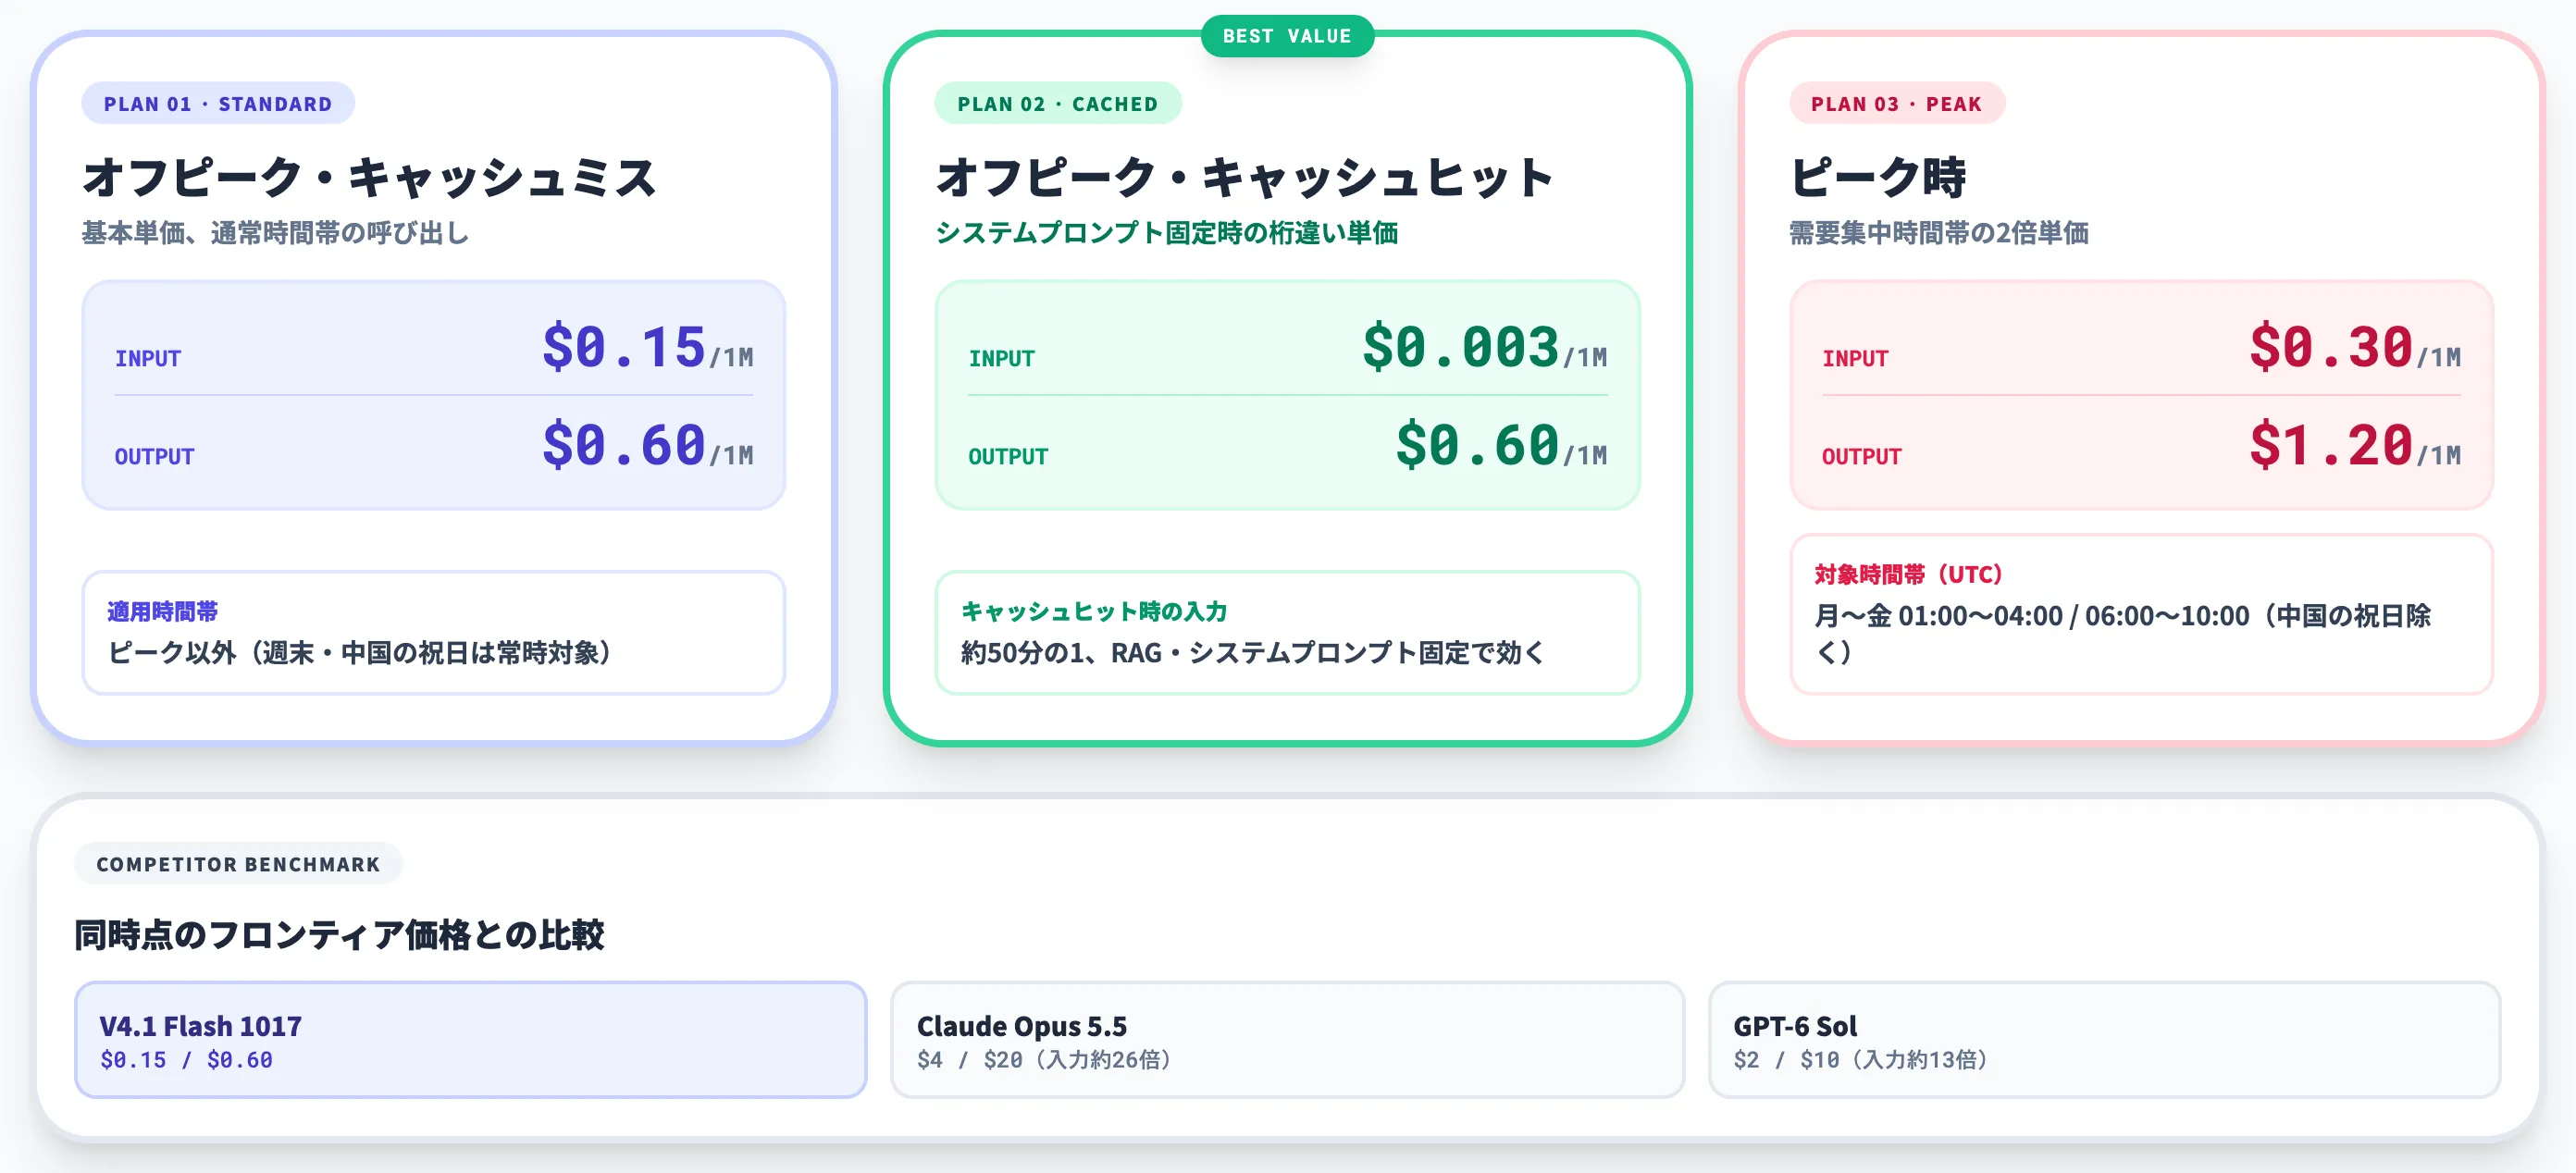
V4.1 Flash 1017の料金は、1017アップデートで変更されず、V4.1 Flash(9/10版)からそのまま据え置かれています。
同時に、料金の読み方は「1Mトークンあたり何ドル」で単純比較できないほど、時間帯・キャッシュヒット・ピーク判定で変動する構造です。
基本単価と時間帯変動
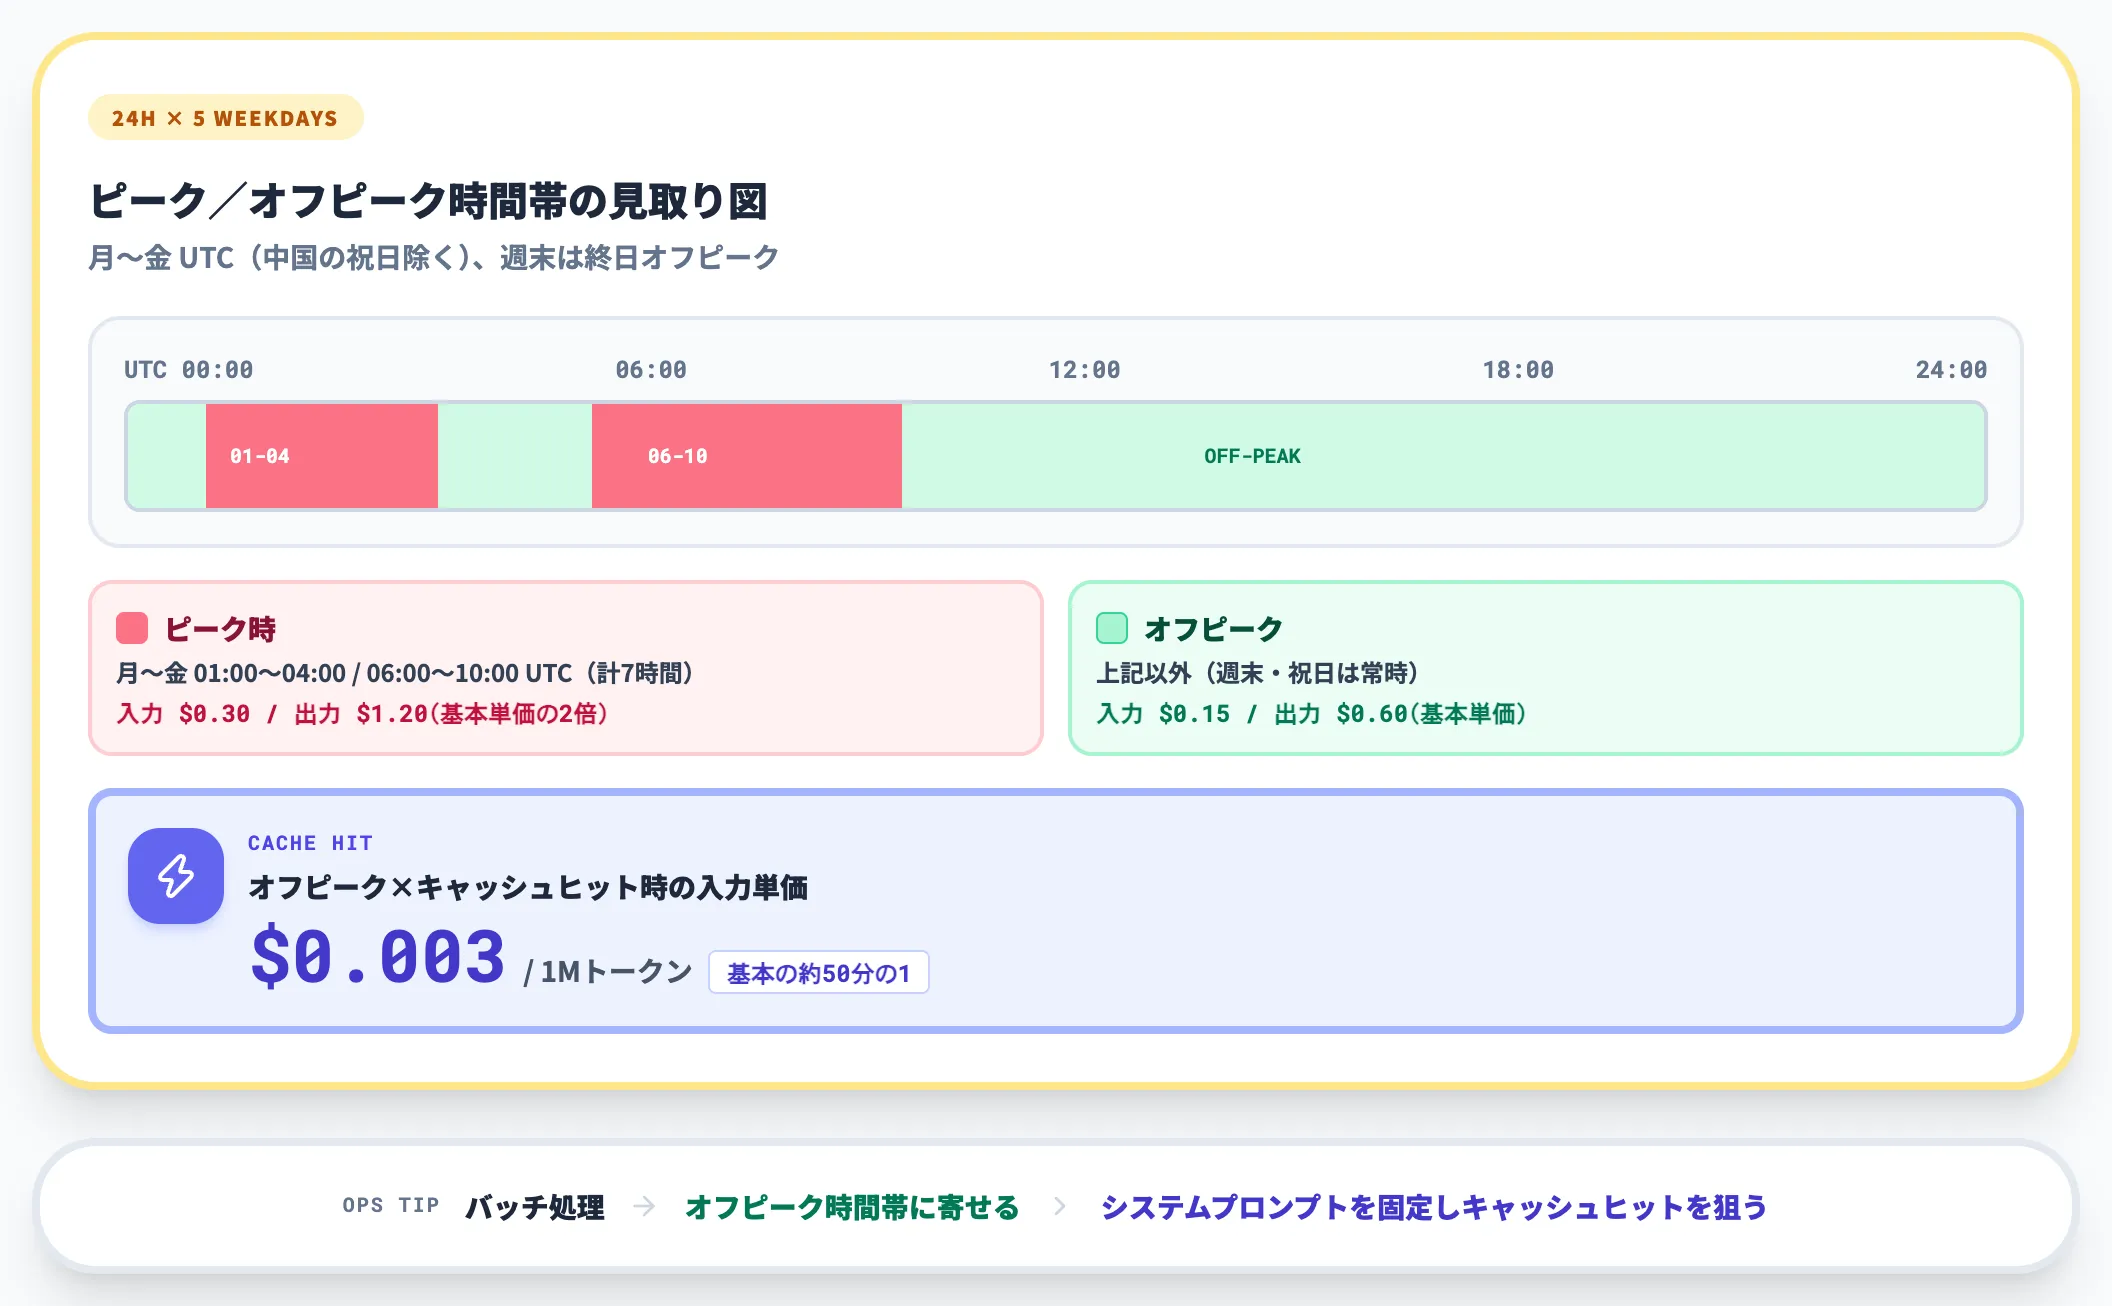
以下の表で、2026年10月時点のDeepSeek V4.1 Flash 1017の料金構造を整理しました(SaaS型なのでリージョン概念はなく、2026年10月時点)。
| 区分 | 入力(1Mトークン) | 出力(1Mトークン) | 適用時間帯 |
|---|---|---|---|
| オフピーク・キャッシュミス | $0.15 | $0.60 | 下記ピーク以外(週末・中国の祝日はすべてオフピーク) |
| オフピーク・キャッシュヒット | $0.003 | $0.60 | 下記ピーク以外 |
| ピーク時(公式料金) | $0.30 | $1.20 | 月〜金 UTC 01:00〜04:00・06:00〜10:00(中国の祝日を除く) |
この表の料金で押さえたいのは、キャッシュヒット時の入力単価が$0.003/Mトークンという桁違いの安さです。システムプロンプトを固定運用する実装・RAGの参照コンテキストを使い回す構成では、キャッシュヒット率が運用コストを一桁変えます。
Claude Opus 5.5の$4/$20、GPT-6 Solの$2/$10(272K入力超は$4/$15)と比較すると、V4.1 Flash 1017は入力で約13〜26分の1、出力で約16〜33分の1という桁の違いになります。
1Mコンテキストでの長文処理コスト試算
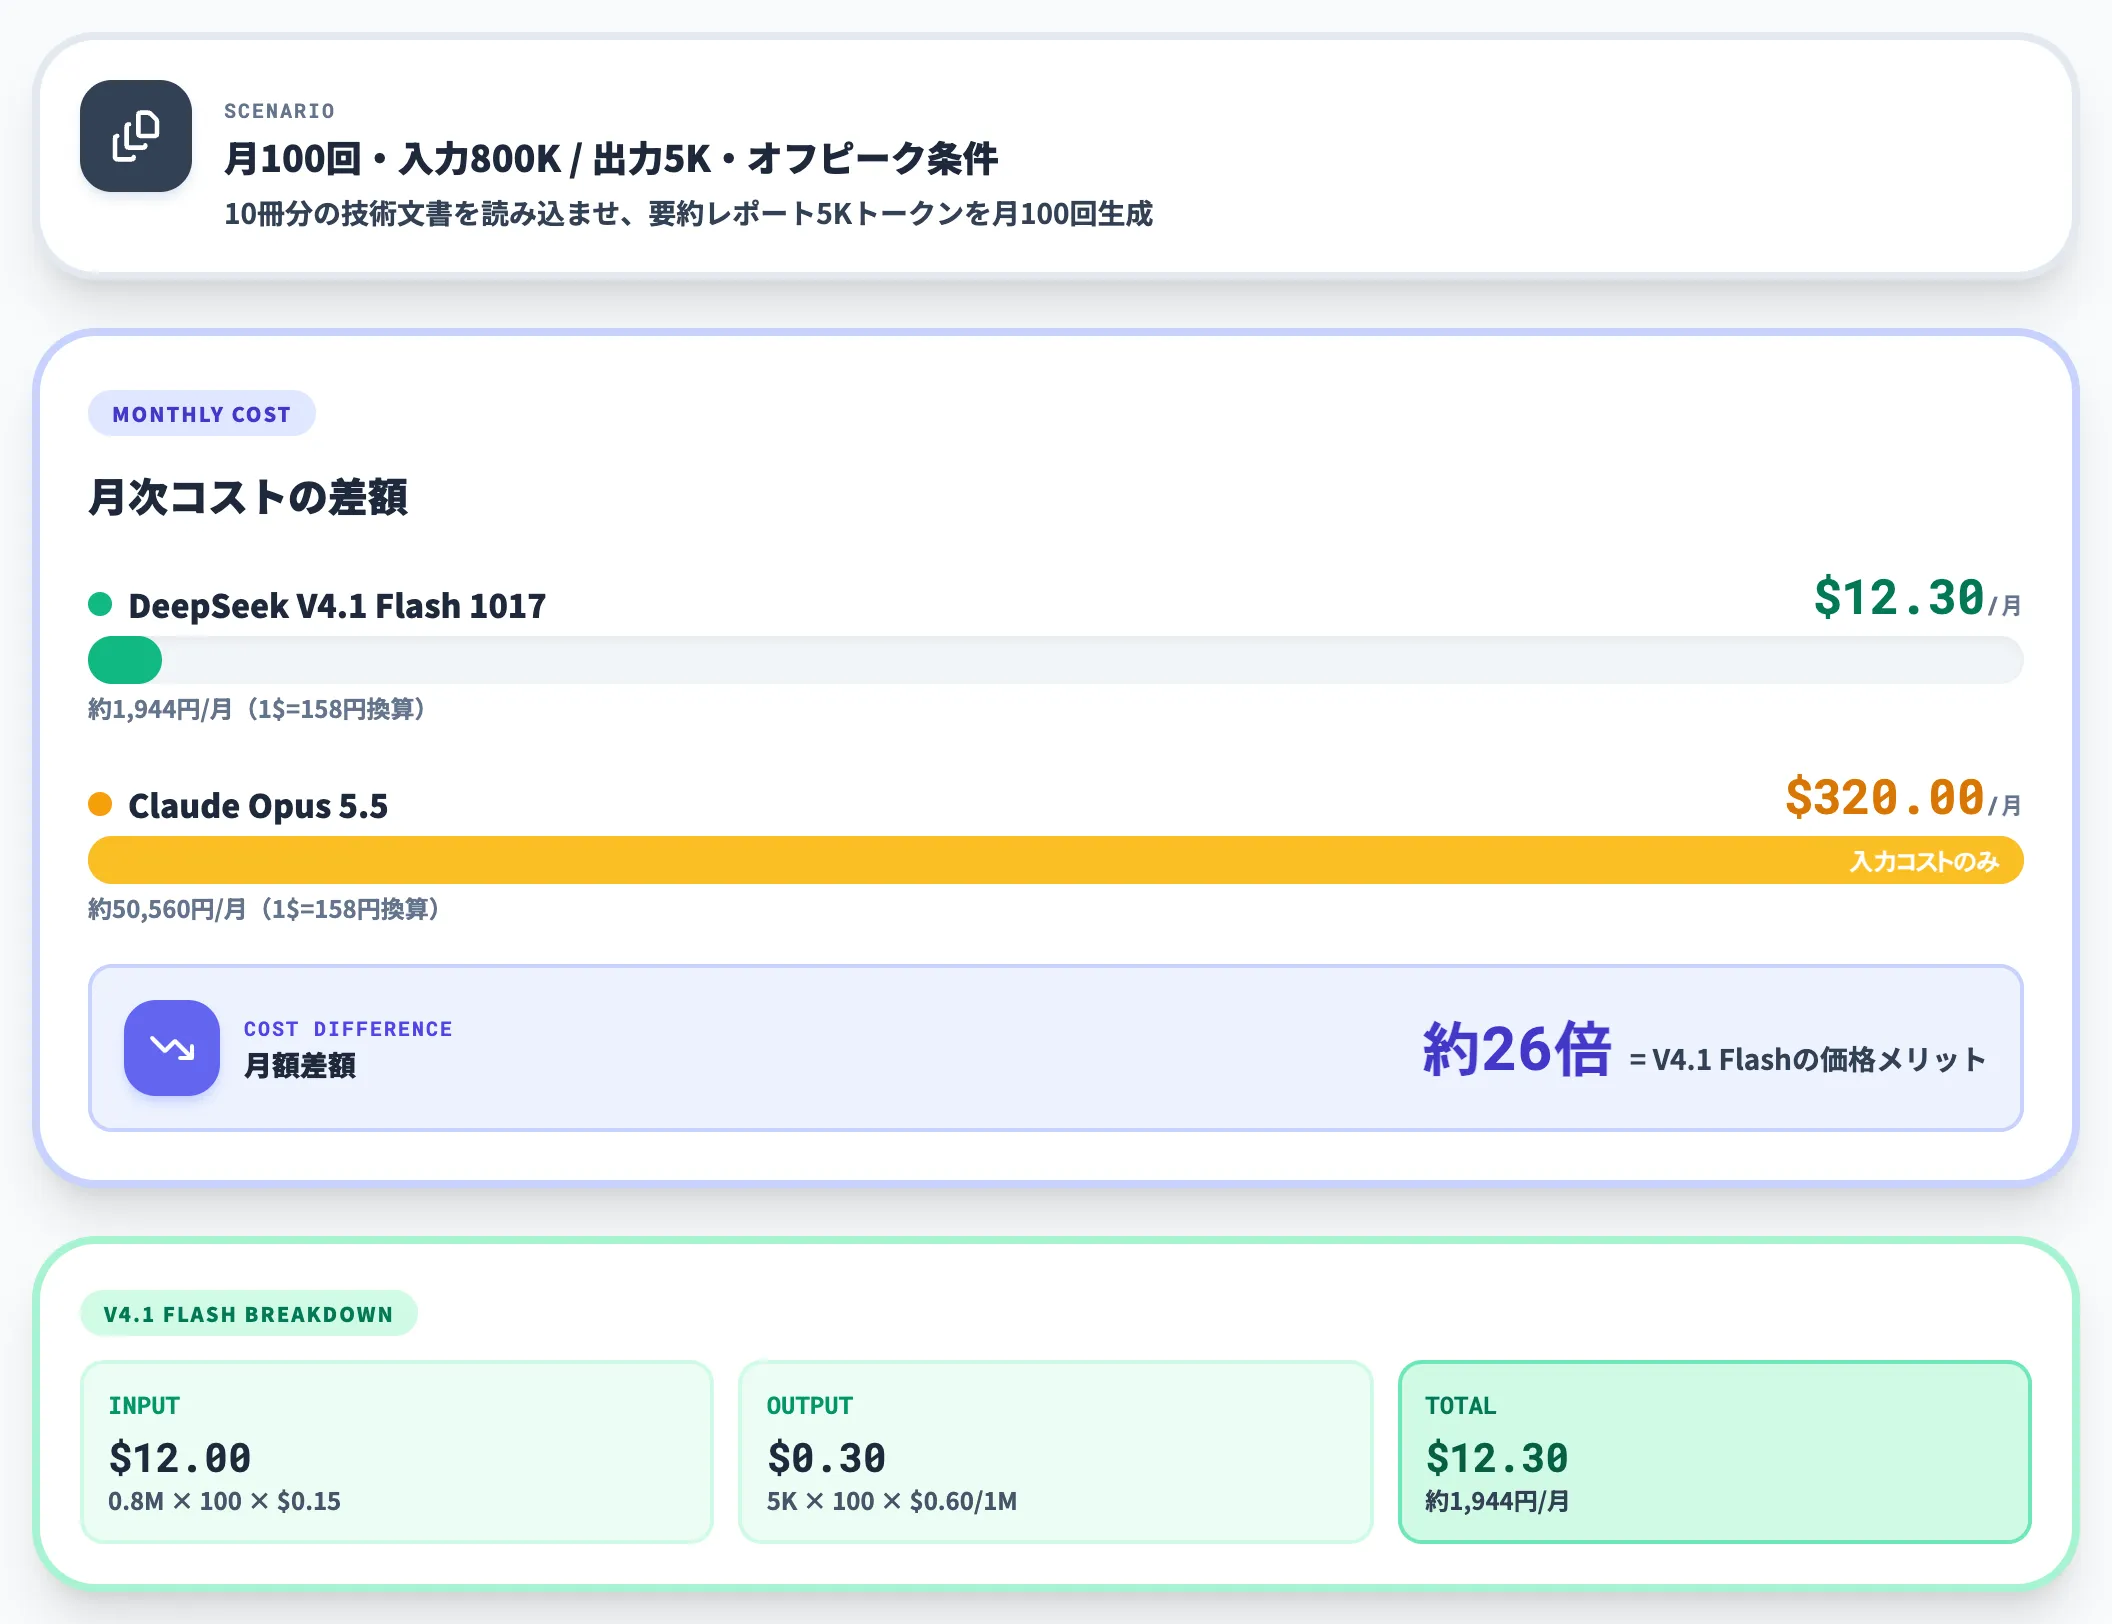
1Mトークンのコンテキスト窓を本気で使った場合のコストを試算します。
シナリオ: 1プロンプトあたり入力800Kトークン(10冊分の技術文書)+出力5Kトークン(要約レポート)を、月100回実行。
- 入力コスト(キャッシュミス・オフピーク): 0.8M × 100 × $0.15 = $12.00/月
- 出力コスト: 5K × 100 × $0.60 / 1M = $0.30/月
- 合計: 約$12.30/月(約1,944円)
同じ使い方をClaude Opus 5.5で回した場合、入力コストだけで $0.8M × 100 × $4 = $320/月(約50,560円)となり、約26倍の差が出ます。
もちろんOpus 5.5のほうが対話品質・推論能力・多言語性能で優位な領域はあり、同じタスクを同じ品質で完了できるかの検証は別途必要です。ただし「長文投入が主で、品質はそこそこでよい」バッチ処理(議事録整理・契約書要約・大量ドキュメントのタグ付け等)では、V4.1 Flash 1017のコスト構造が実務インパクトを持ちます。
Search・Fetch APIの開放と10月31日からの課金開始
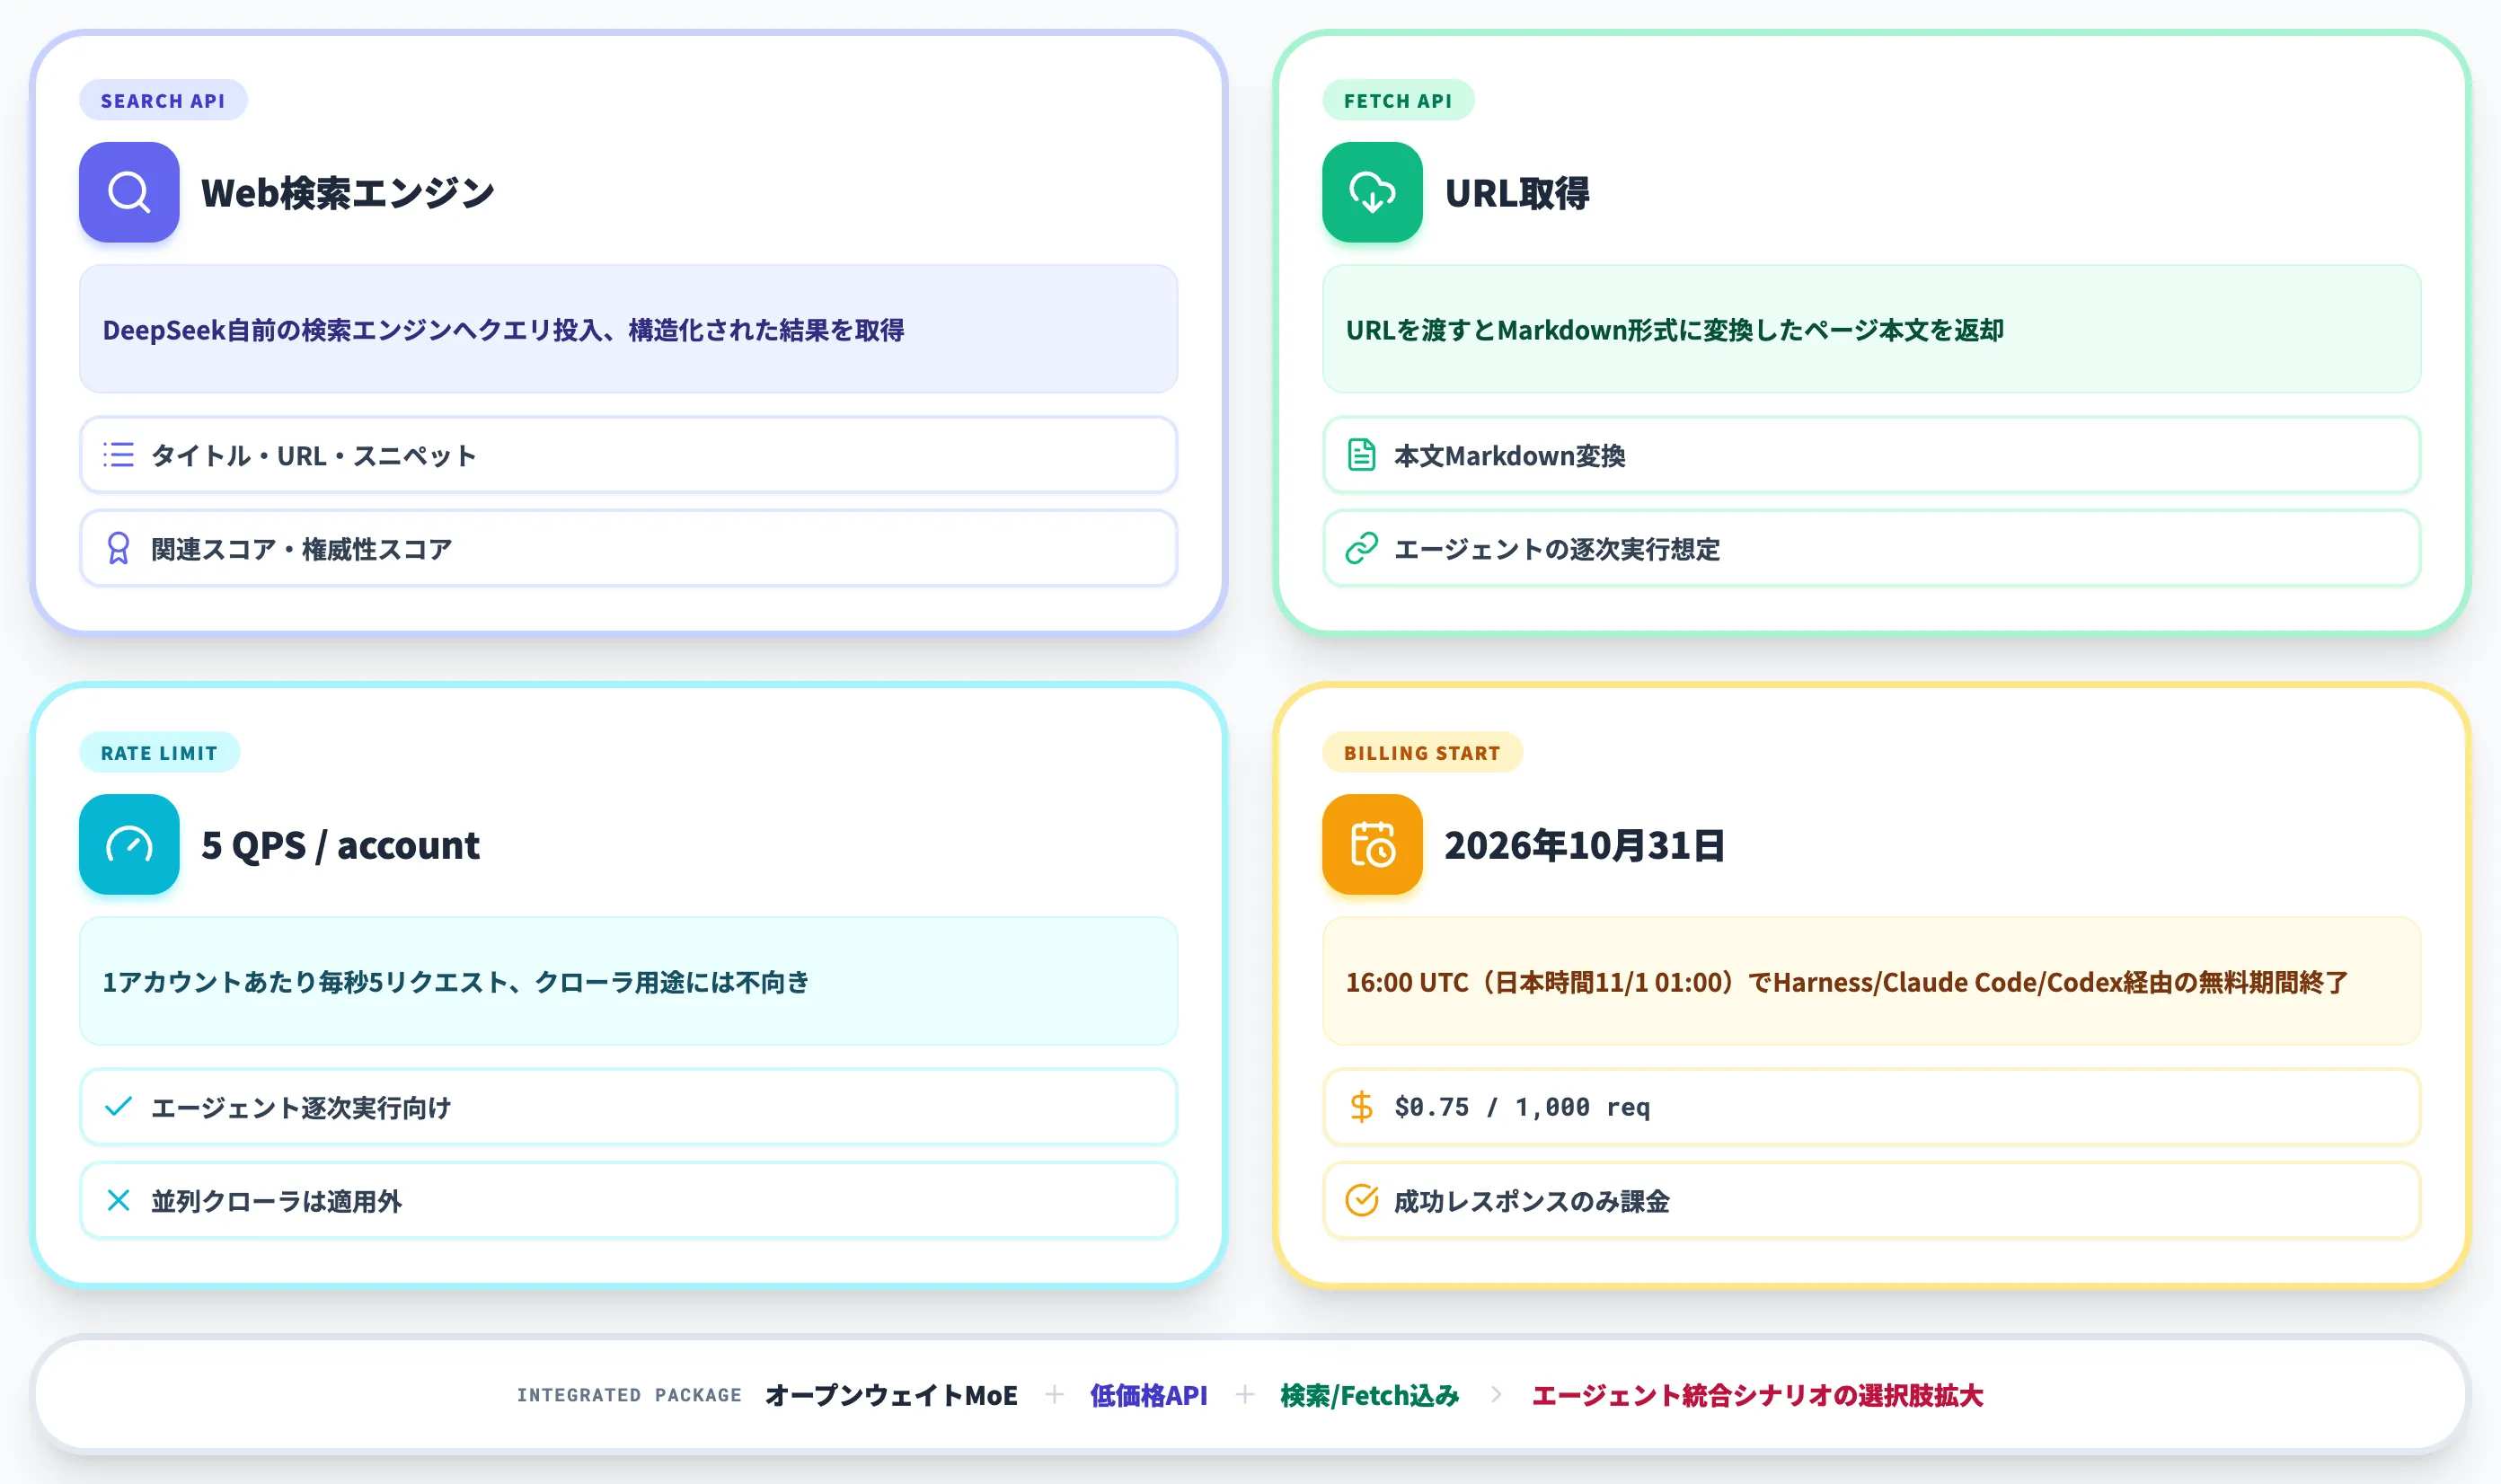
1017のモデルアップデートと同日に発表されたもう一つの大きな動きが、Search API・Fetch APIの全開発者向け開放です。
これまで DeepSeek Harness内のベータ機能として一部ユーザーが使っていたWeb検索・URL取得機能が、通常のAPIとして公開されました。
Search・Fetchが提供する機能
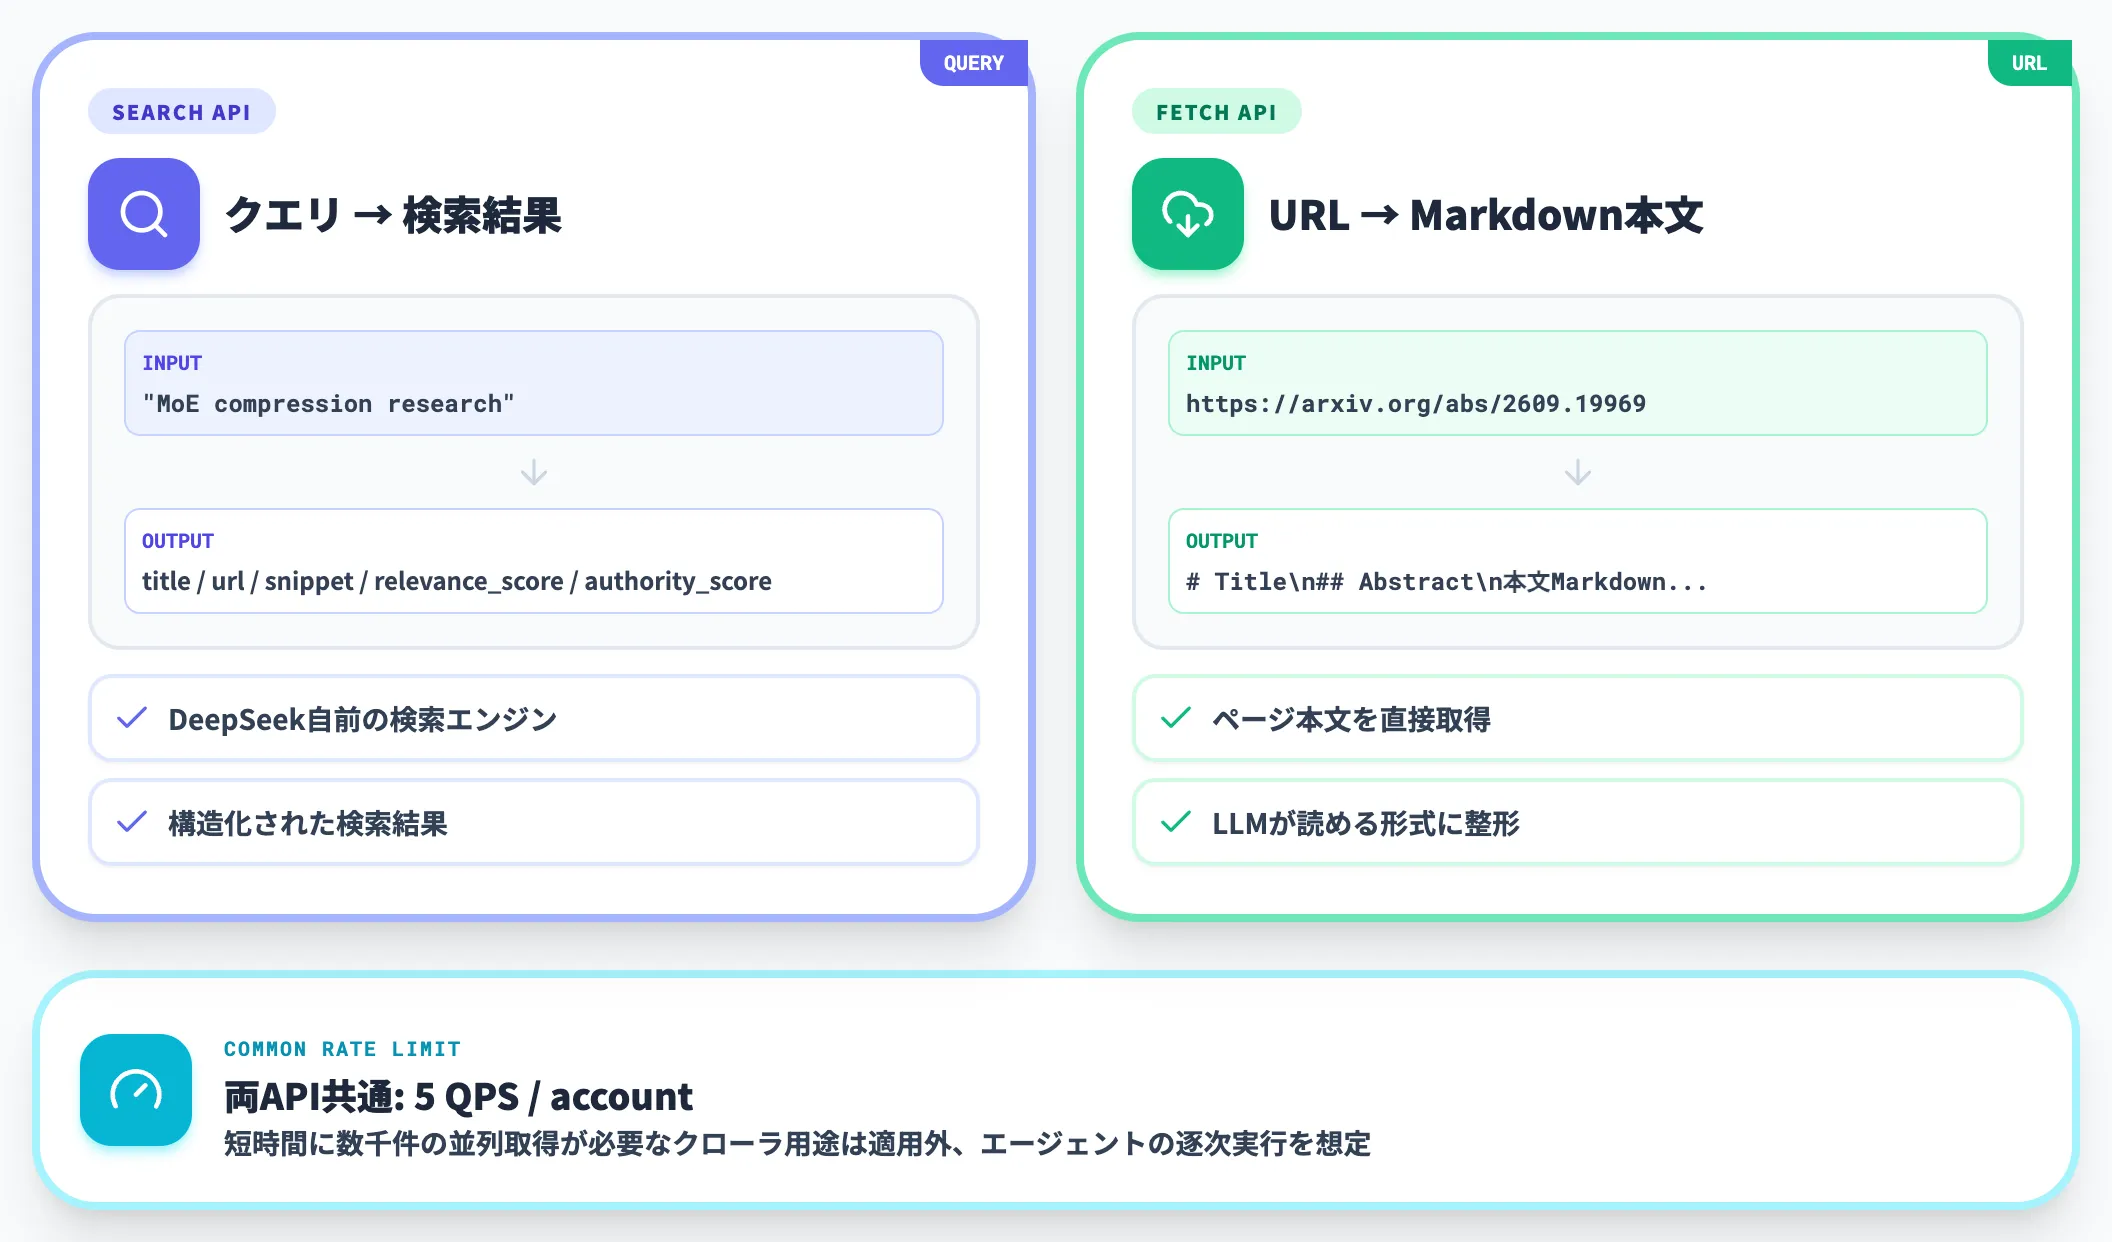
Search APIとFetch APIは、エージェントがWeb情報を扱うための基本機能を分離して提供するものです。
-
Search API
DeepSeek自前の検索エンジンに対してクエリを投げると、関連スコア・権威性スコア付きの構造化された検索結果(タイトル・URL・スニペット)が返る。
-
Fetch API
URLを渡すと、該当ページ本文をMarkdown形式に変換して返す。
-
レート制限
いずれも5 QPS(Queries Per Second)/ account。短時間に数千件の並列取得が必要なクローラ用途には適さず、エージェントの逐次実行を想定した制限。
これらの機能自体はPerplexity Sonar・OpenAI web_search tool・Anthropic Web Searchでも提供されており目新しくはありません。しかし、DeepSeekが「オープンウェイトMoE+低価格API+検索/Fetch込み」の統合パッケージとして出してきた点が実務的に効きます。
2026年10月31日16:00 UTCから課金開始
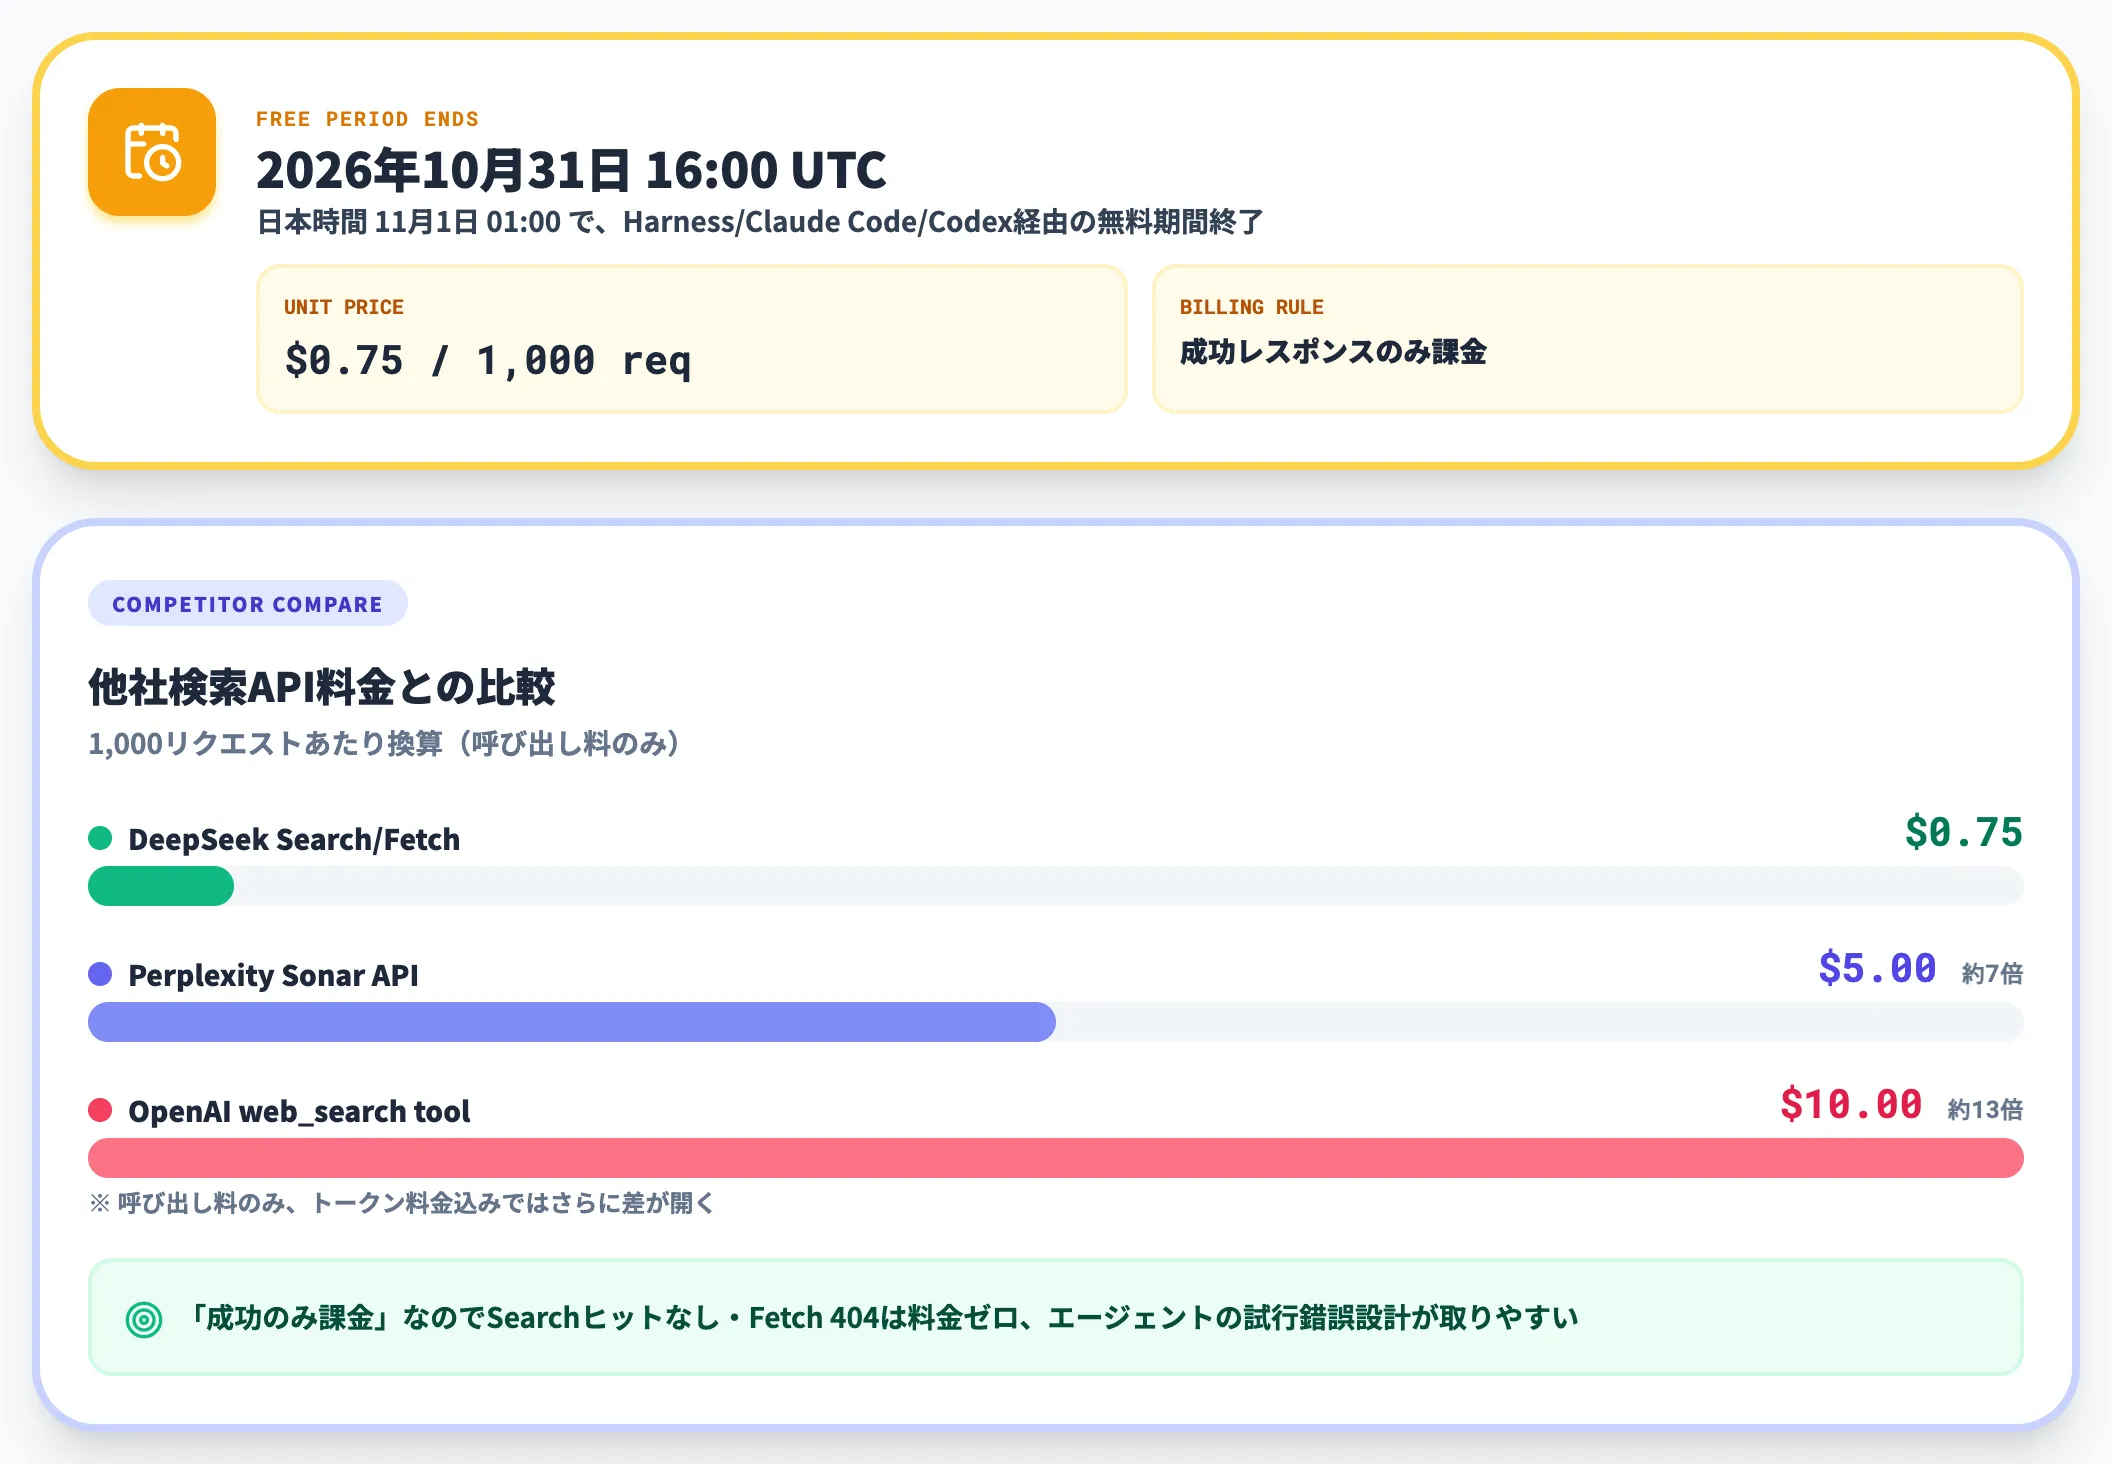
Search・Fetch APIの直接呼び出しは開放時点から有料で、DeepSeek Harness・Claude Code・Codex経由のサーバー側ツール呼び出しのみが2026年10月31日16:00 UTCまで無料提供されていました。無料期間終了後は、これらの経由呼び出しも含めて全開発者が同一単価で課金されます。
| 項目 | 内容 |
|---|---|
| 無料期間終了時刻 | 2026年10月31日 16:00 UTC(日本時間 11月1日 01:00) |
| 無料対象 | DeepSeek Harness・Claude Code・Codex経由のサーバー側ツール呼び出し(直接API呼び出しは開放時点から有料) |
| 単価 | $0.75 / 1,000 successful requests(エンドポイント別) |
| 課金対象 | 成功レスポンスのみ。失敗・タイムアウトは課金なし |
この料金で読み解くと、$0.75/1,000 ≒ $0.00075/件で、Perplexity Search APIの$0.005/リクエストと比べて約7倍安く、OpenAI web_search toolの$0.01/呼び出し+検索コンテンツのトークン料金と比べると、呼び出し料だけなら約13倍安い水準になります(トークン料金込みではさらに差が開きます)。
ただし「成功レスポンスのみ課金」なので、Searchでヒットなし・Fetchで404を返した場合は料金が発生しません。この点はエージェントが大量に試行錯誤するワークロードで実務的な意味が大きく、「とりあえず検索を広く投げる」設計を取りやすくなります。
エージェント基盤での統合シナリオ
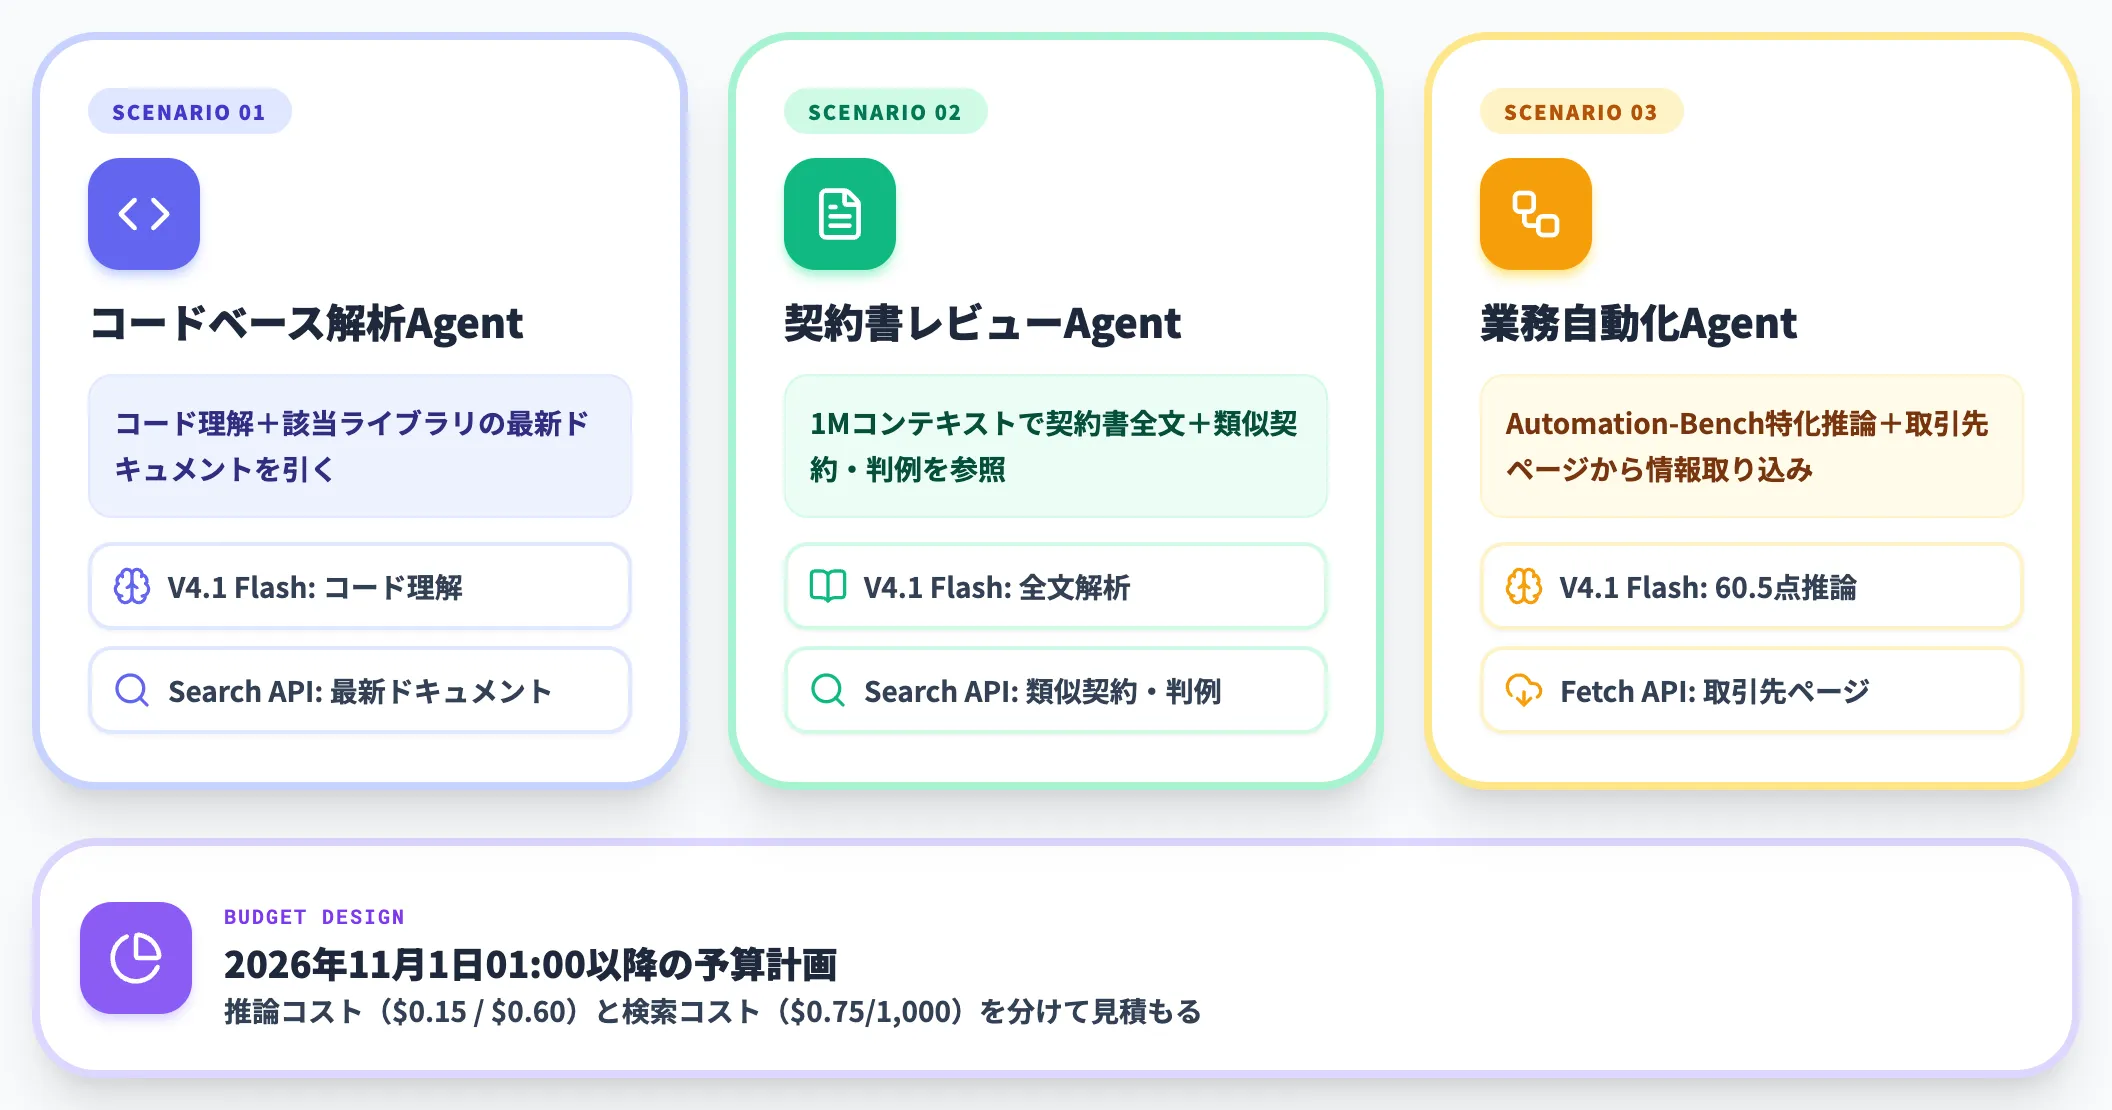
実務の統合シナリオで多いのは、以下のような構成です。
- コードベース解析エージェント: V4.1 Flash 1017でコード理解+Search APIで該当ライブラリの最新ドキュメントを引く
- 契約書レビューエージェント: 1Mコンテキストで契約書全文を読む+Search APIで類似契約・判例を参照
- 業務自動化エージェント: Automation-Bench特化の推論+Fetch APIで取引先ページから情報を取り込む
これらはいずれも「推論特化のLLM」と「Web情報の取得」を別API経由で組んでいた既存構成を、DeepSeek単独で完結させる方向性です。日本時間2026年11月1日01:00以降の予算計画では、推論コスト($0.15/$0.60)と検索コスト($0.75/1,000)を分けて見積もる必要があります。
競合モデルとの比較と選定軸——Opus 5.5・GPT-6 Sol・Qwen3.8
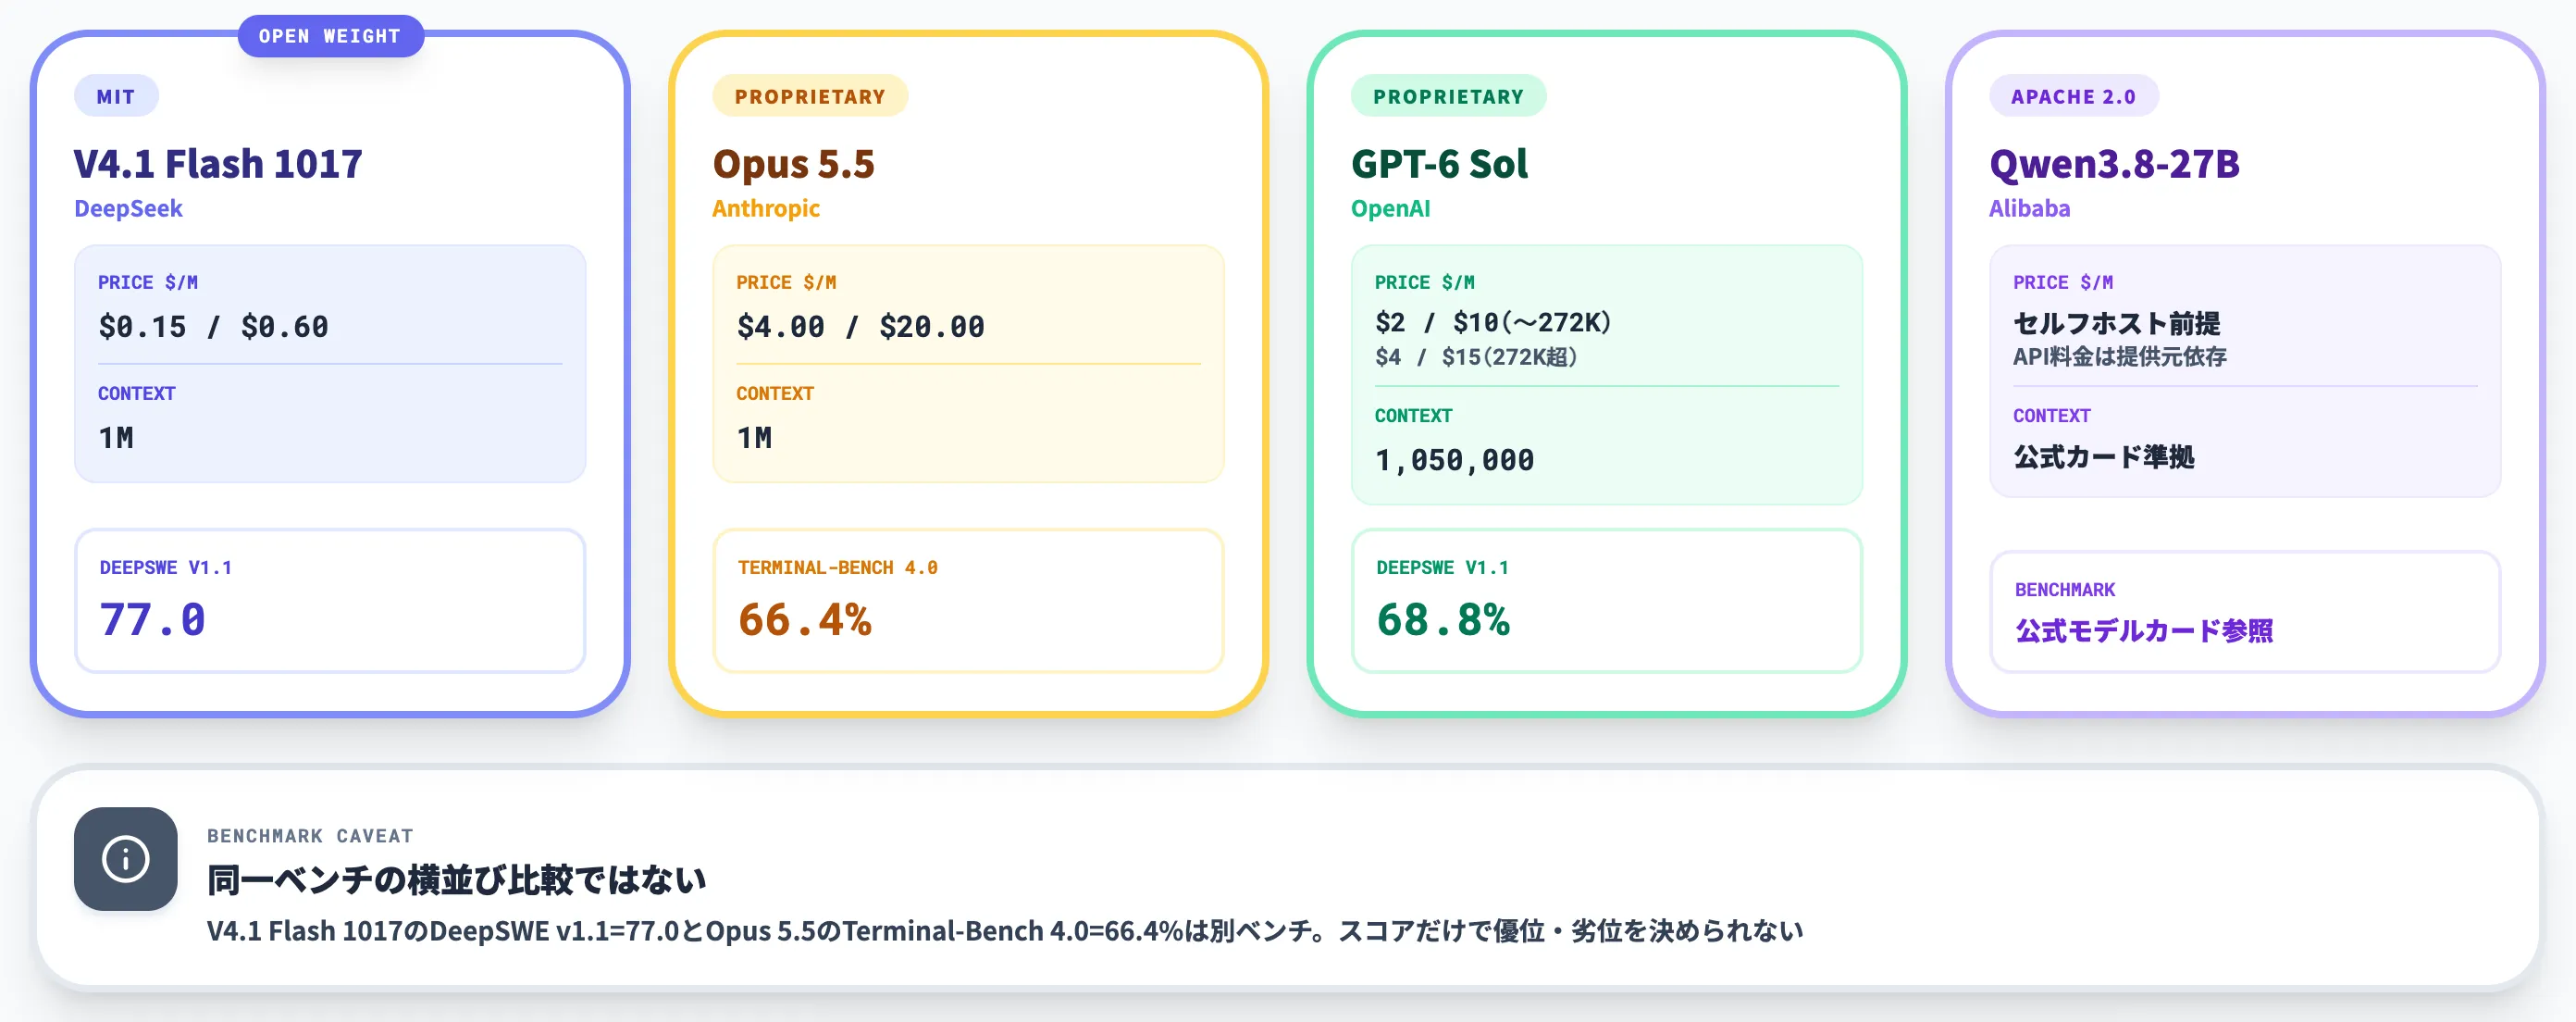
V4.1 Flash 1017を実務で採用するかを判断するには、同時点の競合モデルとの比較軸を持つことが重要です。
2026年10月時点では、AnthropicのClaude Opus 5.5(9月22日発表)、OpenAIのGPT-6 Sol(9月22日発表)・GPT-6.1 Sol(9月30日発表)、Z.aiのGLM-5.3-Flash、AlibabaのQwen3.8-27BがV4.1 Flash 1017の直接比較対象になります。
性能・料金・ライセンスの一覧比較
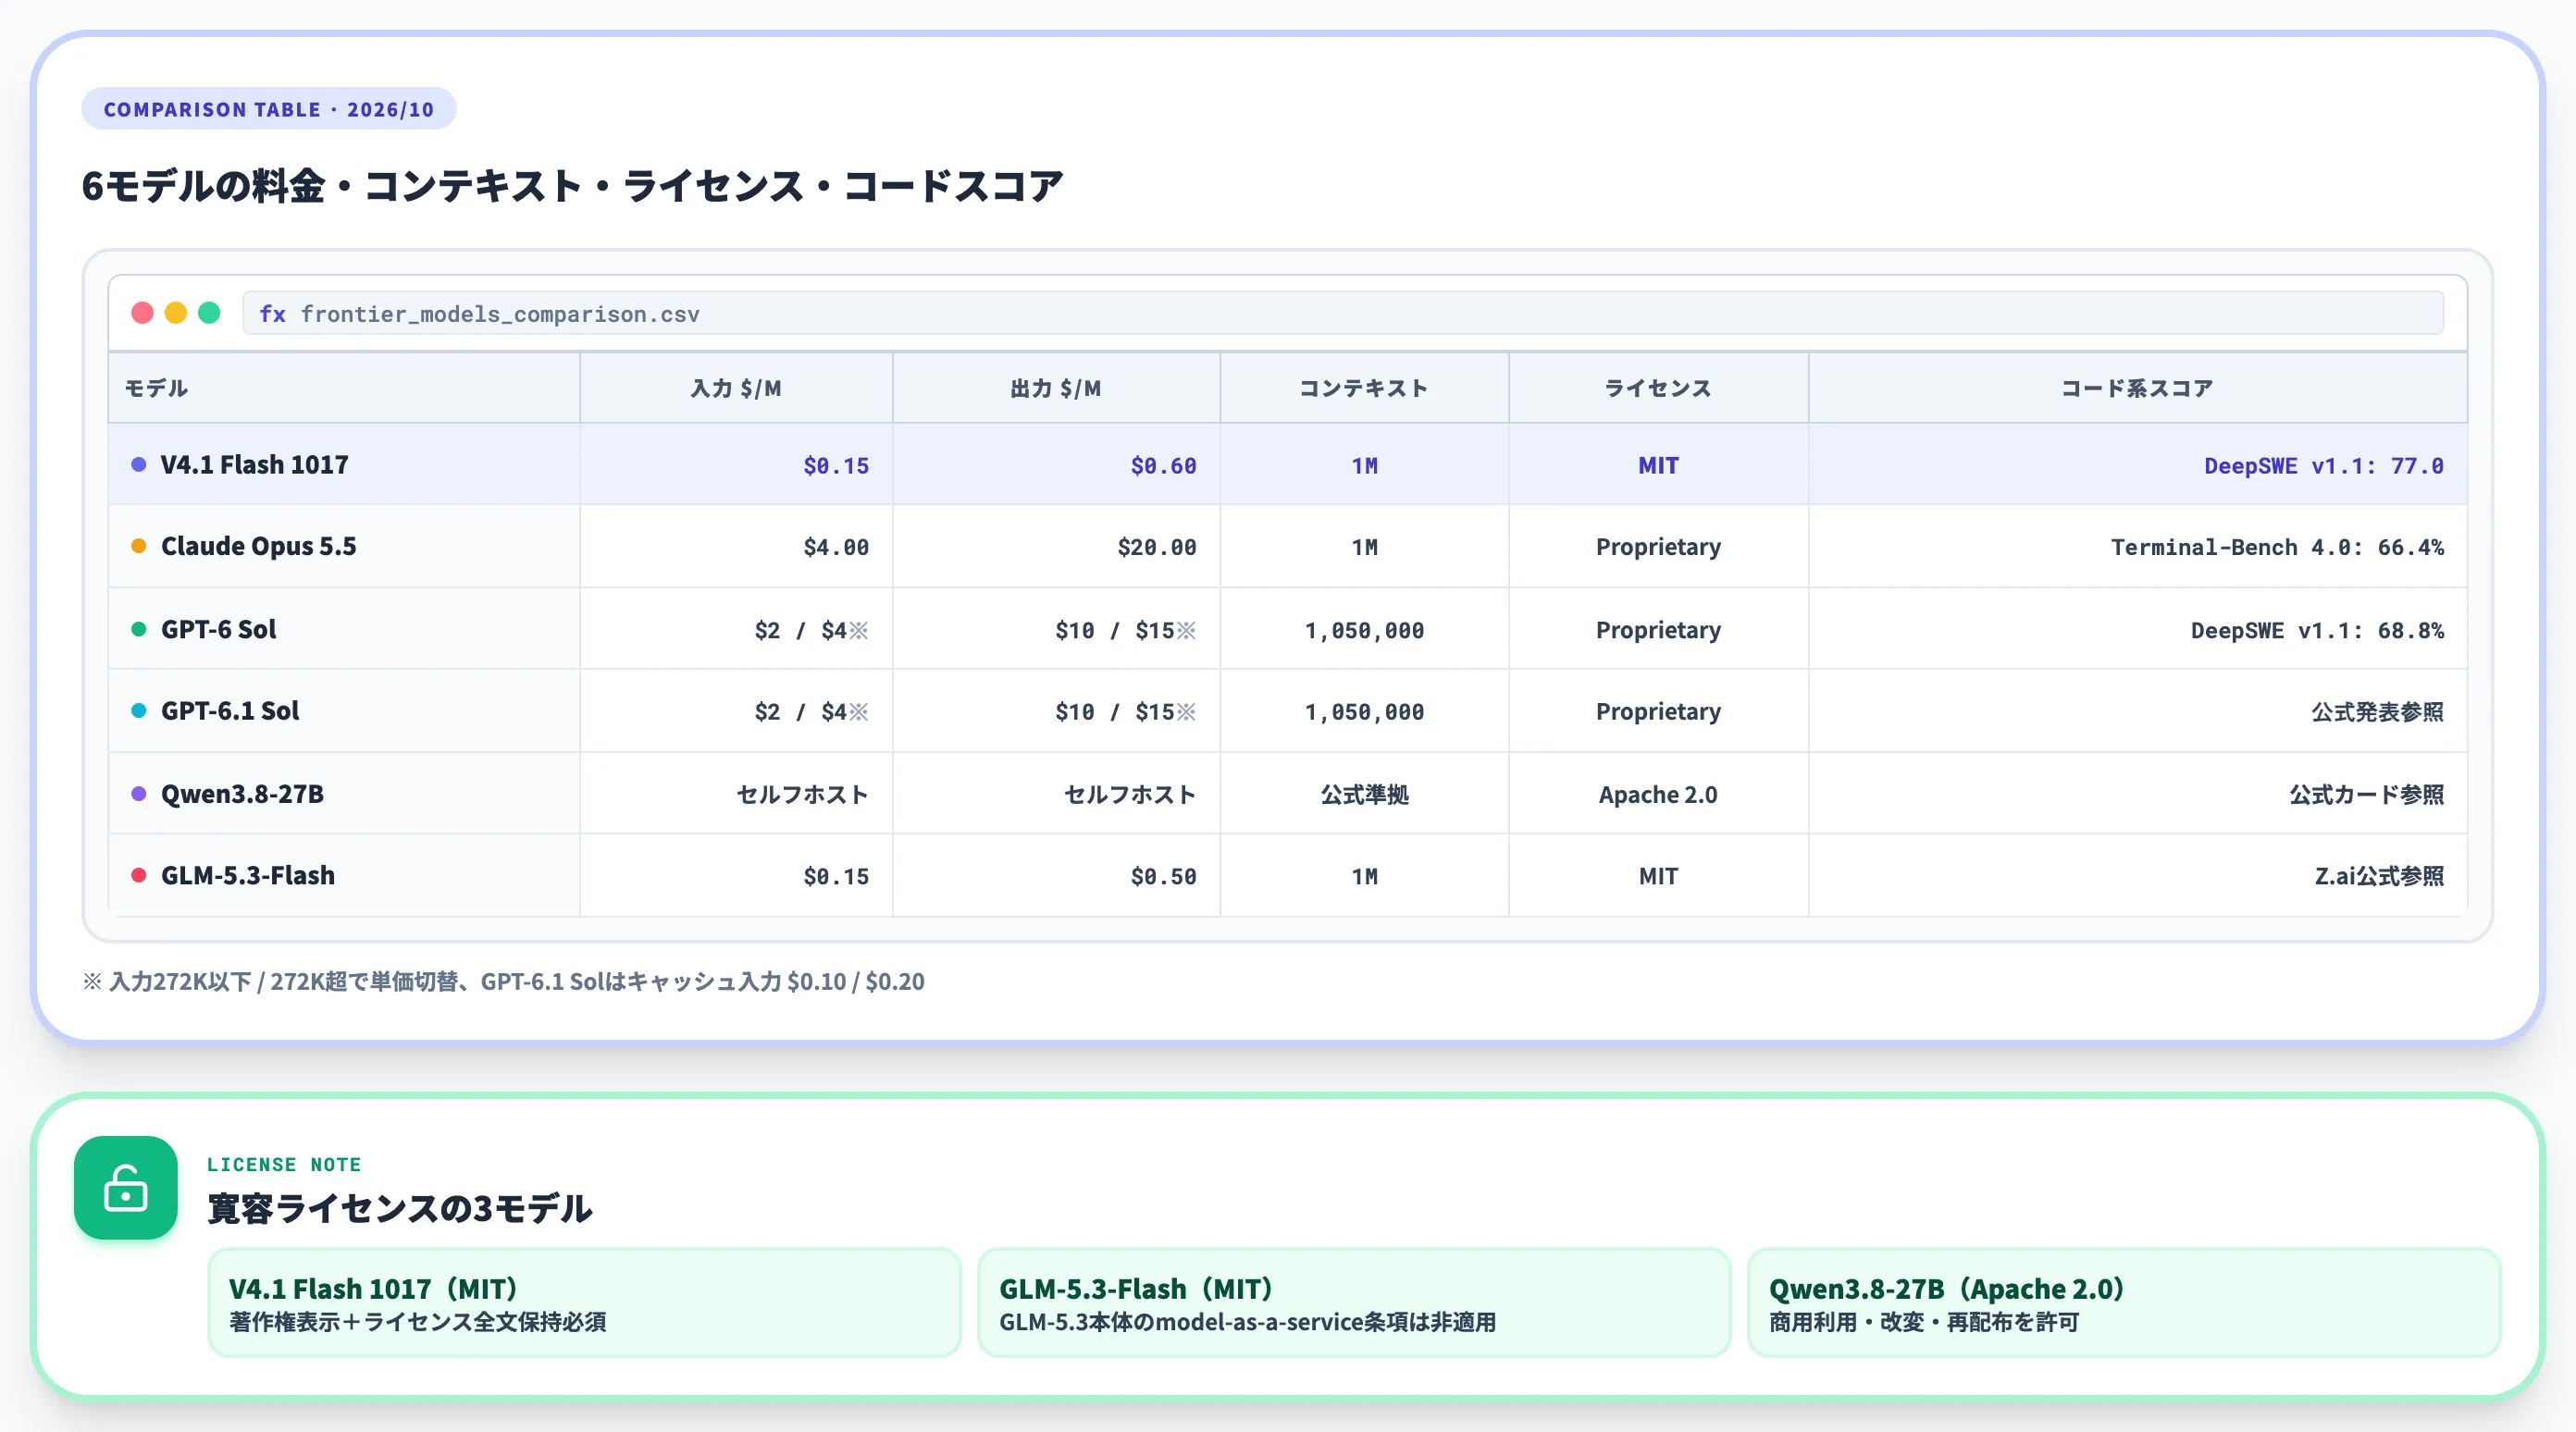
以下の表で、2026年10月時点の主要オープンウェイト・クローズドモデルの要点を整理しました。評価条件が異なる値も混在するため、同一ベンチの横並び比較は注記で補足します。
| モデル | 料金 入力/出力($/M) | コンテキスト | ライセンス | 公表コード系スコア |
|---|---|---|---|---|
| DeepSeek V4.1 Flash 1017 | 0.15 / 0.60 | 1M | MIT | DeepSWE v1.1: 77.0 |
| Claude Opus 5.5 | 4.00 / 20.00 | 1M | Proprietary | Terminal-Bench 4.0: 66.4% |
| GPT-6 Sol | 2.00 / 10.00(〜272K入力) / 4.00 / 15.00(272K超) | 1,050,000 | Proprietary | DeepSWE v1.1: 68.8% |
| GPT-6.1 Sol | 2.00 / 10.00(〜272K入力、キャッシュ入力 0.10) / 4.00 / 15.00(272K超、キャッシュ入力 0.20) | 1,050,000 | Proprietary | DeepSWE v1.1評価あり(公式発表参照) |
| Qwen3.8-27B | セルフホスト前提(API料金は提供元依存) | 公式モデルカード準拠 | Apache 2.0 | 公式ベンチマークはモデルカード参照 |
| GLM-5.3-Flash | 0.15 / 0.50 | 1M | MIT | コード系ベンチはZ.ai公式ドキュメント参照 |
この比較は同一ベンチの横並び比較ではない点に注意が必要です。V4.1 Flash 1017のDeepSWE v1.1=77.0とOpus 5.5のTerminal-Bench 4.0=66.4%はそれぞれ別のベンチマークであり、「どちらが上位か」をスコアだけで判定することはできません。
ライセンス面では、V4.1 Flash 1017のMIT、GLM-5.3-FlashのMIT、Qwen3.8-27BのApache 2.0のいずれも商用利用・改変・再配布を許可する寛容ライセンスです。
MITは「著作権表示とライセンス全文の保持」が必須条件なので、「条件なし」ではなく通知保持は必要です。GLM系では無印GLM-5.3のライセンスに「年商$10B超のmodel-as-a-service事業者はZ.AIのセキュリティレビュー必須」という条項がありますが、GLM-5.3-FlashはMITで提供されており、この条項は適用されません。
選定軸——どの用途でどのモデルを選ぶか
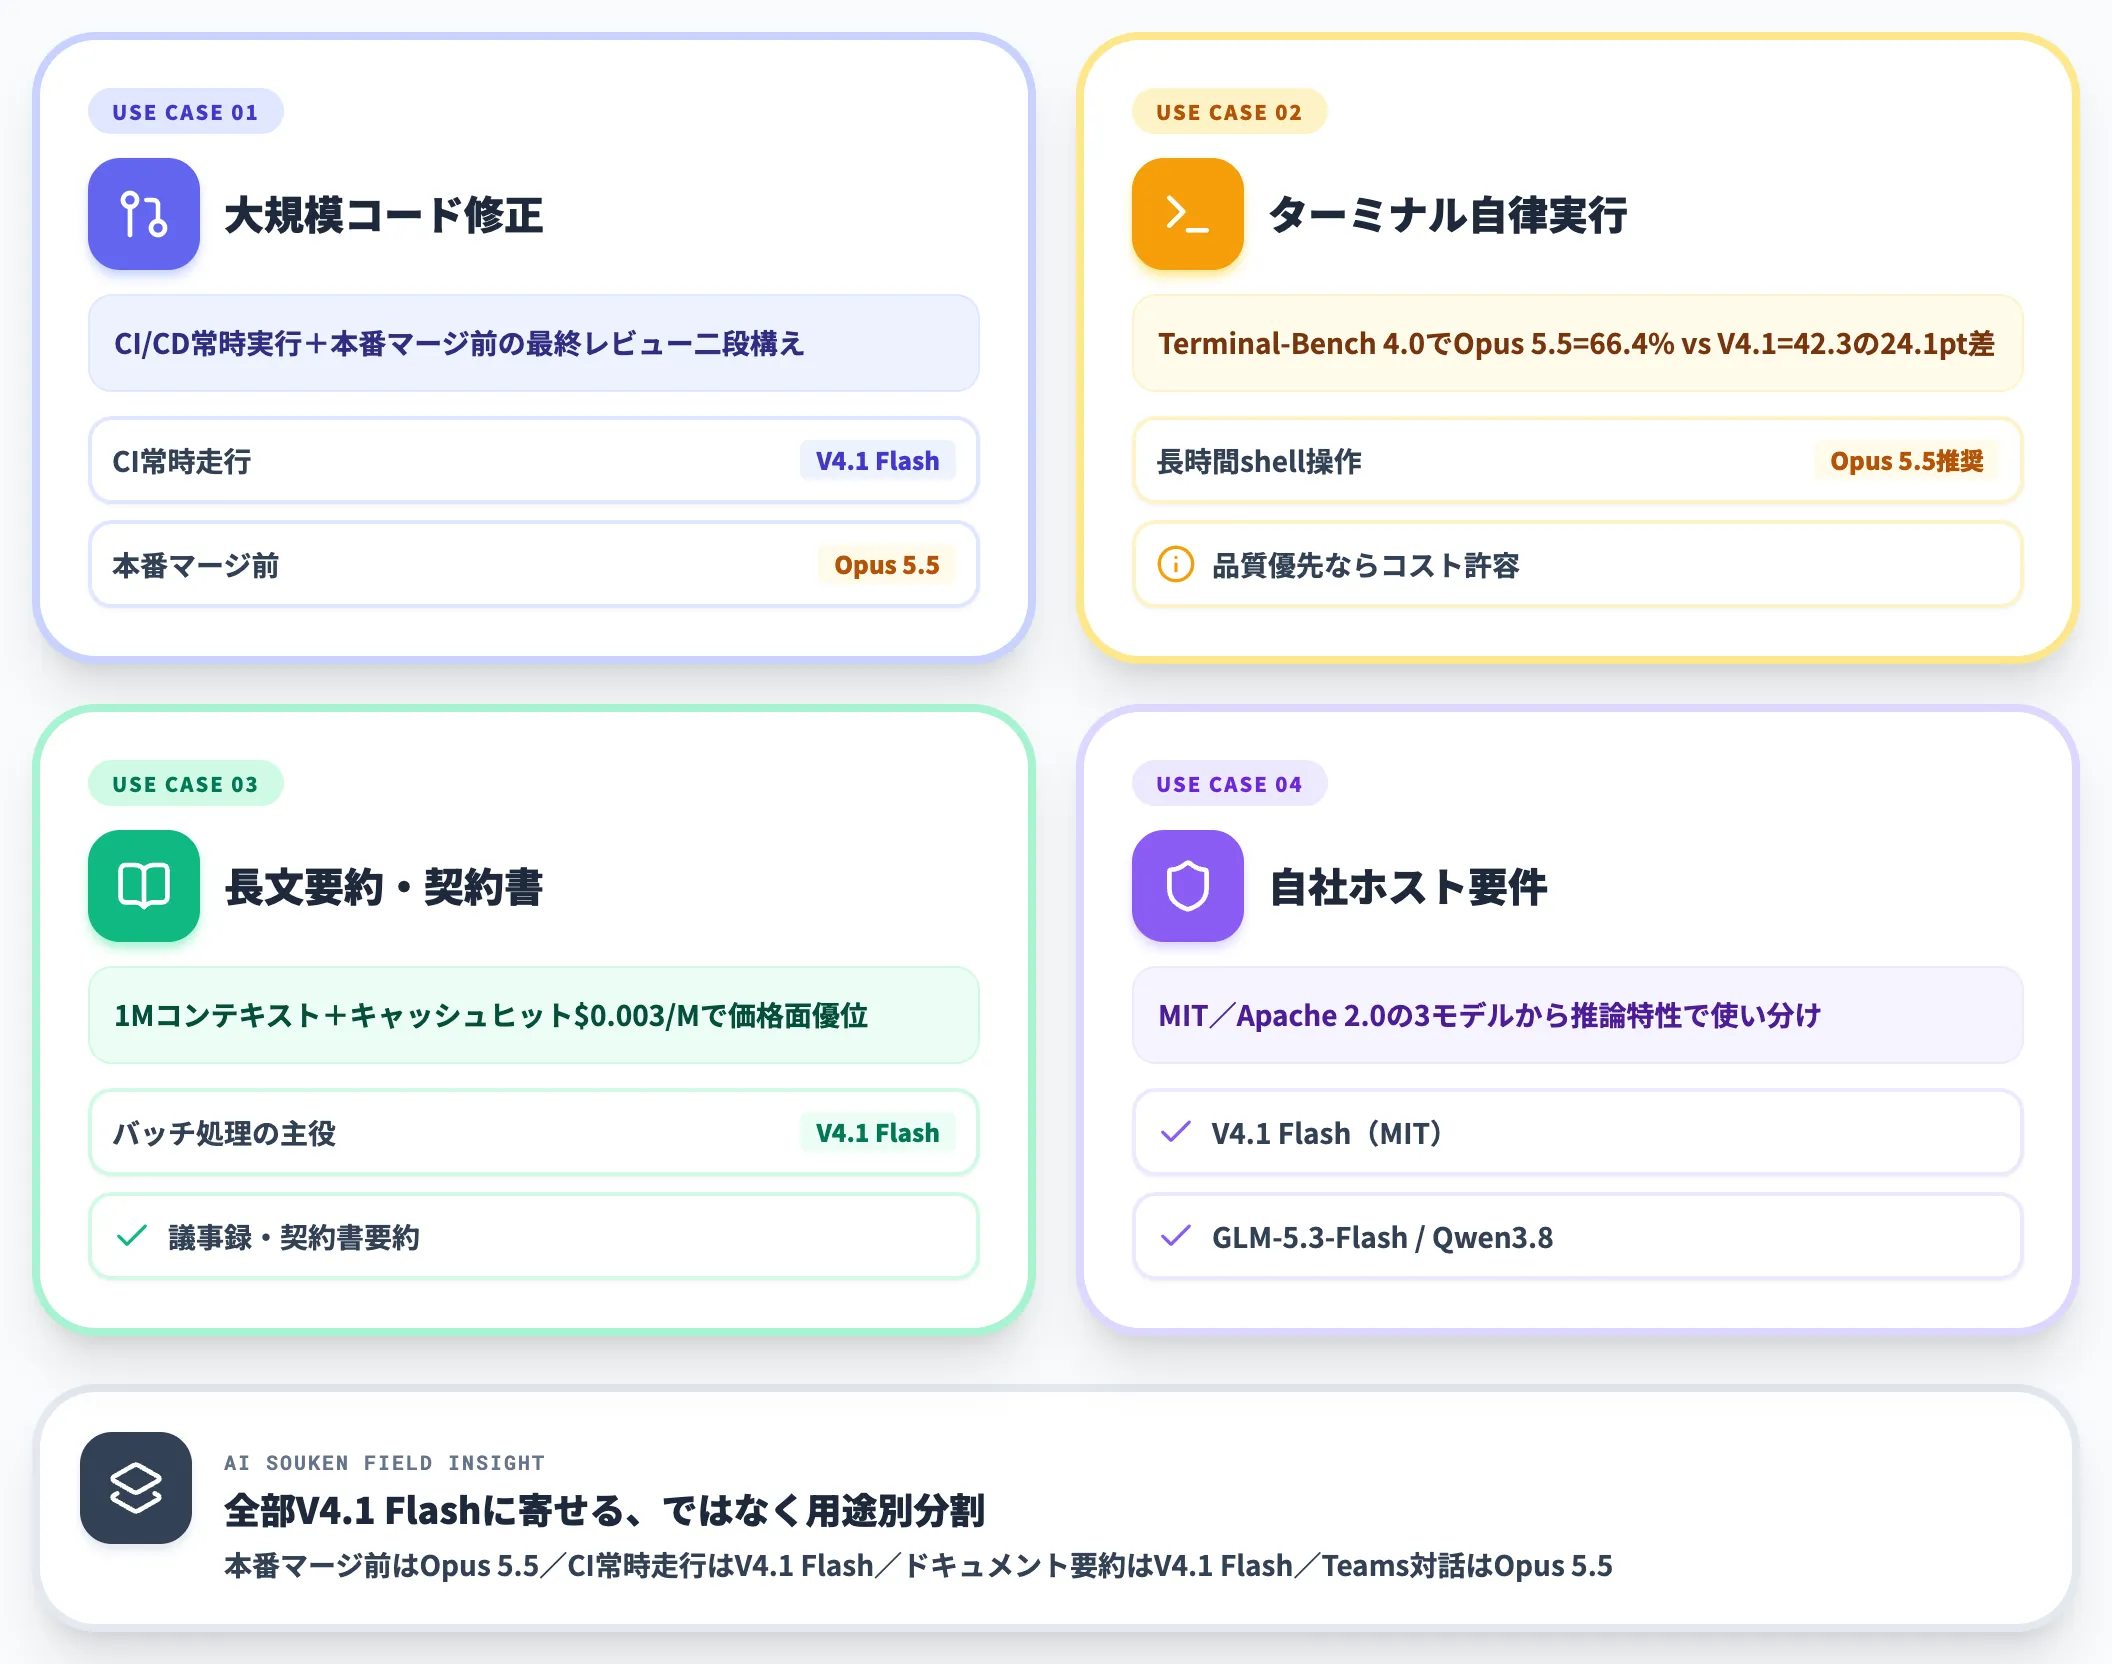
実務で複数モデルを使い分ける場合の軸を、ユースケース別に整理します。各ベンチマークは測定条件が異なるため、同一ベンチで横並び比較できる領域(Terminal-Bench 4.0など)に限定して「優位・劣位」を述べます。
-
大規模コードベースの修正・レビュー
V4.1 Flash 1017のDeepSWE v1.1=77.0と$0.15/M入力の組み合わせは、CI/CDに常時走らせる候補として有力です。品質がシビアな本番マージ前の最終レビューはOpus 5.5で押さえる二段構えが現実的。両モデルを同一ベンチで比較できる領域(例:Terminal-Bench 4.0)では、V4.1 Flash 1017=42.3、Opus 5.5=66.4%で24.1ポイント差があります。
-
ターミナル操作・shell自動化
同一ベンチTerminal-Bench 4.0で比較すると、Opus 5.5=66.4%、V4.1 Flash 1017=42.3の差があります。長時間のshell操作を自律実行させるならOpus 5.5側のコストを払う価値があります。
-
長文の要約・契約書解析
V4.1 Flash 1017の1Mコンテキスト+キャッシュヒット$0.003/Mが効きます。Opus 5.5・GPT-6 Sol・GLM-5.3-Flashも1M〜1,050,000トークン級のコンテキストを提供していますが、価格面でV4.1 Flash 1017が優位です。
-
センシティブデータを扱う自社ホスティング
V4.1 Flash 1017(MIT)、GLM-5.3-Flash(MIT)、Qwen3.8-27B(Apache 2.0)のいずれも自社インフラ上での推論が可能です。モデルサイズ・推論特性で使い分けを設計します。
AI総研の支援現場でも、「全部V4.1 Flash 1017に寄せる」ではなく、「本番マージ前はOpus 5.5、CI常時走行はV4.1 Flash 1017、ドキュメント要約はV4.1 Flash 1017、Teamsからの対話はOpus 5.5」のような用途別のモデル分割を設計するケースが増えています。
日本企業がV4.1 Flash 1017を使うときの判断ポイント
V4.1 Flash 1017を日本の法人環境で導入するにあたっては、純粋な性能・コスト比較の他に、固有の判断軸が加わります。
ここではCrystal Method社の実務分析と、AI総研の支援現場で蓄積している導入パターンを踏まえ、日本企業向けの判断ポイントを整理します。
データ主権リスクと経路設計
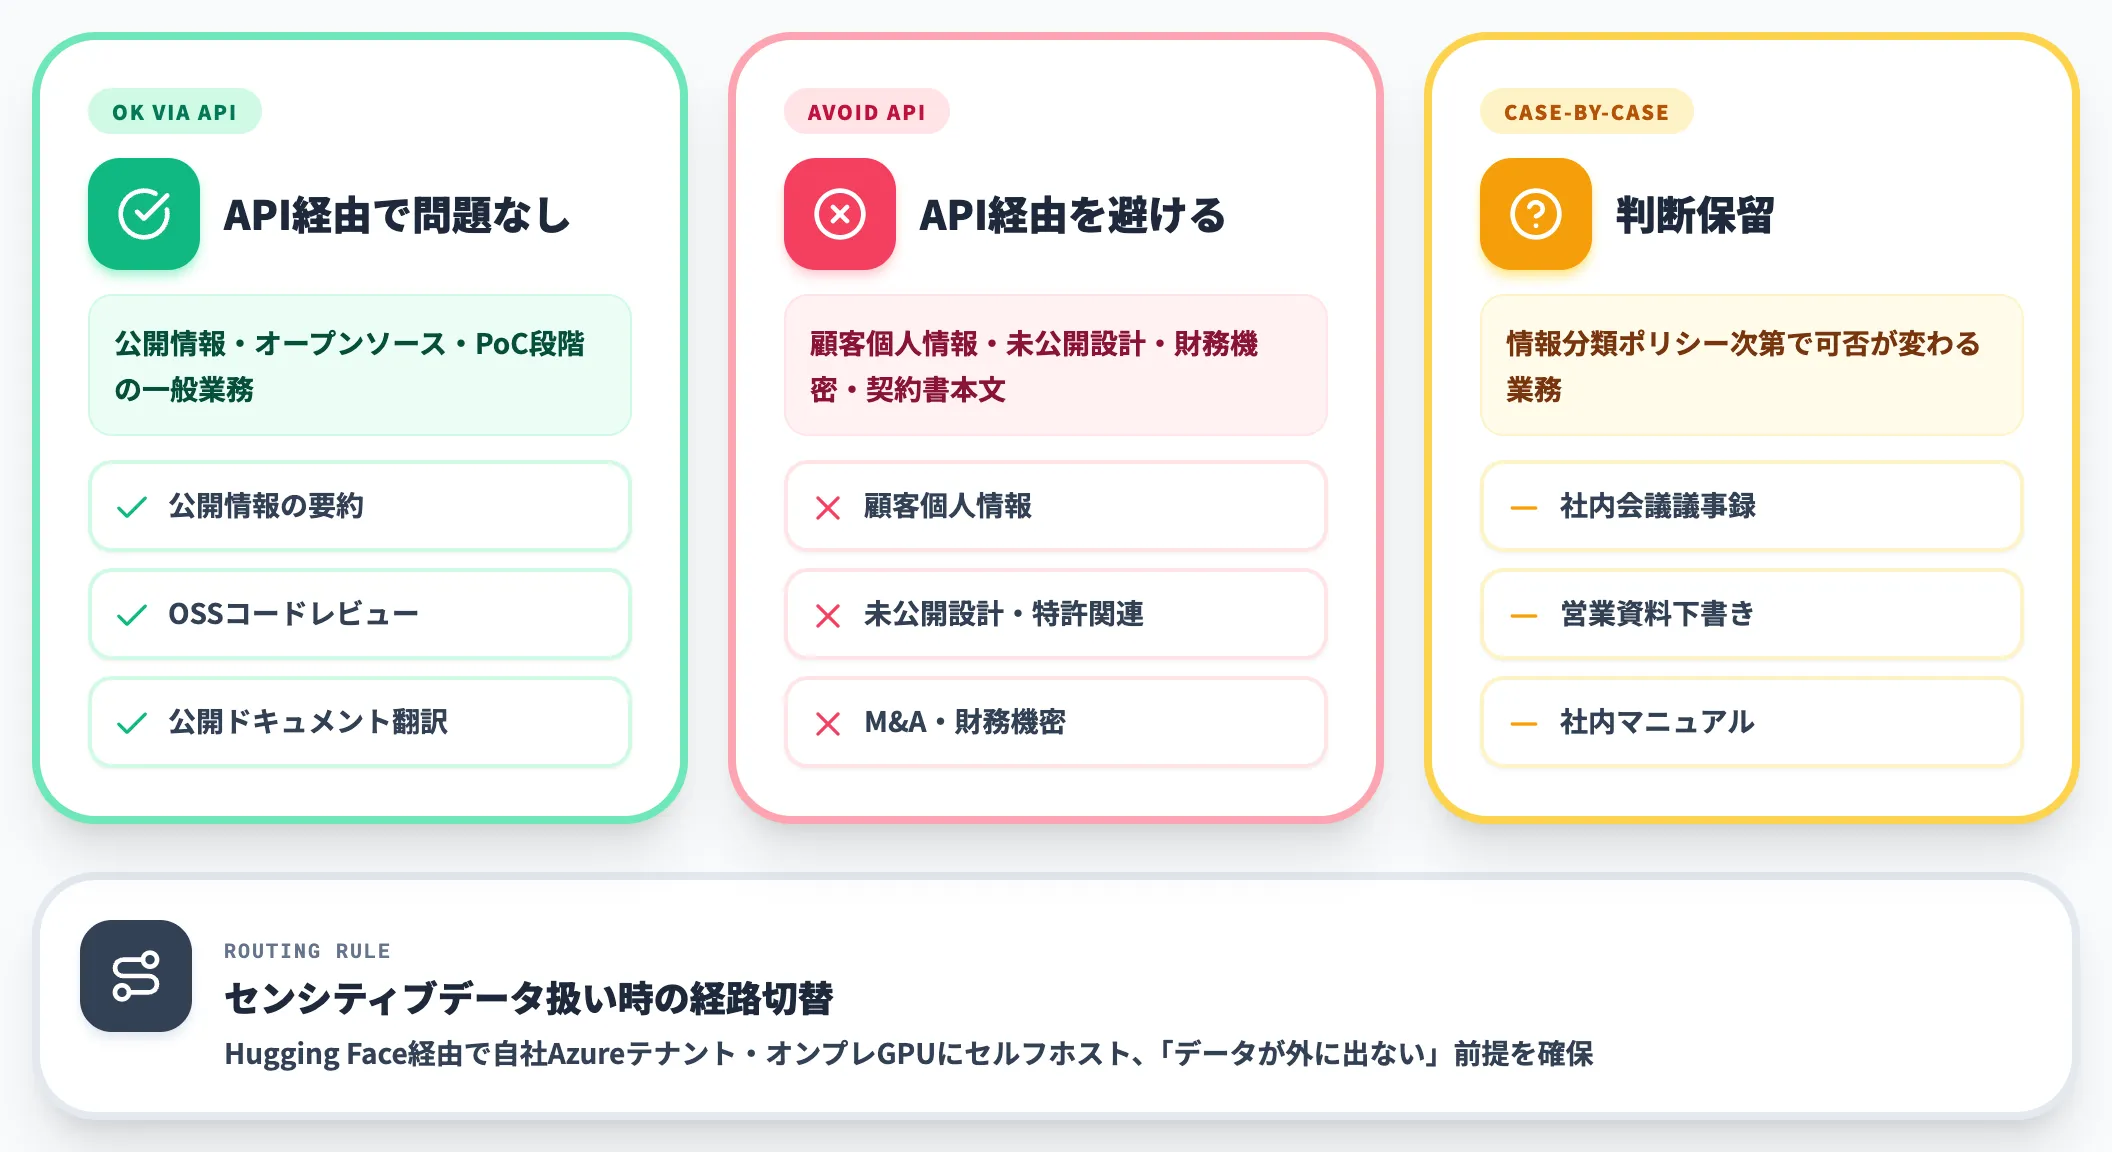
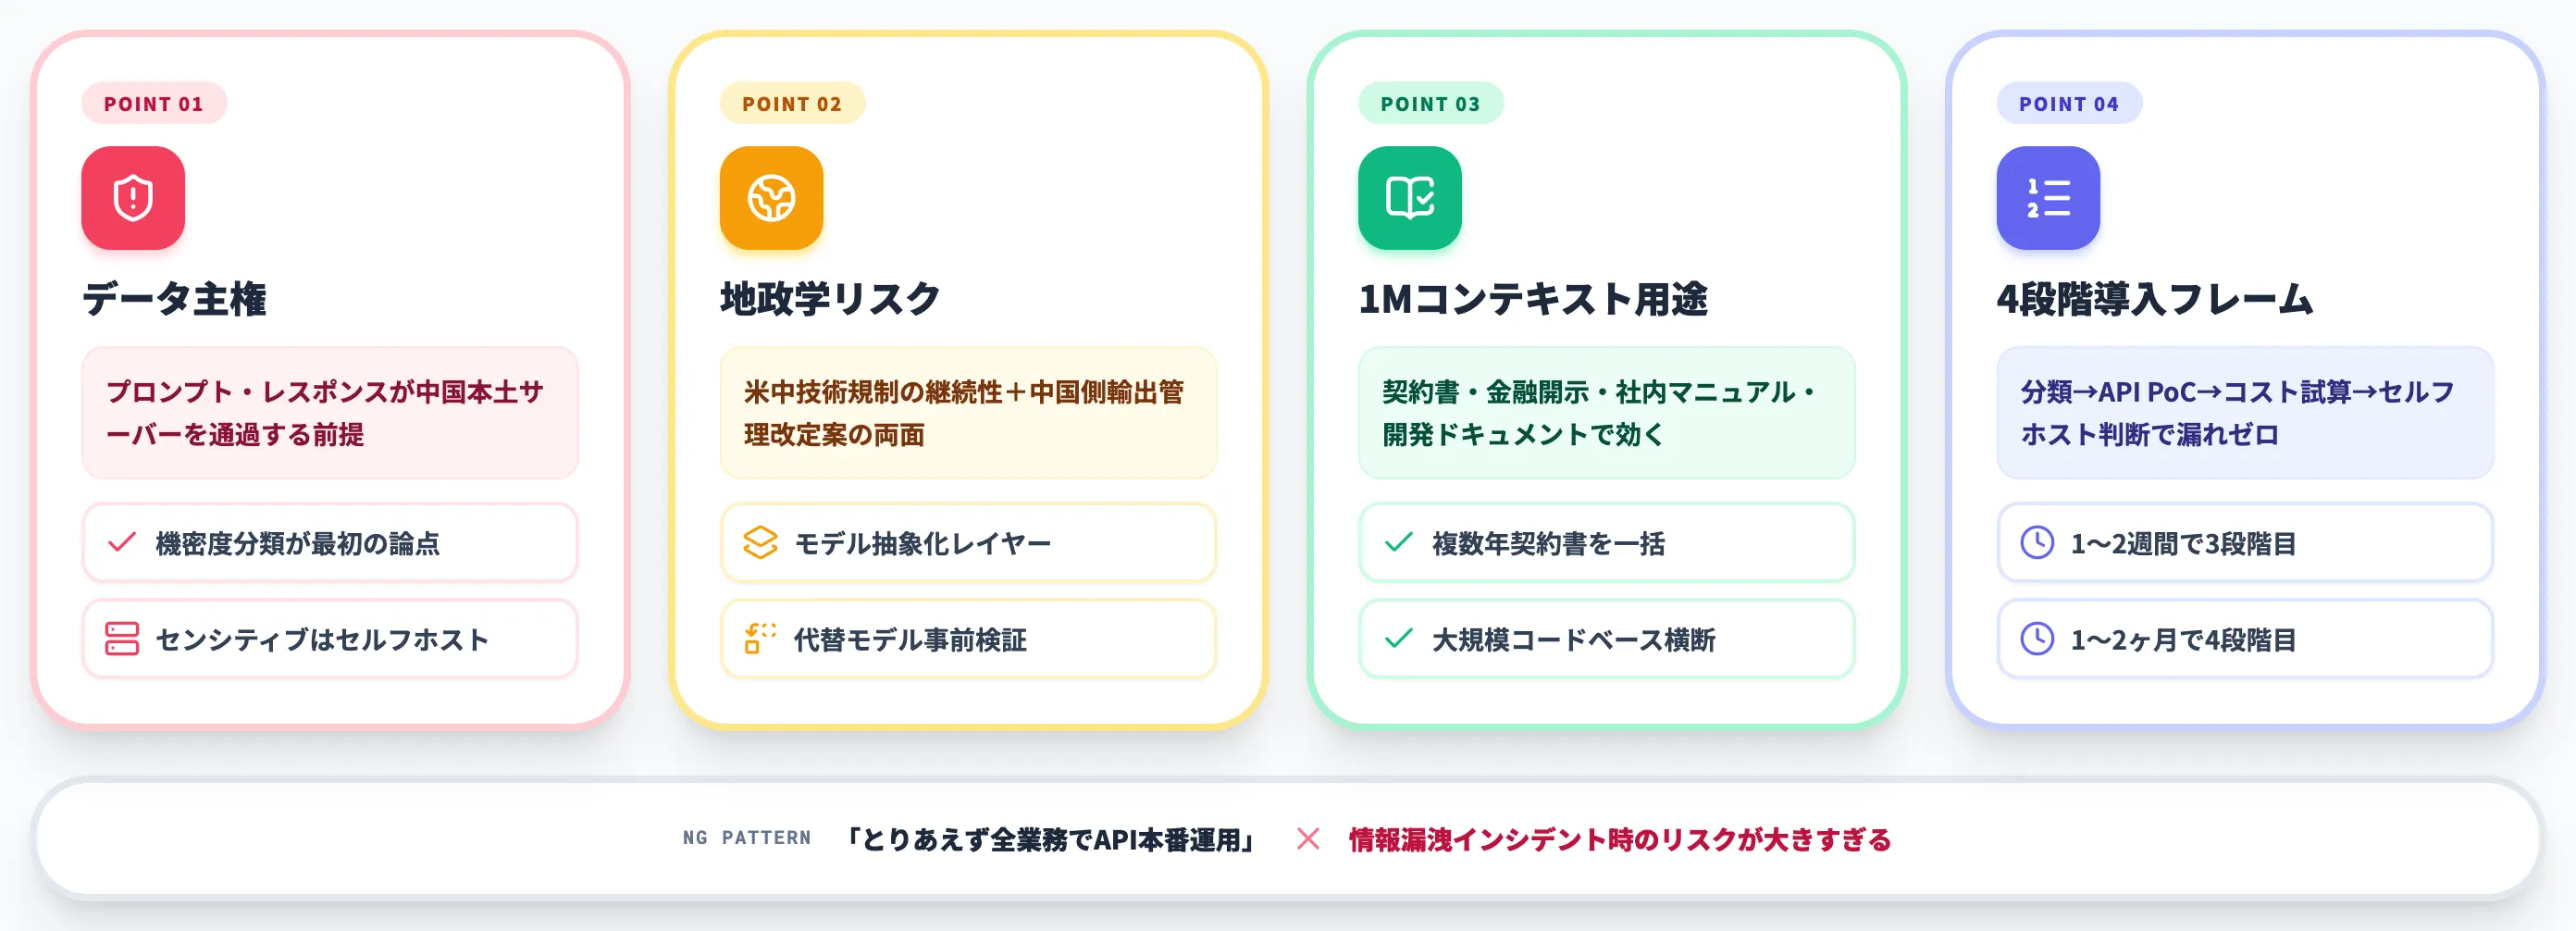
DeepSeek APIを経由する場合、プロンプト・レスポンスがDeepSeekのサーバー(中国本土)を通過します。個人情報・取引機密・未公開の設計情報を扱う業務では、この経路が許容されるかの判断が最初の論点になります。
線引きの実務的な基準は以下のとおりです。
- API経由で問題なしのケース: 公開情報の要約、オープンソースコードのレビュー、公開ドキュメントの翻訳、PoC検証段階の一般業務
- API経由を避けるべきケース: 顧客個人情報を含む問い合わせ対応、未公開の製品設計・特許関連情報、M&A・財務の機密情報、クライアント契約書本文
- 判断保留のケース: 社内会議の議事録、営業資料の下書き、社内マニュアル(情報分類ポリシー次第)
センシティブデータを扱う場合は、Hugging Face経由で自社Azureテナント・自社オンプレGPUにセルフホストする構成に切り替えます。コストは上がりますが、「データが外に出ない」という前提を確保できます。
地政学リスク——米中技術規制の継続性
DeepSeekは中国企業で、米中技術規制の影響を直接受ける位置にあります。
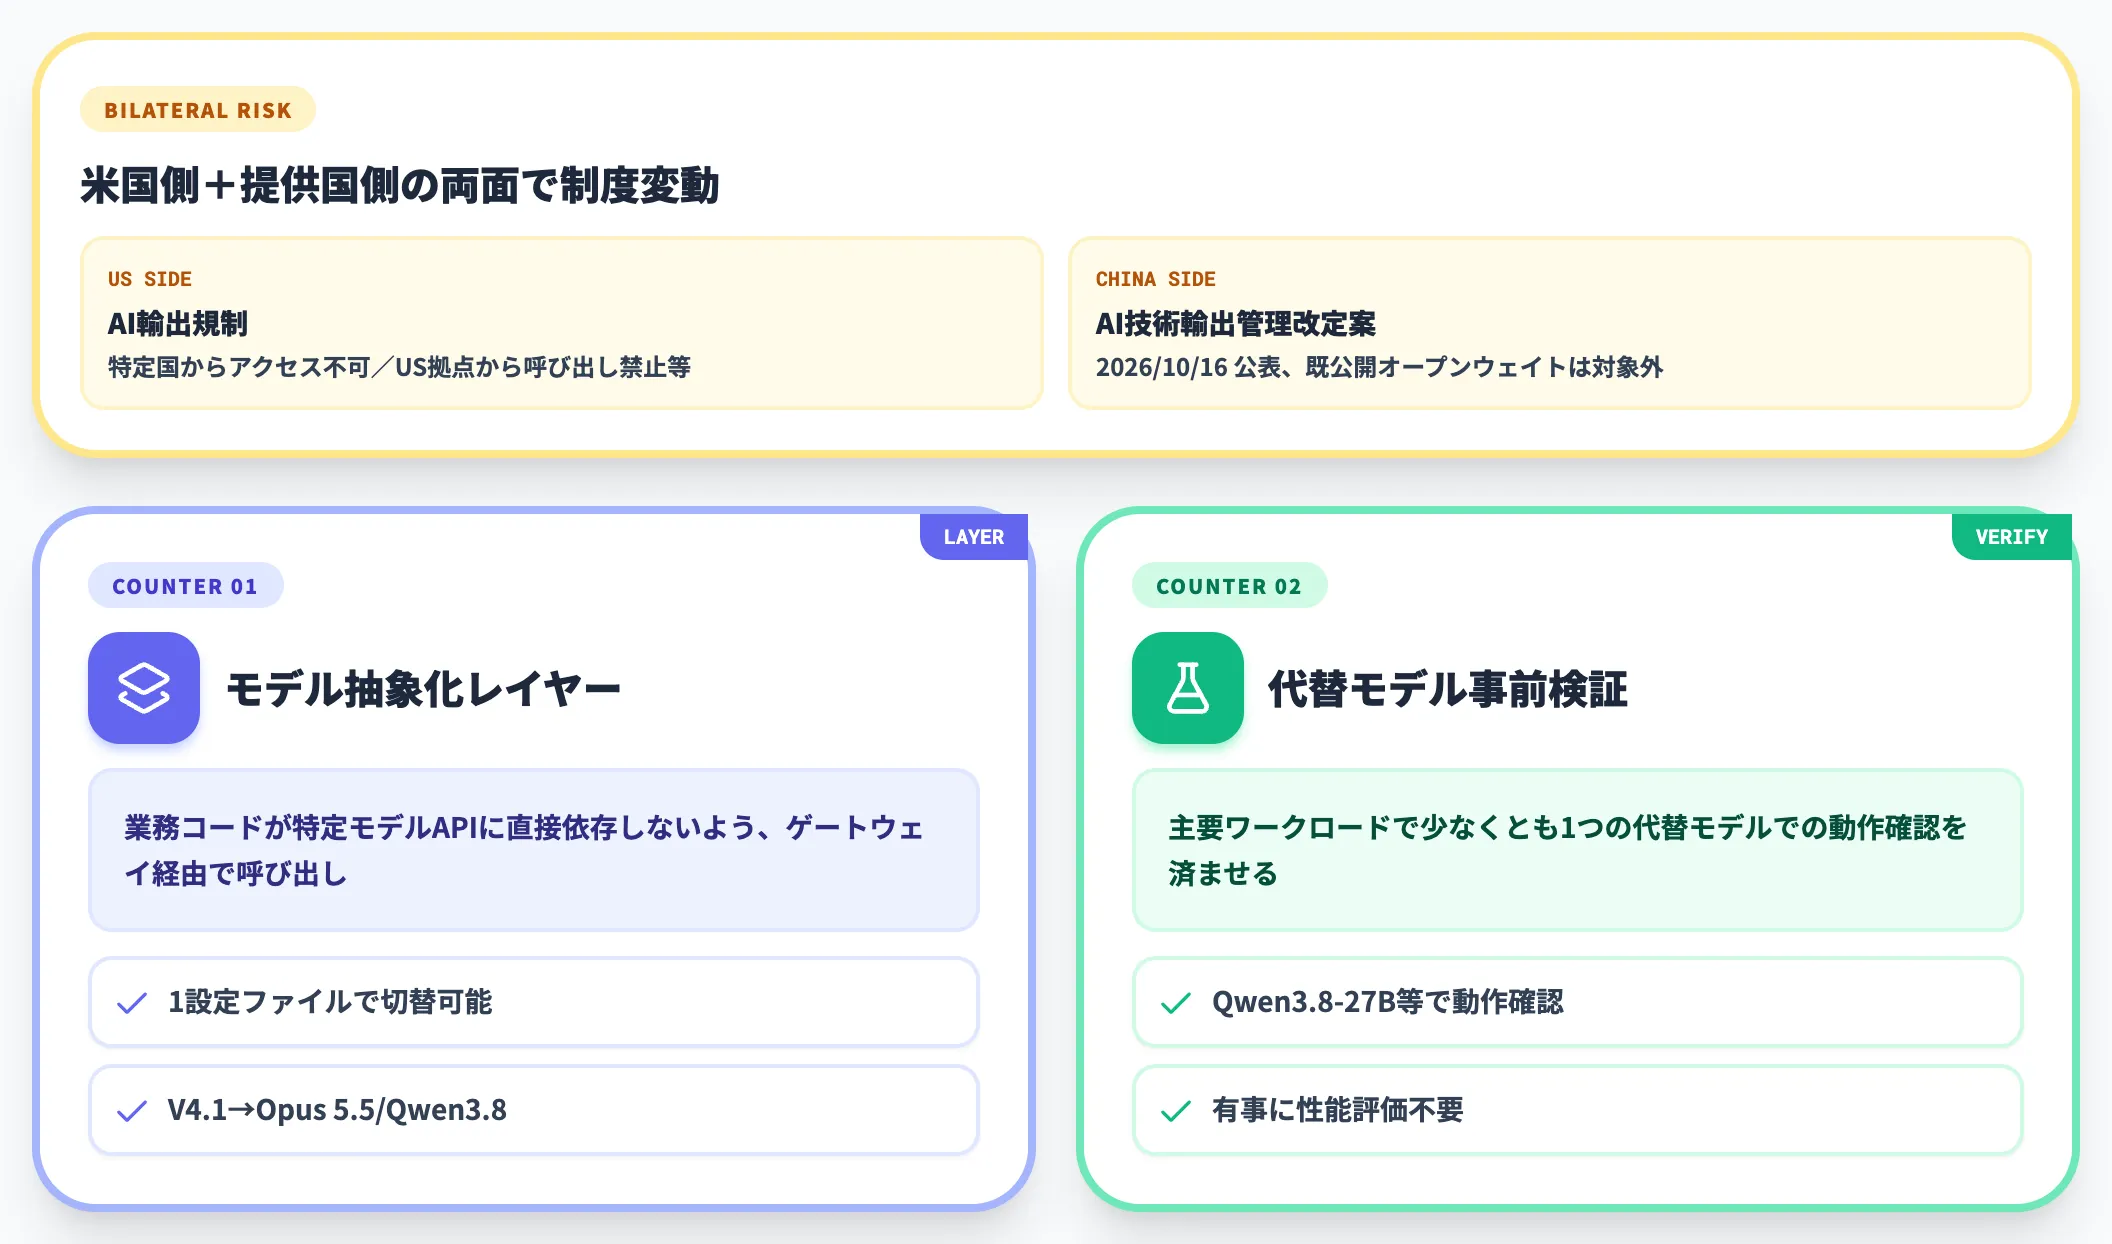
2026年時点では米国のAI輸出規制はモデル提供側に強く効いており、将来的にDeepSeek API自体が特定国からアクセス不可になる・US拠点から呼び出し禁止になる等の変動リスクが残ります。
提供国側(中国)も制度変動の局面にあります。2026年10月16日には中国商務部がAI技術関連の輸出管理改定案を公表しており、既公開のオープンウェイトやAPI提供は対象外と説明されているものの、将来の追加規制や解釈運用の変動は継続ウォッチが必要です。米国側だけでなく、提供国側の制度変動も両面で見ておく必要があります。
実務的な対策は、以下の2軸で組みます。
-
モデル抽象化レイヤーの導入
業務コードが特定モデルAPIに直接依存しないよう、ゲートウェイ経由で呼び出す構成にする。V4.1 Flash 1017からClaude Opus 5.5・Qwen3.8-27Bへの切替が1設定ファイルで済む設計にしておく。
-
代替モデルの事前検証
主要ワークロードで、V4.1 Flash 1017以外に少なくとも1つの代替モデル(Qwen3.8-27Bなど)での動作確認を済ませておく。有事の切替時に性能評価からやり直す状況を避ける。
1Mコンテキストの実務シーン——日本企業で効く用途
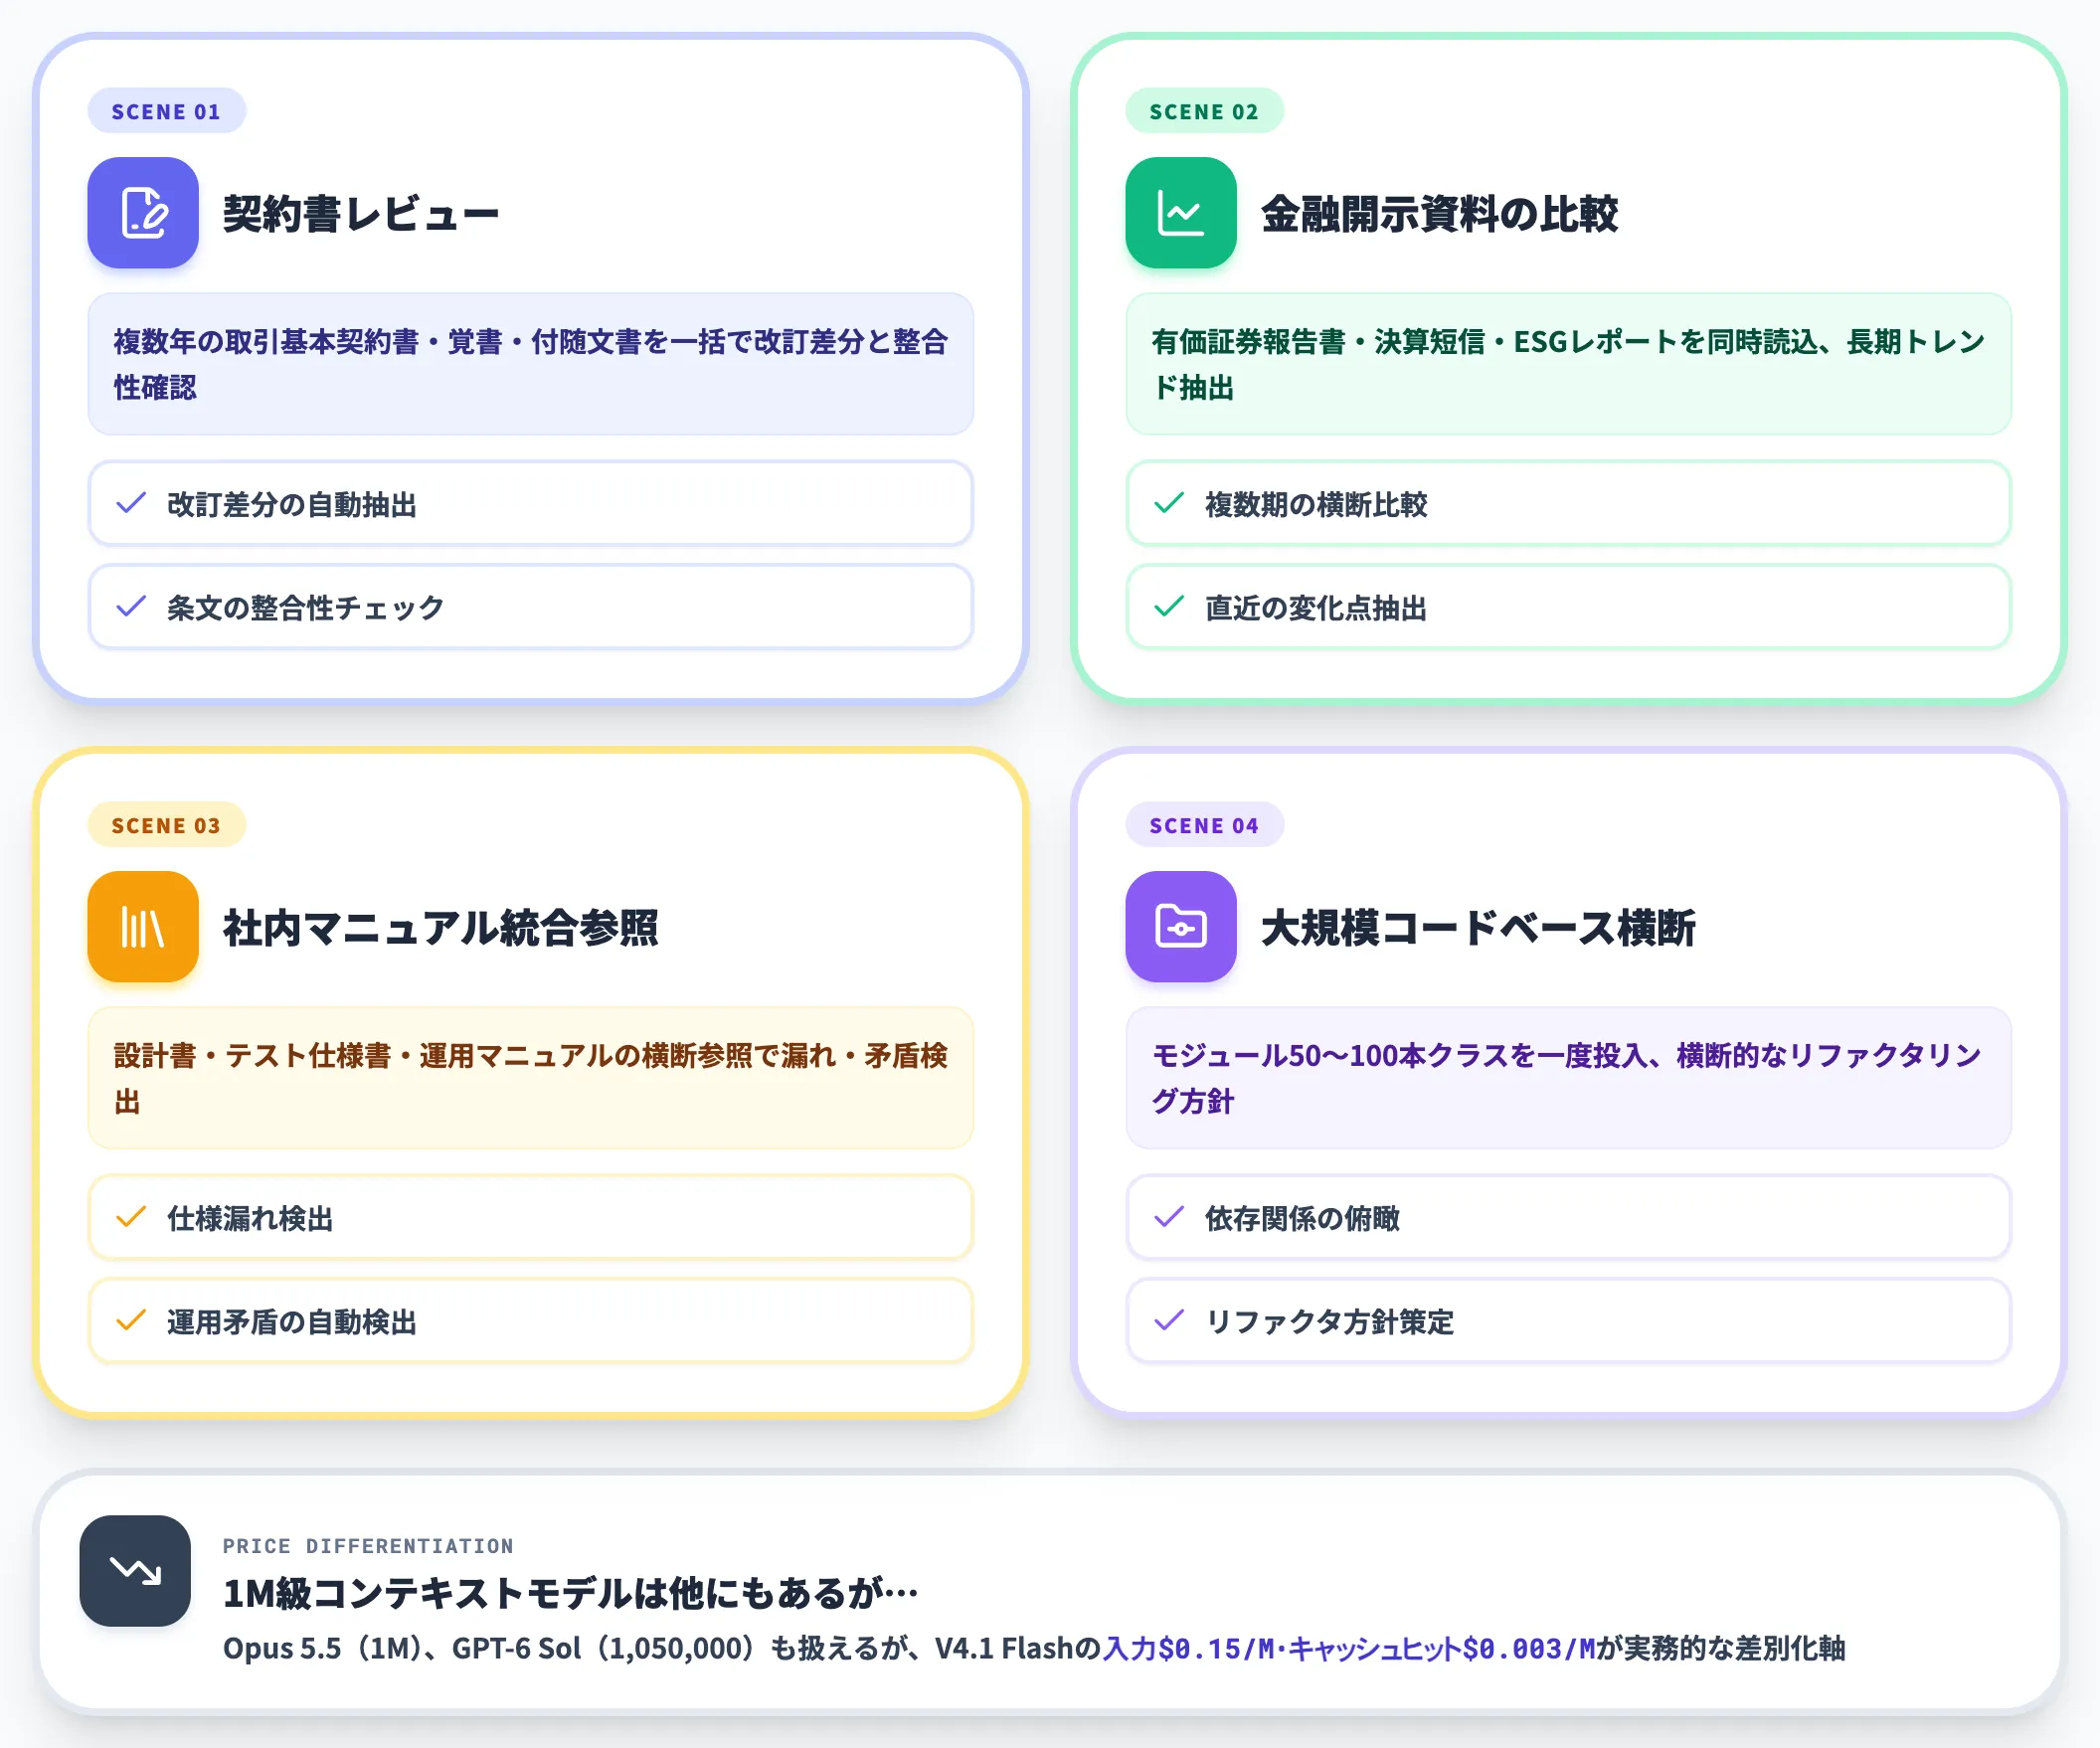
1Mコンテキストは、日本企業の実務では契約書レビュー・金融開示資料の比較・社内マニュアルの横断検索・開発ドキュメントの統合参照といった長文処理で特に効きます。
以下のシナリオで、V4.1 Flash 1017の1Mコンテキストが実務的な価値を発揮します。
- 複数年にわたる取引基本契約書・覚書・付随文書を一括で読み込み、改訂差分と条文の整合性を確認
- 有価証券報告書・決算短信・ESGレポートを同時に読み、長期トレンドと直近の変化点を抽出
- 製品の設計書・テスト仕様書・運用マニュアルを統合参照して、仕様漏れ・運用矛盾を検出
- 大規模コードベース全体(モジュール50〜100本クラス)を一度に投入し、横断的なリファクタリング方針を立てる
これらのワークロードはClaude Opus 5.5(1M)やGPT-6 Sol(1,050,000トークン)など他の1M級コンテキストモデルでも扱えますが、V4.1 Flash 1017は入力$0.15/M・キャッシュヒット$0.003/Mという価格でこの長さを扱える点が実務的な差別化軸になります。
導入判断の4段階フレーム
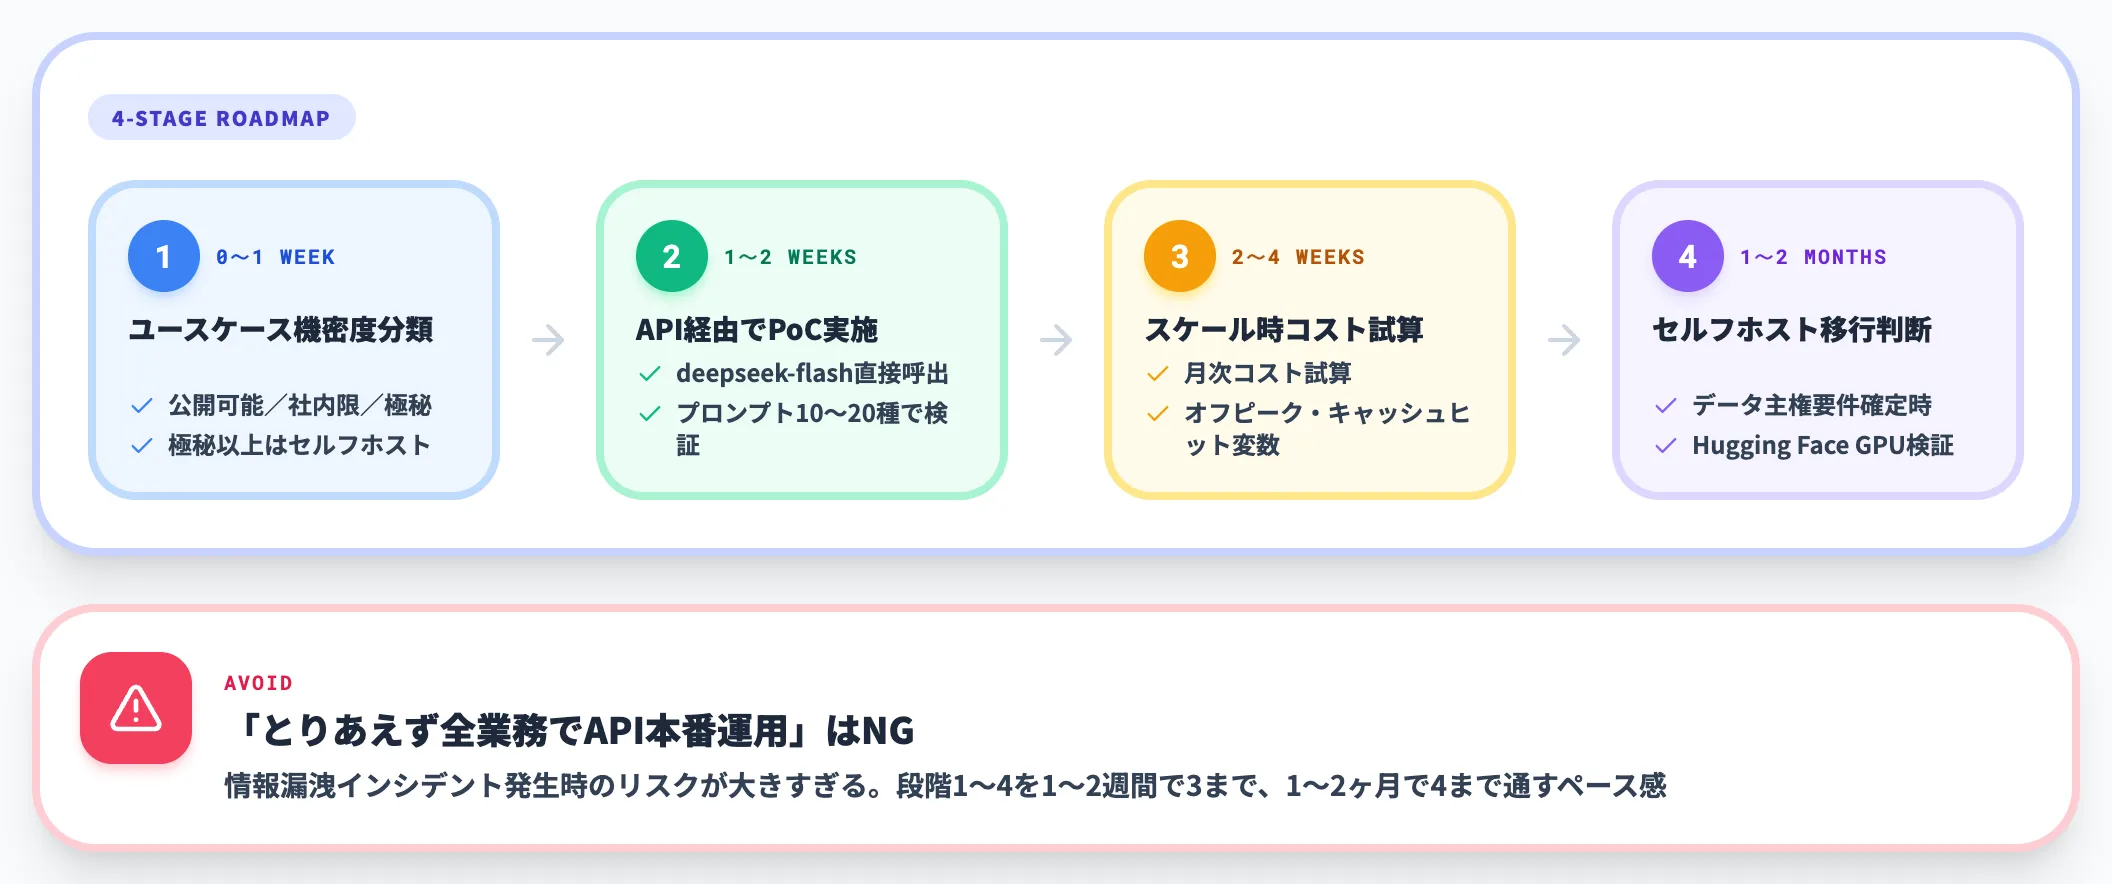
日本企業でV4.1 Flash 1017を本格導入する場合、以下の4段階で検討を進めると判断漏れが起きません。
-
1. ユースケースの機密度分類
全業務シナリオを「公開可能」「社内限」「極秘」の3段階で分類し、API経由で許容される範囲を決める。極秘以上はセルフホスト前提。
-
2. API経由でのPoC実施
「deepseek-flash」 APIを使い、代表的なプロンプト10〜20種で日本語の出力品質を検証する。コードレビュー・契約書要約・業務マニュアル検索など、本番ユースケースに近い課題を用意する。
3. スケール時のコスト試算
PoCで得た平均トークン消費を基に、本番稼働時の月次コストを試算する。オフピーク時間帯の活用・キャッシュヒット率も変数に組み込む。
4. セルフホスティング移行の判断
データ主権要件が確定しなければ、本格展開前にHugging FaceウェイトのGPUセルフホスト構成を検証する。推論コストはAPIより上がるが、情報分類ポリシーを満たす形で運用できる。
この4段階は、1〜2週間で3まで、1〜2ヶ月で4まで通せるペース感が実務的です。「とりあえず全業務でAPI呼び出しを本番運用」という進め方は、情報漏洩インシデント発生時のリスクが大きすぎるため推奨しません。
機密データを扱う業務でもV4.1 Flash 1017を使うなら
V4.1 Flash 1017は、公開情報の要約やオープンソースコードのレビューならAPI経由ですぐに試せますが、顧客情報や契約書本文を扱う業務では、Hugging Faceのウェイトを自社環境でホストする構成が前提になります。そのうえで現場に定着させるには、社員が呼び出す入口と、誰がどの業務に使ったかを残す仕組みまで社内に置く必要があります。
この入口と記録の仕組みを担うのが、自社のAzureテナント内で動くAIエージェント基盤です。AI総合研究所のAI Agent Hubは、社内の業務エージェントを1つのダッシュボードで一元管理する基盤として機能します。
- 機密度に合わせてAgentの利用者を絞る
機密度が違う業務ごとに、Agentのアクセス権限で使える社員を分けられます。
- 実行ログで影響を受けた業務を追える
どのAgentがいつ実行されたかが記録に残るため、silent routingでモデルの挙動が変わったときも、影響を受けた業務を確かめやすくなります。
- 呼び出しの入口はTeamsに集約
社員はTeamsのチャットから業務エージェントを呼び出すため、業務ごとに別のツールを覚える必要がありません。
- 自社でホストしたモデルとの接続も支援
Azure Managed Applicationsとして自社テナント内に構築し、自社でホストしたモデルを前提に、業務システムとの接続設計・構築も支援します。
AI総合研究所の専任チームが、API経由で試す業務と自社テナント内に置く業務の切り分けから伴走します。業務エージェントが実際にどう動くかは、AI Agent Hubのサービスページのデモでご覧いただけます。
APIに出せない業務を自社テナントで
モデルも業務の仕組みも社内に置く
DeepSeek APIに流せない機密データの業務では、モデルだけでなく、社員が呼び出す入口と利用の記録も社内に置く必要があります。AI Agent Hubのサービスページで、業界・業務別のユースケースと動くデモをご確認ください。
まとめ
本記事では、DeepSeek-V4.1-Flash-1017について、CEDアーキテクチャ・DeepSWE 77.0の性能差分・deepseek-flash APIとsilent routing・時間帯別料金・10月31日に無料期間が終了するSearch/Fetch API・Opus 5.5/GPT-6 Solとの比較・日本企業の導入判断フレームまでを、2026年10月時点の最新情報で解説しました。
2026年10月時点で押さえておくべきポイントは次の3つです。
- 1017 snapshotはCEDアーキを土台に、料金を据え置いたまま性能の底上げと出力の短縮を同時に進めた
- 旧V4-Flash系のモデル名は裏でV4.1 Flashへsilent routingされるため、既存コードの挙動変化を検知するベースライン運用が必要
- Search・Fetch APIは無料期間の終了後すべての呼び出しが課金対象になるため、推論とは別に検索コストを見積もる必要がある
V4.1 Flash 1017は、「オープンウェイト+1Mコンテキスト+コーディング特化ベンチでフロンティアモデルと並ぶ」という組み合わせを提供するモデルです。業務での採用判断は、純粋な性能・コストだけでなく、データ主権要件・地政学リスク・silent routingへの運用対策を含めた総合判断が必要になります。
まずは業務を機密度で分類し、API経由で許容できる範囲から代表的なプロンプトでPoCを回して、日本語の出力品質とコストを確かめるのが現実的な進め方です。セルフホスト構成は、データ主権要件が固まった後の第二段階として検討します。