この記事のポイント
 SimVLAはVLA研究テーマ名で、同名の論文が2本存在する点をまず押さえるべき
- 論文Aは0.5BでLIBERO 98.6%、OpenVLA-OFT(7B)やπ0.5(3B)を超える軽量ベースライン
- 論文Bは合成シムデータのみで学習し実機ゼロショット53〜58%を達成するSim-to-Realフレーム
- 用途がアームマニピュのSOTA再現なら論文A、モバイル実機のSim-to-Real検証なら論文Bが参照先
- どちらも学術研究段階で商用SLAはなく、PoC段階の評価ベンチマークとして使うのが実務的
Microsoft MVP・AIパートナー。LinkX Japan株式会社 代表取締役。東京工業大学大学院にて自然言語処理・金融工学を研究。NHK放送技術研究所でAI・ブロックチェーンの研究開発に従事し、国際学会・ジャーナルでの発表多数。経営情報学会 優秀賞受賞。シンガポールでWeb3企業を創業後、現在は企業向けAI導入・DX推進を支援。
SimVLAは、ロボット操作向けのVision-Language-Action(VLA)モデルを対象にした研究テーマの名前です。
検索するとarXivに同じ「SimVLA」というタイトルの論文が2本ヒットし、片方は「シンプル設計で巨大VLAを超えるベースライン」、もう片方は「合成シミュレーションデータだけで実機ゼロショットを目指すフレームワーク」と、まったく別の中身になっています。
本記事では、2つのSimVLAを混同しないための対照整理、各論文の設計と実力、VLA全体の中での位置づけ、用途別にどちらを参照すべきかの判断軸までを体系的に解説します。
あわせて、公開リポジトリ・モデルウェイト・自前環境での再現要件、学術研究段階ゆえの限界も明記します。
目次
SimVLA(Simple VLA Baseline)の設計と実力
「silent drivers of performance」の標準化
LIBERO 98.6%・OpenVLA-OFT(7B)・π0.5(3B)超え
SimVLA(Zero-Shot Sim-to-Real)の設計と実機性能
SimAction・SimVQA・SimDeployの3データセット
実機ゼロショット53〜58%で、実機デモ50本学習ポリシーを上回る
LIBERO・アームマニピュのSOTA再現が目的 → 論文A
SimVLAとは?同名の論文が2本存在するVLA研究テーマ
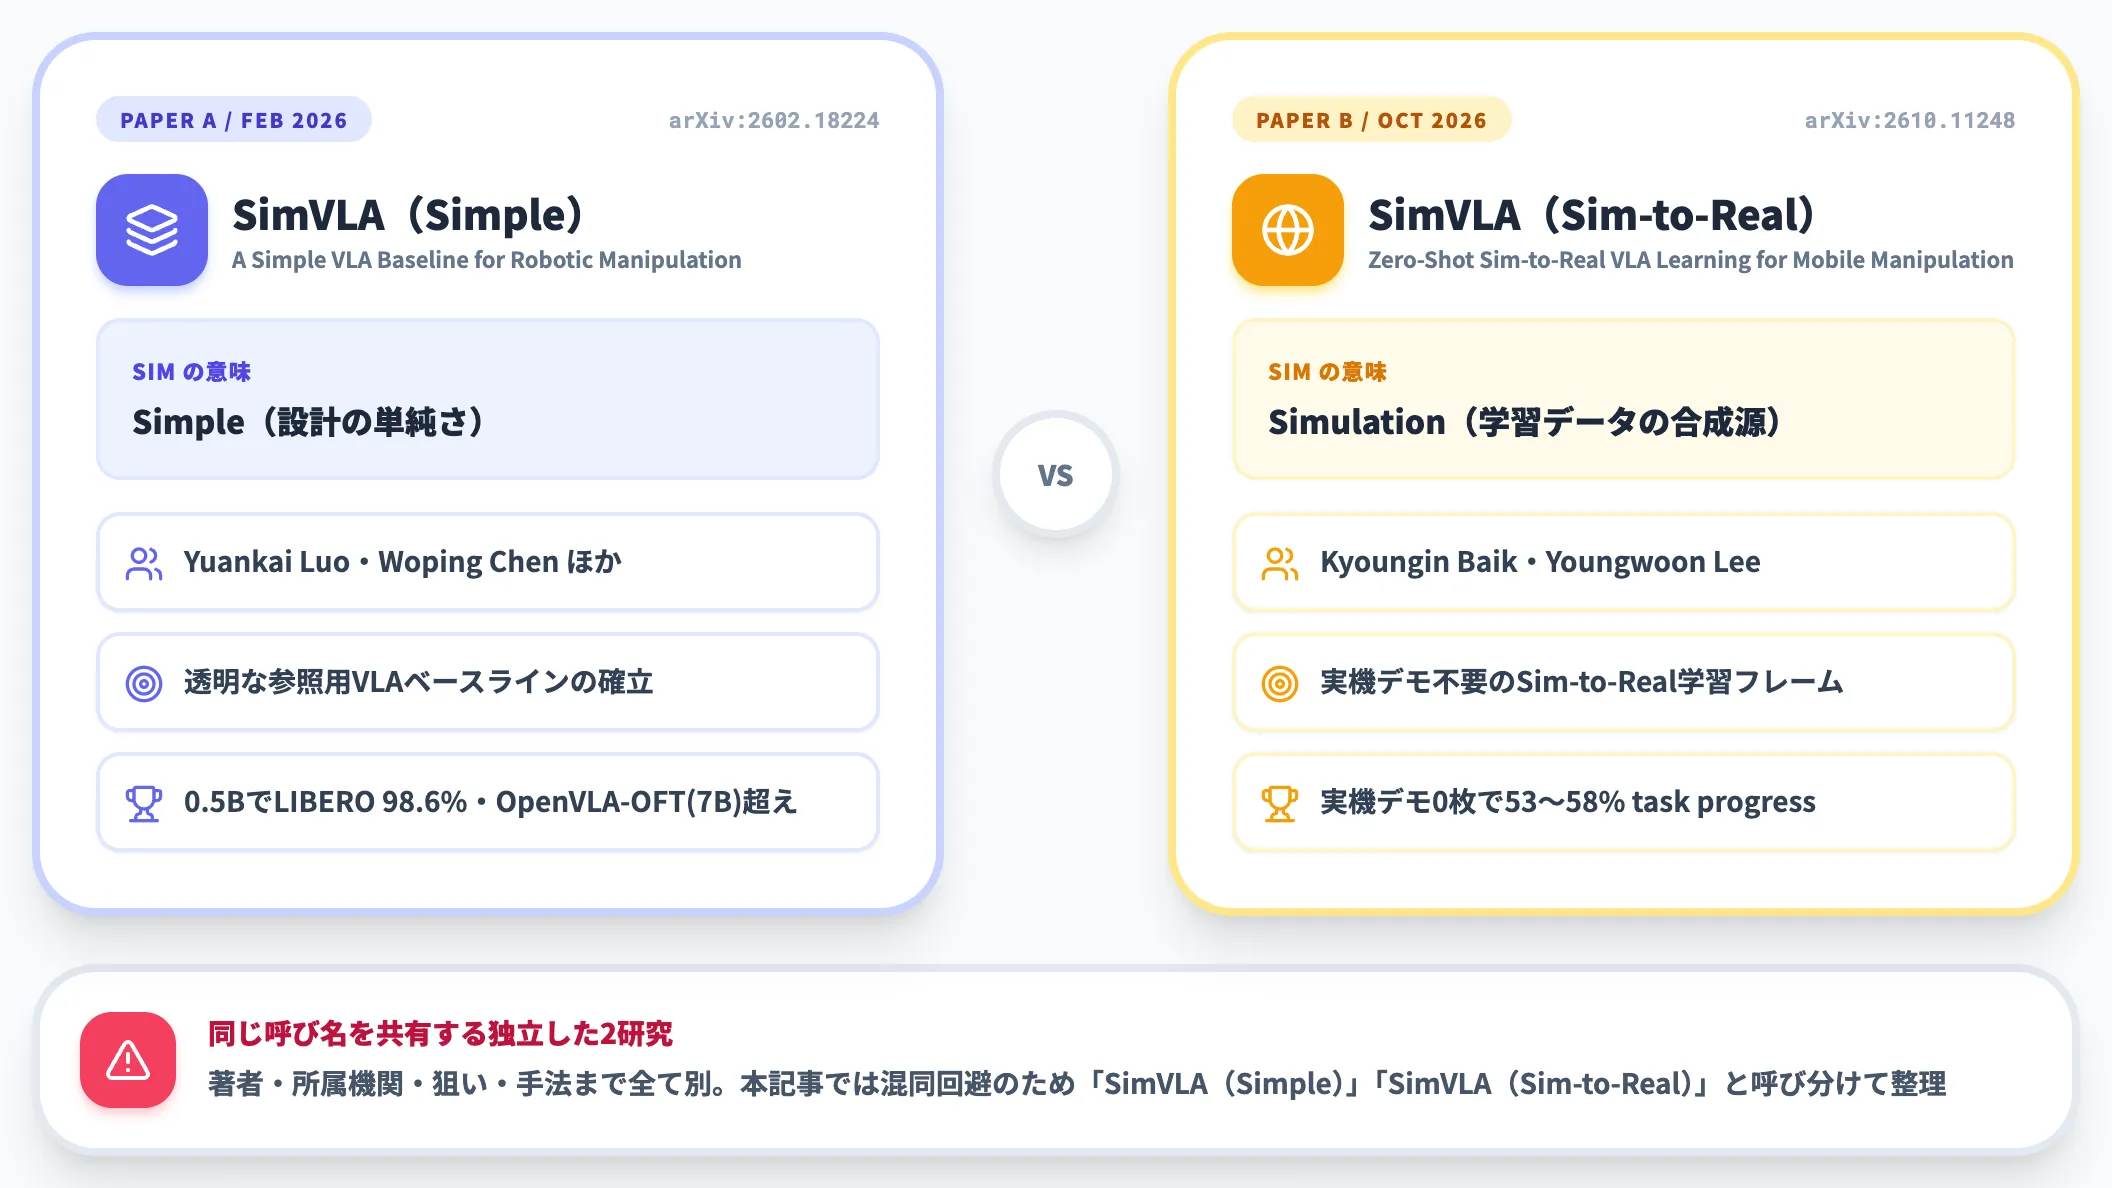
SimVLAは、ロボット操作向けのVLA(Vision-Language-Action)モデルを扱う研究テーマの名前で、arXivには同じタイトルの論文が2本存在します。
一方はYuankai Luoらが2026年2月に公開した「A Simple VLA Baseline for Robotic Manipulation」で、「Sim」は「Simple」の略です。
もう一方はKyoungin Baikらが2026年10月に公開した「Zero-Shot Sim-to-Real VLA Learning for Mobile Manipulation」で、こちらの「Sim」は「Simulation」の略です。
両者は著者も所属機関も狙いも手法もまったく異なる独立した研究で、SimVLAという呼び名を共有しているだけです。本記事では混同を避けるため、前者を「SimVLA(Simple)」、後者を「SimVLA(Sim-to-Real)」と呼び分けながら整理します。
2つのSimVLAの違いを対照表で読み分ける
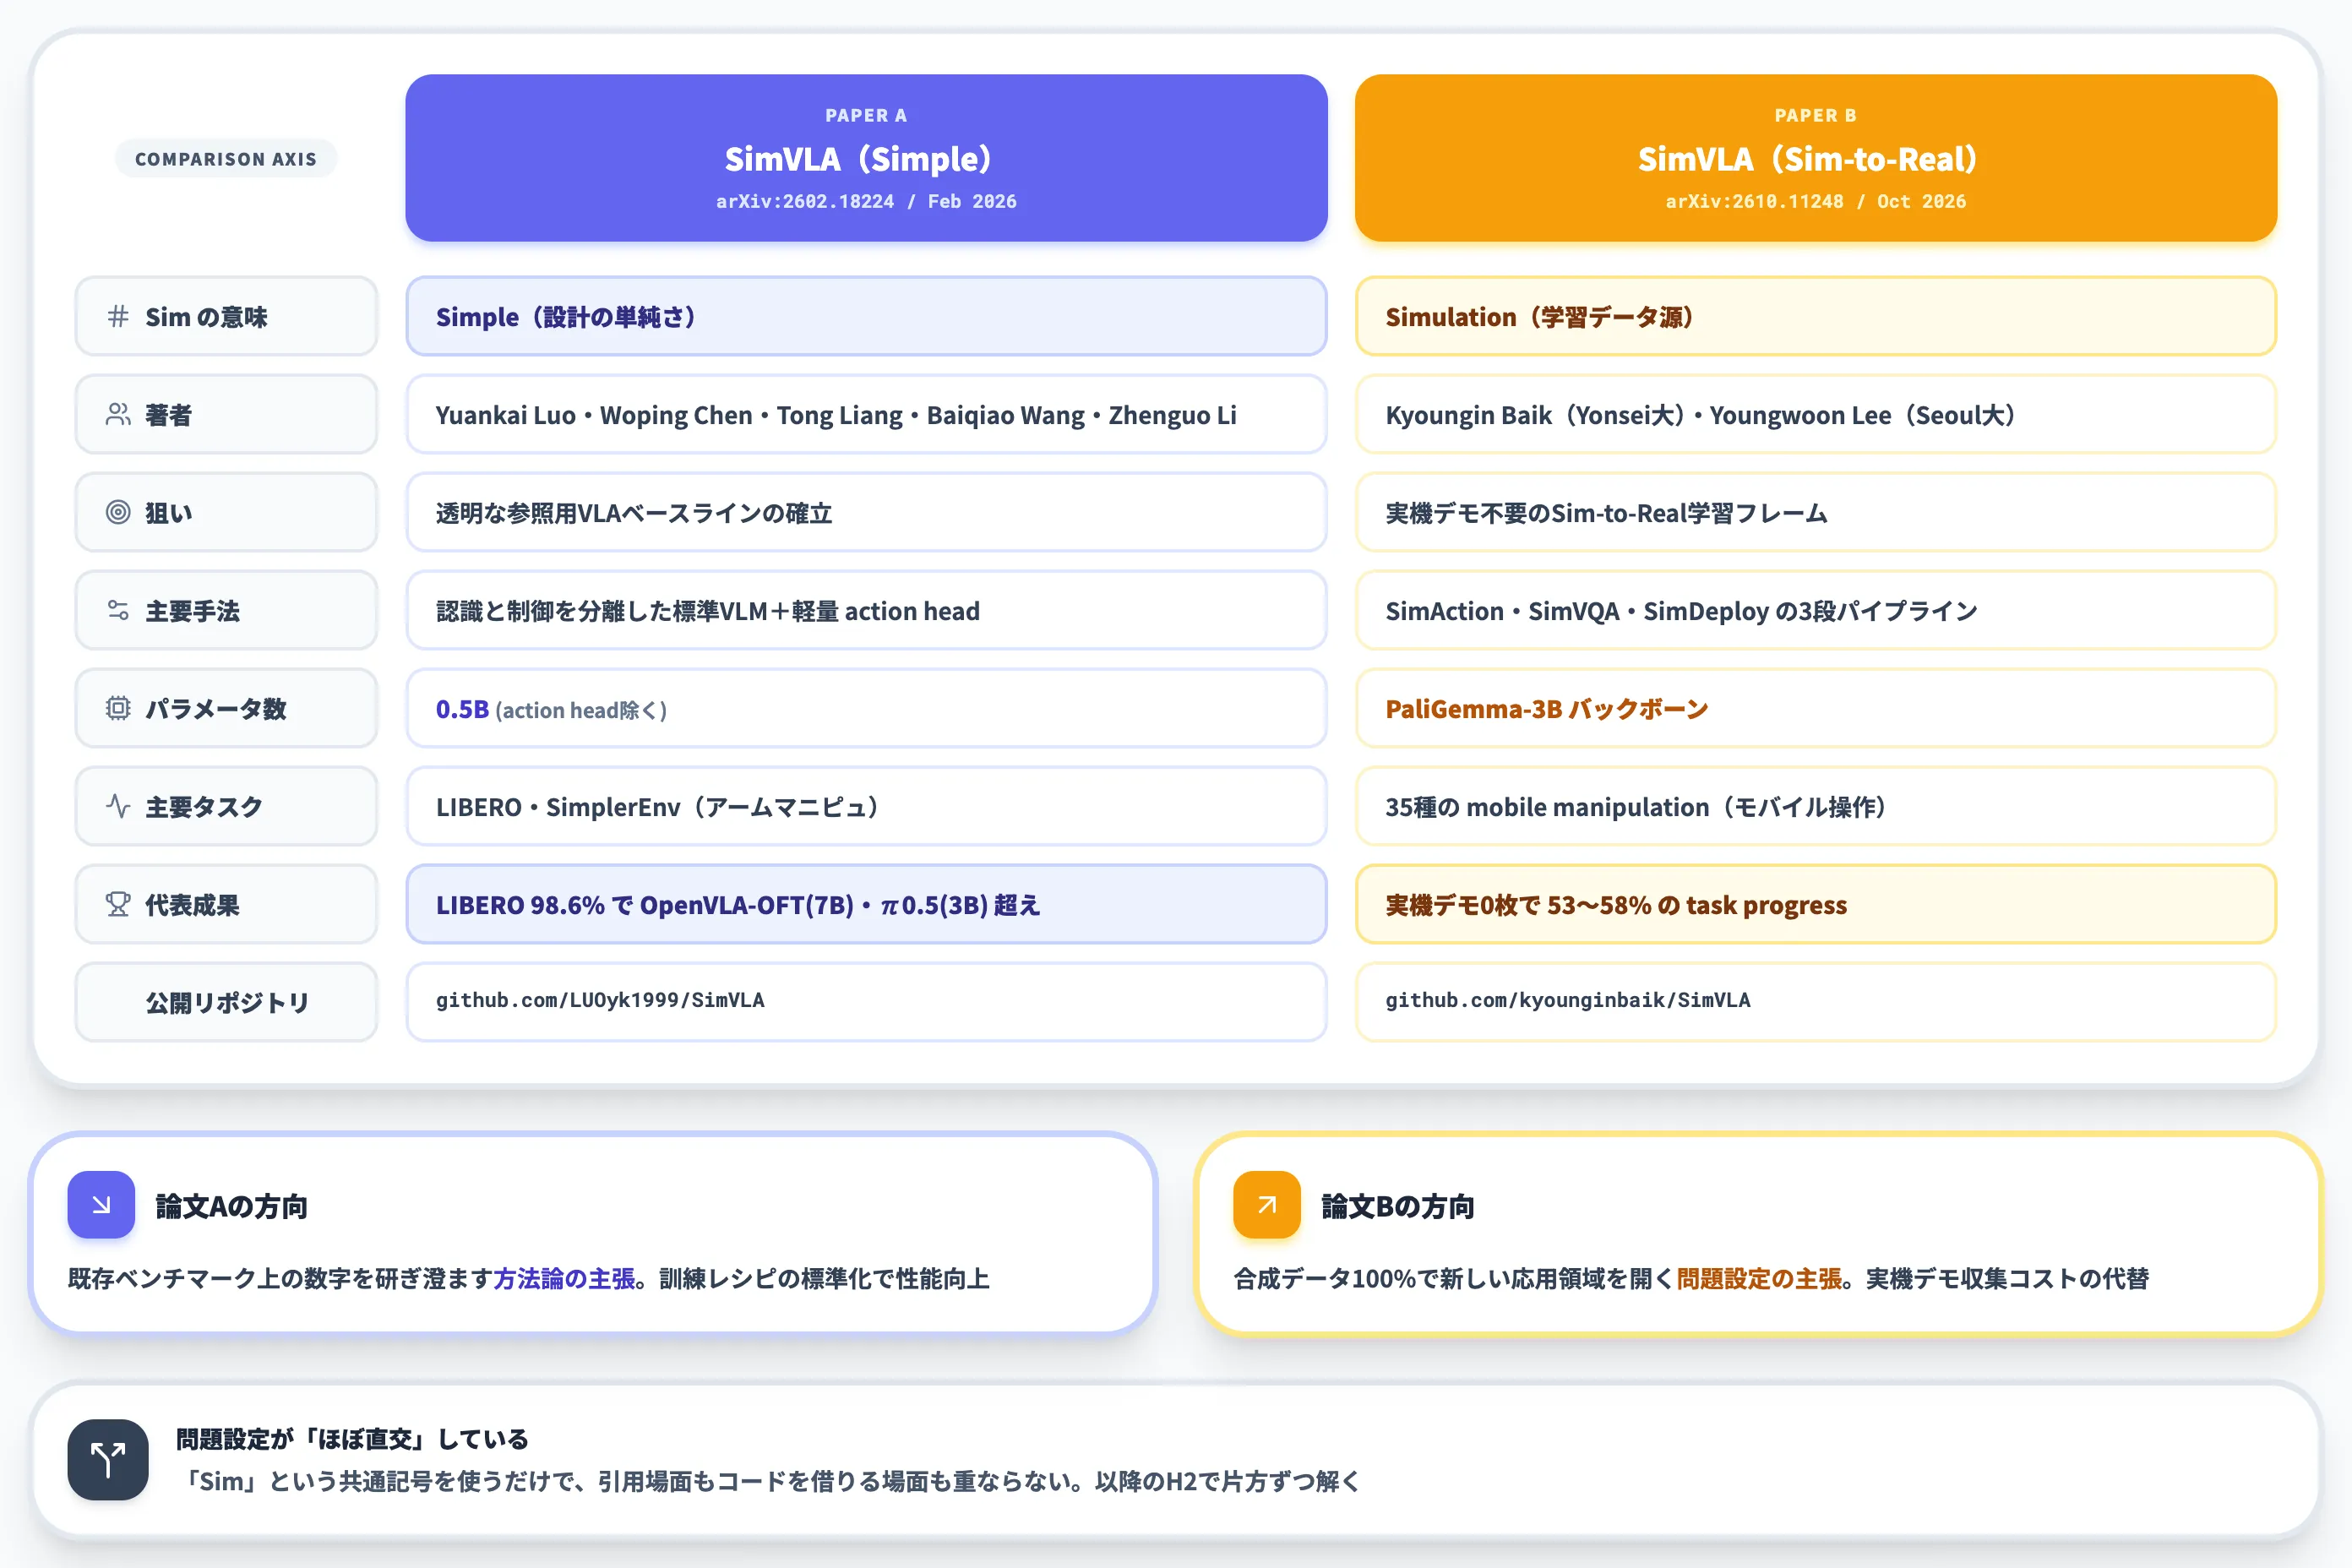
まず両論文の違いを一枚絵で押さえておくと、以降の設計・実力の読解が楽になります。以下の表は著者・公開時期・「Sim」の意味・狙い・主要手法・成果を並べたものです。
| 比較軸 | SimVLA(Simple VLA Baseline) | SimVLA(Zero-Shot Sim-to-Real) |
|---|---|---|
| arXiv ID | 2602.18224 | 2610.11248 |
| 公開日 | 2026年2月20日 | 2026年10月8日 |
| 著者 | Yuankai Luo・Woping Chen・Tong Liang・Baiqiao Wang・Zhenguo Li | Kyoungin Baik(Yonsei大)・Youngwoon Lee(Seoul大) |
| 「Sim」の意味 | Simple(設計の単純さ) | Simulation(学習データの合成源) |
| 狙い | 透明な参照用VLAベースラインの確立 | 実機デモ不要のSim-to-Real学習フレーム |
| 主要手法 | 認識と制御を分離した標準VLM+軽量action head | 合成データSimAction・SimVQA・SimDeployの3段パイプライン |
| パラメータ数 | 0.5B(action headを除く) | PaliGemma-3Bをバックボーン |
| 主要タスク | LIBERO・SimplerEnv(アームマニピュ) | 35の mobile manipulation(モバイル操作) |
| 代表成果 | LIBERO 98.6%でOpenVLA-OFT(7B)・π0.5(3B)超え | 実機デモ0枚で53〜58%の task progress |
| 公開リポジトリ | github.com/LUOyk1999/SimVLA | github.com/kyounginbaik/SimVLA |
対照表から読み取れるのは、両者が「Sim」という共通記号を使いながら、問題設定の方向がほぼ直交しているという点です。
論文Aは「VLAの性能向上はアーキテクチャの複雑化ではなく訓練レシピの標準化で得られる」という方法論の主張で、既存ベンチマーク上の数字を研ぎ澄ます方向です。
論文Bは「実機データ収集コストが大きいモバイルマニピュを合成データのみで解けるか」という問題設定の主張で、VLAを使って新しい応用領域を開く方向です。
同名ではあるものの、引用する場面もコードを借りる場面も重ならないので、以降のH2で片方ずつ中身を解きます。
SimVLA(Simple VLA Baseline)の設計と実力
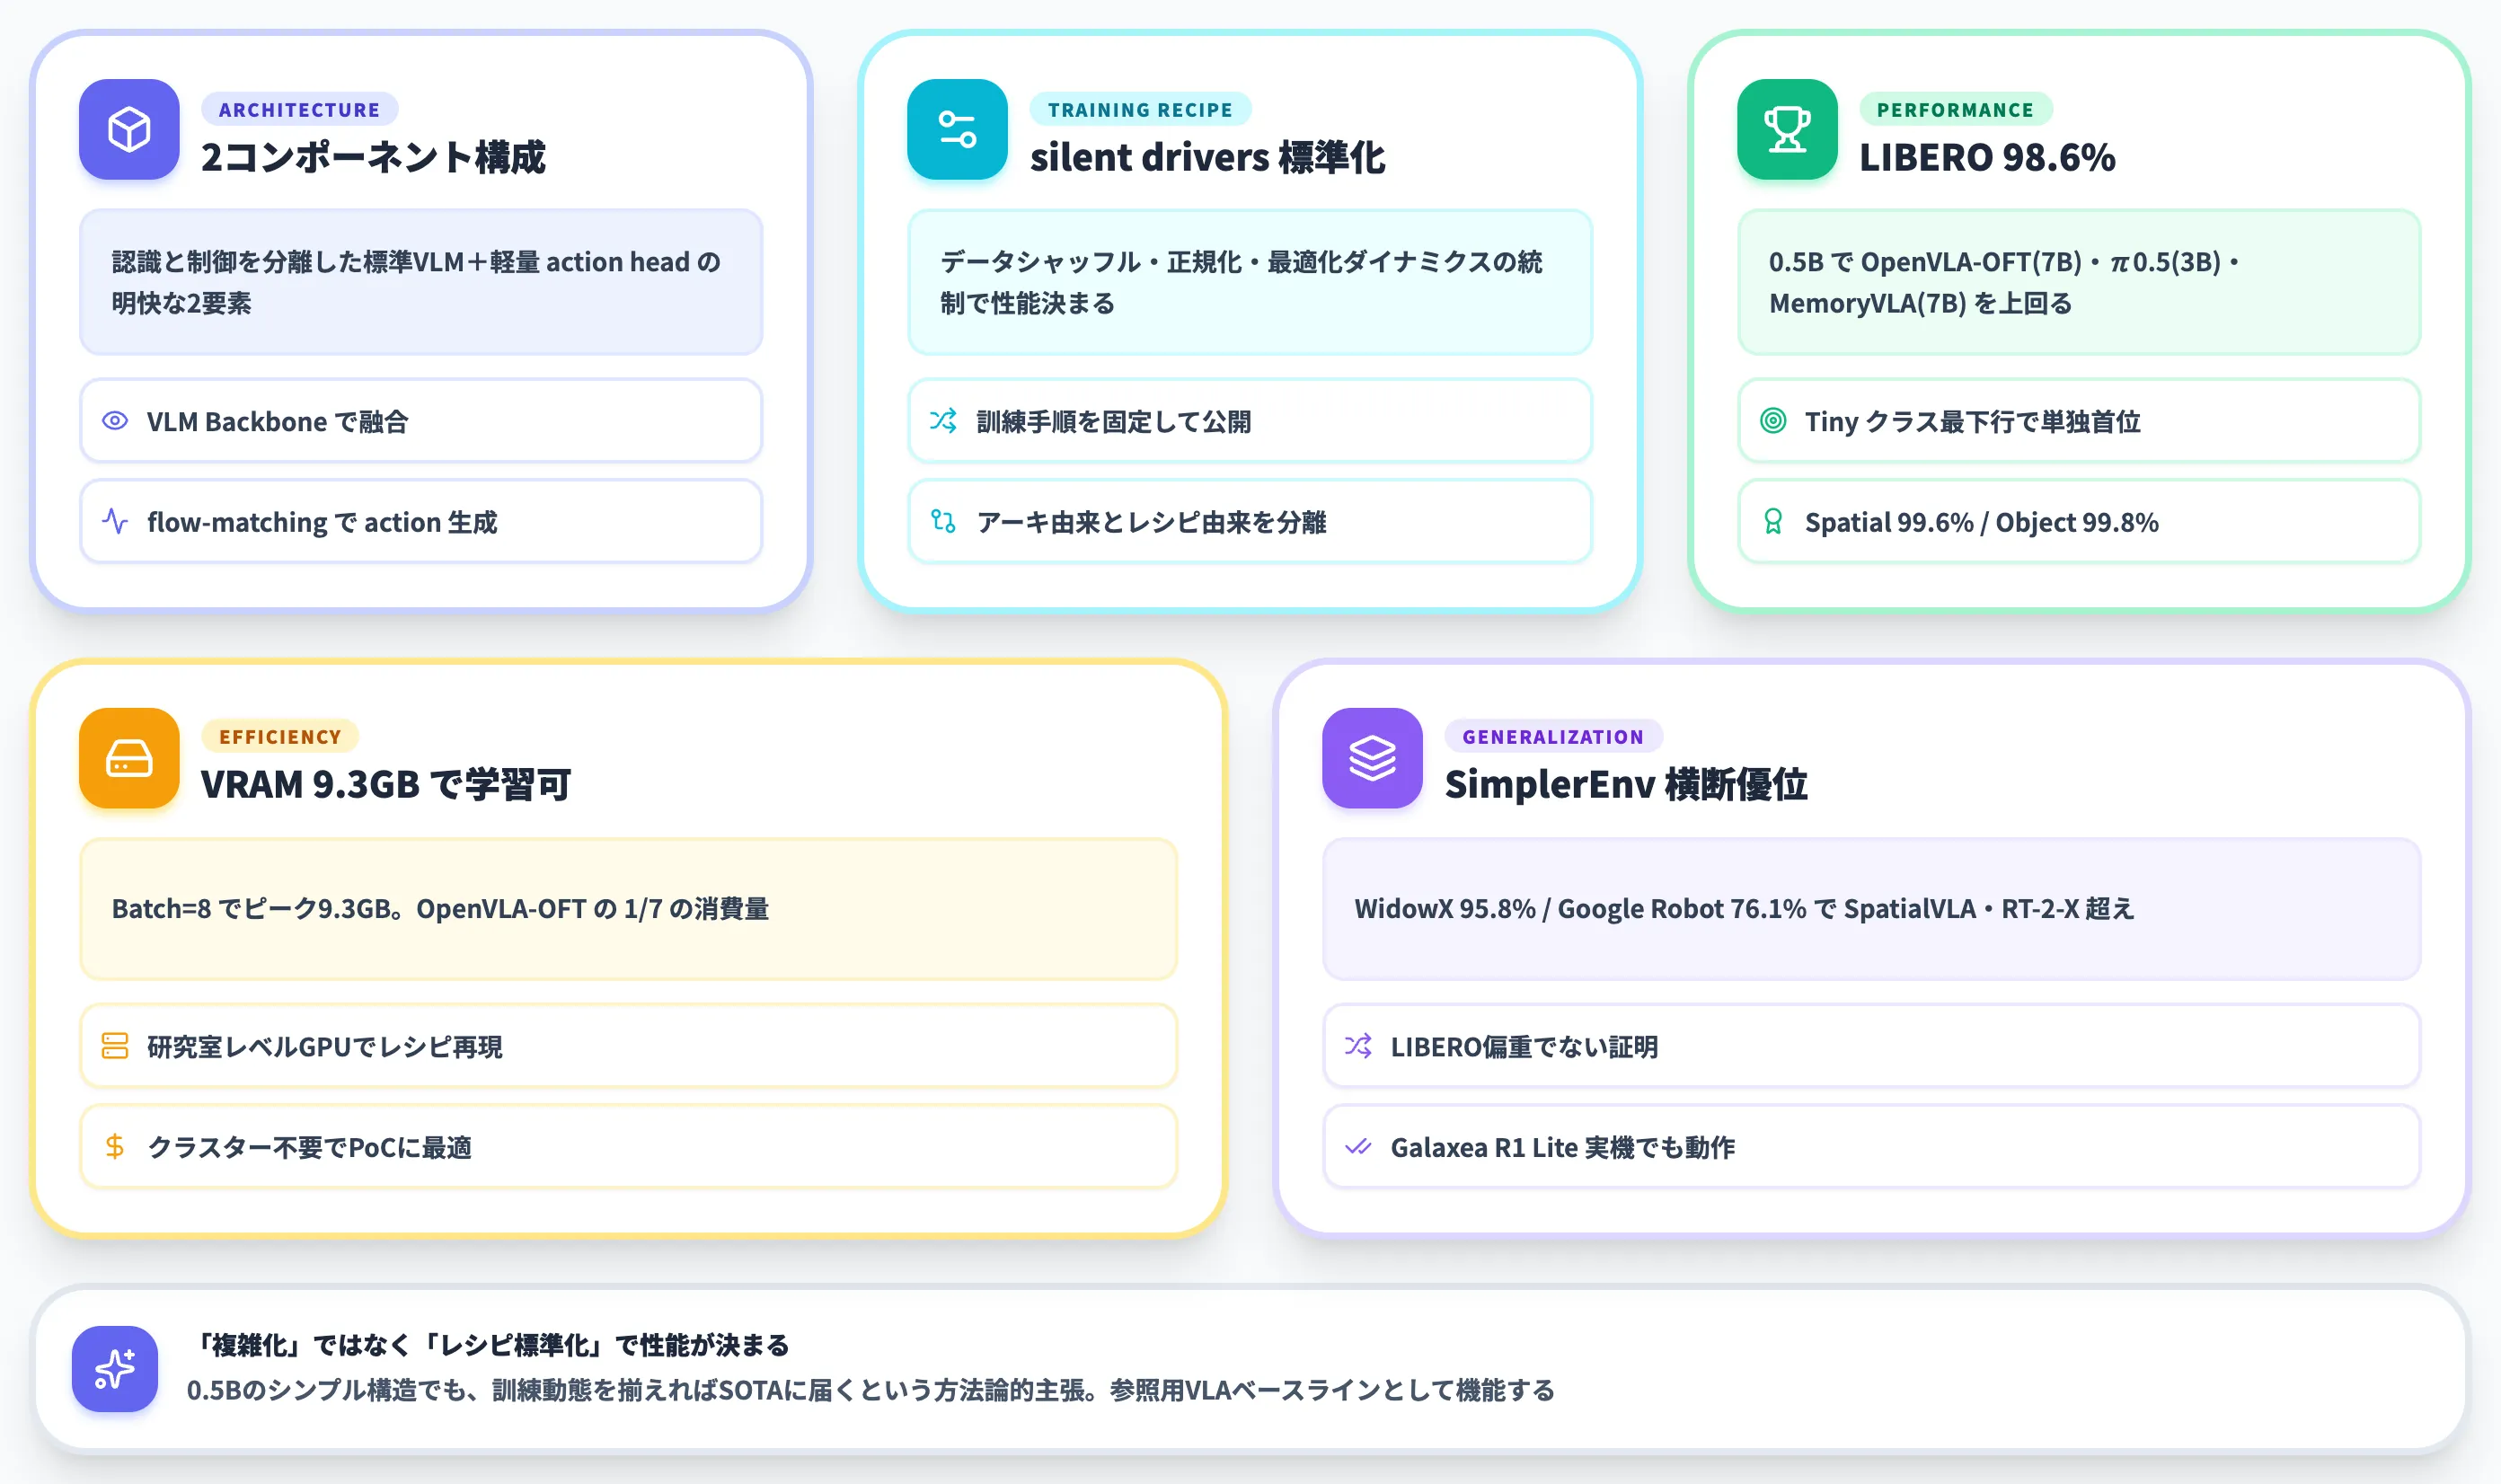
論文Aの核は、Frontier Roboticsが公開した公式プロジェクトページの表現を借りれば「アーキテクチャの複雑さではなく、見落とされがちな訓練動態の標準化で性能が決まる」という主張です。
同論文はこれを示すために、意図的にシンプルな構造だけで既存の多パラメータVLAを上回って見せています。
認識と制御を分離した2コンポーネント構成
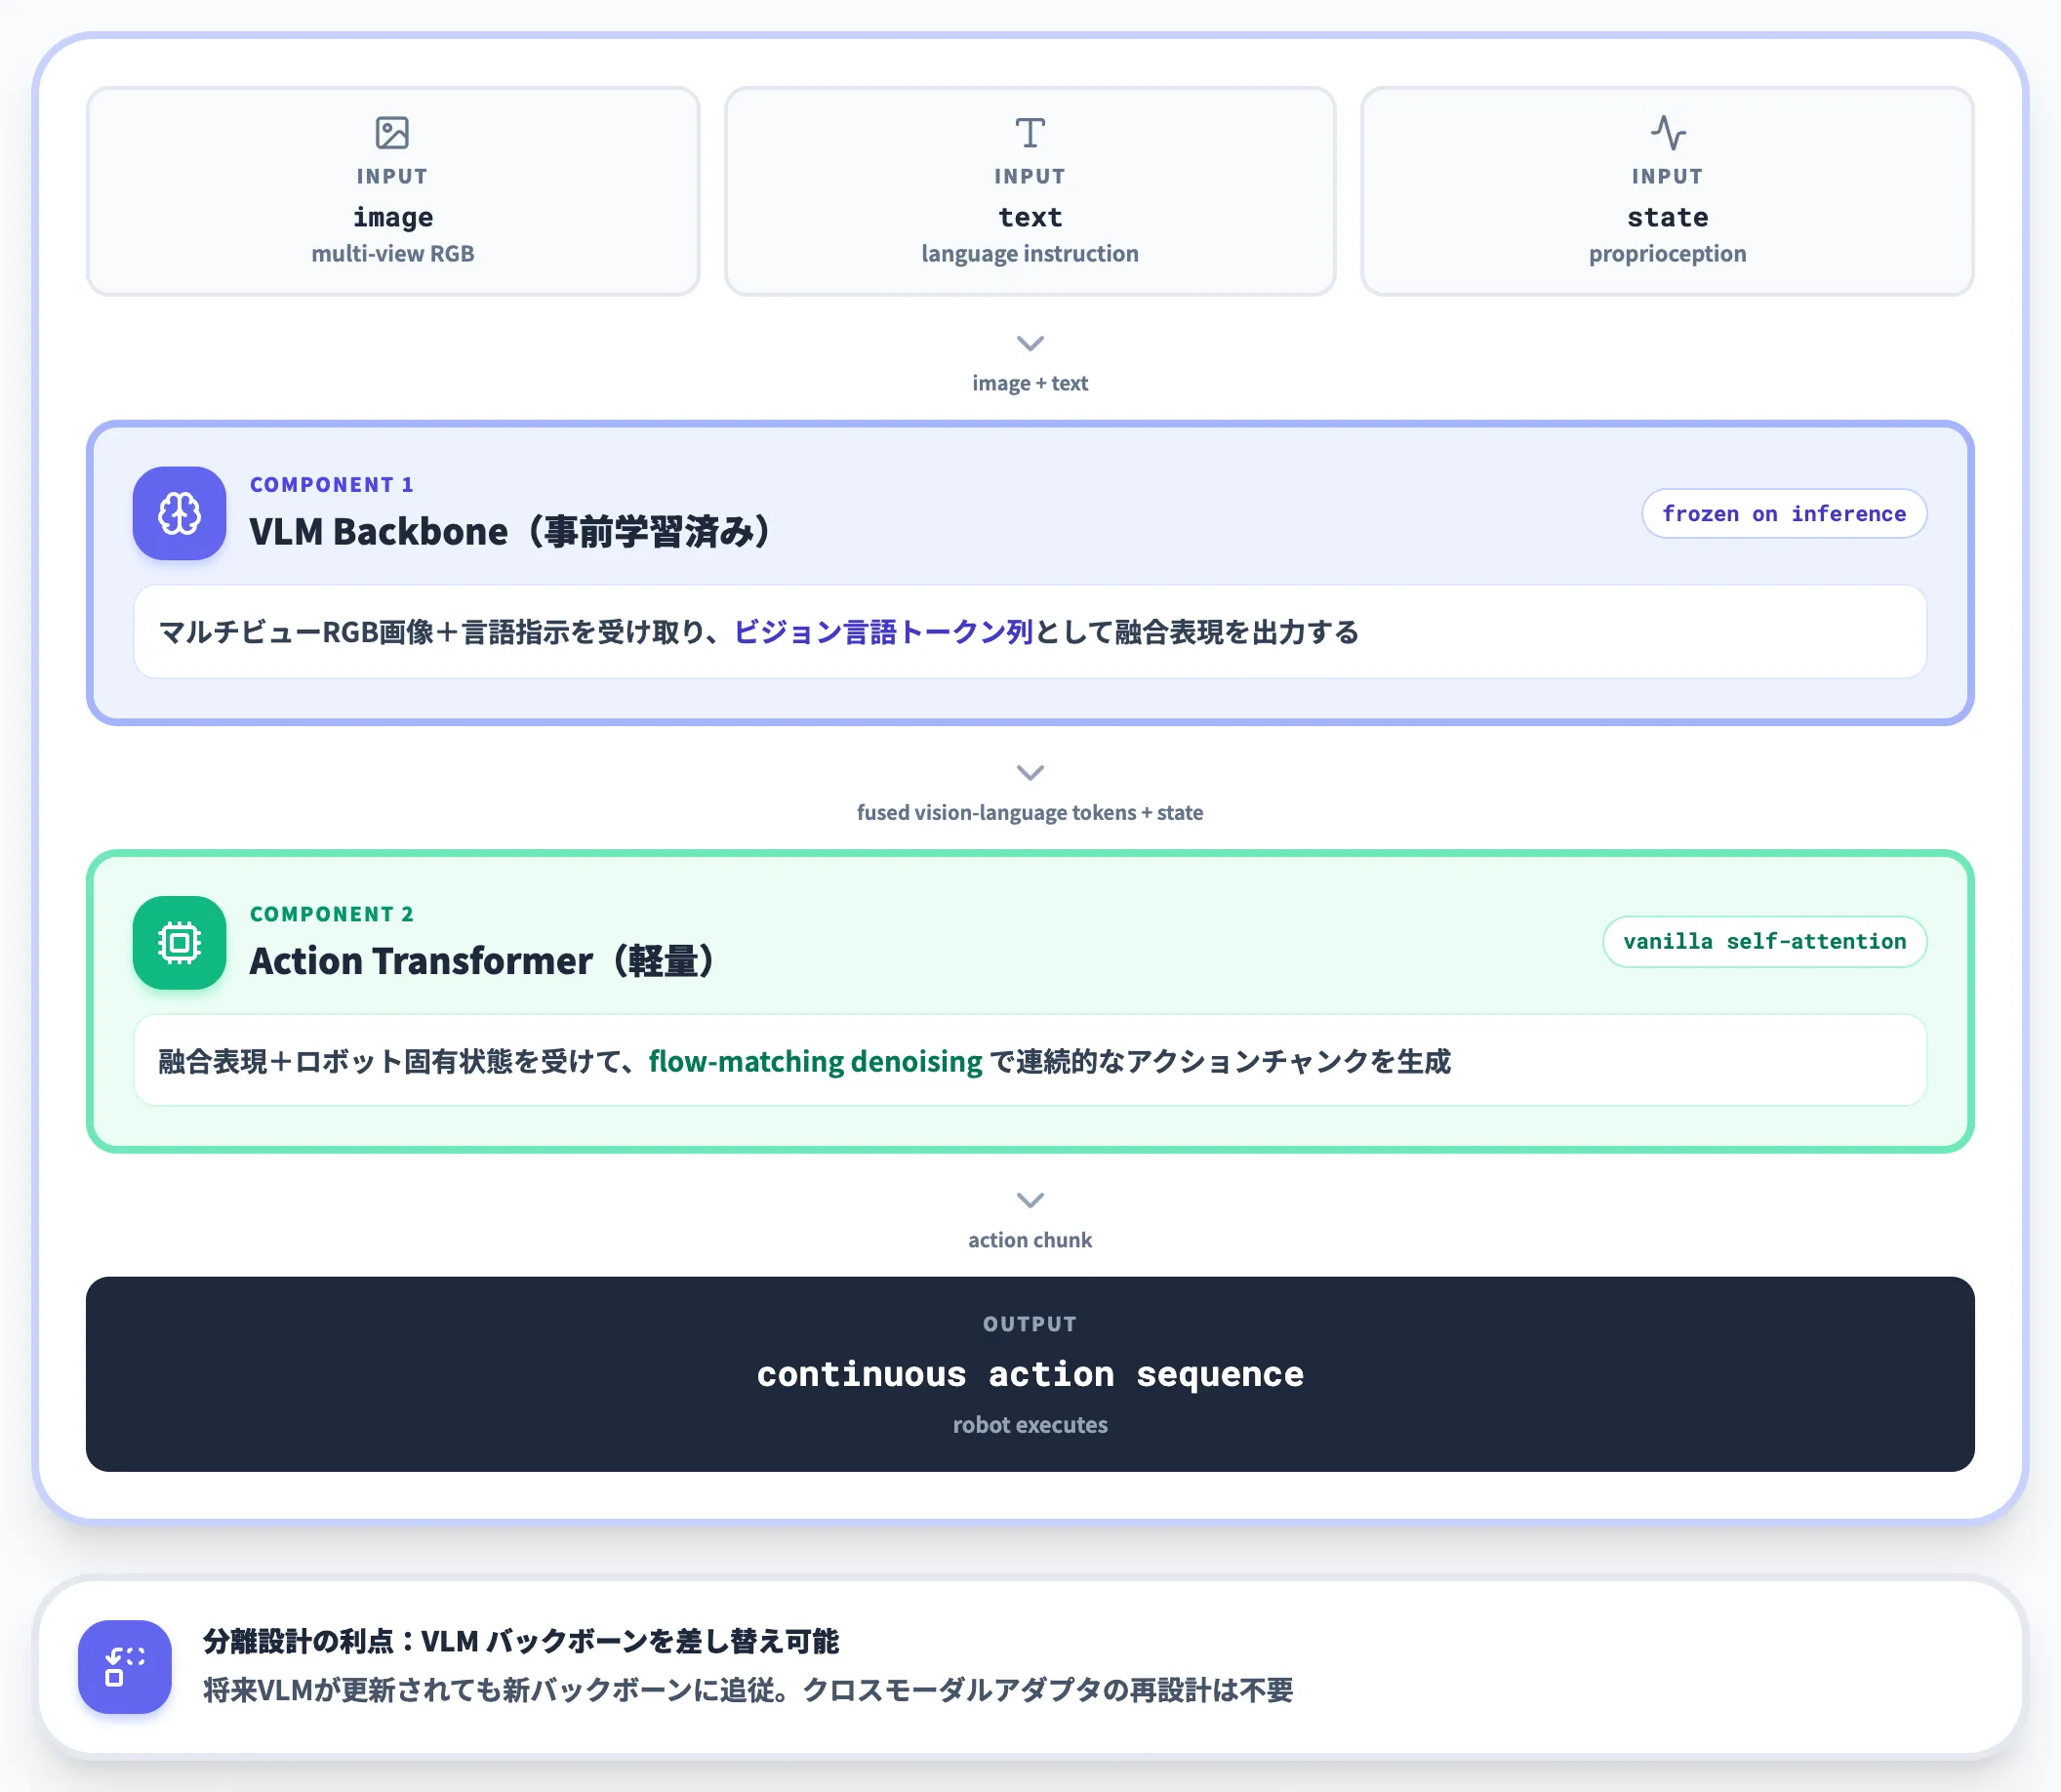
SimVLA(Simple)のアーキテクチャは、事前学習済みのVLMバックボーンと、軽量なaction transformerの2要素で構成されます。
VLMはマルチビューRGB画像と言語指示を受け取り、ビジョン言語トークン列として融合表現を出力します。
action transformerはその融合表現にロボットの固有状態(proprioception)を加えて受け取り、flow-matching denoisingで連続的なアクションチャンクを生成します。
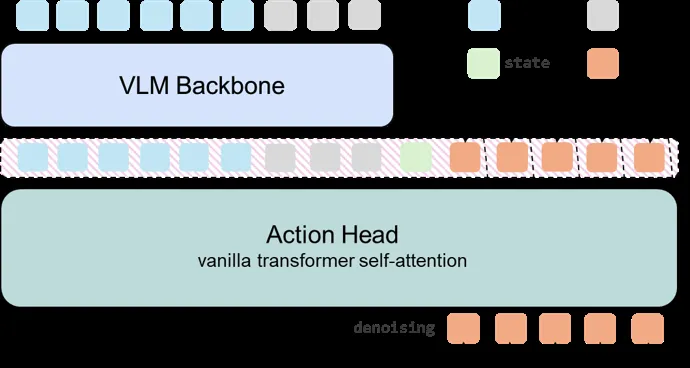
VLM BackboneとAction Head(vanilla transformer self-attention)の2段構成(出典:SimVLA公式プロジェクトページ)
図の上段がVLM Backbone、下段がAction Headで、image / text / state の各トークンを受けて action トークンを denoising で生成する流れが示されています。
この分離設計の利点は、将来VLMが更新されたときに新しいバックボーンを差し替えるだけで追従できる点にあります。公式プロジェクトページは「クロスモーダルアダプタを再設計する必要がない」と説明しています。
「silent drivers of performance」の標準化
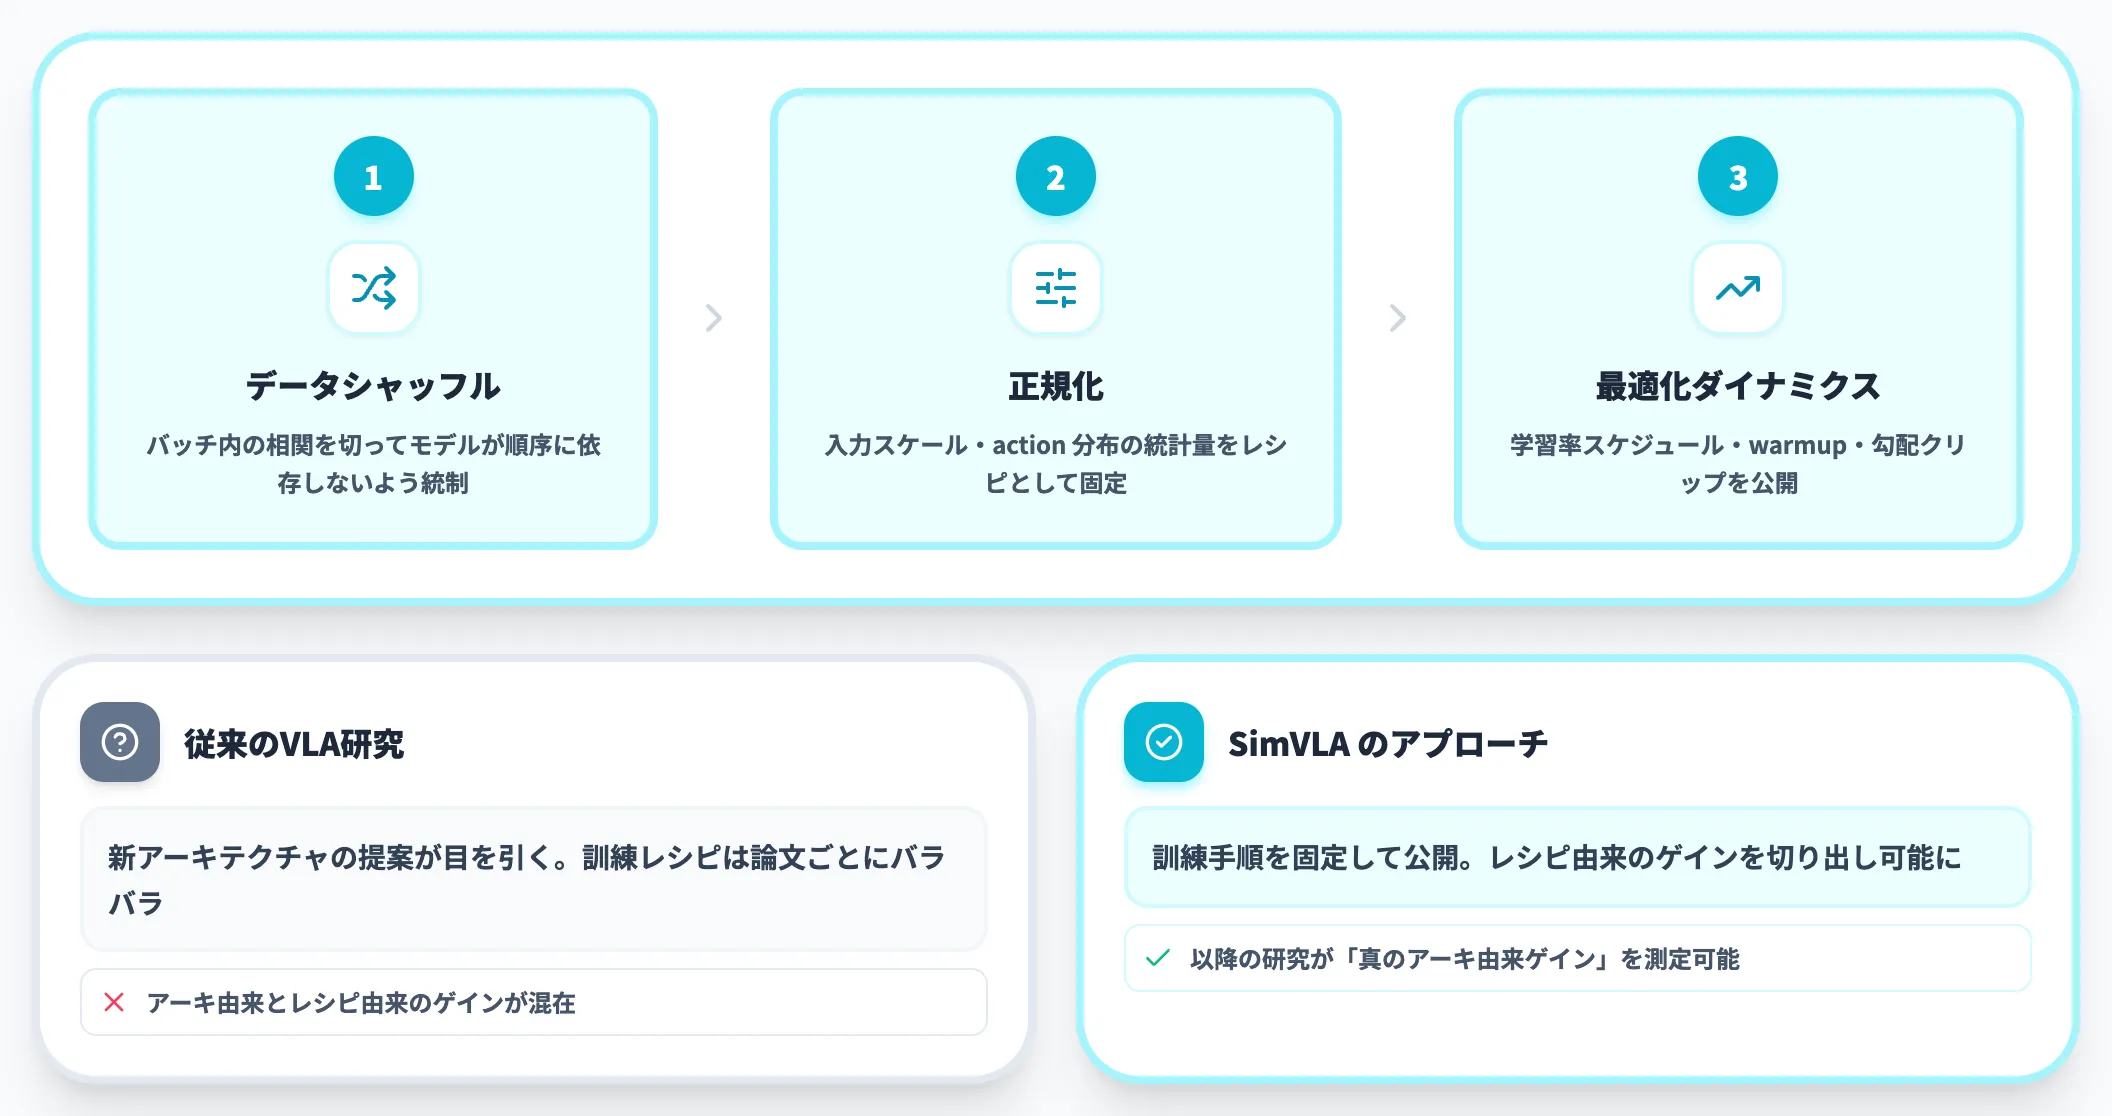
著者が強調するのは、データシャッフル・正規化・最適化ダイナミクスといった「サイレントドライバー」の統制です。
VLA研究では新アーキテクチャの提案が目を引く一方、訓練レシピの違いで数ポイント動くことが知られています。SimVLA(Simple)は訓練手順を固定して公開することで、以降の研究が「アーキ由来のゲイン」と「レシピ由来のゲイン」を切り分けやすくすることを狙っています。
LIBERO 98.6%・OpenVLA-OFT(7B)・π0.5(3B)超え
LIBERO 4スイート平均で**98.6%**という数字は、2026年時点で主要なVLAを上回る水準です。以下の表は公式論文Table 2から主要ベースラインを抜粋したものです。
| モデル | パラメータ | LIBERO平均 |
|---|---|---|
| SimVLA(Simple) | 0.5B | 98.6% |
| X-VLA | 0.9B | 98.1% |
| VLA-Adapter | 0.5B | 97.3% |
| OpenVLA-OFT | 7B | 97.1% |
| π0.5 | 3B | 96.9% |
| MemoryVLA | 7B | 96.7% |
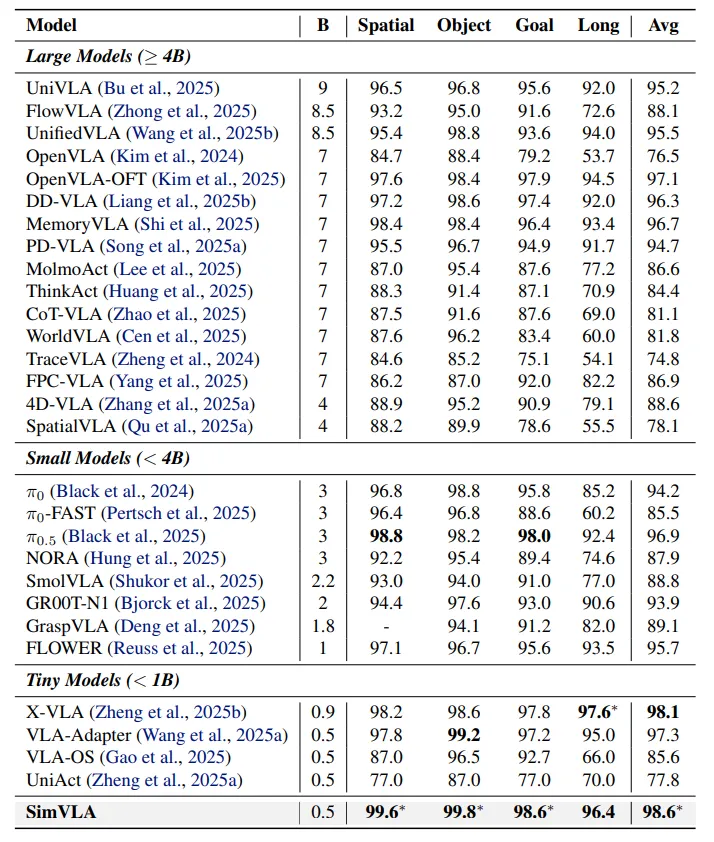
LIBERO 4スイートでのVLA比較。Large / Small / Tiny の3カテゴリに分かれ、最下行のSimVLAが Spatial・Object・Goal と平均で最高値(Long は X-VLA が首位)(出典:SimVLA公式プロジェクトページ)
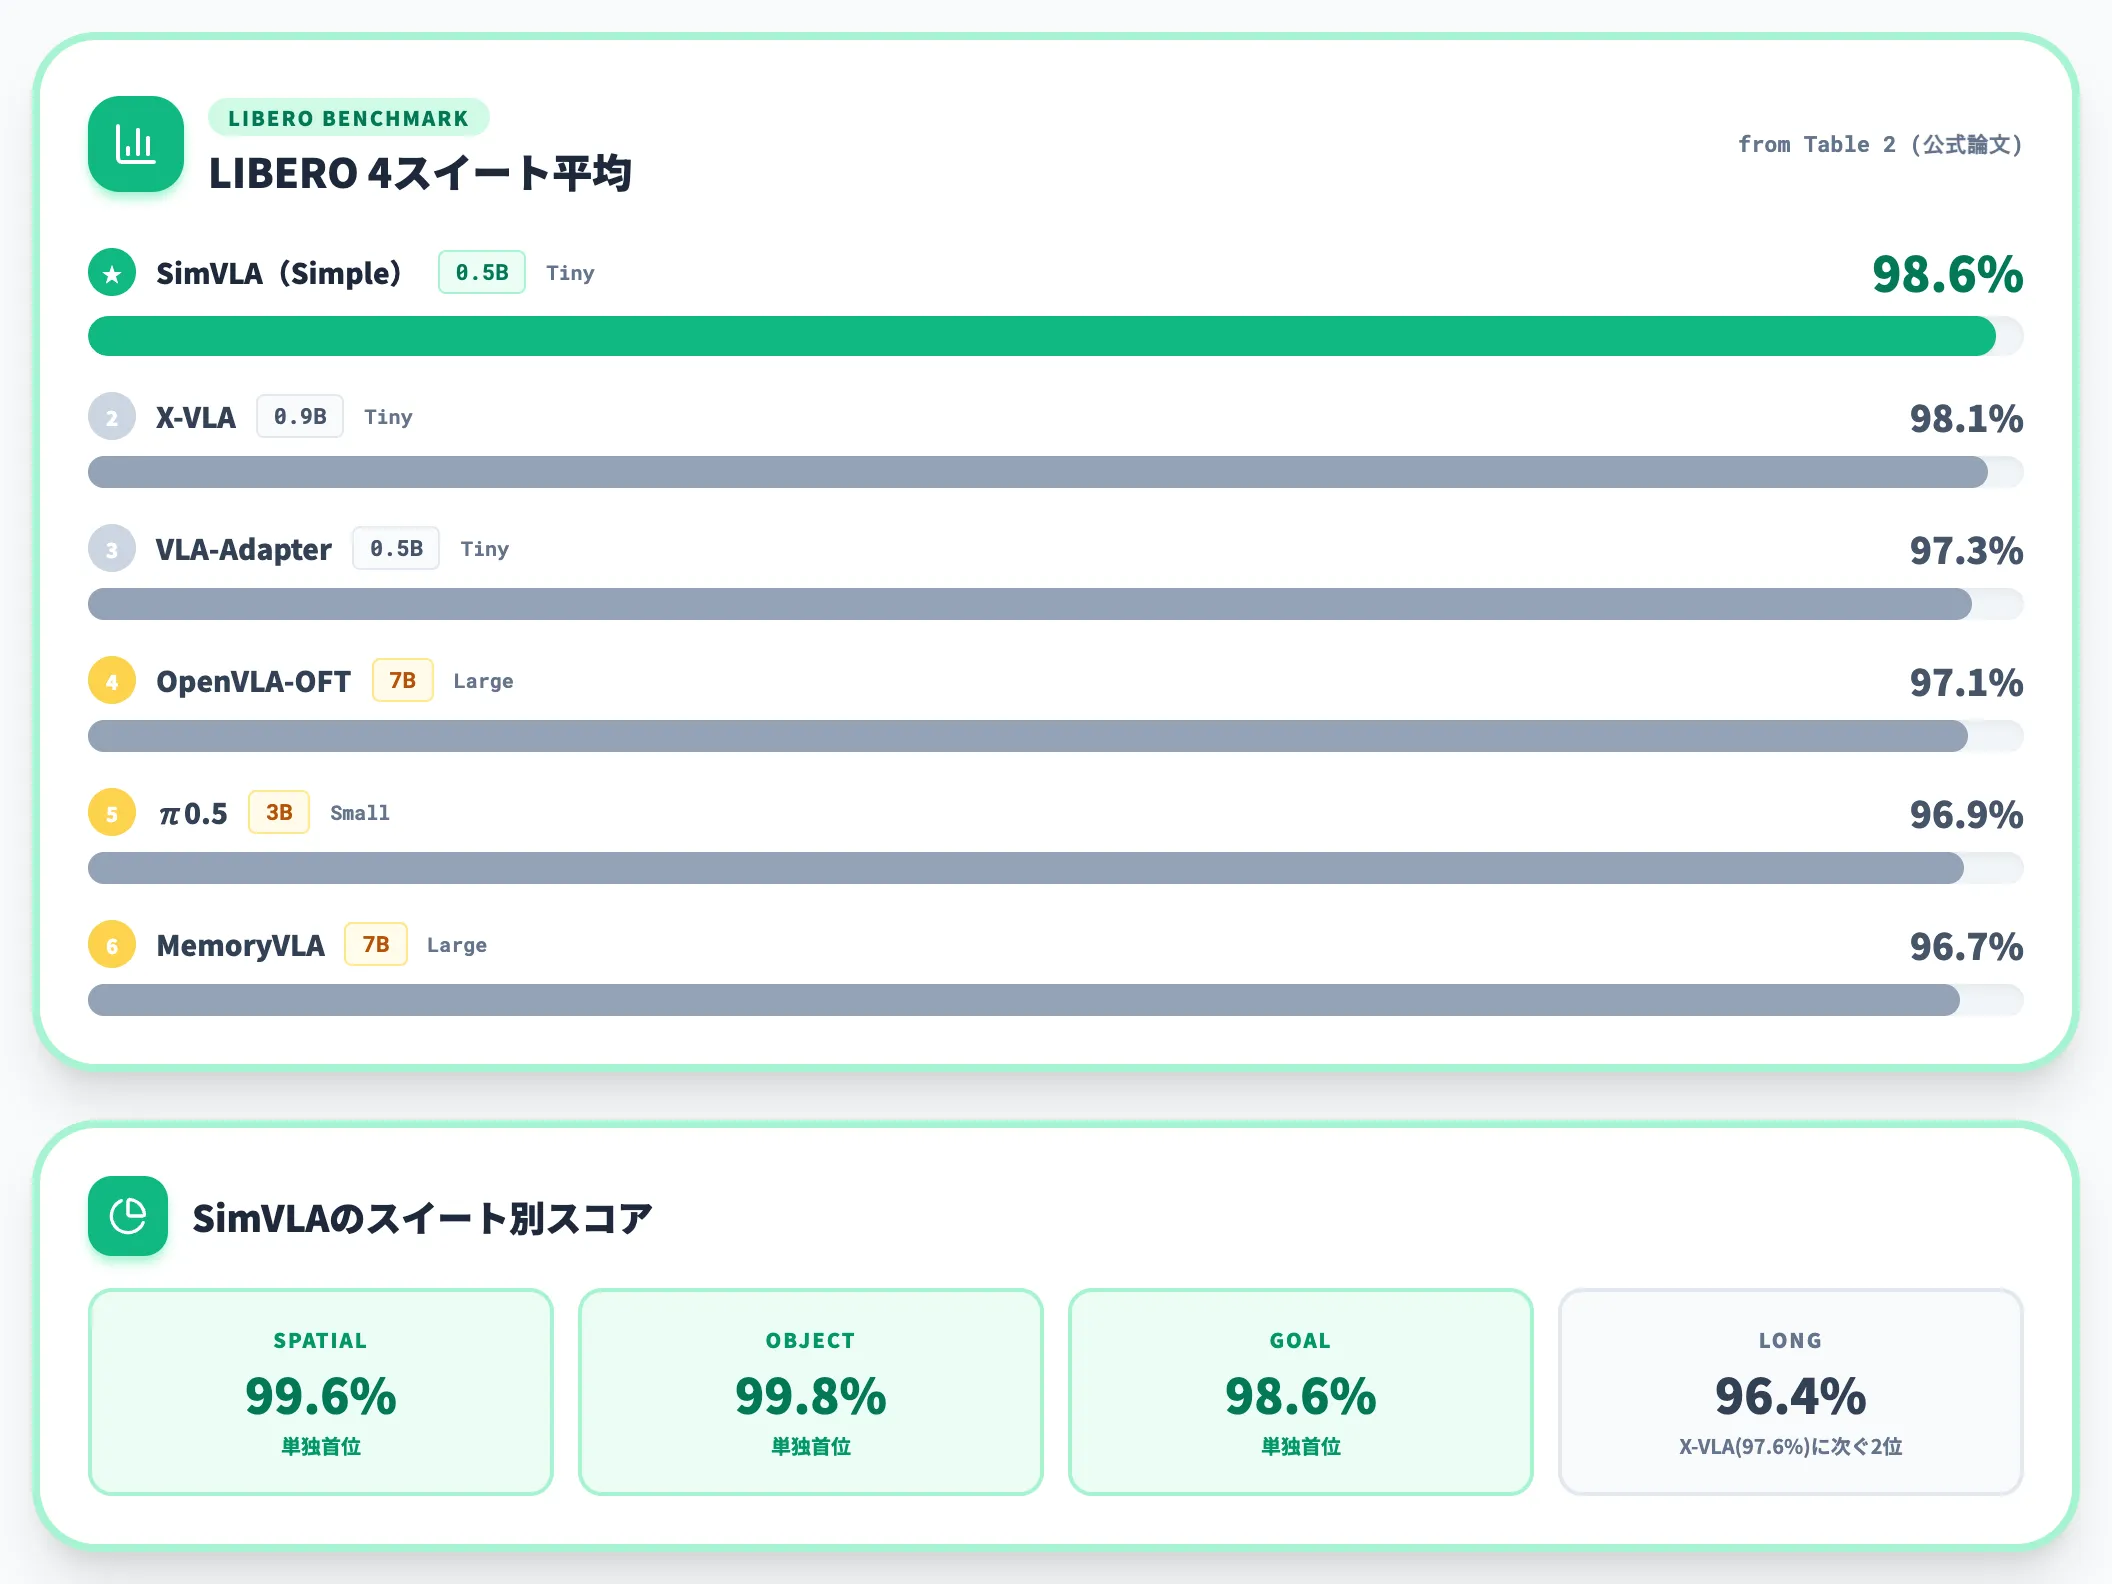
公式Table 2ではモデルを Large(≥4B)・Small(<4B)・Tiny(<1B)の3クラスに分け、Tinyクラスの最下行に位置するSimVLAが Spatial・Object・Goal と平均で単独首位になっています。Long スイートのみ X-VLA(97.6%)が SimVLA(96.4%)を上回ります。
スイート別では、Spatial 99.6%・Object 99.8%・Goal 98.6%・Long 96.4%で、長期タスクを除くほぼ全スイートで99%前後に達しています。
VRAM 9.3GBで学習できる省リソース性
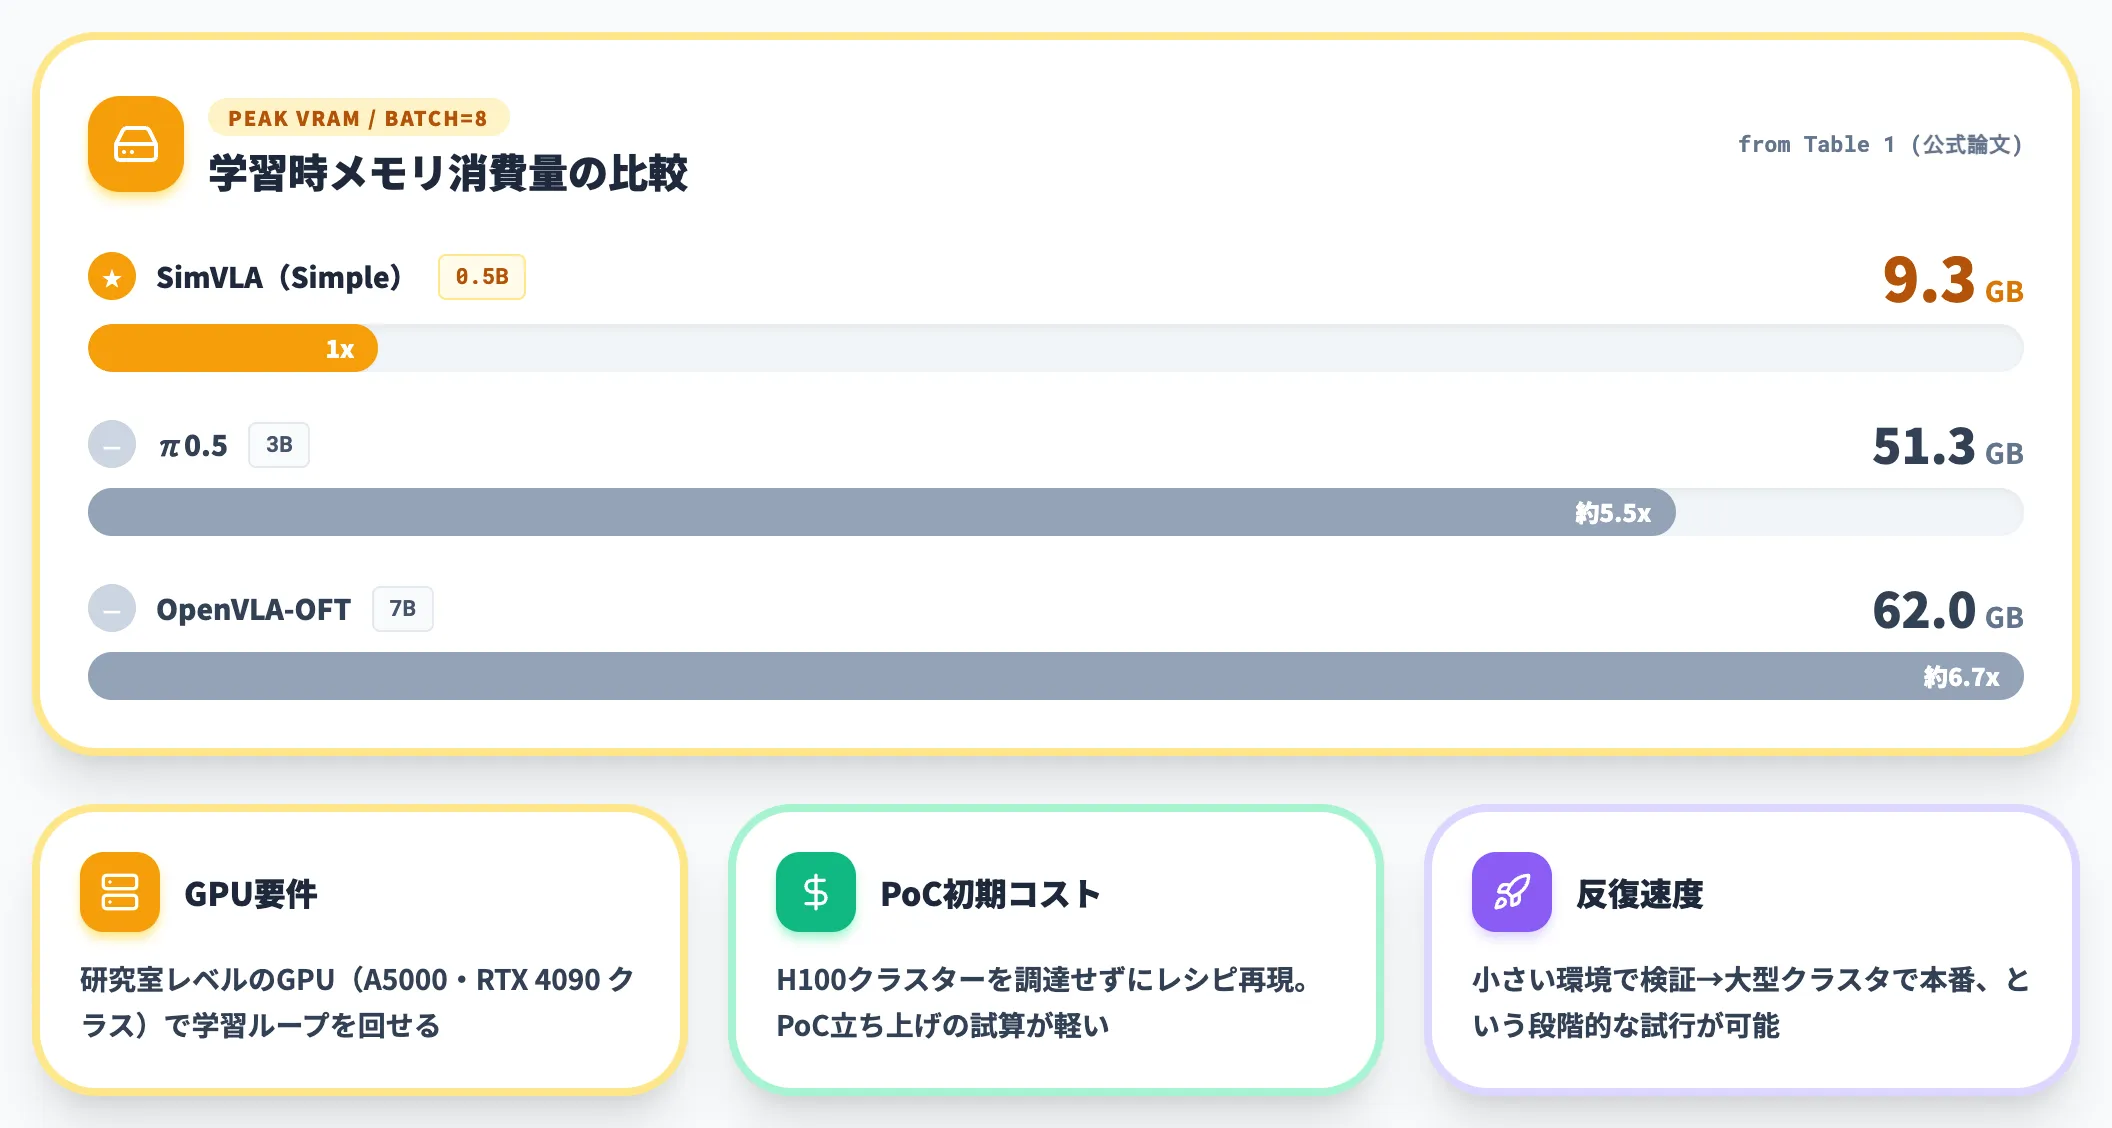
論文Aは学習時のメモリ要件の低さも売りにしており、SimVLA(Simple)はBatch=8で学習時ピーク9.3GBのVRAMに収まります。同じ条件でのOpenVLA-OFTの62.0GB・π0.5の51.3GBと比べて5〜7分の1の消費量です(Table 1)。
学習に大型GPUクラスターを用意しなくても、研究室レベルのGPU環境でレシピを回し直せる点が、ベースラインとして使う上での大きな利点になります。
SimplerEnvでも軽量優位を維持
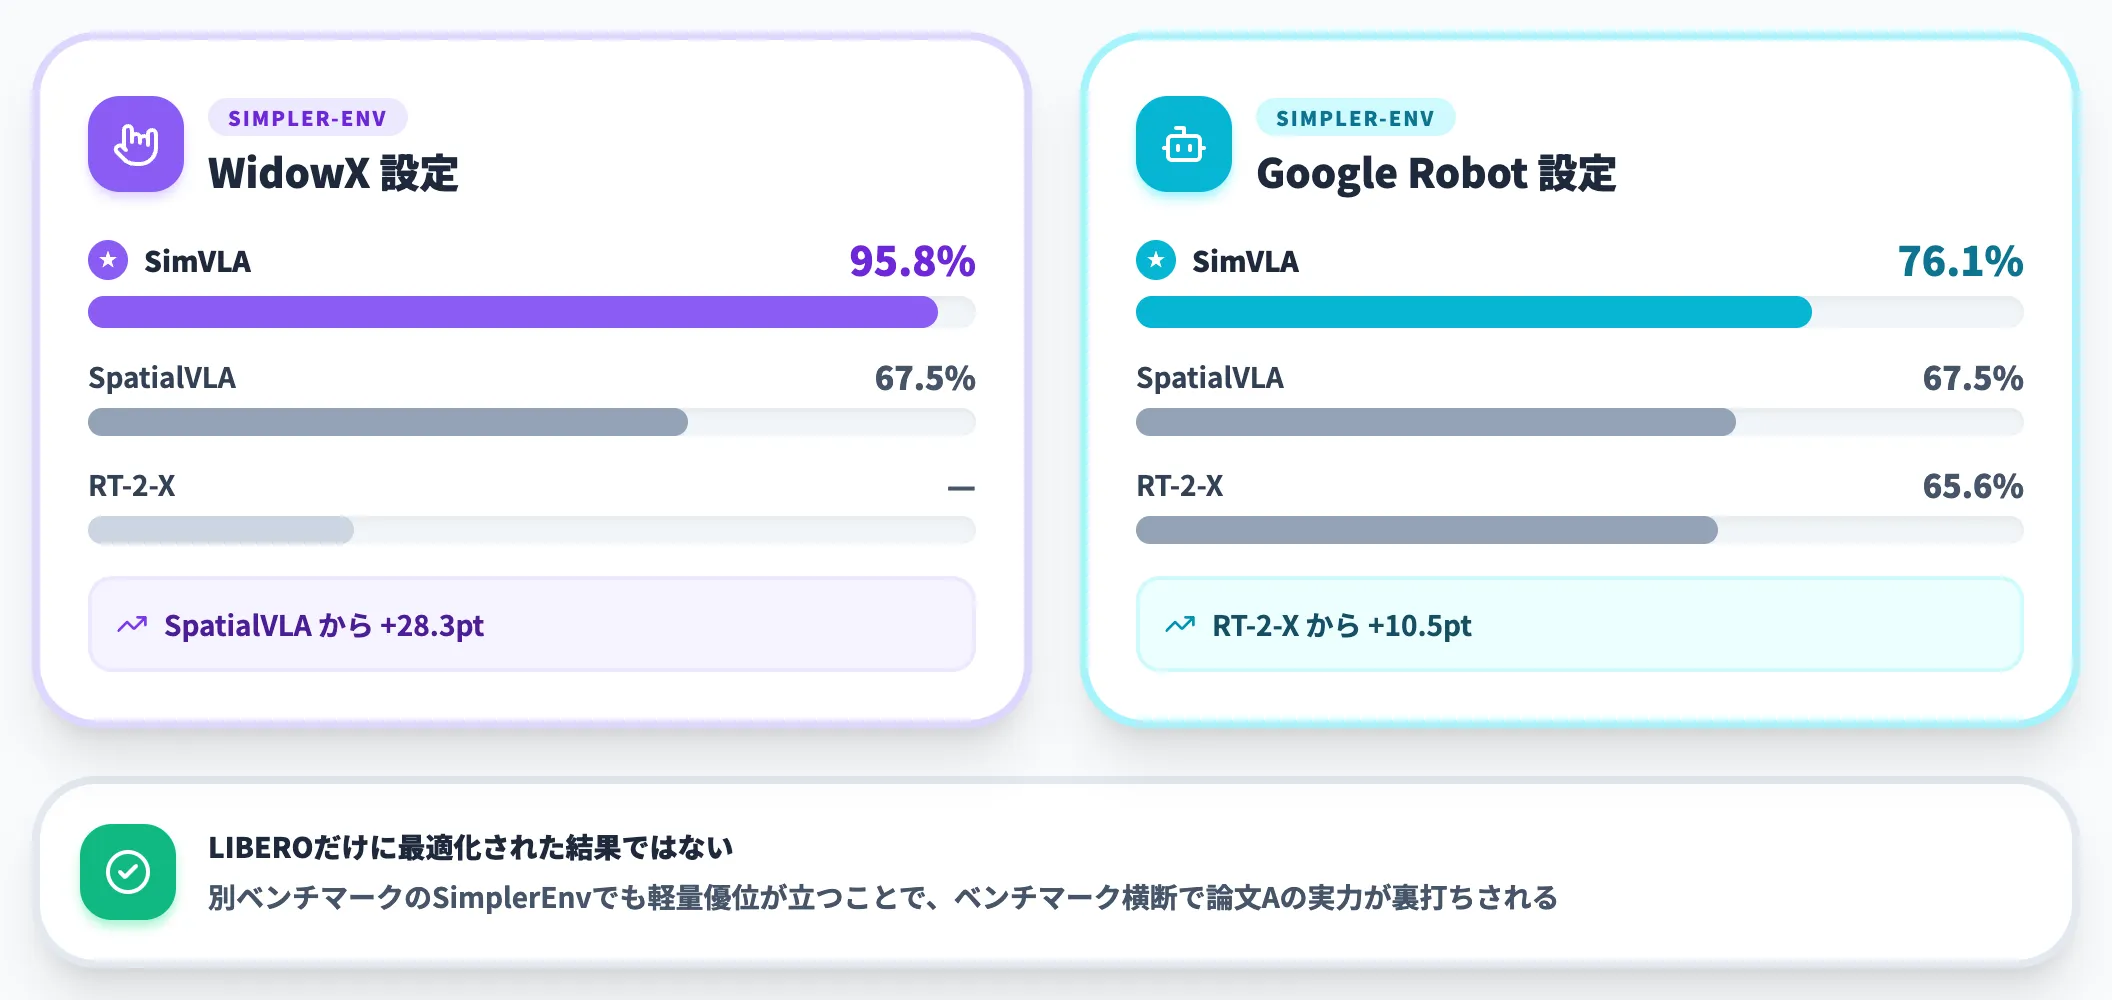
アームマニピュの別ベンチマークであるSimplerEnvでも、WidowX設定で95.8%、Google Robot設定で76.1%と、SpatialVLA(67.5%)やRT-2-X(65.6%)を上回ります。
LIBEROだけに最適化された結果ではなく、ベンチマーク横断で軽量優位が立つことを示している点が、論文Aの実力を裏打ちしています。
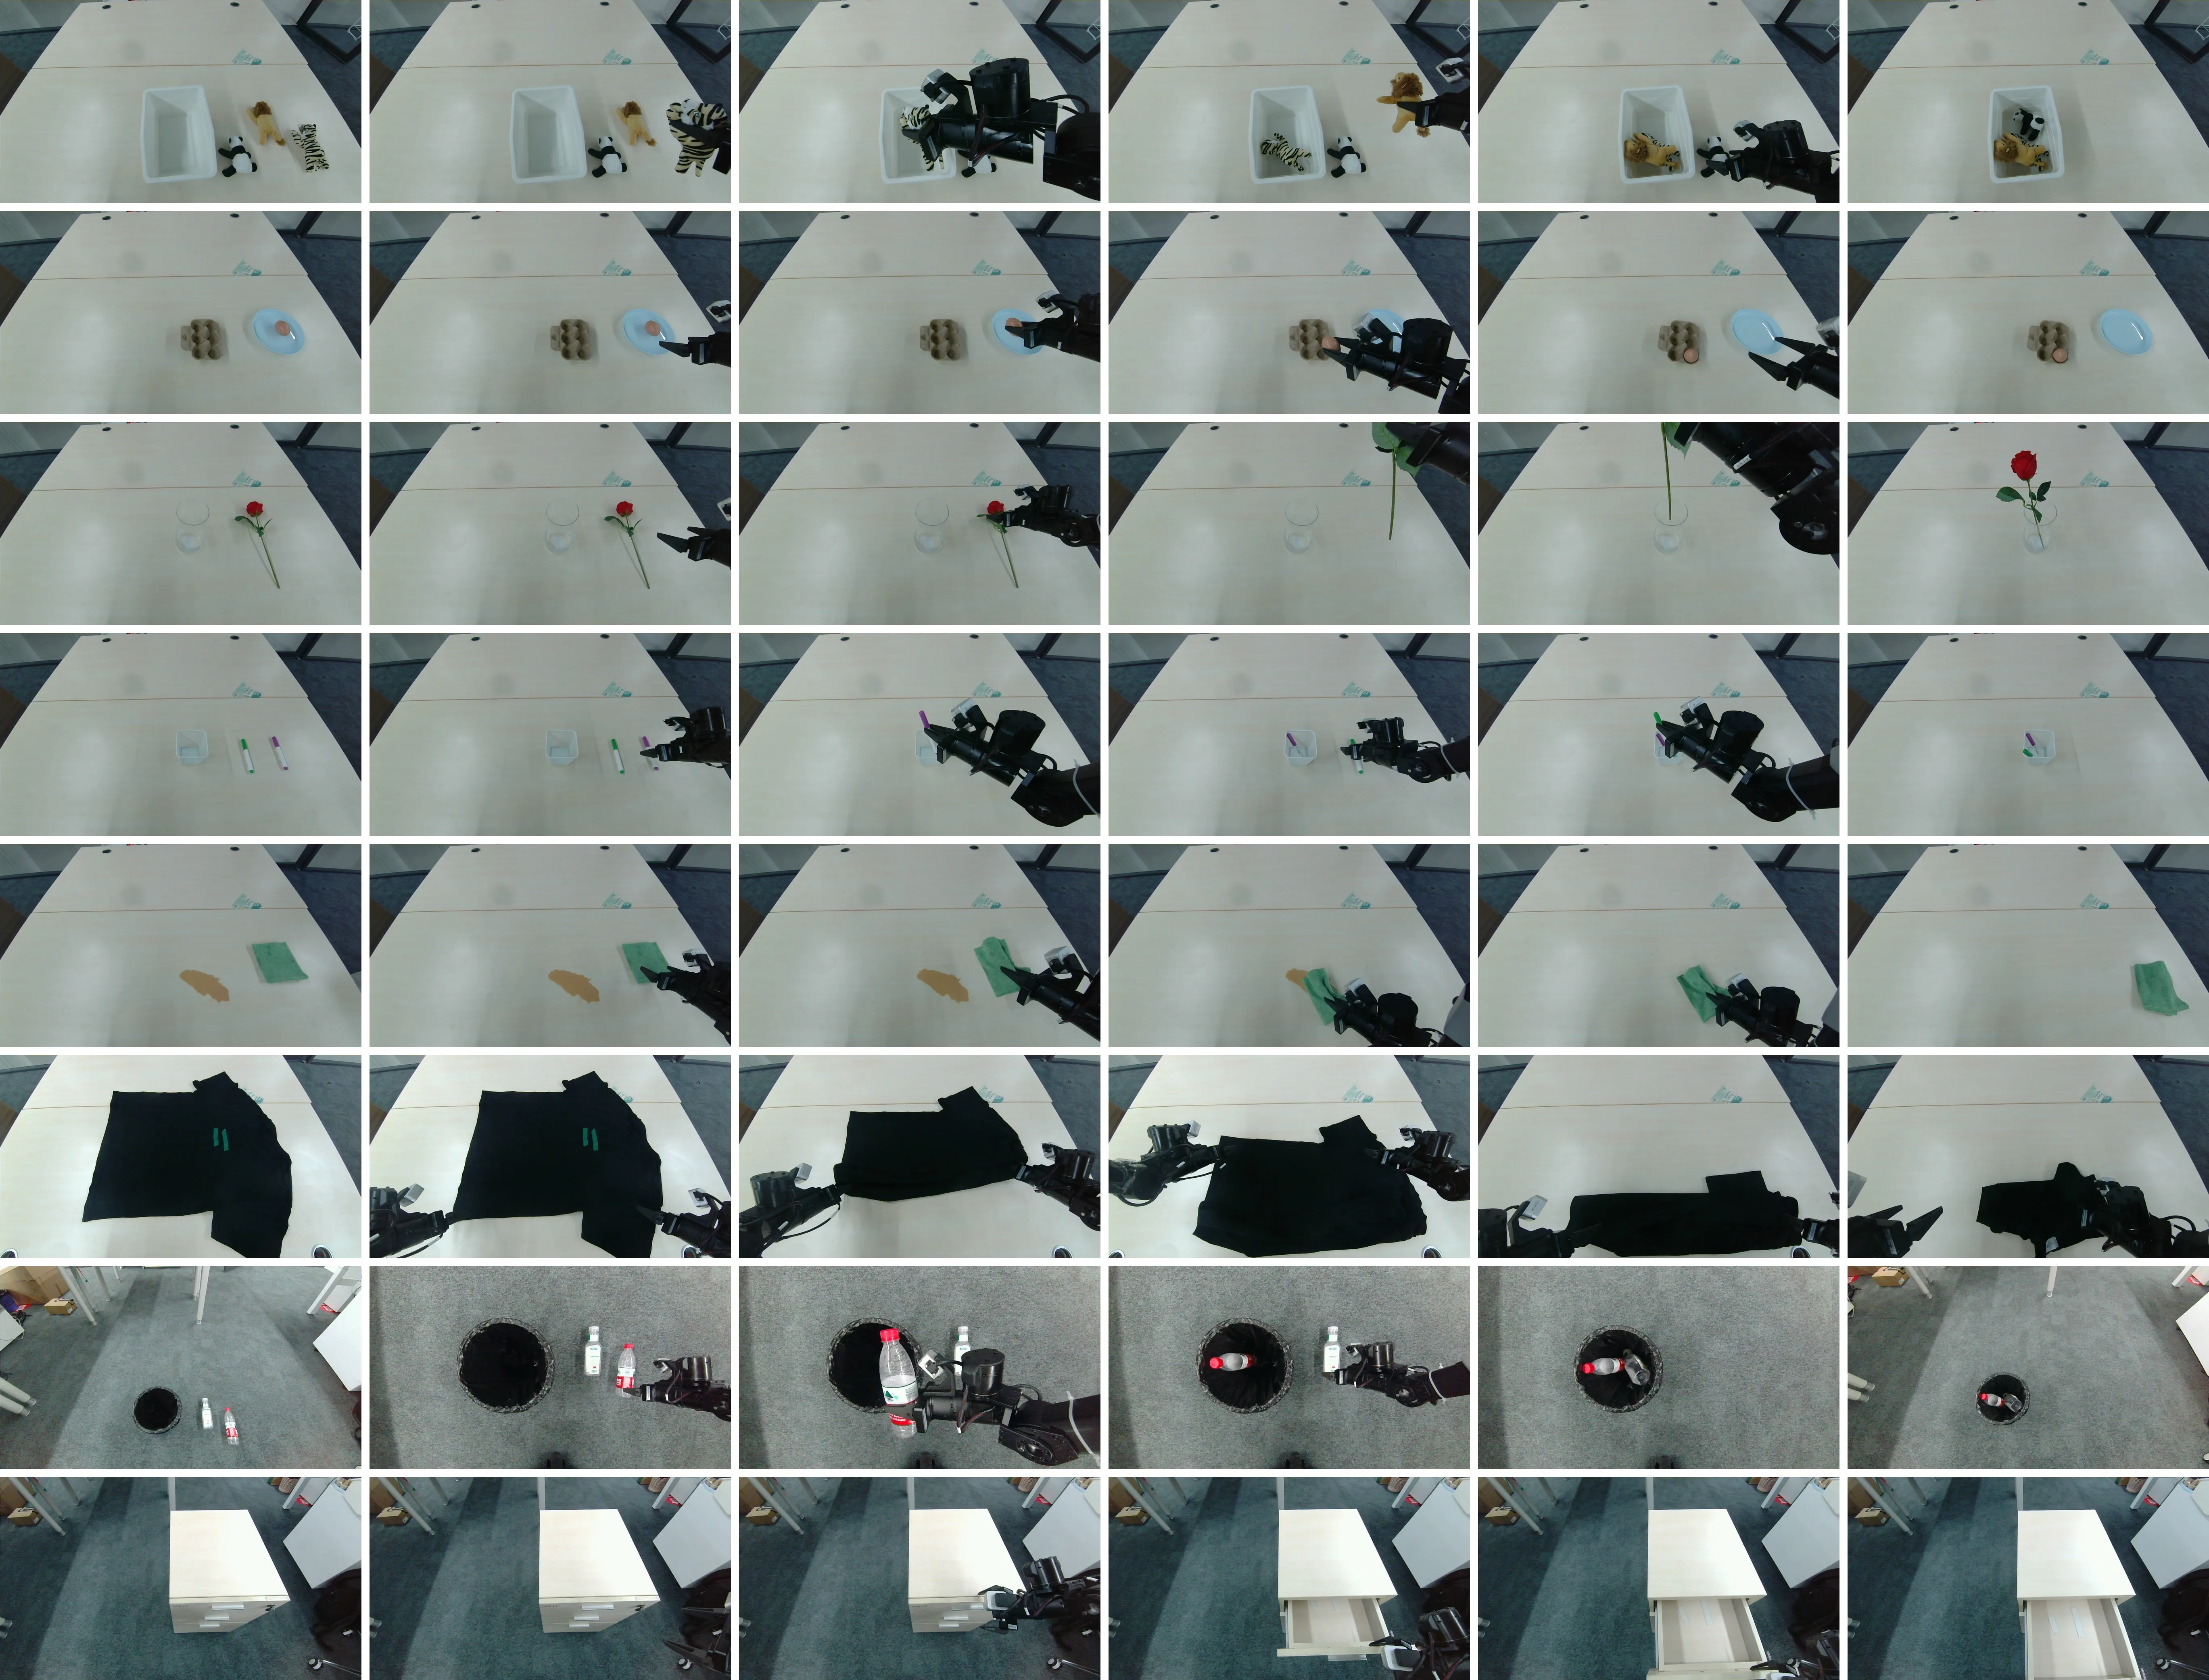
Galaxea R1 Liteで評価された実機マニピュレーションタスクの例。評価シーンへの追加学習なしで動作する様子(Out-of-box real-robot task examples)(出典:SimVLA公式プロジェクトページ)
論文Aは実機データが不要というわけではなく、Galaxea R1 Liteで約500時間の実機データを使って学習したうえで、評価シーンでは追加学習なしに動かすという位置づけです。
SimVLA(Zero-Shot Sim-to-Real)の設計と実機性能
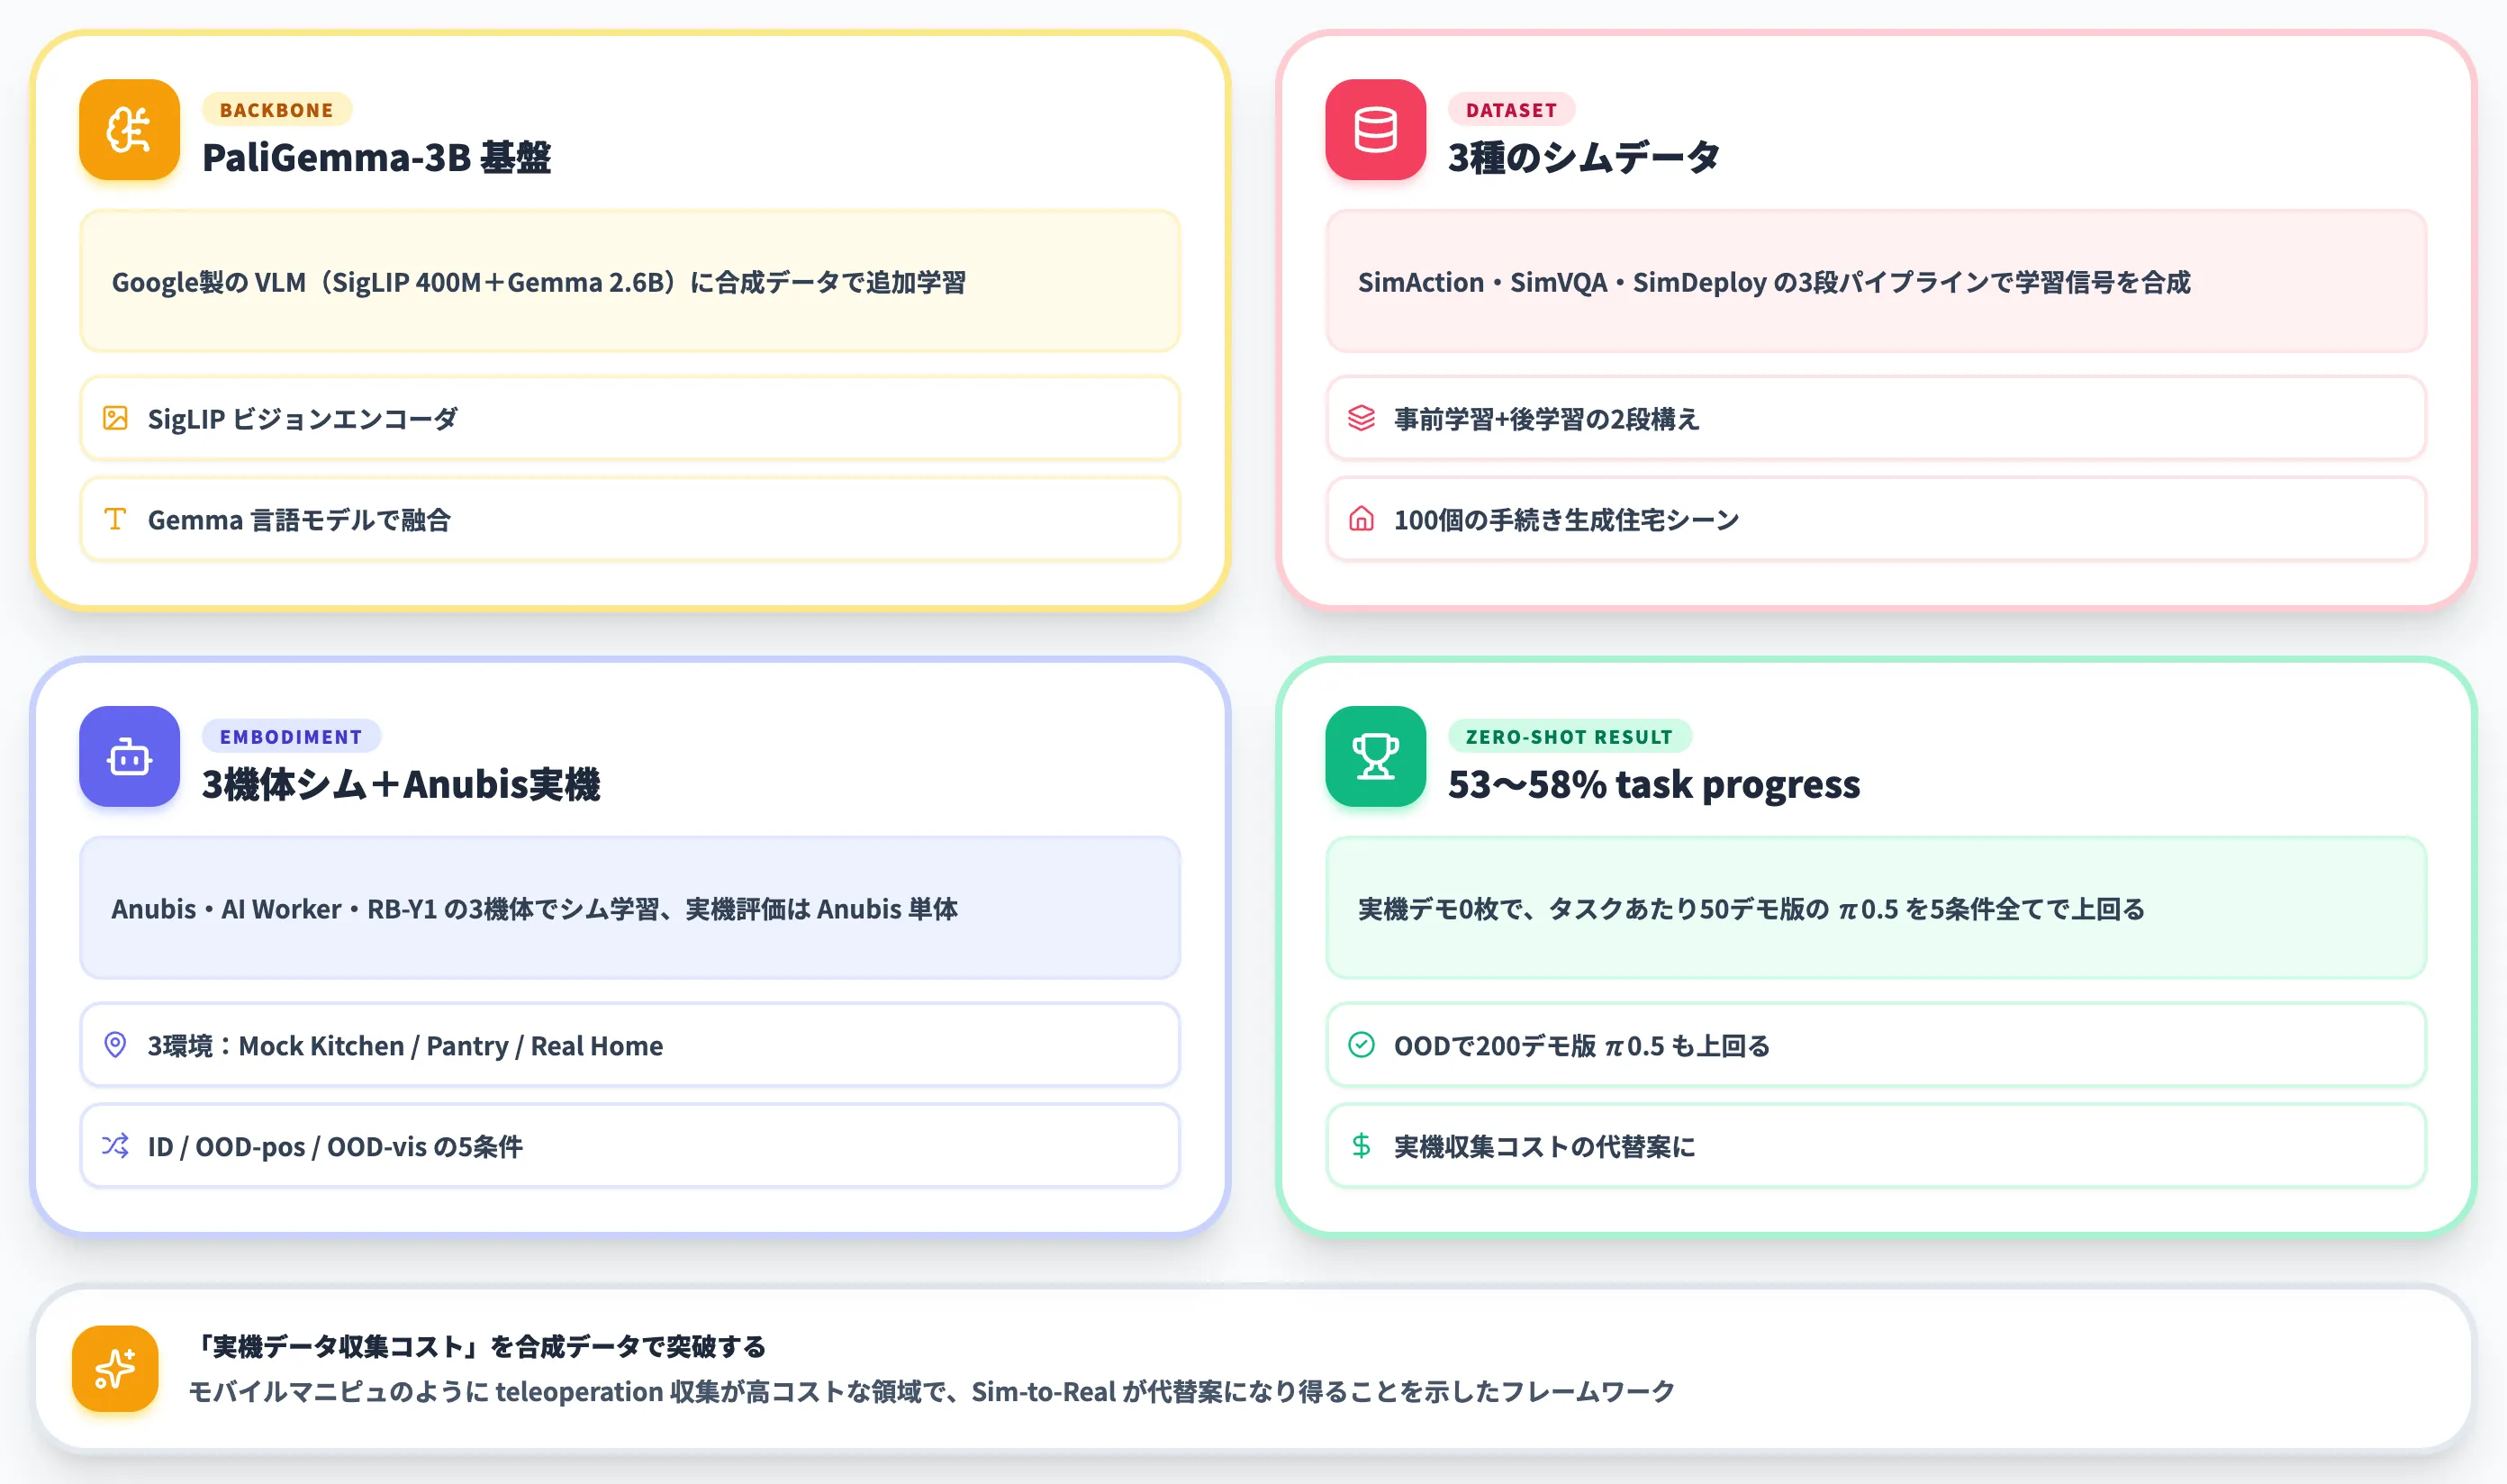
論文Bは、Kyoungin Baik・Youngwoon Leeらの公式プロジェクトページが「ロボットVLAは実機データ収集コストに制約されている」という問題意識から出発しています。
実機でのteleoperation収集を一切使わず、シミュレーションデータのみで学習したVLAを実機にそのままデプロイできるか、という問いに答えるフレームワークです。
バックボーンはPaliGemma-3B
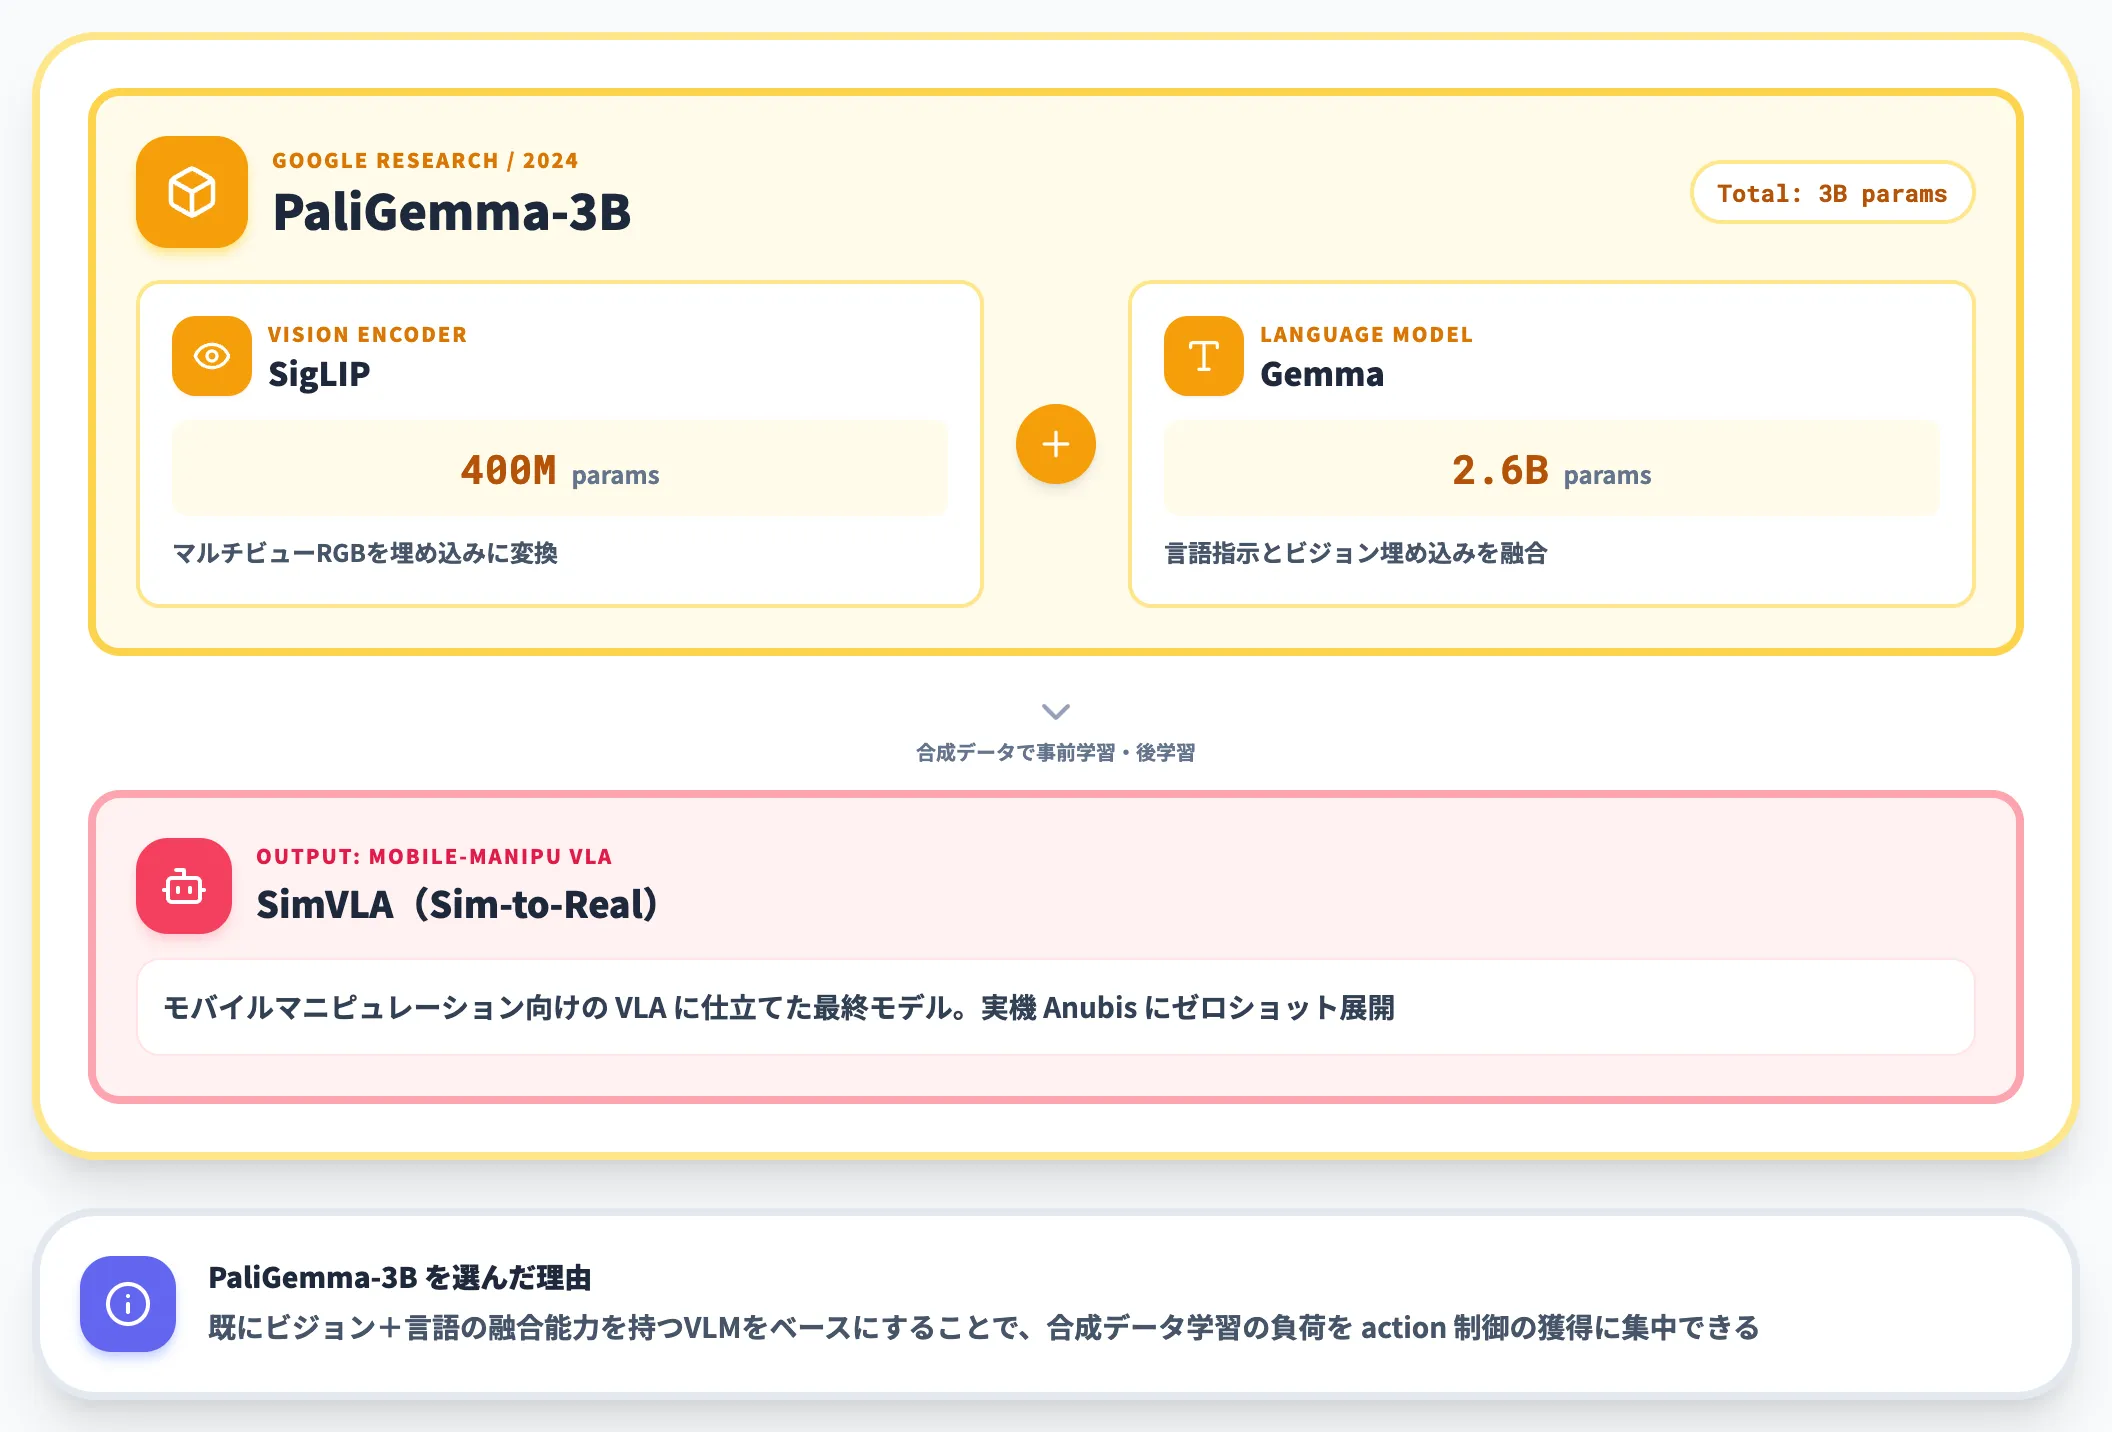
論文Bのベースモデルはgoogle製のPaliGemma-3B(SigLIP 400Mビジョンエンコーダ+Gemma 2.6B言語モデル)です。
ここに合成データで事前学習・後学習を重ね、モバイルマニピュレーション向けのVLAに仕立てる構成を取ります。
SimAction・SimVQA・SimDeployの3データセット
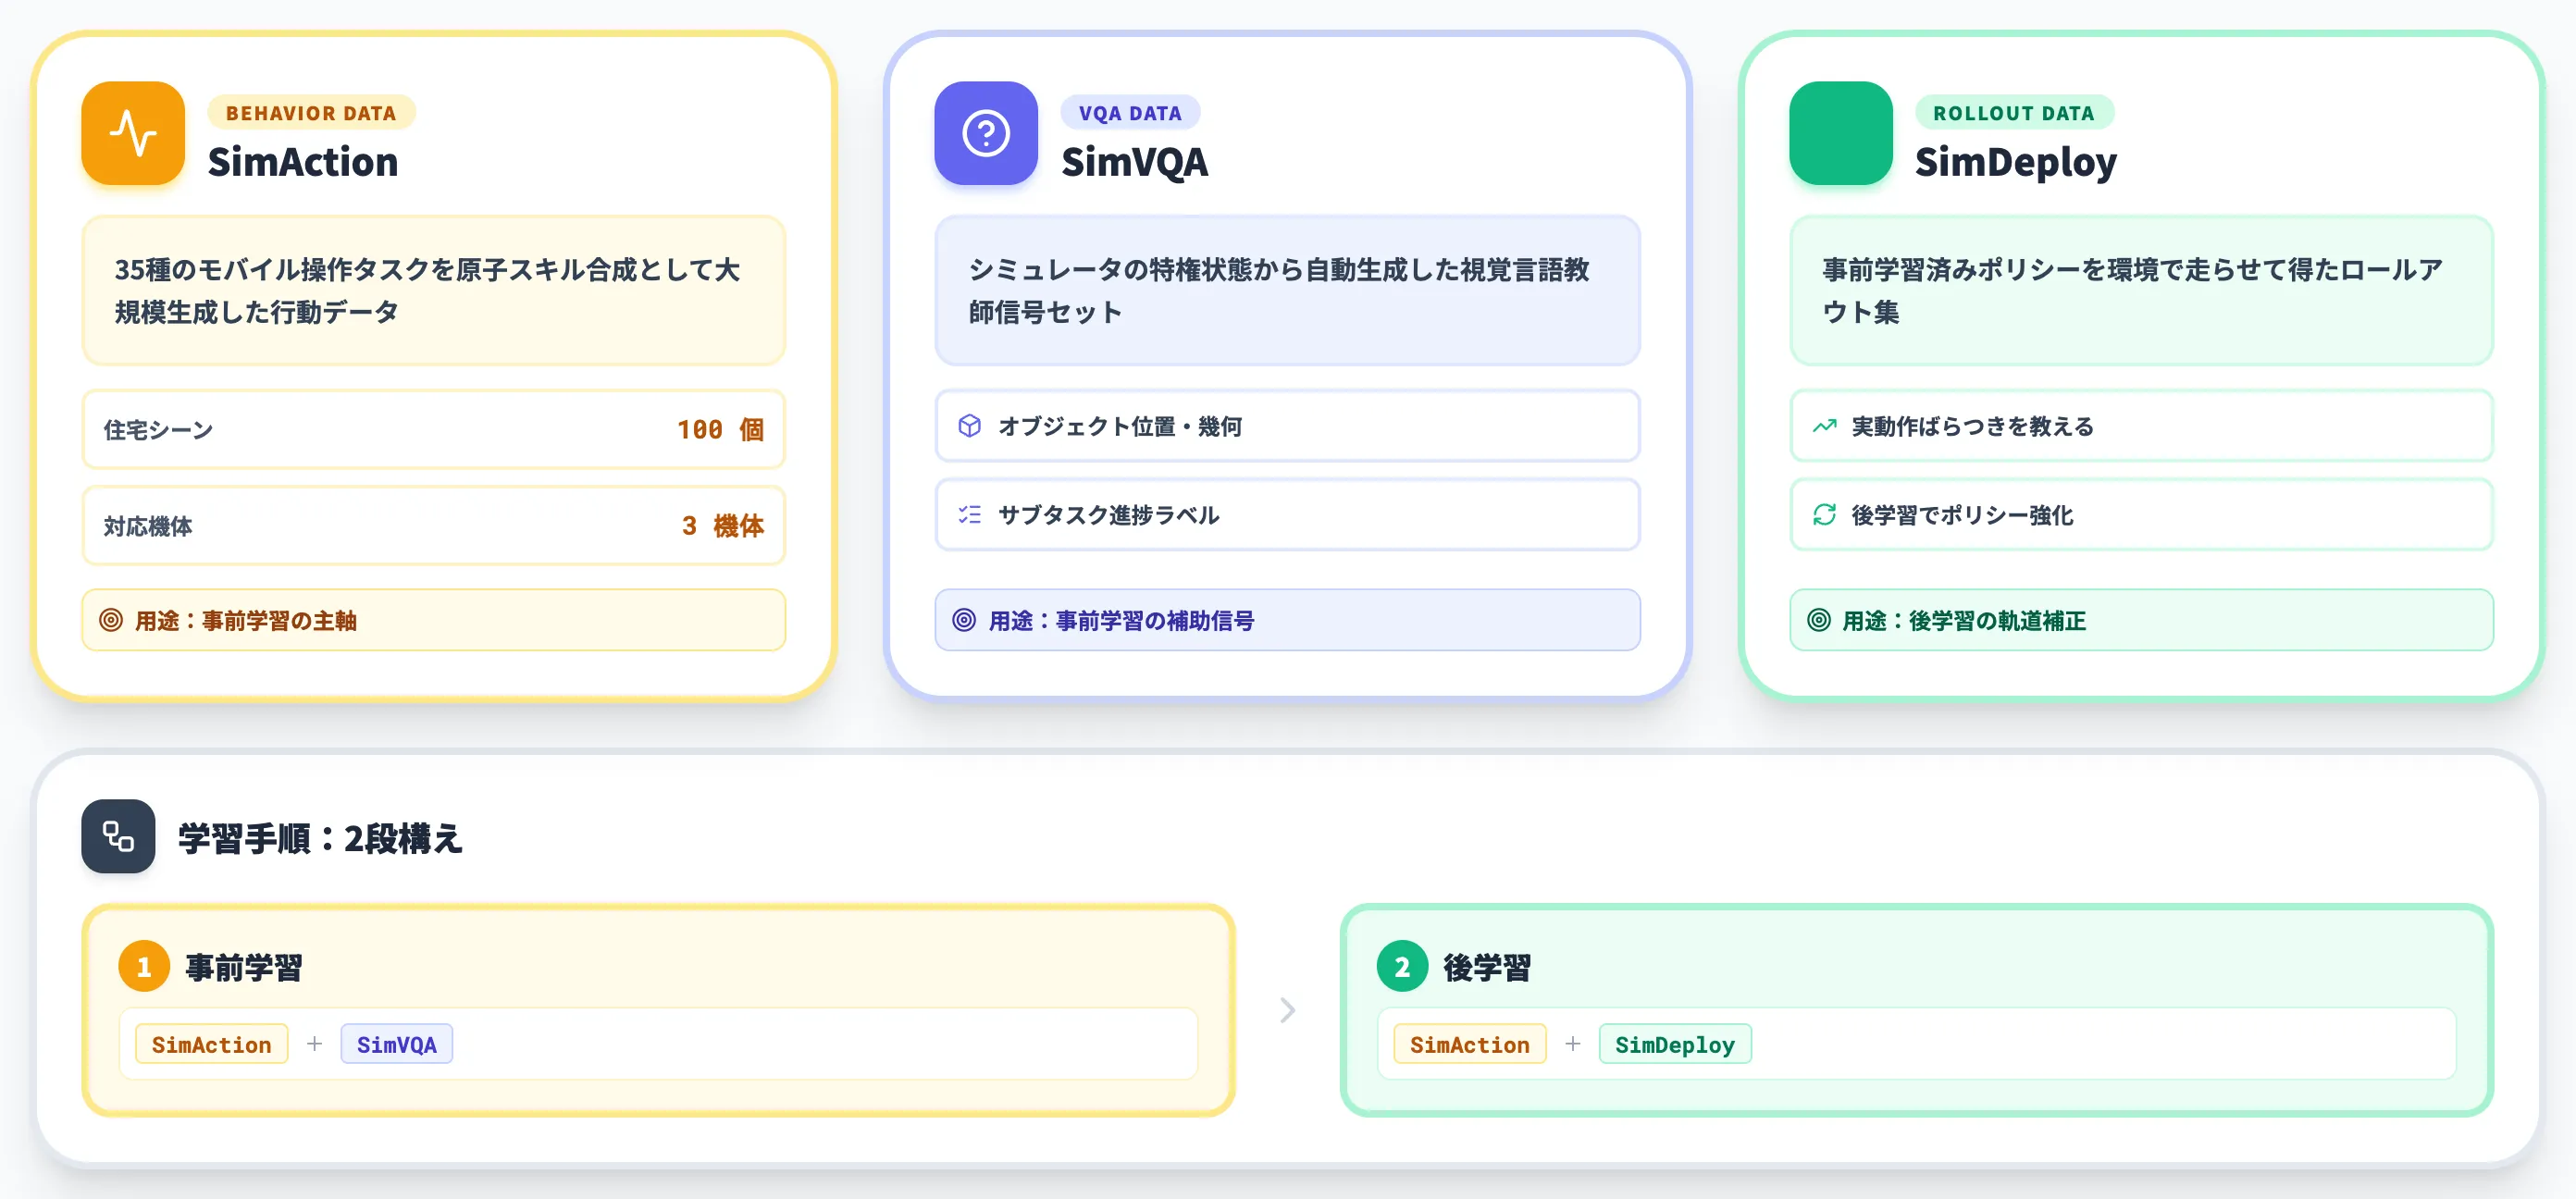
同論文の中核は、学習に使う合成データセットの作り方にあります。公式プロジェクトページによれば、3種類のデータセットを使い分けています。
-
SimAction
35種類のモバイル操作タスクを、原子スキルの合成として大規模に生成した行動データセット。100個の手続き生成住宅シーンを舞台に、Anubis・AI Worker・RB-Y1の3機体でシム内行動軌跡を収集する
-
SimVQA
シミュレータの特権状態(オブジェクト位置・幾何・サブタスク進捗)を使って自動生成した視覚言語教師信号のセット
-
SimDeploy
事前学習済みのポリシーを環境で走らせて得たロールアウトデータセット。後学習時に実動作のばらつきを教える
学習手順は、SimActionとSimVQAで事前学習したあと、SimActionとSimDeployの混合で後学習する2段構えです。
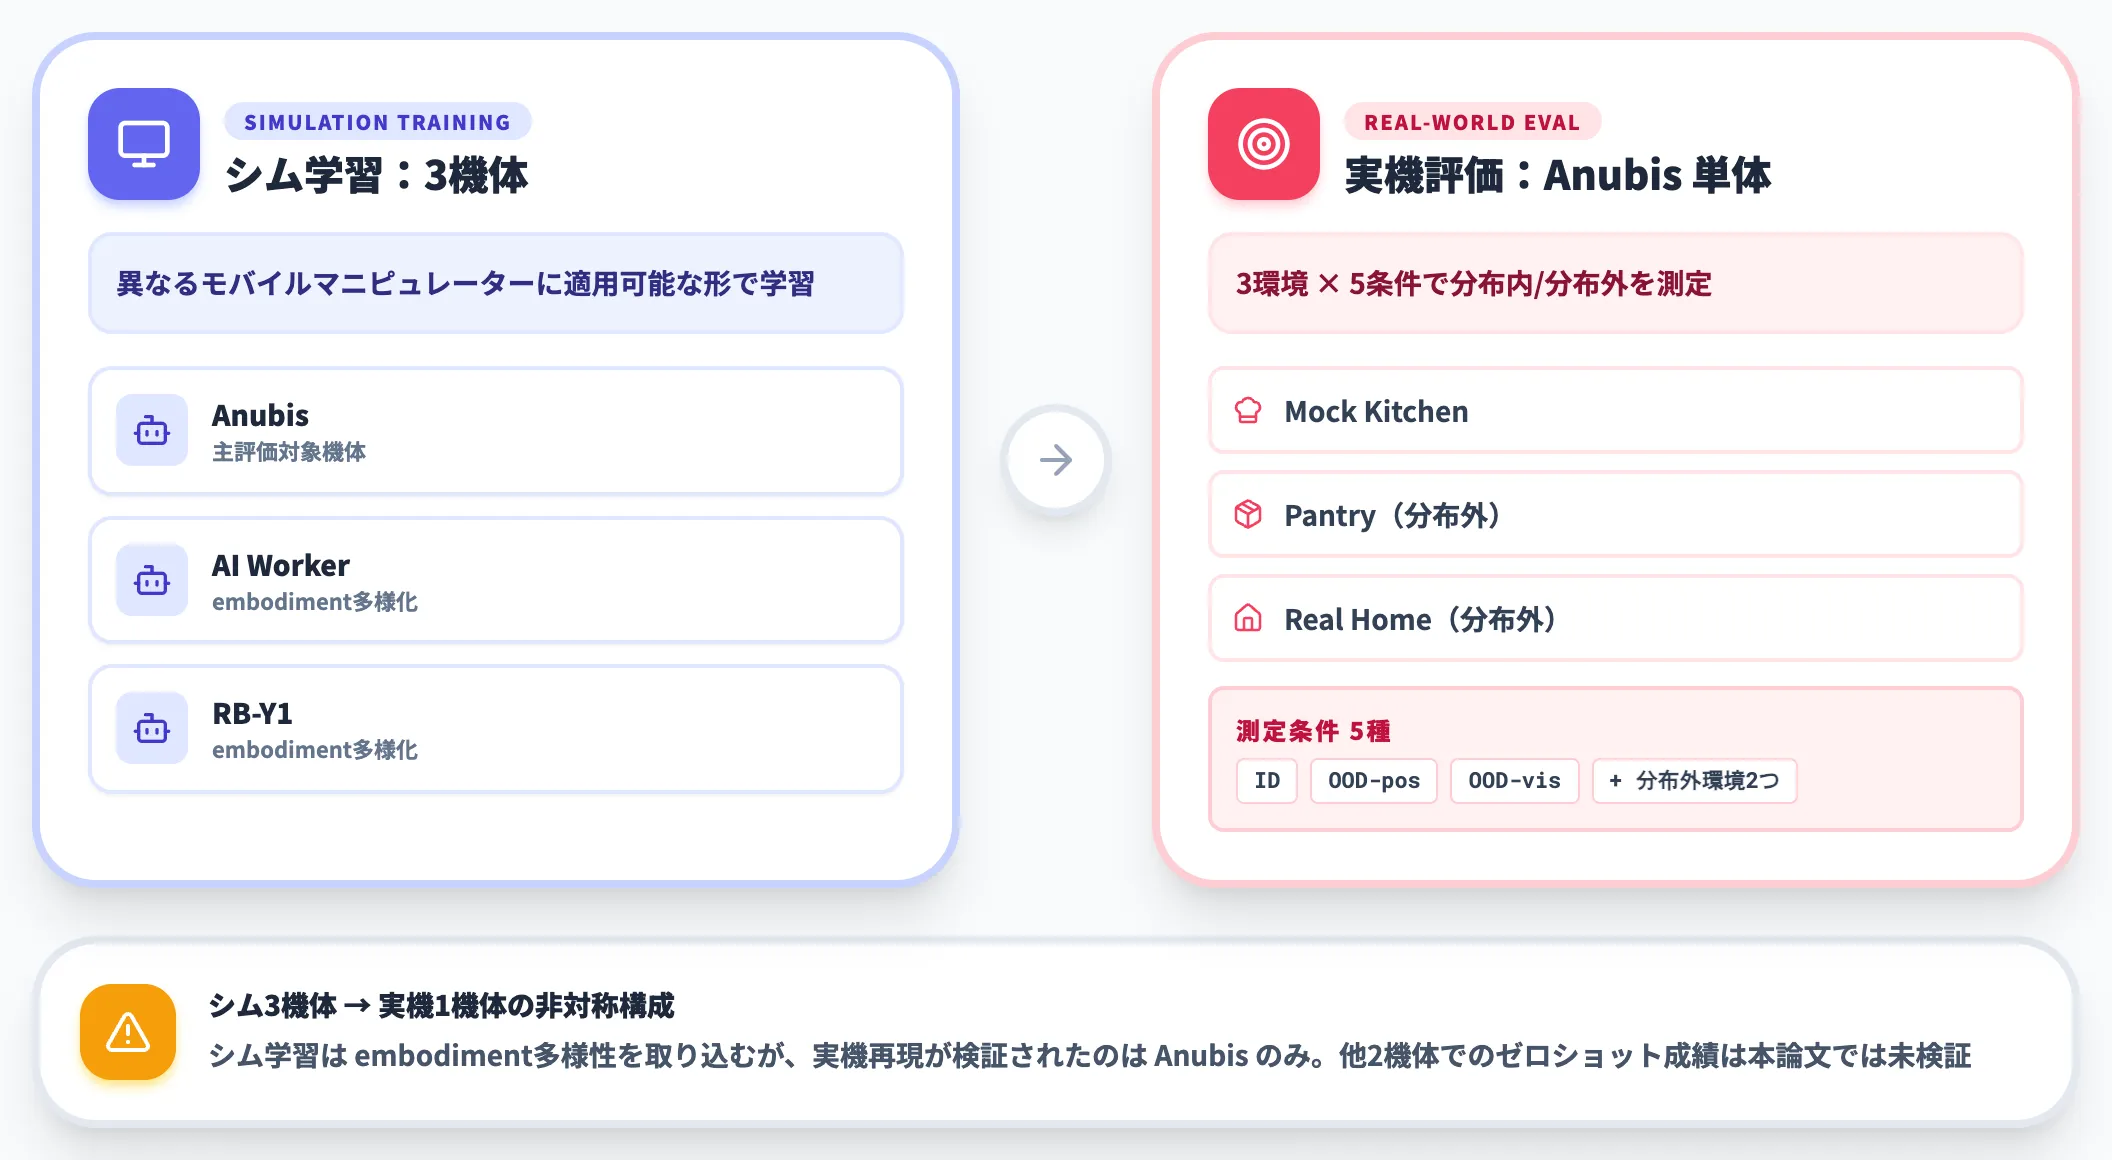
3機体でのシム学習とAnubisでの実機評価
学習データ生成の対象はAnubis・AI Worker・RB-Y1の3機体で、シム内で異なるモバイルマニピュレーターに適用できる形になっています。
実機評価はAnubis単機体で行い、Mock kitchen・Pantry・Real homeの3環境を舞台に、ID(分布内)・OOD-pos(位置ずれ)・OOD-vis(視覚ずれ)を合わせた5条件で測定しています。
事前学習段階(SimAction・SimVQA)のシミュレーション観測例(出典:SimVLA公式プロジェクトページ)
後学習段階(SimDeploy)のシミュレーション観測例。多様なシム環境でポリシーロールアウトを収集して得た観測(出典:SimVLA公式プロジェクトページ)
2枚とも学習段階のシム観測で、SimActionベースの初期シーン(上)と、SimDeployの収集に用いた多様なシム環境のシーン(下)のレンダリング差を見せています。実機への転移はこれらで学んだポリシーをAnubis実機にそのまま流す形で検証されます。
実機ゼロショット53〜58%で、実機デモ50本学習ポリシーを上回る
実機性能は5条件で53〜58%の task progressで、同論文は「各タスクあたり50本の実機デモンストレーションで学習したπ0.5を上回る」と報告しています。
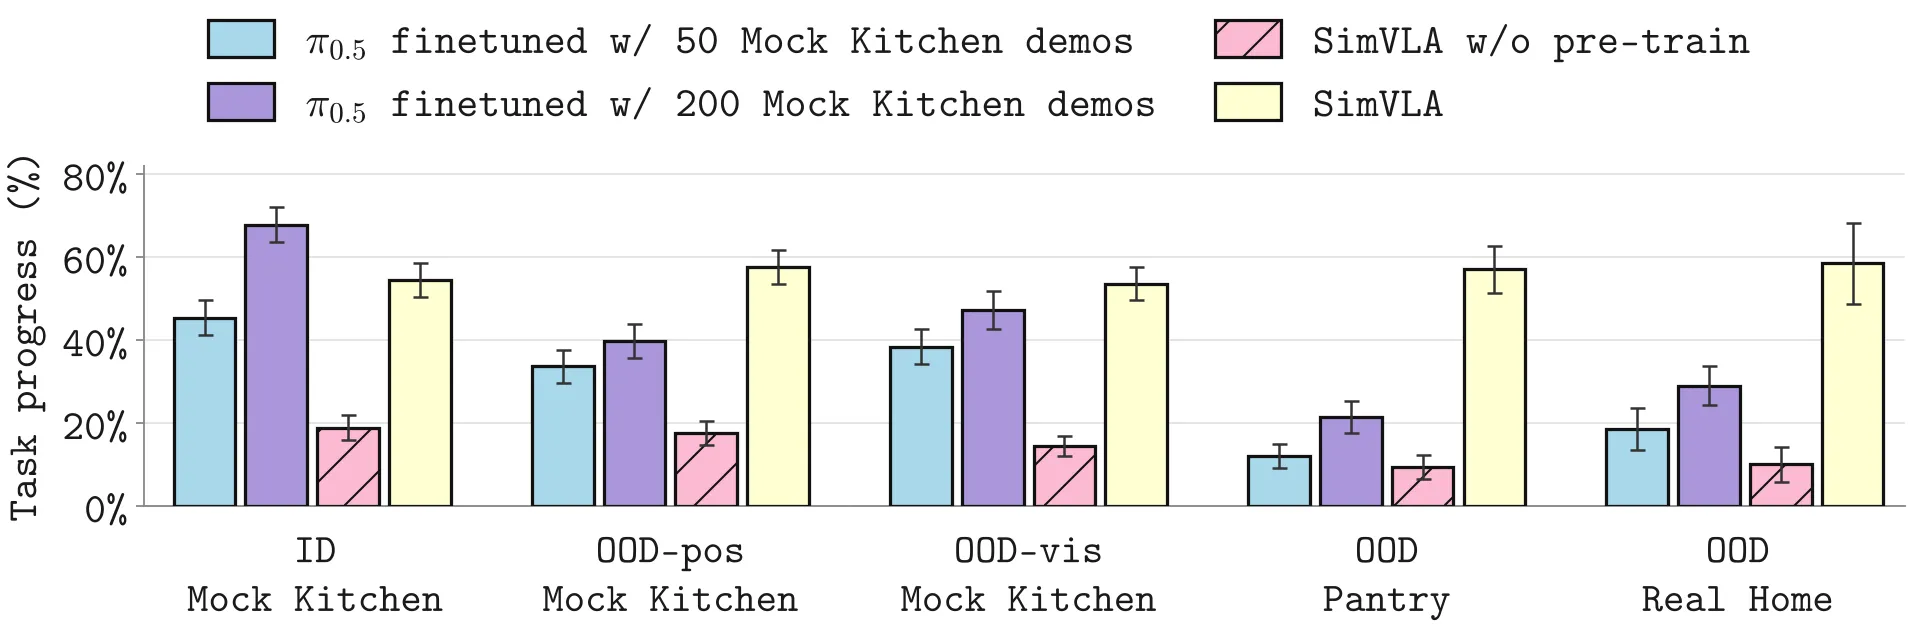
5条件でのtask progress評価。SimVLAはタスクあたり50デモ版のπ0.5を全条件で上回り、タスクあたり200デモ版のπ0.5にはID Mock Kitchenでは届かず、OODの各条件では上回る(出典:SimVLA公式プロジェクトページ)
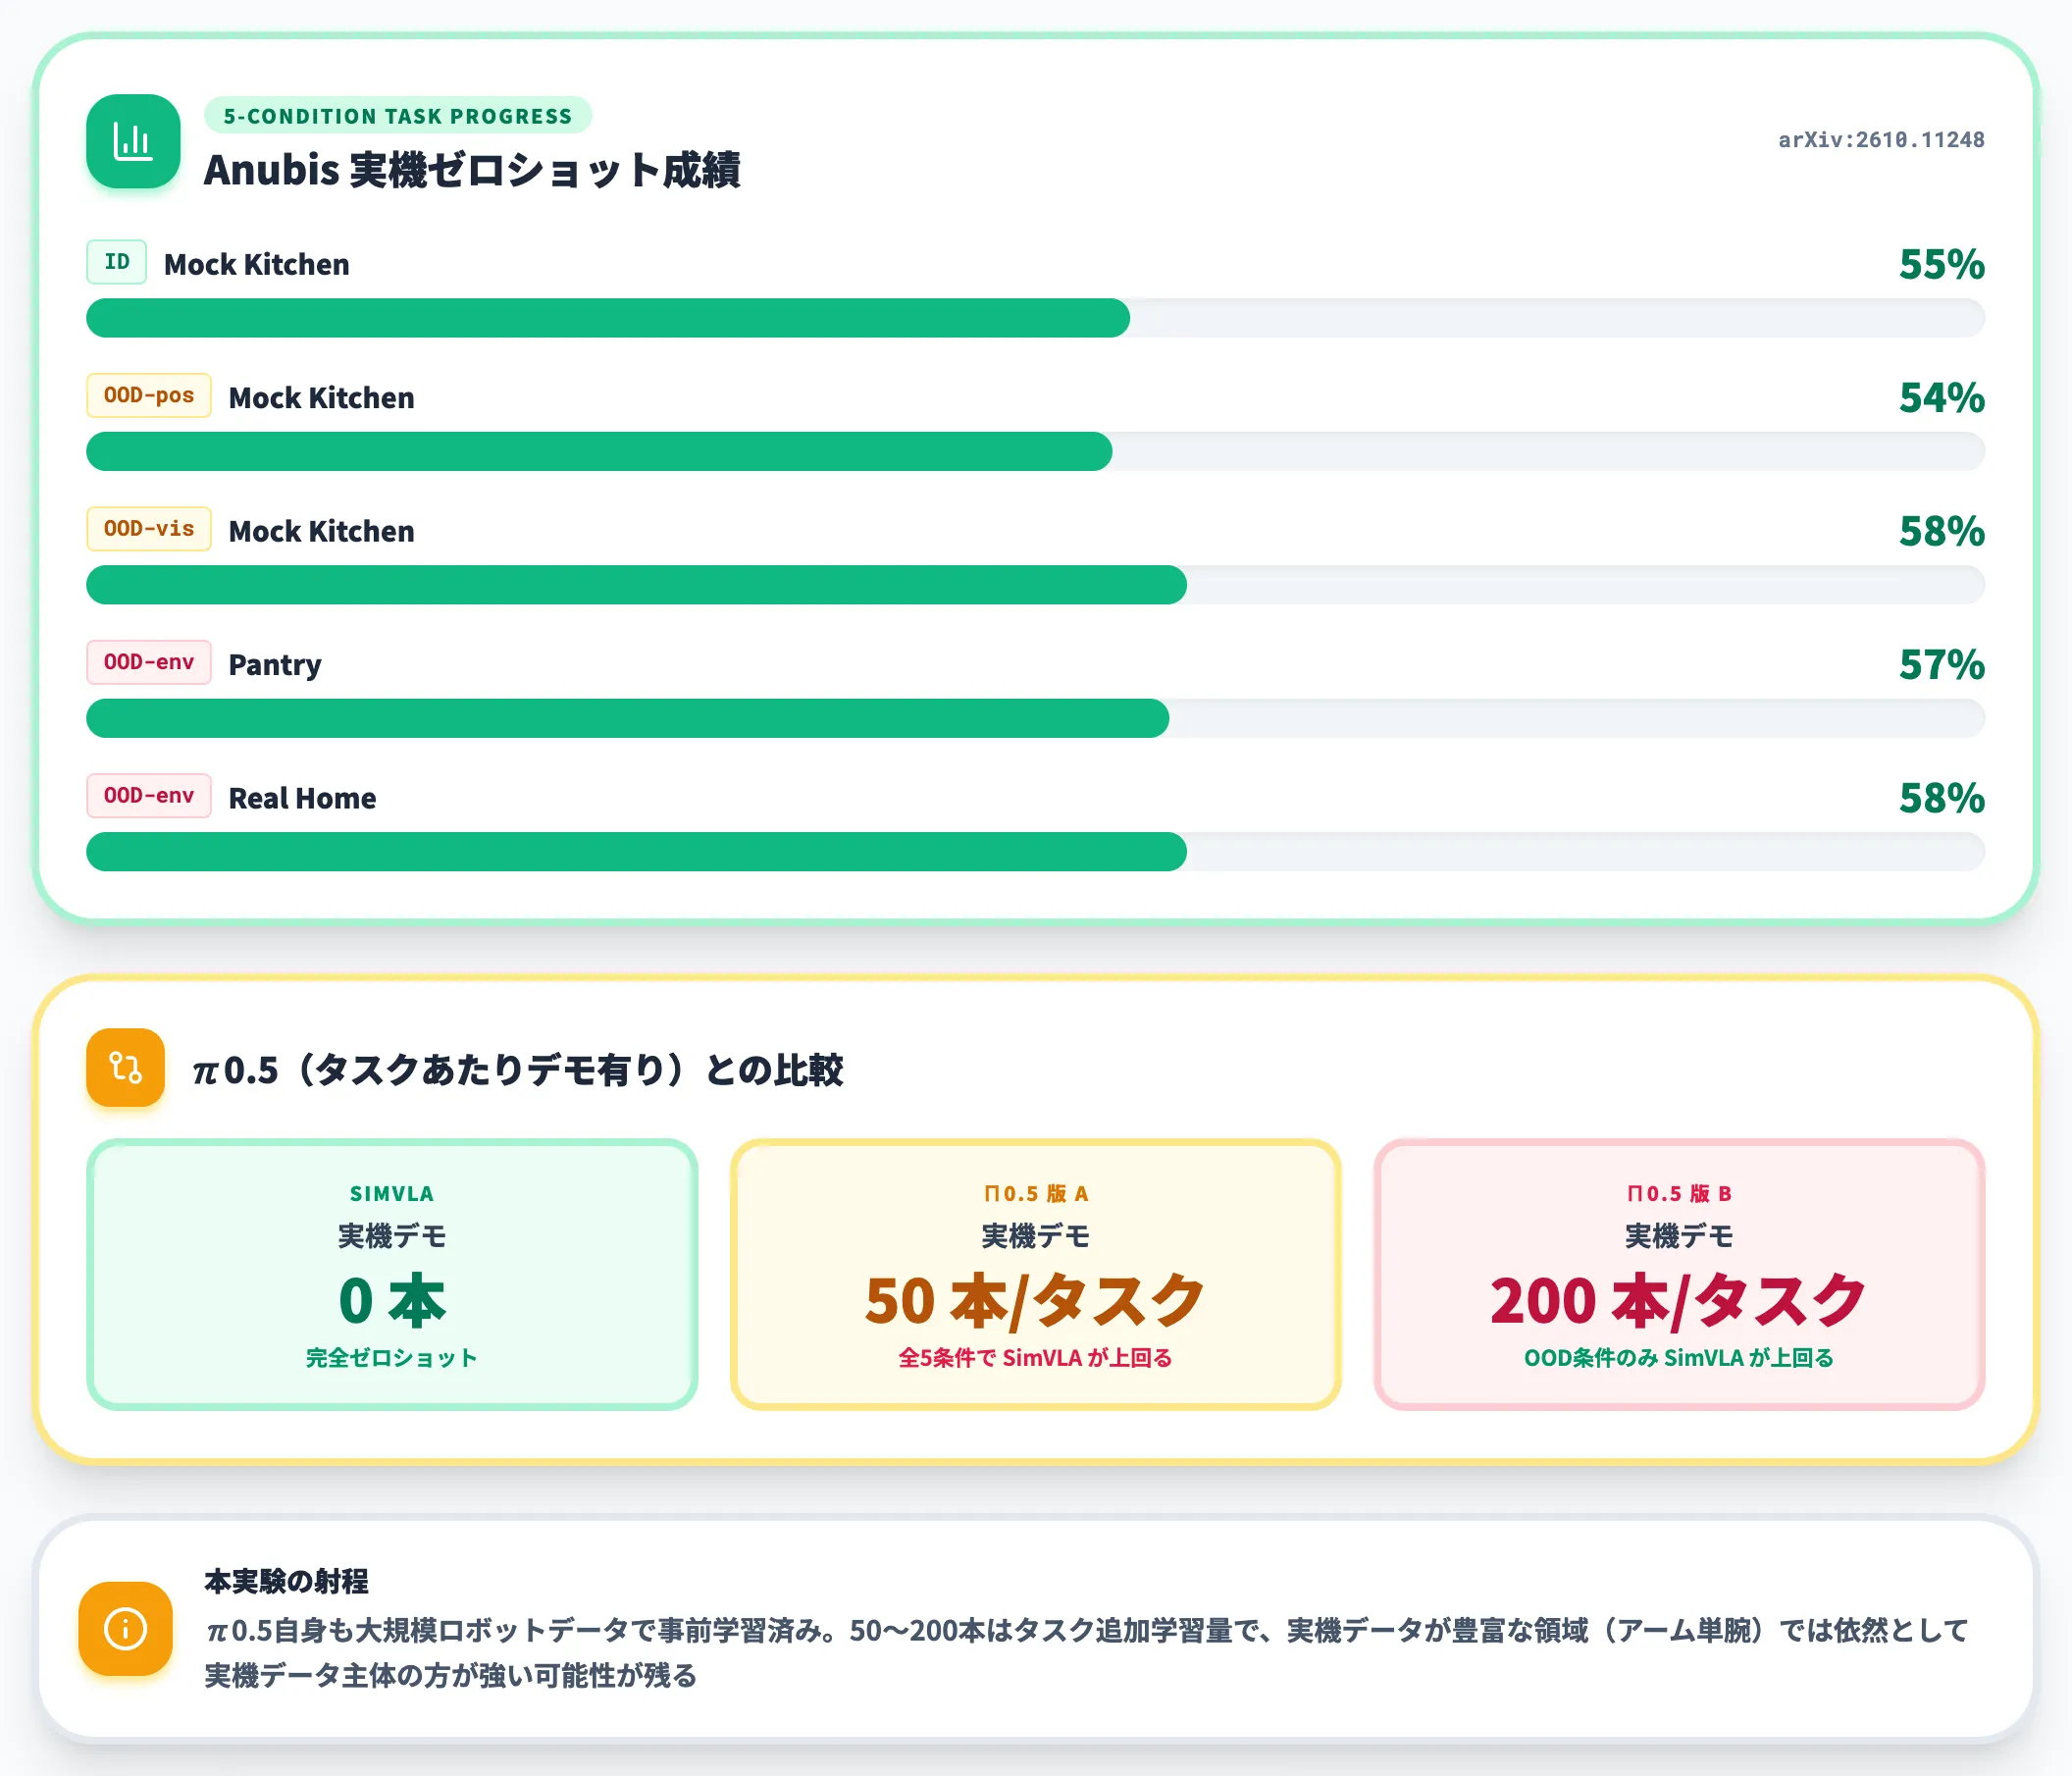
グラフを見ると、SimVLAはID Mock Kitchenで55%、OOD-pos / OOD-vis Mock Kitchenで約54〜58%、分布外のPantryで57%、Real Homeで58%と、条件を変えても安定して50%台を出しています。特にOOD(分布外)条件でπ0.5+タスクあたり200デモ版を明確に上回っている点が、合成データ事前学習の汎化能力の高さを示します。
実機ゼロショットでここまで振るうのは、合成データ事前学習がモバイルマニピュのように「実機デモ収集が高コスト」な領域で代替案になり得ることを示唆します。
ただし比較対象はタスクあたり50〜200デモで追加学習したπ0.5であって、本実験以外の条件・タスクでも優位であることを示したわけではない点には注意が必要です。π0.5自身も大規模なロボットデータで事前学習済みで、50〜200本はあくまでタスクごとの追加学習量です。実機データが豊富な領域(アーム単腕マニピュなど)では、依然として実機データを使ったポリシーの方が強い可能性が残ります。
VLA全体の中でSimVLAが置かれる場所
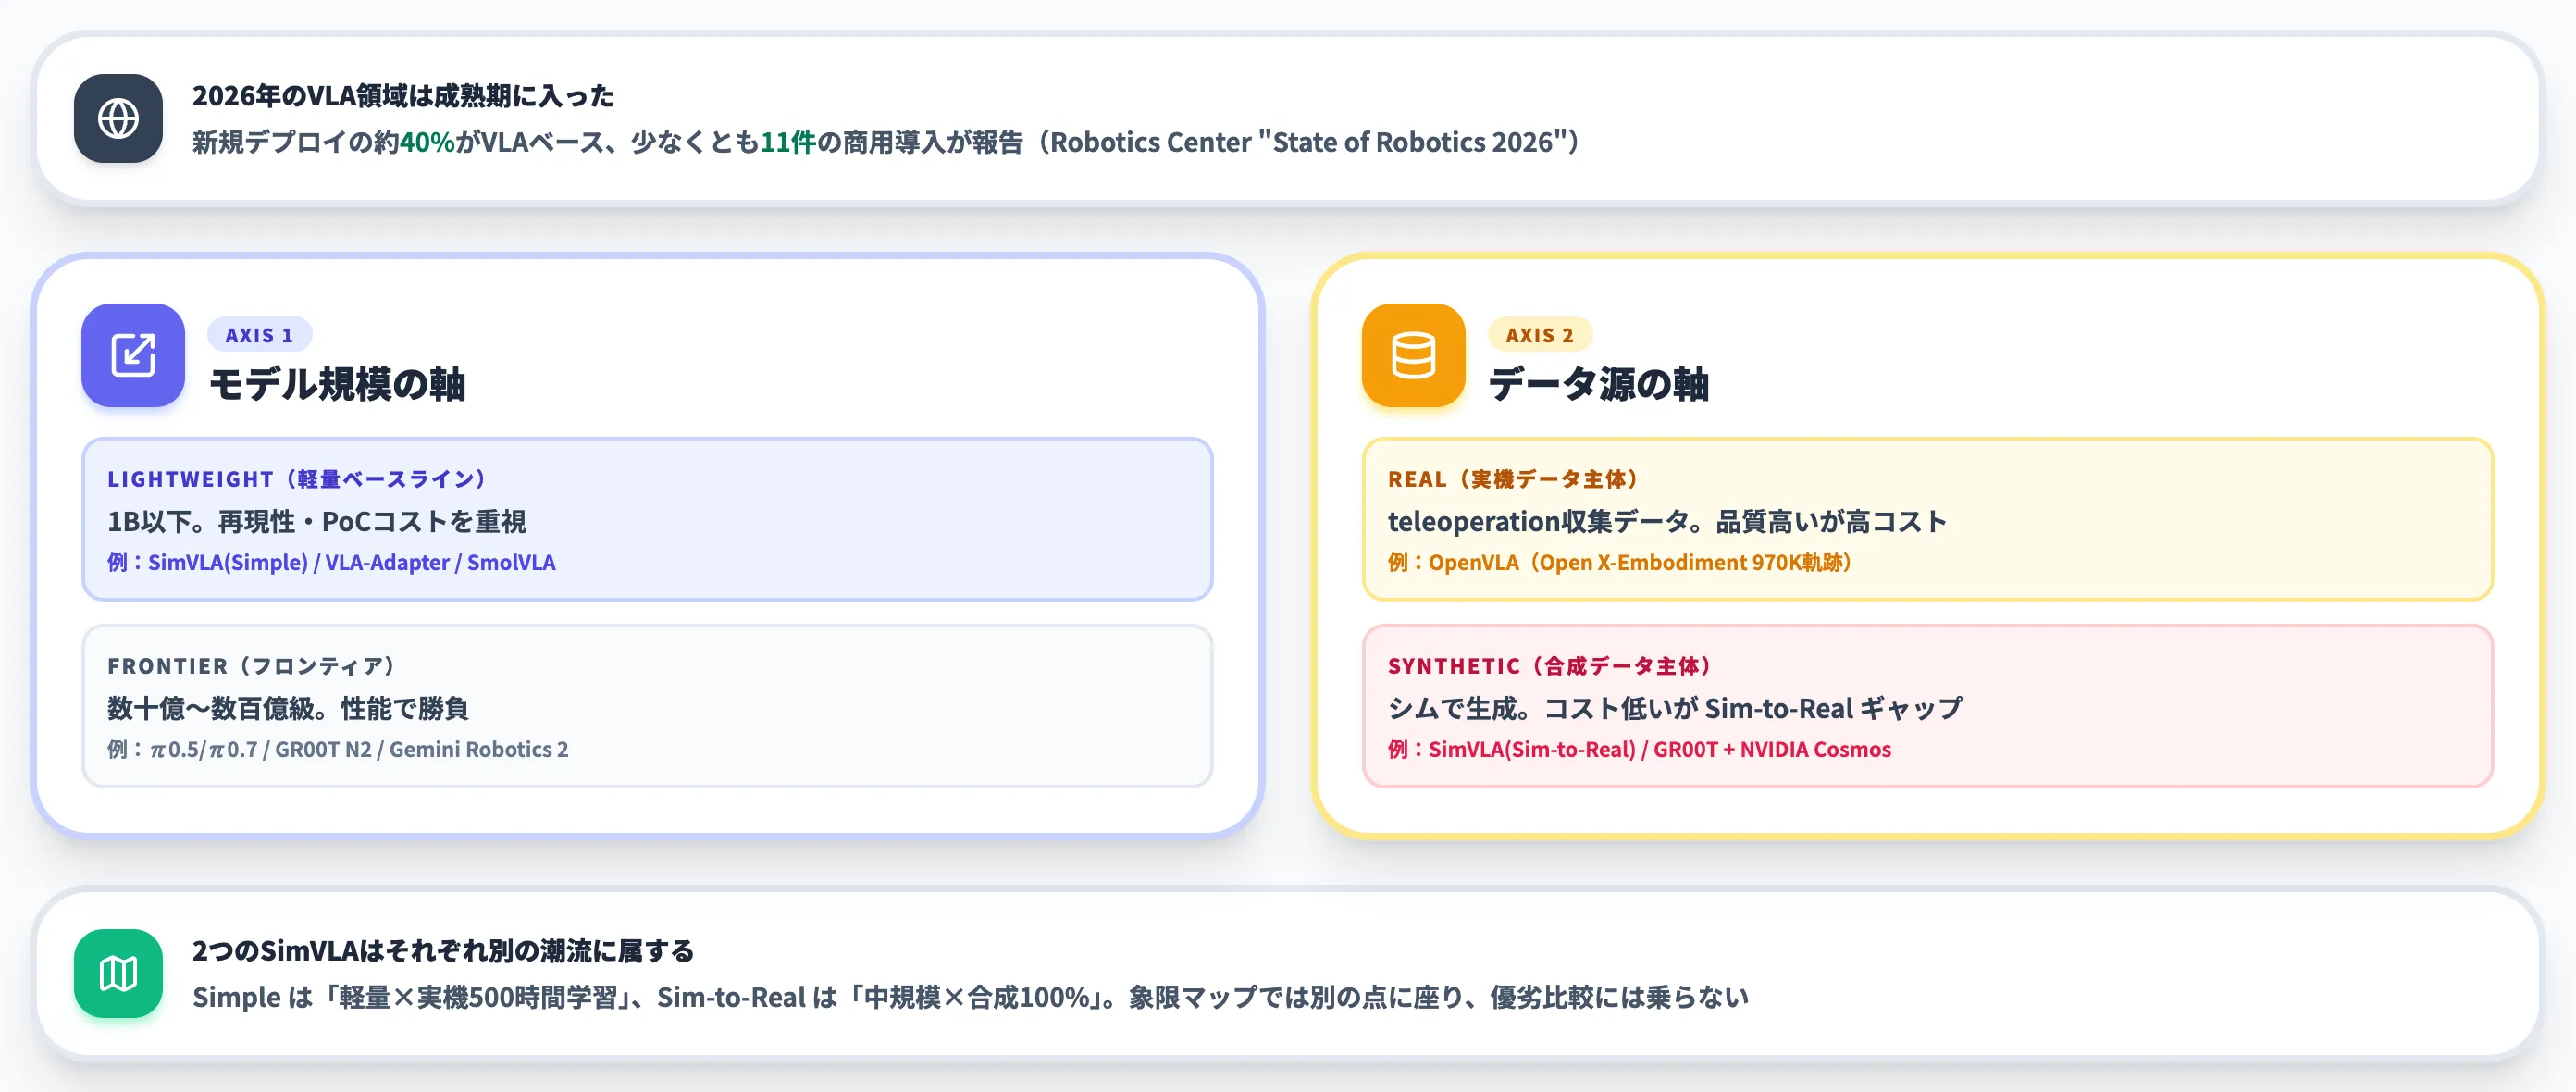
2つのSimVLAはいずれも、2026年のVLA研究の2つの主潮流に位置しています。
Robotics Centerの『State of Robotics 2026』によれば、新規デプロイの約40%がVLAベースに置き換わっており、少なくとも11件の商用導入が報告されています。この成熟期のVLA領域で、どこに位置するかを俯瞰します。
軽量ベースライン潮流とフロンティア潮流
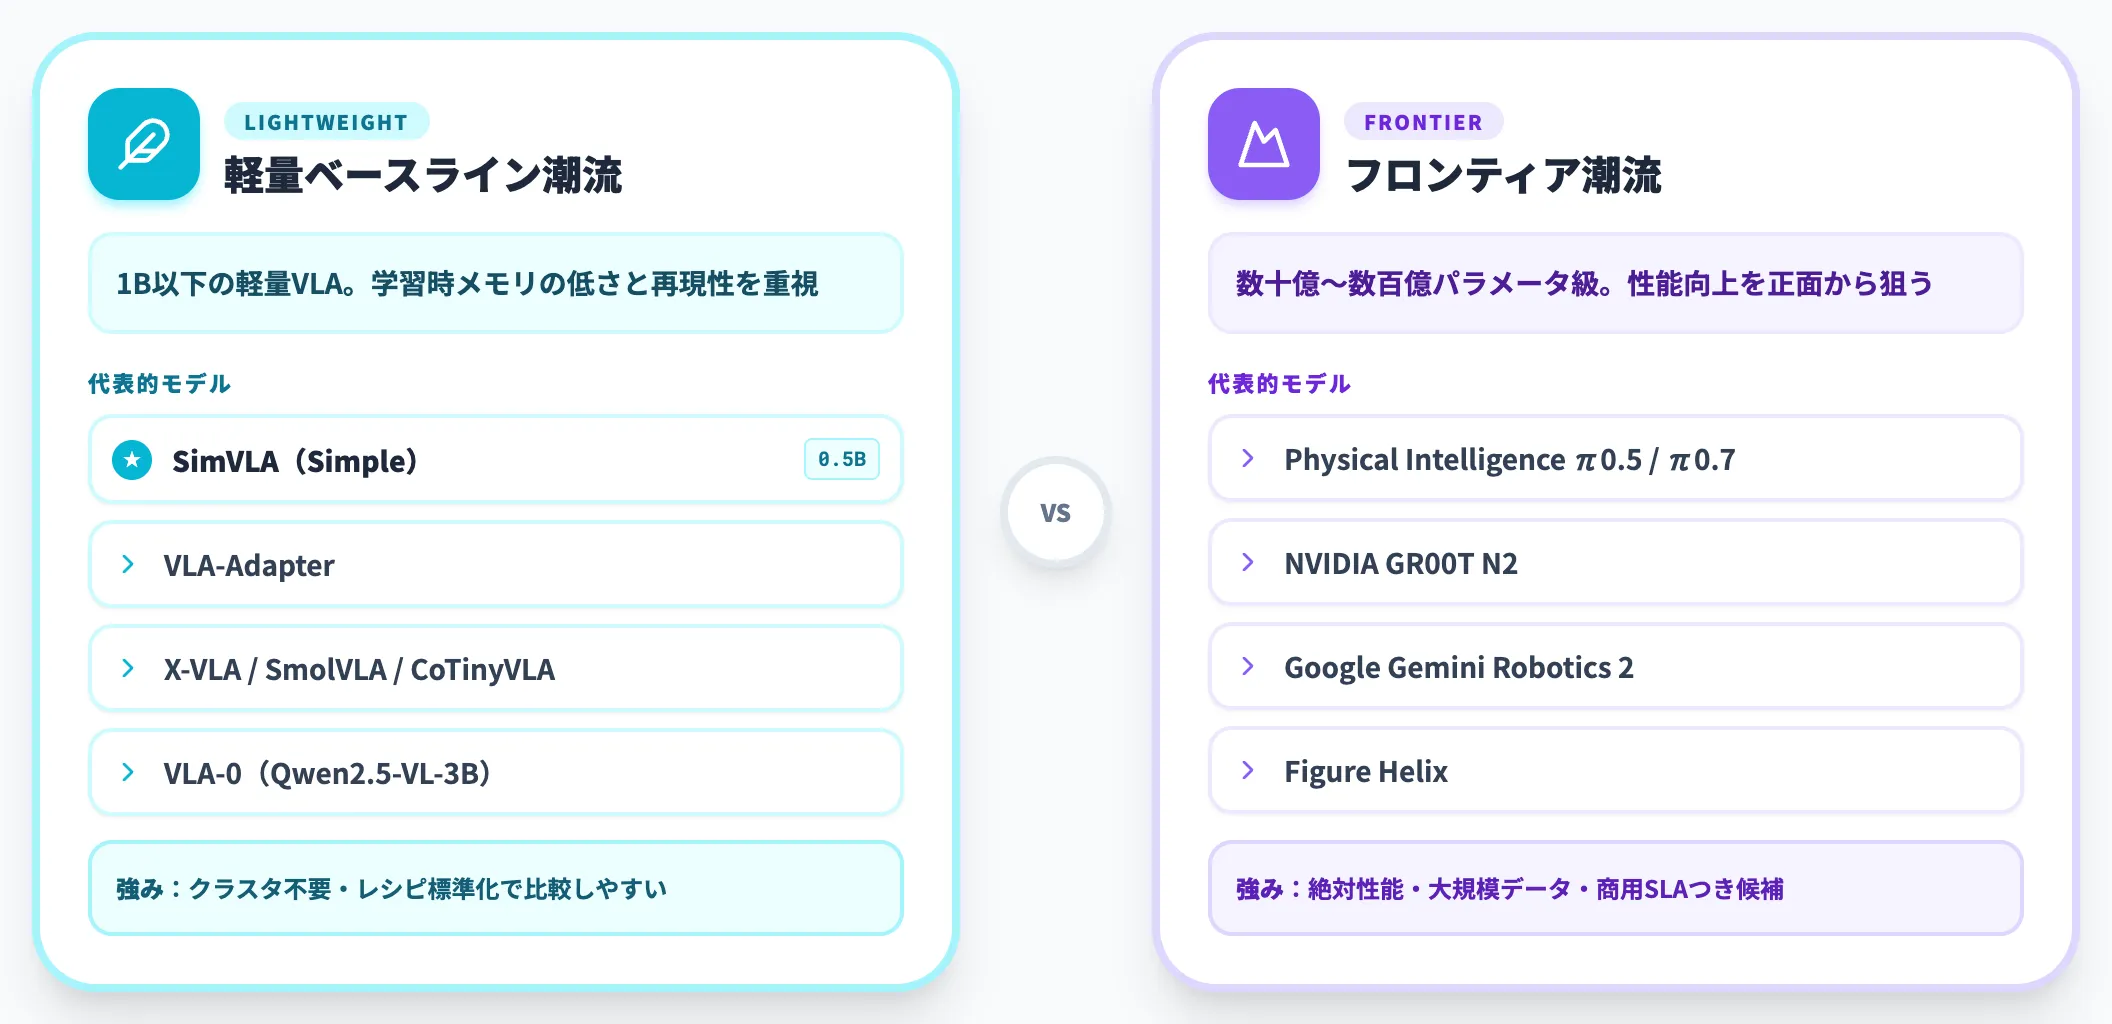
VLA研究は大きく2つの軸で分かれます。
-
フロンティア潮流
Physical Intelligence π0.5/π0.7・NVIDIA GR00T N2・Google Gemini Robotics 2・Figure Helixなど、数十億〜数百億パラメータ級の大型VLAで性能を伸ばす流派。詳細はPhysical Intelligence(π)の解説記事で扱っています
-
軽量ベースライン潮流
1B以下の軽量VLAで、学習時メモリの低さや再現性を重視する流派。SimVLA(Simple)はこの群に属し、同群にはVLA-Adapter・X-VLA・SmolVLA・CoTinyVLAなどが並ぶ。VLA-0(Qwen2.5-VL-3Bベース)はこの枠より一回り大きいが、同じ系譜で参照されることが多い
Sim-to-Real潮流とデータ収集コスト
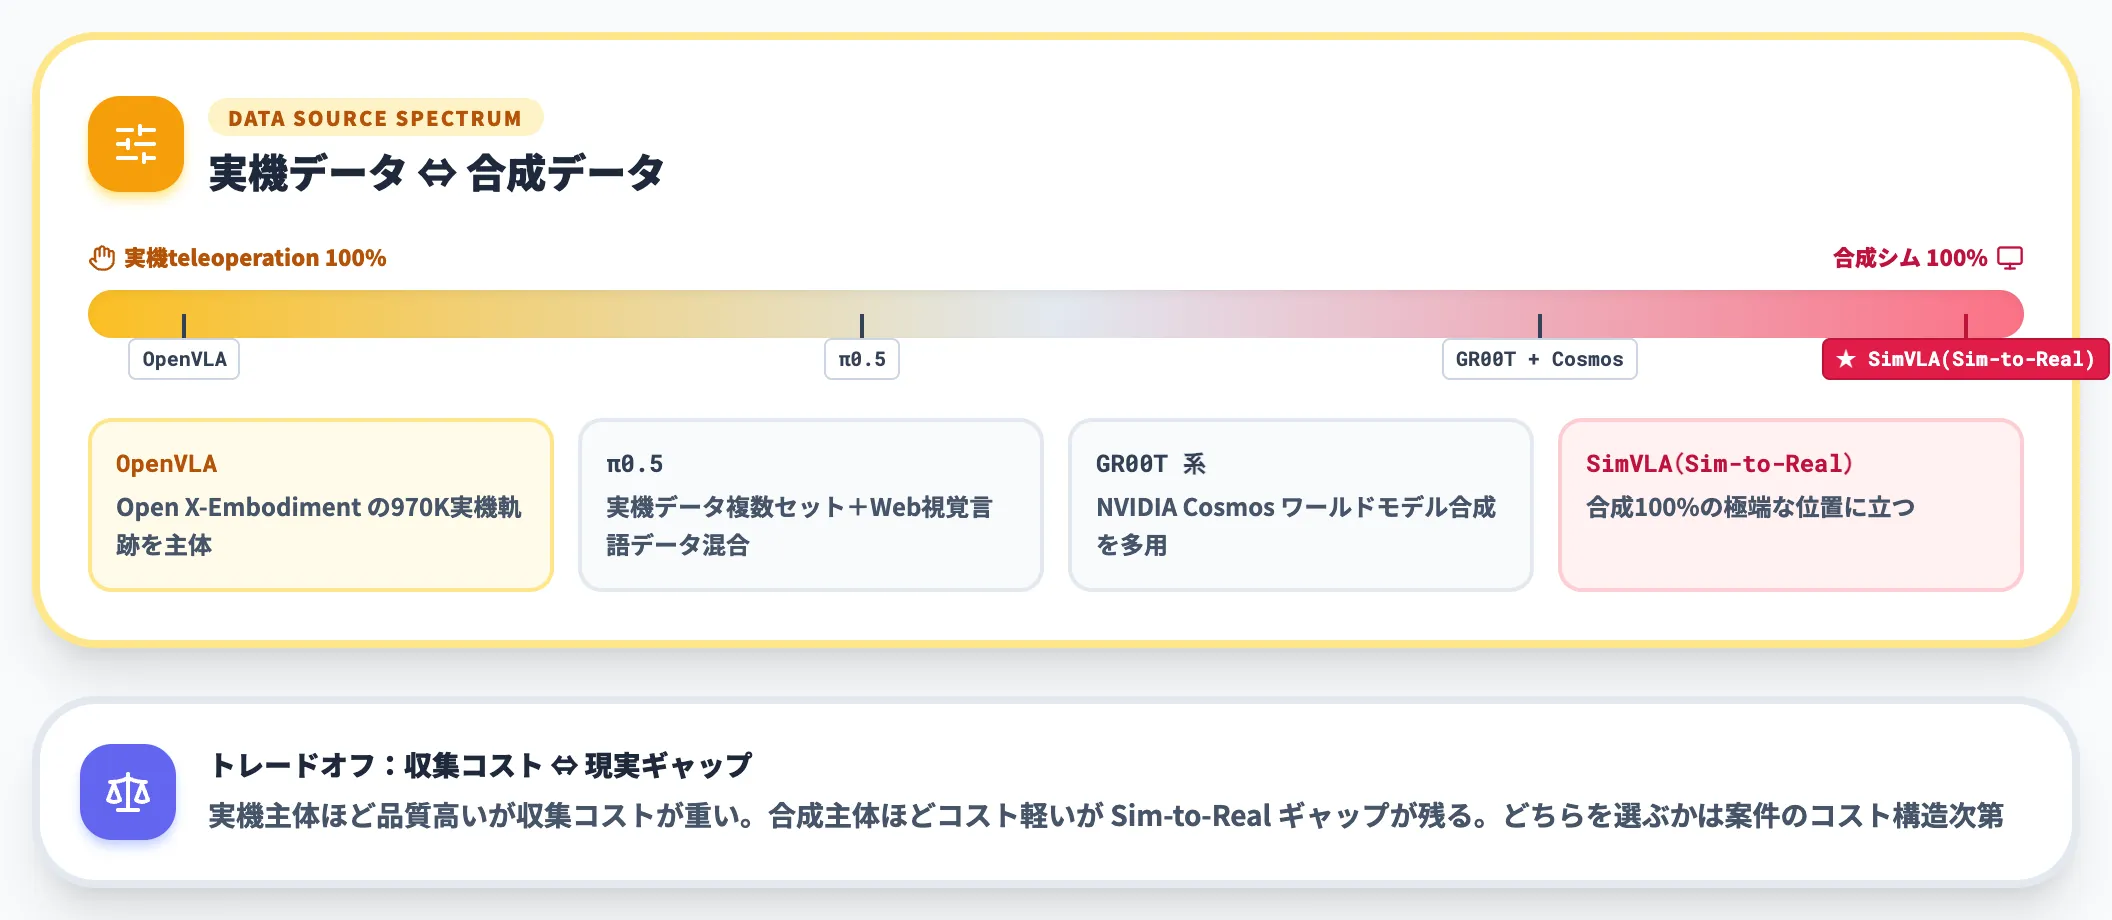
もう1つの軸がデータ源で、実機teleoperationデータに頼るか、合成シミュレーションデータに頼るかで分かれます。
OpenVLAは実機データ(Open X-Embodiment の970Kトラジェクトリ)主体、π0.5は複数の実機データセットとWeb由来の視覚言語データを混合する構成、GR00T系はNVIDIA Cosmosワールドモデルで生成した合成データを多用します。SimVLA(Sim-to-Real)はこの軸で「合成データ100%」の極端な位置に立ちます。
2つのSimVLAはどの潮流に属するか
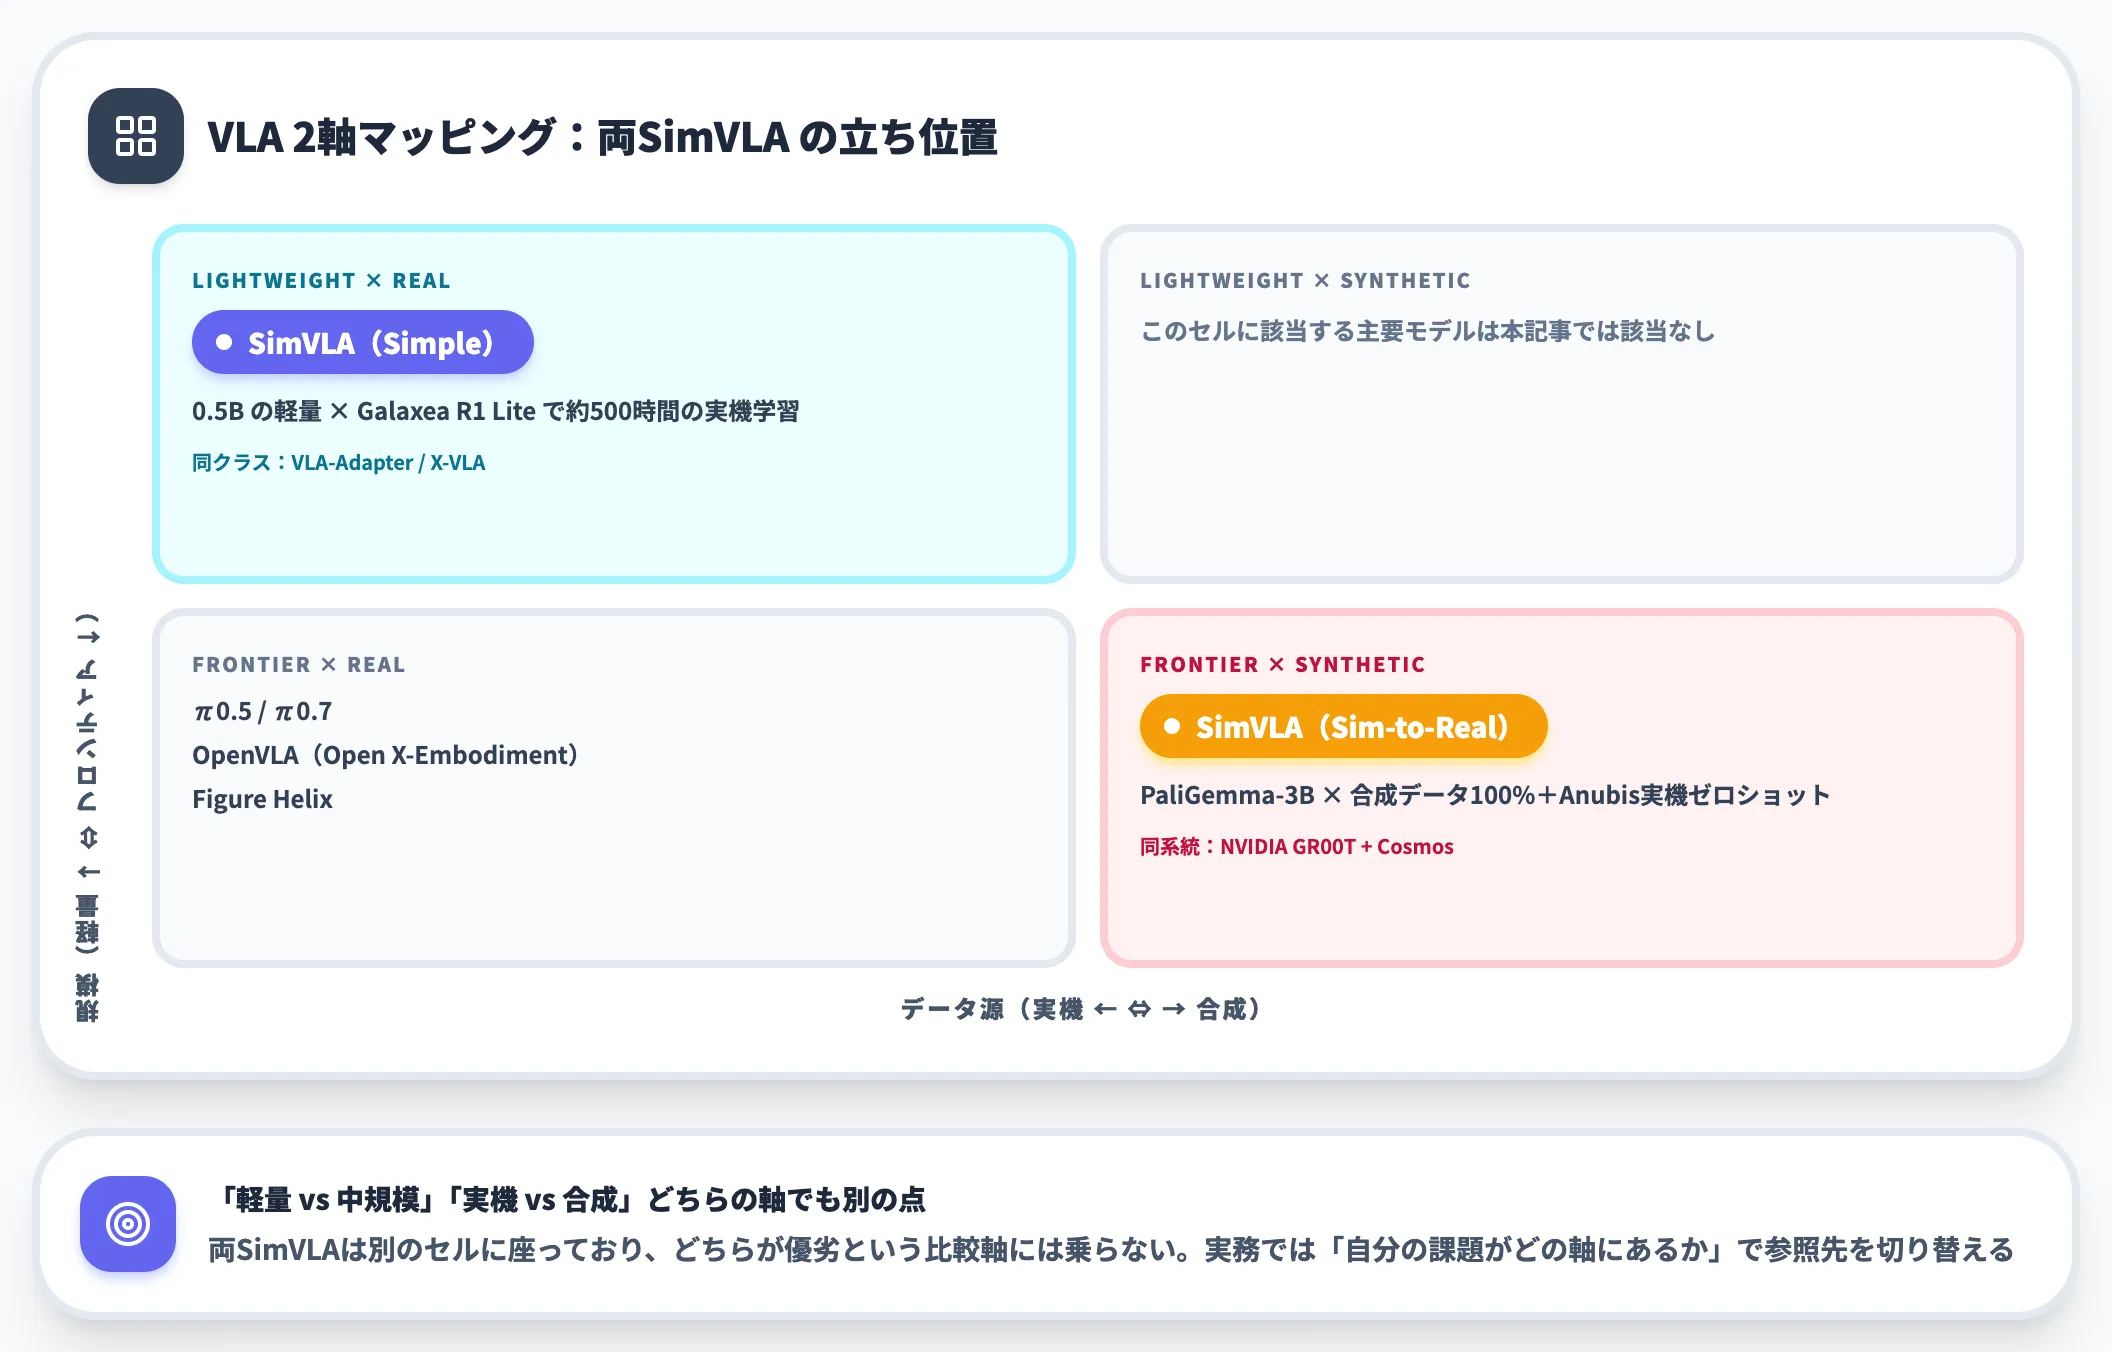
ここまでの軸でまとめると、2本のSimVLAはそれぞれ別の潮流の代表例として読み分けられます。
- SimVLA(Simple) → 軽量ベースライン潮流 × Galaxea R1 Liteで約500時間の実機データ学習+LIBEROのシム評価という組み合わせ
- SimVLA(Sim-to-Real) → PaliGemma-3Bという中規模VLM × 合成データ100%+Anubis実機でのゼロショット評価
「軽量 vs 中規模」「実機データ主体 vs 合成データ主体」のどちらの軸で見ても、両SimVLAは別の設計点に座っており、どちらが優劣という比較軸には乗りません。実務では「自分の課題がどの軸にあるか」で参照先を切り替えるのが正解です。
SimVLAのコードとモデルウェイト・自前環境での再現
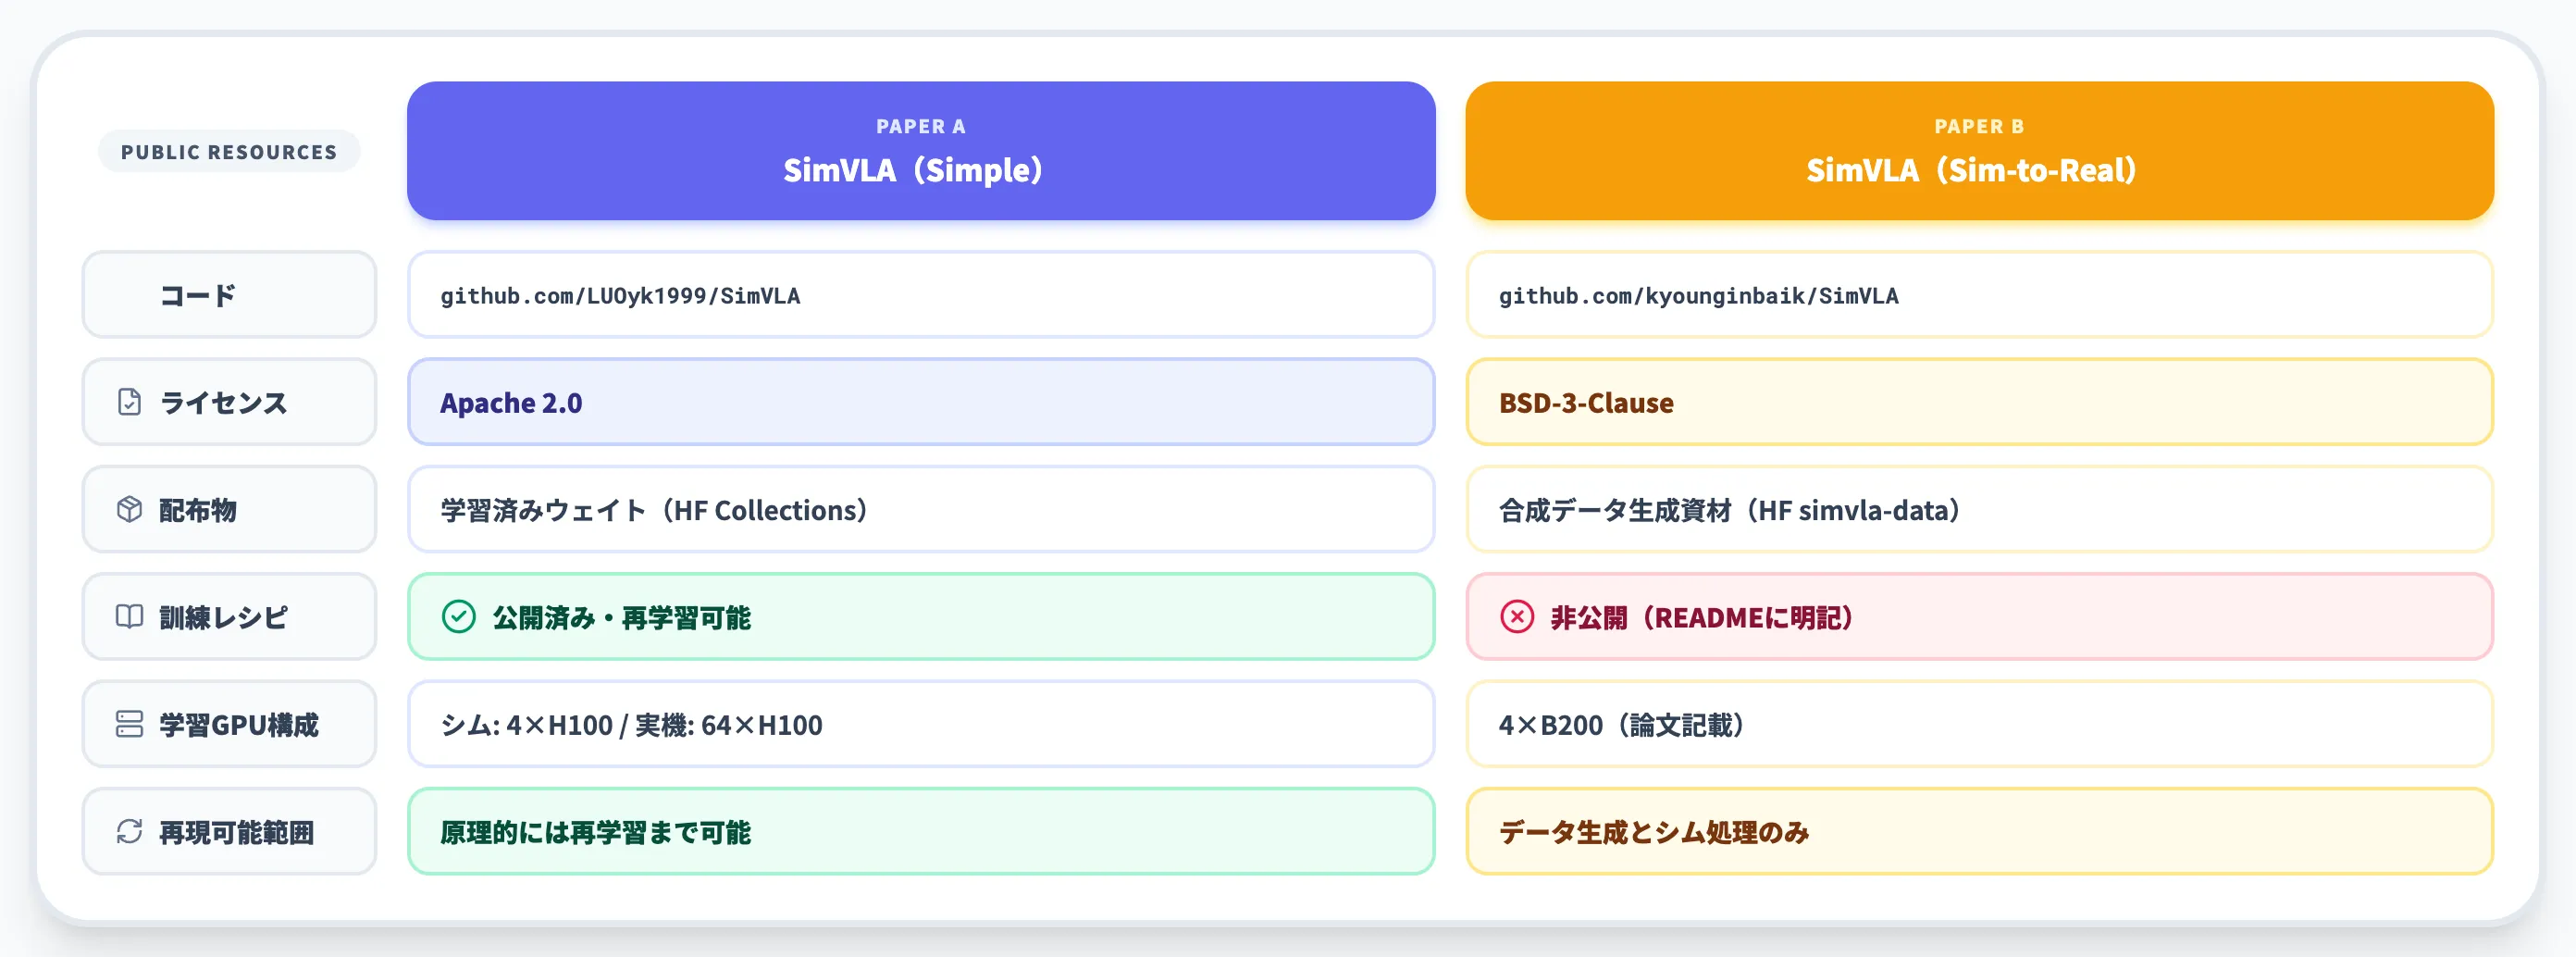
両SimVLAはいずれもGitHubとHugging Faceで公開されていますが、再現できる範囲は論文ごとに異なります。公開物の中身と、論文に書かれている学習構成を分けて見ていきます。
SimVLA(Simple)の公開リソース
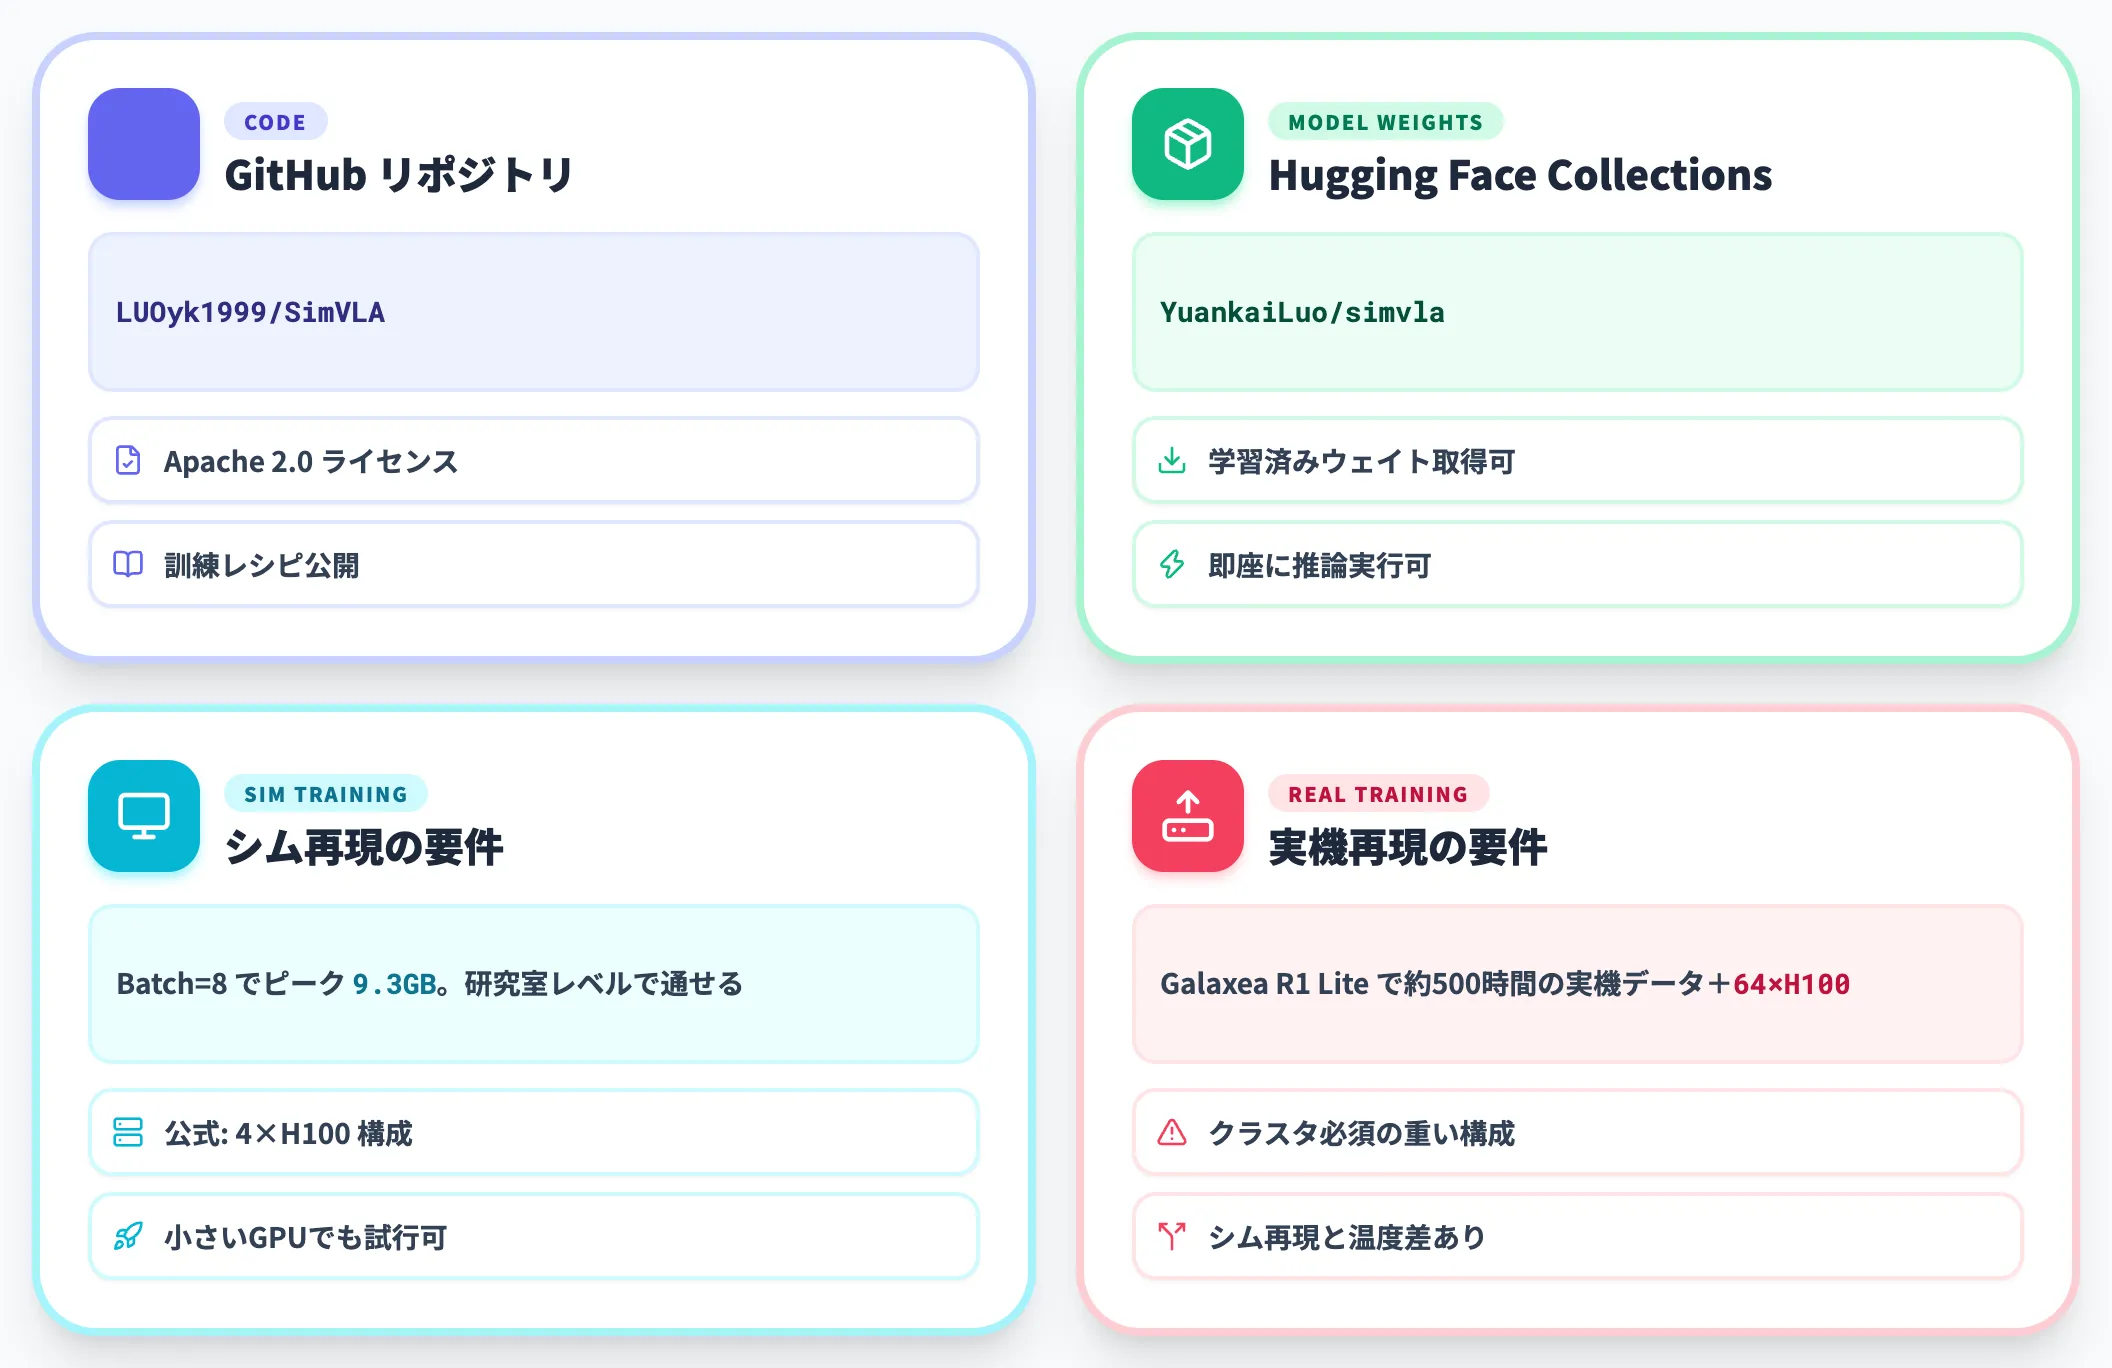
論文Aの実装はLUOyk1999/SimVLA(Apache 2.0)で公開され、学習済みウェイトはHugging Face Collectionsのsimvlaから入手できます。コード・ウェイト・訓練レシピがそろっているので、原理的には再学習まで通せる構成です。
論文によれば、学習時のメモリ要件はBatch=8でピーク9.3GB・学習実験はシム系が4×H100、Galaxea R1 Liteでの実機学習が64×H100という構成で行われています。手元の再現も、シム再現なら小さなGPU、実機データで学習し直すなら相応のクラスタという温度差で考える必要があります。
SimVLA(Sim-to-Real)の公開リソース
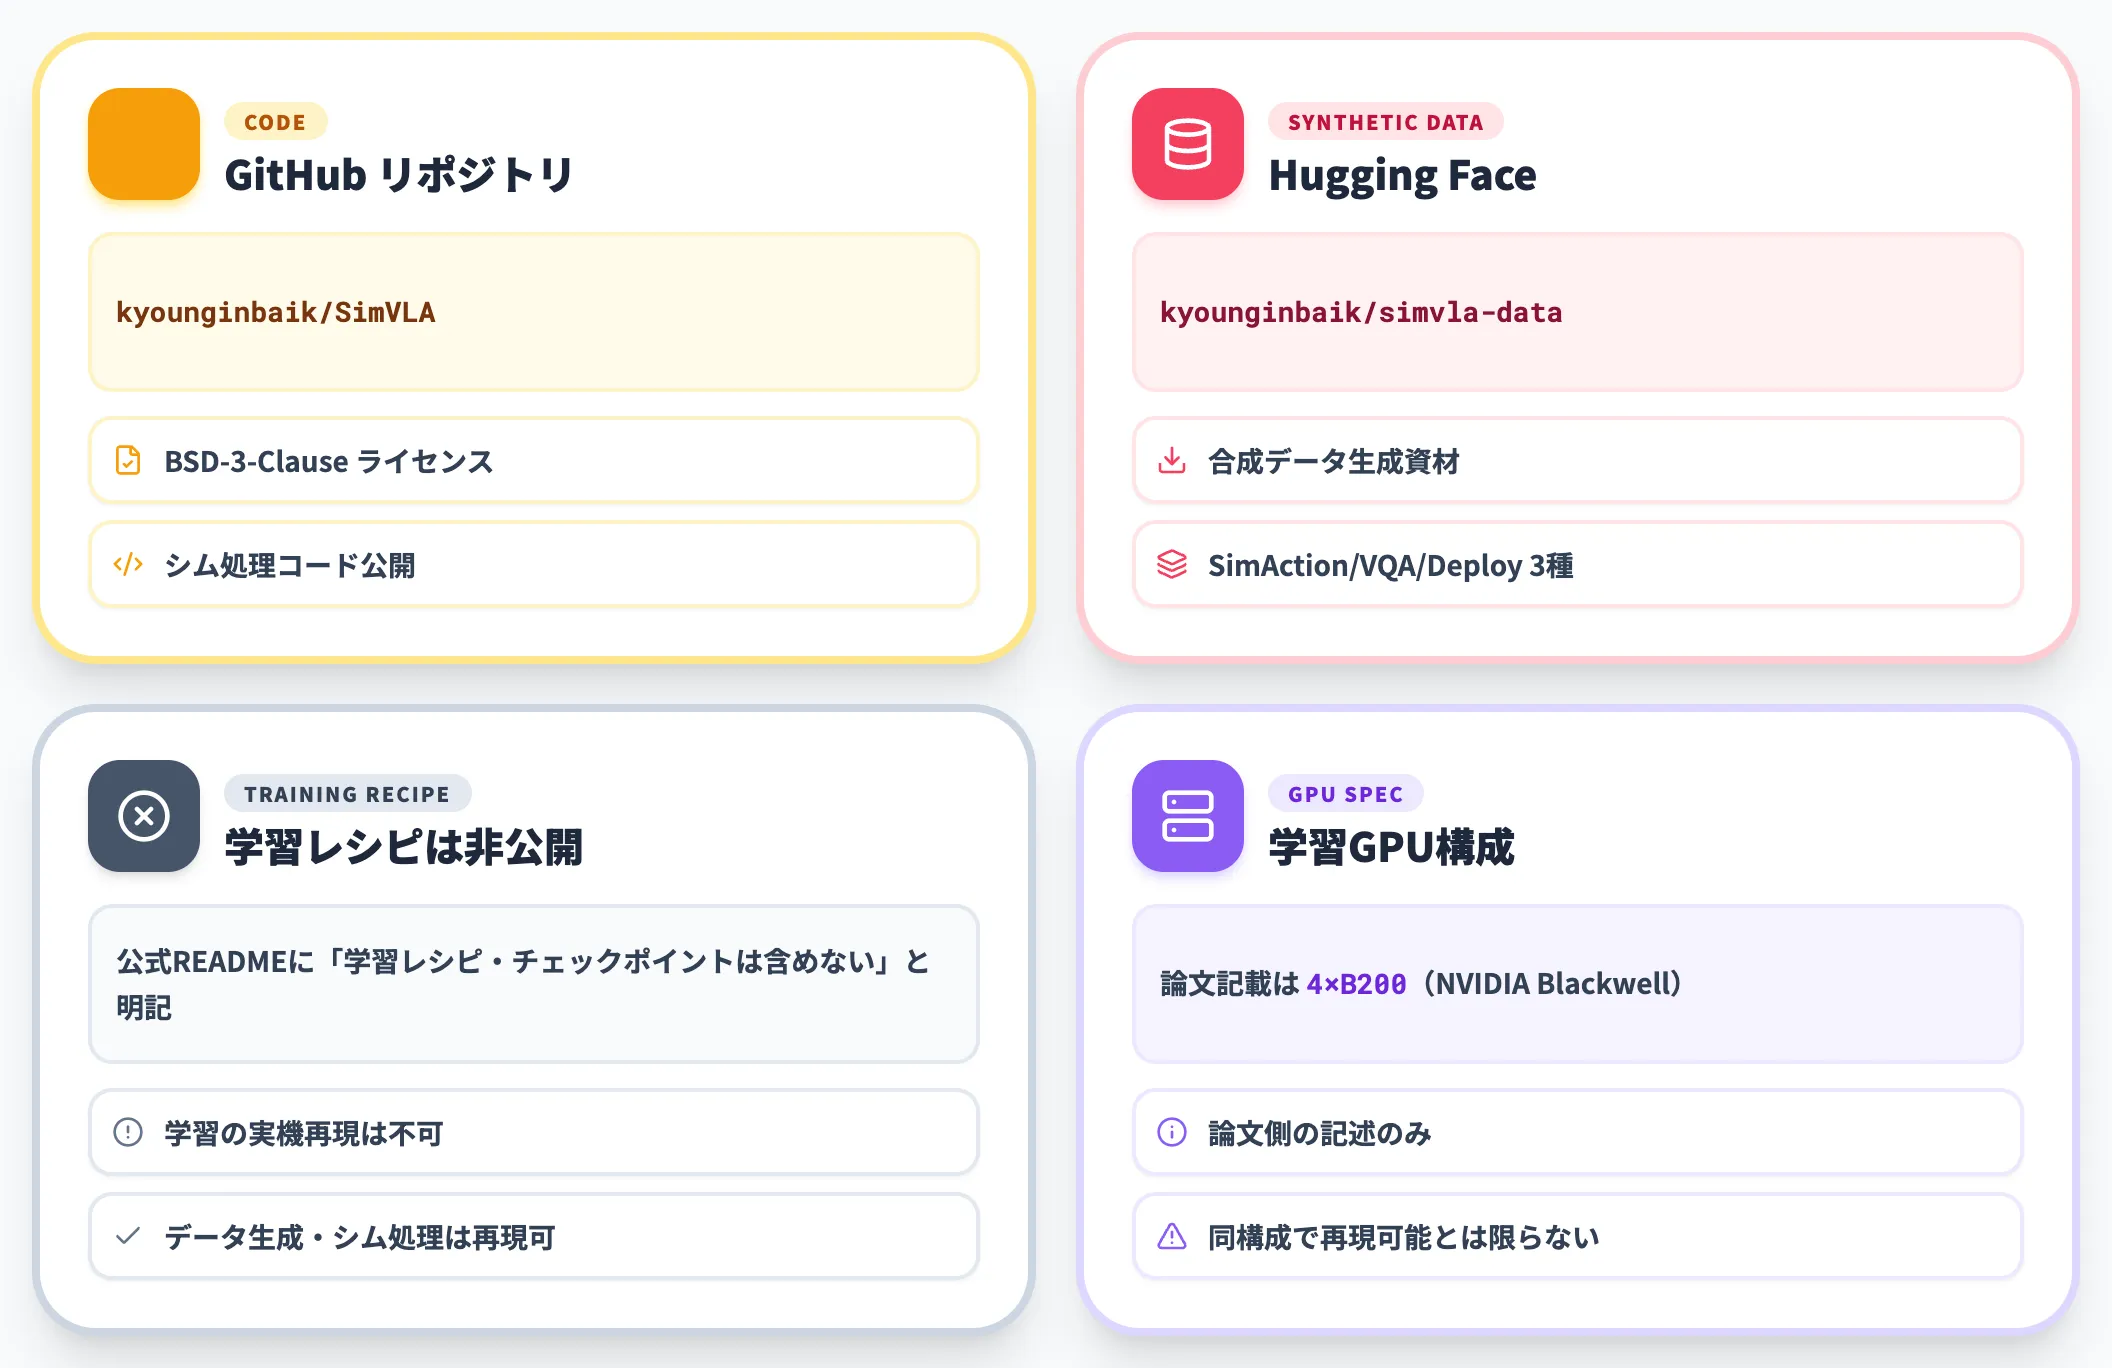
論文Bのコードはkyounginbaik/SimVLA(BSD-3-Clause)、合成データ生成資材はHugging Faceのsimvla-dataで公開されています。
ただし公式READMEと再現性資料は、学習レシピとチェックポイントをリポジトリに含めていないと明記しており、現状公開物で再現できるのはデータ生成とシミュレータ処理の範囲です。学習の実機再現は執筆時点では公開物だけでは完結しません。論文の学習構成としては4×B200が記載されていますが、ここは「論文側の記述」であって「同じ構成で誰でも再現できる」という意味ではない点に注意が必要です。
自前で動かす前のチェック項目
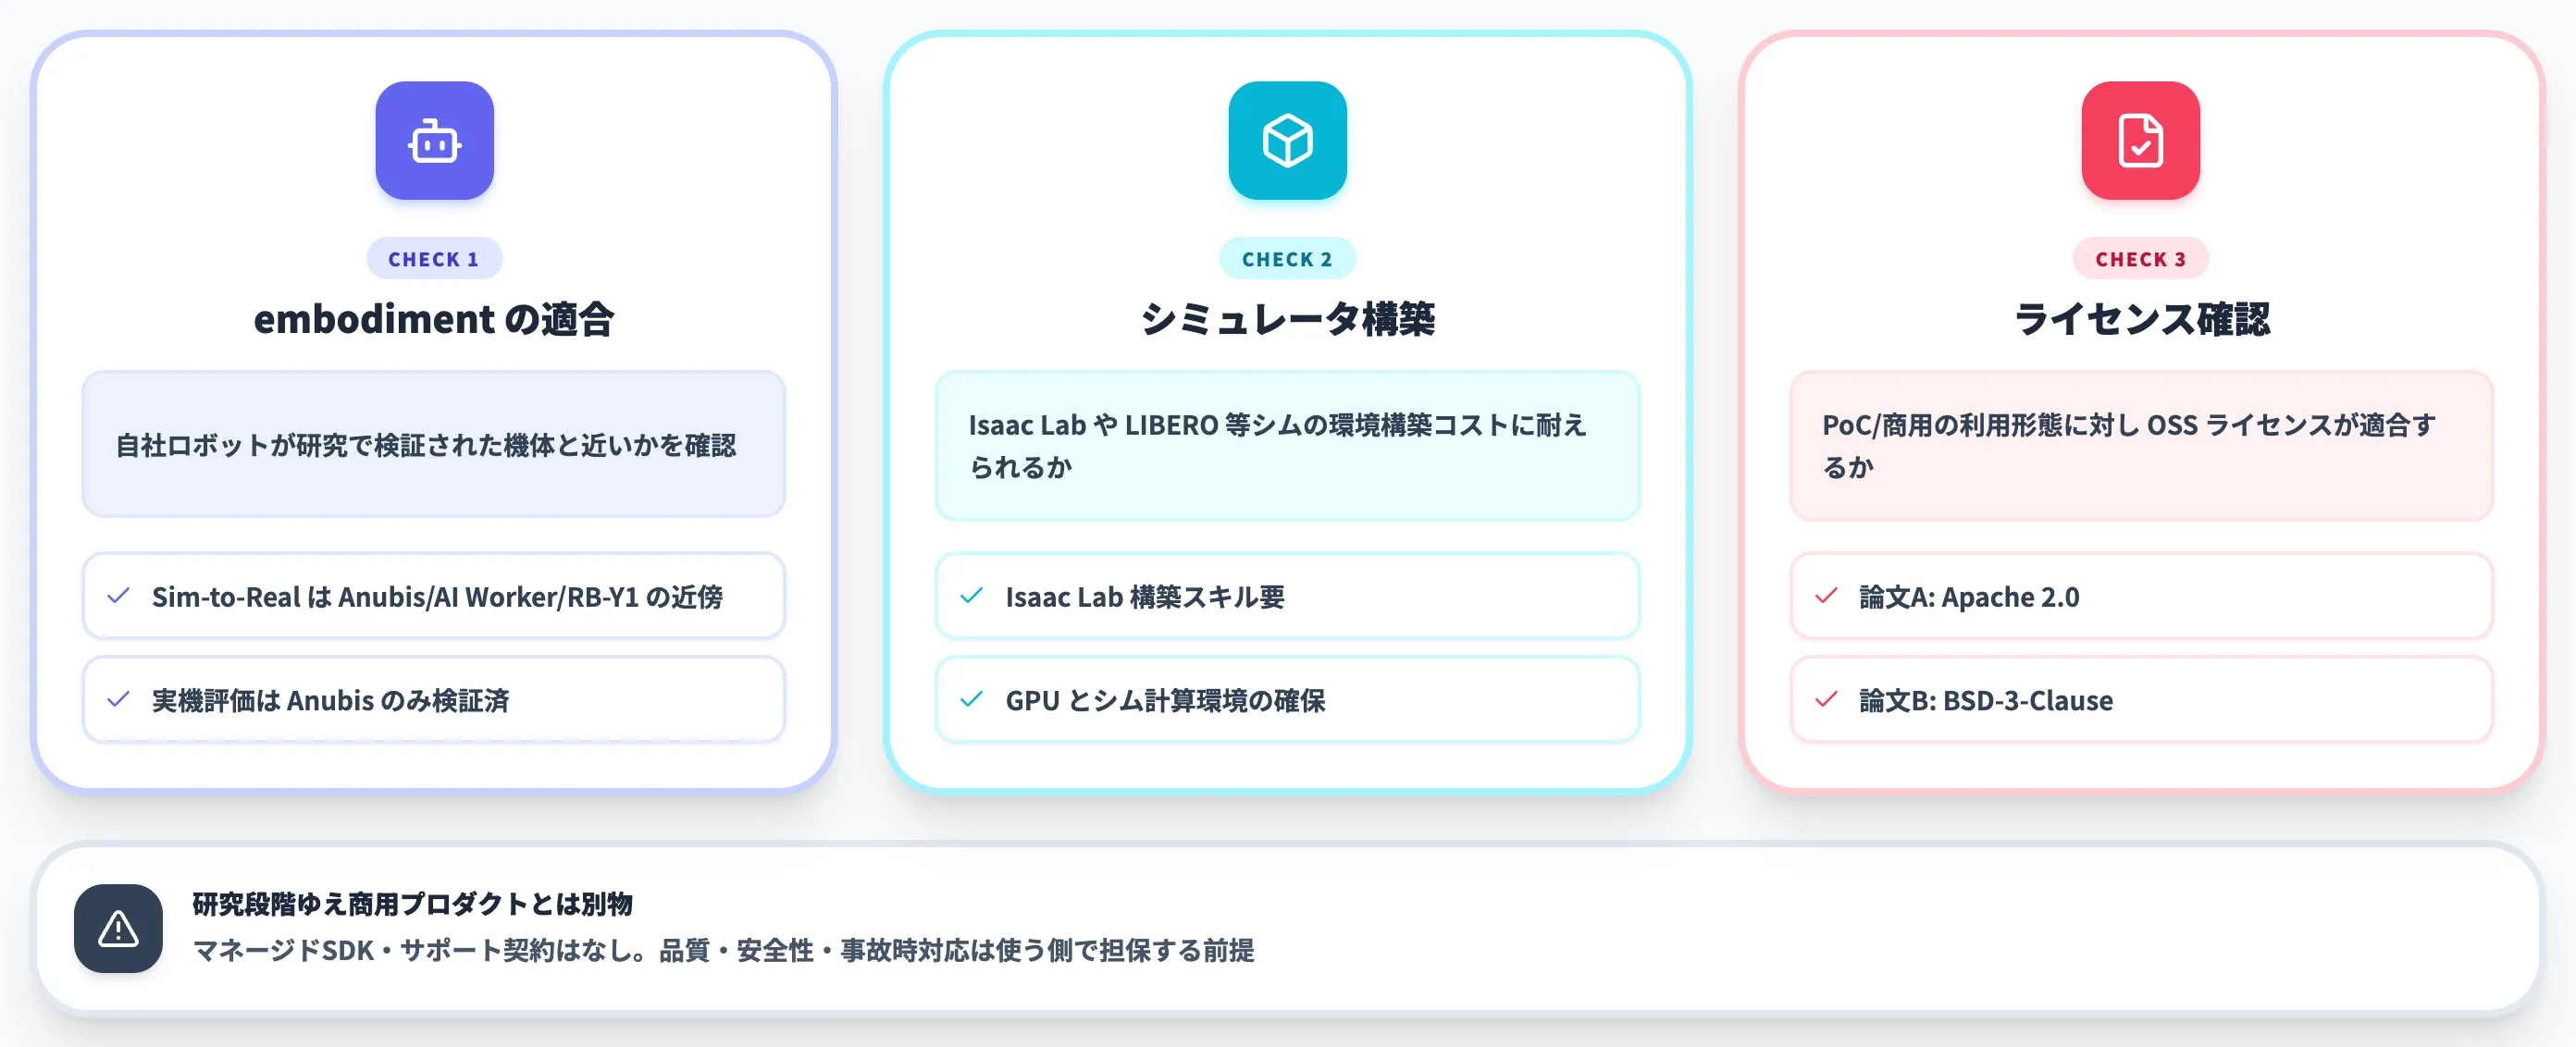
いずれのSimVLAも研究段階のため、商用プロダクト(マネージドSDK・APIで提供されるVLA基盤)とは異なり、追加のサポート契約や保証は付きません。自前環境で動かす前に、以下を押さえておく必要があります。
- 対応するロボットembodimentが研究で検証された機体と近いか(SimVLA Sim-to-Realは Anubis・AI Worker・RB-Y1 の3機体でシム学習、実機評価は Anubis のみ)
- Isaac LabやLIBEROシミュレータの環境構築コストに耐えられるか
- Hugging Faceのウェイトとコードのライセンス(論文A: Apache 2.0、論文Bコード: BSD-3-Clause)がPoCの利用形態に合うか
どちらのSimVLAを選ぶべきか——用途別の判断軸
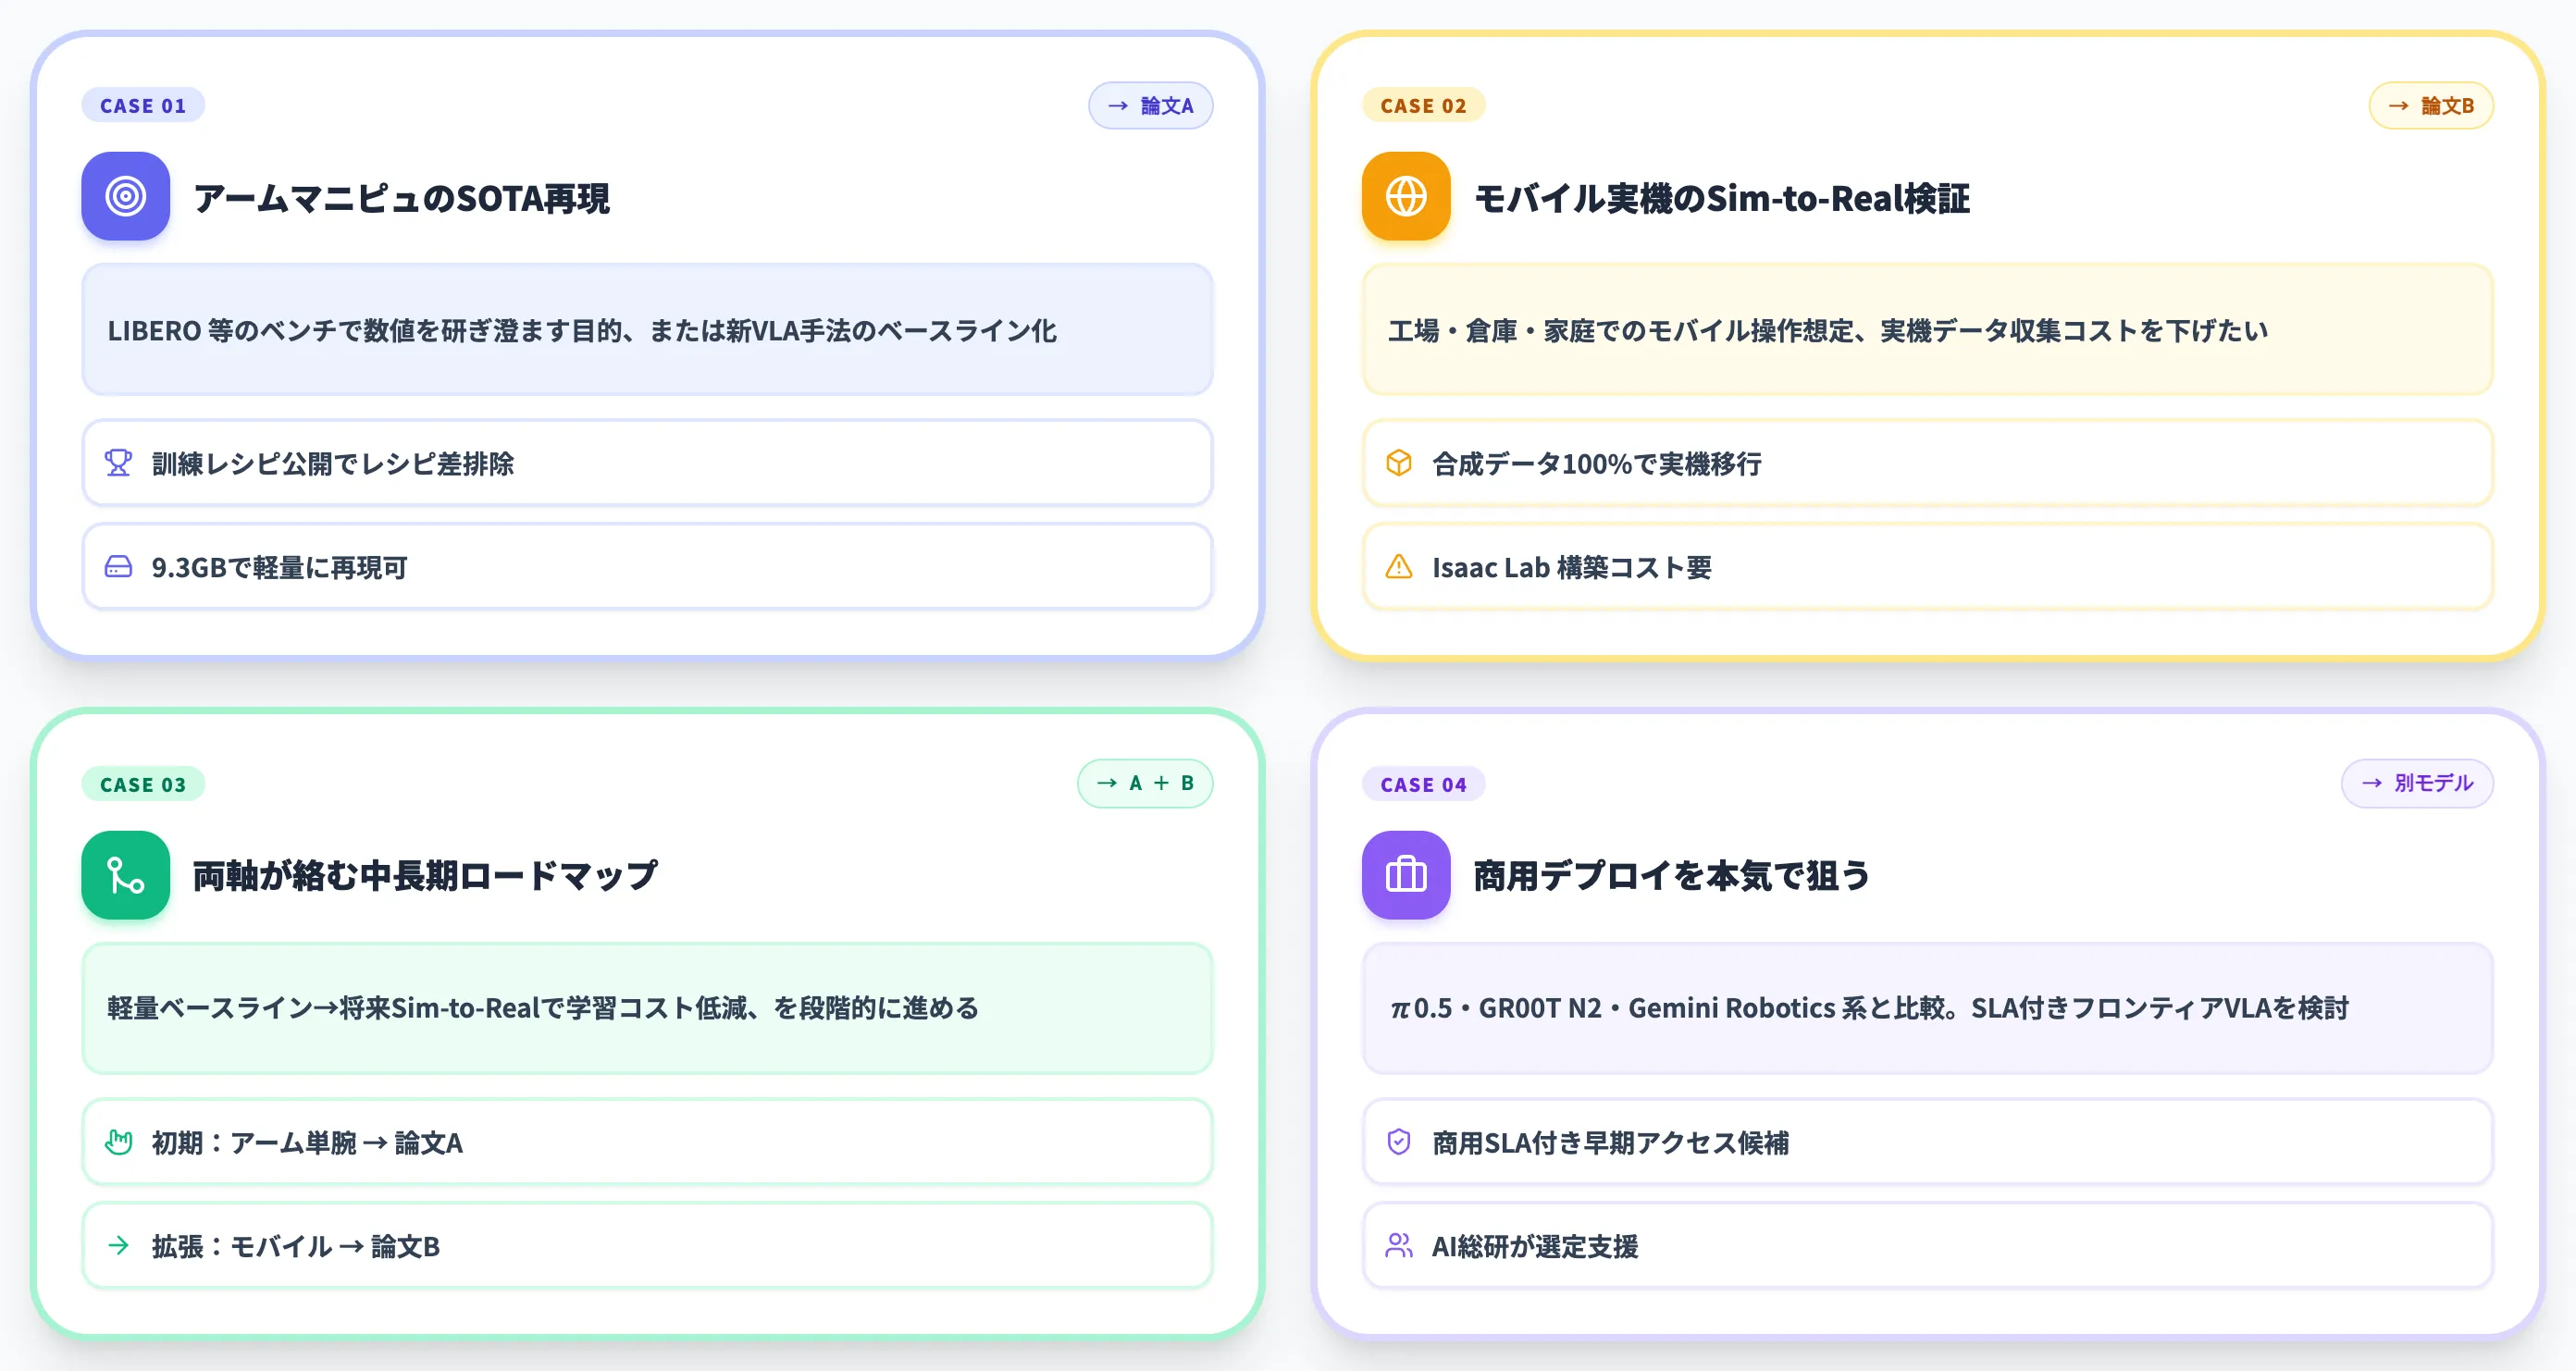
同名の2論文は、問いが別なのでどちらを参照すべきかは用途で決まります。AI総研が実装支援でVLAを選ぶ際の判断軸を踏まえて、ケース別に推奨を整理します。
LIBERO・アームマニピュのSOTA再現が目的 → 論文A
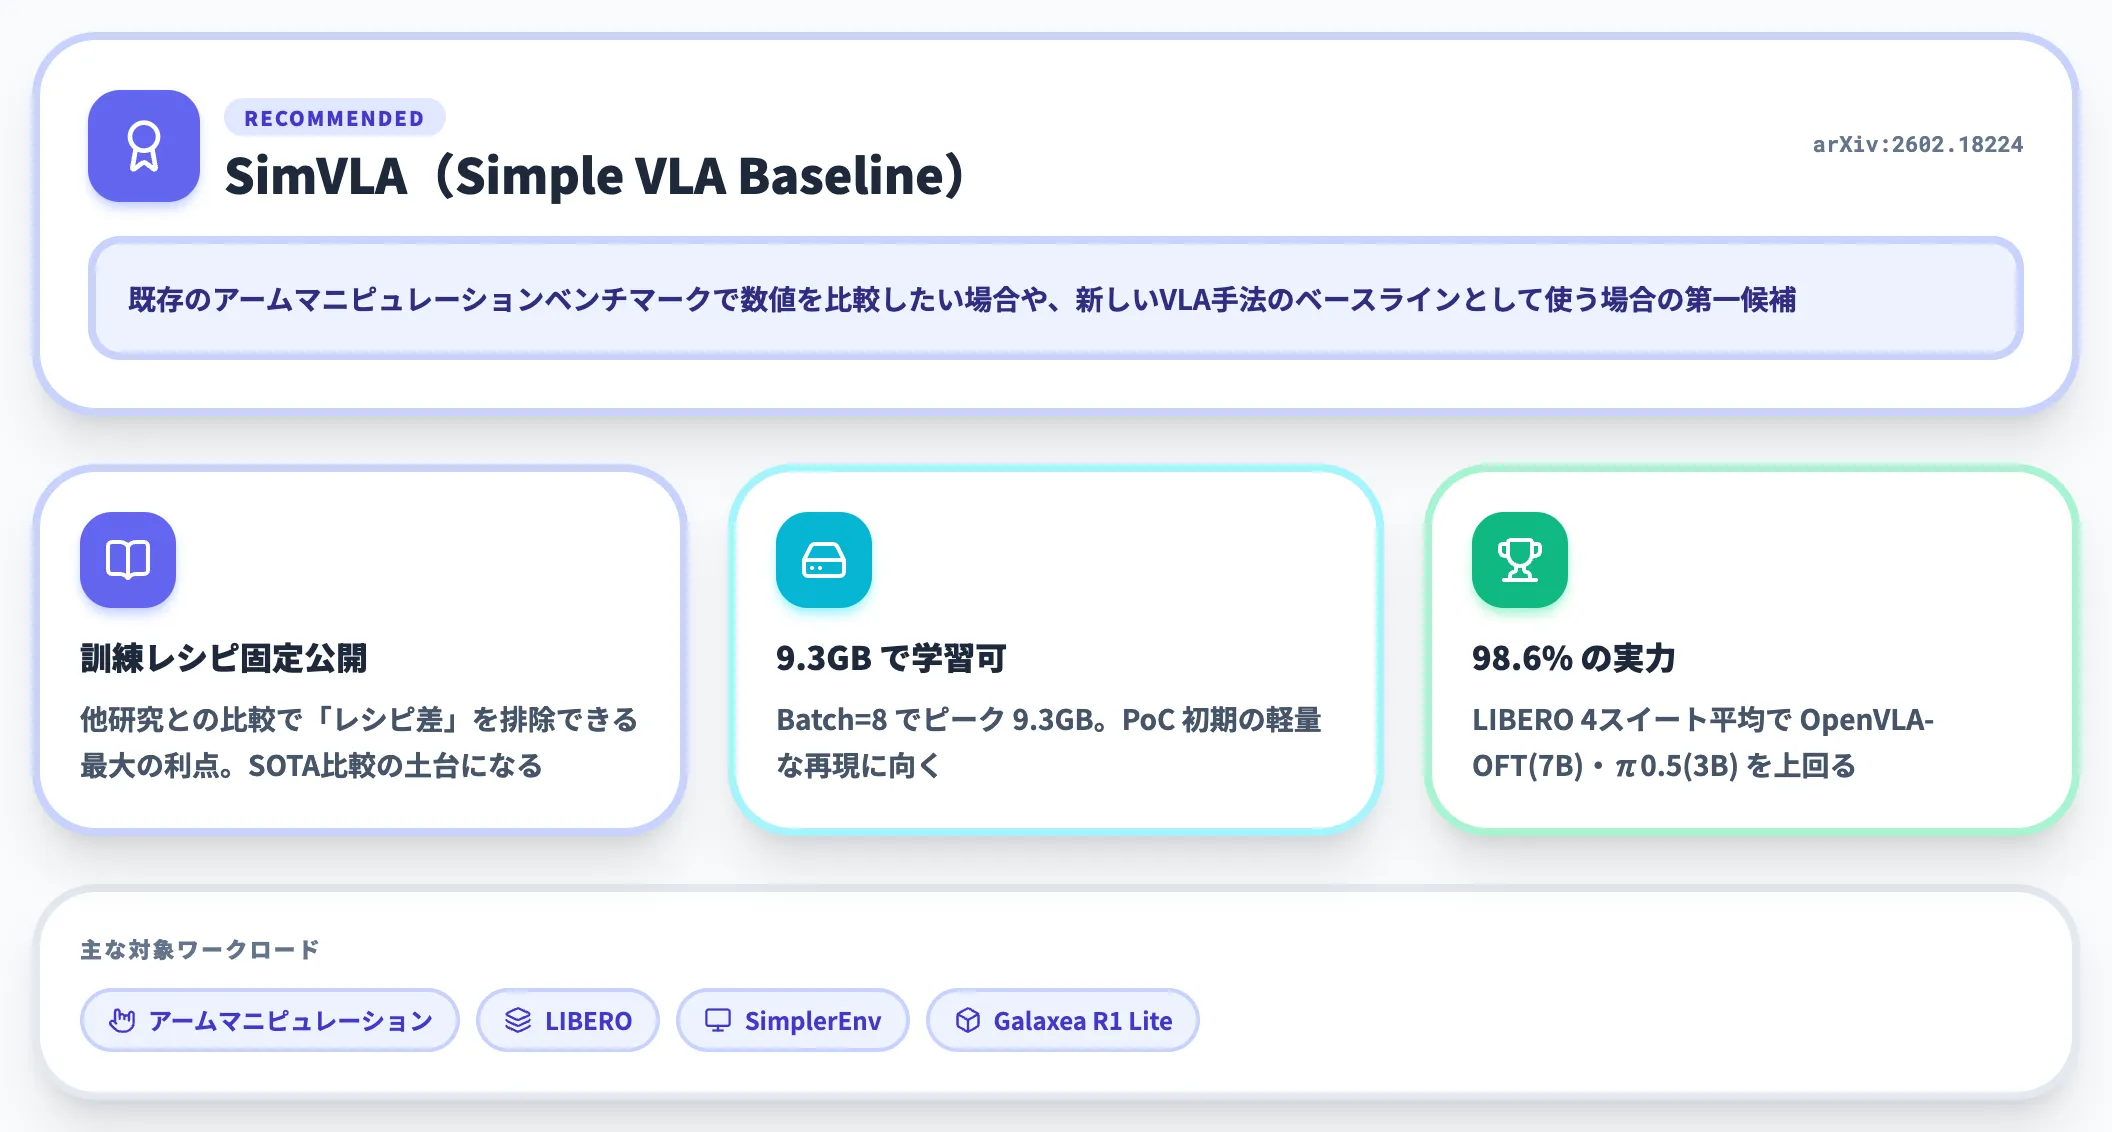
既存のアームマニピュレーションベンチマークで数値を比較したい場合や、新しいVLA手法のベースラインとして使いたい場合は、論文A(Simple VLA Baseline)が第一候補です。
訓練レシピが固定公開されており、他研究との比較で「レシピ差」を排除できる点が最大の利点です。学習時メモリがBatch=8でピーク9.3GBに収まるため、PoC初期の軽量な再現にも向きます。
モバイル実機のSim-to-Real検証が目的 → 論文B
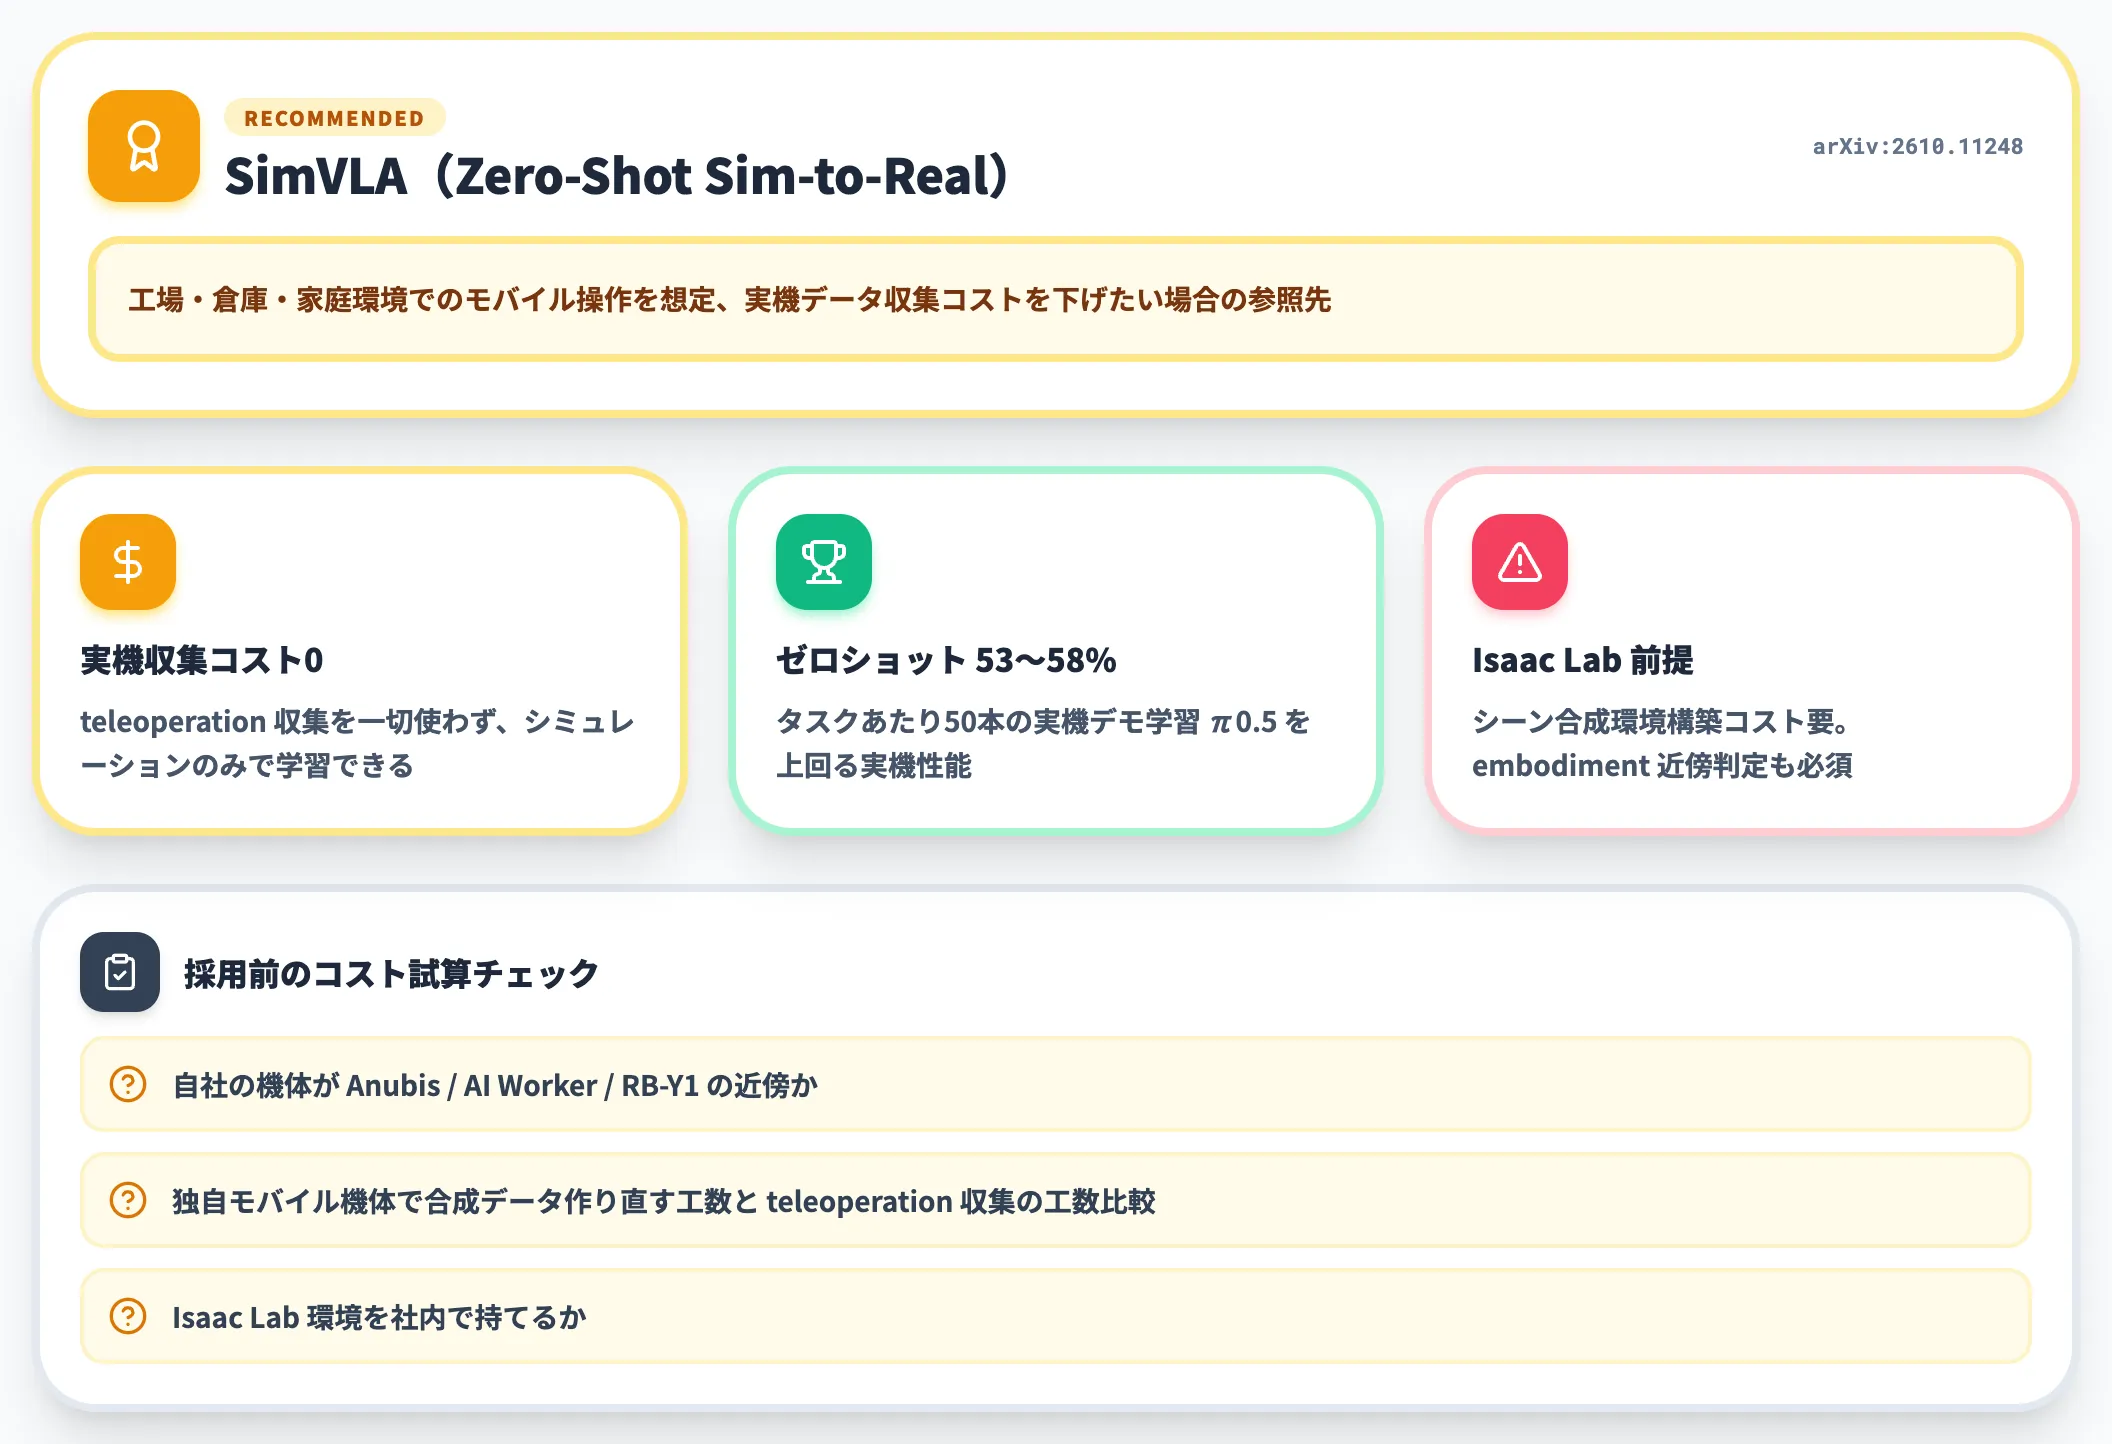
工場・倉庫・家庭環境でのモバイル操作を想定していて、実機データ収集コストを下げたい場合は、論文B(Zero-Shot Sim-to-Real)が参照先になります。
ただし、Isaac Labでのシーン合成環境構築と、Anubis/AI Worker/RB-Y1近傍のembodimentが前提となる点に注意が必要です。独自のモバイル機体で合成データを作り直す工数が、実機teleoperation収集と比べて本当に軽いかは案件ごとに試算すべきです。
両方の軸が絡む場合は組み合わせ検討
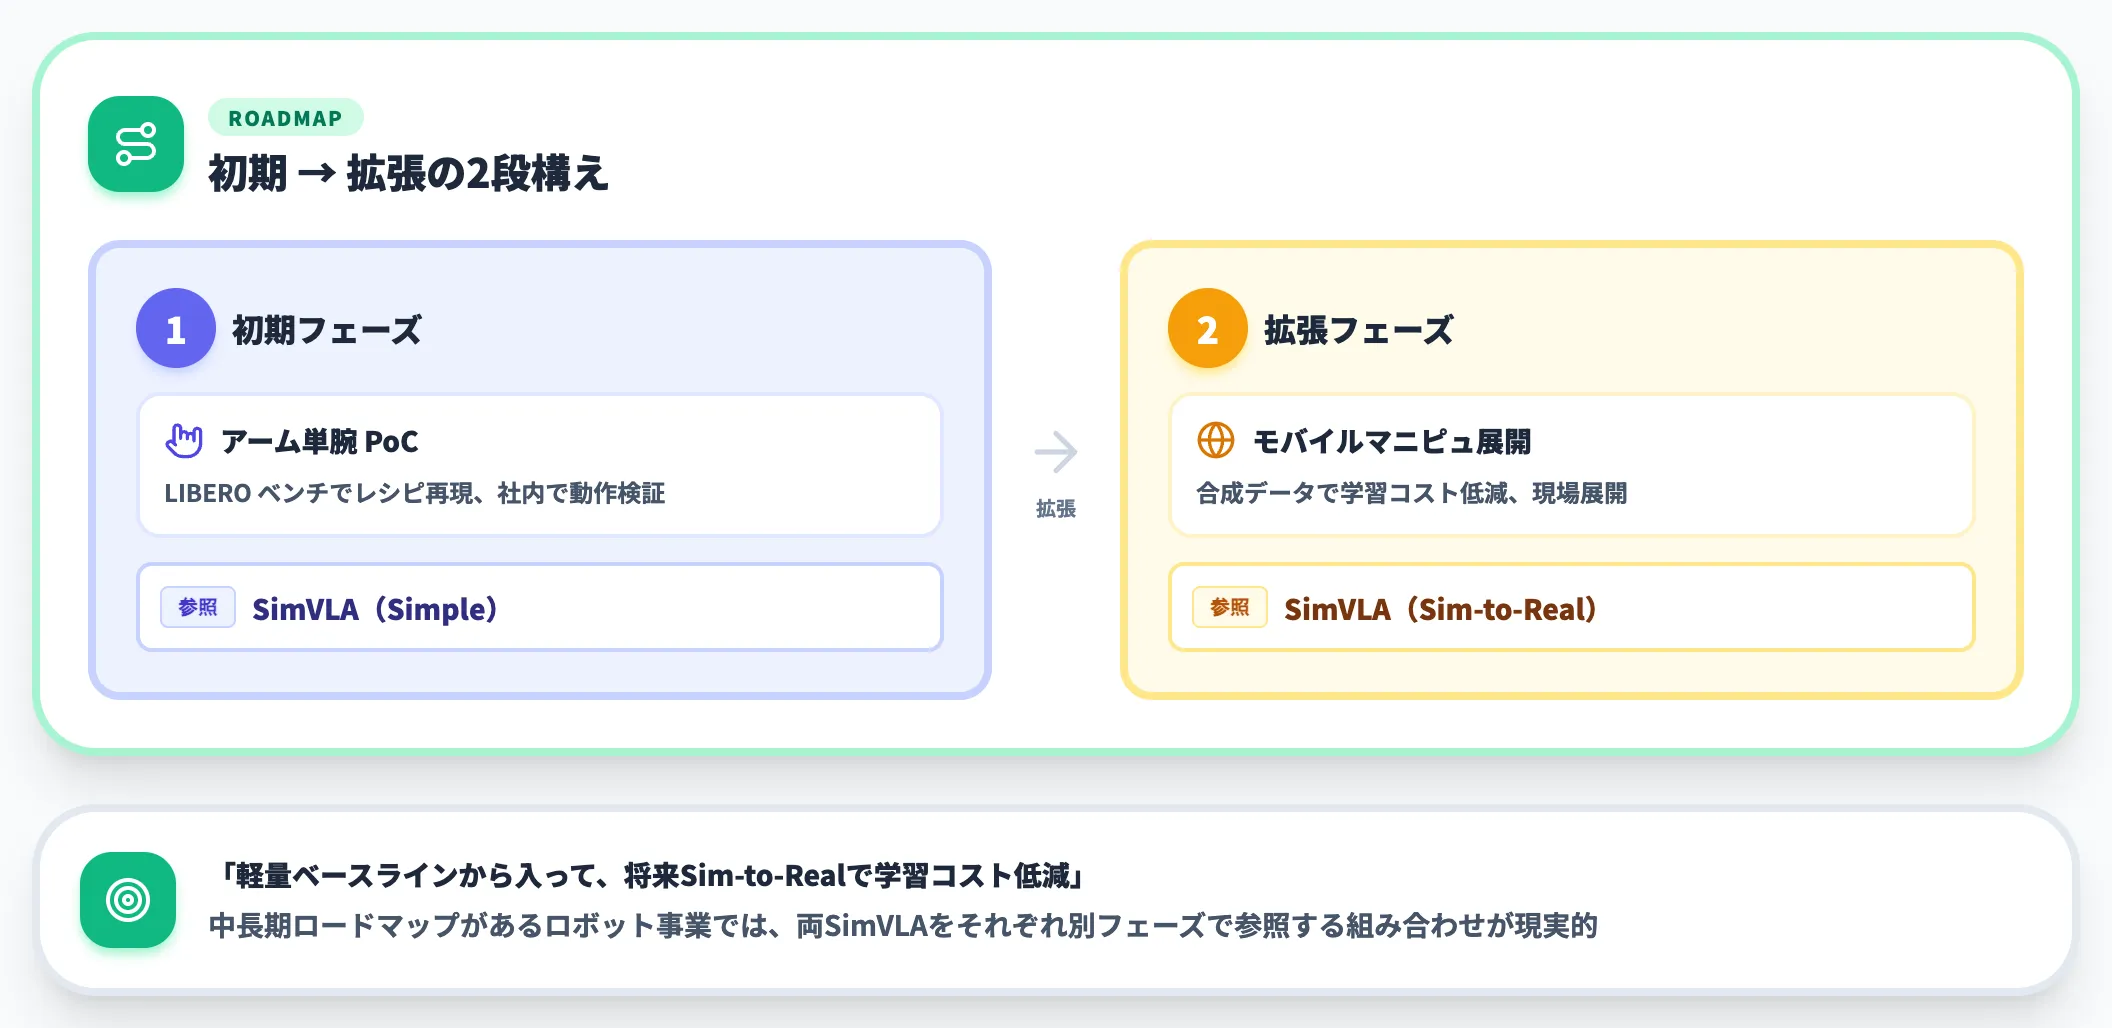
ロボット事業で「軽量ベースラインから入って、ゆくゆくはSim-to-Realで学習コストを下げたい」という中長期ロードマップを描く場合、両SimVLAをそれぞれ別フェーズで参照する組み合わせも成立します。
初期のアーム単腕PoCでは論文Aをベースラインに、拡張時のモバイルマニピュでは論文Bのパイプラインを採用する2段構えが現実的です。
商用デプロイを前提とするなら軸ごと別モデルも検討
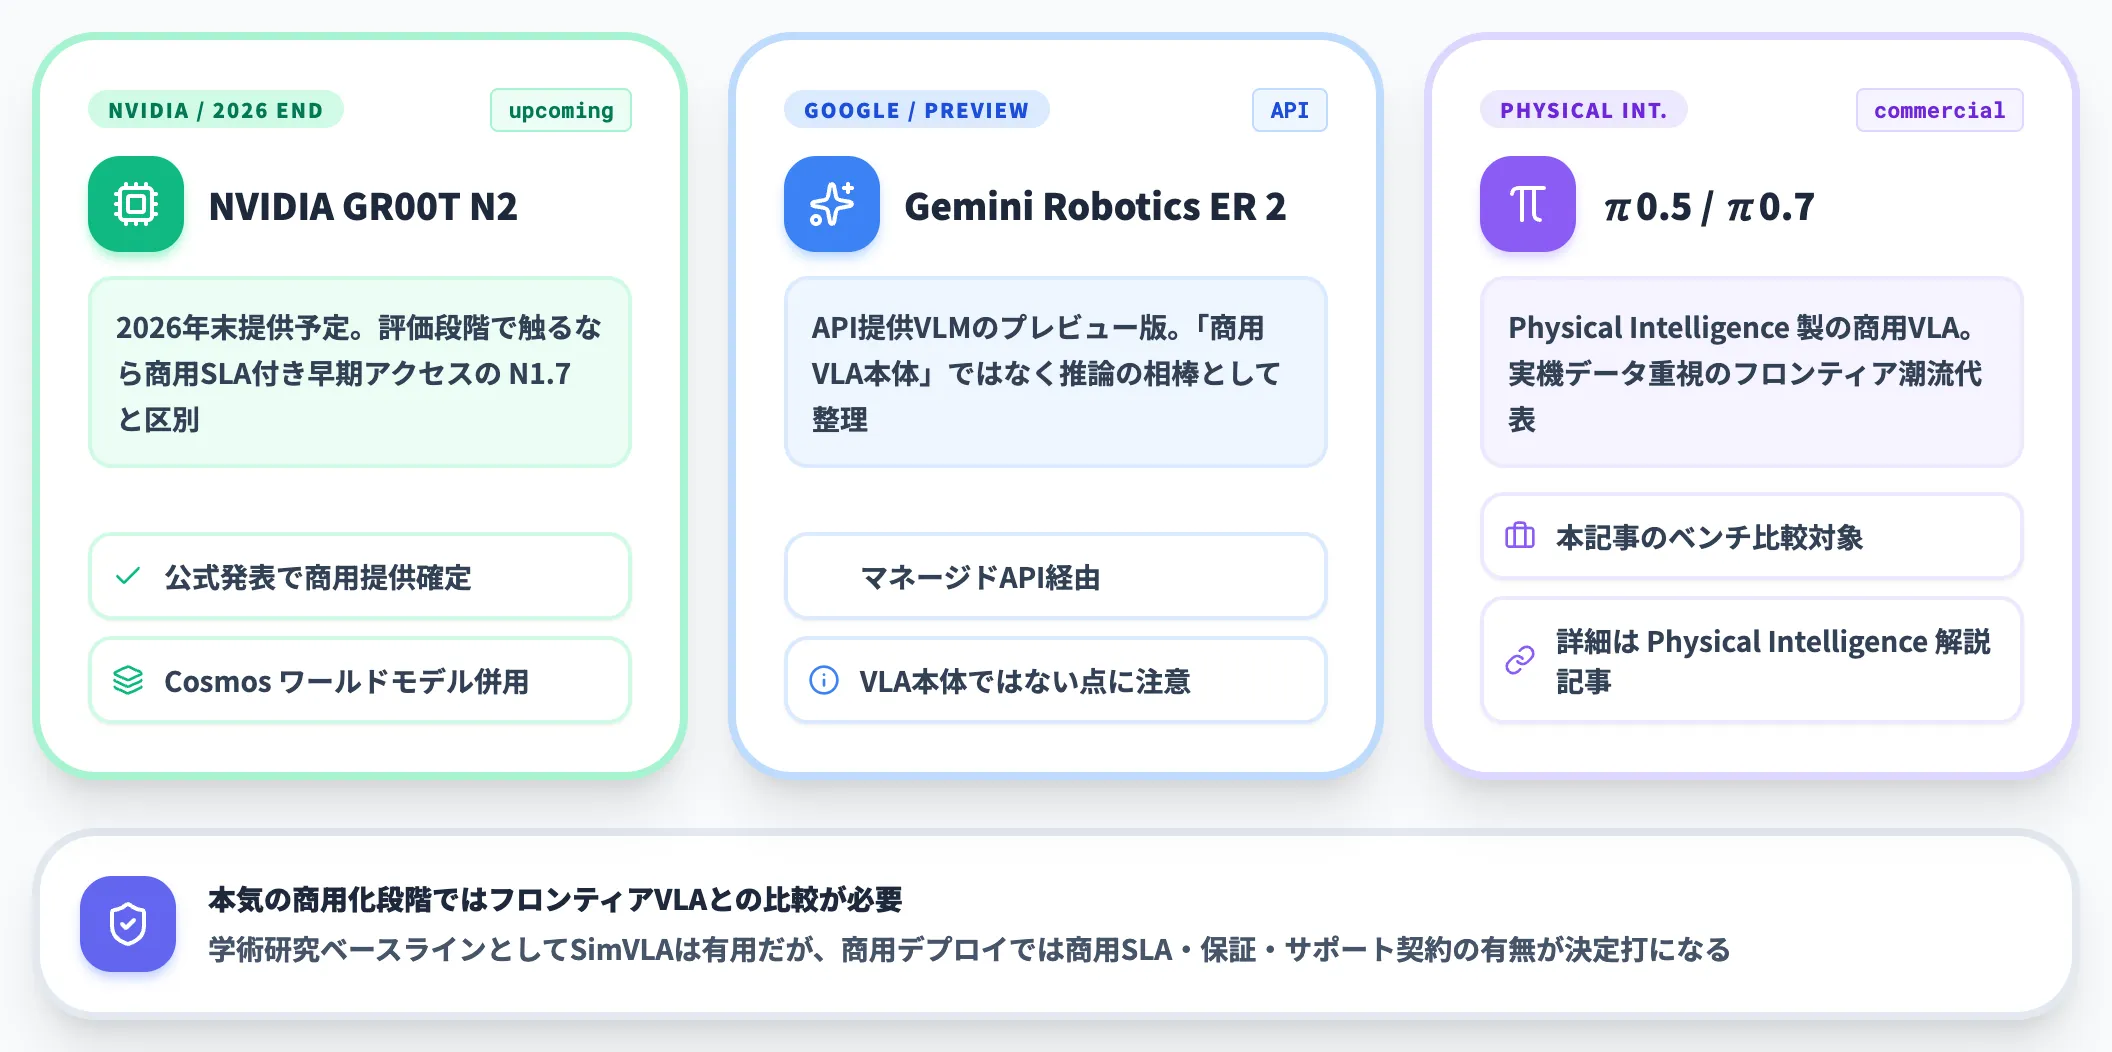
学術研究のベースラインとしては両SimVLAが有用ですが、商用デプロイを本気で狙う段階ではπ0.5・GR00T系・Gemini Robotics系などのフロンティアVLAとの比較が必要になります。
NVIDIA GR00T N2はNVIDIA公式発表で2026年末提供予定と告知されており、評価段階で触れるなら商用ライセンス付き早期アクセスのGR00T N1.7と区別して扱うのが安全です。Google Gemini Robotics ER 2はAPI提供されるVLMのプレビュー版として整理され、「商用VLA本体」ではなく推論の相棒として位置づけるのが正確です。全体像はVLAモデルとはの解説記事で扱っているので、商用化の意思決定にはそちらを合わせて参照いただくのが便利です。
SimVLA研究の限界と注意点
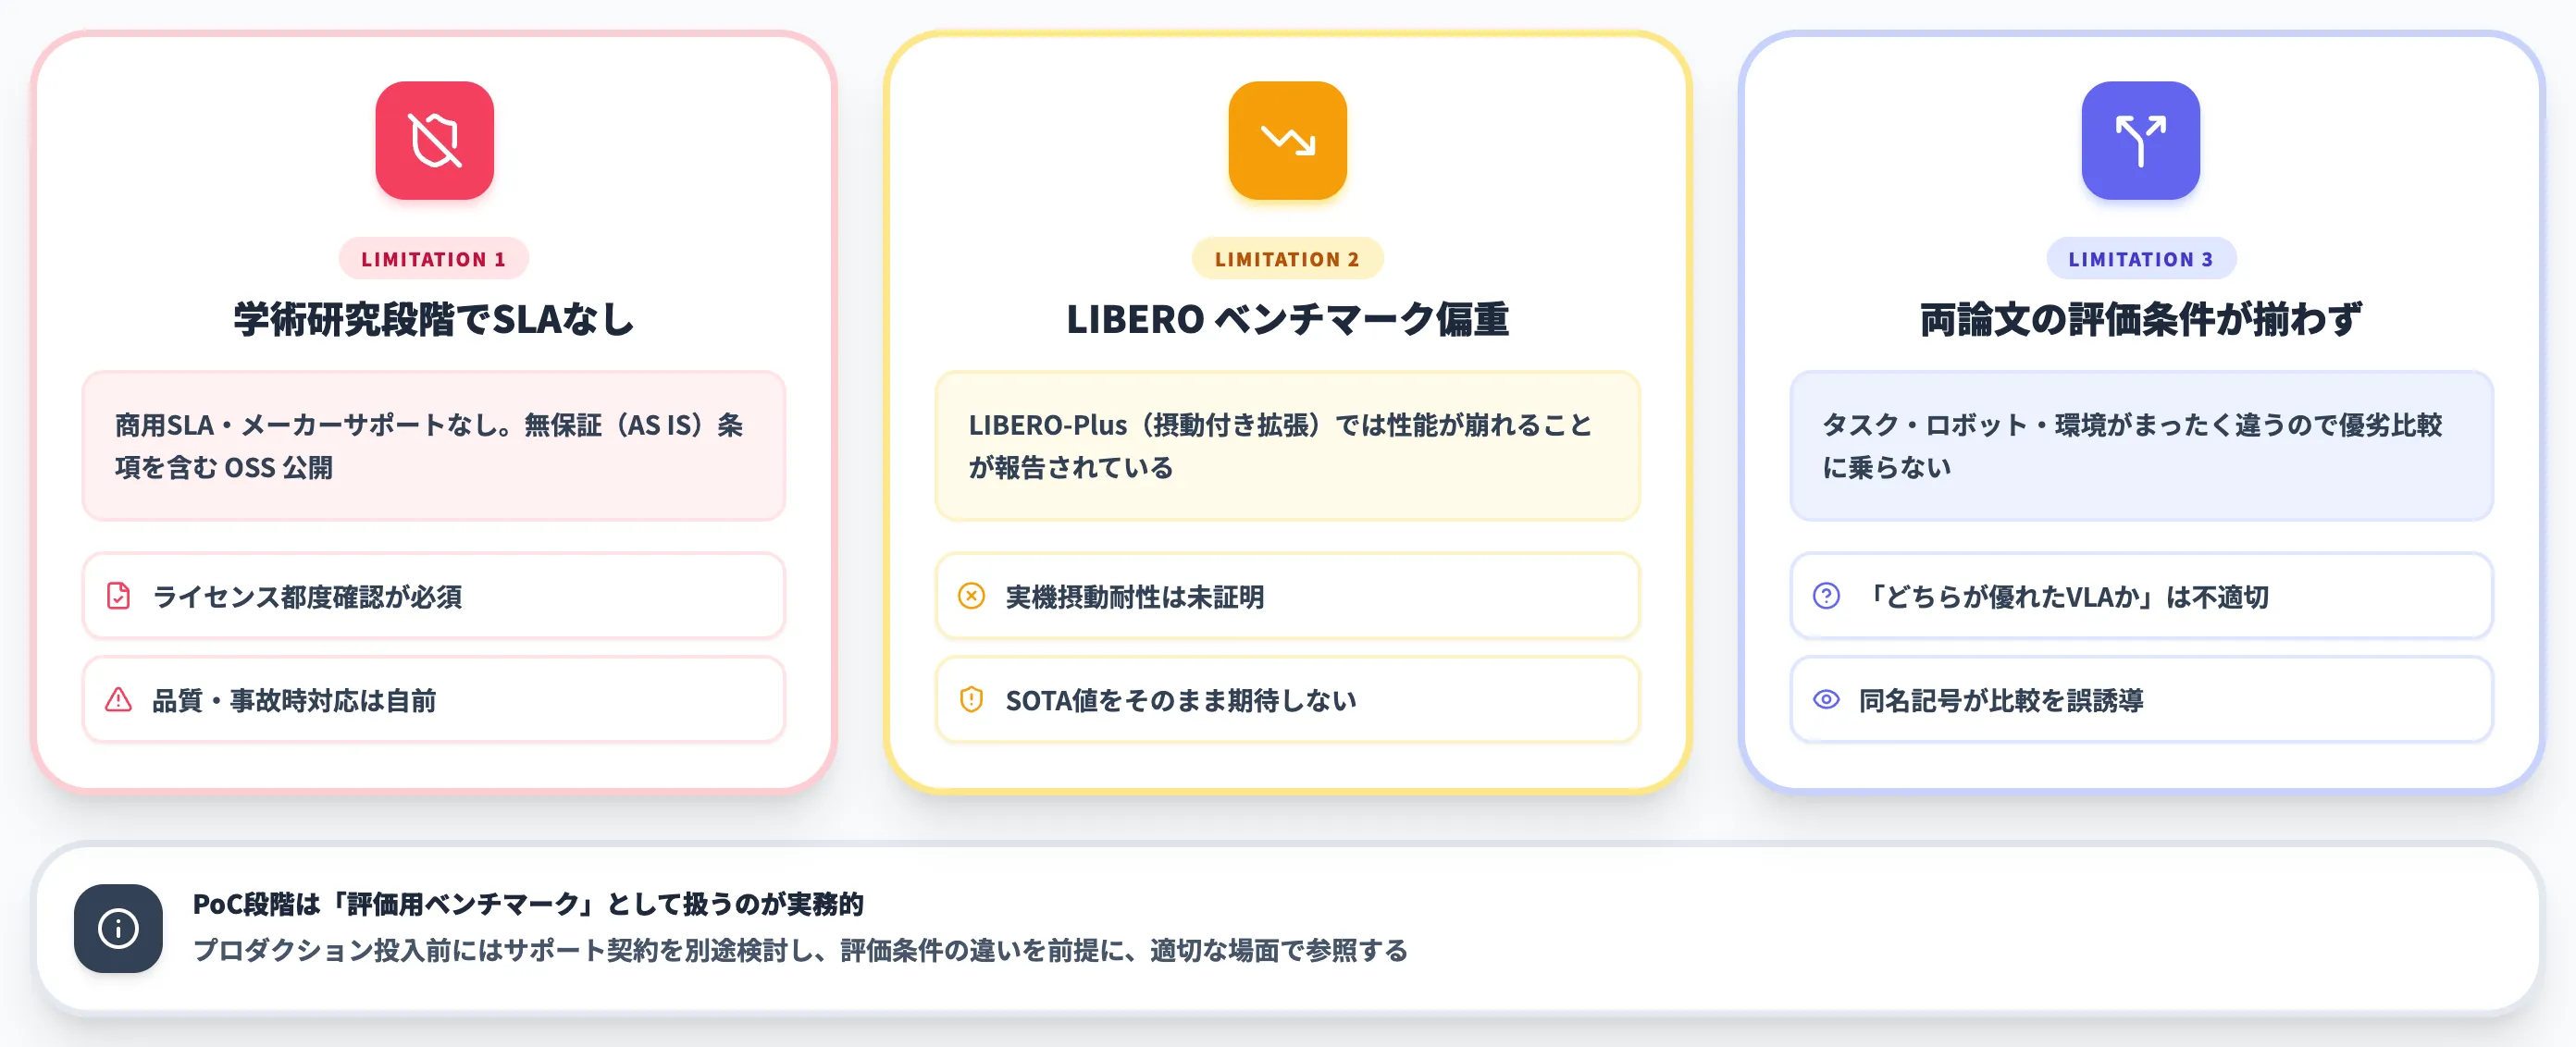
両SimVLAをPoCや研究で使う前に、押さえておきたい限界が3つあります。
学術研究段階でSLA・サポートはない
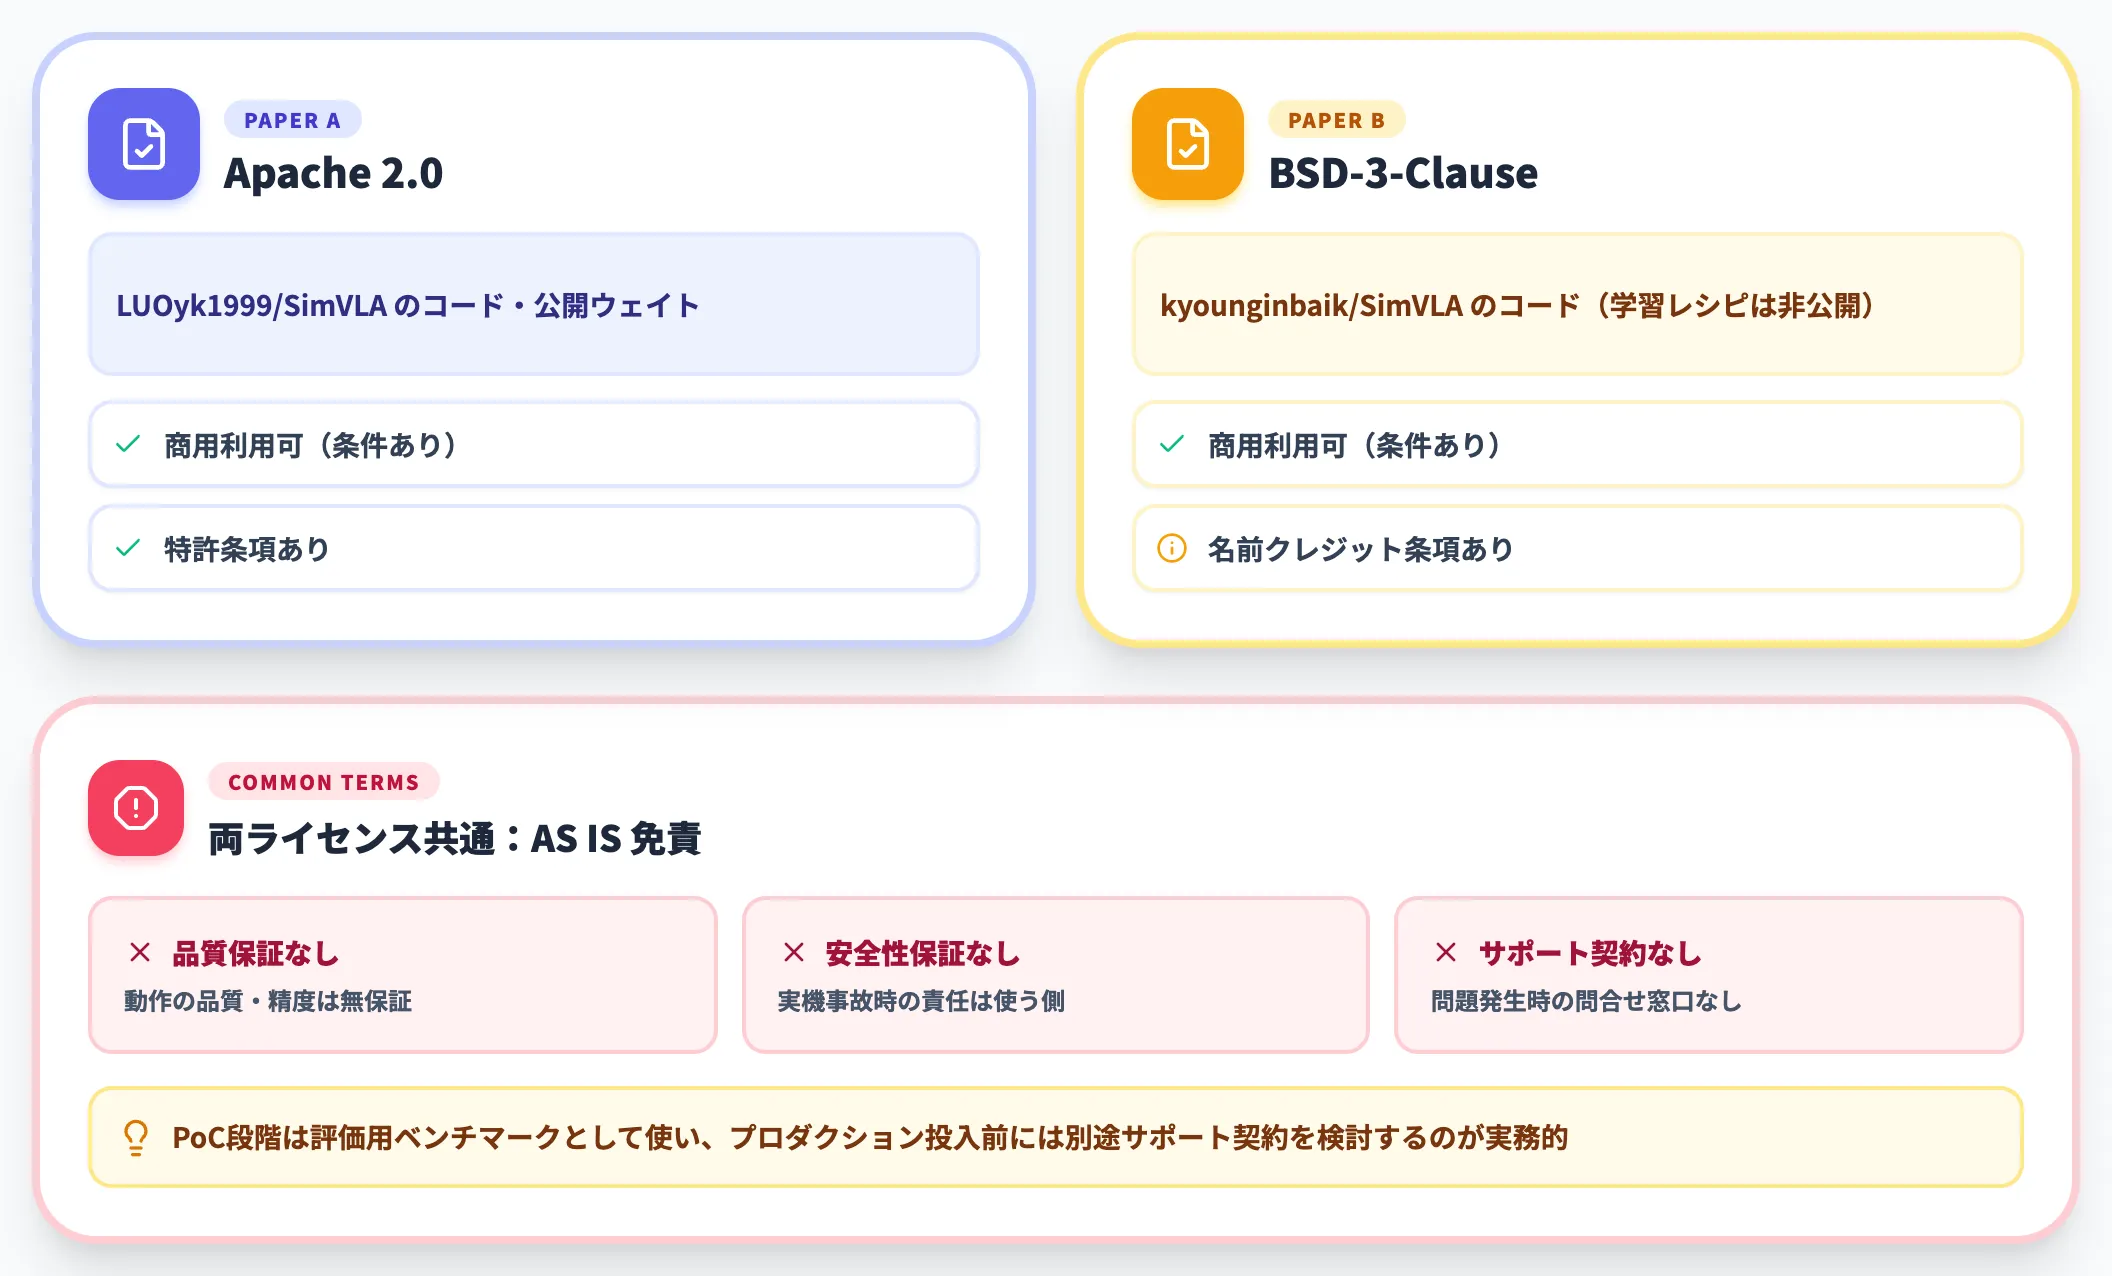
いずれも学術論文のオープンソース公開で、商用SLAやメーカーサポートはありません。論文Aのコード・公開ウェイトはApache 2.0、論文BのコードはBSD-3-Clauseが基本ですが、商用利用時は各リポジトリの最新LICENSEを都度確認する必要があります。
いずれのライセンスも「無保証(AS IS)」の免責条項を含んでおり、実運用に乗せる場合の品質・安全性・事故時対応は、使う側で担保する前提になります。PoC段階ではまず「評価用ベンチマーク」として使い、プロダクション投入前には別のサポート契約を検討するのが実務的です。
LIBEROベンチマーク偏重問題
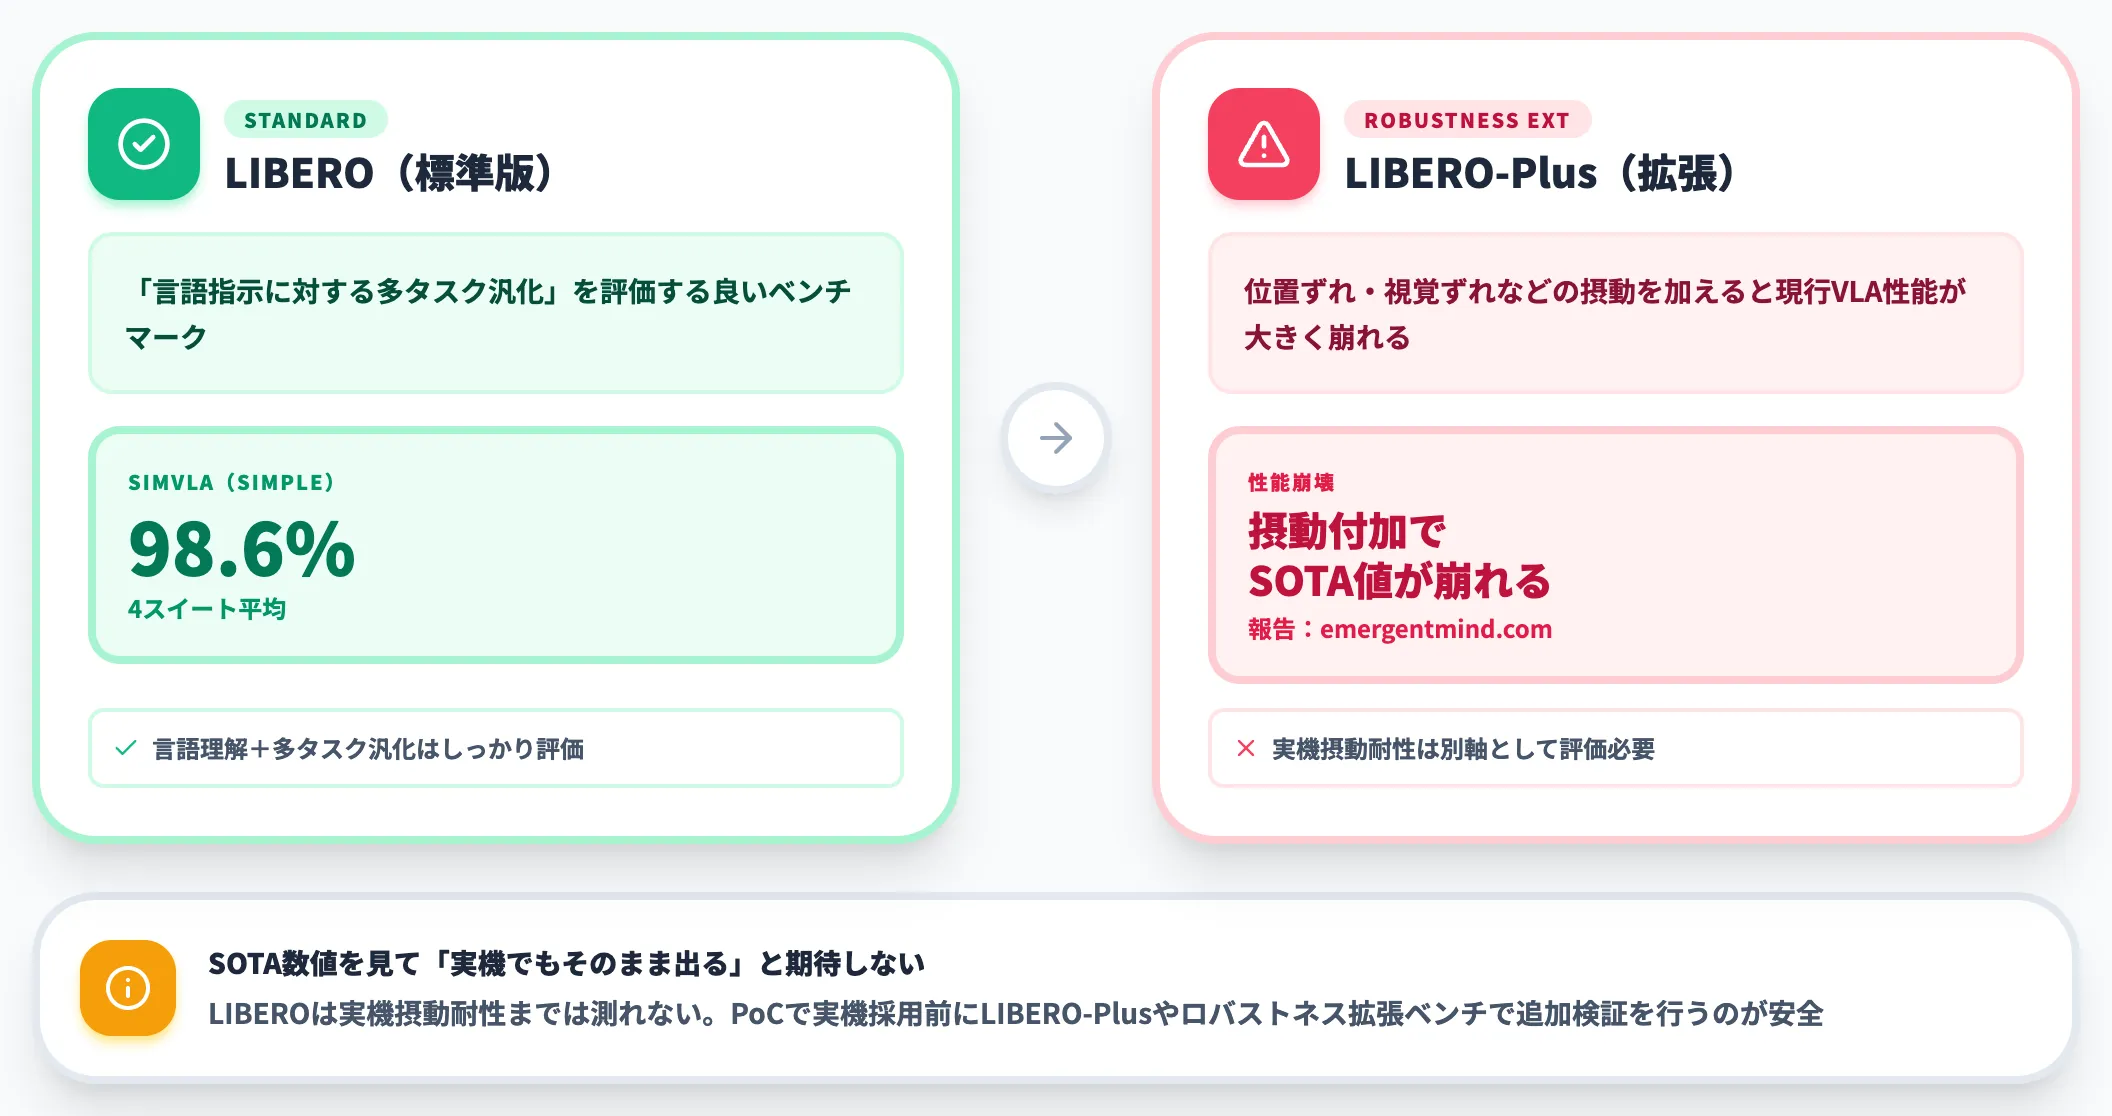
論文Aの98.6%というLIBERO成績は見事ですが、LIBERO-Plusというロバストネス拡張ベンチマークが公開されており、位置ずれ・視覚ずれなどの摂動を加えると現行VLAの性能が大きく崩れることが報告されています。
LIBEROは「言語指示に対する多タスク汎化」を評価する良いベンチですが、実機の摂動耐性までは測れません。SOTA数値を見て「実機でもそのまま出る」と期待すると、実装段階で裏切られます。
両論文の評価条件が揃っていない
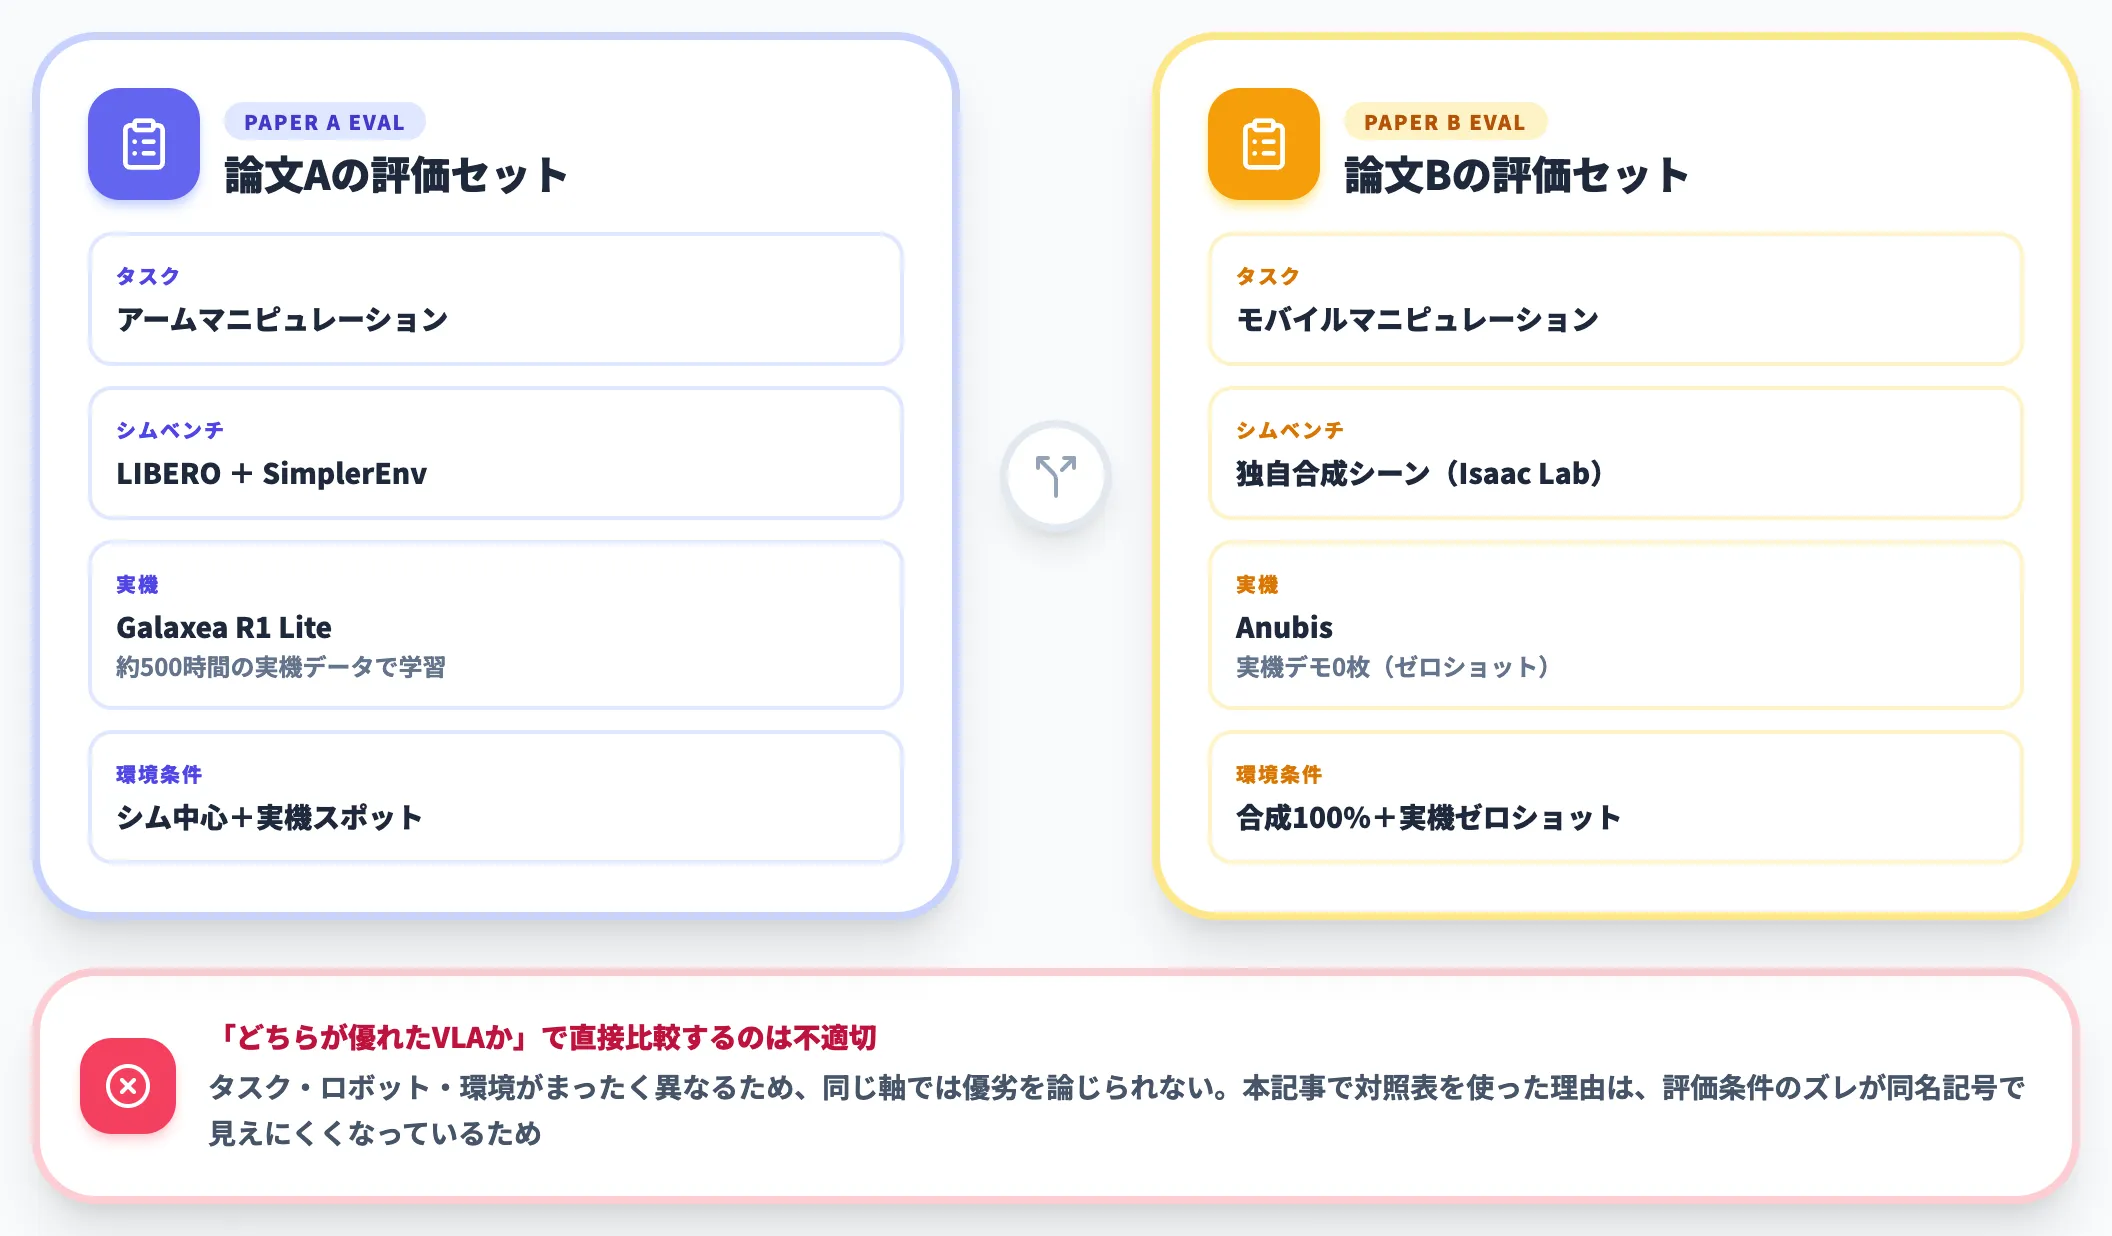
論文Aと論文Bを「どちらが優れたVLAか」で直接比較するのは不適切です。
論文Aはアームマニピュのシミュレーションベンチマークに加え、Galaxea R1 Liteでの実機評価を含めて評価しており、論文BはモバイルマニピュのAnubis実機ゼロショット転移で評価しています。評価対象のタスク・ロボット・環境がまったく異なるため、同じ軸で優劣を論じられません。
本記事で対照表を使って読み分けを示した理由は、この「評価条件のズレ」が同名記号によって見えづらくなっているためです。
SimVLA検証からロボティクス事業の社内実装まで、AI総研が伴走します
VLA基盤モデルの選定・PoC・社内実装は、どのモデルを使うかよりも、自社の設備・工程に対して「何が実装の律速になるか」を正しく見極めるところから始まります。
AI総合研究所は、以下のような論点について、公式ドキュメントだけでは決めきれないものを一括で支援します。
- SimVLAのような軽量ベースラインで足りるのか、π0.5やGR00T N2級のフロンティアVLAが必要なのか
- 合成データ事前学習(SimVLA Sim-to-Real型)と実機teleoperation収集のどちらが自社案件のコスト構造に合うのか
- VLAモデルを現場に乗せる前段で、周辺のAIエージェント・業務プロセスをどうAgent化しておくべきか
- Isaac Lab・LIBERO・SimplerEnvなどのシミュレータ検証体制を社内でどう持つか
VLA導入は「モデルを選ぶ」よりも「評価と周辺実装を回す体制」で勝負が決まります。実装経験に基づいた選定・検証・運用の壁打ちはAI Agent Hubからお問い合わせください。
SimVLAの検証から実機適用まで、AI総研が伴走します
VLA基盤モデルの評価・PoC・社内実装を一括支援
どのVLAを自社の設備・工程に当てるべきか、SimVLAのような軽量ベースラインで足りるのか、π0.5やGR00T N2級が必要なのか。AI総合研究所はVLAの選定からシミュレータ・実機検証、周辺のAIエージェント設計まで一括で支援します。
まとめ
本記事ではSimVLAという研究テーマについて、同名の2論文を混同しないための対照整理と、各論文の設計・実力、VLA全体での位置づけ、用途別の判断軸までを解説しました。
- SimVLAはarXivに同名の論文が2本存在し、片方はSimple、もう片方はSimulationの略
- 論文A(Simple VLA Baseline)は0.5BでLIBERO 98.6%、学習時メモリも9.3GB(Batch=8ピーク)に収まる軽量ベースライン
- 論文B(Zero-Shot Sim-to-Real)は合成データ100%で実機ゼロショット53〜58%を達成
- アームマニピュのSOTA再現なら論文A、モバイル実機のSim-to-Real検証なら論文Bが参照先
- 両論文とも学術研究段階で、商用デプロイには別途フロンティアVLAとの比較が必要
VLA領域はフロンティア潮流と軽量ベースライン潮流が併走している段階で、どちらに賭けるかは案件の制約で決まります。SimVLAの読み分けは、その選定ロジックを研ぎ澄ます最初の一歩として役立ちます。