この記事のポイント
 GNoMEはDeepMindが2023年11月にNatureで発表した結晶構造安定性予測AI、累計10億件超の探索と38.1万件の新規安定構造という規模で材料探索AIの代表事例
- モデル・データセットはGitHubで公開、コードはApache 2.0、データはCC BY NC 4.0の商用制限つき
- A-Labは17日で36件合成(Author Correction後)、ICSDの実験構造との一致736件(うちプロジェクト開始後の報告184件)が別軸のモデル妥当性指標として存在する一方、Cheetham/Seshadri論文とSchoop/Palgraveらが新規性・信頼性・実用性の弱さを指摘
- 後発動向としてMicrosoft MatterGen(拡散モデル・逆設計)とBerkeley Lab FORUM-AI(Agent型)が関連技術として登場し、GNoMEは「候補生成の1手法」に位置づけ直されつつある
- 企業R&Dで使うなら候補生成の予備調査段階に位置づけ、実験検証・特許調査・データ整備の運用設計とセットで判断する
Microsoft MVP・AIパートナー。LinkX Japan株式会社 代表取締役。東京工業大学大学院にて自然言語処理・金融工学を研究。NHK放送技術研究所でAI・ブロックチェーンの研究開発に従事し、国際学会・ジャーナルでの発表多数。経営情報学会 優秀賞受賞。シンガポールでWeb3企業を創業後、現在は企業向けAI導入・DX推進を支援。
GNoME(Graph Networks for Materials Exploration)は、Google DeepMindが2023年11月にNature誌で発表した、結晶構造の安定性を予測するグラフニューラルネットワーク型の材料探索AIです。
予測220万結晶・安定材料38万件・Berkeley Lab A-Labでの17日36件合成(2026年1月Author Correction後)といった数字はAI×材料科学の代表事例として広く引用される一方、Chemistry of Materials誌に掲載された批判論文とSchoop/Palgraveらの独立検証で「新規性・信頼性・実用性が薄い」と指摘され、成果の解釈をめぐる議論も続いています。
本記事では、GNoMEの仕組み・成果・実験検証・批判・GitHubリポジトリの使い方・後発のMatterGenやFORUM-AI・企業R&D現場での位置づけまでを、2026年9月時点の最新情報で体系的に整理します。
目次
GNoMEとは?DeepMindが220万結晶を予測した材料探索AI
GNoMEが打ち出した数字——220万予測・38万安定・A-Labで36件合成
A-Lab連携での17日36件合成(Author Correction後)
A-Lab成果への疑義(Schoop/Palgraveらの独立検証)
GNoMEを実務でどう位置づけるか——研究者・企業R&Dの活用判断
GNoMEとは?DeepMindが220万結晶を予測した材料探索AI
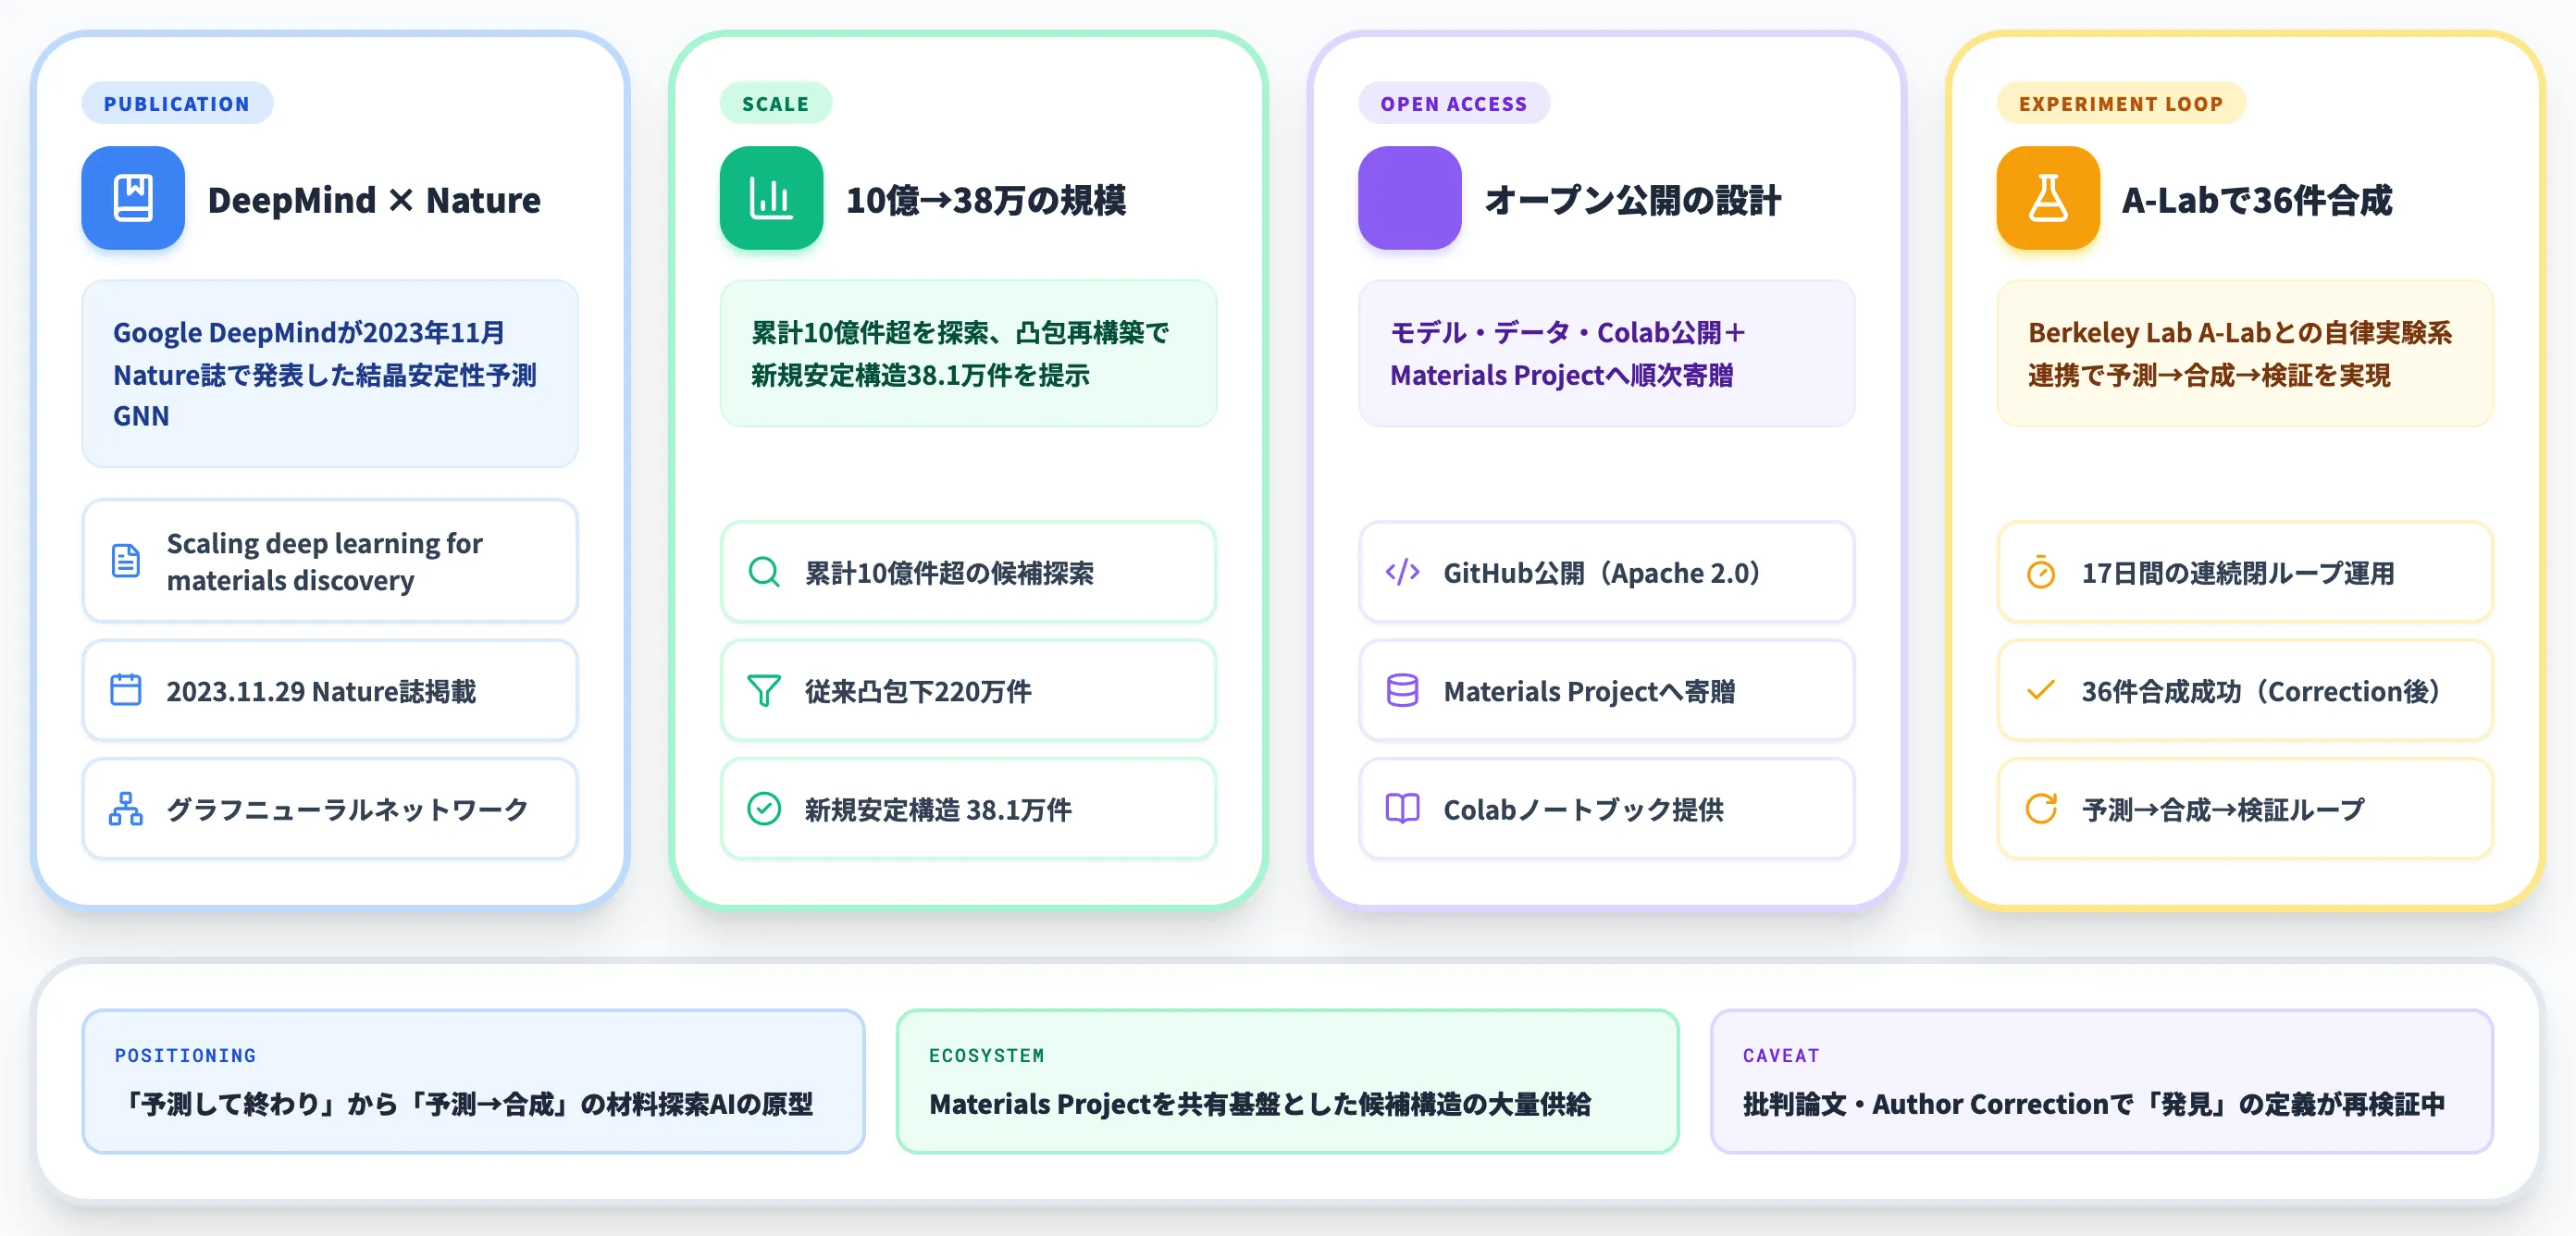
Graph Networks for Materials Exploration(GNoME)は、Google DeepMindが2023年11月29日にNature誌で発表した、無機結晶の安定性を予測するグラフニューラルネットワーク型の材料探索AIです。
論文タイトルは「Scaling deep learning for materials discovery」で、累計10億件超の候補構造を探索し、そのうち約38.1万件を新規安定構造として提示しました(220万件・38.1万件・凸包の関係は後段のセクションで詳述)。
従来のマテリアルズインフォマティクスで使われてきた密度汎関数理論(DFT)計算による第一原理探索を、深層学習によるスクリーニングで大規模化した点が特徴です。
GNoMEが材料科学コミュニティに強いインパクトを与えたのは、単にモデルの精度が高いからではなく、凸包上の安定候補約38万件がGitHubリポジトリで公開されMaterials Projectへも順次取り込まれており、モデル・データセット・Colabノートブックにアクセスできる設計になっている点です。
同時期に発表されたBerkeley Lab A-Labの自律実験系との連携で、AIの予測から実験合成までを17日間の連続運用で回した実績も出ています。
GNoMEを起点として、材料探索AIは「予測して終わり」ではなく「予測→合成→検証」のループを回す段階に移行しつつあります。
命名に込められた設計思想
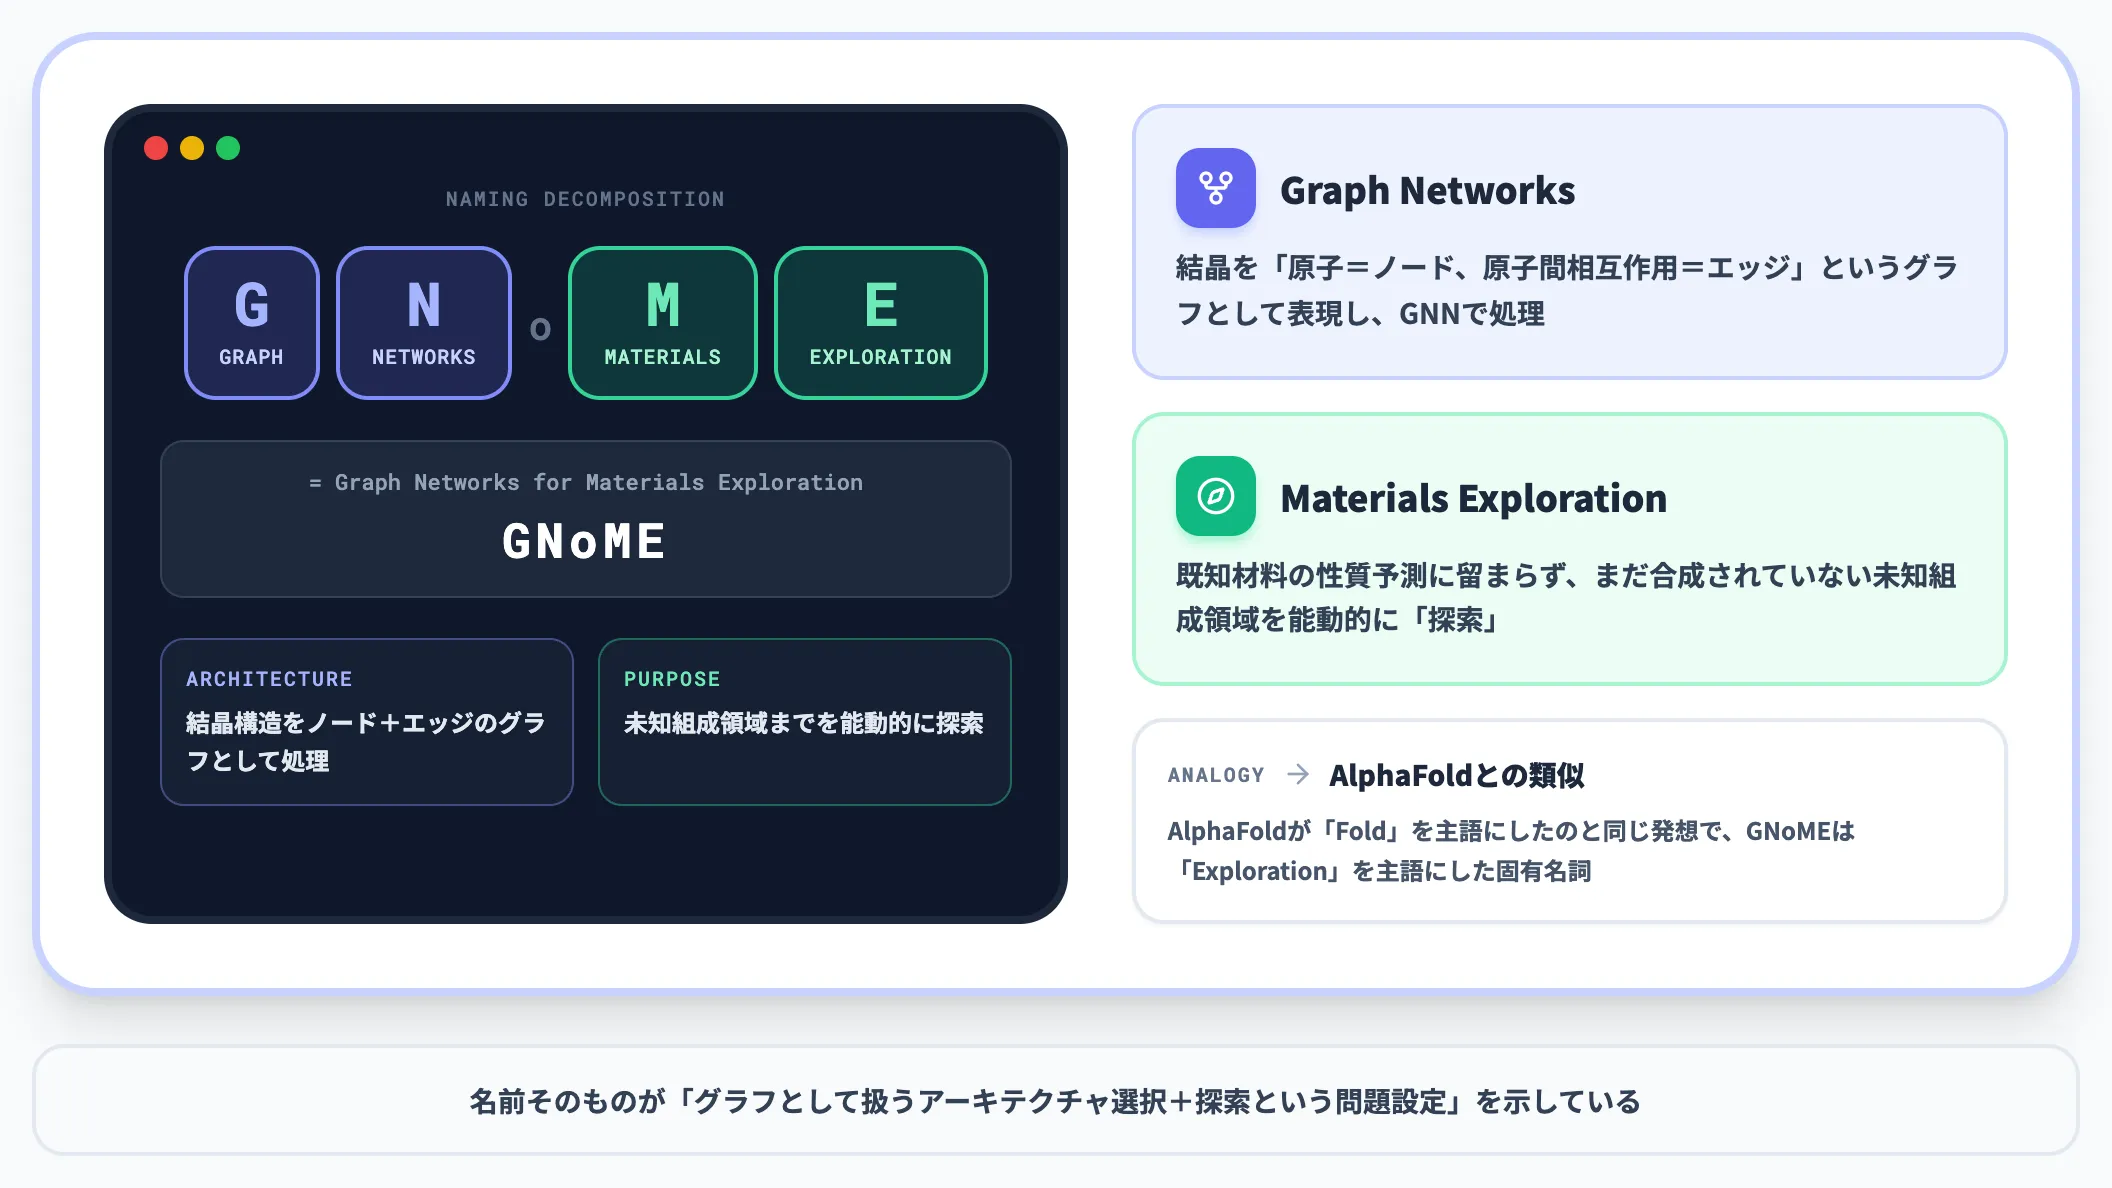
GNoMEの命名には、モデルの設計思想がそのまま反映されています。頭文字の分解は次のとおりです。
-
Graph Networks
結晶構造を「原子=ノード、原子間の相互作用=エッジ」というグラフとして表現し、グラフニューラルネットワーク(GNN)で処理する
-
Materials Exploration
既知材料の性質を予測するだけでなく、まだ合成されていない未知の組成領域を「探索」する
単なるスクリーニング用モデルではなく、結晶をグラフとして扱うアーキテクチャの選択そのものが、材料探索という問題設定に強く紐づいていることが、この名前から読み取れます。
タンパク質構造予測のAlphaFoldが「Fold(折りたたみ)」を主語にしたのと同じ発想で、GNoMEは「Exploration(探索)」を主語にした固有名詞と考えるのが自然です。
GNoMEが打ち出した数字——220万予測・38万安定・A-Labで36件合成
GNoMEが引用され続ける理由は、発表と同時に提示された成果の数字が桁違いだったからです。本セクションでは、モデルの予測数から実験検証結果までを、公式論文と第三者評価の順で整理します。
数字はどれもDeepMind公式ブログとNature論文の記載を基準にしています。Web記事によっては引用元での数字が食い違うことがあるため、後段の批判セクションで扱う「数字の解釈」と合わせて読むと全体像が掴めます。
220万結晶と38万件の安定材料
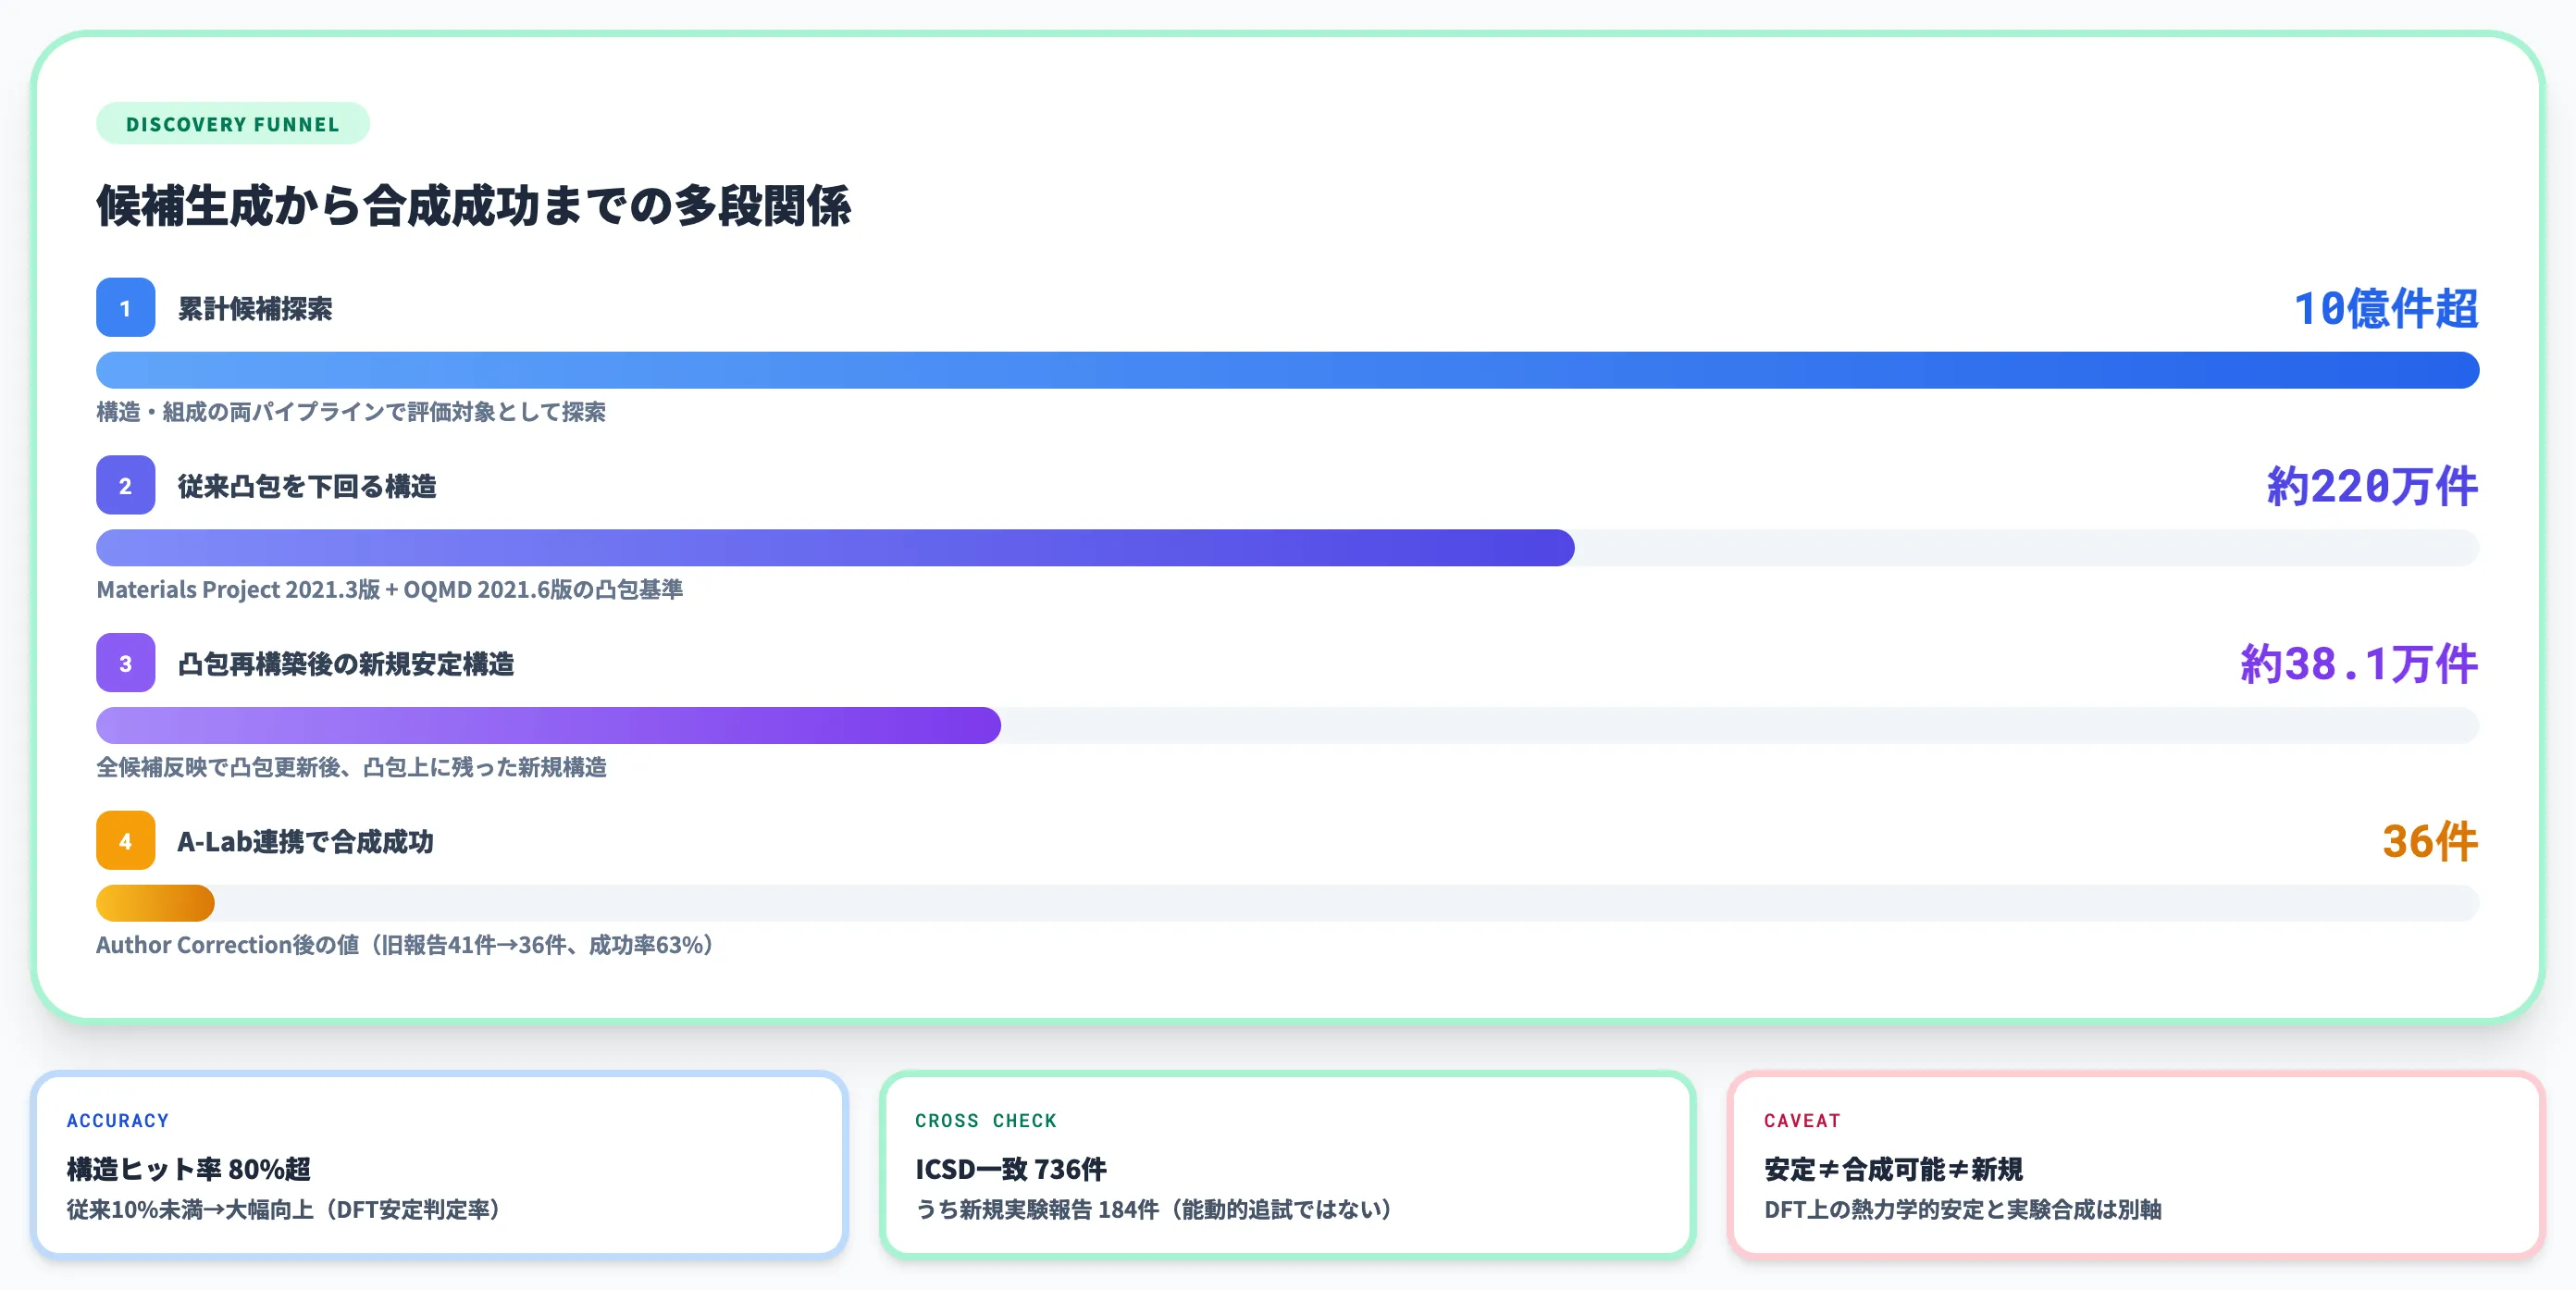
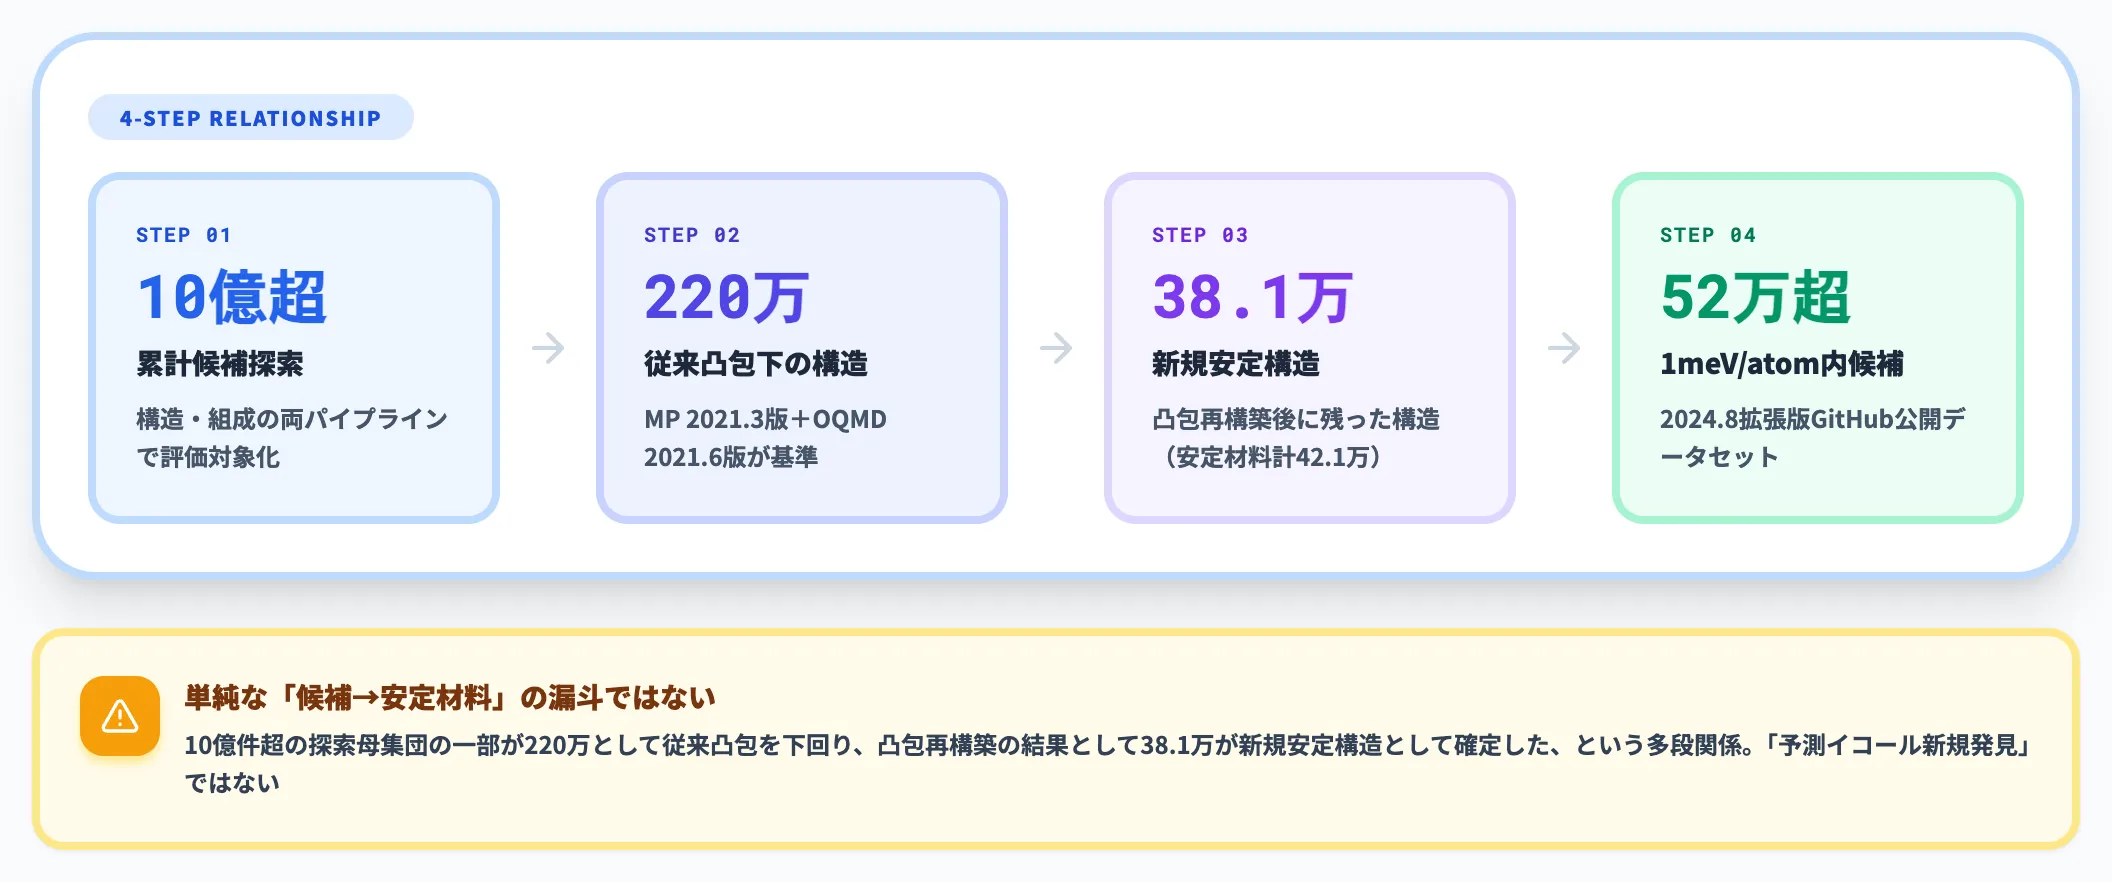
GNoMEが提示した数字は、単純な「候補→安定材料」の漏斗ではなく、以下の多段関係で整理されます。
-
累計10億件超の候補を探索
GNoMEは組成・構造の両パイプラインで累計10億件超の候補を評価対象として探索
-
約220万件: 従来凸包より下に位置した構造
凸包の比較基準はMaterials Project 2021年3月版とOQMD 2021年6月版で、この従来凸包よりエネルギーが下に位置した構造の数。なおGNoMEの初期モデル学習には別途2018年版Materials Project(材料数約6.9万件)が使われており、220万件の比較基準とは分けて扱う
-
約38.1万件: 更新後の凸包上に残った新規安定構造
全候補を反映して凸包を更新し直した結果、その凸包上に残った新規安定構造の数。GNoME寄与を含めた更新後の安定材料総数は約42.1万件(うち新規が約38.1万件)
-
1 meV/atom以内で52万件超(2024年8月拡張版)
GitHubリポジトリで公開されているデータセットは、GNoME公式ドキュメントによれば凸包から1 meV/atom以内の候補として約52万件を収録
「220万→38万」を単純に候補から安定材料への漏斗として理解すると、実際の関係を取り違えます。累計10億件超の探索母集団の一部が220万件として従来凸包を下回り、凸包を再構築した結果として38.1万件の新規安定構造が確定した、という多段の関係で扱うのが妥当です。
「予測されたイコール新規発見された」でもないため、後段の批判セクションと合わせて読み解く必要があります。
エネルギー精度と安定性ヒット率
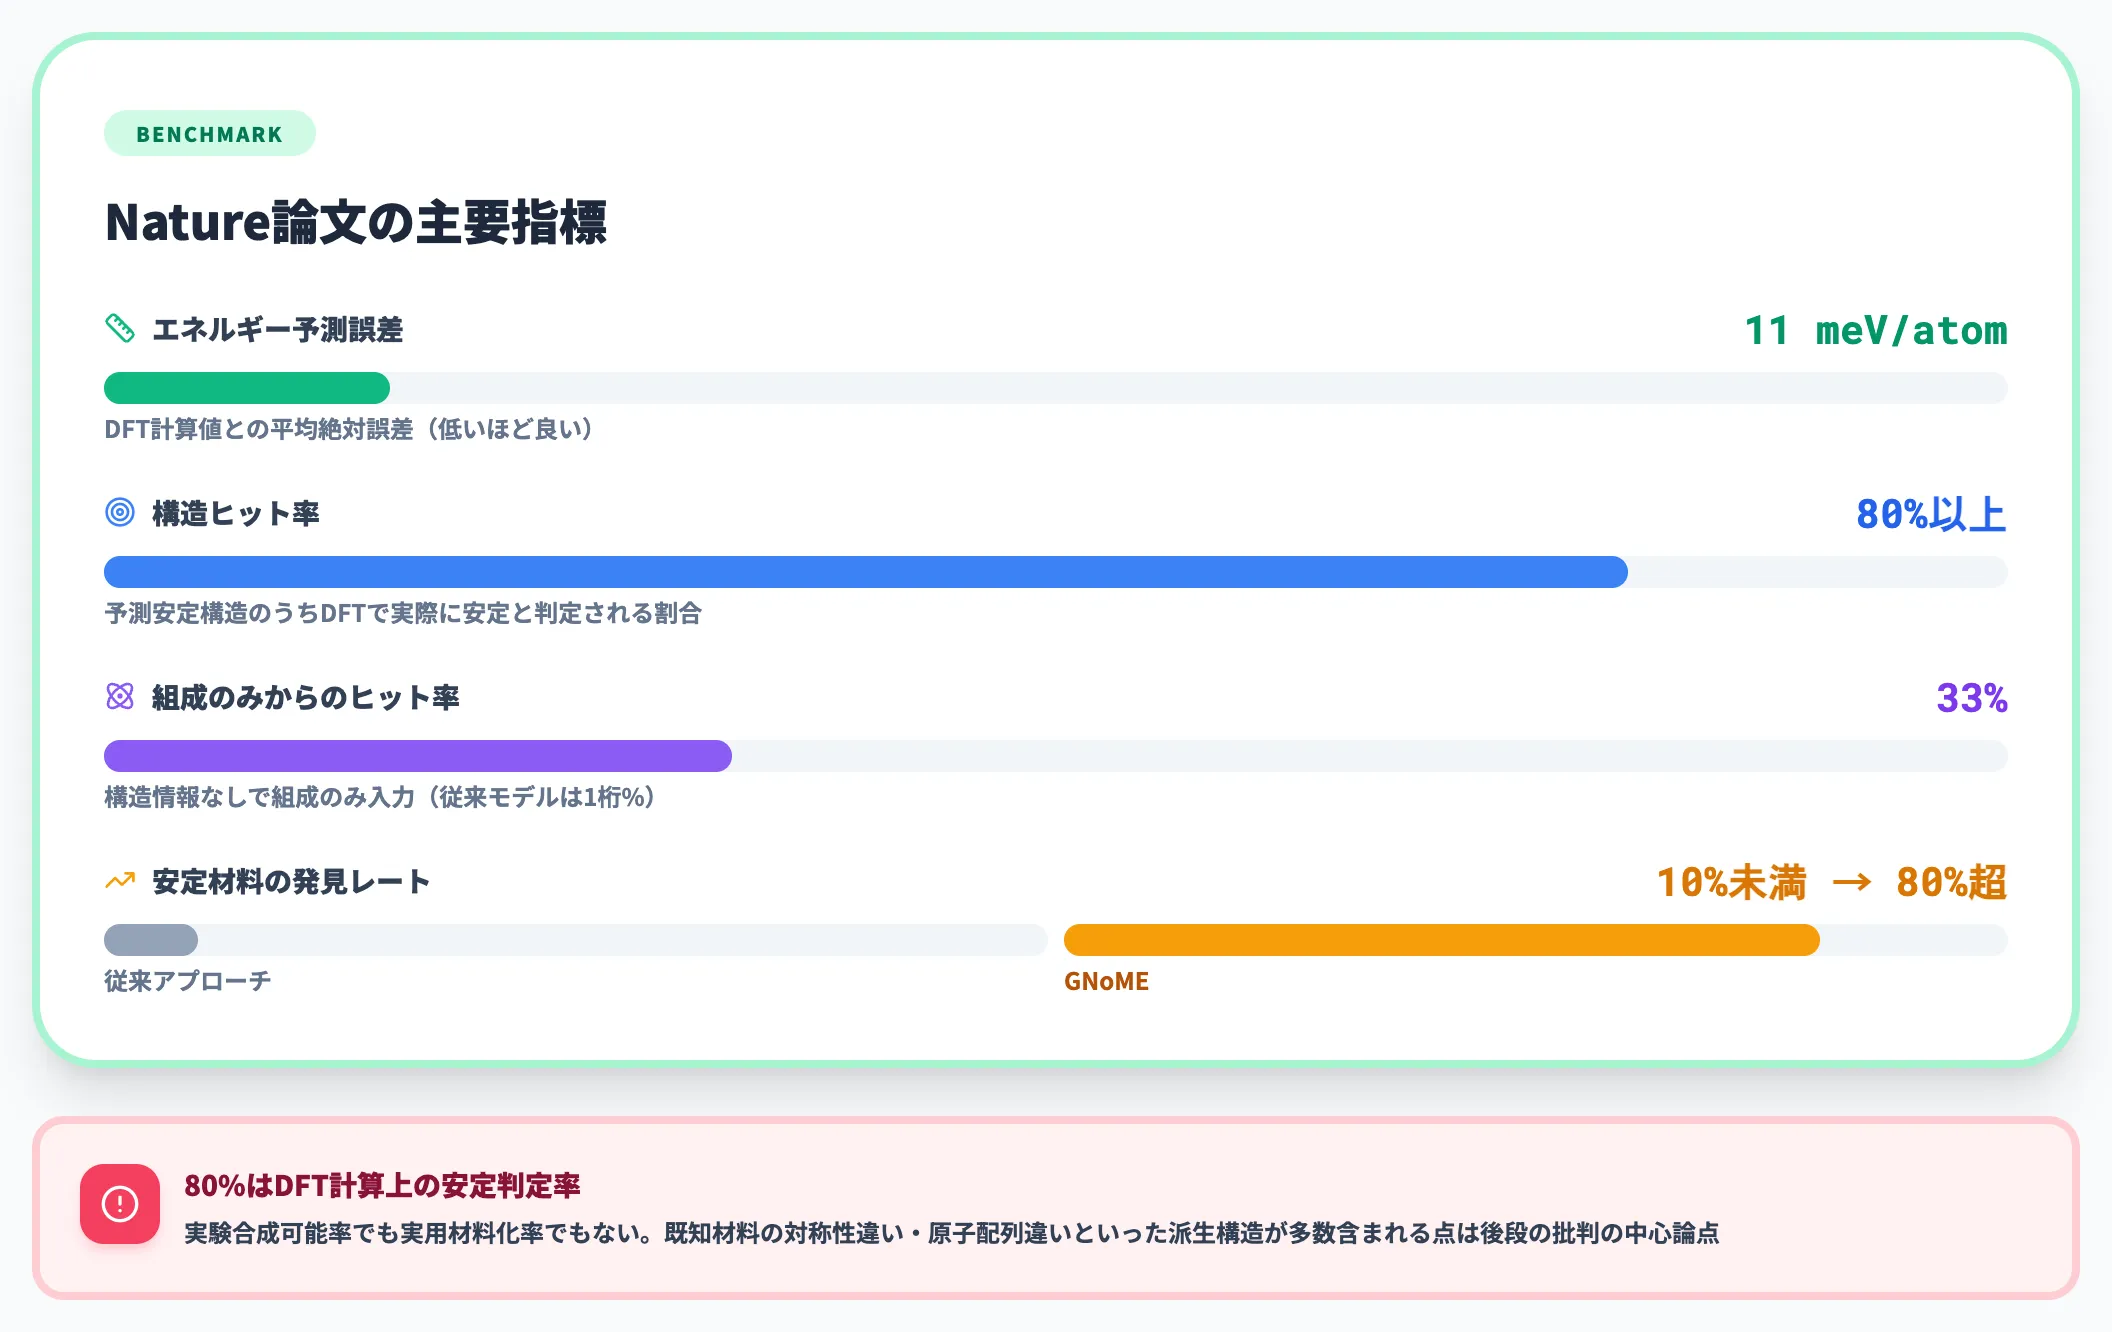
数だけでなく、予測精度も従来モデルから明確に改善されています。
Nature論文の記載では次のとおりです。
| 指標 | 数値 | 補足 |
|---|---|---|
| エネルギー予測誤差 | 約11 meV/atom | 密度汎関数理論(DFT)計算値との平均絶対誤差 |
| 構造ヒット率 | 80%以上 | 予測された安定構造のうち、DFT計算で実際に安定と判定された割合 |
| 組成のみからのヒット率 | 100試行中33件(33%) | 構造情報を与えず組成だけからの予測。従来モデルは1桁% |
| 発見レート | 10%未満 → 80%超 | 従来アプローチと比較したときの安定材料発見効率 |
特に構造ヒット率80%超という数字は、材料探索AIのスクリーニング性能を大きく押し上げました。ただしこの80%はあくまでDFT計算で安定と判定される割合であって、実験的に合成できる割合や実用材料化される割合ではない点に注意が必要です。
「安定=合成可能=新規」ではないという前提を押さえておくべきで、GNoMEが安定と判定した候補のなかには、既知材料の対称性違いや原子配列違いといった派生構造が多数含まれています。この点は次章以降で扱う批判の中心論点になっています。
A-Lab連携での17日36件合成(Author Correction後)
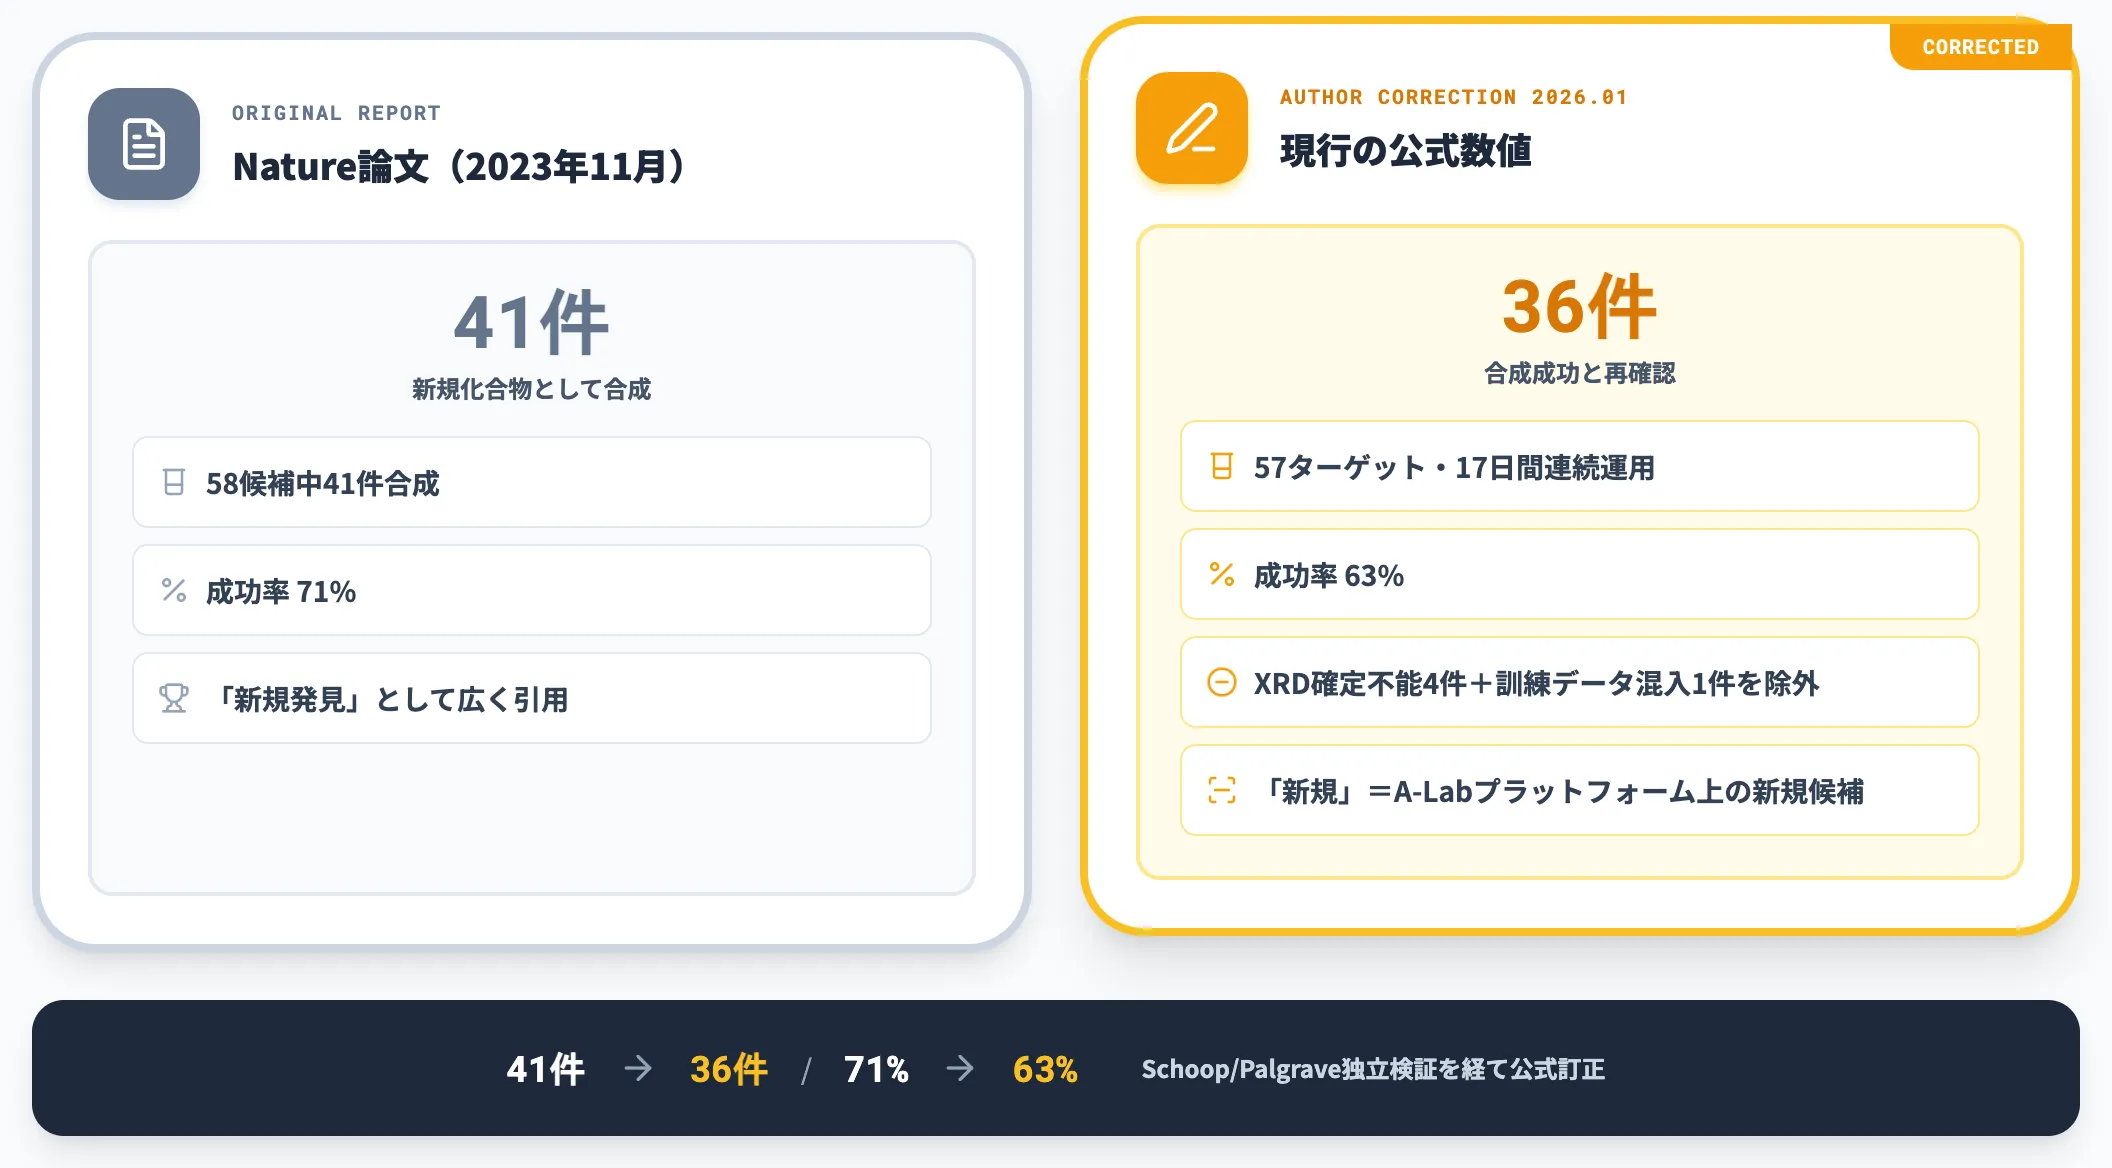
GNoMEの予測を実験に落とし込んだ代表例として広く引用されるのが、UCバークレー校とLawrence Berkeley National Laboratory(LBNL)が運用するA-Labとの連携です。
A-Labは、ロボットアームによる粉末合成・分析・データ回収を1台の閉ループで回す自律実験施設で、Materials Project由来の候補構造をGoogle DeepMindの安定性データベース(GNoMEを含む)でも安定性を確認したうえで合成対象に選ぶ、というワークフローで運用されています。
GNoMEが提示した候補構造をそのまま合成しているわけではない点に注意が必要です。
Nature論文Szymanski et al., 2023は当初「58候補中41件を新規化合物として合成、成功率71%」と報告しましたが、2026年1月にAuthor Correctionが公開され、現在の公式数値は以下に更新されています。
- 17日間の連続運用で57ターゲットを対象に合成試行
- 旧成功40件を再分析し、36件を合成成功と確認(成功率63%)
- 旧成功40件のうち4件は生成物中に対象化合物が存在するかをXRDだけでは確定できないため除外、別途1ターゲットは訓練データ混入で除外
- 「新規」は科学界全体にとっての新規発見ではなく、A-Labの予測プラットフォーム上での新規候補という意味に修正された
GNoMEが「予測して終わり」の紙上プロジェクトではなく、Materials Projectを介した予測データと実験系を接続して合成データを積み上げる材料探索AIの原型を提示したこと自体の意義は残ります。ただし成果数値は上記のAuthor Correction後の値で扱うのが妥当です。
なお、後述するSchoop/Palgraveらの独立検証で同種の懸念が提起された後に、Author Correctionが公開されています。数字の受け取り方はCorrection後を前提に慎重にすべきです。
ICSD実験構造との一致736件
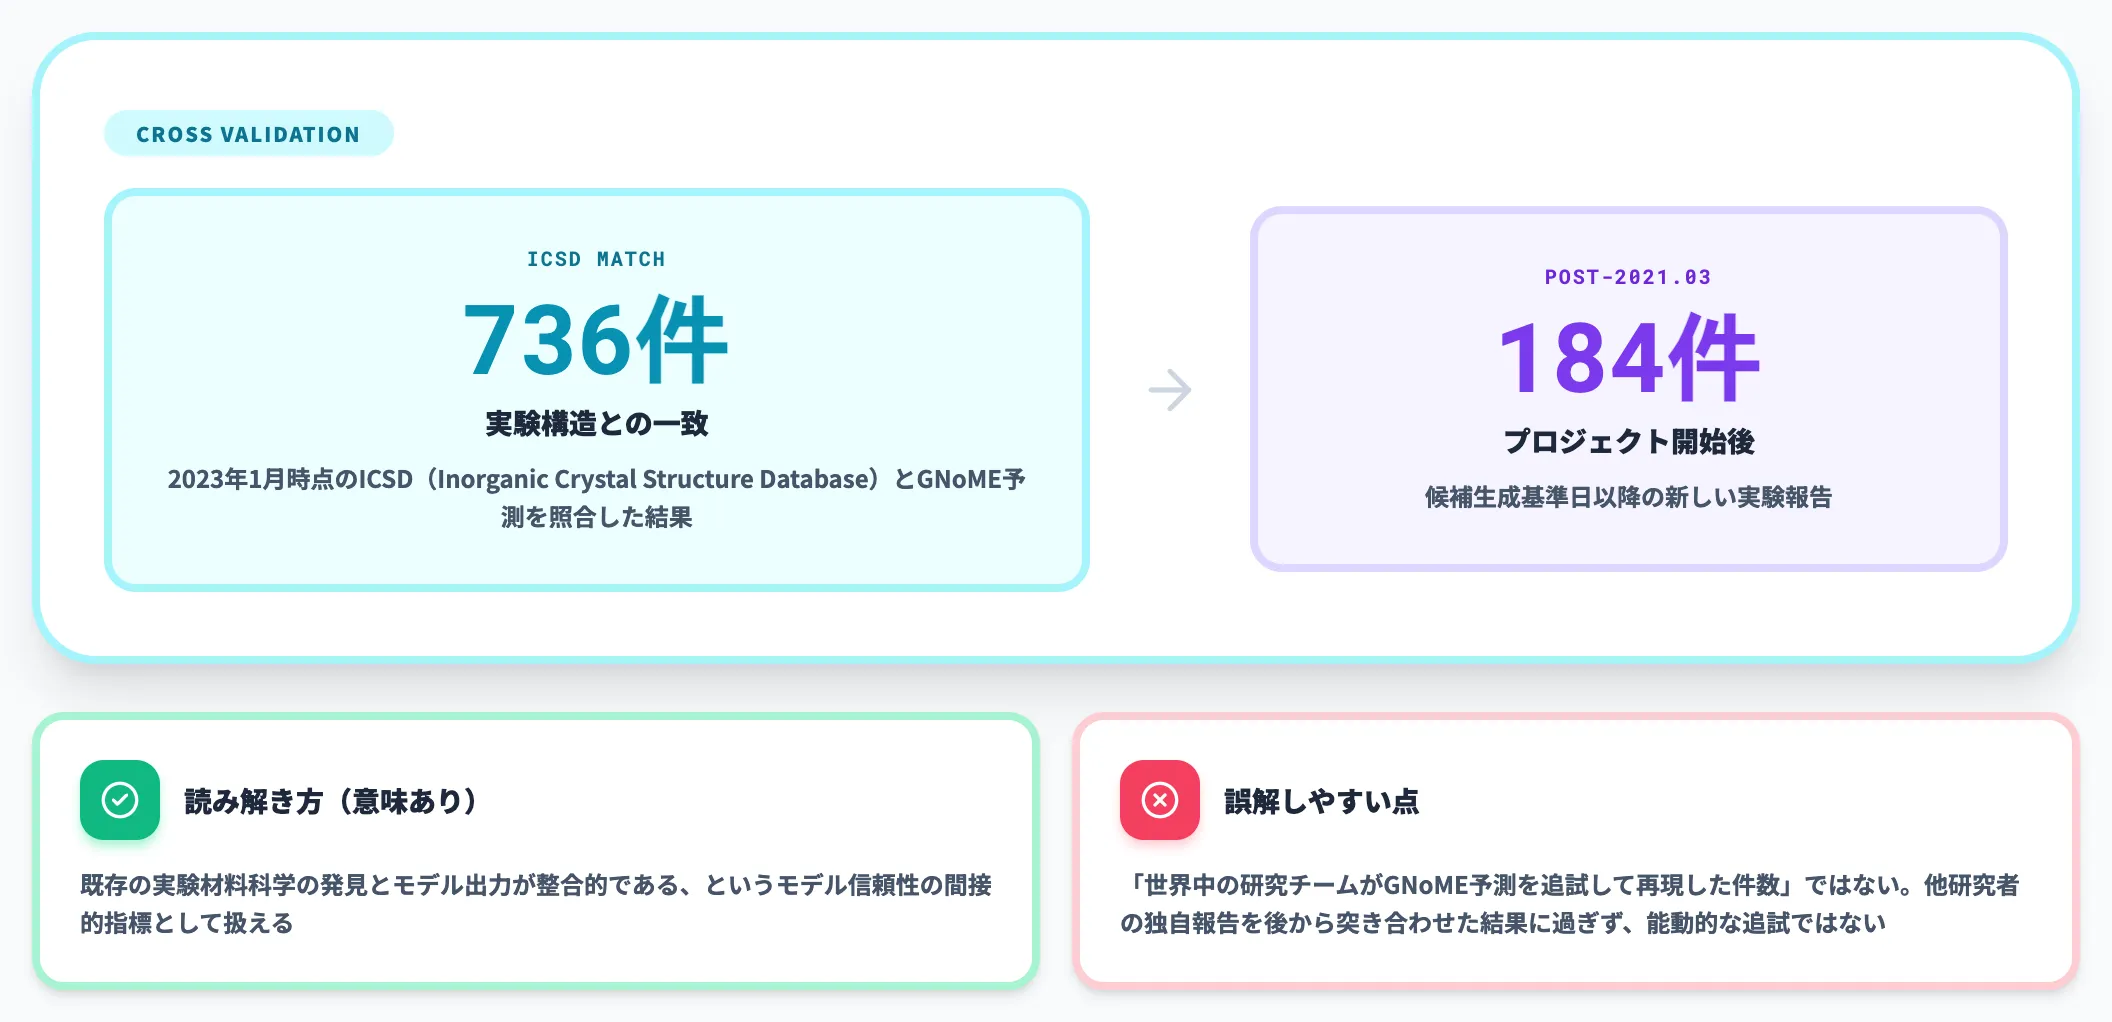
GNoMEのNature論文は、モデル出力の外部妥当性の指標として「736件」の数字を示しています。ただしこれは「GNoMEの予測を見て世界中の研究チームが追試合成に成功した件数」ではありません。
正確には、2023年1月時点でICSD(Inorganic Crystal Structure Database)の実験構造と照合した結果、GNoMEの予測出力と一致したものが736件、うちプロジェクト開始後(候補生成の基準となる2021年3月以降)の新しい実験報告が184件、という意味です。他の研究者が独自の動機で作製・報告した構造を後から突き合わせた結果、GNoME予測との重なりが確認されたという構図で、能動的な追試ではありません。
この数字は、GNoMEの出力が既存の実験材料科学の発見と整合的である、というモデル出力の技術的な裏付けとしては意味があります。ただし「世界中が追試して再現した」という説明は不正確なので、モデル信頼性の間接的指標として扱う程度が妥当です。
材料の新規性・実用性は別軸の議論として切り分けたうえで、次章の批判セクションと合わせて読み解く必要があります。
GNoMEの仕組み——GNN・DFT・データフライホイール
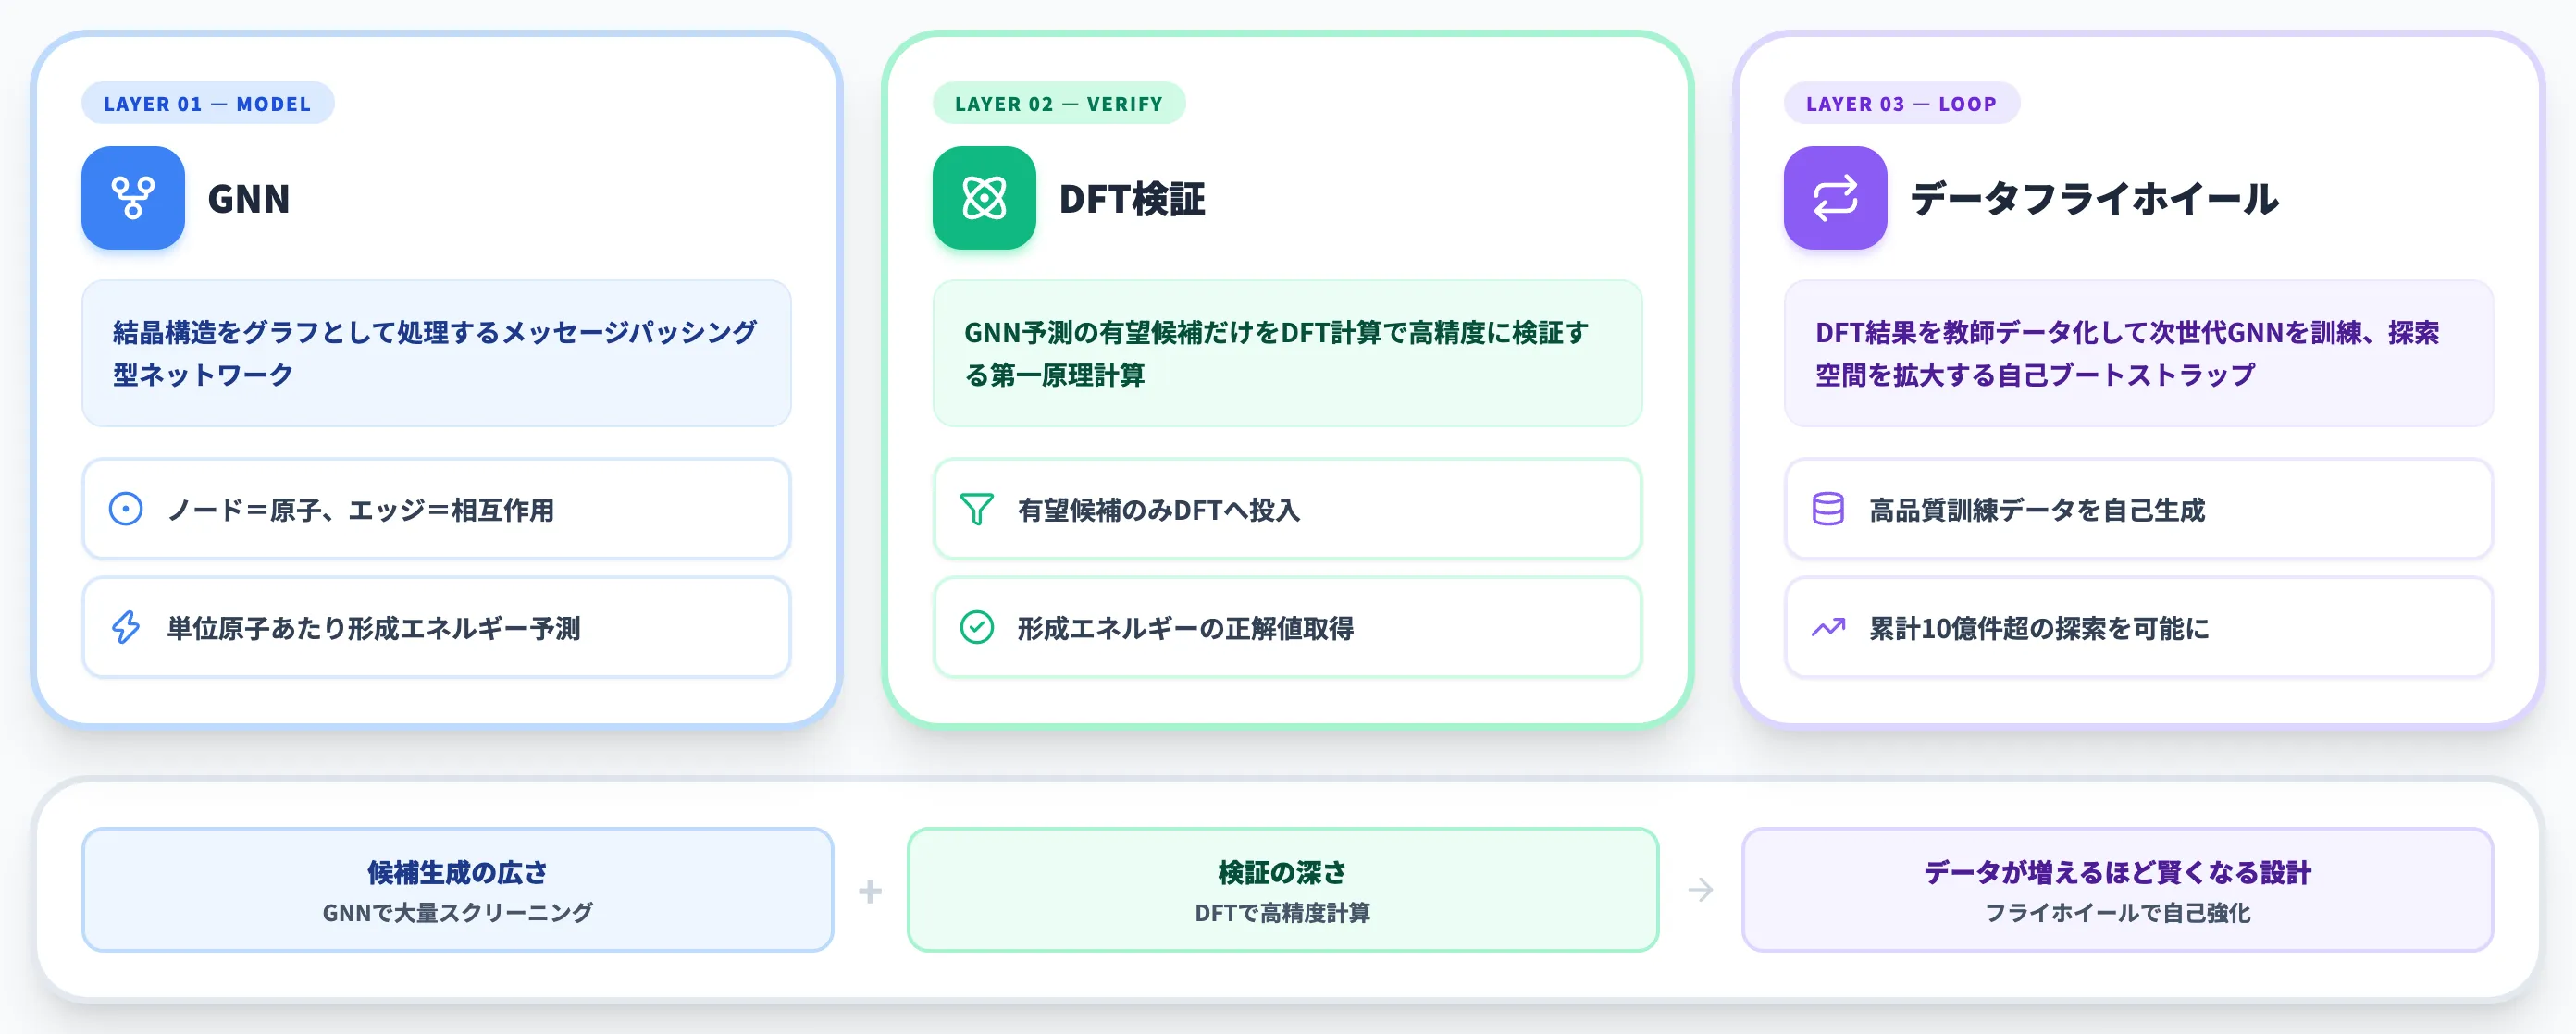
数字の背景にある技術構造を、モデルアーキテクチャ・計算検証・学習ループの3層で整理します。GNoMEを「なぜグラフニューラルネットワークで組んだのか」「DFTとどう役割分担しているか」「なぜ短期間で桁違いの学習データを集められたのか」の順で読むと、後段の批判・関連技術の位置づけが理解しやすくなります。
結晶構造をグラフで表現する
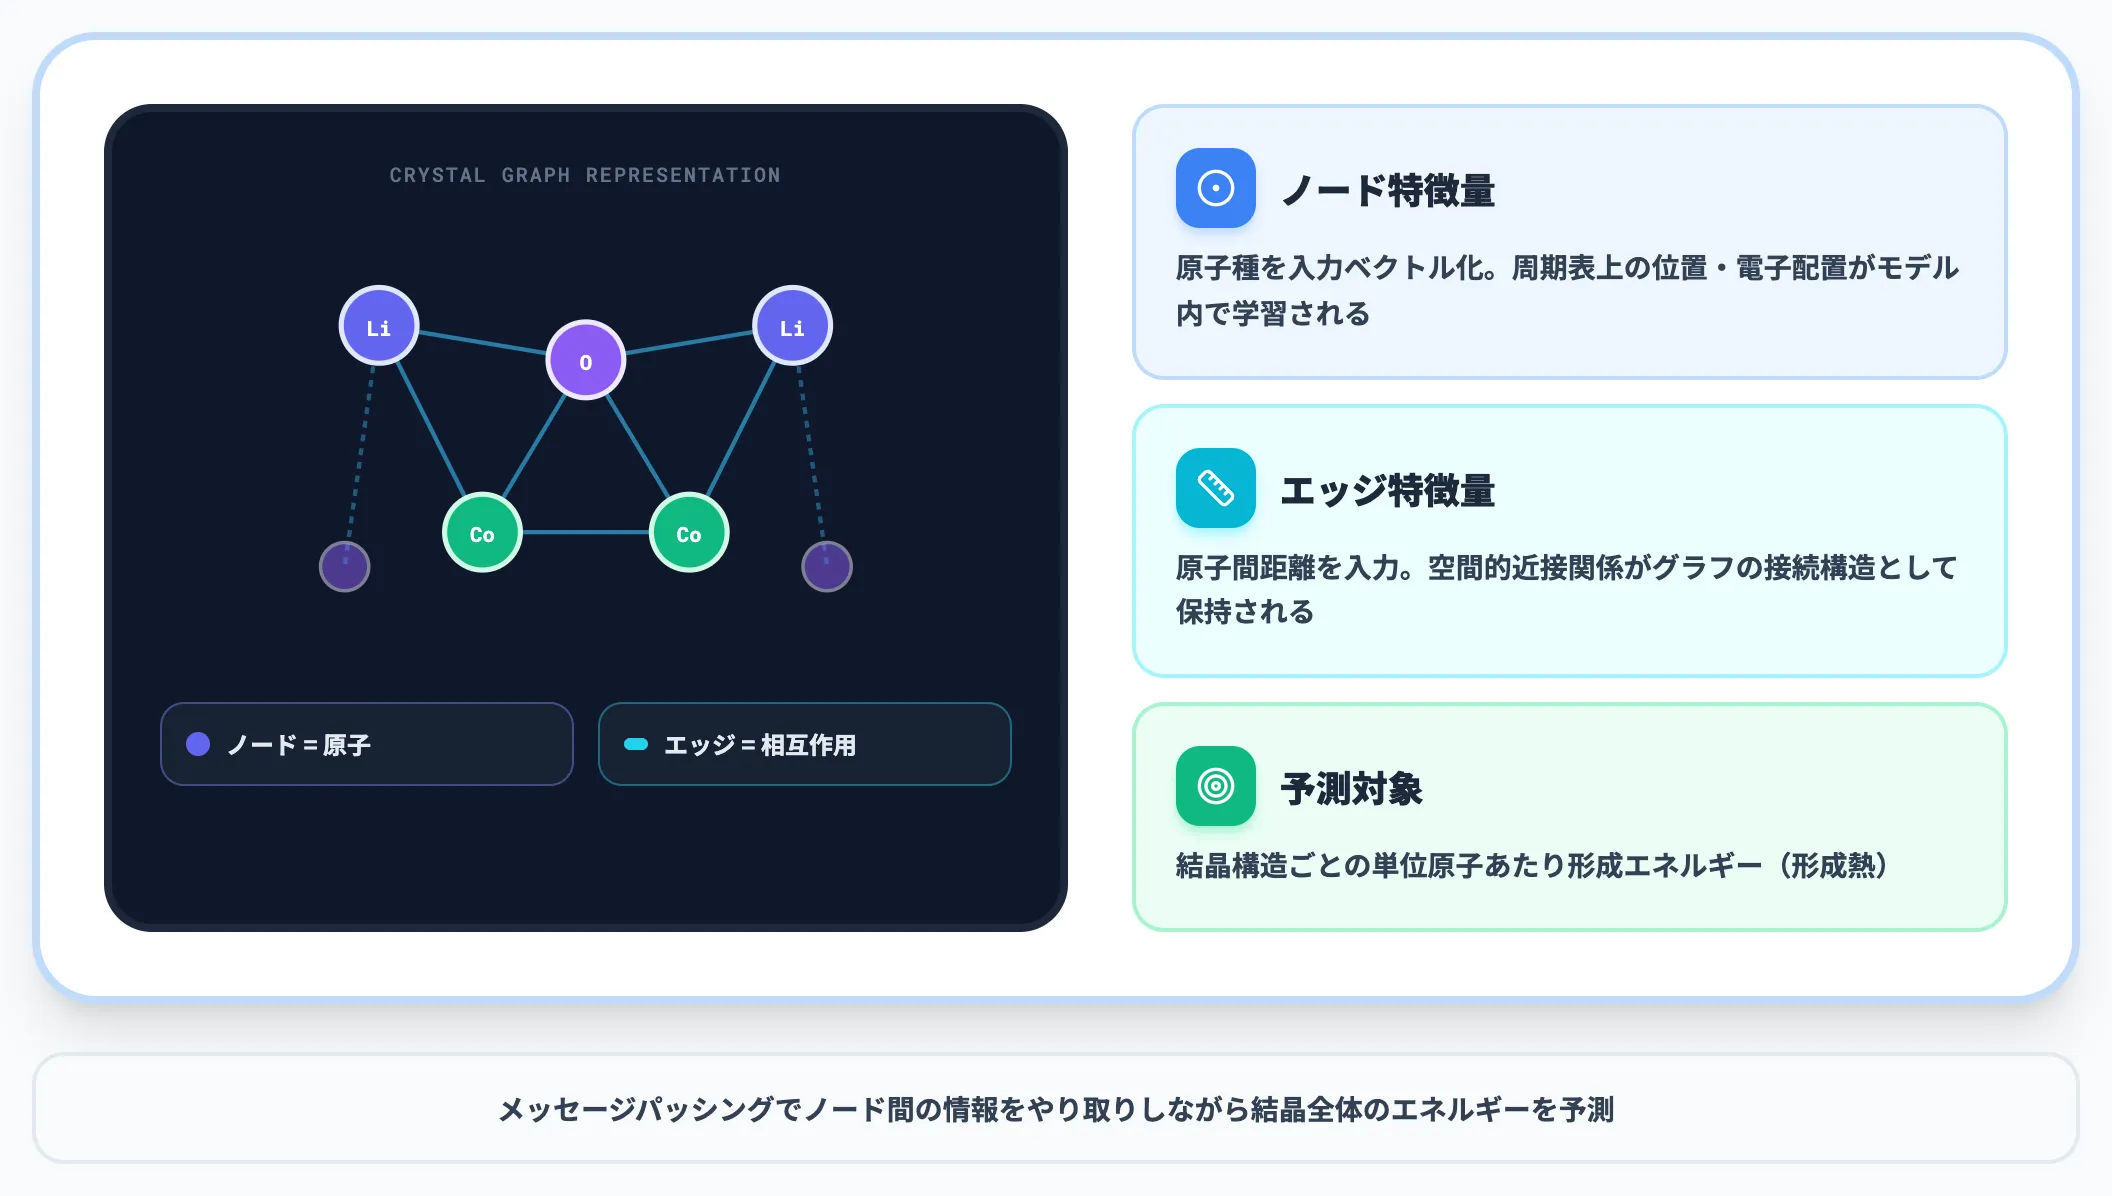
GNoMEの中核は、結晶構造をメッセージパッシング型のグラフニューラルネットワークとして処理するアーキテクチャです。
原子1つを1ノード、原子間の空間的近接関係を1エッジとして表現し、ノード間で情報をやり取りしながら結晶全体のエネルギーを予測します。
-
ノード特徴量
原子種
-
エッジ特徴量
原子間距離
-
予測対象
結晶構造ごとの単位原子あたり形成エネルギー(形成熱)
グラフニューラルネットワーク自体は材料科学で以前から使われていましたが、GNoMEが従来モデルと違うのは学習データの規模と、後述するアクティブラーニングによる自己ブートストラップにあります。
モデルの単発性能というより、「どれだけデータフライホイールを回せるかを前提に設計されているか」がGNoMEを他モデルから分ける鍵です。
DFT×アクティブラーニング
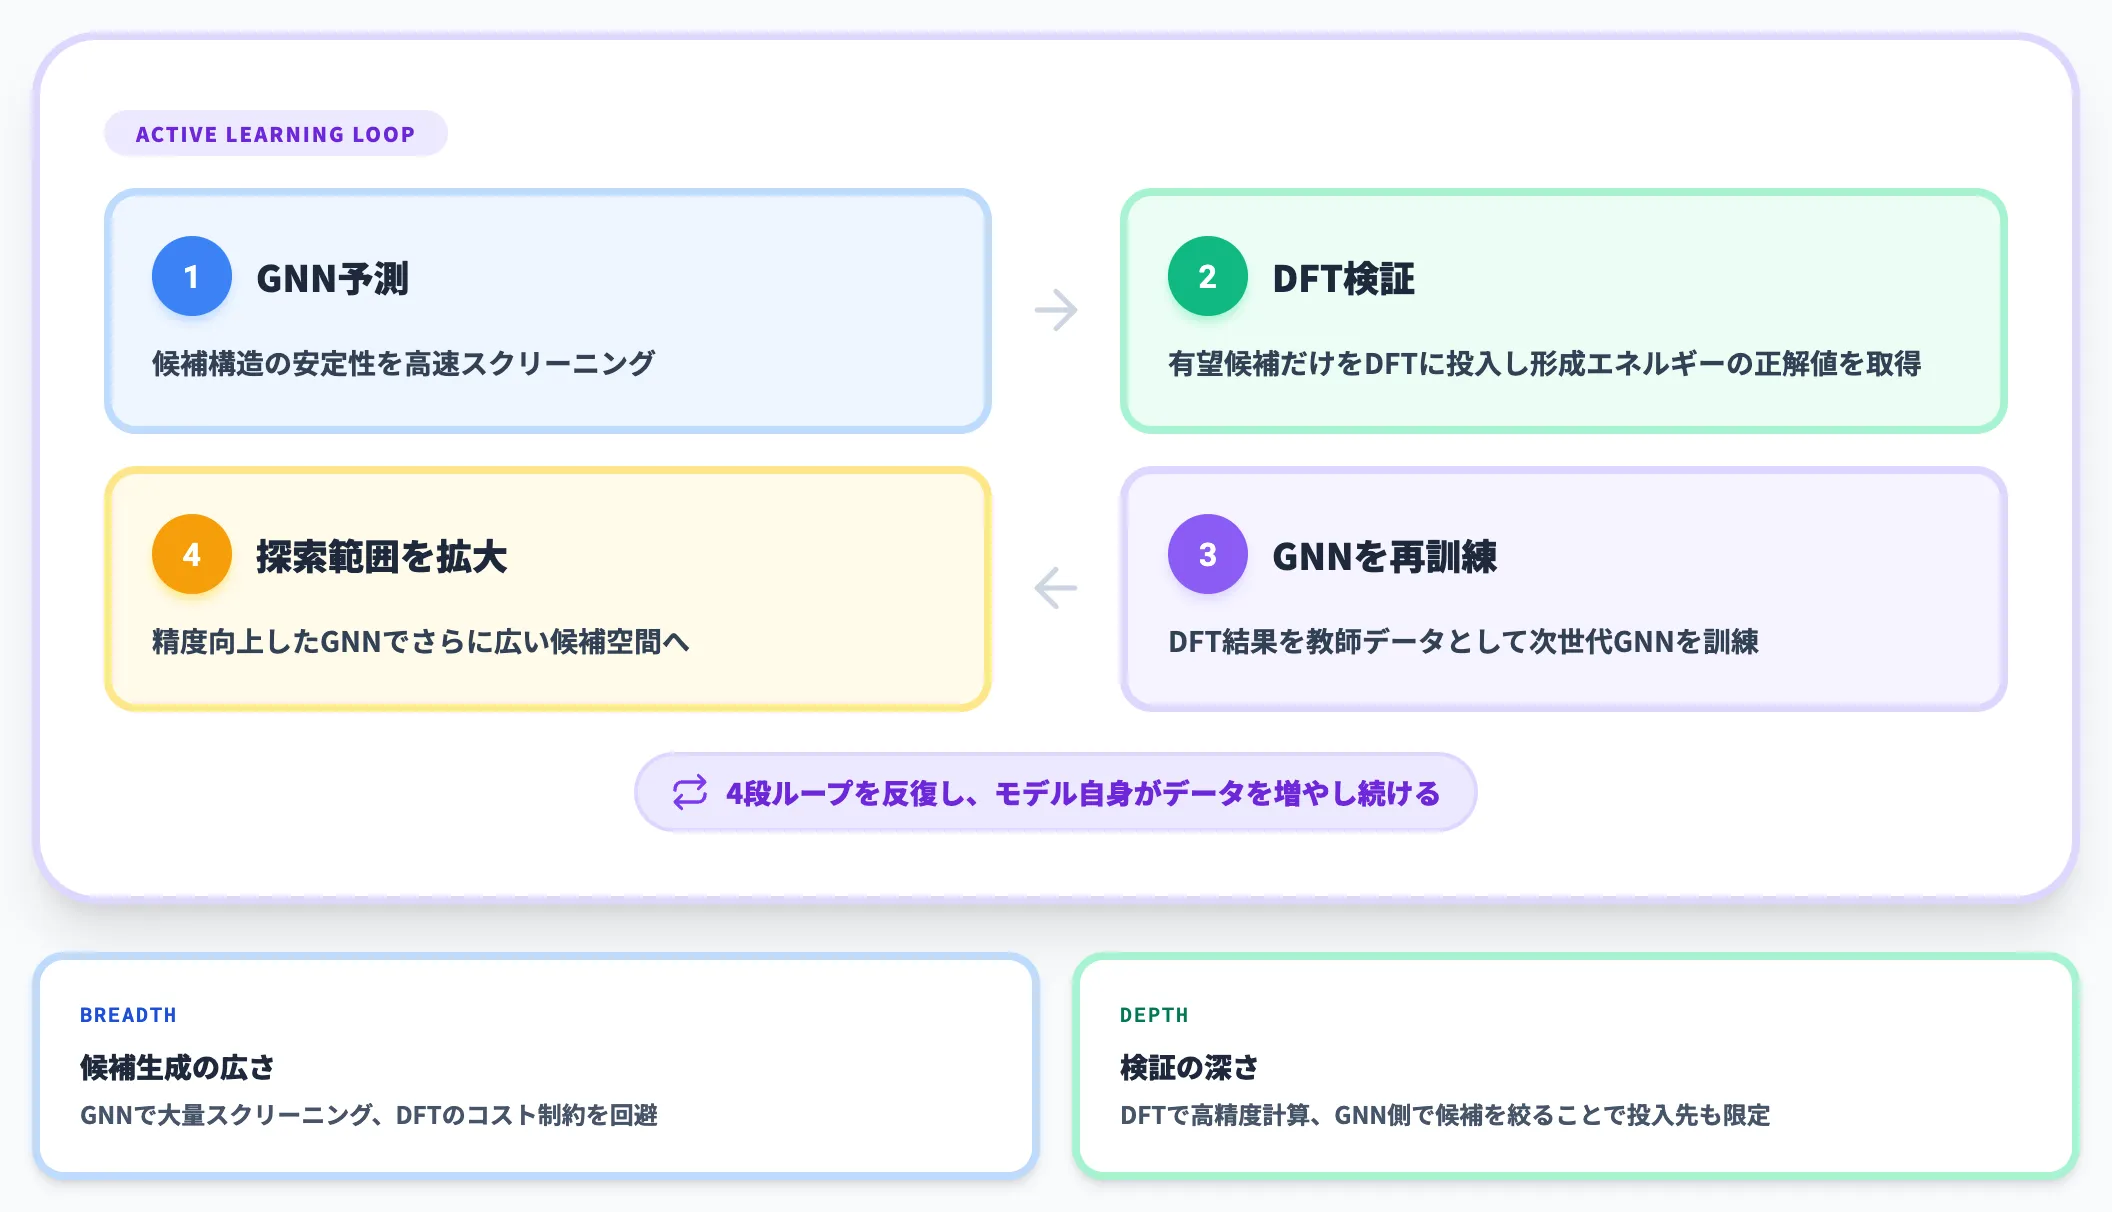
GNoMEの学習パイプラインは、GNNが単独で全てを担うのではなく、**DFT計算による正解データ生成をループの一部に組み込んだ「アクティブラーニング」**として設計されています。
流れは次のとおりです。
- GNNが候補構造の安定性を予測する
- 有望候補だけをDFT計算に回して形成エネルギーの正解値を得る
- DFT結果を教師データとして次世代のGNNを訓練する
- 精度が上がったGNNでさらに広い候補空間を探索する
この4段を繰り返すことで、モデルは自分で高品質な訓練データを増やし続けます。DFT計算はコストが高いため全候補には回せませんが、GNN側で候補を絞ればDFTの投入先も絞れるため、「候補生成の広さ」と「検証の深さ」を両立できる構造になっています。
材料探索AIの多くが「学習データ不足」で頭打ちになるなか、GNoMEはループを組んで自分でデータを生成し続けたことが、累計10億件超の探索と38.1万件の新規安定構造という規模を可能にしました。
構造と組成の2ライン設計
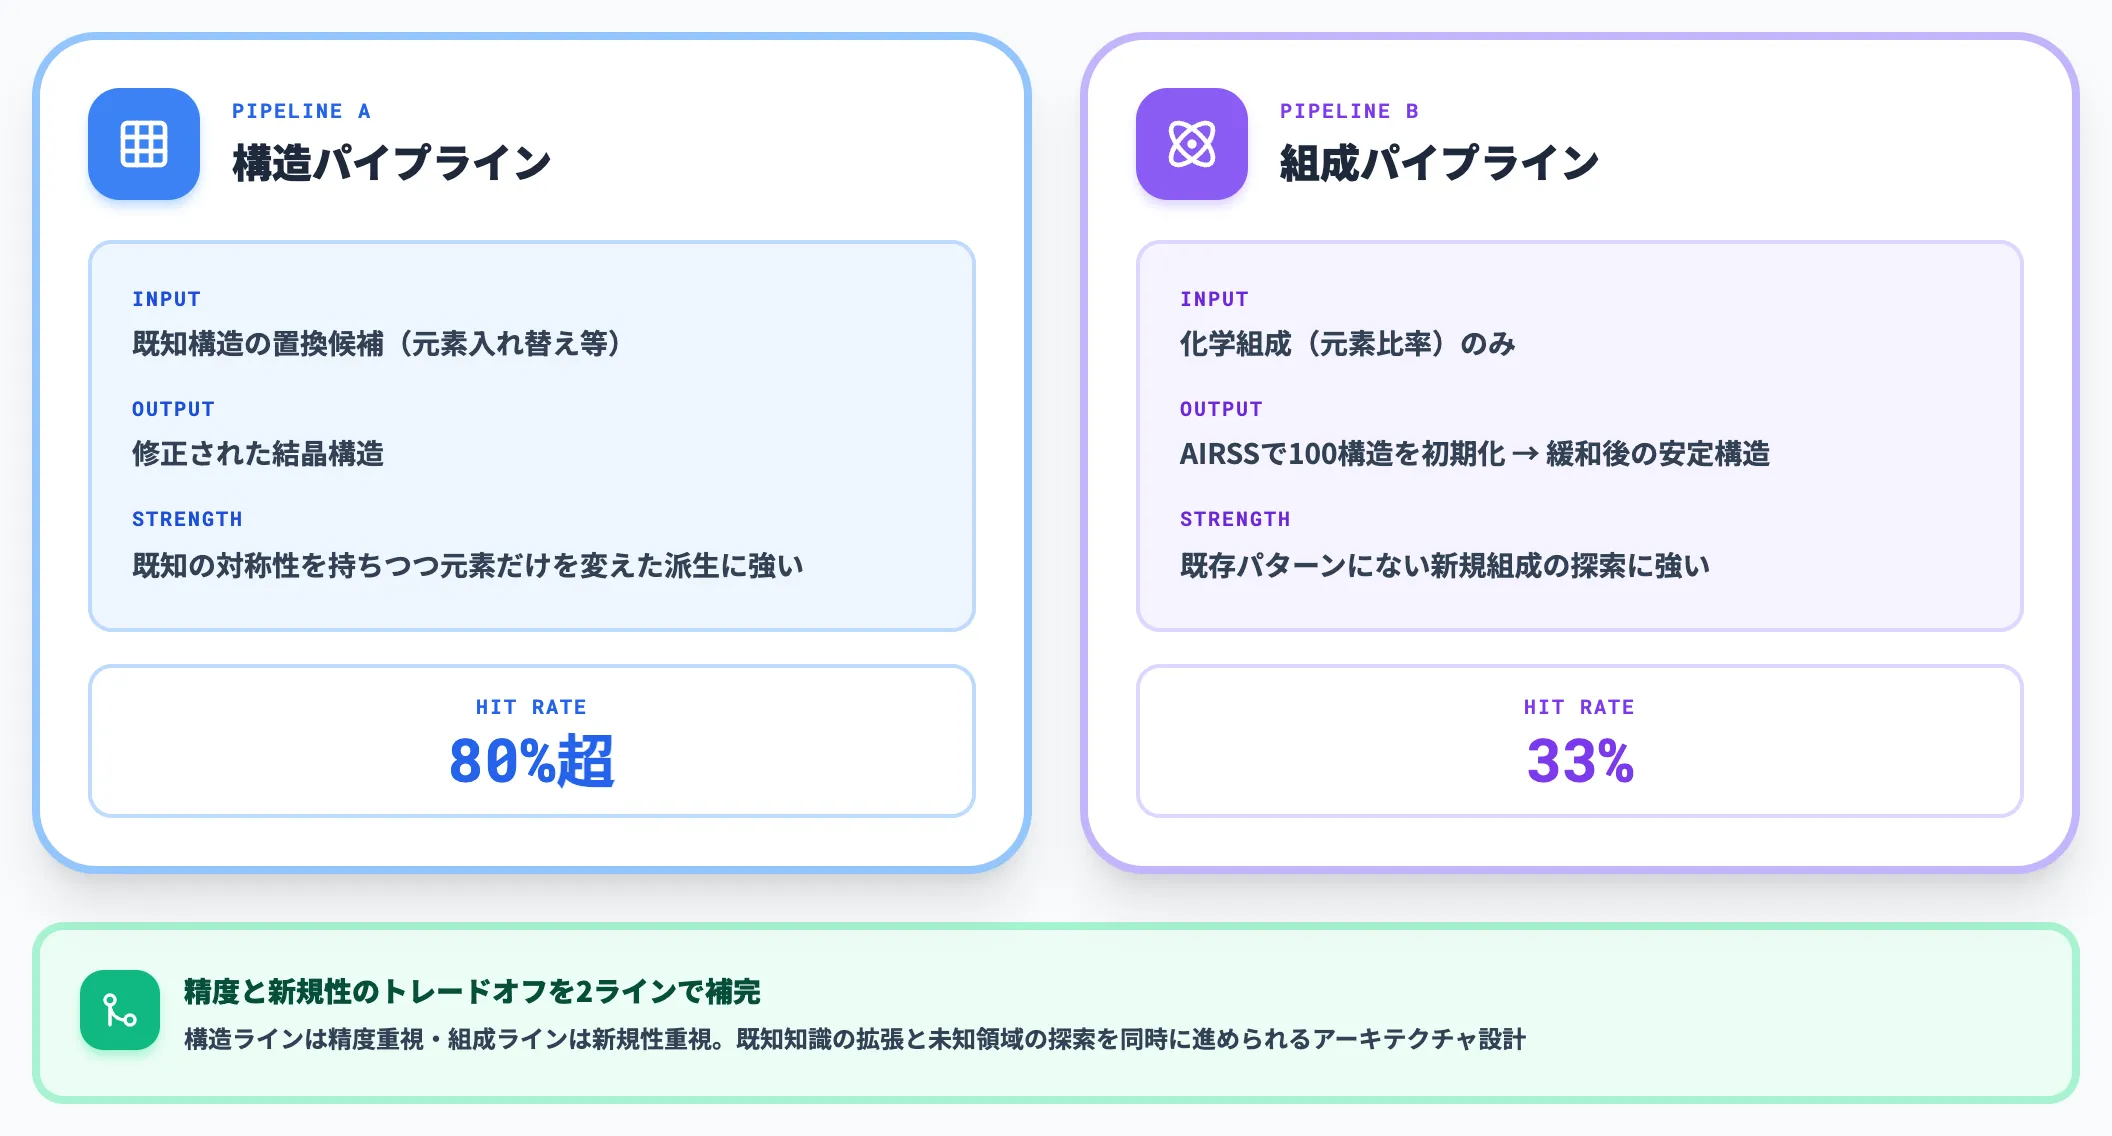
GNoMEはさらに、探索の入り口を構造起点と組成起点の2ラインに分けています。それぞれ得意な探索範囲が違うため、両方を回すことで既知パターンの外側にも手が届く設計です。
以下の表で、2つのパイプラインの役割を整理しました。
| パイプライン | 入力 | 出力 | 得意な探索範囲 |
|---|---|---|---|
| 構造パイプライン | 既知構造の置換候補(元素入れ替え等) | 修正された結晶構造 | 既知の対称性を持ちつつ元素だけを変えた派生 |
| 組成パイプライン | 化学組成(元素比率)のみ | 組成を選別後、AIRSSで100構造を初期化 → 緩和後の安定構造 | 既存パターンにない新規組成の探索 |
構造パイプラインは相対的に精度が高く、組成パイプラインは新規性が高い代わりに精度が落ちる、というトレードオフを2ラインで補い合う設計です。
Nature論文で報告された「組成のみからのヒット率33%」は組成パイプラインの数値で、構造パイプラインの80%と組み合わせて、既知知識の拡張と未知領域の探索を同時に進められる点がGNoMEのアーキテクチャ上の特徴になっています。
GNoMEのデータセットとGitHubリポジトリの使い方
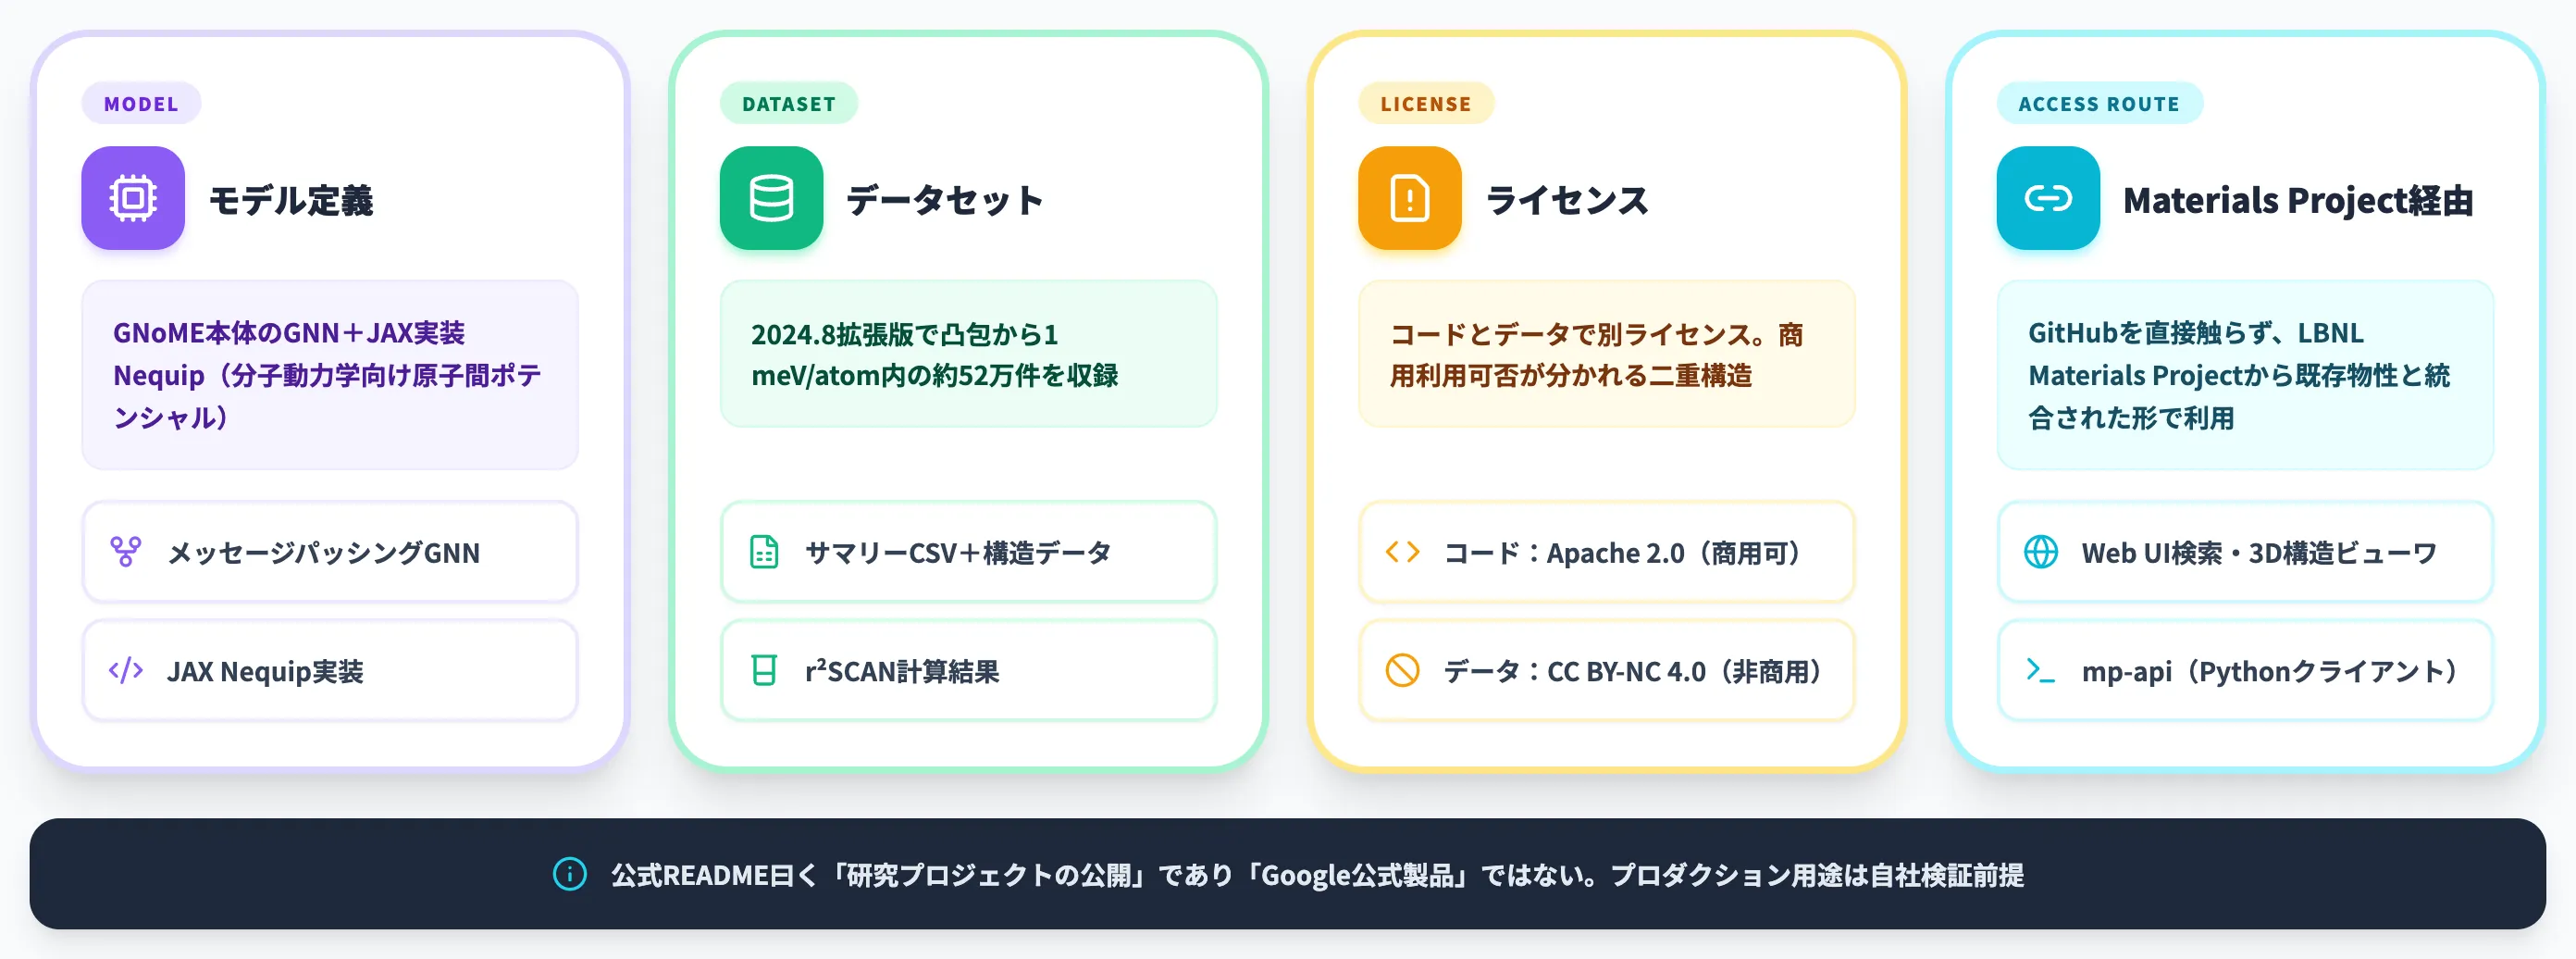
GNoMEは論文発表と同時に、モデル定義とデータセットをgoogle-deepmind/materials_discoveryで公開しています。
ここでは実際にリポジトリと公開データに触るときの入口を、リポジトリ構成・データセット構成・ライセンス・Materials Project経由の利用ルートの順で整理します。
自分でモデルを再訓練したい研究者向けの内容ではなく、公開データを触って結晶構造を眺める・特定の化学系を絞り込むあたりまでを想定した実務者向けの視点でまとめます。
リポジトリの3構成要素
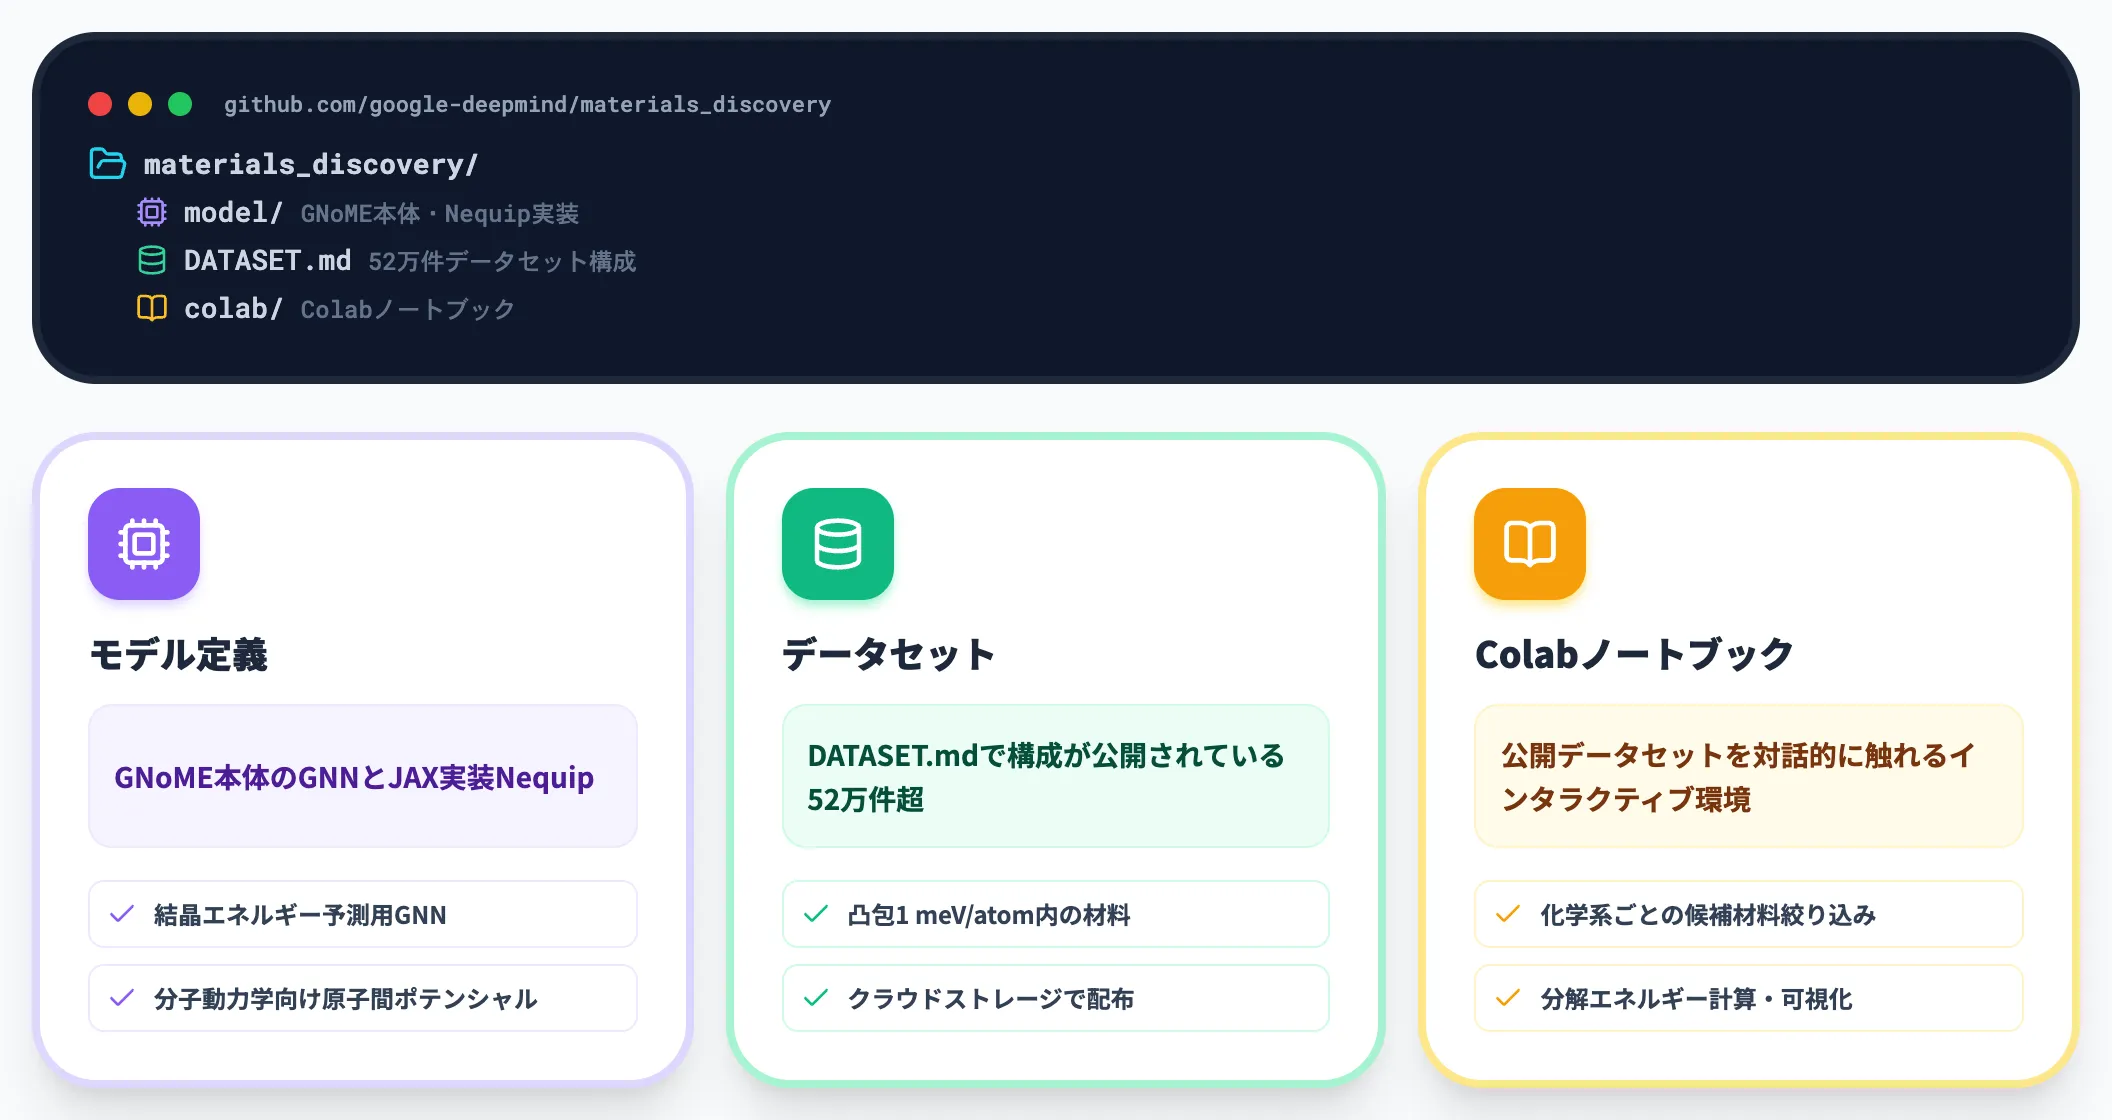
GitHubリポジトリで公開されているのは、大きく次の3つです。
-
モデル定義
GNoME本体のメッセージパッシングGNN、およびJAX実装版のNequip(分子動力学向け原子間ポテンシャル)
-
データセット
公式ドキュメント(DATASET.md)で構成が公開されている、52万件超の材料データ
-
Colabノートブック
公開データセットを触るためのインタラクティブ環境。化学系ごとの候補材料の絞り込み、分解エネルギーの計算、化学ファミリーの可視化などが例示されている
公式README(README.md)では、リポジトリはあくまで「研究プロジェクトの公開」であって「Google公式製品ではない」と明記されています。プロダクション用途で使う場合はライセンス条項と併せて自社で検証する前提です。
データセットの3形式
公開データは目的別に3形式で提供されており、分析したい観点に応じて使い分ける想定です。
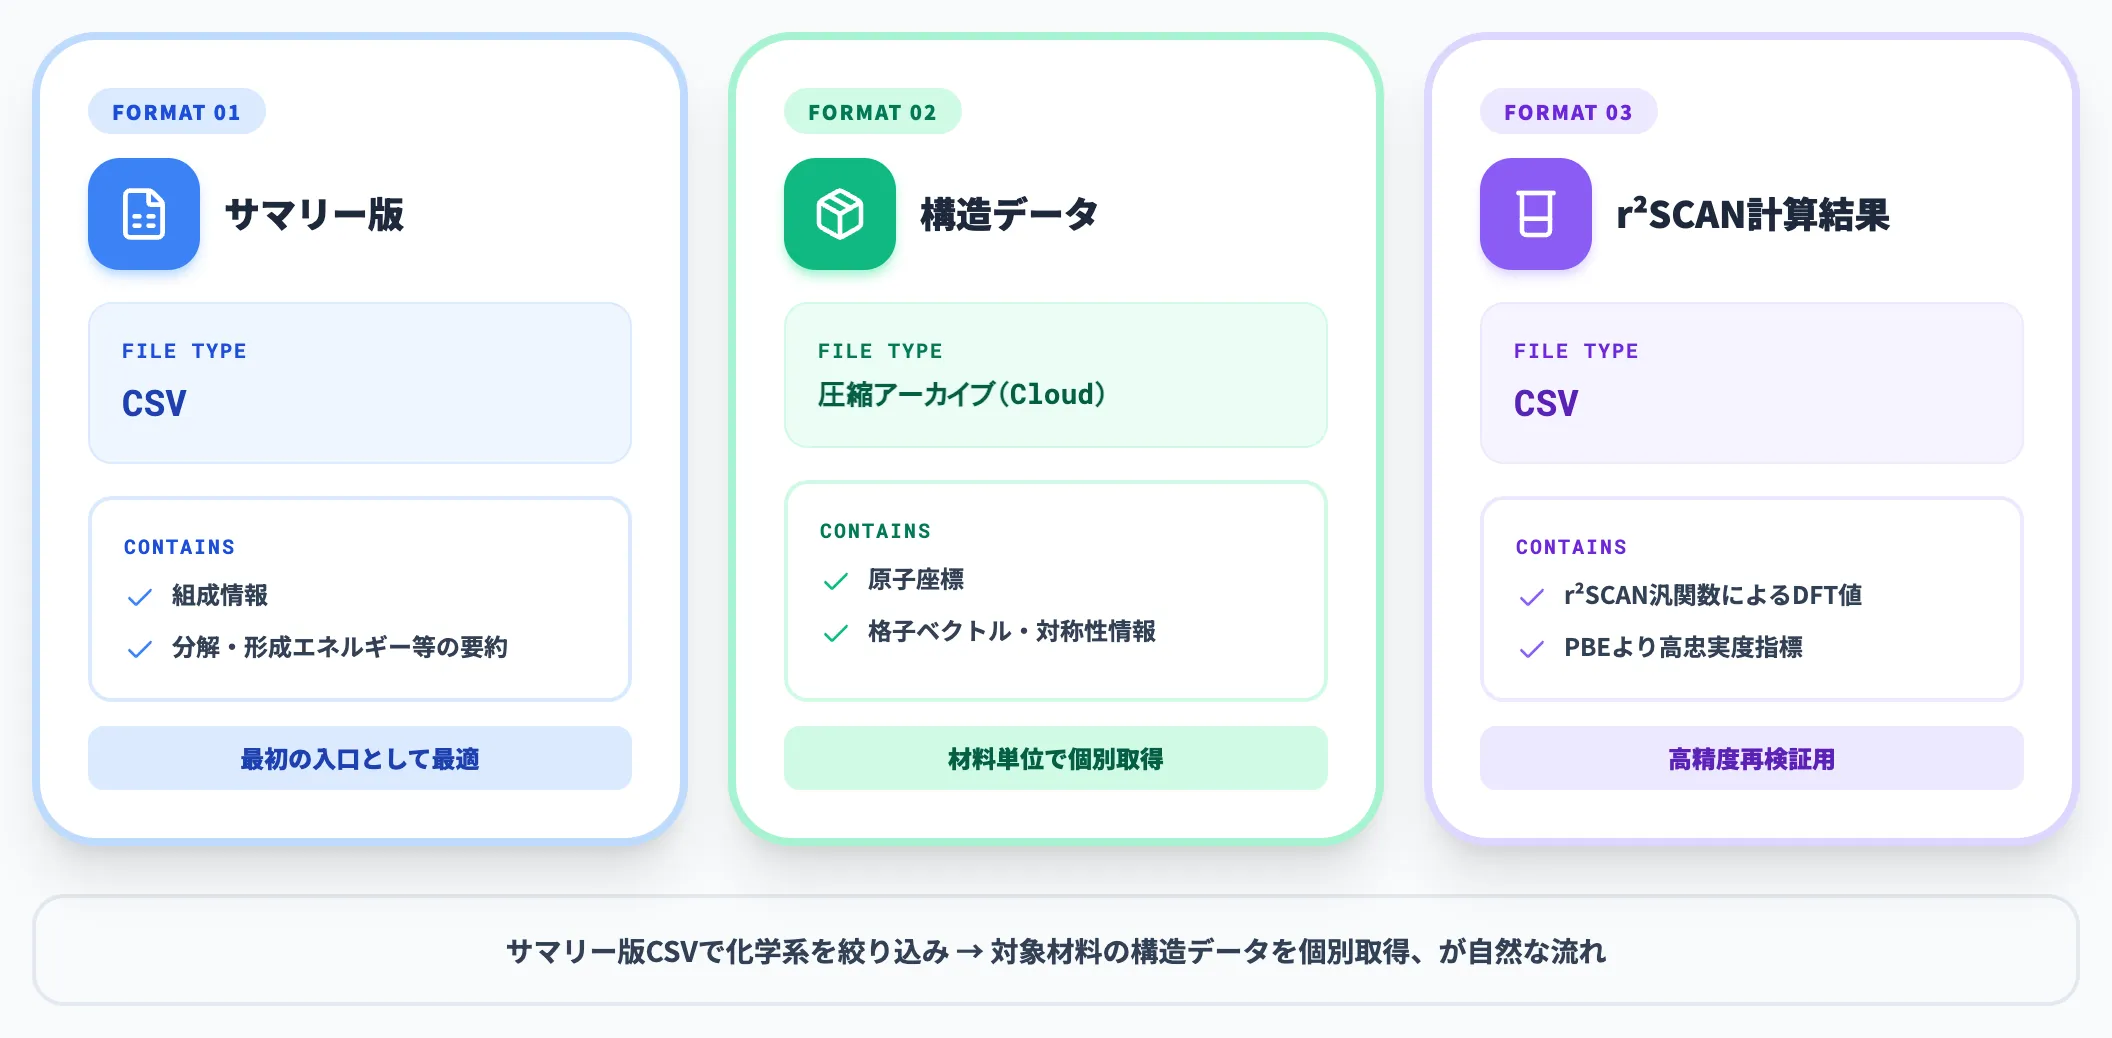
以下の表で、3形式それぞれのファイルタイプと収録内容を整理しました。
| 形式 | ファイルタイプ | 収録内容 |
|---|---|---|
| サマリー版 | CSV | 組成、DFT計算結果の要約(分解エネルギー・形成エネルギー等) |
| 構造データ | 圧縮アーカイブ(クラウドストレージ) | 結晶構造の詳細(原子座標・格子ベクトル・対称性情報) |
| r²SCAN計算結果 | CSV | 安定材料に対する追加DFT指標(r²SCAN汎関数) |
入口として最初に触るなら、サマリー版CSVで化学系を絞り込み、そこから対象材料の構造データを個別に取得するのが自然な流れです。公開バケット全体を一括で扱わなくても、可視化用Colabで例示されている必要な材料だけ取り出す方式で十分にケーススタディを回せます。
r²SCAN計算結果は、一般的なPBE汎関数よりも高忠実度でエネルギー・安定性の再検証が必要なユースケースで使う想定です。
ライセンスと商用利用の範囲
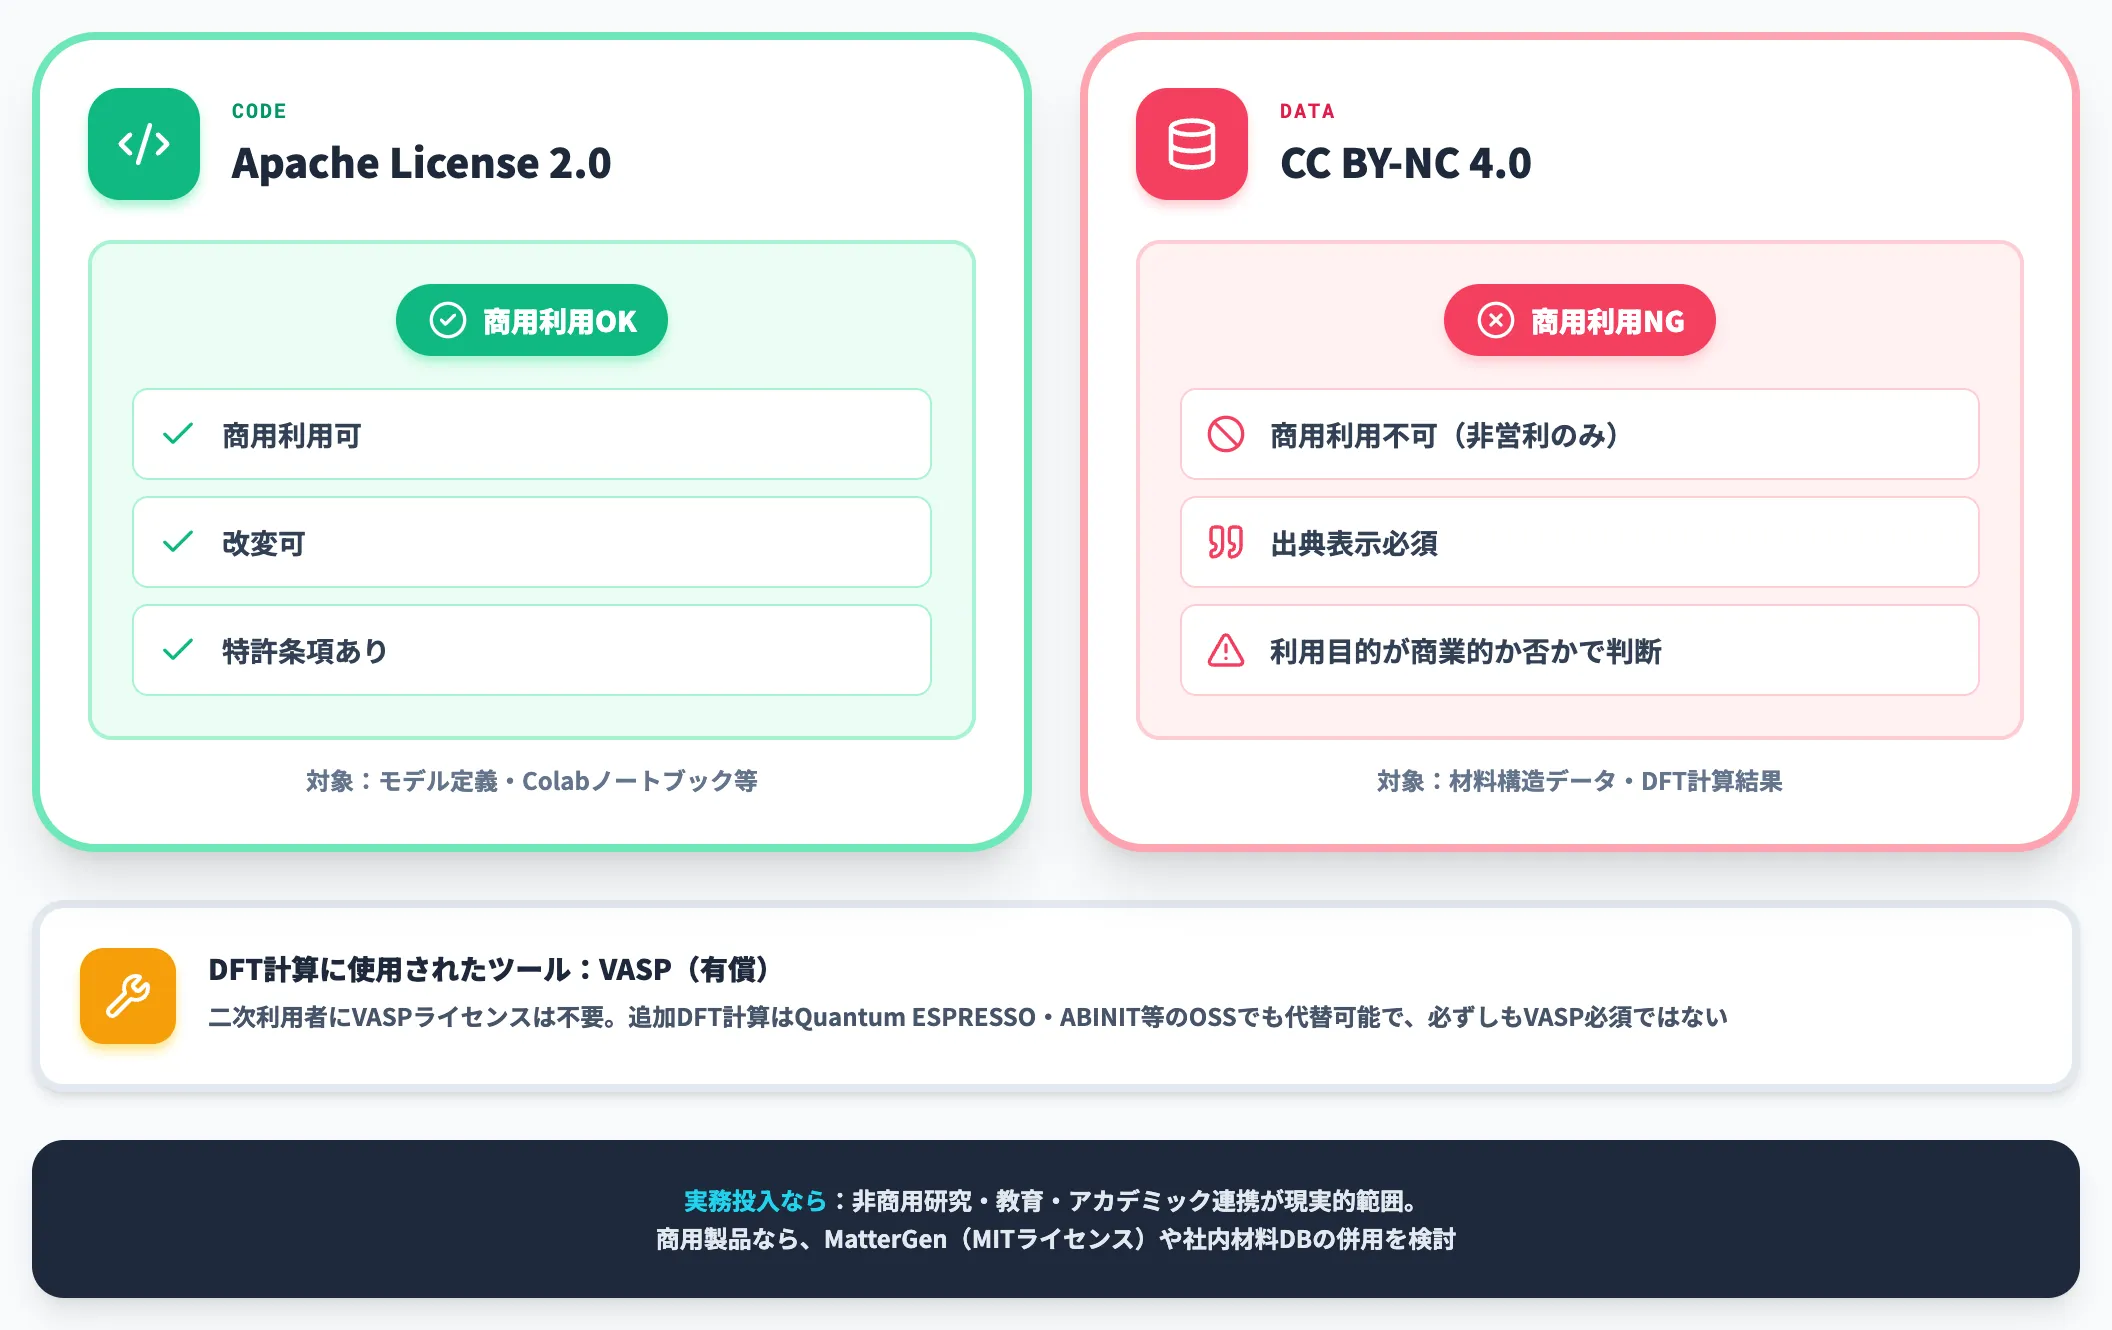
GNoMEを実務で使う際に必ず押さえておくべきなのが、コードとデータで別ライセンスが適用されている点です。
-
コード(モデル定義・Colab等)
Apache License 2.0。商用利用可、改変可、特許条項あり
-
公開データ(材料構造・DFT計算結果)
Creative Commons Attribution-NonCommercial 4.0(CC BY NC 4.0)。商用利用は不可、出典表示必須
-
DFT計算に使用されたツール
公開データセットはDeepMind側でVASP(有償・商用ライセンス)を使って計算されている。二次利用者にVASPライセンスは不要。追加でDFT計算を回す場合、VASPを使うなら別途ライセンス購入が必要だが、Quantum ESPRESSO・ABINIT等のオープンソースDFTコードを使う選択肢もあり、必ずしもVASP必須ではない
CC BY-NC 4.0の非商用条項は「利用者が企業かどうか」ではなく「利用目的が主として商業的利益に向けられているか」で判断される点に注意が必要です。
商用製品にGNoMEデータをそのまま組み込むことはライセンス上できないため、実務投入する場合は「非商用目的の研究・教育で使う」「公開論文の材料として引用する」「アカデミック連携で使う」あたりが現実的な範囲になります。企業内研究であっても、利用目的が商業的利益に直結する場合は別途確認が必要です。
商用製品向けに材料候補を提示したいなら、後述のMatterGen(コードMIT/データCC BY 4.0)や社内で独自に整備した材料データベースを別途検討することになります。
Materials Project経由の利用
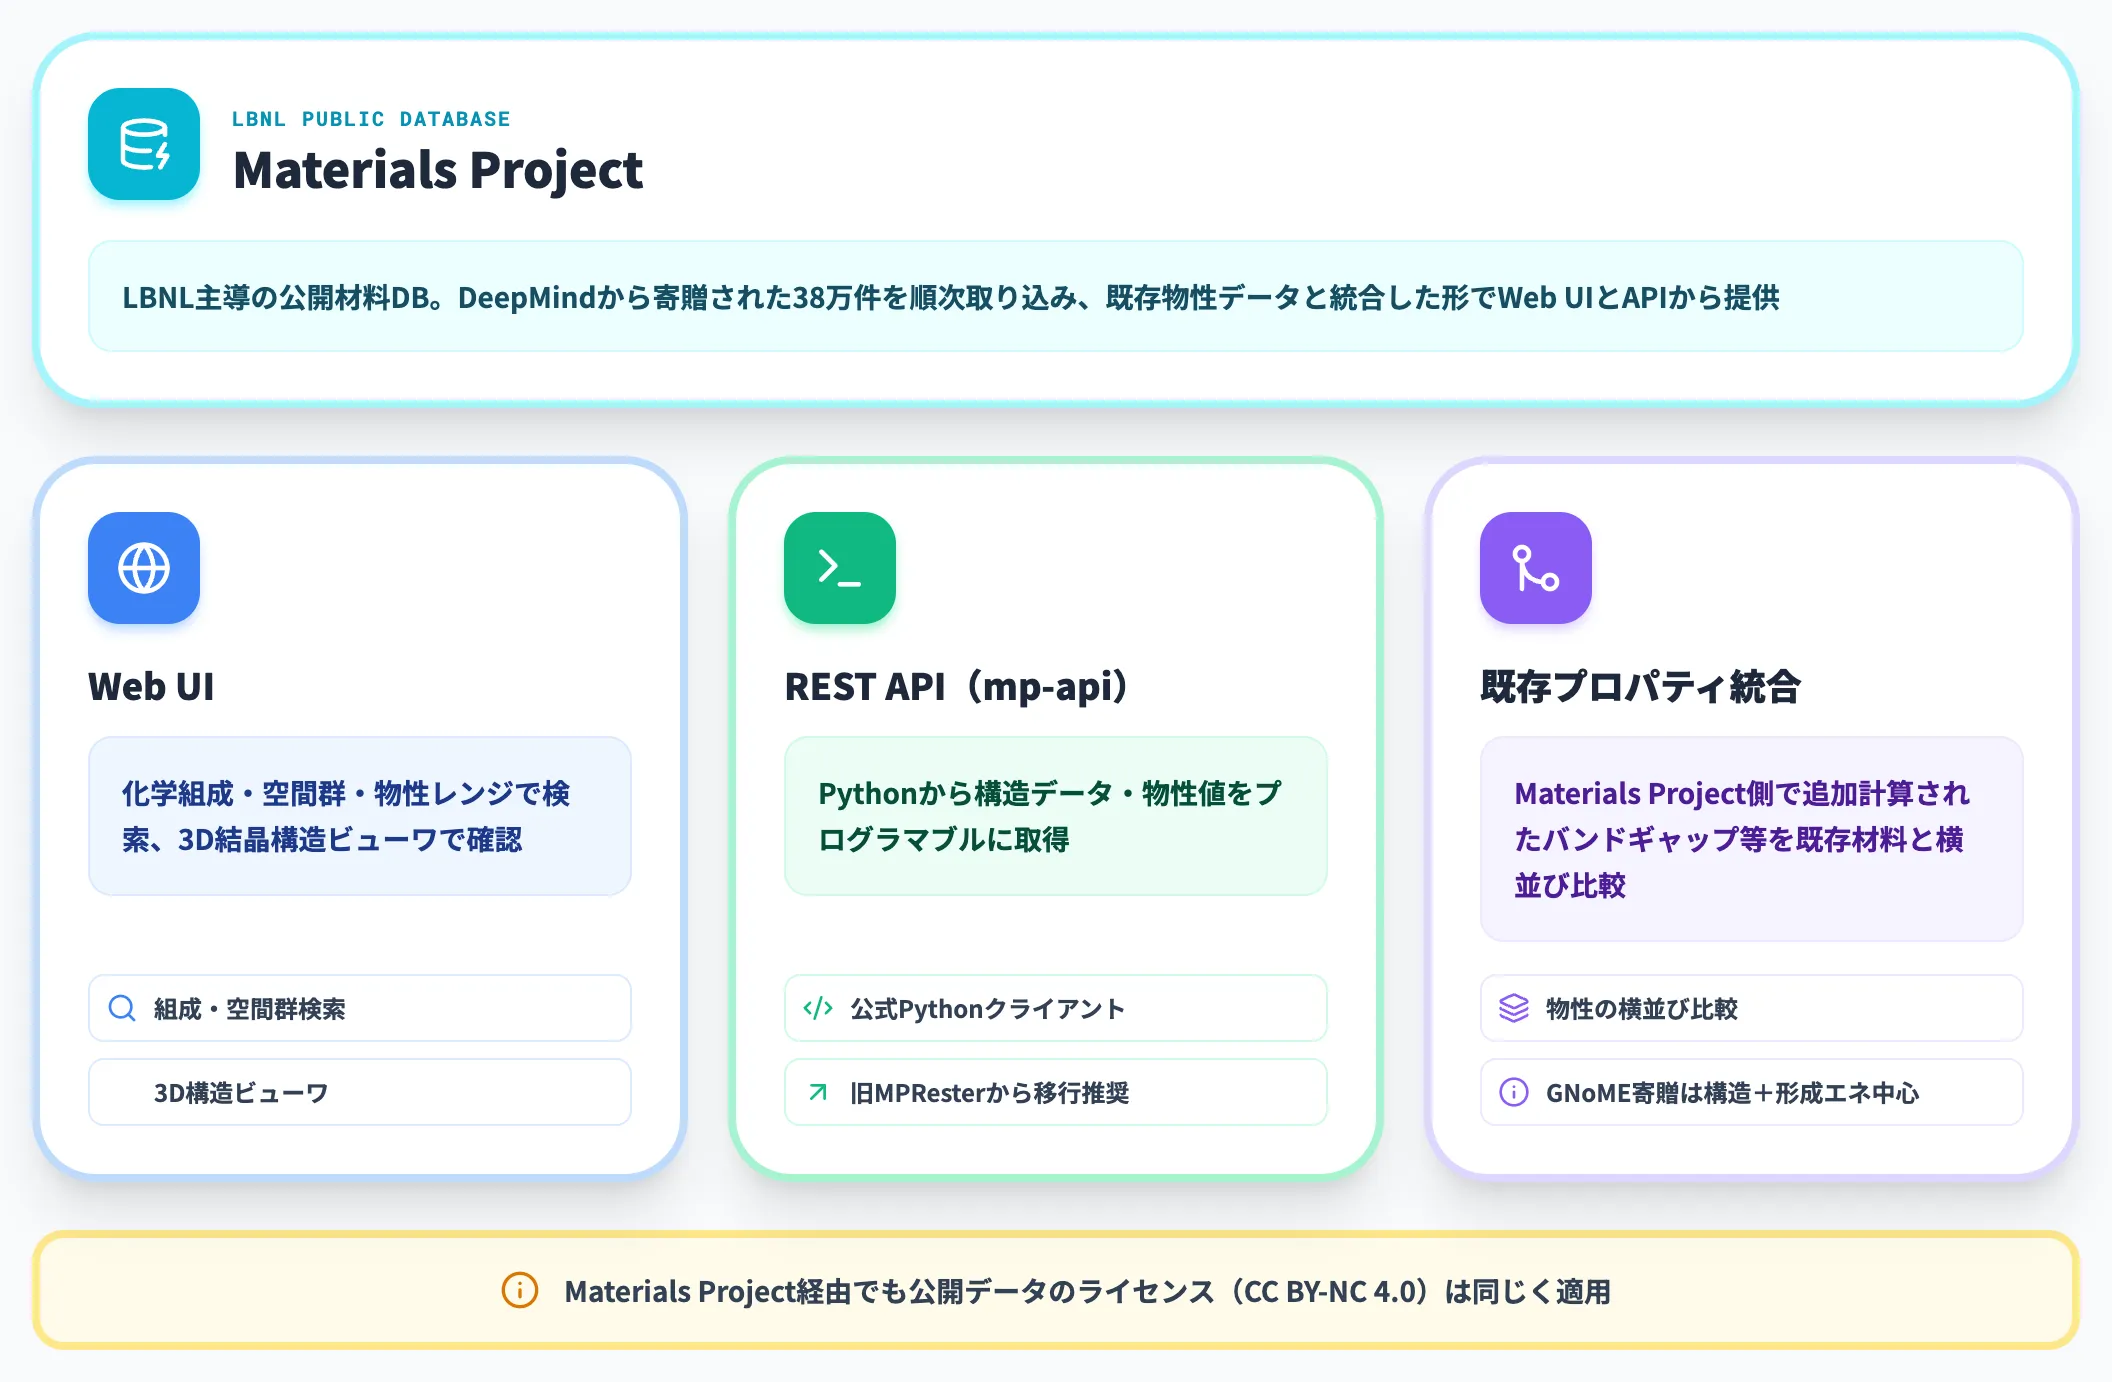
GNoMEのGitHubリポジトリを直接触らずに、Materials Project経由でデータにアクセスするルートもあります。
Materials ProjectはLBNL主導の公開材料データベースで、DeepMindから寄贈された38万件を順次取り込み、既存の物性データと統合した形でWeb UIとAPIから提供しています。
-
Web UI
化学組成・空間群・物性レンジで検索し、結晶構造ビューワで確認できる
-
REST API(現行の公式Pythonクライアントmp-api)
Pythonから構造データ・物性値をプログラマブルに取得できる。旧pymatgenのMPResterから移行が推奨されている
-
既存プロパティとの統合
GNoME起源のデータでも、Materials Project側で追加計算されたバンドギャップ等が付与されている場合は既存材料と横並びで比較できる(GNoMEが寄贈したデータそのものは結晶構造と形成エネルギーが中心)
初めて触る場合は、Materials Projectの検索UIから既知組成の類似構造を眺め、そのうえでGNoMEリポジトリを見に行くルートのほうが情報の位置関係を掴みやすくなります。
Materials Project経由でも公開データのライセンス(CC BY NC 4.0)は同じく適用される点は、忘れずに確認してください。
GNoMEへの批判——論文が指摘した3つの弱点
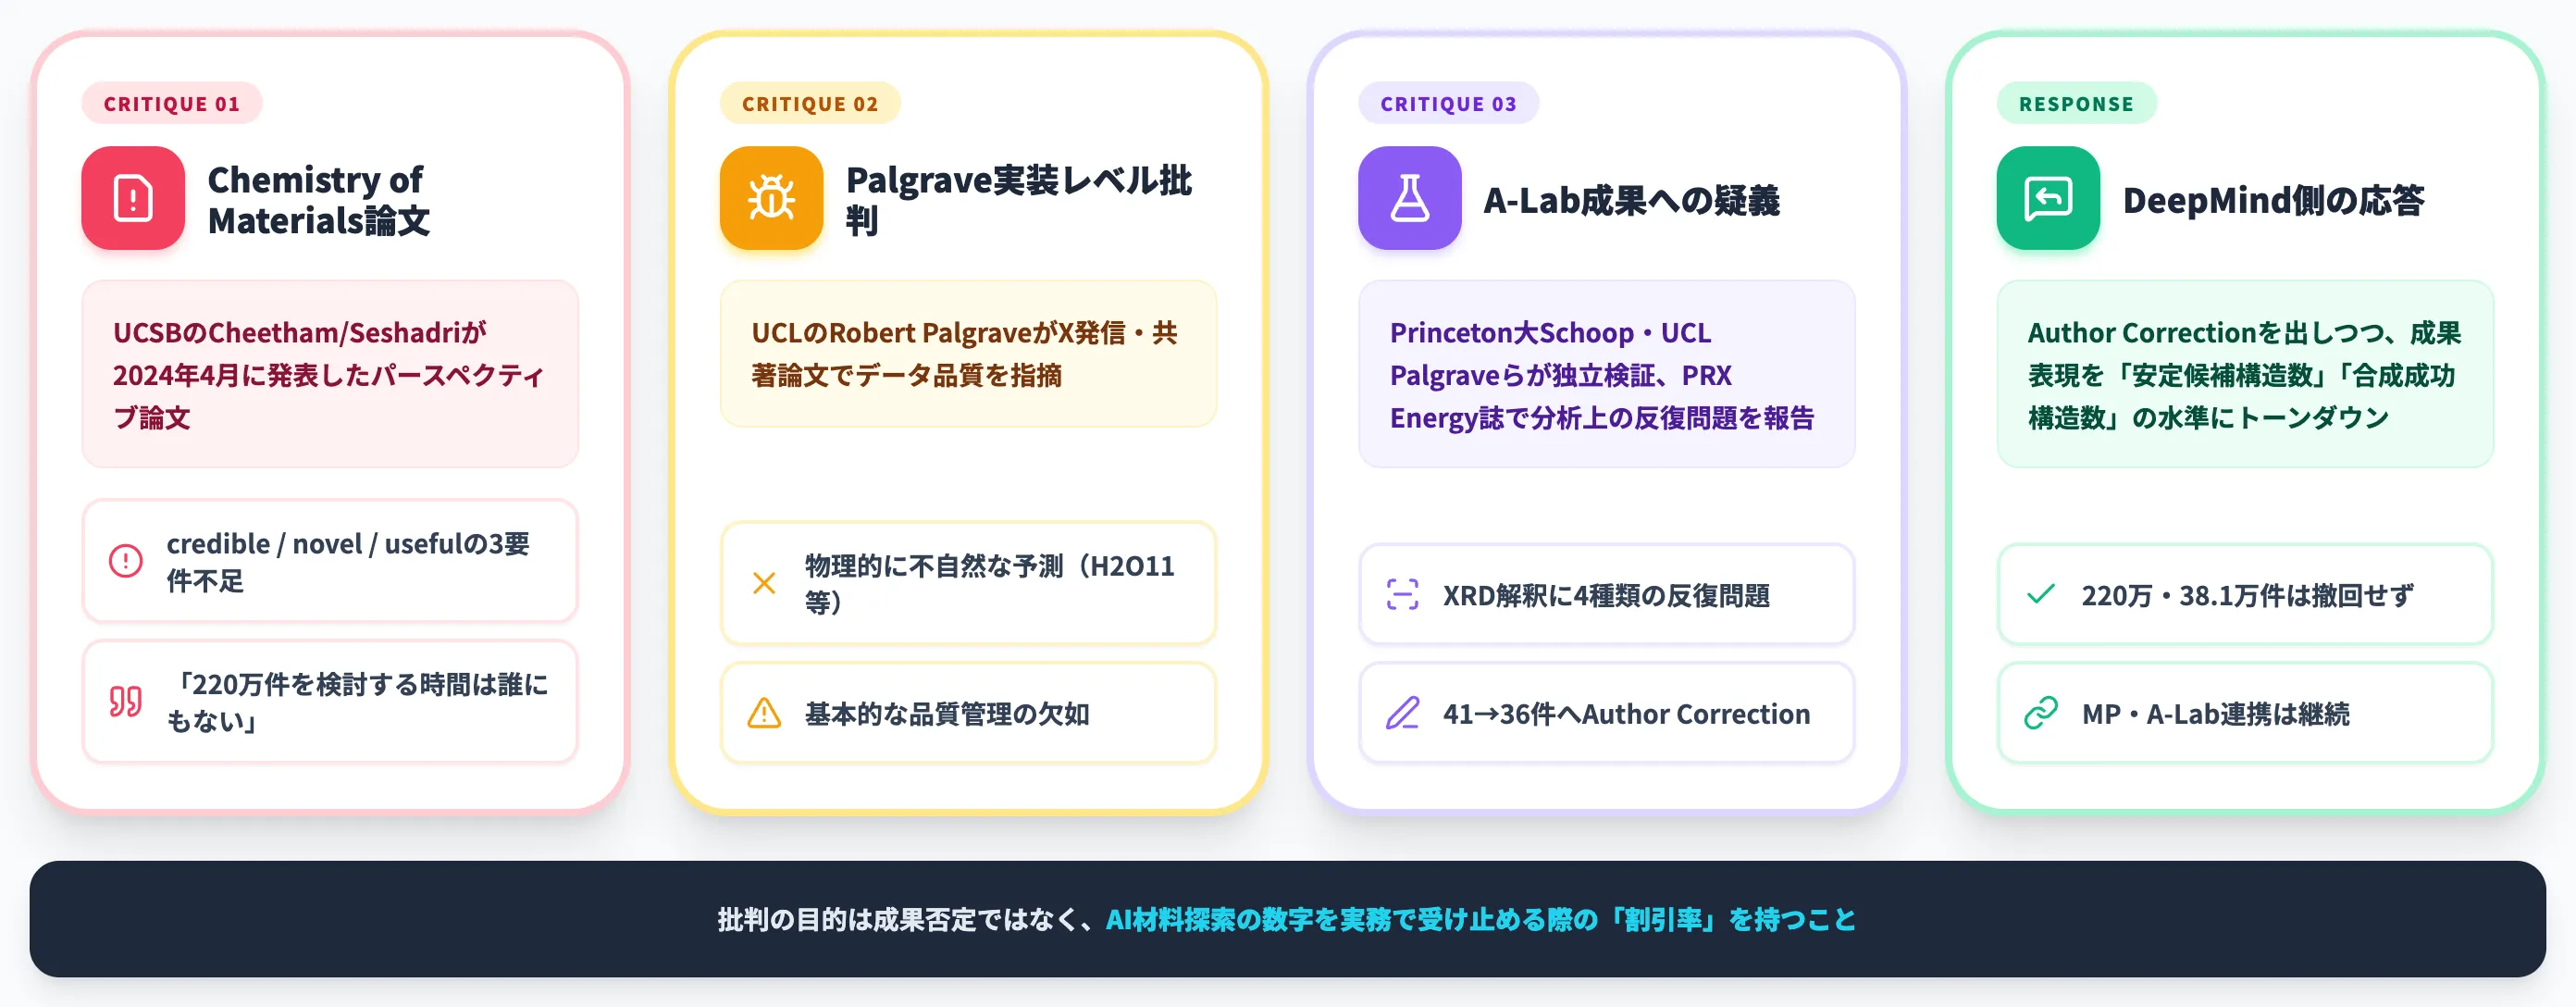
GNoMEは発表と同時に大きな話題を集めましたが、材料科学コミュニティ内部からは「発表された数字と実質的な材料科学への貢献のあいだにギャップがある」という批判が並行して出ました。
本セクションでは、批判論文の内容と実装レベルでの指摘、A-Lab成果への疑義、そしてDeepMind側の応答の順で整理します。
批判を紹介する目的は成果を否定することではなく、AIを活用した材料探索の数字を実務で受け止める際の「割引率」を持っておくためです。
Chemistry of Materials論文の3指摘
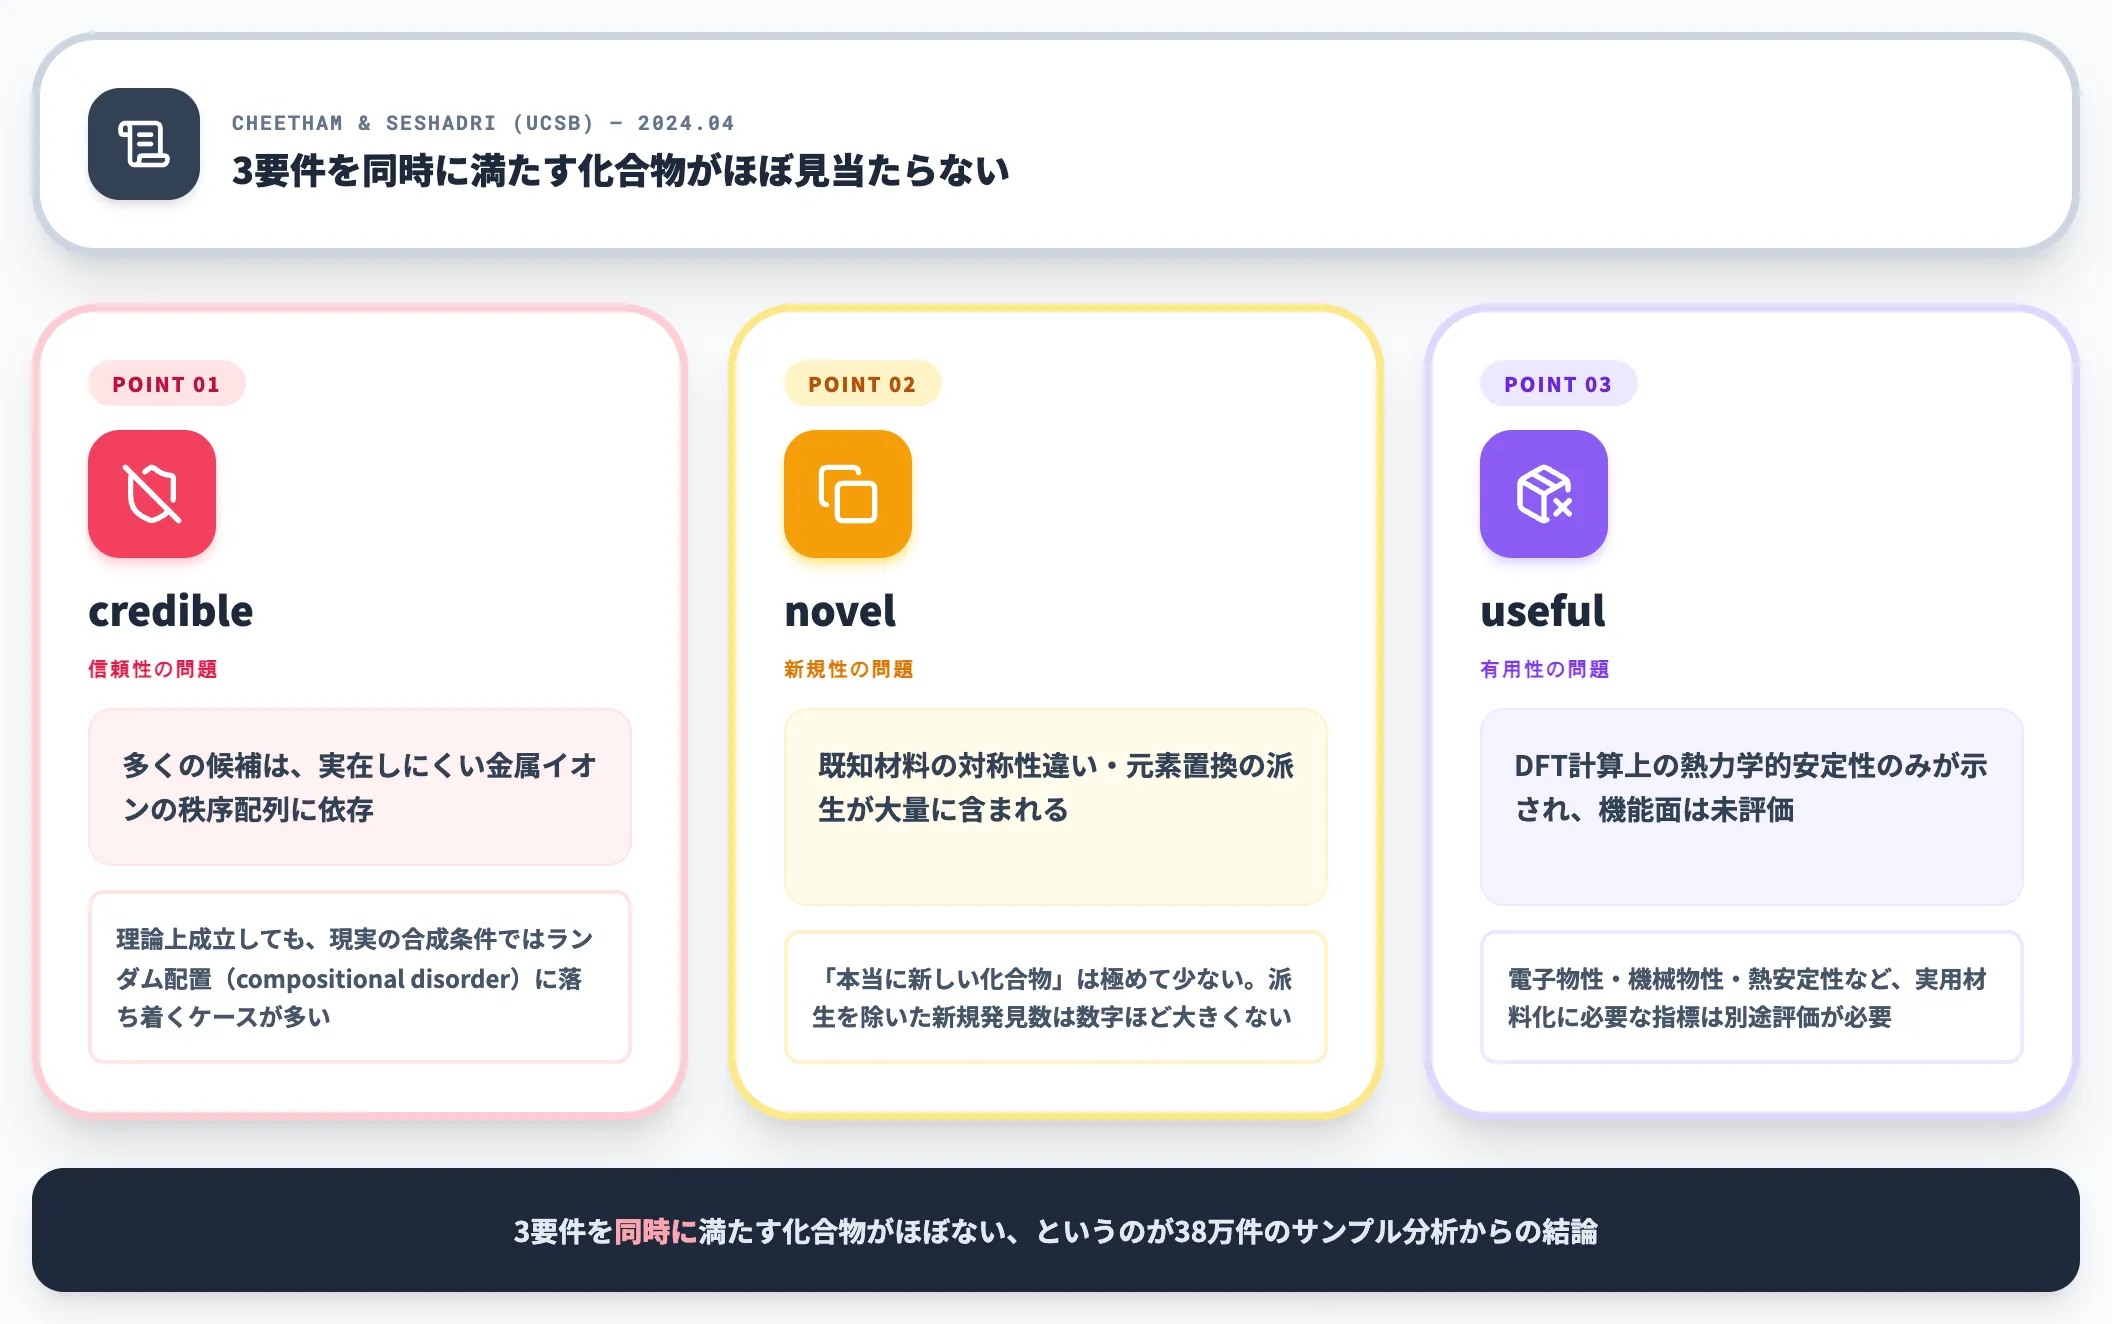
批判の中心となったのは、UC Santa BarbaraのAnthony CheethamとRam Seshadriが2024年4月にChemistry of Materials誌に発表したパースペクティブ論文です。批判の核心にある「compositional disorder」問題を、模式図で押さえておくと3指摘の意味が掴みやすくなります。
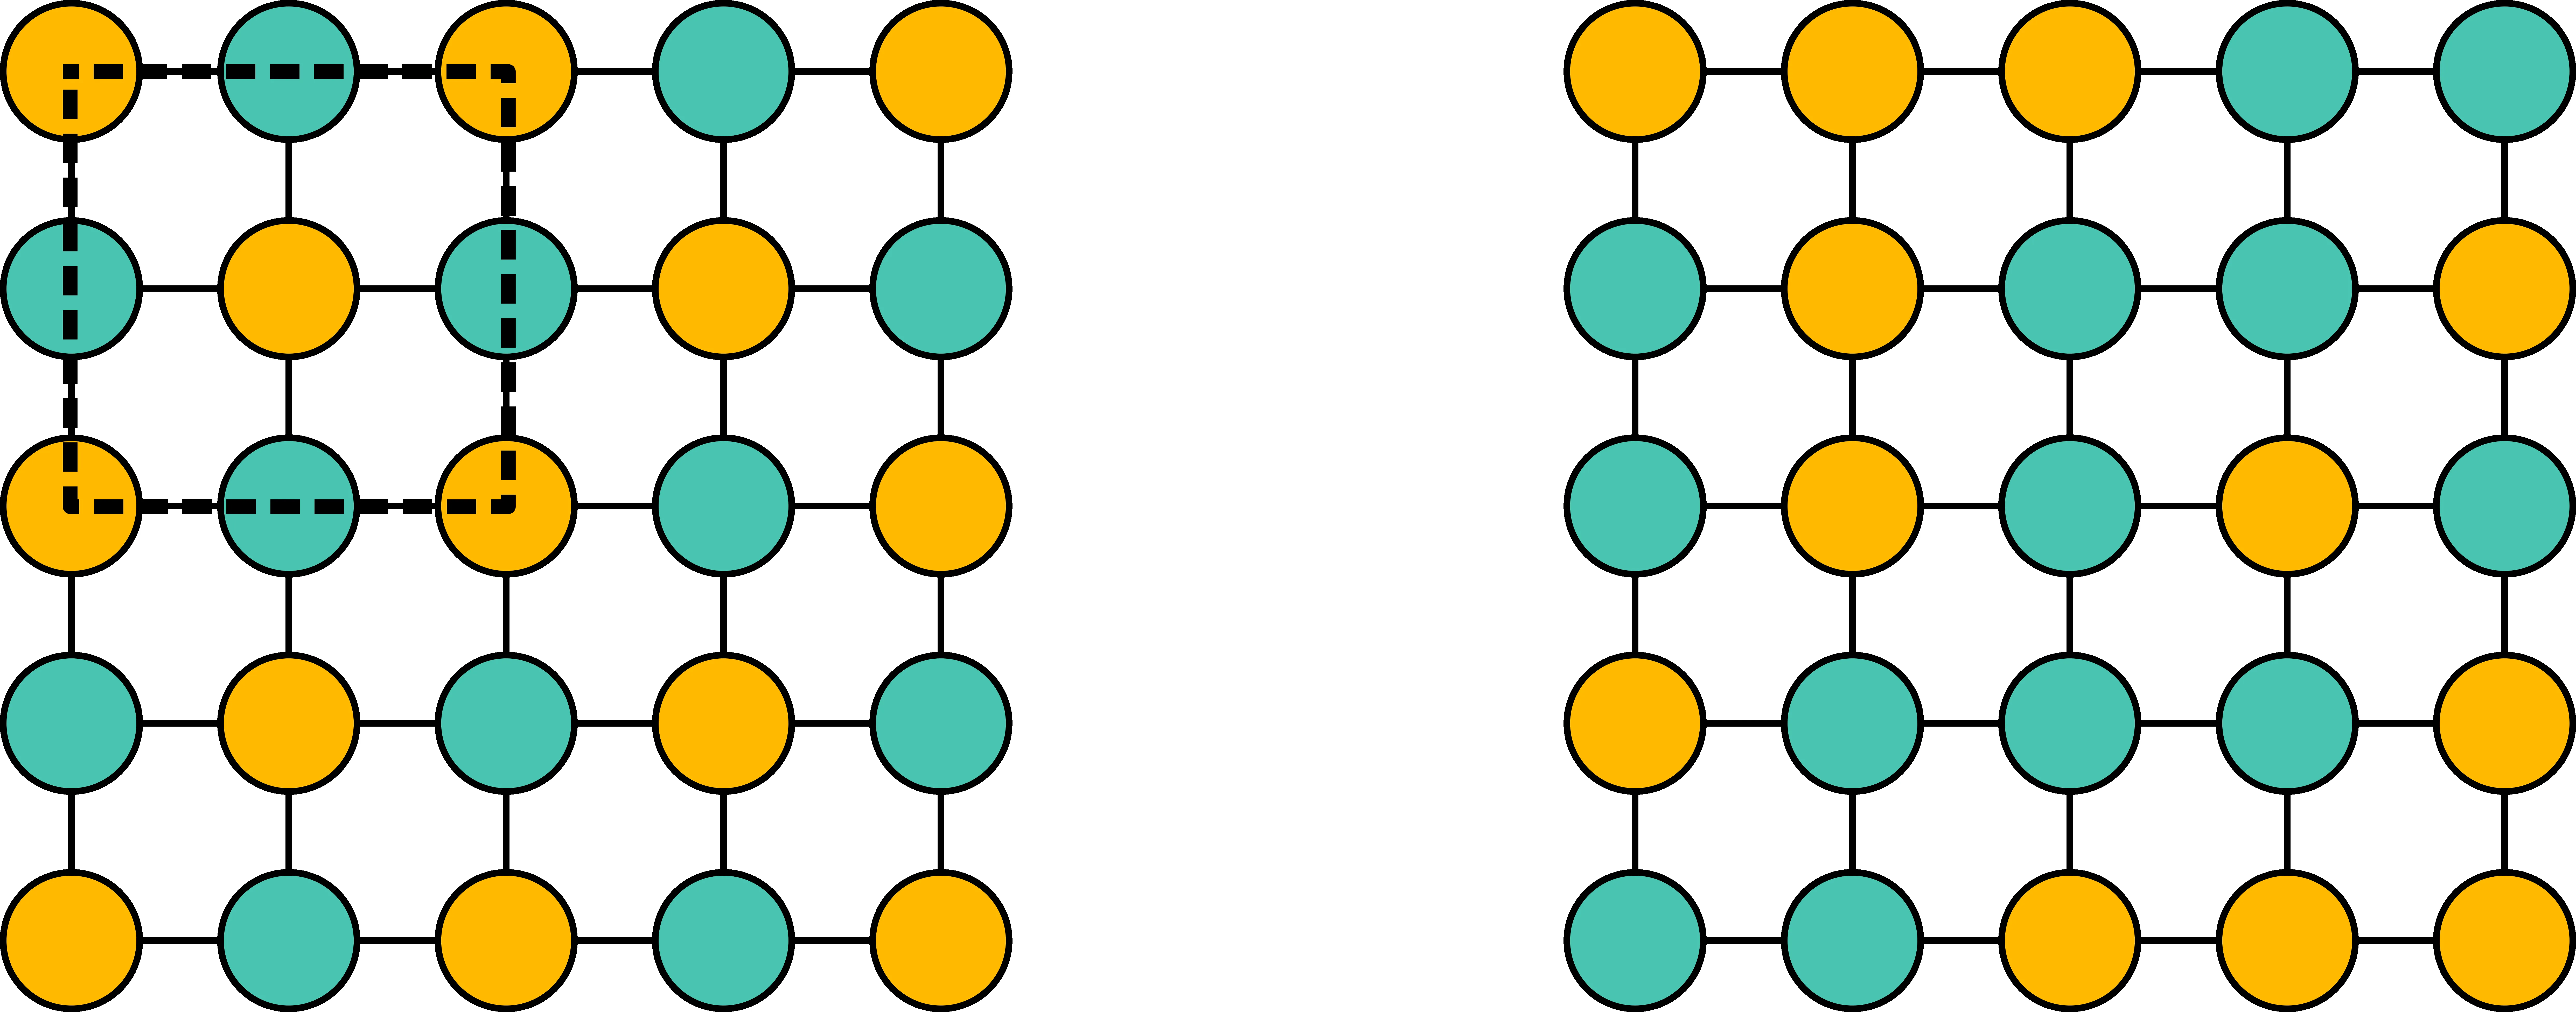
秩序(左)と無秩序(右)の2次元結晶格子。GNoME批判で指摘された「compositional disorder問題」の本質を可視化(出典:Microsoft Research Blog)
左側では原子種が規則的に並び、破線で囲まれたプリミティブセルが繰り返される。
一方で右側では、各原子サイトに黄色と緑がランダムに分布している。AIが理論上安定と判定するのは左のような秩序構造だが、現実の合成条件では右のような無秩序状態に落ち着くケースが多い。CheethamとSeshadriが指摘したのは、この「AI予測と実合成のギャップ」を代表とする3要件不足です。
彼らはGNoMEが提示した38万件の安定材料候補をサンプル分析した結果、credible(信頼できる)・novel(新規である)・useful(有用である)の3要件を同時に満たす化合物がほぼ見当たらないと結論づけました。指摘の要点は次の3点です。
-
信頼性(credible)の問題
「多くの候補は、実在しにくい金属イオンの秩序配列に依存している」。結晶を成す元素配置が理論上は成立しても、現実の合成条件ではランダム配置(compositional disorder)に落ち着くケースが多い
-
新規性(novel)の問題
既知材料の対称性違いや元素置換の派生が大量に含まれており、「本当に新しい化合物」は極めて少ない
-
有用性(useful)の問題
提示された候補は「DFT計算上の熱力学的安定性が示されている」だけであり、電子物性・機械物性・熱安定性などの機能面での有用性は評価されていない
404 Mediaの取材でCheethamは「220万の新規組成を一つずつ検討する時間は誰にもない」と述べ、材料科学者にとって実用的に貢献する形にはなっていないと指摘しました。
この論文は同記事やThe Registerなどの海外メディアで大きく取り上げられ、GNoMEの評価にひとつの区切りをつける議論として業界に定着しています。
Robert Palgrave(UCL)の実装レベル批判
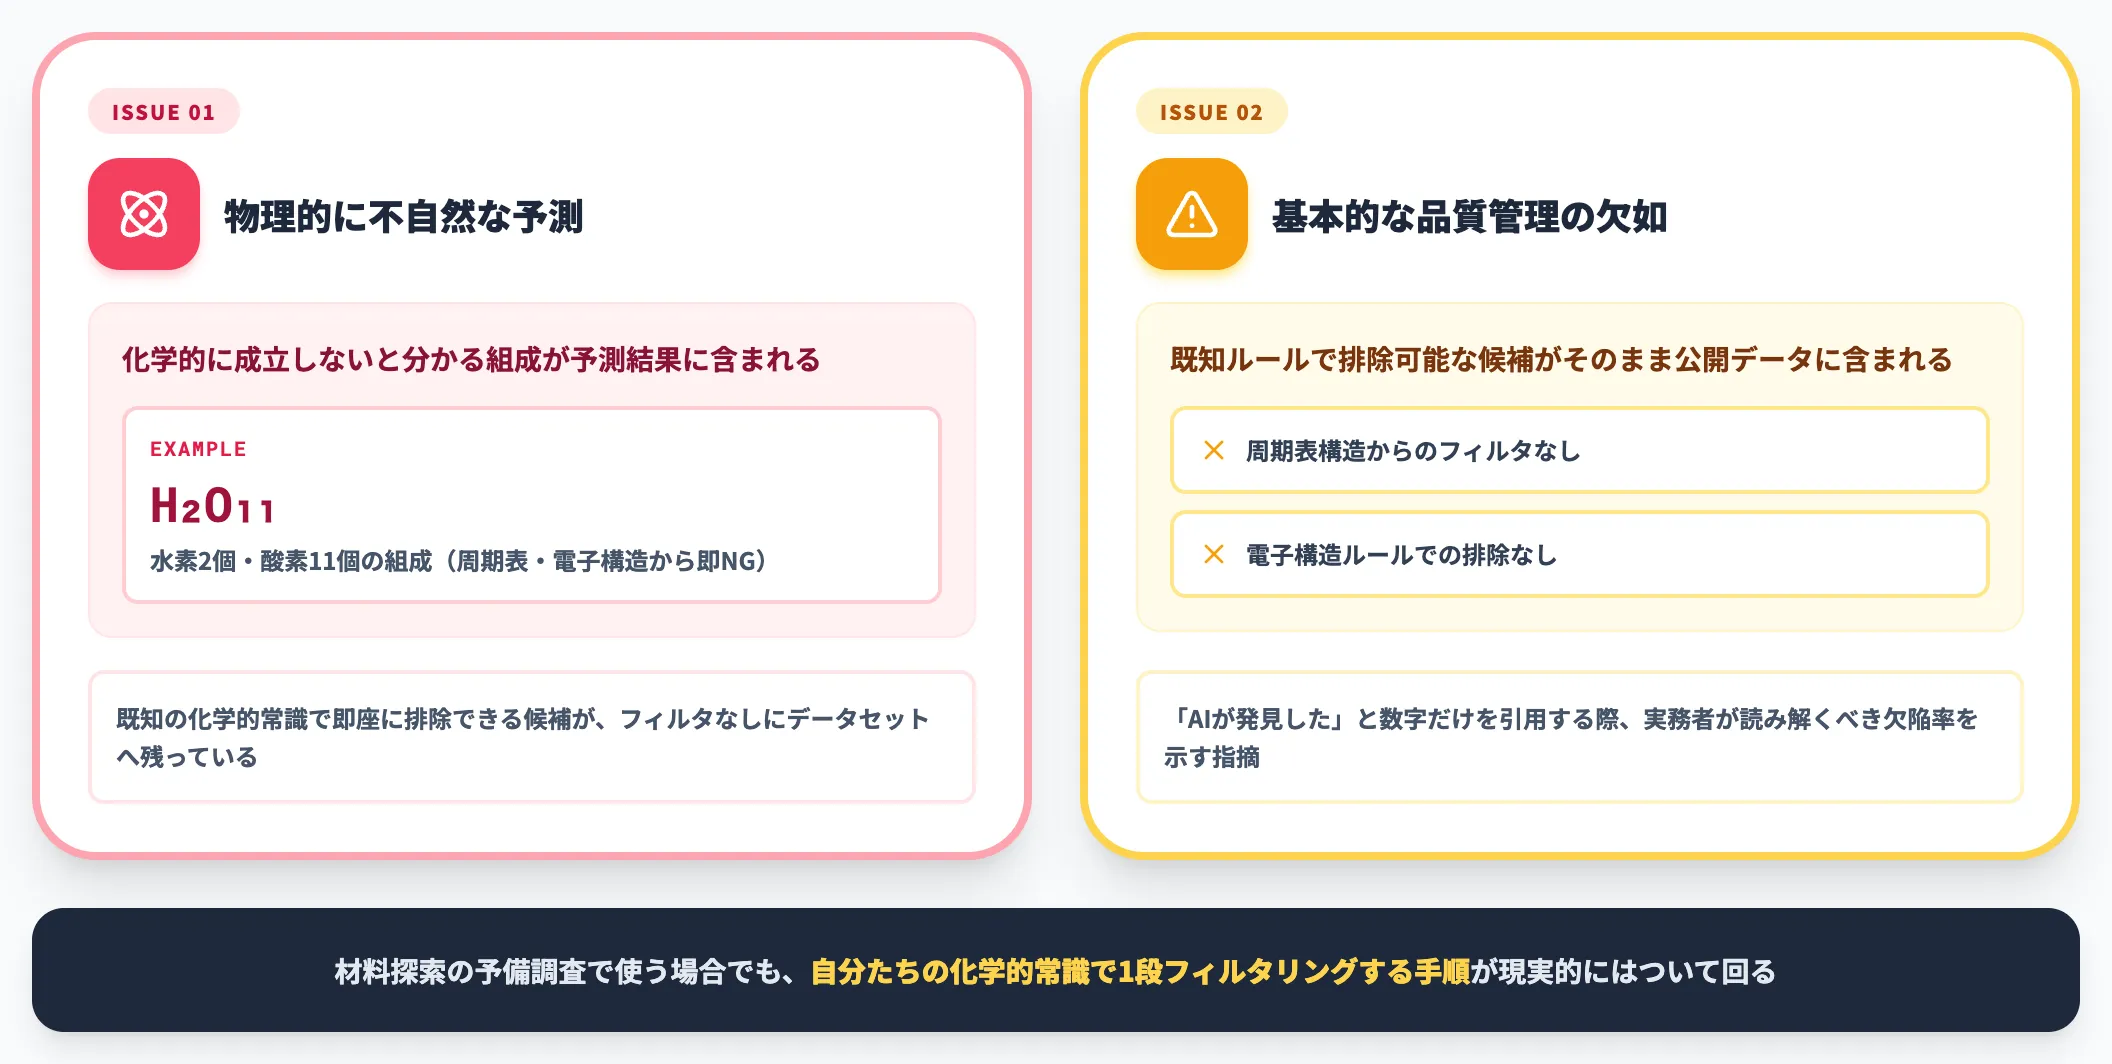
UCLのRobert Palgraveも共著論文やX上の発信でGNoMEの予測結果を精査し、実装レベルでの問題を指摘しました。
-
物理的に不自然な予測が含まれる
「H2O11」(水素2個・酸素11個の組成)のような、化学的に成立しないと分かる組成が予測結果に含まれていた
-
基本的な品質管理の欠如
既知の周期表構造や電子構造ルールで即座に排除できる候補が、そのままデータセットに残っている
これらは「候補を大量提示すること自体に価値がある」という立場からは些細な問題に見えますが、「AIが発見した」と数字だけを引用する際に、実務者が読み解くべき欠陥率を示す指摘です。
材料探索の予備調査で使う場合でも、GNoMEの出力を無条件で信頼せず、自分たちの化学的常識で1段フィルタリングする手順が現実的にはついて回ります。
A-Lab成果への疑義(Schoop/Palgraveらの独立検証)
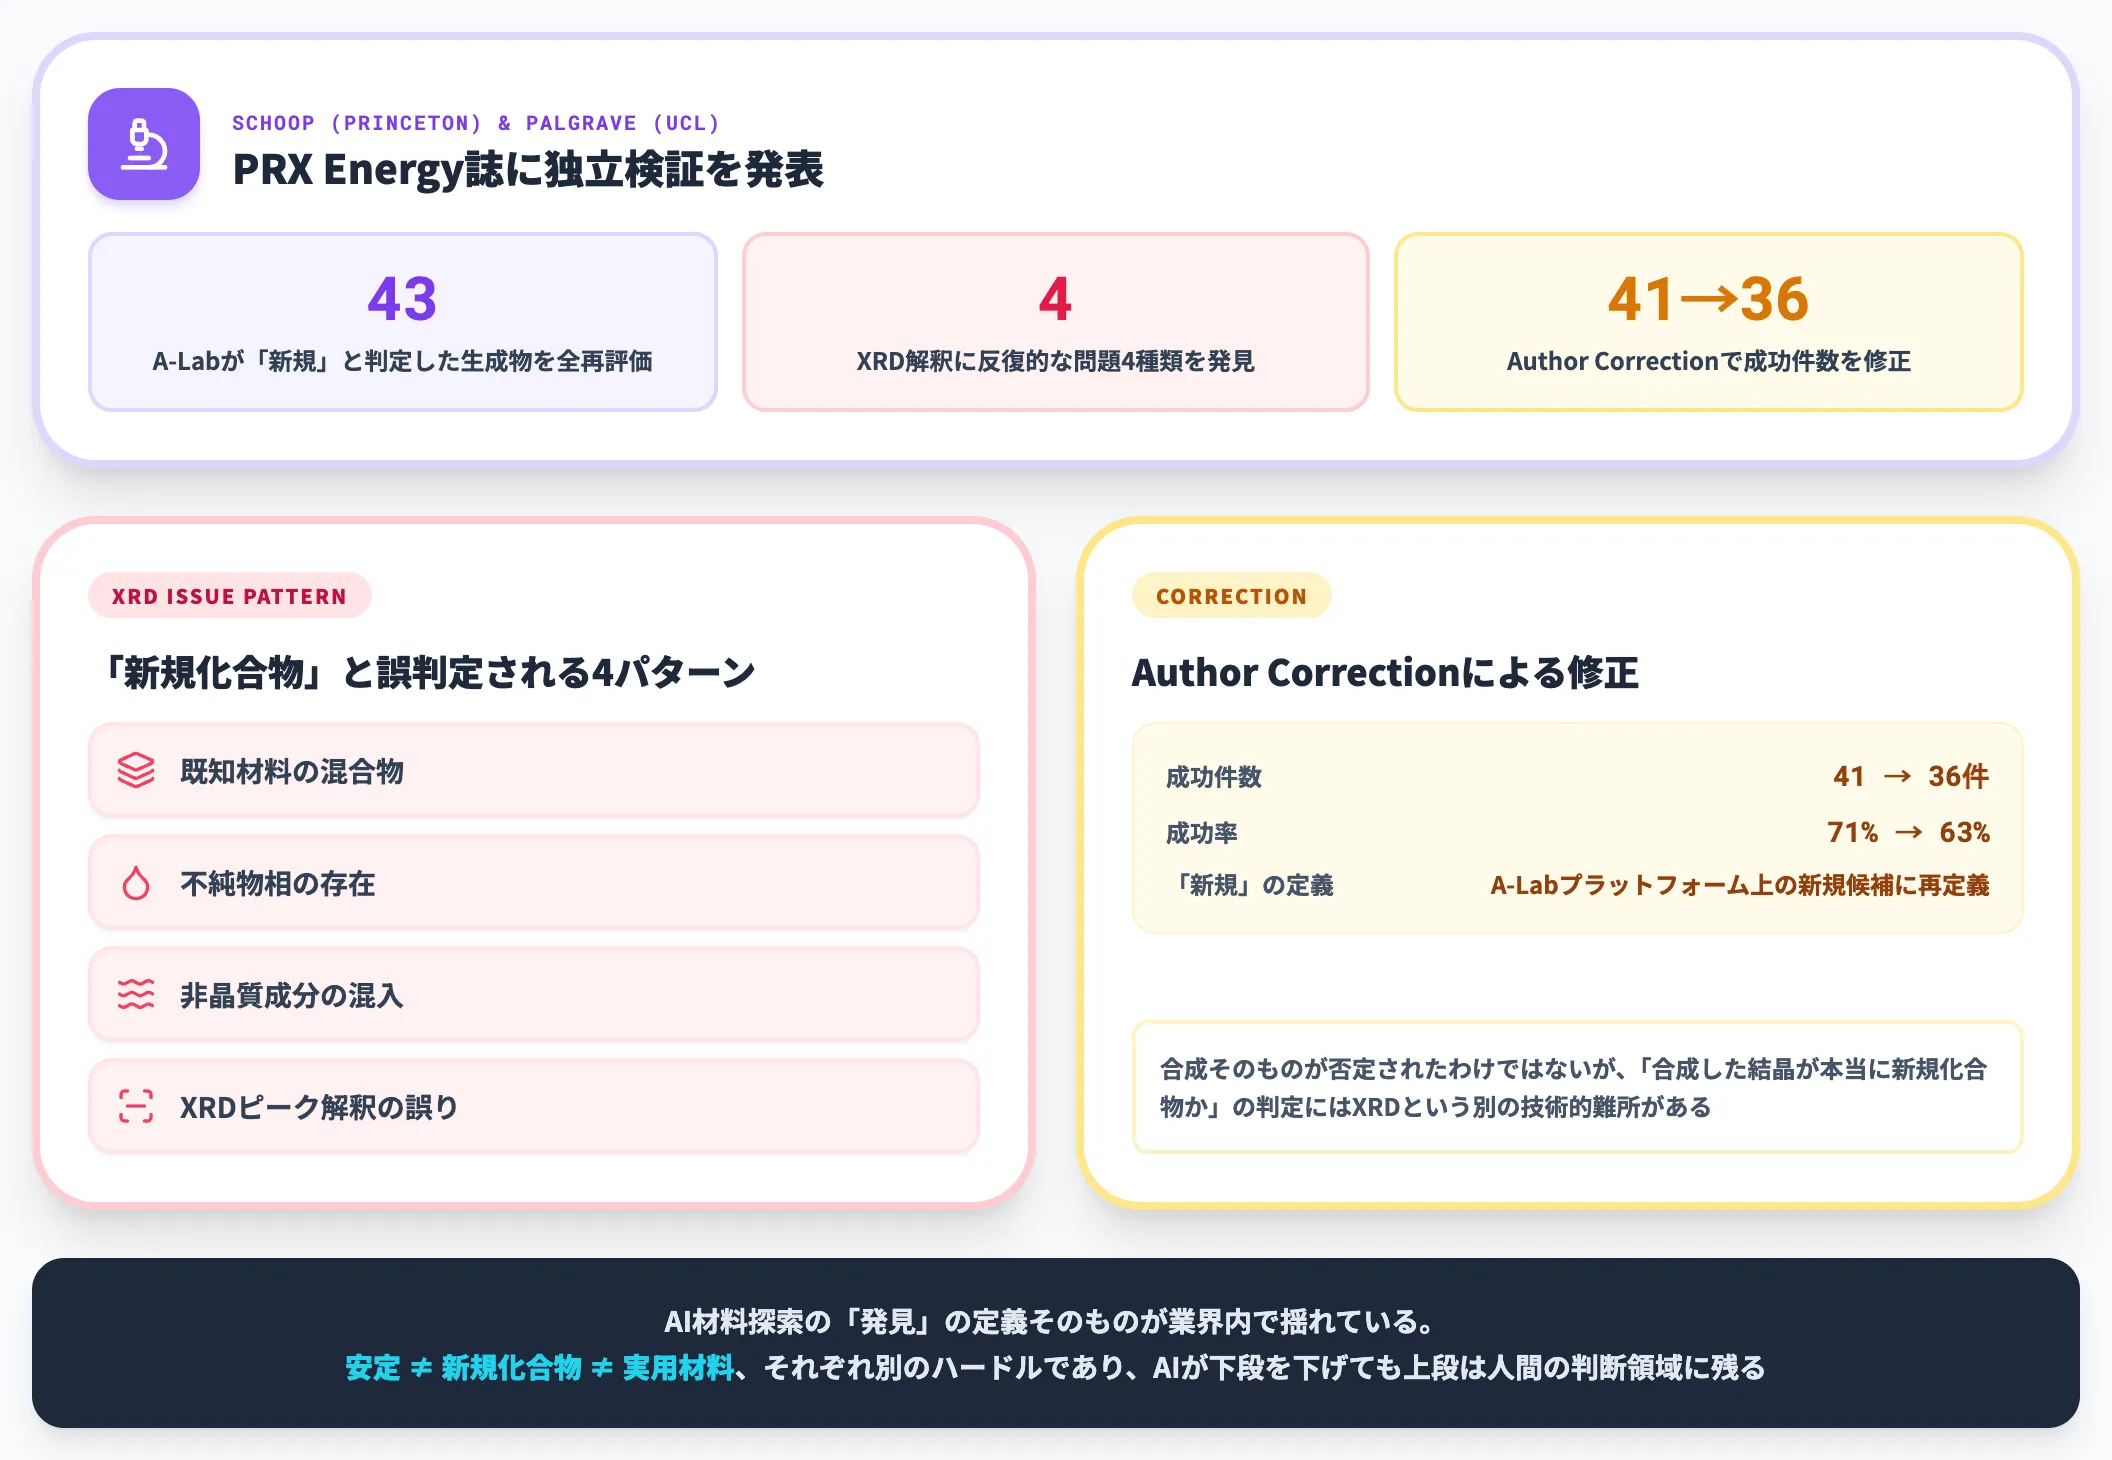
前述したA-Labの成果についても、Princeton大学のLeslie SchoopとUCLのRobert Palgraveらが独立に検証し、PRX Energy誌に発表した論文で分析上の反復的問題を指摘しました。
彼らはA-Labが「新規」と判定した43生成物すべてを再評価した結果、X線回折パターンの解釈に4種類の反復的な問題が見られると報告しています。
具体的には、既知材料の混合物・不純物相・非晶質成分の存在などが「新規化合物」として誤判定される構図です。
こうした懸念を受け、A-LabのNature論文にはAuthor Correction(著者訂正)が入り、成功件数は41件から36件に、成功率は71%から63%に修正されました。「新規」の意味も、科学界全体にとっての新規発見ではなく、A-Labの予測プラットフォーム上の新規候補、という位置づけに再定義されています。
A-Labの合成そのものが否定されたわけではありませんが、「合成した結晶が本当に新規化合物か」の判定にはX線回折の解釈という別の技術的難所があり、AIと自律実験だけでは埋まらない領域が可視化された、というのが批判の核心です。
これは、AI材料探索の「発見」の定義そのものが業界内で揺れていることを示すエピソードです。
結晶構造が理論上安定であることと、合成された物質が新規化合物として登録されることと、実用材料として機能することは、それぞれ別のハードルであり、AIが下段のハードルを大幅に下げても上段は依然として人間の判断領域に残っています。
DeepMind側の応答と数字の分解
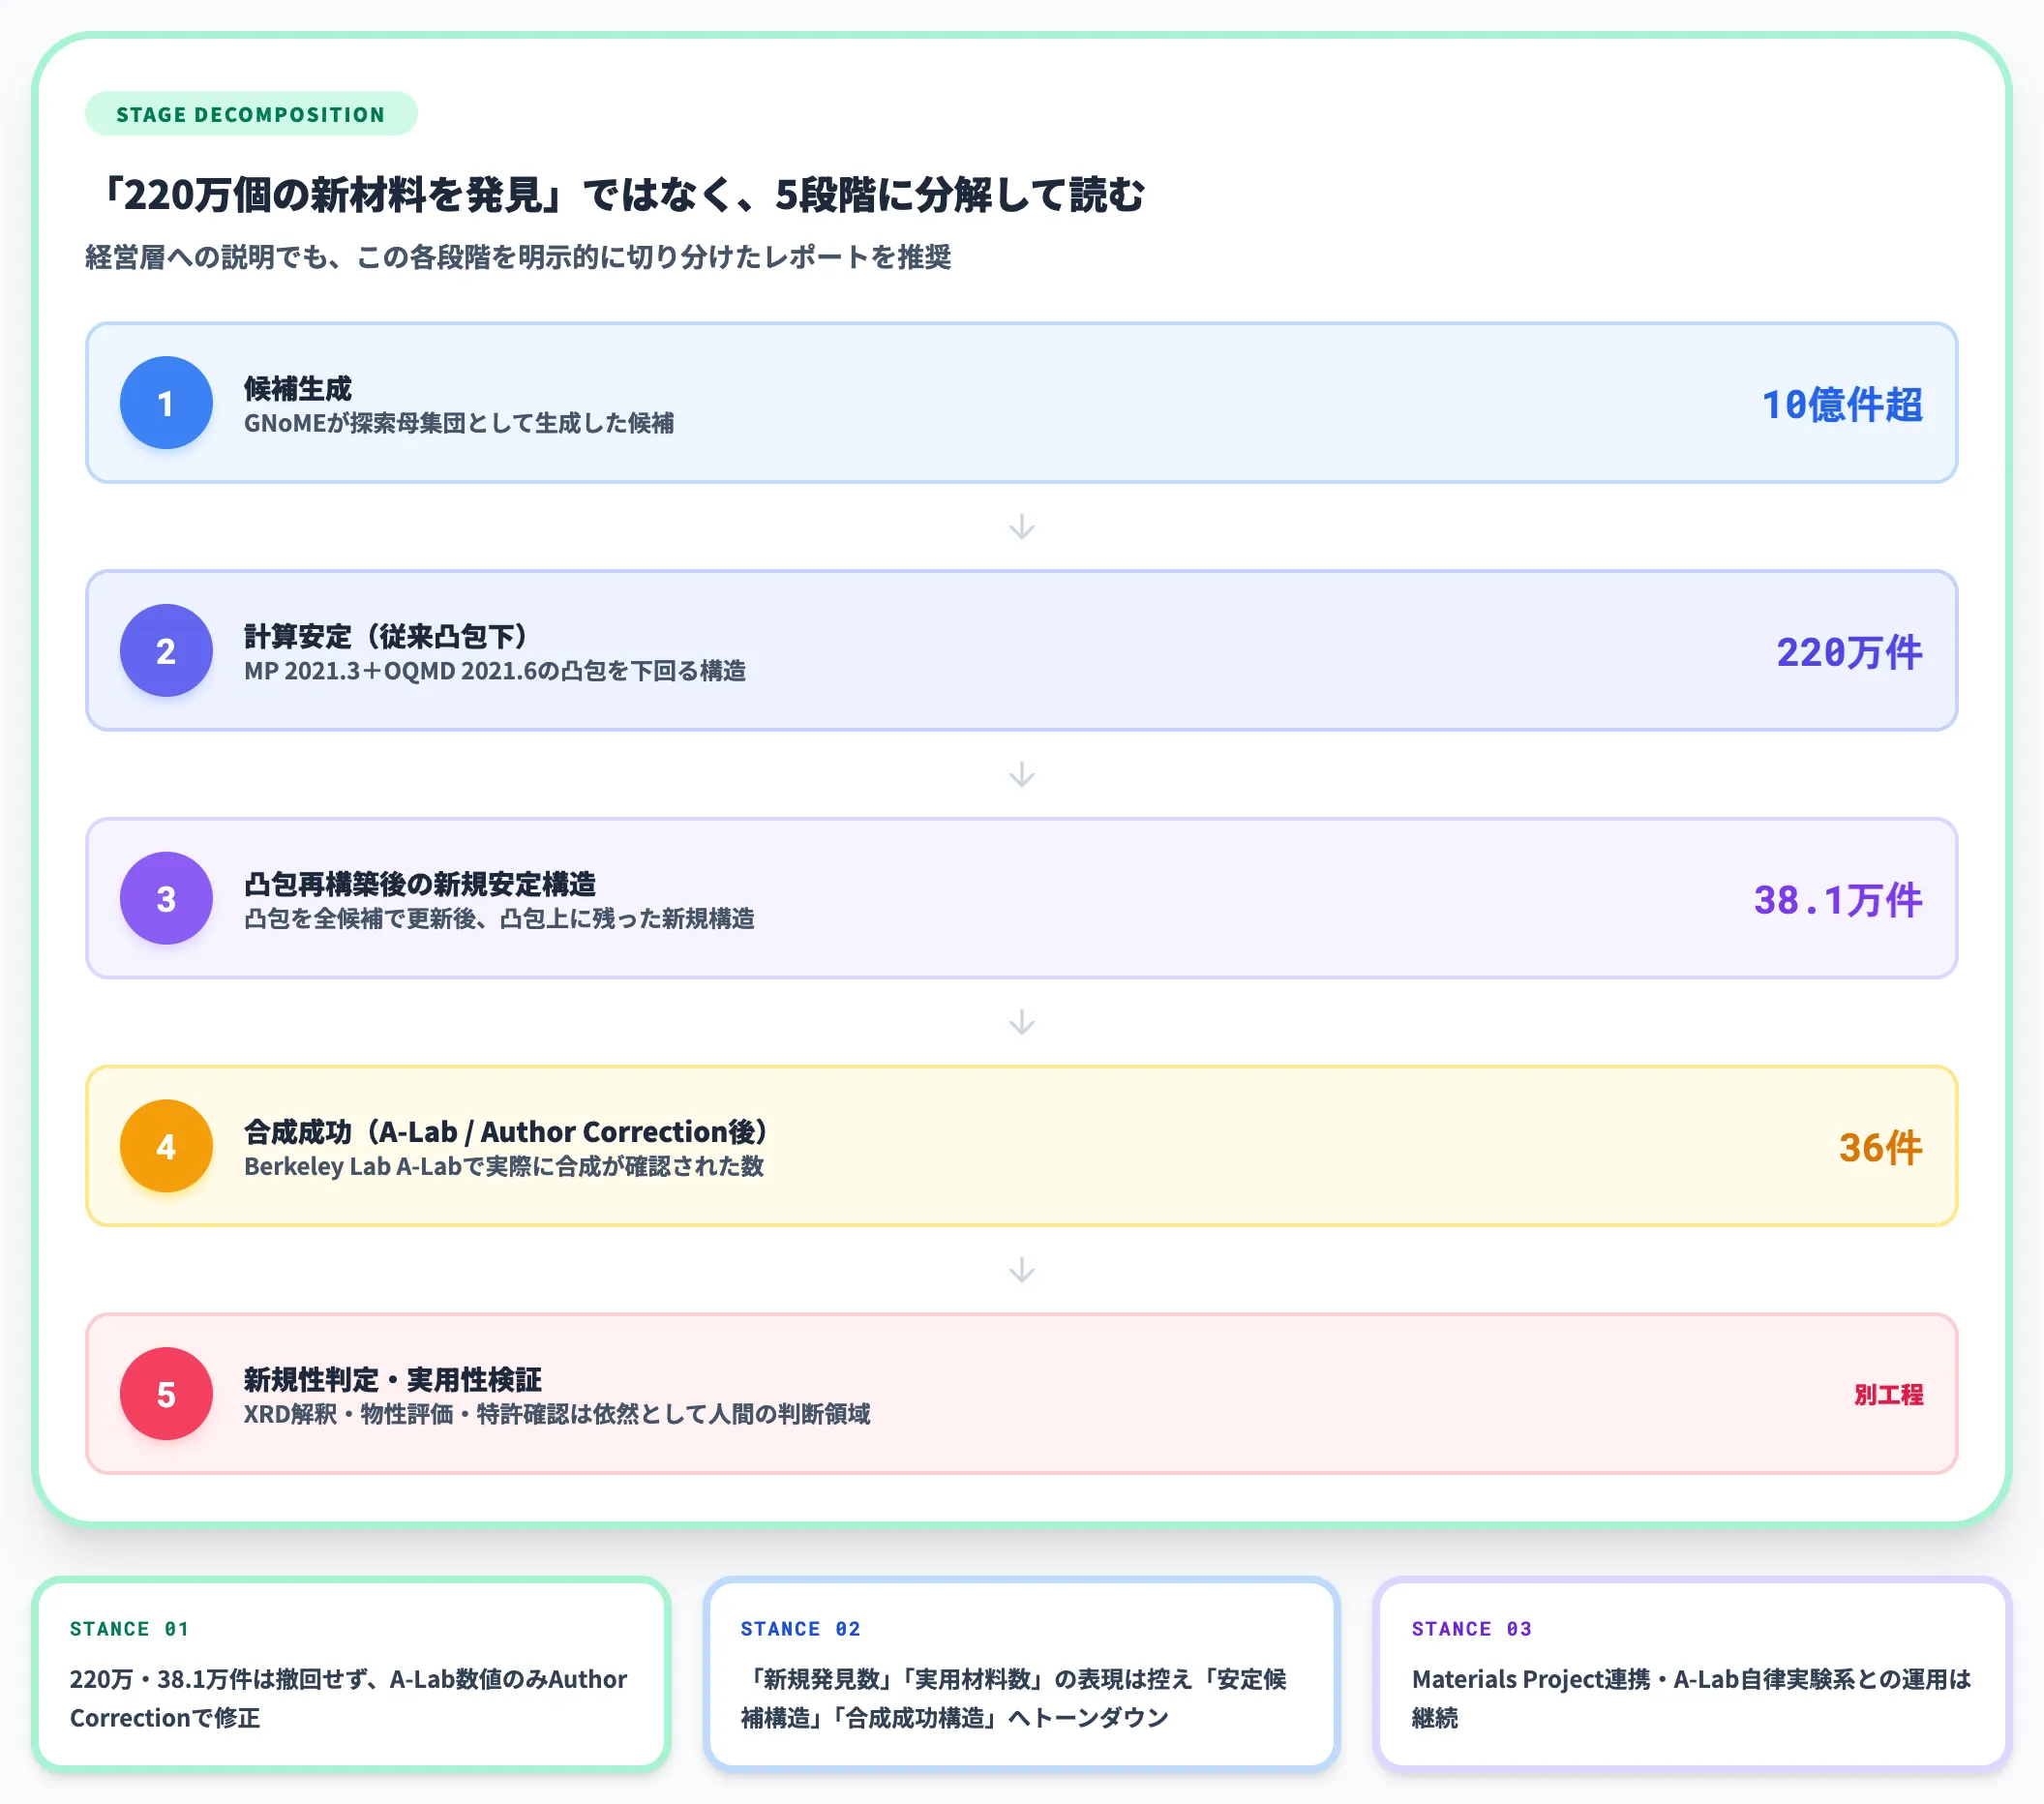
こうした批判に対してDeepMind・A-Lab側は、Nature論文の著者訂正を出しつつ、次のスタンスを取っています。
- GNoME本体の220万件(従来凸包より下)・38.1万件(更新凸包上の新規安定構造)という数字は撤回していない一方、A-LabのNature論文はAuthor Correctionで57ターゲット中36件(成功率63%)に修正され、「新規」の定義もA-Labの予測プラットフォーム上の新規候補と明示された
- 「新規発見数」「実用材料数」といった表現は控え、「安定候補構造数」「合成成功構造数」の水準で成果を扱う方向にトーンダウン
- Materials Projectとの連携は継続、A-Labを含む自律実験系との突き合わせ運用も継続
実務者としてGNoMEの成果を評価するときは、「220万個の新材料を発見した」という見出しではなく、「累計10億件超の候補を探索し、220万件が従来凸包を下回り、凸包再構築後に38.1万件が新規安定構造として残り、A-Lab連携で36件が合成成功と判定された」という粒度で数字を分解して読むのが妥当です。
AI総研の支援現場でも、材料探索AIの出力を経営層に説明する場面では、この「候補生成/計算安定/合成成功/新規性判定/実用性検証」の各段階を明示的に切り分けたレポートを作ることをまず推奨しています。
GNoME以後の隣接する材料探索AI
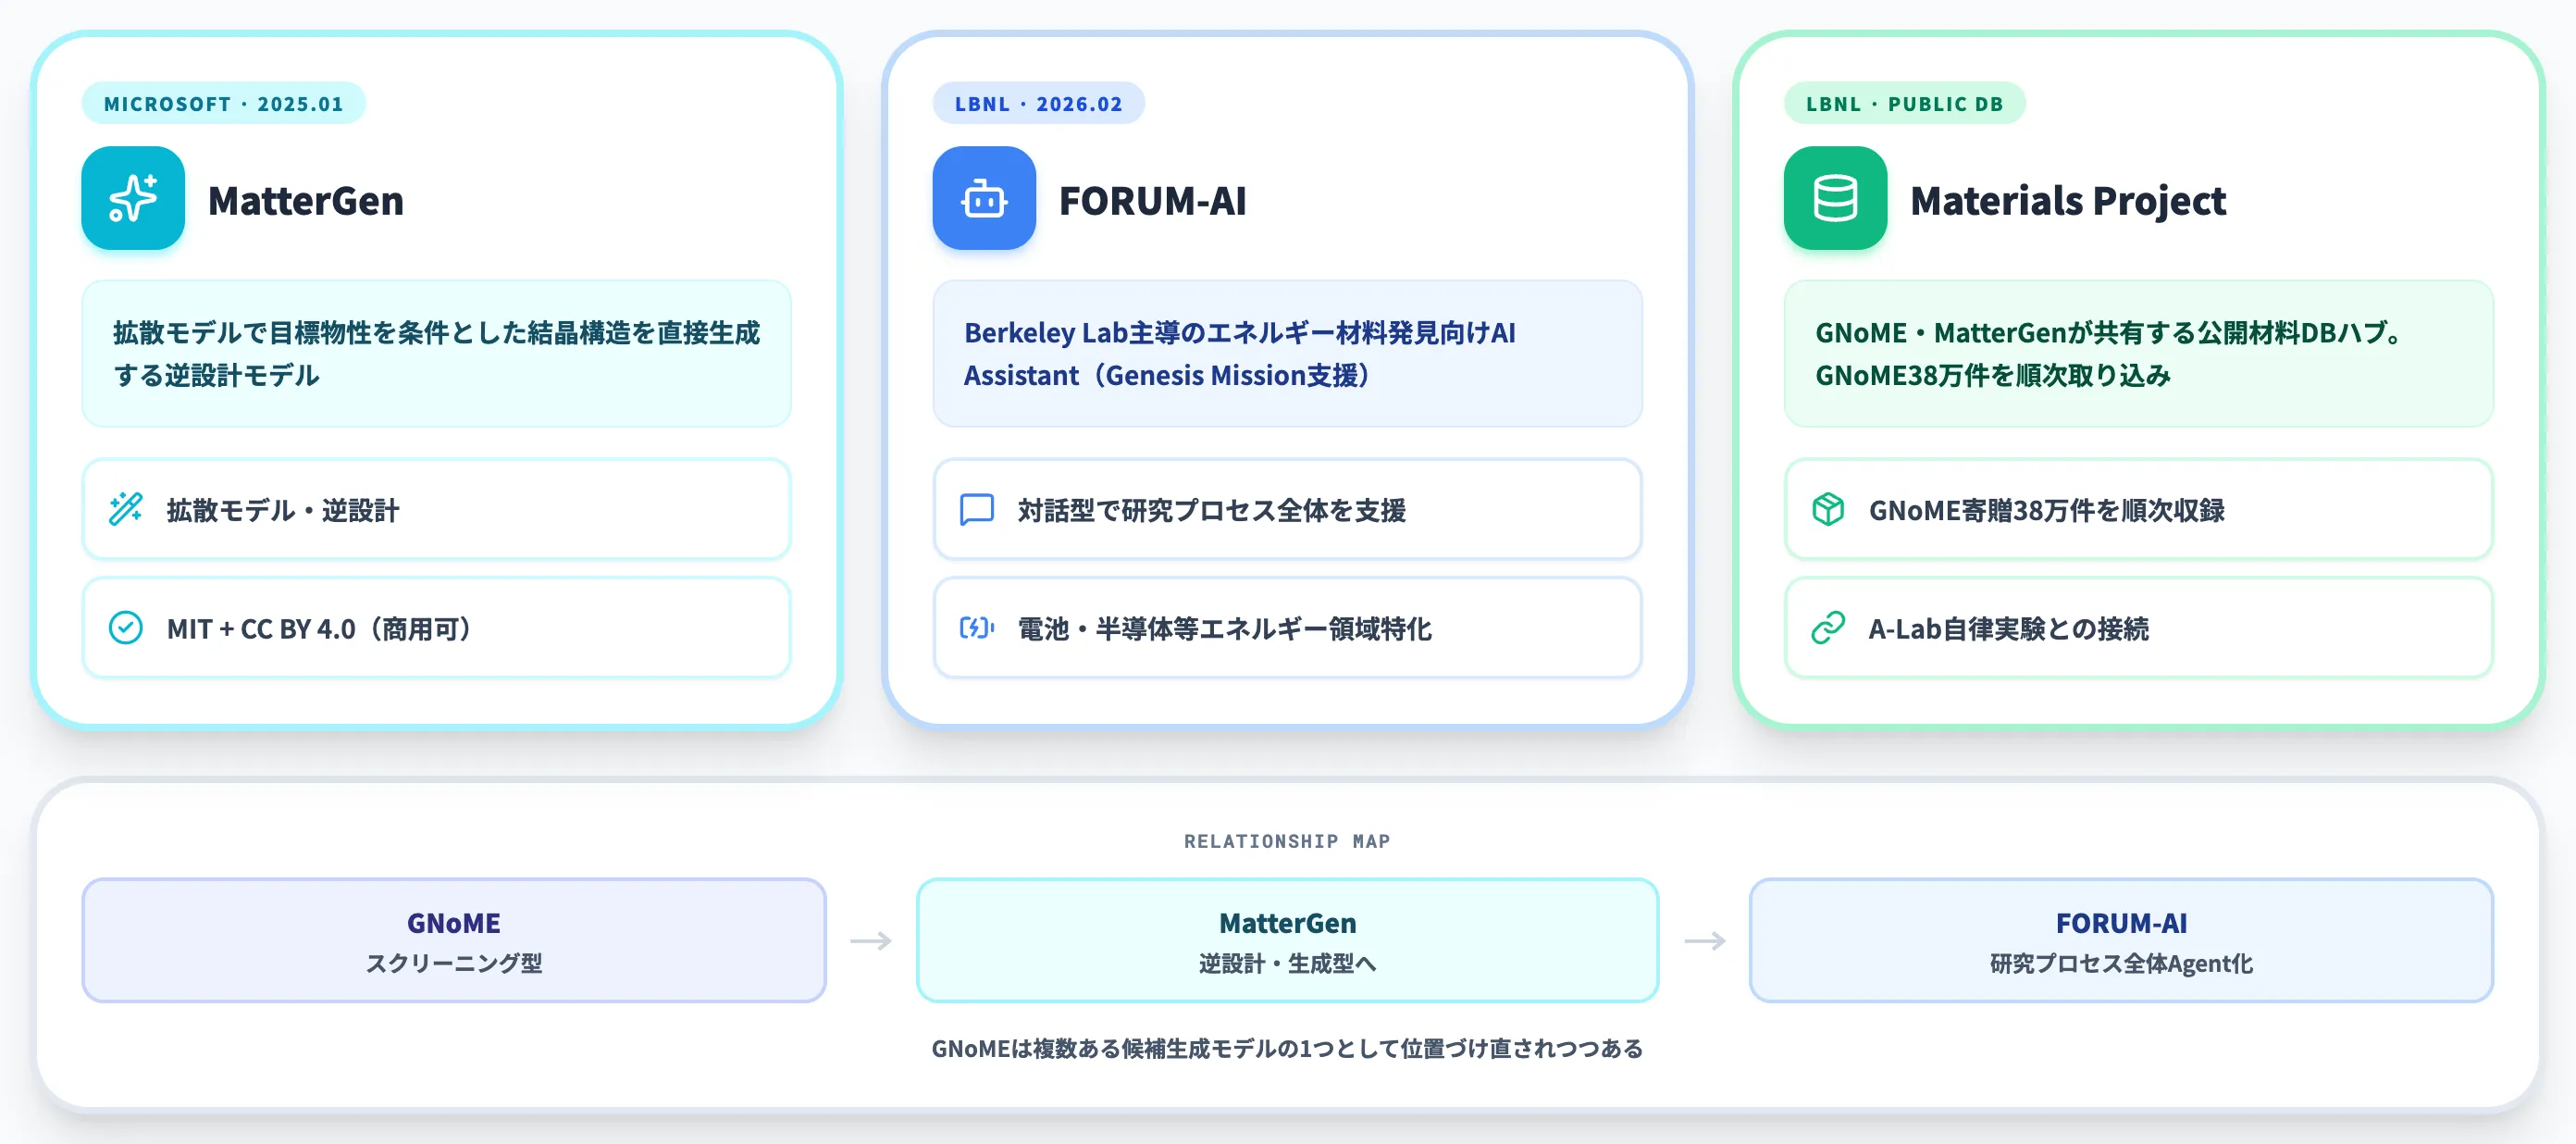
GNoMEの発表から2年強が経過した2026年9月時点で、材料探索AI領域には後発・隣接するアプローチが複数登場しています。
ただし後述するMatterGenやFORUM-AIは、公式発表上「GNoMEの直接の後継」と位置づけられているわけではなく、それぞれ別の設計思想・別の学習データで独立に立ち上がったプロジェクトです。
ここではGNoMEとの関係性を過大に括らず、隣接領域として整理します。
MatterGenの逆設計モデル
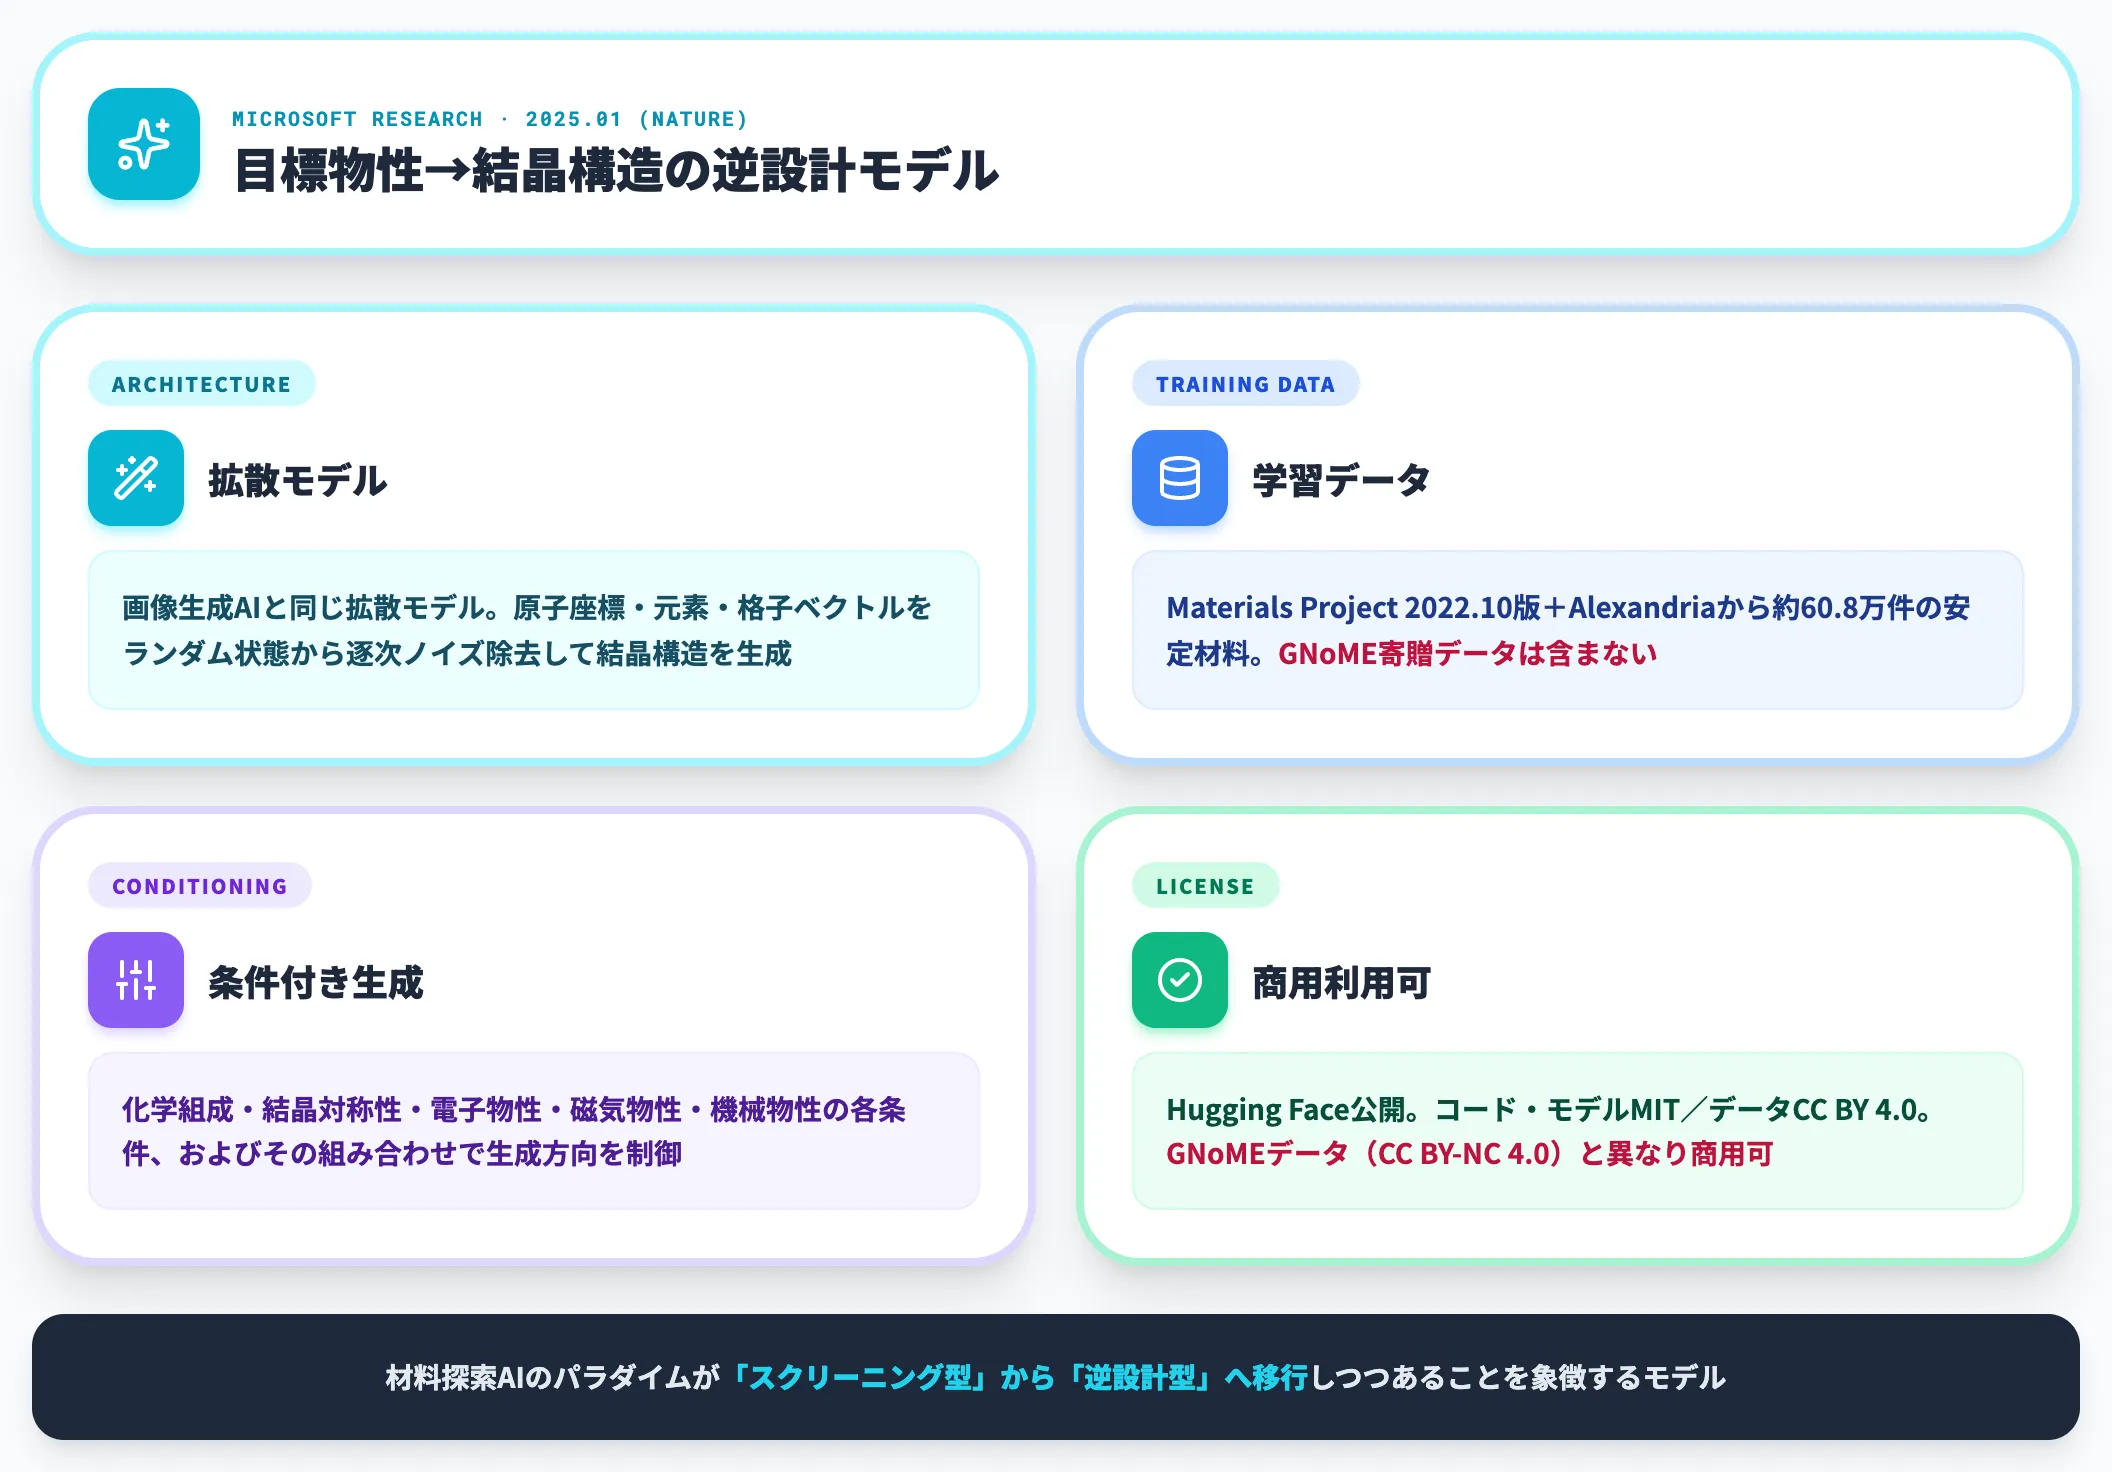
MatterGenは、Microsoft Researchが2025年1月にNature誌で発表した材料設計用の生成AIです。プレプリント自体はGNoME発表の約1週間後(2023年12月)に公開されており、GNoMEの寄贈データを取り込んで作られた後継モデルではなく、同時期に独立に立ち上がった別系統の生成AIです。
ただし発想としてはGNoMEが「既知の探索空間を高精度スクリーニングする」のに対し、MatterGenは目標物性を与えると、その物性を満たす結晶構造を直接生成する逆設計モデルとして設計されています。
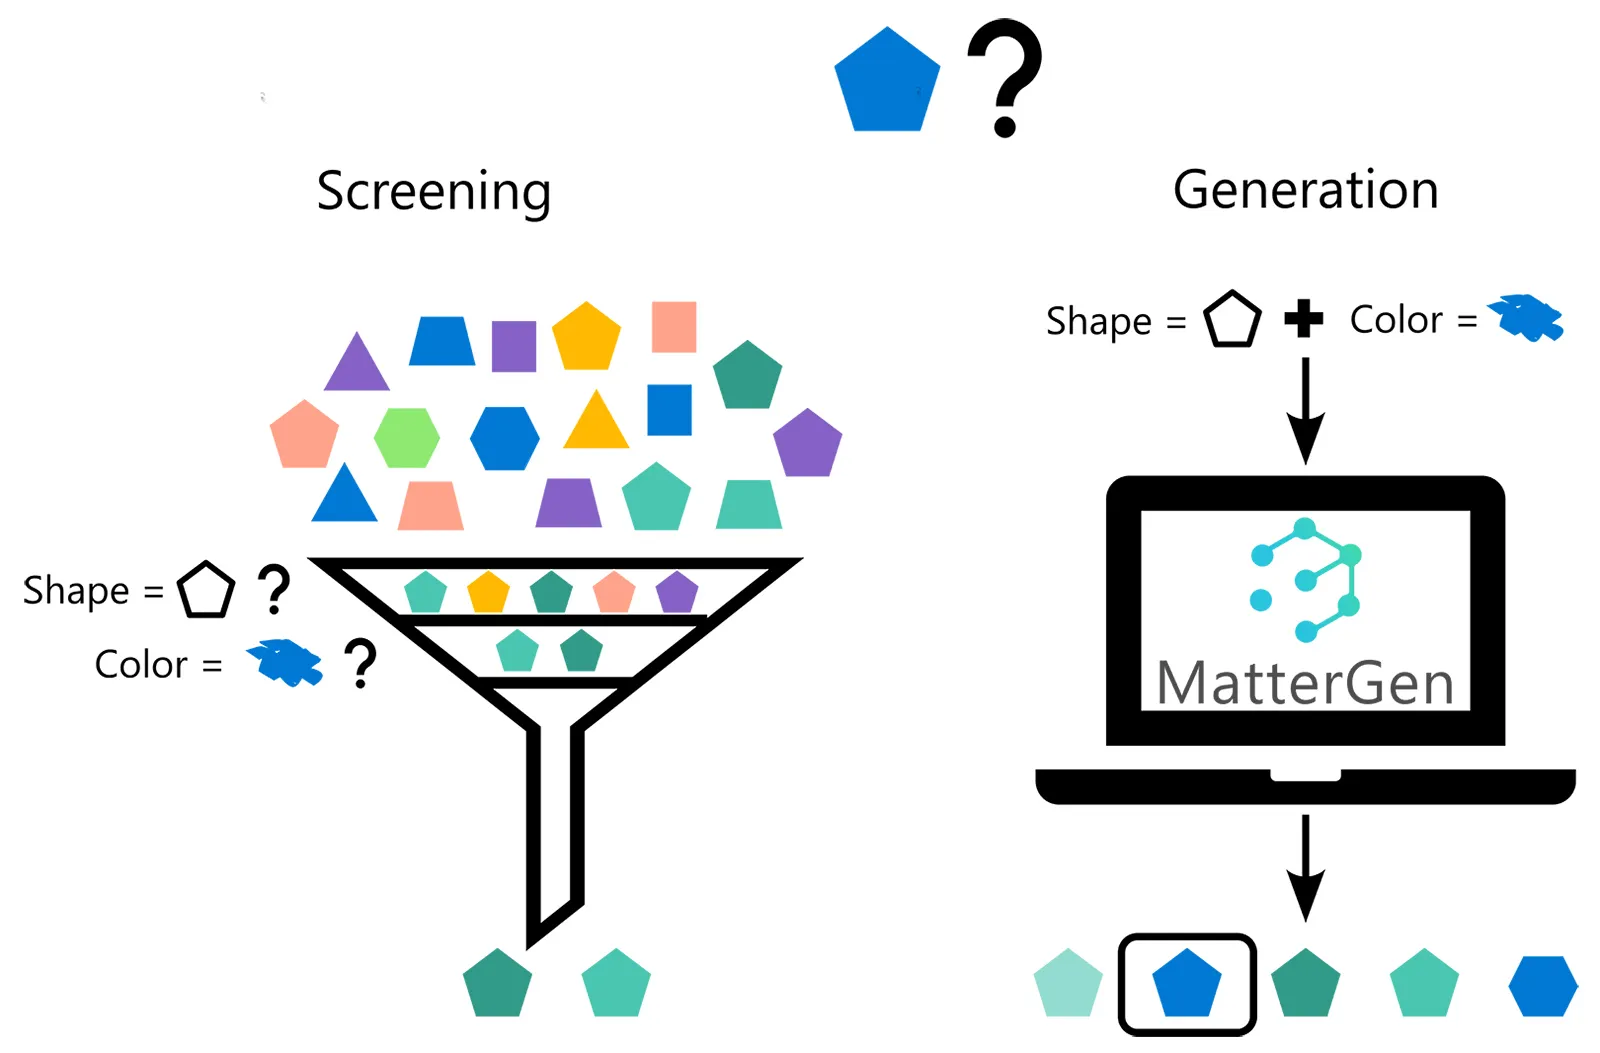
スクリーニング(漏斗=GNoMEを含む従来型)と生成(ラップトップ=MatterGen)のパラダイム対比(出典:Microsoft Research Blog)
左側のスクリーニング型は「多数の候補を漏斗に流し込み、条件を満たすものだけを絞り出す」アプローチで、GNoMEの累計10億件超の探索から凸包再構築による38.1万件の新規安定構造抽出という流れがまさにこれにあたる(A-Labの合成36件は別途Materials Project経由で選定された候補群を扱っており、220万から一直線に絞ったループではない点は前章のとおり)。
右側の生成型は「欲しい形と色を条件として与え、モデルが直接候補を生み出す」逆設計で、青い五角形が欲しければ他の色や形を経由せずに得られる。この転換が材料探索AIのアーキテクチャ選択に新しい選択肢を加えつつあります。
技術的な特徴は次のとおりです。
-
拡散モデルアーキテクチャ
画像生成AIと同じ拡散モデル。原子座標・元素・格子ベクトルをランダム状態から逐次的にノイズ除去して結晶構造を生成する
-
学習データ
Materials Projectの2022年10月版とAlexandriaデータベースから約60.8万件の安定材料。GNoMEの寄贈データは学習データに含まれていない(プレプリントがGNoME発表直後で時期的にも重ならない)
-
条件付き生成
化学組成・結晶対称性・電子物性・磁気物性・機械物性の各条件、およびその組み合わせで生成方向を制御できる
-
ライセンス
Hugging Face公開のリポジトリでソースコードとモデルはMITライセンス、公開学習データはCC BY 4.0で提供される。商用利用可能な点がGNoMEデータ(CC BY NC 4.0)との大きな違い
GNoMEが「候補構造を大量に列挙する」役割だったのに対し、MatterGenは「特定条件を満たす構造をピンポイントで生成する」役割で、材料探索AIのパラダイムが「スクリーニング型」から「逆設計型」に移行しつつあることを象徴するモデルです。
MatterGen公式記事のキービジュアルに描かれた結晶構造(出典:Microsoft Research Blog)
ただし、MatterGenも「生成された候補が実際に合成可能・機能を発揮するか」の実験検証は別プロセスです。
FORUM-AIとエネルギー材料向けAgent
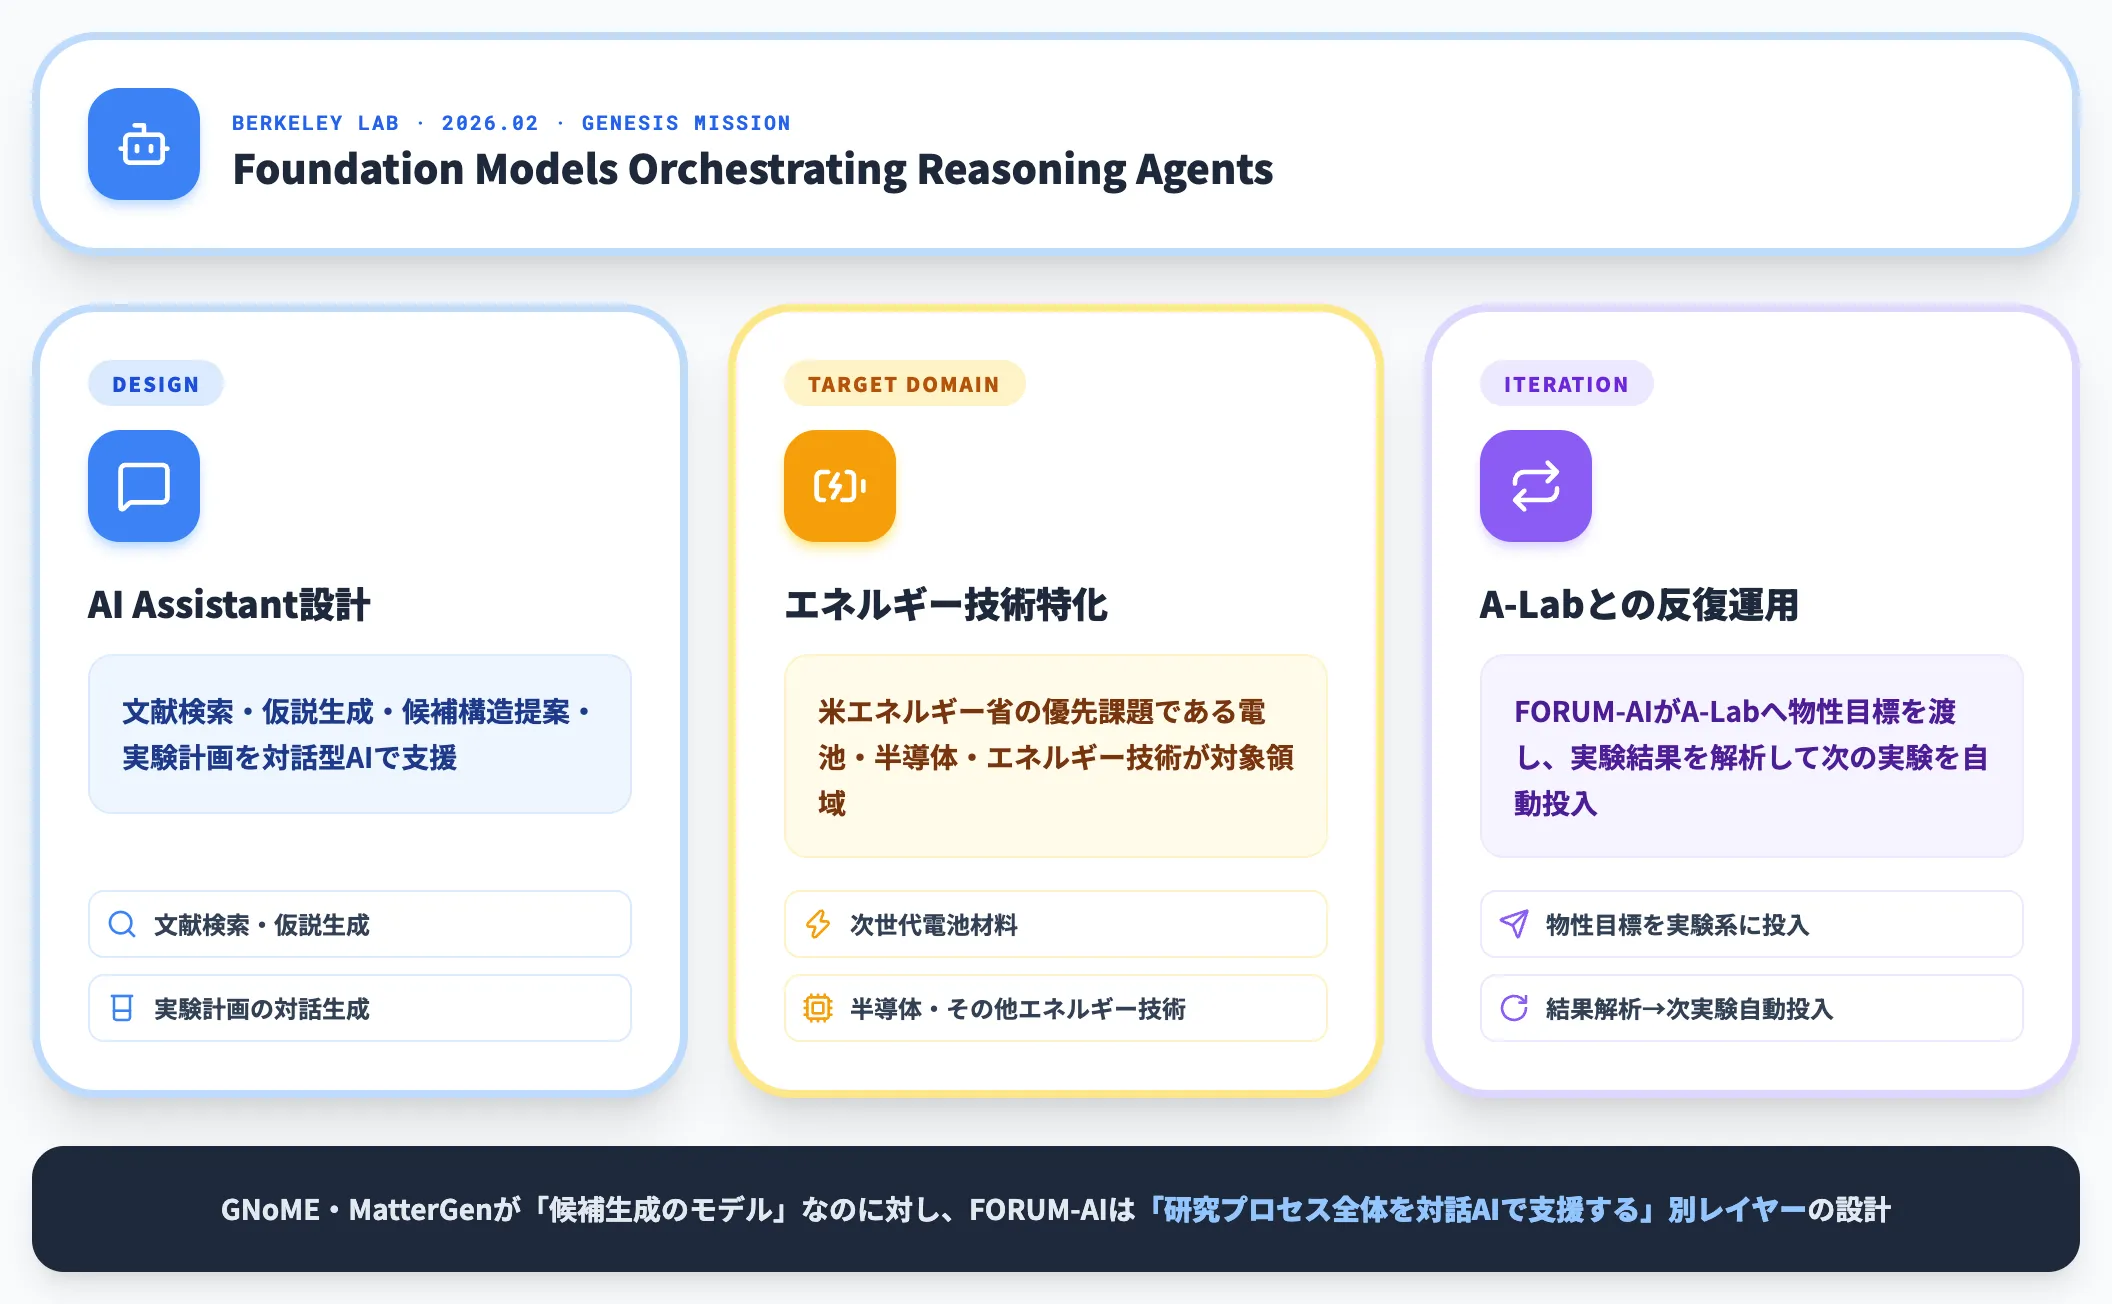
2026年に入って動き始めたのが、Berkeley Labを中心とするFORUM-AI(Foundation Models Orchestrating Reasoning Agents to Uncover Materials Advances and Insights)プロジェクトです。
米エネルギー省のGenesis Missionを支援するプロジェクトとして2026年2月に公表されました。
公式発表は「エネルギー材料発見向けのAI Assistantを構築する」と説明しており、GNoMEやMatterGenと直接の系譜関係にあるとは明記されていません。ここではGNoME・MatterGenと並ぶ隣接プロジェクトとして概要のみ整理します。
-
AI Assistant設計
文献検索・仮説生成・候補構造提案・実験計画までを対話型AIで支援する構想が示されている
-
エネルギー技術が優先ターゲット
公式発表では電池・半導体・その他のエネルギー技術が対象領域として挙げられている
-
A-Labとの反復運用構想
公式発表では、FORUM-AIがA-Labへ物性目標を渡し、実験結果を解析して次の実験を自動投入する反復ループの構想が明記されている
GNoME・MatterGenが「候補生成のモデル」であるのに対し、FORUM-AIは「研究プロセス全体を対話AIで支援する」という別レイヤーの設計です。GNoMEの直接の後継として位置づけるのではなく、材料探索AIの利用範囲が単体モデルから研究プロセス全体に広がっている隣接動向として押さえておくのが妥当です。
Materials Projectの拡大
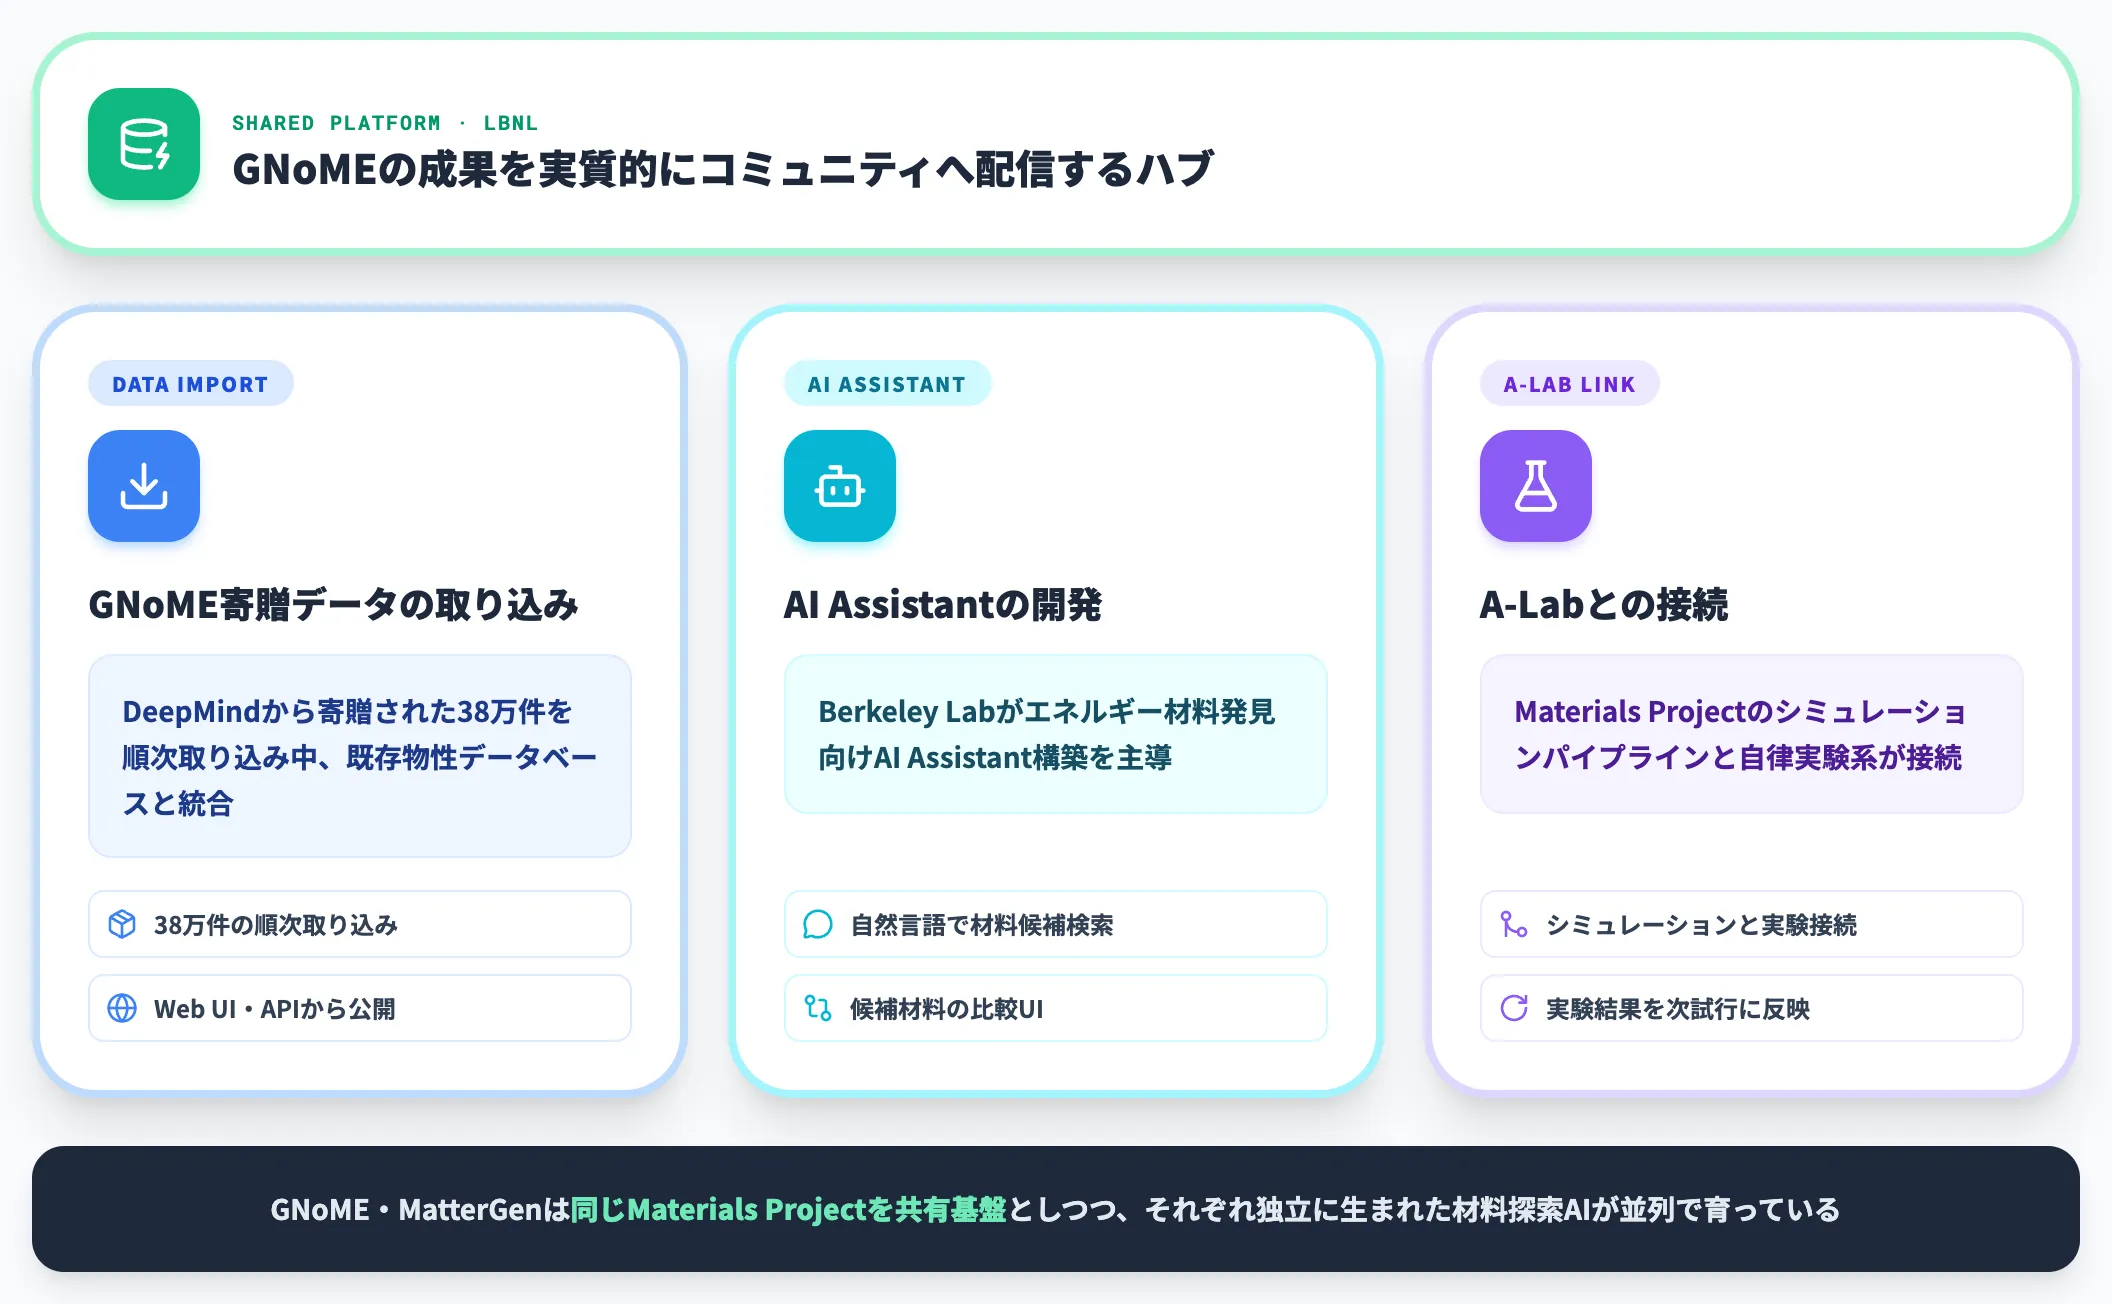
GNoMEの成果を実質的にコミュニティに配信しているのが、Materials Projectです。
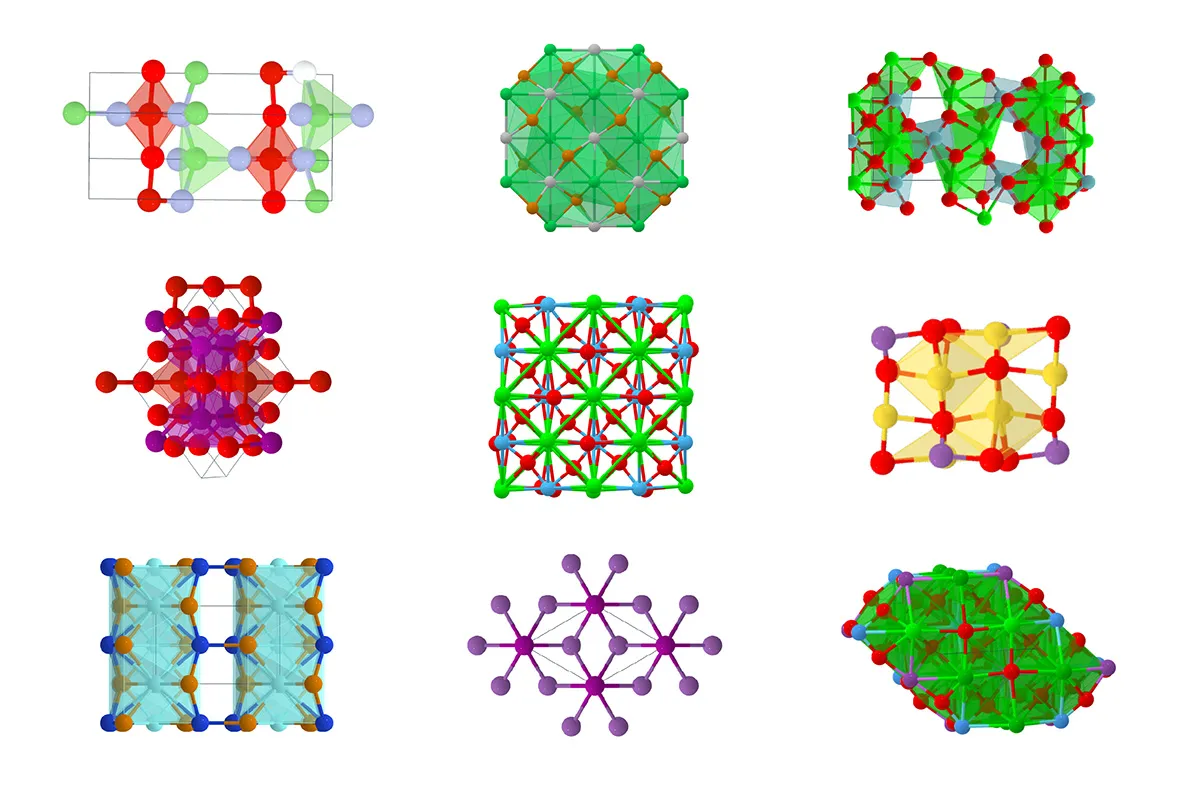
Materials Projectのデータで学習した機械学習モデルが予測したエネルギー関連化合物の例(出典:LBNL News Center)
GNoMEが寄贈した約38万件のうち順次取り込まれた分(GNoME由来データの一部)もMaterials Projectの3D構造ビューワで確認でき、Materials Project側で追加計算されたプロパティがある場合は既存材料と横並びで比較できる状態になっています。
-
GNoME寄贈データの取り込み
DeepMindから寄贈された38万件を順次取り込み中。既存の物性データベースと統合してWeb UI・APIで公開
-
AI Assistantの開発
Berkeley Labがエネルギー材料発見向けのAI Assistant構築を主導。自然言語で材料候補を検索・比較できるインターフェース
-
Materials ProjectとA-Labの接続
Materials Projectのシミュレーションパイプラインと、A-Labの自律実験系が接続され、A-Labでの実験結果は次の実験試行に反映される
GNoMEが起こしたインパクトは、単一モデルの精度ではなく、Materials Projectのエコシステムに大量の候補構造を供給し始めたことにあります。
MatterGenもMaterials Project由来のデータで学習されていますが、こちらは2022年10月版が学習ベースでGNoMEの寄贈データは含んでいません。
同じMaterials Projectを共有基盤としつつ、それぞれ独立に生まれた材料探索AIが並列して育っている、というのが2026年9月時点の実像です。
GNoMEを実務でどう位置づけるか——研究者・企業R&Dの活用判断
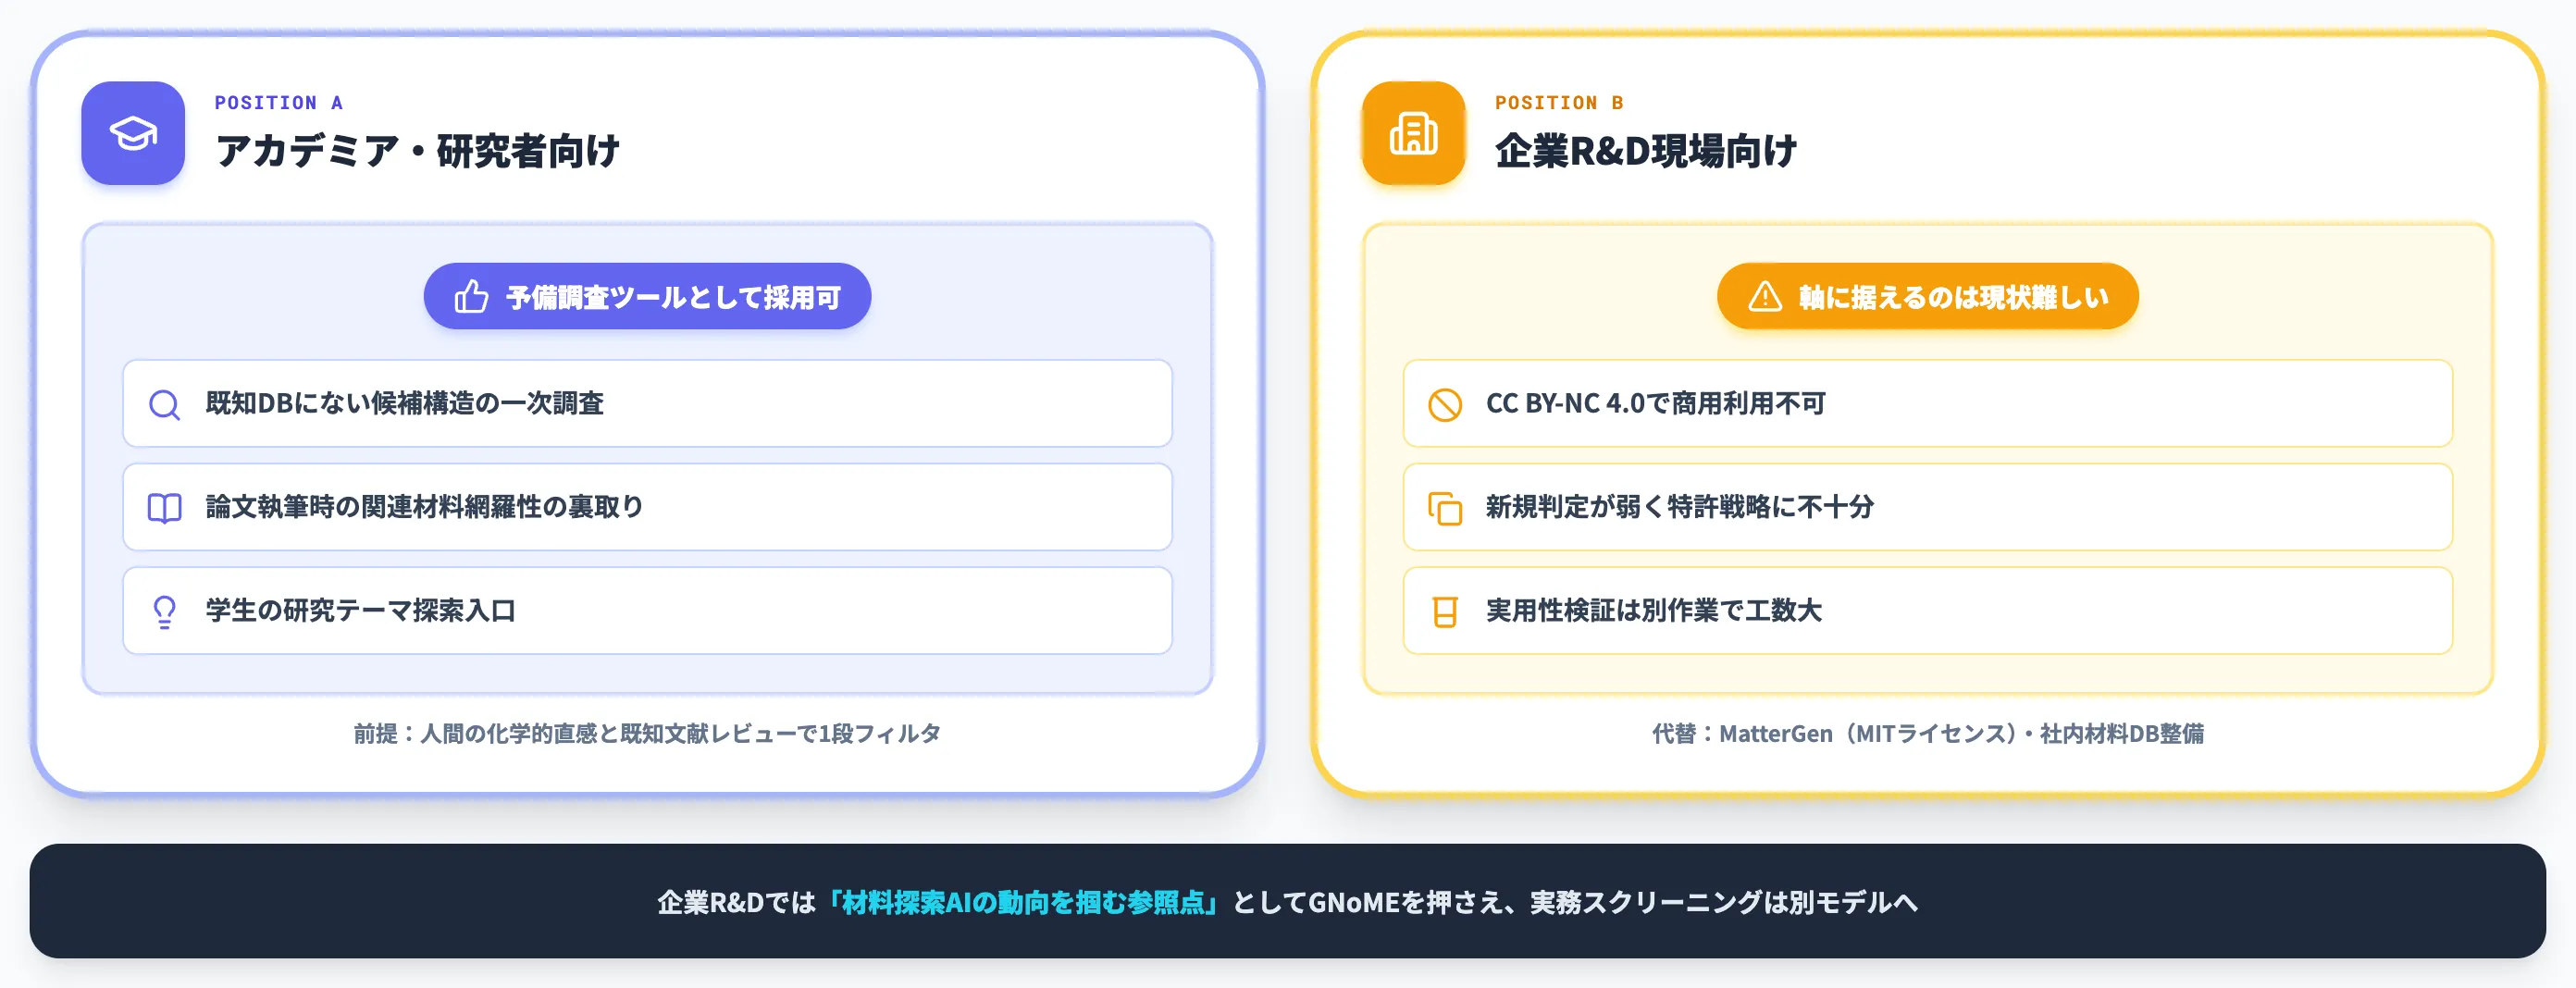
GNoMEを実務で使うか・どのように位置づけるかは、立場によって答えが変わります。ここでは研究者向け・企業R&D向け・関連コストの順で整理し、最後にAI予測を実験に落とすまでで詰まりやすい論点をまとめます。
AI総研が化学・素材メーカーのAI導入支援で相談を受けるときも、まずはこの立場別の切り分けから始めるようにしています。
研究者にとっての使いどころ
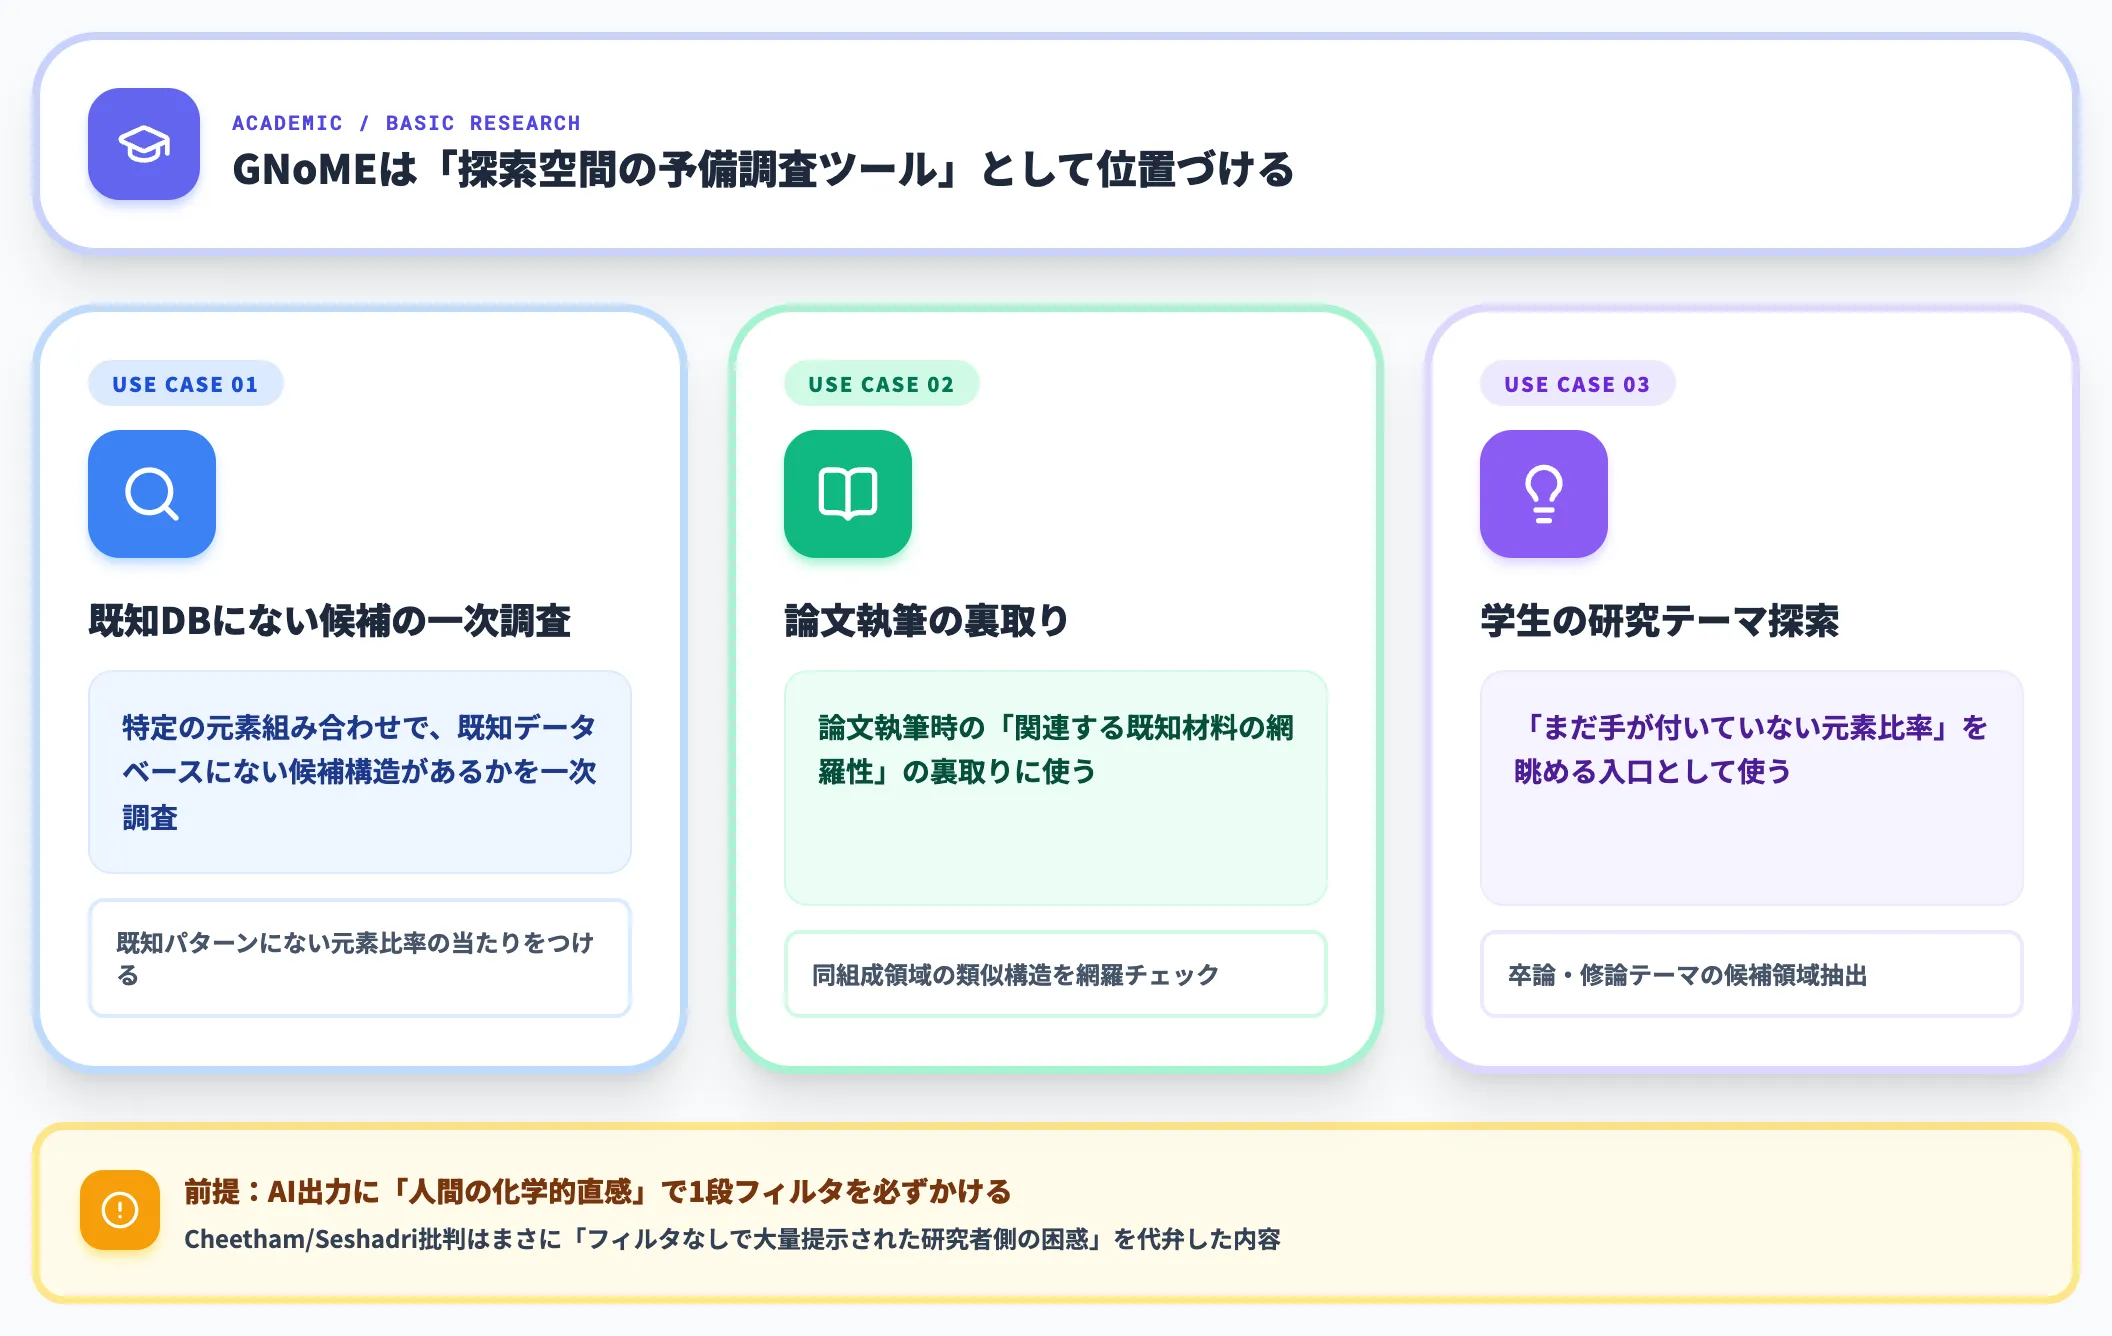
アカデミック研究者、または企業内の基礎研究部門にとって、GNoMEは探索空間の予備調査ツールとして位置づけるのが実用的です。
想定される使い方は次のとおりです。
- 特定の元素組み合わせで、既知データベースにない候補構造があるかを一次調査する
- 論文執筆時の「関連する既知材料の網羅性」の裏取りに使う
- 学生の研究テーマ探索で、「まだ手が付いていない元素比率」を眺める入口として使う
ここでの前提は、GNoMEの出力を「AIが提示した候補」として扱い、必ず人間の化学的直感と既知文献レビューで1段フィルタすることです。前章で扱ったCheetham/Seshadri批判は、まさに「フィルタなしで候補を大量提示された研究者側の困惑」を代弁しています。
企業R&D現場での位置づけ
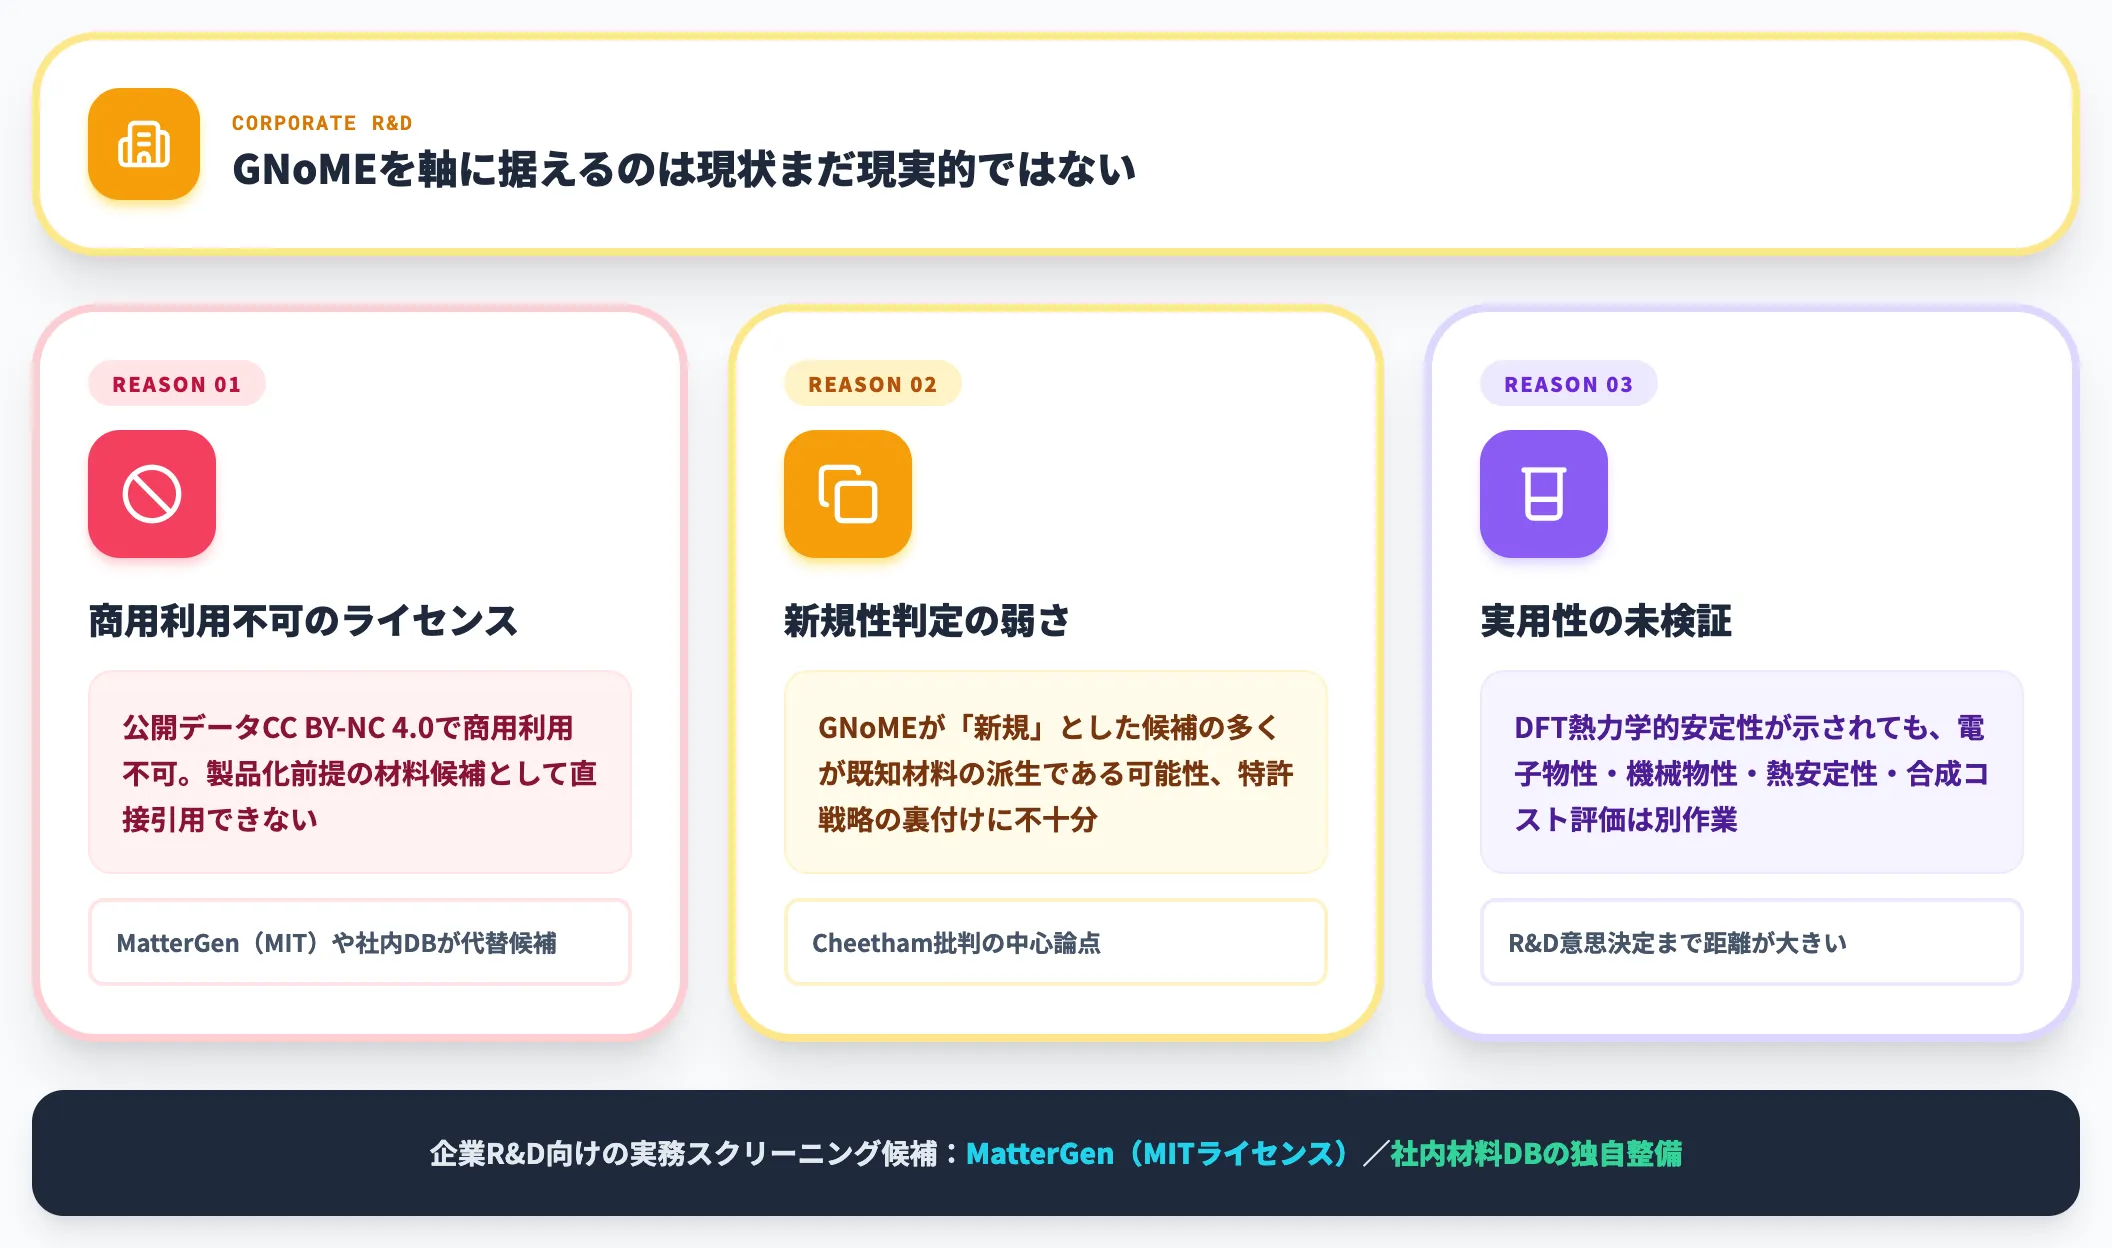
一方、企業のR&D現場——具体的には「この材料を実験に回すか」「量産化を進めるか」といった意思決定——では、GNoMEを軸に据えるのは現状まだ現実的ではないというのがAI総研の見立てです。理由は3つあります。
-
商用利用不可のライセンス
公開データがCC BY NC 4.0で商用利用不可のため、製品化前提の材料候補として直接引用できない
-
新規性判定の弱さ
Cheetham批判で指摘されたように、GNoMEが「新規」とした候補の多くが既知材料の派生である可能性があり、特許戦略上の裏付けとしては不十分
-
実用性の未検証
DFT計算上の熱力学的安定性が示されていても、電子物性・機械物性・熱安定性・合成コストの評価は別作業。GNoMEの出力からR&D意思決定まで距離が大きい
企業R&D現場では、GNoMEは「材料探索AIの動向を掴む参照点」として押さえておき、実務のスクリーニングにはMatterGen(MITライセンス)を使うか、社内で独自の材料データベースを整備する方向のほうが投資対効果が読みやすくなります。
隣接記事の材料探索AIとは?新素材開発をAIエージェントで加速する方法を解説では、企業R&Dで採用しやすいMicrosoft Discoveryや国内SaaSも含めた比較を扱っているので、実務ツール選定の入口としてはそちらを合わせて確認するのが実用的です。
関連コストの内訳
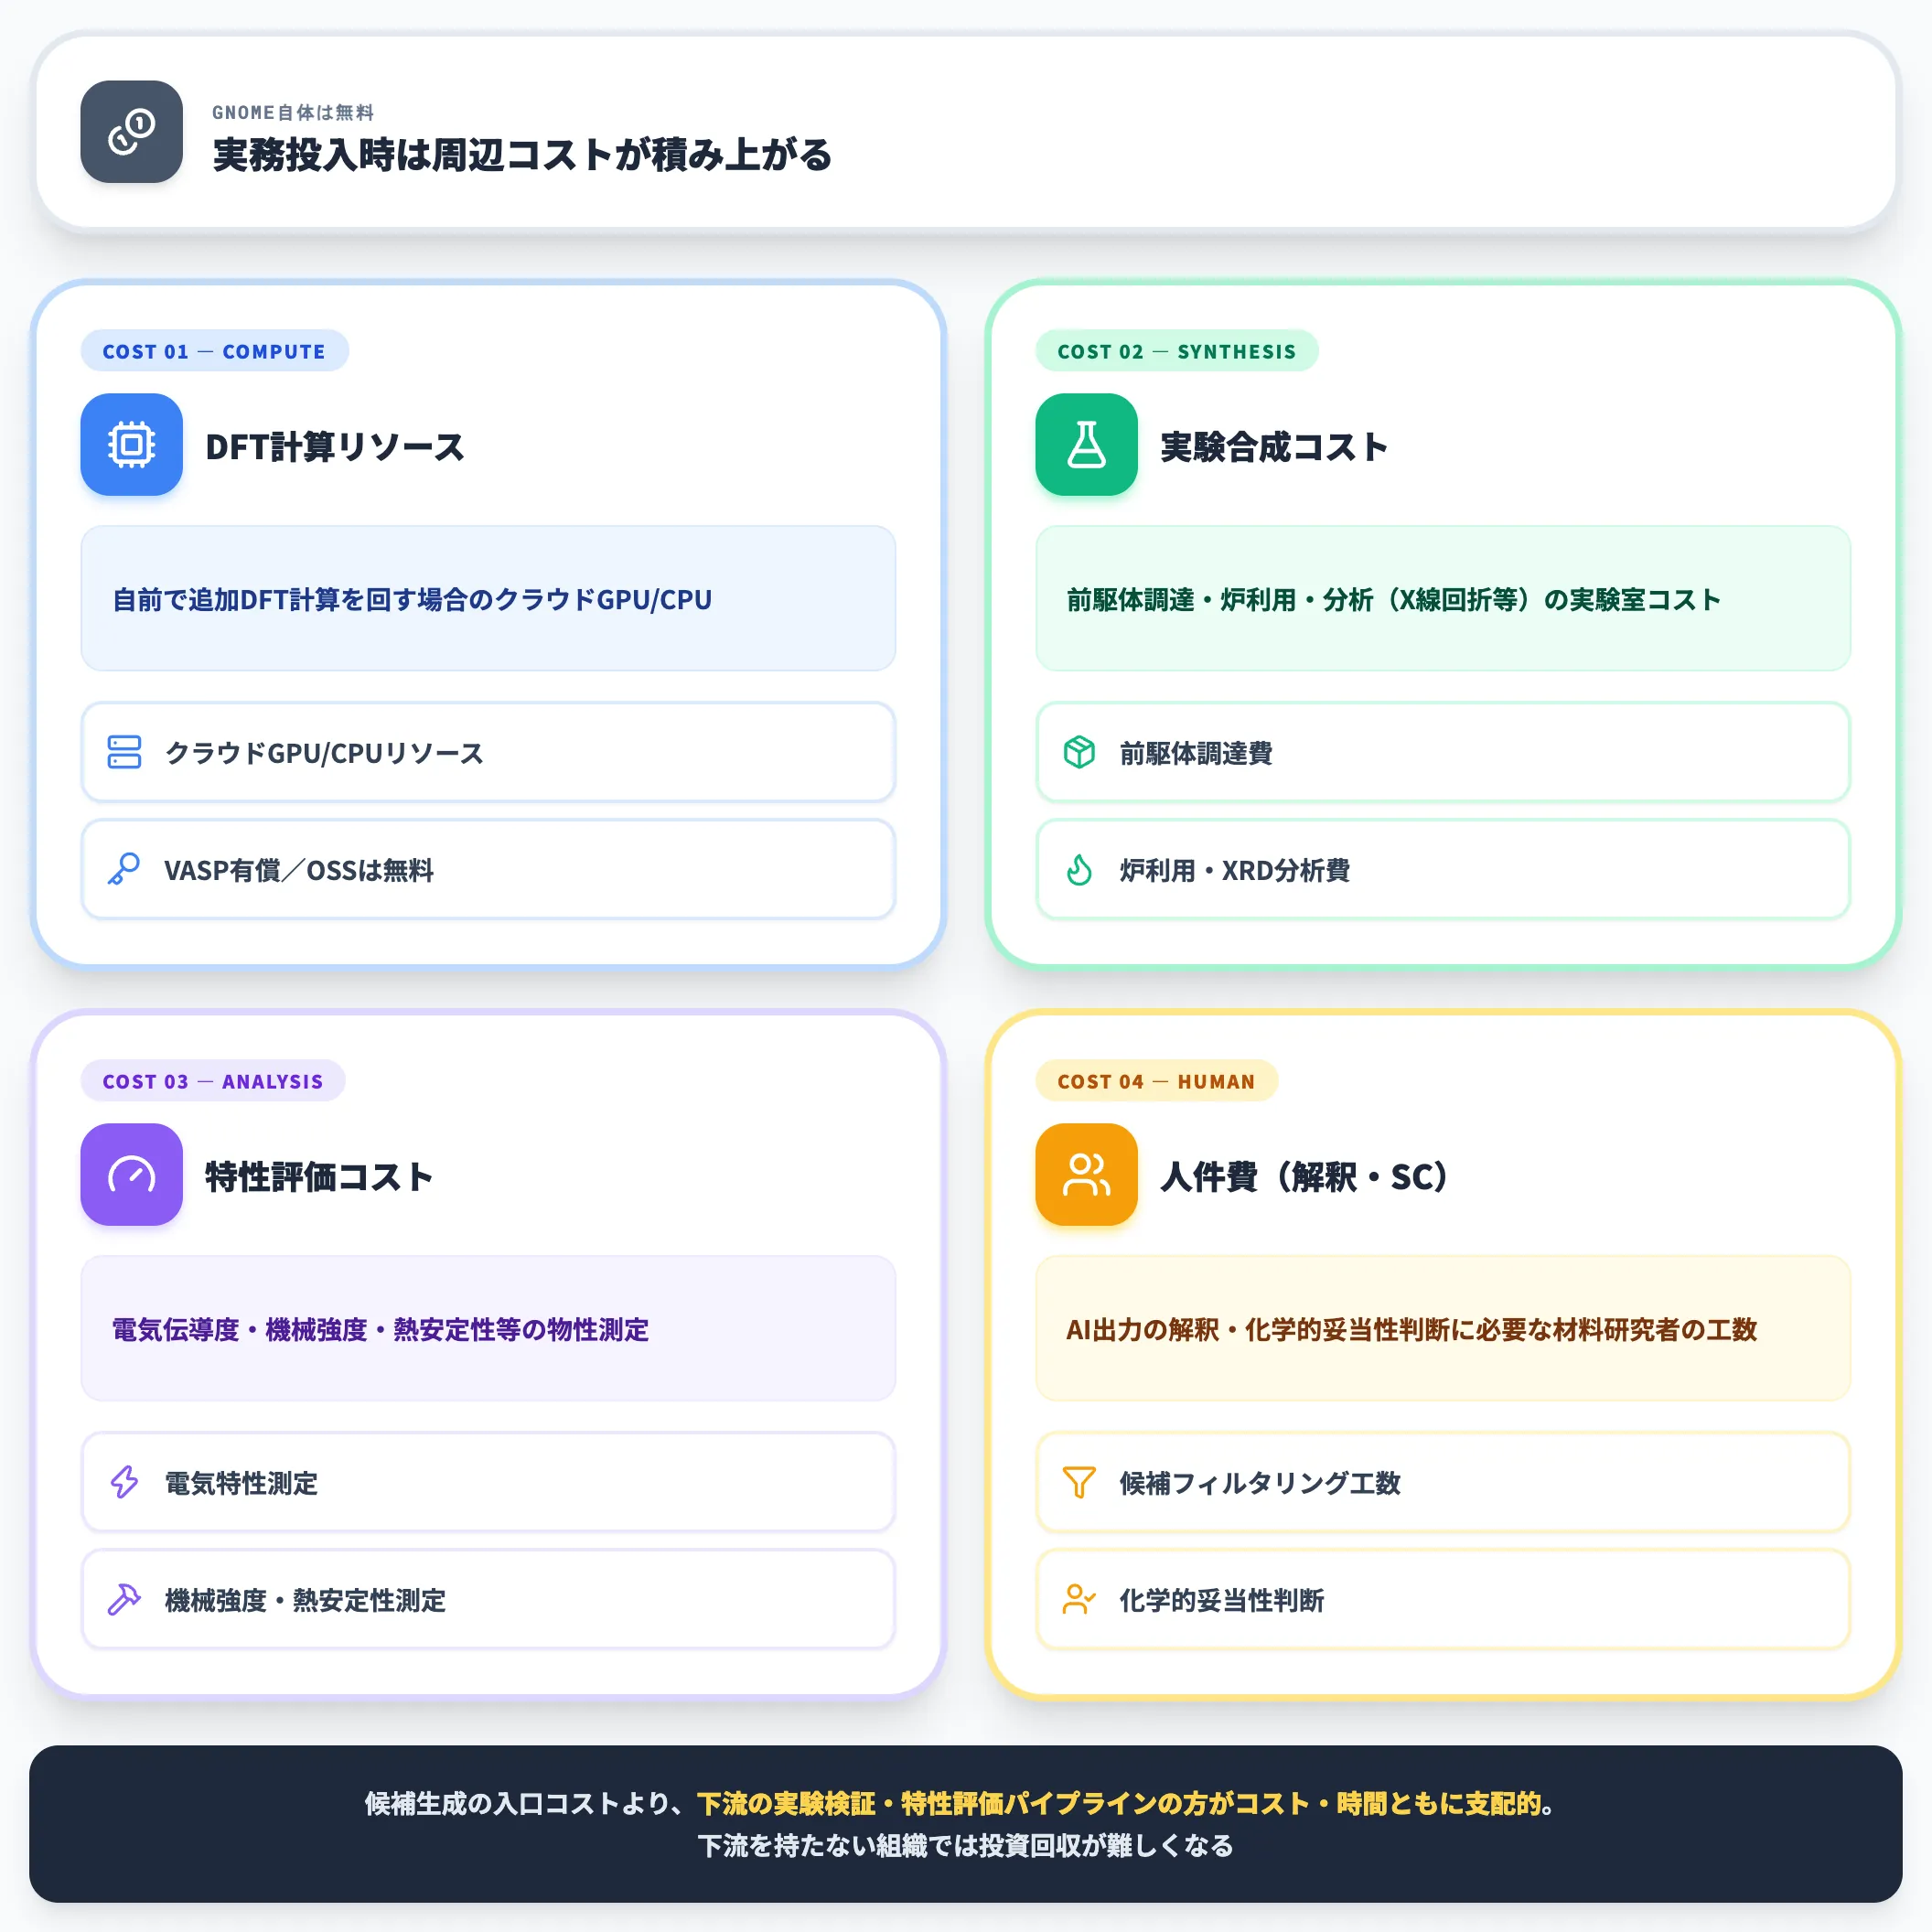
GNoME自体はモデル・データともに公開されているため、直接の利用料金は発生しません。
ただし実務投入する場合、周辺のコストが積み上がる点は最初に見積もる必要があります。
以下の表で、GNoMEを実務パイプラインに載せる際に発生する主なコスト項目を整理しました。
| コスト項目 | 主な内訳 |
|---|---|
| DFT計算リソース(自前で追加計算する場合) | クラウドGPU/CPUリソース。VASPを使う場合はライセンス費用、オープンソースDFTコードなら不要 |
| 実験合成コスト | 前駆体調達・炉利用・分析(X線回折等) |
| 分析・特性評価コスト | 物性測定(電気伝導度・機械強度等) |
| 人件費(AI出力の解釈・スクリーニング) | 候補フィルタリング・化学的妥当性判断に必要な材料研究者の工数 |
実感として、候補生成(GNoMEやその類似モデル)のフロント側よりも、下流の実験検証・特性評価パイプラインのほうがコスト・時間ともに支配的なプロジェクトが多く見られます。
GNoMEの導入で得られる効率化は「候補生成の入口を圧縮できる」効果にとどまるため、下流の実験検証パイプラインを持たない組織では投資回収が難しくなります。
具体的な金額感は自社の候補材料数・実験リソース・DFT環境に依存するため、PoC段階で条件を切って積算するのが現実的です。
AI予測を実験に落とす距離感
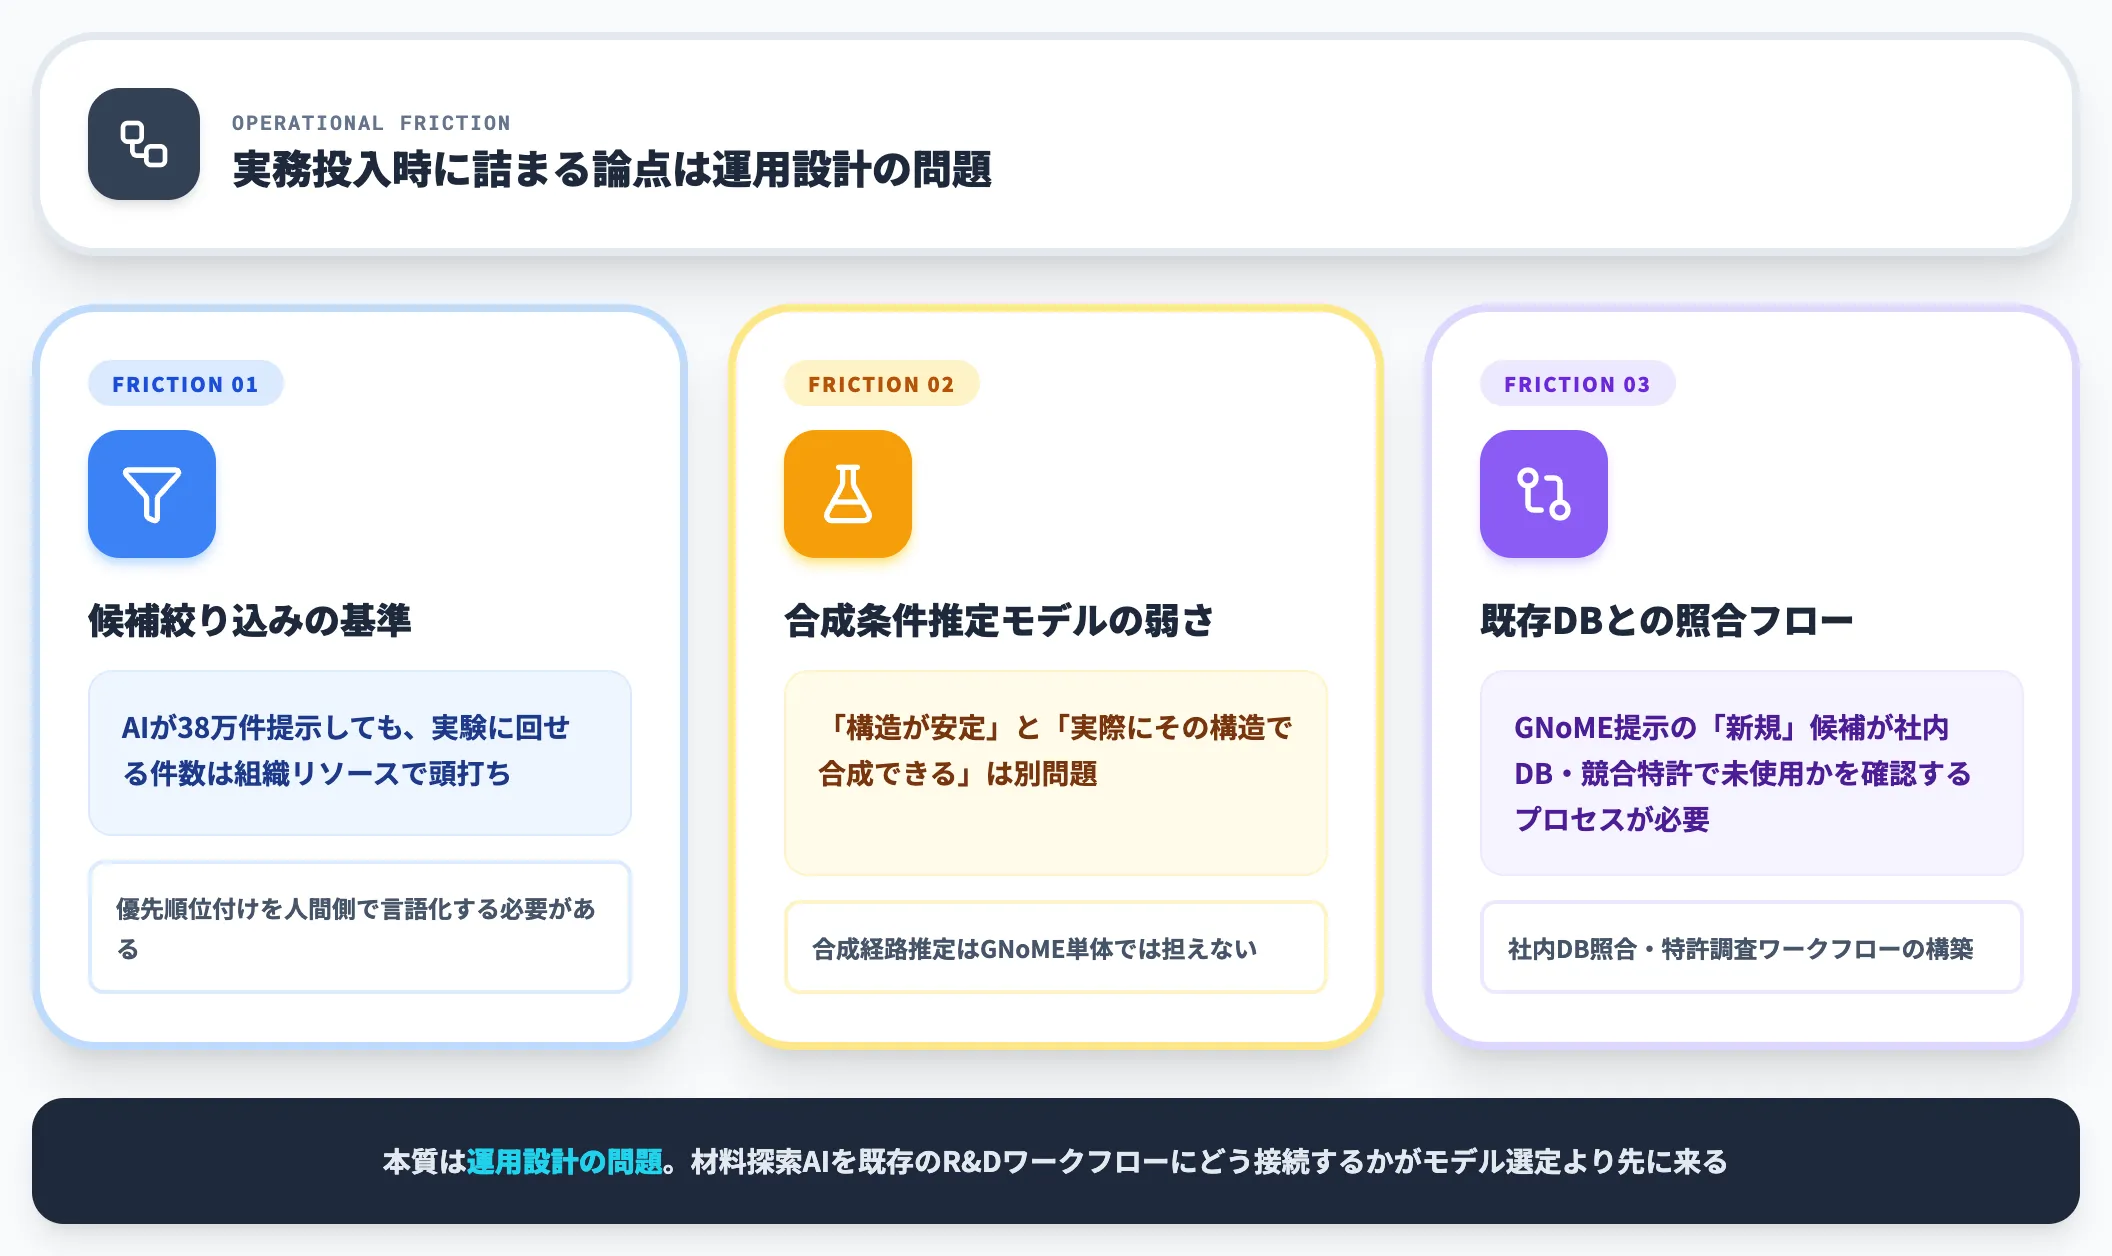
GNoMEを含む材料探索AI全般で、実務投入時に詰まりやすい論点は次の3点に集約されます。
-
候補の絞り込み基準を誰が決めるか
AIが38万件提示しても、実験に回せる件数は組織の実験リソースで頭打ちになる。優先順位付けを人間側で言語化する必要がある
-
合成条件を推定するモデルがまだ弱い
「構造が安定である」ことと「実際にその構造で合成できる」ことは別問題。合成経路推定は現状GNoME単体では担えない
-
既存材料データベースとの照合フロー
「GNoMEが新規と提示した候補が本当に社内DBや競合の特許で未使用か」を確認するプロセスを構築する必要がある
これらは技術的な問題というより運用設計の問題で、材料探索AIを既存のR&Dワークフローにどう接続するかが本質になります。
AI総研の支援現場でも、材料探索AIのモデル選定より前に、社内の実験計画・特許調査・データ整備の運用設計をどう組み直すかの相談を受けるケースが増えています。
GNoME世代の材料探索AIを社内R&Dに組み込むには
GNoMEやMatterGenが提示する候補構造を、社内の実験計画・特許調査・データ整備の運用にどう接続するかは、モデル選定単独では動かない領域です。多くの化学・素材メーカーが直面するのは、「AIが候補を提示できる」の先にある「候補を実験と特許戦略に落とすまでの運用設計」という壁です。
このレイヤーを担うのが、自社Azureテナント内で動くエンタープライズAIエージェント基盤です。
AI総合研究所のAI Agent Hubは、材料探索AIの出力を受け取る「実験計画Agent」「特許調査Agent」「データ整備Agent」といった業務特化Agent群を1つのダッシュボードで統合管理し、R&Dプロセスに載せる運用基盤として機能します。
-
材料探索AIの出力を受け取るAgent群を先行実装
GNoME・MatterGenが提示する候補構造をトリガーに、社内DBとの重複チェック・既存特許との衝突確認・優先度スコアリングを回すAgentをTeamsから起動できる形で提供します。
-
モデル世代交代を吸収する管理層
GNoME・MatterGen・FORUM-AIのように材料探索AIの主流が入れ替わったり並列化しても、業務Agent側の設計は不変。特定モデル依存のワークフロー陥落を回避できます。
-
Agent単位で研究データの統制を1画面統制
社内実験データ・特許情報を扱うAgentごとにアクセス範囲を設計。誰がどのAgentで何を照会したかを不変ログで残し、社内監査・共同研究相手への説明対応をそのまま提出できる形で保管します。
-
データは100%自社Azureテナント内に保持
実験データ・特許情報・材料候補はAIの学習対象から完全除外。Azure Managed Applicationsとして自社テナント内で動作が完了する設計です。
AI総合研究所の専任チームが、材料探索AIの選定から業務Agent基盤の統合設計まで一貫して支援します。AI Agent Hubのサービスページで、材料探索AI×R&D実装例をご確認ください。
GNoME世代の材料探索AIを社内R&Dに組み込むなら

実験計画・特許調査・データ整備をAgentで束ねる
GNoMEやMatterGenが提示する候補構造を、社内の実験計画・特許調査・データ整備の運用にどう接続するかは、モデル選定より運用設計の話です。AI Agent Hubは、業務特化Agent群を1つのダッシュボードで統合管理し、材料探索AIの出力を社内R&Dプロセスに載せる基盤として機能します。
まとめ
本記事では、GNoMEについて、仕組み・成果と実験検証・GitHubの使い方・批判・後発MatterGenとFORUM-AI・企業R&Dでの位置づけまでを、2026年9月時点の最新情報で解説しました。
押さえておくべきポイントは次の3つです。
- GNoMEはDeepMindが2023年11月にNatureで発表した結晶構造安定性予測GNNで、累計10億件超の探索・38.1万件の新規安定構造・A-Lab連携での17日36件合成(Author Correction後)という規模で材料探索AIのエコシステムに大量の候補構造を供給した
- Cheetham/Seshadri論文とSchoop/Palgraveらの独立検証が新規性・信頼性・実用性の弱さを指摘し、A-Lab成果には2026年1月にAuthor Correctionが入るなど、「発見」の定義そのものが業界内で見直されている
- 後発のMicrosoft MatterGen(拡散モデル・コードMIT/データCC BY 4.0)とBerkeley Lab FORUM-AI(エネルギー材料向けAI Assistant)が隣接アプローチとして登場し、GNoMEは複数ある候補生成モデルの1つとして位置づけ直されつつある
企業R&Dの立場でGNoMEを検討するときは、「モデル自体を使えるか」より「材料探索AIの候補を社内の実験計画・特許調査・データ整備のワークフローに載せられるか」が本質的な論点になります。まずは隣接する材料探索AI全般の解説記事で主要プラットフォームの位置関係を掴み、社内R&Dプロセスとの接続点から検討を始めるのが実用的な第一歩です。
材料探索AIは2026年に入り、単体モデルの並列運用に加えてAgentによる研究支援にも利用範囲が広がっています。GNoMEの成果と批判の両方を分解して読み解いておくことが、次世代の材料探索AI導入における判断材料になります。